Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
CLI Agentを使い分ける
Search
Taisei Ozaki
August 19, 2026
1k
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
CLI Agentを使い分ける
Taisei Ozaki
August 19, 2026
Transcript
20 slides
Claude code Orchestra: Claude・Codex・Geminiを使い分ける 2026/8/19 Offers Deep Dive 許諾なく撮影や第三者 への開示を禁止します
©︎MATSUO INSTITUTE, INC.
自己紹介 所属 株式会社 松尾研究所 データサイエンティスト 東京大学 松尾岩澤研究室 学術専門職員 大阪公立大学大学院 博士後期
DynamicsDesign研究室 来歴 2023年:大阪公立大学工学研究科 修士課程 入学 2025年:同大学 博士後期課程 入学 2025年:東京大学及び株式会社松尾研究所 入職 学会 EMNLP / NAACL / AAAI / CHI / JSAI (優秀賞*2) / NLP その他 NLP & JSAI 若手の会委員 / GENIAC / AKATSUKI etc… 研究領域 VLM・LLMの開発 / LLM Agent 応用 Ozaki Taisei (尾崎 大晟) 10B級LLMのフルスクラッチ開発を主導 ©︎MATSUO INSTITUTE, INC. スポーツコーチングAgentを研究 2
メイントピック • 飽和するAgentを使い分けるためのポイント • 実際に使い分けるための具体の方法 ©︎MATSUO INSTITUTE, INC. 3
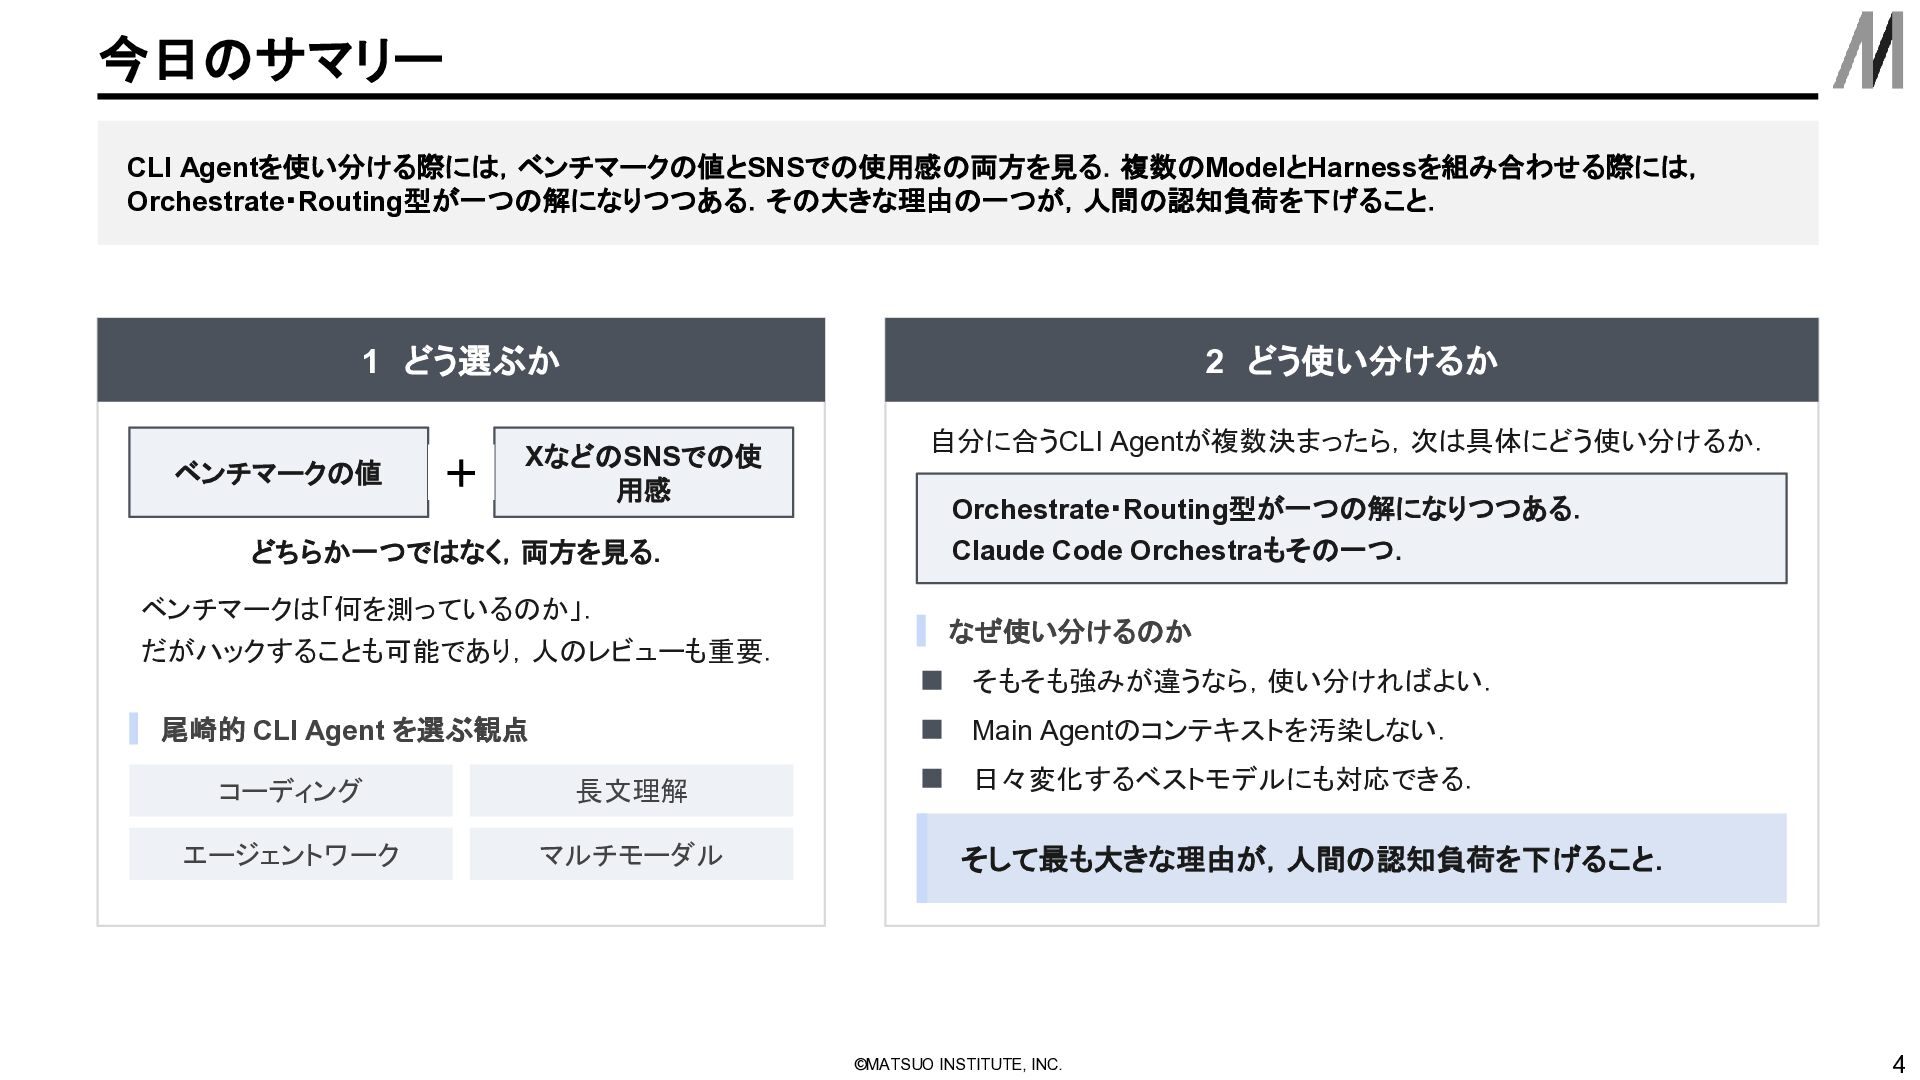
今日のサマリー CLI Agentを使い分ける際には,ベンチマークの値とSNSでの使用感の両方を見る.複数のModelとHarnessを組み合わせる際には, Orchestrate・Routing型が一つの解になりつつある.その大きな理由の一つが,人間の認知負荷を下げること. 1 どう選ぶか ベンチマークの値 + 2 どう使い分けるか
XなどのSNSでの使 用感 どちらか一つではなく,両方を見る. ベンチマークは「何を測っているのか」. だがハックすることも可能であり,人のレビューも重要. 自分に合うCLI Agentが複数決まったら,次は具体にどう使い分けるか. Orchestrate・Routing型が一つの解になりつつある. Claude Code Orchestraもその一つ. なぜ使い分けるのか そもそも強みが違うなら,使い分ければよい. 尾崎的 CLI Agent を選ぶ観点 Main Agentのコンテキストを汚染しない. コーディング 長文理解 エージェントワーク マルチモーダル 日々変化するベストモデルにも対応できる. そして最も大きな理由が,人間の認知負荷を下げること. ©︎MATSUO INSTITUTE, INC. 4
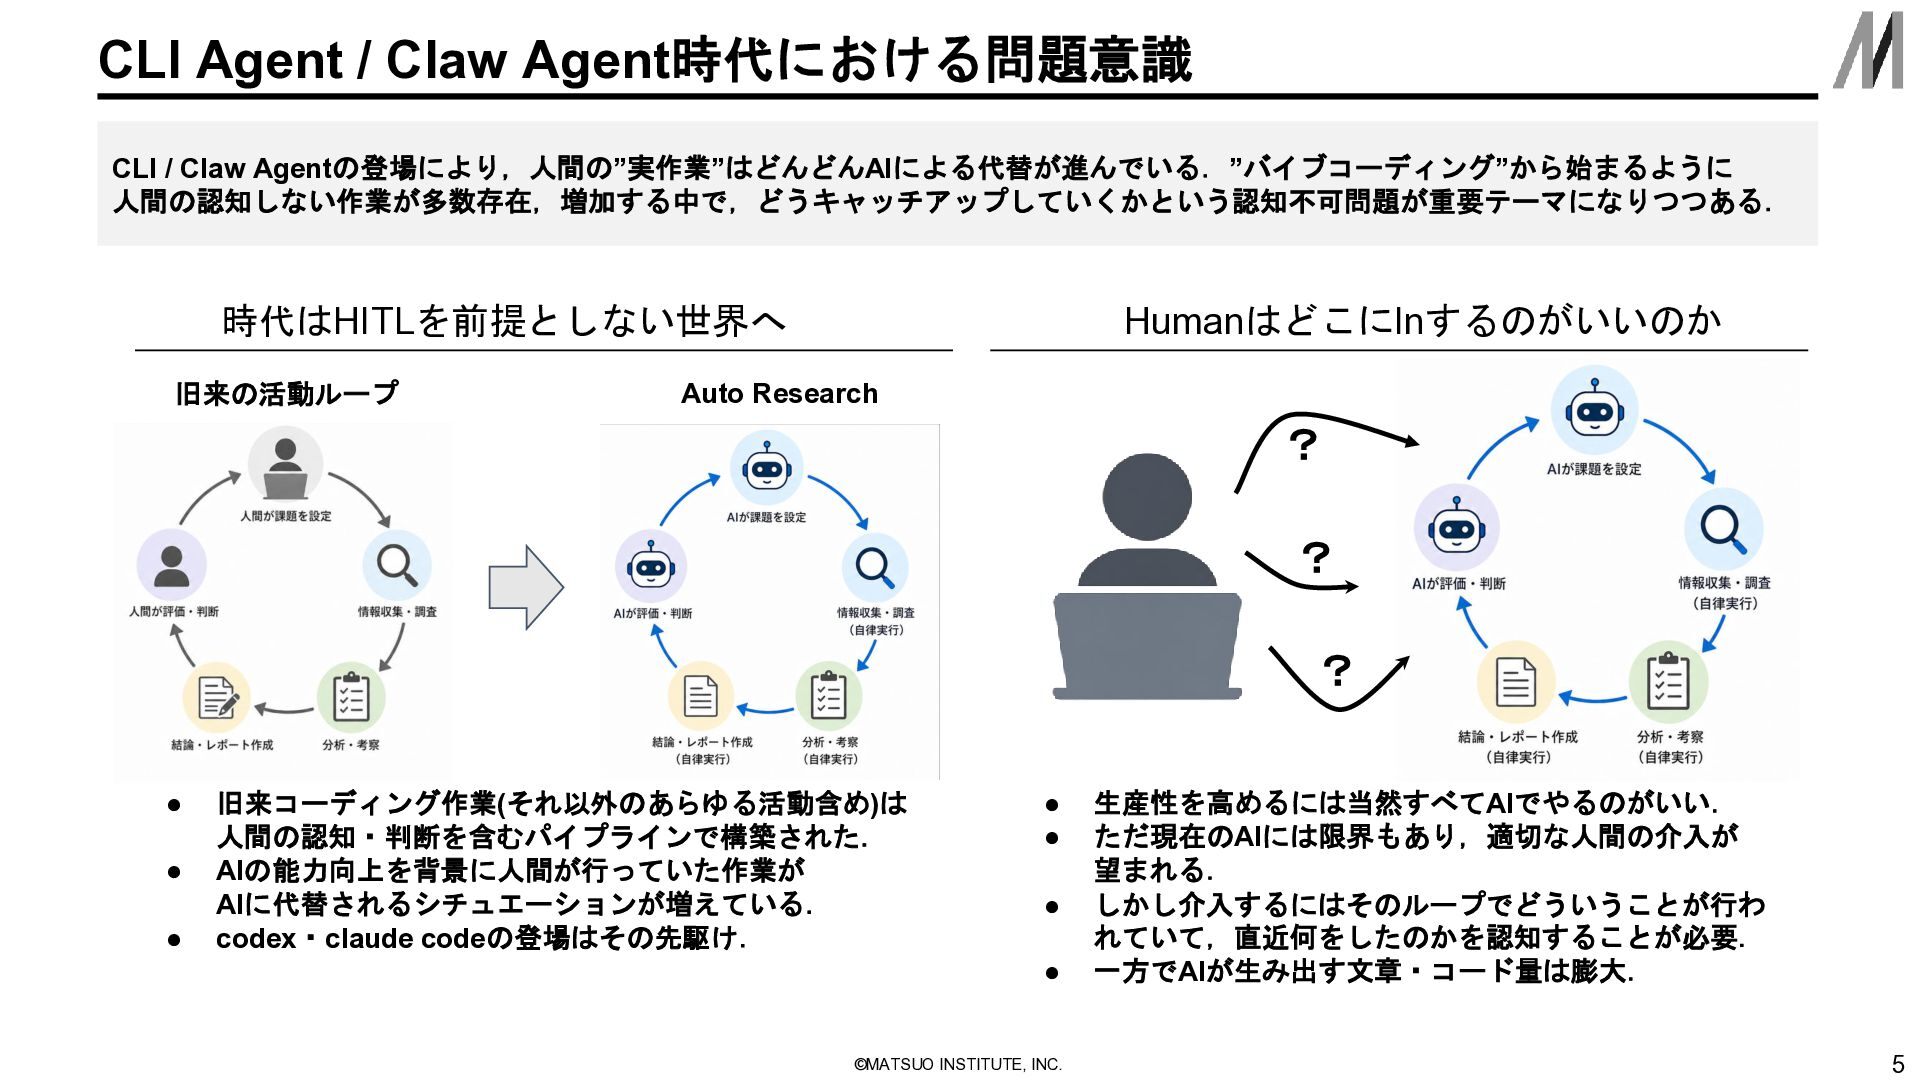
CLI Agent / Claw Agent時代における問題意識 CLI / Claw Agentの登場により,人間の”実作業”はどんどんAIによる代替が進んでいる.”バイブコーディング”から始まるように 人間の認知しない作業が多数存在,増加する中で,どうキャッチアップしていくかという認知不可問題が重要テーマになりつつある.
HumanはどこにInするのがいいのか 時代はHITLを前提としない世界へ 旧来の活動ループ Auto Research ? ? ? • • • 旧来コーディング作業(それ以外のあらゆる活動含め)は 人間の認知・判断を含むパイプラインで構築された. AIの能力向上を背景に人間が行っていた作業が AIに代替されるシチュエーションが増えている. codex・claude codeの登場はその先駆け. • • • • ©︎MATSUO INSTITUTE, INC. 生産性を高めるには当然すべてAIでやるのがいい. ただ現在のAIには限界もあり,適切な人間の介入が 望まれる. しかし介入するにはそのループでどういうことが行わ れていて,直近何をしたのかを認知することが必要. 一方でAIが生み出す文章・コード量は膨大. 5
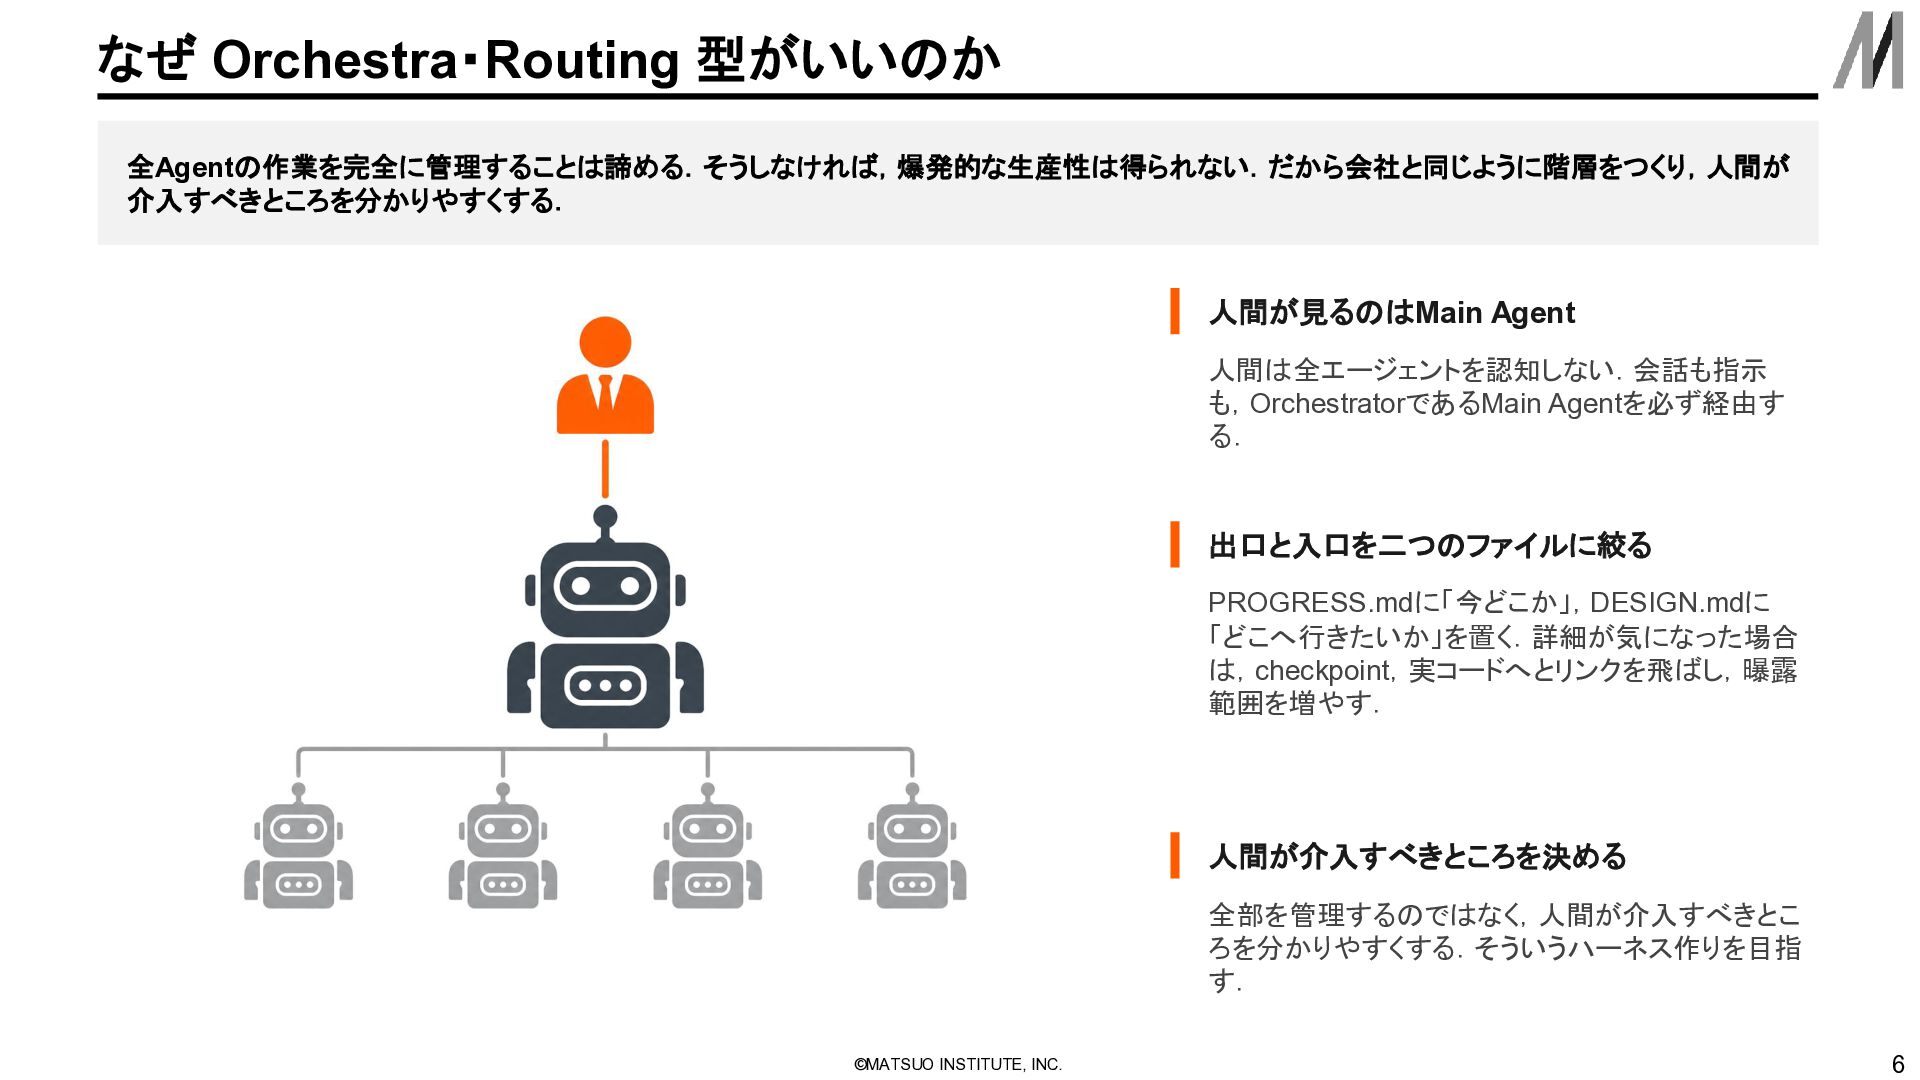
なぜ Orchestra・Routing 型がいいのか 全Agentの作業を完全に管理することは諦める.そうしなければ,爆発的な生産性は得られない.だから会社と同じように階層をつくり,人間が 介入すべきところを分かりやすくする. 人間が見るのはMain Agent 人間は全エージェントを認知しない.会話も指示 も,OrchestratorであるMain Agentを必ず経由す
る. 出口と入口を二つのファイルに絞る PROGRESS.mdに「今どこか」,DESIGN.mdに 「どこへ行きたいか」を置く.詳細が気になった場合 は,checkpoint,実コードへとリンクを飛ばし,曝露 範囲を増やす. 人間が介入すべきところを決める 全部を管理するのではなく,人間が介入すべきとこ ろを分かりやすくする.そういうハーネス作りを目指 す. ©︎MATSUO INSTITUTE, INC. 6
比較検討のためのベンチマークの見方 ©︎MATSUO INSTITUTE, INC.
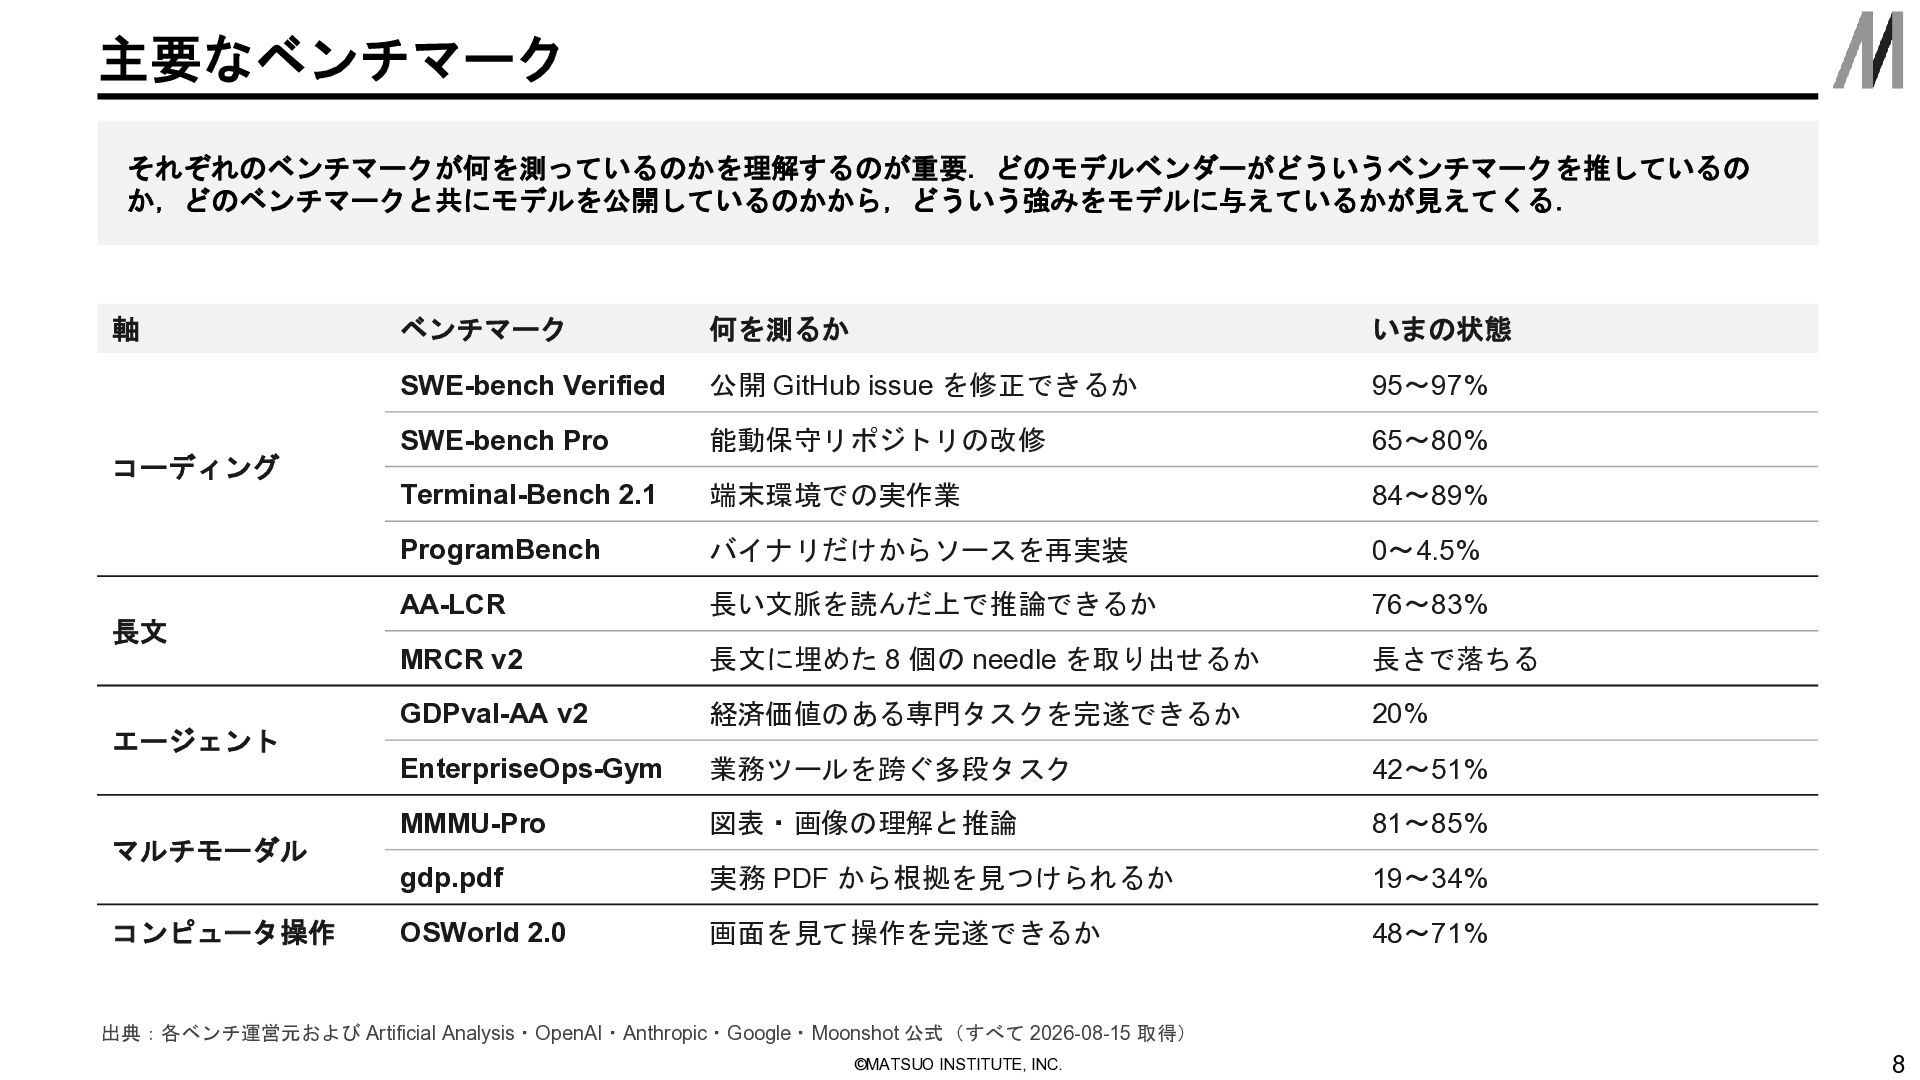
主要なベンチマーク それぞれのベンチマークが何を測っているのかを理解するのが重要.どのモデルベンダーがどういうベンチマークを推しているの か,どのベンチマークと共にモデルを公開しているのかから,どういう強みをモデルに与えているかが見えてくる. 軸 コーディング 長文 エージェント マルチモーダル コンピュータ操作 ベンチマーク
何を測るか いまの状態 SWE-bench Verified 公開 GitHub issue を修正できるか 95〜97% SWE-bench Pro 能動保守リポジトリの改修 65〜80% Terminal-Bench 2.1 端末環境での実作業 84〜89% ProgramBench バイナリだけからソースを再実装 0〜4.5% AA-LCR 長い文脈を読んだ上で推論できるか 76〜83% MRCR v2 長文に埋めた 8 個の needle を取り出せるか 長さで落ちる GDPval-AA v2 経済価値のある専門タスクを完遂できるか 20% EnterpriseOps-Gym 業務ツールを跨ぐ多段タスク 42〜51% MMMU-Pro 図表・画像の理解と推論 81〜85% gdp.pdf 実務 PDF から根拠を見つけられるか 19〜34% OSWorld 2.0 画面を見て操作を完遂できるか 48〜71% 出典:各ベンチ運営元および Artificial Analysis・OpenAI・Anthropic・Google・Moonshot 公式(すべて 2026-08-15 取得) ©︎MATSUO INSTITUTE, INC. 8
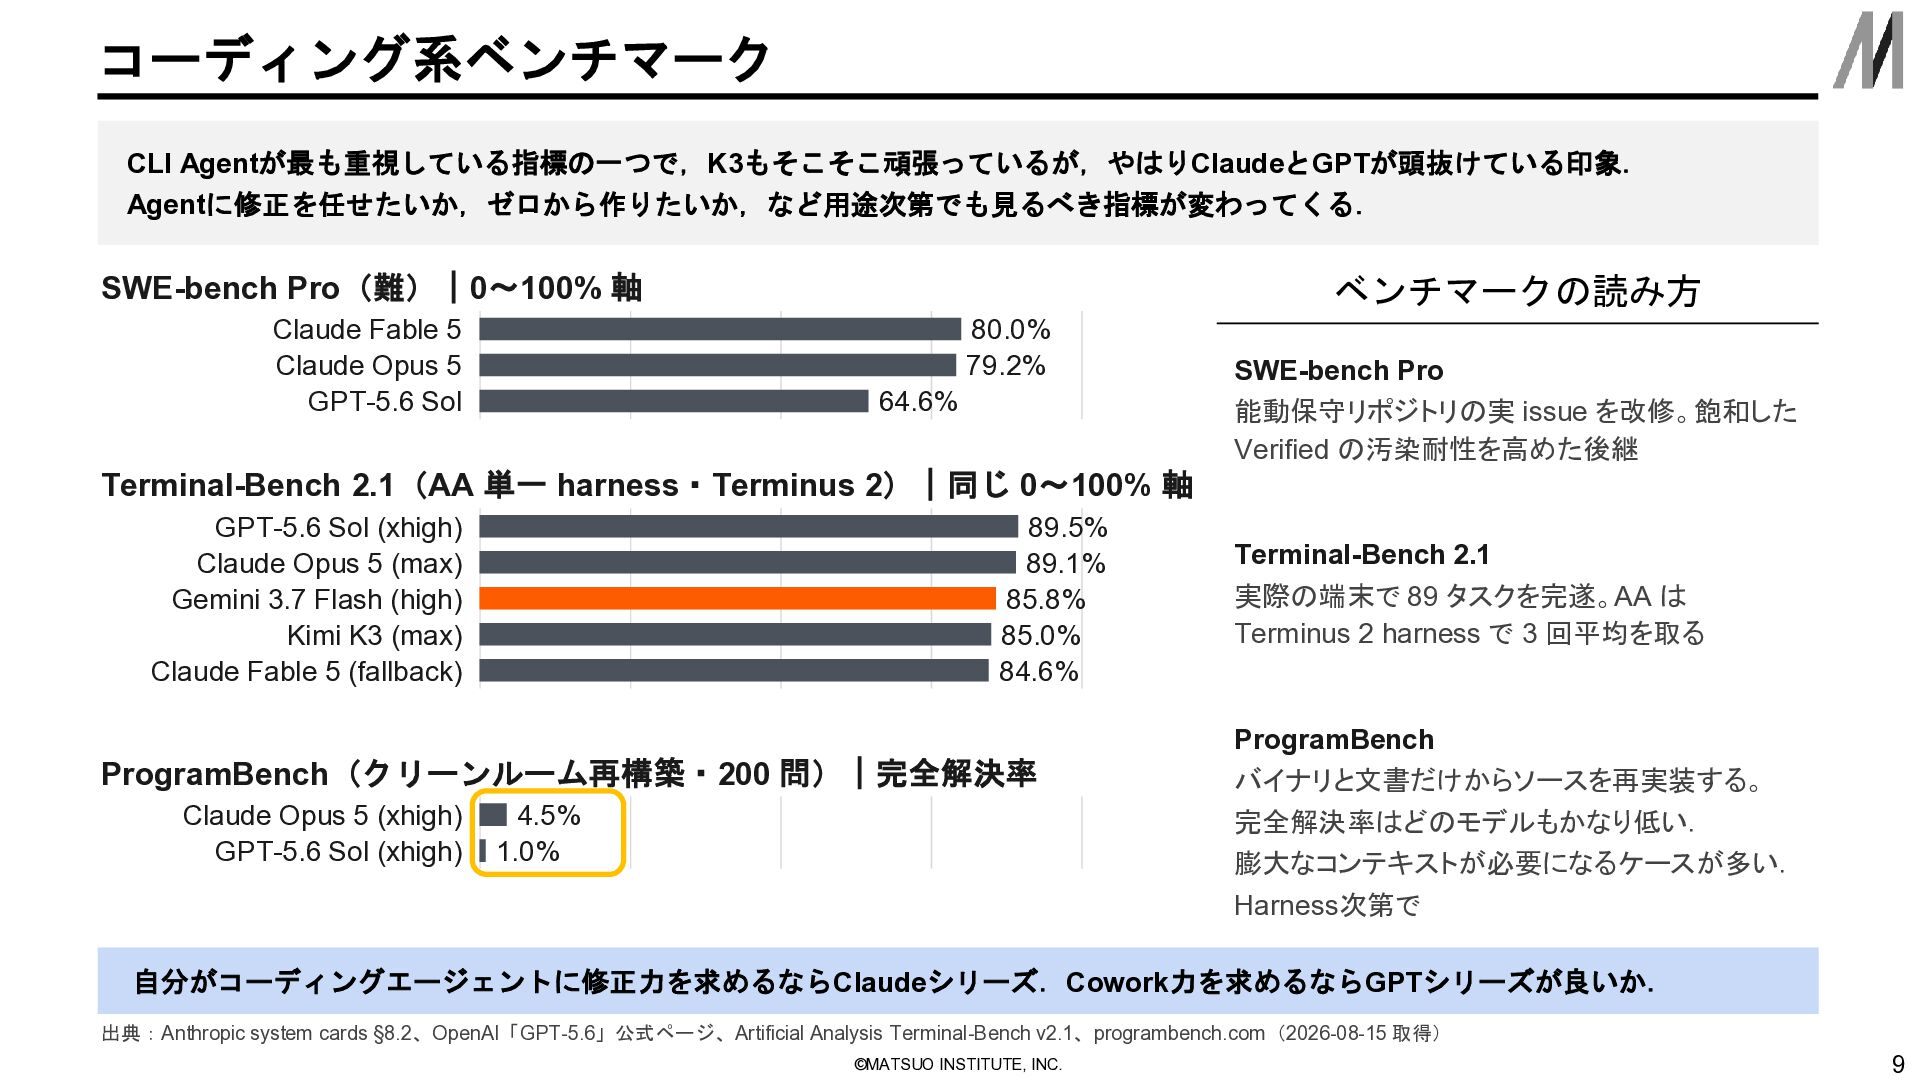
コーディング系ベンチマーク CLI Agentが最も重視している指標の一つで,K3もそこそこ頑張っているが,やはりClaudeとGPTが頭抜けている印象. Agentに修正を任せたいか,ゼロから作りたいか,など用途次第でも見るべき指標が変わってくる. SWE-bench Pro(難)|0〜100% 軸 Claude Fable 5
Claude Opus 5 GPT-5.6 Sol ベンチマークの読み方 80.0% 79.2% 64.6% SWE-bench Pro 能動保守リポジトリの実 issue を改修。飽和した Verified の汚染耐性を高めた後継 Terminal-Bench 2.1(AA 単一 harness・Terminus 2)|同じ 0〜100% 軸 GPT-5.6 Sol (xhigh) Claude Opus 5 (max) Gemini 3.7 Flash (high) Kimi K3 (max) Claude Fable 5 (fallback) 89.5% 89.1% 85.8% 85.0% 84.6% ProgramBench(クリーンルーム再構築・200 問)|完全解決率 Claude Opus 5 (xhigh) GPT-5.6 Sol (xhigh) 4.5% 1.0% Terminal-Bench 2.1 実際の端末で 89 タスクを完遂。AA は Terminus 2 harness で 3 回平均を取る ProgramBench バイナリと文書だけからソースを再実装する。 完全解決率はどのモデルもかなり低い. 膨大なコンテキストが必要になるケースが多い. Harness次第で 自分がコーディングエージェントに修正力を求めるならClaudeシリーズ.Cowork力を求めるならGPTシリーズが良いか. 出典:Anthropic system cards §8.2、OpenAI「GPT-5.6」公式ページ、Artificial Analysis Terminal-Bench v2.1、programbench.com(2026-08-15 取得) ©︎MATSUO INSTITUTE, INC. 9
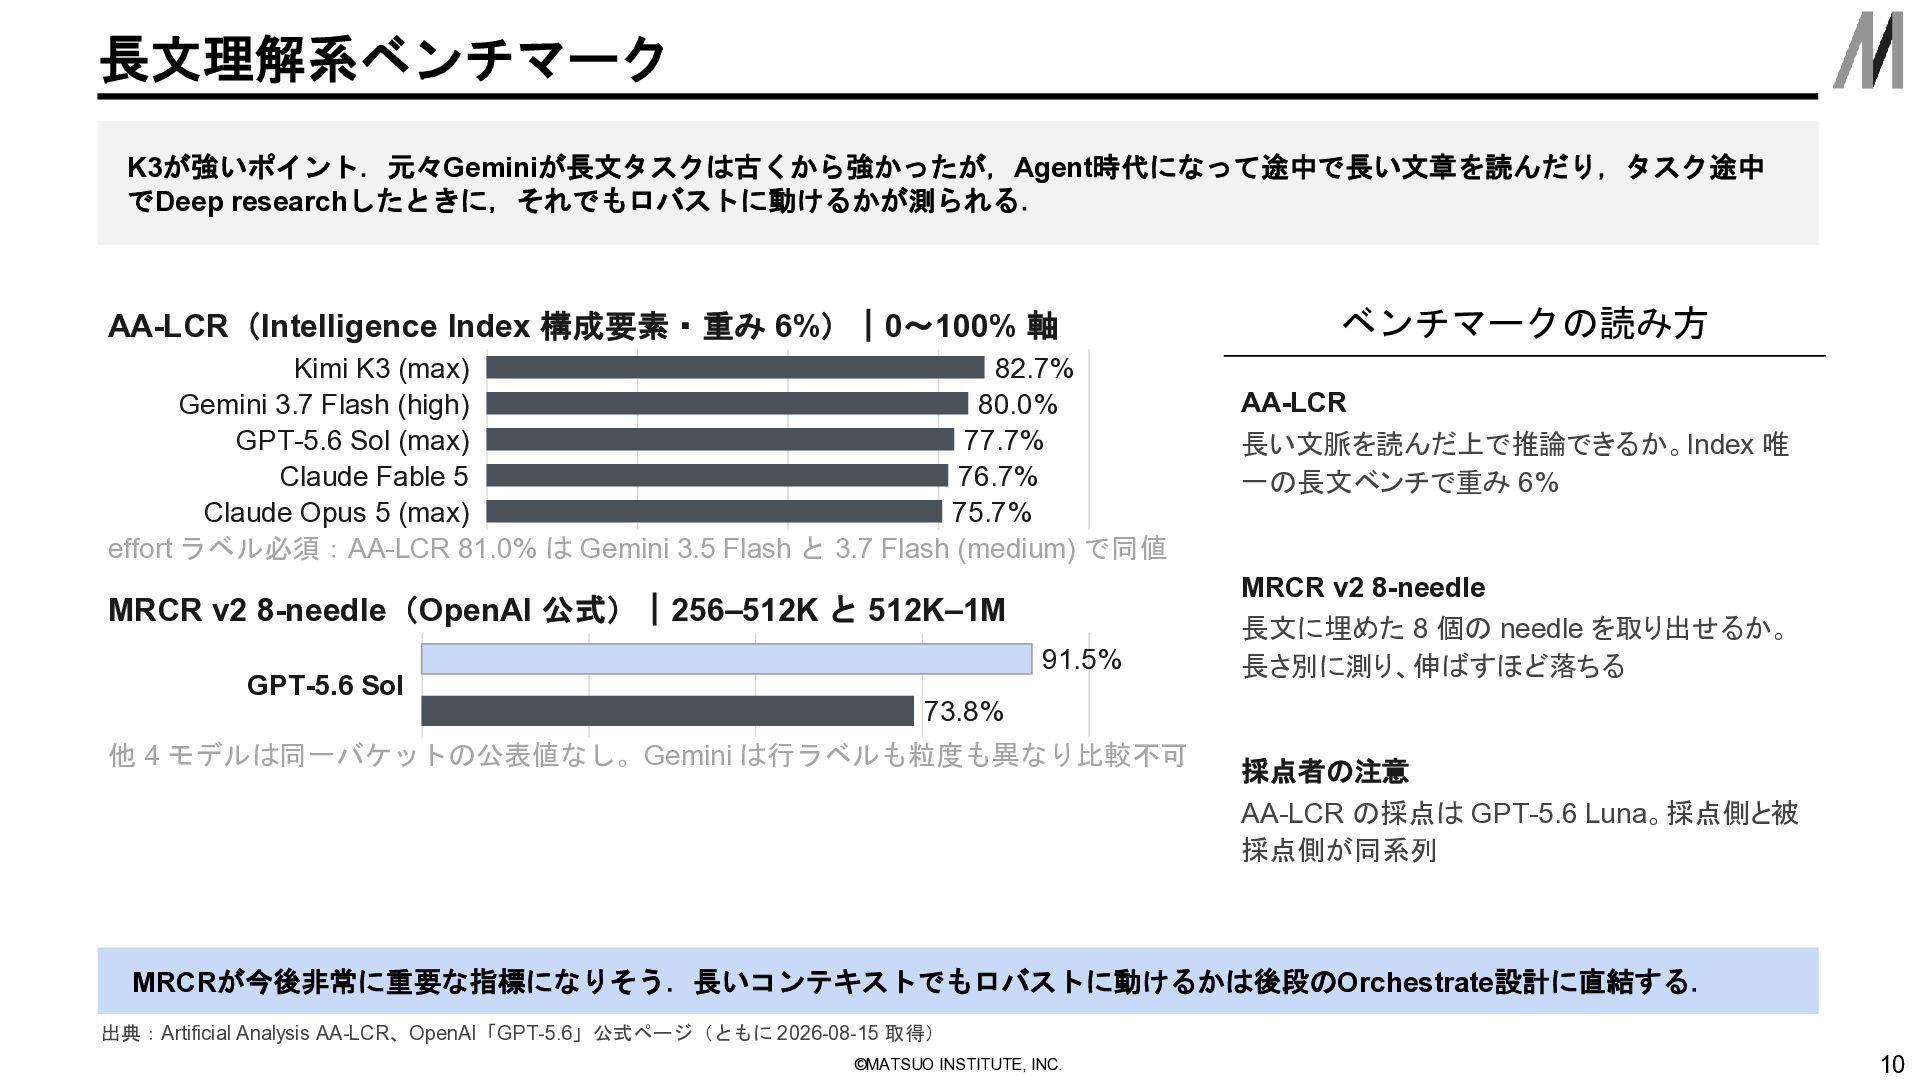
長文理解系ベンチマーク K3が強いポイント.元々Geminiが長文タスクは古くから強かったが,Agent時代になって途中で長い文章を読んだり,タスク途中 でDeep researchしたときに,それでもロバストに動けるかが測られる. AA-LCR(Intelligence Index 構成要素・重み 6%)|0〜100% 軸 Kimi
K3 (max) 82.7% Gemini 3.7 Flash (high) 80.0% GPT-5.6 Sol (max) 77.7% Claude Fable 5 76.7% Claude Opus 5 (max) 75.7% effort ラベル必須:AA-LCR 81.0% は Gemini 3.5 Flash と 3.7 Flash (medium) で同値 MRCR v2 8-needle(OpenAI 公式)|256–512K と 512K–1M GPT-5.6 Sol 91.5% ベンチマークの読み方 AA-LCR 長い文脈を読んだ上で推論できるか。Index 唯 一の長文ベンチで重み 6% MRCR v2 8-needle 長文に埋めた 8 個の needle を取り出せるか。 長さ別に測り、伸ばすほど落ちる 73.8% 他 4 モデルは同一バケットの公表値なし。Gemini は行ラベルも粒度も異なり比較不可 採点者の注意 AA-LCR の採点は GPT-5.6 Luna。採点側と被 採点側が同系列 MRCRが今後非常に重要な指標になりそう.長いコンテキストでもロバストに動けるかは後段のOrchestrate設計に直結する. 出典:Artificial Analysis AA-LCR、OpenAI「GPT-5.6」公式ページ(ともに 2026-08-15 取得) ©︎MATSUO INSTITUTE, INC. 10
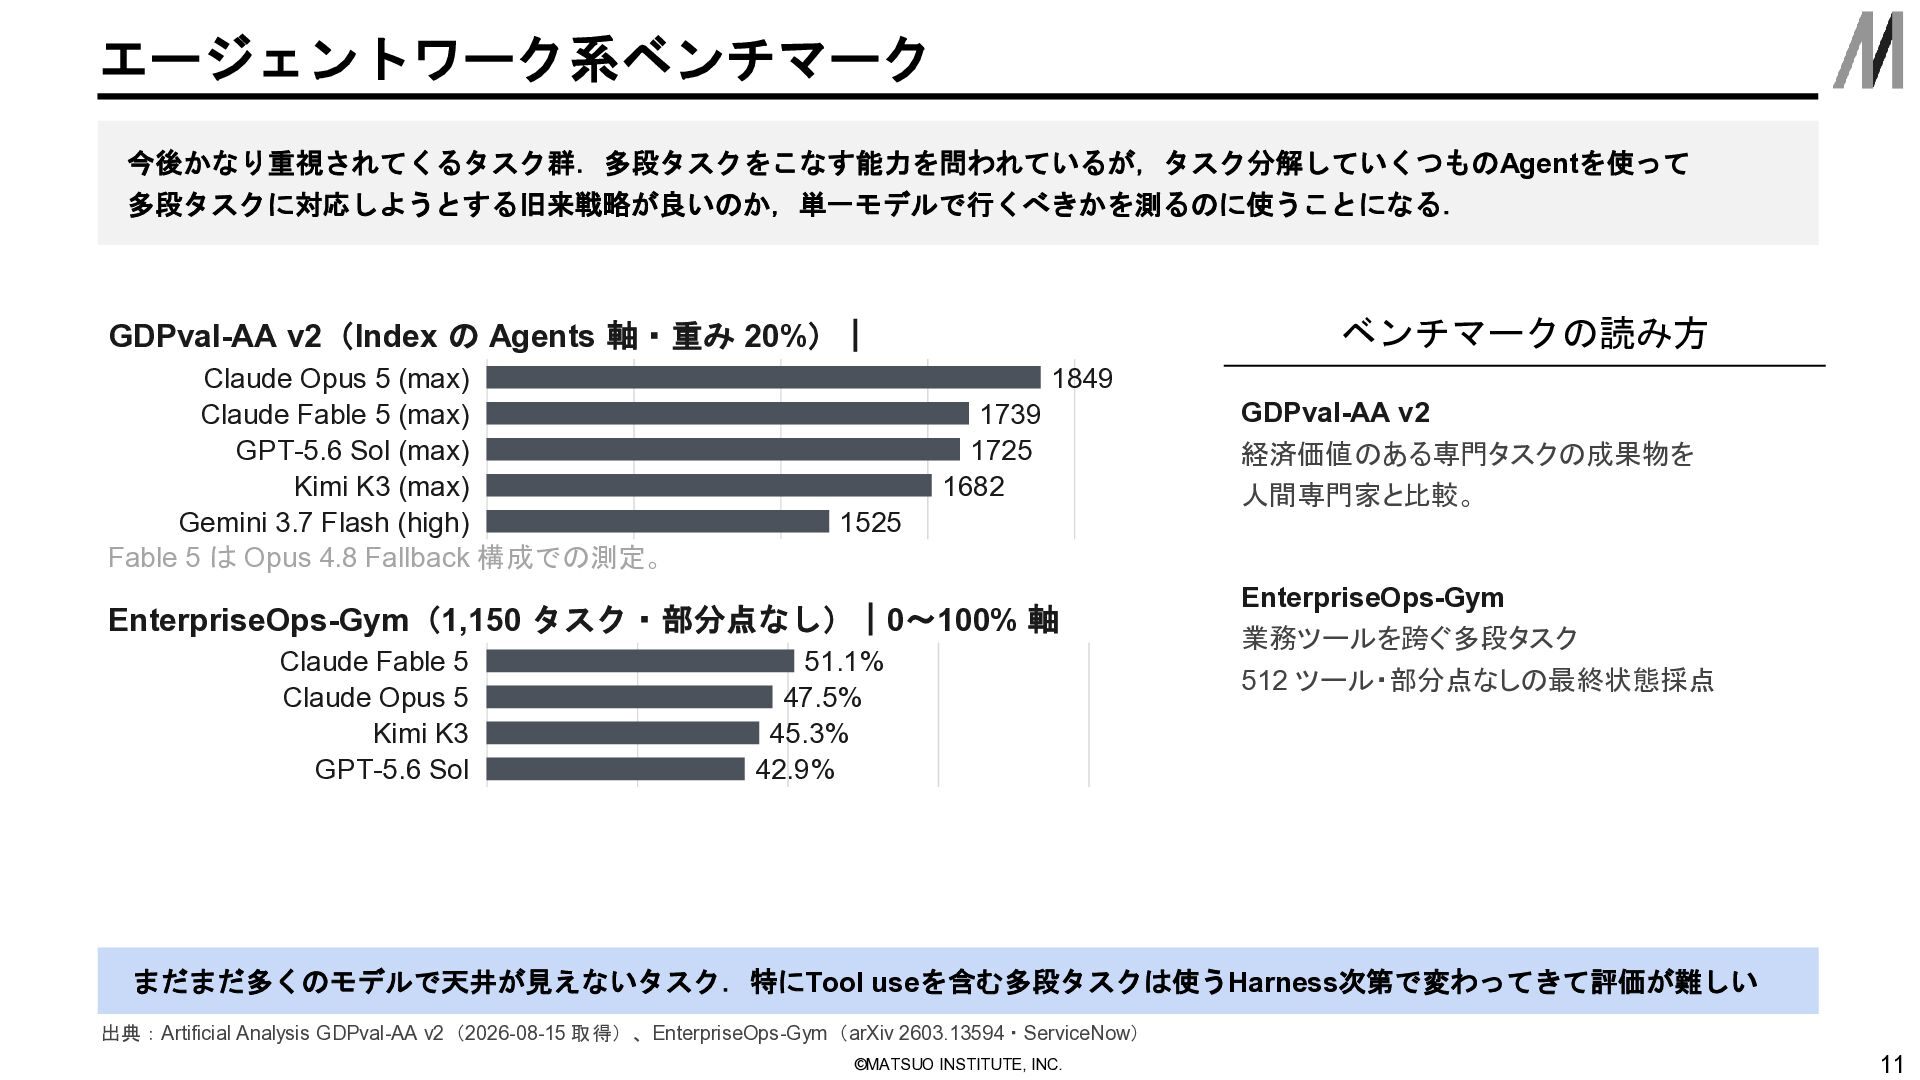
エージェントワーク系ベンチマーク 今後かなり重視されてくるタスク群.多段タスクをこなす能力を問われているが,タスク分解していくつものAgentを使って 多段タスクに対応しようとする旧来戦略が良いのか,単一モデルで行くべきかを測るのに使うことになる. ベンチマークの読み方 GDPval-AA v2(Index の Agents 軸・重み 20%)|
Claude Opus 5 (max) Claude Fable 5 (max) GPT-5.6 Sol (max) Kimi K3 (max) Gemini 3.7 Flash (high) Fable 5 は Opus 4.8 Fallback 構成での測定。 1849 1739 1725 1682 1525 EnterpriseOps-Gym(1,150 タスク・部分点なし)|0〜100% 軸 Claude Fable 5 Claude Opus 5 Kimi K3 GPT-5.6 Sol 51.1% 47.5% 45.3% 42.9% GDPval-AA v2 経済価値のある専門タスクの成果物を 人間専門家と比較。 EnterpriseOps-Gym 業務ツールを跨ぐ多段タスク 512 ツール・部分点なしの最終状態採点 まだまだ多くのモデルで天井が見えないタスク.特にTool useを含む多段タスクは使うHarness次第で変わってきて評価が難しい 出典:Artificial Analysis GDPval-AA v2(2026-08-15 取得)、EnterpriseOps-Gym(arXiv 2603.13594・ServiceNow) ©︎MATSUO INSTITUTE, INC. 11
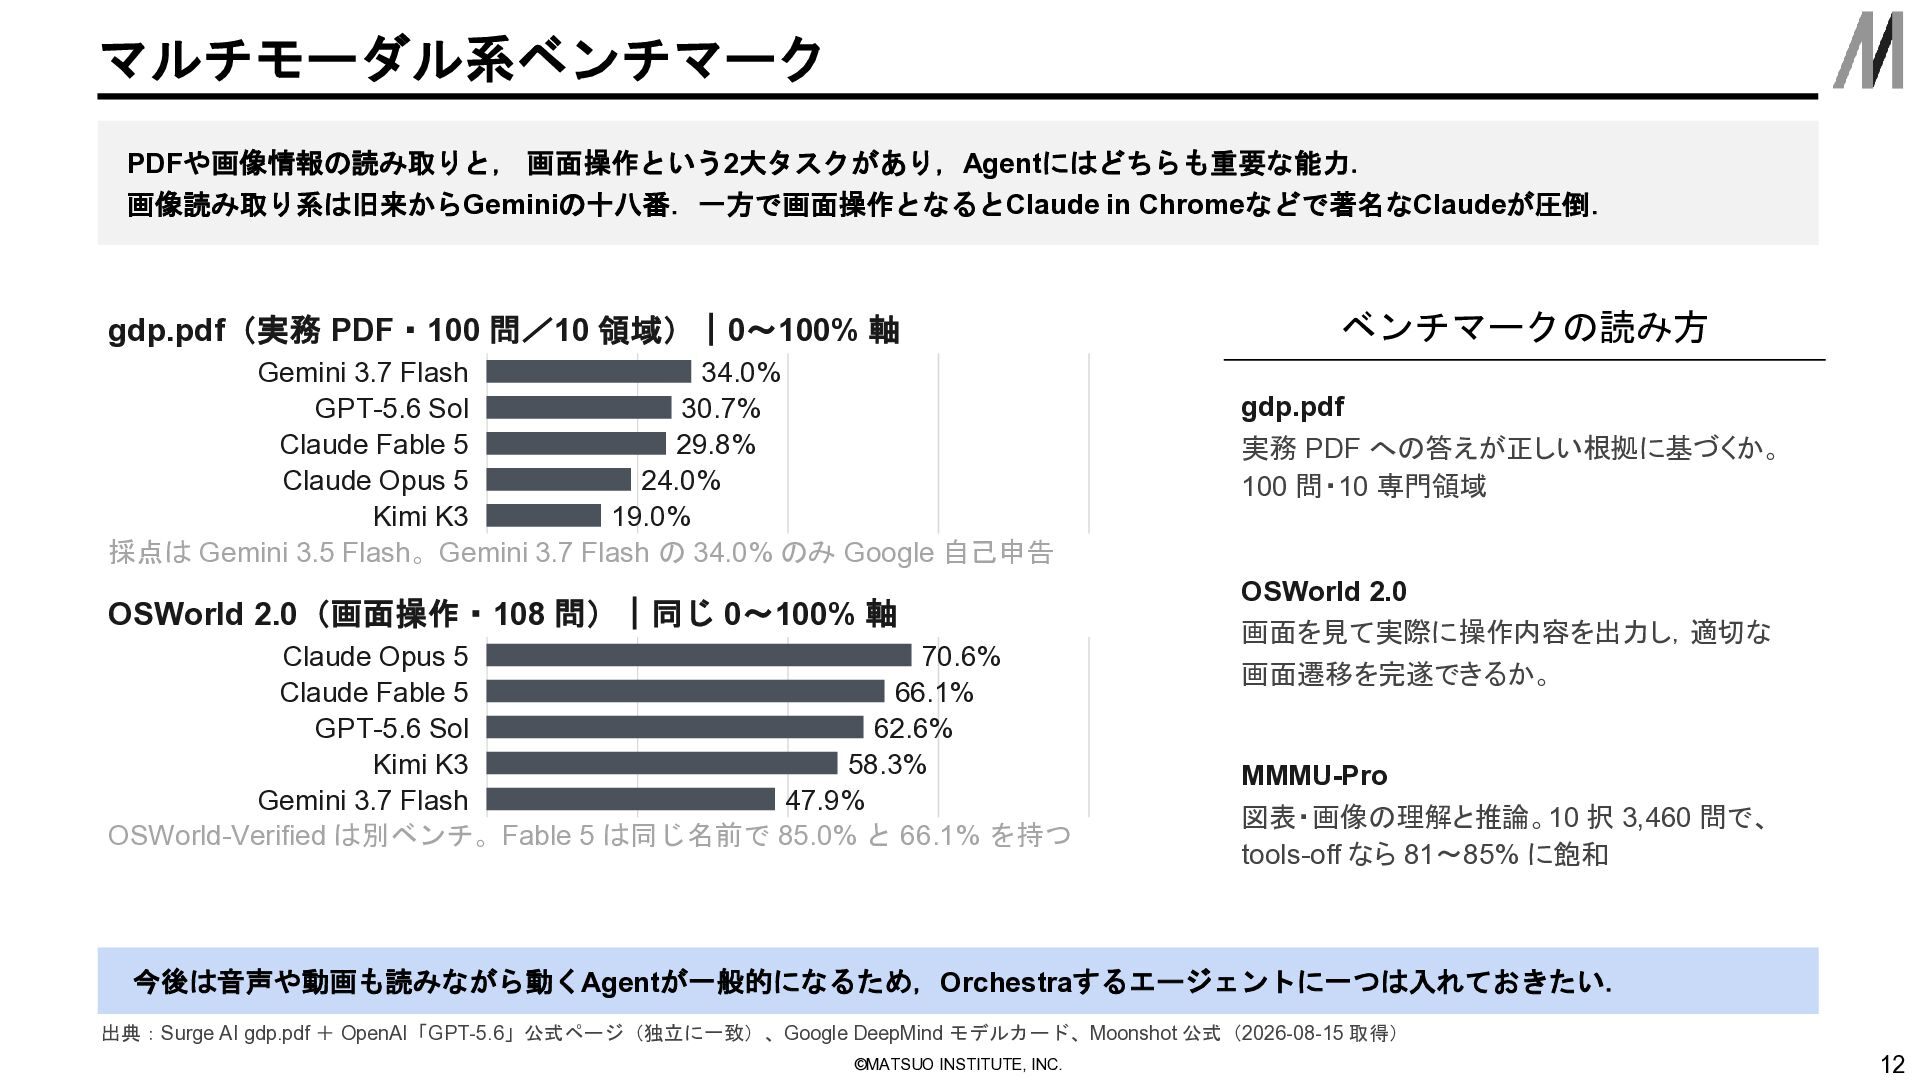
マルチモーダル系ベンチマーク PDFや画像情報の読み取りと, 画面操作という2大タスクがあり,Agentにはどちらも重要な能力. 画像読み取り系は旧来からGeminiの十八番.一方で画面操作となるとClaude in Chromeなどで著名なClaudeが圧倒. gdp.pdf(実務 PDF・100 問/10 領域)|0〜100%
軸 Gemini 3.7 Flash 34.0% GPT-5.6 Sol 30.7% Claude Fable 5 29.8% Claude Opus 5 24.0% Kimi K3 19.0% 採点は Gemini 3.5 Flash。Gemini 3.7 Flash の 34.0% のみ Google 自己申告 OSWorld 2.0(画面操作・108 問)|同じ 0〜100% 軸 Claude Opus 5 70.6% Claude Fable 5 66.1% GPT-5.6 Sol 62.6% Kimi K3 58.3% Gemini 3.7 Flash 47.9% OSWorld-Verified は別ベンチ。Fable 5 は同じ名前で 85.0% と 66.1% を持つ ベンチマークの読み方 gdp.pdf 実務 PDF への答えが正しい根拠に基づくか。 100 問・10 専門領域 OSWorld 2.0 画面を見て実際に操作内容を出力し,適切な 画面遷移を完遂できるか。 MMMU-Pro 図表・画像の理解と推論。10 択 3,460 問で、 tools-off なら 81〜85% に飽和 今後は音声や動画も読みながら動くAgentが一般的になるため,Orchestraするエージェントに一つは入れておきたい. 出典:Surge AI gdp.pdf + OpenAI「GPT-5.6」公式ページ(独立に一致)、Google DeepMind モデルカード、Moonshot 公式(2026-08-15 取得) ©︎MATSUO INSTITUTE, INC. 12
具体的な使い分け ©︎MATSUO INSTITUTE, INC.
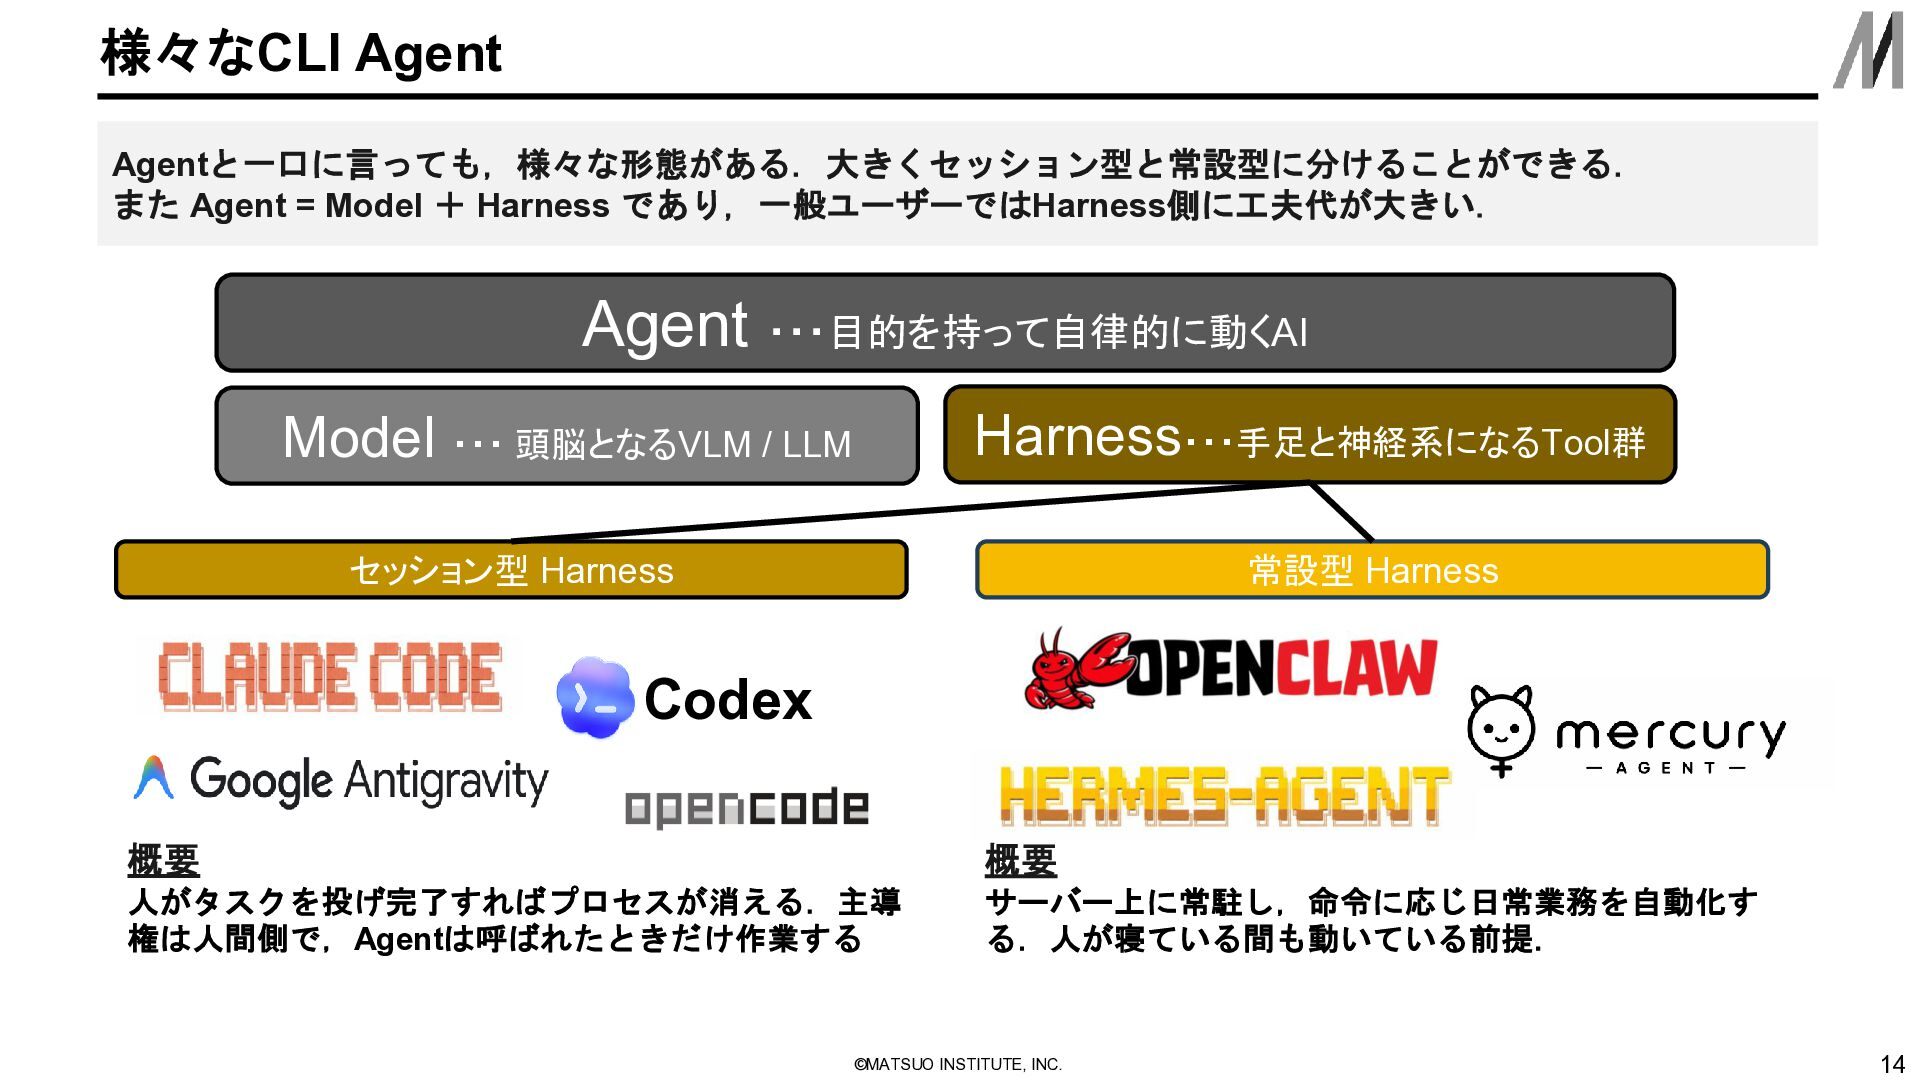
様々なCLI Agent Agentと一口に言っても,様々な形態がある.大きくセッション型と常設型に分けることができる. また Agent = Model + Harness であり,一般ユーザーではHarness側に工夫代が大きい.
Agent ・・・目的を持って自律的に動くAI Harness・・・手足と神経系になるTool群 Model ・・・ 頭脳となるVLM / LLM セッション型 Harness 常設型 Harness Codex 概要 概要 人がタスクを投げ完了すればプロセスが消える.主導 権は人間側で,Agentは呼ばれたときだけ作業する サーバー上に常駐し,命令に応じ日常業務を自動化す る.人が寝ている間も動いている前提. ©︎MATSUO INSTITUTE, INC. 14
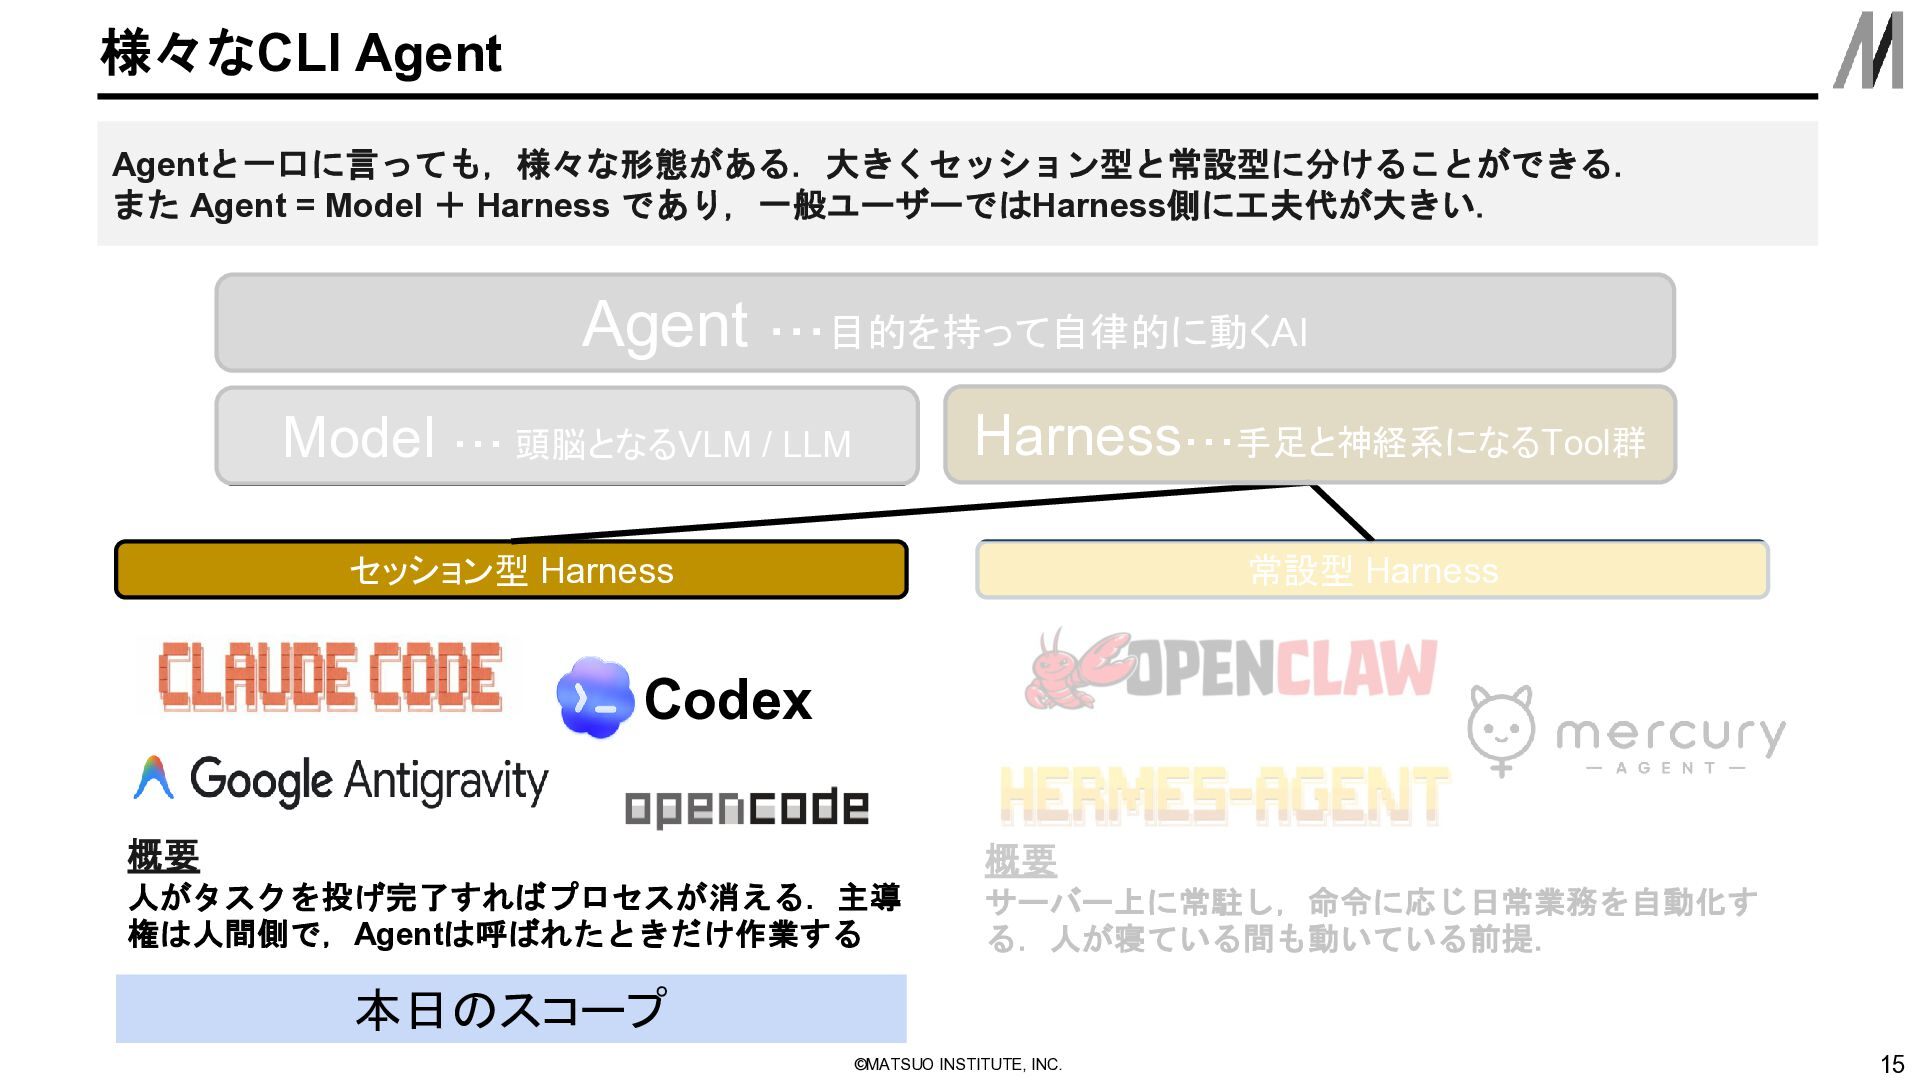
様々なCLI Agent Agentと一口に言っても,様々な形態がある.大きくセッション型と常設型に分けることができる. また Agent = Model + Harness であり,一般ユーザーではHarness側に工夫代が大きい.
Agent ・・・目的を持って自律的に動くAI Harness・・・手足と神経系になるTool群 Model ・・・ 頭脳となるVLM / LLM セッション型 Harness 常設型 Harness Codex 概要 概要 人がタスクを投げ完了すればプロセスが消える.主導 権は人間側で,Agentは呼ばれたときだけ作業する サーバー上に常駐し,命令に応じ日常業務を自動化す る.人が寝ている間も動いている前提. 本日のスコープ ©︎MATSUO INSTITUTE, INC. 15
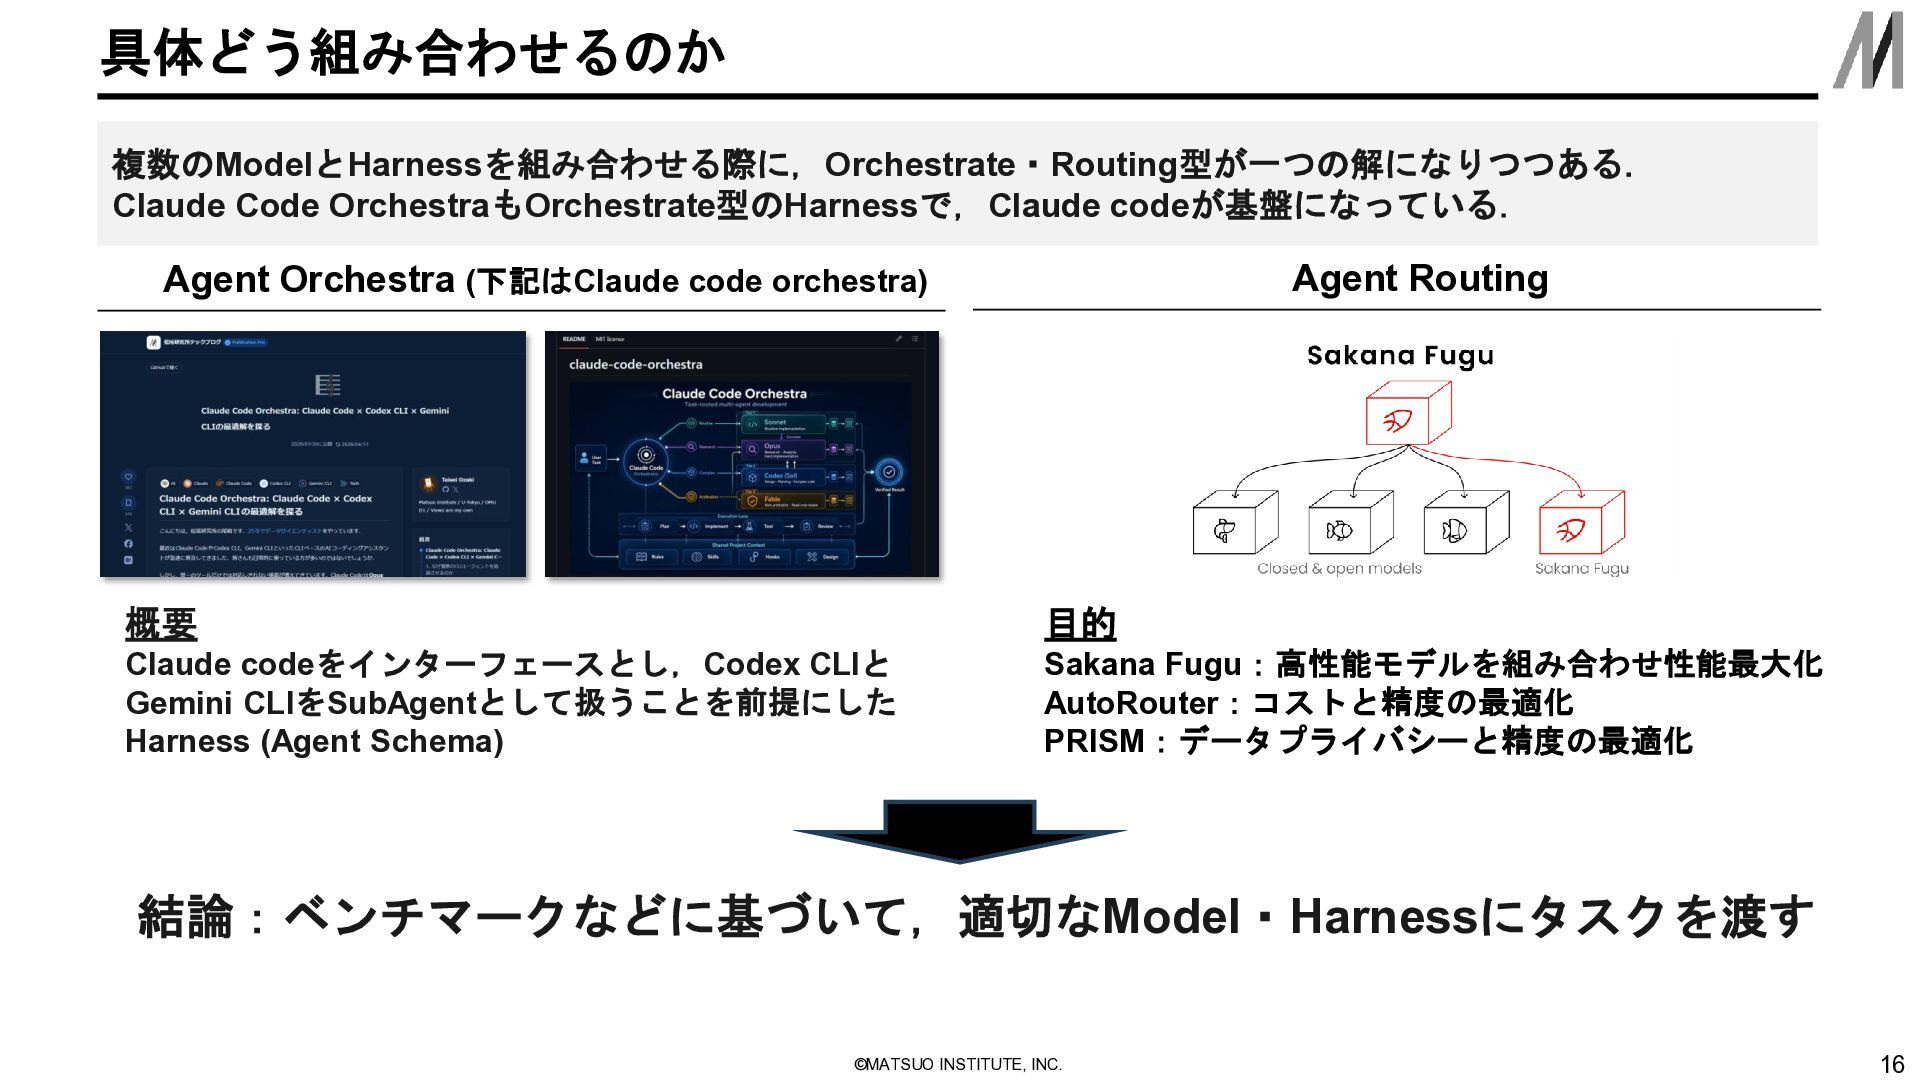
具体どう組み合わせるのか 複数のModelとHarnessを組み合わせる際に,Orchestrate・Routing型が一つの解になりつつある. Claude Code OrchestraもOrchestrate型のHarnessで,Claude codeが基盤になっている. Agent Routing Agent Orchestra
(下記はClaude code orchestra) 概要 目的 Claude codeをインターフェースとし,Codex CLIと Gemini CLIをSubAgentとして扱うことを前提にした Harness (Agent Schema) Sakana Fugu:高性能モデルを組み合わせ性能最大化 AutoRouter:コストと精度の最適化 PRISM:データプライバシーと精度の最適化 結論:ベンチマークなどに基づいて,適切なModel・Harnessにタスクを渡す ©︎MATSUO INSTITUTE, INC. 16
+αの話 Agentと人間の認知負荷 ©︎MATSUO INSTITUTE, INC.
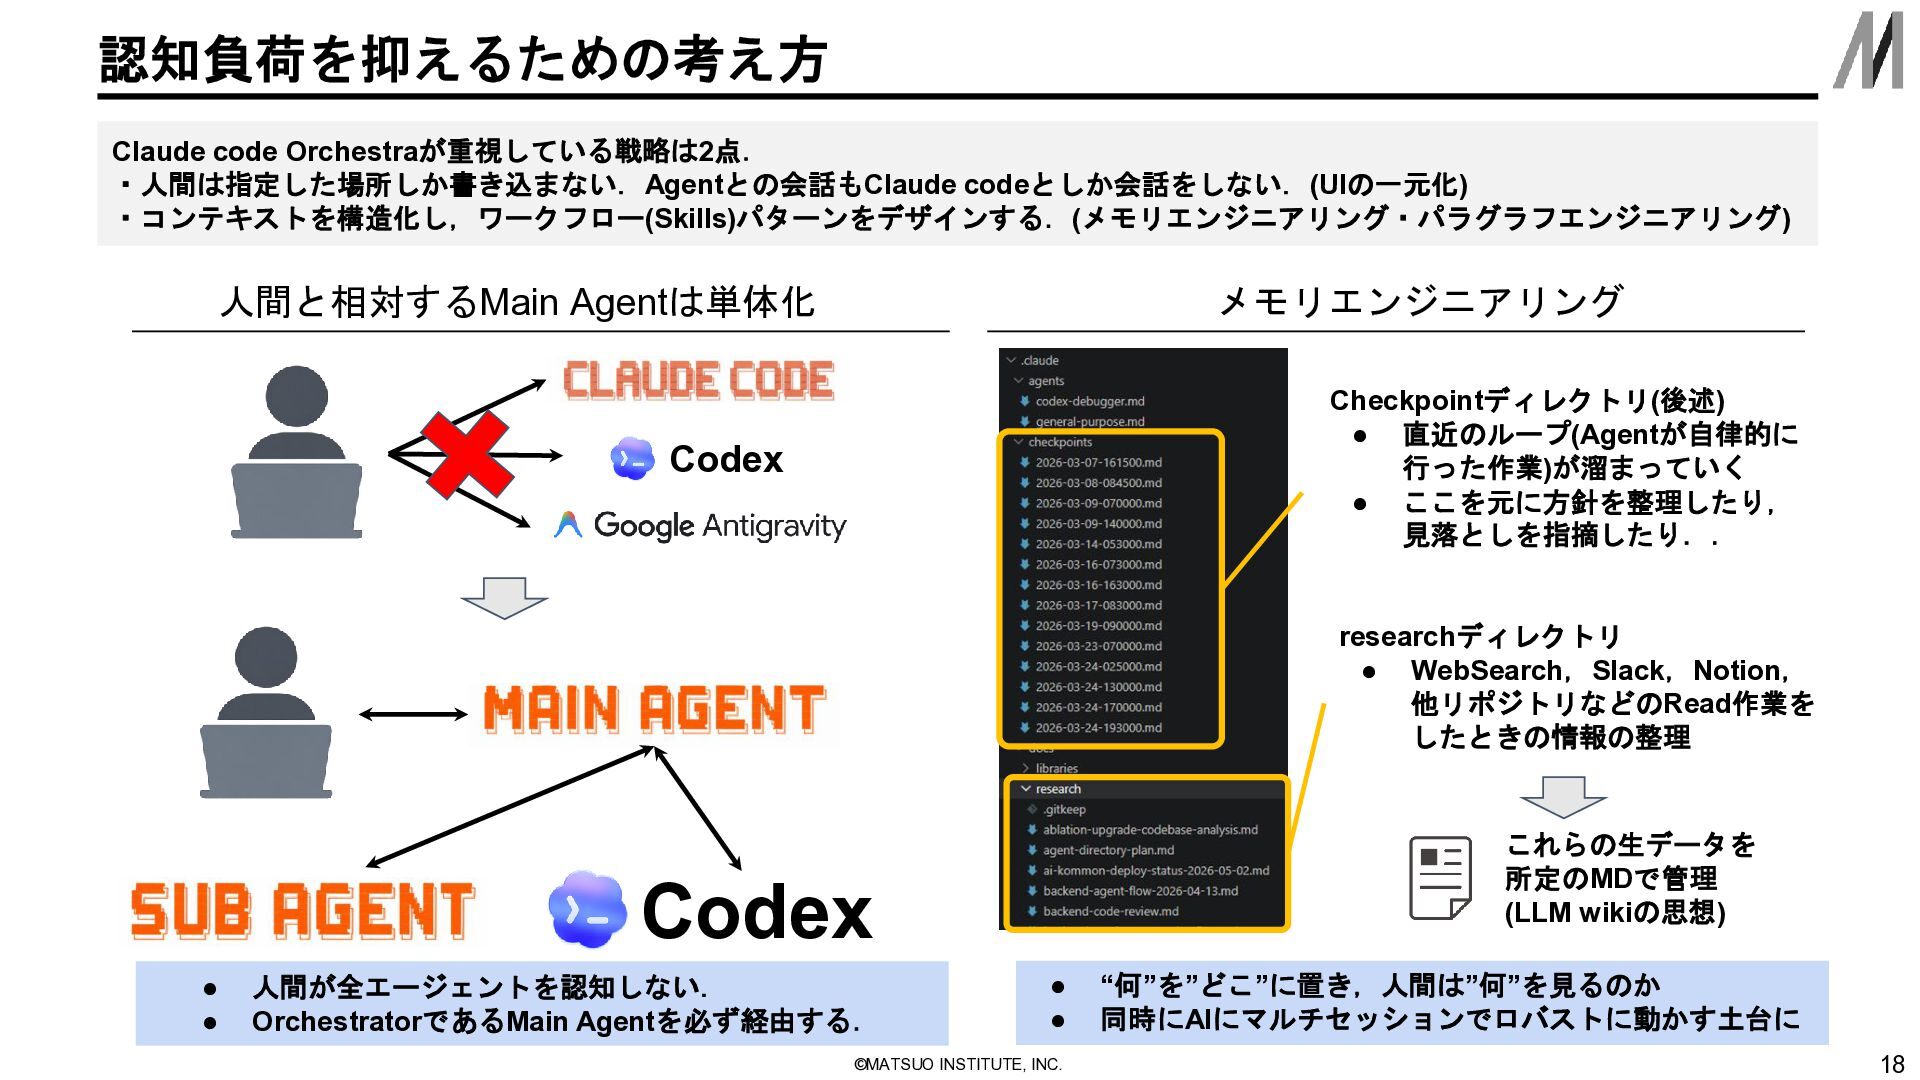
認知負荷を抑えるための考え方 Claude code Orchestraが重視している戦略は2点. ・人間は指定した場所しか書き込まない.Agentとの会話もClaude codeとしか会話をしない.(UIの一元化) ・コンテキストを構造化し,ワークフロー(Skills)パターンをデザインする.(メモリエンジニアリング・パラグラフエンジニアリング) 人間と相対するMain Agentは単体化 メモリエンジニアリング
Checkpointディレクトリ(後述) • 直近のループ(Agentが自律的に 行った作業)が溜まっていく • ここを元に方針を整理したり, 見落としを指摘したり.. Codex researchディレクトリ • WebSearch,Slack,Notion, 他リポジトリなどのRead作業を したときの情報の整理 これらの生データを 所定のMDで管理 (LLM wikiの思想) Codex • • 人間が全エージェントを認知しない. OrchestratorであるMain Agentを必ず経由する. • • ©︎MATSUO INSTITUTE, INC. “何”を”どこ”に置き,人間は”何”を見るのか 同時にAIにマルチセッションでロバストに動かす土台に 18
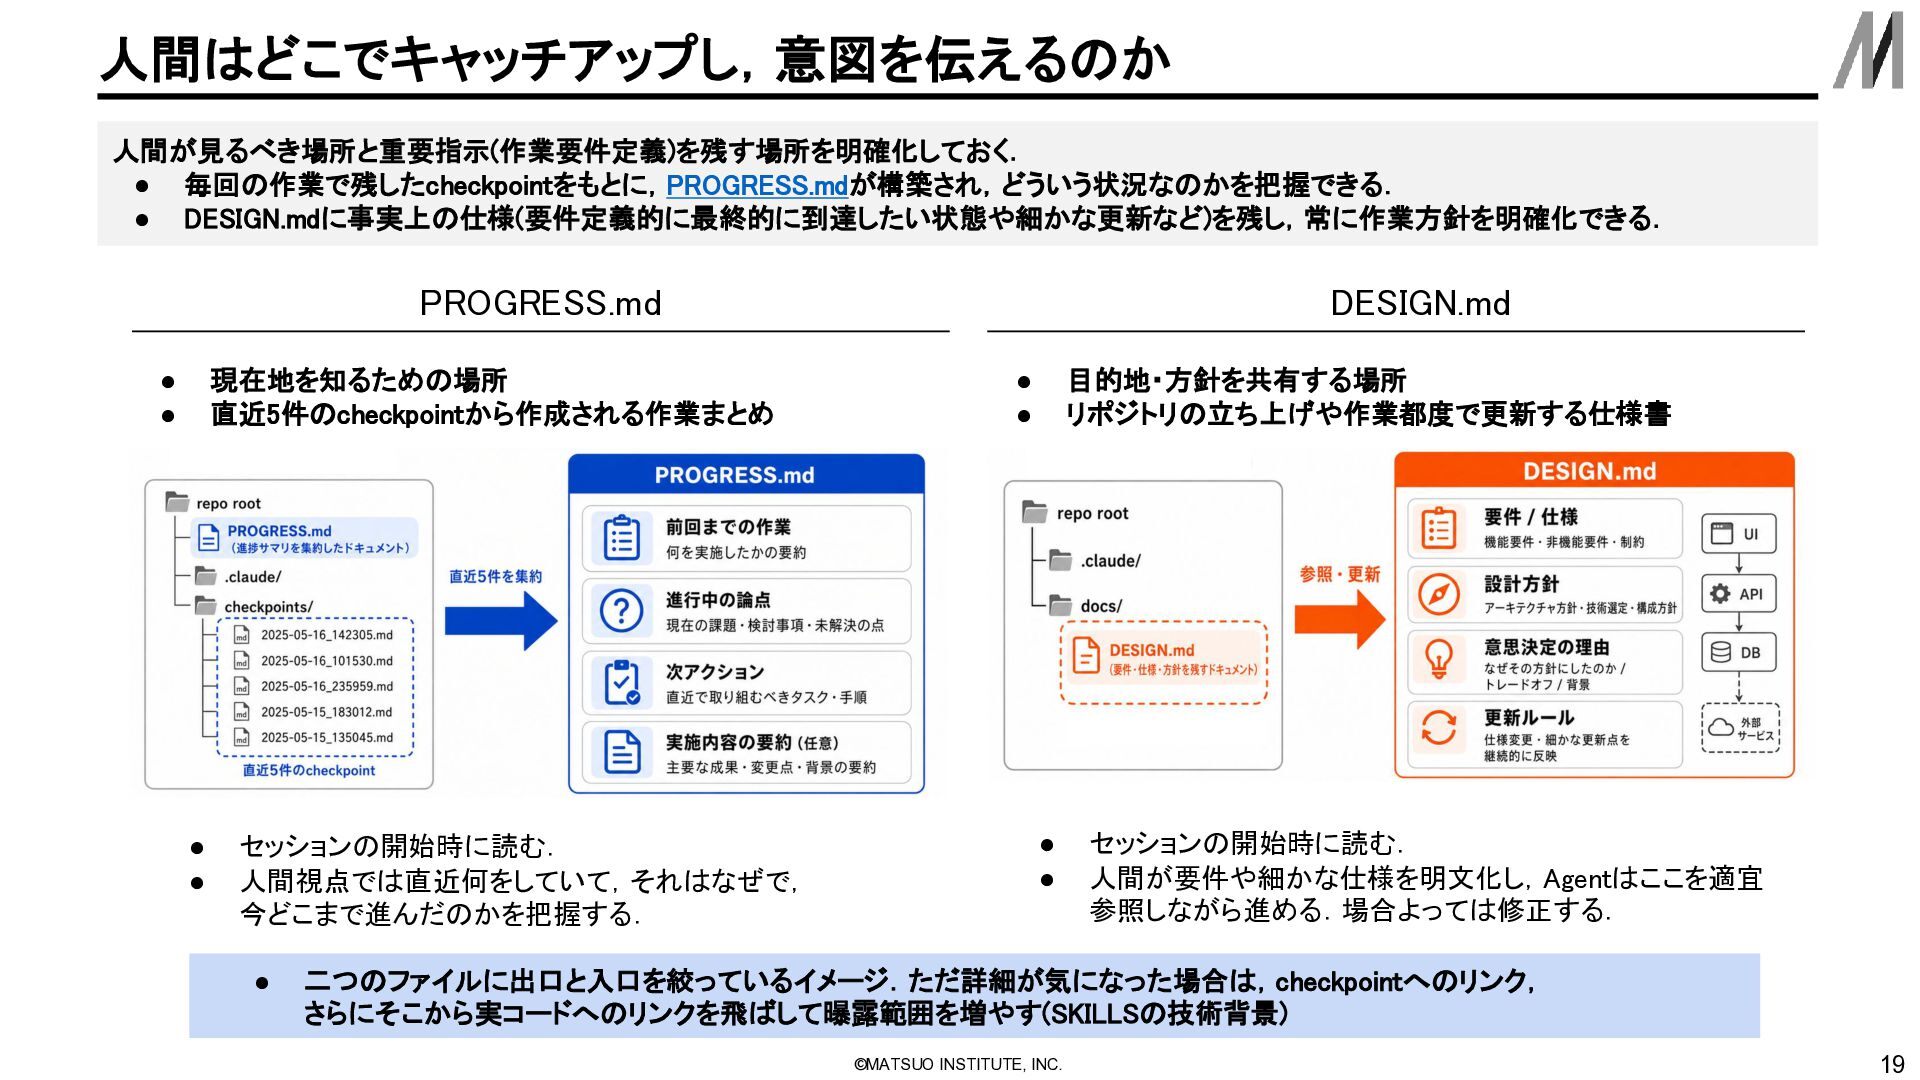
人間はどこでキャッチアップし,意図を伝えるのか 人間が見るべき場所と重要指示(作業要件定義)を残す場所を明確化しておく. • 毎回の作業で残したcheckpointをもとに,PROGRESS.mdが構築され,どういう状況なのかを把握できる. • DESIGN.mdに事実上の仕様(要件定義的に最終的に到達したい状態や細かな更新など)を残し,常に作業方針を明確化できる. PROGRESS.md • • 現在地を知るための場所
直近5件のcheckpointから作成される作業まとめ • • セッションの開始時に読む. 人間視点では直近何をしていて,それはなぜで, 今どこまで進んだのかを把握する. • DESIGN.md • • 目的地・方針を共有する場所 リポジトリの立ち上げや作業都度で更新する仕様書 • • セッションの開始時に読む. 人間が要件や細かな仕様を明文化し,Agentはここを適宜 参照しながら進める.場合よっては修正する. 二つのファイルに出口と入口を絞っているイメージ.ただ詳細が気になった場合は,checkpointへのリンク, さらにそこから実コードへのリンクを飛ばして曝露範囲を増やす(SKILLSの技術背景) ©︎MATSUO INSTITUTE, INC. 19
©︎MATSUO INSTITUTE, INC.
More Decks by Taisei Ozaki
See All by Taisei Ozaki
AIと働く実践 Agentがあなたの生産性を上げてくれない理由
ozakiomumkj
1
200
Claude code Orchestra
ozakiomumkj
4
7.8k
Attention 再入門 is all you need (は言い過ぎ
ozakiomumkj
2
730
Featured
See All Featured
SEO for Brand Visibility & Recognition
aleyda
0
4.9k
How To Speak Unicorn (iThemes Webinar)
marktimemedia
1
640
Build your cross-platform service in a week with App Engine
jlugia
234
19k
Bridging the Design Gap: How Collaborative Modelling removes blockers to flow between stakeholders and teams @FastFlow conf
baasie
0
780
Abbi's Birthday
coloredviolet
5
11k
Self-Hosted WebAssembly Runtime for Runtime-Neutral Checkpoint/Restore in Edge–Cloud Continuum
chikuwait
0
960
Designing for humans not robots
tammielis
254
26k
Documentation Writing (for coders)
carmenintech
77
5.6k
Practical Orchestrator
shlominoach
192
12k
Connecting the Dots Between Site Speed, User Experience & Your Business [WebExpo 2025]
tammyeverts
11
1.1k
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
23k
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3.1k


 ozakiomumkj
 aleyda
 marktimemedia
 jlugia
 baasie
 coloredviolet
 chikuwait
 tammielis
 carmenintech
 shlominoach
 tammyeverts
 smashingmag
 bcantrill