Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
LLMについて深く知る
Search
sato
April 17, 2025
16
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
LLMについて深く知る
sato
April 17, 2025
More Decks by sato
See All by sato
20260227_AgentCore勉強会①
sat0
0
9
20251013_Bedrock_Guardrails
sat0
0
10
20250122_flAWS.pdf
sat0
0
5
20250415_外部ID_「混乱する代理問題」に混乱する
sat0
0
23
Featured
See All Featured
How to Grow Your eCommerce with AI & Automation
katarinadahlin
PRO
2
330
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
1
570
How to Talk to Developers About Accessibility
jct
2
580
Building Flexible Design Systems
yeseniaperezcruz
330
41k
Automating Front-end Workflow
addyosmani
1369
210k
<Decoding/> the Language of Devs - We Love SEO 2024
nikkihalliwell
1
360
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
630
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
940
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2k
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
600
Max Prin - Stacking Signals: How International SEO Comes Together (And Falls Apart)
techseoconnect
PRO
0
490
Game over? The fight for quality and originality in the time of robots
wayneb77
1
300
Transcript
Copyright © SCSK Corporation AI×クラウドのはじめの一歩! AWS Certified AI Practitionerを取得しよう! LLMについて深く知る
ソリューション事業グループ クラウドサービス事業本部 クラウドサービス第二部 第二課 渡邉智士 2024年12月11日
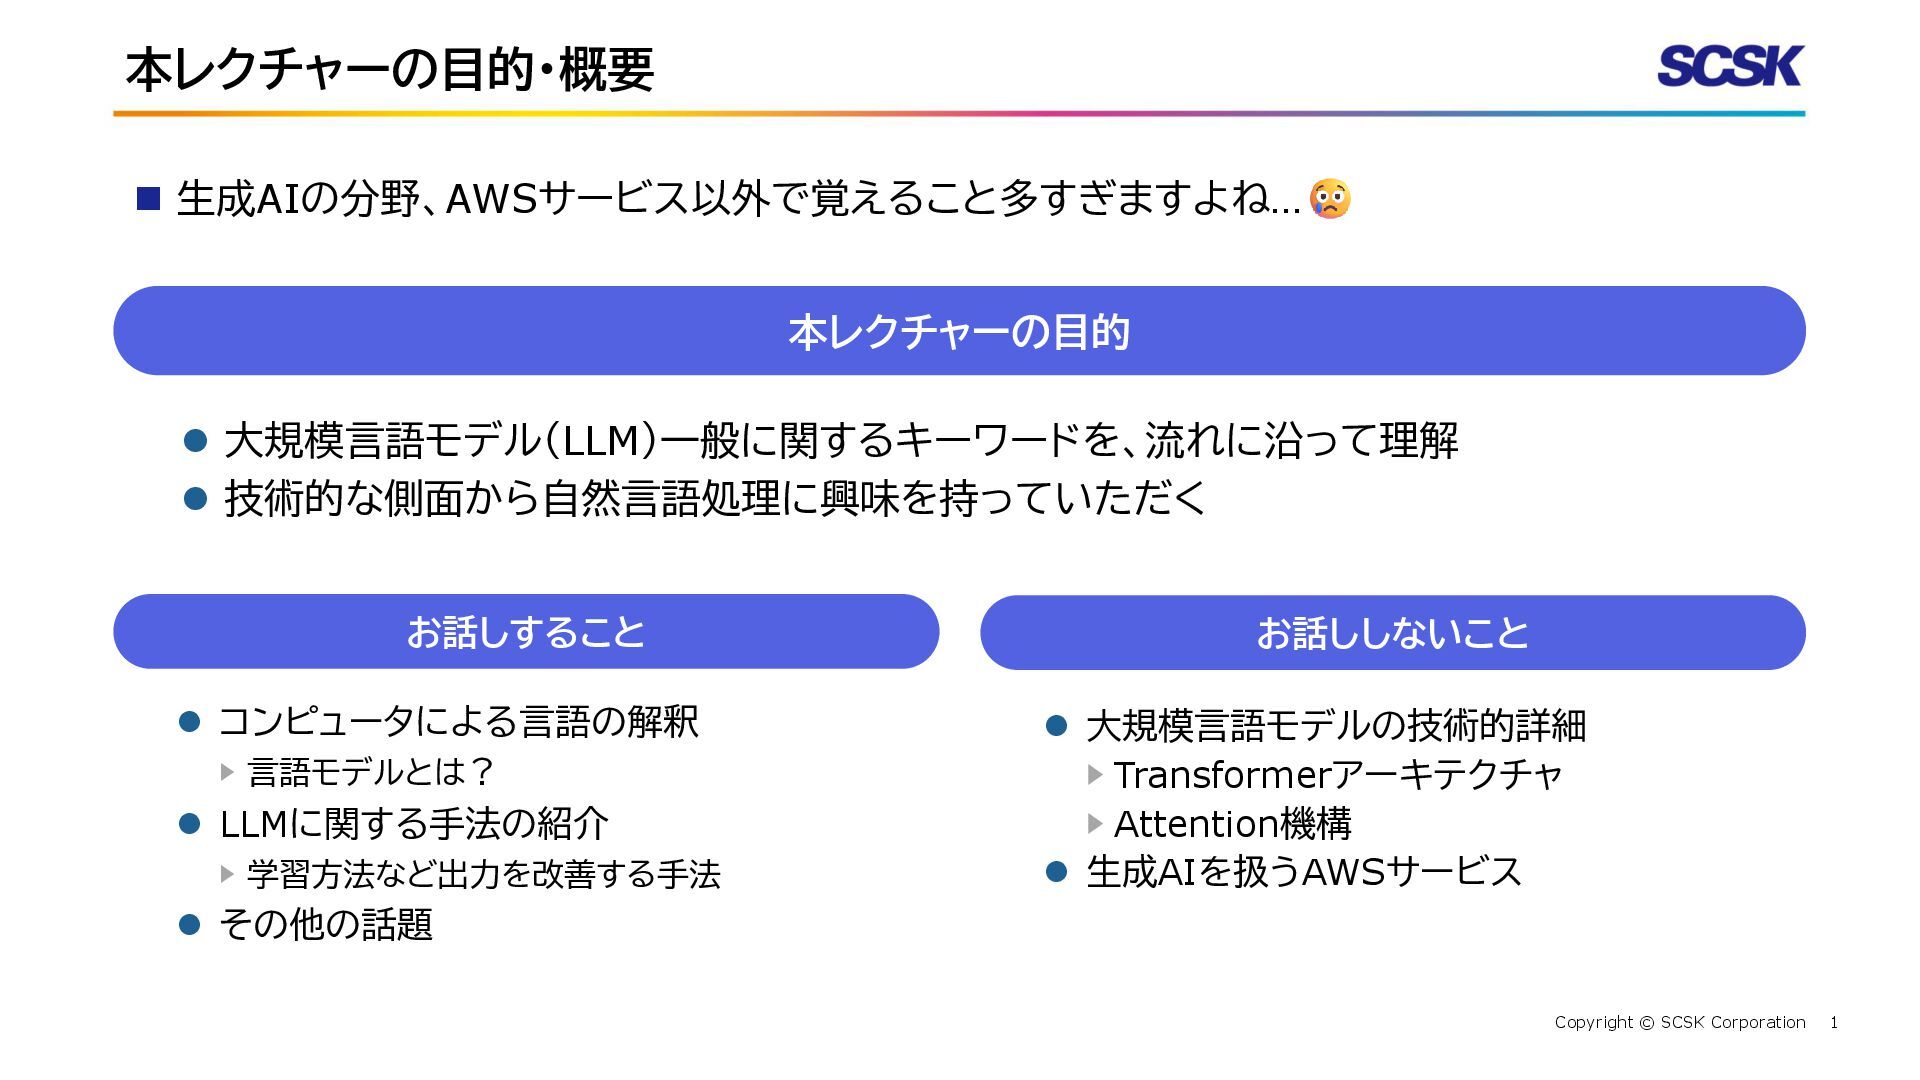
1 Copyright © SCSK Corporation 本レクチャーの目的・概要 ⚫ コンピュータによる言語の解釈 ▶ 言語モデルとは?
⚫ LLMに関する手法の紹介 ▶ 学習方法など出力を改善する手法 ⚫ その他の話題 ⚫ 大規模言語モデルの技術的詳細 ▶ Transformerアーキテクチャ ▶ Attention機構 ⚫ 生成AIを扱うAWSサービス お話しすること お話ししないこと 本レクチャーの目的 ◼ 生成AIの分野、AWSサービス以外で覚えること多すぎますよね… ⚫ 大規模言語モデル(LLM)一般に関するキーワードを、流れに沿って理解 ⚫ 技術的な側面から自然言語処理に興味を持っていただく
Copyright © SCSK Corporation コンピュータによる言語の解釈
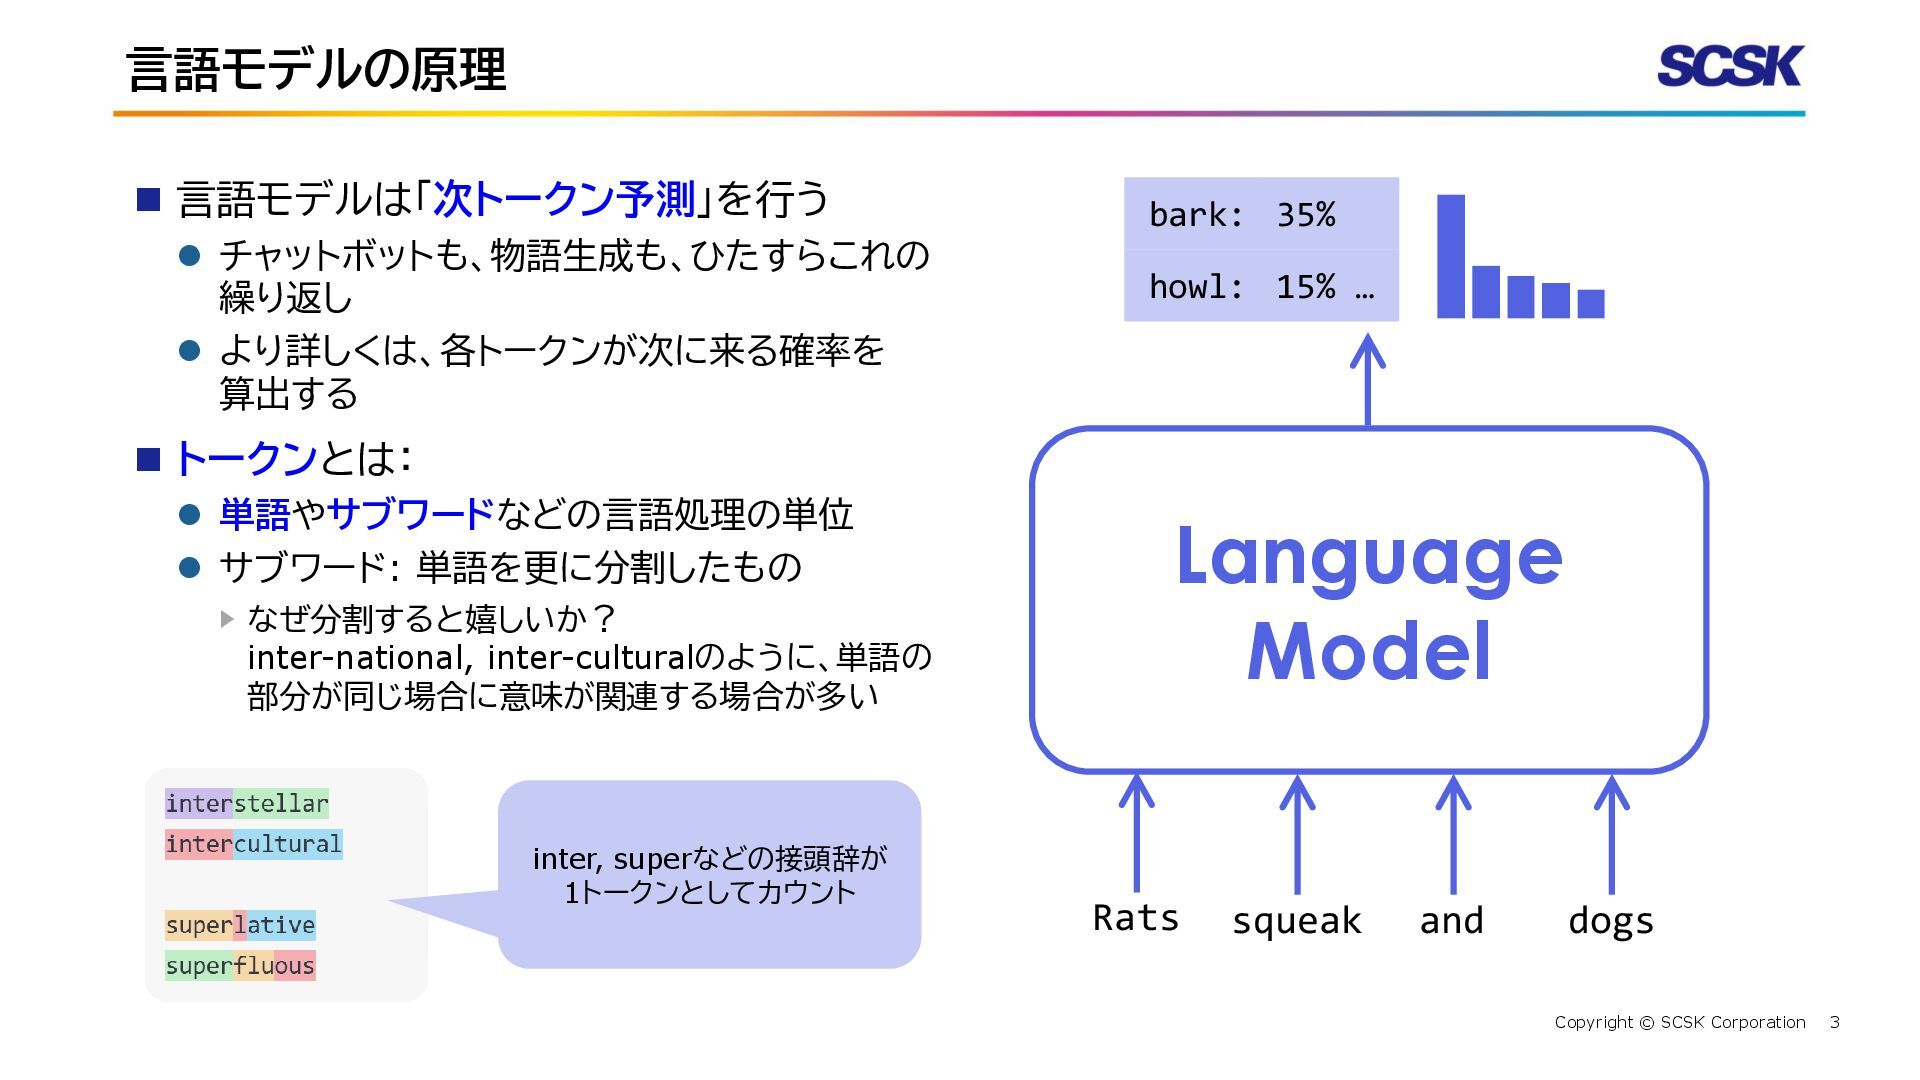
3 Copyright © SCSK Corporation 言語モデルの原理 ◼ 言語モデルは「次トークン予測」を行う ⚫ チャットボットも、物語生成も、ひたすらこれの
繰り返し ⚫ より詳しくは、各トークンが次に来る確率を 算出する ◼ トークンとは: ⚫ 単語やサブワードなどの言語処理の単位 ⚫ サブワード: 単語を更に分割したもの ▶ なぜ分割すると嬉しいか? inter-national, inter-culturalのように、単語の 部分が同じ場合に意味が関連する場合が多い Language Model Rats squeak and dogs bark: 35% howl: 15% … inter, superなどの接頭辞が 1トークンとしてカウント
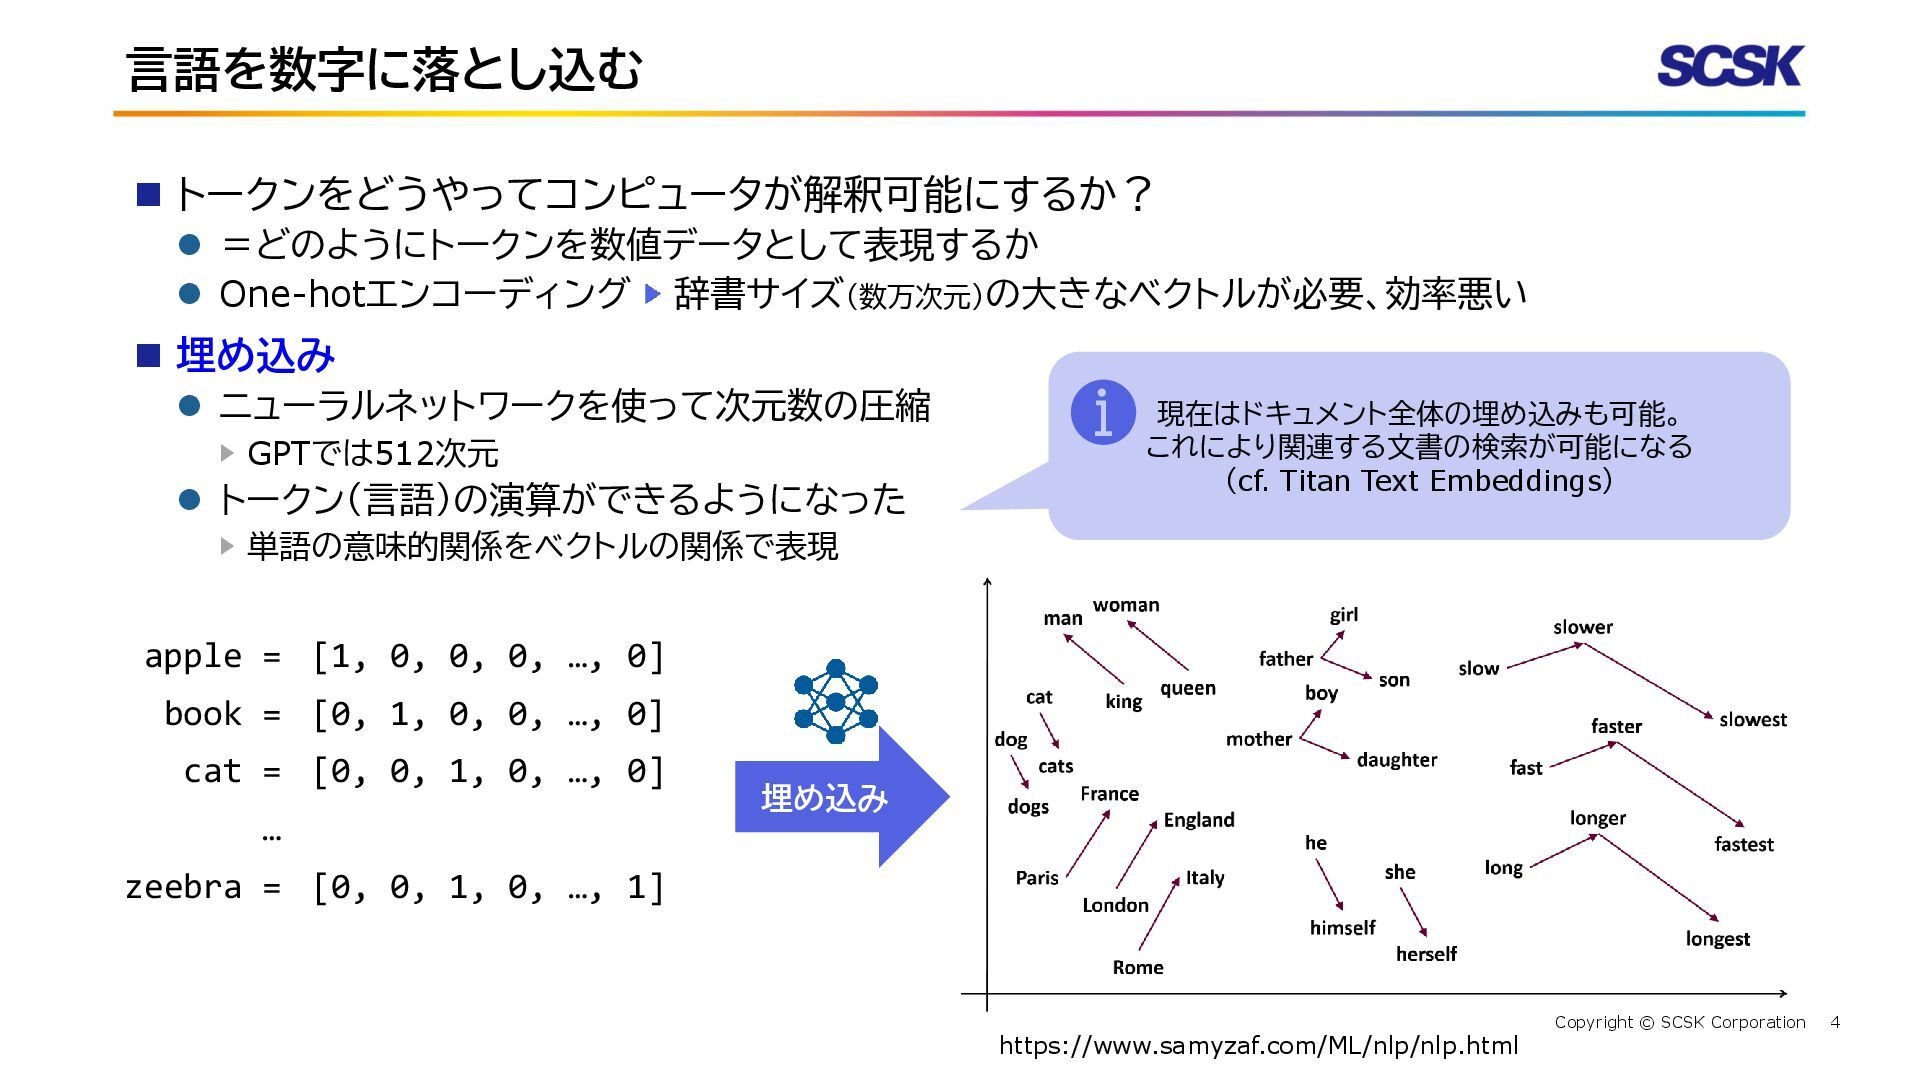
4 Copyright © SCSK Corporation 言語を数字に落とし込む ◼ トークンをどうやってコンピュータが解釈可能にするか? ⚫ =どのようにトークンを数値データとして表現するか
⚫ One-hotエンコーディング 辞書サイズ(数万次元)の大きなベクトルが必要、効率悪い ◼ 埋め込み ⚫ ニューラルネットワークを使って次元数の圧縮 ▶ GPTでは512次元 ⚫ トークン(言語)の演算ができるようになった ▶ 単語の意味的関係をベクトルの関係で表現 埋め込み apple = [1, 0, 0, 0, …, 0] book = [0, 1, 0, 0, …, 0] cat = [0, 0, 1, 0, …, 0] … zeebra = [0, 0, 1, 0, …, 1] https://www.samyzaf.com/ML/nlp/nlp.html 現在はドキュメント全体の埋め込みも可能。 これにより関連する文書の検索が可能になる (cf. Titan Text Embeddings)
Copyright © SCSK Corporation LLMに関する手法の紹介
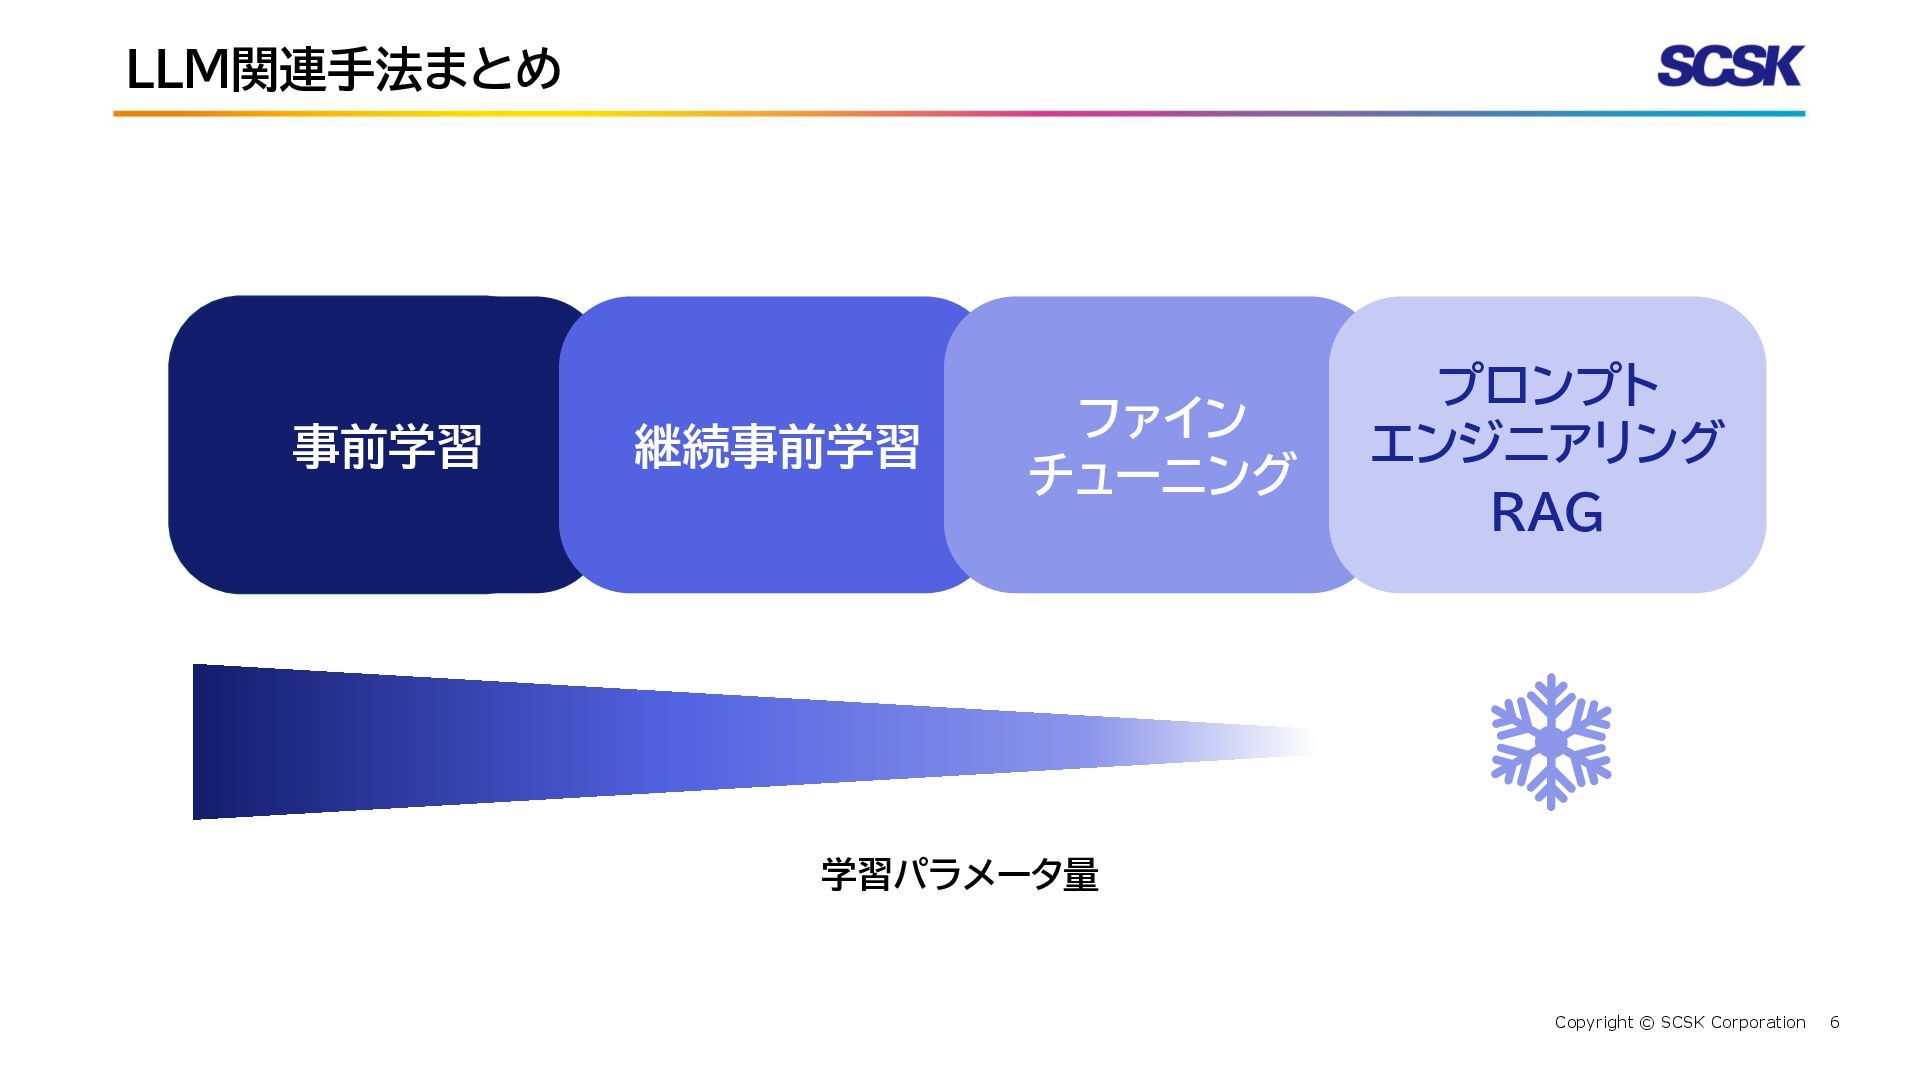
6 Copyright © SCSK Corporation LLM関連手法まとめ 事前学習 事前学習 継続事前学習 ファイン
チューニング プロンプト エンジニアリング RAG 学習パラメータ量
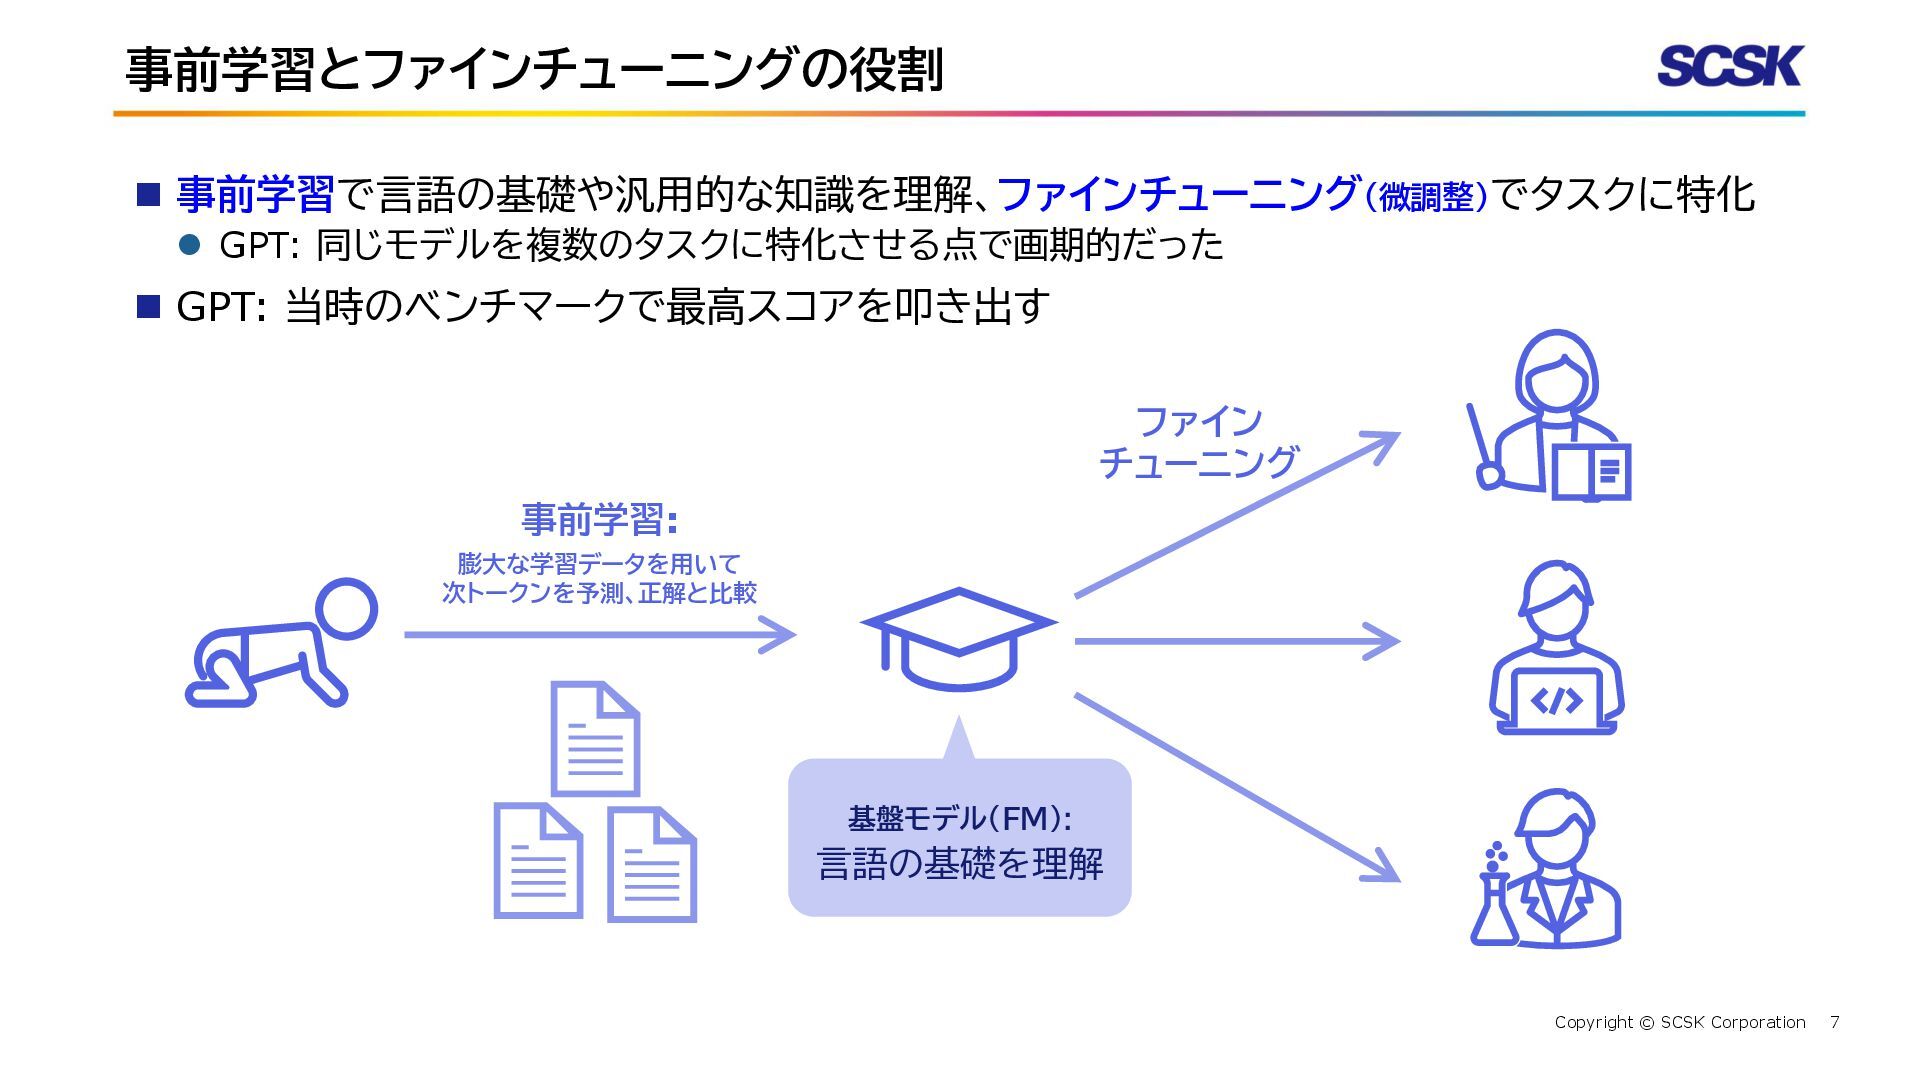
7 Copyright © SCSK Corporation 事前学習とファインチューニングの役割 ◼ 事前学習で言語の基礎や汎用的な知識を理解、ファインチューニング(微調整)でタスクに特化 ⚫ GPT:
同じモデルを複数のタスクに特化させる点で画期的だった ◼ GPT: 当時のベンチマークで最高スコアを叩き出す 事前学習: 膨大な学習データを用いて 次トークンを予測、正解と比較 ファイン チューニング 基盤モデル(FM): 言語の基礎を理解
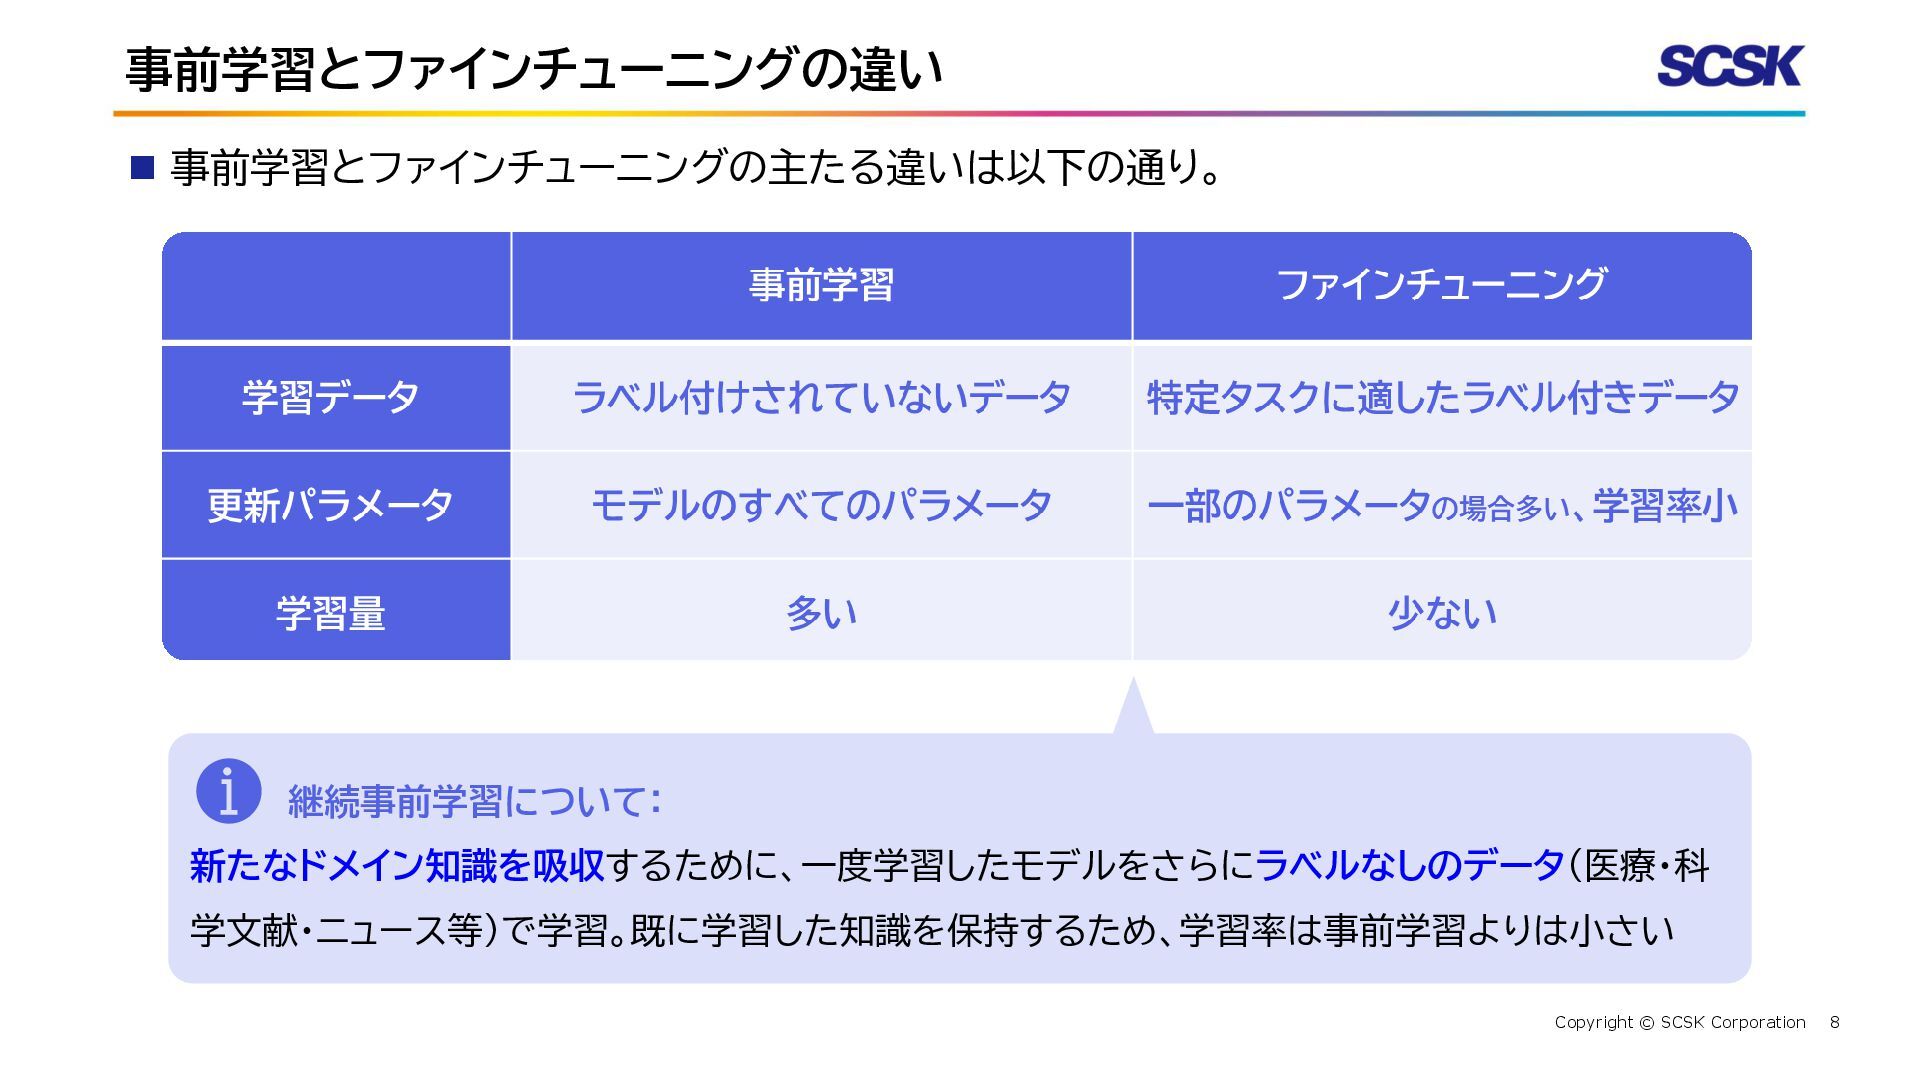
8 Copyright © SCSK Corporation 事前学習とファインチューニングの違い ◼ 事前学習とファインチューニングの主たる違いは以下の通り。 継続事前学習について: 新たなドメイン知識を吸収するために、一度学習したモデルをさらにラベルなしのデータ(医療・科
学文献・ニュース等)で学習。既に学習した知識を保持するため、学習率は事前学習よりは小さい
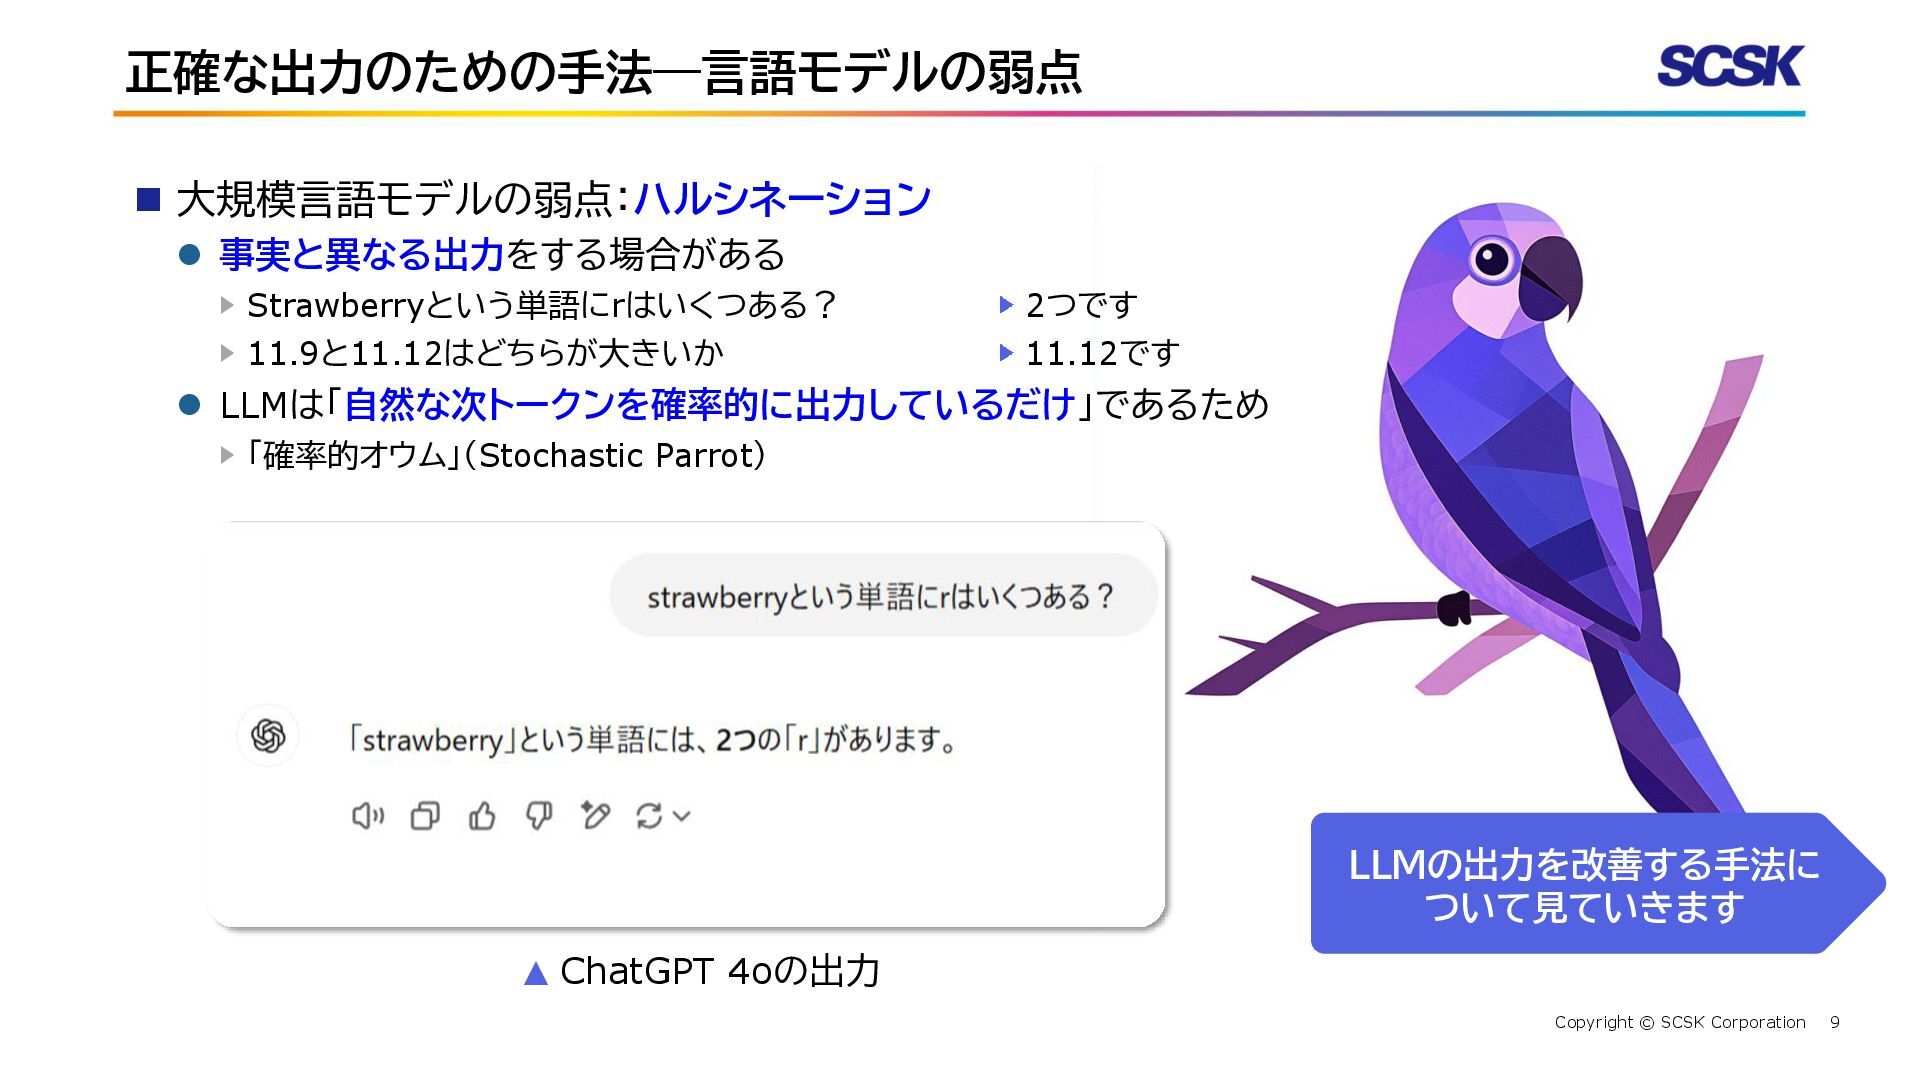
9 Copyright © SCSK Corporation 正確な出力のための手法―言語モデルの弱点 ◼ 大規模言語モデルの弱点:ハルシネーション ⚫ 事実と異なる出力をする場合がある
▶ Strawberryという単語にrはいくつある? 2つです ▶ 11.9と11.12はどちらが大きいか 11.12です ⚫ LLMは「自然な次トークンを確率的に出力しているだけ」であるため ▶ 「確率的オウム」(Stochastic Parrot) ▲ ChatGPT 4oの出力 LLMの出力を改善する手法に ついて見ていきます
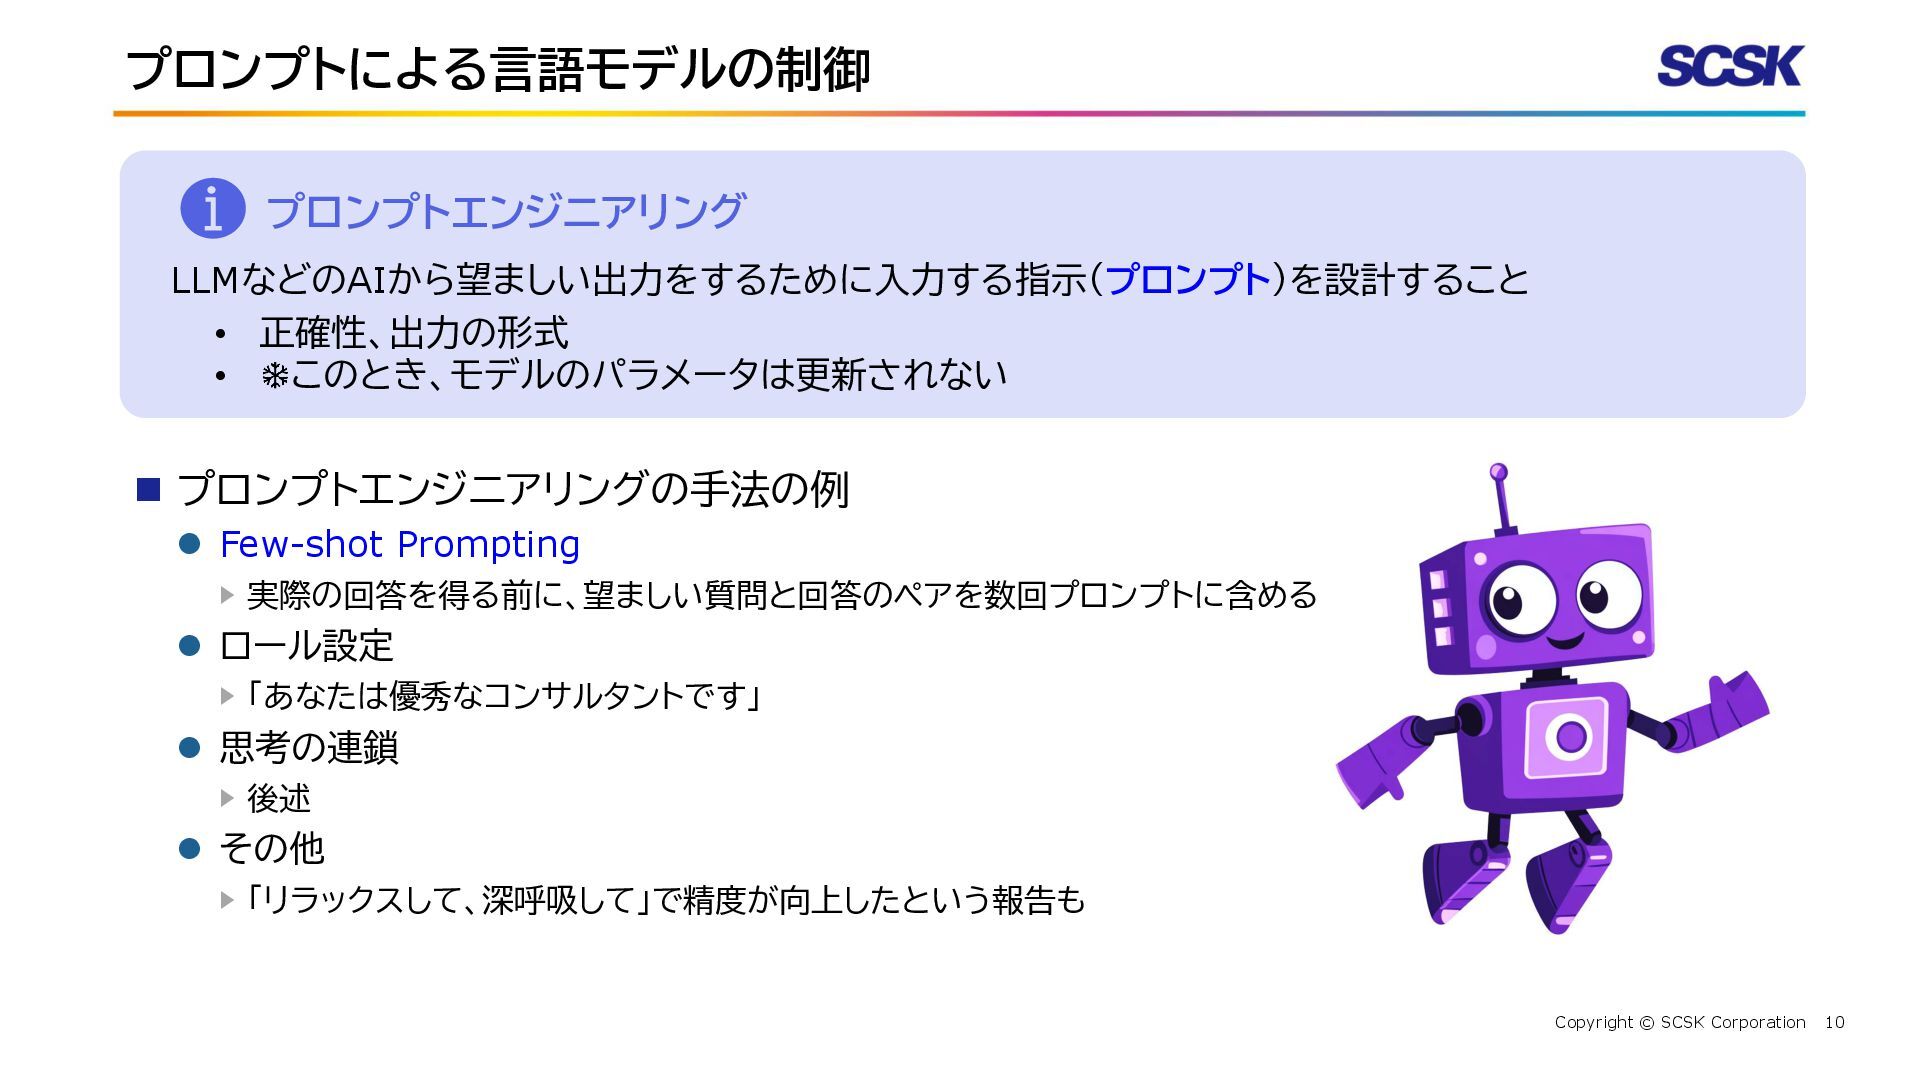
10 Copyright © SCSK Corporation プロンプトによる言語モデルの制御 ◼ プロンプトエンジニアリングの手法の例 ⚫ Few-shot
Prompting ▶ 実際の回答を得る前に、望ましい質問と回答のペアを数回プロンプトに含める ⚫ ロール設定 ▶ 「あなたは優秀なコンサルタントです」 ⚫ 思考の連鎖 ▶ 後述 ⚫ その他 ▶ 「リラックスして、深呼吸して」で精度が向上したという報告も プロンプトエンジニアリング LLMなどのAIから望ましい出力をするために入力する指示(プロンプト)を設計すること • 正確性、出力の形式 • このとき、モデルのパラメータは更新されない
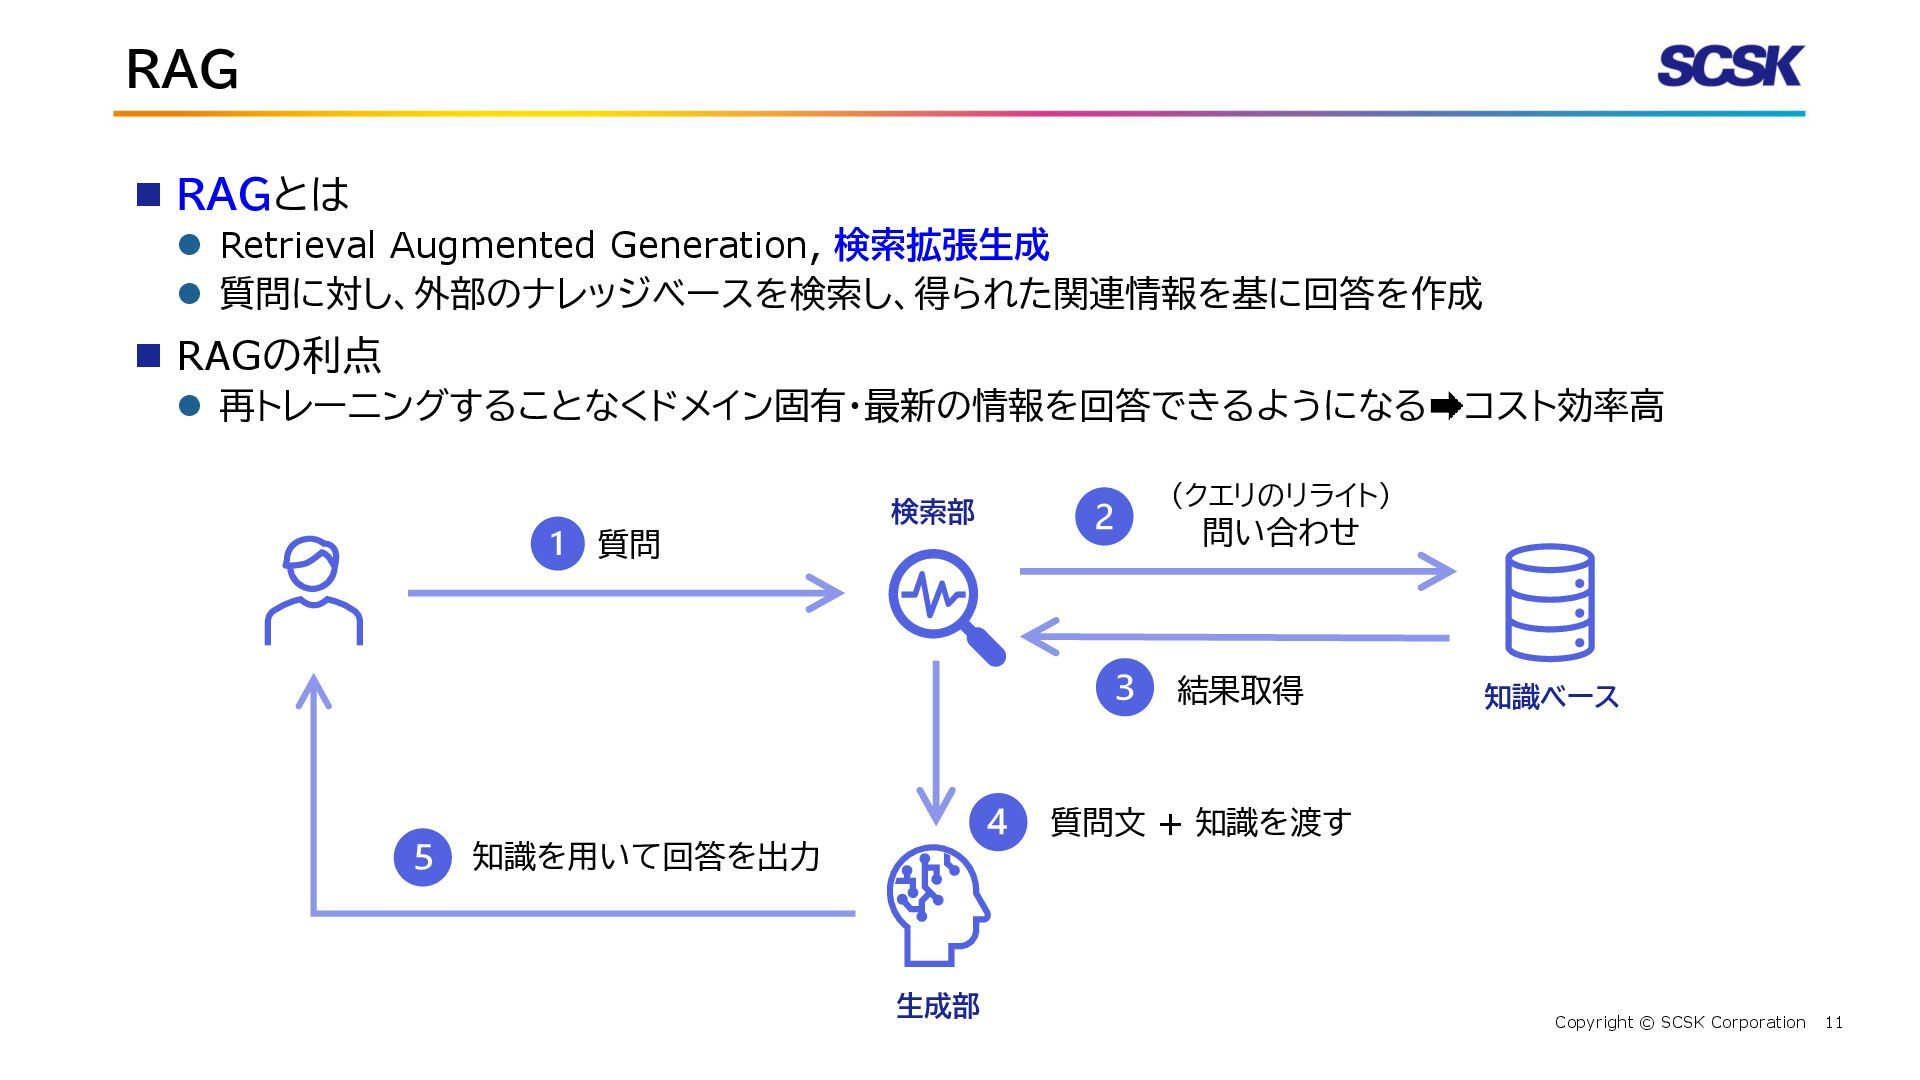
11 Copyright © SCSK Corporation RAG ◼ RAGとは ⚫ Retrieval
Augmented Generation, 検索拡張生成 ⚫ 質問に対し、外部のナレッジベースを検索し、得られた関連情報を基に回答を作成 ◼ RAGの利点 ⚫ 再トレーニングすることなくドメイン固有・最新の情報を回答できるようになる コスト効率高 質問 (クエリのリライト) 問い合わせ 結果取得 質問文 + 知識を渡す 知識を用いて回答を出力 生成部 知識ベース 検索部
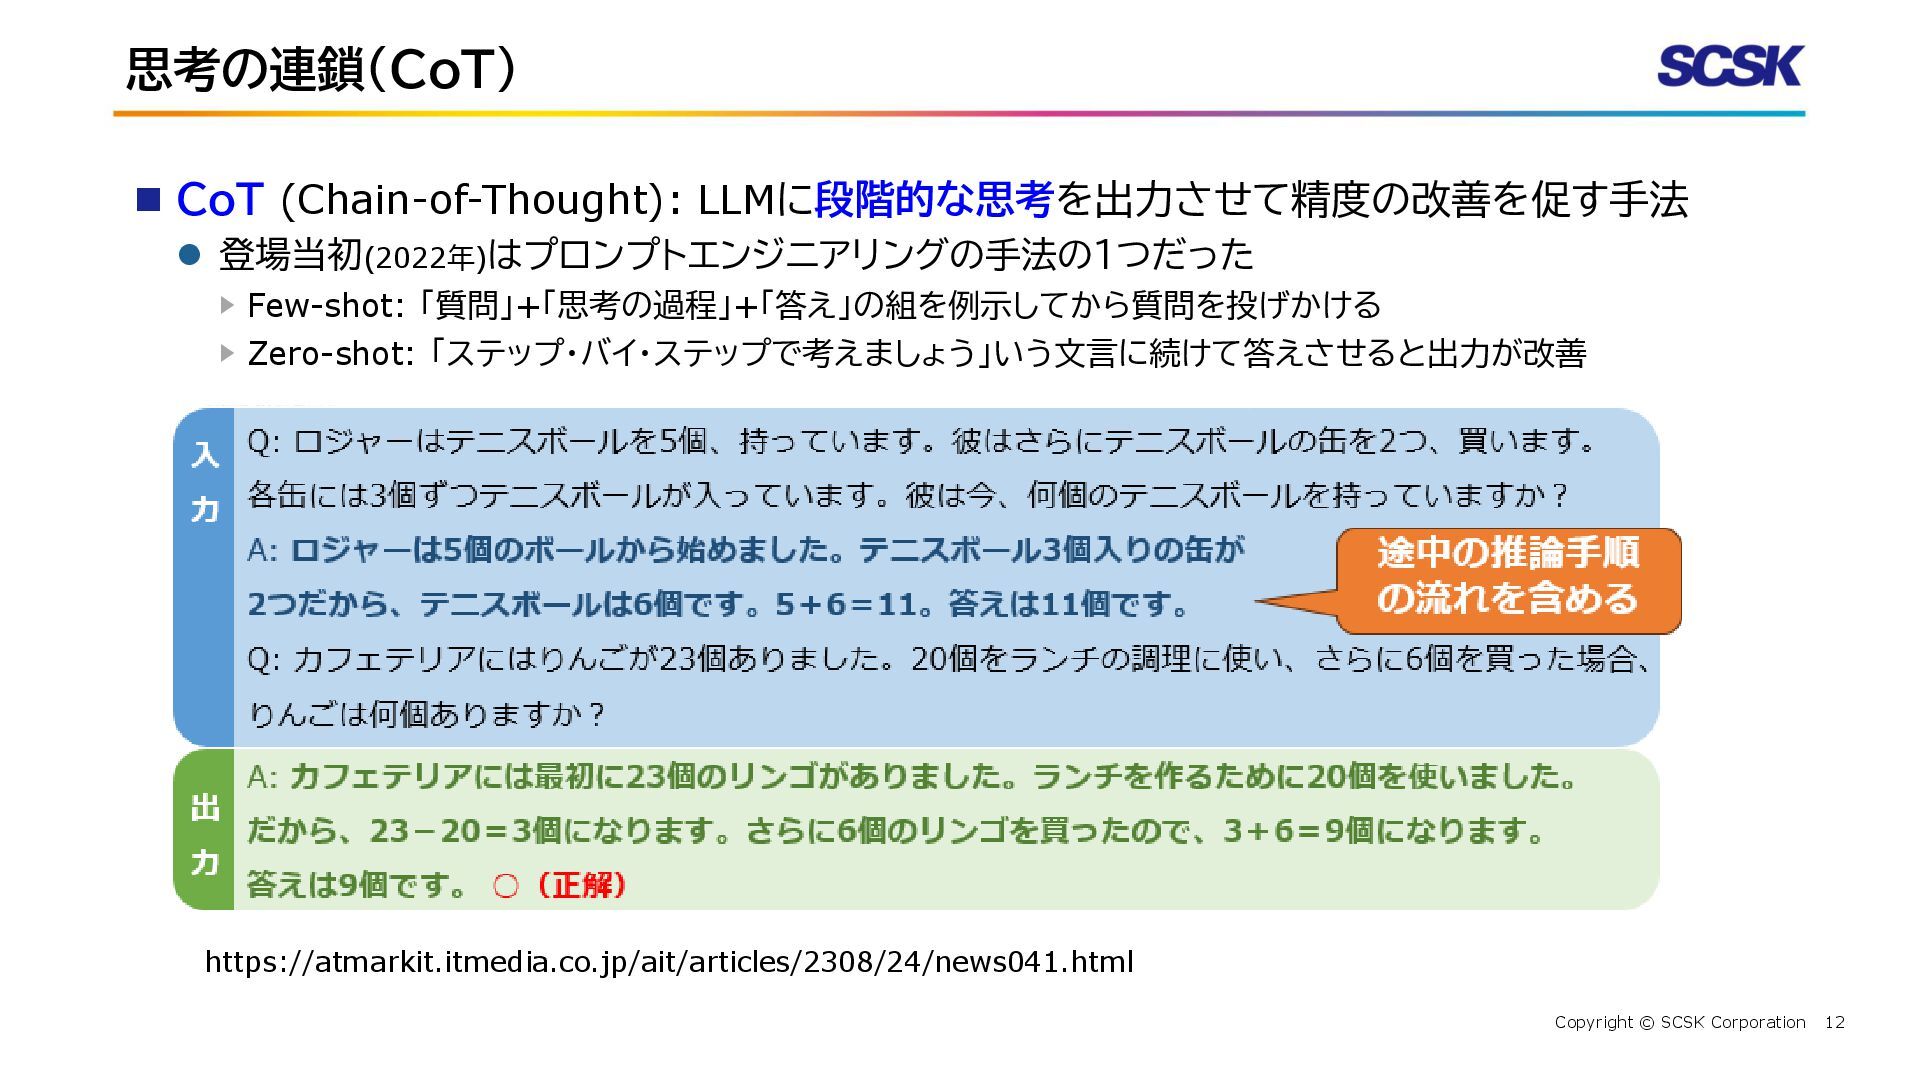
12 Copyright © SCSK Corporation 思考の連鎖(CoT) ◼ CoT (Chain-of-Thought): LLMに段階的な思考を出力させて精度の改善を促す手法
⚫ 登場当初(2022年)はプロンプトエンジニアリングの手法の1つだった ▶ Few-shot: 「質問」+「思考の過程」+「答え」の組を例示してから質問を投げかける ▶ Zero-shot: 「ステップ・バイ・ステップで考えましょう」いう文言に続けて答えさせると出力が改善 https://atmarkit.itmedia.co.jp/ait/articles/2308/24/news041.html
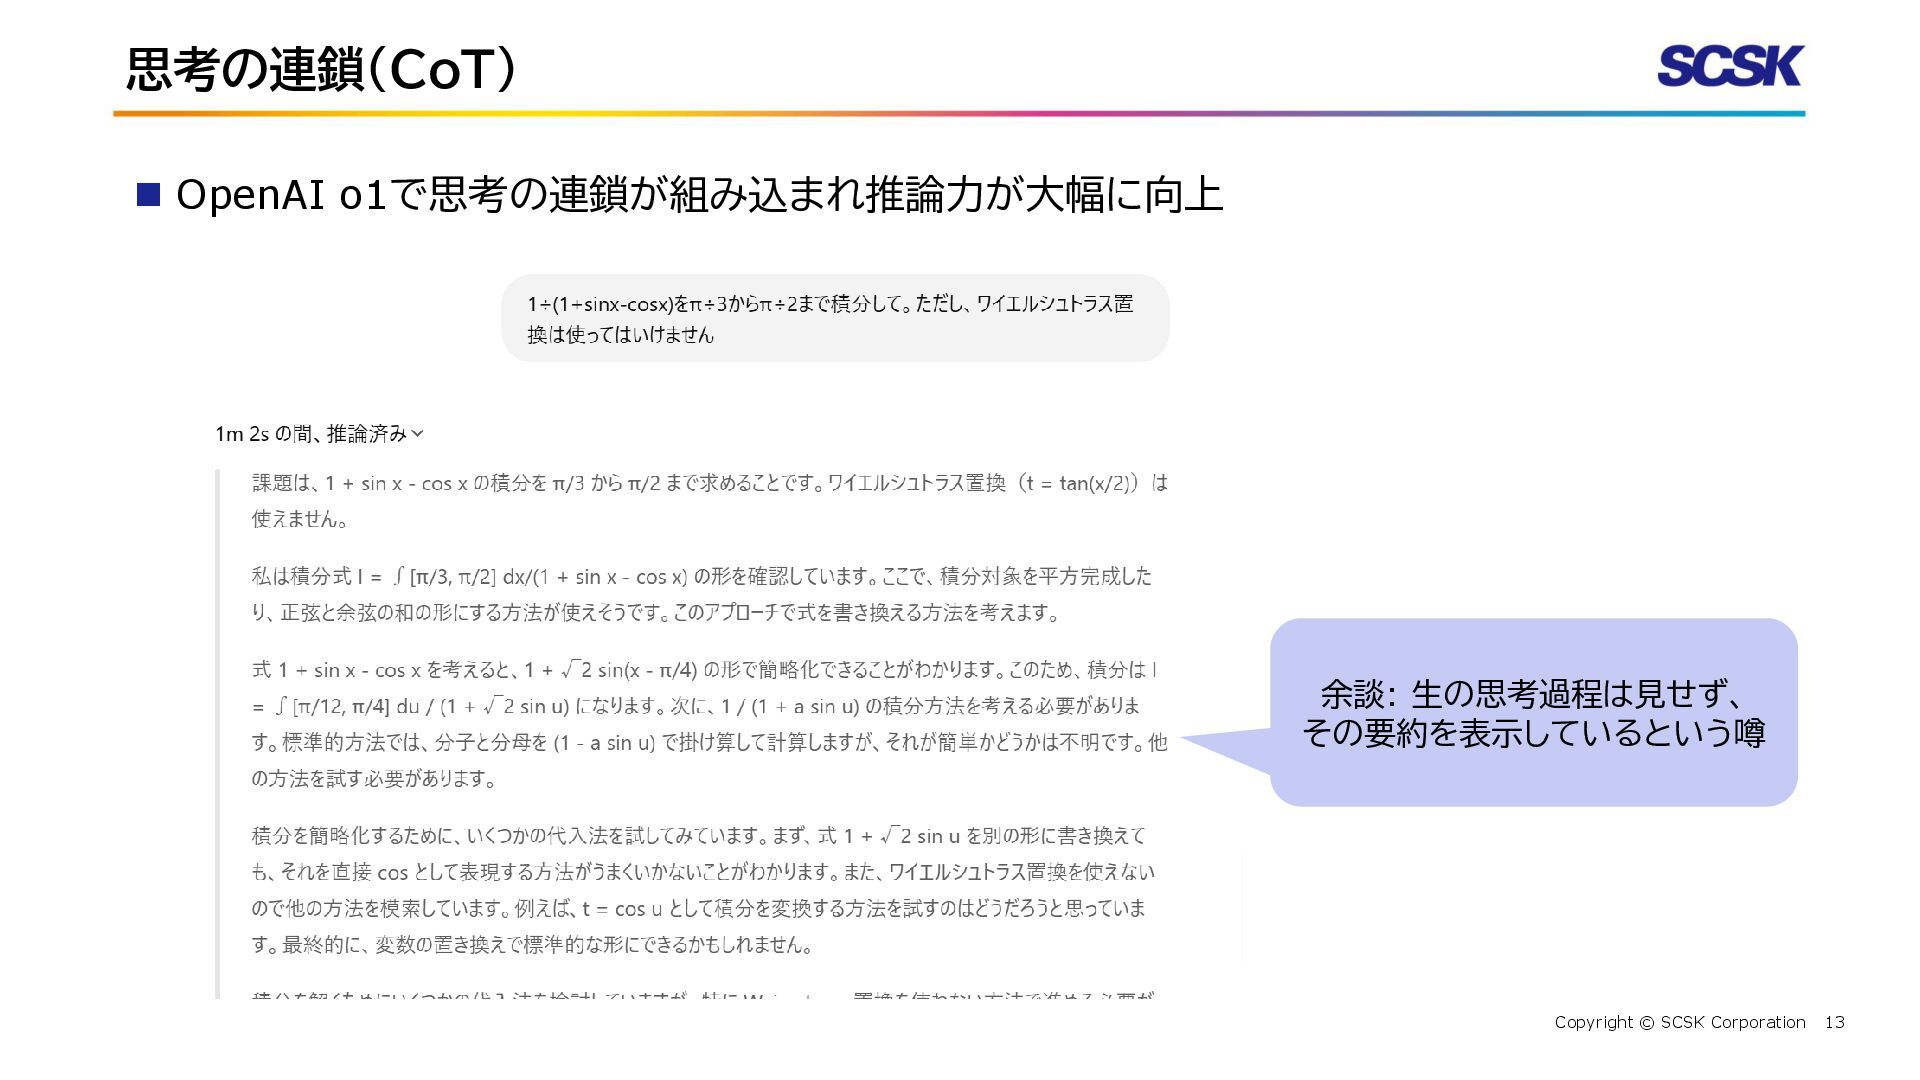
13 Copyright © SCSK Corporation 思考の連鎖(CoT) ◼ OpenAI o1で思考の連鎖が組み込まれ推論力が大幅に向上 余談:
生の思考過程は見せず、 その要約を表示しているという噂
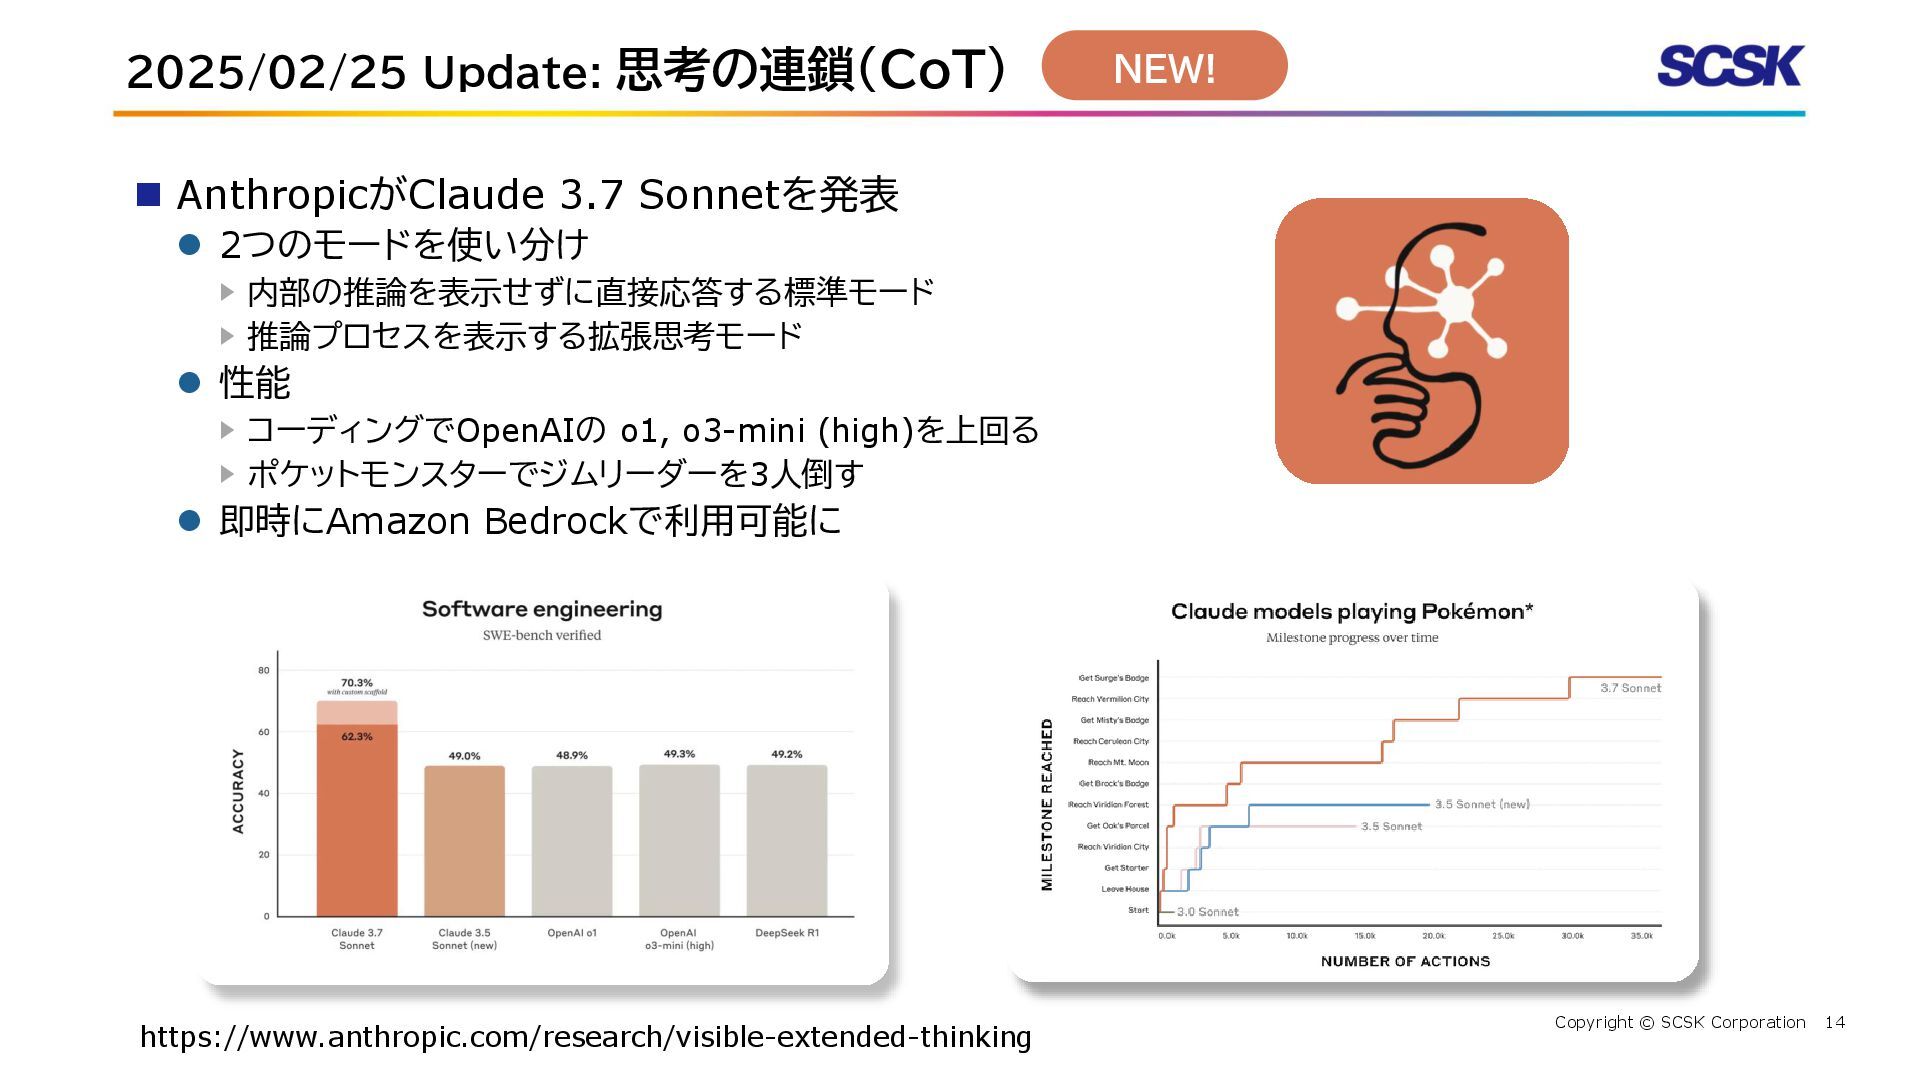
14 Copyright © SCSK Corporation 2025/02/25 Update: 思考の連鎖(CoT) ◼ AnthropicがClaude
3.7 Sonnetを発表 ⚫ 2つのモードを使い分け ▶ 内部の推論を表示せずに直接応答する標準モード ▶ 推論プロセスを表示する拡張思考モード ⚫ 性能 ▶ コーディングでOpenAIの o1, o3-mini (high)を上回る ▶ ポケットモンスターでジムリーダーを3人倒す ⚫ 即時にAmazon Bedrockで利用可能に NEW! https://www.anthropic.com/research/visible-extended-thinking
Copyright © SCSK Corporation その他の話題
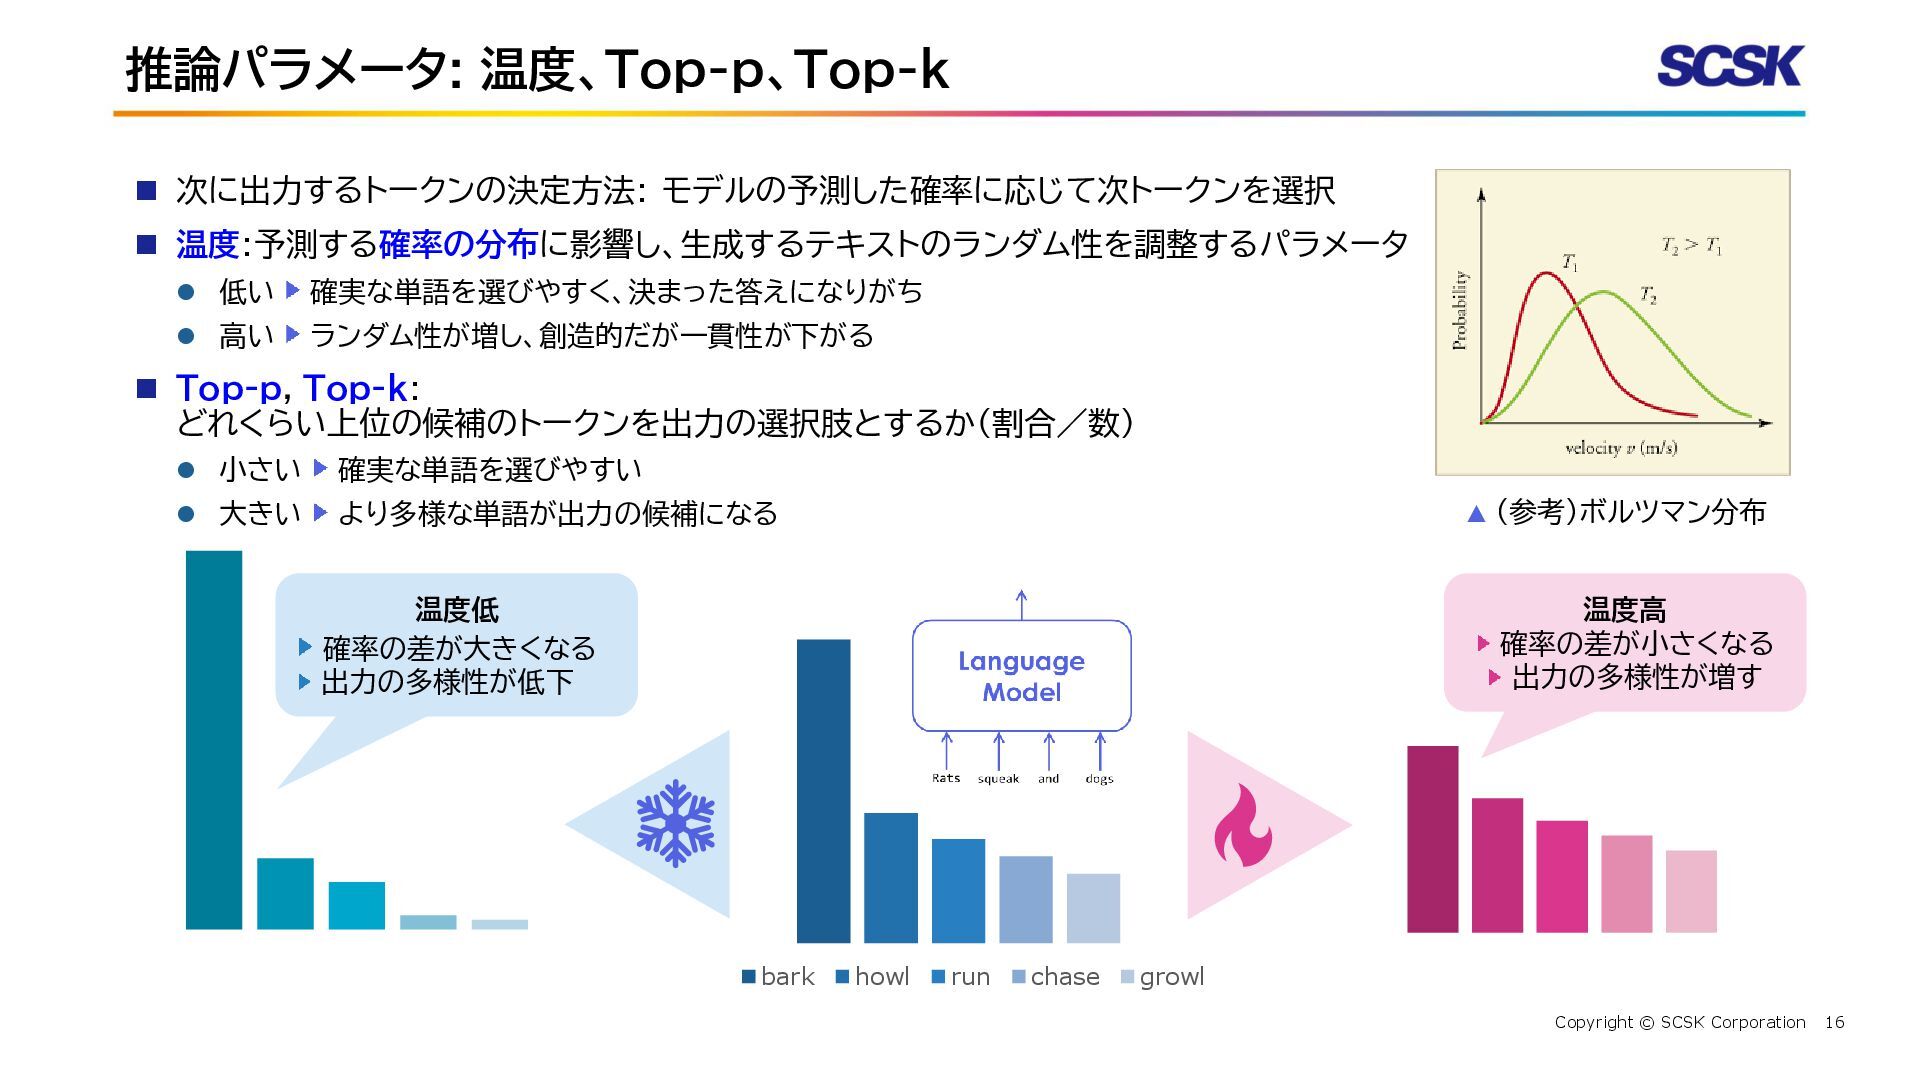
16 Copyright © SCSK Corporation 推論パラメータ: 温度、Top-p、Top-k ◼ 次に出力するトークンの決定方法: モデルの予測した確率に応じて次トークンを選択
◼ 温度:予測する確率の分布に影響し、生成するテキストのランダム性を調整するパラメータ ⚫ 低い 確実な単語を選びやすく、決まった答えになりがち ⚫ 高い ランダム性が増し、創造的だが一貫性が下がる ◼ Top-p, Top-k: どれくらい上位の候補のトークンを出力の選択肢とするか(割合/数) ⚫ 小さい 確実な単語を選びやすい ⚫ 大きい より多様な単語が出力の候補になる bark howl run chase growl 温度高 確率の差が小さくなる 出力の多様性が増す 温度低 確率の差が大きくなる 出力の多様性が低下 ▲ (参考)ボルツマン分布
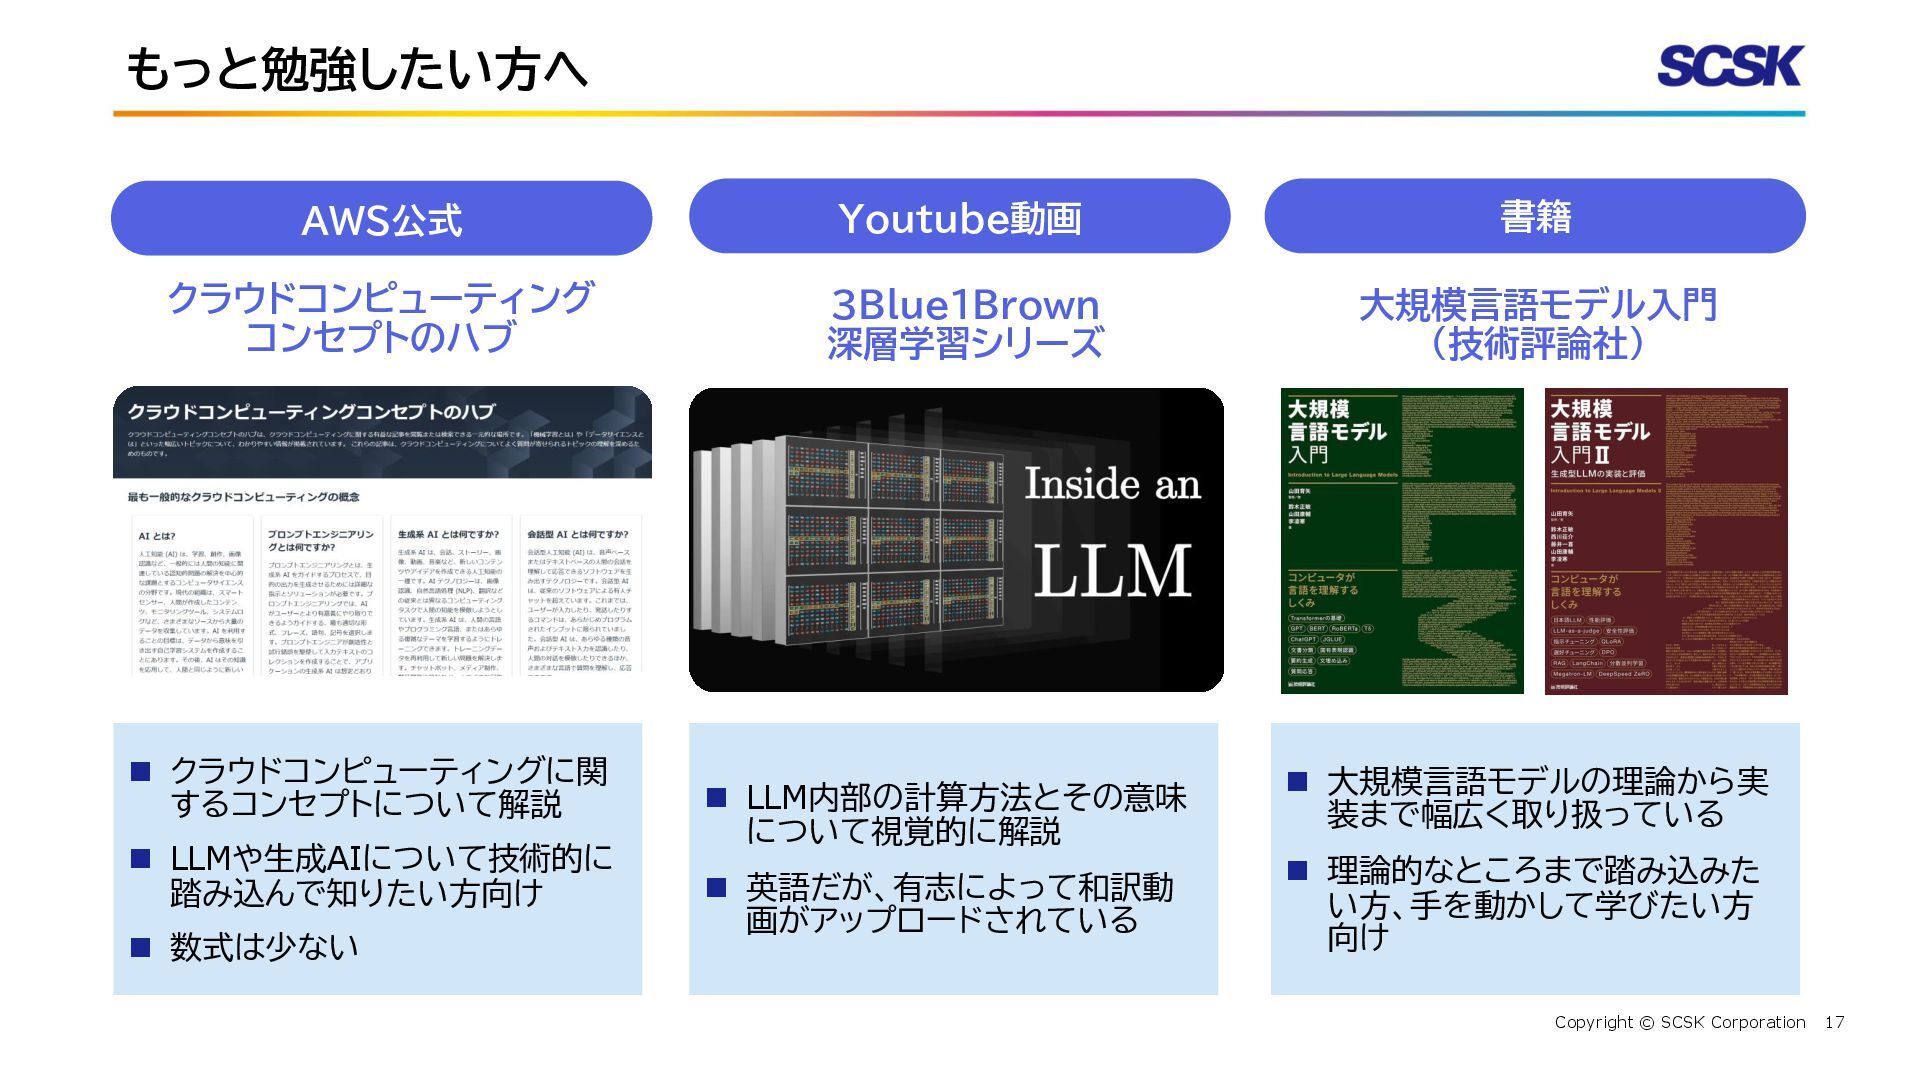
17 Copyright © SCSK Corporation もっと勉強したい方へ クラウドコンピューティング コンセプトのハブ AWS公式 Youtube動画
書籍 ◼ クラウドコンピューティングに関 するコンセプトについて解説 ◼ LLMや生成AIについて技術的に 踏み込んで知りたい方向け ◼ 数式は少ない 3Blue1Brown 深層学習シリーズ ◼ LLM内部の計算方法とその意味 について視覚的に解説 ◼ 英語だが、有志によって和訳動 画がアップロードされている 大規模言語モデル入門 (技術評論社) ◼ 大規模言語モデルの理論から実 装まで幅広く取り扱っている ◼ 理論的なところまで踏み込みた い方、手を動かして学びたい方 向け
None
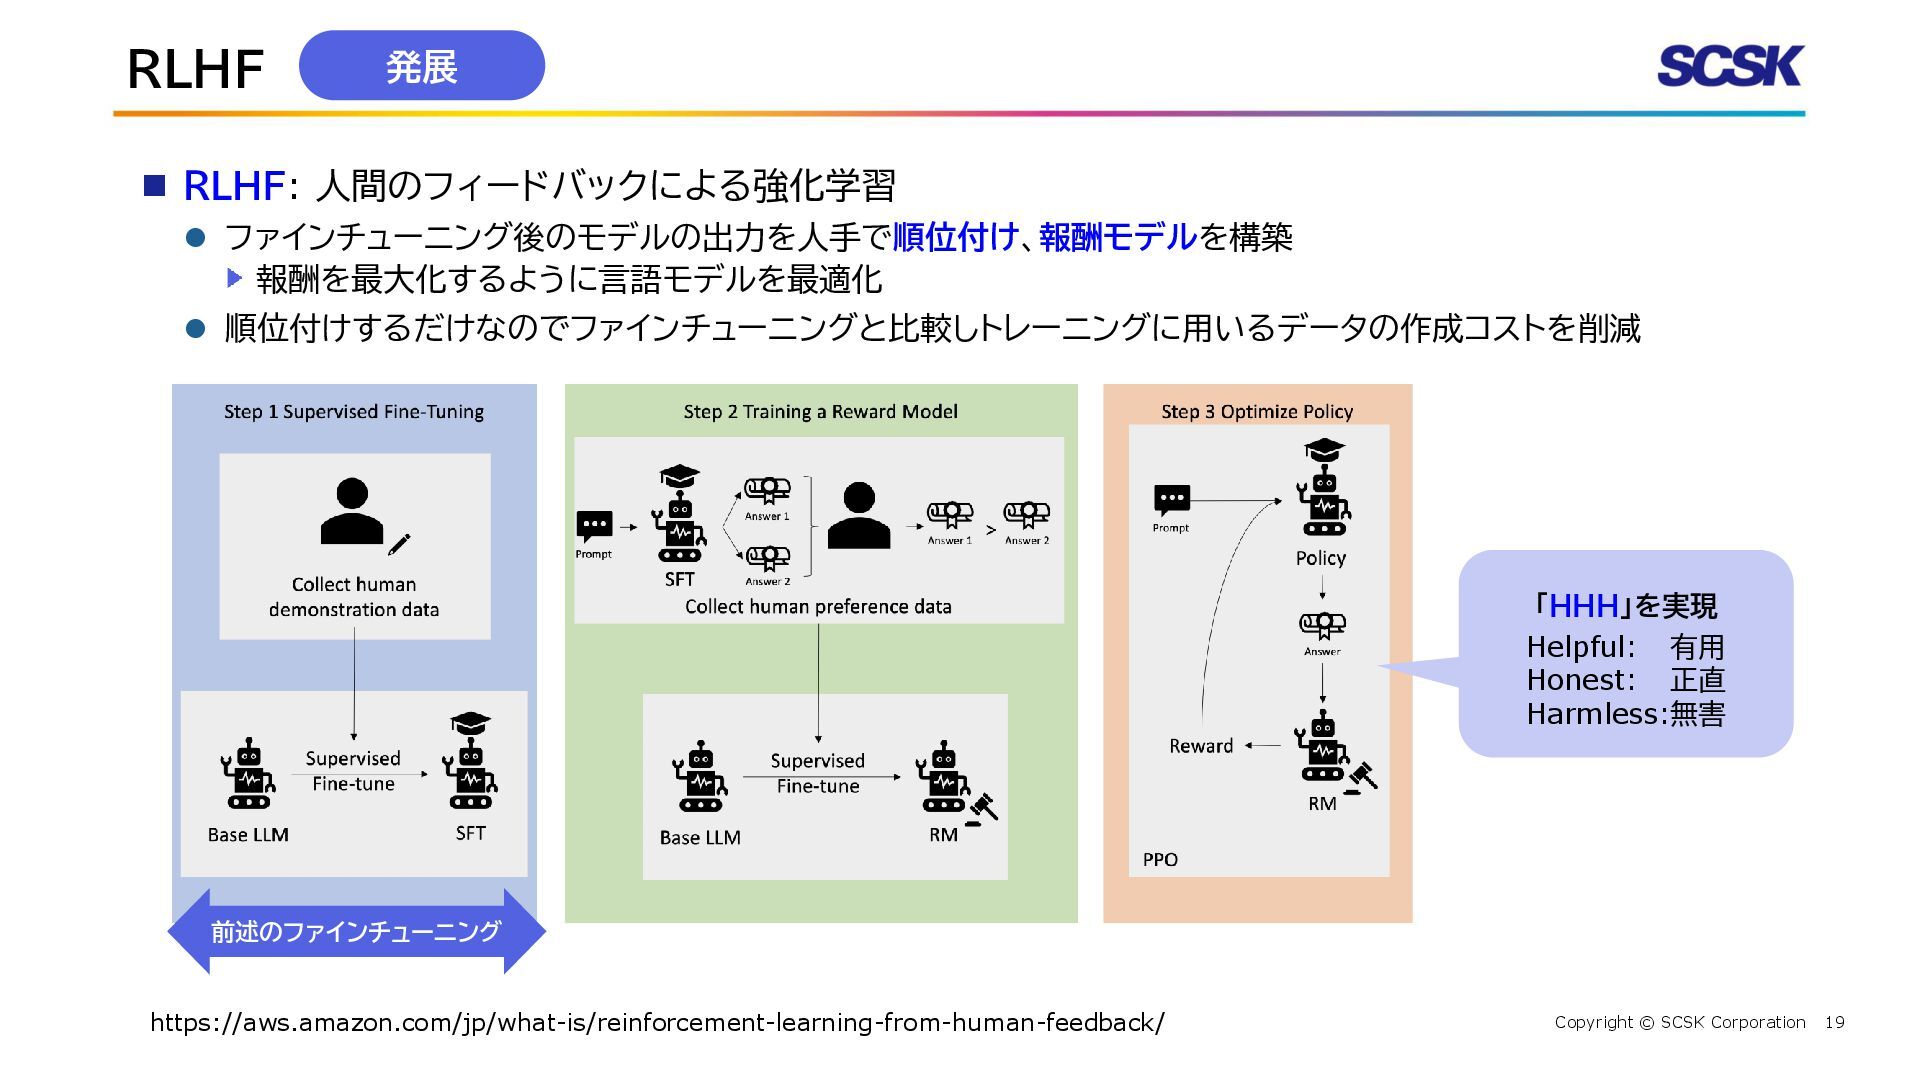
19 Copyright © SCSK Corporation RLHF 発展 ◼ RLHF: 人間のフィードバックによる強化学習
⚫ ファインチューニング後のモデルの出力を人手で順位付け、報酬モデルを構築 報酬を最大化するように言語モデルを最適化 ⚫ 順位付けするだけなのでファインチューニングと比較しトレーニングに用いるデータの作成コストを削減 https://aws.amazon.com/jp/what-is/reinforcement-learning-from-human-feedback/ 前述のファインチューニング 「HHH」を実現 Helpful: 有用 Honest: 正直 Harmless:無害
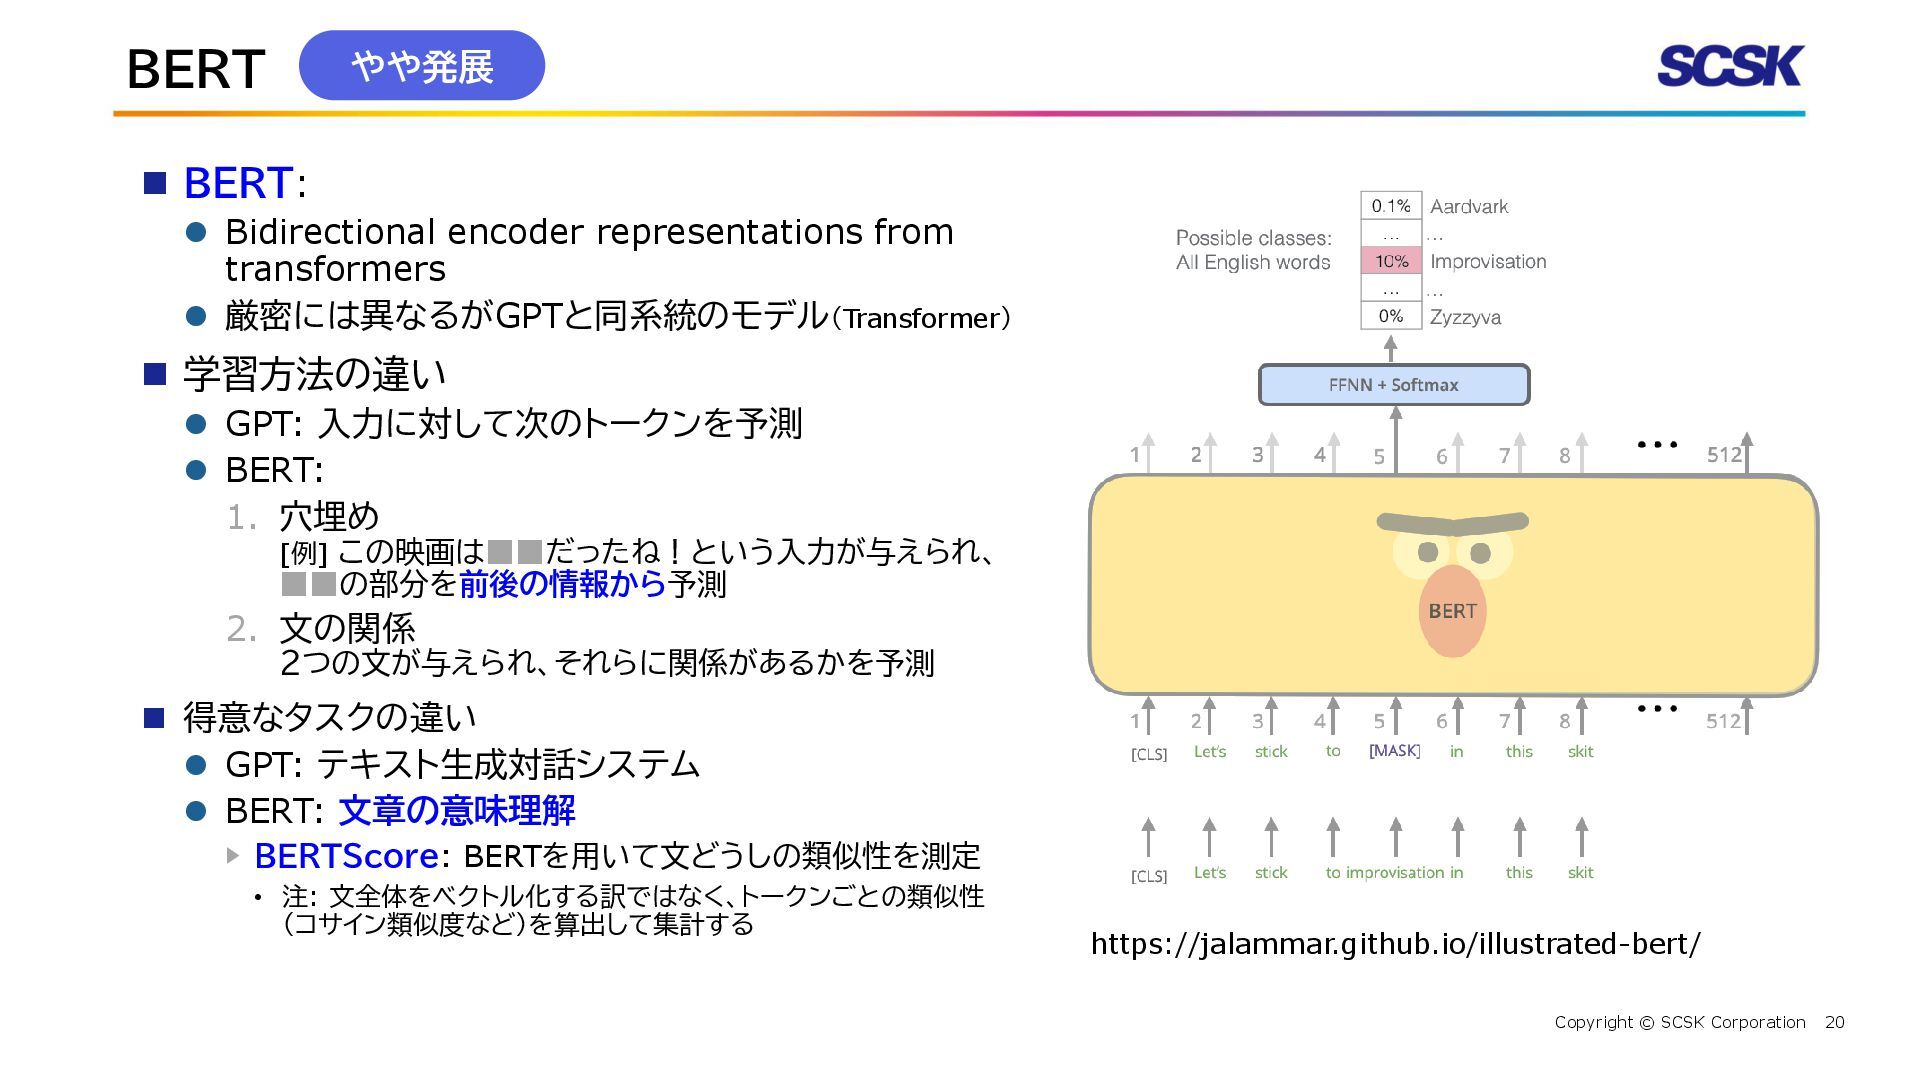
20 Copyright © SCSK Corporation BERT https://jalammar.github.io/illustrated-bert/ ◼ BERT: ⚫
Bidirectional encoder representations from transformers ⚫ 厳密には異なるがGPTと同系統のモデル(Transformer) ◼ 学習方法の違い ⚫ GPT: 入力に対して次のトークンを予測 ⚫ BERT: 1. 穴埋め [例] この映画は▪▪だったね!という入力が与えられ、 ▪▪の部分を前後の情報から予測 2. 文の関係 2つの文が与えられ、それらに関係があるかを予測 ◼ 得意なタスクの違い ⚫ GPT: テキスト生成対話システム ⚫ BERT: 文章の意味理解 ▶ BERTScore: BERTを用いて文どうしの類似性を測定 • 注: 文全体をベクトル化する訳ではなく、トークンごとの類似性 (コサイン類似度など)を算出して集計する やや発展
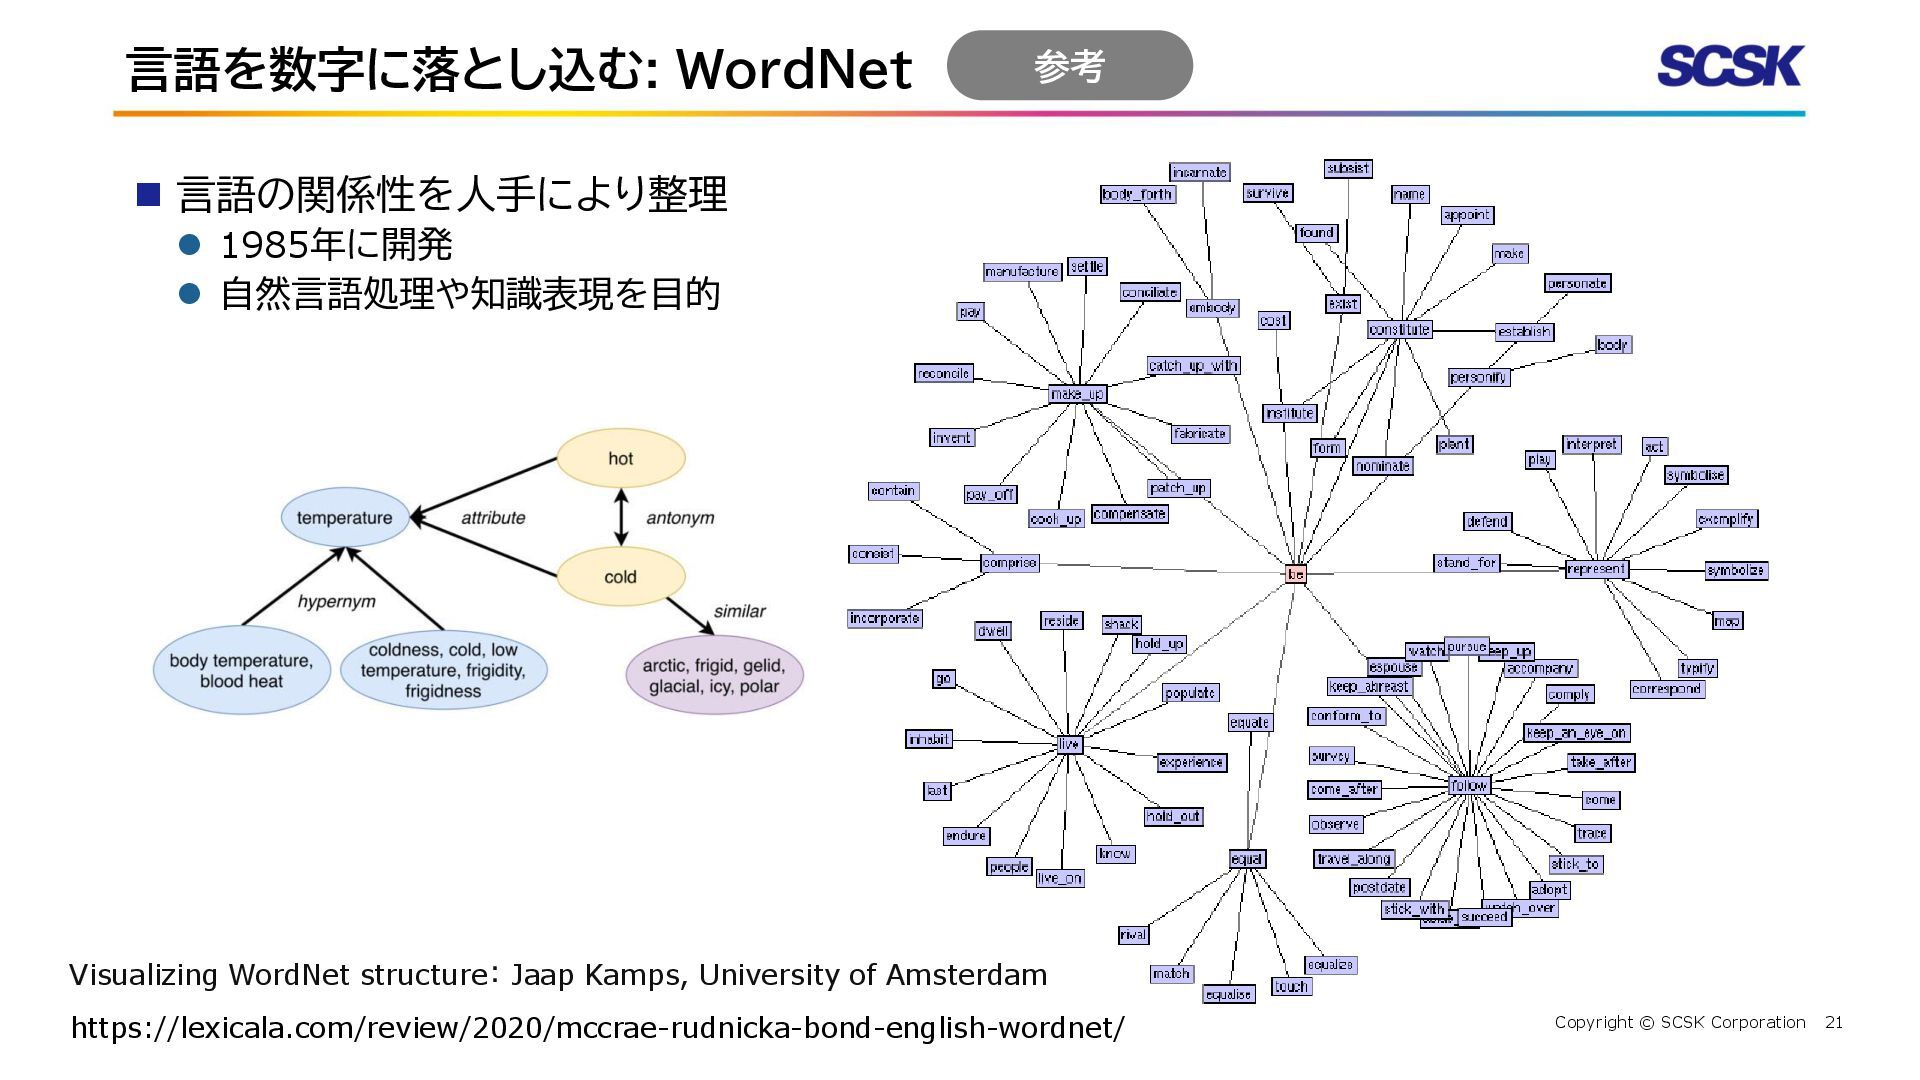
21 Copyright © SCSK Corporation 言語を数字に落とし込む: WordNet 参考 ◼ 言語の関係性を人手により整理
⚫ 1985年に開発 ⚫ 自然言語処理や知識表現を目的 Visualizing WordNet structure: Jaap Kamps, University of Amsterdam https://lexicala.com/review/2020/mccrae-rudnicka-bond-english-wordnet/
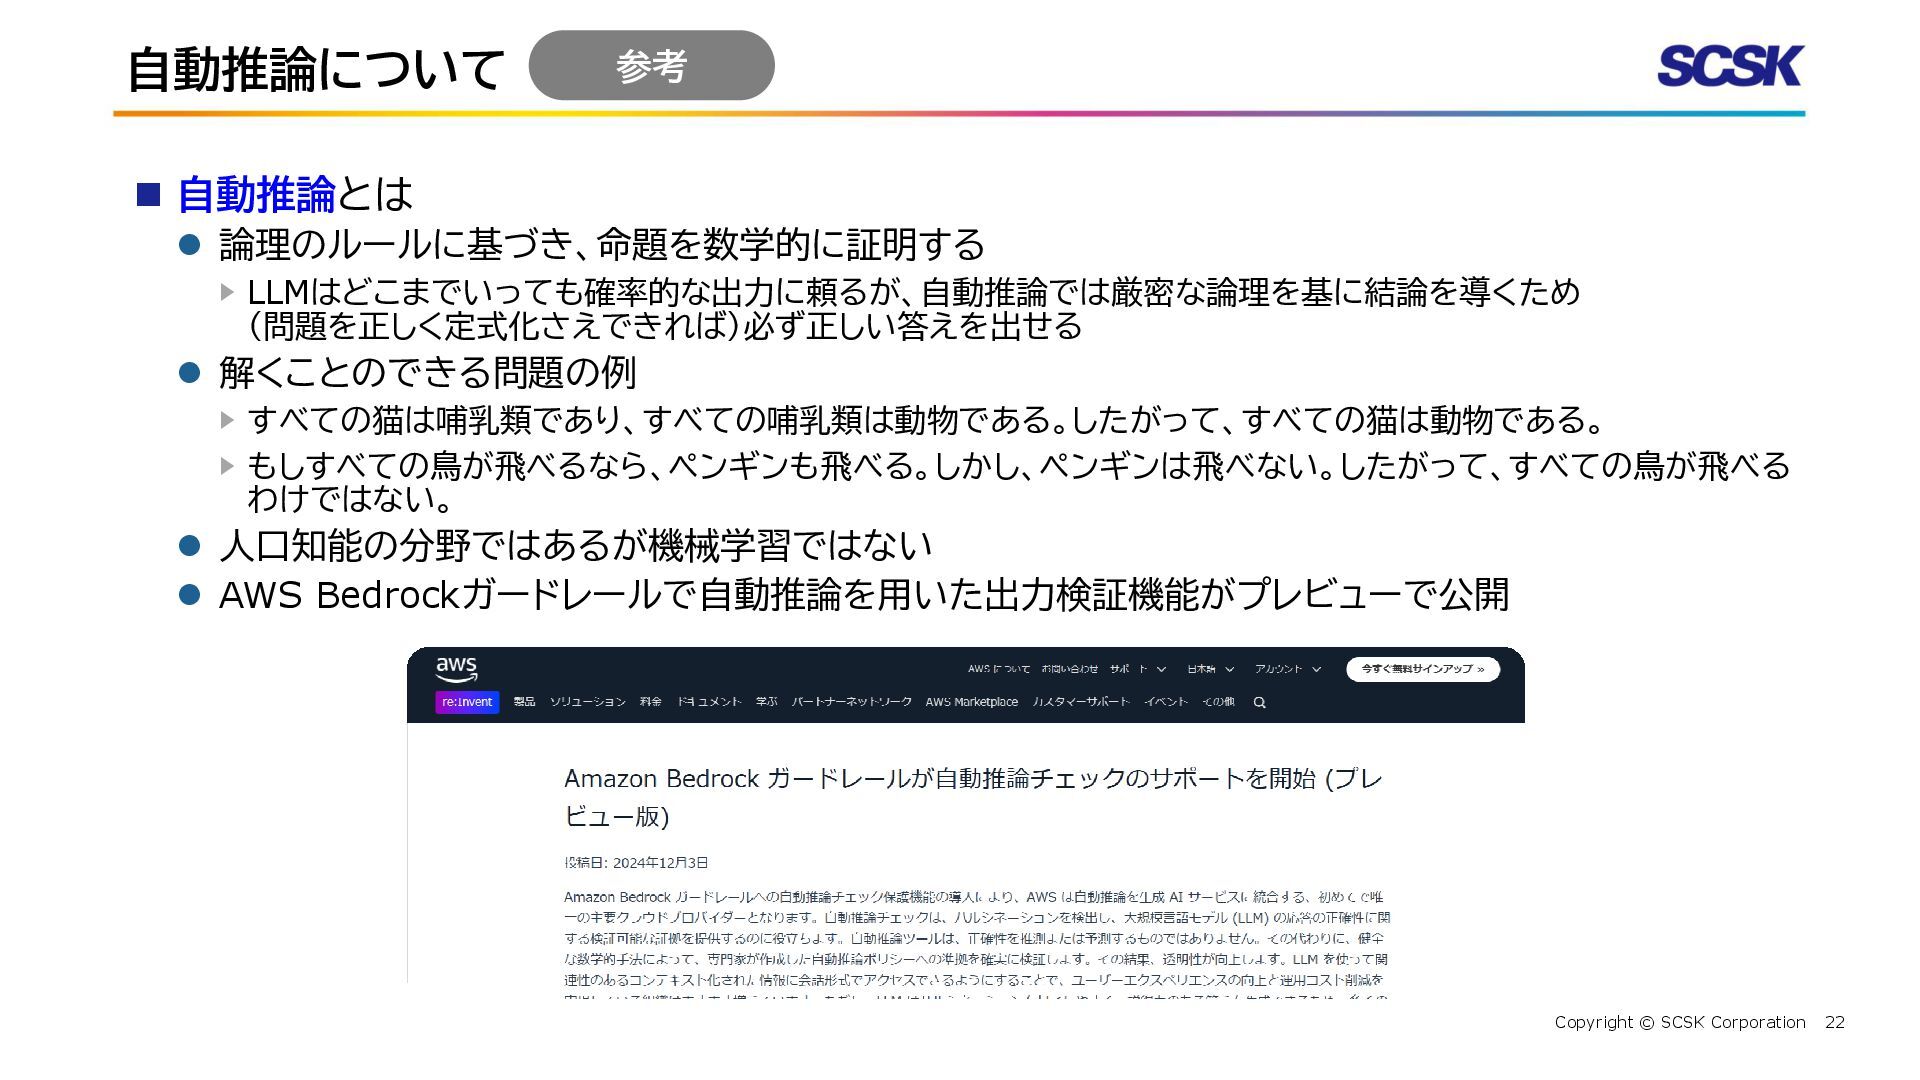
22 Copyright © SCSK Corporation 自動推論について ◼ 自動推論とは ⚫ 論理のルールに基づき、命題を数学的に証明する
▶ LLMはどこまでいっても確率的な出力に頼るが、自動推論では厳密な論理を基に結論を導くため (問題を正しく定式化さえできれば)必ず正しい答えを出せる ⚫ 解くことのできる問題の例 ▶ すべての猫は哺乳類であり、すべての哺乳類は動物である。したがって、すべての猫は動物である。 ▶ もしすべての鳥が飛べるなら、ペンギンも飛べる。しかし、ペンギンは飛べない。したがって、すべての鳥が飛べる わけではない。 ⚫ 人口知能の分野ではあるが機械学習ではない ⚫ AWS Bedrockガードレールで自動推論を用いた出力検証機能がプレビューで公開 参考


 sat0
 katarinadahlin
 baasie
 jct
 yeseniaperezcruz
 addyosmani
 nikkihalliwell
 marktimemedia
 tammyeverts
 joshbly
 reverentgeek
 techseoconnect
 wayneb77