Upgrade to Pro — share decks privately, control downloads, hide ads and more …

【swonet.conf_ 2026】SC2-03_AIワークロードを支える高速・分散データセ...

Avatar for ShowNet ShowNet PRO
September 09, 2026
51

【swonet.conf_ 2026】SC2-03_AIワークロードを支える高速・分散データセンター技術の実証

AIワークロードを支えるデータセンターでは、ネットワークの高速・低遅延化だけでなく、離れた計算資源を活用する広域分散や、コンテナ・仮想化・セキュリティを含む基盤全体の設計が重要になります。本講演では、ShowNet 2026で構築した環境を題材に、800G/1.6Tネットワーク、長距離RoCEv2、分散推論、DPU、SRv6連携コンテナ基盤といった技術を中心に、AIワークロードを支えるデータセンター基盤への取り組みを紹介します。

SPEAKER
ShowNet NOCチームメンバー
岡 大貴(日本ヒューレット・パッカード)
ShowNet NOCチームメンバー
織 学(Red Hat)

Avatar for ShowNet

ShowNet PRO

September 09, 2026

More Decks by ShowNet

Transcript

  1. 3

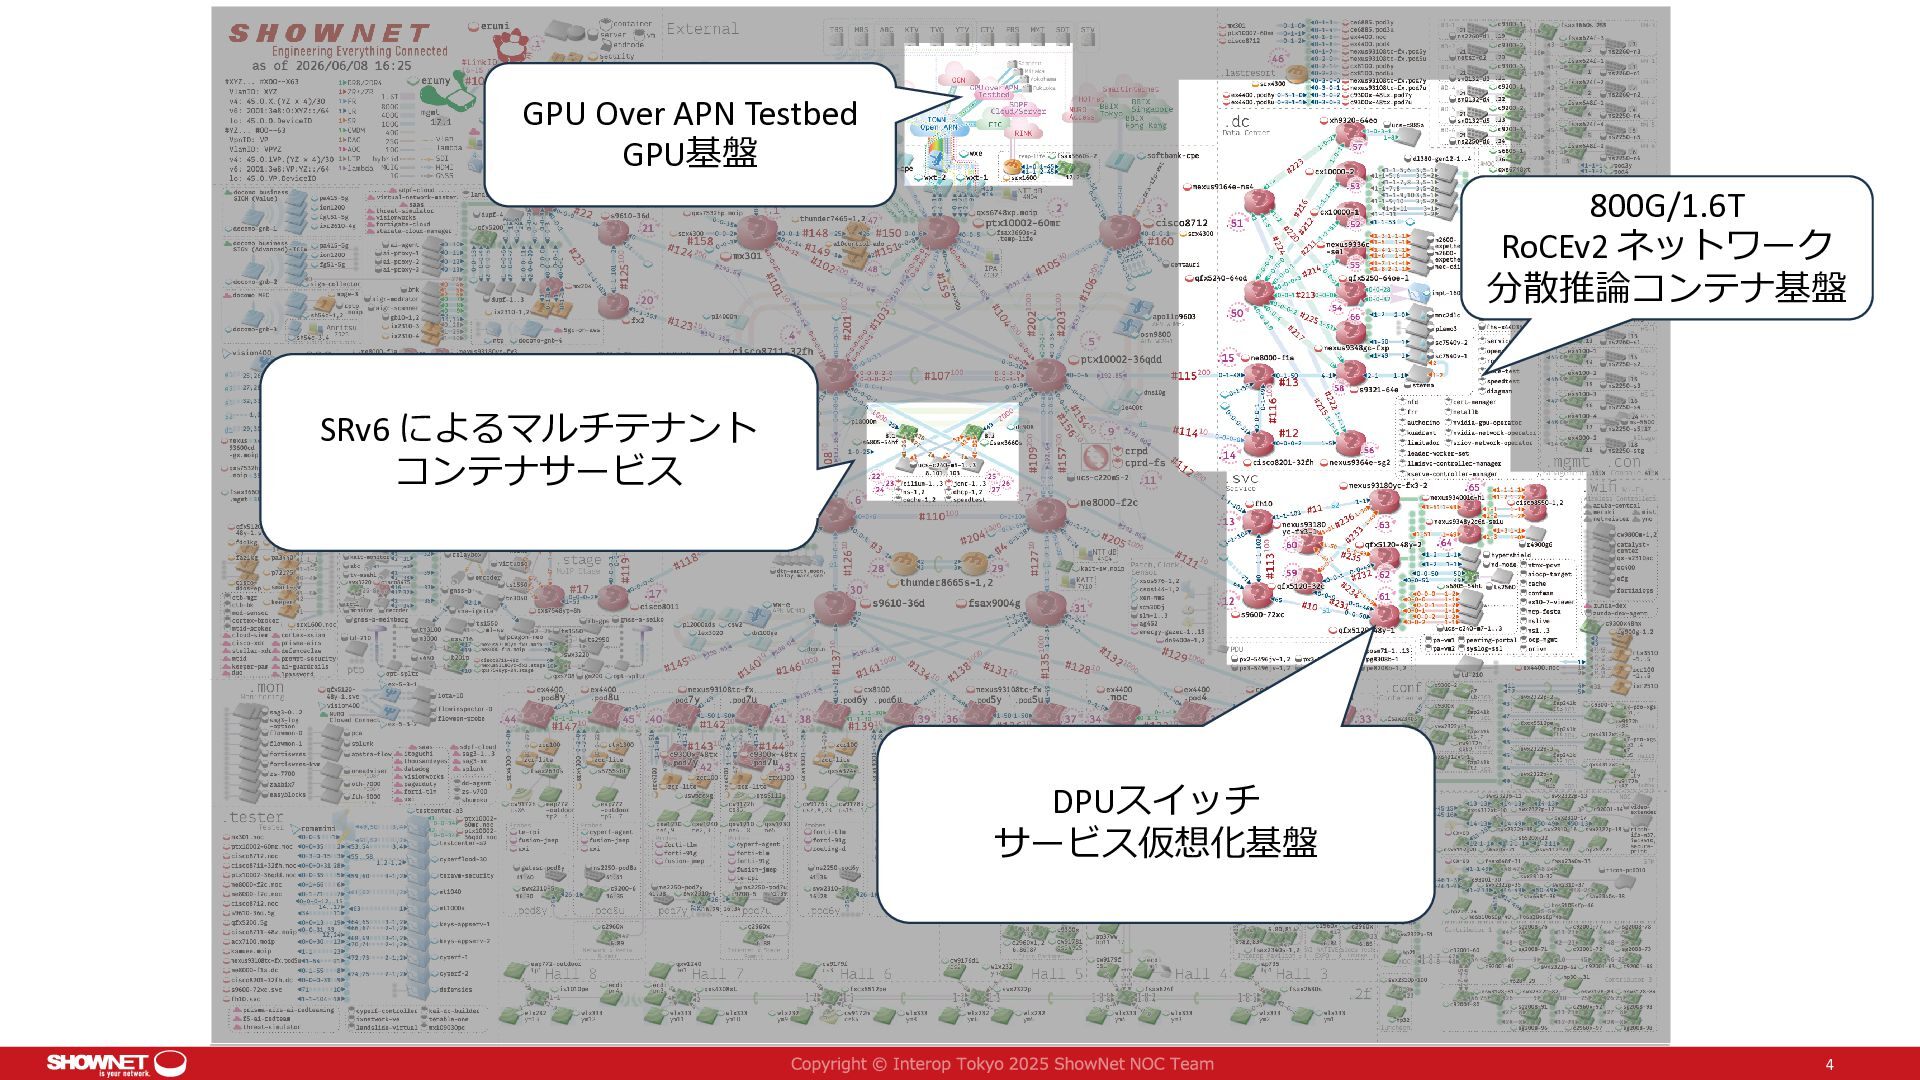
  2. GPU Over APN Testbed GPU基盤 800G/1.6T RoCEv2 ネットワーク 分散推論コンテナ基盤 SRv6

    によるマルチテナント コンテナサービス DPUスイッチ サービス仮想化基盤 4
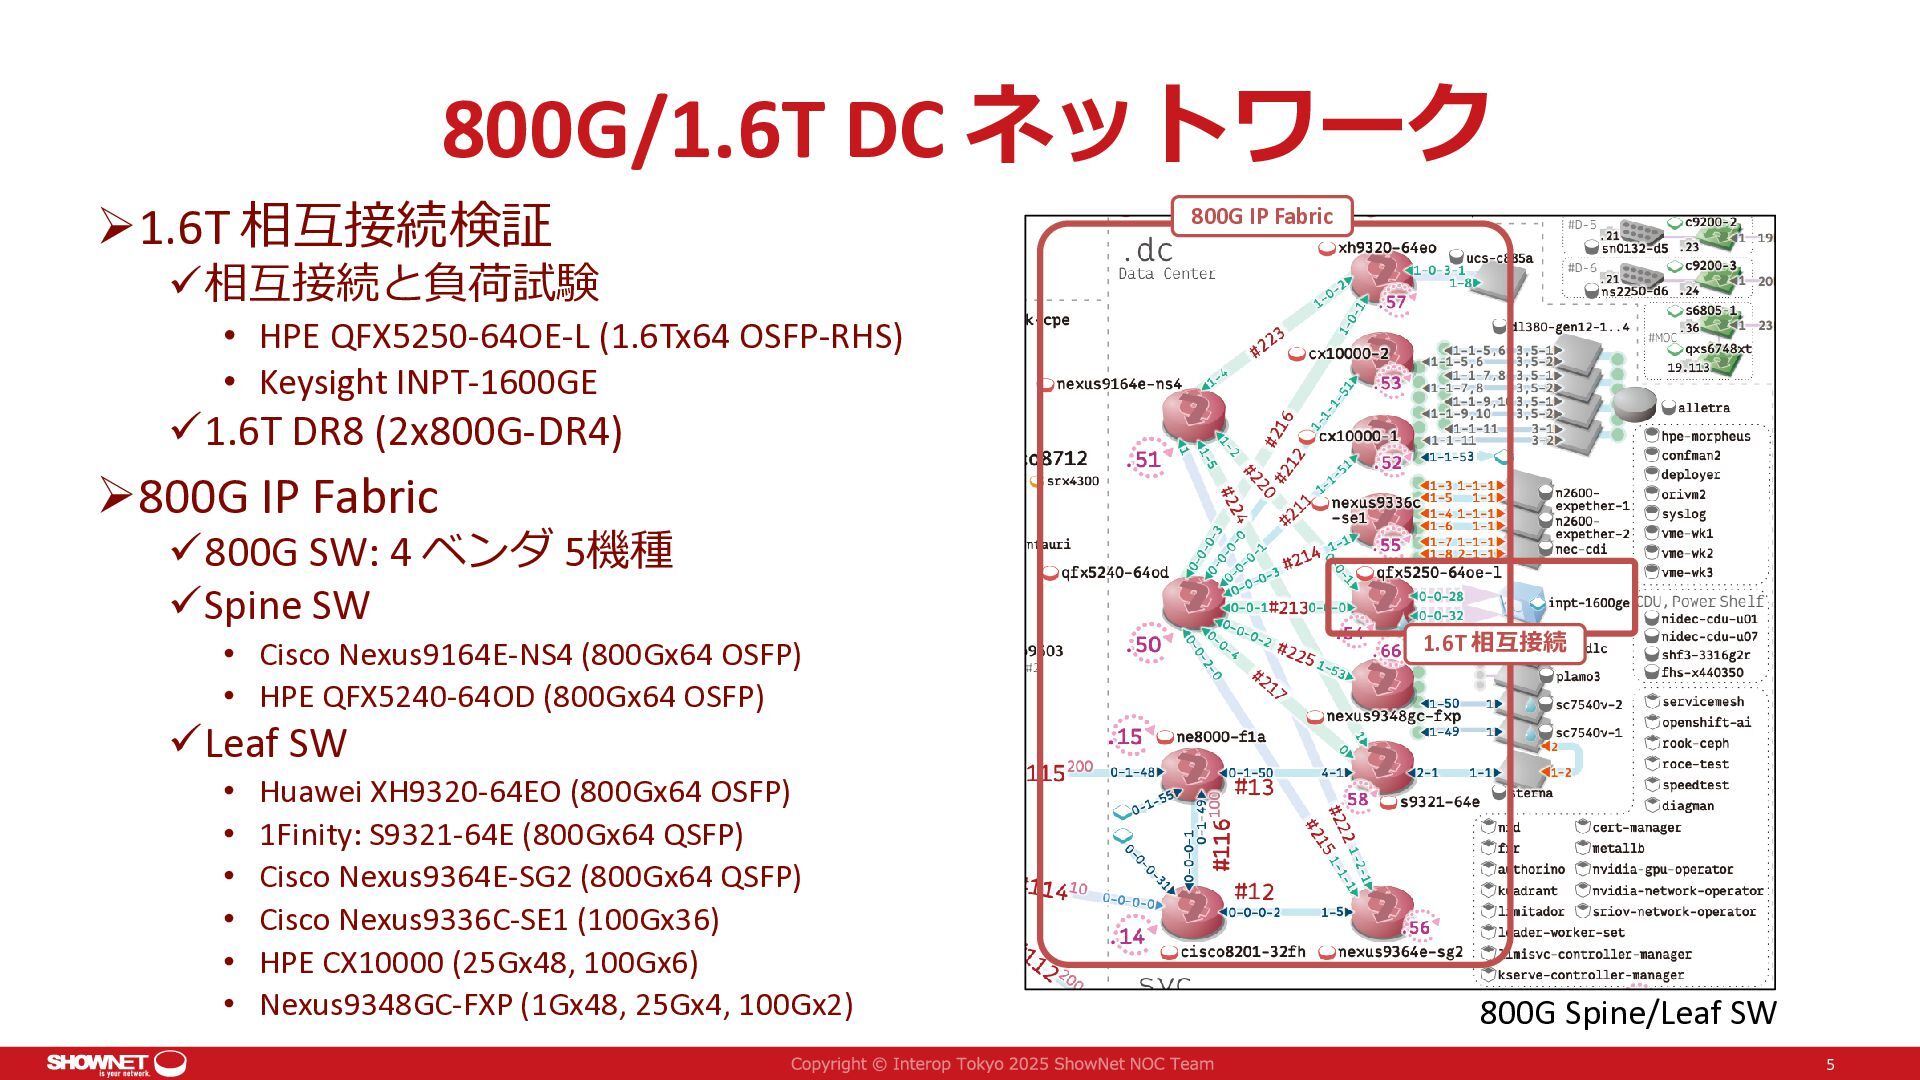
  3. 800G/1.6T DC ネットワーク 1.6T 相互接続検証 800G IP Fabric 相互接続と負荷試験 •

    HPE QFX5250-64OE-L (1.6Tx64 OSFP-RHS) • Keysight INPT-1600GE 1.6T DR8 (2x800G-DR4) 800G IP Fabric 800G SW: 4 ベンダ 5機種 Spine SW • Cisco Nexus9164E-NS4 (800Gx64 OSFP) • HPE QFX5240-64OD (800Gx64 OSFP) 1.6T 相互接続 Leaf SW • • • • • • Huawei XH9320-64EO (800Gx64 OSFP) 1Finity: S9321-64E (800Gx64 QSFP) Cisco Nexus9364E-SG2 (800Gx64 QSFP) Cisco Nexus9336C-SE1 (100Gx36) HPE CX10000 (25Gx48, 100Gx6) Nexus9348GC-FXP (1Gx48, 25Gx4, 100Gx2) 800G Spine/Leaf SW 5
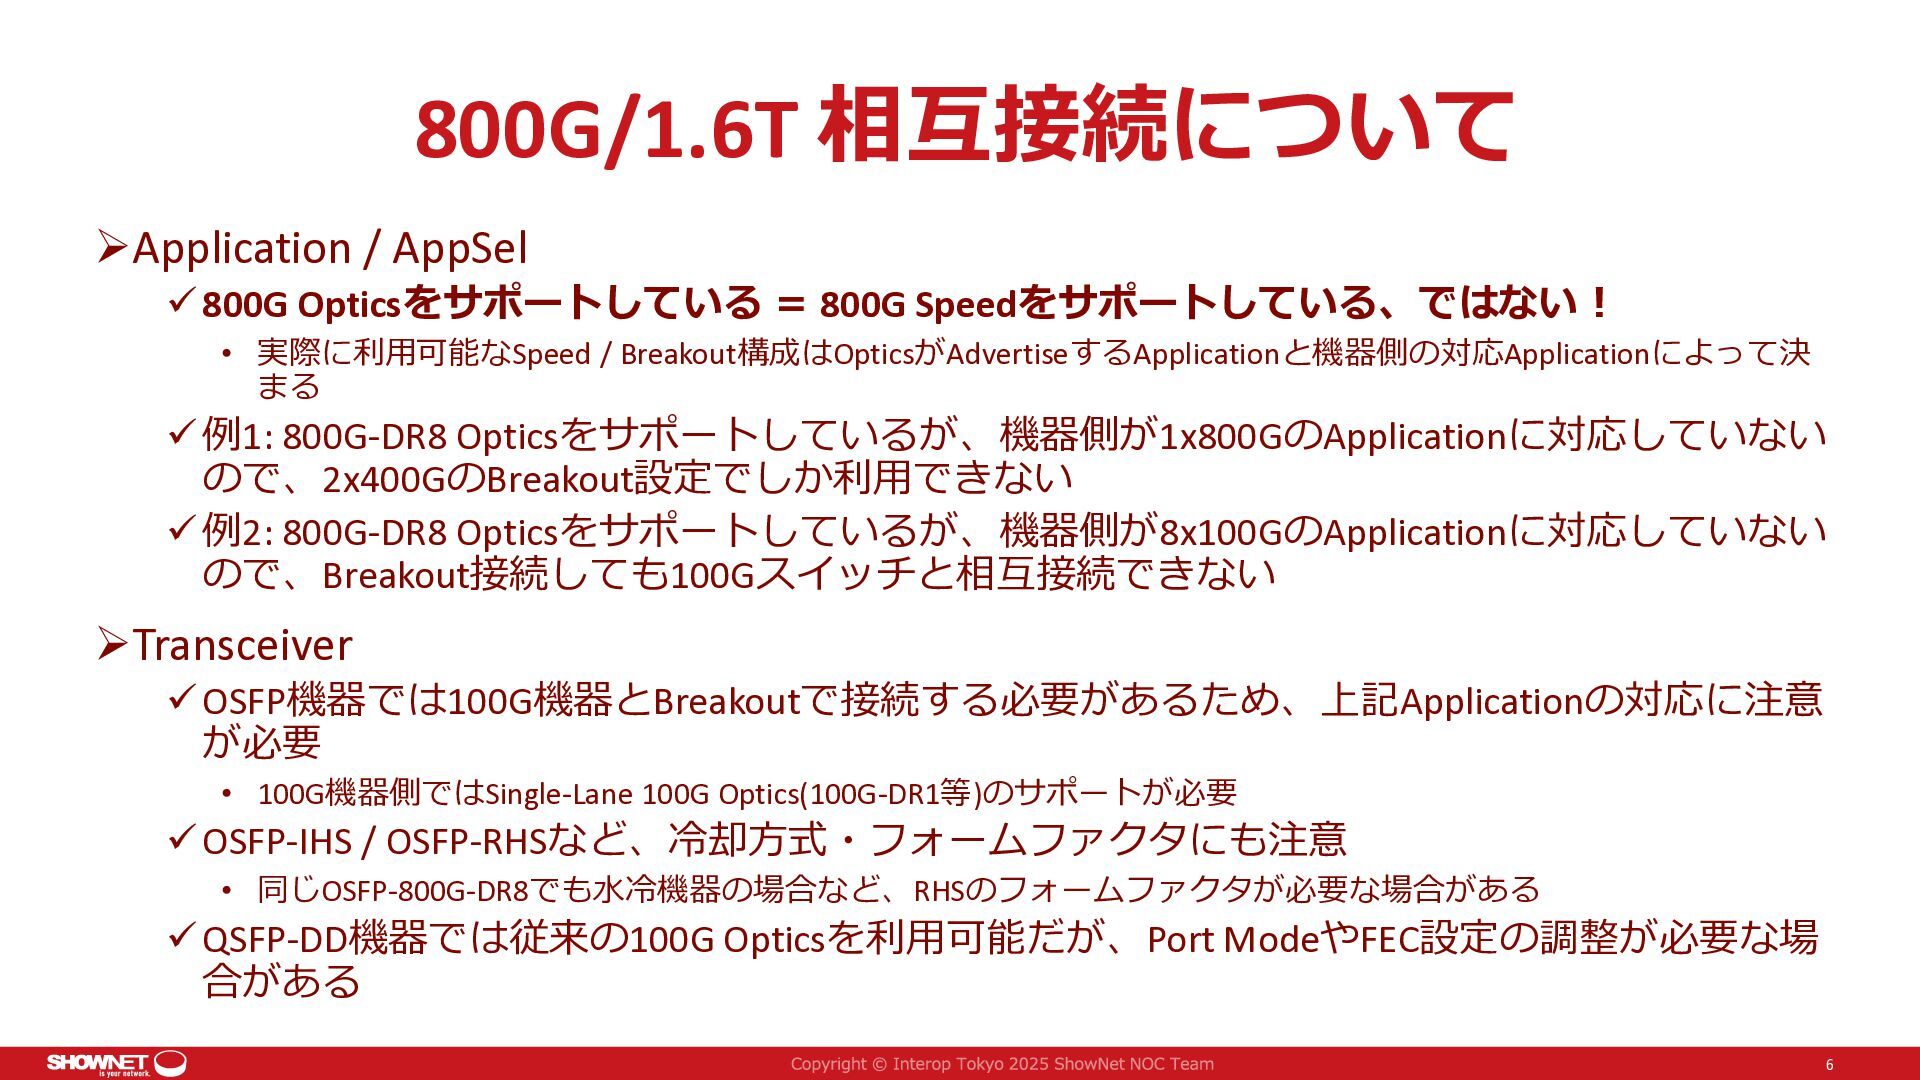
  4. 800G/1.6T 相互接続について Application / AppSel  800G Opticsをサポートしている = 800G

    Speedをサポートしている、ではない! • 実際に利用可能なSpeed / Breakout構成はOpticsがAdvertiseするApplicationと機器側の対応Applicationによって決 まる  例1: 800G-DR8 Opticsをサポートしているが、機器側が1x800GのApplicationに対応していない ので、2x400GのBreakout設定でしか利用できない  例2: 800G-DR8 Opticsをサポートしているが、機器側が8x100GのApplicationに対応していない ので、Breakout接続しても100Gスイッチと相互接続できない Transceiver  OSFP機器では100G機器とBreakoutで接続する必要があるため、上記Applicationの対応に注意 が必要 • 100G機器側ではSingle-Lane 100G Optics(100G-DR1等)のサポートが必要  OSFP-IHS / OSFP-RHSなど、冷却方式・フォームファクタにも注意 • 同じOSFP-800G-DR8でも水冷機器の場合など、RHSのフォームファクタが必要な場合がある  QSFP-DD機器では従来の100G Opticsを利用可能だが、Port ModeやFEC設定の調整が必要な場 合がある 6
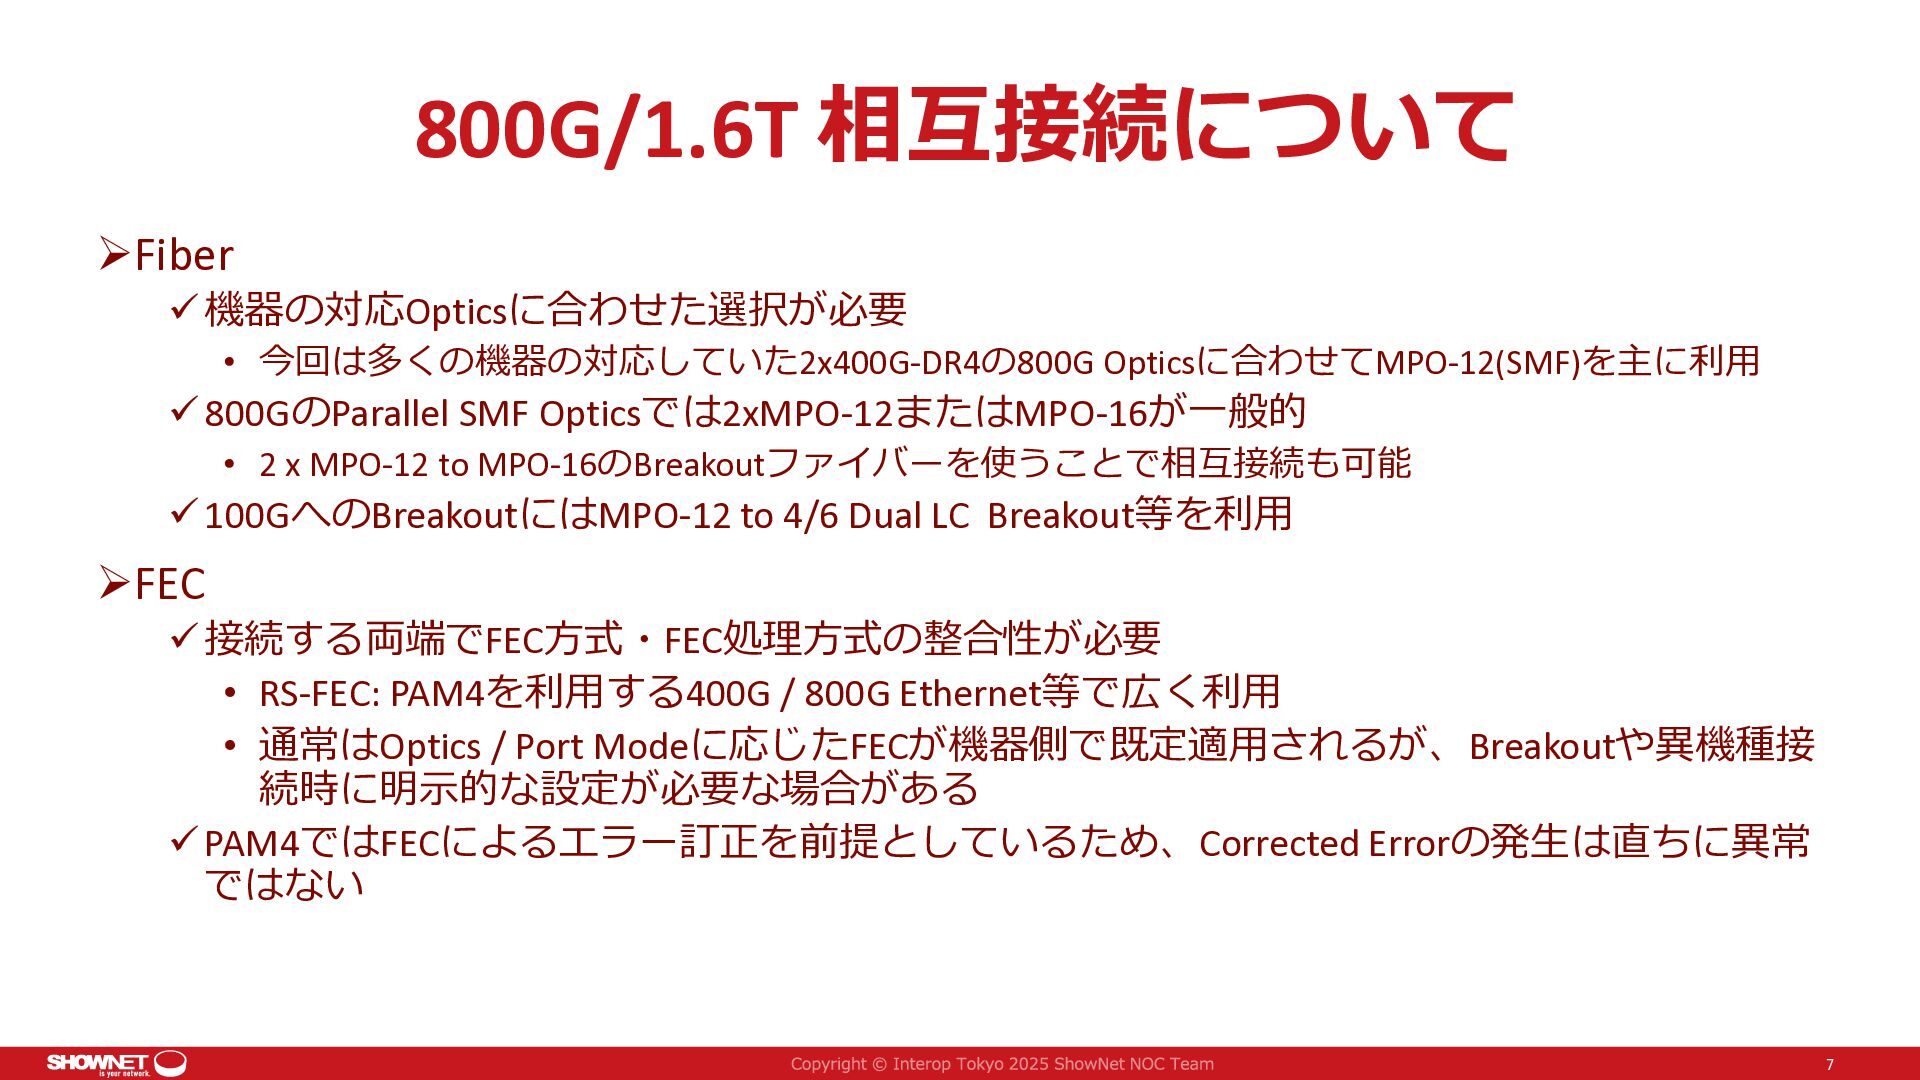
  5. 800G/1.6T 相互接続について Fiber  機器の対応Opticsに合わせた選択が必要 • 今回は多くの機器の対応していた2x400G-DR4の800G Opticsに合わせてMPO-12(SMF)を主に利用  800GのParallel

    SMF Opticsでは2xMPO-12またはMPO-16が一般的 • 2 x MPO-12 to MPO-16のBreakoutファイバーを使うことで相互接続も可能  100GへのBreakoutにはMPO-12 to 4/6 Dual LC Breakout等を利用 FEC  接続する両端でFEC方式・FEC処理方式の整合性が必要 • RS-FEC: PAM4を利用する400G / 800G Ethernet等で広く利用 • 通常はOptics / Port Modeに応じたFECが機器側で既定適用されるが、Breakoutや異機種接 続時に明示的な設定が必要な場合がある  PAM4ではFECによるエラー訂正を前提としているため、Corrected Errorの発生は直ちに異常 ではない 7
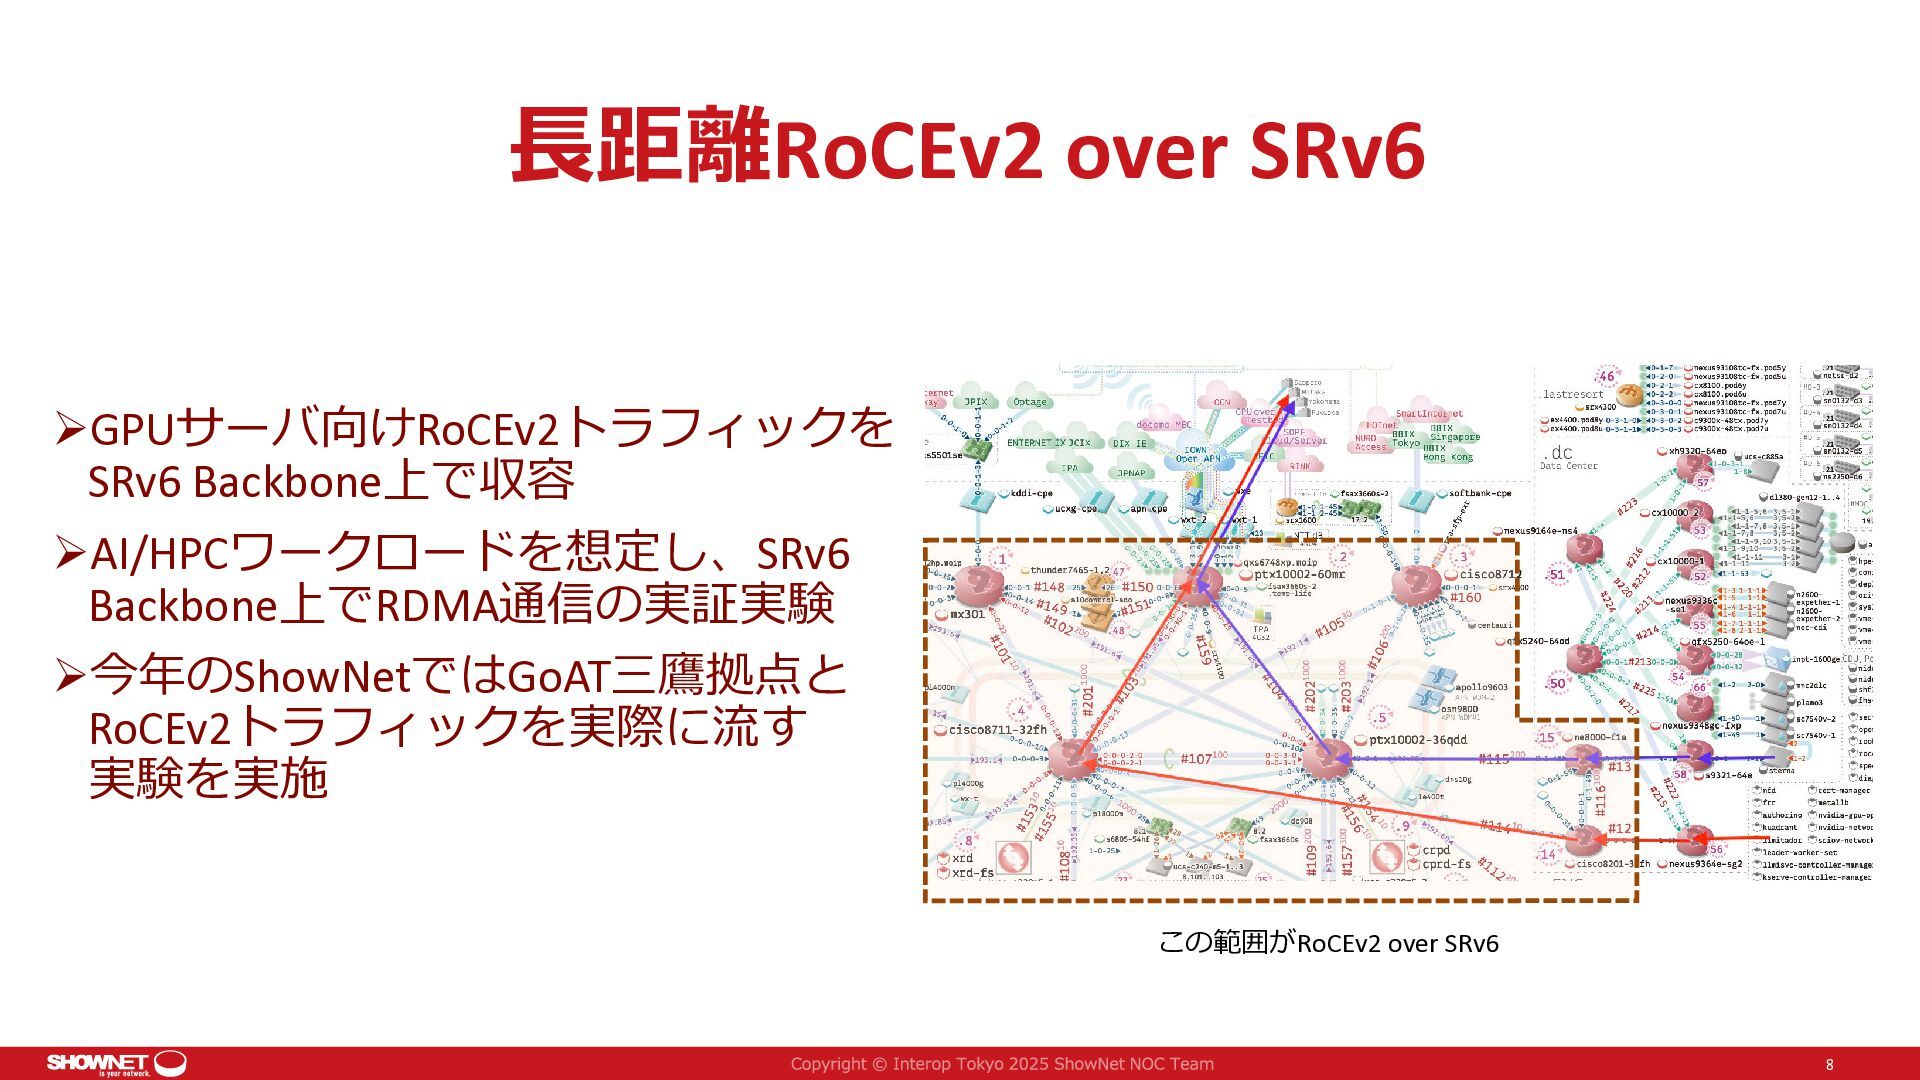
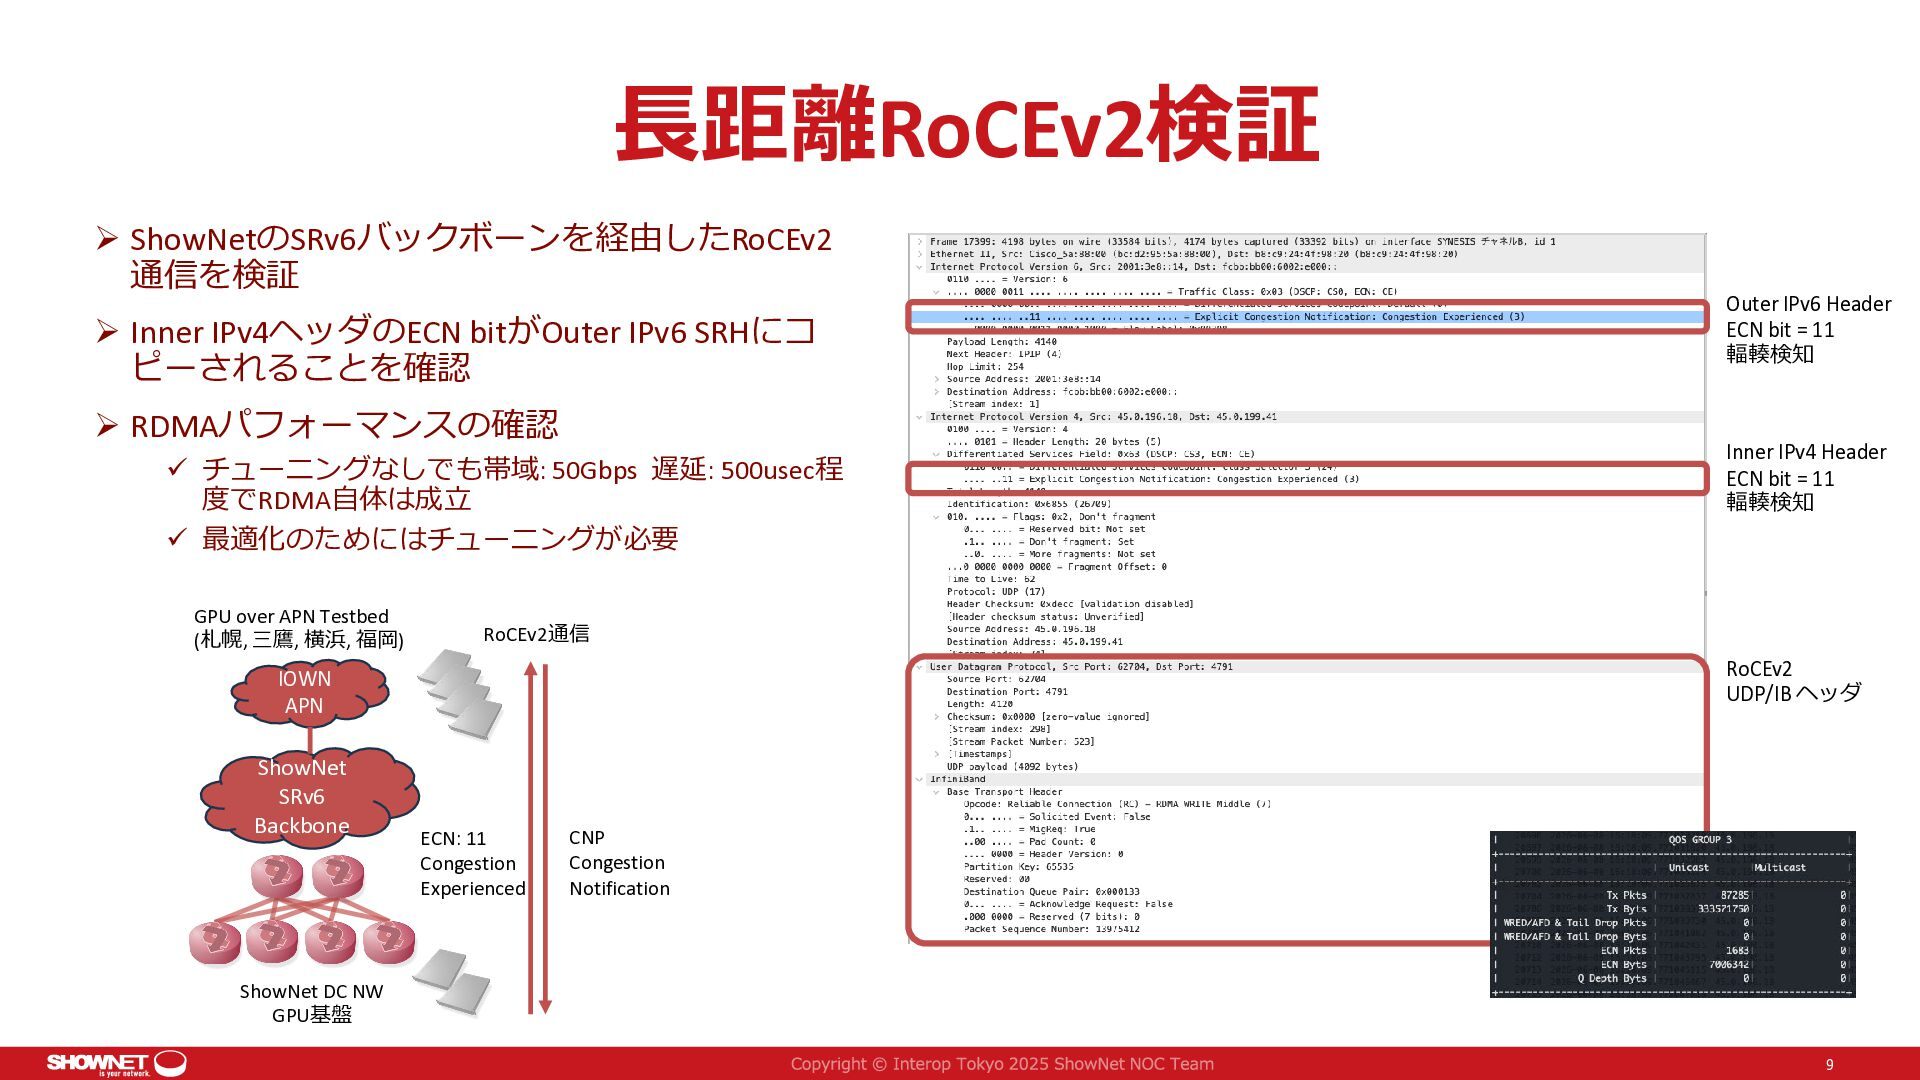
  6. 長距離RoCEv2検証  ShowNetのSRv6バックボーンを経由したRoCEv2 通信を検証  Inner IPv4ヘッダのECN bitがOuter IPv6 SRHにコ

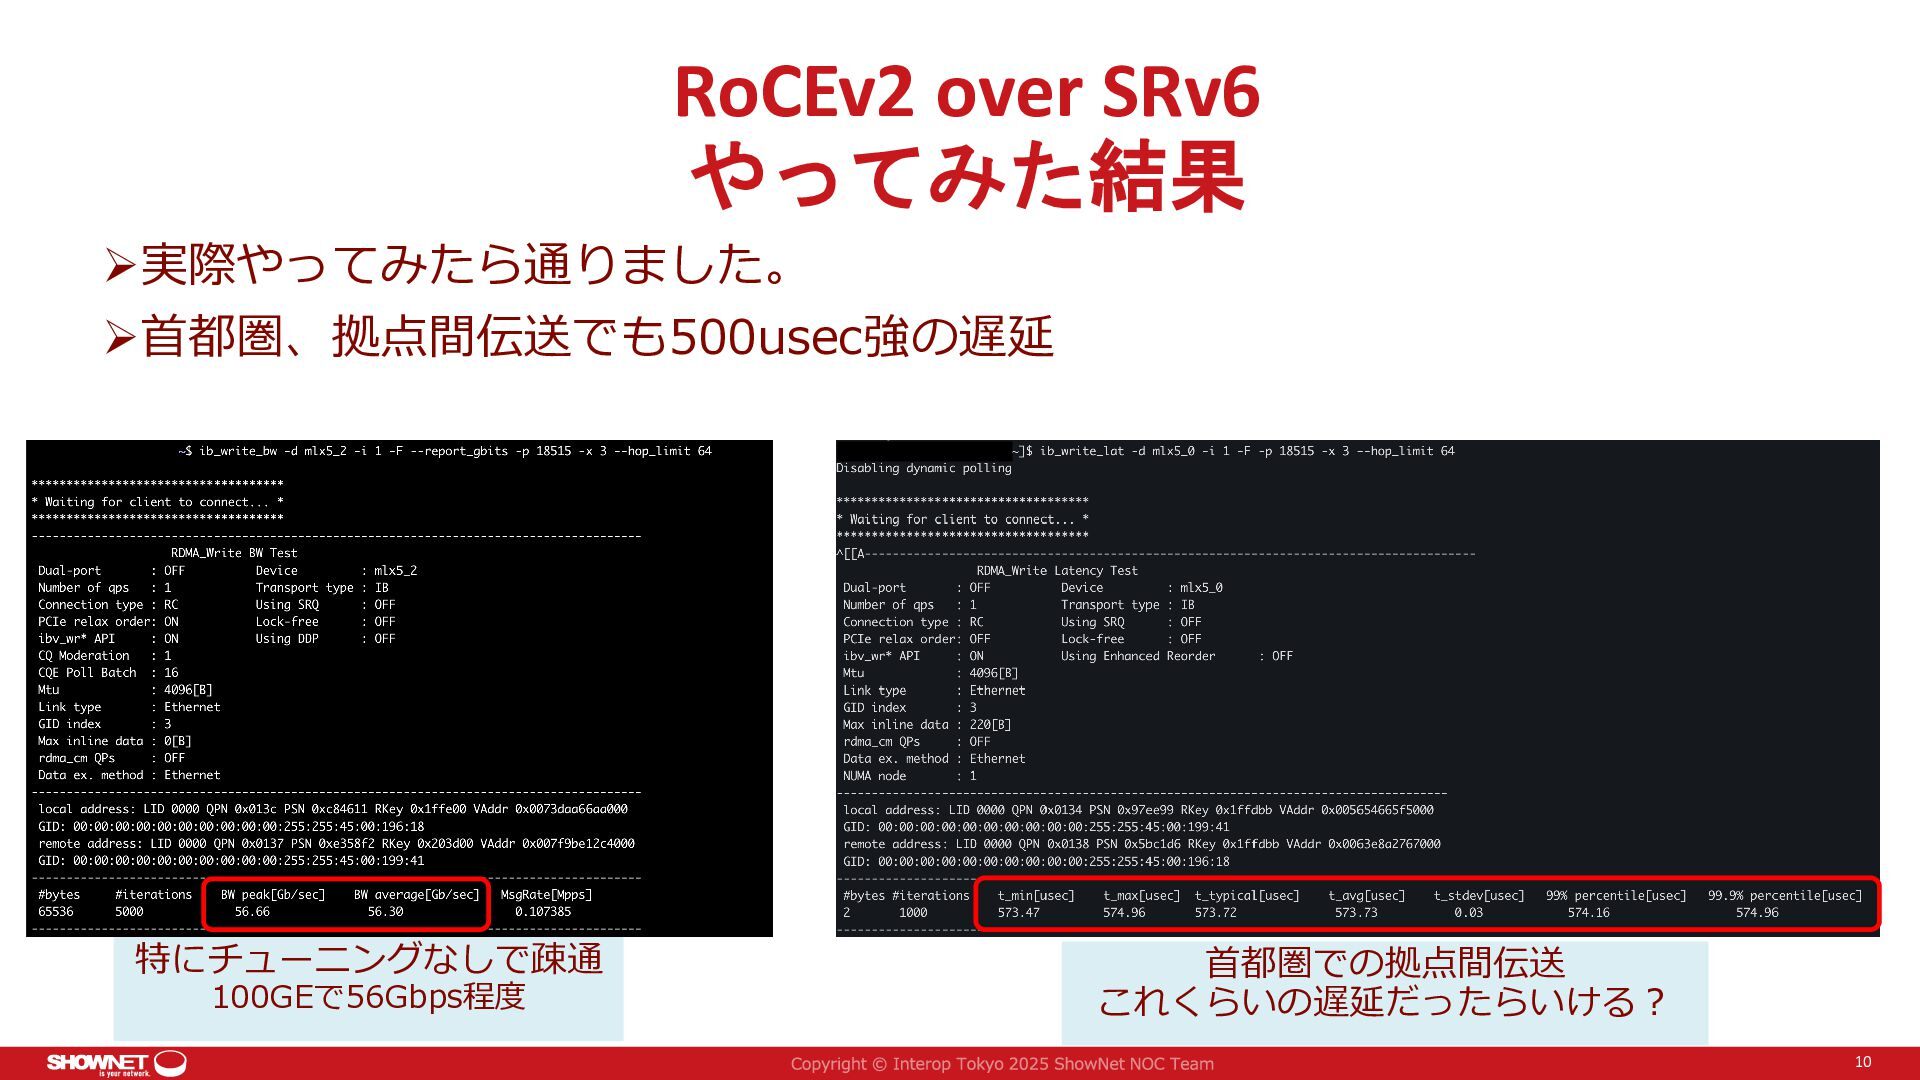
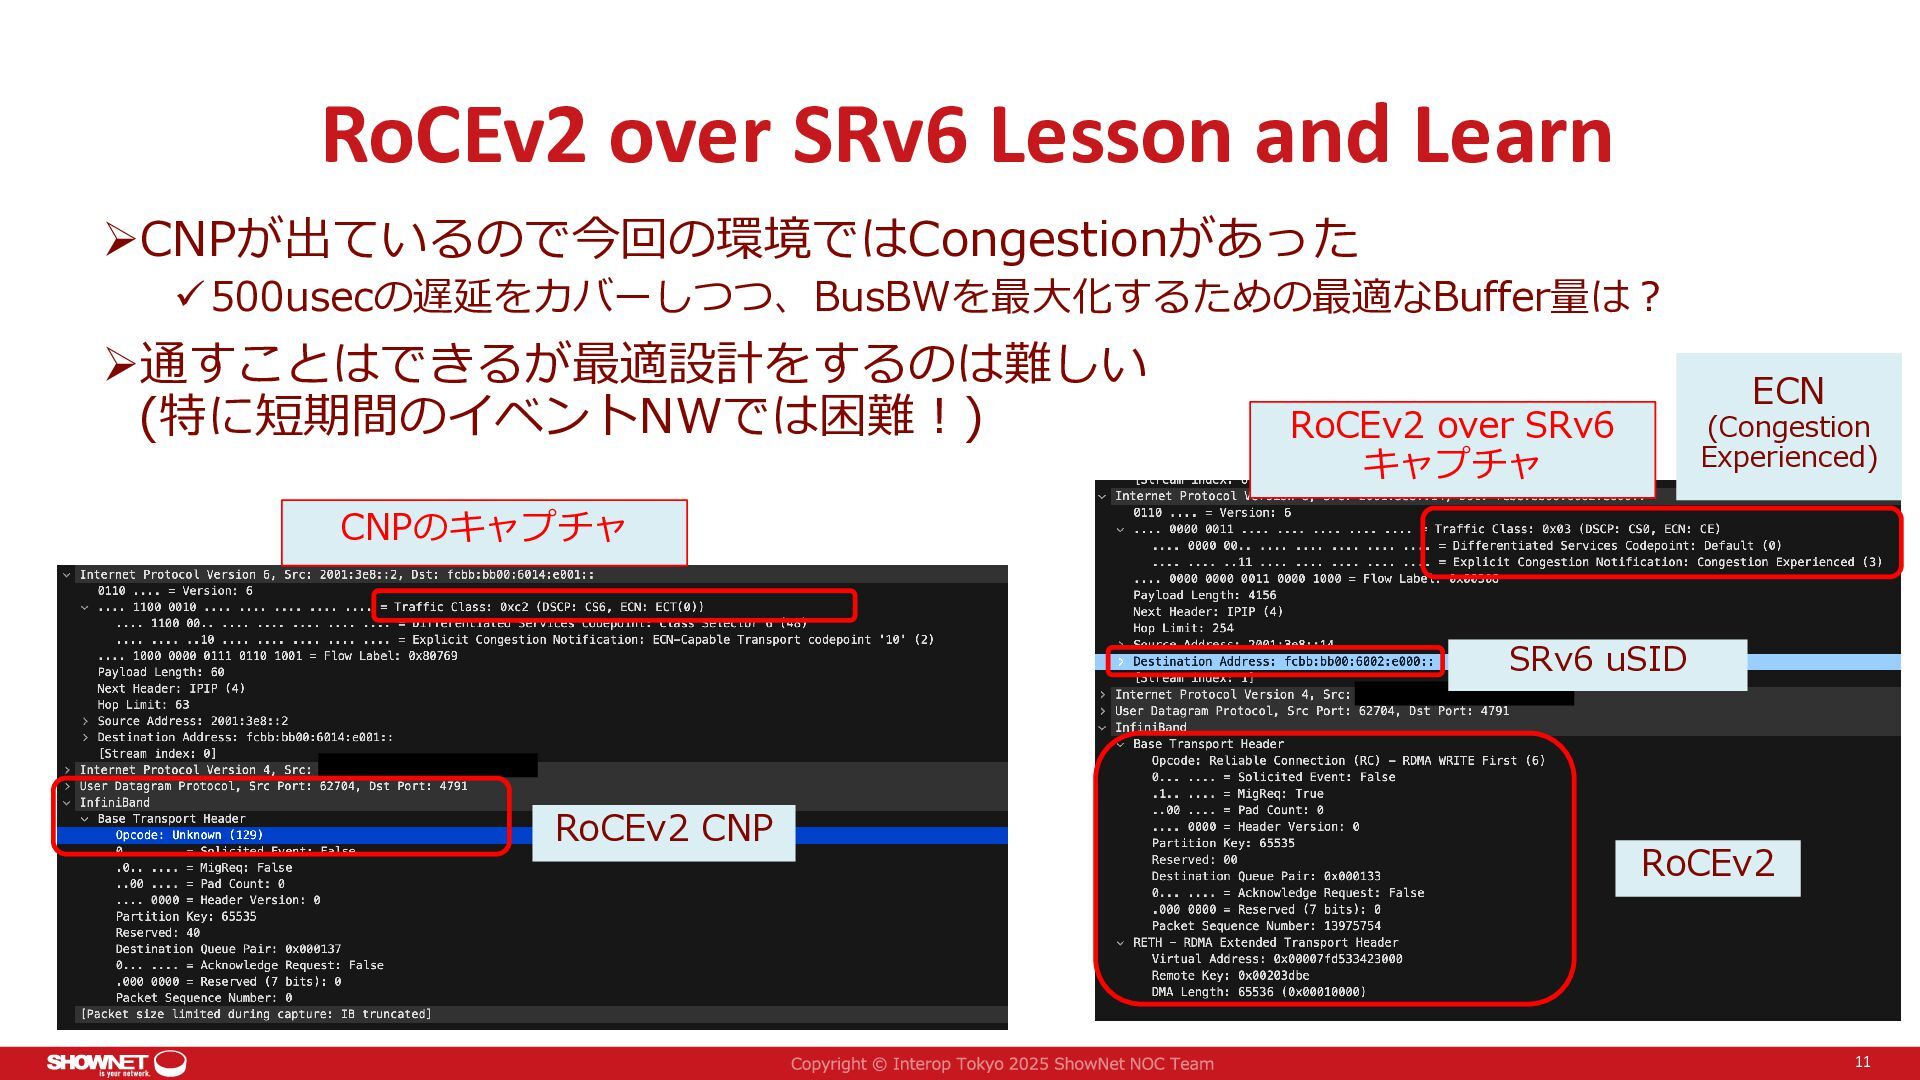
    ピーされることを確認  RDMAパフォーマンスの確認  チューニングなしでも帯域: 50Gbps 遅延: 500usec程 度でRDMA自体は成立  最適化のためにはチューニングが必要 GPU over APN Testbed (札幌, 三鷹, 横浜, 福岡) Inner IPv4 Header ECN bit = 11 輻輳検知 RoCEv2通信 RoCEv2 UDP/IB ヘッダ IOWN APN ShowNet SRv6 Backbone Outer IPv6 Header ECN bit = 11 輻輳検知 ECN: 11 Congestion Experienced CNP Congestion Notification ShowNet DC NW GPU基盤 9
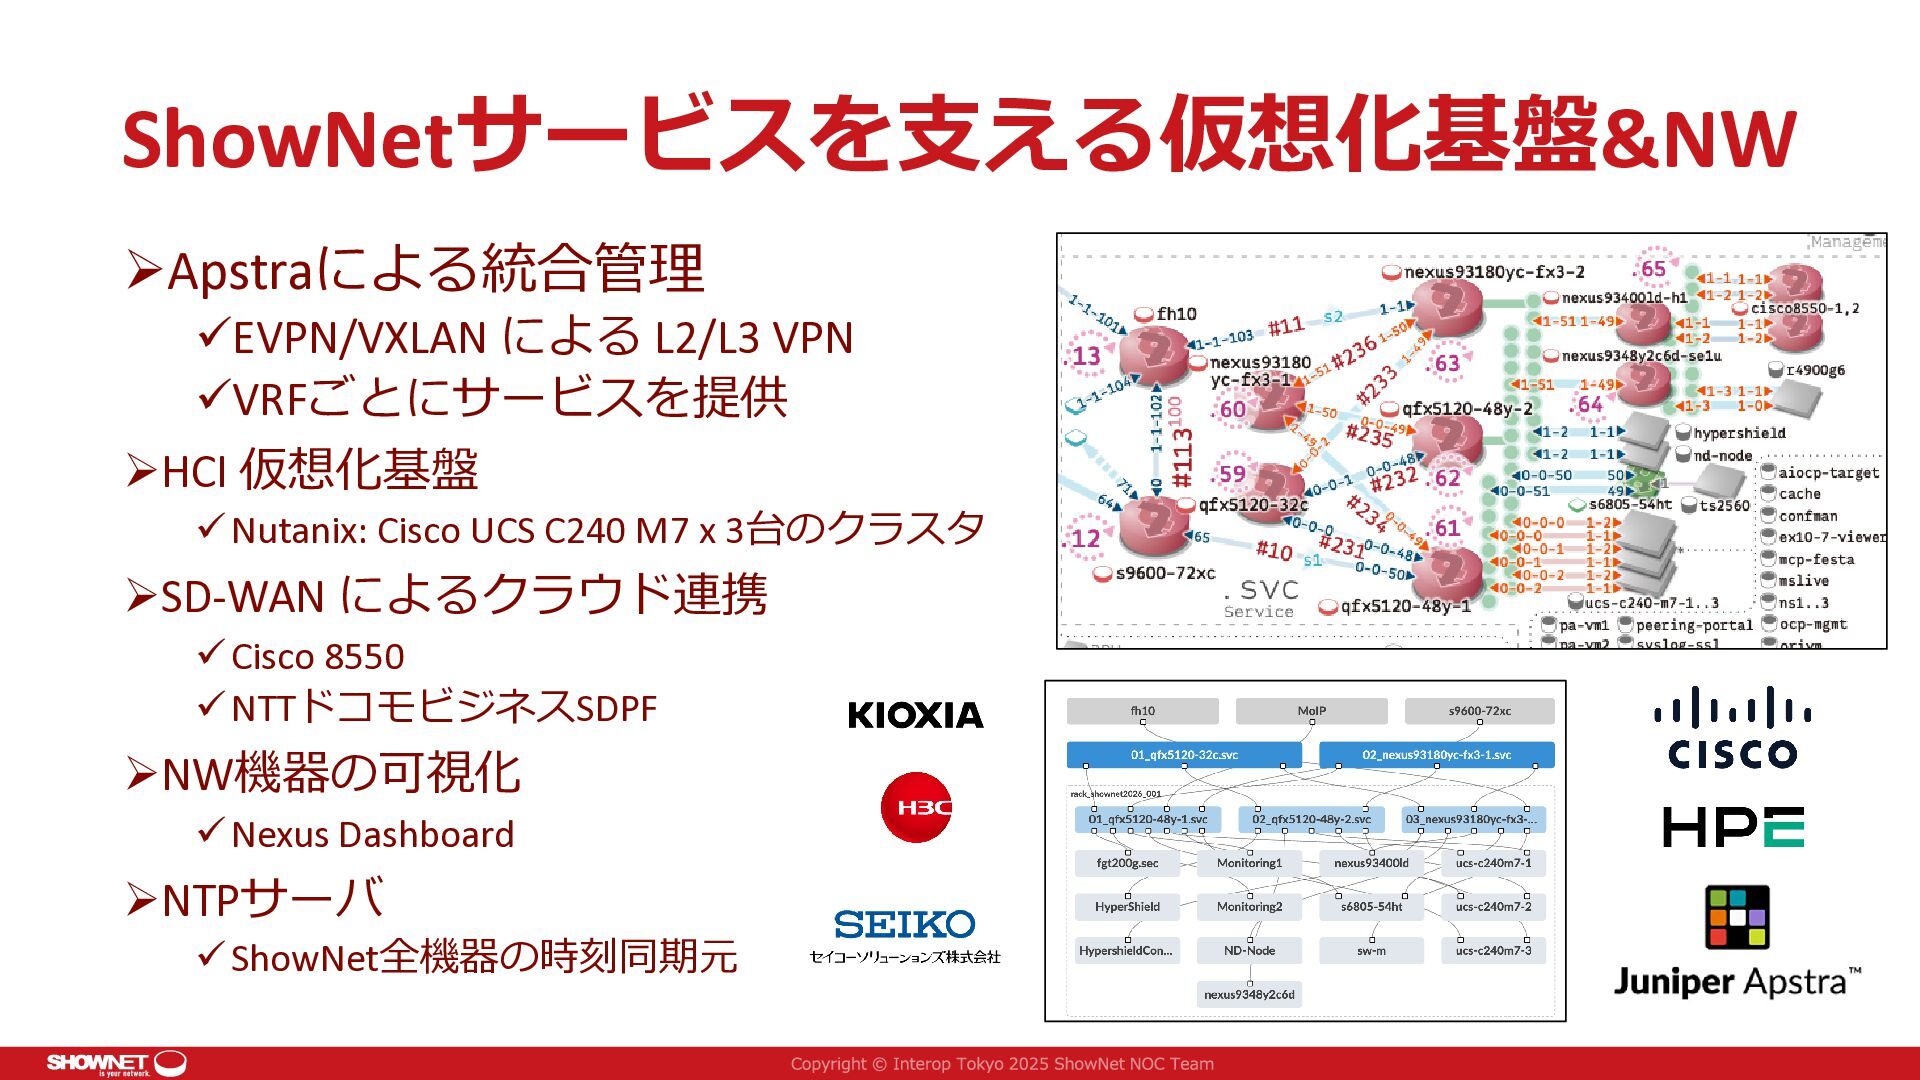
  7. ShowNetサービスを支える仮想化基盤&NW Apstraによる統合管理 EVPN/VXLAN による L2/L3 VPN VRFごとにサービスを提供 HCI 仮想化基盤 

    Nutanix: Cisco UCS C240 M7 x 3台のクラスタ SD-WAN によるクラウド連携  Cisco 8550  NTTドコモビジネスSDPF NW機器の可視化  Nexus Dashboard NTPサーバ  ShowNet全機器の時刻同期元
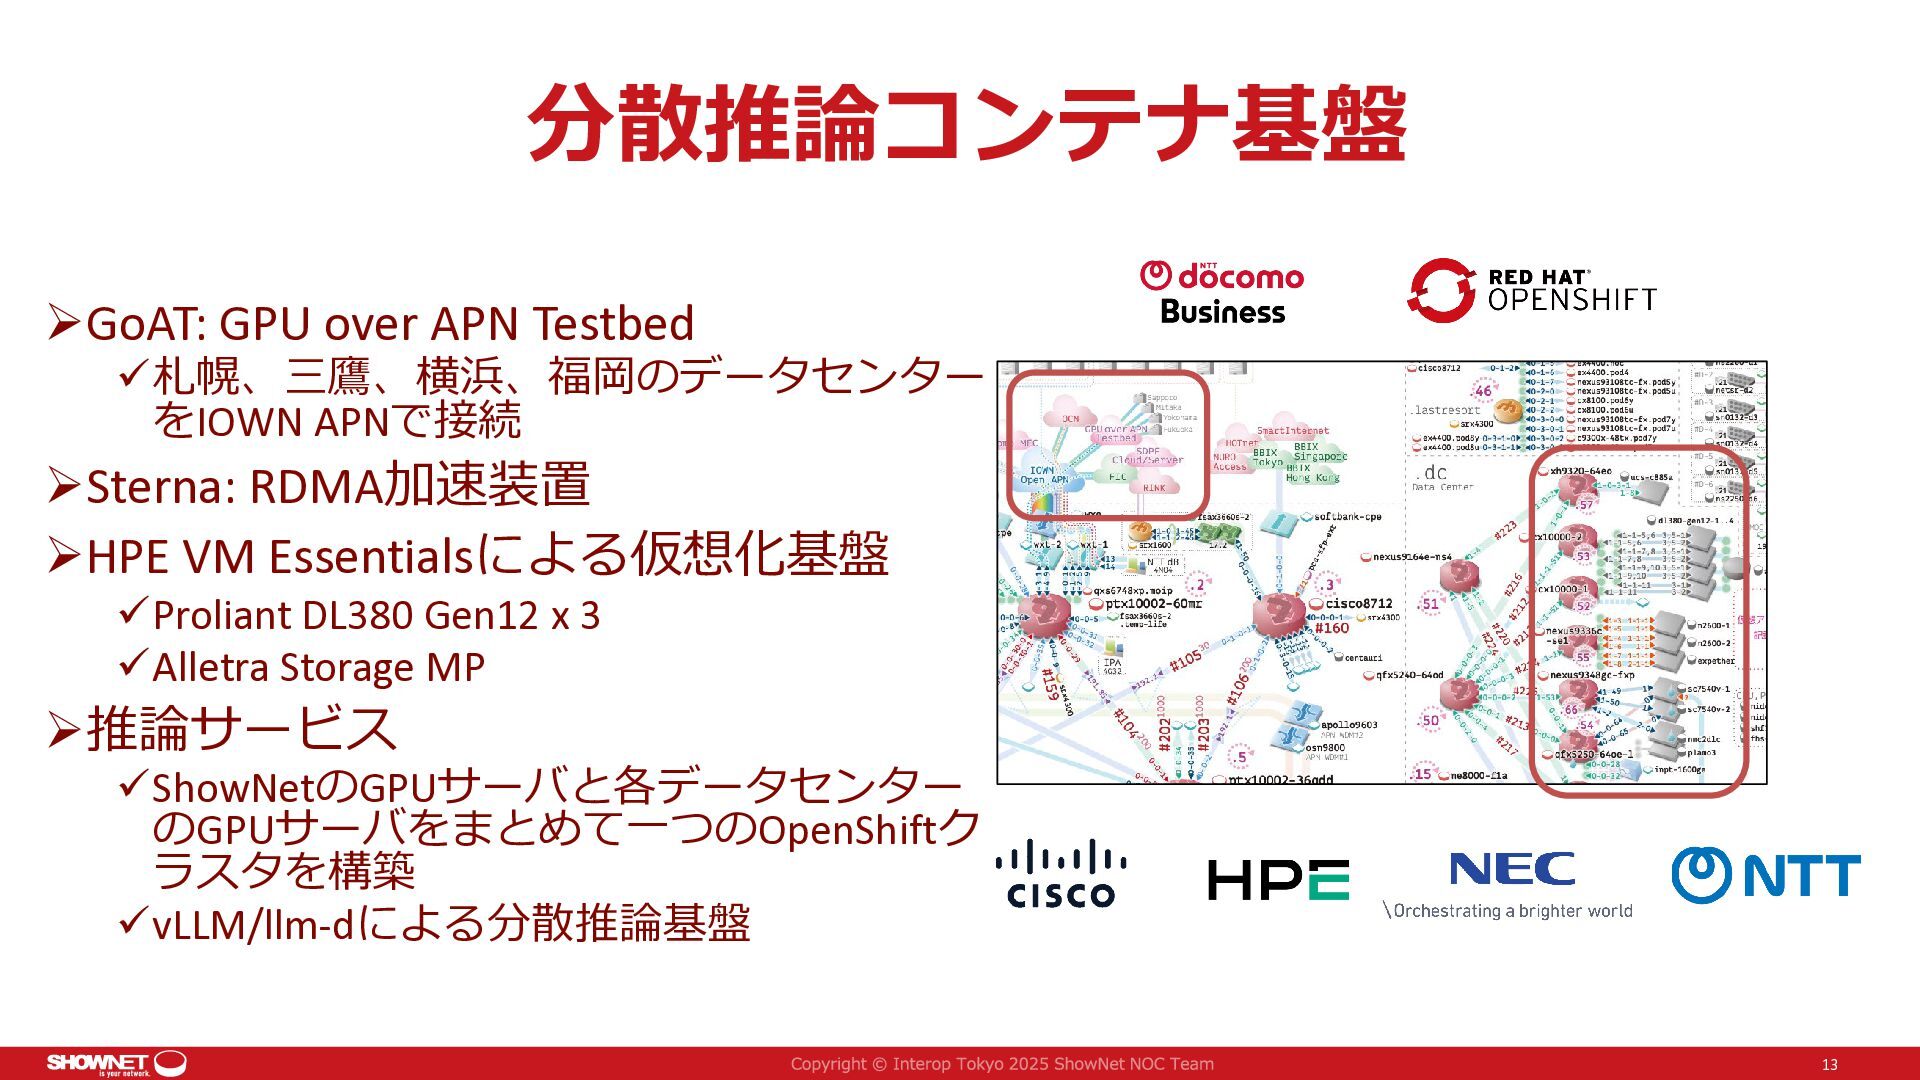
  8. 分散推論コンテナ基盤 GoAT: GPU over APN Testbed 札幌、三鷹、横浜、福岡のデータセンター をIOWN APNで接続 Sterna:

    RDMA加速装置 HPE VM Essentialsによる仮想化基盤 Proliant DL380 Gen12 x 3 Alletra Storage MP 推論サービス ShowNetのGPUサーバと各データセンター のGPUサーバをまとめて一つのOpenShiftク ラスタを構築 vLLM/llm-dによる分散推論基盤 13
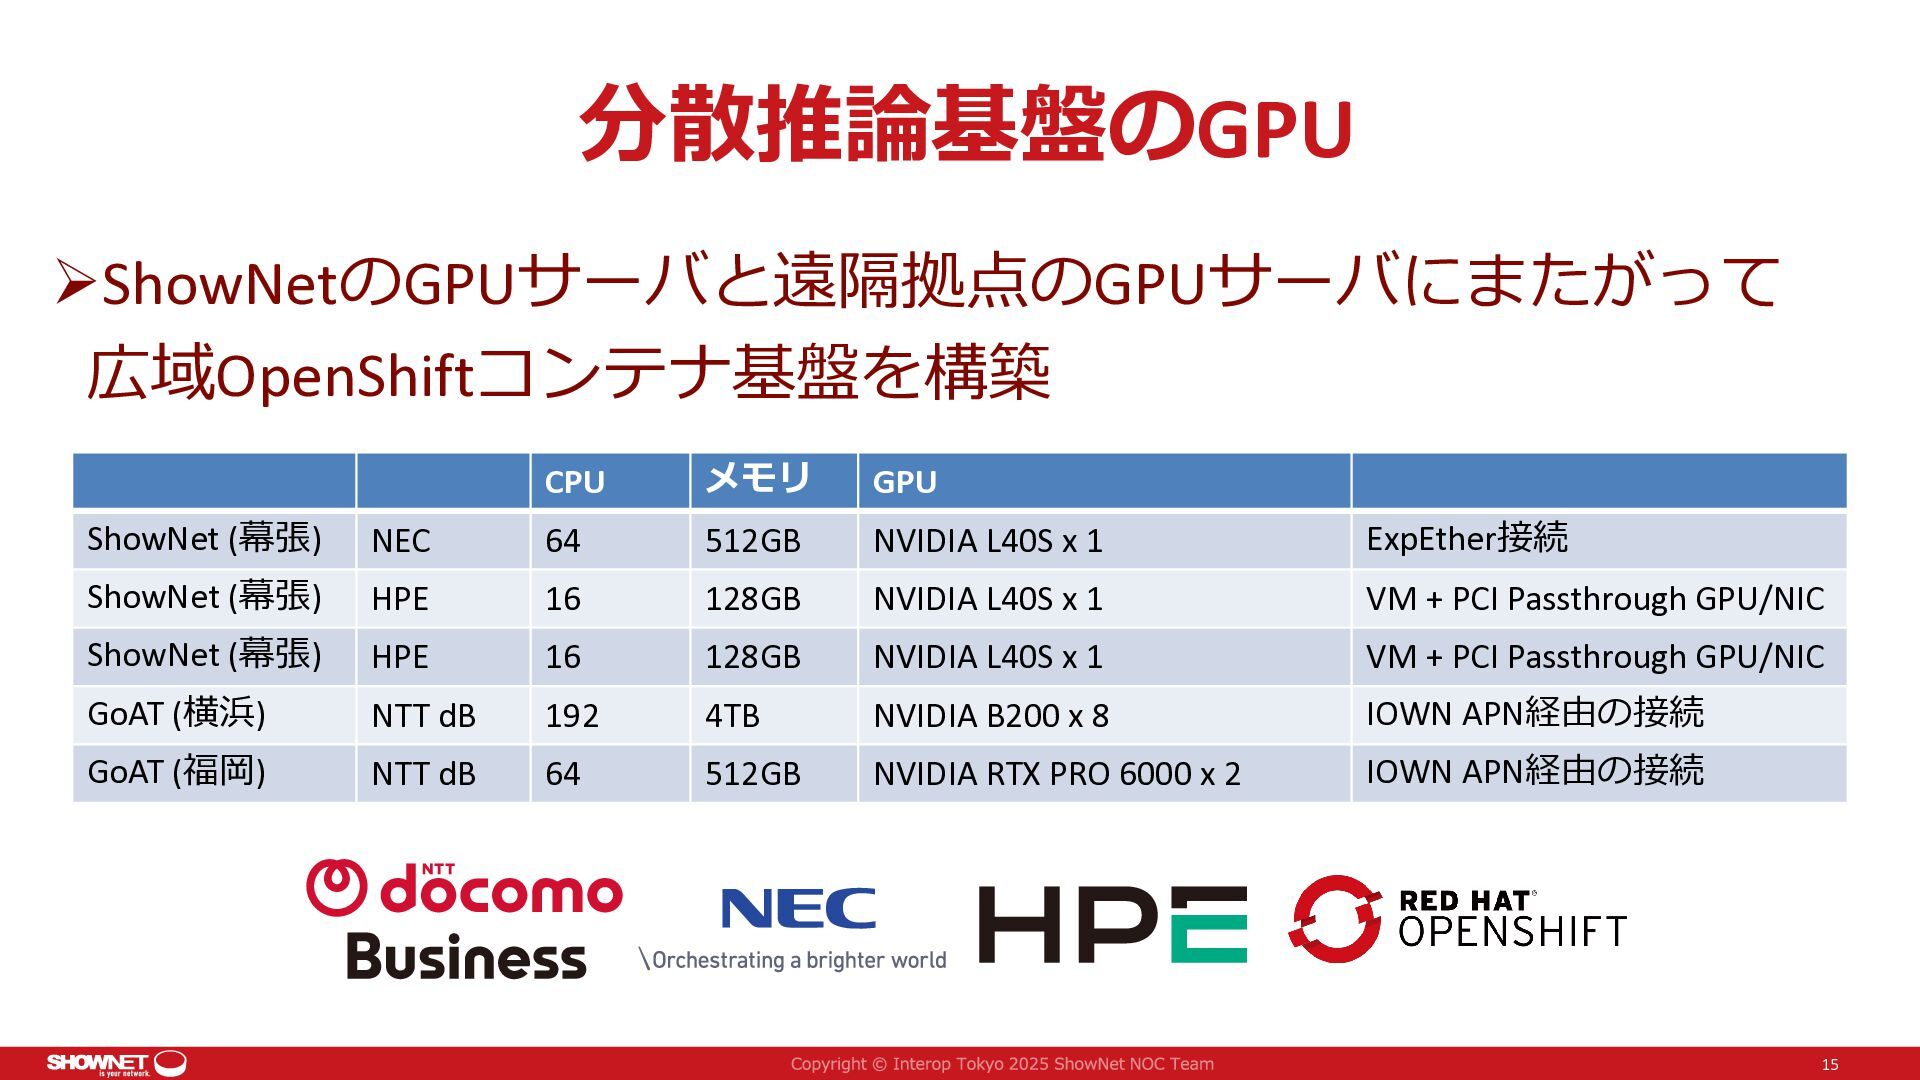
  9. 分散推論基盤のGPU ShowNetのGPUサーバと遠隔拠点のGPUサーバにまたがって 広域OpenShiftコンテナ基盤を構築 CPU メモリ GPU ShowNet (幕張) NEC 64

    512GB NVIDIA L40S x 1 ExpEther接続 ShowNet (幕張) HPE 16 128GB NVIDIA L40S x 1 VM + PCI Passthrough GPU/NIC ShowNet (幕張) HPE 16 128GB NVIDIA L40S x 1 VM + PCI Passthrough GPU/NIC GoAT (横浜) NTT dB 192 4TB NVIDIA B200 x 8 IOWN APN経由の接続 GoAT (福岡) NTT dB 64 512GB NVIDIA RTX PRO 6000 x 2 IOWN APN経由の接続 15
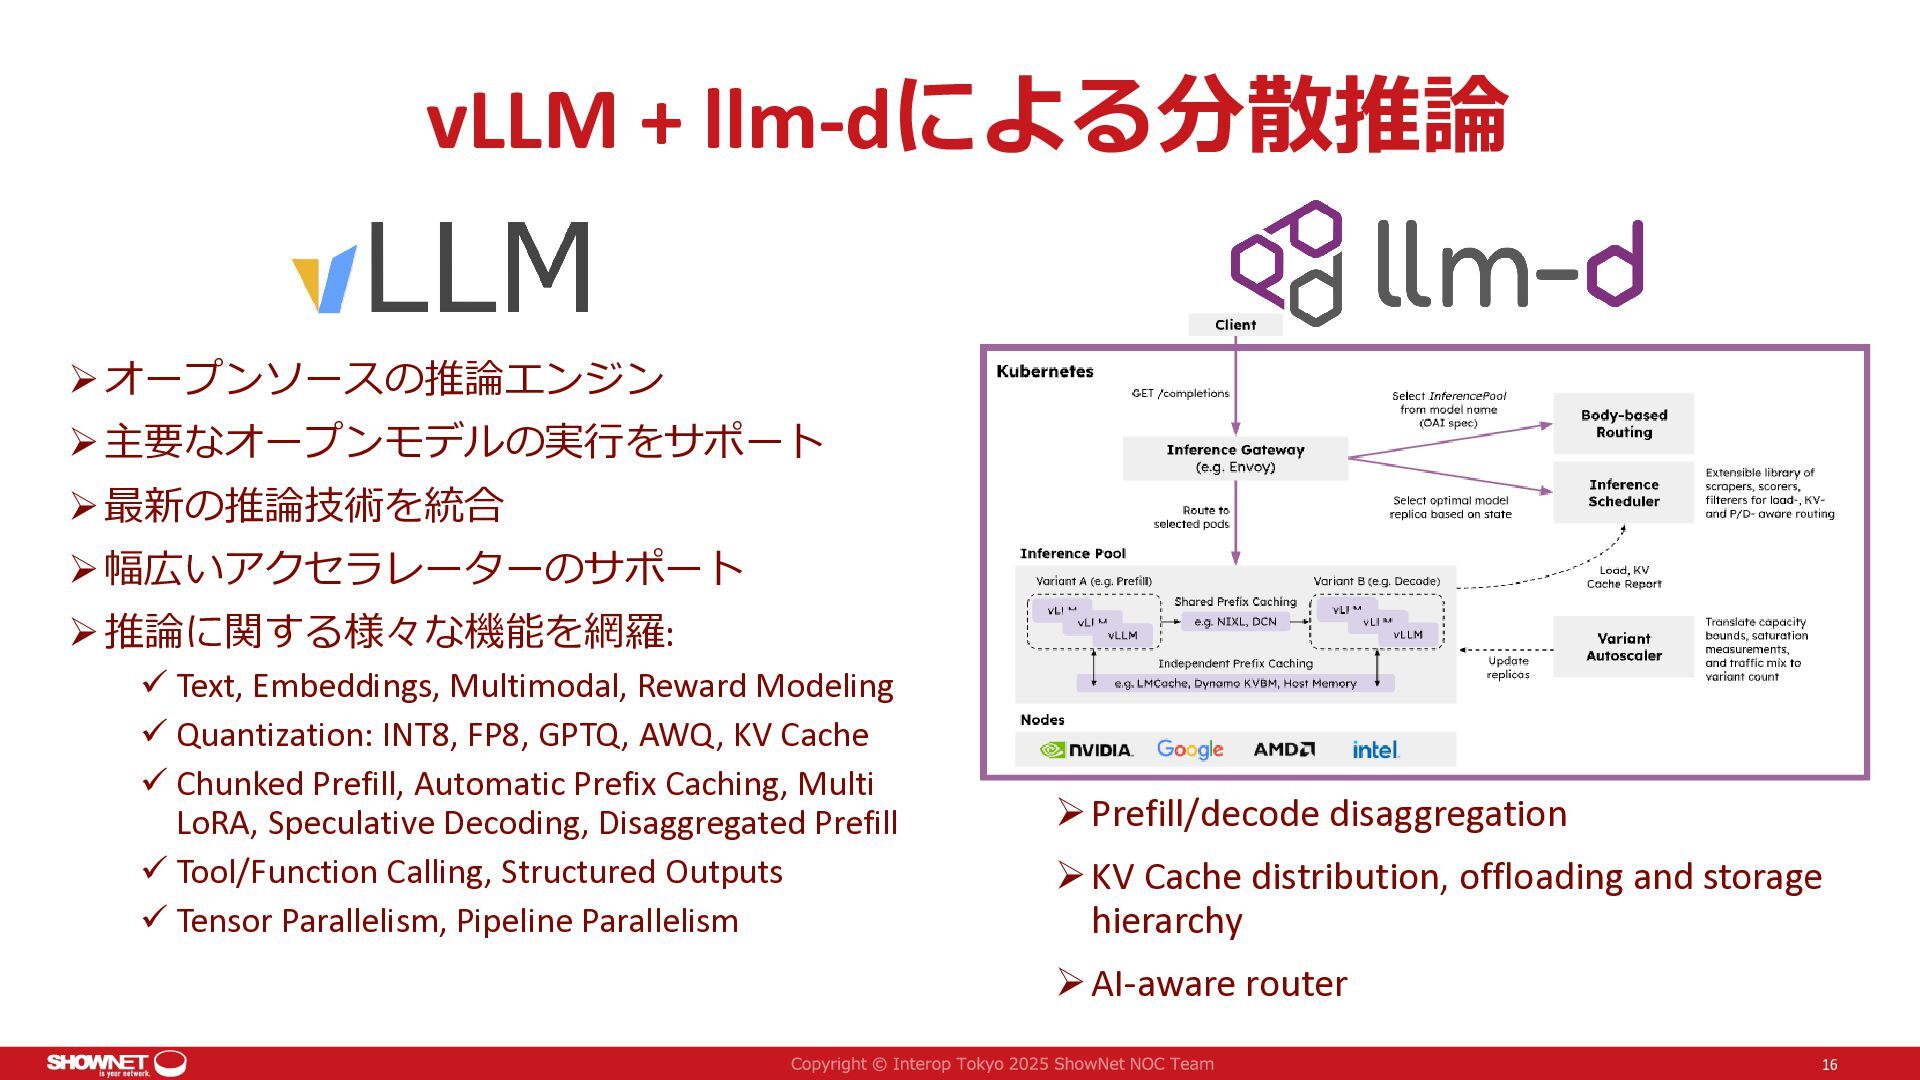
  10. vLLM + llm-dによる分散推論  オープンソースの推論エンジン  主要なオープンモデルの実行をサポート  最新の推論技術を統合 

    幅広いアクセラレーターのサポート  推論に関する様々な機能を網羅:  Text, Embeddings, Multimodal, Reward Modeling  Quantization: INT8, FP8, GPTQ, AWQ, KV Cache  Chunked Prefill, Automatic Prefix Caching, Multi LoRA, Speculative Decoding, Disaggregated Prefill  Tool/Function Calling, Structured Outputs  Tensor Parallelism, Pipeline Parallelism  Prefill/decode disaggregation  KV Cache distribution, offloading and storage hierarchy  AI-aware router 16
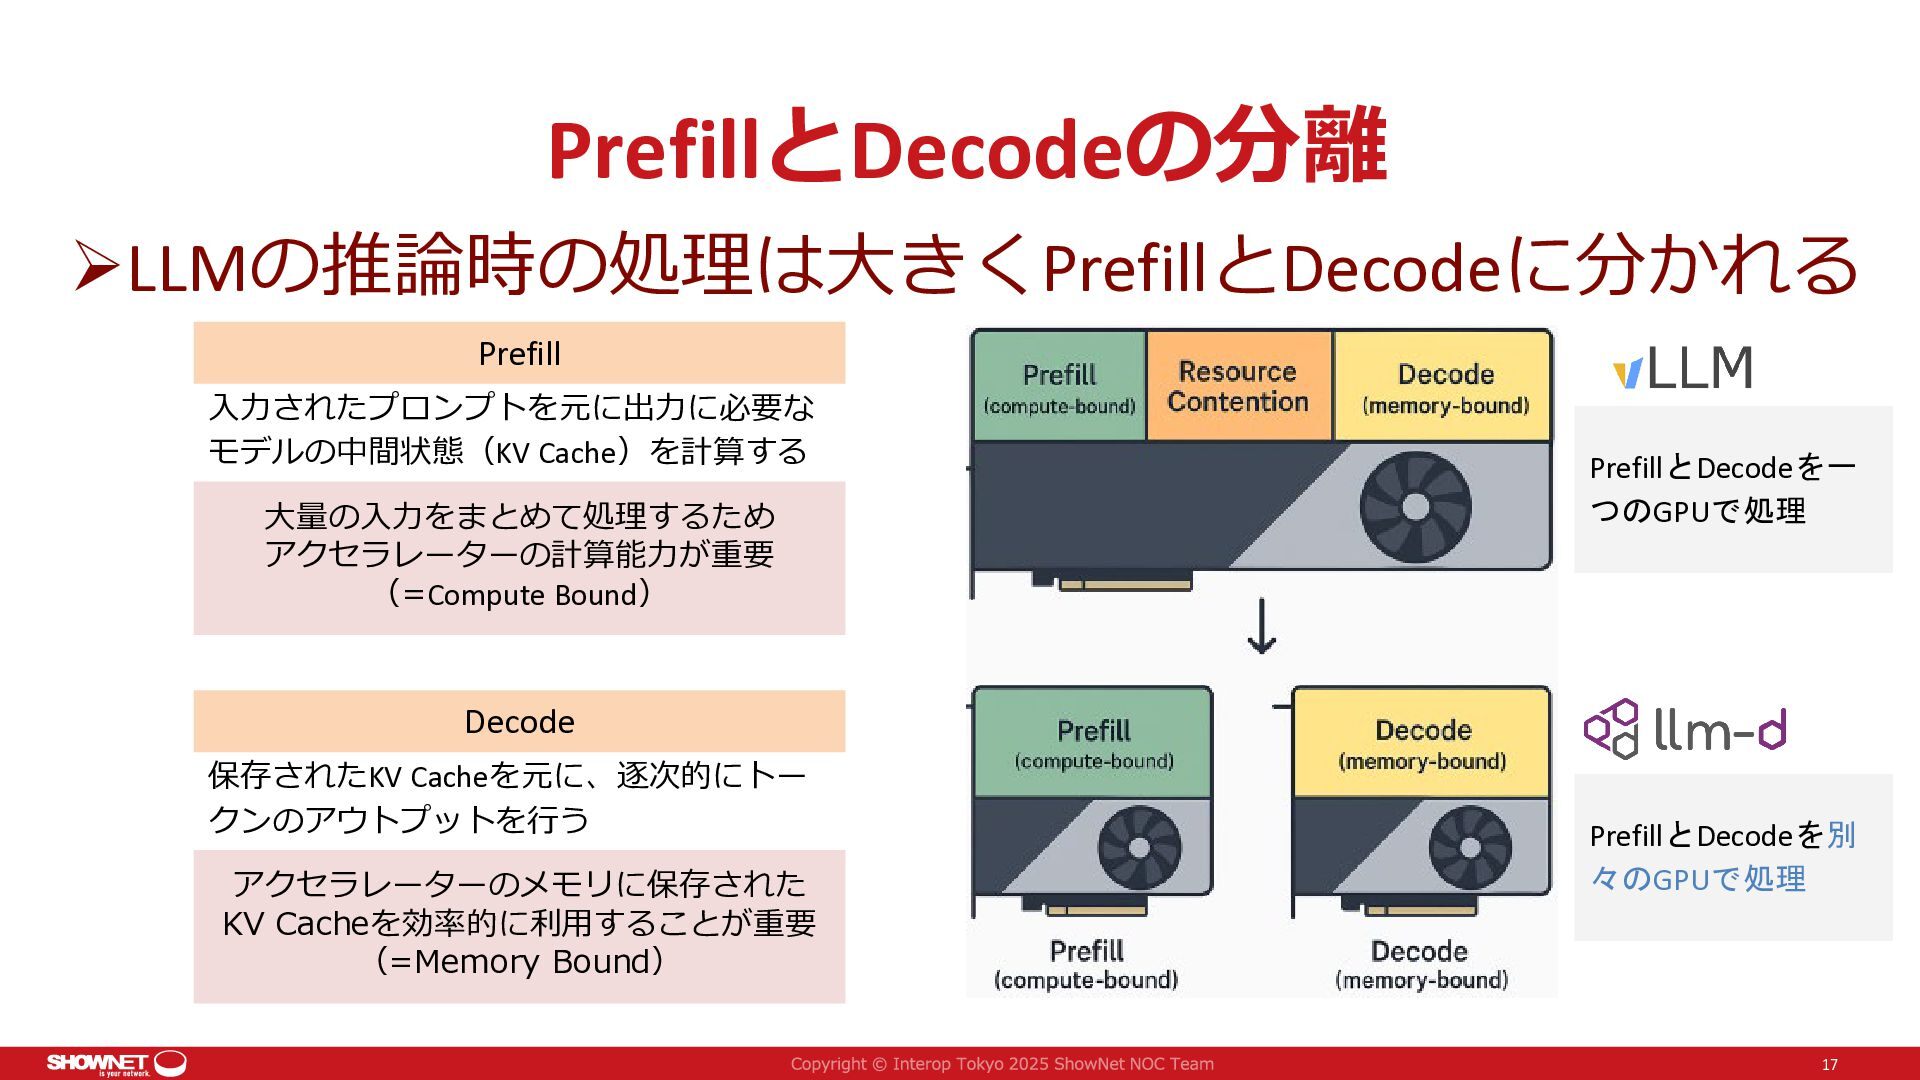
  11. PrefillとDecodeの分離 LLMの推論時の処理は大きくPrefillとDecodeに分かれる Prefill 入力されたプロンプトを元に出力に必要な モデルの中間状態(KV Cache)を計算する 大量の入力をまとめて処理するため アクセラレーターの計算能力が重要 (=Compute Bound)

    PrefillとDecodeを一 つのGPUで処理 Decode 保存されたKV Cacheを元に、逐次的にトー クンのアウトプットを行う アクセラレーターのメモリに保存された KV Cacheを効率的に利用することが重要 (=Memory Bound) PrefillとDecodeを別 々のGPUで処理 17
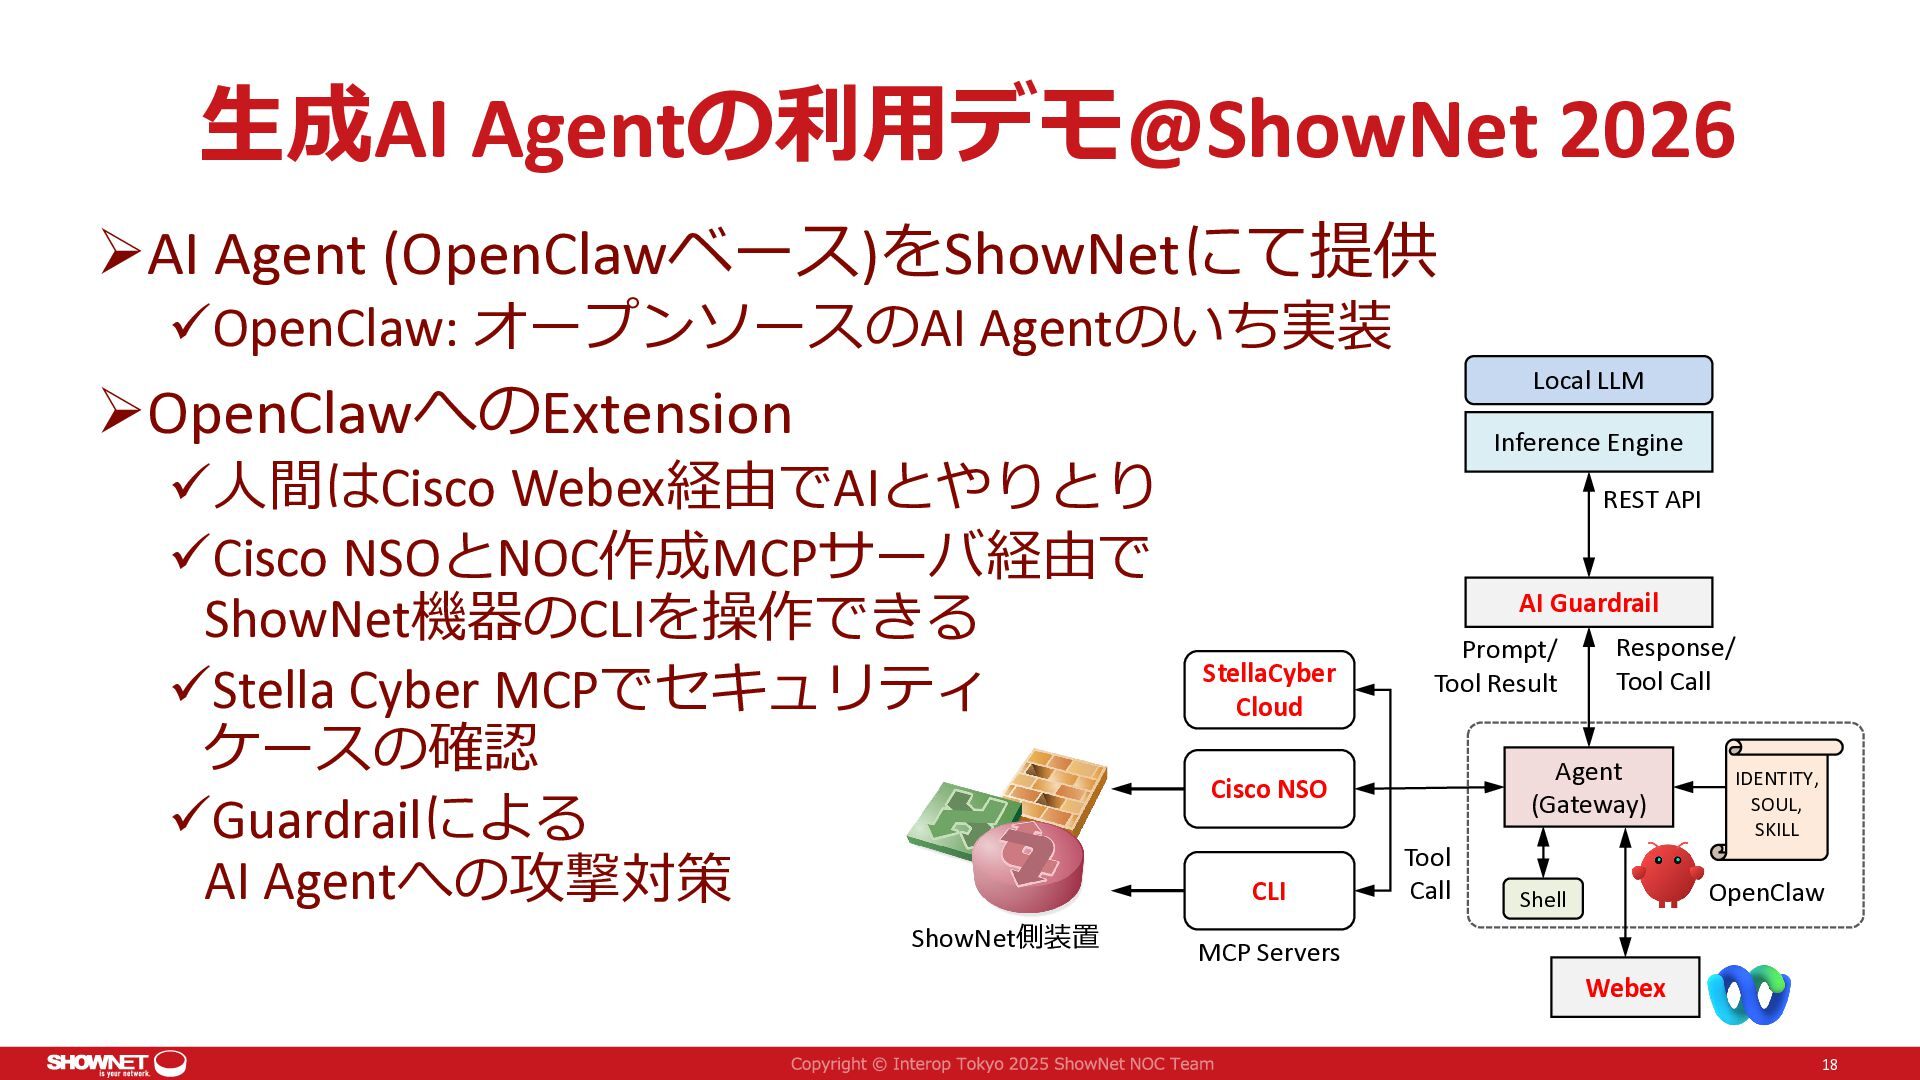
  12. 生成AI Agentの利用デモ@ShowNet 2026 AI Agent (OpenClawベース)をShowNetにて提供 OpenClaw: オープンソースのAI Agentのいち実装 Local

    LLM OpenClawへのExtension 人間はCisco Webex経由でAIとやりとり Cisco NSOとNOC作成MCPサーバ経由で ShowNet機器のCLIを操作できる Stella Cyber MCPでセキュリティ ケースの確認 Guardrailによる AI Agentへの攻撃対策 ShowNet側装置 Inference Engine REST API AI Guardrail StellaCyber Cloud Prompt/ Tool Result Agent (Gateway) Cisco NSO CLI MCP Servers Response/ Tool Call Tool Call IDENTITY, SOUL, SKILL OpenClaw Shell Webex 18
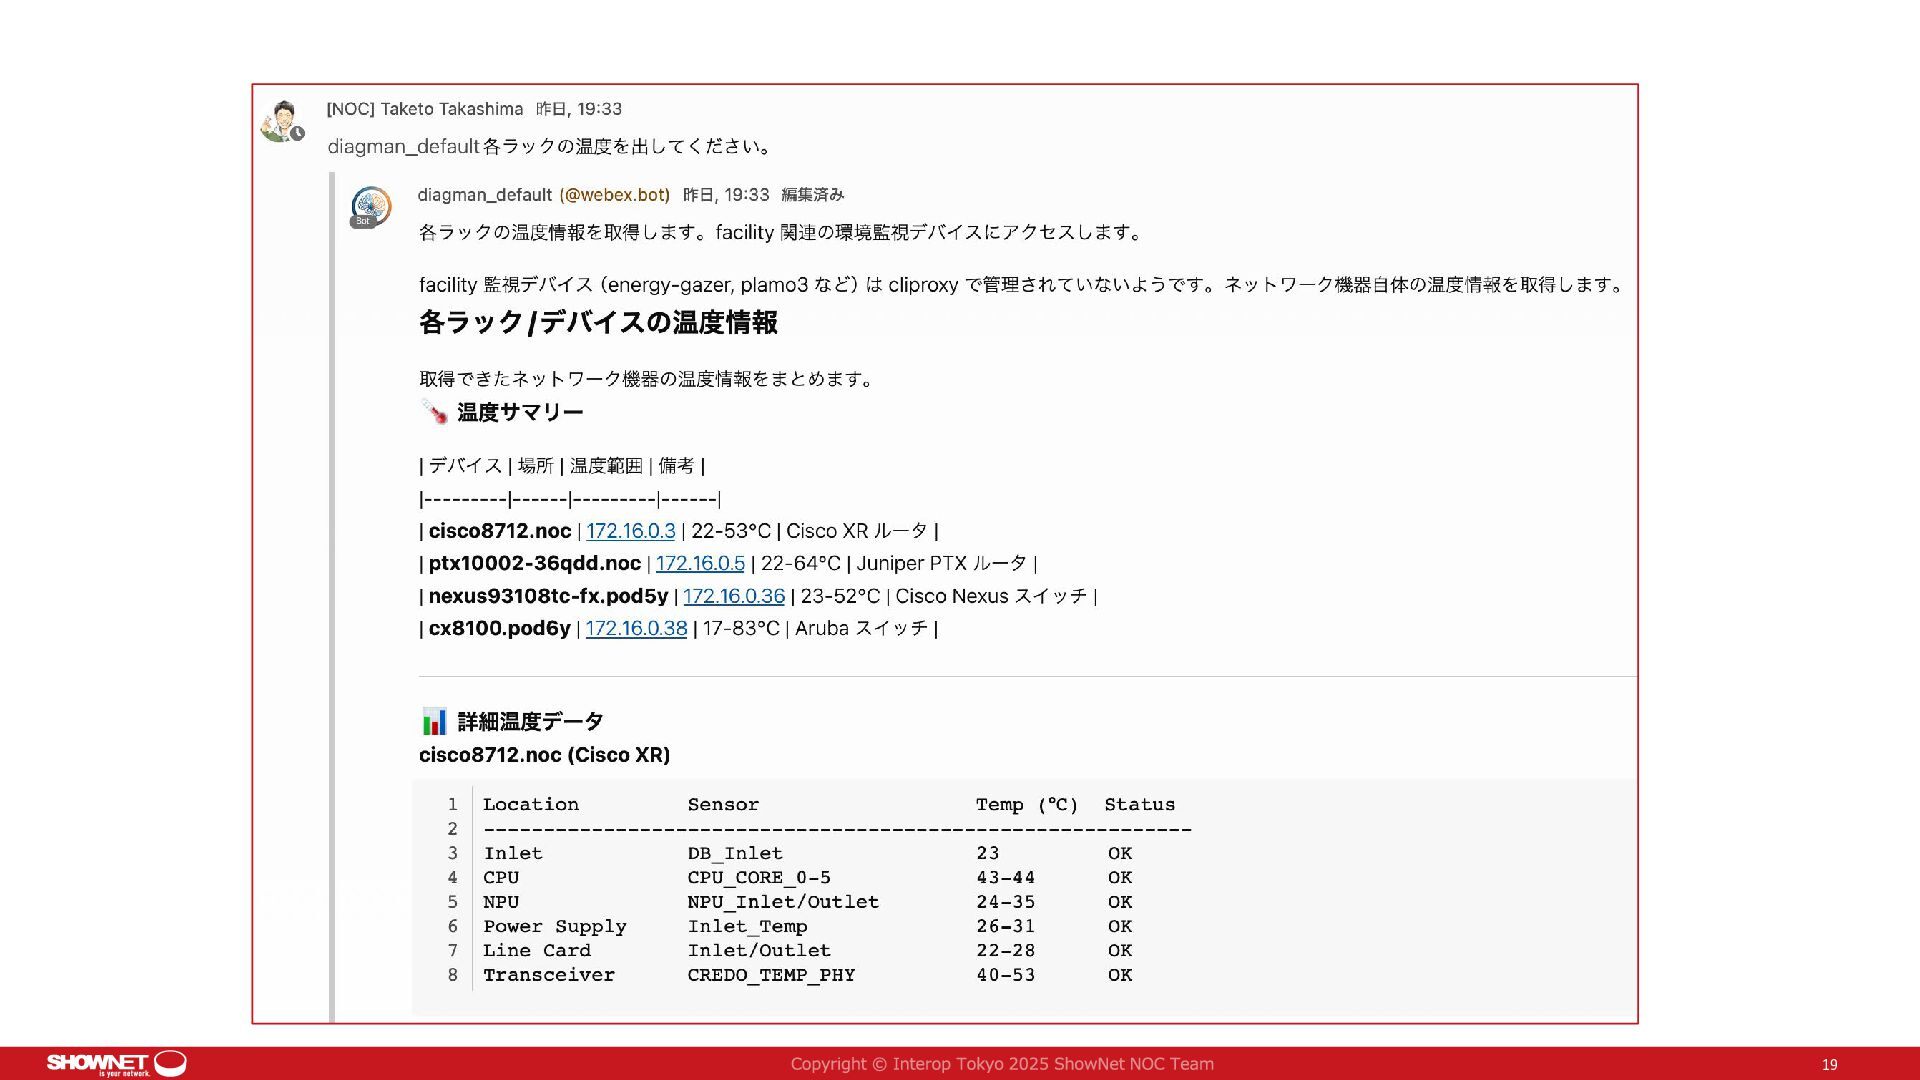
  13. 19

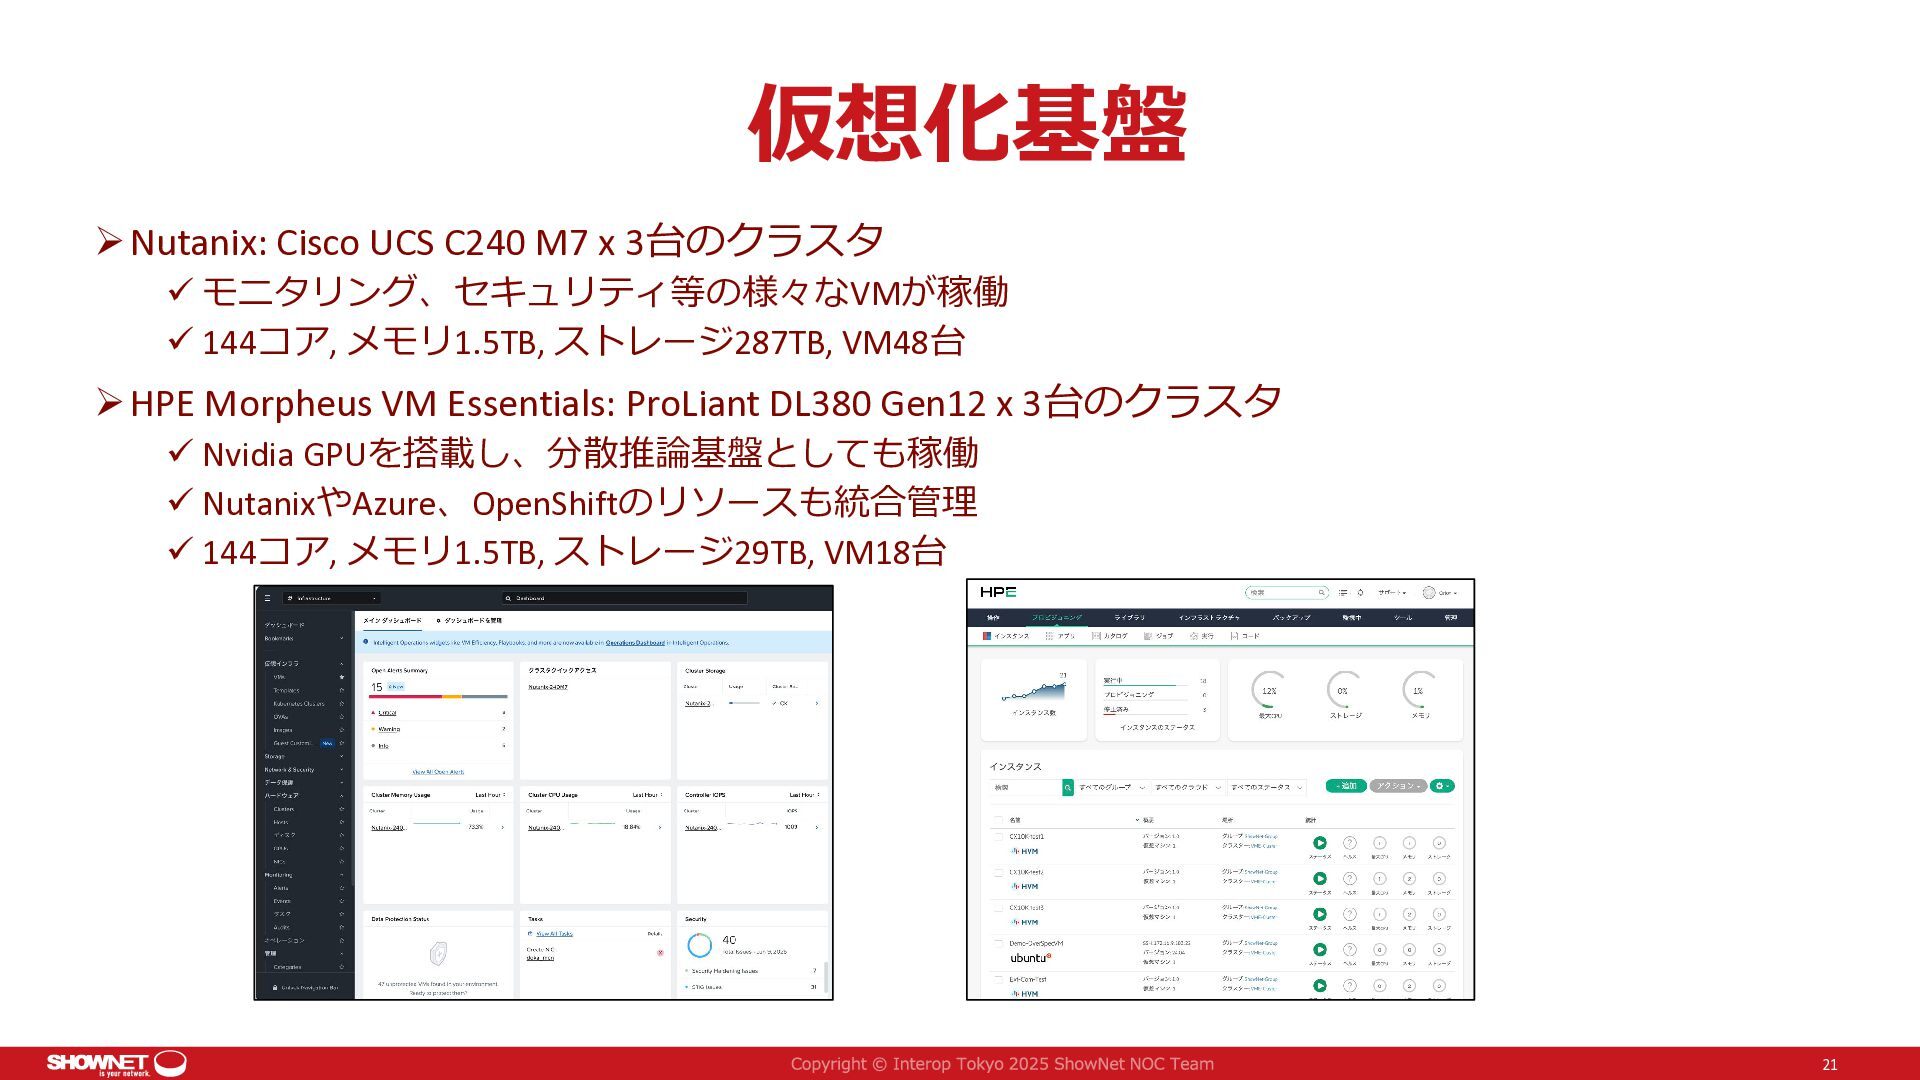
  14. 仮想化基盤  Nutanix: Cisco UCS C240 M7 x 3台のクラスタ 

    モニタリング、セキュリティ等の様々なVMが稼働  144コア, メモリ1.5TB, ストレージ287TB, VM48台  HPE Morpheus VM Essentials: ProLiant DL380 Gen12 x 3台のクラスタ  Nvidia GPUを搭載し、分散推論基盤としても稼働  NutanixやAzure、OpenShiftのリソースも統合管理  144コア, メモリ1.5TB, ストレージ29TB, VM18台 21
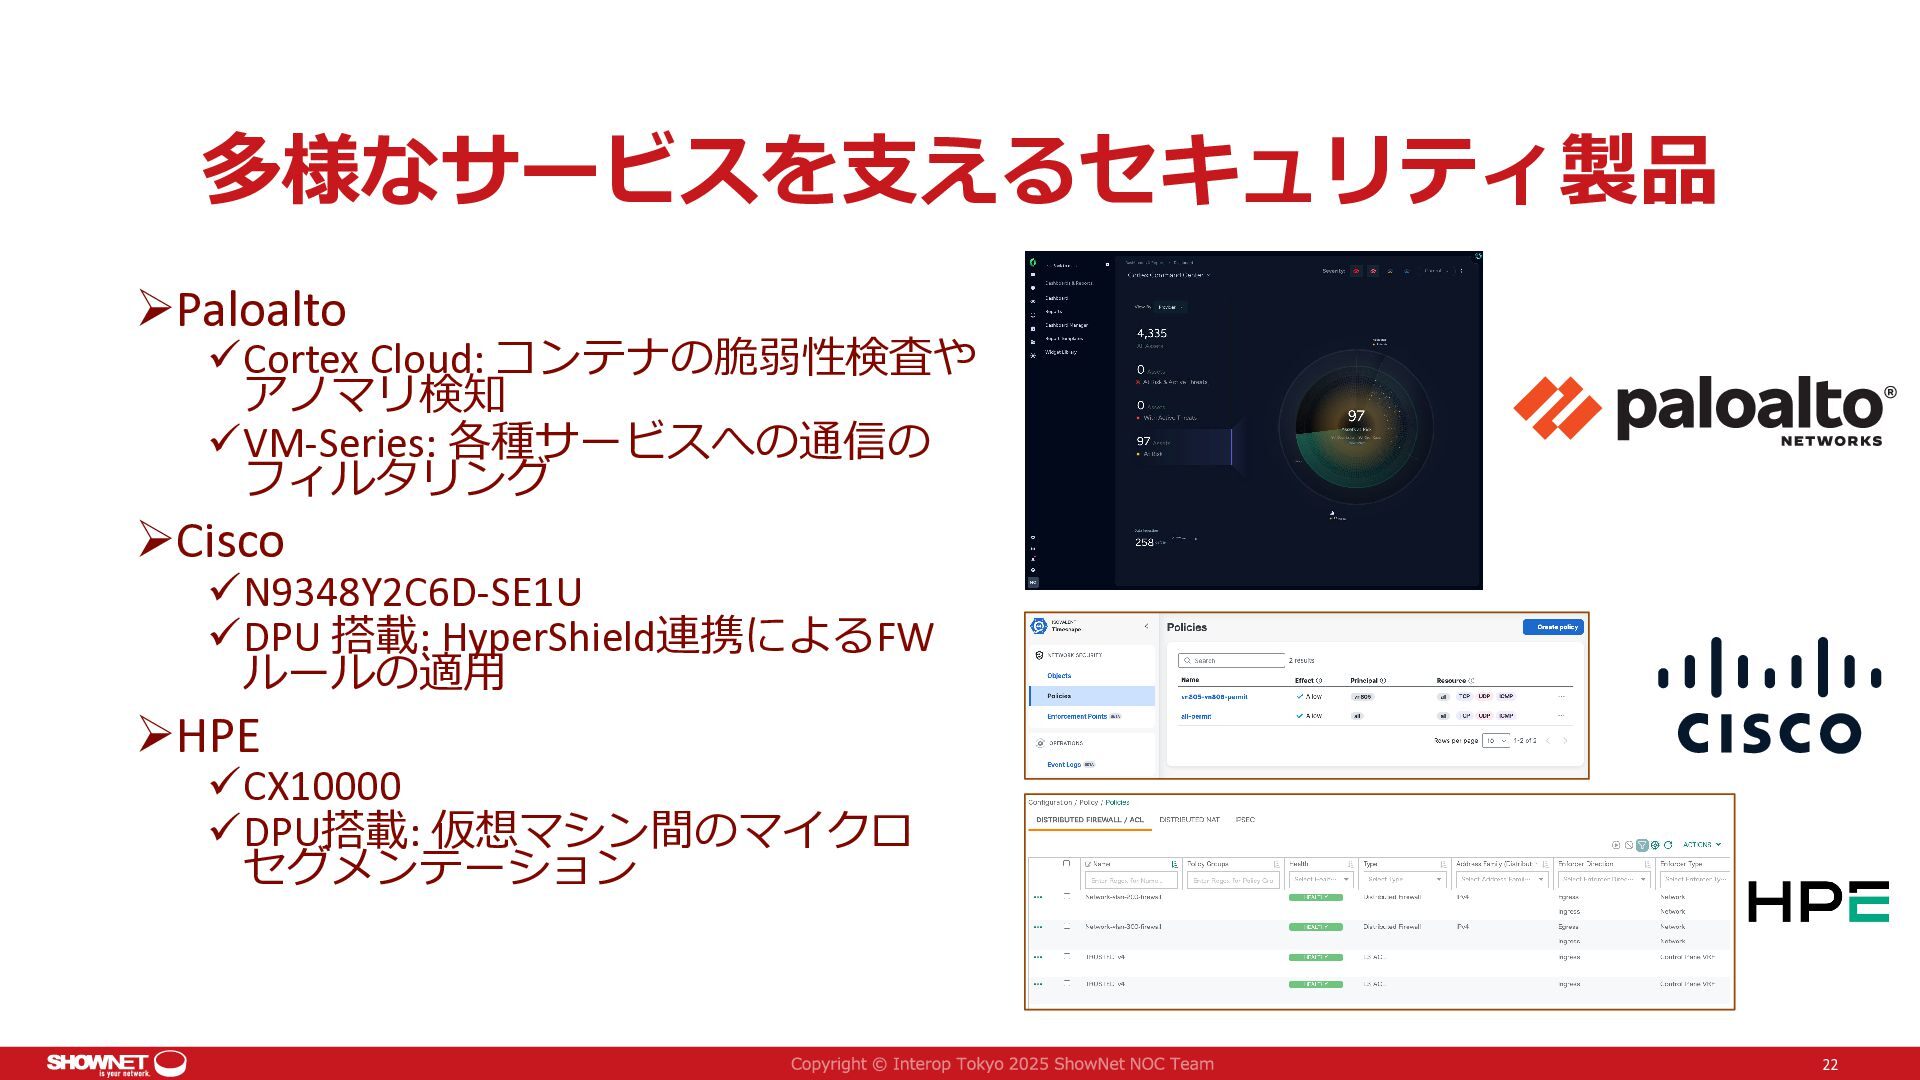
  15. 多様なサービスを支えるセキュリティ製品 Paloalto Cortex Cloud: コンテナの脆弱性検査や アノマリ検知 VM-Series: 各種サービスへの通信の フィルタリング Cisco

    N9348Y2C6D-SE1U DPU 搭載: HyperShield連携によるFW ルールの適用 HPE CX10000 DPU搭載: 仮想マシン間のマイクロ セグメンテーション 22
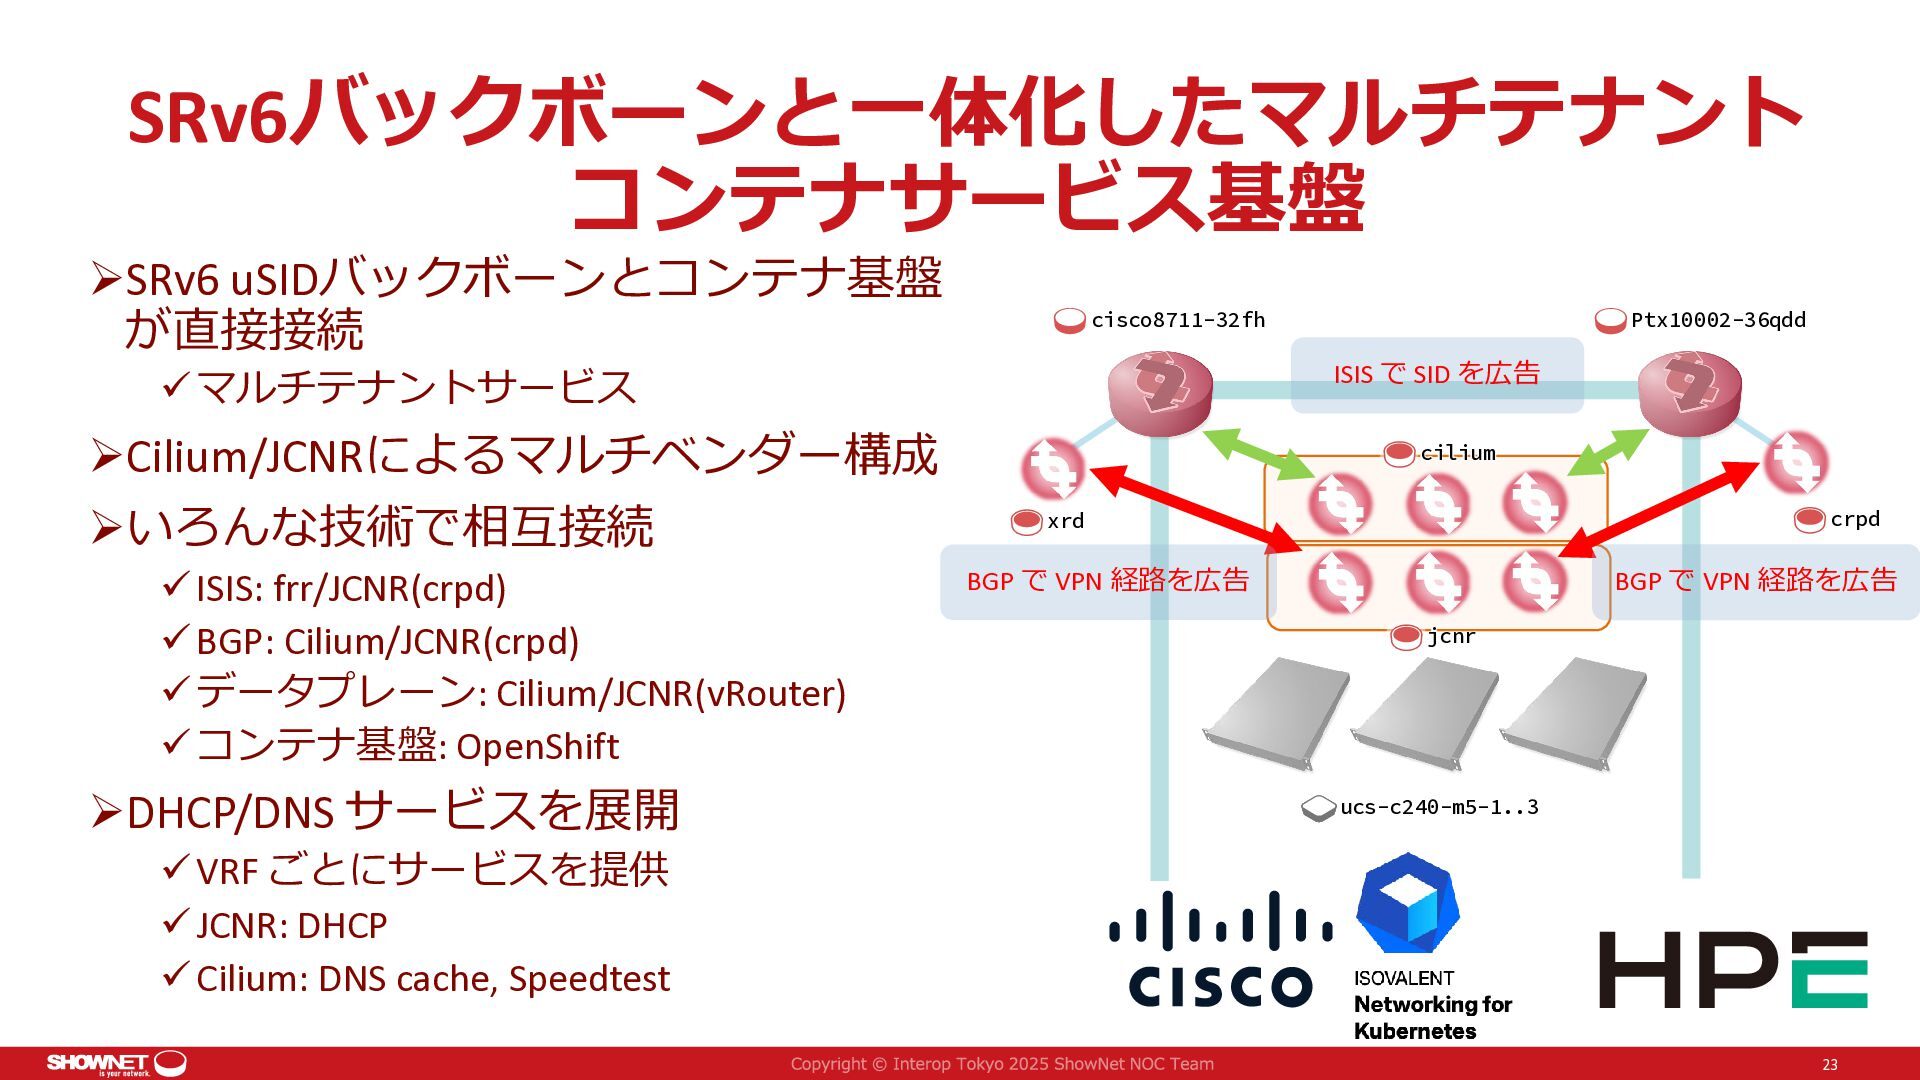
  16. SRv6バックボーンと一体化したマルチテナント コンテナサービス基盤 SRv6 uSIDバックボーンとコンテナ基盤 が直接接続 cisco8711-32fh ISIS で SID を広告

     マルチテナントサービス Cilium/JCNRによるマルチベンダー構成 いろんな技術で相互接続  ISIS: frr/JCNR(crpd)  BGP: Cilium/JCNR(crpd)  データプレーン: Cilium/JCNR(vRouter)  コンテナ基盤: OpenShift DHCP/DNS サービスを展開 Ptx10002-36qdd cilium crpd xrd BGP で VPN 経路を広告 BGP で VPN 経路を広告 jcnr ucs-c240-m5-1..3  VRF ごとにサービスを提供  JCNR: DHCP  Cilium: DNS cache, Speedtest 23
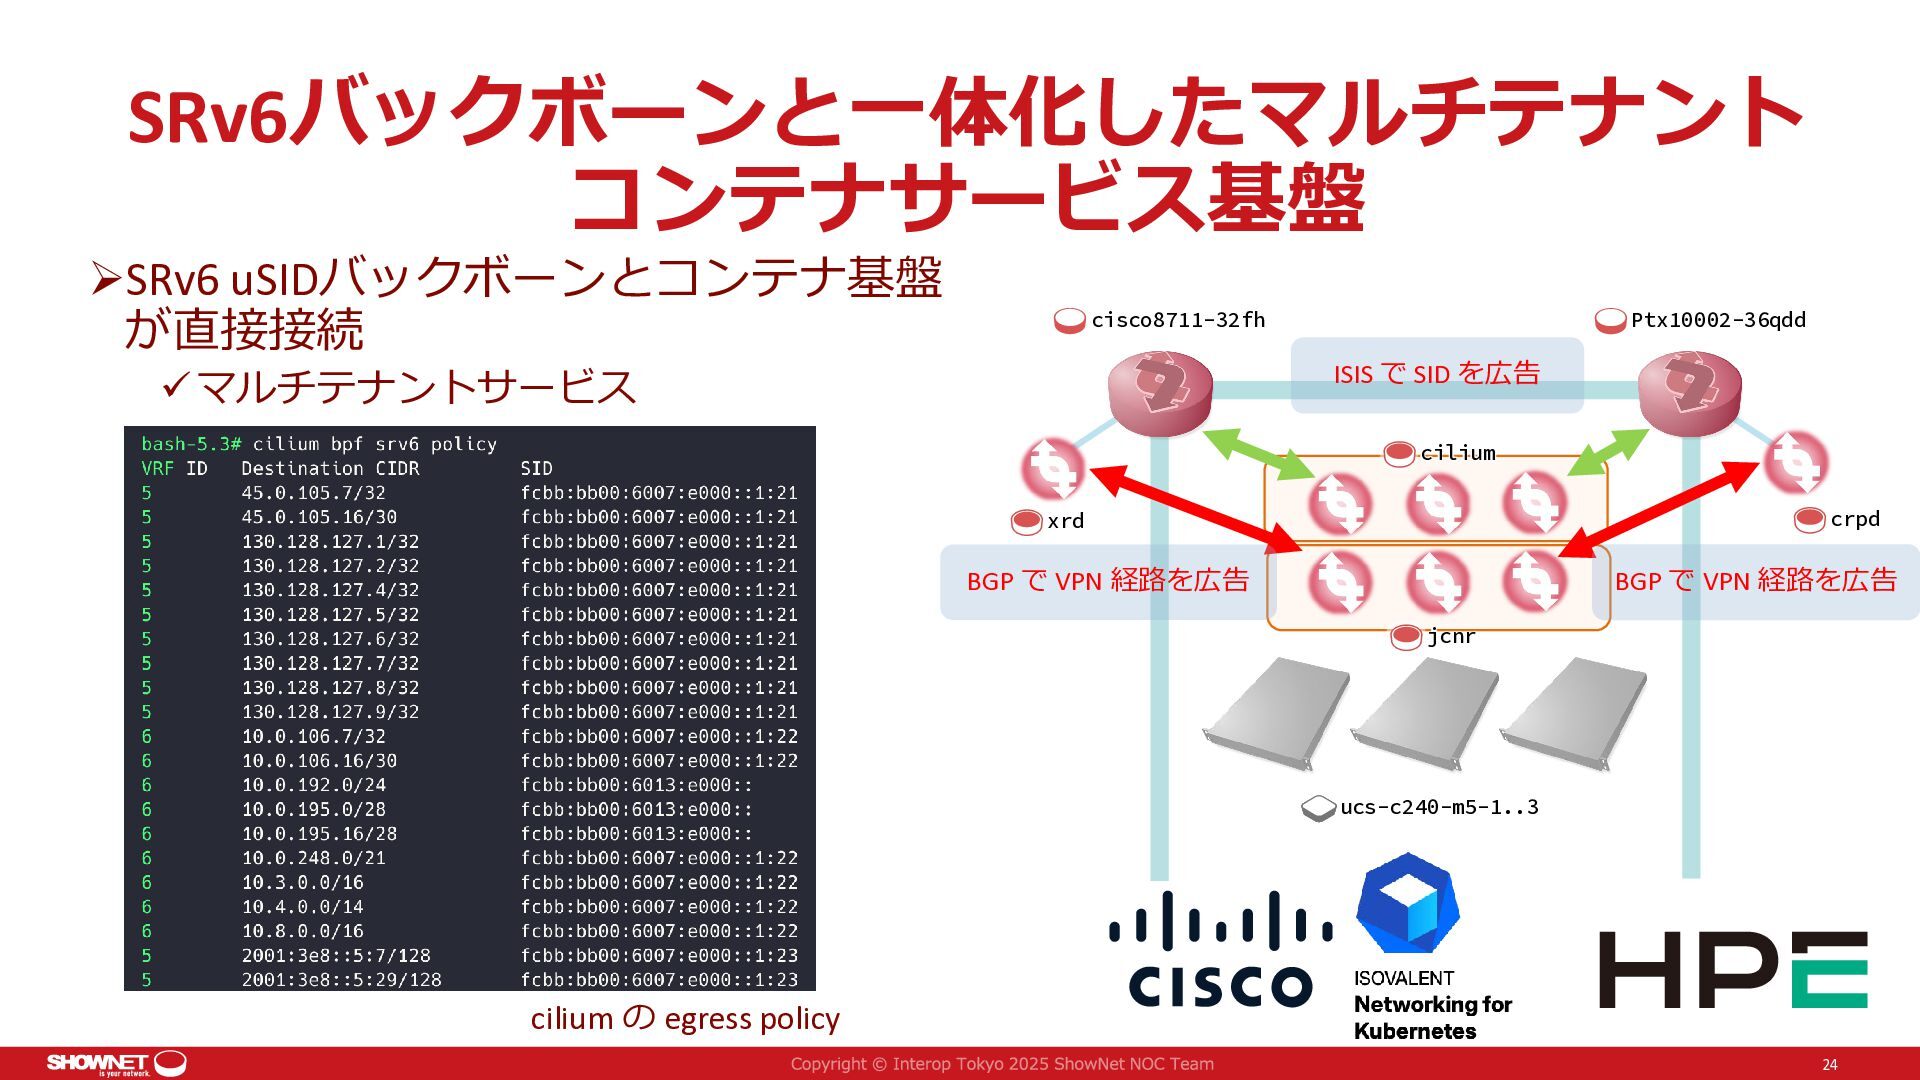
  17. SRv6バックボーンと一体化したマルチテナント コンテナサービス基盤 SRv6 uSIDバックボーンとコンテナ基盤 が直接接続 cisco8711-32fh Ptx10002-36qdd ISIS で SID

    を広告  マルチテナントサービス cilium crpd xrd BGP で VPN 経路を広告 BGP で VPN 経路を広告 jcnr ucs-c240-m5-1..3 cilium の egress policy 24
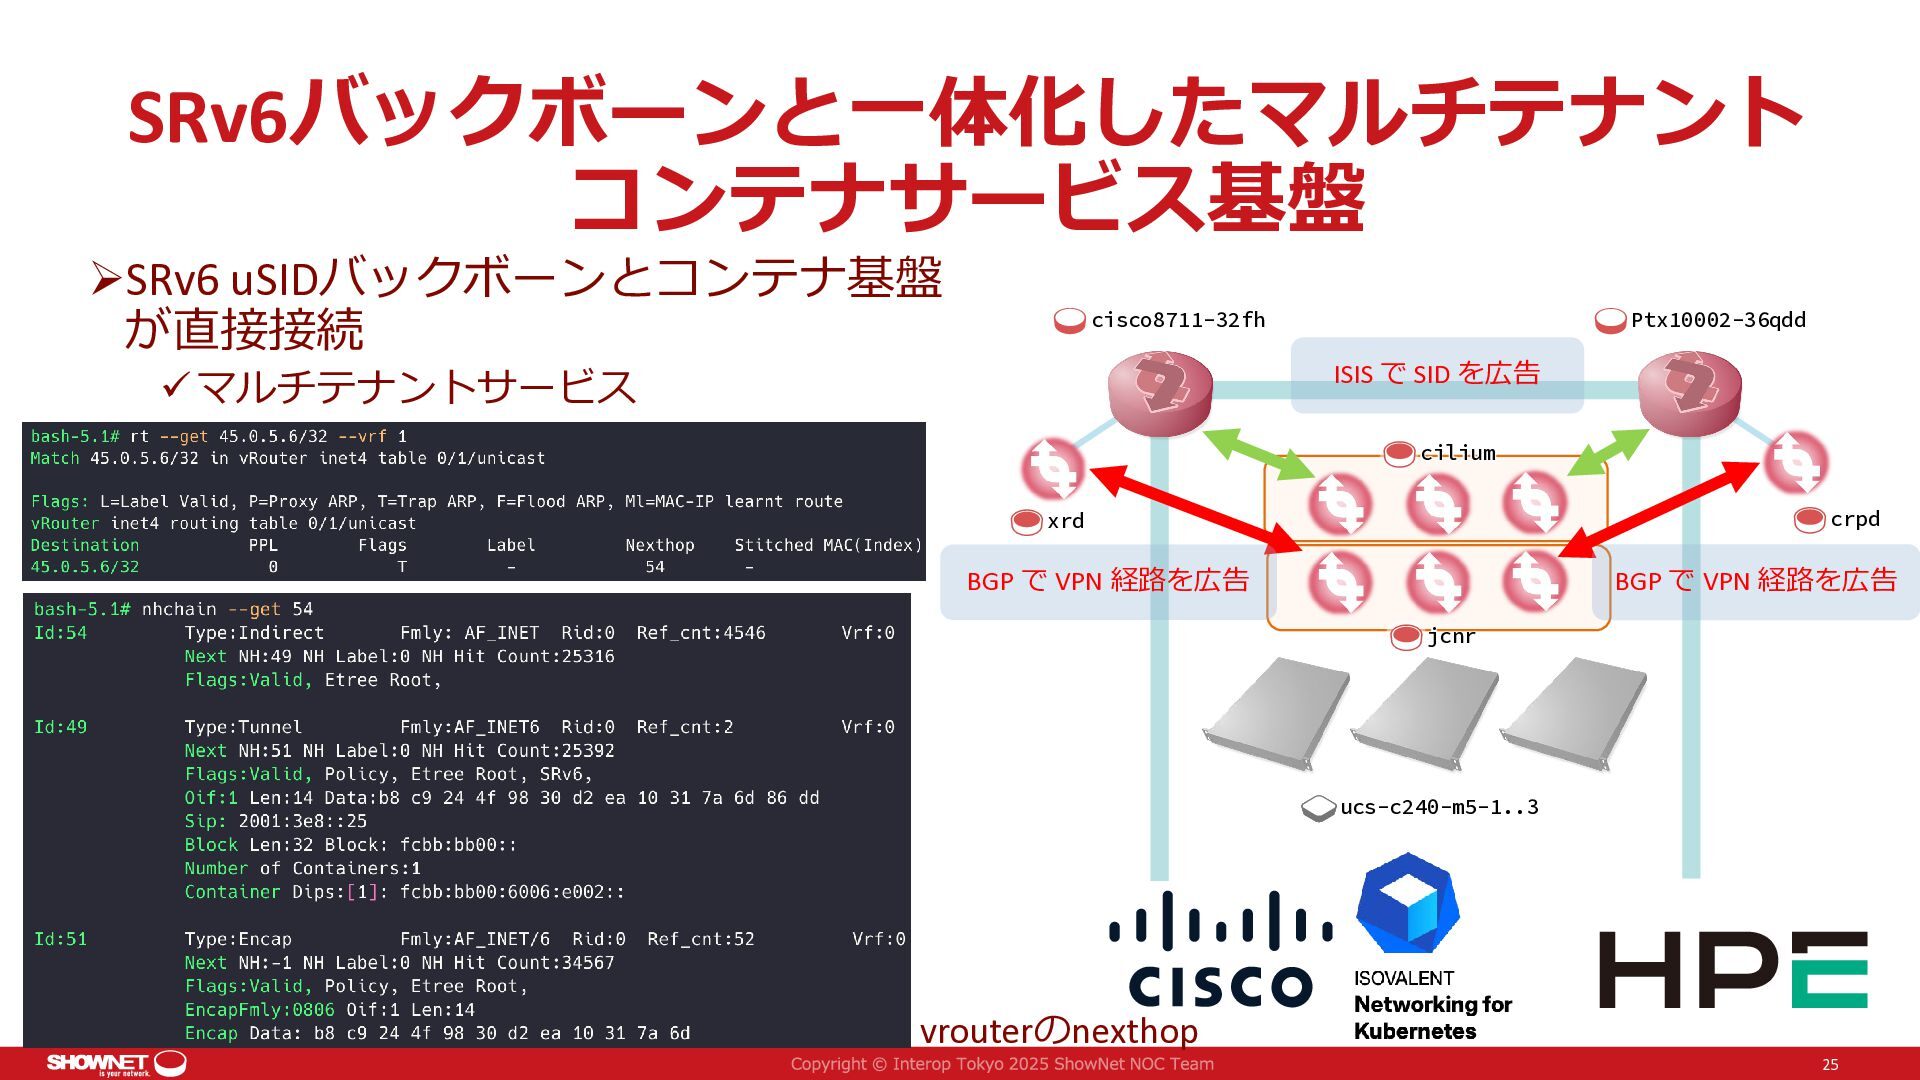
  18. SRv6バックボーンと一体化したマルチテナント コンテナサービス基盤 SRv6 uSIDバックボーンとコンテナ基盤 が直接接続 cisco8711-32fh Ptx10002-36qdd ISIS で SID

    を広告  マルチテナントサービス cilium crpd xrd BGP で VPN 経路を広告 BGP で VPN 経路を広告 jcnr ucs-c240-m5-1..3 vrouterのnexthop 25
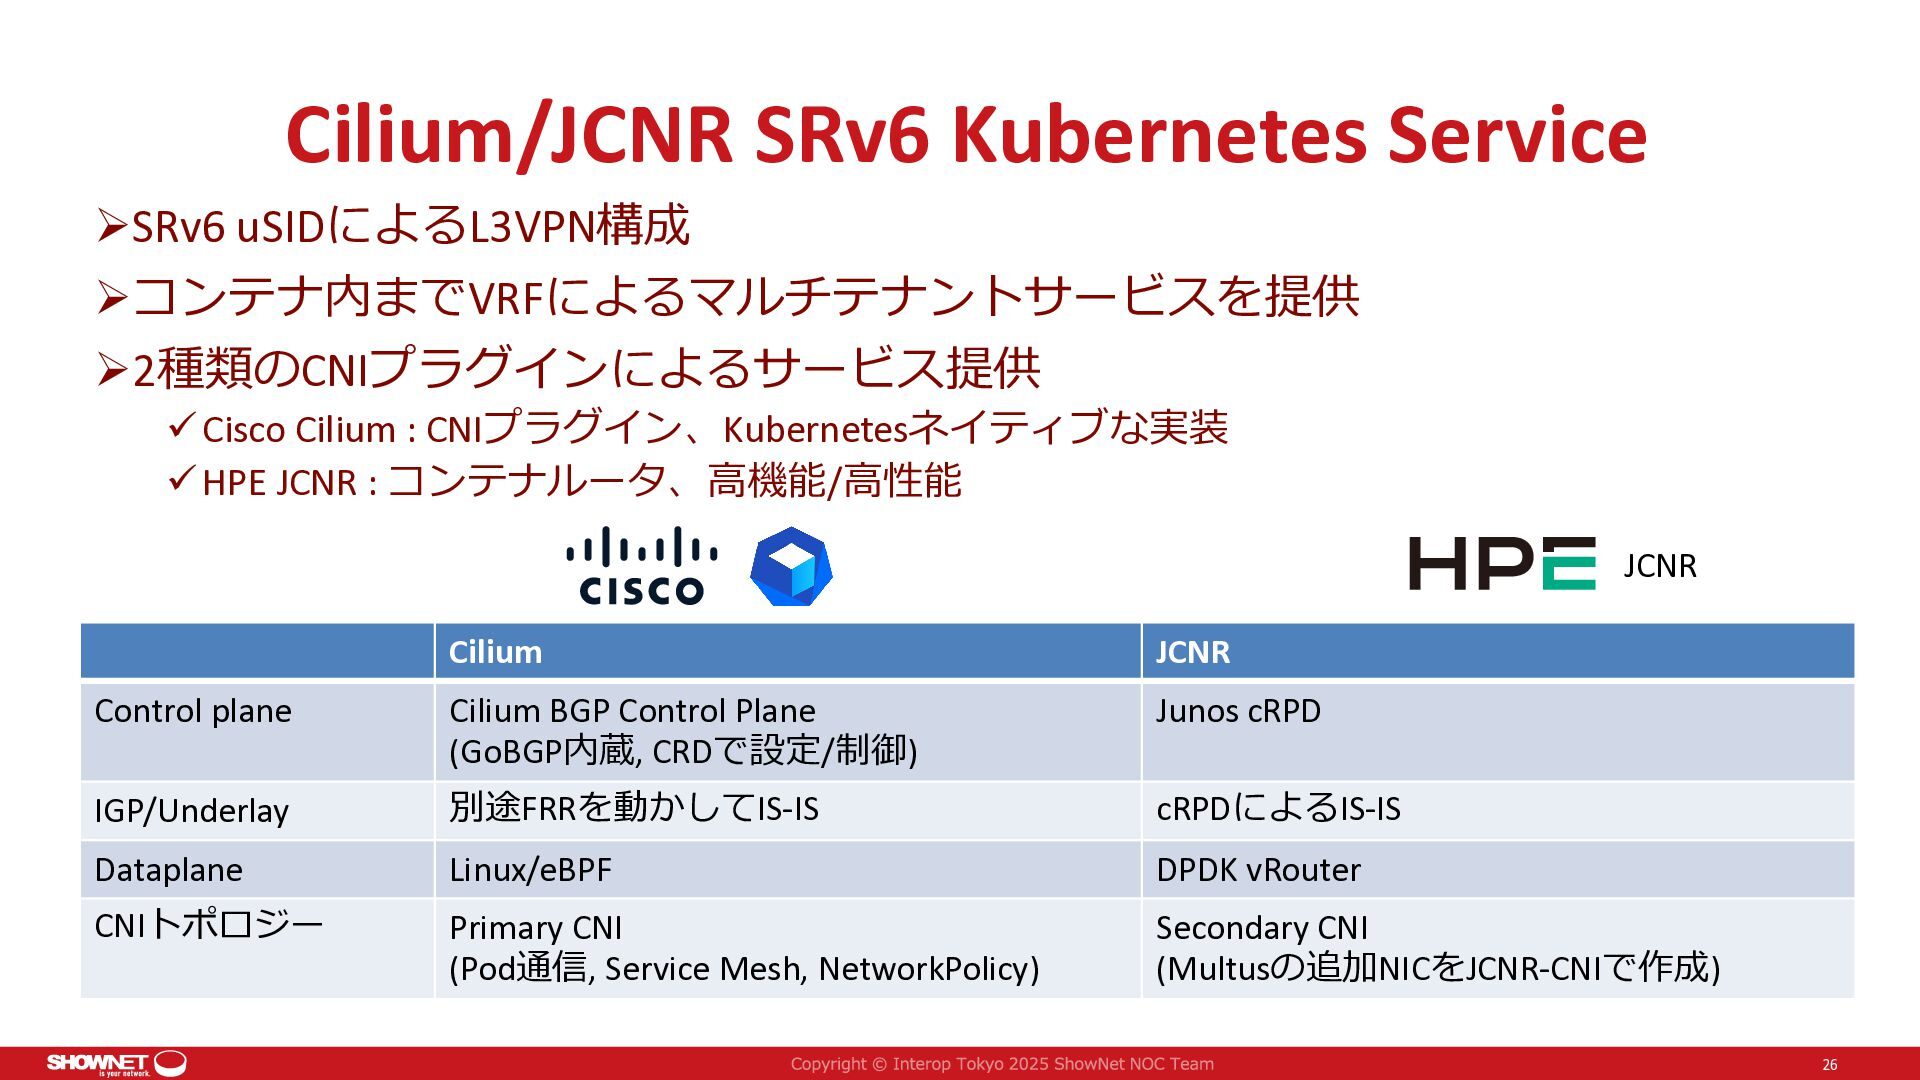
  19. Cilium/JCNR SRv6 Kubernetes Service SRv6 uSIDによるL3VPN構成 コンテナ内までVRFによるマルチテナントサービスを提供 2種類のCNIプラグインによるサービス提供  Cisco

    Cilium : CNIプラグイン、Kubernetesネイティブな実装  HPE JCNR : コンテナルータ、高機能/高性能 JCNR Cilium JCNR Control plane Cilium BGP Control Plane (GoBGP内蔵, CRDで設定/制御) Junos cRPD IGP/Underlay 別途FRRを動かしてIS-IS cRPDによるIS-IS Dataplane Linux/eBPF DPDK vRouter CNIトポロジー Primary CNI (Pod通信, Service Mesh, NetworkPolicy) Secondary CNI (Multusの追加NICをJCNR-CNIで作成) 26
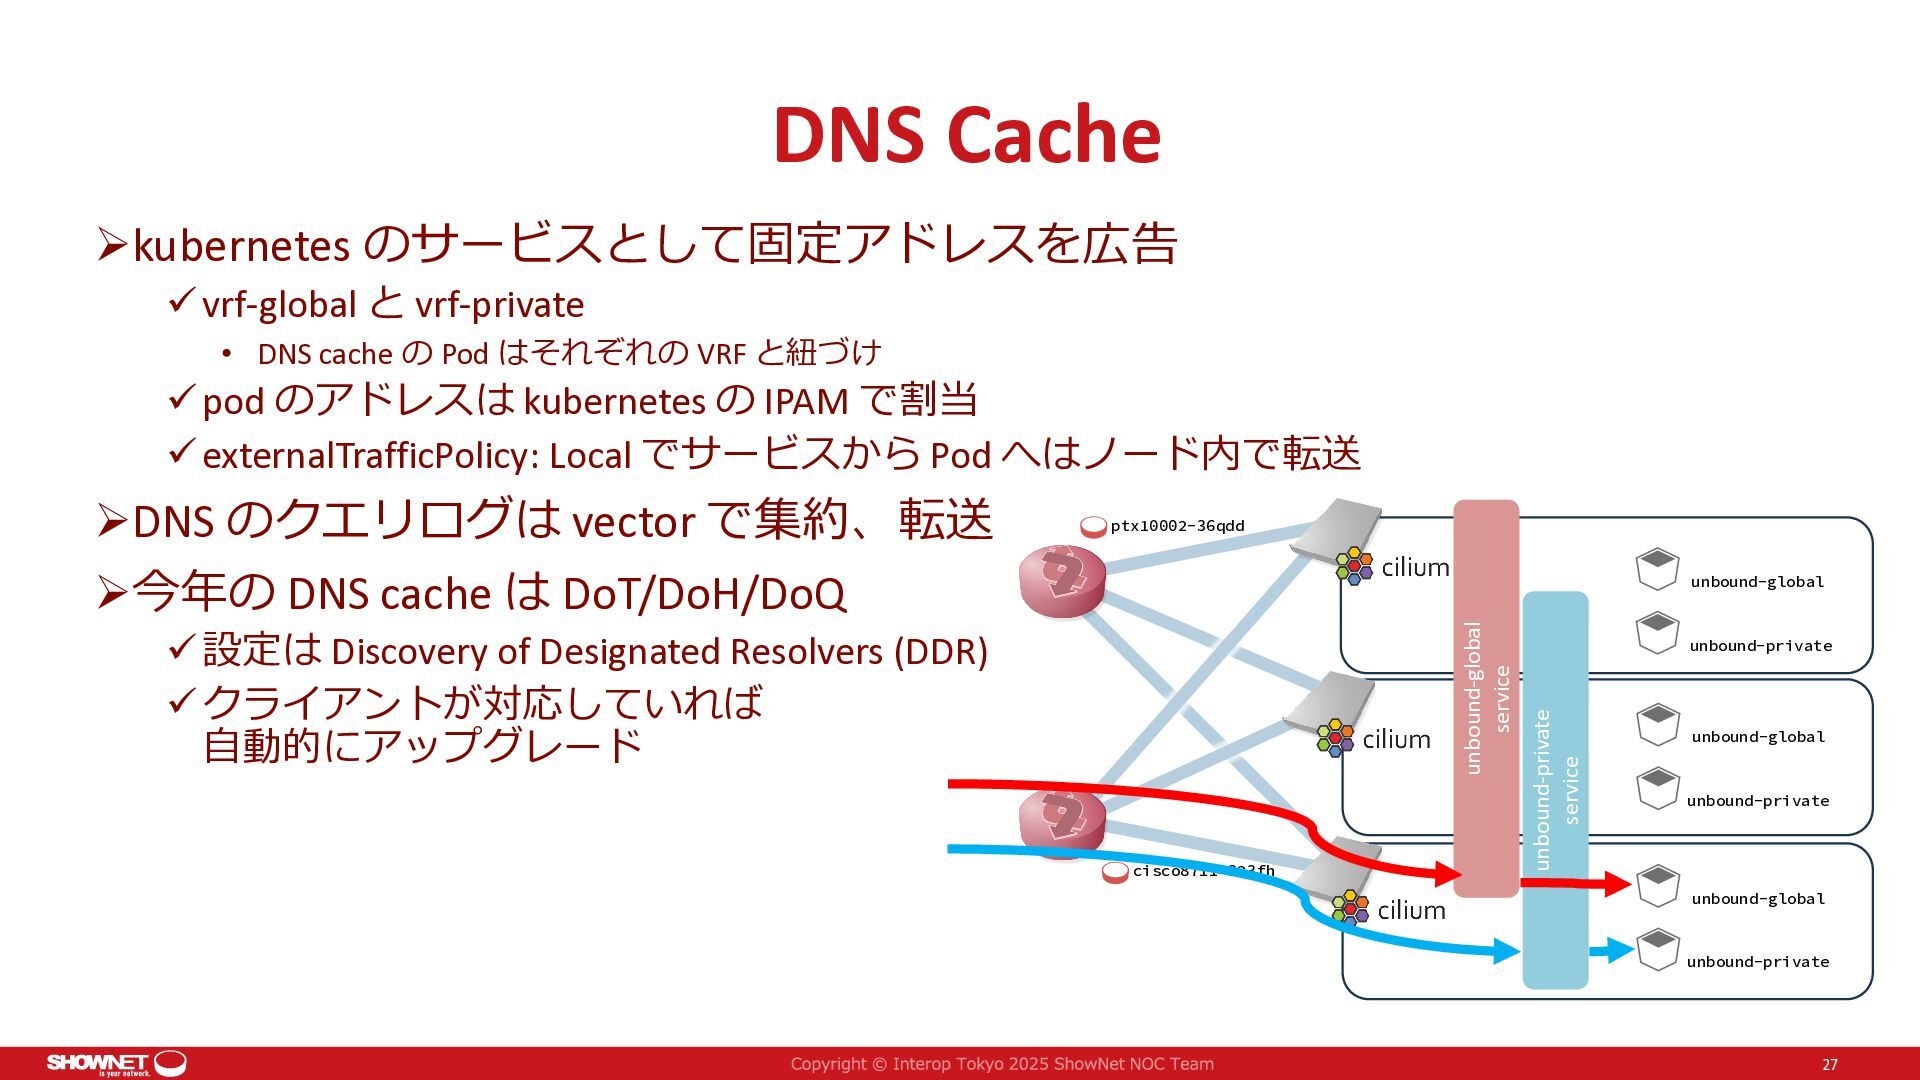
  20. DNS Cache kubernetes のサービスとして固定アドレスを広告  vrf-global と vrf-private • DNS

    cache の Pod はそれぞれの VRF と紐づけ  pod のアドレスは kubernetes の IPAM で割当  externalTrafficPolicy: Local でサービスから Pod へはノード内で転送 ptx10002-36qdd unbound-global  設定は Discovery of Designated Resolvers (DDR)  クライアントが対応していれば 自動的にアップグレード cisco8711-323fh unbound-private unbound-private service unbound-global service DNS のクエリログは vector で集約、転送 今年の DNS cache は DoT/DoH/DoQ unbound-global unbound-private unbound-global unbound-private 27
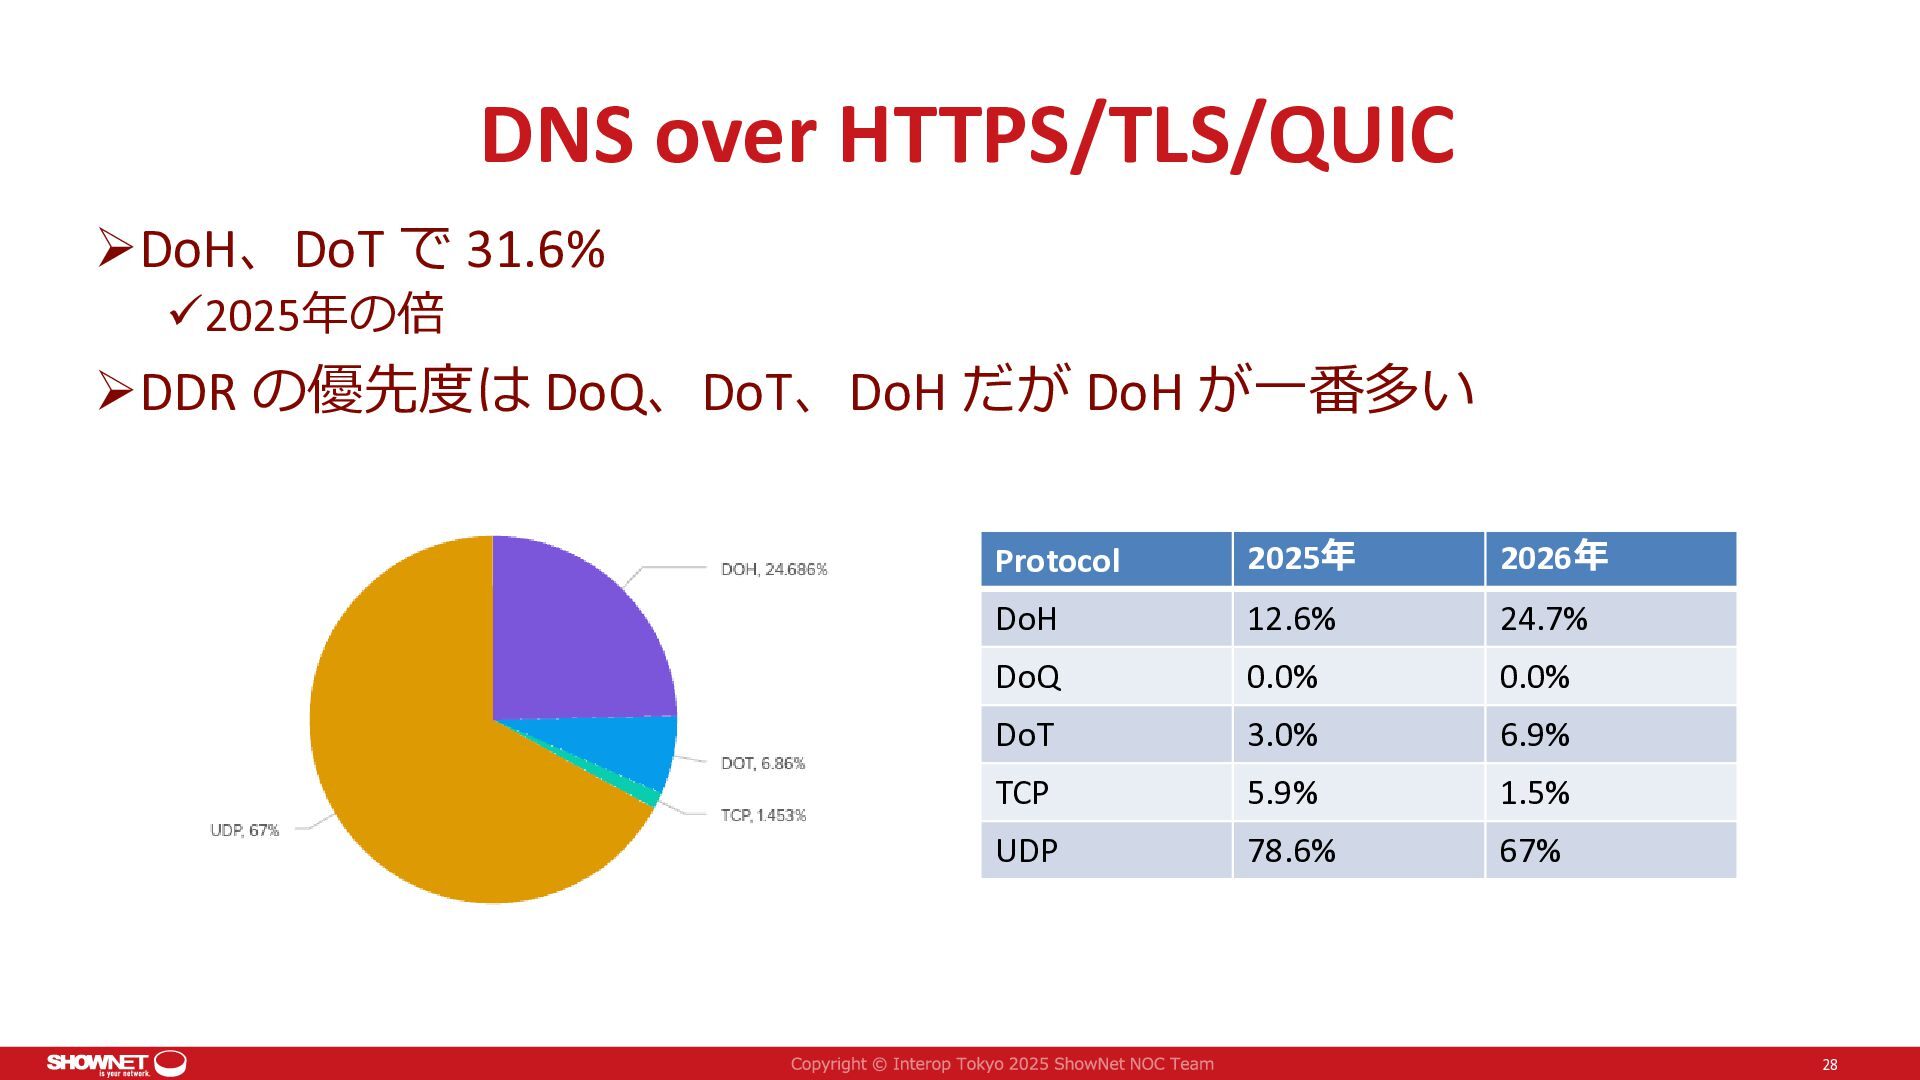
  21. DNS over HTTPS/TLS/QUIC DoH、DoT で 31.6% 2025年の倍 DDR の優先度は DoQ、DoT、DoH

    だが DoH が一番多い Protocol 2025年 2026年 DoH 12.6% 24.7% DoQ 0.0% 0.0% DoT 3.0% 6.9% TCP 5.9% 1.5% UDP 78.6% 67% 28