Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
SRW - Chapter 4. Monitoring
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
coffee
January 05, 2025
8
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
SRW - Chapter 4. Monitoring
coffee
January 05, 2025
More Decks by coffee
See All by coffee
Chapter 2. Implementing SLOs (2)
tai25011601
0
4
Chapter 3. SLO Engineering Case Studies
tai25011601
0
5
Chapter 2. Implementing SLOs
tai25011601
0
12
Featured
See All Featured
My Coaching Mixtape
mlcsv
0
360
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
RailsConf & Balkan Ruby 2019: The Past, Present, and Future of Rails at GitHub
eileencodes
141
35k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
950
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2k
Rebuilding a faster, lazier Slack
samanthasiow
85
9.7k
Data-driven link building: lessons from a $708K investment (BrightonSEO talk)
szymonslowik
1
1.4k
Site-Speed That Sticks
csswizardry
13
1.6k
Dealing with People You Can't Stand - Big Design 2015
cassininazir
367
27k
Navigating Algorithm Shifts & AI Overviews - #SMXNext
aleyda
1
1.7k
Design of three-dimensional binary manipulators for pick-and-place task avoiding obstacles (IECON2024)
konakalab
0
630
Navigating Team Friction
lara
192
16k
Transcript
Chapter 4. Monitoring 1
このプレゼンの目的 監視システムの重要性を理解 効果的な監視戦略を導入するためのヒントを得る 2
アジェンダ 1. 監視の目的 2. 必要な機能 3. 監視データの種類 4. 運用管理 5.
まとめ 3
1. 監視の目的 4
監視の基本的な目的 システムの可視性を向上 システム全体の状態をリアルタイムで把握できる。 見えない部分を可視化することで、問題の早期発見が可能。 サービスの健全性を判断 サービスの主要指標(SLO/SLIなど)を監視。 例: レイテンシー、エラー率、スループット。 問題発生時の診断 異常検知後に迅速な問題解決を支援。
例: 依存関係の問題特定や根本原因の調査。 5
なぜ監視が必要なのか? ダウンタイムのリスクを最小化 監視がなければ問題が見逃され、システム停止や顧客影響が長引く可能性が高い。 信頼性向上 問題を事前に検知・解決することで、ユーザー体験を向上させる。 例: ECサイトでの決済エラーやページ遅延の防止。 運用効率の向上 手動でのチェックや調査の負担を軽減。 アラートやダッシュボードで問題箇所を素早く特定可能。
6
監視の具体的な用途 1. 注意が必要な状況をアラートする 具体例: サーバーのCPU使用率が90%を超えた場合にアラート。 高いエラー率(例: HTTP 500系エラー)をリアルタイムで通知。 なぜ必要か: 問題が重大な障害になる前に迅速に対応可能。
オンコール体制で重要な問題に即応。 7
2. 問題の調査・診断 具体例: サービス停止時にレイテンシーの異常上昇を分析。 ログとメトリクスを組み合わせて根本原因を特定。 なぜ必要か: 問題の原因を迅速に特定し、ダウンタイムを短縮。 ユーザーへの影響範囲を正確に把握。 8
3. システム情報の可視化 具体例: ダッシュボードでトラフィック量、エラー率、リソース使用量を可視化。 チームが共有するビューを作成し、運用状況を確認。 なぜ必要か: 状況を把握しやすくすることで、的確な判断を下せる。 開発者、運用担当者、経営者など関係者間の情報共有を促進。 9
4. リソース使用量や健全性のトレンド把握 具体例: 毎月のCPU、メモリ消費の推移を監視。 ストレージ容量の増加傾向を予測し、事前に拡張を計画。 なぜ必要か: 突発的なリソース不足を防止し、安定稼働を実現。 キャパシティプランニングの基盤として活用。 10
5. 変更前後や実験結果の比較 具体例: 新機能リリース後のエラー率増加を分析。 ABテスト中の異なるグループ間でパフォーマンスを比較。 なぜ必要か: 新機能や変更の影響を正確に評価。 問題があれば迅速にロールバック可能。 11
監視の重要性を強調する事例 ECサイトの事例: セール期間中にサーバー負荷が急上昇。 → 適切な監視でCPUとメモリの高負荷を検知し、サーバー増設で障害を回避。 動画配信サービスの事例: 一部地域で配信遅延が発生。 → 地域ごとのレイテンシーメトリクスに基づき、問題の迅速な特定と解消を実現。 12
2. 監視の概要と目的 13
監視の概要 監視とは何か? システムやサービスの状態をリアルタイムで監視し、正常性を維持するプロセス。 データの収集・分析を通じて、以下を実現する: 問題の早期検知 根本原因の診断 パフォーマンスの最適化 なぜ監視が重要か? 信頼性向上: 障害を防ぎ、システムの安定性を高める。
ユーザー満足度向上: ユーザーが問題を感じる前に解決する。 コスト削減: 障害発生後の対応コストを低減。 14
1. システムの可視性向上 現状把握: システム全体の稼働状況を一目で確認できる。 具体例: ダッシュボードでCPU、メモリ、ディスク使用率を確認。 依存するサービス間のトラフィックやエラー率を把握。 2. サービスの健全性を判断 指標:
レイテンシー(遅延)、エラー率、スループットなどの主要なSLI/SLO。 具体例: 平均応答時間が300msを超えた場合に問題を検知。 SLA違反を防ぐためのリアルタイム監視。 3. 問題発生時の診断 目的: 問題の発生箇所を迅速に特定し、原因を分析。 15
監視の目的に基づく具体的な用途 用途 1: 注意が必要な状況をアラートする 説明: 異常値や閾値を超えた場合に通知。 具体例: メモリ使用率が90%を超える。 エラー率が10%を超えた場合にオンコール通知を送信。 16
用途 2: 問題の調査・診断 説明: 障害の根本原因を特定し、適切な対応を迅速化。 具体例: サービス停止時に依存関係のレイテンシーを分析。 ログデータを分析し、エラー原因を特定。 17
用途 3: トレンド把握とリソース計画 説明: リソース使用状況を長期的に分析し、キャパシティプランニングに活用。 具体例: ストレージ容量の増加傾向を予測して事前に対策を講じる。 ピーク時のトラフィックに基づくサーバー増設計画。 18
用途 4: 変更前後や実験結果の比較 説明: 新しいリリースや設定変更の影響を分析。 具体例: 新機能リリース後にエラー率が増加していないかを確認。 A/Bテスト中の異なるバージョンのパフォーマンス比較。 19
監視が果たす役割 サービス運用における中心的役割 事例: ECサイト: セール時の負荷を監視し、必要に応じてスケールアップ。 動画配信: 地域別のレイテンシーを監視し、遅延の発生源を特定。 監視の失敗が引き起こすリスク 問題の発見が遅れる →
顧客影響が拡大。 トラブルシューティングに時間がかかる → 修復コスト増加。 20
まとめ: 監視の概要と目的 監視はシステム運用の基盤: 問題の予防、迅速な解決、運用効率の向上を実現する。 各用途に合わせた監視戦略: アラート、トレンド把握、変更影響の分析を組み合わせ、信頼性向上を図る。 21
3. 監視システムに求められる機能 22
監視システムの重要な要素 監視システムには以下の4つの要素が求められます: 1. 速度(Speed) データの新鮮さや取得速度が重要。 2. 計算機能(Calculations) データの集計や複雑な計算を効率的に処理。 3. インターフェース(Interfaces)
見やすいダッシュボードやグラフで情報を可視化。 4. アラート(Alerts) 必要な情報を迅速かつ的確に通知。 23
1. 速度(Speed) なぜ速度が重要か? リアルタイム性: インシデント対応時にデータが遅れると迅速な対応が難しい。 影響: データ遅延が5分以上になると、対応速度や判断に悪影響。 実装例 事前計算: 大規模なデータクエリに時間がかかる場合、新しい時系列データを事前計算。
例: トラフィックデータを集約してリアルタイム表示。 具体例 インシデント時の応答時間短縮: 障害発生時、エラー率やトラフィック急増をリアルタイムで検知し通知。 24
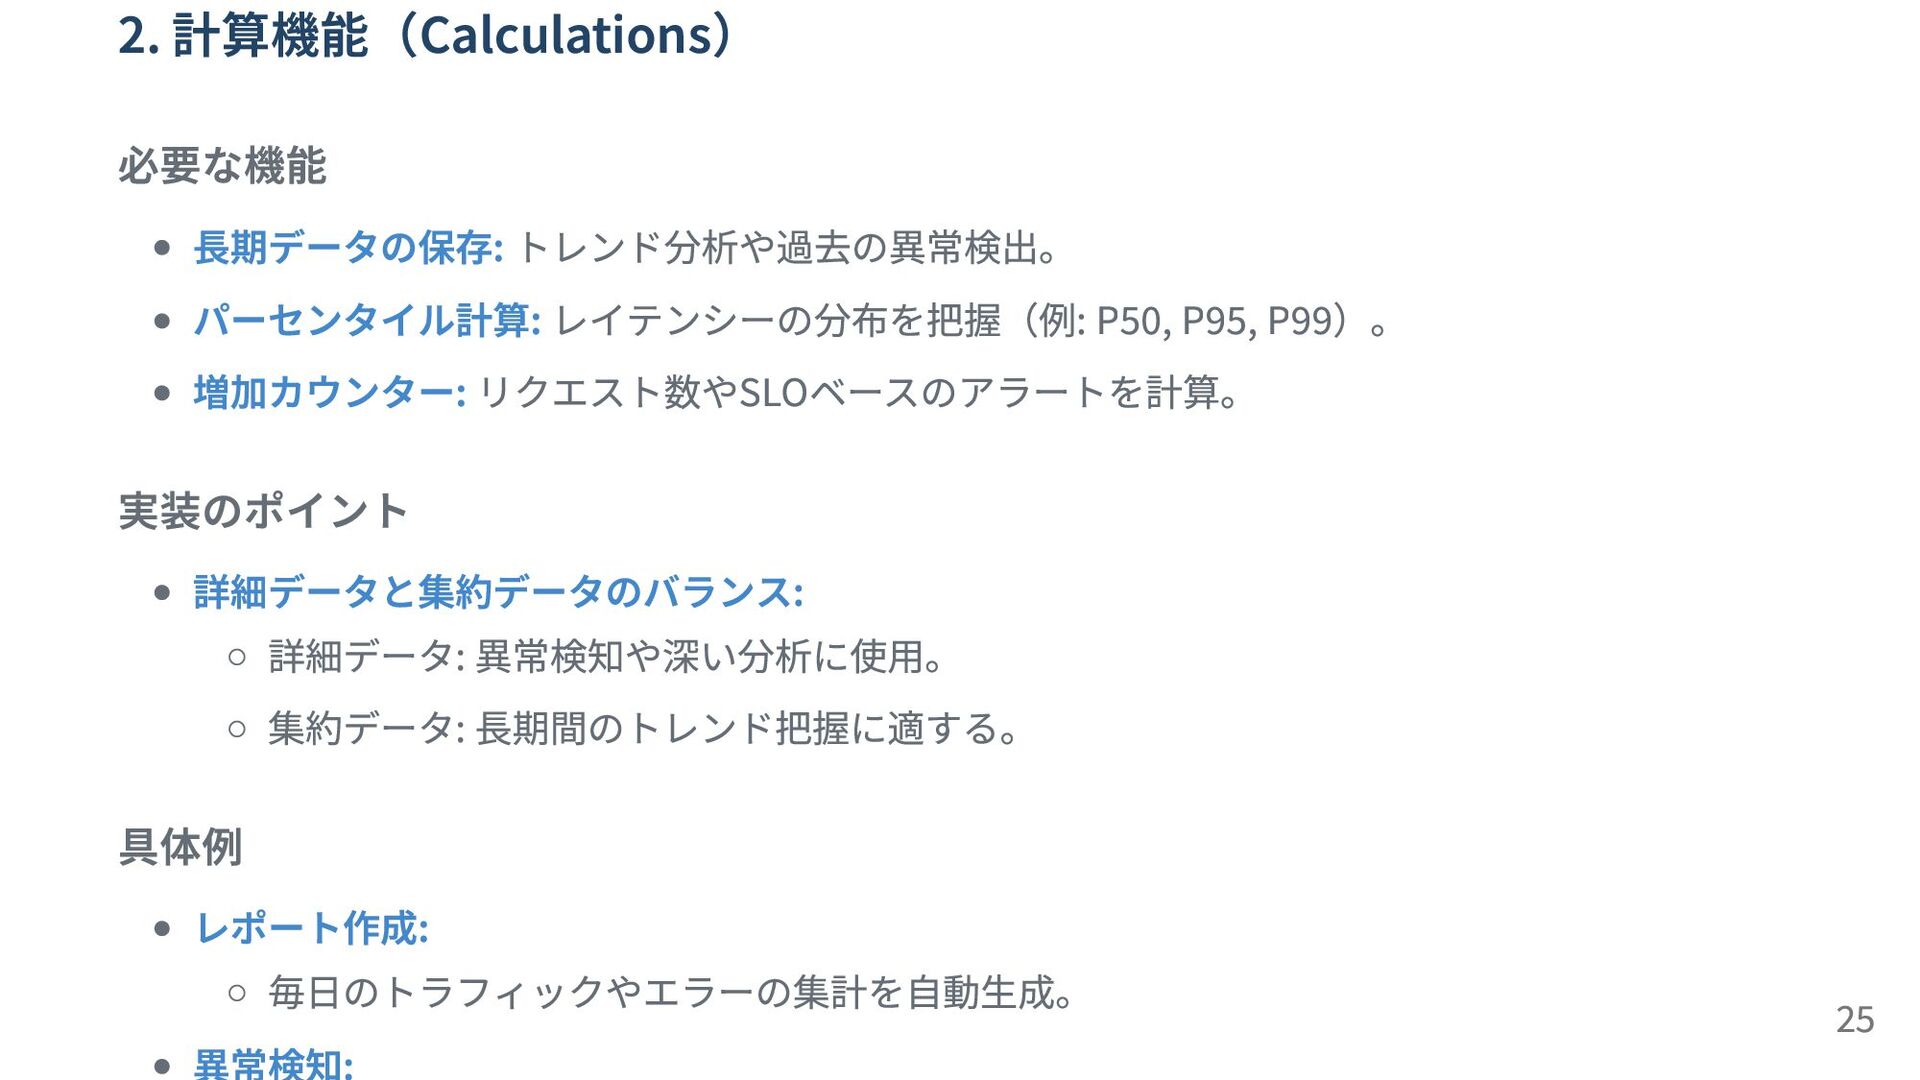
2. 計算機能(Calculations) 必要な機能 長期データの保存: トレンド分析や過去の異常検出。 パーセンタイル計算: レイテンシーの分布を把握(例: P50, P95, P99)。
増加カウンター: リクエスト数やSLOベースのアラートを計算。 実装のポイント 詳細データと集約データのバランス: 詳細データ: 異常検知や深い分析に使用。 集約データ: 長期間のトレンド把握に適する。 具体例 レポート作成: 毎日のトラフィックやエラーの集計を自動生成。 異常検知: 25
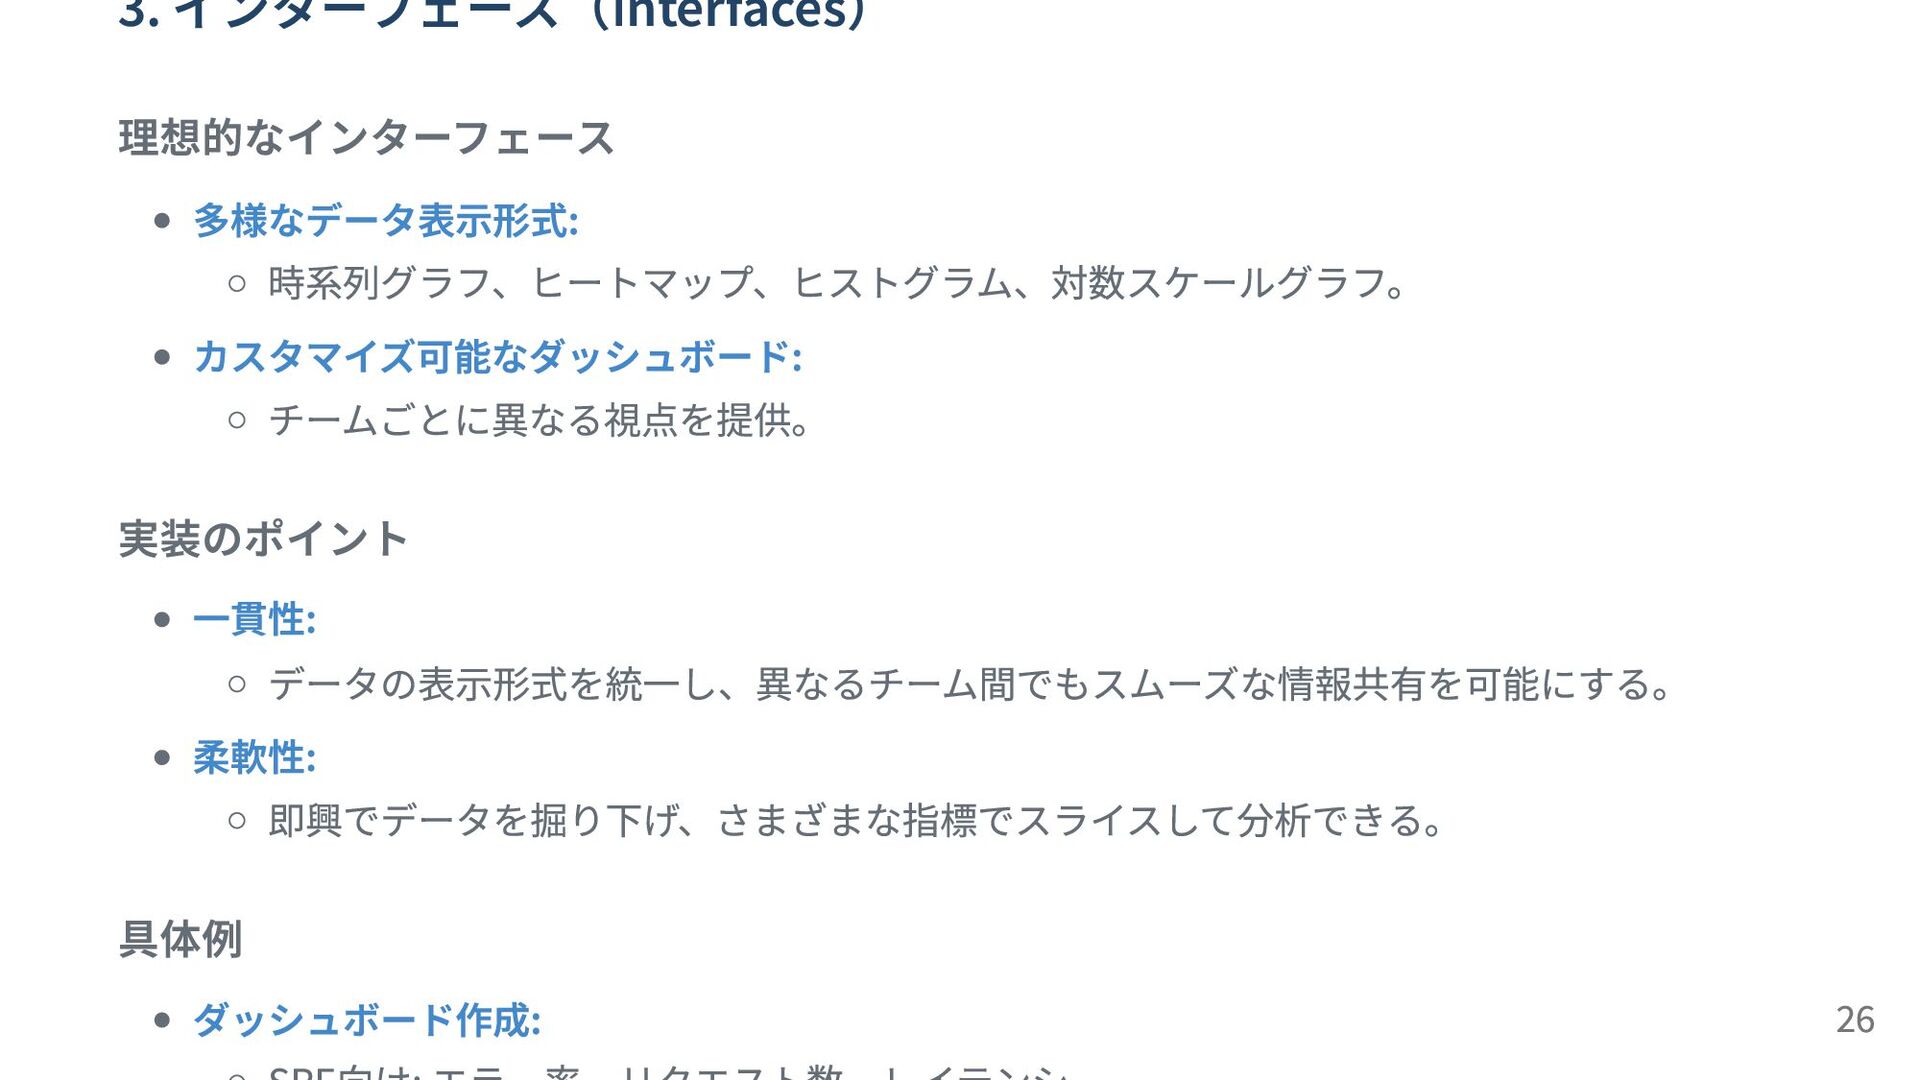
3. インターフェース(Interfaces) 理想的なインターフェース 多様なデータ表示形式: 時系列グラフ、ヒートマップ、ヒストグラム、対数スケールグラフ。 カスタマイズ可能なダッシュボード: チームごとに異なる視点を提供。 実装のポイント 一貫性: データの表示形式を統一し、異なるチーム間でもスムーズな情報共有を可能にする。
柔軟性: 即興でデータを掘り下げ、さまざまな指標でスライスして分析できる。 具体例 ダッシュボード作成: 26
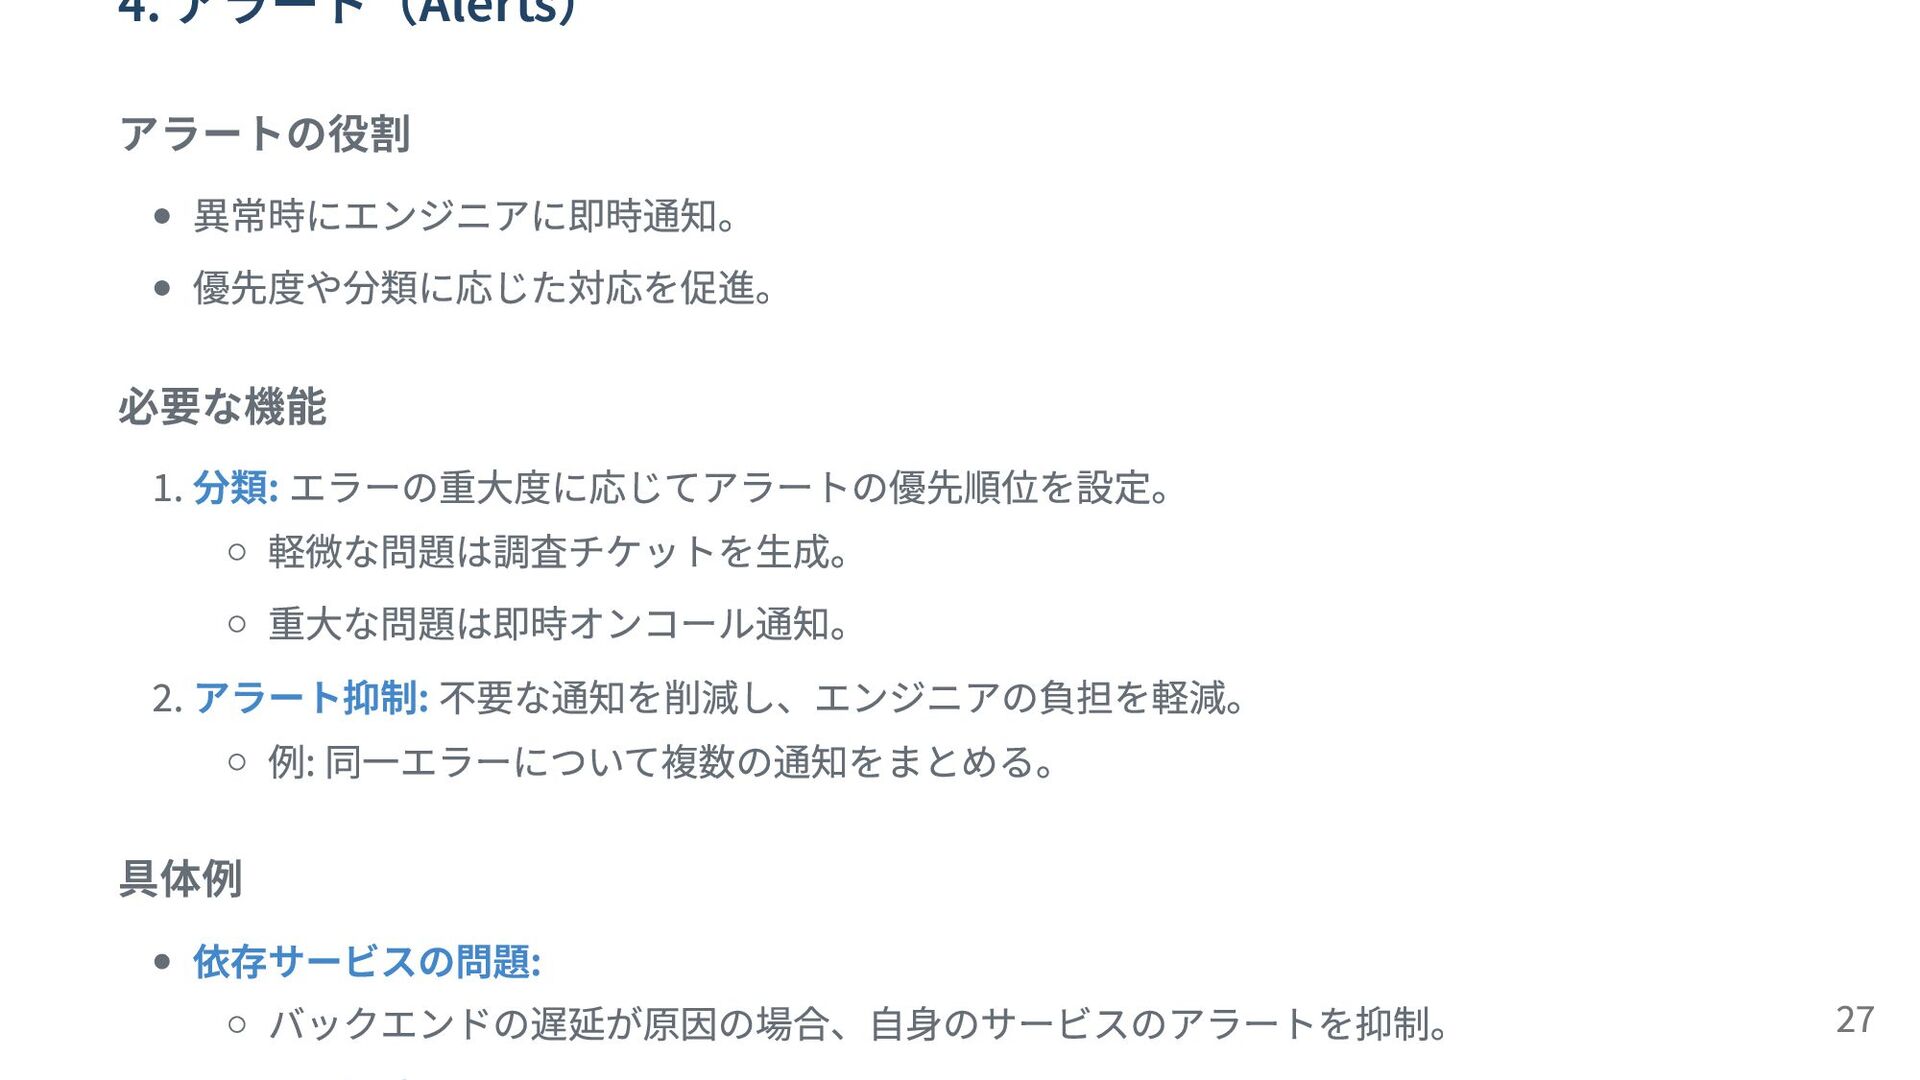
4. アラート(Alerts) アラートの役割 異常時にエンジニアに即時通知。 優先度や分類に応じた対応を促進。 必要な機能 1. 分類: エラーの重大度に応じてアラートの優先順位を設定。 軽微な問題は調査チケットを生成。
重大な問題は即時オンコール通知。 2. アラート抑制: 不要な通知を削減し、エンジニアの負担を軽減。 例: 同一エラーについて複数の通知をまとめる。 具体例 依存サービスの問題: バックエンドの遅延が原因の場合、自身のサービスのアラートを抑制。 27
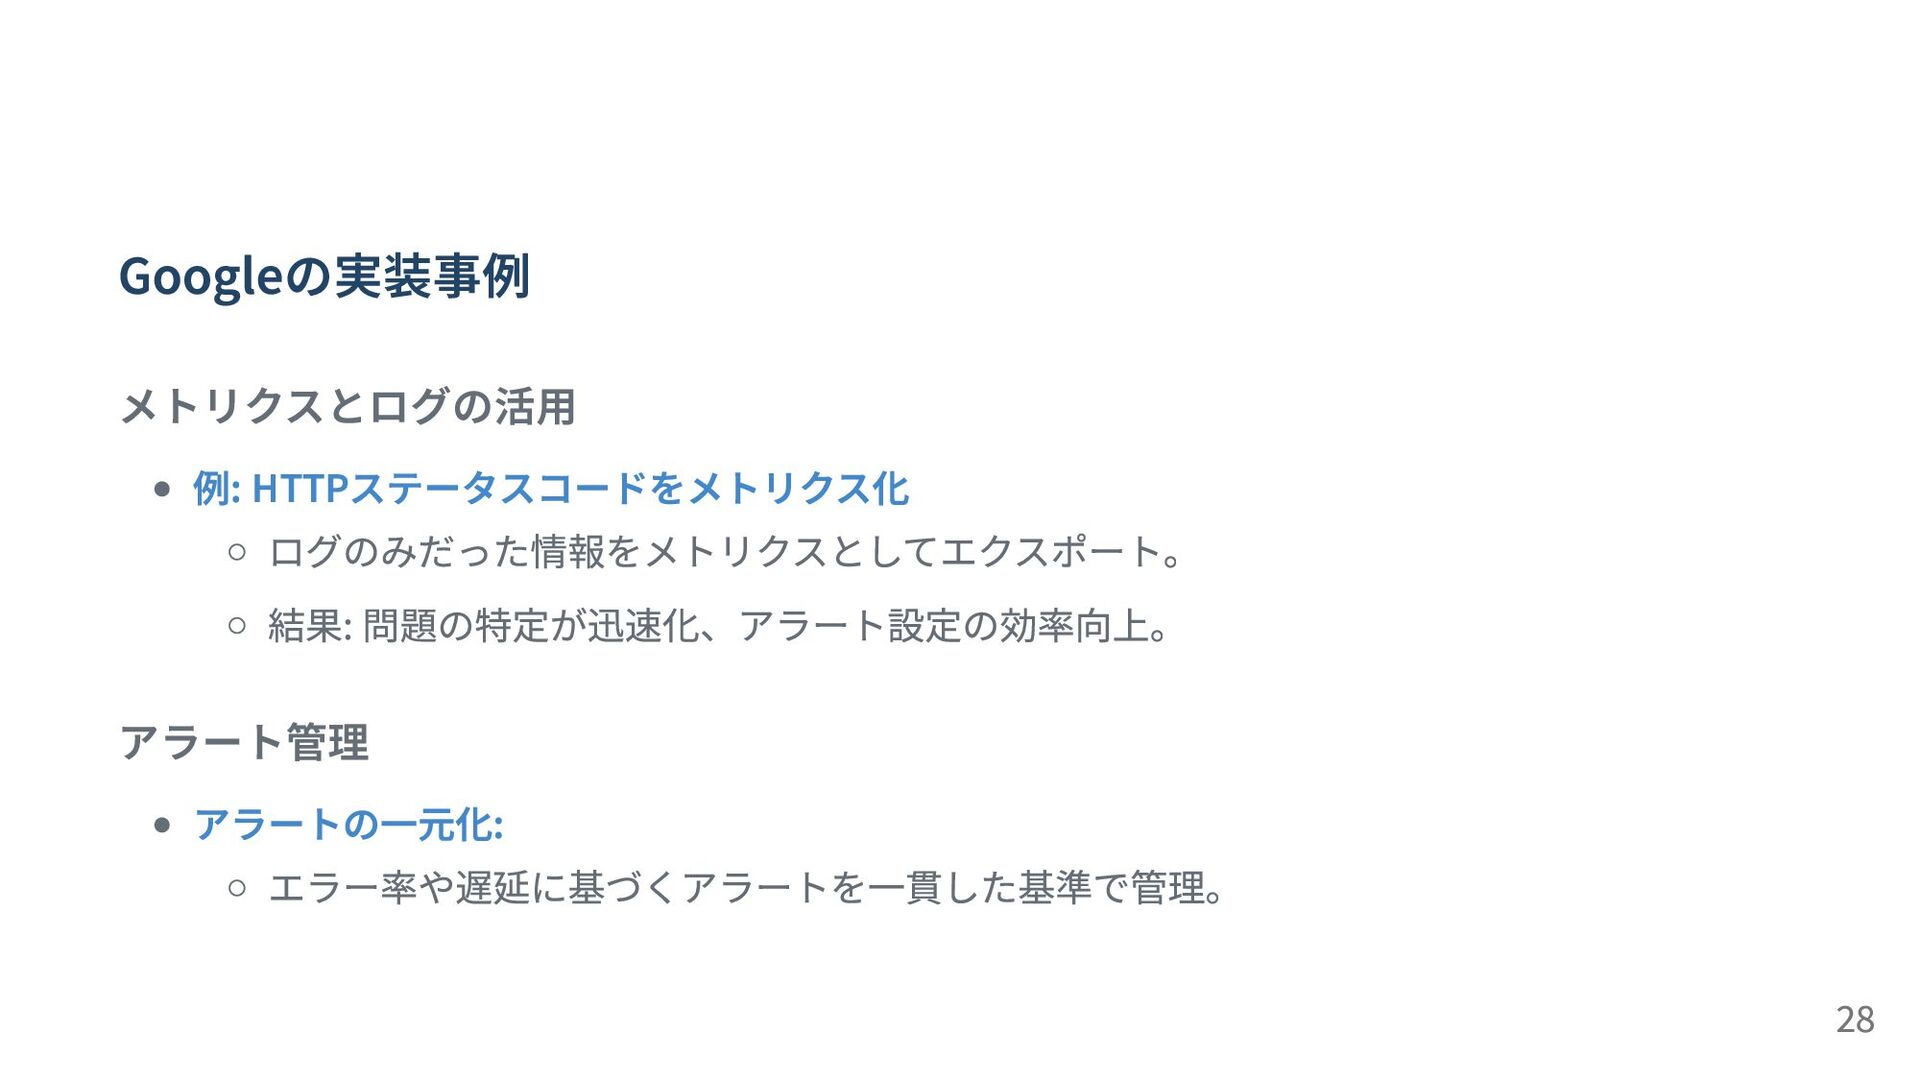
Googleの実装事例 メトリクスとログの活用 例: HTTPステータスコードをメトリクス化 ログのみだった情報をメトリクスとしてエクスポート。 結果: 問題の特定が迅速化、アラート設定の効率向上。 アラート管理 アラートの一元化: エラー率や遅延に基づくアラートを一貫した基準で管理。
28
まとめ: 監視システムの理想的な機能 速度: データのリアルタイム性を確保。 計算: 長期的なデータ保存とリアルタイム分析を両立。 インターフェース: 見やすく柔軟なダッシュボード設計。 アラート: 適切な分類と抑制機能でエンジニアを支援。
29
4. 監視データの種類 30
監視データの主要な種類 監視で扱うデータは主に2つに分類されます: 1. メトリクス(Metrics) 定期的に収集される数値データ。 システムやサービスの状態をリアルタイムに把握するために利用。 2. ログ(Logs) イベントの詳細な記録。 問題の深い分析や原因追及に活用。
31
特徴 リアルタイム性: データを頻繁に収集し、即時利用可能。 可視化: ダッシュボードやアラートで使用される。 粒度: 高レベルのシステム状態を把握するためのデータ。 主な用途 サービスの状態監視 リアルタイムアラート
長期的なトレンド分析 メトリクスの具体例 システム指標: CPU使用率、メモリ使用率、ディスクI/O アプリケーション指標: レイテンシー(P50、P95、P99)、エラー率 32
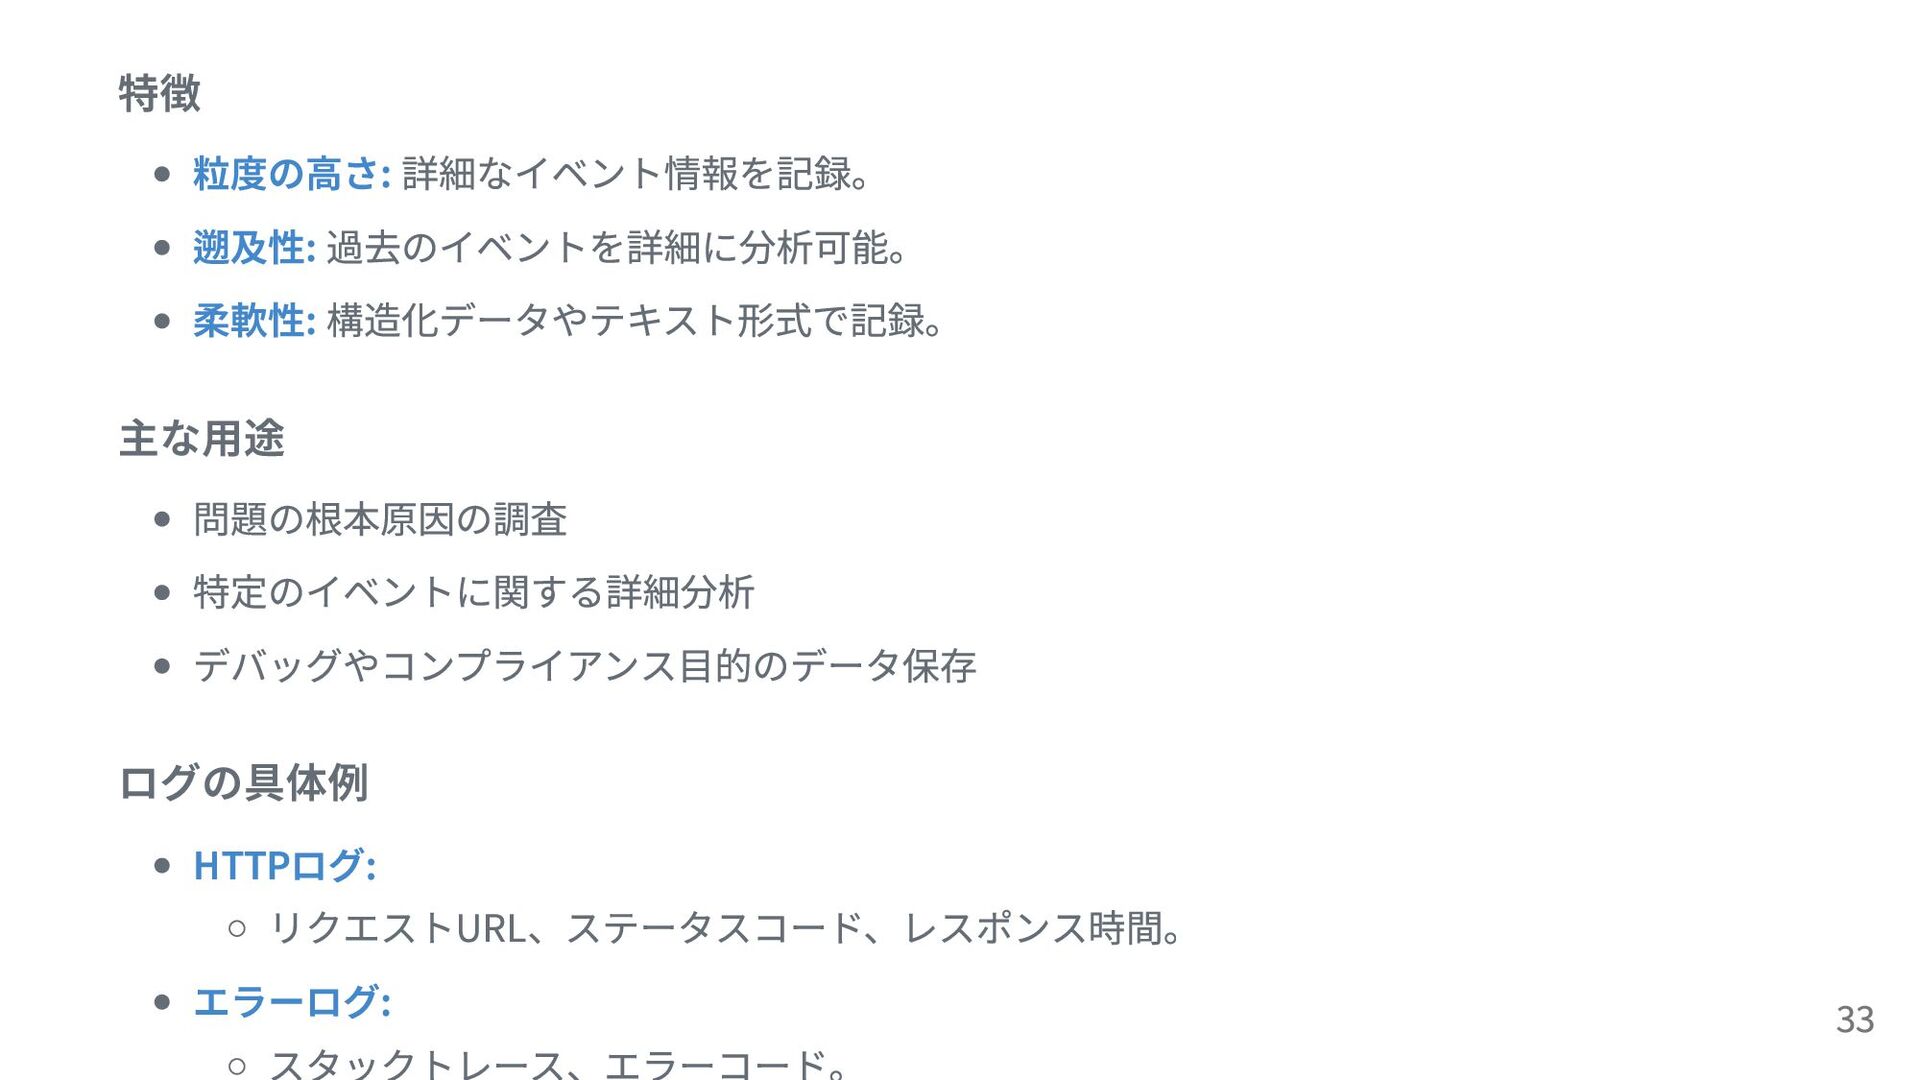
特徴 粒度の高さ: 詳細なイベント情報を記録。 遡及性: 過去のイベントを詳細に分析可能。 柔軟性: 構造化データやテキスト形式で記録。 主な用途 問題の根本原因の調査 特定のイベントに関する詳細分析
デバッグやコンプライアンス目的のデータ保存 ログの具体例 HTTPログ: リクエストURL、ステータスコード、レスポンス時間。 エラーログ: スタックトレース、エラーコード。 33
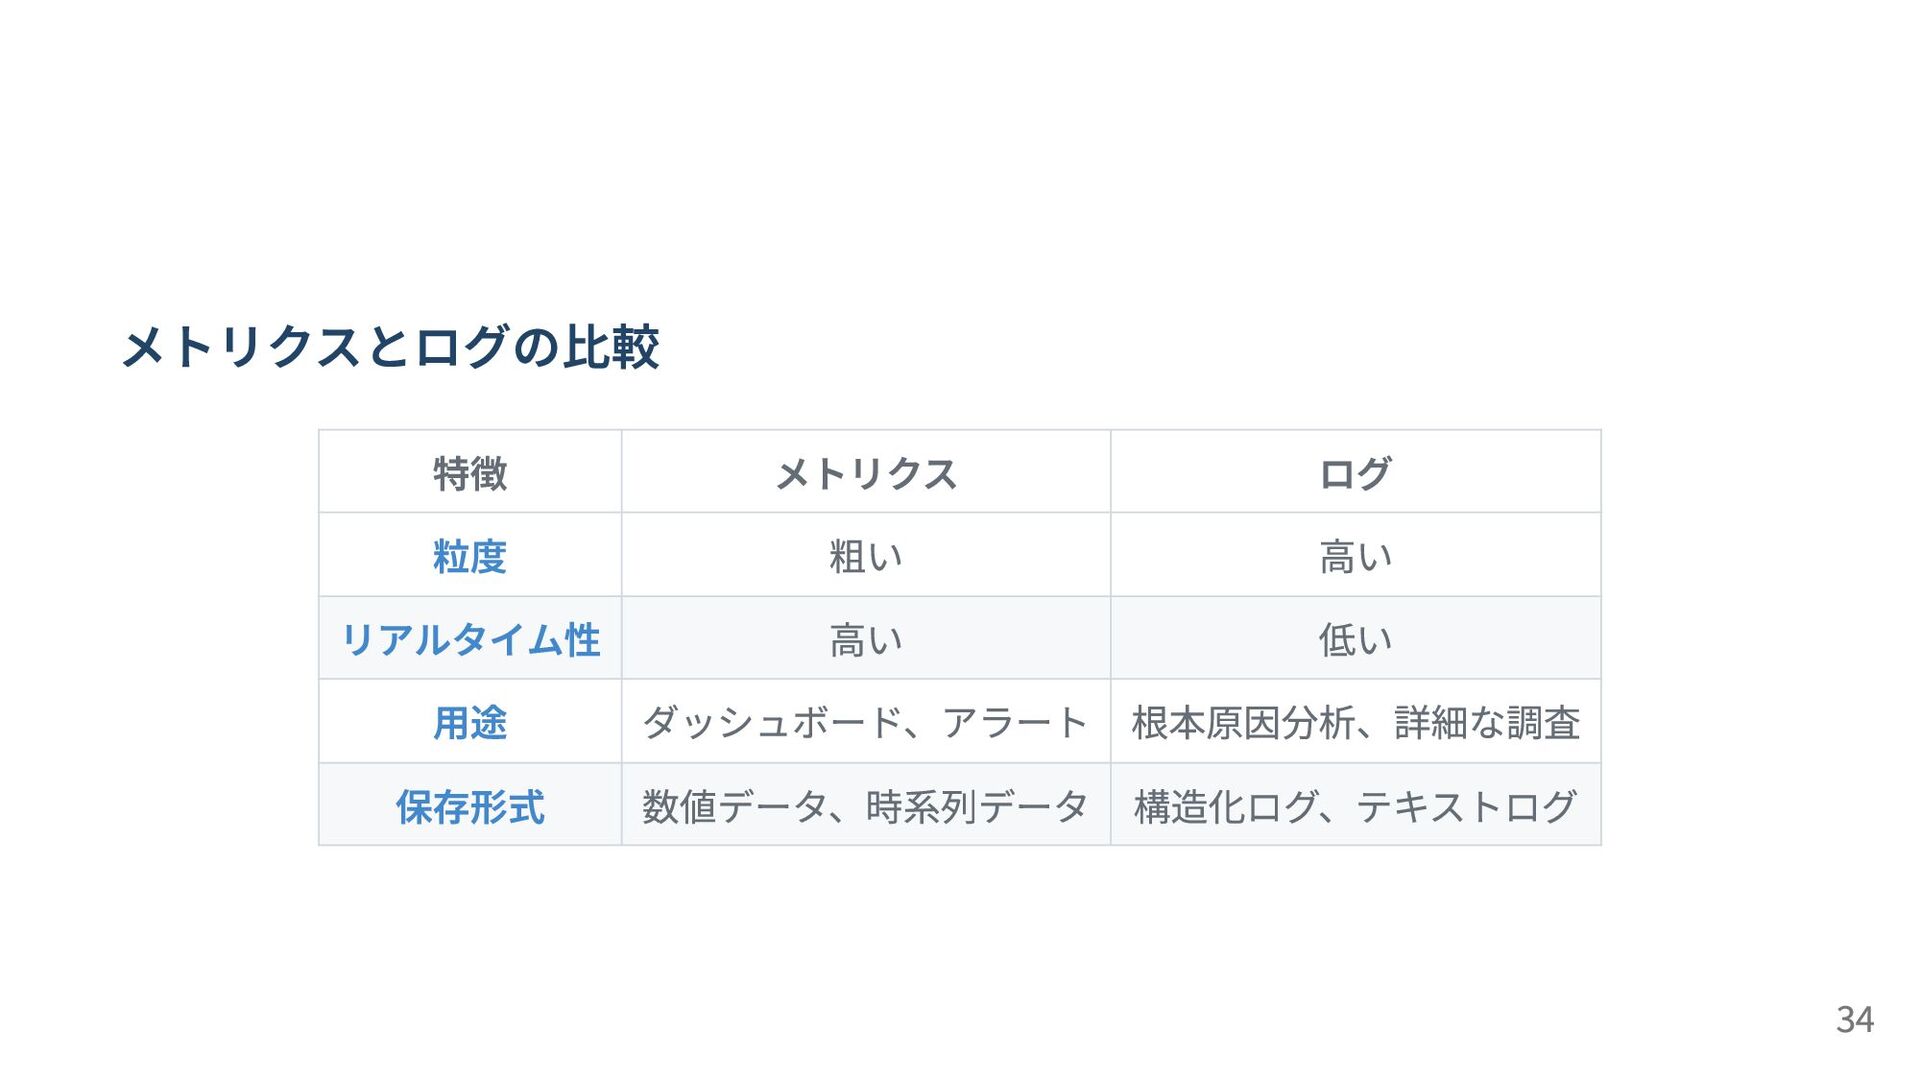
メトリクスとログの比較 特徴 メトリクス ログ 粒度 粗い 高い リアルタイム性 高い 低い
用途 ダッシュボード、アラート 根本原因分析、詳細な調査 保存形式 数値データ、時系列データ 構造化ログ、テキストログ 34
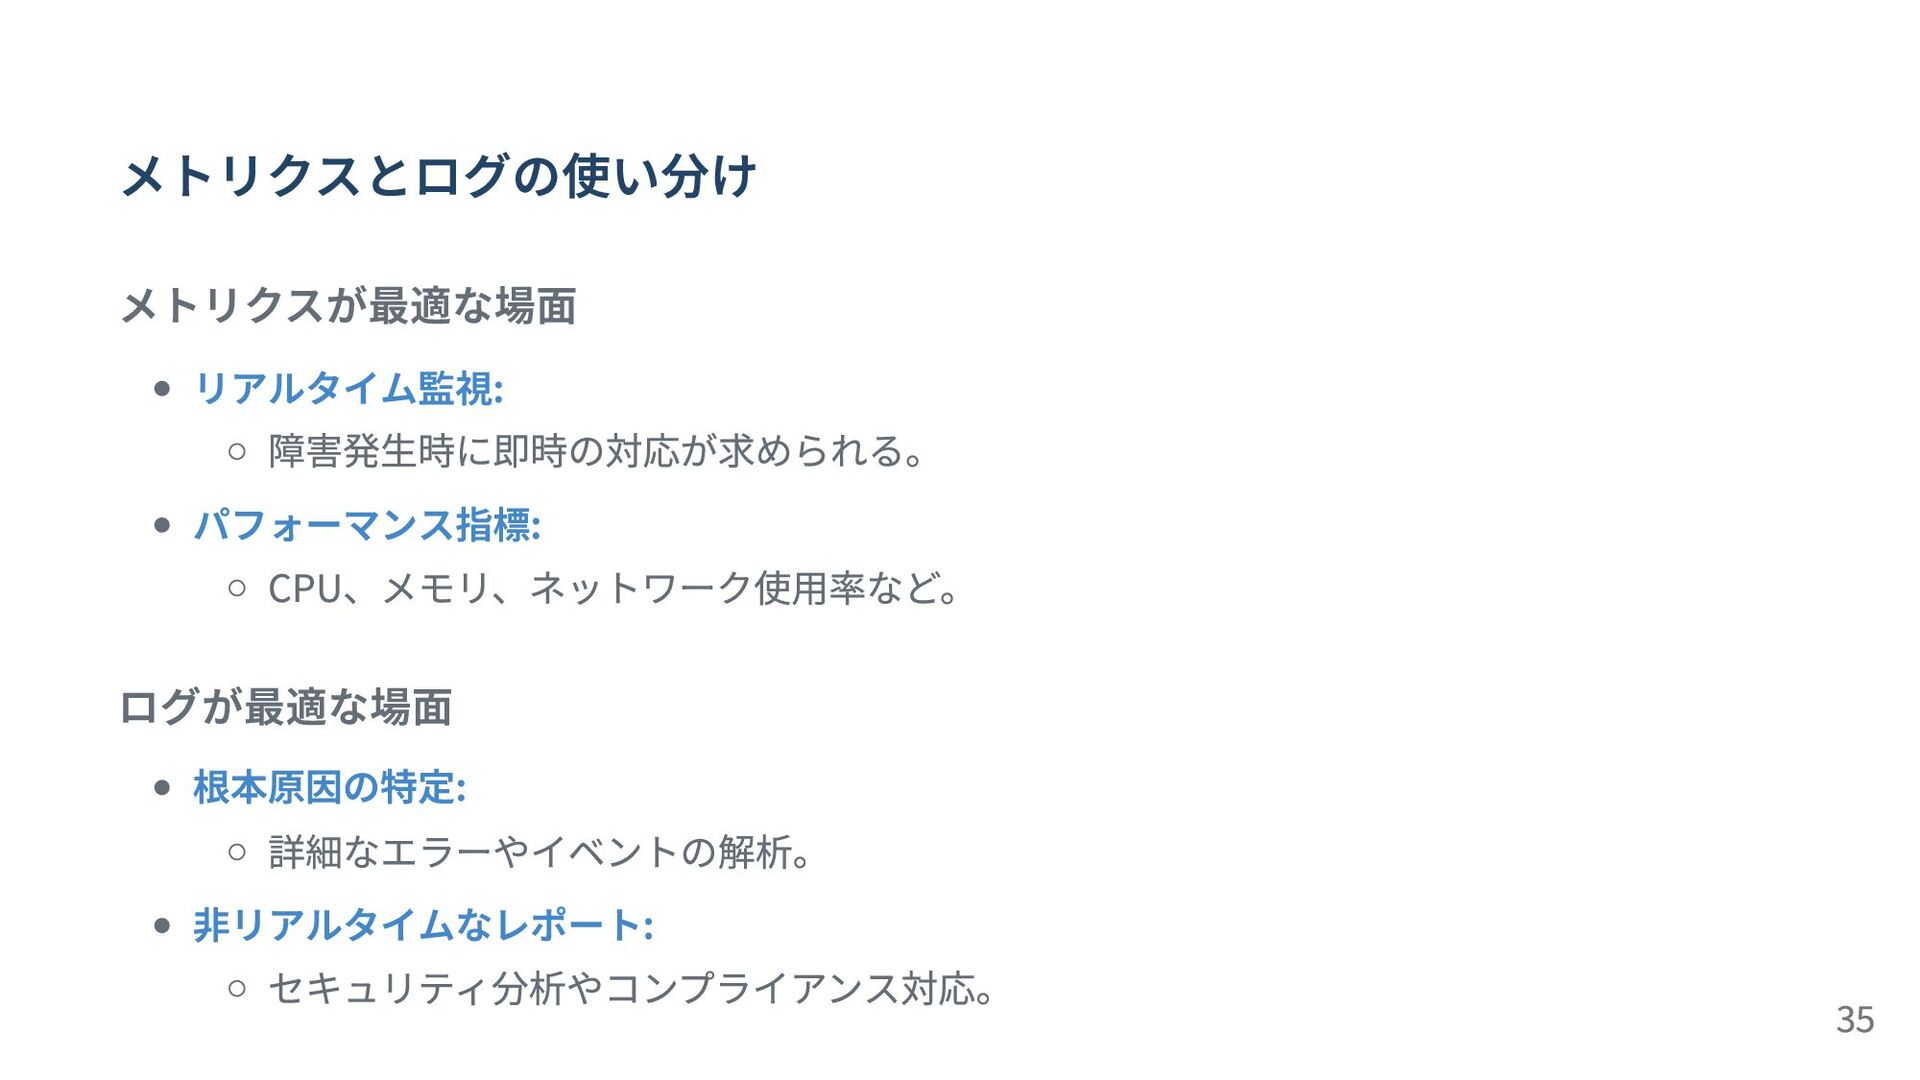
メトリクスとログの使い分け メトリクスが最適な場面 リアルタイム監視: 障害発生時に即時の対応が求められる。 パフォーマンス指標: CPU、メモリ、ネットワーク使用率など。 ログが最適な場面 根本原因の特定: 詳細なエラーやイベントの解析。 非リアルタイムなレポート:
セキュリティ分析やコンプライアンス対応。 35
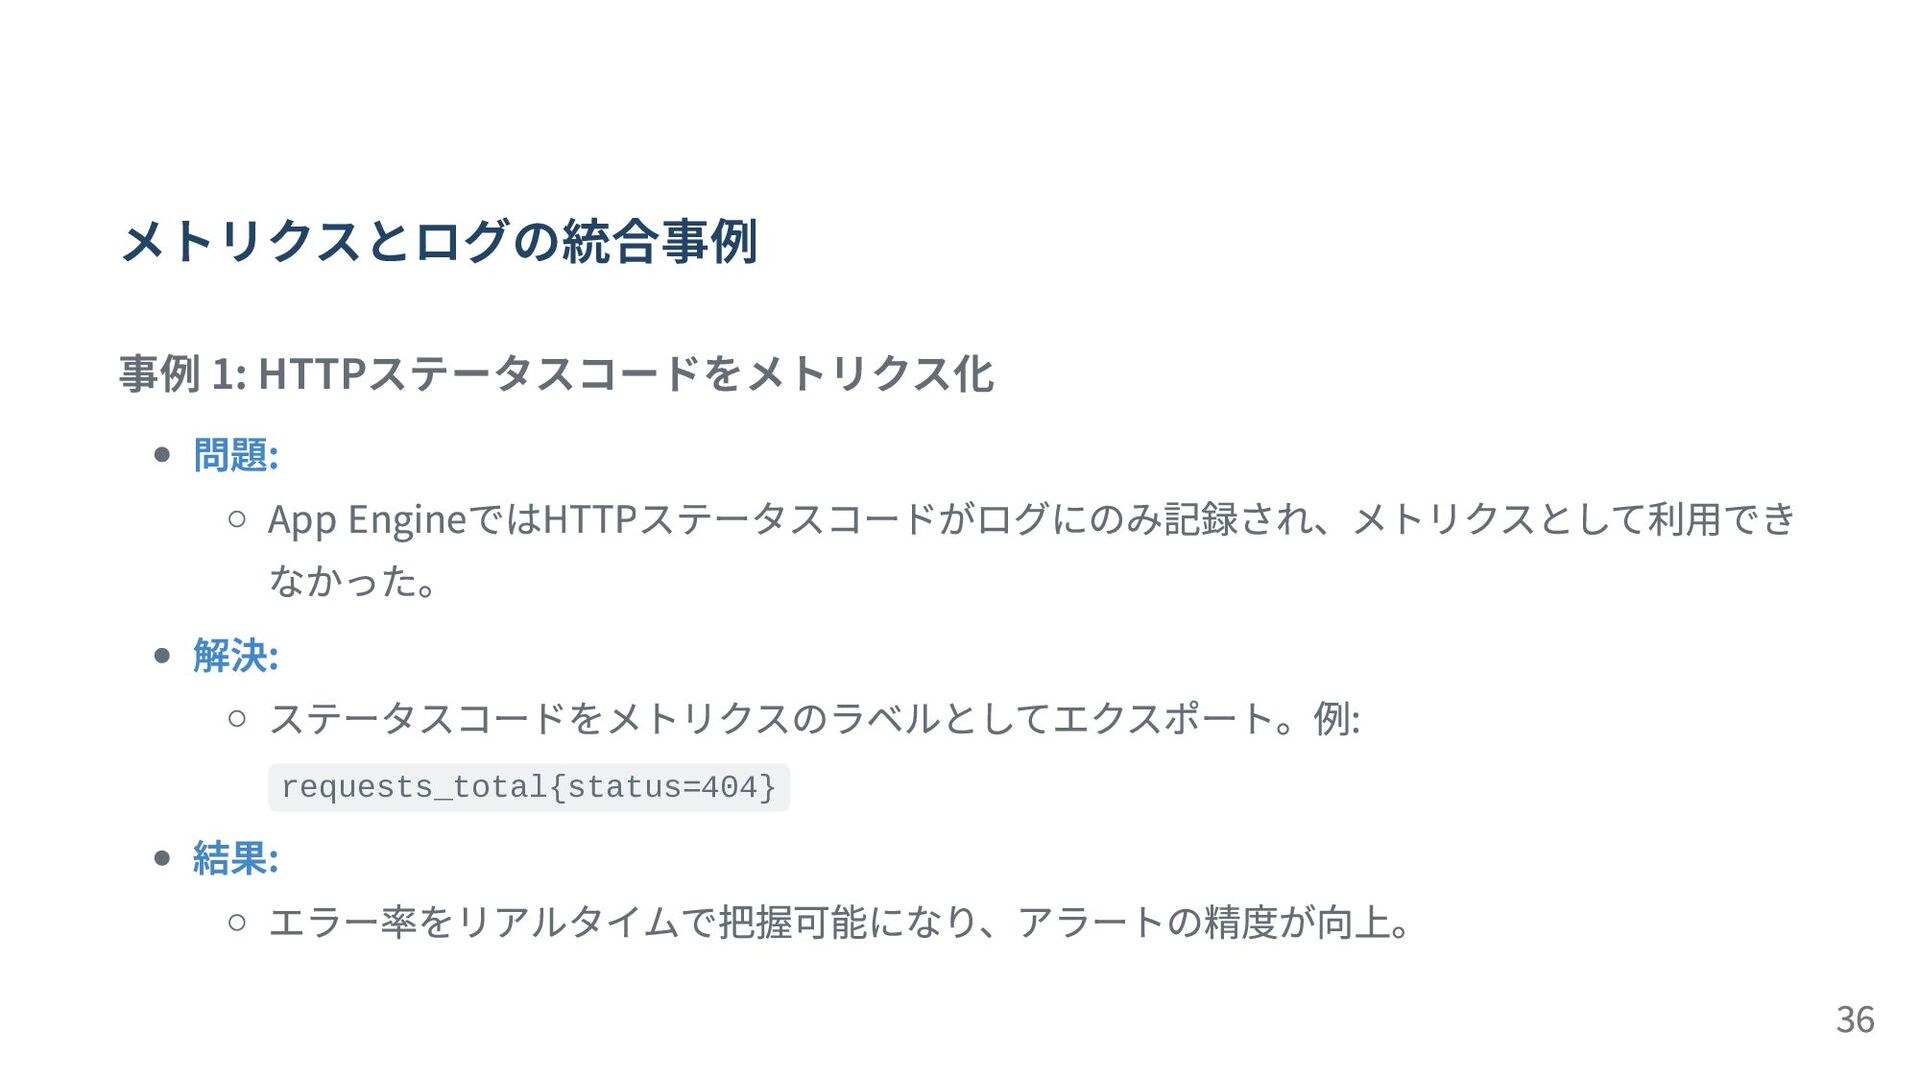
メトリクスとログの統合事例 事例 1: HTTPステータスコードをメトリクス化 問題: App EngineではHTTPステータスコードがログにのみ記録され、メトリクスとして利用でき なかった。 解決: ステータスコードをメトリクスのラベルとしてエクスポート。例:
requests_total{status=404} 結果: エラー率をリアルタイムで把握可能になり、アラートの精度が向上。 36
事例 2: ログを利用したエラー調査 問題: AdsのSREチームでは、複数フレームワークを持つ50以上のサービスを管理しており、特定 の条件でのエラー調査が困難だった。 解決: 統一されたログフォーマットを導入し、詳細なイベントデータを収集。 結果: 問題特定とデバッグプロセスの効率が向上。
37
監視システムにおけるメトリクスとログの活用 メトリクス: システム全体の状態を俯瞰する。 ログ: 問題が発生した際に詳細を深掘りする。 統合: メトリクスとログを組み合わせることで、より強力な監視体制を実現。 38
まとめ: 監視データの種類 メトリクスとログの両方を活用することが重要。 メトリクスで問題を検知し、ログで原因を追跡。 データの種類に応じた最適な使い方を考慮する。 リアルタイム性、粒度、保存形式などの特性を活かす。 39
5. 運用管理 40
運用管理の重要性 なぜ運用管理が必要か? 監視システムの持続的な効果を維持するため。 設定の一貫性を保ち、変更の影響を最小化。 迅速な問題解決と改善を可能にするため。 異常時に適切な情報を得て対応できる環境を整備。 41
運用管理の主要な要素 1. 設定管理(Configuration Management) 2. 一貫性の確保(Consistency) 3. 疎結合の推奨(Loose Coupling) 42
1. 設定管理(Configuration Management) 設定をコードとして管理する 利点: 変更履歴を追跡可能: どの設定がいつ変更されたかを把握。 ロールバックが容易: 問題発生時に迅速に元の状態に戻せる。 チーム間の透明性:
設定変更をコードレビューで確認可能。 推奨される実践 バージョン管理システムを活用: 監視設定をGitなどで管理し、チームで共有。 ツールの利用例: Grafanalib: ダッシュボード設定をコードとして扱うツール。 具体例 アラート設定のコード化: 43
2. 一貫性の確保(Consistency) なぜ一貫性が重要か? チーム間の連携を強化: 異動したメンバーでもすぐに運用環境に適応可能。 デバッグ効率の向上: 各チームで共通の設定があると問題特定が容易。 実装のポイント 1. 中央管理:
共通フレームワークや標準ダッシュボードを導入。 2. 自動適用: 全サービスに基本的な監視設定を自動適用。 Googleの事例 Googleでは、全サービスが基本メトリクス(例: CPU使用率、リクエスト数)を自動エクスポー 44
疎結合とは? 各コンポーネント(データ収集、保存、アラート、可視化)を独立して設計。 依存性を最小限にし、必要に応じて容易に交換可能。 なぜ疎結合が重要か? 柔軟性: 監視システムが進化する要件に対応。 スケーラビリティ: 特定の機能を独立して拡張可能。 実践例 オープンソースツールの分離設計:
Prometheus: データ収集とルール評価 Alertmanager: アラート管理 Grafana: ダッシュボード作成 Googleの事例: 45
運用管理の改善事例 事例 1: 設定管理のコード化 問題: 手動での設定変更が原因でミスが頻発。 解決: 監視設定をコード化し、コードレビューを導入。 結果: 設定変更の品質が向上し、ミスが大幅に減少。
46
事例 2: 一貫性の確保 問題: 各チームが独自の監視設定を採用し、デバッグが困難。 解決: 中央管理フレームワークを導入し、基本設定を標準化。 結果: デバッグ効率が向上し、運用負荷が軽減。 47
事例 3: 疎結合設計 問題: 既存の監視システムが依存性の高いモノリシック構造。 解決: 各機能を分離し、独立したサービスとして運用。 結果: システムの柔軟性とスケーラビリティが向上。 48
運用管理のまとめ 1. 設定管理: コードとして扱い、バージョン管理を活用。 2. 一貫性: 中央管理で共通フレームワークを提供。 3. 疎結合: 独立したコンポーネント設計で柔軟性を確保。
運用管理の効果 安定性: システム変更による問題を最小限に抑える。 効率性: 問題解決と運用負荷の軽減。 進化性: 監視システムが新たな要件に適応可能。 49
6. 具体的な改善事例 50
改善事例の概要 なぜ改善事例が重要か? 実践的な知識: 理論だけでなく、実際の改善プロセスを共有。 成功体験の活用: 他チームや組織で適用可能なベストプラクティスを学べる。 課題の再現性: 類似の課題を解決するヒントを提供。 51
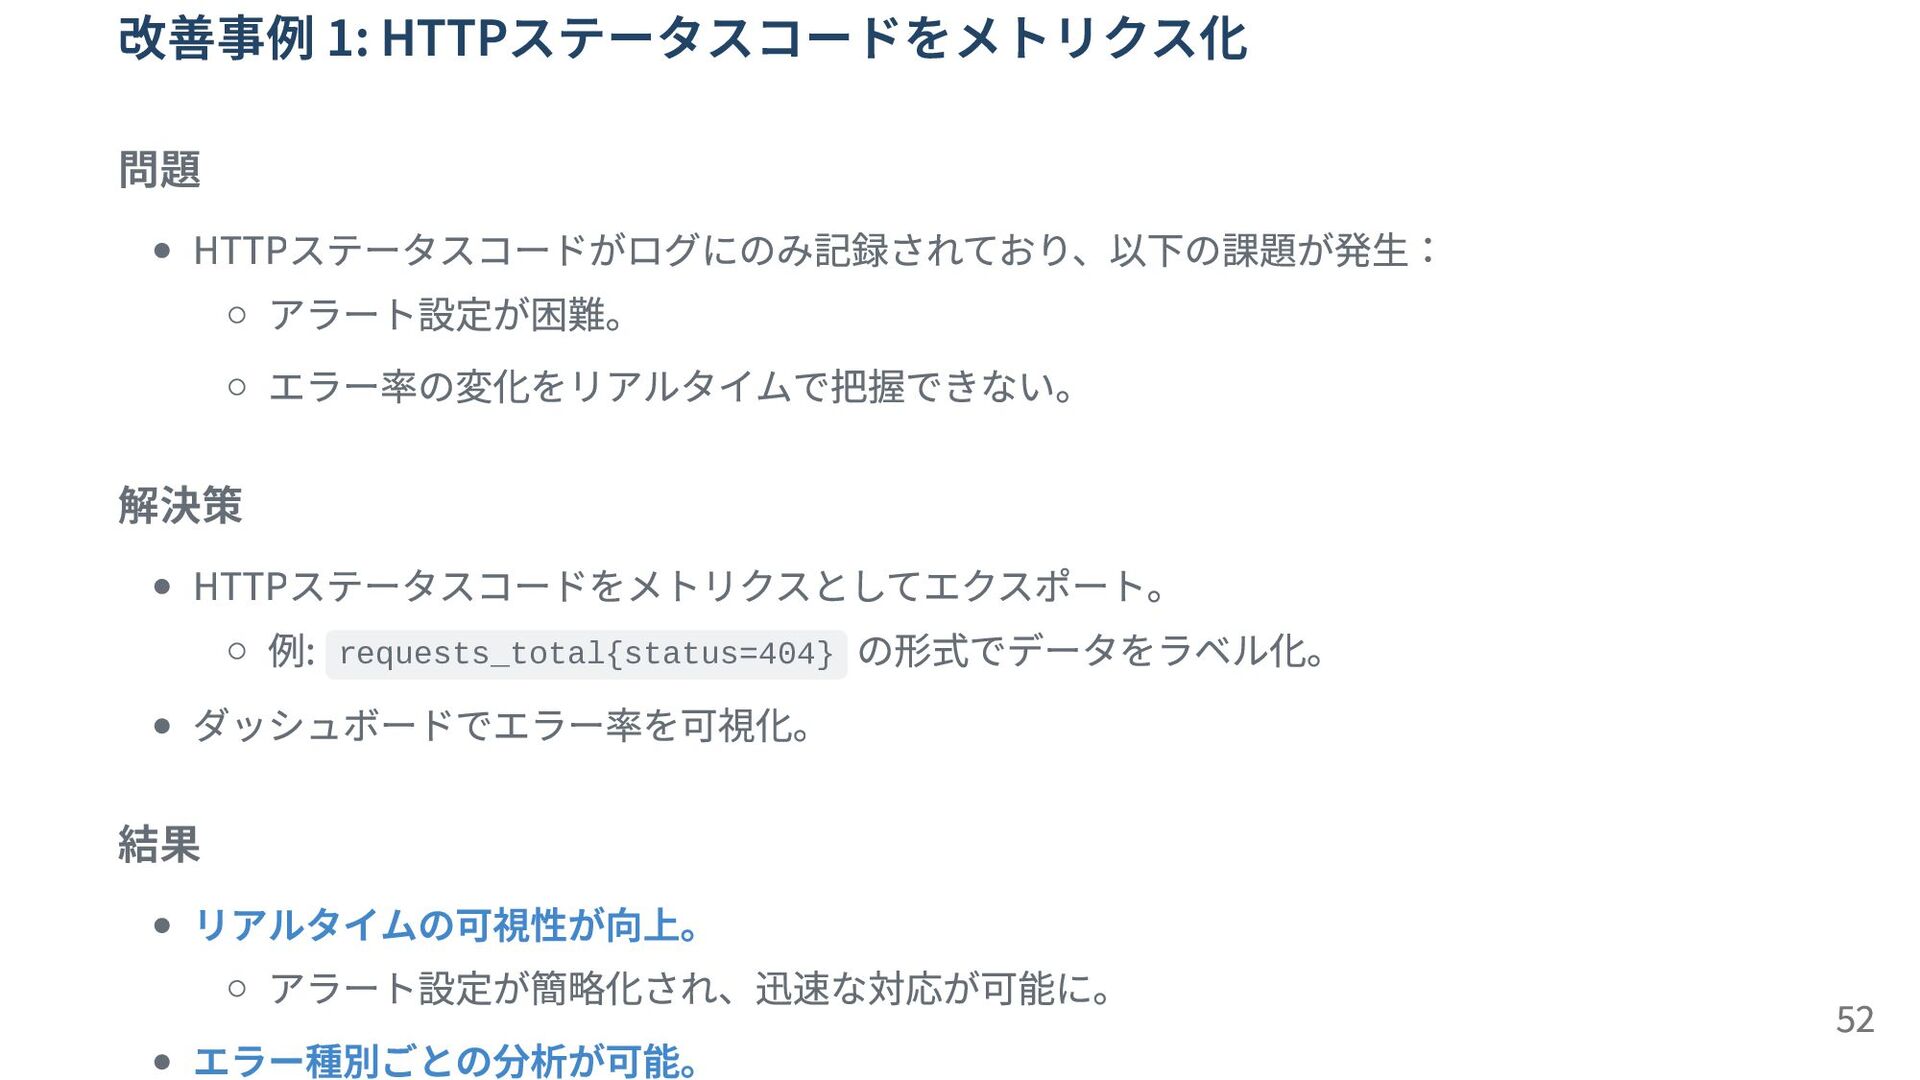
改善事例 1: HTTPステータスコードをメトリクス化 問題 HTTPステータスコードがログにのみ記録されており、以下の課題が発生: アラート設定が困難。 エラー率の変化をリアルタイムで把握できない。 解決策 HTTPステータスコードをメトリクスとしてエクスポート。 例:
requests_total{status=404} の形式でデータをラベル化。 ダッシュボードでエラー率を可視化。 結果 リアルタイムの可視性が向上。 アラート設定が簡略化され、迅速な対応が可能に。 エラー種別ごとの分析が可能。 52
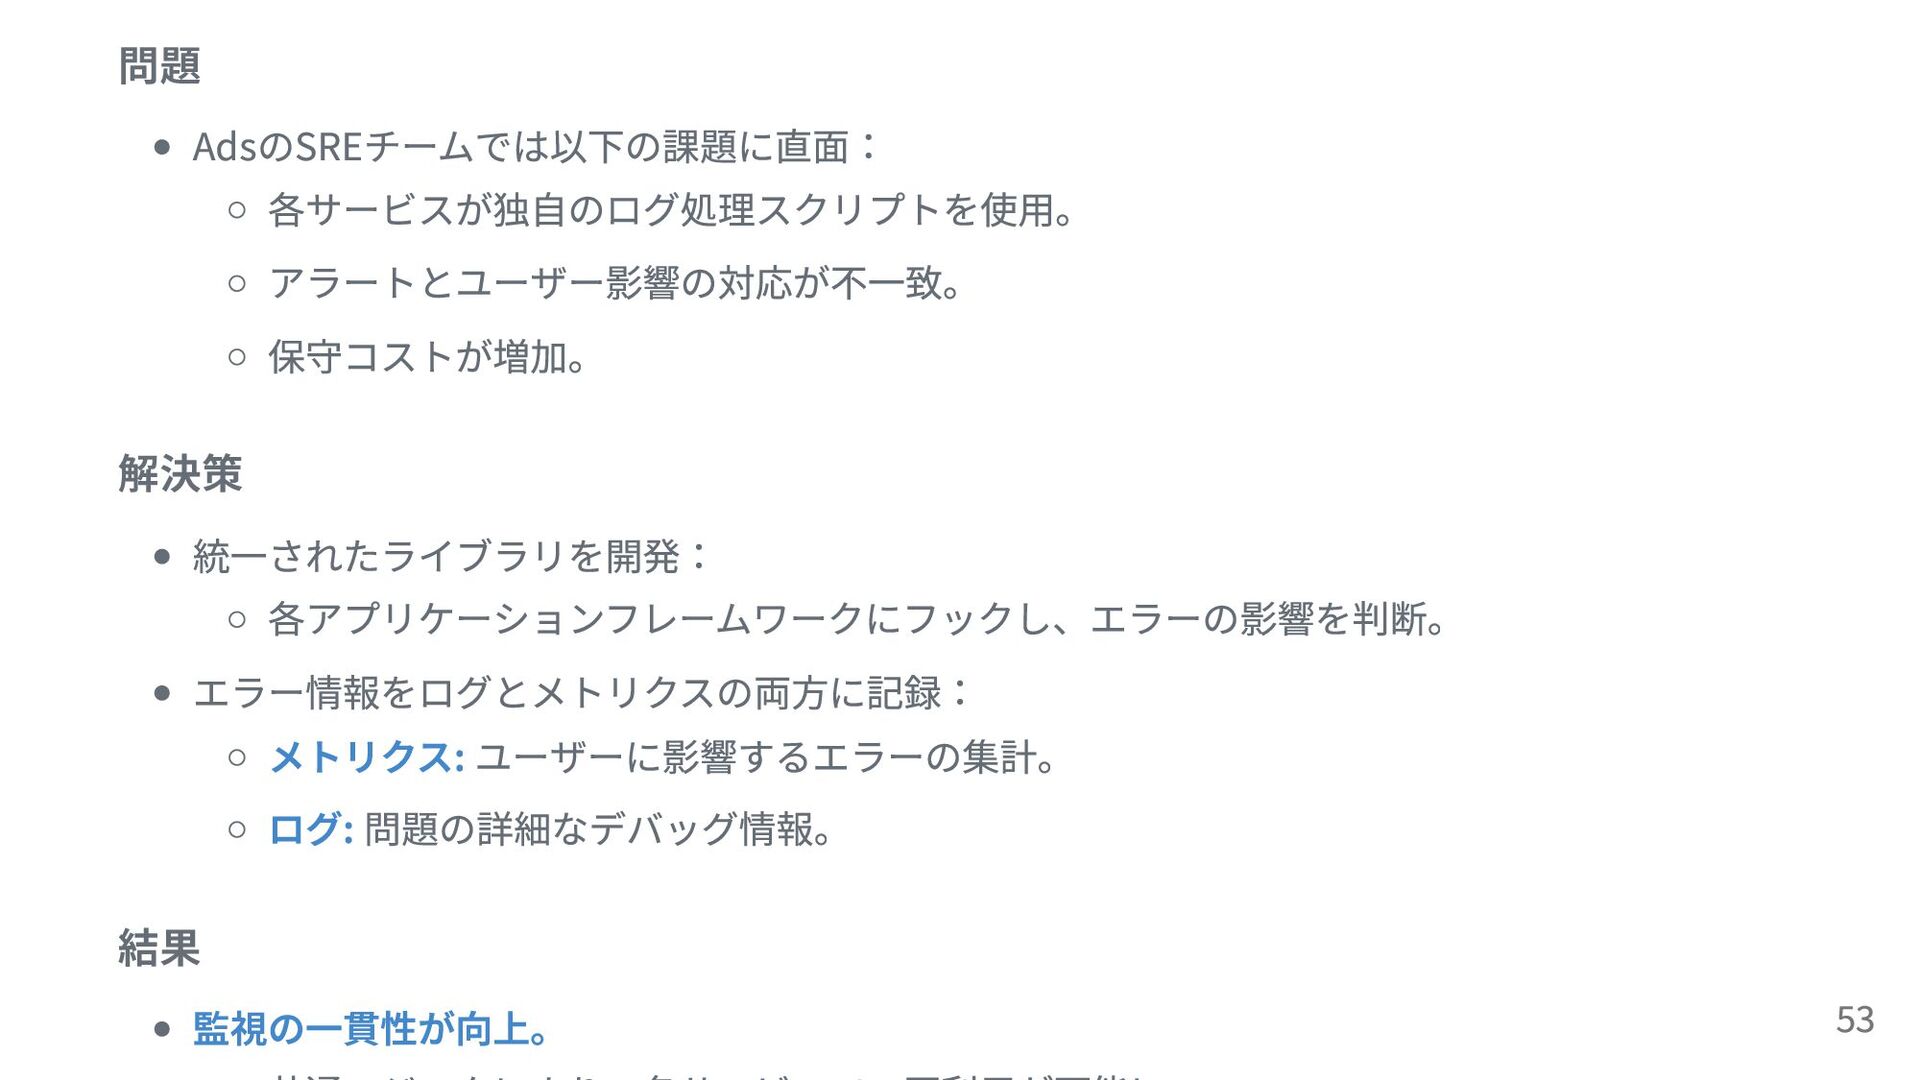
問題 AdsのSREチームでは以下の課題に直面: 各サービスが独自のログ処理スクリプトを使用。 アラートとユーザー影響の対応が不一致。 保守コストが増加。 解決策 統一されたライブラリを開発: 各アプリケーションフレームワークにフックし、エラーの影響を判断。 エラー情報をログとメトリクスの両方に記録: メトリクス:
ユーザーに影響するエラーの集計。 ログ: 問題の詳細なデバッグ情報。 結果 監視の一貫性が向上。 53
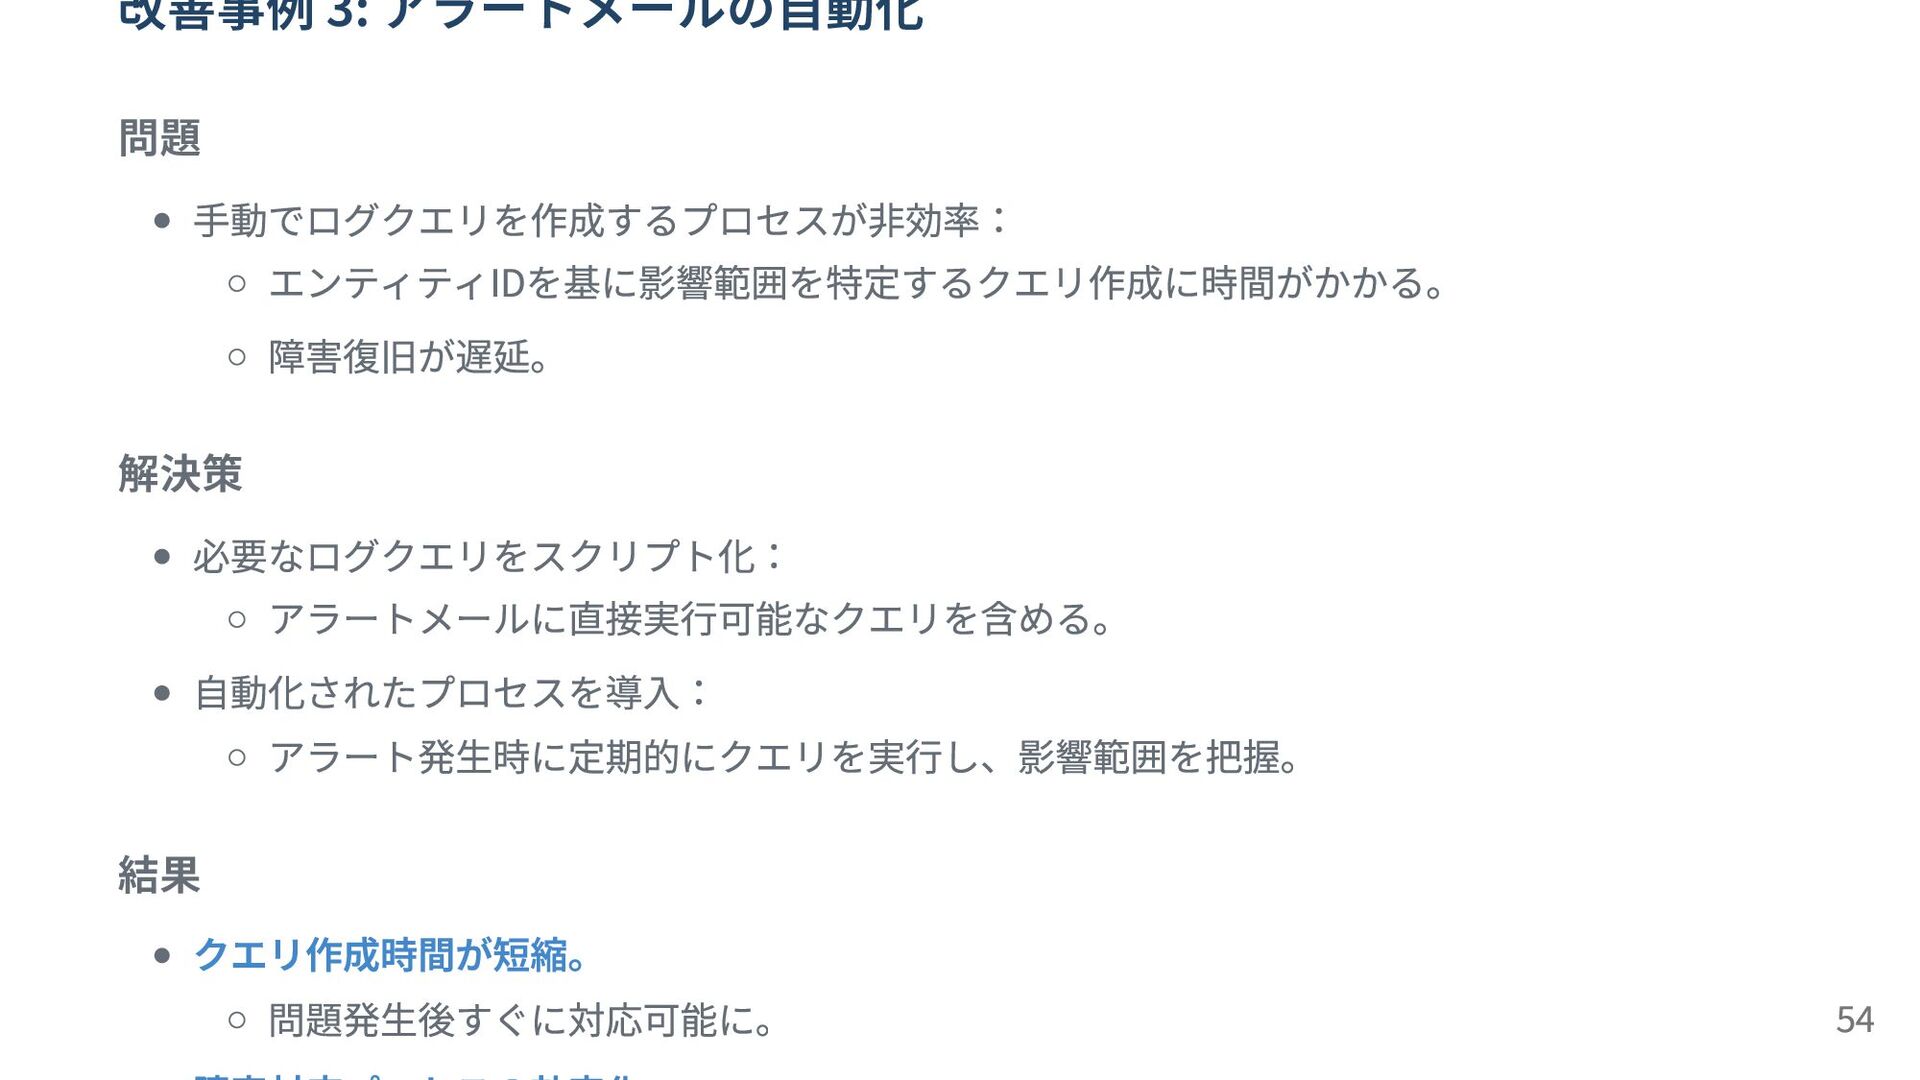
改善事例 3: アラートメールの自動化 問題 手動でログクエリを作成するプロセスが非効率: エンティティIDを基に影響範囲を特定するクエリ作成に時間がかかる。 障害復旧が遅延。 解決策 必要なログクエリをスクリプト化: アラートメールに直接実行可能なクエリを含める。
自動化されたプロセスを導入: アラート発生時に定期的にクエリを実行し、影響範囲を把握。 結果 クエリ作成時間が短縮。 問題発生後すぐに対応可能に。 54
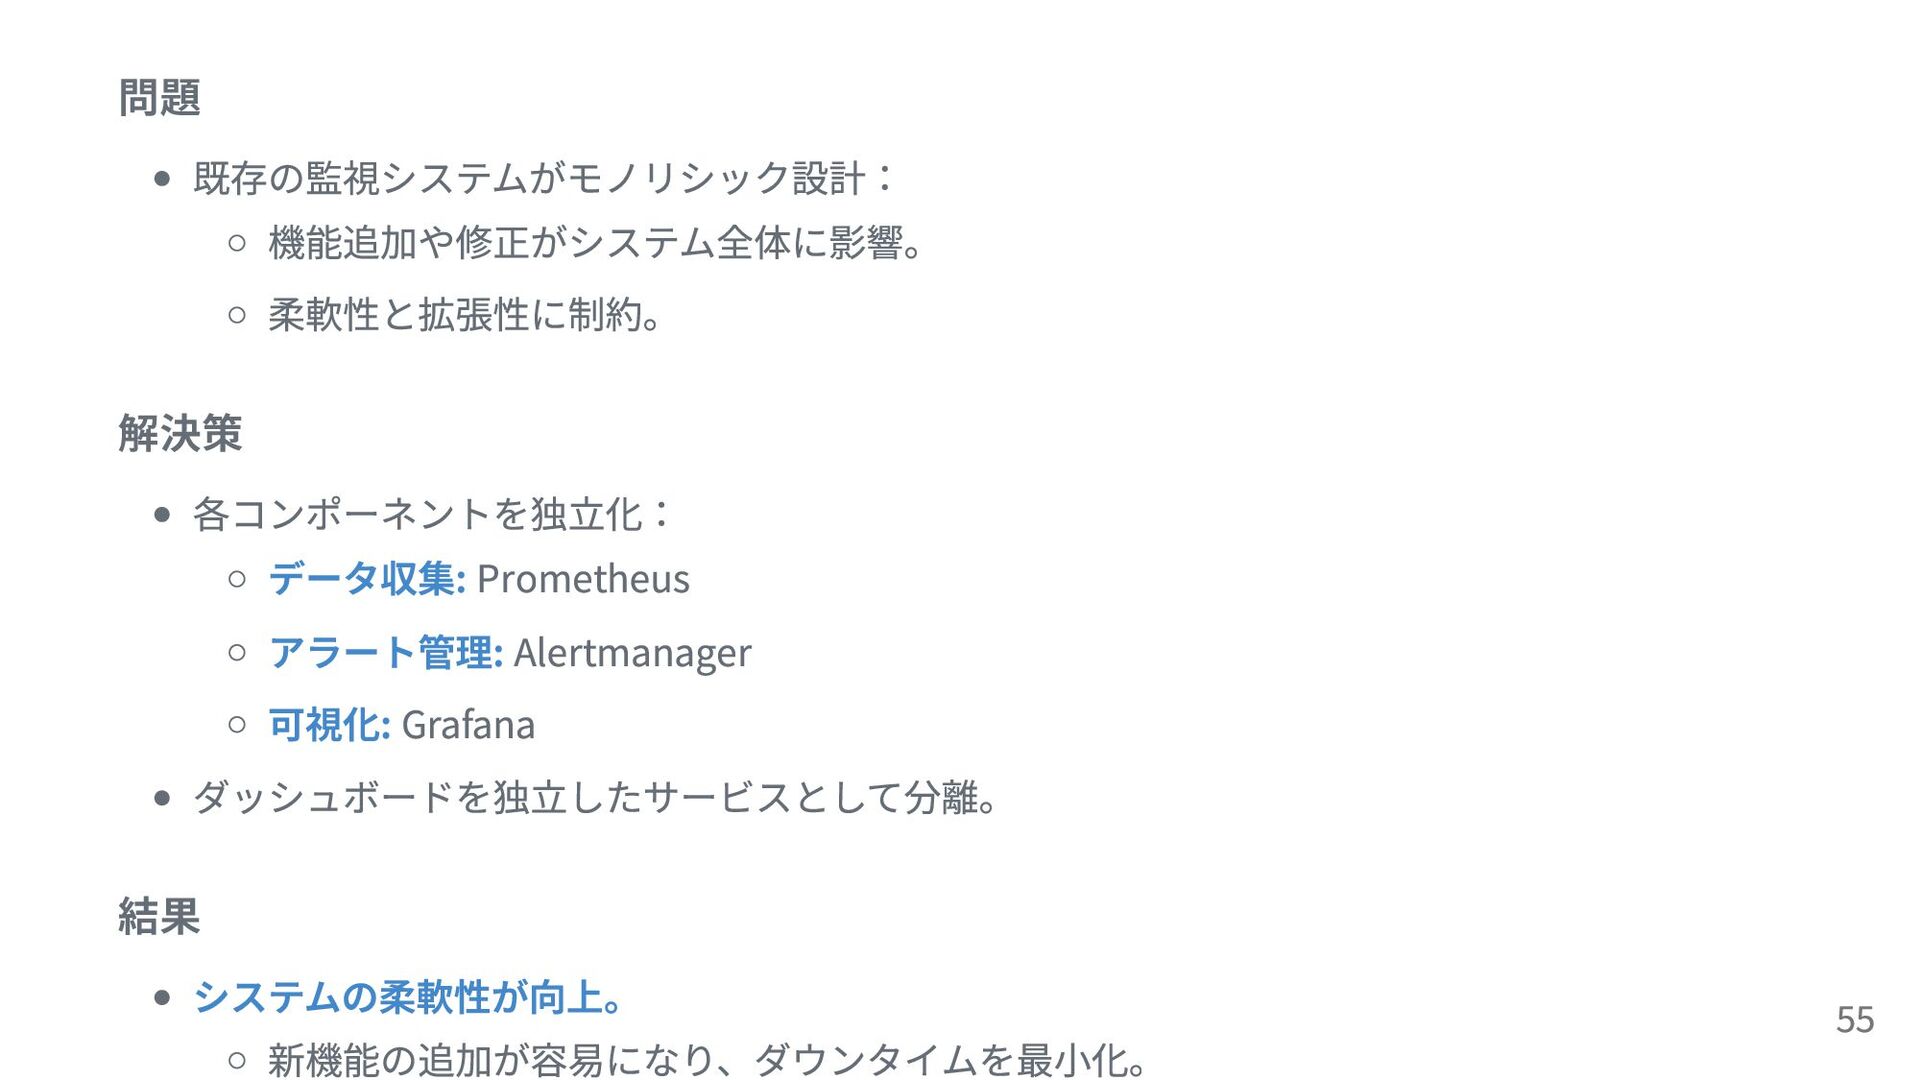
問題 既存の監視システムがモノリシック設計: 機能追加や修正がシステム全体に影響。 柔軟性と拡張性に制約。 解決策 各コンポーネントを独立化: データ収集: Prometheus アラート管理: Alertmanager
可視化: Grafana ダッシュボードを独立したサービスとして分離。 結果 システムの柔軟性が向上。 新機能の追加が容易になり、ダウンタイムを最小化。 55
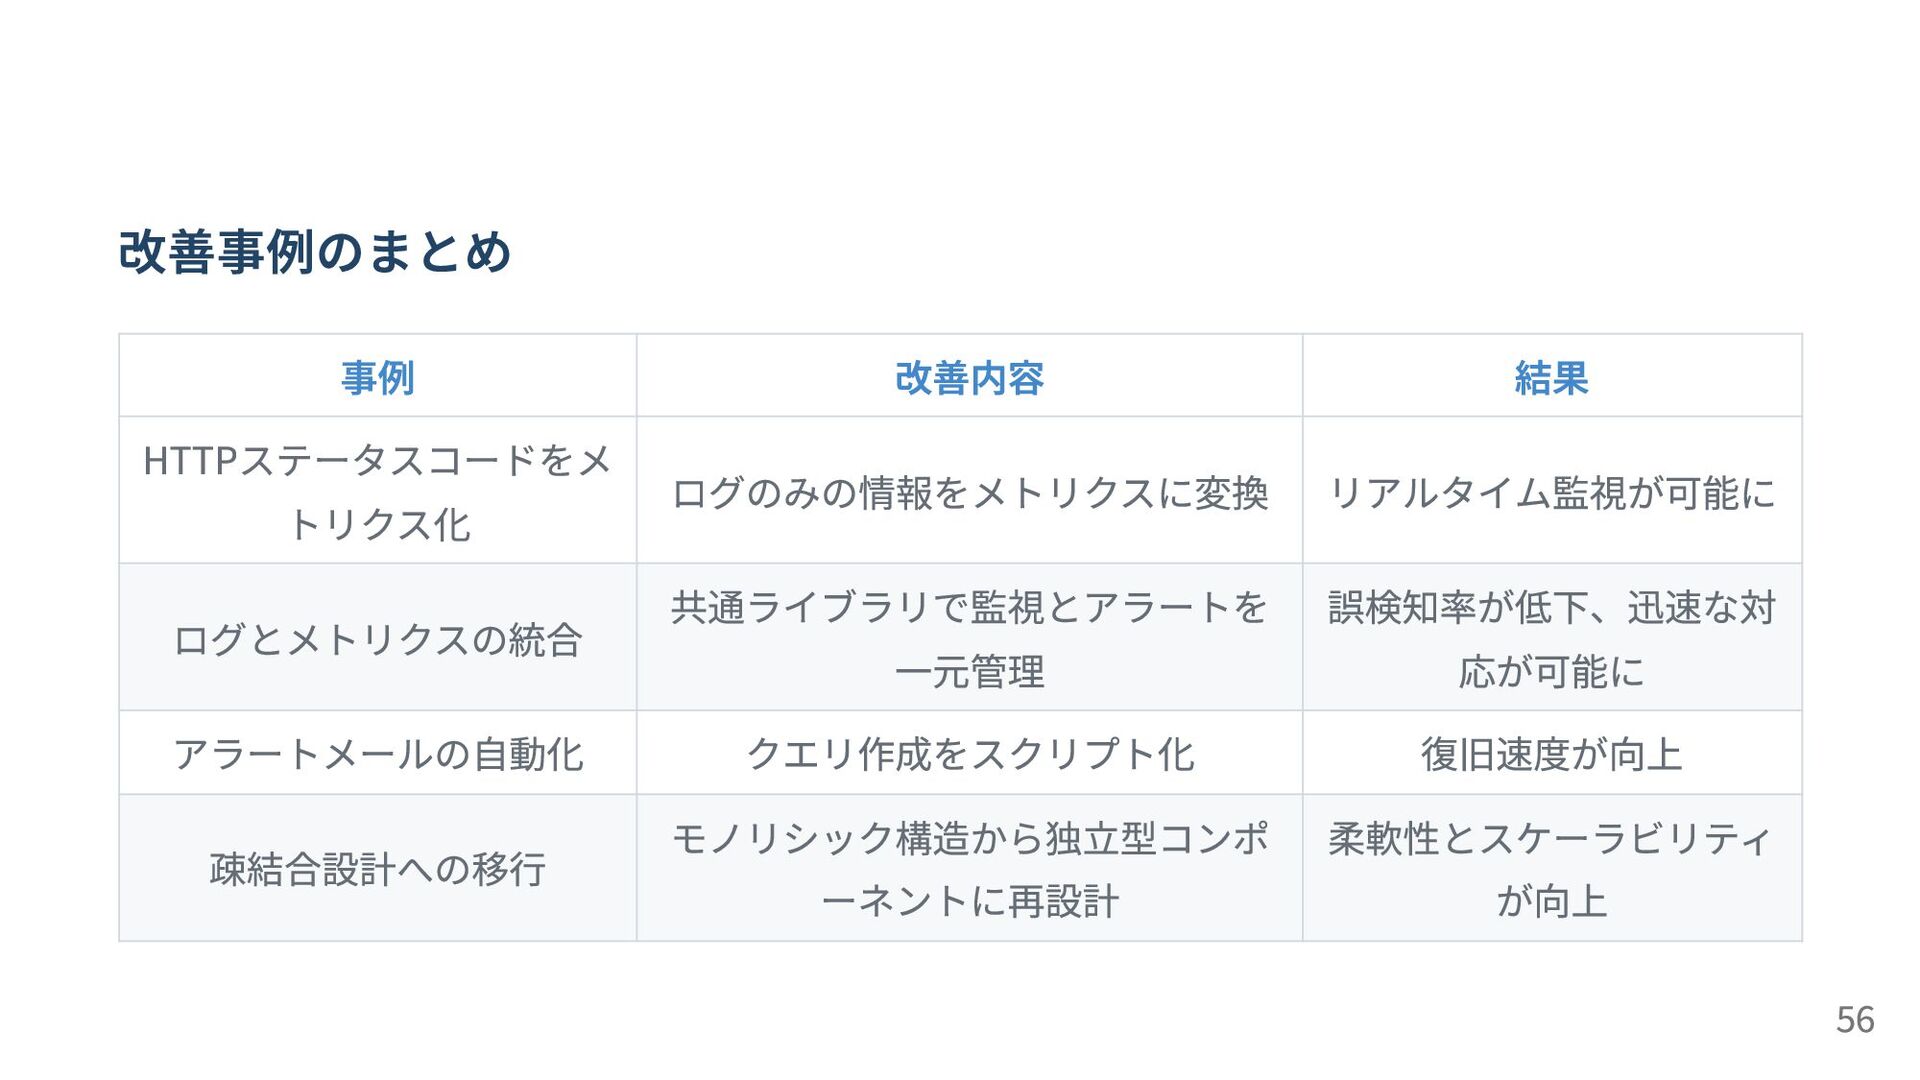
改善事例のまとめ 事例 改善内容 結果 HTTPステータスコードをメ トリクス化 ログのみの情報をメトリクスに変換 リアルタイム監視が可能に ログとメトリクスの統合 共通ライブラリで監視とアラートを
一元管理 誤検知率が低下、迅速な対 応が可能に アラートメールの自動化 クエリ作成をスクリプト化 復旧速度が向上 疎結合設計への移行 モノリシック構造から独立型コンポ ーネントに再設計 柔軟性とスケーラビリティ が向上 56
改善事例を活用するためのポイント 1. 既存の課題を正確に把握する。 監視データや運用プロセスを詳細に分析。 2. 段階的な改善を目指す。 小規模な変更を試し、徐々に範囲を拡大。 3. 成功事例を参考にする。 他チームや他社の実践を取り入れる。
57
7. まとめ 58
本プレゼンテーションの要点 監視システムの重要性 信頼性向上: 問題を早期に検知し、迅速に対応する。 効率的な運用: リアルタイム性と詳細なデータ分析を両立。 コスト削減: ダウンタイムやトラブル対応の負担を軽減。 59
監視システムの基礎 1. 監視の目的: システムの可視性を向上し、サービスの健全性を評価。 問題発生時の迅速な診断を支援。 2. 必要な機能: 速度、計算機能、インターフェース、アラートを最適化。 各チームや状況に応じた柔軟な設計。 3.
監視データの種類: メトリクスとログの特性を理解し、適切に活用。 60
運用と改善のポイント 運用管理の実践 設定管理: コード化して一貫性を確保。 一貫性: 中央管理でチーム間の連携を強化。 疎結合: 柔軟で拡張可能な設計を採用。 改善事例から学ぶ HTTPステータスコードのメトリクス化でリアルタイム監視を実現。
ログとメトリクスの統合で誤検知率を低下。 アラートメールの自動化で対応速度を向上。 疎結合設計で柔軟性とスケーラビリティを強化。 61
今後のアクション 監視システムの評価 1. 現在の監視システムが目的に合っているか確認。 2. 必要な機能が不足している場合は改善を検討。 チーム内の導入 改善事例を参考に自チームに適した方法を模索。 一貫性を保ちながら柔軟な運用を目指す。 継続的な改善
メトリクスとログの収集方法を定期的に見直し。 新しいツールや手法の導入を検討。 62
最後に 良い監視システムとは 問題を迅速に発見し、対応を支援する。 データが視覚的で使いやすい。 チーム間で共有しやすく、適応性がある。 投資の価値 監視システムの改善は、長期的に大きな効果をもたらす。 最適なソリューションを目指して試行錯誤を続けることが重要。 63


 tai25011601
 mlcsv
 bermonpainter
 eileencodes
 nmsamuel
 joshbly
 samanthasiow
 szymonslowik
 csswizardry
 cassininazir
 aleyda
 konakalab
 lara