Share
Embed
AIプラットフォームにおける検索基盤
takatori
November 17, 2026
Transcript
31 slides
-
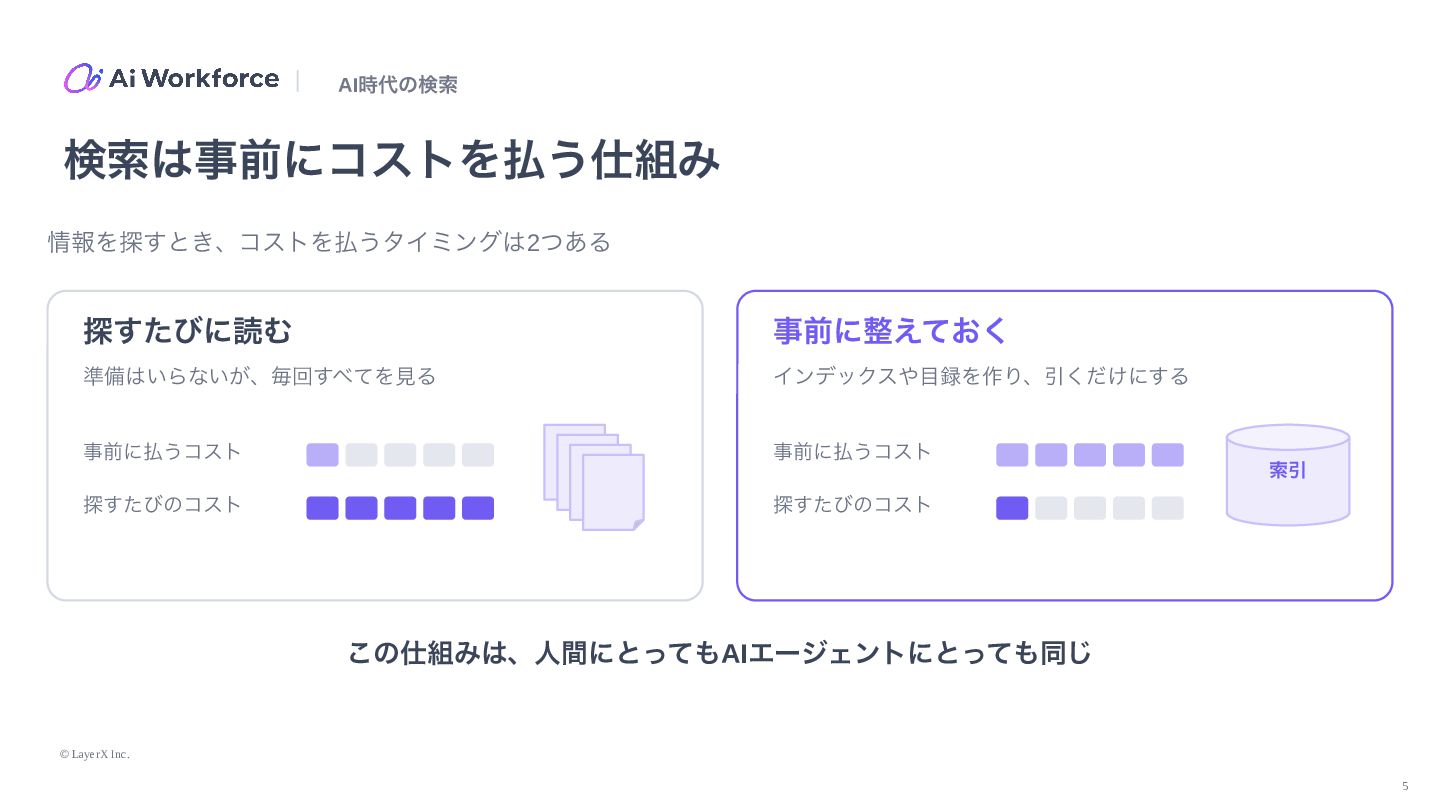
AI時代の検索 検索は事前にコストを払う仕組み 情報を探すとき、コストを払うタイミングは2つある 探すたびに読む 事前に整えておく 準備はいらないが、毎回すべてを見る インデックスや目録を作り、引くだけにする 事前に払うコスト 事前に払うコスト 探すたびのコスト
探すたびのコスト 索引 この仕組みは、人間にとってもAIエージェントにとっても同じ © LayerX Inc. 5 -
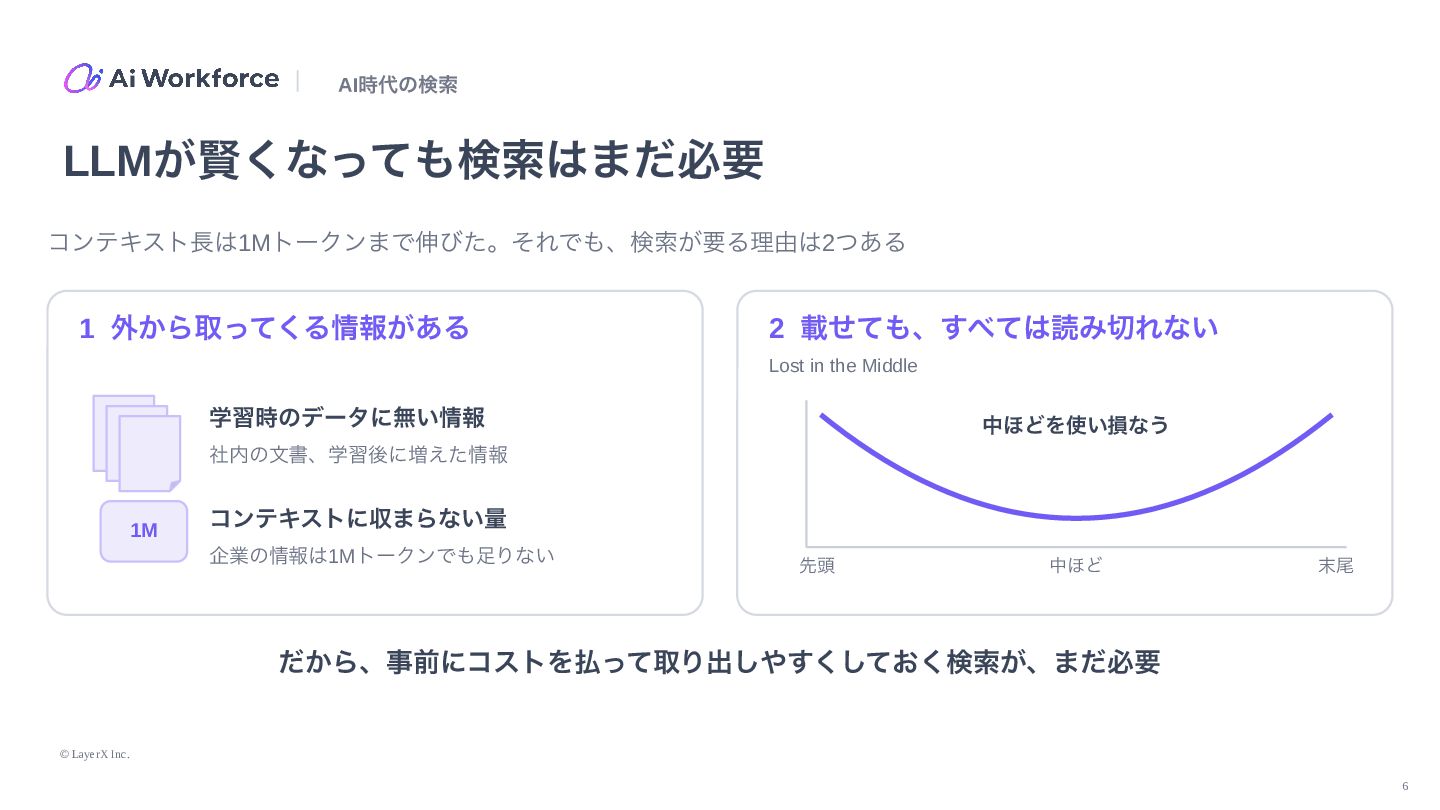
AI時代の検索 LLMが賢くなっても検索はまだ必要 コンテキスト長は1Mトークンまで伸びた。それでも、検索が要る理由は2つある 1 外から取ってくる情報がある 2 載せても、すべては読み切れない Lost in the
Middle 学習時のデータに無い情報 中ほどを使い損なう 社内の文書、学習後に増えた情報 1M コンテキストに収まらない量 企業の情報は1Mトークンでも足りない 先頭 中ほど 末尾 だから、事前にコストを払って取り出しやすくしておく検索が、まだ必要 © LayerX Inc. 6 -
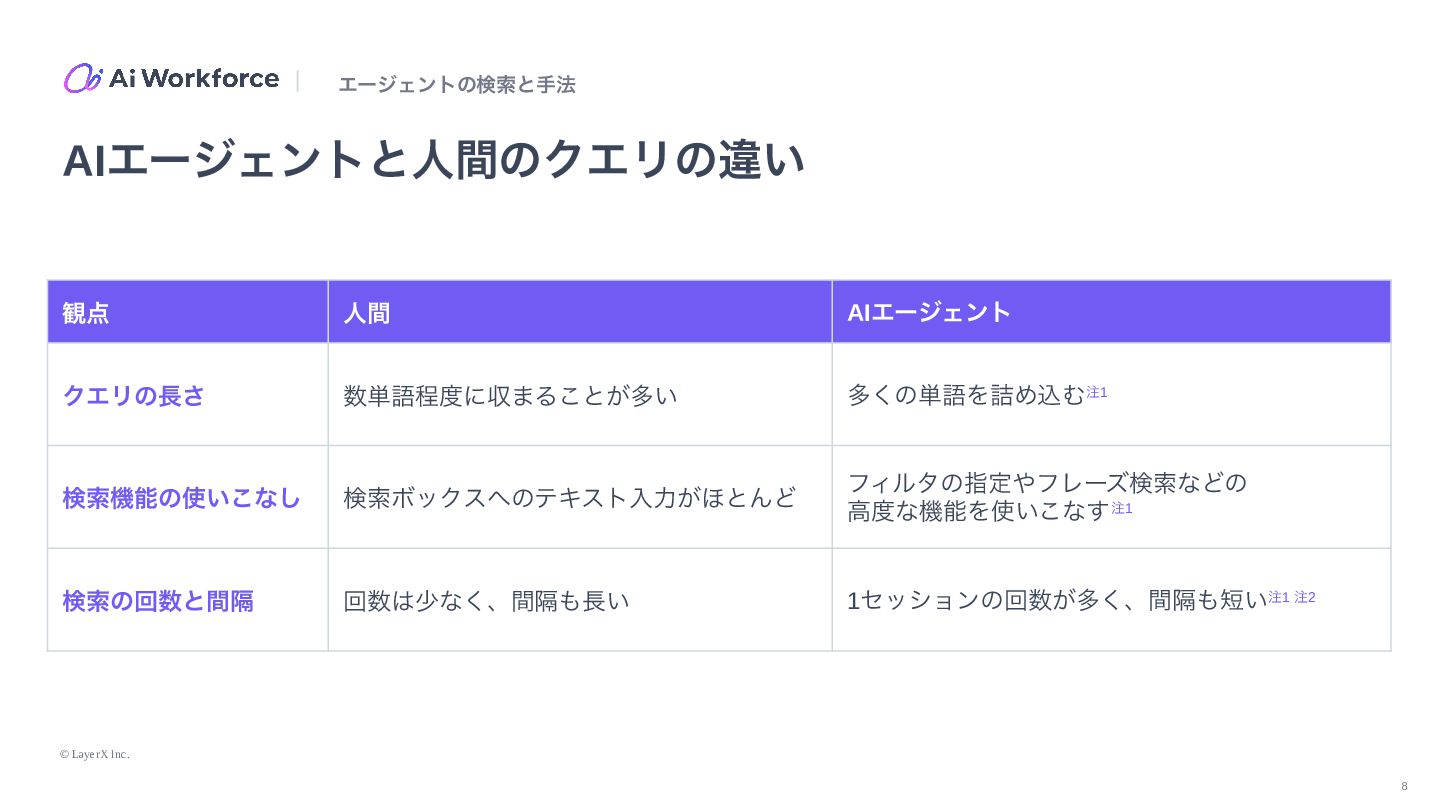
エージェントの検索と手法 AIエージェントと人間のクエリの違い 観点 人間 AIエージェント クエリの長さ 数単語程度に収まることが多い 多くの単語を詰め込む注1 検索機能の使いこなし 検索ボックスへのテキスト入力がほとんど
フィルタの指定やフレーズ検索などの 高度な機能を使いこなす注1 検索の回数と間隔 回数は少なく、間隔も長い 1セッションの回数が多く、間隔も短い注1 注2 © LayerX Inc. 8 -
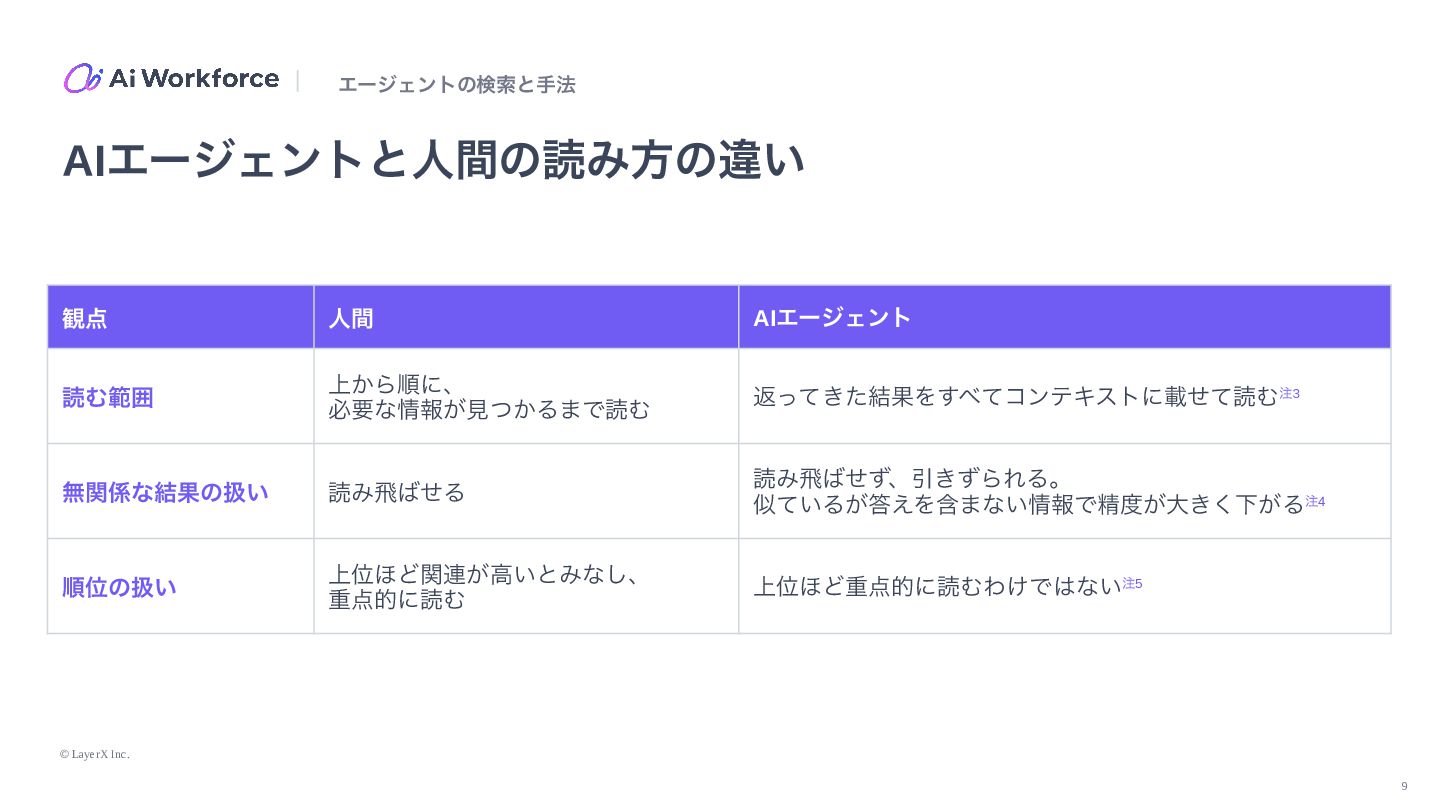
エージェントの検索と手法 AIエージェントと人間の読み方の違い 観点 人間 AIエージェント 読む範囲 上から順に、 必要な情報が見つかるまで読む 返ってきた結果をすべてコンテキストに載せて読む注3 無関係な結果の扱い
読み飛ばせる 読み飛ばせず、引きずられる。 似ているが答えを含まない情報で精度が大きく下がる注4 順位の扱い 上位ほど関連が高いとみなし、 重点的に読む 上位ほど重点的に読むわけではない注5 © LayerX Inc. 9 -
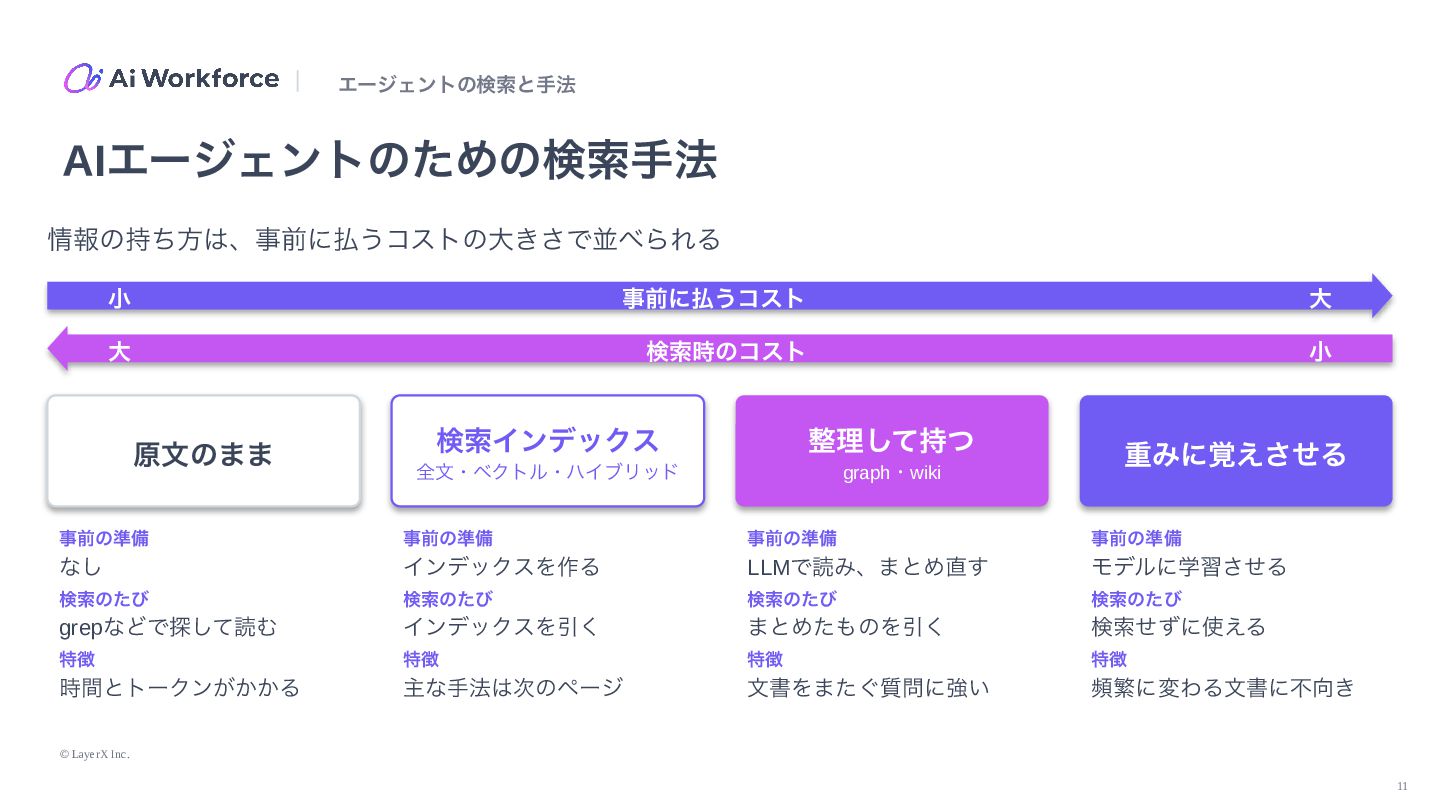
エージェントの検索と手法 AIエージェントのための検索手法 情報の持ち方は、事前に払うコストの大きさで並べられる 小 事前に払うコスト 大 大 検索時のコスト 小 原文のまま
検索インデックス 整理して持つ 全文・ベクトル・ハイブリッド graph・wiki 重みに覚えさせる 事前の準備 事前の準備 事前の準備 事前の準備 なし インデックスを作る LLMで読み、まとめ直す モデルに学習させる 検索のたび 検索のたび 検索のたび 検索のたび grepなどで探して読む インデックスを引く まとめたものを引く 検索せずに使える 特徴 特徴 特徴 特徴 時間とトークンがかかる 主な手法は次のページ 文書をまたぐ質問に強い 頻繁に変わる文書に不向き © LayerX Inc. 11 -
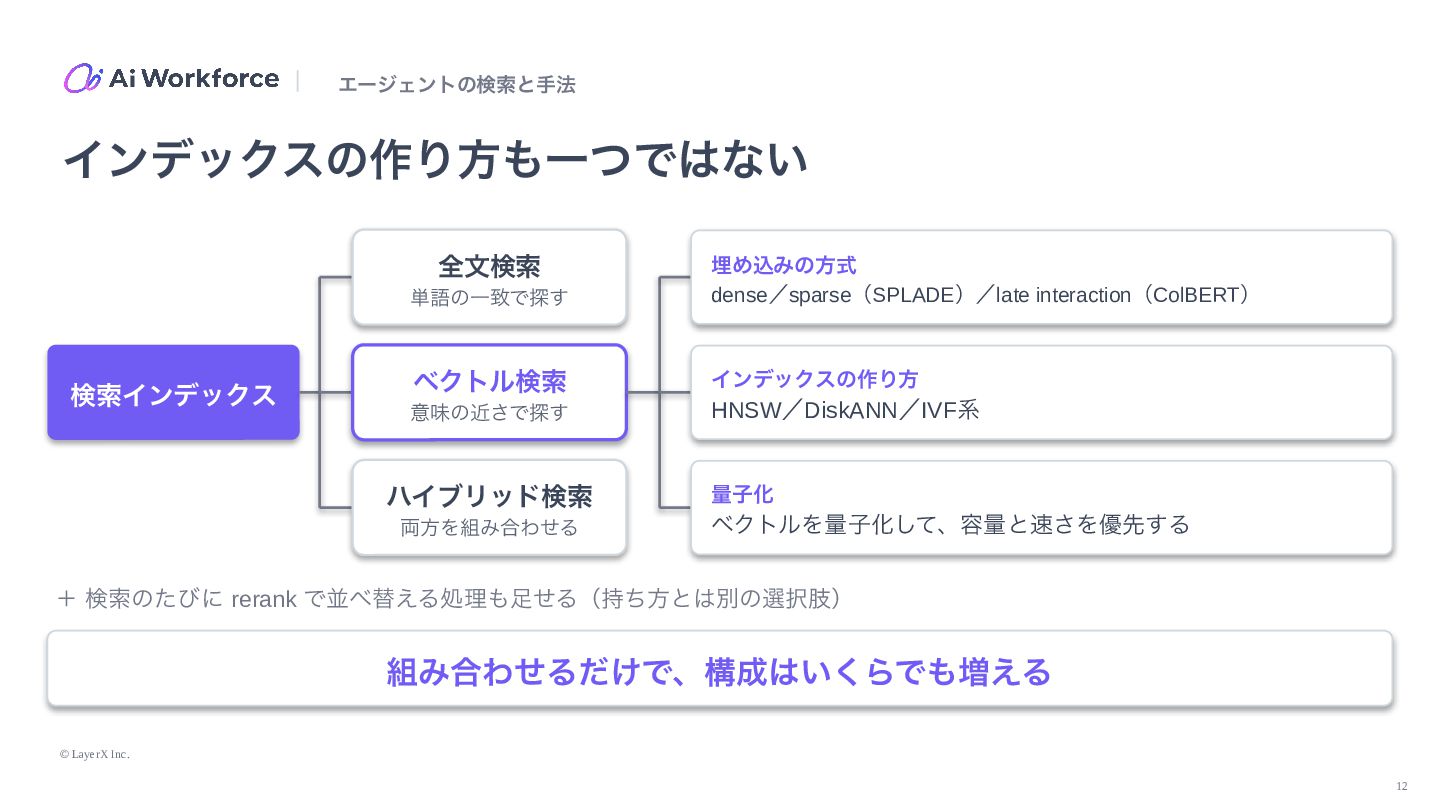
エージェントの検索と手法 インデックスの作り方も一つではない 全文検索 検索インデックス 単語の一致で探す 埋め込みの方式 dense/sparse(SPLADE)/late interaction(ColBERT) ベクトル検索 インデックスの作り方
意味の近さで探す ハイブリッド検索 両方を組み合わせる HNSW/DiskANN/IVF系 量子化 ベクトルを量子化して、容量と速さを優先する + 検索のたびに rerank で並べ替える処理も足せる(持ち方とは別の選択肢) 組み合わせるだけで、構成はいくらでも増える © LayerX Inc. 12 -
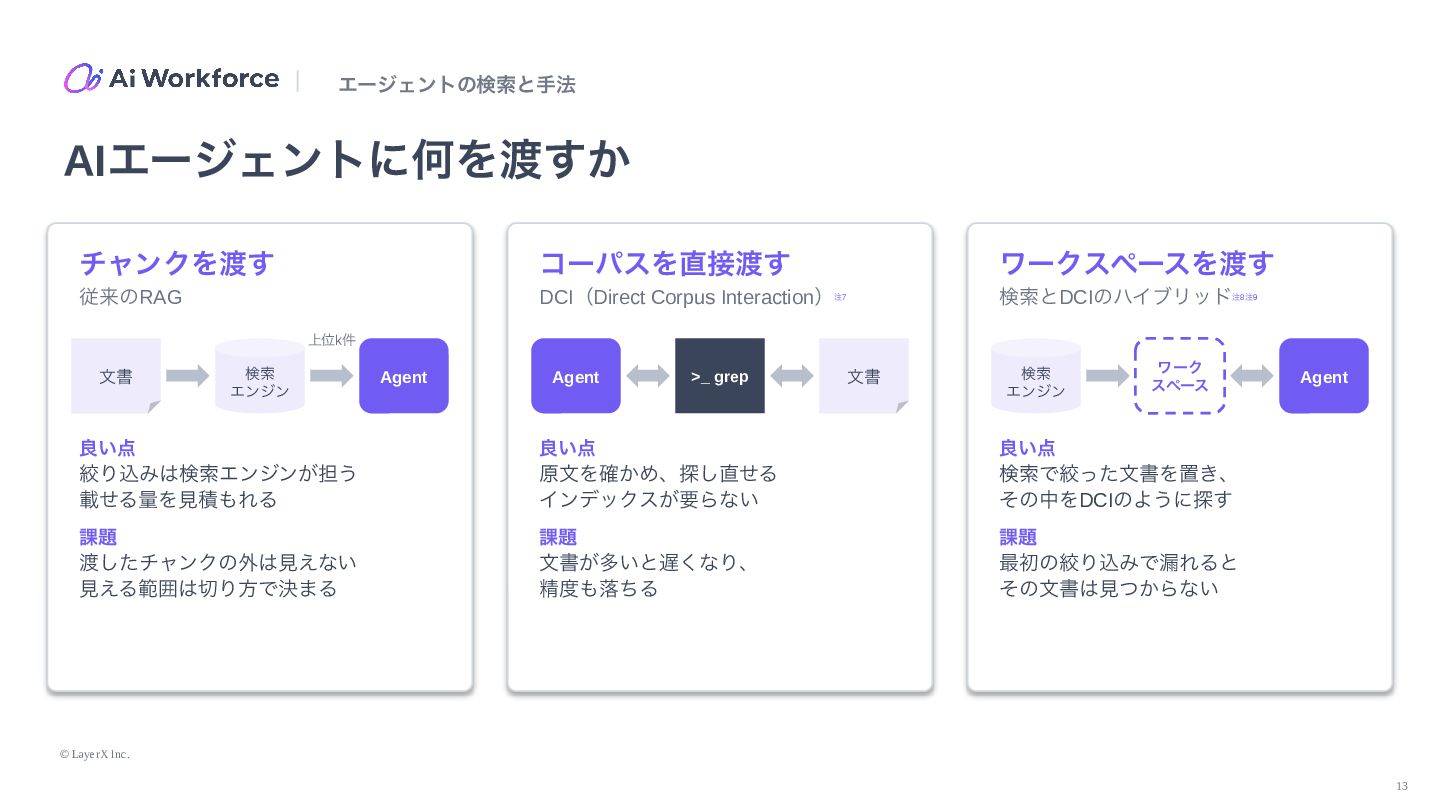
エージェントの検索と手法 AIエージェントに何を渡すか チャンクを渡す コーパスを直接渡す ワークスペースを渡す 従来のRAG DCI(Direct Corpus Interaction)注7 検索とDCIのハイブリッド注8注9
上位k件 文書 検索 エンジン Agent Agent >_ grep 文書 検索 エンジン ワーク スペース 良い点 良い点 良い点 絞り込みは検索エンジンが担う 載せる量を見積もれる 原文を確かめ、探し直せる インデックスが要らない 検索で絞った文書を置き、 その中をDCIのように探す 課題 課題 課題 渡したチャンクの外は見えない 見える範囲は切り方で決まる 文書が多いと遅くなり、 精度も落ちる 最初の絞り込みで漏れると その文書は見つからない Agent © LayerX Inc. 13 -
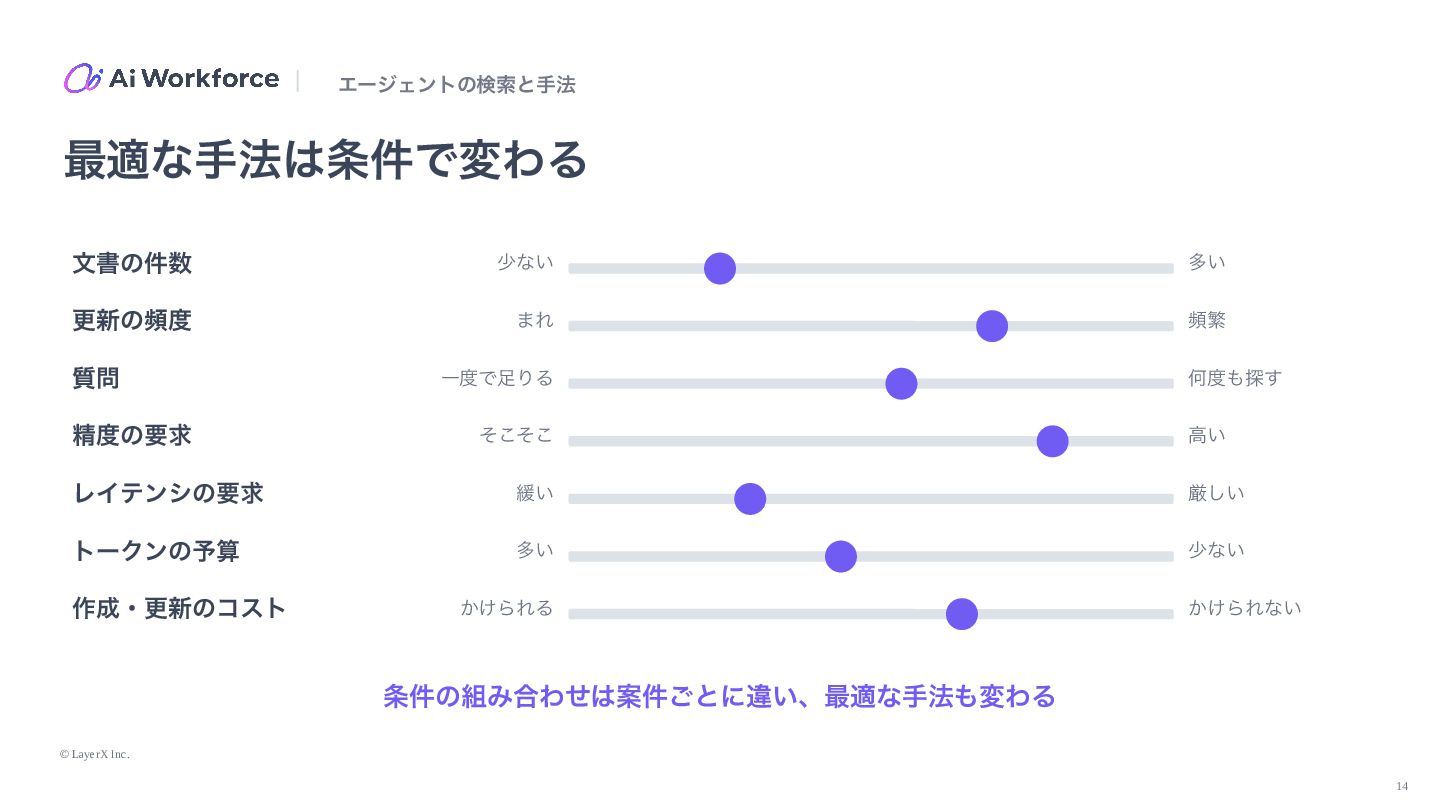
エージェントの検索と手法 最適な手法は条件で変わる 文書の件数 少ない 多い 更新の頻度 まれ 頻繁 質問 精度の要求
一度で足りる そこそこ 何度も探す 高い レイテンシの要求 緩い 厳しい トークンの予算 多い 少ない 作成・更新のコスト かけられる かけられない 条件の組み合わせは案件ごとに違い、最適な手法も変わる © LayerX Inc. 14 -
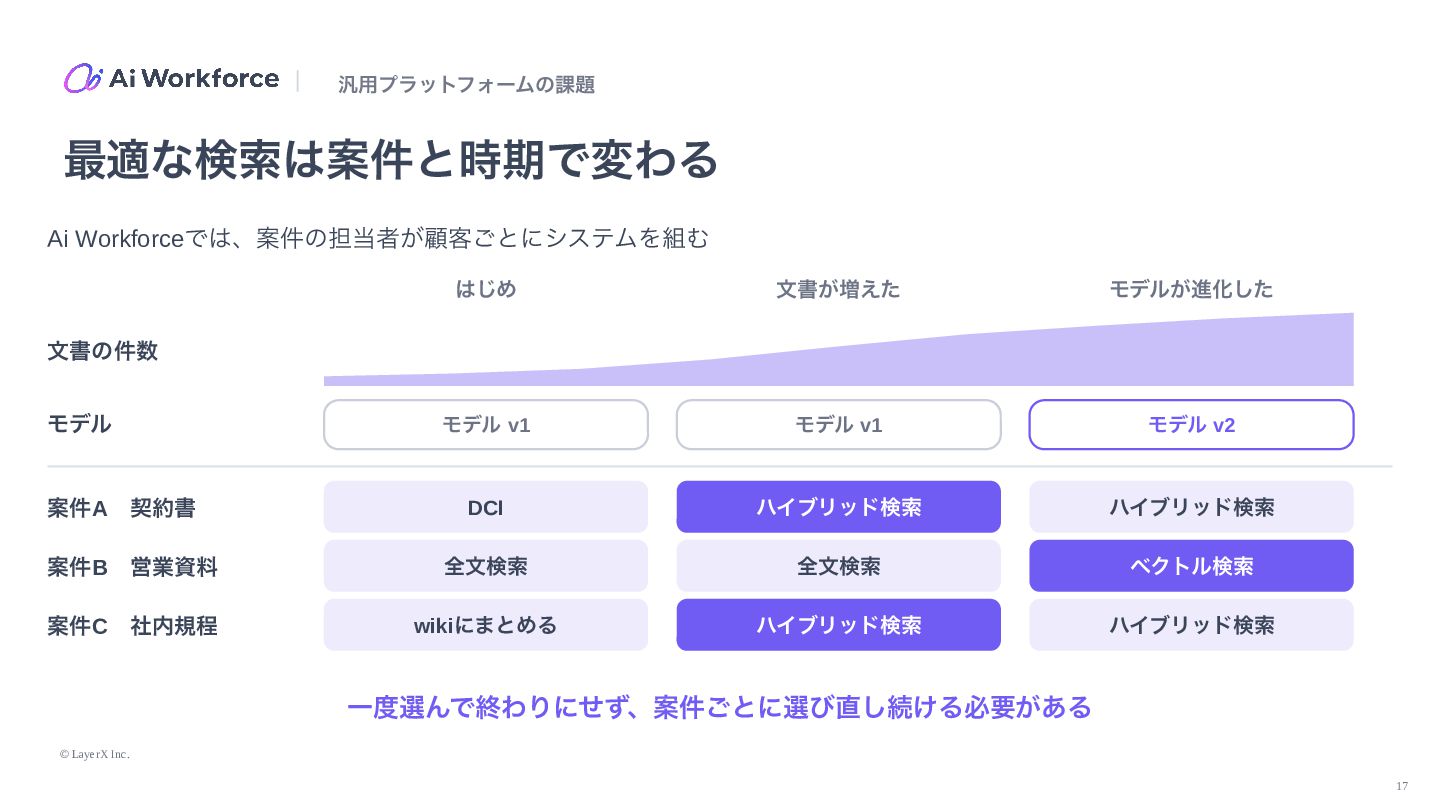
汎用プラットフォームの課題 最適な検索は案件と時期で変わる Ai Workforceでは、案件の担当者が顧客ごとにシステムを組む はじめ 文書が増えた モデルが進化した モデル v1 モデル
v1 モデル v2 文書の件数 モデル 案件A 契約書 DCI ハイブリッド検索 ハイブリッド検索 案件B 営業資料 全文検索 全文検索 ベクトル検索 案件C 社内規程 wikiにまとめる ハイブリッド検索 ハイブリッド検索 一度選んで終わりにせず、案件ごとに選び直し続ける必要がある © LayerX Inc. 17 -
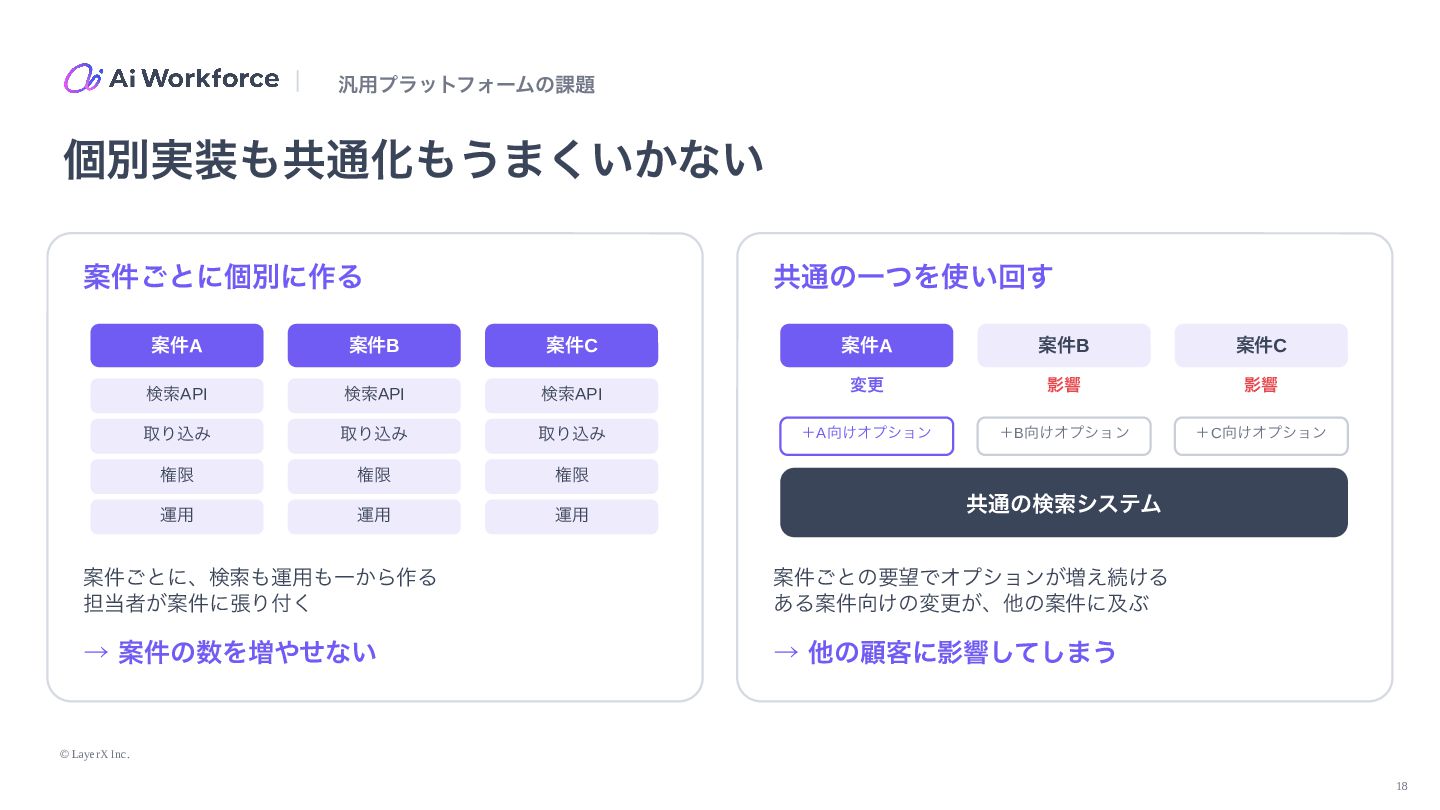
汎用プラットフォームの課題 個別実装も共通化もうまくいかない 案件ごとに個別に作る 共通の一つを使い回す 案件A 案件B 案件C 案件A 案件B 案件C
検索API 検索API 検索API 変更 影響 影響 取り込み 取り込み 取り込み +A向けオプション +B向けオプション +C向けオプション 権限 権限 権限 運用 運用 運用 共通の検索システム 案件ごとに、検索も運用も一から作る 担当者が案件に張り付く 案件ごとの要望でオプションが増え続ける ある案件向けの変更が、他の案件に及ぶ → 案件の数を増やせない → 他の顧客に影響してしまう © LayerX Inc. 18 -
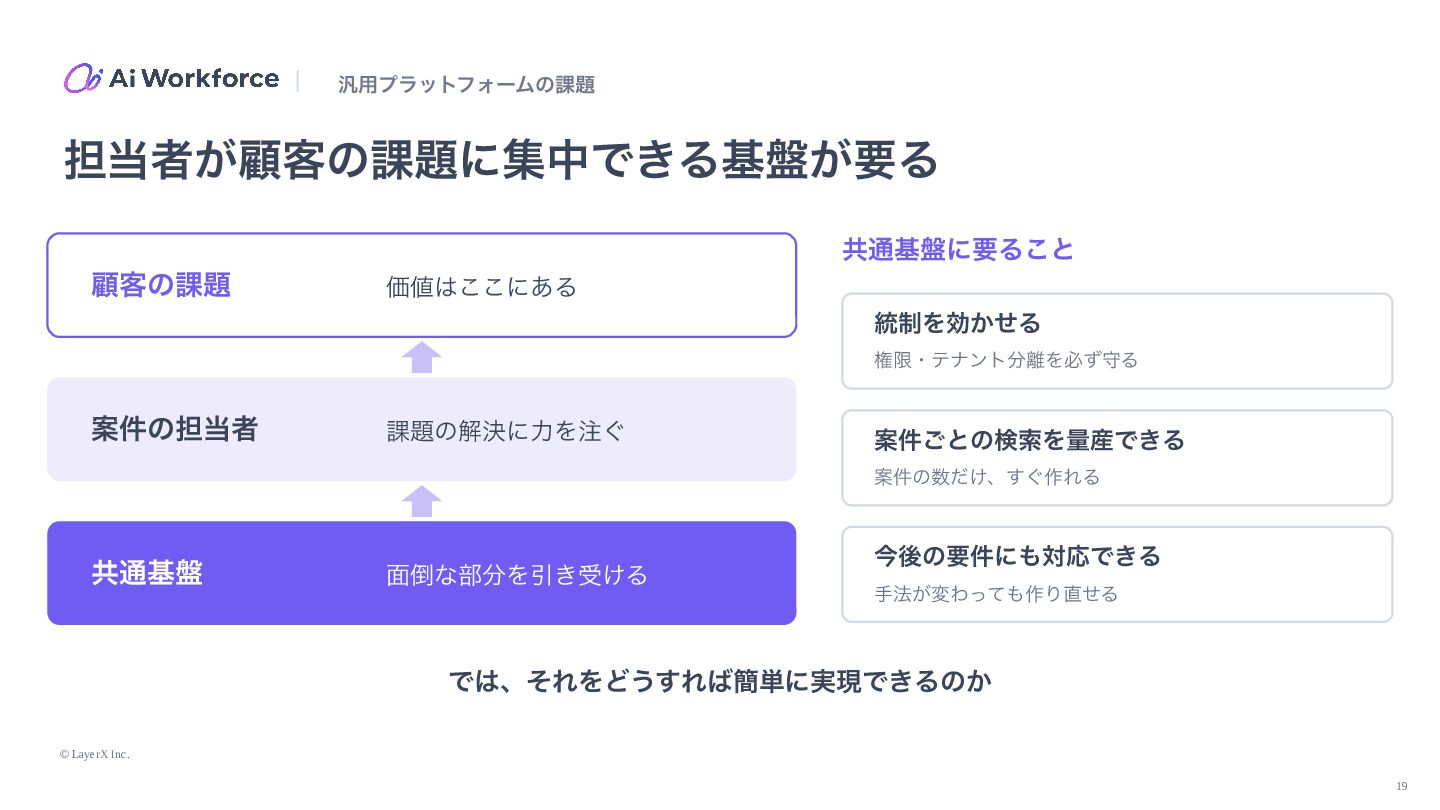
汎用プラットフォームの課題 担当者が顧客の課題に集中できる基盤が要る 顧客の課題 共通基盤に要ること 価値はここにある 統制を効かせる 権限・テナント分離を必ず守る 案件の担当者 課題の解決に力を注ぐ 案件ごとの検索を量産できる
案件の数だけ、すぐ作れる 共通基盤 面倒な部分を引き受ける 今後の要件にも対応できる 手法が変わっても作り直せる では、それをどうすれば簡単に実現できるのか © LayerX Inc. 19 -
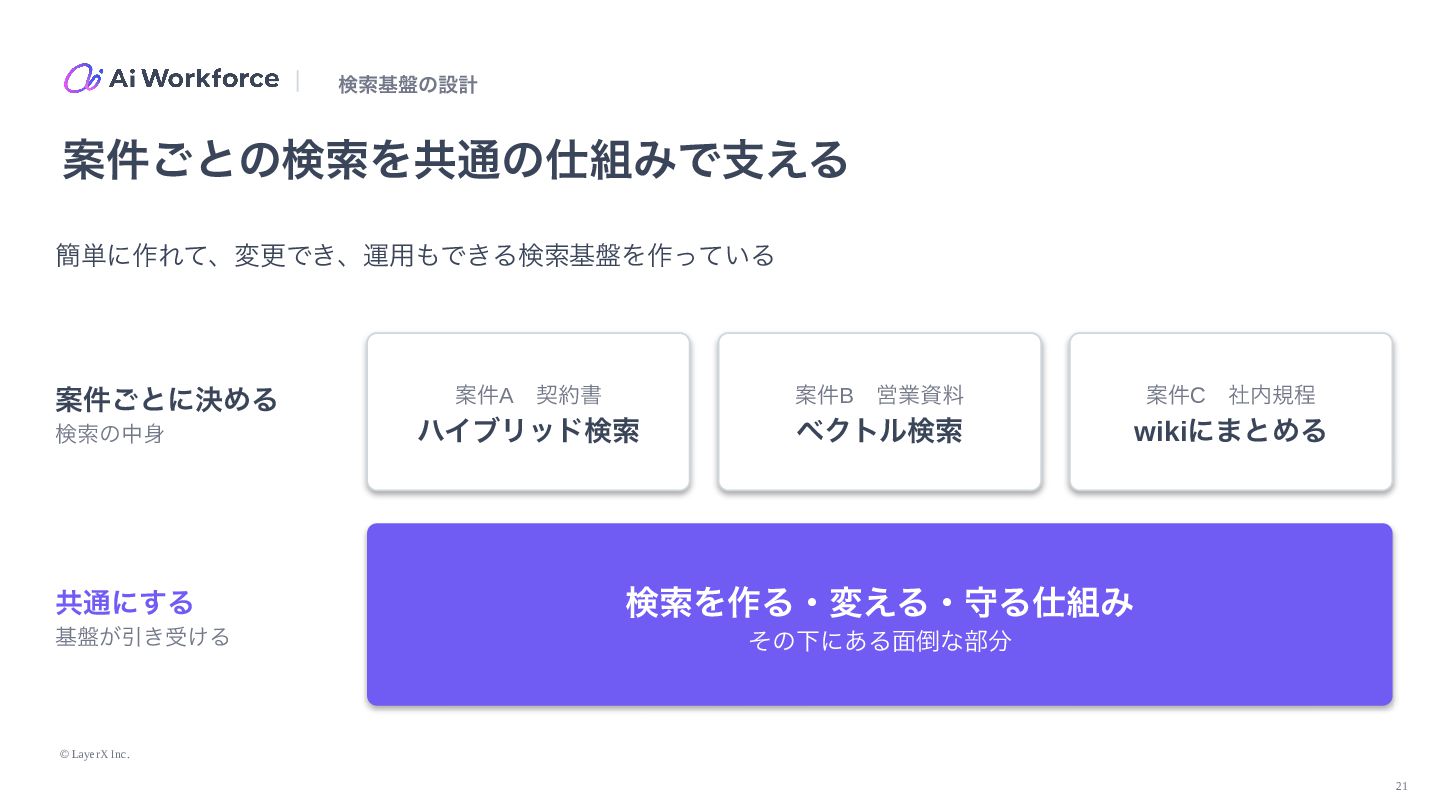
検索基盤の設計 案件ごとの検索を共通の仕組みで支える 簡単に作れて、変更でき、運用もできる検索基盤を作っている 案件ごとに決める 検索の中身 共通にする 基盤が引き受ける 案件A 契約書 案件B
ハイブリッド検索 営業資料 ベクトル検索 案件C 社内規程 wikiにまとめる 検索を作る・変える・守る仕組み その下にある面倒な部分 © LayerX Inc. 21 -
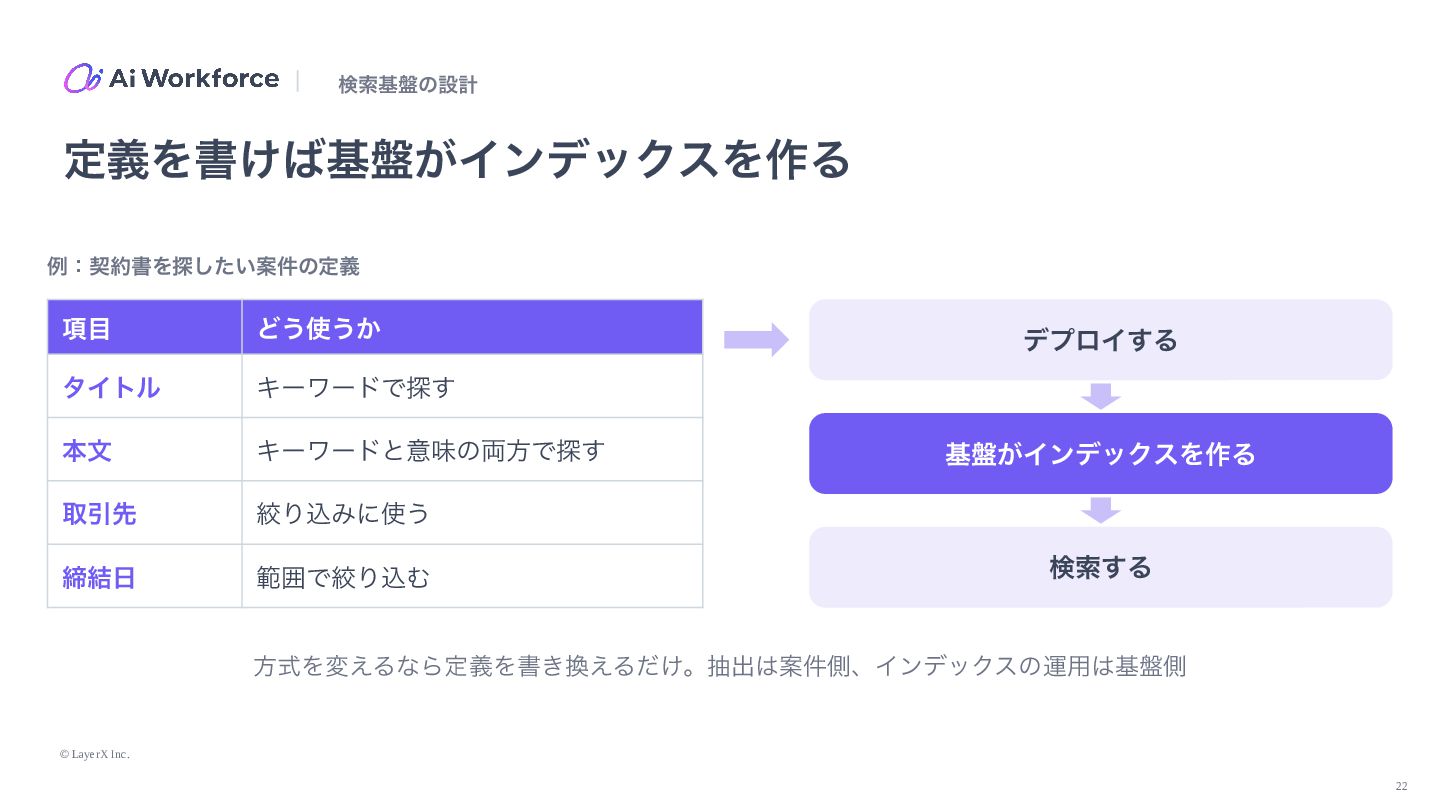
検索基盤の設計 定義を書けば基盤がインデックスを作る 例:契約書を探したい案件の定義 項目 どう使うか タイトル キーワードで探す 本文 キーワードと意味の両方で探す 取引先
絞り込みに使う 締結日 範囲で絞り込む デプロイする 基盤がインデックスを作る 検索する 方式を変えるなら定義を書き換えるだけ。抽出は案件側、インデックスの運用は基盤側 © LayerX Inc. 22 -
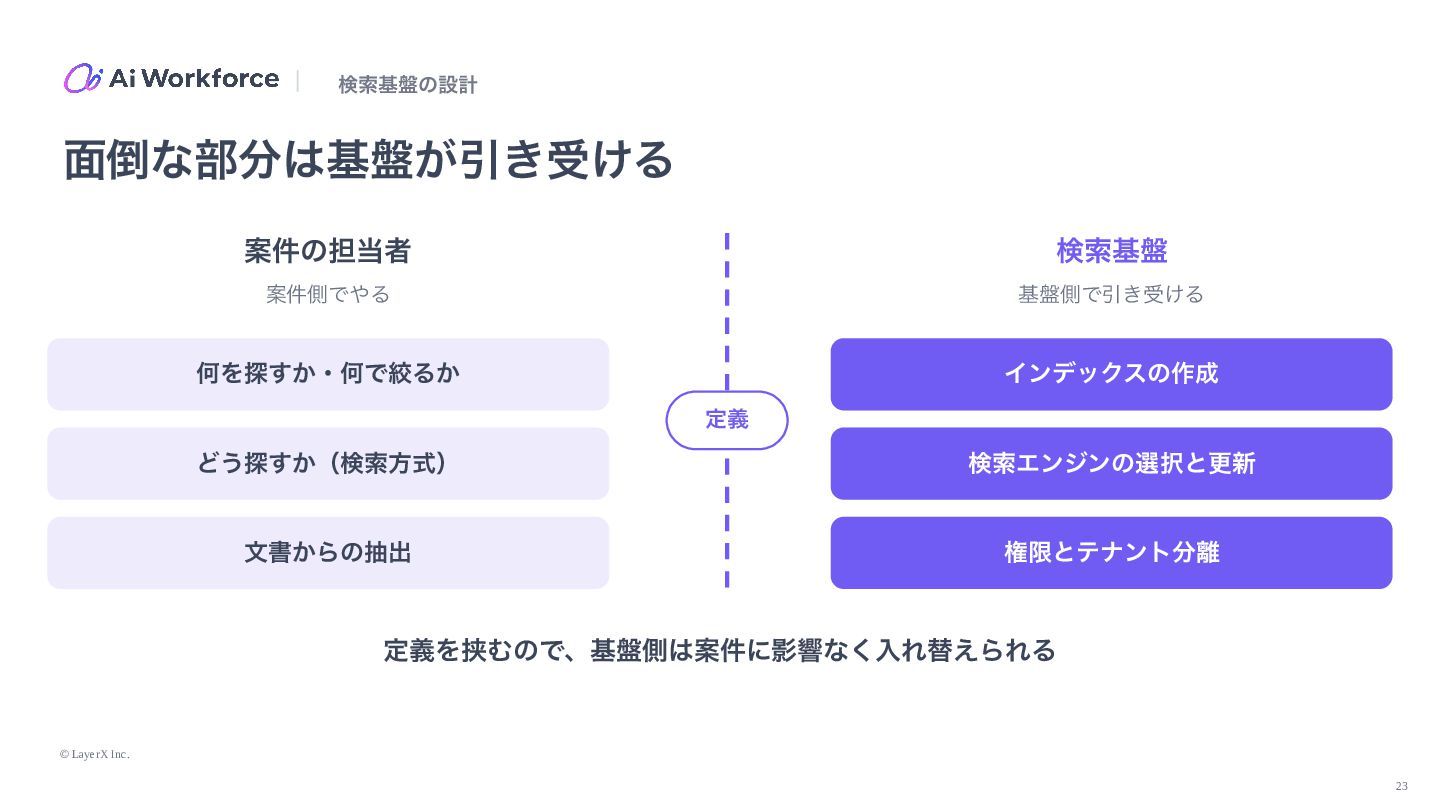
検索基盤の設計 面倒な部分は基盤が引き受ける 案件の担当者 検索基盤 案件側でやる 基盤側で引き受ける 何を探すか・何で絞るか インデックスの作成 定義 どう探すか(検索方式)
検索エンジンの選択と更新 文書からの抽出 権限とテナント分離 定義を挟むので、基盤側は案件に影響なく入れ替えられる © LayerX Inc. 23 -
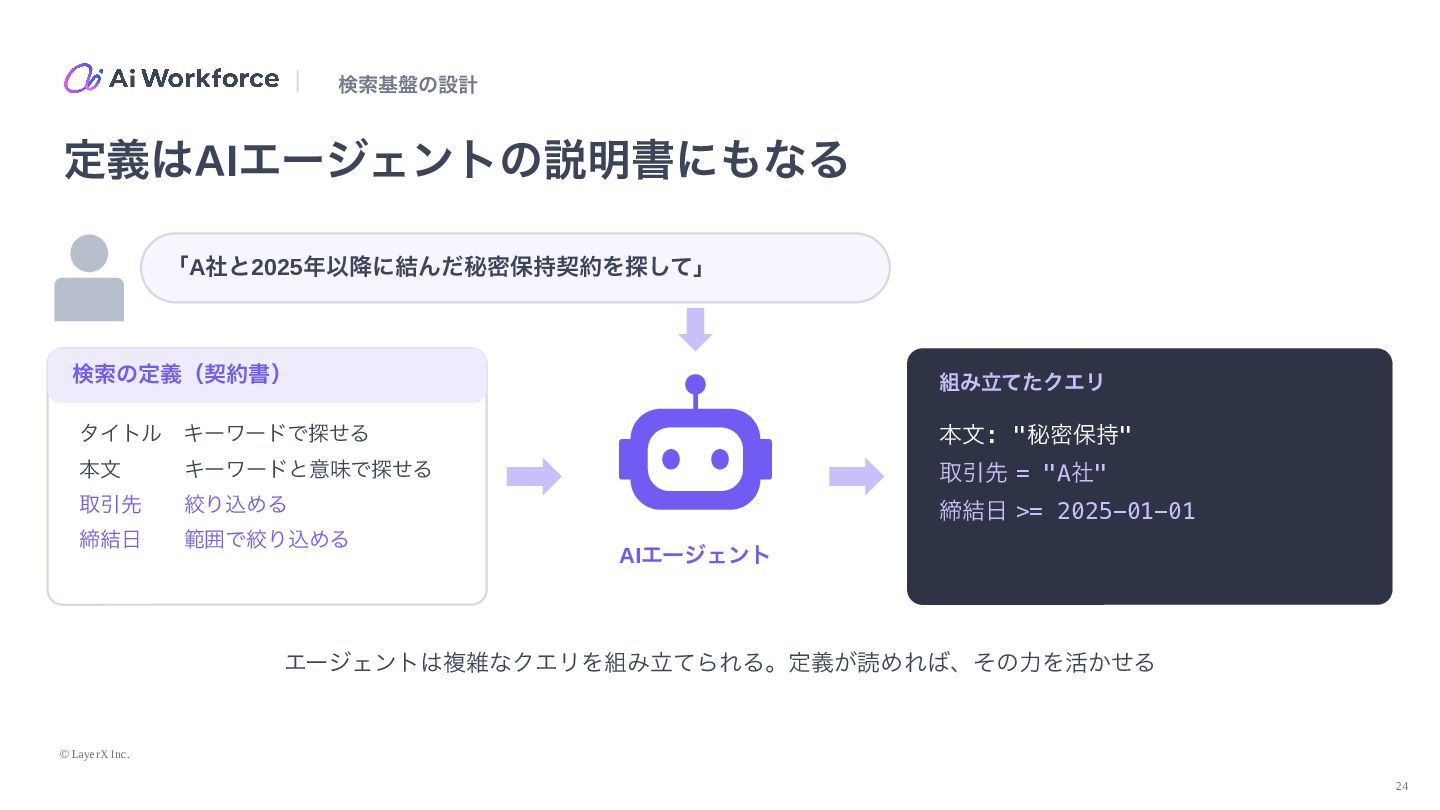
検索基盤の設計 定義はAIエージェントの説明書にもなる 「A社と2025年以降に結んだ秘密保持契約を探して」 検索の定義(契約書) 組み立てたクエリ タイトル キーワードで探せる 本文: "秘密保持" 本文
キーワードと意味で探せる 取引先 = "A社" 取引先 絞り込める 締結日 >= 2025-01-01 締結日 範囲で絞り込める AIエージェント エージェントは複雑なクエリを組み立てられる。定義が読めれば、その力を活かせる © LayerX Inc. 24 -
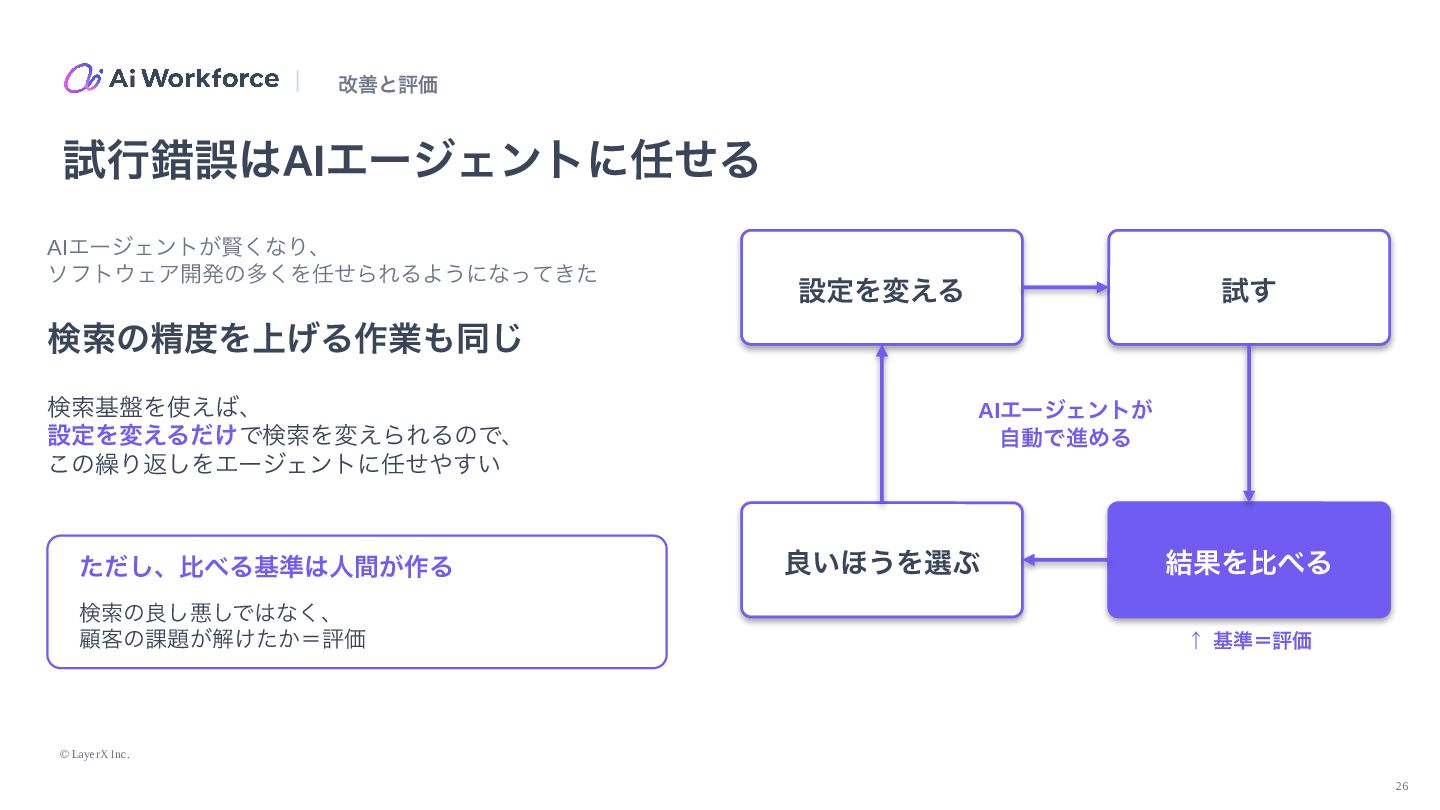
改善と評価 試行錯誤はAIエージェントに任せる AIエージェントが賢くなり、 ソフトウェア開発の多くを任せられるようになってきた 設定を変える 試す 検索の精度を上げる作業も同じ 検索基盤を使えば、 設定を変えるだけで検索を変えられるので、 この繰り返しをエージェントに任せやすい
ただし、比べる基準は人間が作る 検索の良し悪しではなく、 顧客の課題が解けたか=評価 AIエージェントが 自動で進める 良いほうを選ぶ 結果を比べる ↑ 基準=評価 © LayerX Inc. 26 -
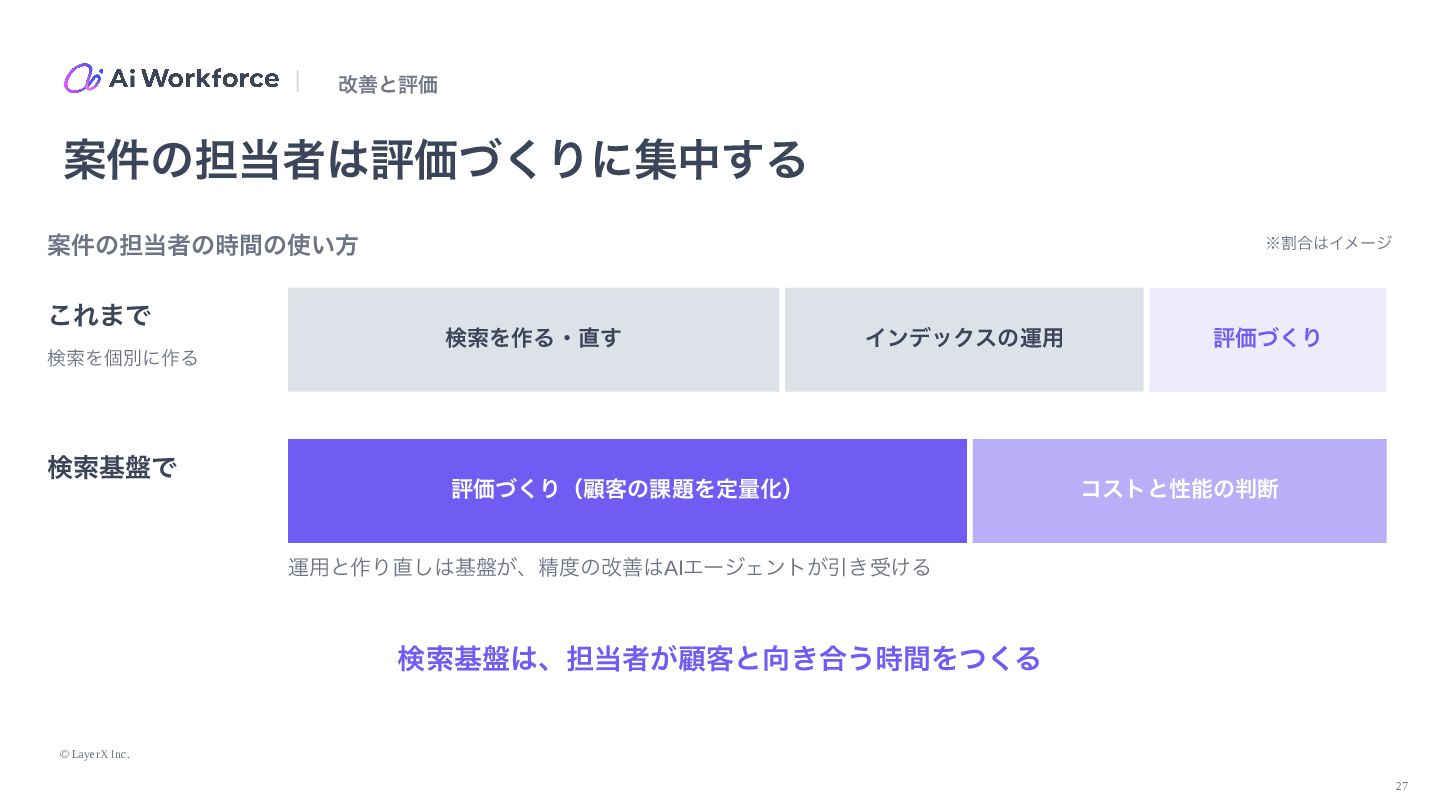
改善と評価 案件の担当者は評価づくりに集中する 案件の担当者の時間の使い方 これまで 検索を個別に作る 検索基盤で ※割合はイメージ 検索を作る・直す インデックスの運用 評価づくり(顧客の課題を定量化)
評価づくり コストと性能の判断 運用と作り直しは基盤が、精度の改善はAIエージェントが引き受ける 検索基盤は、担当者が顧客と向き合う時間をつくる © LayerX Inc. 27 -
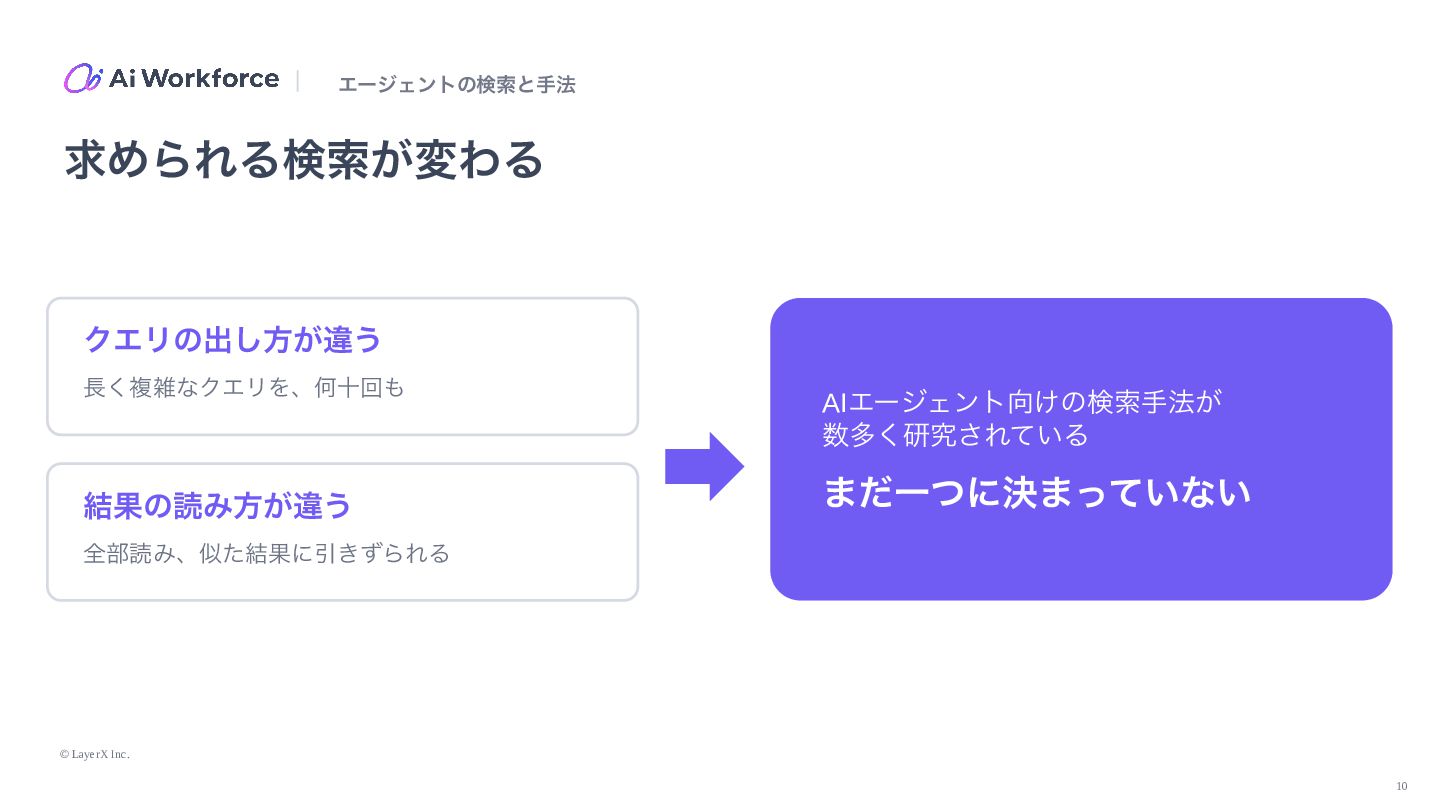
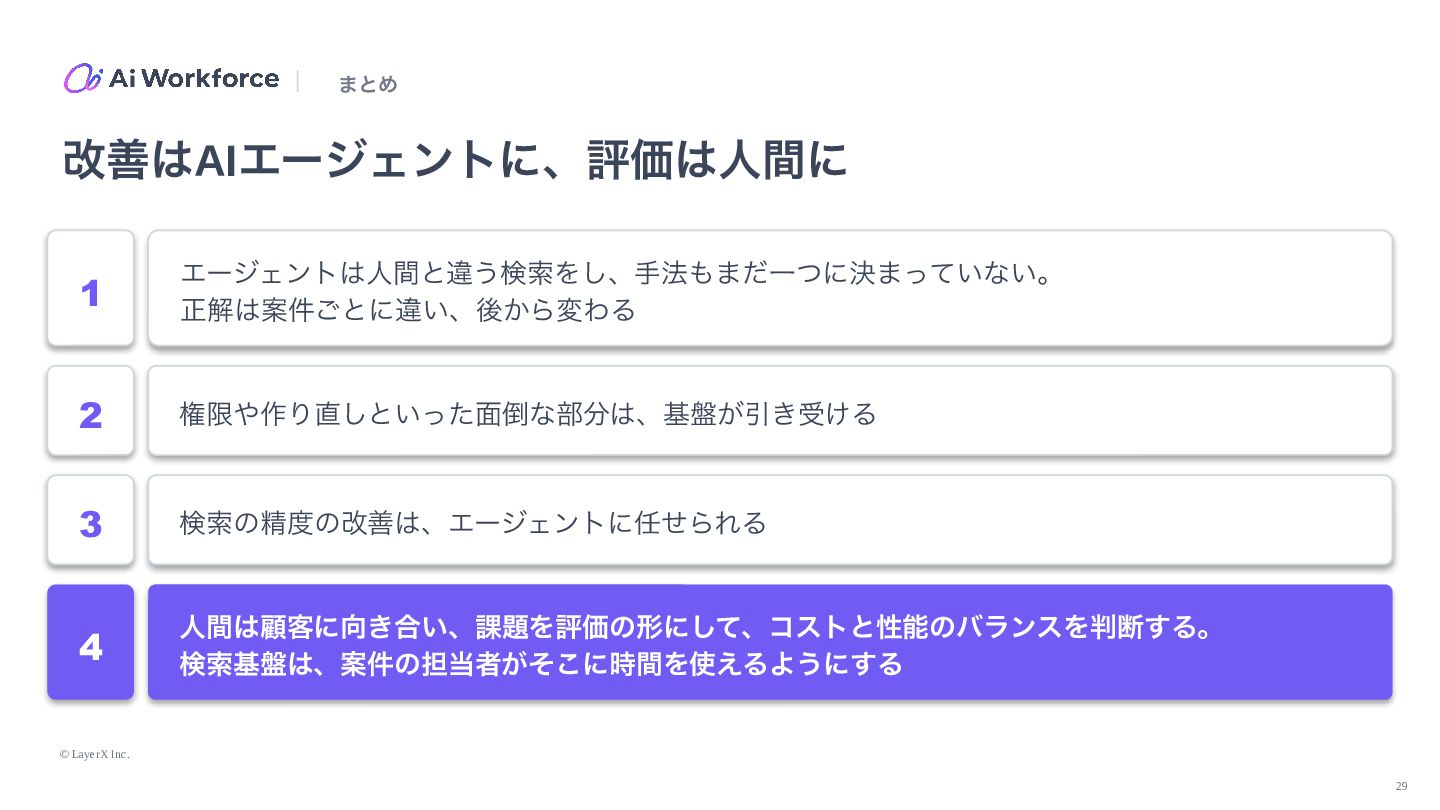
まとめ 改善はAIエージェントに、評価は人間に 1 エージェントは人間と違う検索をし、手法もまだ一つに決まっていない。 正解は案件ごとに違い、後から変わる 2 権限や作り直しといった面倒な部分は、基盤が引き受ける 3 検索の精度の改善は、エージェントに任せられる 4
人間は顧客に向き合い、課題を評価の形にして、コストと性能のバランスを判断する。 検索基盤は、案件の担当者がそこに時間を使えるようにする © LayerX Inc. 29 -
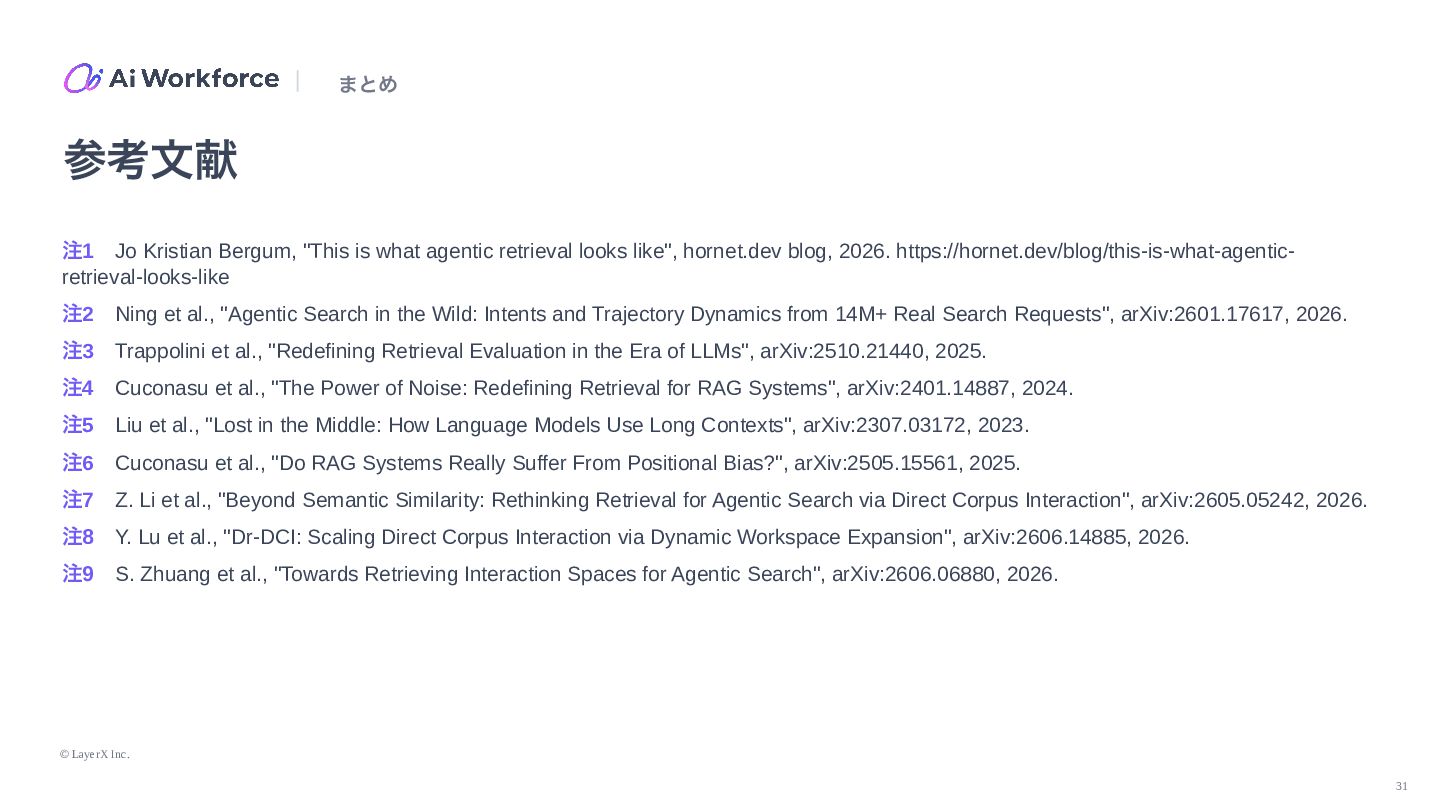
まとめ 参考文献 注1 Jo Kristian Bergum, "This is what agentic
retrieval looks like", hornet.dev blog, 2026. https://hornet.dev/blog/this-is-what-agenticretrieval-looks-like 注2 Ning et al., "Agentic Search in the Wild: Intents and Trajectory Dynamics from 14M+ Real Search Requests", arXiv:2601.17617, 2026. 注3 Trappolini et al., "Redefining Retrieval Evaluation in the Era of LLMs", arXiv:2510.21440, 2025. 注4 Cuconasu et al., "The Power of Noise: Redefining Retrieval for RAG Systems", arXiv:2401.14887, 2024. 注5 Liu et al., "Lost in the Middle: How Language Models Use Long Contexts", arXiv:2307.03172, 2023. 注6 Cuconasu et al., "Do RAG Systems Really Suffer From Positional Bias?", arXiv:2505.15561, 2025. 注7 Z. Li et al., "Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction", arXiv:2605.05242, 2026. 注8 Y. Lu et al., "Dr-DCI: Scaling Direct Corpus Interaction via Dynamic Workspace Expansion", arXiv:2606.14885, 2026. 注9 S. Zhuang et al., "Towards Retrieving Interaction Spaces for Agentic Search", arXiv:2606.06880, 2026. © LayerX Inc. 31