Upgrade to Pro — share decks privately, control downloads, hide ads and more …

RL in LLM ~ より実践的に使うための知識 (ノウハウ)

Avatar for 松崎剛 松崎剛
December 20, 2025
170

RL in LLM ~ より実践的に使うための知識 (ノウハウ)

Avatar for 松崎剛

松崎剛

December 20, 2025

Transcript

  1. 過去の実施 Microsoft Research の研究 work から見る生成 AI トレンド 2024年08月 言語モデルはどこまで賢くなるのか

    ... ~ o1 登場で注目を集める高度な CoT 能力の獲得について ~ 2024年12月 ここで紹介した Reinforcement Learning による言語モデル学習 を掘り下げる (実際に使う際に参考になりそうな情報) 今年
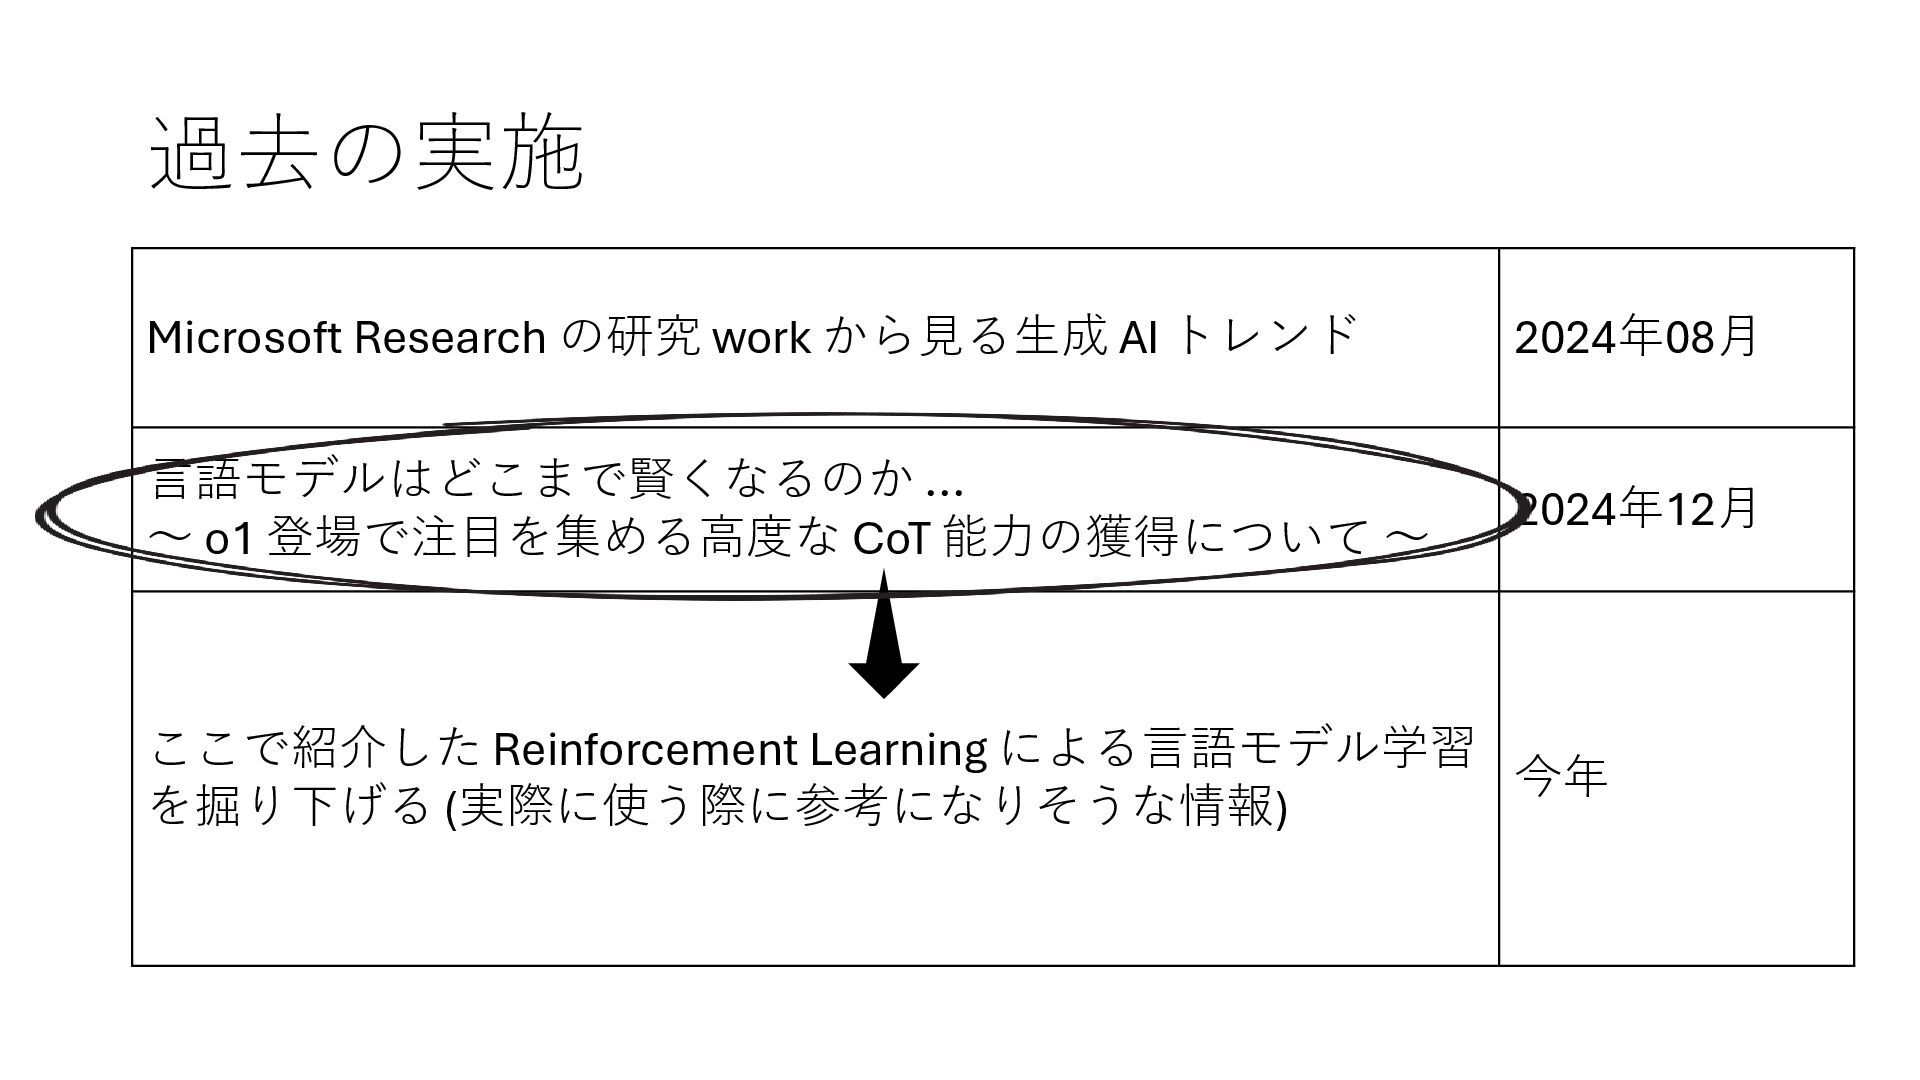
  2. 過去の実施 Microsoft Research の研究 work から見る生成 AI トレンド 2024年08月 言語モデルはどこまで賢くなるのか

    ... ~ o1 登場で注目を集める高度な CoT 能力の獲得について ~ 2024年12月 ここで紹介した Reinforcement Learning による言語モデル学習 を掘り下げる (実際に使う際に参考になりそうな情報) 今年
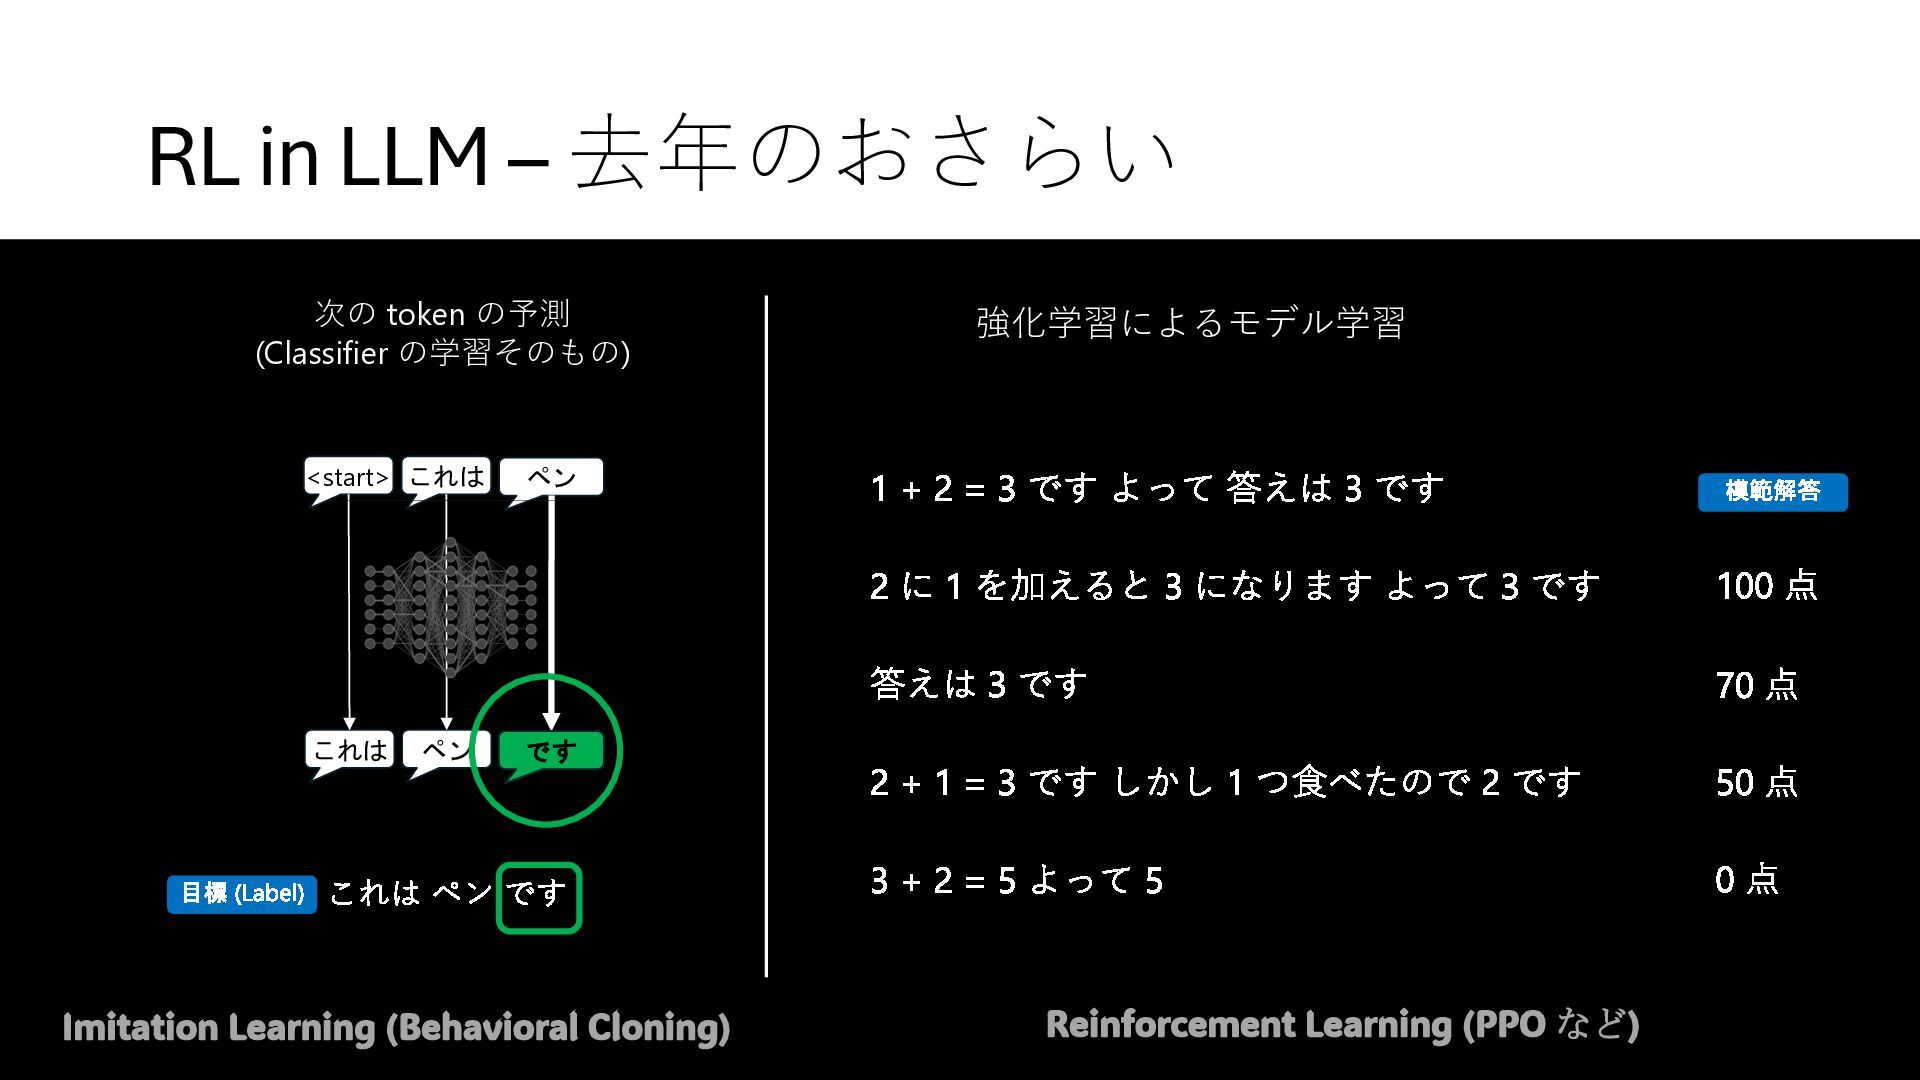
  3. RL in LLM – 去年のおさらい だった これは ペン ペン <start>

    これは これは ペン です 目標 (Label) だ ます か だろう です 次の token の予測 (Classifier の学習そのもの) 1 + 2 = 3 です よって 答えは 3 です 2 に 1 を加えると 3 になります よって 3 です 100 点 答えは 3 です 2 + 1 = 3 です しかし 1 つ食べたので 2 です 3 + 2 = 5 よって 5 70 点 50 点 0 点 強化学習によるモデル学習 模範解答 Imitation Learning (Behavioral Cloning) Reinforcement Learning (PPO など)
  4. RL in LLM – 去年のおさらい だった これは ペン ペン <start>

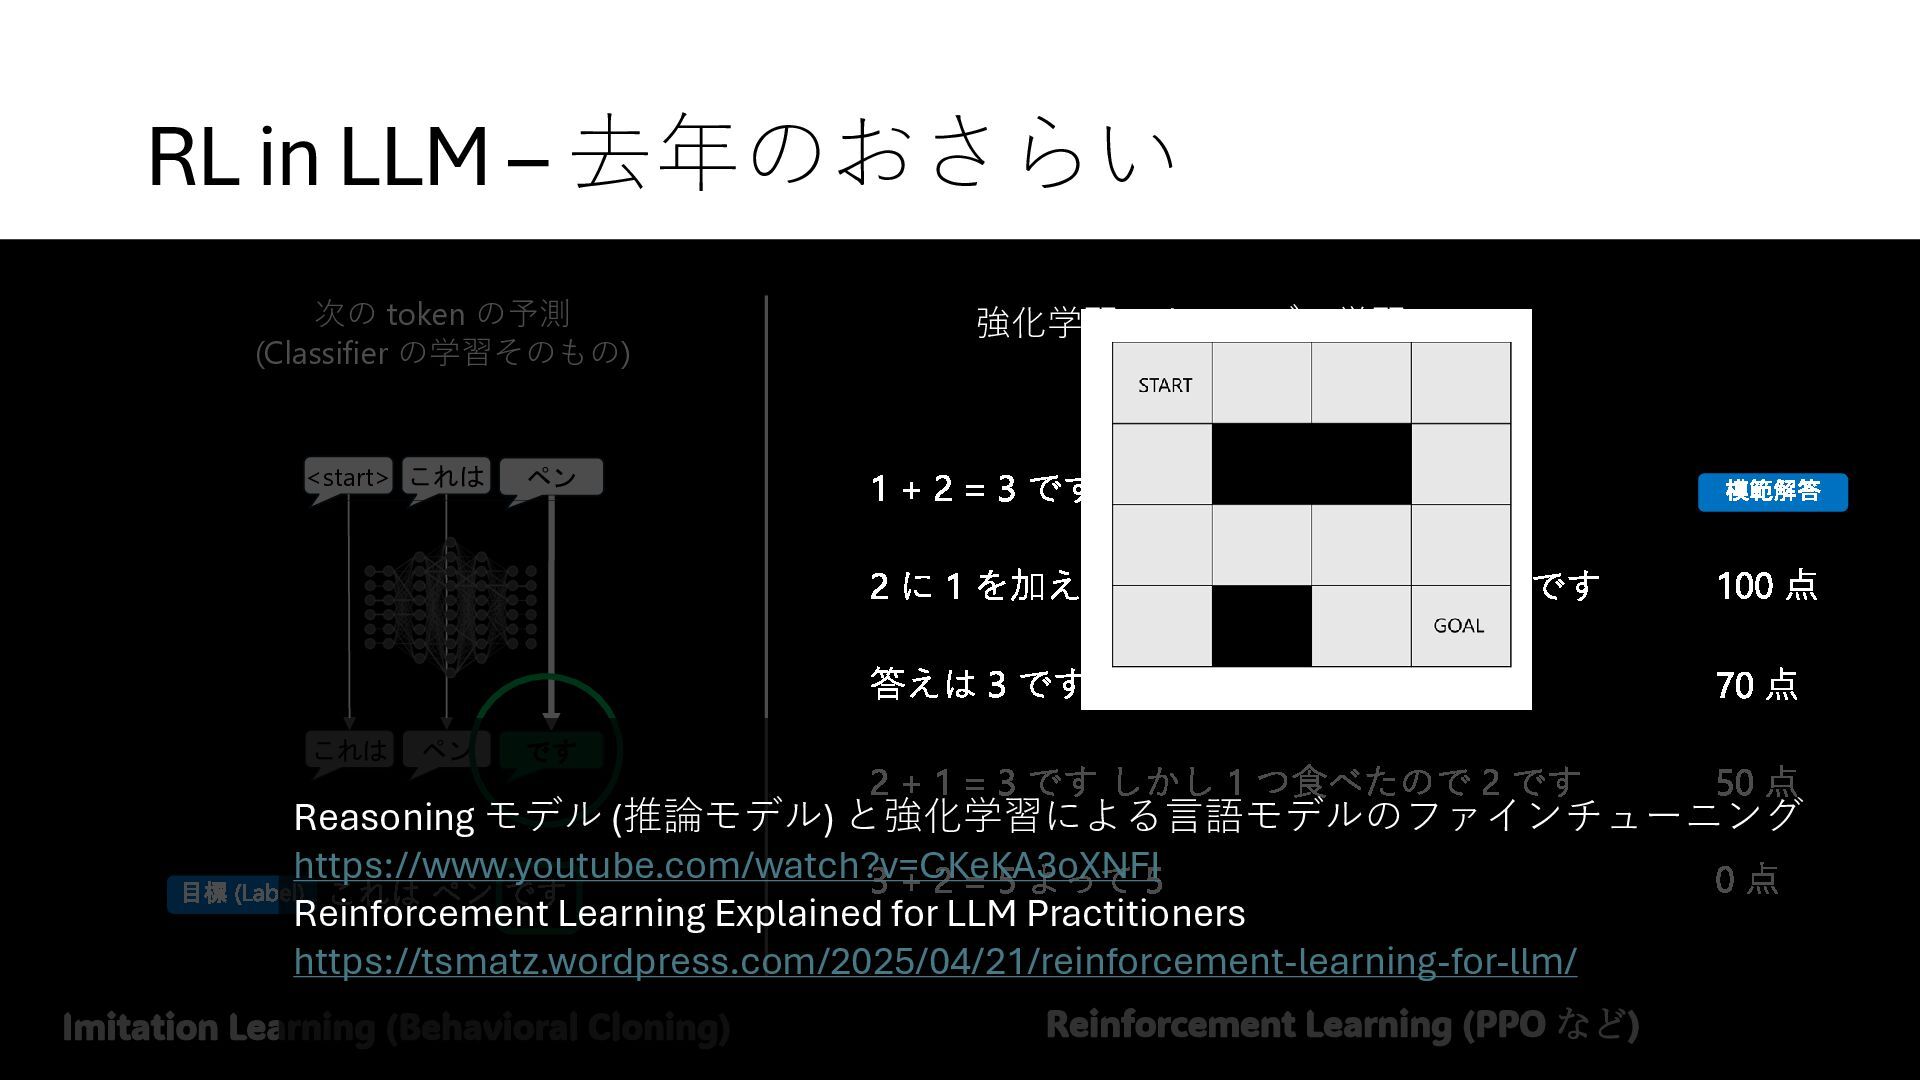
    これは これは ペン です 目標 (Label) だ ます か だろう です 次の token の予測 (Classifier の学習そのもの) 1 + 2 = 3 です よって 答えは 3 です 2 に 1 を加えると 3 になります よって 3 です 100 点 答えは 3 です 2 + 1 = 3 です しかし 1 つ食べたので 2 です 3 + 2 = 5 よって 5 70 点 50 点 0 点 強化学習によるモデル学習 模範解答 Imitation Learning (Behavioral Cloning) Reinforcement Learning (PPO など) Reasoning モデル (推論モデル) と強化学習による言語モデルのファインチューニング https://www.youtube.com/watch?v=CKeKA3oXNFI Reinforcement Learning Explained for LLM Practitioners https://tsmatz.wordpress.com/2025/04/21/reinforcement-learning-for-llm/
  5. RL in LLM – 去年のおさらい だった これは ペン ペン <start>

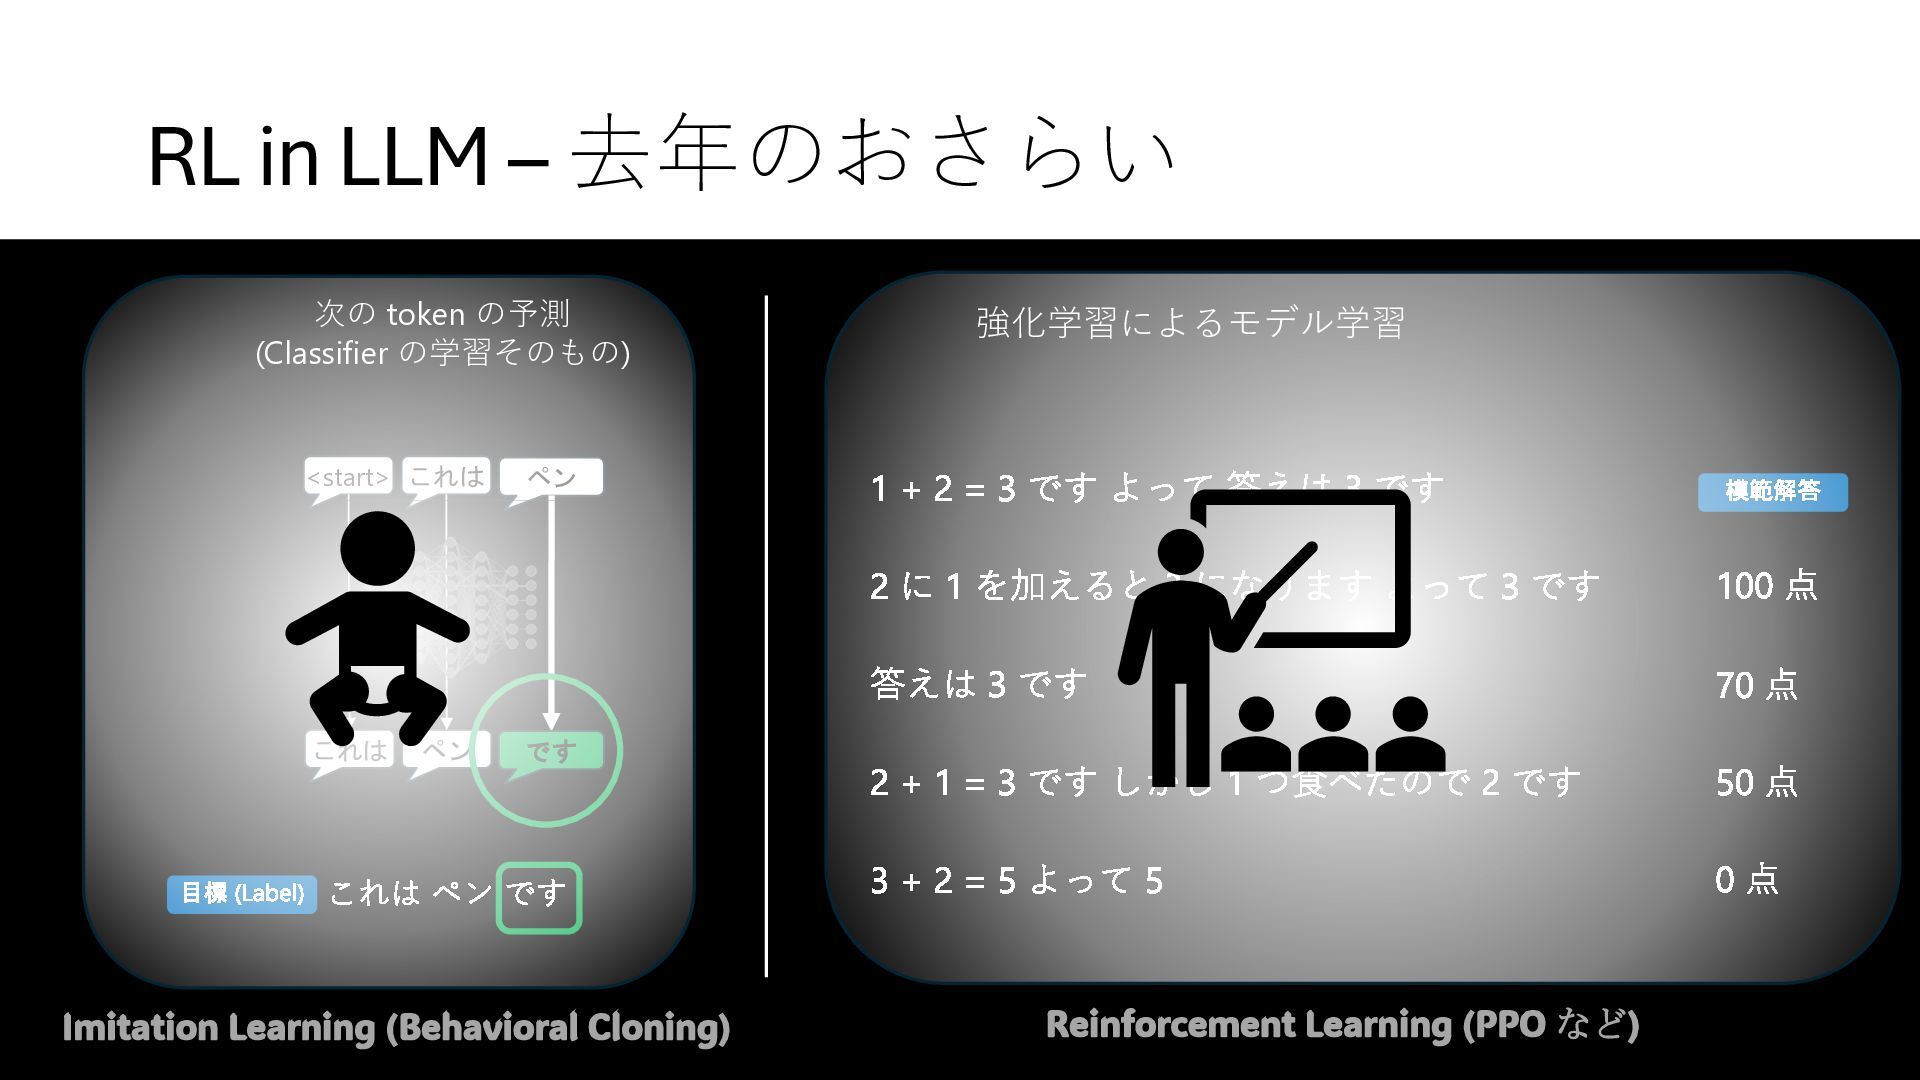
    これは これは ペン です 目標 (Label) だ ます か だろう です 次の token の予測 (Classifier の学習そのもの) 1 + 2 = 3 です よって 答えは 3 です 2 に 1 を加えると 3 になります よって 3 です 100 点 答えは 3 です 2 + 1 = 3 です しかし 1 つ食べたので 2 です 3 + 2 = 5 よって 5 70 点 50 点 0 点 強化学習によるモデル学習 模範解答 Imitation Learning (Behavioral Cloning) Reinforcement Learning (PPO など)
  6. RL in LLM – 去年のおさらい • Training language models to

    follow instructions with human feedback https://arxiv.org/pdf/2203.02155 • 実は、2022 年末の ChatGPT 登場当初から利用されていた . . . (厳密には、その前バージョンの InstructGPT から採用) • DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models https://arxiv.org/pdf/2402.03300 • 現在多くの場面で利用され、代表的なのは reasoning
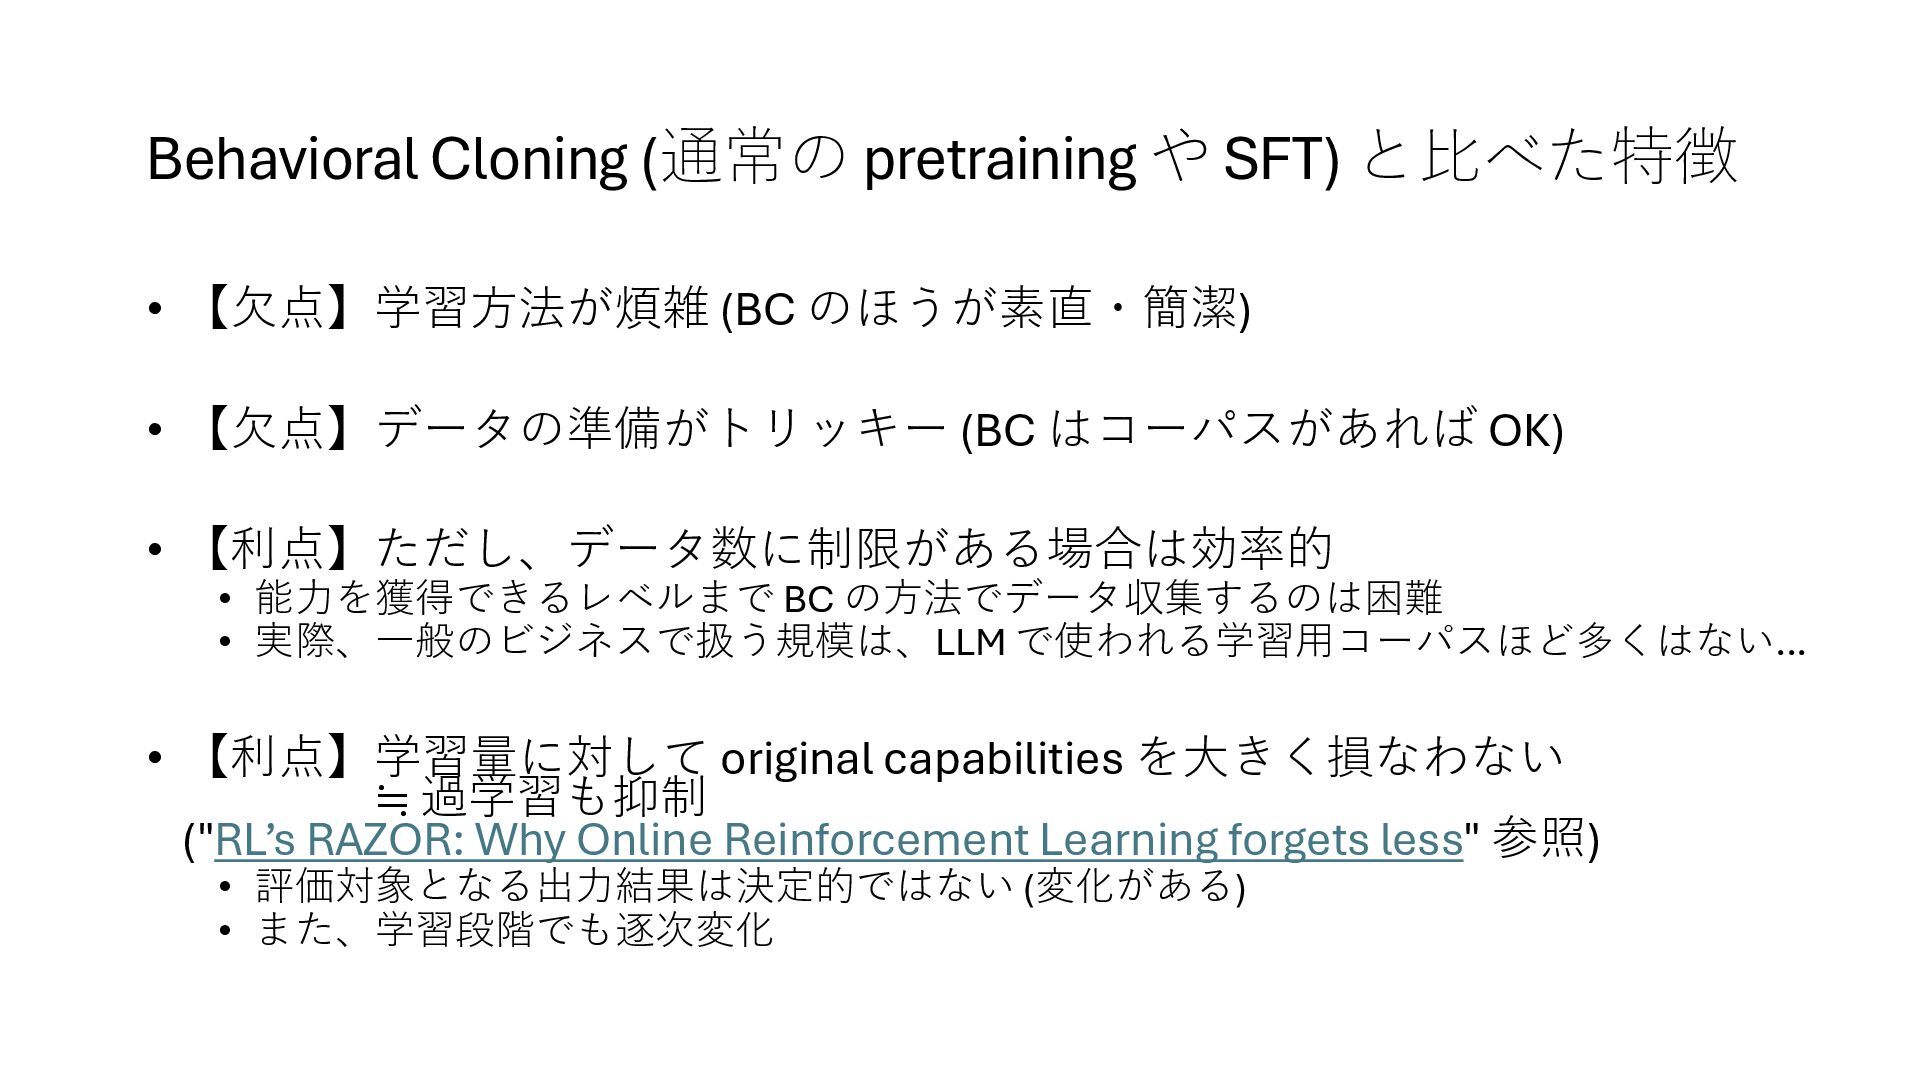
  7. Behavioral Cloning (通常の pretraining や SFT) と比べた特徴 • 【欠点】学習方法が煩雑 (BC

    のほうが素直・簡潔) • 【欠点】データの準備がトリッキー (BC はコーパスがあれば OK) • 【利点】ただし、データ数に制限がある場合は効率的 • 能力を獲得できるレベルまで BC の方法でデータ収集するのは困難 • 実際、一般のビジネスで扱う規模は、LLM で使われる学習用コーパスほど多くはない… • 【利点】学習量に対して original capabilities を大きく損なわない ≒ 過学習も抑制 ("RL’s RAZOR: Why Online Reinforcement Learning forgets less" 参照) • 評価対象となる出力結果は決定的ではない (変化がある) • また、学習段階でも逐次変化
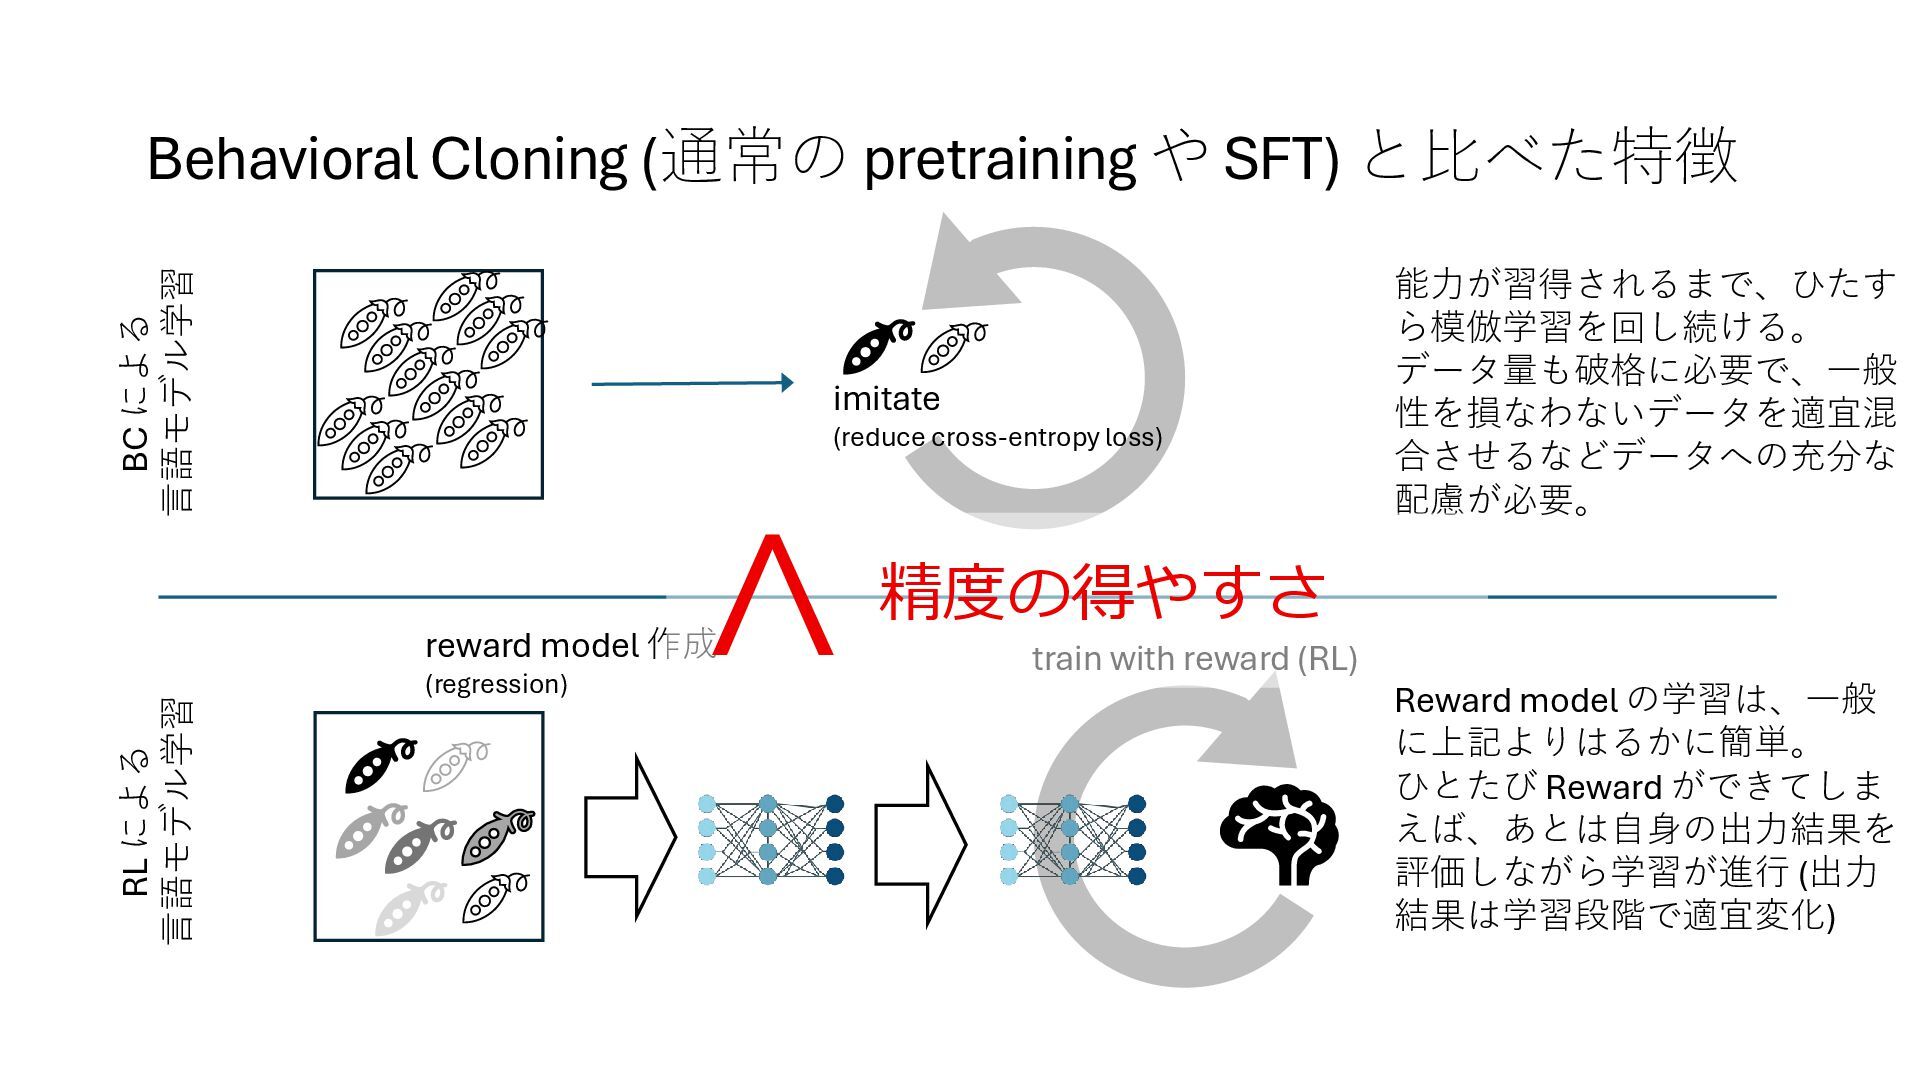
  8. Behavioral Cloning (通常の pretraining や SFT) と比べた特徴 imitate (reduce cross-entropy

    loss) reward model 作成 (regression) train with reward (RL) BC による 言語モデル学習 RL による 言語モデル学習 能力が習得されるまで、ひたす ら模倣学習を回し続ける。 データ量も破格に必要で、一般 性を損なわないデータを適宜混 合させるなどデータへの充分な 配慮が必要。 Reward model の学習は、一般 に上記よりはるかに簡単。 ひとたび Reward ができてしま えば、あとは自身の出力結果を 評価しながら学習が進行 (出力 結果は学習段階で適宜変化) 精度の得やすさ <
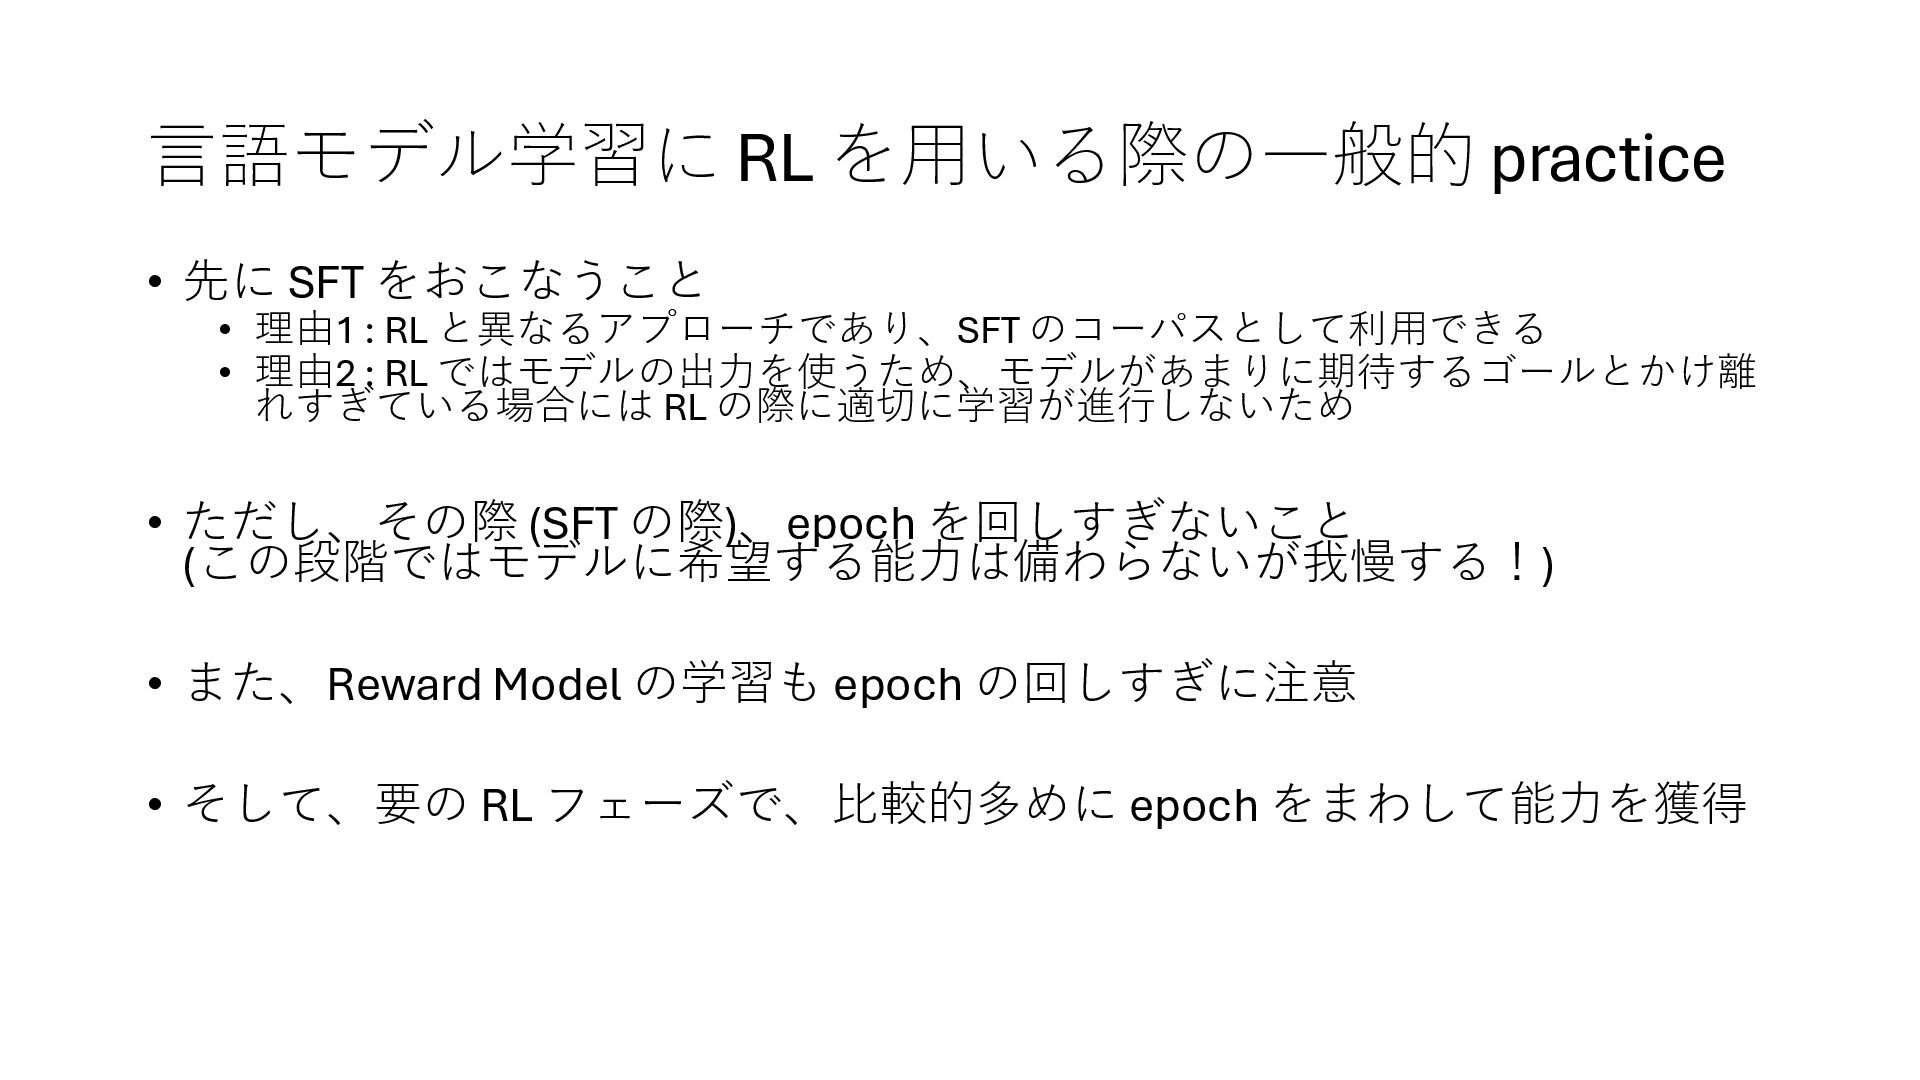
  9. 言語モデル学習に RL を用いる際の一般的 practice • 先に SFT をおこなうこと • 理由1

    : RL と異なるアプローチであり、SFT のコーパスとして利用できる • 理由2 : RL ではモデルの出力を使うため、モデルがあまりに期待するゴールとかけ離 れすぎている場合には RL の際に適切に学習が進行しないため • ただし、その際 (SFT の際)、epoch を回しすぎないこと (この段階ではモデルに希望する能力は備わらないが我慢する!) • また、Reward Model の学習も epoch の回しすぎに注意 • そして、要の RL フェーズで、比較的多めに epoch をまわして能力を獲得
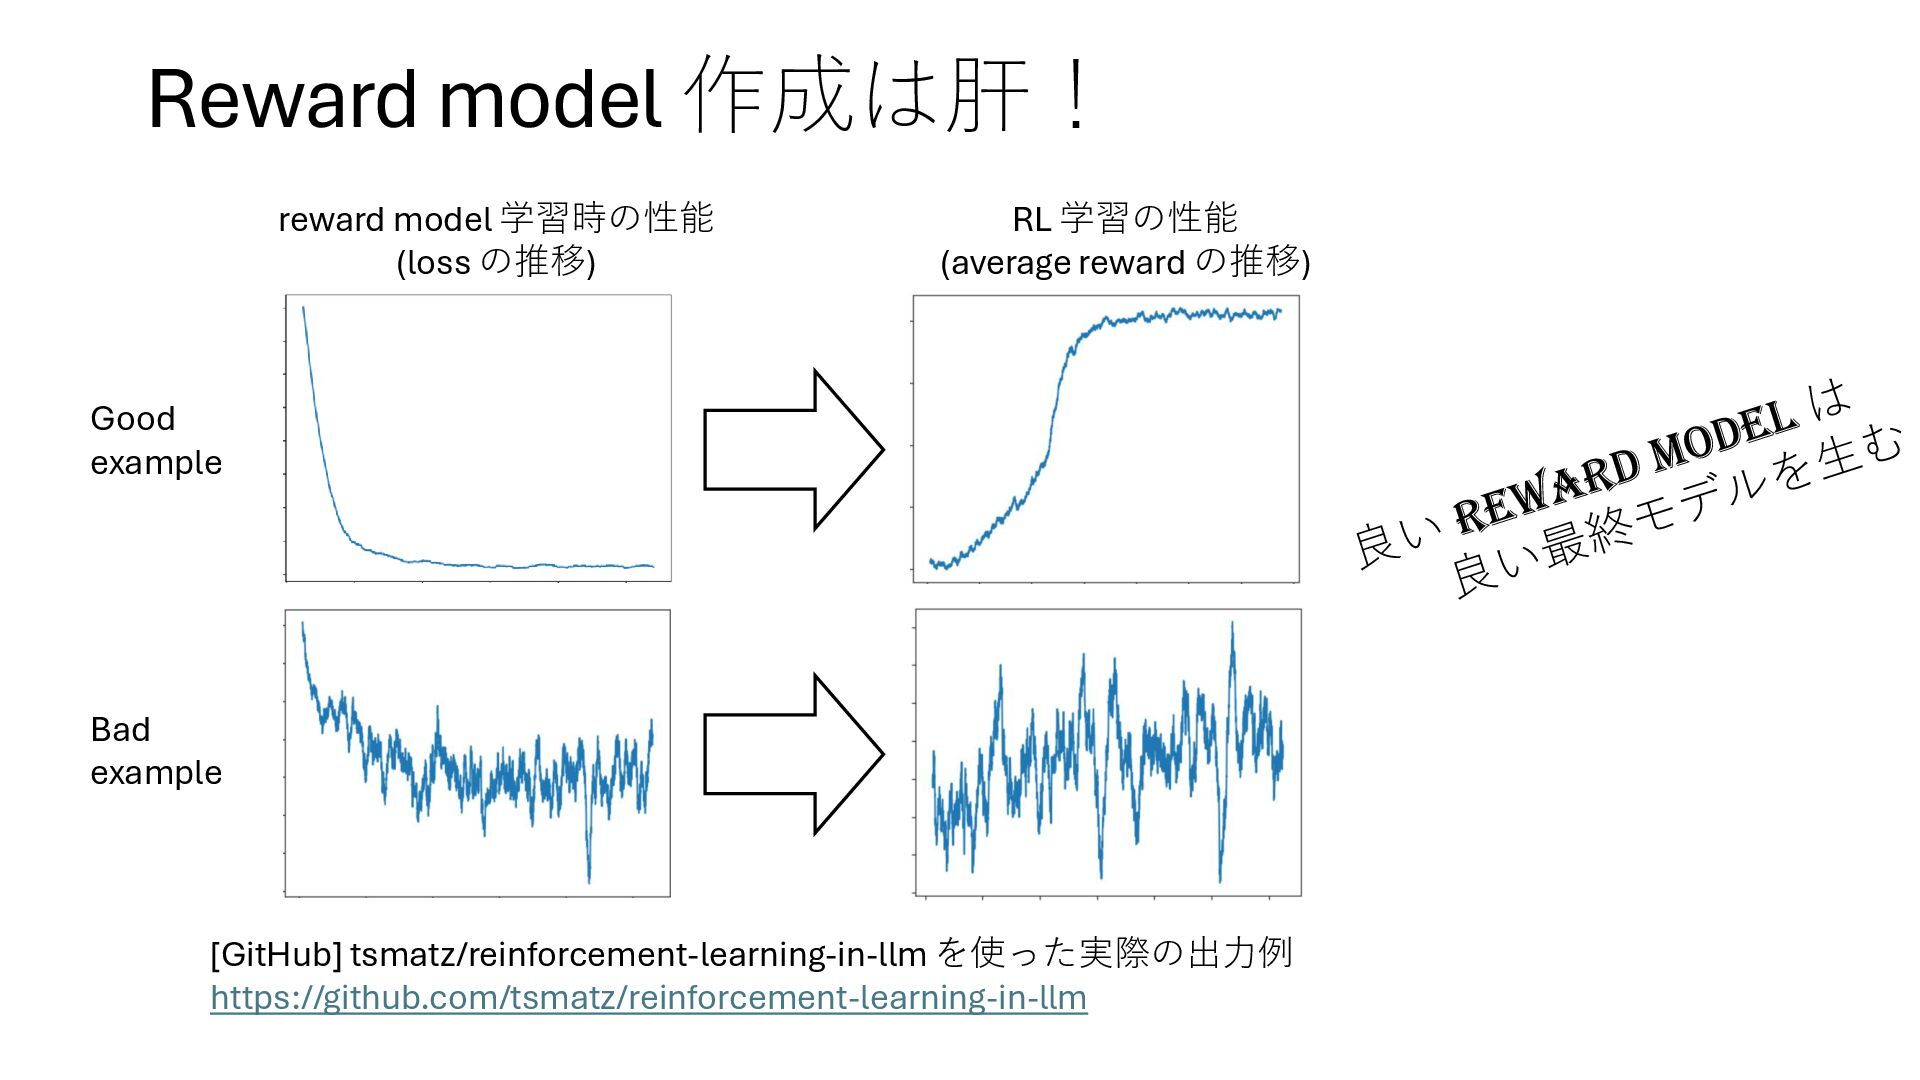
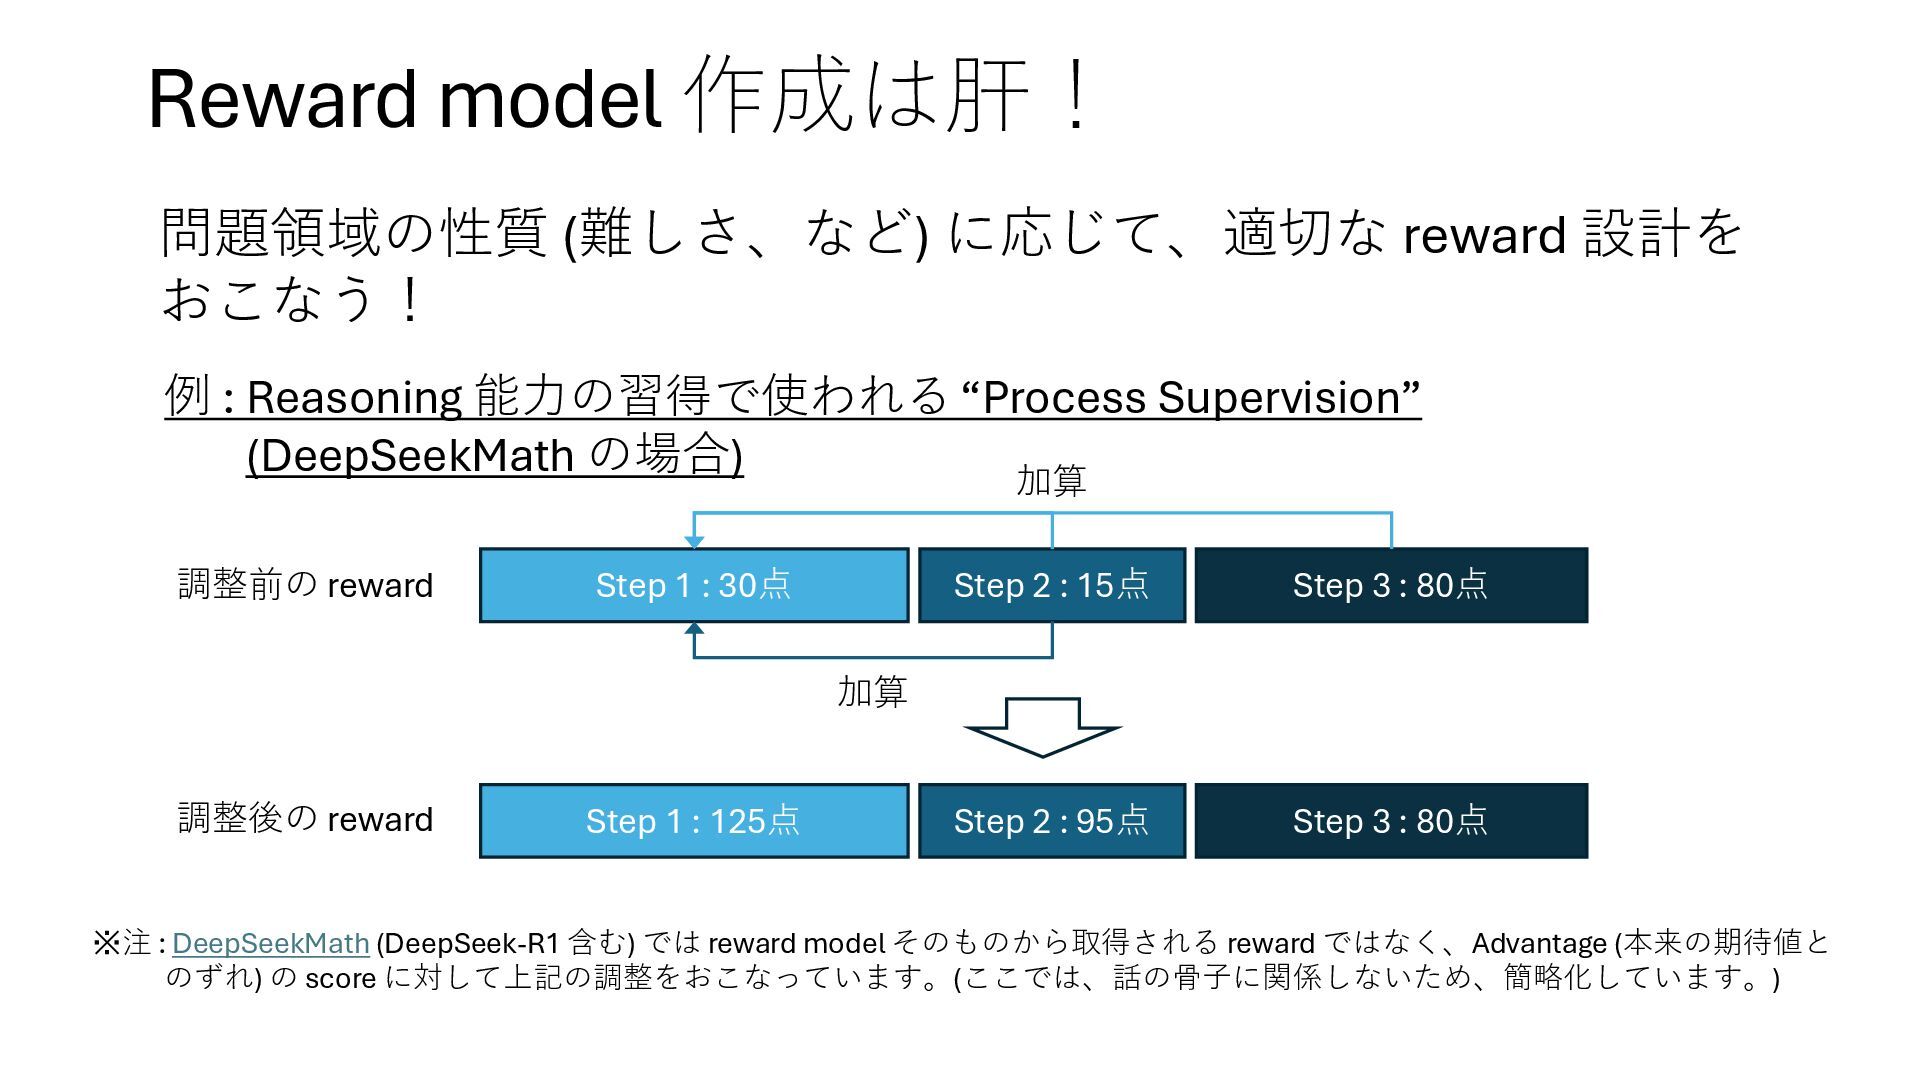
  10. Reward model 作成は肝! 例 : Reasoning 能力の習得で使われる “Process Supervision” (DeepSeekMath

    の場合) Step 1 : 30点 Step 2 : 15点 Step 3 : 80点 加算 加算 Step 1 : 125点 Step 2 : 95点 Step 3 : 80点 調整前の reward 調整後の reward ※注 : DeepSeekMath (DeepSeek-R1 含む) では reward model そのものから取得される reward ではなく、Advantage (本来の期待値と のずれ) の score に対して上記の調整をおこなっています。(ここでは、話の骨子に関係しないため、簡略化しています。) 問題領域の性質 (難しさ、など) に応じて、適切な reward 設計を おこなう!
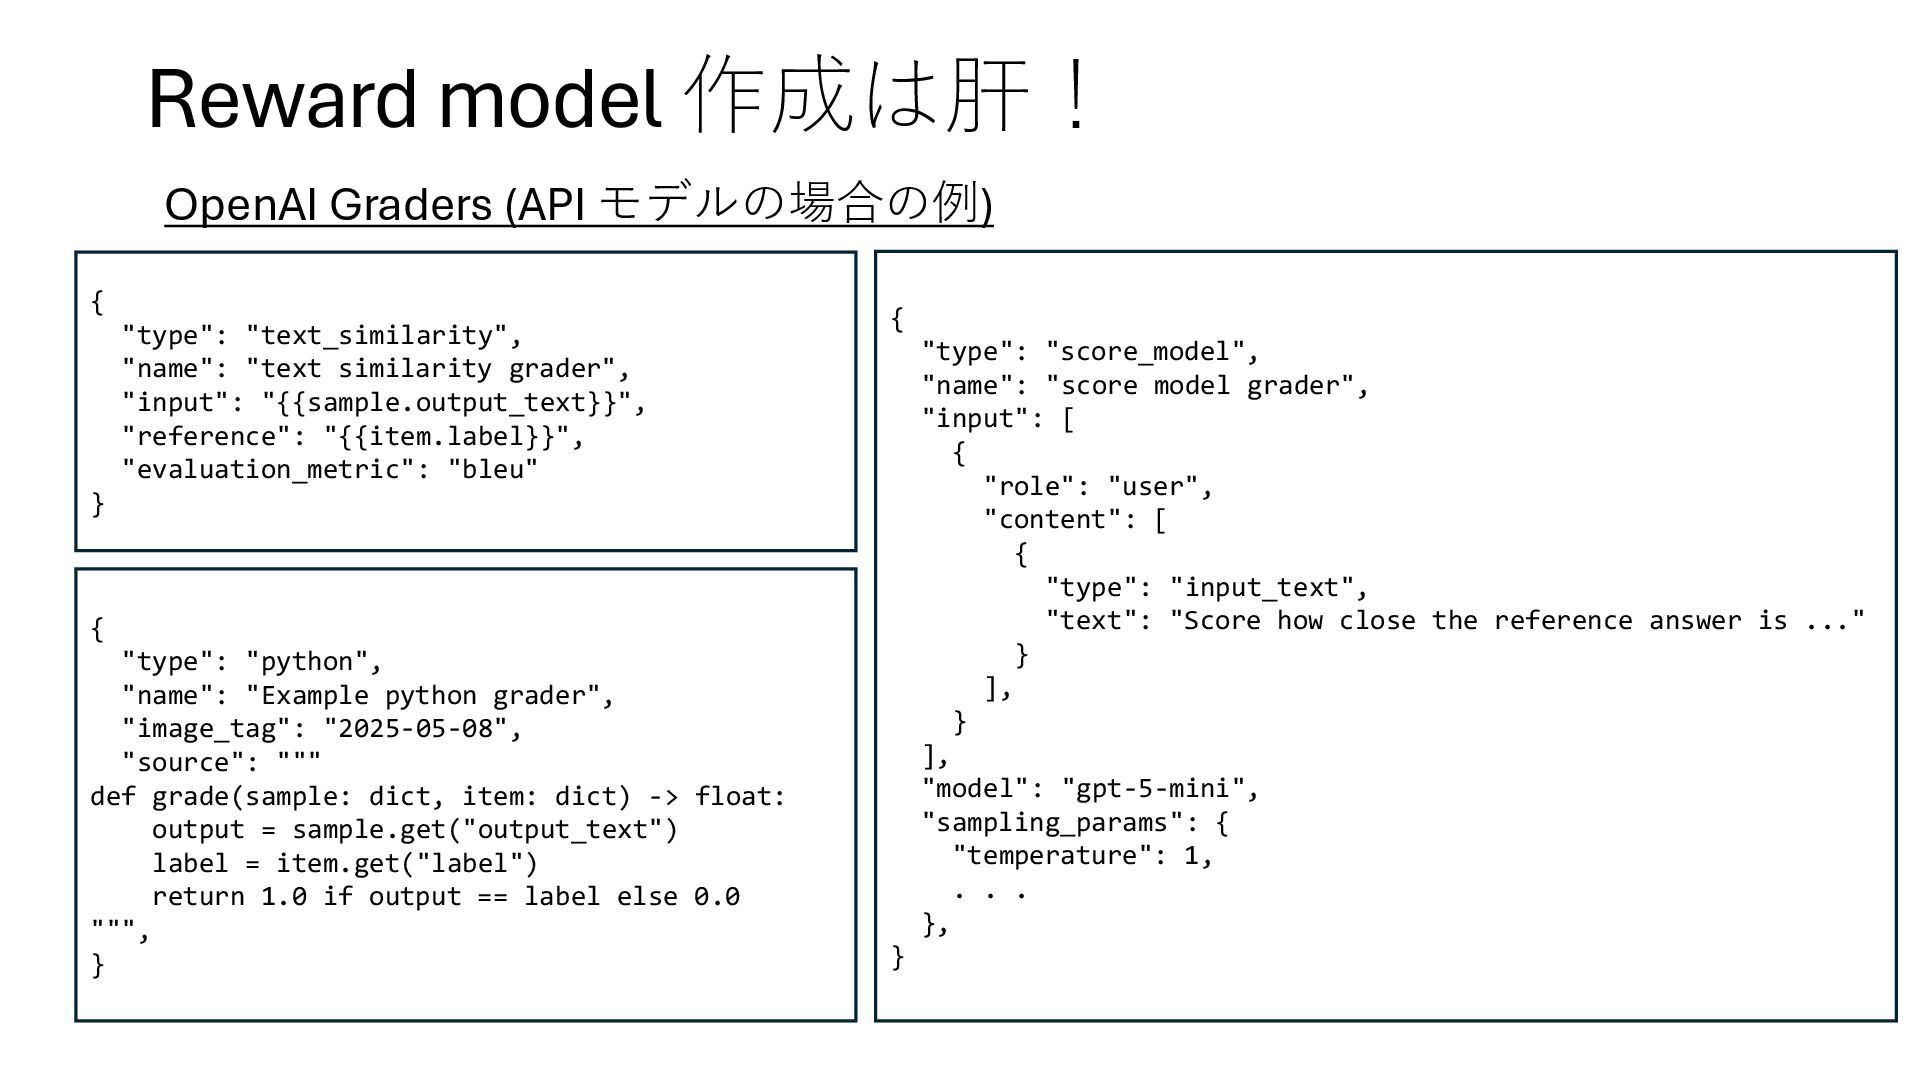
  11. Reward model 作成は肝! OpenAI Graders (API モデルの場合の例) { "type": "text_similarity",

    "name": "text similarity grader", "input": "{{sample.output_text}}", "reference": "{{item.label}}", "evaluation_metric": "bleu" } { "type": "score_model", "name": "score model grader", "input": [ { "role": "user", "content": [ { "type": "input_text", "text": "Score how close the reference answer is ..." } ], } ], "model": "gpt-5-mini", "sampling_params": { "temperature": 1, . . . }, } { "type": "python", "name": "Example python grader", "image_tag": "2025-05-08", "source": """ def grade(sample: dict, item: dict) -> float: output = sample.get("output_text") label = item.get("label") return 1.0 if output == label else 0.0 """, }
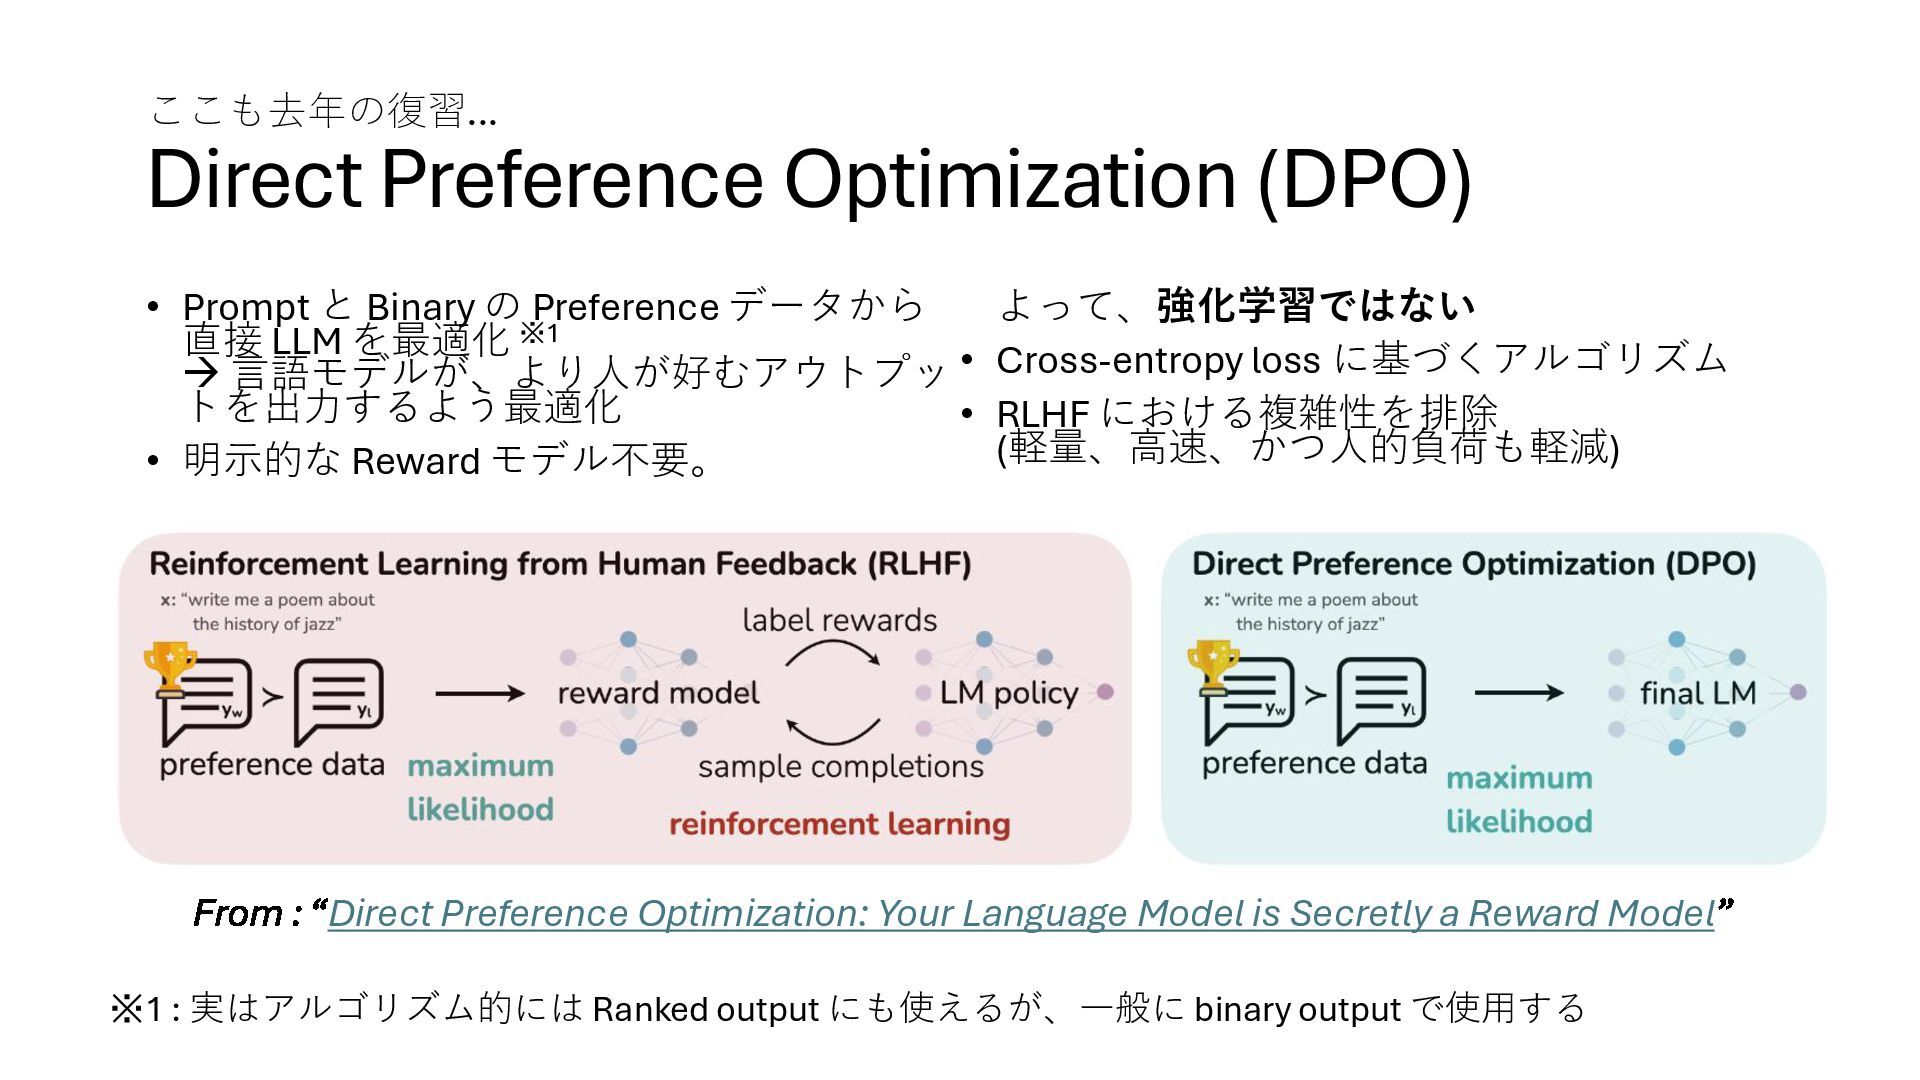
  12. ここも去年の復習… Direct Preference Optimization (DPO) • Prompt と Binary の

    Preference データから 直接 LLM を最適化 ※1 → 言語モデルが、より人が好むアウトプッ トを出力するよう最適化 • 明示的な Reward モデル不要。 よって、強化学習ではない • Cross-entropy loss に基づくアルゴリズム • RLHF における複雑性を排除 (軽量、高速、かつ人的負荷も軽減) ※1 : 実はアルゴリズム的には Ranked output にも使えるが、一般に binary output で使用する From : “Direct Preference Optimization: Your Language Model is Secretly a Reward Model”
  13. DPO で注意すべき点 (松崎視点) • DPO による学習ループが本質にやっていることは、trajectory 探索 (RL の方式) ではなく

    reward 学習 (reward model 学習を何度もまわしているのと本質的に同じ) • つまり、同一のデータで大量に学習させると、純粋な RL よりも 過学習 (または distribution shift) を誘発しやすい • 学習量を増やしたい場合には、多様で量の豊富なラベル付き (annotation済) データセットが必要 • このため Llama など著名なモデルの多くでは、 post-training として DPO と RL を併用
  14. 実際の学習における さまざまな最適化 (ケース・バイ・ケースで利用する) • ほとんどの学習で Monte-Carlo approximation を適用 (計算負荷の軽減) •

    KL penalty の対象 (基準となるモデル) は、学習目的にあわせてカスタマイズ • 例1 : Alignment 学習 (OpenAI の RLHF) では、オリジナルのモデルと大きく異なる振る 舞いとならないよう SFT 後のモデルを固定で使用 • 例2 : reasoning 能力の習得 (DeepSeek AI) では、振る舞いが大きく遷移していくため、 段階的に最新のモデル (学習中のモデル) を基準のモデルとして使用 • Reasoning 能力の習得 (DeepSeek-R1 などの場合) では、Reward Model も学 習段階に応じて、適宜、最新のモデルに更新 (一方、Alignment 学習では、ここは固定) [GitHub] tsmatz/reinforcement-learning-in-llm 参考 https://github.com/tsmatz/reinforcement-learning-in-llm
  15. [反復 / 再掲] RL は言語モデル学習における強力な手法 まるで赤ちゃんに教えるように、何度も手本を示し、 うまく真似してもらえるまで ひたすら続ける 命題 :

    ある程度の能力を持った人に 何らかの振る舞いや能力を教えたい! (SFT のみに頼った学習手法) RL による学習も是非検討してみてください