Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ACL2026_yamauchi
Search
23110 山内 大暉(YAMAUCHI TAIKI)
September 24, 2026
78
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ACL2026_yamauchi
23110 山内 大暉(YAMAUCHI TAIKI)
September 24, 2026
Featured
See All Featured
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
The Art of Programming - Codeland 2020
erikaheidi
57
14k
Collaborative Software Design: How to facilitate domain modelling decisions
baasie
1
340
Introduction to Domain-Driven Design and Collaborative software design
baasie
1
1k
Build your cross-platform service in a week with App Engine
jlugia
234
19k
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
630
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
930
Organizational Design Perspectives: An Ontology of Organizational Design Elements
kimpetersen
PRO
1
850
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
Claude Code のすすめ
schroneko
67
230k
Measuring & Analyzing Core Web Vitals
bluesmoon
9
1k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Transcript
※図表は当該論文から引用 読み手:知識データ工学研究室 学部4年 山内大暉
概要 • 拡散言語モデルにおける生成文の自己評価法を提案 • 得られた自己評価の有効性を3つの実験で確認 • 解答候補の選択 • 自己評価スコアと正解の相関 •
生成⾧の決定 2
背景 |拡散言語モデルとは • 拡散言語モデル:ノイズを徐々に除去して生成するモデル • 並列・任意順序での生成,双方向文脈の利用が可能 • 本論文では拡散モデルの中でもマスク拡散を対象 2
背景 | 言語モデルの自己評価 • 言語モデルの自己評価:生成文の自己評価 • 生成文の評価には様々な用途が存在 • 最高評価の解答候補を選択
解答品質の向上 • 評価の低い生成結果を疑う ハルシネーションの検知 • 生成⾧の伸⾧の評価 可変⾧生成 現代の大規模言語モデルの基本 2
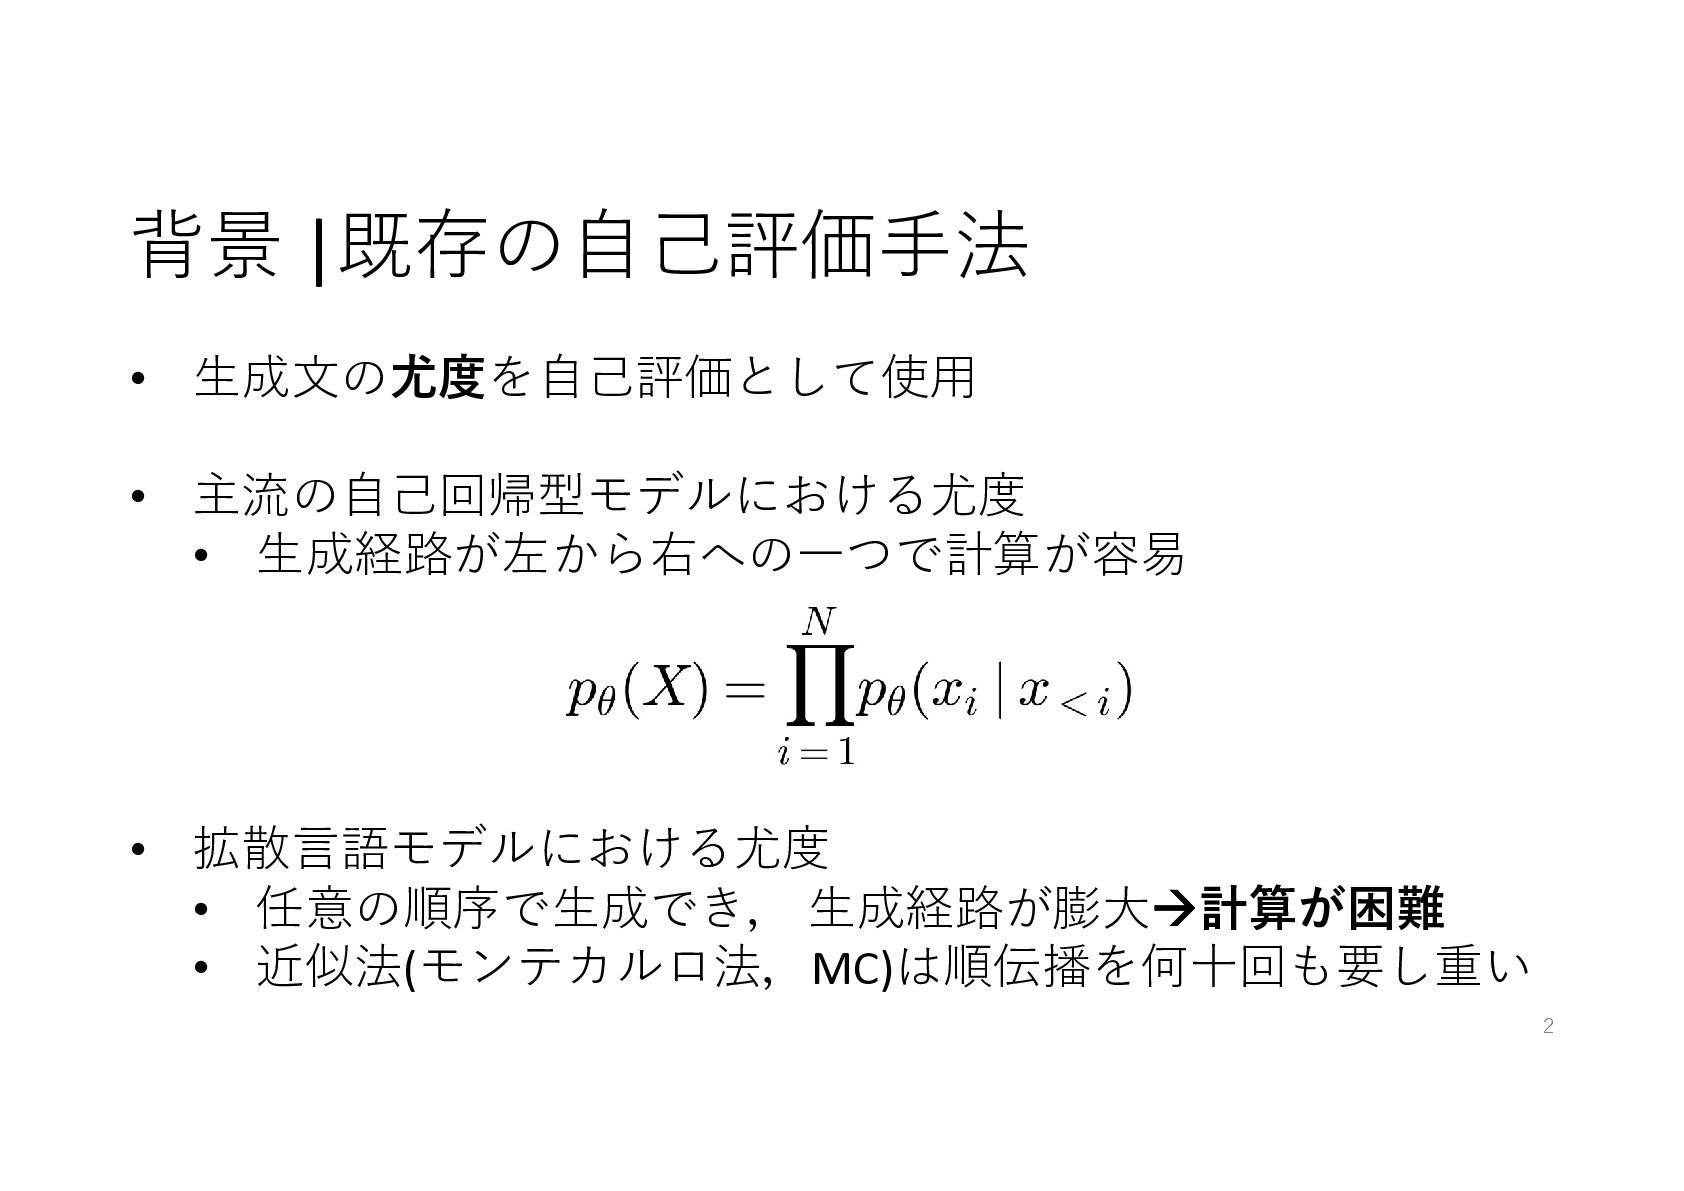
背景 |既存の自己評価手法 • 生成文の尤度を自己評価として使用 • 主流の自己回帰型モデルにおける尤度 • 生成経路が左から右への一つで計算が容易 • 拡散言語モデルにおける尤度
• 任意の順序で生成でき, 生成経路が膨大計算が困難 • 近似法(モンテカルロ法,MC)は順伝播を何十回も要し重い 2
研究課題 • 本論文の2つの RQ(Research Question) RQ1 マスク拡散言語モデルにおける尤度ベースの自己評価を,どうすれば高速かつ 効果的に行えるか? また,その手法に解釈性と経験的な裏付けを与えられるか? RQ2
より効率的な自己評価が得られたとき, 実用上どのような応用(メリット)が生まれるか? 7
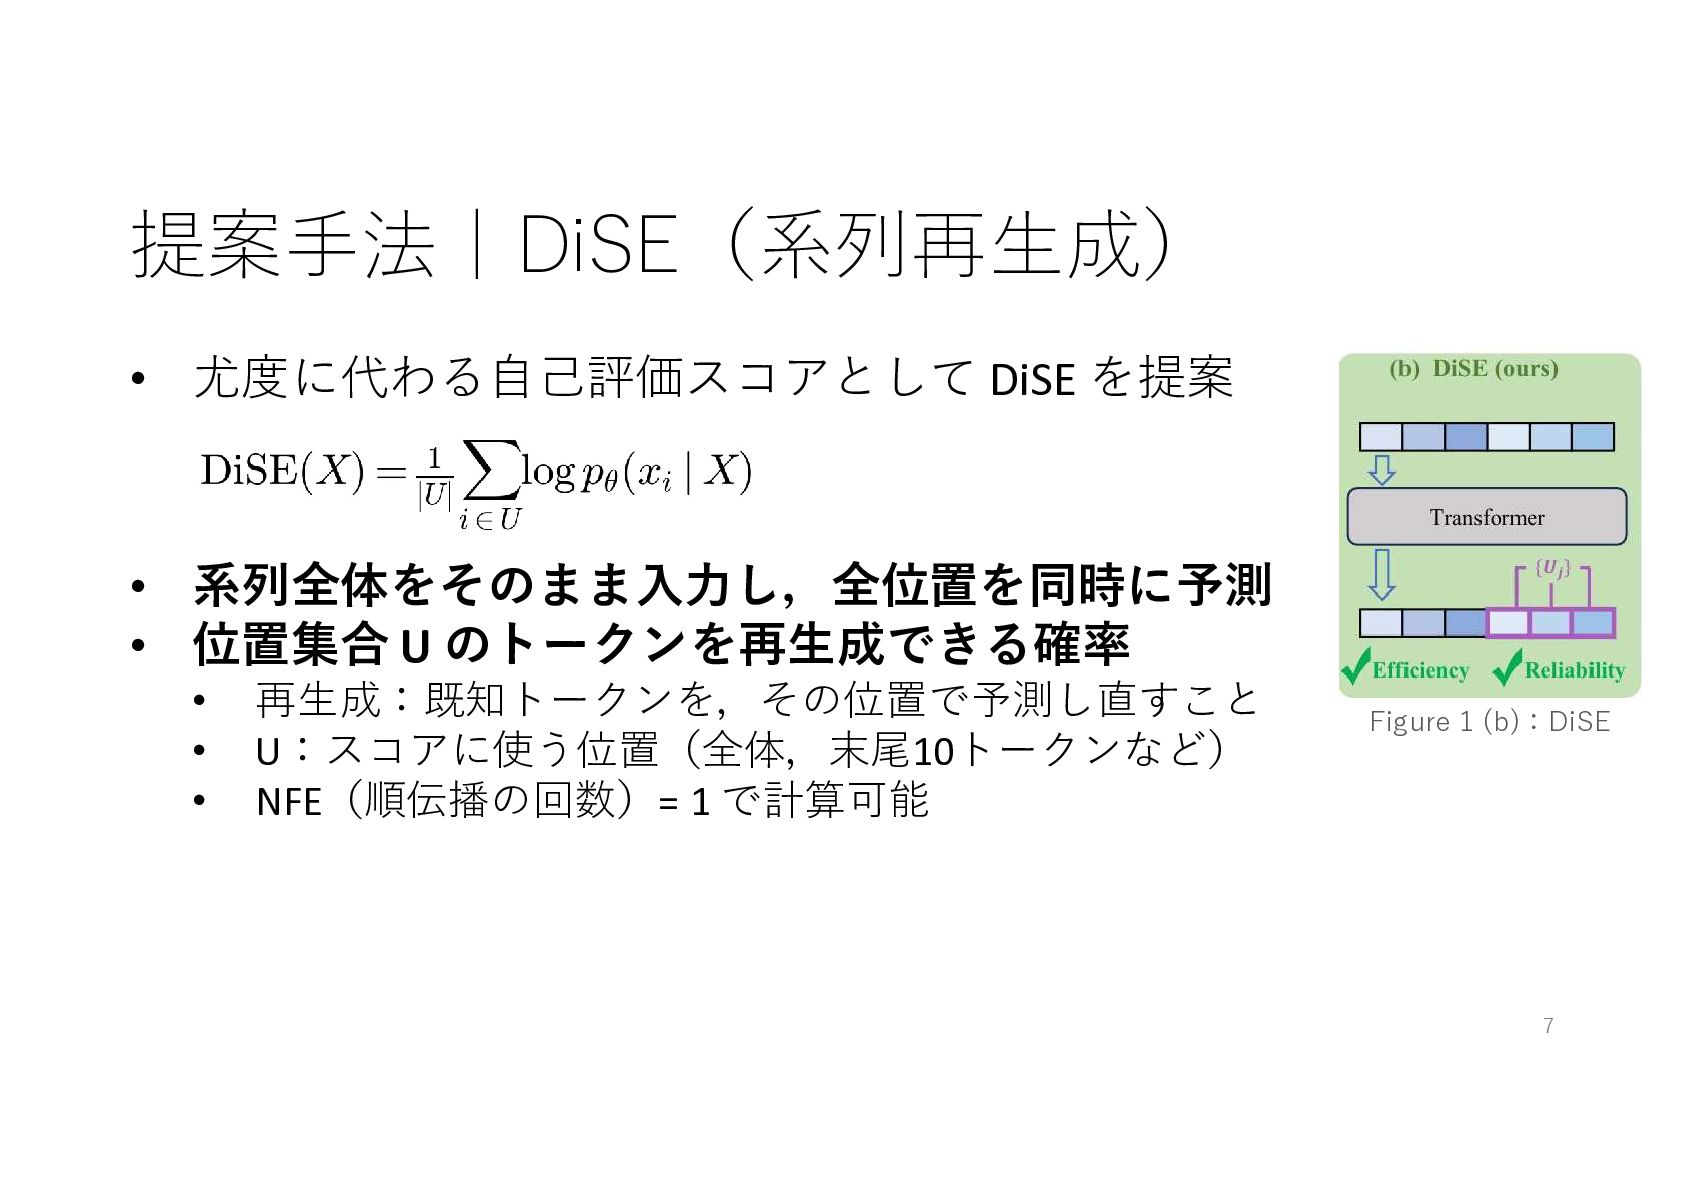
提案手法|DiSE(系列再生成) • 尤度に代わる自己評価スコアとして DiSE を提案 • 系列全体をそのまま入力し,全位置を同時に予測 • 位置集合 U
のトークンを再生成できる確率 • • • 再生成:既知トークンを,その位置で予測し直すこと U:スコアに使う位置(全体,末尾10トークンなど) NFE(順伝播の回数)= 1 で計算可能 Figure 1 (b):DiSE 7
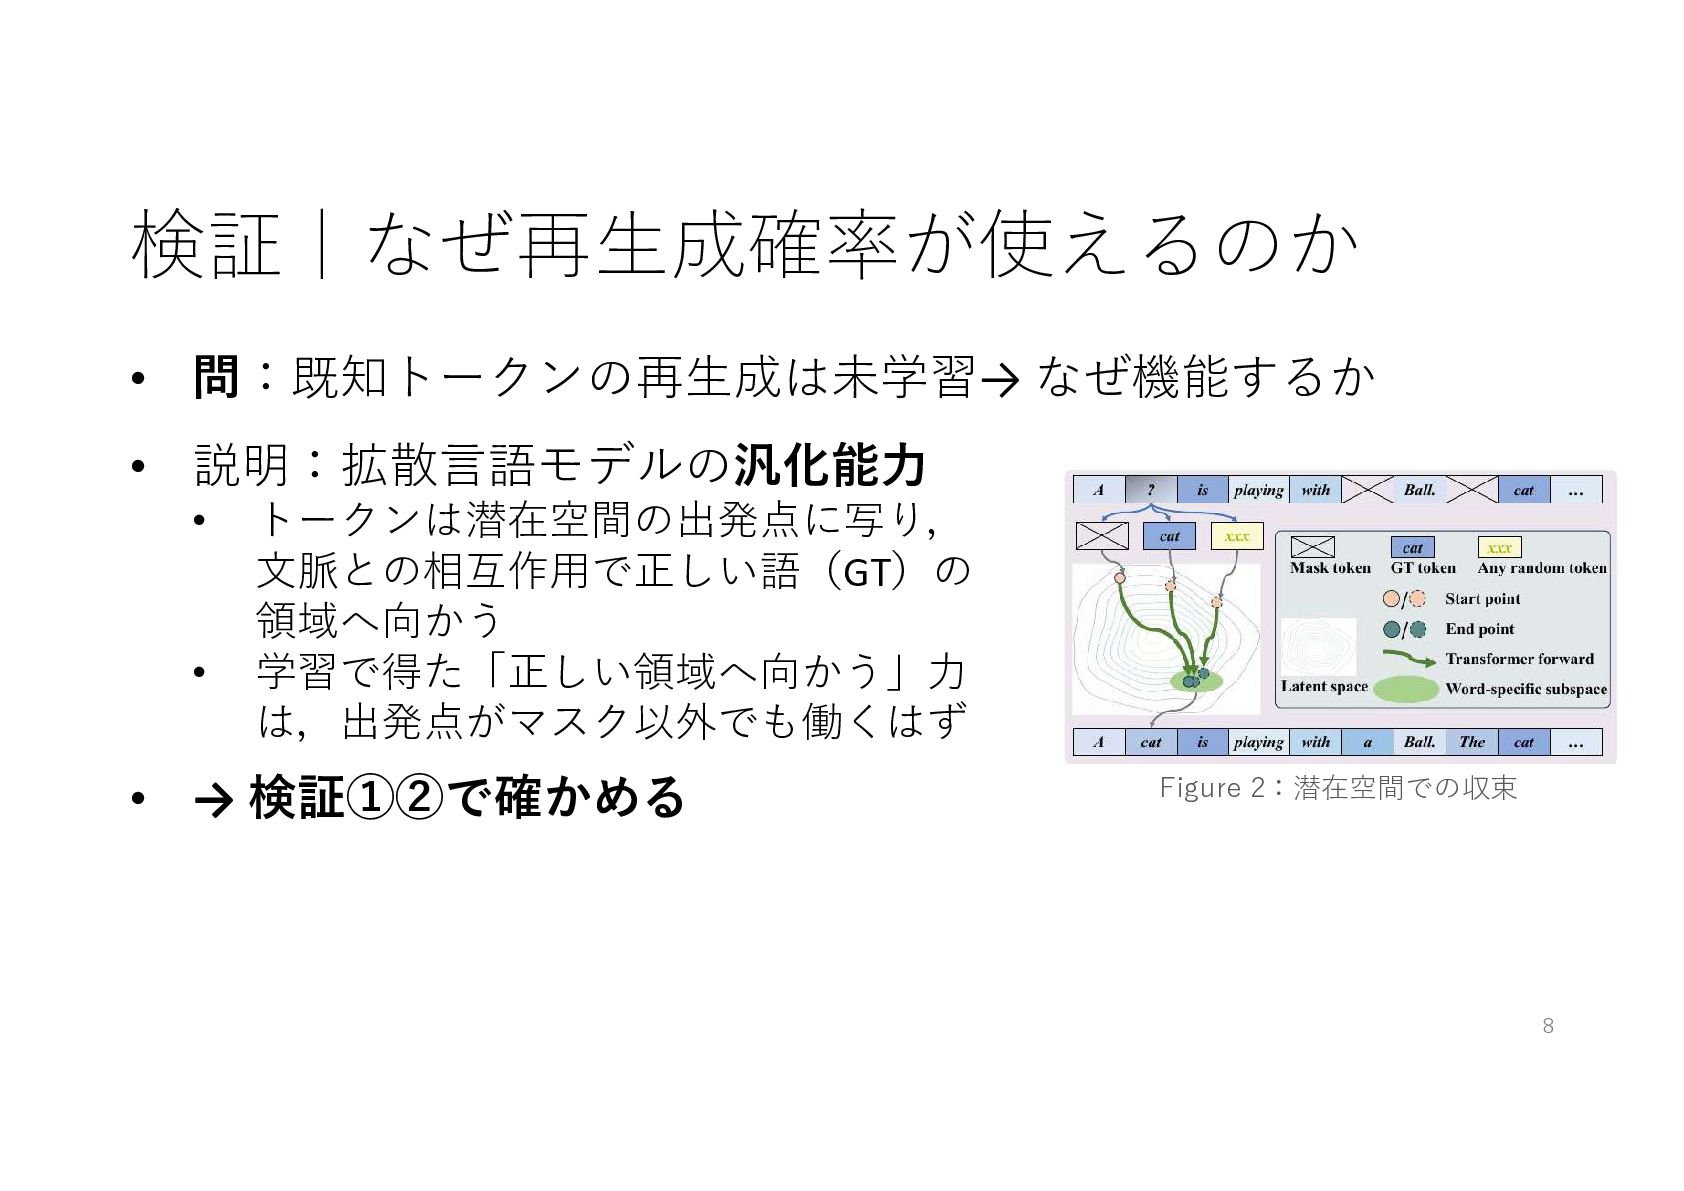
検証|なぜ再生成確率が使えるのか • 問:既知トークンの再生成は未学習→ なぜ機能するか • 説明:拡散言語モデルの汎化能力 • • トークンは潜在空間の出発点に写り, 文脈との相互作用で正しい語(GT)の
領域へ向かう 学習で得た「正しい領域へ向かう」力 は,出発点がマスク以外でも働くはず • → 検証①②で確かめる Figure 2:潜在空間での収束 8
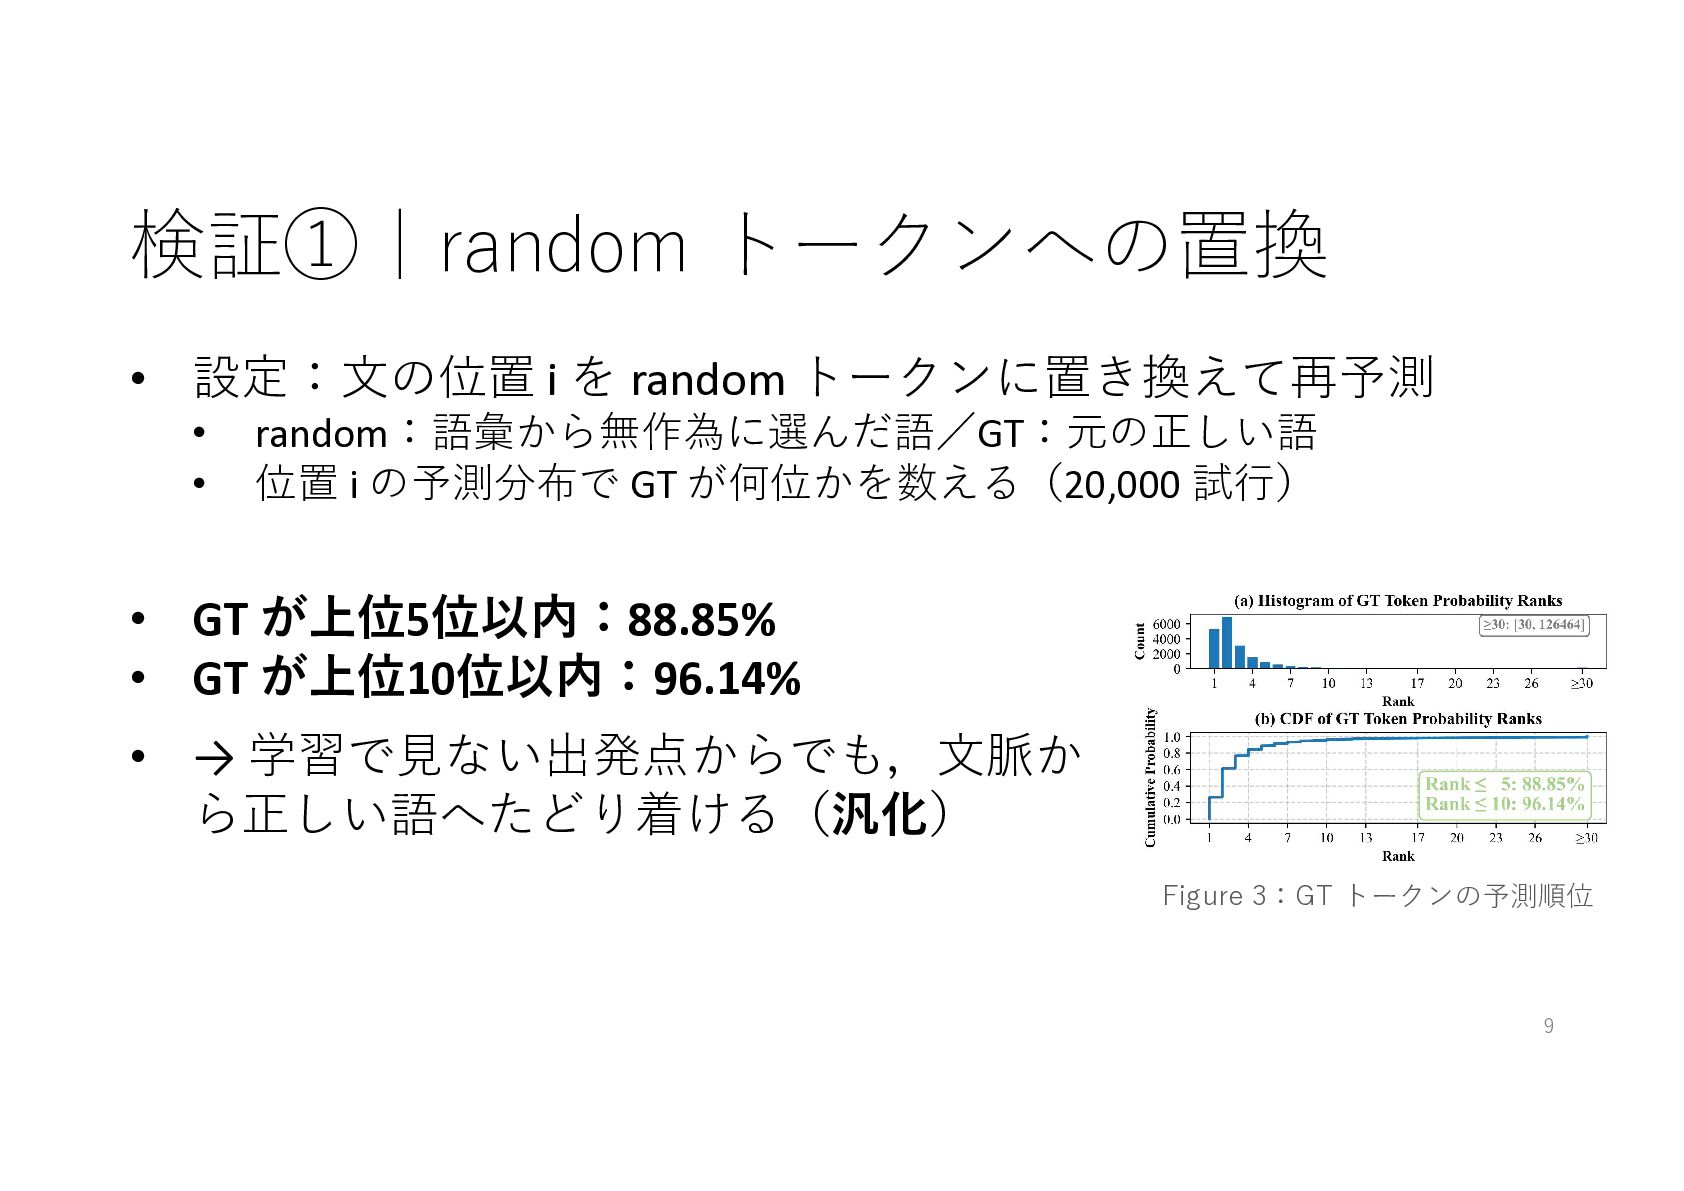
検証①|random トークンへの置換 • 設定:文の位置 i を random トークンに置き換えて再予測 • •
random:語彙から無作為に選んだ語/GT:元の正しい語 位置 i の予測分布で GT が何位かを数える(20,000 試行) • GT が上位5位以内:88.85% • GT が上位10位以内:96.14% • → 学習で見ない出発点からでも,文脈か ら正しい語へたどり着ける(汎化) Figure 3:GT トークンの予測順位 9
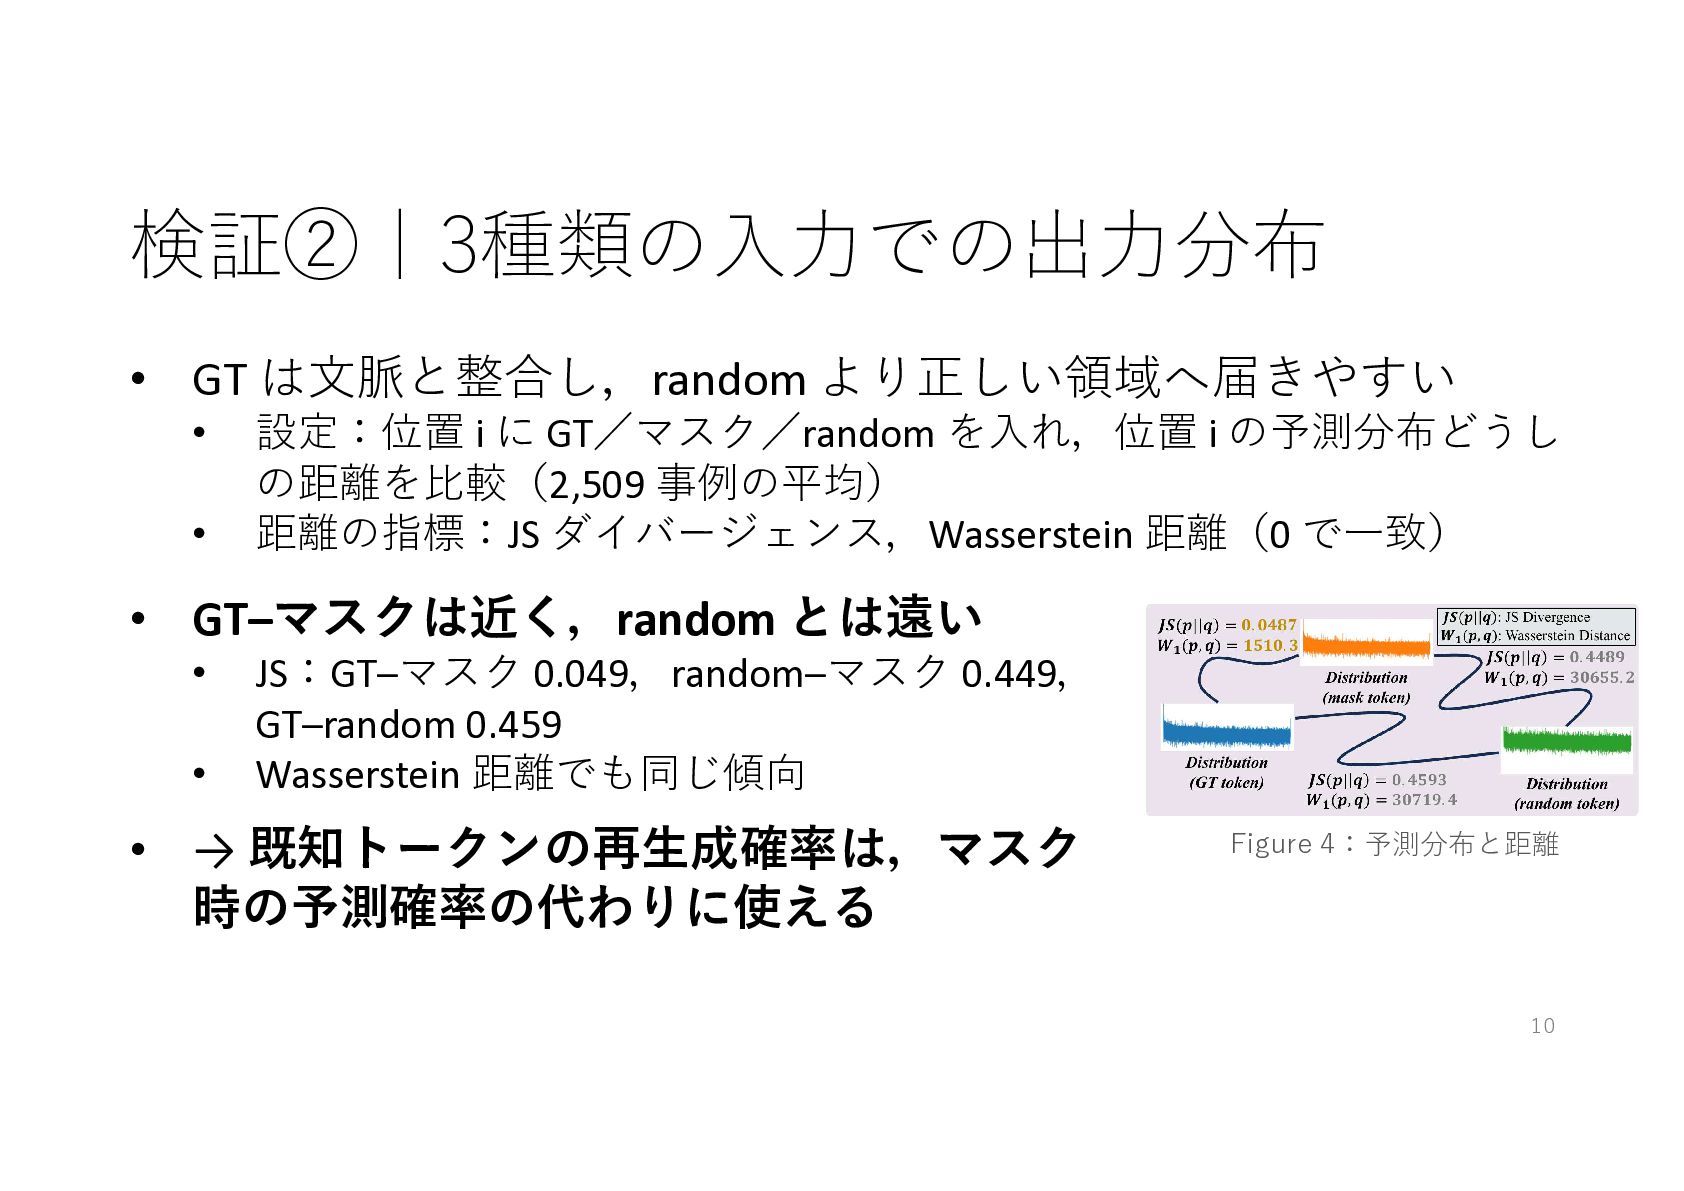
検証②|3種類の入力での出力分布 • GT は文脈と整合し,random より正しい領域へ届きやすい • • 設定:位置 i に
GT/マスク/random を入れ,位置 i の予測分布どうし の距離を比較(2,509 事例の平均) 距離の指標:JS ダイバージェンス,Wasserstein 距離(0 で一致) • GT–マスクは近く,random とは遠い • • JS:GT–マスク 0.049,random–マスク 0.449, GT–random 0.459 Wasserstein 距離でも同じ傾向 • → 既知トークンの再生成確率は,マスク 時の予測確率の代わりに使える Figure 4:予測分布と距離 10
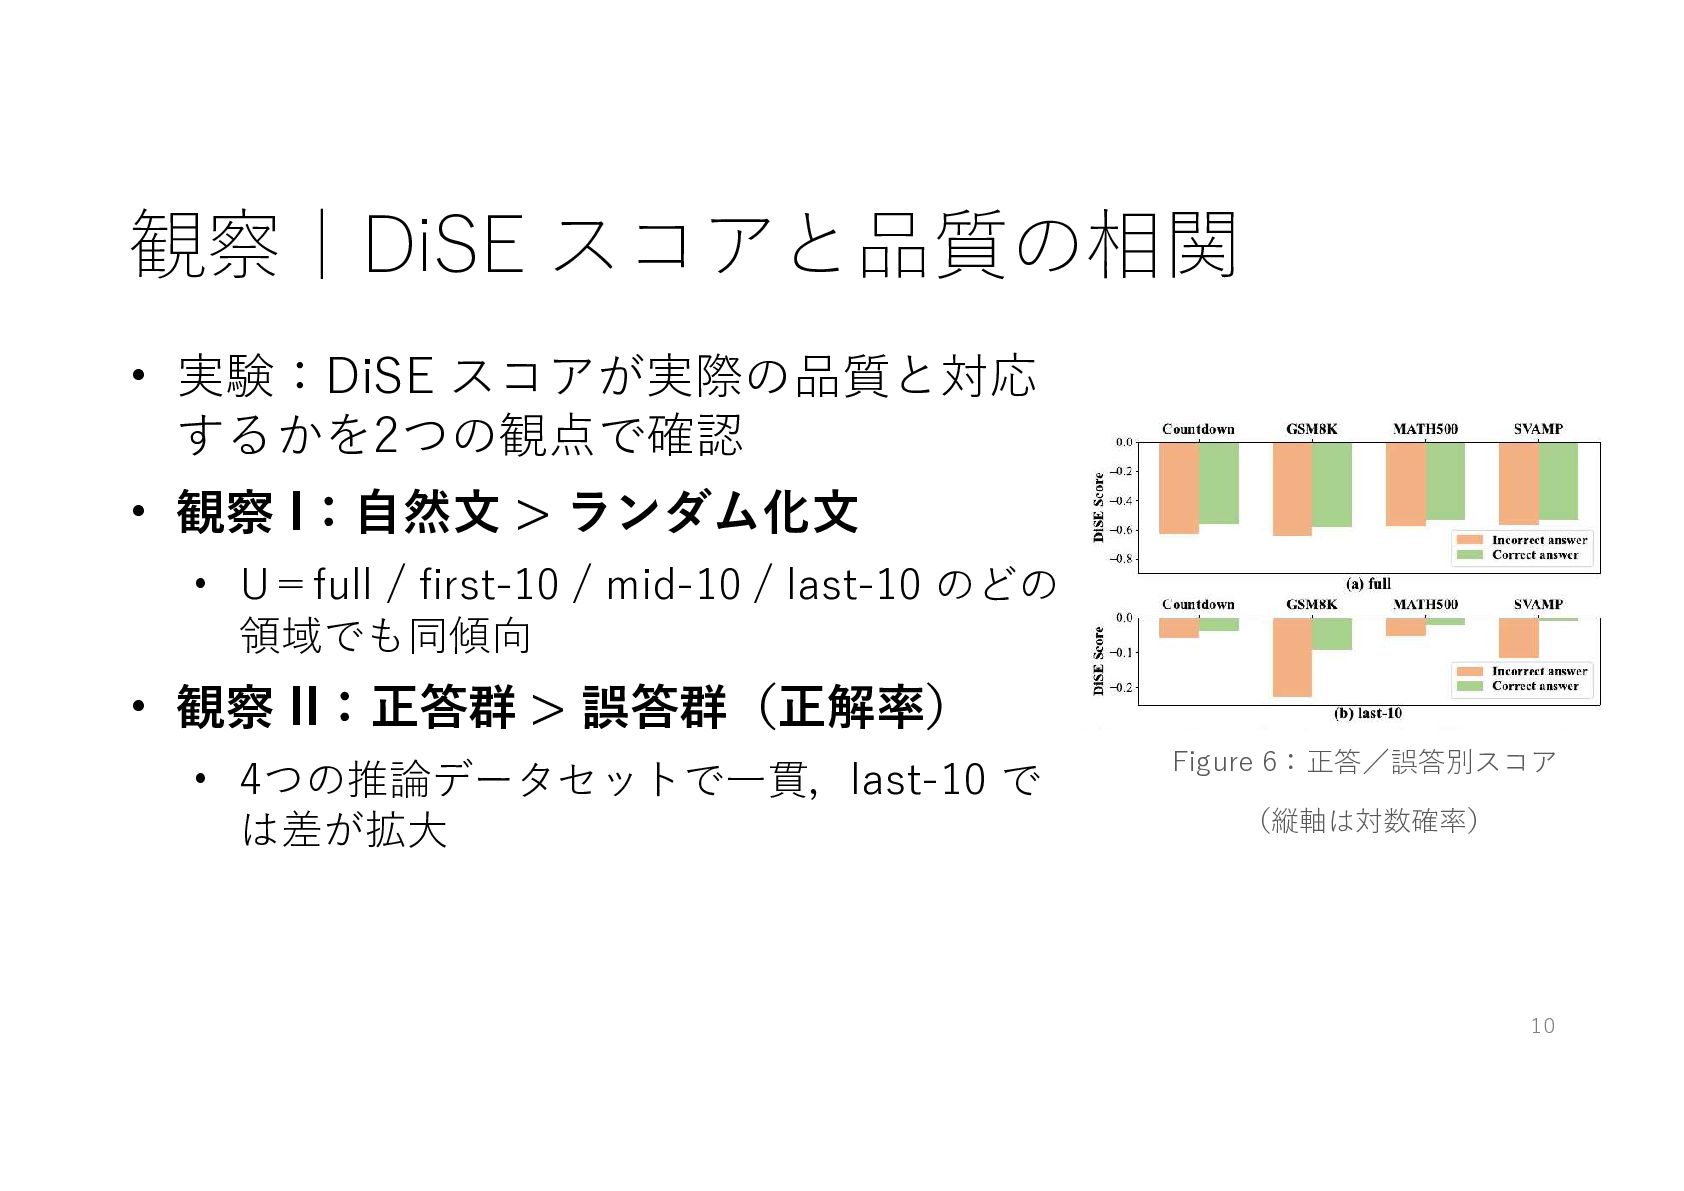
観察|DiSE スコアと品質の相関 • 実験:DiSE スコアが実際の品質と対応 するかを2つの観点で確認 • 観察 I:自然文 >
ランダム化文 • U=full / first-10 / mid-10 / last-10 のどの 領域でも同傾向 • 観察 II:正答群 > 誤答群(正解率) • 4つの推論データセットで一貫,last-10 で は差が拡大 Figure 6:正答/誤答別スコア (縦軸は対数確率) 10
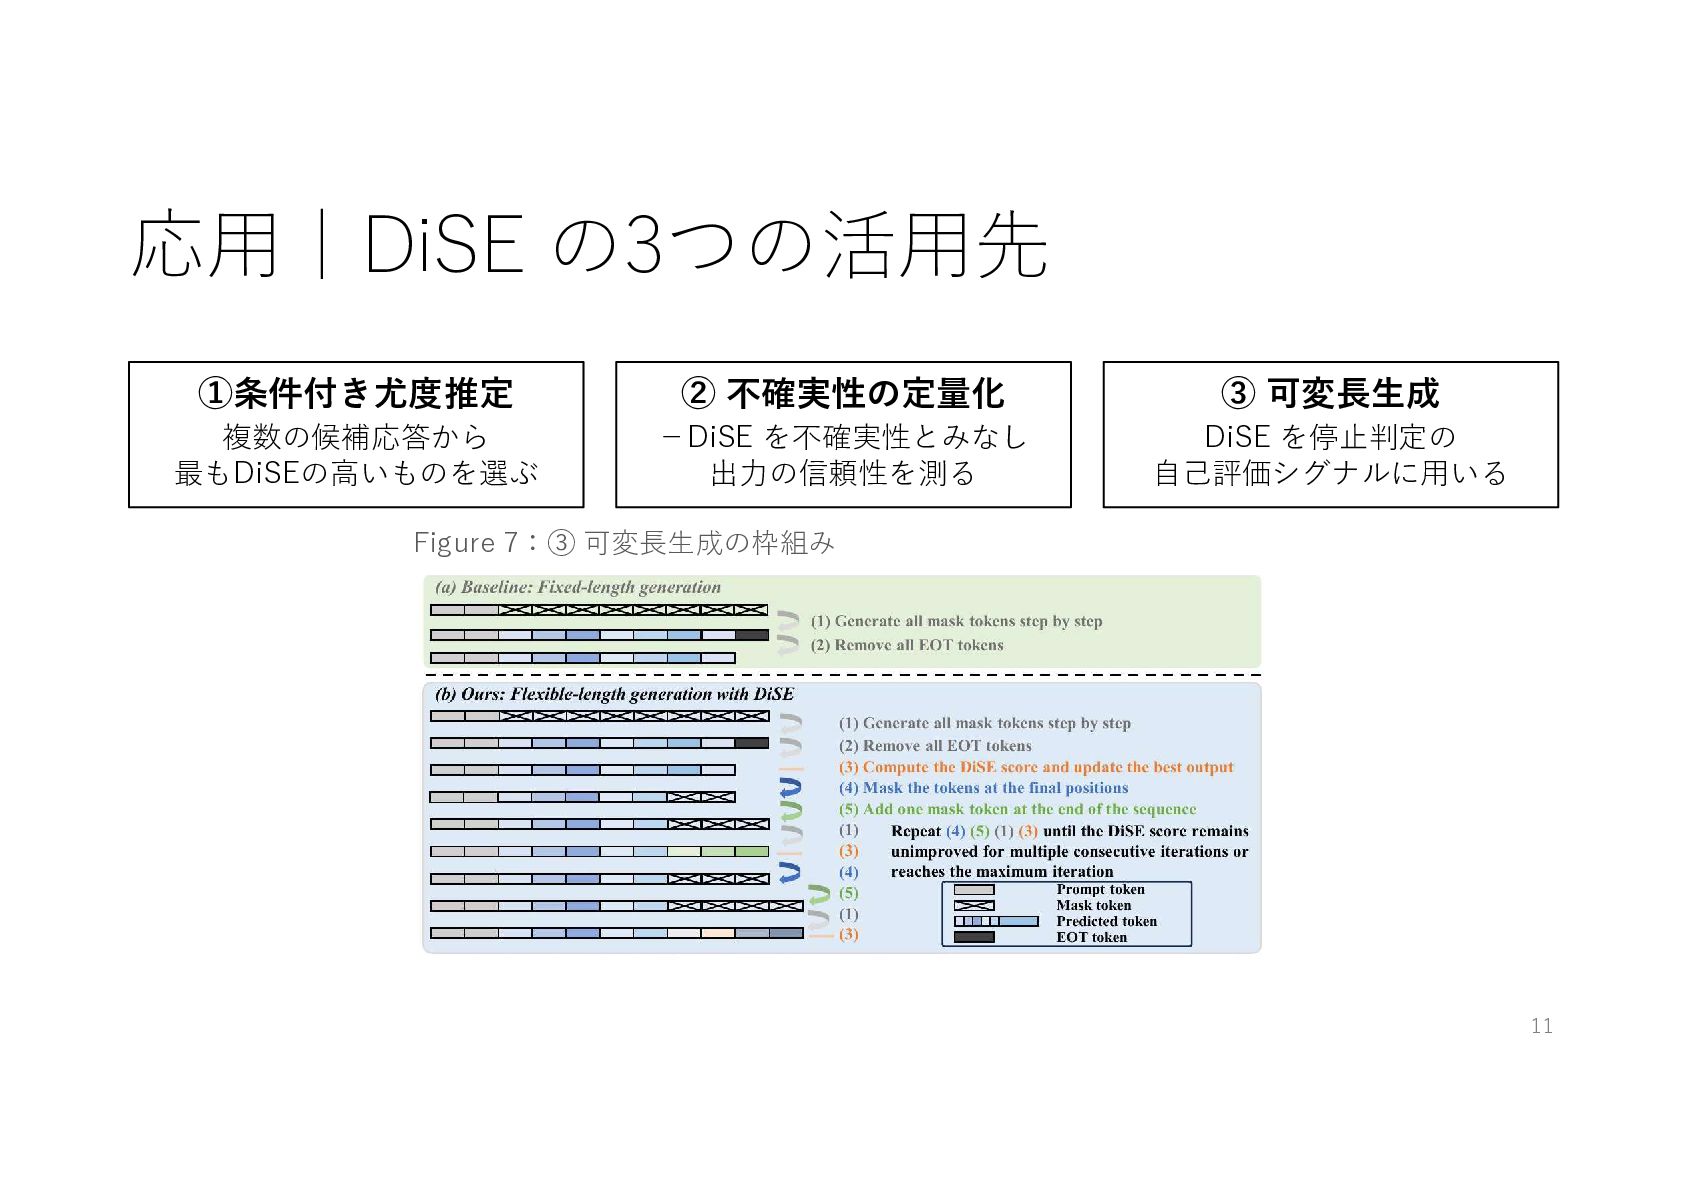
応用|DiSE の3つの活用先 ①条件付き尤度推定 ② 不確実性の定量化 ③ 可変⾧生成 複数の候補応答から 最もDiSEの高いものを選ぶ -DiSE
を不確実性とみなし 出力の信頼性を測る DiSE を停止判定の 自己評価シグナルに用いる Figure 7:③ 可変⾧生成の枠組み 11
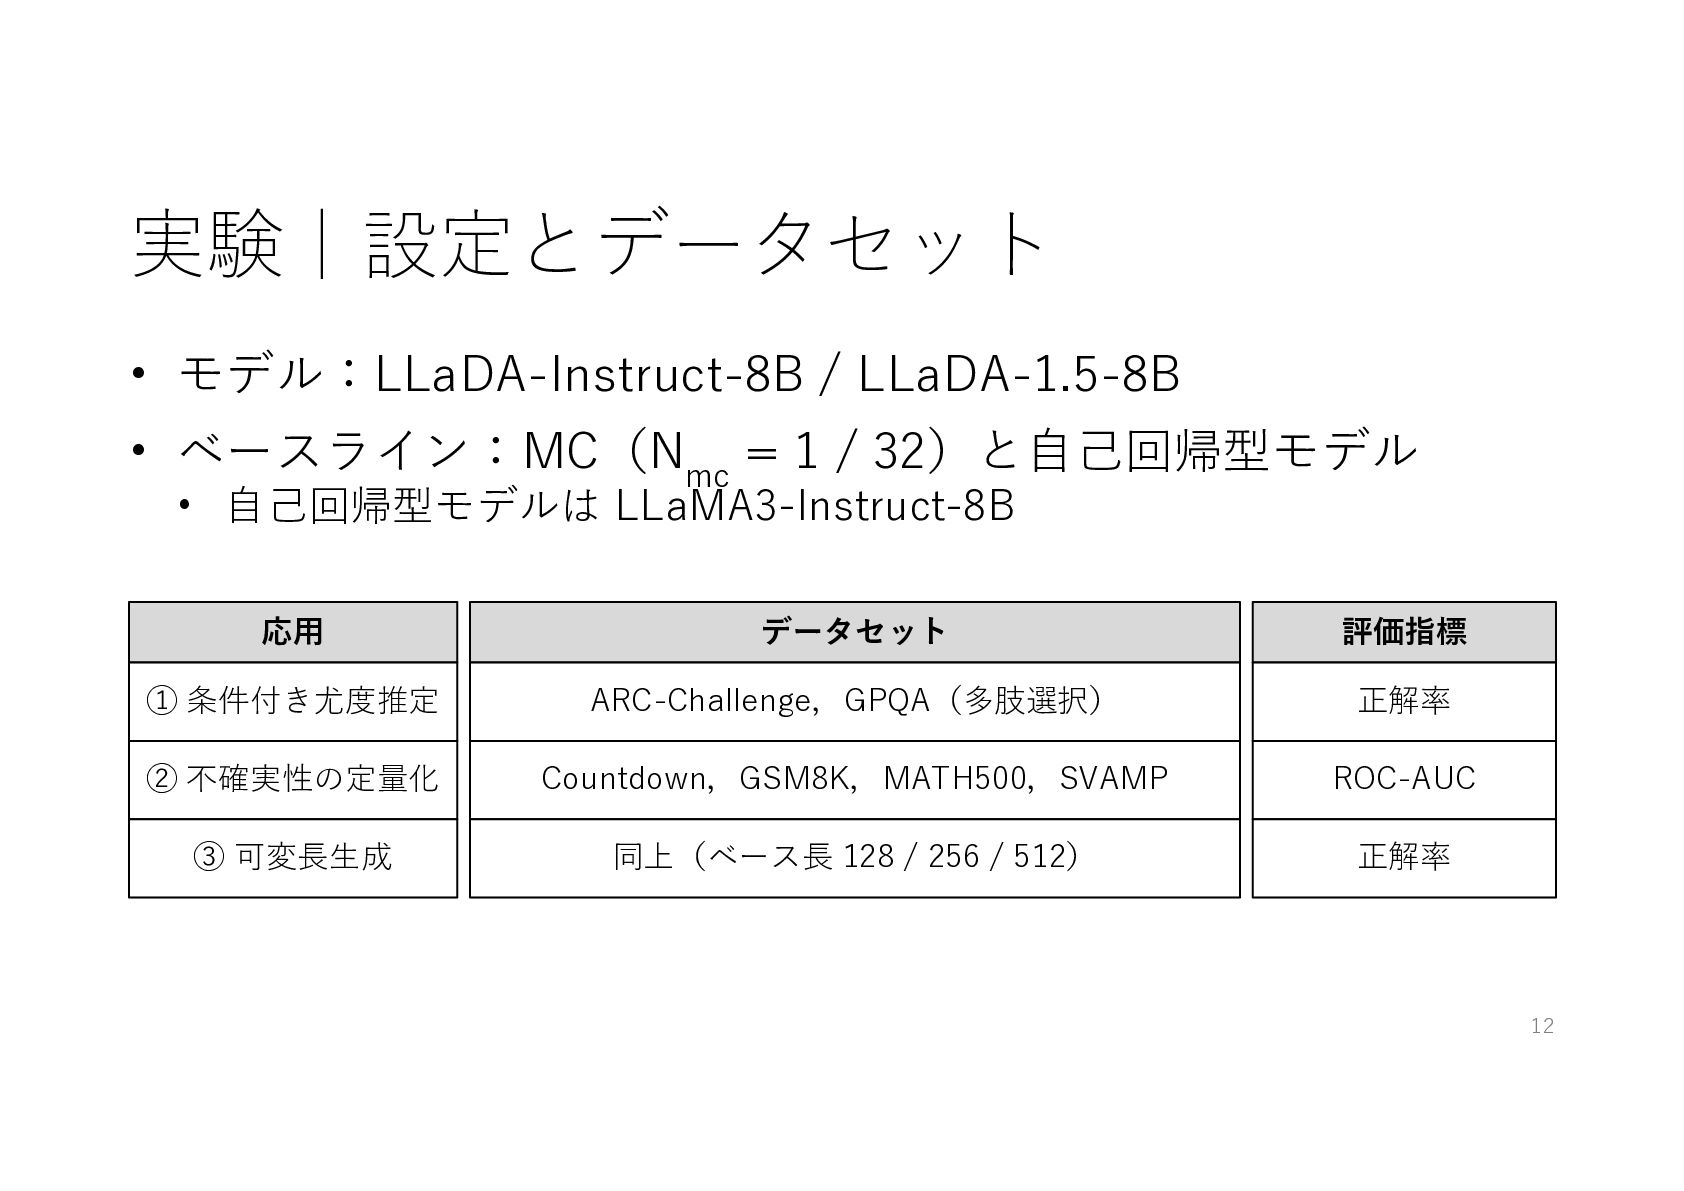
実験|設定とデータセット • モデル:LLaDA-Instruct-8B / LLaDA-1.5-8B • ベースライン:MC(Nmc = 1 /
32)と自己回帰型モデル • 自己回帰型モデルは LLaMA3-Instruct-8B 応用 データセット 評価指標 ① 条件付き尤度推定 ARC-Challenge,GPQA(多肢選択) 正解率 ② 不確実性の定量化 Countdown,GSM8K,MATH500,SVAMP ROC-AUC ③ 可変⾧生成 同上(ベース⾧ 128 / 256 / 512) 正解率 12
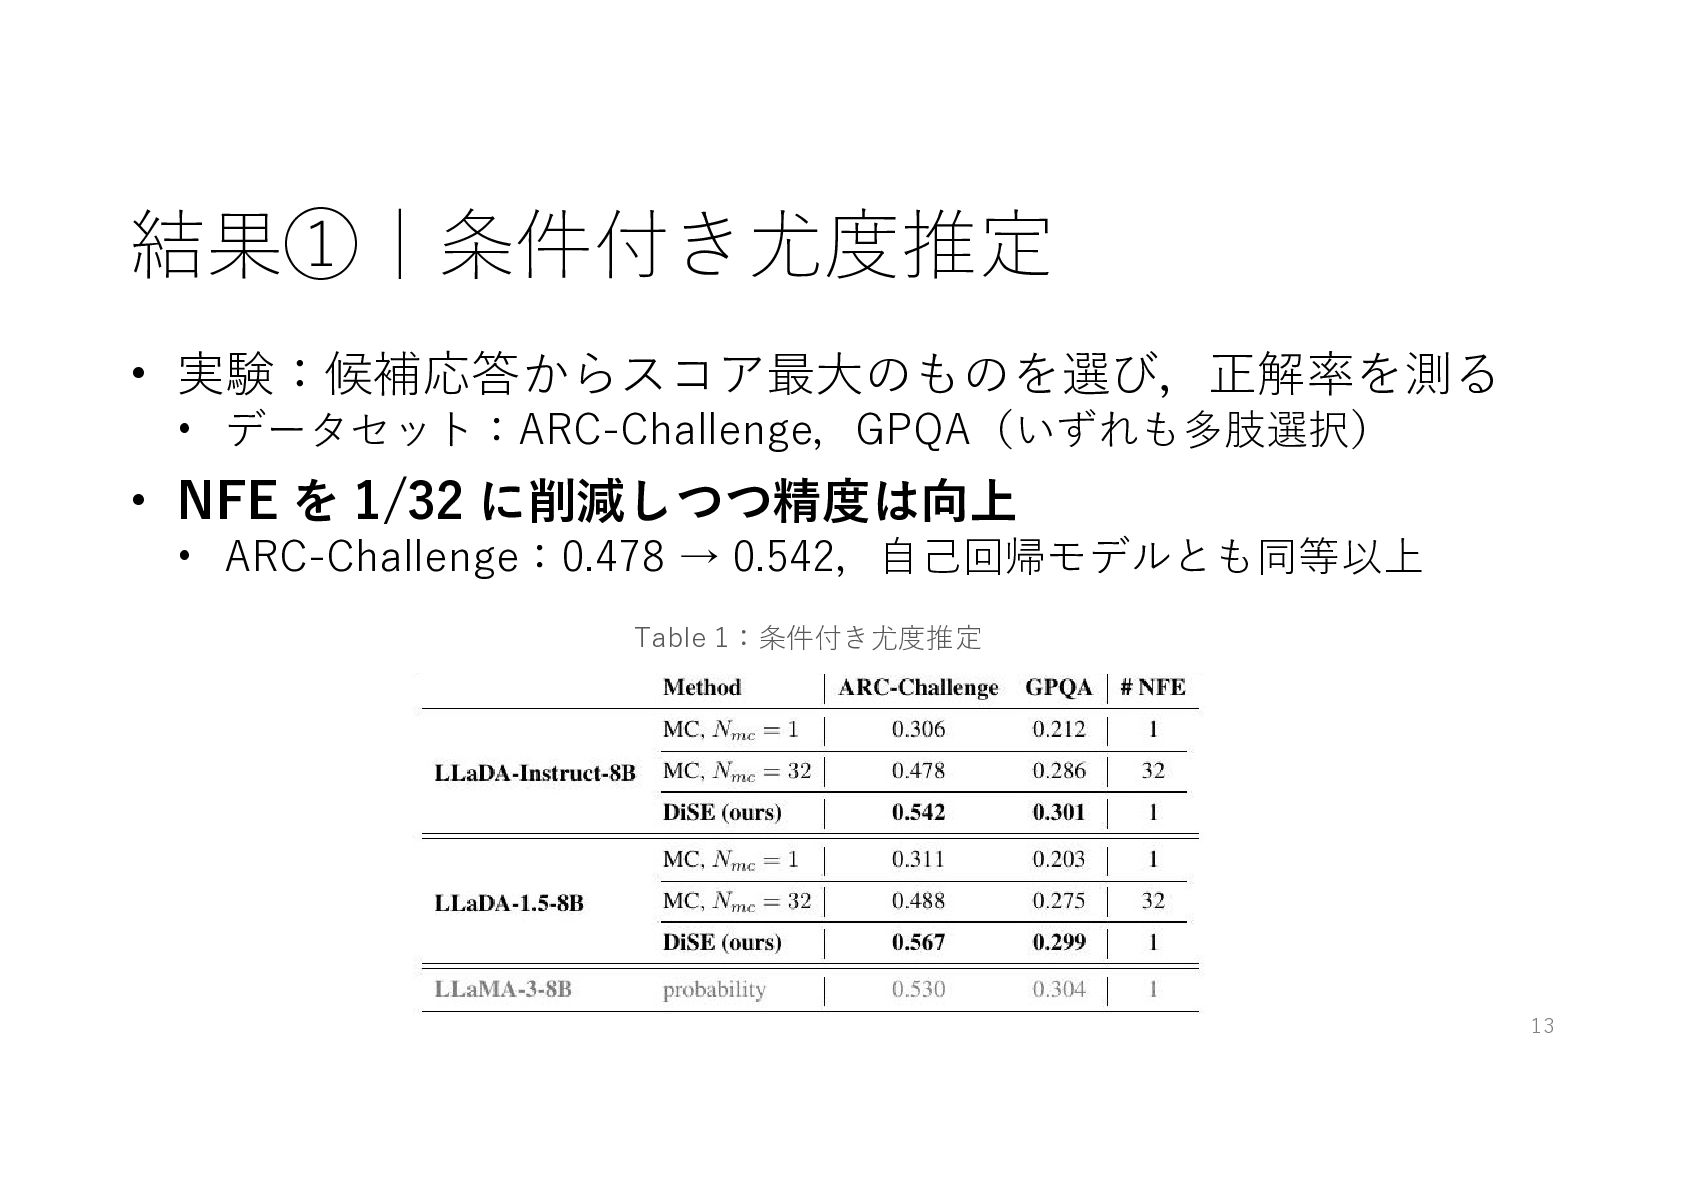
結果①|条件付き尤度推定 • 実験:候補応答からスコア最大のものを選び,正解率を測る • データセット:ARC-Challenge,GPQA(いずれも多肢選択) • NFE を 1/32 に削減しつつ精度は向上
• ARC-Challenge:0.478 → 0.542,自己回帰モデルとも同等以上 Table 1:条件付き尤度推定 13
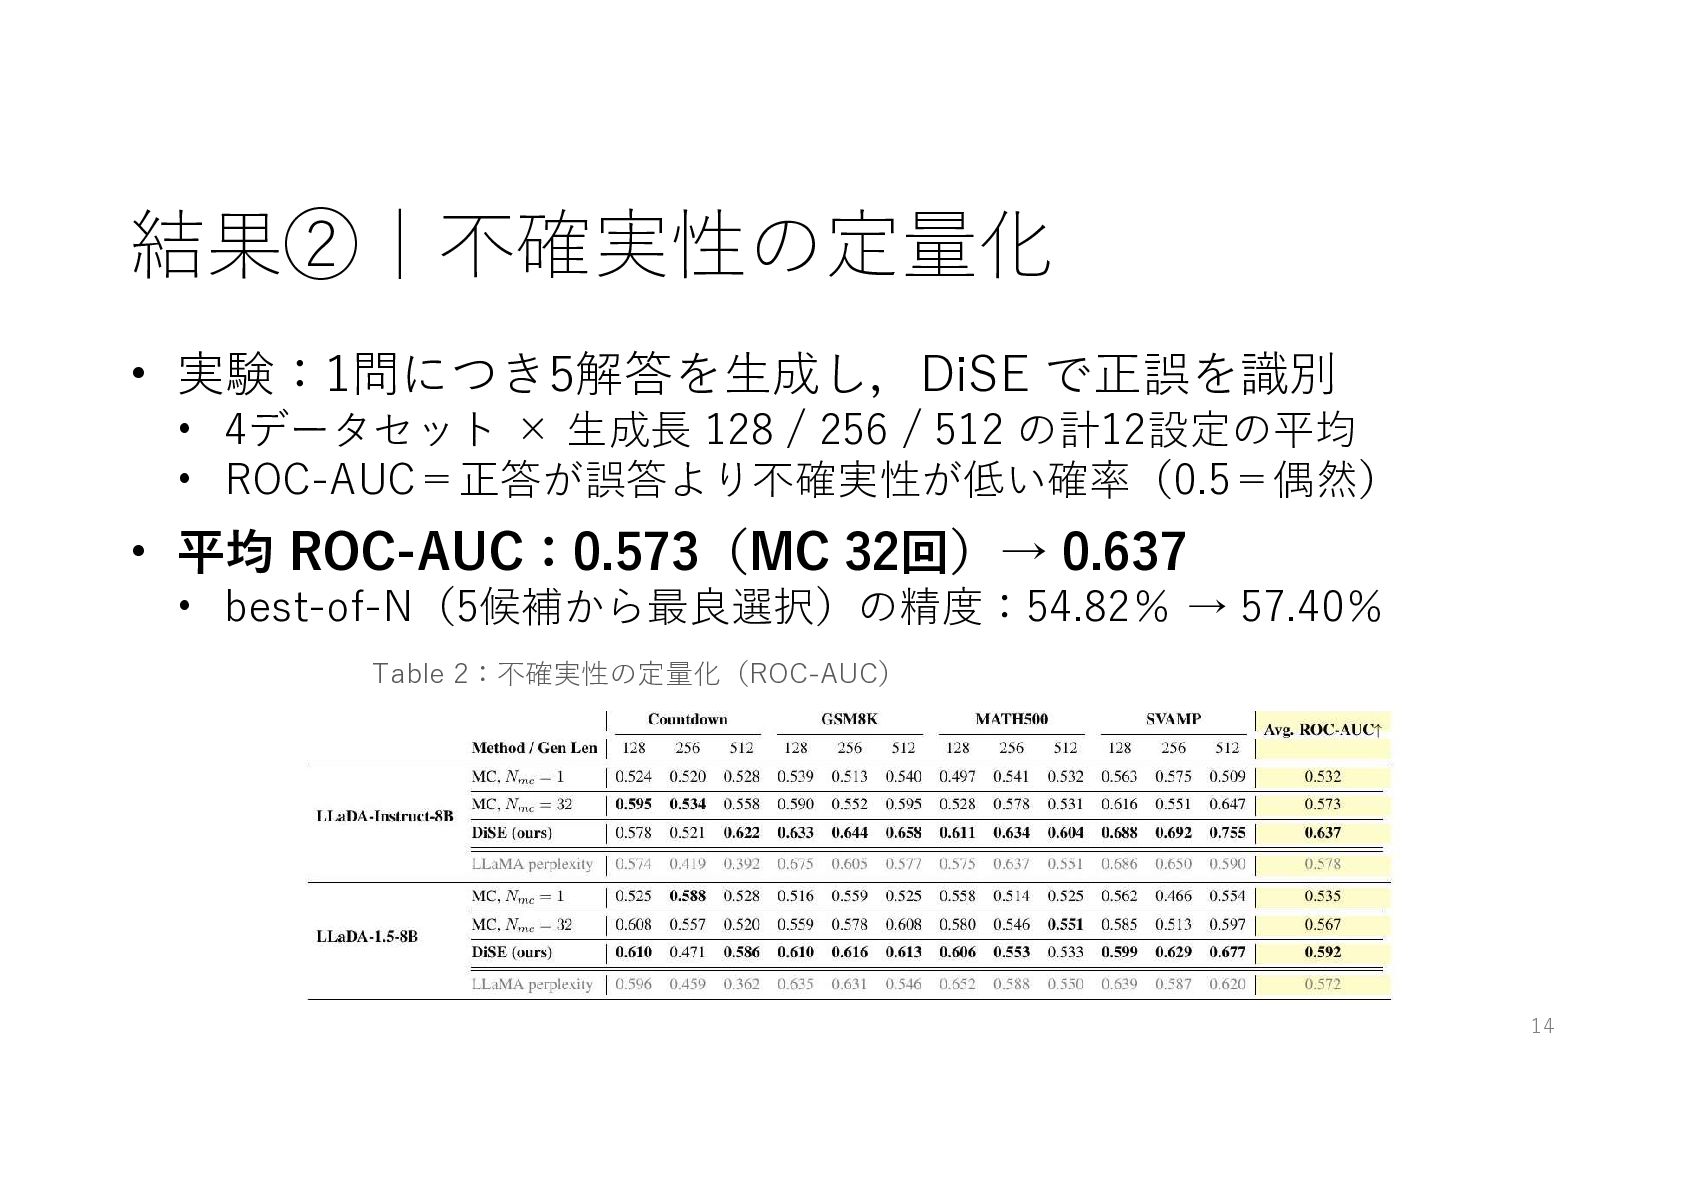
結果②|不確実性の定量化 • 実験:1問につき5解答を生成し,DiSE で正誤を識別 • 4データセット × 生成⾧ 128 /
256 / 512 の計12設定の平均 • ROC-AUC=正答が誤答より不確実性が低い確率(0.5=偶然) • 平均 ROC-AUC:0.573(MC 32回)→ 0.637 • best-of-N(5候補から最良選択)の精度:54.82% → 57.40% Table 2:不確実性の定量化(ROC-AUC) 14
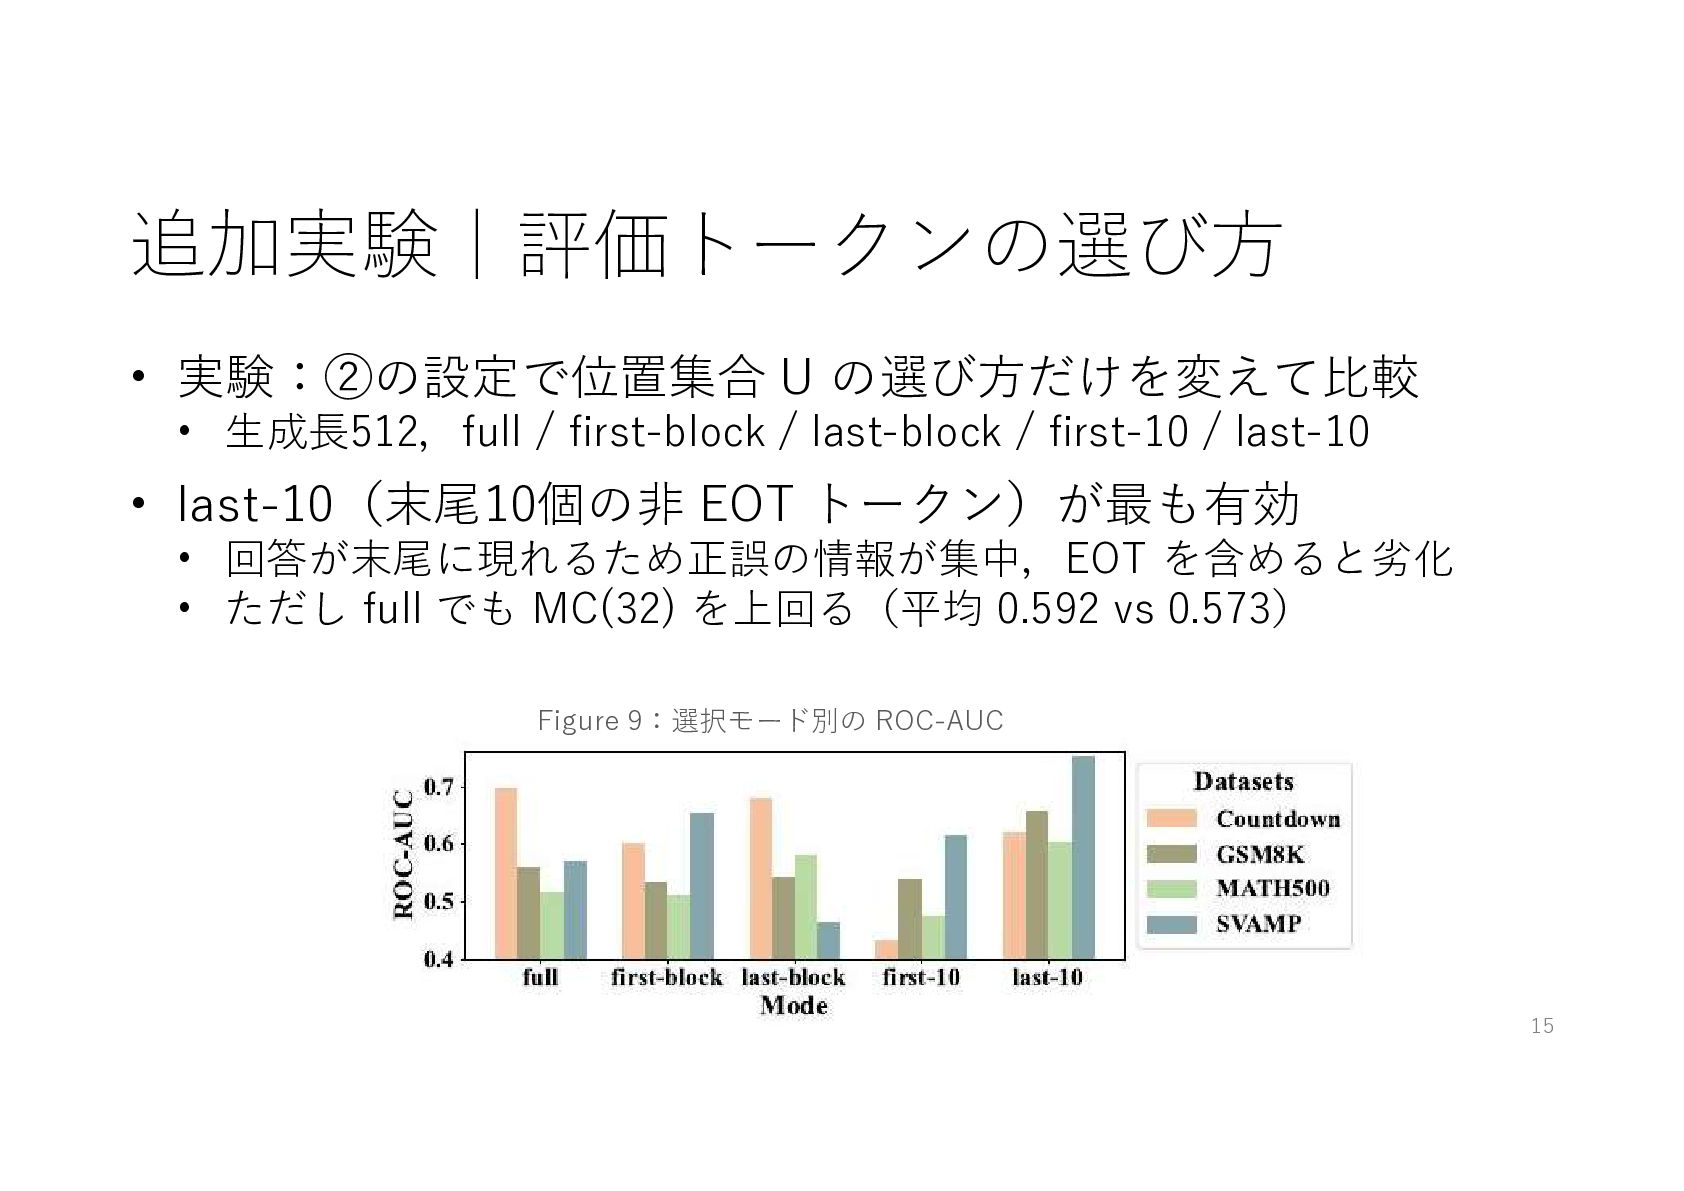
追加実験|評価トークンの選び方 • 実験:②の設定で位置集合 U の選び方だけを変えて比較 • 生成⾧512,full / first-block /
last-block / first-10 / last-10 • last-10(末尾10個の非 EOT トークン)が最も有効 • 回答が末尾に現れるため正誤の情報が集中,EOT を含めると劣化 • ただし full でも MC(32) を上回る(平均 0.592 vs 0.573) Figure 9:選択モード別の ROC-AUC 15
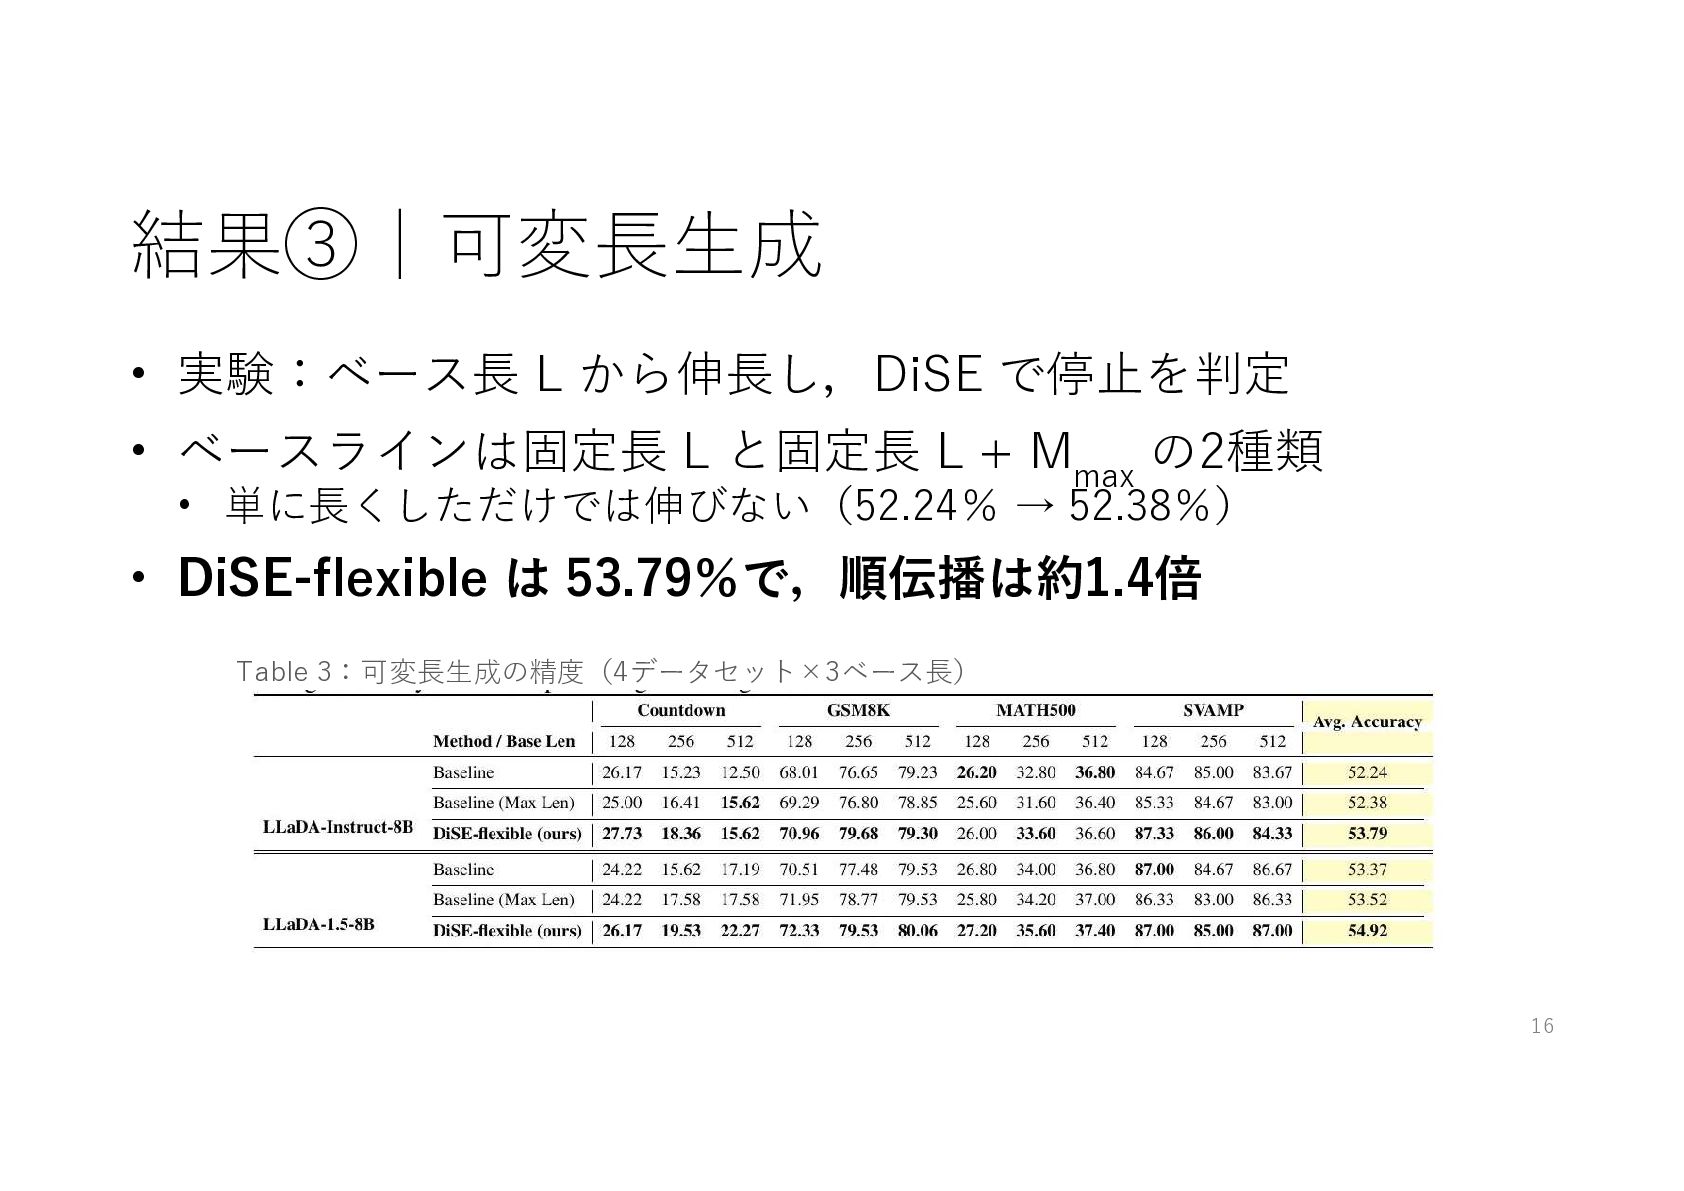
結果③|可変⾧生成 • 実験:ベース⾧ L から伸⾧し,DiSE で停止を判定 • ベースラインは固定⾧ L と固定⾧
L + Mmax の2種類 • 単に⾧くしただけでは伸びない(52.24% → 52.38%) • DiSE-flexible は 53.79%で,順伝播は約1.4倍 Table 3:可変⾧生成の精度(4データセット×3ベース⾧) 16
まとめ • 拡散言語モデル向けの学習不要な自己評価指標 DiSEを提案 • 汎化能力による解釈と正解率との相関で裏付け • 貢献1:順伝播1回の尤度近似で,MC 比 約32倍の効率化
• 貢献2:固定⾧生成の制約を解除 17
所感 • 訓練不要で使えるのがいい • 既存のモデルにそのまま適用でき,追加コストは順伝播1回 • 理論的裏付けの弱さ • GT と
Mask の出力分布が近いという経験的観察にとどまる • GTはモデルの生成時には現れない 検証時と同じ挙動をするか疑問 18


 aleyda
 erikaheidi
 baasie
 jlugia
 marktimemedia
 katarinadahlin
 kimpetersen
 marcelosomers
 schroneko
 bluesmoon
 honnibal