Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
NRUG Vol.19 New Relic AI Agentでアラート疲れを軽減した話
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
大村雄哉
September 16, 2026
210
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
NRUG Vol.19 New Relic AI Agentでアラート疲れを軽減した話
大村雄哉
September 16, 2026
More Decks by 大村雄哉
See All by 大村雄哉
New Relic導入後...オブザーバビリティ文化の浸透
youmjww
1
710
Featured
See All Featured
The Cult of Friendly URLs
andyhume
79
7k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
1
450
ラッコキーワード サービス紹介資料
rakko
1
5.2M
It's Worth the Effort
3n
188
29k
Practical Orchestrator
shlominoach
192
12k
Noah Learner - AI + Me: how we built a GSC Bulk Export data pipeline
techseoconnect
PRO
0
450
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
1
550
What's in a price? How to price your products and services
michaelherold
247
13k
Scaling GitHub
holman
464
140k
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
Fireside Chat
paigeccino
43
4k
How to train your dragon (web standard)
notwaldorf
96
6.8k
Transcript
2026年9月16日 New Relic AI機能やってみた LT&事例共有ナイト by NRUG Vol.19 New Relic
AI Agentで アラート疲れを軽減した話し 千株式会社 システム横断本部 システム開発部 横断開発課 SREチーム 氏名 大村雄哉
自己紹介 所属: 千株式会社 システム横断本部 システム開発部 横断開発課 SREチーム 氏名: 大村 雄哉
@yuotech 2018年にエンジニアとして新卒入社し、 アプリケーション開発を経て現在はSREとして活動しています。 現在はNew Relicを活用しながら、オブザーバビリティの向上と、トラブル シューティングの効率化に取り組んでいます。 SEN CORPORATION
None
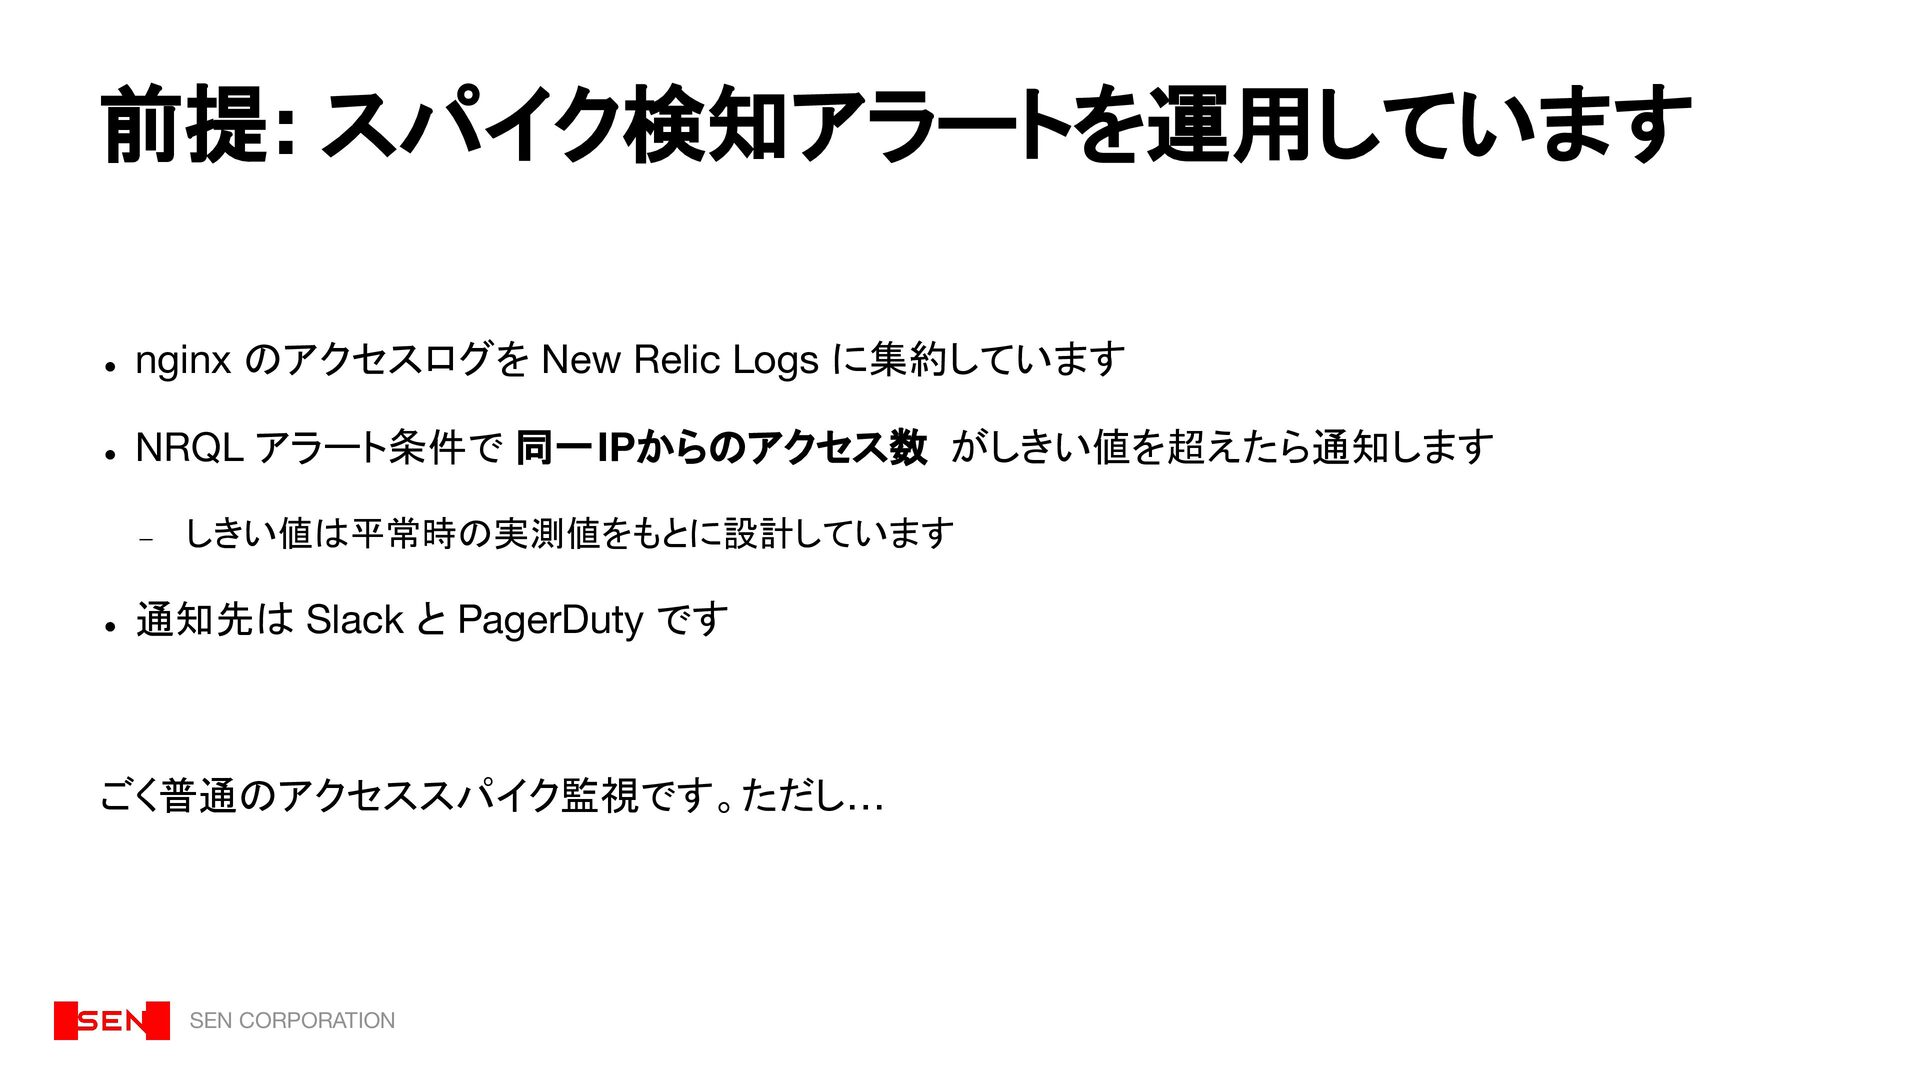
前提: スパイク検知アラートを運用しています • nginx のアクセスログを New Relic Logs に集約しています •
NRQL アラート条件で 同一IPからのアクセス数 がしきい値を超えたら通知します - • しきい値は平常時の実測値をもとに設計しています 通知先は Slack と PagerDuty です ごく普通のアクセススパイク監視です。ただし… SEN CORPORATION
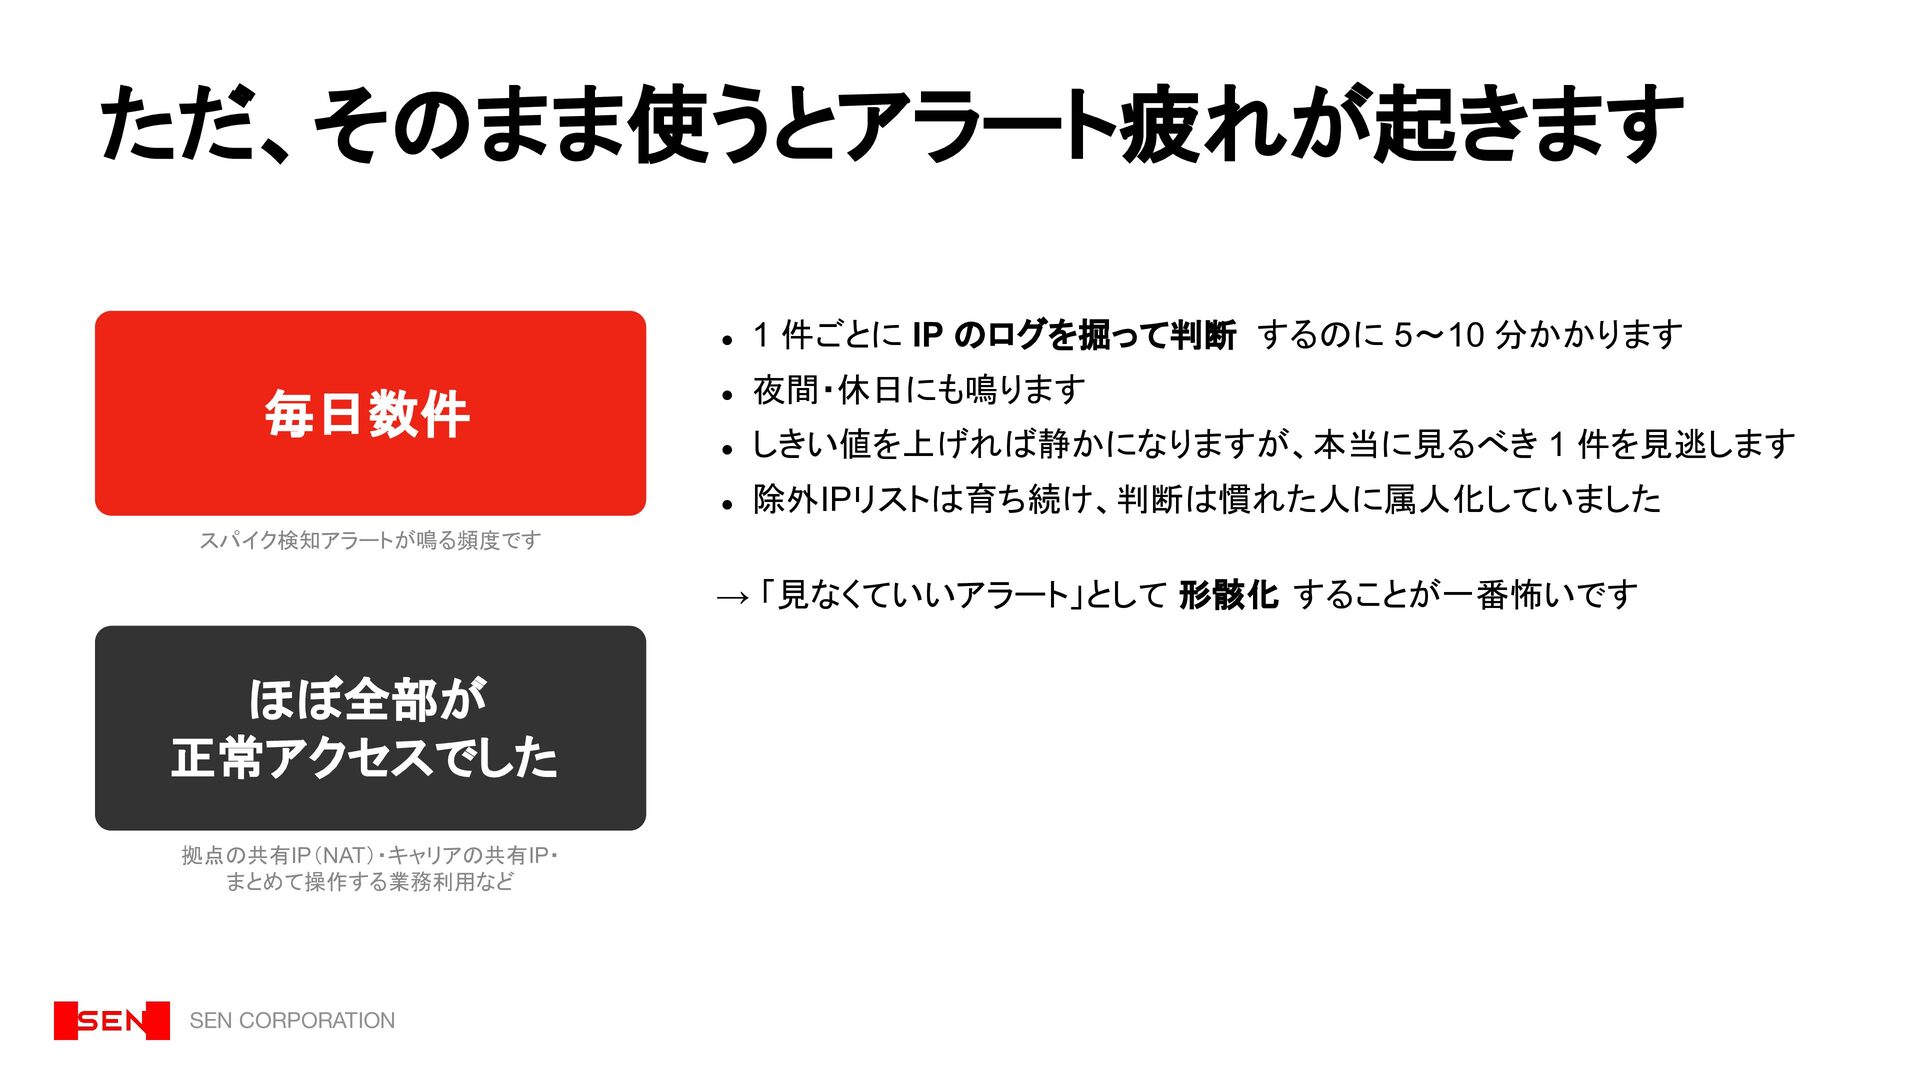
ただ、そのまま使うとアラート疲れが起きます 毎日数件 • 1 件ごとに IP のログを掘って判断 するのに 5〜10 分かかります
• 夜間・休日にも鳴ります • しきい値を上げれば静かになりますが、本当に見るべき 1 件を見逃します • 除外IPリストは育ち続け、判断は慣れた人に属人化していました スパイク検知アラートが鳴る頻度です → 「見なくていいアラート」として 形骸化 することが一番怖いです ほぼ全部が 正常アクセスでした 拠点の共有IP(NAT)・キャリアの共有IP・ まとめて操作する業務利用など SEN CORPORATION
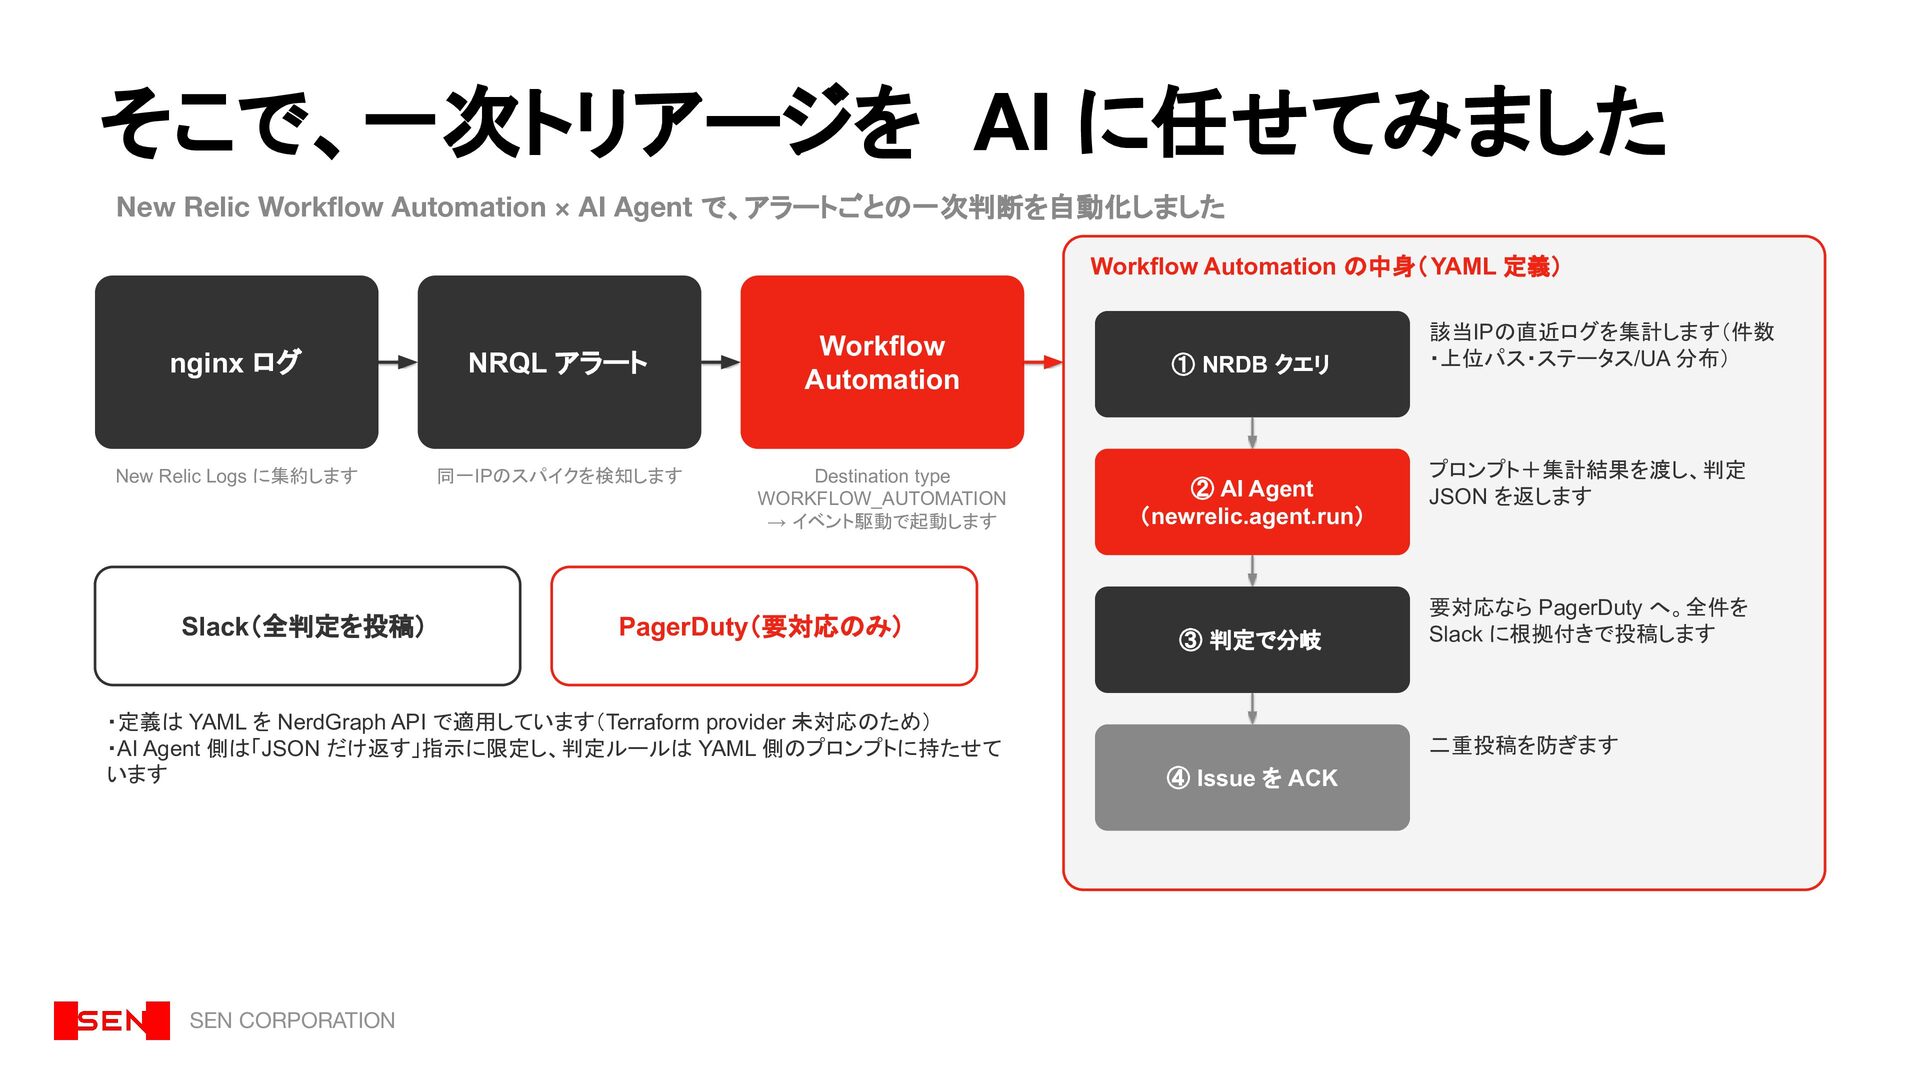
そこで、一次トリアージを AI に任せてみました New Relic Workflow Automation × AI Agent
で、アラートごとの一次判断を自動化しました Workflow Automation の中身( YAML 定義) nginx ログ NRQL アラート New Relic Logs に集約します 同一IPのスパイクを検知します Slack(全判定を投稿) Workflow Automation Destination type WORKFLOW_AUTOMATION → イベント駆動で起動します PagerDuty(要対応のみ) ・定義は YAML を NerdGraph API で適用しています(Terraform provider 未対応のため) ・AI Agent 側は「JSON だけ返す」指示に限定し、判定ルールは YAML 側のプロンプトに持たせて います SEN CORPORATION ① NRDB クエリ ② AI Agent (newrelic.agent.run) ③ 判定で分岐 該当IPの直近ログを集計します(件数 ・上位パス・ステータス/UA 分布) プロンプト+集計結果を渡し、判定 JSON を返します 要対応なら PagerDuty へ。全件を Slack に根拠付きで投稿します 二重投稿を防ぎます ④ Issue を ACK
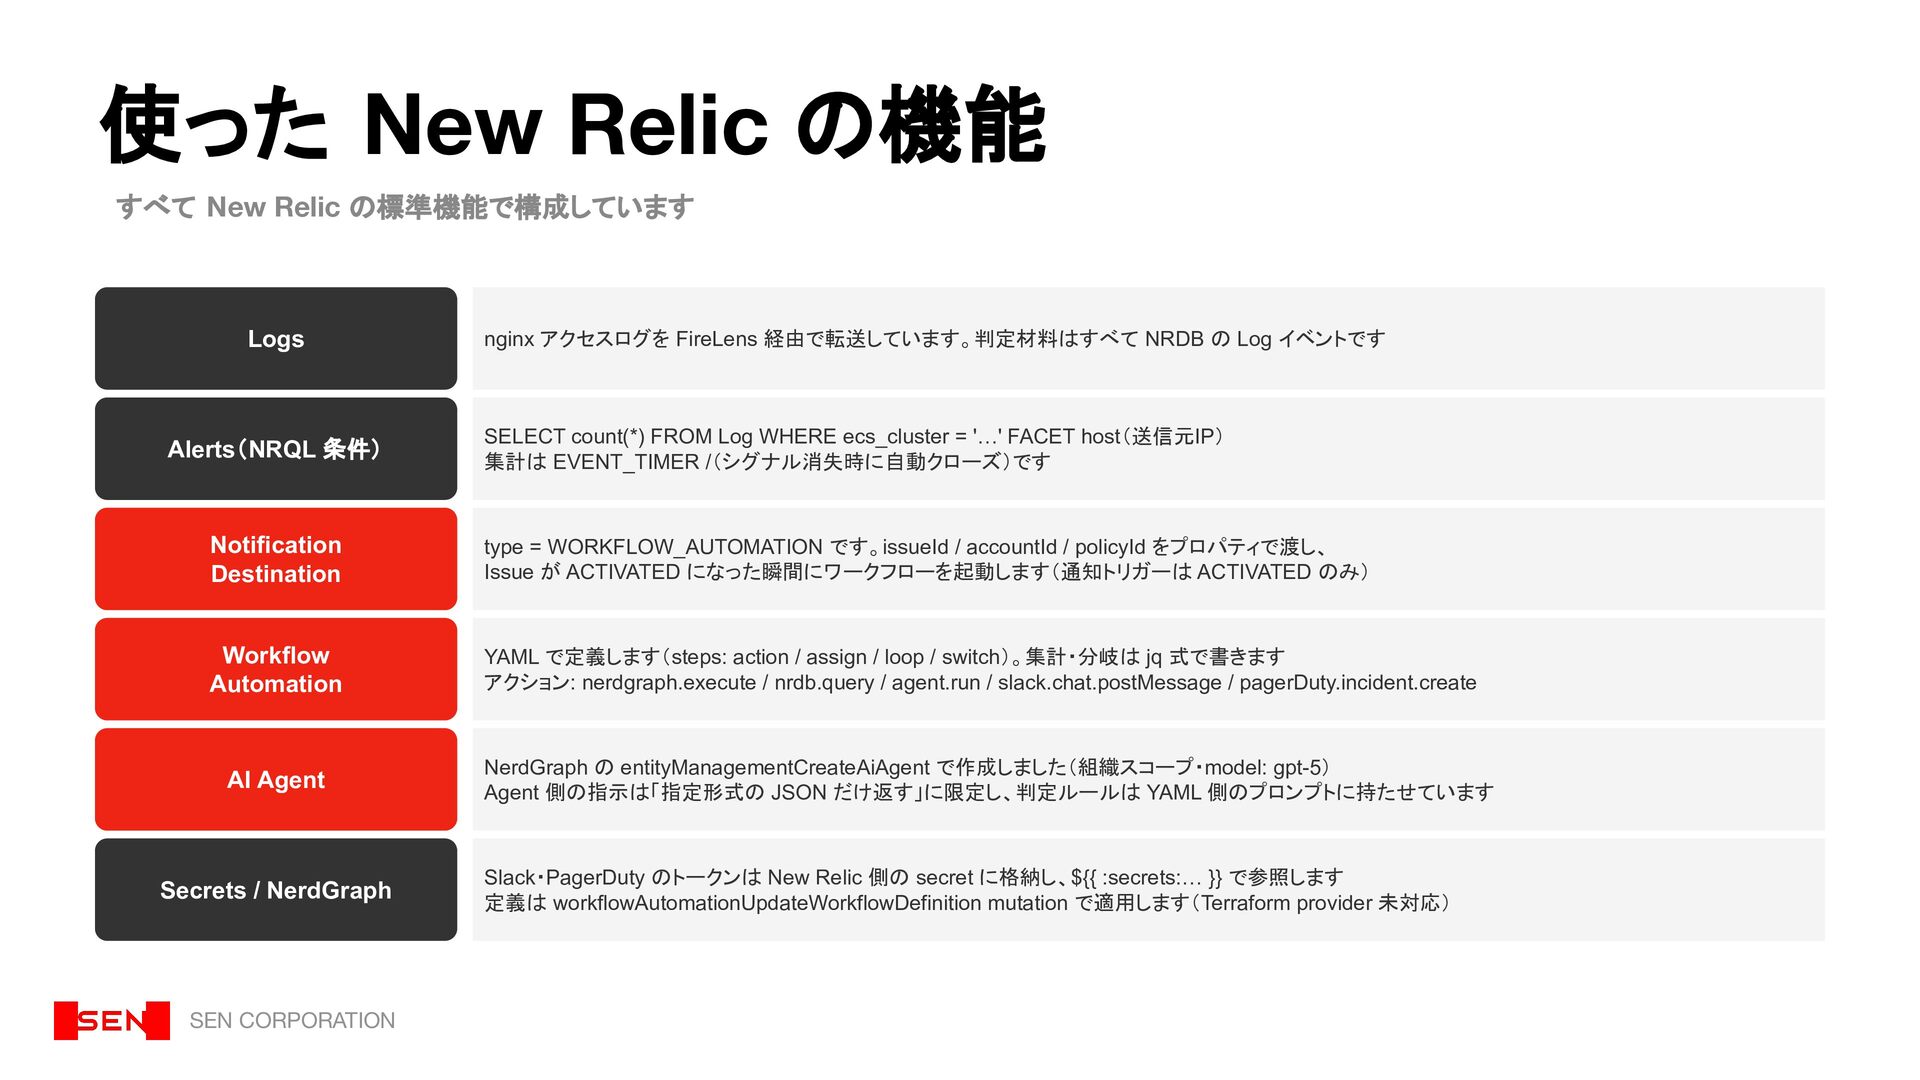
使った New Relic の機能 すべて New Relic の標準機能で構成しています Logs Alerts(NRQL
条件) nginx アクセスログを FireLens 経由で転送しています。判定材料はすべて NRDB の Log イベントです SELECT count(*) FROM Log WHERE ecs_cluster = '…' FACET host(送信元IP) 集計は EVENT_TIMER /(シグナル消失時に自動クローズ)です Notification Destination type = WORKFLOW_AUTOMATION です。issueId / accountId / policyId をプロパティで渡し、 Issue が ACTIVATED になった瞬間にワークフローを起動します(通知トリガーは ACTIVATED のみ) Workflow Automation YAML で定義します(steps: action / assign / loop / switch)。集計・分岐は jq 式で書きます アクション: nerdgraph.execute / nrdb.query / agent.run / slack.chat.postMessage / pagerDuty.incident.create AI Agent NerdGraph の entityManagementCreateAiAgent で作成しました(組織スコープ・model: gpt-5) Agent 側の指示は「指定形式の JSON だけ返す」に限定し、判定ルールは YAML 側のプロンプトに持たせています Secrets / NerdGraph SEN CORPORATION Slack・PagerDuty のトークンは New Relic 側の secret に格納し、${{ :secrets:… }} で参照します 定義は workflowAutomationUpdateWorkflowDefinition mutation で適用します(Terraform provider 未対応)
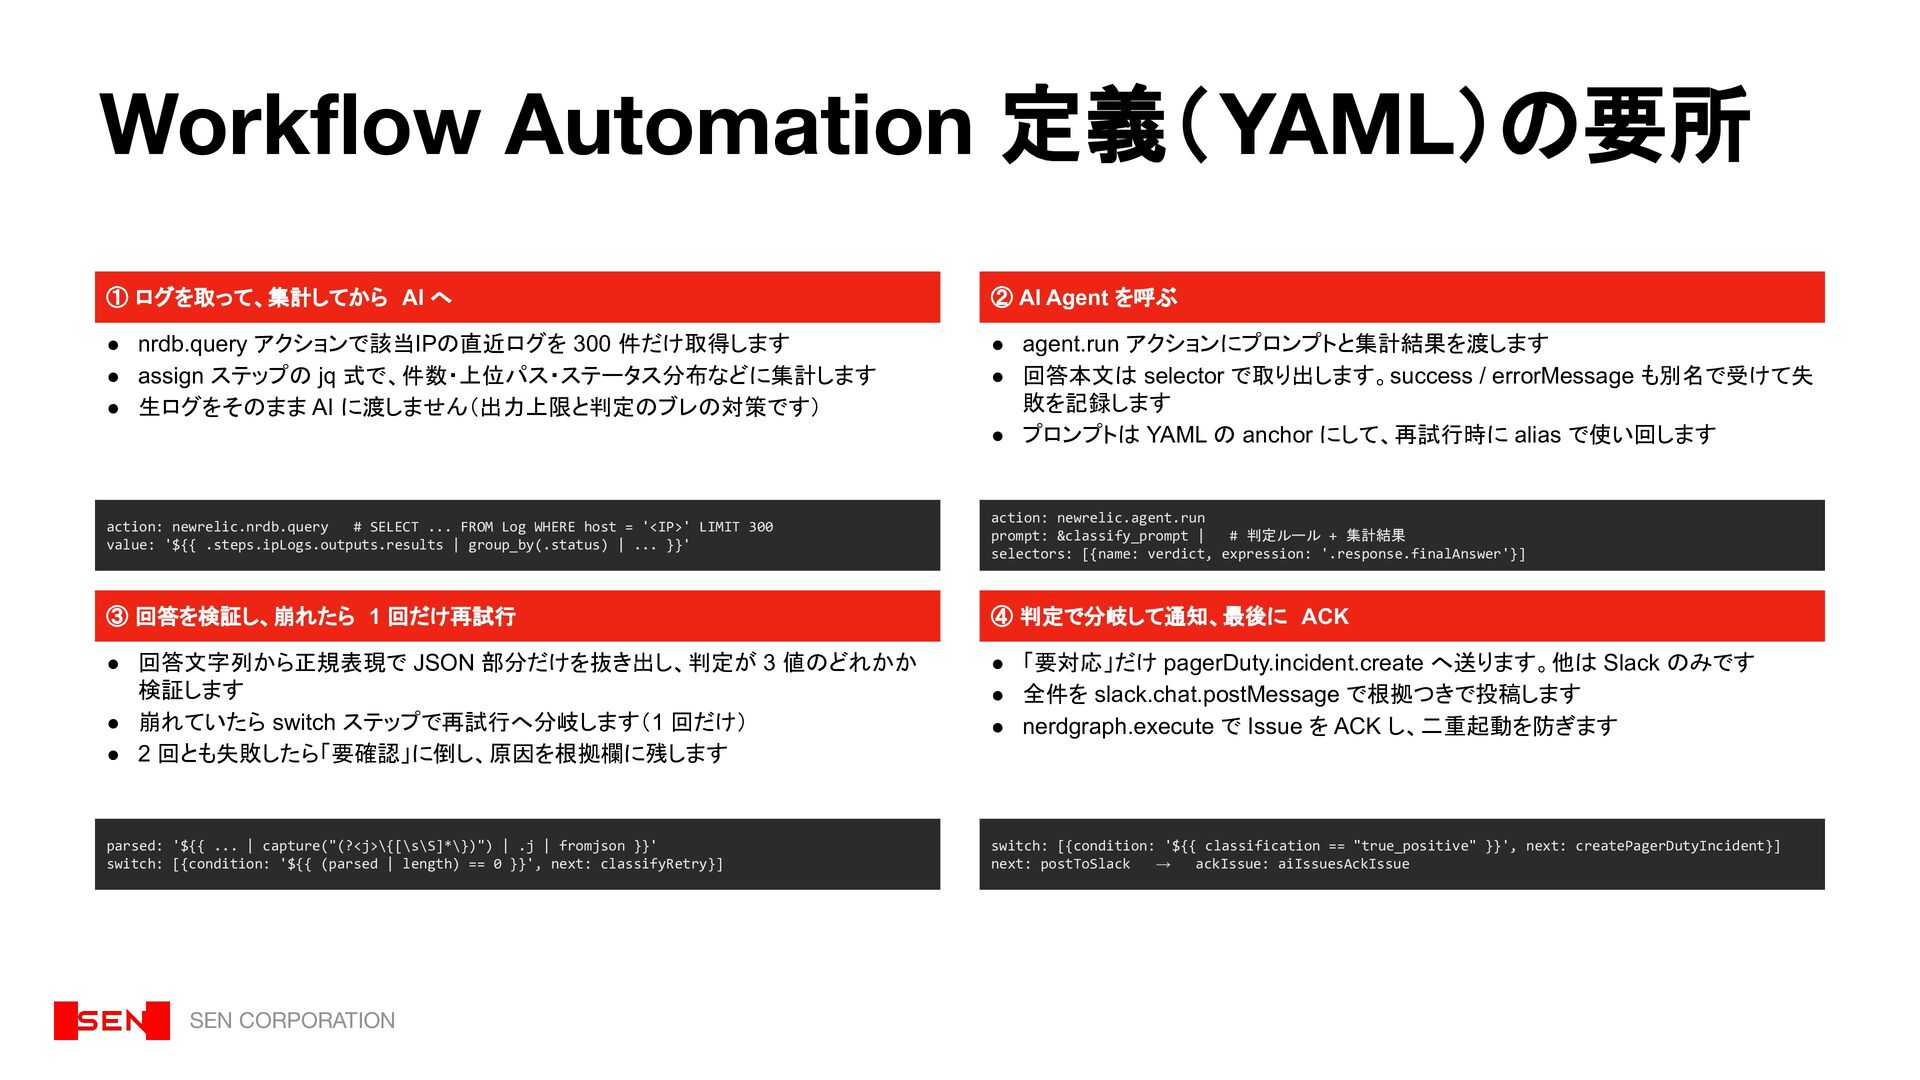
Workflow Automation 定義(YAML)の要所 ① ログを取って、集計してから AI へ ② AI Agent
を呼ぶ • nrdb.query アクションで該当IPの直近ログを 300 件だけ取得します • assign ステップの jq 式で、件数・上位パス・ステータス分布などに集計します • 生ログをそのまま AI に渡しません(出力上限と判定のブレの対策です) • agent.run アクションにプロンプトと集計結果を渡します • 回答本文は selector で取り出します。success / errorMessage も別名で受けて失 敗を記録します • プロンプトは YAML の anchor にして、再試行時に alias で使い回します action: newrelic.nrdb.query # SELECT ... FROM Log WHERE host = '<IP>' LIMIT 300 value: '${{ .steps.ipLogs.outputs.results | group_by(.status) | ... }}' action: newrelic.agent.run prompt: &classify_prompt | # 判定ルール + 集計結果 selectors: [{name: verdict, expression: '.response.finalAnswer'}] ③ 回答を検証し、崩れたら 1 回だけ再試行 ④ 判定で分岐して通知、最後に ACK • 回答文字列から正規表現で JSON 部分だけを抜き出し、判定が 3 値のどれかか 検証します • 崩れていたら switch ステップで再試行へ分岐します(1 回だけ) • 2 回とも失敗したら「要確認」に倒し、原因を根拠欄に残します • 「要対応」だけ pagerDuty.incident.create へ送ります。他は Slack のみです • 全件を slack.chat.postMessage で根拠つきで投稿します • nerdgraph.execute で Issue を ACK し、二重起動を防ぎます parsed: '${{ ... | capture("(?<j>\{[\s\S]*\})") | .j | fromjson }}' switch: [{condition: '${{ (parsed | length) == 0 }}', next: classifyRetry}] switch: [{condition: '${{ classification == "true_positive" }}', next: createPagerDutyIncident}] next: postToSlack → ackIssue: aiIssuesAckIssue SEN CORPORATION
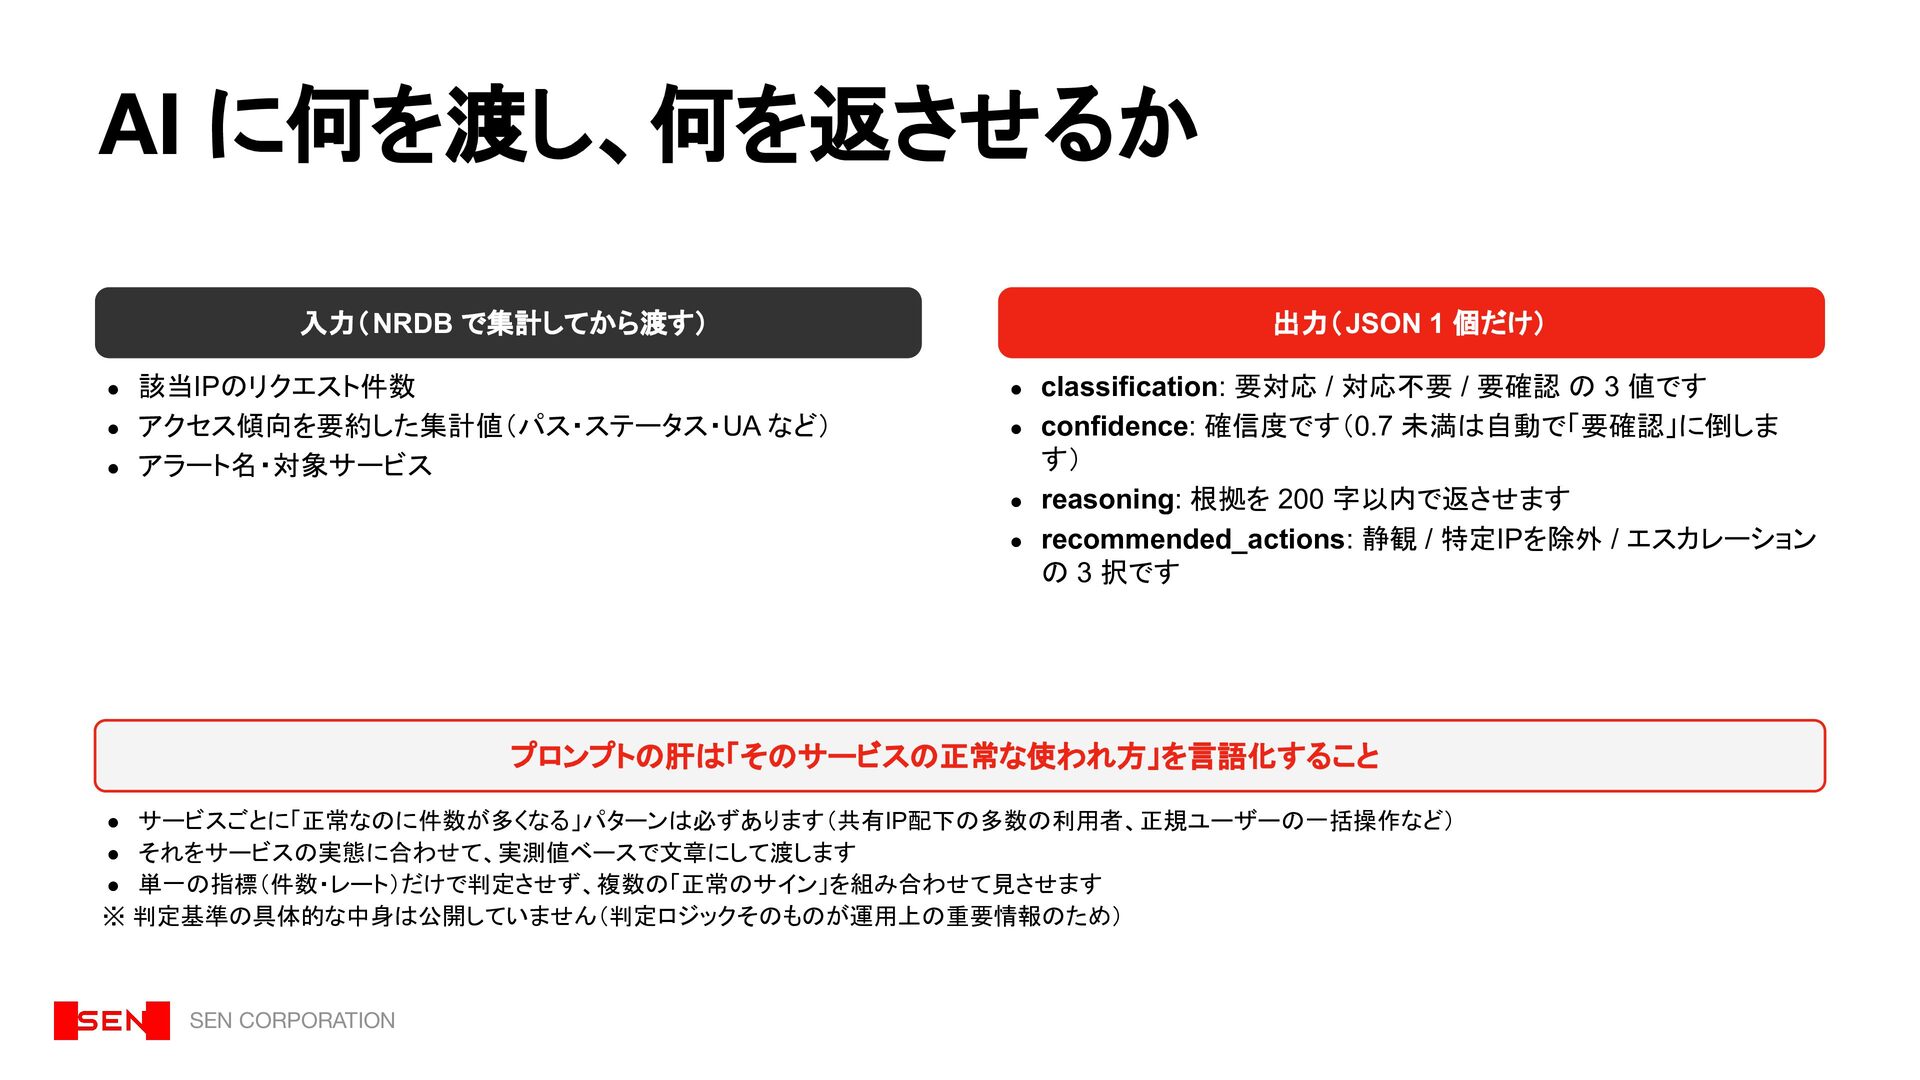
AI に何を渡し、何を返させるか 入力(NRDB で集計してから渡す) 該当IPのリクエスト件数 • アクセス傾向を要約した集計値(パス・ステータス・UA など) • アラート名・対象サービス
• 出力(JSON 1 個だけ) classification: 要対応 / 対応不要 / 要確認 の 3 値です • confidence: 確信度です(0.7 未満は自動で「要確認」に倒しま す) • reasoning: 根拠を 200 字以内で返させます • recommended_actions: 静観 / 特定IPを除外 / エスカレーション の 3 択です • プロンプトの肝は「そのサービスの正常な使われ方」を言語化すること • サービスごとに「正常なのに件数が多くなる」パターンは必ずあります(共有IP配下の多数の利用者、正規ユーザーの一括操作など) • それをサービスの実態に合わせて、実測値ベースで文章にして渡します • 単一の指標(件数・レート)だけで判定させず、複数の「正常のサイン」を組み合わせて見させます ※ 判定基準の具体的な中身は公開していません(判定ロジックそのものが運用上の重要情報のため) SEN CORPORATION
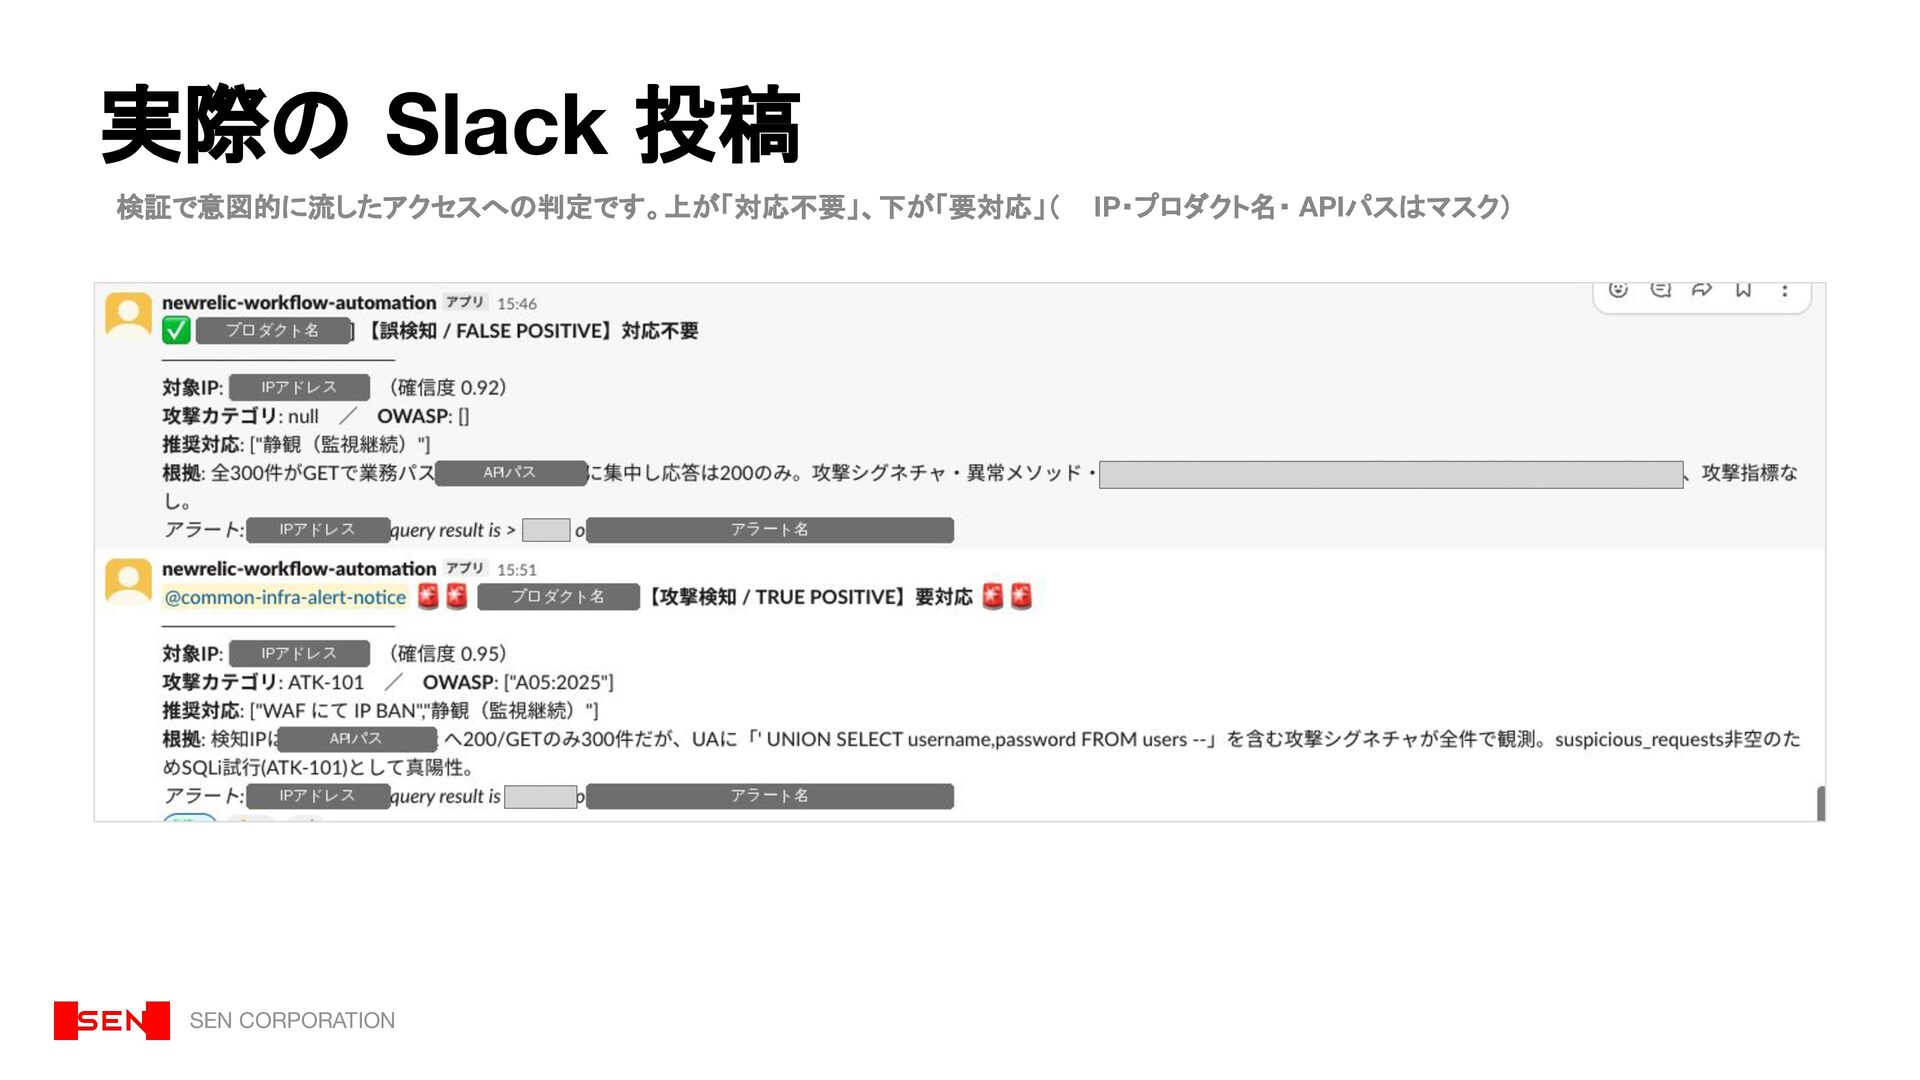
実際の Slack 投稿 検証で意図的に流したアクセスへの判定です。上が「対応不要」、下が「要対応」( SEN CORPORATION IP・プロダクト名・ APIパスはマスク)
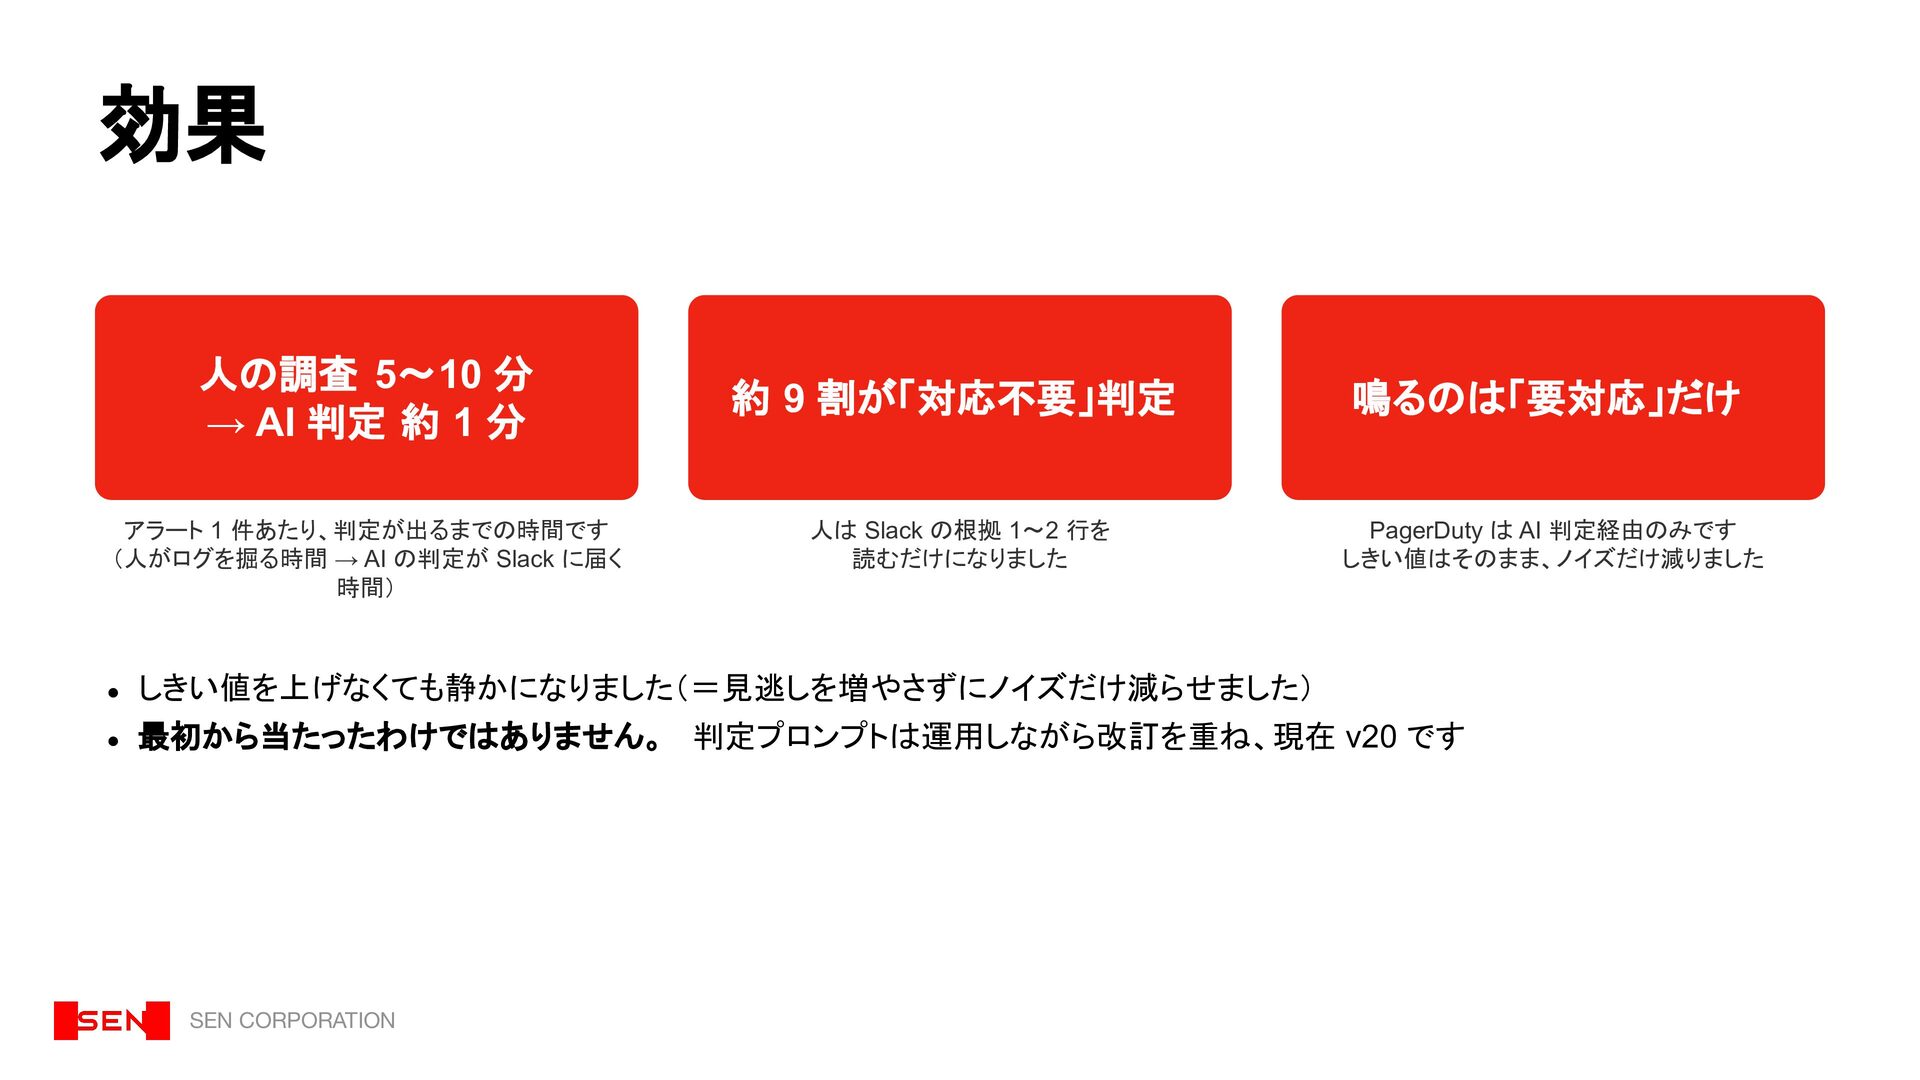
効果 人の調査 5〜10 分 → AI 判定 約 1 分
アラート 1 件あたり、判定が出るまでの時間です (人がログを掘る時間 → AI の判定が Slack に届く 時間) 約 9 割が「対応不要」判定 鳴るのは「要対応」だけ 人は Slack の根拠 1〜2 行を 読むだけになりました PagerDuty は AI 判定経由のみです しきい値はそのまま、ノイズだけ減りました • しきい値を上げなくても静かになりました(=見逃しを増やさずにノイズだけ減らせました) • 最初から当たったわけではありません。 判定プロンプトは運用しながら改訂を重ね、現在 v20 です SEN CORPORATION
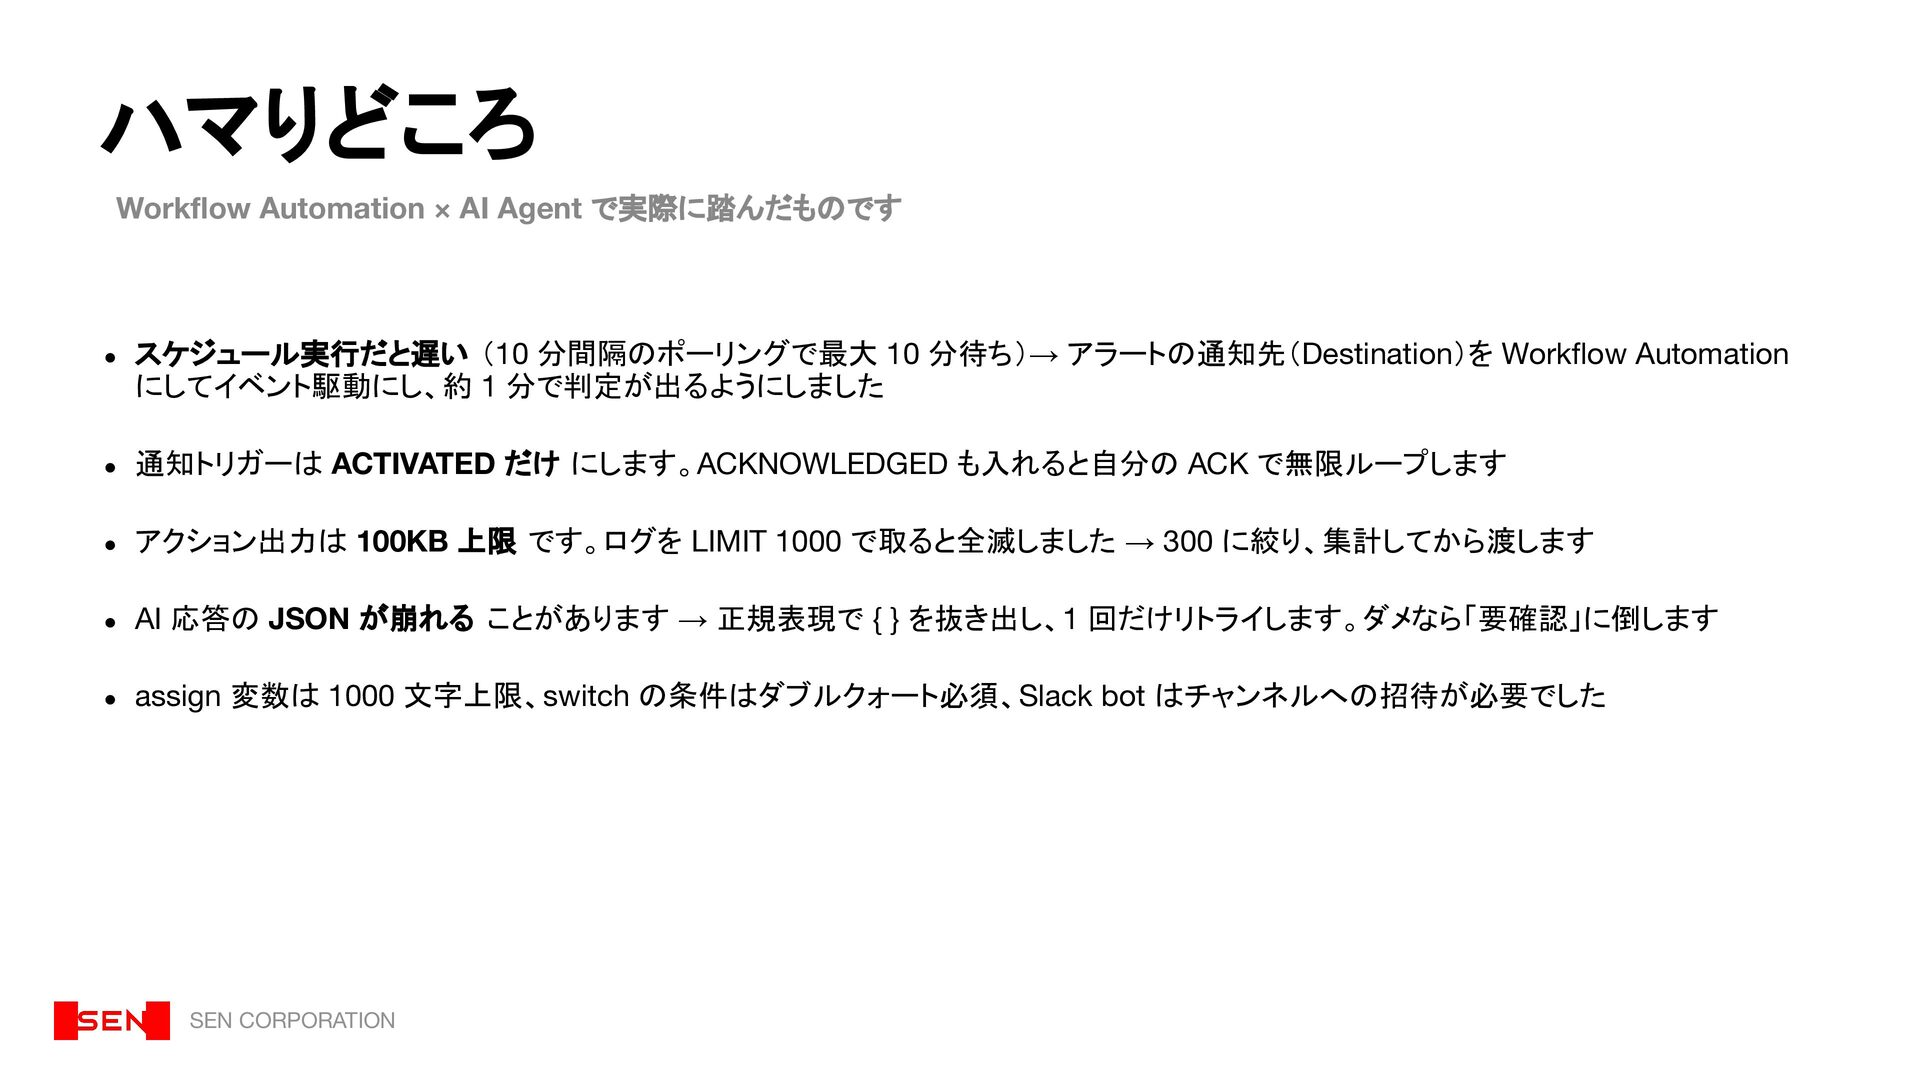
ハマりどころ Workflow Automation × AI Agent で実際に踏んだものです • スケジュール実行だと遅い (10
分間隔のポーリングで最大 10 分待ち)→ アラートの通知先(Destination)を Workflow Automation にしてイベント駆動にし、約 1 分で判定が出るようにしました • 通知トリガーは ACTIVATED だけ にします。ACKNOWLEDGED も入れると自分の ACK で無限ループします • アクション出力は 100KB 上限 です。ログを LIMIT 1000 で取ると全滅しました → 300 に絞り、集計してから渡します • AI 応答の JSON が崩れる ことがあります → 正規表現で { } を抜き出し、1 回だけリトライします。ダメなら「要確認」に倒します • assign 変数は 1000 文字上限、switch の条件はダブルクォート必須、Slack bot はチャンネルへの招待が必要でした SEN CORPORATION
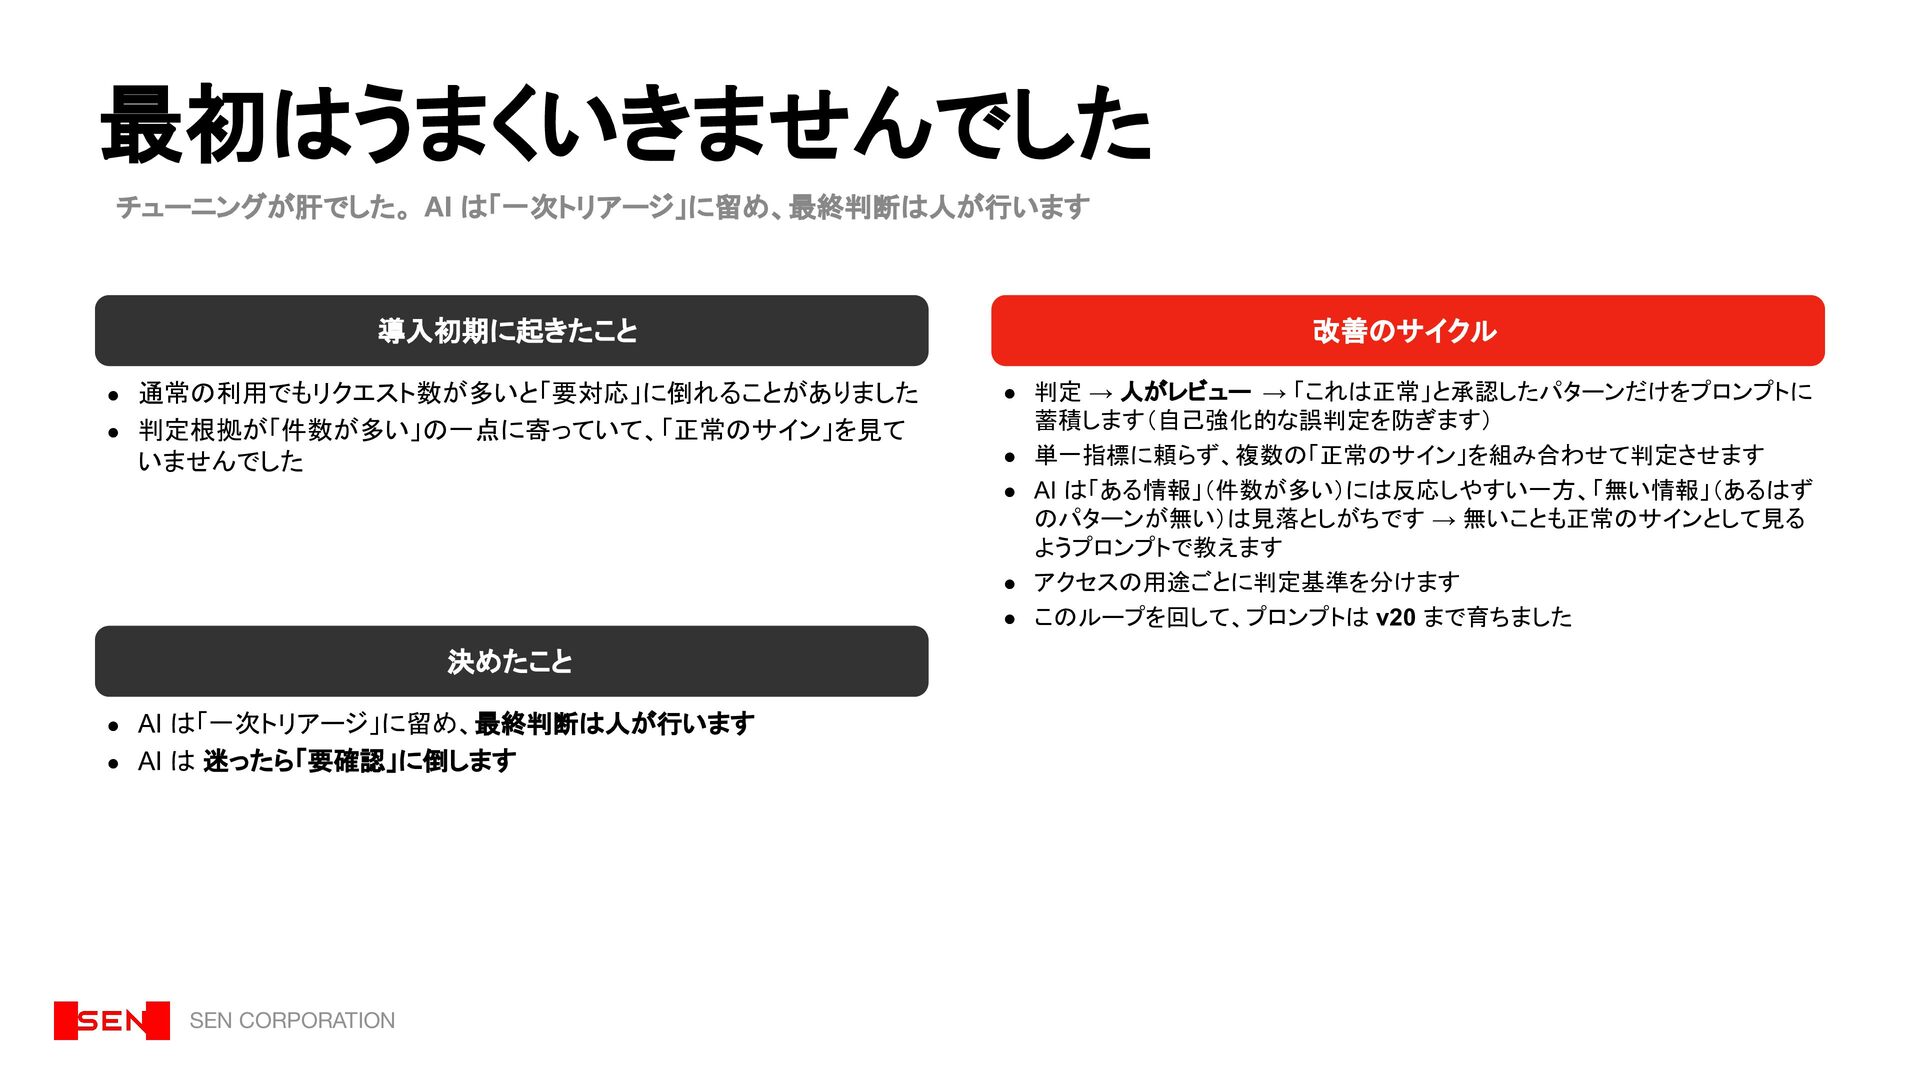
最初はうまくいきませんでした チューニングが肝でした。 AI は「一次トリアージ」に留め、最終判断は人が行います 導入初期に起きたこと 改善のサイクル • 通常の利用でもリクエスト数が多いと「要対応」に倒れることがありました • 判定
→ 人がレビュー → 「これは正常」と承認したパターンだけをプロンプトに • 判定根拠が「件数が多い」の一点に寄っていて、「正常のサイン」を見て 蓄積します(自己強化的な誤判定を防ぎます) 単一指標に頼らず、複数の「正常のサイン」を組み合わせて判定させます AI は「ある情報」(件数が多い)には反応しやすい一方、「無い情報」(あるはず のパターンが無い)は見落としがちです → 無いことも正常のサインとして見る ようプロンプトで教えます アクセスの用途ごとに判定基準を分けます このループを回して、プロンプトは v20 まで育ちました • いませんでした • • • 決めたこと • AI は「一次トリアージ」に留め、最終判断は人が行います • AI は 迷ったら「要確認」に倒します SEN CORPORATION
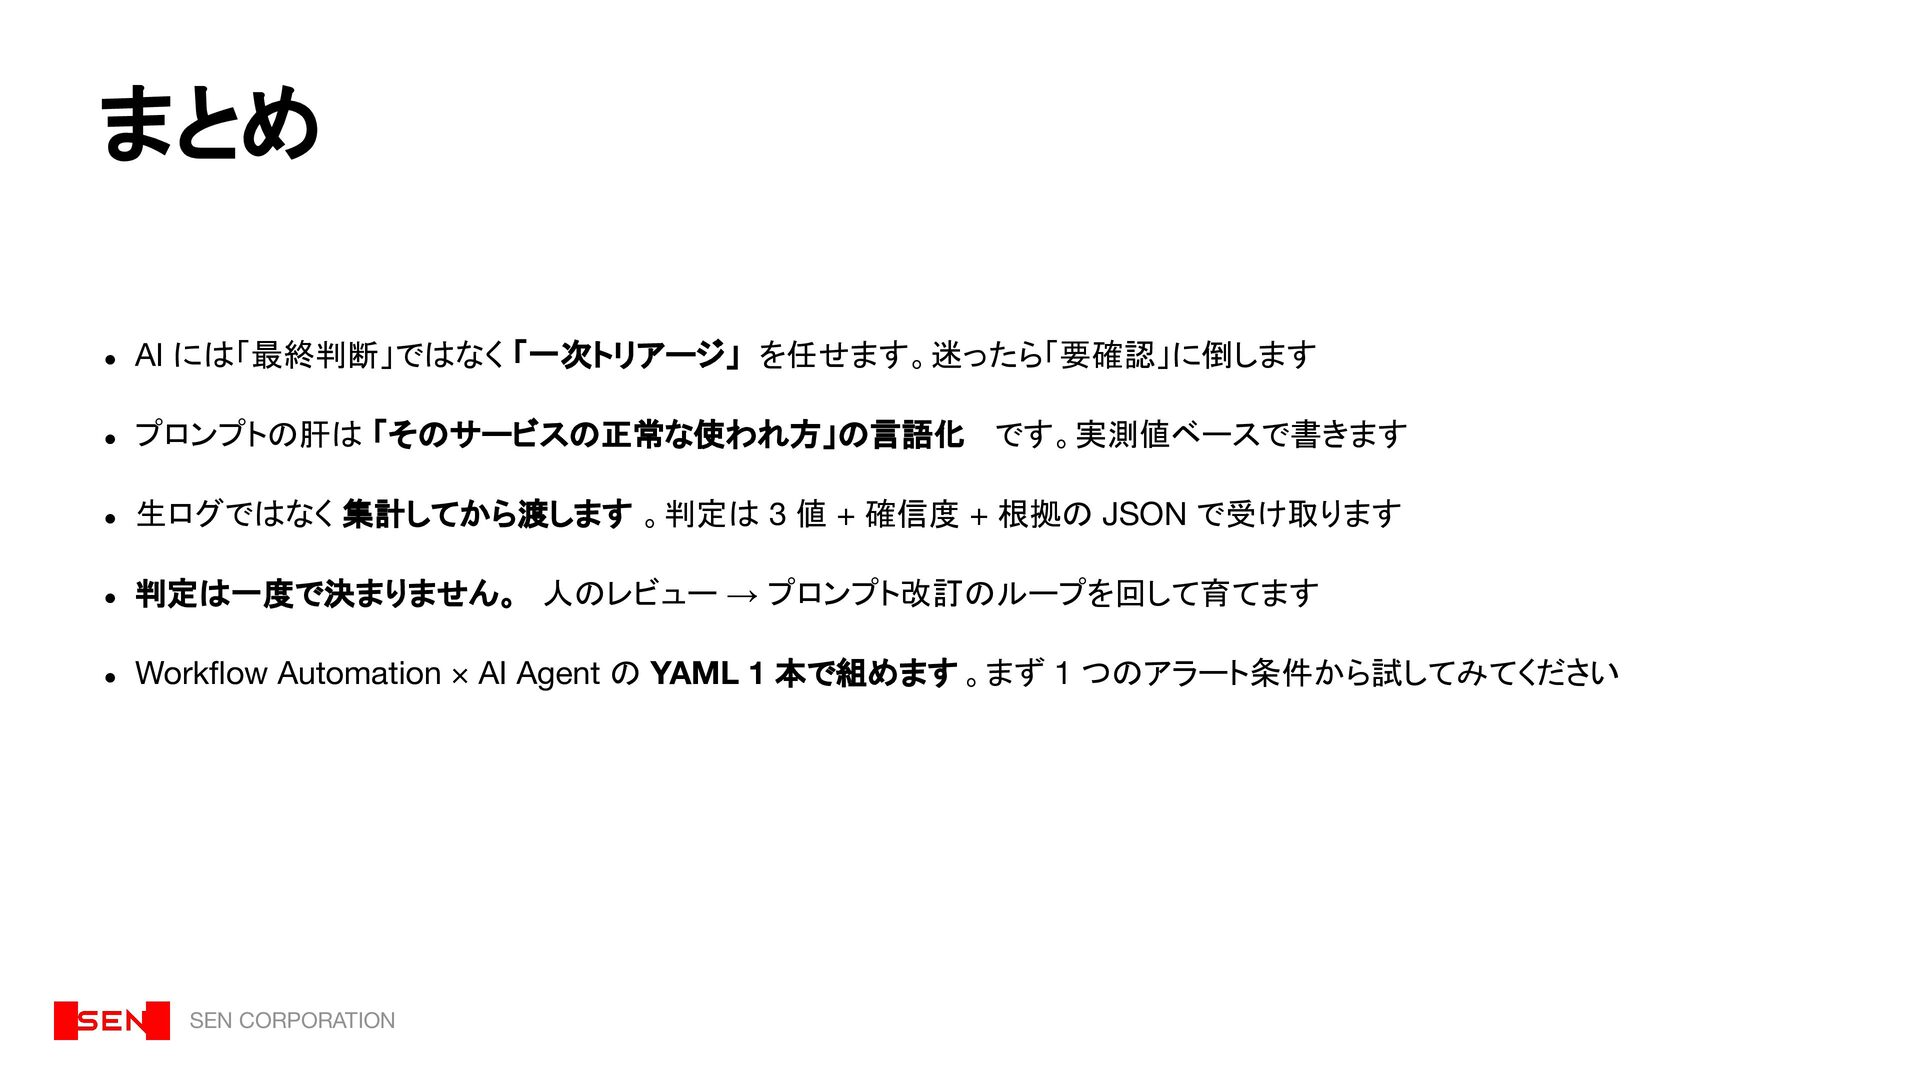
まとめ • AI には「最終判断」ではなく 「一次トリアージ」 を任せます。迷ったら「要確認」に倒します • プロンプトの肝は 「そのサービスの正常な使われ方」の言語化 です。実測値ベースで書きます
• 生ログではなく 集計してから渡します 。判定は 3 値 + 確信度 + 根拠の JSON で受け取ります • 判定は一度で決まりません。 人のレビュー → プロンプト改訂のループを回して育てます • Workflow Automation × AI Agent の YAML 1 本で組めます 。まず 1 つのアラート条件から試してみてください SEN CORPORATION
We are Hiring! 千株式会社では 一緒に子どもたちの未来を作る仲間を募集しています https://sencorp.co.jp/recruit-career/

 Your Podcast. Everywhere. Effortlessly.


 youmjww
 andyhume
 axbom
 rakko
 3n
 shlominoach
 techseoconnect
 baasie
 michaelherold
 holman
 marcelosomers
 paigeccino
 notwaldorf