Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Incorporating Convolution Designs into Visual T...

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

Incorporating Convolution Designs into Visual Transformers

「第六回 全日本コンピュータビジョン勉強会」で発表した資料です。
下記論文の紹介になります。
Kun Yuan, Shaopeng Guo, Ziwei Liu, Aojun Zhou, Fengwei Yu, Wei Wu, “Incorporating Convolution Designs into Visual Transformers ,” ; [arXiv:2103.11816 [cs.CV]].

Avatar for Masafumi Abeta

Masafumi Abeta

April 24, 2021

More Decks by Masafumi Abeta

Other Decks in Science

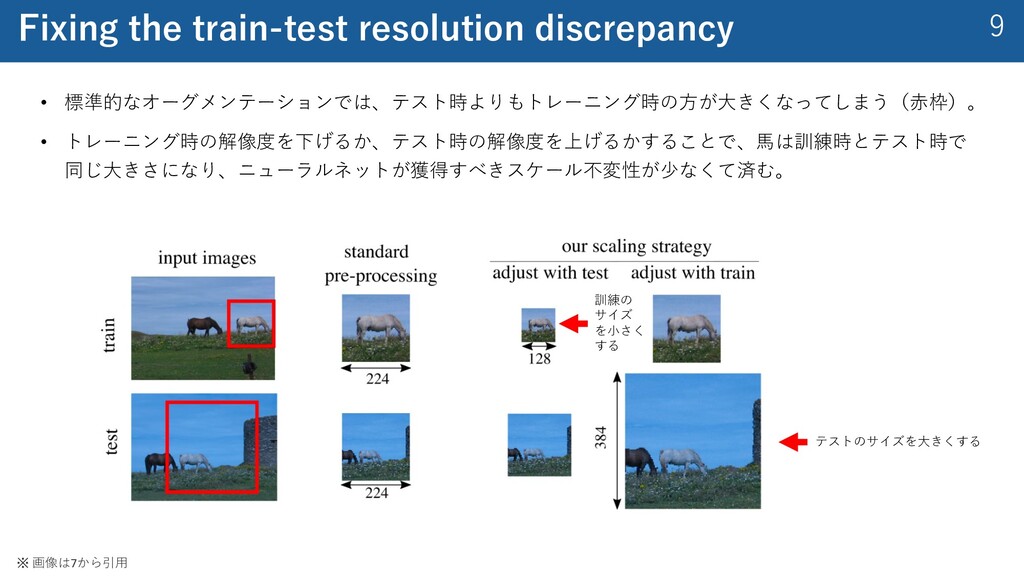
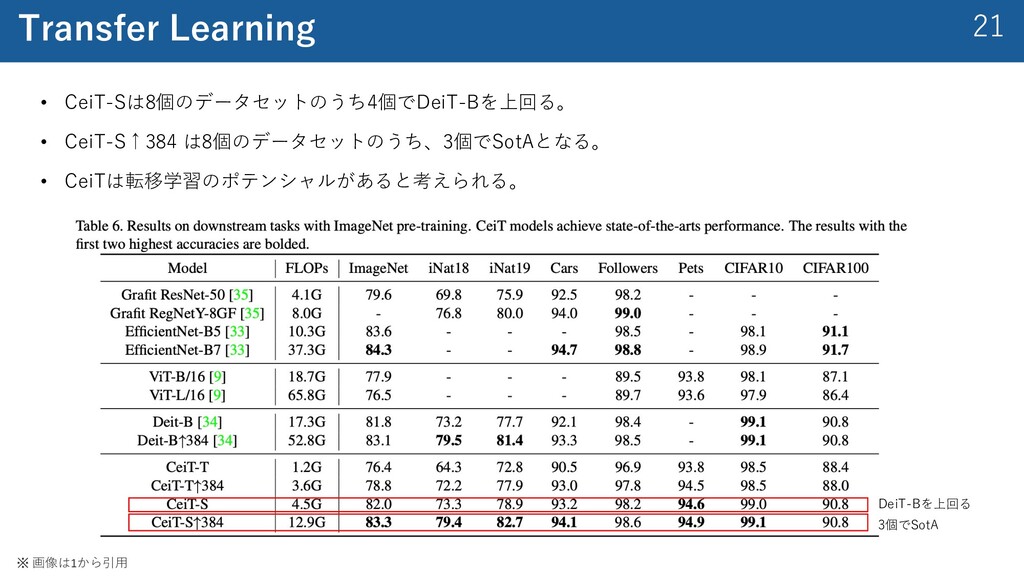
Transcript

  1. 2 ⾃⼰紹介:阿部⽥ 将史 • 某SIerのデータサイエンティスト • 最近の興味 • 画像の異常検知 •

    ニューラルネットワークに適切な帰納バイアスを取り 込むにはどのような構造を導⼊すればよいか • その他 • E資格2021#1取得しました • 全⽇本コンピュータビジョン勉強会 初参加です
  2. 4 論⽂情報 タイトル Incorporating Convolution Designs into Visual Transformers 著者

    Kun Yuan1, Shaopeng Guo1, Ziwei Liu2, Aojun Zhou1, Fengwei Yu1, Wei Wu1 1SenseTime Research , 2S-Lab, Nanyang Technological University
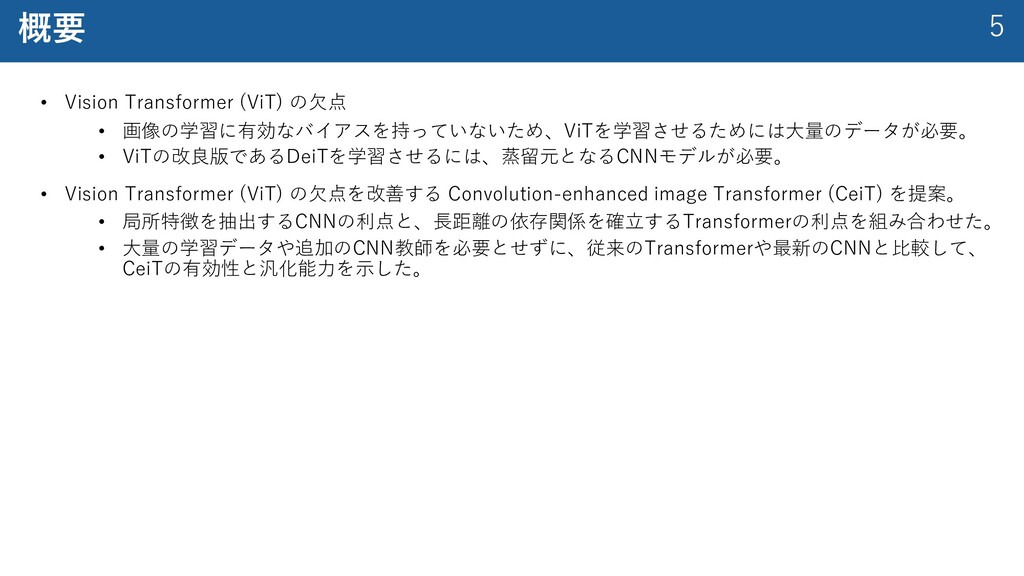
  3. 5 概要 • Vision Transformer (ViT) の⽋点 • 画像の学習に有効なバイアスを持っていないため、ViTを学習させるためには⼤量のデータが必要。 •

    ViTの改良版であるDeiTを学習させるには、蒸留元となるCNNモデルが必要。 • Vision Transformer (ViT) の⽋点を改善する Convolution-enhanced image Transformer (CeiT) を提案。 • 局所特徴を抽出するCNNの利点と、⻑距離の依存関係を確⽴するTransformerの利点を組み合わせた。 • ⼤量の学習データや追加のCNN教師を必要とせずに、従来のTransformerや最新のCNNと⽐較して、 CeiTの有効性と汎化能⼒を⽰した。
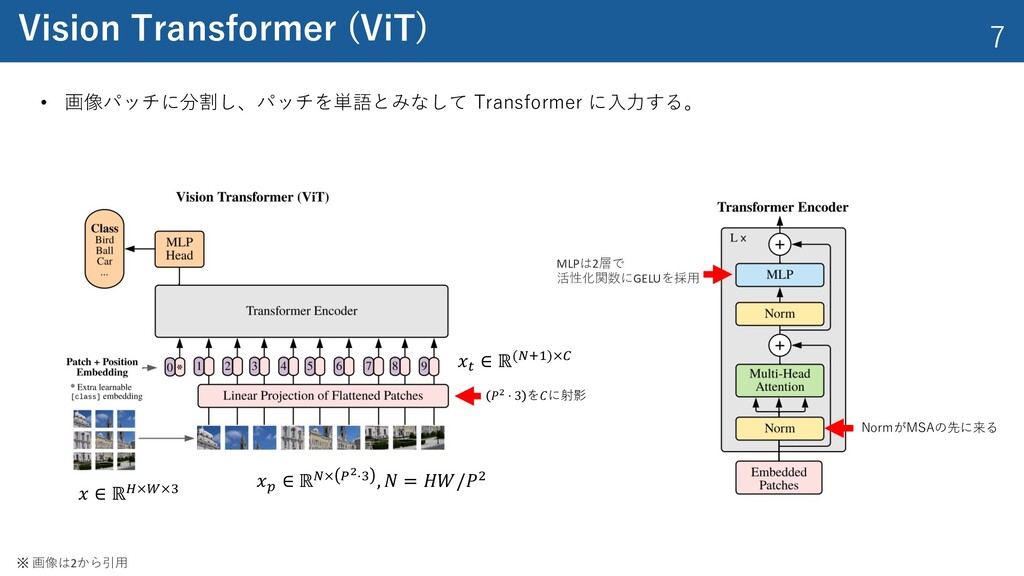
  4. 7 Vision Transformer (ViT) • 画像パッチに分割し、パッチを単語とみなして Transformer に⼊⼒する。 𝑥 ∈

    ℝ!×#×$ 𝑥% ∈ ℝ&× '!⋅$ , 𝑁 = 𝐻𝑊/𝑃) 𝑥* ∈ ℝ(&,-)×/ MLPは2層で 活性化関数にGELUを採⽤ NormがMSAの先に来る ※ 画像は2から引⽤ 𝑃! ⋅ 3 を𝐶に射影
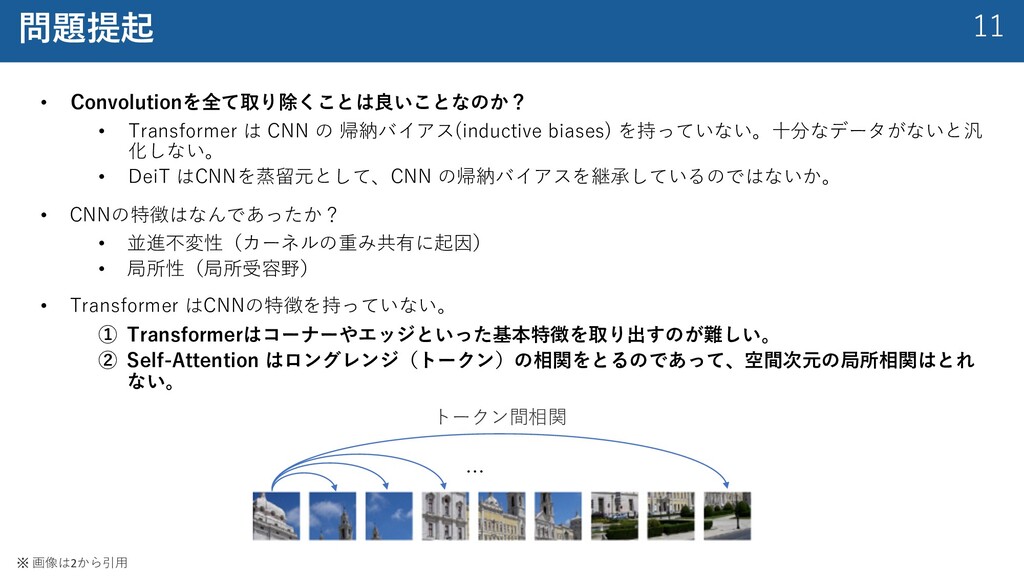
  5. 11 問題提起 • Convolutionを全て取り除くことは良いことなのか? • Transformer は CNN の 帰納バイアス(inductive

    biases) を持っていない。⼗分なデータがないと汎 化しない。 • DeiT はCNNを蒸留元として、CNN の帰納バイアスを継承しているのではないか。 • CNNの特徴はなんであったか? • 並進不変性(カーネルの重み共有に起因) • 局所性(局所受容野) • Transformer はCNNの特徴を持っていない。 ① Transformerはコーナーやエッジといった基本特徴を取り出すのが難しい。 ② Self-Attention はロングレンジ(トークン)の相関をとるのであって、空間次元の局所相関はとれ ない。 … トークン間相関 ※ 画像は2から引⽤
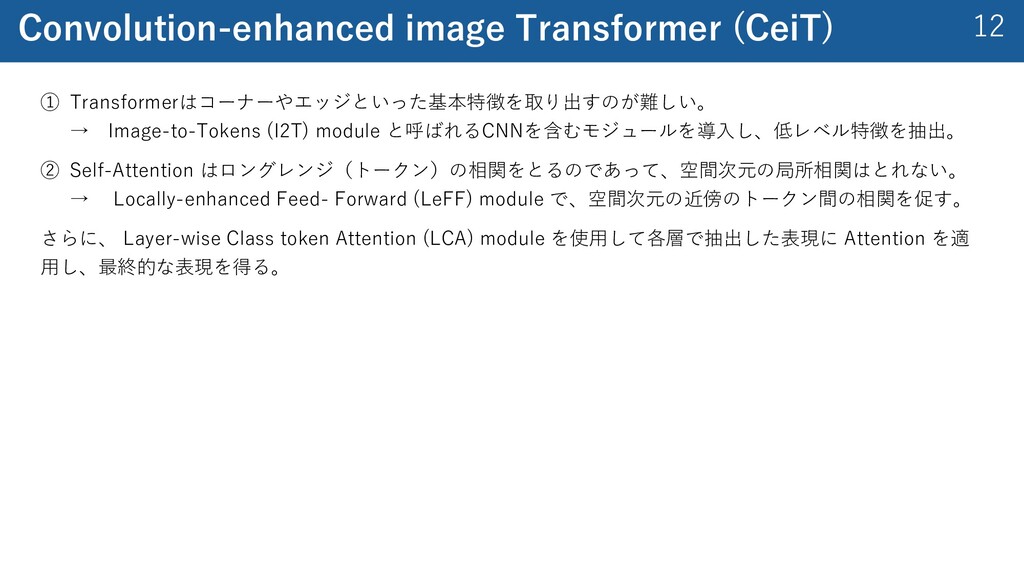
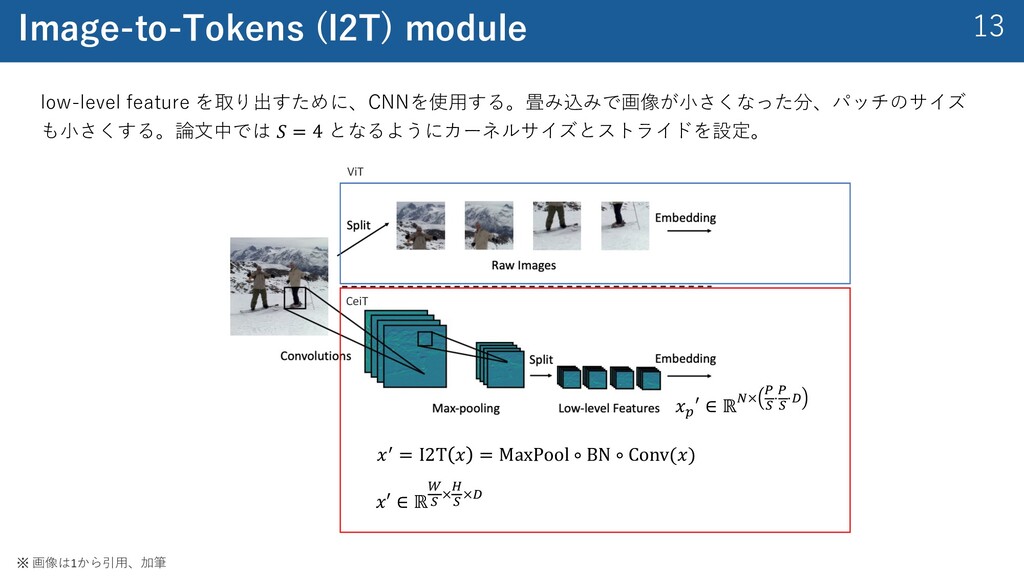
  6. 12 Convolution-enhanced image Transformer (CeiT) ① Transformerはコーナーやエッジといった基本特徴を取り出すのが難しい。 → Image-to-Tokens (I2T)

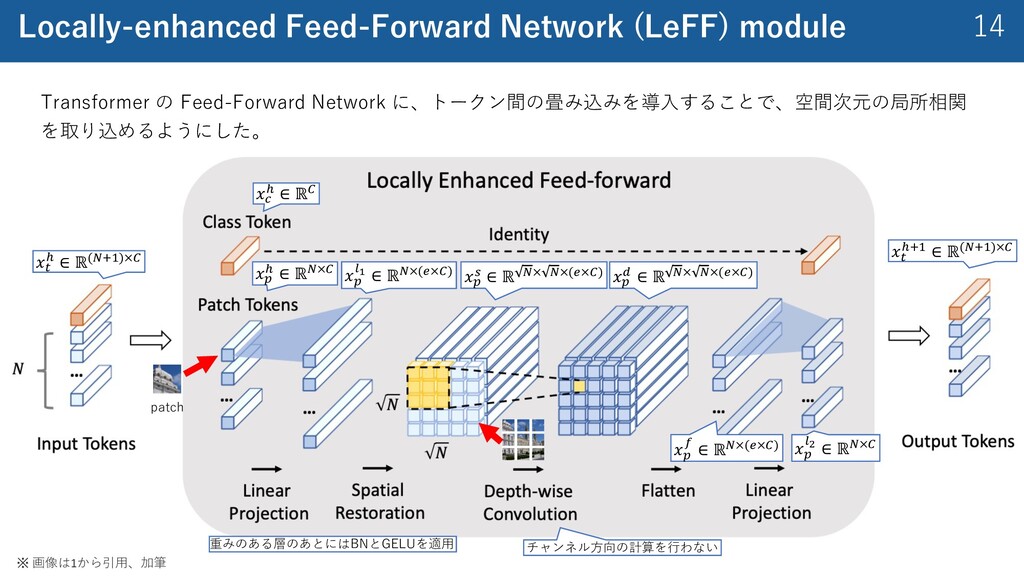
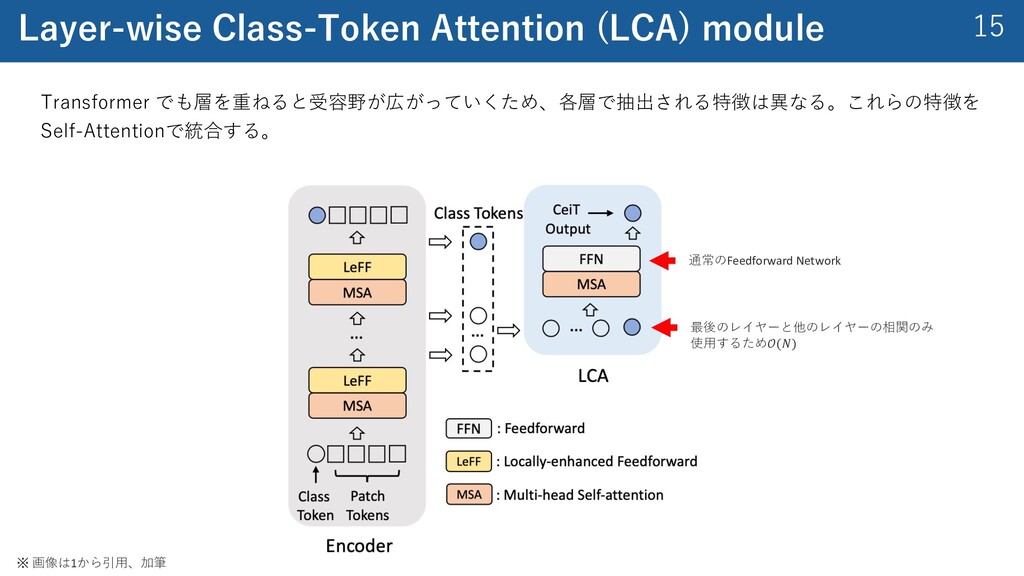
    module と呼ばれるCNNを含むモジュールを導⼊し、低レベル特徴を抽出。 ② Self-Attention はロングレンジ(トークン)の相関をとるのであって、空間次元の局所相関はとれない。 → Locally-enhanced Feed- Forward (LeFF) module で、空間次元の近傍のトークン間の相関を促す。 さらに、 Layer-wise Class token Attention (LCA) module を使⽤して各層で抽出した表現に Attention を適 ⽤し、最終的な表現を得る。
  7. 13 Image-to-Tokens (I2T) module low-level feature を取り出すために、CNNを使⽤する。畳み込みで画像が⼩さくなった分、パッチのサイズ も⼩さくする。論⽂中では 𝑆 =

    4 となるようにカーネルサイズとストライドを設定。 𝑥0 = I2T 𝑥 = MaxPool ∘ BN ∘ Conv(𝑥) ※ 画像は1から引⽤、加筆 𝑥′ ∈ ℝ # 1 × ! 1 ×2 𝑥% ′ ∈ ℝ&× ' 1 ⋅ ' 1 ⋅2 ViT CeiT
  8. 14 Locally-enhanced Feed-Forward Network (LeFF) module Transformer の Feed-Forward Network

    に、トークン間の畳み込みを導⼊することで、空間次元の局所相関 を取り込めるようにした。 𝑥% & ∈ ℝ(()*)×- 𝑥. & ∈ ℝ(×- 𝑥/ & ∈ ℝ- 𝑥. 0! ∈ ℝ(×(1×-) 𝑥. 2 ∈ ℝ (× (×(1×-) 𝑥. 3 ∈ ℝ (× (×(1×-) チャンネル⽅向の計算を⾏わない 𝑥. 4 ∈ ℝ(×(1×-) 𝑥. 0" ∈ ℝ(×- 𝑥% &)* ∈ ℝ(()*)×- patch 重みのある層のあとにはBNとGELUを適⽤ ※ 画像は1から引⽤、加筆
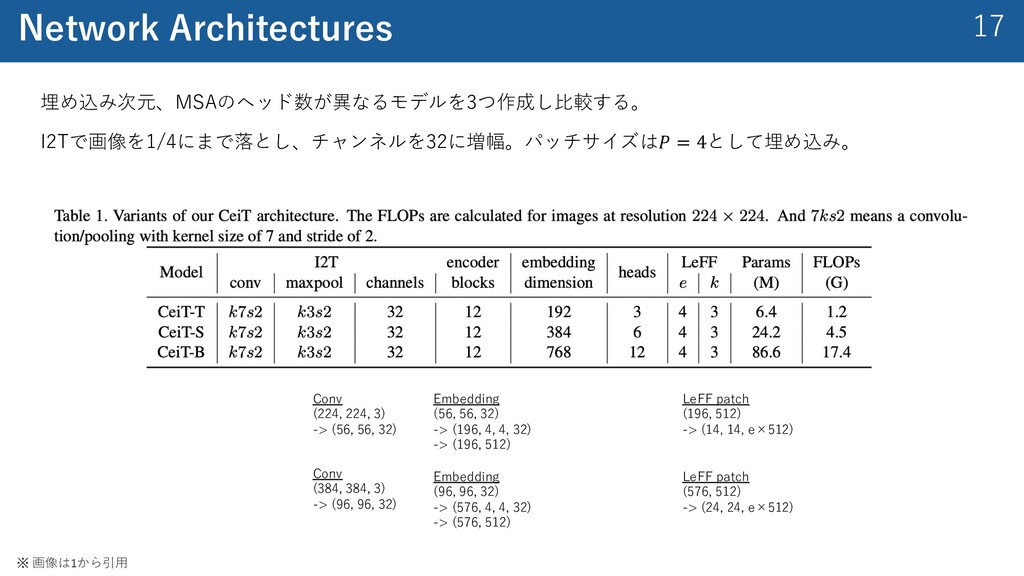
  9. 17 Network Architectures 埋め込み次元、MSAのヘッド数が異なるモデルを3つ作成し⽐較する。 I2Tで画像を1/4にまで落とし、チャンネルを32に増幅。パッチサイズは𝑃 = 4として埋め込み。 Conv (224, 224,

    3) -> (56, 56, 32) Embedding (56, 56, 32) -> (196, 4, 4, 32) -> (196, 512) LeFF patch (196, 512) -> (14, 14, e×512) ※ 画像は1から引⽤ Conv (384, 384, 3) -> (96, 96, 32) Embedding (96, 96, 32) -> (576, 4, 4, 32) -> (576, 512) LeFF patch (576, 512) -> (24, 24, e×512)
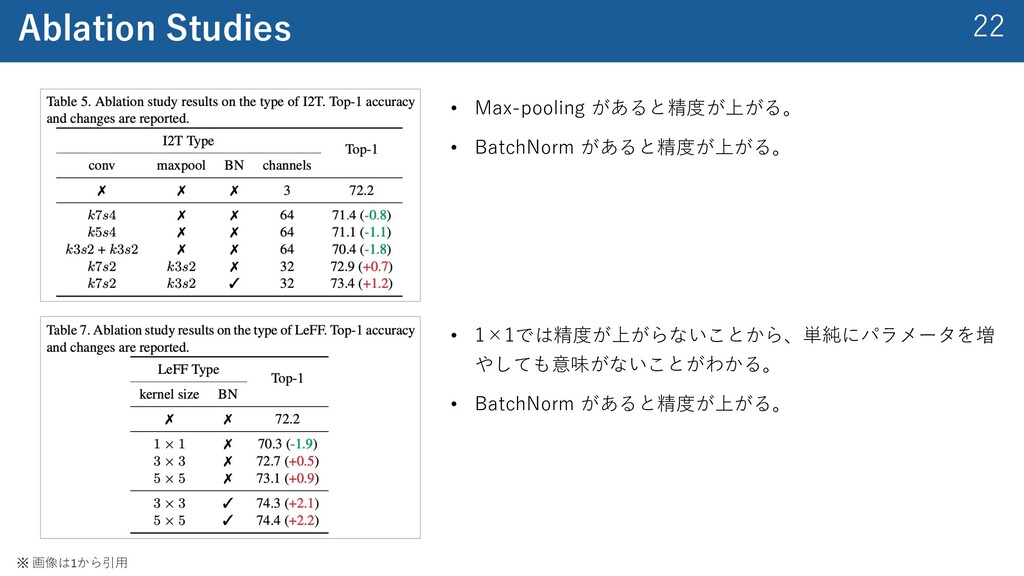
  10. 22 Ablation Studies • Max-pooling があると精度が上がる。 • BatchNorm があると精度が上がる。 •

    1×1では精度が上がらないことから、単純にパラメータを増 やしても意味がないことがわかる。 • BatchNorm があると精度が上がる。 ※ 画像は1から引⽤
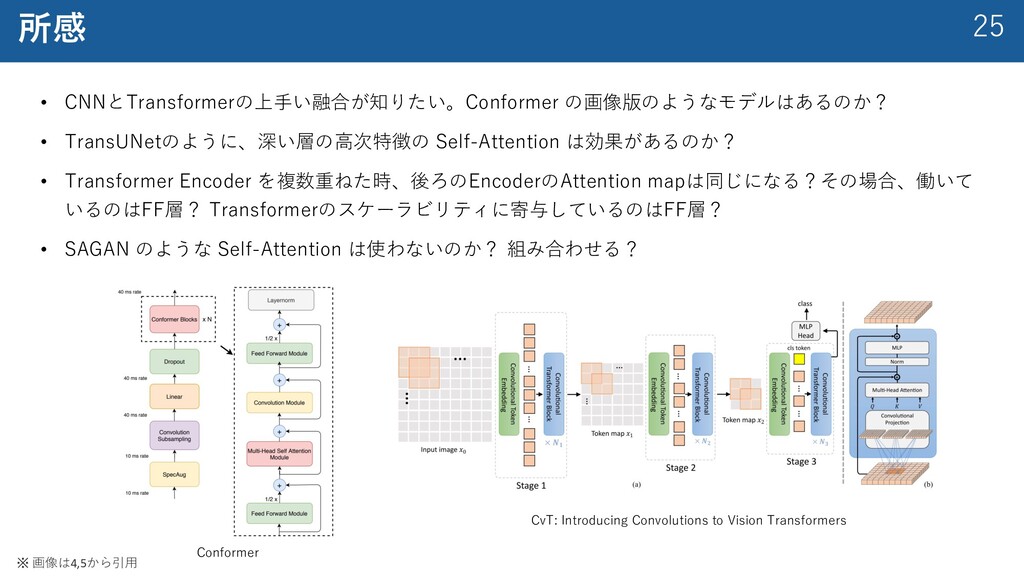
  11. 25 所感 • CNNとTransformerの上⼿い融合が知りたい。Conformer の画像版のようなモデルはあるのか? • TransUNetのように、深い層の⾼次特徴の Self-Attention は効果があるのか? •

    Transformer Encoder を複数重ねた時、後ろのEncoderのAttention mapは同じになる?その場合、働いて いるのはFF層? Transformerのスケーラビリティに寄与しているのはFF層? • SAGAN のような Self-Attention は使わないのか? 組み合わせる? Conformer CvT: Introducing Convolutions to Vision Transformers ※ 画像は4,5から引⽤
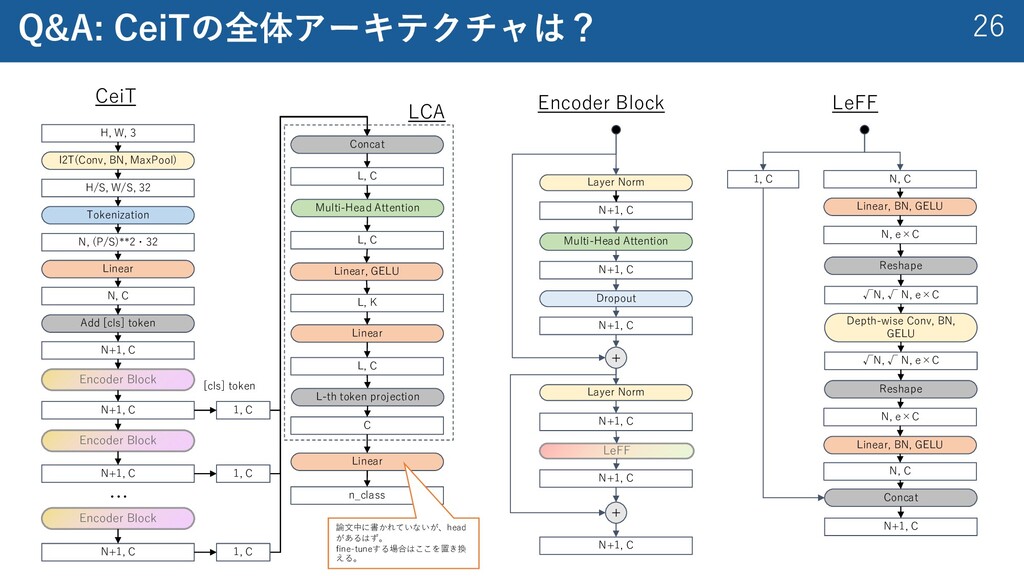
  12. 26 Q&A: CeiTの全体アーキテクチャは? H, W, 3 I2T(Conv, BN, MaxPool) H/S,

    W/S, 32 Tokenization N, (P/S)**2・32 N, C N+1, C Linear Add [cls] token Encoder Block Encoder Block … Encoder Block N+1, C N+1, C N+1, C Encoder Block Layer Norm Multi-Head Attention Dropout + Layer Norm + LeFF N+1, C N+1, C N+1, C N+1, C N+1, C [cls] token 1, C 1, C 1, C N+1, C LeFF CeiT 1, C N, C Linear, BN, GELU N, e×C Reshape √N, √ N, e×C Depth-wise Conv, BN, GELU √N, √ N, e×C Reshape N, e×C Linear, BN, GELU N, C Concat N+1, C Concat L, C Multi-Head Attention L, C Linear, GELU L, K Linear L, C LCA L-th token projection C Linear n_class 論⽂中に書かれていないが、head があるはず。 fine-tuneする場合はここを置き換 える。
  13. 29 Q&A: class tokenの意味は? • シンプルに、BERTの構造を踏襲していると考えられる。 • BERTでは、次の⽂が正しいか判定するタスクに使⽤されるトークンだった。 • [考察]

    Self-Attentionでは、⾃⾝のトークンとの相関が⼤きくなるはず?なので、⼊⼒画像に依存しない トークンを最終特徴にした⽅がよいのでは? 左上のトークンを分類に使⽤すると、 左上の画像の特徴に依存してしまう? 画像に傾向があると精度が変わってし まう? ※ 画像は2から引⽤
  14. 30 参考⽂献 1. Kun Yuan, Shaopeng Guo, Ziwei Liu, Aojun

    Zhou, Fengwei Yu, Wei Wu, “Incorporating Convolution Designs into Visual Transformers ,” ; [arXiv:2103.11816 [cs.CV]]. 2. Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov, Dirk Weissenborn, Xiaohua Zhai, Thomas Unterthiner, Mostafa Dehghani, Matthias Minderer, Georg Heigold, Syl- vain Gelly, Jakob Uszkoreit, and Neil Houlsby. “An image is worth 16x16 words: Transformers for image recognition at scale,” ; [arXiv:2010.11929[cs.CV]]. 3. Hugo Touvron, Matthieu Cord, Matthijs Douze, Francisco Massa, Alexandre Sablayrolles, Hervé Jégou. “Training data-efficient image transformers & distillation through attention,” ; [arXiv:2012.12877[cs.CV]]. 4. Anmol Gulati, James Qin, Chung-Cheng Chiu, Niki Parmar, Yu Zhang, Jiahui Yu, Wei Han, Shibo Wang, Zhengdong Zhang, Yonghui Wu, Ruoming Pang, “Conformer: Convolution-augmented Transformer for Speech Recognition,” ; [arXiv:2005.08100[eess.AS]]. 5. Haiping Wu, Bin Xiao, Noel Codella, Mengchen Liu, Xiyang Dai, Lu Yuan, Lei Zhang, “CvT: Introducing Convolutions to Vision Transformers,” ; [arXiv:2103.15808[cs.CV]]. 6. Samira Abnar, Mostafa Dehghani, Willem Zuidema, “Transferring Inductive Biases through Knowledge Distillation,” ; [arXiv:2006.00555[cs.LG]]. 7. Hugo Touvron, Andrea Vedaldi, Matthijs Douze, Hervé Jégou, “Fixing the train-test resolution discrepancy,” ; [arXiv:1906.06423[cs.CV]]. 8. @takoroy, “【論⽂読解めも】Training data-efficient image transformers & distillation through attention,” https://zenn.dev/takoroy/scraps/ced7059a36d846 9. Jieneng Chen, Yongyi Lu, Qihang Yu, Xiangde Luo, Ehsan Adeli, Yan Wang, Le Lu, Alan L. Yuille, Yuyin Zhou, “TransUNet: Transformers Make Strong Encoders for Medical Image Segmentation,” [arXiv:2102.04306 [cs.CV]].