Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
SREという共通言語
Search
あせあせ
September 08, 2026
87
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
SREという共通言語
あせあせ
September 08, 2026
Featured
See All Featured
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
600
Thoughts on Productivity
jonyablonski
76
5.4k
Groundhog Day: Seeking Process in Gaming for Health
codingconduct
0
410
Unsuck your backbone
ammeep
672
58k
Context Engineering - Making Every Token Count
addyosmani
9
1.2k
Paper Plane
katiecoart
PRO
5
54k
Skip the Path - Find Your Career Trail
mkilby
1
260
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
300
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
590
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
Typedesign – Prime Four
hannesfritz
42
3.2k
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
Transcript
ENGINEERING RELIABILITY SRE(Site Reliability Engineering)とは
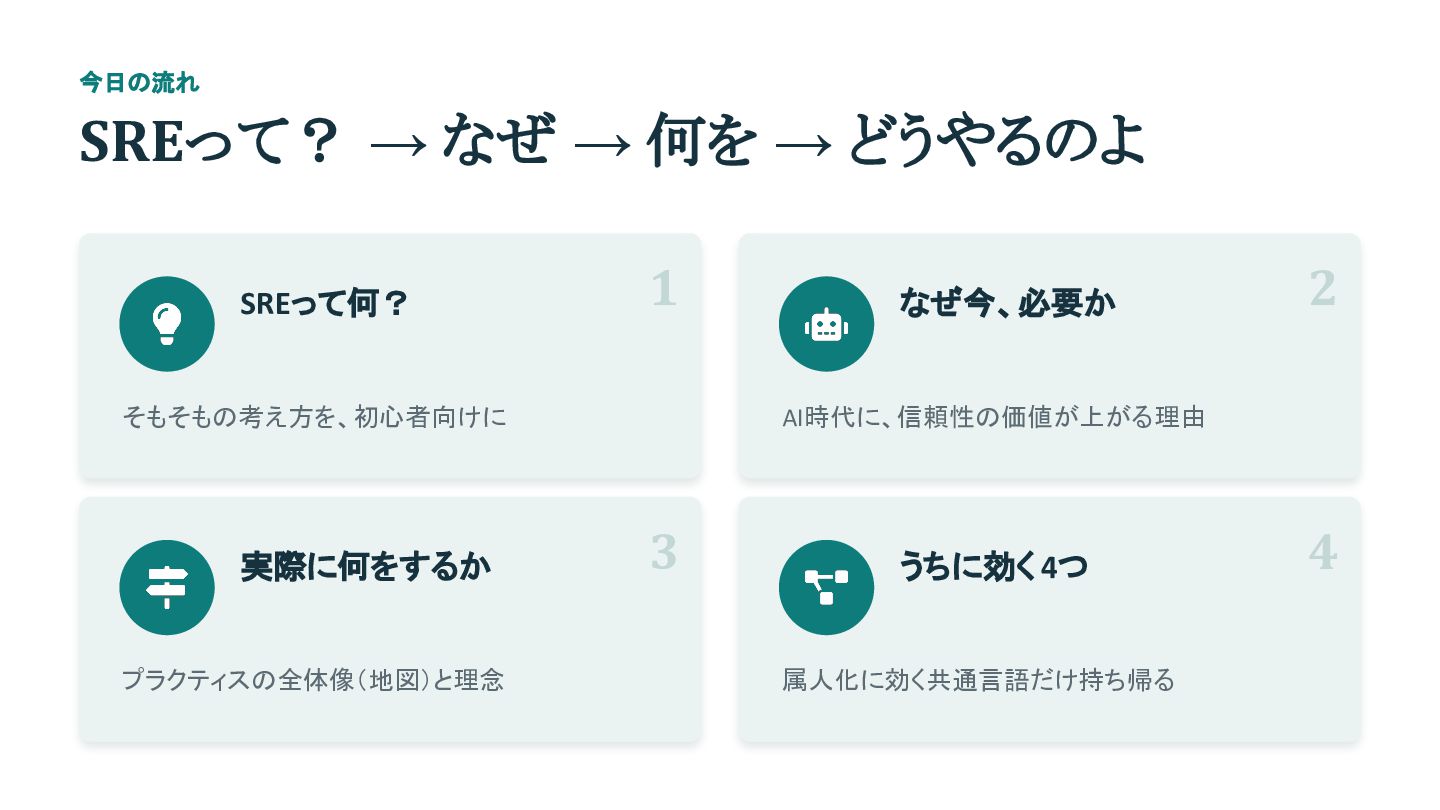
今日の流れ SREって? → なぜ → 何を → どうやるのよ SREって何? 1
そもそもの考え方を、初心者向けに 実際に何をするか プラクティスの全体像(地図)と理念 なぜ今、必要か 2 AI時代に、信頼性の価値が上がる理由 3 うちに効く 4つ 属人化に効く共通言語だけ持ち帰る 4
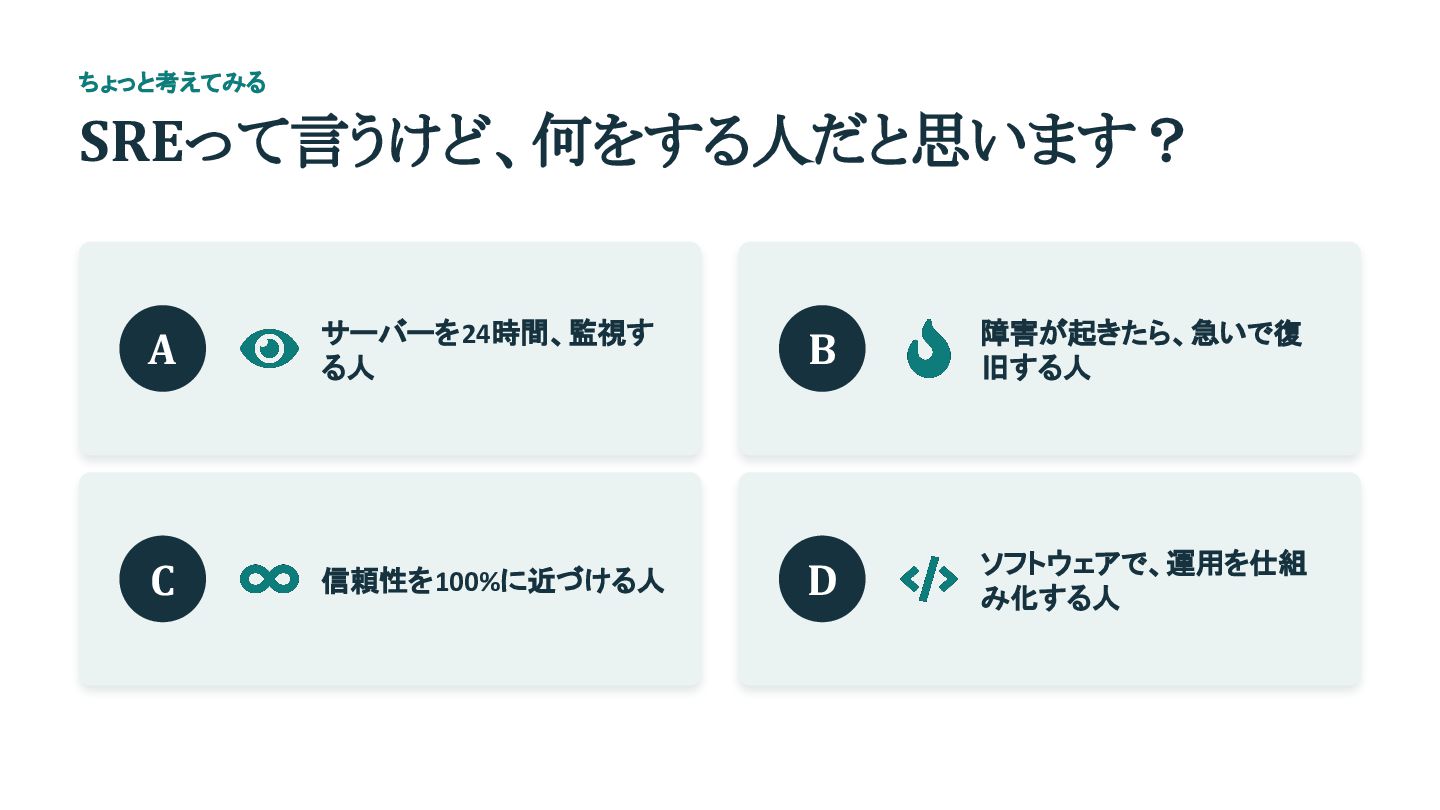
ちょっと考えてみる SREって言うけど、何をする人だと思います? A サーバーを24時間、監視す る人 B 障害が起きたら、急いで復 旧する人 C 信頼性を100%に近づける人
D ソフトウェアで、運用を仕組 み化する人
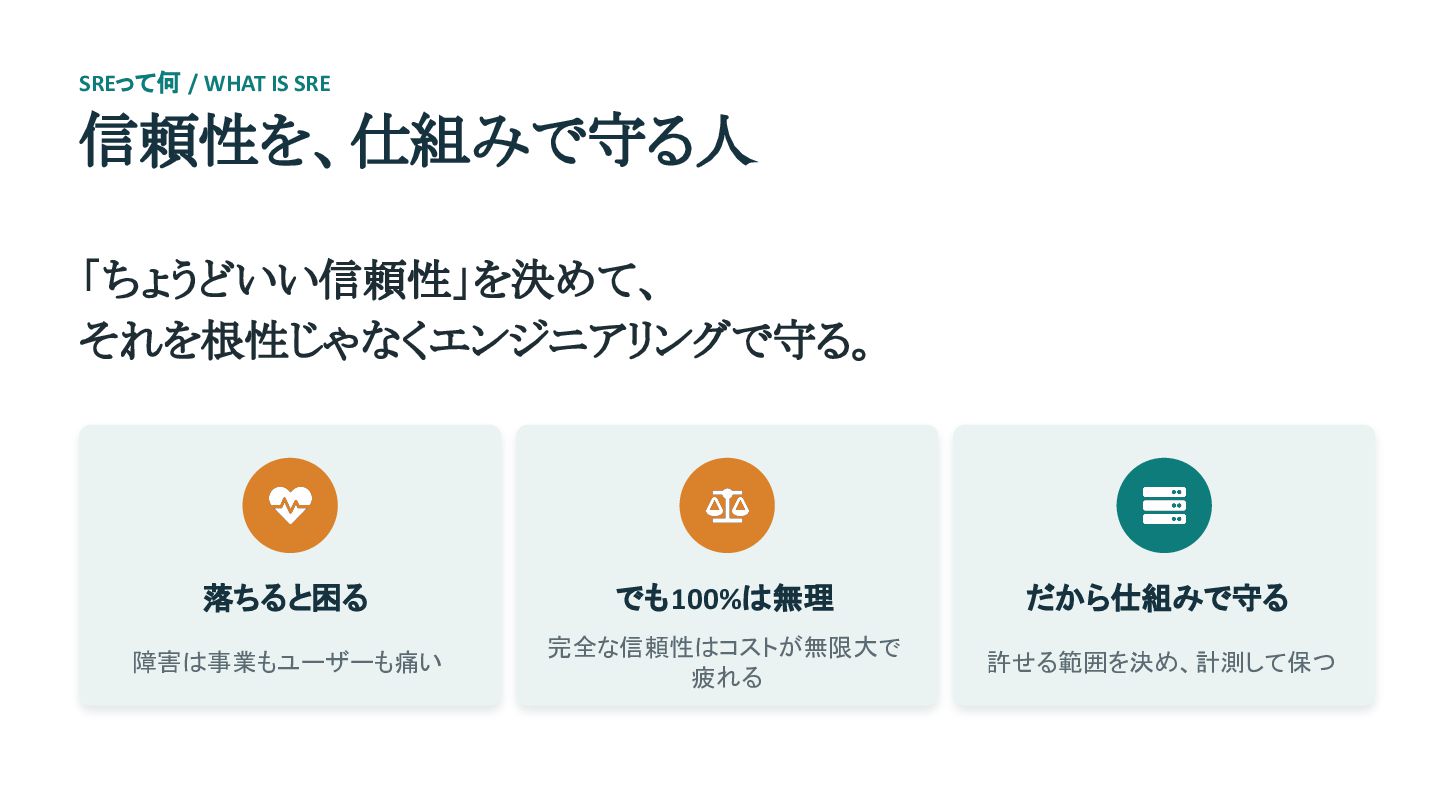
SREって何 / WHAT IS SRE 信頼性を、仕組みで守る人 「ちょうどいい信頼性」を決めて、 それを根性じゃなくエンジニアリングで守る。 落ちると困る でも100%は無理
だから仕組みで守る 障害は事業もユーザーも痛い 完全な信頼性はコストが無限大で 疲れる 許せる範囲を決め、計測して保つ
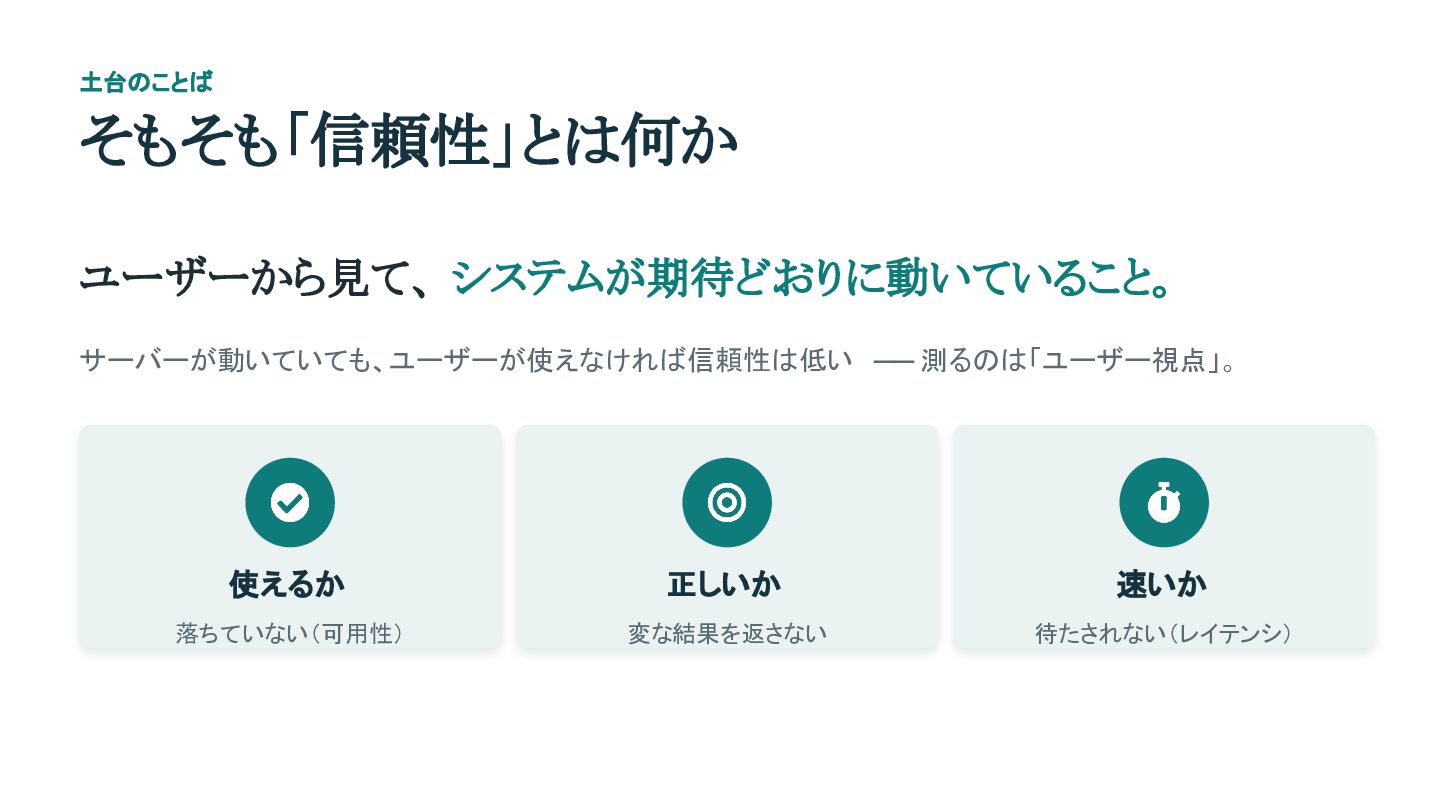
土台のことば そもそも「信頼性」とは何か ユーザーから見て、 システムが期待どおりに動いていること。 サーバーが動いていても、ユーザーが使えなければ信頼性は低い ── 測るのは「ユーザー視点」。 使えるか 正しいか 速いか
落ちていない(可用性) 変な結果を返さない 待たされない(レイテンシ)
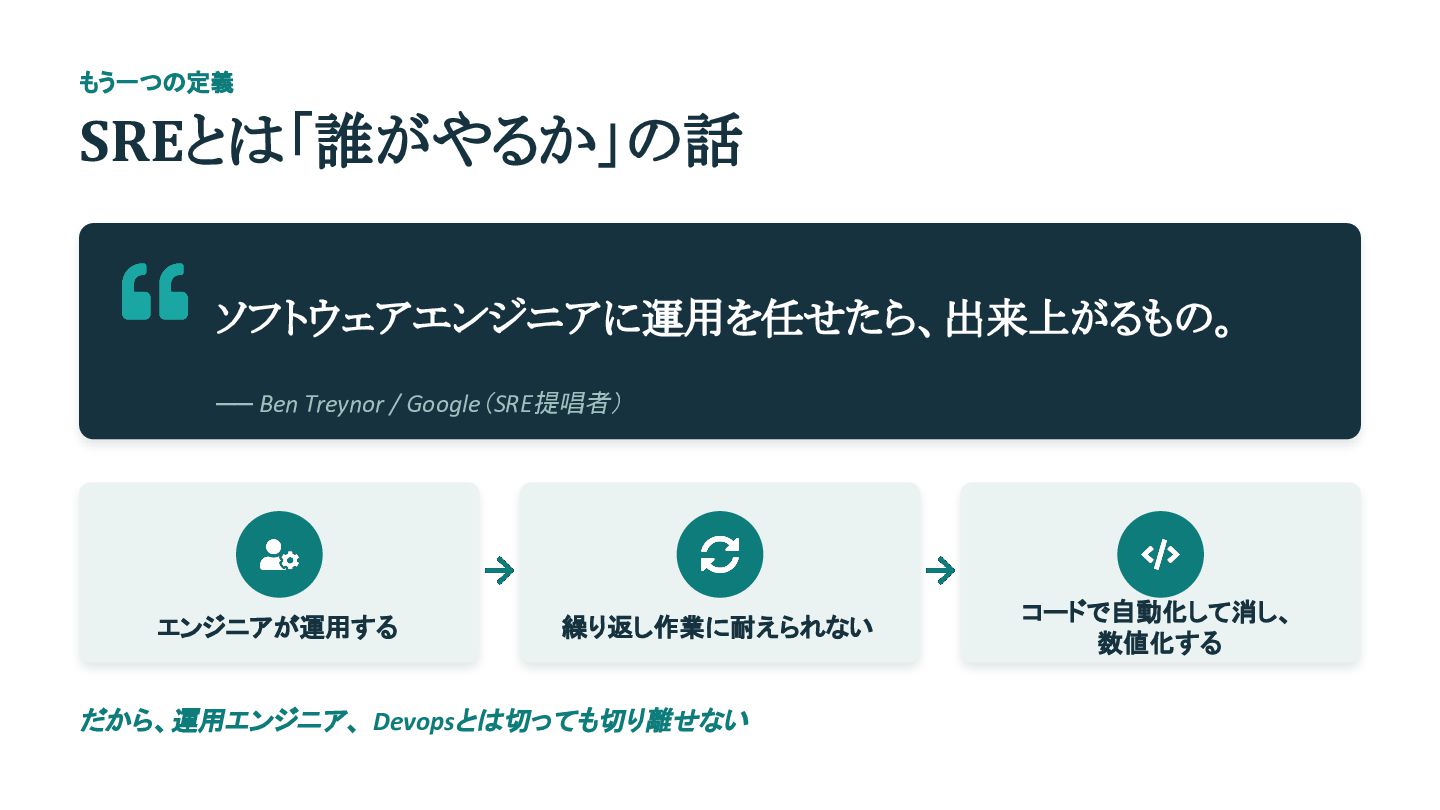
もう一つの定義 SREとは「誰がやるか」の話 ソフトウェアエンジニアに運用を任せたら、出来上がるもの。 ── Ben Treynor / Google(SRE提唱者) エンジニアが運用する 繰り返し作業に耐えられない
だから、運用エンジニア、 Devopsとは切っても切り離せない コードで自動化して消し、 数値化する
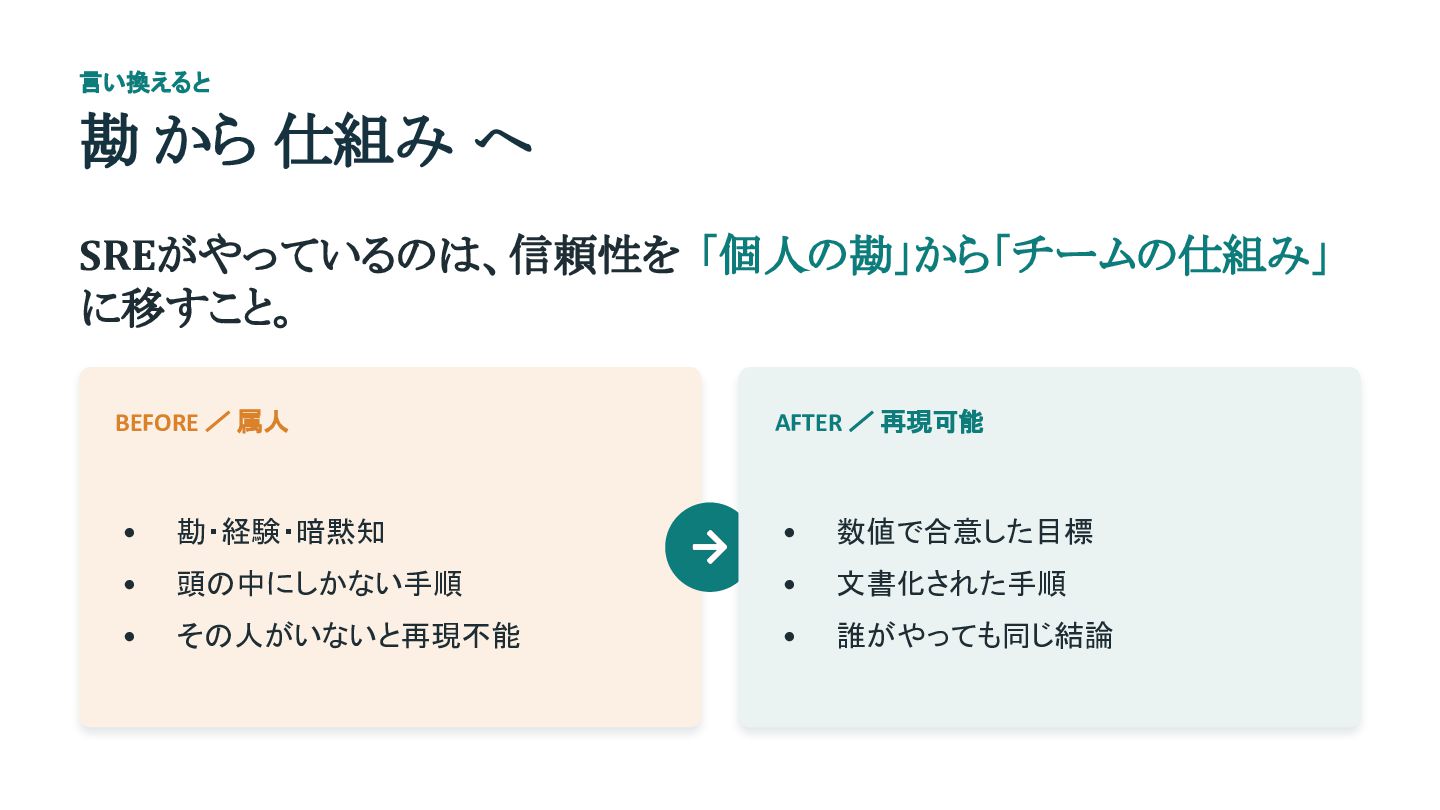
言い換えると 勘 から 仕組み へ SREがやっているのは、信頼性を 「個人の勘」から「チームの仕組み」 に移すこと。 BEFORE /
属人 AFTER / 再現可能 • 勘・経験・暗黙知 • 数値で合意した目標 • 頭の中にしかない手順 • 文書化された手順 • その人がいないと再現不能 • 誰がやっても同じ結論
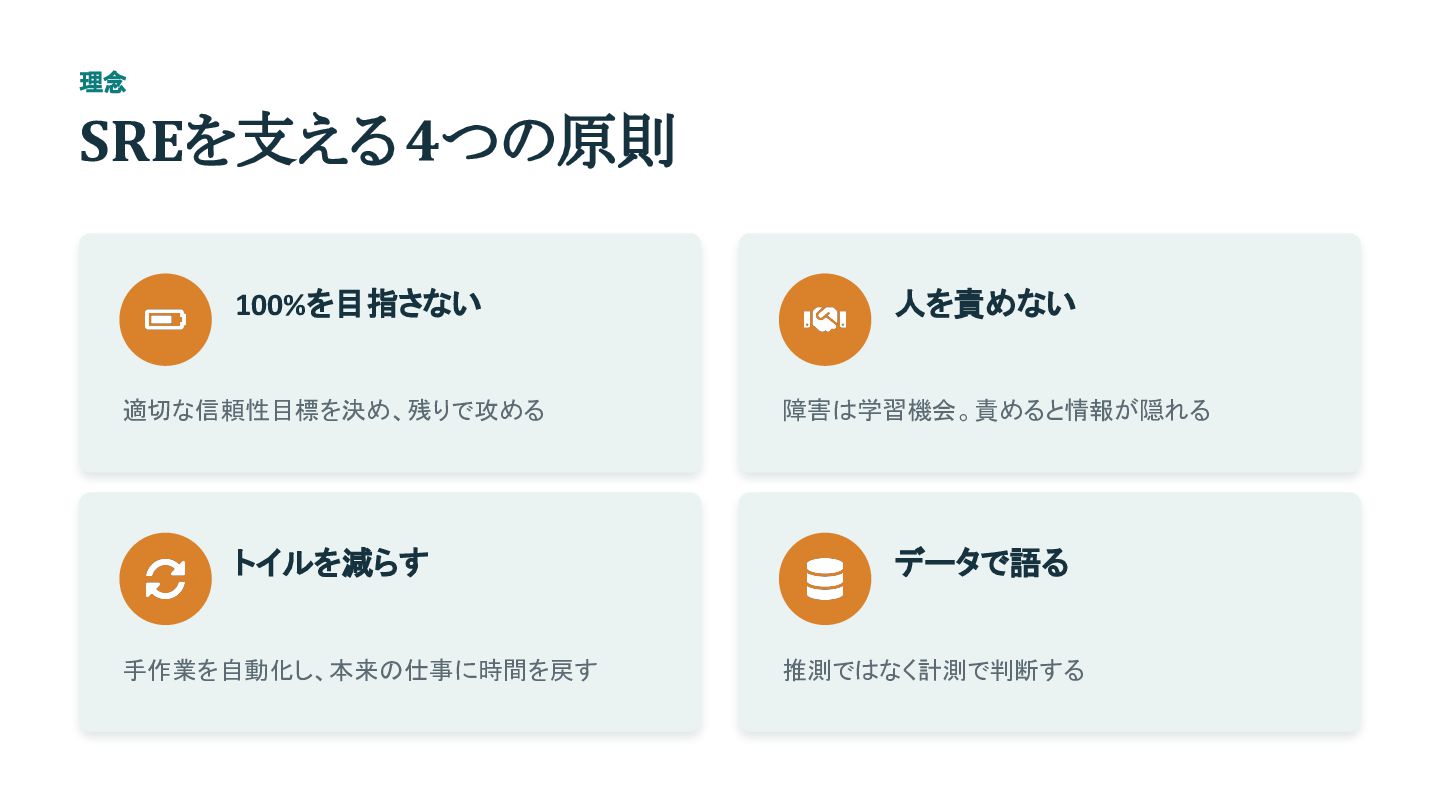
理念 SREを支える 4つの原則 100%を目指さない 人を責めない 適切な信頼性目標を決め、残りで攻める 障害は学習機会。責めると情報が隠れる トイルを減らす データで語る 手作業を自動化し、本来の仕事に時間を戻す
推測ではなく計測で判断する
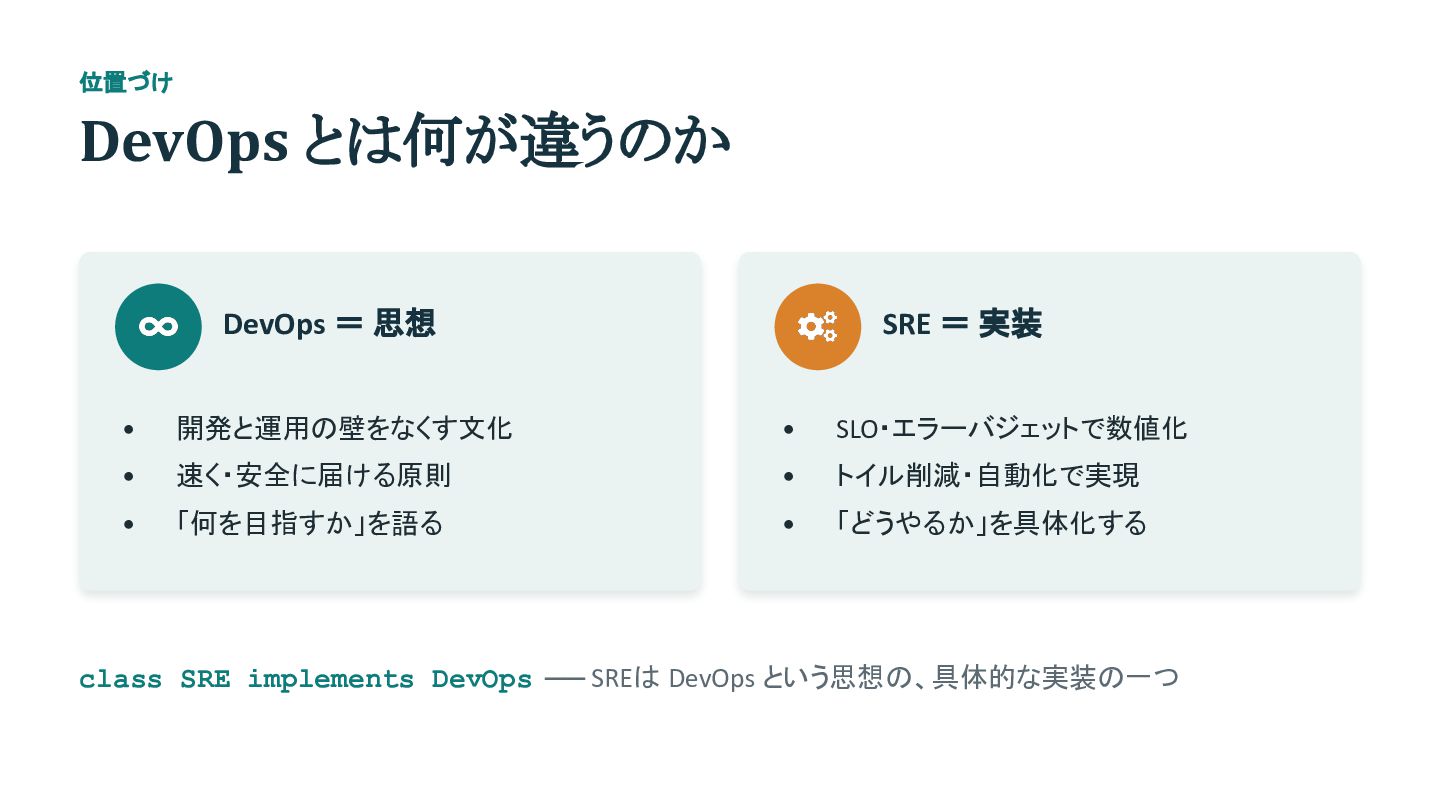
位置づけ DevOps とは何が違うのか DevOps = 思想 SRE = 実装 •
開発と運用の壁をなくす文化 • SLO・エラーバジェットで数値化 • 速く・安全に届ける原則 • トイル削減・自動化で実現 • 「何を目指すか」を語る • 「どうやるか」を具体化する class SRE implements DevOps ── SREは DevOps という思想の、具体的な実装の一つ
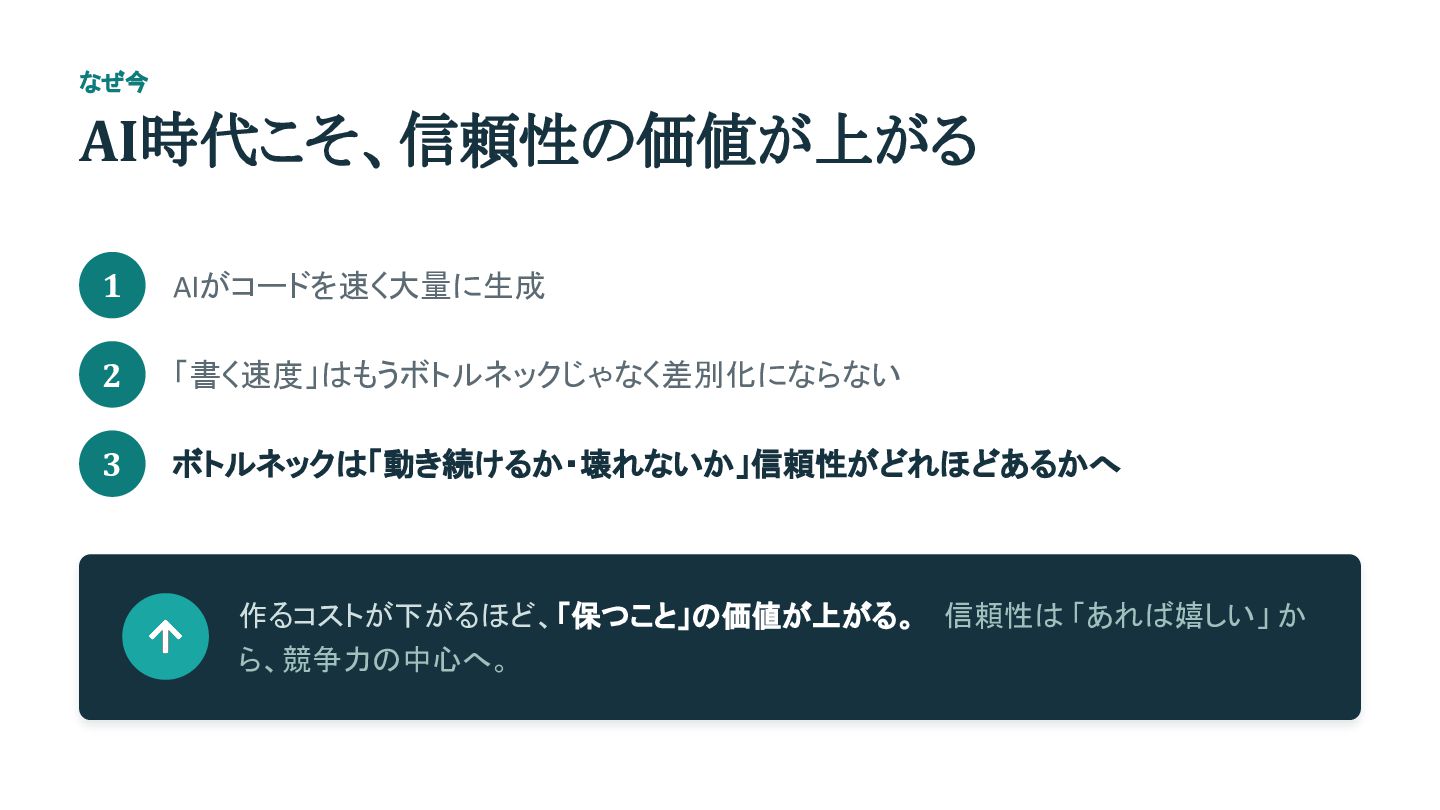
なぜ今 AI時代こそ、信頼性の価値が上がる 1 AIがコードを速く大量に生成 2 「書く速度」はもうボトルネックじゃなく差別化にならない 3 ボトルネックは「動き続けるか・壊れないか」信頼性がどれほどあるかへ 作るコストが下がるほど、「保つこと」の価値が上がる。 信頼性は
「あれば嬉しい」 か ら、競争力の中心へ。
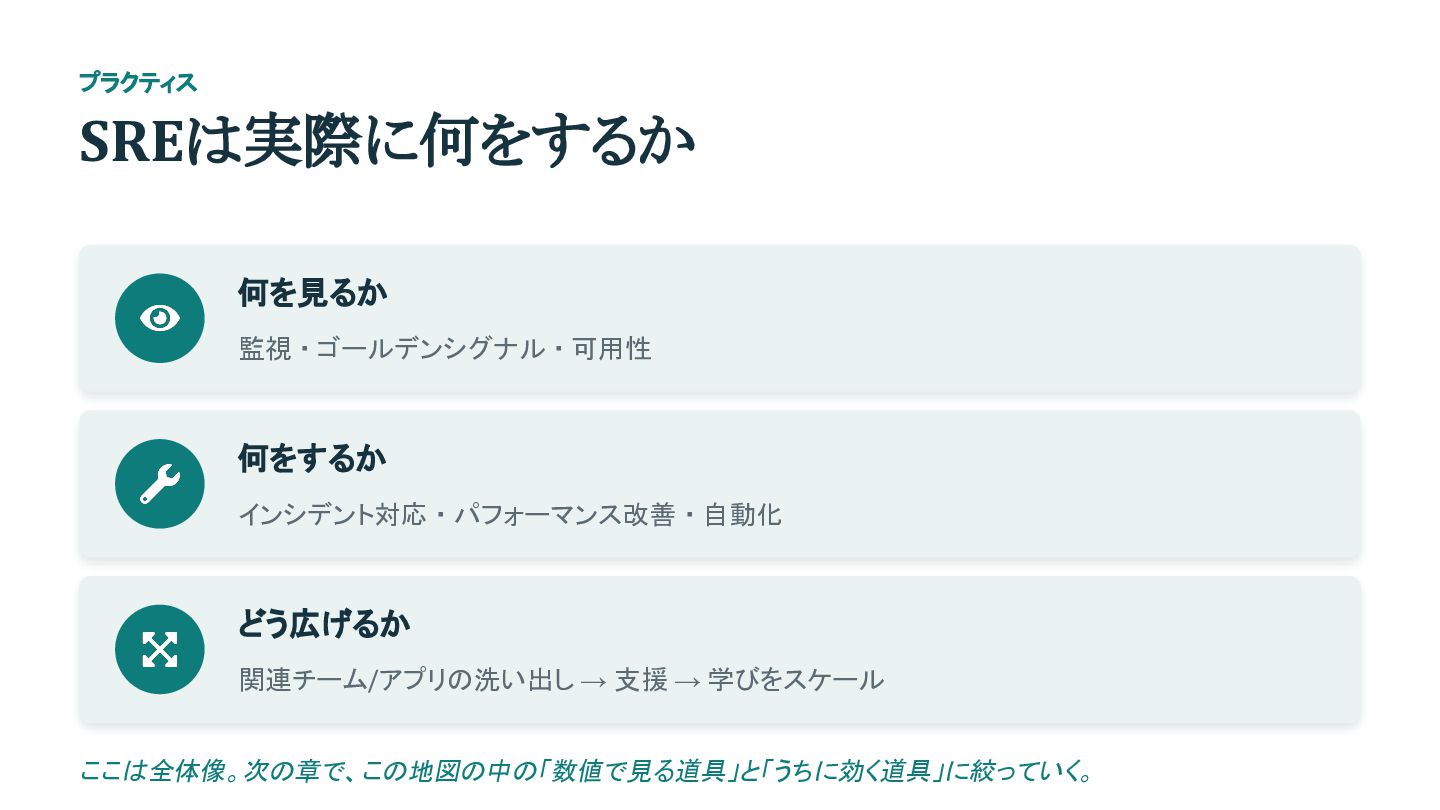
プラクティス SREは実際に何をするか 何を見るか 監視 ・ ゴールデンシグナル ・ 可用性 何をするか インシデント対応
・ パフォーマンス改善 ・ 自動化 どう広げるか 関連チーム/アプリの洗い出し → 支援 → 学びをスケール ここは全体像。次の章で、この地図の中の「数値で見る道具」と「うちに効く道具」に絞っていく。
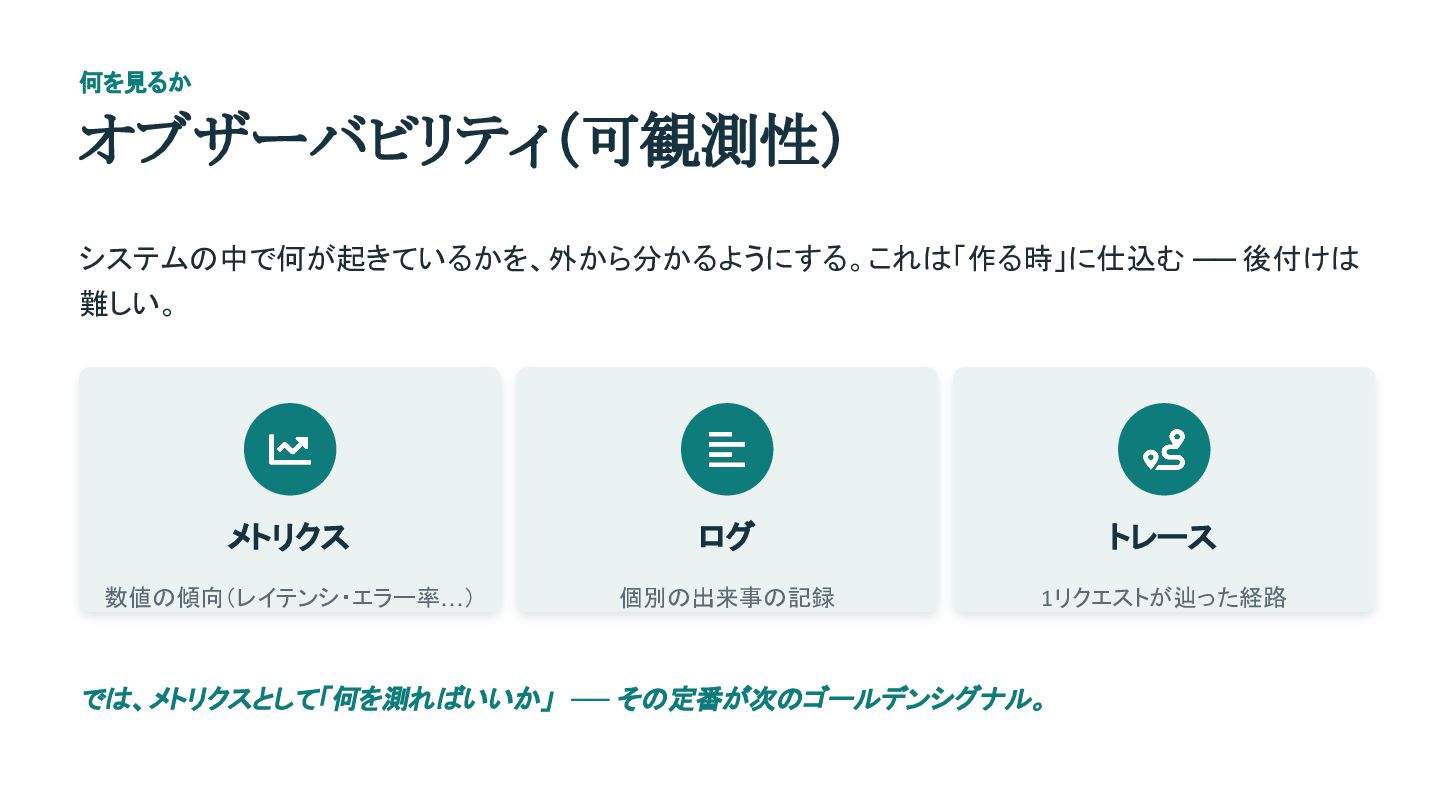
何を見るか オブザーバビリティ(可観測性) システムの中で何が起きているかを、外から分かるようにする。これは「作る時」に仕込む ── 後付けは 難しい。 メトリクス ログ トレース 数値の傾向(レイテンシ・エラー率…)
個別の出来事の記録 1リクエストが辿った経路 では、メトリクスとして「何を測ればいいか」 ── その定番が次のゴールデンシグナル。
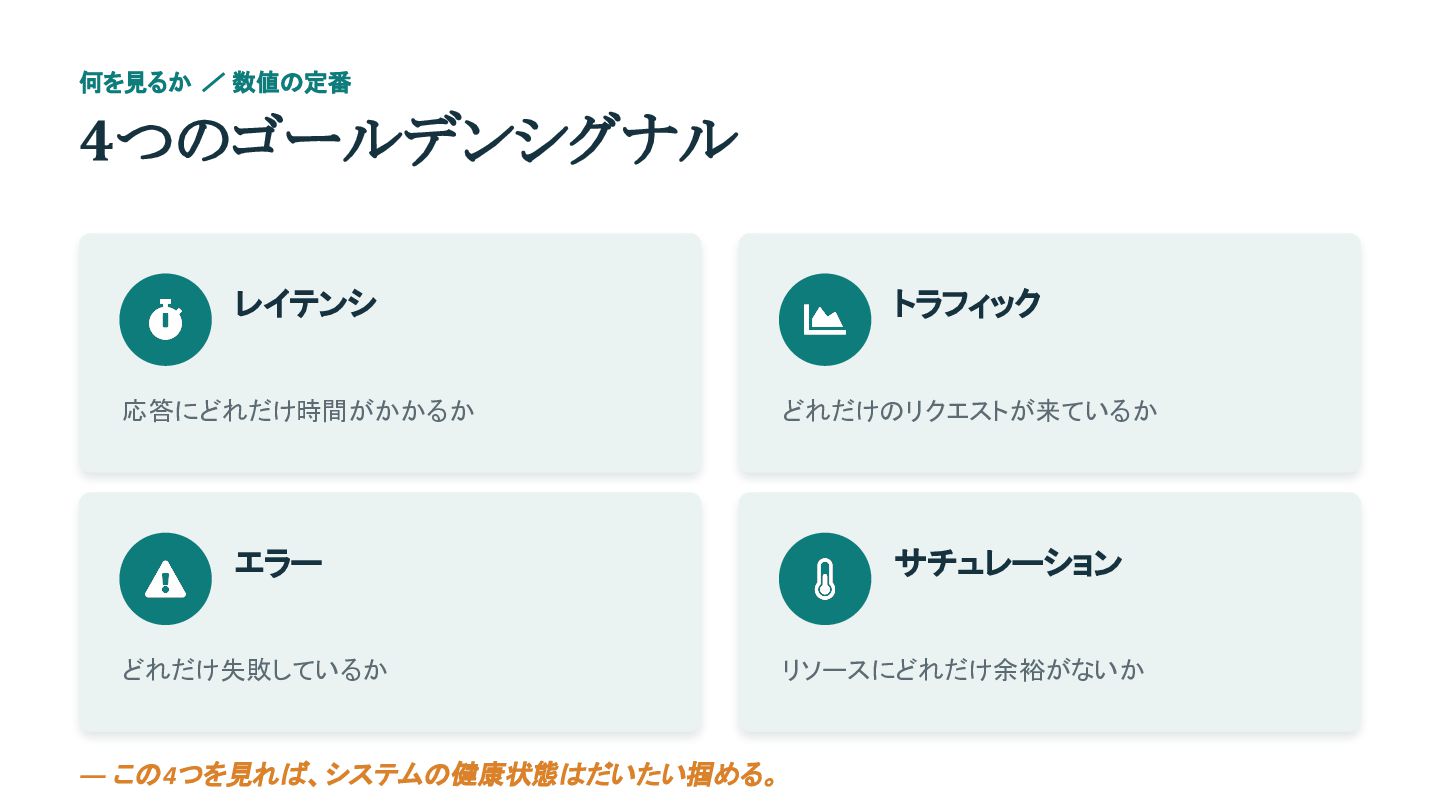
何を見るか / 数値の定番 4つのゴールデンシグナル レイテンシ トラフィック 応答にどれだけ時間がかかるか どれだけのリクエストが来ているか エラー どれだけ失敗しているか
― この 4つを見れば、システムの健康状態はだいたい掴める。 サチュレーション リソースにどれだけ余裕がないか
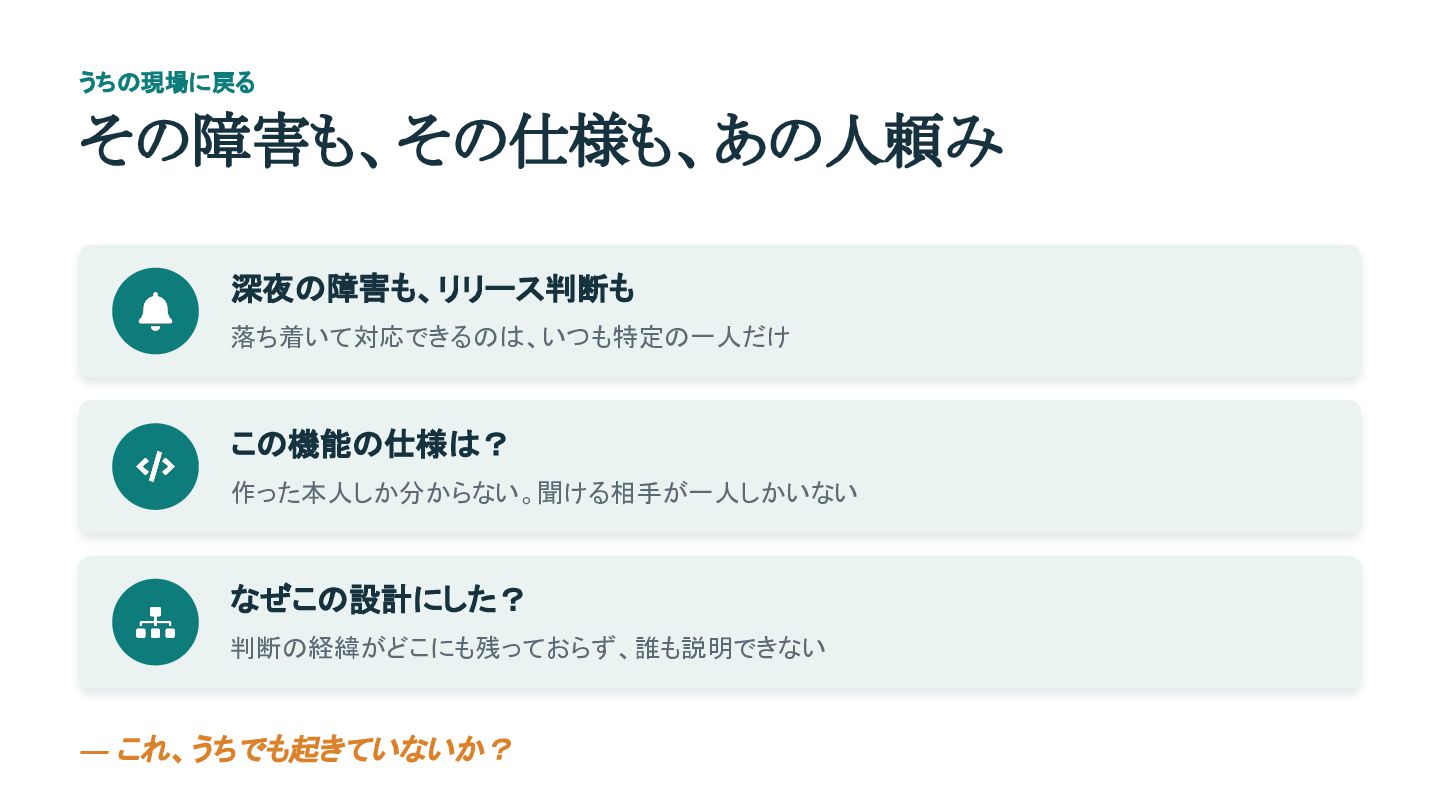
うちの現場に戻る その障害も、その仕様も、あの人頼み 深夜の障害も、リリース判断も 落ち着いて対応できるのは、いつも特定の一人だけ この機能の仕様は? 作った本人しか分からない。聞ける相手が一人しかいない なぜこの設計にした? 判断の経緯がどこにも残っておらず、誰も説明できない ― これ、うちでも起きていないか?
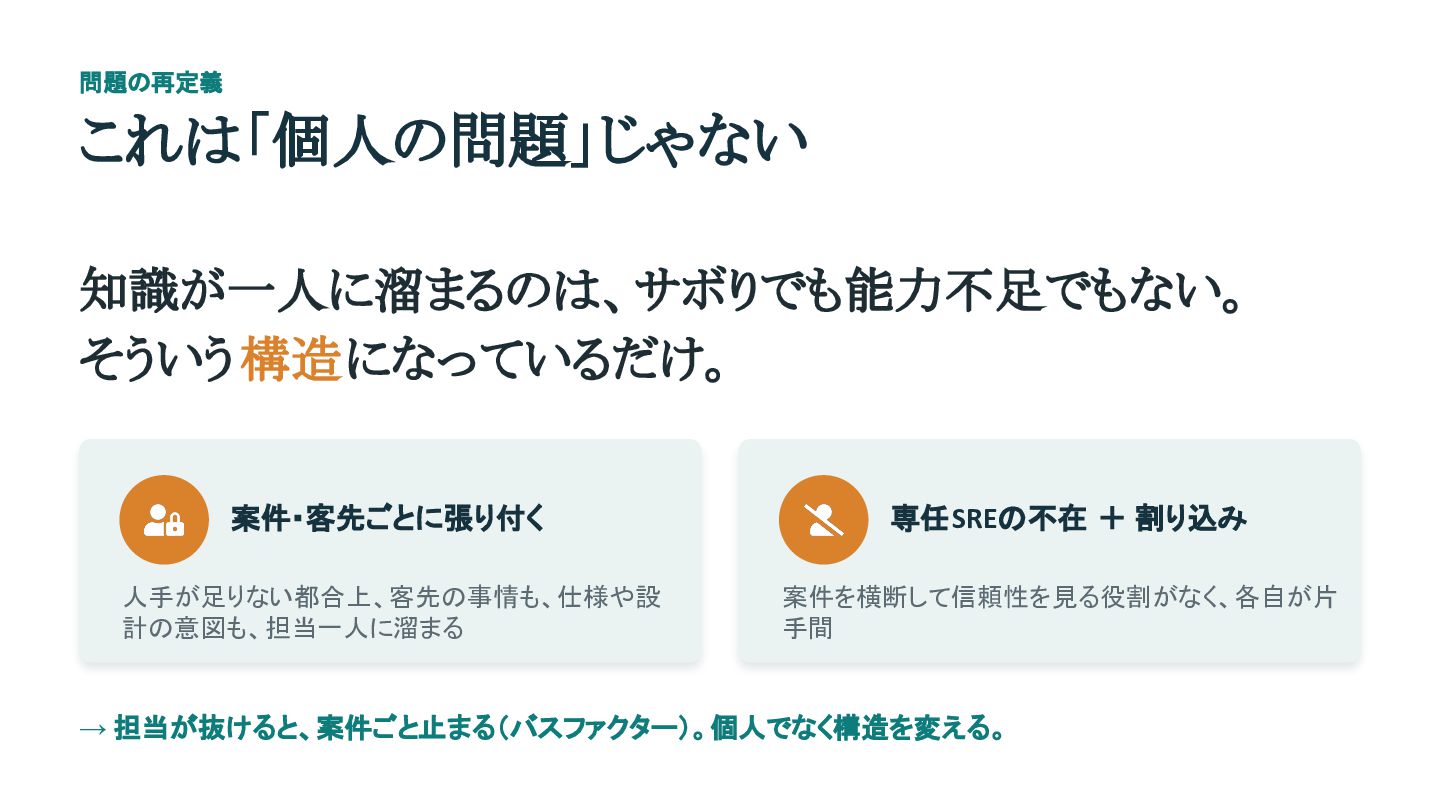
問題の再定義 これは「個人の問題」じゃない 知識が一人に溜まるのは、サボりでも能力不足でもない。 そういう 構造になっているだけ。 案件・客先ごとに張り付く 専任SREの不在 + 割り込み 人手が足りない都合上、客先の事情も、仕様や設
計の意図も、担当一人に溜まる 案件を横断して信頼性を見る役割がなく、各自が片 手間 → 担当が抜けると、案件ごと止まる(バスファクター)。個人でなく構造を変える。
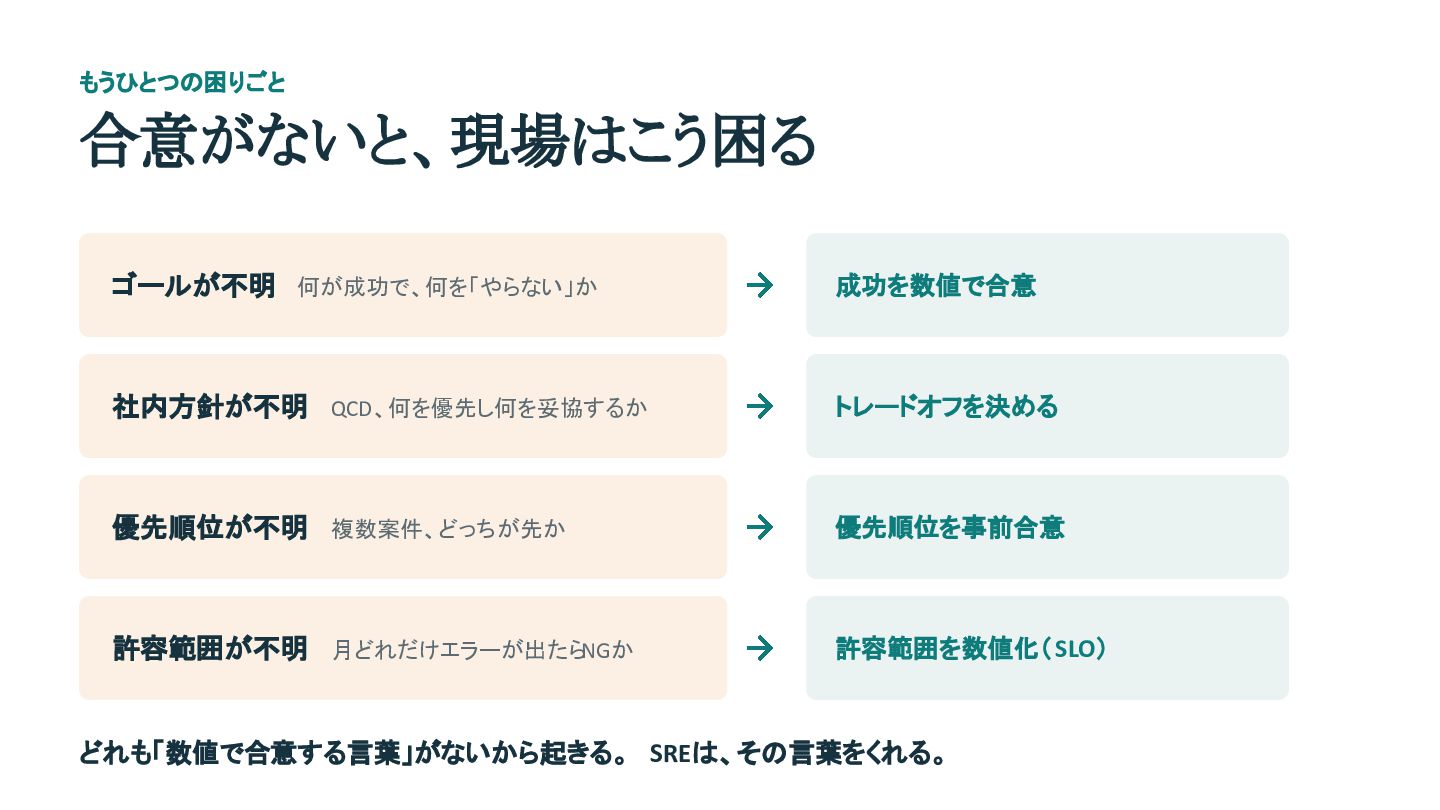
もうひとつの困りごと 合意がないと、現場はこう困る ゴールが不明 何が成功で、何を「やらない」か 成功を数値で合意 社内方針が不明 QCD、何を優先し何を妥協するか トレードオフを決める 優先順位が不明 複数案件、どっちが先か
優先順位を事前合意 許容範囲が不明 月どれだけエラーが出たらNGか 許容範囲を数値化( SLO) どれも「数値で合意する言葉」がないから起きる。 SREは、その言葉をくれる。
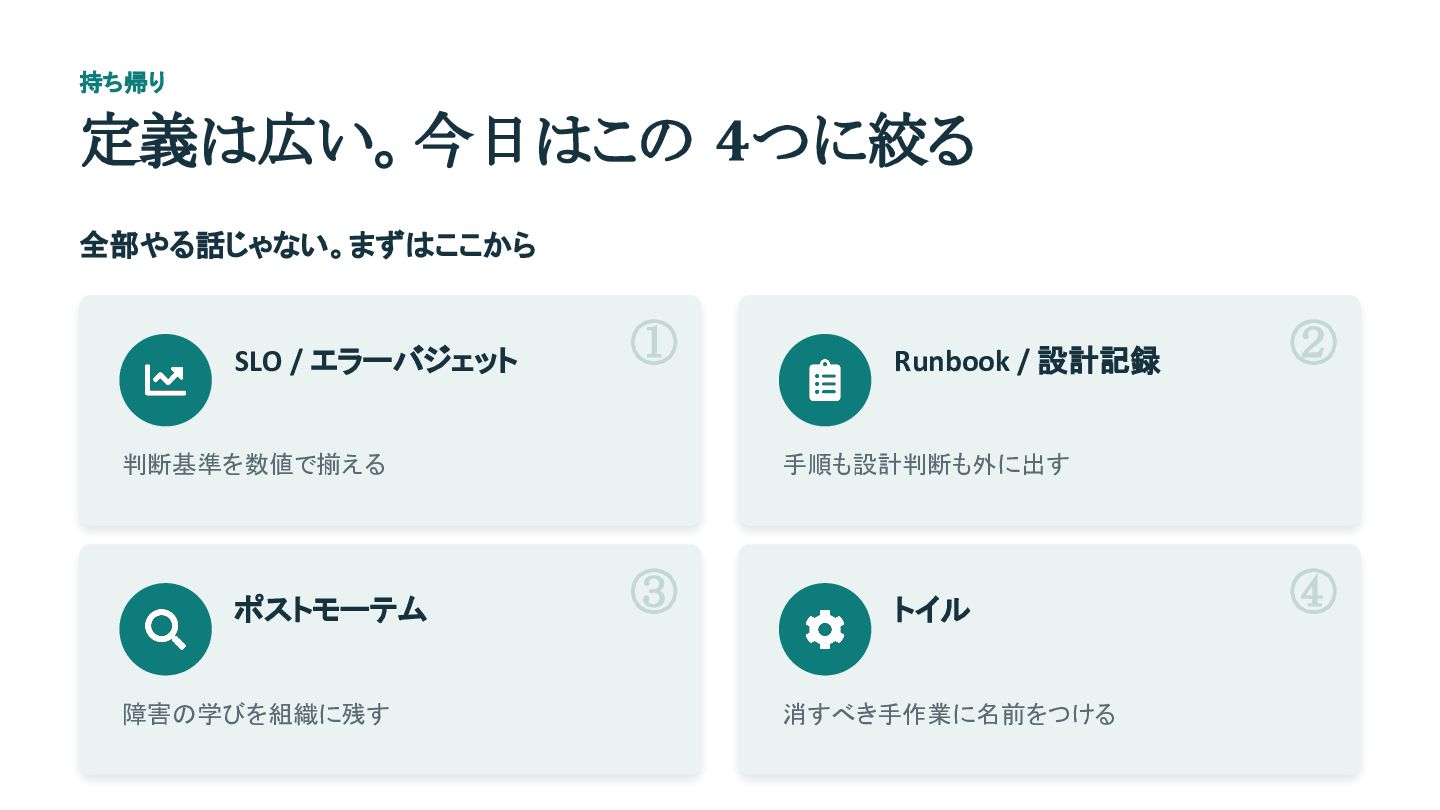
持ち帰り 定義は広い。今日はこの 4つに絞る 全部やる話じゃない。まずはここから SLO / エラーバジェット ① 判断基準を数値で揃える ポストモーテム
障害の学びを組織に残す Runbook / 設計記録 ② 手順も設計判断も外に出す ③ トイル 消すべき手作業に名前をつける ④
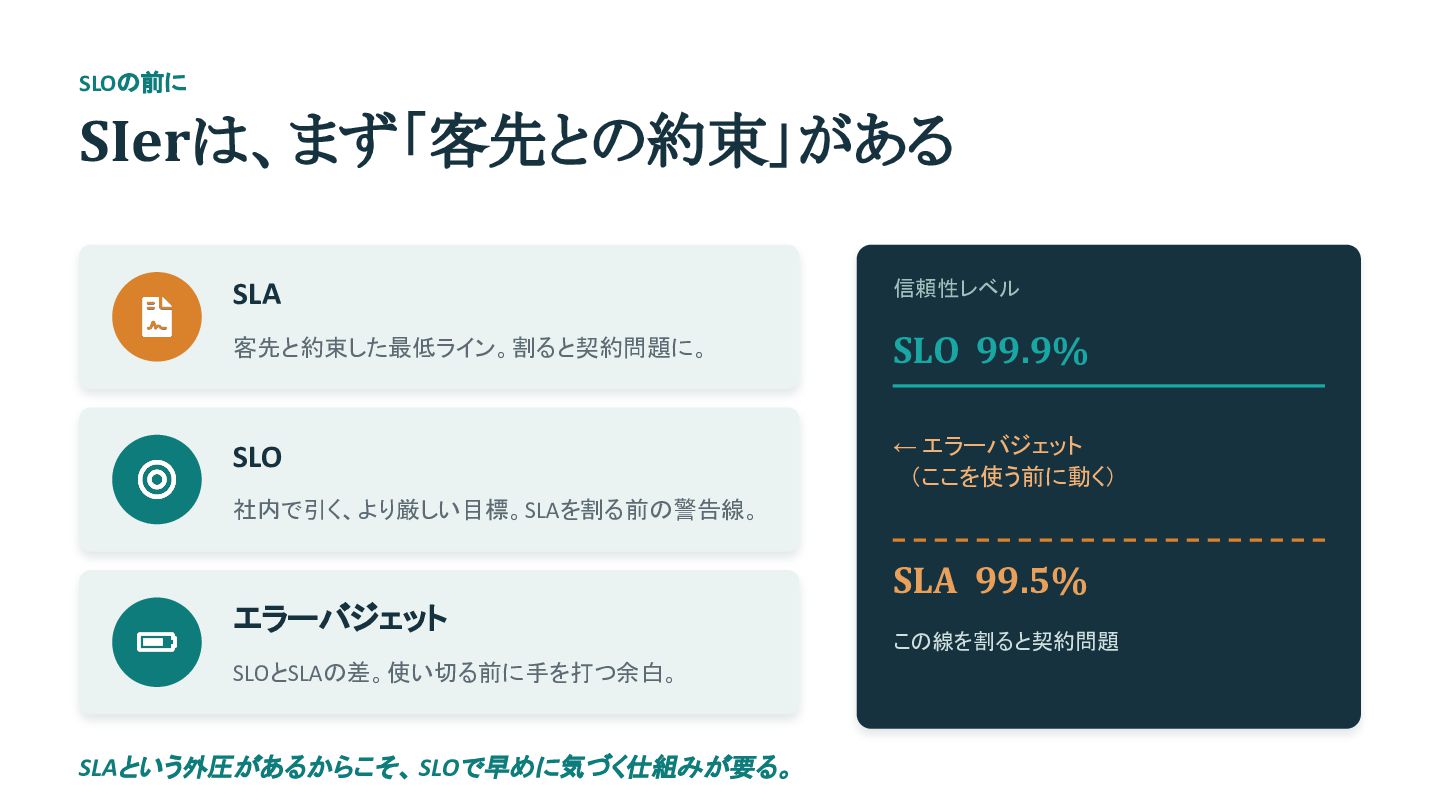
SLOの前に SIerは、まず「客先との約束」がある SLA 信頼性レベル 客先と約束した最低ライン。割ると契約問題に。 SLO 99.9% SLO ← エラーバジェット
(ここを使う前に動く) 社内で引く、より厳しい目標。SLAを割る前の警告線。 SLA 99.5% エラーバジェット SLOとSLAの差。使い切る前に手を打つ余白。 SLAという外圧があるからこそ、 SLOで早めに気づく仕組みが要る。 この線を割ると契約問題
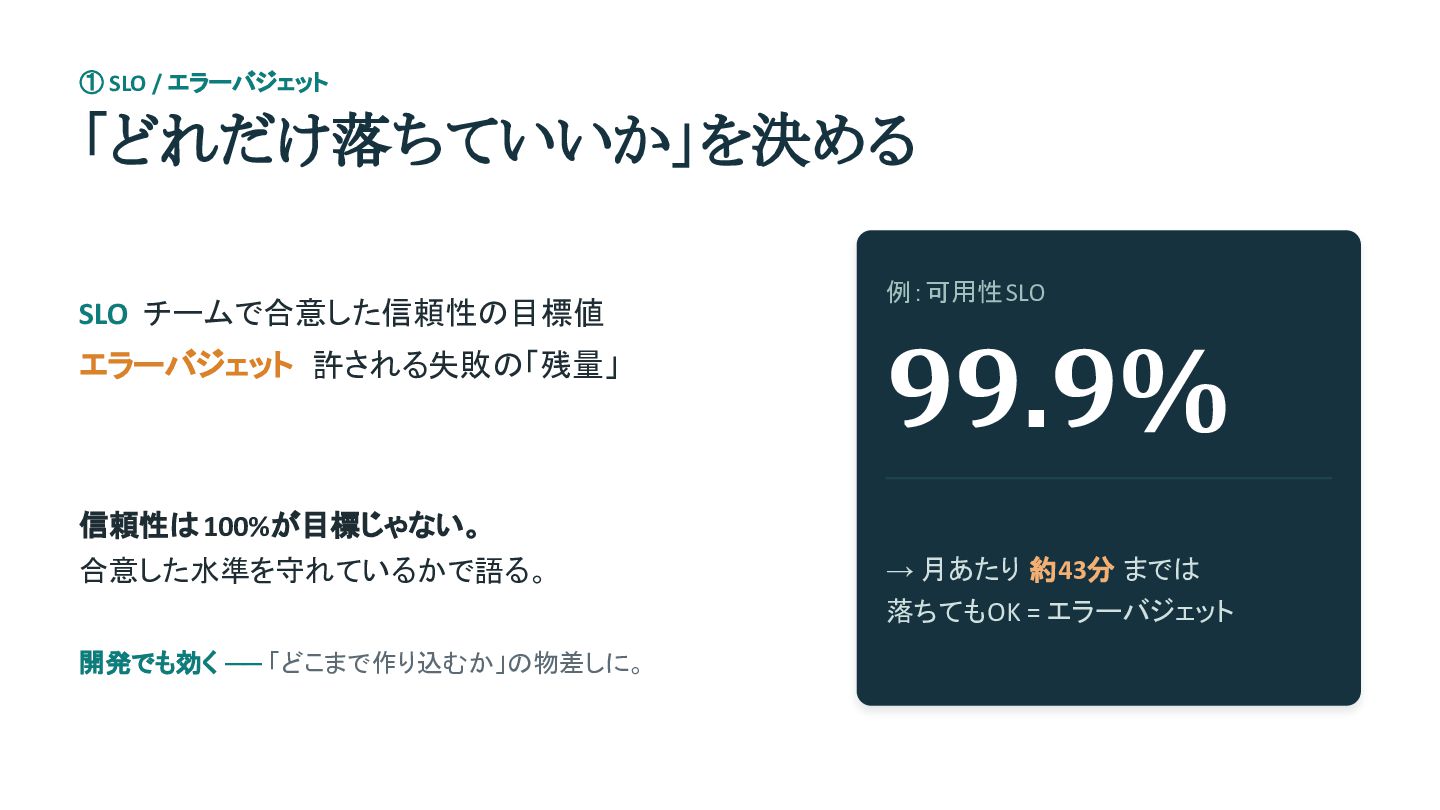
① SLO / エラーバジェット 「どれだけ落ちていいか」を決める SLO チームで合意した信頼性の目標値 エラーバジェット 許される失敗の「残量」 信頼性は
100%が目標じゃない。 合意した水準を守れているかで語る。 開発でも効く ── 「どこまで作り込むか」の物差しに。 例:可用性 SLO 99.9% → 月あたり 約43分 までは 落ちてもOK = エラーバジェット
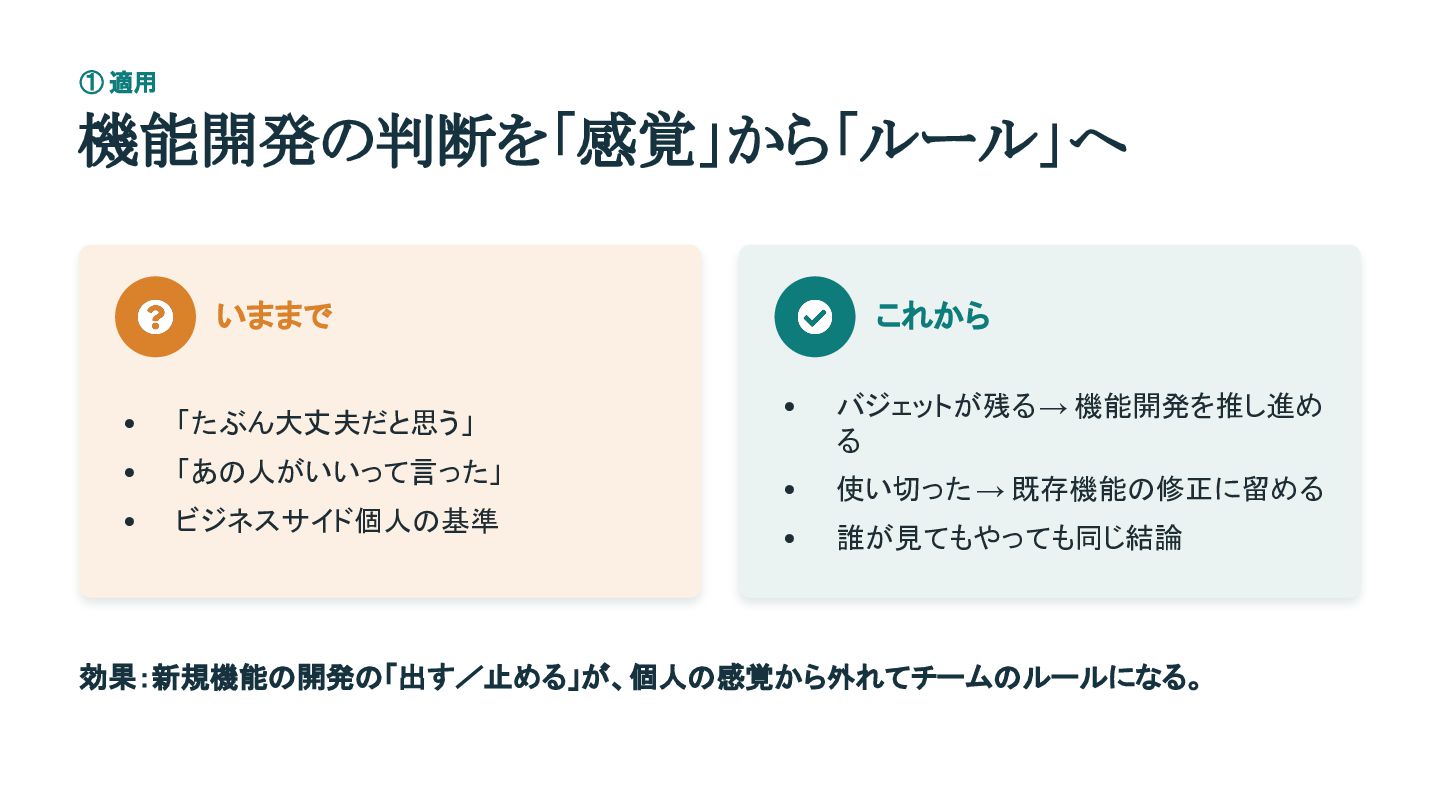
① 適用 機能開発の判断を「感覚」から「ルール」へ いままで • 「たぶん大丈夫だと思う」 • 「あの人がいいって言った」 • ビジネスサイド個人の基準
これから • バジェットが残る → 機能開発を推し進め る • 使い切った → 既存機能の修正に留める • 誰が見てもやっても同じ結論 効果:新規機能の開発の「出す/止める」が、個人の感覚から外れてチームのルールになる。
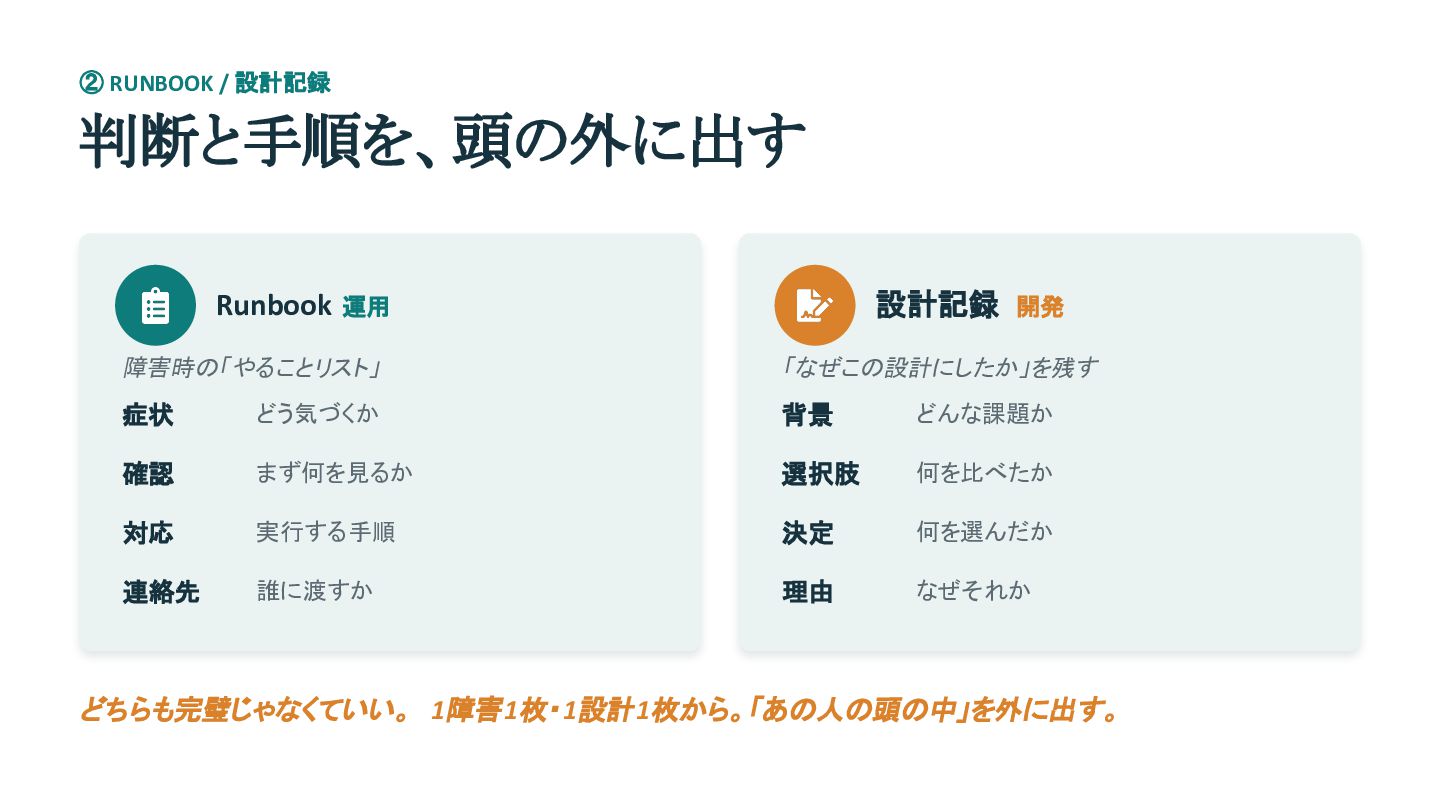
② RUNBOOK / 設計記録 判断と手順を、頭の外に出す 設計記録 開発 Runbook 運用 障害時の「やることリスト」
「なぜこの設計にしたか」を残す 症状 どう気づくか 背景 どんな課題か 確認 まず何を見るか 選択肢 何を比べたか 対応 実行する手順 決定 何を選んだか 連絡先 誰に渡すか 理由 なぜそれか どちらも完璧じゃなくていい。 1障害 1枚・ 1設計 1枚から。「あの人の頭の中」を外に出す。
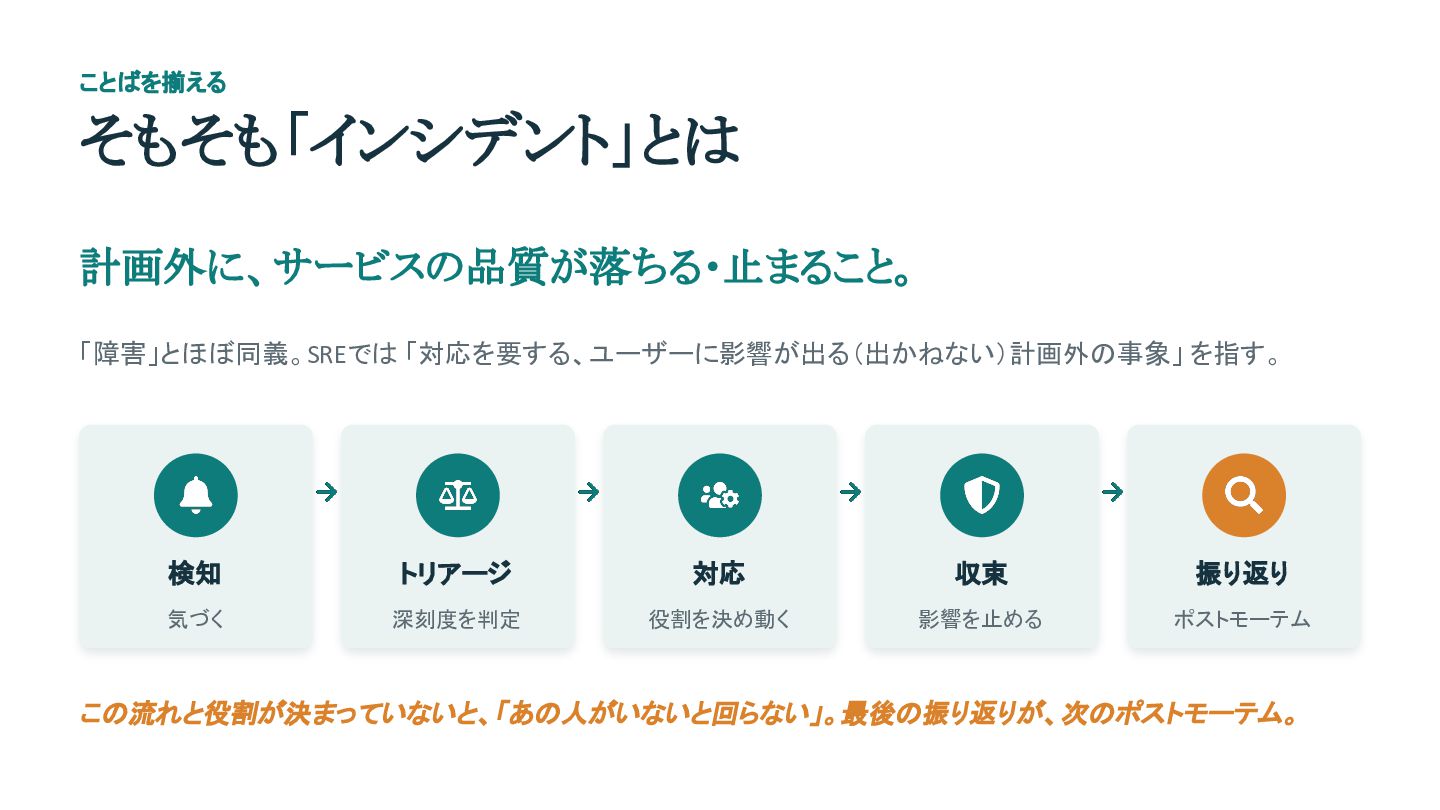
ことばを揃える そもそも「インシデント」とは 計画外に、サービスの品質が落ちる・止まること。 「障害」とほぼ同義。SREでは 「対応を要する、ユーザーに影響が出る(出かねない)計画外の事象」 を指す。 検知 トリアージ 対応 収束
振り返り 気づく 深刻度を判定 役割を決め動く 影響を止める ポストモーテム この流れと役割が決まっていないと、「あの人がいないと回らない」。最後の振り返りが、次のポストモーテム。
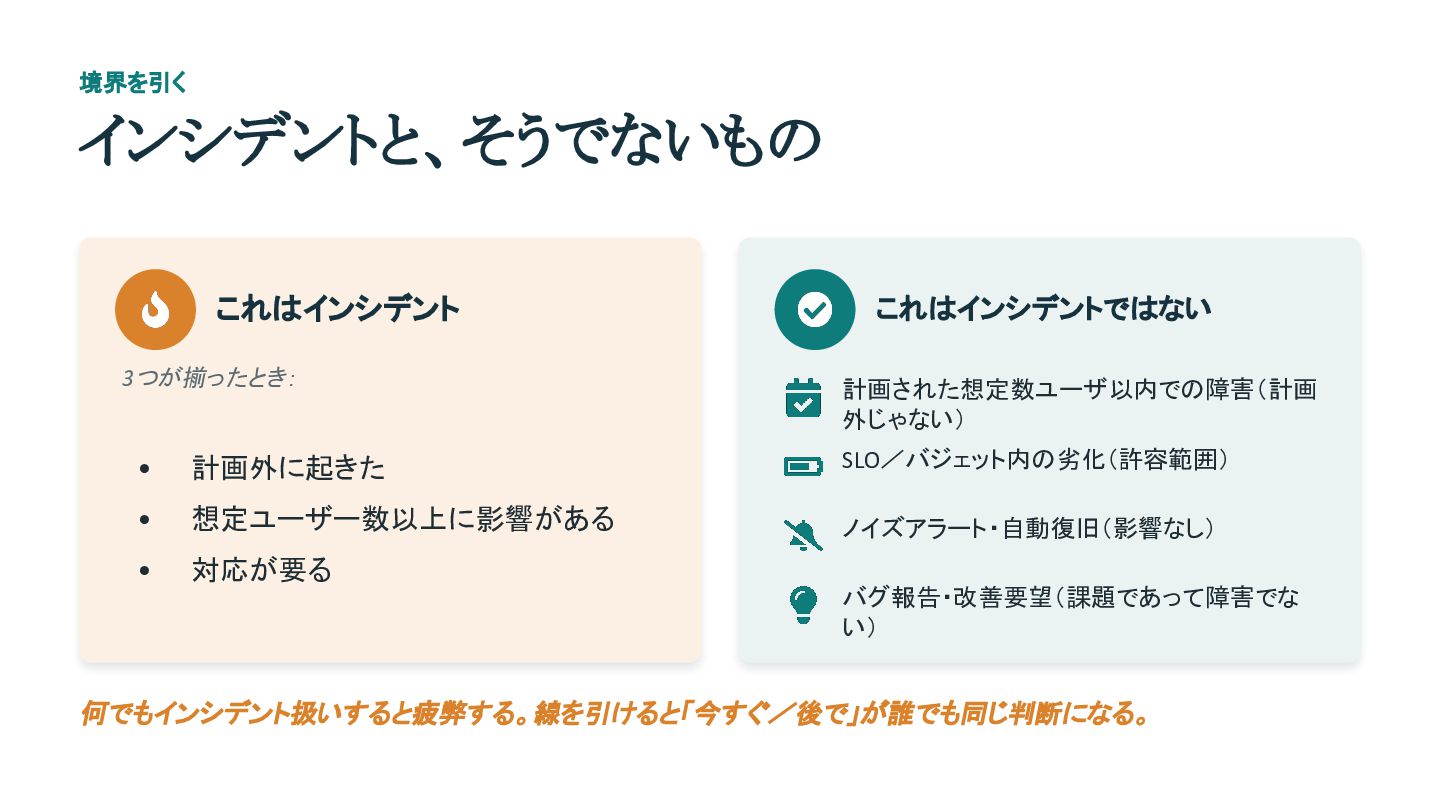
境界を引く インシデントと、そうでないもの これはインシデント 3つが揃ったとき: これはインシデントではない 計画された想定数ユーザ以内での障害(計画 外じゃない) • 計画外に起きた SLO/バジェット内の劣化(許容範囲)
• 想定ユーザー数以上に影響がある ノイズアラート・自動復旧(影響なし) • 対応が要る バグ報告・改善要望(課題であって障害でな い) 何でもインシデント扱いすると疲弊する。線を引けると「今すぐ/後で」が誰でも同じ判断になる。
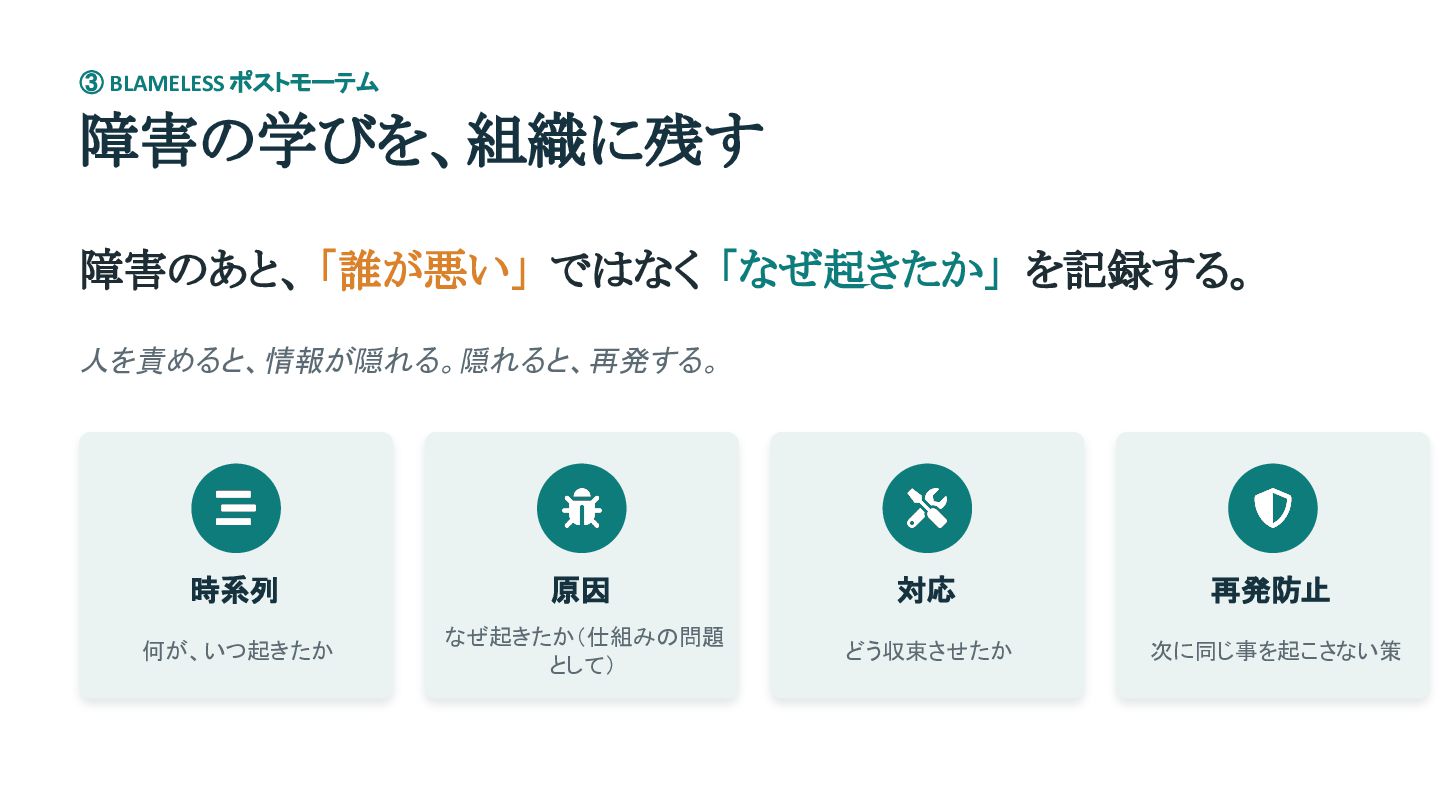
③ BLAMELESS ポストモーテム 障害の学びを、組織に残す 障害のあと、 「誰が悪い」 ではなく 「なぜ起きたか」 を記録する。 人を責めると、情報が隠れる。隠れると、再発する。
時系列 原因 対応 再発防止 何が、いつ起きたか なぜ起きたか(仕組みの問題 として) どう収束させたか 次に同じ事を起こさない策
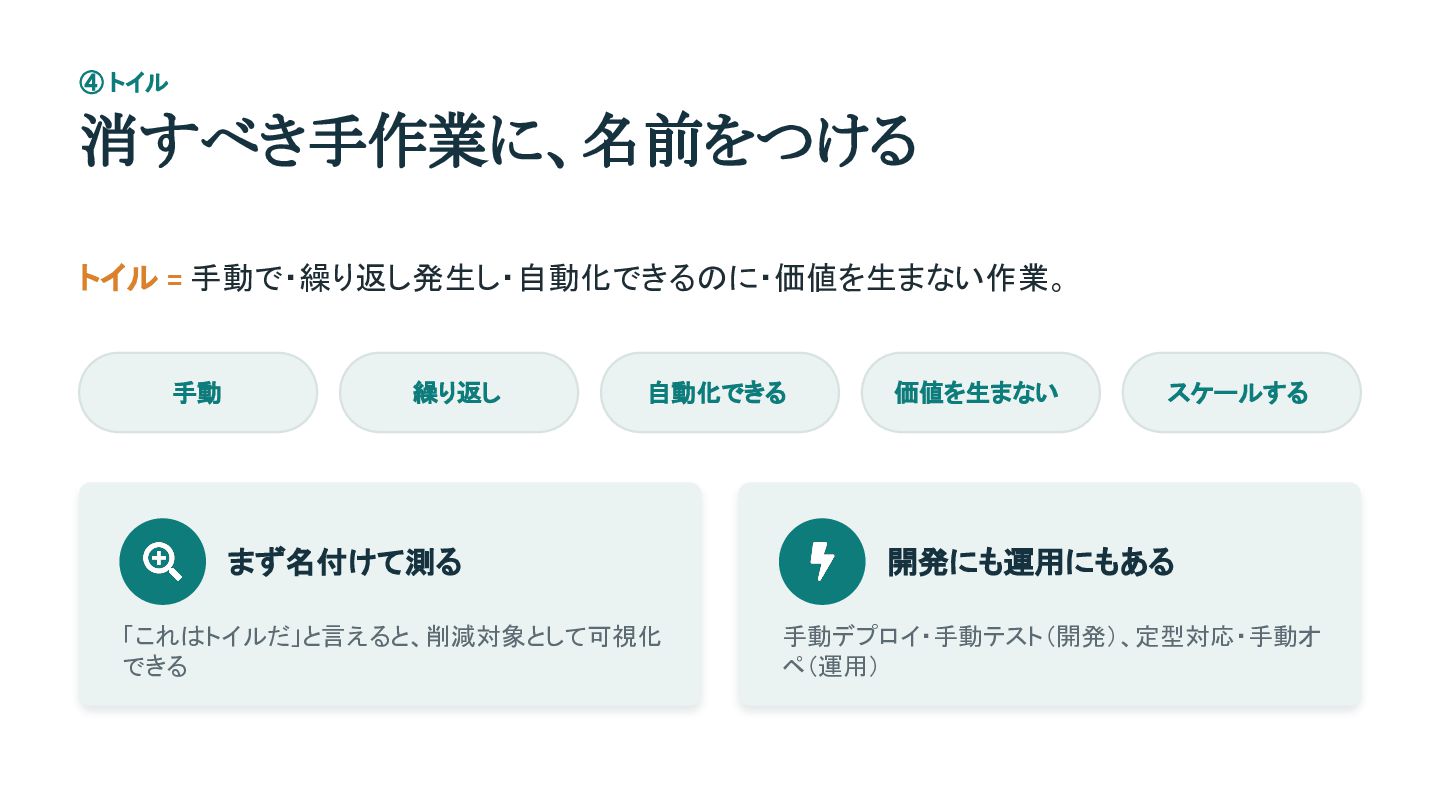
④ トイル 消すべき手作業に、名前をつける トイル = 手動で・繰り返し発生し・自動化できるのに・価値を生まない作業。 手動 繰り返し 自動化できる まず名付けて測る
「これはトイルだ」と言えると、削減対象として可視化 できる 価値を生まない スケールする 開発にも運用にもある 手動デプロイ・手動テスト(開発)、定型対応・手動オ ペ(運用)
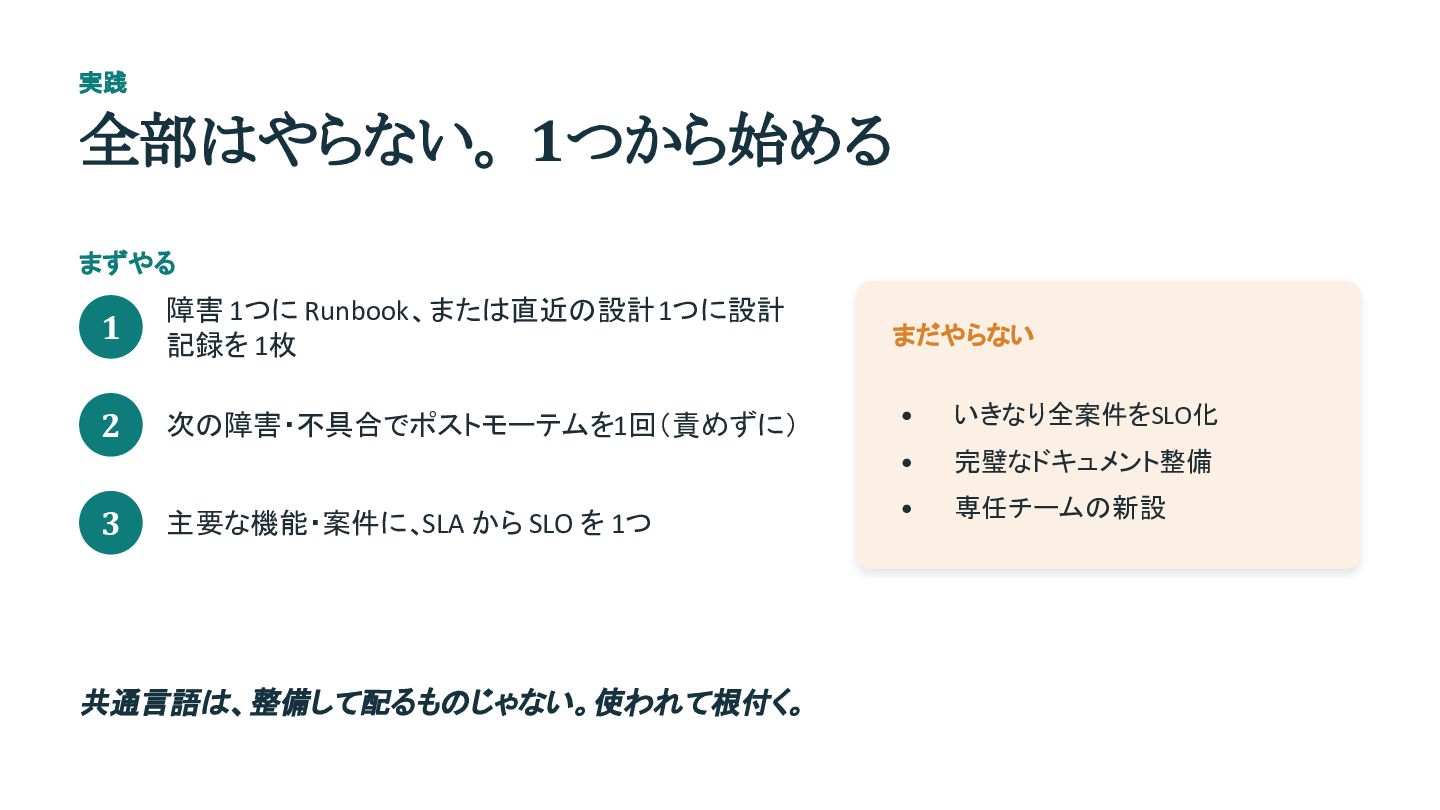
実践 全部はやらない。 1つから始める まずやる 1 障害 1つに Runbook、または直近の設計 1つに設計 記録を
1枚 まだやらない 2 次の障害・不具合でポストモーテムを1回(責めずに) • いきなり全案件をSLO化 • 完璧なドキュメント整備 • 専任チームの新設 3 主要な機能・案件に、SLA から SLO を 1つ 共通言語は、整備して配るものじゃない。使われて根付く。
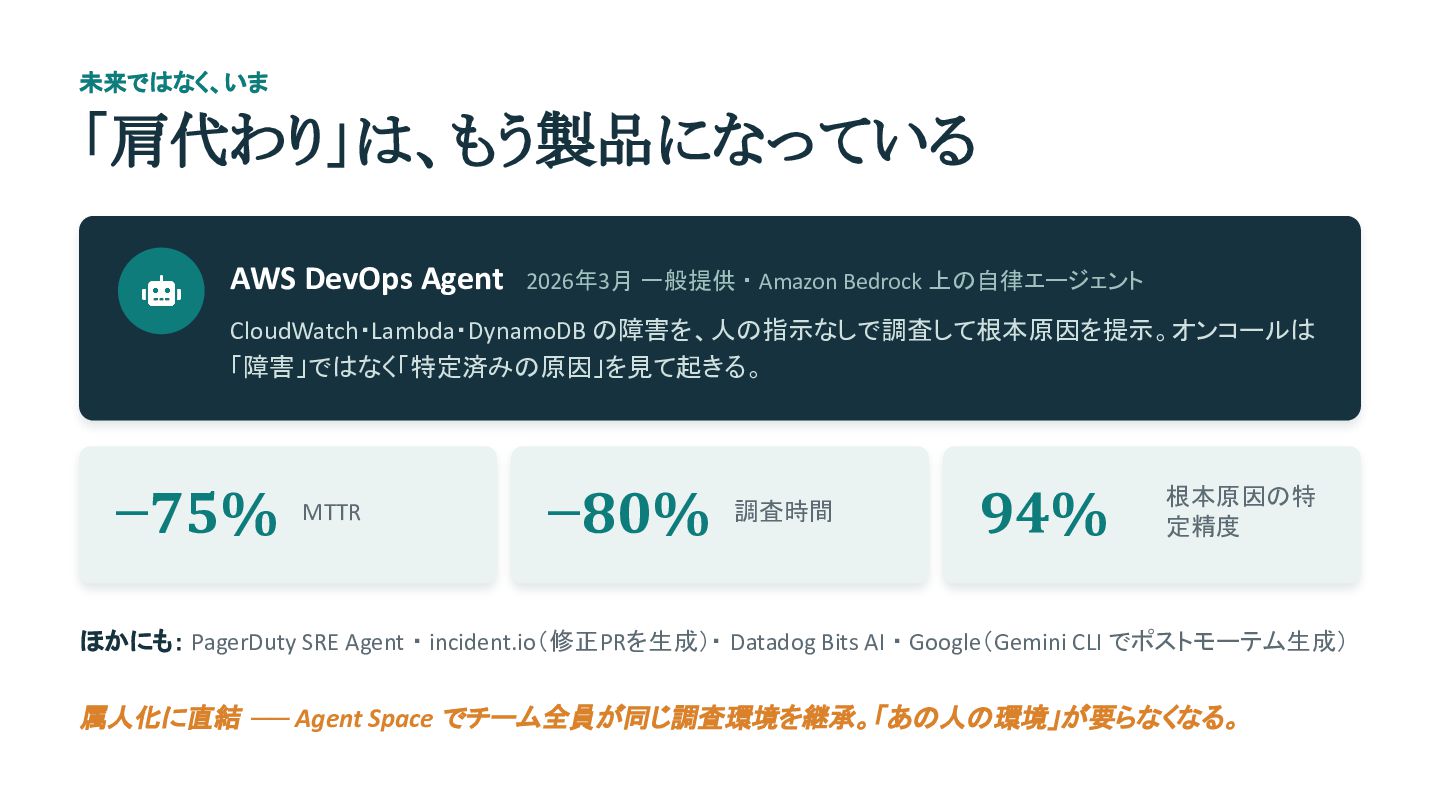
未来ではなく、いま 「肩代わり」は、もう製品になっている AWS DevOps Agent 2026年3月 一般提供 ・ Amazon Bedrock
上の自律エージェント CloudWatch・Lambda・DynamoDB の障害を、人の指示なしで調査して根本原因を提示。オンコールは 「障害」ではなく「特定済みの原因」を見て起きる。 −75% MTTR −80% 調査時間 94% 根本原因の特 定精度 ほかにも: PagerDuty SRE Agent ・ incident.io(修正PRを生成)・ Datadog Bits AI ・ Google(Gemini CLI でポストモーテム生成) 属人化に直結 ── Agent Space でチーム全員が同じ調査環境を継承。「あの人の環境」が要らなくなる。
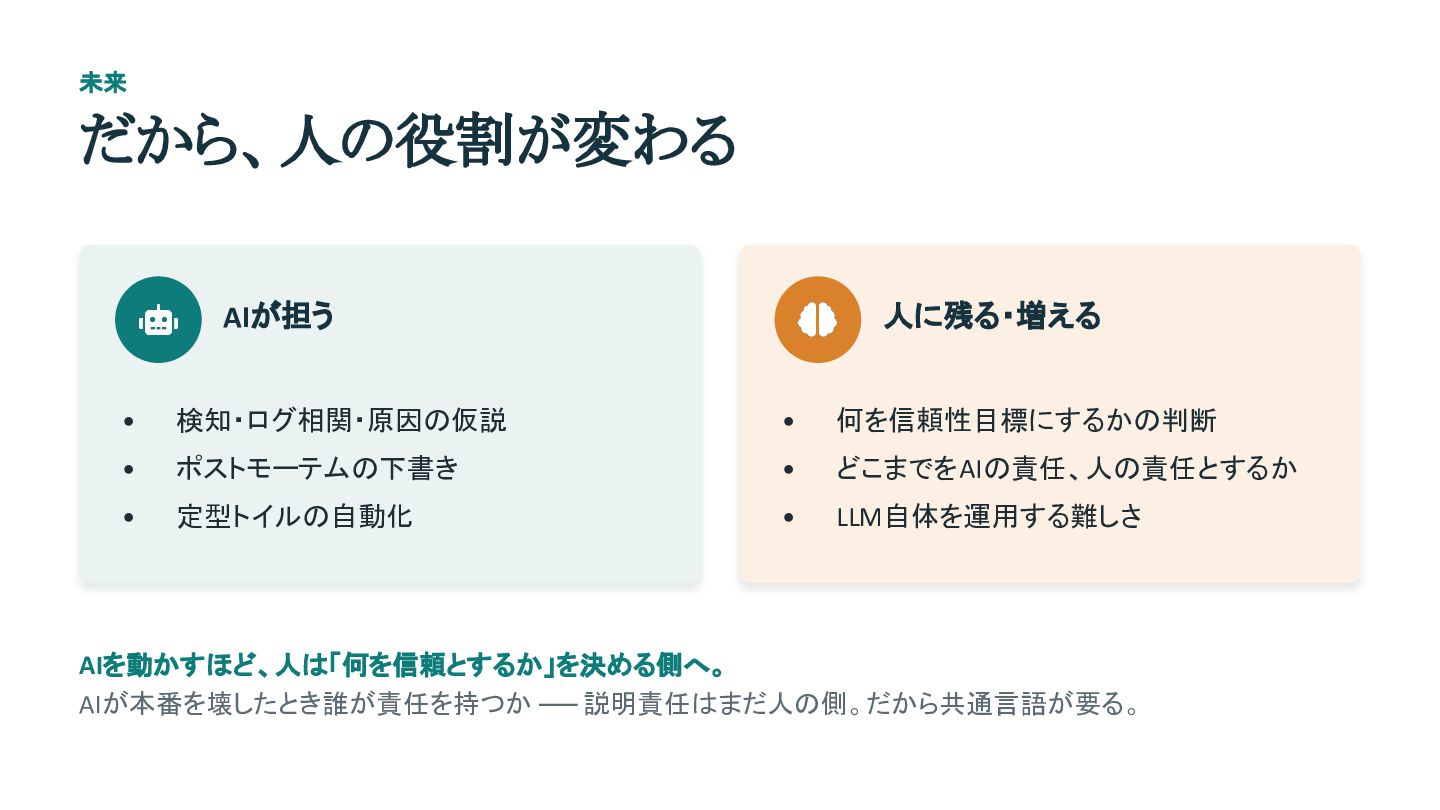
未来 だから、人の役割が変わる 人に残る・増える AIが担う • 検知・ログ相関・原因の仮説 • 何を信頼性目標にするかの判断 • ポストモーテムの下書き
• どこまでをAIの責任、人の責任とするか • 定型トイルの自動化 • LLM自体を運用する難しさ AIを動かすほど、人は「何を信頼とするか」を決める側へ。 AIが本番を壊したとき誰が責任を持つか ── 説明責任はまだ人の側。だから共通言語が要る。
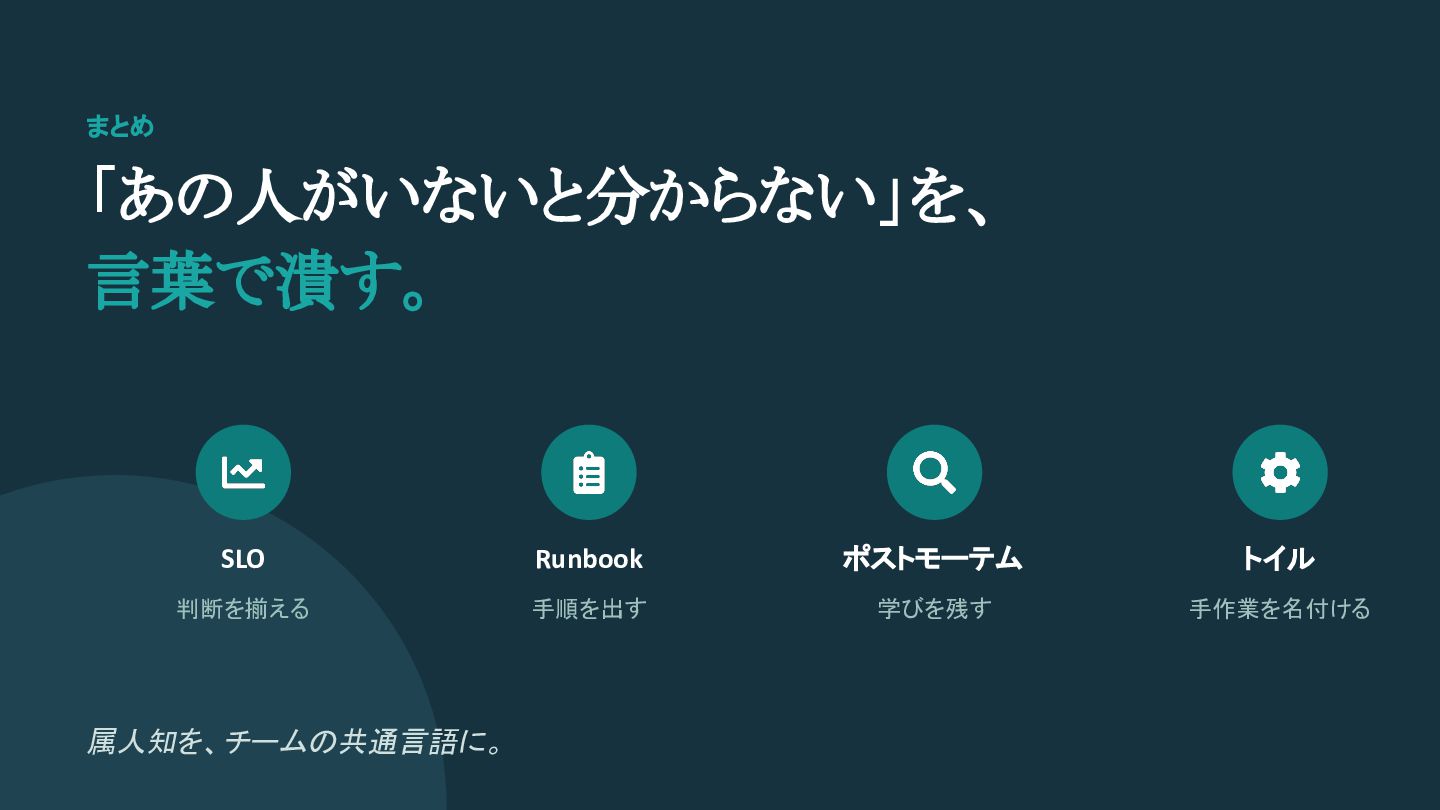
まとめ 「あの人がいないと分からない」を、 言葉で潰す。 SLO Runbook ポストモーテム トイル 判断を揃える 手順を出す 学びを残す
手作業を名付ける 属人知を、チームの共通言語に。
最後に 完璧な仕組みより、 共通言語を 1つ、使い始める。


 reverentgeek
 jonyablonski
 codingconduct
 ammeep
 addyosmani
 katiecoart
 mkilby
 sabderemane
 mfonobong
 hannesfritz
 keithpitt