как промежуточный этап при конвертации сканов и pdf документов в редактируемый формат. • BusinessCardsReader использует анализ документов в режиме выделения текста как промежуточный этап при извлечении информации из визиток. • FlexiCapture использует анализ документов в режиме выделения текста как промежуточный этап при извлечении информации из финансовых документов. • И т.д.
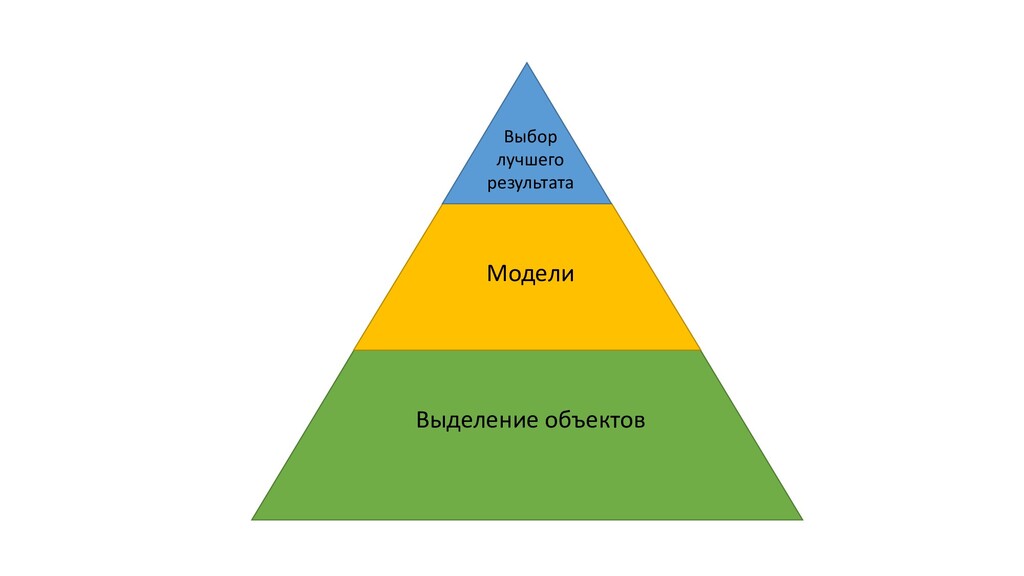
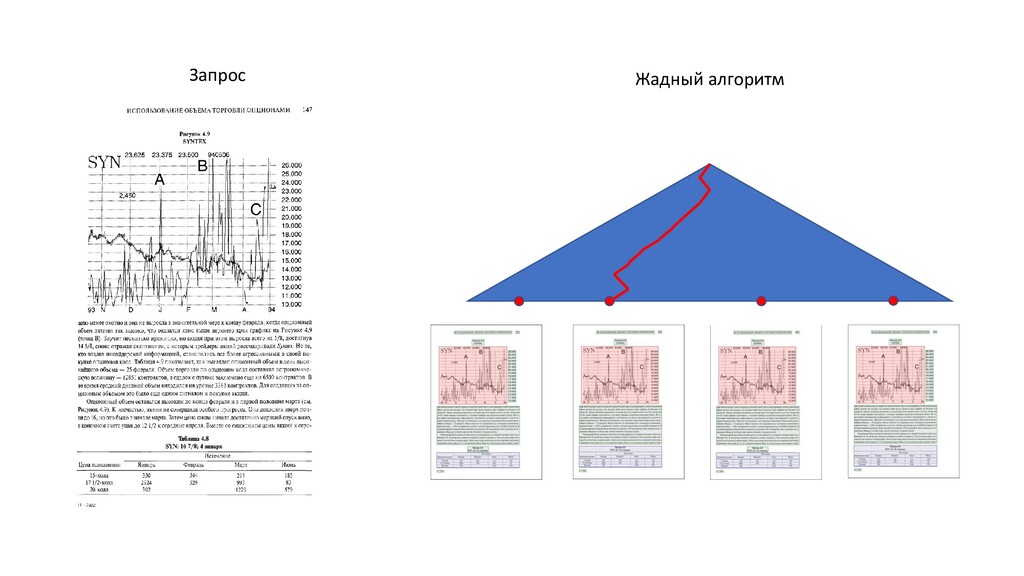
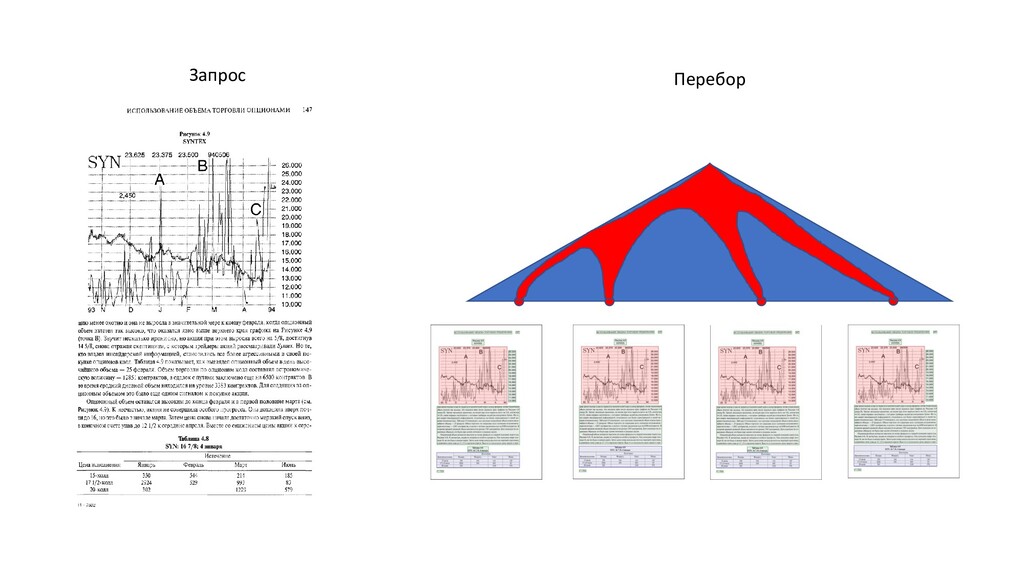
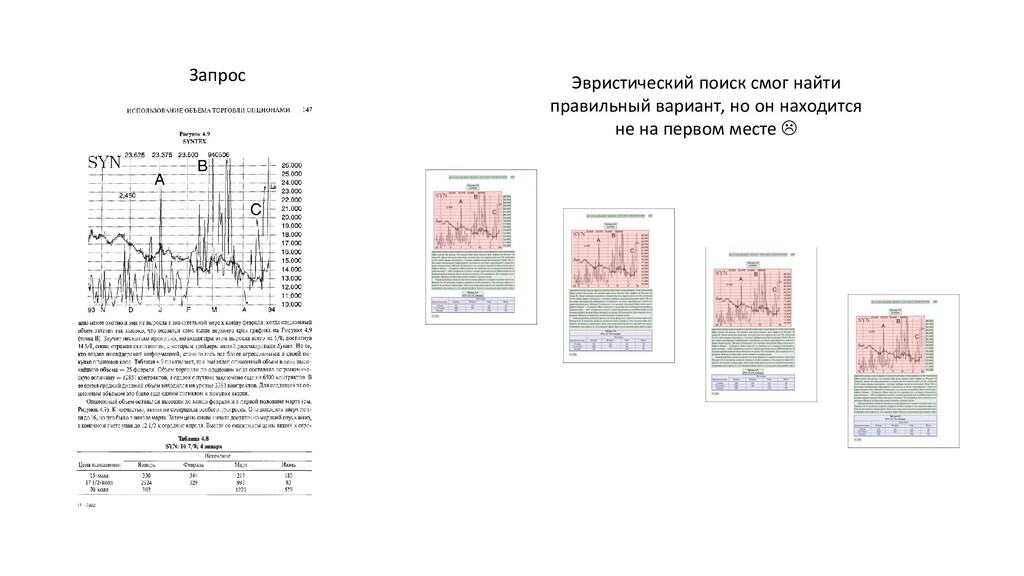
поиска в пространстве состояний. • Жадные алгоритмы относительно просты в написании и обладают рядом преимуществ, в особенности - скорость работы. • Переборные алгоритмы позволяют сделать систему более устойчивой, что ведет к повышению качества на реальных документах ценой потери в скорости.
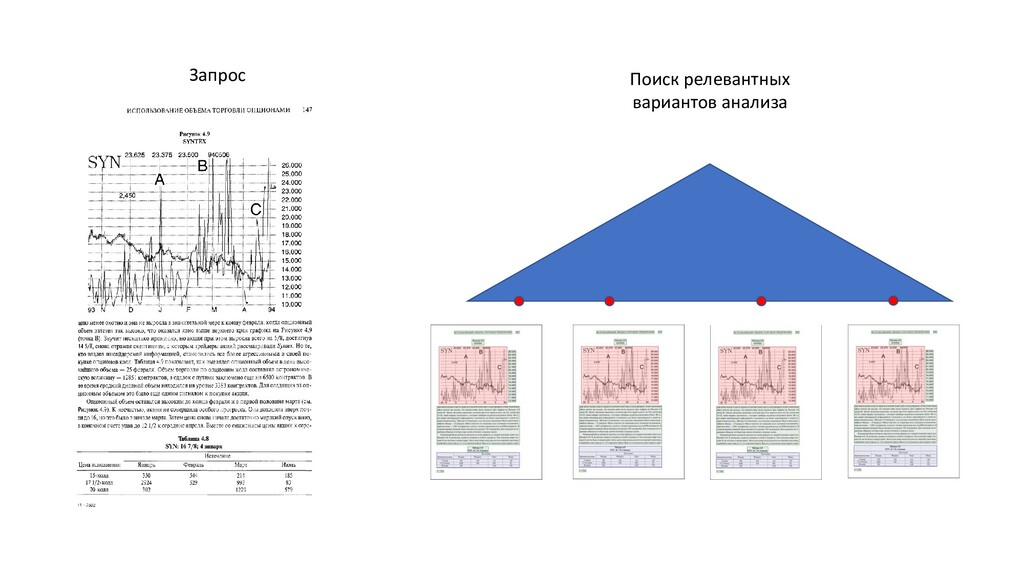
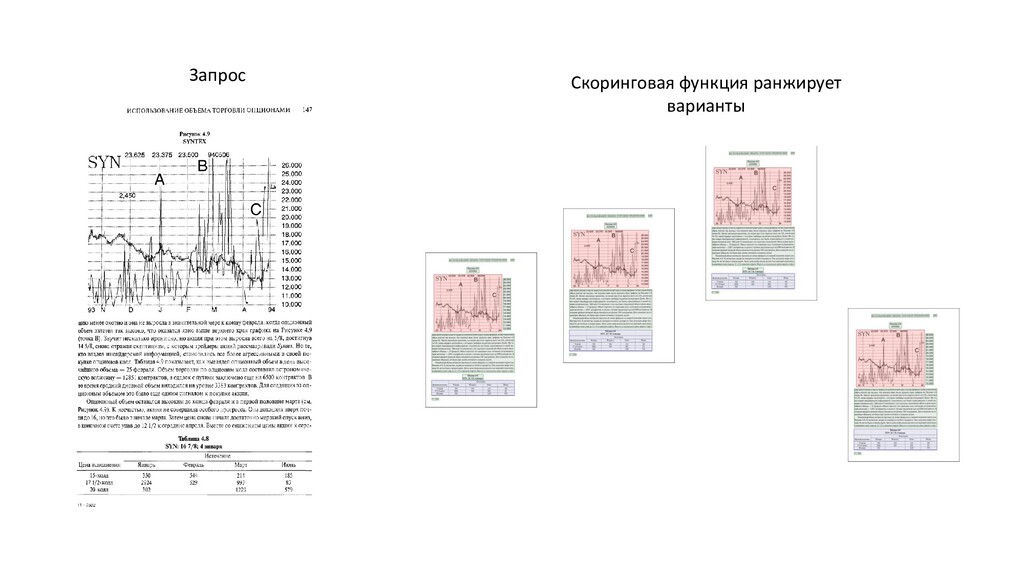
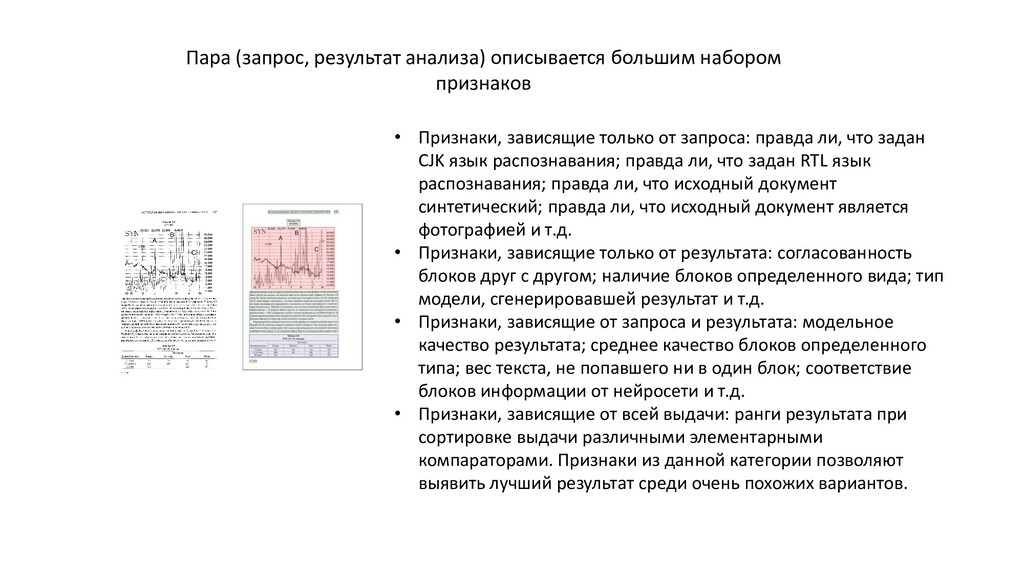
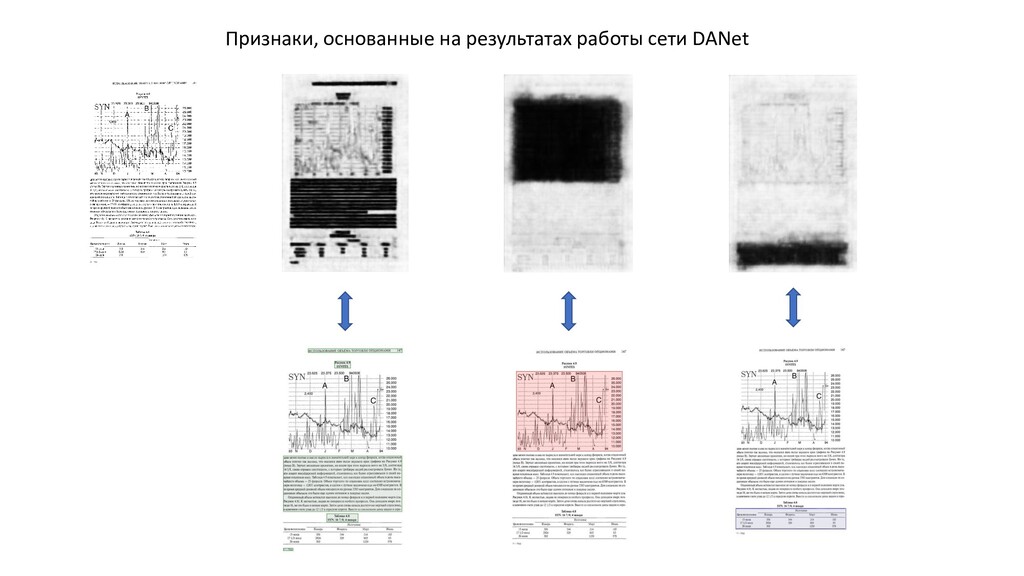
зависящие только от запроса: правда ли, что задан CJK язык распознавания; правда ли, что задан RTL язык распознавания; правда ли, что исходный документ синтетический; правда ли, что исходный документ является фотографией и т.д. • Признаки, зависящие только от результата: согласованность блоков друг с другом; наличие блоков определенного вида; тип модели, сгенерировавшей результат и т.д. • Признаки, зависящие от запроса и результата: модельное качество результата; среднее качество блоков определенного типа; вес текста, не попавшего ни в один блок; соответствие блоков информации от нейросети и т.д. • Признаки, зависящие от всей выдачи: ранги результата при сортировке выдачи различными элементарными компараторами. Признаки из данной категории позволяют выявить лучший результат среди очень похожих вариантов.
задачи ранжирования, и успешно решается методами из данной области. • Деревья рулят. • Нейросетевые признаки являются одними из самых значимых. Чистый профит от них составляет 3.2% качества работы системы.
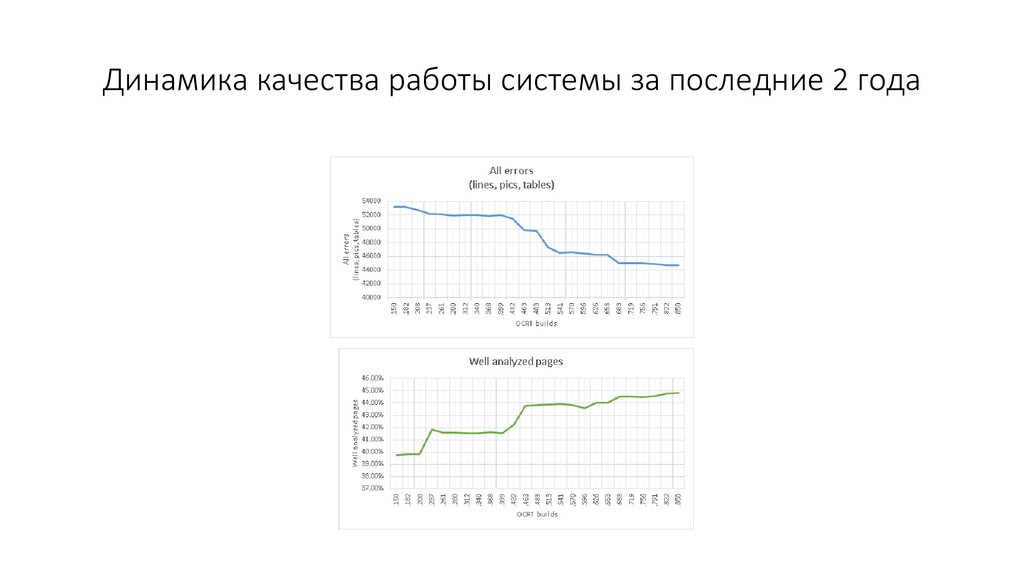
и результат анализа в единое семантическое пространство так, чтобы их скалярное произведение в этом пространстве аппроксимировало релевантность. Семантическое описание можно использовать в качестве признаков как запроса, так и результата. • Текущий алгоритм обучения хорошо оптимизирует суммарное количество ошибок системы, но не количество хорошо проанализированных страниц. Есть основания полагать, что обучение на парах будет лучше оптимизировать данную метрику. Предлагается двухуровневая схема: на первом уровне фильтруем плохие варианты функцией, оптимизирующей точечный функционал, на втором уровне отбираем лучшую гипотезу функцией, оптимизирующей парный функционал.
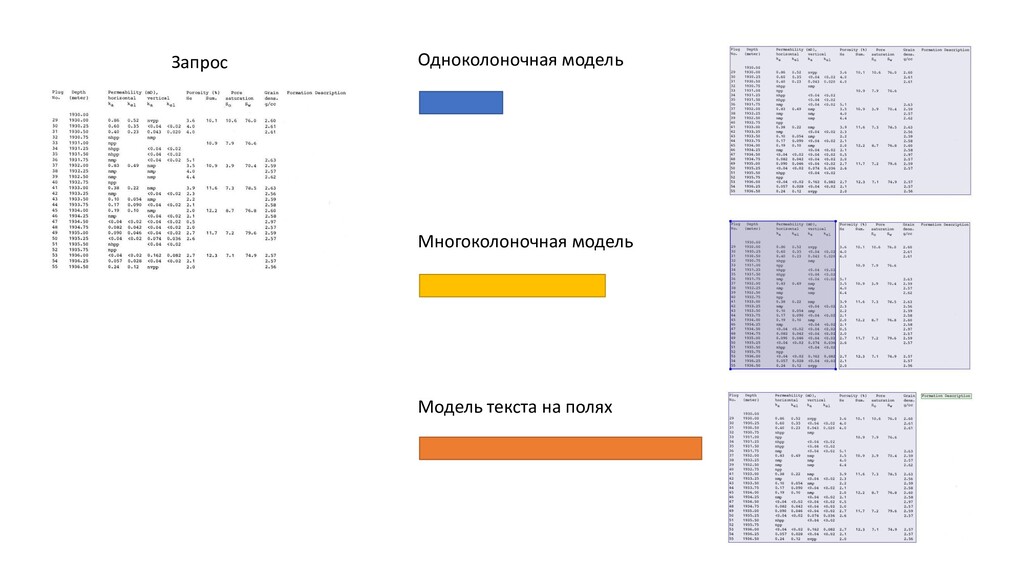
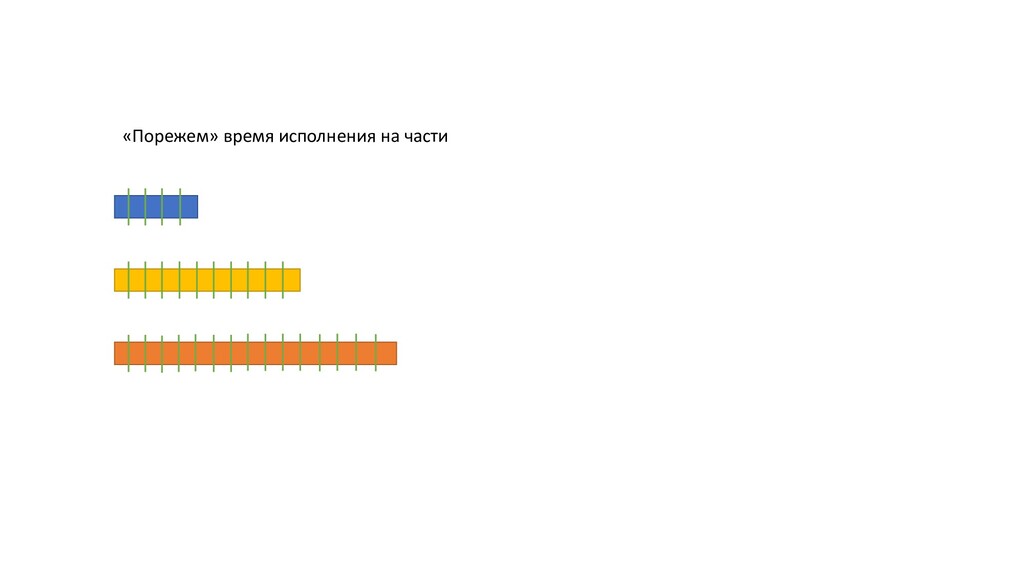
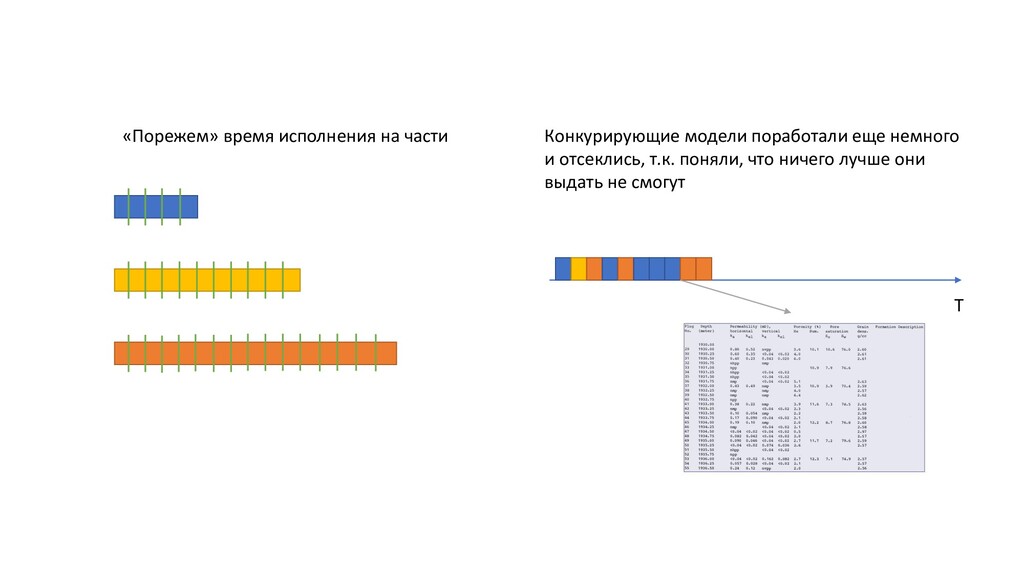
в качестве. • Алгоритм естественным образом адаптируется к сложности запроса. Чем проще запрос, тем меньше время работы отличается от теоретически оптимального. • Подход позволяет масштабировать количество моделей без заметных потерь в скорости.
и низкоконтрастных сканах. oИспользование нейросетевых признаков в задаче выбора лучшей гипотезы сегментации таблицы на ячейки. oАльтернативный способ выделения объектов с использованием нейросетей. • Увеличение качества работы на PDF документах за счет более полного и целенаправленного использования информации из PDF.


 steliosf
 dske104
 akihisaikeda
 deka_morita
 kasacchiful
 n_takehata
 ryu1013
 hschwentner
 ichirokano2
 ivargrimstad
 takai
 yumnumm
 techseoconnect
 pauljervisheath
 addyosmani
 palkan
 chikuwait
 destraynor
 garrettdimon
 aleyda
 reverentgeek
 tanoku
 honzajavorek
 baasie