Share
Embed
不完全情報ゲームAIを支えるゲーム理論的技術の進展
2026年度人工知能学会全国大会 (JSAI2026) の企画セッション「学習理論におけるゲーム理論のフロンティア」での発表資料です.
https://conf.ai-gakkai.or.jp/jsai2026/ks/#ks-6
Kenshi Abe
June 13, 2026
Transcript
26 slides
-
JSAI2026 اըηογϣϯ KS-6 ʗ 2026.6.12 Ѩ෦ ݓ೭ʢαΠόʔΤʔδΣϯτ AI Lab /
Game AI labʣ ෆશใήʔϜAIΛࢧ͑Δ ήʔϜཧతٕज़ͷਐల -
2 • ໊લ o Ѩ෦ ݓ೭ʢ͋ ͚Μ͠ʣ o @bakanaouji •
ܦྺ o αΠόʔΤʔδΣϯτ AI Labʢ2018ʙʣ q γχΞϦαʔναΠΤϯςΟετ o ಉࣾ Game AI Lab ݉ʢ2025ʙʣ • ઐྖҬ o Learning in Games o ڧԽֶश o ΦϯϥΠϯֶश ࣗݾհ 01 OVERVIEW -
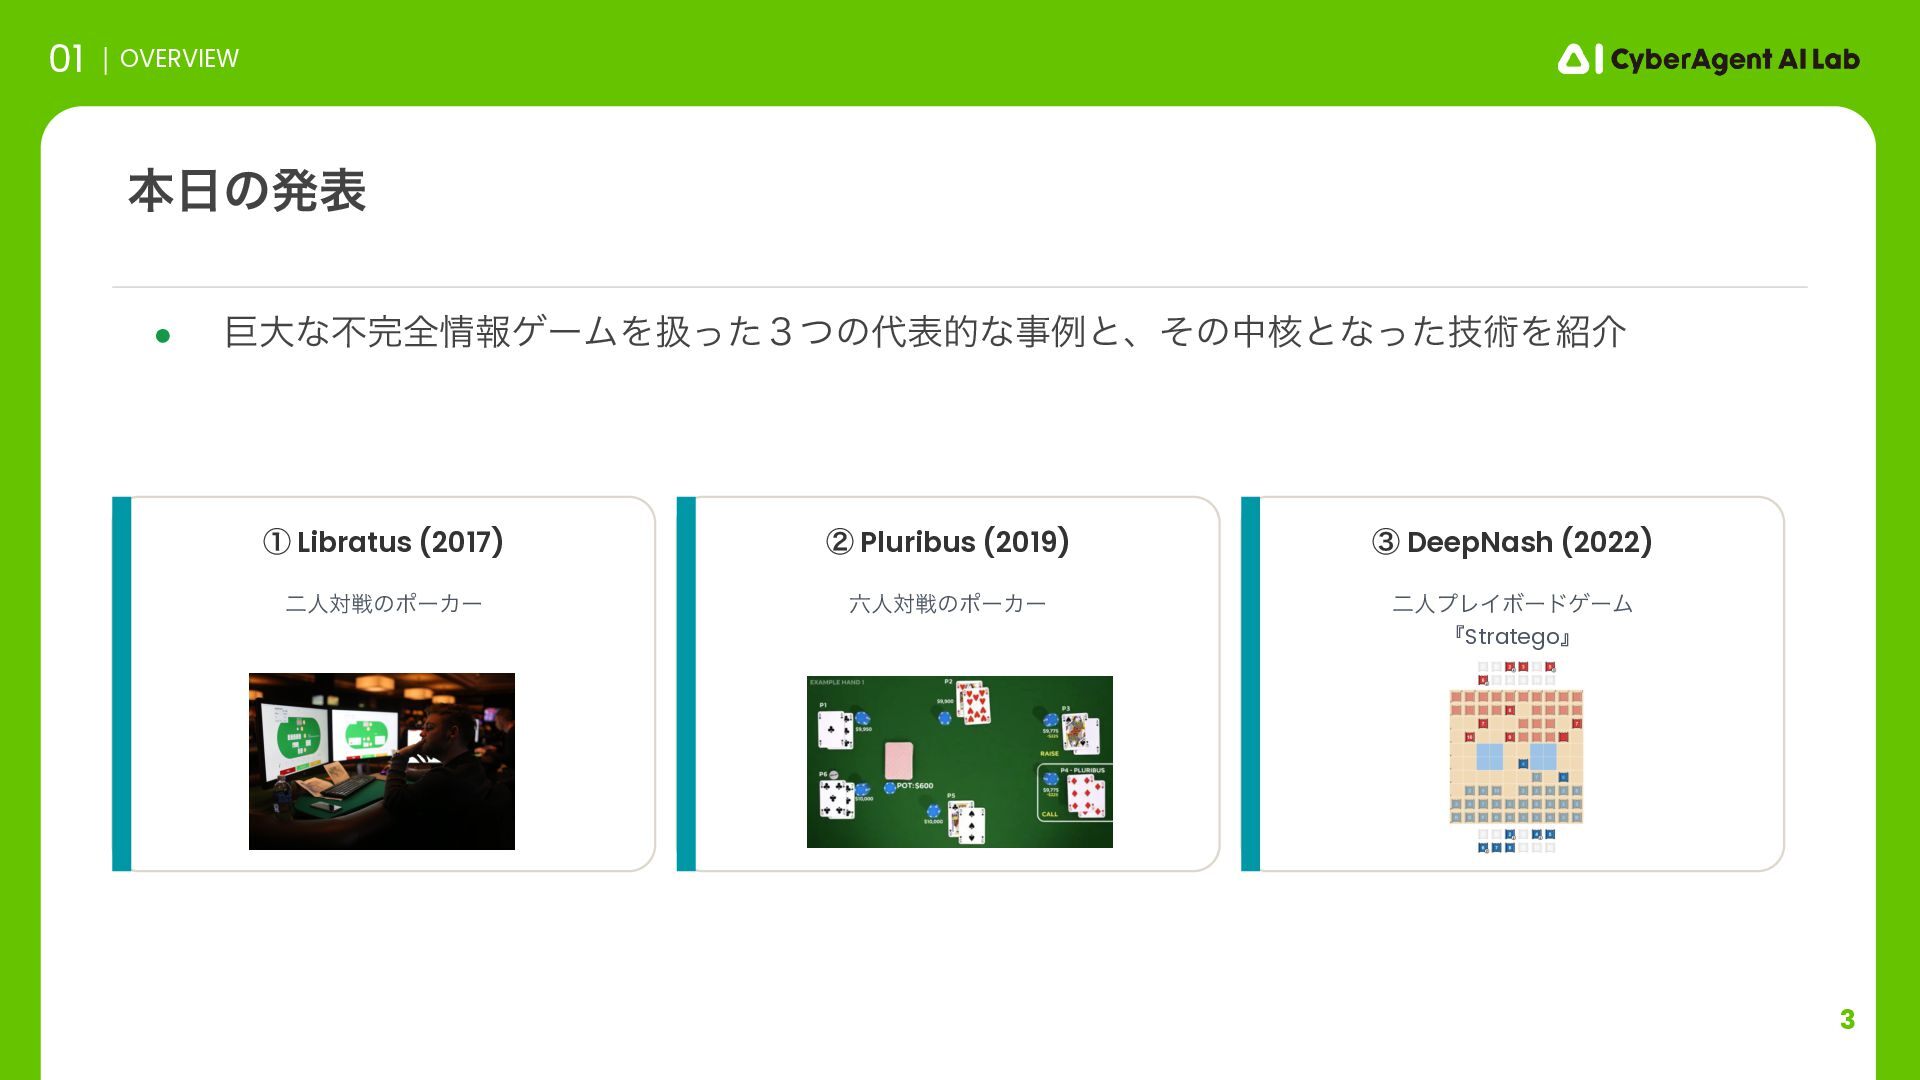
3 • ڊେͳෆશใήʔϜΛѻͬͨ̏ͭͷදతͳࣄྫͱɺͦͷத֩ͱͳٕͬͨज़Λհ ຊͷൃද 01 OVERVIEW ᶃ Libratus (2017) ೋਓରઓͷϙʔΧʔ
ᶄ Pluribus (2019) ਓରઓͷϙʔΧʔ ᶅ DeepNash (2022) ೋਓϓϨΠϘʔυήʔϜ ʰStrategoʱ -
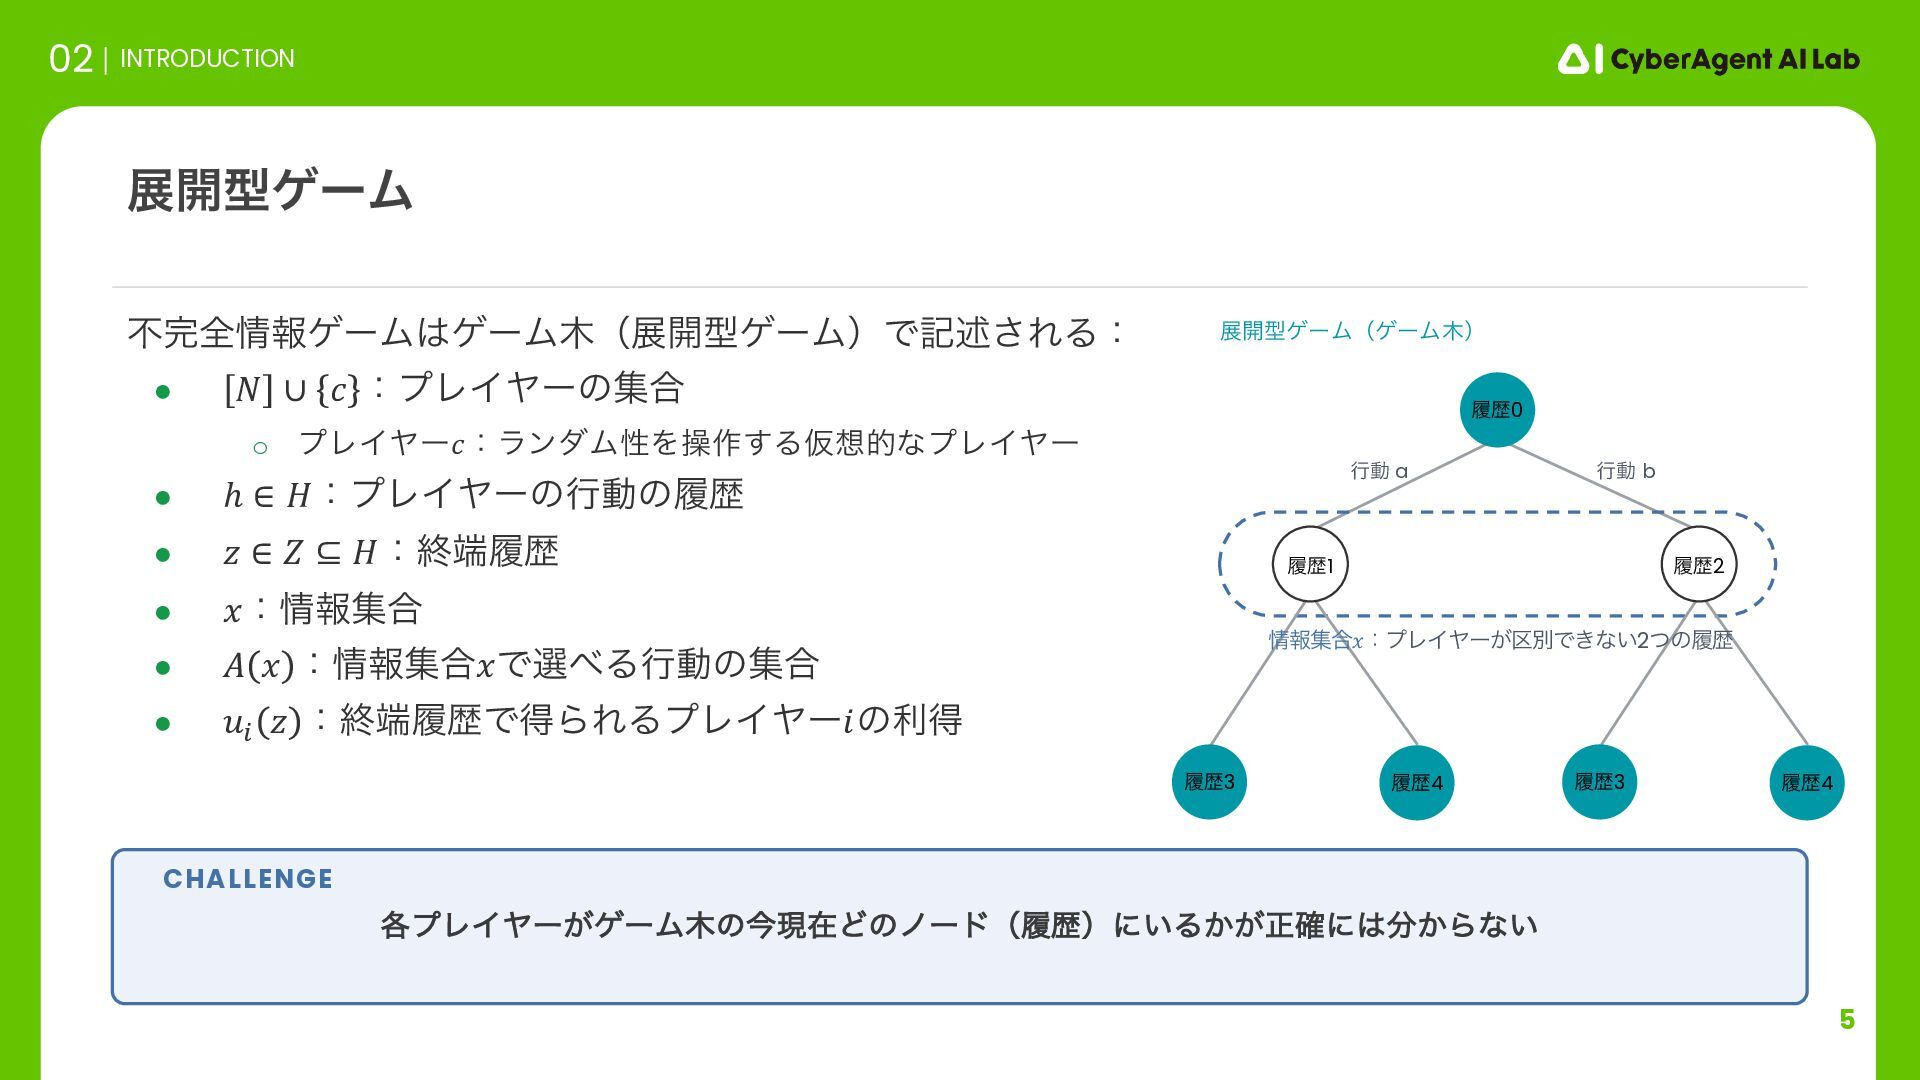
5 ෆશใήʔϜήʔϜʢల։ܕήʔϜʣͰهड़͞ΕΔɿ • 𝑁 ∪ 𝑐 ɿϓϨΠϠʔͷू߹ o ϓϨΠϠʔ𝑐ɿϥϯμϜੑΛૢ࡞͢ΔԾతͳϓϨΠϠʔ •
ℎ ∈ 𝐻ɿϓϨΠϠʔͷߦಈͷཤྺ • 𝑧 ∈ 𝑍 ⊆ 𝐻ɿऴཤྺ • 𝑥ɿใू߹ • 𝐴 𝑥 ɿใू߹𝑥ͰબΔߦಈͷू߹ • 𝑢! 𝑧 ɿऴཤྺͰಘΒΕΔϓϨΠϠʔ𝑖ͷརಘ ల։ܕήʔϜ 02 INTRODUCTION ల։ܕήʔϜʢήʔϜʣ ߦಈ a ֤ϓϨΠϠʔ͕ήʔϜͷࠓݱࡏͲͷϊʔυʢཤྺʣʹ͍Δ͔͕ਖ਼֬ʹ͔Βͳ͍ CHALLENGE ߦಈ b ཤྺ0 ཤྺ1 ཤྺ3 ཤྺ4 ཤྺ3 ཤྺ4 ཤྺ2 ใू߹𝑥ɿϓϨΠϠʔ͕۠ผͰ͖ͳ͍2ͭͷཤྺ -
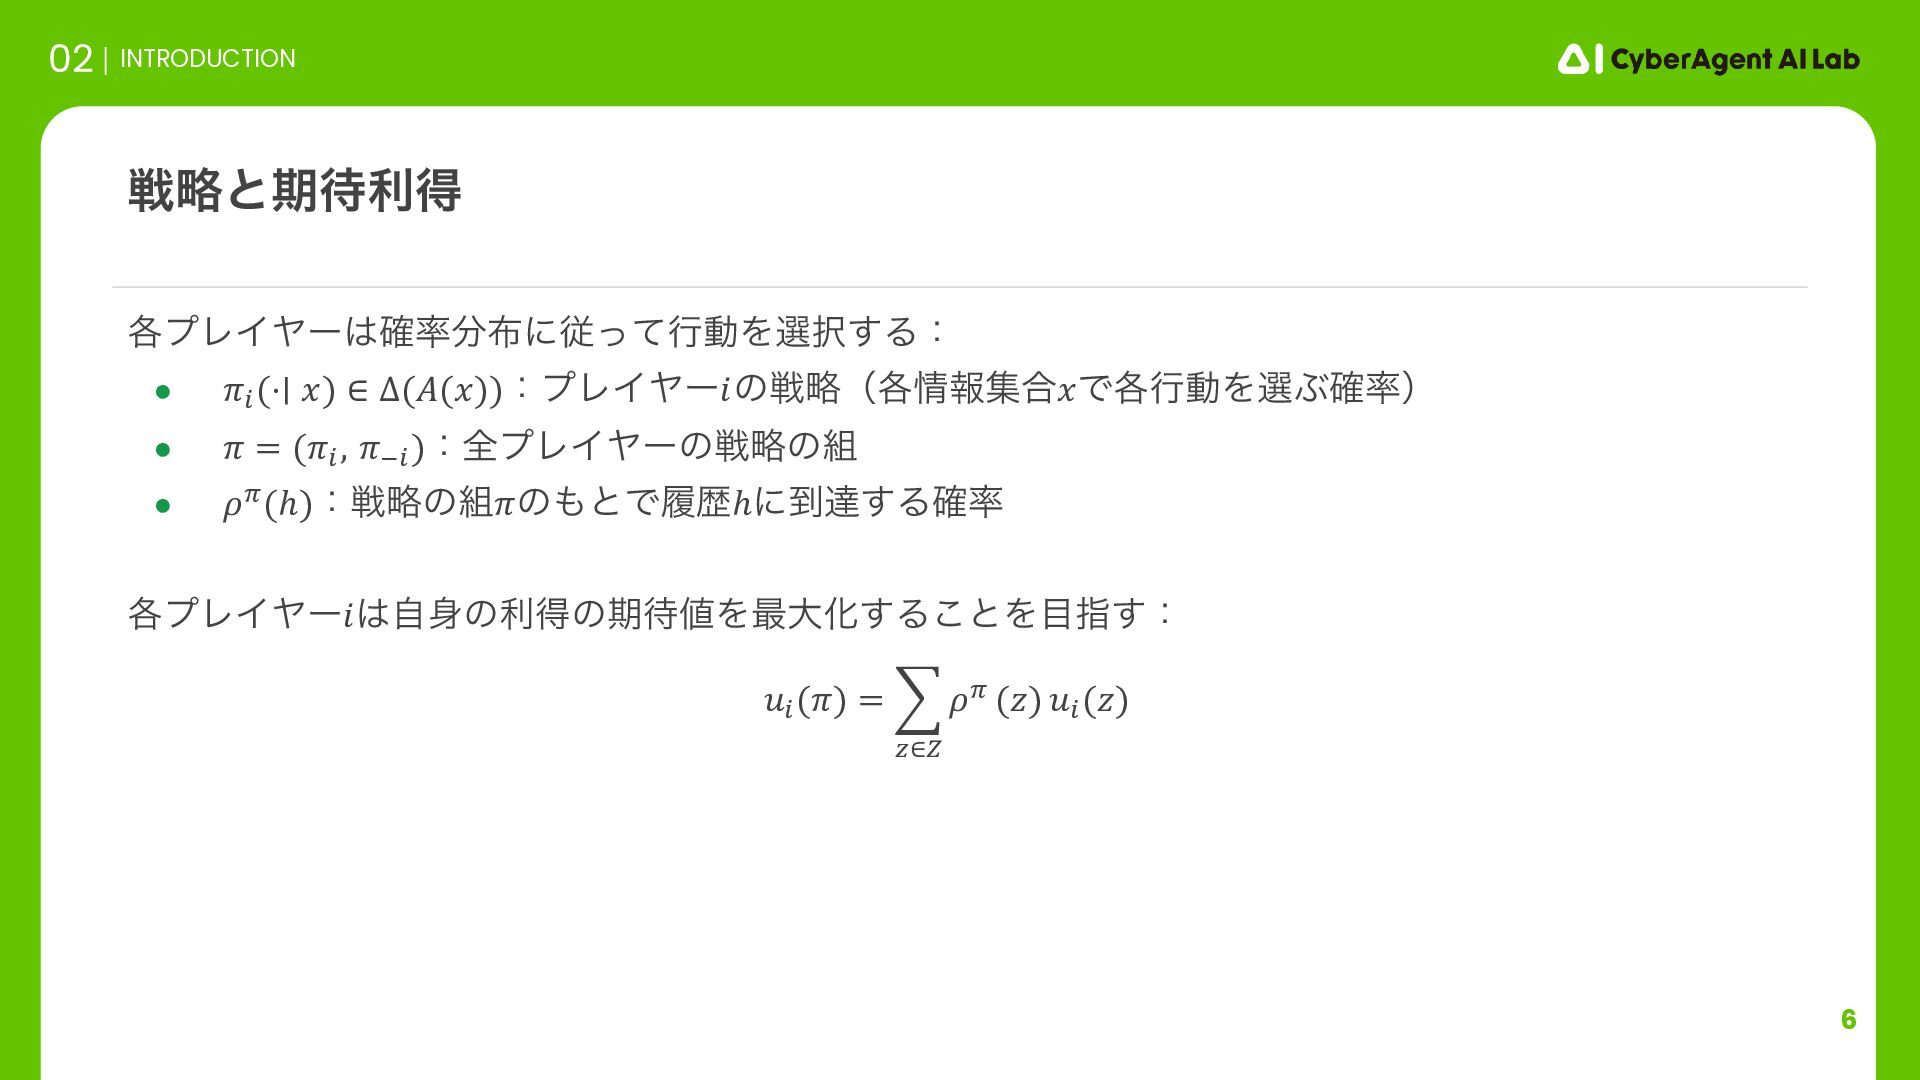
6 ֤ϓϨΠϠʔ֬ʹैͬͯߦಈΛબ͢Δɿ • 𝜋! (⋅∣ 𝑥) ∈ Δ(𝐴(𝑥))ɿϓϨΠϠʔ𝑖ͷઓུʢ֤ใू߹𝑥Ͱ֤ߦಈΛબͿ֬ʣ • 𝜋
= (𝜋! , 𝜋"! )ɿશϓϨΠϠʔͷઓུͷ • 𝜌#(ℎ)ɿઓུͷ𝜋ͷͱͰཤྺℎʹ౸ୡ͢Δ֬ ֤ϓϨΠϠʔ𝑖ࣗͷརಘͷظΛ࠷େԽ͢Δ͜ͱΛࢦ͢ɿ 𝑢! (𝜋) = 7 $∈& 𝜌# (𝑧) 𝑢! (𝑧) ઓུͱظརಘ 02 INTRODUCTION -
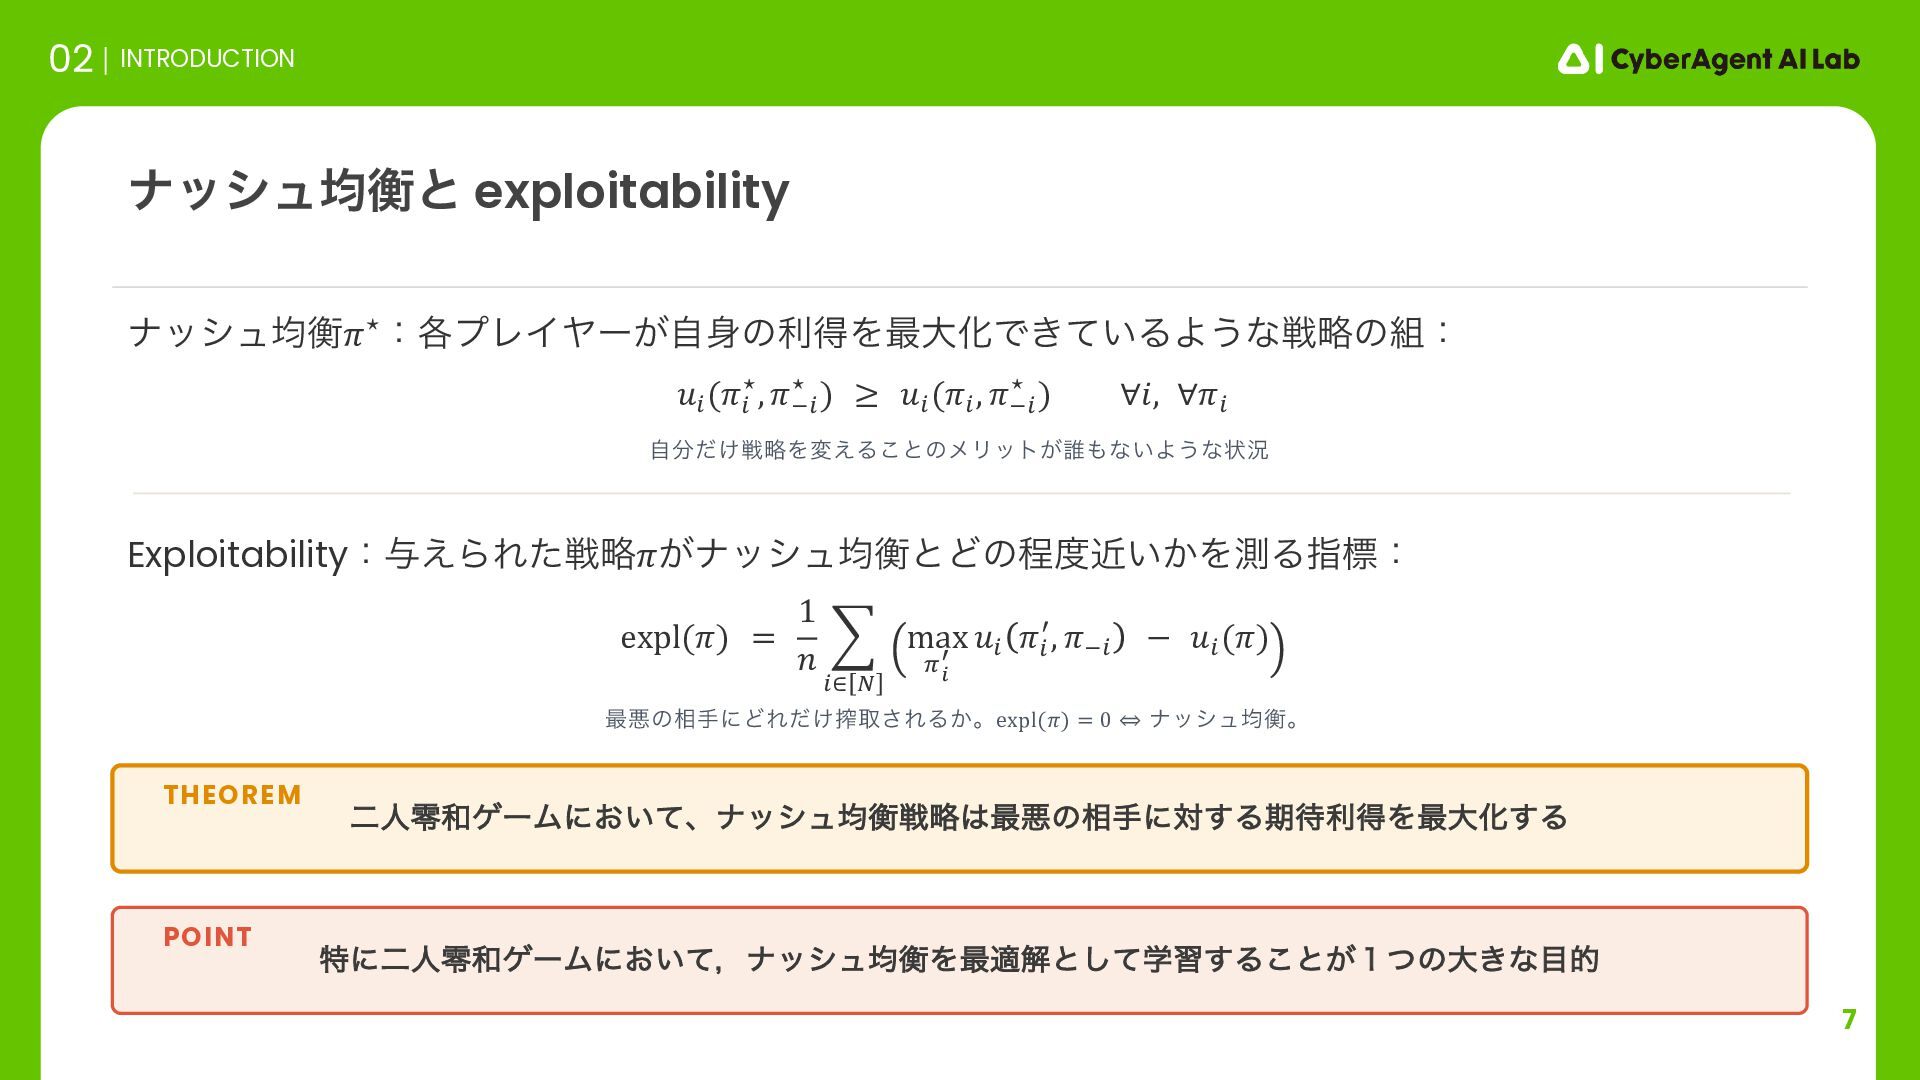
7 φογϡۉߧ𝜋⋆ɿ֤ϓϨΠϠʔ͕ࣗͷརಘΛ࠷େԽͰ͖͍ͯΔΑ͏ͳઓུͷɿ Exploitabilityɿ༩͑ΒΕͨઓུ𝜋͕φογϡۉߧͱͲͷఔ͍͔ۙΛଌΔࢦඪɿ φογϡۉߧͱ exploitability 02 INTRODUCTION 𝑢! (𝜋! ⋆,
𝜋#! ⋆ ) ≥ 𝑢! (𝜋! , 𝜋#! ⋆ ) ∀𝑖, ∀𝜋! expl(𝜋) = 1 𝑛 0 !∈ % max &! " 𝑢! 𝜋! ', 𝜋#! − 𝑢! (𝜋) ࠷ѱͷ૬खʹͲΕ͚ͩࡡऔ͞ΕΔ͔ɻexpl(𝜋) = 0 ⇔ φογϡۉߧɻ ͚ࣗͩઓུΛม͑Δ͜ͱͷϝϦοτ͕୭ͳ͍Α͏ͳঢ়گ ಛʹೋਓྵήʔϜʹ͓͍ͯɼφογϡۉߧΛ࠷దղͱֶͯ͠श͢Δ͜ͱ͕̍ͭͷେ͖ͳత POINT ೋਓྵήʔϜʹ͓͍ͯɺφογϡۉߧઓུ࠷ѱͷ૬खʹର͢ΔظརಘΛ࠷େԽ͢Δ THEOREM -
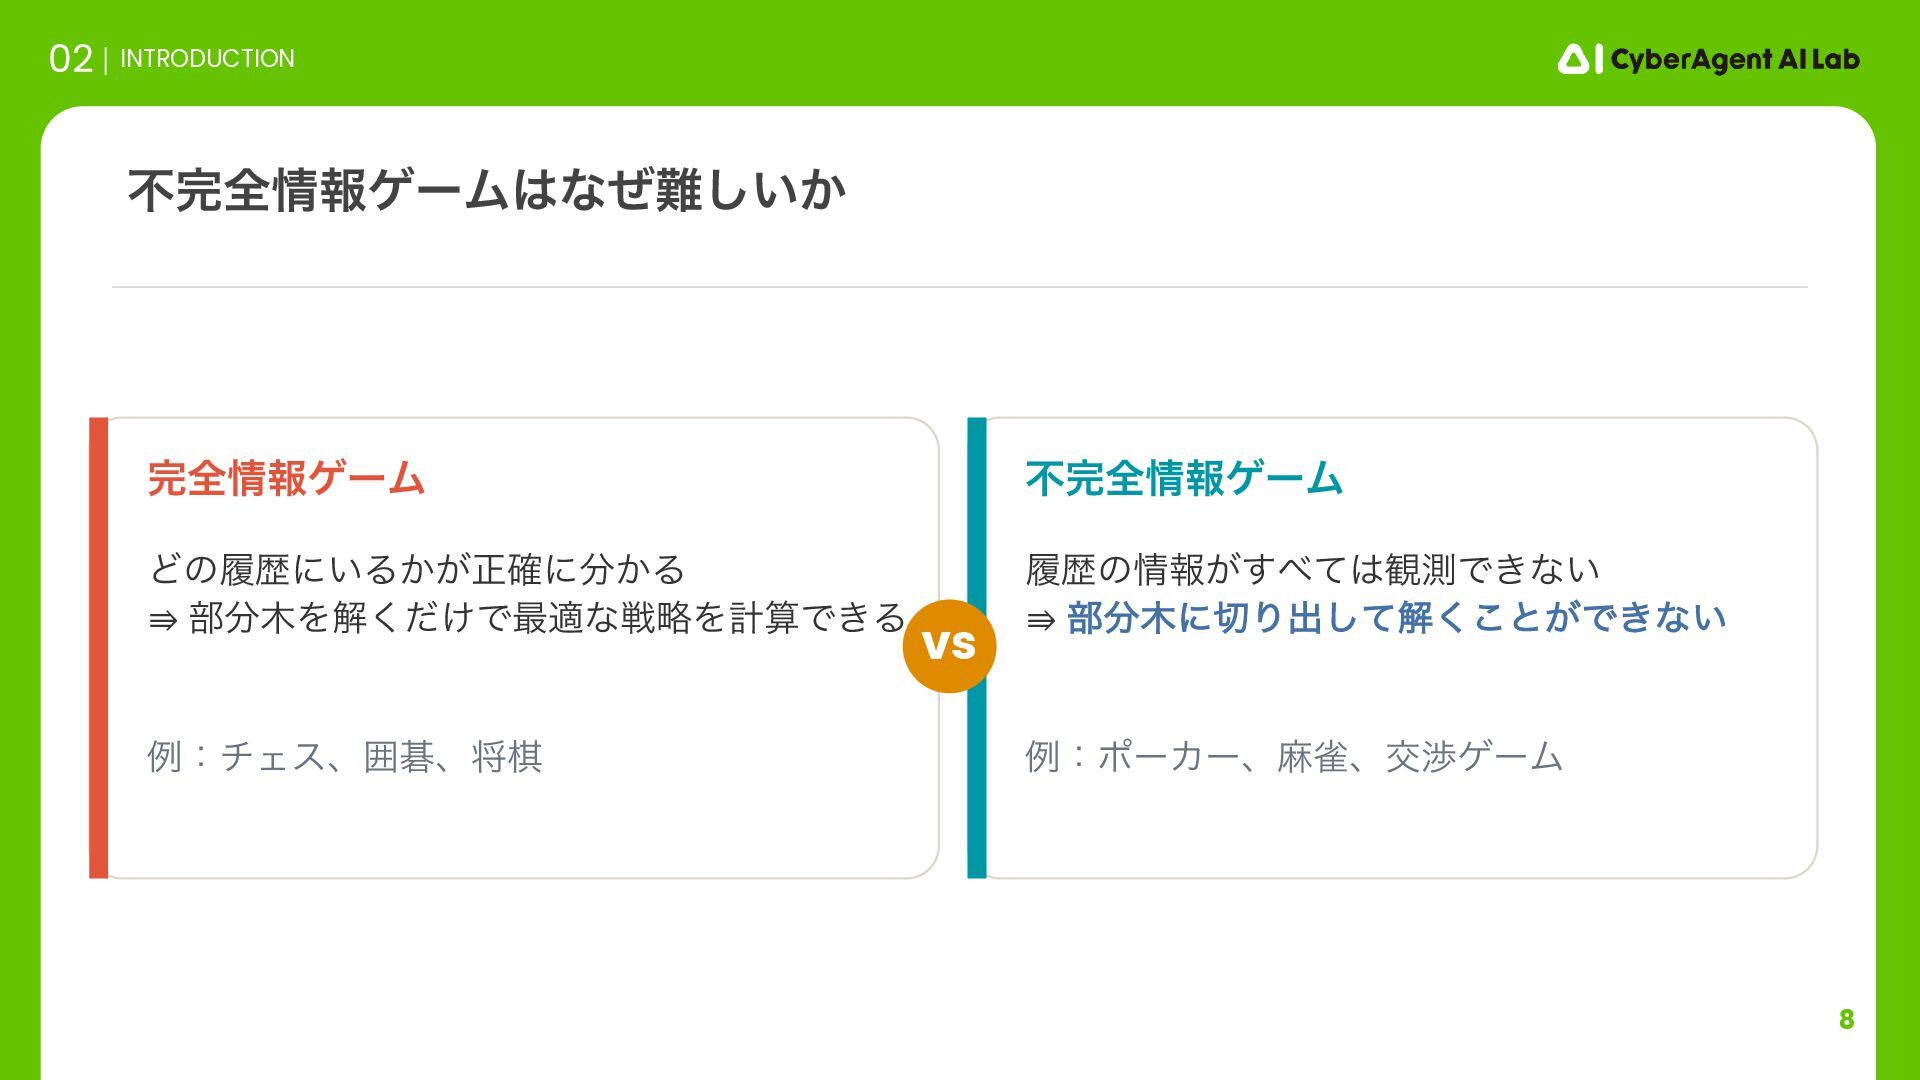
8 ෆશใήʔϜͳ͍͔ͥ͠ 02 INTRODUCTION શใήʔϜ Ͳͷཤྺʹ͍Δ͔͕ਖ਼֬ʹ͔Δ ⇛ ෦Λղ͚ͩ͘Ͱ࠷దͳઓུΛܭࢉͰ͖Δ ྫɿνΣεɺғޟɺকع ෆશใήʔϜ
ཤྺͷใ͕ͯ͢؍ଌͰ͖ͳ͍ ⇛ ෦ʹΓग़ͯ͠ղ͘͜ͱ͕Ͱ͖ͳ͍ ྫɿϙʔΧʔɺຑɺަবήʔϜ vs -
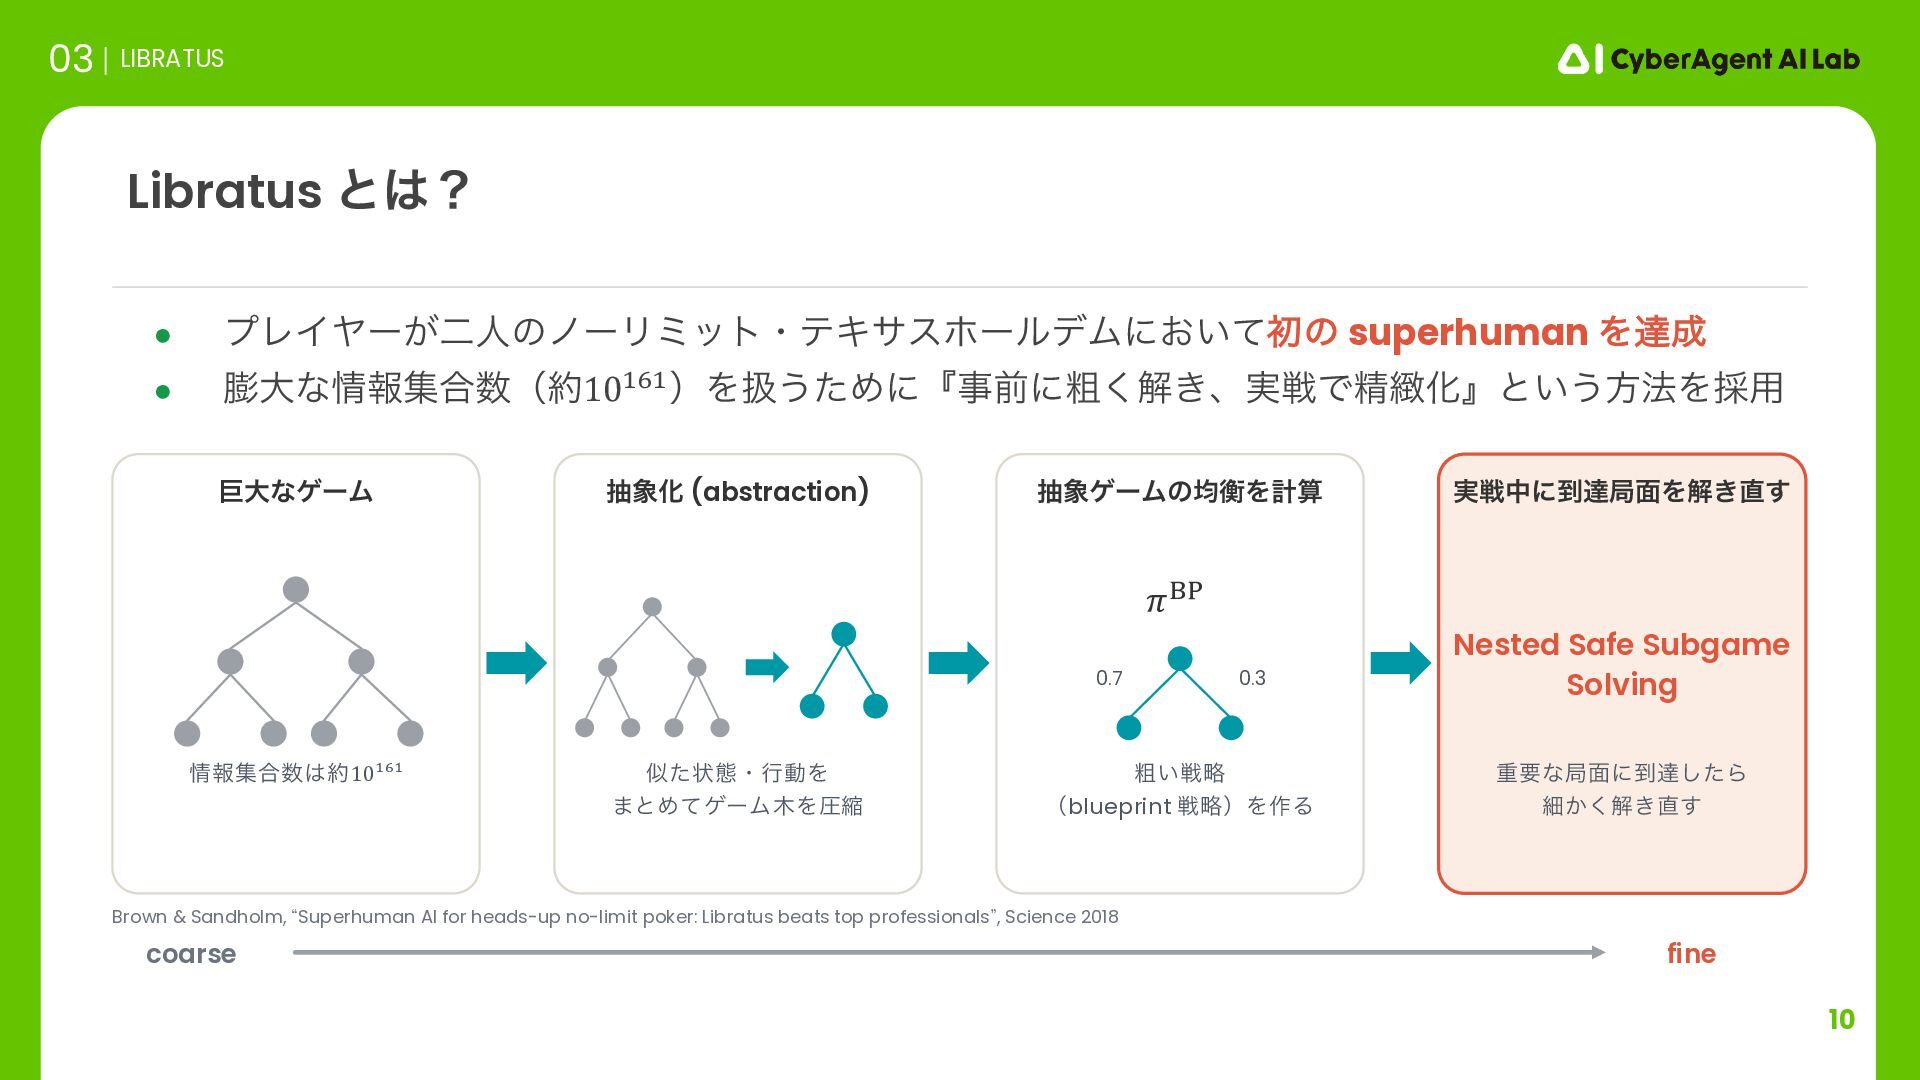
10 • ϓϨΠϠʔ͕ೋਓͷϊʔϦϛοτɾςΩαεϗʔϧσϜʹ͓͍ͯॳͷ superhuman Λୡ • େͳใू߹ʢ10()(ʣΛѻ͏ͨΊʹʰࣄલʹૈ͘ղ͖ɺ࣮ઓͰਫ਼៛Խʱͱ͍͏ํ๏Λ࠾༻ Libratus ͱʁ 03
LIBRATUS ڊେͳήʔϜ நԽ (abstraction) நήʔϜͷۉߧΛܭࢉ ࣮ઓதʹ౸ୡہ໘Λղ͖͢ ใू߹10¹⁶¹ ࣅͨঢ়ଶɾߦಈΛ ·ͱΊͯήʔϜΛѹॖ ૈ͍ઓུ ʢblueprint ઓུʣΛ࡞Δ ॏཁͳہ໘ʹ౸ୡͨ͠Β ࡉ͔͘ղ͖͢ 𝜋*+ 0.7 0.3 Nested Safe Subgame Solving coarse fine Brown & Sandholm, lSuperhuman AI for heads-up no-limit poker: Libratus beats top professionalsz, Science 2018 -
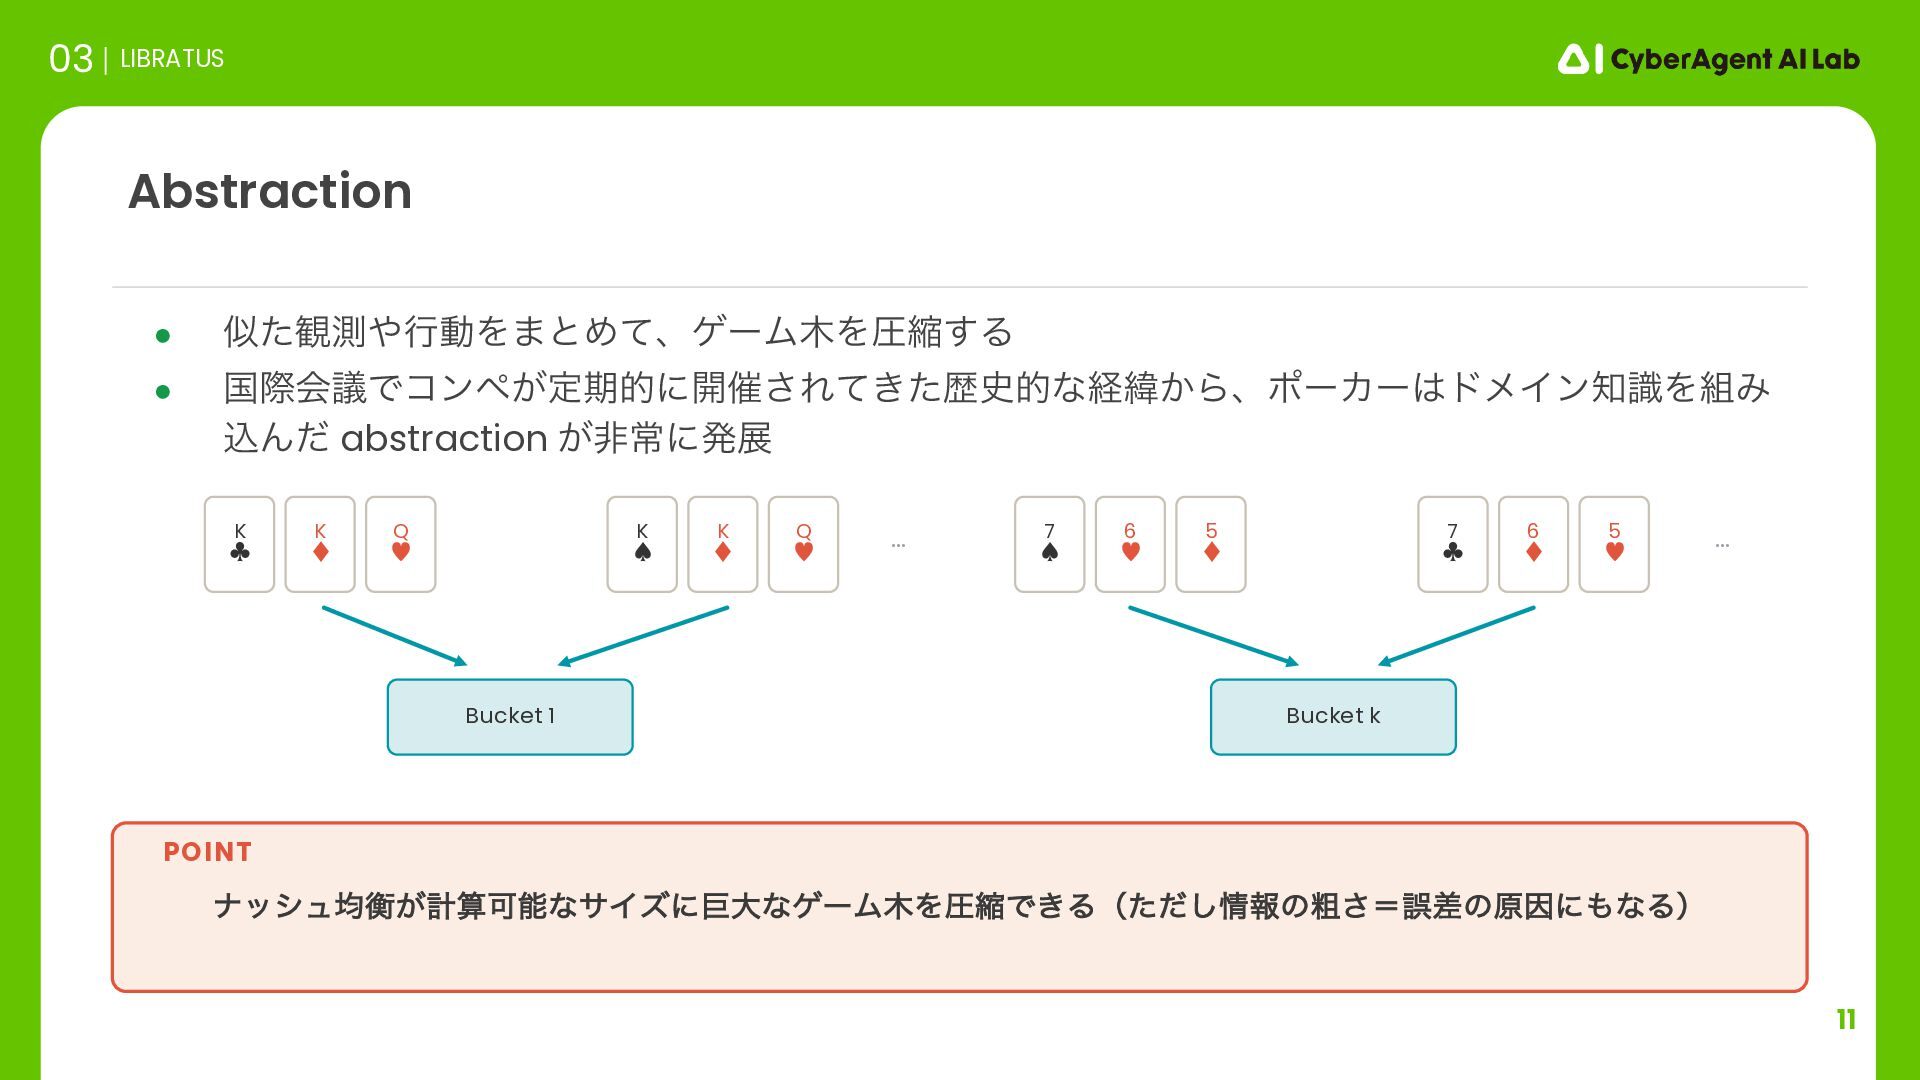
11 • ࣅͨ؍ଌߦಈΛ·ͱΊͯɺήʔϜΛѹॖ͢Δ • ࠃࡍձٞͰίϯϖ͕ఆظతʹ։࠵͞Ε͖ͯͨྺ࢙తͳܦҢ͔ΒɺϙʔΧʔυϝΠϯࣝΛΈ ࠐΜͩ abstraction ͕ඇৗʹൃల Abstraction 03
LIBRATUS K ― K ‖ Q — K – K ‖ Q — … 7 – 6 — 5 ‖ 7 ― 6 ‖ 5 — … Bucket 1 Bucket k φογϡۉߧ͕ܭࢉՄೳͳαΠζʹڊେͳήʔϜΛѹॖͰ͖Δʢͨͩ͠ใͷૈ͞ʹޡࠩͷݪҼʹͳΔʣ POINT -
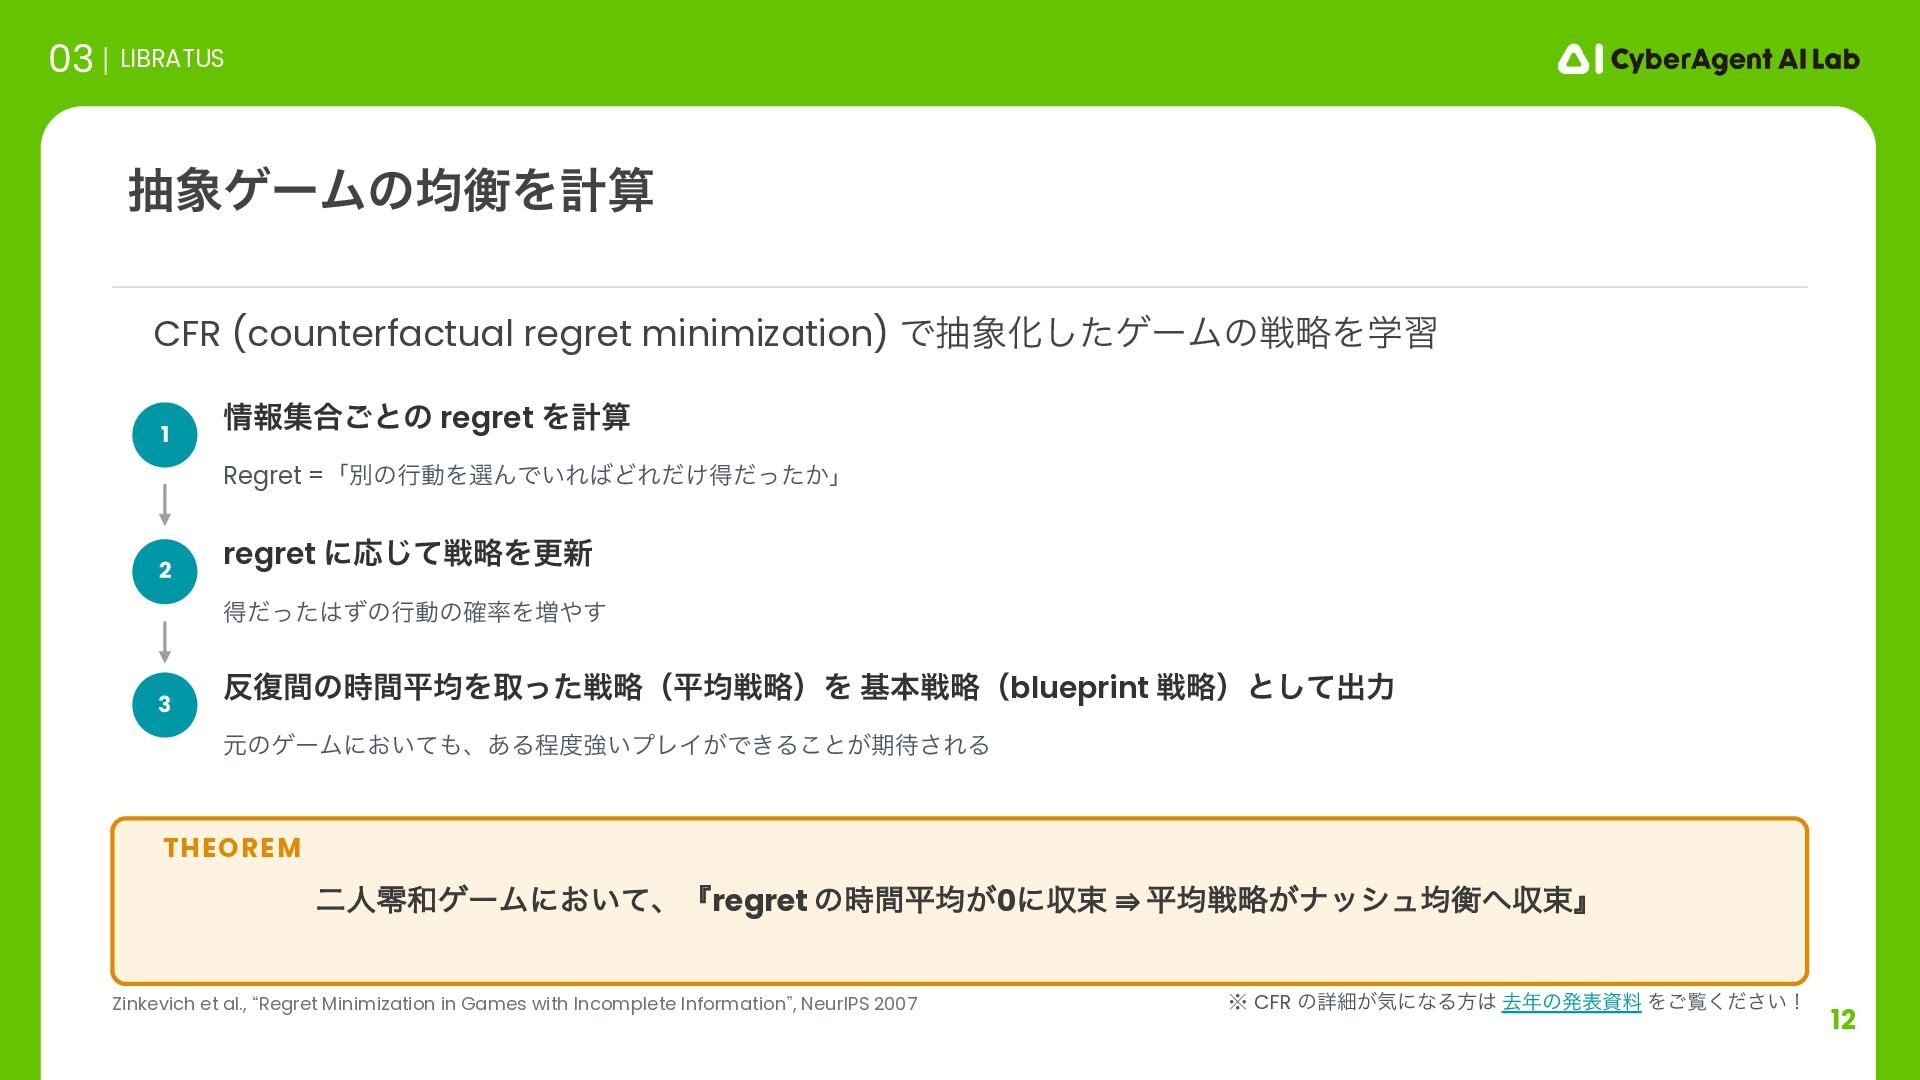
12 CFR (counterfactual regret minimization) ͰநԽͨ͠ήʔϜͷઓུΛֶश நήʔϜͷۉߧΛܭࢉ 03 LIBRATUS 1
ใू߹͝ͱͷ regret Λܭࢉ Regret =ʮผͷߦಈΛબΜͰ͍ΕͲΕ͚ͩಘ͔ͩͬͨʯ 2 regret ʹԠͯ͡ઓུΛߋ৽ ಘͩͬͨͣͷߦಈͷ֬Λ૿͢ 3 ෮ؒͷ࣌ؒฏۉΛऔͬͨઓུʢฏۉઓུʣΛ جຊઓུʢblueprint ઓུʣͱͯ͠ग़ྗ ݩͷήʔϜʹ͓͍ͯɺ͋Δఔڧ͍ϓϨΠ͕Ͱ͖Δ͜ͱ͕ظ͞ΕΔ ೋਓྵήʔϜʹ͓͍ͯɺʰregret ͷ࣌ؒฏۉ͕0ʹऩଋ ⇛ ฏۉઓུ͕φογϡۉߧऩଋʱ THEOREM Zinkevich et al., lRegret Minimization in Games with Incomplete Informationz, NeurIPS 2007 ※ CFR ͷৄࡉ͕ؾʹͳΔํ ڈͷൃදࢿྉ Λ͝ཡ͍ͩ͘͞ʂ -
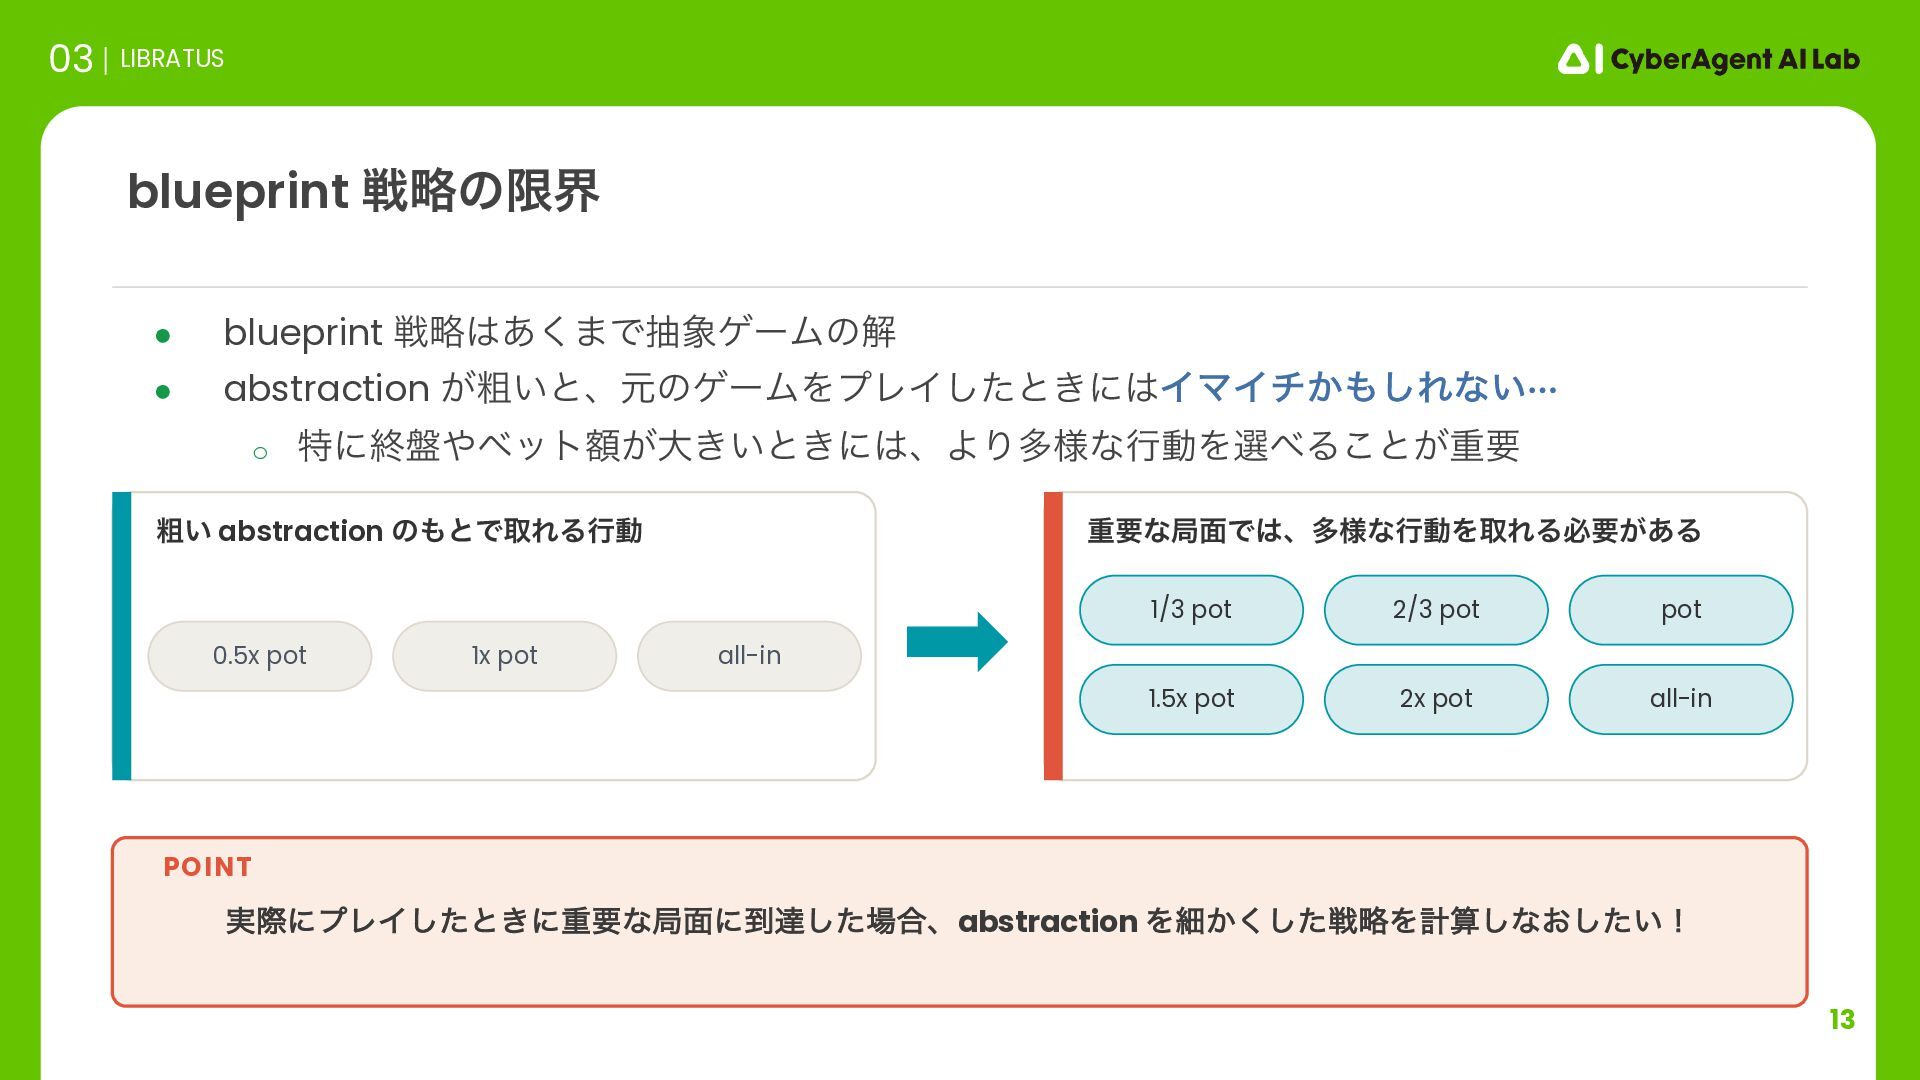
13 • blueprint ઓུ͋͘·ͰநήʔϜͷղ • abstraction ͕ૈ͍ͱɺݩͷήʔϜΛϓϨΠͨ͠ͱ͖ʹΠϚΠν͔͠Εͳ͍⋯ o ಛʹऴ൫ϕοτֹ͕େ͖͍ͱ͖ʹɺΑΓଟ༷ͳߦಈΛબΔ͜ͱ͕ॏཁ blueprint
ઓུͷݶք 03 LIBRATUS ૈ͍ abstraction ͷͱͰऔΕΔߦಈ ॏཁͳہ໘Ͱɺଟ༷ͳߦಈΛऔΕΔඞཁ͕͋Δ 0.5x pot 1x pot all-in 1/3 pot 2/3 pot pot 1.5x pot 2x pot all-in ࣮ࡍʹϓϨΠͨ͠ͱ͖ʹॏཁͳہ໘ʹ౸ୡͨ͠߹ɺabstraction Λࡉ͔ͨ͘͠ઓུΛܭࢉ͠ͳ͓͍ͨ͠ʂ POINT -
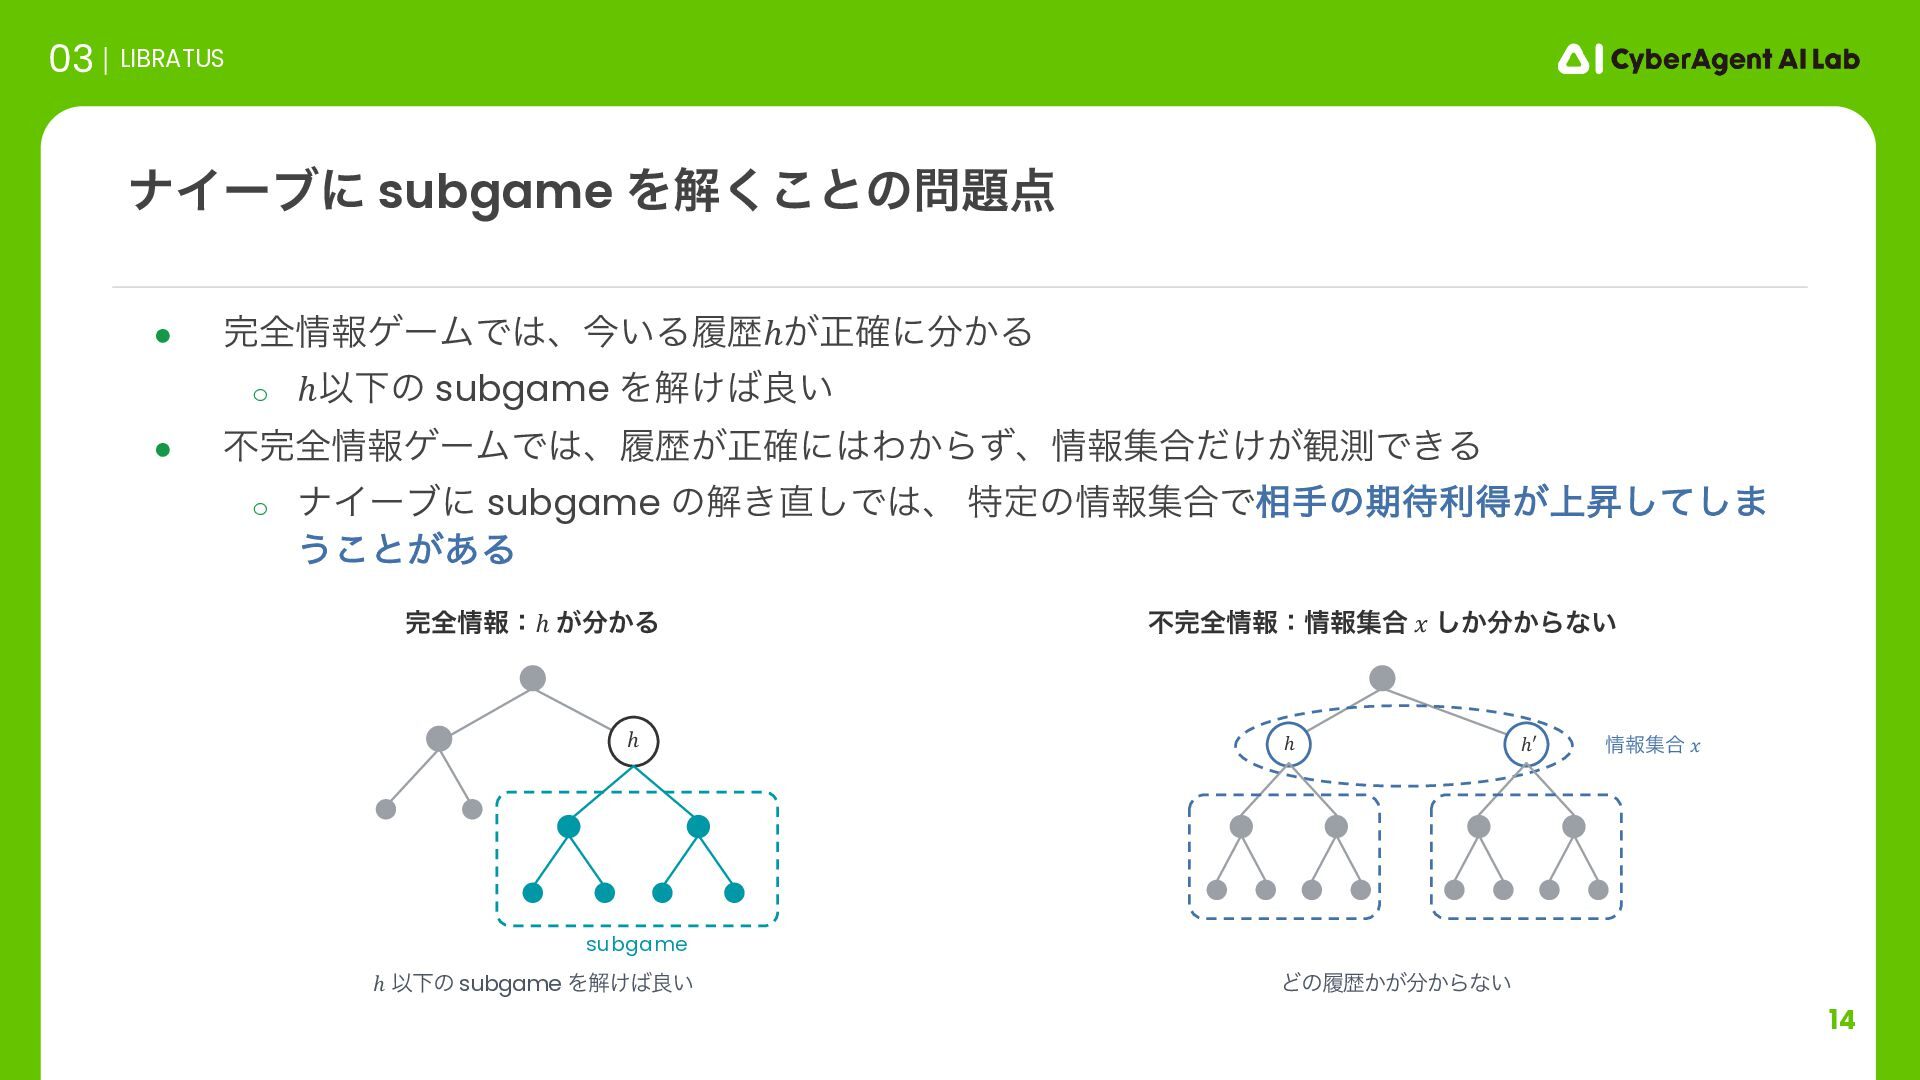
14 • શใήʔϜͰɺࠓ͍Δཤྺℎ͕ਖ਼֬ʹ͔Δ o ℎҎԼͷ subgame Λղ͚ྑ͍ • ෆશใήʔϜͰɺཤྺ͕ਖ਼֬ʹΘ͔Βͣɺใू߹͚͕ͩ؍ଌͰ͖Δ o
φΠʔϒʹ subgame ͷղ͖͠Ͱɺ ಛఆͷใू߹Ͱ૬खͷظརಘ্͕ঢͯ͠͠· ͏͜ͱ͕͋Δ φΠʔϒʹ subgame Λղ͘͜ͱͷ 03 LIBRATUS શใɿℎ ͕͔Δ ℎ subgame ℎ ҎԼͷ subgame Λղ͚ྑ͍ ෆશใɿใू߹ 𝑥 ͔͔͠Βͳ͍ ℎ ℎ′ ใू߹ 𝑥 Ͳͷཤྺ͔͕͔Βͳ͍ -
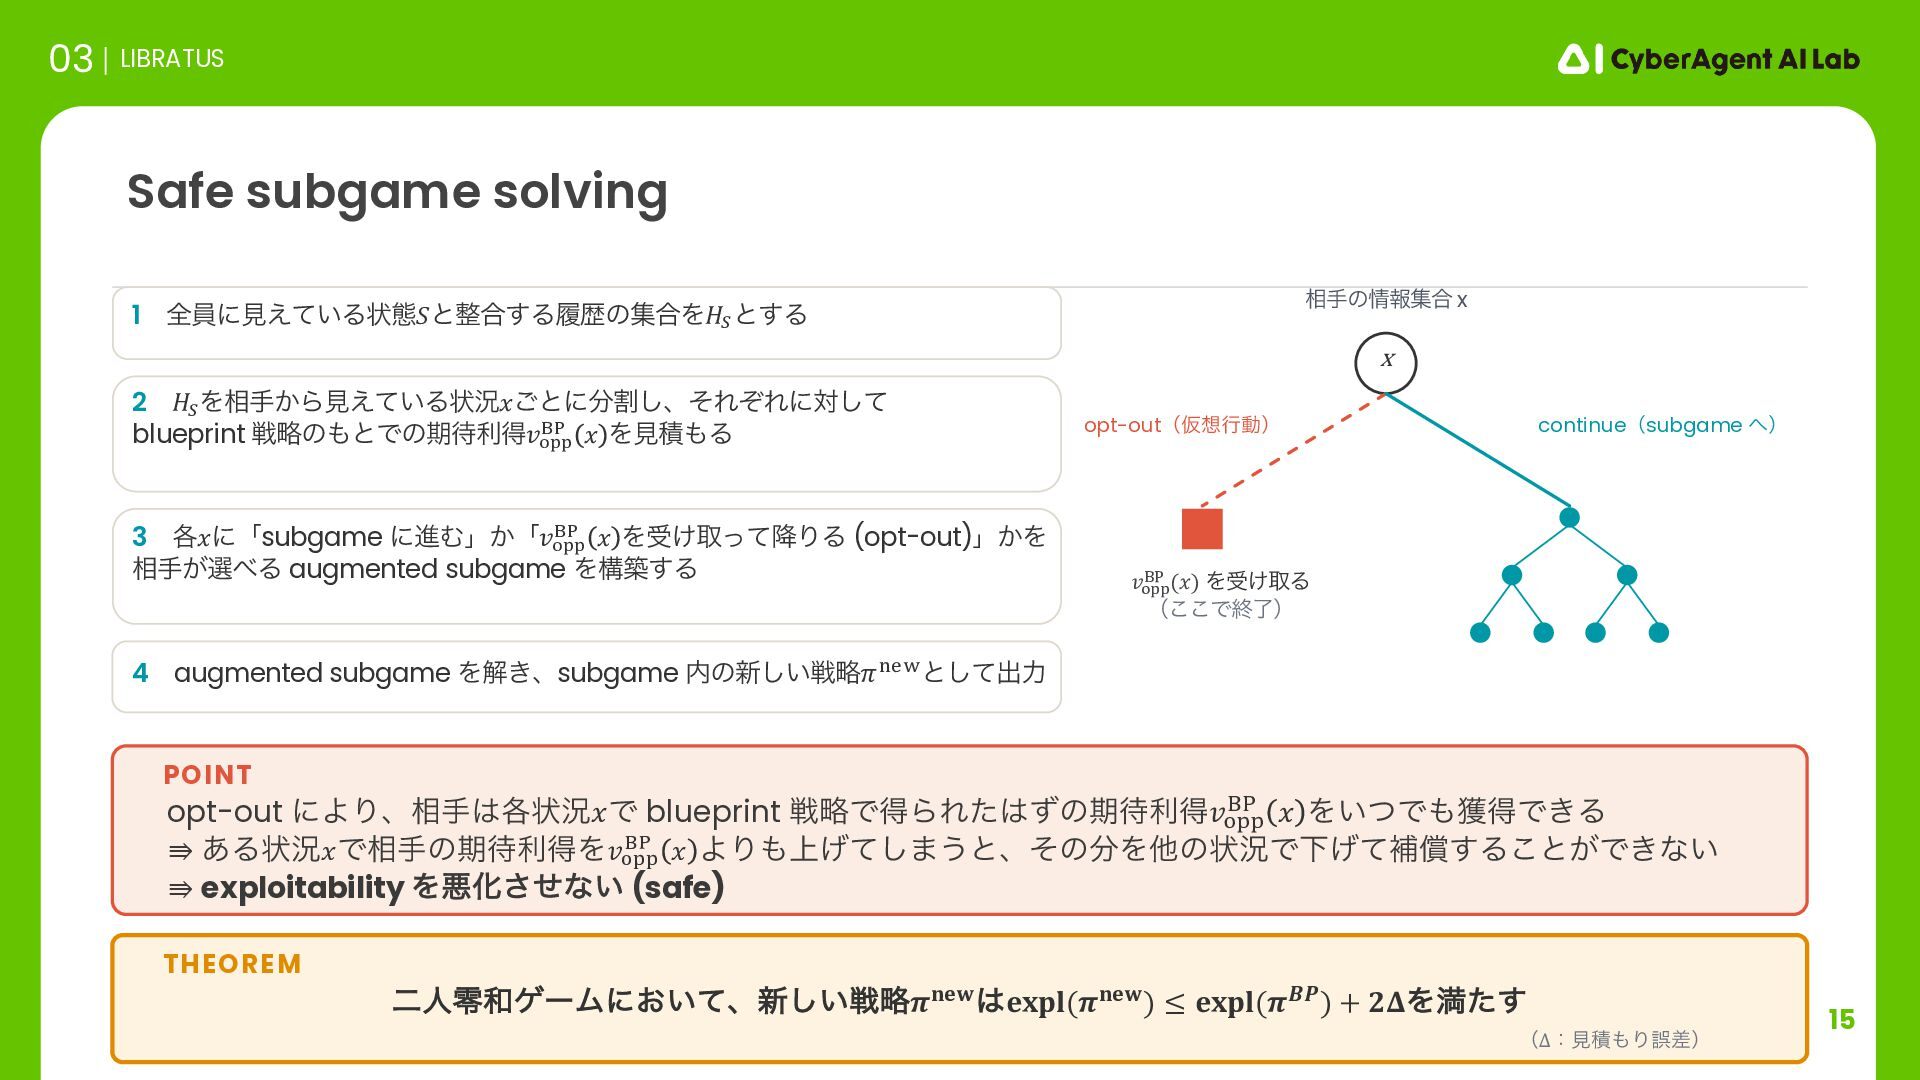
15 Safe subgame solving 03 LIBRATUS 1 શһʹݟ͍͑ͯΔঢ়ଶ𝑆ͱ߹͢Δཤྺͷू߹Λ𝐻! ͱ͢Δ 2
𝐻! Λ૬ख͔Βݟ͍͑ͯΔঢ়گ𝑥͝ͱʹׂ͠ɺͦΕͧΕʹରͯ͠ blueprint ઓུͷͱͰͷظརಘ𝑣"## $% 𝑥 ΛݟੵΔ 3 ֤𝑥ʹʮsubgame ʹਐΉʯ͔ʮ𝑣"## $% 𝑥 Λड͚औͬͯ߱ΓΔ (opt-out)ʯ͔Λ ૬ख͕બΔ augmented subgame Λߏங͢Δ 4 augmented subgame Λղ͖ɺsubgame ͷ৽͍͠ઓུ𝜋$%&ͱͯ͠ग़ྗ ૬खͷใू߹ x x opt-outʢԾߦಈʣ continueʢsubgame ʣ 𝑣!"" #$ (𝑥) Λड͚औΔ ʢ͜͜Ͱऴྃʣ THEOREM ʢΔɿݟੵΓޡࠩʣ opt-out ʹΑΓɺ૬ख֤ঢ়گ𝑥Ͱ blueprint ઓུͰಘΒΕͨͣͷظརಘ𝑣122 34 𝑥 Λ͍ͭͰ֫ಘͰ͖Δ ⇛ ͋Δঢ়گ𝑥Ͱ૬खͷظརಘΛ𝑣'(( )* 𝑥 ΑΓ্͛ͯ͠·͏ͱɺͦͷΛଞͷঢ়گͰԼ͛ͯิঈ͢Δ͜ͱ͕Ͱ͖ͳ͍ ⇛ exploitability ΛѱԽͤ͞ͳ͍ (safe) POINT ೋਓྵήʔϜʹ͓͍ͯɺ৽͍͠ઓུ𝝅𝐧𝐞𝐰𝐞𝐱𝐩𝐥(𝝅𝐧𝐞𝐰) ≤ 𝐞𝐱𝐩𝐥(𝝅𝑩𝑷) + 𝟐𝚫Λຬͨ͢ -
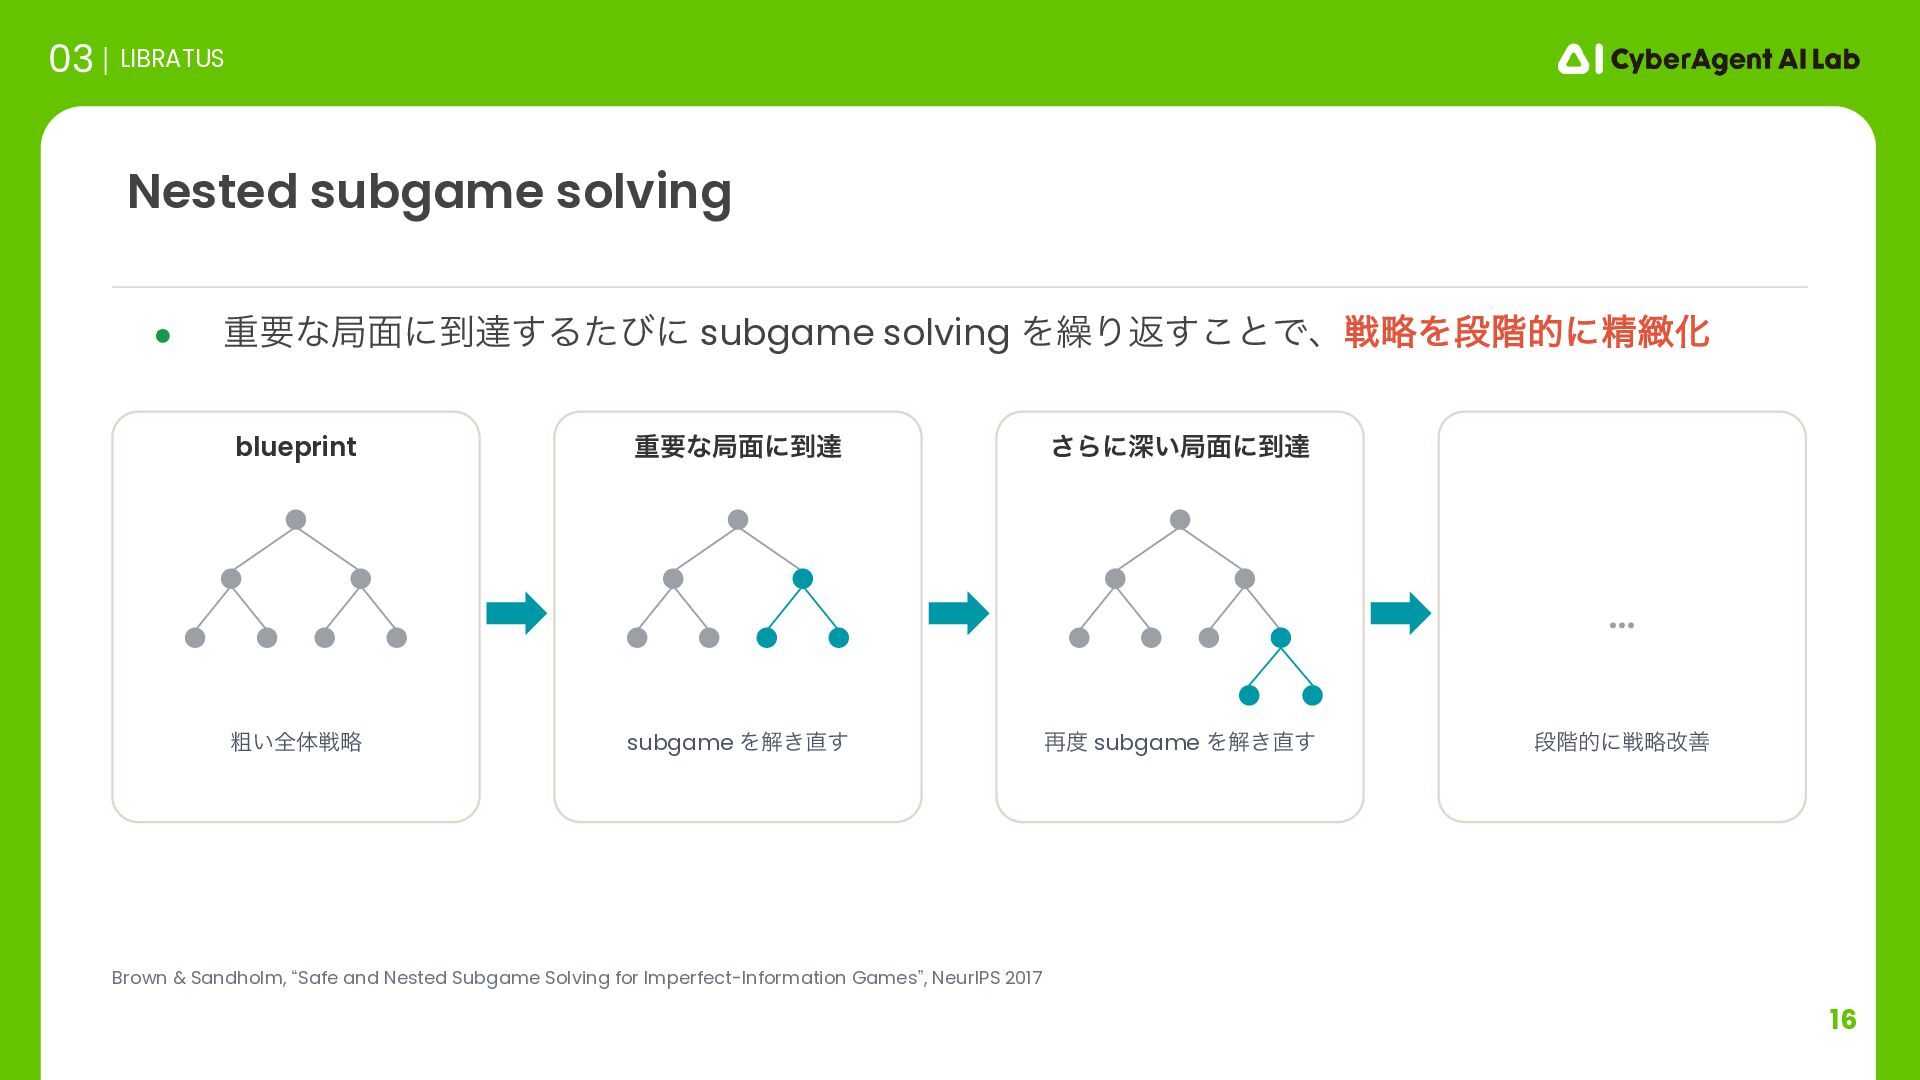
16 • ॏཁͳہ໘ʹ౸ୡ͢Δͨͼʹ subgame solving Λ܁Γฦ͢͜ͱͰɺઓུΛஈ֊తʹਫ਼៛Խ Nested subgame solving 03
LIBRATUS blueprint ૈ͍શମઓུ ॏཁͳہ໘ʹ౸ୡ subgame Λղ͖͢ ͞Βʹਂ͍ہ໘ʹ౸ୡ ࠶ subgame Λղ͖͢ ஈ֊తʹઓུվળ … Brown & Sandholm, lSafe and Nested Subgame Solving for Imperfect-Information Gamesz, NeurIPS 2017 -
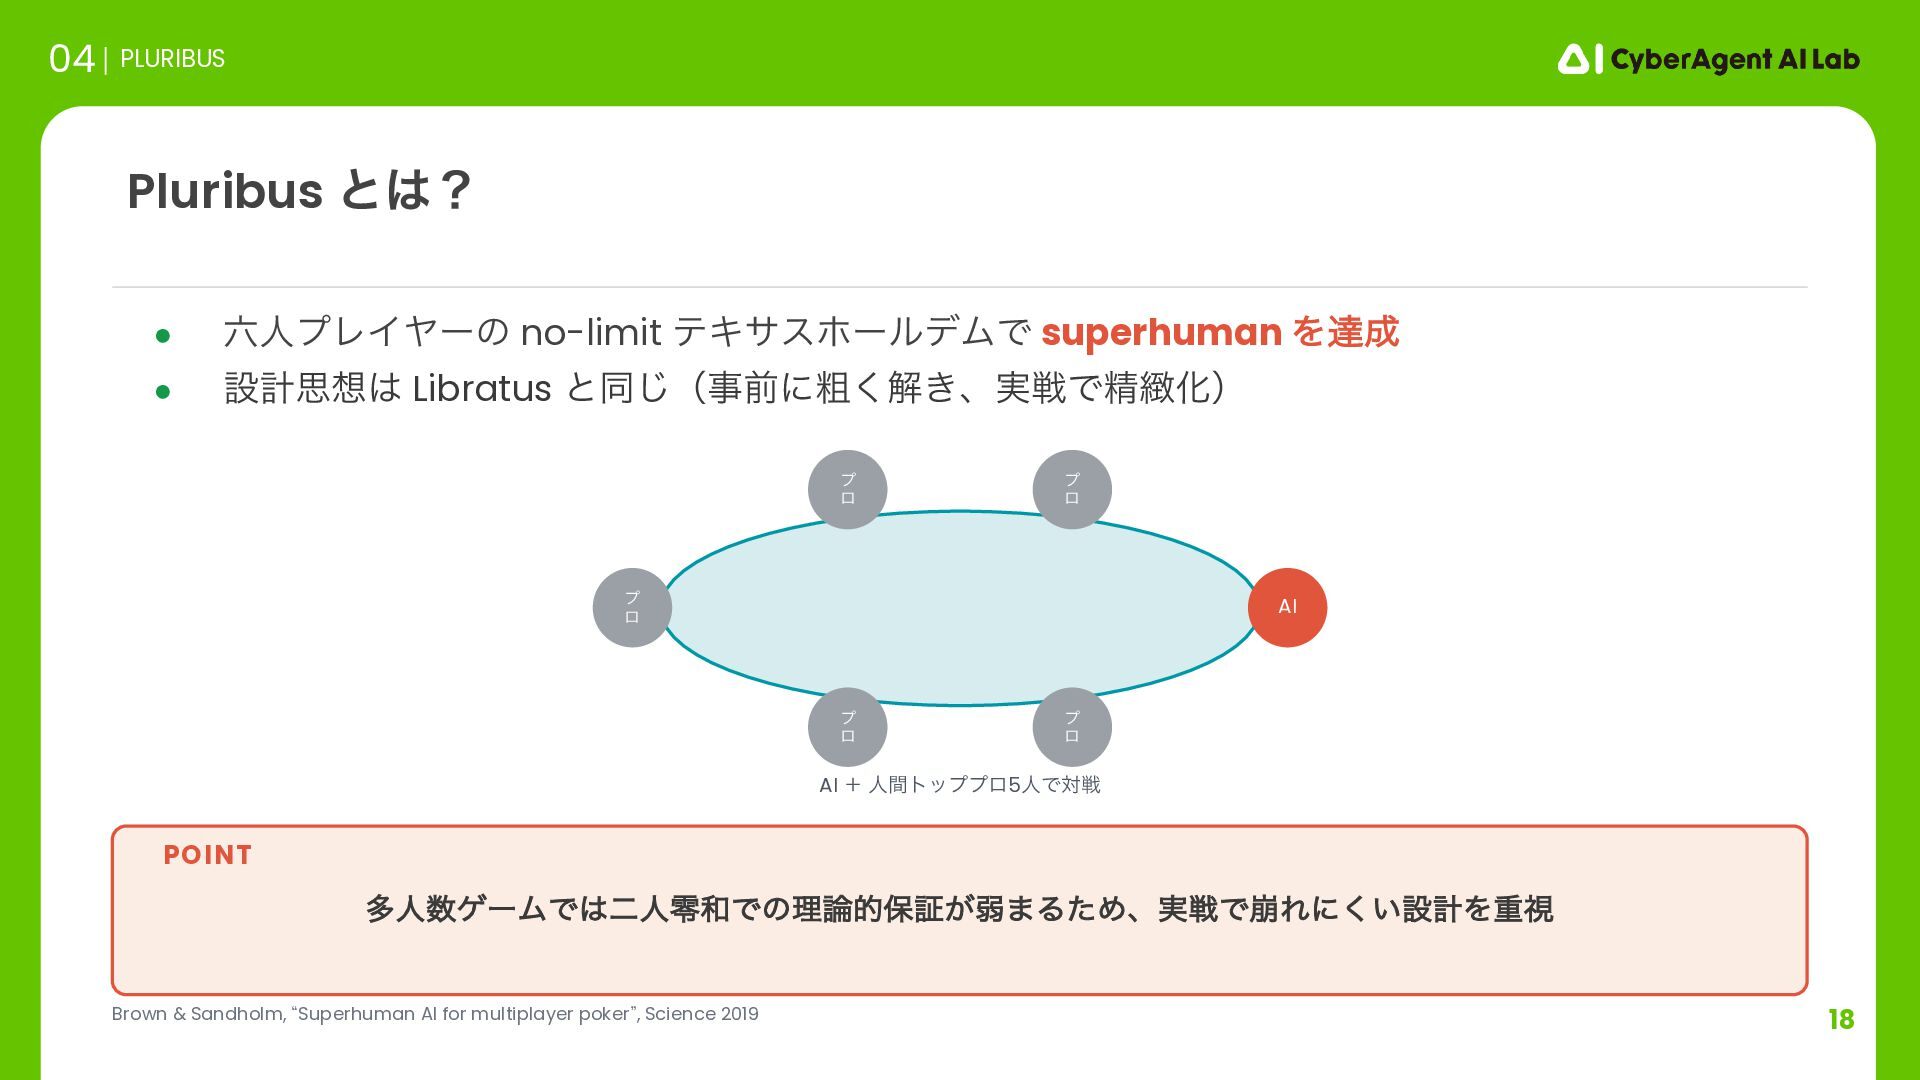
18 • ਓϓϨΠϠʔͷ no-limit ςΩαεϗʔϧσϜͰ superhuman Λୡ • ઃܭࢥ Libratus
ͱಉ͡ʢࣄલʹૈ͘ղ͖ɺ࣮ઓͰਫ਼៛Խʣ Pluribus ͱʁ 04 PLURIBUS ϓ ϩ ϓ ϩ ϓ ϩ AI ϓ ϩ ϓ ϩ AI ʴ ਓؒτοϓϓϩ5ਓͰରઓ Brown & Sandholm, lSuperhuman AI for multiplayer pokerz, Science 2019 ଟਓήʔϜͰೋਓྵͰͷཧతอূ͕ऑ·ΔͨΊɺ࣮ઓͰ่Εʹ͍͘ઃܭΛॏࢹ POINT -
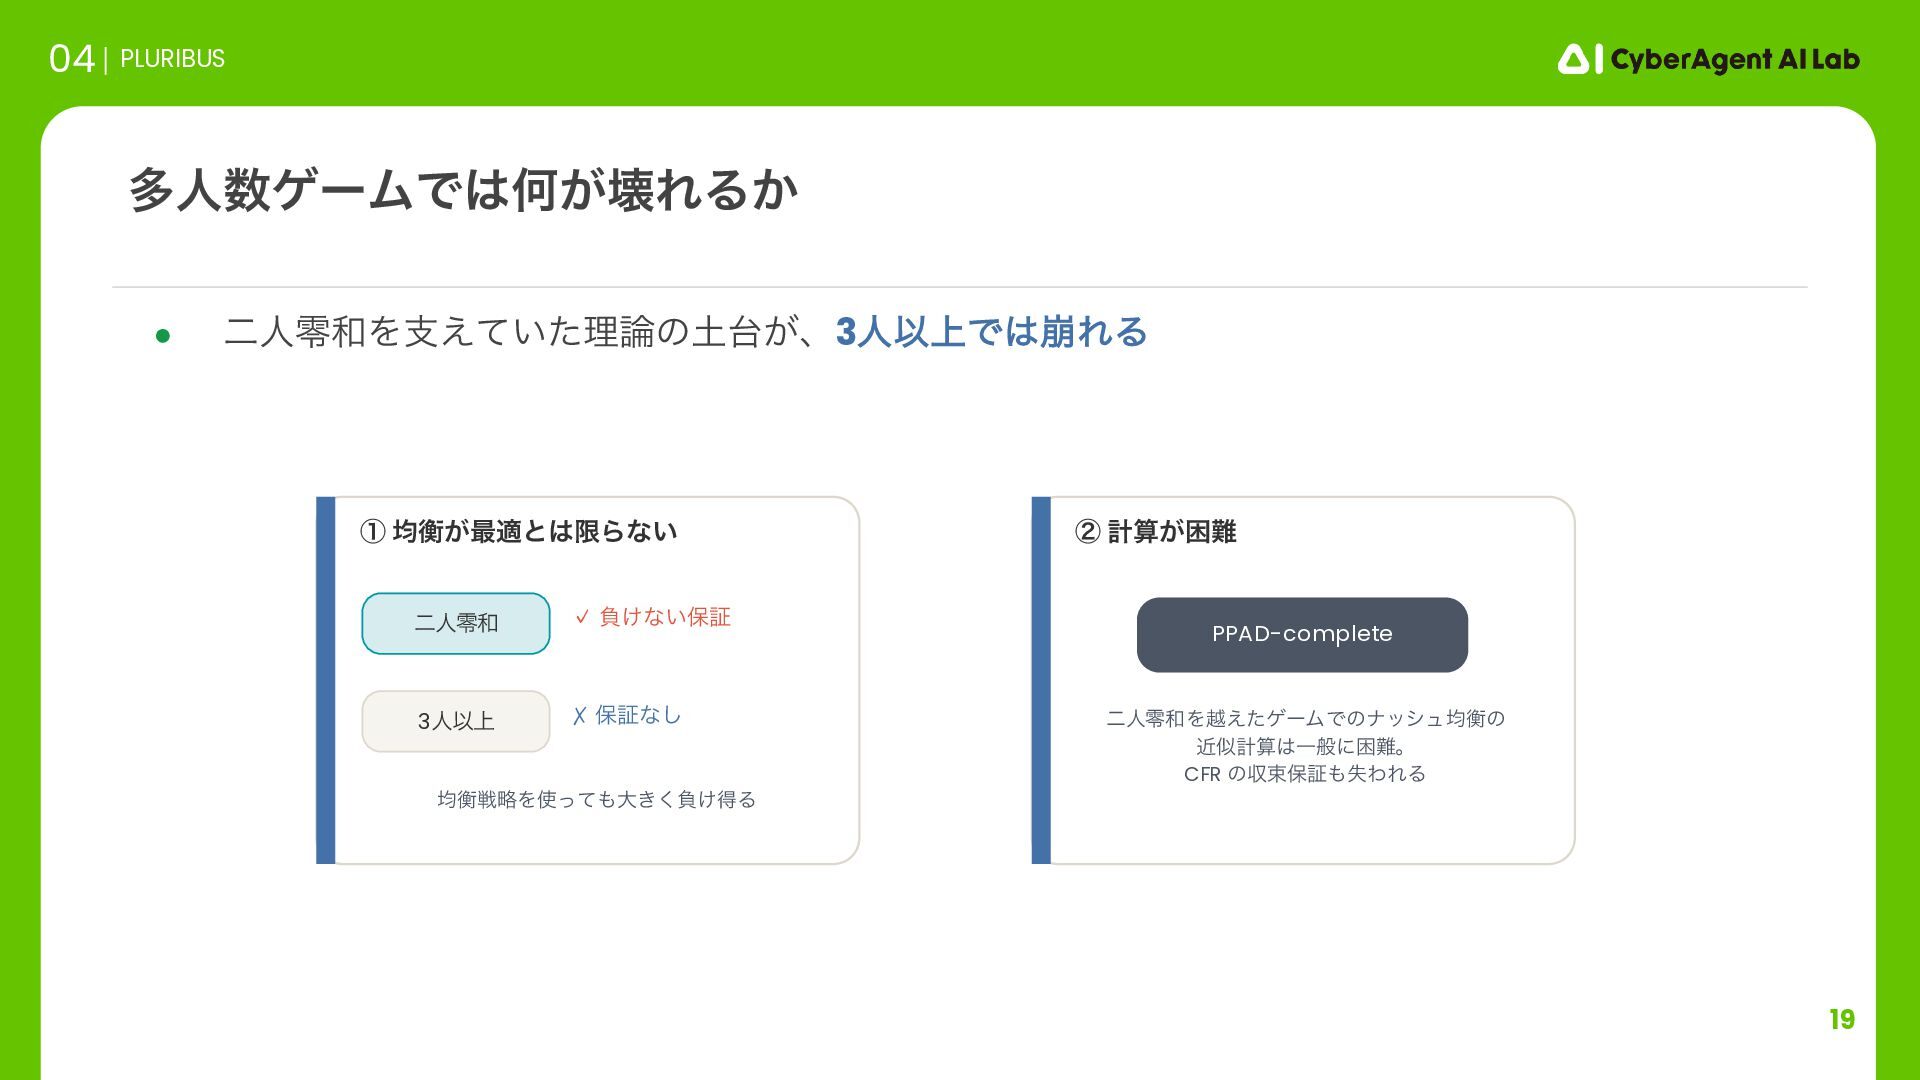
19 • ೋਓྵΛࢧ͍͑ͯͨཧͷ͕ɺ3ਓҎ্Ͱ่ΕΔ ଟਓήʔϜͰԿ͕յΕΔ͔ 04 PLURIBUS ᶃ ۉߧ͕࠷దͱݶΒͳ͍ ᶄ ܭࢉ͕ࠔ
ೋਓྵ 㾎 ෛ͚ͳ͍อূ 3ਓҎ্ ✗ อূͳ͠ ۉߧઓུΛͬͯେ͖͘ෛ͚ಘΔ PPAD-complete ೋਓྵΛӽ͑ͨήʔϜͰͷφογϡۉߧͷ ۙࣅܭࢉҰൠʹࠔɻ CFR ͷऩଋอূࣦΘΕΔ -
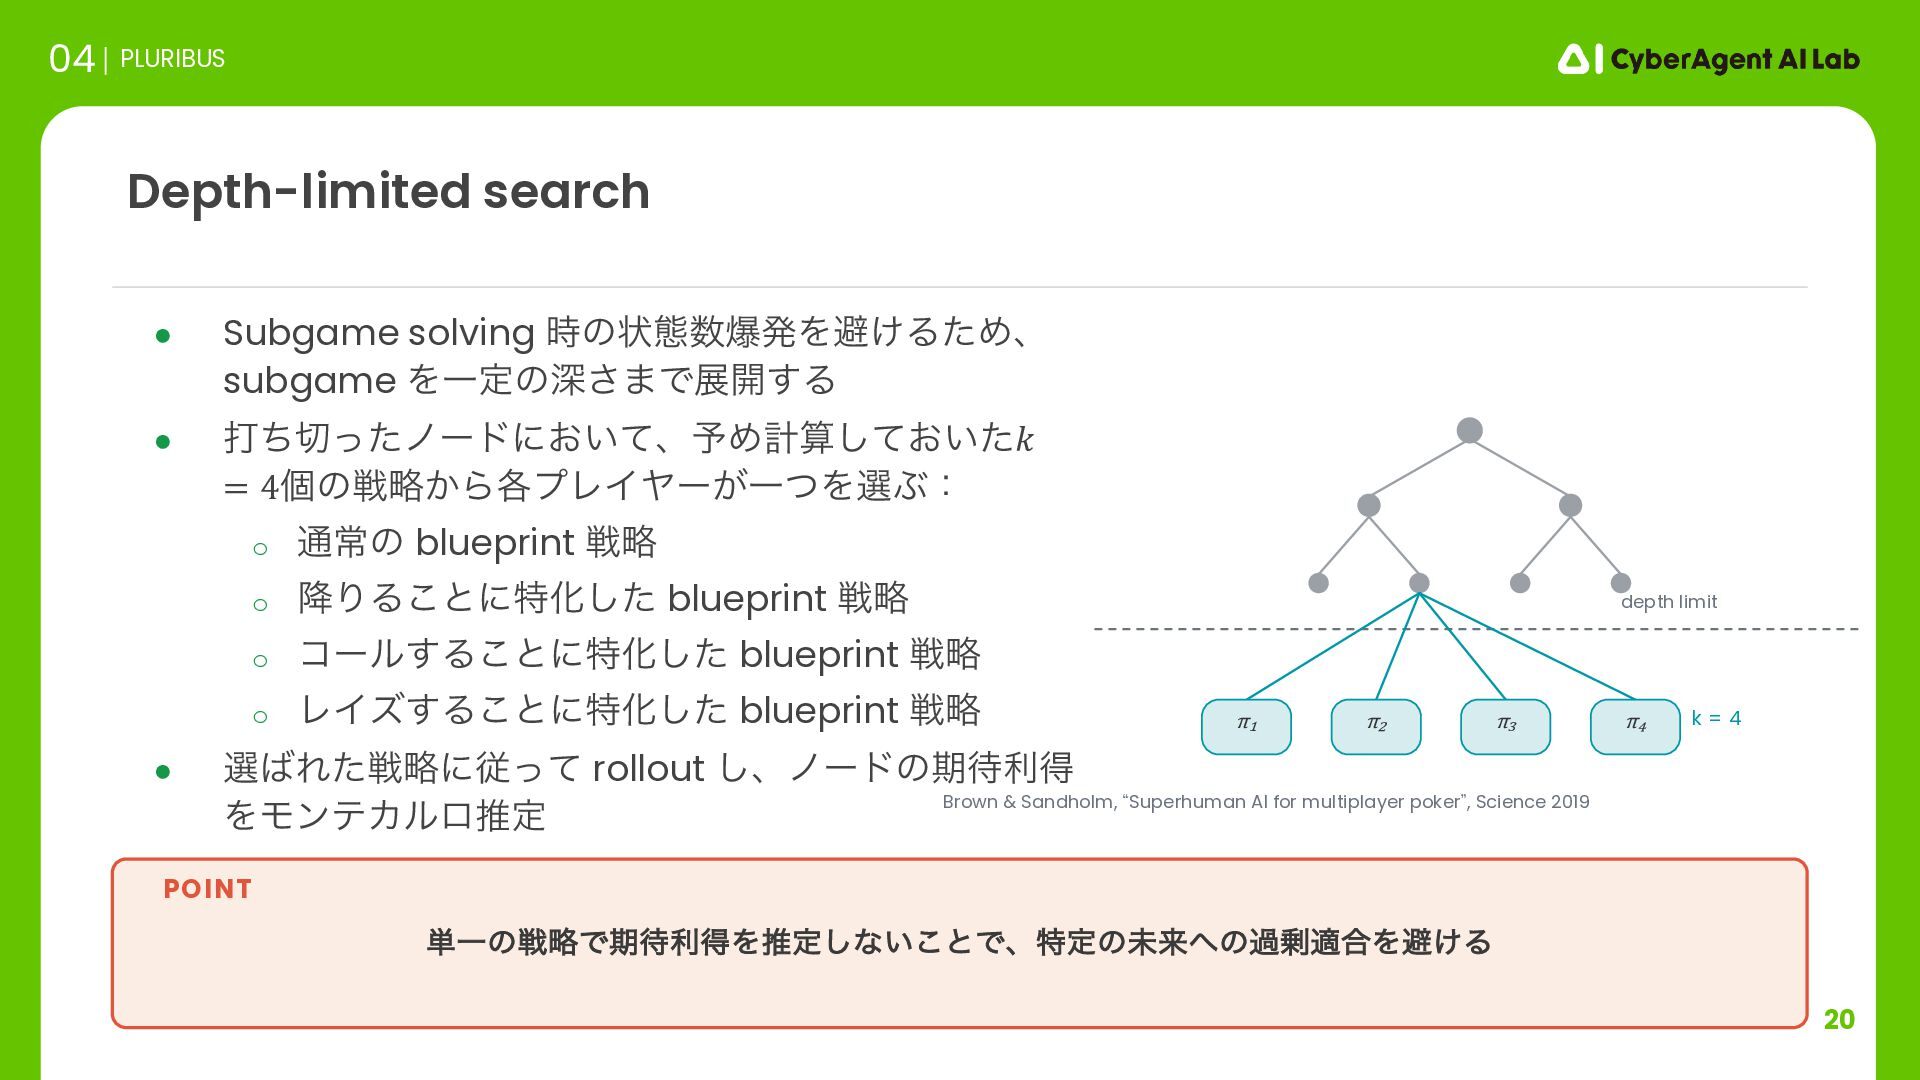
20 • Subgame solving ࣌ͷঢ়ଶരൃΛආ͚ΔͨΊɺ subgame ΛҰఆͷਂ͞·Ͱల։͢Δ • ଧͪͬͨϊʔυʹ͓͍ͯɺ༧Ίܭࢉ͓͍ͯͨ͠𝑘 =
4ݸͷઓུ͔Β֤ϓϨΠϠʔ͕ҰͭΛબͿɿ o ௨ৗͷ blueprint ઓུ o ߱ΓΔ͜ͱʹಛԽͨ͠ blueprint ઓུ o ίʔϧ͢Δ͜ͱʹಛԽͨ͠ blueprint ઓུ o ϨΠζ͢Δ͜ͱʹಛԽͨ͠ blueprint ઓུ • બΕͨઓུʹैͬͯ rollout ͠ɺϊʔυͷظརಘ ΛϞϯςΧϧϩਪఆ Depth-limited search 04 PLURIBUS depth limit π₁ π₂ π₃ π₄ k = 4 Brown & Sandholm, lSuperhuman AI for multiplayer pokerz, Science 2019 ୯ҰͷઓུͰظརಘΛਪఆ͠ͳ͍͜ͱͰɺಛఆͷະདྷͷաద߹Λආ͚Δ POINT -
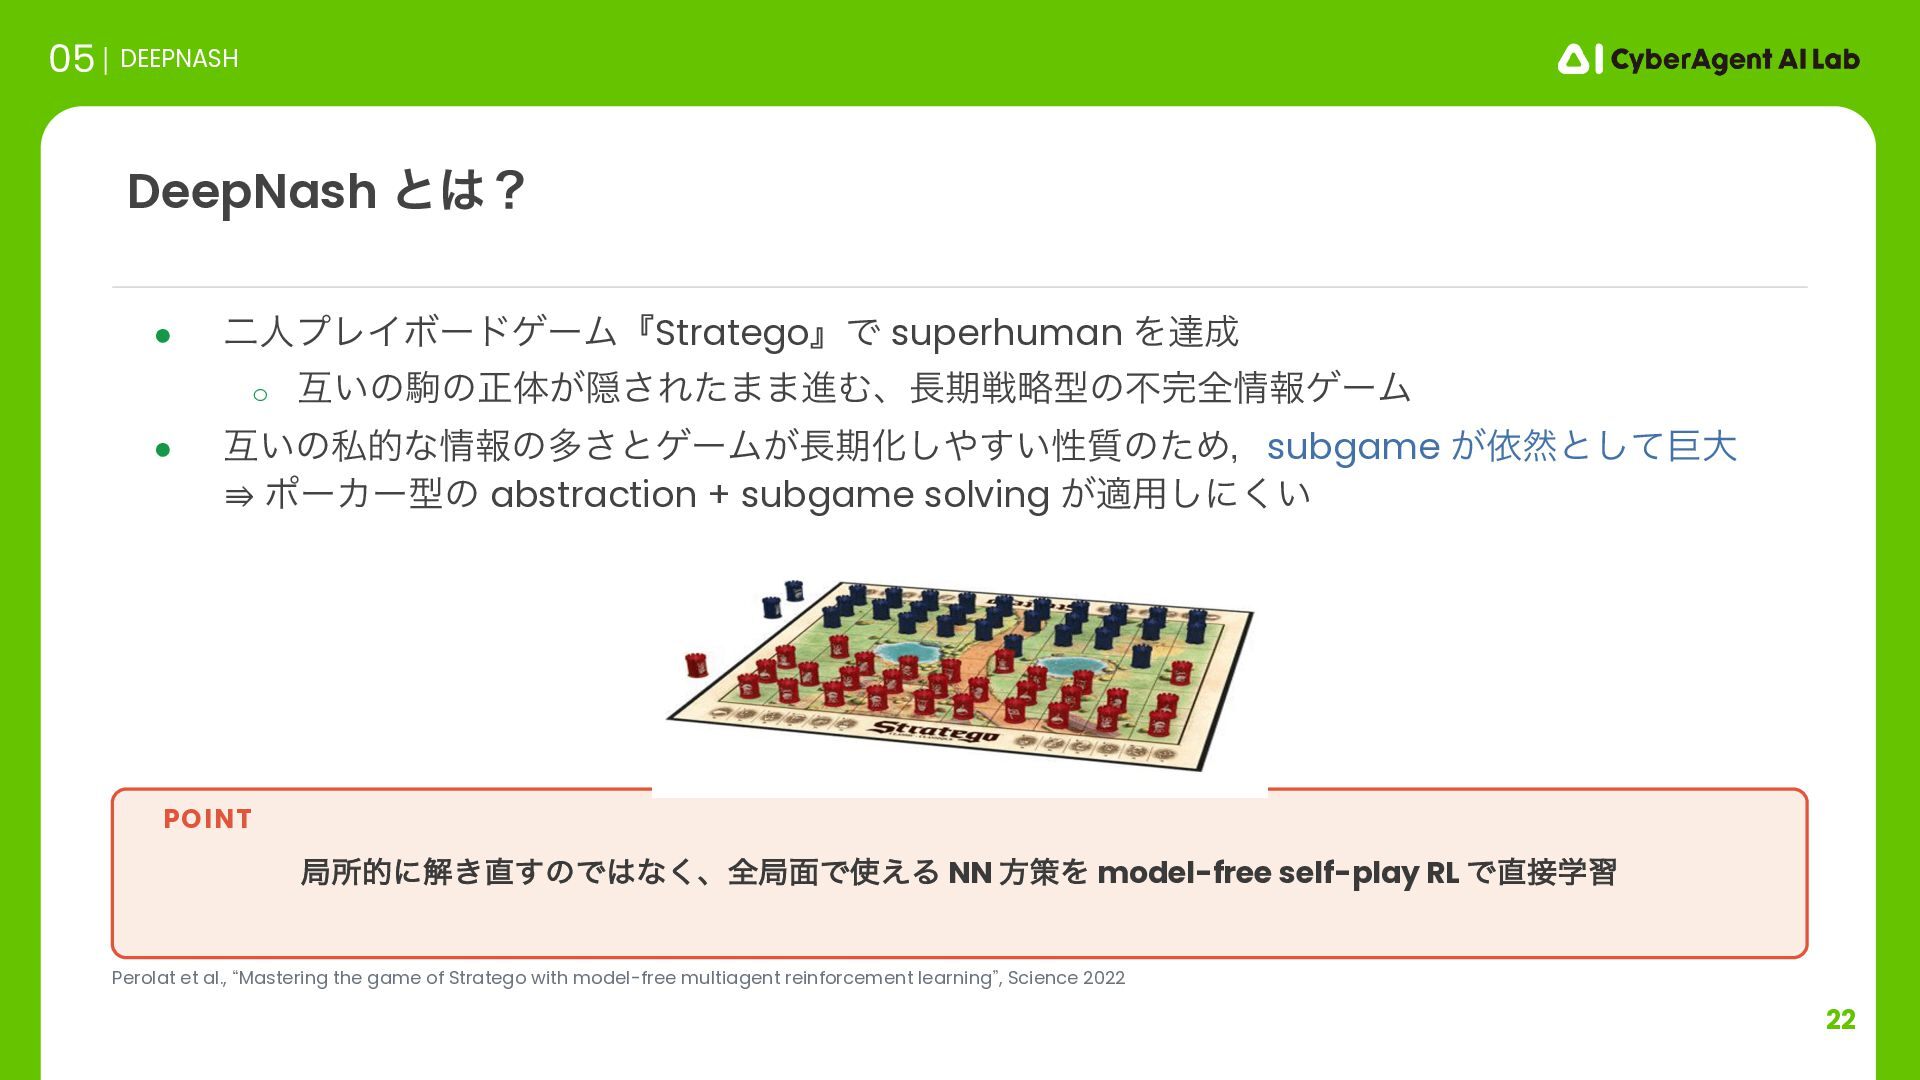
22 • ೋਓϓϨΠϘʔυήʔϜʰStrategoʱͰ superhuman Λୡ o ޓ͍ͷۨͷਖ਼ମ͕Ӆ͞Εͨ··ਐΉɺظઓུܕͷෆશใήʔϜ • ޓ͍ͷࢲతͳใͷଟ͞ͱήʔϜ͕ظԽ͍͢͠ੑ࣭ͷͨΊɼsubgame ͕ґવͱͯ͠ڊେ
⇛ ϙʔΧʔܕͷ abstraction + subgame solving ͕ద༻͠ʹ͍͘ DeepNash ͱʁ 05 DEEPNASH ہॴతʹղ͖͢ͷͰͳ͘ɺશہ໘Ͱ͑Δ NN ํࡦΛ model-free self-play RL Ͱֶश POINT Perolat et al., lMastering the game of Stratego with model-free multiagent reinforcement learningz, Science 2022 -
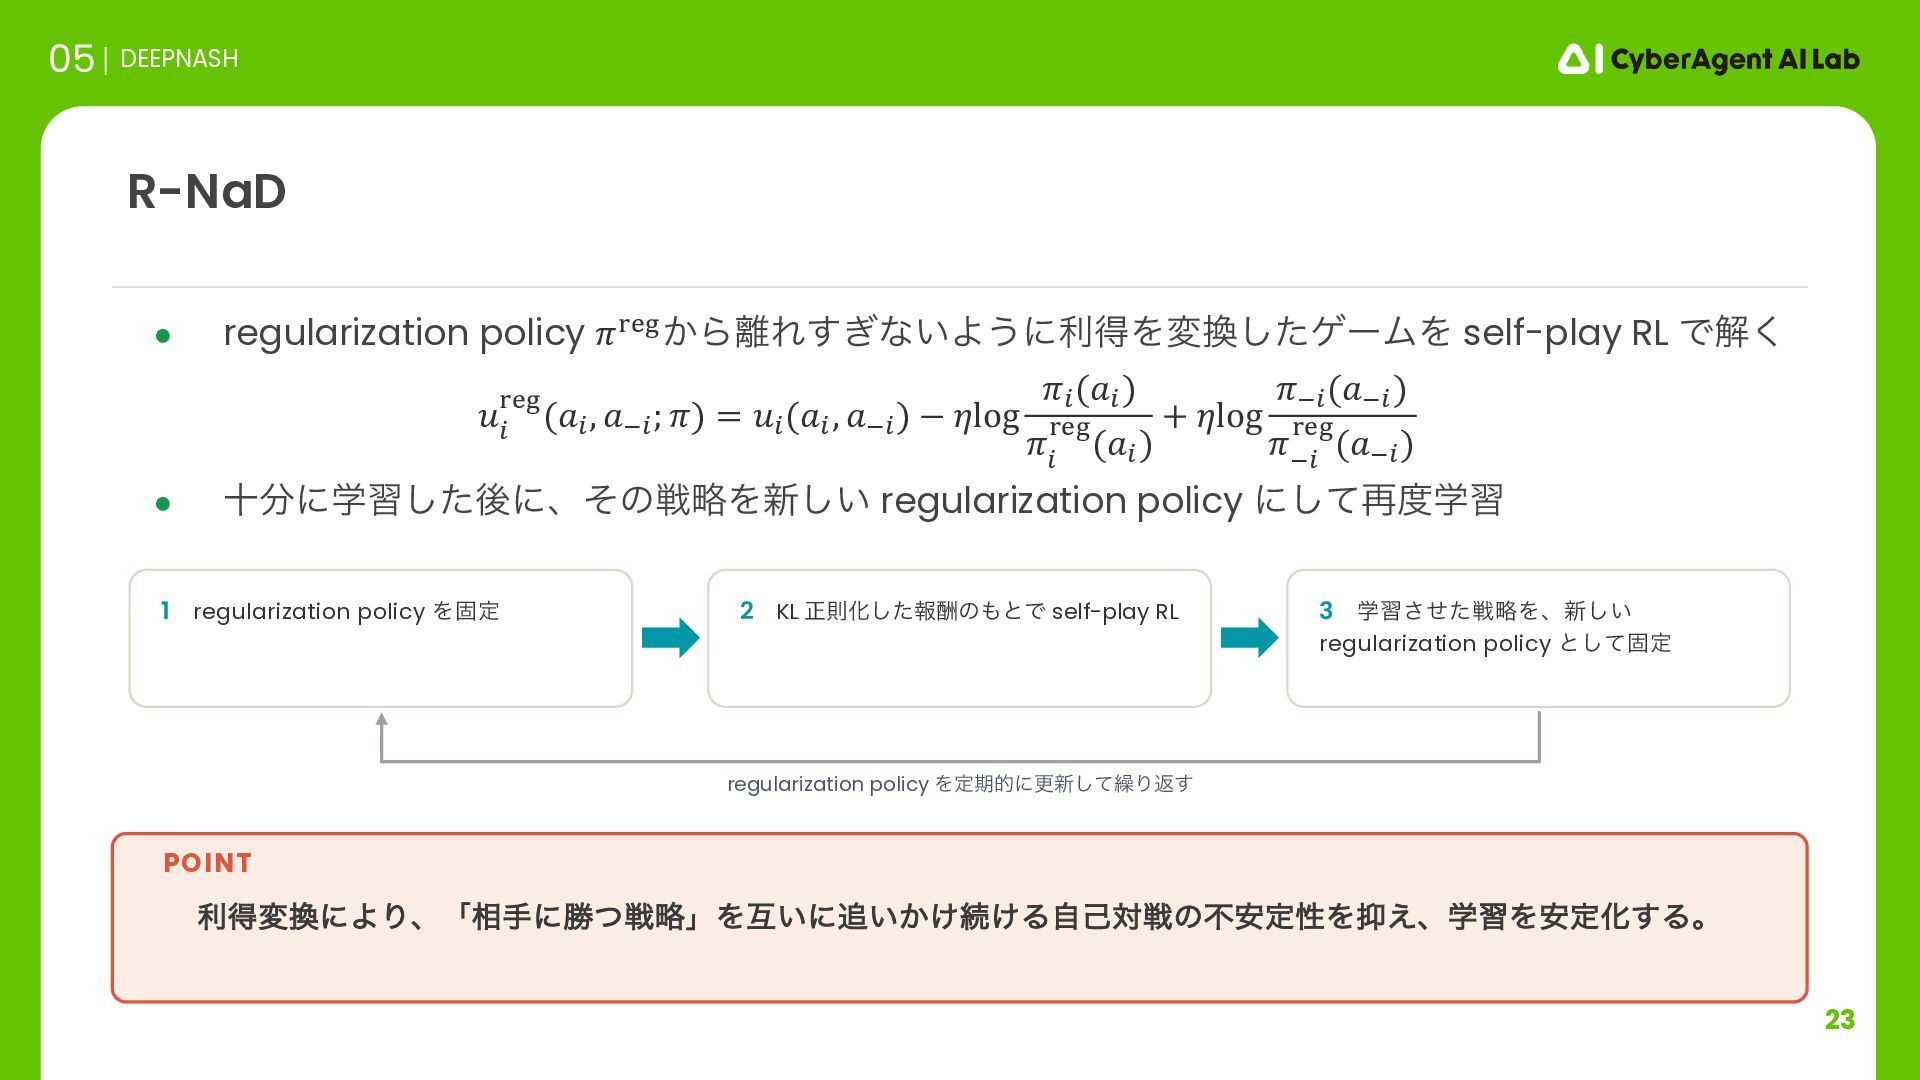
23 • regularization policy 𝜋234͔ΒΕ͗͢ͳ͍Α͏ʹརಘΛมͨ͠ήʔϜΛ self-play RL Ͱղ͘ 𝑢 !
234(𝑎! , 𝑎"! ; 𝜋) = 𝑢! (𝑎! , 𝑎"! ) − 𝜂log 𝜋! (𝑎! ) 𝜋 ! 234(𝑎! ) + 𝜂log 𝜋"! (𝑎"! ) 𝜋 "! 234(𝑎"! ) • ेʹֶशͨ͠ޙʹɺͦͷઓུΛ৽͍͠ regularization policy ʹͯ͠࠶ֶश R-NaD 05 DEEPNASH 1 regularization policy Λݻఆ 2 KL ਖ਼ଇԽͨ͠ใुͷͱͰ self-play RL 3 ֶशͤͨ͞ઓུΛɺ৽͍͠ regularization policy ͱͯ͠ݻఆ regularization policy Λఆظతʹߋ৽ͯ͠܁Γฦ͢ རಘมʹΑΓɺʮ૬खʹউͭઓུʯΛޓ͍ʹ͍͔͚ଓ͚Δࣗݾରઓͷෆ҆ఆੑΛ͑ɺֶशΛ҆ఆԽ͢Δɻ POINT -
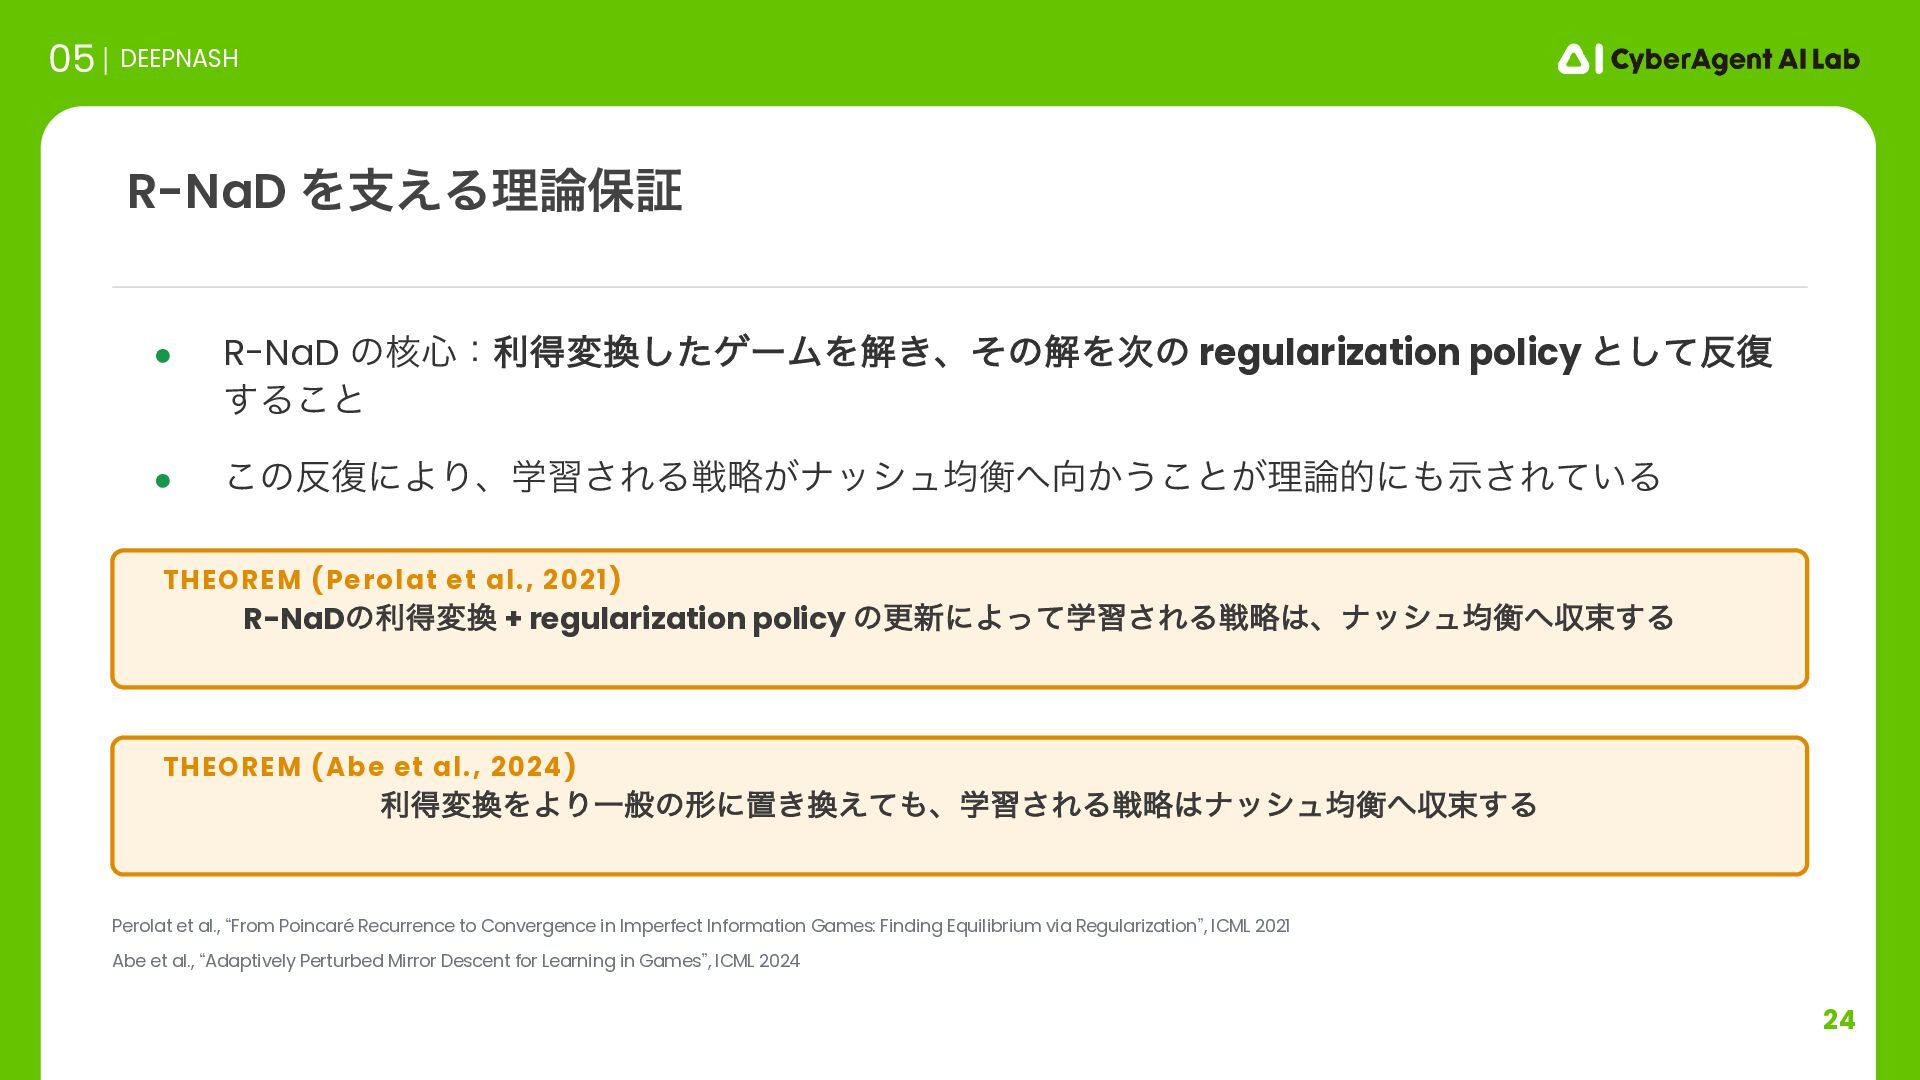
24 • R-NaD ͷ֩৺ɿརಘมͨ͠ήʔϜΛղ͖ɺͦͷղΛ࣍ͷ regularization policy ͱͯ͠෮ ͢Δ͜ͱ • ͜ͷ෮ʹΑΓɺֶश͞ΕΔઓུ͕φογϡۉߧ͔͏͜ͱ͕ཧతʹࣔ͞Ε͍ͯΔ
R-NaD Λࢧ͑Δཧอূ 05 DEEPNASH Perolat et al., lFrom Poincaré Recurrence to Convergence in Imperfect Information Games: Finding Equilibrium via Regularizationz, ICML 2021 Abe et al., lAdaptively Perturbed Mirror Descent for Learning in Gamesz, ICML 2024 R-NaDͷརಘม + regularization policy ͷߋ৽ʹΑֶͬͯश͞ΕΔઓུɺφογϡۉߧऩଋ͢Δ THEOREM (Perolat et al., 2021) རಘมΛΑΓҰൠͷܗʹஔ͖͑ͯɺֶश͞ΕΔઓུφογϡۉߧऩଋ͢Δ THEOREM (Abe et al., 2024) -
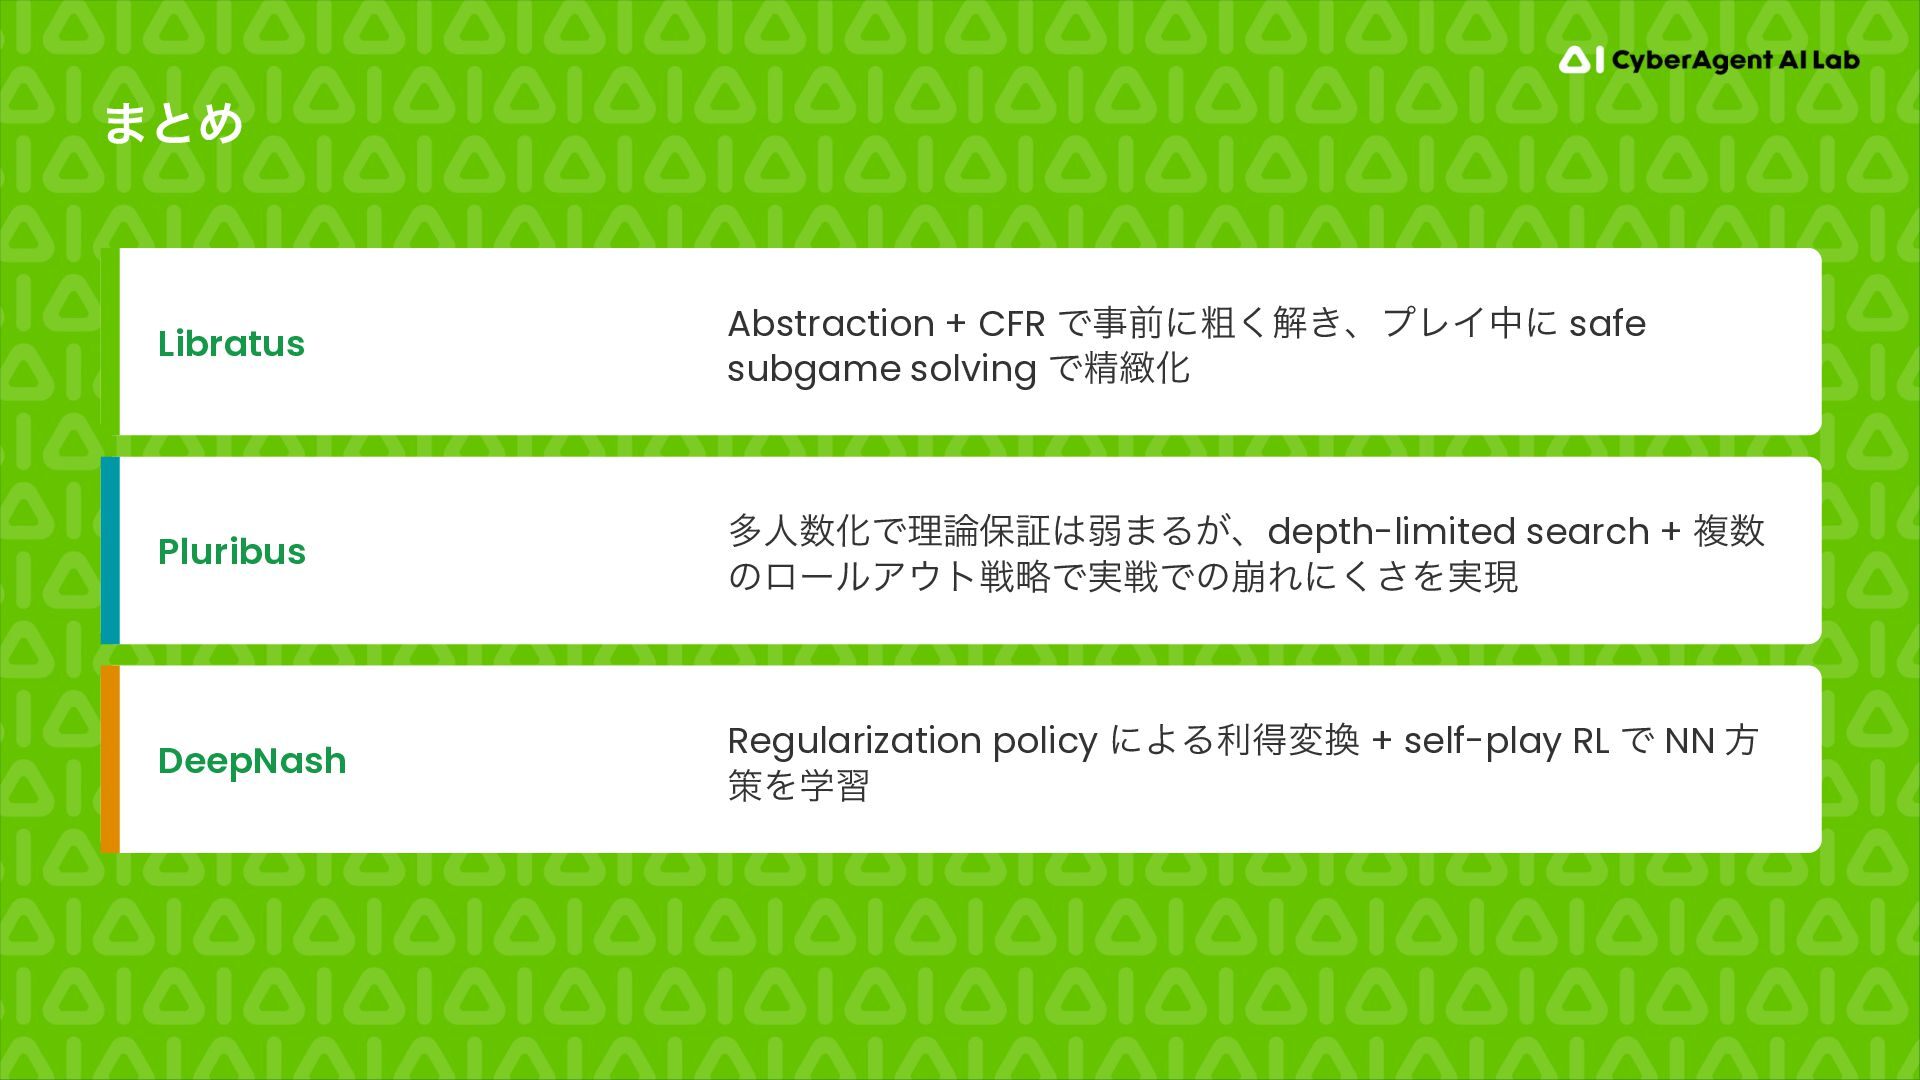
25 ·ͱΊ Libratus Abstraction + CFR Ͱࣄલʹૈ͘ղ͖ɺϓϨΠதʹ safe subgame solving
Ͱਫ਼៛Խ Pluribus ଟਓԽͰཧอূऑ·Δ͕ɺdepth-limited search + ෳ ͷϩʔϧΞτઓུͰ࣮ઓͰͷ่Εʹ͘͞Λ࣮ݱ DeepNash Regularization policy ʹΑΔརಘม + self-play RL Ͱ NN ํ ࡦΛֶश -
26 • N. Brown & T. Sandholm, “Superhuman AI for
heads-up no-limit poker: Libratus beats top professionals”, Science, 2018. • N. Brown & T. Sandholm, “Safe and Nested Subgame Solving for Imperfect-Information Games”, NeurIPS 2017. • N. Burch, M. Johanson & M. Bowling, “Solving Imperfect Information Games Using Decomposition”, AAAI 2014. • M. Zinkevich, M. Johanson, M. Bowling & C. Piccione, “Regret Minimization in Games with Incomplete Information”, NeurIPS 2007. • N. Brown & T. Sandholm, “Superhuman AI for multiplayer poker”, Science, 2019. • J. Perolat et al., “Mastering the game of Stratego with model-free multiagent reinforcement learning”, Science, 2022. • J. Perolat et al., “From Poincaré Recurrence to Convergence in Imperfect Information Games: Finding Equilibrium via Regularization”, ICML 2021. • K. Abe et al., “Adaptively Perturbed Mirror Descent for Learning in Games”, ICML 2024. ࢀߟจݙ 06 REFERENCES