Share
Embed
Transcript
26 slides
-
ECCV 2026 読み会 ロボット制御に未来の映像はどこまで 必要か? RoboTALES ・ StructVLA ・ LaMP
2026年10月25日 @caprest -
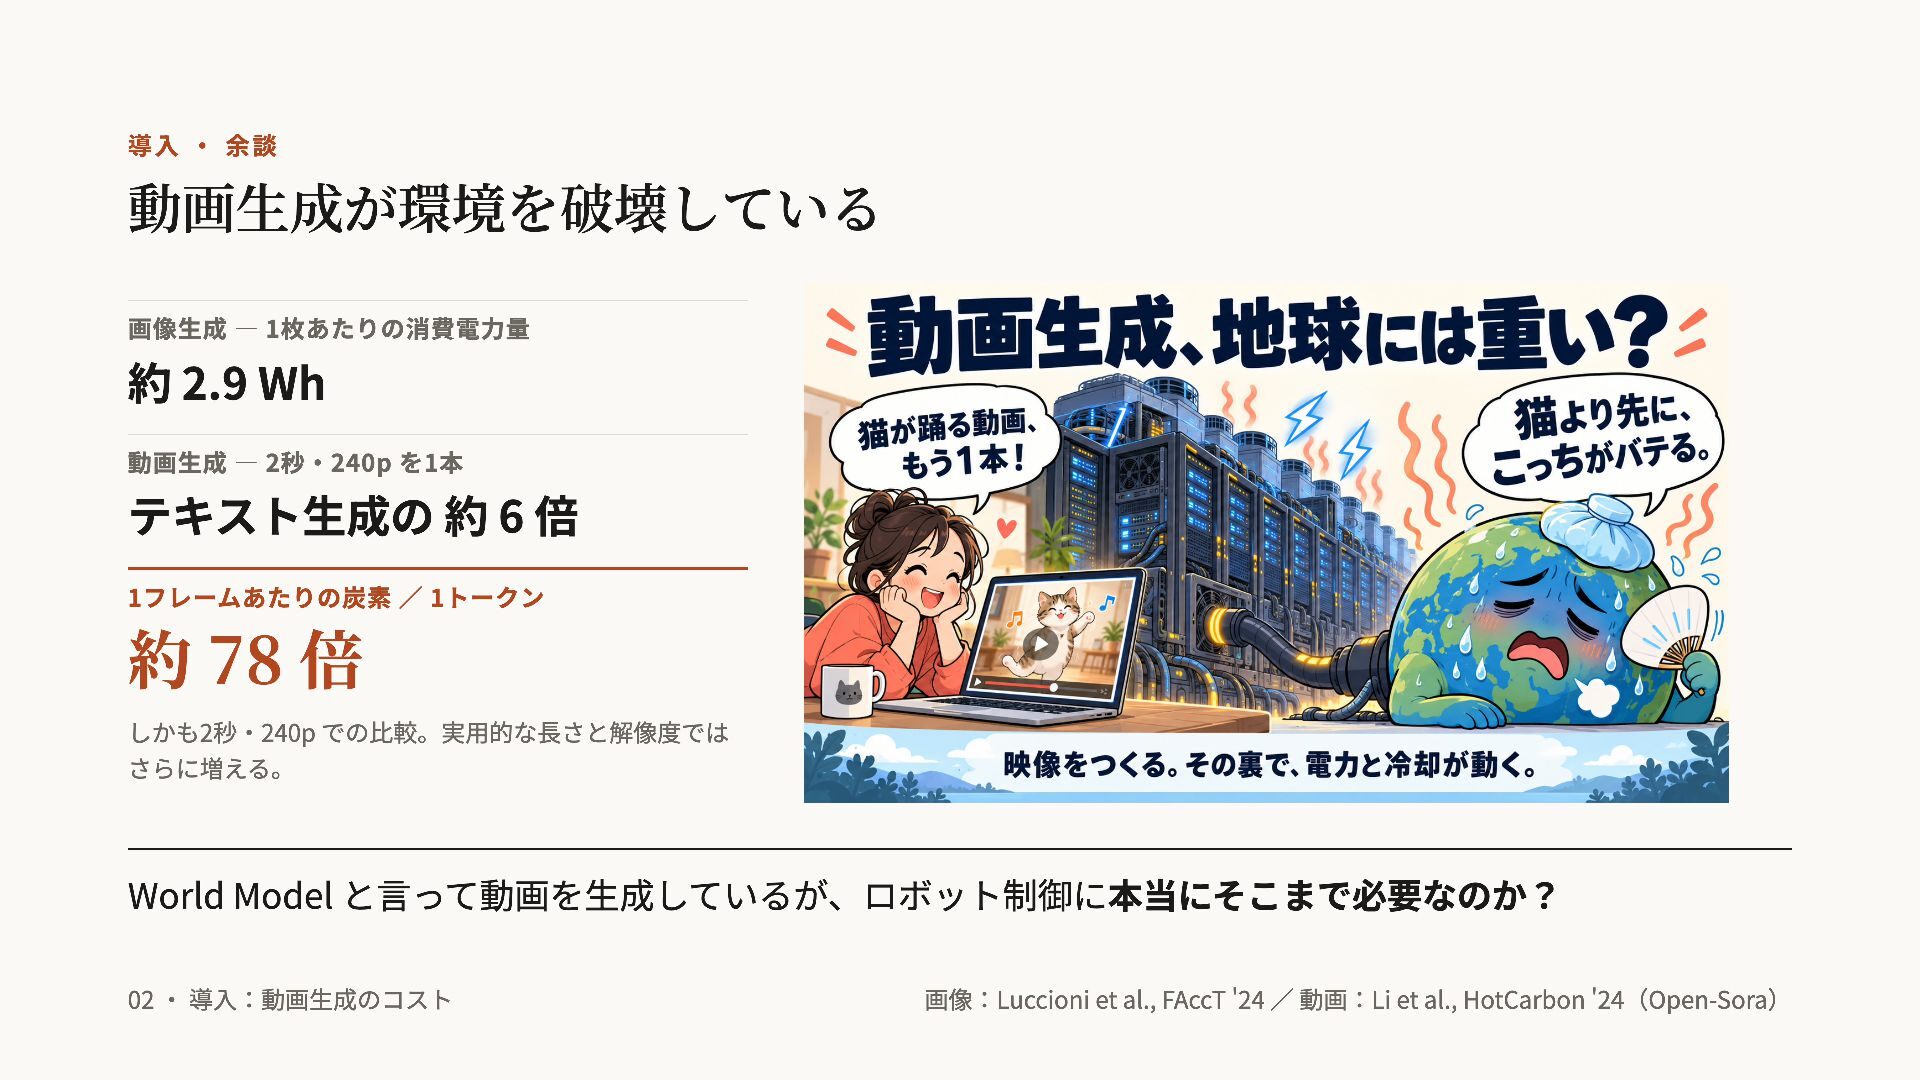
導入 ・ 余談 動画生成が環境を破壊している 画像生成 ― 1枚あたりの消費電力量 約 2.9 Wh
動画生成 ― 2秒・240p を1本 テキスト生成の 約 6 倍 1フレームあたりの炭素 / 1トークン 約 78 倍 しかも2秒・240p での比較。実用的な長さと解像度では さらに増える。 World Model と言って動画を生成しているが、ロボット制御に本当にそこまで必要なのか? 02 ・ 導入:動画生成のコスト 画像:Luccioni et al., FAccT '24 / 動画:Li et al., HotCarbon '24(Open-Sora) -
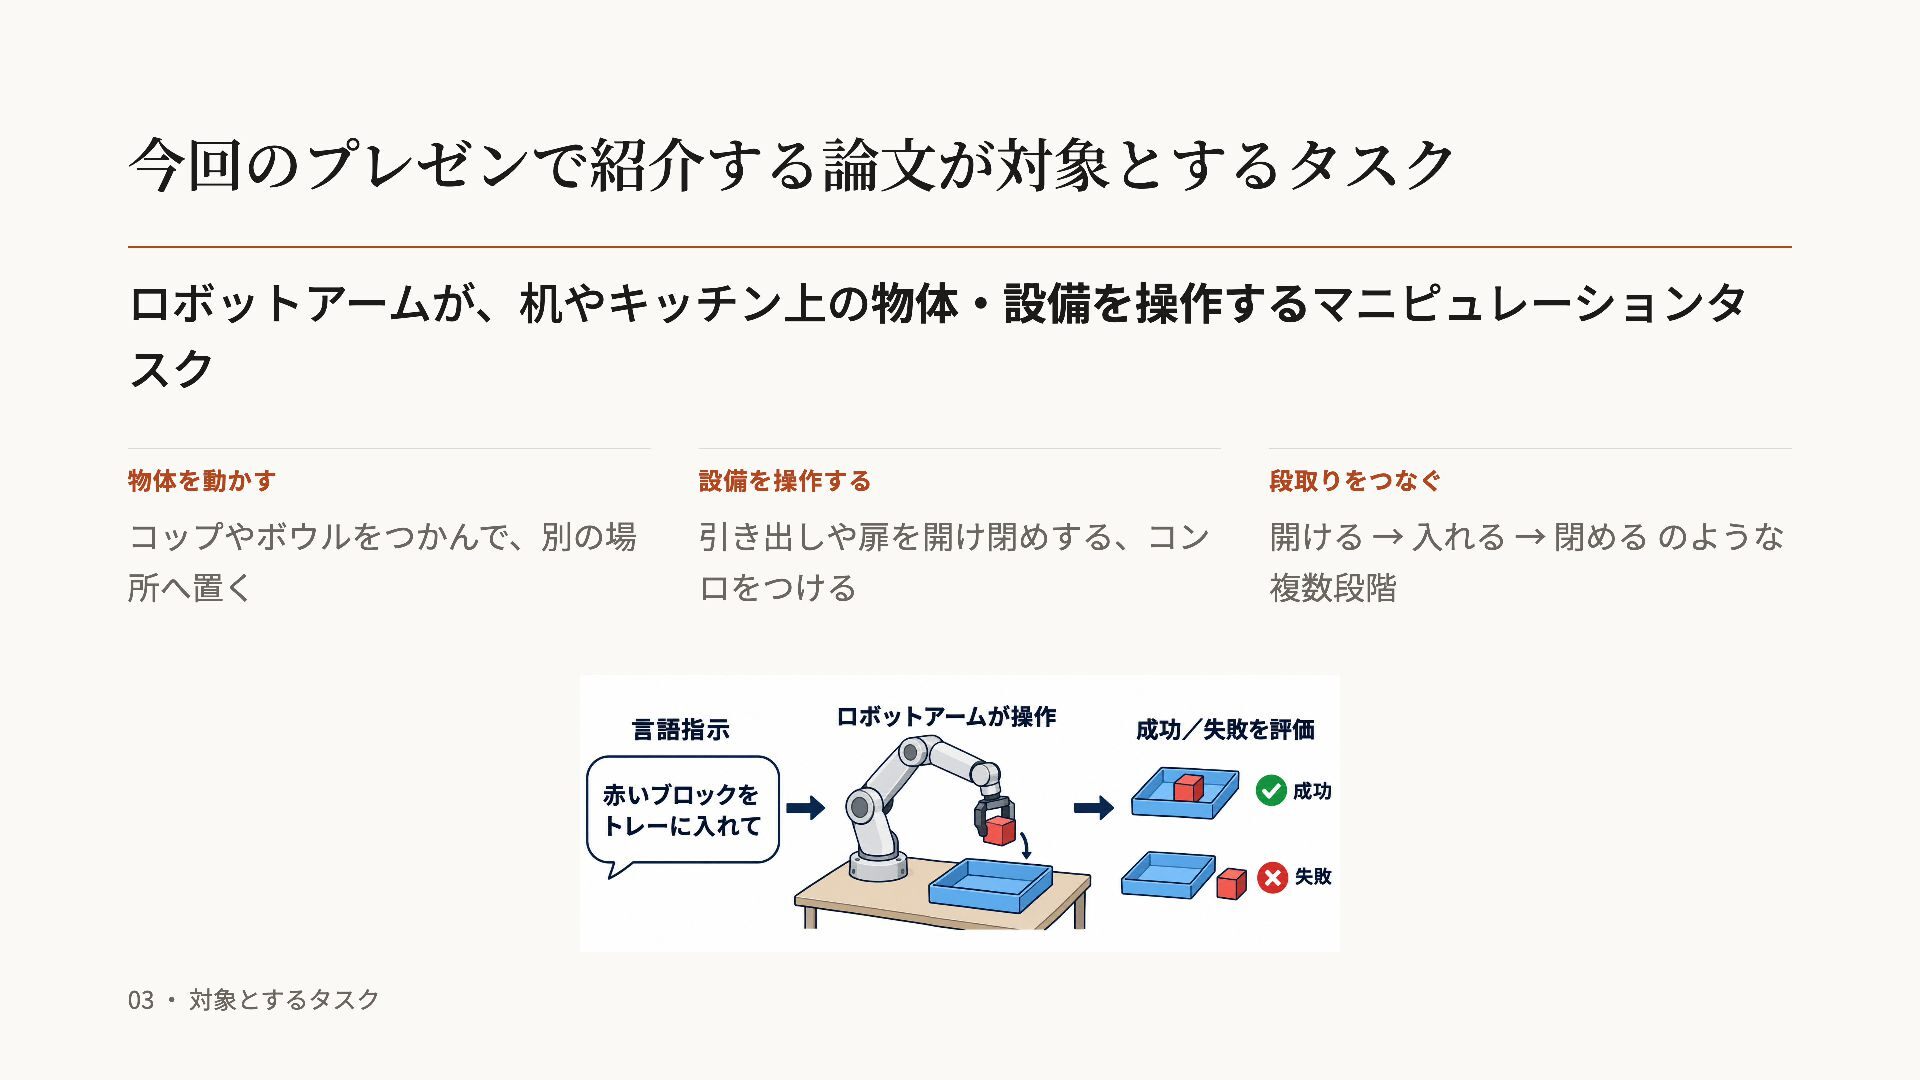
今回のプレゼンで紹介する論文が対象とするタスク ロボットアームが、机やキッチン上の物体・設備を操作するマニピュレーションタ スク 物体を動かす 設備を操作する 段取りをつなぐ コップやボウルをつかんで、別の場 引き出しや扉を開け閉めする、コン 開ける →
入れる → 閉める のような 所へ置く ロをつける 複数段階 03 ・ 対象とするタスク -
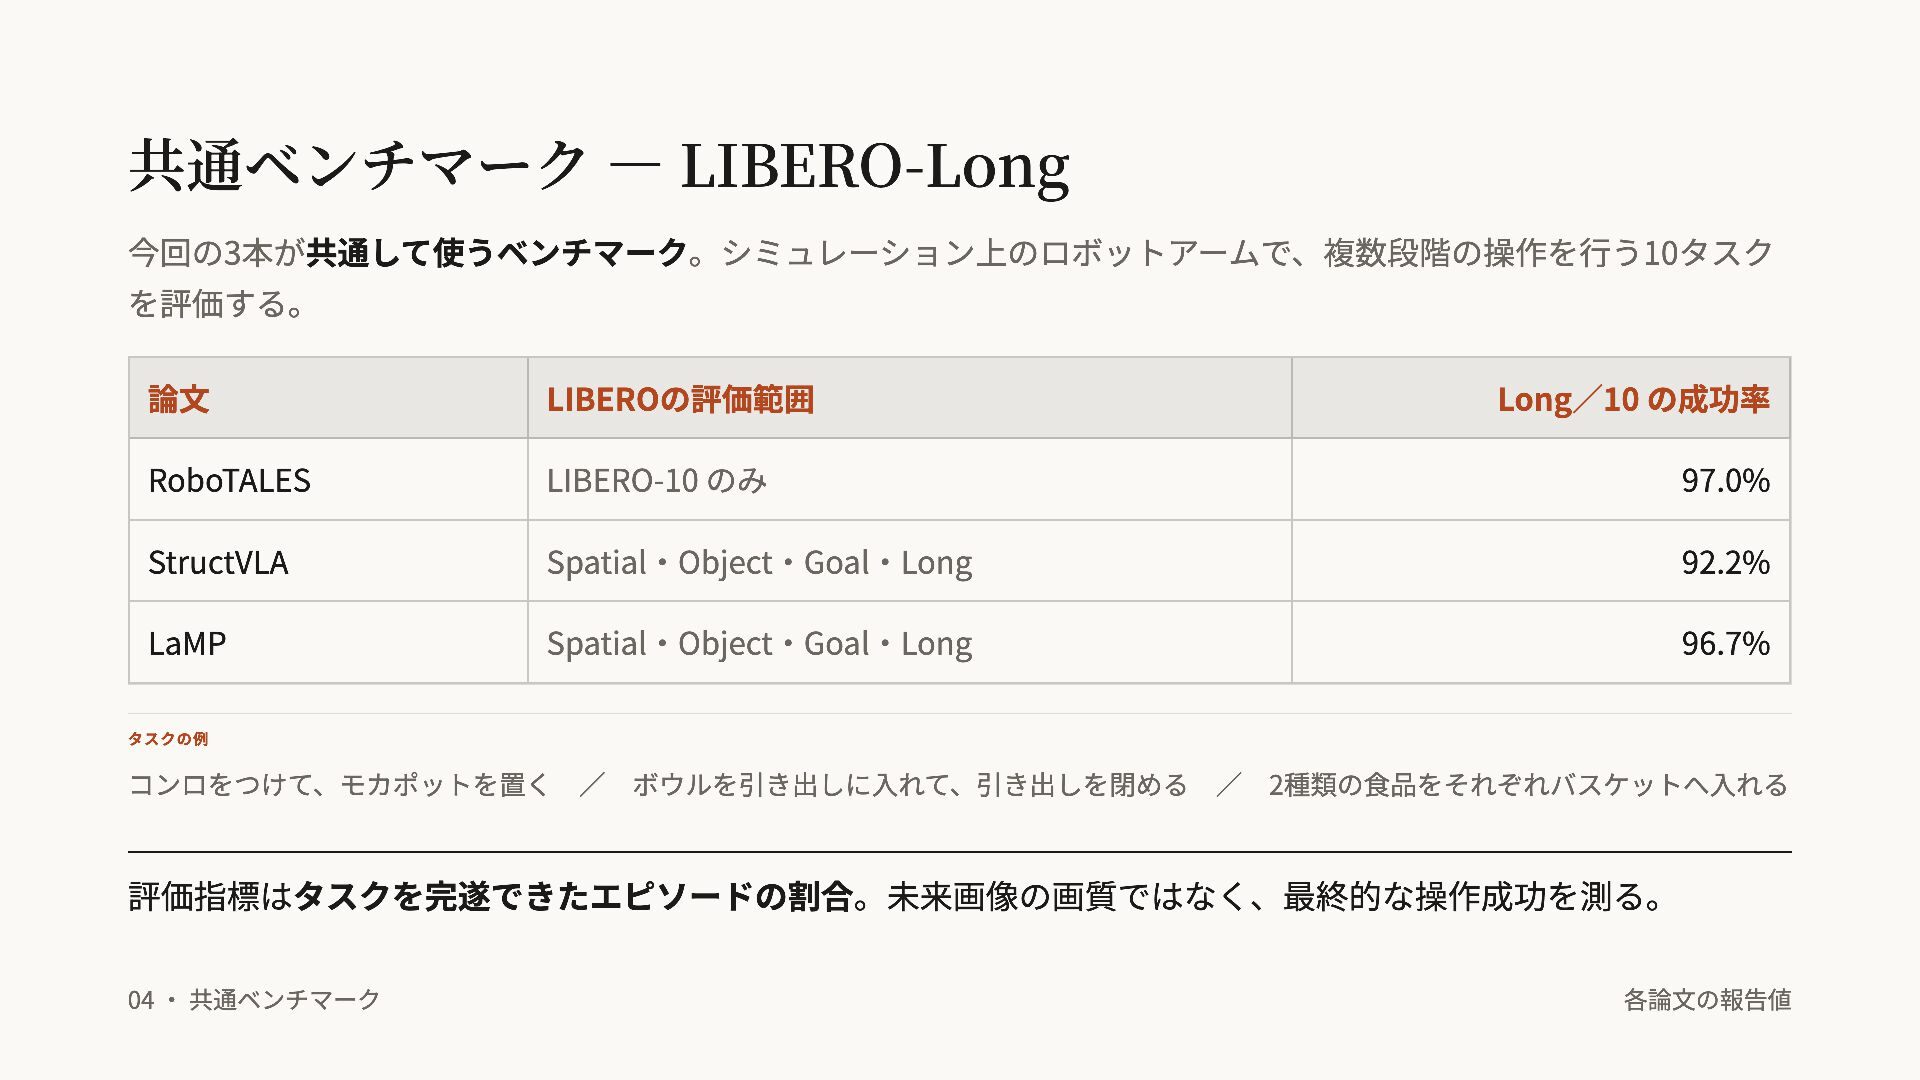
共通ベンチマーク ― LIBERO-Long 今回の3本が共通して使うベンチマーク。シミュレーション上のロボットアームで、複数段階の操作を行う10タスク を評価する。 論文 LIBEROの評価範囲 Long/10 の成功率 RoboTALES
LIBERO-10 のみ 97.0% StructVLA Spatial・Object・Goal・Long 92.2% LaMP Spatial・Object・Goal・Long 96.7% タスクの例 コンロをつけて、モカポットを置く / ボウルを引き出しに入れて、引き出しを閉める / 2種類の食品をそれぞれバスケットへ入れる 評価指標はタスクを完遂できたエピソードの割合。未来画像の画質ではなく、最終的な操作成功を測る。 04 ・ 共通ベンチマーク 各論文の報告値 -
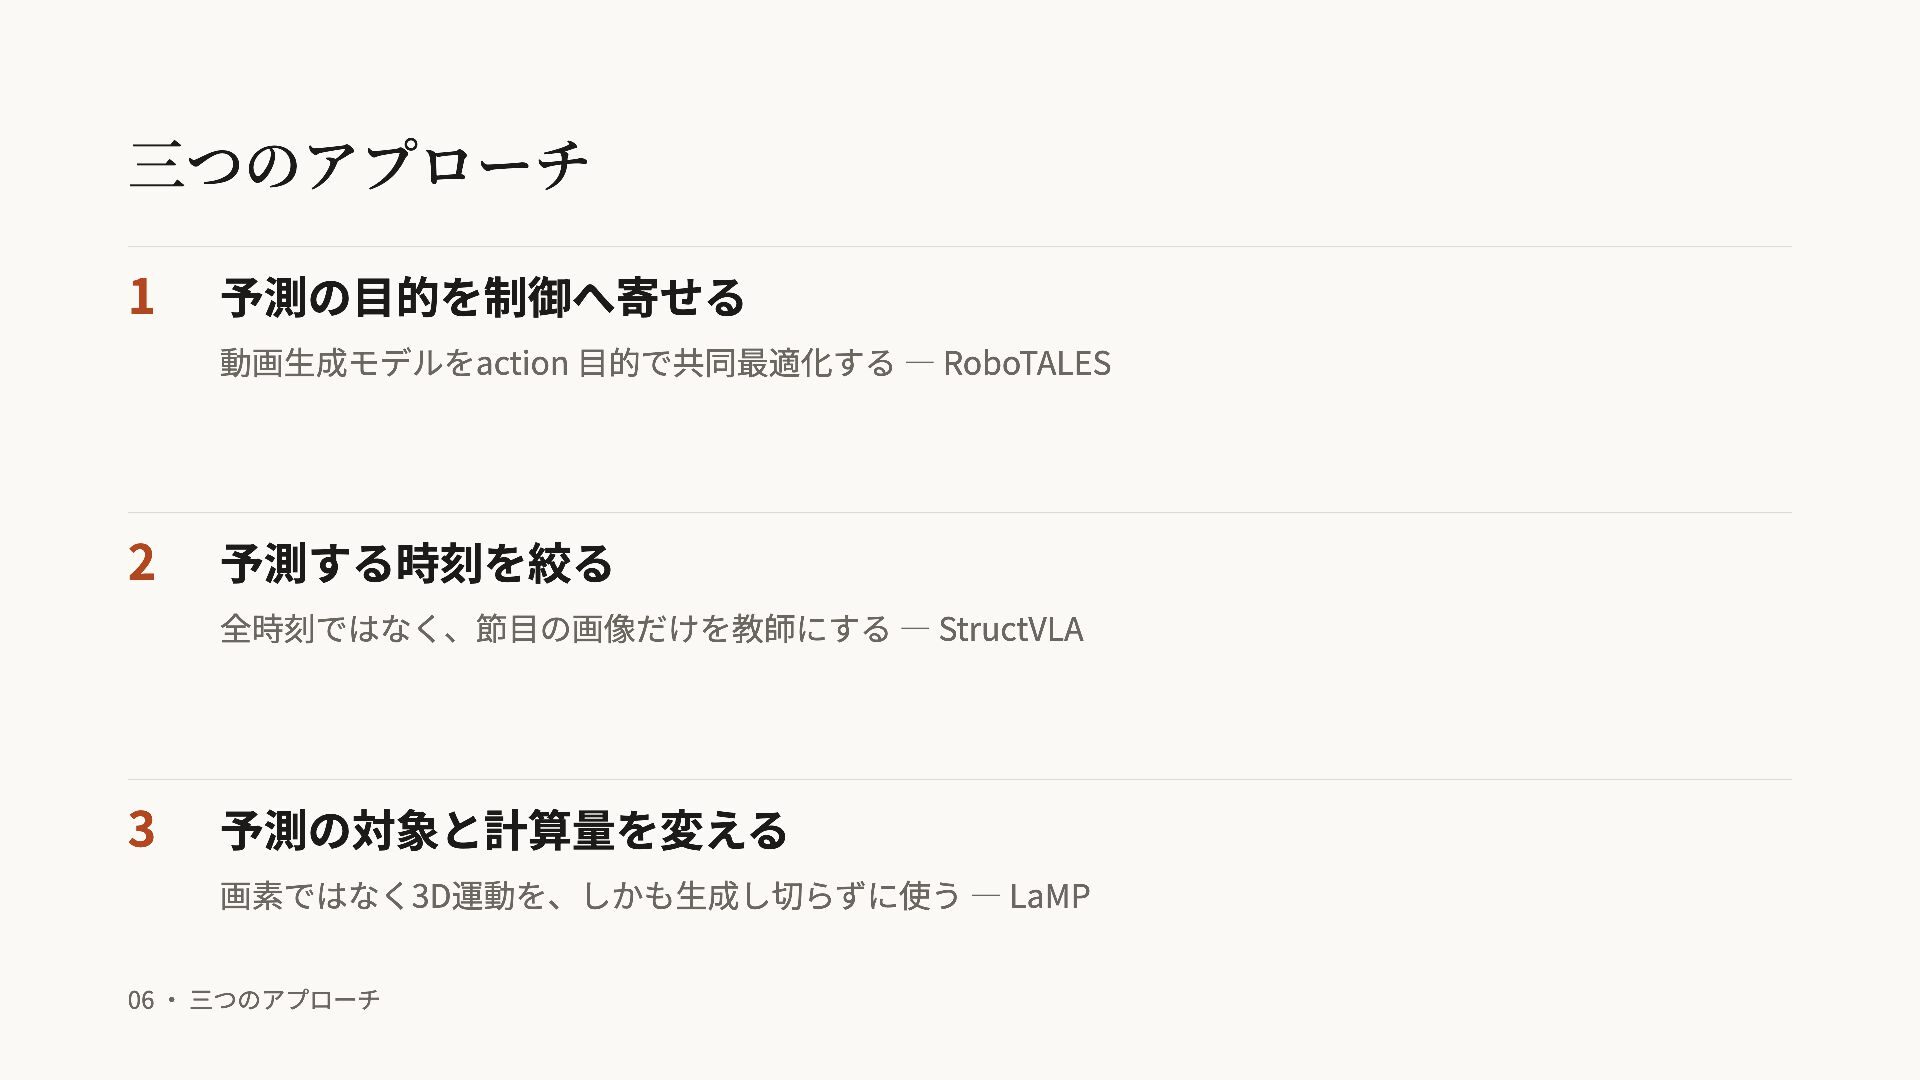
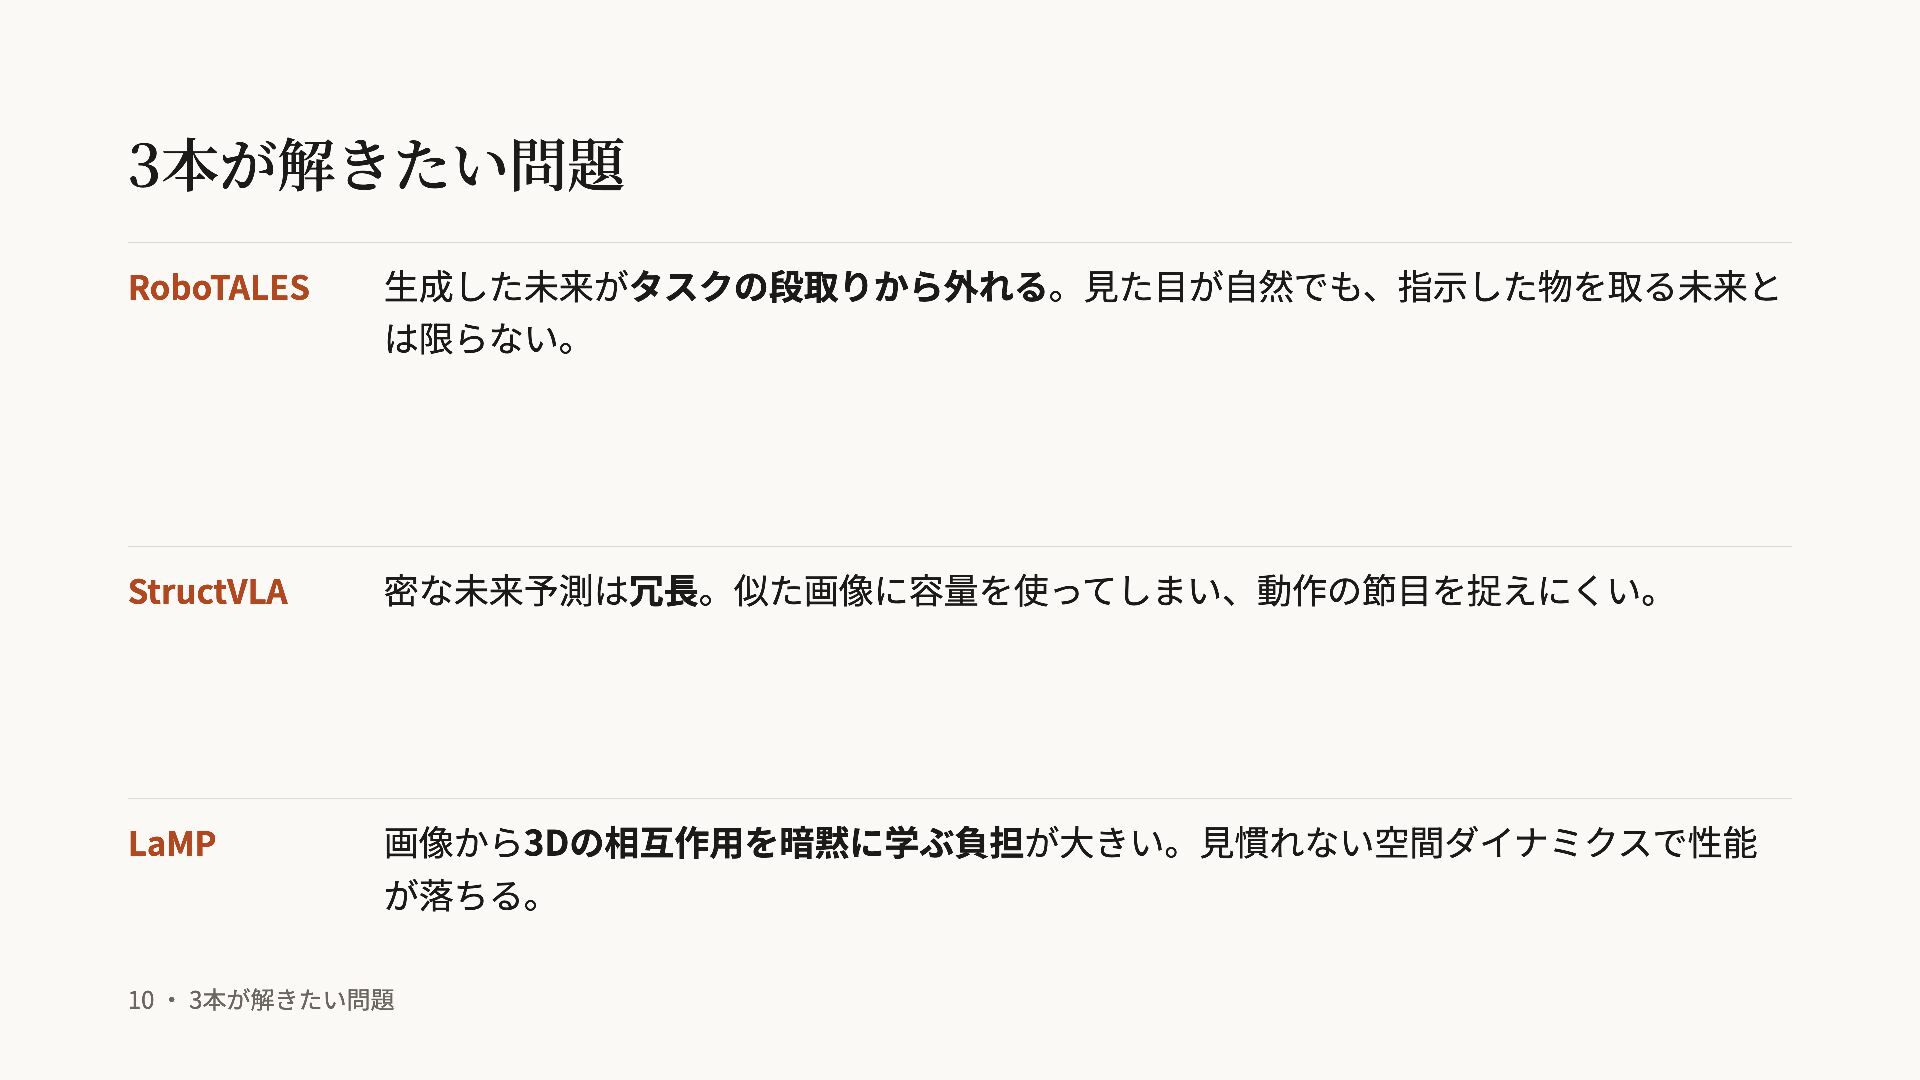
三つのアプローチ 1 予測の目的を制御へ寄せる 動画生成モデルをaction 目的で共同最適化する ― RoboTALES 2 予測する時刻を絞る 全時刻ではなく、節目の画像だけを教師にする
― StructVLA 3 予測の対象と計算量を変える 画素ではなく3D運動を、しかも生成し切らずに使う ― LaMP 06 ・ 三つのアプローチ -
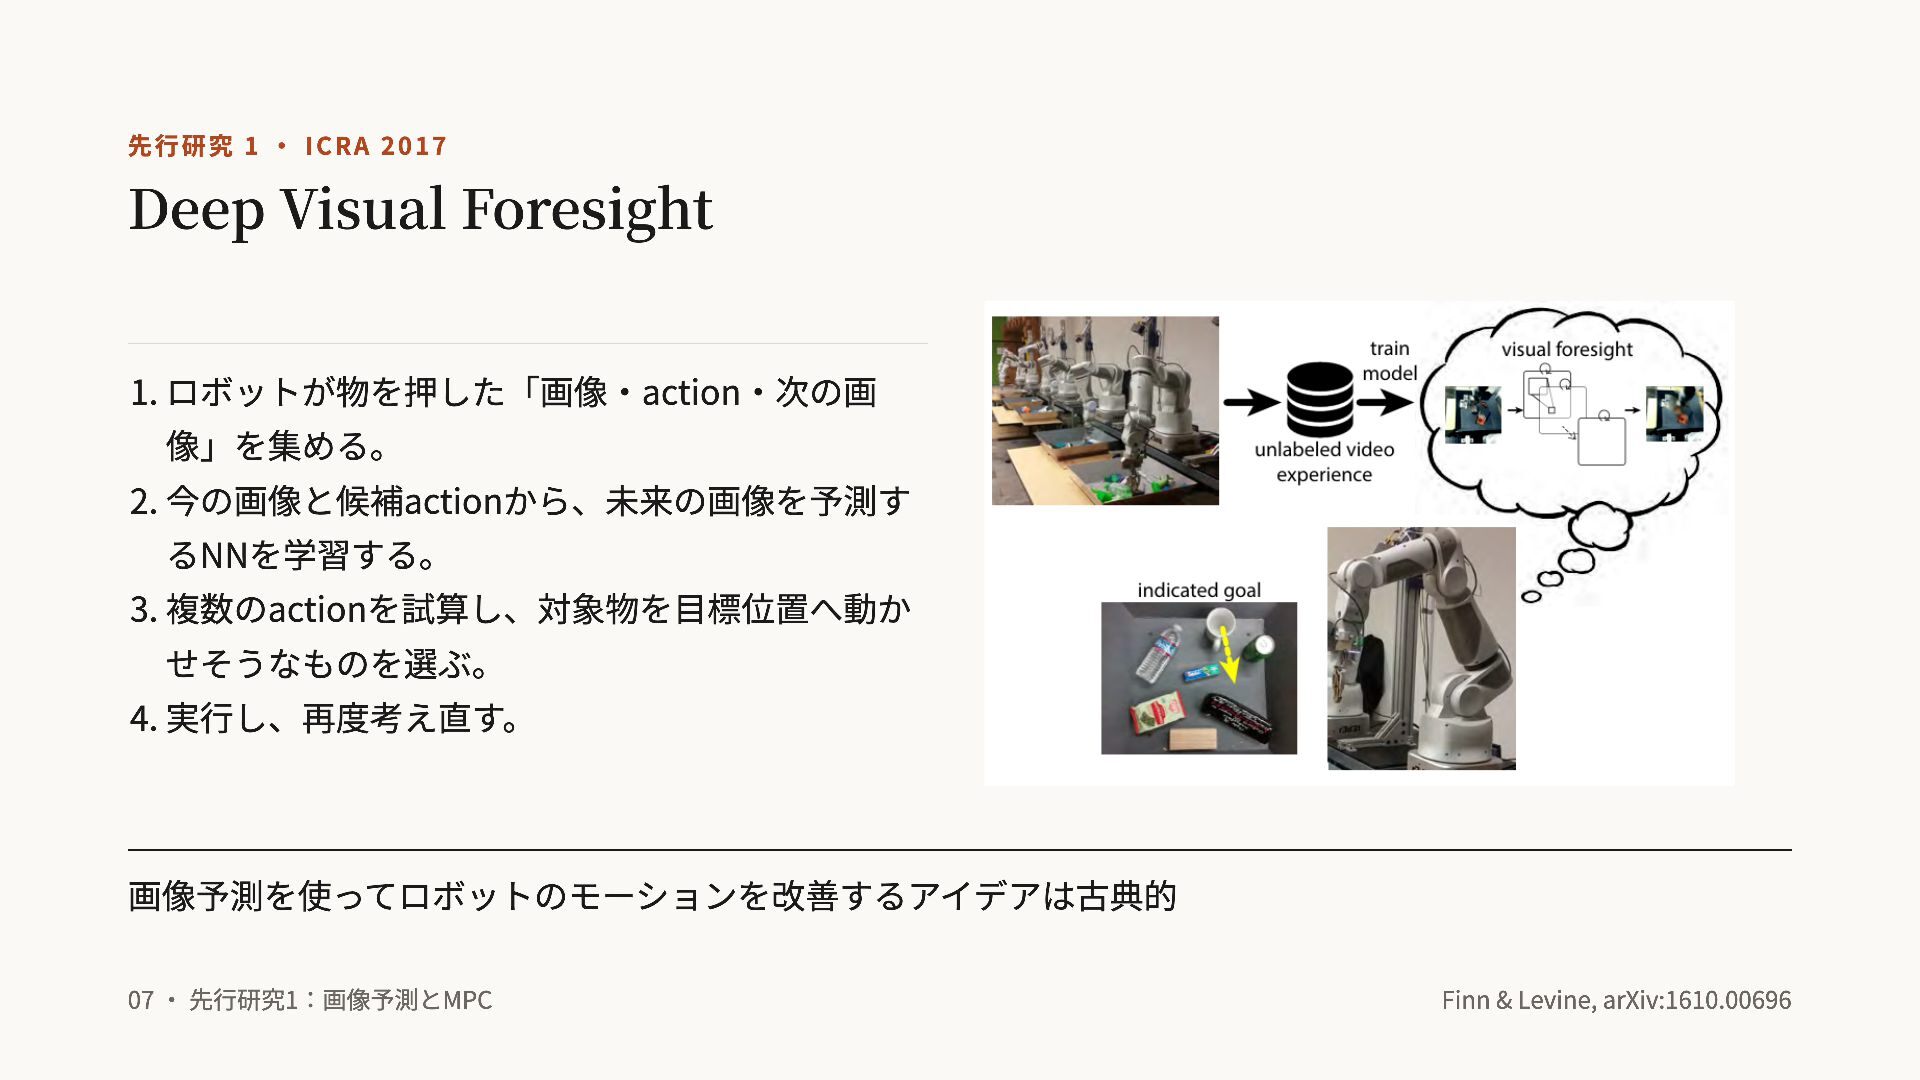
先行研究 1 ・ ICRA 2017 Deep Visual Foresight ロボットが物を押した「画像・action・次の画 像」を集める。
今の画像と候補actionから、未来の画像を予測す るNNを学習する。 複数のactionを試算し、対象物を目標位置へ動か せそうなものを選ぶ。 実行し、再度考え直す。 画像予測を使ってロボットのモーションを改善するアイデアは古典的 07 ・ 先行研究1:画像予測とMPC Finn & Levine, arXiv:1610.00696 -
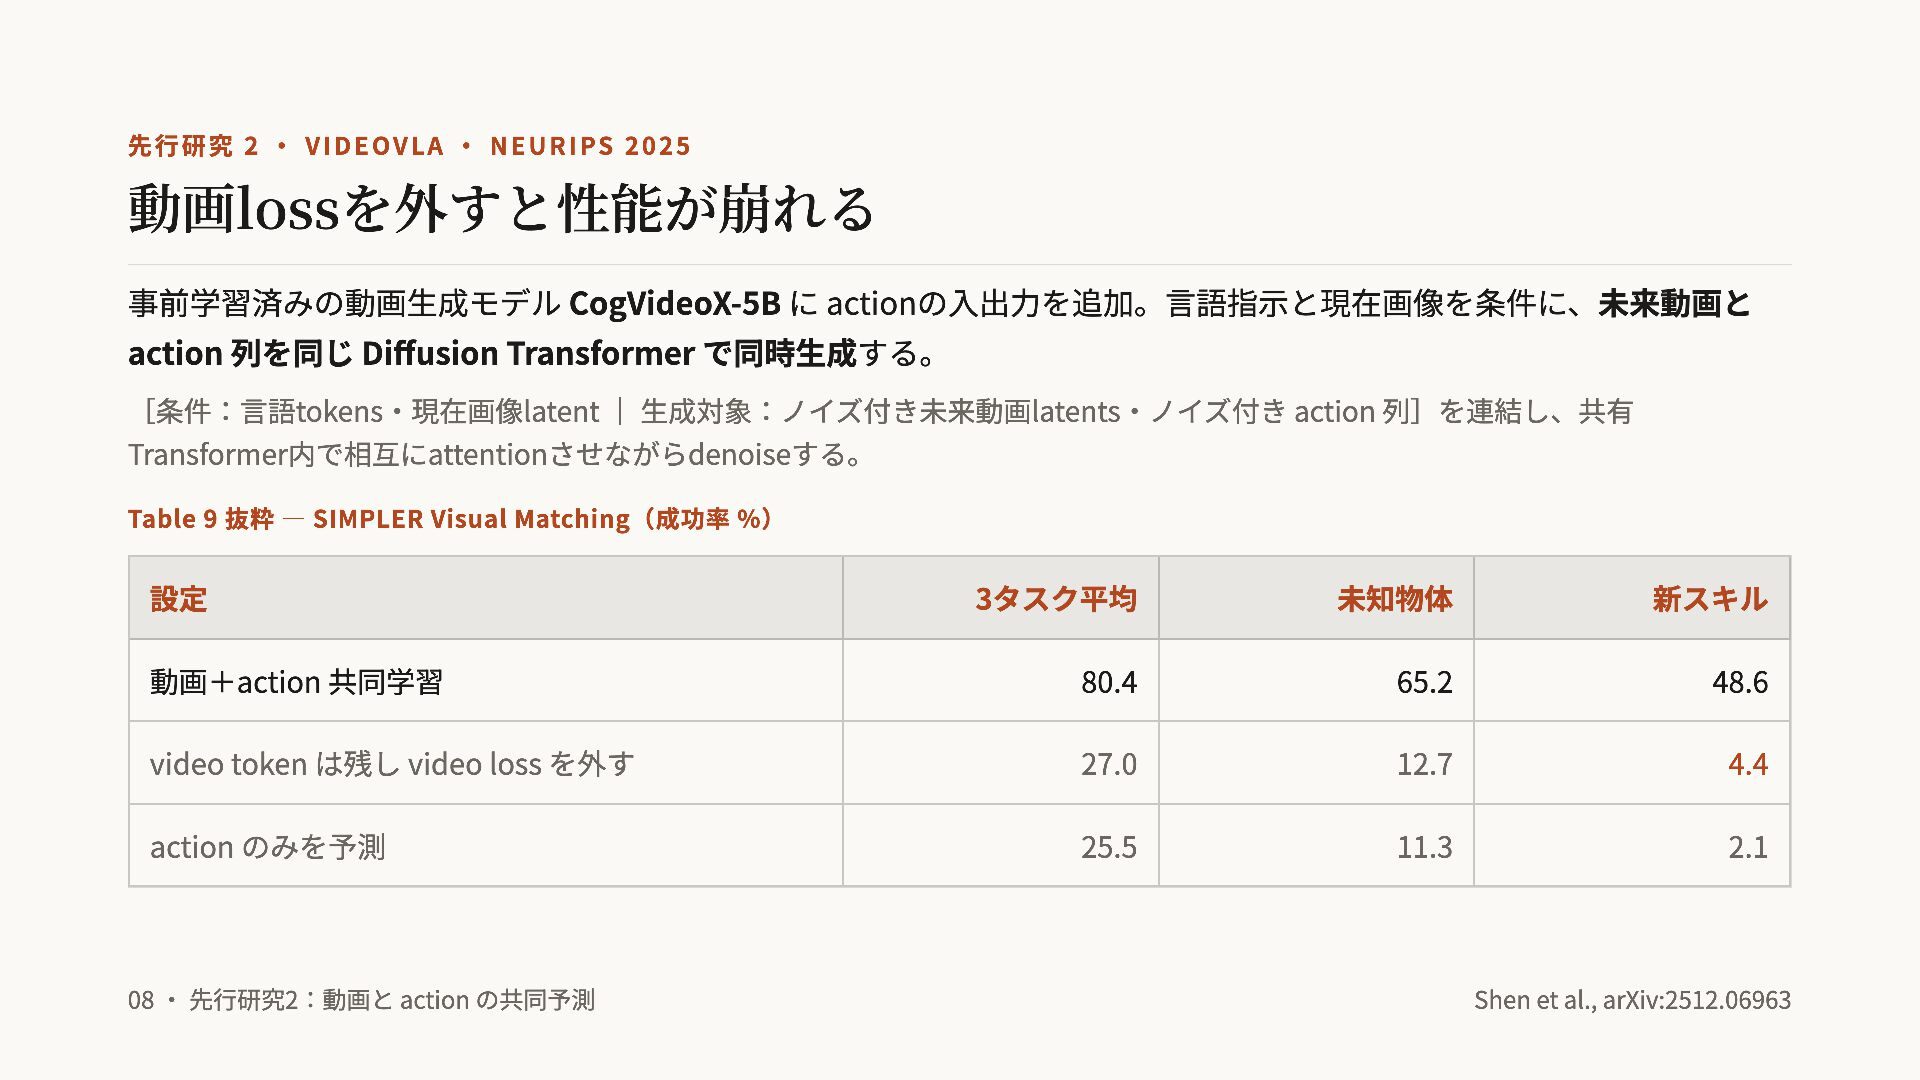
先行研究 2 ・ VIDEOVLA ・ NEURIPS 2025 動画lossを外すと性能が崩れる 事前学習済みの動画生成モデル CogVideoX-5B
に actionの入出力を追加。言語指示と現在画像を条件に、未来動画と action 列を同じ Diffusion Transformer で同時生成する。 [条件:言語tokens・現在画像latent | 生成対象:ノイズ付き未来動画latents・ノイズ付き action 列]を連結し、共有 Transformer内で相互にattentionさせながらdenoiseする。 Table 9 抜粋 ― SIMPLER Visual Matching(成功率 %) 設定 3タスク平均 未知物体 新スキル 動画+action 共同学習 80.4 65.2 48.6 video token は残し video loss を外す 27.0 12.7 4.4 action のみを予測 25.5 11.3 2.1 08 ・ 先行研究2:動画と action の共同予測 Shen et al., arXiv:2512.06963 -
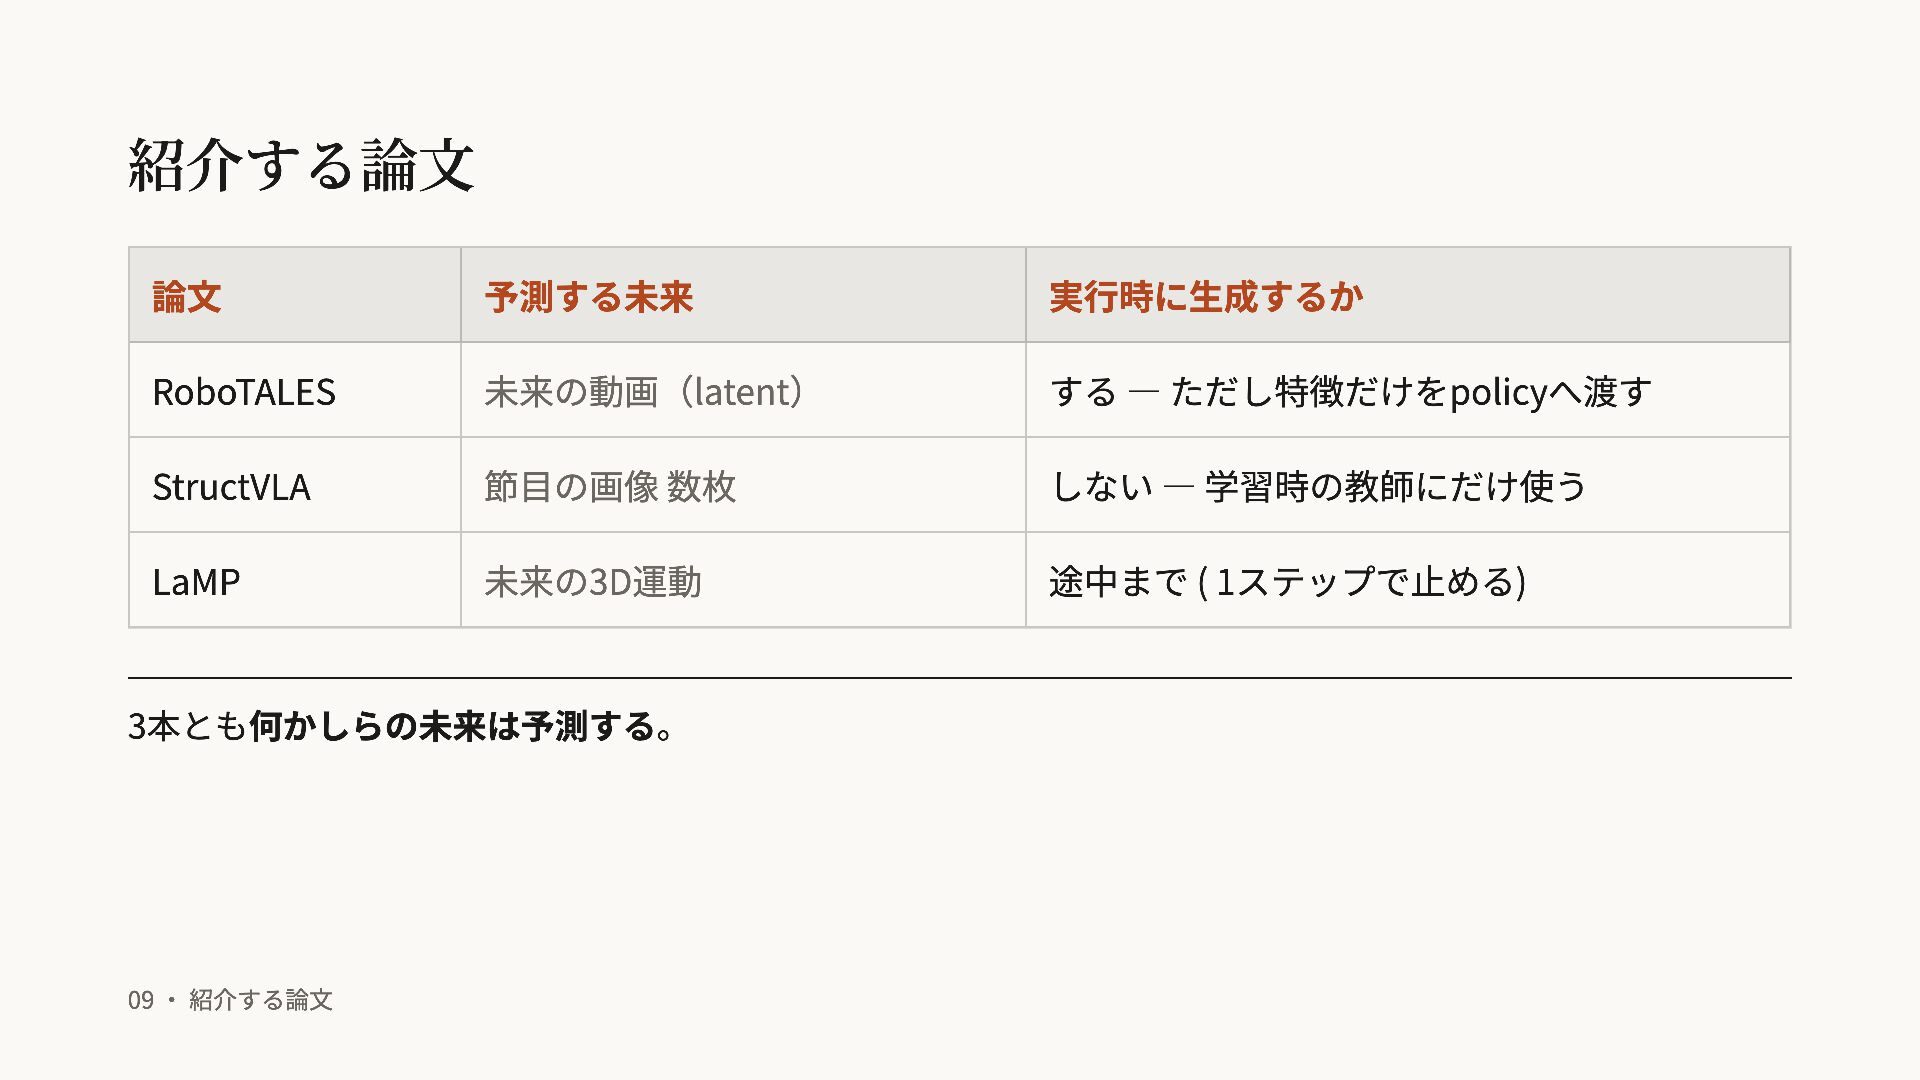
紹介する論文 論文 予測する未来 実行時に生成するか RoboTALES 未来の動画(latent) する ― ただし特徴だけをpolicyへ渡す StructVLA
節目の画像 数枚 しない ― 学習時の教師にだけ使う LaMP 未来の3D運動 途中まで ( 1ステップで止める) 3本とも何かしらの未来は予測する。 09 ・ 紹介する論文 -
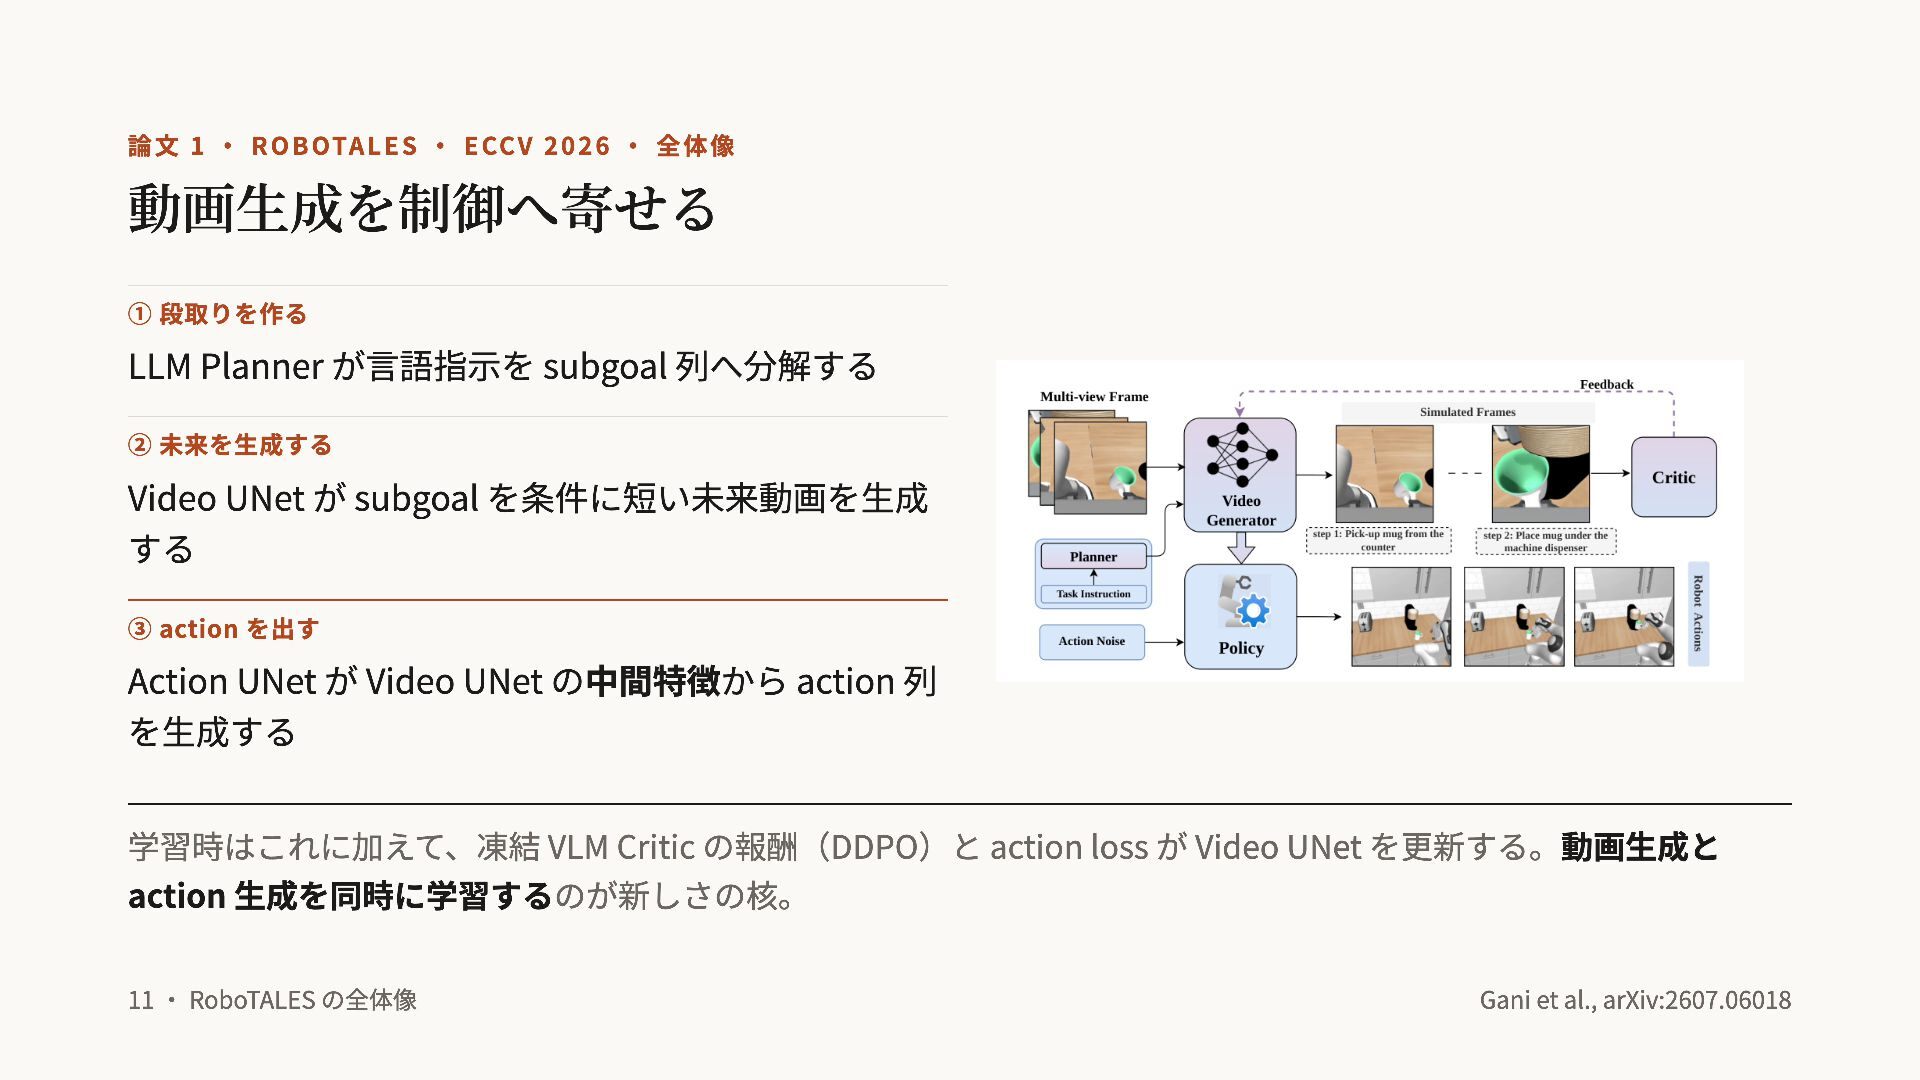
論文 1 ・ ROBOTALES ・ ECCV 2026 ・ 全体像 動画生成を制御へ寄せる
① 段取りを作る LLM Planner が言語指示を subgoal 列へ分解する ② 未来を生成する Video UNet が subgoal を条件に短い未来動画を生成 する ③ action を出す Action UNet が Video UNet の中間特徴から action 列 を生成する 学習時はこれに加えて、凍結 VLM Critic の報酬(DDPO)と action loss が Video UNet を更新する。動画生成と action 生成を同時に学習するのが新しさの核。 11 ・ RoboTALES の全体像 Gani et al., arXiv:2607.06018 -
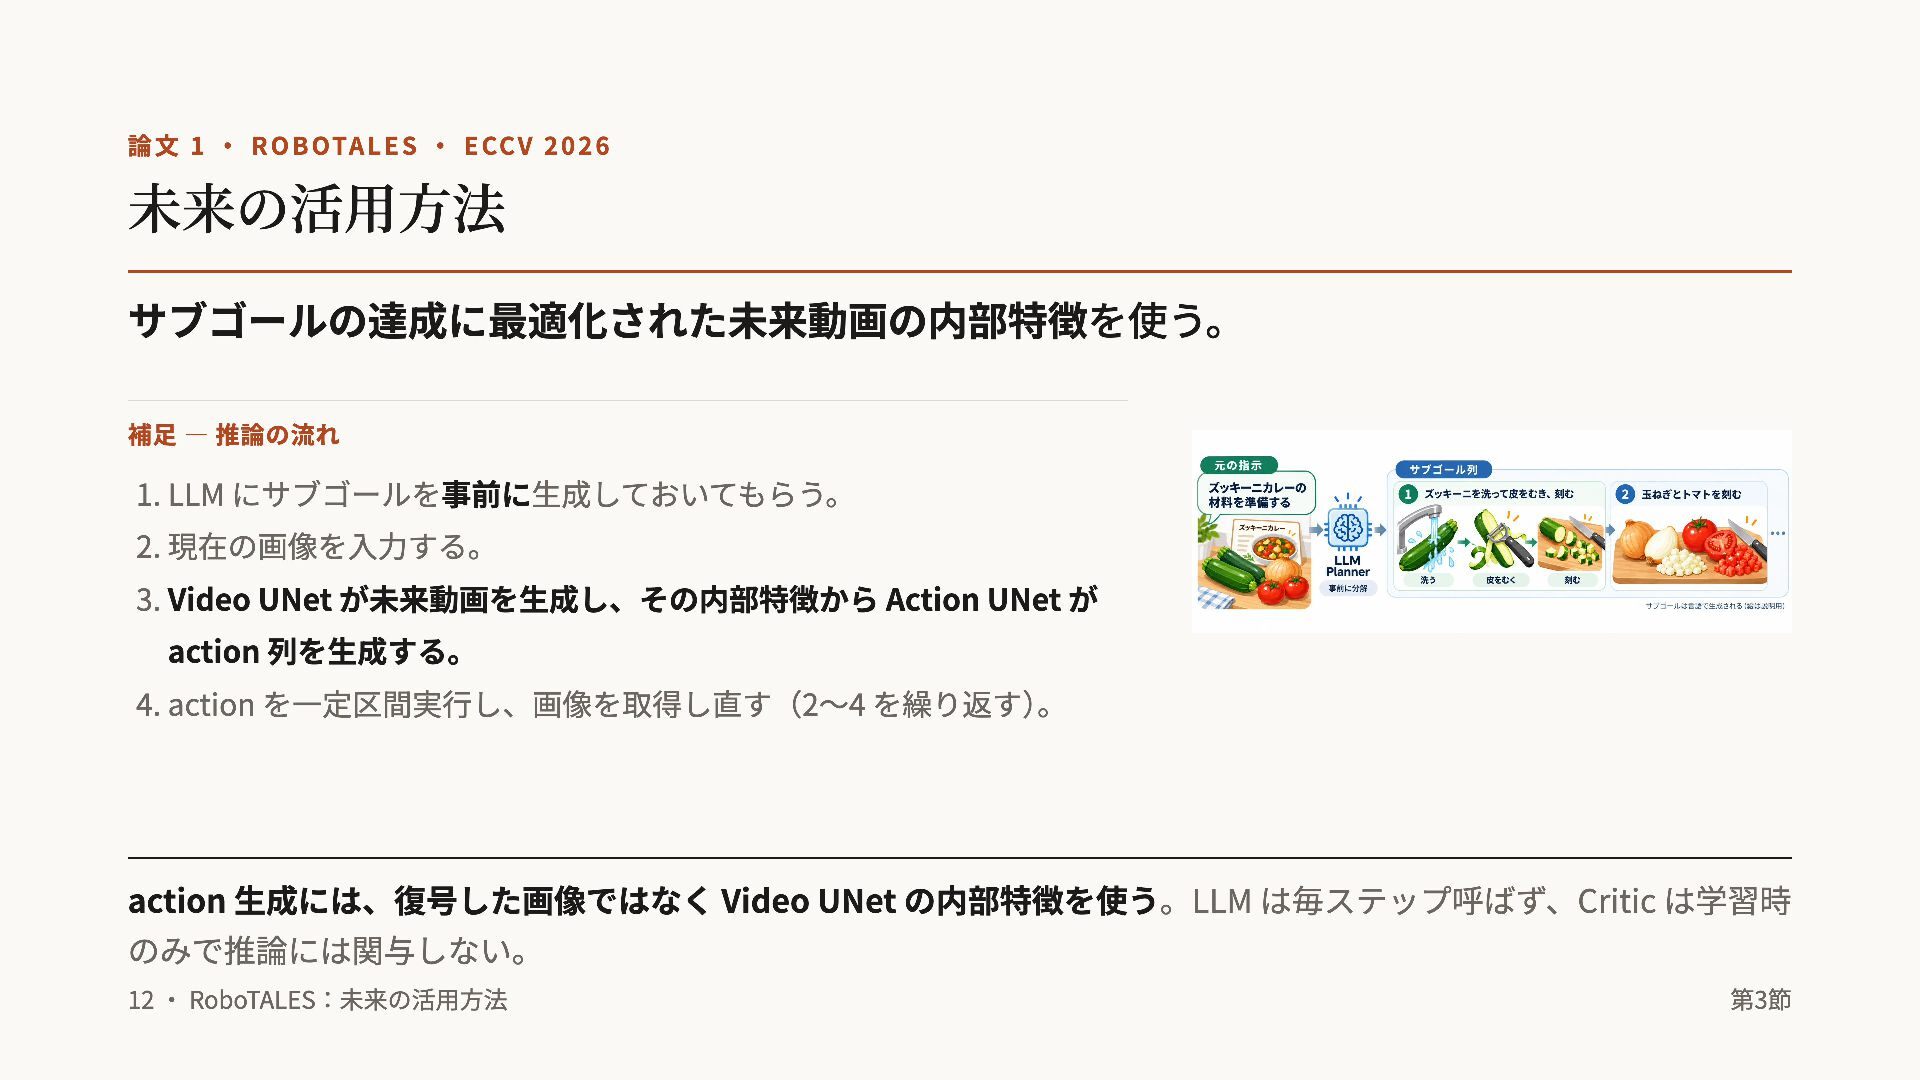
論文 1 ・ ROBOTALES ・ ECCV 2026 未来の活用方法 サブゴールの達成に最適化された未来動画の内部特徴を使う。 補足
― 推論の流れ LLM にサブゴールを事前に生成しておいてもらう。 現在の画像を入力する。 Video UNet が未来動画を生成し、その内部特徴から Action UNet が action 列を生成する。 action を一定区間実行し、画像を取得し直す(2〜4 を繰り返す)。 action 生成には、復号した画像ではなく Video UNet の内部特徴を使う。LLM は毎ステップ呼ばず、Critic は学習時 のみで推論には関与しない。 12 ・ RoboTALES:未来の活用方法 第3節 -
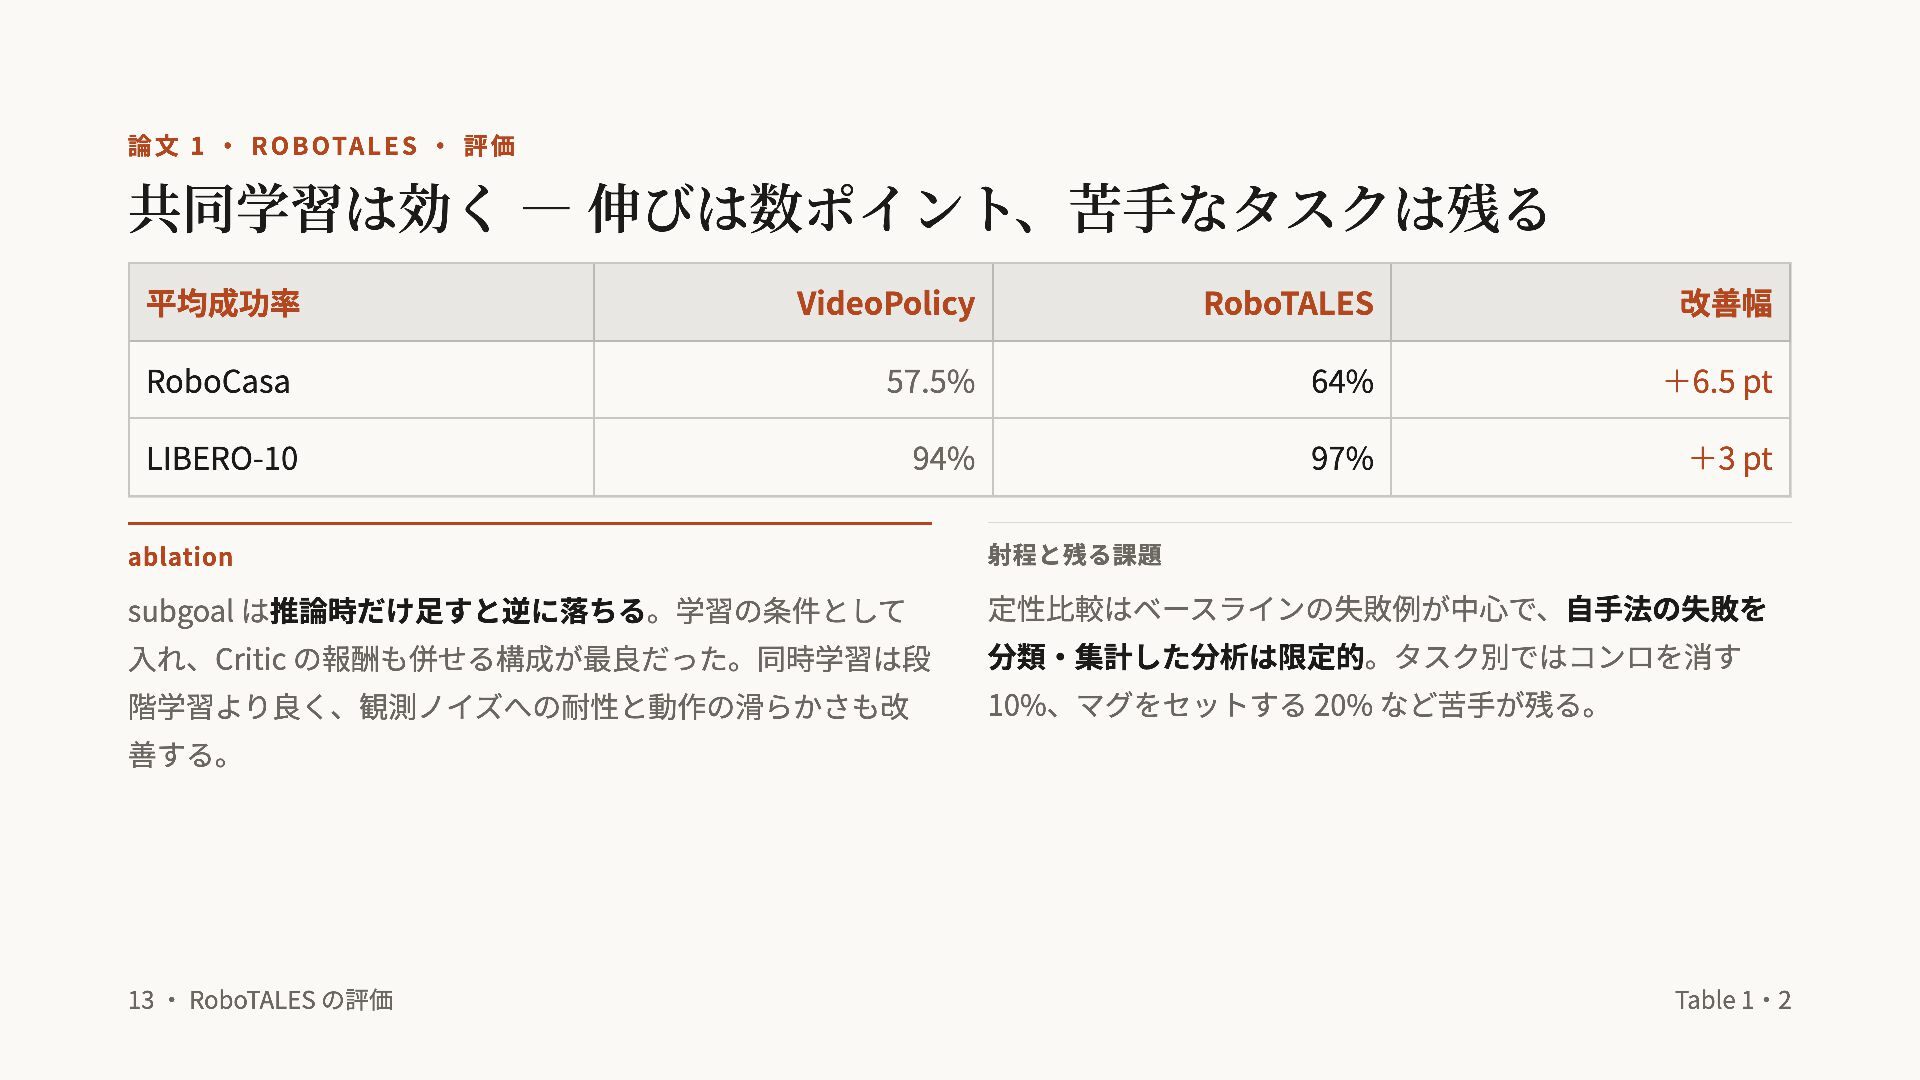
論文 1 ・ ROBOTALES ・ 評価 共同学習は効く ― 伸びは数ポイント、苦手なタスクは残る 平均成功率
VideoPolicy RoboTALES 改善幅 RoboCasa 57.5% 64% +6.5 pt LIBERO-10 94% 97% +3 pt ablation 射程と残る課題 subgoal は推論時だけ足すと逆に落ちる。学習の条件として 定性比較はベースラインの失敗例が中心で、自手法の失敗を 入れ、Critic の報酬も併せる構成が最良だった。同時学習は段 分類・集計した分析は限定的。タスク別ではコンロを消す 階学習より良く、観測ノイズへの耐性と動作の滑らかさも改 10%、マグをセットする 20% など苦手が残る。 善する。 13 ・ RoboTALES の評価 Table 1・2 -
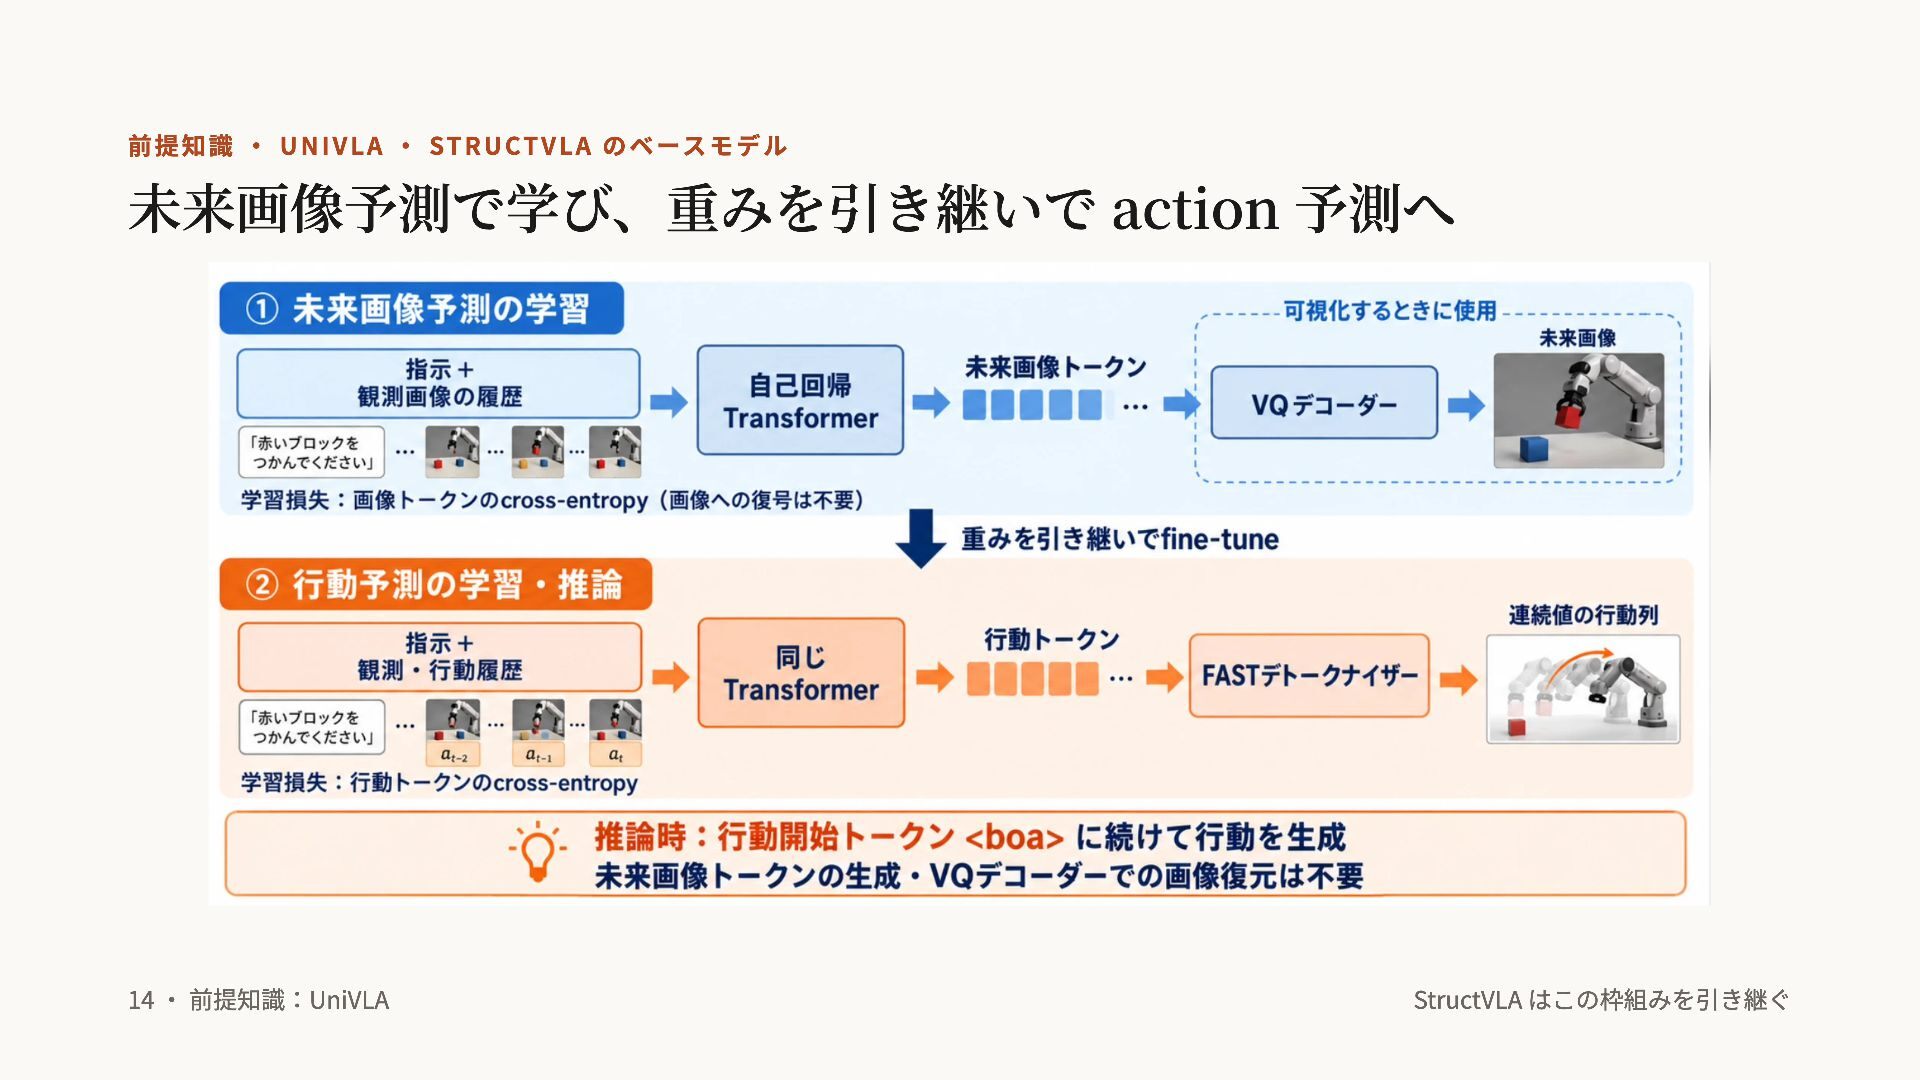
前提知識 ・ UNIVLA ・ STRUCTVLA のベースモデル 未来画像予測で学び、重みを引き継いで action 予測へ 14
・ 前提知識:UniVLA StructVLA はこの枠組みを引き継ぐ -
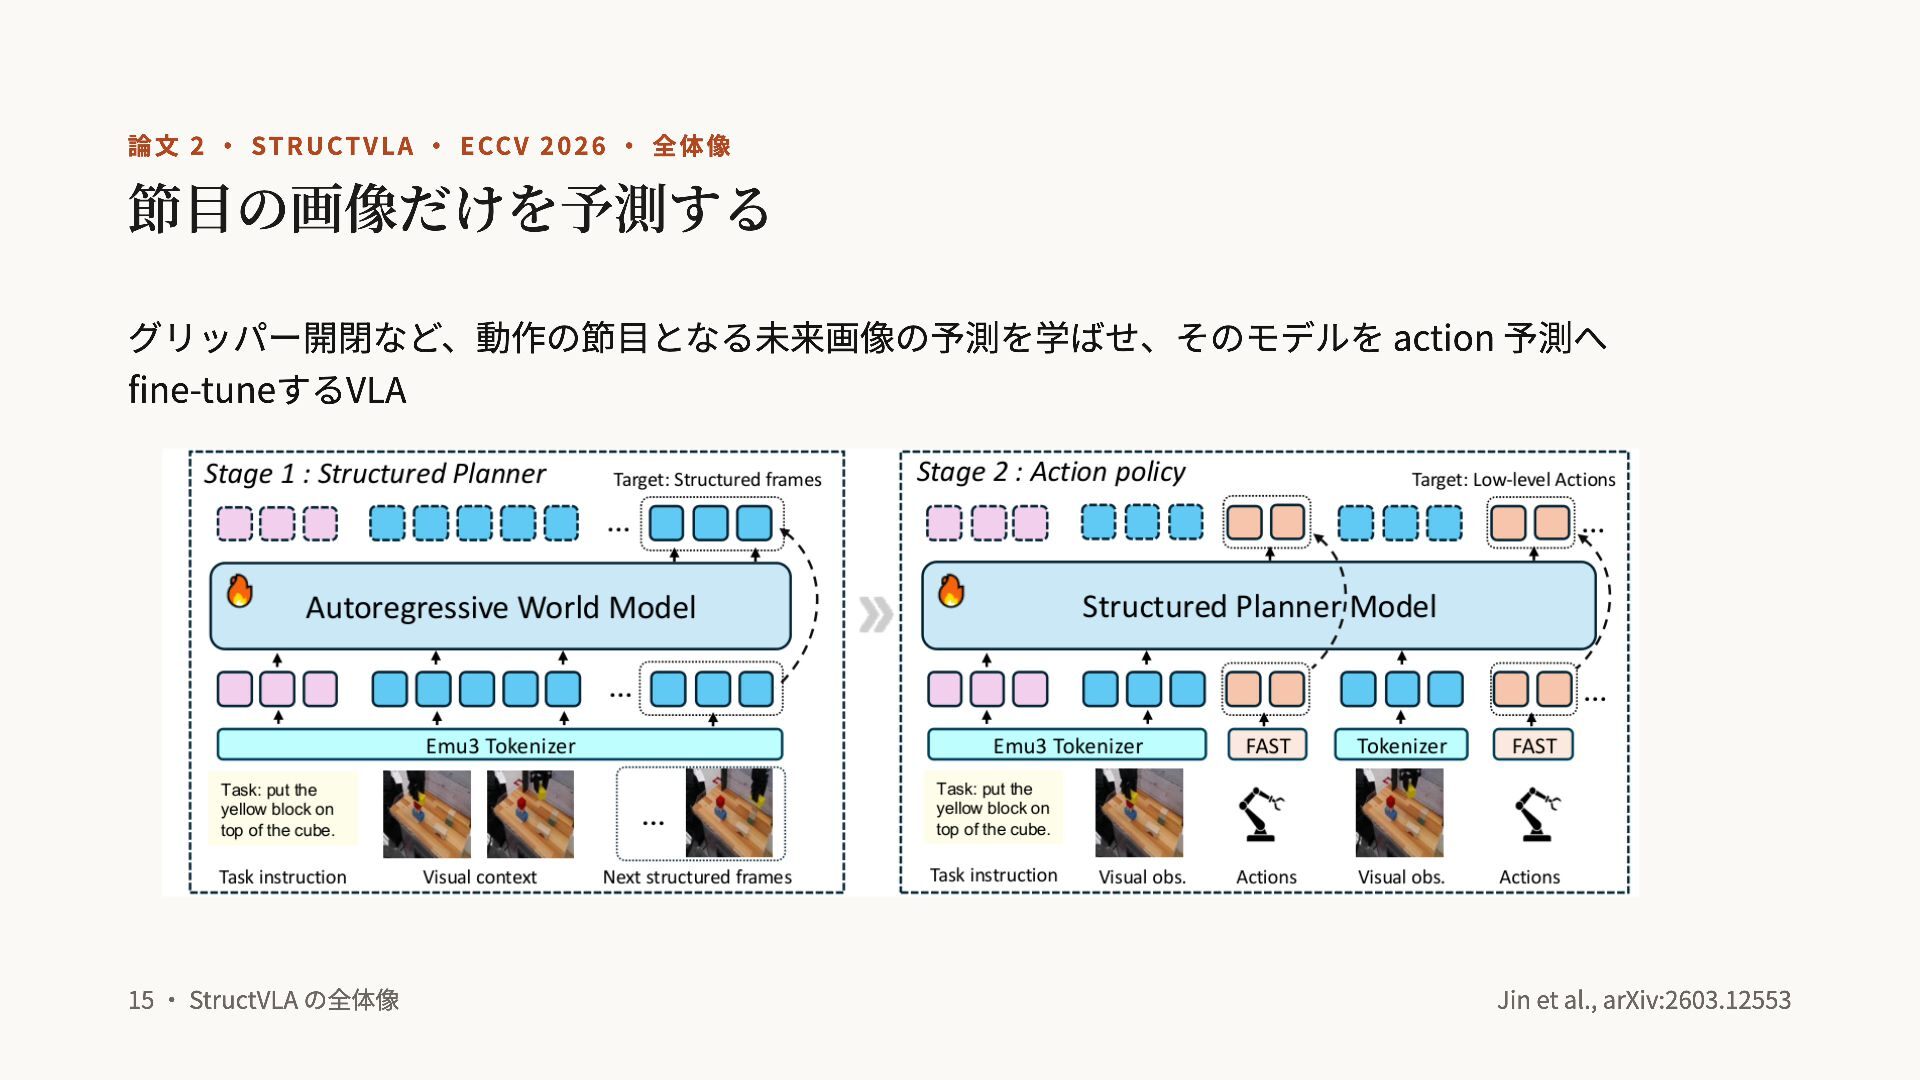
論文 2 ・ STRUCTVLA ・ ECCV 2026 ・ 全体像 節目の画像だけを予測する
グリッパー開閉など、動作の節目となる未来画像の予測を学ばせ、そのモデルを action 予測へ fine-tuneするVLA 15 ・ StructVLA の全体像 Jin et al., arXiv:2603.12553 -
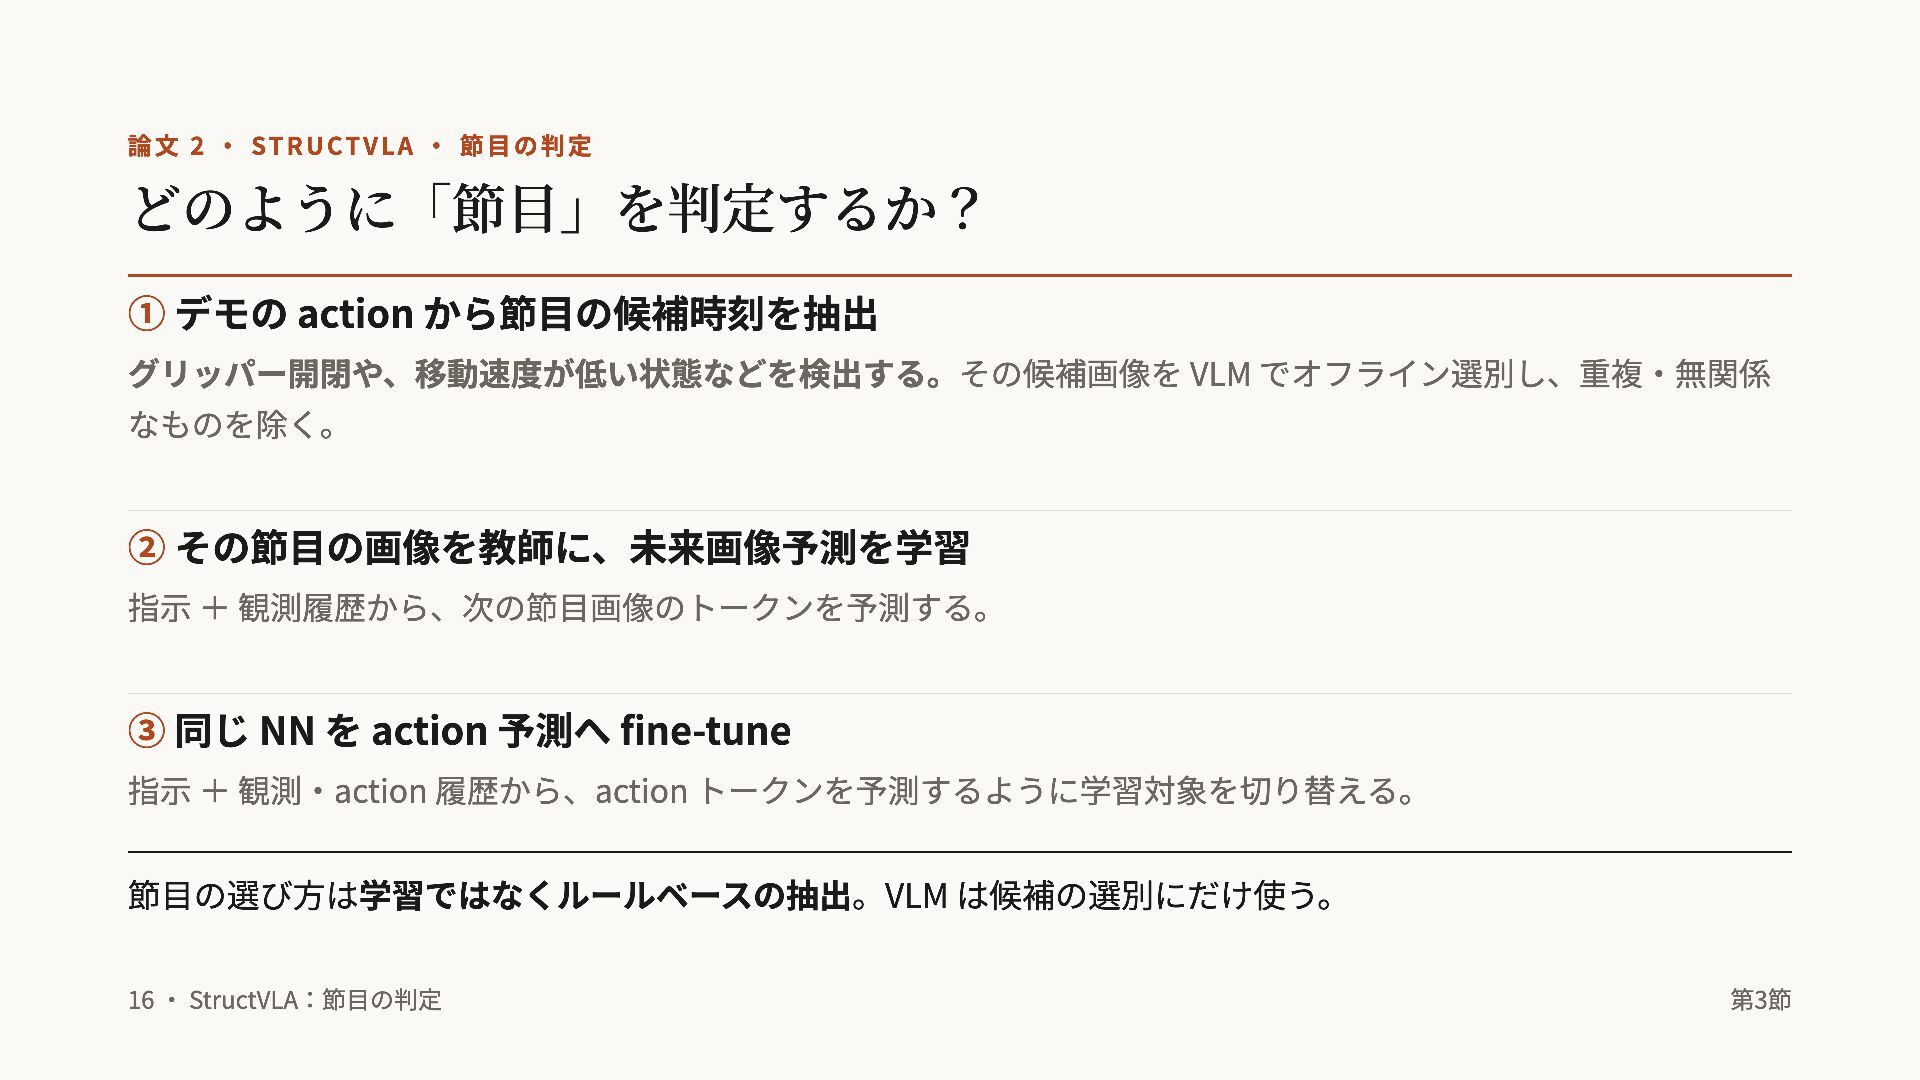
論文 2 ・ STRUCTVLA ・ 節目の判定 どのように「節目」を判定するか? ① デモの action
から節目の候補時刻を抽出 グリッパー開閉や、移動速度が低い状態などを検出する。その候補画像を VLM でオフライン選別し、重複・無関係 なものを除く。 ② その節目の画像を教師に、未来画像予測を学習 指示 + 観測履歴から、次の節目画像のトークンを予測する。 ③ 同じ NN を action 予測へ fine-tune 指示 + 観測・action 履歴から、action トークンを予測するように学習対象を切り替える。 節目の選び方は学習ではなくルールベースの抽出。VLM は候補の選別にだけ使う。 16 ・ StructVLA:節目の判定 第3節 -
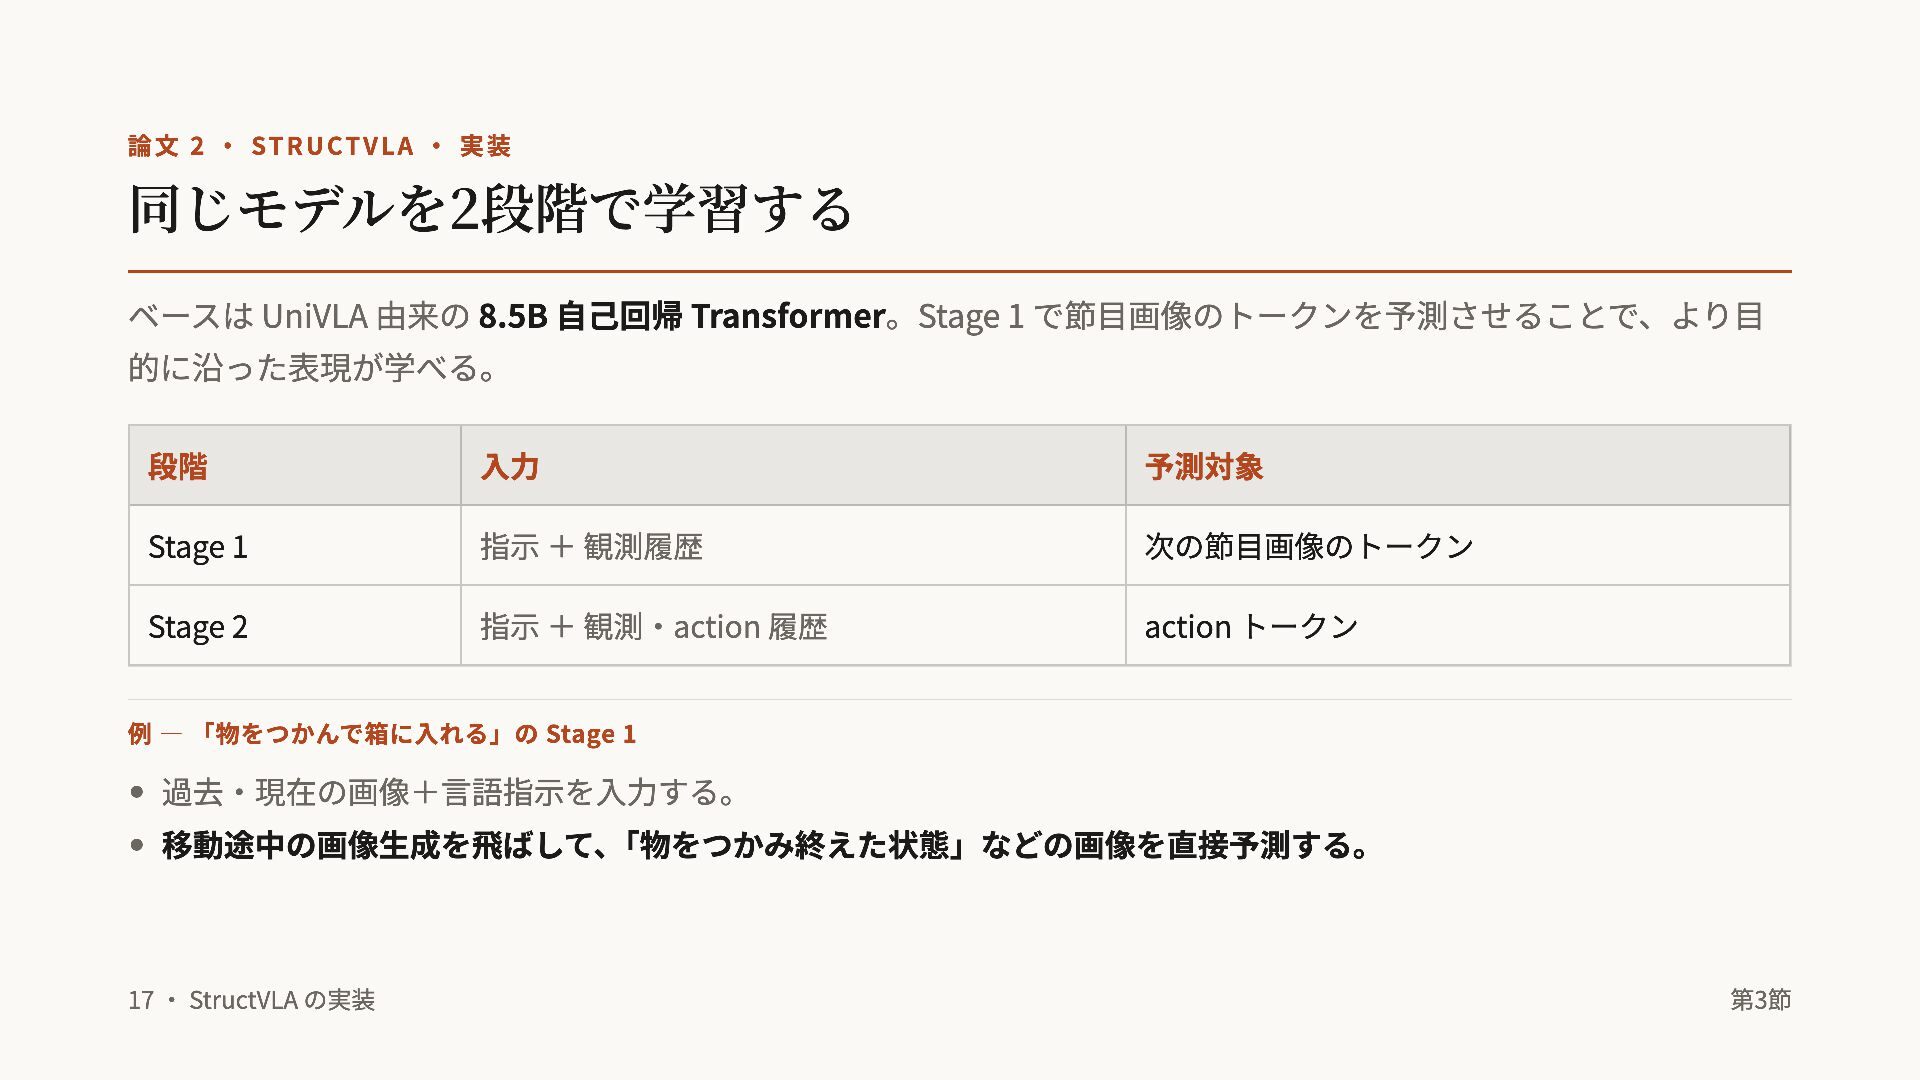
論文 2 ・ STRUCTVLA ・ 実装 同じモデルを2段階で学習する ベースは UniVLA 由来の
8.5B 自己回帰 Transformer。Stage 1 で節目画像のトークンを予測させることで、より目 的に沿った表現が学べる。 段階 入力 予測対象 Stage 1 指示 + 観測履歴 次の節目画像のトークン Stage 2 指示 + 観測・action 履歴 action トークン 例 ― 「物をつかんで箱に入れる」の Stage 1 過去・現在の画像+言語指示を入力する。 移動途中の画像生成を飛ばして、「物をつかみ終えた状態」などの画像を直接予測する。 17 ・ StructVLA の実装 第3節 -
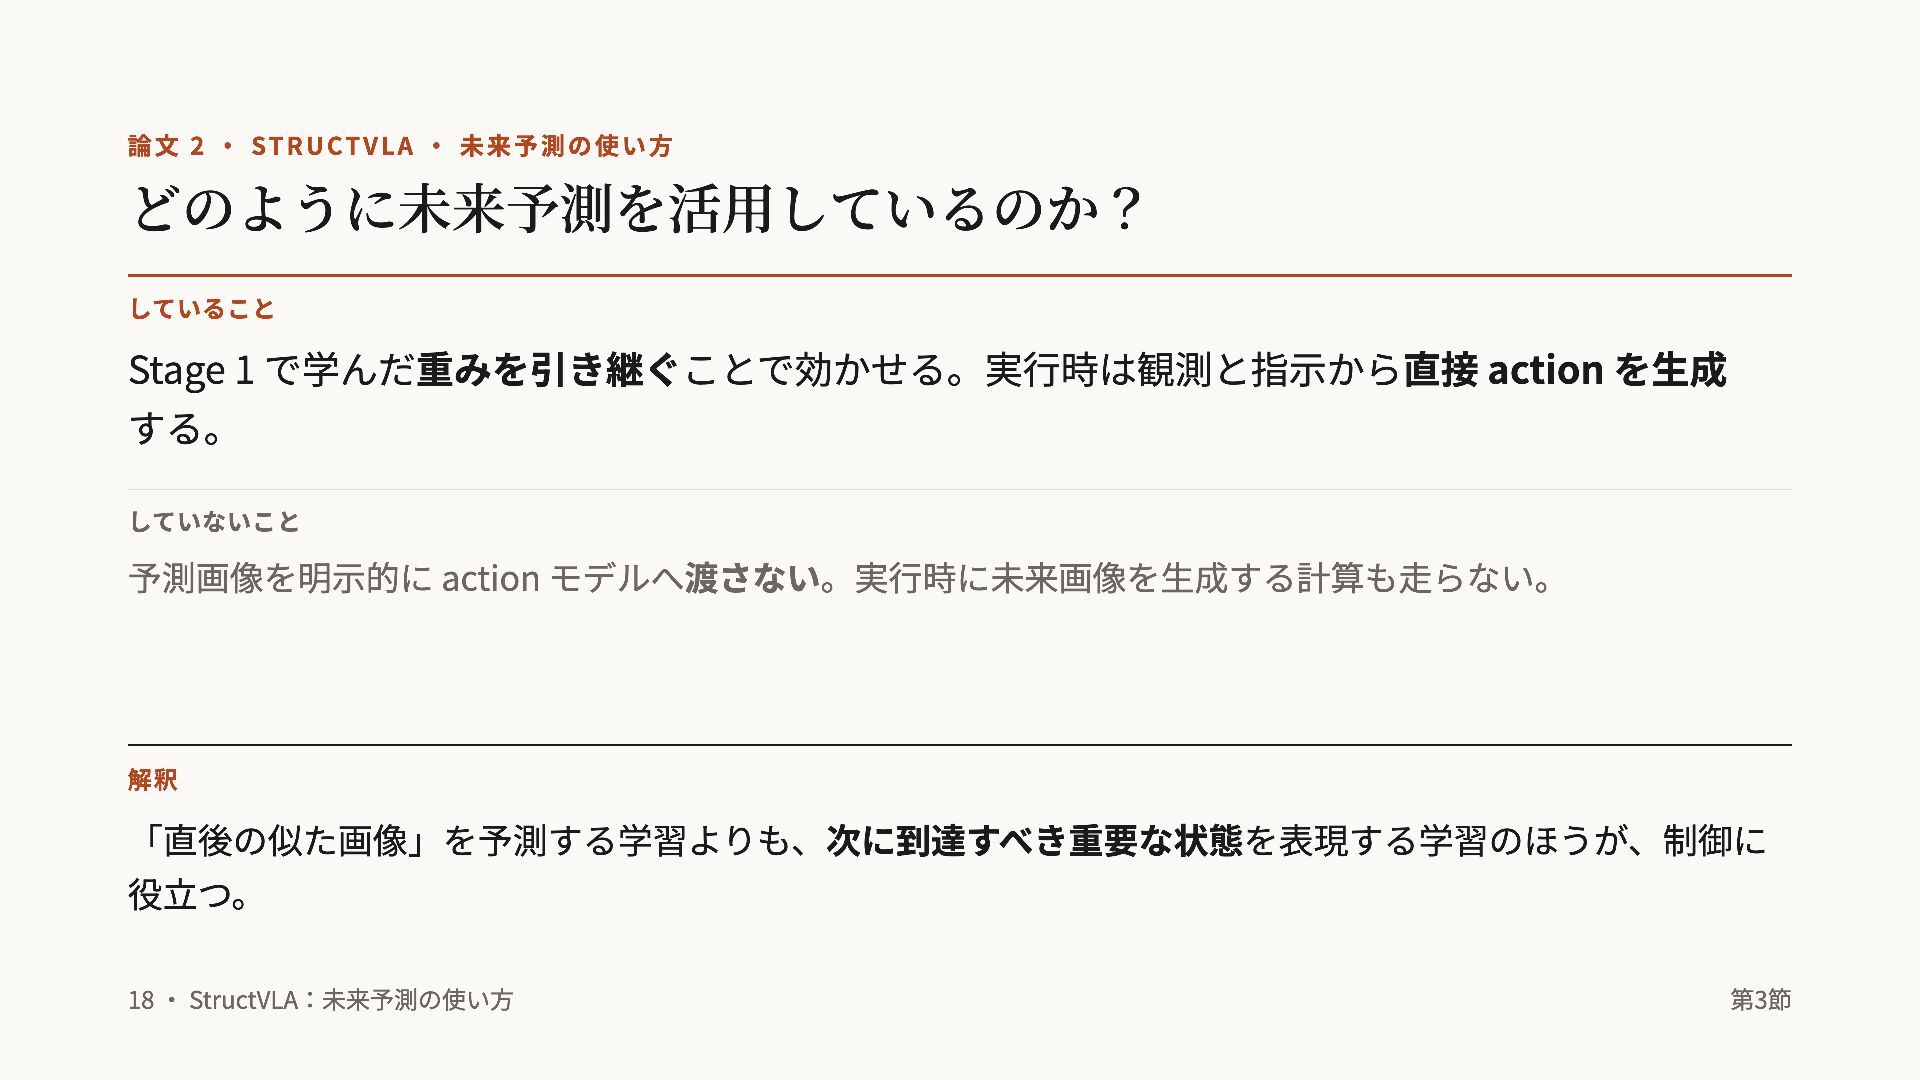
論文 2 ・ STRUCTVLA ・ 未来予測の使い方 どのように未来予測を活用しているのか? していること Stage 1
で学んだ重みを引き継ぐことで効かせる。実行時は観測と指示から直接 action を生成 する。 していないこと 予測画像を明示的に action モデルへ渡さない。実行時に未来画像を生成する計算も走らない。 解釈 「直後の似た画像」を予測する学習よりも、次に到達すべき重要な状態を表現する学習のほうが、制御に 役立つ。 18 ・ StructVLA:未来予測の使い方 第3節 -
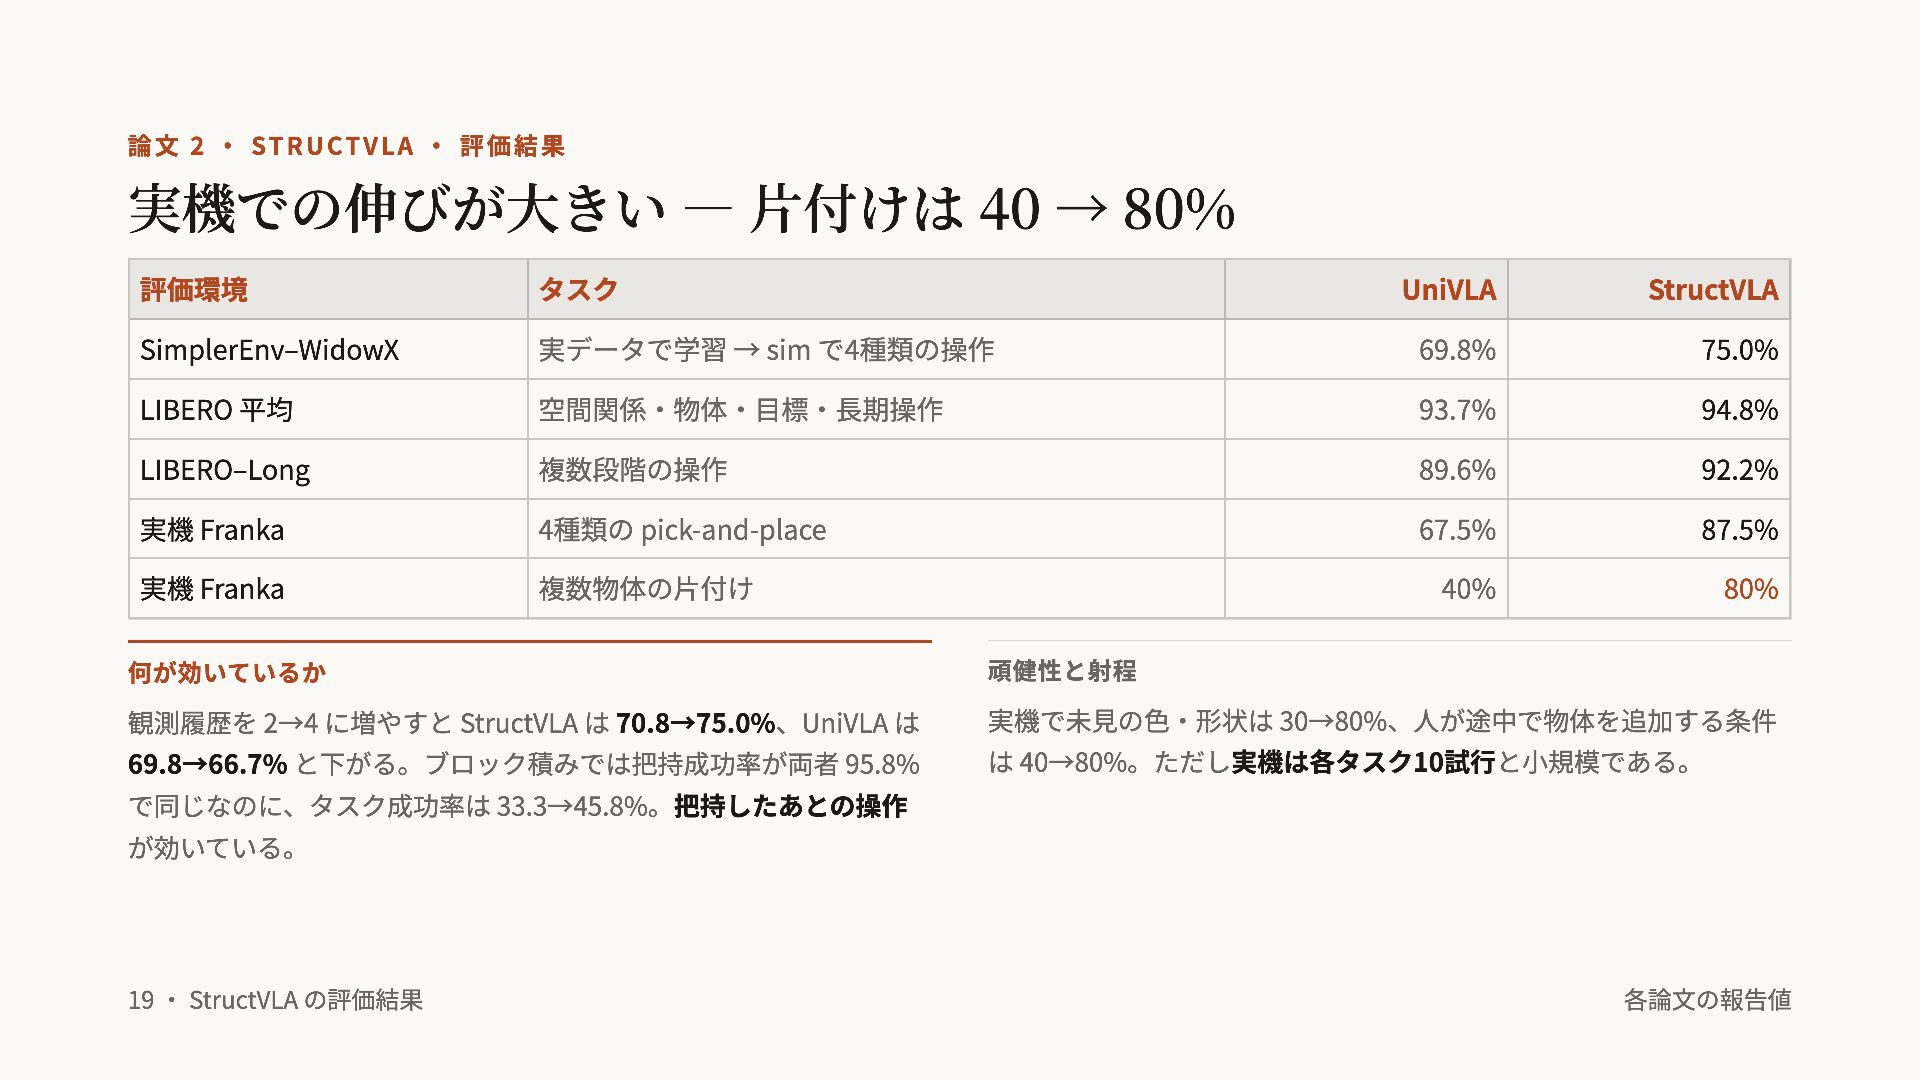
論文 2 ・ STRUCTVLA ・ 評価結果 実機での伸びが大きい ― 片付けは 40
→ 80% 評価環境 タスク UniVLA StructVLA SimplerEnv–WidowX 実データで学習 → sim で4種類の操作 69.8% 75.0% LIBERO 平均 空間関係・物体・目標・長期操作 93.7% 94.8% LIBERO–Long 複数段階の操作 89.6% 92.2% 実機 Franka 4種類の pick-and-place 67.5% 87.5% 実機 Franka 複数物体の片付け 40% 80% 何が効いているか 頑健性と射程 観測履歴を 2→4 に増やすと StructVLA は 70.8→75.0%、UniVLA は 実機で未見の色・形状は 30→80%、人が途中で物体を追加する条件 69.8→66.7% と下がる。ブロック積みでは把持成功率が両者 95.8% は 40→80%。ただし実機は各タスク10試行と小規模である。 で同じなのに、タスク成功率は 33.3→45.8%。把持したあとの操作 が効いている。 19 ・ StructVLA の評価結果 各論文の報告値 -
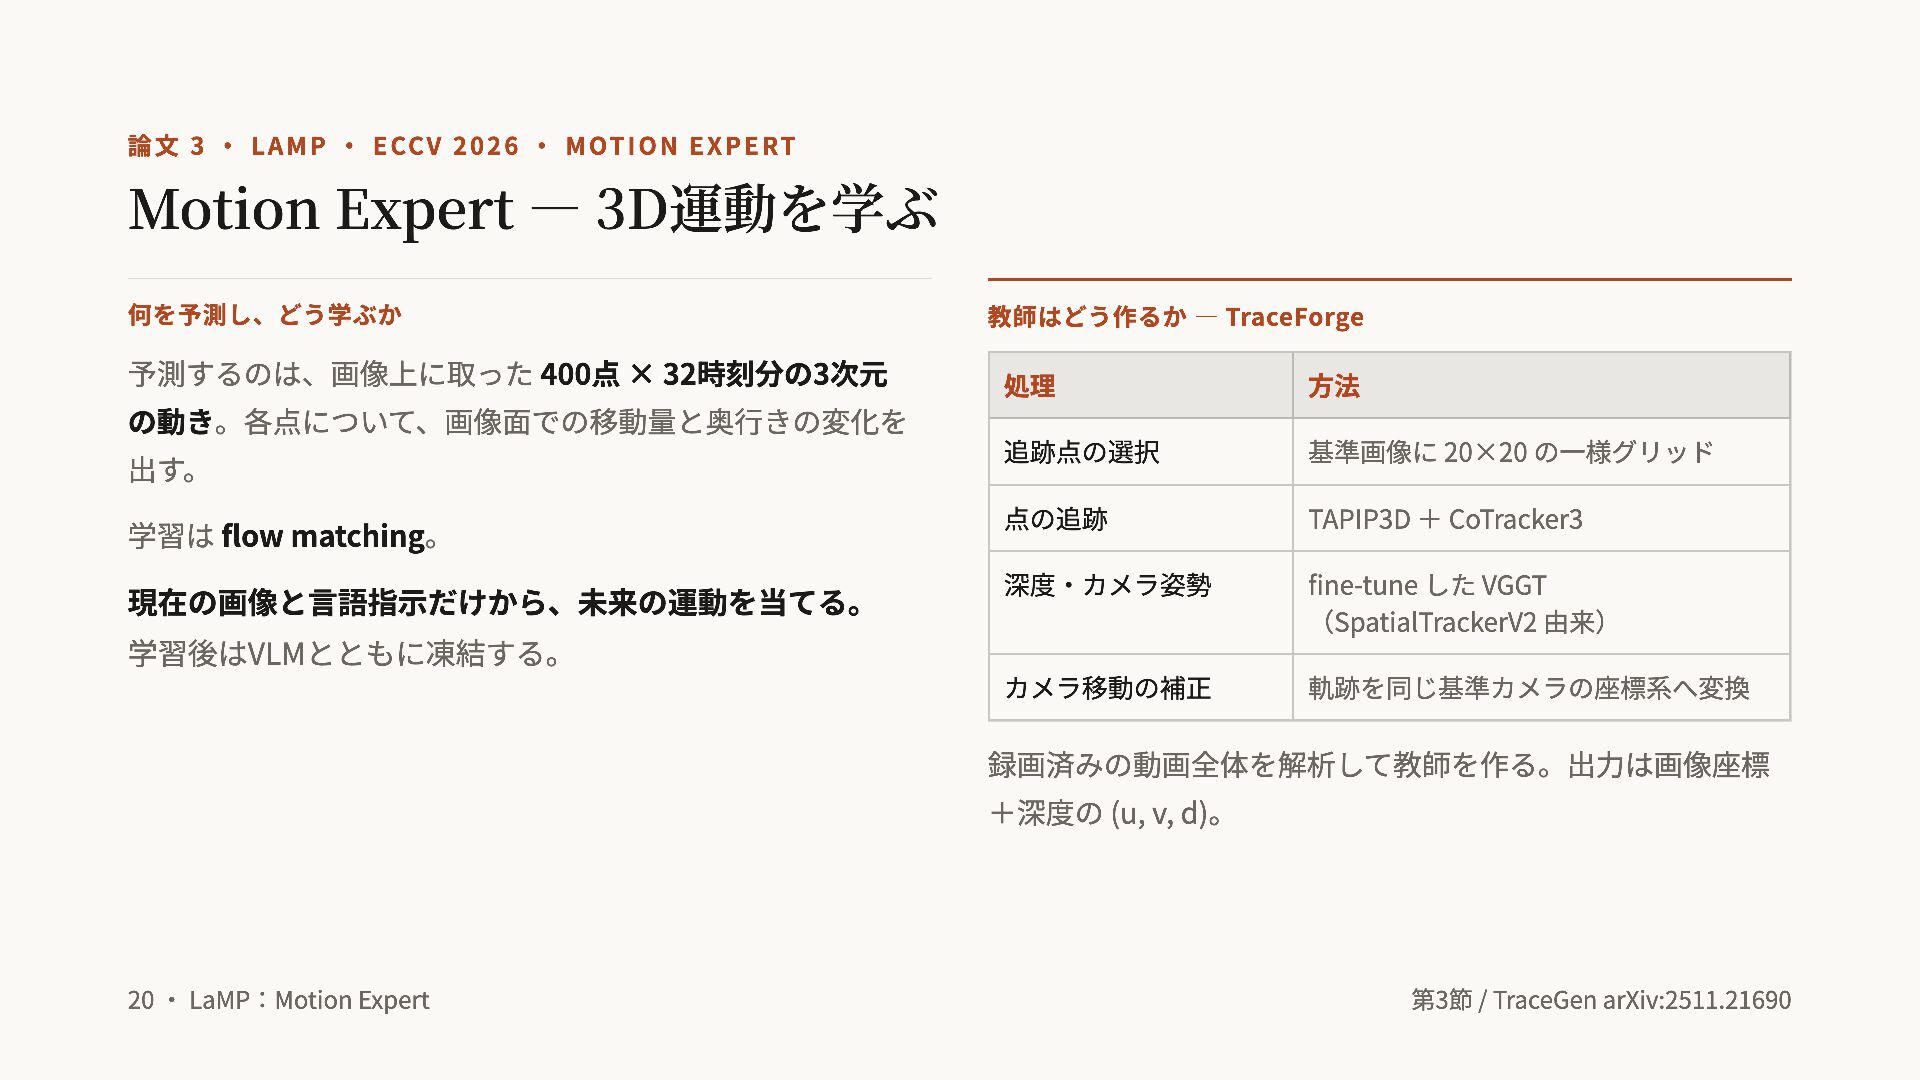
論文 3 ・ LAMP ・ ECCV 2026 ・ MOTION EXPERT
Motion Expert ― 3D運動を学ぶ 何を予測し、どう学ぶか 教師はどう作るか ― TraceForge 予測するのは、画像上に取った 400点 × 32時刻分の3次元 処理 方法 追跡点の選択 基準画像に 20×20 の一様グリッド 点の追跡 TAPIP3D + CoTracker3 深度・カメラ姿勢 fine-tune した VGGT (SpatialTrackerV2 由来) カメラ移動の補正 軌跡を同じ基準カメラの座標系へ変換 の動き。各点について、画像面での移動量と奥行きの変化を 出す。 学習は flow matching。 現在の画像と言語指示だけから、未来の運動を当てる。 学習後はVLMとともに凍結する。 録画済みの動画全体を解析して教師を作る。出力は画像座標 +深度の (u, v, d)。 20 ・ LaMP:Motion Expert 第3節 / TraceGen arXiv:2511.21690 -
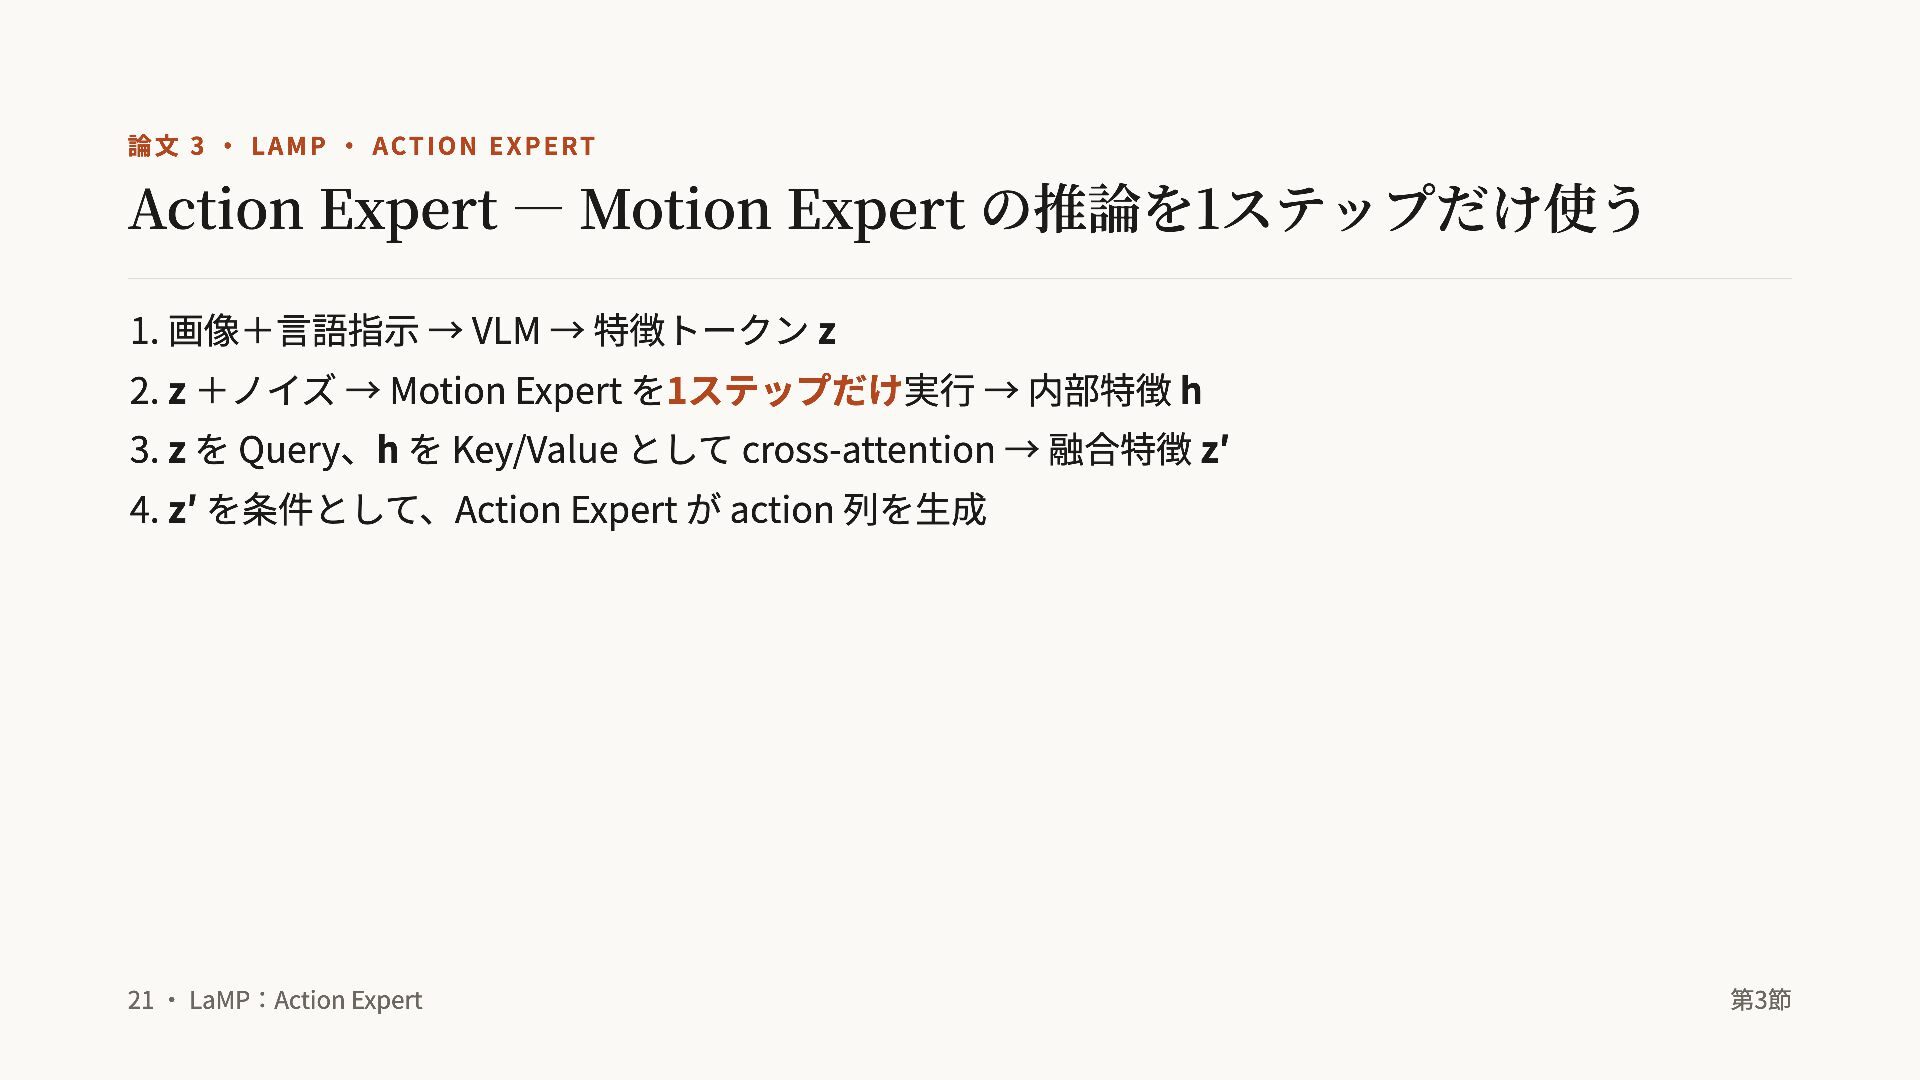
論文 3 ・ LAMP ・ ACTION EXPERT Action Expert ―
Motion Expert の推論を1ステップだけ使う 画像+言語指示 → VLM → 特徴トークン z z +ノイズ → Motion Expert を1ステップだけ実行 → 内部特徴 h z を Query、h を Key/Value として cross-attention → 融合特徴 z′ z′ を条件として、Action Expert が action 列を生成 21 ・ LaMP:Action Expert 第3節 -
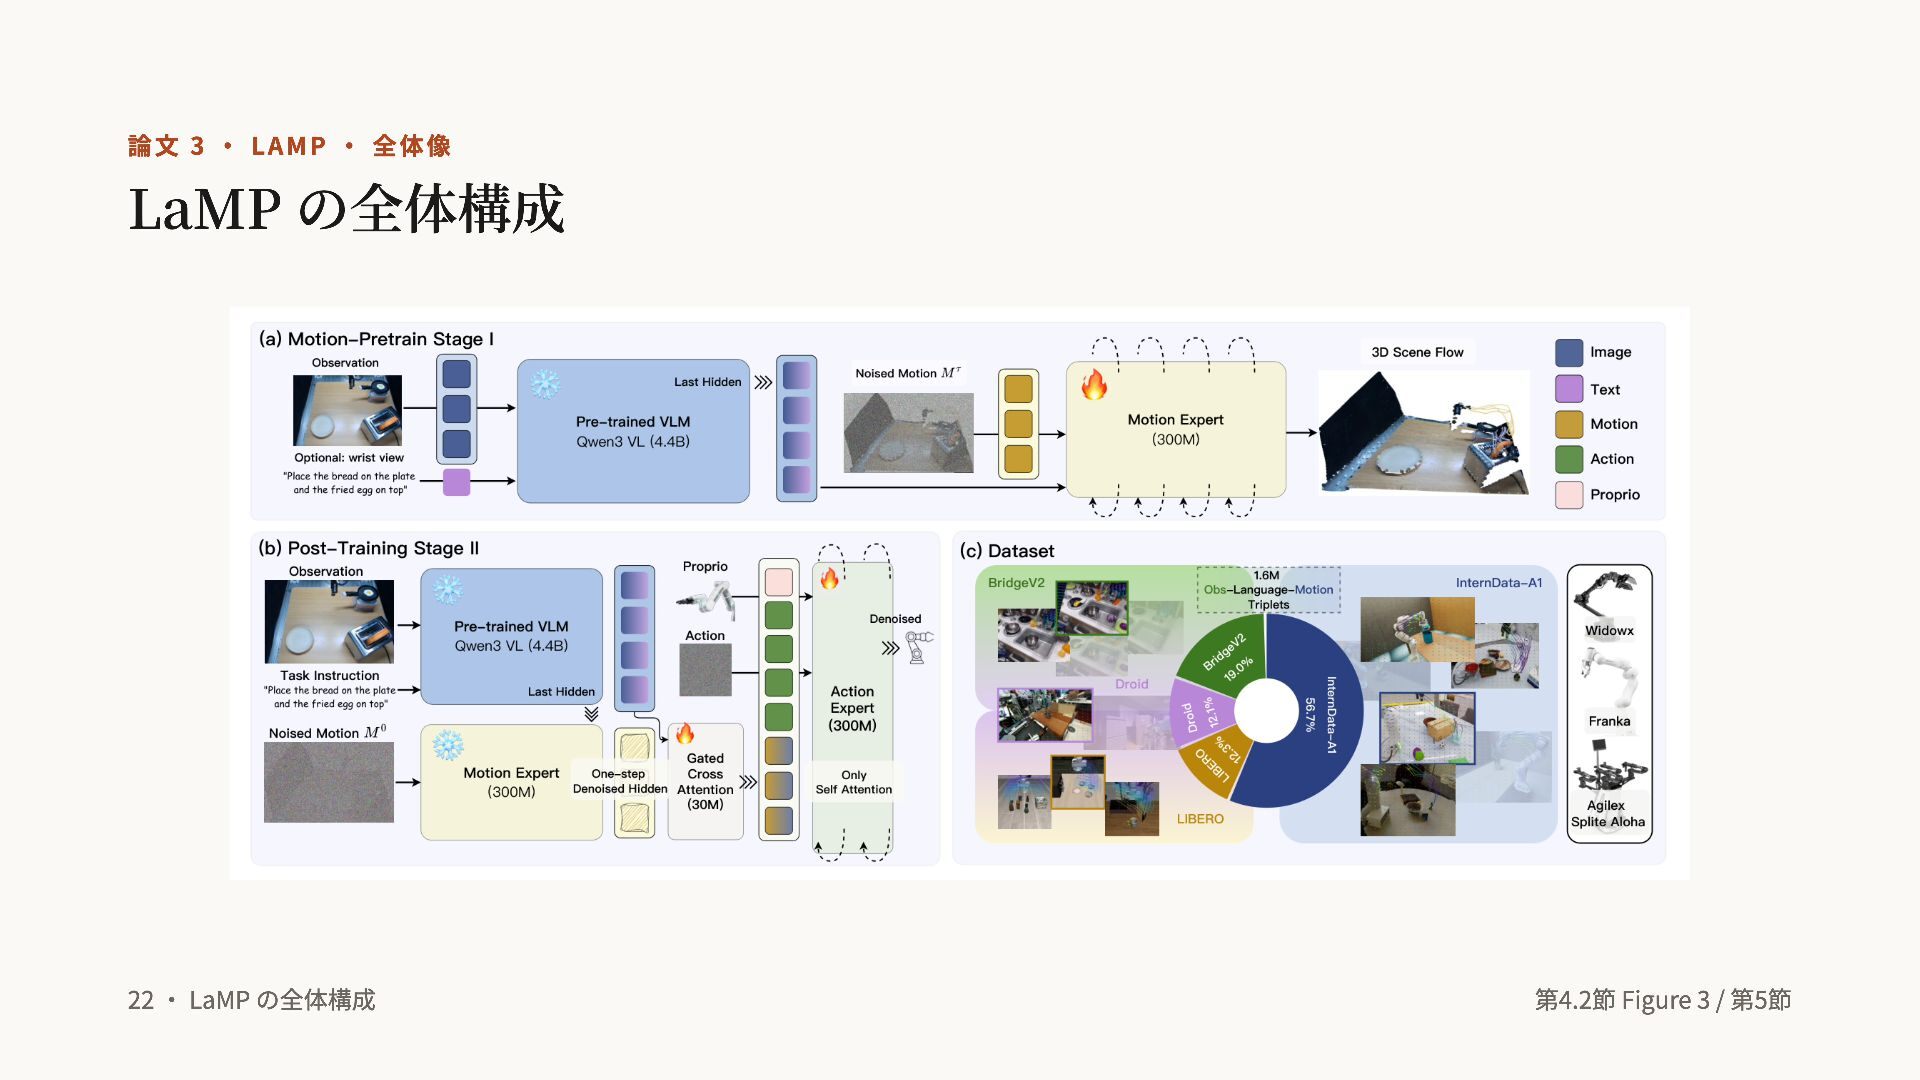
論文 3 ・ LAMP ・ 全体像 LaMP の全体構成 22 ・
LaMP の全体構成 第4.2節 Figure 3 / 第5節 -
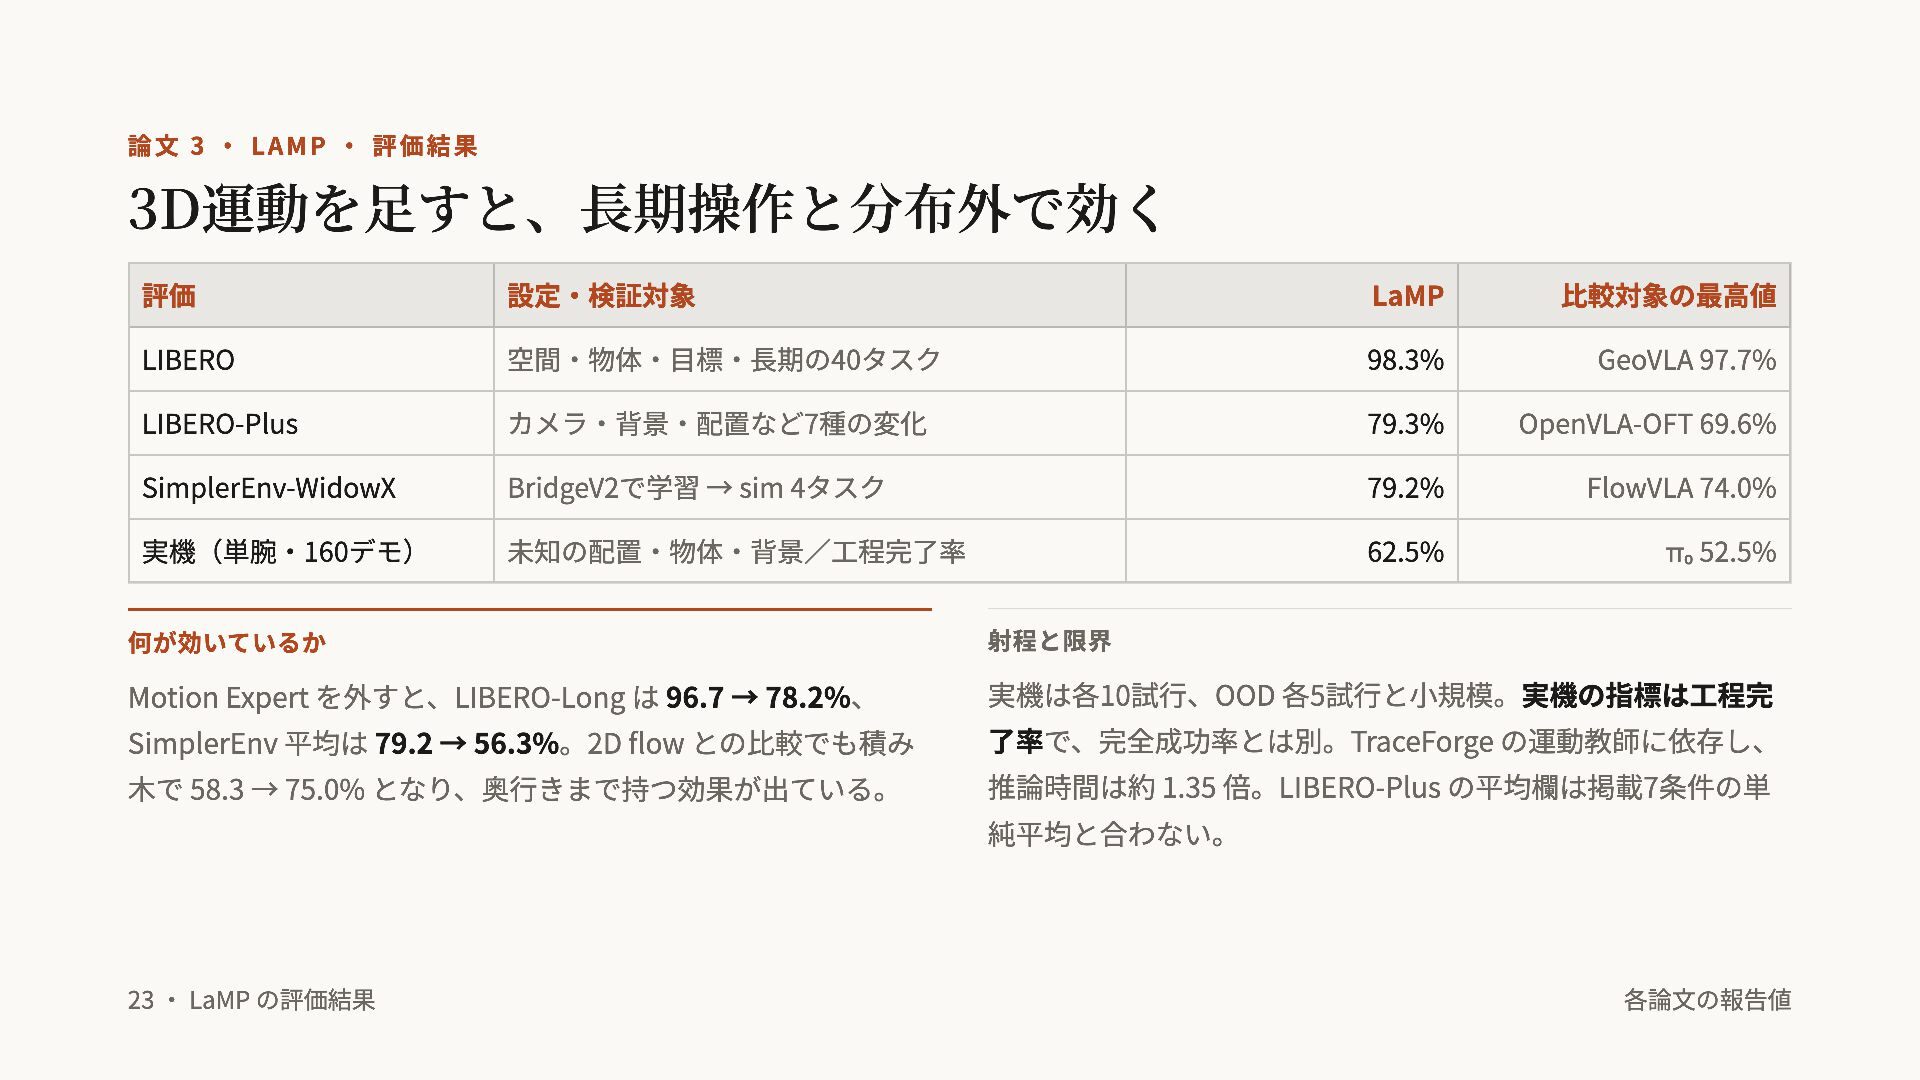
論文 3 ・ LAMP ・ 評価結果 3D運動を足すと、長期操作と分布外で効く 評価 設定・検証対象 LaMP
比較対象の最高値 LIBERO 空間・物体・目標・長期の40タスク 98.3% GeoVLA 97.7% LIBERO-Plus カメラ・背景・配置など7種の変化 79.3% OpenVLA-OFT 69.6% SimplerEnv-WidowX BridgeV2で学習 → sim 4タスク 79.2% FlowVLA 74.0% 実機(単腕・160デモ) 未知の配置・物体・背景/工程完了率 62.5% π₀ 52.5% 何が効いているか 射程と限界 Motion Expert を外すと、LIBERO-Long は 96.7 → 78.2%、 実機は各10試行、OOD 各5試行と小規模。実機の指標は工程完 SimplerEnv 平均は 79.2 → 56.3%。2D flow との比較でも積み 了率で、完全成功率とは別。TraceForge の運動教師に依存し、 木で 58.3 → 75.0% となり、奥行きまで持つ効果が出ている。 推論時間は約 1.35 倍。LIBERO-Plus の平均欄は掲載7条件の単 純平均と合わない。 23 ・ LaMP の評価結果 各論文の報告値 -
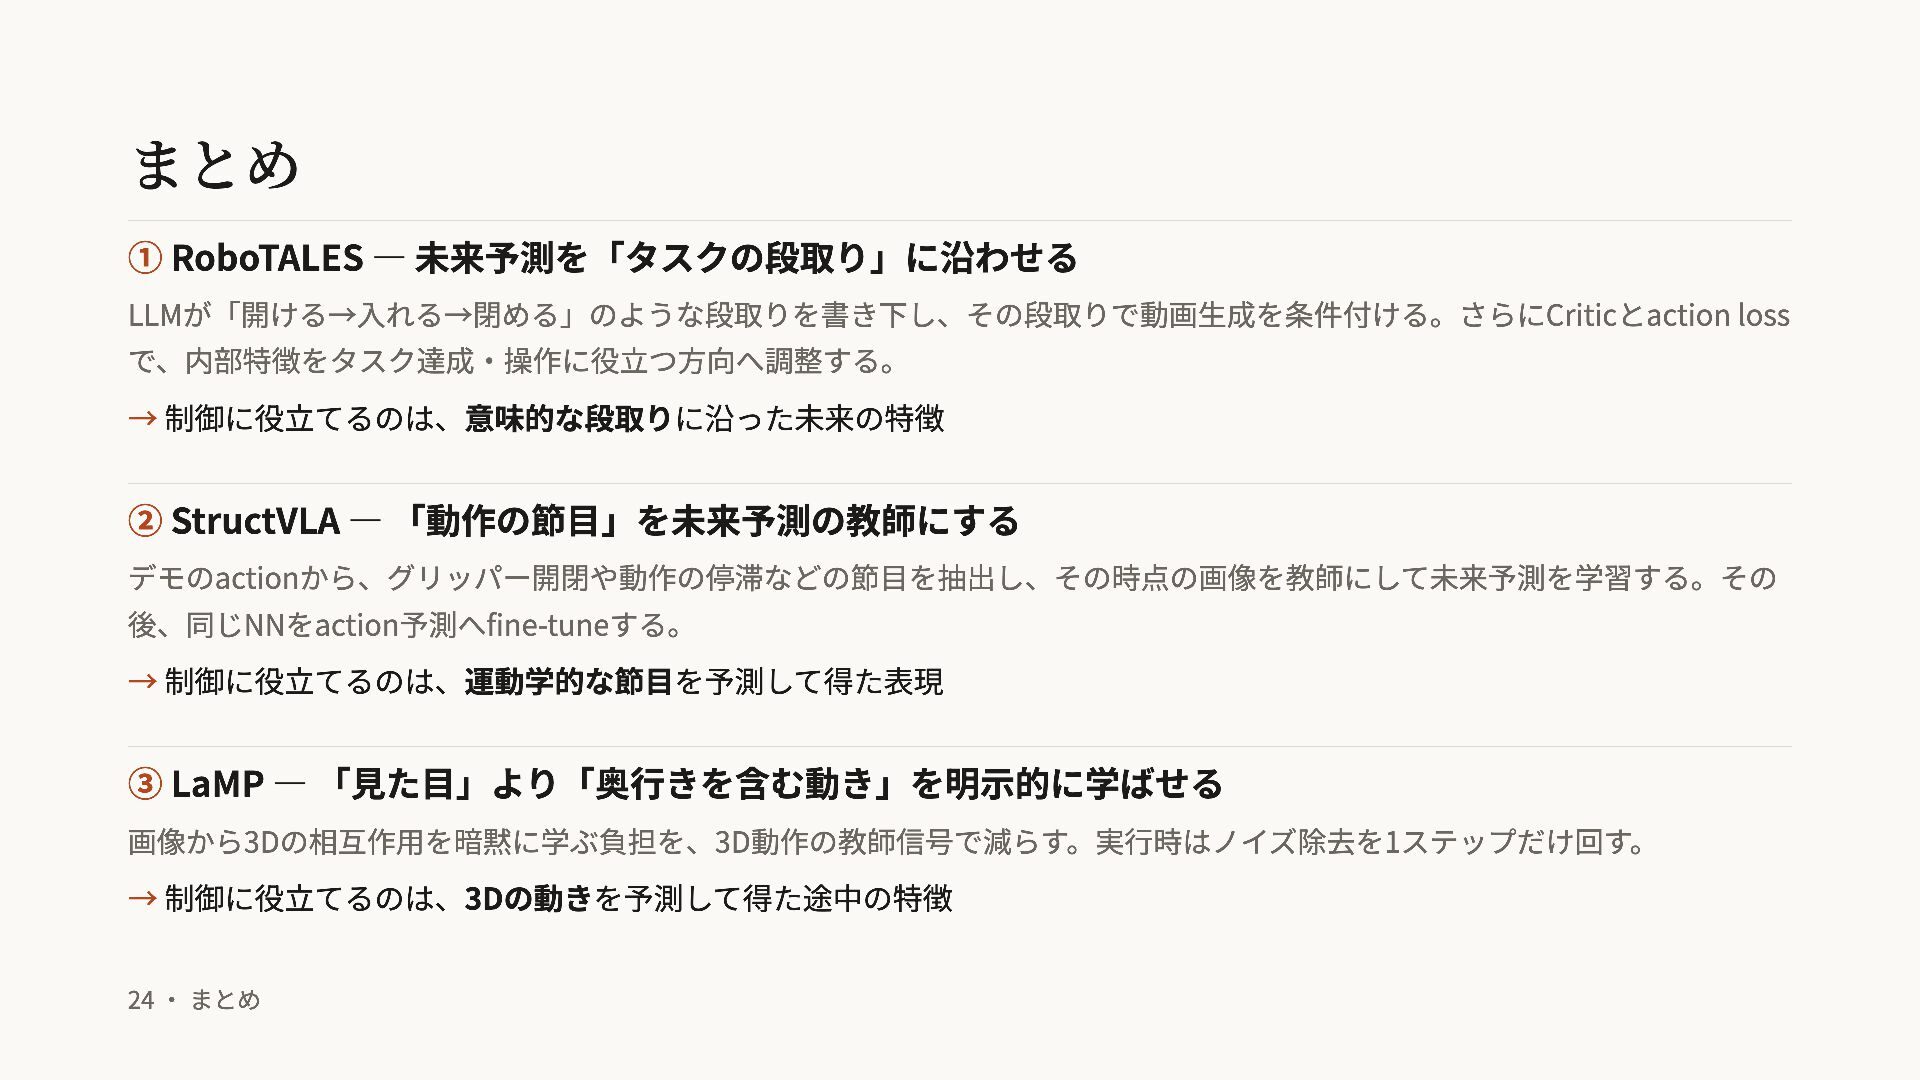
まとめ ① RoboTALES ― 未来予測を「タスクの段取り」に沿わせる LLMが「開ける→入れる→閉める」のような段取りを書き下し、その段取りで動画生成を条件付ける。さらにCriticとaction loss で、内部特徴をタスク達成・操作に役立つ方向へ調整する。 → 制御に役立てるのは、意味的な段取りに沿った未来の特徴
② StructVLA ― 「動作の節目」を未来予測の教師にする デモのactionから、グリッパー開閉や動作の停滞などの節目を抽出し、その時点の画像を教師にして未来予測を学習する。その 後、同じNNをaction予測へfine-tuneする。 → 制御に役立てるのは、運動学的な節目を予測して得た表現 ③ LaMP ― 「見た目」より「奥行きを含む動き」を明示的に学ばせる 画像から3Dの相互作用を暗黙に学ぶ負担を、3D動作の教師信号で減らす。実行時はノイズ除去を1ステップだけ回す。 → 制御に役立てるのは、3Dの動きを予測して得た途中の特徴 24 ・ まとめ -
結論 ― ロボット制御に未来の映像はどこまで必要か? 1 動画予測は教師として有益。 2 その利益は別の形で取り出せるため、画像を推論時に予測する必要性は低い(潜在表現で十分) 3 目的に合わせた予測を作る様々なアプローチが模索されているが、決定的な手法はまだ出ていない 発表者の感想
全体的に、まだ手法がごちゃごちゃしている印象。方向性としては StructVLA のようにシンプルな事前学習で効かせ るほうがスケールしそうで、Motion Expert のように3次元の点を予測するのもリーズナブルだと思う。 25 ・ 結論 -
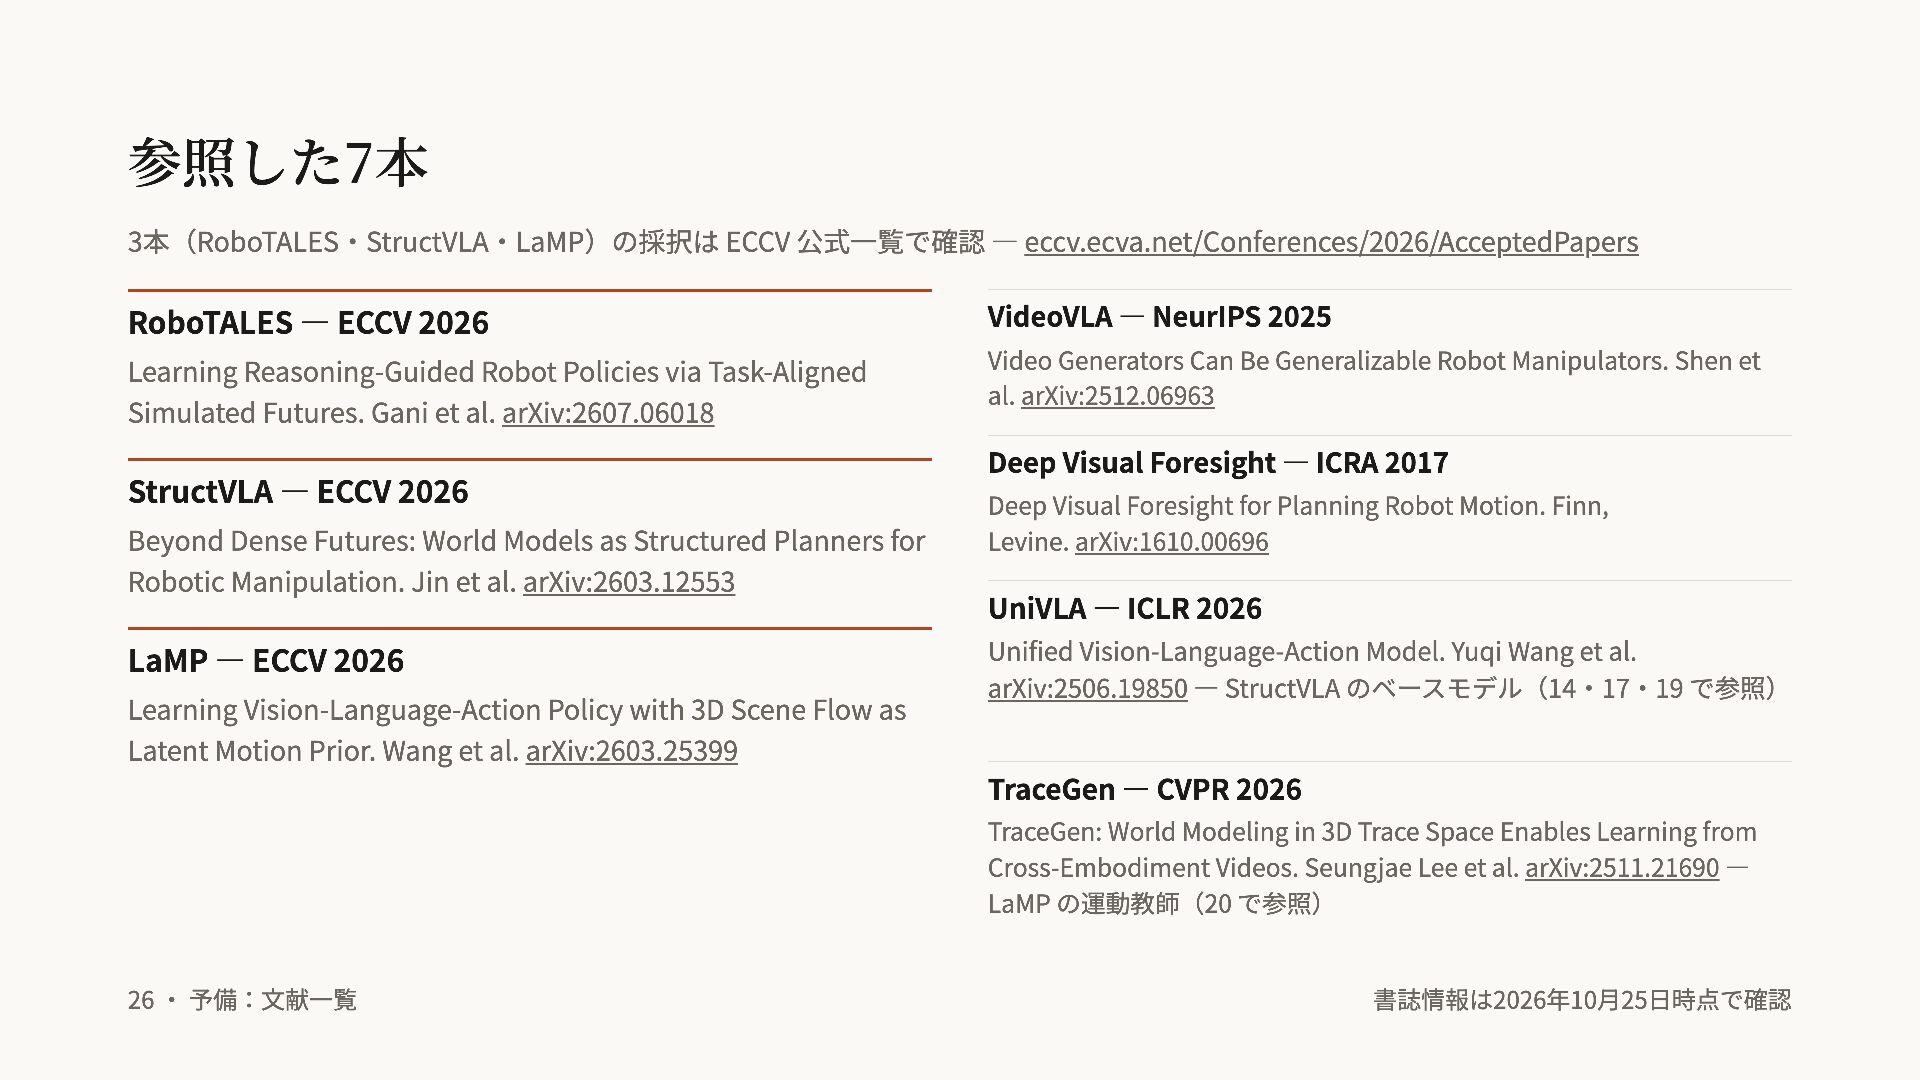
参照した7本 3本(RoboTALES・StructVLA・LaMP)の採択は ECCV 公式一覧で確認 ― eccv.ecva.net/Conferences/2026/AcceptedPapers RoboTALES ― ECCV 2026
VideoVLA ― NeurIPS 2025 Learning Reasoning-Guided Robot Policies via Task-Aligned Simulated Futures. Gani et al. arXiv:2607.06018 Video Generators Can Be Generalizable Robot Manipulators. Shen et al. arXiv:2512.06963 Deep Visual Foresight ― ICRA 2017 StructVLA ― ECCV 2026 Beyond Dense Futures: World Models as Structured Planners for Robotic Manipulation. Jin et al. arXiv:2603.12553 Deep Visual Foresight for Planning Robot Motion. Finn, Levine. arXiv:1610.00696 UniVLA ― ICLR 2026 LaMP ― ECCV 2026 Learning Vision-Language-Action Policy with 3D Scene Flow as Latent Motion Prior. Wang et al. arXiv:2603.25399 Unified Vision-Language-Action Model. Yuqi Wang et al. arXiv:2506.19850 ― StructVLA のベースモデル(14・17・19 で参照) TraceGen ― CVPR 2026 TraceGen: World Modeling in 3D Trace Space Enables Learning from Cross-Embodiment Videos. Seungjae Lee et al. arXiv:2511.21690 ― LaMP の運動教師(20 で参照) 26 ・ 予備:文献一覧 書誌情報は2026年10月25日時点で確認