Share
Embed
第61回 コンピュータビジョン勉強会@関東/CVPR2024読み会 Localization is all you evaluate data leakage in online mapping datasets and how to fix it
Fumiya Simada
August 03, 2024
Transcript
23 slides
-
論文紹介:Localization Is All You Evaluate: Data Leakage in Online Mapping
Datasets and How to Fix It 第61回 コンピュータビジョン勉強会@関東/CVPR2024読み会 @caprest 1 -
書誌情報 Adam Lilja, Junsheng Fu, Erik Stenborg, Lars Hammarstrand; Proceedings
of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2024, pp. 22150-22159 • 著者の所属はチャルマース工科大学(スウェーデン) とzenseact(volvoの完全子会社) スライド中の図表は特に言及のない限り論文から引用しています。 URL :https://openaccess.thecvf.com/content/CVPR2024/html/Lilja_Localization_Is_All_You_Evaluate_Data_Leakage_in_Online_Mapping_CVPR_2024_paper.html * 2 -
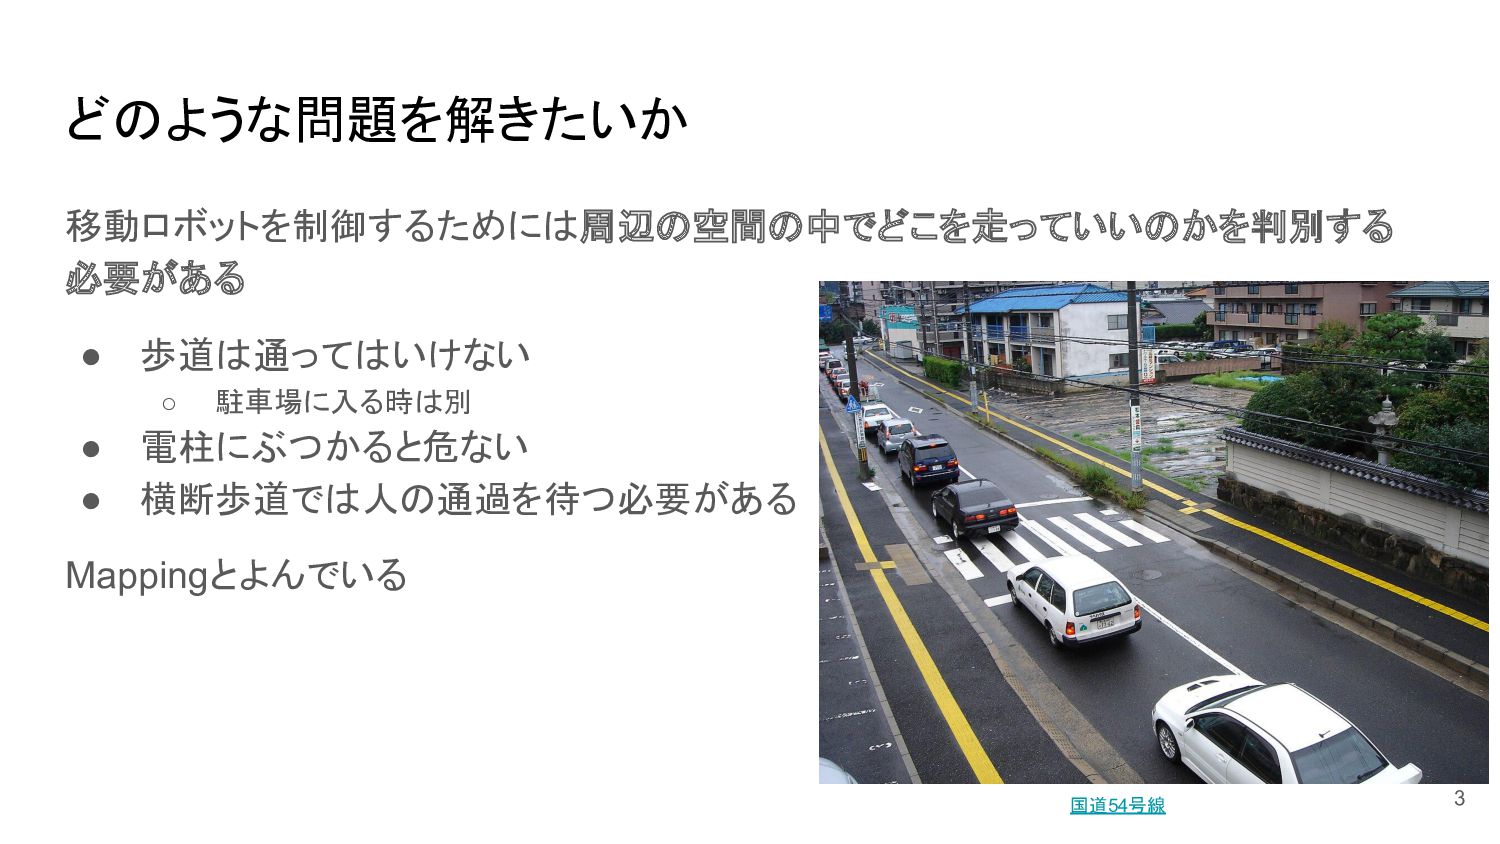
どのような問題を解きたいか 移動ロボットを制御するためには周辺の空間の中でどこを走っていいのかを判別する 必要がある • 歩道は通ってはいけない ◦ 駐車場に入る時は別 • 電柱にぶつかると危ない •
横断歩道では人の通過を待つ必要がある Mappingとよんでいる 3 国道54号線 -
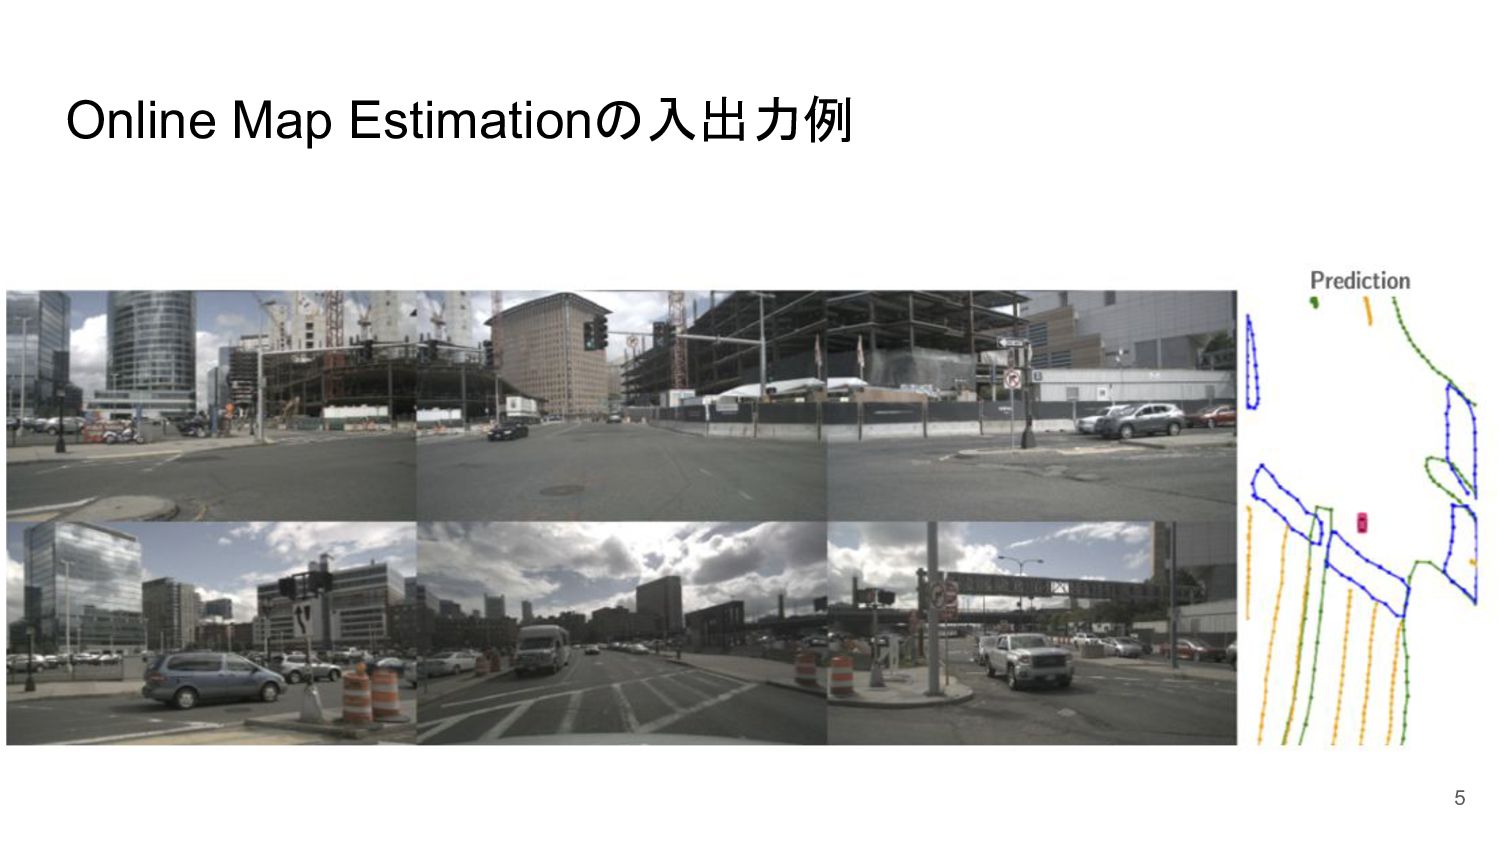
マッピングに対する二つのアプローチとは? • Online Map Retrieval ◦ 事前に構築されたマップをもとに、センサー入力から自分が地図上のどこにいるのかを判定するこ とで、周辺の情報を取得するアプローチ ◦ 地図が必要
▪ 地図に変更があったら更新が必要 ▪ 事前に地図を取得している地域でしか走れない • Online Map Estimation ◦ センサー入力から直接周辺の情報を推定する ▪ チャレンジングだが、事前の情報なしで走るためには必須 ▪ 「人間的」なアプローチ • We briefly barked up the tree of high precision lane line [maps], but decided it wasn't a good idea. -- Elon Musk 4 -
Online Mappingの二つのアプローチ • Segmentation base ◦ 空間をグリッドに分割して、それぞれを分類する( empty, lane marking,
road edge) • Vector base ◦ オブジェクト(laneline)のセットを予測する HDMapNetなど いずれの手法にしても nuScenesと Argoverse2のようなデータセットを評価に使っている 6 -
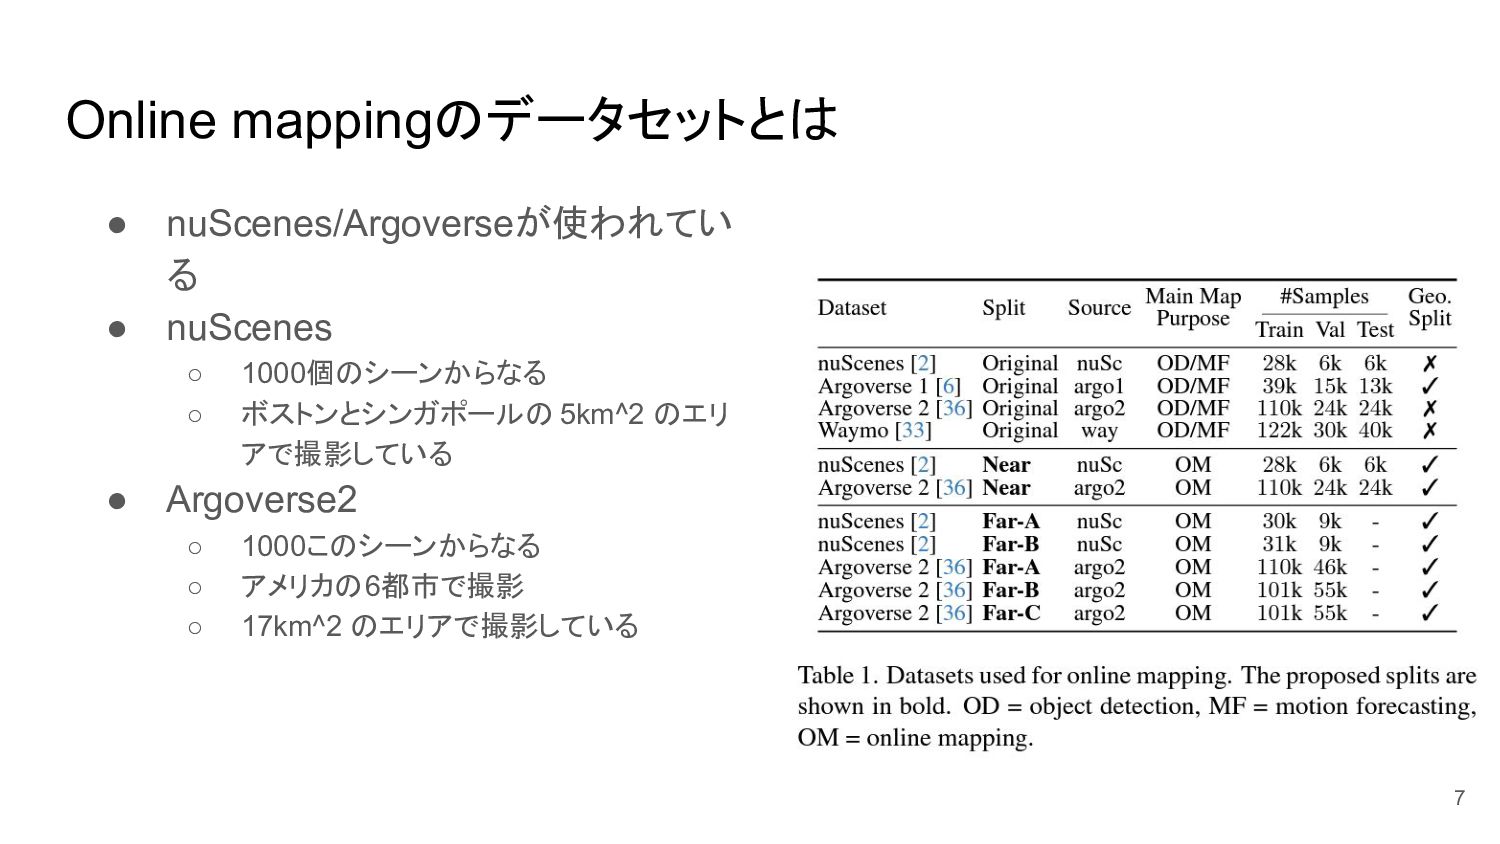
Online mappingのデータセットとは • nuScenes/Argoverseが使われてい る • nuScenes ◦ 1000個のシーンからなる ◦
ボストンとシンガポールの 5km^2 のエリ アで撮影している • Argoverse2 ◦ 1000このシーンからなる ◦ アメリカの6都市で撮影 ◦ 17km^2 のエリアで撮影している 7 -
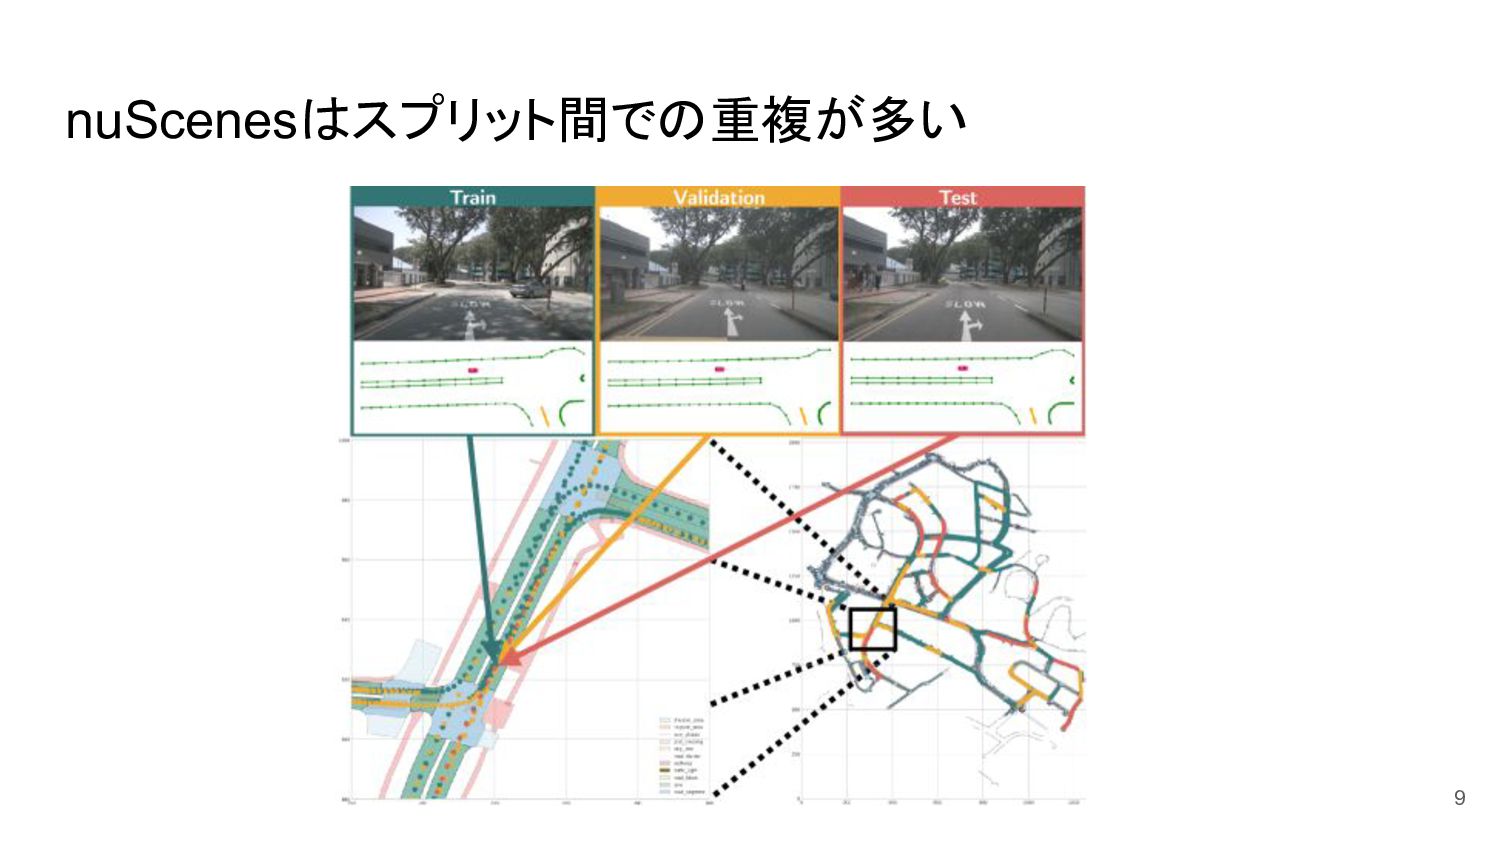
Online mapping のデータセットの問題点とは • もともと物体検出、motion predictionなど別のタスク向けに設計されているものを 使いまわしているため地理的に同じ場所が Train/Val/Testセットに含まれてしまっ ている ◦
これでは事前にmapを知っている前提の Online Map Retrieval (localization) を評価していることに なっていしまう 8 -
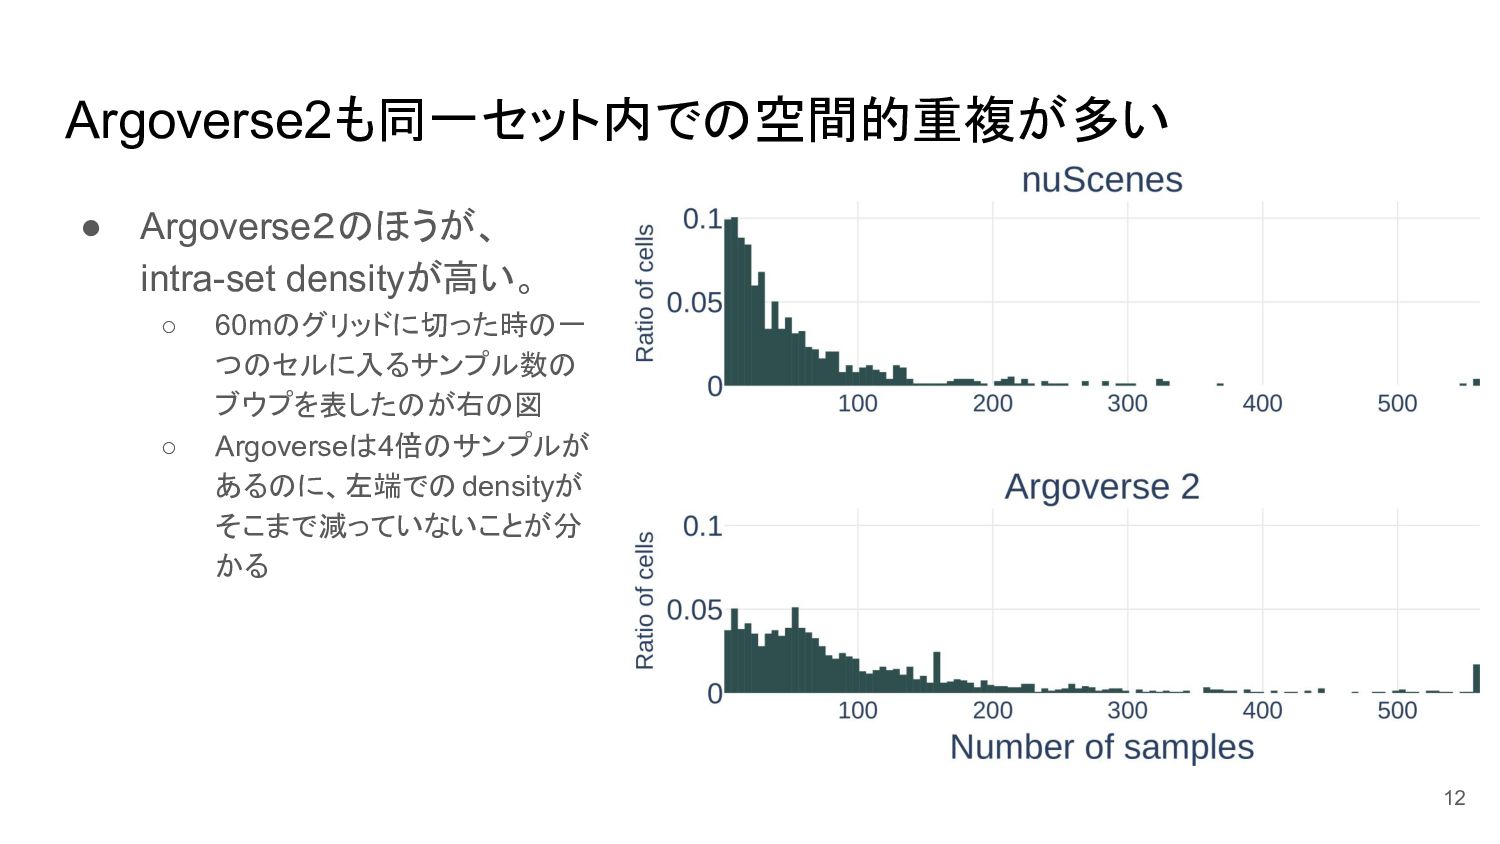
Argoverse2も同一セット内での空間的重複が多い • Argoverse2のほうが、 intra-set densityが高い。 ◦ 60mのグリッドに切った時の一 つのセルに入るサンプル数の ブウプを表したのが右の図 ◦
Argoverseは4倍のサンプルが あるのに、左端でのdensityが そこまで減っていないことが分 かる 12 -
先行研究で提案されていたスプリットは? 先行研究では、適切なtrain/val/testに分けたものを提案できていなかった • Roddick and Cipolla [2020]でこの問題は指摘されていた ◦ しかし新しいtrain/val/test を提案はしていない
◦ データ量を削減するアプローチを取ってしまっている • Qin et al. [2023]で提案されたスプリットは都市間のスプリット ◦ これだけではむずかしすぎる 13 -
本論文で新しく提唱されたスプリットとは? 本論文では地理的に分離された二つのスプリットを提案して公開している 1. Near Extropolation a. 地理的にある程度近接したマップを予測させるように設計されたスプリット b. zone クラス(住宅エリアか、工場エリアカなど)
,物体の出現頻度、天気、時間帯などの要素の分布 が一致するように分割した 2. Far Extrapolation a. 都市ごとに分割されたスプリットよりチャレンジング b. 元々の都市の分布に偏りがあったためクロスバリデーション用に複数に分割して公開している 14 -
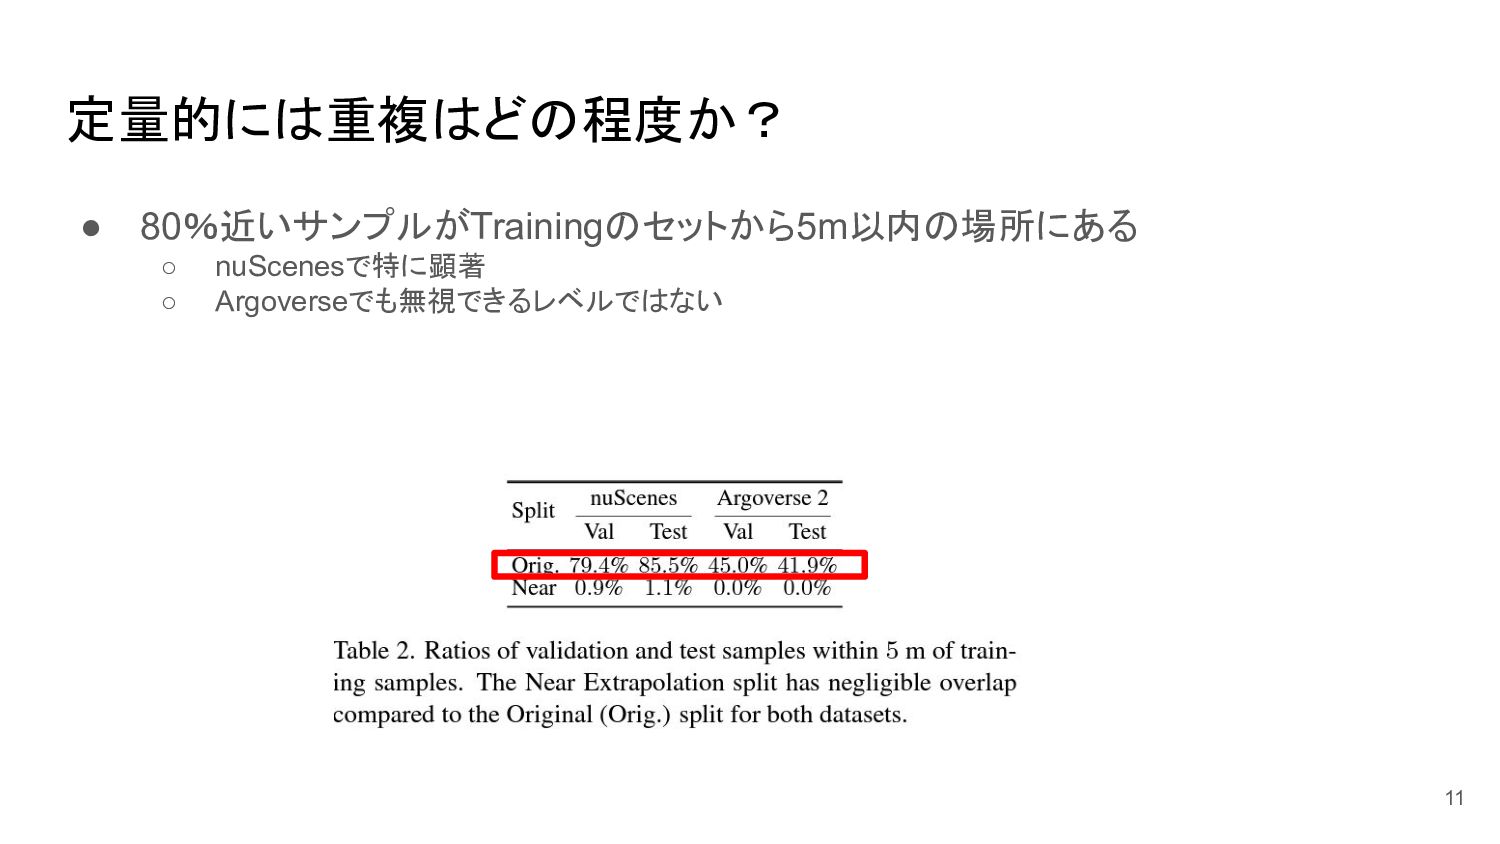
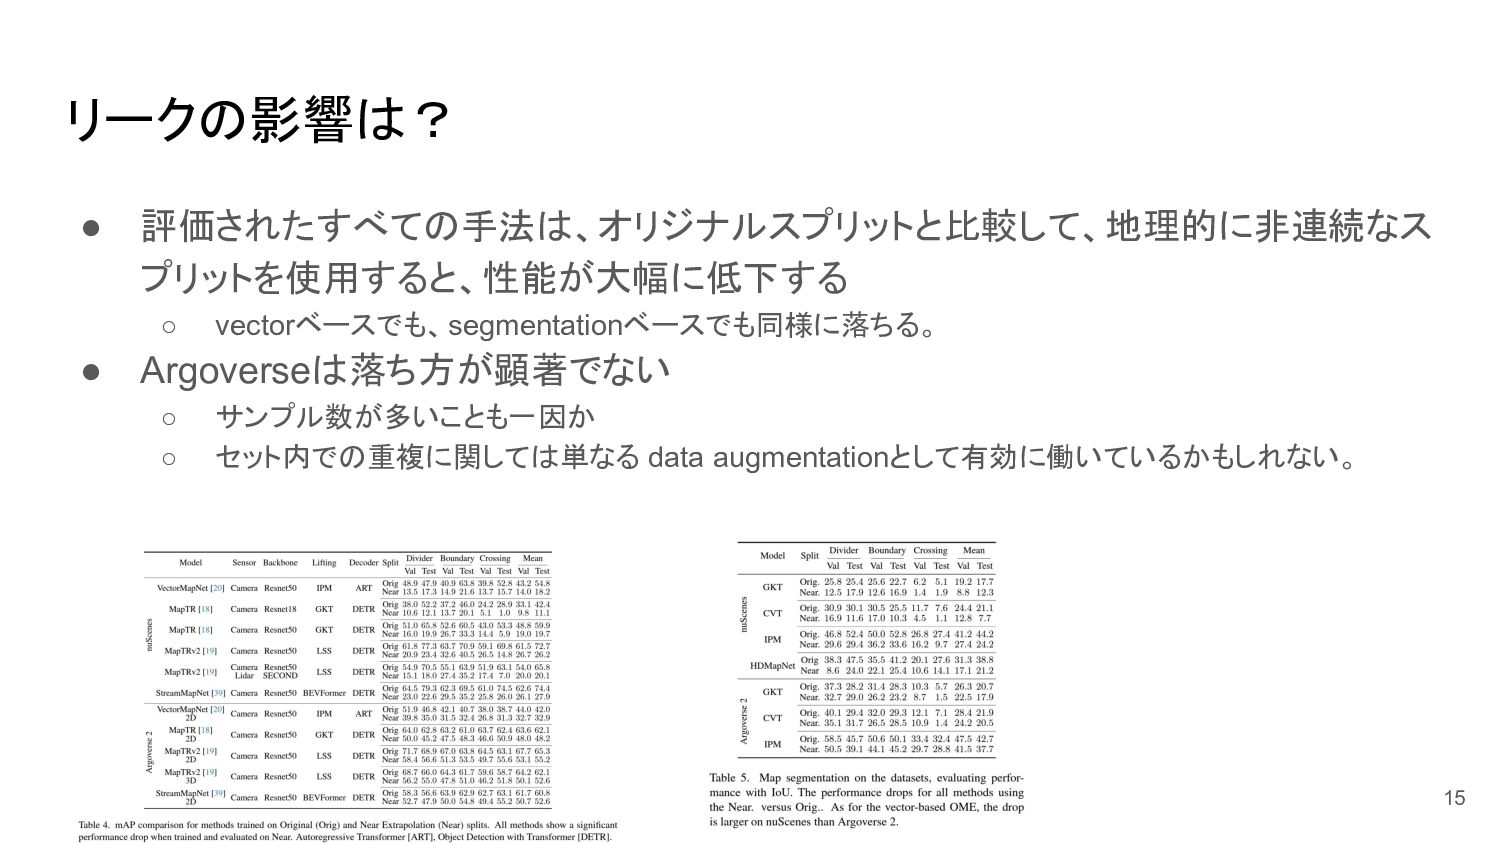
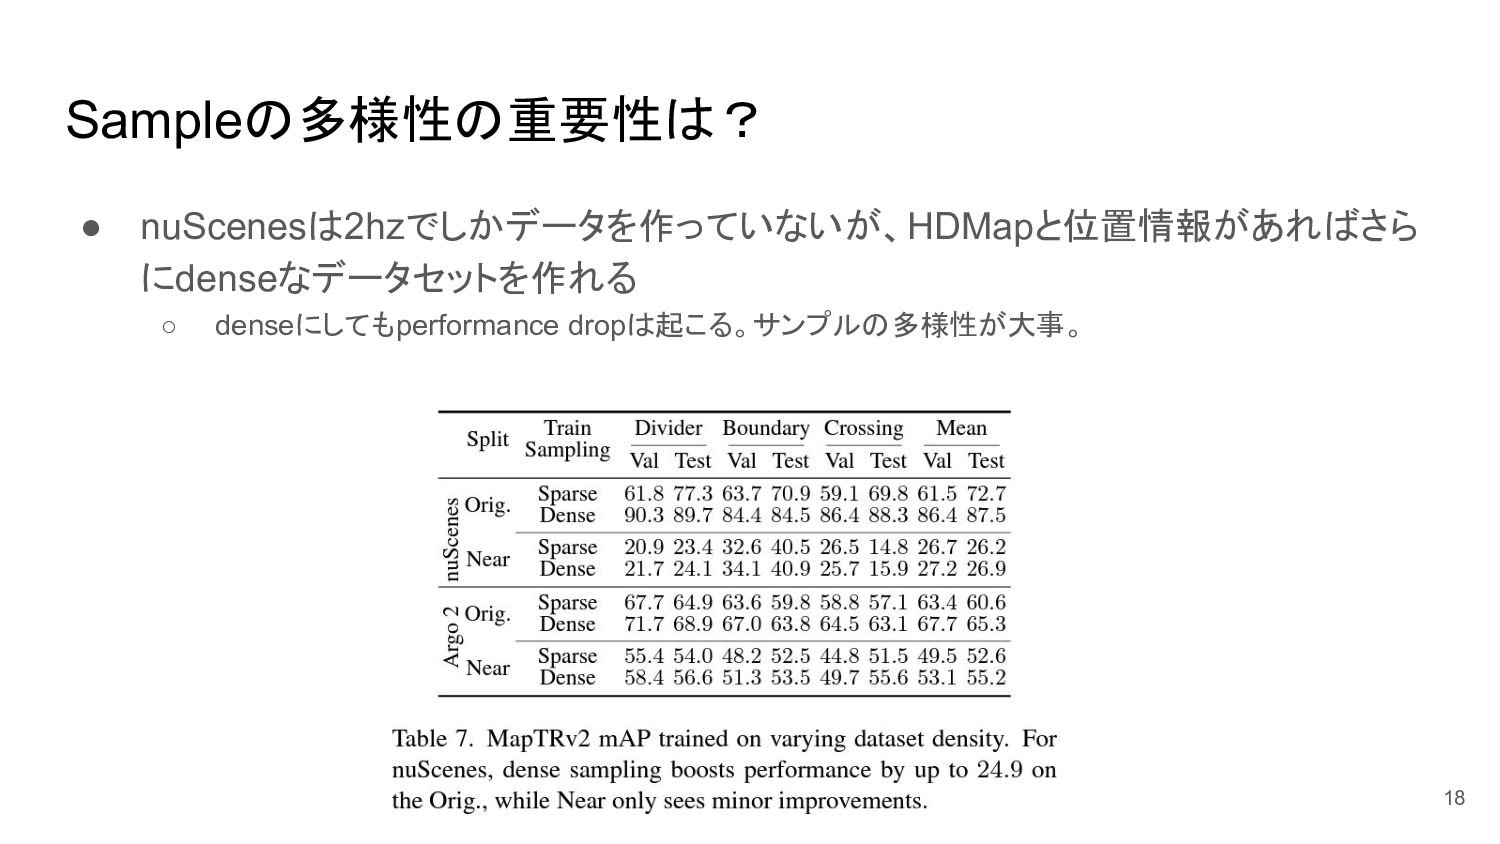
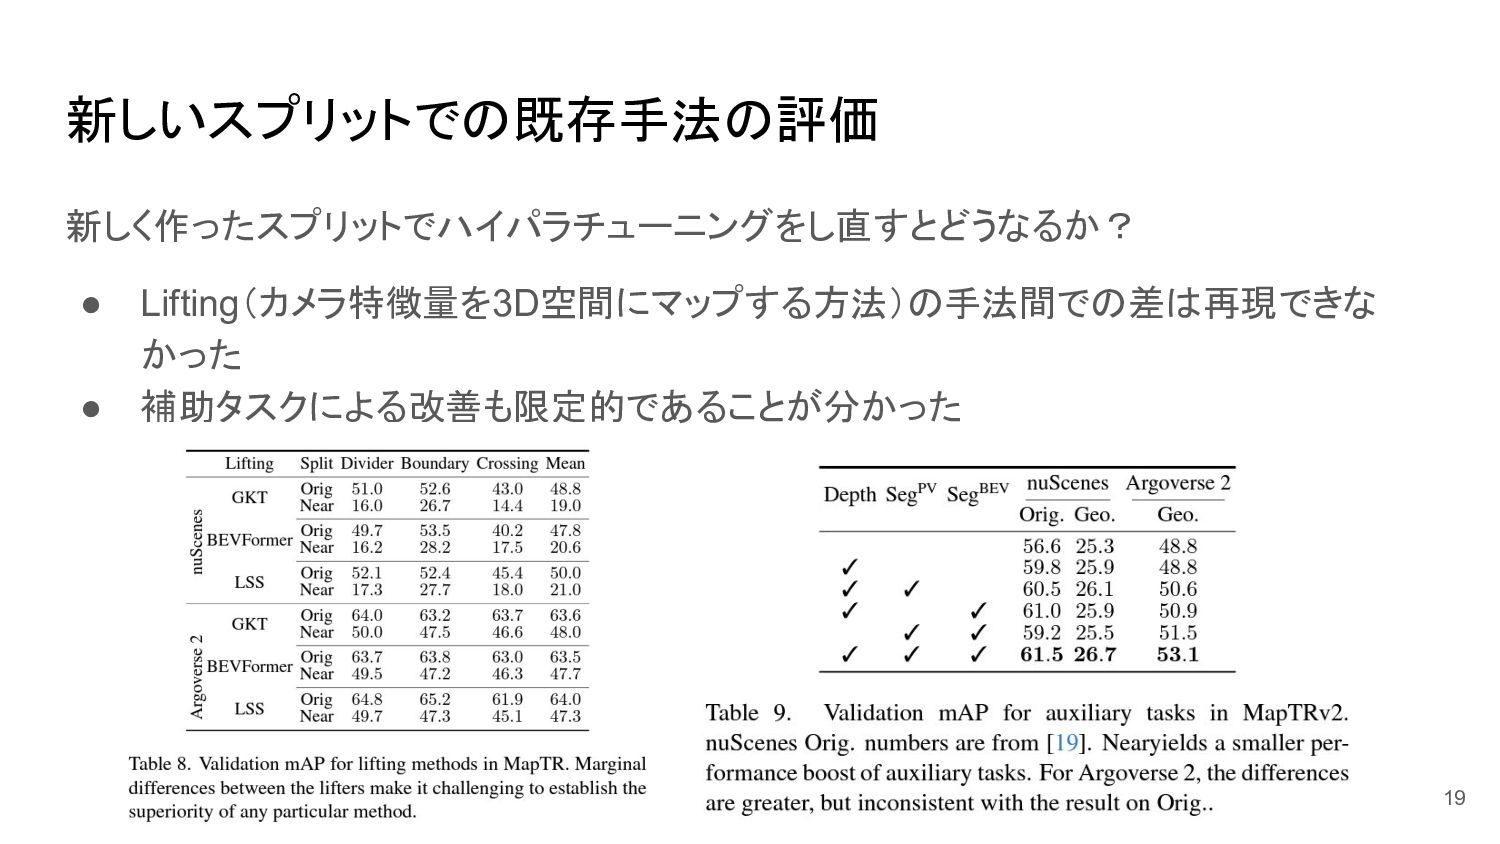
リークの影響は? • 評価されたすべての手法は、オリジナルスプリットと比較して、地理的に非連続なス プリットを使用すると、性能が大幅に低下する ◦ vectorベースでも、segmentationベースでも同様に落ちる。 • Argoverseは落ち方が顕著でない ◦ サンプル数が多いことも一因か
◦ セット内での重複に関しては単なる data augmentationとして有効に働いているかもしれない。 15 -
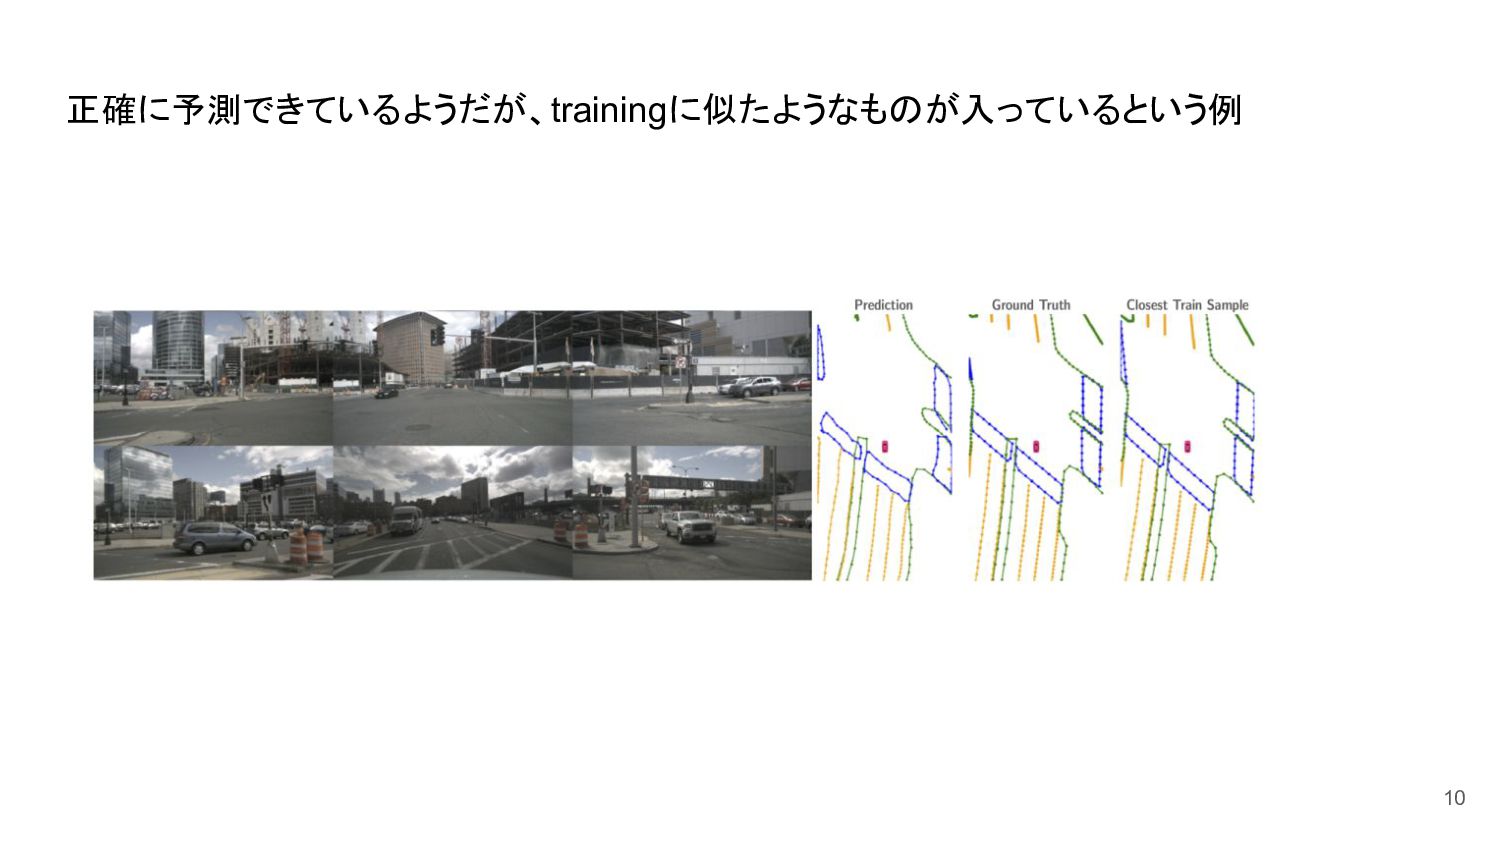
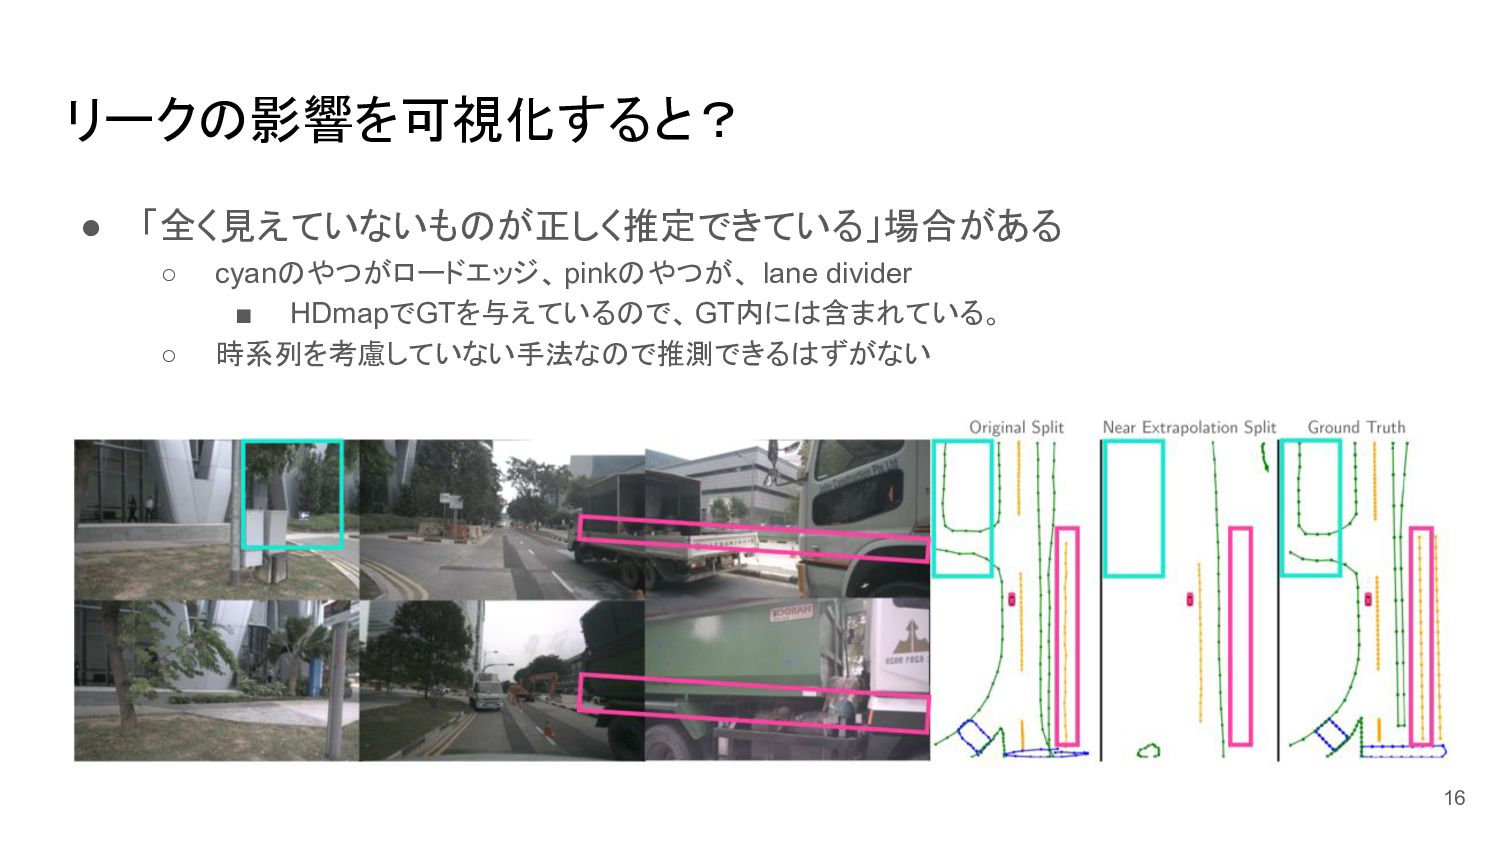
リークの影響を可視化すると? • 「全く見えていないものが正しく推定できている」場合がある ◦ cyanのやつがロードエッジ、 pinkのやつが、 lane divider ▪ HDmapでGTを与えているので、GT内には含まれている。
◦ 時系列を考慮していない手法なので推測できるはずがない 16 -
(分からなかったこと) • 様々な要素を均等になるように分割したと行っているが、そのための手法はあまり よく分からなかった ◦ 均等に分割したい様々な要素を考え始めると、大抵サンプルが足りないことになりがち ▪ 例えば urbanで、pedestrianが二人以上で、雨で 17時台のようなサンプルは
1000シーンの中 にはそこまでたくさん含まれていないはず ◦ 全ての組み合わせを考えることもできないので ◦ (個人的にはシーンをベクトル化する技術が重要かなと思っている) 20 -
感想:評価指標で何を評価しているのかに自覚的になるべき • 「グッドハートの法則」(Goodhart's Law) ◦ 「ある指標が目標として使われ始めると、それはもはや良い指標ではなくなる」 • LLMで毎週のようにSoTAが出ているが本当にGPT-3 -> GPT-4
レベルのジャンプ を感じられているかというと ……? ◦ SoTAでもつかってみないとよくわからないことがある ▪ 手軽に試せるUIとかも大切 • 実際に使ってみないと分からない所も多い ▪ 実際のサンプルで可視化することも大切 ◦ 本論文では指摘されていないが mAPなどの数値指標の妥当性も随時検討すべき ▪ あなたの最適化している評価指標をスクラッチで実装できますか? 21 -
ポエム:そもそも自動運転にMapping は必要か? • 様々なタスクを正確に評価するのは本当に大変 ◦ データセット構築一つとってもかなり大変だし、罠も多い • The parable of
the parser ◦ https://drive.google.com/file/d/1VodGljuEhBKwZIXQwN-ApH6g2wBAVAdK/view ◦ “ Identify your real tasks” • End to End というので何とかしてくれるらしい • Vapnikの原理 ◦ 「ある問題を解くとき,その問題よりも難しい問題を途中段階で解いてはならない」 22 -
まとめ • Online mapping Estimationにおけるデータセットの既存のsplitには大きな問題が ある ◦ 殆ど同じ場所がTrain/Validation / Testで含まれてしまっていることが分かった
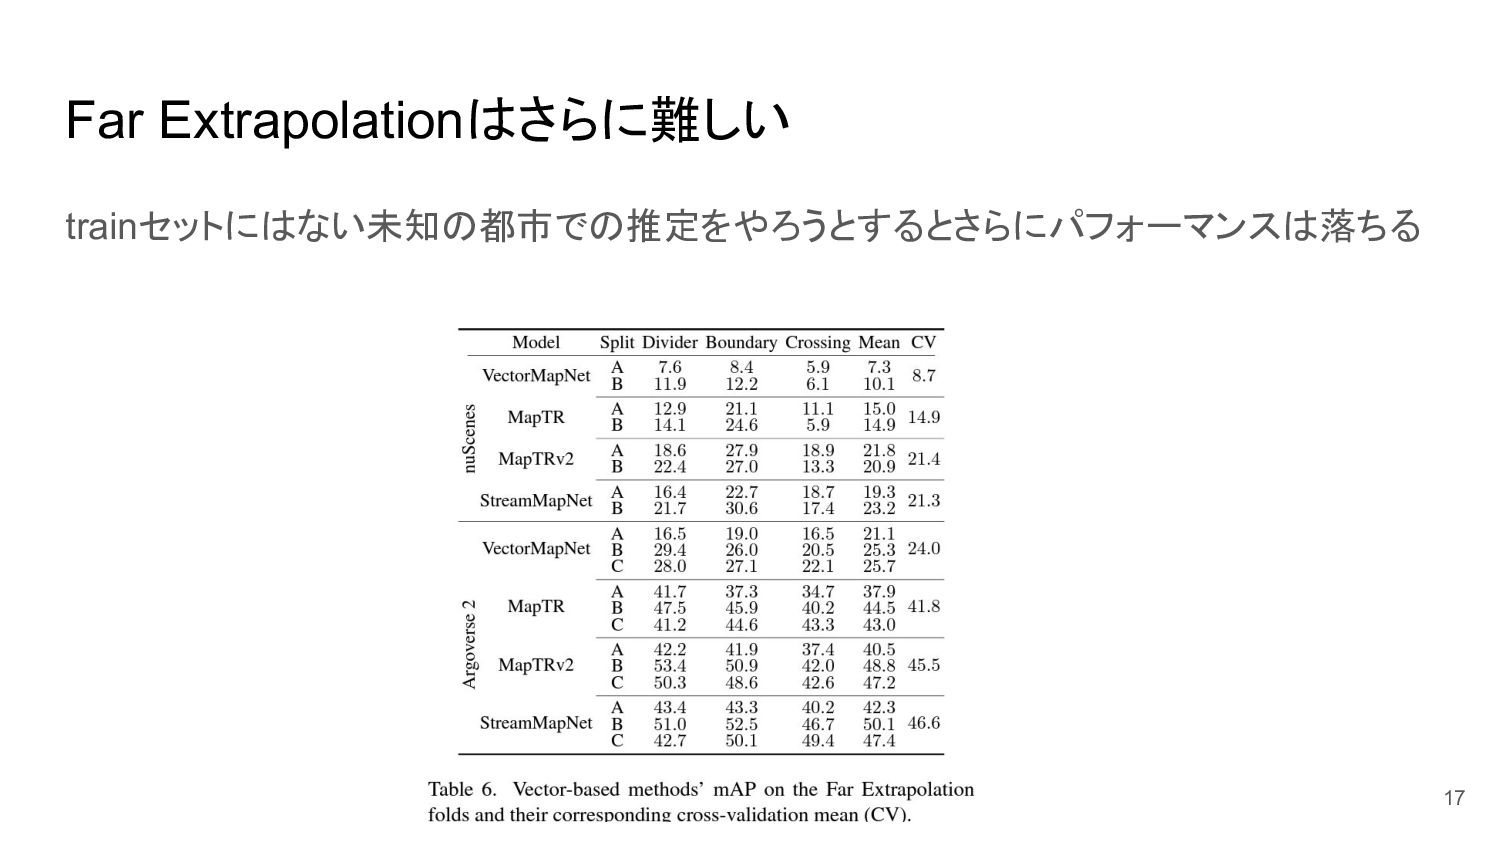
◦ 実質的にLocalizationを解いていることになっていた • Training / Validation / Test で地理的に分離されたデータセットを構築した ◦ 既存手法の大幅なパフォーマンスの低下を確認した ◦ 異なる都市で学習したモデルは殆どワークしないことが確認された • 23