Upgrade to Pro — share decks privately, control downloads, hide ads and more …

DBについての基礎説明(MySQL編) - コロプラ 2026年度 新卒研修

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

DBについての基礎説明(MySQL編) - コロプラ 2026年度 新卒研修

コロプラの2026年度新卒研修で、エンジニア向けに実施した「DBについての基礎説明(MySQL編)」の資料です。
MySQL を題材に、RDB の基本や SQL、インデックス、トランザクションと排他制御、実行計画、スケーリングまで、データベースの基礎を一通り紹介しています。

Avatar for COLOPL Inc.

COLOPL Inc.

October 16, 2026

More Decks by COLOPL Inc.

Other Decks in Technology

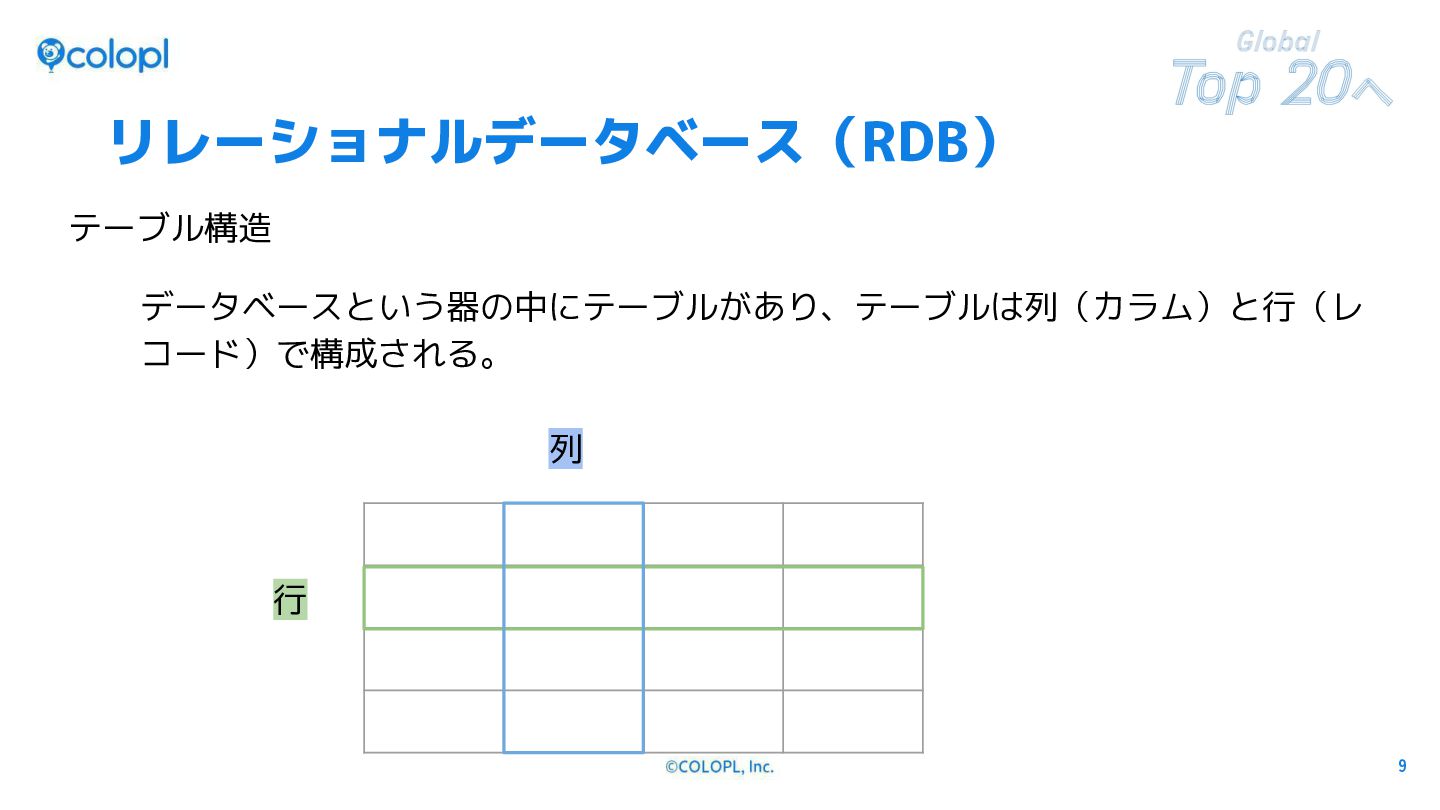
Transcript

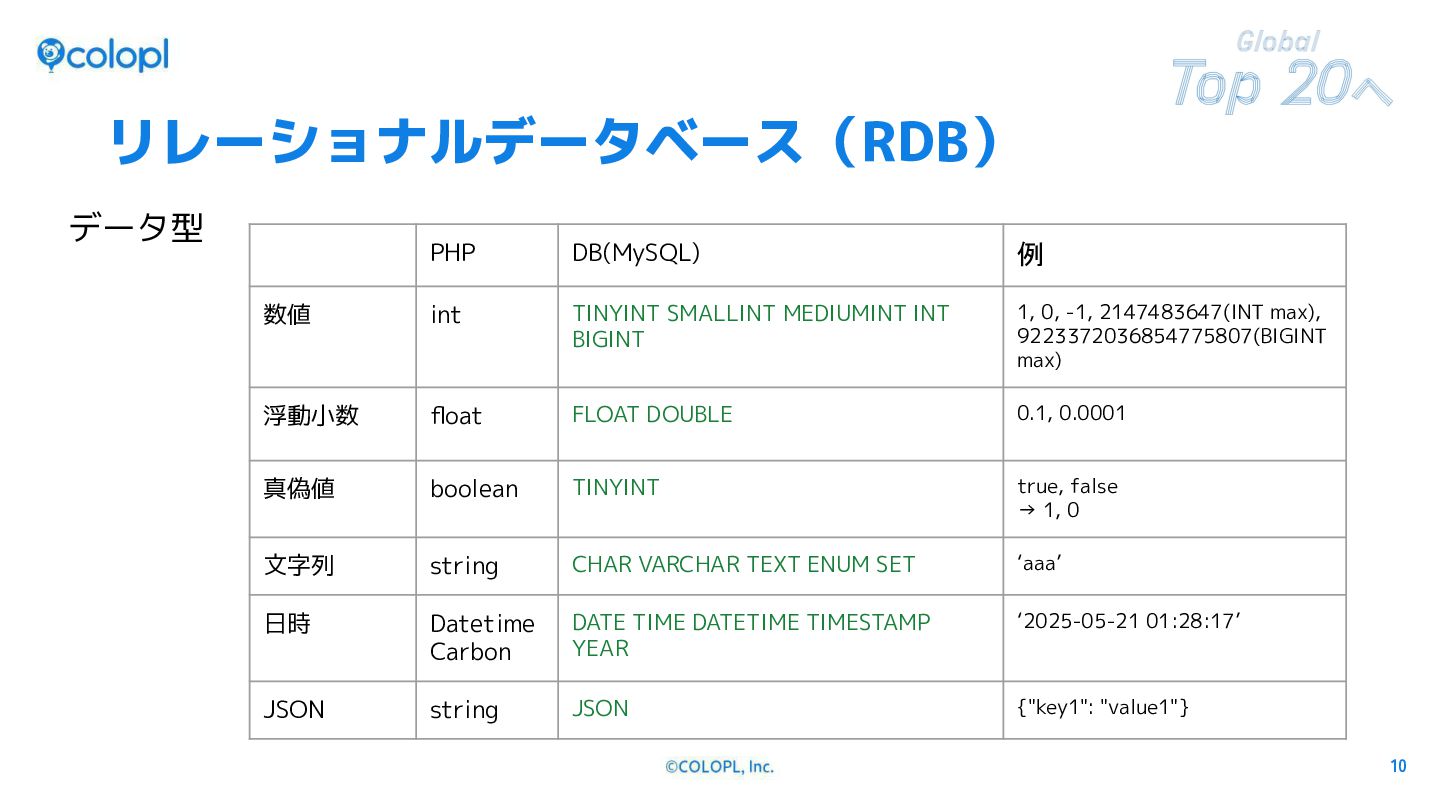
  1. リレーショナルデータベース(RDB) データ型 CONFIDENTIAL PHP DB(MySQL) 例 数値 int TINYINT SMALLINT

    MEDIUMINT INT BIGINT 1, 0, -1, 2147483647(INT max), 9223372036854775807(BIGINT max) 浮動小数 float FLOAT DOUBLE 0.1, 0.0001 真偽値 boolean TINYINT true, false → 1, 0 文字列 string CHAR VARCHAR TEXT ENUM SET ‘aaa’ 日時 Datetime Carbon DATE TIME DATETIME TIMESTAMP YEAR ‘2025-05-21 01:28:17’ JSON string JSON {"key1": "value1"} 10
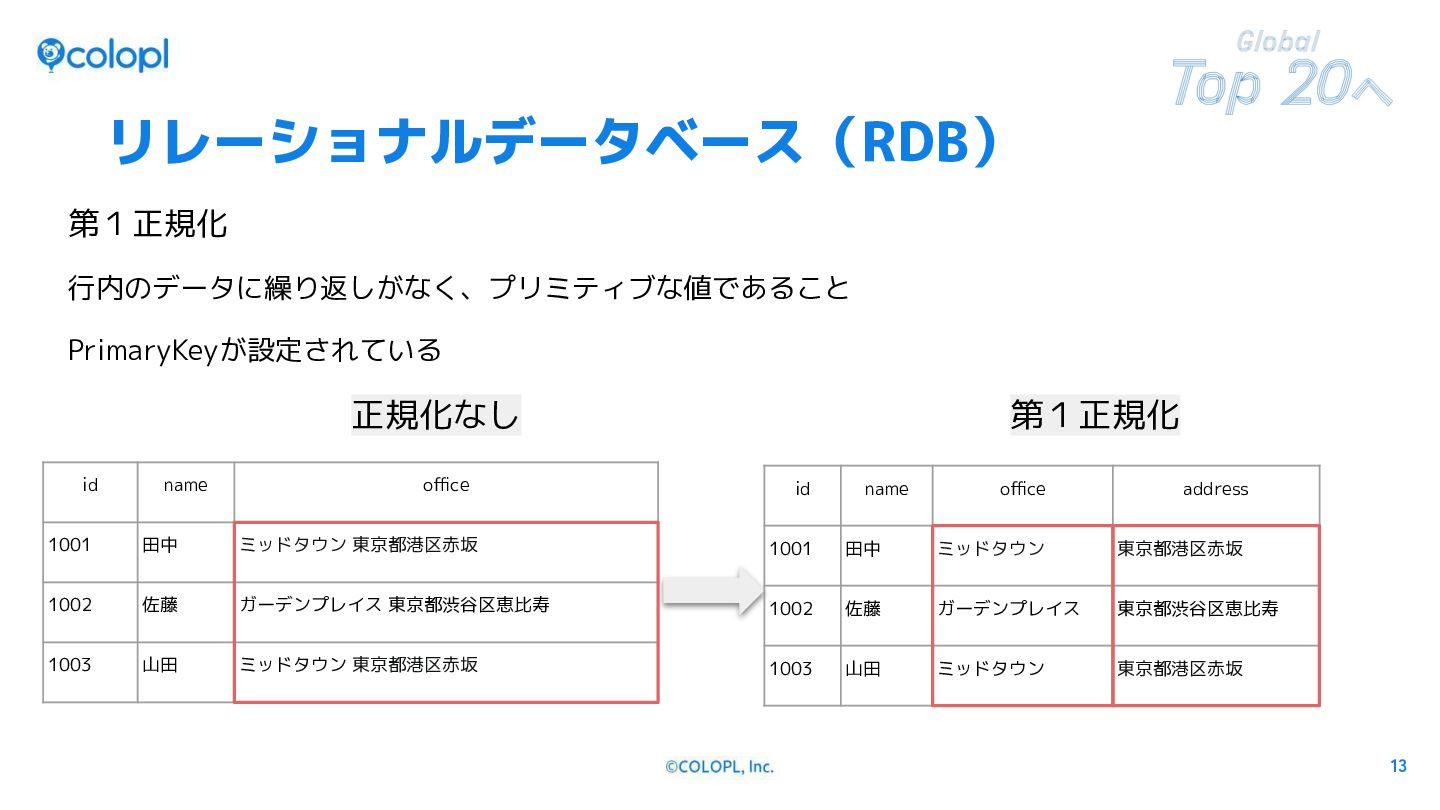
  2. リレーショナルデータベース(RDB) 第1正規化 行内のデータに繰り返しがなく、プリミティブな値であること PrimaryKeyが設定されている 正規化なし id name 第1正規化 office id

    name office address 1001 田中 ミッドタウン 東京都港区赤坂 1001 田中 ミッドタウン 東京都港区赤坂 1002 佐藤 ガーデンプレイス 東京都渋谷区恵比寿 1002 佐藤 ガーデンプレイス 東京都渋谷区恵比寿 1003 山田 ミッドタウン 東京都港区赤坂 1003 山田 ミッドタウン 東京都港区赤坂 CONFIDENTIAL 13
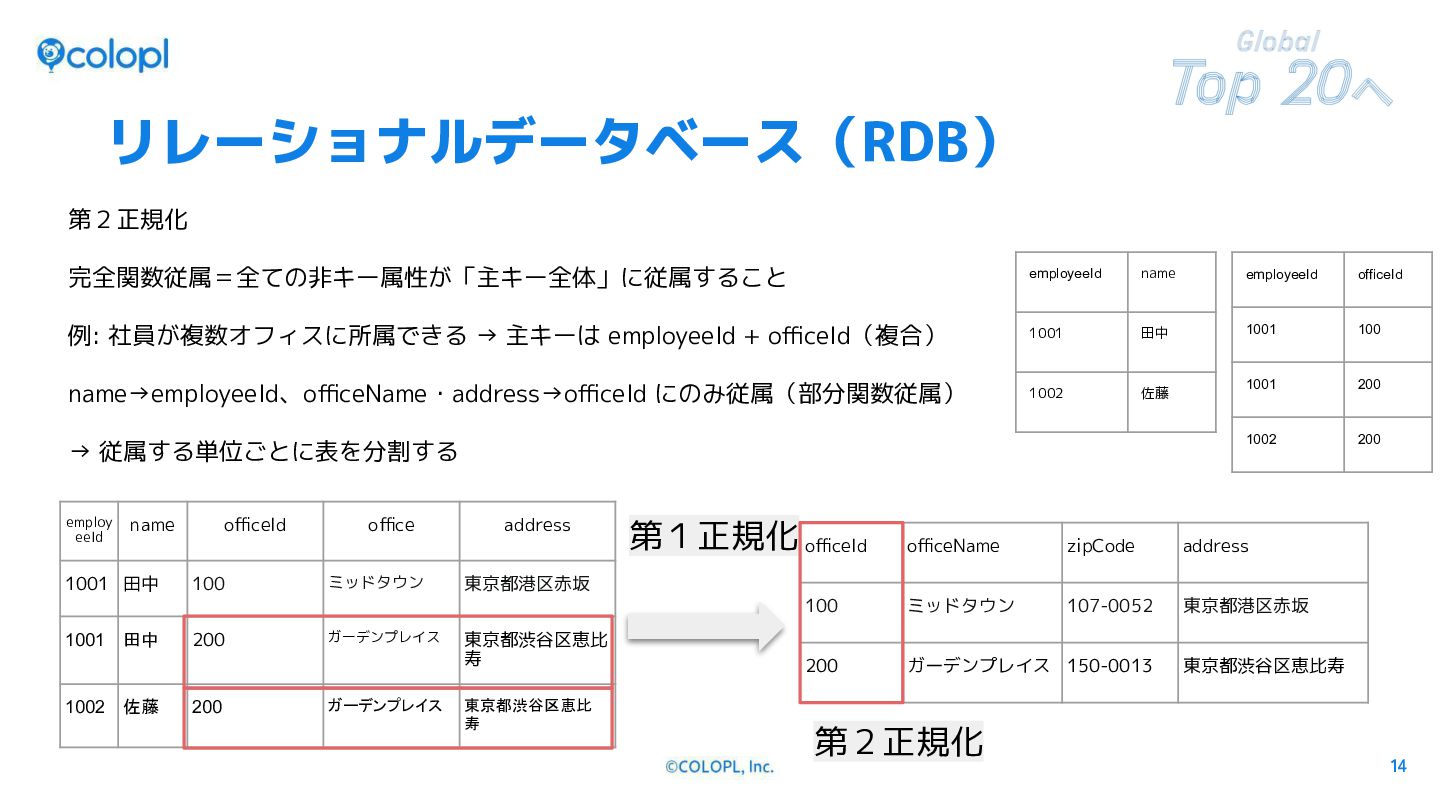
  3. リレーショナルデータベース(RDB) 第2正規化 完全関数従属=全ての非キー属性が「主キー全体」に従属すること employeeId name employeeId officeId 例: 社員が複数オフィスに所属できる →

    主キーは employeeId + officeId(複合) 1001 田中 1001 100 name→employeeId、officeName・address→officeId にのみ従属(部分関数従属) 1002 佐藤 1001 200 1002 200 → 従属する単位ごとに表を分割する employ eeId name 1001 田中 1001 田中 1002 佐藤 CONFIDENTIAL officeId 100 200 200 office ミッドタウン ガーデンプレイス ガーデンプレイス address 第1正規化 officeId officeName zipCode address 100 ミッドタウン 107-0052 東京都港区赤坂 200 ガーデンプレイス 150-0013 東京都港区赤坂 東京都渋谷区恵比 寿 東京都渋谷区恵比 寿 第2正規化 東京都渋谷区恵比寿 14
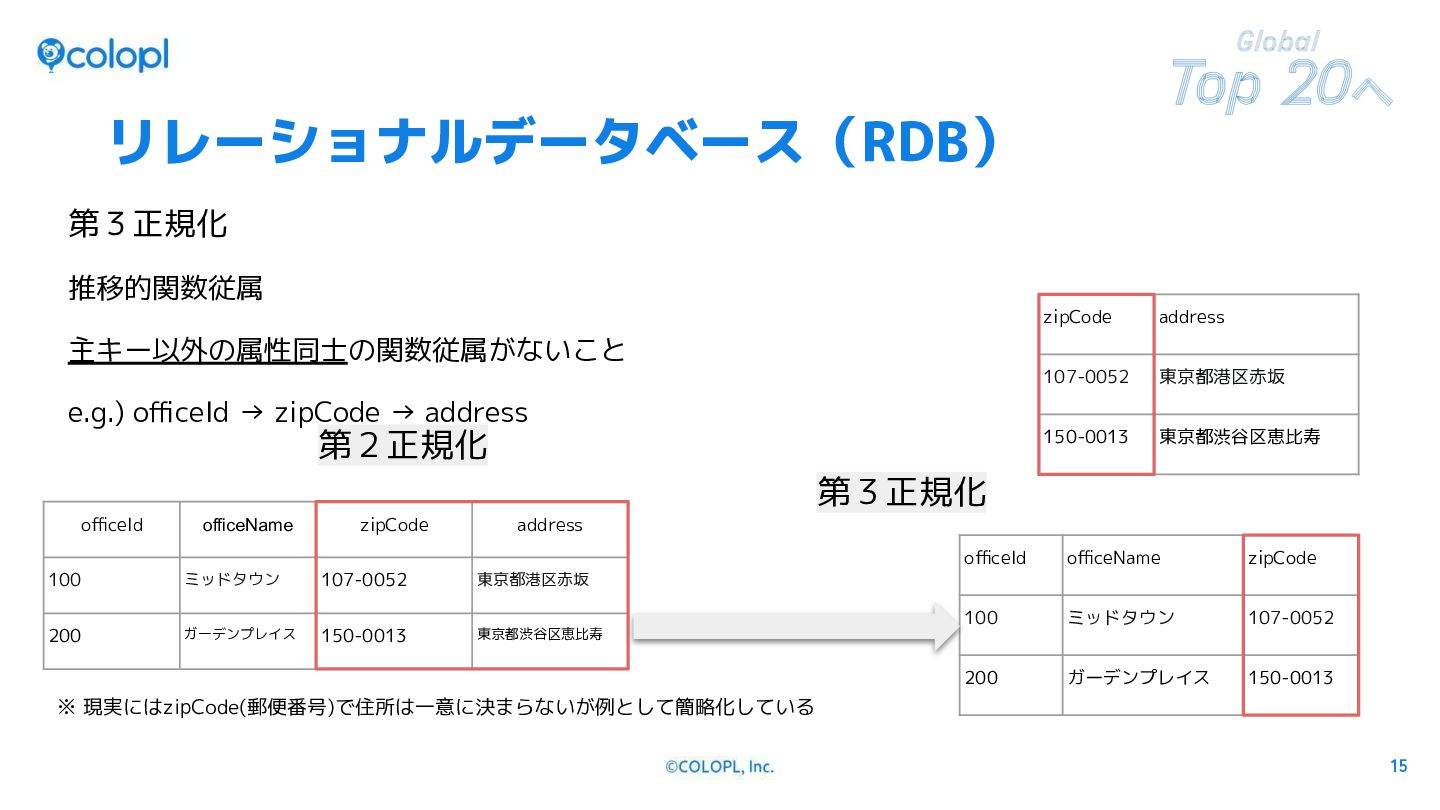
  4. リレーショナルデータベース(RDB) 第3正規化 推移的関数従属 zipCode address 107-0052 東京都港区赤坂 150-0013 東京都渋谷区恵比寿 主キー以外の属性同士の関数従属がないこと

    e.g.) officeId → zipCode → address 第2正規化 第3正規化 officeId officeName zipCode address 100 ミッドタウン 107-0052 東京都港区赤坂 200 ガーデンプレイス 150-0013 東京都渋谷区恵比寿 officeId officeName zipCode 100 ミッドタウン 107-0052 200 ガーデンプレイス 150-0013 ※ 現実にはzipCode(郵便番号)で住所は一意に決まらないが例として簡略化している CONFIDENTIAL 15
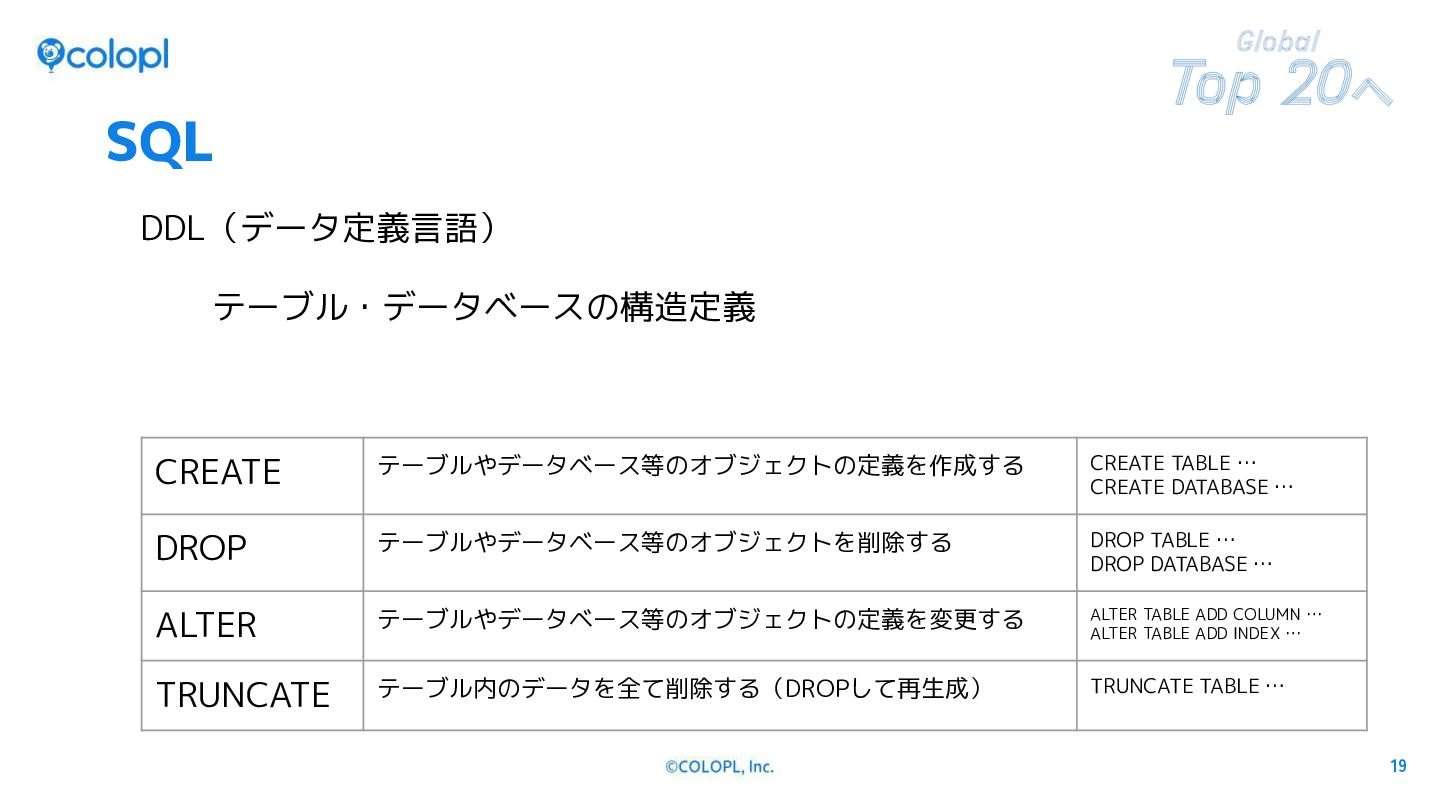
  5. SQL DDL(データ定義言語) テーブル・データベースの構造定義 CREATE テーブルやデータベース等のオブジェクトの定義を作成する CREATE TABLE … CREATE DATABASE

    … DROP テーブルやデータベース等のオブジェクトを削除する DROP TABLE … DROP DATABASE … ALTER テーブルやデータベース等のオブジェクトの定義を変更する ALTER TABLE ADD COLUMN … ALTER TABLE ADD INDEX … TRUNCATE テーブル内のデータを全て削除する(DROPして再生成) TRUNCATE TABLE … CONFIDENTIAL 19
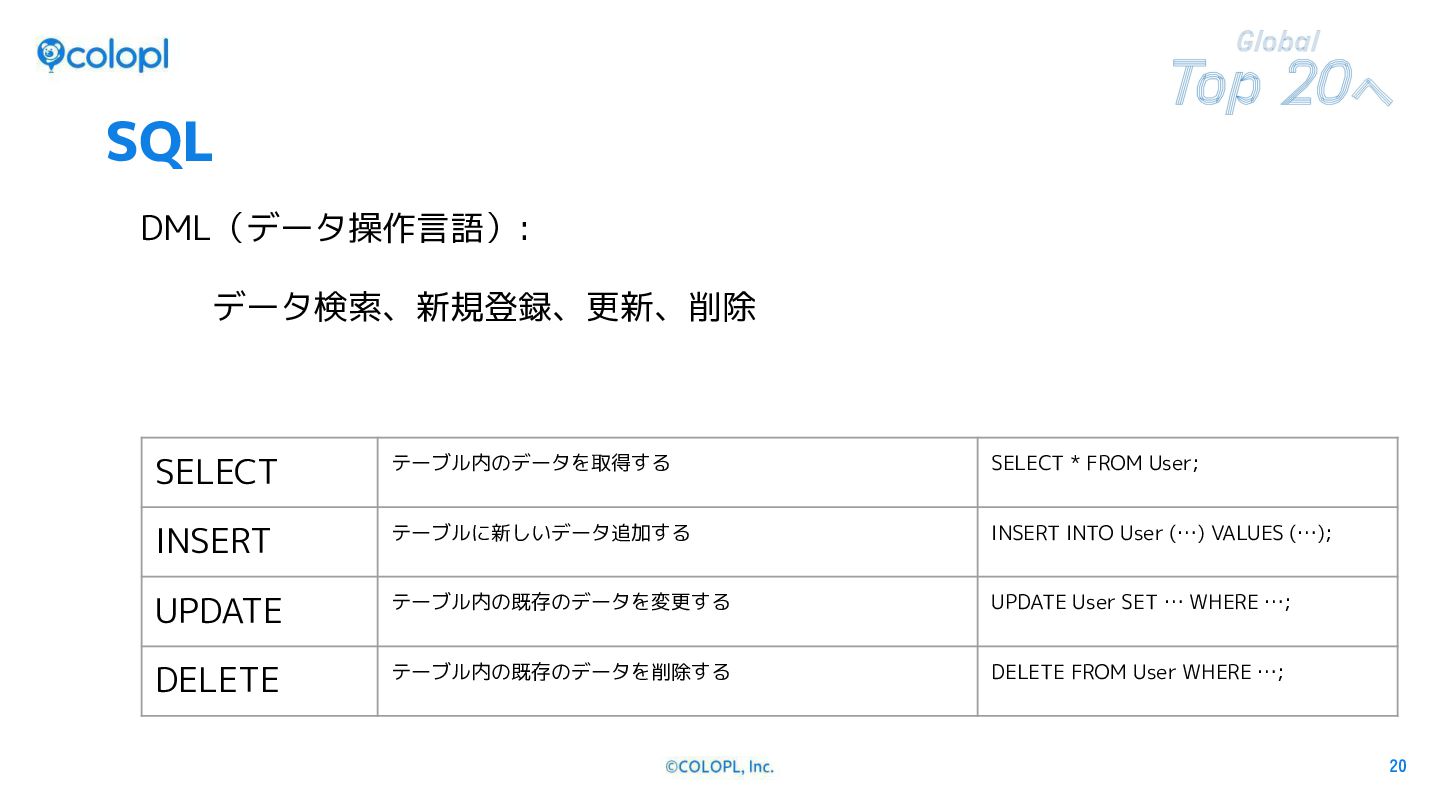
  6. SQL DML(データ操作言語): データ検索、新規登録、更新、削除 SELECT テーブル内のデータを取得する SELECT * FROM User; INSERT

    テーブルに新しいデータ追加する INSERT INTO User (…) VALUES (…); UPDATE テーブル内の既存のデータを変更する UPDATE User SET … WHERE …; DELETE テーブル内の既存のデータを削除する DELETE FROM User WHERE …; CONFIDENTIAL 20
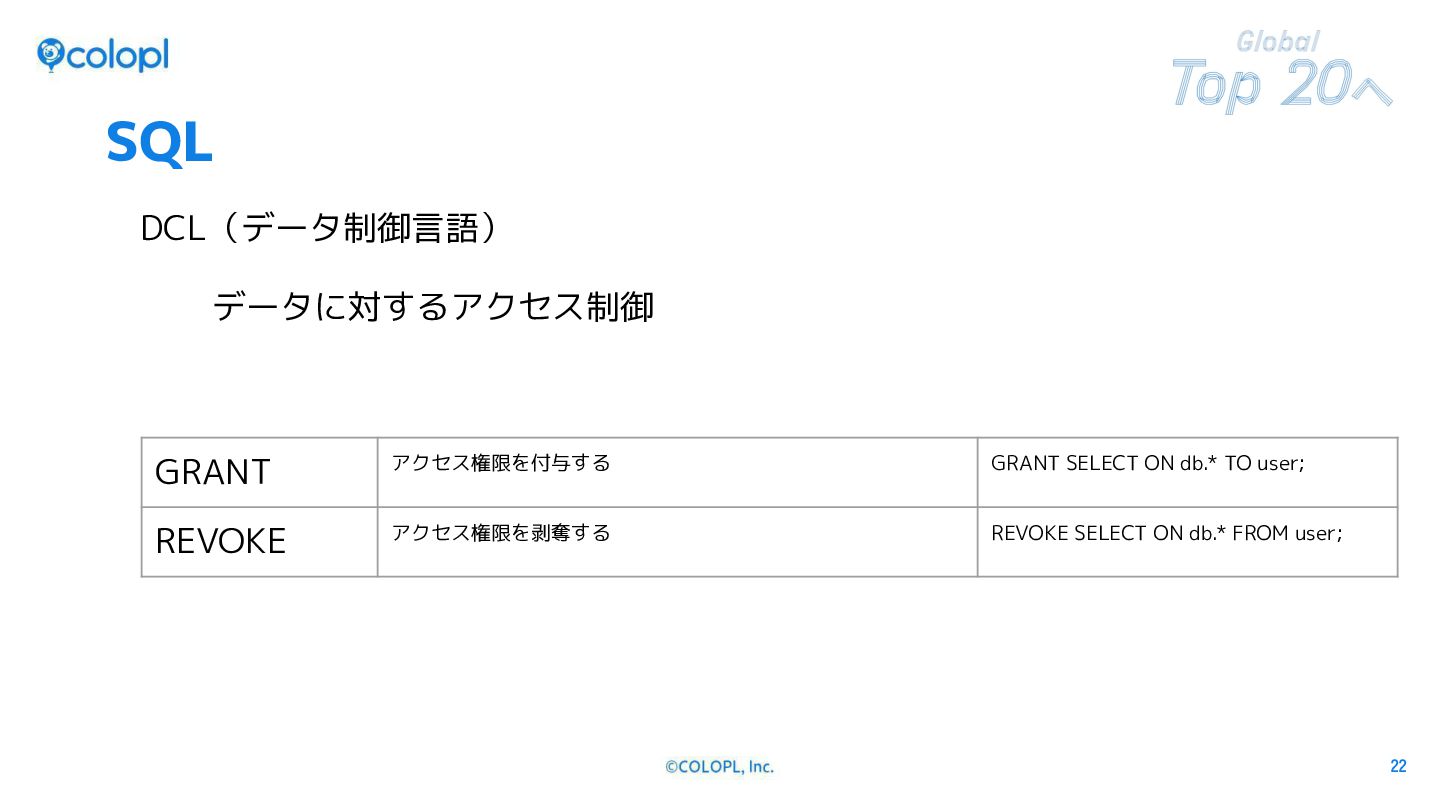
  7. SQL DCL(データ制御言語) データに対するアクセス制御 GRANT アクセス権限を付与する GRANT SELECT ON db.* TO

    user; REVOKE アクセス権限を剥奪する REVOKE SELECT ON db.* FROM user; CONFIDENTIAL 22
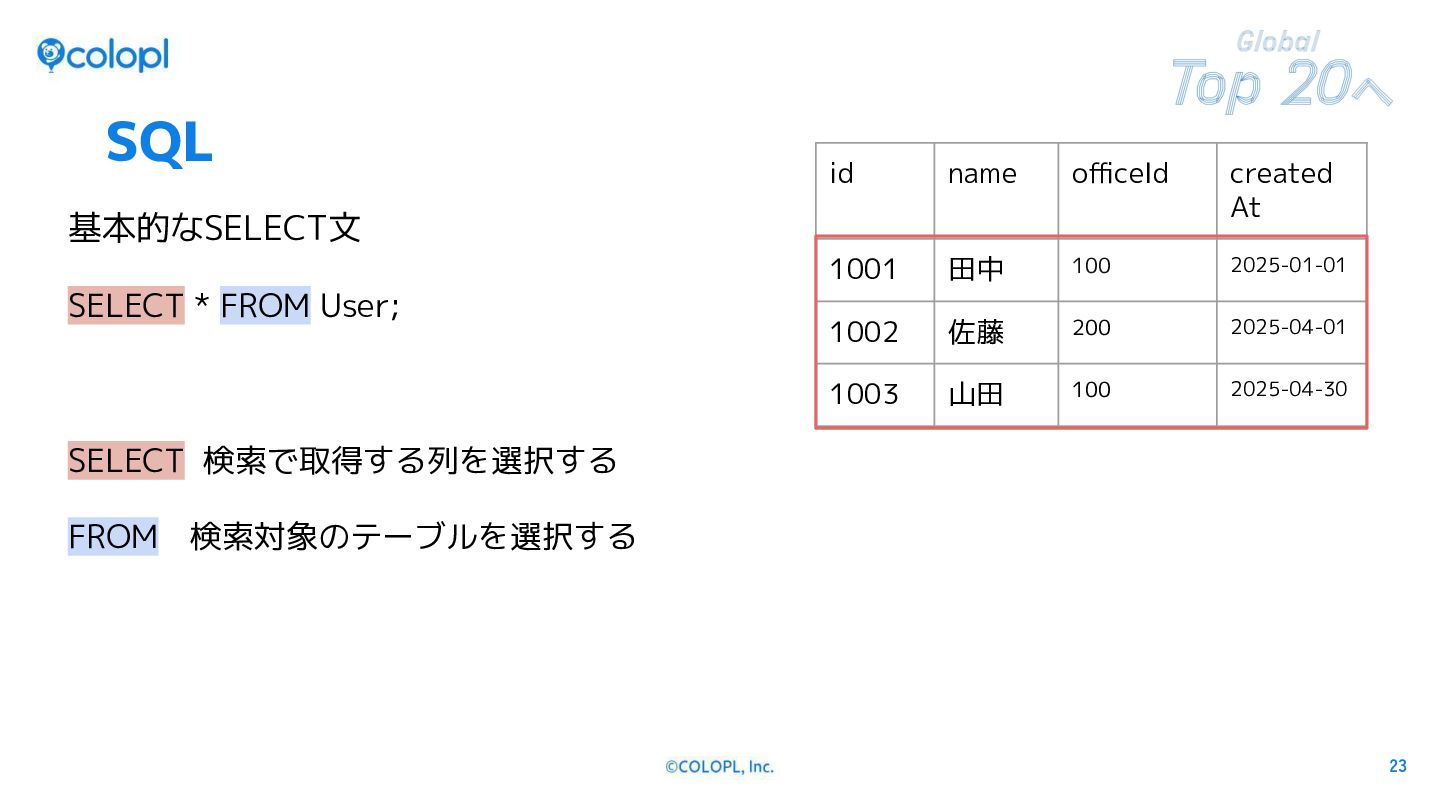
  8. SQL id name officeId created At 1001 田中 100 2025-01-01

    1002 佐藤 200 2025-04-01 1003 山田 100 2025-04-30 基本的なSELECT文 SELECT * FROM User; SELECT 検索で取得する列を選択する FROM 検索対象のテーブルを選択する CONFIDENTIAL 23
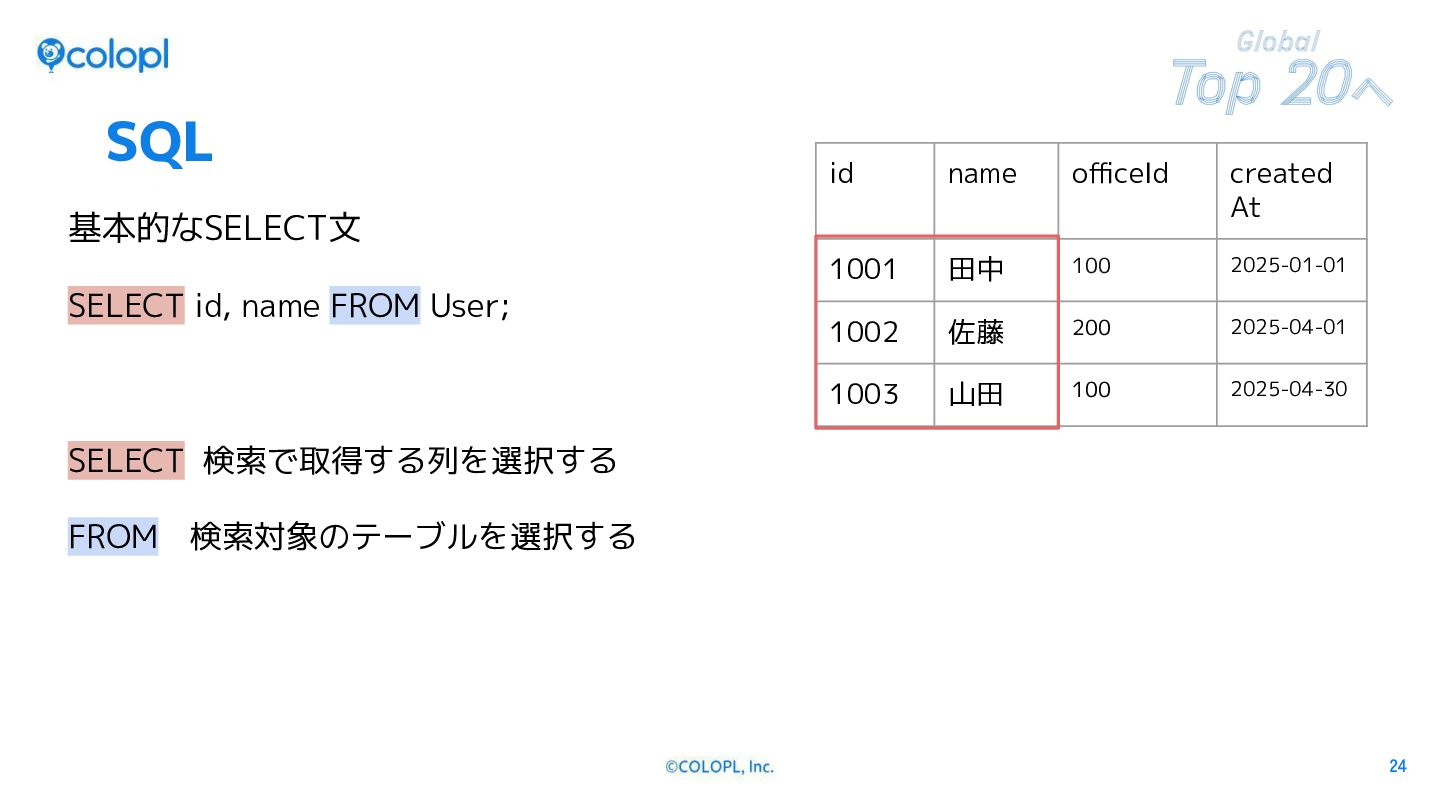
  9. SQL id name officeId created At 1001 田中 100 2025-01-01

    1002 佐藤 200 2025-04-01 1003 山田 100 2025-04-30 基本的なSELECT文 SELECT id, name FROM User; SELECT 検索で取得する列を選択する FROM 検索対象のテーブルを選択する CONFIDENTIAL 24
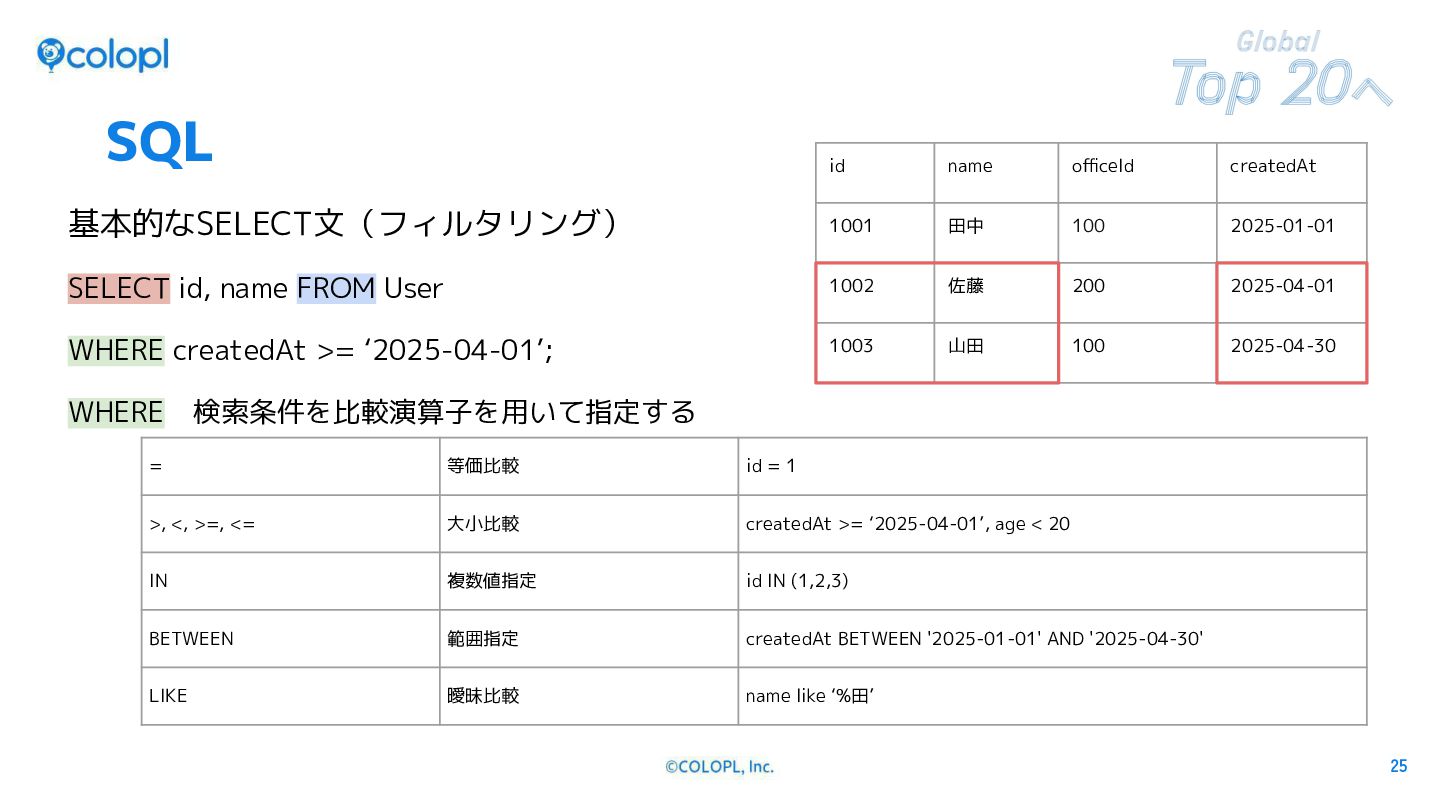
  10. SQL id name officeId createdAt 基本的なSELECT文(フィルタリング) 1001 田中 100 2025-01-01

    SELECT id, name FROM User 1002 佐藤 200 2025-04-01 WHERE createdAt >= ‘2025-04-01’; 1003 山田 100 2025-04-30 WHERE 検索条件を比較演算子を用いて指定する = 等価比較 id = 1 >, <, >=, <= 大小比較 createdAt >= ‘2025-04-01’, age < 20 IN 複数値指定 id IN (1,2,3) BETWEEN 範囲指定 createdAt BETWEEN '2025-01-01' AND '2025-04-30' LIKE 曖昧比較 name like ‘%田’ CONFIDENTIAL 25
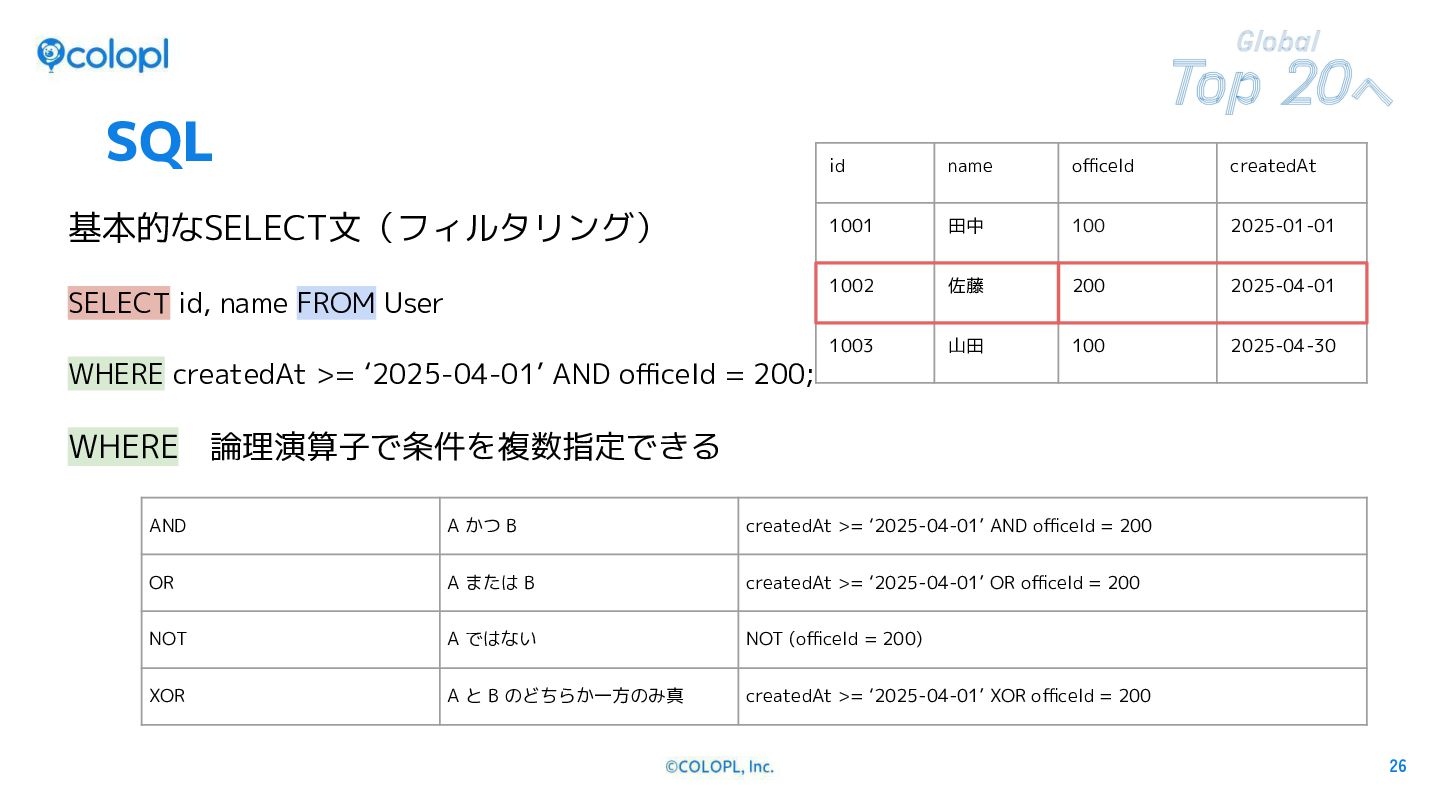
  11. SQL 基本的なSELECT文(フィルタリング) SELECT id, name FROM User id name officeId

    createdAt 1001 田中 100 2025-01-01 1002 佐藤 200 2025-04-01 1003 山田 100 2025-04-30 WHERE createdAt >= ‘2025-04-01’ AND officeId = 200; WHERE 論理演算子で条件を複数指定できる AND A かつ B createdAt >= ‘2025-04-01’ AND officeId = 200 OR A または B createdAt >= ‘2025-04-01’ OR officeId = 200 NOT A ではない NOT (officeId = 200) XOR A と B のどちらか一方のみ真 createdAt >= ‘2025-04-01’ XOR officeId = 200 CONFIDENTIAL 26
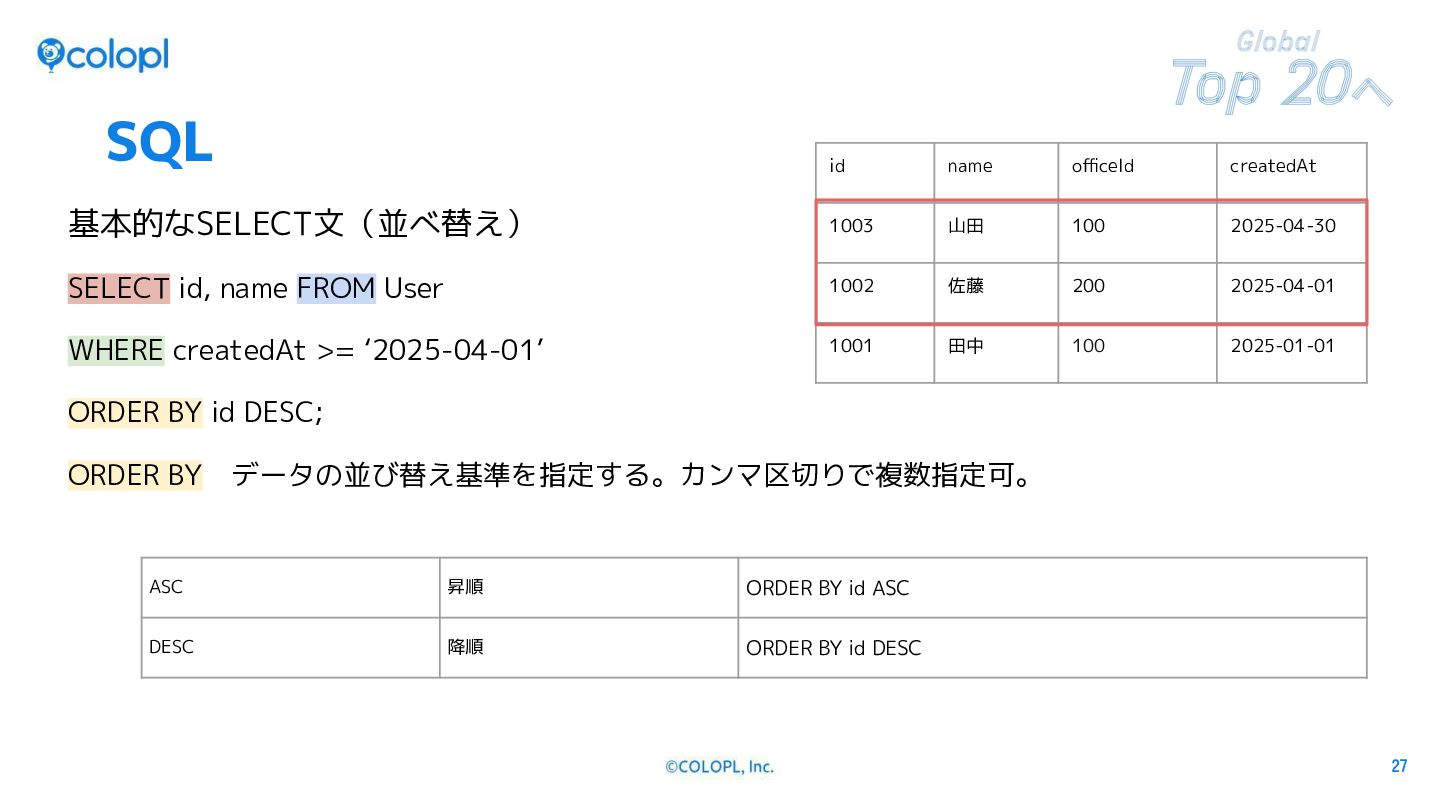
  12. SQL id name officeId createdAt 基本的なSELECT文(並べ替え) 1003 山田 100 2025-04-30

    SELECT id, name FROM User 1002 佐藤 200 2025-04-01 WHERE createdAt >= ‘2025-04-01’ 1001 田中 100 2025-01-01 ORDER BY id DESC; ORDER BY データの並び替え基準を指定する。カンマ区切りで複数指定可。 ASC 昇順 ORDER BY id ASC DESC 降順 ORDER BY id DESC CONFIDENTIAL 27
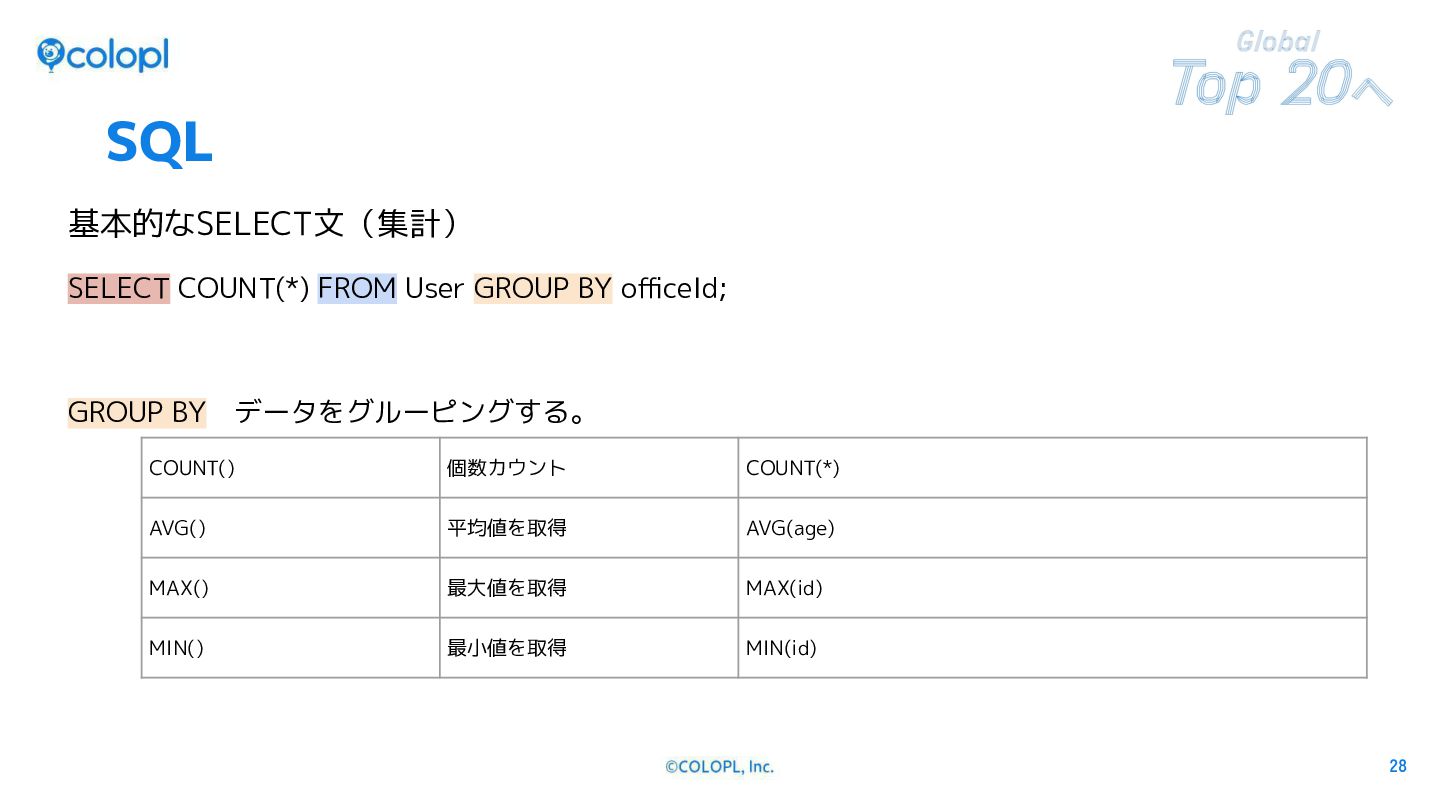
  13. SQL 基本的なSELECT文(集計) SELECT COUNT(*) FROM User GROUP BY officeId; GROUP

    BY データをグルーピングする。 COUNT() 個数カウント COUNT(*) AVG() 平均値を取得 AVG(age) MAX() 最大値を取得 MAX(id) MIN() 最小値を取得 MIN(id) CONFIDENTIAL 28
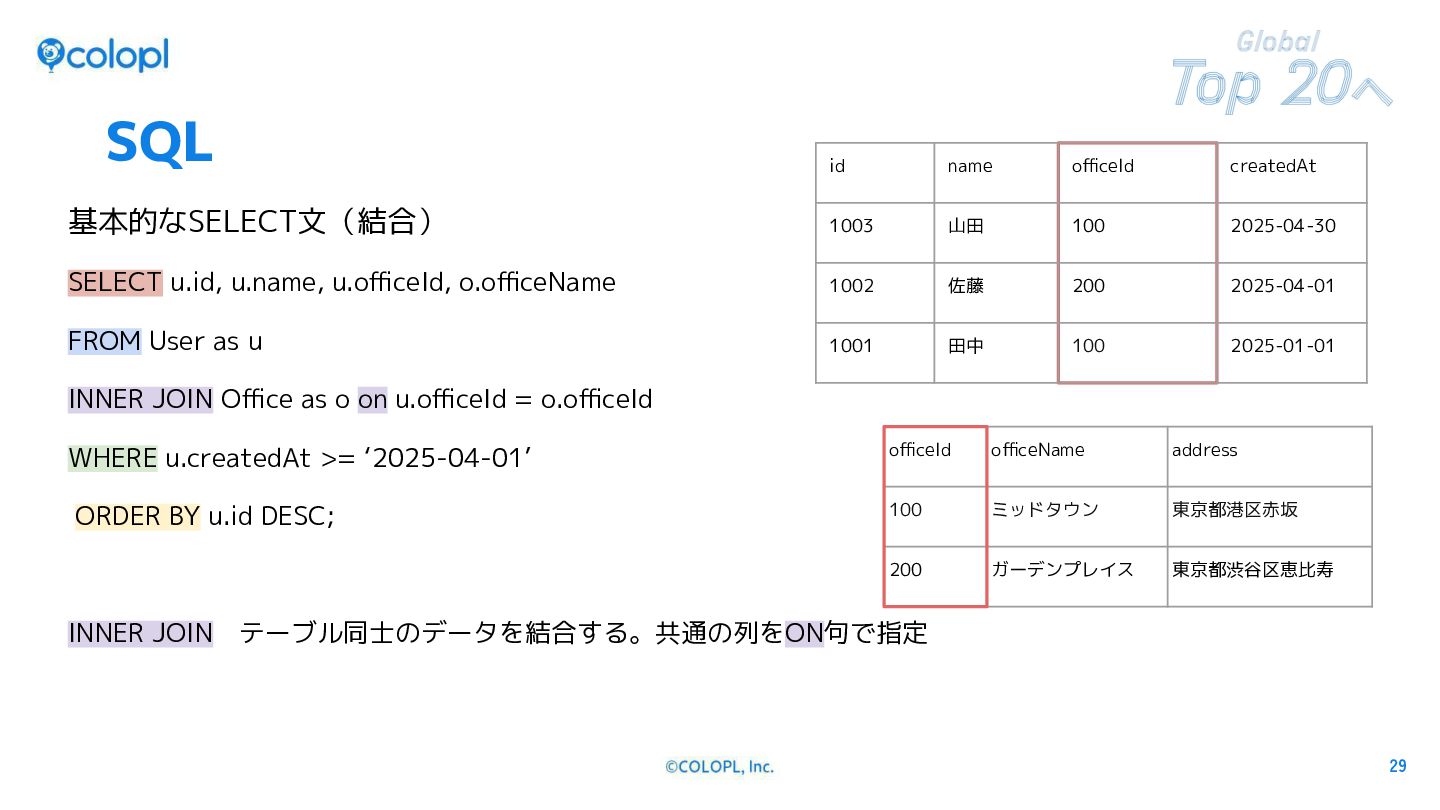
  14. SQL id name officeId createdAt 基本的なSELECT文(結合) 1003 山田 100 2025-04-30

    SELECT u.id, u.name, u.officeId, o.officeName 1002 佐藤 200 2025-04-01 FROM User as u 1001 田中 100 2025-01-01 INNER JOIN Office as o on u.officeId = o.officeId WHERE u.createdAt >= ‘2025-04-01’ officeId officeName address ORDER BY u.id DESC; 100 ミッドタウン 東京都港区赤坂 200 ガーデンプレイス 東京都渋谷区恵比寿 INNER JOIN テーブル同士のデータを結合する。共通の列をON句で指定 CONFIDENTIAL 29
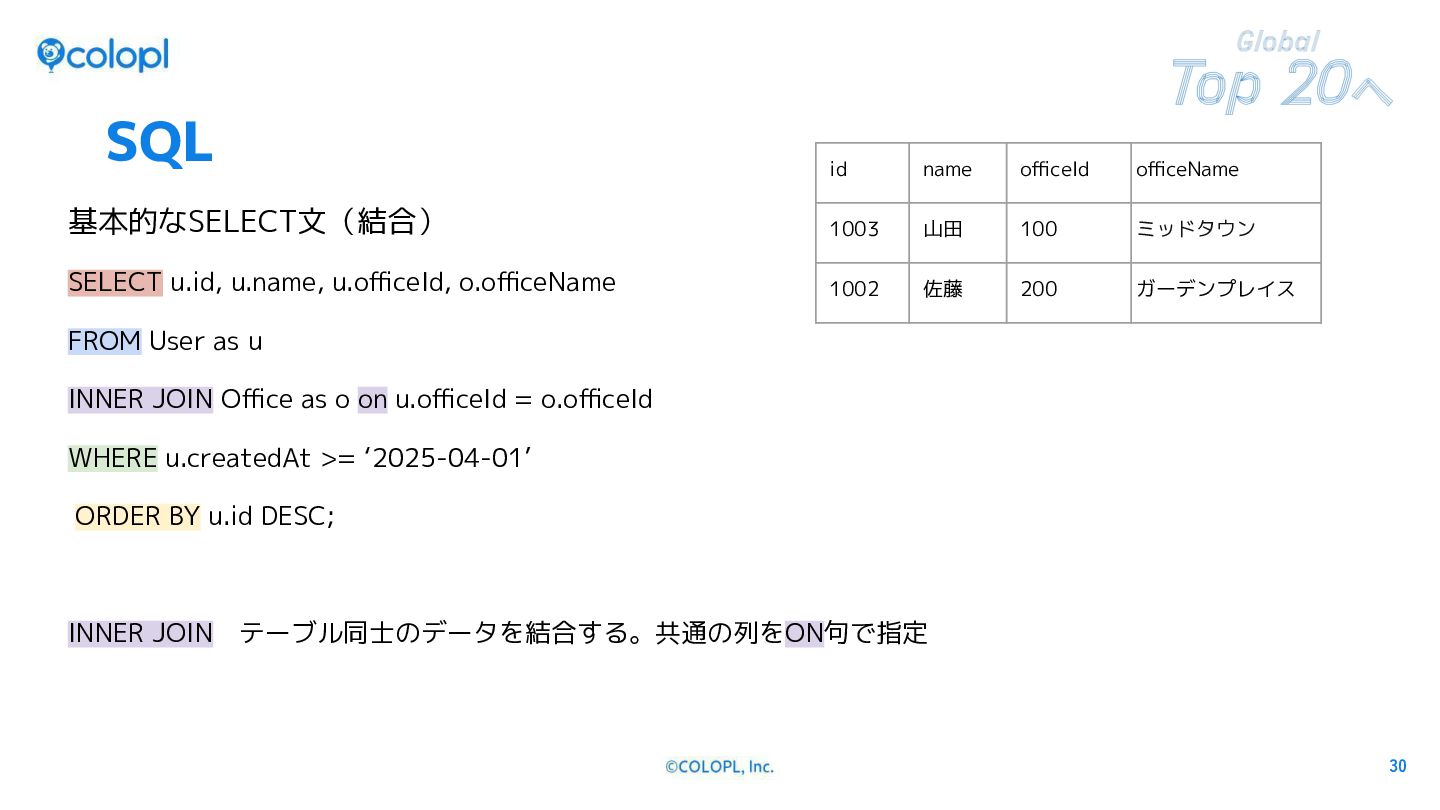
  15. SQL id name officeId officeName 基本的なSELECT文(結合) 1003 山田 100 ミッドタウン

    SELECT u.id, u.name, u.officeId, o.officeName 1002 佐藤 200 ガーデンプレイス FROM User as u INNER JOIN Office as o on u.officeId = o.officeId WHERE u.createdAt >= ‘2025-04-01’ ORDER BY u.id DESC; INNER JOIN テーブル同士のデータを結合する。共通の列をON句で指定 CONFIDENTIAL 30
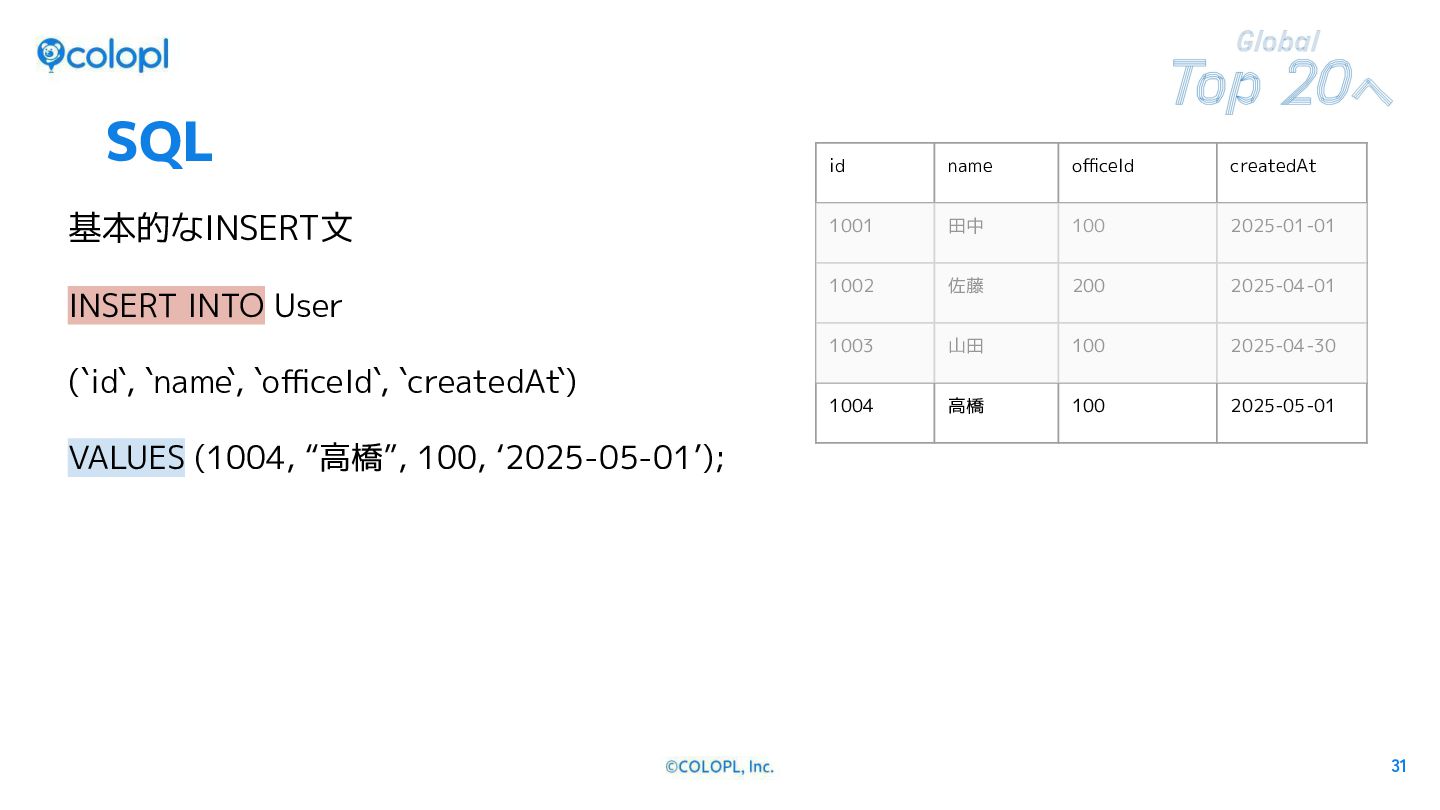
  16. SQL 基本的なINSERT文 INSERT INTO User (`id`, `name`, `officeId`, `createdAt`) id

    name officeId createdAt 1001 田中 100 2025-01-01 1002 佐藤 200 2025-04-01 1003 山田 100 2025-04-30 1004 高橋 100 2025-05-01 VALUES (1004, “高橋”, 100, ‘2025-05-01’); CONFIDENTIAL 31
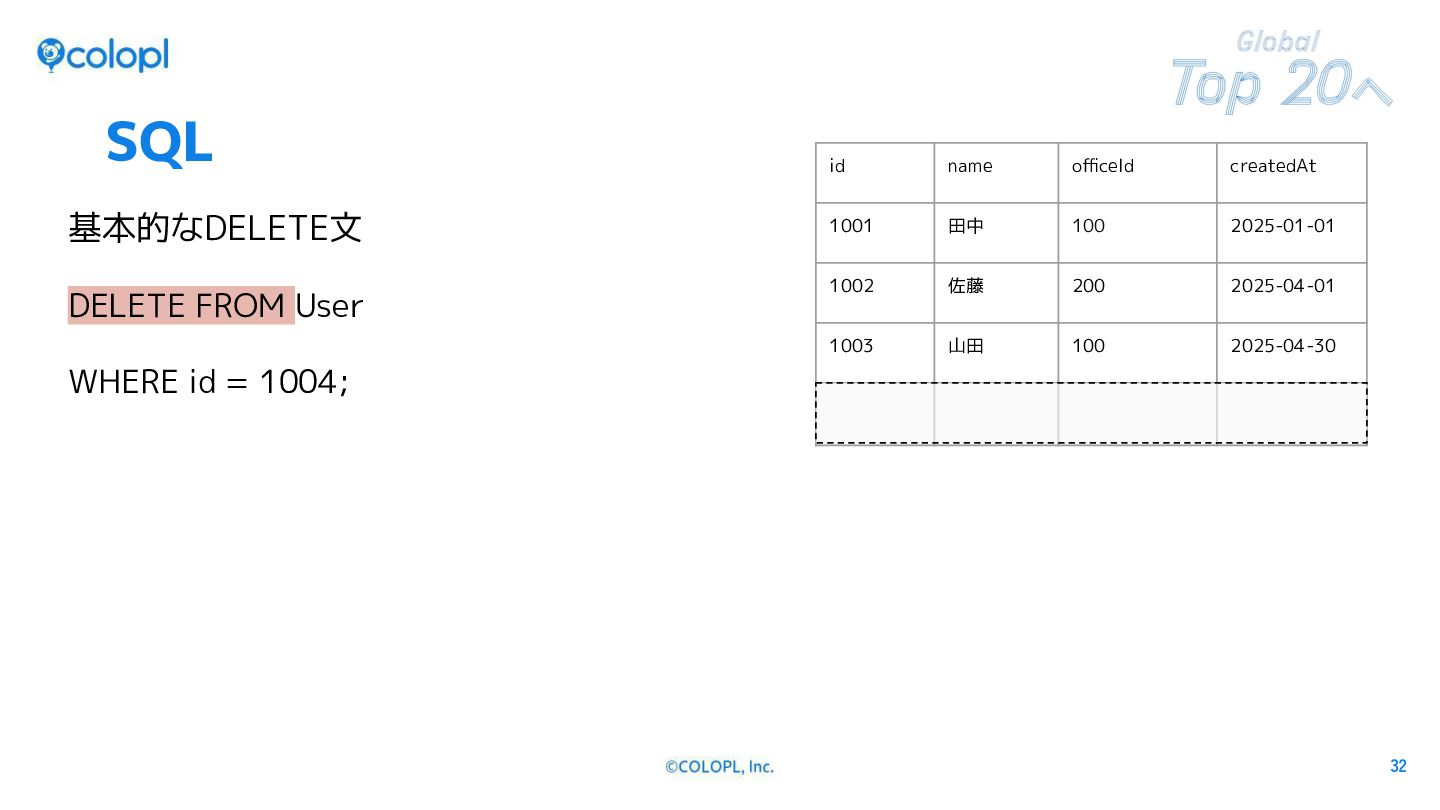
  17. SQL 基本的なDELETE文 DELETE FROM User id name officeId createdAt 1001

    田中 100 2025-01-01 1002 佐藤 200 2025-04-01 1003 山田 100 2025-04-30 WHERE id = 1004; CONFIDENTIAL 32
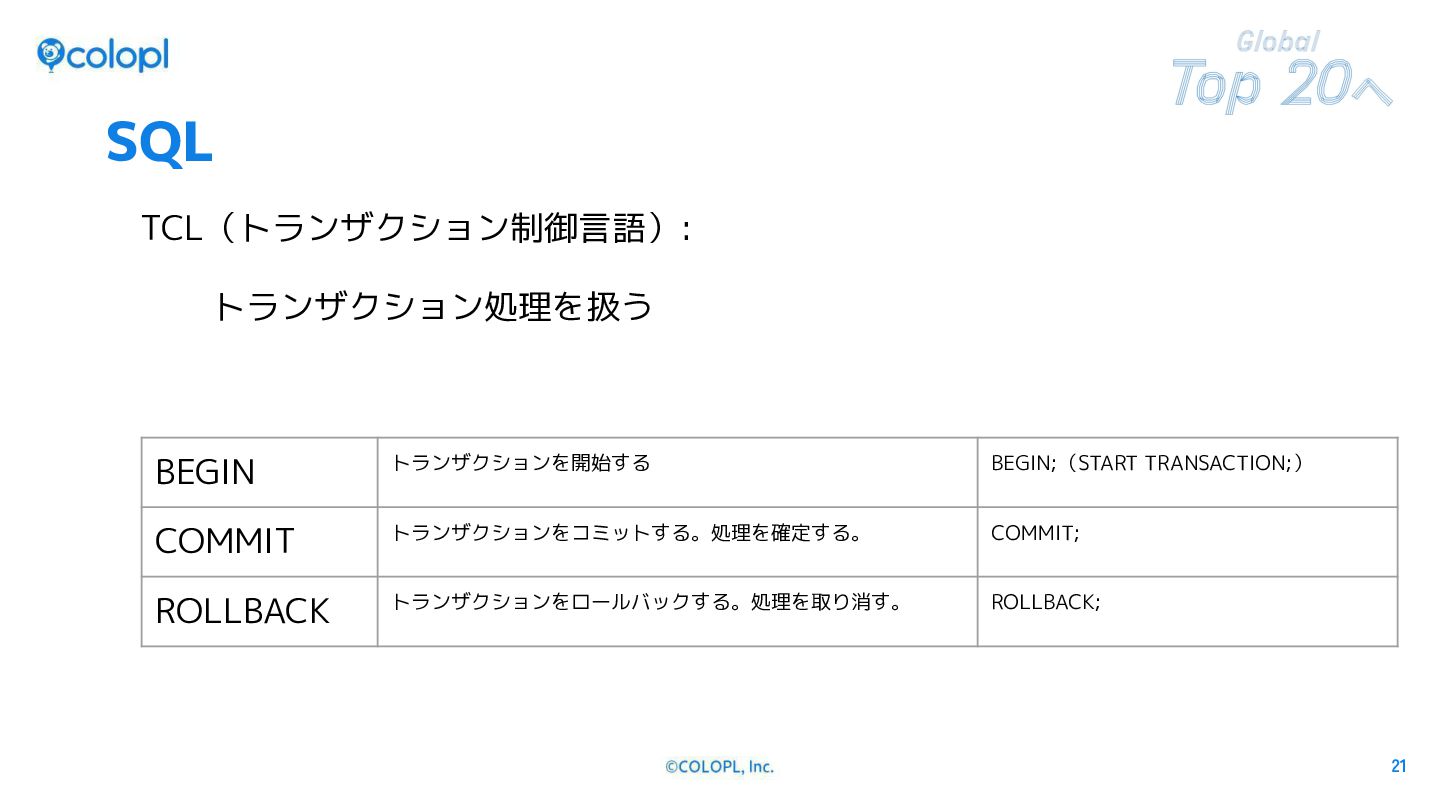
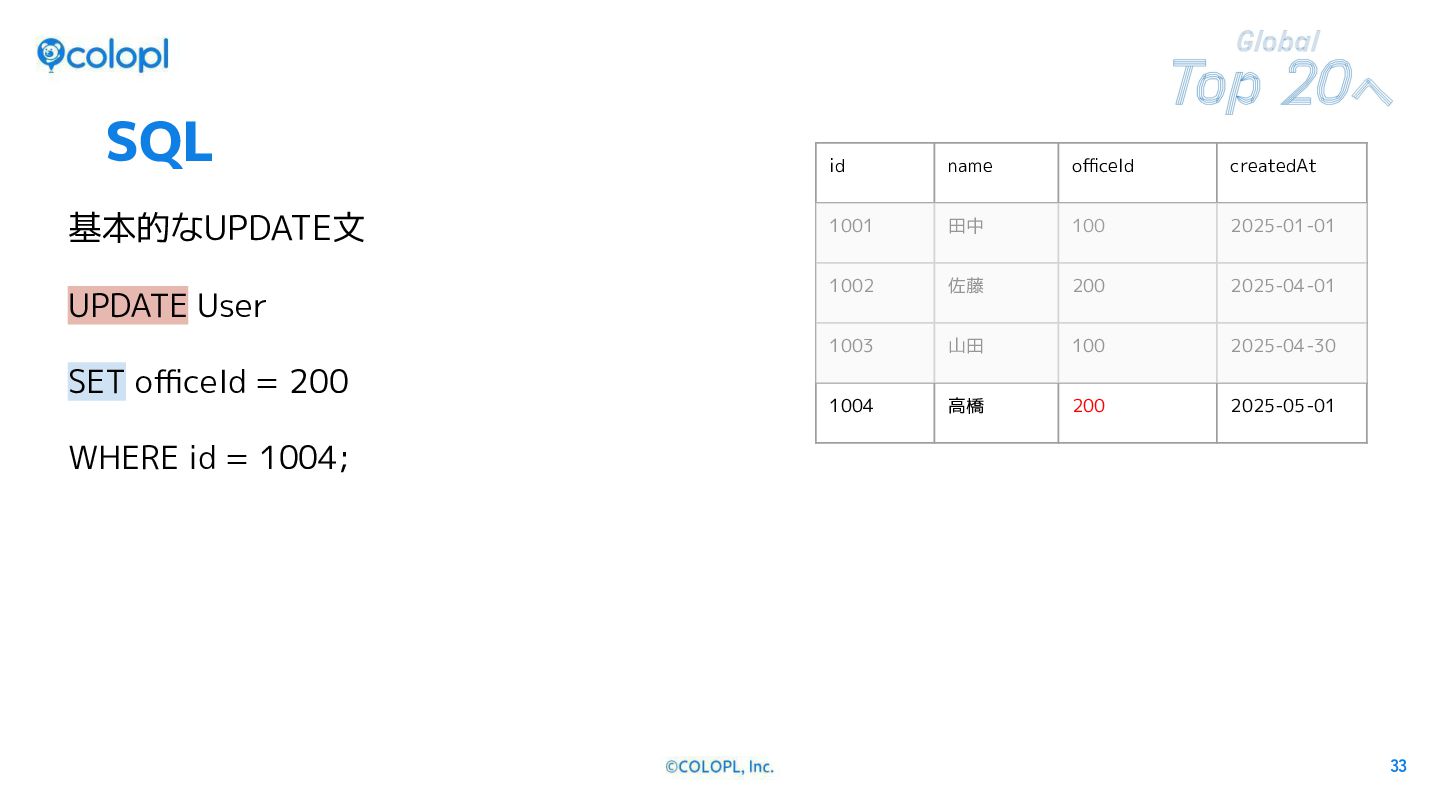
  18. SQL 基本的なUPDATE文 UPDATE User SET officeId = 200 id name

    officeId createdAt 1001 田中 100 2025-01-01 1002 佐藤 200 2025-04-01 1003 山田 100 2025-04-30 1004 高橋 200 2025-05-01 WHERE id = 1004; CONFIDENTIAL 33
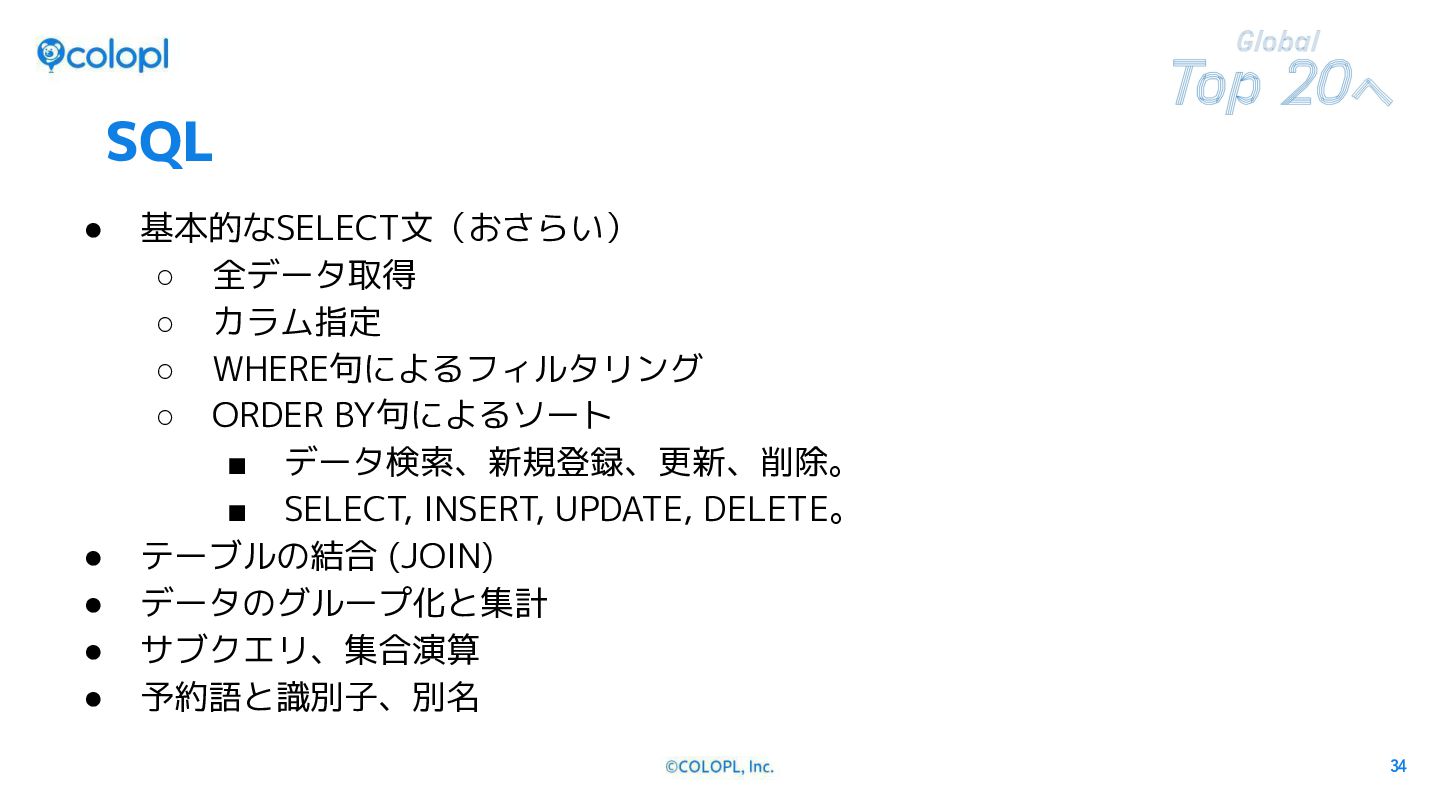
  19. SQL • • • • • 基本的なSELECT文(おさらい) ◦ 全データ取得 ◦

    カラム指定 ◦ WHERE句によるフィルタリング ◦ ORDER BY句によるソート ▪ データ検索、新規登録、更新、削除。 ▪ SELECT, INSERT, UPDATE, DELETE。 テーブルの結合 (JOIN) データのグループ化と集計 サブクエリ、集合演算 予約語と識別子、別名 CONFIDENTIAL 34
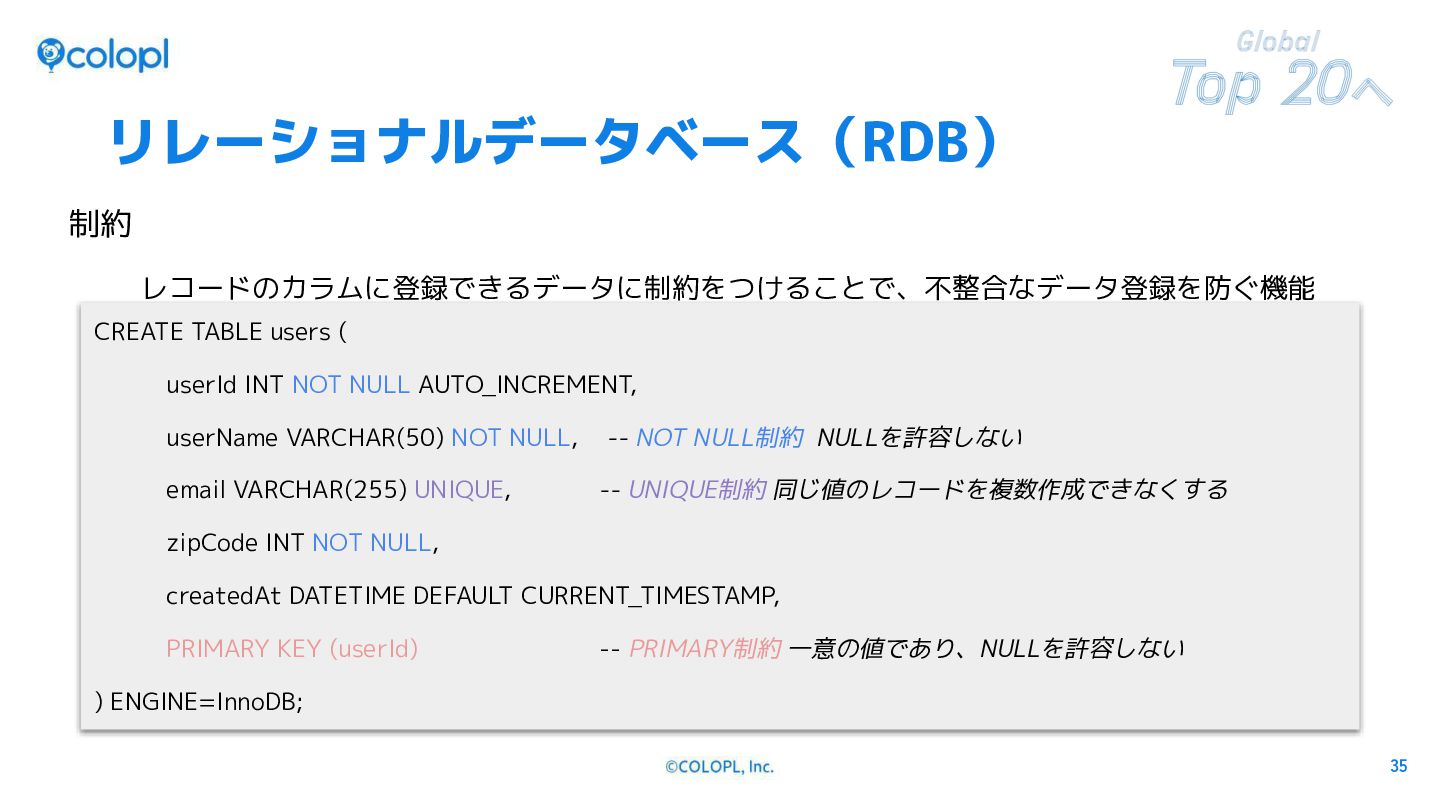
  20. リレーショナルデータベース(RDB) 制約 レコードのカラムに登録できるデータに制約をつけることで、不整合なデータ登録を防ぐ機能 CREATE TABLE users ( userId INT NOT

    NULL AUTO_INCREMENT, userName VARCHAR(50) NOT NULL, -- NOT NULL制約 NULLを許容しない email VARCHAR(255) UNIQUE, -- UNIQUE制約 同じ値のレコードを複数作成できなくする zipCode INT NOT NULL, createdAt DATETIME DEFAULT CURRENT_TIMESTAMP, PRIMARY KEY (userId) -- PRIMARY制約 一意の値であり、NULLを許容しない ) ENGINE=InnoDB; CONFIDENTIAL 35
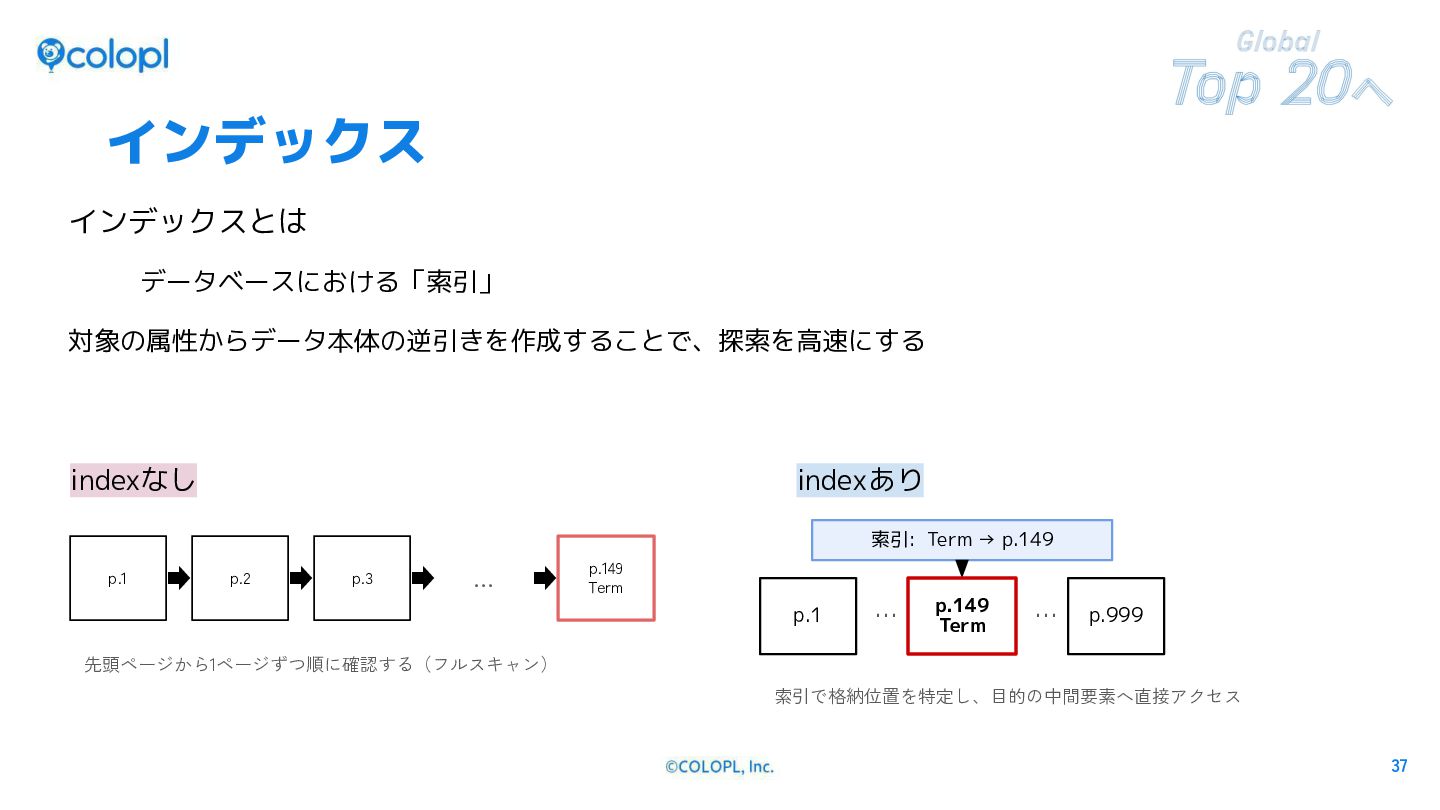
  21. インデックス インデックスとは データベースにおける「索引」 対象の属性からデータ本体の逆引きを作成することで、探索を高速にする indexなし indexあり 索引: Term → p.149

    p.1 p.2 p.3 … p.149 Term p.1 … p.149 Term … p.999 先頭ページから1ページずつ順に確認する(フルスキャン) 索引で格納位置を特定し、目的の中間要素へ直接アクセス CONFIDENTIAL 37
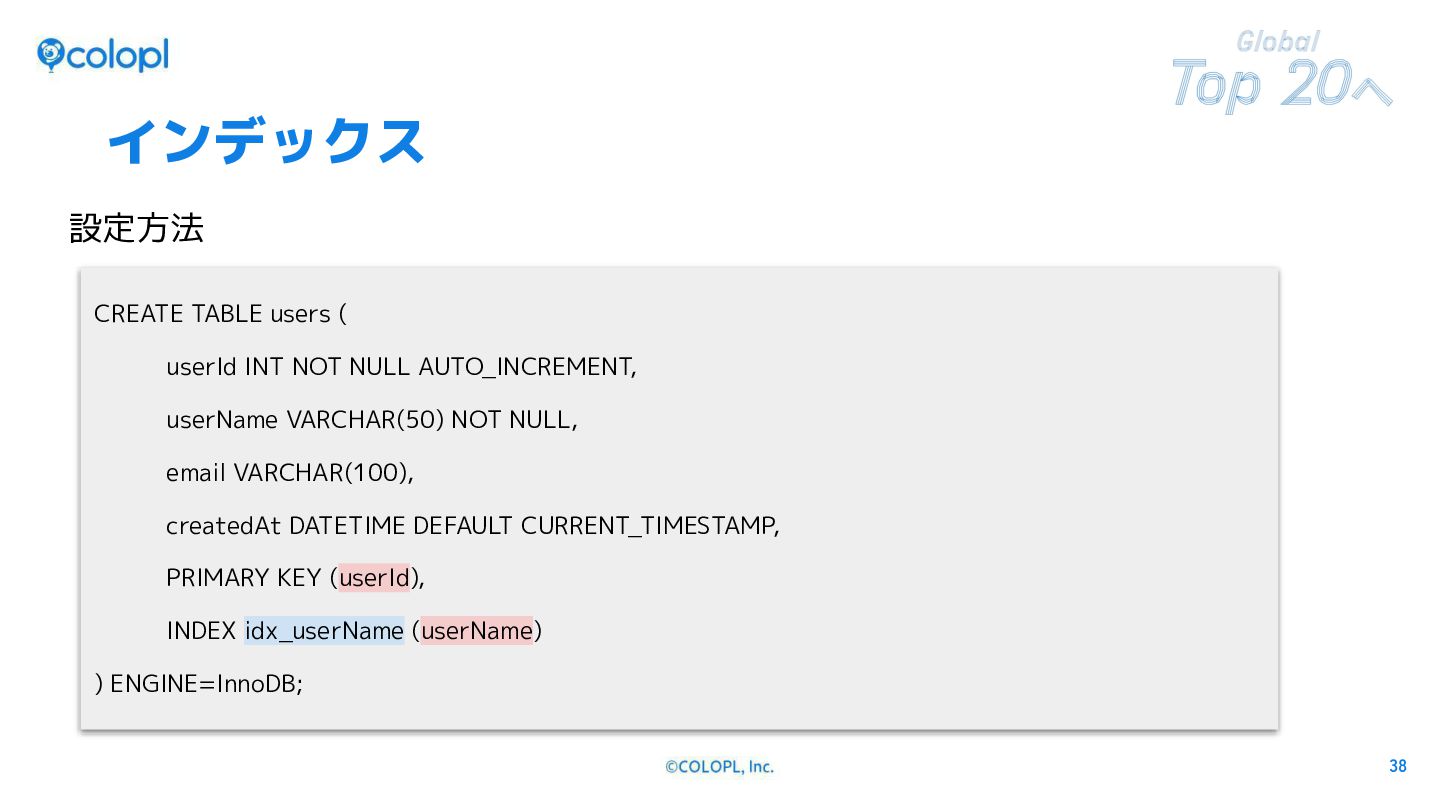
  22. インデックス 設定方法 テーブル定義に KEY index名 (カラム名)を追加する CREATE TABLE users (

    userId INT NOT NULL AUTO_INCREMENT, userName VARCHAR(50) NOT NULL, email VARCHAR(100), createdAt DATETIME DEFAULT CURRENT_TIMESTAMP, PRIMARY KEY (userId), INDEX idx_userName (userName) ) ENGINE=InnoDB; CONFIDENTIAL 38
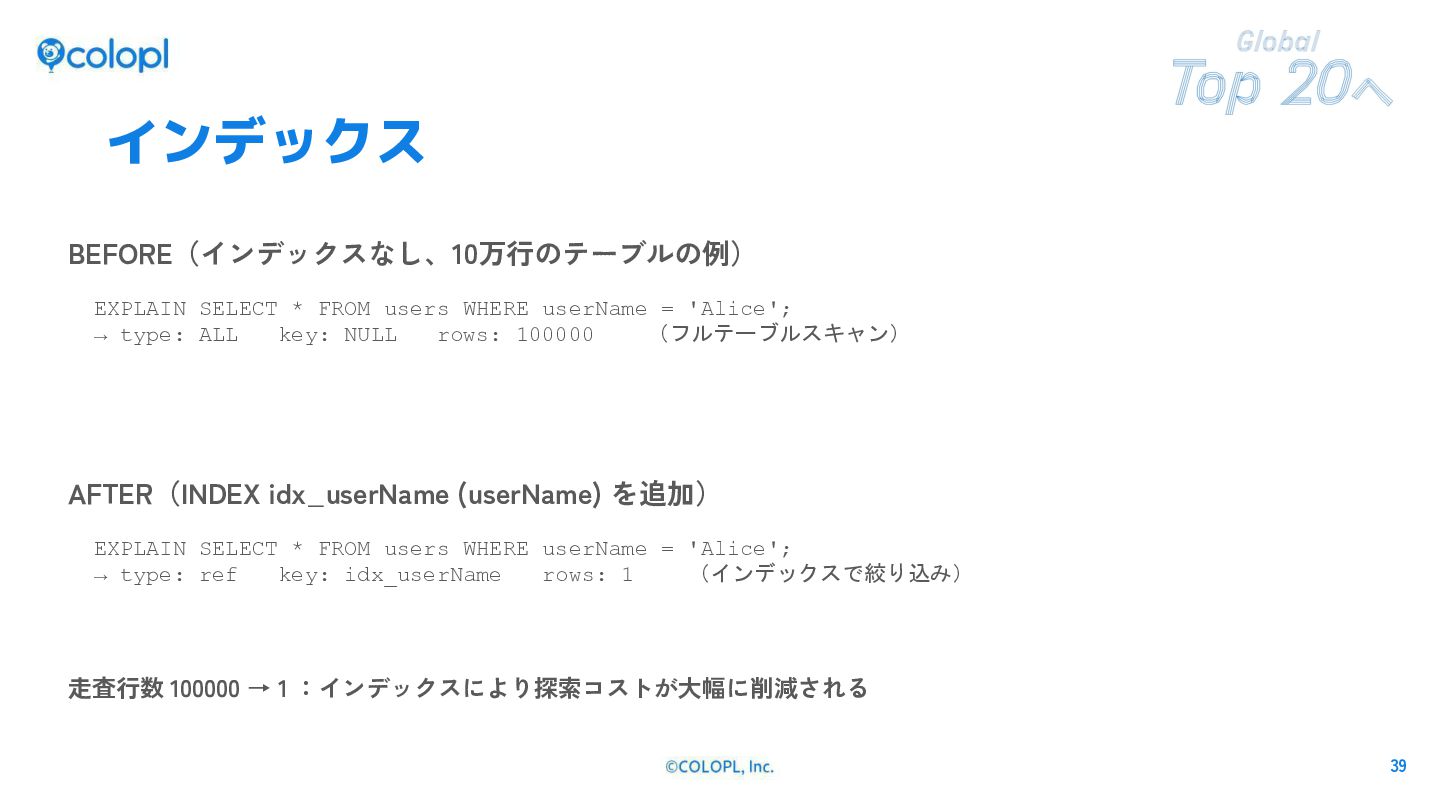
  23. インデックス BEFORE(インデックスなし、10万行のテーブルの例) EXPLAIN SELECT * FROM users WHERE userName =

    'Alice'; → type: ALL key: NULL rows: 100000 (フルテーブルスキャン) AFTER(INDEX idx_userName (userName) を追加) EXPLAIN SELECT * FROM users WHERE userName = 'Alice'; → type: ref key: idx_userName rows: 1 (インデックスで絞り込み) 走査行数 100000 → 1 :インデックスにより探索コストが大幅に削減される CONFIDENTIAL 39
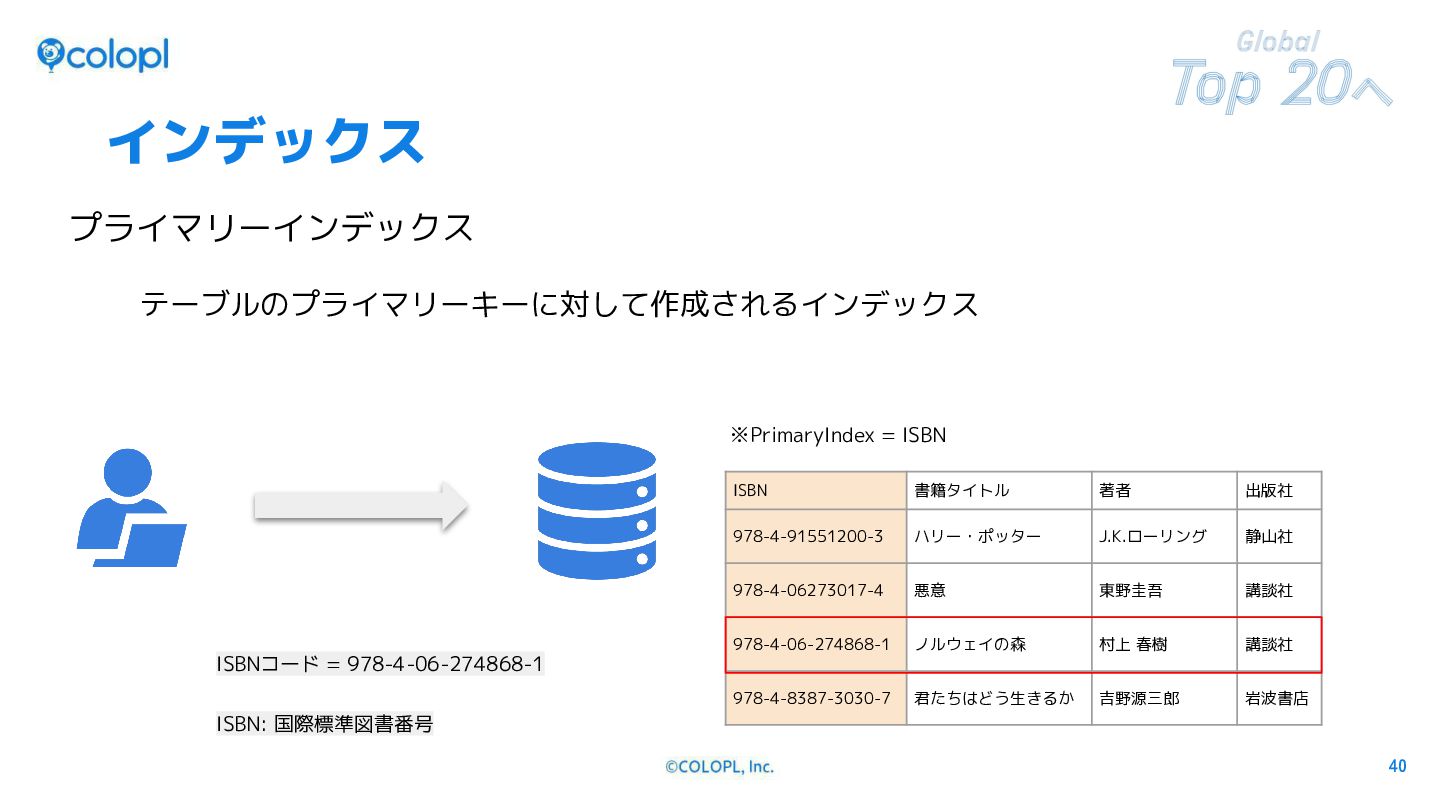
  24. インデックス プライマリーインデックス テーブルのプライマリーキーに対して作成されるインデックス ※PrimaryIndex = ISBN ISBN 書籍タイトル 著者 出版社

    978-4-91551200-3 ハリー・ポッター J.K.ローリング 静山社 978-4-06273017-4 悪意 東野圭吾 講談社 978-4-06-274868-1 ノルウェイの森 村上 春樹 講談社 978-4-8387-3030-7 君たちはどう生きるか 吉野源三郎 岩波書店 ISBNコード = 978-4-06-274868-1 ISBN: 国際標準図書番号 CONFIDENTIAL 40
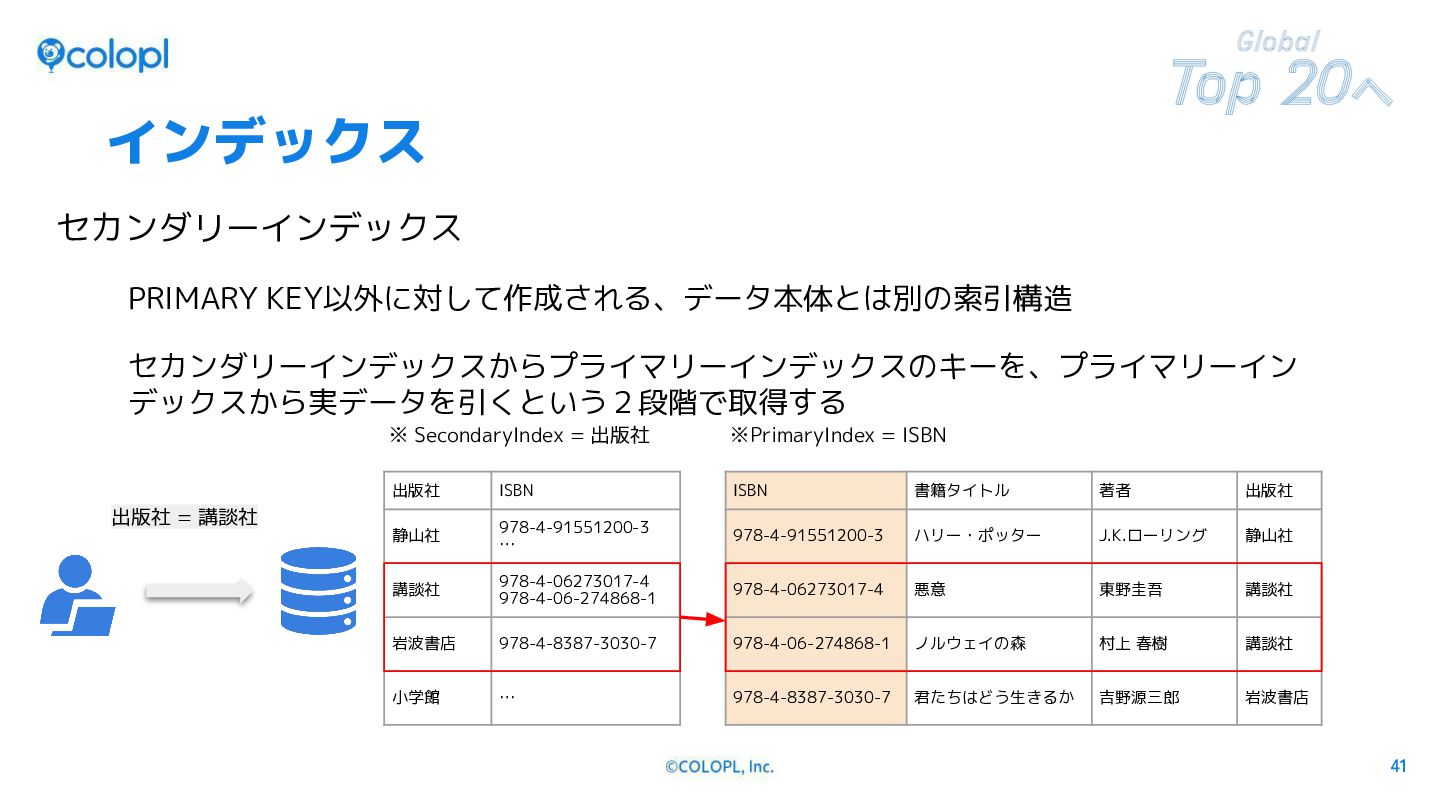
  25. インデックス セカンダリーインデックス PRIMARY KEY以外に対して作成される、データ本体とは別の索引構造 セカンダリーインデックスからプライマリーインデックスのキーを、プライマリーイン デックスから実データを引くという2段階で取得する ※ SecondaryIndex = 出版社

    ※PrimaryIndex = ISBN 出版社 ISBN ISBN 書籍タイトル 著者 出版社 静山社 978-4-91551200-3 … 978-4-91551200-3 ハリー・ポッター J.K.ローリング 静山社 講談社 978-4-06273017-4 978-4-06-274868-1 978-4-06273017-4 悪意 東野圭吾 講談社 岩波書店 978-4-8387-3030-7 978-4-06-274868-1 ノルウェイの森 村上 春樹 講談社 小学館 … 978-4-8387-3030-7 君たちはどう生きるか 吉野源三郎 岩波書店 出版社 = 講談社 CONFIDENTIAL 41
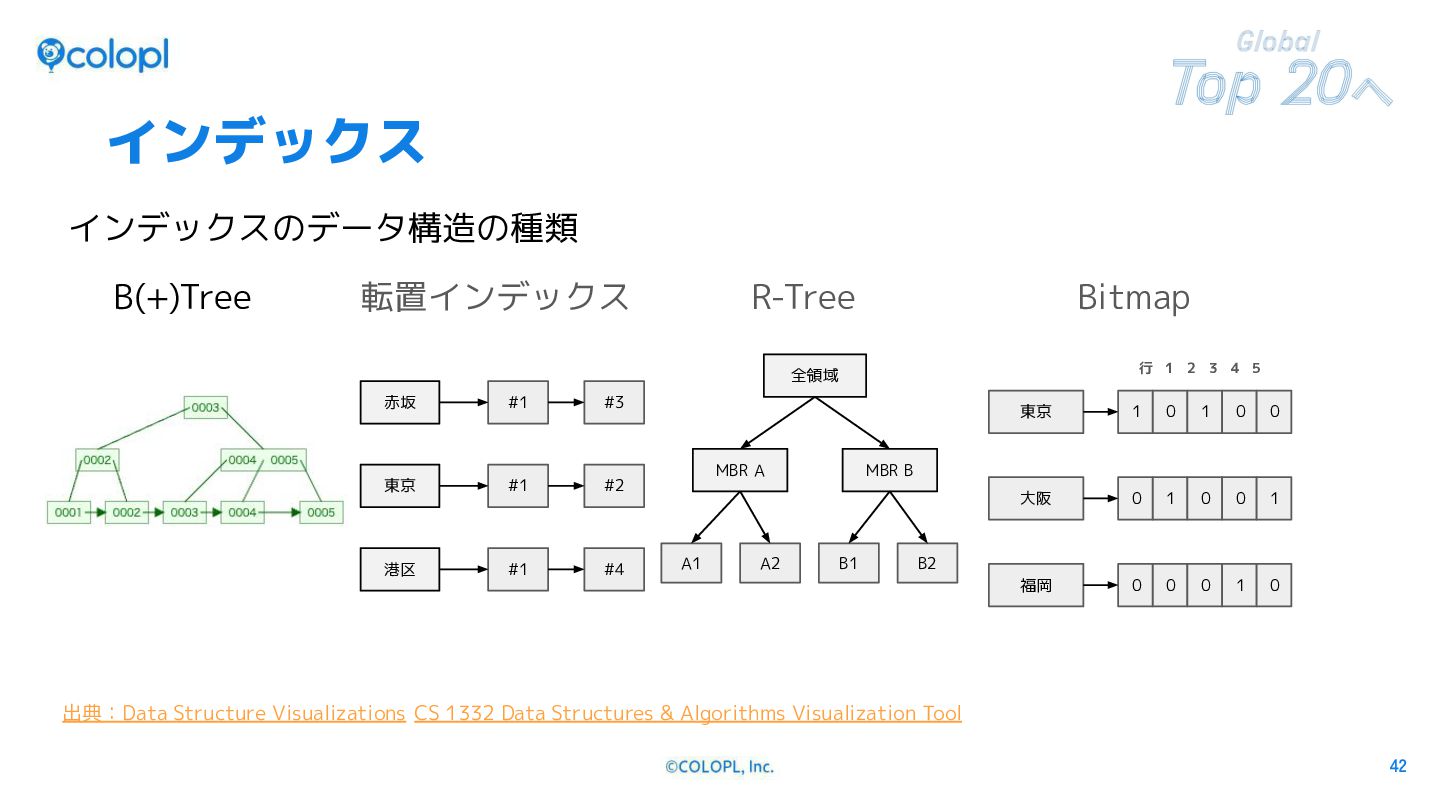
  26. インデックス インデックスのデータ構造の種類 B(+)Tree 転置インデックス R-Tree Bitmap 行 1 2 3

    4 5 全領域 赤坂 #1 #3 東京 #1 #2 港区 #1 #4 MBR A A1 A2 東京 1 0 1 0 0 大阪 0 1 0 0 1 福岡 0 0 0 1 0 MBR B B1 B2 出典:Data Structure Visualizations CS 1332 Data Structures & Algorithms Visualization Tool CONFIDENTIAL 42
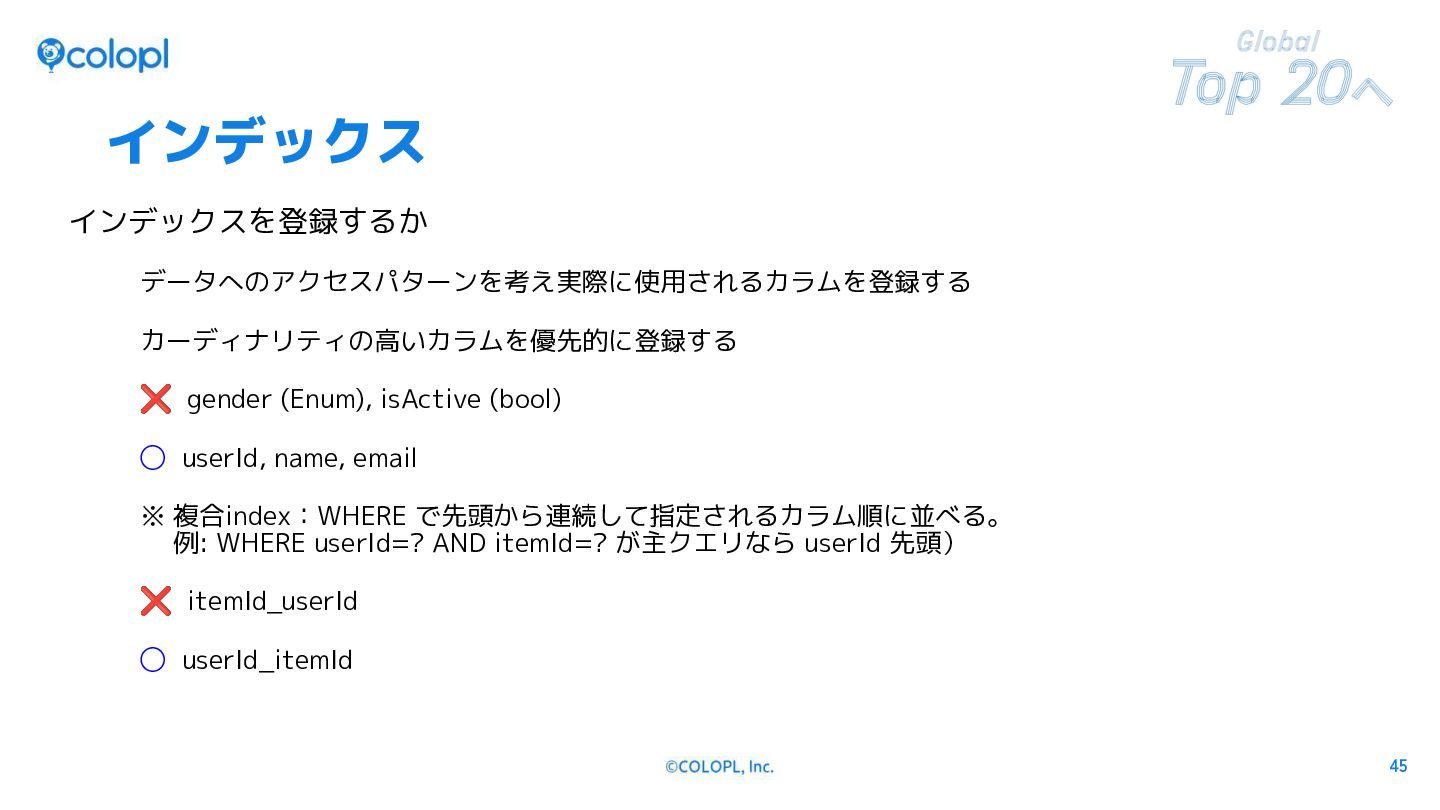
  27. インデックス インデックスを登録するか データへのアクセスパターンを考え実際に使用されるカラムを登録する カーディナリティの高いカラムを優先的に登録する ❌ gender (Enum), isActive (bool) ◯

    userId, name, email ※ 複合index:WHERE で先頭から連続して指定されるカラム順に並べる。 例: WHERE userId=? AND itemId=? が主クエリなら userId 先頭) ❌ itemId_userId ◯ userId_itemId CONFIDENTIAL 45
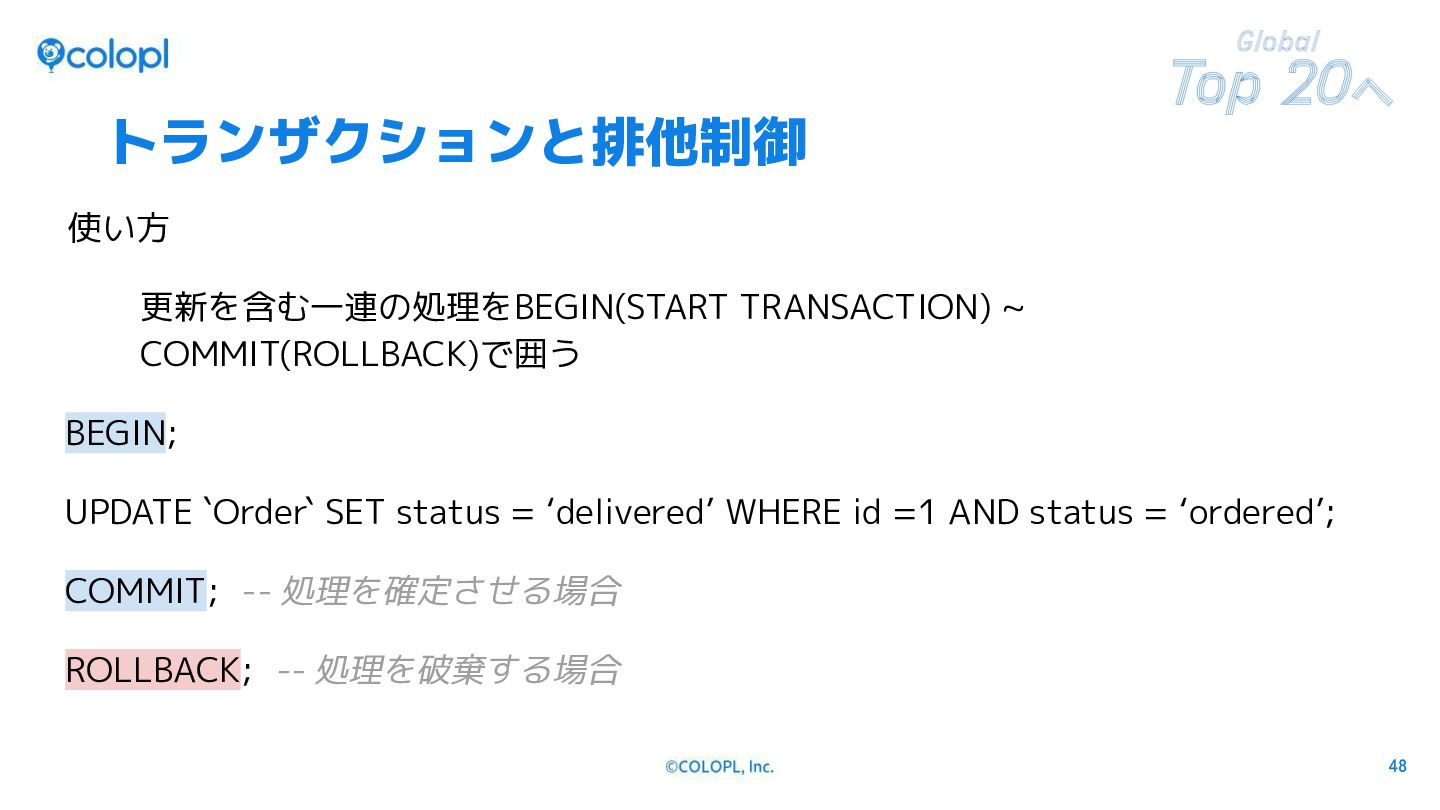
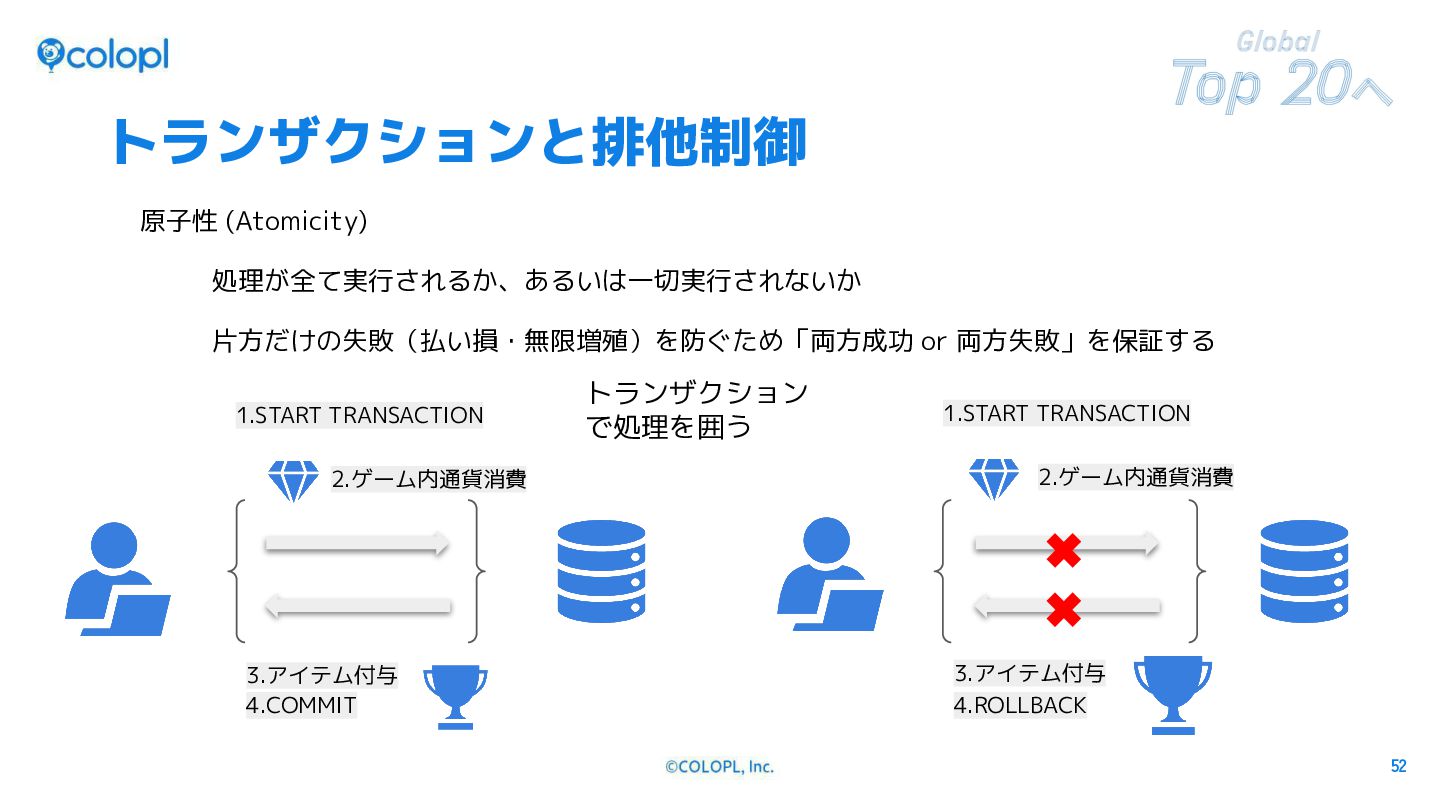
  28. トランザクションと排他制御 使い方 更新を含む一連の処理をBEGIN(START TRANSACTION) ~ COMMIT(ROLLBACK)で囲う BEGIN; UPDATE `Order` SET

    status = ‘delivered’ WHERE id =1 AND status = ‘ordered’; COMMIT; -- 処理を確定させる場合 ROLLBACK; -- 処理を破棄する場合 CONFIDENTIAL 48
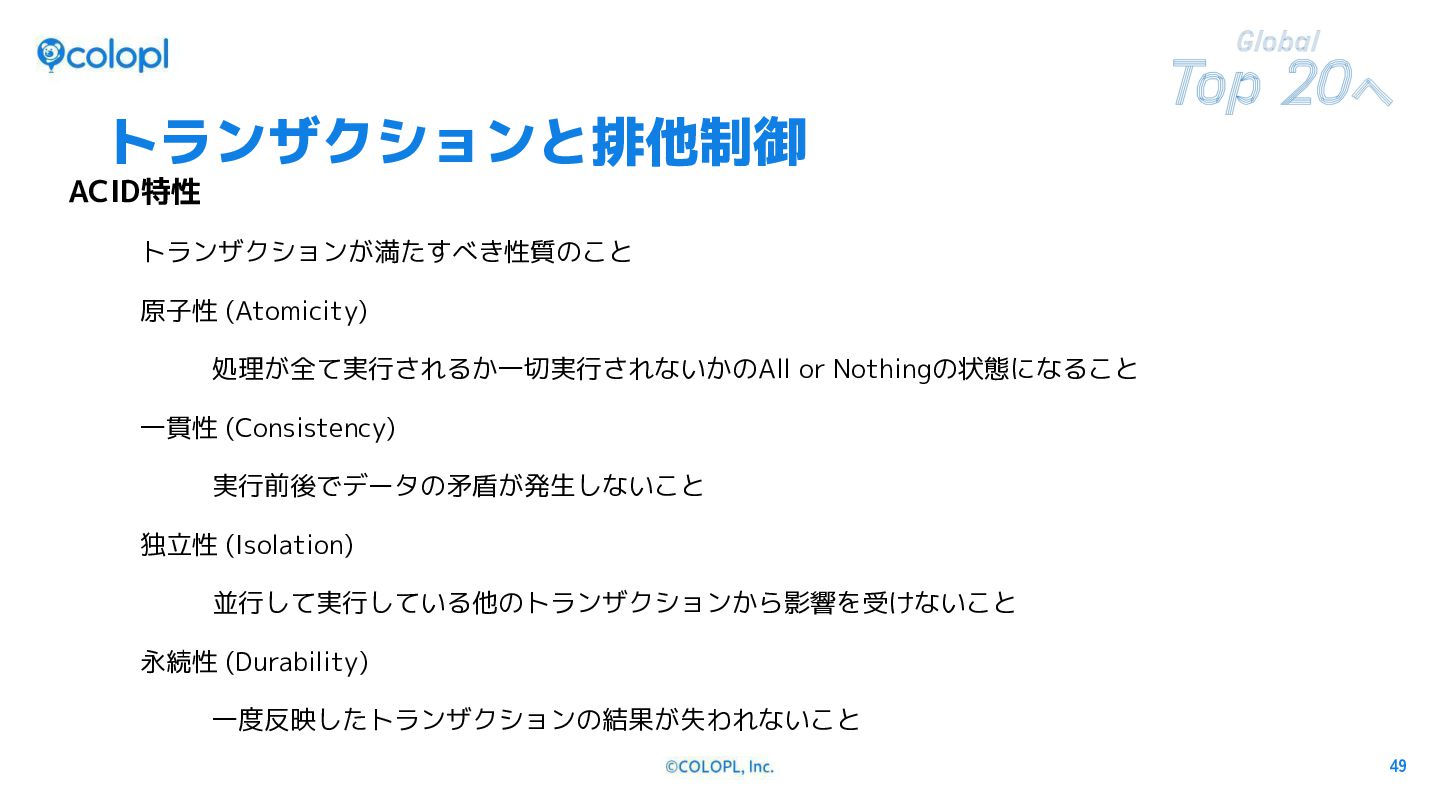
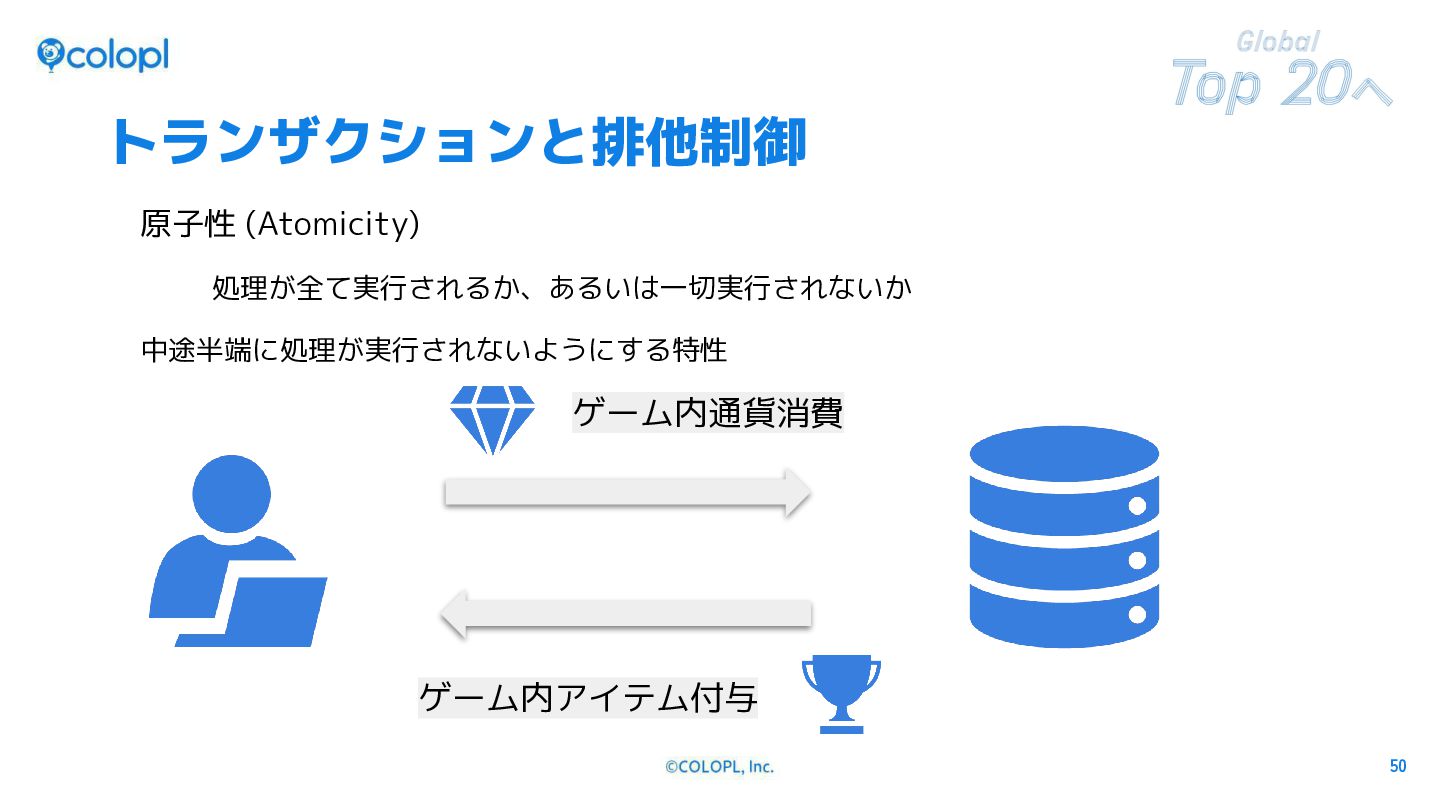
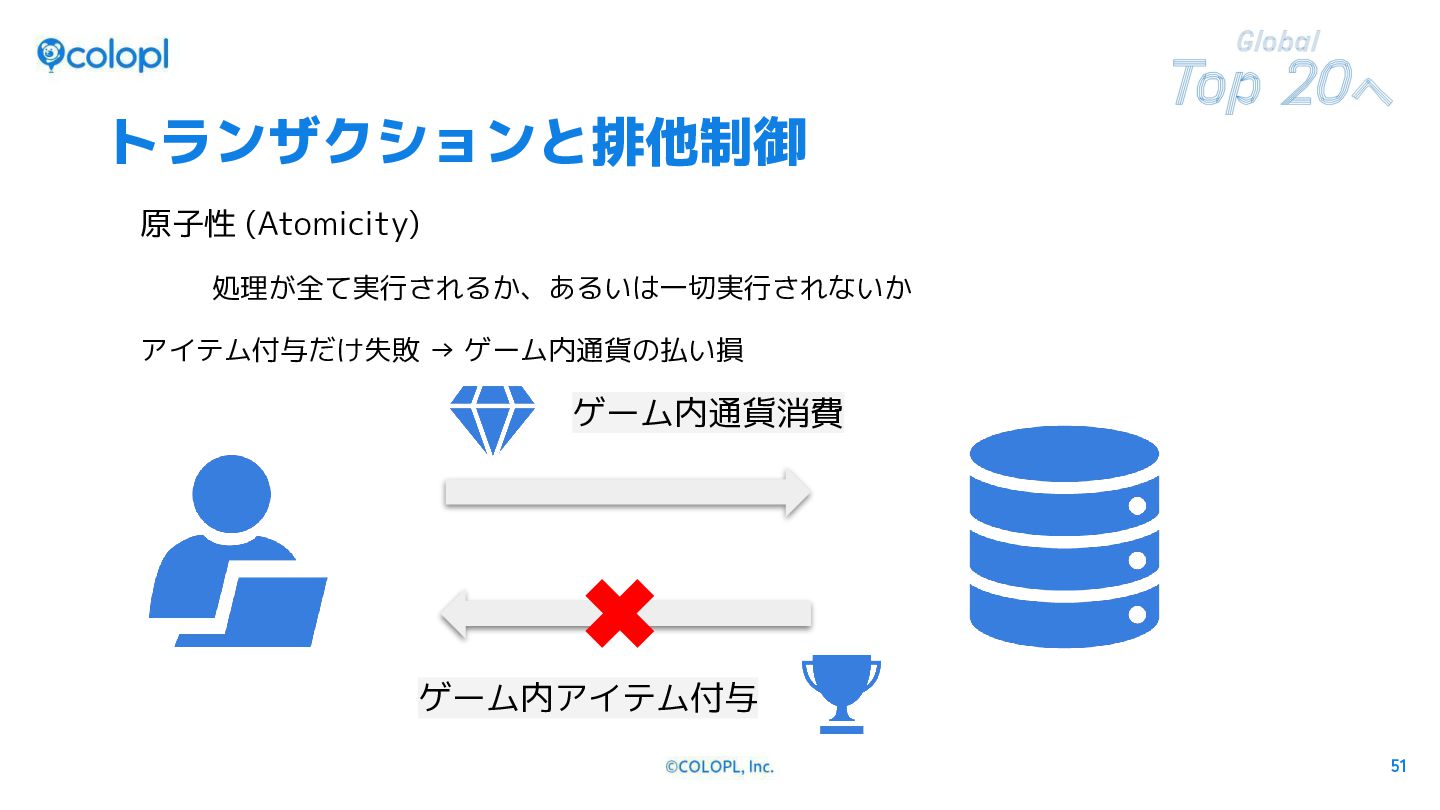
  29. トランザクションと排他制御 ACID特性 トランザクションが満たすべき性質のこと 原子性 (Atomicity) 処理が全て実行されるか一切実行されないかのAll or Nothingの状態になること 一貫性 (Consistency)

    実行前後でデータの矛盾が発生しないこと 独立性 (Isolation) 並行して実行している他のトランザクションから影響を受けないこと 永続性 (Durability) 一度反映したトランザクションの結果が失われないこと CONFIDENTIAL 49
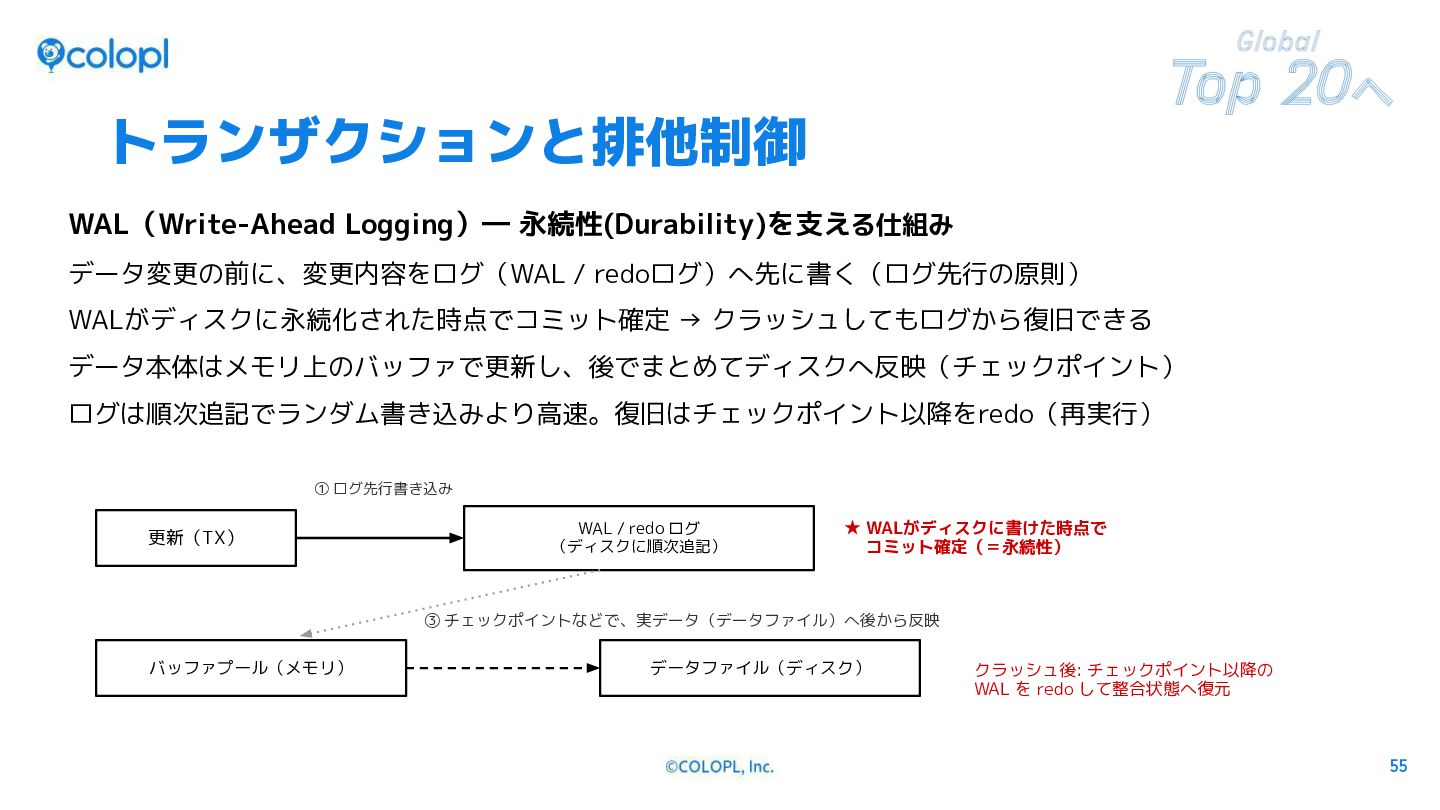
  30. トランザクションと排他制御 WAL(Write-Ahead Logging)― 永続性(Durability)を支える仕組み データ変更の前に、変更内容をログ(WAL / redoログ)へ先に書く(ログ先行の原則) WALがディスクに永続化された時点でコミット確定 → クラッシュしてもログから復旧できる

    データ本体はメモリ上のバッファで更新し、後でまとめてディスクへ反映(チェックポイント) ログは順次追記でランダム書き込みより高速。復旧はチェックポイント以降をredo(再実行) ① ログ先行書き込み 更新(TX) WAL / redo ログ (ディスクに順次追記) ★ WALがディスクに書けた時点で コミット確定(=永続性) ③ チェックポイントなどで、実データ(データファイル)へ後から反映 バッファプール(メモリ) CONFIDENTIAL データファイル(ディスク) クラッシュ後: チェックポイント以降の WAL を redo して整合状態へ復元 55
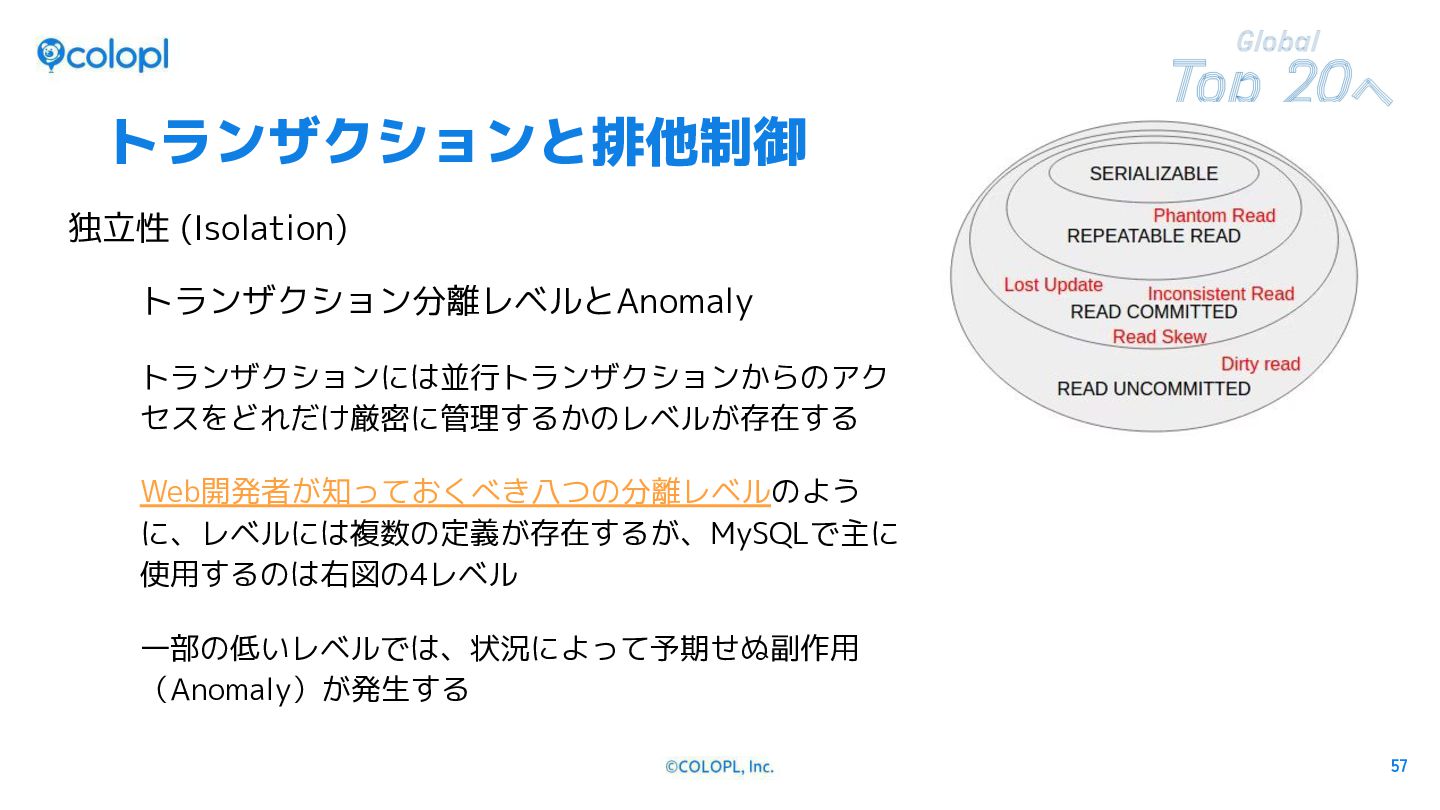
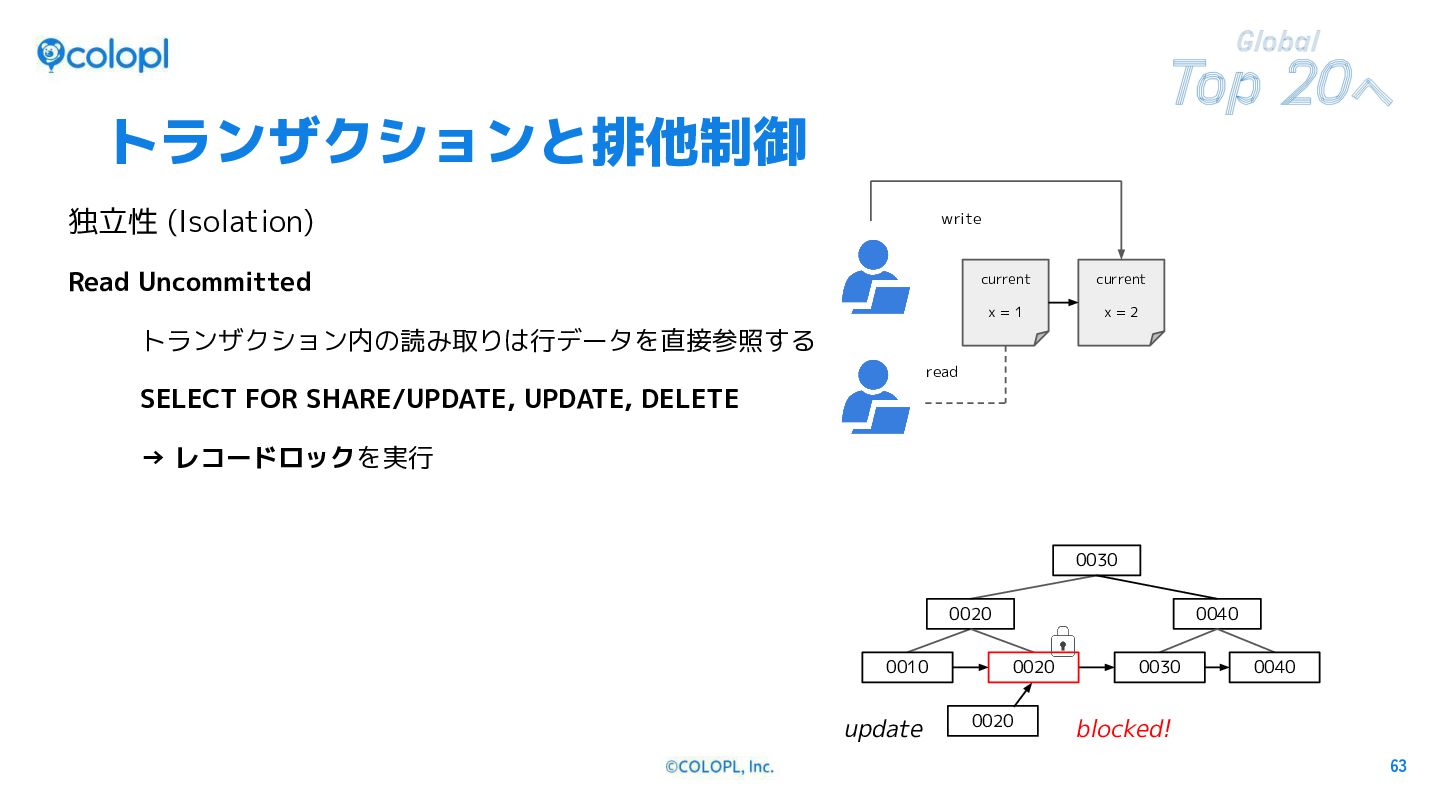
  31. トランザクションと排他制御 独立性 (Isolation) Read Uncommitted write current current x=1 x=2

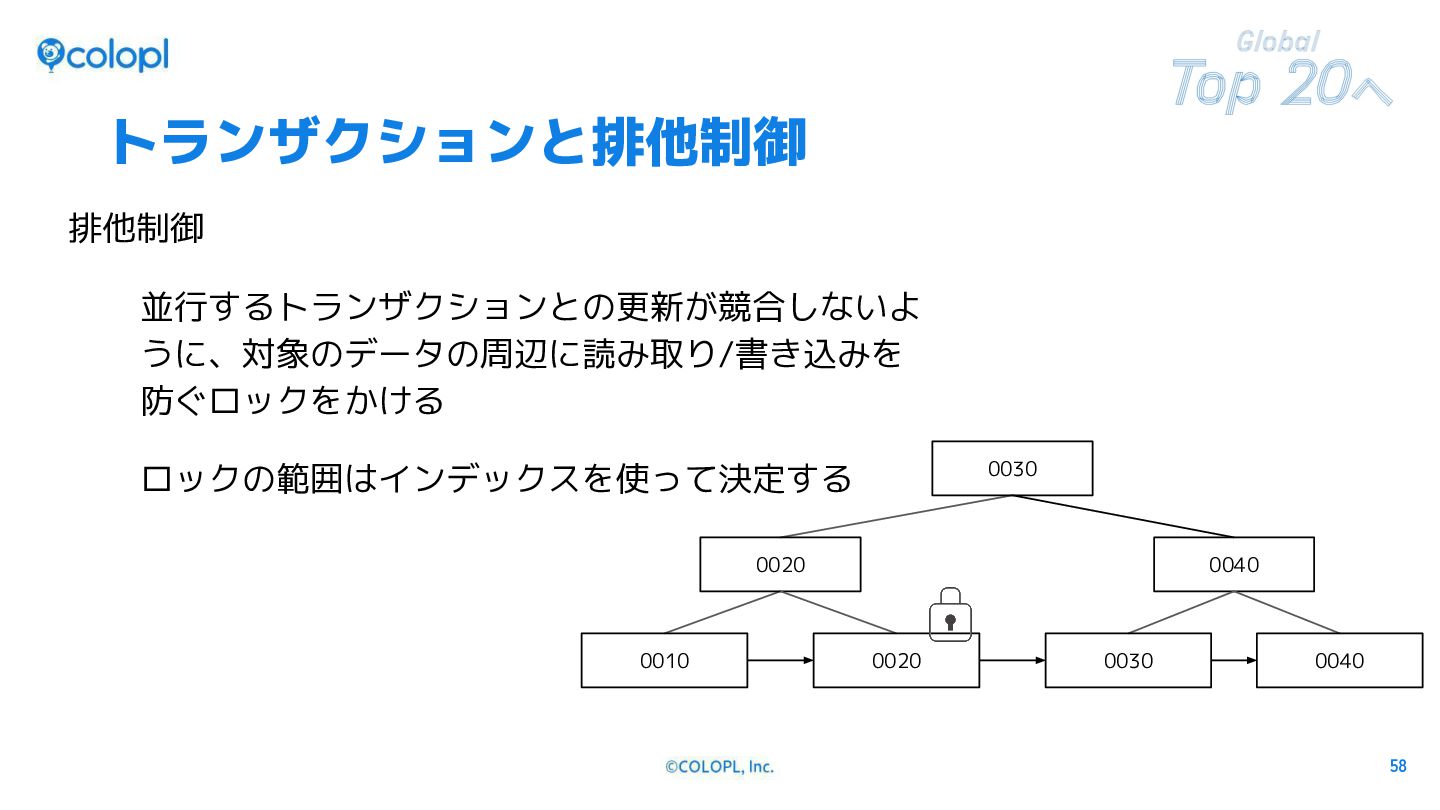
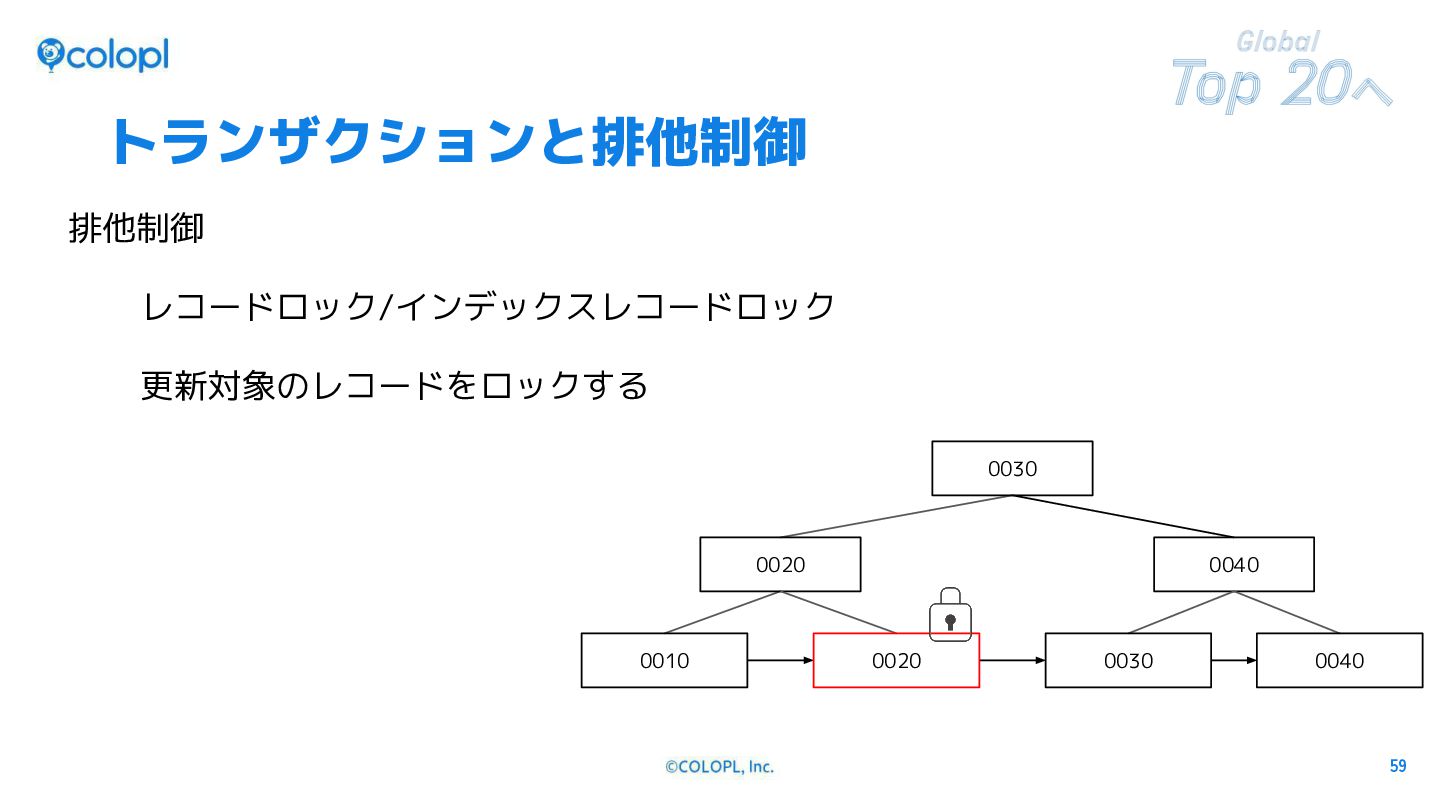
    TX:bbb トランザクション内の読み取りは行データを直接参照する read SELECT FOR SHARE/UPDATE, UPDATE, DELETE TX: aaa → レコードロックを実行 0030 0020 0010 update CONFIDENTIAL 0040 0020 0020 0030 0040 blocked! 63
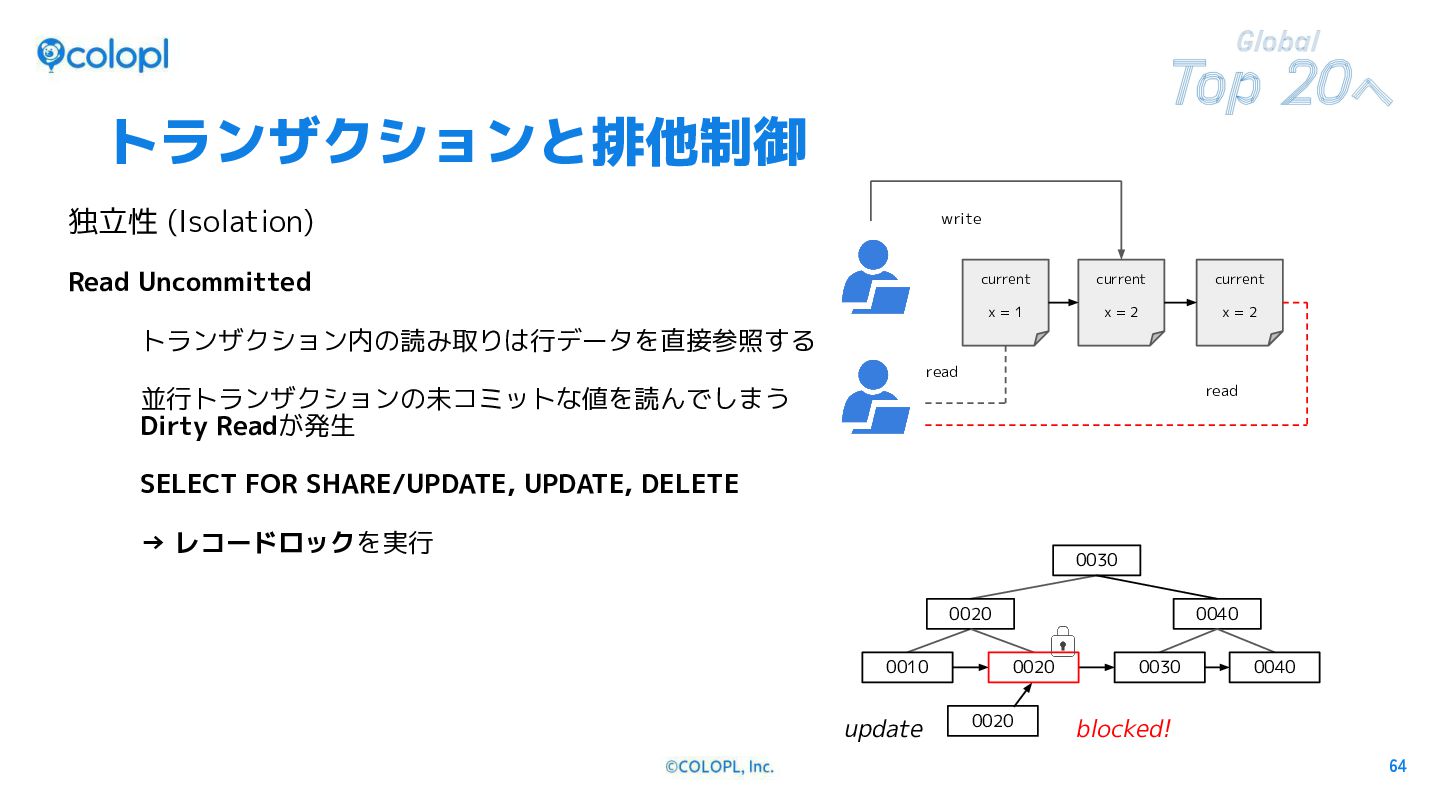
  32. トランザクションと排他制御 独立性 (Isolation) Read Uncommitted write current current current x=1

    x=2 x=2 TX:bbb トランザクション内の読み取りは行データを直接参照する read read 並行トランザクションの未コミットな値を読んでしまう Dirty Readが発生 SELECT FOR SHARE/UPDATE, UPDATE, DELETE → レコードロックを実行 0030 0020 0010 update CONFIDENTIAL 0040 0020 0020 0030 0040 blocked! 64
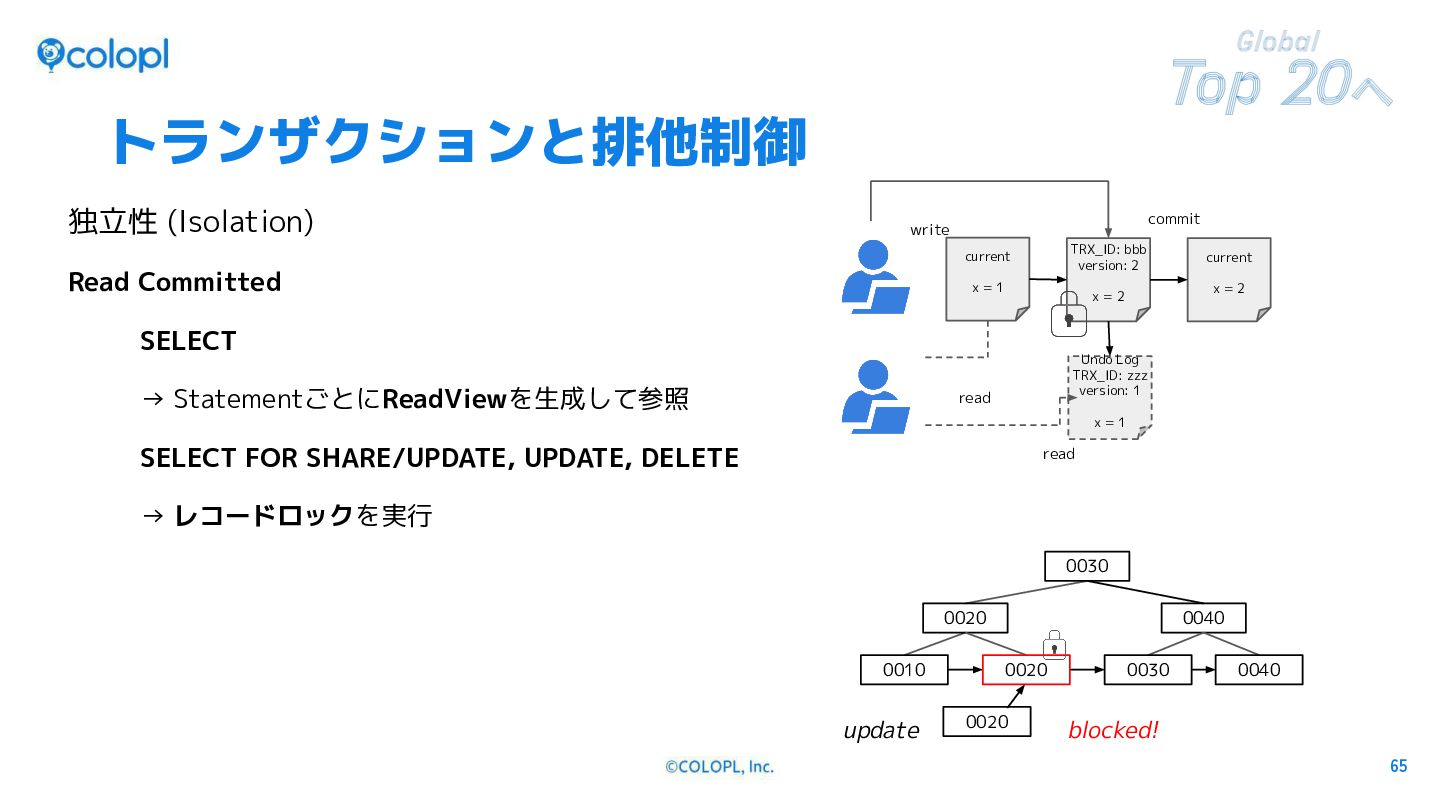
  33. トランザクションと排他制御 独立性 (Isolation) commit write TRX_ID: bbb version: 2 current

    Read Committed x=1 SELECT → StatementごとにReadViewを生成して参照 x=2 x=2 TX:bbb current Undo Log TRX_ID: zzz version: 1 read x=1 SELECT FOR SHARE/UPDATE, UPDATE, DELETE read → レコードロックを実行 0030 0020 0010 update CONFIDENTIAL 0040 0020 0020 0030 0040 blocked! 65
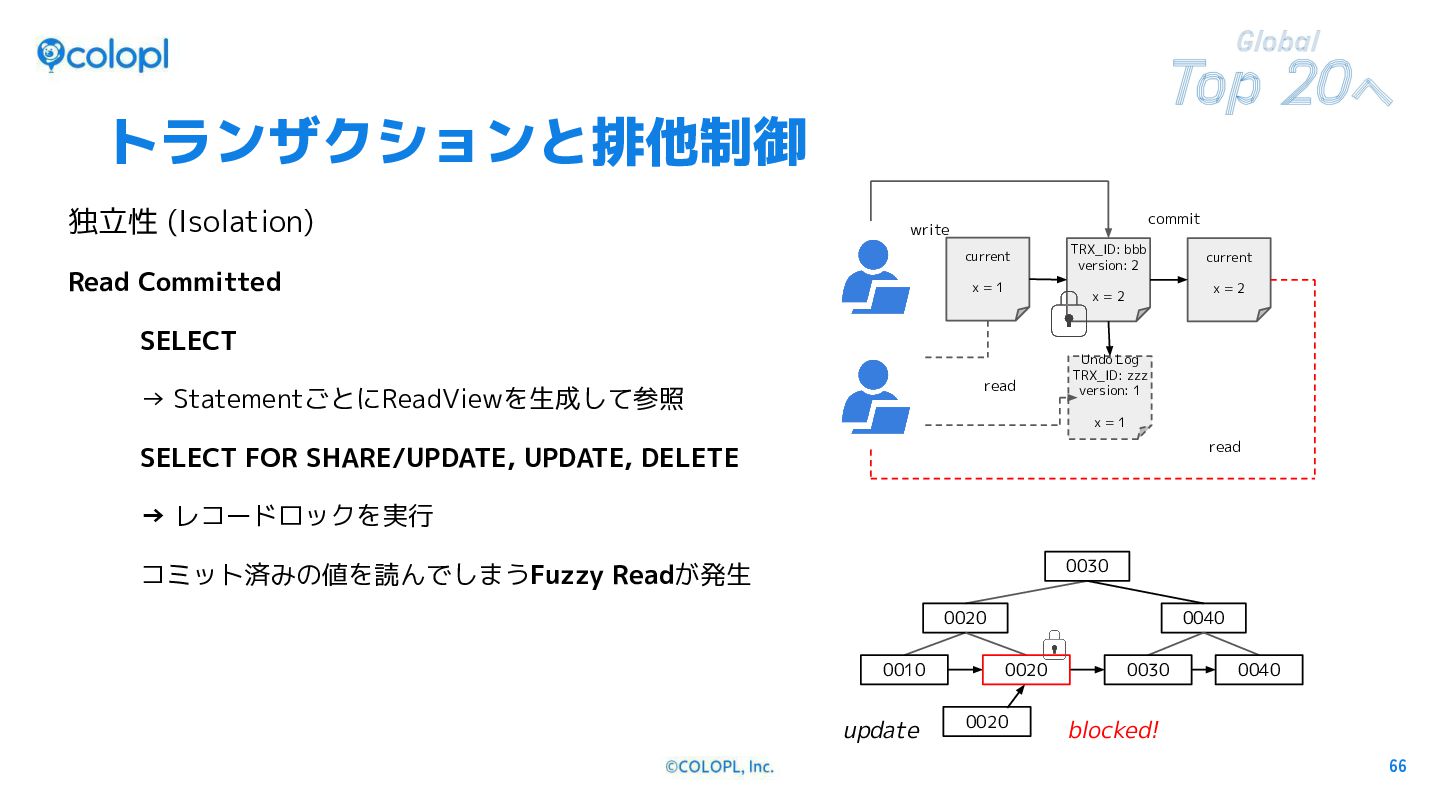
  34. トランザクションと排他制御 独立性 (Isolation) commit write current Read Committed x=1 SELECT

    read SELECT FOR SHARE/UPDATE, UPDATE, DELETE TX: aaa current x=2 x=2 TX:bbb → StatementごとにReadViewを生成して参照 TRX_ID: bbb version: 2 Undo Log TRX_ID: zzz version: 1 x=1 read → レコードロックを実行 0030 コミット済みの値を読んでしまうFuzzy Readが発生 0020 0010 update CONFIDENTIAL 0040 0020 0020 0030 0040 blocked! 66
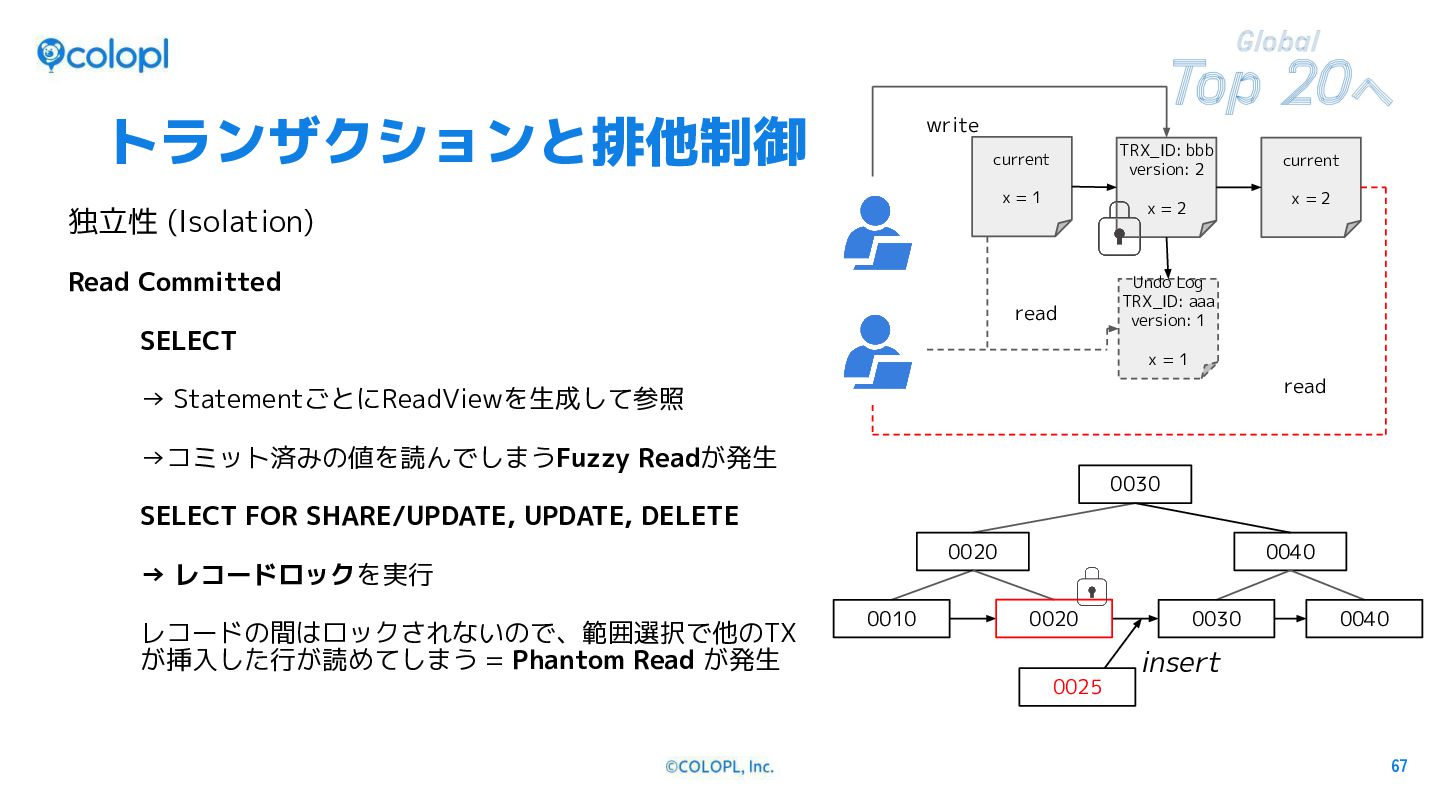
  35. トランザクションと排他制御 write TRX_ID: bbb version: 2 current x=1 x=2 x=2

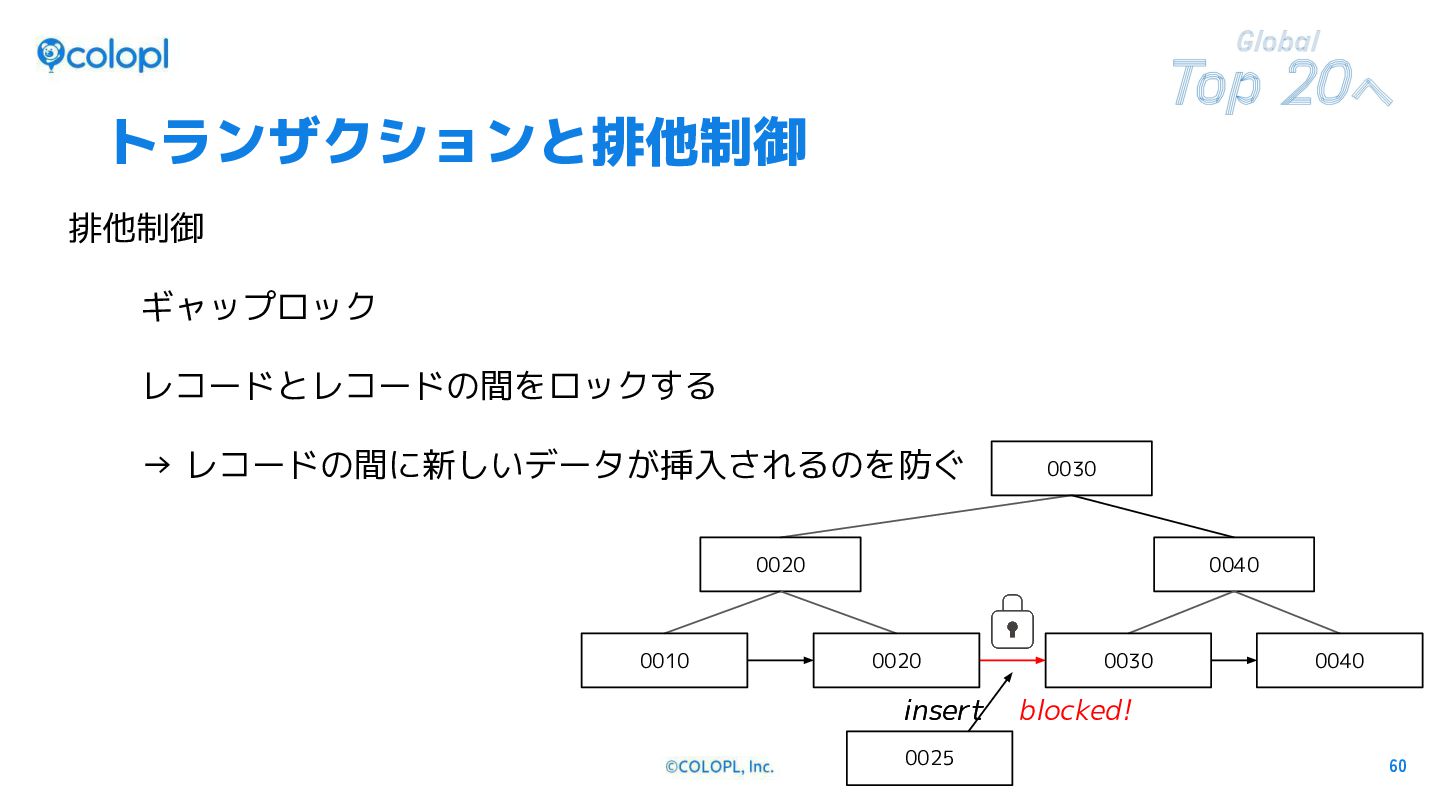
    独立性 (Isolation) Read Committed read SELECT current Undo Log TRX_ID: aaa version: 1 x=1 read → StatementごとにReadViewを生成して参照 →コミット済みの値を読んでしまうFuzzy Readが発生 0030 SELECT FOR SHARE/UPDATE, UPDATE, DELETE 0020 → レコードロックを実行 レコードの間はロックされないので、範囲選択で他のTX が挿入した行が読めてしまう = Phantom Read が発生 0010 0040 0020 0030 0040 insert 0025 CONFIDENTIAL 67
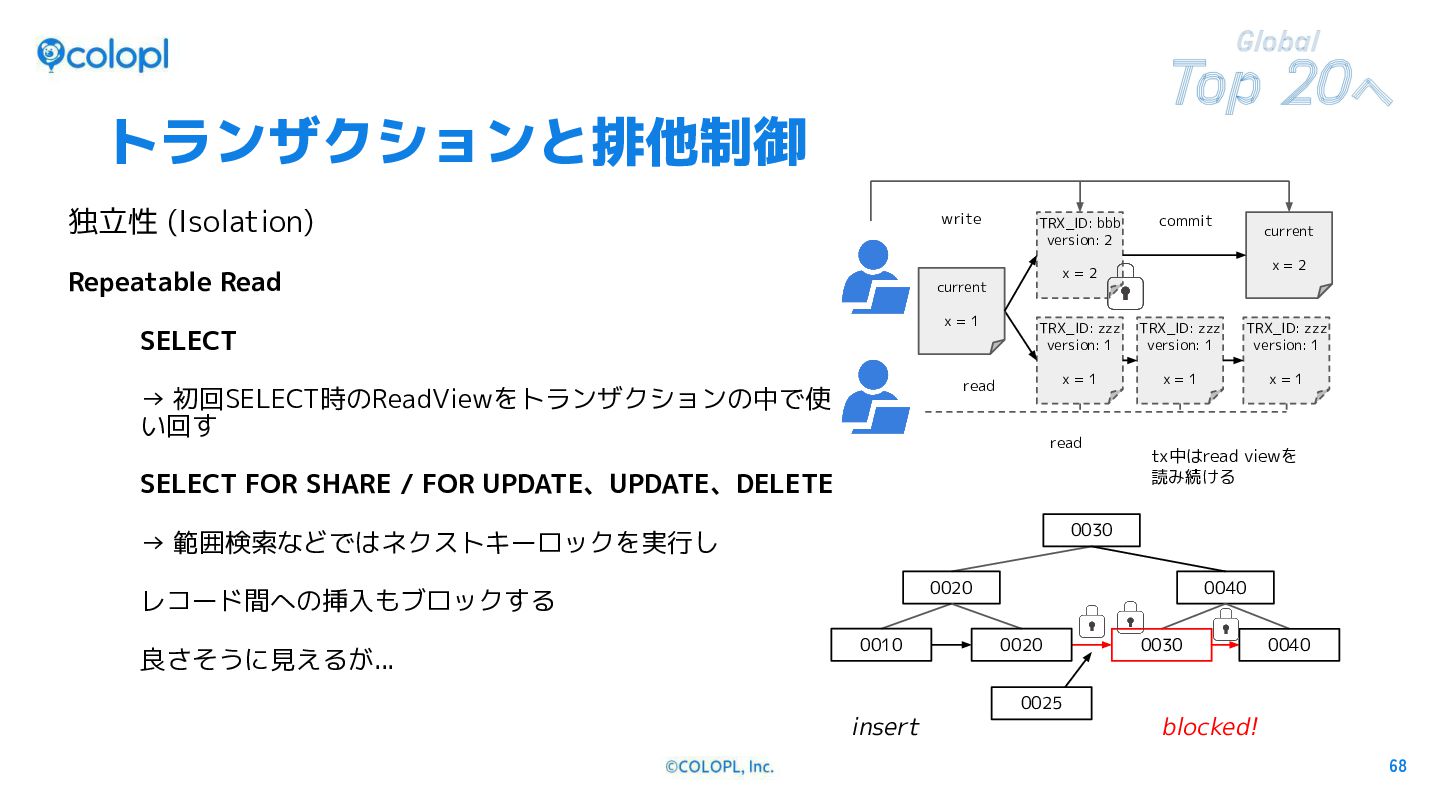
  36. トランザクションと排他制御 独立性 (Isolation) write Repeatable Read current TX:bbb x=1 SELECT

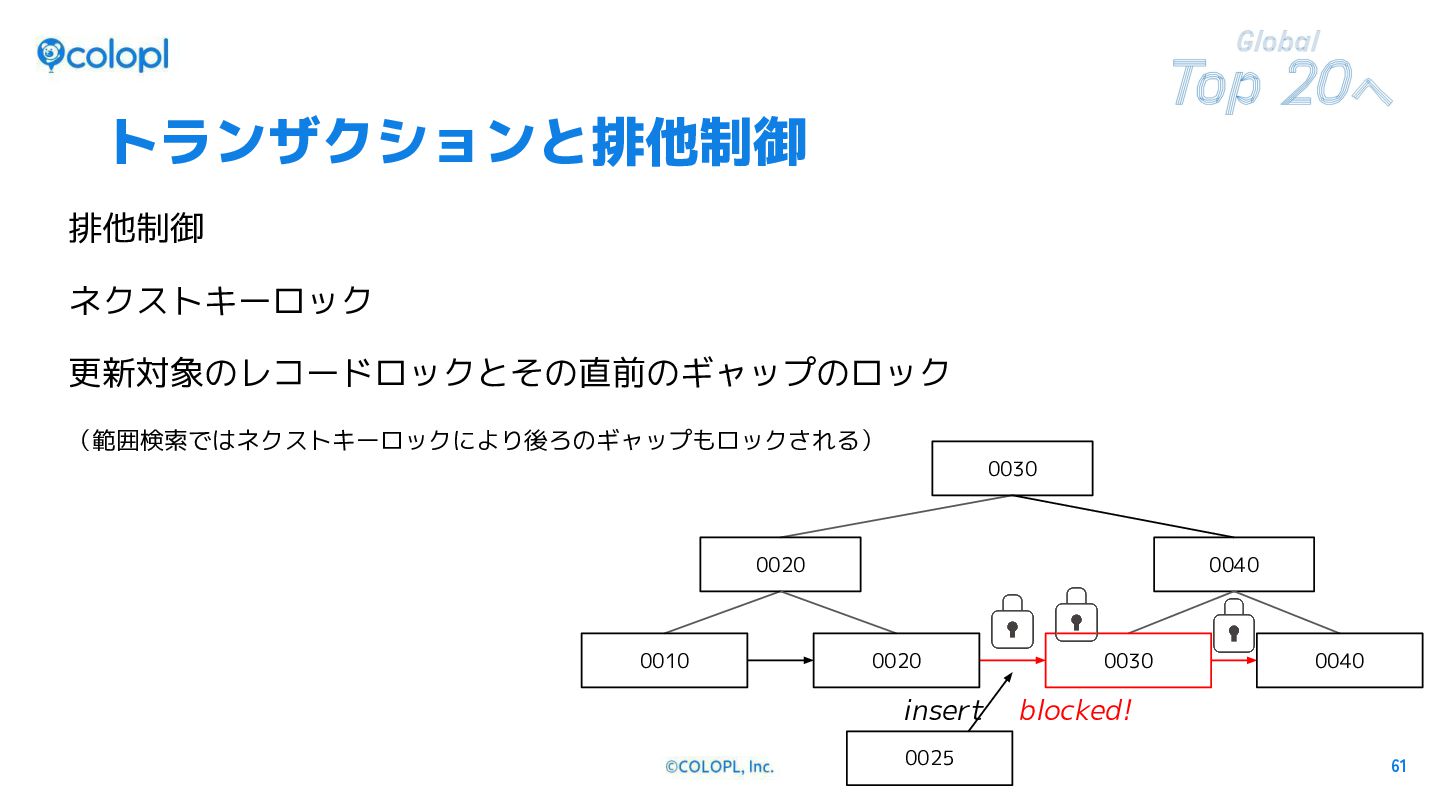
    TRX_ID: bbb version: 2 x=2 TRX_ID: zzz version: 1 TRX_ID: zzz version: 1 TRX_ID: zzz version: 1 x=1 x=1 x=1 read SELECT FOR SHARE / FOR UPDATE、UPDATE、DELETE tx中はread viewを 読み続ける 0030 → 範囲検索などではネクストキーロックを実行し 0020 レコード間への挿入もブロックする 良さそうに見えるが... current x=2 read → 初回SELECT時のReadViewをトランザクションの中で使 い回す commit 0010 0040 0020 0030 0040 0025 insert CONFIDENTIAL blocked! 68
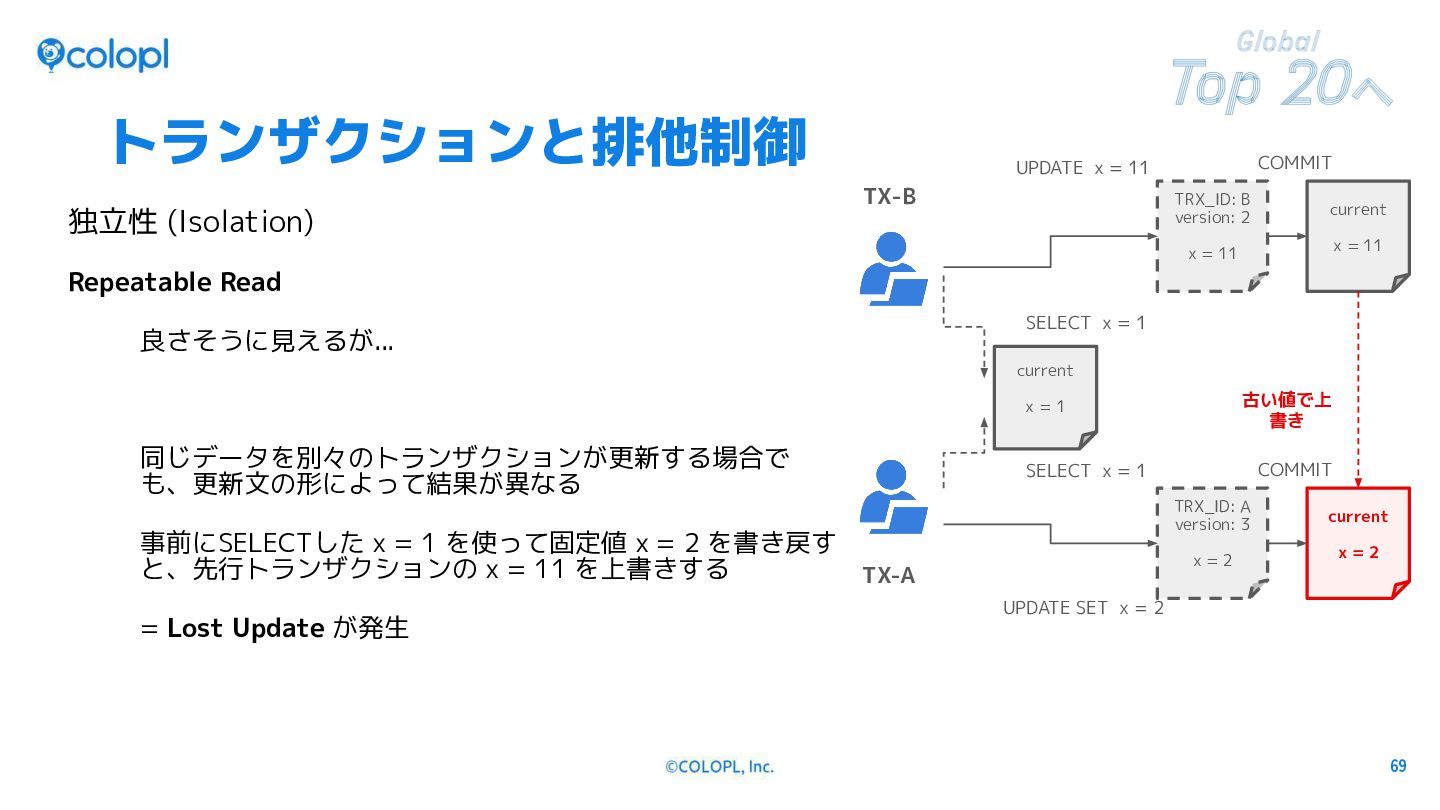
  37. トランザクションと排他制御 独立性 (Isolation) COMMIT UPDATE x = 11 TX-B TRX_ID:

    B version: 2 current x = 11 x = 11 Repeatable Read 良さそうに見えるが... SELECT x = 1 current 古い値で上 書き x=1 同じデータを別々のトランザクションが更新する場合で も、更新文の形によって結果が異なる TRX_ID: A version: 3 事前にSELECTした x = 1 を使って固定値 x = 2 を書き戻す と、先行トランザクションの x = 11 を上書きする TX-A = Lost Update が発生 CONFIDENTIAL COMMIT SELECT x = 1 x=2 current x=2 UPDATE SET x = 2 69
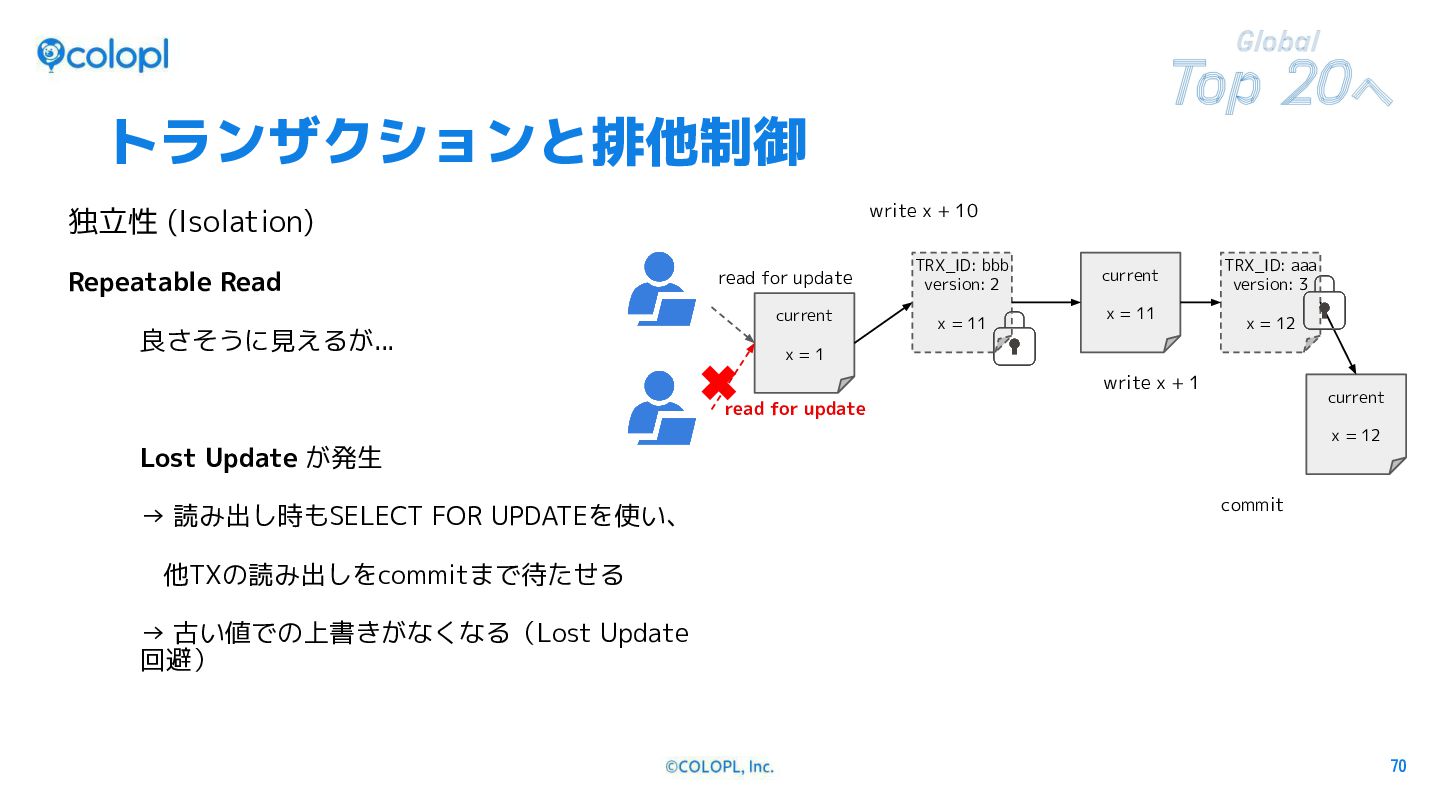
  38. トランザクションと排他制御 write x + 10 独立性 (Isolation) Repeatable Read read

    for update TX:bbb 良さそうに見えるが... current TRX_ID: bbb version: 2 x = 11 current x = 11 TRX_ID: aaa version: 3 x = 12 x=1 write x + 1 current read for update x = 12 Lost Update が発生 TX: aaa → 読み出し時もSELECT FOR UPDATEを使い、 commit 他TXの読み出しをcommitまで待たせる → 古い値での上書きがなくなる(Lost Update 回避) CONFIDENTIAL 70
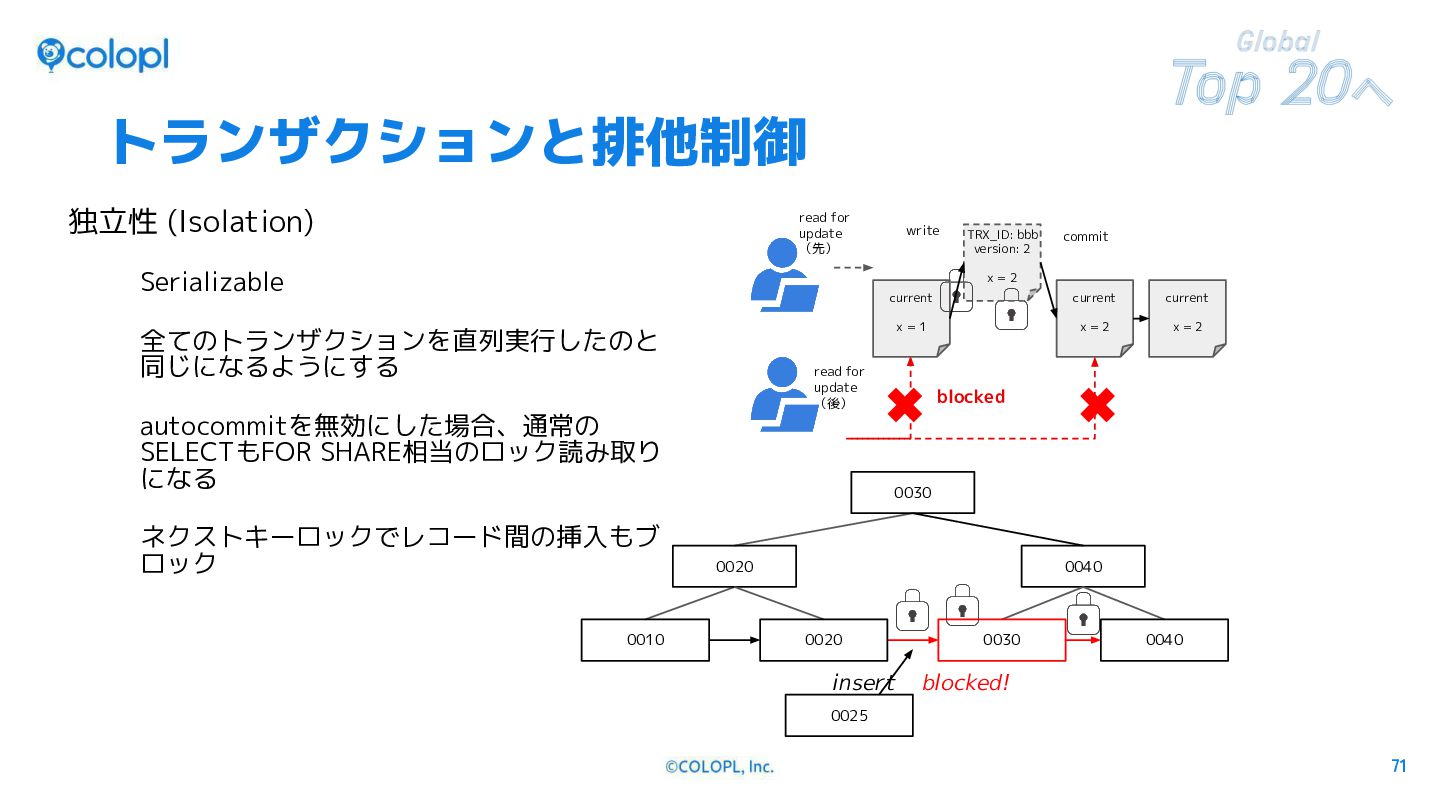
  39. トランザクションと排他制御 独立性 (Isolation) read for update (先) Serializable write TRX_ID:

    bbb version: 2 commit x=2 全てのトランザクションを直列実行したのと 同じになるようにする 0010 current current x=1 x=2 x=2 read for update (後) autocommitを無効にした場合、通常の SELECTもFOR SHARE相当のロック読み取り になる ネクストキーロックでレコード間の挿入もブ ロック current blocked 0030 0020 0040 0020 insert 0030 0040 blocked! 0025 CONFIDENTIAL 71
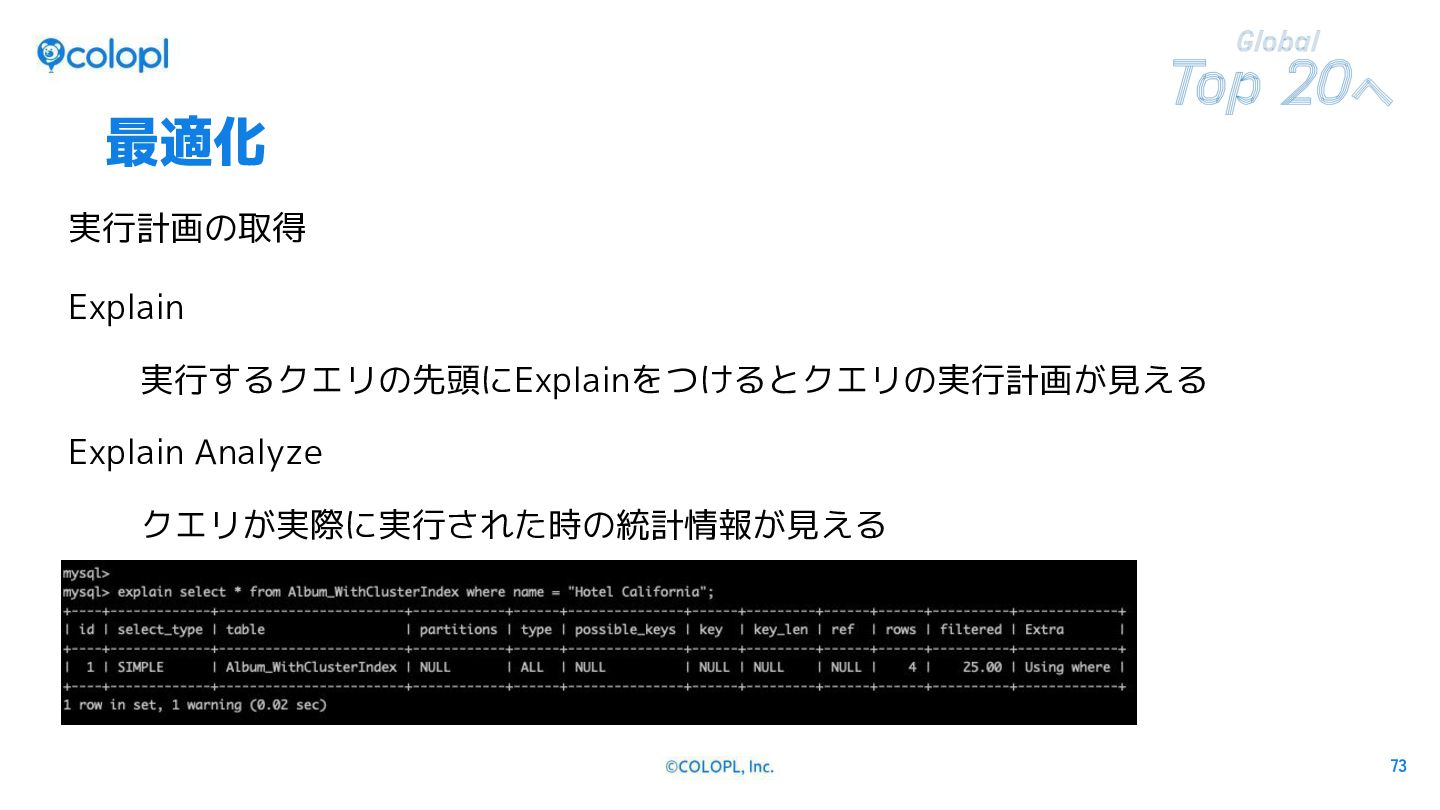
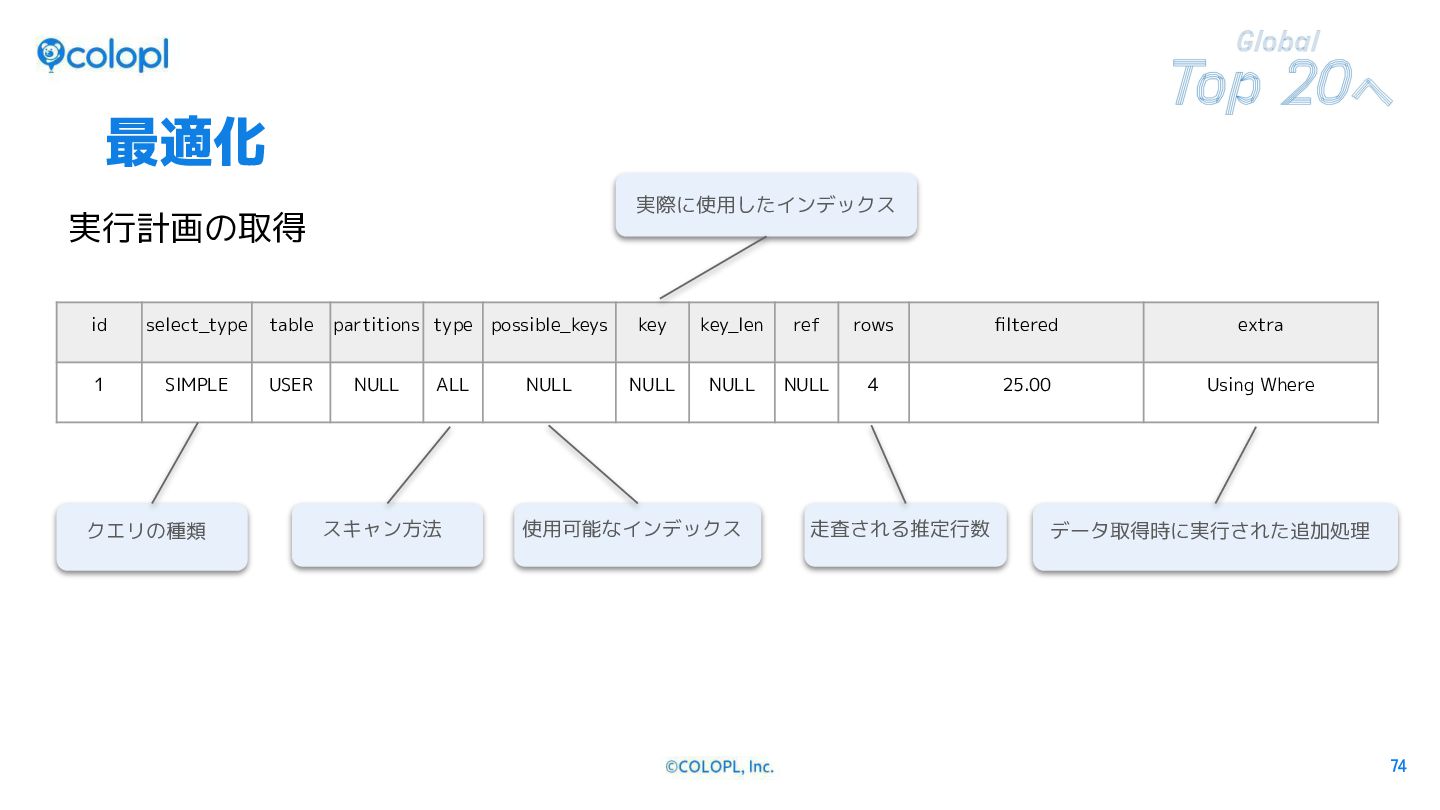
  40. 最適化 実際に使用したインデックス 実行計画の取得 id select_type table 1 SIMPLE USER クエリの種類

    CONFIDENTIAL partitions type possible_keys NULL ALL スキャン方法 NULL key key_len ref rows filtered extra NULL NULL NULL 4 25.00 Using Where 使用可能なインデックス 走査される推定行数 データ取得時に実行された追加処理 74
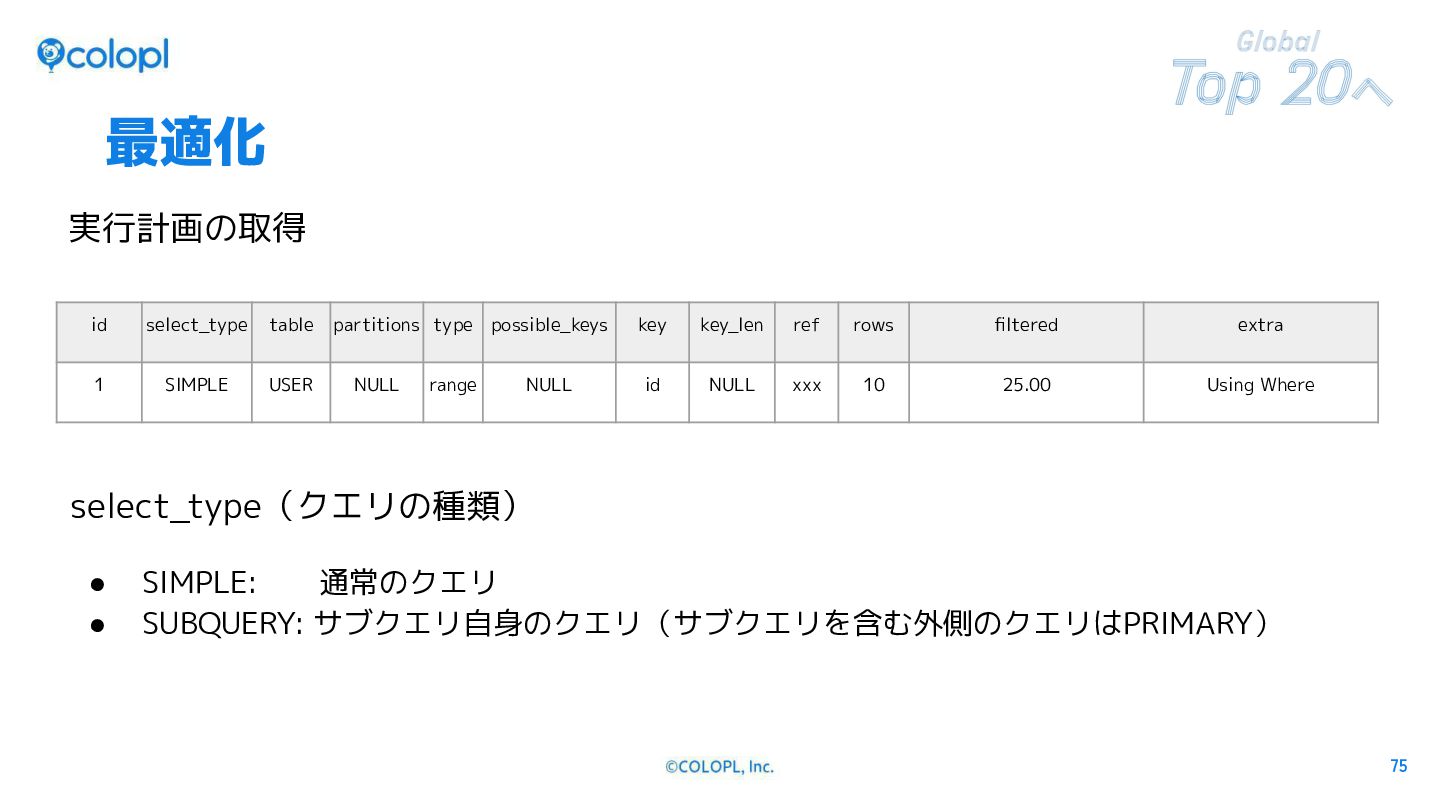
  41. 最適化 実行計画の取得 id select_type table 1 SIMPLE USER partitions type

    possible_keys NULL range NULL key key_len ref rows filtered extra id NULL xxx 10 25.00 Using Where select_type(クエリの種類) • • SIMPLE: 通常のクエリ SUBQUERY: サブクエリ自身のクエリ(サブクエリを含む外側のクエリはPRIMARY) CONFIDENTIAL 75
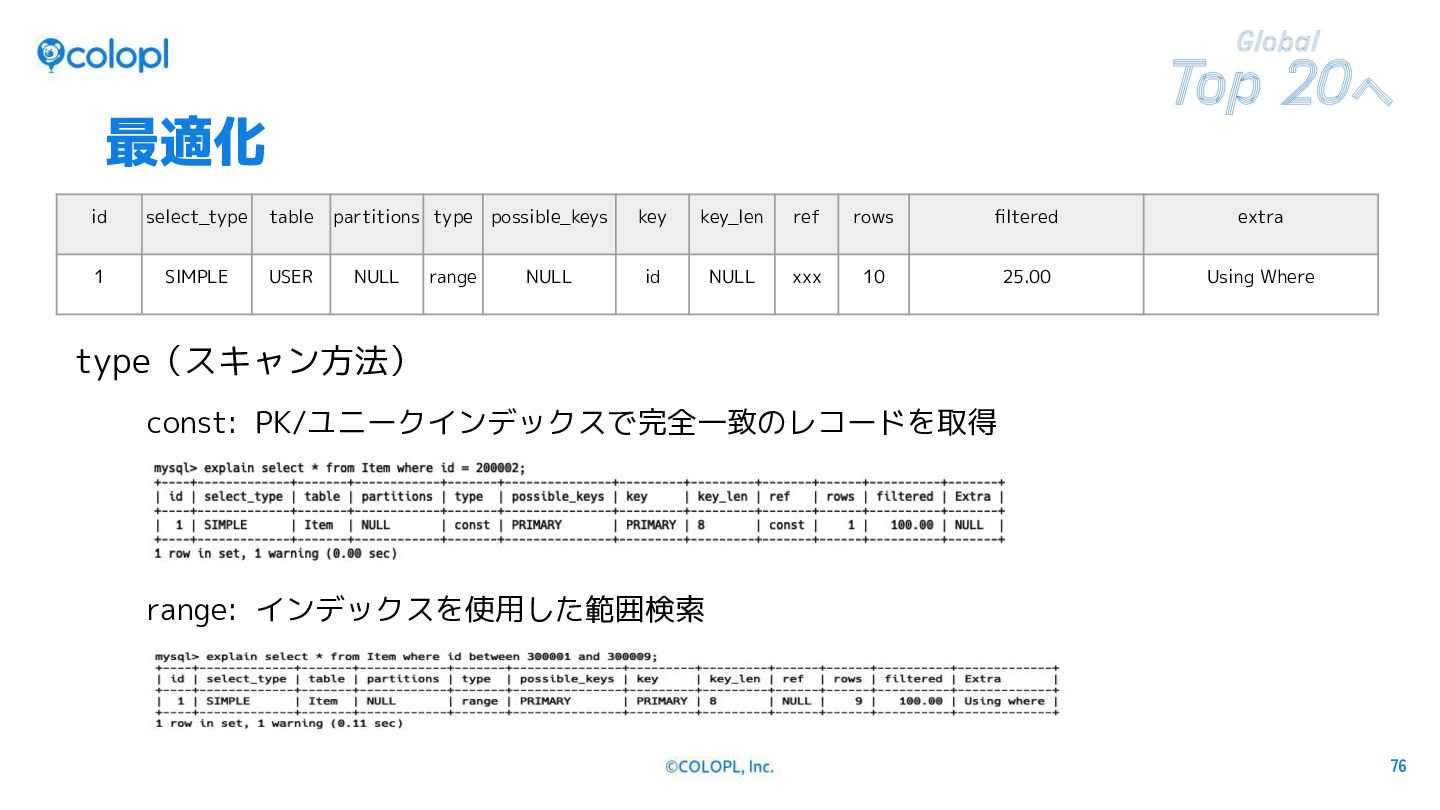
  42. 最適化 id select_type table partitions type possible_keys 実行計画の取得 1 SIMPLE

    USER NULL range NULL key key_len ref rows filtered extra id NULL xxx 10 25.00 Using Where type(スキャン方法) const: PK/ユニークインデックスで完全一致のレコードを取得 range: インデックスを使用した範囲検索 CONFIDENTIAL 76
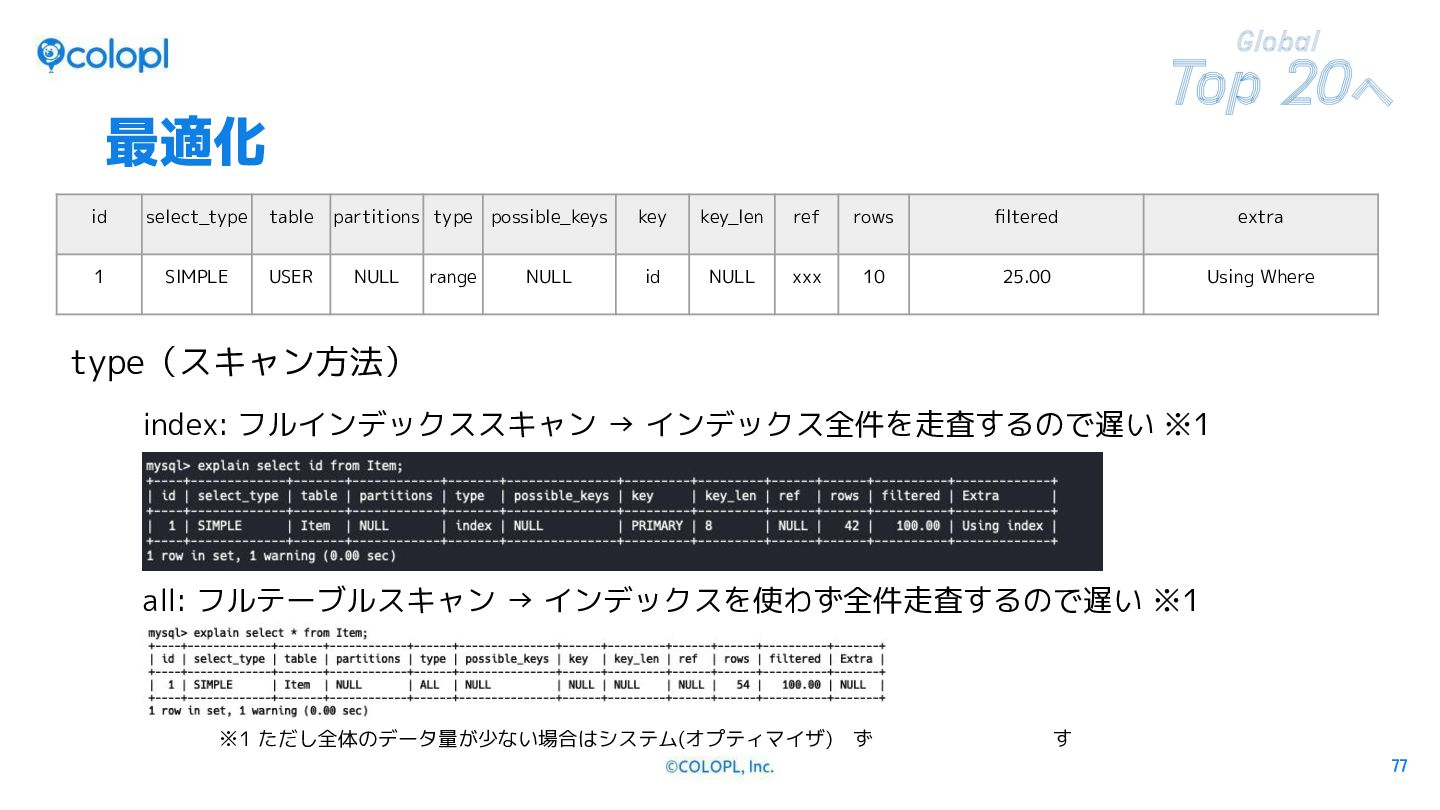
  43. 最適化 id select_type table partitions type possible_keys 実行計画の取得 1 SIMPLE

    USER NULL range NULL key key_len ref rows filtered extra id NULL xxx 10 25.00 Using Where type(スキャン方法) index: フルインデックススキャン → インデックス全件を走査するので遅い ※1 all: フルテーブルスキャン → インデックスを使わず全件走査するので遅い ※1 CONFIDENTIAL ※1 ただし全体のデータ量が少ない場合はシステム(オプティマイザ)が全件走査が速いと判断し実行することもある 77
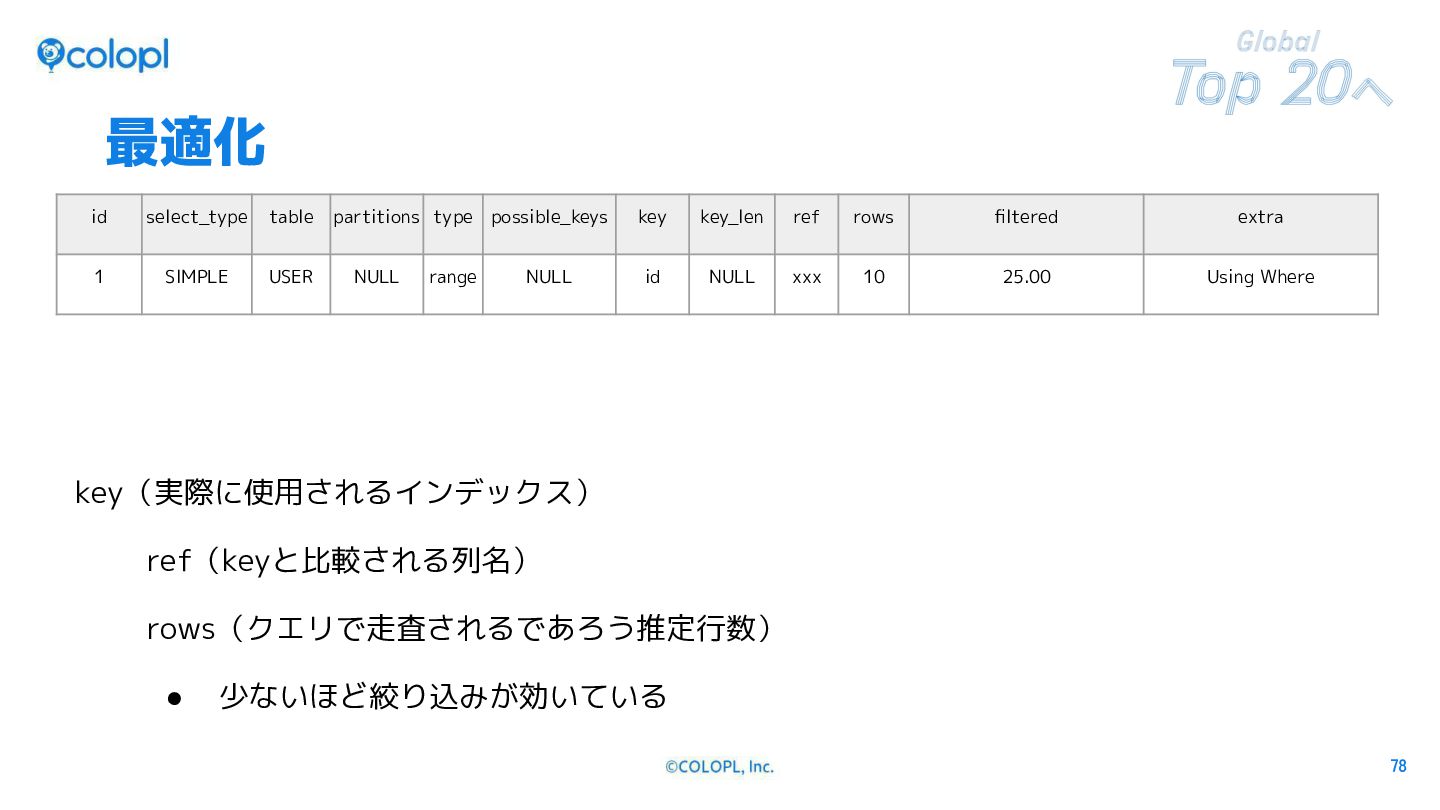
  44. 最適化 id select_type table partitions type possible_keys 実行計画の取得 1 SIMPLE

    USER NULL range NULL key key_len ref rows filtered extra id NULL xxx 10 25.00 Using Where key(実際に使用されるインデックス) ref(keyと比較される列名) rows(クエリで走査されるであろう推定行数) • CONFIDENTIAL 少ないほど絞り込みが効いている 78
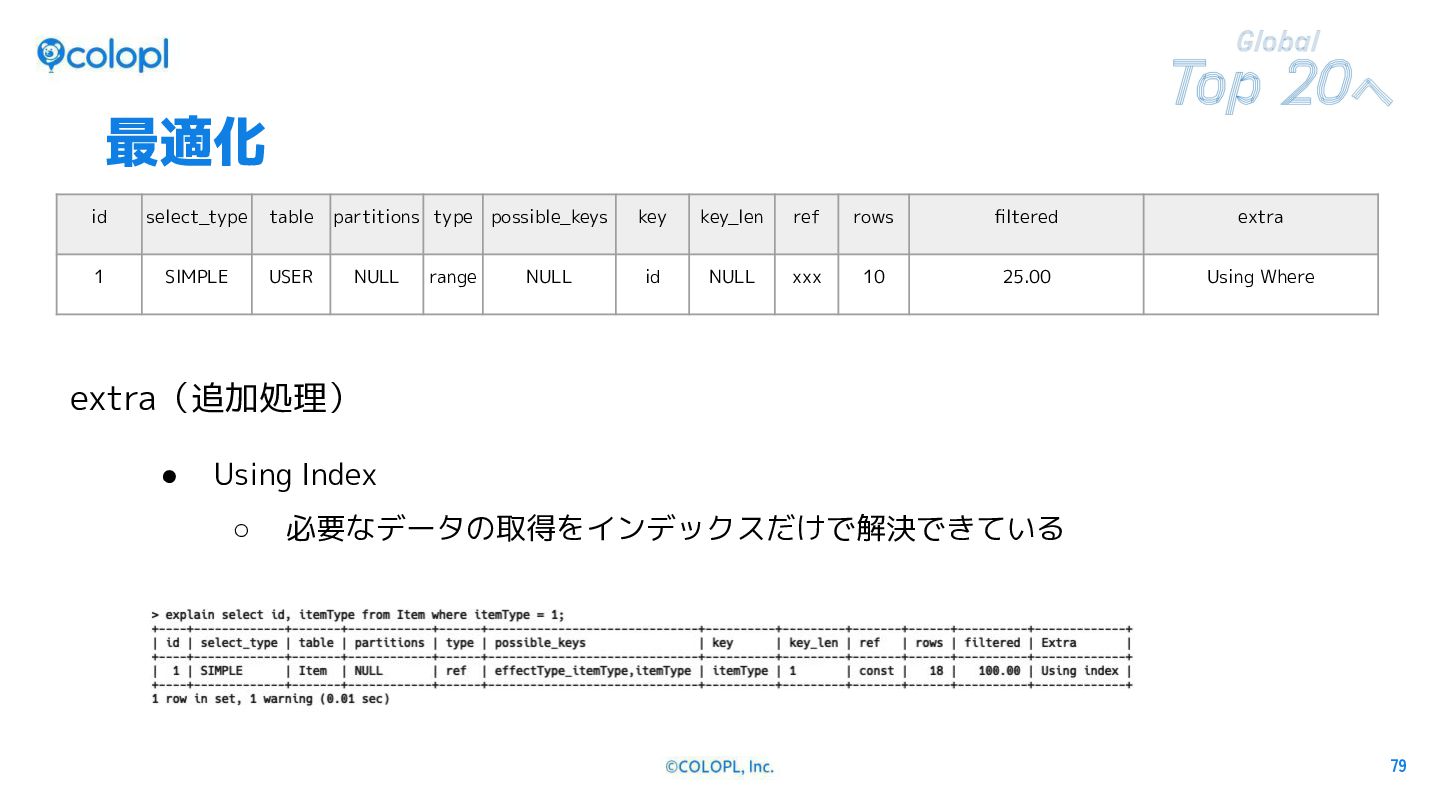
  45. 最適化 id select_type table partitions type possible_keys 実行計画の取得 1 SIMPLE

    USER NULL range NULL key key_len ref rows filtered extra id NULL xxx 10 25.00 Using Where extra(追加処理) • Using Index ◦ CONFIDENTIAL 必要なデータの取得をインデックスだけで解決できている 79
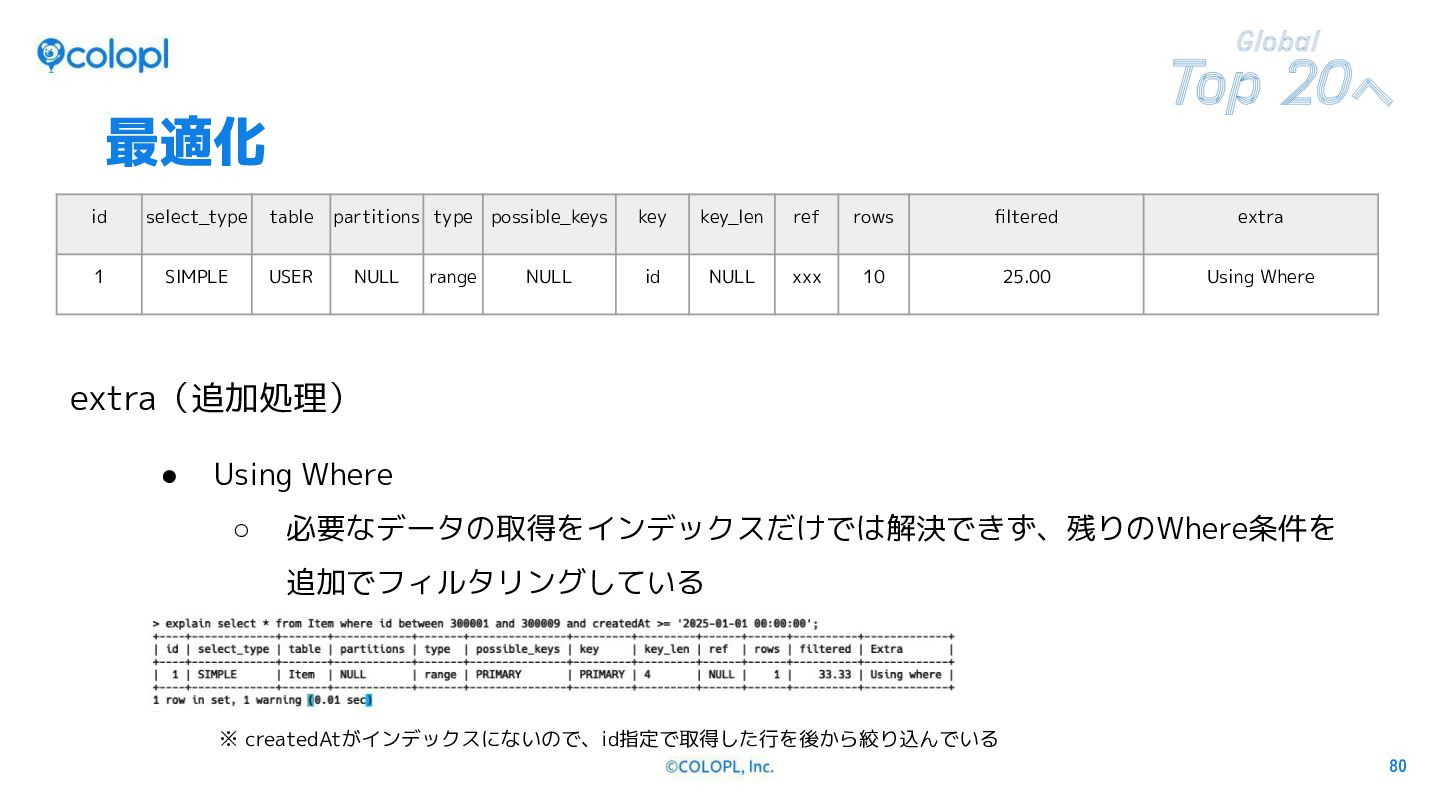
  46. 最適化 id select_type table partitions type possible_keys 実行計画の取得 1 SIMPLE

    USER NULL range NULL key key_len ref rows filtered extra id NULL xxx 10 25.00 Using Where extra(追加処理) • Using Where ◦ 必要なデータの取得をインデックスだけでは解決できず、残りのWhere条件を 追加でフィルタリングしている CONFIDENTIAL ※ createdAtがインデックスにないので、id指定で取得した行を後から絞り込んでいる 80
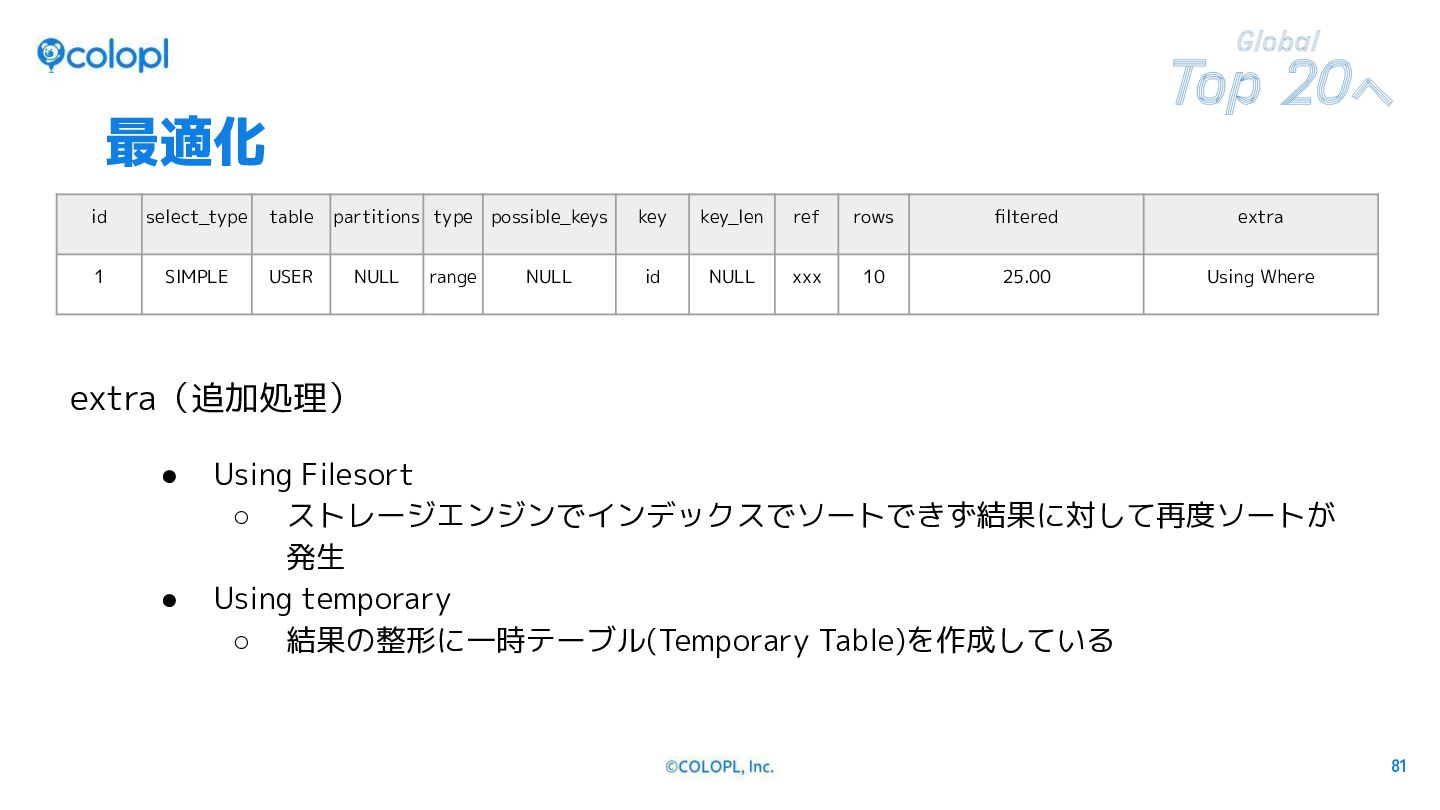
  47. 最適化 id select_type table partitions type possible_keys 実行計画の取得 1 SIMPLE

    USER NULL range NULL key key_len ref rows filtered extra id NULL xxx 10 25.00 Using Where extra(追加処理) • • CONFIDENTIAL Using Filesort ◦ ストレージエンジンでインデックスでソートできず結果に対して再度ソートが 発生 Using temporary ◦ 結果の整形に一時テーブル(Temporary Table)を作成している 81
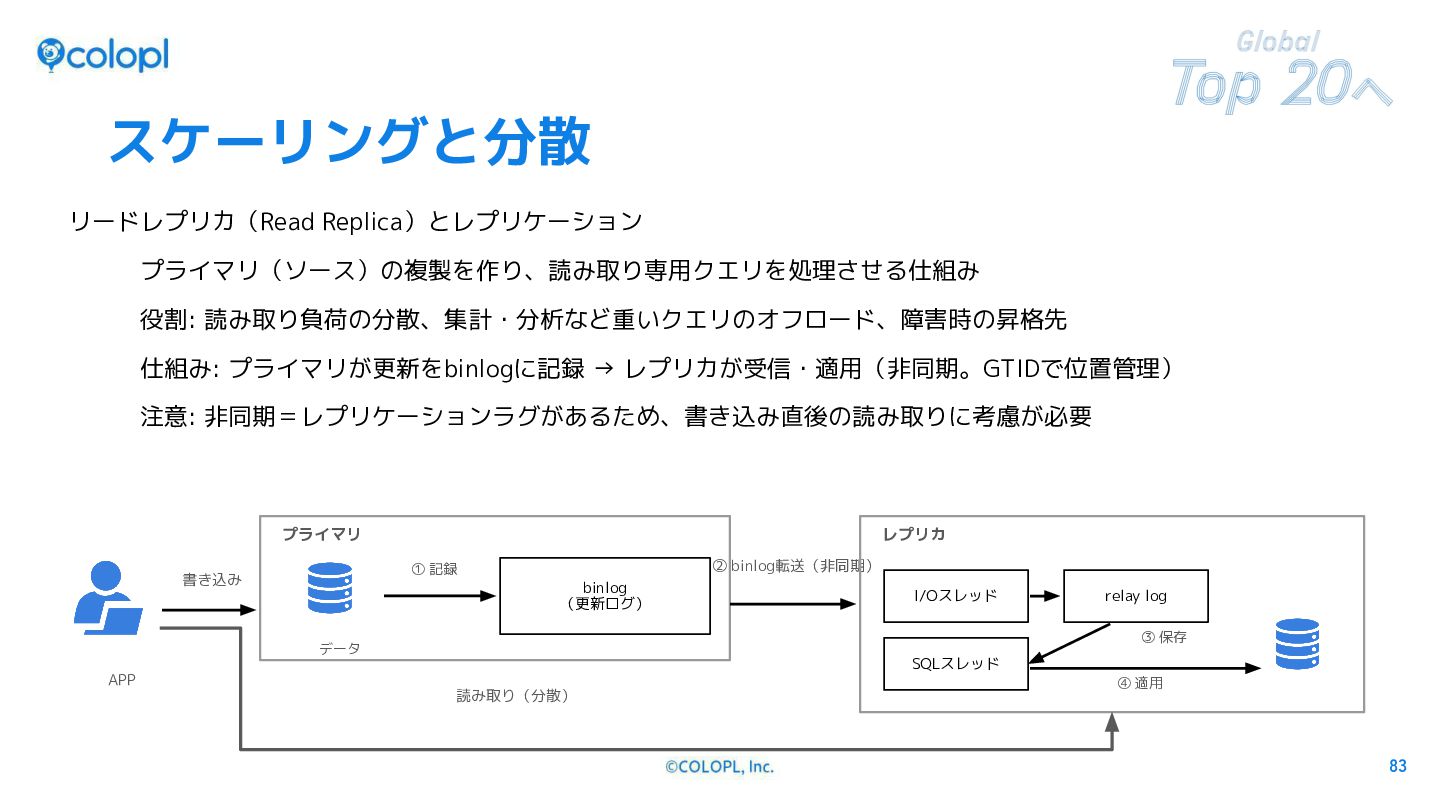
  48. スケーリングと分散 リードレプリカ(Read Replica)とレプリケーション プライマリ(ソース)の複製を作り、読み取り専用クエリを処理させる仕組み 役割: 読み取り負荷の分散、集計・分析など重いクエリのオフロード、障害時の昇格先 仕組み: プライマリが更新をbinlogに記録 → レプリカが受信・適用(非同期。GTIDで位置管理)

    注意: 非同期=レプリケーションラグがあるため、書き込み直後の読み取りに考慮が必要 プライマリ レプリカ ② binlog転送(非同期) ① 記録 書き込み binlog (更新ログ) I/Oスレッド relay log ③ 保存 データ SQLスレッド APP 読み取り(分散) CONFIDENTIAL ④ 適用 83
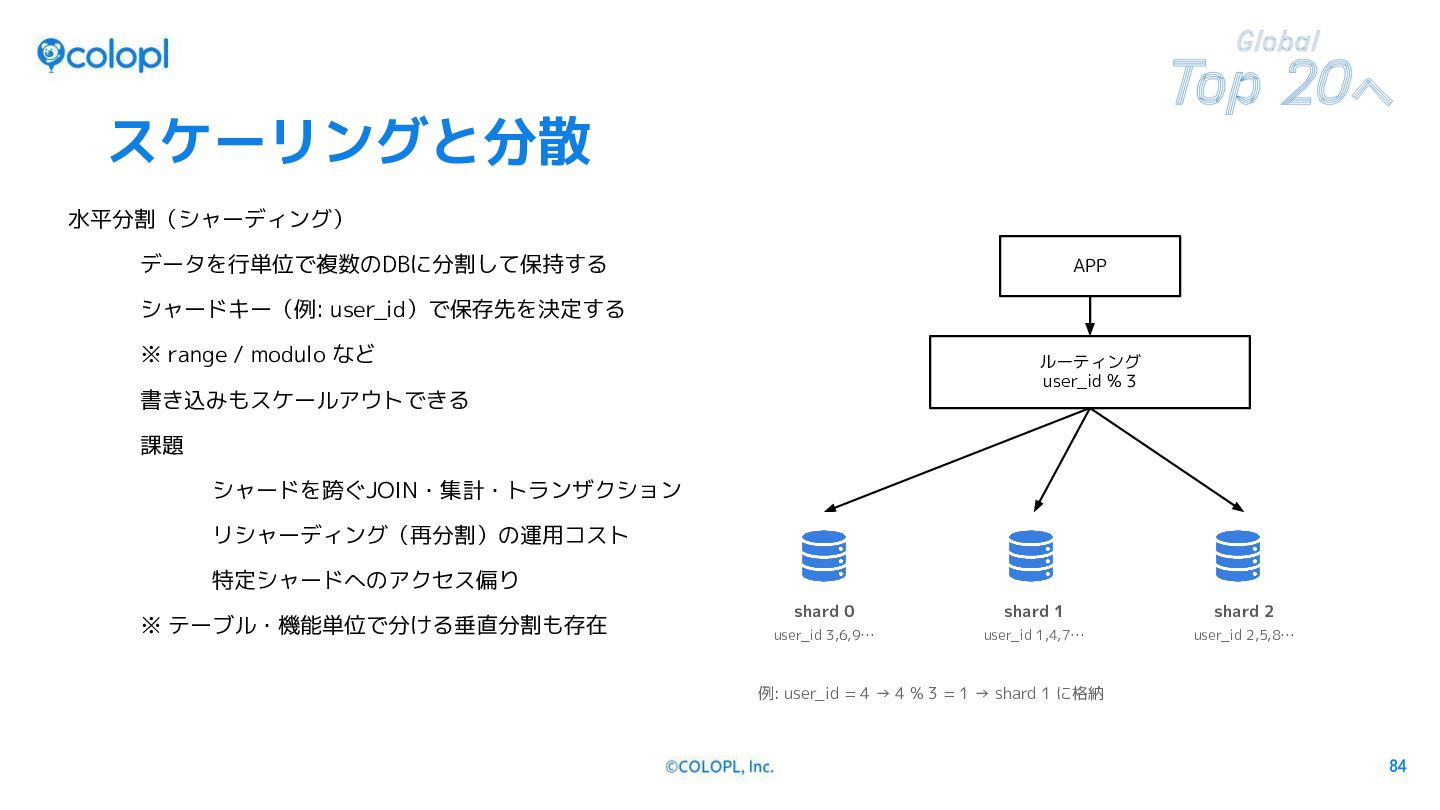
  49. スケーリングと分散 水平分割(シャーディング) データを行単位で複数のDBに分割して保持する APP シャードキー(例: user_id)で保存先を決定する ※ range / modulo

    など ルーティング user_id % 3 書き込みもスケールアウトできる 課題 シャードを跨ぐJOIN・集計・トランザクション リシャーディング(再分割)の運用コスト 特定シャードへのアクセス偏り ※ テーブル・機能単位で分ける垂直分割も存在 shard 0 shard 1 shard 2 user_id 3,6,9… user_id 1,4,7… user_id 2,5,8… 例: user_id = 4 → 4 % 3 = 1 → shard 1 に格納 CONFIDENTIAL 84
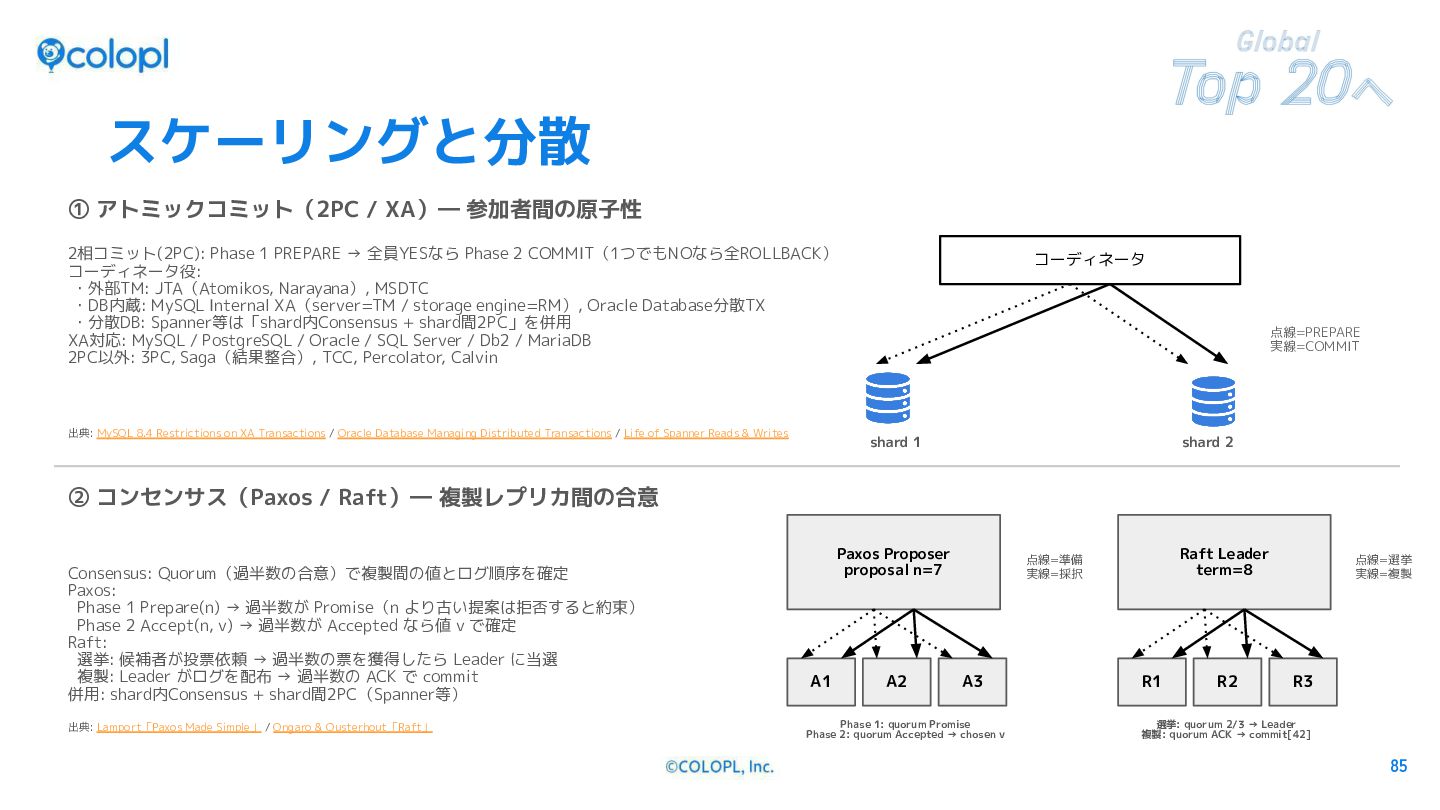
  50. スケーリングと分散 ① アトミックコミット(2PC / XA)― 参加者間の原子性 2相コミット(2PC): Phase 1 PREPARE

    → 全員YESなら Phase 2 COMMIT(1つでもNOなら全ROLLBACK) コーディネータ役: ・外部TM: JTA(Atomikos, Narayana), MSDTC ・DB内蔵: MySQL Internal XA(server=TM / storage engine=RM), Oracle Database分散TX ・分散DB: Spanner等は「shard内Consensus + shard間2PC」を併用 XA対応: MySQL / PostgreSQL / Oracle / SQL Server / Db2 / MariaDB 2PC以外: 3PC, Saga(結果整合), TCC, Percolator, Calvin 出典: MySQL 8.4 Restrictions on XA Transactions / Oracle Database Managing Distributed Transactions / Life of Spanner Reads & Writes コーディネータ 点線=PREPARE 実線=COMMIT shard 1 shard 2 ② コンセンサス(Paxos / Raft)― 複製レプリカ間の合意 Consensus: Quorum(過半数の合意)で複製間の値とログ順序を確定 Paxos: Phase 1 Prepare(n) → 過半数が Promise(n より古い提案は拒否すると約束) Phase 2 Accept(n, v) → 過半数が Accepted なら値 v で確定 Raft: 選挙: 候補者が投票依頼 → 過半数の票を獲得したら Leader に当選 複製: Leader がログを配布 → 過半数の ACK で commit 併用: shard内Consensus + shard間2PC(Spanner等) 出典: Lamport「Paxos Made Simple」 / Ongaro & Ousterhout「Raft」 CONFIDENTIAL Paxos Proposer proposal n=7 A1 A2 Raft Leader term=8 点線=準備 実線=採択 A3 Phase 1: quorum Promise Phase 2: quorum Accepted → chosen v R1 R2 点線=選挙 実線=複製 R3 選挙: quorum 2/3 → Leader 複製: quorum ACK → commit[42] 85
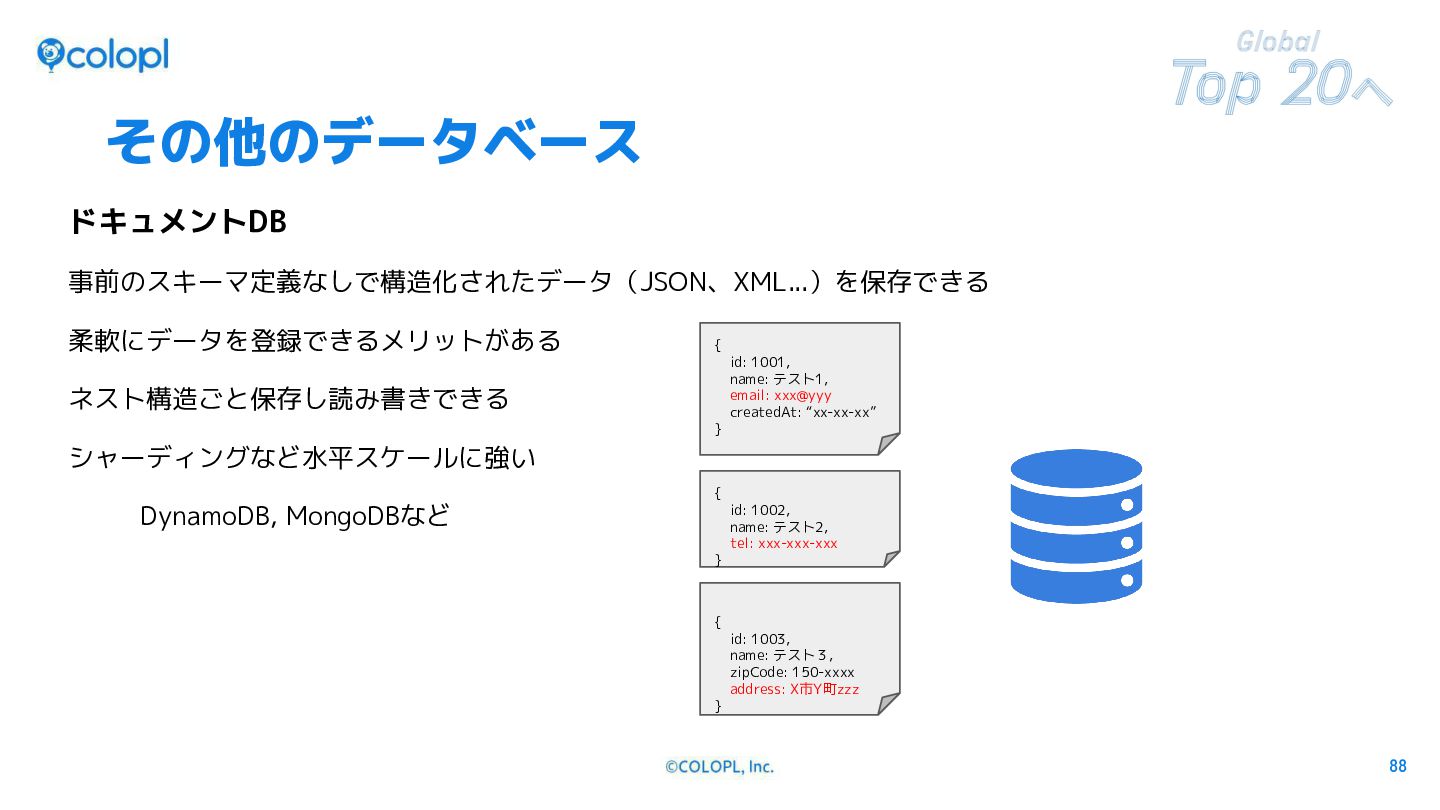
  51. その他のデータベース ドキュメントDB 事前のスキーマ定義なしで構造化されたデータ(JSON、XML...)を保存できる 柔軟にデータを登録できるメリットがある { id: 1001, name: テスト1, email:

    xxx@yyy createdAt: “xx-xx-xx” ネスト構造ごと保存し読み書きできる } シャーディングなど水平スケールに強い { id: 1002, name: テスト2, tel: xxx-xxx-xxx DynamoDB, MongoDBなど } { id: 1003, name: テスト3, zipCode: 150-xxxx address: X市Y町zzz } CONFIDENTIAL 88
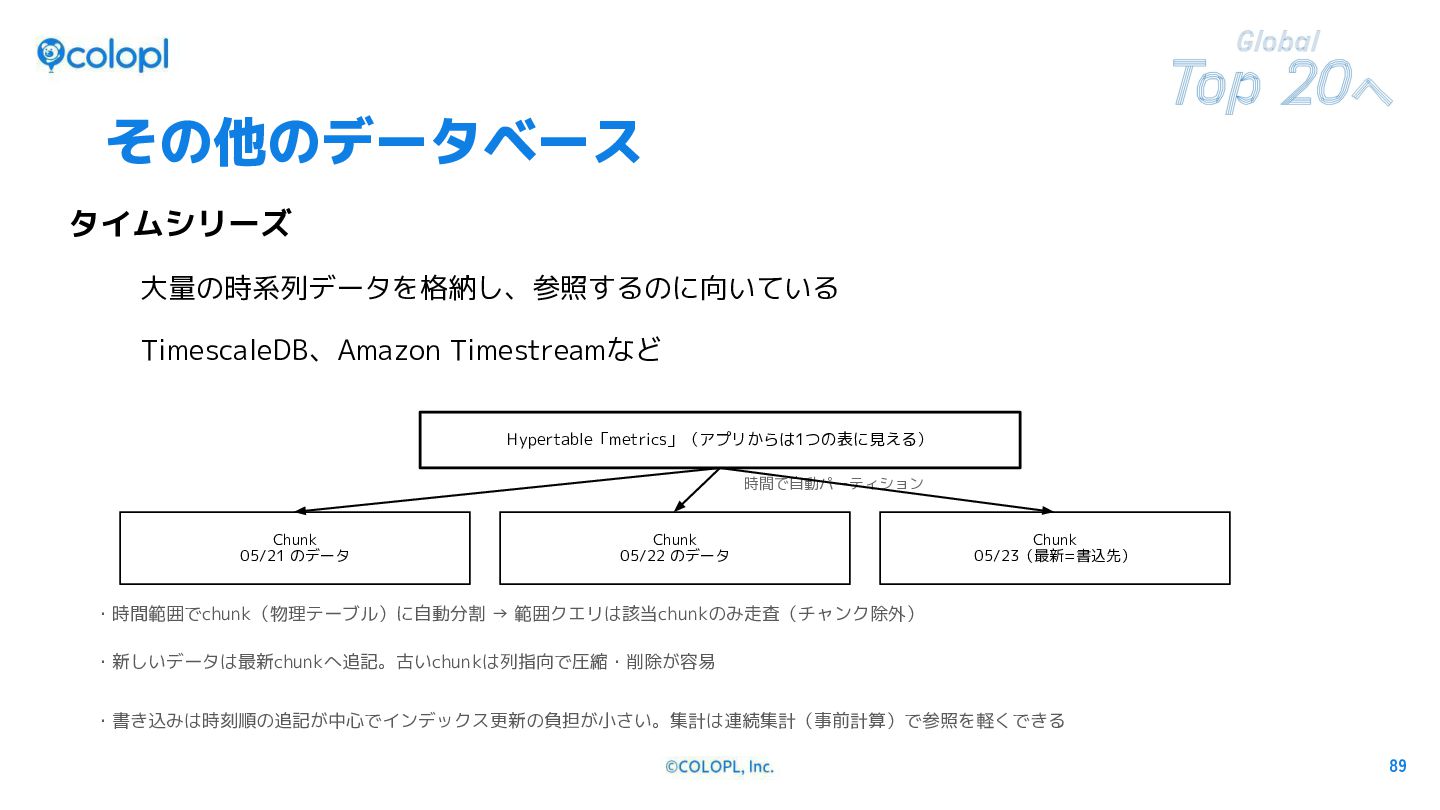
  52. その他のデータベース タイムシリーズ 大量の時系列データを格納し、参照するのに向いている TimescaleDB、Amazon Timestreamなど Hypertable「metrics」(アプリからは1つの表に見える) 時間で自動パーティション Chunk 05/21 のデータ

    Chunk 05/22 のデータ Chunk 05/23(最新=書込先) ・時間範囲でchunk(物理テーブル)に自動分割 → 範囲クエリは該当chunkのみ走査(チャンク除外) ・新しいデータは最新chunkへ追記。古いchunkは列指向で圧縮・削除が容易 ・書き込みは時刻順の追記が中心でインデックス更新の負担が小さい。集計は連続集計(事前計算)で参照を軽くできる CONFIDENTIAL 89