Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ポケカコンペ2位解法&振り返り
Search
ebinan92
October 03, 2026
1.1k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ポケカコンペ2位解法&振り返り
ebinan92
October 03, 2026
Featured
See All Featured
Test your architecture with Archunit
thirion
2
2.4k
YesSQL, Process and Tooling at Scale
rocio
174
15k
AI: The stuff that nobody shows you
jnunemaker
PRO
10
1.2k
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.5k
30 Presentation Tips
portentint
PRO
1
430
4 Signs Your Business is Dying
shpigford
187
23k
Optimizing for Happiness
mojombo
378
71k
Darren the Foodie - Storyboard
khoart
PRO
4
4k
Git: the NoSQL Database
bkeepers
PRO
433
67k
We Are The Robots
honzajavorek
0
400
コードの90%をAIが書く世界で何が待っているのか / What awaits us in a world where 90% of the code is written by AI
rkaga
63
46k
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
43k
Transcript
ポケカコンペ 2位解法と振り返り 沖縄Kaggler会 Ebi / ebinan92 Team palsystem
⽬次 アジェンダ 1. ⾃⼰紹介 2. コンペについて 3. 2nd Place Solution
4. 上位解法の⽐較‧考察 5. その他コメント 2 / 18
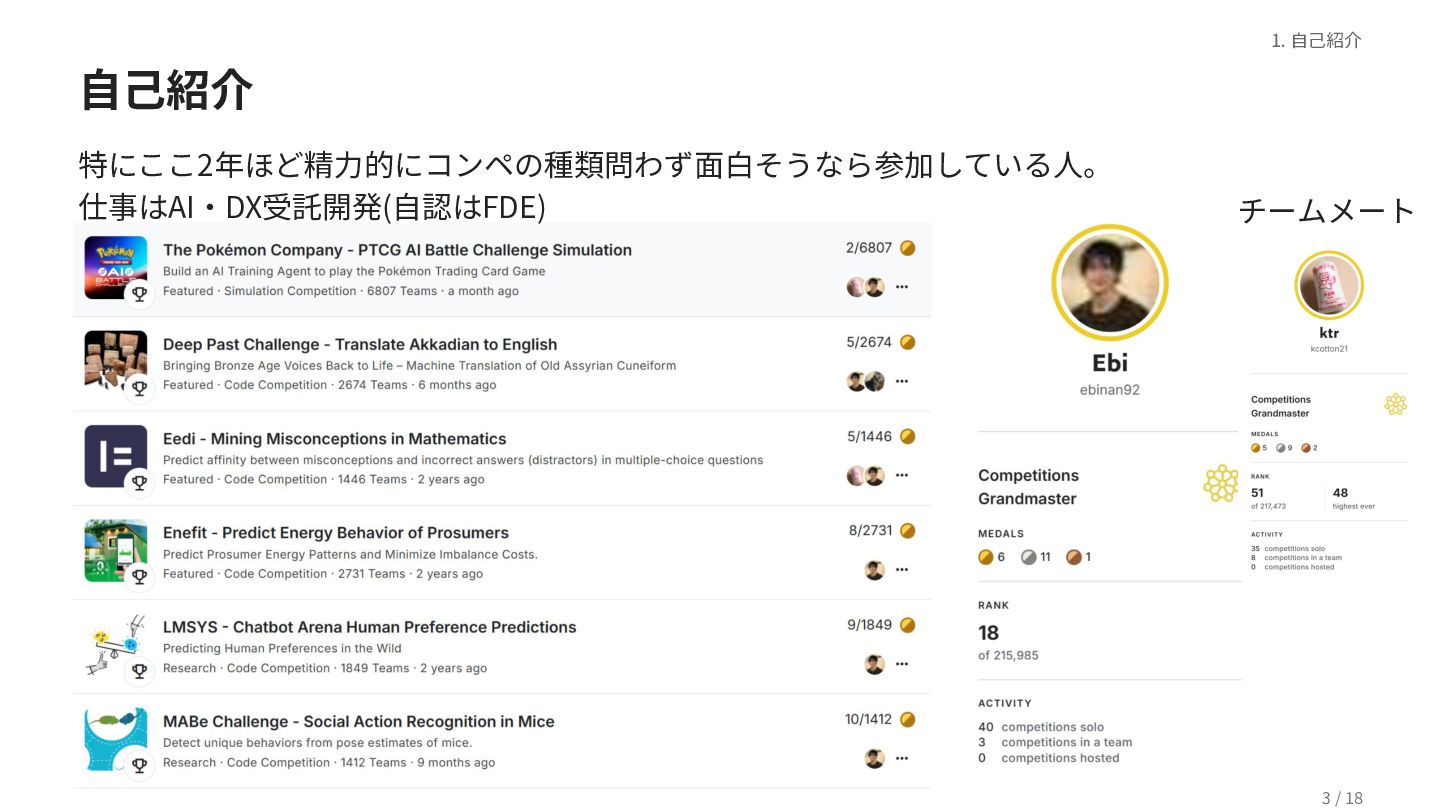
1. ⾃⼰紹介 ⾃⼰紹介 特にここ2年ほど精⼒的にコンペの種類問わず⾯⽩そうなら参加している⼈。 仕事はAI‧DX受託開発(⾃認はFDE) チームメート 3 / 18
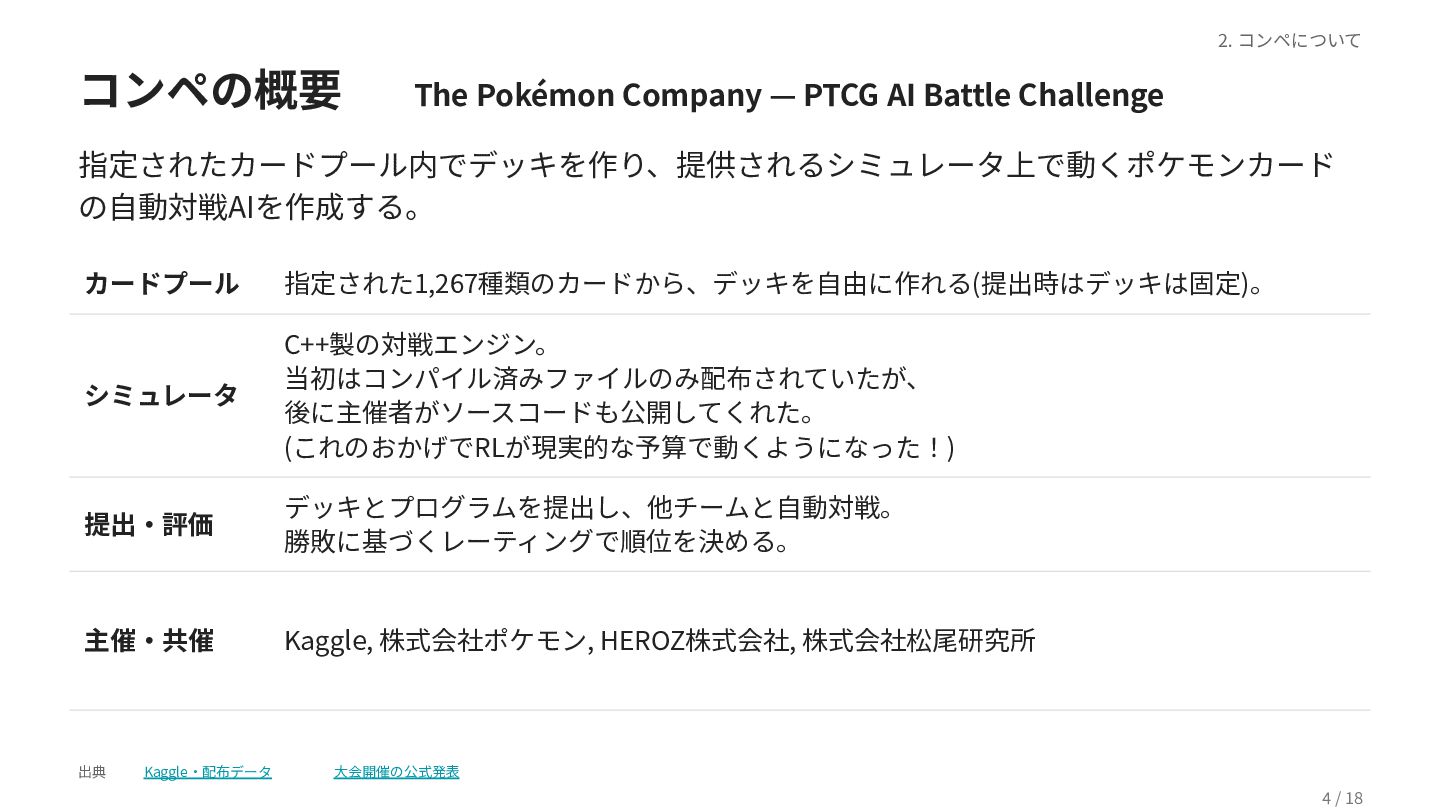
2. コンペについて コンペの概要 The Pokémon Company — PTCG AI Battle
Challenge 指定されたカードプール内でデッキを作り、提供されるシミュレータ上で動くポケモンカード の⾃動対戦AIを作成する。 カードプール 指定された1,267種類のカードから、デッキを⾃由に作れる(提出時はデッキは固定)。 シミュレータ C++製の対戦エンジン。 当初はコンパイル済みファイルのみ配布されていたが、 後に主催者がソースコードも公開してくれた。 (これのおかげでRLが現実的な予算で動くようになった!) 提出‧評価 デッキとプログラムを提出し、他チームと⾃動対戦。 勝敗に基づくレーティングで順位を決める。 主催‧共催 Kaggle, 株式会社ポケモン, HEROZ株式会社, 株式会社松尾研究所 出典 Kaggle‧配布データ ⼤会開催の公式発表 4 / 18
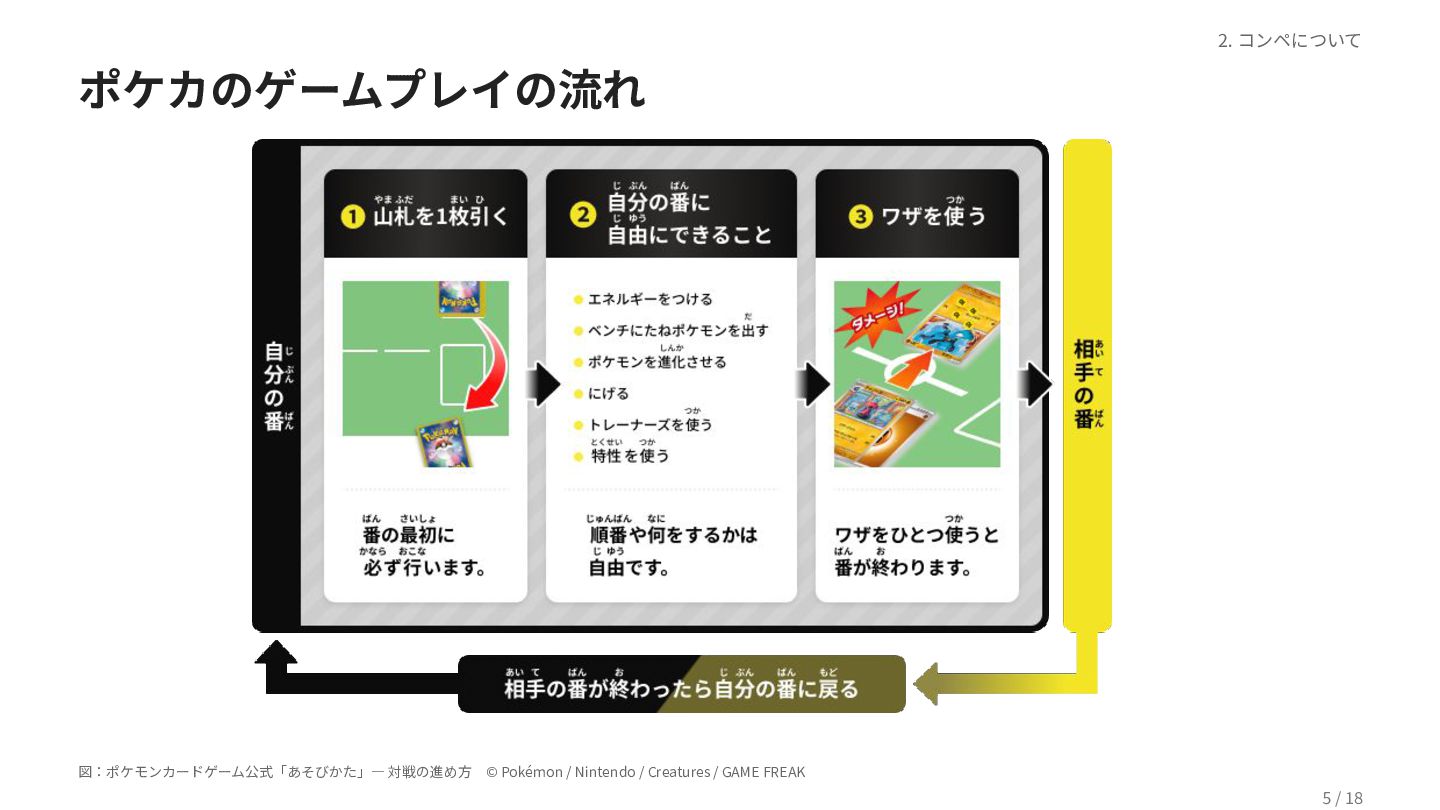
2. コンペについて ポケカのゲームプレイの流れ 図:ポケモンカードゲーム公式「あそびかた」― 対戦の進め⽅ © Pokémon / Nintendo /
Creatures / GAME FREAK 5 / 18
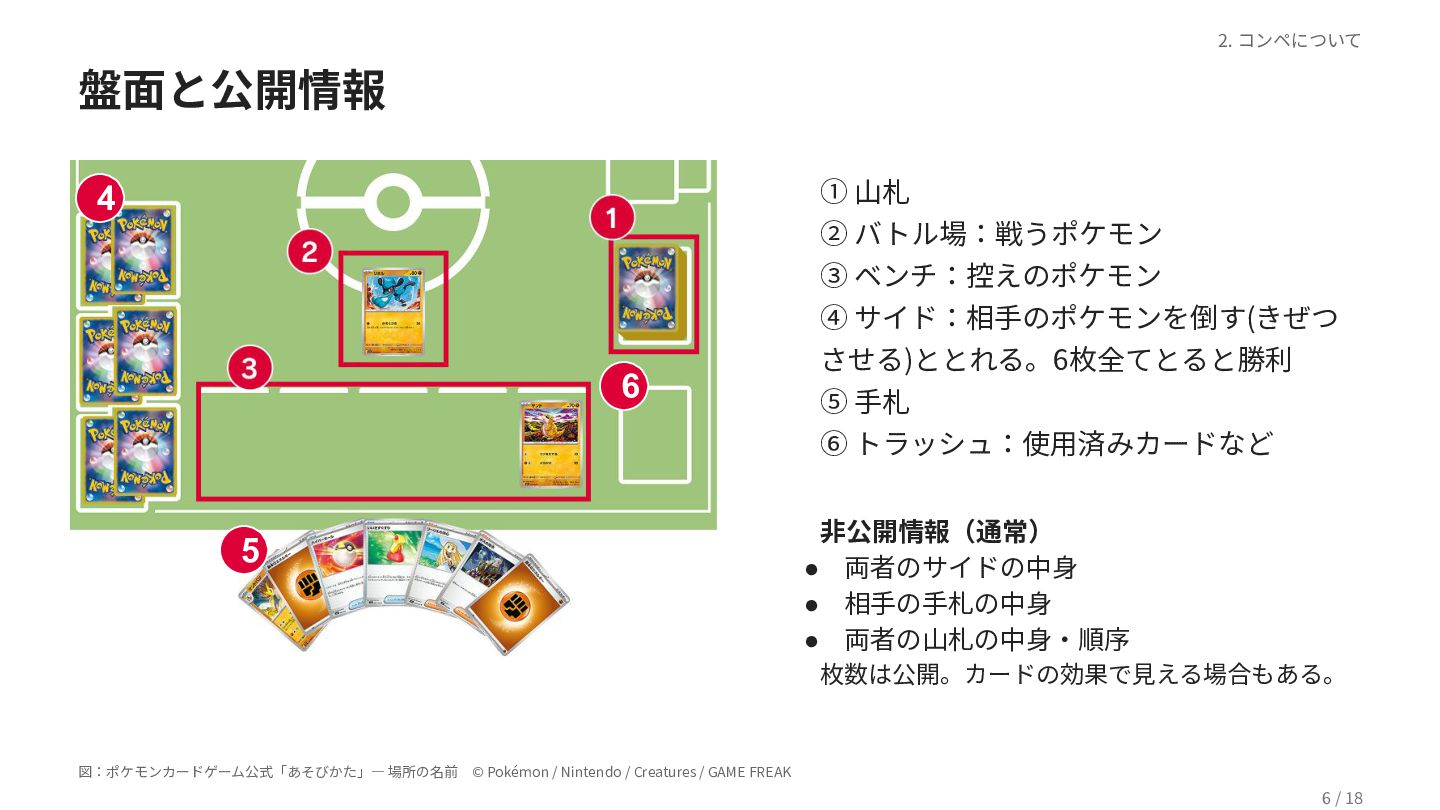
2. コンペについて 盤⾯と公開情報 ① ⼭札 4 ② バトル場:戦うポケモン ③ ベンチ:控えのポケモン
④ サイド:相⼿のポケモンを倒す(きぜつ 6 させる)ととれる。6枚全てとると勝利 ⑤ ⼿札 ⑥ トラッシュ:使⽤済みカードなど 5 ⾮公開情報(通常) • 両者のサイドの中⾝ • 相⼿の⼿札の中⾝ • 両者の⼭札の中⾝‧順序 枚数は公開。カードの効果で⾒える場合もある。 図:ポケモンカードゲーム公式「あそびかた」― 場所の名前 © Pokémon / Nintendo / Creatures / GAME FREAK 6 / 18
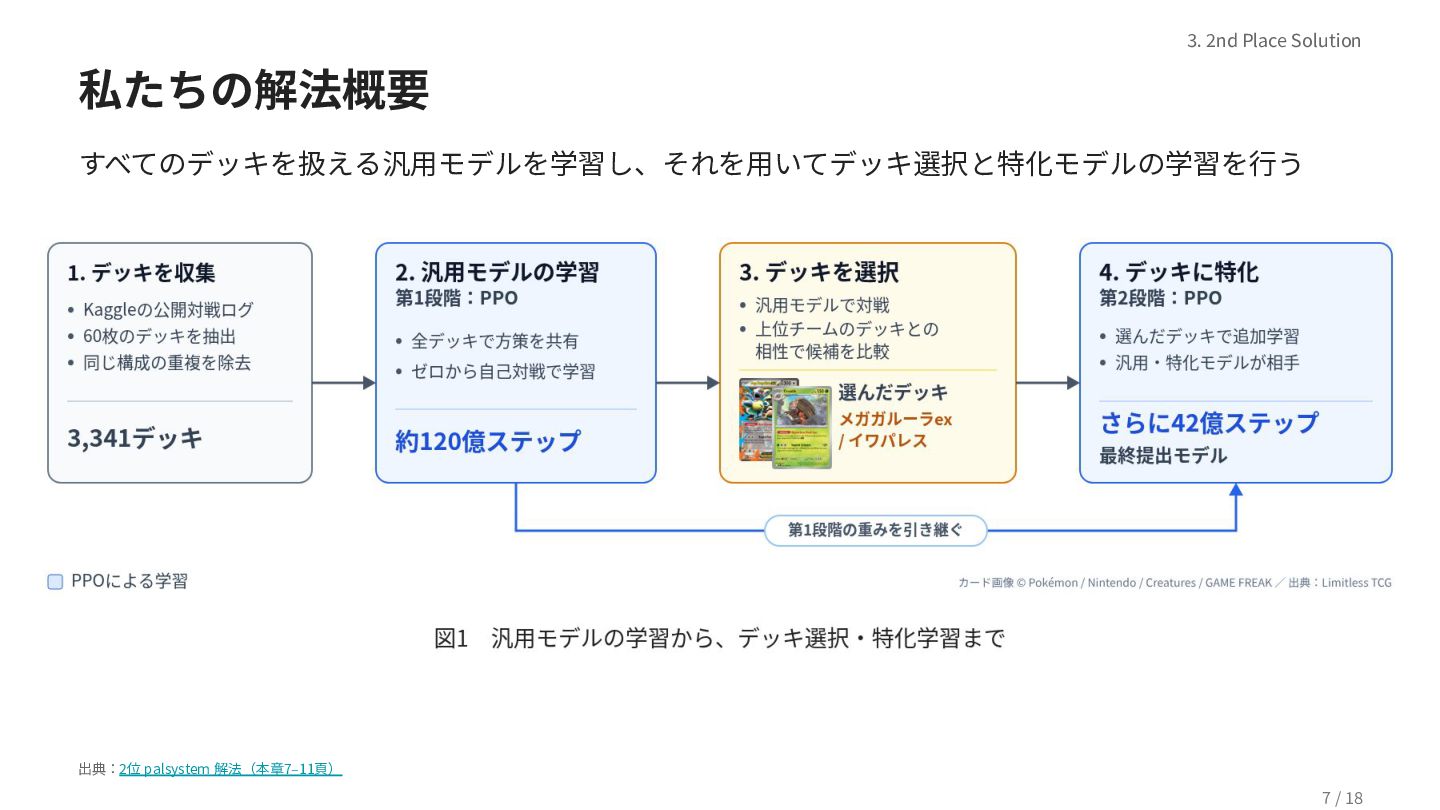
3. 2nd Place Solution 私たちの解法概要 すべてのデッキを扱える汎⽤モデルを学習し、それを⽤いてデッキ選択と特化モデルの学習を⾏う 出典:2位 palsystem 解法(本章7‒11⾴) 7
/ 18
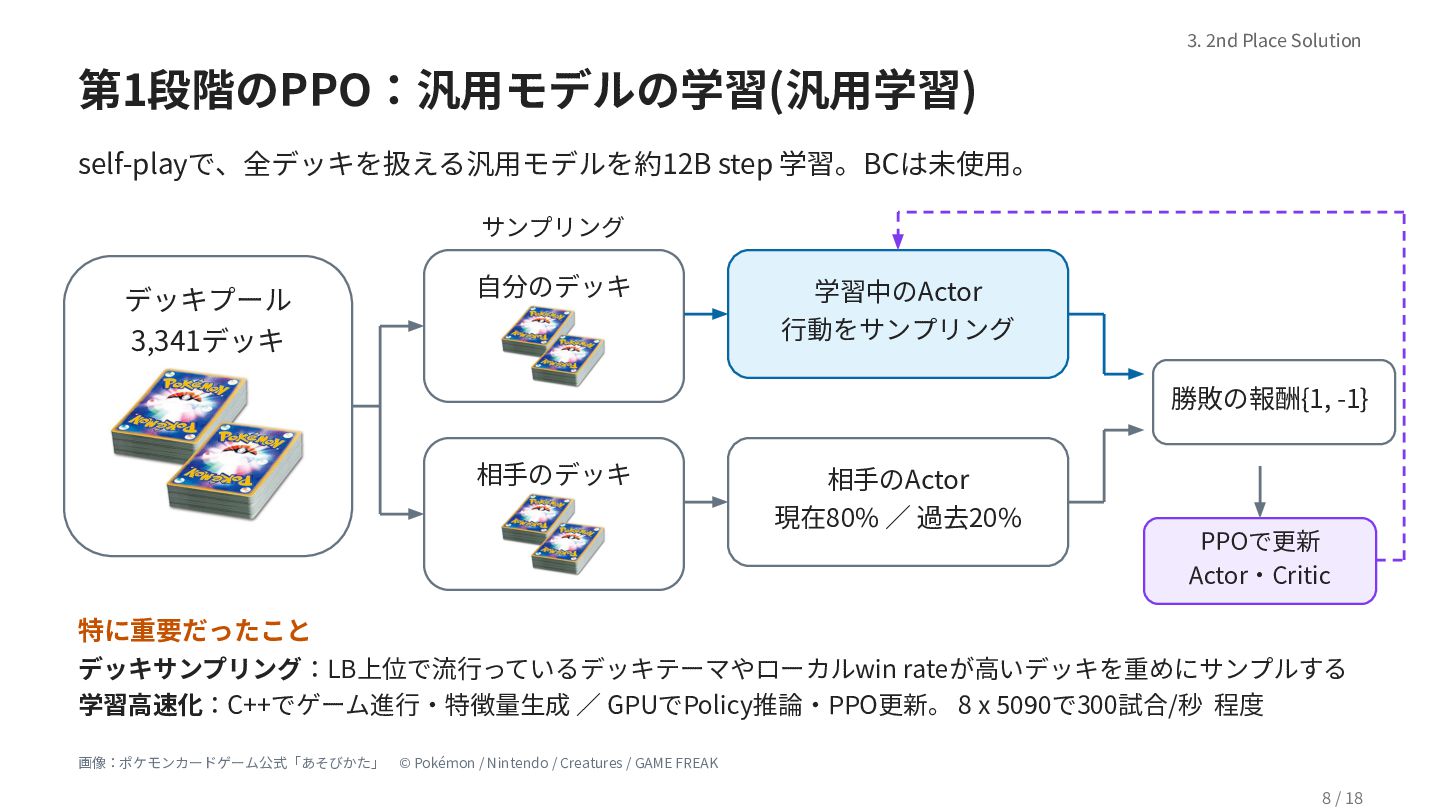
3. 2nd Place Solution 第1段階のPPO:汎⽤モデルの学習(汎⽤学習) self-playで、全デッキを扱える汎⽤モデルを約12B step 学習。BCは未使⽤。 サンプリング デッキプール
3,341デッキ ⾃分のデッキ 学習中のActor ⾏動をサンプリング 勝敗の報酬{1, -1} 相⼿のデッキ 相⼿のActor 現在80% ∕ 過去20% PPOで更新 Actor‧Critic 特に重要だったこと デッキサンプリング:LB上位で流⾏っているデッキテーマやローカルwin rateが⾼いデッキを重めにサンプルする 学習⾼速化:C++でゲーム進⾏‧特徴量⽣成 ∕ GPUでPolicy推論‧PPO更新。 8 x 5090で300試合/秒 程度 画像:ポケモンカードゲーム公式「あそびかた」 © Pokémon / Nintendo / Creatures / GAME FREAK 8 / 18
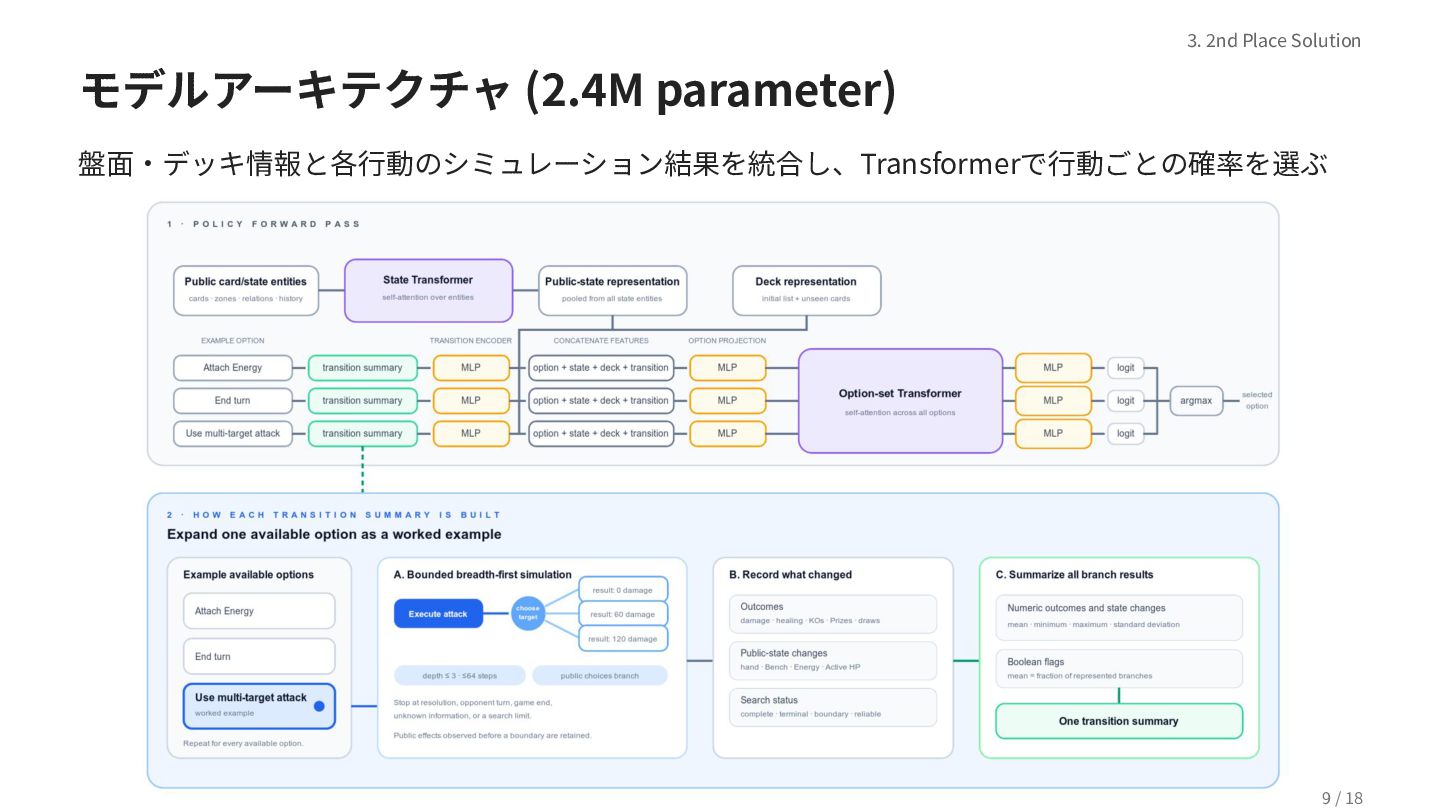
3. 2nd Place Solution モデルアーキテクチャ (2.4M parameter) 盤⾯‧デッキ情報と各⾏動のシミュレーション結果を統合し、Transformerで⾏動ごとの確率を選ぶ 9 /
18
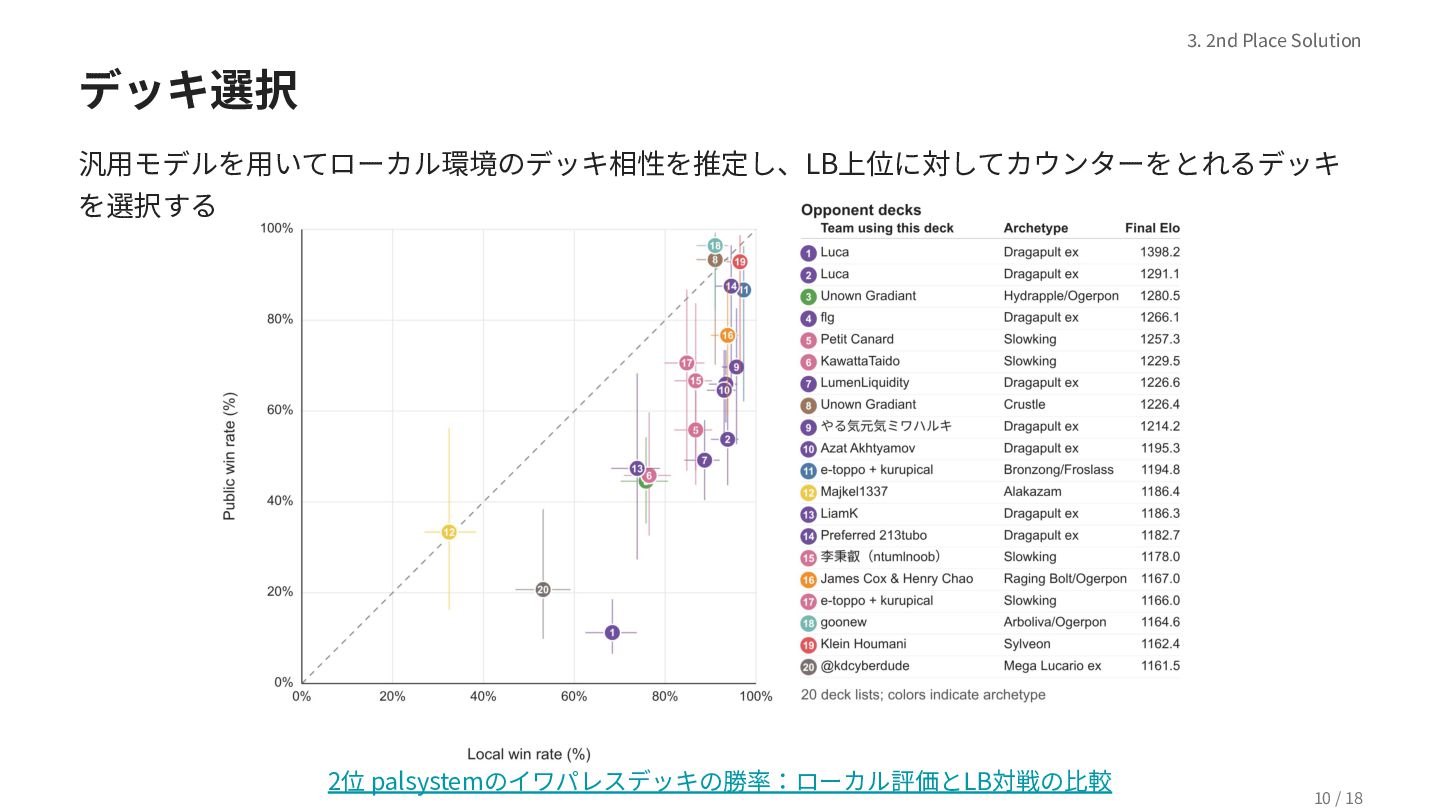
3. 2nd Place Solution デッキ選択 汎⽤モデルを⽤いてローカル環境のデッキ相性を推定し、LB上位に対してカウンターをとれるデッキ を選択する 2位 palsystemのイワパレスデッキの勝率:ローカル評価とLB対戦の⽐較 10
/ 18
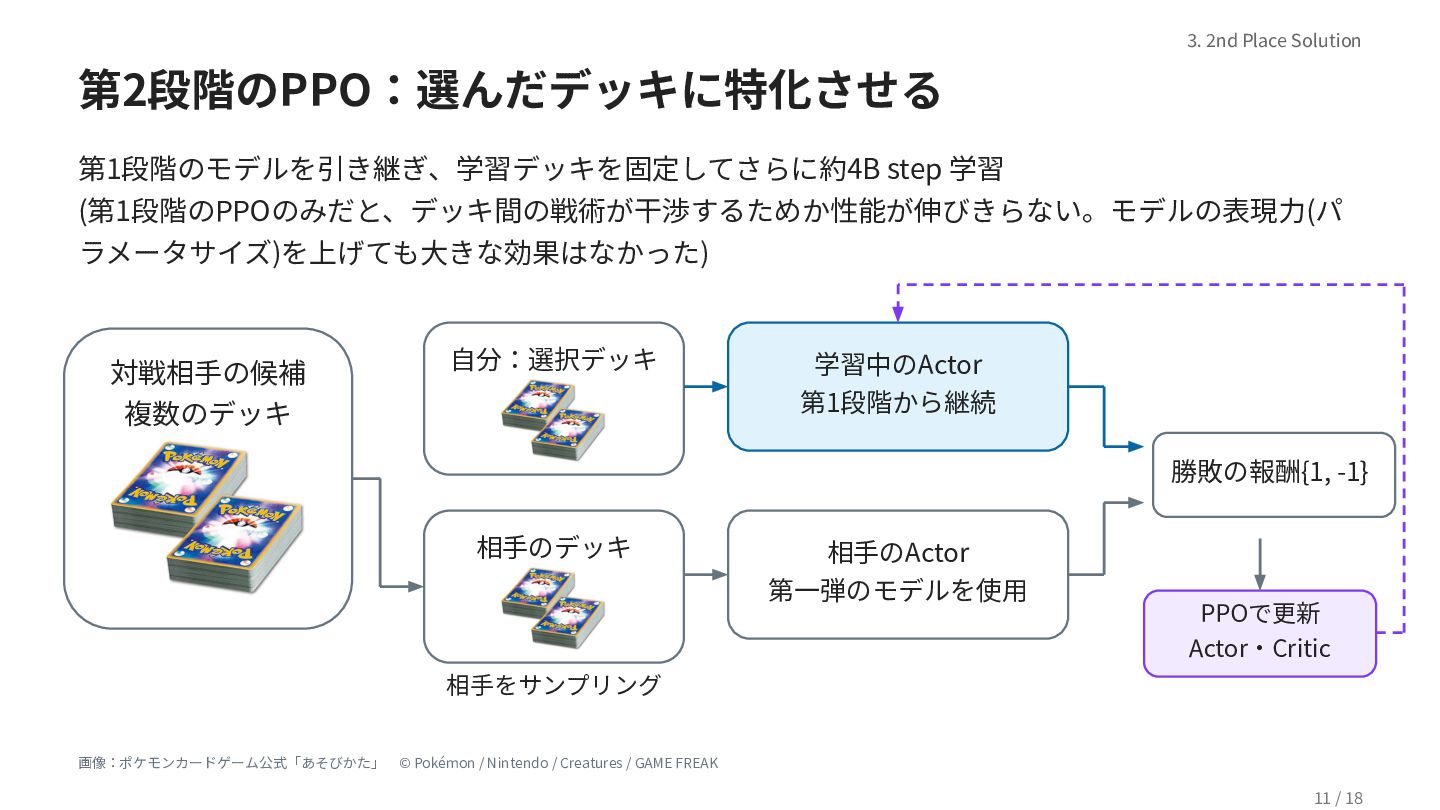
3. 2nd Place Solution 第2段階のPPO:選んだデッキに特化させる 第1段階のモデルを引き継ぎ、学習デッキを固定してさらに約4B step 学習 (第1段階のPPOのみだと、デッキ間の戦術が⼲渉するためか性能が伸びきらない。モデルの表現⼒(パ ラメータサイズ)を上げても⼤きな効果はなかった)
対戦相⼿の候補 複数のデッキ ⾃分:選択デッキ 学習中のActor 第1段階から継続 勝敗の報酬{1, -1} 相⼿のデッキ 相⼿のActor 第⼀弾のモデルを使⽤ PPOで更新 Actor‧Critic 相⼿をサンプリング 画像:ポケモンカードゲーム公式「あそびかた」 © Pokémon / Nintendo / Creatures / GAME FREAK 11 / 18
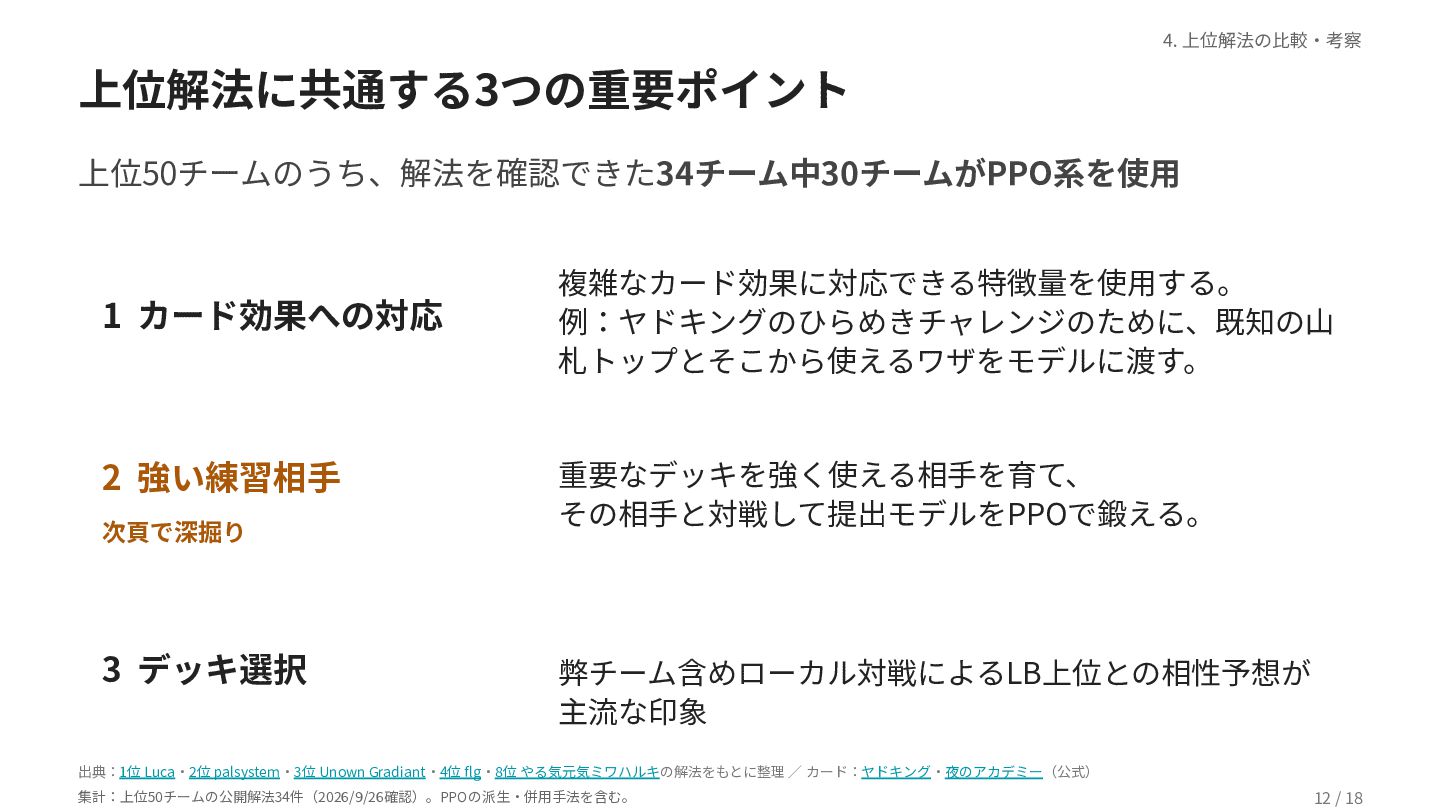
4. 上位解法の⽐較‧考察 上位解法に共通する3つの重要ポイント 上位50チームのうち、解法を確認できた34チーム中30チームがPPO系を使⽤ 1 カード効果への対応 2 強い練習相⼿ 次⾴で深掘り 3
デッキ選択 複雑なカード効果に対応できる特徴量を使⽤する。 例:ヤドキングのひらめきチャレンジのために、既知の⼭ 札トップとそこから使えるワザをモデルに渡す。 重要なデッキを強く使える相⼿を育て、 その相⼿と対戦して提出モデルをPPOで鍛える。 弊チーム含めローカル対戦によるLB上位との相性予想が 主流な印象 出典:1位 Luca‧2位 palsystem‧3位 Unown Gradiant‧4位 flg‧8位 やる気元気ミワハルキの解法をもとに整理 ∕ カード:ヤドキング‧夜のアカデミー(公式) 集計:上位50チームの公開解法34件(2026/9/26確認)。PPOの派⽣‧併⽤⼿法を含む。 12 / 18
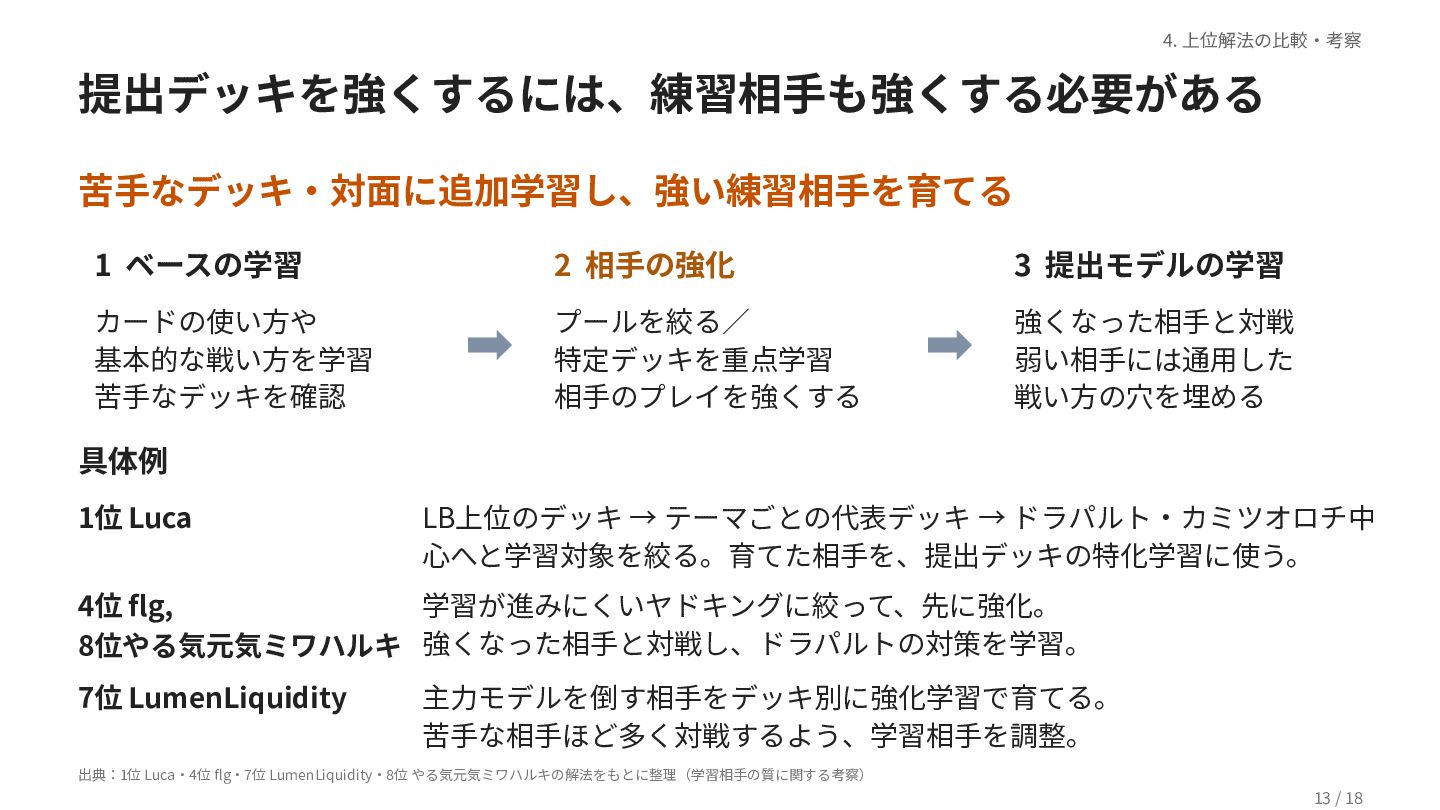
4. 上位解法の⽐較‧考察 提出デッキを強くするには、練習相⼿も強くする必要がある 苦⼿なデッキ‧対⾯に追加学習し、強い練習相⼿を育てる 1 ベースの学習 2 相⼿の強化 3 提出モデルの学習
カードの使い⽅や 基本的な戦い⽅を学習 苦⼿なデッキを確認 プールを絞る∕ 特定デッキを重点学習 相⼿のプレイを強くする 強くなった相⼿と対戦 弱い相⼿には通⽤した 戦い⽅の⽳を埋める 具体例 1位 Luca LB上位のデッキ → テーマごとの代表デッキ → ドラパルト‧カミツオロチ中 ⼼へと学習対象を絞る。育てた相⼿を、提出デッキの特化学習に使う。 4位 flg, 学習が進みにくいヤドキングに絞って、先に強化。 8位やる気元気ミワハルキ 強くなった相⼿と対戦し、ドラパルトの対策を学習。 7位 LumenLiquidity 主⼒モデルを倒す相⼿をデッキ別に強化学習で育てる。 苦⼿な相⼿ほど多く対戦するよう、学習相⼿を調整。 出典:1位 Luca‧4位 flg‧7位 LumenLiquidity‧8位 やる気元気ミワハルキの解法をもとに整理(学習相⼿の質に関する考察) 13 / 18
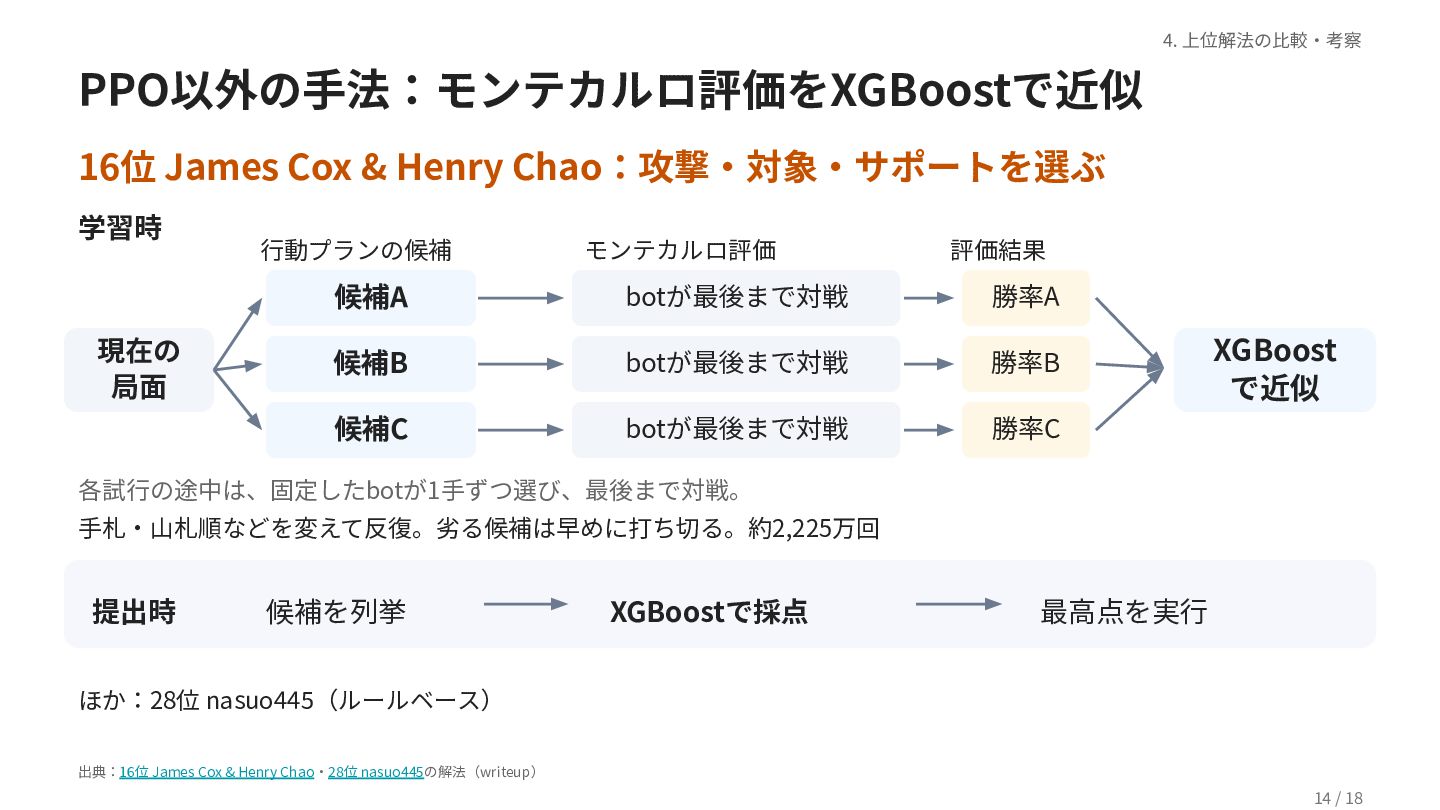
4. 上位解法の⽐較‧考察 PPO以外の⼿法:モンテカルロ評価をXGBoostで近似 16位 James Cox & Henry Chao:攻撃‧対象‧サポートを選ぶ 学習時
現在の 局⾯ ⾏動プランの候補 モンテカルロ評価 評価結果 候補A botが最後まで対戦 勝率A 候補B botが最後まで対戦 勝率B 候補C botが最後まで対戦 勝率C XGBoost で近似 各試⾏の途中は、固定したbotが1⼿ずつ選び、最後まで対戦。 ⼿札‧⼭札順などを変えて反復。劣る候補は早めに打ち切る。約2,225万回 提出時 候補を列挙 XGBoostで採点 最⾼点を実⾏ ほか:28位 nasuo445(ルールベース) 出典:16位 James Cox & Henry Chao‧28位 nasuo445の解法(writeup) 14 / 18
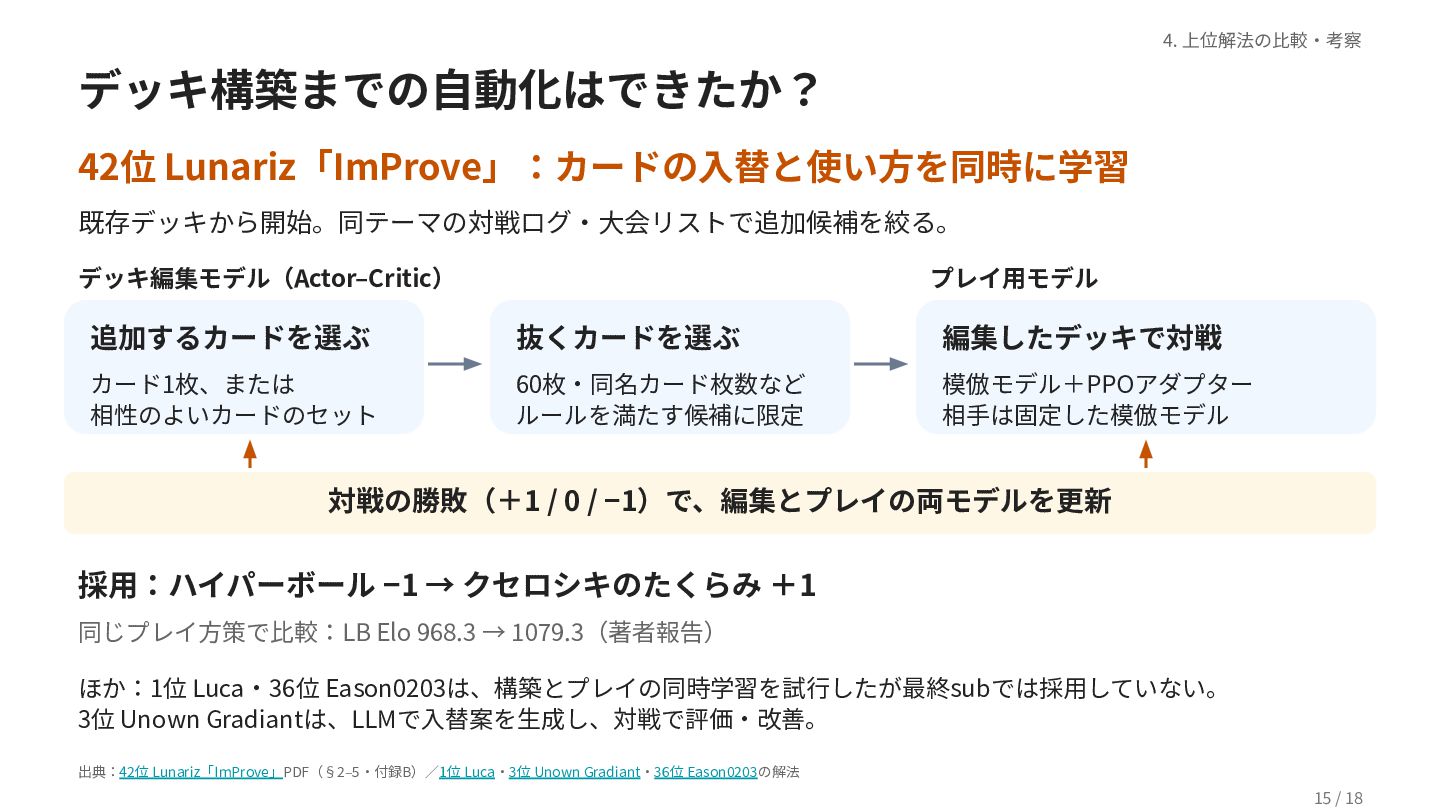
4. 上位解法の⽐較‧考察 デッキ構築までの⾃動化はできたか? 42位 Lunariz「ImProve」:カードの⼊替と使い⽅を同時に学習 既存デッキから開始。同テーマの対戦ログ‧⼤会リストで追加候補を絞る。 デッキ編集モデル(Actor‒Critic) プレイ⽤モデル 追加するカードを選ぶ 抜くカードを選ぶ
編集したデッキで対戦 カード1枚、または 相性のよいカードのセット 60枚‧同名カード枚数など ルールを満たす候補に限定 模倣モデル+PPOアダプター 相⼿は固定した模倣モデル 対戦の勝敗(+1 / 0 / −1)で、編集とプレイの両モデルを更新 採⽤:ハイパーボール −1 → クセロシキのたくらみ +1 同じプレイ⽅策で⽐較:LB Elo 968.3 → 1079.3(著者報告) ほか:1位 Luca‧36位 Eason0203は、構築とプレイの同時学習を試⾏したが最終subでは採⽤していない。 3位 Unown Gradiantは、LLMで⼊替案を⽣成し、対戦で評価‧改善。 出典:42位 Lunariz「ImProve」PDF(§2‒5‧付録B)∕1位 Luca‧3位 Unown Gradiant‧36位 Eason0203の解法 15 / 18
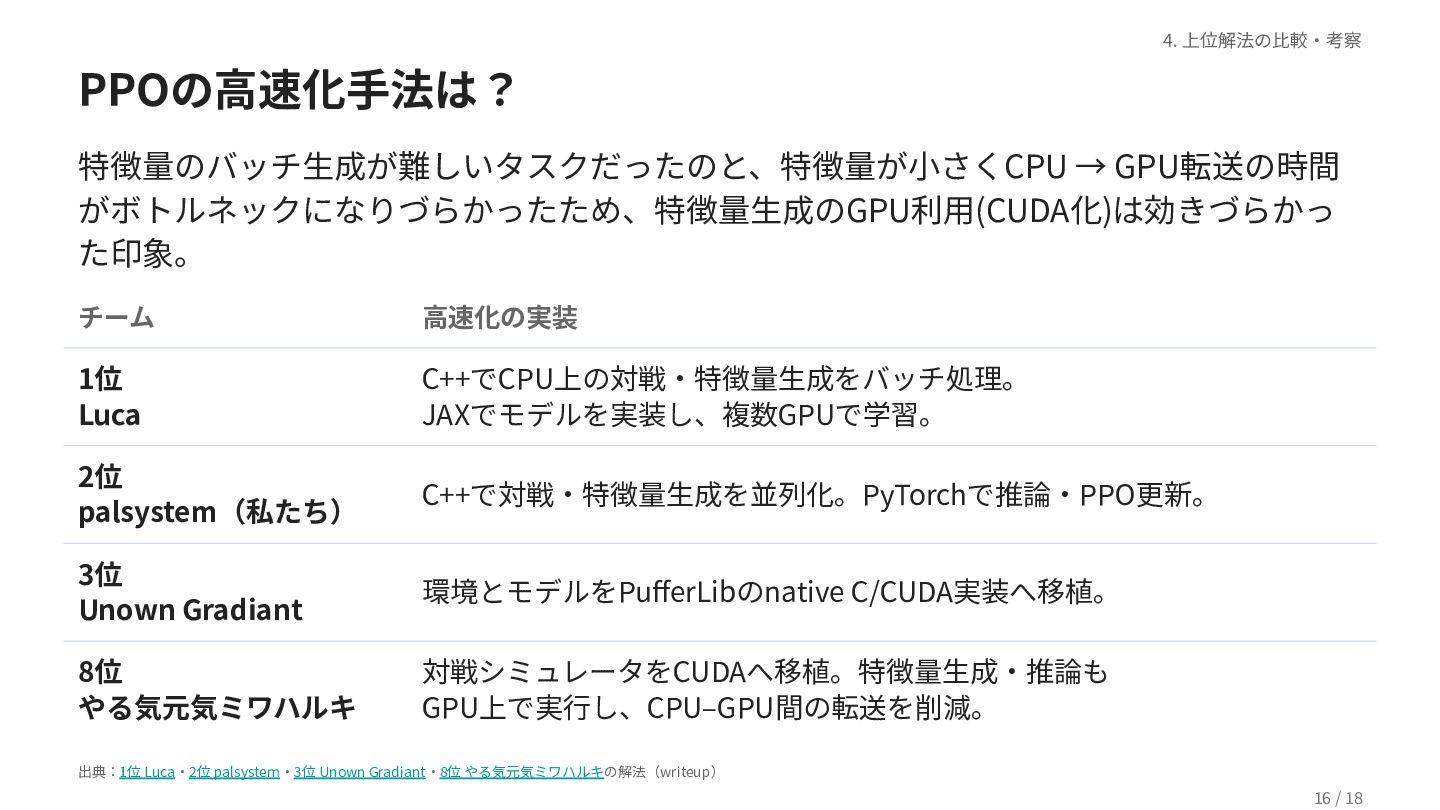
4. 上位解法の⽐較‧考察 PPOの⾼速化⼿法は? 特徴量のバッチ⽣成が難しいタスクだったのと、特徴量が⼩さくCPU → GPU転送の時間 がボトルネックになりづらかったため、特徴量⽣成のGPU利⽤(CUDA化)は効きづらかっ た印象。 チーム ⾼速化の実装
1位 Luca C++でCPU上の対戦‧特徴量⽣成をバッチ処理。 JAXでモデルを実装し、複数GPUで学習。 2位 palsystem(私たち) C++で対戦‧特徴量⽣成を並列化。PyTorchで推論‧PPO更新。 3位 Unown Gradiant 環境とモデルをPufferLibのnative C/CUDA実装へ移植。 8位 やる気元気ミワハルキ 対戦シミュレータをCUDAへ移植。特徴量⽣成‧推論も GPU上で実⾏し、CPU‒GPU間の転送を削減。 出典:1位 Luca‧2位 palsystem‧3位 Unown Gradiant‧8位 やる気元気ミワハルキの解法(writeup) 16 / 18
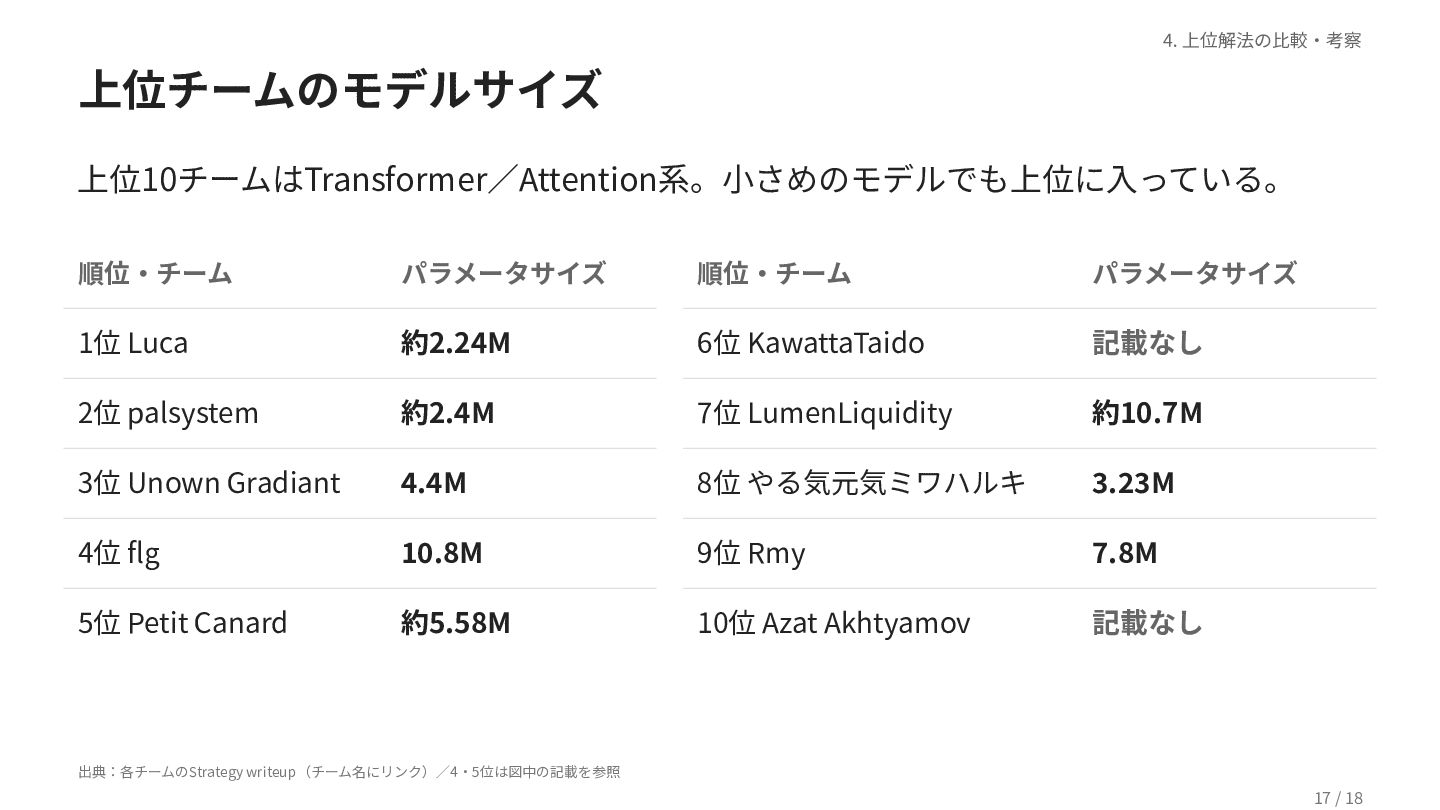
4. 上位解法の⽐較‧考察 上位チームのモデルサイズ 上位10チームはTransformer∕Attention系。⼩さめのモデルでも上位に⼊っている。 順位‧チーム パラメータサイズ 順位‧チーム パラメータサイズ 1位 Luca
約2.24M 6位 KawattaTaido 記載なし 2位 palsystem 約2.4M 7位 LumenLiquidity 約10.7M 3位 Unown Gradiant 4.4M 8位 やる気元気ミワハルキ 3.23M 4位 flg 10.8M 9位 Rmy 7.8M 5位 Petit Canard 約5.58M 10位 Azat Akhtyamov 記載なし 出典:各チームのStrategy writeup(チーム名にリンク)∕4‧5位は図中の記載を参照 17 / 18
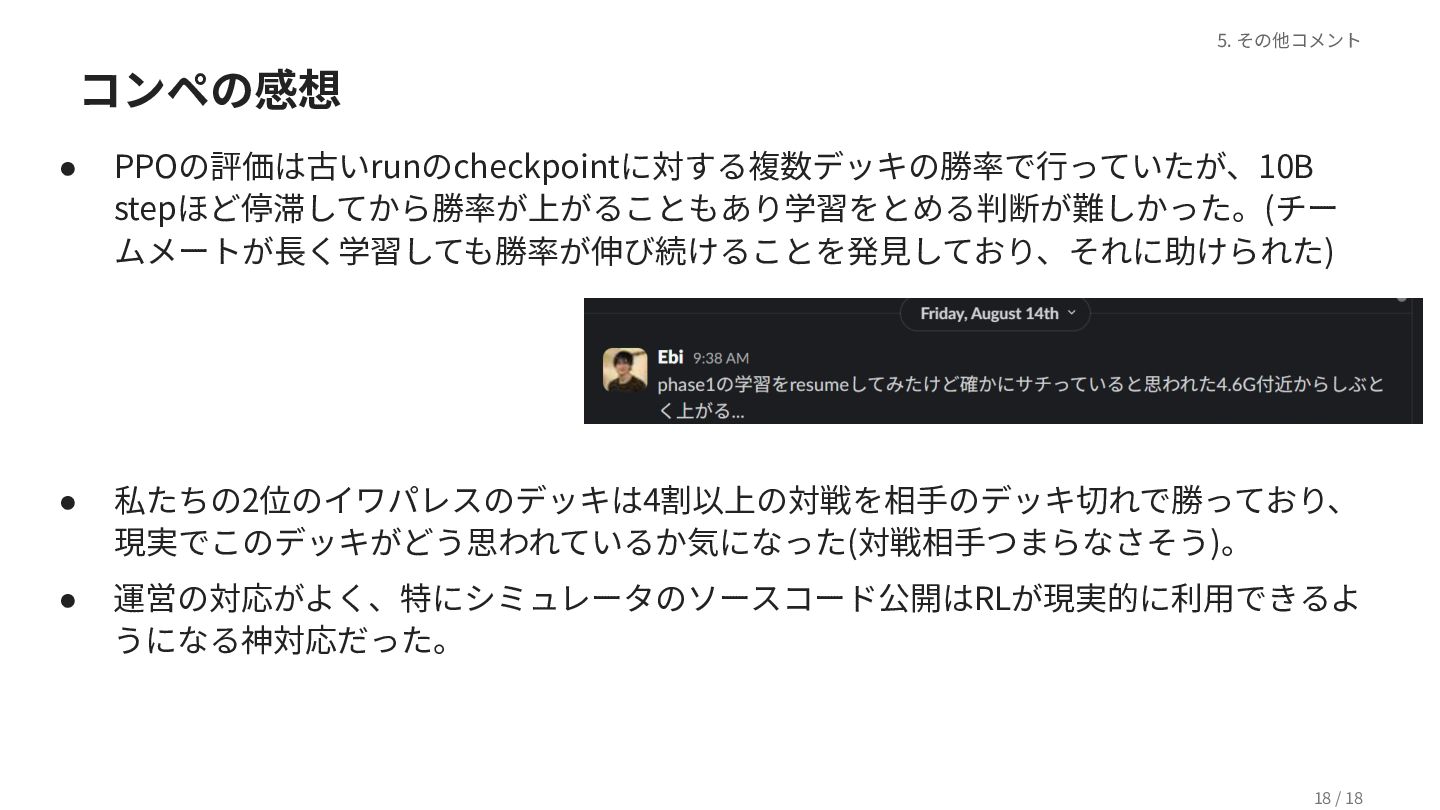
5. その他コメント コンペの感想 • PPOの評価は古いrunのcheckpointに対する複数デッキの勝率で⾏っていたが、10B stepほど停滞してから勝率が上がることもあり学習をとめる判断が難しかった。(チー ムメートが⻑く学習しても勝率が伸び続けることを発⾒しており、それに助けられた) • 私たちの2位のイワパレスのデッキは4割以上の対戦を相⼿のデッキ切れで勝っており、 現実でこのデッキがどう思われているか気になった(対戦相⼿つまらなさそう)。
• 運営の対応がよく、特にシミュレータのソースコード公開はRLが現実的に利⽤できるよ うになる神対応だった。 18 / 18


 thirion
 rocio
 jnunemaker
 inesmontani
 portentint
 shpigford
 mojombo
 khoart
 bkeepers
 honzajavorek
 rkaga
 akihiro_kokubo