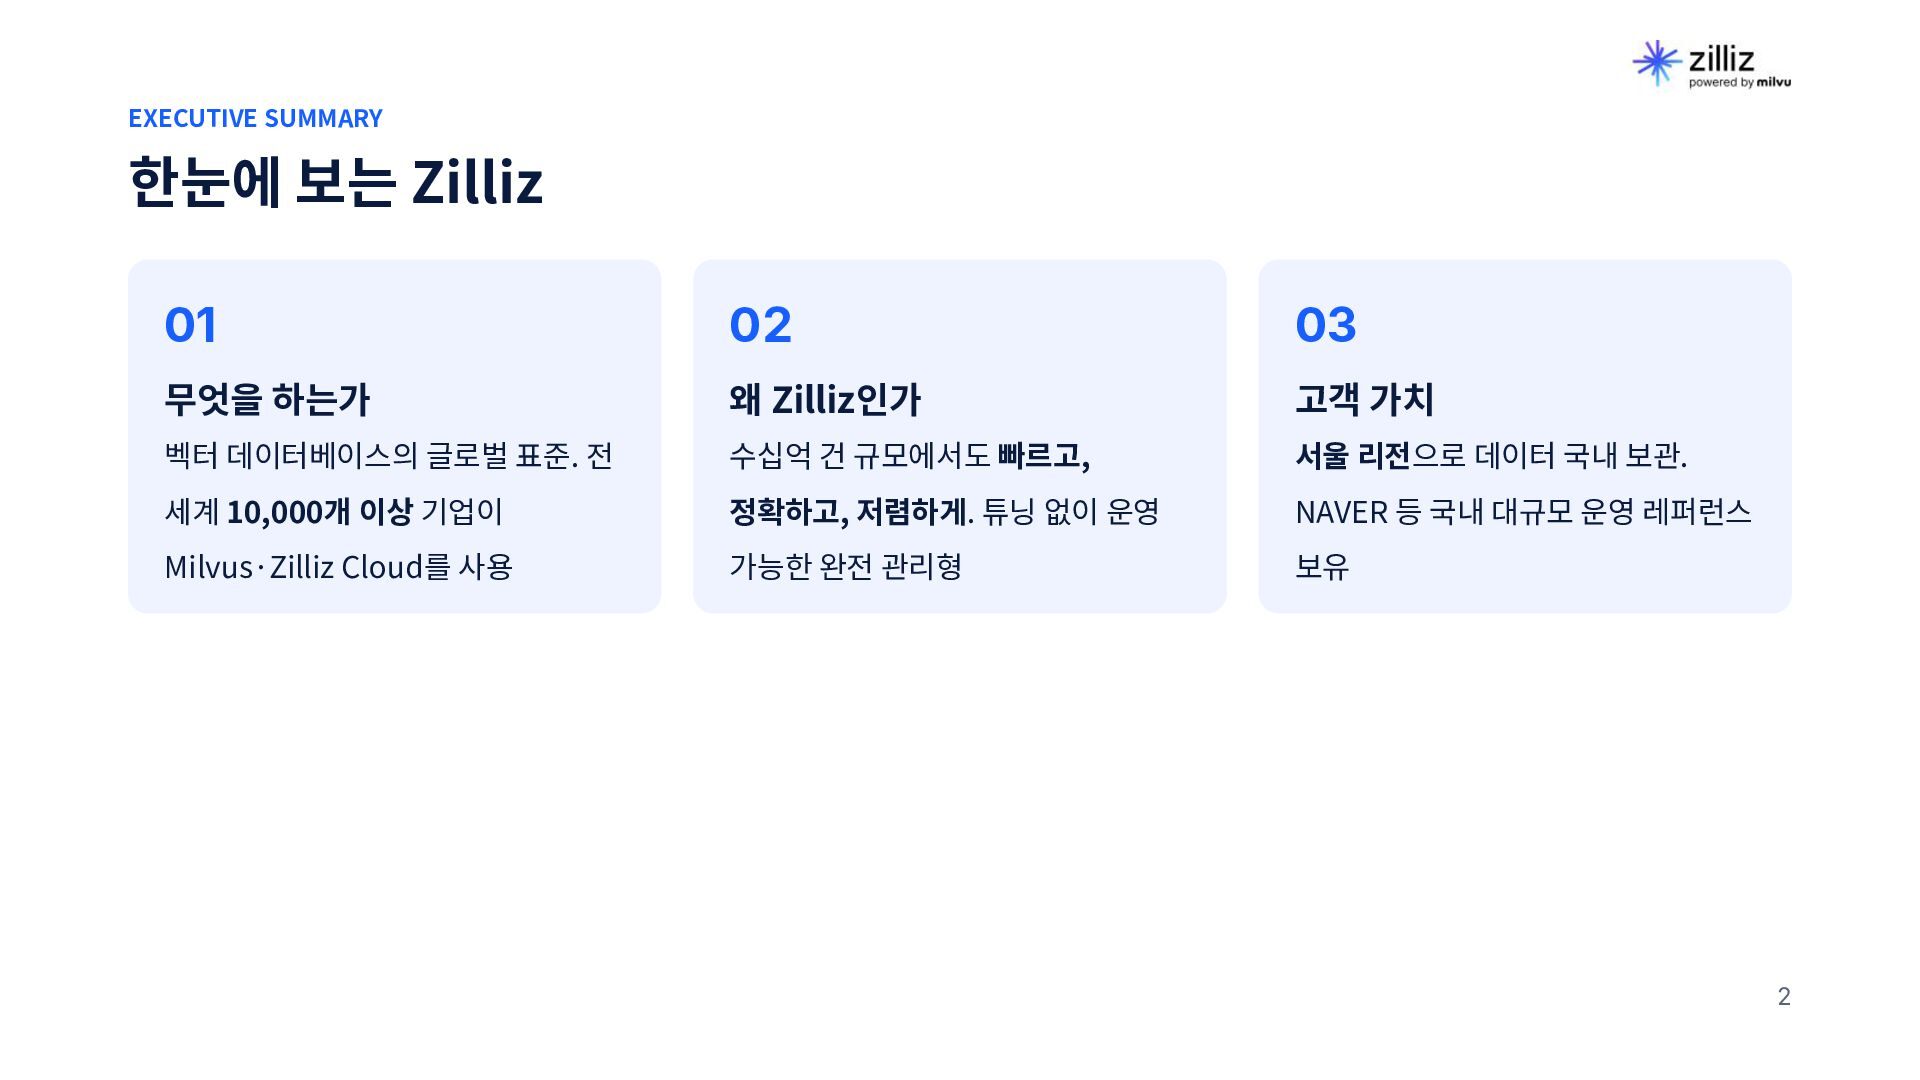
왜 Zilliz인가 고객 가치 벡터 데이터베이스의 글로벌 표준. 전 수십억 건 규모에서도 빠르고, 서울 리전으로 데이터 국내 보관. 세계 10,000개 이상 기업이 정확하고, 저렴하게. 튜닝 없이 운영 NAVER 등 국내 대규모 운영 레퍼런스 Milvus·Zilliz Cloud를 사용 가능한 완전 관리형 보유 2
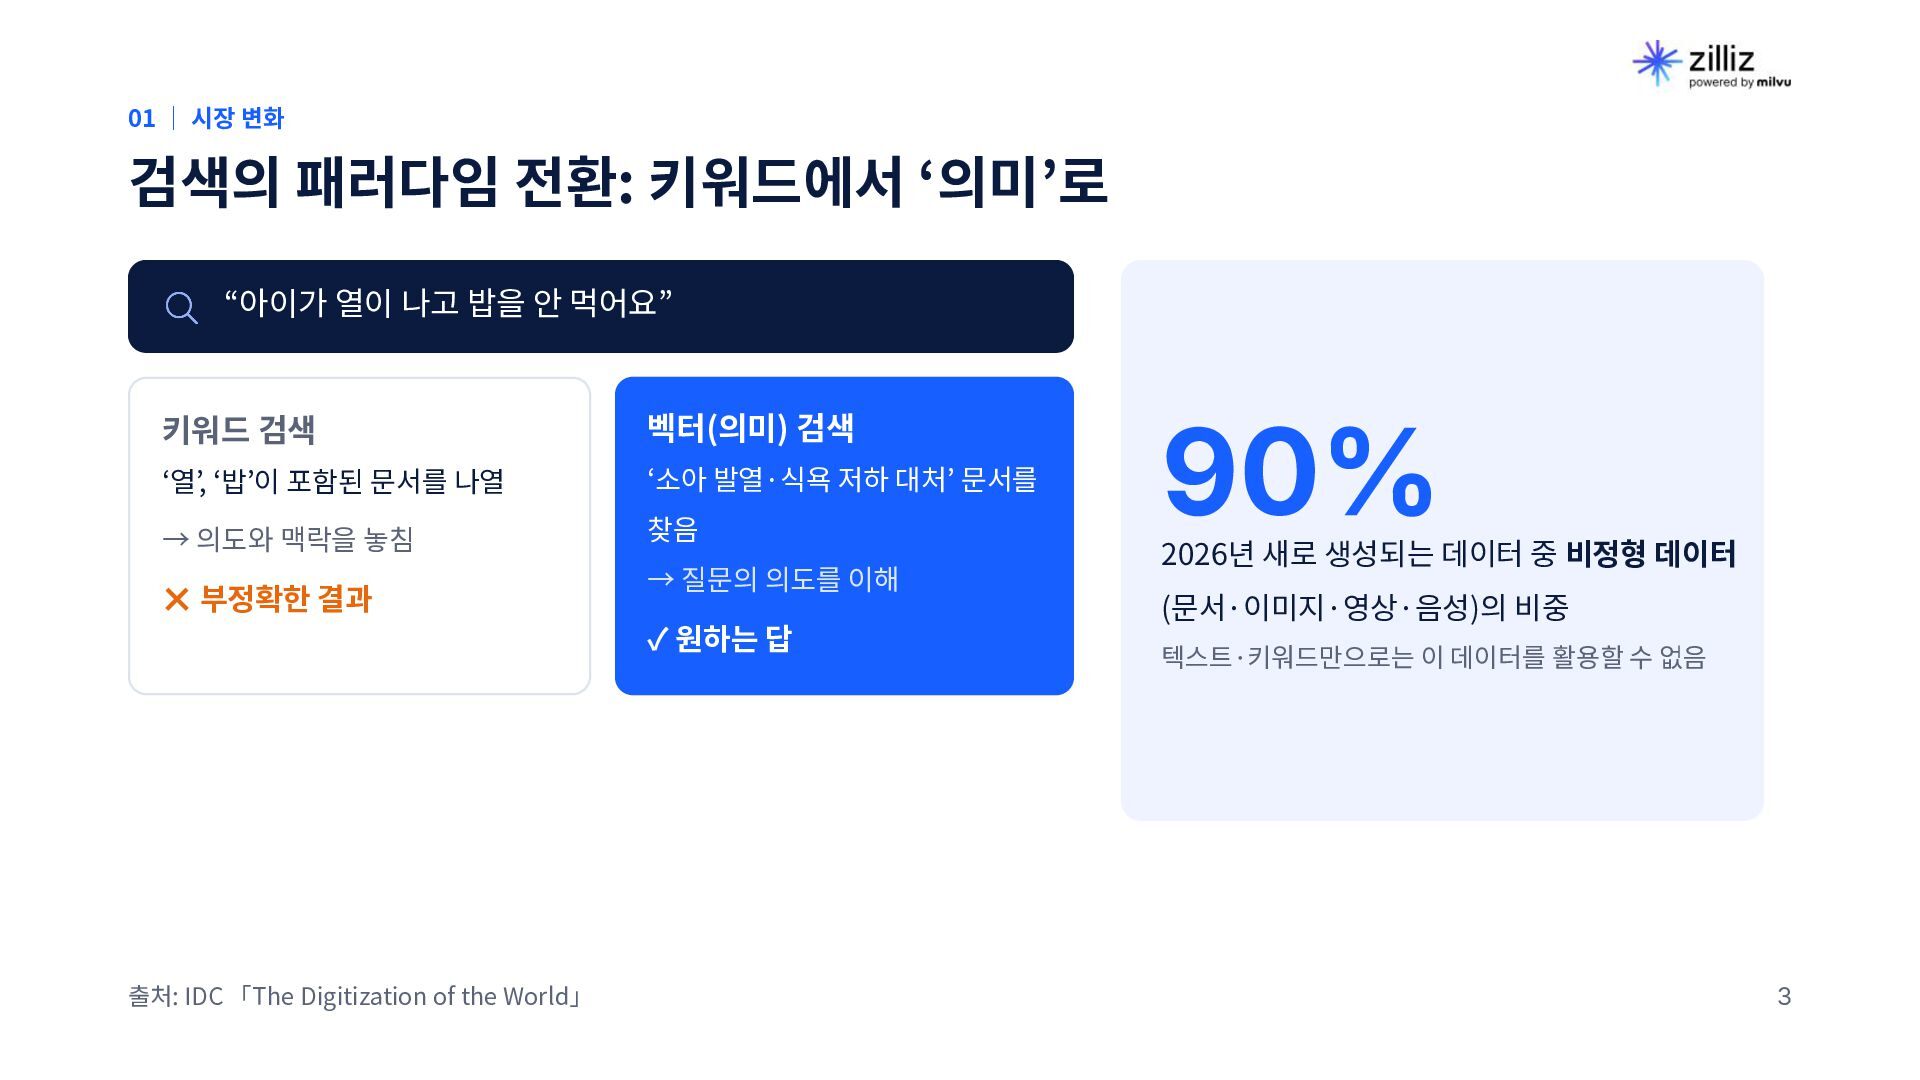
열이 나고 밥을 안 먹어요” 키워드 검색 벡터(의미) 검색 ʻ열’, ʻ밥’이 포함된 문서를 나열 ʻ소아 발열·식욕 저하 대처’ 문서를 → 의도와 맥락을 놓침 찾음 ✕ 부정확한 결과 → 질문의 의도를 이해 ✓ 원하는 답 출처: IDC 「The Digitization of the World」 90% 2026년 새로 생성되는 데이터 중 비정형 데이터 (문서·이미지·영상·음성)의 비중 텍스트·키워드만으로는 이 데이터를 활용할 수 없음 3
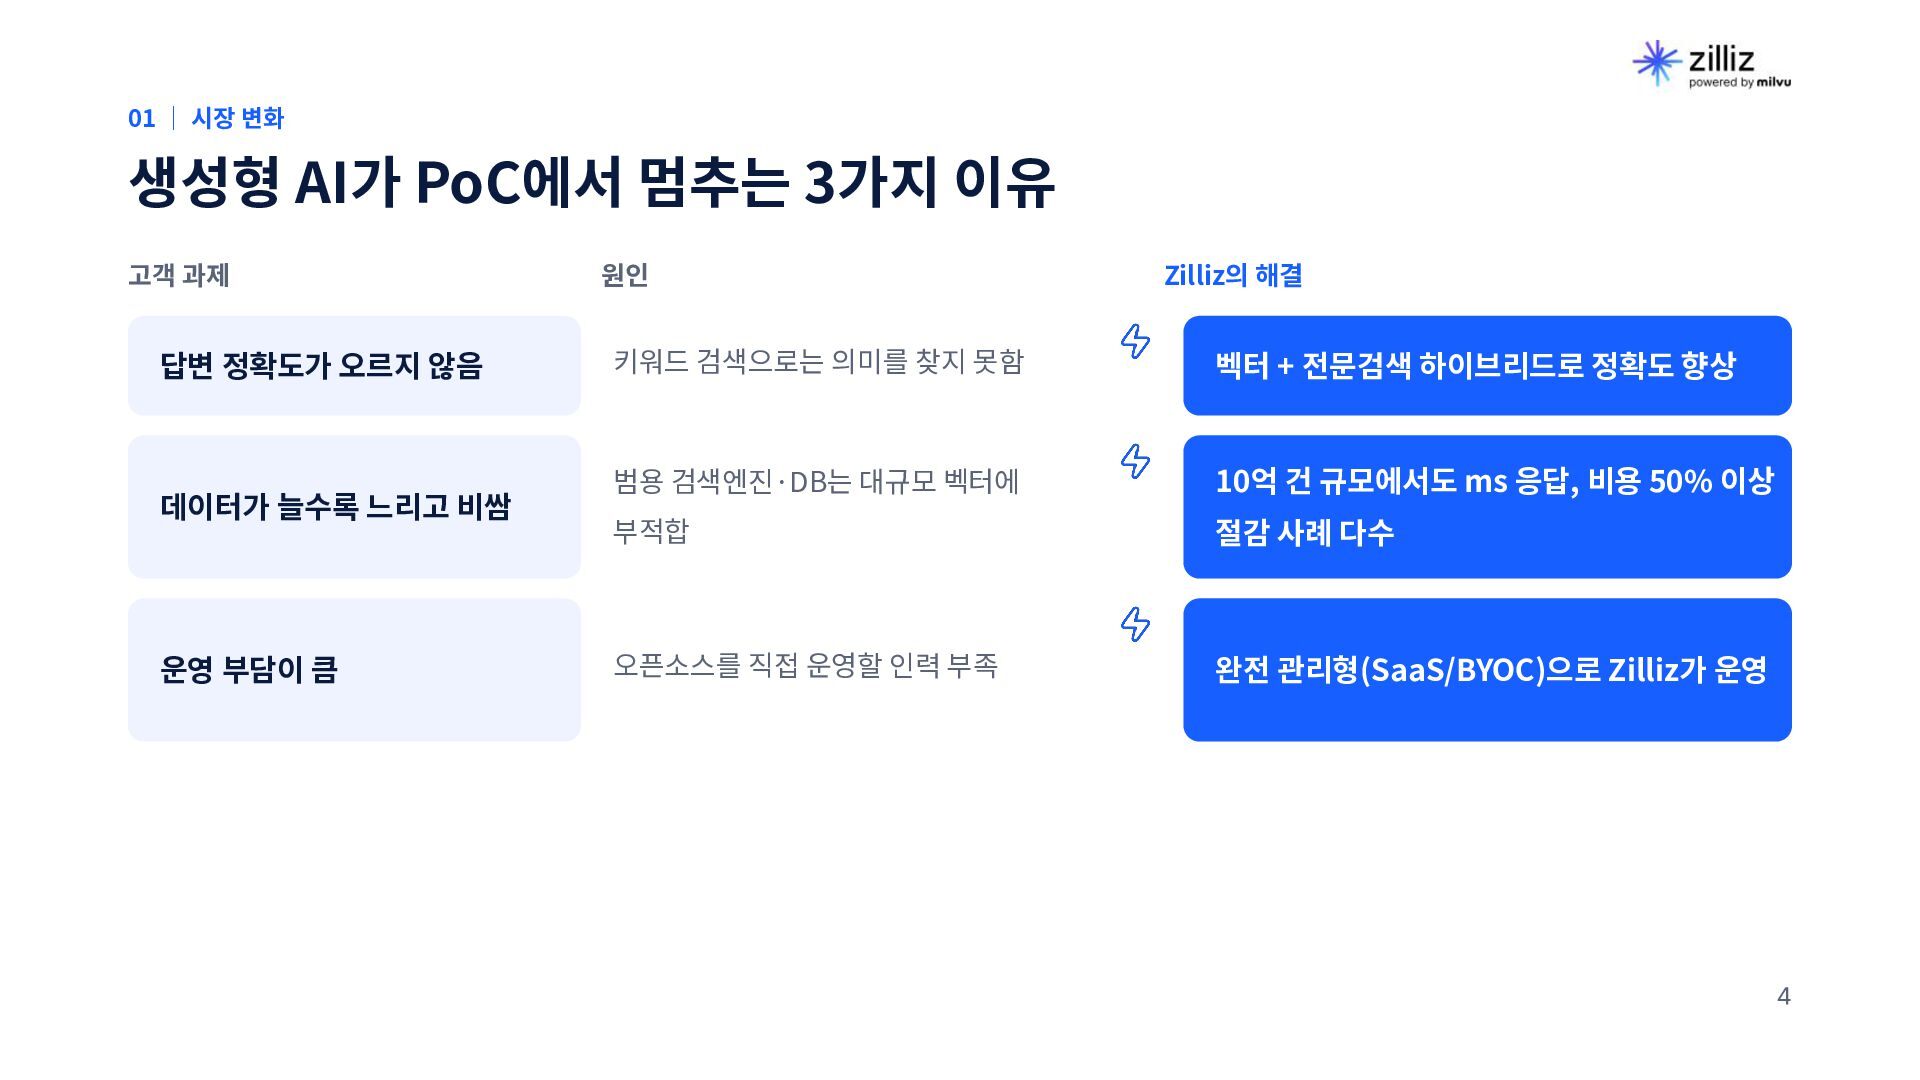
고객 과제 답변 정확도가 오르지 않음 데이터가 늘수록 느리고 비쌈 운영 부담이 큼 원인 Zilliz의 해결 키워드 검색으로는 의미를 찾지 못함 벡터 + 전문검색 하이브리드로 정확도 향상 범용 검색엔진·DB는 대규모 벡터에 10억 건 규모에서도 ms 응답, 비용 50% 이상 부적합 절감 사례 다수 오픈소스를 직접 운영할 인력 부족 완전 관리형(SaaS/BYOC)으로 Zilliz가 운영 4
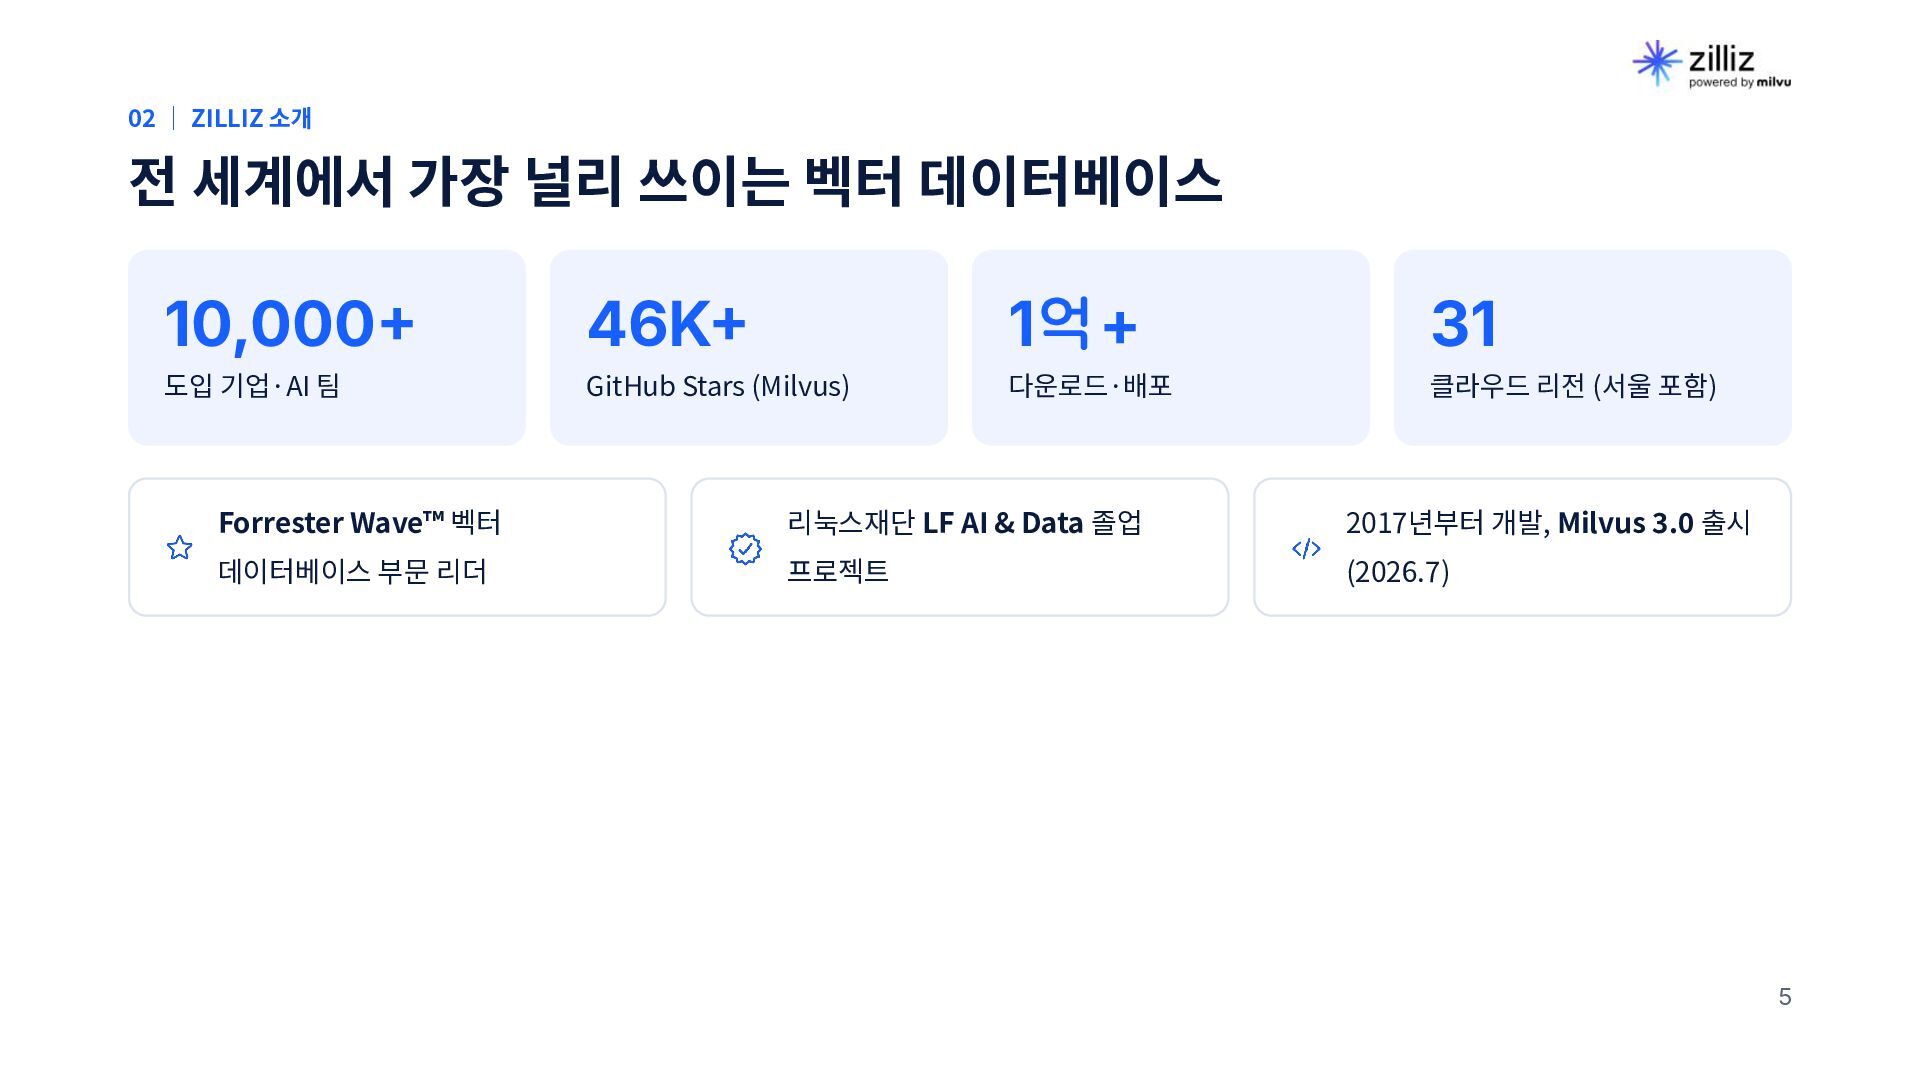
데이터베이스 10,000 46K 1억+ 31 도입 기업·AI 팀 GitHub Stars (Milvus) 다운로드·배포 클라우드 리전 (서울 포함) Forrester Wave™ 벡터 리눅스재단 LF AI & Data 졸업 2017년부터 개발, Milvus 3.0 출시 데이터베이스 부문 리더 프로젝트 (2026.7) 5
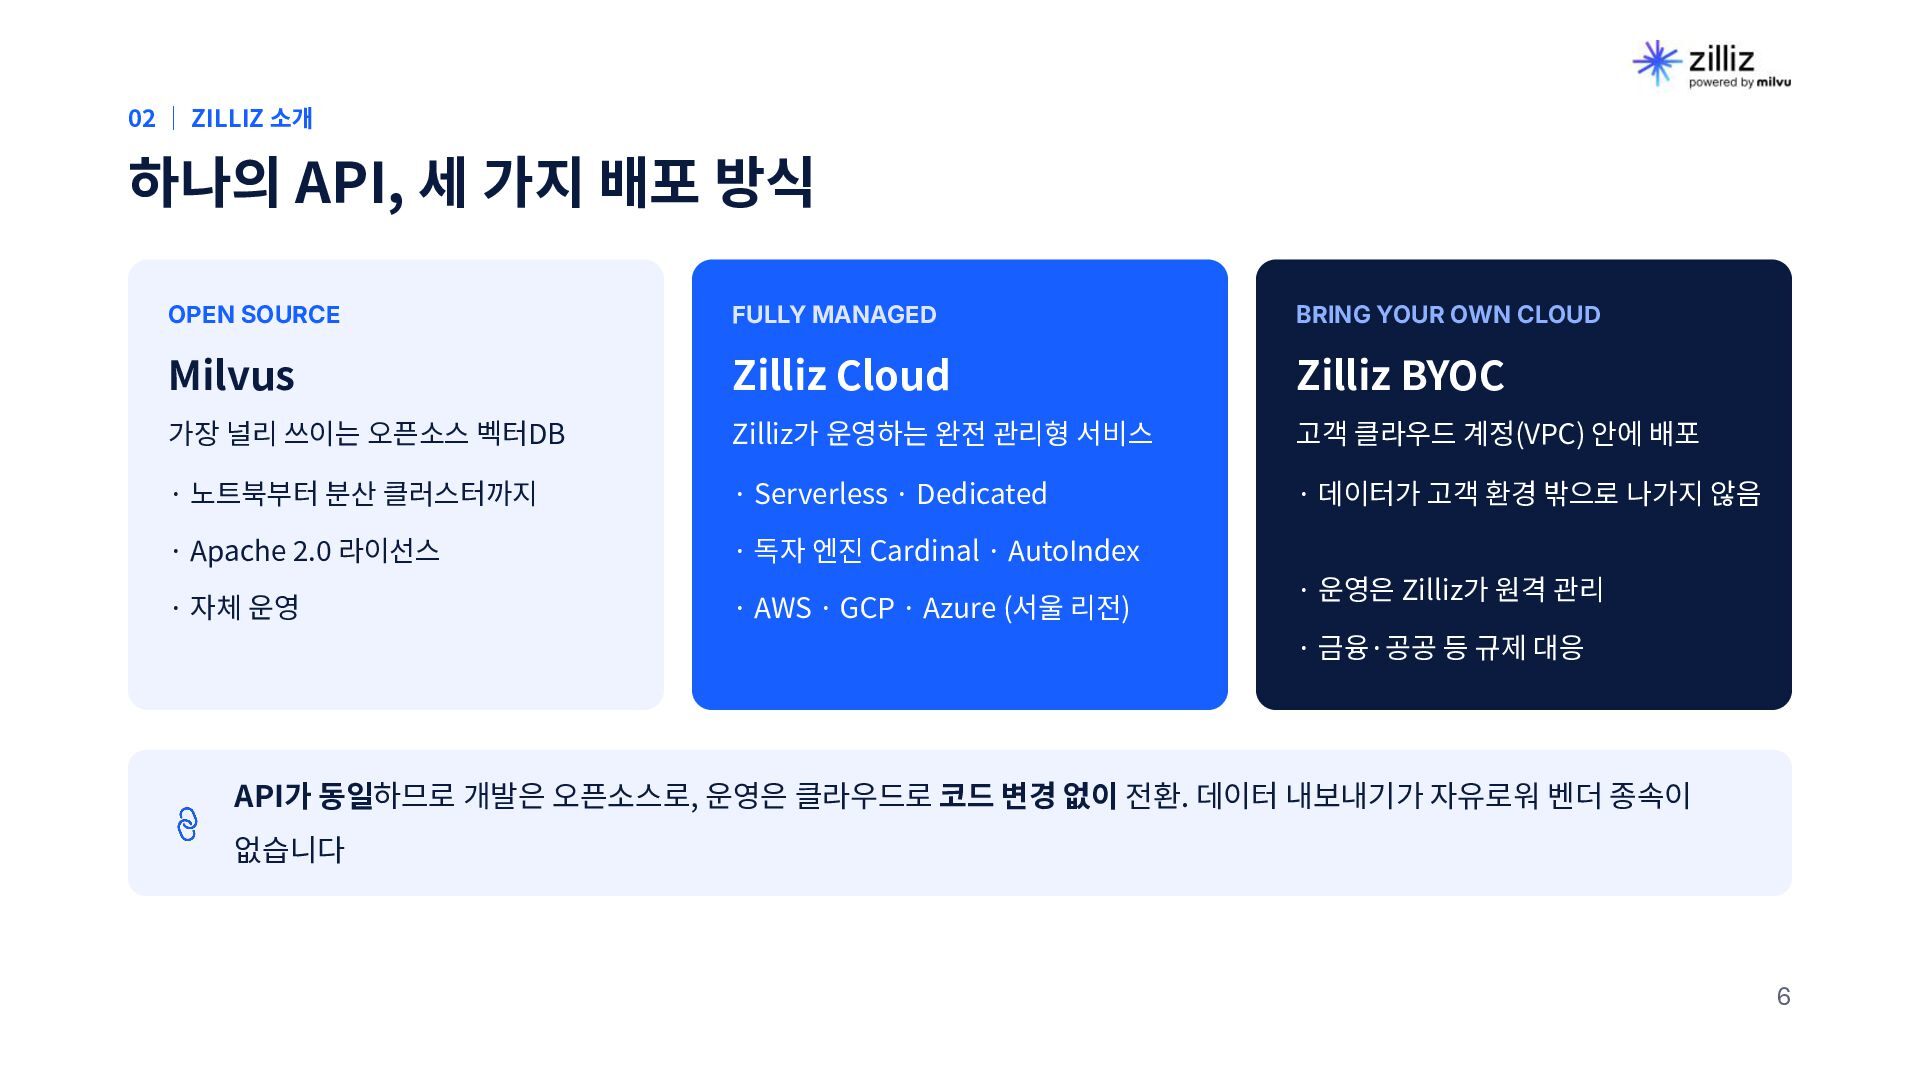
OPEN SOURCE FULLY MANAGED BRING YOUR OWN CLOUD Milvus Zilliz Cloud Zilliz BYOC 가장 널리 쓰이는 오픈소스 벡터DB Zilliz가 운영하는 완전 관리형 서비스 고객 클라우드 계정(VPC) 안에 배포 · 노트북부터 분산 클러스터까지 · Serverless · Dedicated · 데이터가 고객 환경 밖으로 나가지 않음 · Apache 2.0 라이선스 · 독자 엔진 Cardinal · AutoIndex · 자체 운영 · AWS · GCP · Azure (서울 리전) · 운영은 Zilliz가 원격 관리 · 금융·공공 등 규제 대응 API가 동일하므로 개발은 오픈소스로, 운영은 클라우드로 코드 변경 없이 전환. 데이터 내보내기가 자유로워 벤더 종속이 없습니다 6
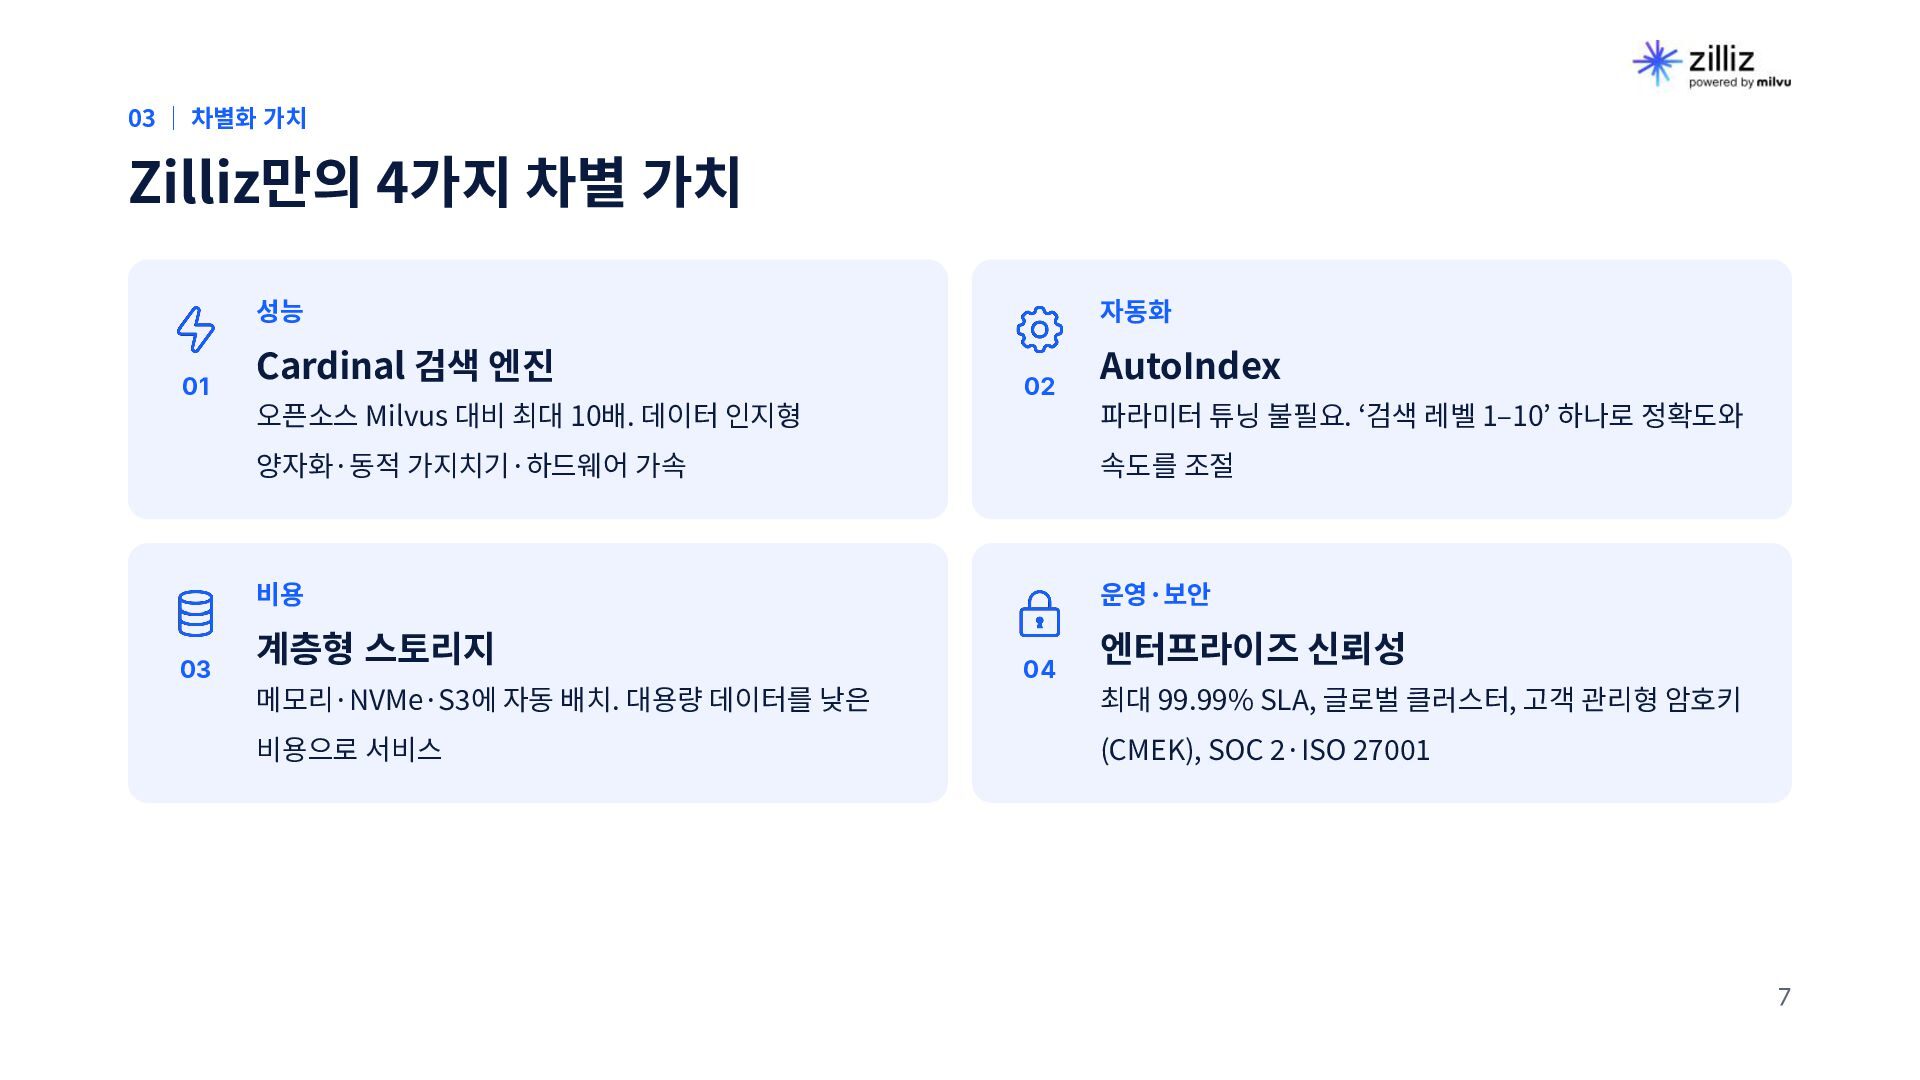
03 Cardinal 검색 엔진 자동화 02 AutoIndex 오픈소스 Milvus 대비 최대 10배. 데이터 인지형 파라미터 튜닝 불필요. ʻ검색 레벨 1‒10’ 하나로 정확도와 양자화·동적 가지치기·하드웨어 가속 속도를 조절 비용 운영·보안 계층형 스토리지 04 엔터프라이즈 신뢰성 메모리·NVMe·S3에 자동 배치. 대용량 데이터를 낮은 최대 99.99% SLA, 글로벌 클러스터, 고객 관리형 암호키 비용으로 서비스 (CMEK), SOC 2·ISO 27001 7
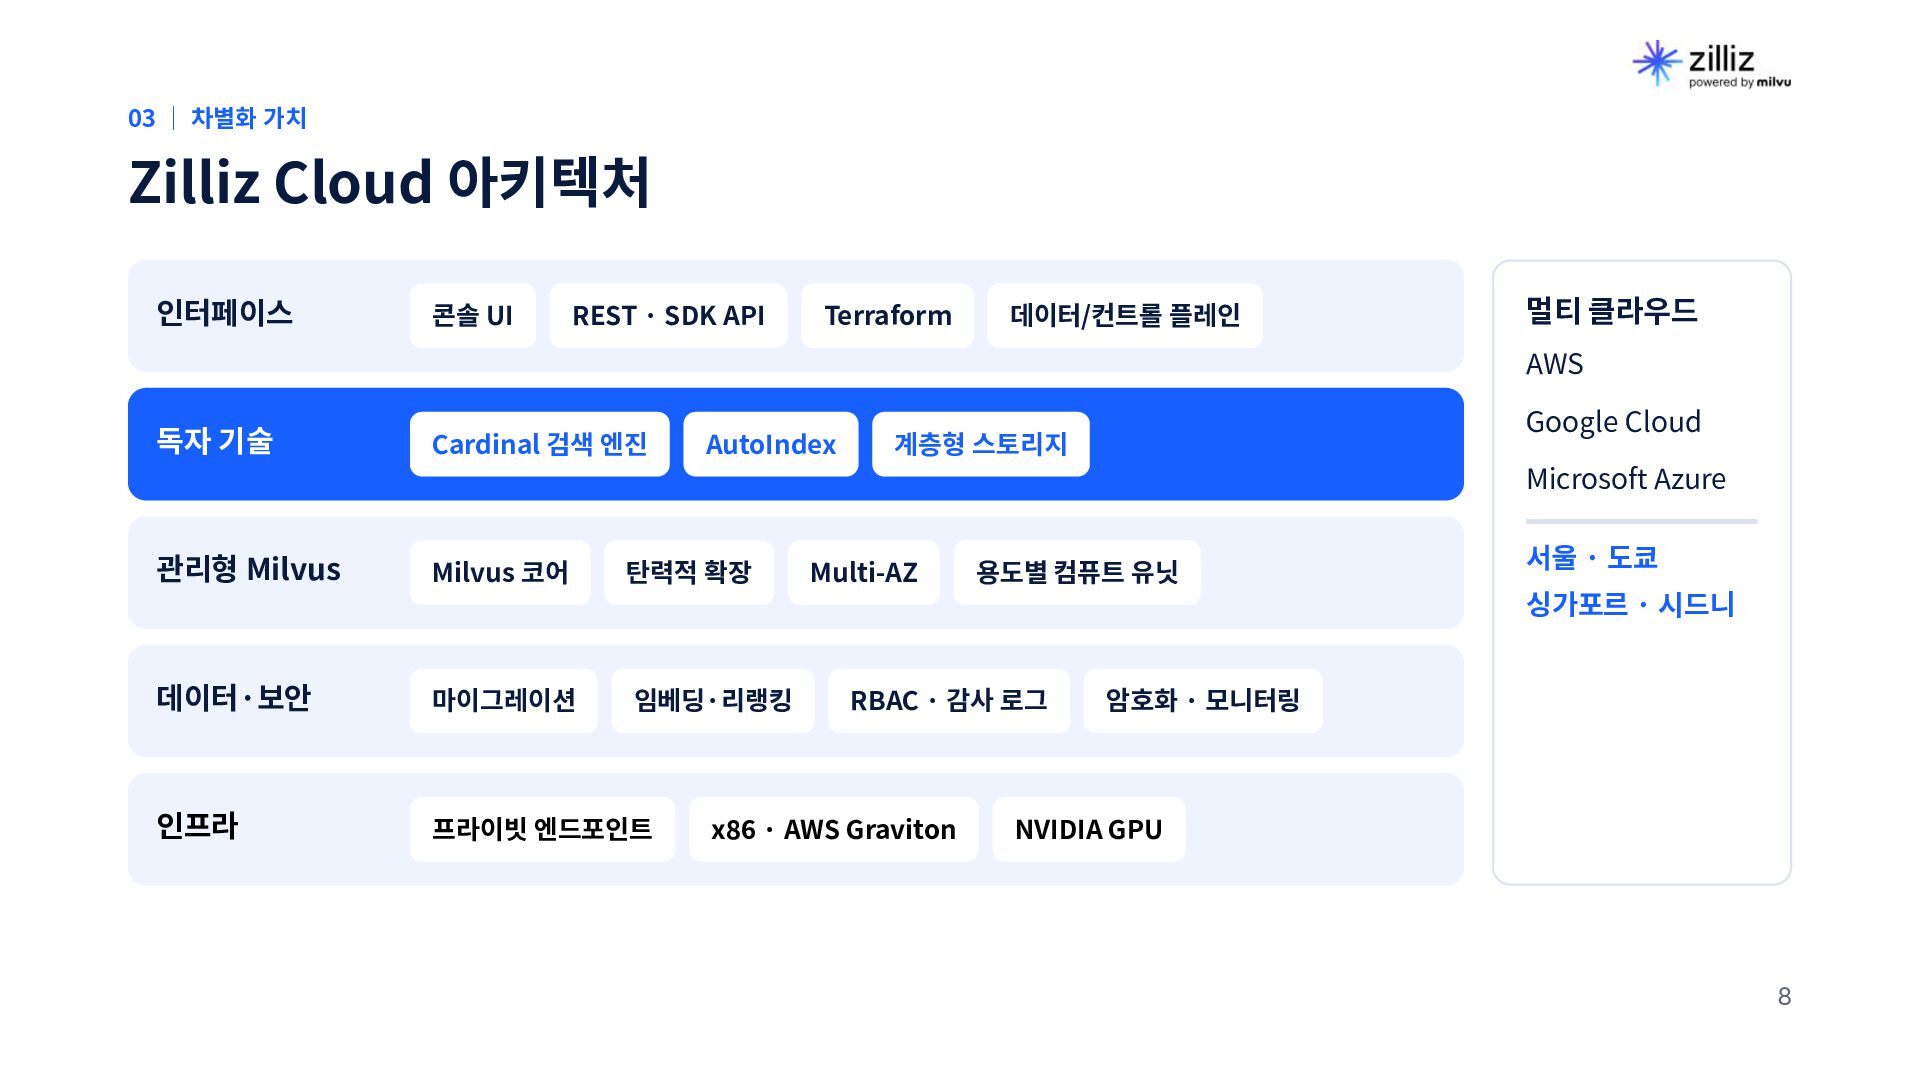
REST · SDK API Terraform 데이터/컨트롤 플레인 멀티 클라우드 AWS 독자 기술 Cardinal 검색 엔진 AutoIndex Google Cloud 계층형 스토리지 Microsoft Azure 관리형 Milvus Milvus 코어 탄력적 확장 Multi-AZ 용도별 컴퓨트 유닛 서울 · 도쿄 싱가포르 · 시드니 데이터·보안 마이그레이션 인프라 프라이빗 엔드포인트 임베딩·리랭킹 RBAC · 감사 로그 x86 · AWS Graviton 암호화 · 모니터링 NVIDIA GPU 8
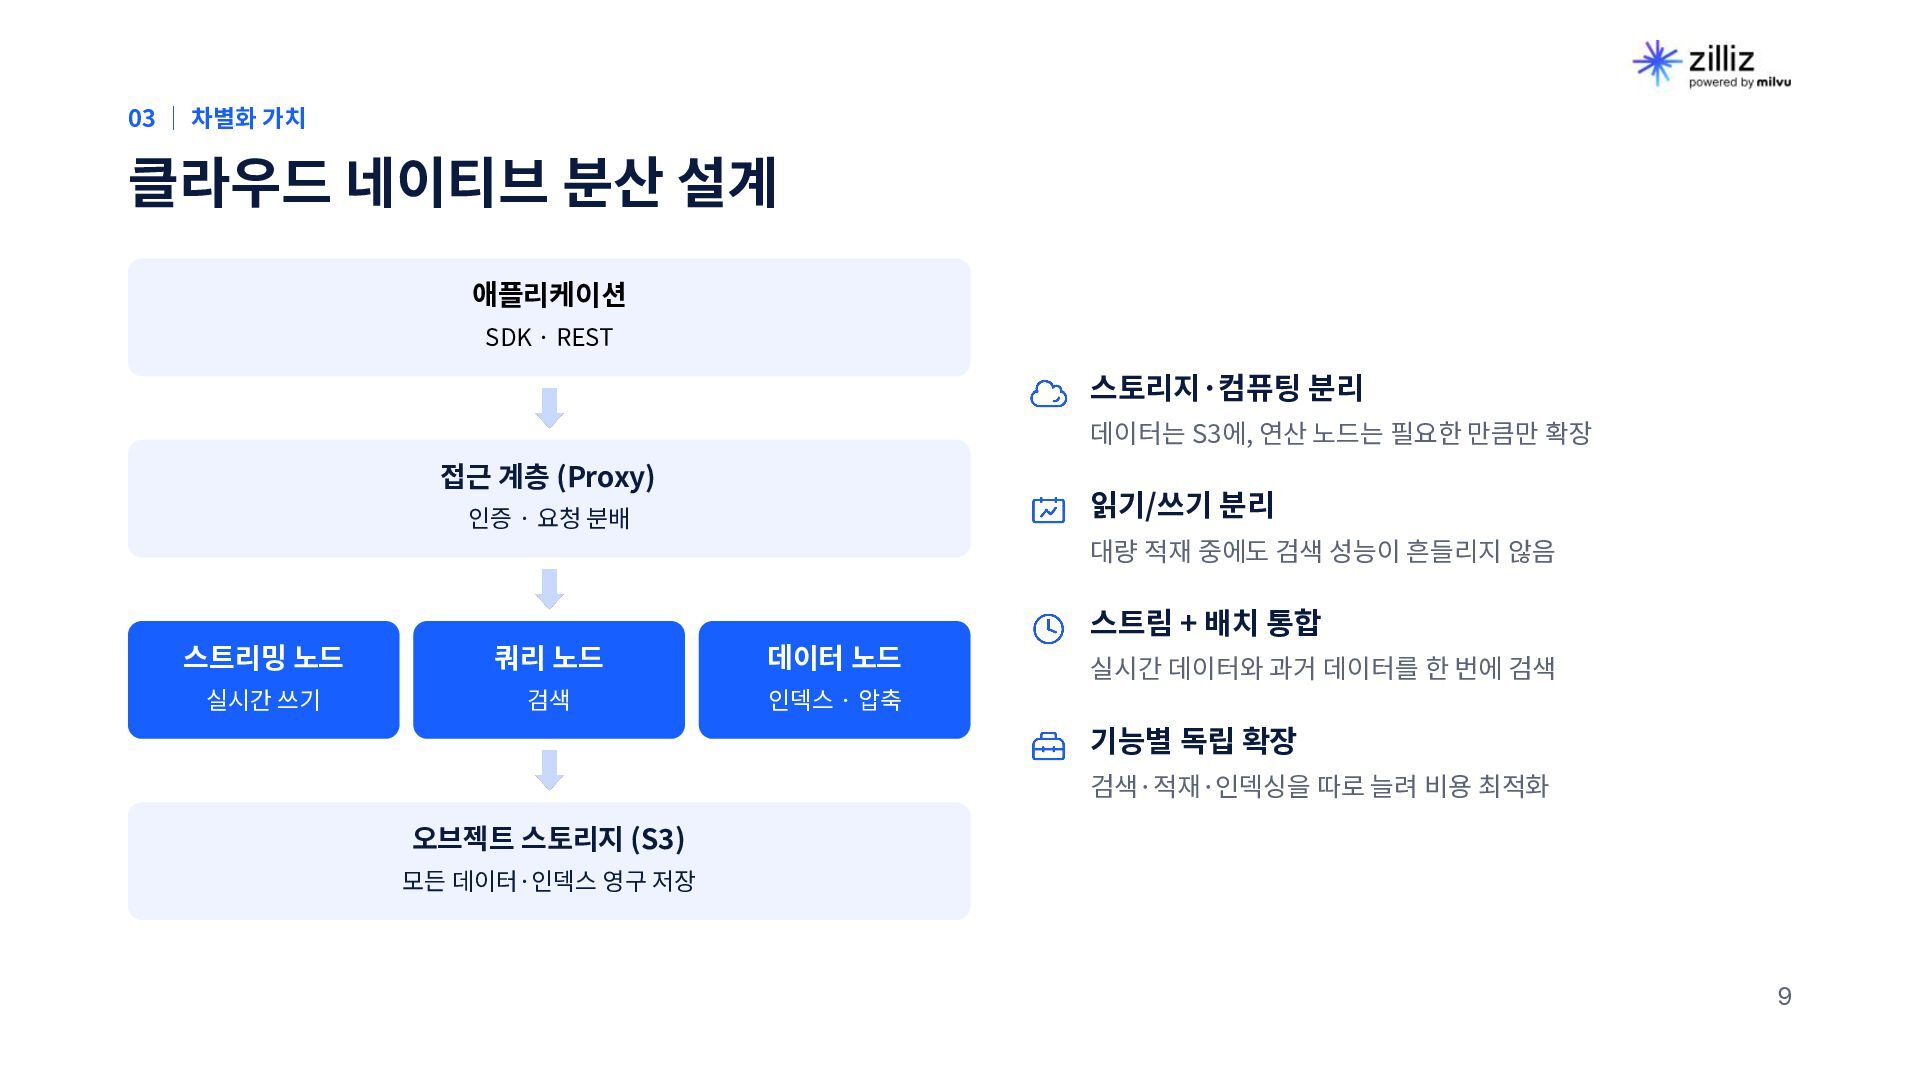
· REST 스토리지·컴퓨팅 분리 데이터는 S3에, 연산 노드는 필요한 만큼만 확장 접근 계층 (Proxy) 읽기/쓰기 분리 인증 · 요청 분배 대량 적재 중에도 검색 성능이 흔들리지 않음 스트림 + 배치 통합 스트리밍 노드 쿼리 노드 데이터 노드 실시간 쓰기 검색 인덱스 · 압축 실시간 데이터와 과거 데이터를 한 번에 검색 기능별 독립 확장 검색·적재·인덱싱을 따로 늘려 비용 최적화 오브젝트 스토리지 (S3) 모든 데이터·인덱스 영구 저장 9
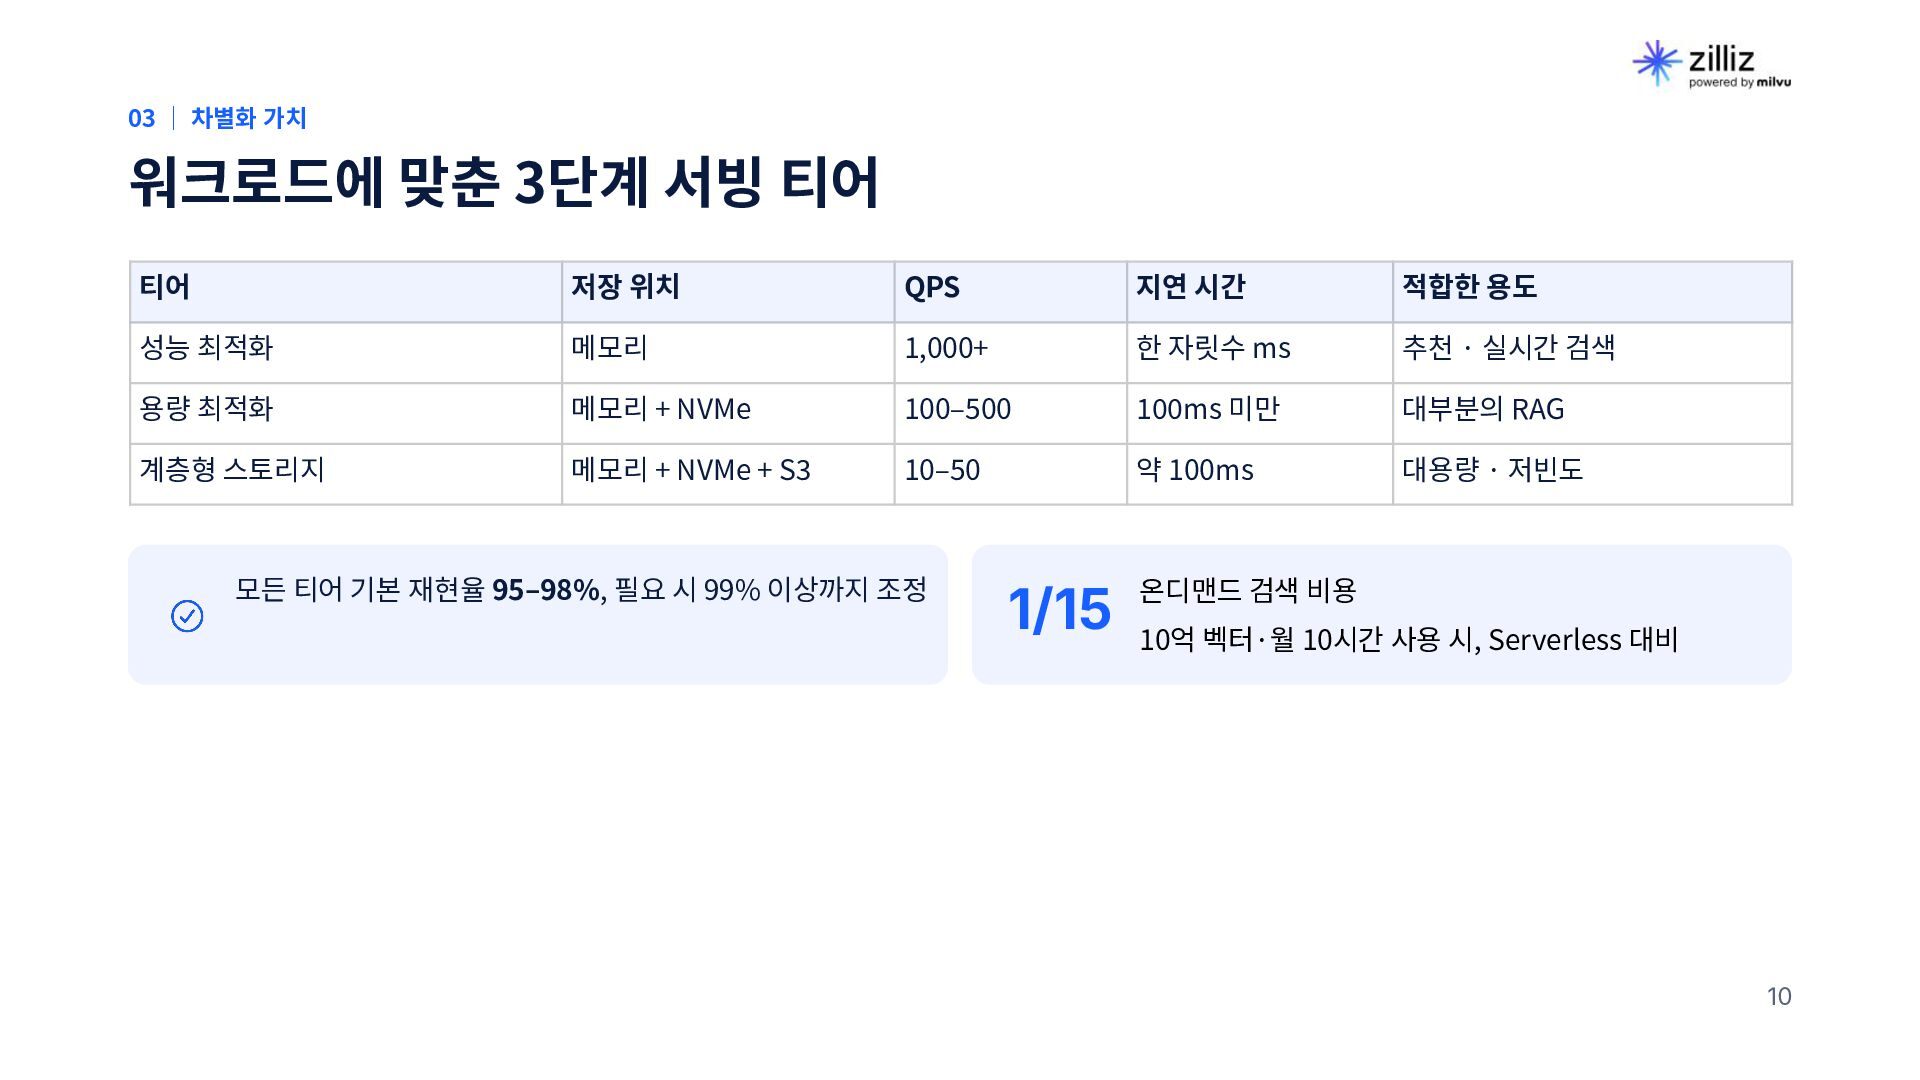
저장 위치 QPS 지연 시간 적합한 용도 성능 최적화 메모리 1,000+ 한 자릿수 ms 추천 · 실시간 검색 용량 최적화 메모리 + NVMe 100‒500 100ms 미만 대부분의 RAG 계층형 스토리지 메모리 + NVMe + S3 10‒50 약 100ms 대용량 · 저빈도 모든 티어 기본 재현율 95‒98%, 필요 시 99% 이상까지 조정 1/15 10억 벡터·월 10시간 사용 시, Serverless 대비 온디맨드 검색 비용 10
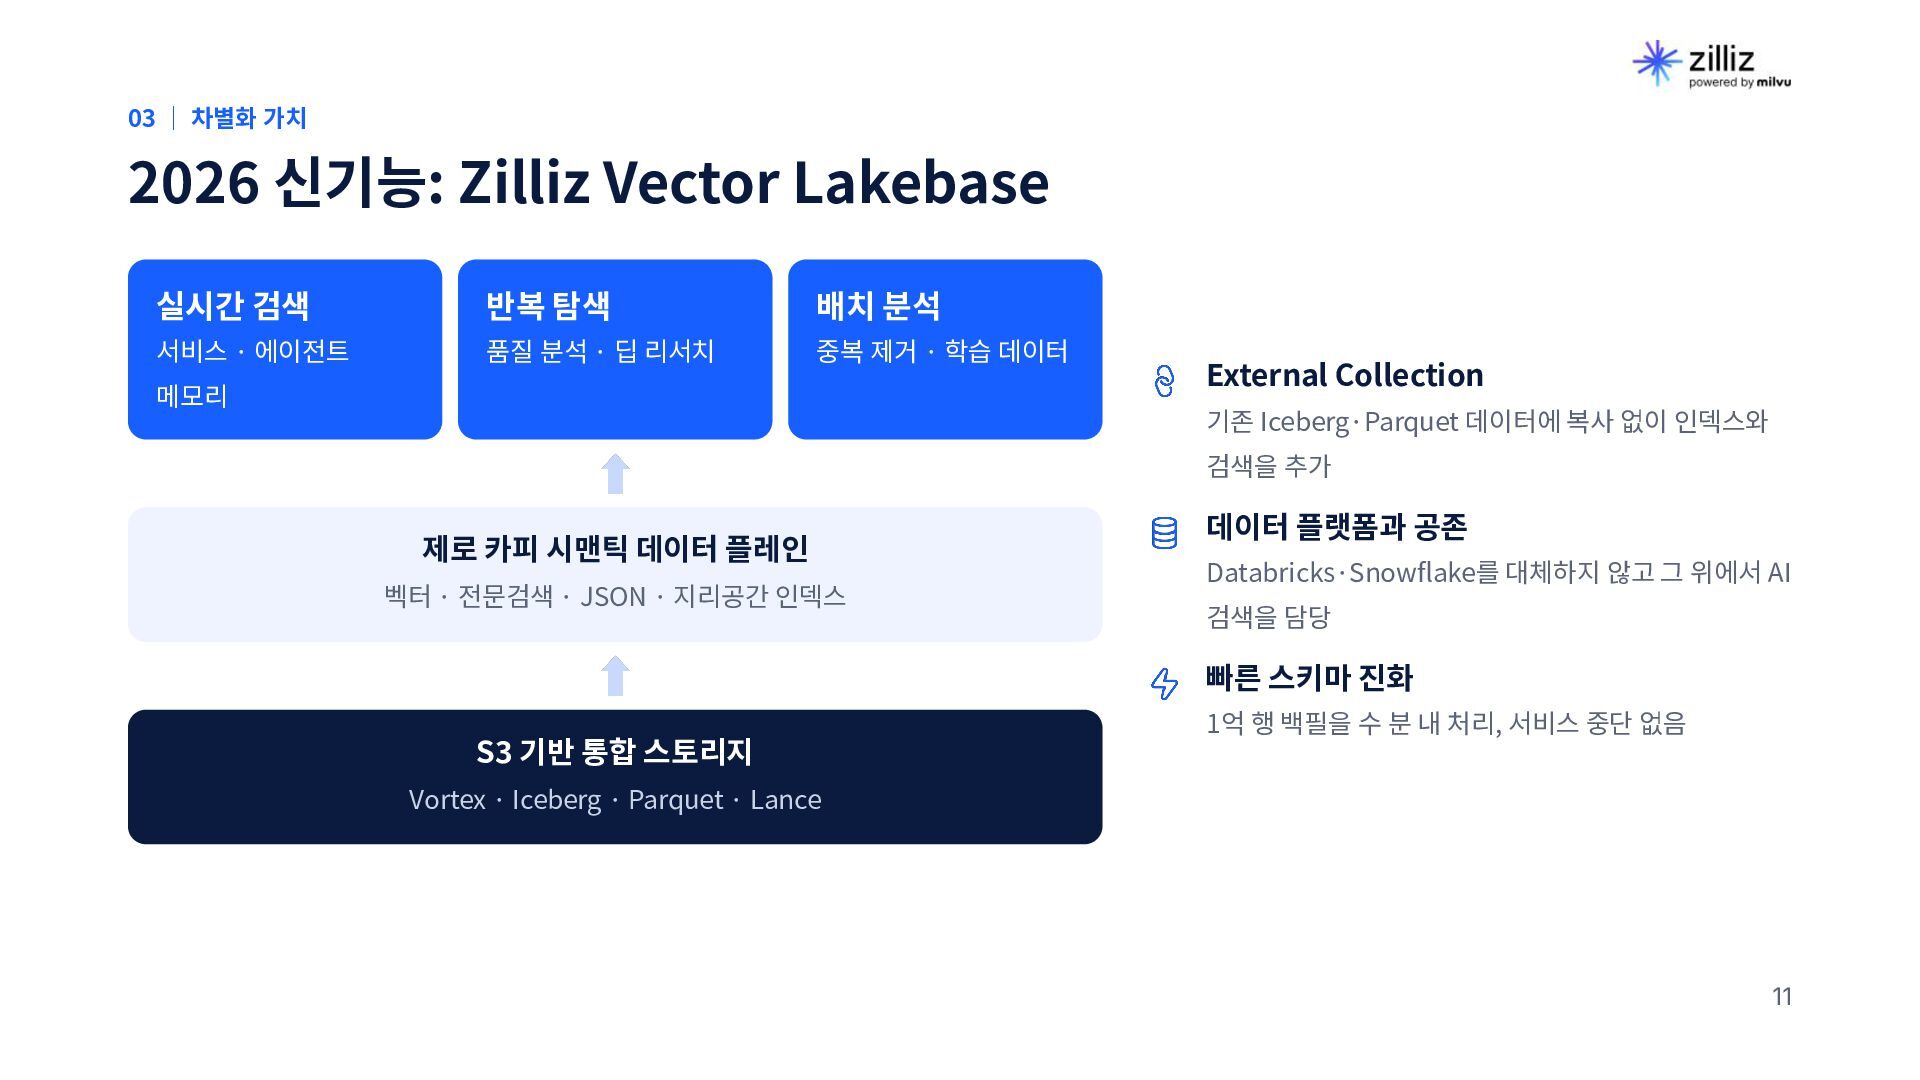
검색 반복 탐색 배치 분석 서비스 · 에이전트 품질 분석 · 딥 리서치 중복 제거 · 학습 데이터 메모리 External Collection 기존 Iceberg·Parquet 데이터에 복사 없이 인덱스와 검색을 추가 제로 카피 시맨틱 데이터 플레인 벡터 · 전문검색 · JSON · 지리공간 인덱스 데이터 플랫폼과 공존 Databricks·Snowflake를 대체하지 않고 그 위에서 AI 검색을 담당 빠른 스키마 진화 S3 기반 통합 스토리지 1억 행 백필을 수 분 내 처리, 서비스 중단 없음 Vortex · Iceberg · Parquet · Lance 11
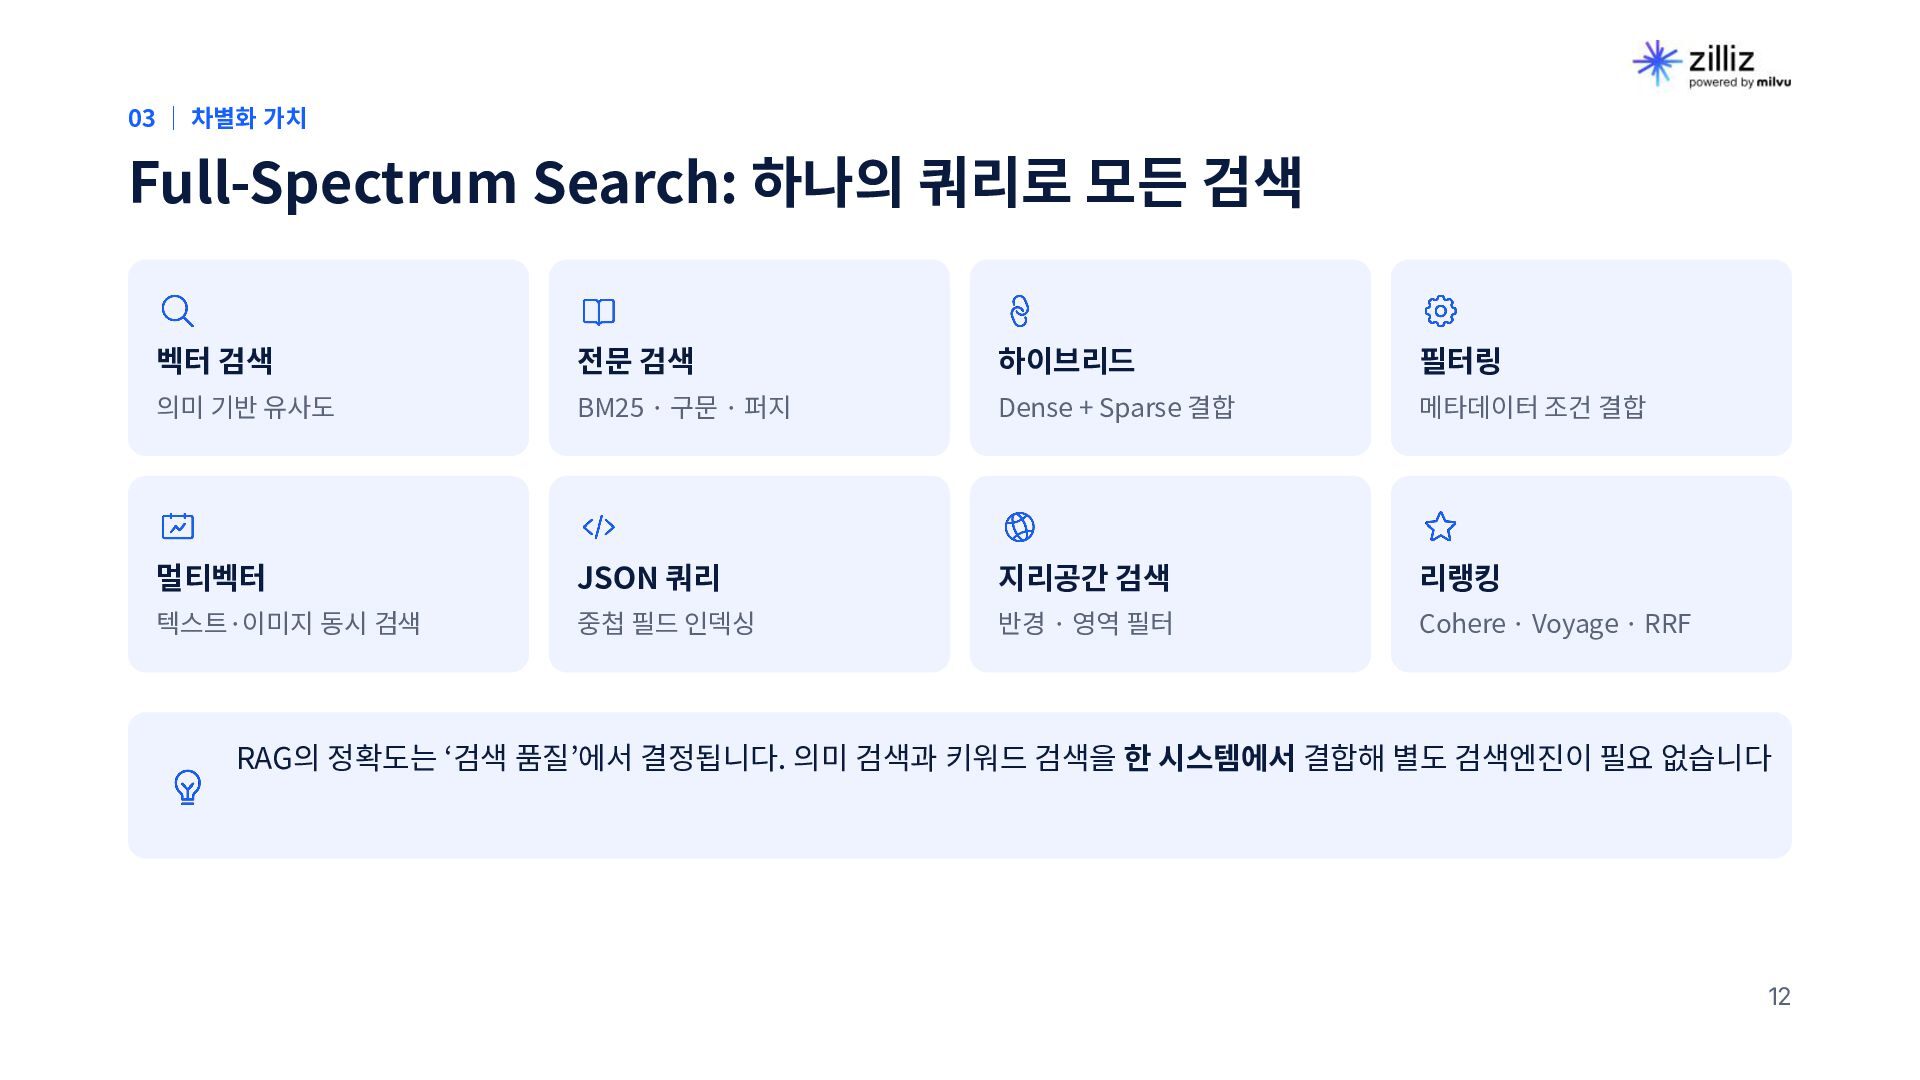
벡터 검색 전문 검색 하이브리드 필터링 의미 기반 유사도 BM25 · 구문 · 퍼지 Dense + Sparse 결합 메타데이터 조건 결합 멀티벡터 JSON 쿼리 지리공간 검색 리랭킹 텍스트·이미지 동시 검색 중첩 필드 인덱싱 반경 · 영역 필터 Cohere · Voyage · RRF RAG의 정확도는 ʻ검색 품질’에서 결정됩니다. 의미 검색과 키워드 검색을 한 시스템에서 결합해 별도 검색엔진이 필요 없습니다 12
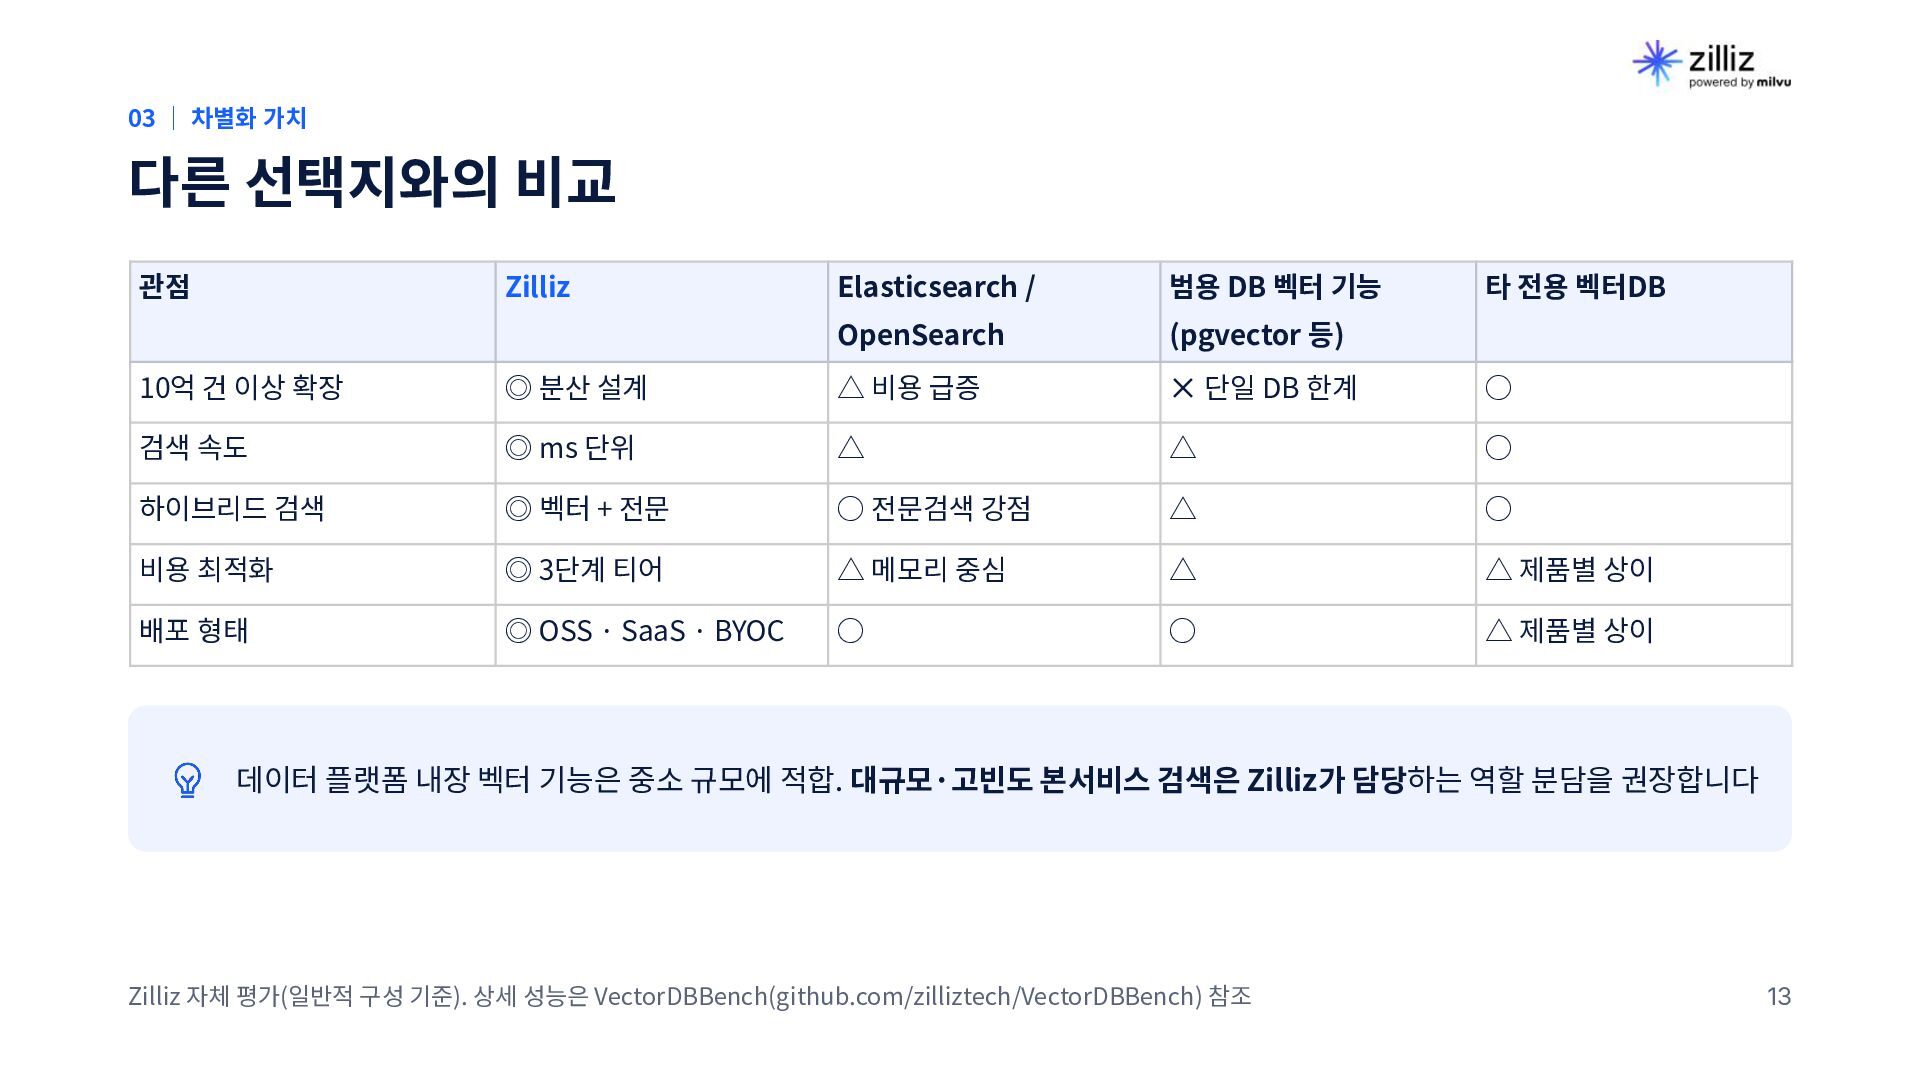
/ 범용 DB 벡터 기능 OpenSearch (pgvector 등) 타 전용 벡터DB 10억 건 이상 확장 ◎ 분산 설계 △ 비용 급증 ✕ 단일 DB 한계 ◦ 검색 속도 ◎ ms 단위 △ △ ◦ 하이브리드 검색 ◎ 벡터 + 전문 ◦ 전문검색 강점 △ ◦ 비용 최적화 ◎ 3단계 티어 △ 메모리 중심 △ △ 제품별 상이 배포 형태 ◎ OSS · SaaS · BYOC ◦ ◦ △ 제품별 상이 데이터 플랫폼 내장 벡터 기능은 중소 규모에 적합. 대규모·고빈도 본서비스 검색은 Zilliz가 담당하는 역할 분담을 권장합니다 Zilliz 자체 평가(일반적 구성 기준). 상세 성능은 VectorDBBench(github.com/zilliztech/VectorDBBench) 참조 13
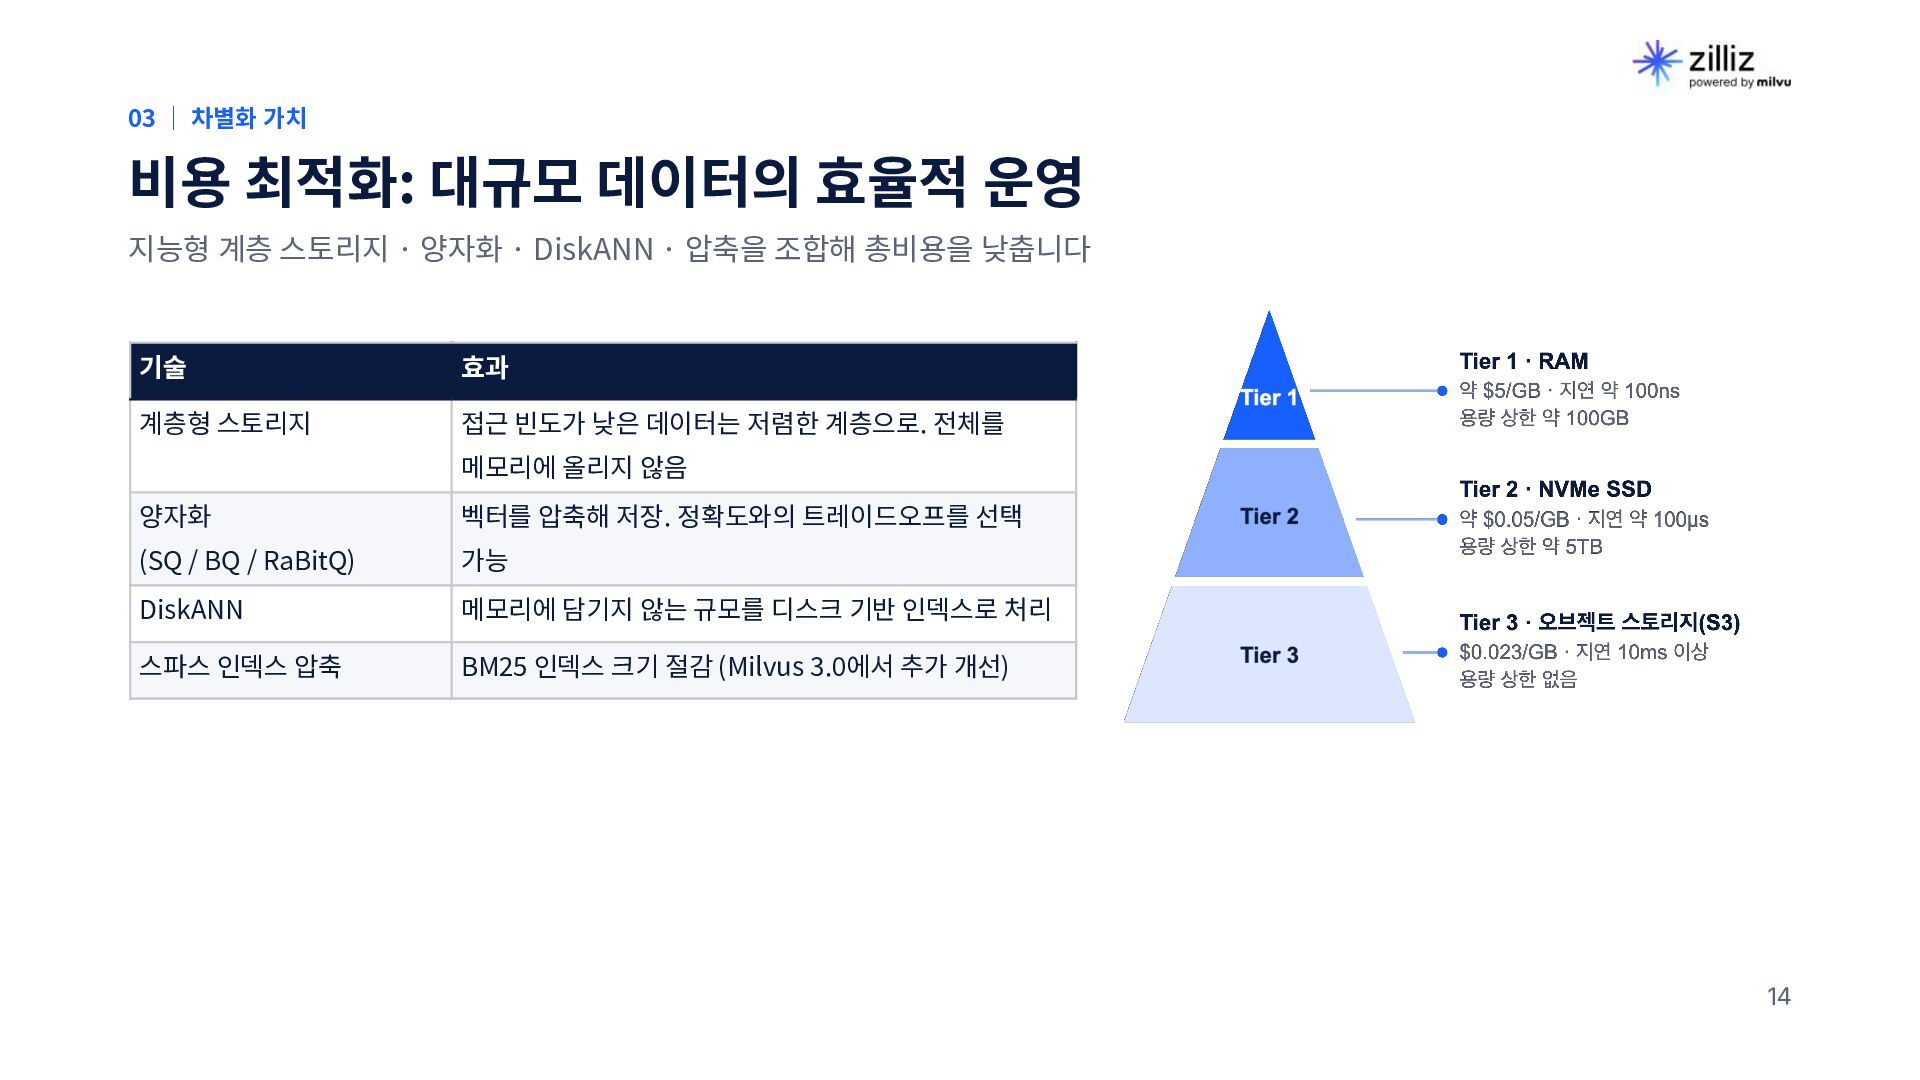
지능형 계층 스토리지 · 양자화 · DiskANN · 압축을 조합해 총비용을 낮춥니다 기술 효과 계층형 스토리지 접근 빈도가 낮은 데이터는 저렴한 계층으로. 전체를 메모리에 올리지 않음 양자화 벡터를 압축해 저장. 정확도와의 트레이드오프를 선택 (SQ / BQ / RaBitQ) 가능 DiskANN 메모리에 담기지 않는 규모를 디스크 기반 인덱스로 처리 스파스 인덱스 압축 BM25 인덱스 크기 절감 (Milvus 3.0에서 추가 개선) 14
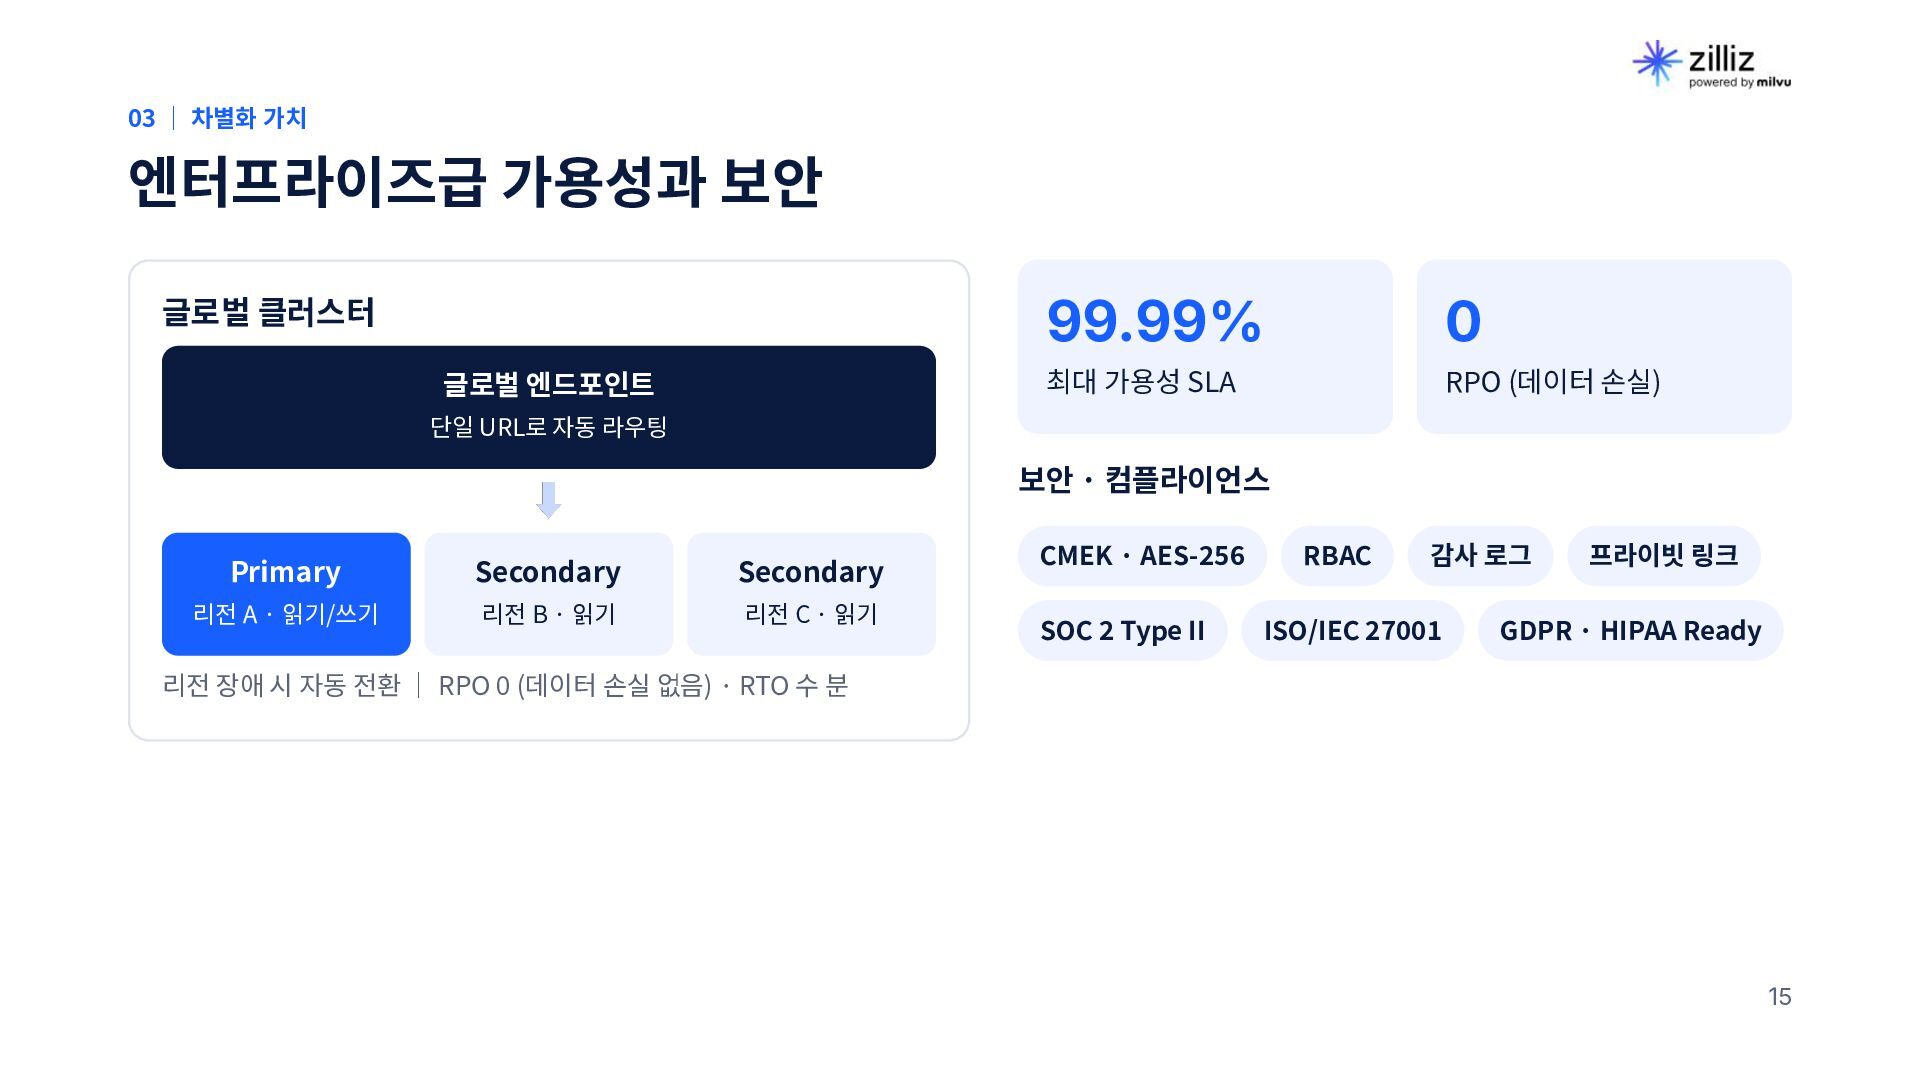
엔드포인트 99.99% 0 최대 가용성 SLA RPO (데이터 손실) 단일 URL로 자동 라우팅 보안 · 컴플라이언스 Primary Secondary Secondary 리전 A · 읽기/쓰기 리전 B · 읽기 리전 C · 읽기 CMEK · AES-256 SOC 2 Type II RBAC 감사 로그 ISO/IEC 27001 프라이빗 링크 GDPR · HIPAA Ready 리전 장애 시 자동 전환 | RPO 0 (데이터 손실 없음) · RTO 수 분 15
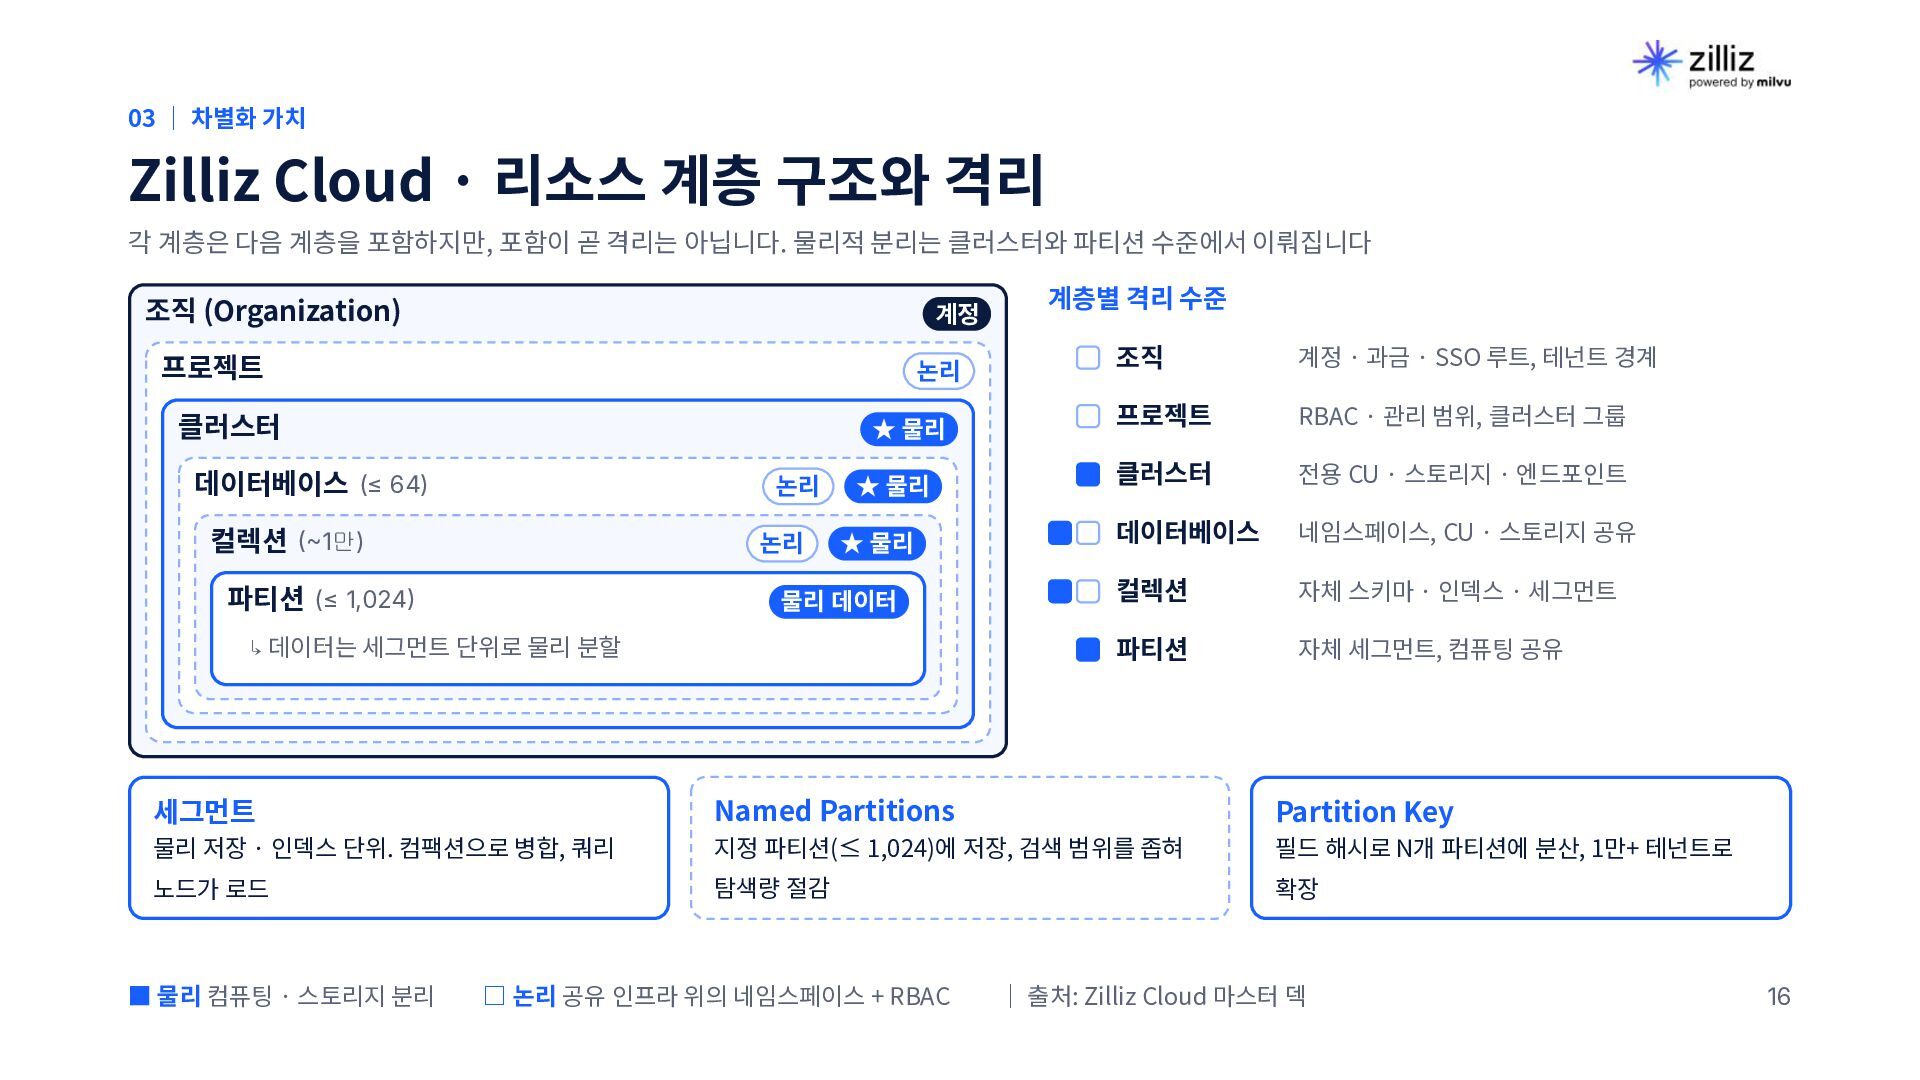
격리 각 계층은 다음 계층을 포함하지만, 포함이 곧 격리는 아닙니다. 물리적 분리는 클러스터와 파티션 수준에서 이뤄집니다 조직 (Organization) 계정 프로젝트 논리 클러스터 ★ 물리 계층별 격리 수준 조직 계정 · 과금 · SSO 루트, 테넌트 경계 프로젝트 RBAC · 관리 범위, 클러스터 그룹 데이터베이스 (≤ 64) 논리 ★ 물리 클러스터 전용 CU · 스토리지 · 엔드포인트 컬렉션 1만) 논리 ★ 물리 데이터베이스 네임스페이스, CU · 스토리지 공유 컬렉션 자체 스키마 · 인덱스 · 세그먼트 파티션 자체 세그먼트, 컴퓨팅 공유 파티션 (≤ 1,024 물리 데이터 ↳ 데이터는 세그먼트 단위로 물리 분할 세그먼트 Named Partitions Partition Key 물리 저장 · 인덱스 단위. 컴팩션으로 병합, 쿼리 지정 파티션(≤ 1,024)에 저장, 검색 범위를 좁혀 필드 해시로 N개 파티션에 분산, 1만+ 테넌트로 노드가 로드 탐색량 절감 확장 ▪ 물리 컴퓨팅 · 스토리지 분리 □ 논리 공유 인프라 위의 네임스페이스 + RBAC | 출처: Zilliz Cloud 마스터 덱 16
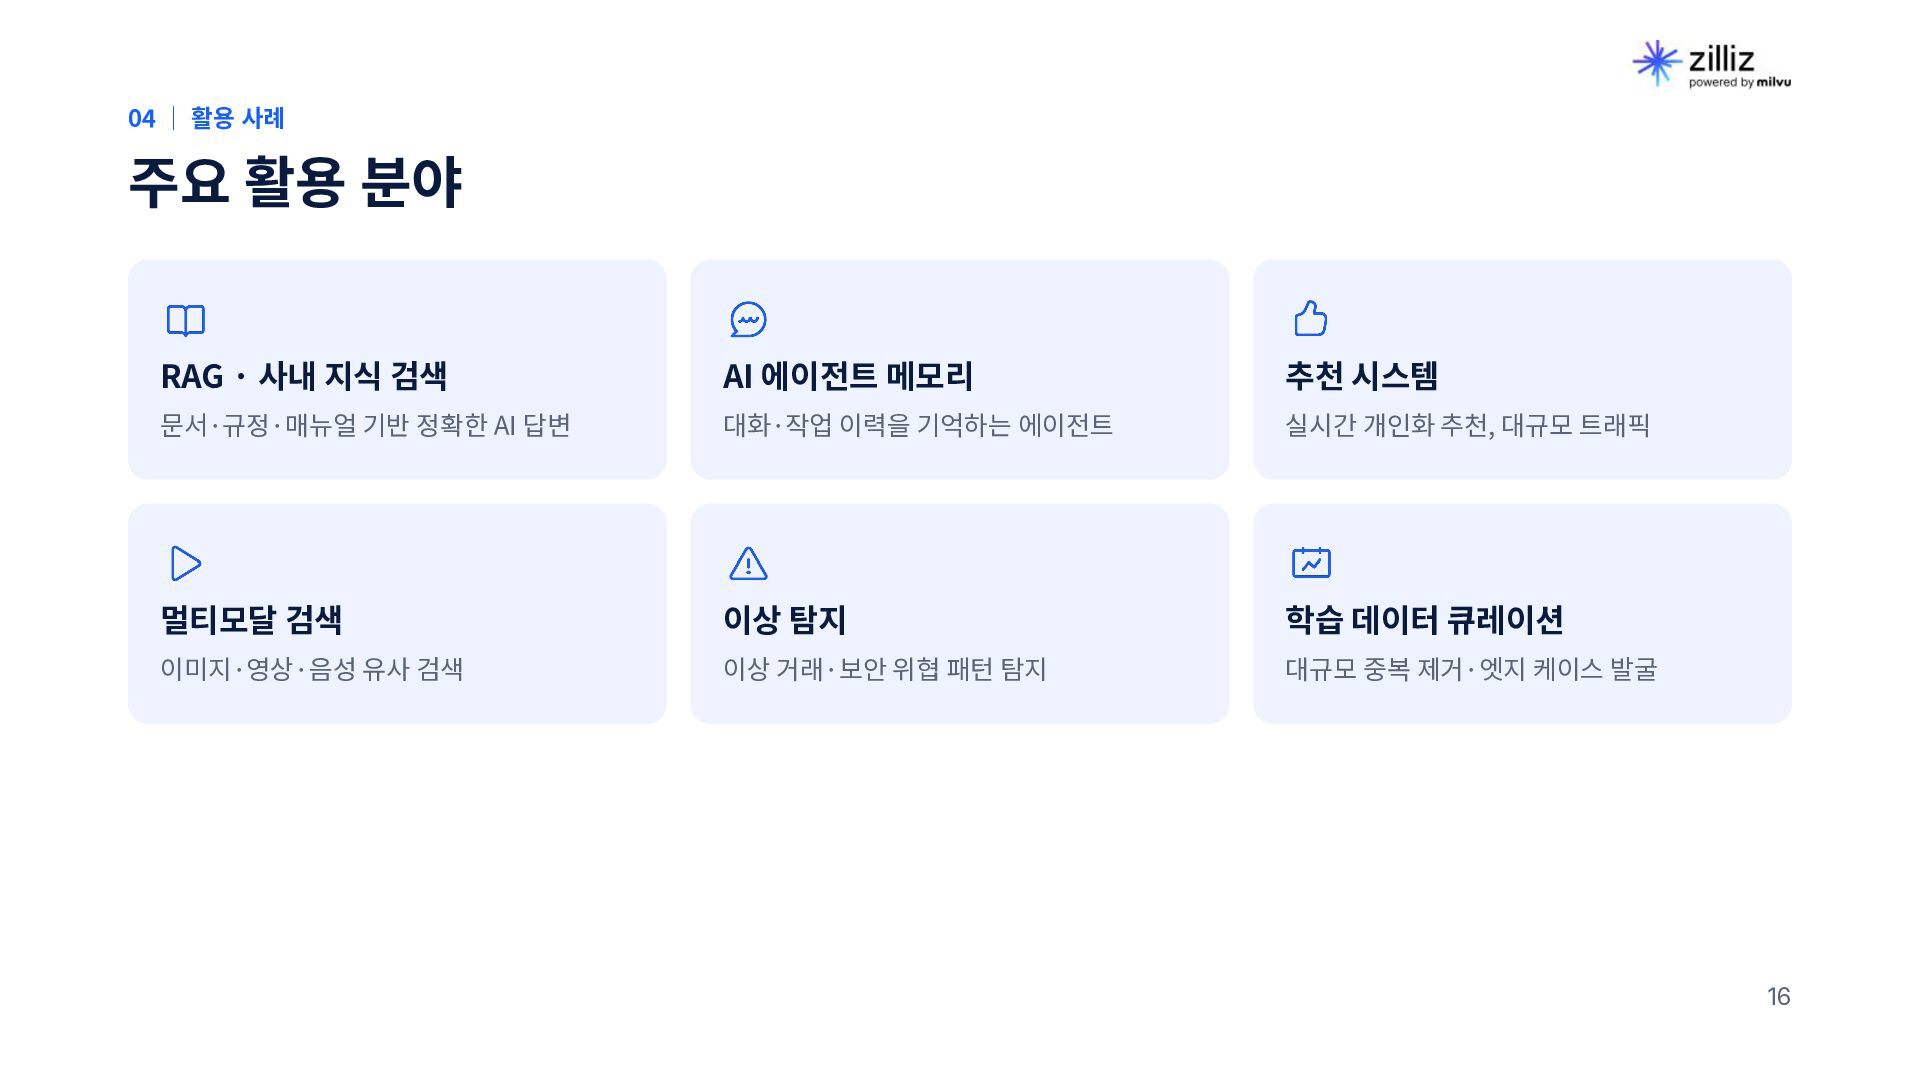
지식 검색 AI 에이전트 메모리 추천 시스템 문서·규정·매뉴얼 기반 정확한 AI 답변 대화·작업 이력을 기억하는 에이전트 실시간 개인화 추천, 대규모 트래픽 멀티모달 검색 이상 탐지 학습 데이터 큐레이션 이미지·영상·음성 유사 검색 이상 거래·보안 위협 패턴 탐지 대규모 중복 제거·엣지 케이스 발굴 16
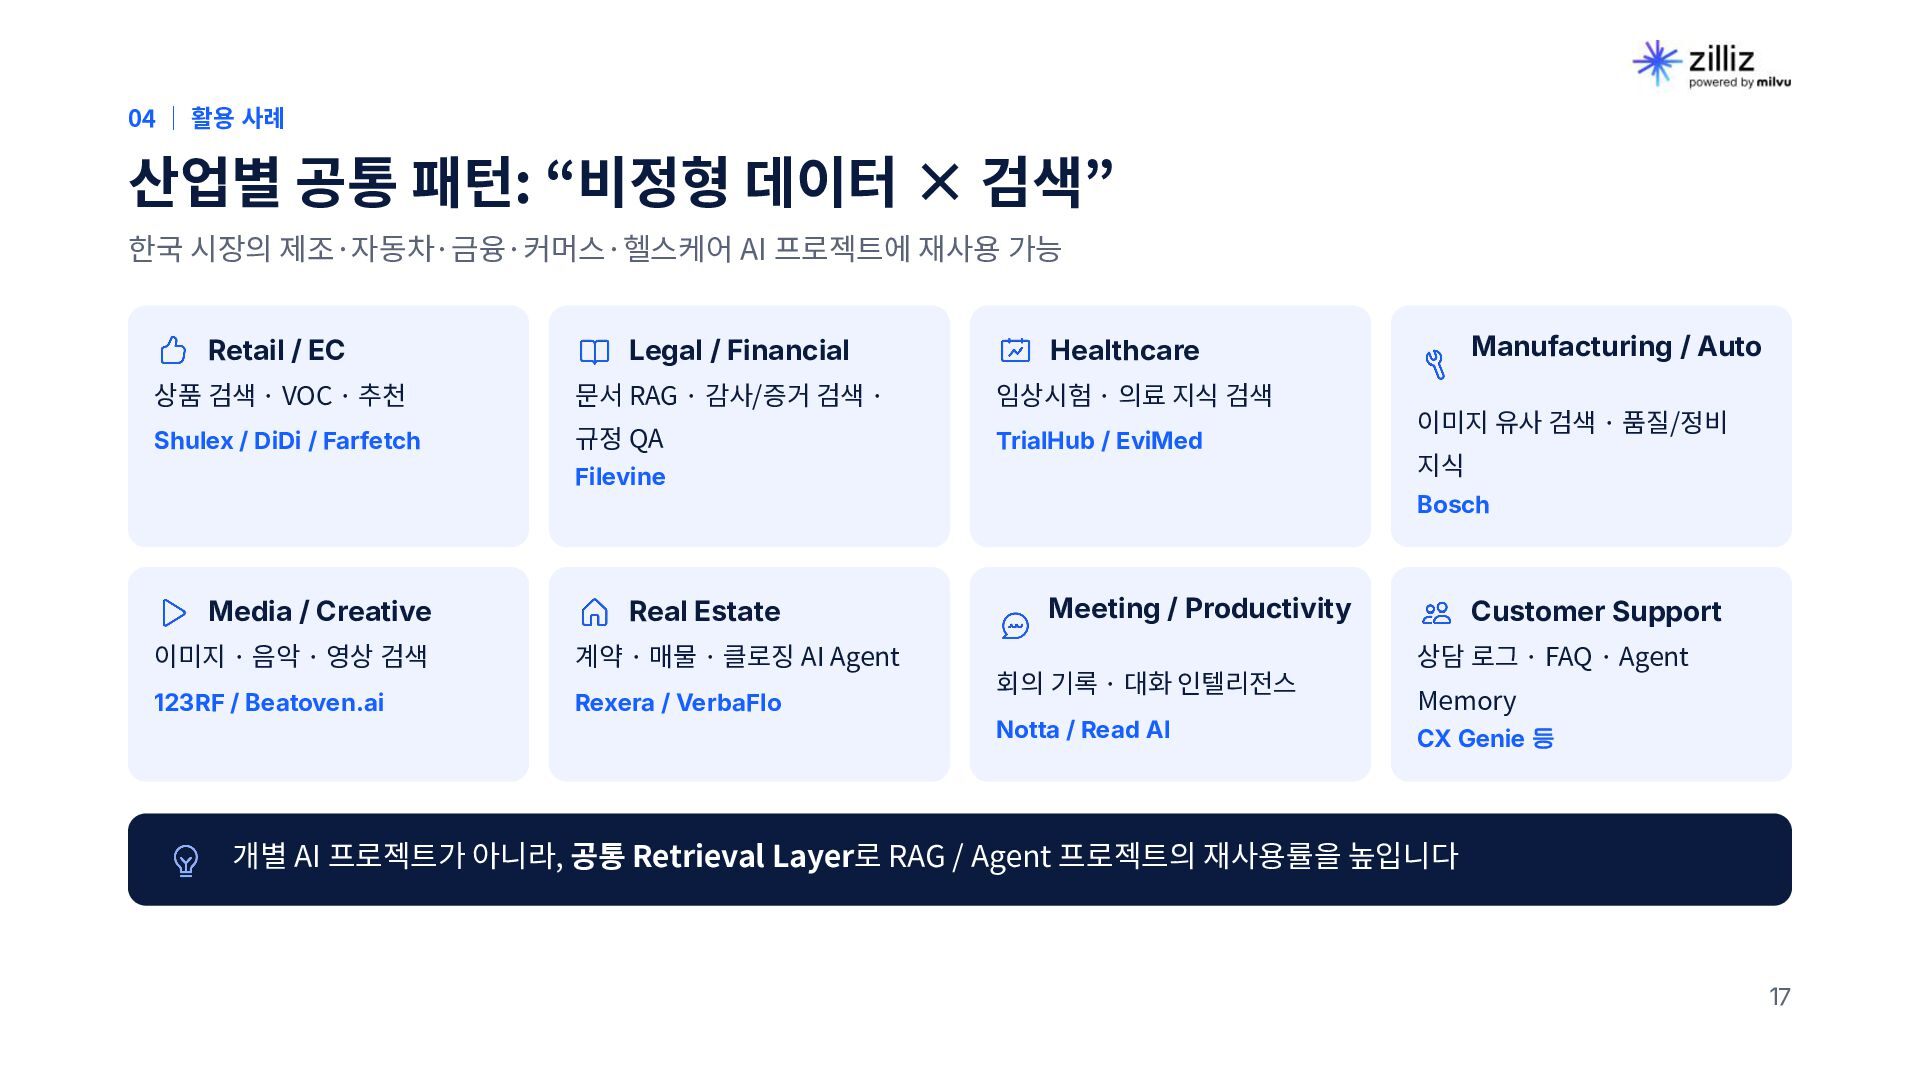
검색” 한국 시장의 제조·자동차·금융·커머스·헬스케어 AI 프로젝트에 재사용 가능 Retail / EC Legal / Financial Healthcare 상품 검색 · VOC · 추천 문서 RAG · 감사/증거 검색 · 임상시험 · 의료 지식 검색 Shulex / DiDi / Farfetch 규정 QA TrialHub / EviMed Filevine Media / Creative 이미지 · 음악 · 영상 검색 123RF / Beatoven.ai Real Estate 이미지 유사 검색 · 품질/정비 지식 Bosch Meeting / Productivity 계약 · 매물 · 클로징 AI Agent Rexera / VerbaFlo Manufacturing / Auto Customer Support 상담 로그 · FAQ · Agent 회의 기록 · 대화 인텔리전스 Notta / Read AI Memory CX Genie 등 개별 AI 프로젝트가 아니라, 공통 Retrieval Layer로 RAG / Agent 프로젝트의 재사용률을 높입니다 17
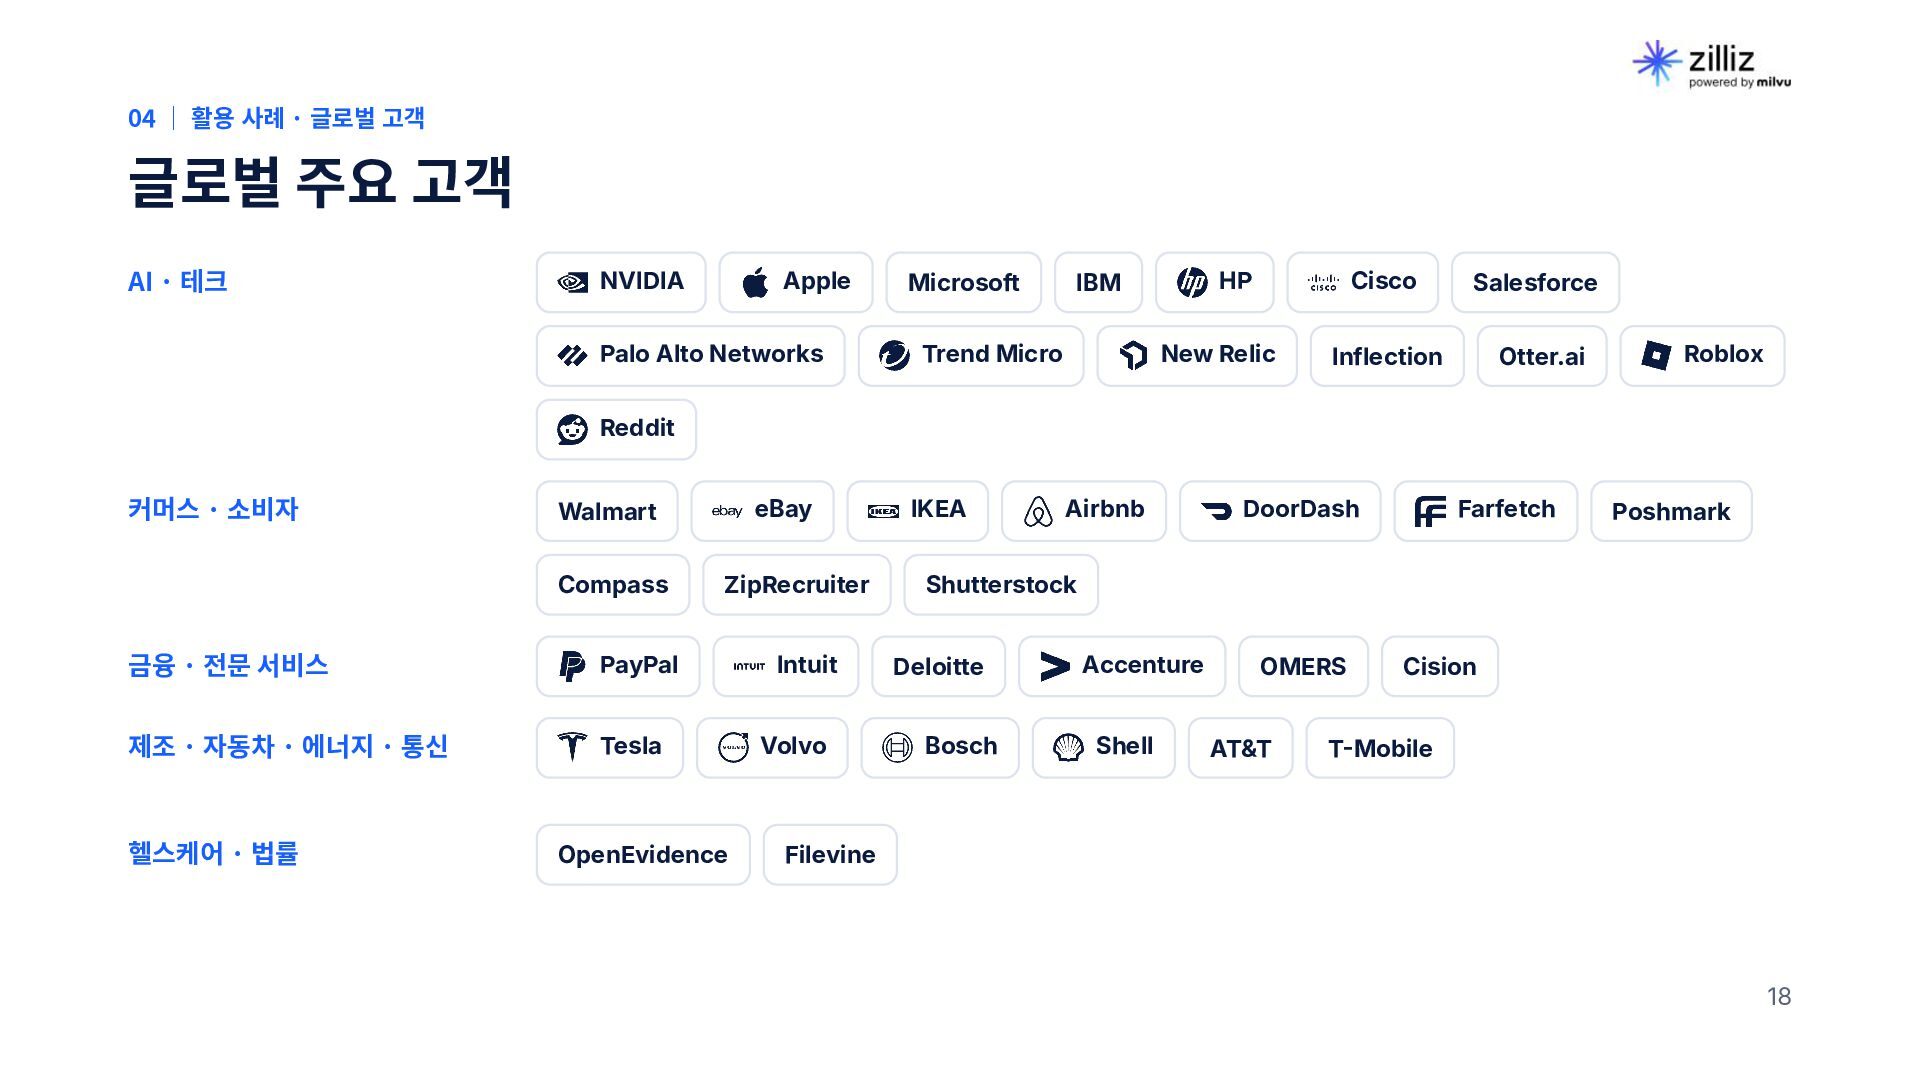
AI · 테크 NVIDIA Apple Palo Alto Networks Microsoft HP IBM Trend Micro New Relic Cisco Salesforce Inflection Otter.ai Roblox Reddit 커머스 · 소비자 Walmart eBay Compass ZipRecruiter IKEA PayPal Intuit Deloitte 제조 · 자동차 · 에너지 · 통신 Tesla Volvo Bosch OpenEvidence DoorDash Farfetch Poshmark Shutterstock 금융 · 전문 서비스 헬스케어 · 법률 Airbnb Accenture Shell OMERS AT&T Cision TMobile Filevine 18
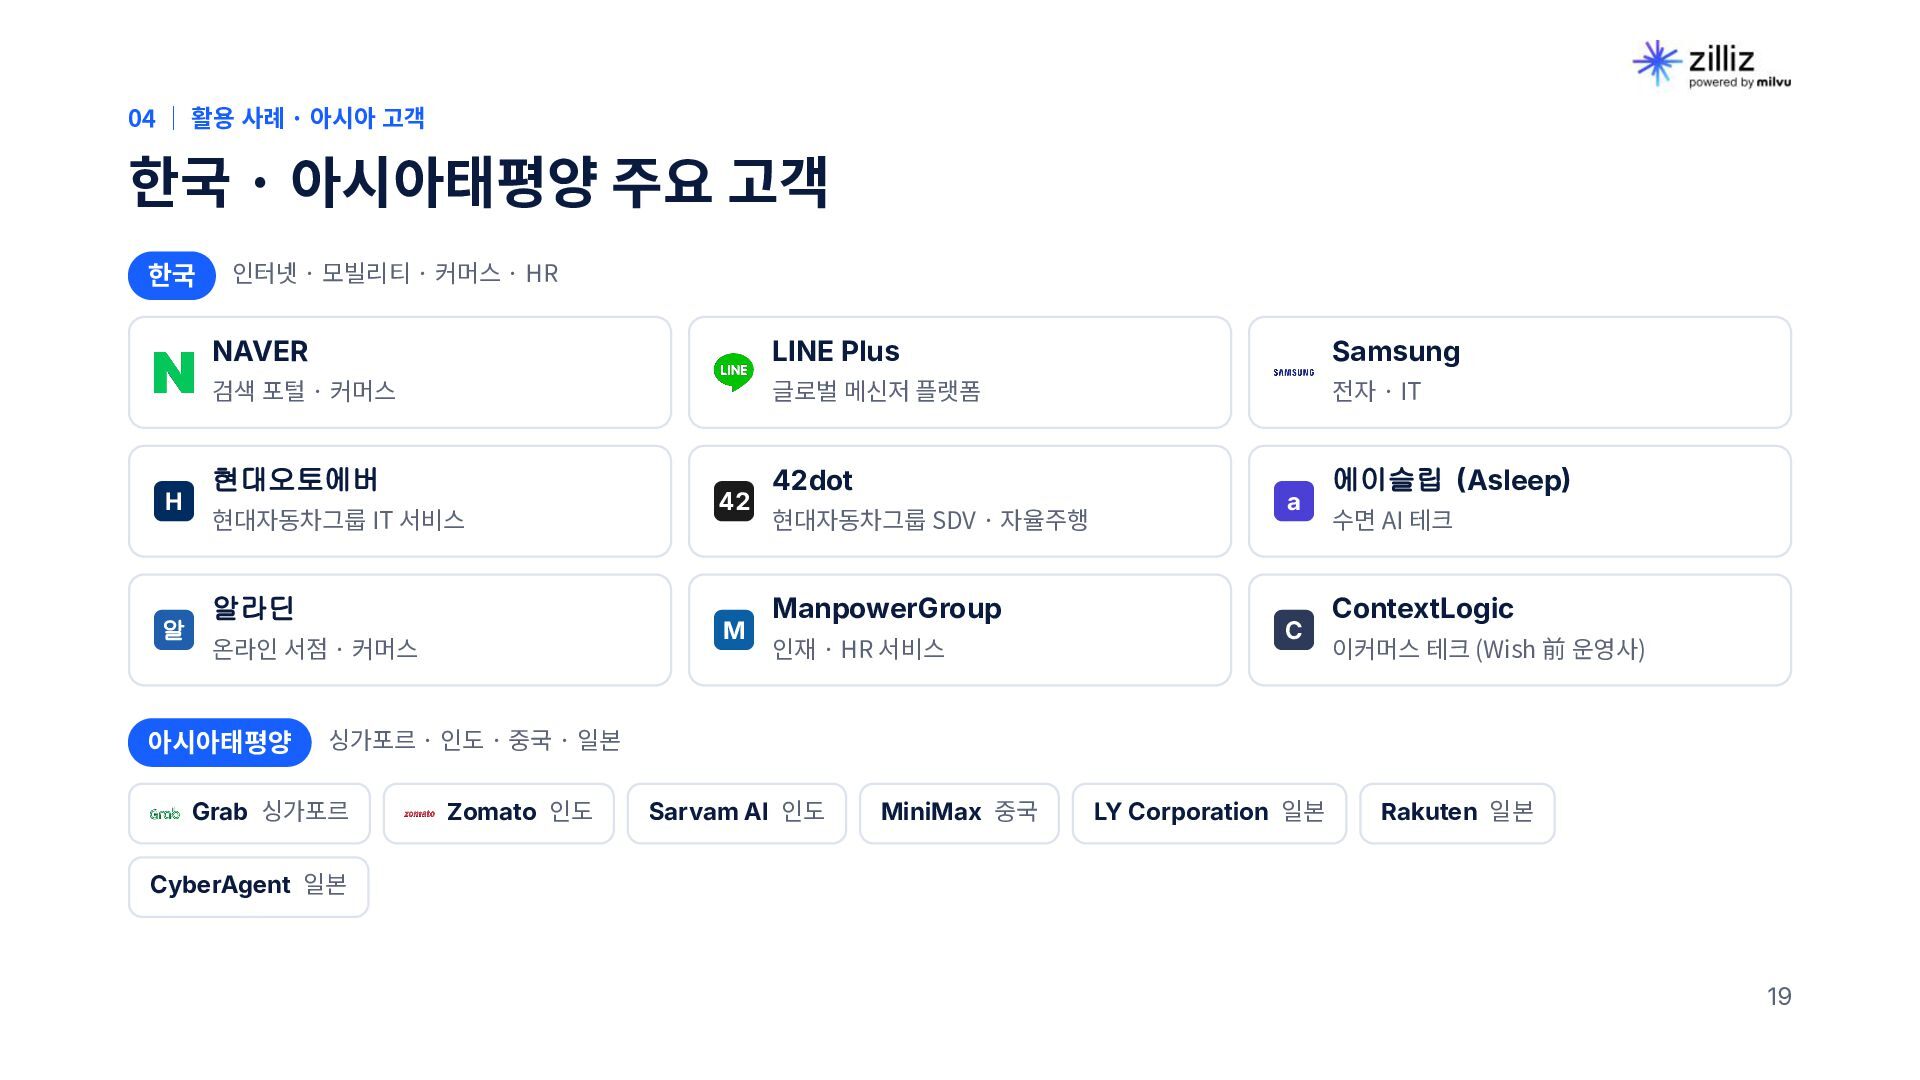
주요 고객 한국 H 알 인터넷 · 모빌리티 · 커머스 · HR NAVER LINE Plus Samsung 검색 포털 · 커머스 글로벌 메신저 플랫폼 전자 · IT 현대오토에버 현대자동차그룹 IT 서비스 알라딘 M 온라인 서점 · 커머스 아시아태평양 42 42dot 현대자동차그룹 SDV · 자율주행 ManpowerGroup 인재 · HR 서비스 a C 에이슬립 Asleep 수면 AI 테크 ContextLogic 이커머스 테크 (Wish 前 운영사) 싱가포르 · 인도 · 중국 · 일본 Grab 싱가포르 Zomato 인도 Sarvam AI 인도 MiniMax 중국 LY Corporation 일본 Rakuten 일본 CyberAgent 일본 19
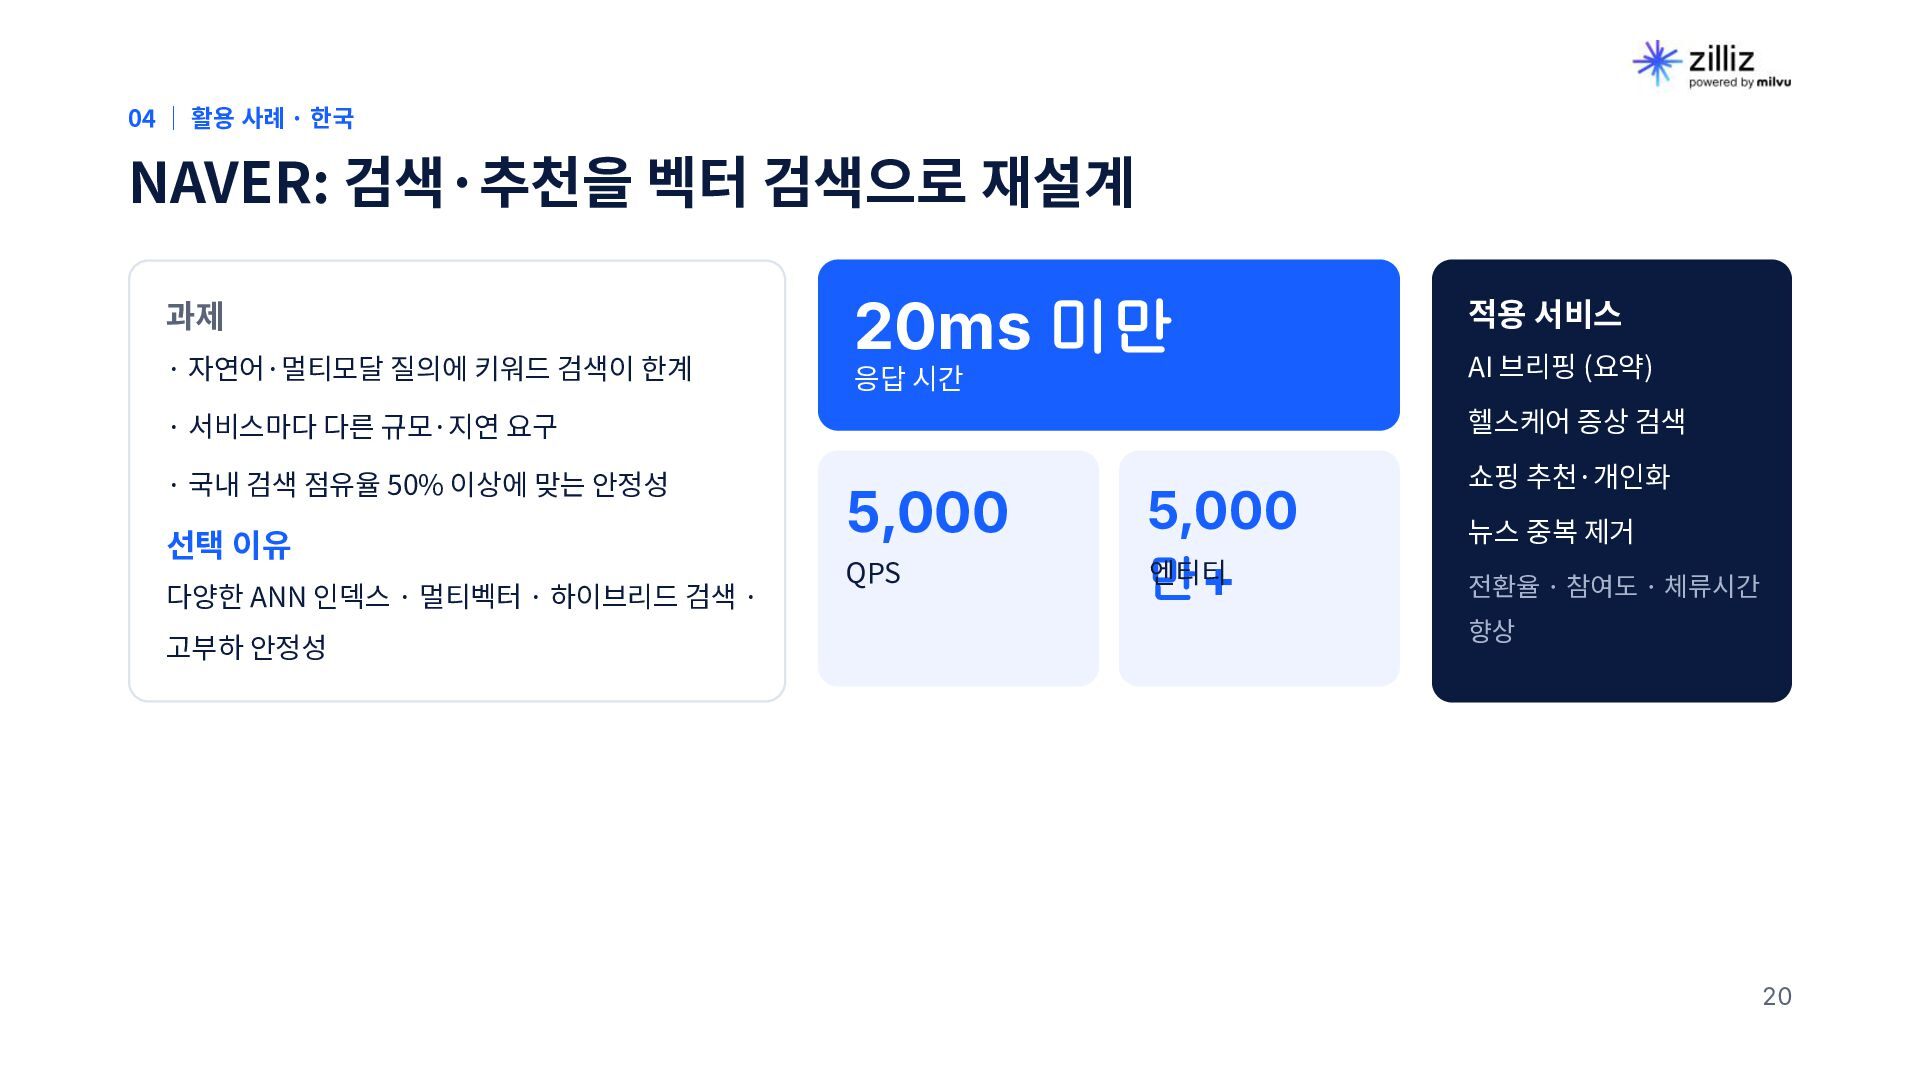
재설계 과제 · 자연어·멀티모달 질의에 키워드 검색이 한계 20ms 미만 응답 시간 적용 서비스 AI 브리핑 (요약) · 서비스마다 다른 규모·지연 요구 헬스케어 증상 검색 · 국내 검색 점유율 50% 이상에 맞는 안정성 쇼핑 추천·개인화 선택 이유 다양한 ANN 인덱스 · 멀티벡터 · 하이브리드 검색 · 고부하 안정성 5,000 QPS 5,000 엔티티 만+ 뉴스 중복 제거 전환율 · 참여도 · 체류시간 향상 20
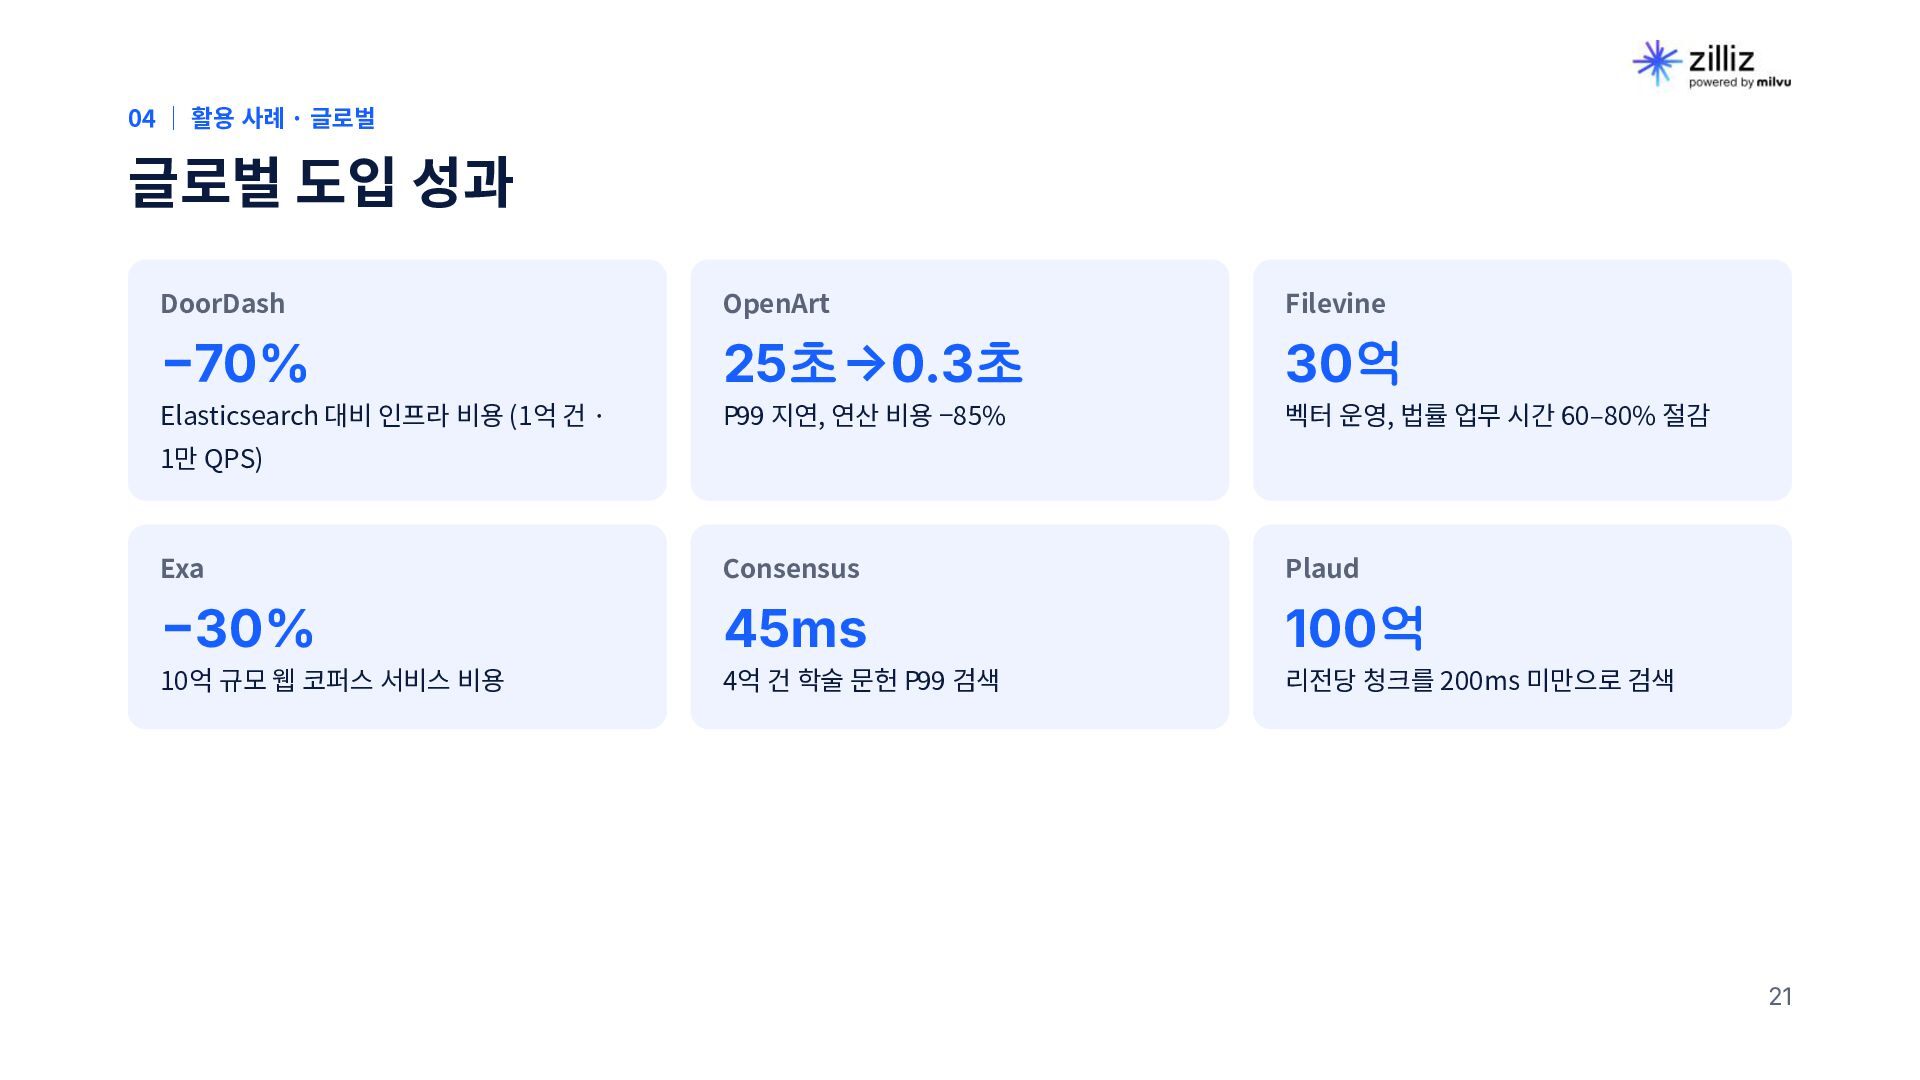
OpenArt Filevine 70% 25초0.3초 30억 Elasticsearch 대비 인프라 비용 (1억 건 · P99 지연, 연산 비용 −85% 벡터 운영, 법률 업무 시간 60‒80% 절감 Exa Consensus Plaud 30% 45ms 100억 10억 규모 웹 코퍼스 서비스 비용 4억 건 학술 문헌 P99 검색 리전당 청크를 200ms 미만으로 검색 1만 QPS) 21
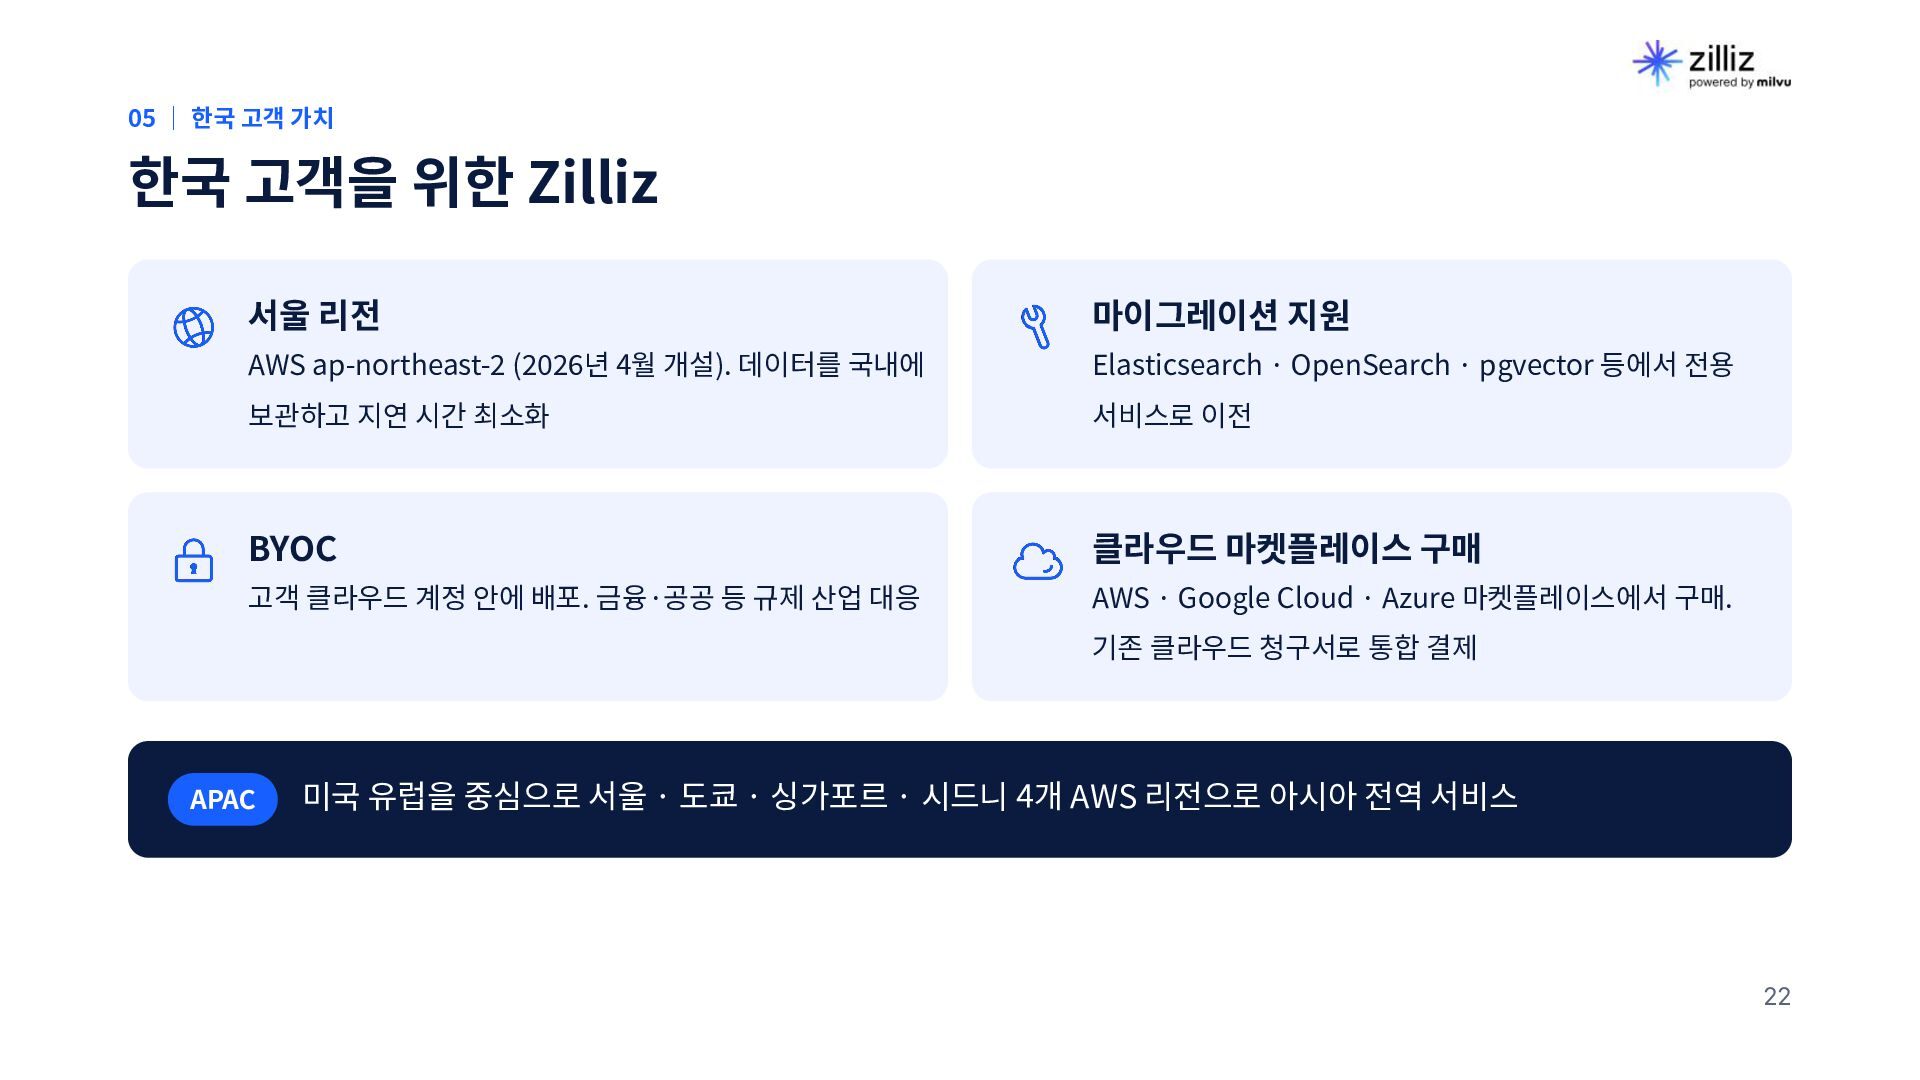
리전 마이그레이션 지원 AWS ap-northeast-2 (2026년 4월 개설). 데이터를 국내에 Elasticsearch · OpenSearch · pgvector 등에서 전용 보관하고 지연 시간 최소화 서비스로 이전 BYOC 클라우드 마켓플레이스 구매 고객 클라우드 계정 안에 배포. 금융·공공 등 규제 산업 대응 AWS · Google Cloud · Azure 마켓플레이스에서 구매. 기존 클라우드 청구서로 통합 결제 APAC 미국 유럽을 중심으로 서울 · 도쿄 · 싱가포르 · 시드니 4개 AWS 리전으로 아시아 전역 서비스 22
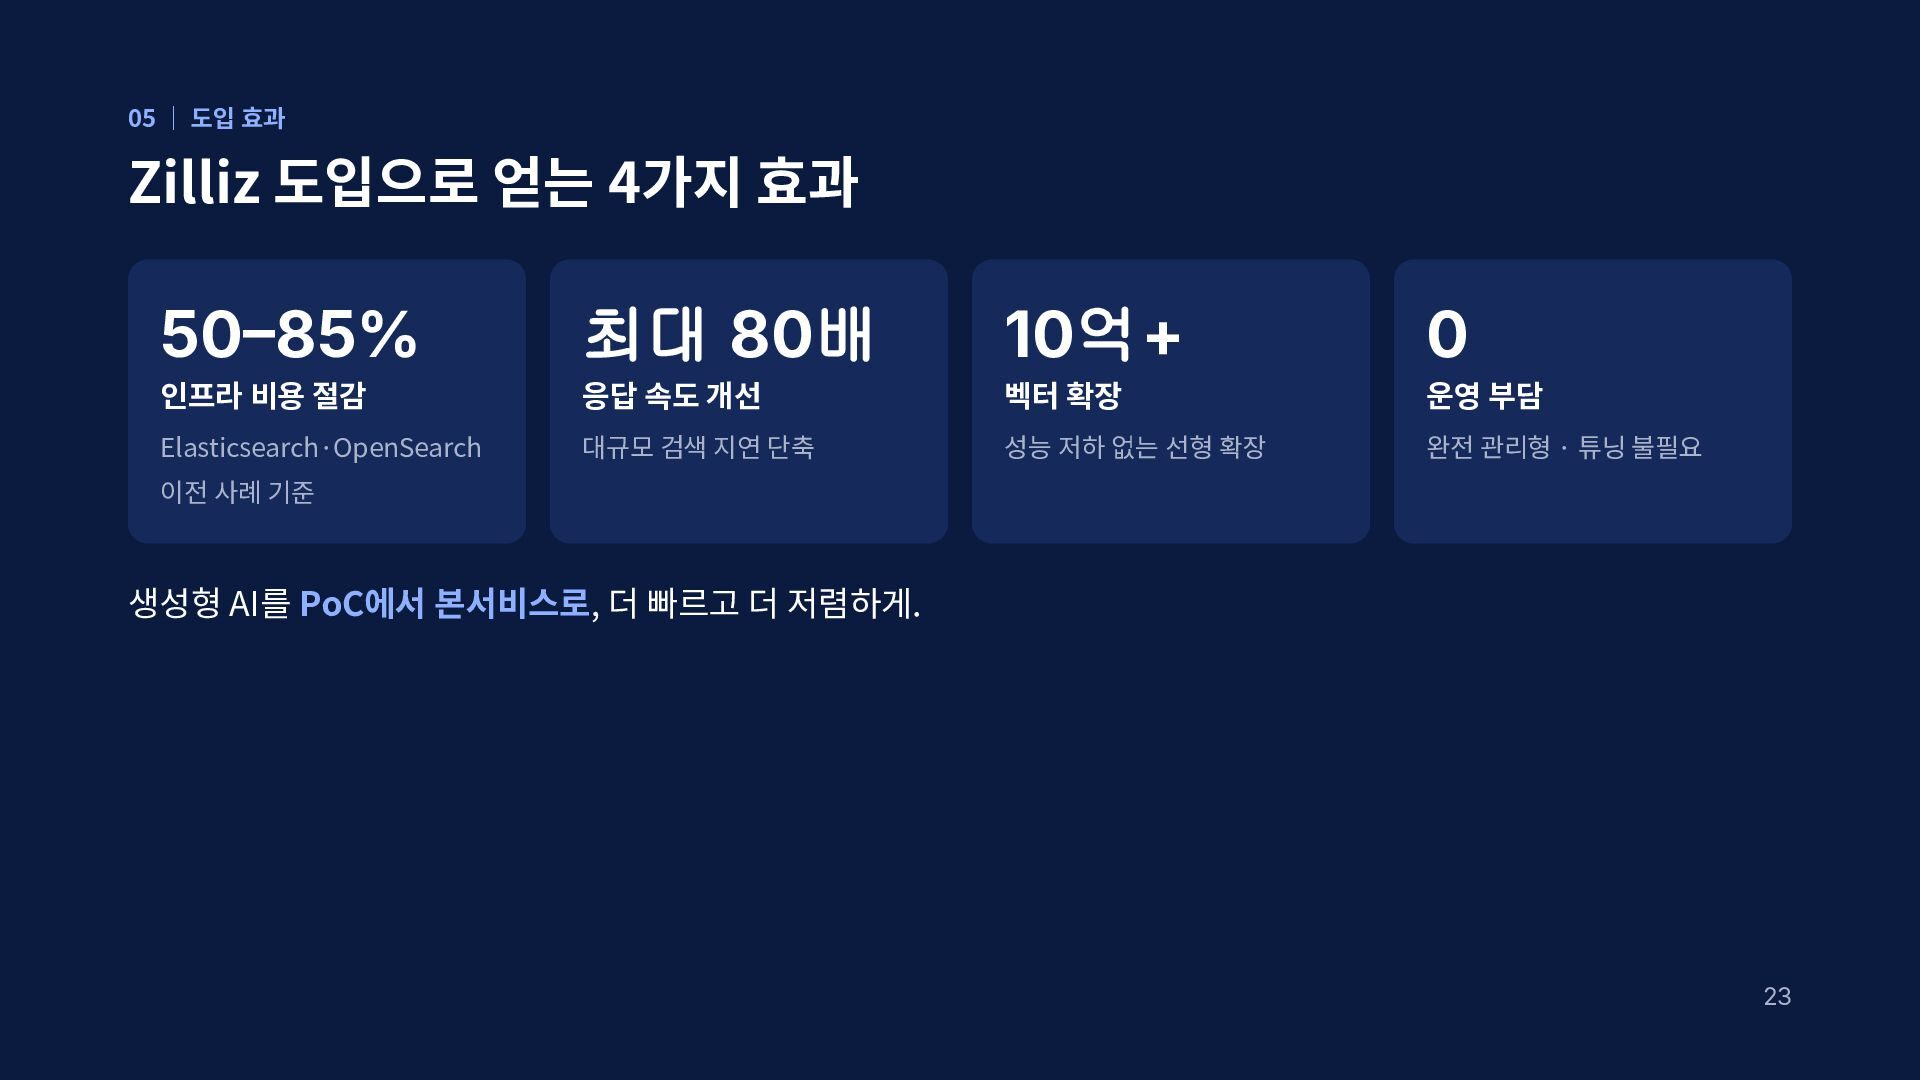
최대 80배 10억+ 0 인프라 비용 절감 응답 속도 개선 벡터 확장 운영 부담 Elasticsearch·OpenSearch 대규모 검색 지연 단축 성능 저하 없는 선형 확장 완전 관리형 · 튜닝 불필요 이전 사례 기준 생성형 AI를 PoC에서 본서비스로, 더 빠르고 더 저렴하게. 23
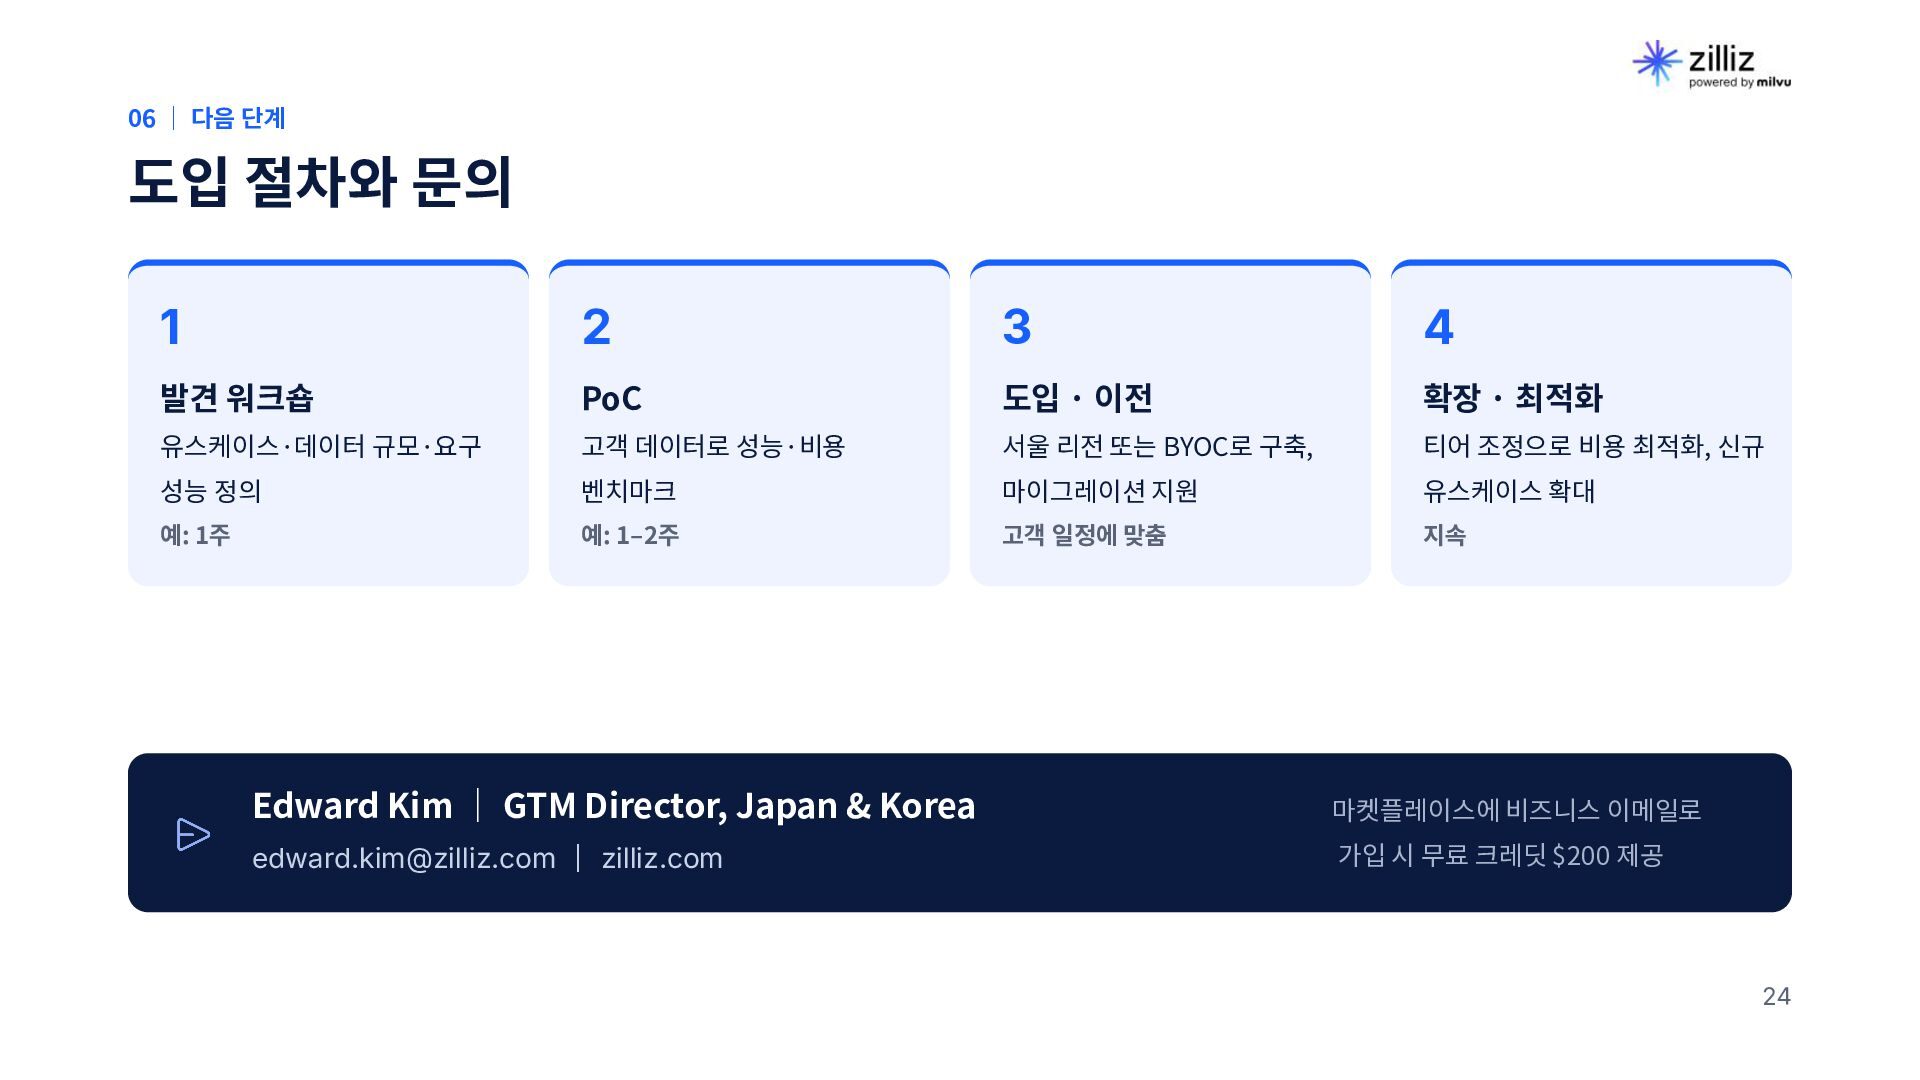
4 발견 워크숍 PoC 도입 · 이전 확장 · 최적화 유스케이스·데이터 규모·요구 고객 데이터로 성능·비용 서울 리전 또는 BYOC로 구축, 티어 조정으로 비용 최적화, 신규 성능 정의 벤치마크 마이그레이션 지원 유스케이스 확대 예: 1주 예: 1‒2주 고객 일정에 맞춤 지속 Edward Kim | GTM Director, Japan & Korea 마켓플레이스에 비즈니스 이메일로 [email protected] | zilliz.com 가입 시 무료 크레딧 $200 제공 24


 edwardkim
 bluesmoon
 tammyeverts
 addyosmani
 dugsong
 schroneko
 notwaldorf
 baasie
 jonoalderson
 inesmontani
 trallard
 akosma
 ammeep