Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
uv・Polarsの知見をエージェントに組み込む
Search
eikichi
July 16, 2026
1.5k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
uv・Polarsの知見をエージェントに組み込む
eikichi
July 16, 2026
More Decks by eikichi
See All by eikichi
今日からすぐできる Kaggleのススメ
eikichi838
1
1.1k
Featured
See All Featured
Context Engineering - Making Every Token Count
addyosmani
9
1.2k
Conquering PDFs: document understanding beyond plain text
inesmontani
PRO
4
3.2k
New Earth Scene 8
popppiees
4
2.7k
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
2
6.3k
Stop Working from a Prison Cell
hatefulcrawdad
274
21k
Statistics for Hackers
jakevdp
799
230k
Fireside Chat
paigeccino
43
4.1k
The Cult of Friendly URLs
andyhume
79
7k
SERP Conf. Vienna - Web Accessibility: Optimizing for Inclusivity and SEO
sarafernandez
2
1.6k
Tell your own story through comics
letsgokoyo
1
1.1k
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.4k
Leadership Guide Workshop - DevTernity 2021
reverentgeek
1
390
Transcript
eikichi uv・Polarsの知見をエージェントに組み込む 〜Kaggleのチュートリアル第7版 実践編 LT〜 2026/07/16
自己紹介 Kaggle: @ekichi Xaggle: @eikichi838 Qiitale: @eikichi838 仕事: DS・AI機能受託開発 趣味:
Kaggle, 旅行 Kaggle関連: Competition Master (金2, 銀2) Udemy講師 関西Kaggler会 × Thinkit 『Kaggleは「◦◦」に役 立つ』 第2回寄稿 Kaggleのチュートリアル第7版寄稿 ← New!! eikichi (えいきち)
アジェンダ 1. 寄稿内容の概要 2. エージェントへの反映 3. まとめ 🎊 ご出版おめでとうございます 🙌
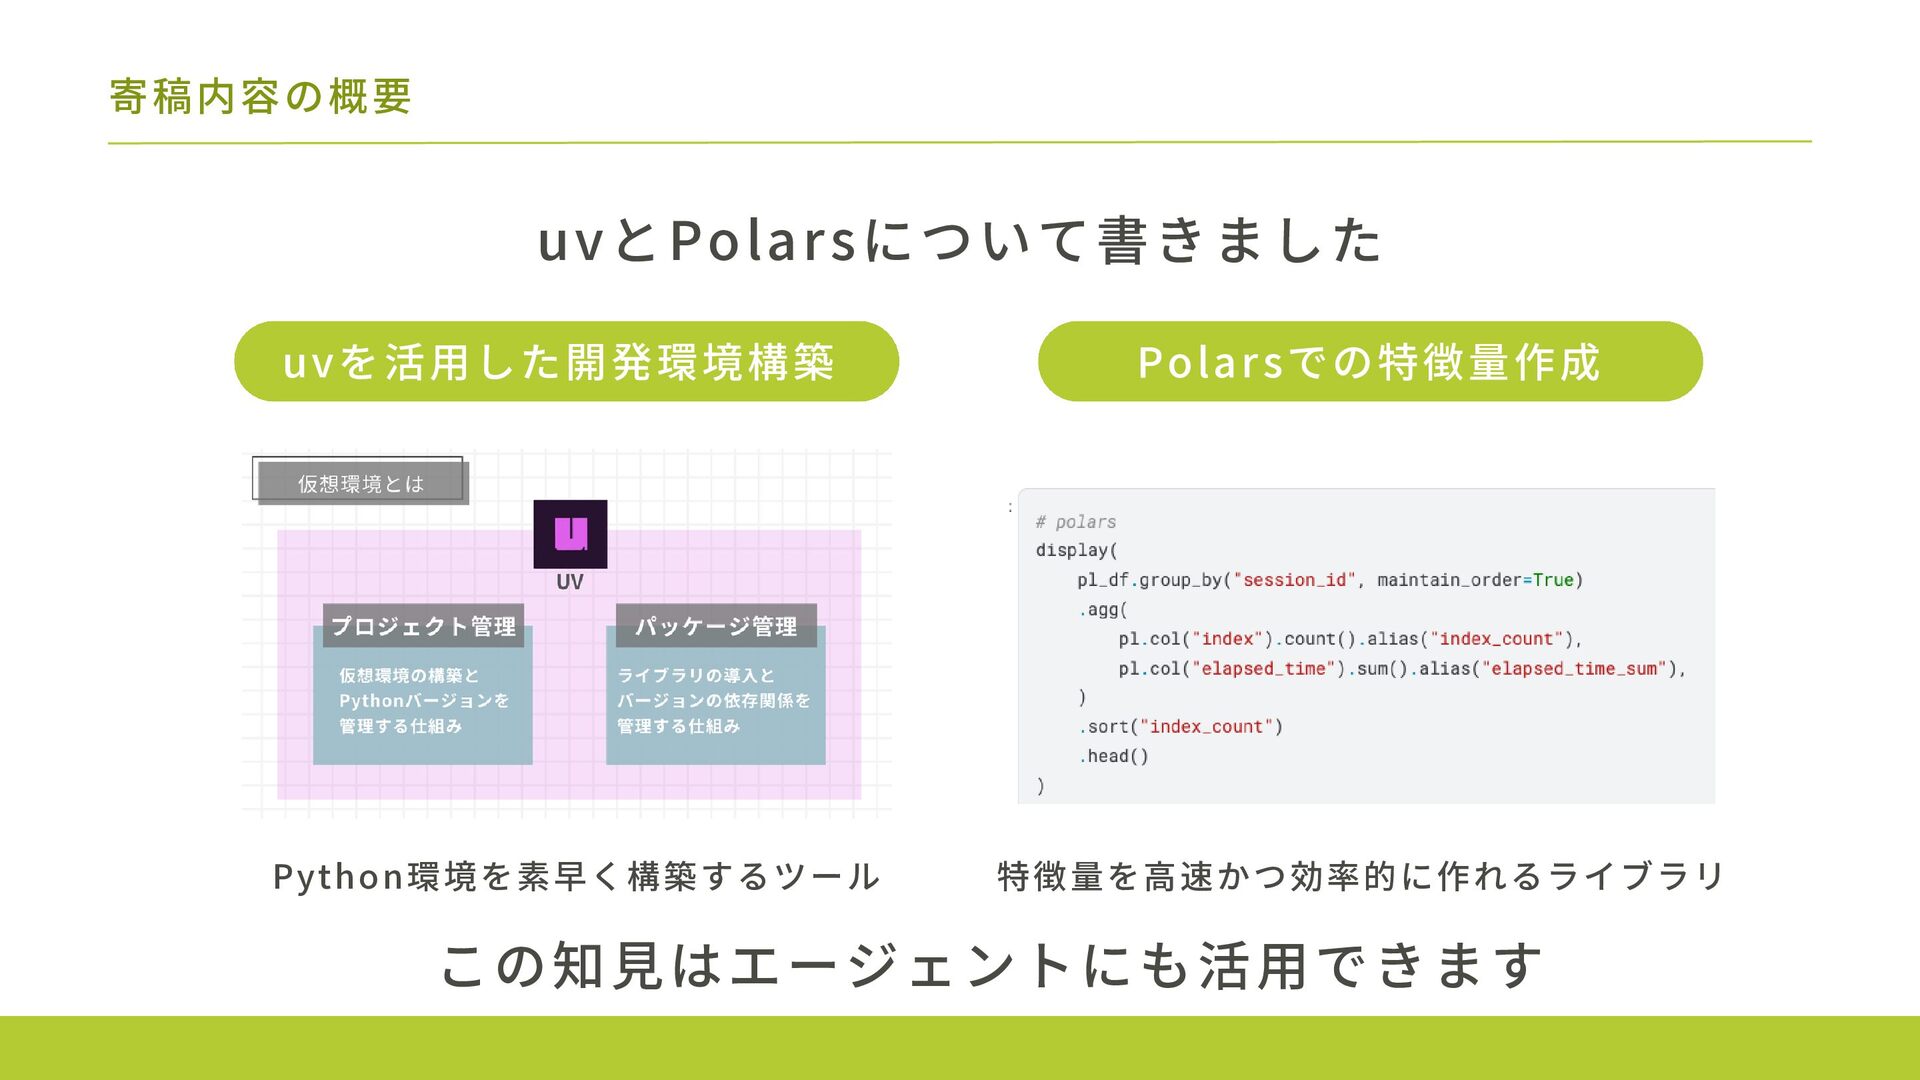
Polarsでの特徴量作成 寄稿内容の概要 uvとPolarsについて書きました Python環境を素早く構築するツール uvを活用した開発環境構築 特徴量を高速かつ効率的に作れるライブラリ この知見はエージェントにも活用できます
寄稿内容の概要 なぜコーディングエージェントに 組み込む必要があるのか
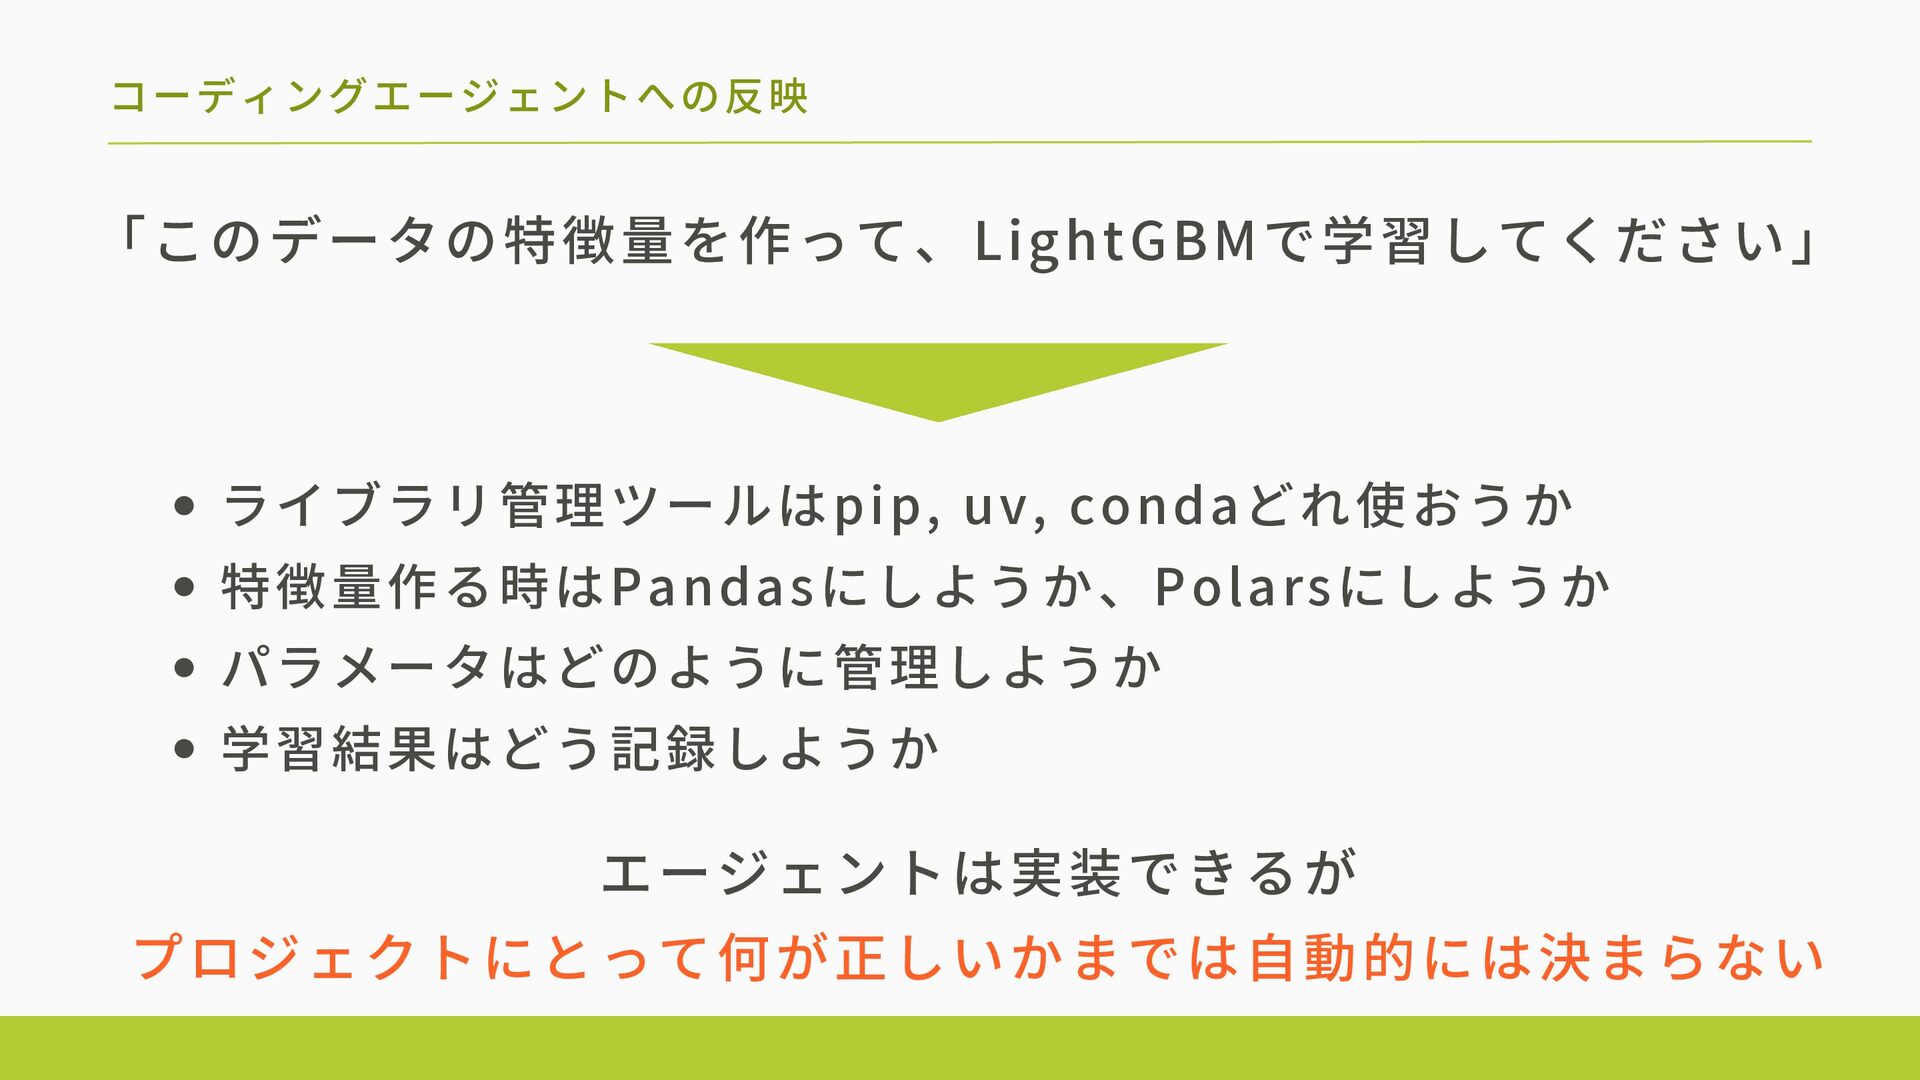
コーディングエージェントへの反映 「このデータの特徴量を作って、LightGBMで学習してください」 ライブラリ管理ツールはpip, uv, condaどれ使おうか 特徴量作る時はPandasにしようか、Polarsにしようか パラメータはどのように管理しようか 学習結果はどう記録しようか エージェントは実装できるが プロジェクトにとって何が正しいかまでは自動的には決まらない
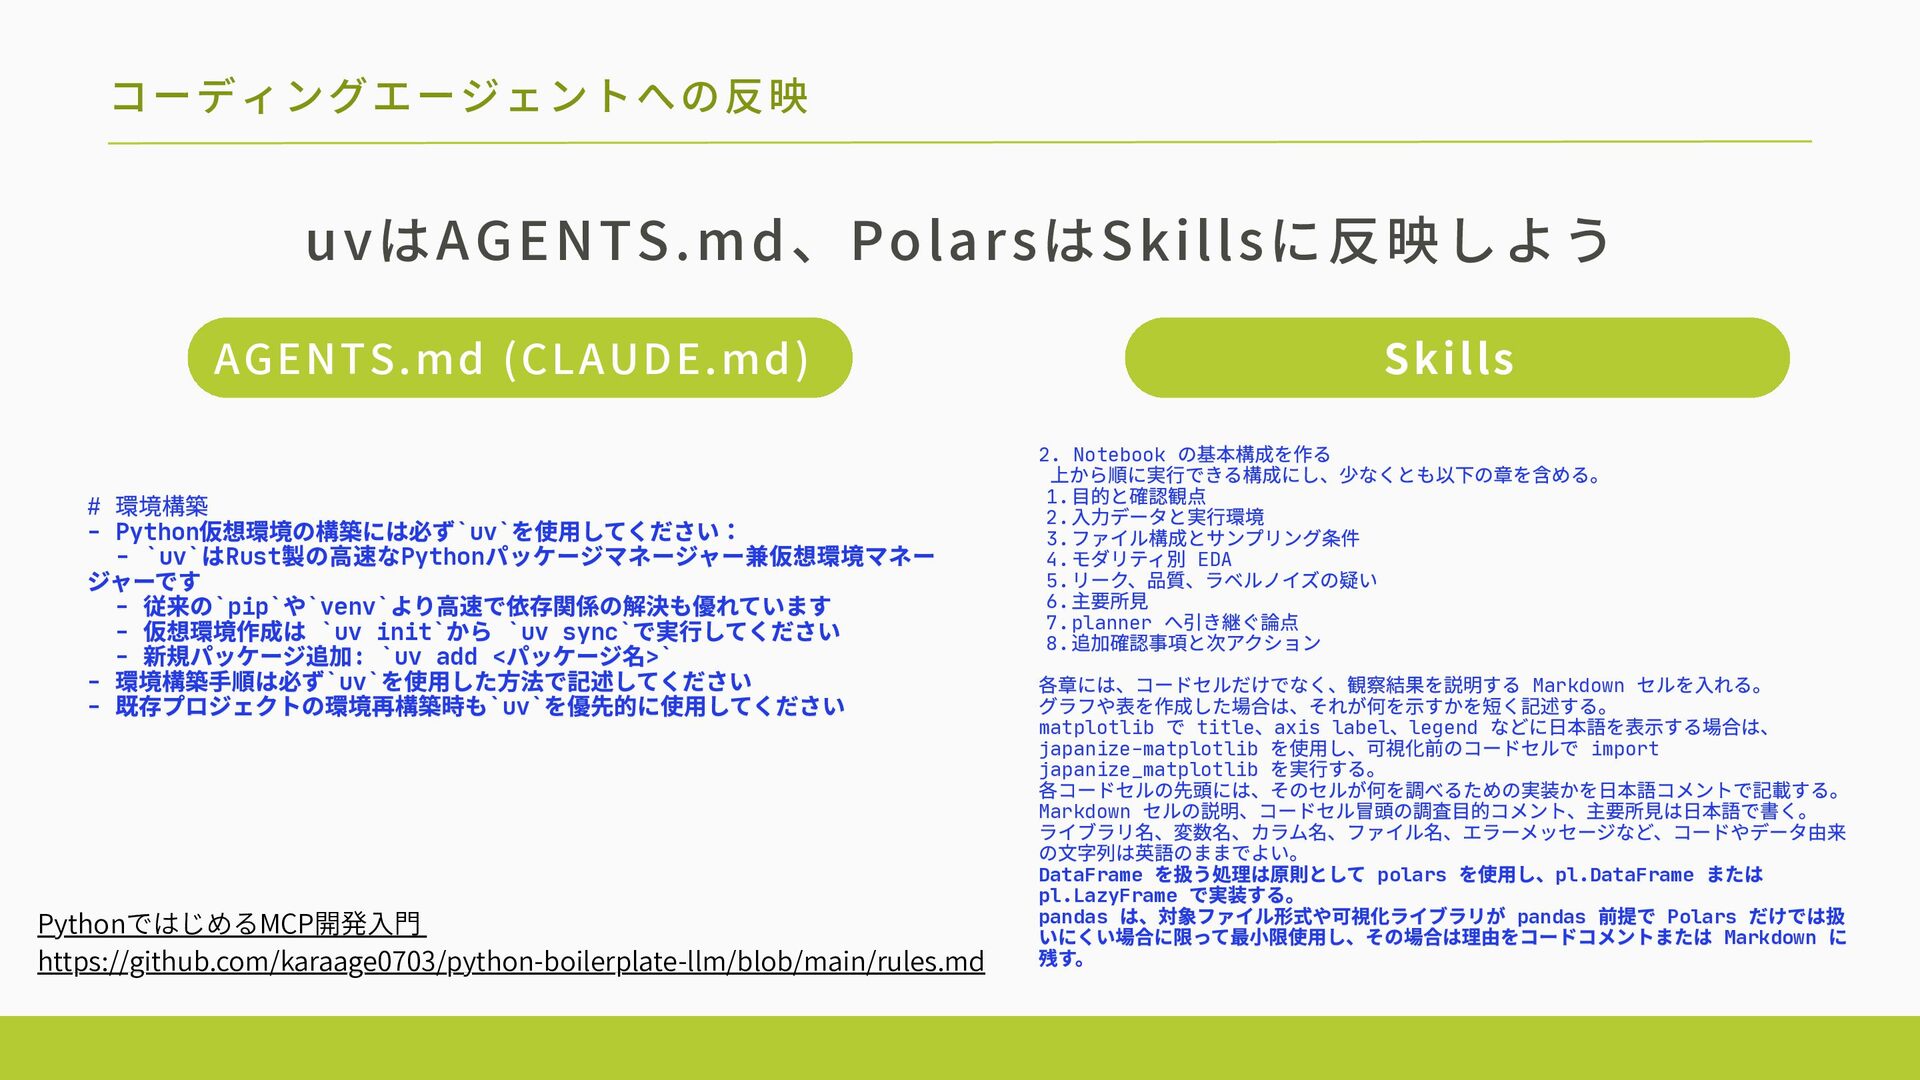
Skills コーディングエージェントへの反映 uvはAGENTS.md、PolarsはSkillsに反映しよう AGENTS.md (CLAUDE.md) PythonではじめるMCP開発入門 https://github.com/karaage0703/python-boilerplate-llm/blob/main/rules.md 2. Notebook の基本構成を作る
上から順に実⾏できる構成にし、少なくとも以下の章を含める。 1. ⽬的と確認観点 2. 入⼒データと実⾏環境 3. ファイル構成とサンプリング条件 4. モダリティ別 EDA 5. リーク、品質、ラベルノイズの疑い 6. 主要所⾒ 7.planner へ引き継ぐ論点 8. 追加確認事項と次アクション 各章には、コードセルだけでなく、観察結果を説明する Markdown セルを入れる。 グラフや表を作成した場合は、それが何を⽰すかを短く記述する。 matplotlib で title 、axis label 、legend などに⽇本語を表⽰する場合は、 japanize-matplotlib を使⽤し、可視化前のコードセルで import japanize_matplotlib を実⾏する。 各コードセルの先頭には、そのセルが何を調べるための実装かを⽇本語コメントで記載する。 Markdown セルの説明、コードセル冒頭の調査⽬的コメント、主要所⾒は⽇本語で書く。 ライブラリ名、変数名、カラム名、ファイル名、エラーメッセージなど、コードやデータ由来 の文字列は英語のままでよい。 DataFrame を扱う処理は原則として polars を使⽤し、pl.DataFrame または pl.LazyFrame で実装する。 pandas は、対象ファイル形式や可視化ライブラリが pandas 前提で Polars だけでは扱 いにくい場合に限って最⼩限使⽤し、その場合は理由をコードコメントまたは Markdown に 残す。 2. Notebook の基本構成を作る 上から順に実行できる構成にし、少なくとも以下の章を含める。 1. 目的と確認観点 2. 入力データと実⾏環境 3. ファイル構成とサンプリング条件 4. モダリティ別 EDA 5. リーク、品質、ラベルノイズの疑い 6. 主要所見 7.planner へ引き継ぐ論点 8. 追加確認事項と次アクション 各章には、コードセルだけでなく、観察結果を説明する Markdown セルを入れる。 グラフや表を作成した場合は、それが何を示すかを短く記述する。 matplotlib で title 、axis label 、legend などに日本語を表示する場合は、 japanize-matplotlib を使用し、可視化前のコードセルで import japanize_matplotlib を実行する。 各コードセルの先頭には、そのセルが何を調べるための実装かを日本語コメントで記載する。 Markdown セルの説明、コードセル冒頭の調査目的コメント、主要所⾒は⽇本語で書く。 ライブラリ名、変数名、カラム名、ファイル名、エラーメッセージなど、コードやデータ由来 の文字列は英語のままでよい。 DataFrame を扱う処理は原則として polars を使用し、pl.DataFrame または pl.LazyFrame で実装する。 pandas は、対象ファイル形式や可視化ライブラリが pandas 前提で Polars だけでは扱 いにくい場合に限って最小限使用し、その場合は理由をコードコメントまたは Markdown に 残す。 # 環境構築 - Python 仮想環境の構築には必ず`uv` を使⽤してください: - `uv` はRust 製の高速なPython パッケージマネージャー兼仮想環境マネー ジャーです - 従来の`pip` や`venv` より高速で依存関係の解決も優れています - 仮想環境作成は `uv init` から `uv sync` で実⾏してください - 新規パッケージ追加: `uv add < パッケージ名>` - 環境構築⼿順は必ず`uv` を使⽤した方法で記述してください - 既存プロジェクトの環境再構築時も`uv` を優先的に使⽤してください # 環境構築 - Python 仮想環境の構築には必ず`uv` を使用してください: - `uv` はRust 製の高速なPython パッケージマネージャー兼仮想環境マネー ジャーです - 従来の`pip` や`venv` より高速で依存関係の解決も優れています - 仮想環境作成は `uv init` から `uv sync` で実行してください - 新規パッケージ追加: `uv add < パッケージ名>` - 環境構築手順は必ず`uv` を使⽤した方法で記述してください - 既存プロジェクトの環境再構築時も`uv` を優先的に使用してください
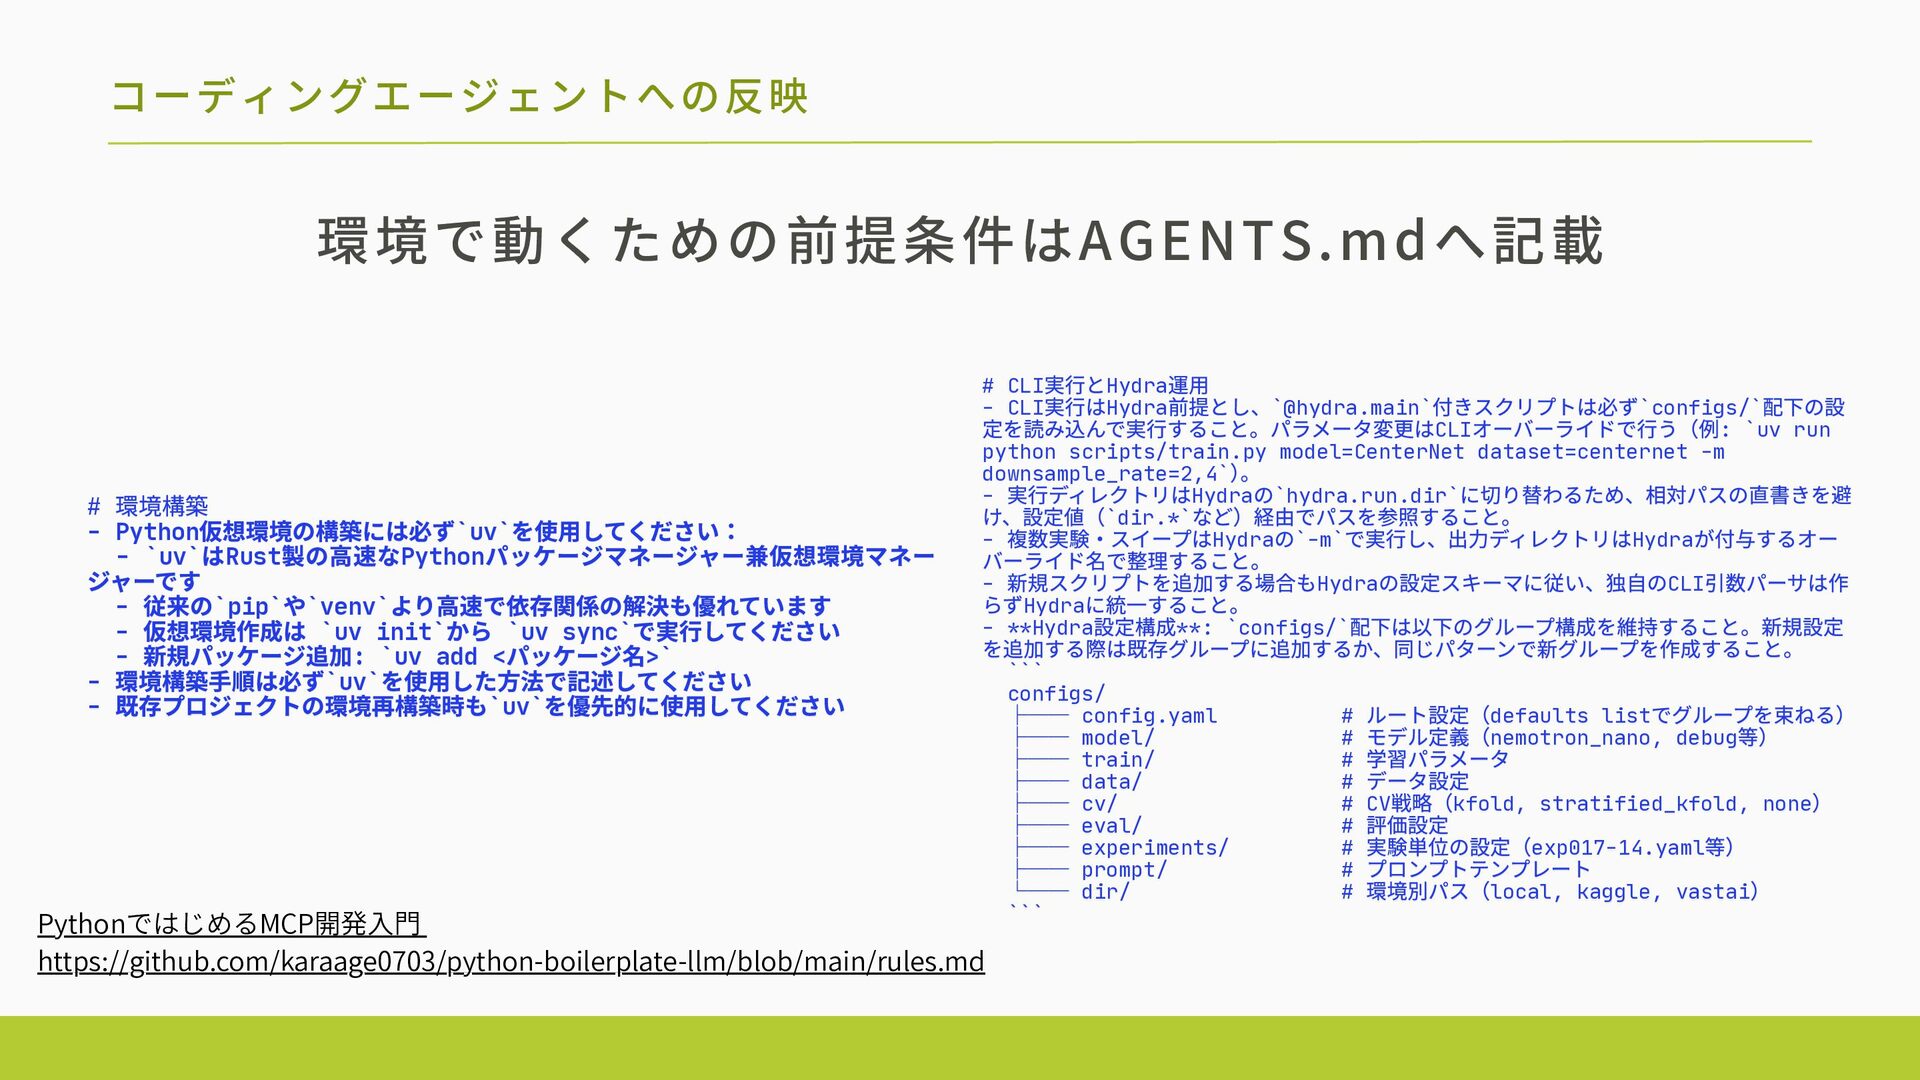
コーディングエージェントへの反映 環境で動くための前提条件はAGENTS.mdへ記載 # 環境構築 - Python 仮想環境の構築には必ず`uv` を使⽤してください: - `uv`
はRust 製の高速なPython パッケージマネージャー兼仮想環境マネー ジャーです - 従来の`pip` や`venv` より高速で依存関係の解決も優れています - 仮想環境作成は `uv init` から `uv sync` で実⾏してください - 新規パッケージ追加: `uv add < パッケージ名>` - 環境構築⼿順は必ず`uv` を使⽤した方法で記述してください - 既存プロジェクトの環境再構築時も`uv` を優先的に使⽤してください # 環境構築 - Python 仮想環境の構築には必ず`uv` を使用してください: - `uv` はRust 製の高速なPython パッケージマネージャー兼仮想環境マネー ジャーです - 従来の`pip` や`venv` より高速で依存関係の解決も優れています - 仮想環境作成は `uv init` から `uv sync` で実行してください - 新規パッケージ追加: `uv add < パッケージ名>` - 環境構築手順は必ず`uv` を使用した方法で記述してください - 既存プロジェクトの環境再構築時も`uv` を優先的に使用してください # CLI 実⾏とHydra 運⽤ - CLI 実⾏はHydra 前提とし、`@hydra.main` 付きスクリプトは必ず`configs/` 配下の設 定を読み込んで実⾏すること。パラメータ変更はCLI オーバーライドで⾏う(例: `uv run python scripts/train.py model=CenterNet dataset=centernet -m downsample_rate=2,4` ) 。 - 実⾏ディレクトリはHydra の`hydra.run.dir` に切り替わるため、相対パスの直書きを避 け、設定値(`dir.*` など)経由でパスを参照すること。 - 複数実験・スイープはHydra の`-m` で実⾏し、出⼒ディレクトリはHydra が付与するオー バーライド名で整理すること。 - 新規スクリプトを追加する場合もHydra の設定スキーマに従い、独⾃のCLI 引数パーサは作 らずHydra に統⼀すること。 - **Hydra 設定構成**: `configs/` 配下は以下のグループ構成を維持すること。新規設定 を追加する際は既存グループに追加するか、同じパターンで新グループを作成すること。 ``` configs/ ├── config.yaml # ルート設定(defaults list でグループを束ねる) ├── model/ # モデル定義(nemotron_nano, debug 等) ├── train/ # 学習パラメータ ├── data/ # データ設定 ├── cv/ # CV 戦略(kfold, stratified_kfold, none ) ├── eval/ # 評価設定 ├── experiments/ # 実験単位の設定(exp017-14.yaml 等) ├── prompt/ # プロンプトテンプレート └── dir/ # 環境別パス(local, kaggle, vastai ) ``` # CLI 実行とHydra 運⽤ - CLI 実行はHydra 前提とし、`@hydra.main` 付きスクリプトは必ず`configs/` 配下の設 定を読み込んで実行すること。パラメータ変更はCLI オーバーライドで行う(例: `uv run python scripts/train.py model=CenterNet dataset=centernet -m downsample_rate=2,4` ) 。 - 実行ディレクトリはHydra の`hydra.run.dir` に切り替わるため、相対パスの直書きを避 け、設定値(`dir.*` など)経由でパスを参照すること。 - 複数実験・スイープはHydra の`-m` で実行し、出力ディレクトリはHydra が付与するオー バーライド名で整理すること。 - 新規スクリプトを追加する場合もHydra の設定スキーマに従い、独自のCLI 引数パーサは作 らずHydra に統一すること。 - **Hydra 設定構成**: `configs/` 配下は以下のグループ構成を維持すること。新規設定 を追加する際は既存グループに追加するか、同じパターンで新グループを作成すること。 ``` configs/ ├── config.yaml # ルート設定(defaults list でグループを束ねる) ├── model/ # モデル定義(nemotron_nano, debug 等) ├── train/ # 学習パラメータ ├── data/ # データ設定 ├── cv/ # CV 戦略(kfold, stratified_kfold, none ) ├── eval/ # 評価設定 ├── experiments/ # 実験単位の設定(exp017-14.yaml 等) ├── prompt/ # プロンプトテンプレート └── dir/ # 環境別パス(local, kaggle, vastai ) ``` PythonではじめるMCP開発入門 https://github.com/karaage0703/python-boilerplate-llm/blob/main/rules.md
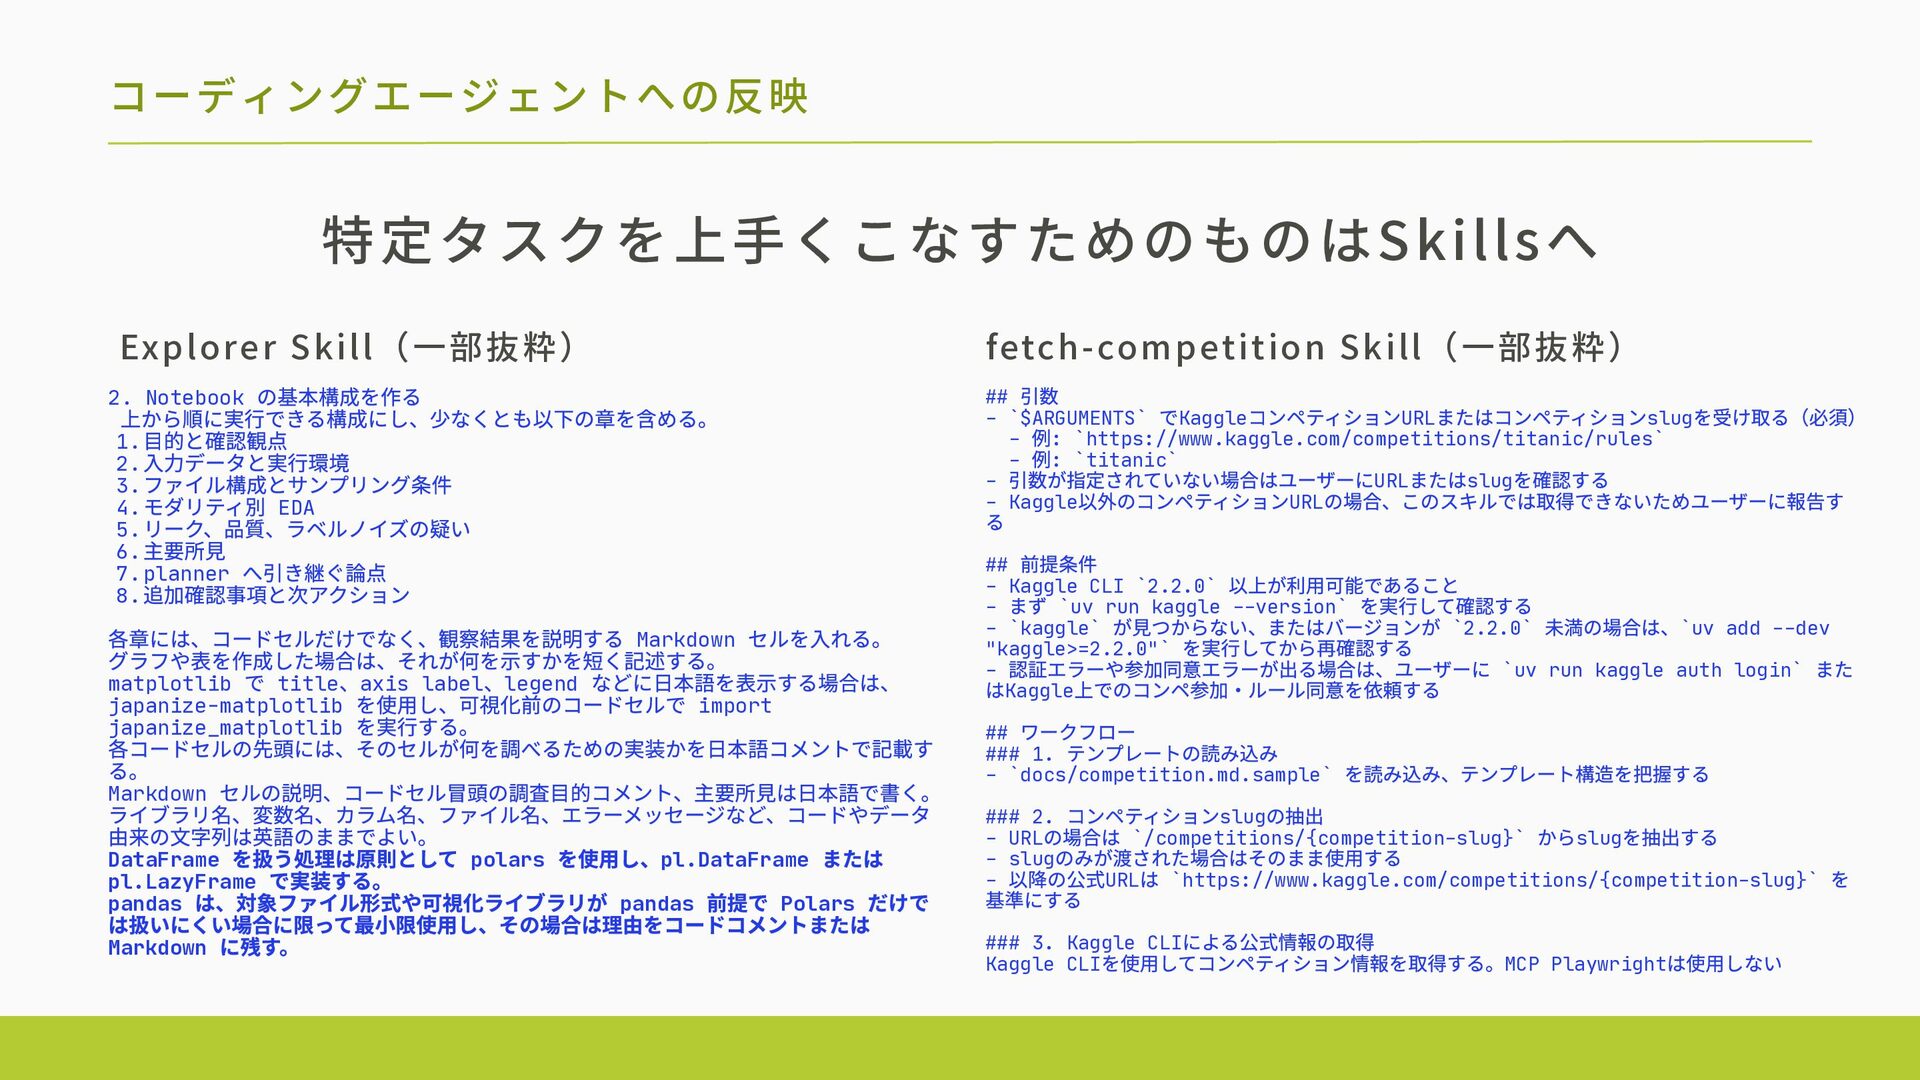
コーディングエージェントへの反映 特定タスクを上手くこなすためのものはSkillsへ ## 引数 - `$ARGUMENTS` でKaggle コンペティションURL またはコンペティションslug を受け取る(必須)
- 例: `https://www.kaggle.com/competitions/titanic/rules` - 例: `titanic` - 引数が指定されていない場合はユーザーにURL またはslug を確認する - Kaggle 以外のコンペティションURL の場合、このスキルでは取得できないためユーザーに報告す る ## 前提条件 - Kaggle CLI `2.2.0` 以上が利⽤可能であること - まず `uv run kaggle --version` を実⾏して確認する - `kaggle` が⾒つからない、またはバージョンが `2.2.0` 未満の場合は、`uv add --dev "kaggle>=2.2.0"` を実⾏してから再確認する - 認証エラーや参加同意エラーが出る場合は、ユーザーに `uv run kaggle auth login` また はKaggle 上でのコンペ参加・ルール同意を依頼する ## ワークフロー ### 1. テンプレートの読み込み - `docs/competition.md.sample` を読み込み、テンプレート構造を把握する ### 2. コンペティションslug の抽出 - URL の場合は `/competitions/{competition-slug}` からslug を抽出する - slug のみが渡された場合はそのまま使⽤する - 以降の公式URL は `https://www.kaggle.com/competitions/{competition-slug}` を 基準にする ### 3. Kaggle CLI による公式情報の取得 Kaggle CLI を使⽤してコンペティション情報を取得する。MCP Playwright は使⽤しない ## 引数 - `$ARGUMENTS` でKaggle コンペティションURL またはコンペティションslug を受け取る(必須) - 例: `https://www.kaggle.com/competitions/titanic/rules` - 例: `titanic` - 引数が指定されていない場合はユーザーにURL またはslug を確認する - Kaggle 以外のコンペティションURL の場合、このスキルでは取得できないためユーザーに報告す る ## 前提条件 - Kaggle CLI `2.2.0` 以上が利⽤可能であること - まず `uv run kaggle --version` を実行して確認する - `kaggle` が見つからない、またはバージョンが `2.2.0` 未満の場合は、`uv add --dev "kaggle>=2.2.0"` を実行してから再確認する - 認証エラーや参加同意エラーが出る場合は、ユーザーに `uv run kaggle auth login` また はKaggle 上でのコンペ参加・ルール同意を依頼する ## ワークフロー ### 1. テンプレートの読み込み - `docs/competition.md.sample` を読み込み、テンプレート構造を把握する ### 2. コンペティションslug の抽出 - URL の場合は `/competitions/{competition-slug}` からslug を抽出する - slug のみが渡された場合はそのまま使用する - 以降の公式URL は `https://www.kaggle.com/competitions/{competition-slug}` を 基準にする ### 3. Kaggle CLI による公式情報の取得 Kaggle CLI を使用してコンペティション情報を取得する。MCP Playwright は使⽤しない 2. Notebook の基本構成を作る 上から順に実⾏できる構成にし、少なくとも以下の章を含める。 1. ⽬的と確認観点 2. 入⼒データと実⾏環境 3. ファイル構成とサンプリング条件 4. モダリティ別 EDA 5. リーク、品質、ラベルノイズの疑い 6. 主要所⾒ 7.planner へ引き継ぐ論点 8. 追加確認事項と次アクション 各章には、コードセルだけでなく、観察結果を説明する Markdown セルを入れる。 グラフや表を作成した場合は、それが何を⽰すかを短く記述する。 matplotlib で title 、axis label 、legend などに⽇本語を表⽰する場合は、 japanize-matplotlib を使⽤し、可視化前のコードセルで import japanize_matplotlib を実⾏する。 各コードセルの先頭には、そのセルが何を調べるための実装かを⽇本語コメントで記載す る。 Markdown セルの説明、コードセル冒頭の調査⽬的コメント、主要所⾒は⽇本語で書く。 ライブラリ名、変数名、カラム名、ファイル名、エラーメッセージなど、コードやデータ 由来の文字列は英語のままでよい。 DataFrame を扱う処理は原則として polars を使⽤し、pl.DataFrame または pl.LazyFrame で実装する。 pandas は、対象ファイル形式や可視化ライブラリが pandas 前提で Polars だけで は扱いにくい場合に限って最⼩限使⽤し、その場合は理由をコードコメントまたは Markdown に残す。 2. Notebook の基本構成を作る 上から順に実行できる構成にし、少なくとも以下の章を含める。 1. 目的と確認観点 2. 入力データと実⾏環境 3. ファイル構成とサンプリング条件 4. モダリティ別 EDA 5. リーク、品質、ラベルノイズの疑い 6. 主要所見 7.planner へ引き継ぐ論点 8. 追加確認事項と次アクション 各章には、コードセルだけでなく、観察結果を説明する Markdown セルを入れる。 グラフや表を作成した場合は、それが何を示すかを短く記述する。 matplotlib で title 、axis label 、legend などに日本語を表示する場合は、 japanize-matplotlib を使用し、可視化前のコードセルで import japanize_matplotlib を実行する。 各コードセルの先頭には、そのセルが何を調べるための実装かを日本語コメントで記載す る。 Markdown セルの説明、コードセル冒頭の調査目的コメント、主要所⾒は⽇本語で書く。 ライブラリ名、変数名、カラム名、ファイル名、エラーメッセージなど、コードやデータ 由来の文字列は英語のままでよい。 DataFrame を扱う処理は原則として polars を使用し、pl.DataFrame または pl.LazyFrame で実装する。 pandas は、対象ファイル形式や可視化ライブラリが pandas 前提で Polars だけで は扱いにくい場合に限って最小限使用し、その場合は理由をコードコメントまたは Markdown に残す。 Explorer Skill(一部抜粋) fetch-competition Skill(一部抜粋)
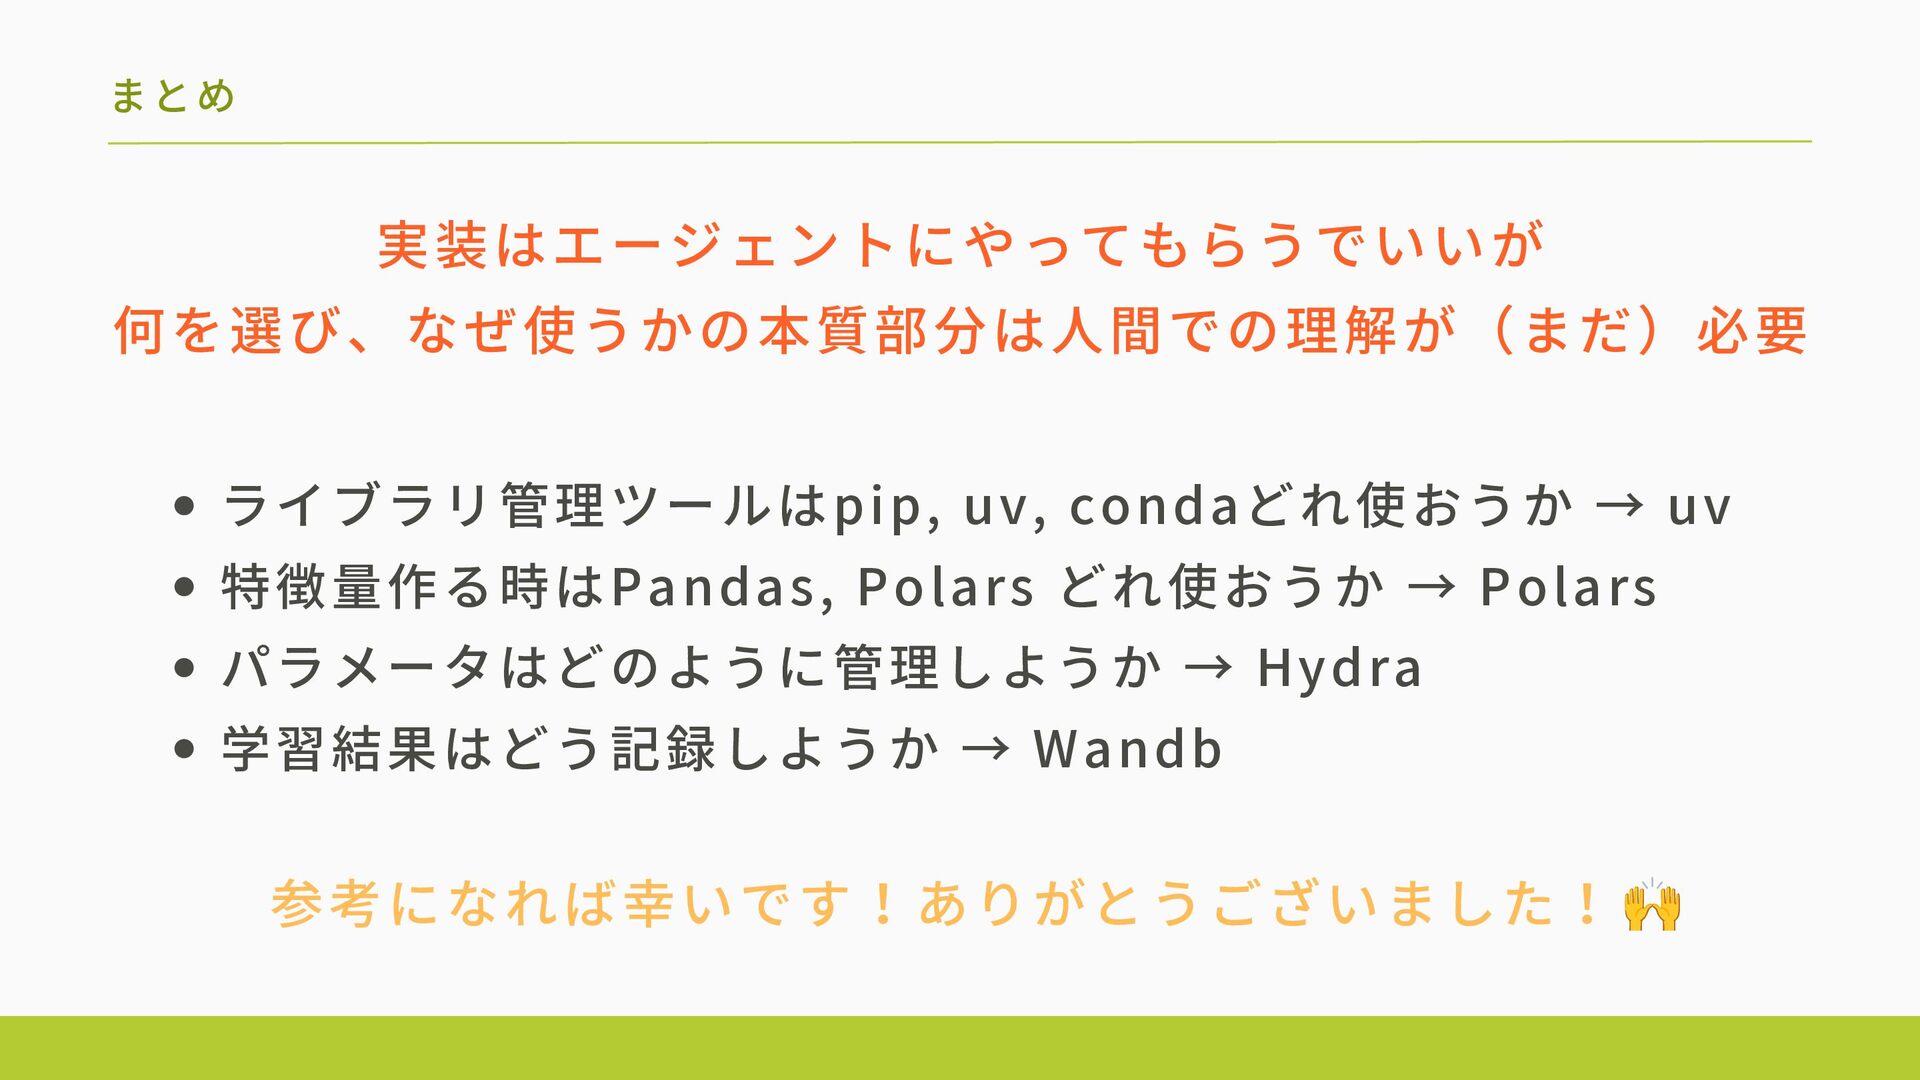
まとめ 実装はエージェントにやってもらうでいいが 何を選び、なぜ使うかの本質部分は人間での理解が(まだ)必要 ライブラリ管理ツールはpip, uv, condaどれ使おうか → uv 特徴量作る時はPandas, Polars
どれ使おうか → Polars パラメータはどのように管理しようか → Hydra 学習結果はどう記録しようか → Wandb 参考になれば幸いです!ありがとうございました! 🙌


 eikichi838
 addyosmani
 inesmontani
 popppiees
 aleyda
 hatefulcrawdad
 jakevdp
 paigeccino
 andyhume
 sarafernandez
 letsgokoyo
 eileencodes
 reverentgeek