Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Attachez vos ceintures, le deep learning a emba...

Sponsored · SiteGround - Reliable hosting with speed, security, and support you can count on. →

Attachez vos ceintures, le deep learning a embarqué !

Démocratiser le deep learning est l'un des challenges les plus passionnants que tente de relever la communauté data. À l'aide de GPUs embarqués dans des cartes ultra-performantes, de nouvelles possibilités s'ouvrent à nous pour relever ce challenge.

Venez découvrir à travers ces slides comment concrétiser un projet utilisant du deep learning embarqué. Nous nous aiderons de la toute dernière Nvidia Jetson Nano pour faire tourner des réseaux de neurones profonds (deep neural network ou DNN) et faire chauffer des GPUs. Nous présenterons pas à pas les étapes entreprises pour mener à bien un tel projet, en partant de l'installation de la carte jusqu'à faire de la reconnaissance d'images en temps réel.

Avatar for ElhadiCherifi

ElhadiCherifi

November 28, 2019

Other Decks in Programming

Transcript

  1. • Deep learning: petite introduction • Le monde de l’embarqué

    • Spécificités du DL embarqué • Notre cas d’usage • Démo • Conclusion et questions Plan de la présentation 3 @ElhadiCherifi
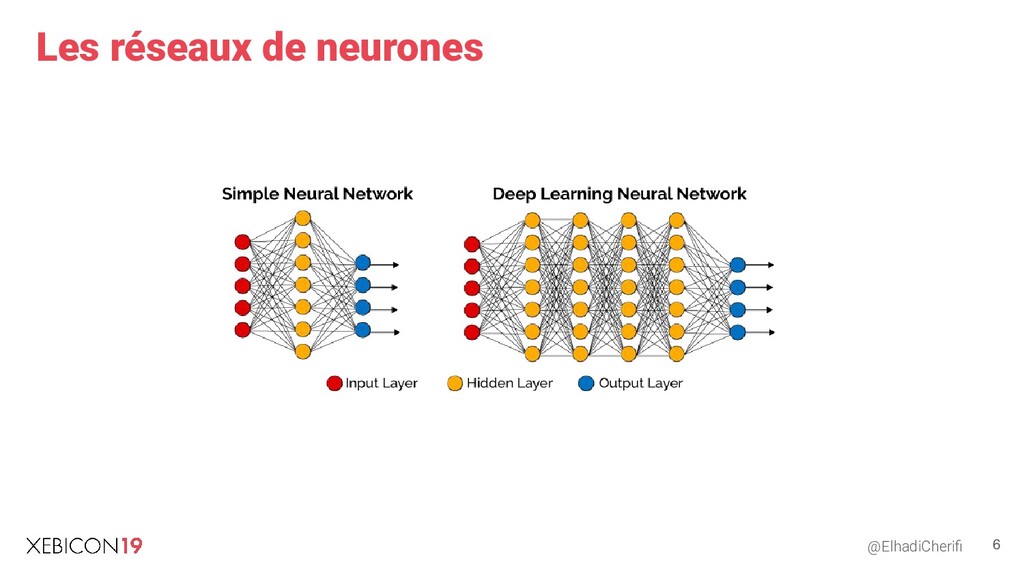
  2. Le deep learning: sens général • Ensemble de méthodes d’apprentissage

    automatique. • Se base sur une architecture de “neurones” • Un “neurone” est caractérisé par une condition et une fonction d’activation • Milliers ou millions de neurones organisés en couches et reliés à l’aide de liens pondérés • On cherche à optimiser le lien pondéré et les éléments du neurones • Cas d’utilisation: Reconnaissance vocale, facial, traitement du langage, ... 5 @ElhadiCherifi
  3. Les GPU • “GPU” = Graphics processing unit • Processeurs

    adaptés à l’entraînement de RN • Architecture hautement parallèle qui accélère les calculs • Milliers de coeurs ! • Fabricants: Nvidia, AMD, Intel, ... 7 @ElhadiCherifi
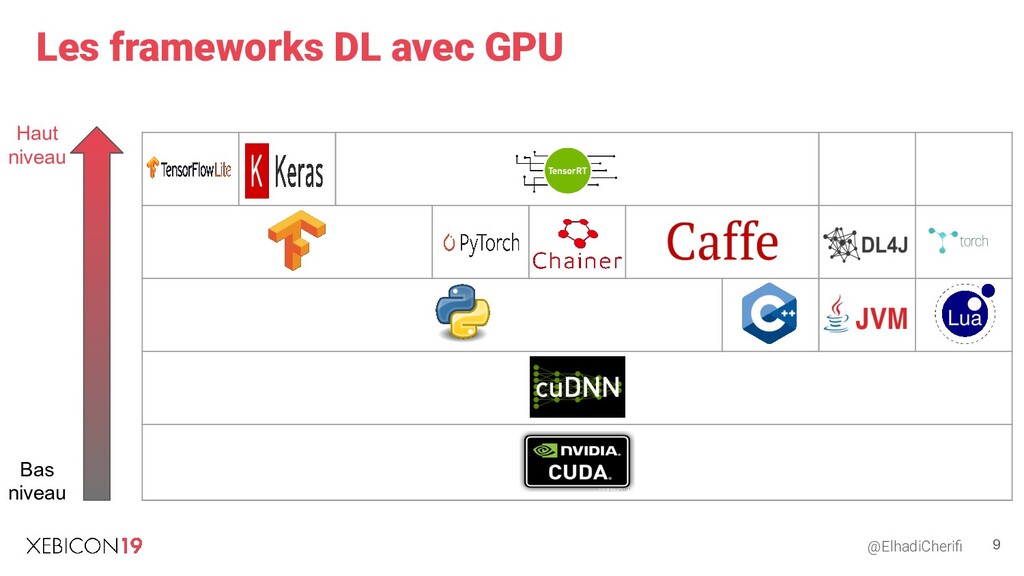
  4. Les frameworks • Une multitude librairies existent • Définissent l’architecture,

    l’entraînement et la validation du modèle • Langages en haut et bas niveau 8 @ElhadiCherifi
  5. L’entraînement du modèle • Phase d’apprentissage du modèle sur les

    données • Demande une consommation importante de ressources par rapport à la phase de prédiction • L’entraînement n’est pas à réaliser sur la carte embarqué 10 @ElhadiCherifi
  6. Division des données • Les données sont divisés en deux

    ensembles : Train et Test • Train pour l’entraînement du modèle, donc à enrichir • Test pour la validation de l’entraînement, donc doit être représentatif des données de production • Se découpe en ⅔, ⅓ en général • Permets d’avoir en amont la performance réalisée en production 11 @ElhadiCherifi
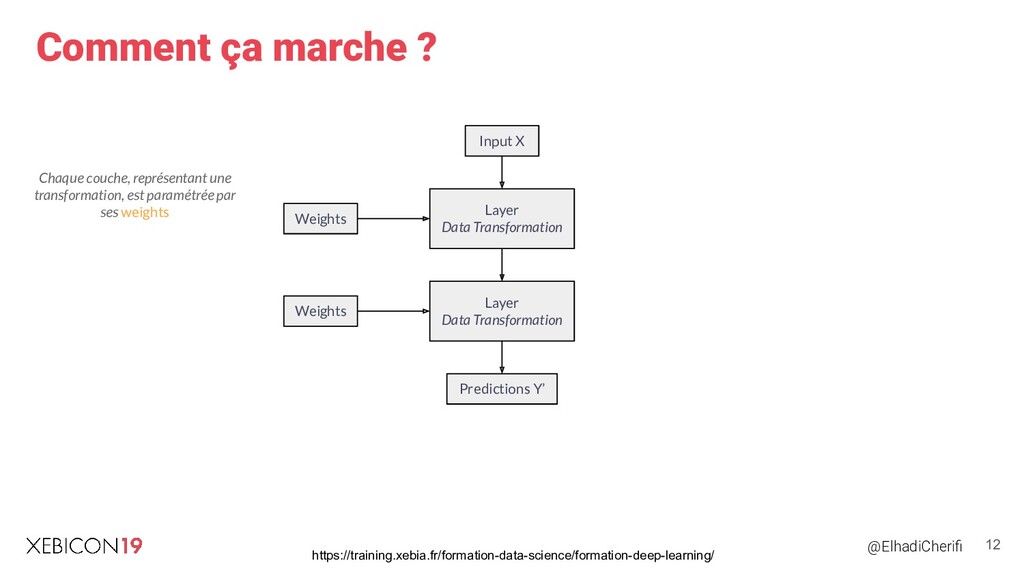
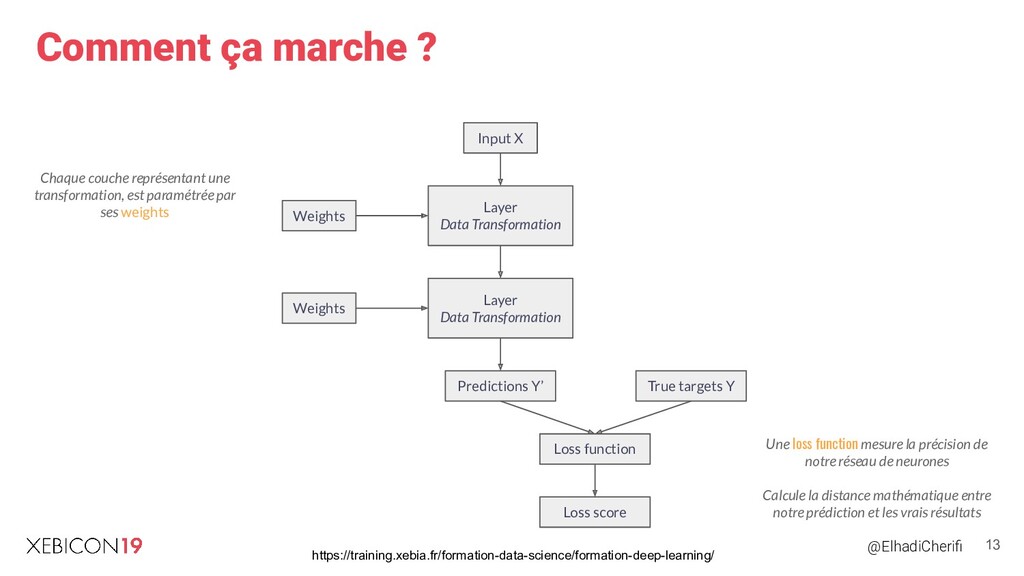
  7. Comment ça marche ? Chaque couche, représentant une transformation, est

    paramétrée par ses weights Layer Data Transformation Layer Data Transformation Weights Weights Input X Predictions Y’ 12 @ElhadiCherifi https://training.xebia.fr/formation-data-science/formation-deep-learning/
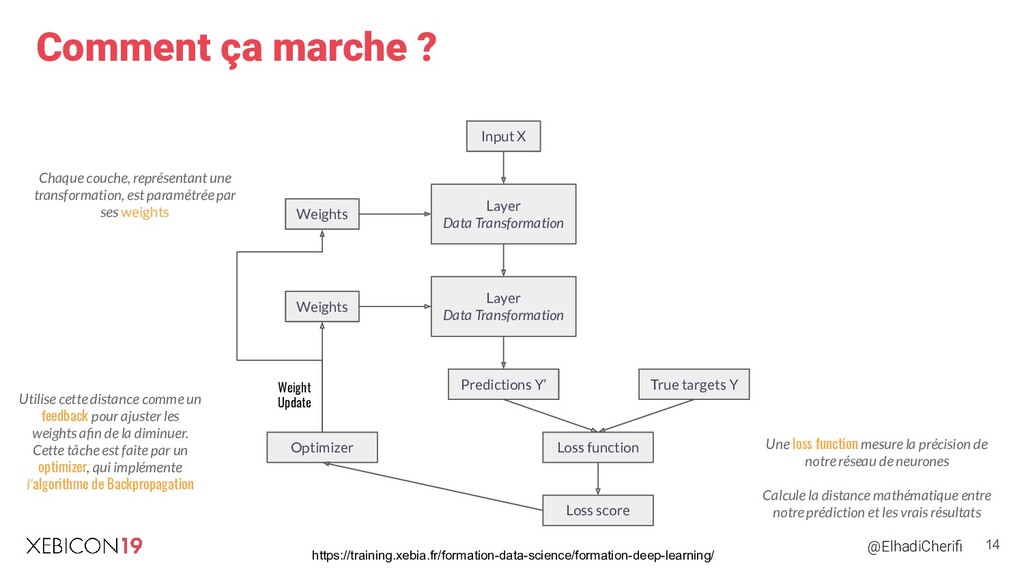
  8. Comment ça marche ? Layer Data Transformation Layer Data Transformation

    Weights Weights Input X Predictions Y’ Loss score Loss function True targets Y Une loss function mesure la précision de notre réseau de neurones Calcule la distance mathématique entre notre prédiction et les vrais résultats Chaque couche représentant une transformation, est paramétrée par ses weights 13 @ElhadiCherifi https://training.xebia.fr/formation-data-science/formation-deep-learning/
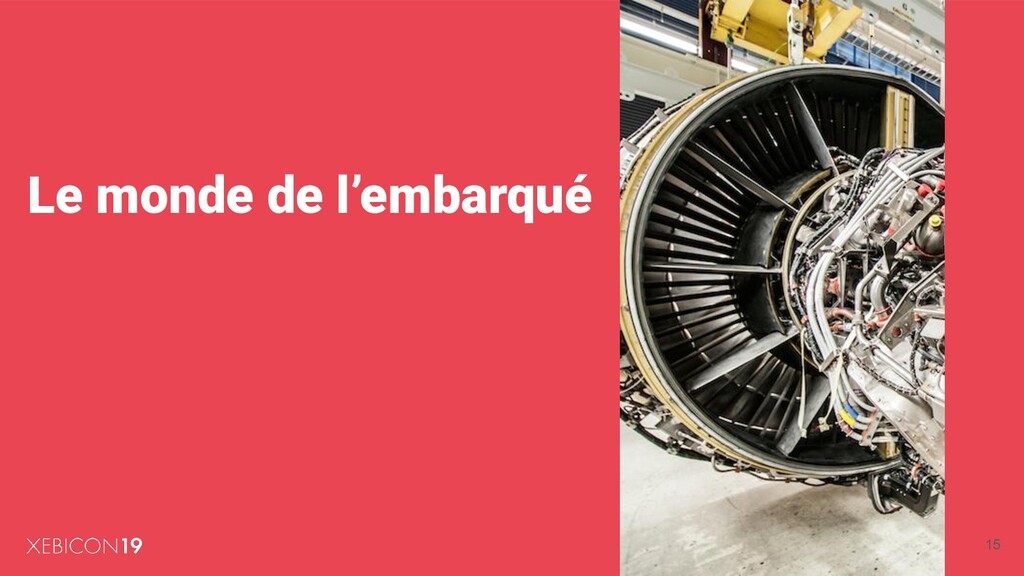
  9. Comment ça marche ? Layer Data Transformation Layer Data Transformation

    Weights Weights Input X Predictions Y’ Loss score Loss function True targets Y Optimizer Weight Update Utilise cette distance comme un feedback pour ajuster les weights afin de la diminuer. Cette tâche est faite par un optimizer, qui implémente l’algorithme de Backpropagation Une loss function mesure la précision de notre réseau de neurones Calcule la distance mathématique entre notre prédiction et les vrais résultats Chaque couche, représentant une transformation, est paramétrée par ses weights 14 @ElhadiCherifi https://training.xebia.fr/formation-data-science/formation-deep-learning/
  10. Ses spécificités • Limitation spatiale, pour prendre le moins de

    place possible • Autonomie, pour une consommation d’énergie réduite • Les performances à maximiser • Optionnel: Interface utilisateur, connectiques variées, … • Domaines d’application: Automobile, aéronautique, multimédia, ... 16 @ElhadiCherifi
  11. Processeurs ARM • ARM signifie “Advanced RISC Machine” • Architecture

    de type RISC (Reduced Instruction Set Computer) • Jeu d’instruction CPU simplifié • Ayant moins de transistors, ces processeurs ont une consommation et taille réduite • Fonctionne à vitesse élevée, en million d’instructions par seconde 17 @ElhadiCherifi
  12. Plusieurs modèles • Raspberry Pi 3 / 4 • Google

    Coral • Jetson Nano 18 @ElhadiCherifi
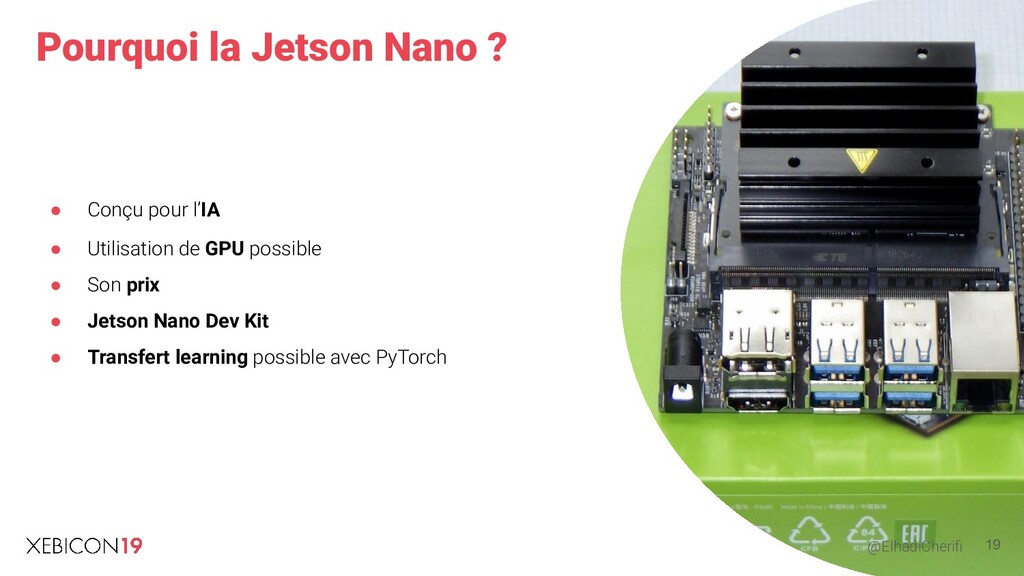
  13. Pourquoi la Jetson Nano ? • Conçu pour l’IA •

    Utilisation de GPU possible • Son prix • Jetson Nano Dev Kit • Transfert learning possible avec PyTorch 19 @ElhadiCherifi
  14. La Jetson Nano: architecture • Dimension: 69.6 mm x 45

    mm • CPU: Processeur ARM QuadCore à 1,4 GHz • Mémoire: 4Go de RAM • GPU: Maxwell avec 128 coeurs CUDA • OS: Ubuntu • Prix: ~ 100$ 20 @ElhadiCherifi
  15. La Jetson Nano: connectique • Ethernet Gigabit • 4 ports

    USB • HDMI • MicroSD • GPIO 40 broches 21 @ElhadiCherifi
  16. La Jetson Nano: prérequis • MicroSD >= 16Go • Souris,

    clavier • Un écran avec HDMI • Chargeur Micro-USB • Une autre machine pour flasher la MicroSD 22 @ElhadiCherifi
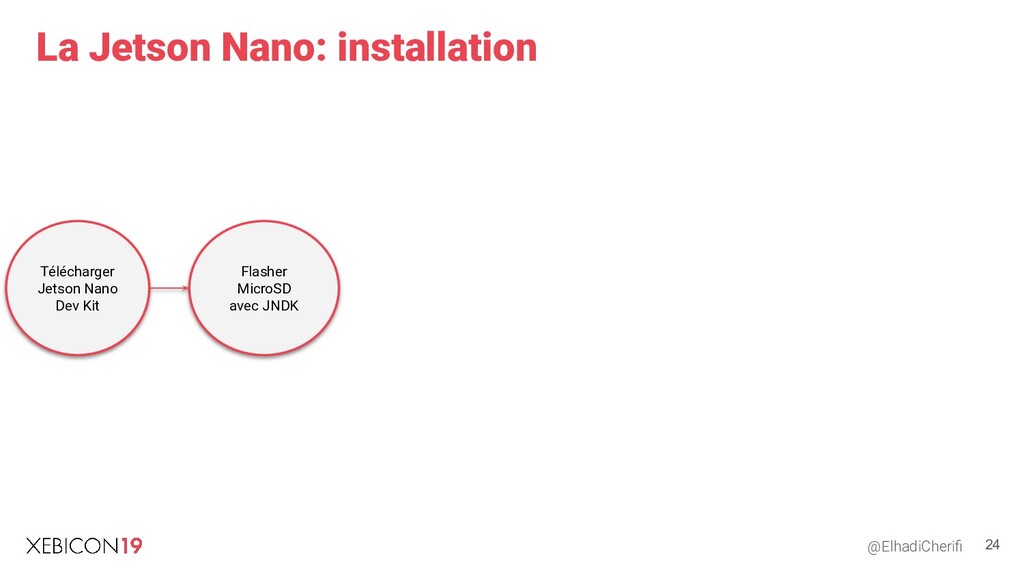
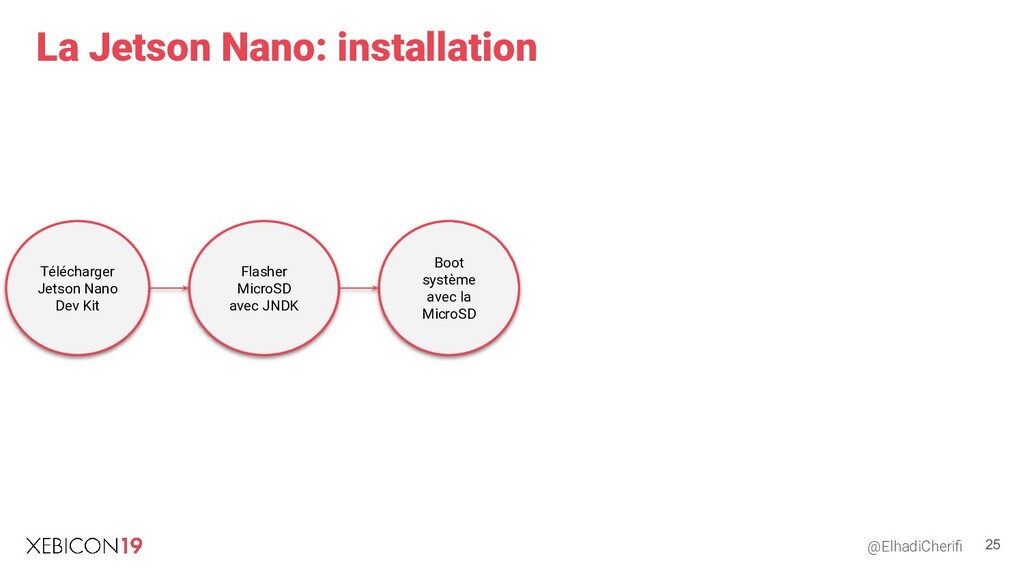
  17. La Jetson Nano: installation Télécharger Jetson Nano Dev Kit Flasher

    MicroSD avec JNDK Boot système avec la MicroSD 25 @ElhadiCherifi
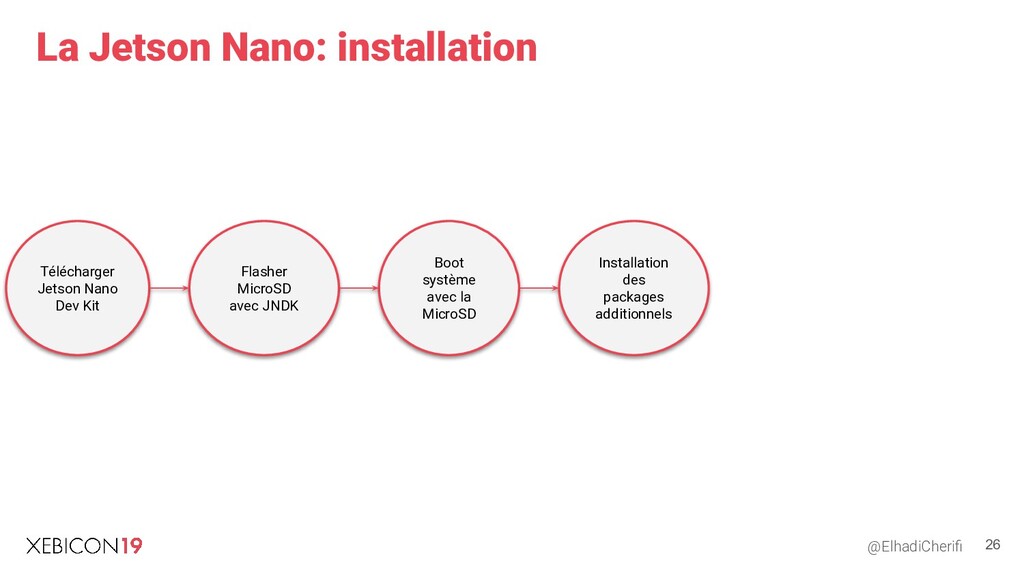
  18. La Jetson Nano: installation Télécharger Jetson Nano Dev Kit Flasher

    MicroSD avec JNDK Boot système avec la MicroSD Installation des packages additionnels 26 @ElhadiCherifi
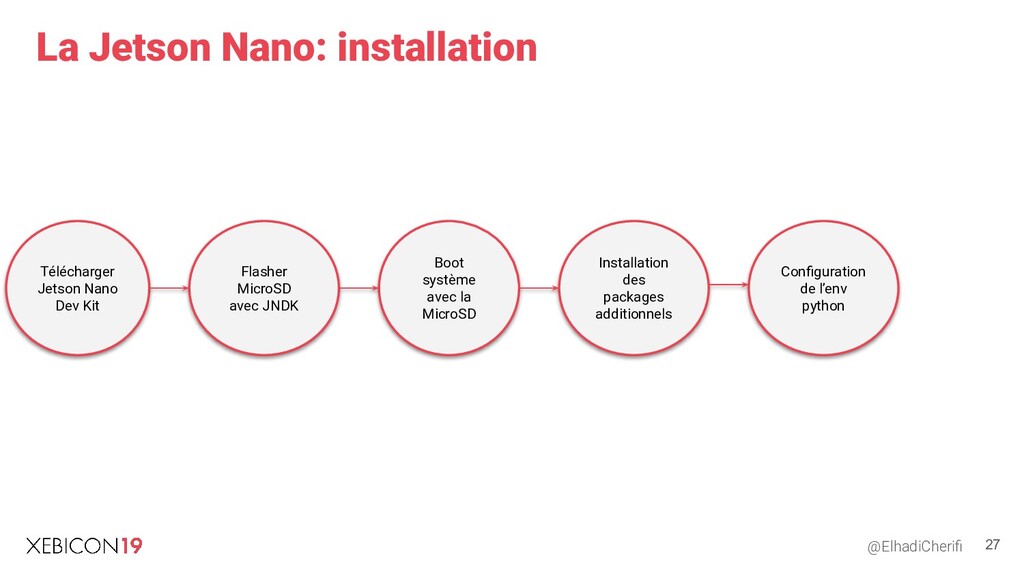
  19. La Jetson Nano: installation Télécharger Jetson Nano Dev Kit Flasher

    MicroSD avec JNDK Boot système avec la MicroSD Installation des packages additionnels Configuration de l’env python 27 @ElhadiCherifi
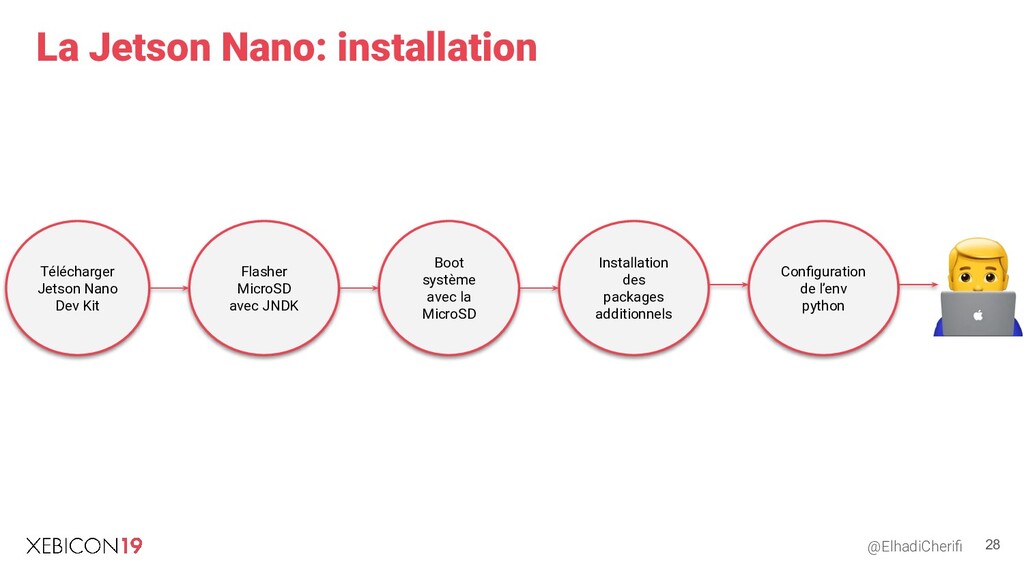
  20. La Jetson Nano: installation Télécharger Jetson Nano Dev Kit Flasher

    MicroSD avec JNDK Boot système avec la MicroSD Installation des packages additionnels Configuration de l’env python 28 @ElhadiCherifi
  21. Sauvegarde du modèle • Transférer le modèle de la machine

    d’entraînement vers la carte embarqué • Sauvegarde au format binaire: ◦ HDF5 ◦ Protobuf ◦ Pickle ◦ Joblib ◦ ... 30 @ElhadiCherifi
  22. Déploiement du modèle • Nerf de la guerre • Configurations

    différentes des machines d’entraînement et la carte embarqué • Vérifier en amont si la version ARM du framework utilisé existent. • Rebuild avec les bonnes versions et packages • Merci à la communauté !!! 31 @ElhadiCherifi
  23. Automatisation du déploiement • Pour un cycle de développement efficace

    • Plusieurs outils: Ansible, ... • Ansible: ◦ Outil d'exécution de tâches sur une machine distante via SSH ◦ Playbooks contenant l’installation des librairies utilisées lors de l’entraînement. 32 @ElhadiCherifi
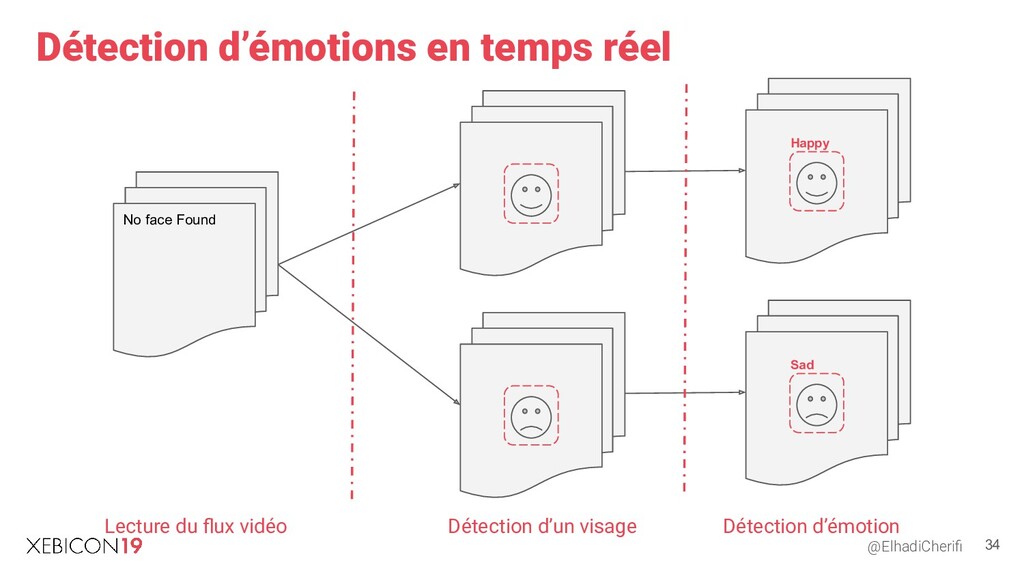
  24. Détection d’émotions en temps réel No face Found Happy Sad

    Lecture du flux vidéo Détection d’un visage Détection d’émotion 34 @ElhadiCherifi
  25. Détection du visage • La librairie utilisée est face_recognition •

    Elle même utilise la librairie Dlib: un toolkit contenant un ensemble d’algo de ML. • A une précision de 99,38% • Supporte l’utilisation des GPU 35 @ElhadiCherifi
  26. Détection d’émotion • La librairie utilisée est Keras • L’architecture

    du modèle se base sur 4 types de layers • A une précision de 61,3% • Code original disponible ici • Adaptation pour utiliser les GPU et Le flux vidéo 36 @ElhadiCherifi
  27. Méthode 1: “à la one again” • Utilisation direct du
    modèle sauvegardée • Ajout uniquement de l’utilisation des GPU et de la caméra de la Jetson Nano • Inférence lente, taille du modèle conséquente 23Mo • Mais ça marche ! 38 @ElhadiCherifi
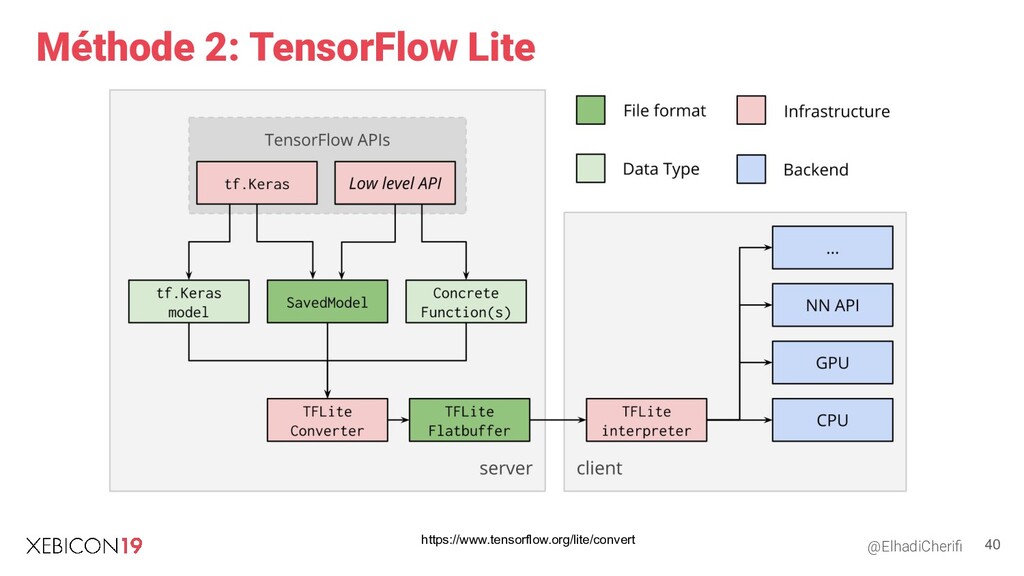
  28. Méthode 2: TensorFlow Lite • Librairie permettant l’utilisation de modèle

    TensorFlow “on device” • Se compose de deux modules: TF Lite Converter et TF Lite Interpreter • Modèle passe de 23Mo à 950Ko • Inférence du modèle plus fluide 39 @ElhadiCherifi
  29. Méthode 3: TensorRT • Optimiseur de modèle de DL créée

    par Nvidia • Performant sur les gros modèles • Ne supporte que les GPU Nvidia • Utilise des modèles TF, Matlab et tout modèle pouvant être parsé via ONNX (PyTorch, Caffe, Chainer, CNTK, ...) • Applique une série de transformations sur l’archi du réseau de neurones. 41 @ElhadiCherifi
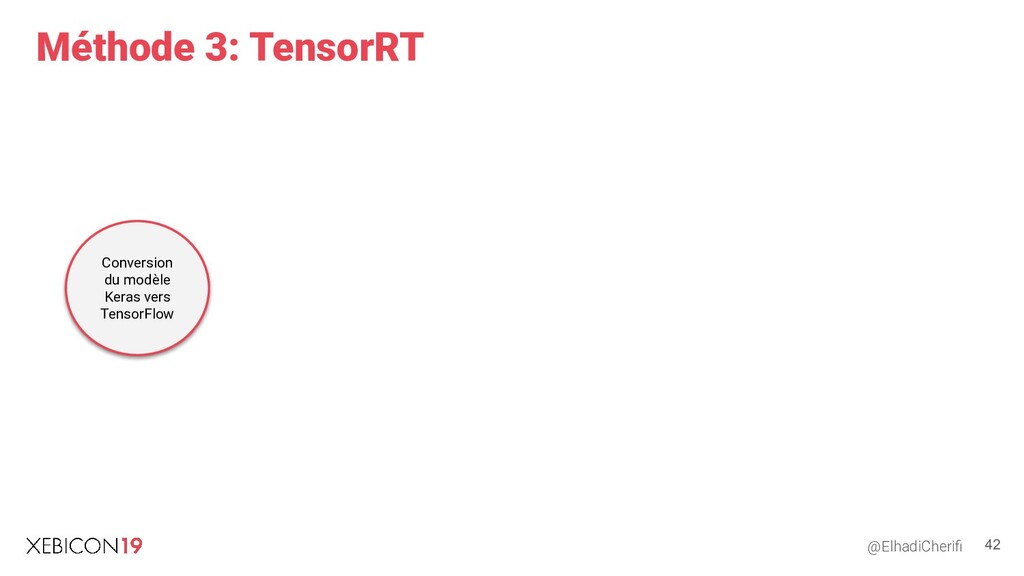
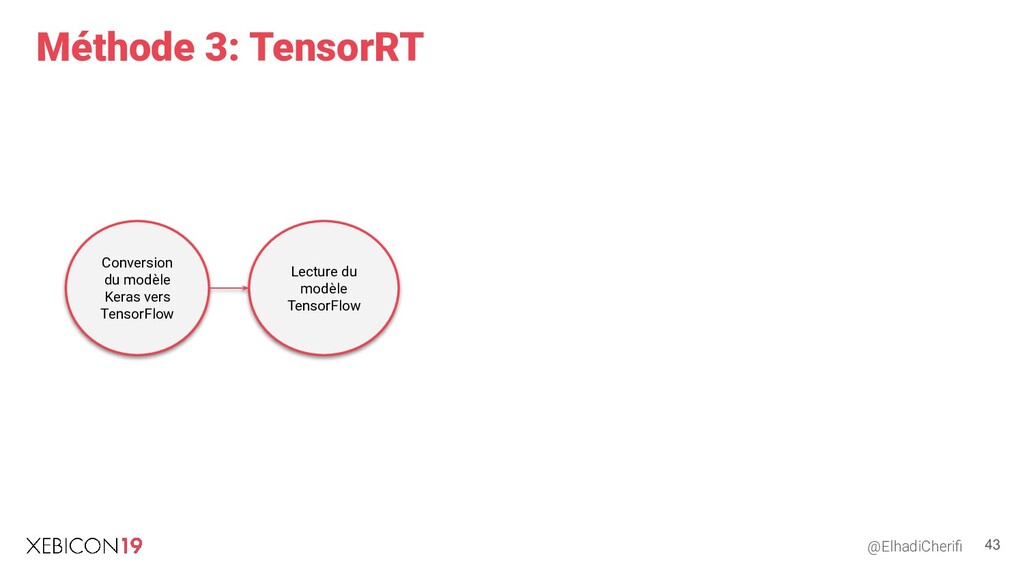
  30. Méthode 3: TensorRT Conversion du modèle Keras vers TensorFlow Lecture

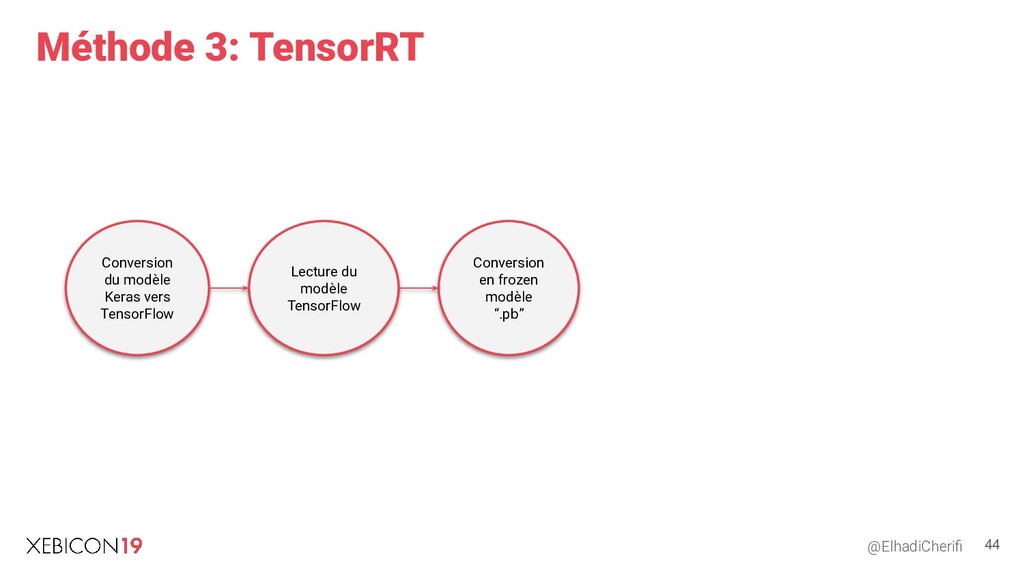
    du modèle TensorFlow Conversion en frozen modèle “.pb” 44 @ElhadiCherifi
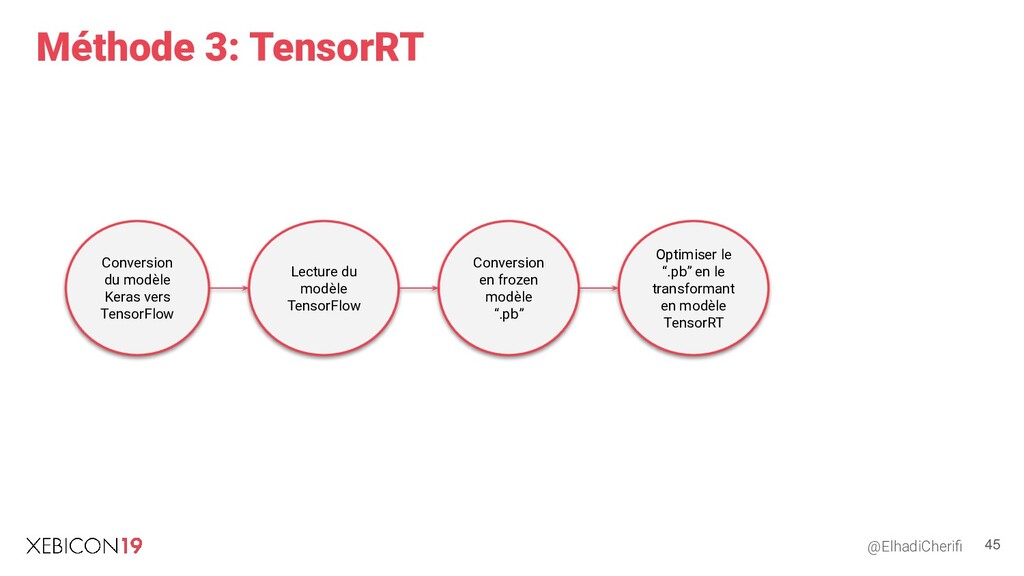
  31. Méthode 3: TensorRT Conversion du modèle Keras vers TensorFlow Lecture

    du modèle TensorFlow Conversion en frozen modèle “.pb” Optimiser le “.pb” en le transformant en modèle TensorRT 45 @ElhadiCherifi
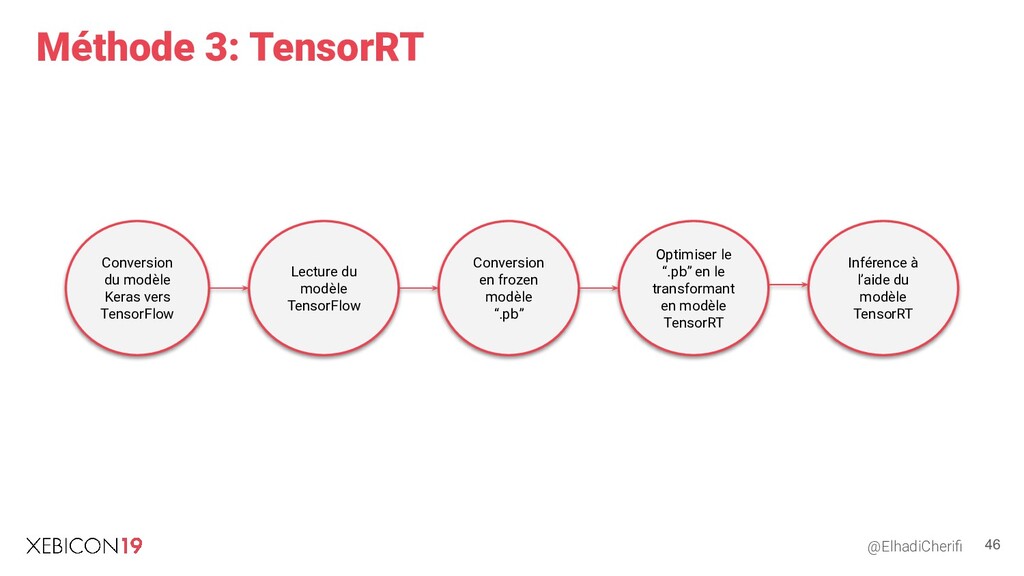
  32. Méthode 3: TensorRT Conversion du modèle Keras vers TensorFlow Lecture

    du modèle TensorFlow Conversion en frozen modèle “.pb” Optimiser le “.pb” en le transformant en modèle TensorRT Inférence à l’aide du modèle TensorRT 46 @ElhadiCherifi
  33. Conclusions • Voir en amont les librairies utilisées pour la

    compatibilité avec la carte embarquée • Bien choisir son outil de déploiement est crucial • Les GPU embarqués donnent de nouveaux horizons • À absolument tester sur vos projets persos 48 @ElhadiCherifi
  34. Links • Photo by Sebastian Klein on Unsplash • Image

    • Image • Photo by Mitchel Boot on Unsplash • Photo by louis magnotti on Unsplash • Image 50 @ElhadiCherifi