Upgrade to Pro — share decks privately, control downloads, hide ads and more …

半永久的に提供し続けられるプライベートクラウドを目指して ― 利用者の認知負荷を抑えるAPI抽...

半永久的に提供し続けられるプライベートクラウドを目指して ― 利用者の認知負荷を抑えるAPI抽象化とハードウェア世代交代の基盤設計

CIU(CyberAgent group Infrastructure Unit)では、サイバーエージェントグループ向けのプライベートクラウド「Cycloud」を開発・運用しています。プライベートクラウドのVM基盤では、ハードウェアの世代交代を繰り返しながら基盤を維持していく必要があります。これまでは世代交代のたびにプライベートクラウドのシステムを作り直してきましたが、そのたびに利用者がVMやボリュームデータ、マネージドサービスの設定等を移設しなければならず、CIU・利用者の双方にとって大きな負担となっていました。さらに、新しいシステムでは提供されるサービスの構成やAPIの仕様も置き換わるため、利用者は移設のたびに大きな学習コストを強いられてきました。ハードウェアの寿命が、そのまま利用者の移行負担として現れていたのです。

そこで、Cycloudの新リージョンでは、「半永久的に提供し続けられるプライベートクラウド」を目標として掲げました。鍵になるのはAPIの抽象化です。VM基盤の本体であるOpenStackのAPIを、利用者へは直接見せずに独自のgRPC APIでラップして提供し、KubernetesのCRD(Custom Resource Definition)とカスタムコントローラーによってOpenStack へ反映するという方式をとりました。これにより、利用者から見えるインターフェースを固定したまま、裏側のOpenStackだけを新しいものに入れ替えることが可能になります。ハードウェアの世代交代はOpenStackの置き換えとして処理され、利用者はVMのインスタンスタイプを変更して再起動するだけで、透過的に新しい世代のマシンを利用できます。

本セッションでは、そのような抽象化の仕組みを実現した基盤設計を深掘りします。まず、利用者の要求をそのまま表す「Interface CRD」と、OpenStackなどのプロバイダーへの反映を担う「Provider CRD」による二層アーキテクチャ、それらを制御し、インフラの状態を利用者が要求する状態へ収束させるKubernetesカスタムコントローラーの設計について紹介します。さらに、インスタンスタイプの変更を契機として、世代の異なるクラスター間でVMやボリュームを移行する仕組みについてもお話しします。

Avatar for Tomofumi Kondo

Tomofumi Kondo

September 26, 2026

More Decks by Tomofumi Kondo
Other Decks in Programming

Transcript

  1. 自己紹介 近藤 智文 長井 佑太 株式会社サイバーエージェント CIU Compute チーム 株式会社サイバーエージェント

    CIU AKE チーム @tomokon_0314 — 2024年新卒入社 — IaaS 基盤の開発・運用 — 2024年新卒入社 — マネージド Kubernetes サービス「AKE」の開発・運用 #OpenStack #Kubernetes #IaaS #OVS #Kubernetes #Go 2
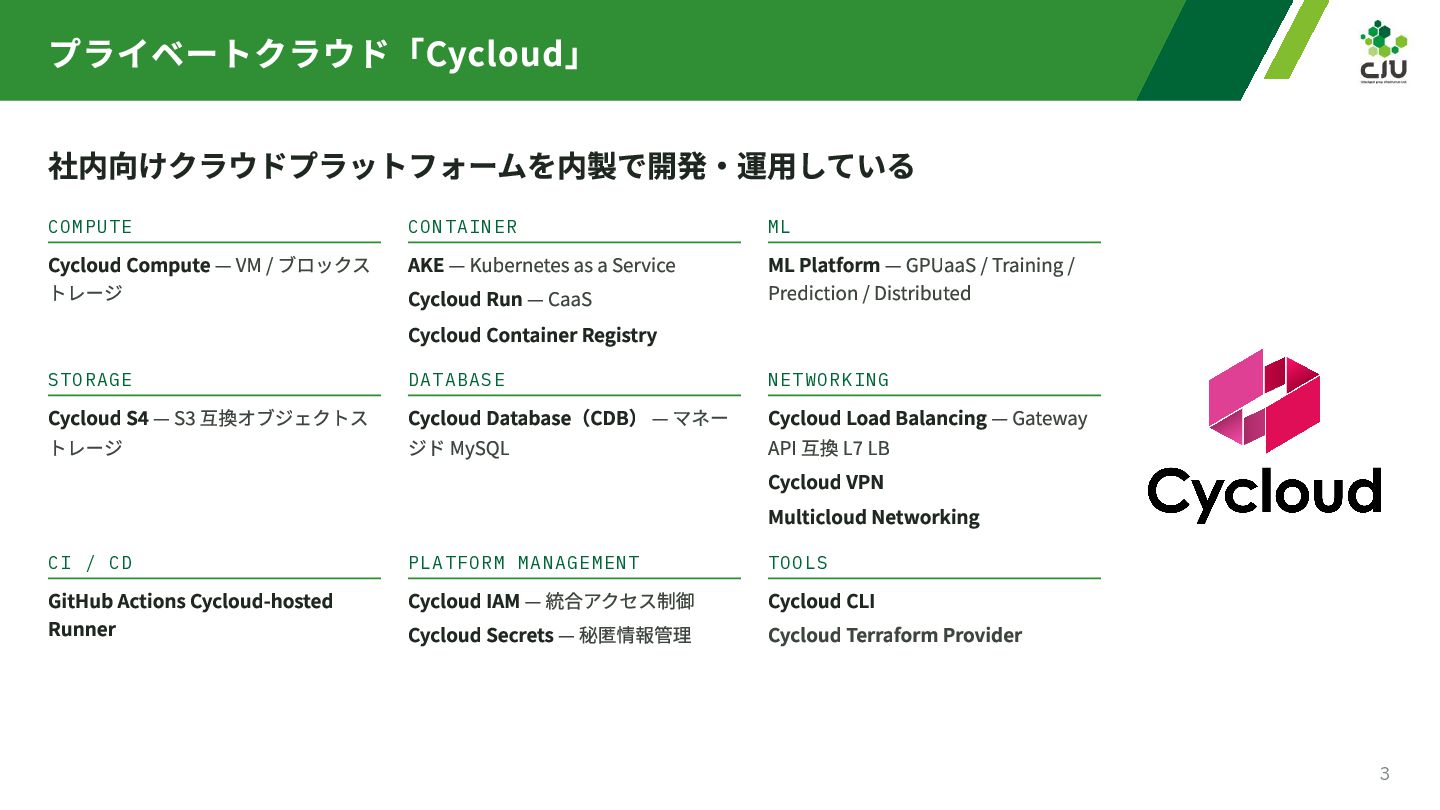
  2. プライベートクラウド「Cycloud」 社内向けクラウドプラットフォームを内製で開発・運用している COMPUTE CONTAINER ML STORAGE DATABASE NETWORKING CI /

    CD PLATFORM MANAGEMENT TOOLS Cycloud Compute — VM / ブロックス AKE — Kubernetes as a Service トレージ Cycloud Run — CaaS Cycloud Container Registry Cycloud S4 — S3 互換オブジェクトス トレージ GitHub Actions Cycloud-hosted Runner Cycloud Database(CDB) — マネー ジド MySQL Cycloud IAM — 統合アクセス制御 Cycloud Secrets — 秘匿情報管理 ML Platform — GPUaaS / Training / Prediction / Distributed Cycloud Load Balancing — Gateway API 互換 L7 LB Cycloud VPN Multicloud Networking Cycloud CLI Cycloud Terraform Provider 3
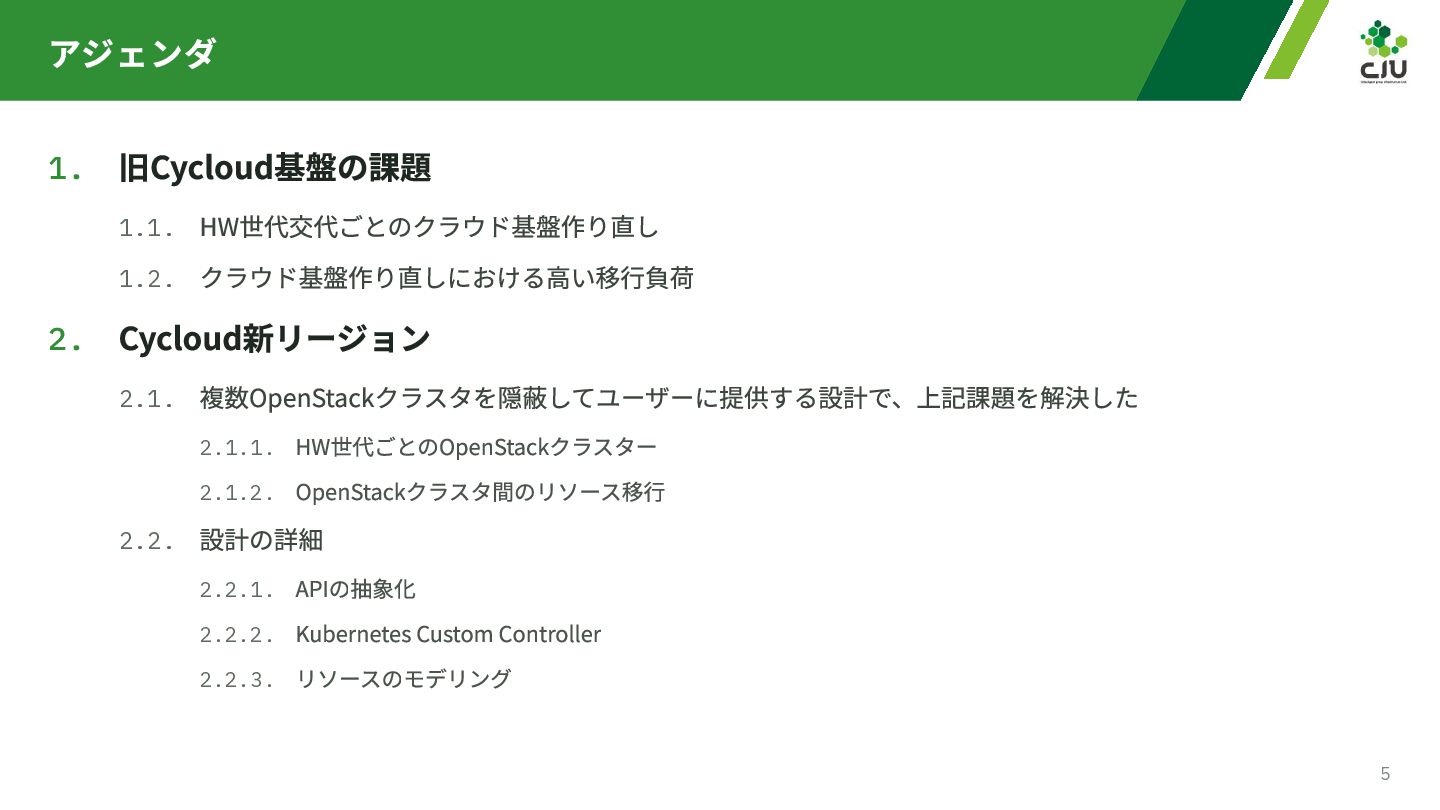
  3. アジェンダ 1. 旧Cycloud基盤の課題 HW世代交代ごとのクラウド基盤作り直し 1.2. クラウド基盤作り直しにおける高い移行負荷 1.1. 2. Cycloud新リージョン 2.1.

    複数OpenStackクラスタを隠蔽してユーザーに提供する設計で、上記課題を解決した HW世代ごとのOpenStackクラスター 2.1.2. OpenStackクラスタ間のリソース移行 2.1.1. 2.2. 設計の詳細 APIの抽象化 2.2.2. Kubernetes Custom Controller 2.2.3. リソースのモデリング 2.2.1. 5
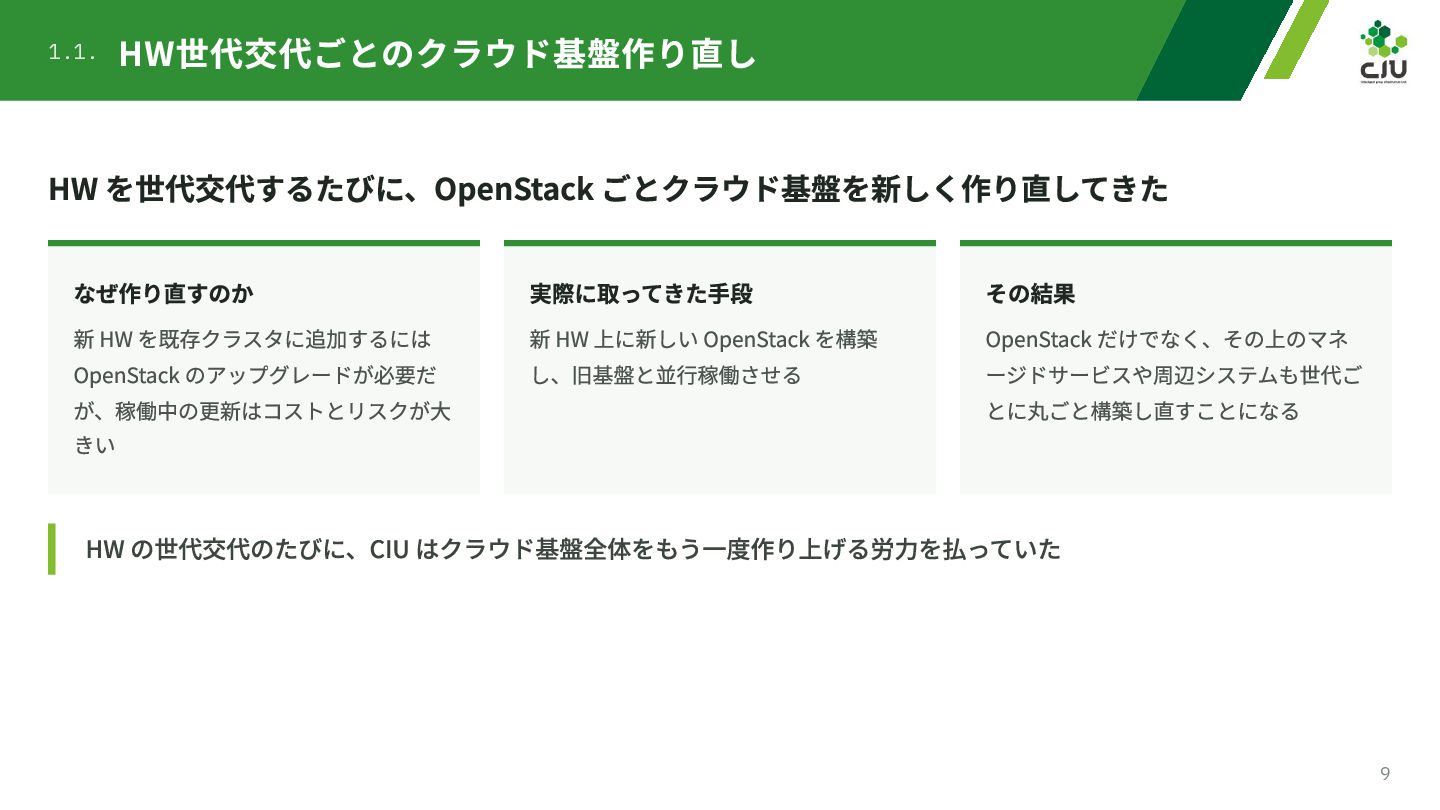
  4. 1.1. HW世代交代ごとのクラウド基盤作り直し HW を世代交代するたびに、OpenStack ごとクラウド基盤を新しく作り直してきた なぜ作り直すのか 新 HW を既存クラスタに追加するには OpenStack

    のアップグレードが必要だ が、稼働中の更新はコストとリスクが大 きい 実際に取ってきた手段 新 HW 上に新しい OpenStack を構築 し、旧基盤と並行稼働させる その結果 OpenStack だけでなく、その上のマネ ージドサービスや周辺システムも世代ご とに丸ごと構築し直すことになる HW の世代交代のたびに、CIU はクラウド基盤全体をもう一度作り上げる労力を払っていた 9
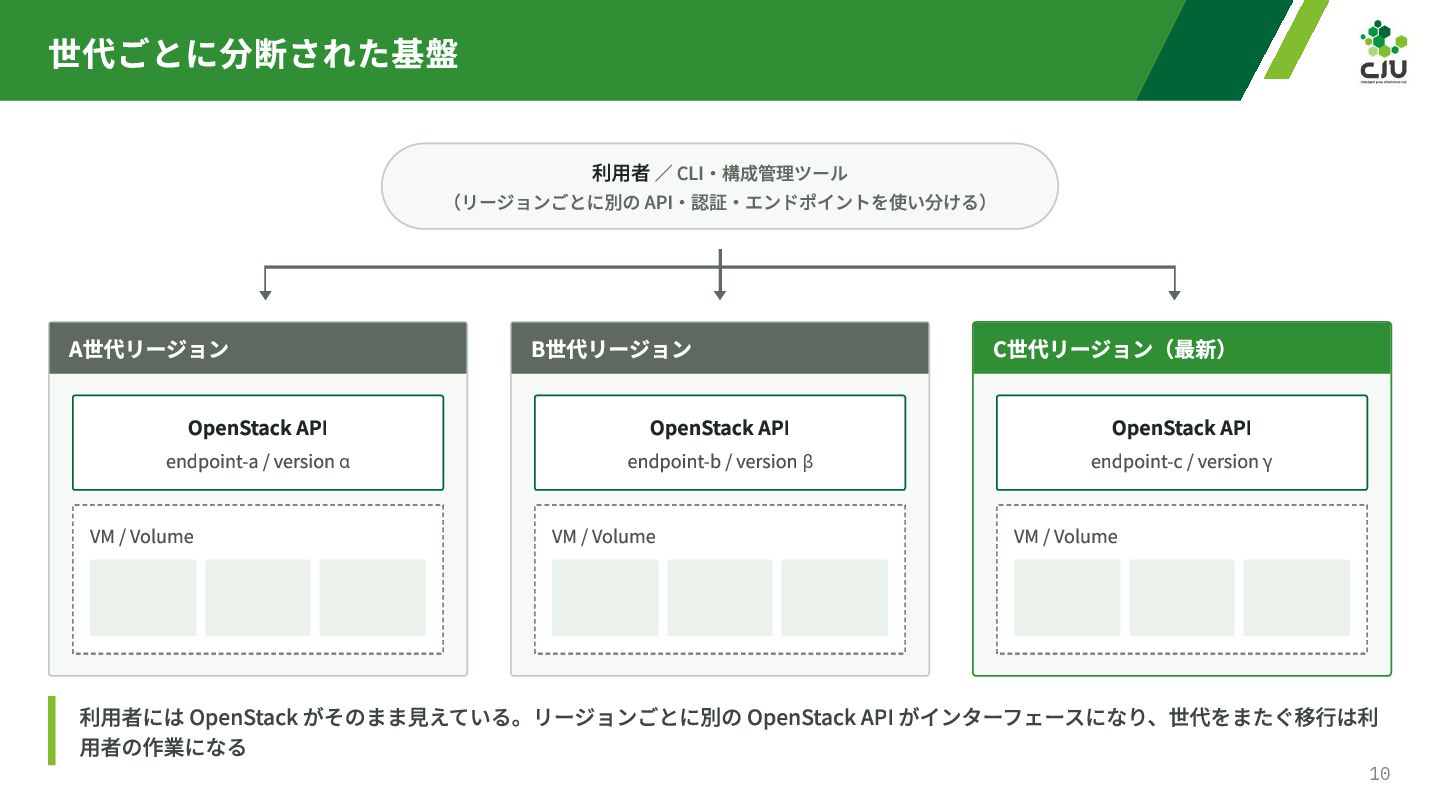
  5. 世代ごとに分断された基盤 利用者 / CLI・構成管理ツール (リージョンごとに別の API・認証・エンドポイントを使い分ける) A世代リージョン OpenStack API endpoint-a

    / version α VM / Volume B世代リージョン OpenStack API endpoint-b / version β VM / Volume C世代リージョン(最新) OpenStack API endpoint-c / version γ VM / Volume 利用者には OpenStack がそのまま見えている。リージョンごとに別の OpenStack API がインターフェースになり、世代をまたぐ移行は利 用者の作業になる 10
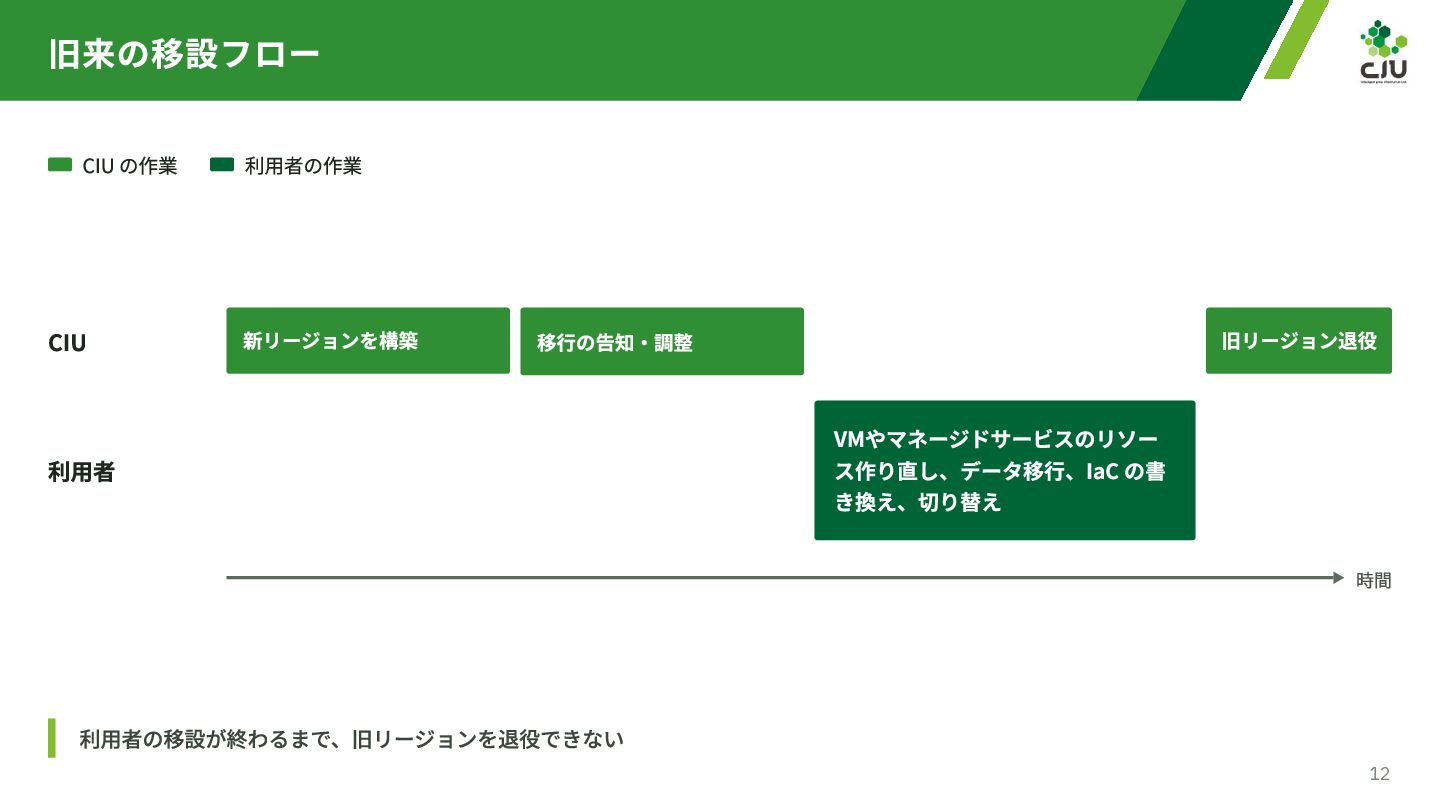
  6. 旧来の移設フロー CIU の作業 CIU 利用者の作業 新リージョンを構築 旧リージョン退役 移行の告知・調整 利用者 VMやマネージドサービスのリソー

    ス作り直し、データ移行、IaC の書 き換え、切り替え 時間 利用者の移設が終わるまで、旧リージョンを退役できない 12
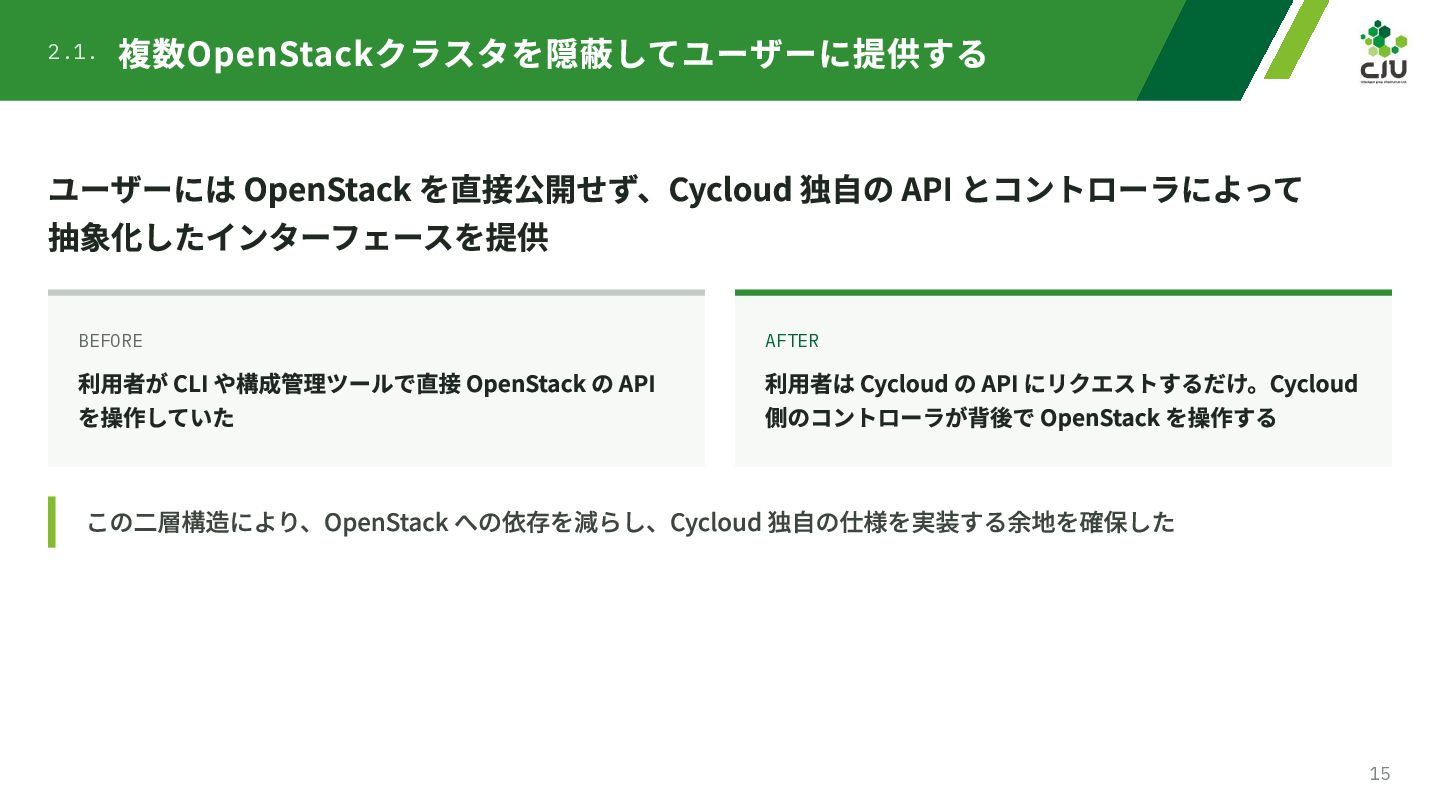
  7. 2.1. 複数OpenStackクラスタを隠蔽してユーザーに提供する ユーザーには OpenStack を直接公開せず、Cycloud 独自の API とコントローラによって 抽象化したインターフェースを提供 BEFORE

    利用者が CLI や構成管理ツールで直接 OpenStack の API を操作していた AFTER 利用者は Cycloud の API にリクエストするだけ。Cycloud 側のコントローラが背後で OpenStack を操作する この二層構造により、OpenStack への依存を減らし、Cycloud 独自の仕様を実装する余地を確保した 15
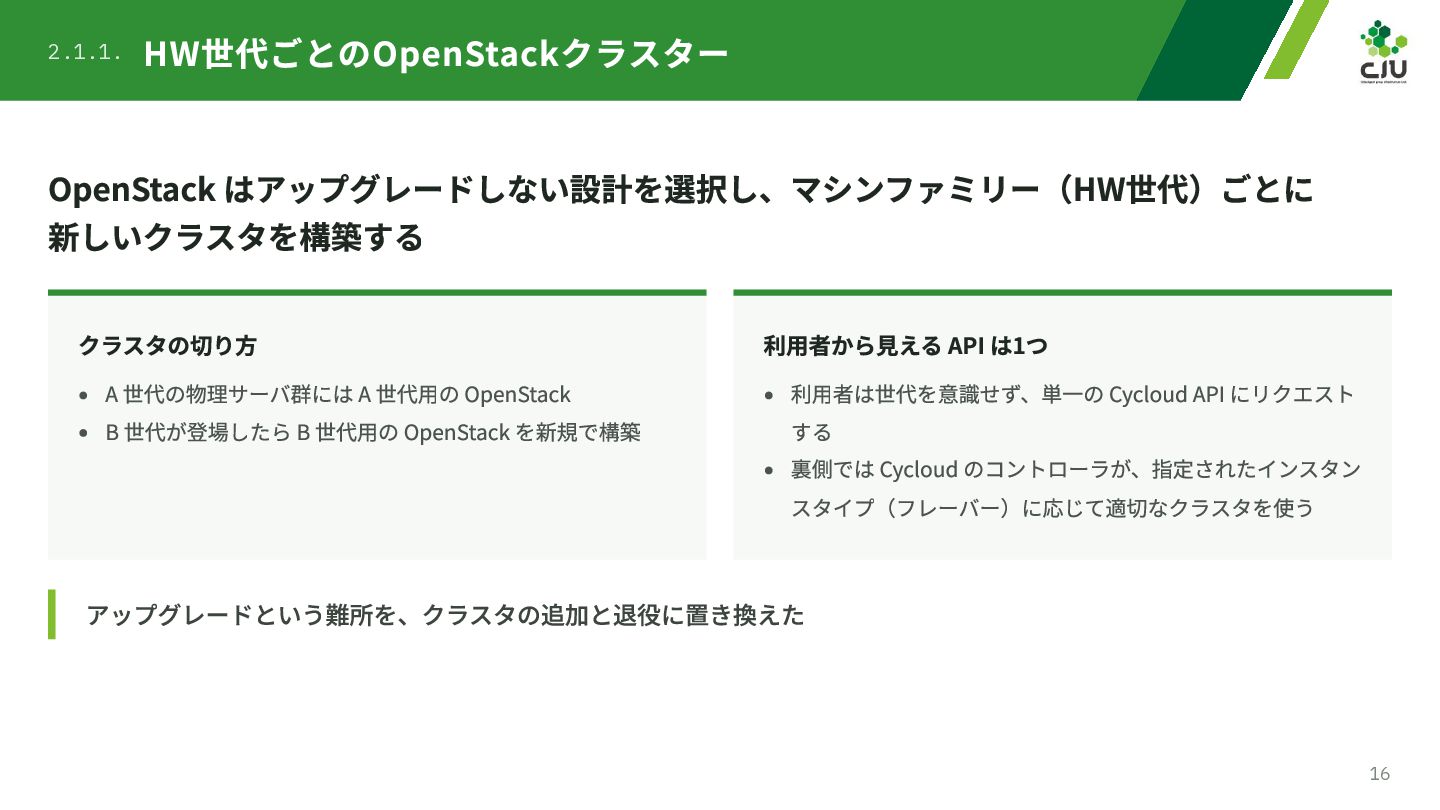
  8. 2.1.1. HW世代ごとのOpenStackクラスター OpenStack はアップグレードしない設計を選択し、マシンファミリー(HW世代)ごとに 新しいクラスタを構築する クラスタの切り方 A 世代の物理サーバ群には A 世代用の

    OpenStack B 世代が登場したら B 世代用の OpenStack を新規で構築 利用者から見える API は1つ 利用者は世代を意識せず、単一の Cycloud API にリクエスト する 裏側では Cycloud のコントローラが、指定されたインスタン スタイプ(フレーバー)に応じて適切なクラスタを使う アップグレードという難所を、クラスタの追加と退役に置き換えた 16
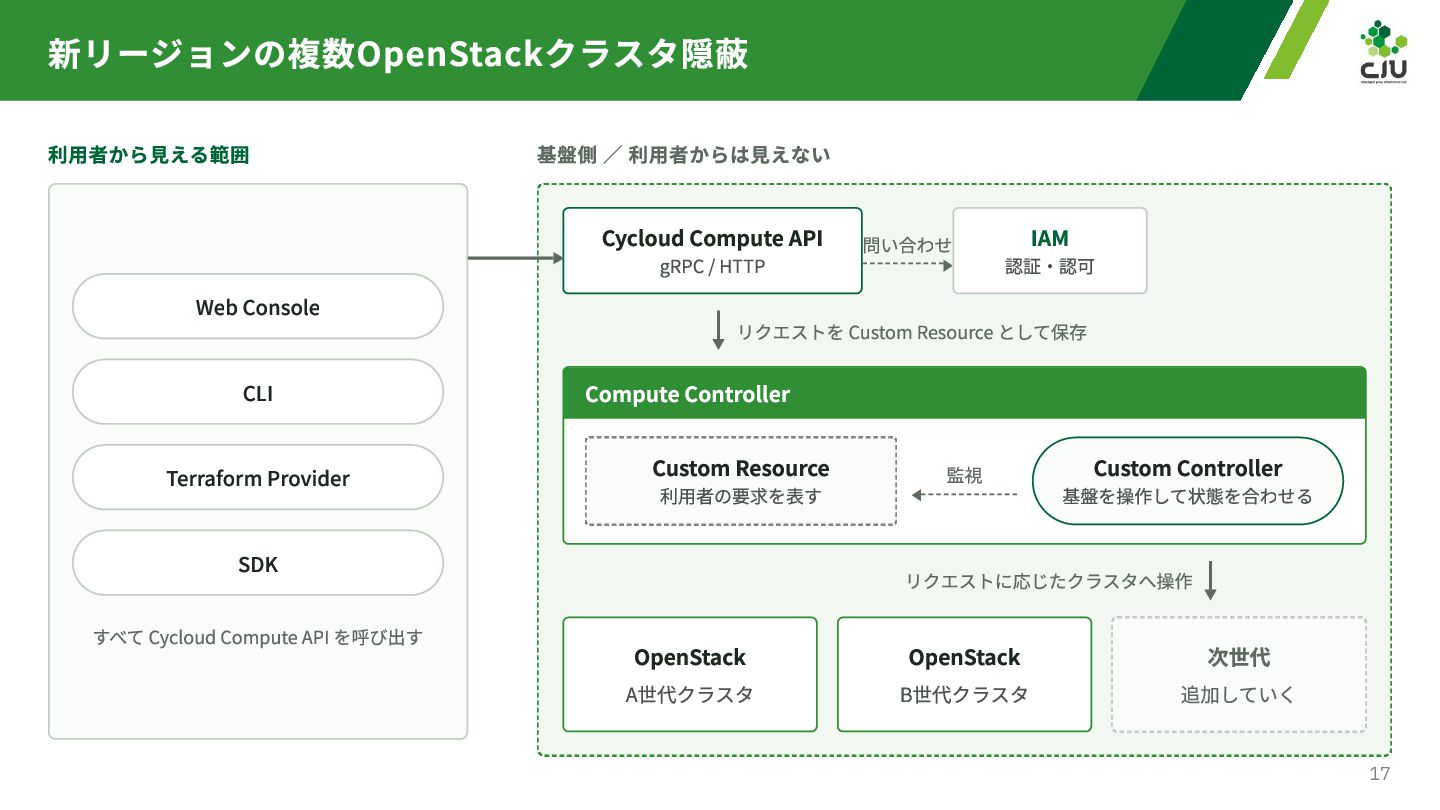
  9. 新リージョンの複数OpenStackクラスタ隠蔽 利用者から見える範囲 Web Console CLI Terraform Provider 基盤側 / 利用者からは見えない

    Cycloud Compute API 問い合わせ gRPC / HTTP 認証・認可 リクエストを Custom Resource として保存 Compute Controller Custom Resource 利用者の要求を表す SDK すべて Cycloud Compute API を呼び出す IAM 監視 Custom Controller 基盤を操作して状態を合わせる リクエストに応じたクラスタへ操作 OpenStack A世代クラスタ OpenStack B世代クラスタ 次世代 追加していく 17
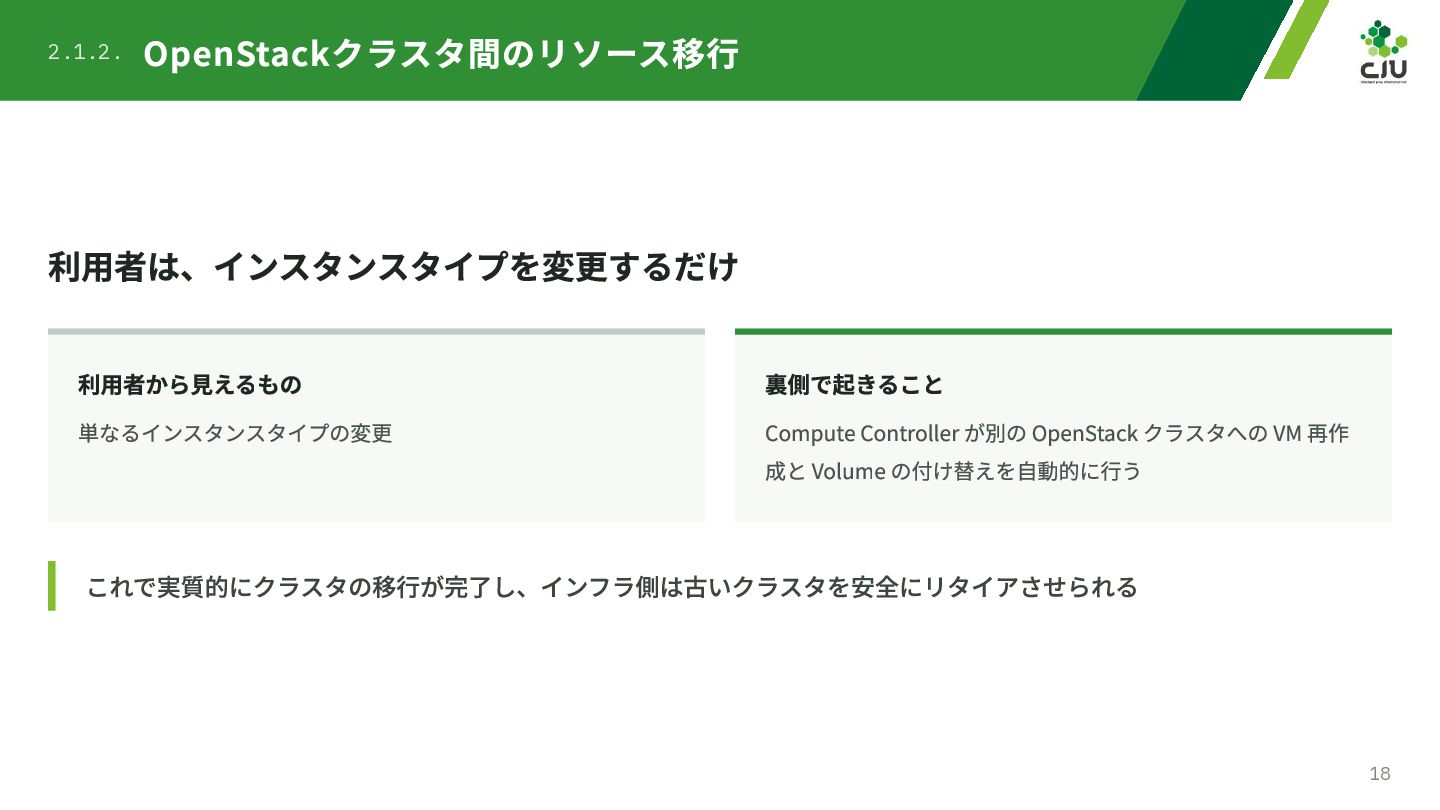
  10. 2.1.2. OpenStackクラスタ間のリソース移行 利用者は、インスタンスタイプを変更するだけ 利用者から見えるもの 単なるインスタンスタイプの変更 裏側で起きること Compute Controller が別の OpenStack

    クラスタへの VM 再作 成と Volume の付け替えを自動的に行う これで実質的にクラスタの移行が完了し、インフラ側は古いクラスタを安全にリタイアさせられる 18
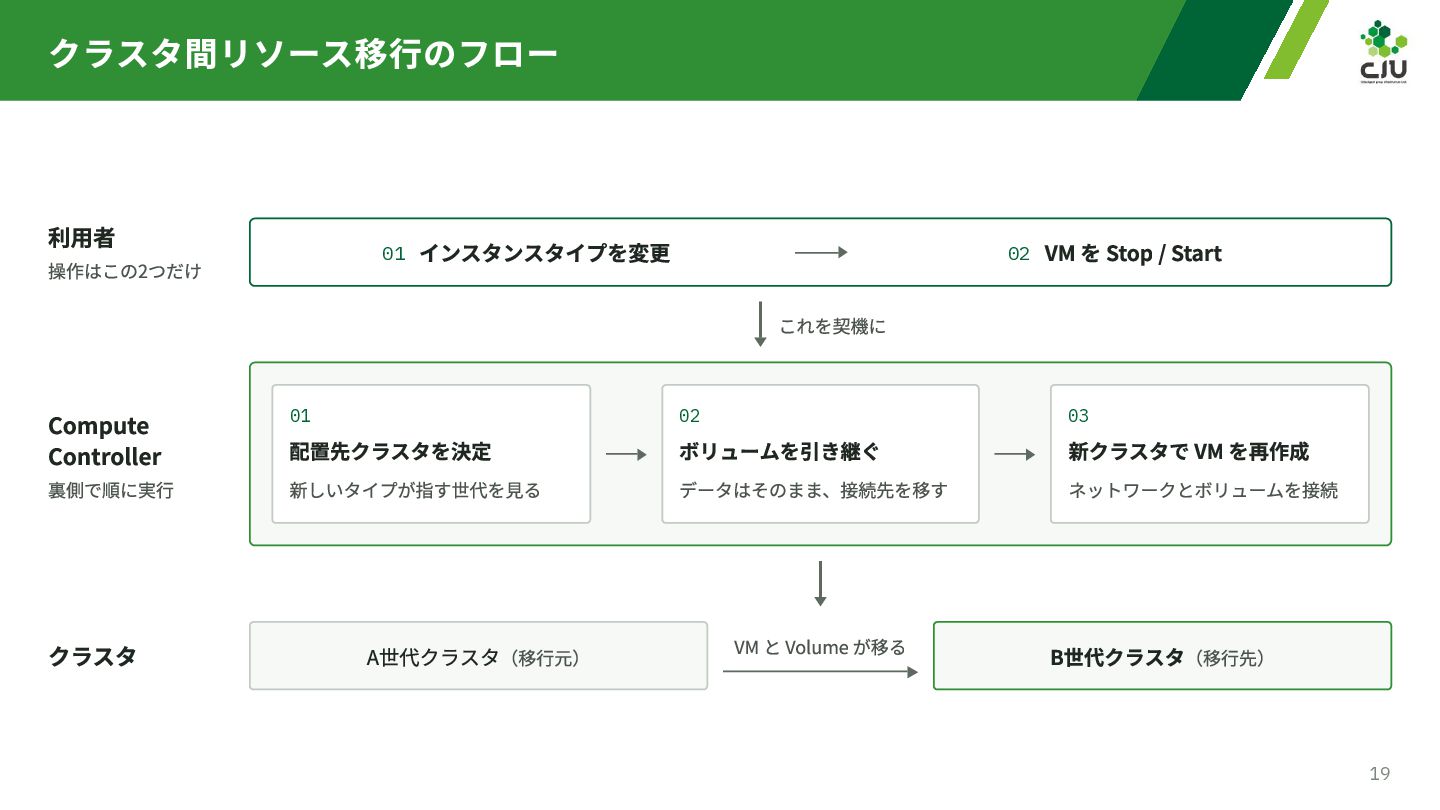
  11. クラスタ間リソース移行のフロー 利用者 01 操作はこの2つだけ インスタンスタイプを変更 02 VM を Stop /

    Start これを契機に Compute Controller 裏側で順に実行 クラスタ 01 02 03 新しいタイプが指す世代を見る データはそのまま、接続先を移す ネットワークとボリュームを接続 配置先クラスタを決定 A世代クラスタ(移行元) ボリュームを引き継ぐ VM と Volume が移る 新クラスタで VM を再作成 B世代クラスタ(移行先) 19
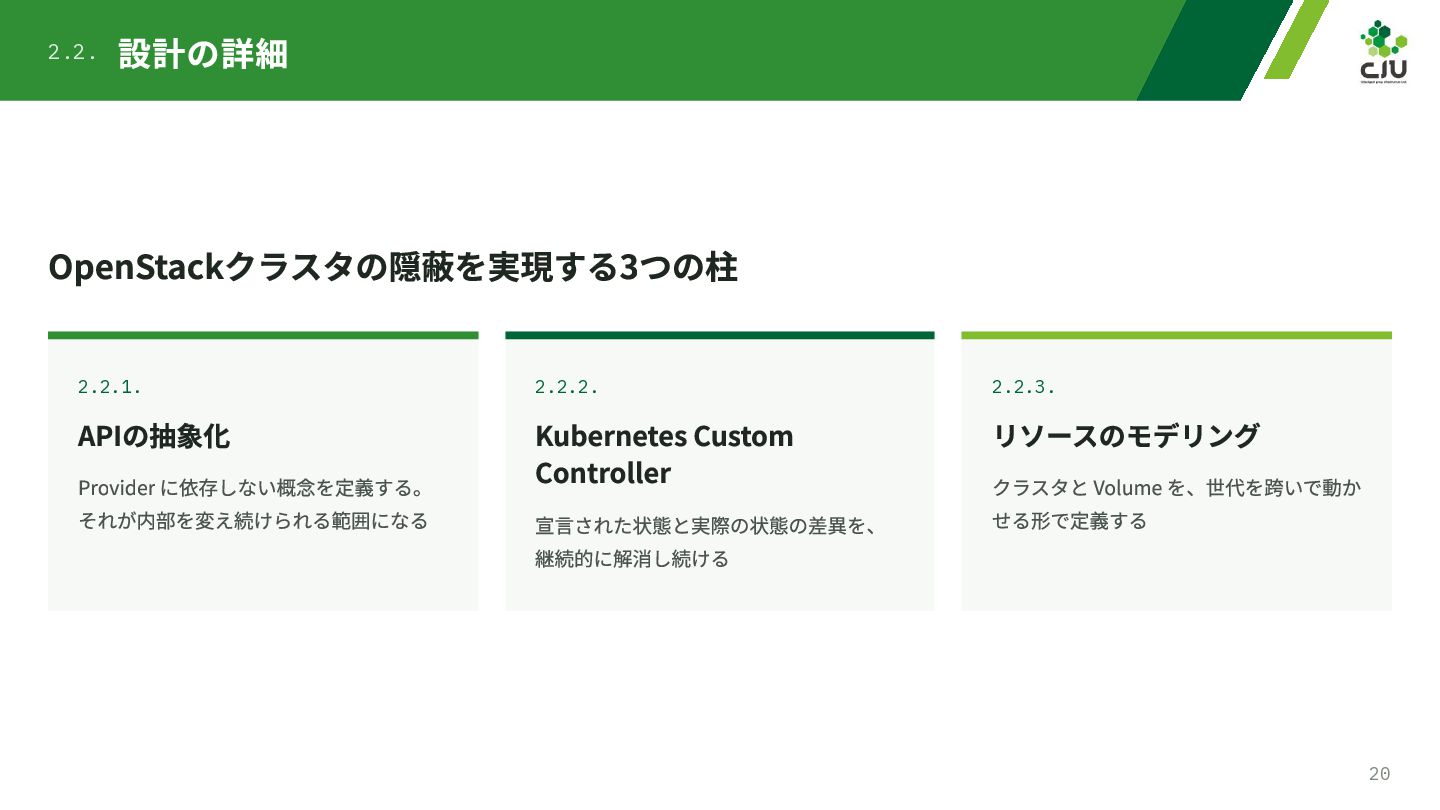
  12. 2.2. 設計の詳細 OpenStackクラスタの隠蔽を実現する3つの柱 2.2.1. APIの抽象化 Provider に依存しない概念を定義する。 それが内部を変え続けられる範囲になる 2.2.2. Kubernetes

    Custom Controller 宣言された状態と実際の状態の差異を、 継続的に解消し続ける 2.2.3. リソースのモデリング クラスタと Volume を、世代を跨いで動か せる形で定義する 20
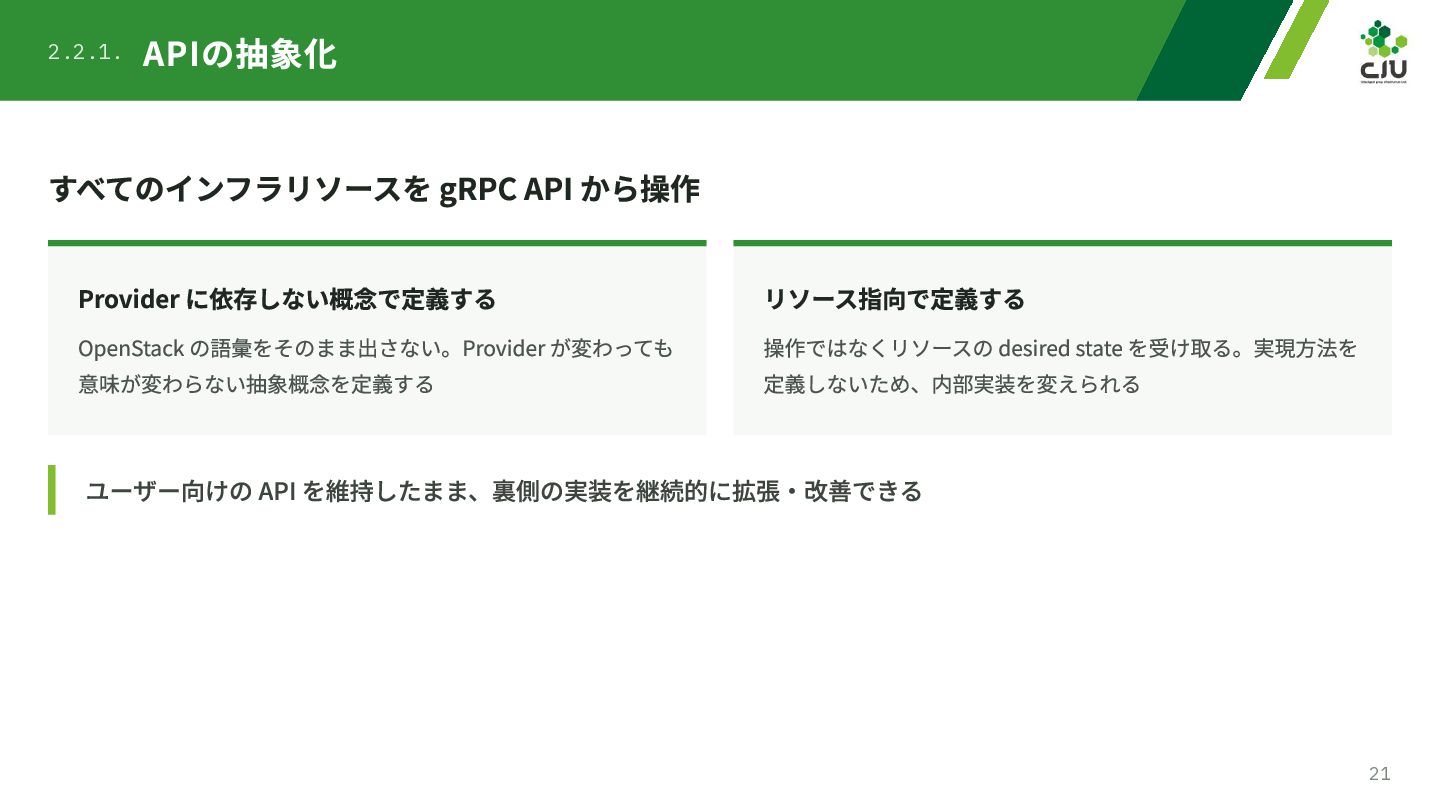
  13. 2.2.1. APIの抽象化 すべてのインフラリソースを gRPC API から操作 Provider に依存しない概念で定義する OpenStack の語彙をそのまま出さない。Provider

    が変わっても 意味が変わらない抽象概念を定義する リソース指向で定義する 操作ではなくリソースの desired state を受け取る。実現方法を 定義しないため、内部実装を変えられる ユーザー向けの API を維持したまま、裏側の実装を継続的に拡張・改善できる 21
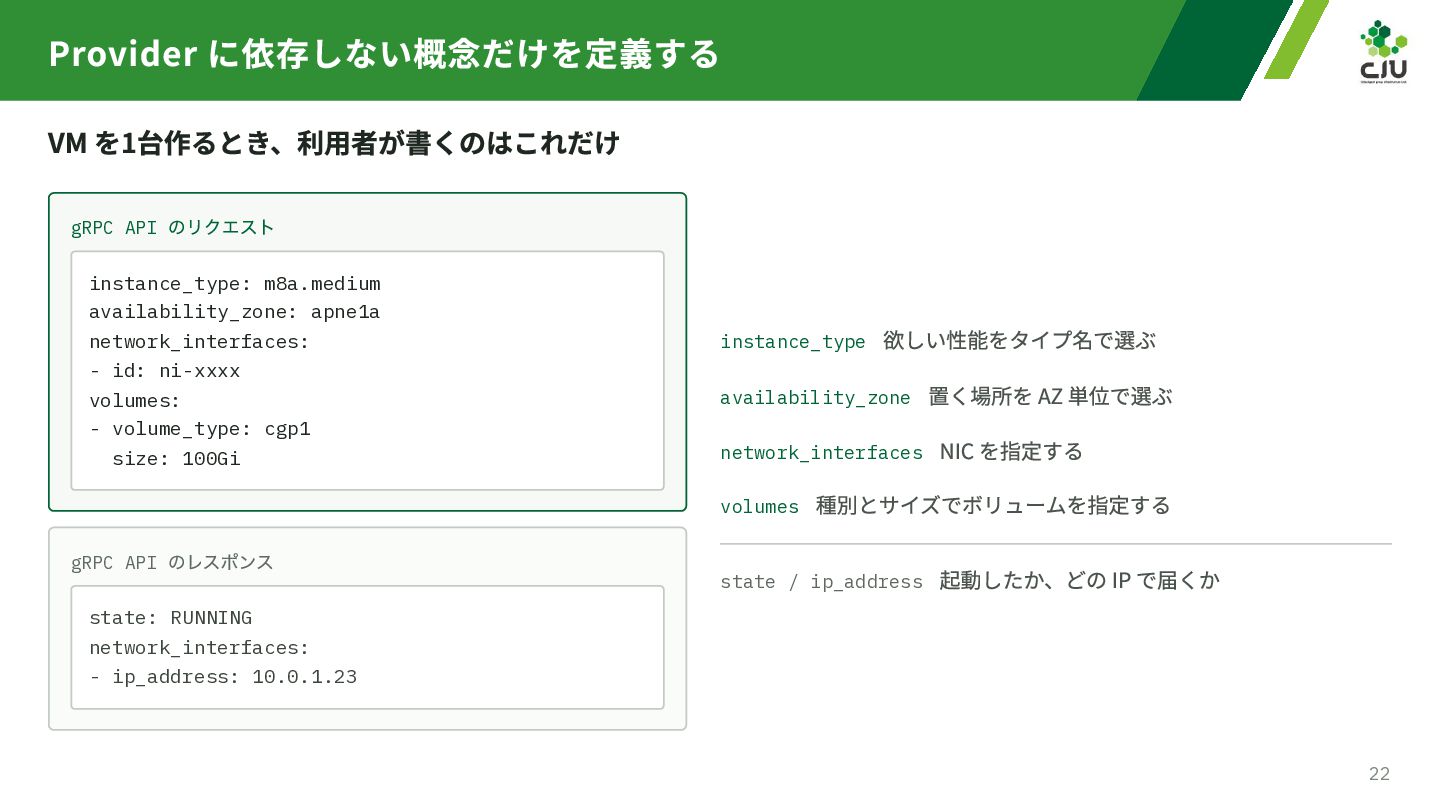
  14. Provider に依存しない概念だけを定義する VM を1台作るとき、利用者が書くのはこれだけ gRPC API のリクエスト instance_type: m8a.medium availability_zone:

    apne1a network_interfaces: - id: ni-xxxx volumes: - volume_type: cgp1 size: 100Gi gRPC API のレスポンス 欲しい性能をタイプ名で選ぶ availability_zone 置く場所を AZ 単位で選ぶ network_interfaces NIC を指定する volumes 種別とサイズでボリュームを指定する instance_type state / ip_address 起動したか、どの IP で届くか state: RUNNING network_interfaces: - ip_address: 10.0.1.23 22
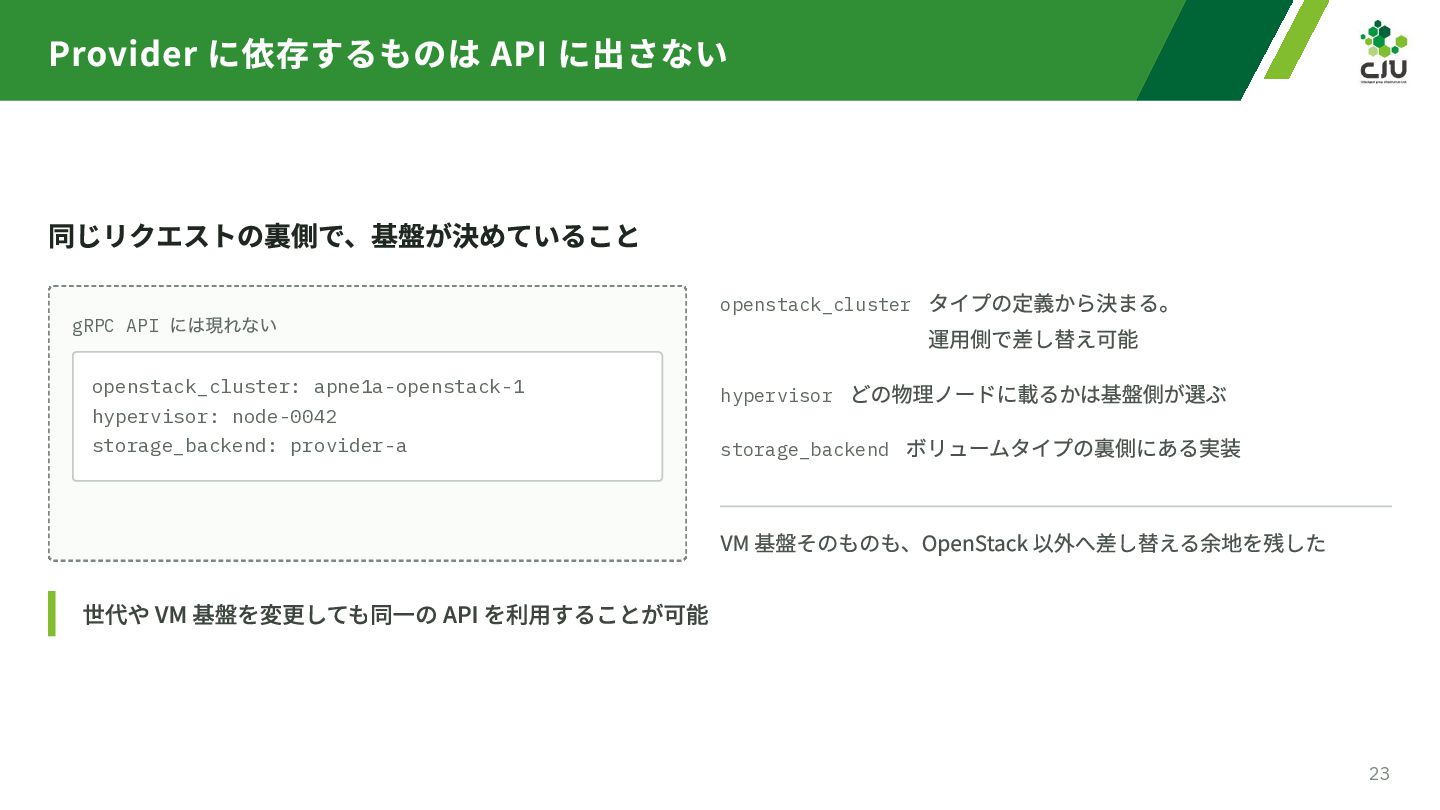
  15. Provider に依存するものは API に出さない 同じリクエストの裏側で、基盤が決めていること gRPC API には現れない openstack_cluster: apne1a-openstack-1

    hypervisor: node-0042 storage_backend: provider-a タイプの定義から決まる。 運用側で差し替え可能 hypervisor どの物理ノードに載るかは基盤側が選ぶ storage_backend ボリュームタイプの裏側にある実装 openstack_cluster VM 基盤そのものも、OpenStack 以外へ差し替える余地を残した 世代や VM 基盤を変更しても同一の API を利用することが可能 23
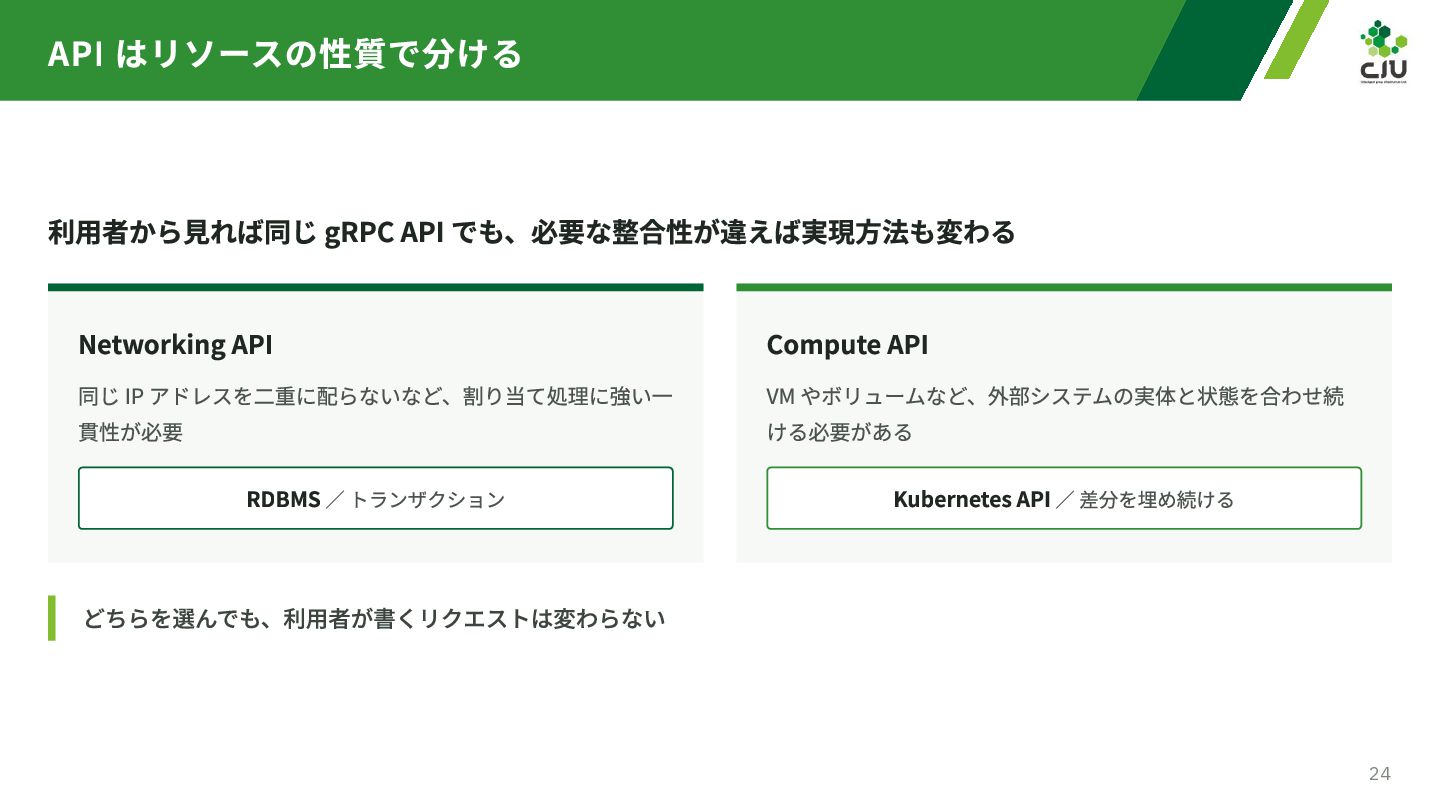
  16. API はリソースの性質で分ける 利用者から見れば同じ gRPC API でも、必要な整合性が違えば実現方法も変わる Networking API 同じ IP

    アドレスを二重に配らないなど、割り当て処理に強い一 貫性が必要 RDBMS / トランザクション Compute API VM やボリュームなど、外部システムの実体と状態を合わせ続 ける必要がある Kubernetes API / 差分を埋め続ける どちらを選んでも、利用者が書くリクエストは変わらない 24
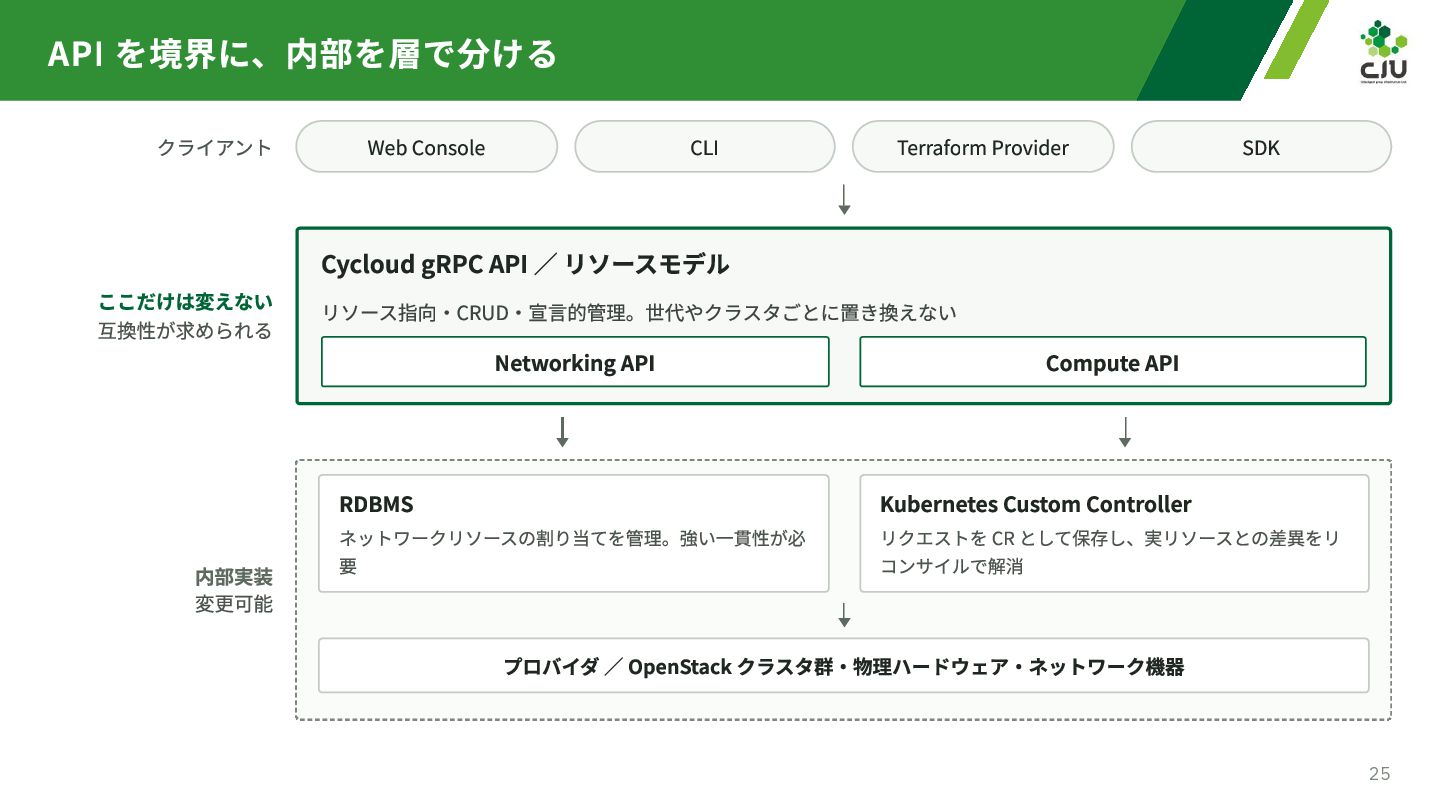
  17. API を境界に、内部を層で分ける クライアント ここだけは変えない 互換性が求められる Web Console Terraform Provider SDK

    Cycloud gRPC API / リソースモデル リソース指向・CRUD・宣言的管理。世代やクラスタごとに置き換えない Networking API RDBMS 内部実装 変更可能 CLI ネットワークリソースの割り当てを管理。強い一貫性が必 要 Compute API Kubernetes Custom Controller リクエストを CR として保存し、実リソースとの差異をリ コンサイルで解消 プロバイダ / OpenStack クラスタ群・物理ハードウェア・ネットワーク機器 25
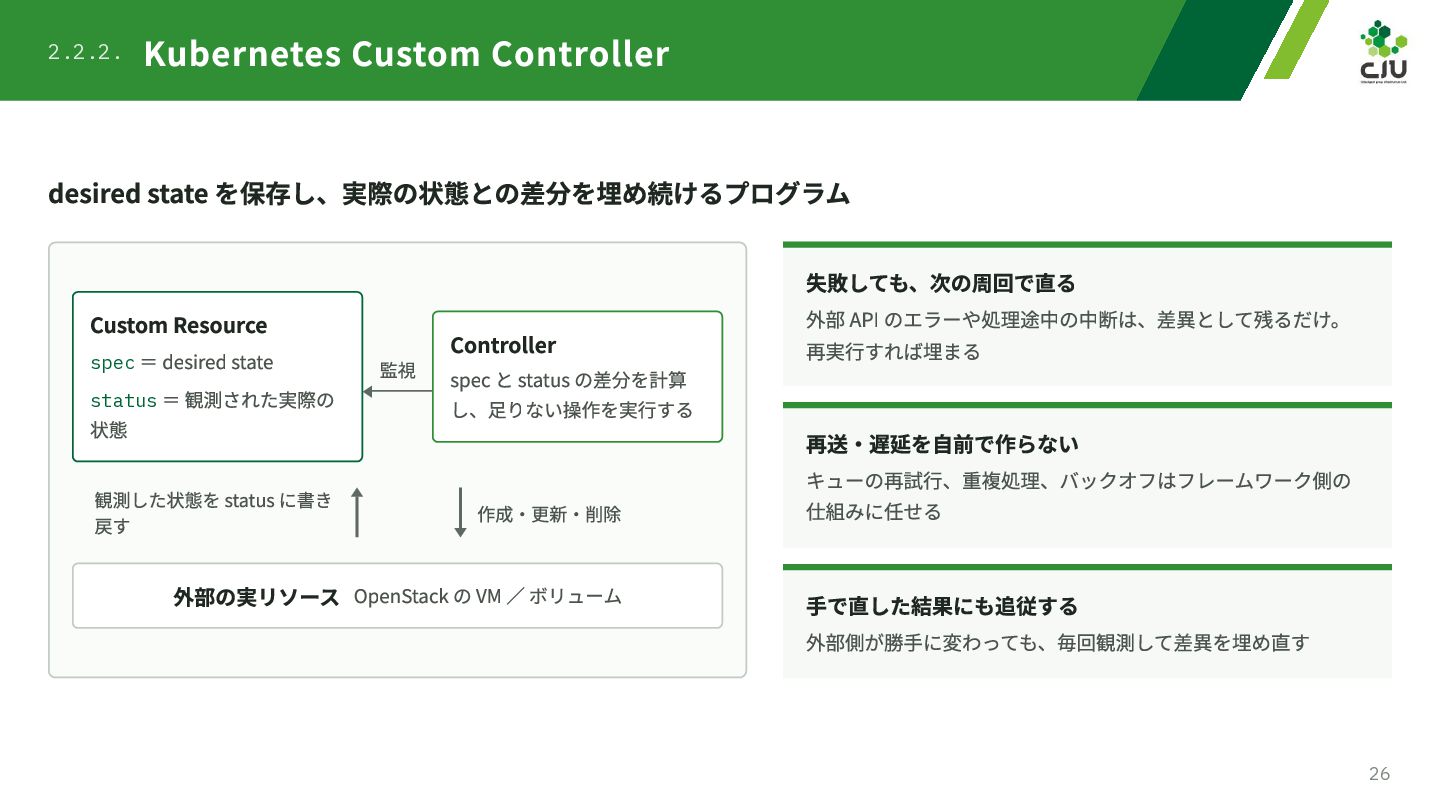
  18. 2.2.2. Kubernetes Custom Controller desired state を保存し、実際の状態との差分を埋め続けるプログラム Custom Resource =

    desired state status = 観測された実際の 状態 spec 観測した状態を status に書き 戻す 失敗しても、次の周回で直る Controller 監視 spec と status の差分を計算 し、足りない操作を実行する 作成・更新・削除 外部の実リソース OpenStack の VM / ボリューム 外部 API のエラーや処理途中の中断は、差異として残るだけ。 再実行すれば埋まる 再送・遅延を自前で作らない キューの再試行、重複処理、バックオフはフレームワーク側の 仕組みに任せる 手で直した結果にも追従する 外部側が勝手に変わっても、毎回観測して差異を埋め直す 26
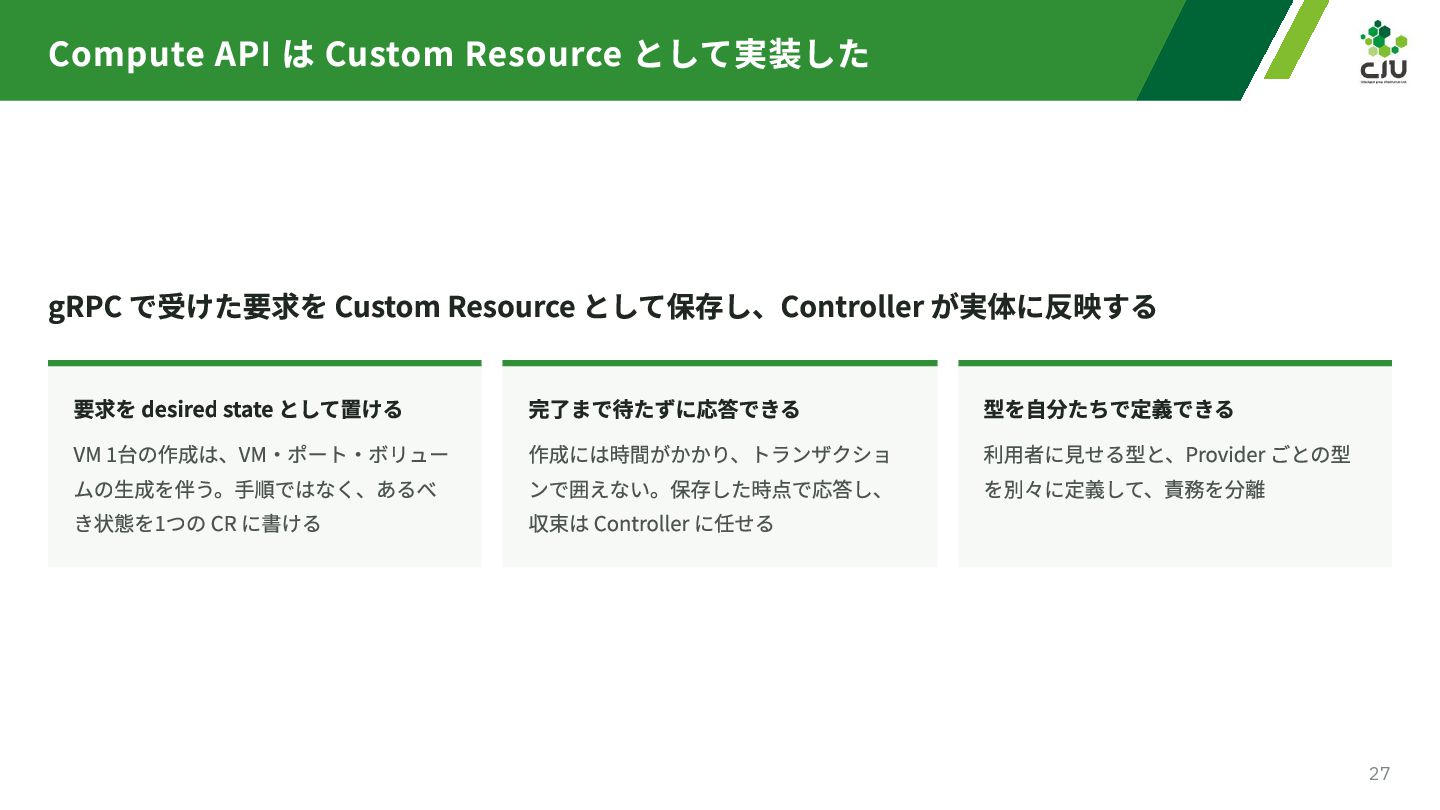
  19. Compute API は Custom Resource として実装した gRPC で受けた要求を Custom Resource

    として保存し、Controller が実体に反映する 要求を desired state として置ける VM 1台の作成は、VM・ポート・ボリュー ムの生成を伴う。手順ではなく、あるべ き状態を1つの CR に書ける 完了まで待たずに応答できる 作成には時間がかかり、トランザクショ ンで囲えない。保存した時点で応答し、 収束は Controller に任せる 型を自分たちで定義できる 利用者に見せる型と、Provider ごとの型 を別々に定義して、責務を分離 27
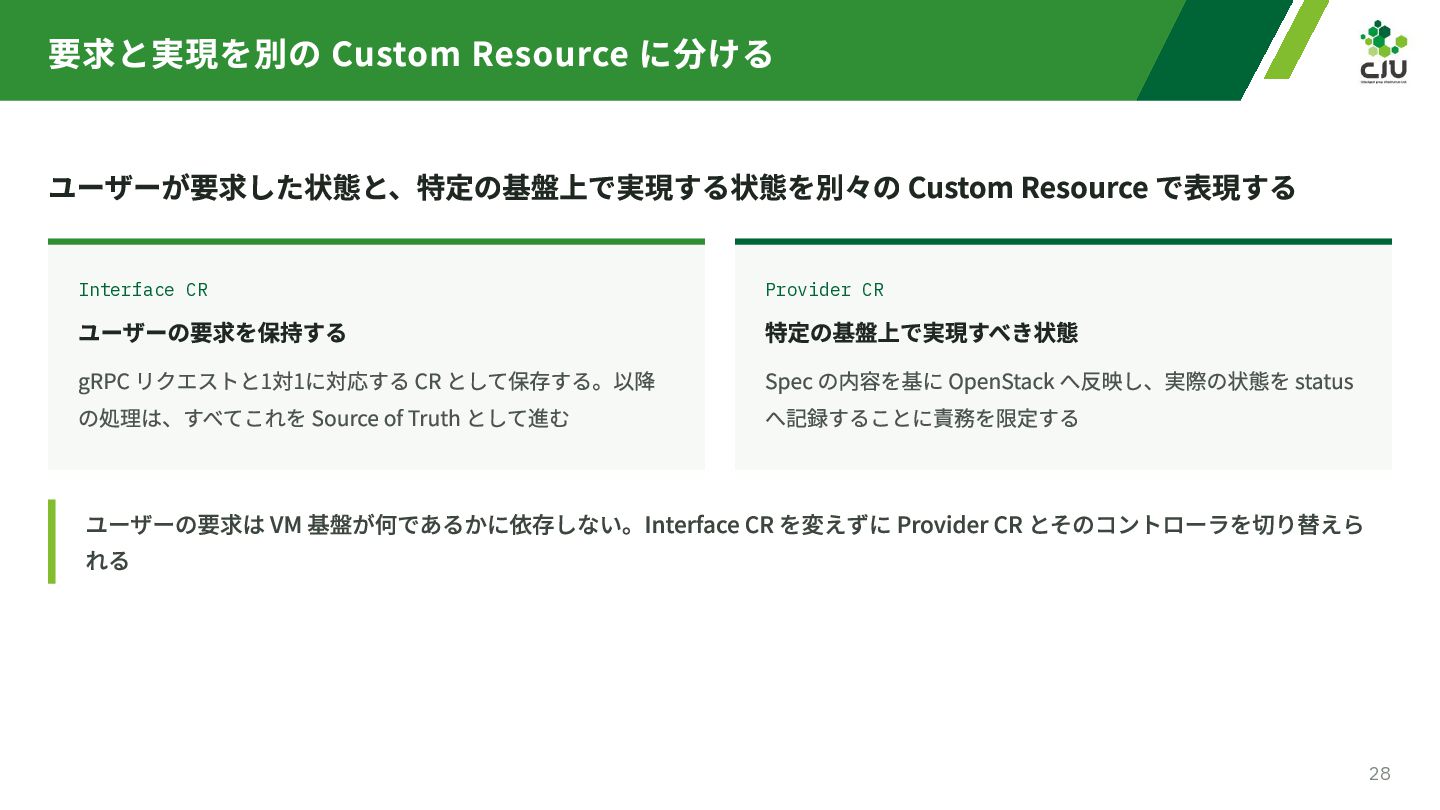
  20. 要求と実現を別の Custom Resource に分ける ユーザーが要求した状態と、特定の基盤上で実現する状態を別々の Custom Resource で表現する Interface CR

    Provider CR gRPC リクエストと1対1に対応する CR として保存する。以降 の処理は、すべてこれを Source of Truth として進む Spec の内容を基に OpenStack へ反映し、実際の状態を status へ記録することに責務を限定する ユーザーの要求を保持する 特定の基盤上で実現すべき状態 ユーザーの要求は VM 基盤が何であるかに依存しない。Interface CR を変えずに Provider CR とそのコントローラを切り替えら れる 28
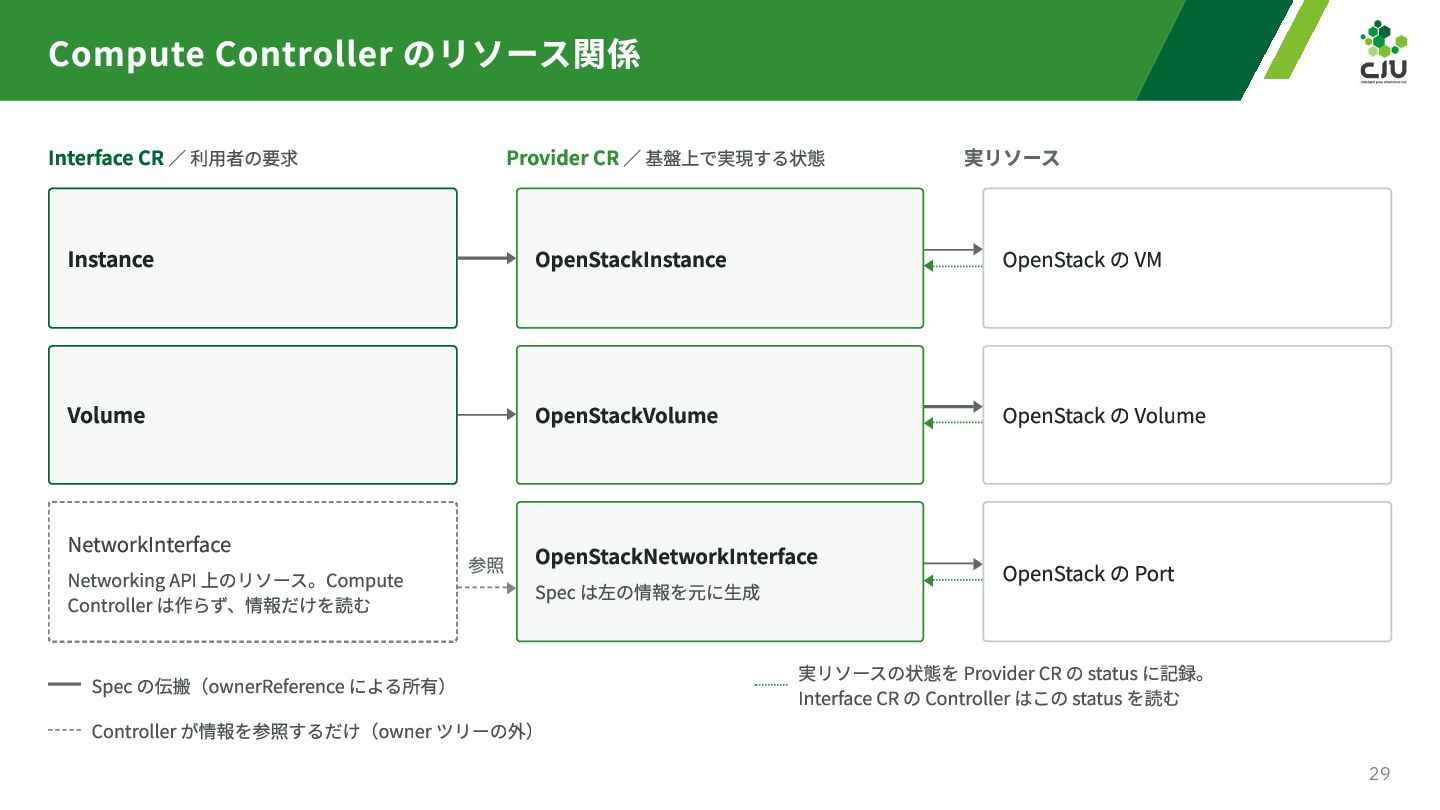
  21. Compute Controller のリソース関係 Interface CR / 利用者の要求 Provider CR /

    基盤上で実現する状態 実リソース Instance OpenStackInstance OpenStack の VM Volume OpenStackVolume OpenStack の Volume 参照 OpenStackNetworkInterface Spec は左の情報を元に生成 OpenStack の Port NetworkInterface Networking API 上のリソース。Compute Controller は作らず、情報だけを読む Spec の伝搬(ownerReference による所有) Controller が情報を参照するだけ(owner ツリーの外) 実リソースの状態を Provider CR の status に記録。 Interface CR の Controller はこの status を読む 29
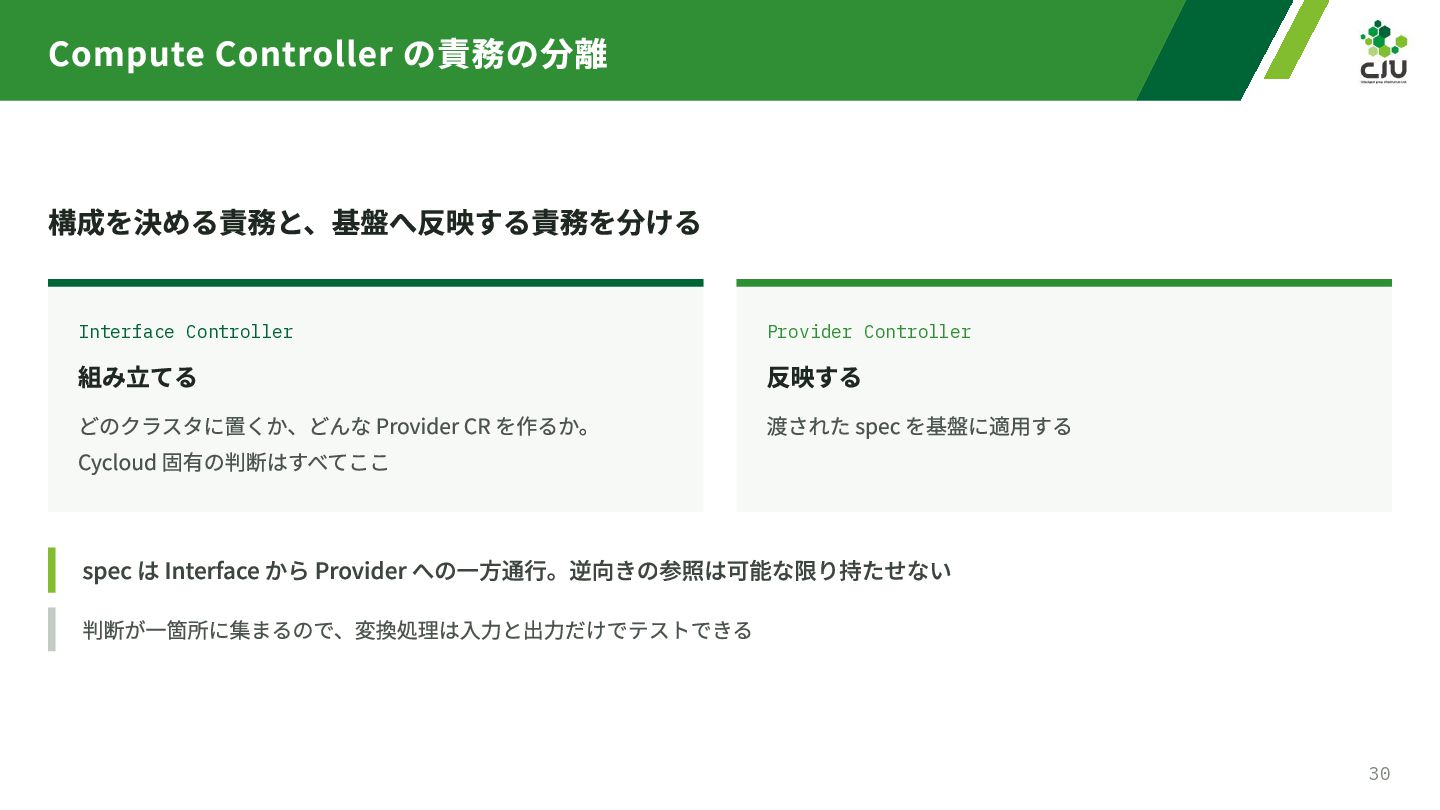
  22. Compute Controller の責務の分離 構成を決める責務と、基盤へ反映する責務を分ける Interface Controller Provider Controller どのクラスタに置くか、どんな Provider

    CR を作るか。 Cycloud 固有の判断はすべてここ 渡された spec を基盤に適用する 組み立てる 反映する spec は Interface から Provider への一方通行。逆向きの参照は可能な限り持たせない 判断が一箇所に集まるので、変換処理は入力と出力だけでテストできる 30
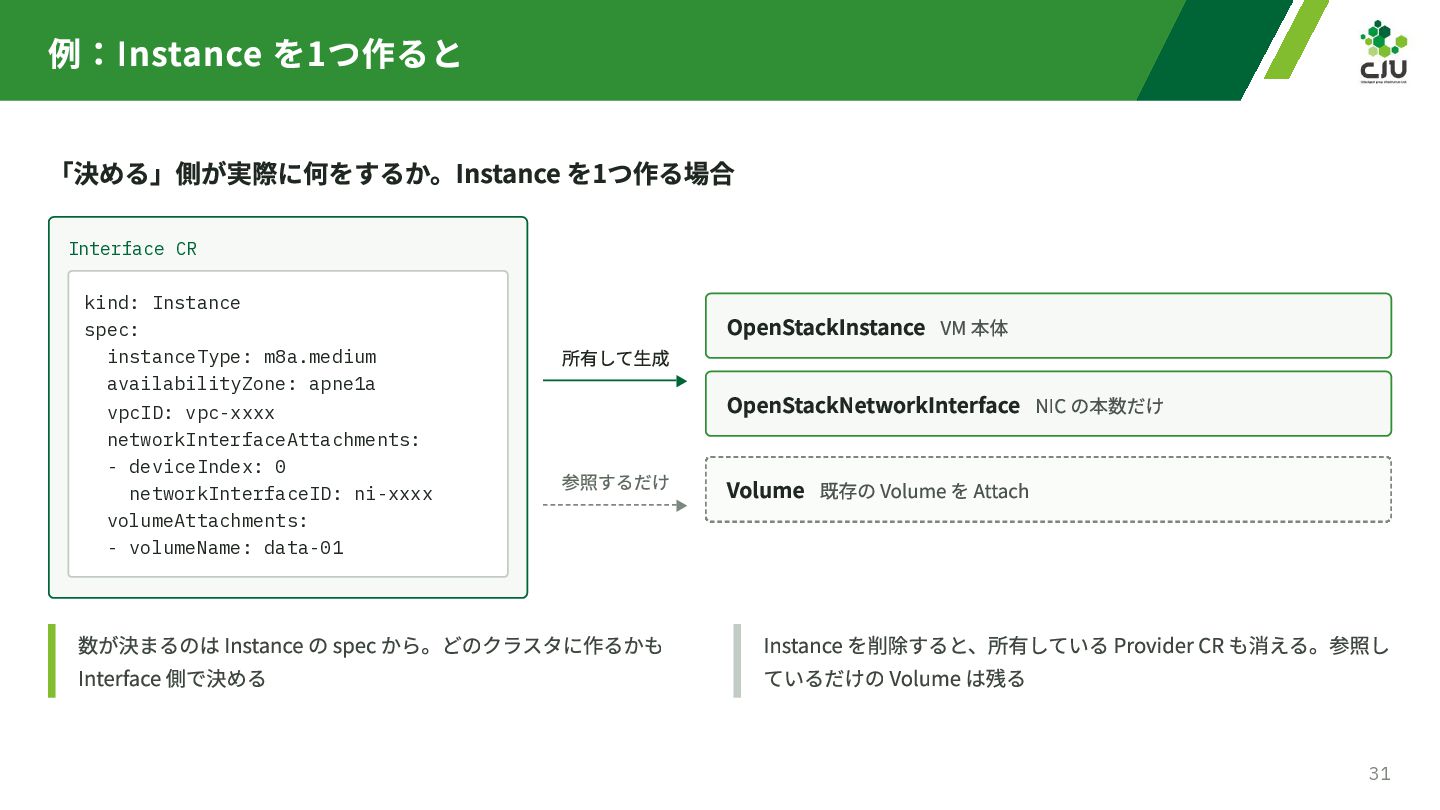
  23. 例:Instance を1つ作ると 「決める」側が実際に何をするか。Instance を1つ作る場合 Interface CR kind: Instance spec: instanceType:

    m8a.medium availabilityZone: apne1a vpcID: vpc-xxxx networkInterfaceAttachments: - deviceIndex: 0 networkInterfaceID: ni-xxxx volumeAttachments: - volumeName: data-01 所有して生成 参照するだけ 数が決まるのは Instance の spec から。どのクラスタに作るかも Interface 側で決める OpenStackInstance VM 本体 OpenStackNetworkInterface NIC の本数だけ Volume 既存の Volume を Attach Instance を削除すると、所有している Provider CR も消える。参照し ているだけの Volume は残る 31
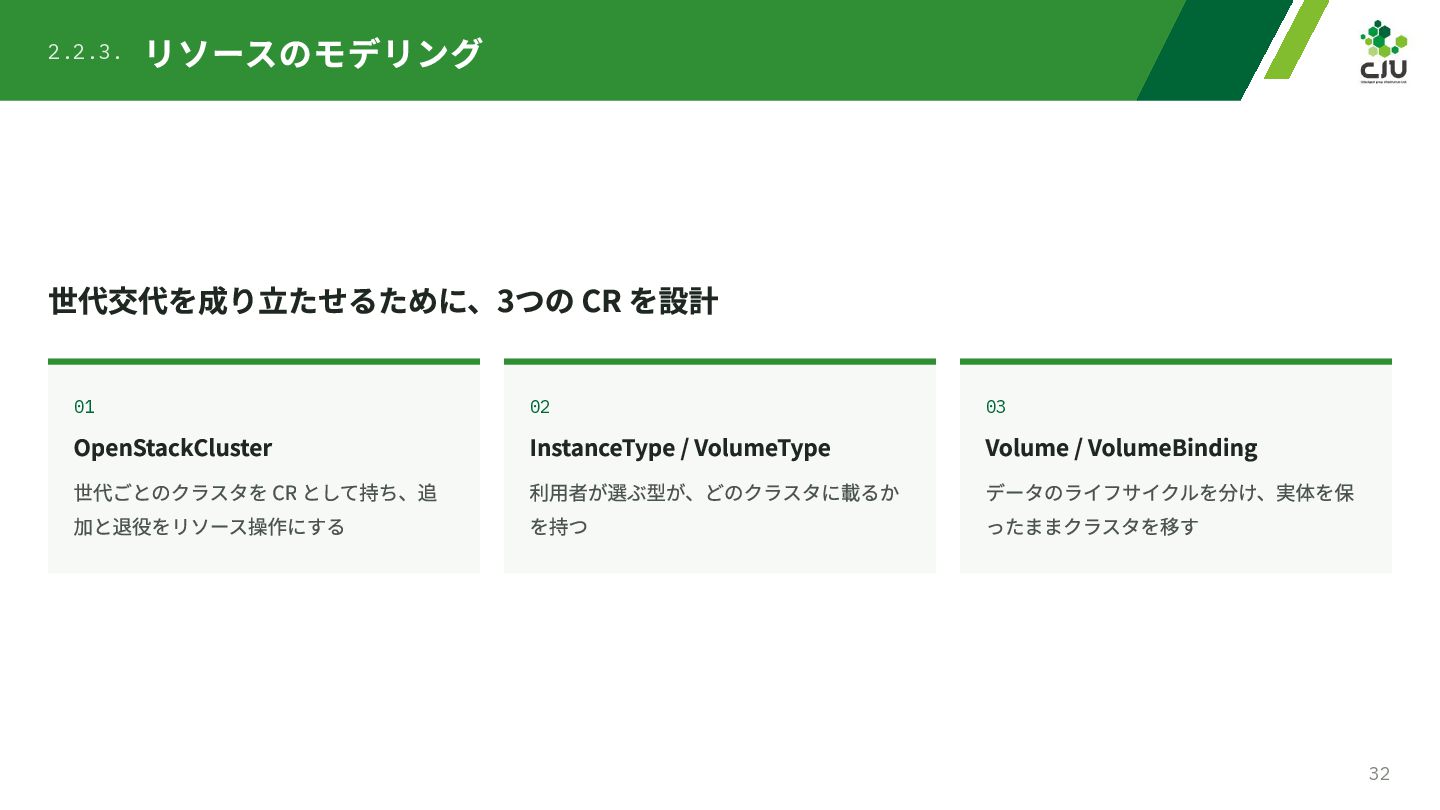
  24. 2.2.3. リソースのモデリング 世代交代を成り立たせるために、3つの CR を設計 01 02 03 世代ごとのクラスタを CR

    として持ち、追 加と退役をリソース操作にする 利用者が選ぶ型が、どのクラスタに載るか を持つ データのライフサイクルを分け、実体を保 ったままクラスタを移す OpenStackCluster InstanceType / VolumeType Volume / VolumeBinding 32
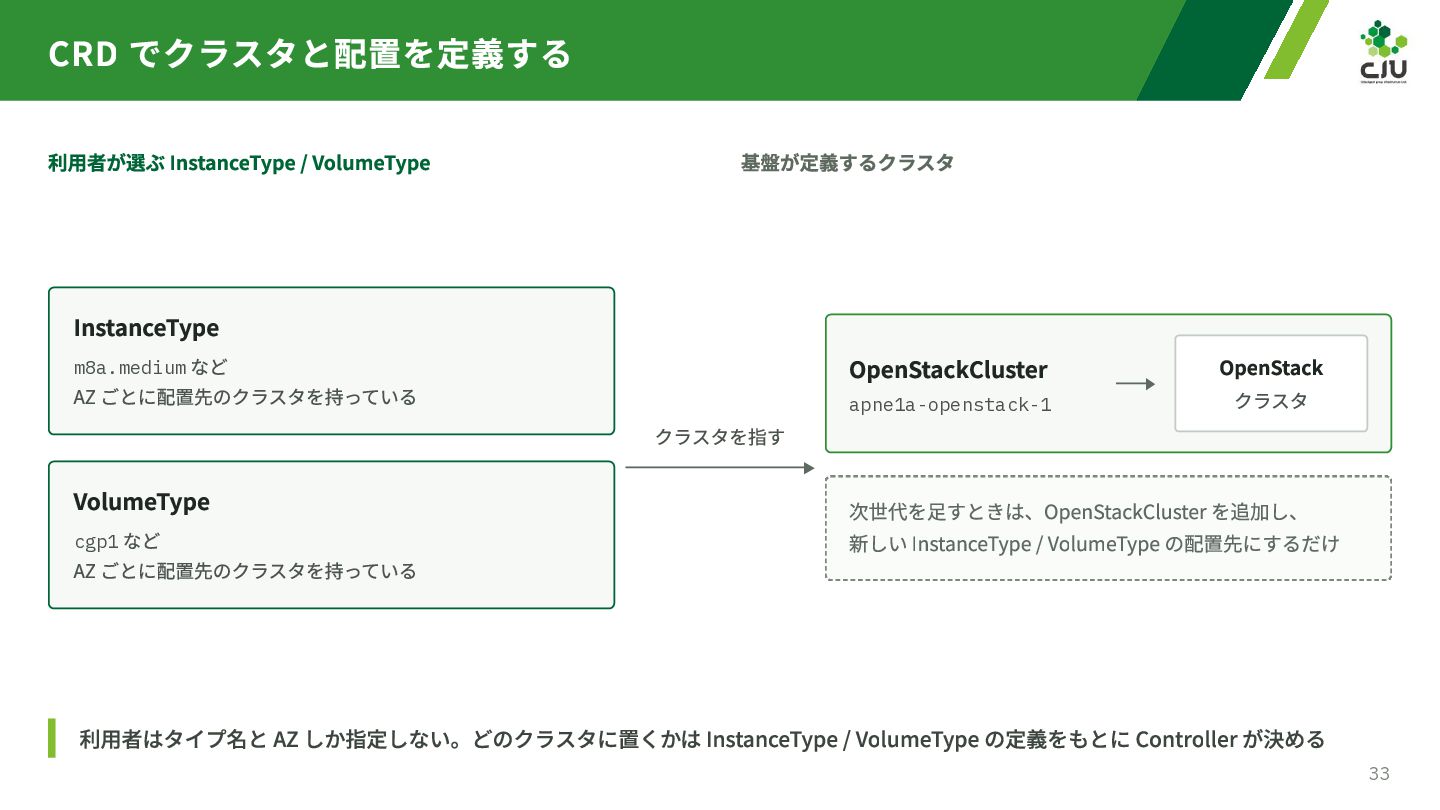
  25. CRD でクラスタと配置を定義する 利用者が選ぶ InstanceType / VolumeType 基盤が定義するクラスタ InstanceType など AZ

    ごとに配置先のクラスタを持っている OpenStackCluster m8a.medium VolumeType など AZ ごとに配置先のクラスタを持っている cgp1 クラスタを指す apne1a-openstack-1 OpenStack クラスタ 次世代を足すときは、OpenStackCluster を追加し、 新しい InstanceType / VolumeType の配置先にするだけ 利用者はタイプ名と AZ しか指定しない。どのクラスタに置くかは InstanceType / VolumeType の定義をもとに Controller が決める 33
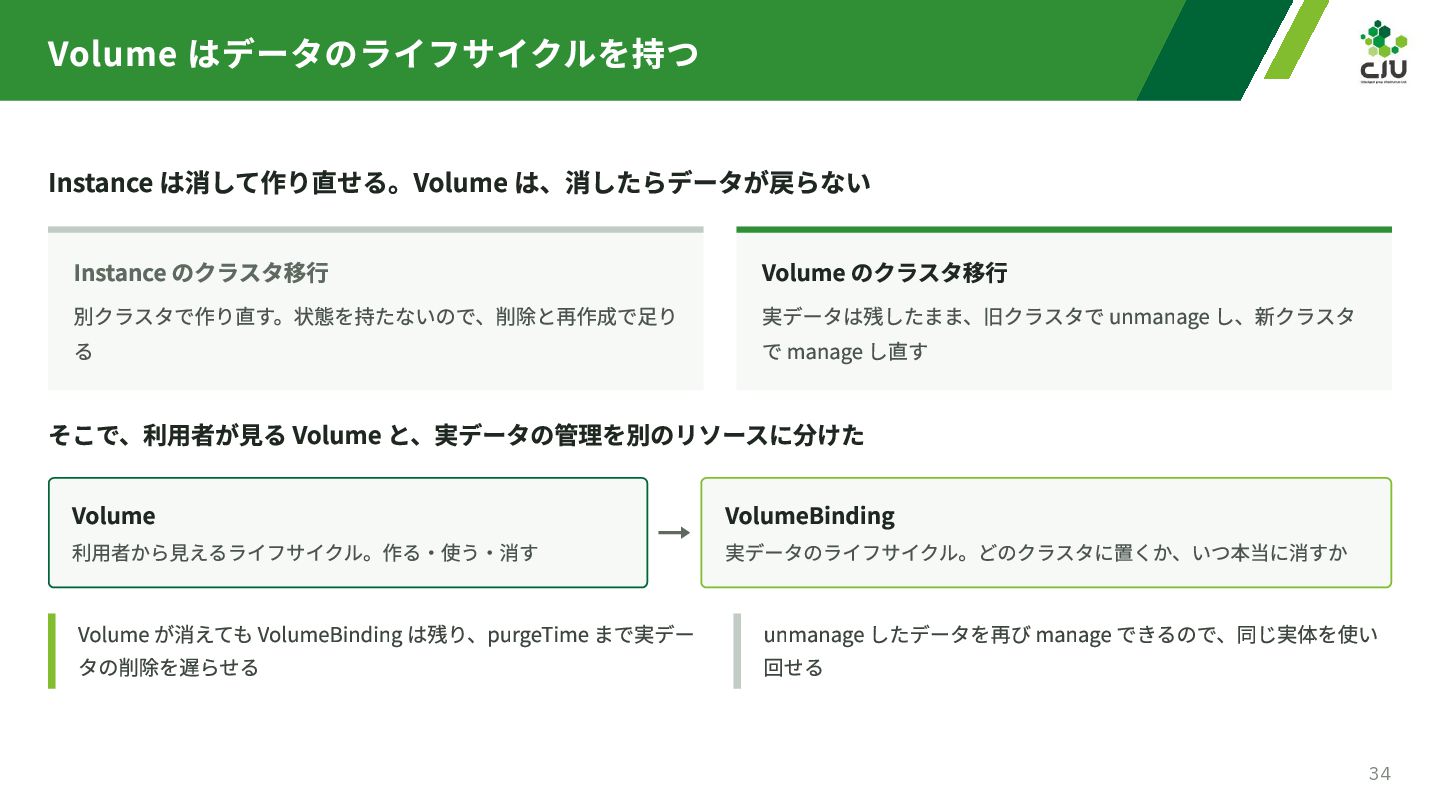
  26. Volume はデータのライフサイクルを持つ Instance は消して作り直せる。Volume は、消したらデータが戻らない Instance のクラスタ移行 別クラスタで作り直す。状態を持たないので、削除と再作成で足り る Volume

    のクラスタ移行 実データは残したまま、旧クラスタで unmanage し、新クラスタ で manage し直す そこで、利用者が見る Volume と、実データの管理を別のリソースに分けた Volume 利用者から見えるライフサイクル。作る・使う・消す Volume が消えても VolumeBinding は残り、purgeTime まで実デー タの削除を遅らせる VolumeBinding 実データのライフサイクル。どのクラスタに置くか、いつ本当に消すか unmanage したデータを再び manage できるので、同じ実体を使い 回せる 34
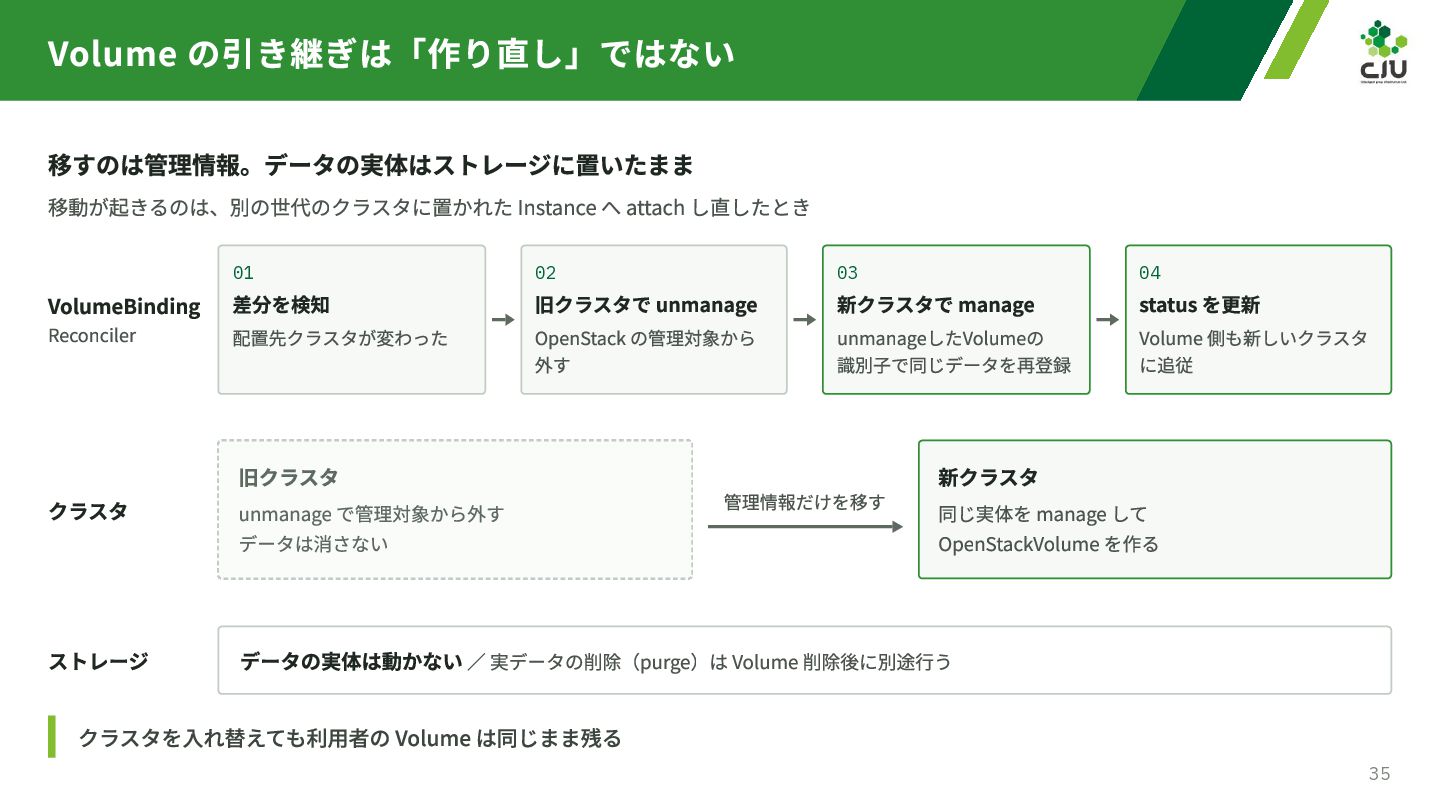
  27. Volume の引き継ぎは「作り直し」ではない 移すのは管理情報。データの実体はストレージに置いたまま 移動が起きるのは、別の世代のクラスタに置かれた Instance へ attach し直したとき 01 02

    03 04 配置先クラスタが変わった OpenStack の管理対象から 外す unmanageしたVolumeの 識別子で同じデータを再登録 Volume 側も新しいクラスタ に追従 VolumeBinding 差分を検知 Reconciler クラスタ ストレージ 旧クラスタで unmanage 旧クラスタ unmanage で管理対象から外す データは消さない 新クラスタで manage 管理情報だけを移す status を更新 新クラスタ 同じ実体を manage して OpenStackVolume を作る データの実体は動かない / 実データの削除(purge)は Volume 削除後に別途行う クラスタを入れ替えても利用者の Volume は同じまま残る 35
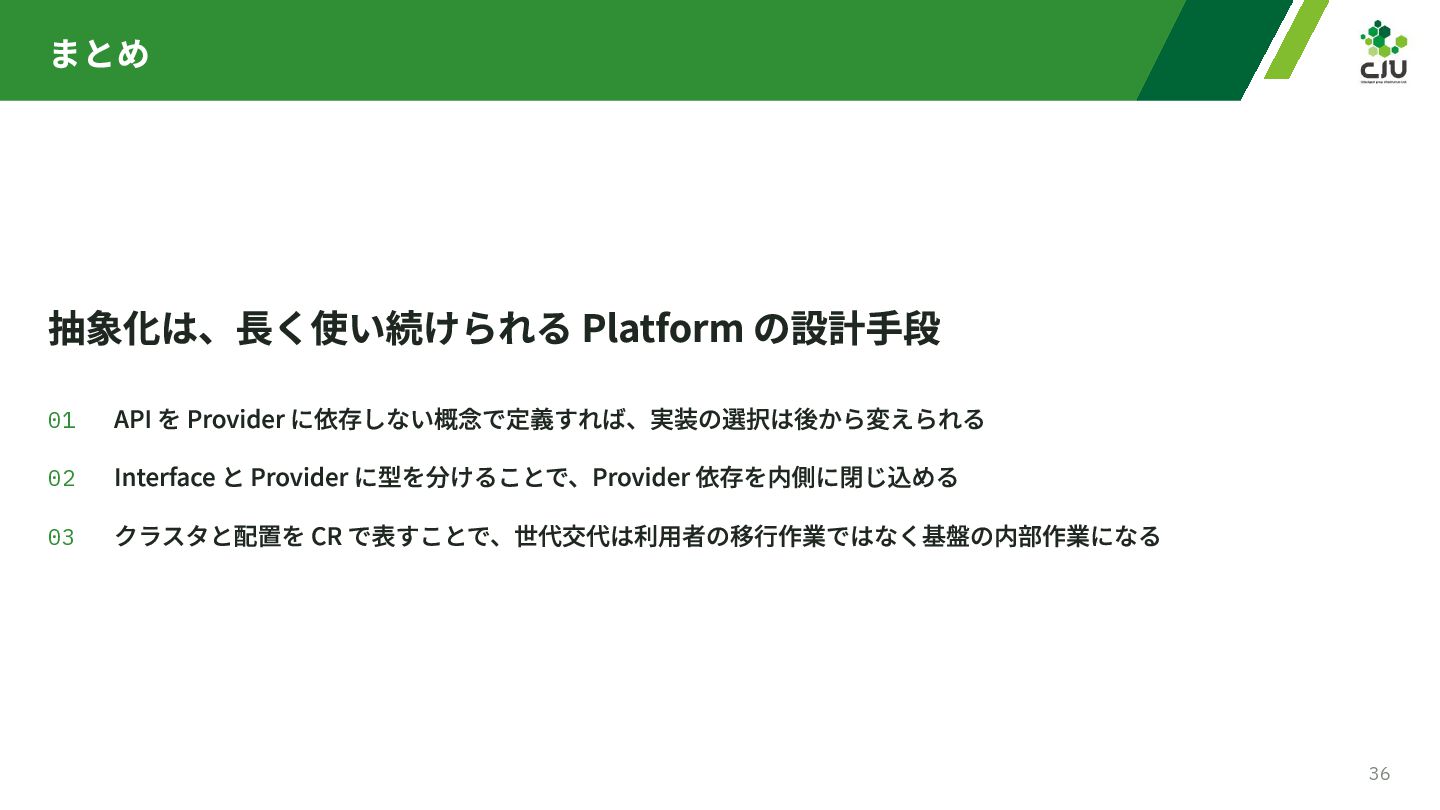
  28. まとめ 抽象化は、長く使い続けられる Platform の設計手段 01 02 03 API を Provider

    に依存しない概念で定義すれば、実装の選択は後から変えられる Interface と Provider に型を分けることで、Provider 依存を内側に閉じ込める クラスタと配置を CR で表すことで、世代交代は利用者の移行作業ではなく基盤の内部作業になる 36
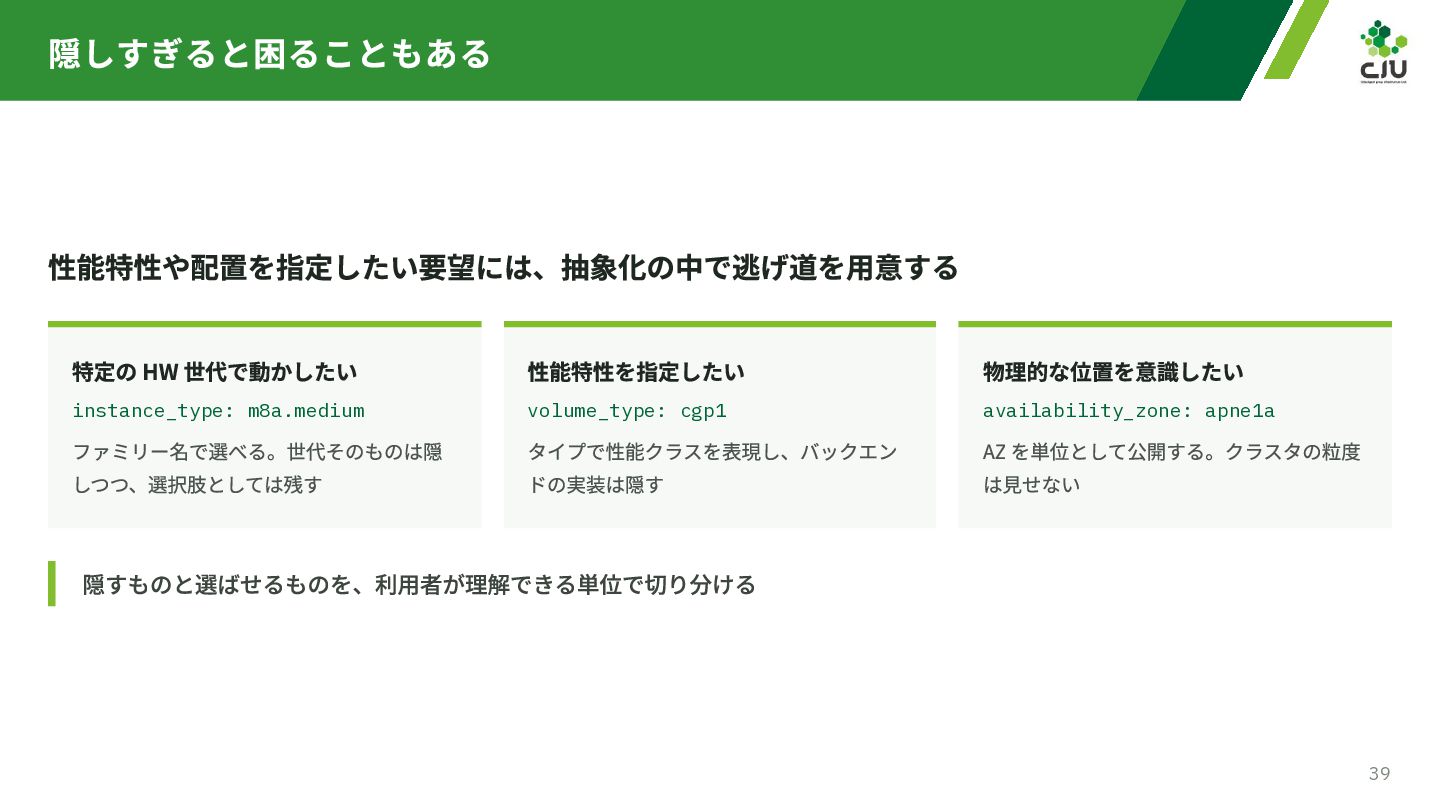
  29. 隠しすぎると困ることもある 性能特性や配置を指定したい要望には、抽象化の中で逃げ道を用意する 特定の HW 世代で動かしたい 性能特性を指定したい 物理的な位置を意識したい instance_type: m8a.medium volume_type:

    cgp1 availability_zone: apne1a ファミリー名で選べる。世代そのものは隠 しつつ、選択肢としては残す タイプで性能クラスを表現し、バックエン ドの実装は隠す AZ を単位として公開する。クラスタの粒度 は見せない 隠すものと選ばせるものを、利用者が理解できる単位で切り分ける 39
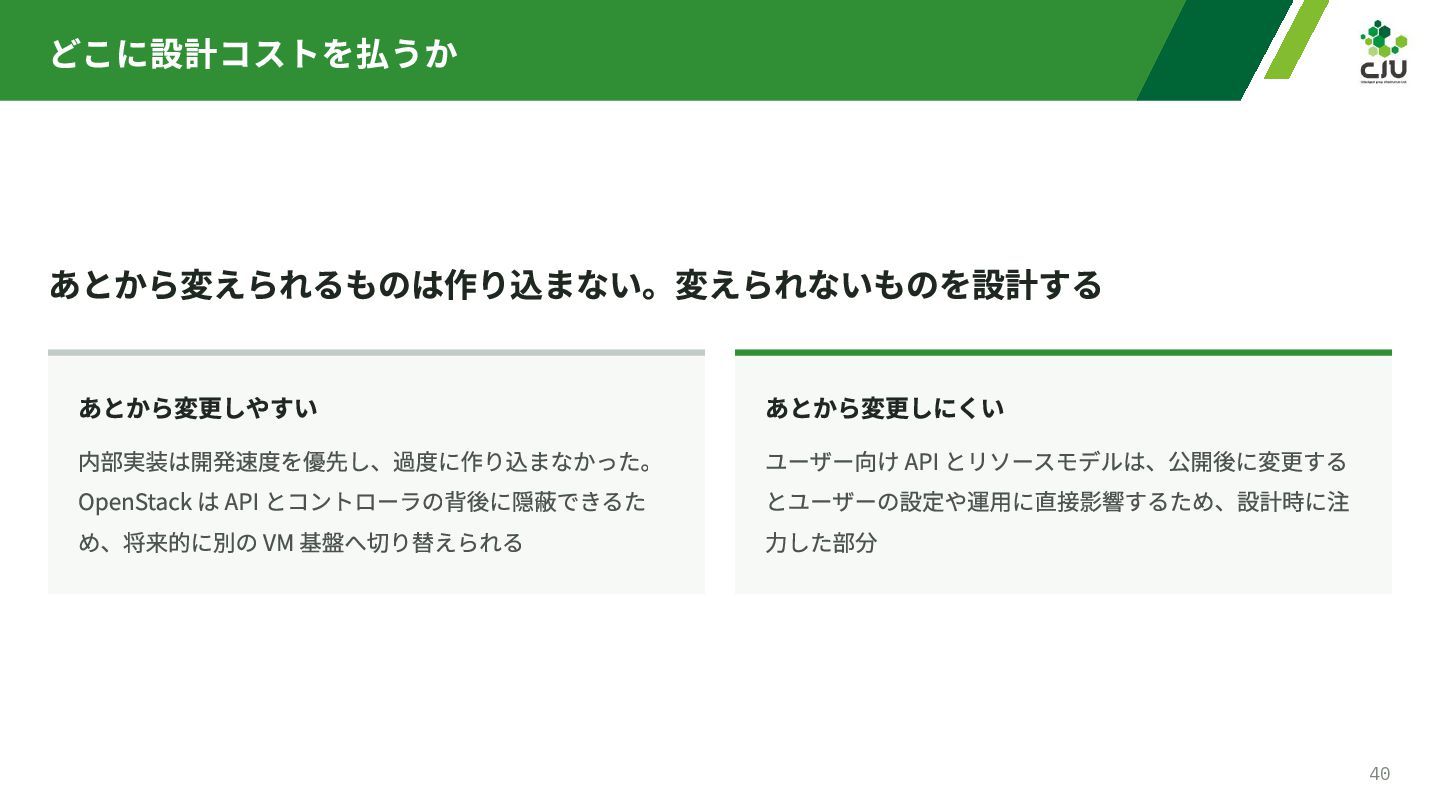
  30. どこに設計コストを払うか あとから変えられるものは作り込まない。変えられないものを設計する あとから変更しやすい 内部実装は開発速度を優先し、過度に作り込まなかった。 OpenStack は API とコントローラの背後に隠蔽できるた め、将来的に別の VM

    基盤へ切り替えられる あとから変更しにくい ユーザー向け API とリソースモデルは、公開後に変更する とユーザーの設定や運用に直接影響するため、設計時に注 力した部分 40
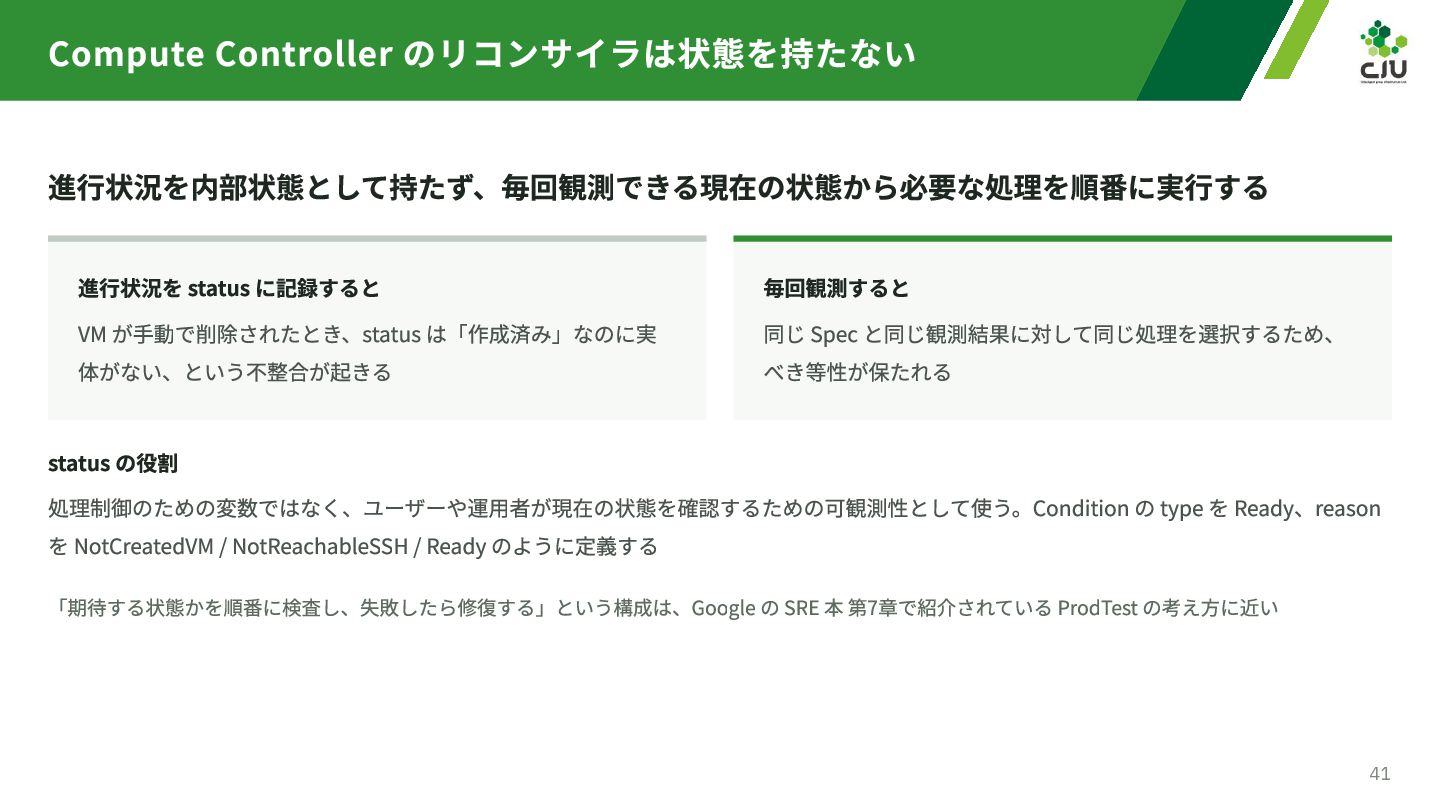
  31. Compute Controller のリコンサイラは状態を持たない 進行状況を内部状態として持たず、毎回観測できる現在の状態から必要な処理を順番に実行する 進行状況を status に記録すると VM が手動で削除されたとき、status は「作成済み」なのに実

    体がない、という不整合が起きる 毎回観測すると 同じ Spec と同じ観測結果に対して同じ処理を選択するため、 べき等性が保たれる status の役割 処理制御のための変数ではなく、ユーザーや運用者が現在の状態を確認するための可観測性として使う。Condition の type を Ready、reason を NotCreatedVM / NotReachableSSH / Ready のように定義する 「期待する状態かを順番に検査し、失敗したら修復する」という構成は、Google の SRE 本 第7章で紹介されている ProdTest の考え方に近い 41
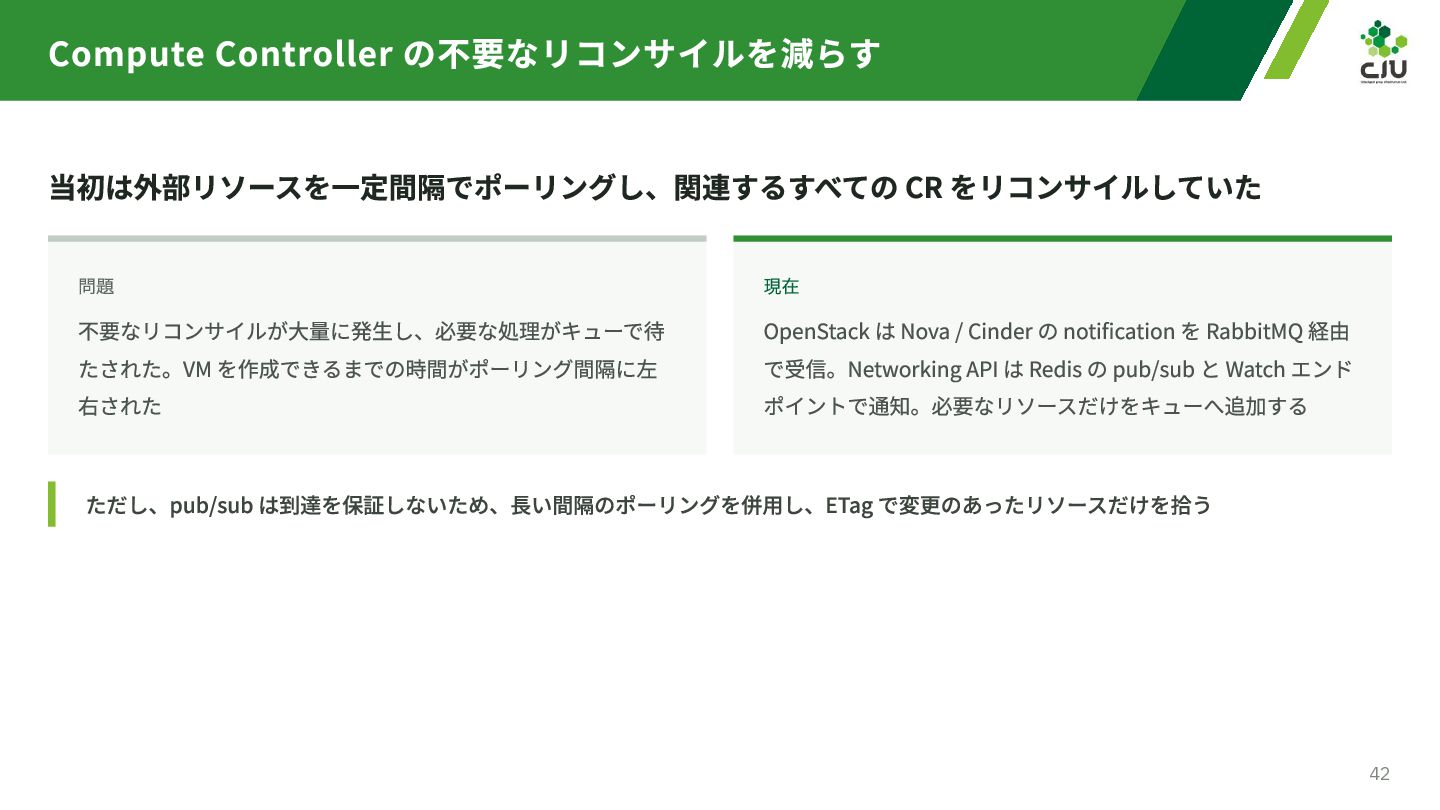
  32. Compute Controller の不要なリコンサイルを減らす 当初は外部リソースを一定間隔でポーリングし、関連するすべての CR をリコンサイルしていた 問題 不要なリコンサイルが大量に発生し、必要な処理がキューで待 たされた。VM を作成できるまでの時間がポーリング間隔に左

    右された 現在 OpenStack は Nova / Cinder の notification を RabbitMQ 経由 で受信。Networking API は Redis の pub/sub と Watch エンド ポイントで通知。必要なリソースだけをキューへ追加する ただし、pub/sub は到達を保証しないため、長い間隔のポーリングを併用し、ETag で変更のあったリソースだけを拾う 42
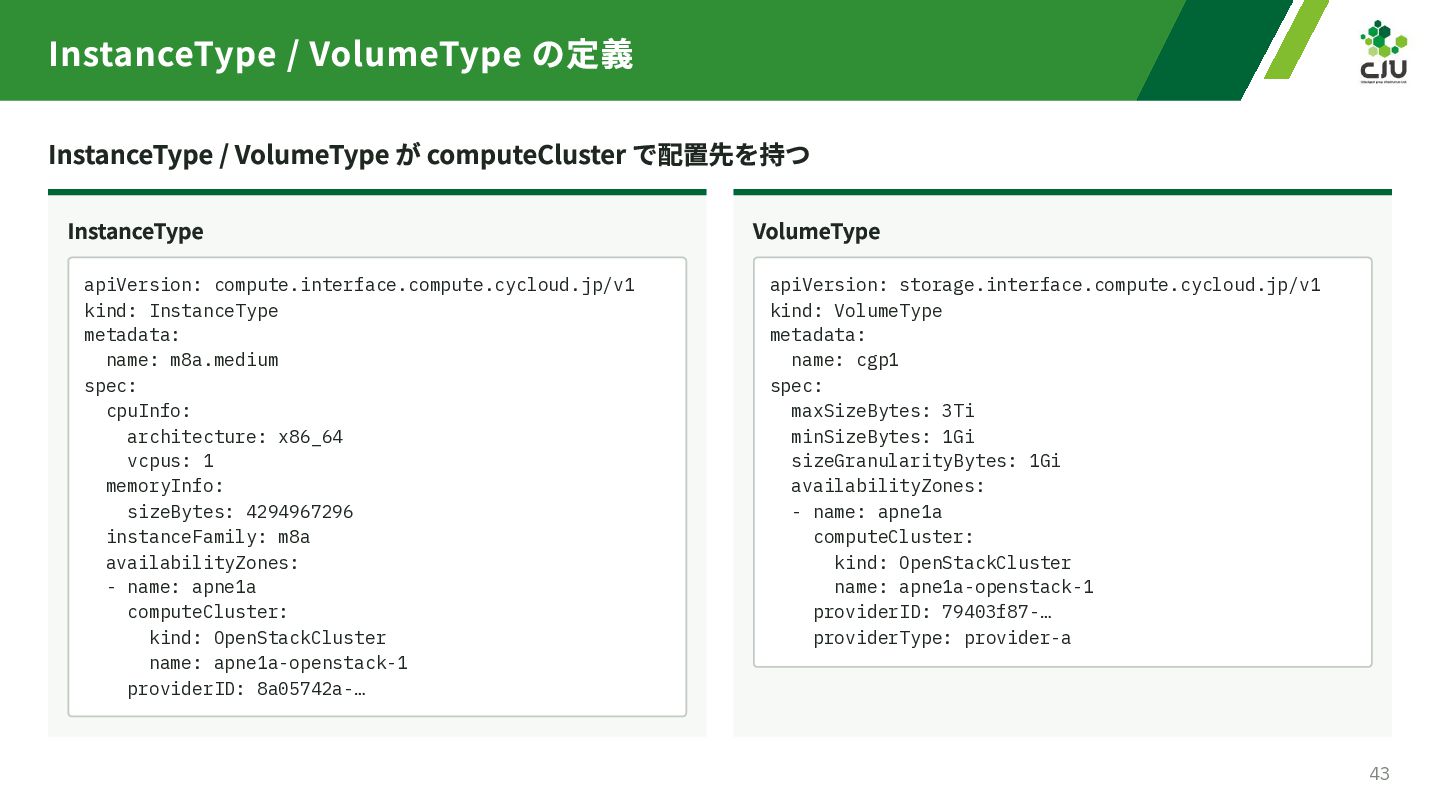
  33. InstanceType / VolumeType の定義 InstanceType / VolumeType が computeCluster で配置先を持つ

    InstanceType apiVersion: compute.interface.compute.cycloud.jp/v1 kind: InstanceType metadata: name: m8a.medium spec: cpuInfo: architecture: x86_64 vcpus: 1 memoryInfo: sizeBytes: 4294967296 instanceFamily: m8a availabilityZones: - name: apne1a computeCluster: kind: OpenStackCluster name: apne1a-openstack-1 providerID: 8a05742a-… VolumeType apiVersion: storage.interface.compute.cycloud.jp/v1 kind: VolumeType metadata: name: cgp1 spec: maxSizeBytes: 3Ti minSizeBytes: 1Gi sizeGranularityBytes: 1Gi availabilityZones: - name: apne1a computeCluster: kind: OpenStackCluster name: apne1a-openstack-1 providerID: 79403f87-… providerType: provider-a 43
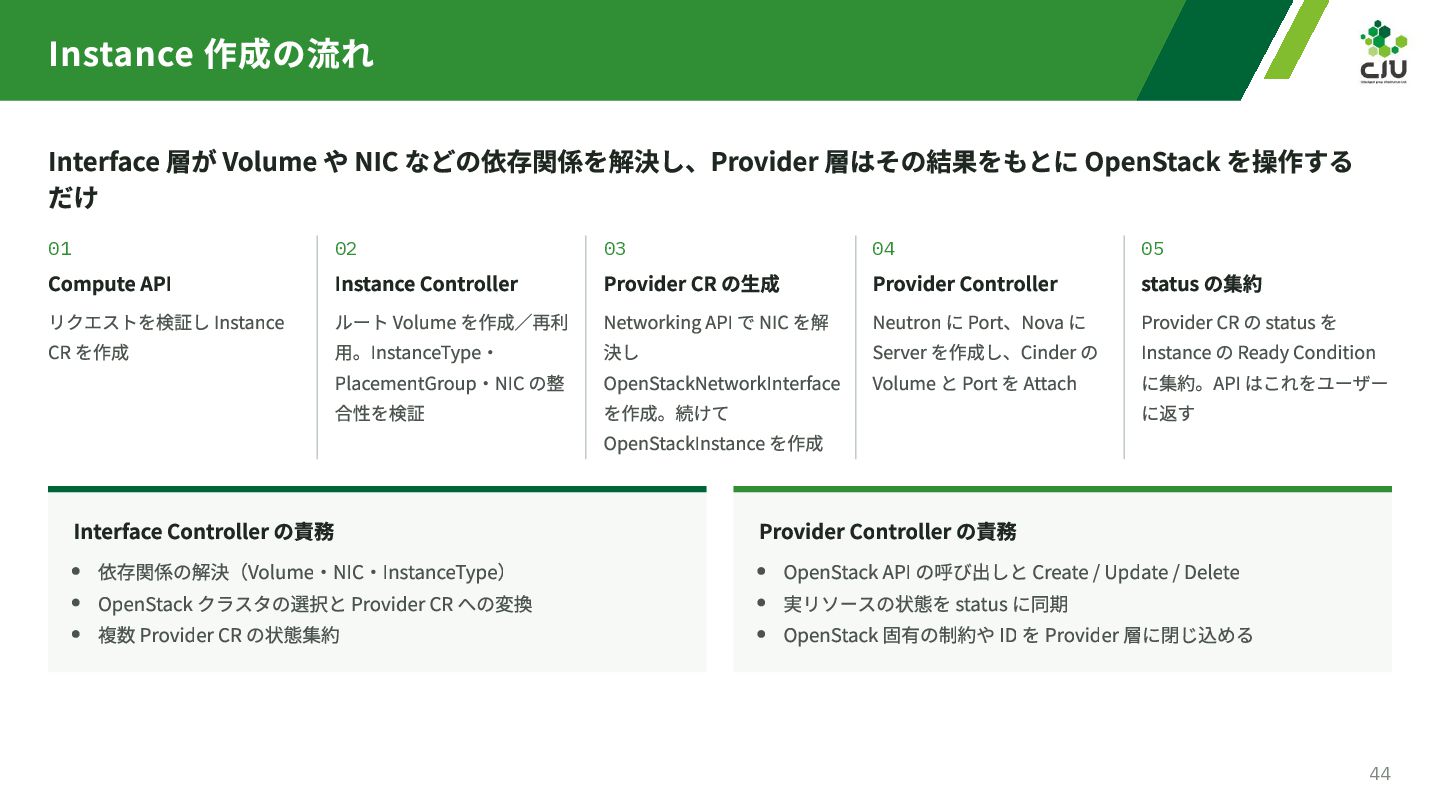
  34. Instance 作成の流れ Interface 層が Volume や NIC などの依存関係を解決し、Provider 層はその結果をもとに OpenStack

    を操作する だけ 01 02 03 リクエストを検証し Instance CR を作成 ルート Volume を作成/再利 用。InstanceType・ PlacementGroup・NIC の整 合性を検証 Networking API で NIC を解 Neutron に Port、Nova に 決し Server を作成し、Cinder の OpenStackNetworkInterface Volume と Port を Attach を作成。続けて OpenStackInstance を作成 Compute API Interface Controller の責務 Instance Controller 依存関係の解決(Volume・NIC・InstanceType) OpenStack クラスタの選択と Provider CR への変換 複数 Provider CR の状態集約 Provider CR の生成 04 Provider Controller 05 status の集約 Provider CR の status を Instance の Ready Condition に集約。API はこれをユーザー に返す Provider Controller の責務 OpenStack API の呼び出しと Create / Update / Delete 実リソースの状態を status に同期 OpenStack 固有の制約や ID を Provider 層に閉じ込める 44
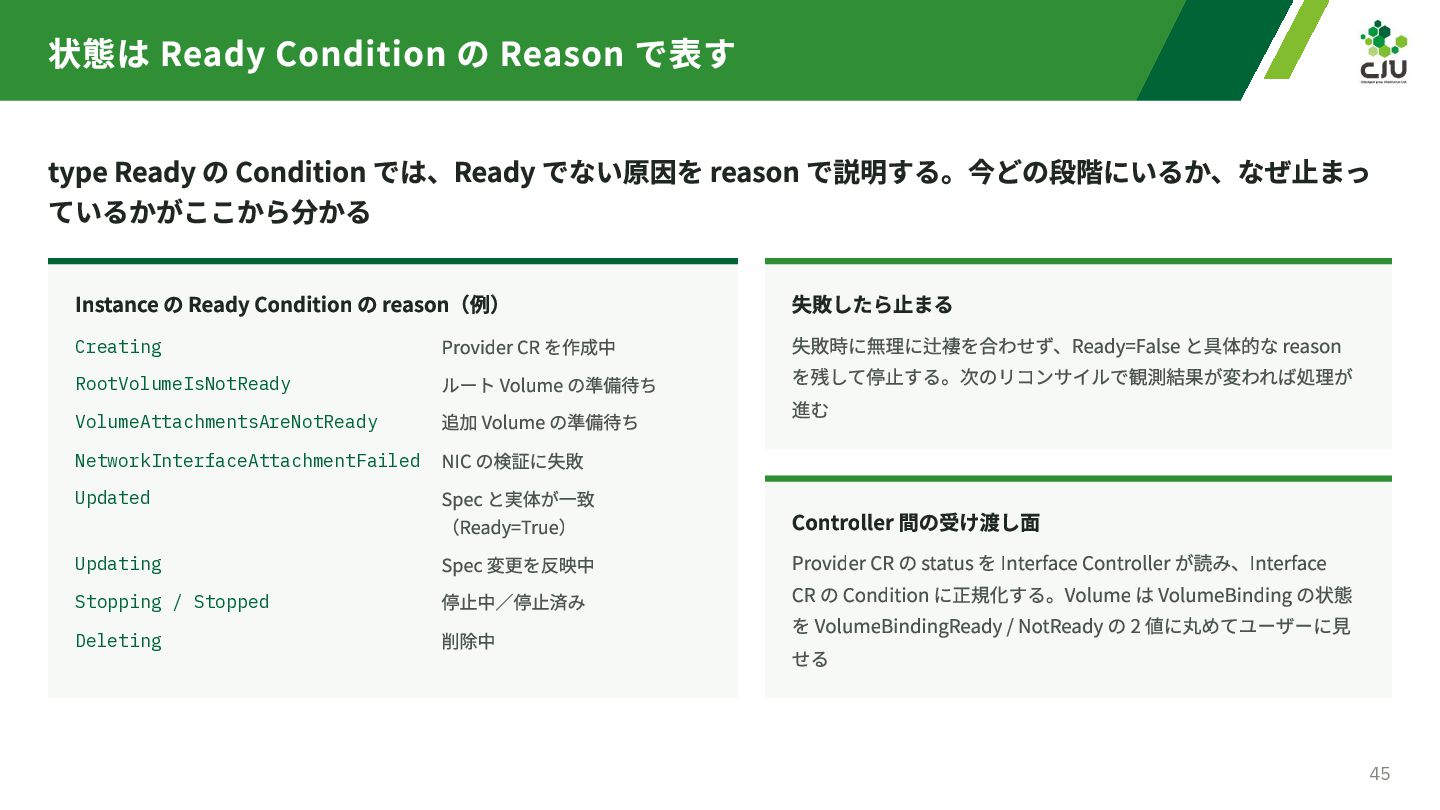
  35. 状態は Ready Condition の Reason で表す type Ready の Condition

    では、Ready でない原因を reason で説明する。今どの段階にいるか、なぜ止まっ ているかがここから分かる Instance の Ready Condition の reason(例) Provider CR を作成中 RootVolumeIsNotReady ルート Volume の準備待ち VolumeAttachmentsAreNotReady 追加 Volume の準備待ち NetworkInterfaceAttachmentFailed NIC の検証に失敗 Updated Spec と実体が一致 (Ready=True) Updating Spec 変更を反映中 Stopping / Stopped 停止中/停止済み Deleting 削除中 Creating 失敗したら止まる 失敗時に無理に辻褄を合わせず、Ready=False と具体的な reason を残して停止する。次のリコンサイルで観測結果が変われば処理が 進む Controller 間の受け渡し面 Provider CR の status を Interface Controller が読み、Interface CR の Condition に正規化する。Volume は VolumeBinding の状態 を VolumeBindingReady / NotReady の 2 値に丸めてユーザーに見 せる 45
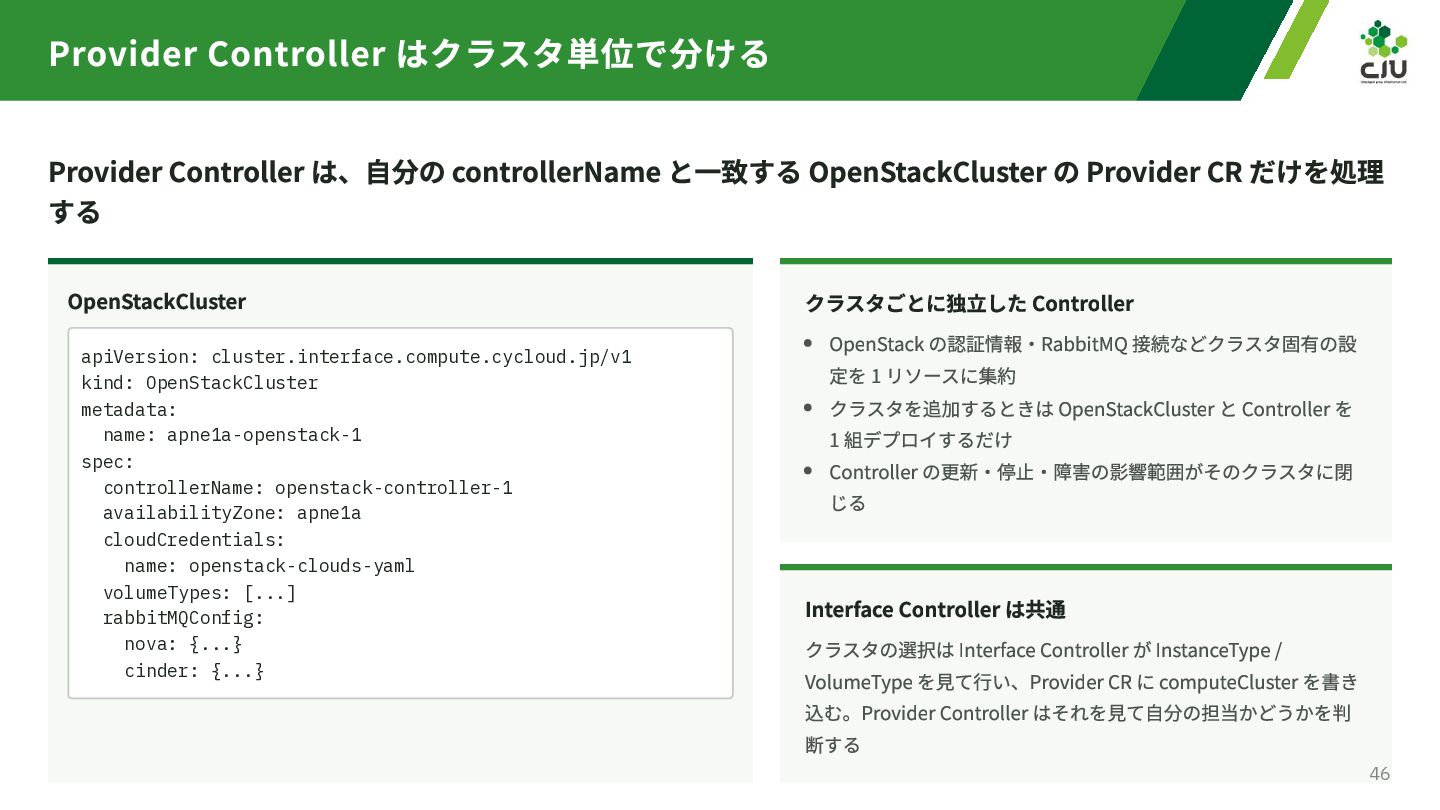
  36. Provider Controller はクラスタ単位で分ける Provider Controller は、自分の controllerName と一致する OpenStackCluster の

    Provider CR だけを処理 する OpenStackCluster apiVersion: cluster.interface.compute.cycloud.jp/v1 kind: OpenStackCluster metadata: name: apne1a-openstack-1 spec: controllerName: openstack-controller-1 availabilityZone: apne1a cloudCredentials: name: openstack-clouds-yaml volumeTypes: [...] rabbitMQConfig: nova: {...} cinder: {...} クラスタごとに独立した Controller OpenStack の認証情報・RabbitMQ 接続などクラスタ固有の設 定を 1 リソースに集約 クラスタを追加するときは OpenStackCluster と Controller を 1 組デプロイするだけ Controller の更新・停止・障害の影響範囲がそのクラスタに閉 じる Interface Controller は共通 クラスタの選択は Interface Controller が InstanceType / VolumeType を見て行い、Provider CR に computeCluster を書き 込む。Provider Controller はそれを見て自分の担当かどうかを判 断する 46
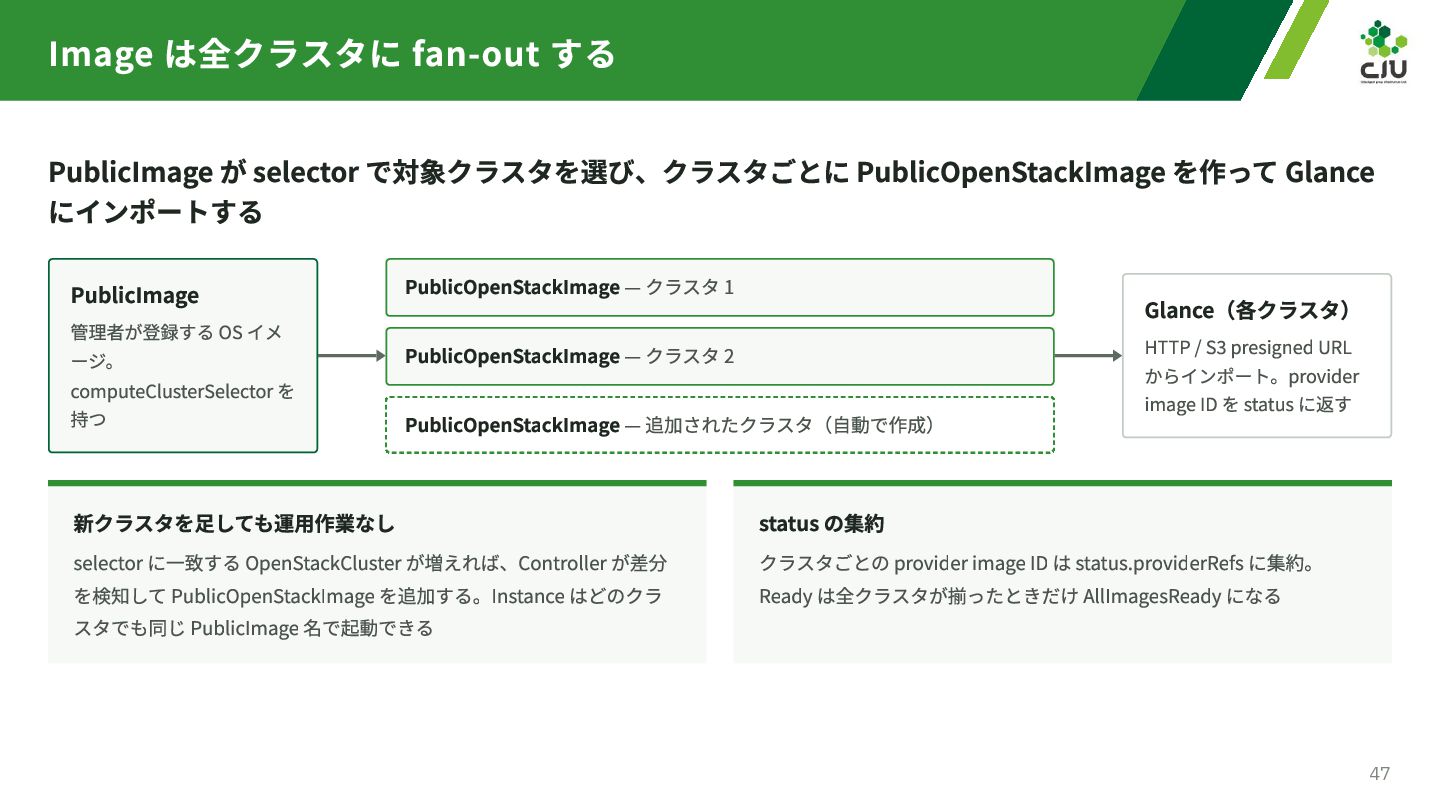
  37. Image は全クラスタに fan-out する PublicImage が selector で対象クラスタを選び、クラスタごとに PublicOpenStackImage を作って

    Glance にインポートする PublicImage 管理者が登録する OS イメ ージ。 computeClusterSelector を 持つ 新クラスタを足しても運用作業なし PublicOpenStackImage — クラスタ 1 Glance(各クラスタ) PublicOpenStackImage — クラスタ 2 PublicOpenStackImage — 追加されたクラスタ(自動で作成) selector に一致する OpenStackCluster が増えれば、Controller が差分 を検知して PublicOpenStackImage を追加する。Instance はどのクラ スタでも同じ PublicImage 名で起動できる HTTP / S3 presigned URL からインポート。provider image ID を status に返す status の集約 クラスタごとの provider image ID は status.providerRefs に集約。 Ready は全クラスタが揃ったときだけ AllImagesReady になる 47
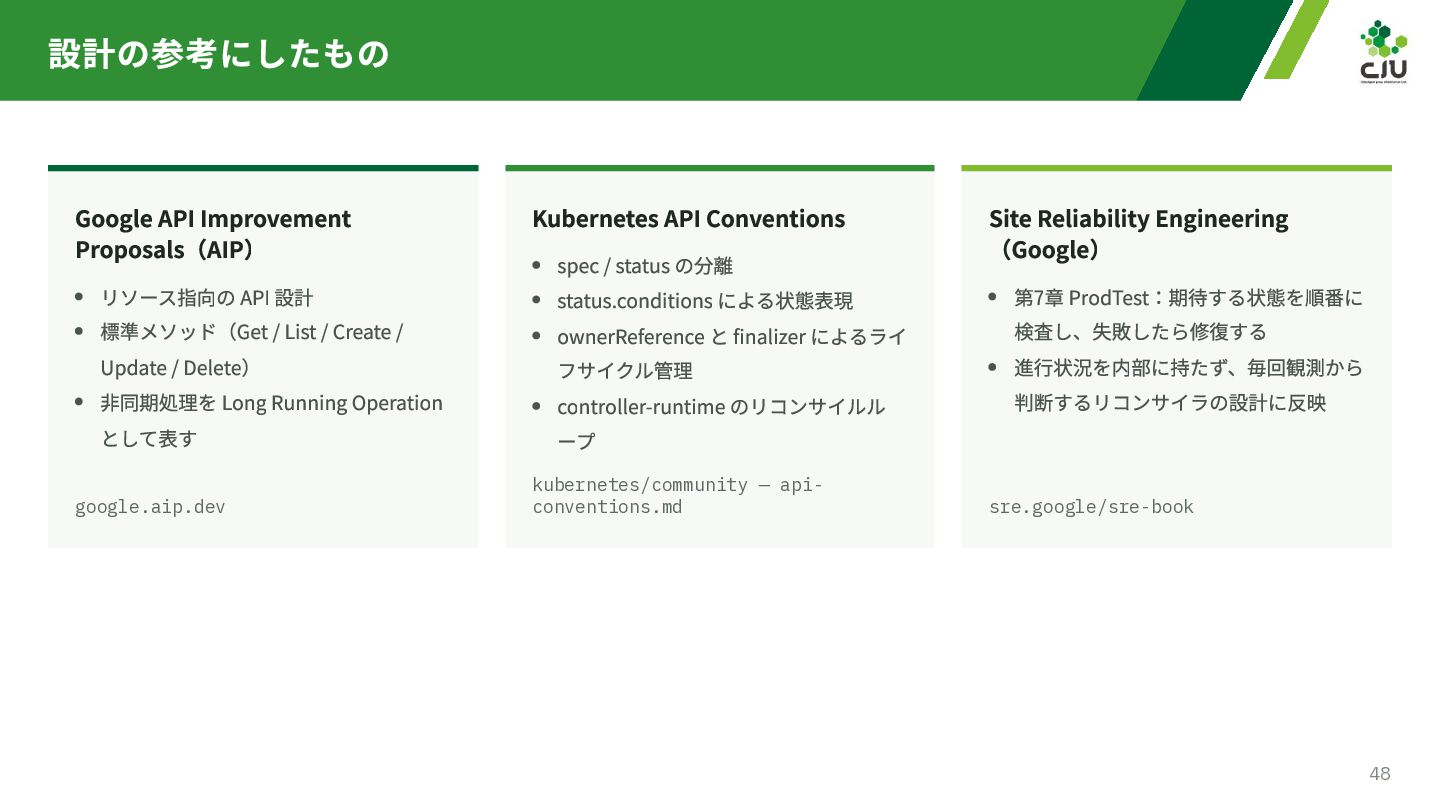
  38. 設計の参考にしたもの Google API Improvement Proposals(AIP) リソース指向の API 設計 標準メソッド(Get /

    List / Create / Update / Delete) 非同期処理を Long Running Operation として表す google.aip.dev Kubernetes API Conventions spec / status の分離 status.conditions による状態表現 ownerReference と finalizer によるライ フサイクル管理 controller-runtime のリコンサイルル ープ kubernetes/community — apiconventions.md Site Reliability Engineering (Google) 第7章 ProdTest:期待する状態を順番に 検査し、失敗したら修復する 進行状況を内部に持たず、毎回観測から 判断するリコンサイラの設計に反映 sre.google/sre-book 48