Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
第2回ディープラーニング勉強会~画像処理編~
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
EngineerCafe
February 05, 2022
Technology
130
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
第2回ディープラーニング勉強会~画像処理編~
EngineerCafe
February 05, 2022
More Decks by EngineerCafe
See All by EngineerCafe
台湾デジタルフェス2026参加報告
engineercafe
0
22
Hacktivation2025_イントロダクション_ブロックチェーンことはじめ
engineercafe
0
330
エンジニアカフェ台湾ツアー2025
engineercafe
0
170
台湾視察報告レポート_2024
engineercafe
1
190
インド・バンガロール視察報告会
engineercafe
0
180
イベントレポート_Hacktivation 続:生成AI時代におけるブロックチェーンの可能性
engineercafe
0
150
Docker はじめの一歩 #1 Dockerコンテナを動かしてみよう
engineercafe
0
120
git勉強会 (基本的なコマンドを覚えよう)
engineercafe
0
200
エンジニアのための論文ゆる輪読会 #1【 #ゆるりん 】
engineercafe
0
200
Other Decks in Technology
See All in Technology
「図書館」という名前のままでいいのか -Code4Lib JAPANカンファレンス2026 アンカンファレンス報告- / Code4Lib JAPAN Conference 2026: Unconference Report
ykiyota
0
170
HRC_Frontend_Conference_Fukuoka_2026.pdf
ts020
0
660
AIで仕事のやり方を変える
matsu7874
3
1.1k
2026-09-10 【Snowflake World Tour Tokyo 2026】dbt Core と Snowflake で実現する多層的なデータガバナンス / Multi-Layered Data Governance Powered by dbt Core and Snowflake
civitaspo
0
370
AI 時代のスタートアップエコシステ厶から考究する技術的負債との向き合い方
m3m0r7
PRO
2
830
20260912_スクフェス三河
kgnkhkr
0
340
例外の正しい扱い方 そのエラー try-catchして大丈夫?
jinwatanabe
3
480
AI時代、データエンジニアが一番おもろい
genshun9
0
480
Screen Lens - 今見てる画面を翻訳する
komagata
0
270
ASTを使って影響範囲を特定する
nealle
0
180
Sigmaユーザーのための有用リソース一挙公開 & Sigmaで使えるMCP #sigma_ucj /useful-resources-for-sigma-computing-users-and-mcps-with-sigma
shinyaa31
0
210
ペアプロの価値はコードを書くことだけじゃない
codmoninc
PRO
0
230
Featured
See All Featured
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
202
76k
Optimizing for Happiness
mojombo
378
71k
sira's awesome portfolio website redesign presentation
elsirapls
0
410
Darren the Foodie - Storyboard
khoart
PRO
3
3.9k
Being A Developer After 40
akosma
91
590k
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
530
Skip the Path - Find Your Career Trail
mkilby
1
230
ReactJS: Keep Simple. Everything can be a component!
pedronauck
666
130k
The SEO Collaboration Effect
kristinabergwall1
1
560
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
Bridging the Design Gap: How Collaborative Modelling removes blockers to flow between stakeholders and teams @FastFlow conf
baasie
0
700
Transcript
第2回ディープラーニング 勉強会 ~画像処理編~
⽬次 ▪ ⾃⼰紹介 ▪ 本の紹介 ▪ ResNetとは ▪ VGGとは ▪
画像分類のディープラーニングにおい て ▪ Loss関数とOptimizer ▪ VGGの実装 ▪ 汎化性能 ▪ 学習⽤データと評価⽤データ ▪ オンライン学習 ▪ 混同⾏列 ▪ バッチ学習の利⽤ ▪ 過学習 ▪ 最後にやってみて
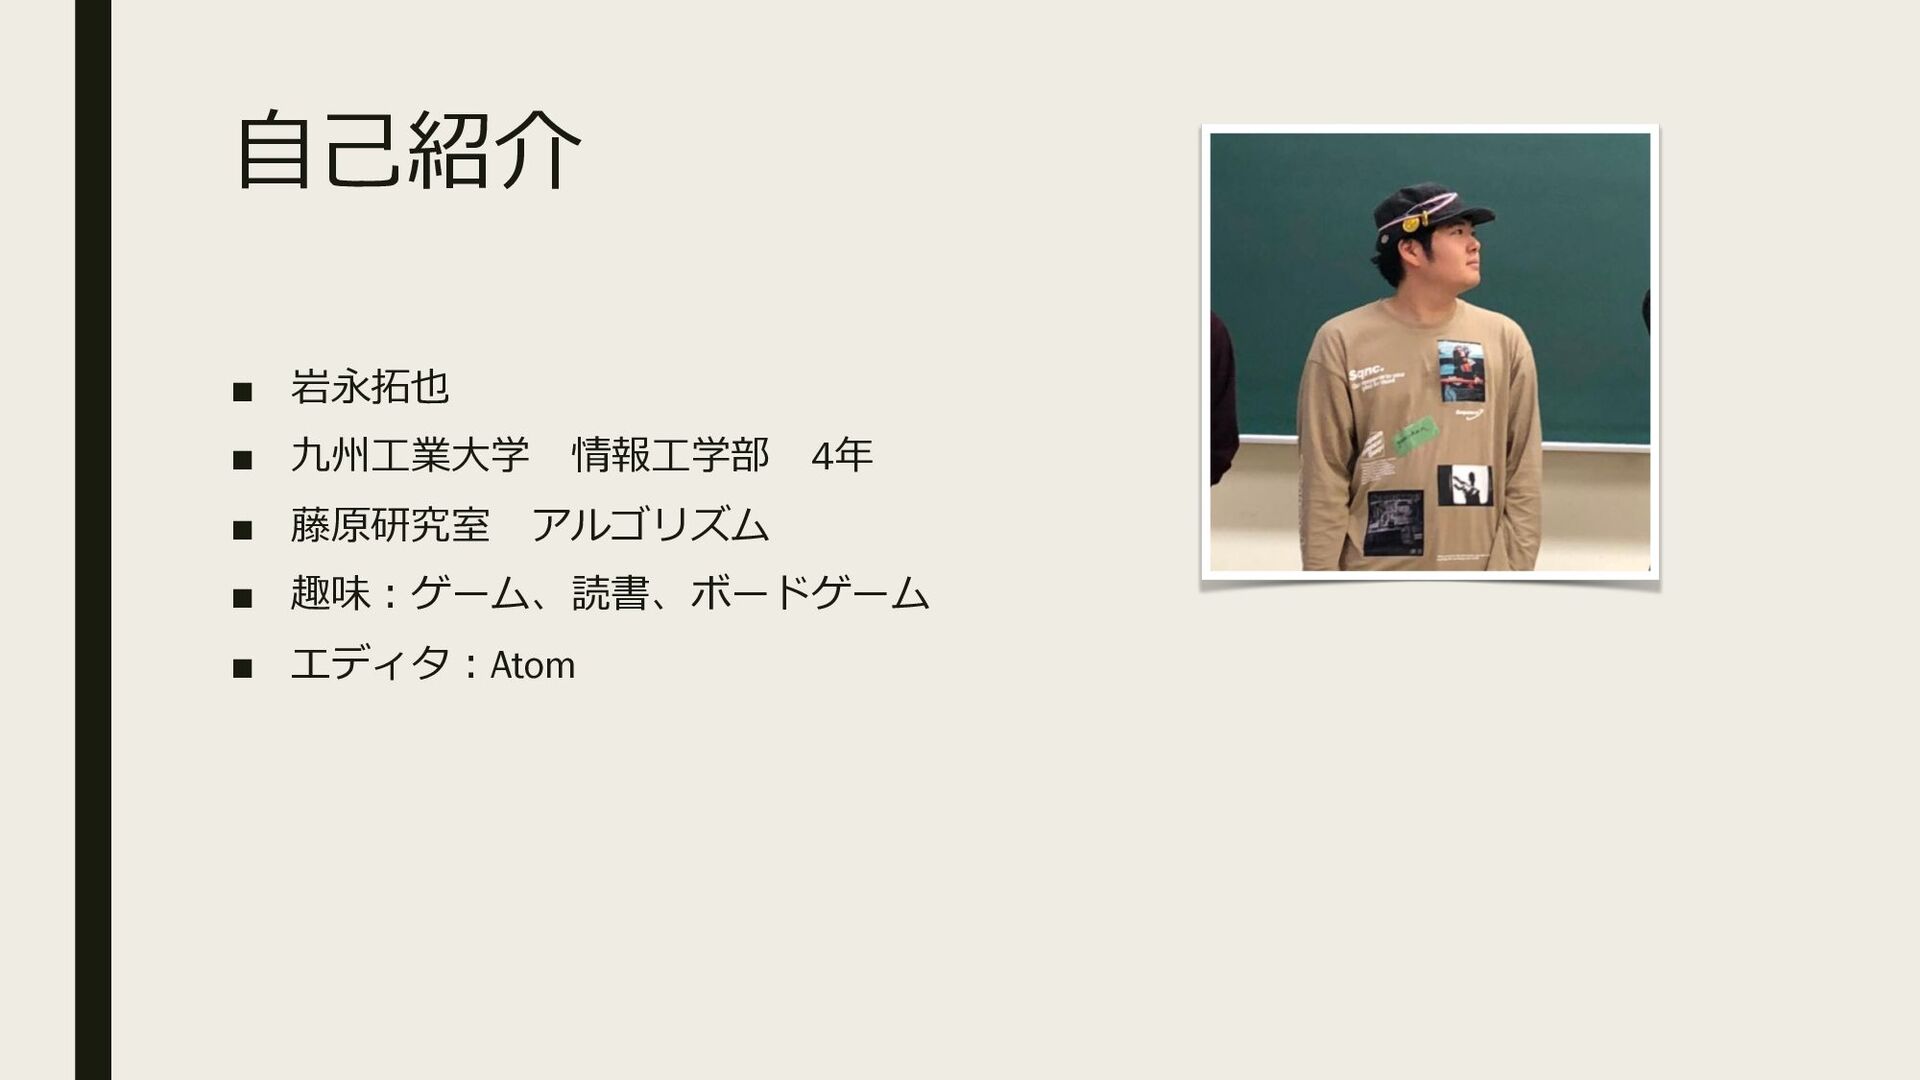
⾃⼰紹介 ▪ 岩永拓也 ▪ 九州⼯業⼤学 情報⼯学部 4年 ▪ 藤原研究室 アルゴリズム
▪ 趣味︓ゲーム、読書、ボードゲーム ▪ エディタ︓Atom
本の紹介 ▪ 即戦⼒になるための ディープラーニング開発実践ハンズオン ▪ [著]井上⼤樹、佐藤峻 ▪ 価格︓3280円(税抜) ▪ リンク︓
https://gihyo.jp/book/2021/978-4-297-11942-3
ResNetとは ▪ 2015年のLISVRC(ImageNet Large Scale Visual Recognition Challenge)で1位に なったモデル。以前の優勝したモデルの層の数が約20なのに対し、ResNetは 152層
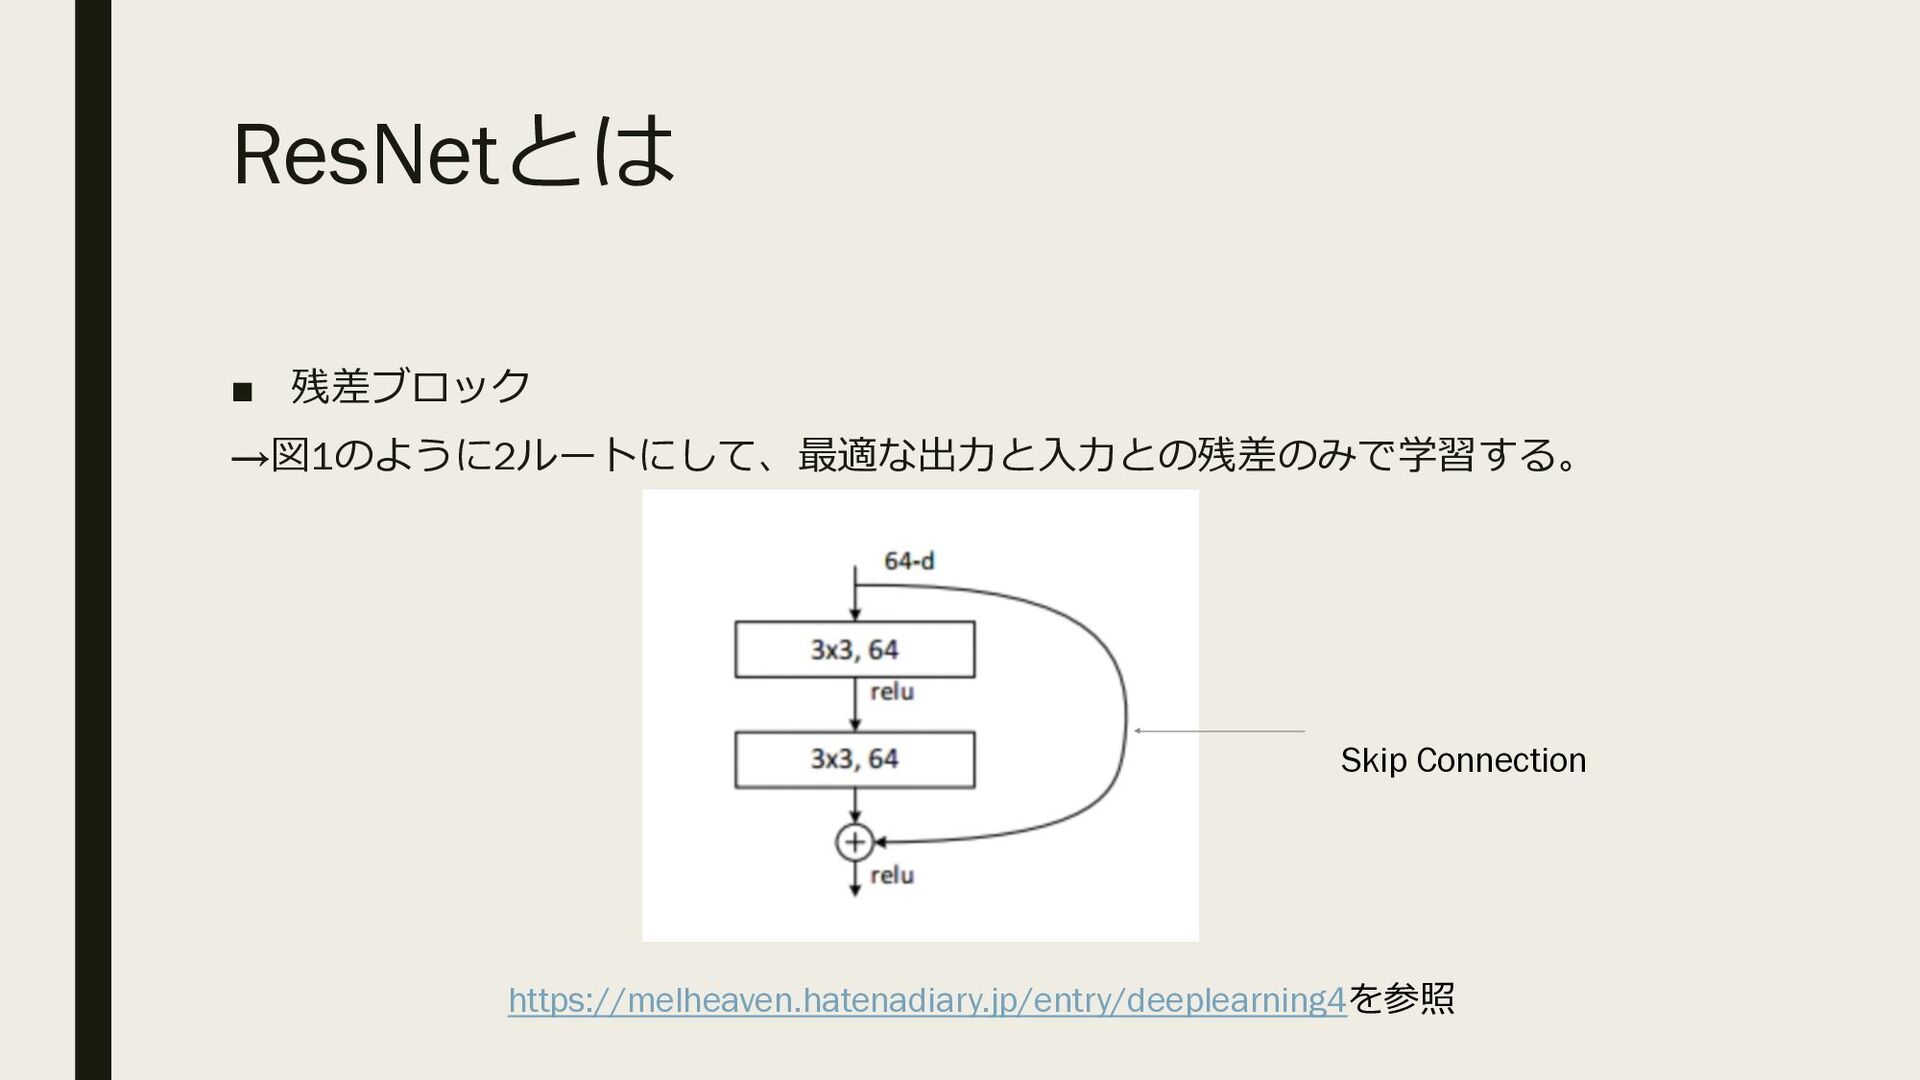
▪ ⼀般的に層が多くなるほど複雑になっていき、勾配消失問題などが出てくるた め学習が進まない。 →その解決法として残差ブロックを置くこと
ResNetとは ▪ 残差ブロック →図1のように2ルートにして、最適な出⼒と⼊⼒との残差のみで学習する。 https://melheaven.hatenadiary.jp/entry/deeplearning4を参照 Skip Connection
VGGとは ▪ 2014年のILSVRCでローカリゼーション(画像の中の物体の検出)の分野にて1位、 画像分類の分野で2位になったアルゴリズム。 ▪ 前年のILSVRCの画像分野で1位だったZFNetが8層に対し、VGGは最⼤で19層。
画像分類のディープラーニングにお いて ▪ メリット →⼯場での製品の検査などにおいて従来は前からのものに限定していたのに対し、 ディープラーニングを取り⼊れることで横からや斜めに撮影した映像や写真といっ た場合でも特徴を抽出し、検出が可能 ▪ デメリット →実装には莫⼤なコストがかかる。
例︓データの質と量の確保、学習にかかる時間
画像分類のディープラーニングにお いて ▪ アルゴリズムの選定⽅法 →ディープラーニングのアルゴリズムは毎年数多く発表されている。⾼い制度を持 つからといって、実際の事業などで有⽤とは限らない。 ⾼い処理速度を要するものにとっては、コンピュータのメモリが⼗分に搭載されて いなかったり、ハードウェアを容易に拡張できない場合があるため慎重に選ぶ必要 がある。
Loss関数とOptimizer 今まで受け取った画像を処理する⼿順のみ定義してた →学習を進めるためLoss関数(損失関数)とOptimizer(最適化関数)が必要になる ▪ Loss関数 →理想とする結果から現在の処理結果がどれだけの誤差があるか表現した関数 主に平均⼆乗誤差かクロスエントロピーに使⽤。
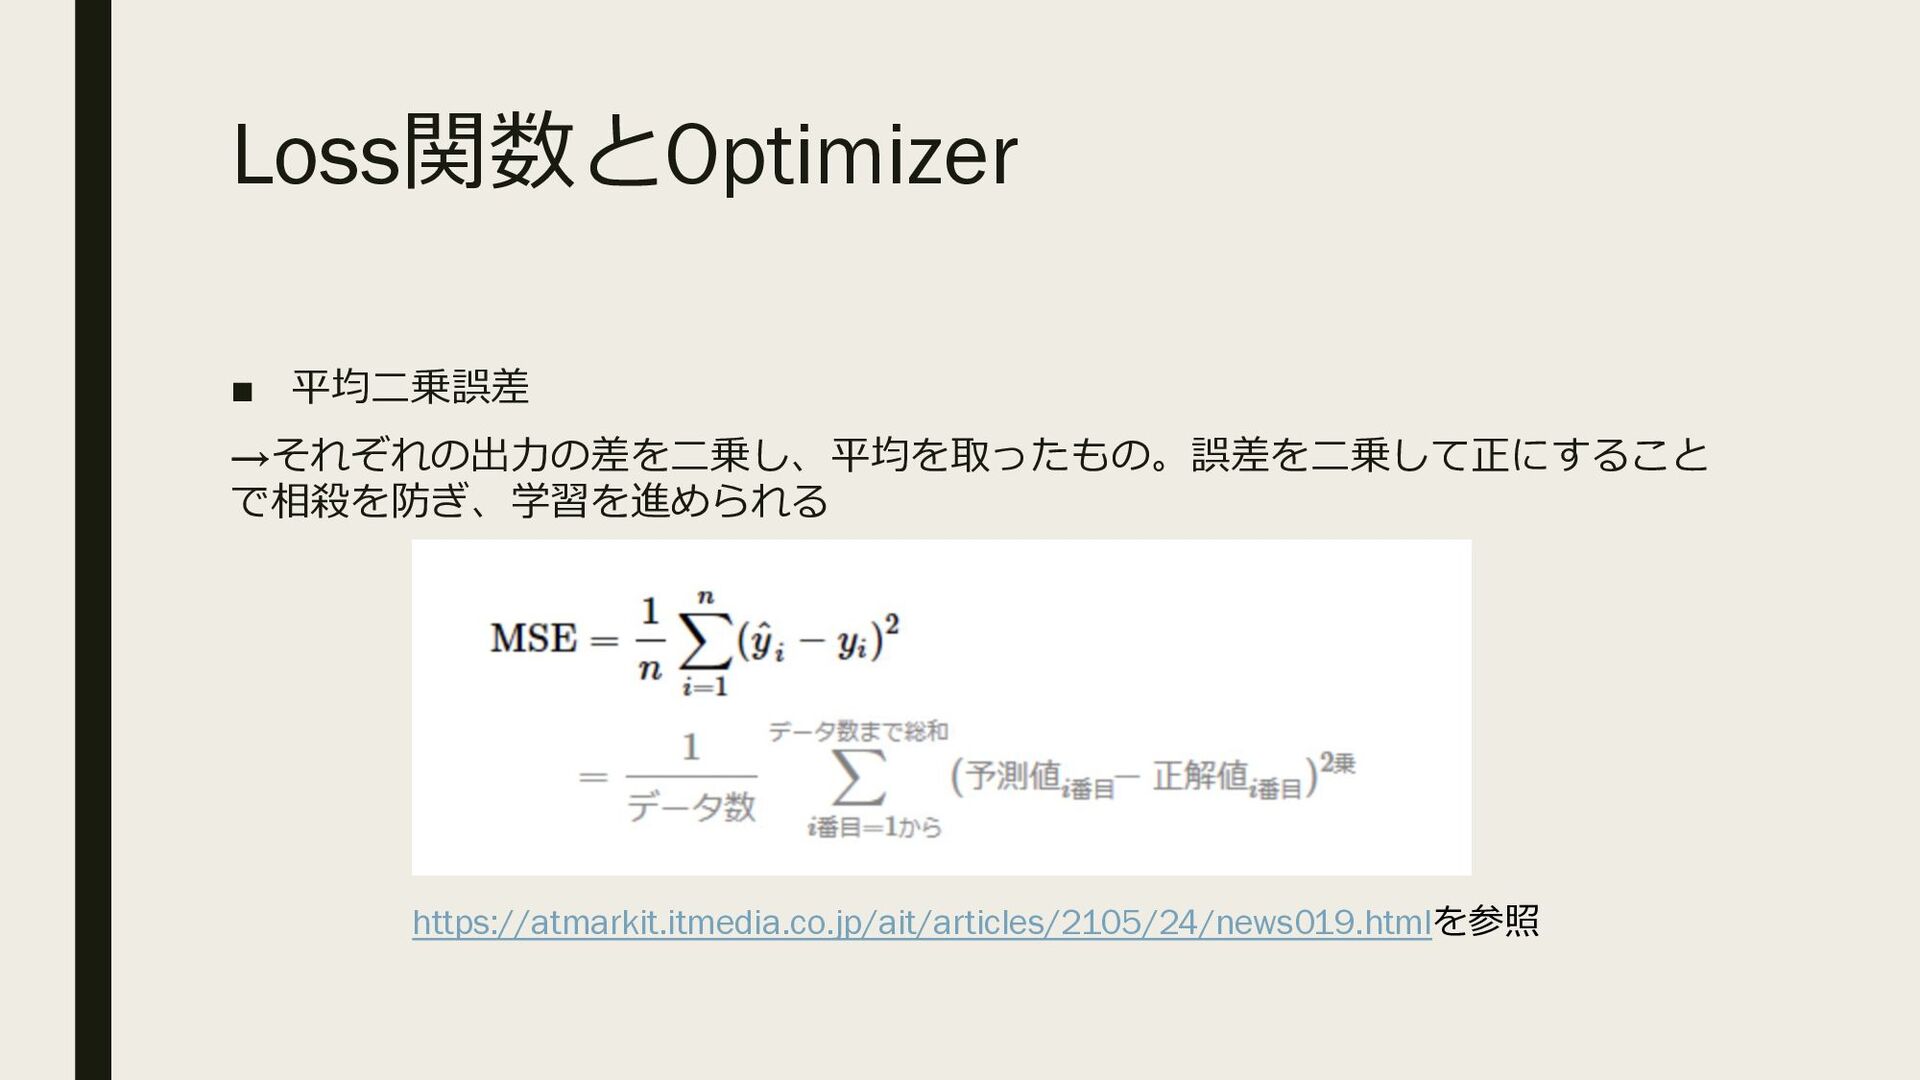
Loss関数とOptimizer ▪ 平均⼆乗誤差 →それぞれの出⼒の差を⼆乗し、平均を取ったもの。誤差を⼆乗して正にすること で相殺を防ぎ、学習を進められる https://atmarkit.itmedia.co.jp/ait/articles/2105/24/news019.htmlを参照
Loss関数とOptimizer ▪ クロスエントロピー →分類タスクで⽤いられ、分類時の確率が100%になるような出⼒になり、正解ク ラスの確率が1に近いほど良いことからLogを⽤いてその誤差を表現する。 ※今回はクロスエントロピーを⽤いる →「categorical_crossentropy」を使⽤
Loss関数とOptimizer ▪ Optimizer →Loss関数によって求めた誤差をどのような⽅針で修正するか表現する関数。 ディープラーニングでは⼤量の変数を取り扱うので、ただ求めた結果の通り修正し ているだけでは誤差が⼩さくなりません。 →⽅法としてLearningRate(学習率)で修正する量を⼩さくする。
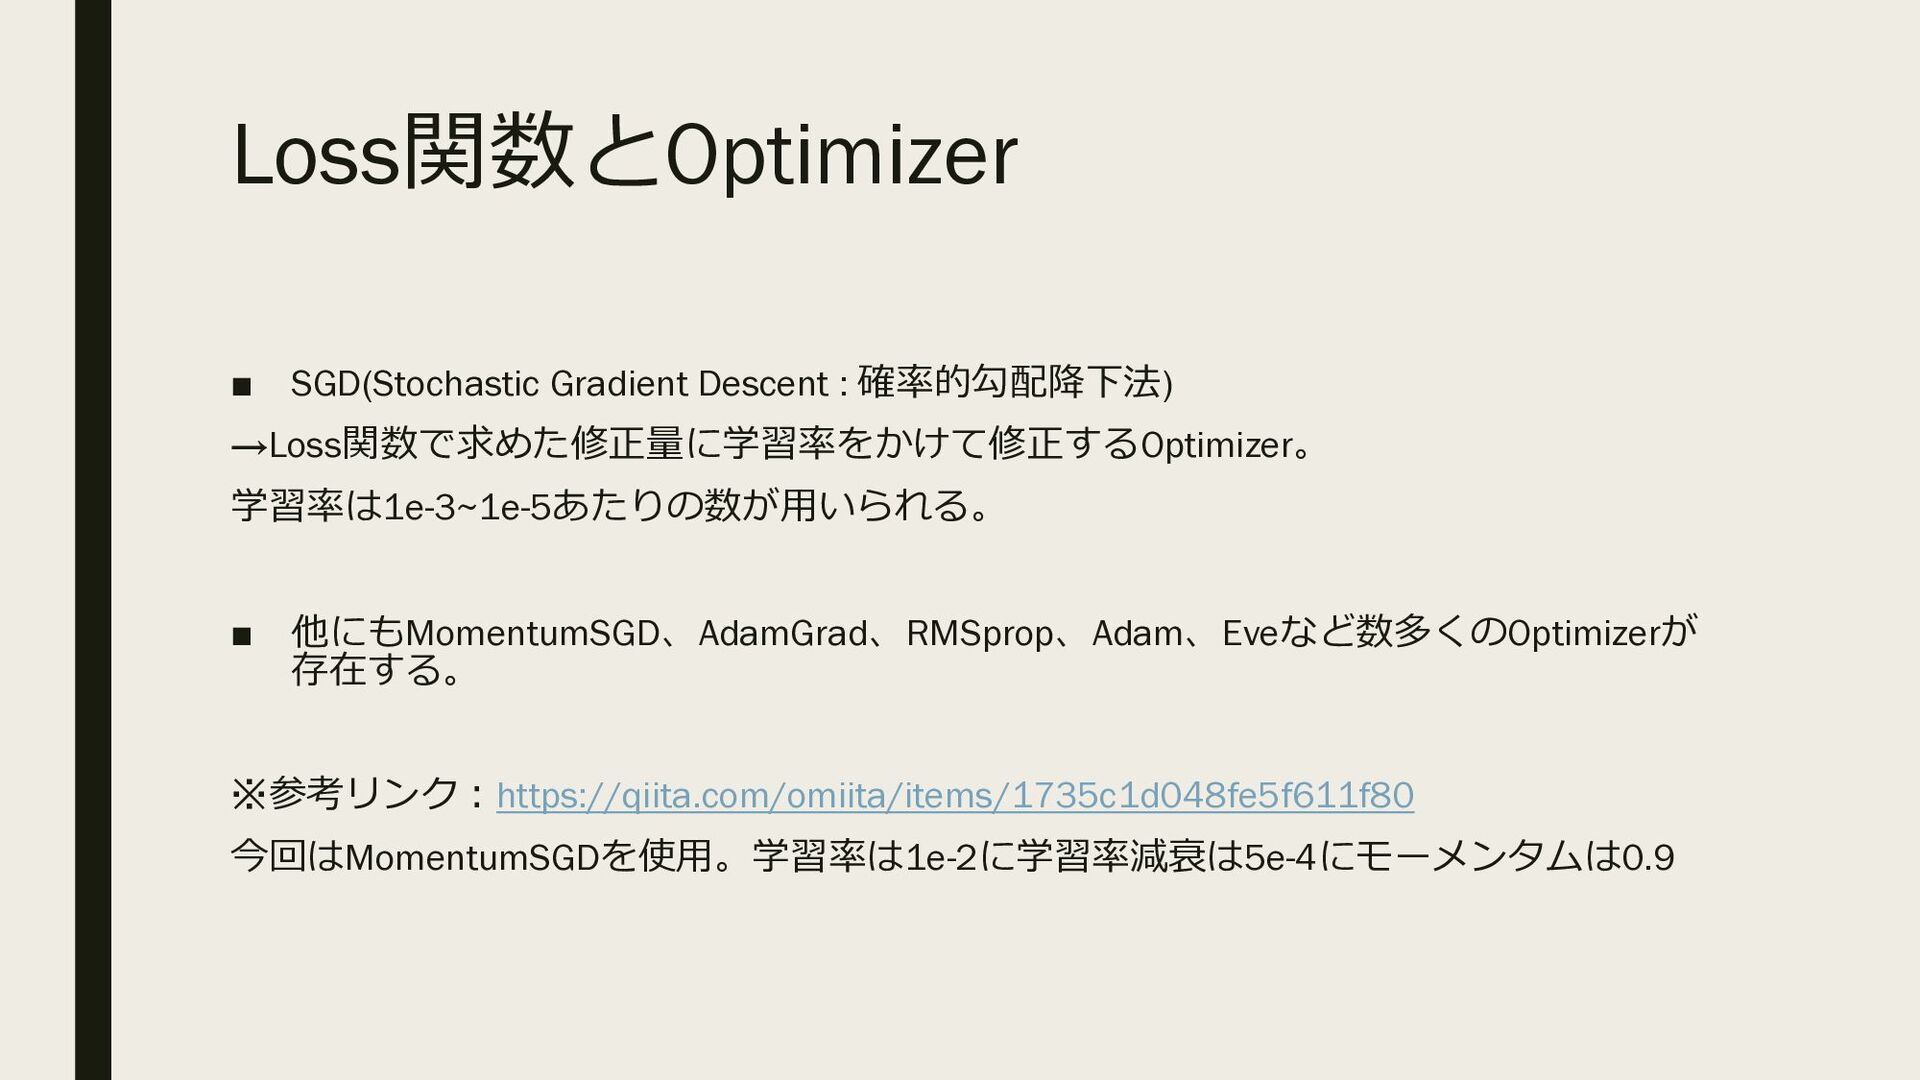
Loss関数とOptimizer ▪ SGD(Stochastic Gradient Descent : 確率的勾配降下法) →Loss関数で求めた修正量に学習率をかけて修正するOptimizer。 学習率は1e-3~1e-5あたりの数が⽤いられる。 ▪
他にもMomentumSGD、AdamGrad、RMSprop、Adam、Eveなど数多くのOptimizerが 存在する。 ※参考リンク︓https://qiita.com/omiita/items/1735c1d048fe5f611f80 今回はMomentumSGDを使⽤。学習率は1e-2に学習率減衰は5e-4にモーメンタムは0.9
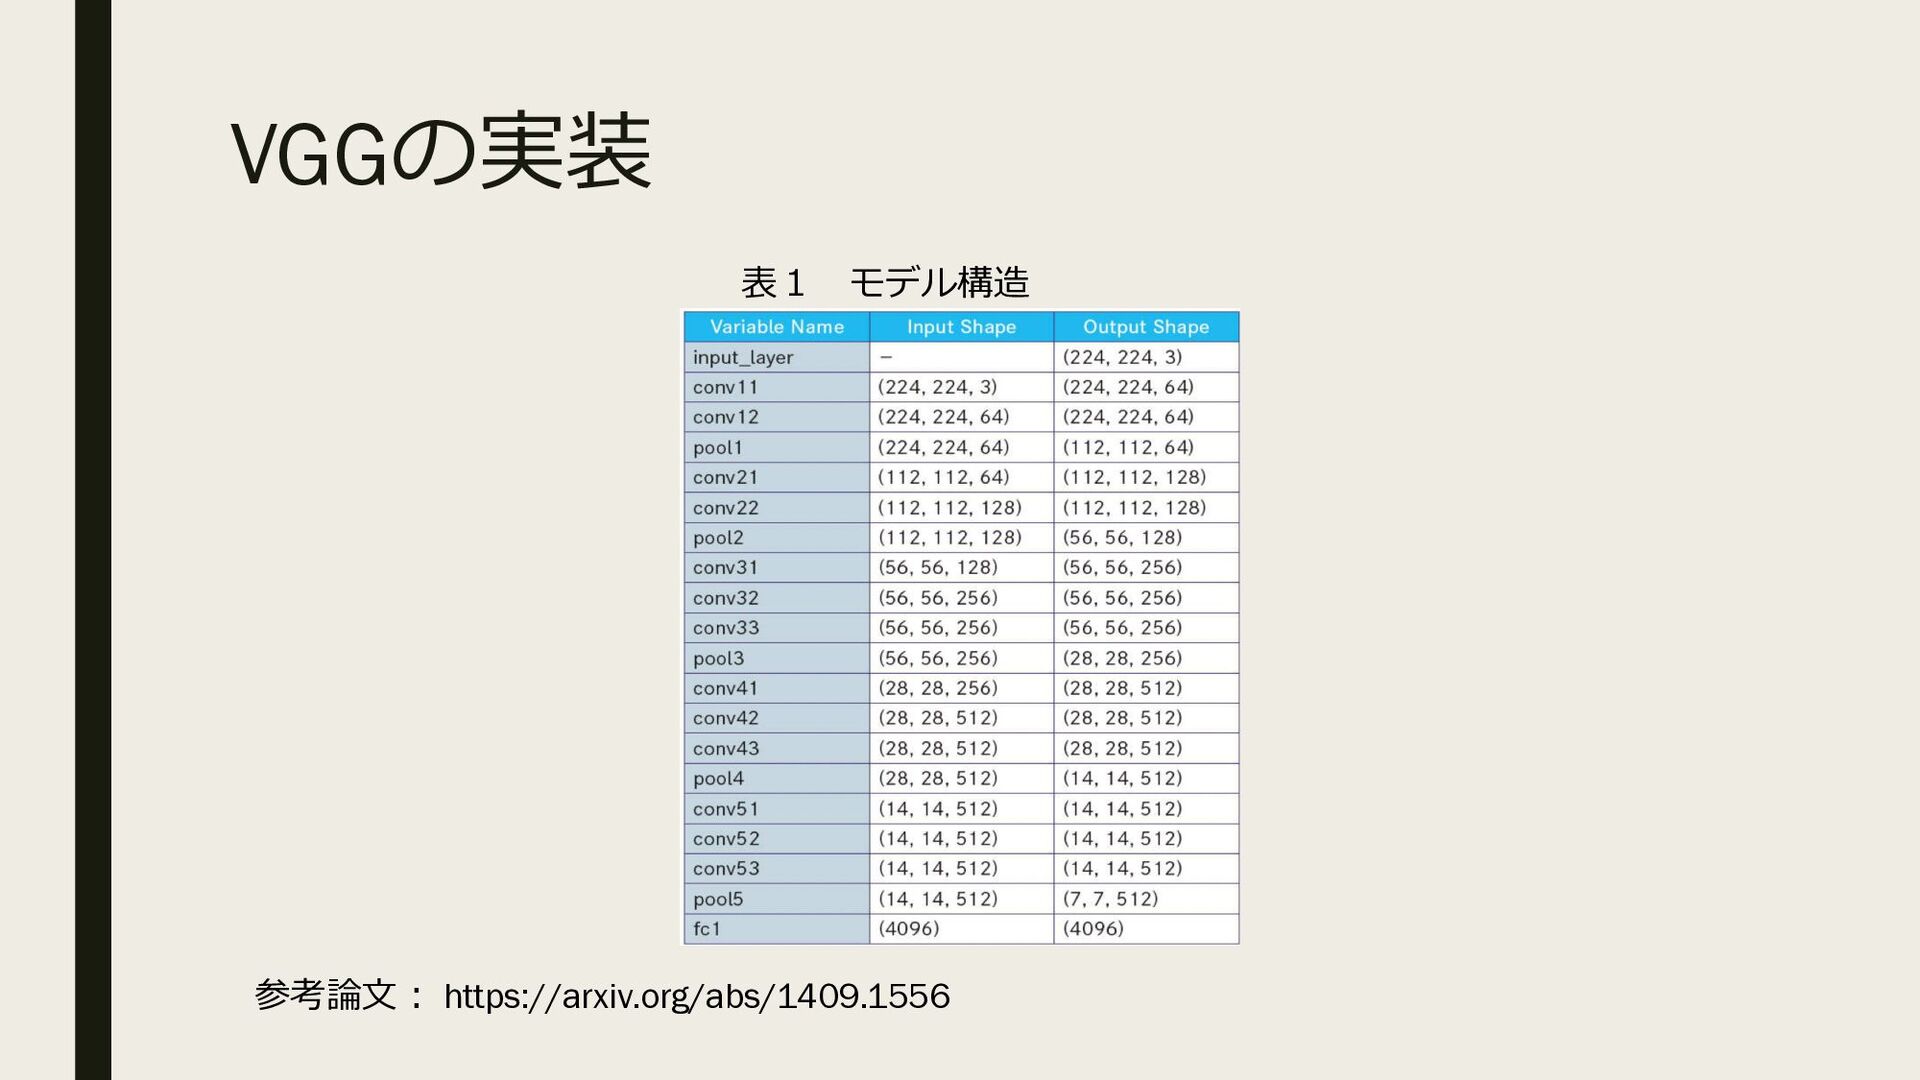
VGGの実装 参考論⽂︓ https://arxiv.org/abs/1409.1556 表1 モデル構造
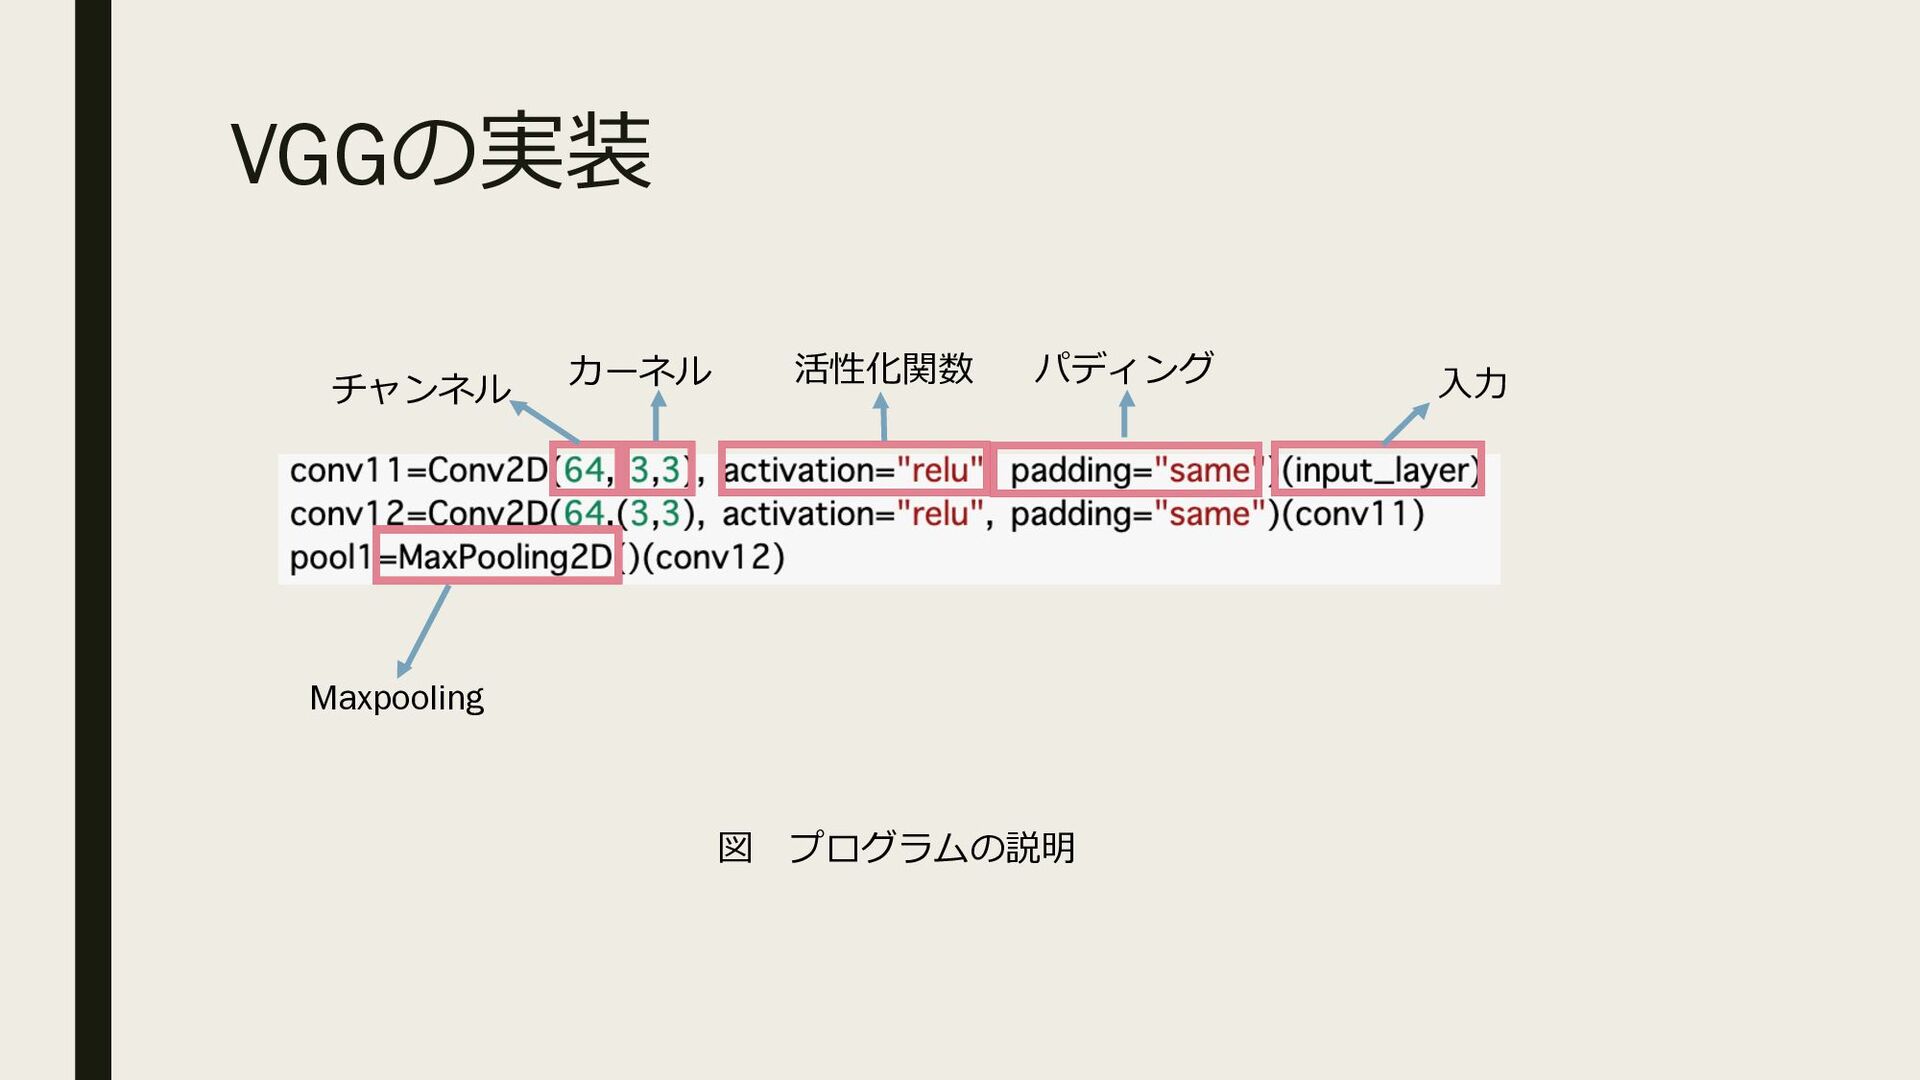
VGGの実装 チャンネル カーネル 活性化関数 パディング ⼊⼒ Maxpooling 図 プログラムの説明
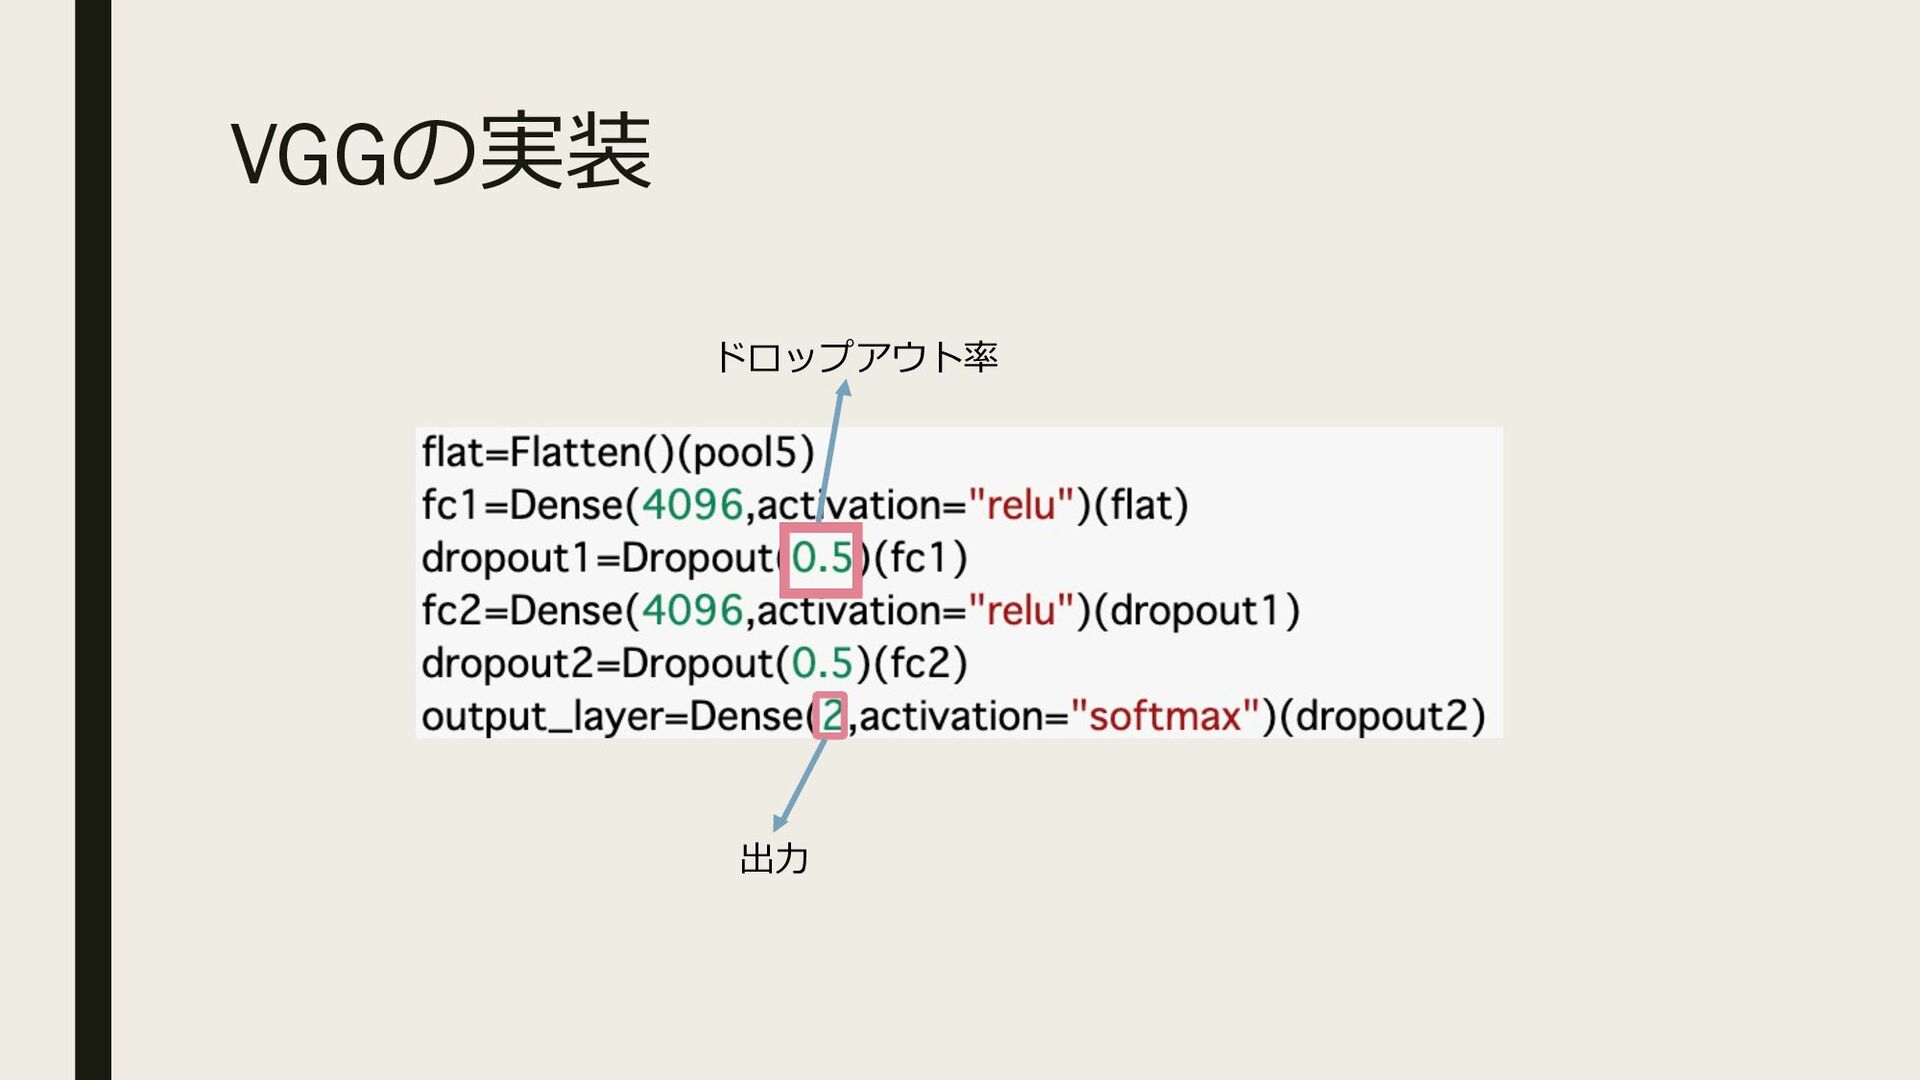
VGGの実装 出⼒ ドロップアウト率
汎化性能 ▪ 汎化性能 →1つのモデルがどれだけ幅広いデータに適応できるかを⽰すもの。⾼いほど学習 してないデータに対して適応できる可能性が⾼い。精度とはトレードオフの関係に あることが多く、どちらかを⾼くするかはプロジェクトの要件によって異なる。
学習⽤データと評価⽤データ ▪ ディープラーニングは⽤意したデータ全てをモデルに学習させるわけではなく、 その⼀部を使って学習したモデルの性能を学習の際に与えなかった残りのデー タで評価する。これにより、実際にそのモデルを使⽤する状況に近い状態で精 度評価を⾏える。この時学習⽤データと評価⽤データは7:3の⽐率でランダムに 分割することが多い。
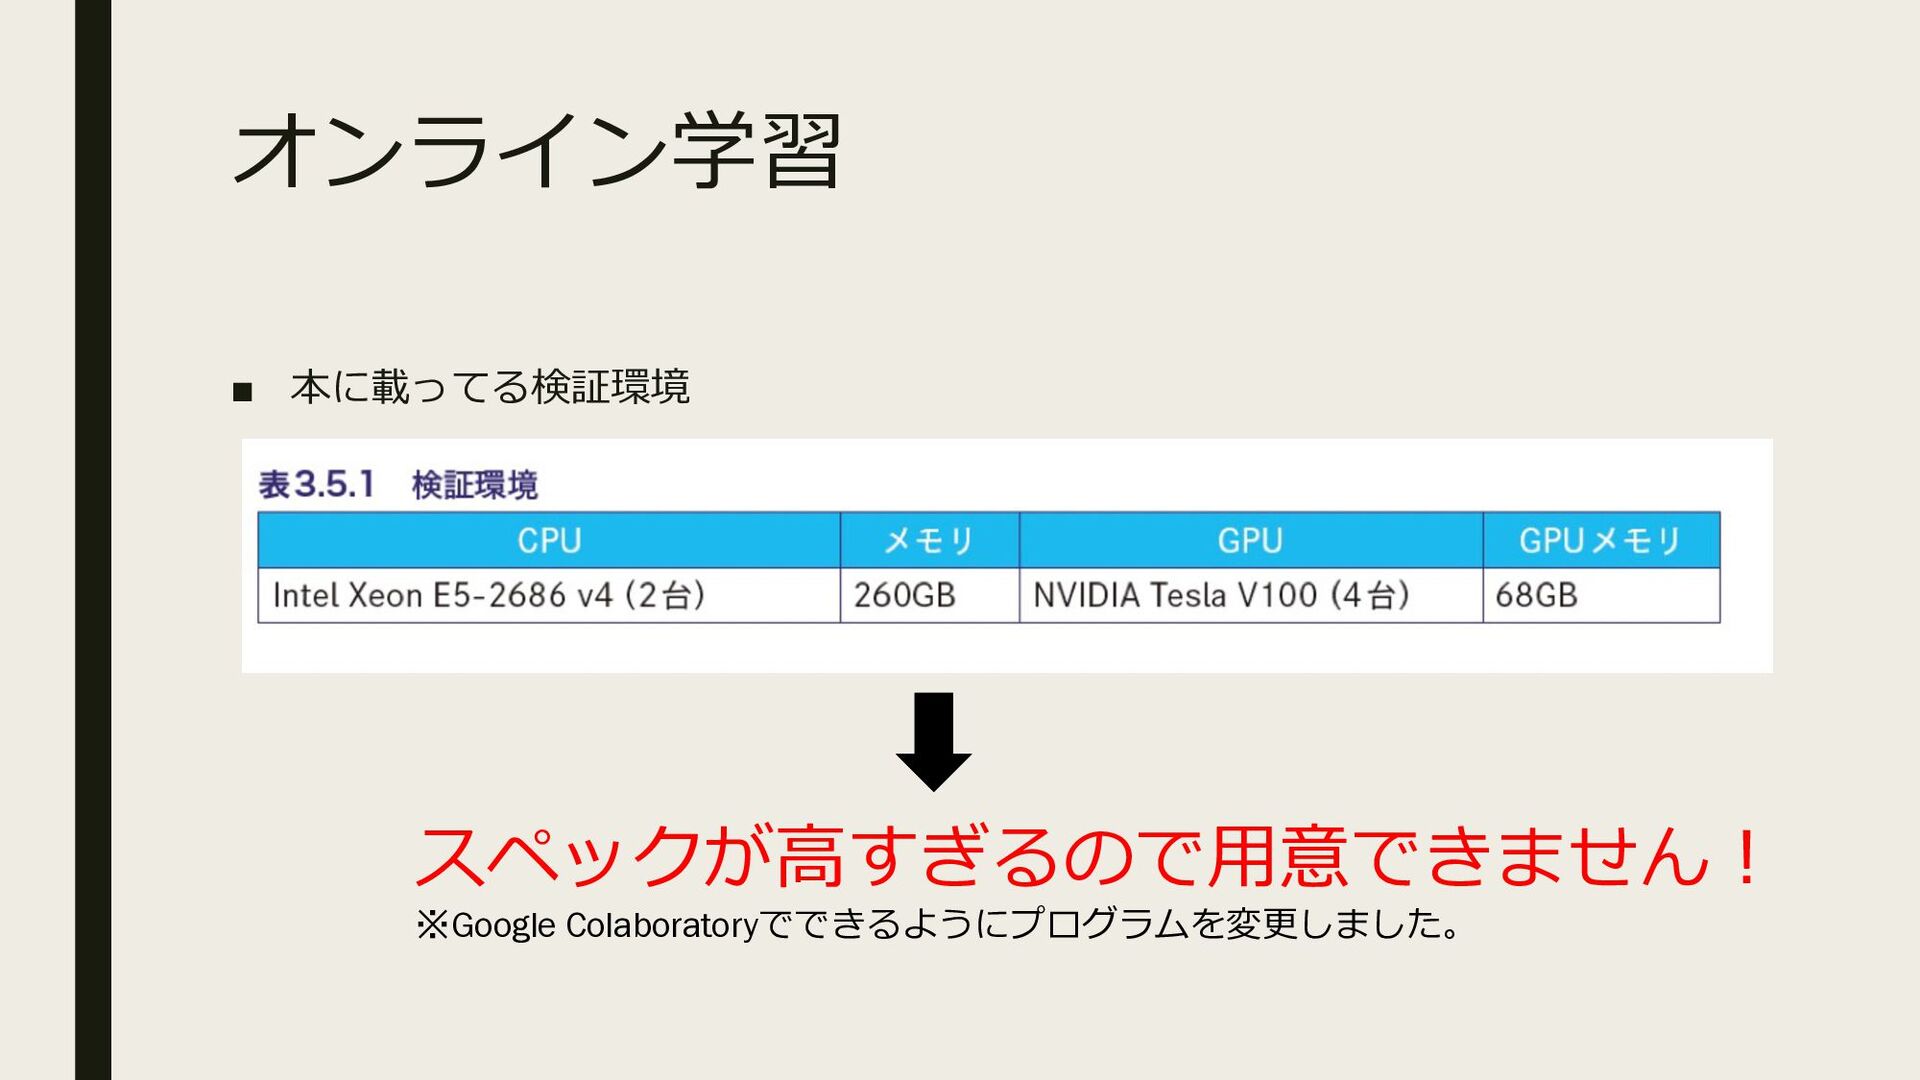
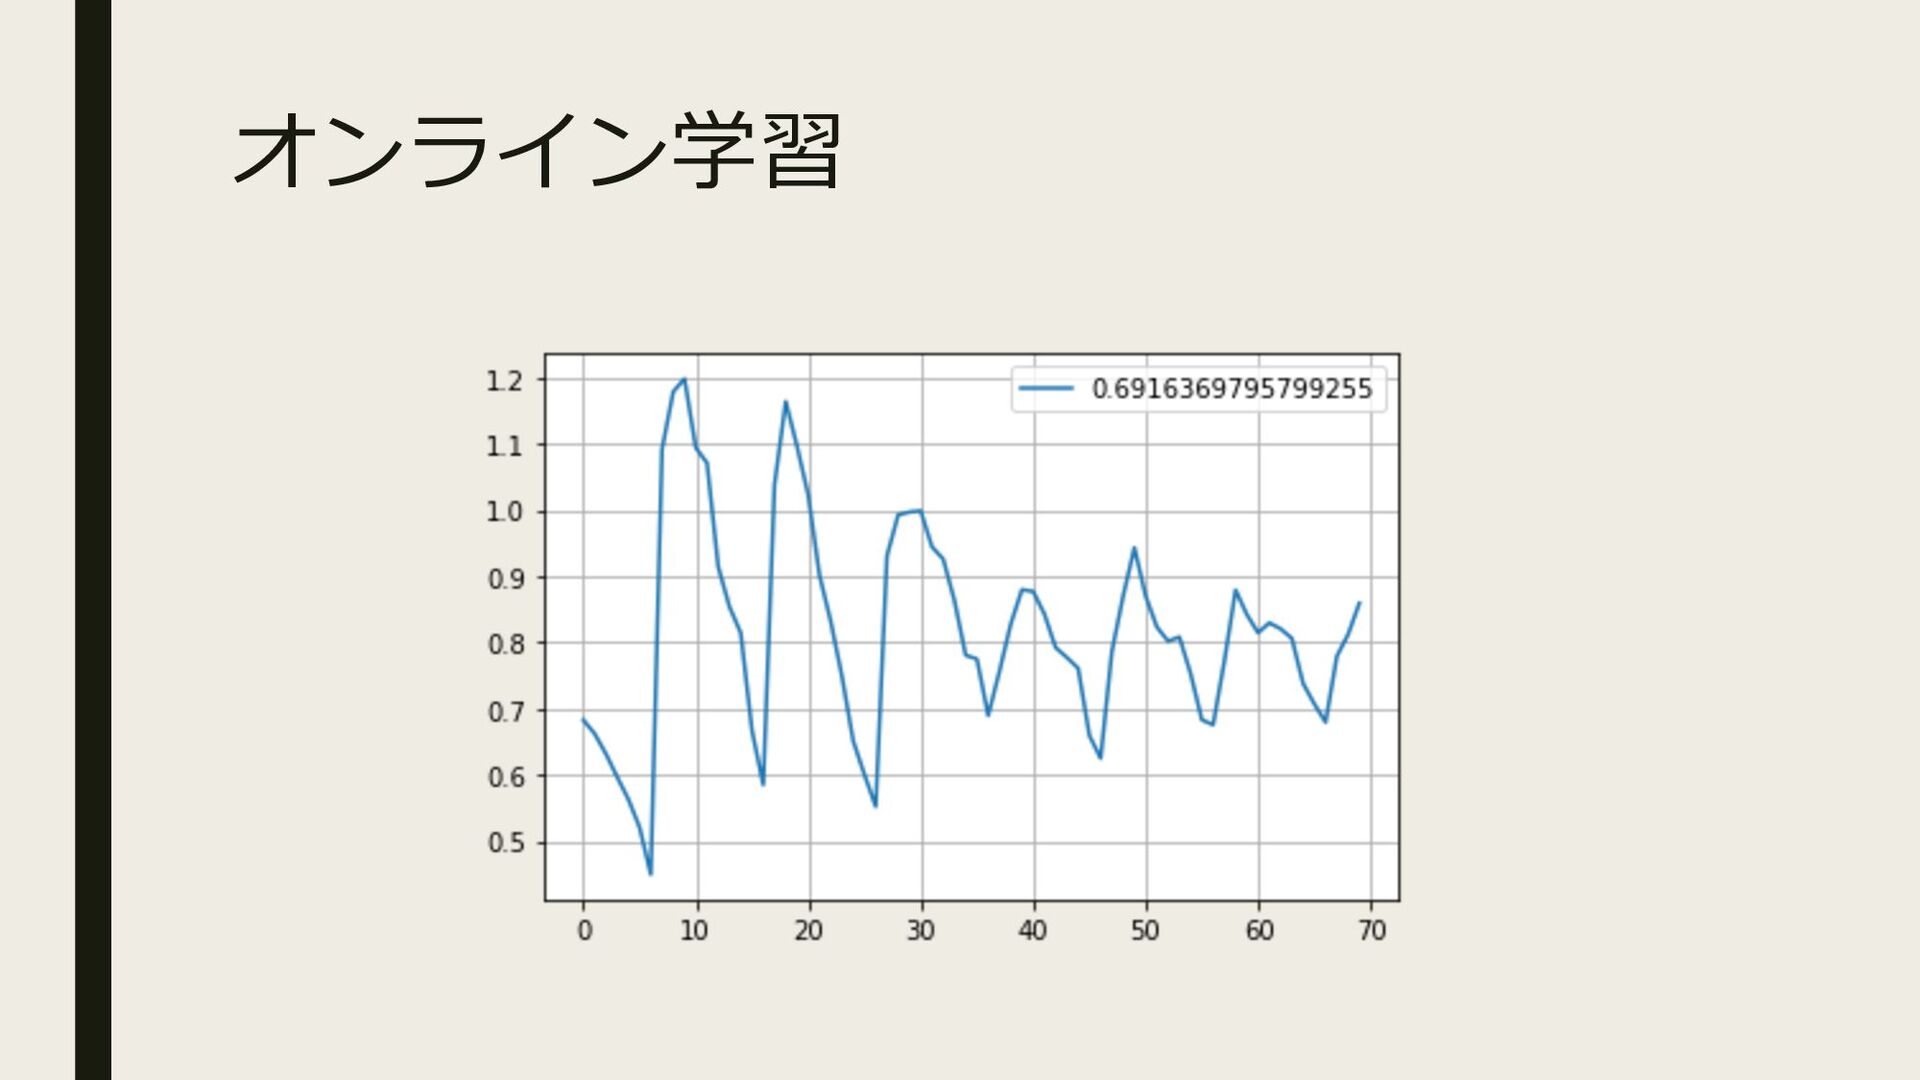
オンライン学習 ▪ 本に載ってる検証環境 スペックが⾼すぎるので⽤意できません︕ ※Google Colaboratoryでできるようにプログラムを変更しました。
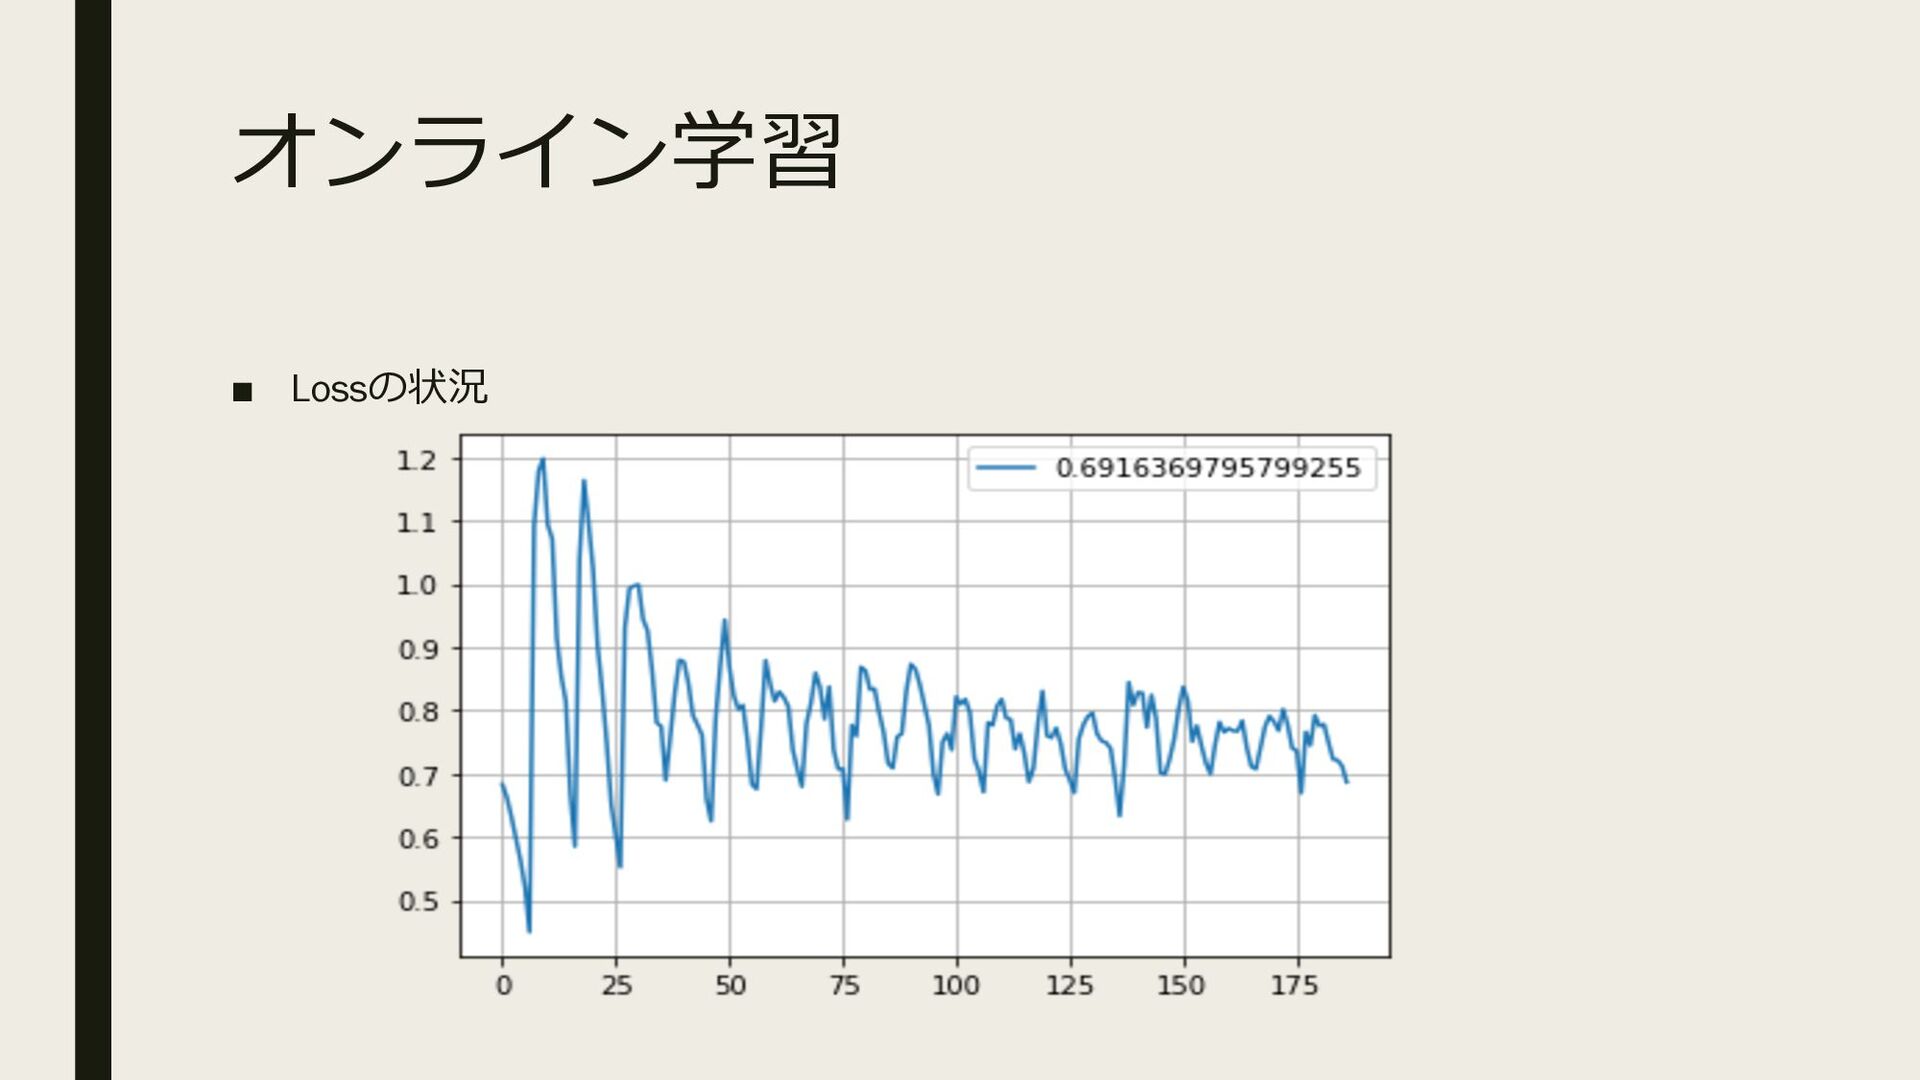
オンライン学習 ▪ Lossの状況
オンライン学習
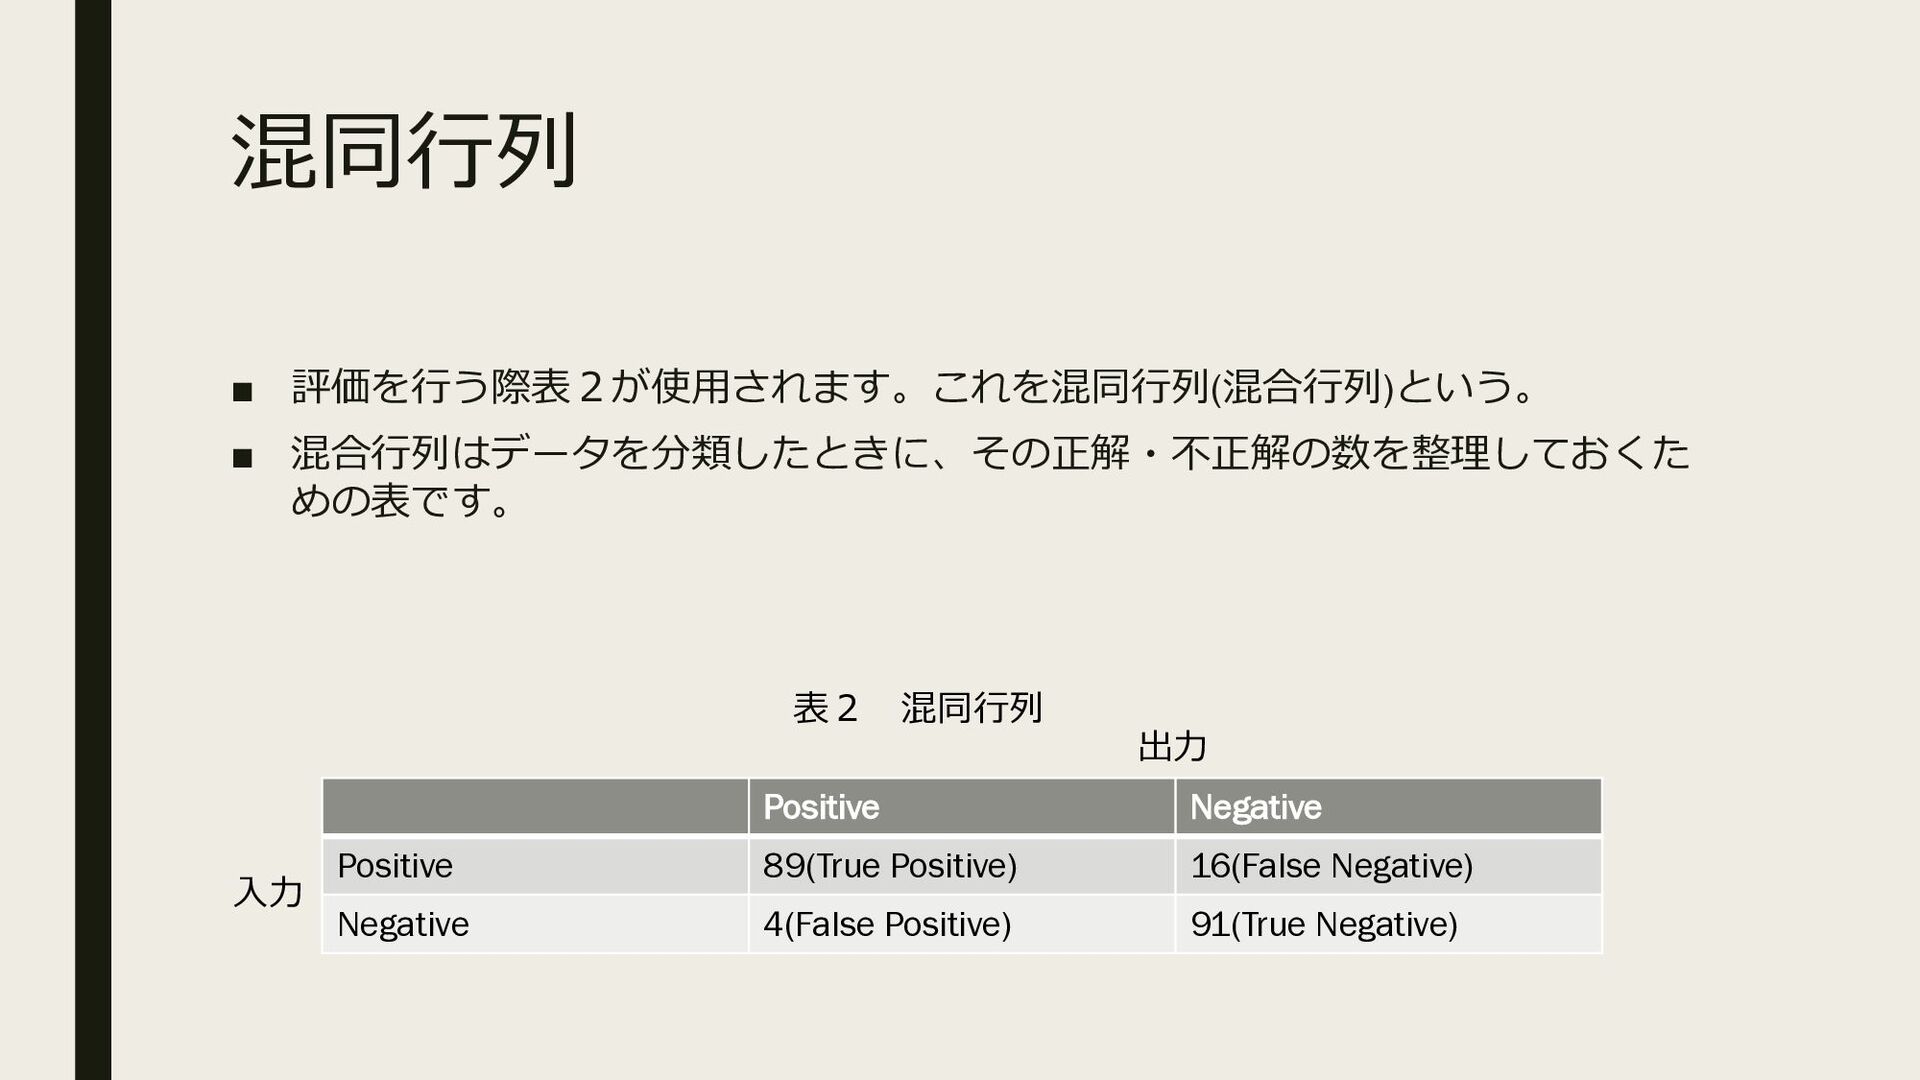
混同⾏列 ▪ 評価を⾏う際表2が使⽤されます。これを混同⾏列(混合⾏列)という。 ▪ 混合⾏列はデータを分類したときに、その正解・不正解の数を整理しておくた めの表です。 Positive Negative Positive 89(True
Positive) 16(False Negative) Negative 4(False Positive) 91(True Negative) ⼊⼒ 出⼒ 表2 混同⾏列
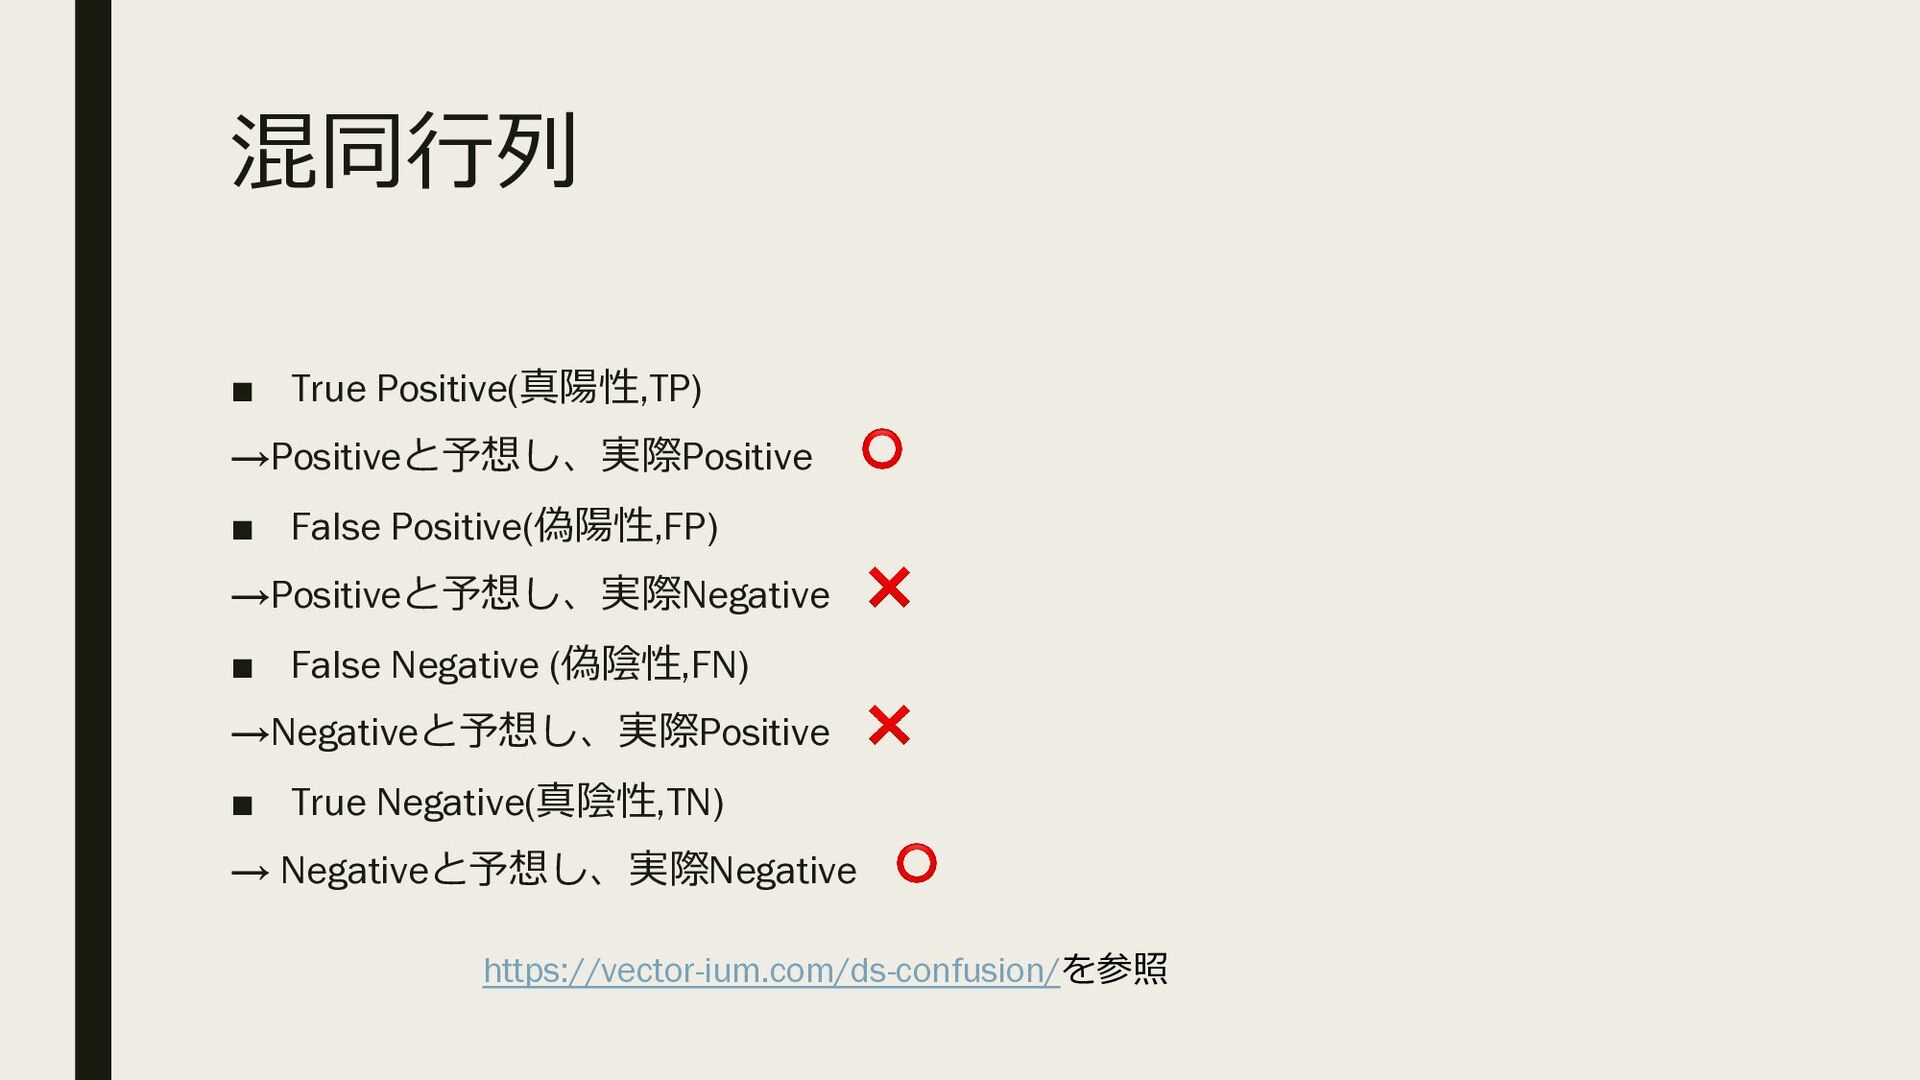
混同⾏列 ▪ True Positive(真陽性,TP) →Positiveと予想し、実際Positive ⭕ ▪ False Positive(偽陽性,FP) →Positiveと予想し、実際Negative
❌ ▪ False Negative (偽陰性,FN) →Negativeと予想し、実際Positive ❌ ▪ True Negative(真陰性,TN) → Negativeと予想し、実際Negative ⭕ https://vector-ium.com/ds-confusion/を参照
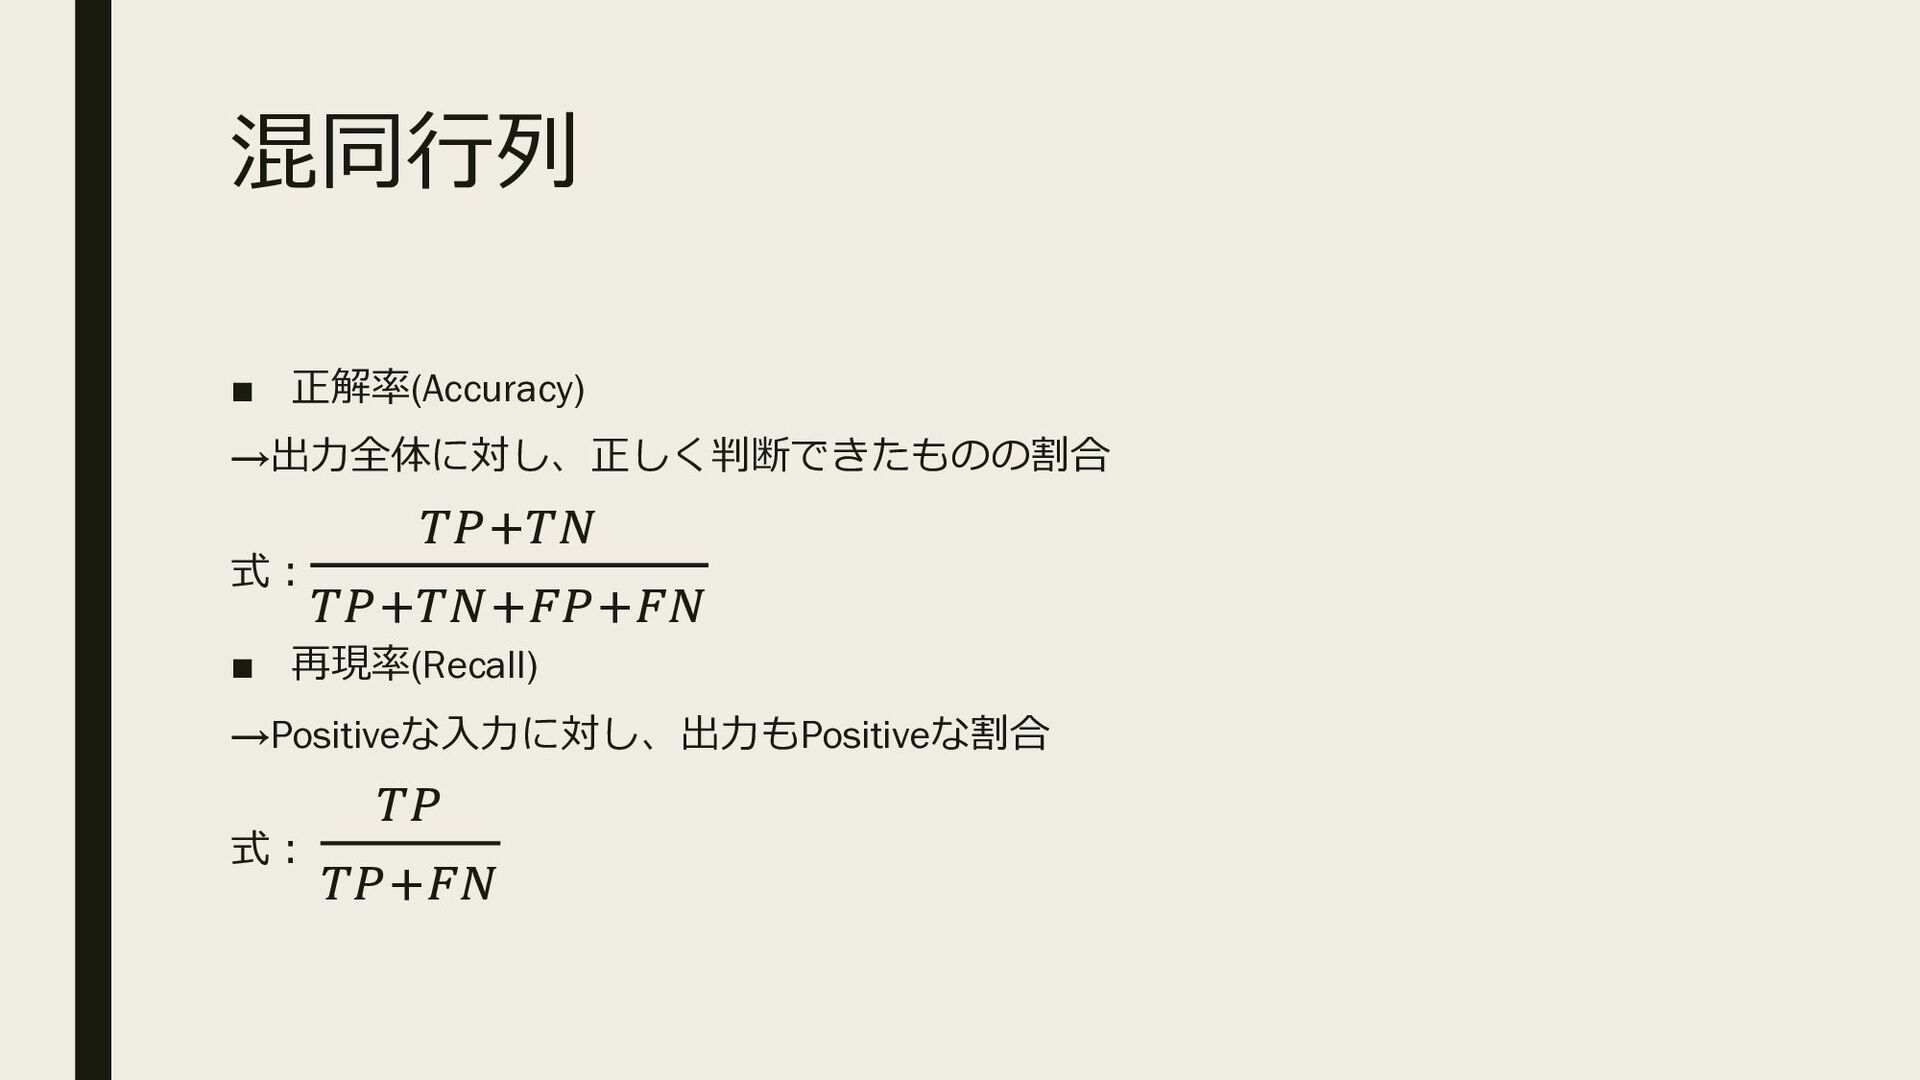
混同⾏列 ▪ 正解率(Accuracy) →出⼒全体に対し、正しく判断できたものの割合 式︓ !"#!$ !"#!$#%"#%$ ▪ 再現率(Recall) →Positiveな⼊⼒に対し、出⼒もPositiveな割合
式︓ !" !"#%$
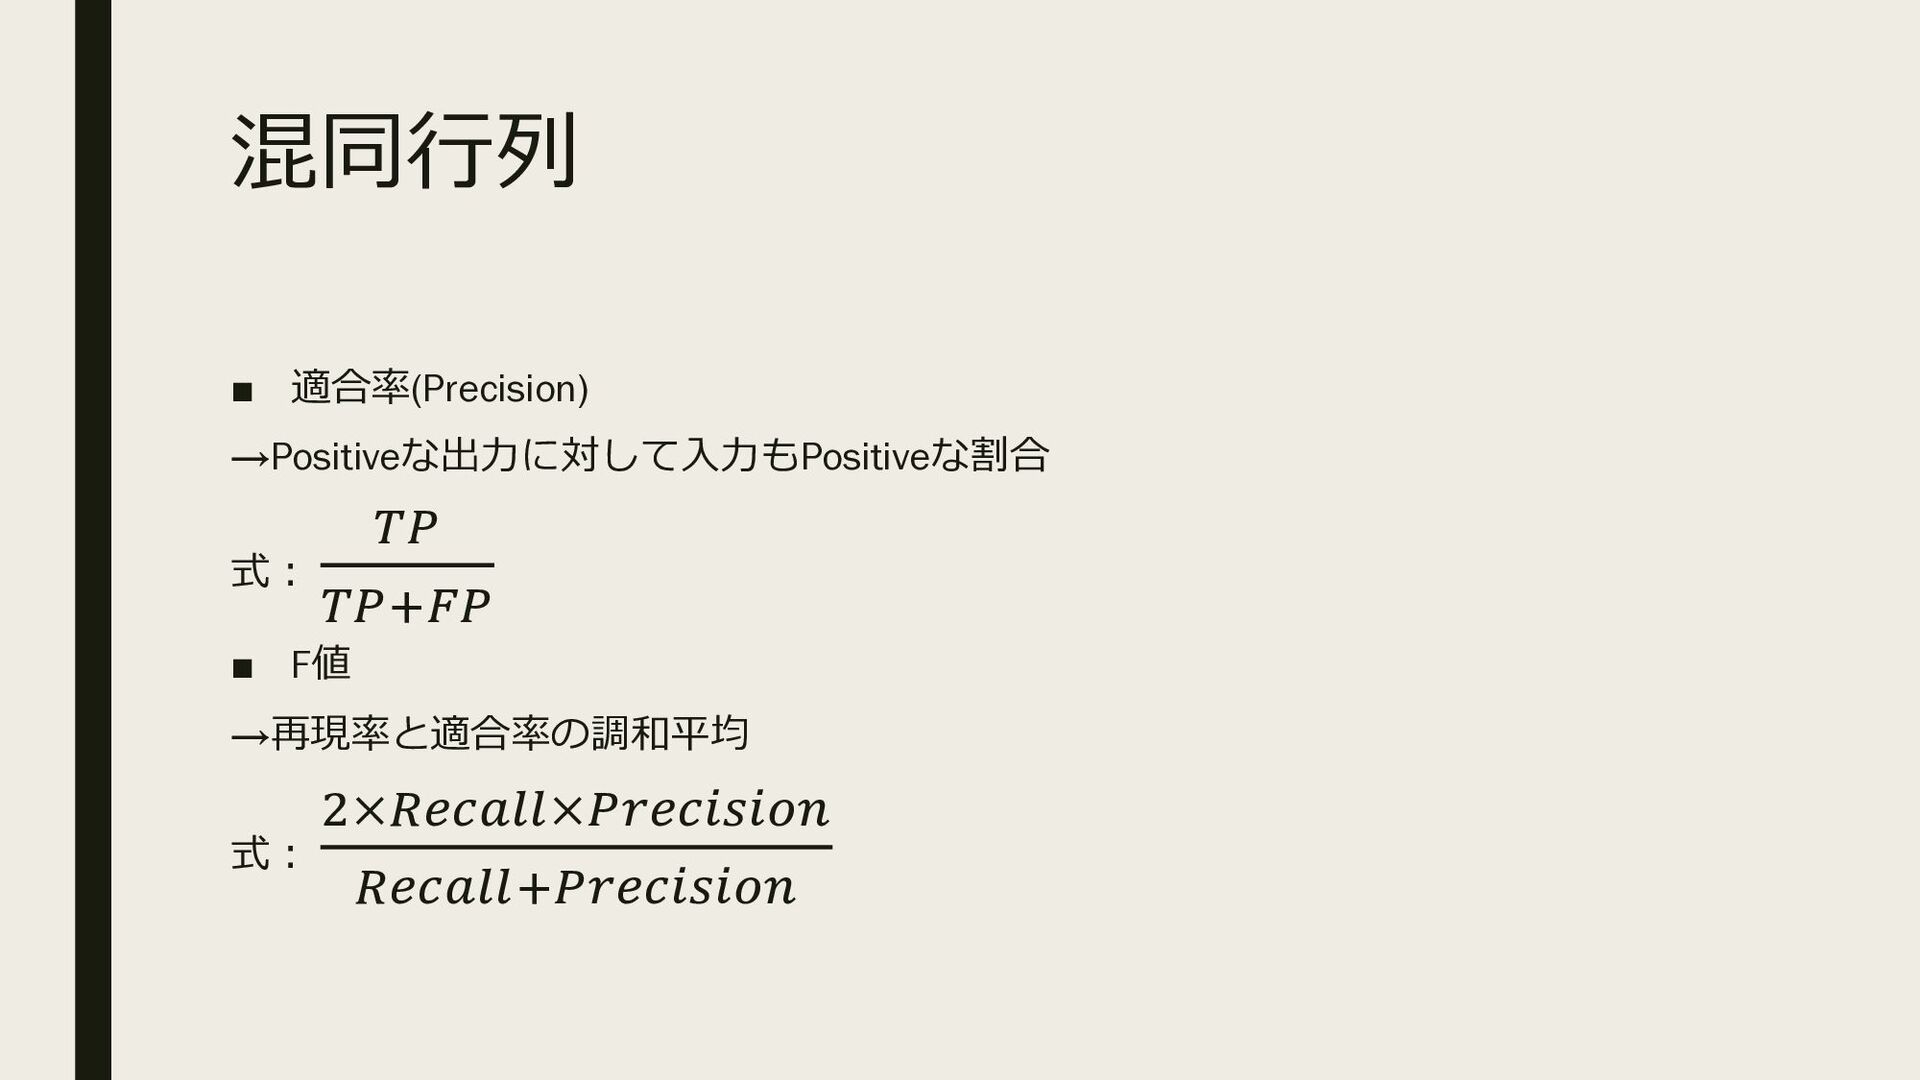
混同⾏列 ▪ 適合率(Precision) →Positiveな出⼒に対して⼊⼒もPositiveな割合 式︓ !" !"#%" ▪ F値 →再現率と適合率の調和平均
式︓ &×()*+,,×"-)*./.01 ()*+,,#"-)*./.01
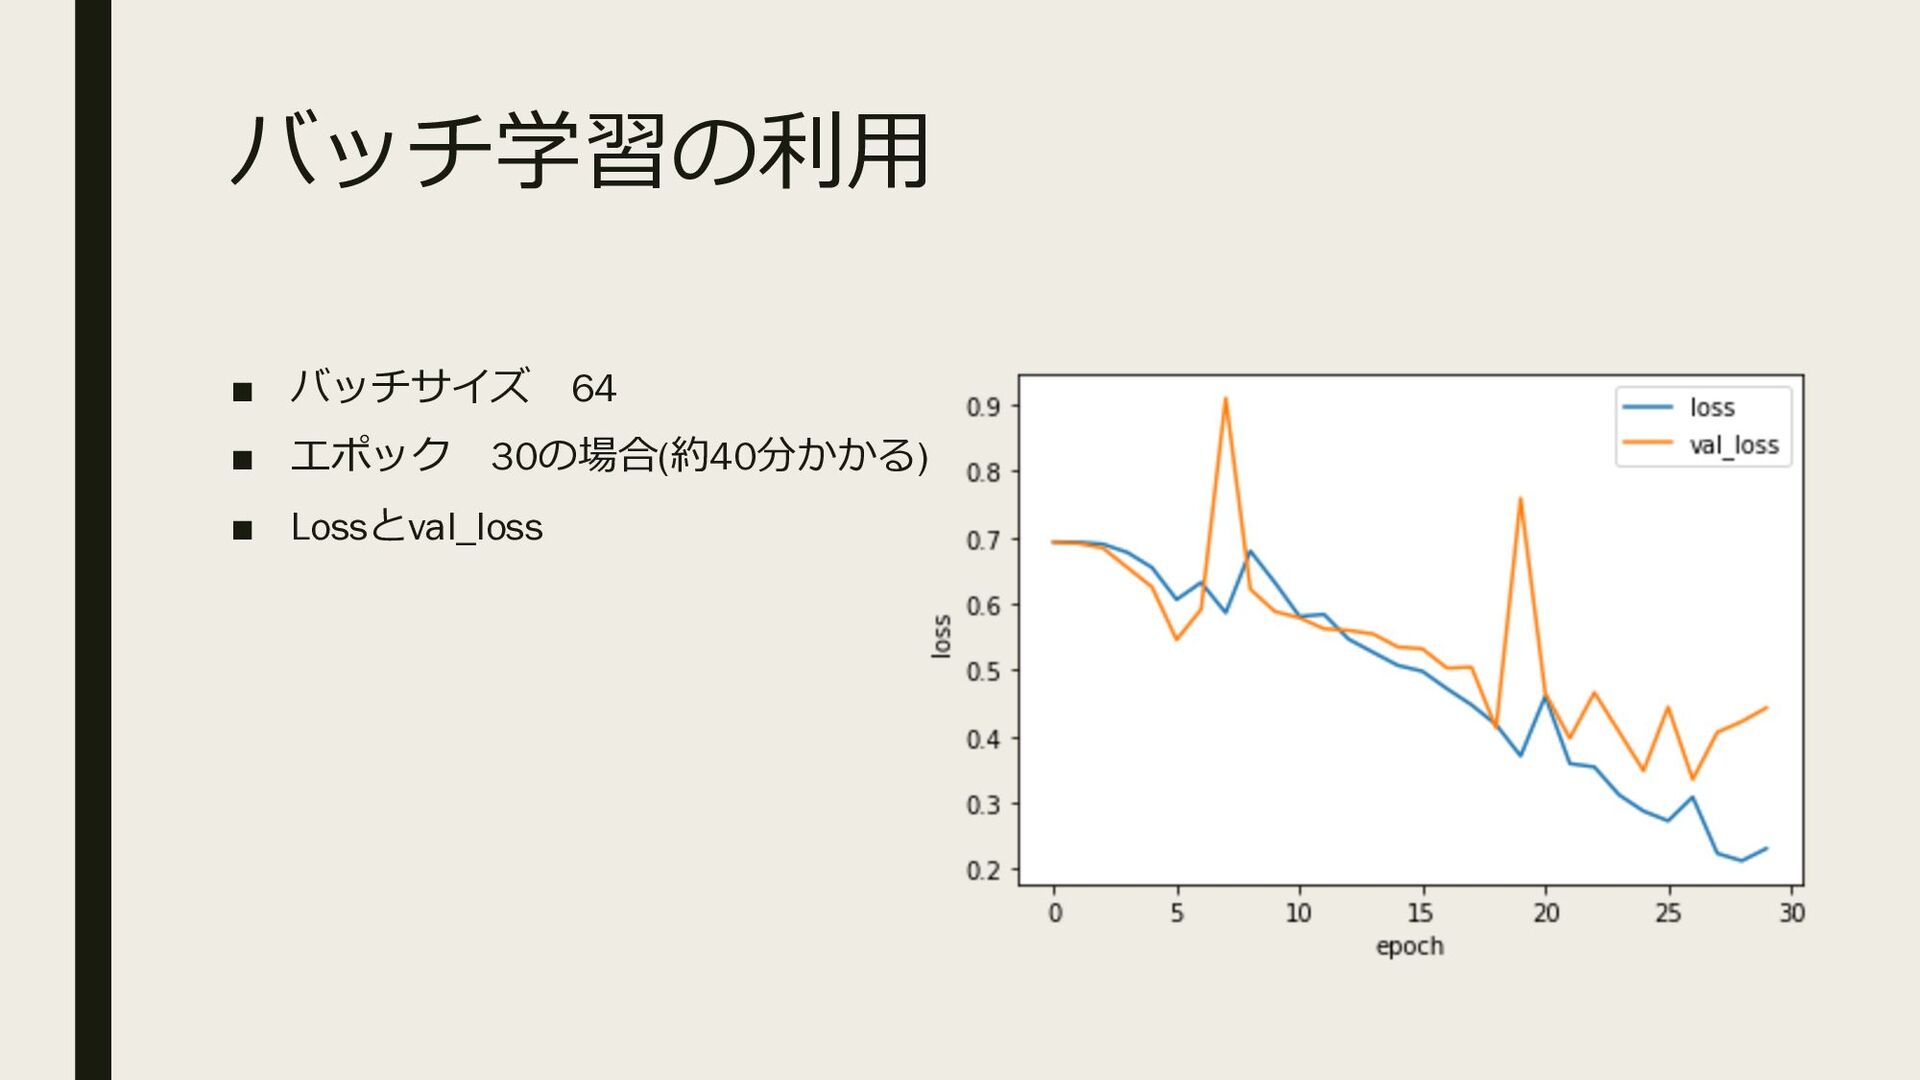
バッチ学習の利⽤ ▪ バッチサイズ 64 ▪ エポック 30の場合(約40分かかる) ▪ Lossとval_loss
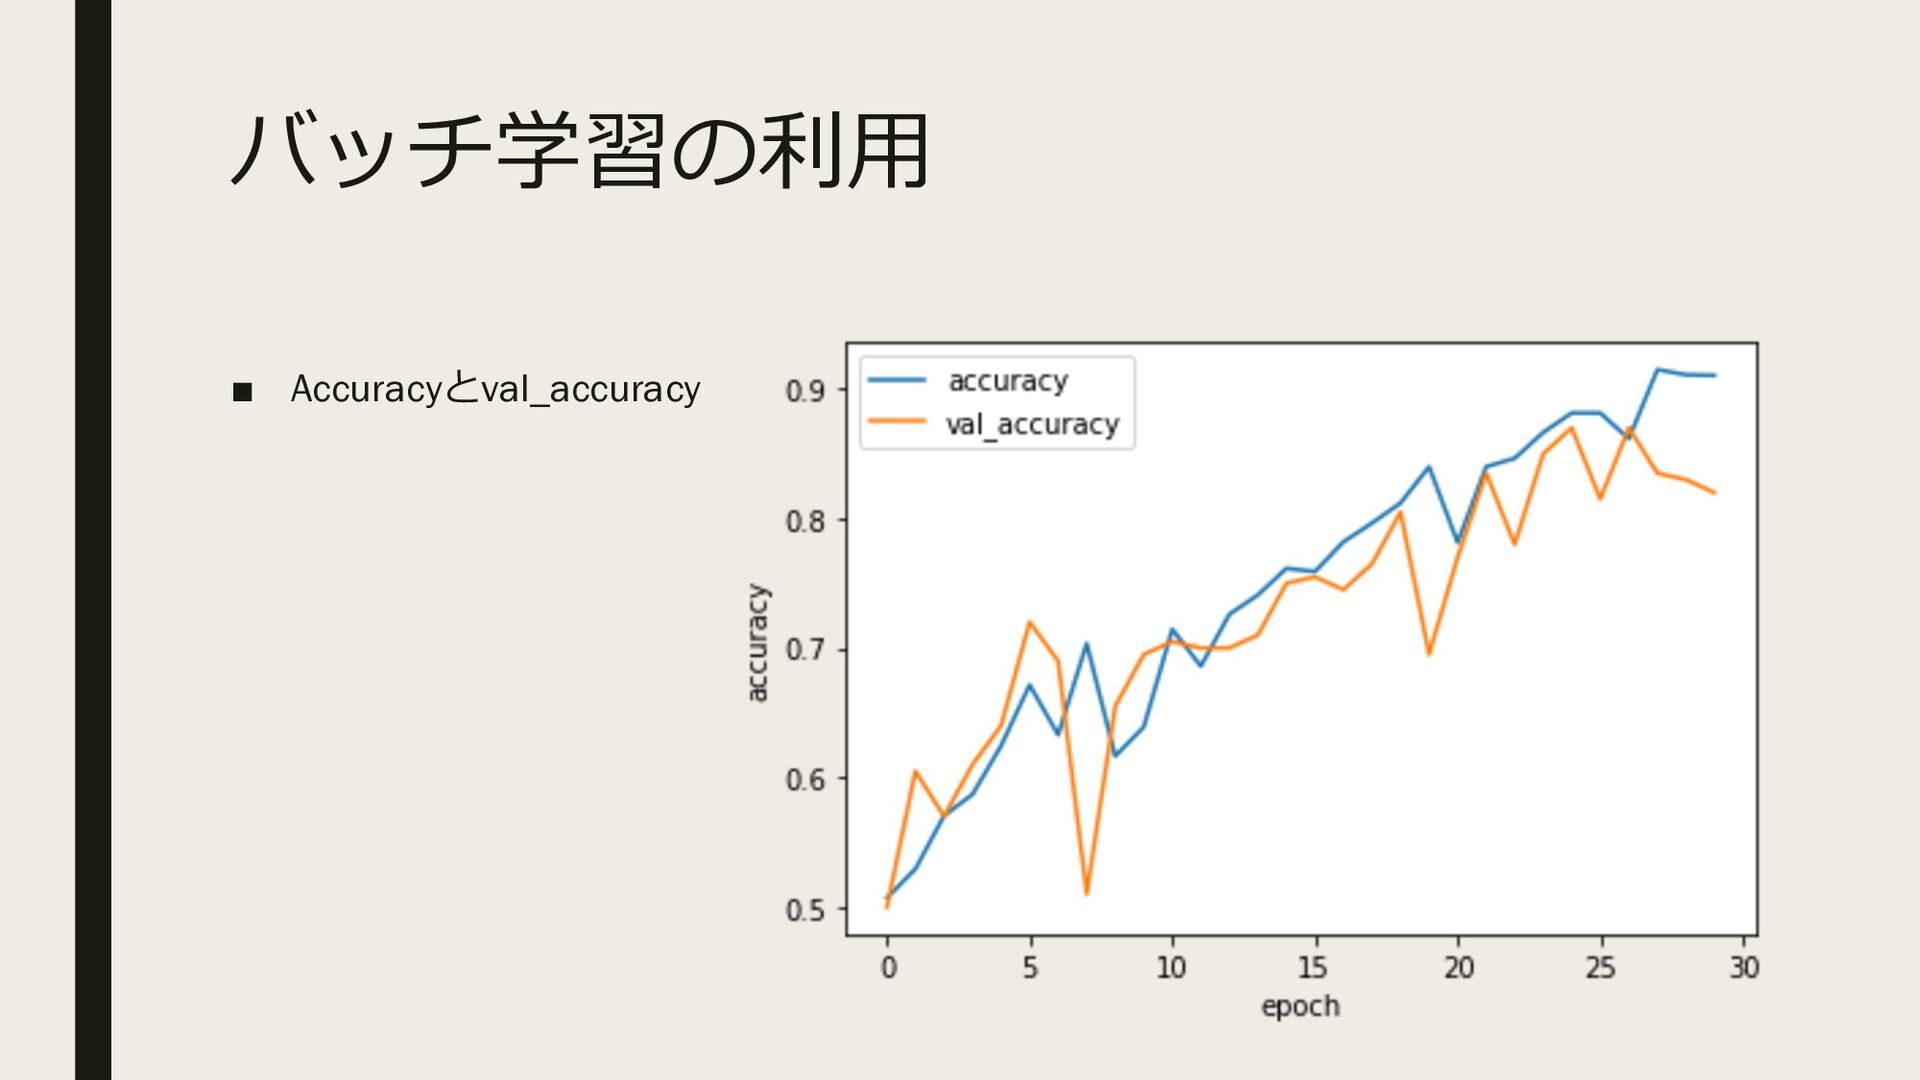
バッチ学習の利⽤ ▪ Accuracyとval_accuracy
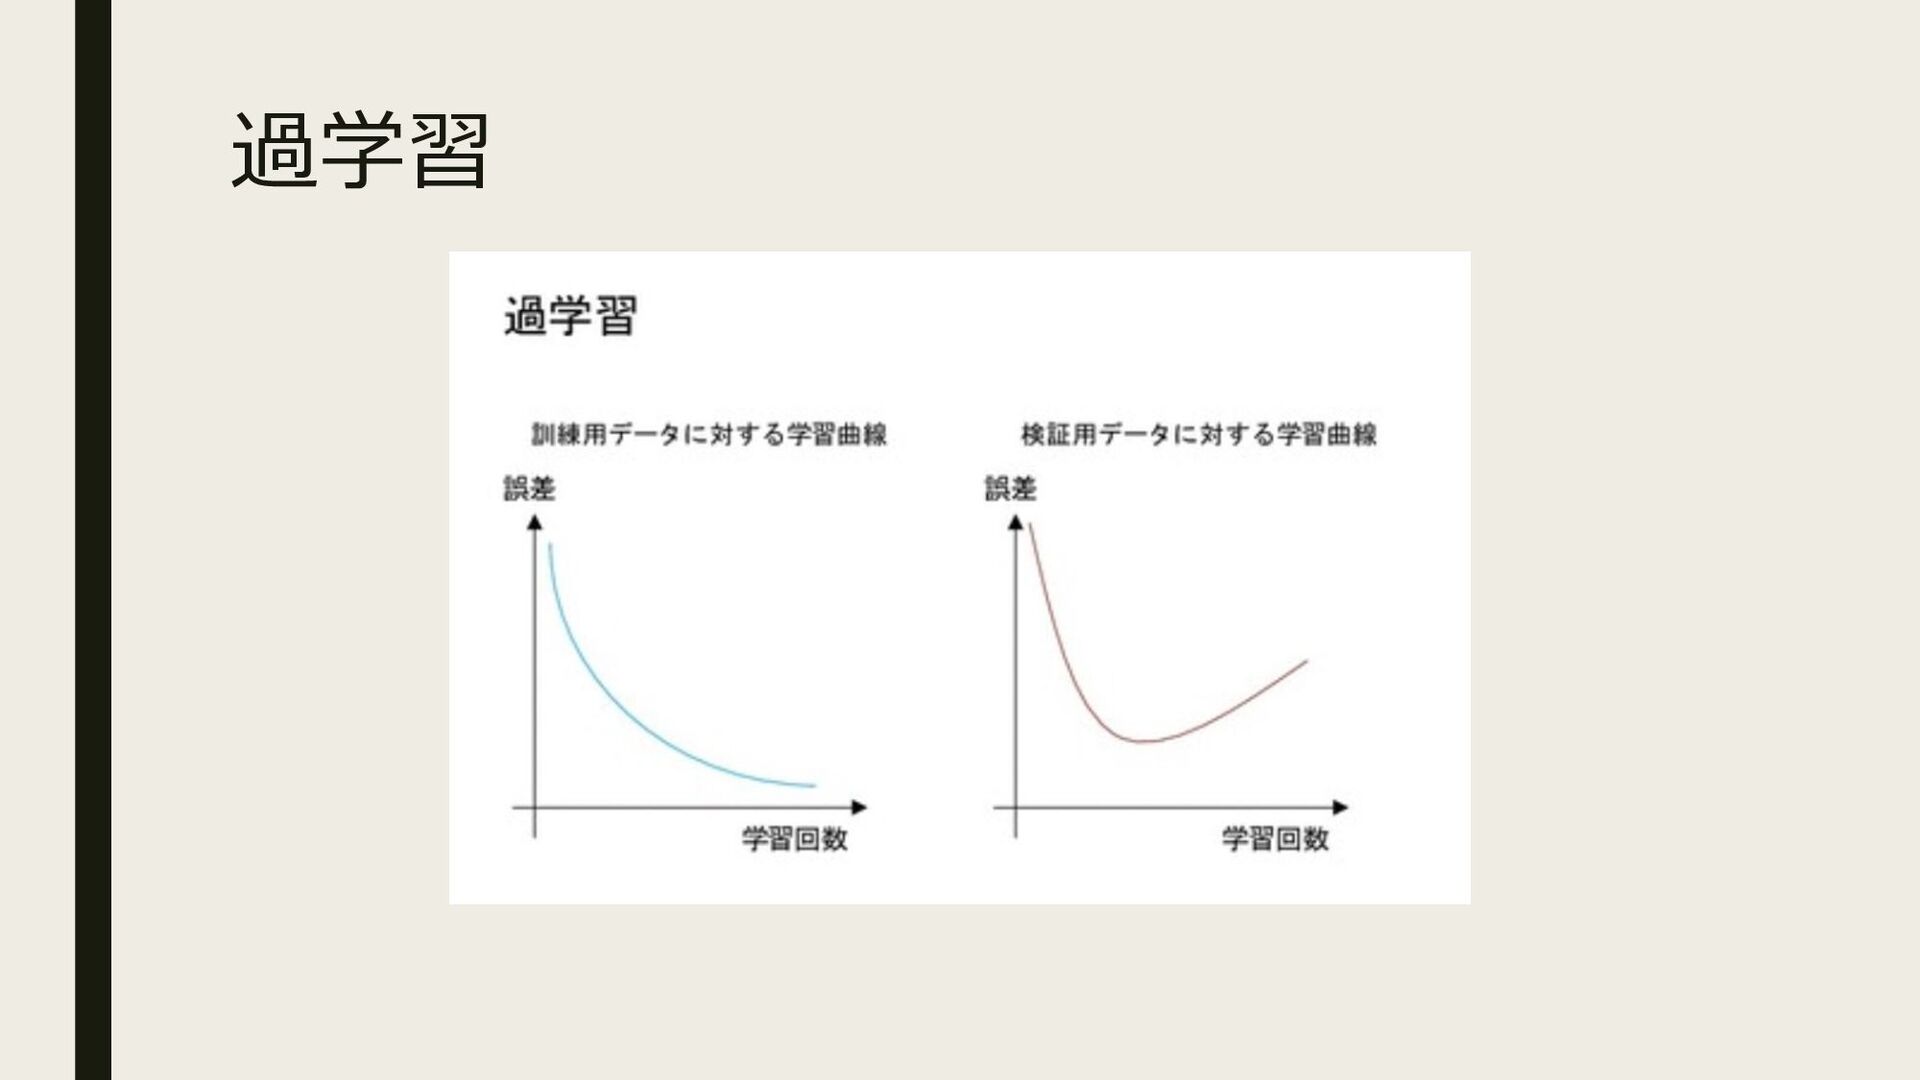
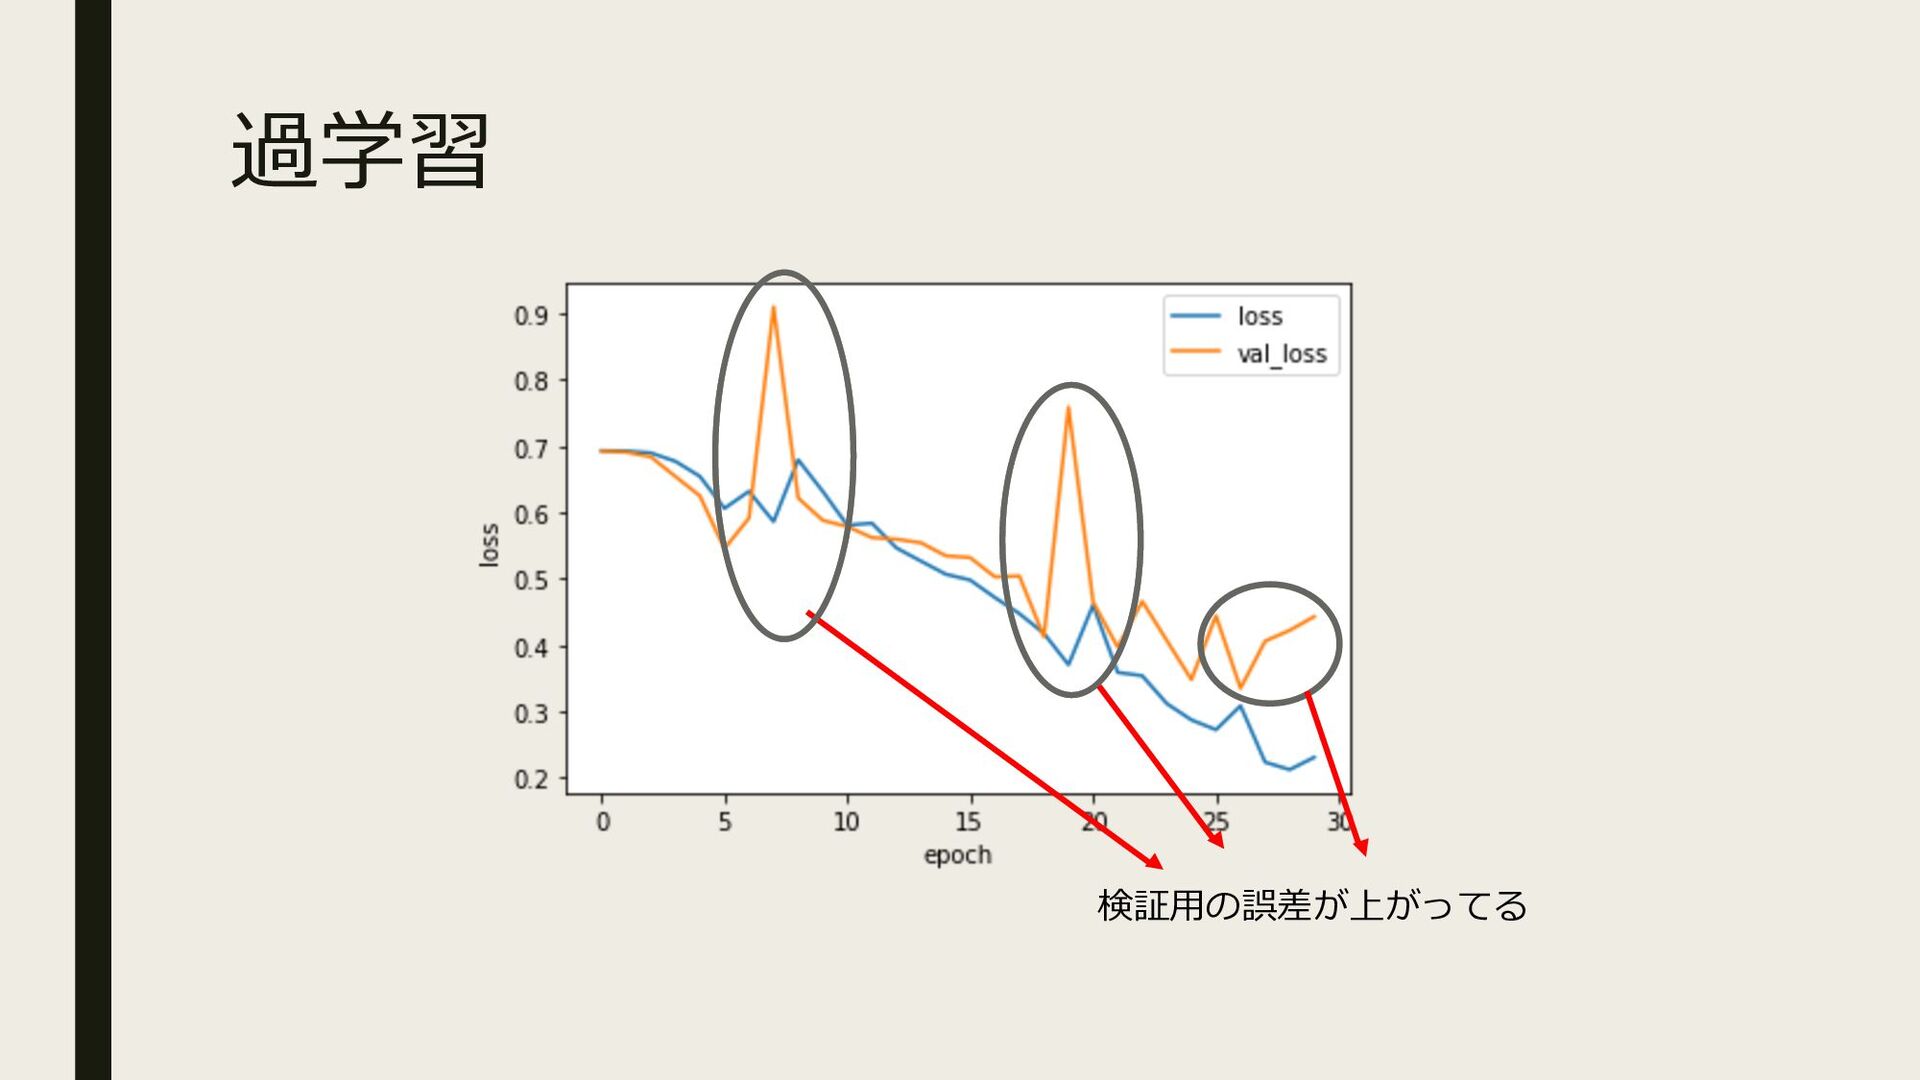
過学習
過学習 検証⽤の誤差が上がってる
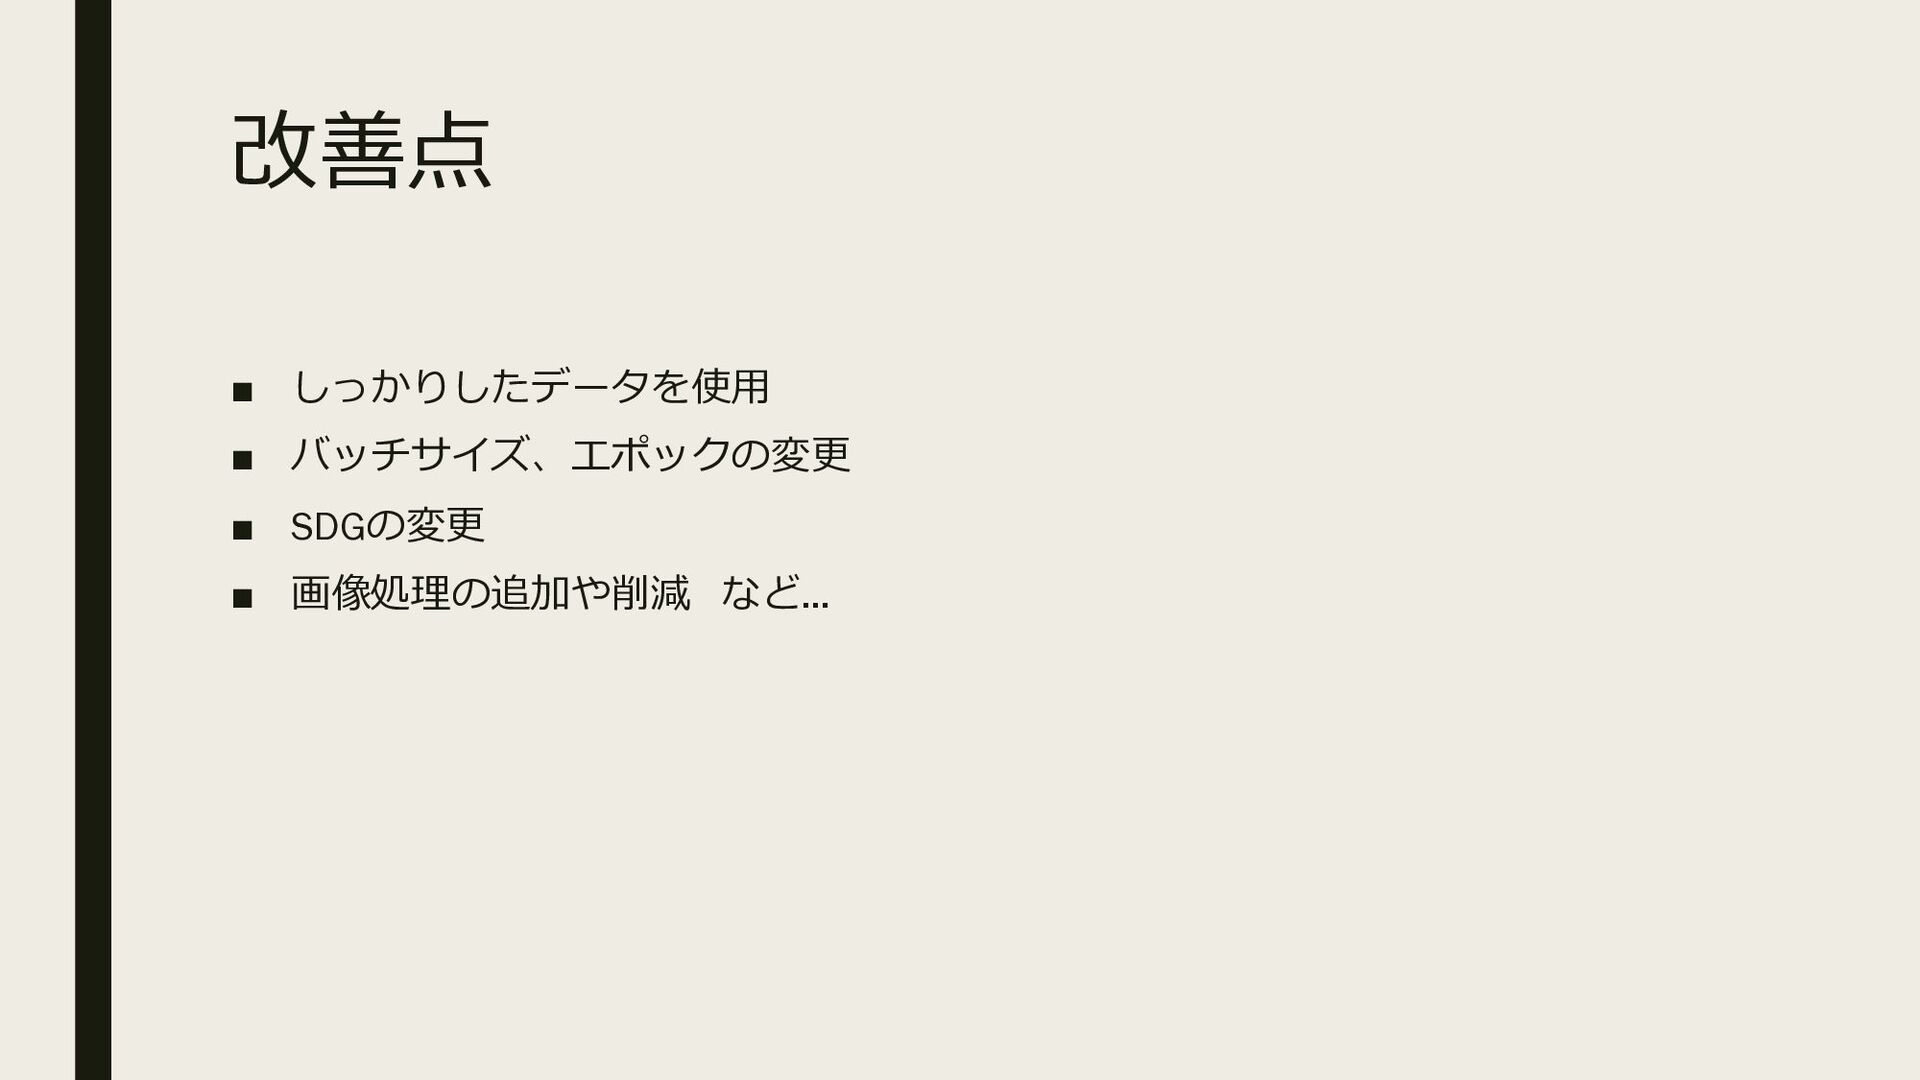
改善点 ▪ しっかりしたデータを使⽤ ▪ バッチサイズ、エポックの変更 ▪ SDGの変更 ▪ 画像処理の追加や削減 など…
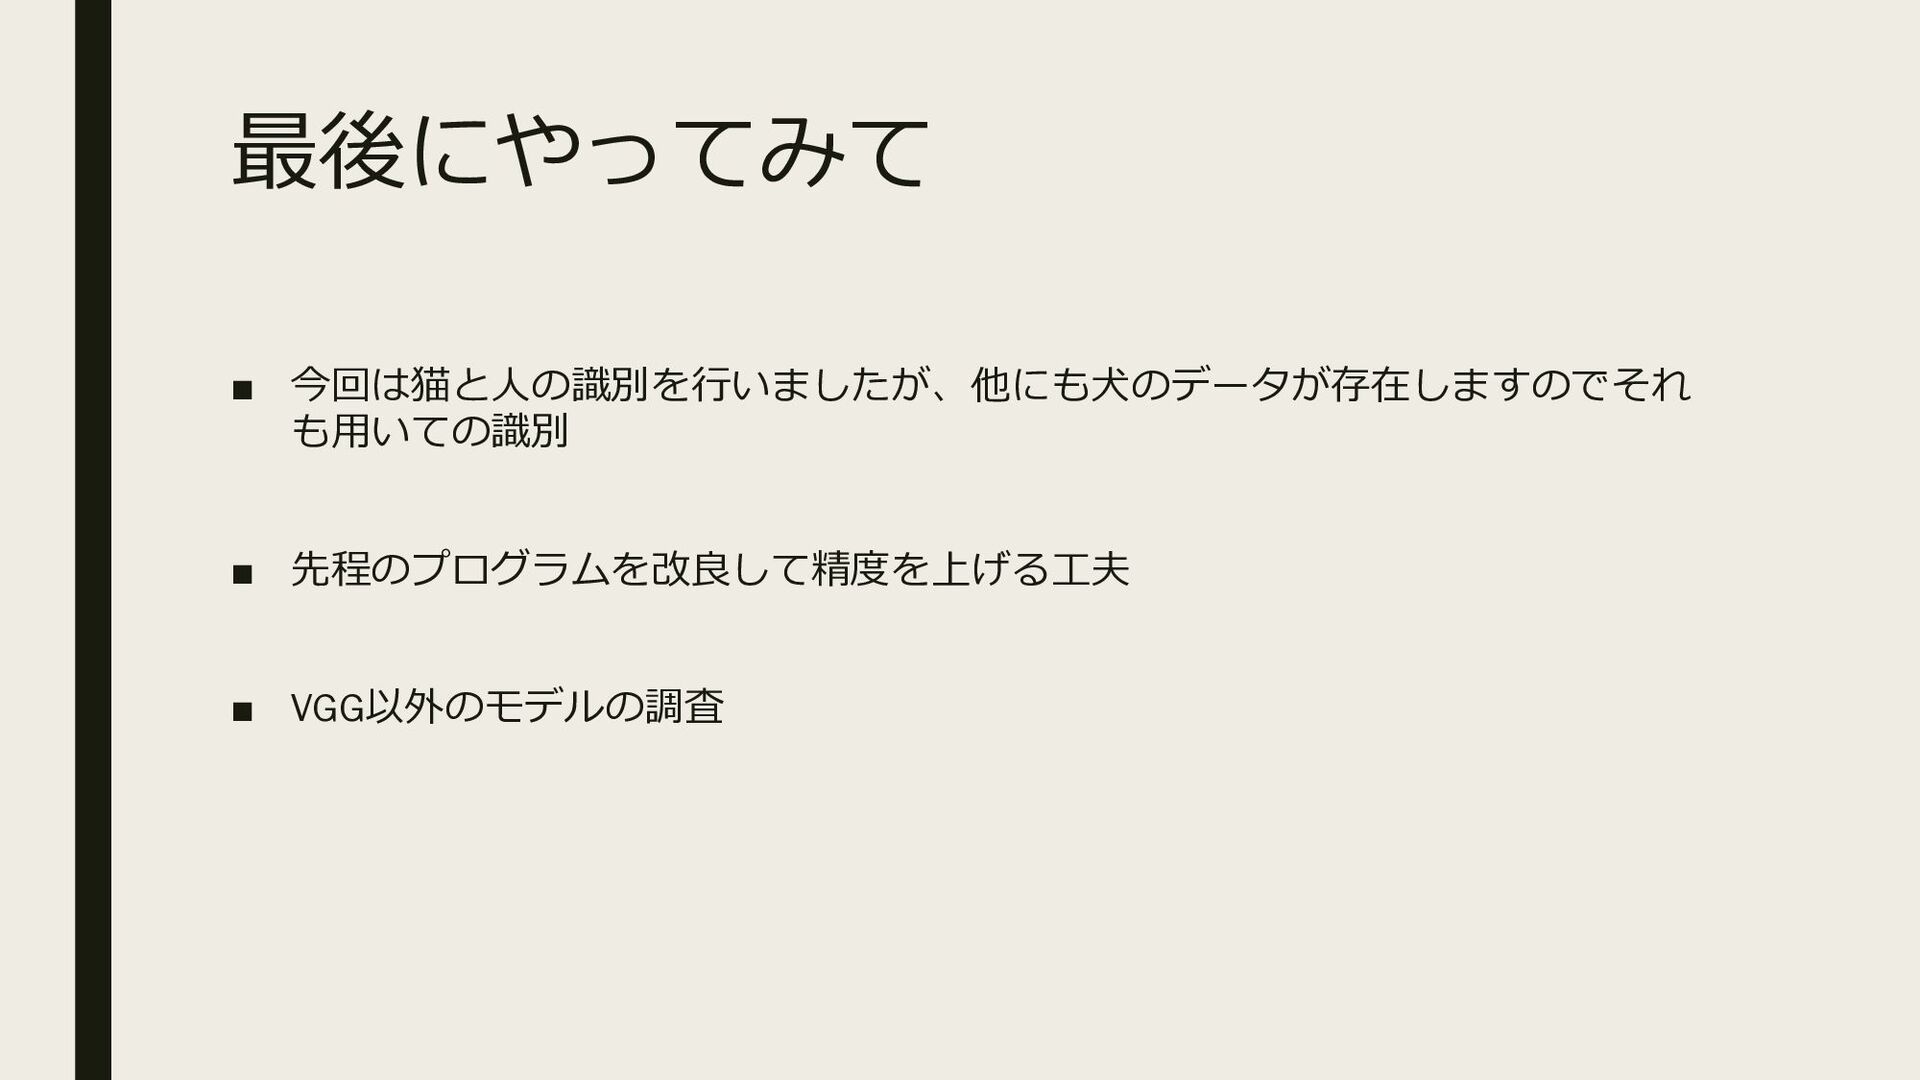
最後にやってみて ▪ 今回は猫と⼈の識別を⾏いましたが、他にも⽝のデータが存在しますのでそれ も⽤いての識別 ▪ 先程のプログラムを改良して精度を上げる⼯夫 ▪ VGG以外のモデルの調査


 engineercafe
 ykiyota
 ts020
 matsu7874
 civitaspo
 m3m0r7
 kgnkhkr
 jinwatanabe
 genshun9
 komagata
 nealle
 shinyaa31
 codmoninc
 soudai
 mojombo
 elsirapls
 khoart
 akosma
 samtorres
 mkilby
 pedronauck
 kristinabergwall1
 sonatard
 twada
 baasie