Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Agent Routerで作るマルチテナント 推論基盤 #CNDW2026 / Buildi...

Shingo Omura
November 16, 2026

Agent Routerで作るマルチテナント 推論基盤 #CNDW2026 / Building Multi-Tenant Inference Platform with Agent Router #CNDW2026

This is a presentation slide at Cloud Native Days(CNDW) 2026
https://event.cloudnativedays.jp/cndw2026/talks/3282

Shingo Omura

November 16, 2026

Transcript

27 slides
  1. LLMを「動かす」から「みんなで使う」へ Agent Routerで作るマルチテナント 推論基盤 CloudNative Days Winter 2026 #CNDW2026 |

    2026-11-18 - Room I ⼤村 伸吾(@everpeace), Principal Architect of AI Infrastructure, LINEヤフー © LY Corporation
  2. ⾃⼰紹介: ⼤村伸吾 (@somura) 💻 業務内容 ☸ AI/ML向けオンプレKubernetes GPU クラスタの開発/運⽤ 🧠

    社内向けLLM推論サービスの開発/運⽤ 🌐 Community & OSS ⼤村 伸吾 🏆 Kubernetes Japanʼs DevStats 2025 6位 @everpeace • KEP-3619: Fine-grained SupplementalGroups control (v1.35, GA) • KEP-5055: DRA: device taints and tolerations (v1.37, GA) • KEP-5491: DRA: List Types for Attributes (v1.38, Beta予定) • KEP-2172: Warn users about insecure pods (v1.38, Alpha予定) Principal Architect of AI Infrastructure 🤝 CNCJ SIG AI Infraの設⽴ & Organizer • Launch of the AI Infra SIG under the CNCF Japan chapter: First meetup and call for speakers 2 © LY Corporation
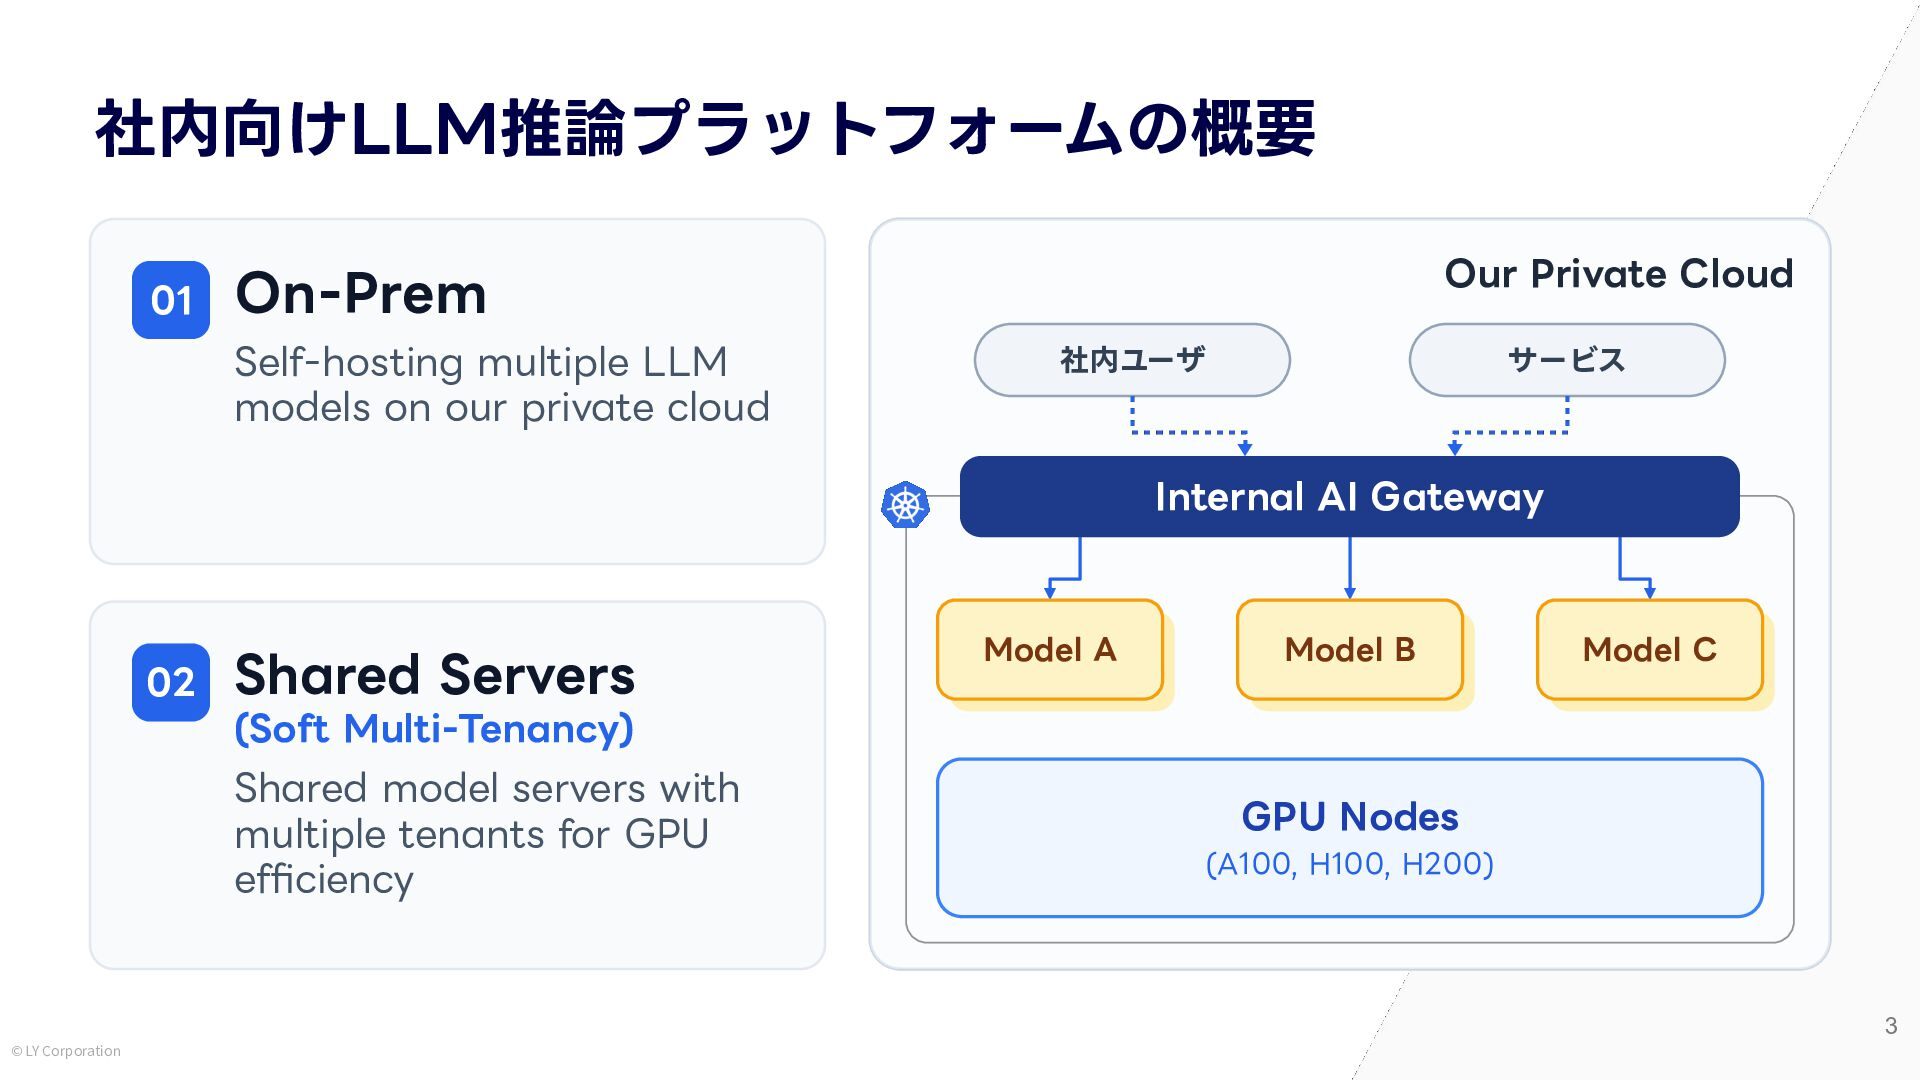
  3. 社内向けLLM推論プラットフォームの概要 01 Our Private Cloud On-Prem Self-hosting multiple LLM models

    on our private cloud 社内ユーザ サービス Internal AI Gateway 02 Shared Servers Model A Model B Model C (Soft Multi-Tenancy) Shared model servers with multiple tenants for GPU efficiency GPU Nodes (A100, H100, H200) 3 © LY Corporation
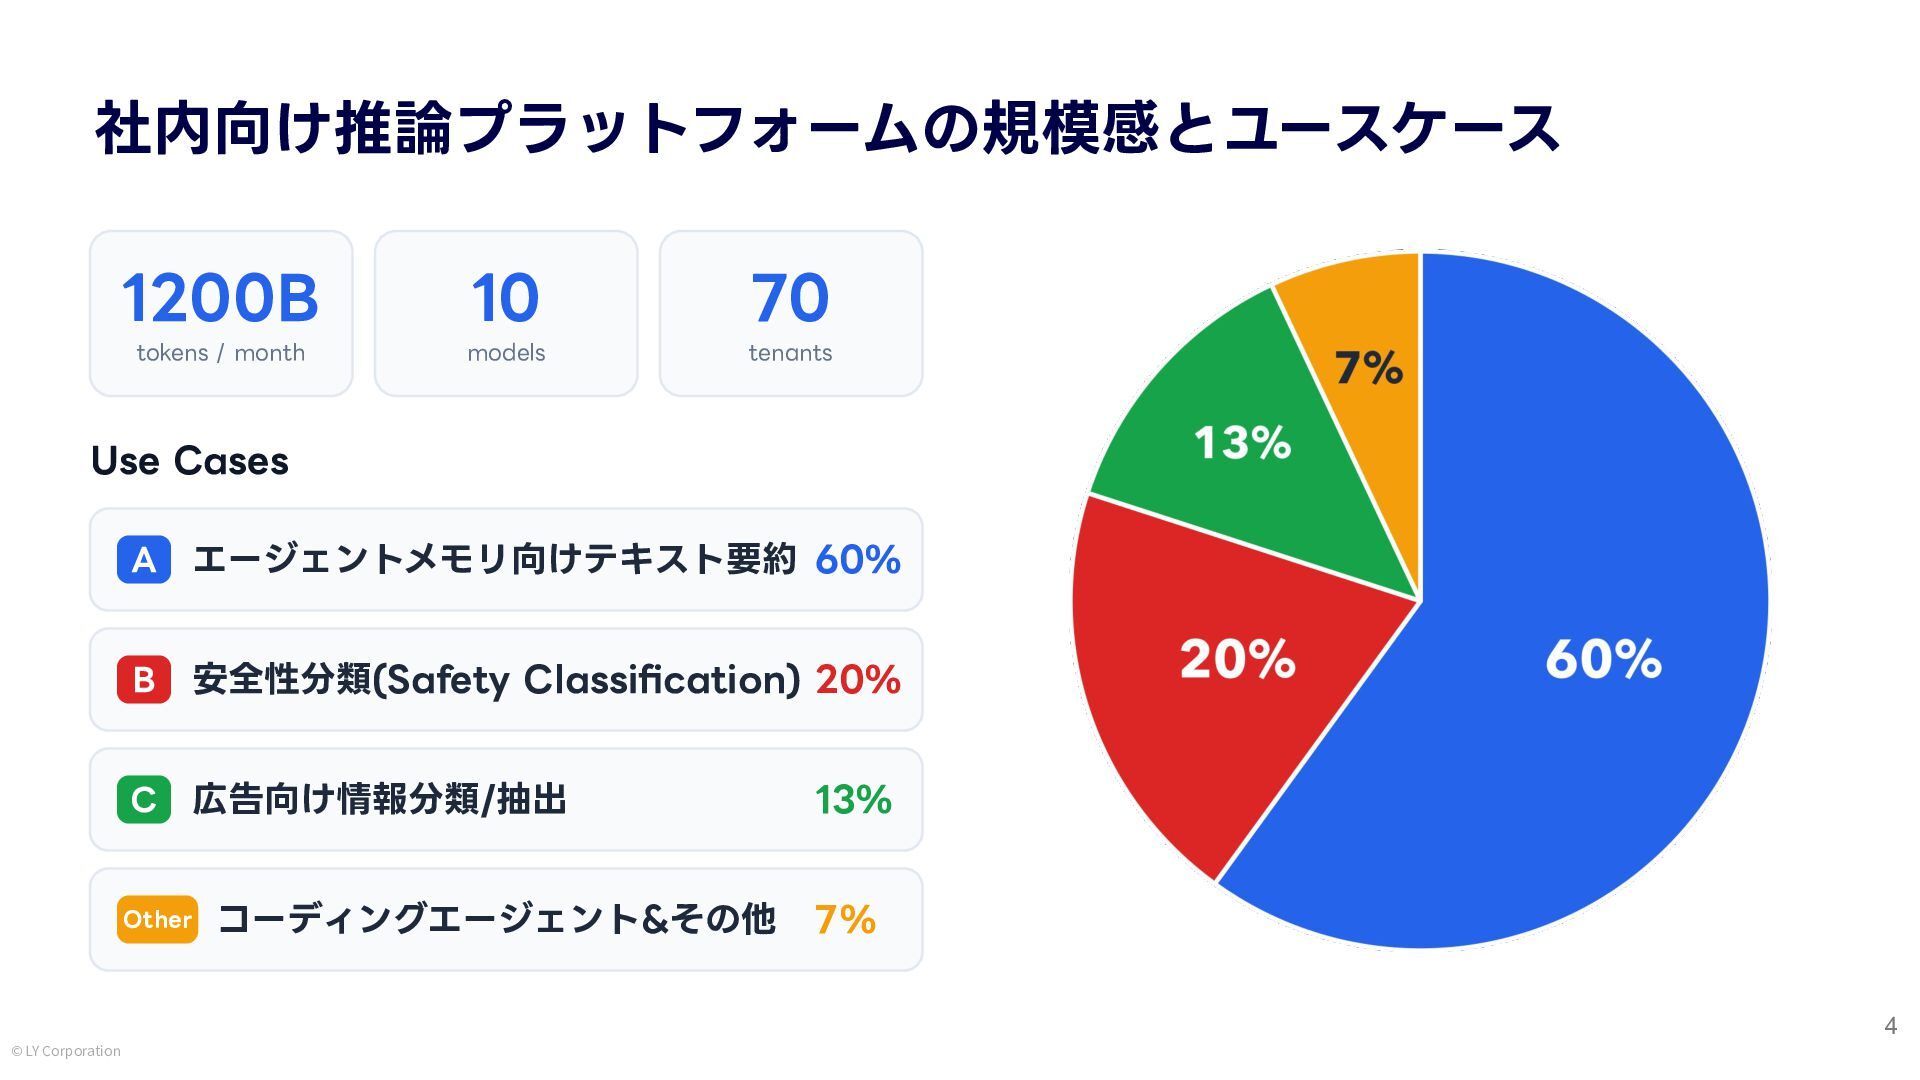
  4. 社内向け推論プラットフォームの規模感とユースケース 1200B 10 70 tokens / month models tenants Use

    Cases A エージェントメモリ向けテキスト要約 60% B 安全性分類(Safety Classification) 20% C 広告向け情報分類/抽出 13% コーディングエージェント&その他 7% Other 4 © LY Corporation
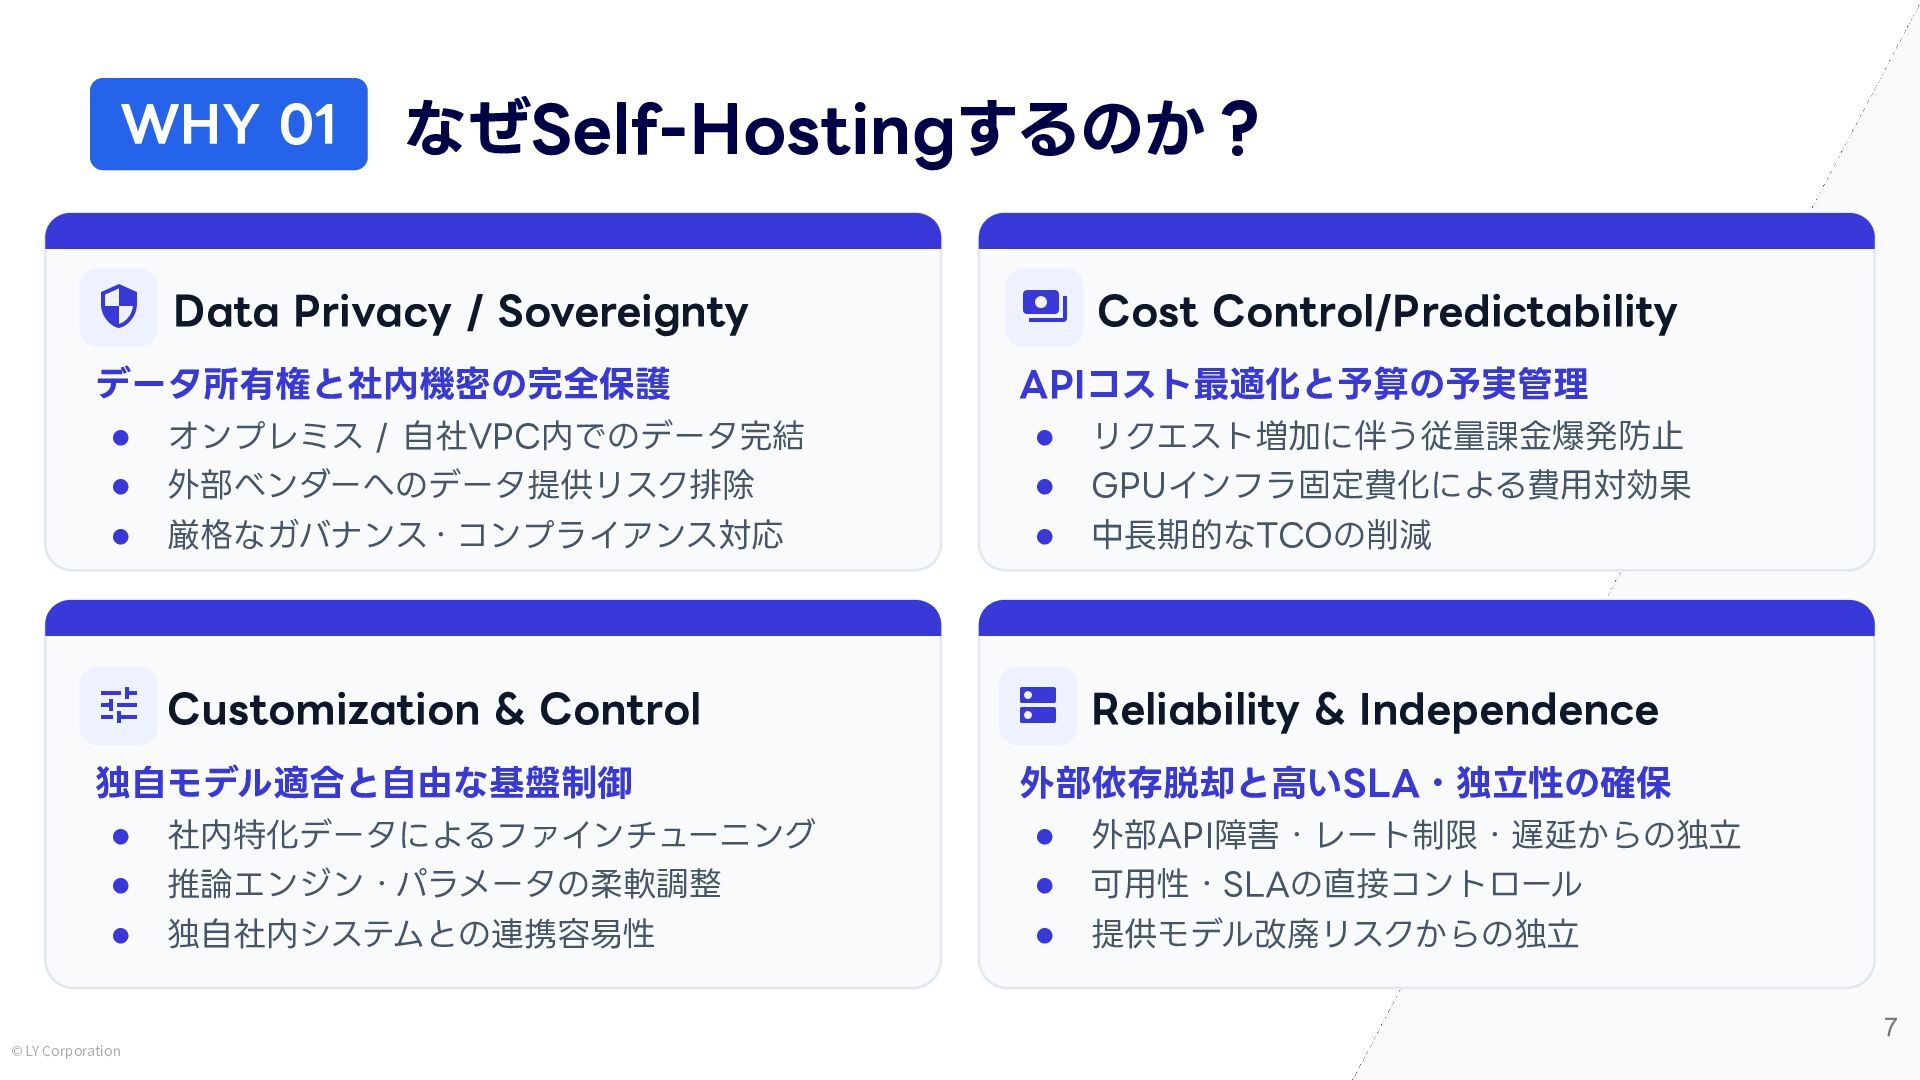
  5. WHY 01 なぜSelf-Hostingするのか?  Data Privacy / Sovereignty  Cost

    Control/Predictability データ所有権と社内機密の完全保護 • オンプレミス / ⾃社VPC内でのデータ完結 • 外部ベンダーへのデータ提供リスク排除 • 厳格なガバナンス・コンプライアンス対応 APIコスト最適化と予算の予実管理 • リクエスト増加に伴う従量課⾦爆発防⽌ • GPUインフラ固定費化による費⽤対効果 • 中⻑期的なTCOの削減  Customization & Control  Reliability & Independence 独⾃モデル適合と⾃由な基盤制御 • 社内特化データによるファインチューニング • 推論エンジン・パラメータの柔軟調整 • 独⾃社内システムとの連携容易性 外部依存脱却と⾼いSLA・独⽴性の確保 • 外部API障害・レート制限・遅延からの独⽴ • 可⽤性・SLAの直接コントロール • 提供モデル改廃リスクからの独⽴ 7 © LY Corporation
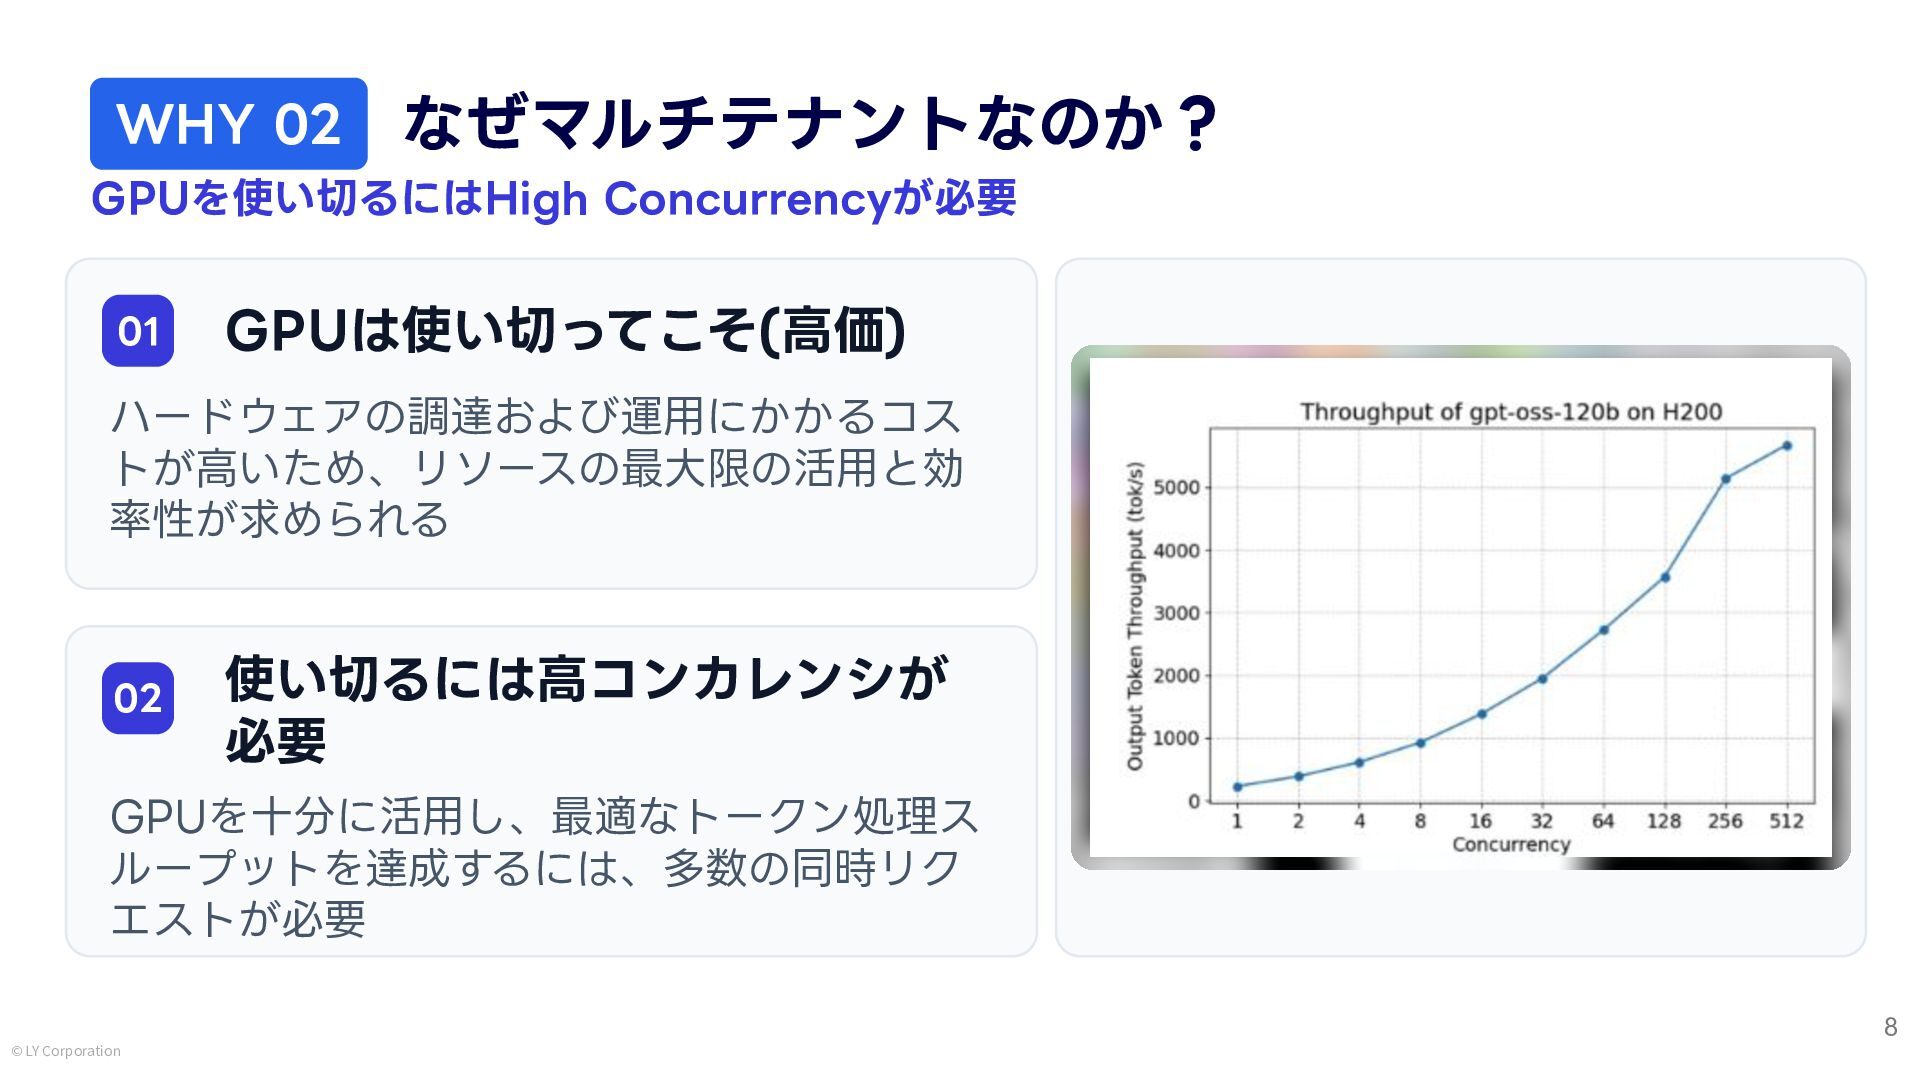
  6. WHY 02 なぜマルチテナントなのか? GPUを使い切るにはHigh Concurrencyが必要 01 GPUは使い切ってこそ(⾼価) ハードウェアの調達および運⽤にかかるコス トが⾼いため、リソースの最⼤限の活⽤と効 率性が求められる

    02 使い切るには⾼コンカレンシが 必要 GPUを⼗分に活⽤し、最適なトークン処理ス ループットを達成するには、多数の同時リク エストが必要 8 © LY Corporation
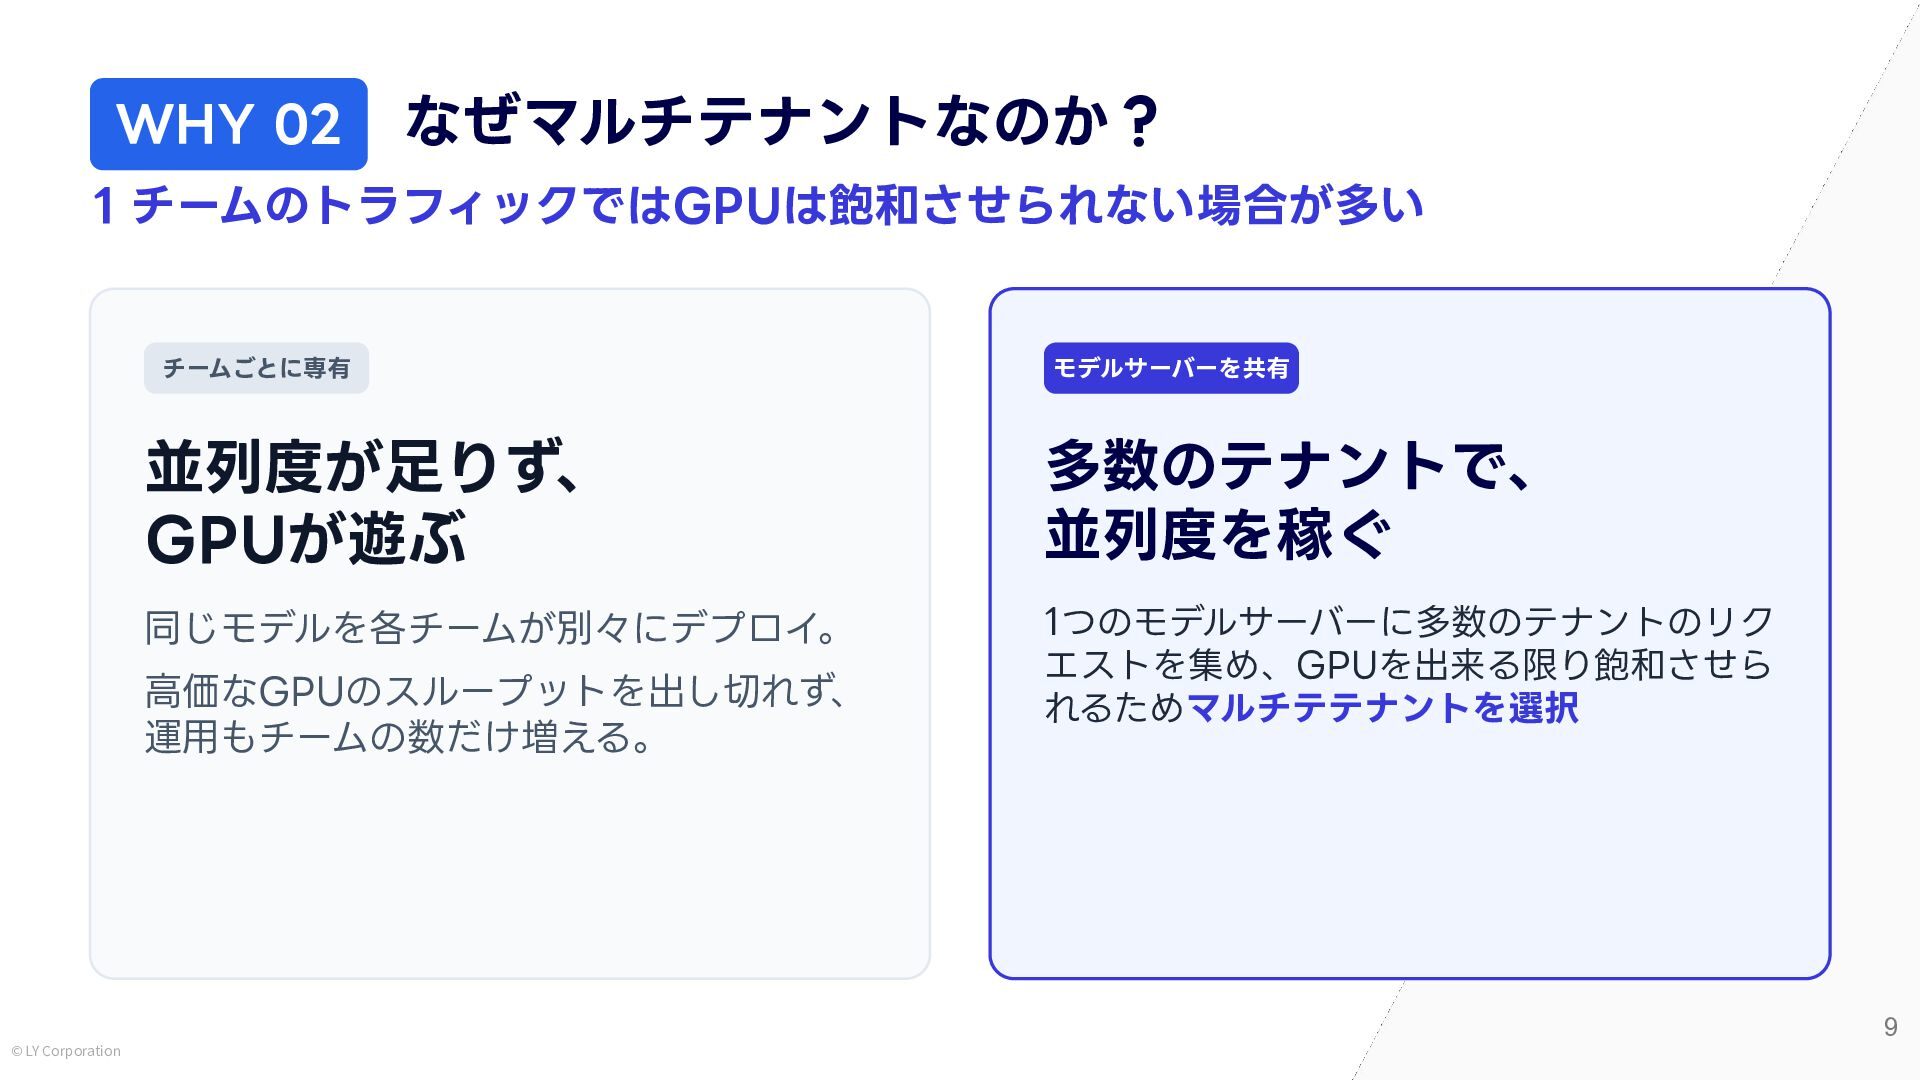
  7. WHY 02 なぜマルチテナントなのか? 1 チームのトラフィックではGPUは飽和させられない場合が多い チームごとに専有 モデルサーバーを共有 並列度が⾜りず、 GPUが遊ぶ 多数のテナントで、

    並列度を稼ぐ 同じモデルを各チームが別々にデプロイ。 1つのモデルサーバーに多数のテナントのリク エストを集め、GPUを出来る限り飽和させら れるためマルチテテナントを選択 ⾼価なGPUのスループットを出し切れず、 運⽤もチームの数だけ増える。 9 © LY Corporation
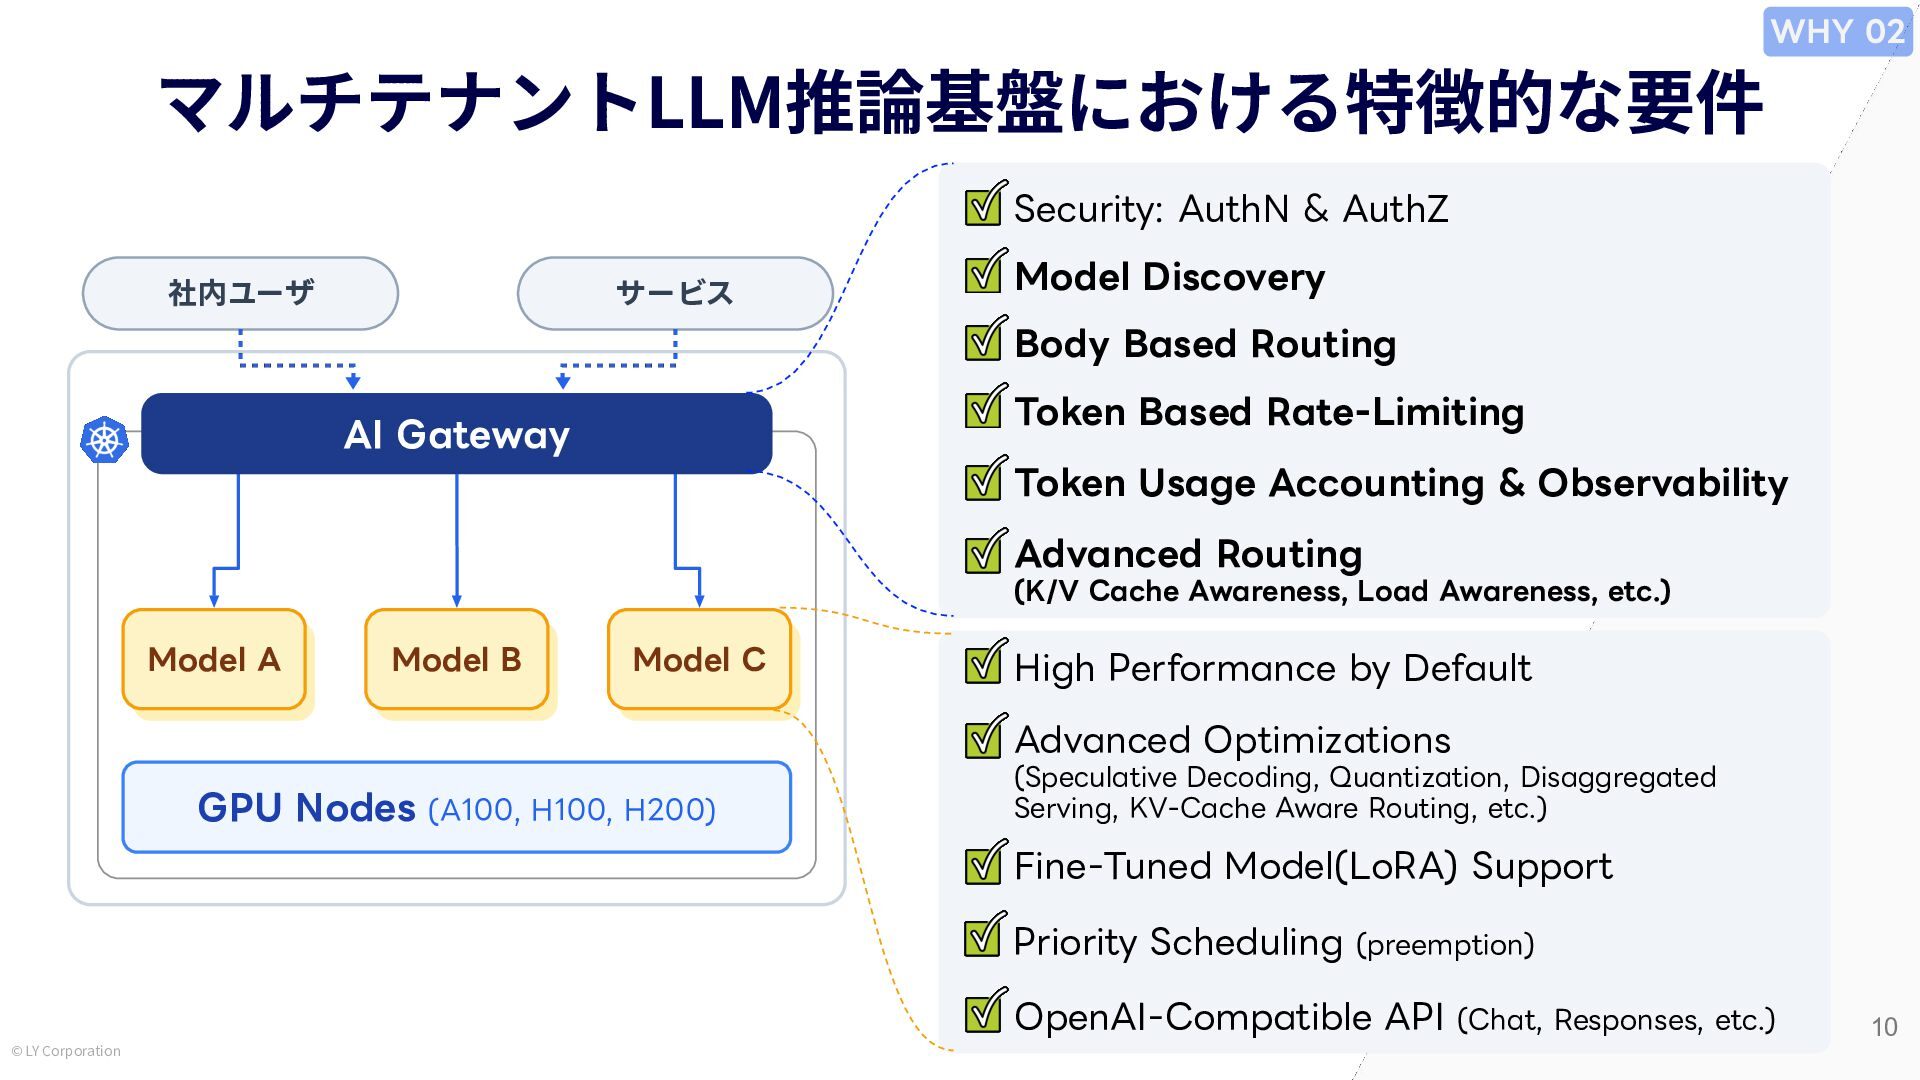
  8. WHY 02 マルチテナントLLM推論基盤における特徴的な要件 Security: AuthN & AuthZ 社内ユーザ サービス Model

    Discovery Body Based Routing Token Based Rate-Limiting AI Gateway Token Usage Accounting & Observability Advanced Routing (K/V Cache Awareness, Load Awareness, etc.) Model A Model B Model C High Performance by Default Advanced Optimizations GPU Nodes (A100, H100, H200) (Speculative Decoding, Quantization, Disaggregated Serving, KV-Cache Aware Routing, etc.) Fine-Tuned Model(LoRA) Support Priority Scheduling (preemption) OpenAI-Compatible API (Chat, Responses, etc.) © LY Corporation 10
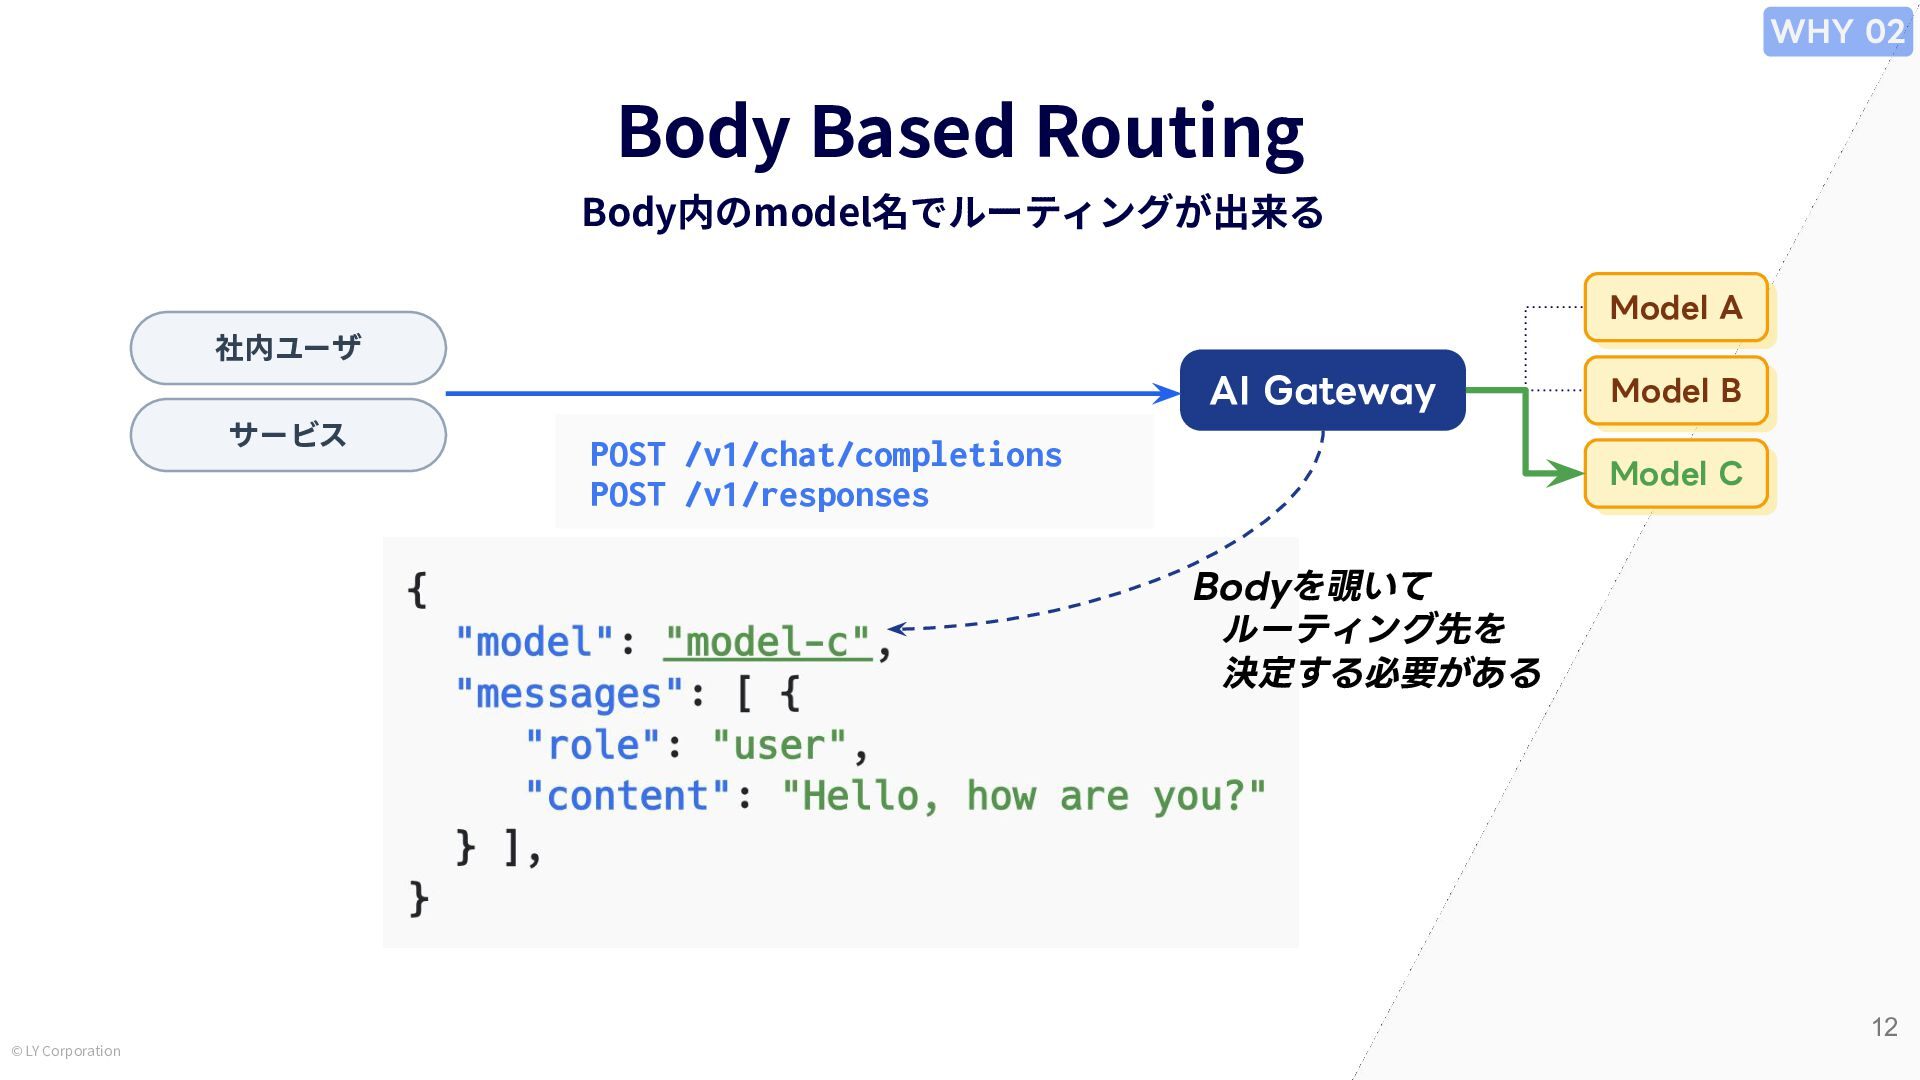
  9. WHY 02 Body Based Routing Body内のmodel名でルーティングが出来る Model A 社内ユーザ AI

    Gateway サービス POST /v1/chat/completions POST /v1/responses Model B Model C Bodyを覗いて ルーティング先を 決定する必要がある 12 © LY Corporation
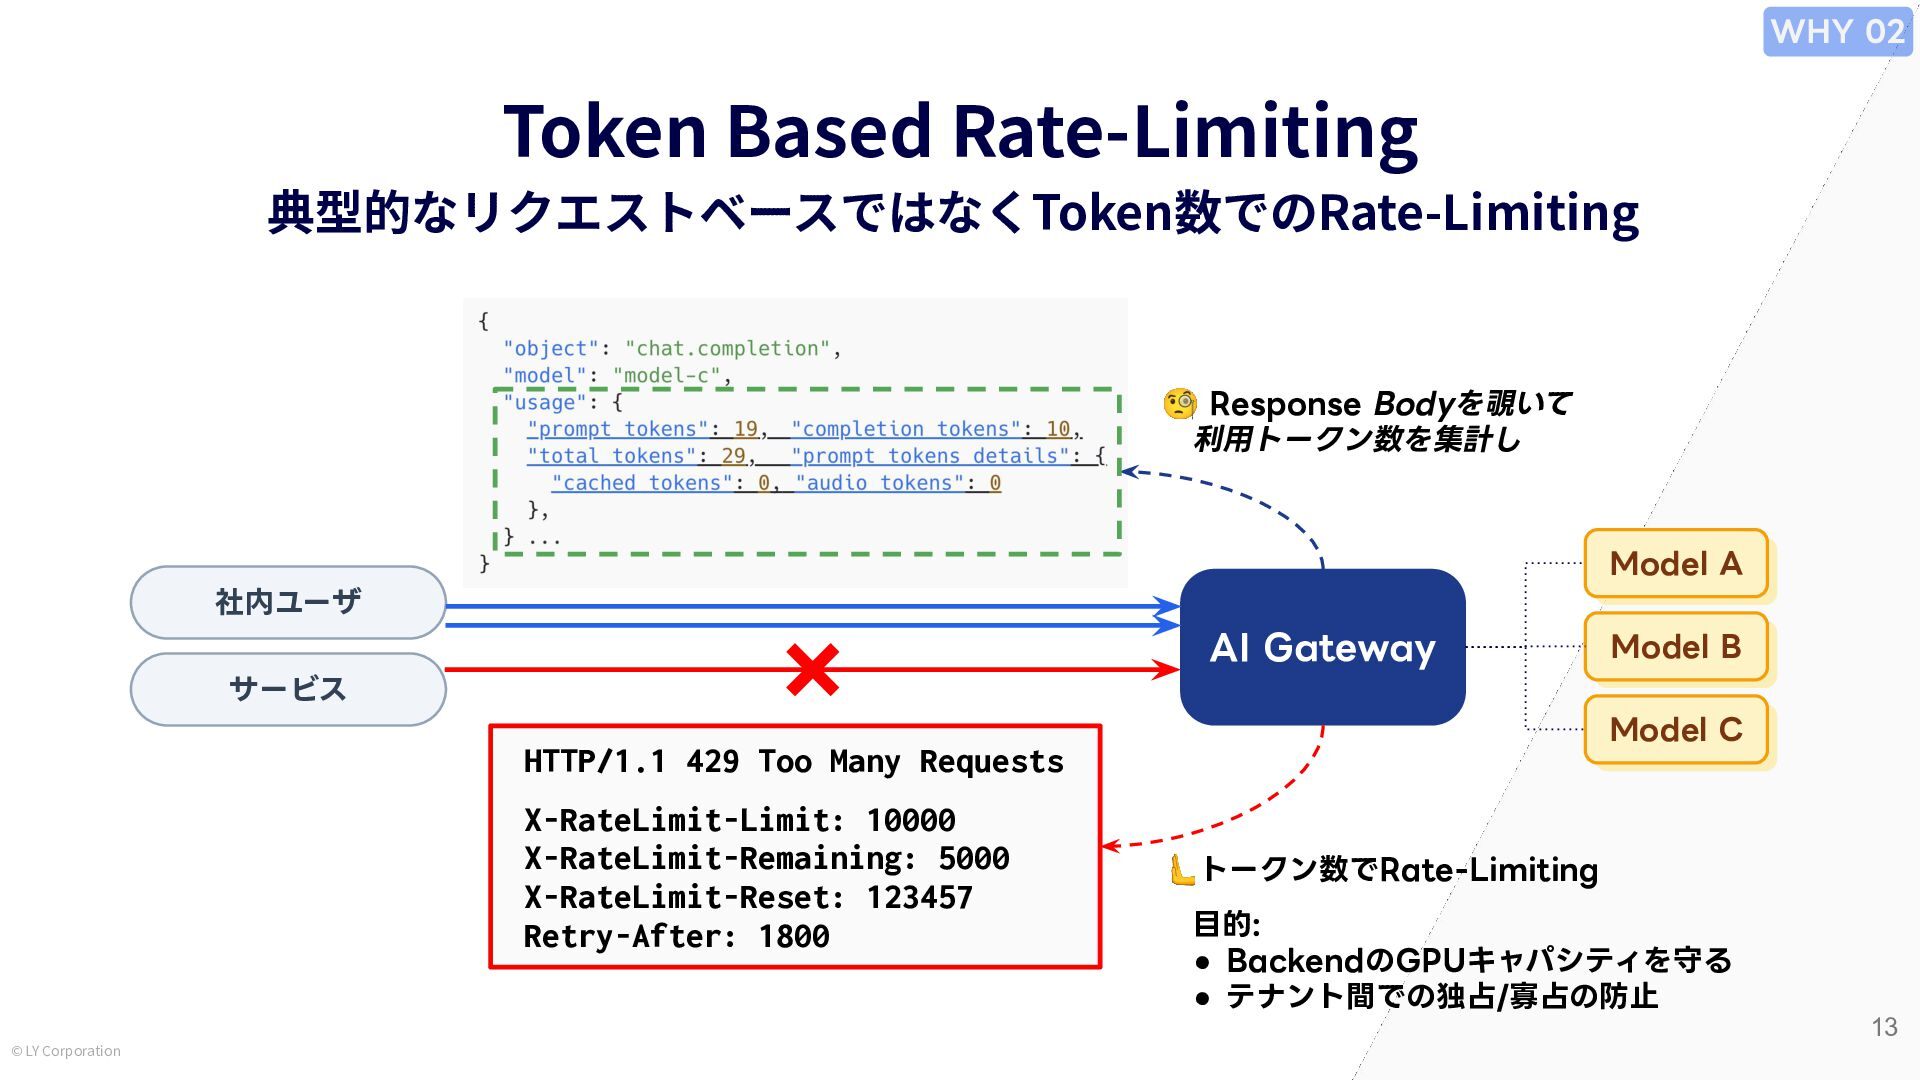
  10. WHY 02 Token Based Rate-Limiting 典型的なリクエストベースではなくToken数でのRate-Limiting 🧐 Response Bodyを覗いて 利⽤トークン数を集計し

    Model A 社内ユーザ AI Gateway Model B サービス Model C HTTP/1.1 429 Too Many Requests X-RateLimit-Limit: 10000 X-RateLimit-Remaining: 5000 X-RateLimit-Reset: 123457 Retry-After: 1800 🫷トークン数でRate-Limiting ⽬的: • BackendのGPUキャパシティを守る • テナント間での独占/寡占の防⽌ 13 © LY Corporation
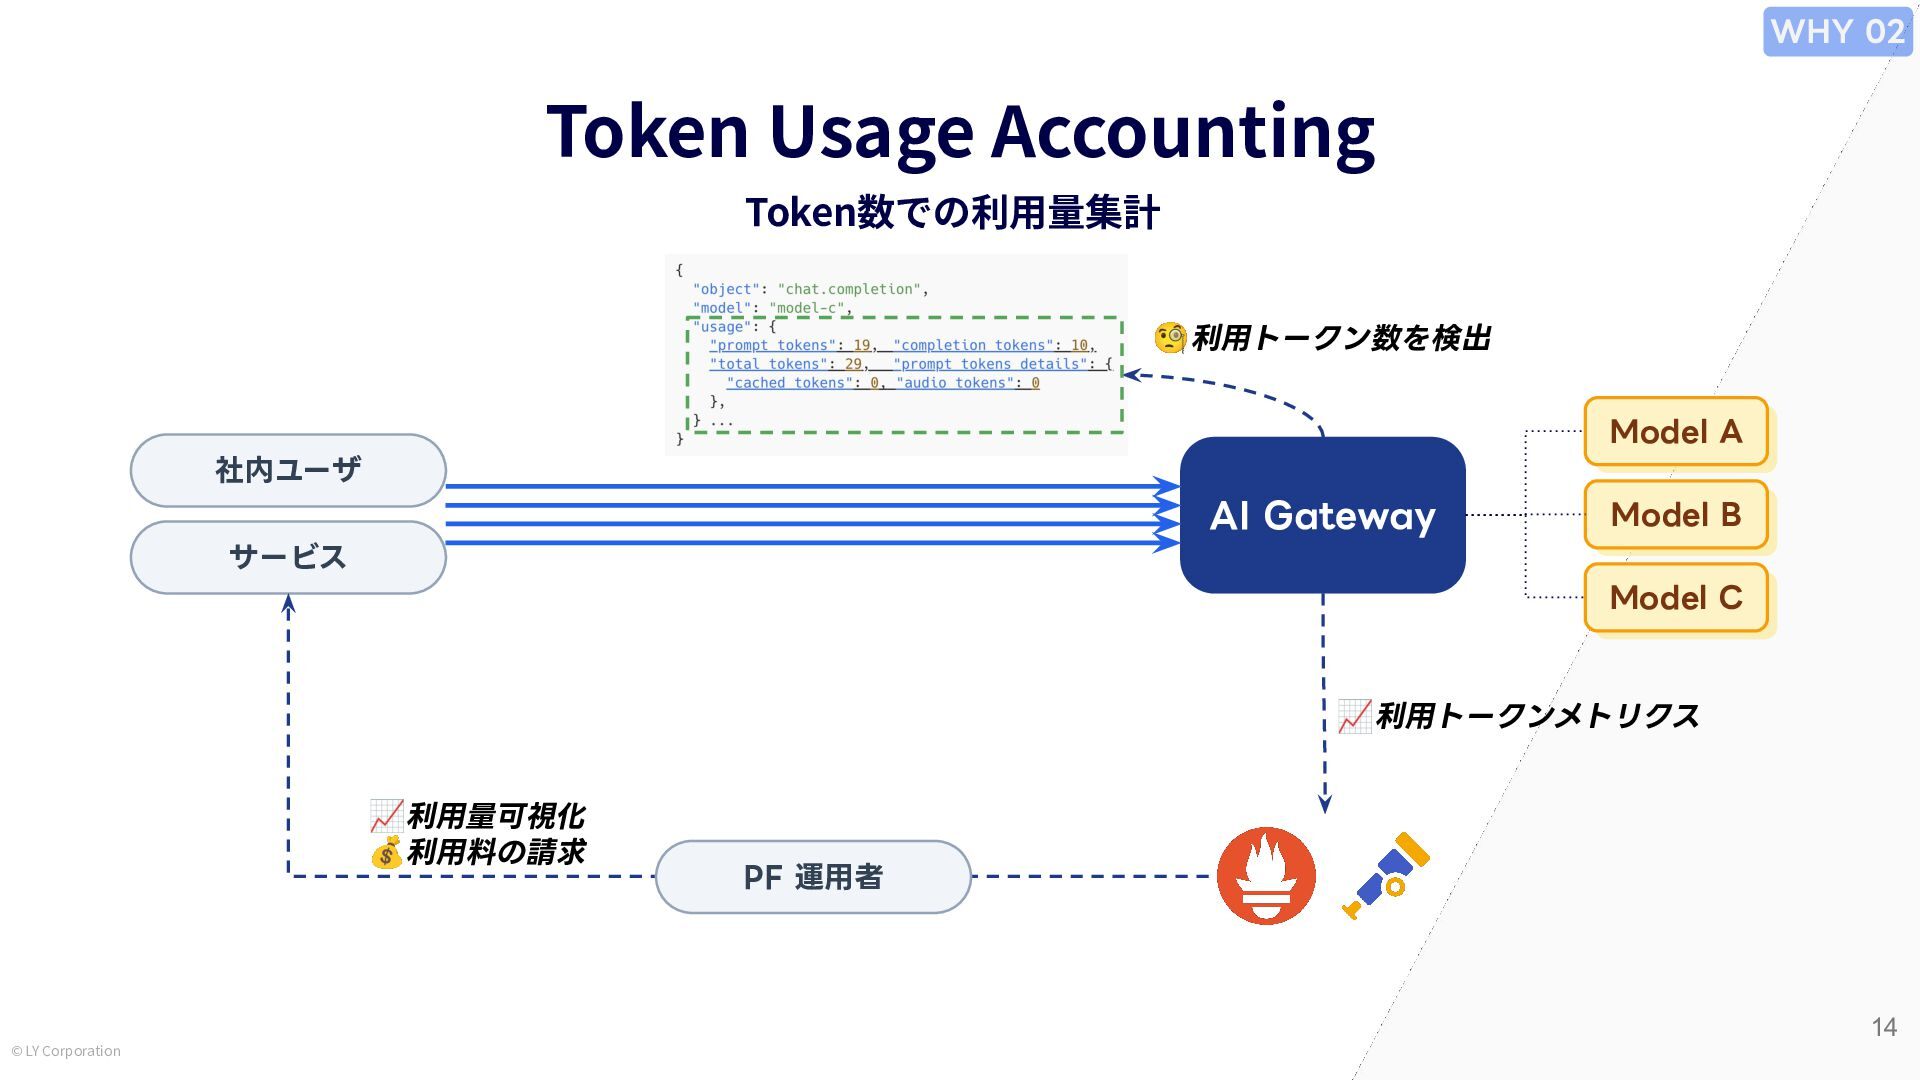
  11. WHY 02 Token Usage Accounting Token数での利⽤量集計 🧐利⽤トークン数を検出 Model A 社内ユーザ

    AI Gateway Model B サービス Model C 📈利⽤トークンメトリクス 📈利⽤量可視化 💰利⽤料の請求 PF 運⽤者 14 © LY Corporation
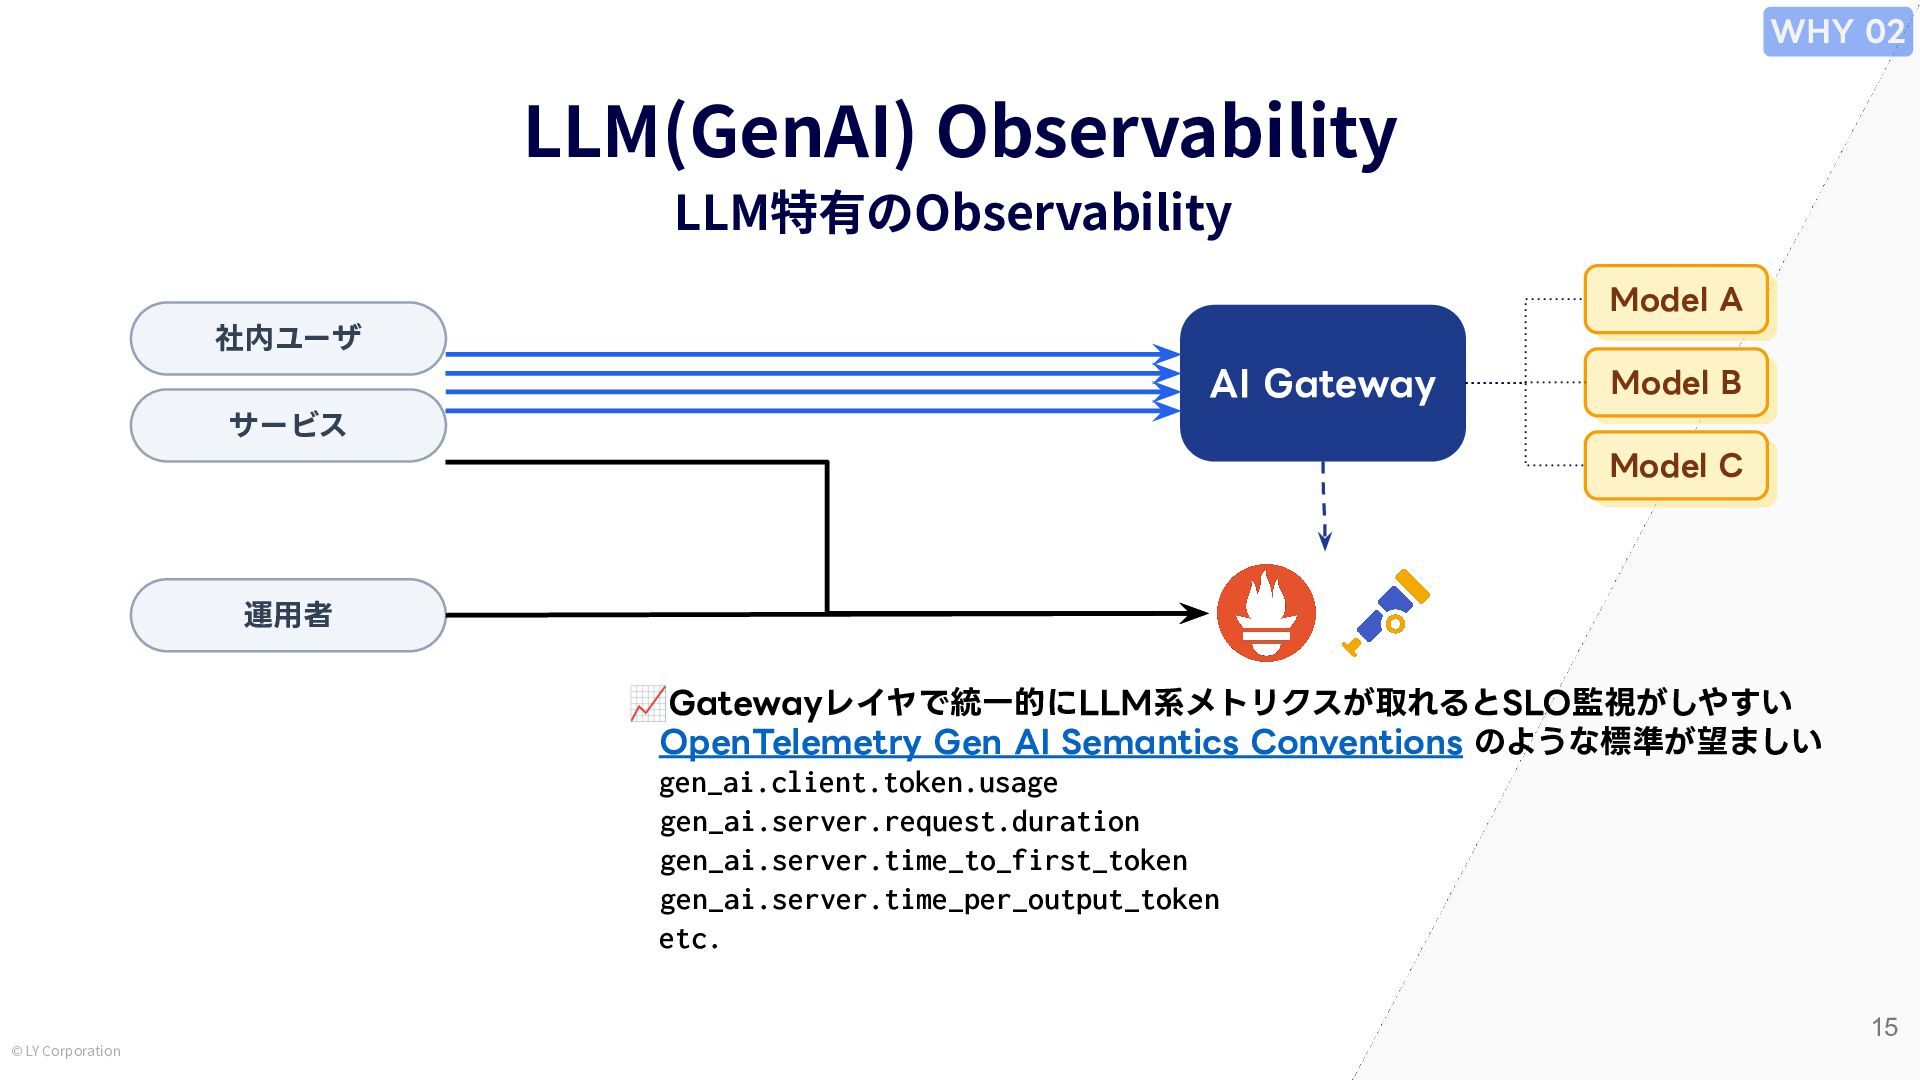
  12. WHY 02 LLM(GenAI) Observability LLM特有のObservability Model A 社内ユーザ AI Gateway

    Model B サービス Model C 運⽤者 📈Gatewayレイヤで統⼀的にLLM系メトリクスが取れるとSLO監視がしやすい OpenTelemetry Gen AI Semantics Conventions のような標準が望ましい gen_ai.client.token.usage gen_ai.server.request.duration gen_ai.server.time_to_first_token gen_ai.server.time_per_output_token etc. 15 © LY Corporation
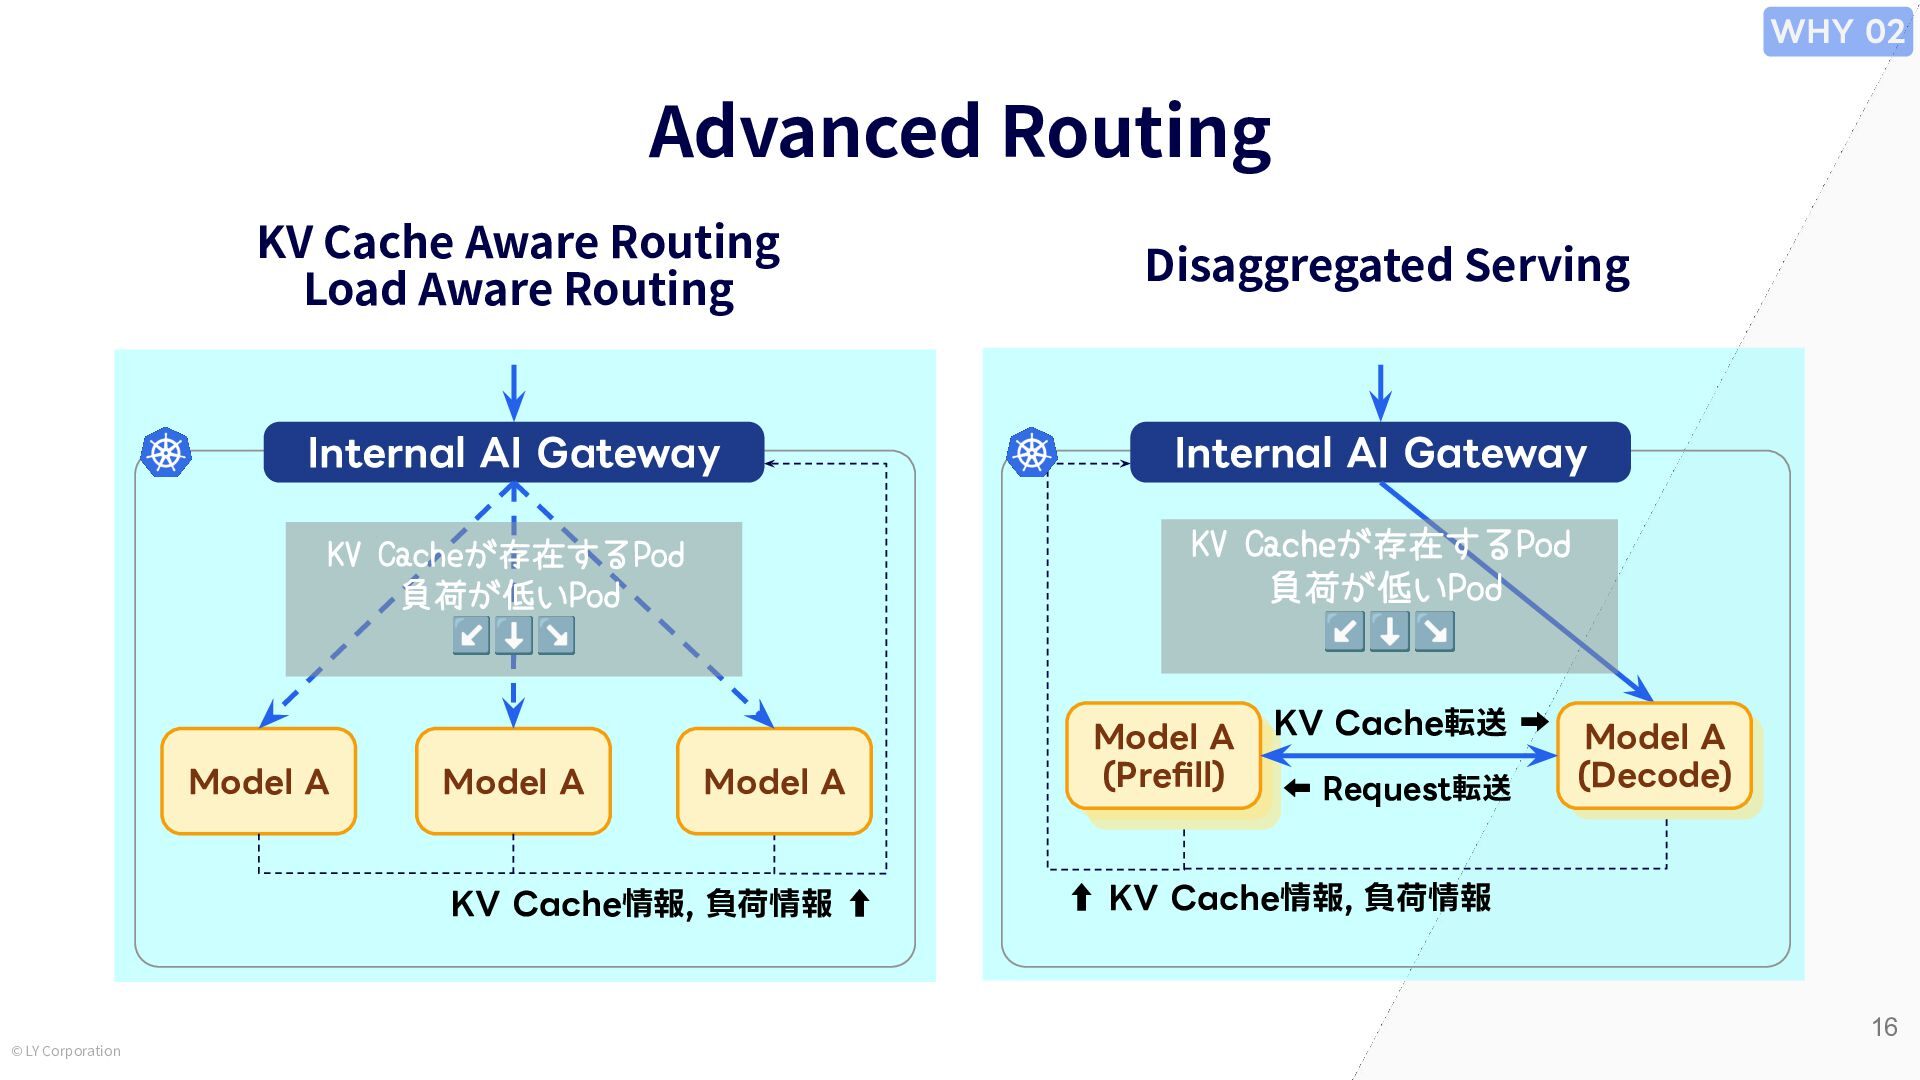
  13. WHY 02 Advanced Routing KV Cache Aware Routing Load Aware

    Routing Disaggregated Serving Internal AI Gateway Internal AI Gateway KV Cacheが存在するPod 負荷が低いPod ↙⬇↘ KV Cacheが存在するPod 負荷が低いPod ↙⬇↘ Model A Model A Model A KV Cache情報, 負荷情報 ⬆ Model A (Prefill) KV Cache転送 ➡ ⬅ Request転送 Model A (Decode) ⬆ KV Cache情報, 負荷情報 16 © LY Corporation
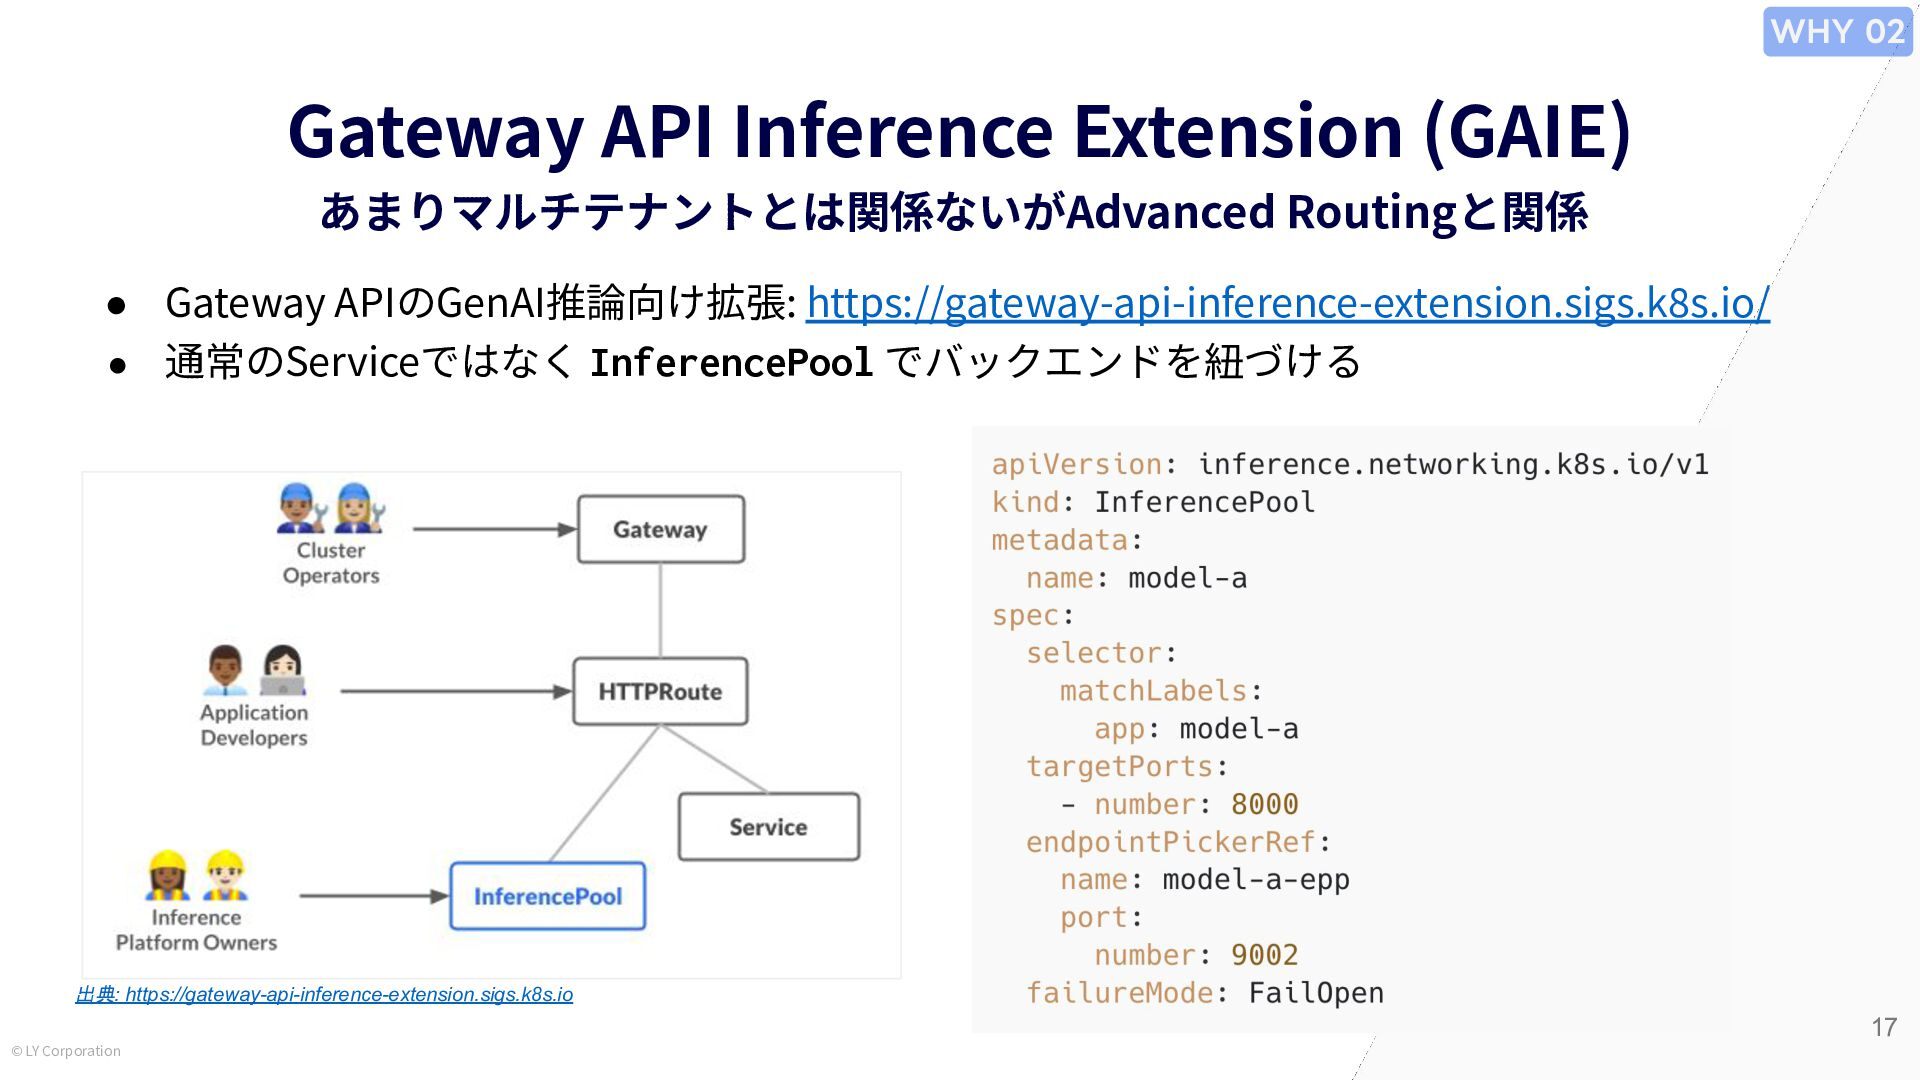
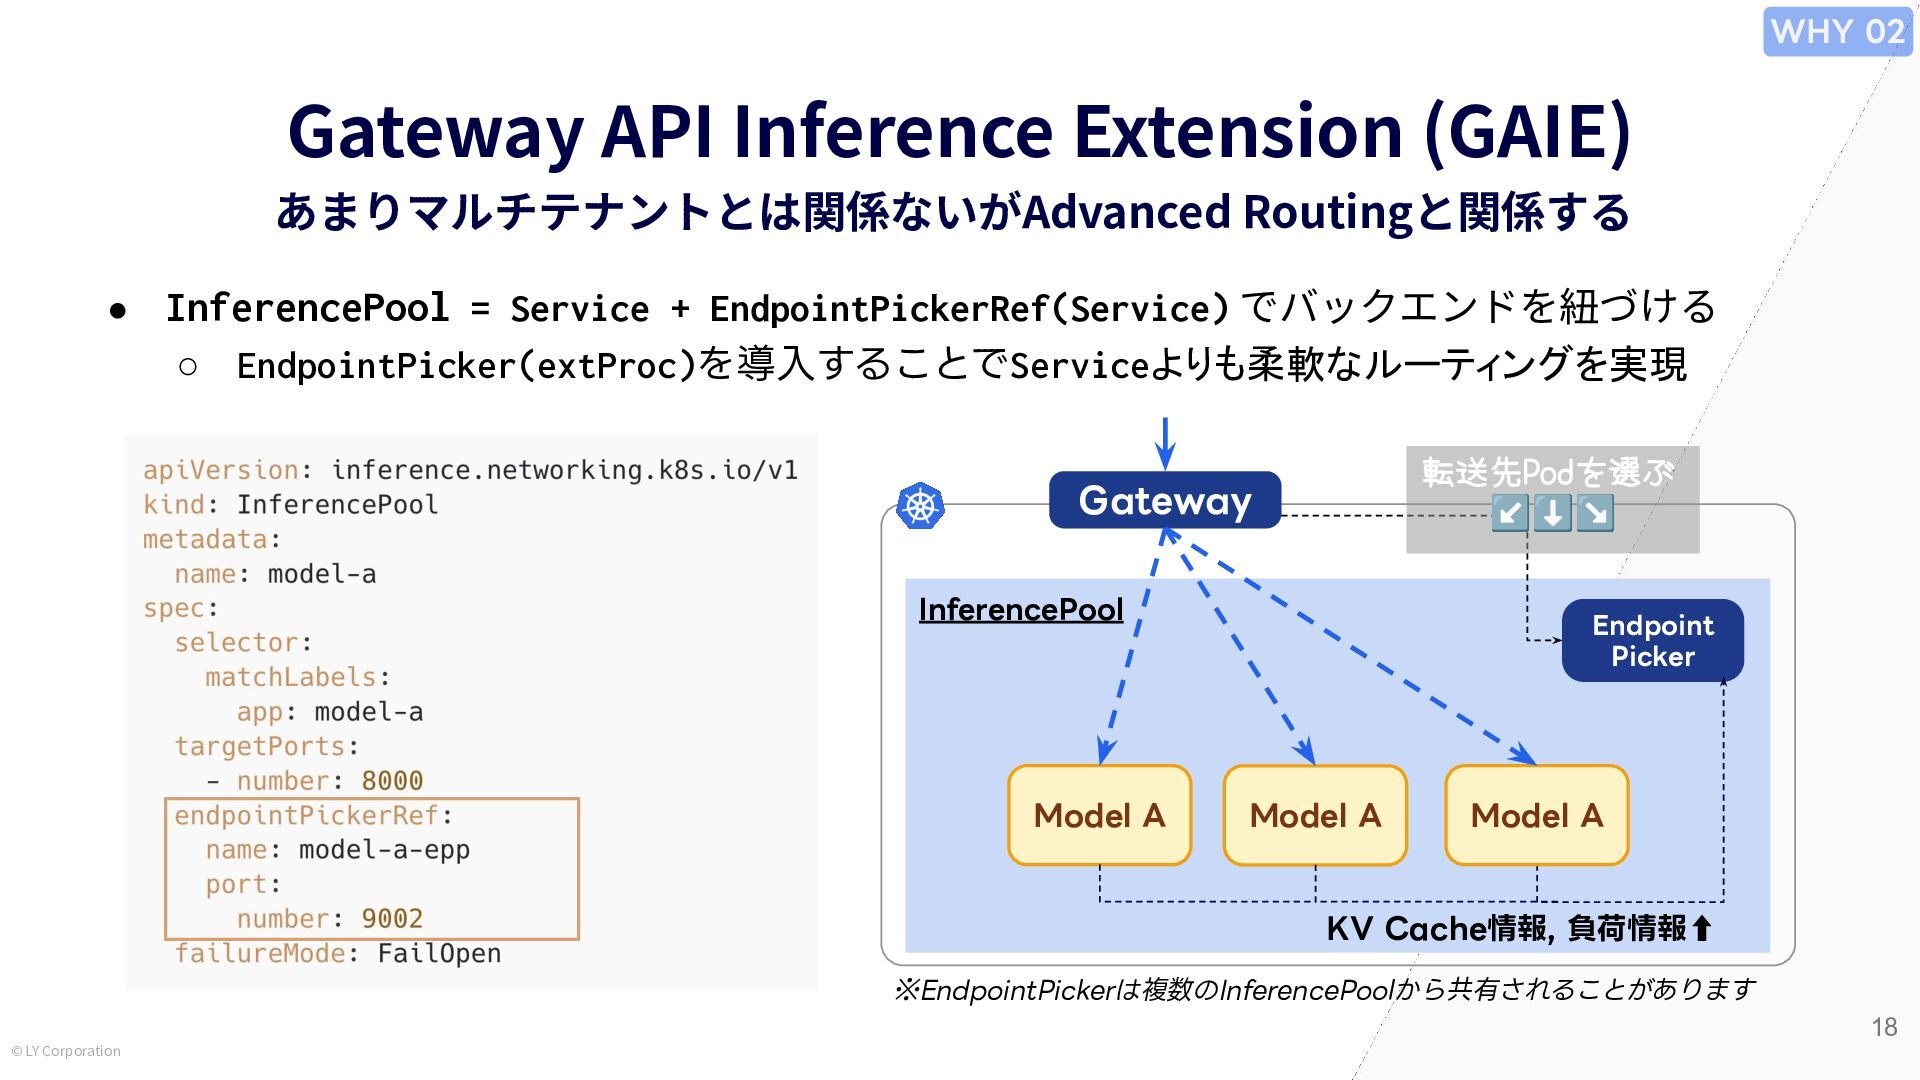
  14. WHY 02 Gateway API Inference Extension (GAIE) あまりマルチテナントとは関係ないがAdvanced Routingと関係 •

    Gateway APIのGenAI推論向け拡張: https://gateway-api-inference-extension.sigs.k8s.io/ • 通常のServiceではなく InferencePool でバックエンドを紐づける 出典: https://gateway-api-inference-extension.sigs.k8s.io 17 © LY Corporation
  15. WHY 02 Gateway API Inference Extension (GAIE) あまりマルチテナントとは関係ないがAdvanced Routingと関係する •

    InferencePool = Service + EndpointPickerRef(Service) でバックエンドを紐づける ◦ EndpointPicker(extProc)を導⼊することでServiceよりも柔軟なルーティングを実現 転送先Podを選ぶ ↙⬇↘ Gateway InferencePool Model A Endpoint Picker Model A Model A KV Cache情報, 負荷情報⬆ ※EndpointPickerは複数のInferencePoolから共有されることがあります 18 © LY Corporation
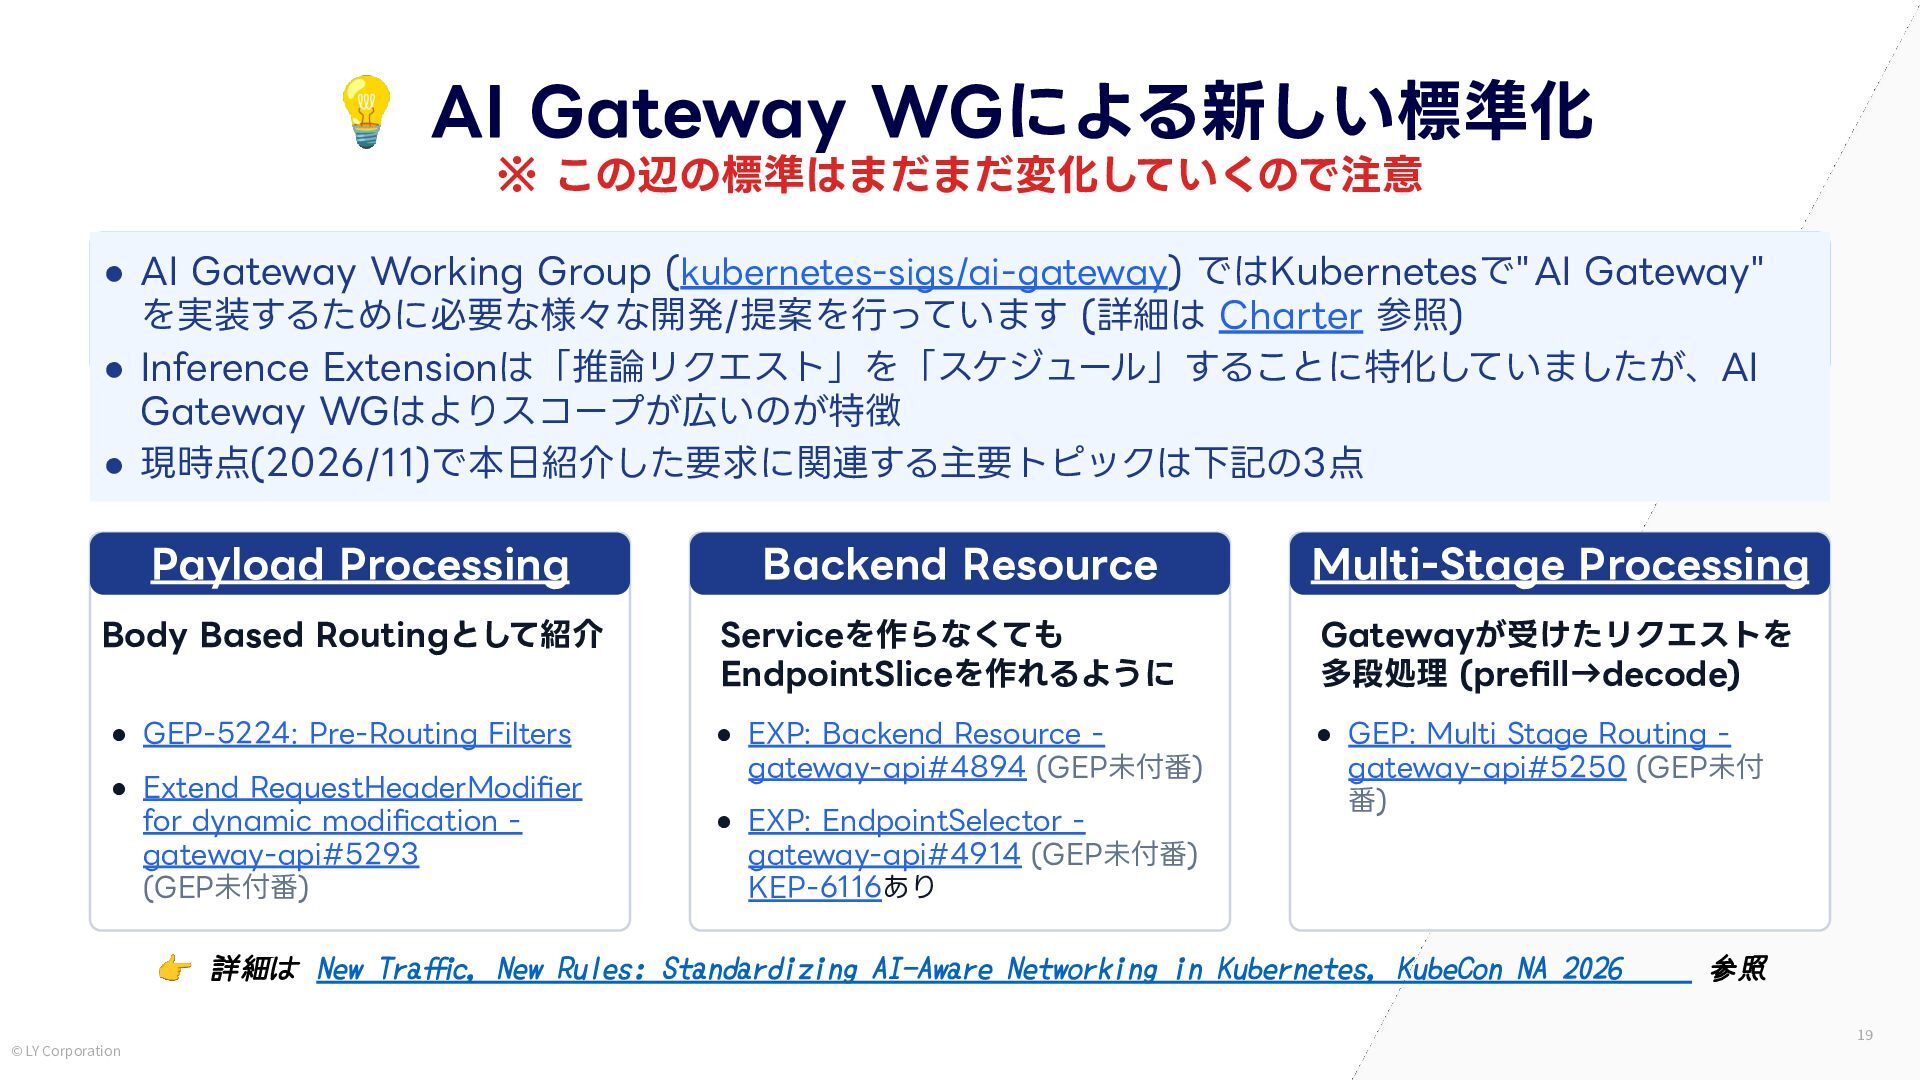
  16. 💡 AI Gateway WGによる新しい標準化 ※ この辺の標準はまだまだ変化していくので注意 • AI Gateway Working

    Group (kubernetes-sigs/ai-gateway) ではKubernetesで"AI Gateway" を実装するために必要な様々な開発/提案を⾏っています (詳細は Charter 参照) • Inference Extensionは「推論リクエスト」を「スケジュール」することに特化していましたが、AI Gateway WGはよりスコープが広いのが特徴 • 現時点(2026/11)で本⽇紹介した要求に関連する主要トピックは下記の3点 Payload Processing Backend Resource Multi-Stage Processing Body Based Routingとして紹介 Serviceを作らなくても EndpointSliceを作れるように Gatewayが受けたリクエストを 多段処理 (prefill→decode) • GEP-5224: Pre-Routing Filters • EXP: Backend Resource gateway-api#4894 (GEP未付番) • GEP: Multi Stage Routing gateway-api#5250 (GEP未付 番) • Extend RequestHeaderModifier for dynamic modification gateway-api#5293 (GEP未付番) • EXP: EndpointSelector gateway-api#4914 (GEP未付番) KEP-6116あり 👉 詳細は New Traffic, New Rules: Standardizing AI-Aware Networking in Kubernetes, KubeCon NA 2026 参照 19 © LY Corporation
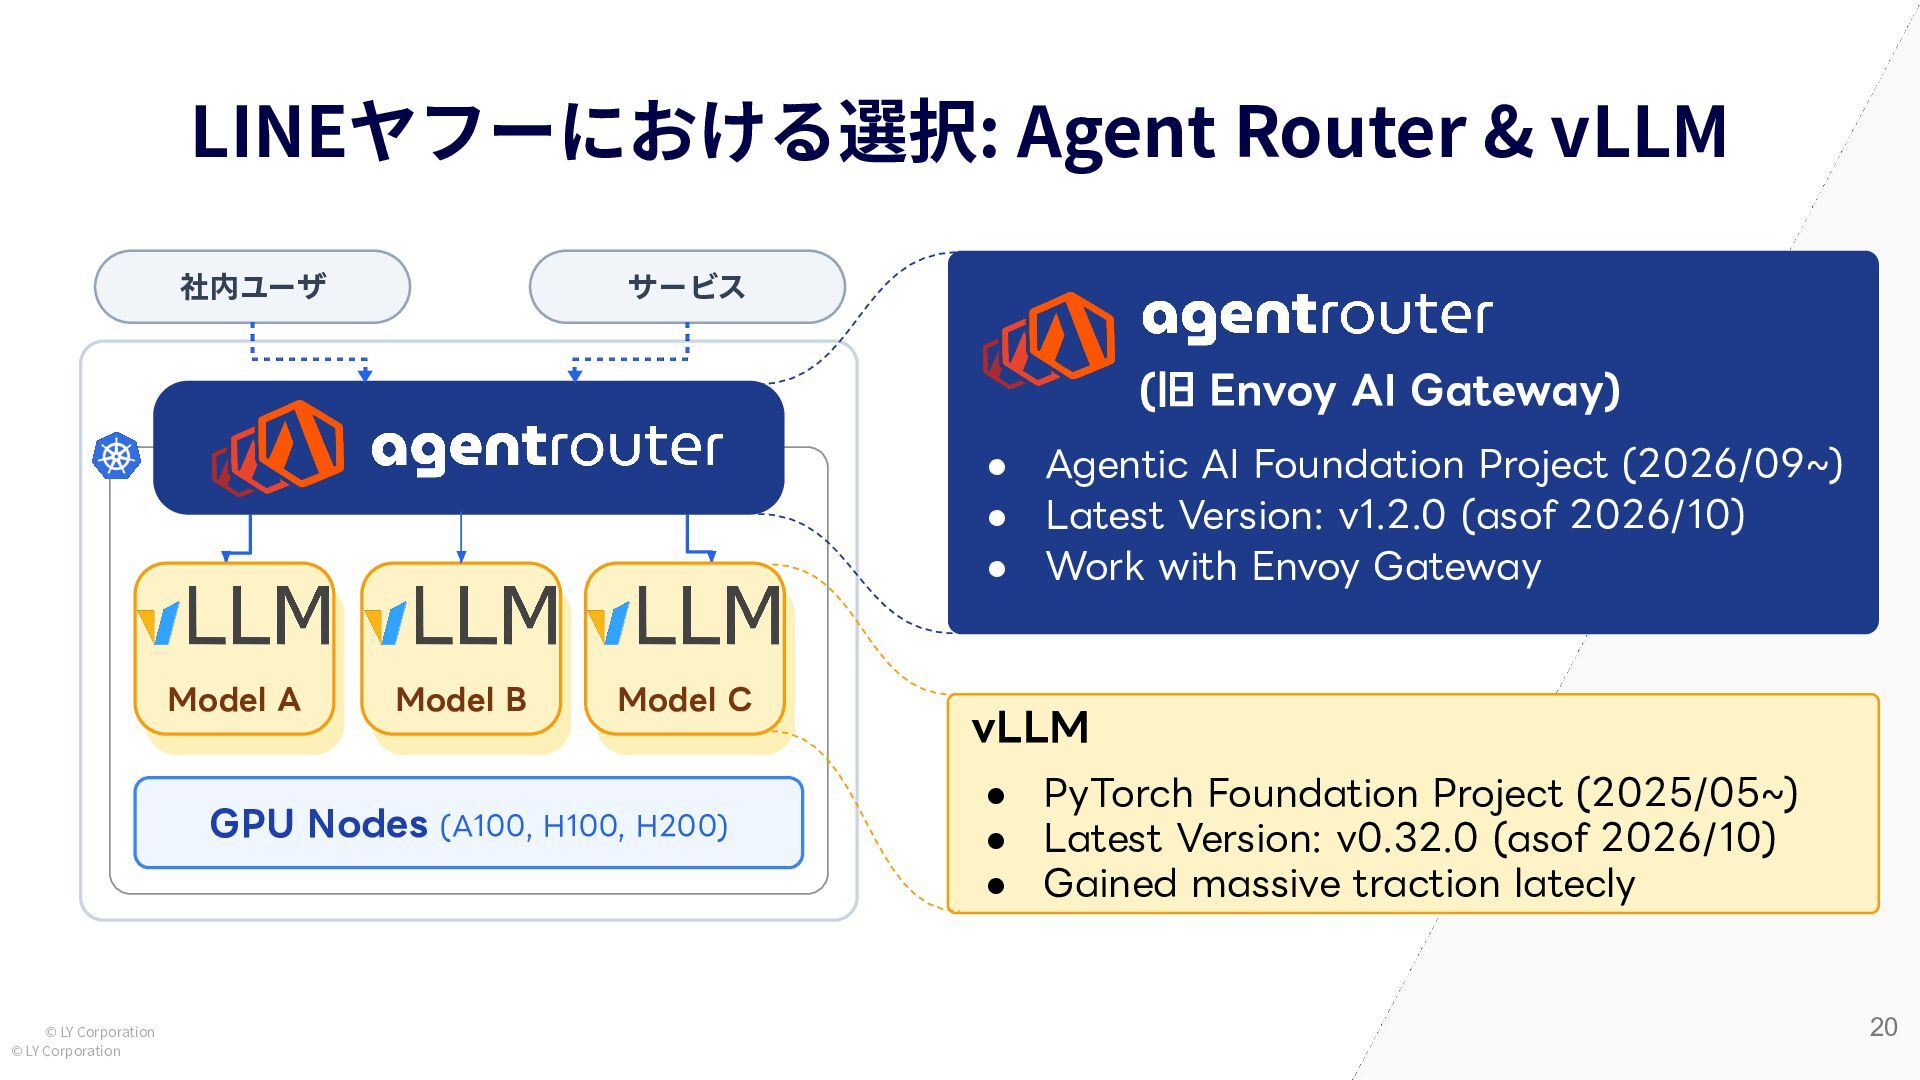
  17. LINEヤフーにおける選択: Agent Router & vLLM 社内ユーザ サービス (旧 Envoy AI

    Gateway) • Agentic AI Foundation Project (2026/09~) • Latest Version: v1.2.0 (asof 2026/10) • Work with Envoy Gateway Model A Model B Model C GPU Nodes (A100, H100, H200) © LY Corporation © LY Corporation vLLM • PyTorch Foundation Project (2025/05~) • Latest Version: v0.32.0 (asof 2026/10) • Gained massive traction latecly 20
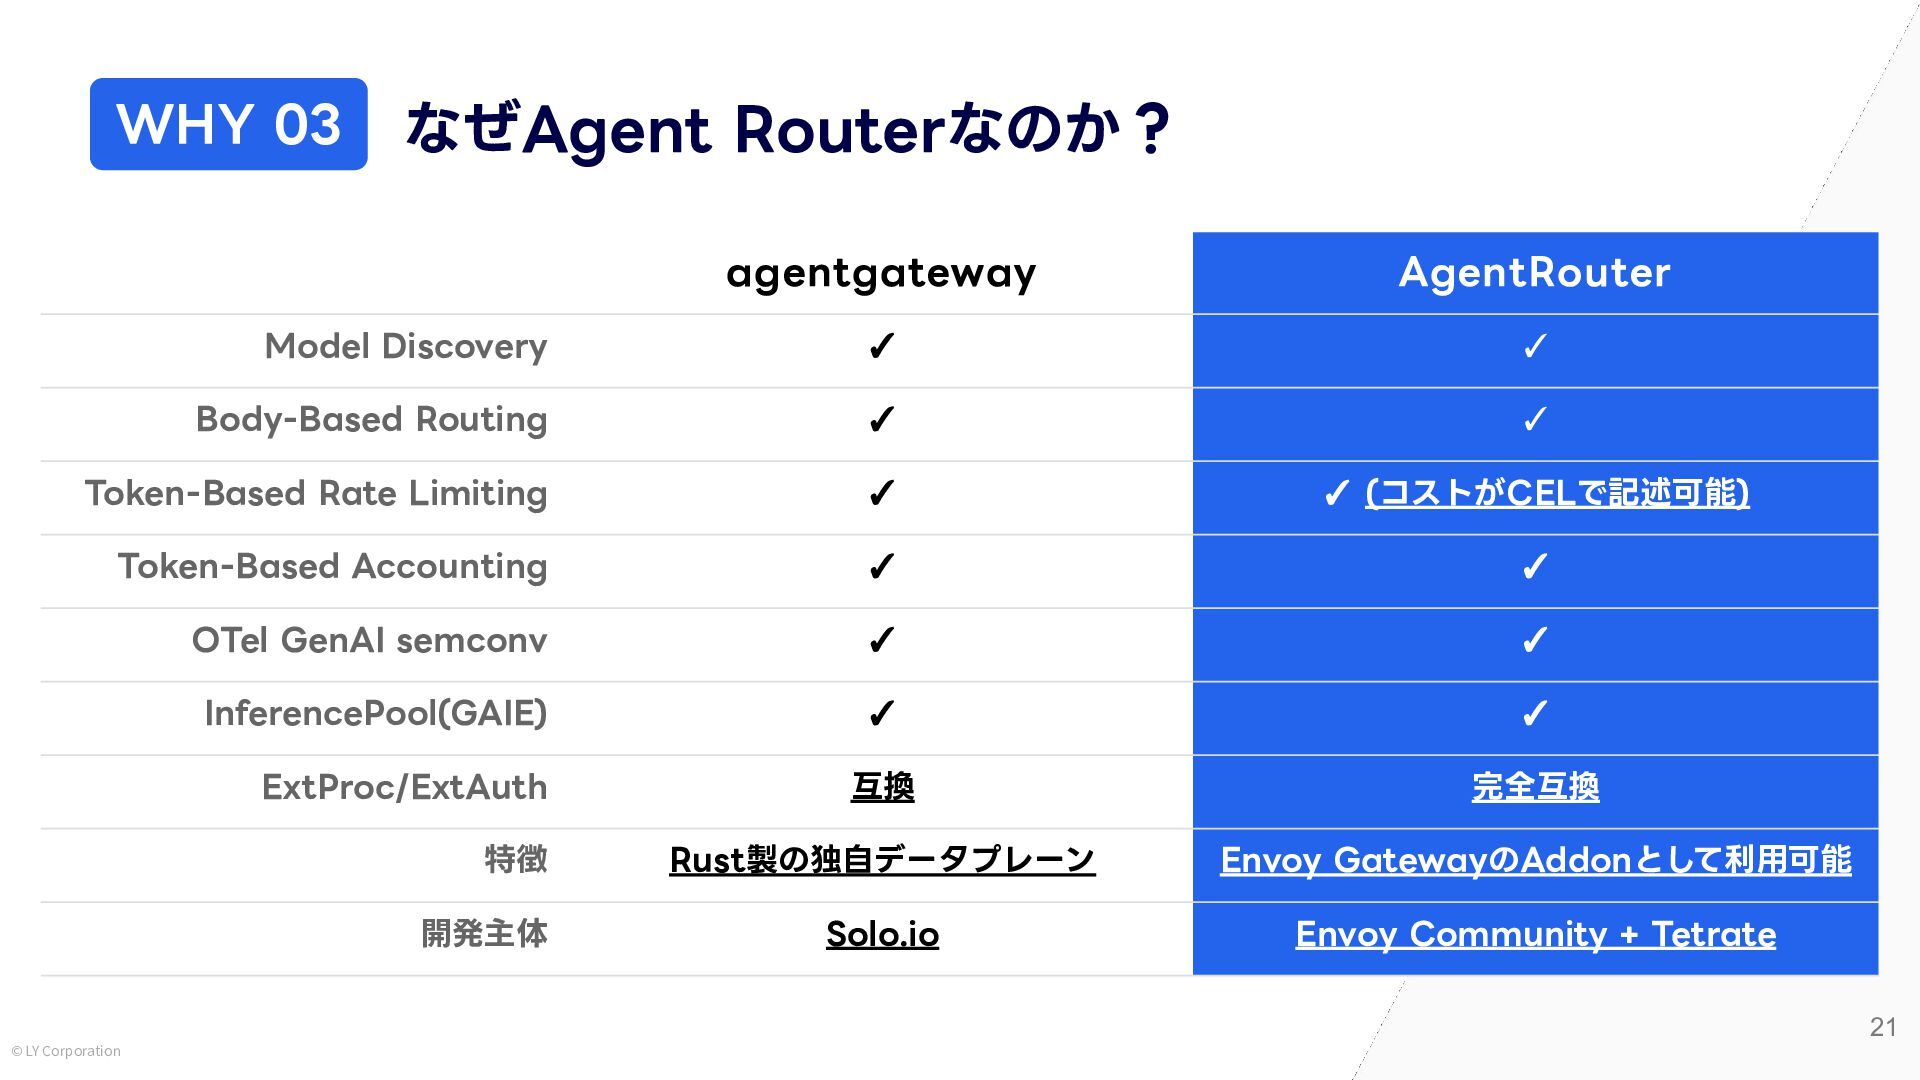
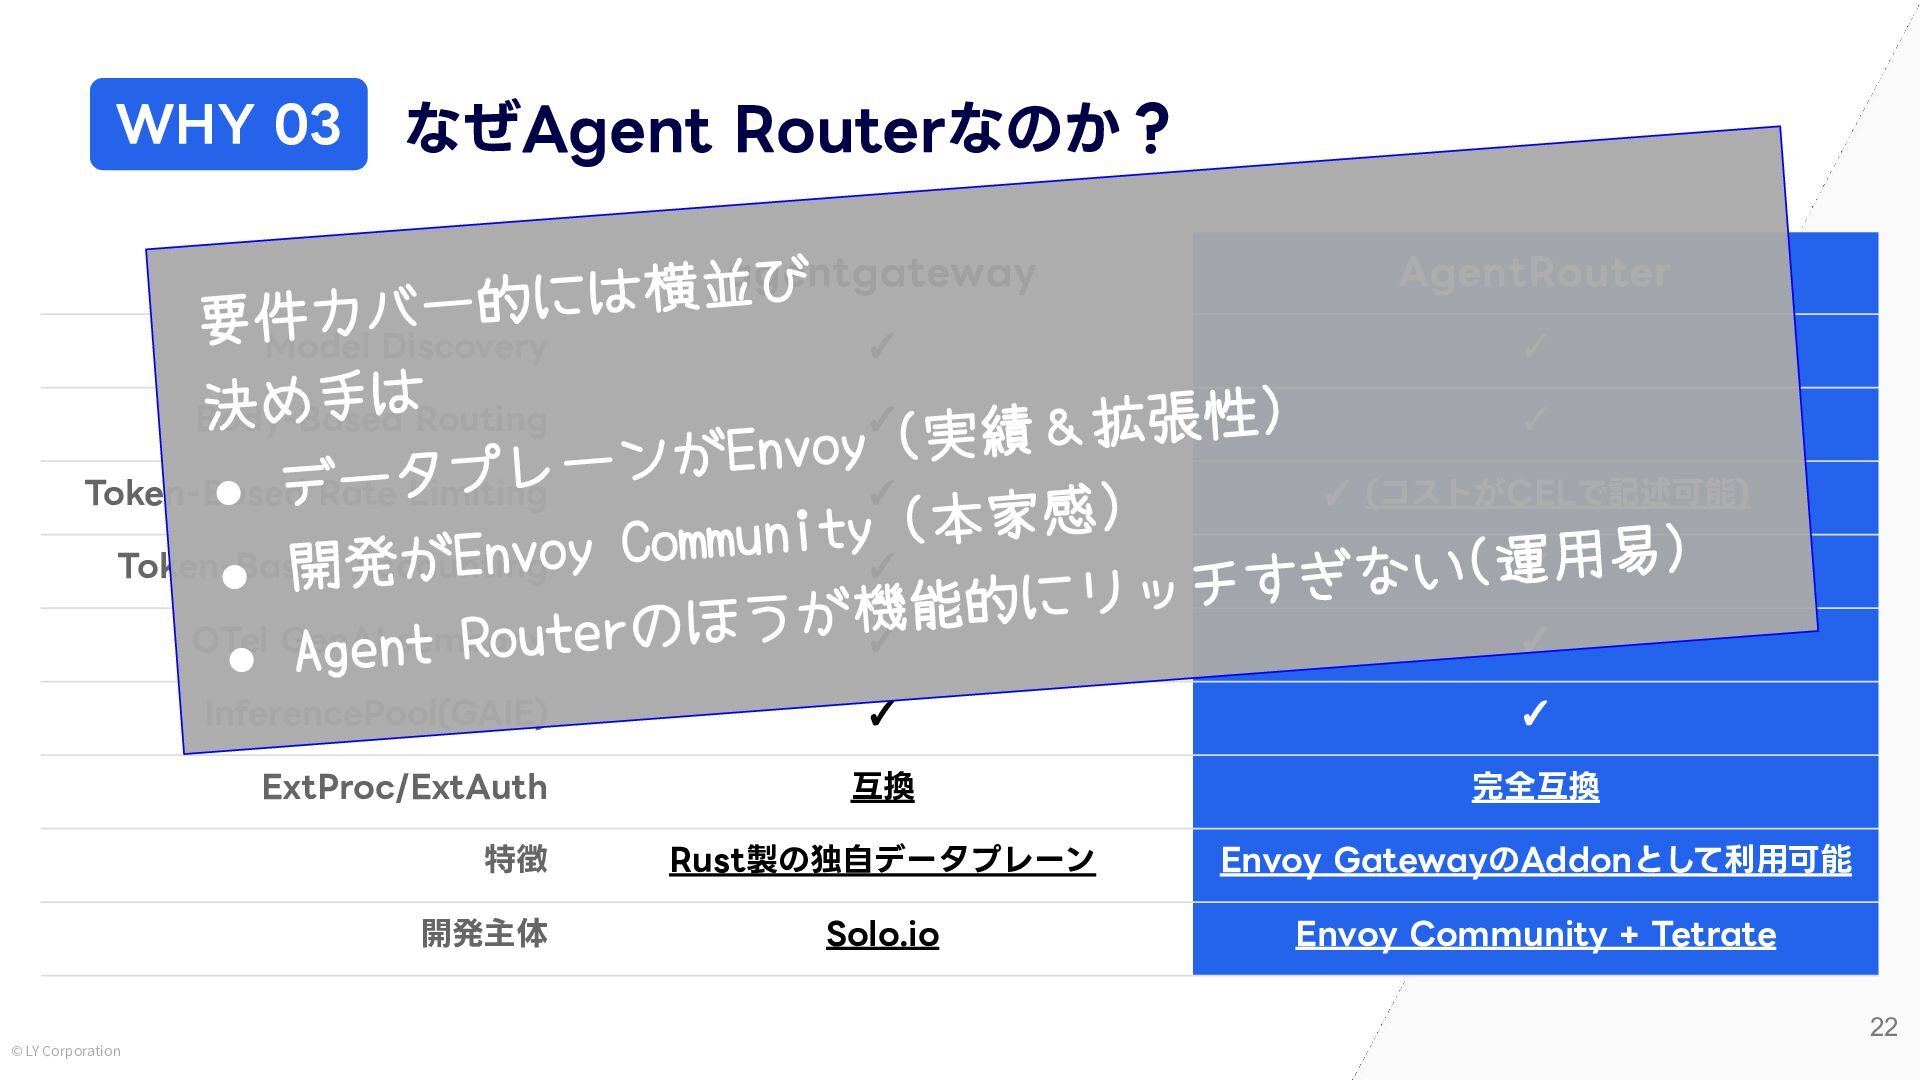
  18. WHY 03 なぜAgent Routerなのか? agentgateway AgentRouter Model Discovery ✓ ✓

    Body-Based Routing ✓ ✓ Token-Based Rate Limiting ✓ ✓ (コストがCELで記述可能) Token-Based Accounting ✓ ✓ OTel GenAI semconv ✓ ✓ InferencePool(GAIE) ✓ ✓ ExtProc/ExtAuth 互換 完全互換 Rust製の独⾃データプレーン Envoy GatewayのAddonとして利⽤可能 Solo.io Envoy Community + Tetrate 特徴 開発主体 21 © LY Corporation
  19. WHY 03 なぜAgent Routerなのか? agentgateway び 並 横 は に

    的 ー カバ AgentRouter 要件 Model Discovery ✓ ✓ 決め手はRouting Body-Based ✓ ✓ ) 性 張 拡 & 績 y (実 o v n E が ン ー レ プ ータ Token-Based Limiting ✓ ✓ (コストがCELで記述可能) • デRate ) 感 家 本 ( y t i n u m m Co y o v n E Token-Based Accounting ✓ ✓用易) が 運 ( 発 い 開 な • ぎ チす ッ リ に 的 能 機 うが ✓ ほ の r OTel GenAInsemconv ✓ e t u o R t • Age InferencePool(GAIE) ✓ ✓ ExtProc/ExtAuth 互換 完全互換 Rust製の独⾃データプレーン Envoy GatewayのAddonとして利⽤可能 Solo.io Envoy Community + Tetrate 特徴 開発主体 22 © LY Corporation
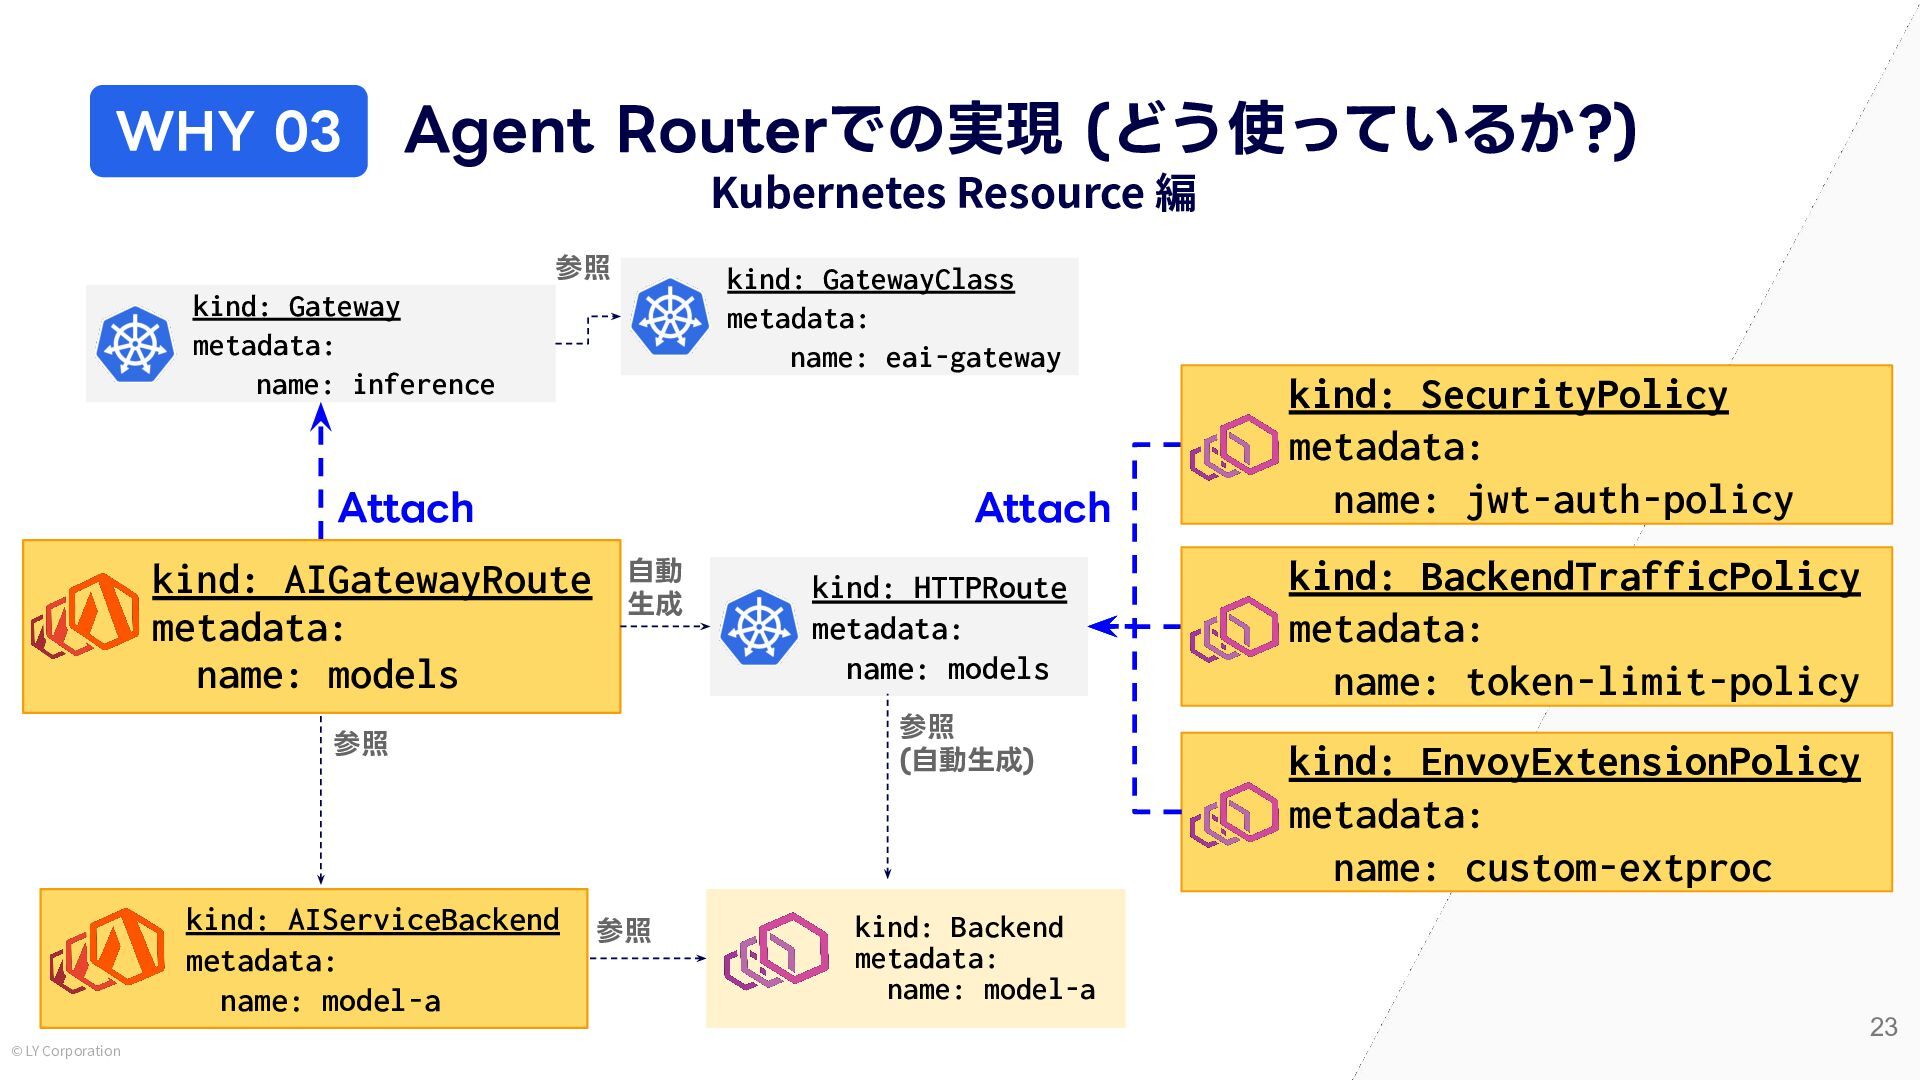
  20. WHY 03 Agent Routerでの実現 (どう使っているか?) Kubernetes Resource 編 参照 kind:

    GatewayClass metadata: name: eai-gateway kind: Gateway metadata: name: inference Attach kind: AIGatewayRoute metadata: name: models Attach ⾃動 ⽣成 参照 (⾃動⽣成) 参照 kind: AIServiceBackend metadata: name: model-a © LY Corporation kind: HTTPRoute metadata: name: models 参照 kind: SecurityPolicy metadata: name: jwt-auth-policy kind: BackendTrafficPolicy metadata: name: token-limit-policy kind: EnvoyExtensionPolicy metadata: name: custom-extproc kind: Backend metadata: name: model-a 23
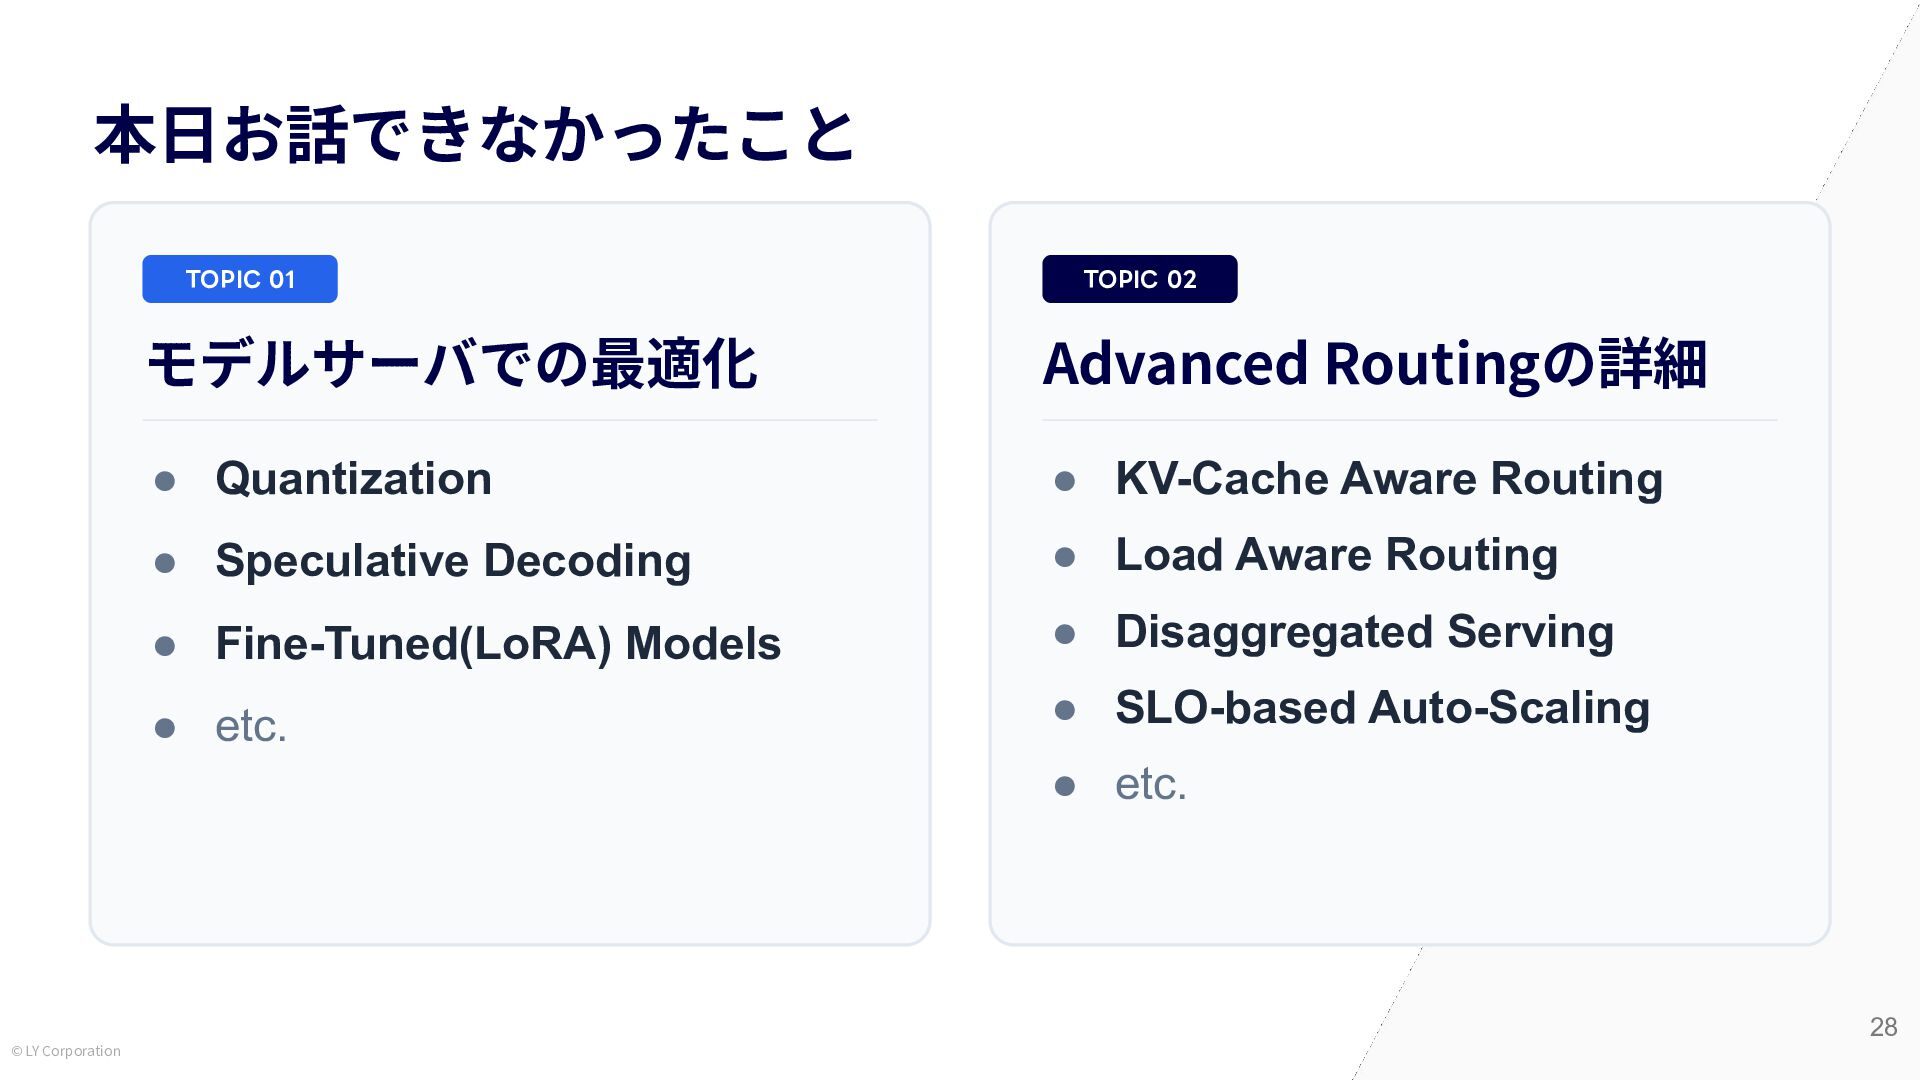
  21. 本⽇お話できなかったこと TOPIC 01 TOPIC 02 モデルサーバでの最適化 Advanced Routingの詳細 • Quantization

    • KV-Cache Aware Routing • Speculative Decoding • Load Aware Routing • Fine-Tuned(LoRA) Models • Disaggregated Serving • etc. • SLO-based Auto-Scaling • etc. 28 © LY Corporation

More Decks by Shingo Omura

Other Decks in Technology