Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AIエージェントの開発・提供におけるセキュリティリスクの論点と対策

 AIエージェントの開発・提供におけるセキュリティリスクの論点と対策

2026年9月2日(水)開催「Product Security Square」に登壇した梅内のスライド資料です。
https://flatt.connpass.com/event/393895/

Avatar for GMO Flatt Security

GMO Flatt Security

September 03, 2026

More Decks by GMO Flatt Security

Other Decks in Technology

Transcript

  1. 自己紹介 梅内 翼 Umeuchi Tsubasa ・ GMO Flatt Security株式会社 ソフトウェアエンジニア

    ・ セキュリティAI エージェント Takumi byGMO の開発に従事 02 / 23
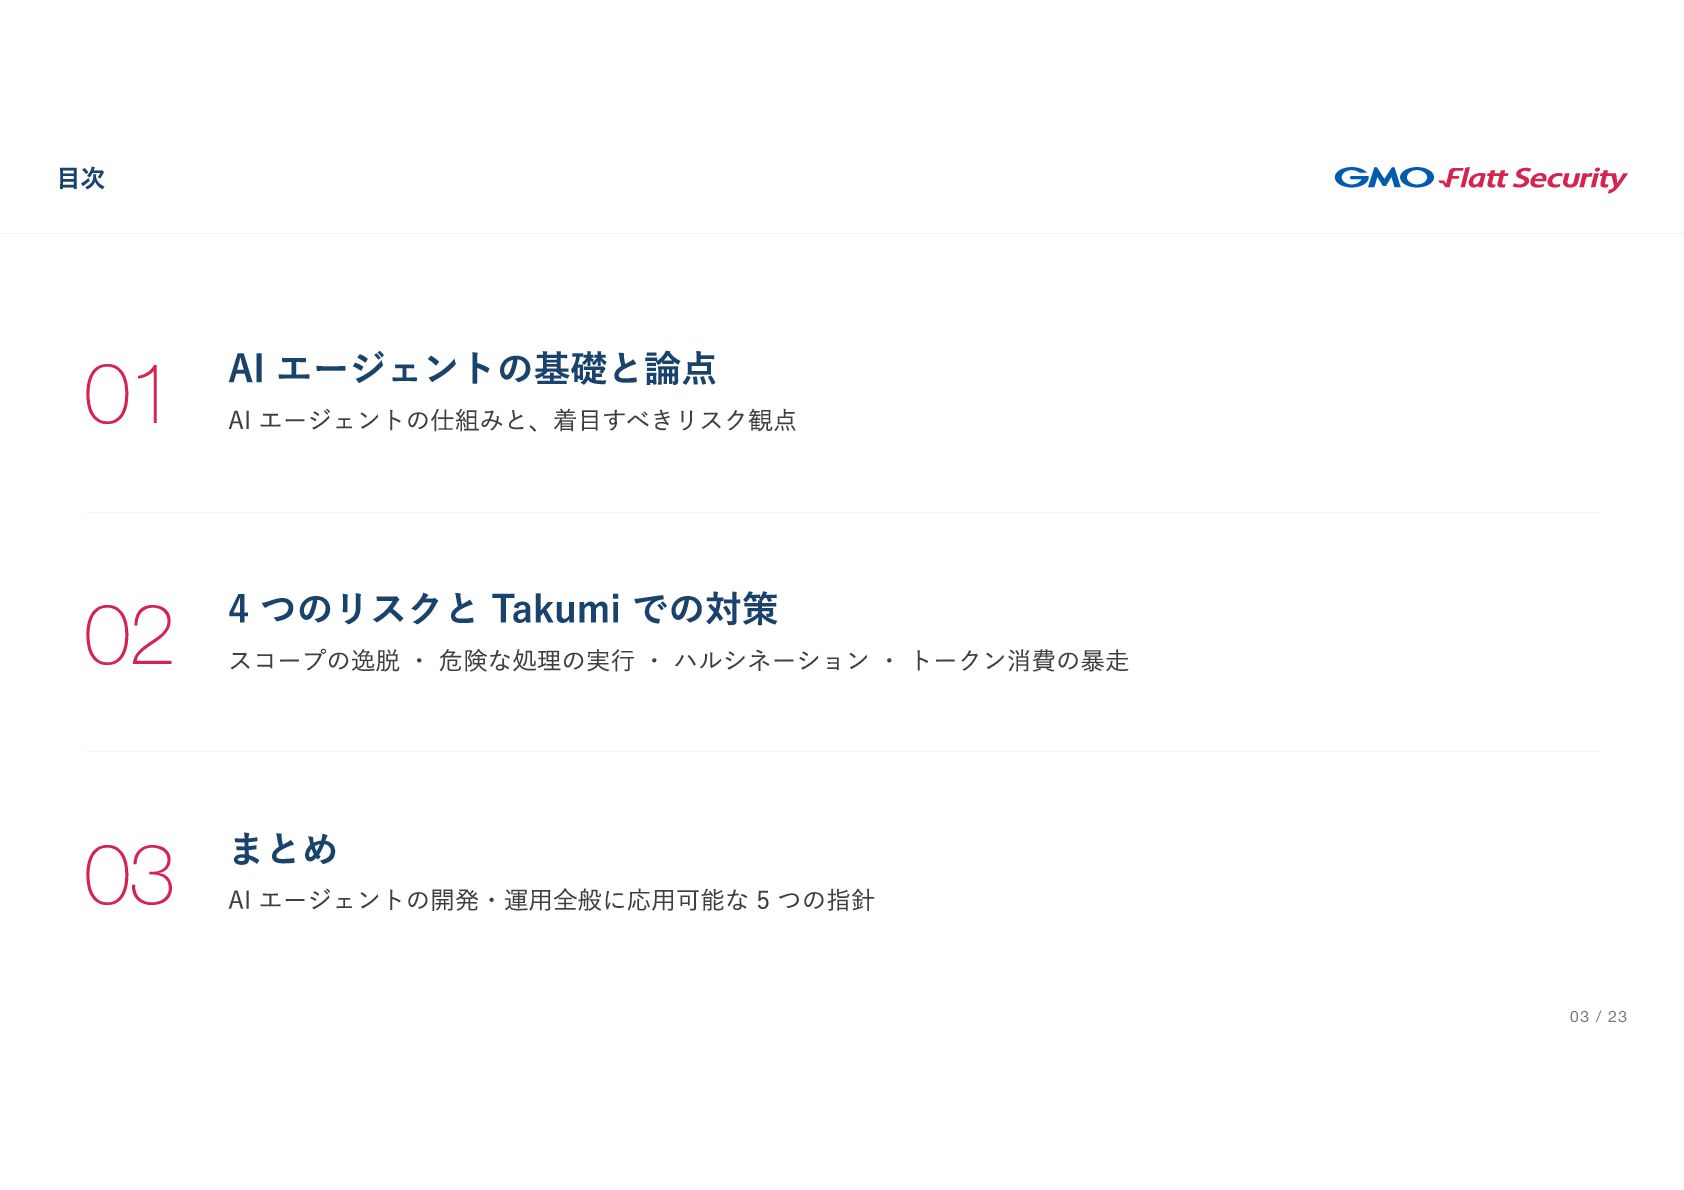
  2. 目次 AI エージェントの基礎と論点 01 AI エージェントの仕組みと、着目すべきリスク観点 4 つのリスクと Takumi での対策

    02 スコープの逸脱 ・ 危険な処理の実行 ・ ハルシネーション ・ トークン消費の暴走 まとめ 03 AI エージェントの開発・運用全般に応用可能な 5 つの指針 03 / 23
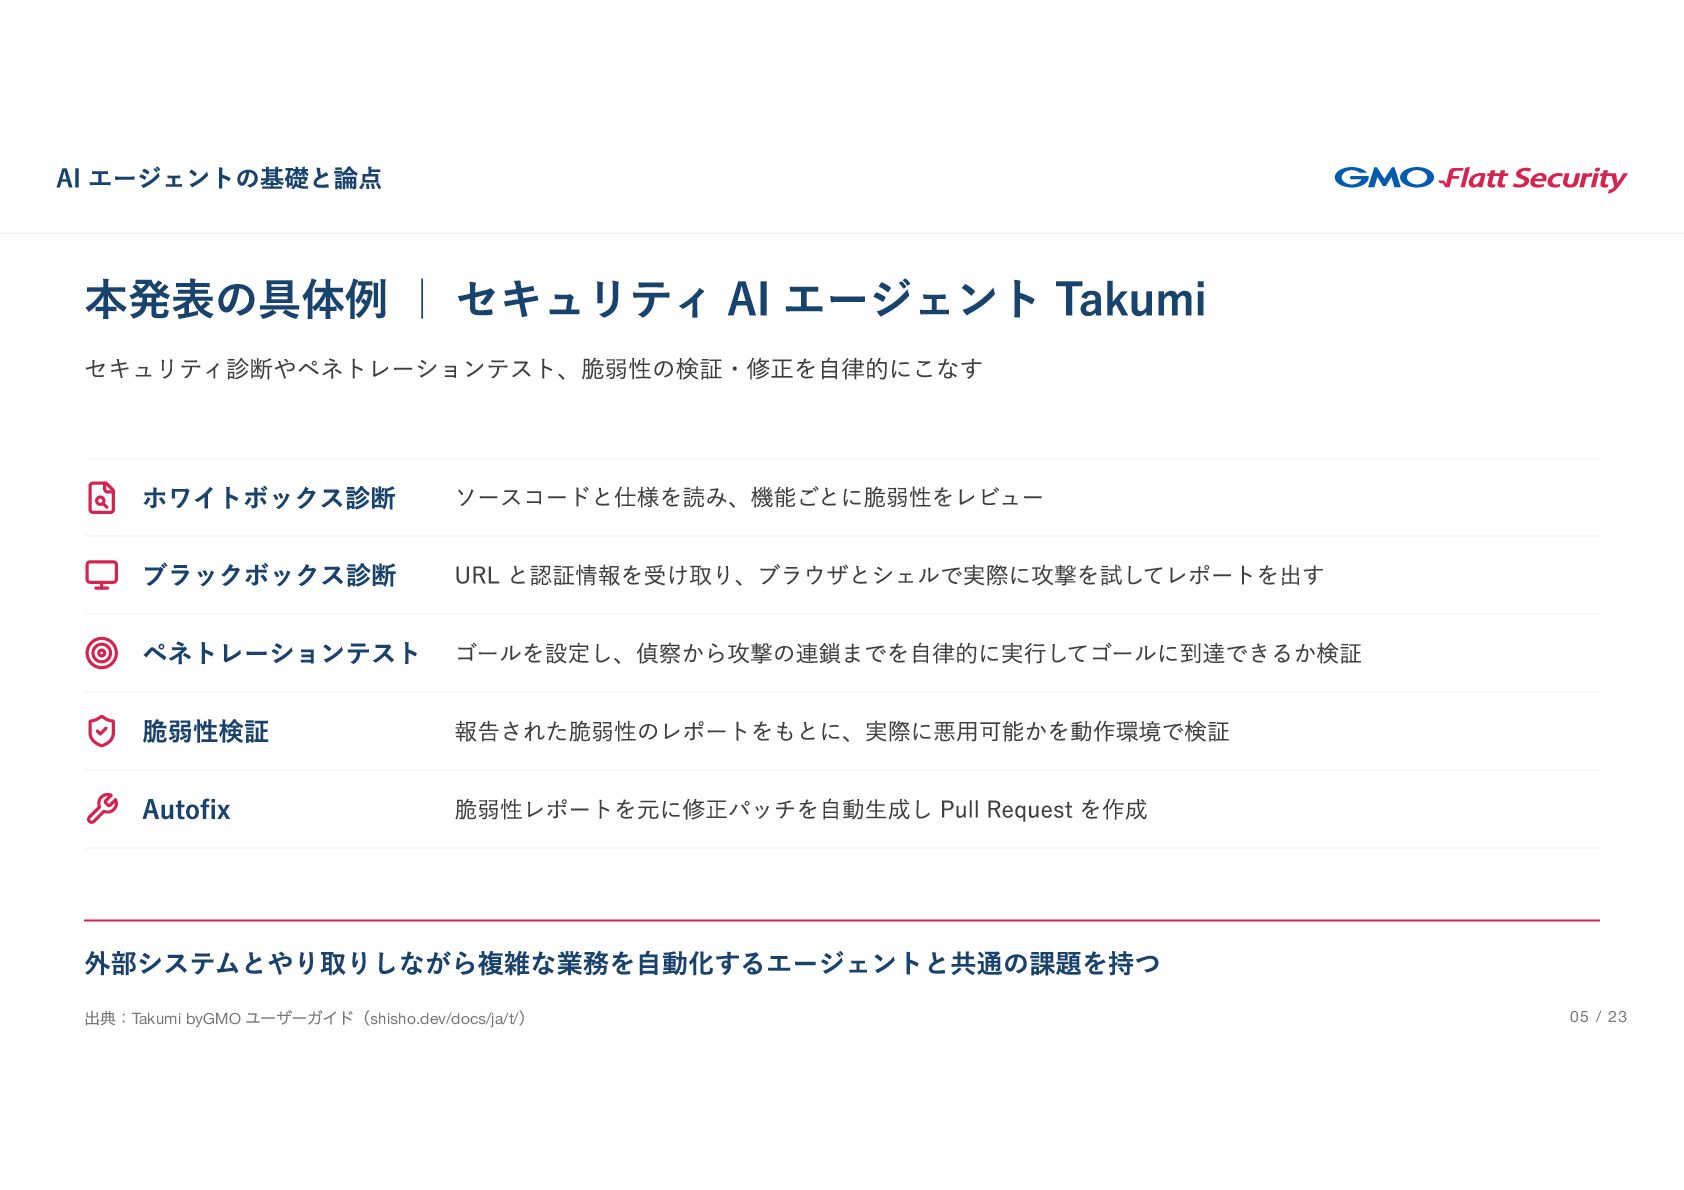
  3. AI エージェントの基礎と論点 本発表の具体例 | セキュリティ AI エージェント Takumi セキュリティ診断やペネトレーションテスト、脆弱性の検証・修正を自律的にこなす ホワイトボックス診断

    ソースコードと仕様を読み、機能ごとに脆弱性をレビュー ブラックボックス診断 URL と認証情報を受け取り、ブラウザとシェルで実際に攻撃を試してレポートを出す ペネトレーションテスト ゴールを設定し、偵察から攻撃の連鎖までを自律的に実行してゴールに到達できるか検証 脆弱性検証 報告された脆弱性のレポートをもとに、実際に悪用可能かを動作環境で検証 Autofix 脆弱性レポートを元に修正パッチを自動生成し Pull Request を作成 外部システムとやり取りしながら複雑な業務を自動化するエージェントと共通の課題を持つ 出典:Takumi byGMO ユーザーガイド(shisho.dev/docs/ja/t/) 05 / 23
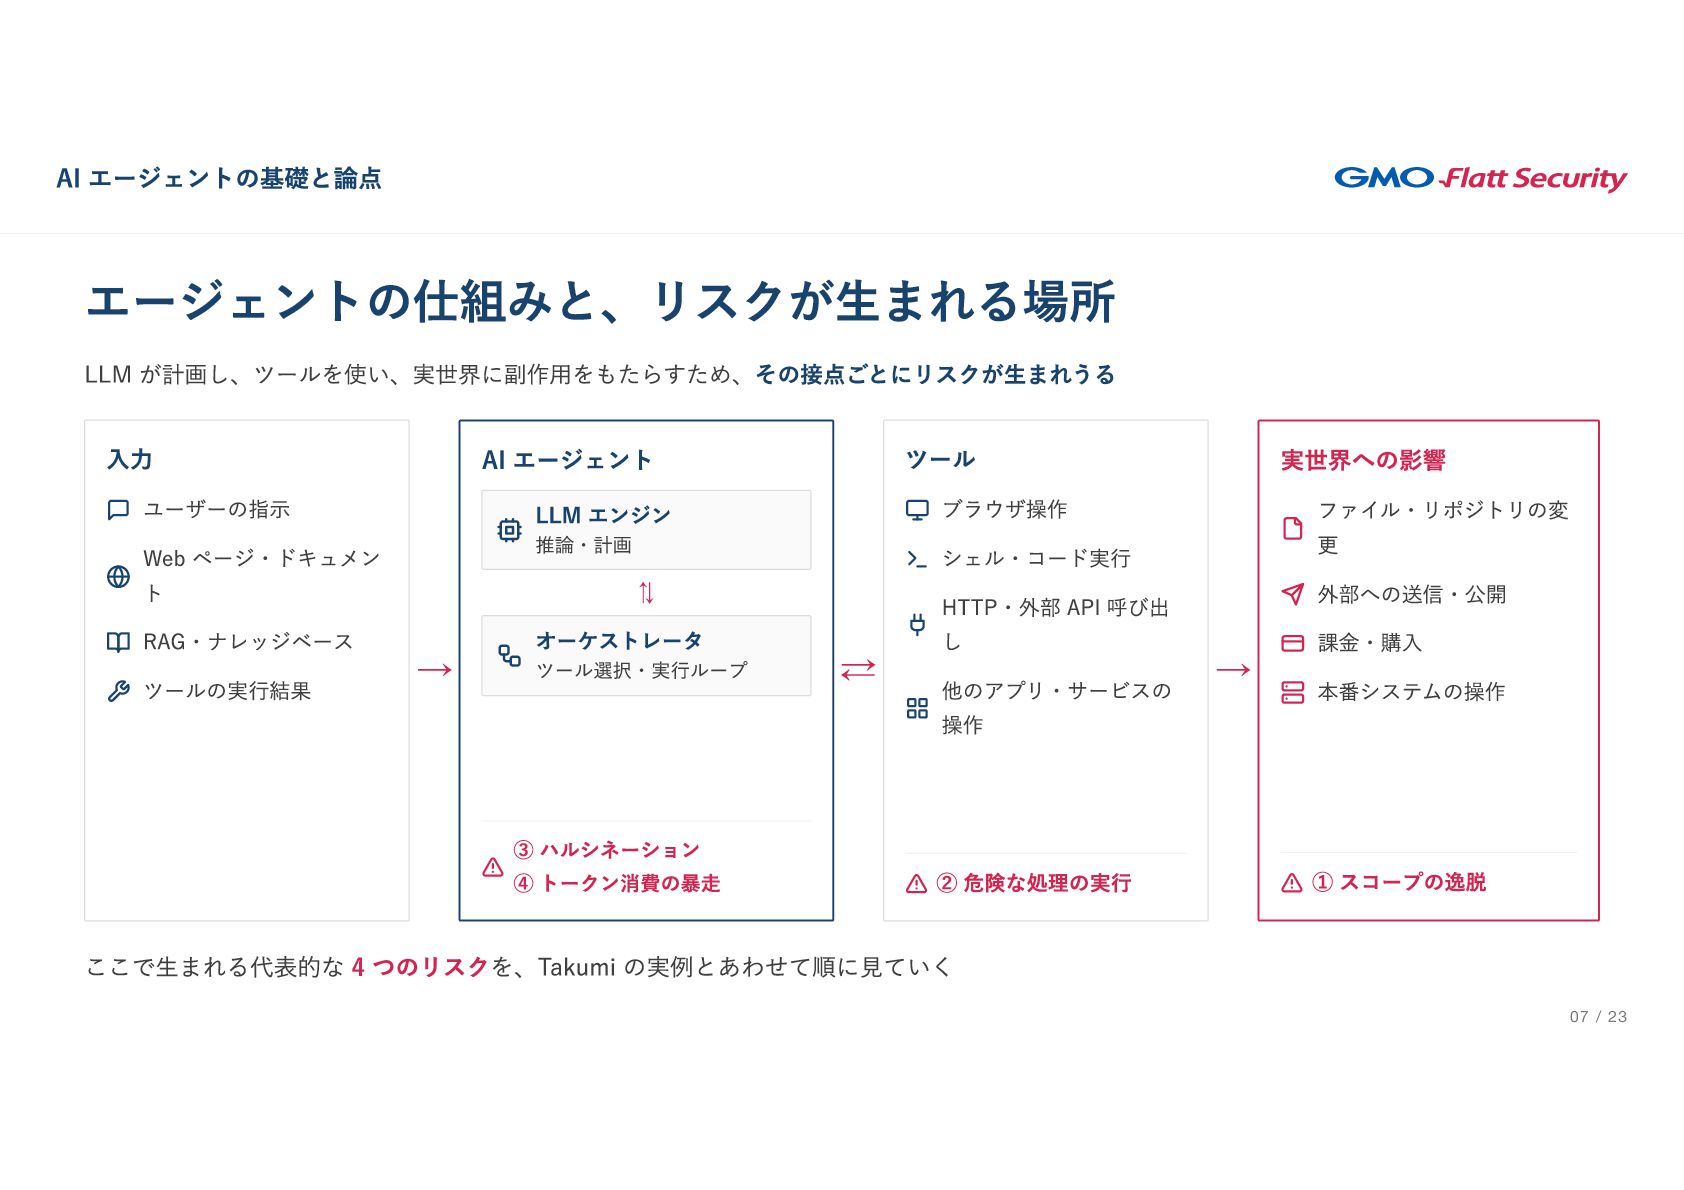
  4. AI エージェントの基礎と論点 エージェントの仕組みと、リスクが生まれる場所 LLM が計画し、ツールを使い、実世界に副作用をもたらすため、その接点ごとにリスクが生まれうる 入力 ユーザーの指示 Web ページ・ドキュメン ト

    RAG・ナレッジベース ツールの実行結果 AI エージェント ツール LLM エンジン 推論・計画 → ⇅ オーケストレータ ツール選択・実行ループ ③ ハルシネーション ④ トークン消費の暴走 ⇄ ブラウザ操作 シェル・コード実行 HTTP・外部 API 呼び出 し 他のアプリ・サービスの 操作 ② 危険な処理の実行 実世界への影響 → ファイル・リポジトリの変 更 外部への送信・公開 課金・購入 本番システムの操作 ① スコープの逸脱 ここで生まれる代表的な 4 つのリスクを、Takumi の実例とあわせて順に見ていく 07 / 23
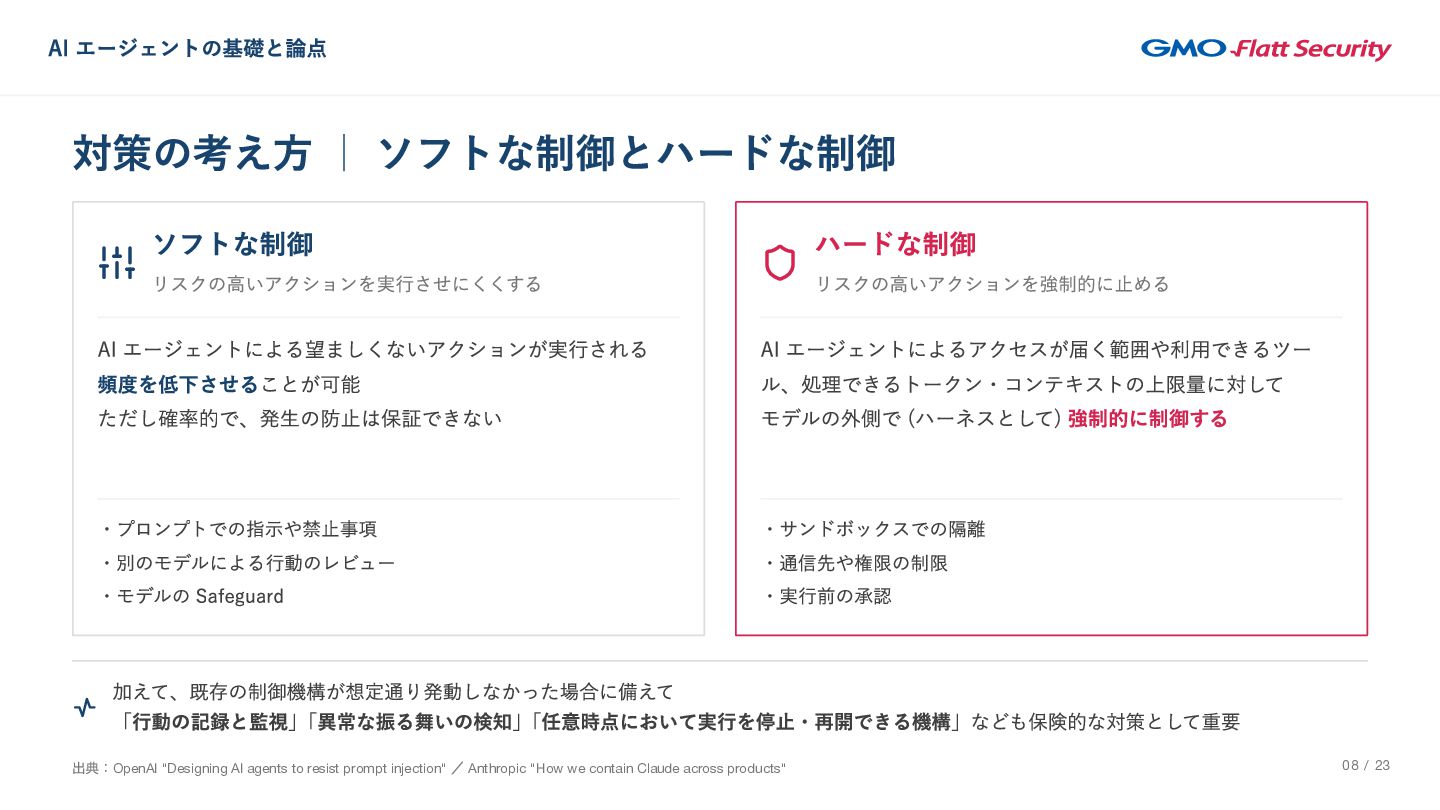
  5. AI エージェントの基礎と論点 対策の考え方 | ソフトな制御とハードな制御 ソフトな制御 ハードな制御 リスクの高いアクションを実行させにくくする リスクの高いアクションを強制的に止める AI

    エージェントによる望ましくないアクションが実行される 頻度を低下させることが可能 ただし確率的で、発生の防止は保証できない AI エージェントによるアクセスが届く範囲や利用できるツー ル、処理できるトークン・コンテキストの上限量に対して モデルの外側で (ハーネスとして) 強制的に制御する ・プロンプトでの指示や禁止事項 ・別のモデルによる行動のレビュー ・モデルの Safeguard ・サンドボックスでの隔離 ・通信先や権限の制限 ・実行前の承認 加えて、既存の制御機構が想定通り発動しなかった場合に備えて 「行動の記録と監視」「異常な振る舞いの検知」「任意時点において実行を停止・再開できる機構」なども保険的な対策として重要 出典:OpenAI "Designing AI agents to resist prompt injection" / Anthropic "How we contain Claude across products" 08 / 23
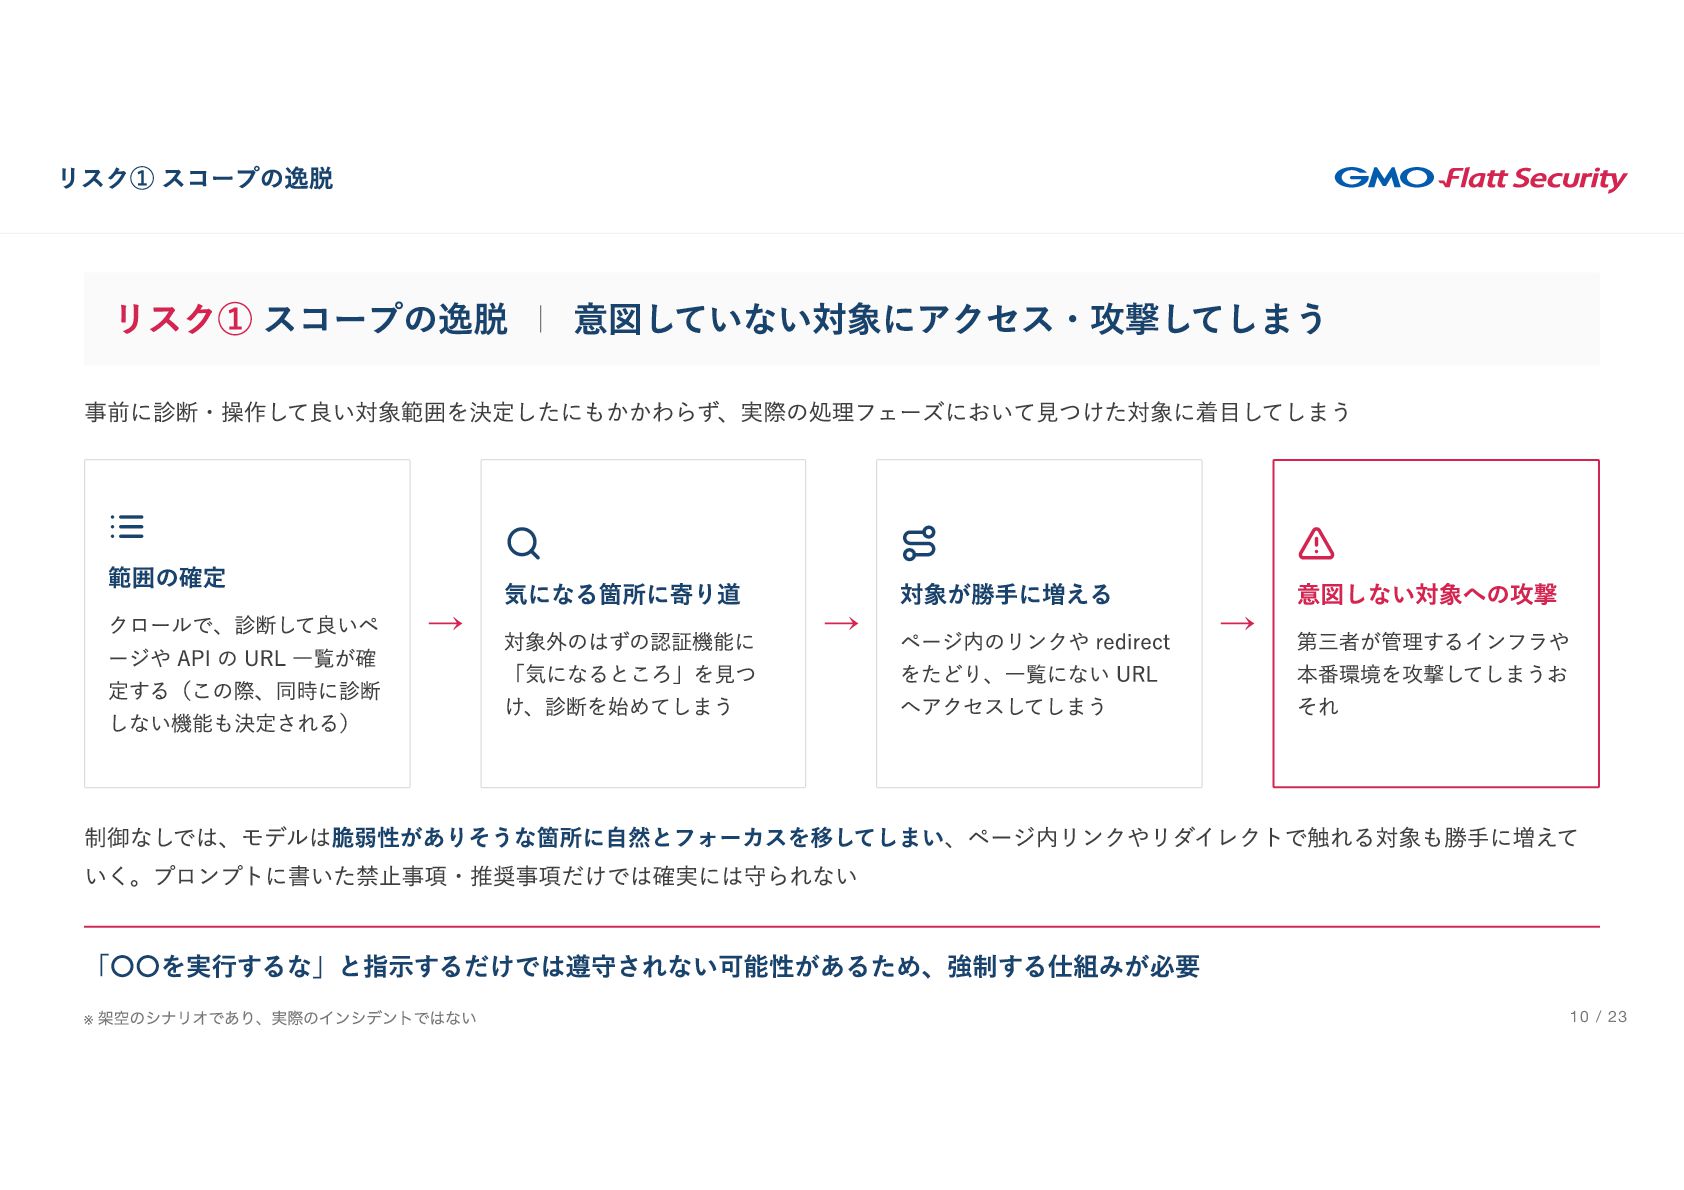
  6. リスク① スコープの逸脱 リスク① スコープの逸脱 | 意図していない対象にアクセス・攻撃してしまう 事前に診断・操作して良い対象範囲を決定したにもかかわらず、実際の処理フェーズにおいて見つけた対象に着目してしまう 範囲の確定 クロールで、診断して良いペ ージや

    API の URL 一覧が確 定する(この際、同時に診断 しない機能も決定される) 気になる箇所に寄り道 対象が勝手に増える 意図しない対象への攻撃 「気になるところ」を見つ け、診断を始めてしまう をたどり、一覧にない URL へアクセスしてしまう 本番環境を攻撃してしまうお それ → 対象外のはずの認証機能に → ページ内のリンクや redirect → 第三者が管理するインフラや 制御なしでは、モデルは脆弱性がありそうな箇所に自然とフォーカスを移してしまい、ページ内リンクやリダイレクトで触れる対象も勝手に増えて いく。プロンプトに書いた禁止事項・推奨事項だけでは確実には守られない 「〇〇を実行するな」と指示するだけでは遵守されない可能性があるため、強制する仕組みが必要 ※ 架空のシナリオであり、実際のインシデントではない 10 / 23
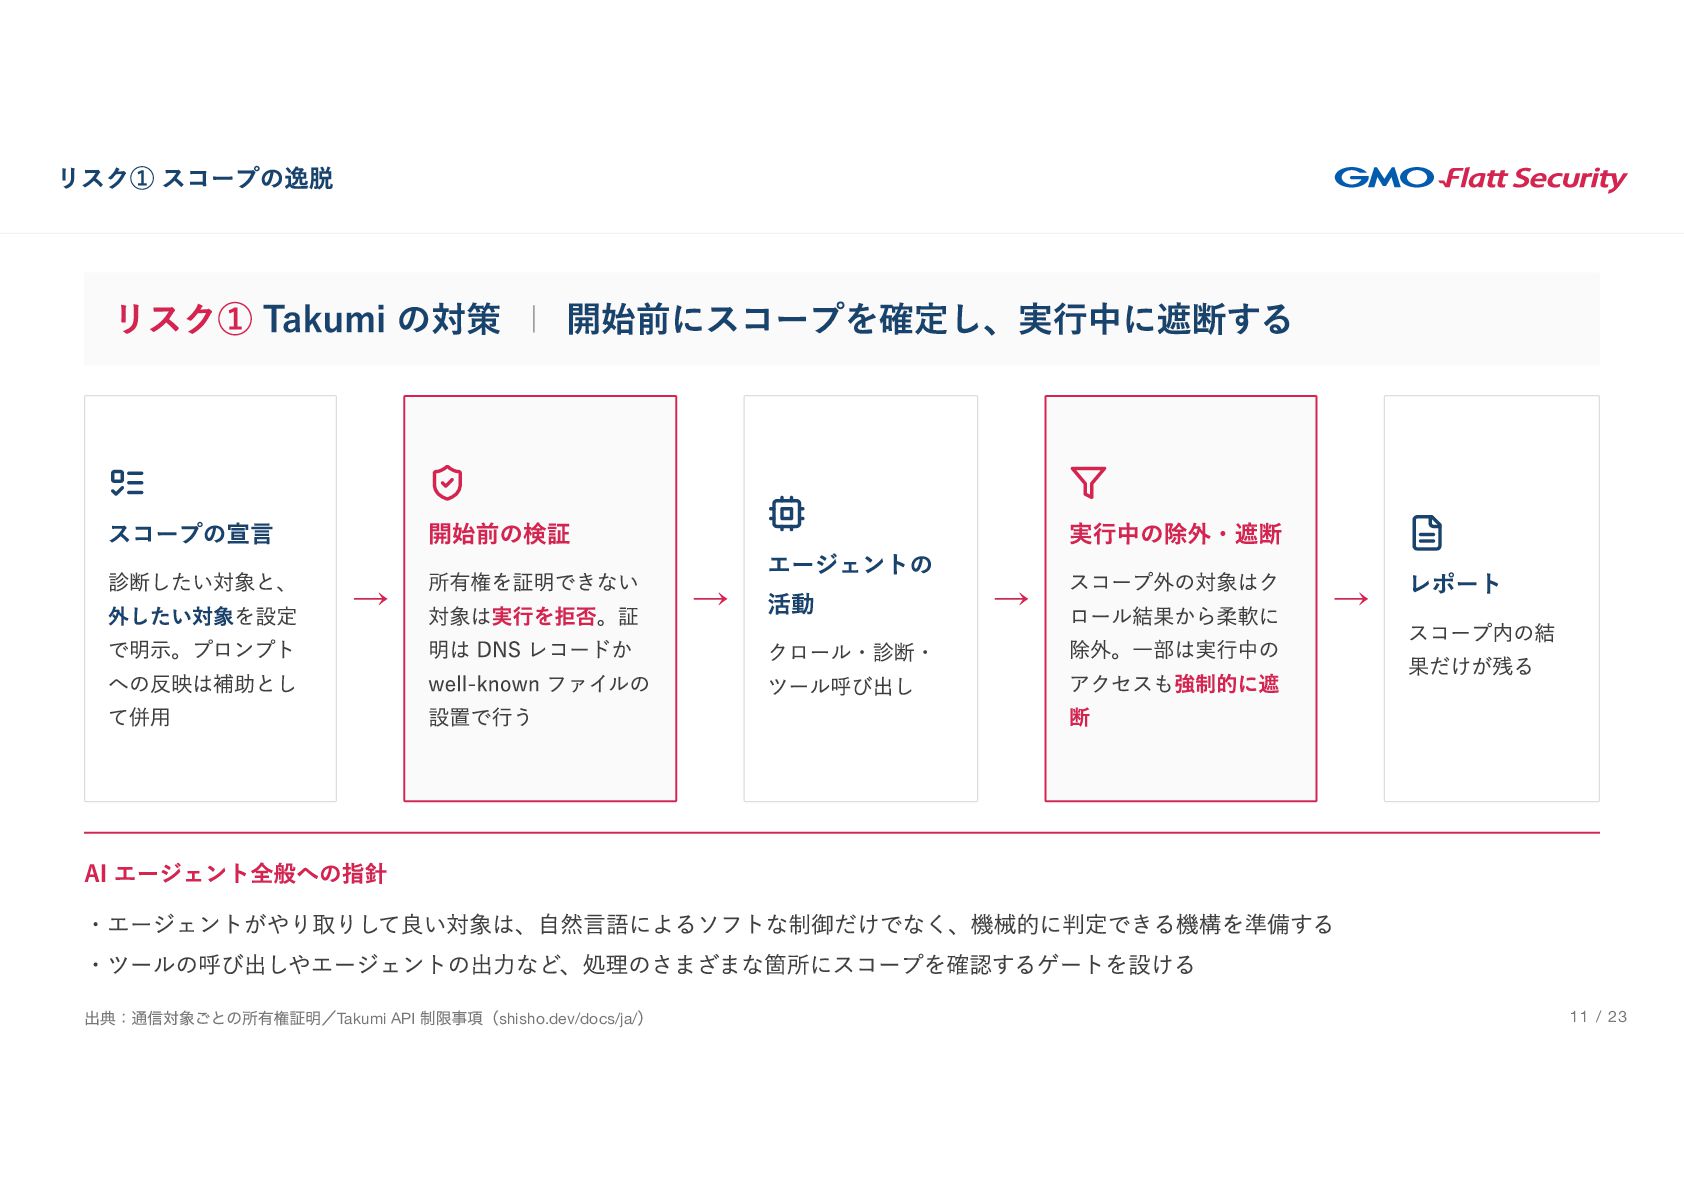
  7. リスク① スコープの逸脱 リスク① Takumi の対策 | 開始前にスコープを確定し、実行中に遮断する スコープの宣言 診断したい対象と、 外したい対象を設定

    で明示。プロンプト への反映は補助とし て併用 → 開始前の検証 所有権を証明できない 対象は実行を拒否。証 明は DNS レコードか well-known ファイルの 設置で行う → エージェントの 活動 クロール・診断・ ツール呼び出し 実行中の除外・遮断 レポート → スコープ外の対象はク ロール結果から柔軟に → スコープ内の結 除外。一部は実行中の アクセスも強制的に遮 断 果だけが残る AI エージェント全般への指針 ・エージェントがやり取りして良い対象は、自然言語によるソフトな制御だけでなく、機械的に判定できる機構を準備する ・ツールの呼び出しやエージェントの出力など、処理のさまざまな箇所にスコープを確認するゲートを設ける 出典:通信対象ごとの所有権証明/Takumi API 制限事項(shisho.dev/docs/ja/) 11 / 23
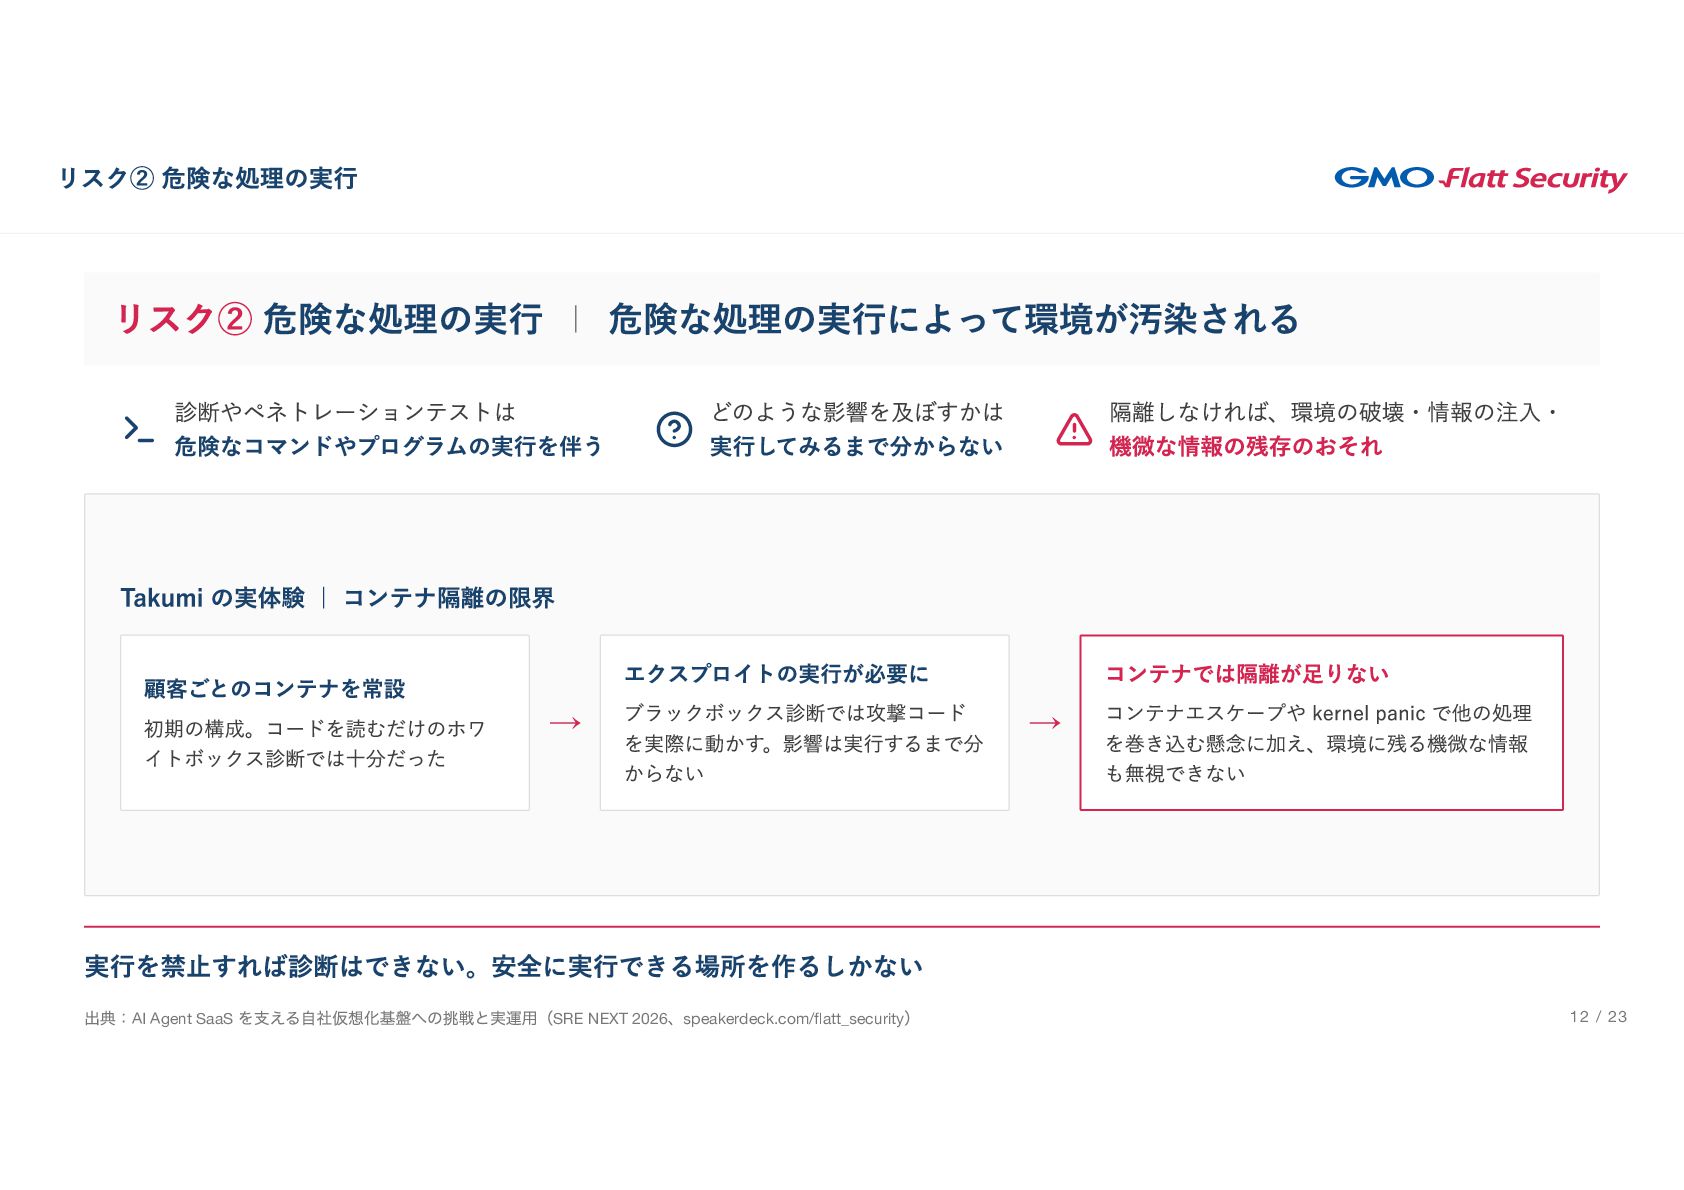
  8. リスク② 危険な処理の実行 リスク② 危険な処理の実行 | 危険な処理の実行によって環境が汚染される 診断やペネトレーションテストは 危険なコマンドやプログラムの実行を伴う どのような影響を及ぼすかは 実行してみるまで分からない

    隔離しなければ、環境の破壊・情報の注入・ 機微な情報の残存のおそれ Takumi の実体験 | コンテナ隔離の限界 顧客ごとのコンテナを常設 初期の構成。コードを読むだけのホワ イトボックス診断では十分だった エクスプロイトの実行が必要に コンテナでは隔離が足りない からない も無視できない コンテナエスケープや kernel panic で他の処理 → ブラックボックス診断では攻撃コード を実際に動かす。影響は実行するまで分 → を巻き込む懸念に加え、環境に残る機微な情報 実行を禁止すれば診断はできない。安全に実行できる場所を作るしかない 出典:AI Agent SaaS を支える自社仮想化基盤への挑戦と実運用(SRE NEXT 2026、speakerdeck.com/flatt_security) 12 / 23
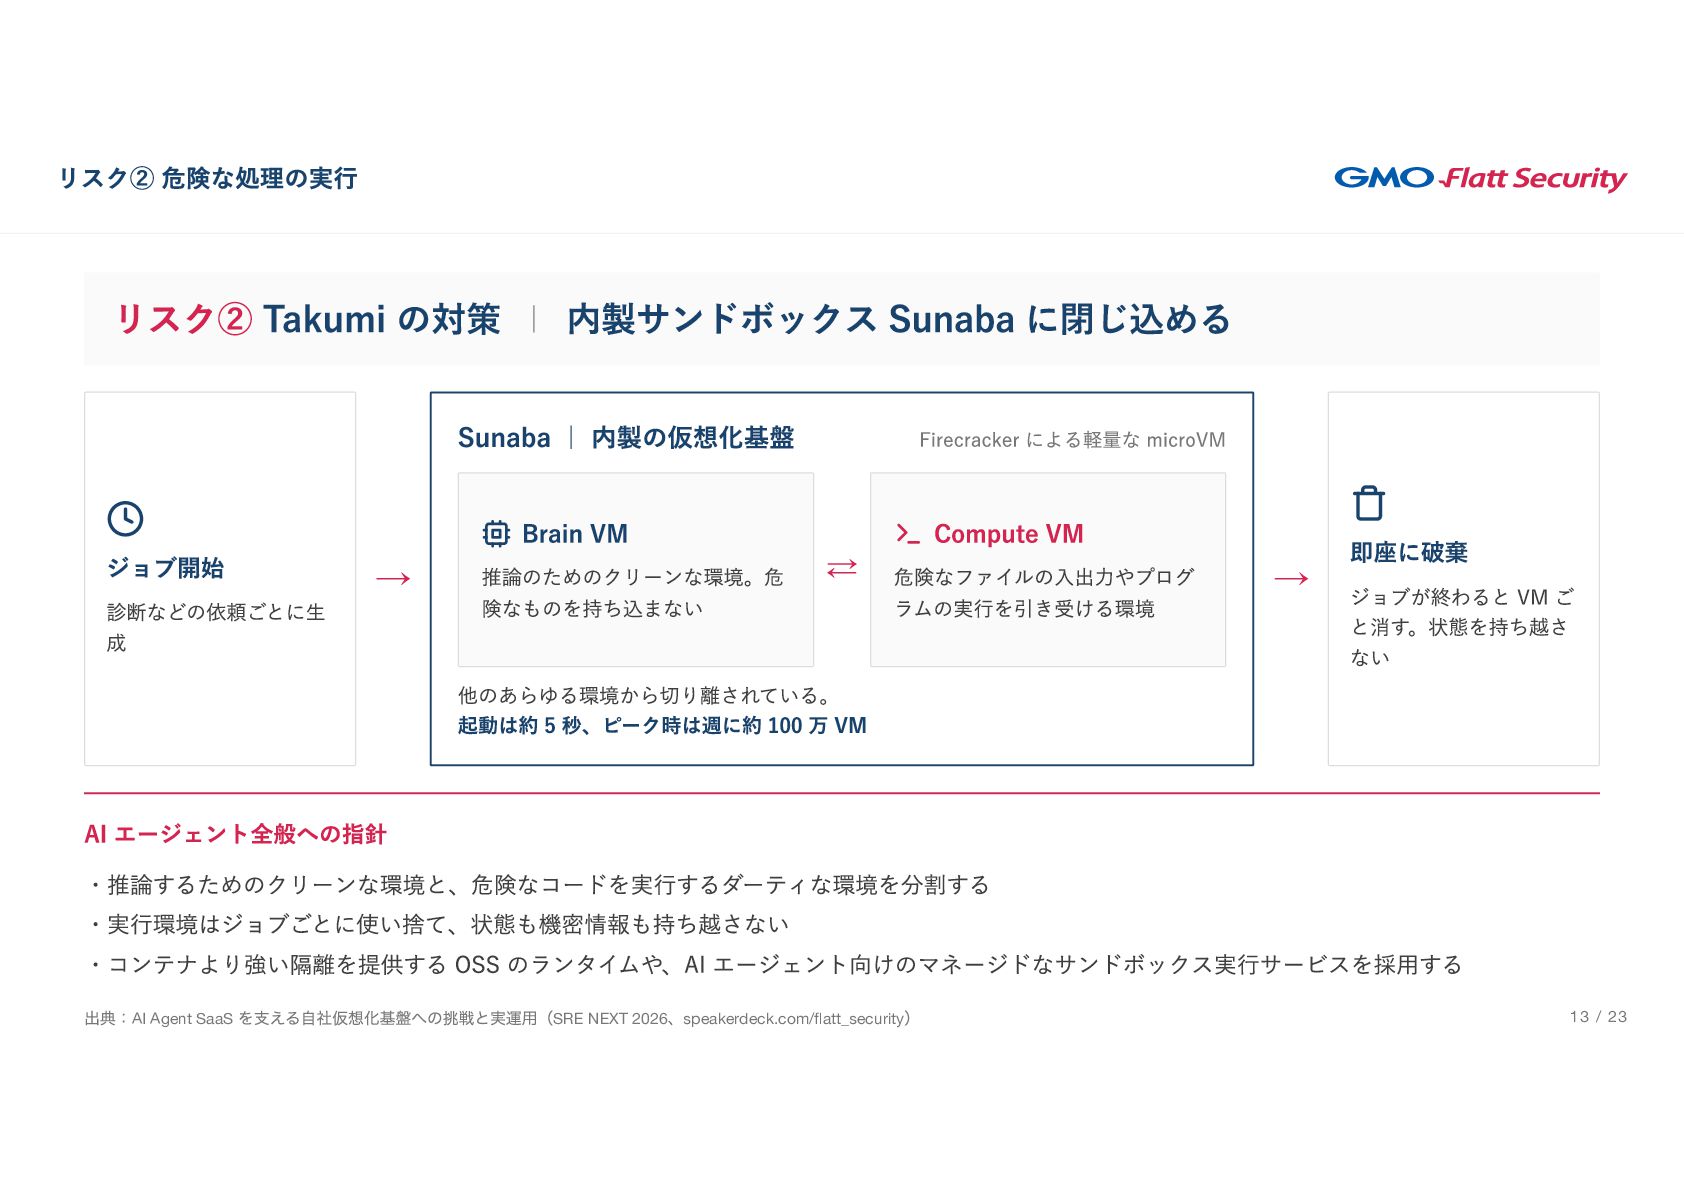
  9. リスク② 危険な処理の実行 リスク② Takumi の対策 | 内製サンドボックス Sunaba に閉じ込める Sunaba

    | 内製の仮想化基盤 → 診断などの依頼ごとに生 ジョブ開始 成 Brain VM 推論のためのクリーンな環境。危 険なものを持ち込まない Firecracker による軽量な microVM Compute VM ⇄ 危険なファイルの入出力やプログ ラムの実行を引き受ける環境 他のあらゆる環境から切り離されている。 起動は約 5 秒、ピーク時は週に約 100 万 VM → 即座に破棄 ジョブが終わると VM ご と消す。状態を持ち越さ ない AI エージェント全般への指針 ・推論するためのクリーンな環境と、危険なコードを実行するダーティな環境を分割する ・実行環境はジョブごとに使い捨て、状態も機密情報も持ち越さない ・コンテナより強い隔離を提供する OSS のランタイムや、AI エージェント向けのマネージドなサンドボックス実行サービスを採用する 出典:AI Agent SaaS を支える自社仮想化基盤への挑戦と実運用(SRE NEXT 2026、speakerdeck.com/flatt_security) 13 / 23
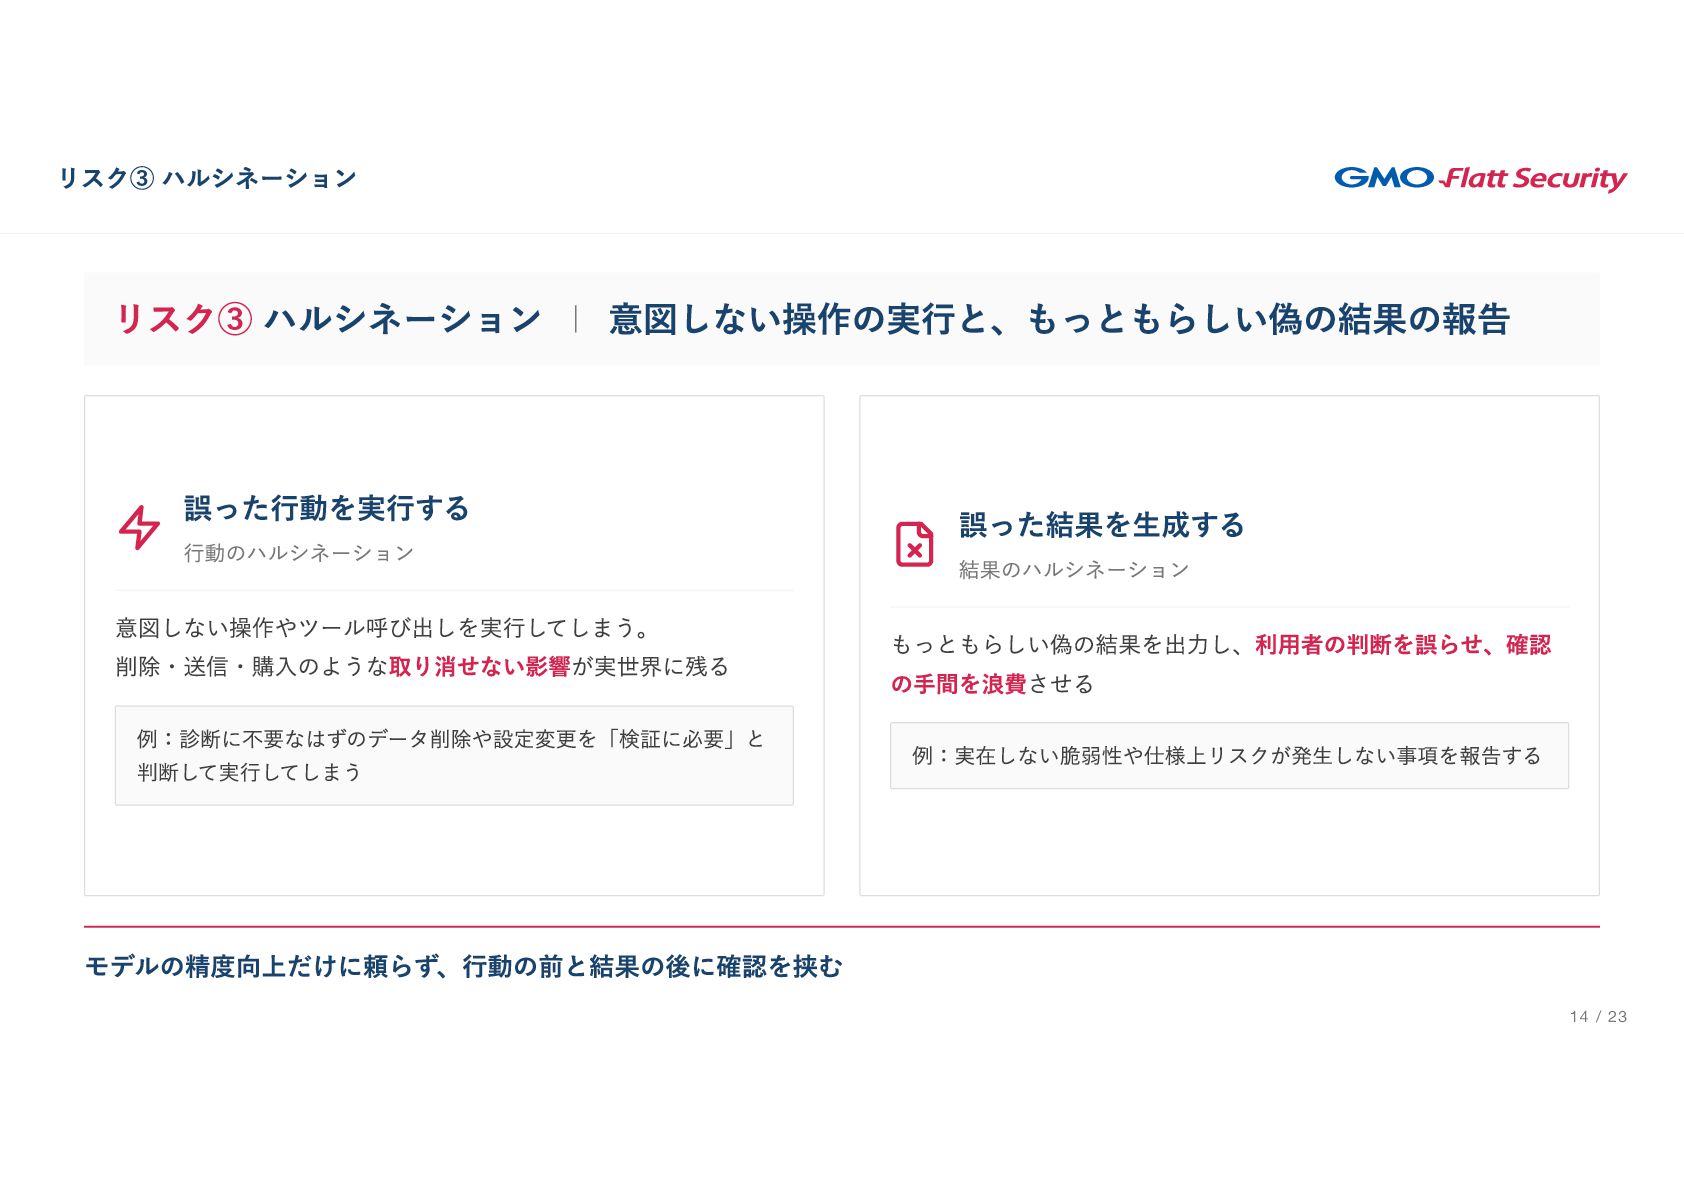
  10. リスク③ ハルシネーション リスク③ ハルシネーション | 意図しない操作の実行と、もっともらしい偽の結果の報告 誤った行動を実行する 行動のハルシネーション 誤った結果を生成する 結果のハルシネーション

    意図しない操作やツール呼び出しを実行してしまう。 削除・送信・購入のような取り消せない影響が実世界に残る もっともらしい偽の結果を出力し、利用者の判断を誤らせ、確認 の手間を浪費させる 例:診断に不要なはずのデータ削除や設定変更を「検証に必要」と 判断して実行してしまう 例:実在しない脆弱性や仕様上リスクが発生しない事項を報告する モデルの精度向上だけに頼らず、行動の前と結果の後に確認を挟む 14 / 23
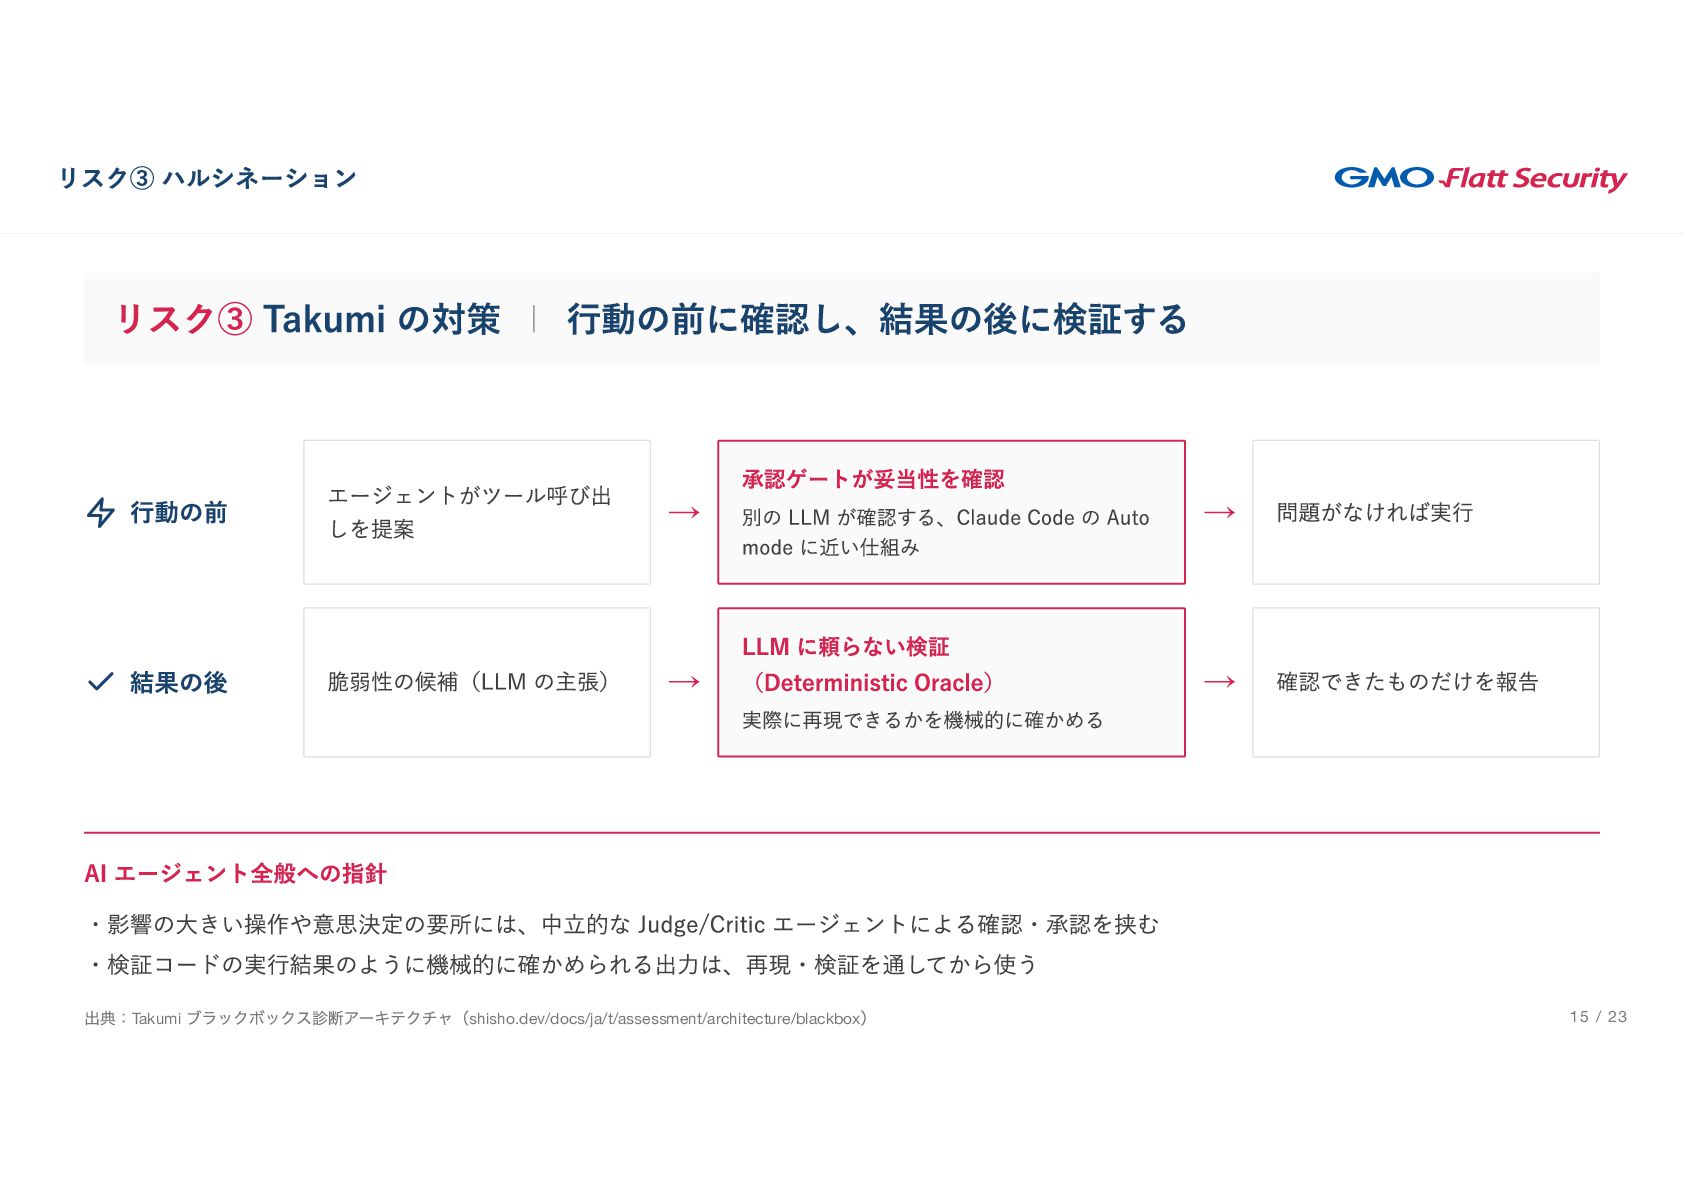
  11. リスク③ ハルシネーション リスク③ Takumi の対策 | 行動の前に確認し、結果の後に検証する 行動の前 結果の後 エージェントがツール呼び出

    しを提案 脆弱性の候補(LLM の主張) 承認ゲートが妥当性を確認 → 別の LLM が確認する、Claude Code の Auto → 問題がなければ実行 mode に近い仕組み LLM に頼らない検証 (Deterministic Oracle) → 実際に再現できるかを機械的に確かめる → 確認できたものだけを報告 AI エージェント全般への指針 ・影響の大きい操作や意思決定の要所には、中立的な Judge/Critic エージェントによる確認・承認を挟む ・検証コードの実行結果のように機械的に確かめられる出力は、再現・検証を通してから使う 出典:Takumi ブラックボックス診断アーキテクチャ(shisho.dev/docs/ja/t/assessment/architecture/blackbox) 15 / 23
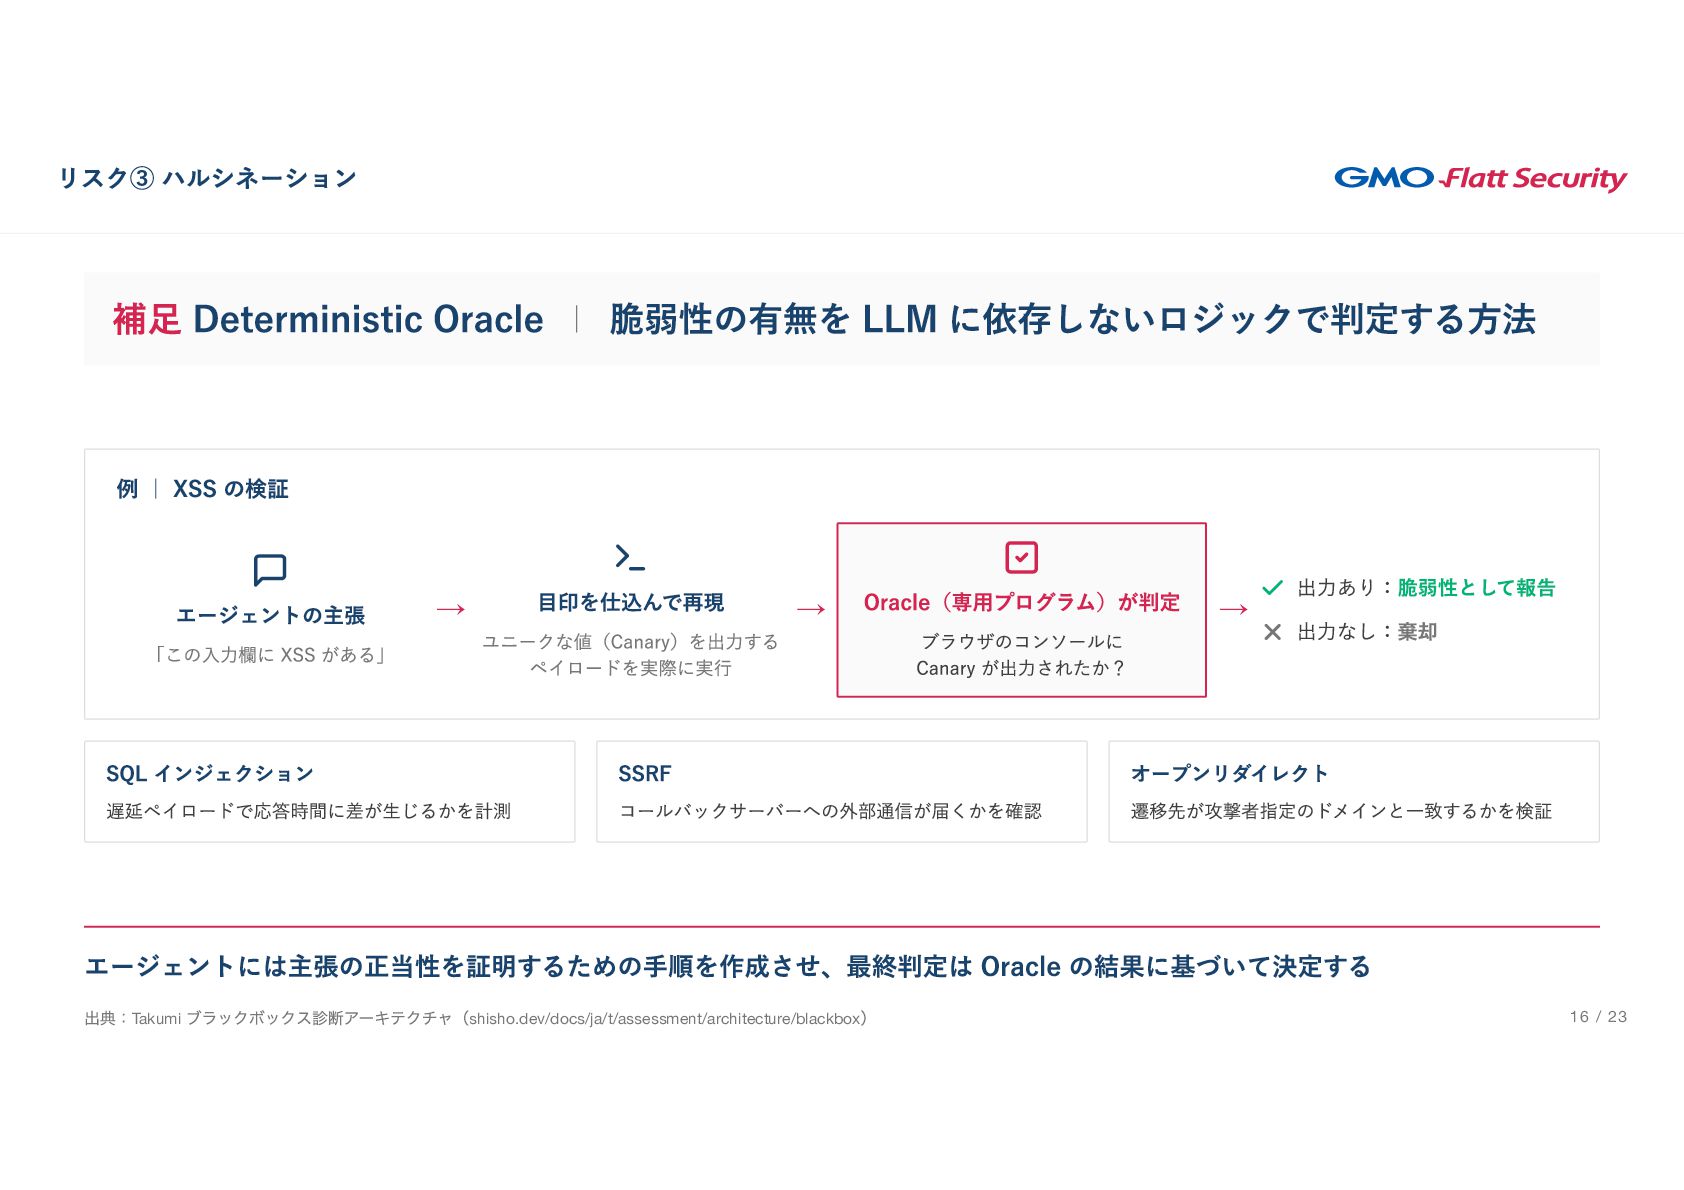
  12. リスク③ ハルシネーション 補足 Deterministic Oracle | 脆弱性の有無を LLM に依存しないロジックで判定する方法 例

    | XSS の検証 エージェントの主張 「この入力欄に XSS がある」 SQL インジェクション 目印を仕込んで再現 → ユニークな値(Canary)を出力する → Oracle(専用プログラム)が判定 → ブラウザのコンソールに 遅延ペイロードで応答時間に差が生じるかを計測 ペイロードを実際に実行 SSRF Canary が出力されたか? コールバックサーバーへの外部通信が届くかを確認 出力あり:脆弱性として報告 出力なし:棄却 オープンリダイレクト 遷移先が攻撃者指定のドメインと一致するかを検証 エージェントには主張の正当性を証明するための手順を作成させ、最終判定は Oracle の結果に基づいて決定する 出典:Takumi ブラックボックス診断アーキテクチャ(shisho.dev/docs/ja/t/assessment/architecture/blackbox) 16 / 23
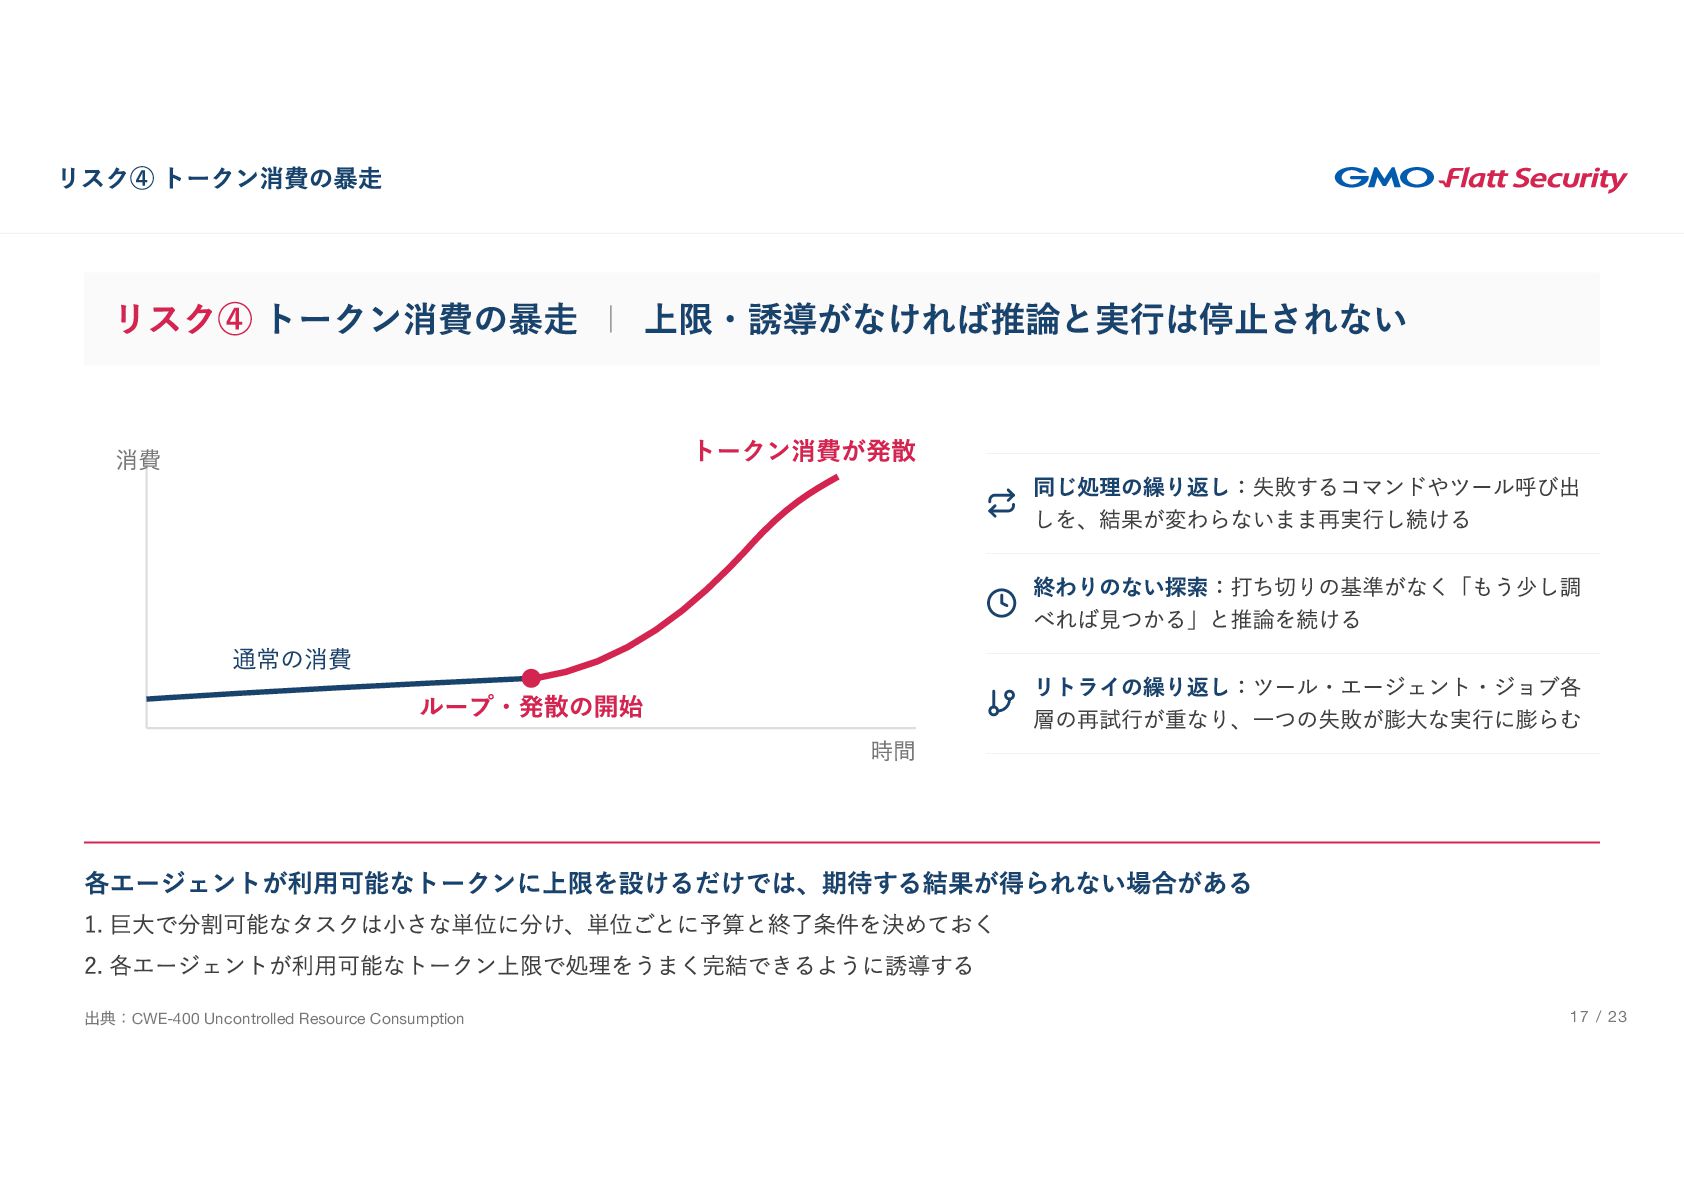
  13. リスク④ トークン消費の暴走 リスク④ トークン消費の暴走 | 上限・誘導がなければ推論と実行は停止されない トークン消費が発散 消費 通常の消費 同じ処理の繰り返し:失敗するコマンドやツール呼び出

    しを、結果が変わらないまま再実行し続ける 終わりのない探索:打ち切りの基準がなく「もう少し調 べれば見つかる」と推論を続ける ループ・発散の開始 時間 リトライの繰り返し:ツール・エージェント・ジョブ各 層の再試行が重なり、一つの失敗が膨大な実行に膨らむ 各エージェントが利用可能なトークンに上限を設けるだけでは、期待する結果が得られない場合がある 1. 巨大で分割可能なタスクは小さな単位に分け、単位ごとに予算と終了条件を決めておく 2. 各エージェントが利用可能なトークン上限で処理をうまく完結できるように誘導する 出典:CWE-400 Uncontrolled Resource Consumption 17 / 23
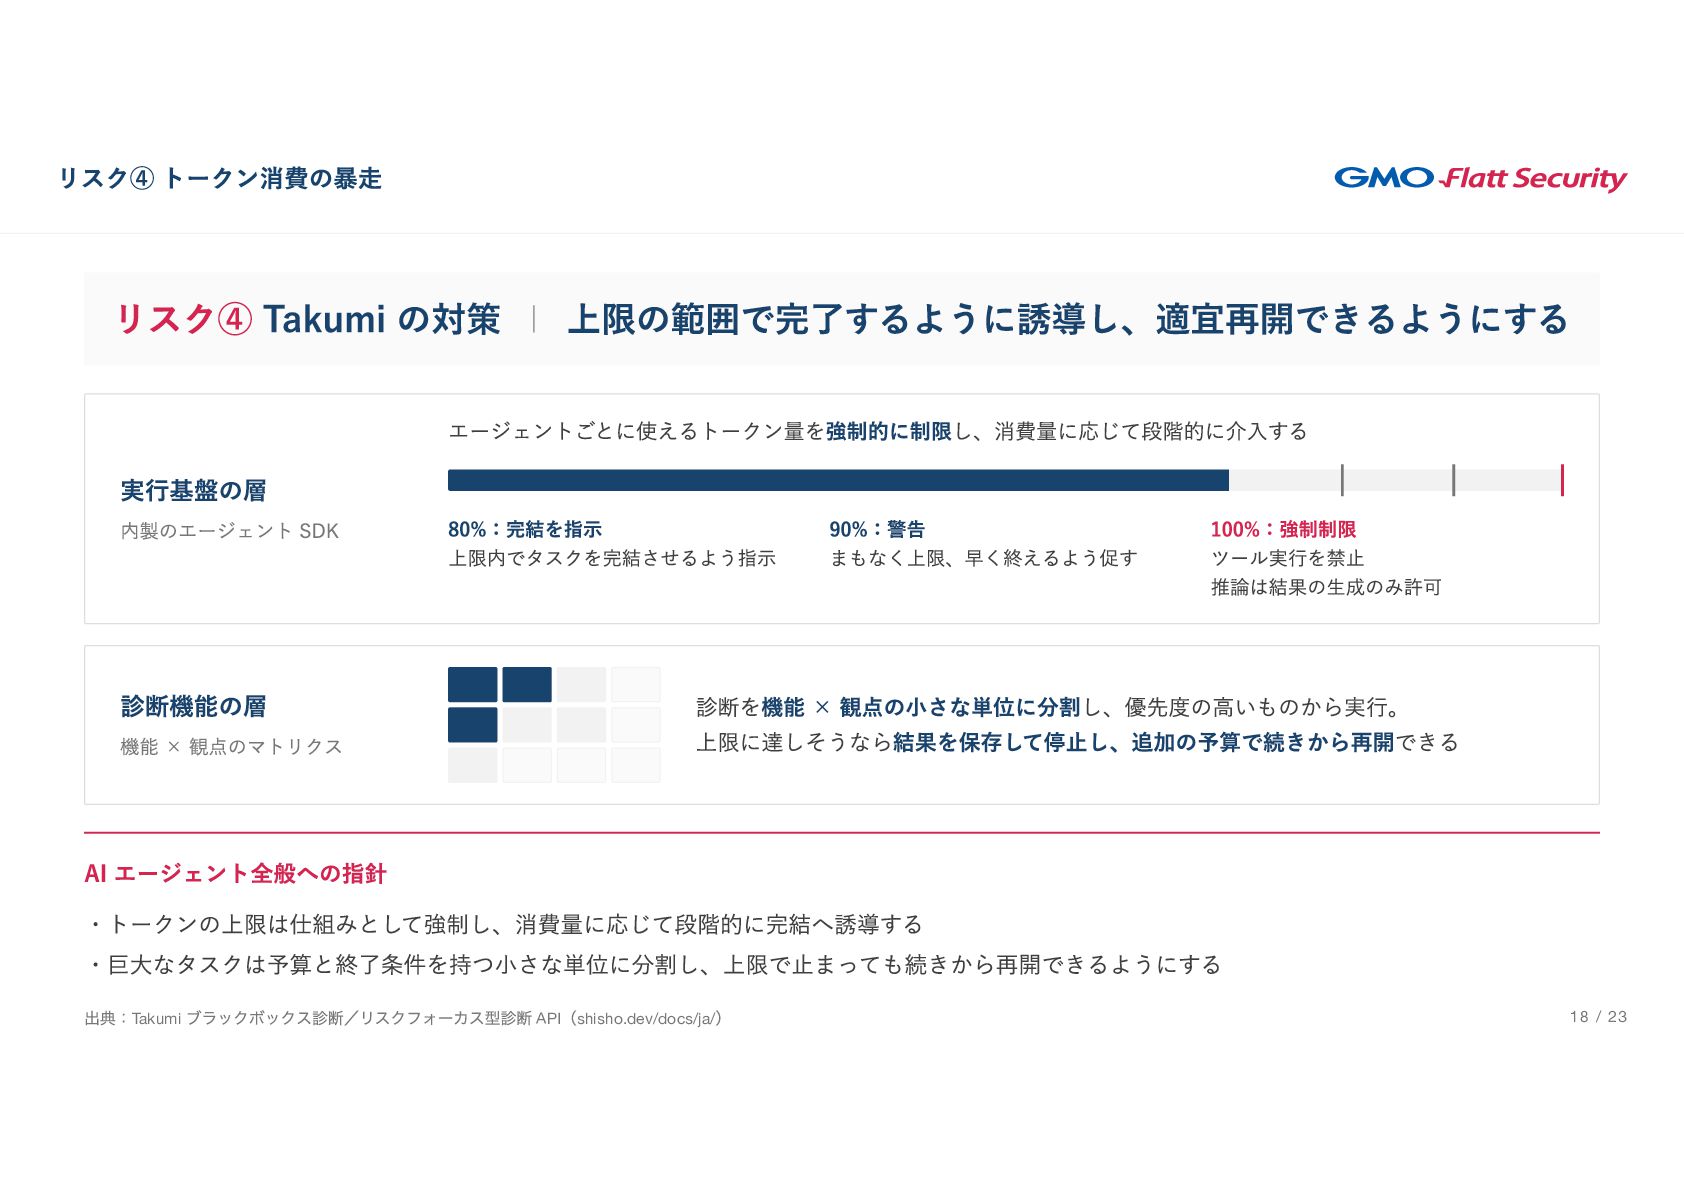
  14. リスク④ トークン消費の暴走 リスク④ Takumi の対策 | 上限の範囲で完了するように誘導し、適宜再開できるようにする 実行基盤の層 内製のエージェント SDK

    診断機能の層 機能 × 観点のマトリクス エージェントごとに使えるトークン量を強制的に制限し、消費量に応じて段階的に介入する 80%:完結を指示 上限内でタスクを完結させるよう指示 90%:警告 まもなく上限、早く終えるよう促す 100%:強制制限 ツール実行を禁止 推論は結果の生成のみ許可 診断を機能 × 観点の小さな単位に分割し、優先度の高いものから実行。 上限に達しそうなら結果を保存して停止し、追加の予算で続きから再開できる AI エージェント全般への指針 ・トークンの上限は仕組みとして強制し、消費量に応じて段階的に完結へ誘導する ・巨大なタスクは予算と終了条件を持つ小さな単位に分割し、上限で止まっても続きから再開できるようにする 出典:Takumi ブラックボックス診断/リスクフォーカス型診断 API(shisho.dev/docs/ja/) 18 / 23
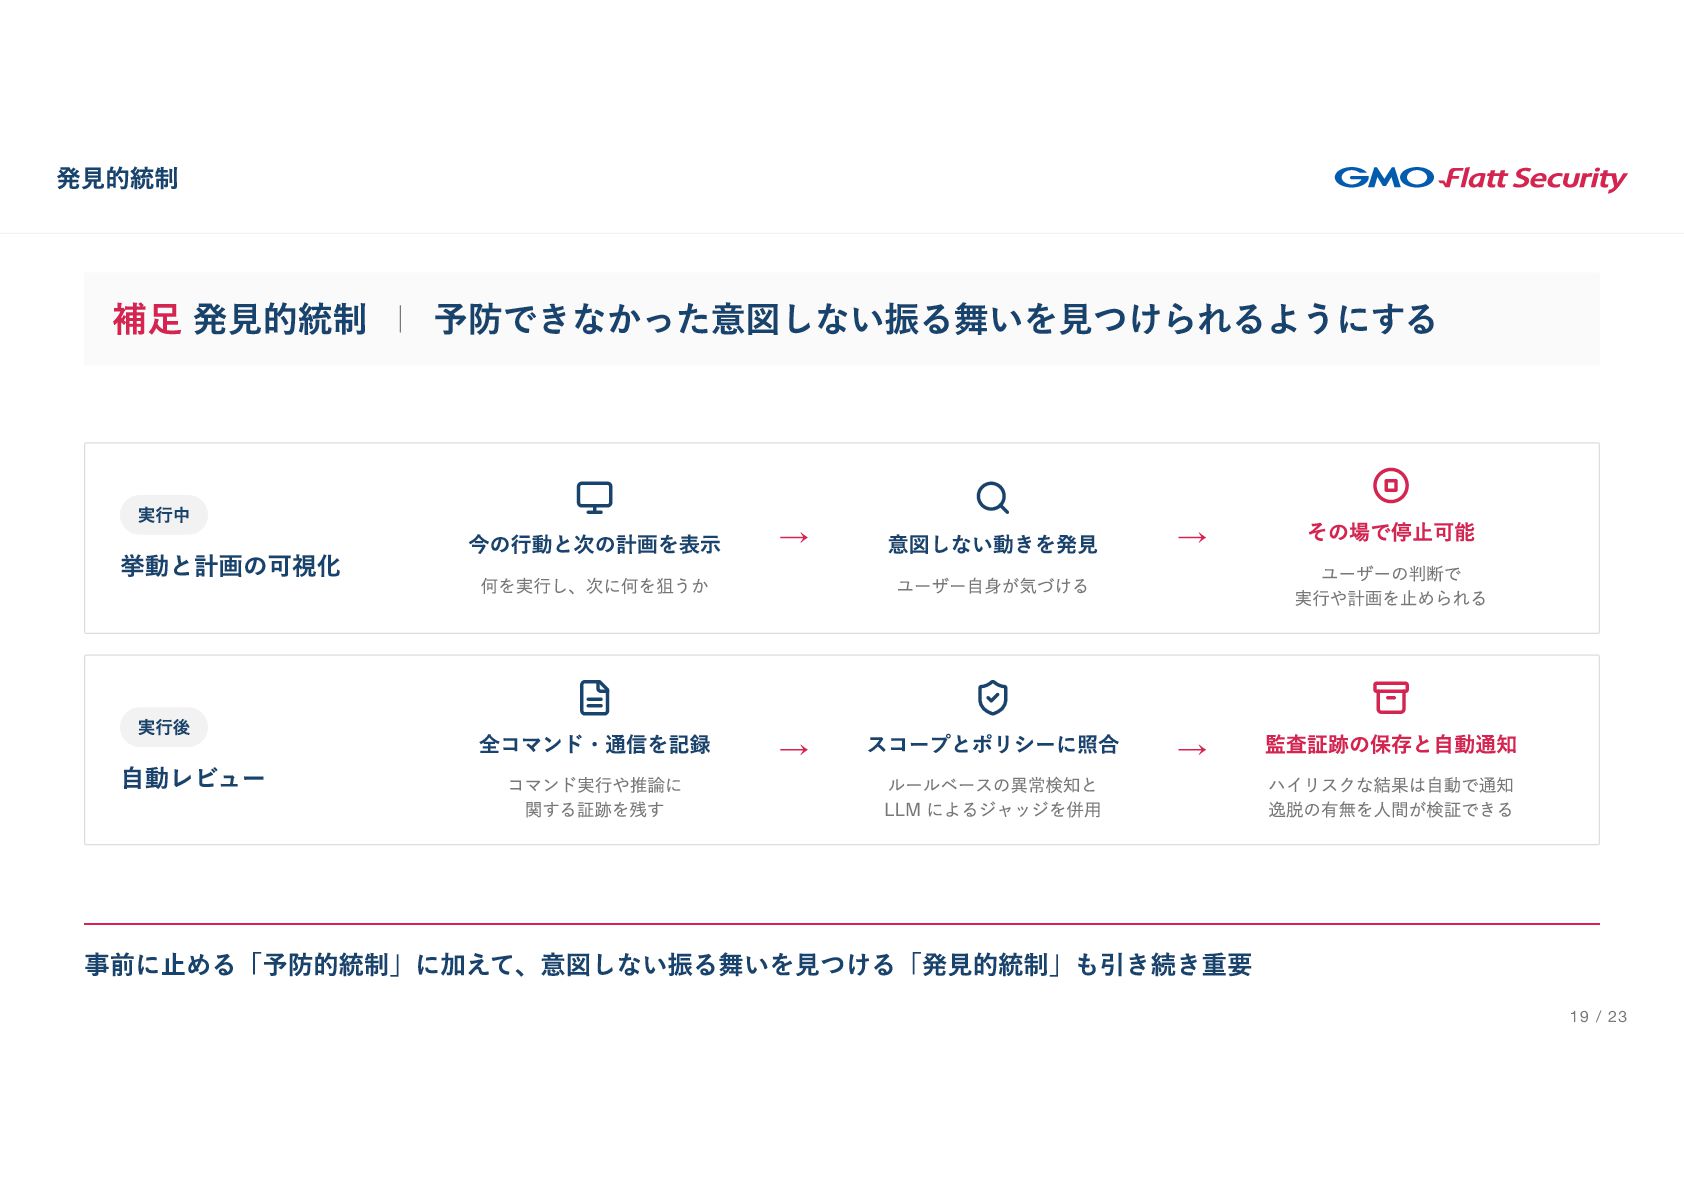
  15. 発見的統制 補足 発見的統制 | 予防できなかった意図しない振る舞いを見つけられるようにする 実行中 挙動と計画の可視化 今の行動と次の計画を表示 → 意図しない動きを発見

    → 実行後 全コマンド・通信を記録 → スコープとポリシーに照合 → 自動レビュー 何を実行し、次に何を狙うか コマンド実行や推論に 関する証跡を残す ユーザー自身が気づける ルールベースの異常検知と LLM によるジャッジを併用 その場で停止可能 ユーザーの判断で 実行や計画を止められる 監査証跡の保存と自動通知 ハイリスクな結果は自動で通知 逸脱の有無を人間が検証できる 事前に止める「予防的統制」に加えて、意図しない振る舞いを見つける「発見的統制」も引き続き重要 19 / 23
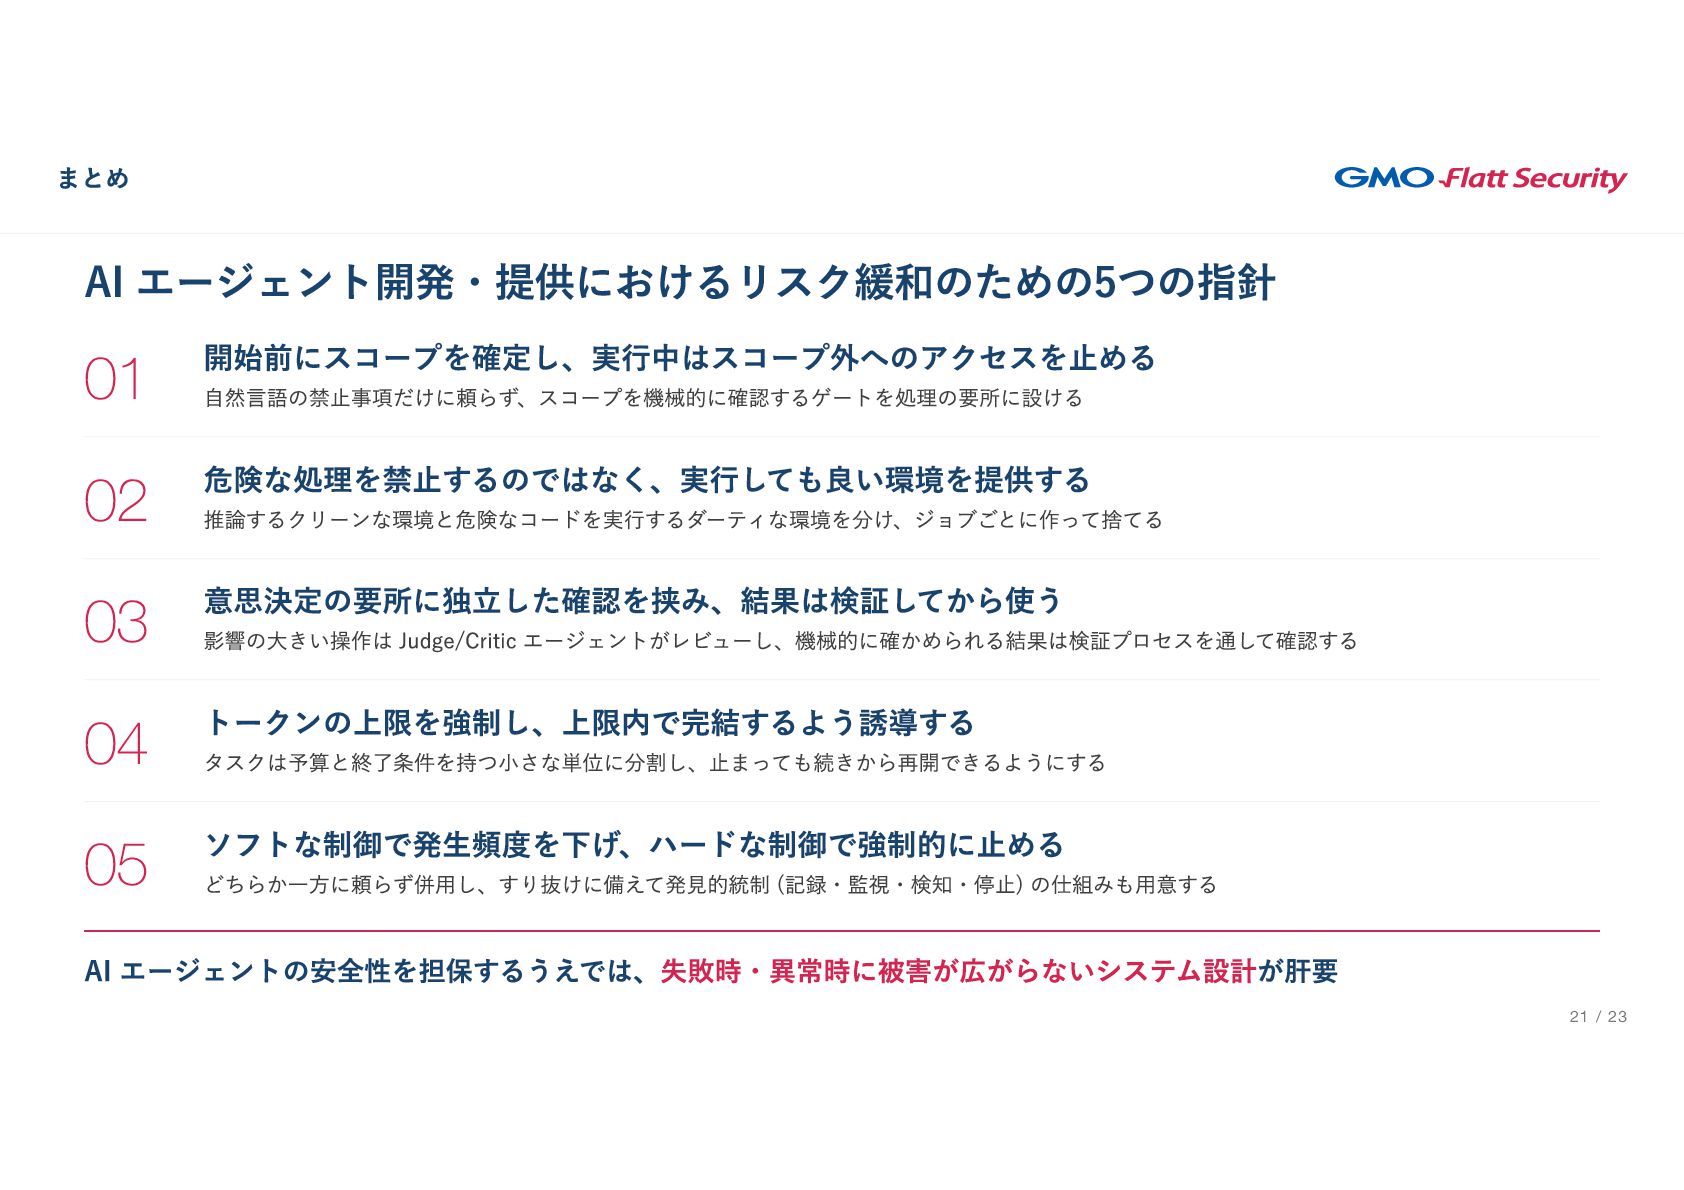
  16. まとめ AI エージェント開発・提供におけるリスク緩和のための5つの指針 01 開始前にスコープを確定し、実行中はスコープ外へのアクセスを止める 02 危険な処理を禁止するのではなく、実行しても良い環境を提供する 03 意思決定の要所に独立した確認を挟み、結果は検証してから使う 自然言語の禁止事項だけに頼らず、スコープを機械的に確認するゲートを処理の要所に設ける

    推論するクリーンな環境と危険なコードを実行するダーティな環境を分け、ジョブごとに作って捨てる 影響の大きい操作は Judge/Critic エージェントがレビューし、機械的に確かめられる結果は検証プロセスを通して確認する 04 トークンの上限を強制し、上限内で完結するよう誘導する タスクは予算と終了条件を持つ小さな単位に分割し、止まっても続きから再開できるようにする 05 ソフトな制御で発生頻度を下げ、ハードな制御で強制的に止める どちらか一方に頼らず併用し、すり抜けに備えて発見的統制 (記録・監視・検知・停止) の仕組みも用意する AI エージェントの安全性を担保するうえでは、失敗時・異常時に被害が広がらないシステム設計が肝要 21 / 23
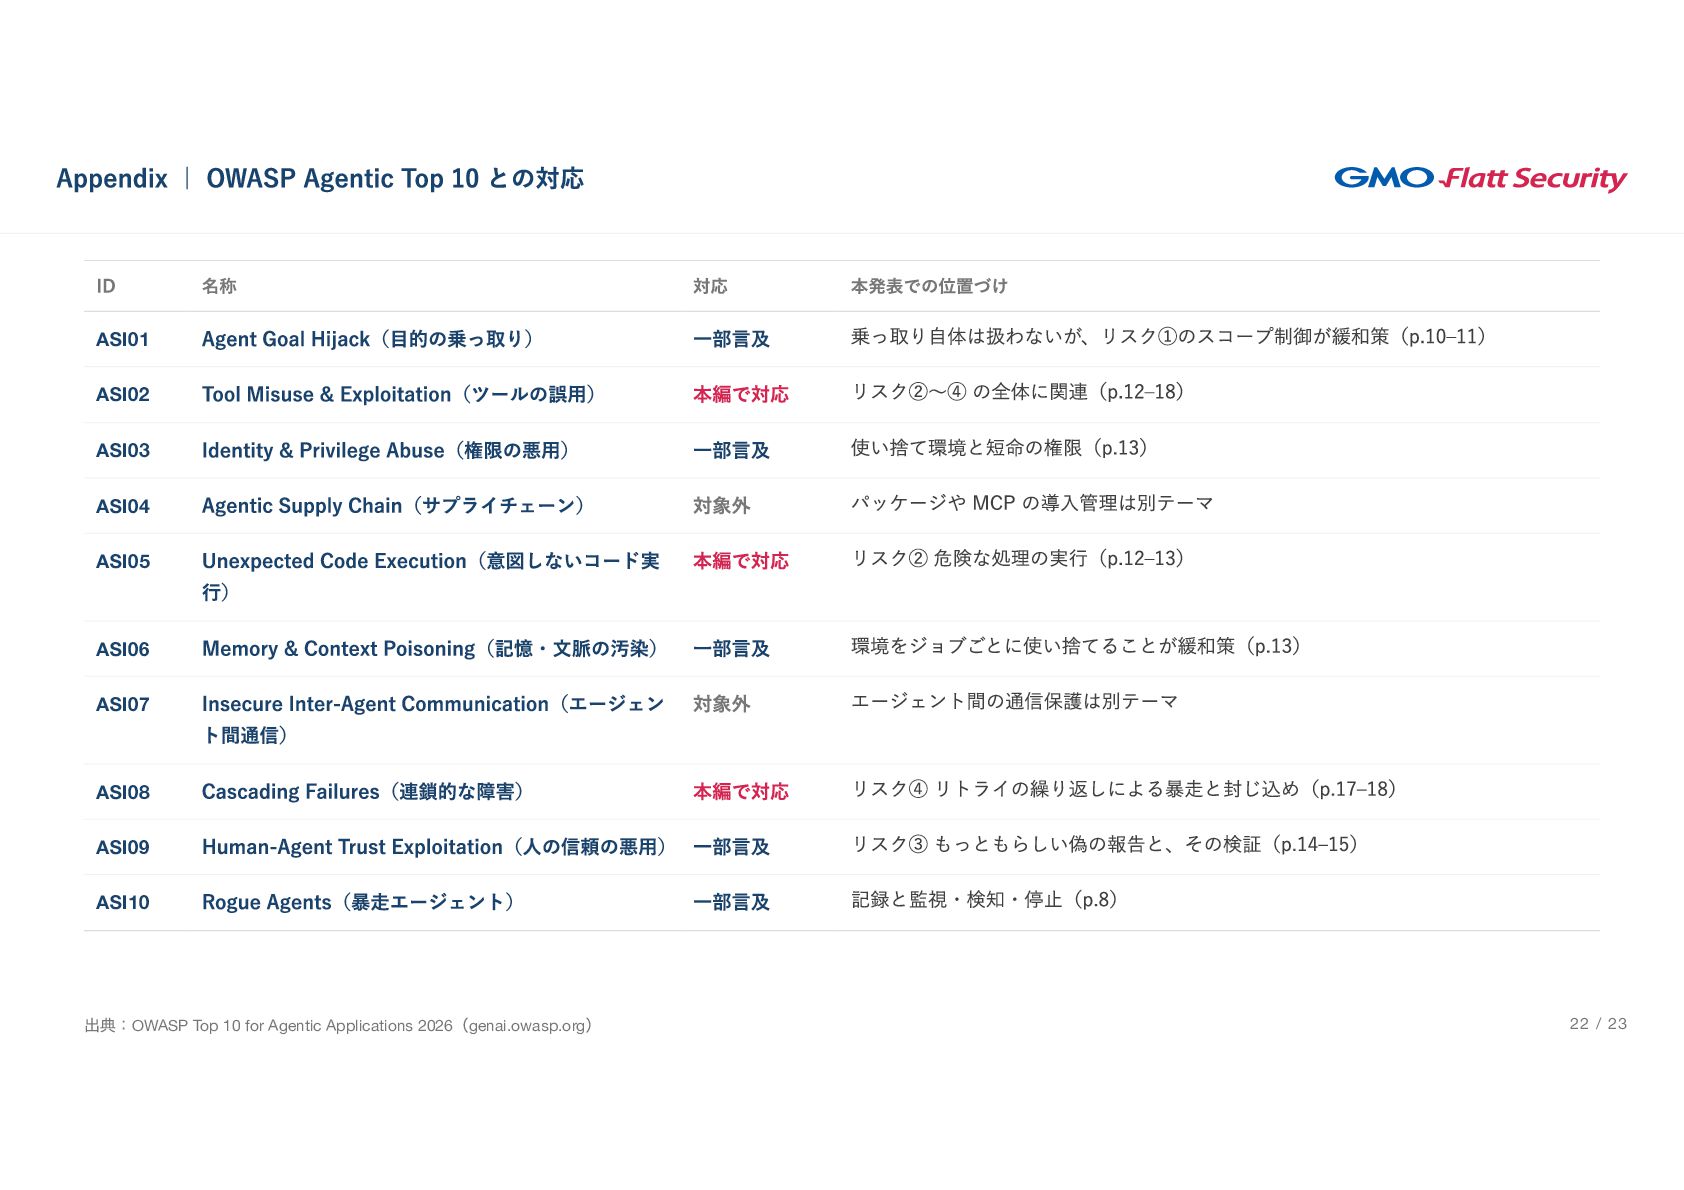
  17. Appendix | OWASP Agentic Top 10 との対応 ID ASI01 ASI02

    ASI03 ASI04 ASI05 ASI06 ASI07 ASI08 ASI09 ASI10 名称 対応 Agent Goal Hijack(目的の乗っ取り) 一部言及 Tool Misuse & Exploitation(ツールの誤用) 本編で対応 Identity & Privilege Abuse(権限の悪用) 一部言及 Agentic Supply Chain(サプライチェーン) 対象外 Unexpected Code Execution(意図しないコード実 本編で対応 行) Memory & Context Poisoning(記憶・文脈の汚染) 一部言及 Insecure Inter-Agent Communication(エージェン 対象外 ト間通信) Cascading Failures(連鎖的な障害) 本編で対応 Human-Agent Trust Exploitation(人の信頼の悪用) 一部言及 Rogue Agents(暴走エージェント) 一部言及 出典:OWASP Top 10 for Agentic Applications 2026(genai.owasp.org) 本発表での位置づけ 乗っ取り自体は扱わないが、リスク①のスコープ制御が緩和策(p.10–11) リスク②〜④ の全体に関連(p.12–18) 使い捨て環境と短命の権限(p.13) パッケージや MCP の導入管理は別テーマ リスク② 危険な処理の実行(p.12–13) 環境をジョブごとに使い捨てることが緩和策(p.13) エージェント間の通信保護は別テーマ リスク④ リトライの繰り返しによる暴走と封じ込め(p.17–18) リスク③ もっともらしい偽の報告と、その検証(p.14–15) 記録と監視・検知・停止(p.8) 22 / 23