Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AI Agent、思ってたのと違った
Search
hasuto sasaki
February 23, 2026
Technology
350
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AI Agent、思ってたのと違った
hasuto sasaki
February 23, 2026
Transcript
21 slides
AI Agent 、思ってたのと違った ※ 半分以上LLM の話です @HasutoSasaki
Hasuto (Sasaki Hasuto ) Server-side Engineer 筋トレ アニメ 低レイヤー Golang
Neovim GitHub @vt23358 2023.04 - SES 企業 Web サイト・Web アプリ開発 Vue.js / Nuxt.js + Lambda / DynamoDB 2026.01 - classmethod Web アプリ開発 TypeScript / React + Lambda / DynamoDB
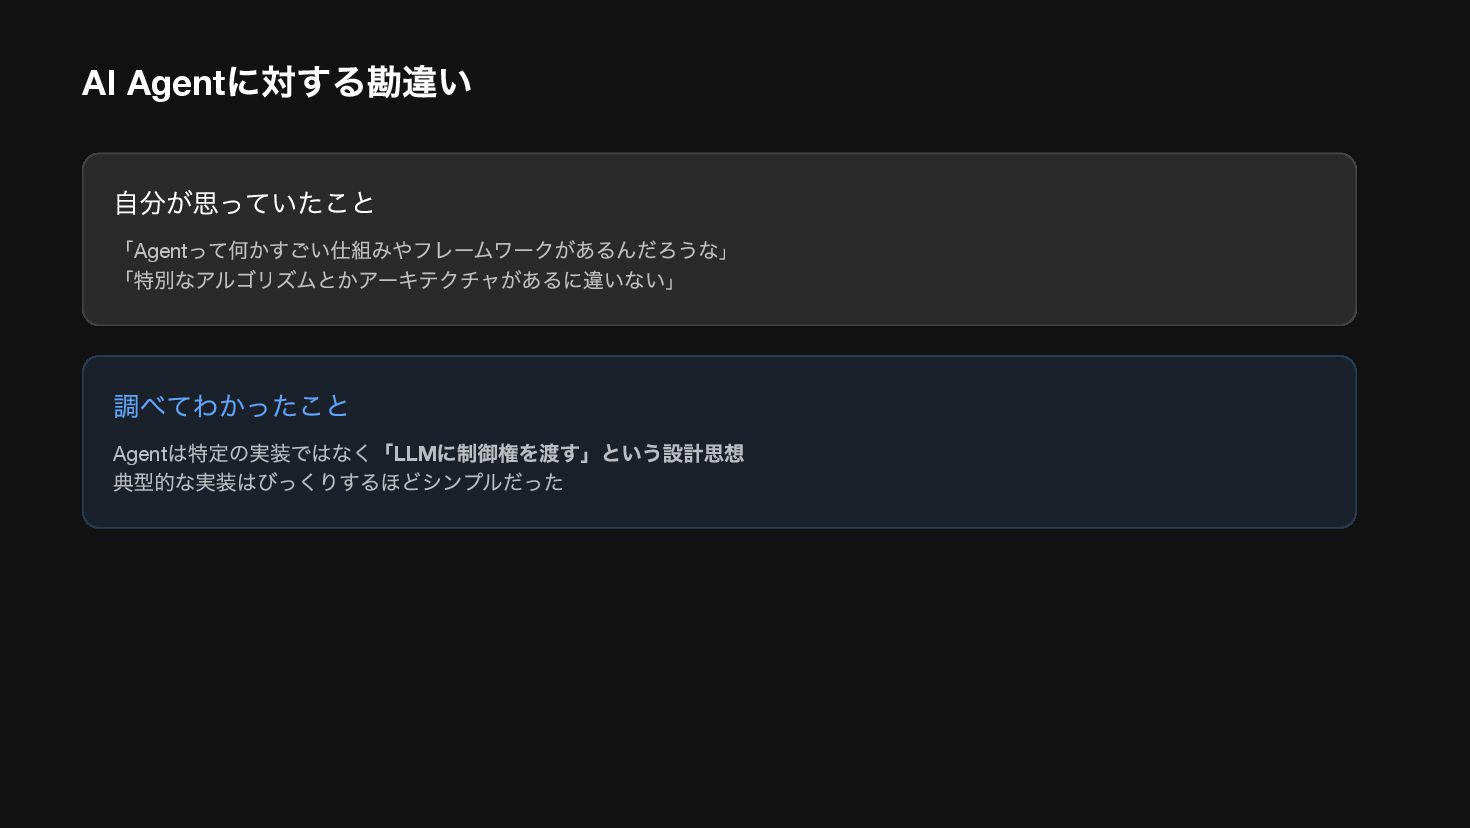
AI Agent に対する勘違い 自分が思っていたこと 「Agent って何かすごい仕組みやフレームワークがあるんだろうな」 「特別なアルゴリズムとかアーキテクチャがあるに違いない」 調べてわかったこと Agent は特定の実装ではなく「LLM
に制御権を渡す」という設計思想 典型的な実装はびっくりするほどシンプルだった
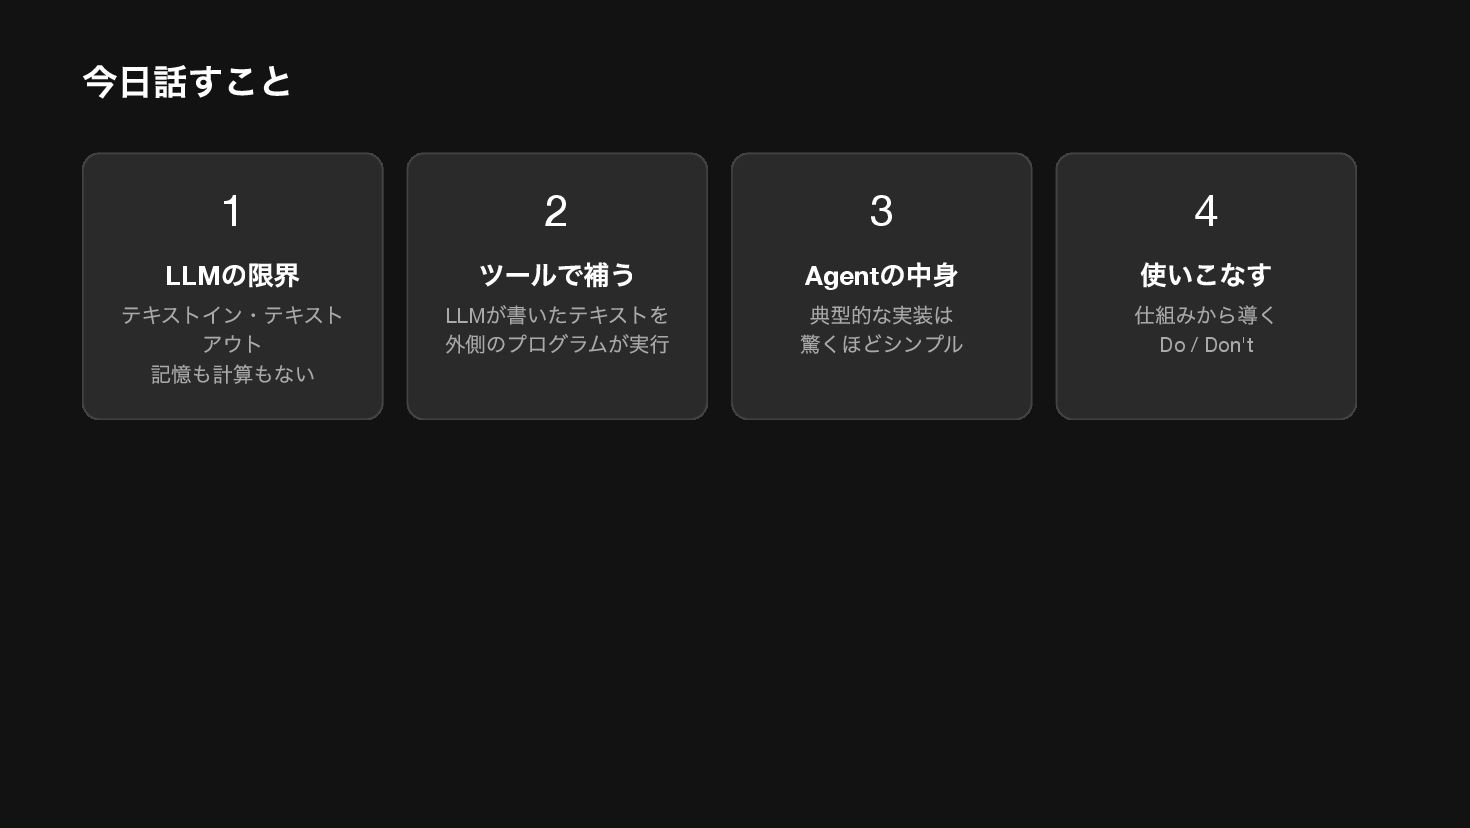
今日話すこと 1 LLM の限界 テキストイン・テキスト アウト 記憶も計算もない 2 ツールで補う LLM
が書いたテキストを 外側のプログラムが実行 3 Agent の中身 典型的な実装は 驚くほどシンプル 4 使いこなす 仕組みから導く Do / Don't
LLM は魔法ではない
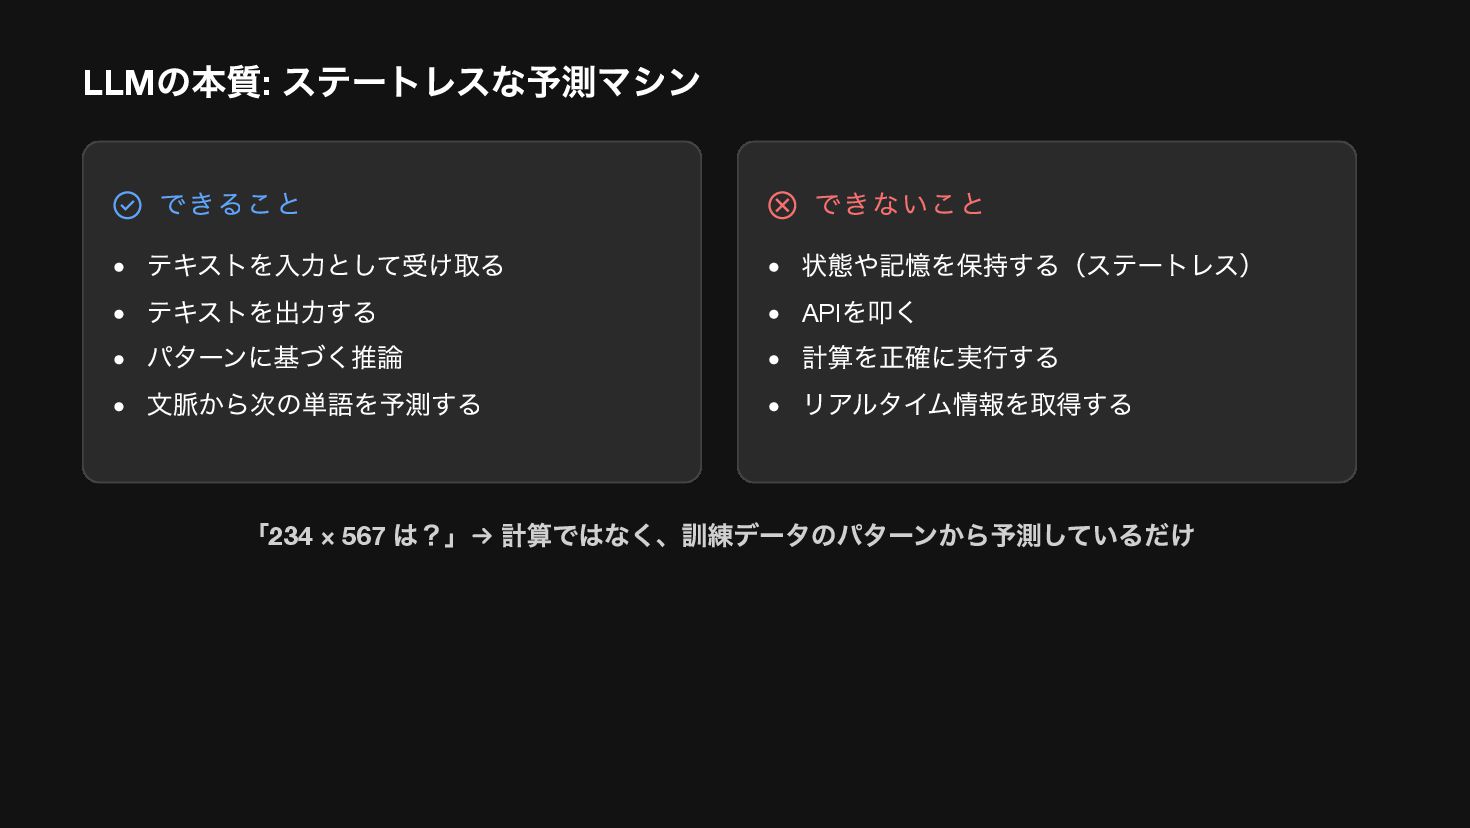
LLM の本質: ステートレスな予測マシン できること テキストを入力として受け取る テキストを出力する パターンに基づく推論 文脈から次の単語を予測する できないこと 状態や記憶を保持する(ステートレス)
API を叩く 計算を正確に実行する リアルタイム情報を取得する 「234 × 567 は?」→ 計算ではなく、訓練データのパターンから予測しているだけ
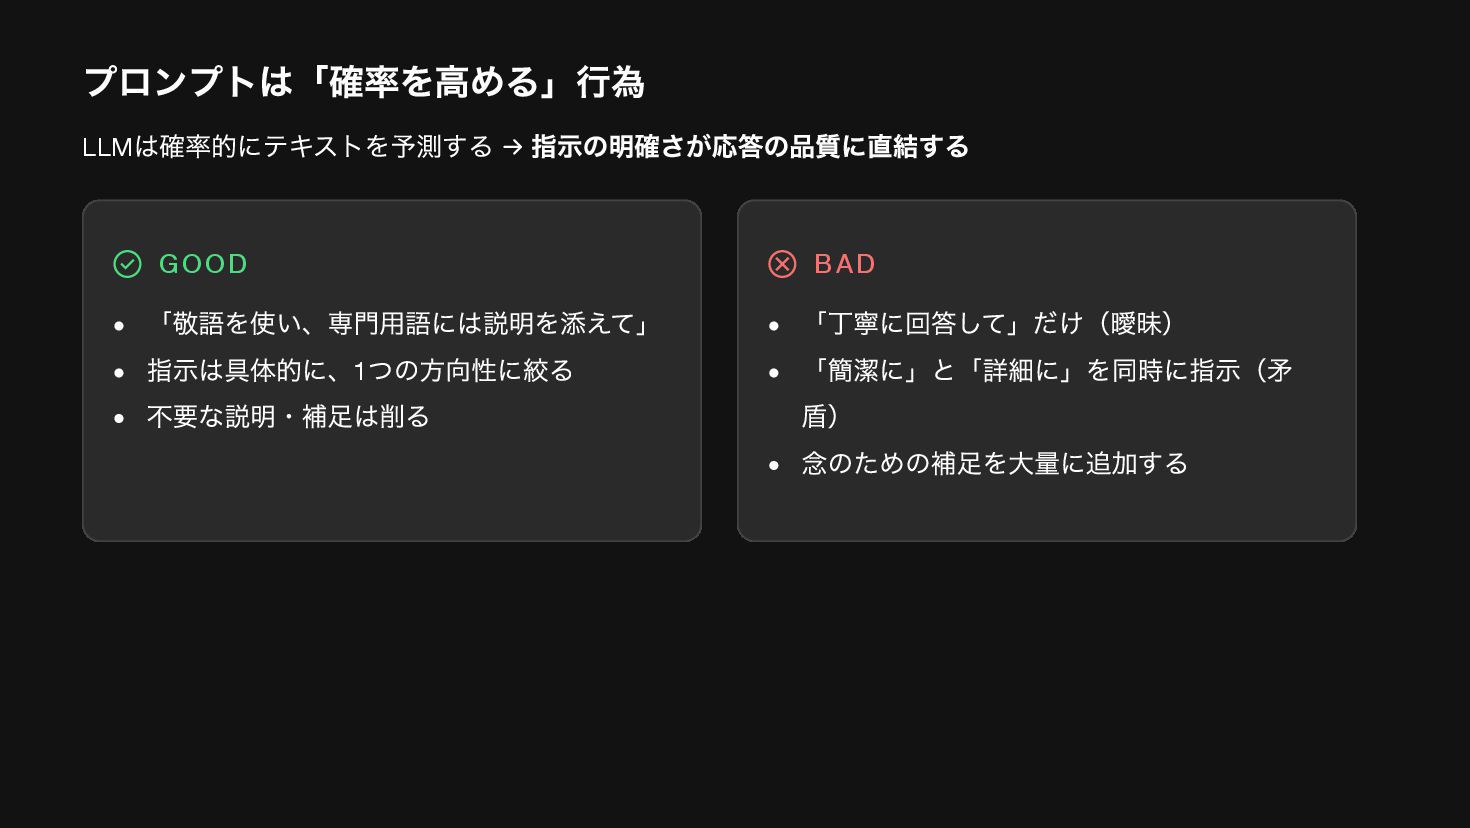
プロンプトは「確率を高める」行為 LLM は確率的にテキストを予測する → 指示の明確さが応答の品質に直結する GOOD 「敬語を使い、専門用語には説明を添えて」 指示は具体的に、1 つの方向性に絞る 不要な説明・補足は削る
BAD 「丁寧に回答して」だけ(曖昧) 「簡潔に」と「詳細に」を同時に指示(矛 盾) 念のための補足を大量に追加する
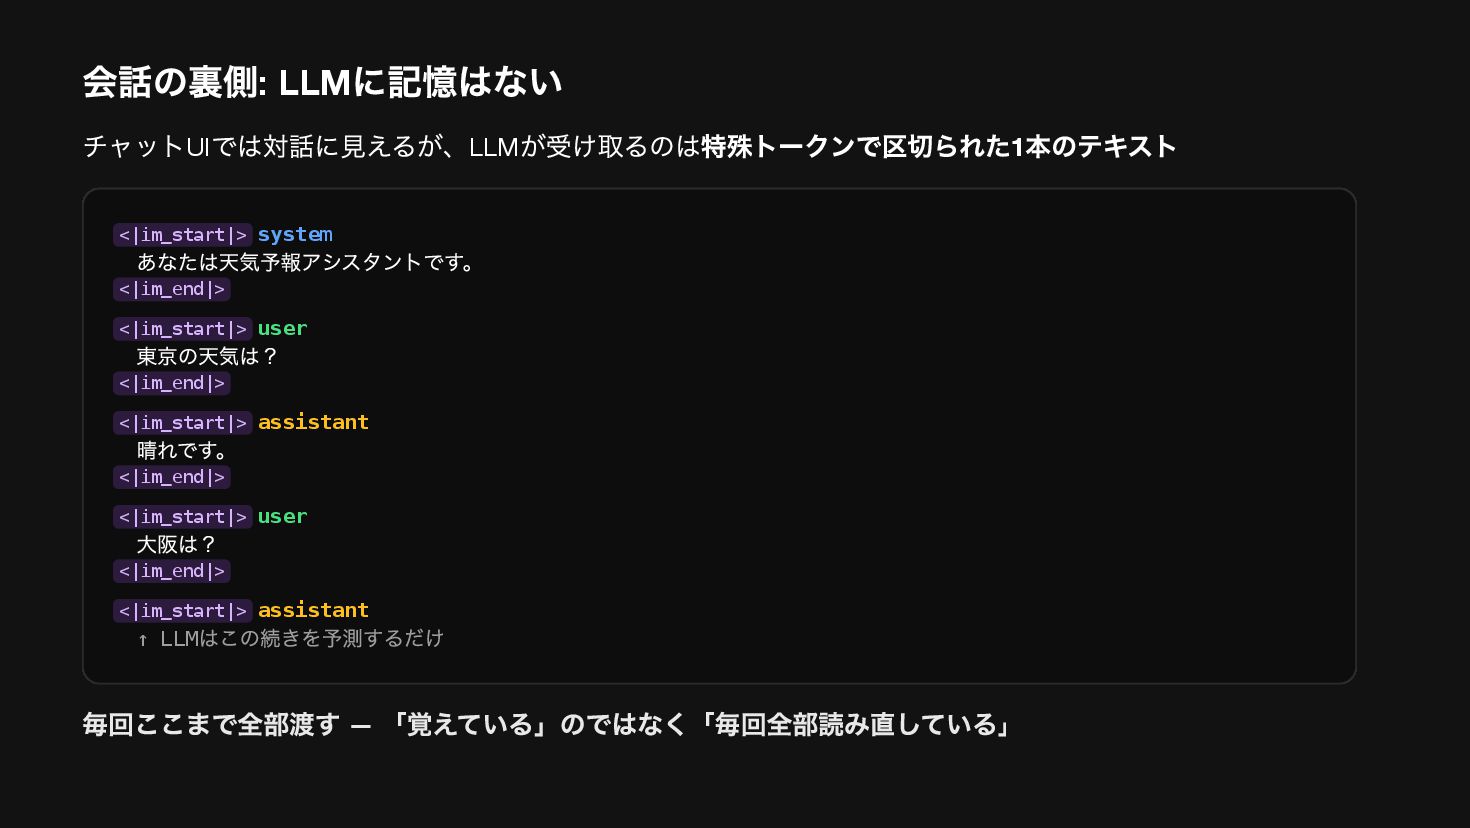
会話の裏側: LLM に記憶はない チャットUI では対話に見えるが、LLM が受け取るのは特殊トークンで区切られた1 本のテキスト <|im_start|> system あなたは天気予報アシスタントです。
<|im_end|> <|im_start|> user 東京の天気は? <|im_end|> <|im_start|> assistant 晴れです。 <|im_end|> <|im_start|> user 大阪は? <|im_end|> <|im_start|> assistant ↑ LLM はこの続きを予測するだけ 毎回ここまで全部渡す — 「覚えている」のではなく「毎回全部読み直している」
これを踏まえて…
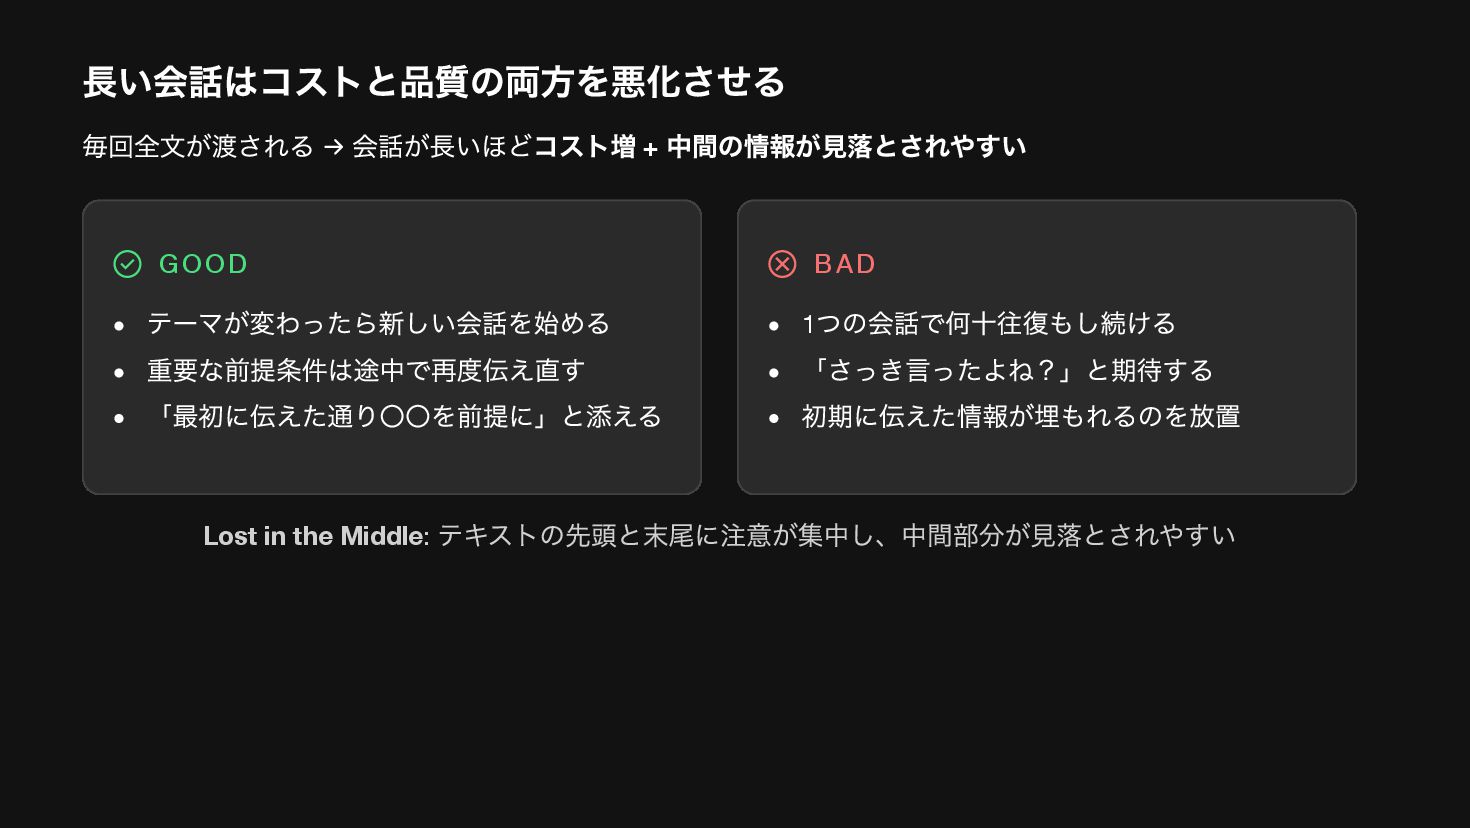
長い会話はコストと品質の両方を悪化させる 毎回全文が渡される → 会話が長いほどコスト増 + 中間の情報が見落とされやすい GOOD テーマが変わったら新しい会話を始める 重要な前提条件は途中で再度伝え直す 「最初に伝えた通り〇〇を前提に」と添える
BAD 1 つの会話で何十往復もし続ける 「さっき言ったよね?」と期待する 初期に伝えた情報が埋もれるのを放置 Lost in the Middle: テキストの先頭と末尾に注意が集中し、中間部分が見落とされやすい
LLM の限界を どう補うか
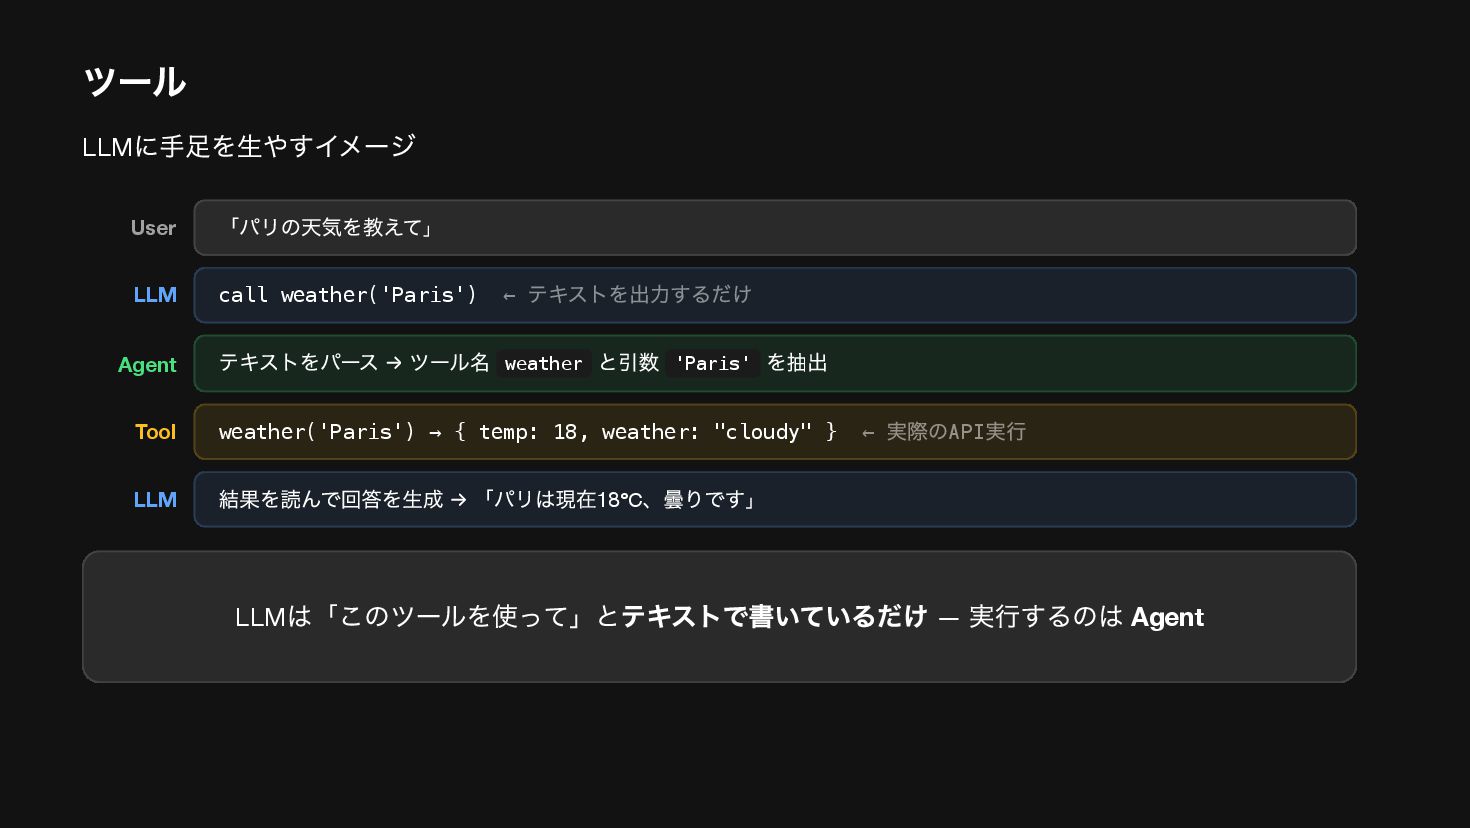
ツール LLM に手足を生やすイメージ 「パリの天気を教えて」 LLM call weather('Paris') Agent テキストをパース →
ツール名 weather と引数 'Paris' を抽出 Tool weather('Paris') → { temp: 18, weather: "cloudy" } LLM 結果を読んで回答を生成 → 「パリは現在18℃ 、曇りです」 User ← テキストを出力するだけ ← 実際のAPI 実行 LLM は「このツールを使って」とテキストで書いているだけ — 実行するのは Agent
これをループさせると Agent になる
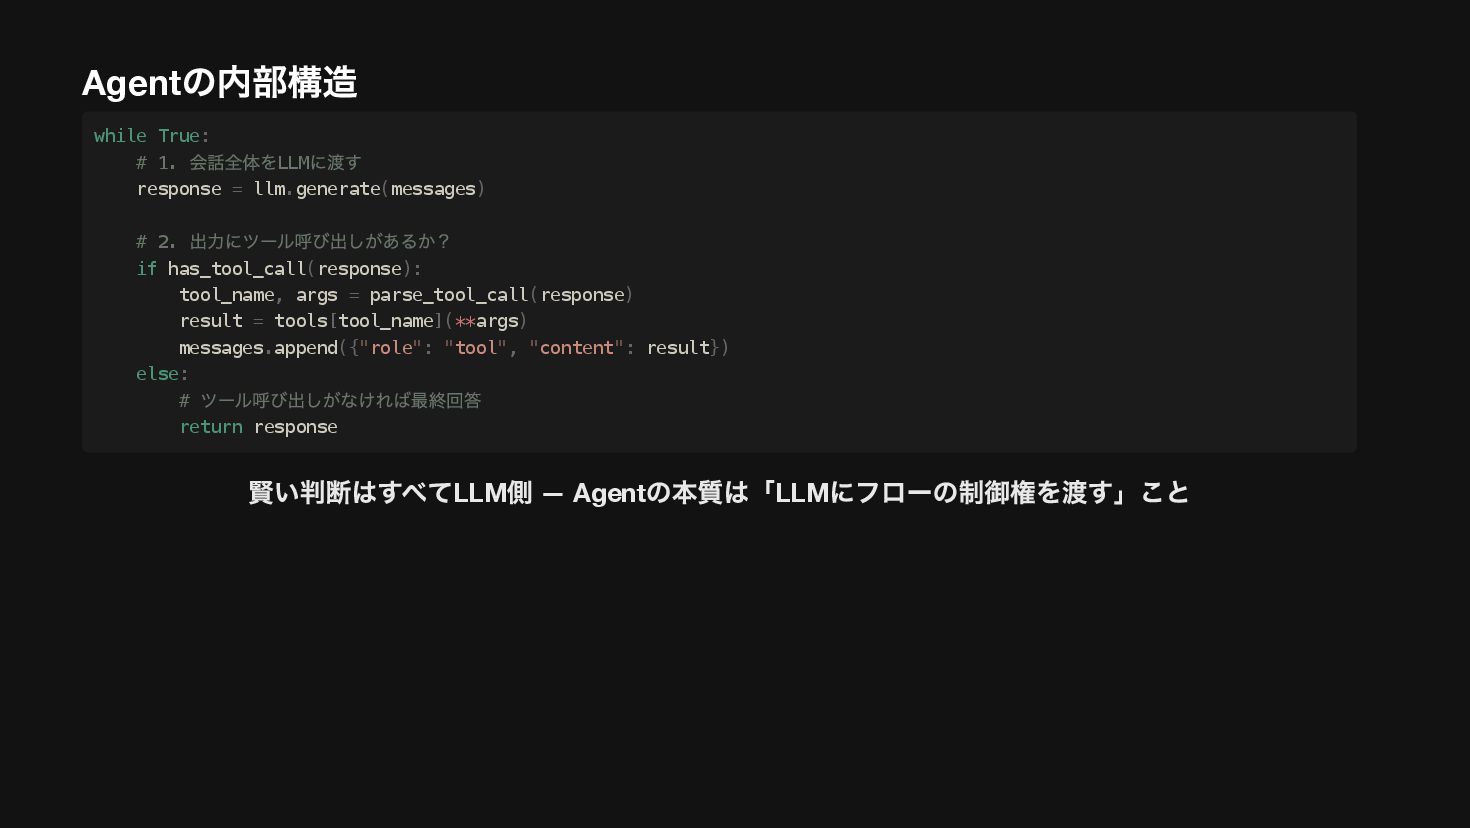
Agent の内部構造 while True: # 1. 会話全体をLLM に渡す response =
llm.generate(messages) # 2. 出力にツール呼び出しがあるか? if has_tool_call(response): tool_name, args = parse_tool_call(response) result = tools[tool_name](**args) messages.append({"role": "tool", "content": result}) else: # ツール呼び出しがなければ最終回答 return response 賢い判断はすべてLLM 側 — Agent の本質は「LLM にフローの制御権を渡す」こと
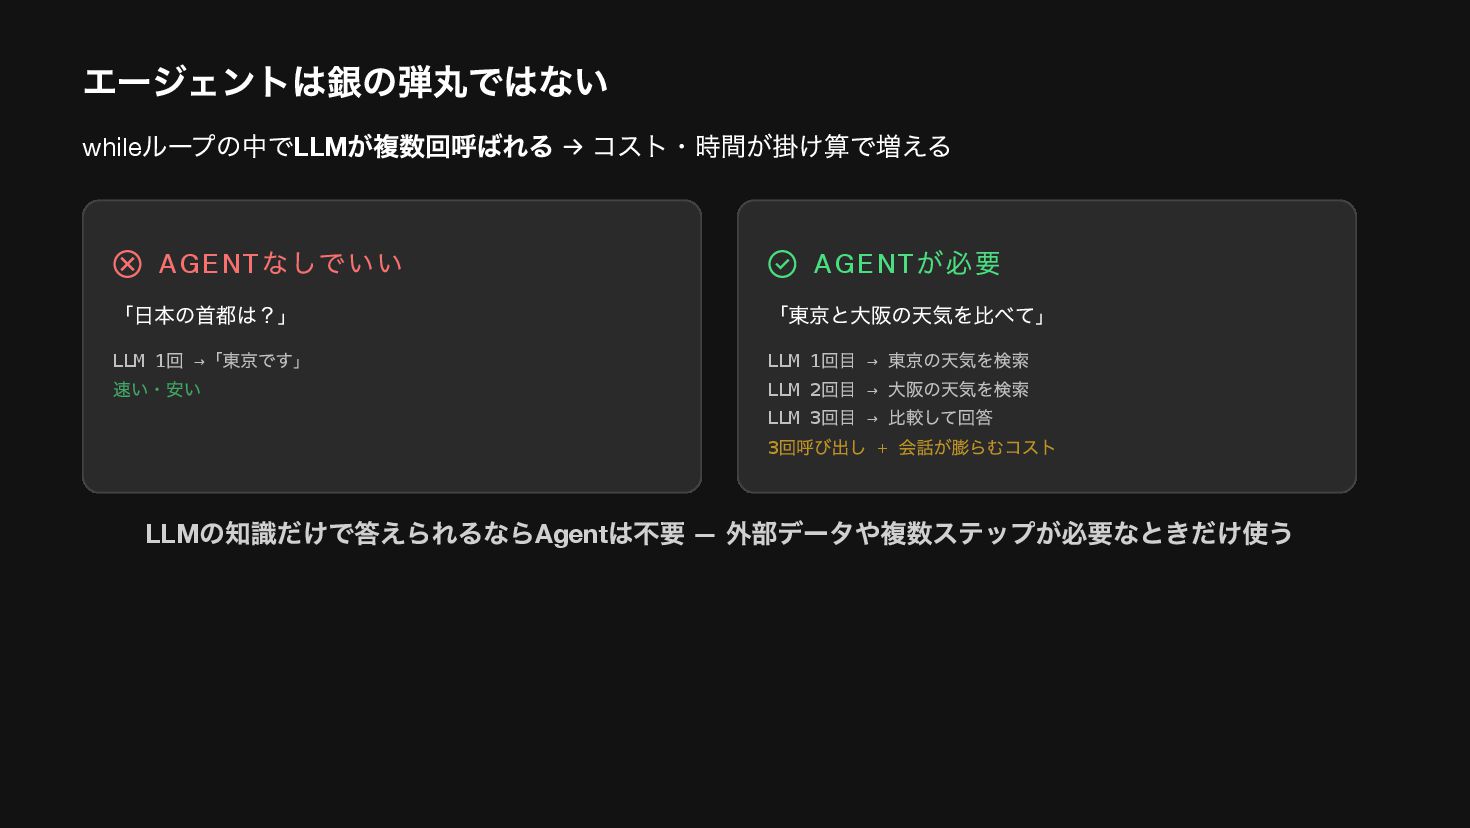
エージェントは銀の弾丸ではない while ループの中でLLM が複数回呼ばれる → コスト・時間が掛け算で増える AGENT なしでいい 「日本の首都は?」 LLM
1 回 → 「東京です」 速い・安い AGENT が必要 「東京と大阪の天気を比べて」 LLM 1 回目 → 東京の天気を検索 LLM 2 回目 → 大阪の天気を検索 LLM 3 回目 → 比較して回答 3 回呼び出し + 会話が膨らむコスト LLM の知識だけで答えられるならAgent は不要 — 外部データや複数ステップが必要なときだけ使う
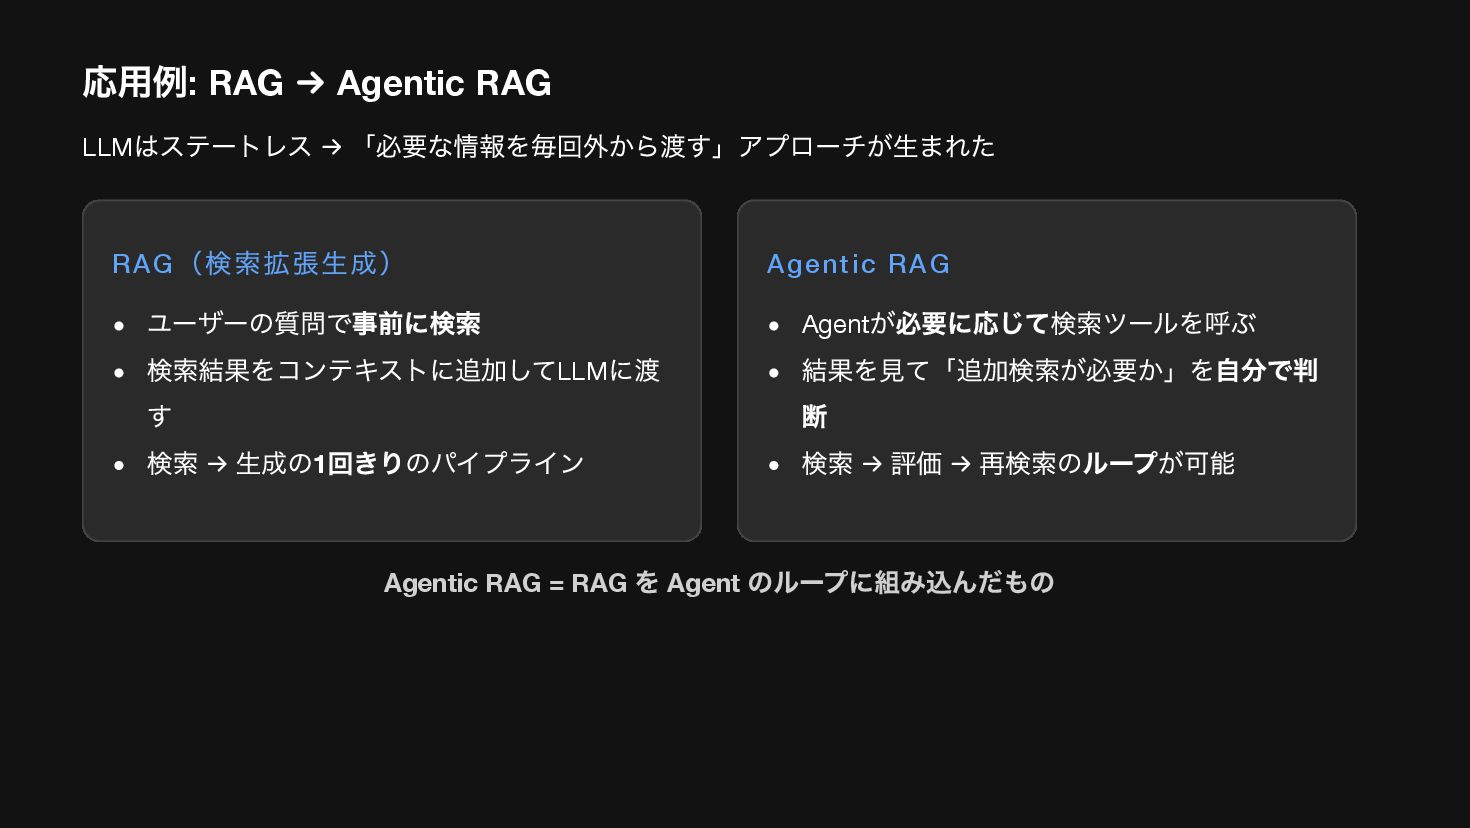
応用例: RAG → Agentic RAG LLM はステートレス → 「必要な情報を毎回外から渡す」アプローチが生まれた RAG
(検索拡張生成) ユーザーの質問で事前に検索 検索結果をコンテキストに追加してLLM に渡 す 検索 → 生成の1 回きりのパイプライン Agentic RAG Agent が必要に応じて検索ツールを呼ぶ 結果を見て「追加検索が必要か」を自分で判 断 検索 → 評価 → 再検索のループが可能 Agentic RAG = RAG を Agent のループに組み込んだもの
ここまでを整理する
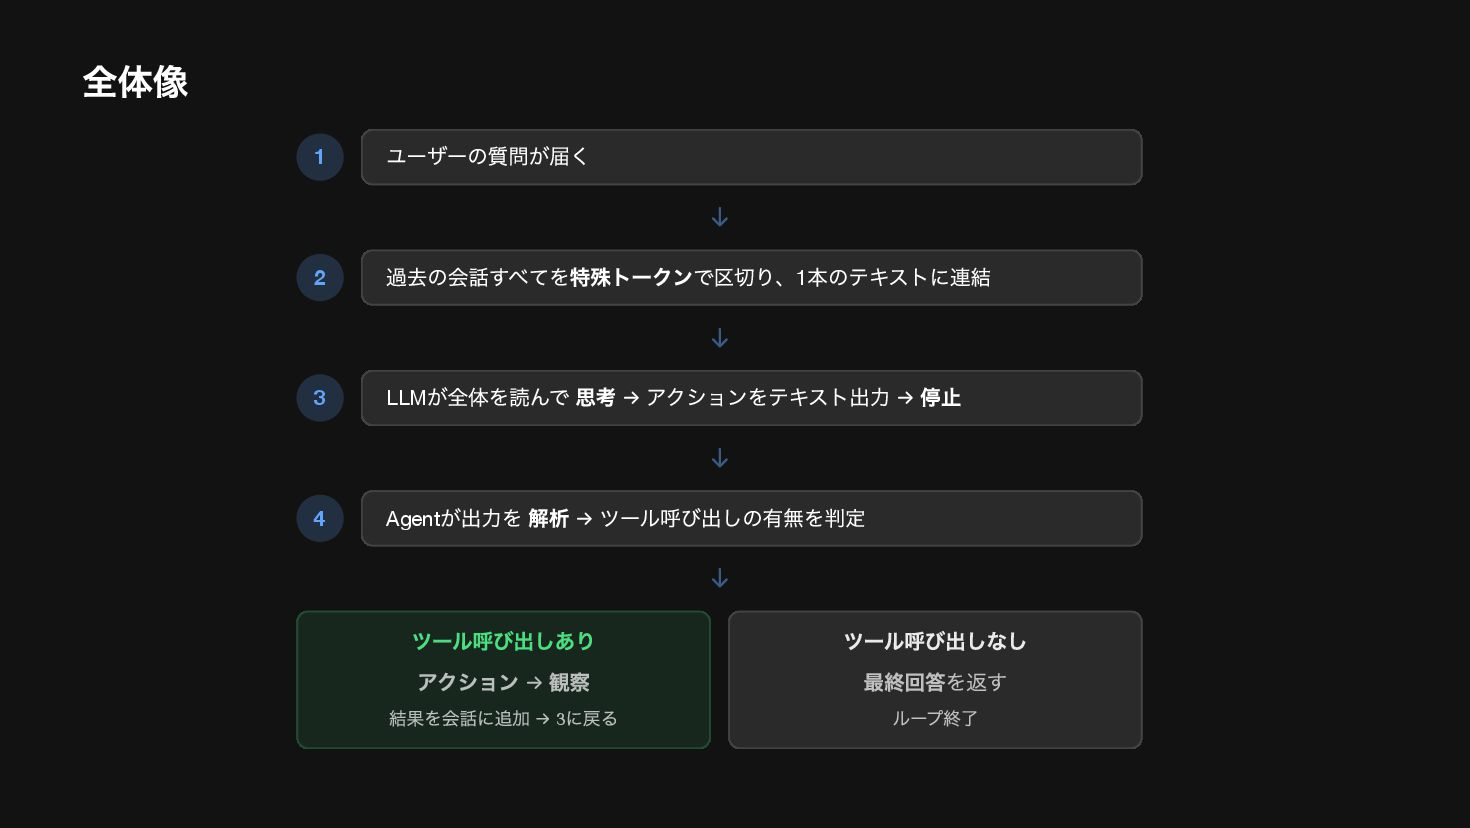
全体像 1 ユーザーの質問が届く ↓ 2 過去の会話すべてを特殊トークンで区切り、1 本のテキストに連結 ↓ 3 LLM
が全体を読んで 思考 → アクションをテキスト出力 → 停止 ↓ 4 Agent が出力を 解析 → ツール呼び出しの有無を判定 ↓ ツール呼び出しあり アクション → 観察 結果を会話に追加 → 3 に戻る ツール呼び出しなし 最終回答を返す ループ終了
仕組みがわかれば 使い方が変わる
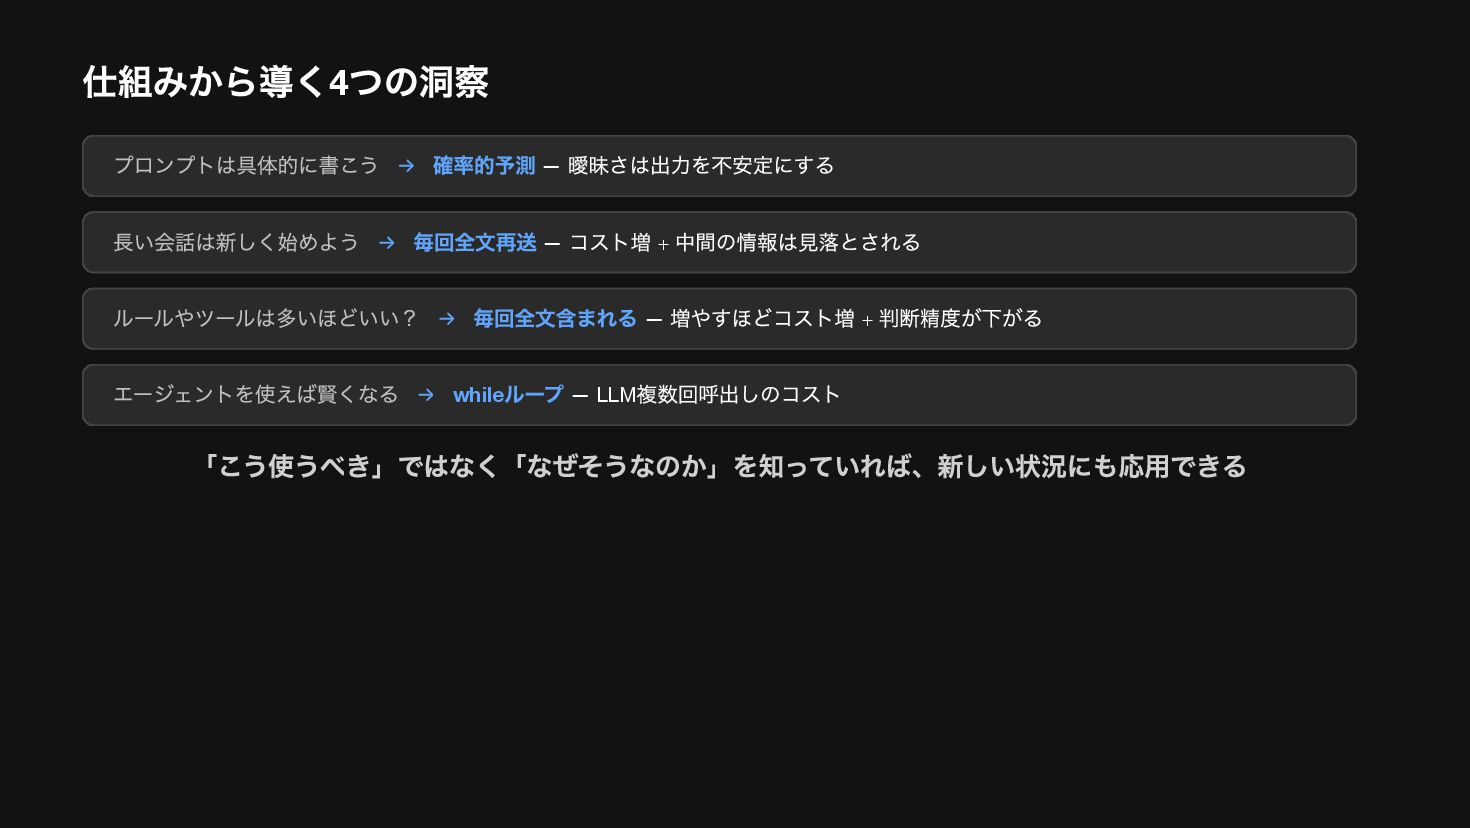
仕組みから導く4 つの洞察 → 確率的予測 — 曖昧さは出力を不安定にする → 毎回全文再送 — コスト増
+ 中間の情報は見落とされる → 毎回全文含まれる — 増やすほどコスト増 + 判断精度が下がる → while ループ — LLM 複数回呼出しのコスト プロンプトは具体的に書こう 長い会話は新しく始めよう ルールやツールは多いほどいい? エージェントを使えば賢くなる 「こう使うべき」ではなく「なぜそうなのか」を知っていれば、新しい状況にも応用できる
ありがとうございました 参考: Hugging Face Agents Course
More Decks by hasuto sasaki
See All by hasuto sasaki
あなたの await、OS まで届いてる? strace で覗く JavaScript の非同期
hasutosasaki
1
2.3k
筋トレ哲学_押し付け_トレーナーを作ってみた
hasutosasaki
0
520
DynamoDB_Scan_vs_Query__検証で見えた境界線__-_Slidev.pdf
hasutosasaki
0
78
Other Decks in Technology
See All in Technology
業務でAWSをあまり使っていない私が、AWSへのモチベを保つ方法
smt7174
0
190
少ない人手 限られた予算 それでも守る 消せない・見つける・戻れる オールハザード型BCP on AWS / 20261107 Mitsutoshi Matsuo
shift_evolve
PRO
0
380
小さなエージェントから始めてみよう!実践コンテキストエンジニアリング
iwamot
PRO
0
120
BALLAS Technology Deck
ballas_inc
0
610
田んぼの見回りをIoTで減らしたい!水位監視から電池駆動カメラまでの試行錯誤
itosoft
1
180
Reticulum, le réseau cypherpunk dont vous avez besoin !
rlifchitz
0
140
ぼくのClaude Codeの使い方
falken
PRO
4
6.9k
うちなーぐちが認識できるなら、秋田弁もいけるはず!? Amazon Transcribe方言チューニング検証
ryouto715
1
170
Frontier Teams — Amazon は AI で「開発のやり方」をどう変えたのか
kmotohas
0
250
Go初心者のクラウドエンジニアが、デプロイを通して旨味を知っていく話
ryudai
1
200
Active Directory と Entra ID のむむむな関係
murachiakira
PRO
4
1.8k
Kiro CLI 入門 (ターミナルと CI で使う) | 目指せ Kiro マスター 03
inariku
PRO
2
150
Featured
See All Featured
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
2
520
The Curse of the Amulet
leimatthew05
4
17k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
1k
Faster Mobile Websites
deanohume
310
32k
Unsuck your backbone
ammeep
672
58k
Six Lessons from altMBA
skipperchong
29
4.6k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.4k
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Noah Learner - AI + Me: how we built a GSC Bulk Export data pipeline
techseoconnect
PRO
0
480
HDC tutorial
michielstock
2
1k
Odyssey Design
rkendrick25
PRO
3
940


 hasutosasaki
 smt7174
 shift_evolve
 iwamot
 ballas_inc
 itosoft
 rlifchitz
 falken
 ryouto715
 kmotohas
 ryudai
 murachiakira
 inariku
 uxyall
 leimatthew05
 frankvandijk
 deanohume
 ammeep
 skipperchong
 jeffersonlam
 codingconduct
 sugarenia
 techseoconnect
 michielstock
 rkendrick25