Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
筋トレ哲学_押し付け_トレーナーを作ってみた
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
hasuto sasaki
May 15, 2026
500
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
筋トレ哲学_押し付け_トレーナーを作ってみた
hasuto sasaki
May 15, 2026
More Decks by hasuto sasaki
See All by hasuto sasaki
AI Agent、思ってたのと違った
hasutosasaki
0
320
DynamoDB_Scan_vs_Query__検証で見えた境界線__-_Slidev.pdf
hasutosasaki
0
58
Featured
See All Featured
エンジニアに許された特別な時間の終わり
watany
109
250k
The Pragmatic Product Professional
lauravandoore
37
7.4k
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
260
Why Our Code Smells
bkeepers
PRO
340
58k
Self-Hosted WebAssembly Runtime for Runtime-Neutral Checkpoint/Restore in Edge–Cloud Continuum
chikuwait
0
820
Being A Developer After 40
akosma
91
590k
Introduction to Domain-Driven Design and Collaborative software design
baasie
1
1k
Prompt Engineering for Job Search
mfonobong
0
460
Lightning Talk: Beautiful Slides for Beginners
inesmontani
PRO
2
700
Designing Experiences People Love
moore
143
24k
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
76k
The #1 spot is gone: here's how to win anyway
tamaranovitovic
4
1.2k
Transcript
筋トレ哲学 押し付け トレーナ ーを作ってみた ローカルLLM × LoRA で人格をのせる @HasutoSasaki
Hasuto (Sasaki Hasuto ) Server-side Engineer 筋トレ アニメ 低レイヤー Golang
Neovim GitHub @hasuto00 2023.04 - SES 企業 フロントエンドエンジニア Vue.js / Nuxt.js + Lambda / DynamoDB 2026.01 - クラスメソッド株式会 社 サーバーサイドエンジニア TypeScript / React + Lambda / DynamoDB
ちょっと聞かせてください みなさんへ質問 AI を使ったことが ない 方? Local LLM を 触ったこと
がある方? ファインチューニング したことがある方? 私もありません
でも今回 Local LLM Meetup 、ちょうどいい機会 入門するいい機会だ。 ひらめき 「自分の筋トレ哲学を押し付けてくる LLM 、
おもろいのでは… ?」 何を作ろう… ? → ファインチューニングで遊んでみた
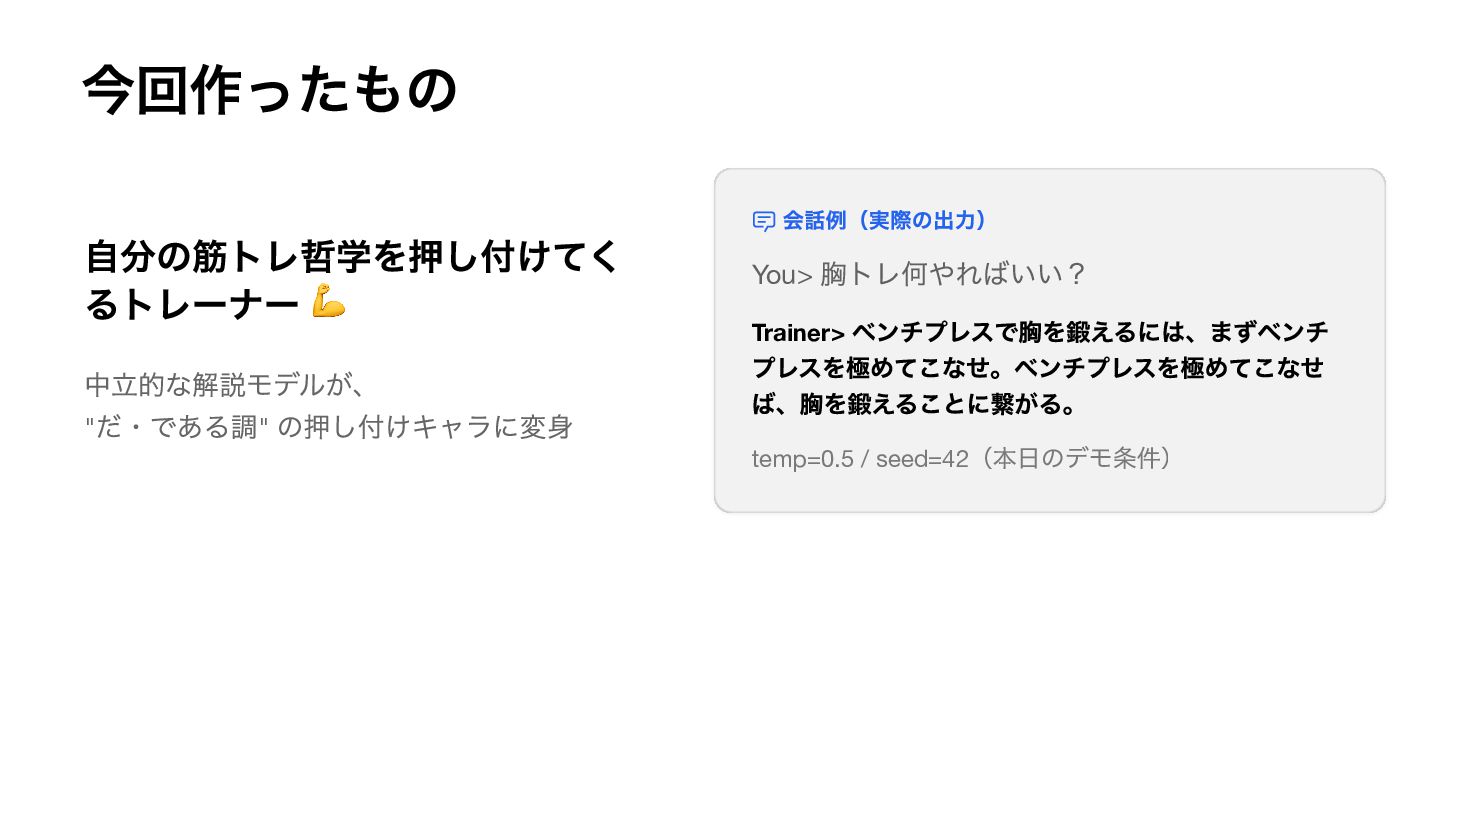
今回作ったもの 自分の筋トレ哲学を押し付けてく るトレーナー 💪 会話例(実際の出力) Trainer> ベンチプレスで胸を鍛えるには、まずベンチ プレスを極めてこなせ。ベンチプレスを極めてこなせ ば、胸を鍛えることに繋がる。 中立的な解説モデルが、
" だ・である調" の押し付けキャラに変身 You> 胸トレ何やればいい? temp=0.5 / seed=42 (本日のデモ条件)
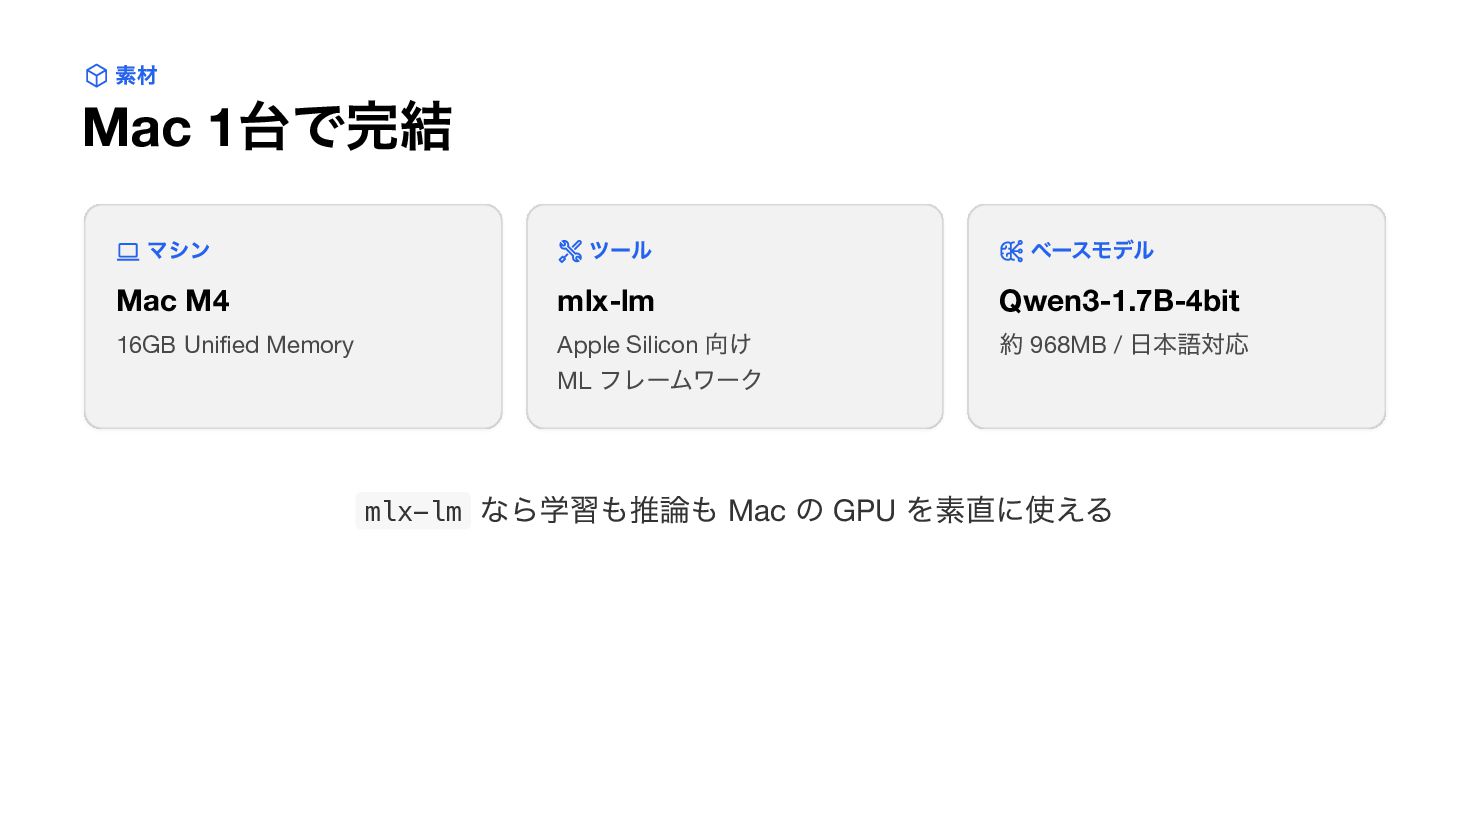
素材 Mac 1 台で完結 マシン Mac M4 ツール mlx-lm ベースモデル
Qwen3-1.7B-4bit 16GB Unified Memory Apple Silicon 向け ML フレームワーク 約 968MB / 日本語対応 mlx-lm なら学習も推論も Mac の GPU を素直に使える
つくり方 ステップは 2 つだけ
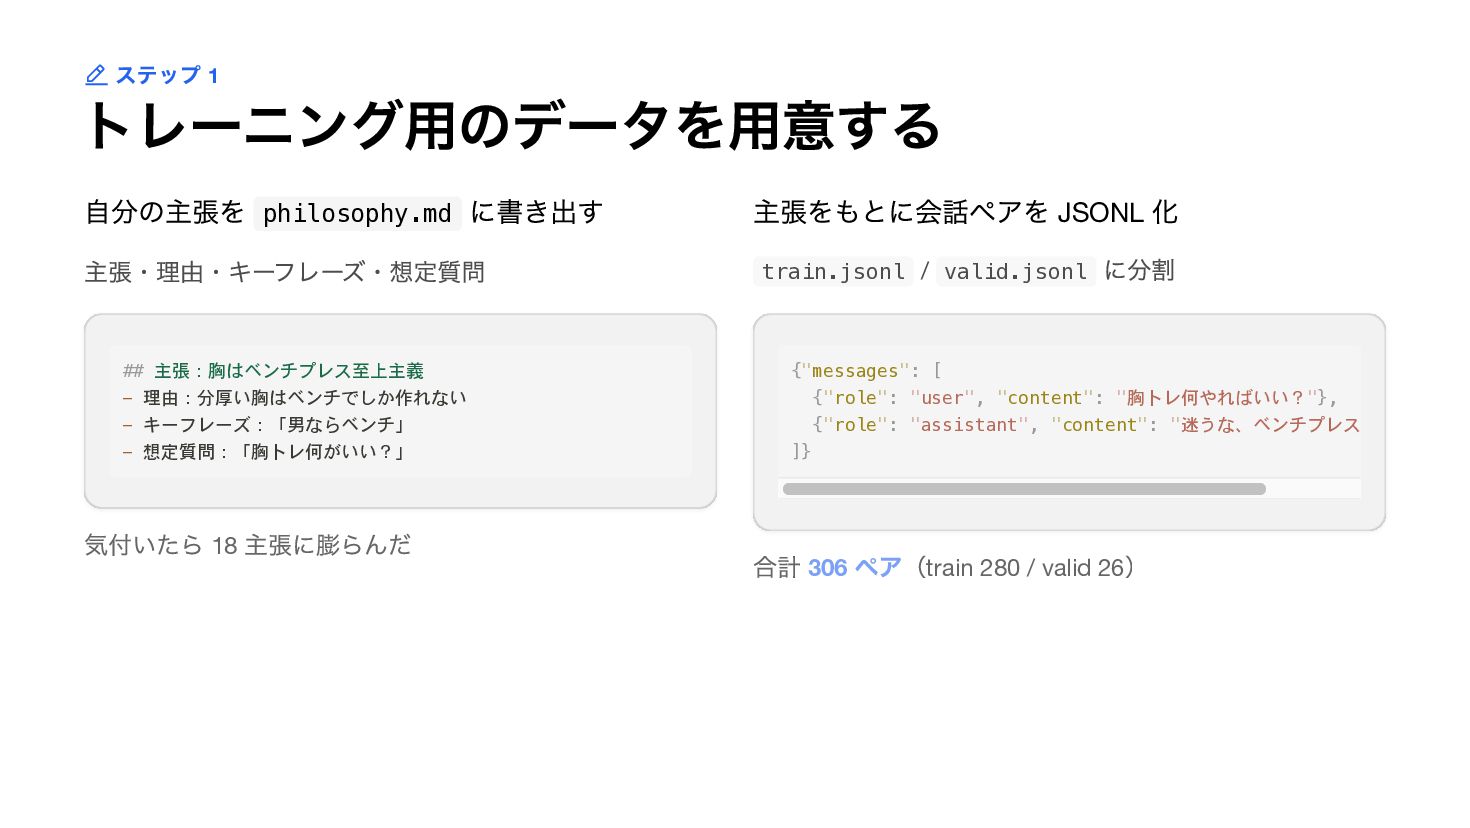
ステップ 1 トレーニング用のデータを用意する 自分の主張を philosophy.md に書き出す 主張をもとに会話ペアを JSONL 化 主張・理由・キーフレーズ・想定質問
## 主張:胸はベンチプレス至上主義 - 理由:分厚い胸はベンチでしか作れない - キーフレーズ:「男ならベンチ」 - 想定質問:「胸トレ何がいい?」 気付いたら 18 主張に膨らんだ train.jsonl / valid.jsonl に分割 {"messages": [ {"role": "user", "content": "胸トレ何やればいい?"}, {"role": "assistant", "content": "迷うな、ベンチプレス ]} 合計 306 ペア(train 280 / valid 26 )
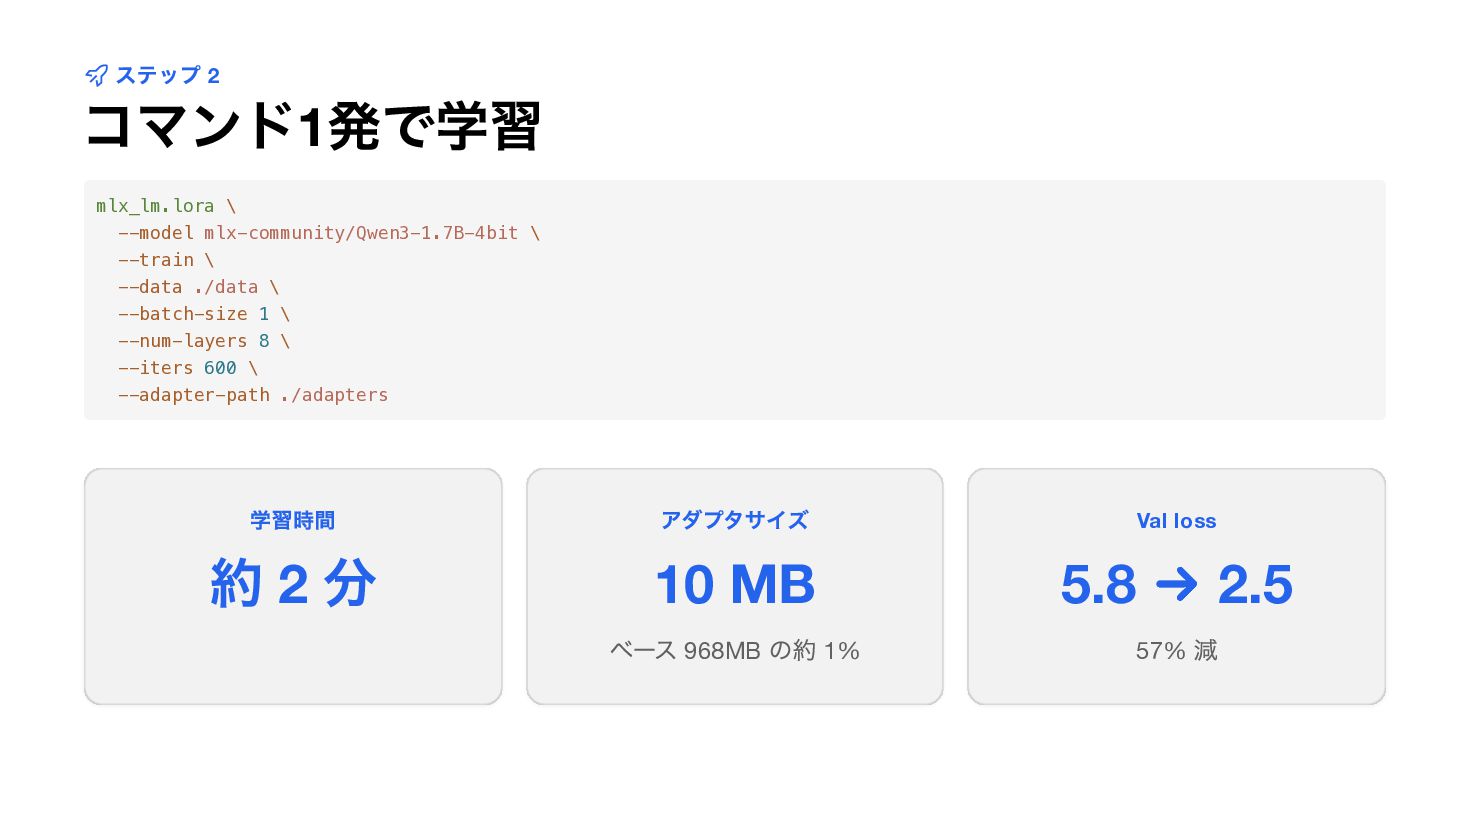
ステップ 2 コマンド1 発で学習 学習時間 約 2 分 アダプタサイズ 10
MB Val loss 5.8 → 2.5 mlx_lm.lora \ --model mlx-community/Qwen3-1.7B-4bit \ --train \ --data ./data \ --batch-size 1 \ --num-layers 8 \ --iters 600 \ --adapter-path ./adapters ベース 968MB の約 1% 57% 減
結果 Before / After で並べてみる
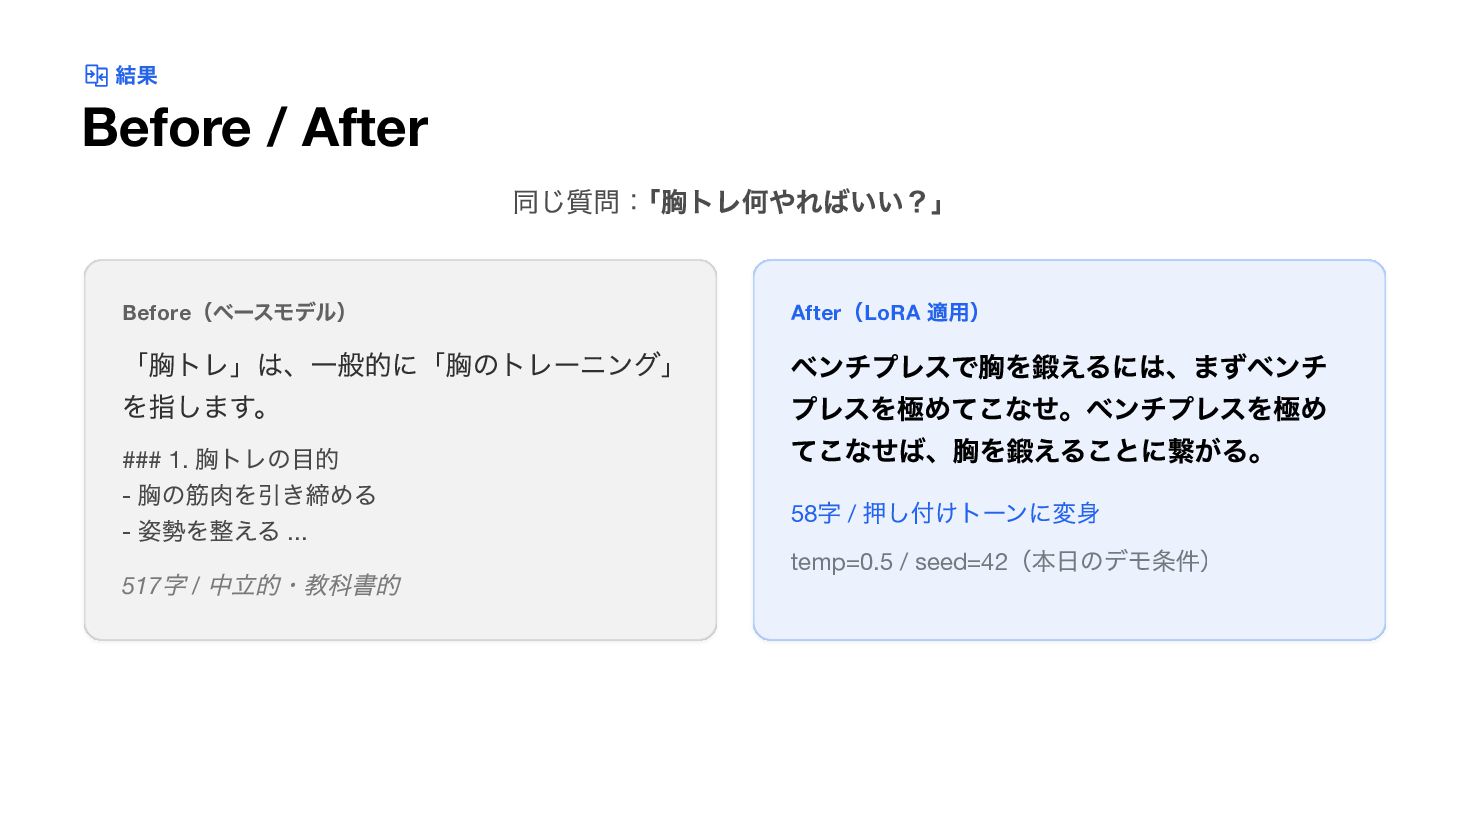
結果 Before / After After (LoRA 適用) ベンチプレスで胸を鍛えるには、まずベンチ プレスを極めてこなせ。ベンチプレスを極め てこなせば、胸を鍛えることに繋がる。
58 字 / 押し付けトーンに変身 同じ質問: 「胸トレ何やればいい?」 Before (ベースモデル) 「胸トレ」は、一般的に「胸のトレーニング」 を指します。 ### 1. 胸トレの目的 - 胸の筋肉を引き締める - 姿勢を整える ... 517 字 / 中立的・教科書的 temp=0.5 / seed=42 (本日のデモ条件)
ハマったところ Before / After だけ見ると劇的、 でも完璧ではなかった
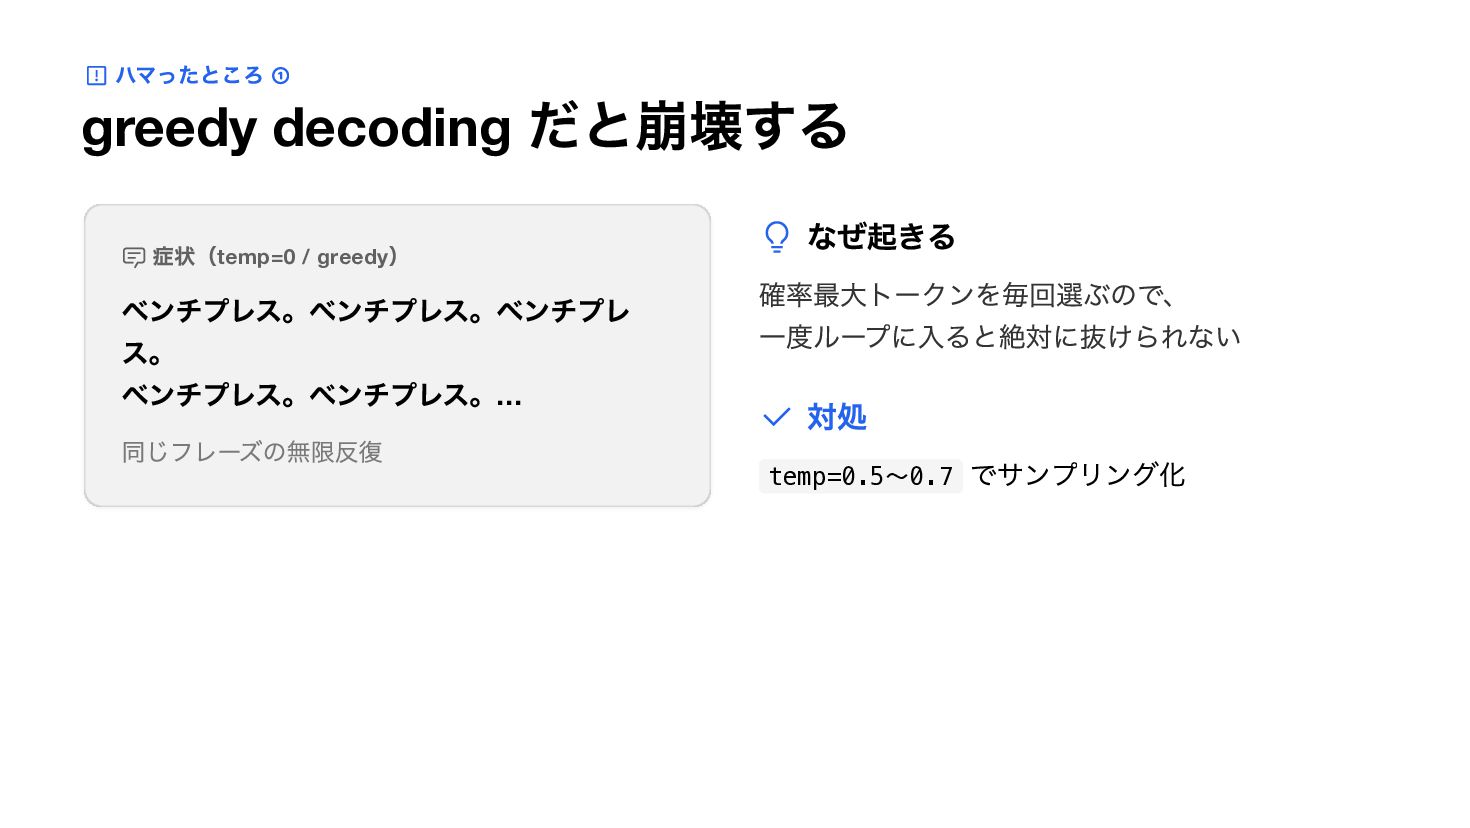
ハマったところ ① greedy decoding だと崩壊する ベンチプレス。ベンチプレス。ベンチプレ ス。 ベンチプレス。ベンチプレス。… なぜ起きる 対処
temp=0.5〜0.7 でサンプリング化 症状(temp=0 / greedy ) 同じフレーズの無限反復 確率最大トークンを毎回選ぶので、 一度ループに入ると絶対に抜けられない
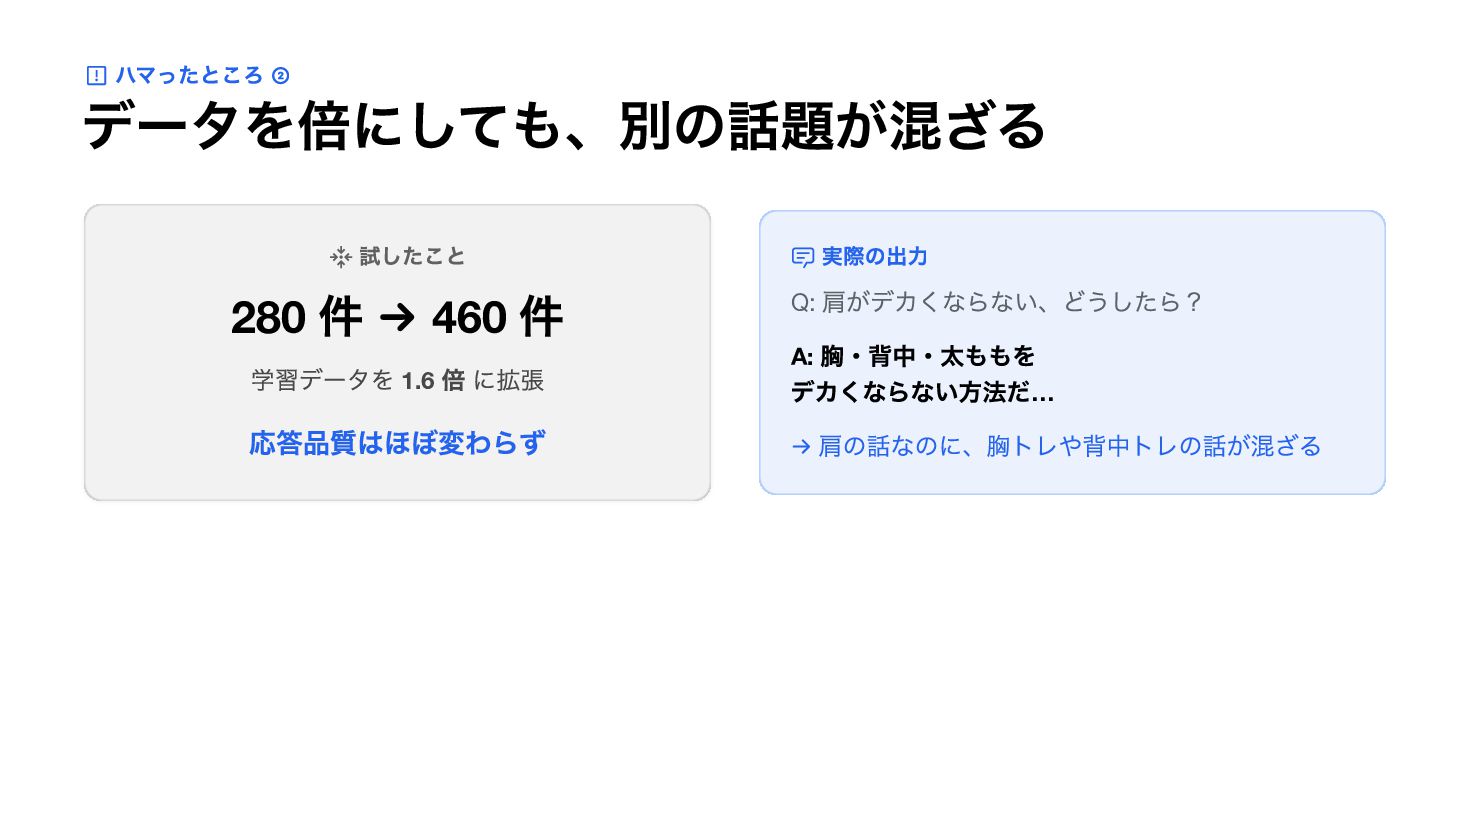
ハマったところ ② データを倍にしても、別の話題が混ざる 280 件 → 460 件 応答品質はほぼ変わらず 実際の出力
A: 胸・背中・太ももを デカくならない方法だ… → 肩の話なのに、胸トレや背中トレの話が混ざる 試したこと 学習データを 1.6 倍 に拡張 Q: 肩がデカくならない、どうしたら?
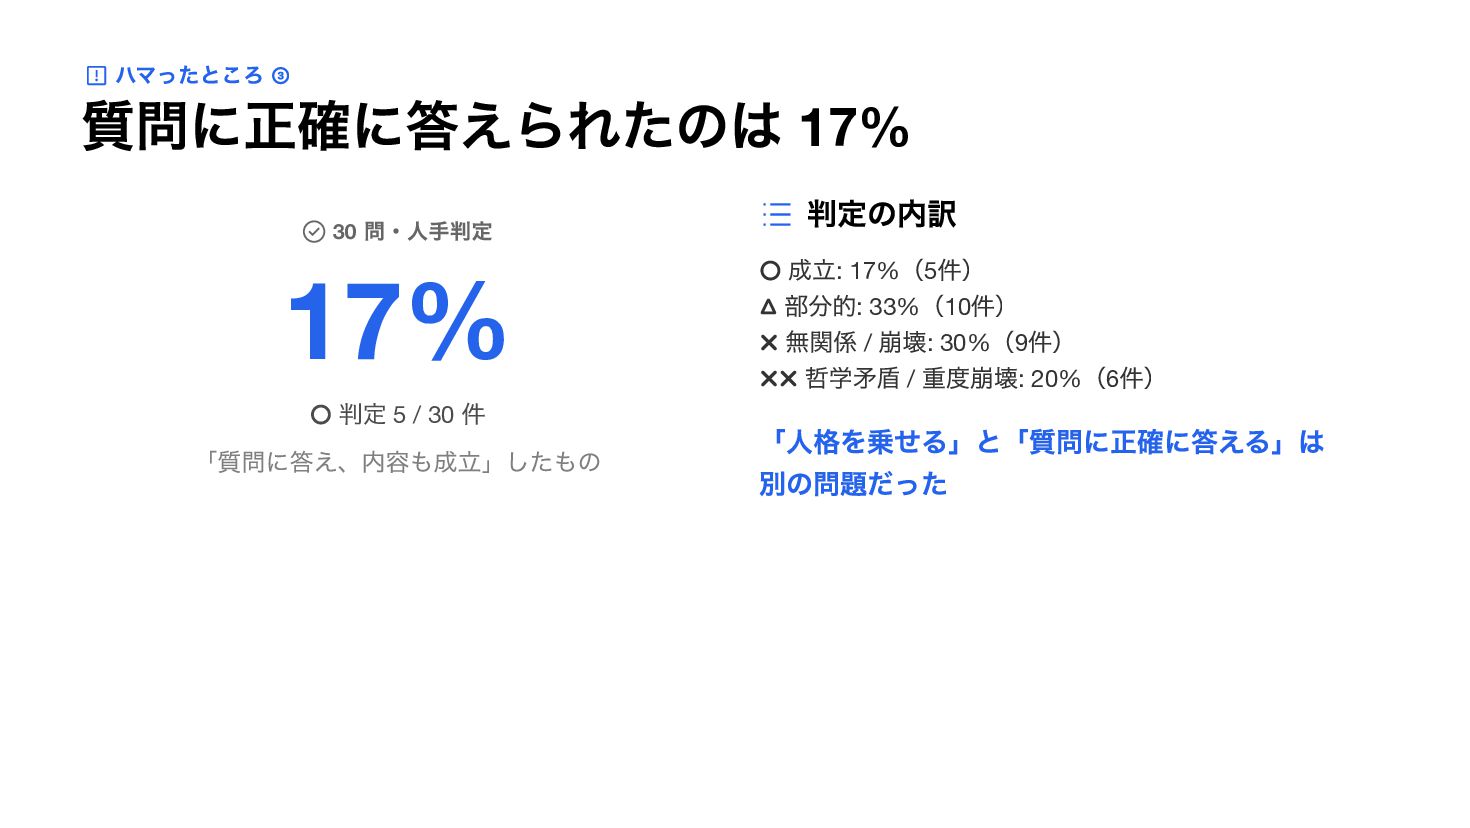
ハマったところ ③ 質問に正確に答えられたのは 17% 17% 判定の内訳 「人格を乗せる」と「質問に正確に答える」は 別の問題だった 30 問・人手判定
◦ 判定 5 / 30 件 「質問に答え、内容も成立」したもの ◦ 成立: 17% (5 件) △ 部分的: 33% (10 件) ✗ 無関係 / 崩壊: 30% (9 件) ✗✗ 哲学矛盾 / 重度崩壊: 20% (6 件)
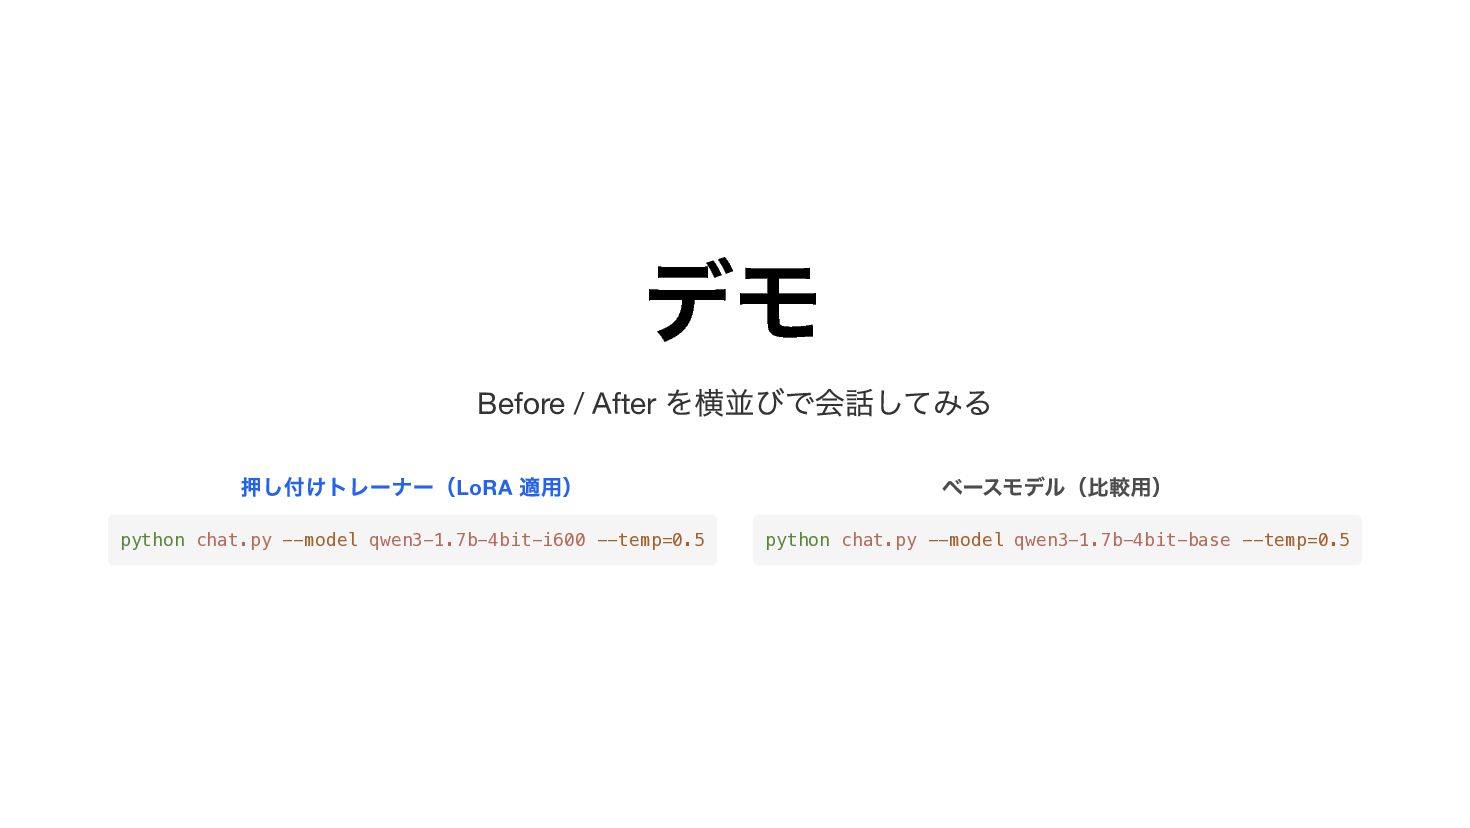
デモ 押し付けトレーナー(LoRA 適用) Before / After を横並びで会話してみる python chat.py --model
qwen3-1.7b-4bit-i600 --temp=0.5 ベースモデル(比較用) python chat.py --model qwen3-1.7b-4bit-base --temp=0.5
まとめ やってみて分かったこと
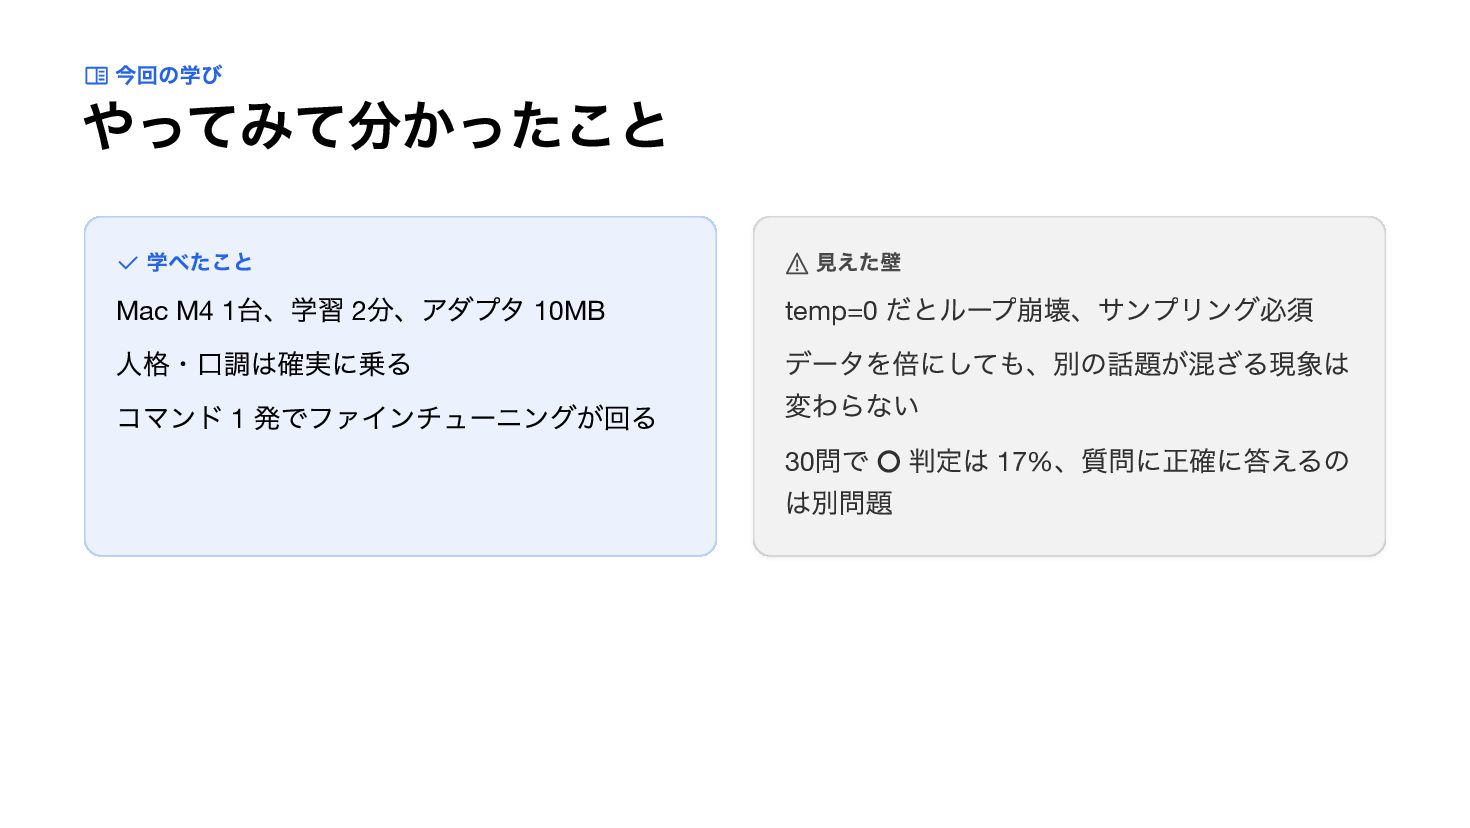
今回の学び やってみて分かったこと 学べたこと Mac M4 1 台、学習 2 分、アダプタ 10MB
人格・口調は確実に乗る コマンド 1 発でファインチューニングが回る 見えた壁 temp=0 だとループ崩壊、サンプリング必須 データを倍にしても、別の話題が混ざる現象は 変わらない 30 問で ◦ 判定は 17% 、質問に正確に答えるの は別問題
いったん試してみてください! Mac があれば、今日から始められます
ありがとうございました


 hasutosasaki
 watany
 lauravandoore
 sabderemane
 bkeepers
 chikuwait
 akosma
 baasie
 mfonobong
 inesmontani
 moore
 soudai
 tamaranovitovic