Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
CVPR2025論文紹介:OVO-Bench
Search
Hironori TAKAGI
August 07, 2025
200
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
CVPR2025論文紹介:OVO-Bench
Hironori TAKAGI
August 07, 2025
Featured
See All Featured
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
560
Money Talks: Using Revenue to Get Sh*t Done
nikkihalliwell
0
520
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
930
Utilizing Notion as your number one productivity tool
mfonobong
4
620
Fireside Chat
paigeccino
43
4.1k
Raft: Consensus for Rubyists
vanstee
142
7.8k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
540
Visualization
eitanlees
153
17k
Mobile First: as difficult as doing things right
swwweet
225
10k
Impact Scores and Hybrid Strategies: The future of link building
tamaranovitovic
0
460
The Anti-SEO Checklist Checklist. Pubcon Cyber Week
ryanjones
0
270
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
Transcript
OVO-Bench: How Far is Your Video-LLMs from Real-World Online Video
Understanding? Junbo Niu,Yifei Li, Ziyang Miao, Chunjiang Ge, Yuanhang Zhou, Qihao He, Xiaoyi Dong, Haodong Duan, Shuangrui Ding, Rui Qian, Pan Zhang, Yuhang Zang, Yuhang Cao, Conghui He, Jiaqi Wang CVPR2025 高木洋徳(名工大玉木研) 2025/7/10
Vision Language Model ◼VLM(視覚言語モデル)とは • 視覚情報と言語情報を同時に理解・生成できるAIモデル ◼VLMが用いられるタスク • 画像キャプション生成 •
視覚質問応答 • シーン理解や物体検出など ◼VLMの例 • Qwen2-VL [Wang+, arXiv2024] • Llava-Video [Zhang+, arXiv2024] • GPT-4o
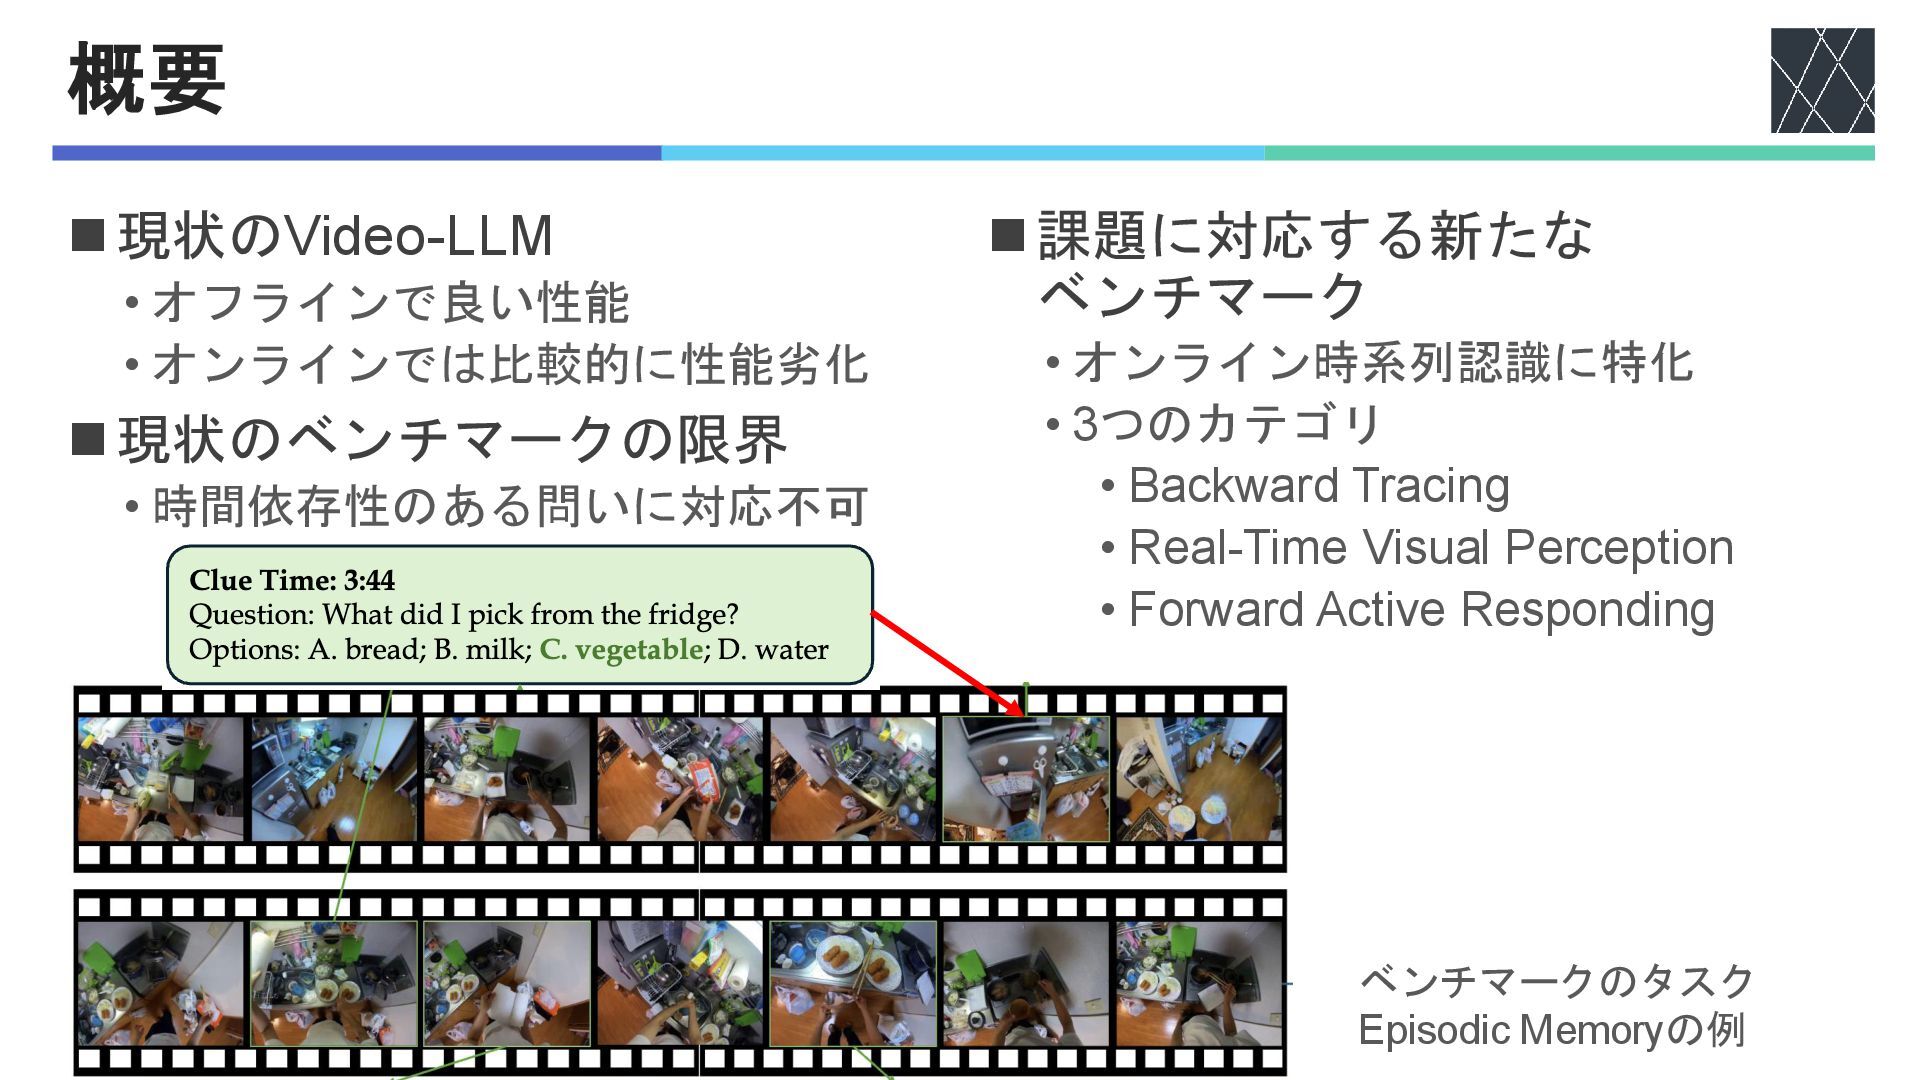
概要 ◼現状のVideo-LLM • オフラインで良い性能 • オンラインでは比較的に性能劣化 ◼現状のベンチマークの限界 • 時間依存性のある問いに対応不可 ◼課題に対応する新たな
ベンチマーク • オンライン時系列認識に特化 • 3つのカテゴリ • Backward Tracing • Real-Time Visual Perception • Forward Active Responding ベンチマークのタスク Episodic Memoryの例
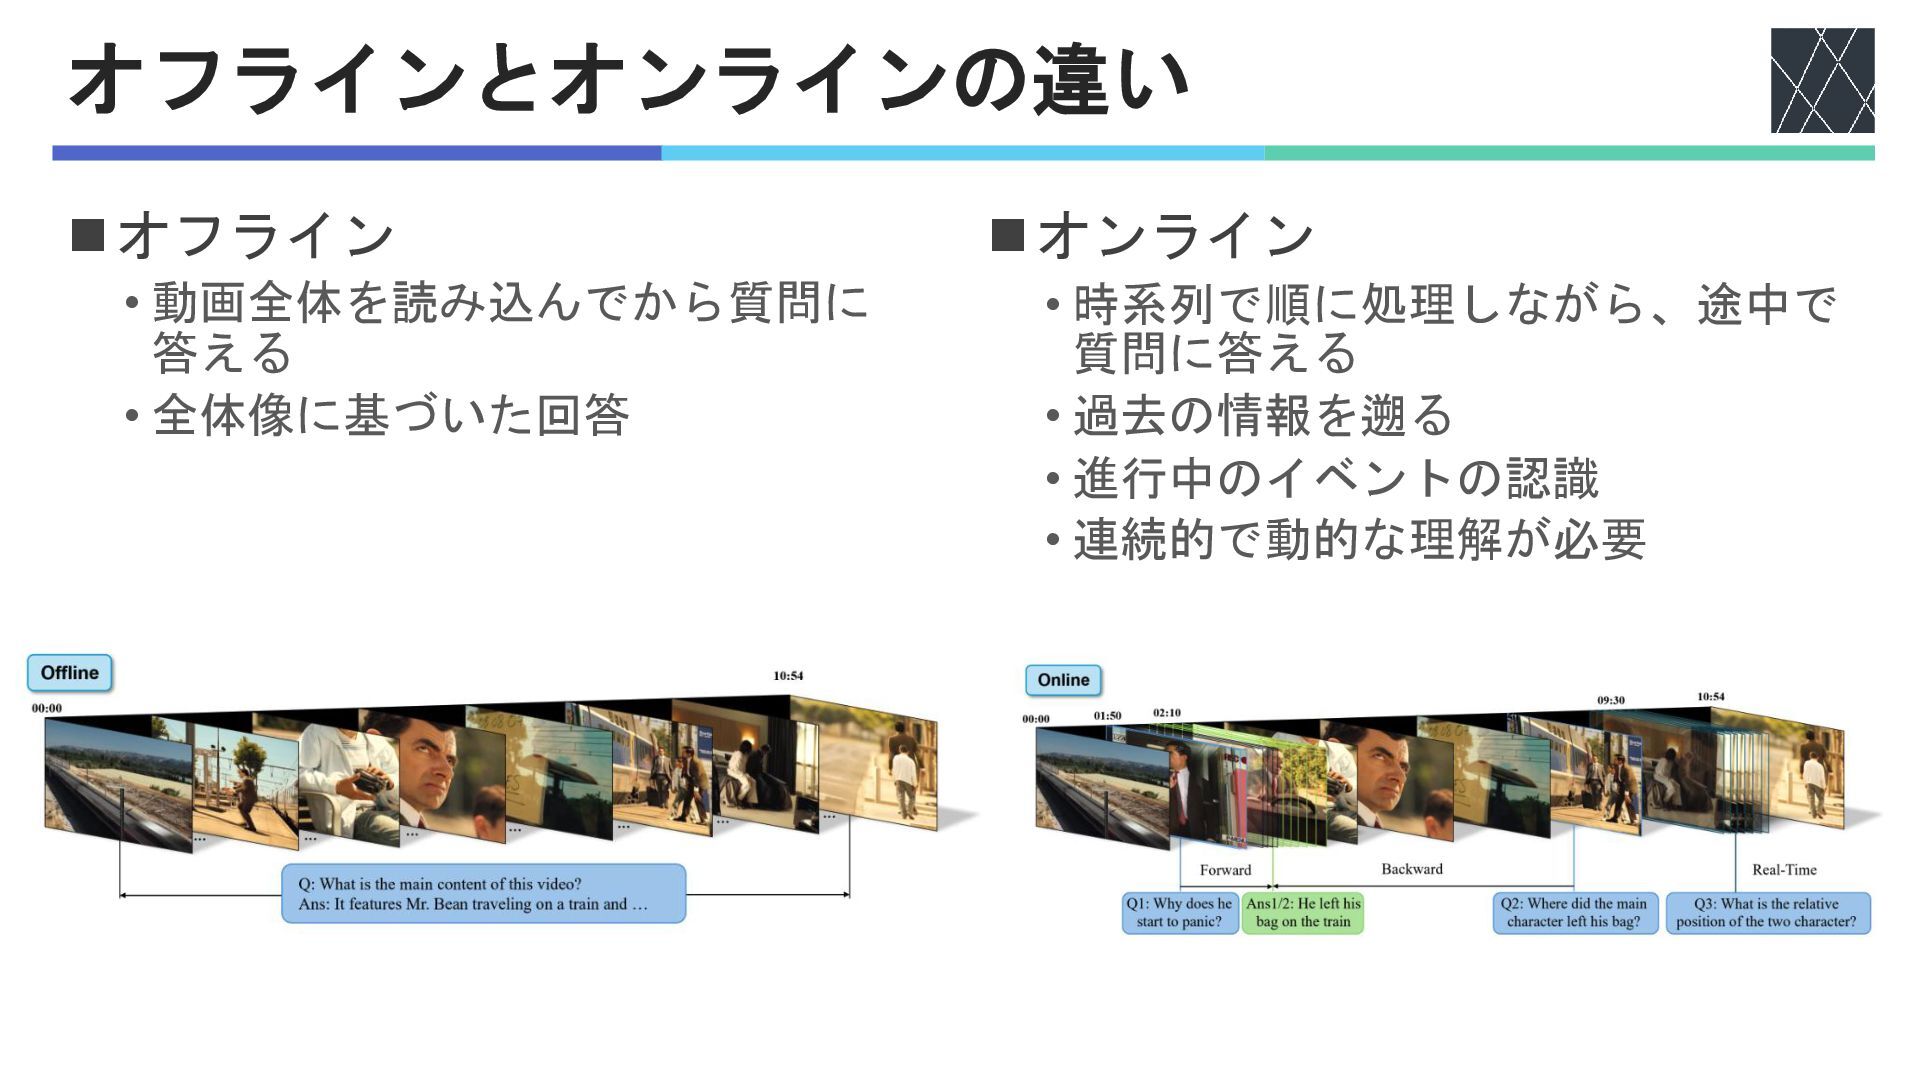
オフラインとオンラインの違い ◼オフライン • 動画全体を読み込んでから質問に 答える • 全体像に基づいた回答 ◼オンライン • 時系列で順に処理しながら、途中で
質問に答える • 過去の情報を遡る • 進行中のイベントの認識 • 連続的で動的な理解が必要
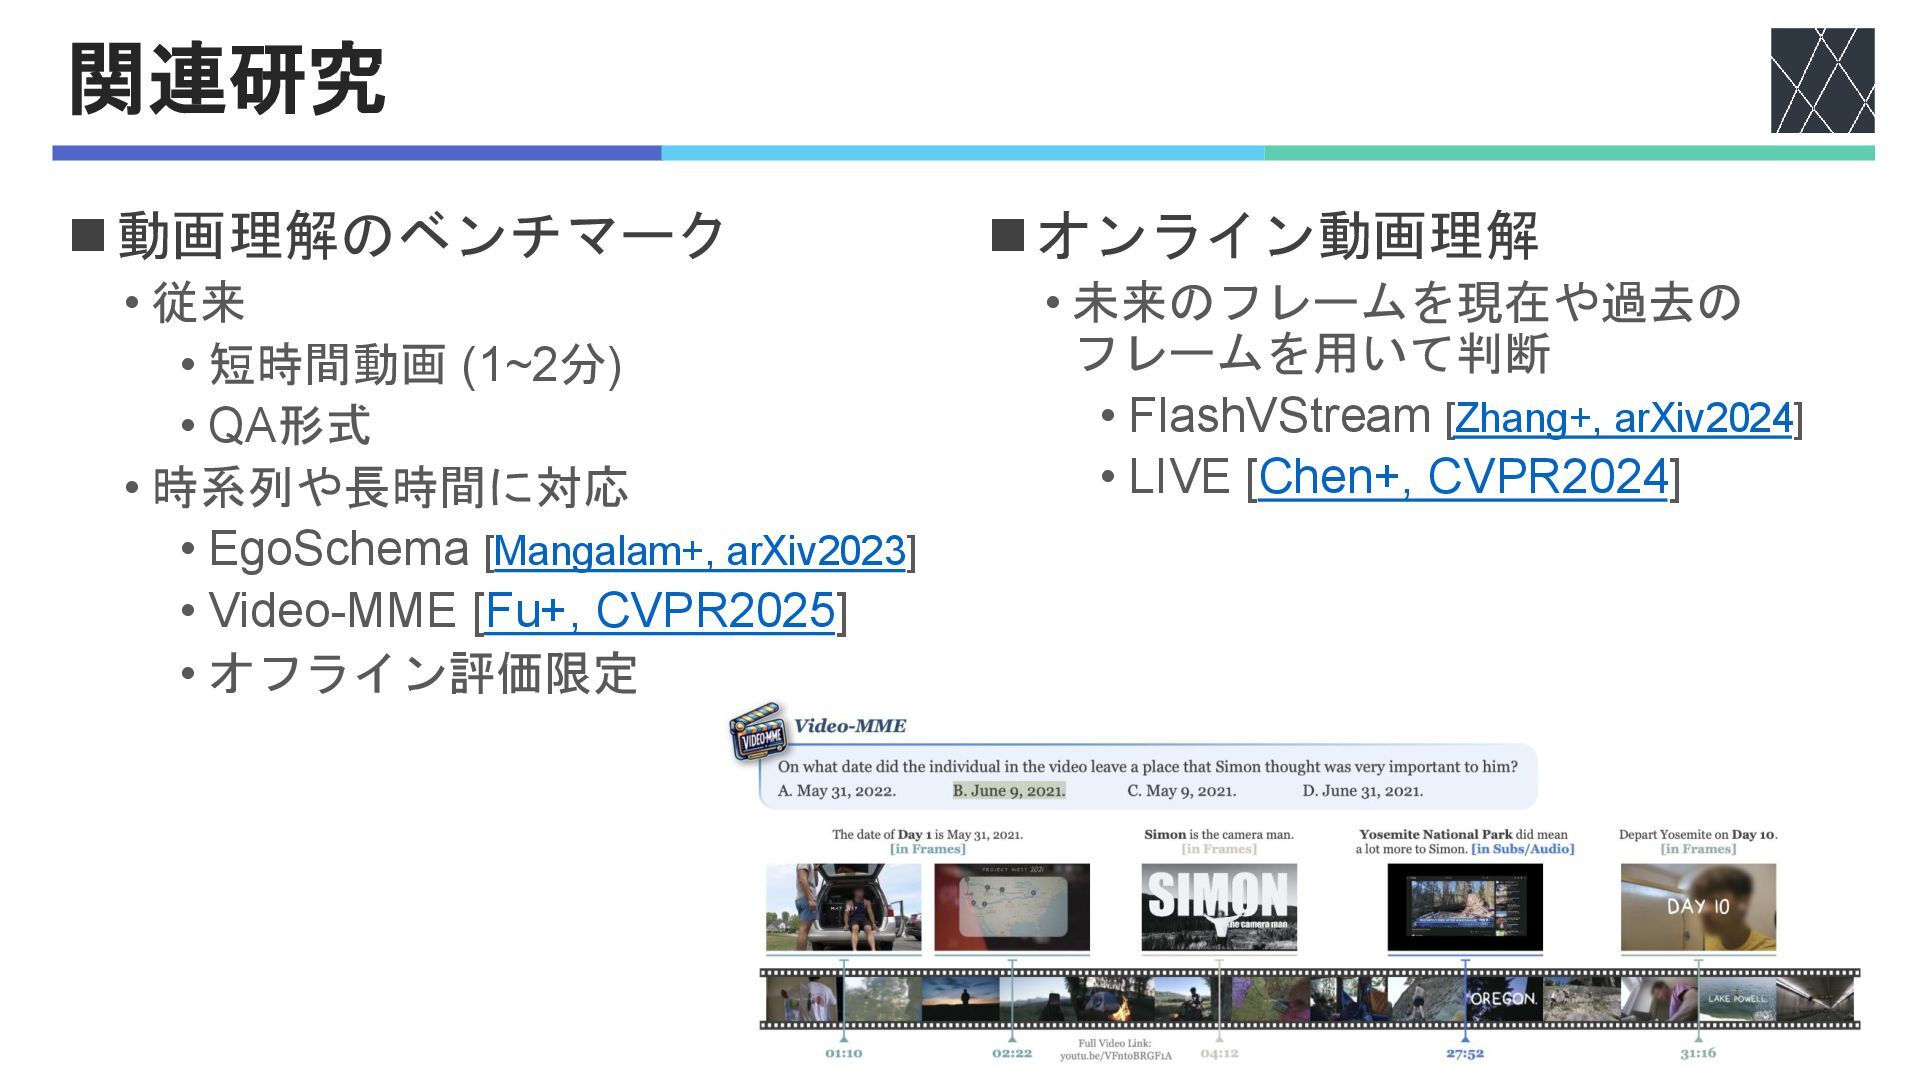
関連研究 ◼動画理解のベンチマーク • 従来 • 短時間動画 (1~2分) • QA形式 •
時系列や長時間に対応 • EgoSchema [Mangalam+, arXiv2023] • Video-MME [Fu+, CVPR2025] • オフライン評価限定 ◼オンライン動画理解 • 未来のフレームを現在や過去の フレームを用いて判断 • FlashVStream [Zhang+, arXiv2024] • LIVE [Chen+, CVPR2024]
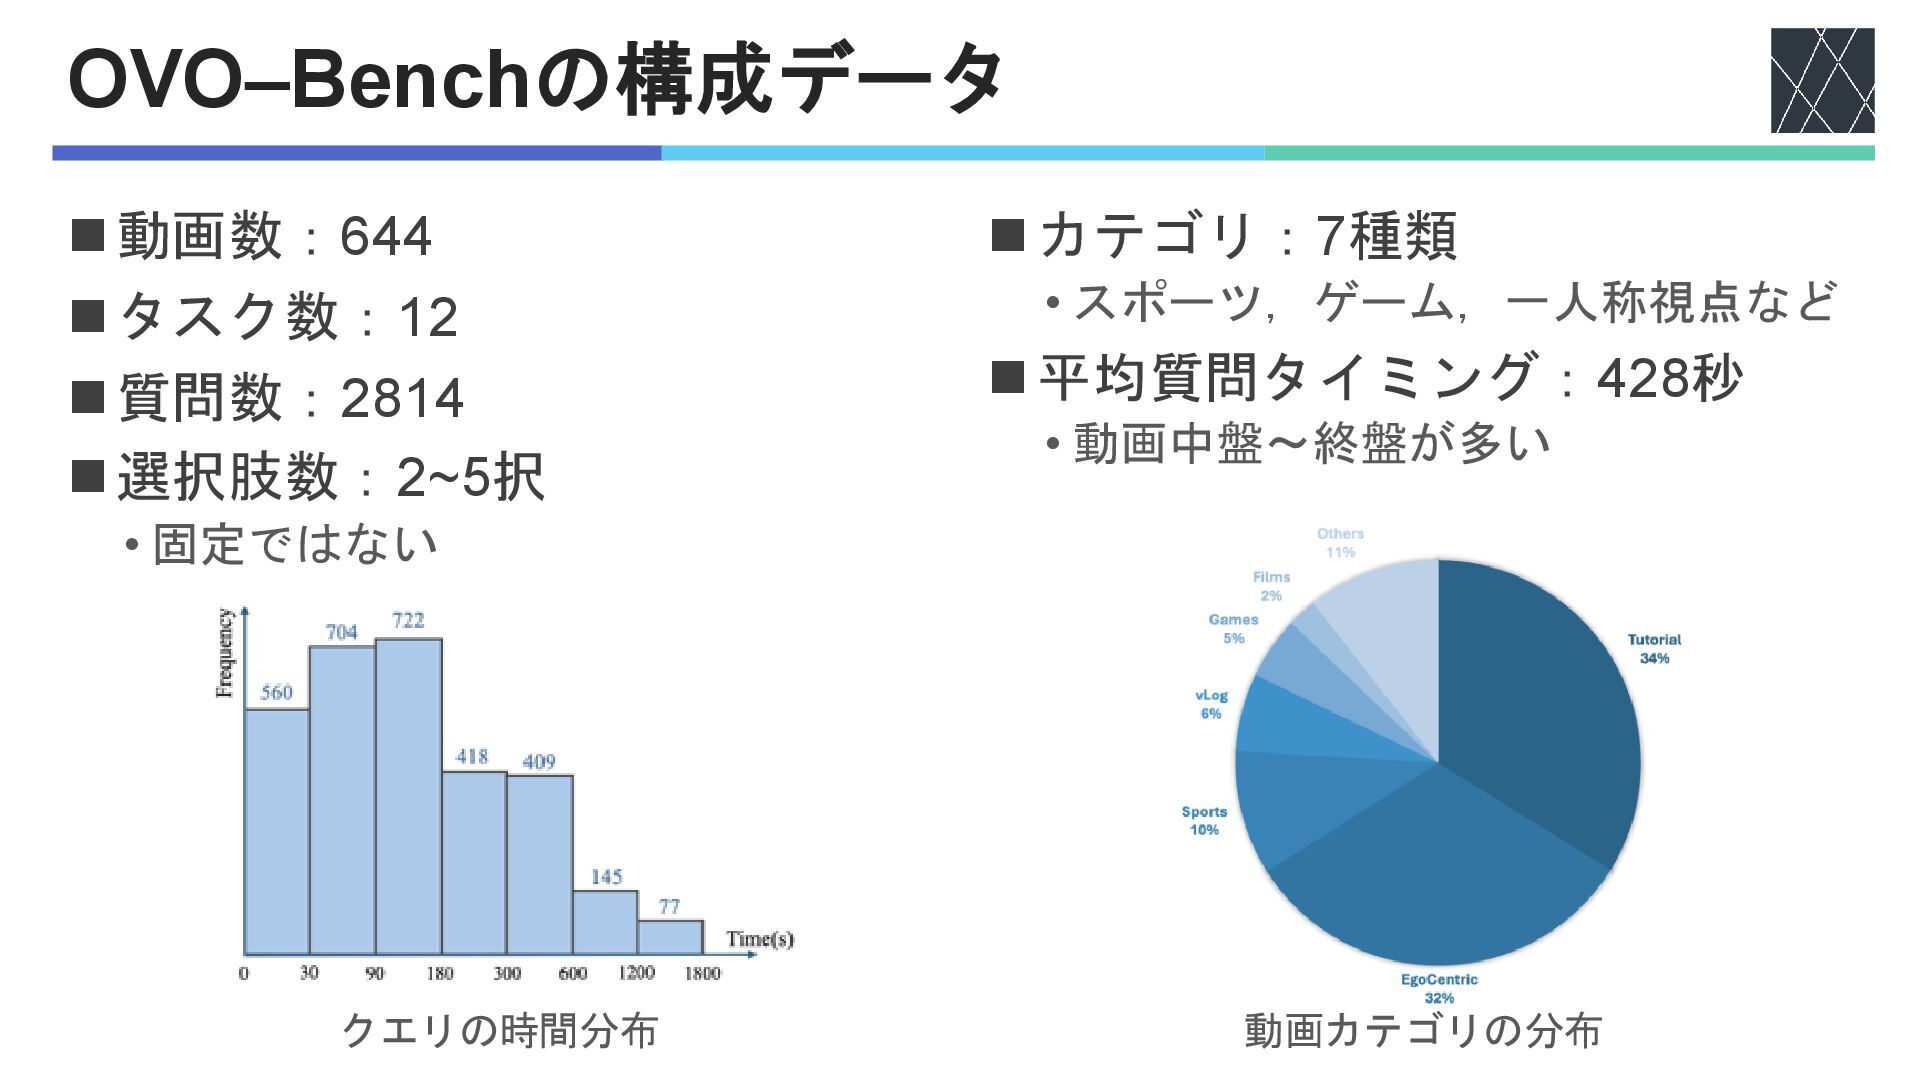
OVO–Benchの構成データ ◼動画数:644 ◼タスク数:12 ◼質問数:2814 ◼選択肢数:2~5択 • 固定ではない ◼カテゴリ:7種類 • スポーツ,ゲーム,一人称視点など
◼平均質問タイミング:428秒 • 動画中盤〜終盤が多い クエリの時間分布 動画カテゴリの分布
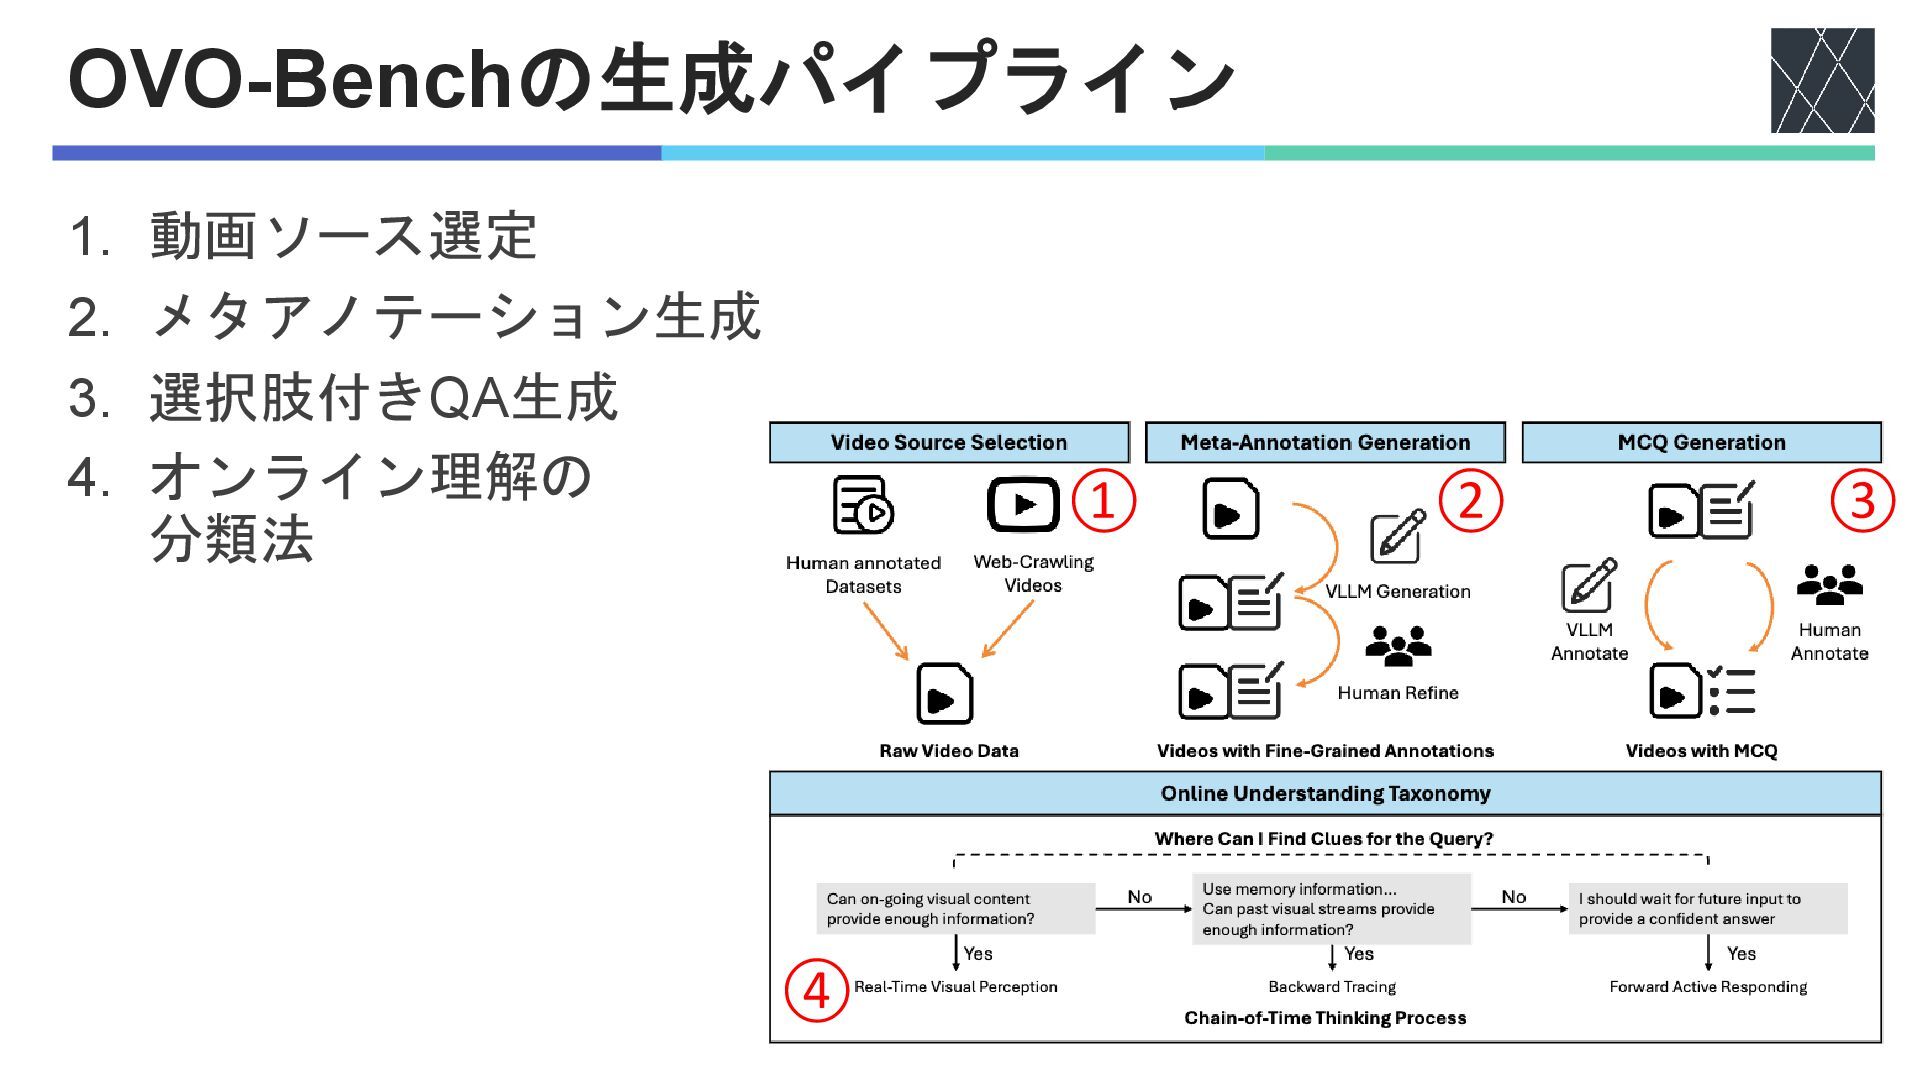
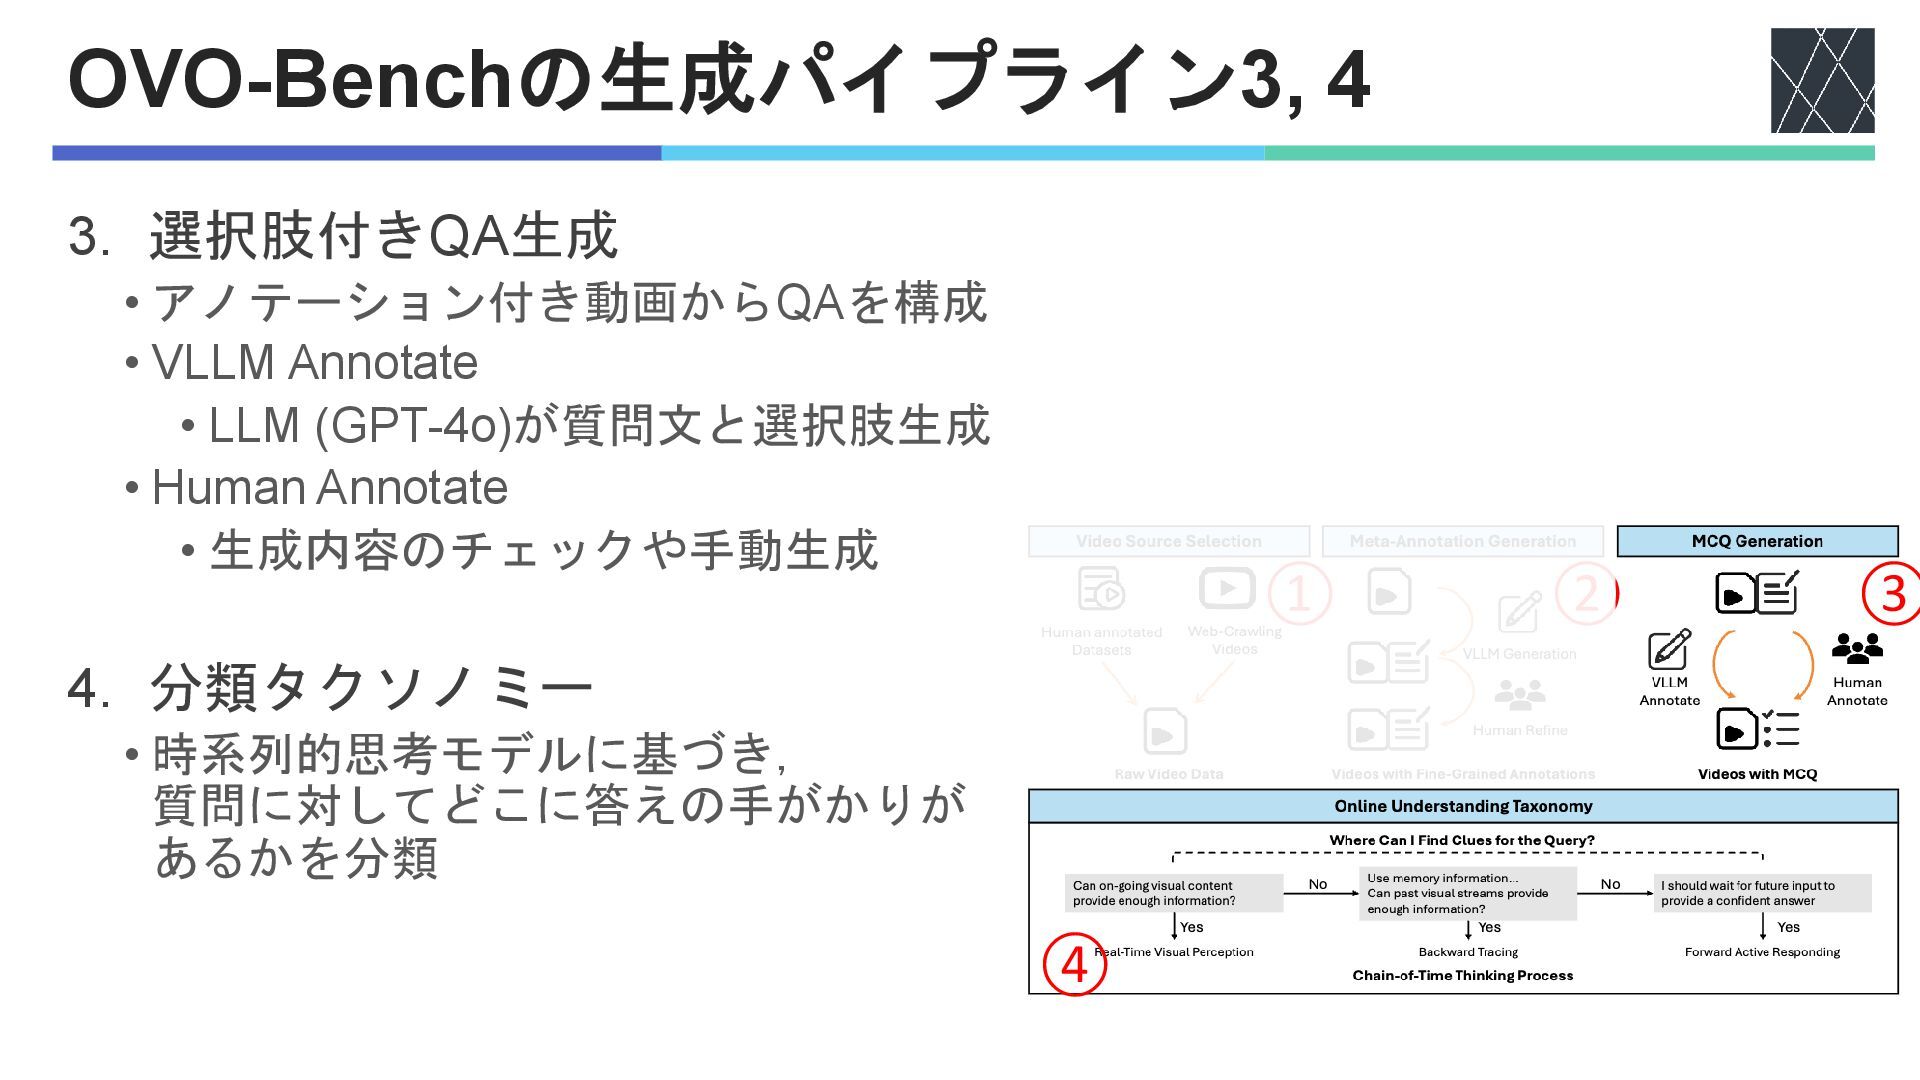
OVO-Benchの生成パイプライン 1. 動画ソース選定 2. メタアノテーション生成 3. 選択肢付きQA生成 4. オンライン理解の 分類法
① ② ③ ④
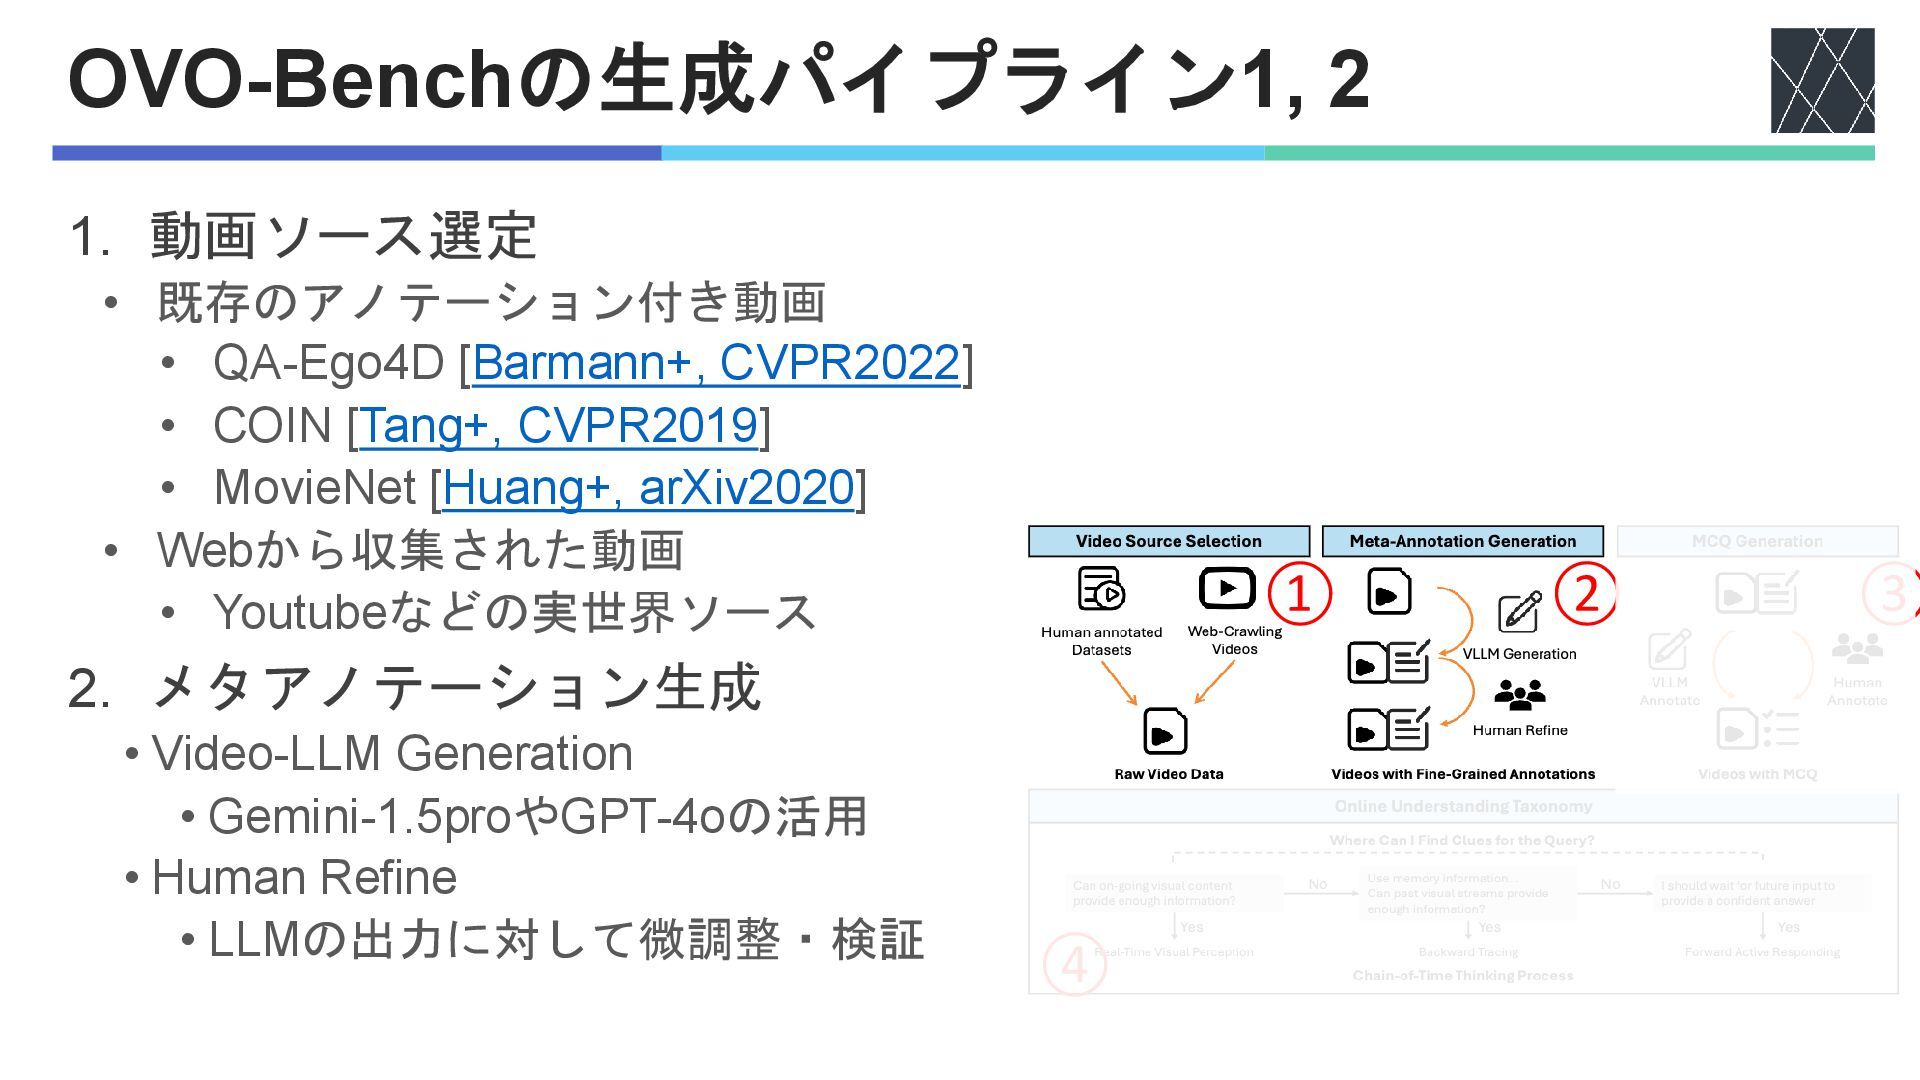
OVO-Benchの生成パイプライン1, 2 1. 動画ソース選定 • 既存のアノテーション付き動画 • QA-Ego4D [Barmann+, CVPR2022]
• COIN [Tang+, CVPR2019] • MovieNet [Huang+, arXiv2020] • Webから収集された動画 • Youtubeなどの実世界ソース 2. メタアノテーション生成 • Video-LLM Generation • Gemini-1.5proやGPT-4oの活用 • Human Refine • LLMの出力に対して微調整・検証 ① ② ③ ④
OVO-Benchの生成パイプライン3, 4 3. 選択肢付きQA生成 • アノテーション付き動画からQAを構成 • VLLM Annotate •
LLM (GPT-4o)が質問文と選択肢生成 • Human Annotate • 生成内容のチェックや手動生成 4. 分類タクソノミー • 時系列的思考モデルに基づき, 質問に対してどこに答えの手がかりが あるかを分類 ① ② ③ ④
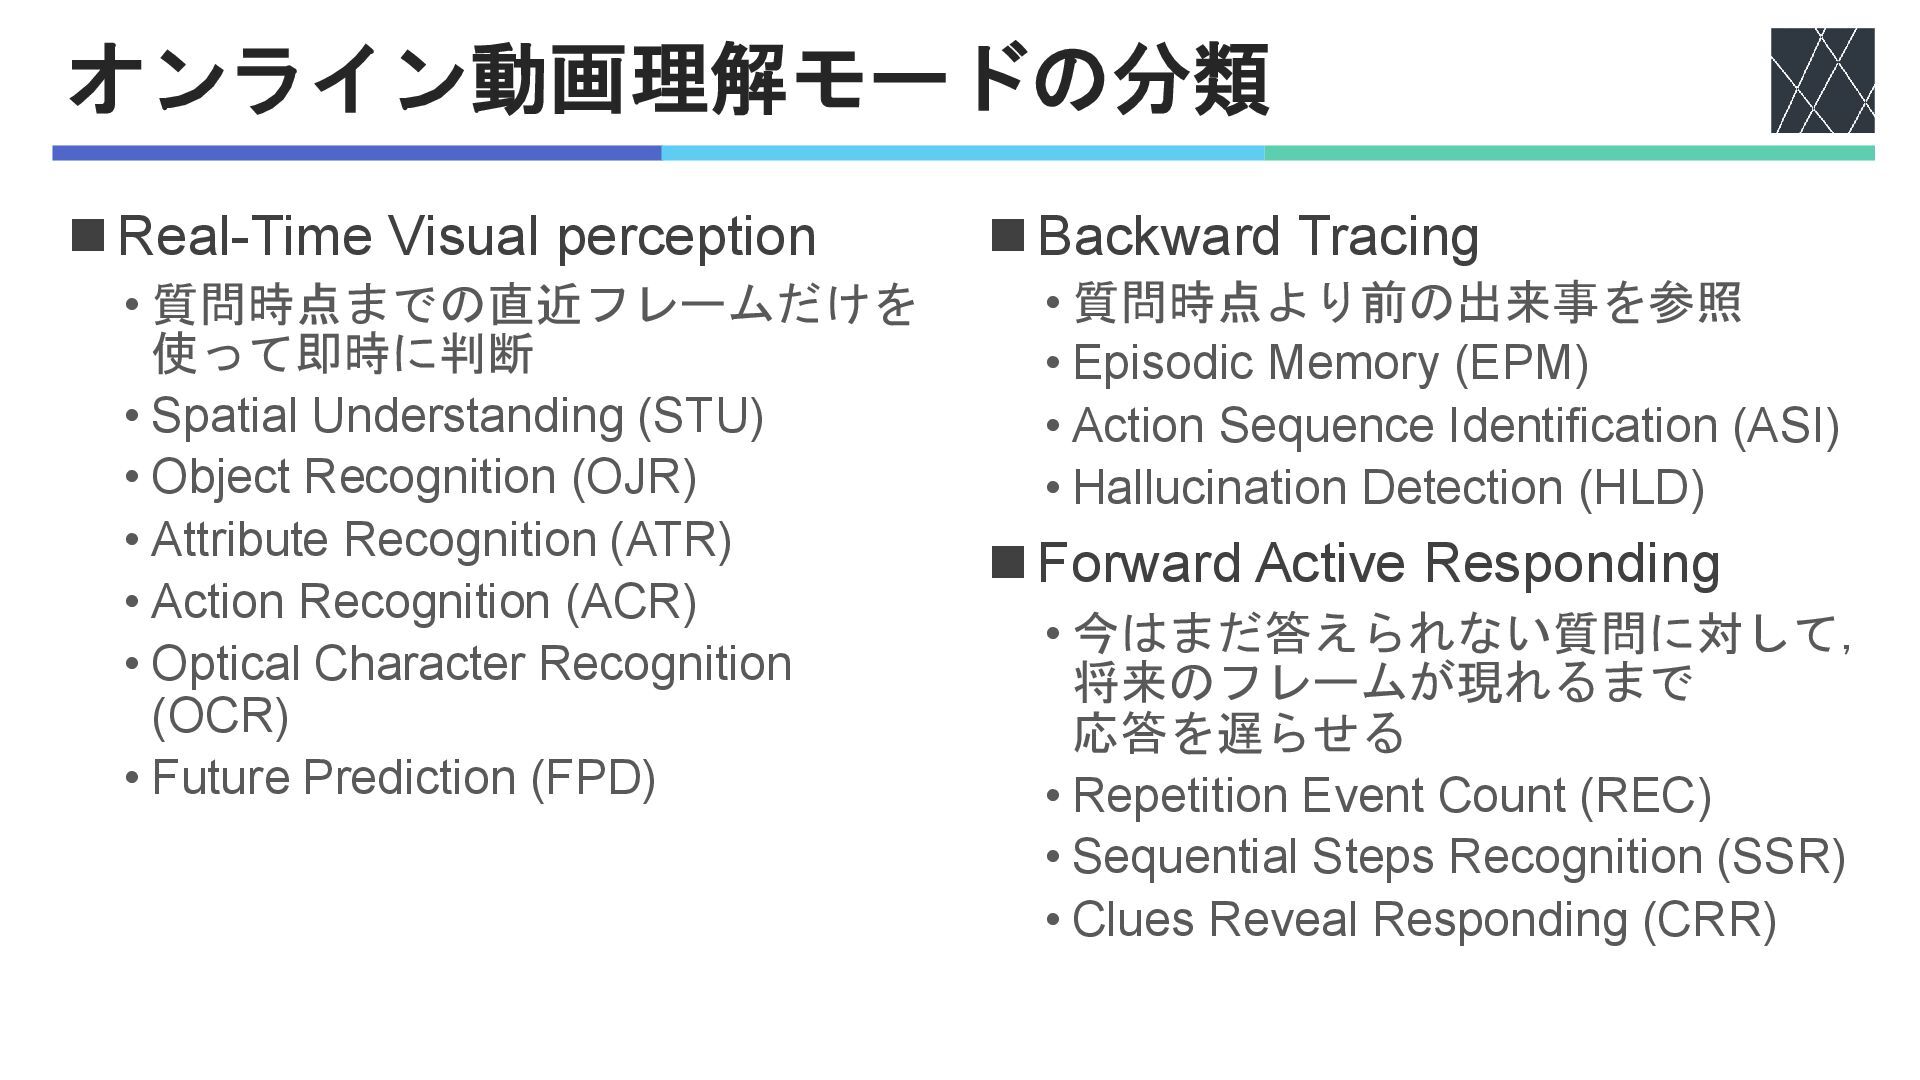
オンライン動画理解モードの分類 ◼Real-Time Visual perception • 質問時点までの直近フレームだけを 使って即時に判断 • Spatial Understanding
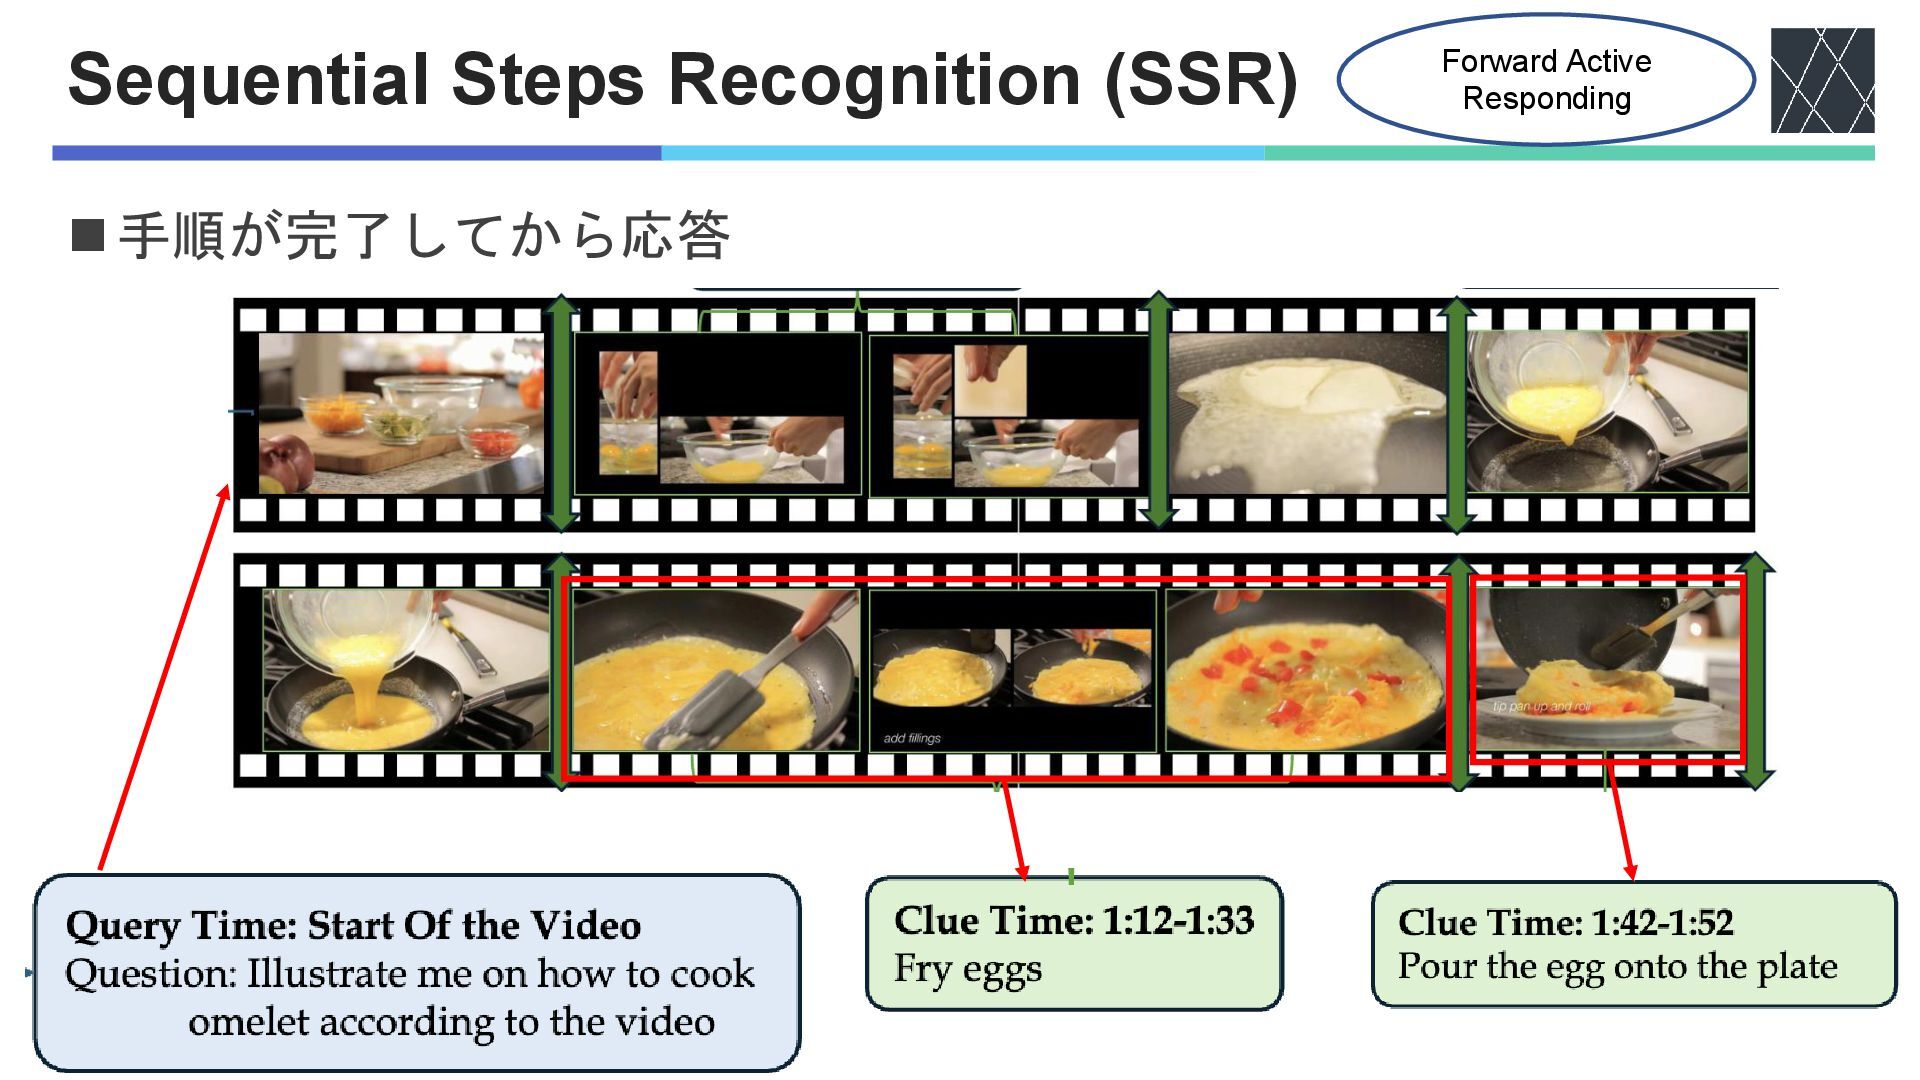
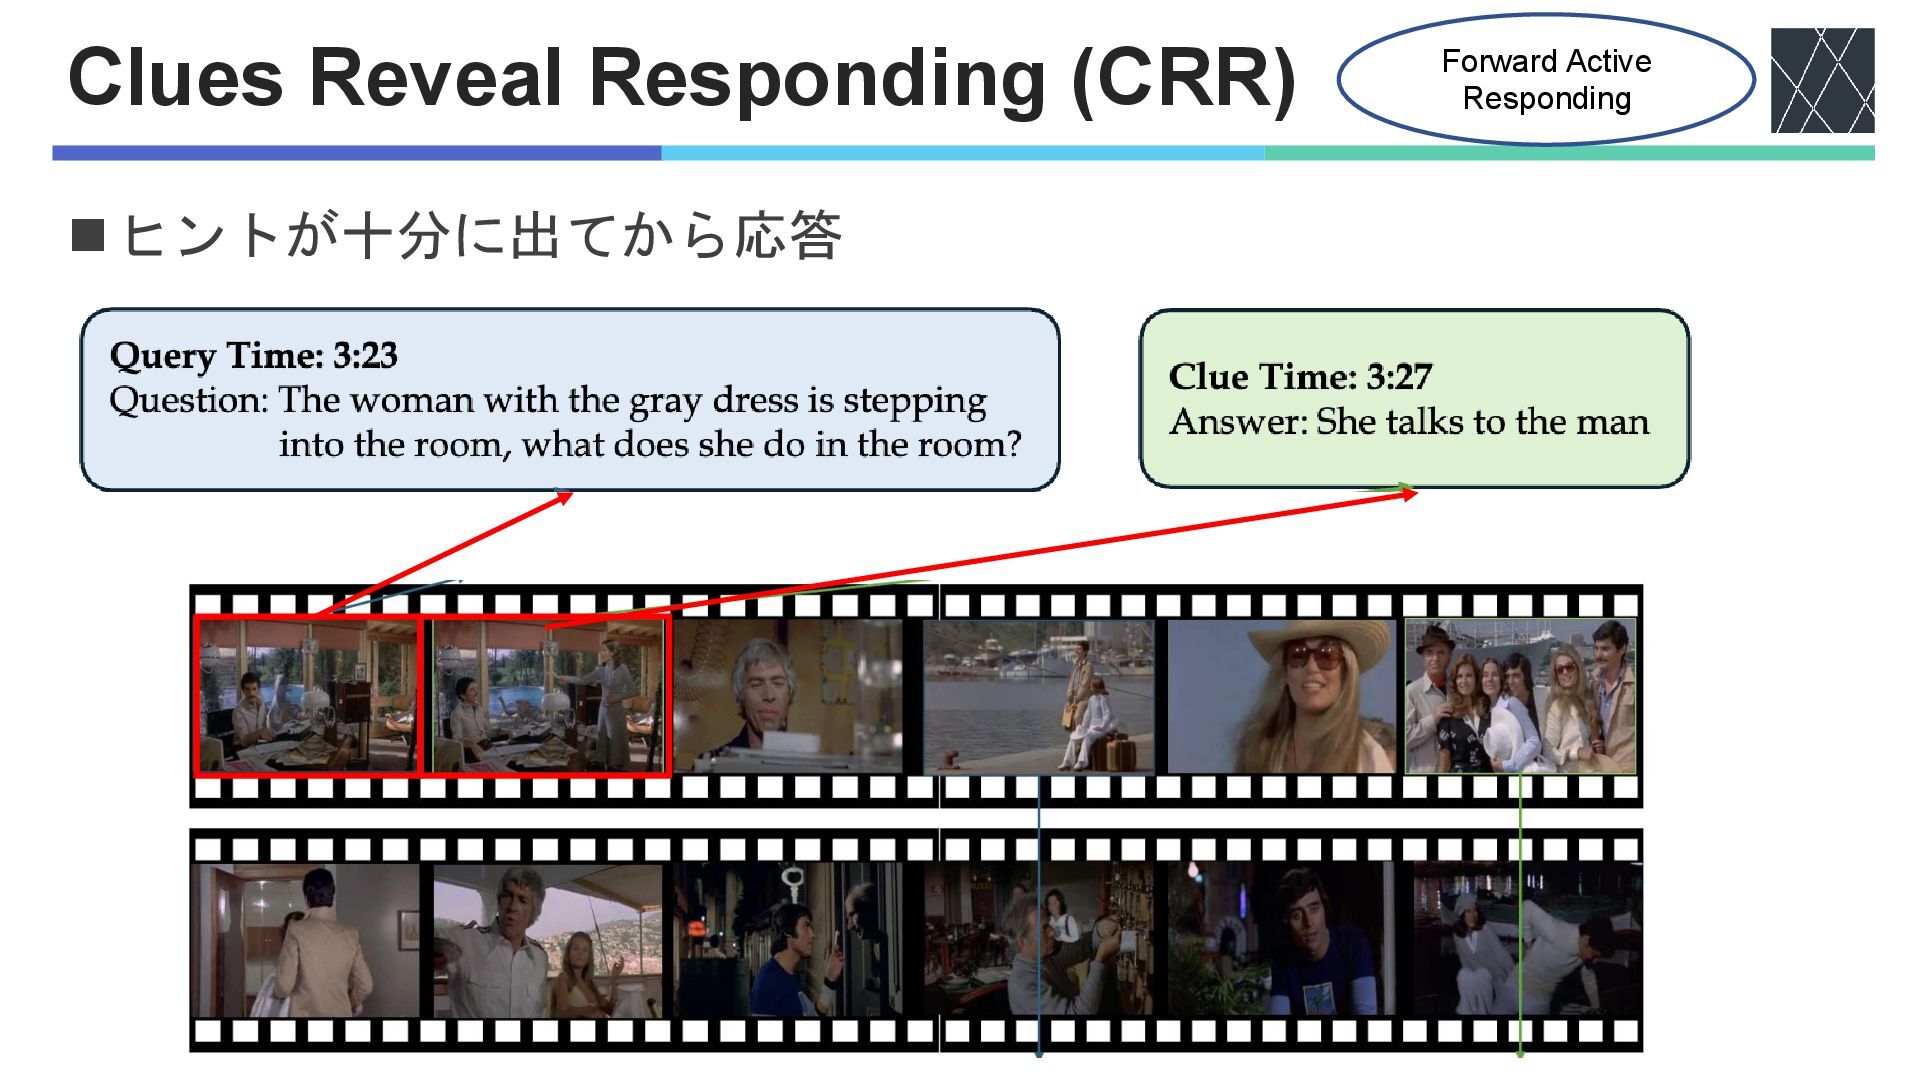
(STU) • Object Recognition (OJR) • Attribute Recognition (ATR) • Action Recognition (ACR) • Optical Character Recognition (OCR) • Future Prediction (FPD) ◼Backward Tracing • 質問時点より前の出来事を参照 • Episodic Memory (EPM) • Action Sequence Identification (ASI) • Hallucination Detection (HLD) ◼Forward Active Responding • 今はまだ答えられない質問に対して, 将来のフレームが現れるまで 応答を遅らせる • Repetition Event Count (REC) • Sequential Steps Recognition (SSR) • Clues Reveal Responding (CRR)
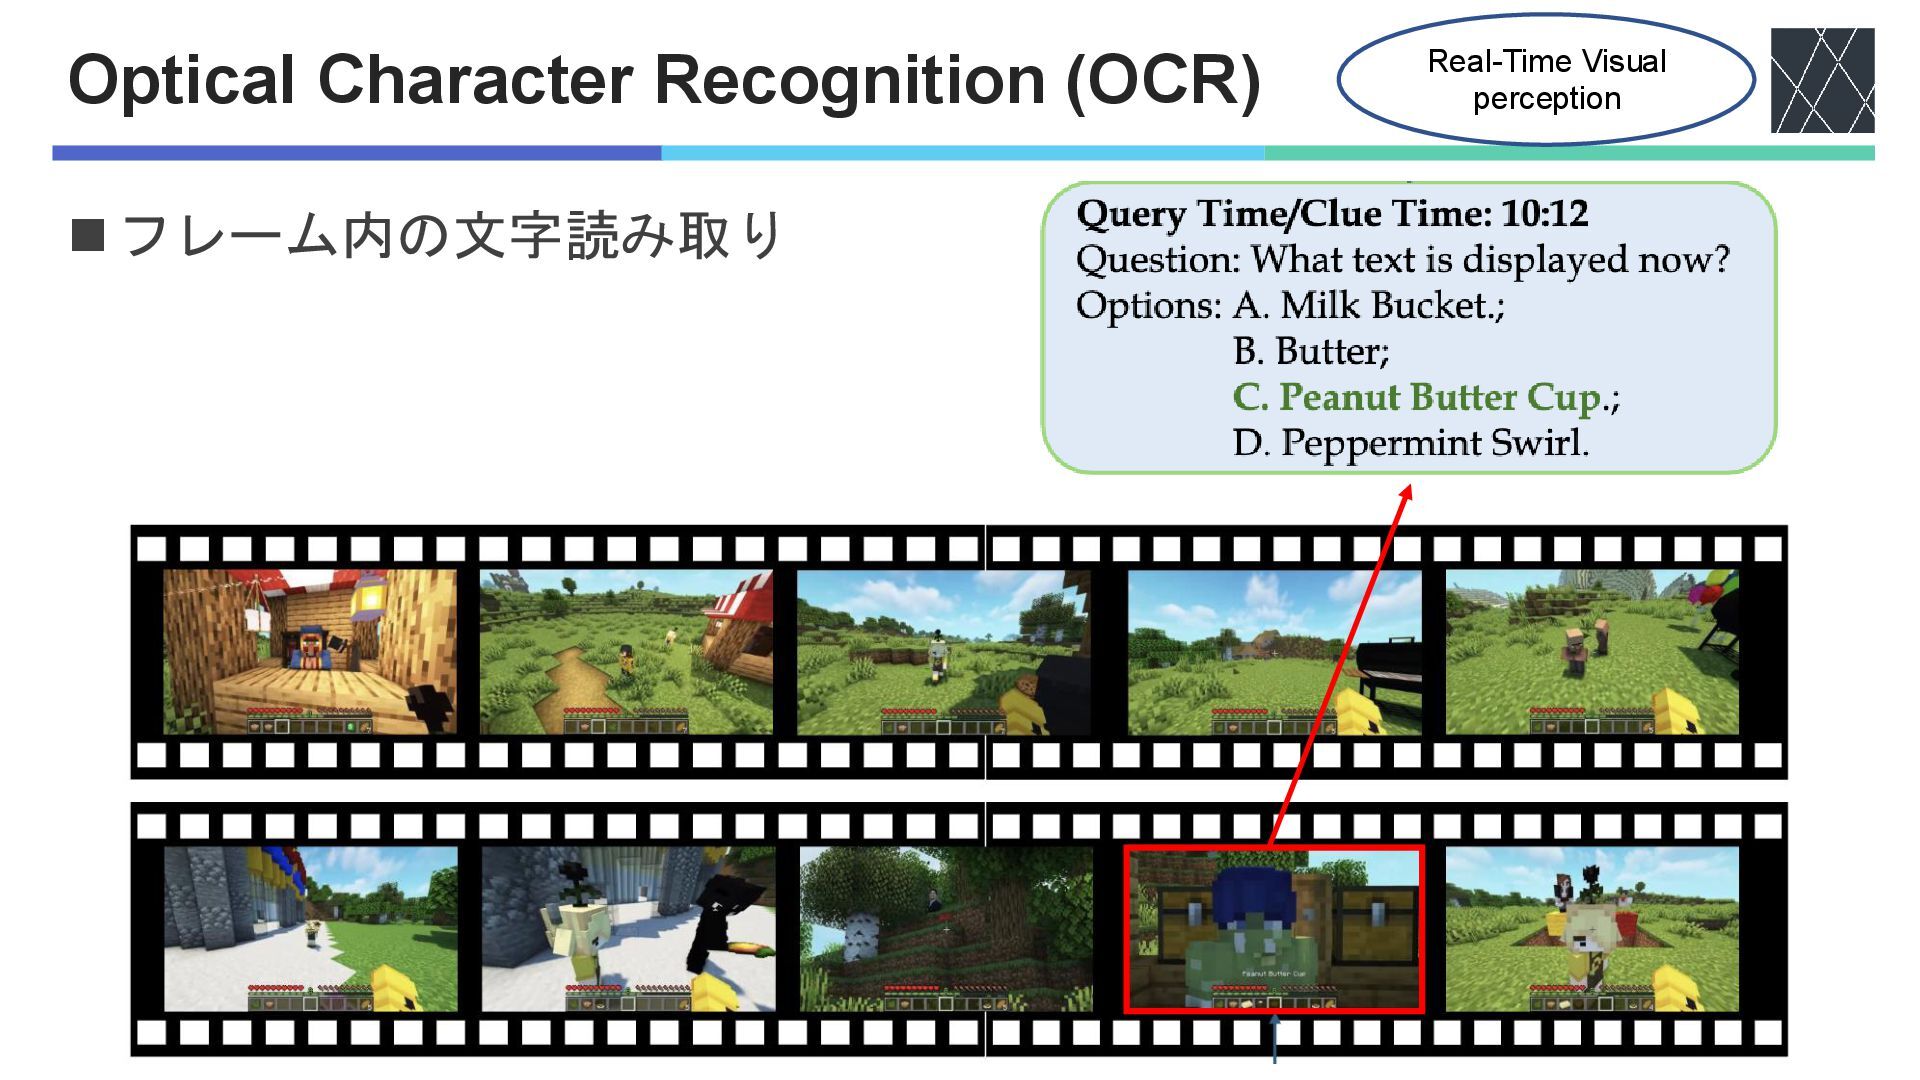
Optical Character Recognition (OCR) ◼フレーム内の文字読み取り Real-Time Visual perception
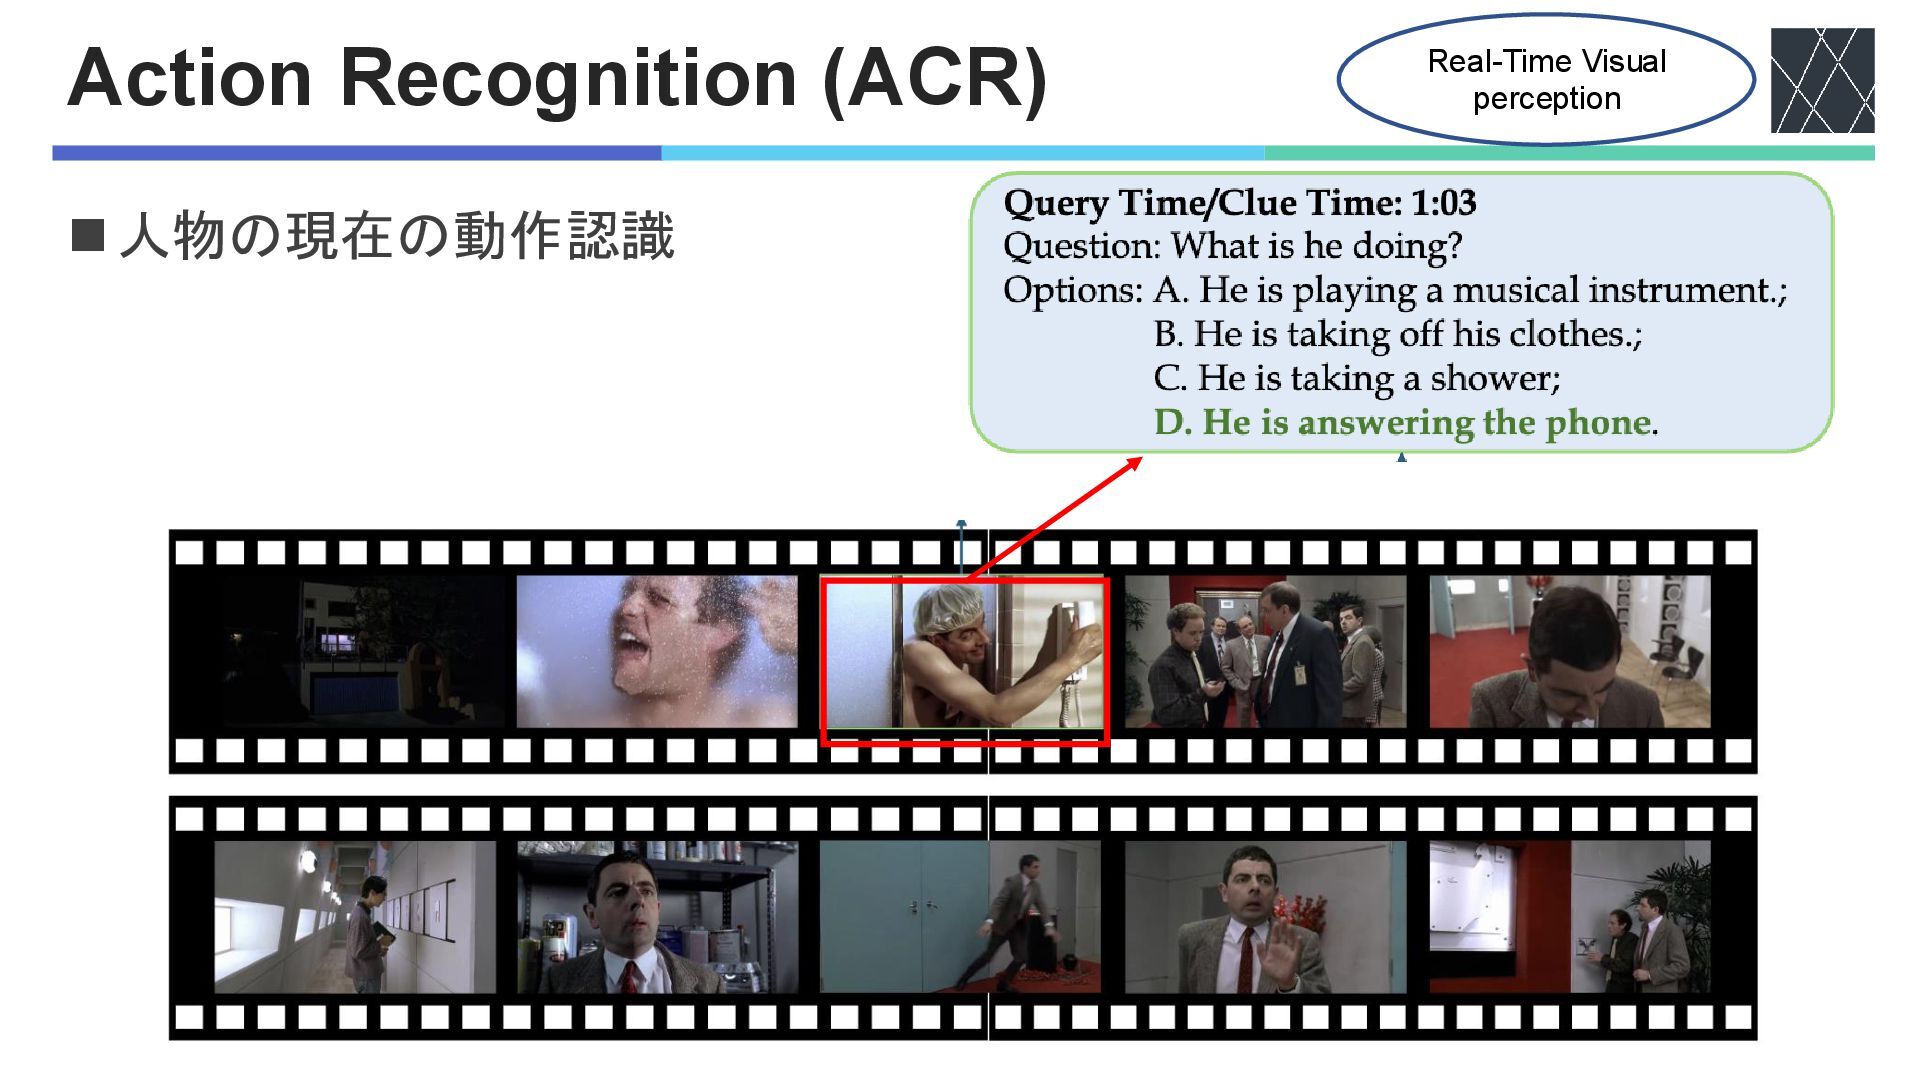
Action Recognition (ACR) ◼人物の現在の動作認識 Real-Time Visual perception
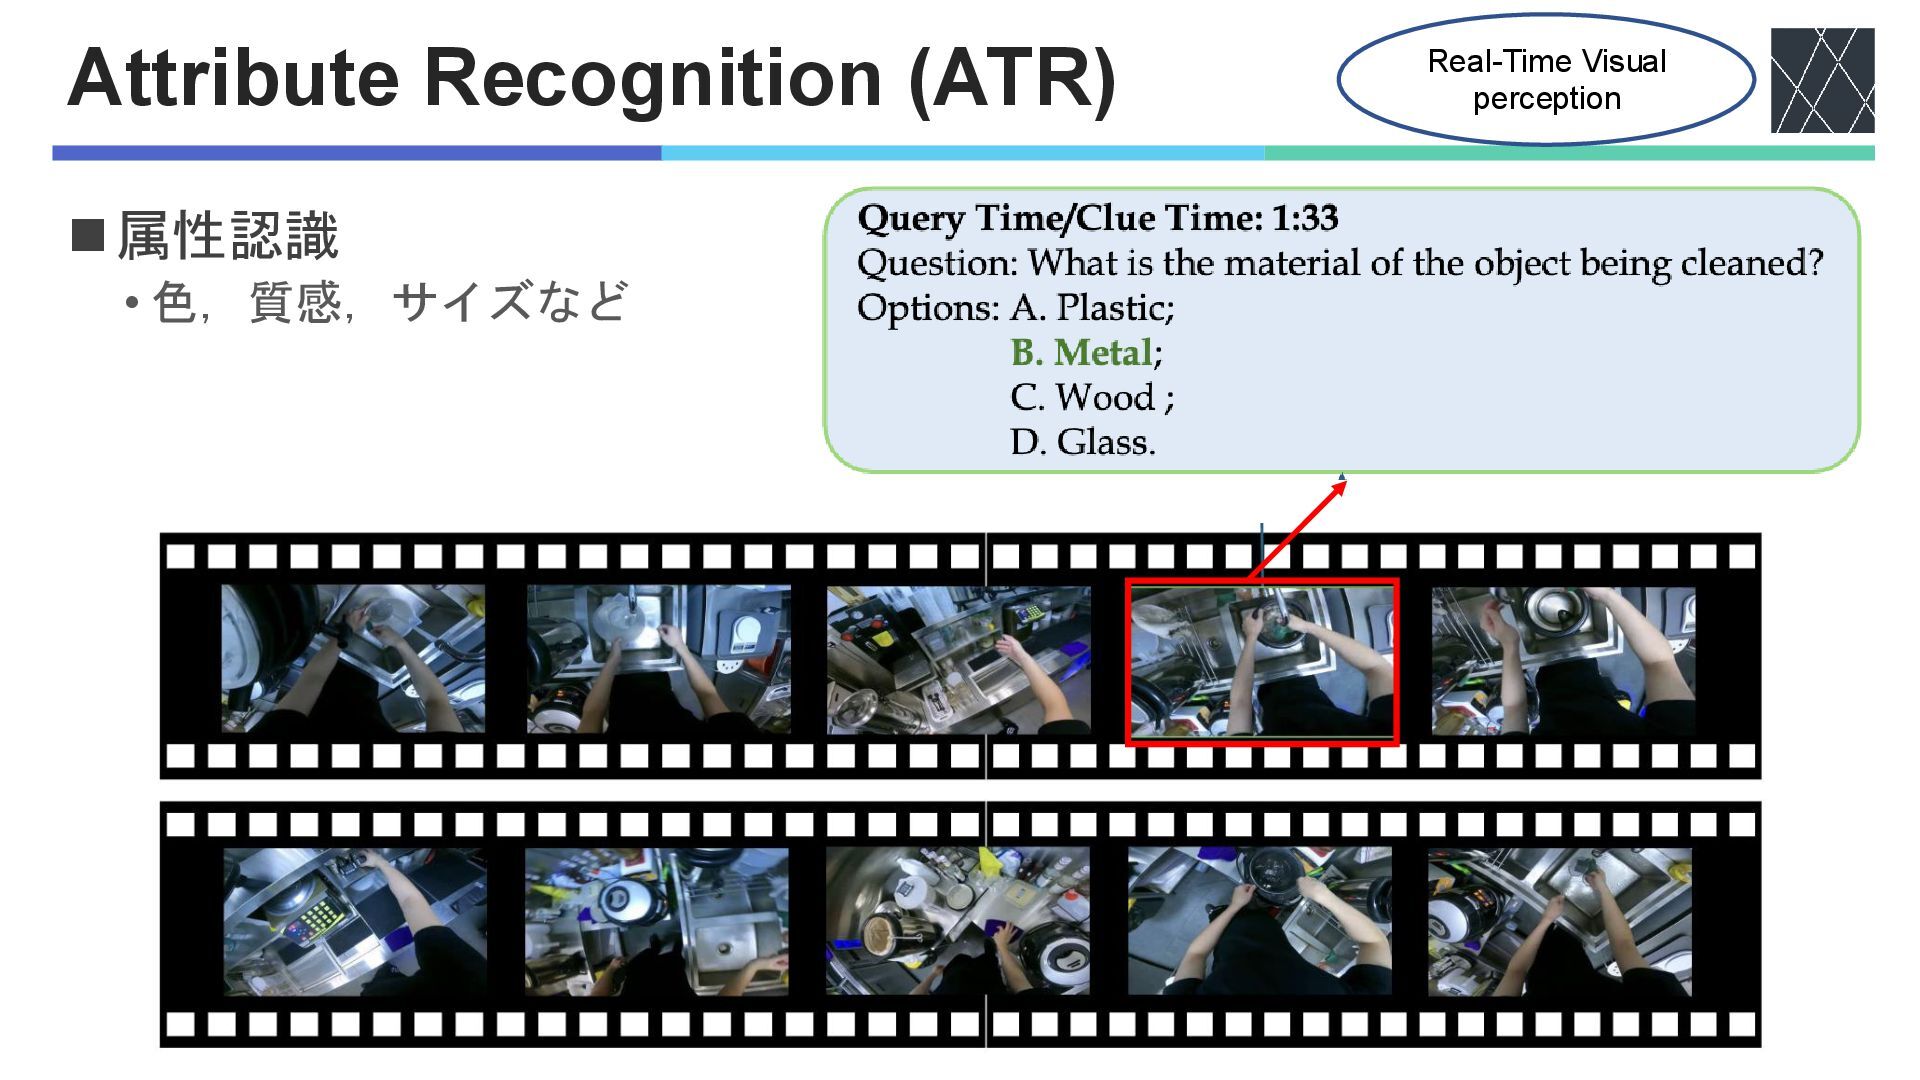
Attribute Recognition (ATR) ◼属性認識 • 色,質感,サイズなど Real-Time Visual perception
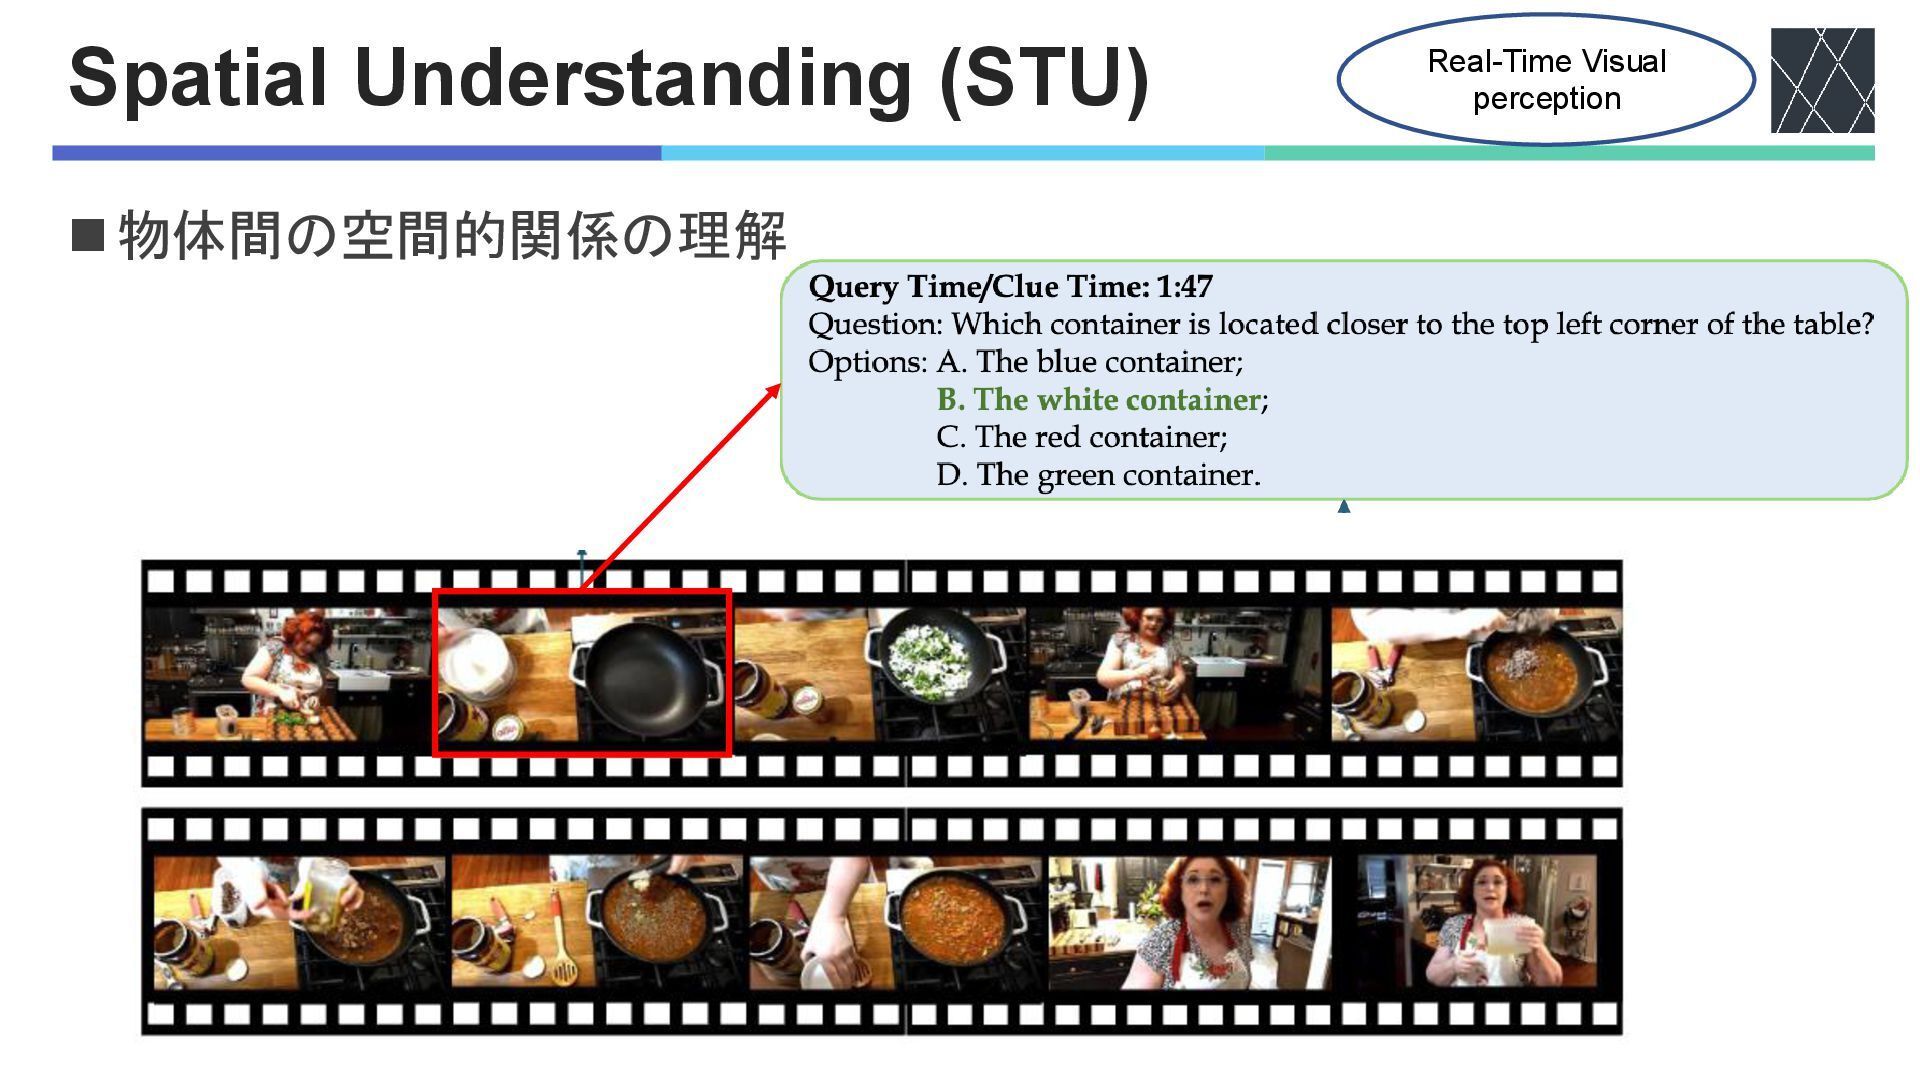
Spatial Understanding (STU) ◼物体間の空間的関係の理解 Real-Time Visual perception
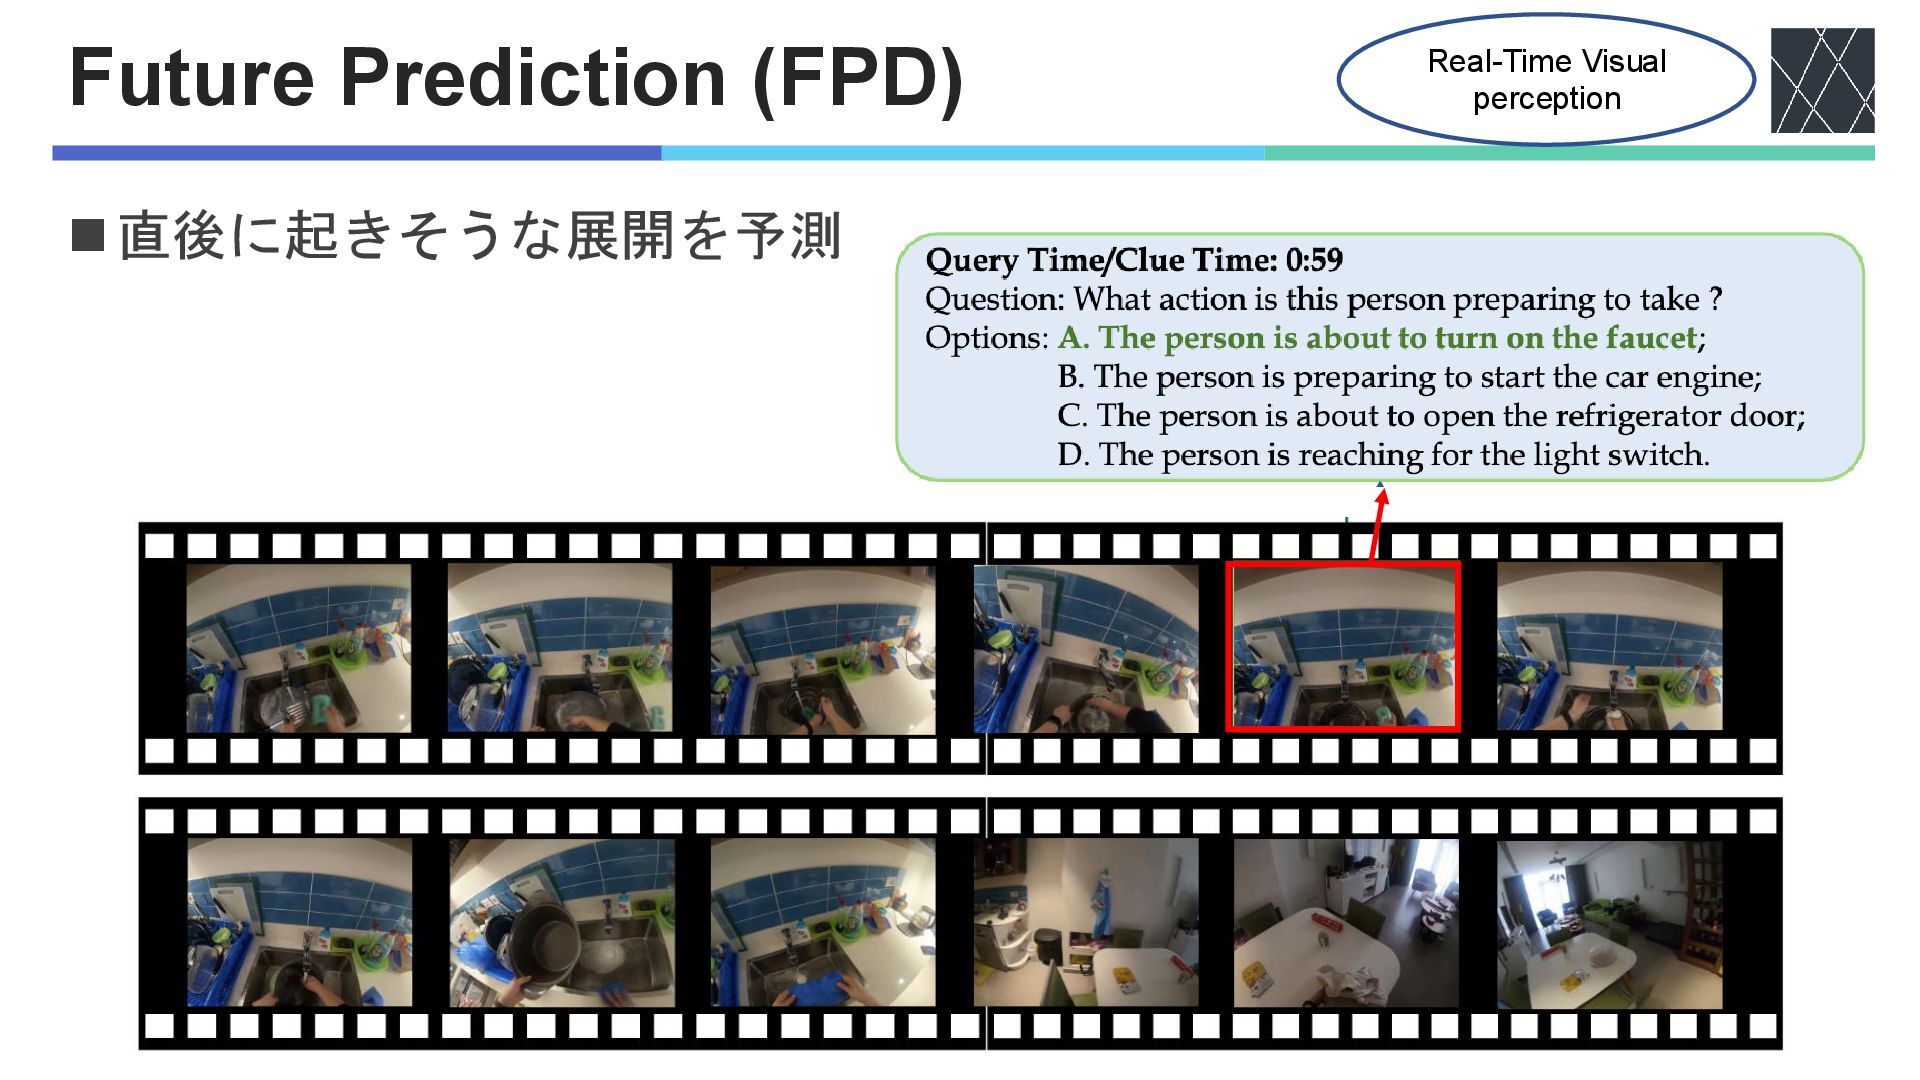
Future Prediction (FPD) ◼直後に起きそうな展開を予測 Real-Time Visual perception
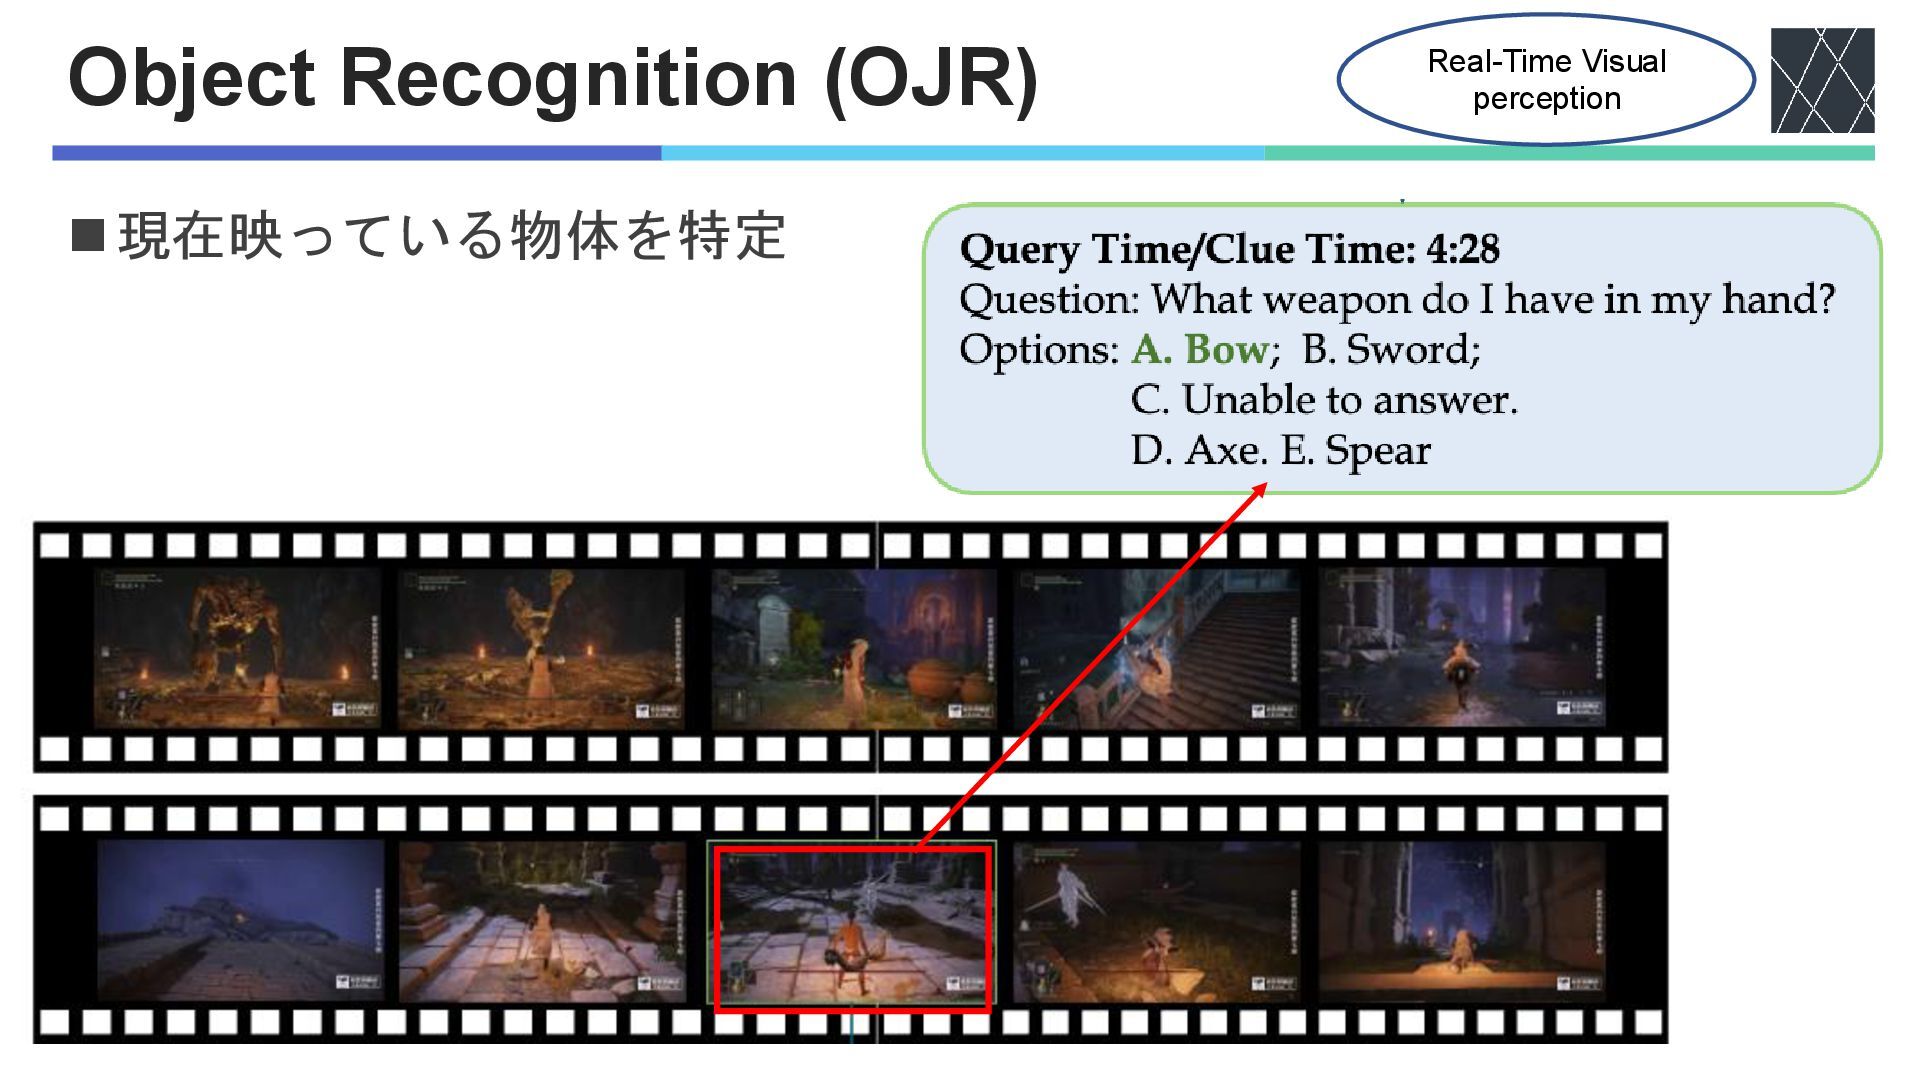
Object Recognition (OJR) ◼現在映っている物体を特定 Real-Time Visual perception
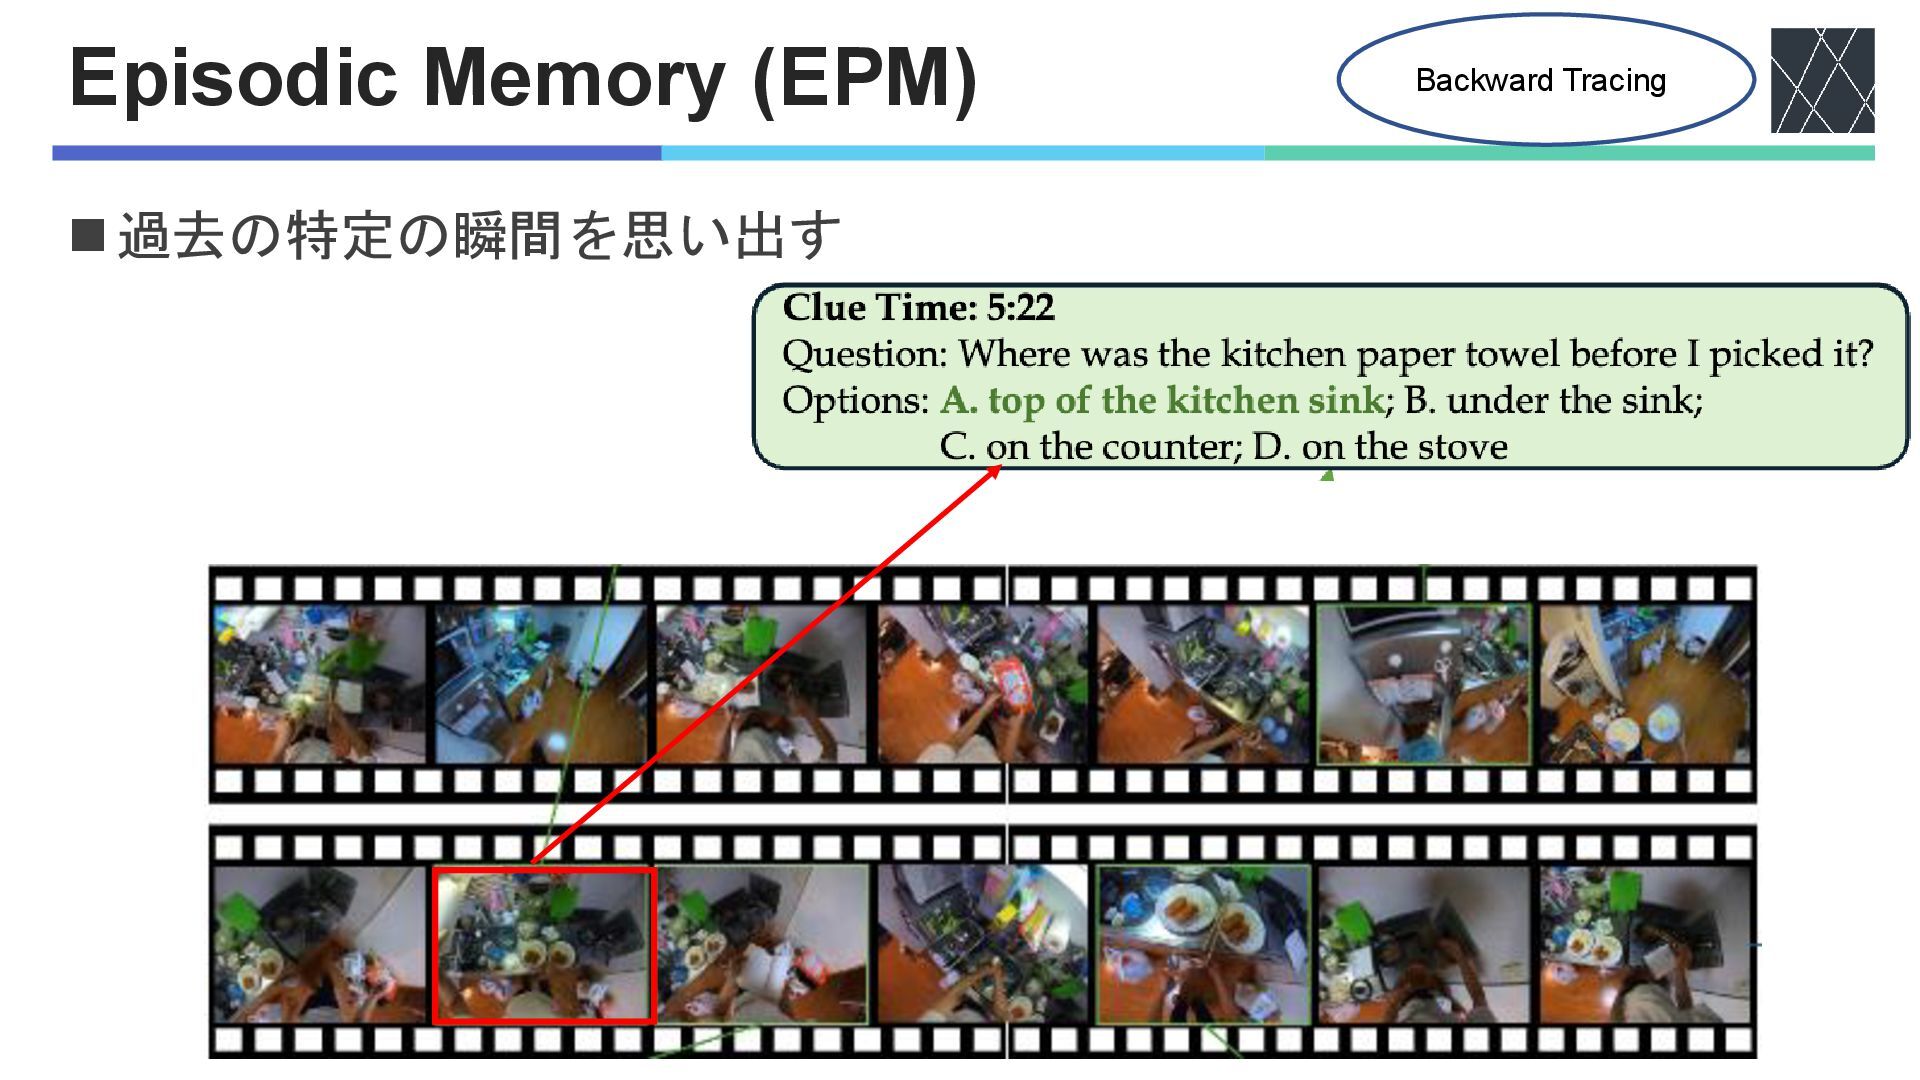
Episodic Memory (EPM) ◼過去の特定の瞬間を思い出す Backward Tracing
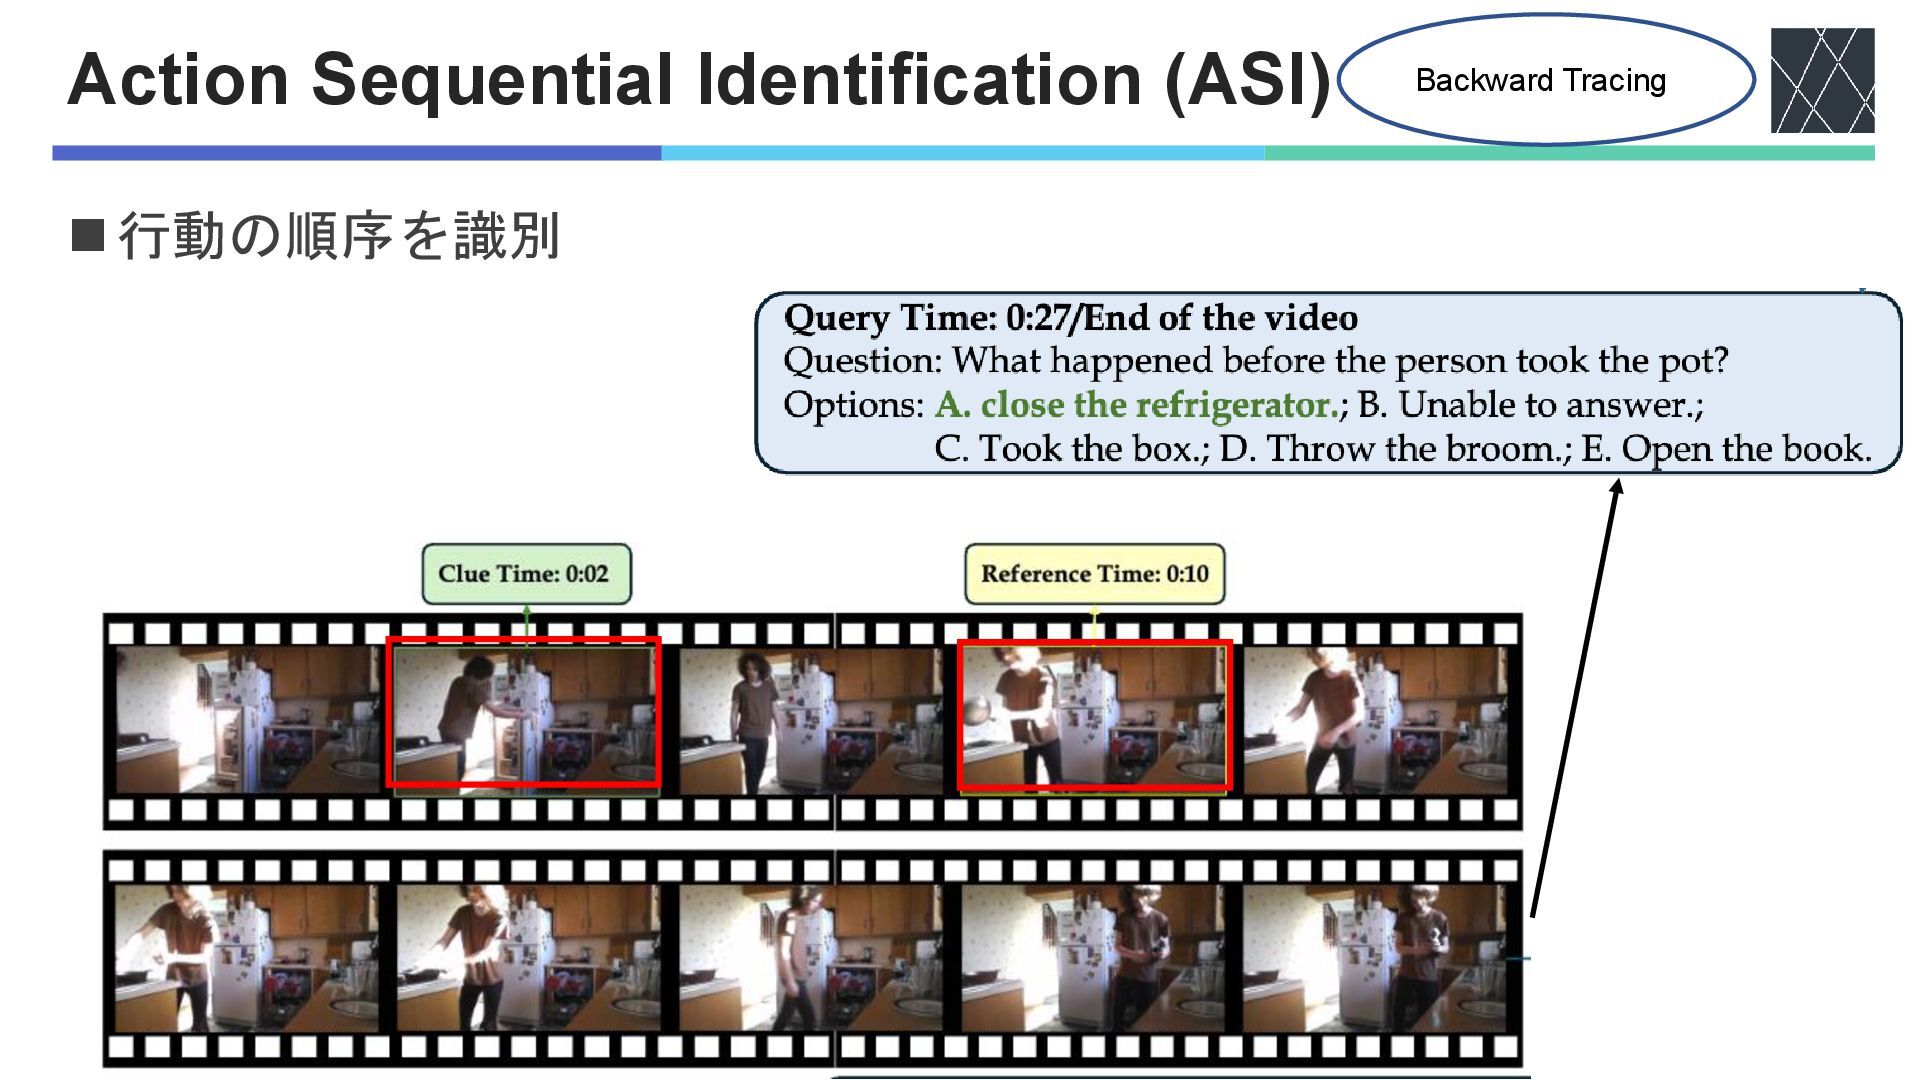
Action Sequential Identification (ASI) ◼行動の順序を識別 Backward Tracing
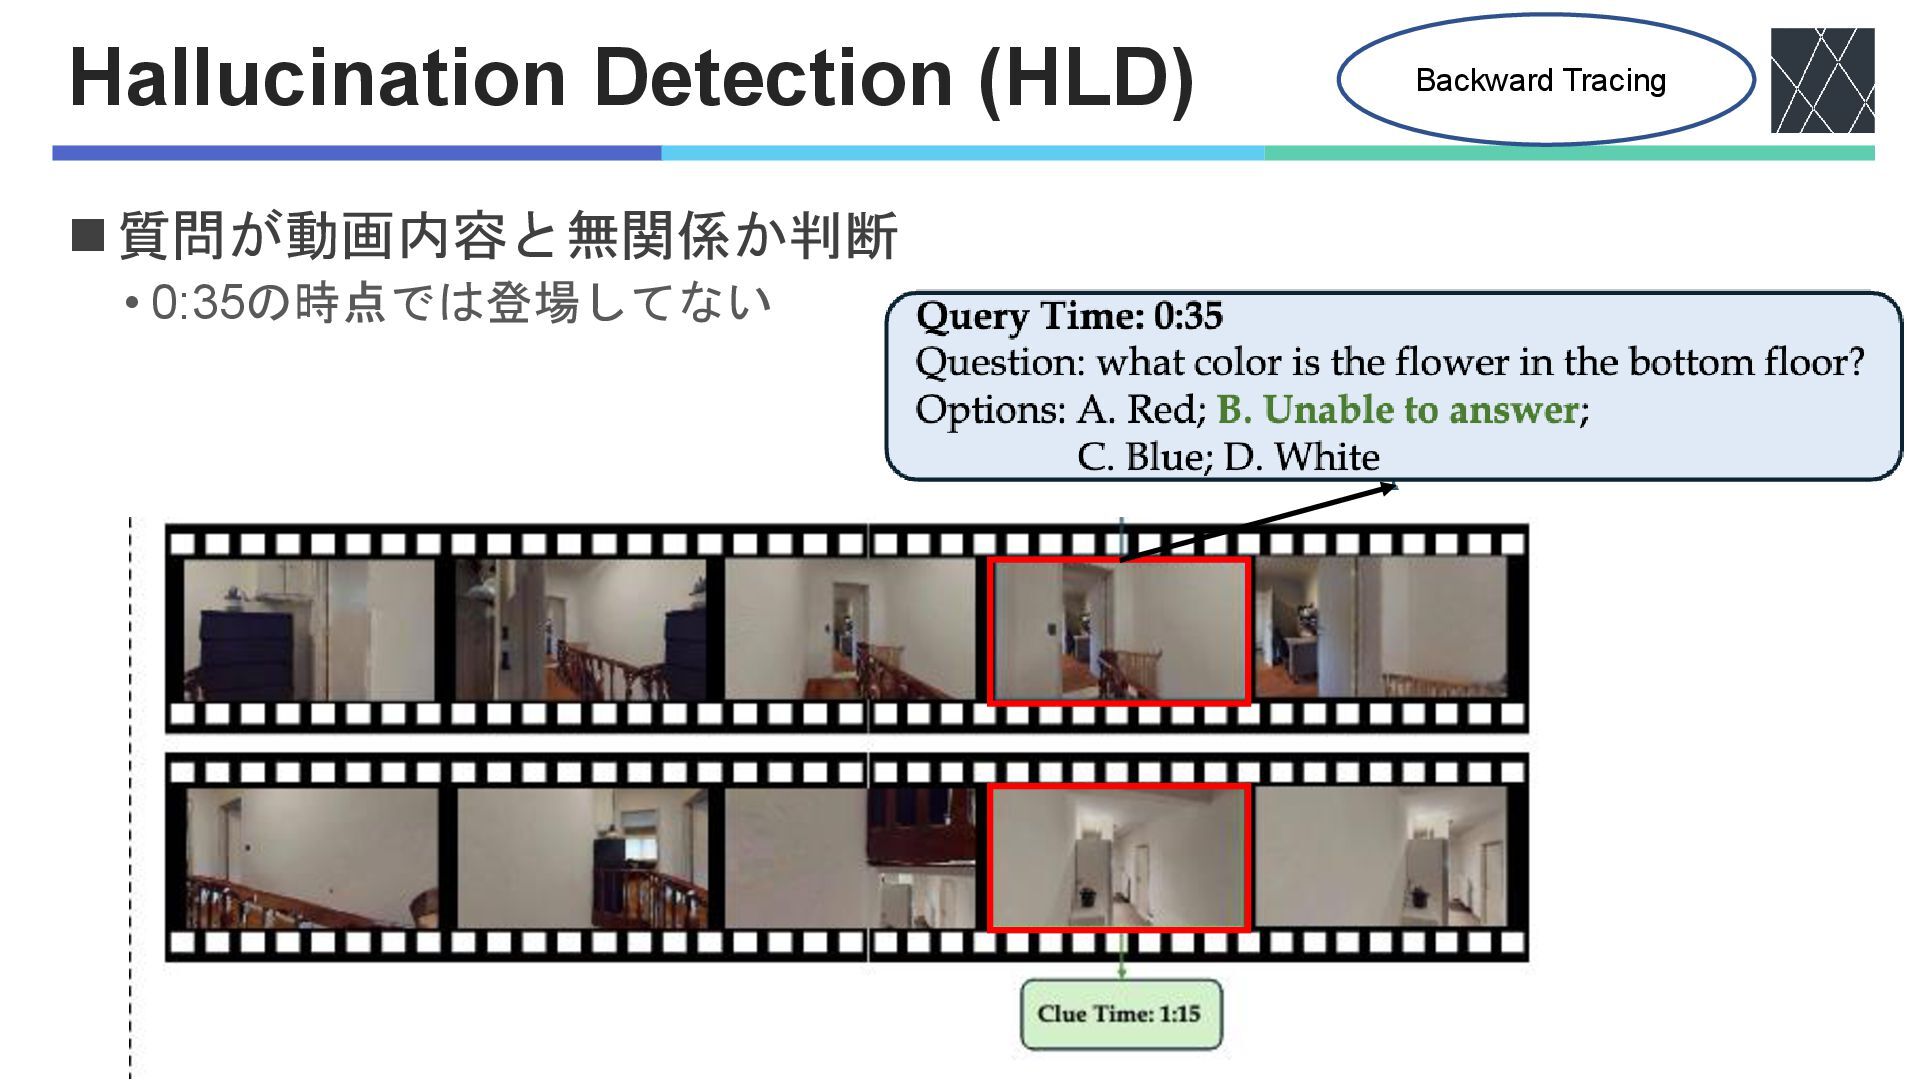
Hallucination Detection (HLD) ◼質問が動画内容と無関係か判断 • 0:35の時点では登場してない Backward Tracing
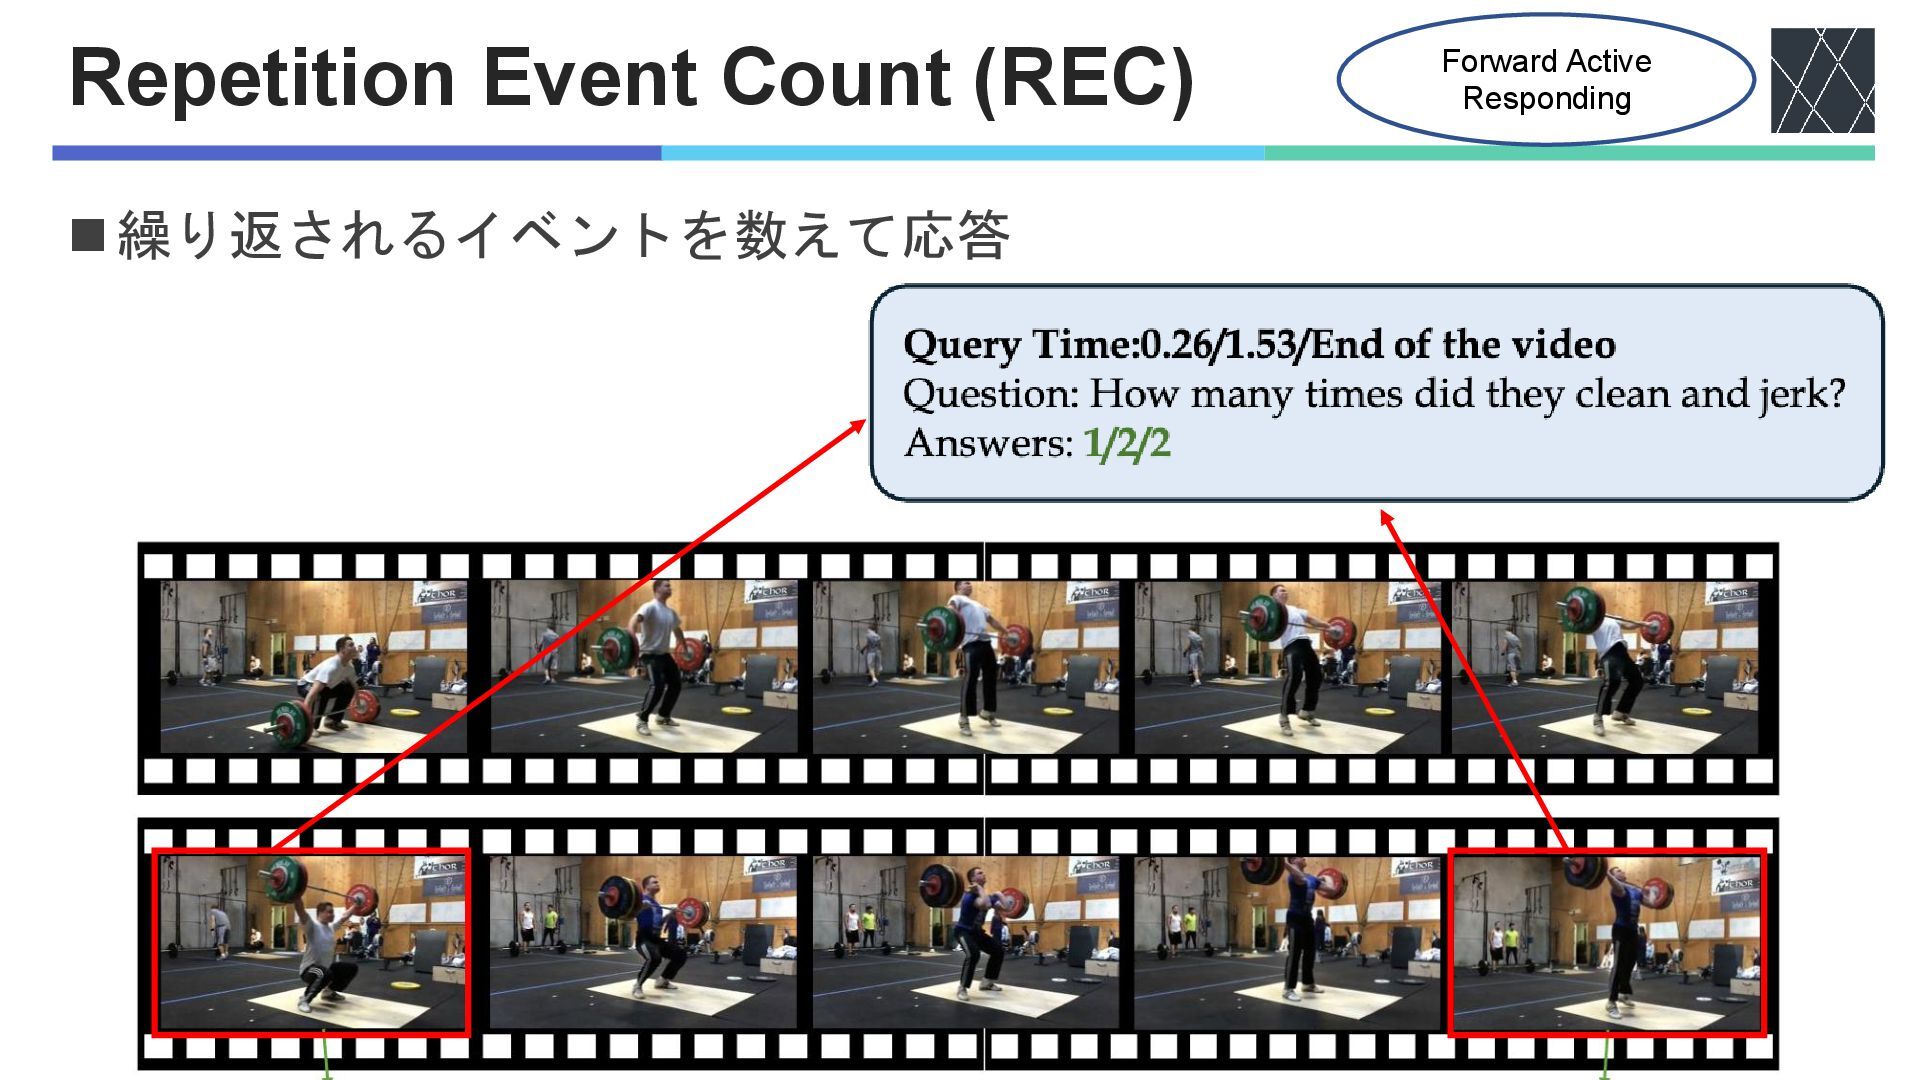
Repetition Event Count (REC) ◼繰り返されるイベントを数えて応答 Forward Active Responding
Sequential Steps Recognition (SSR) ◼手順が完了してから応答 Forward Active Responding
Clues Reveal Responding (CRR) ◼ヒントが十分に出てから応答 Forward Active Responding
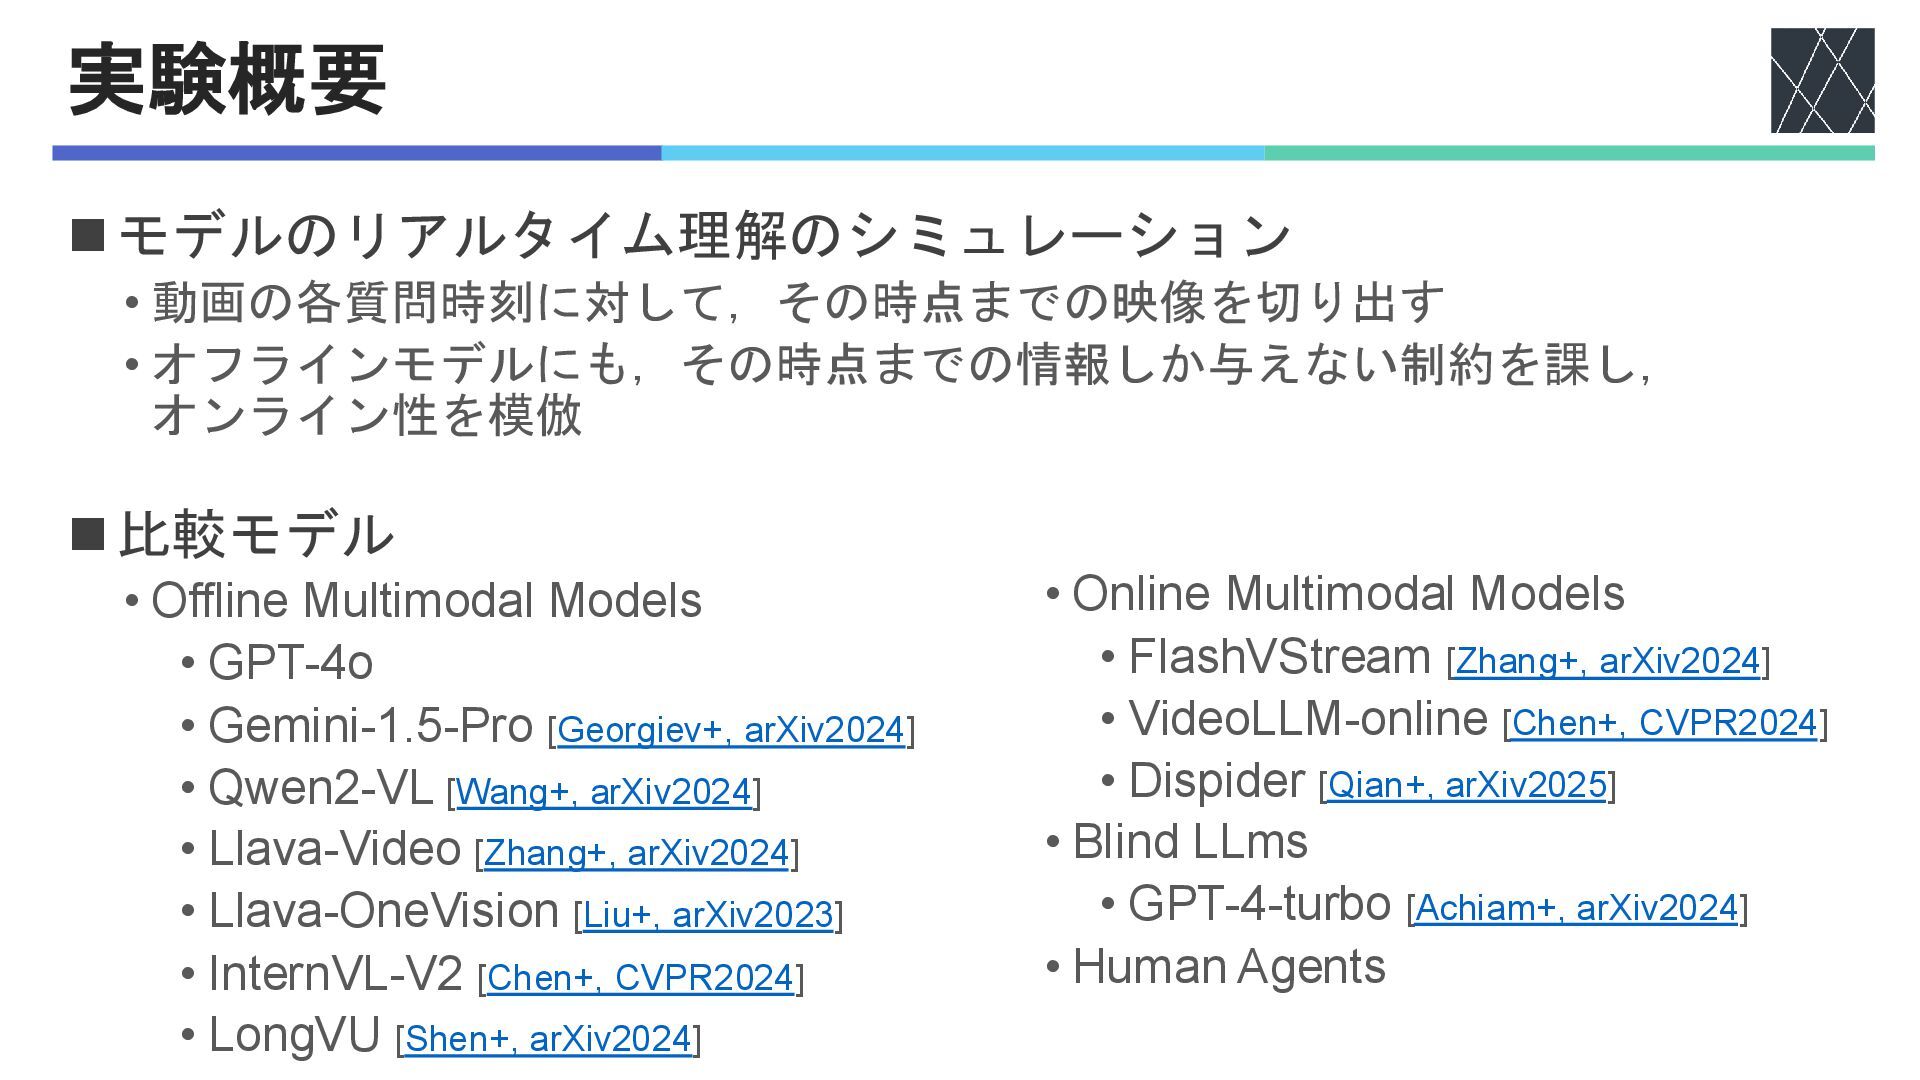
実験概要 ◼比較モデル • Offline Multimodal Models • GPT-4o • Gemini-1.5-Pro
[Georgiev+, arXiv2024] • Qwen2-VL [Wang+, arXiv2024] • Llava-Video [Zhang+, arXiv2024] • Llava-OneVision [Liu+, arXiv2023] • InternVL-V2 [Chen+, CVPR2024] • LongVU [Shen+, arXiv2024] • Online Multimodal Models • FlashVStream [Zhang+, arXiv2024] • VideoLLM-online [Chen+, CVPR2024] • Dispider [Qian+, arXiv2025] • Blind LLms • GPT-4-turbo [Achiam+, arXiv2024] • Human Agents ◼モデルのリアルタイム理解のシミュレーション • 動画の各質問時刻に対して,その時点までの映像を切り出す • オフラインモデルにも,その時点までの情報しか与えない制約を課し, オンライン性を模倣
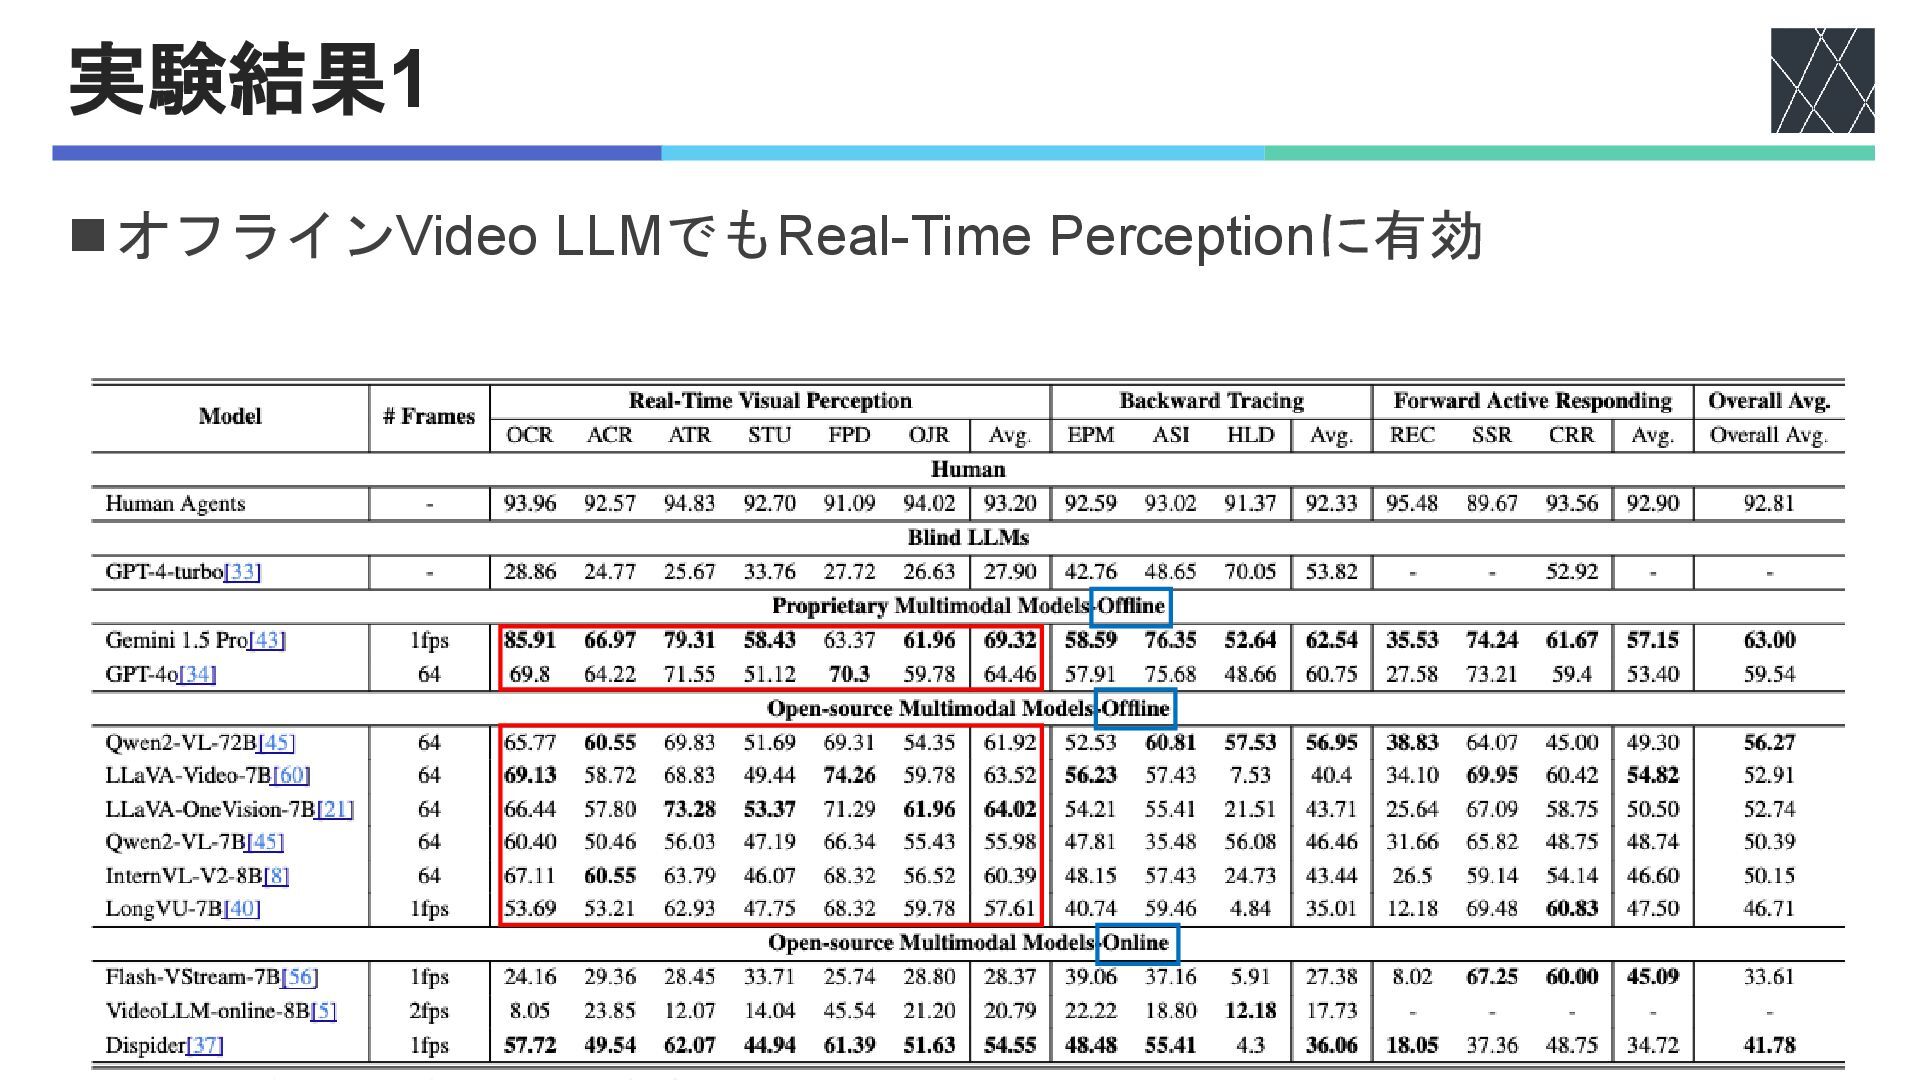
実験結果1 ◼オフラインVideo LLMでもReal-Time Perceptionに有効
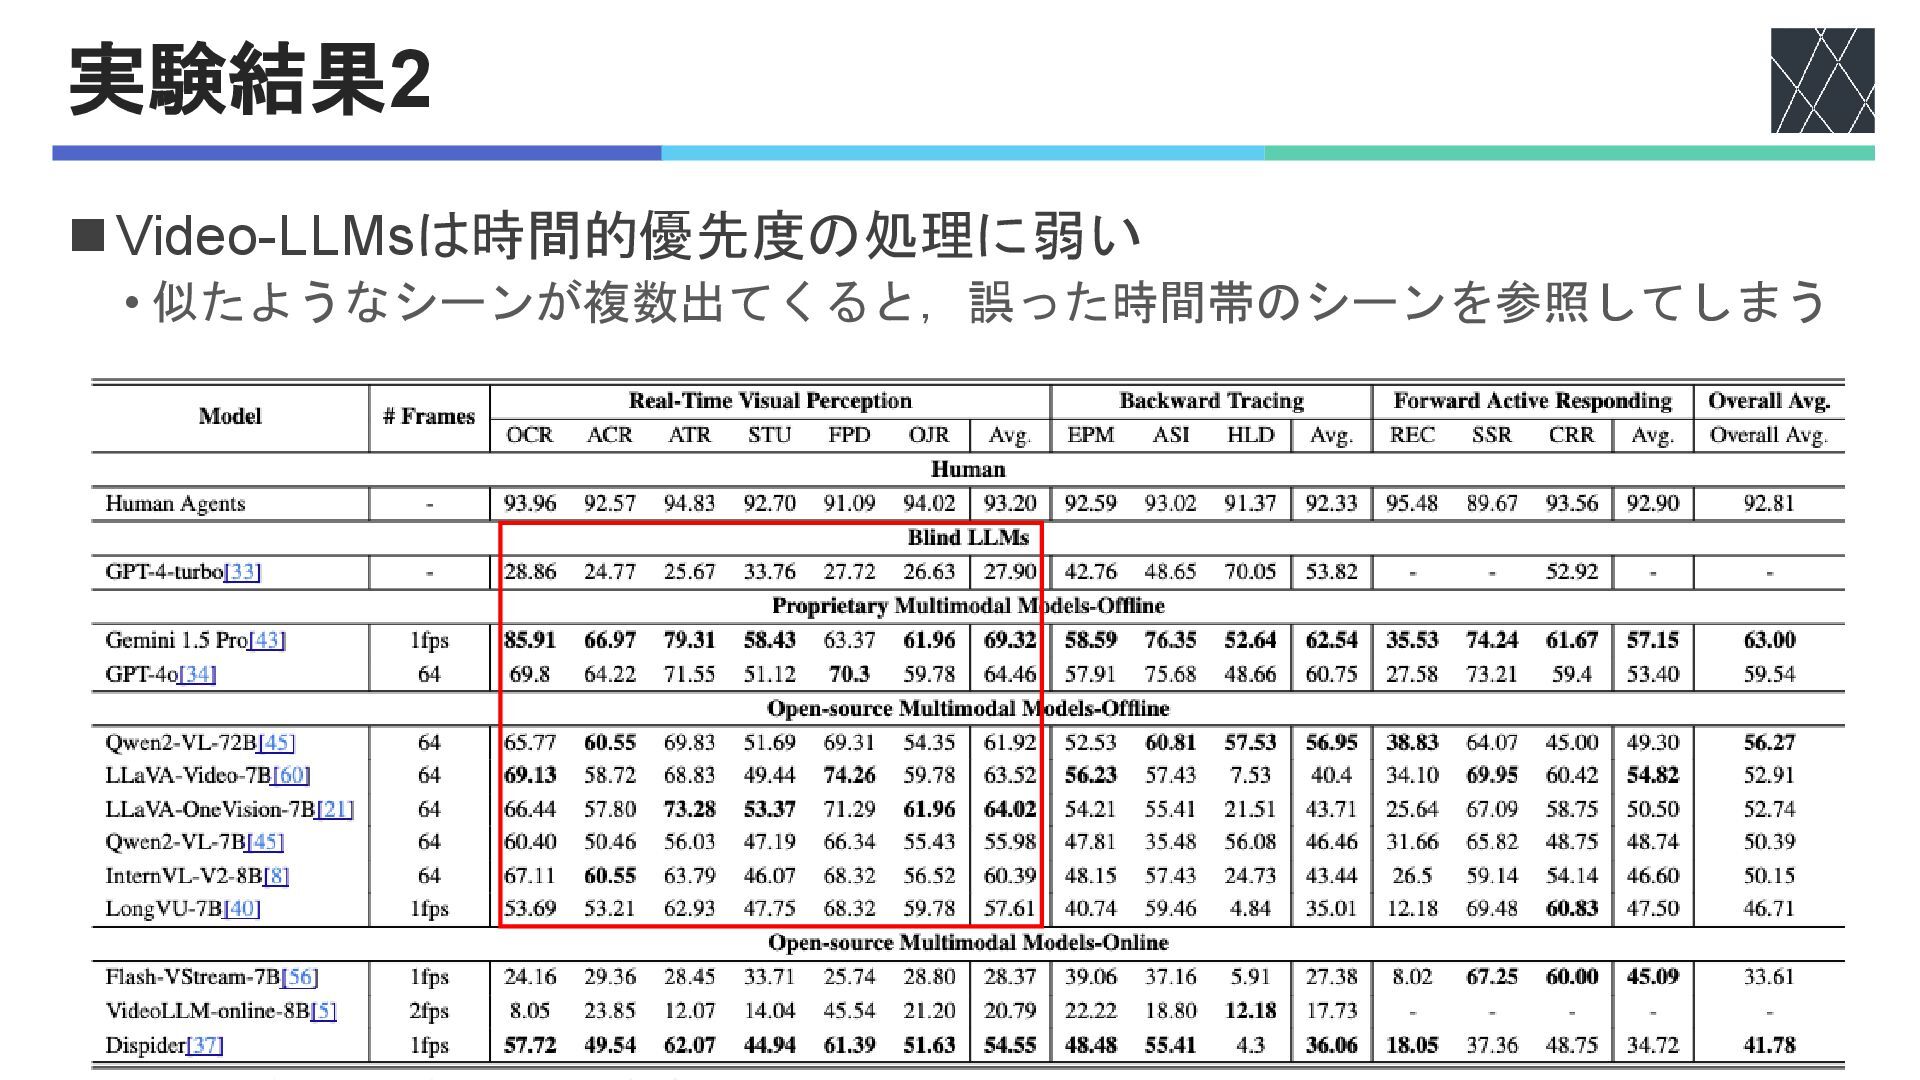
実験結果2 ◼Video-LLMsは時間的優先度の処理に弱い • 似たようなシーンが複数出てくると,誤った時間帯のシーンを参照してしまう
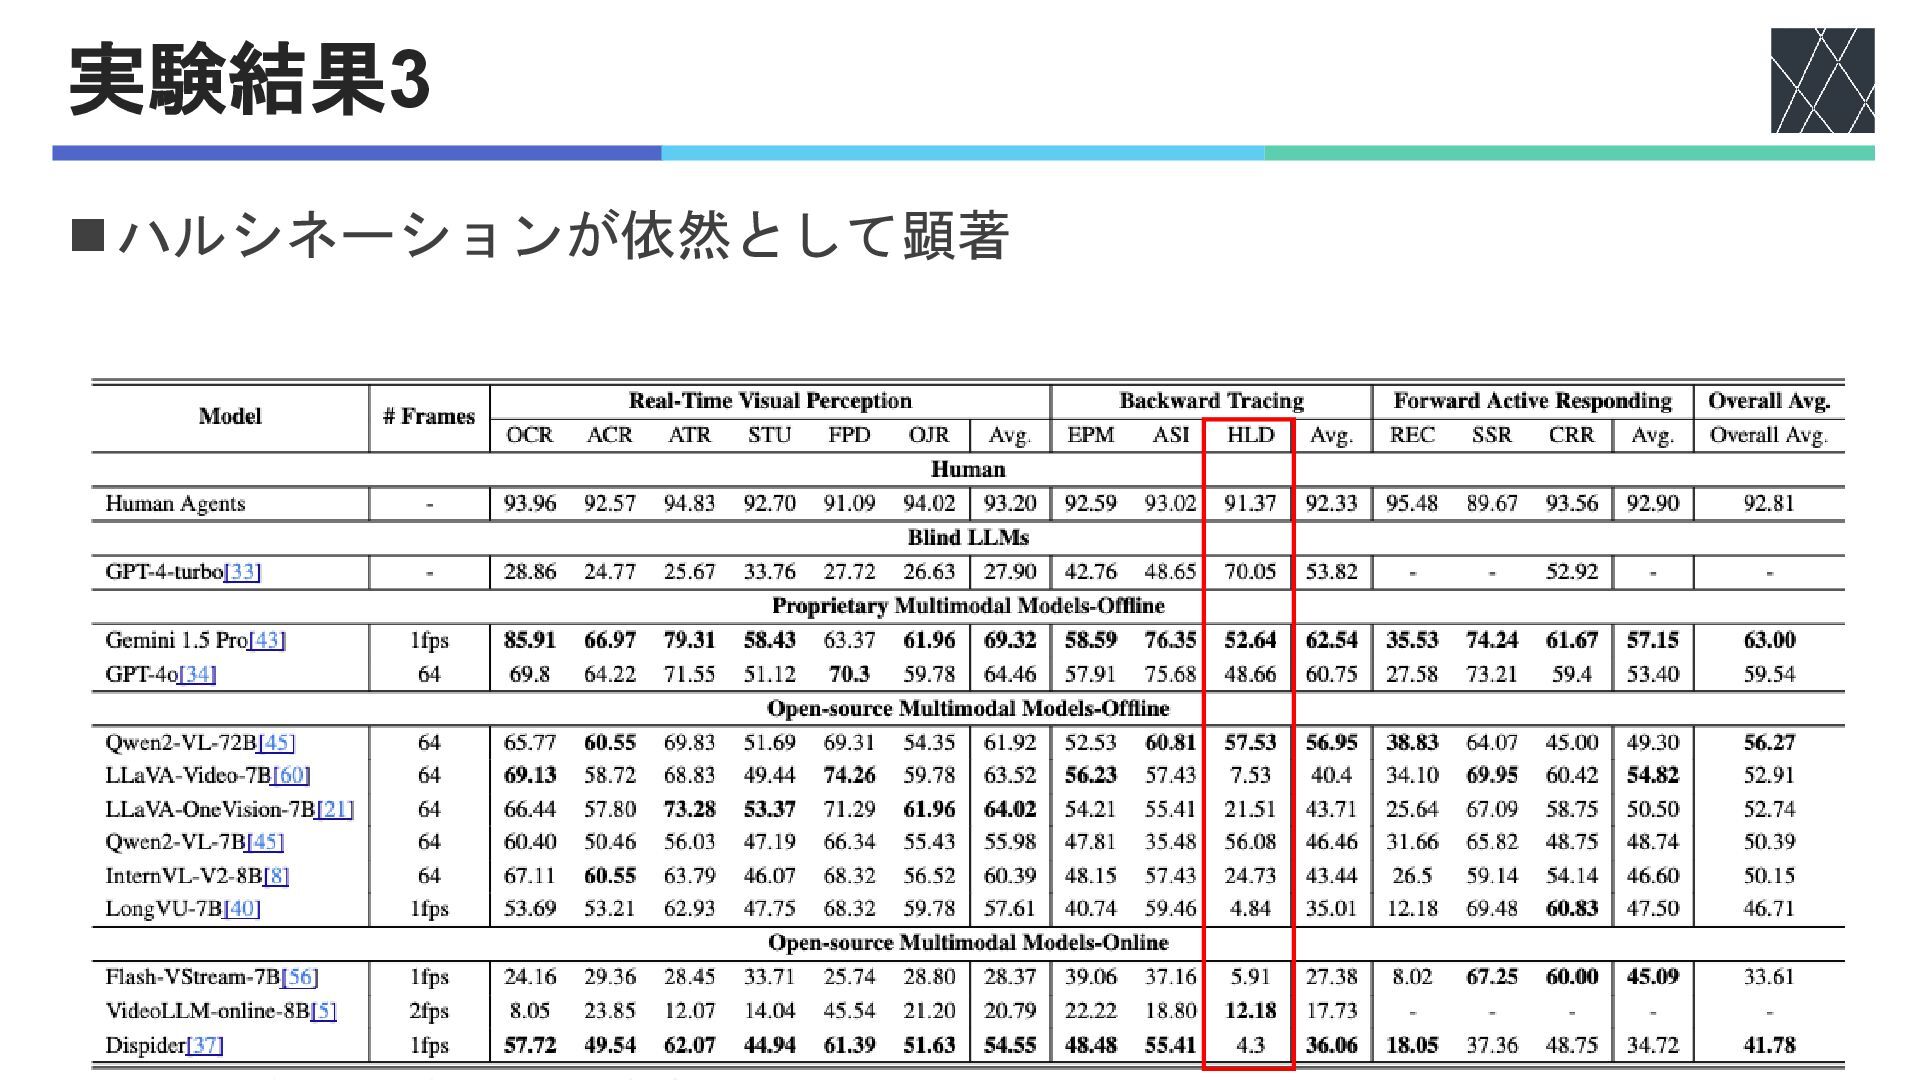
実験結果3 ◼ハルシネーションが依然として顕著
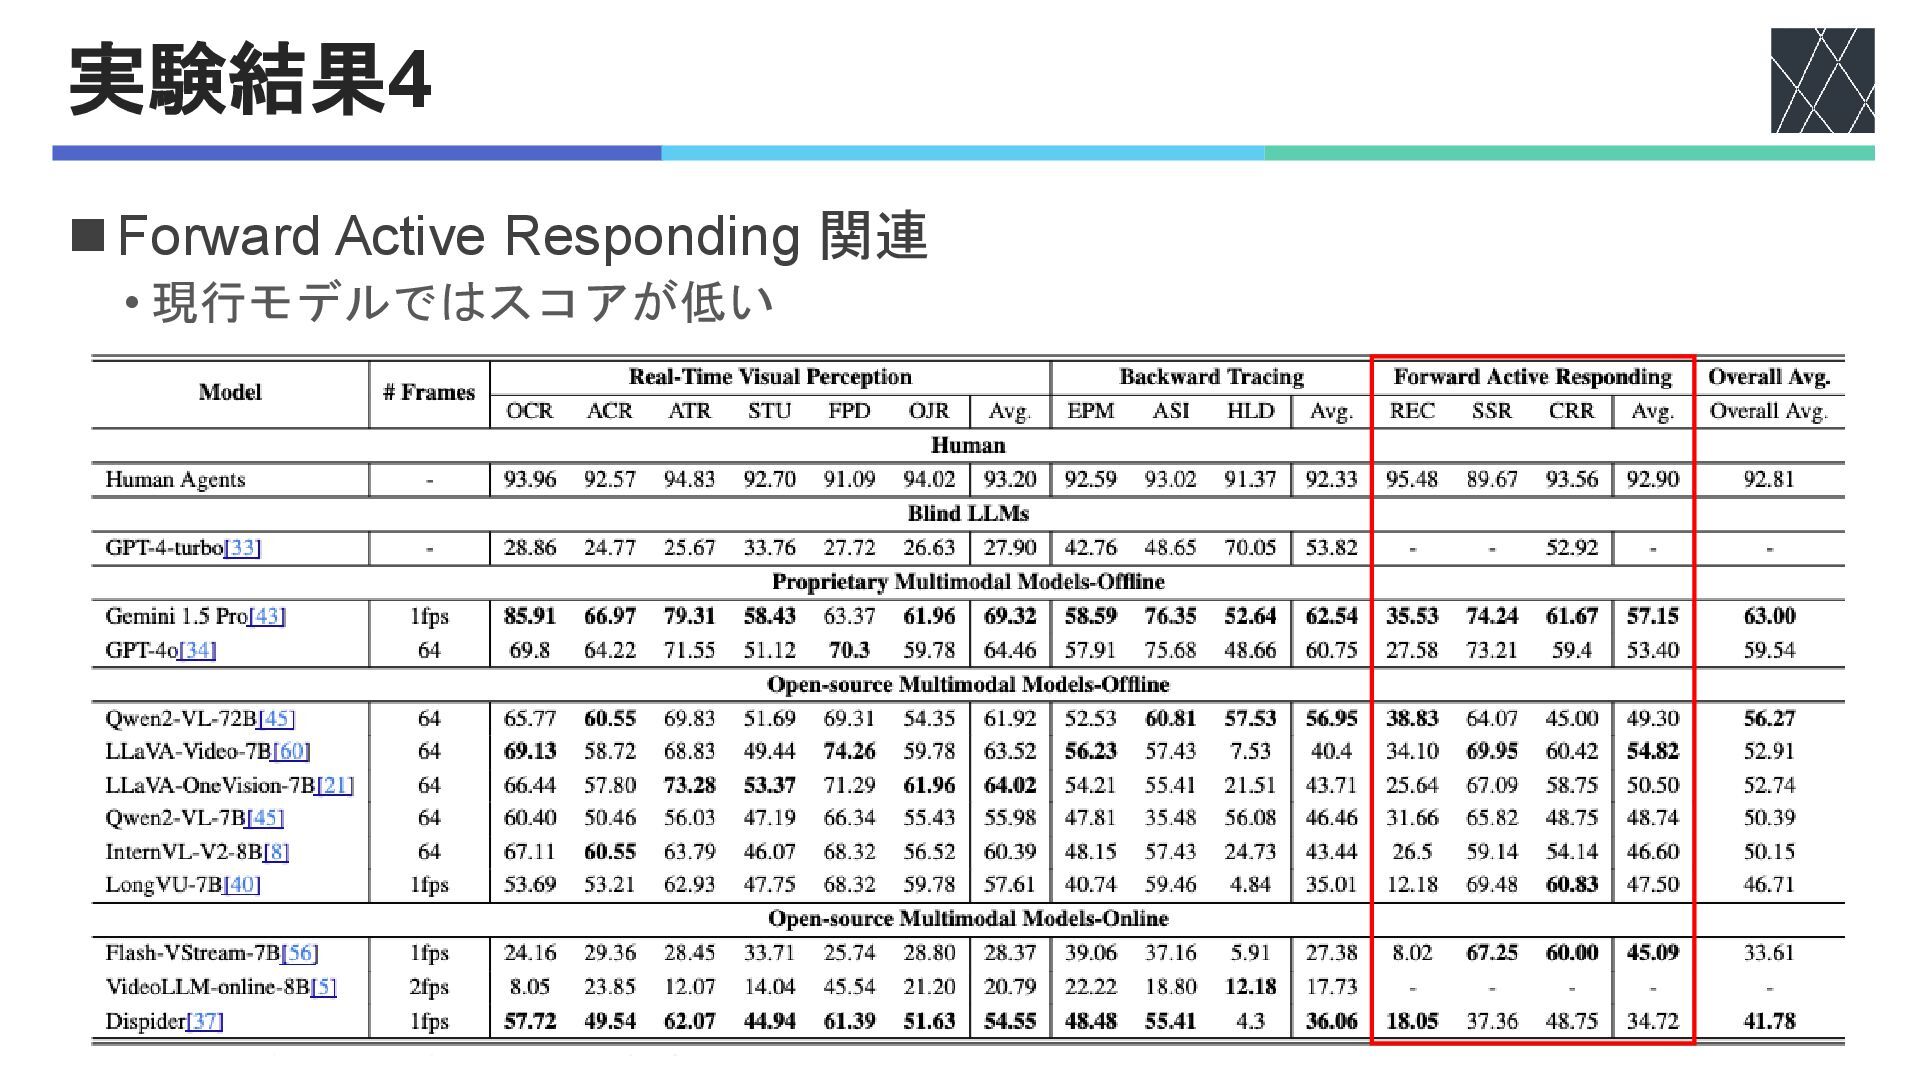
実験結果4 ◼Forward Active Responding 関連 • 現行モデルではスコアが低い
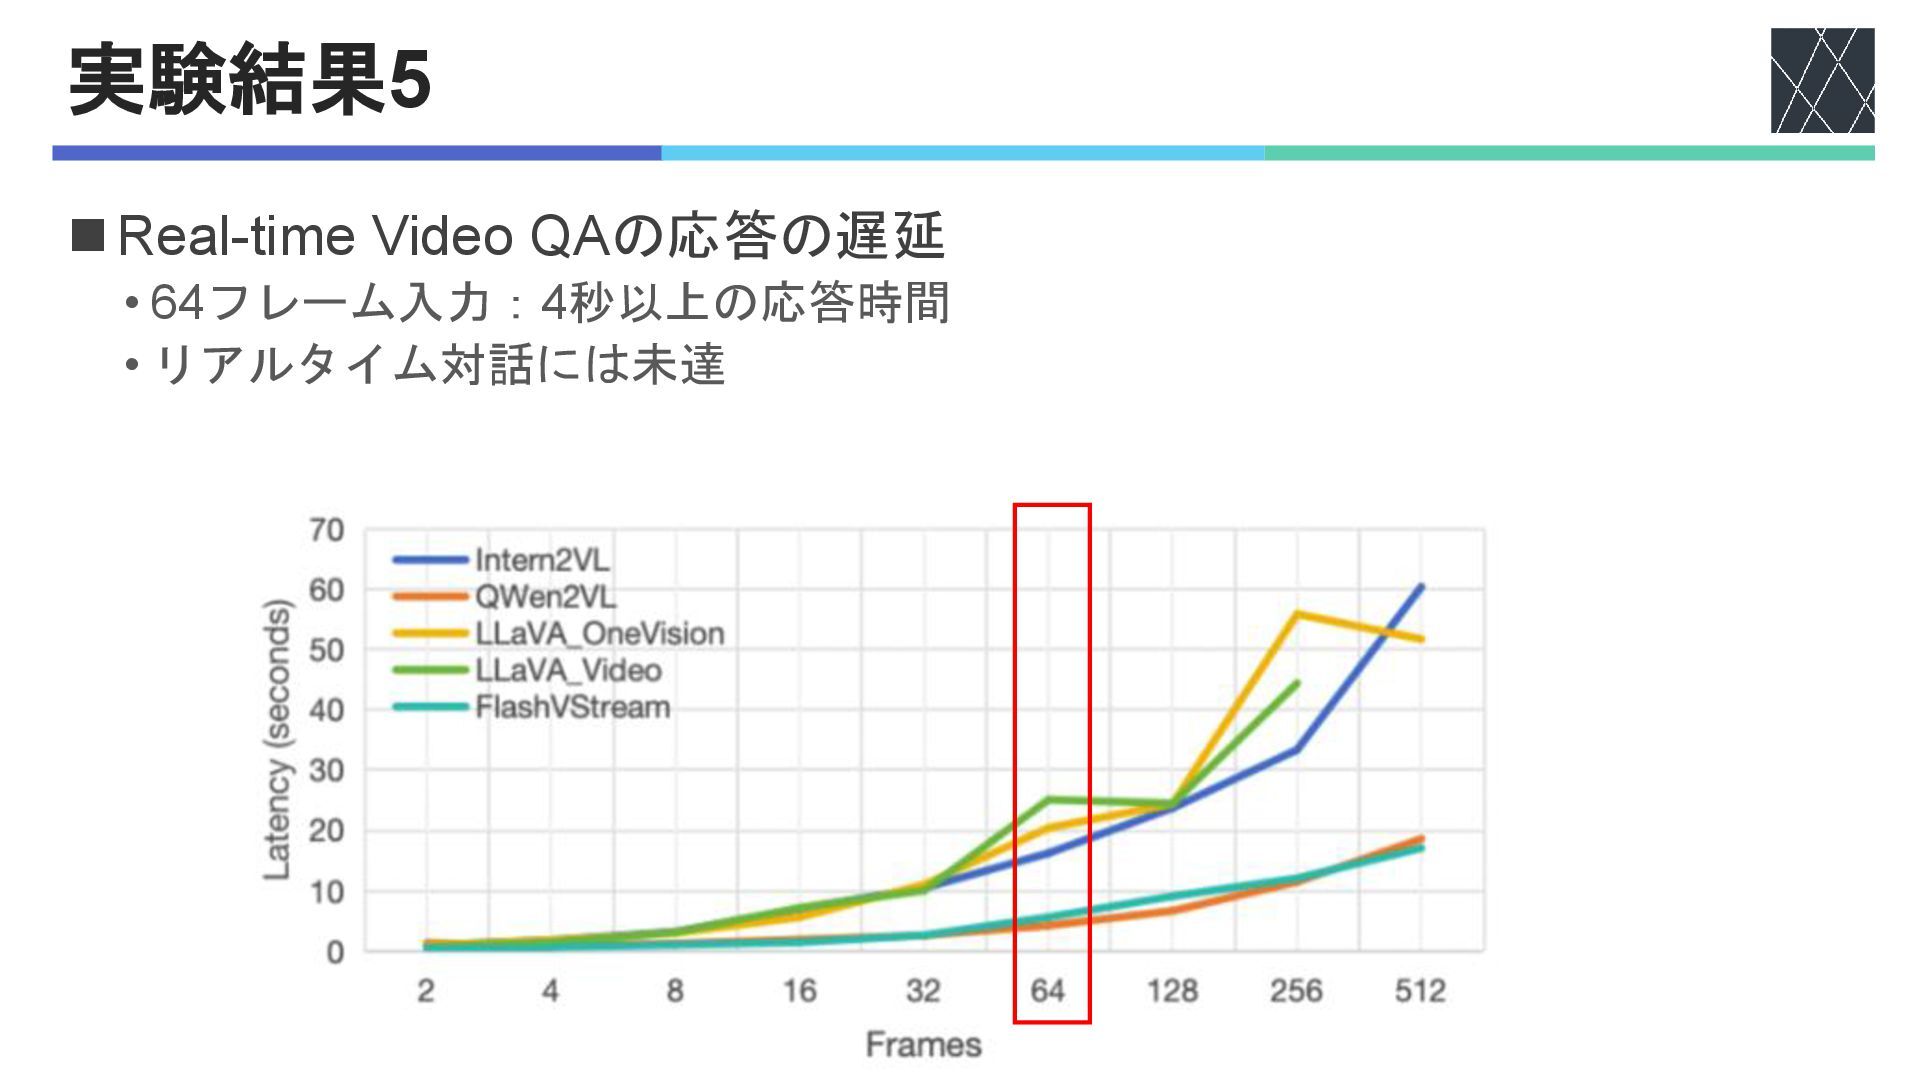
実験結果5 ◼Real-time Video QAの応答の遅延 • 64フレーム入力:4秒以上の応答時間 • リアルタイム対話には未達
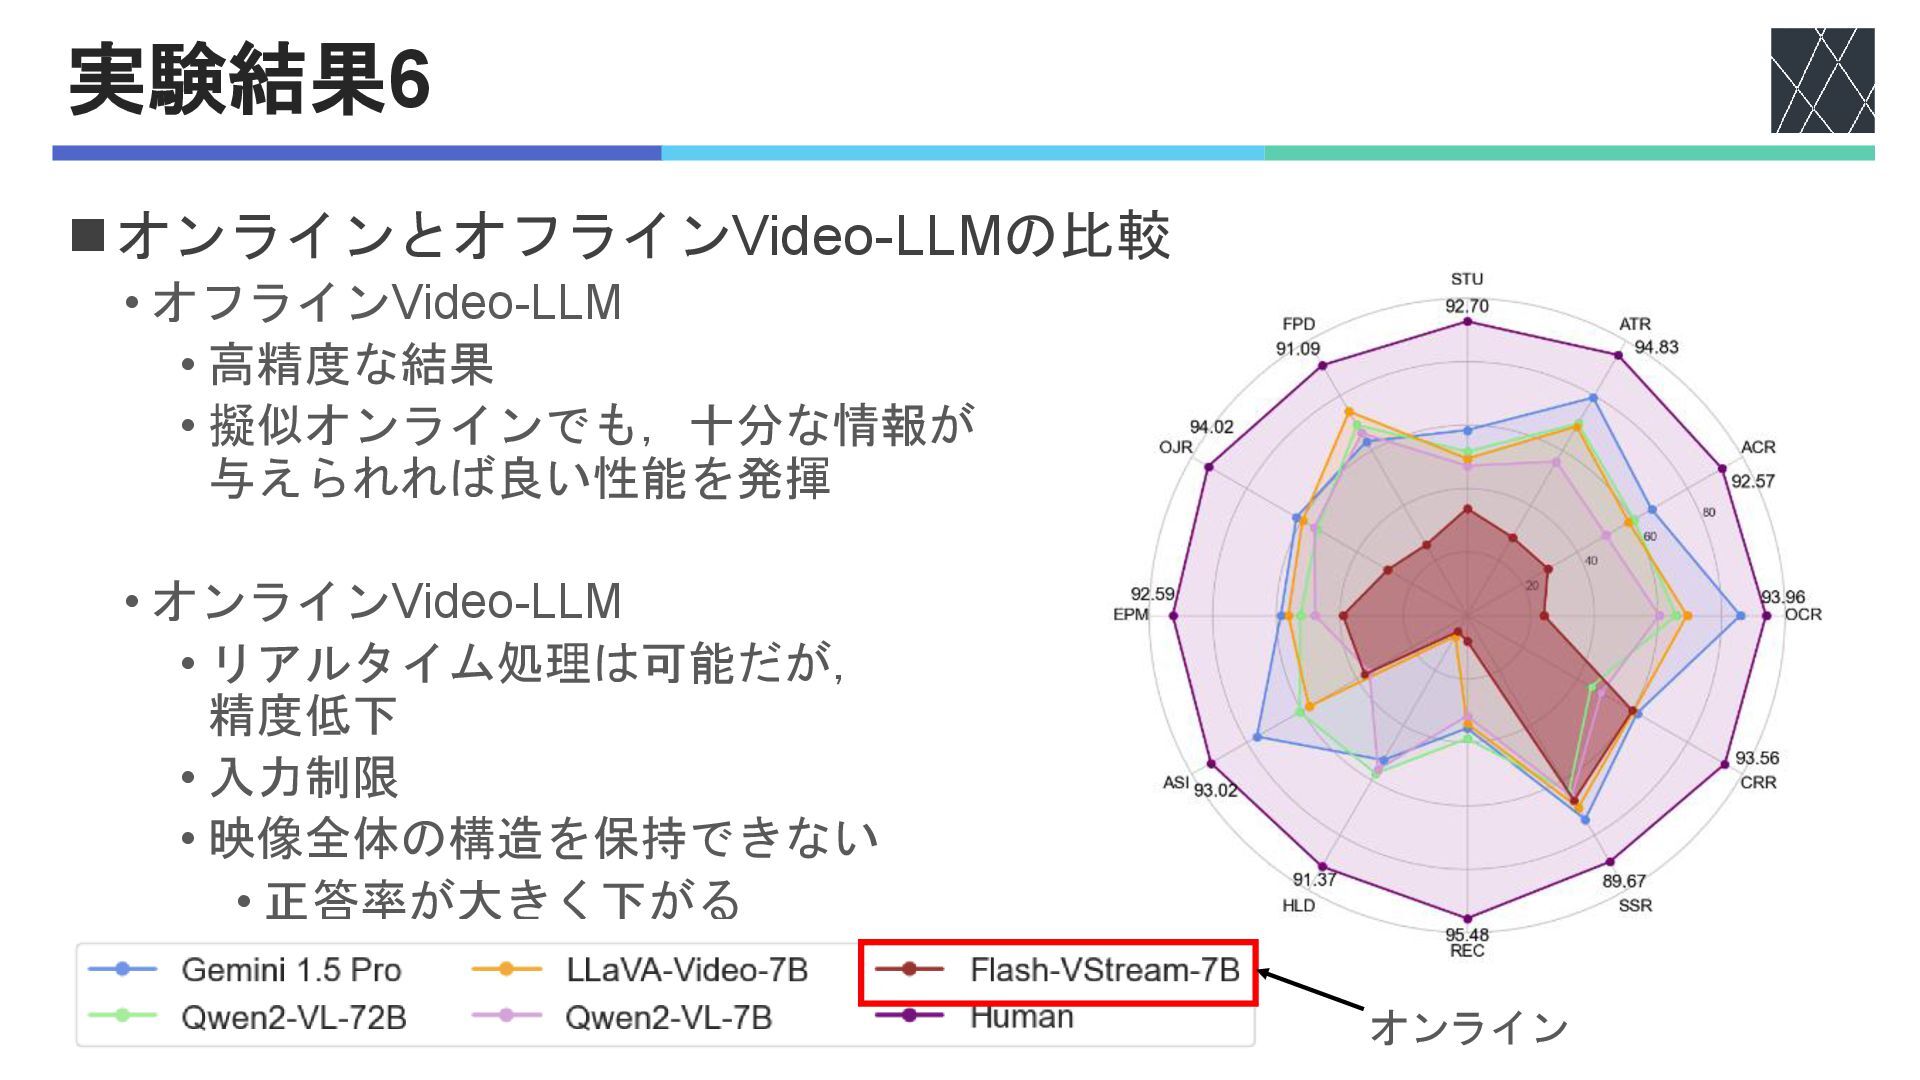
実験結果6 ◼オンラインとオフラインVideo-LLMの比較 • オフラインVideo-LLM • 高精度な結果 • 擬似オンラインでも,十分な情報が 与えられれば良い性能を発揮 •
オンラインVideo-LLM • リアルタイム処理は可能だが, 精度低下 • 入力制限 • 映像全体の構造を保持できない • 正答率が大きく下がる オンライン
まとめ ◼OVO-Bench • Video-LLMのオンラインビデオ理解能力を3つの重要なモードにわたって評価 • Backward Tracing • Forward Active
Responding • Real-Time Visual Perception • 様々なVideo-LLMsの性能を評価 • オンライン的な理解力を評価 • 映像をリアルタイムに追いながら,適切なタイミングで正確に答えるモデルは まだ出てきていない


 pwiseman
 nikkihalliwell
 katarinadahlin
 mfonobong
 paigeccino
 vanstee
 jct
 eitanlees
 swwweet
 tamaranovitovic
 ryanjones
 marcduiker