Upgrade to Pro — share decks privately, control downloads, hide ads and more …

なぜ「検索」が成果物の質の上限を決めるのか

 なぜ「検索」が成果物の質の上限を決めるのか

AIエージェント設計勉強会 ~自己改善、検索編~
なぜ「検索」が成果物の質の上限を決めるのか
― 安く正しく探すための Deep Research 設計 ―
2026年9月15日 株式会社電通総研 事業開発室 Engineeringグループ
主催:株式会社LayerX / 共催:株式会社電通総研

Avatar for Hisanori Ozaki

Hisanori Ozaki

September 24, 2026

More Decks by Hisanori Ozaki

Other Decks in Technology

Transcript

  1. AI エ ージ ェ ン ト設 計 勉 強会 ~

    自己 改 善 、検 索 編 ~ なぜ「検索」が成果物の質の 上限を決めるのか ― 安く正しく探すための Deep Research 設計 ― 2026年9月15日 株式会社電通総研 事業開発室 Engineeringグループ 登壇者:里中 裕輔 主催:株式会社LayerX / 共催:株式会社電通総研
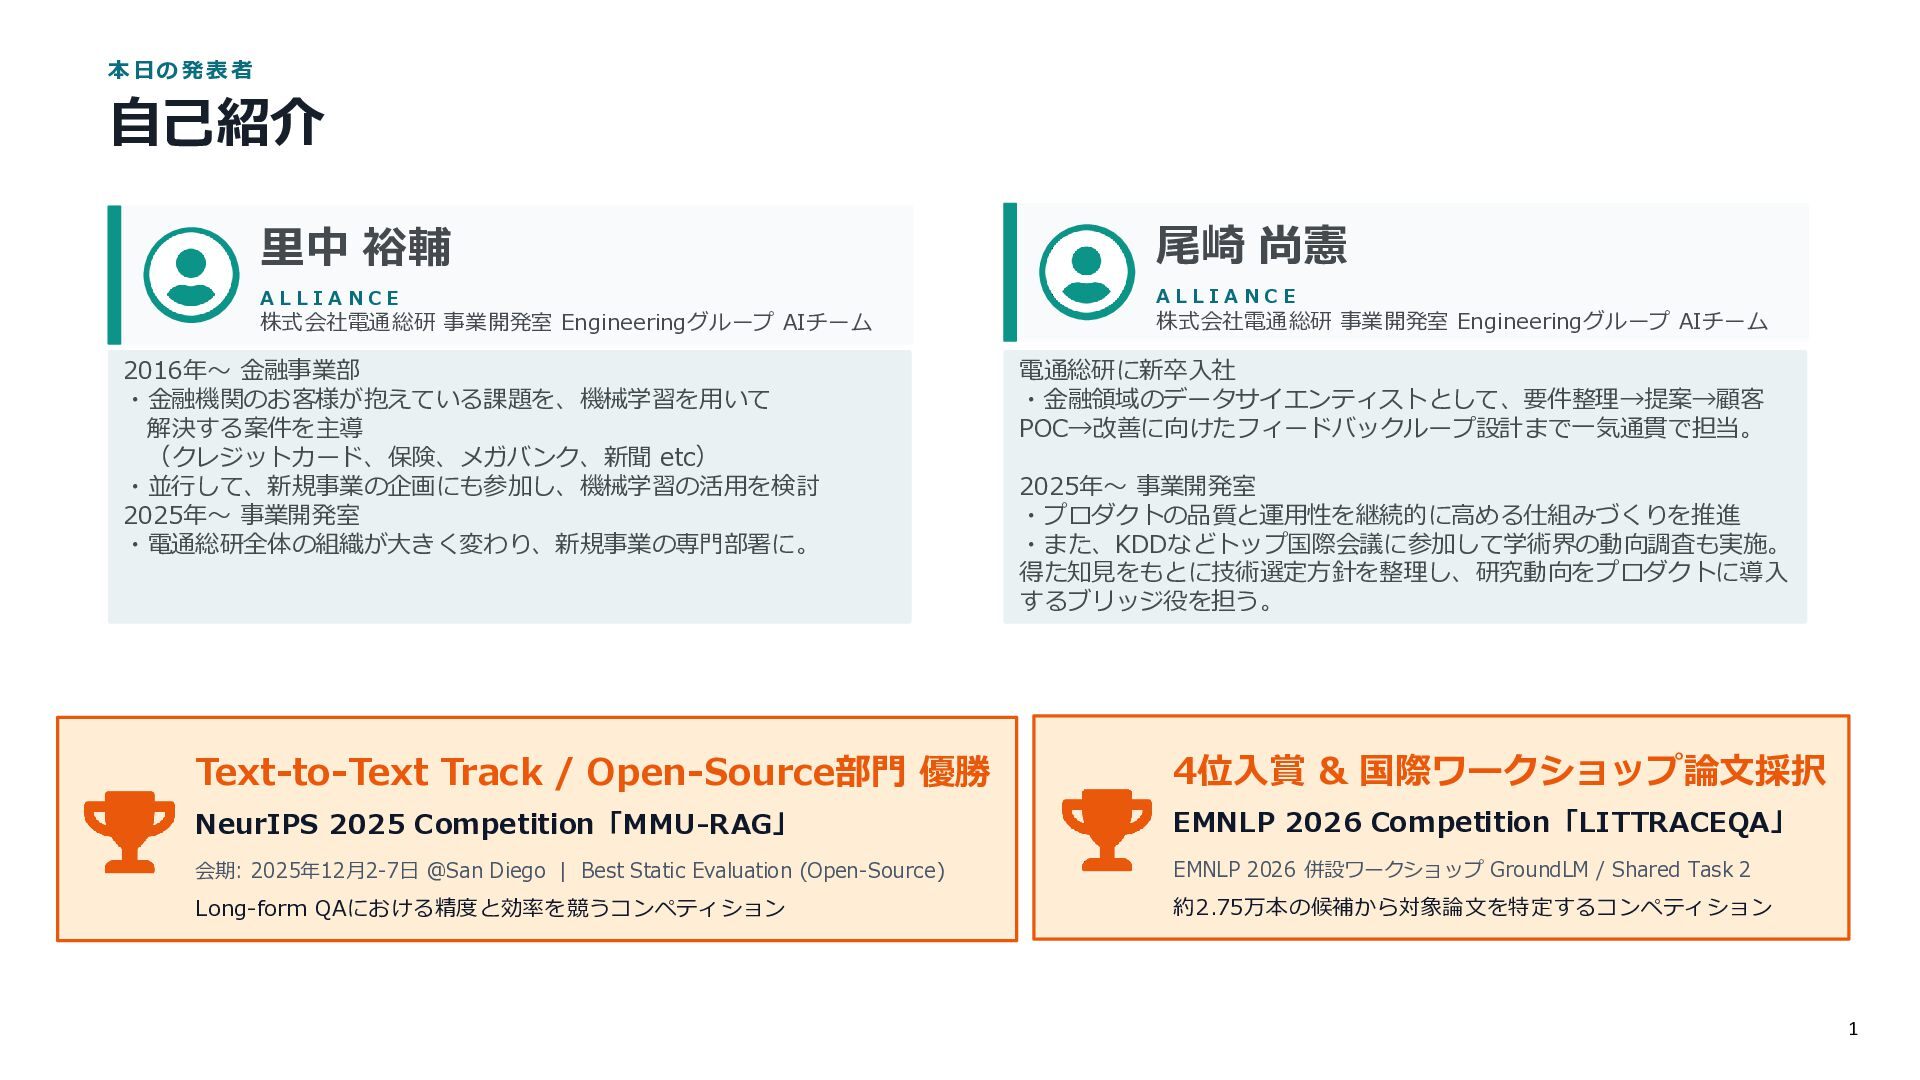
  2. 本日の発表者 自己紹介 里中 裕輔 尾崎 尚憲 ALLIA NCE ALLIA NCE

    株式会社電通総研 事業開発室 Engineeringグループ AIチーム 2016年~ 金融事業部 ・金融機関のお客様が抱えている課題を、機械学習を用いて 解決する案件を主導 (クレジットカード、保険、メガバンク、新聞 etc) ・並行して、新規事業の企画にも参加し、機械学習の活用を検討 ​2025年~ 事業開発室 ・電通総研全体の組織が大きく変わり、新規事業の専門部署に。 株式会社電通総研 事業開発室 Engineeringグループ AIチーム 電通総研に新卒入社 ・金融領域のデータサイエンティストとして、要件整理→提案→顧客 POC→改善に向けたフィードバックループ設計まで一気通貫で担当。 2025年~ 事業開発室 ・プロダクトの品質と運用性を継続的に高める仕組みづくりを推進 ・また、KDDなどトップ国際会議に参加して学術界の動向調査も実施。 得た知見をもとに技術選定方針を整理し、研究動向をプロダクトに導入 するブリッジ役を担う。 Text-to-Text Track / Open-Source部門 優勝 4位入賞 & 国際ワークショップ論文採択 NeurIPS 2025 Competition「MMU-RAG」 EMNLP 2026 Competition「LITTRACEQA」 会期: 2025年12月2-7日 @San Diego | Best Static Evaluation (Open-Source) EMNLP 2026 併設ワークショップ GroundLM / Shared Task 2 Long-form QAにおける精度と効率を競うコンペティション 約2.75万本の候補から対象論文を特定するコンペティション 1
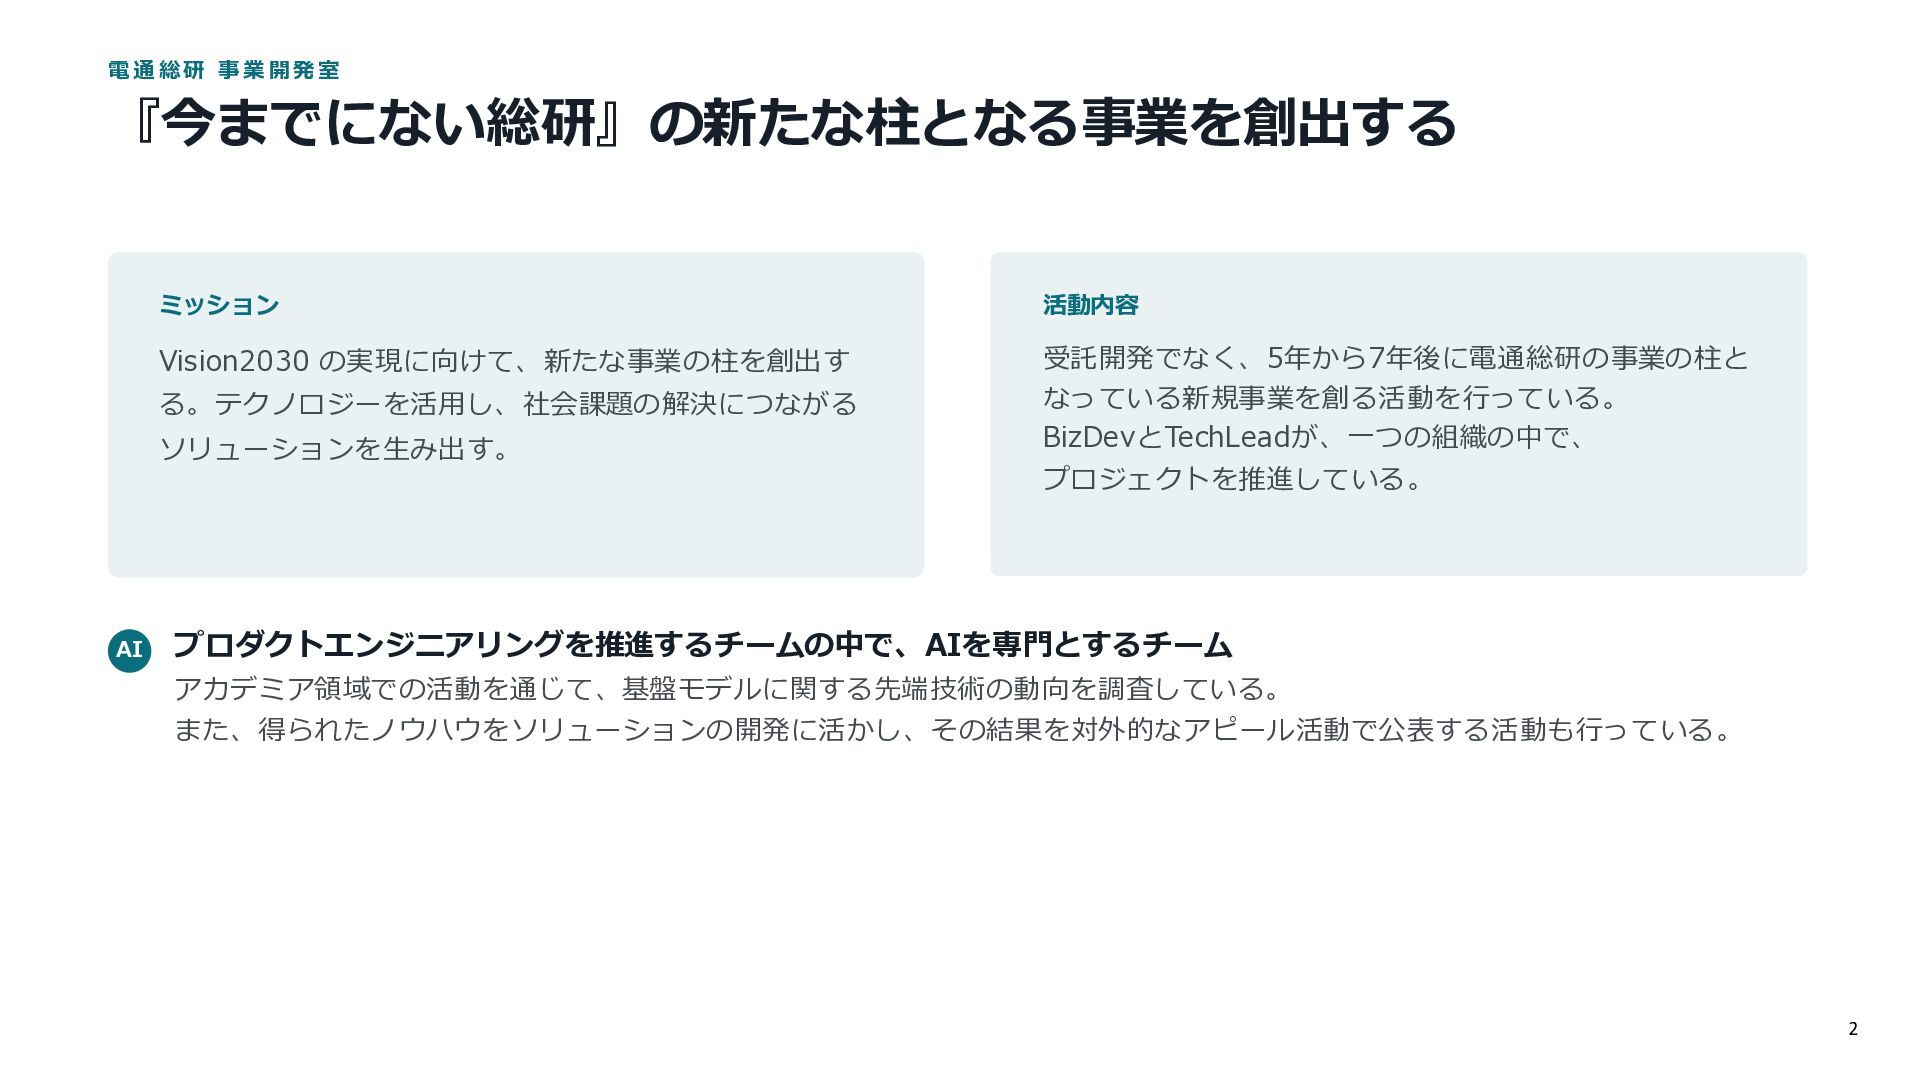
  3. 電通 総研 事業 開発室 『今までにない総研』の新たな柱となる事業を創出する ミッション 活動内容 Vision2030 の実現に向けて、新たな事業の柱を創出す 受託開発でなく、5年から7年後に電通総研の事業の柱と

    なっている新規事業を創る活動を行っている。 BizDevとTechLeadが、一つの組織の中で、 る。テクノロジーを活用し、社会課題の解決につながる ソリューションを生み出す。 AI プロジェクトを推進している。 プロダクトエンジニアリングを推進するチームの中で、AIを専門とするチーム アカデミア領域での活動を通じて、基盤モデルに関する先端技術の動向を調査している。 また、得られたノウハウをソリューションの開発に活かし、その結果を対外的なアピール活動で公表する活動も行っている。 2
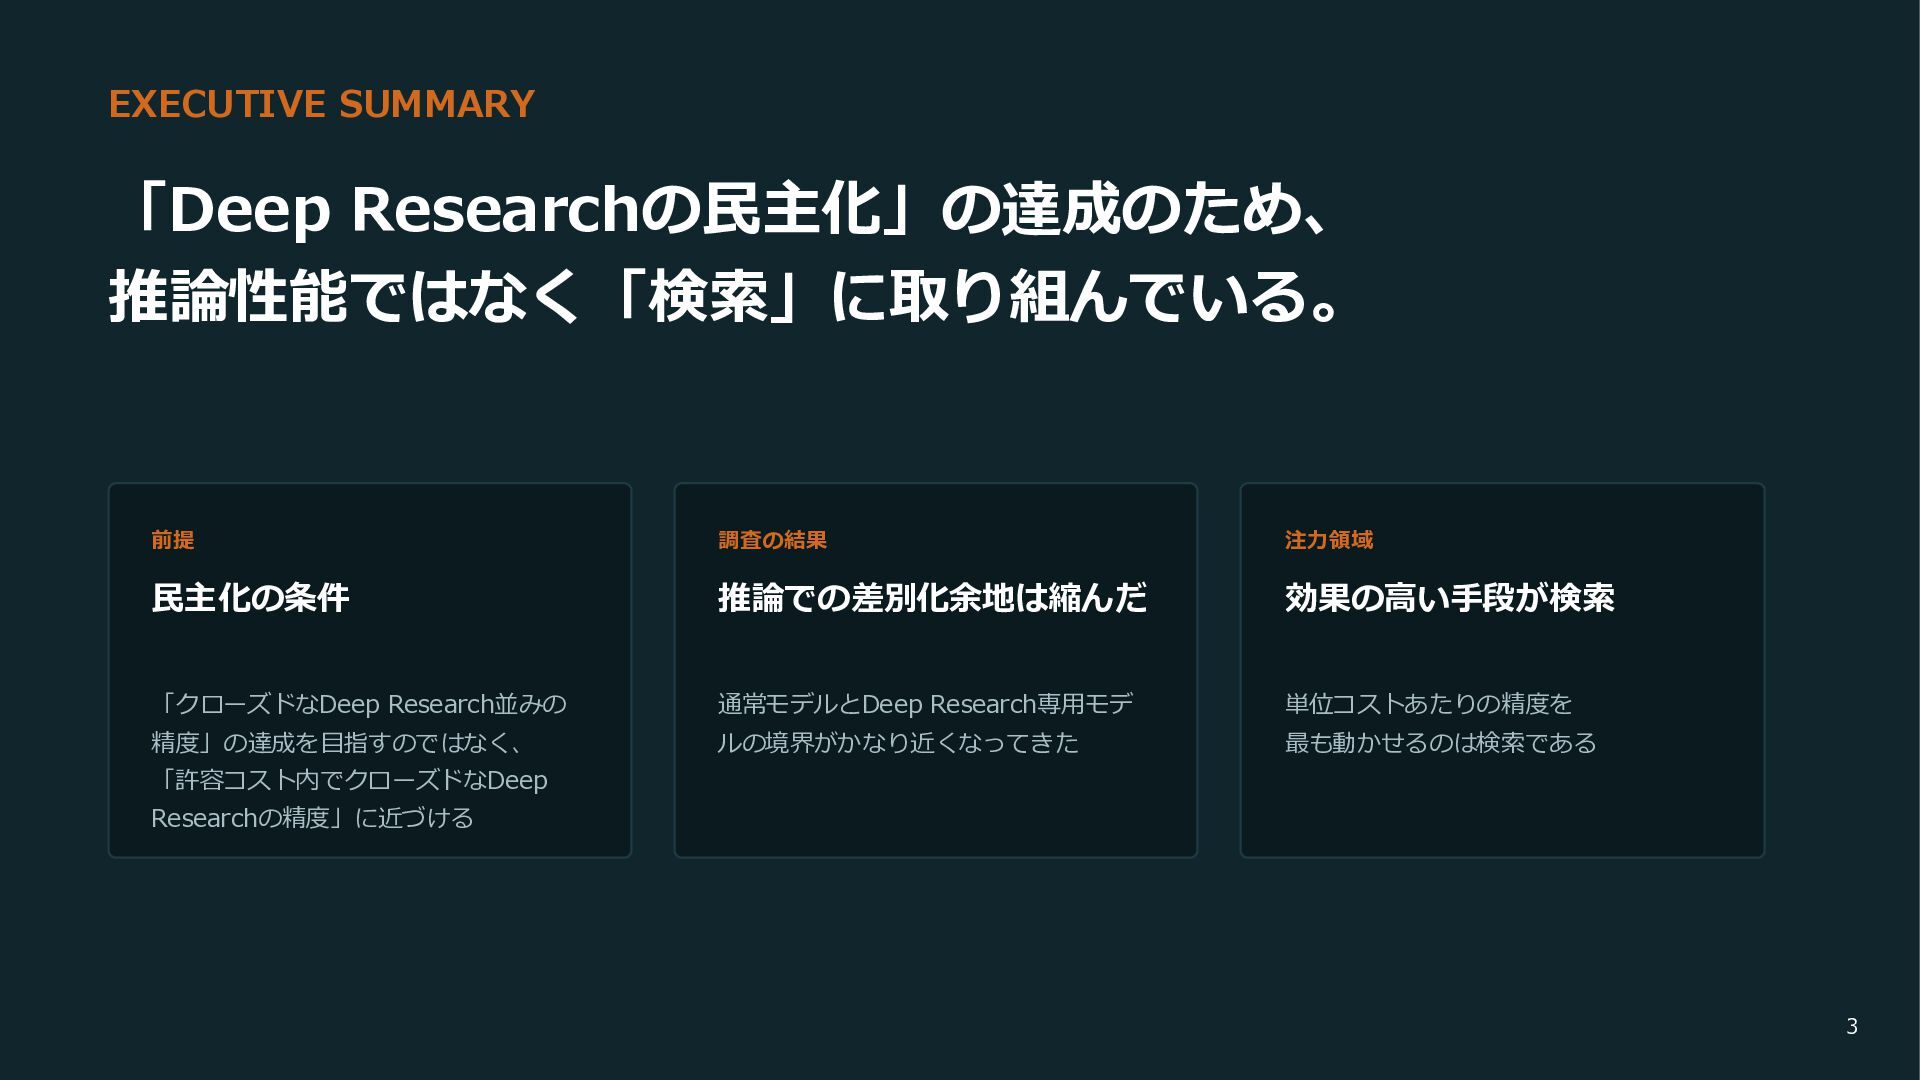
  4. EXECUTIVE SUMMARY 「Deep Researchの民主化」の達成のため、 推論性能ではなく「検索」に取り組んでいる。 前提 調査の結果 注力領域 民主化の条件 推論での差別化余地は縮んだ

    効果の高い手段が検索 「クローズドなDeep Research並みの 通常モデルとDeep Research専用モデ 単位コストあたりの精度を 精度」の達成を目指すのではなく、 ルの境界がかなり近くなってきた 最も動かせるのは検索である 「許容コスト内でクローズドなDeep Researchの精度」に近づける 3
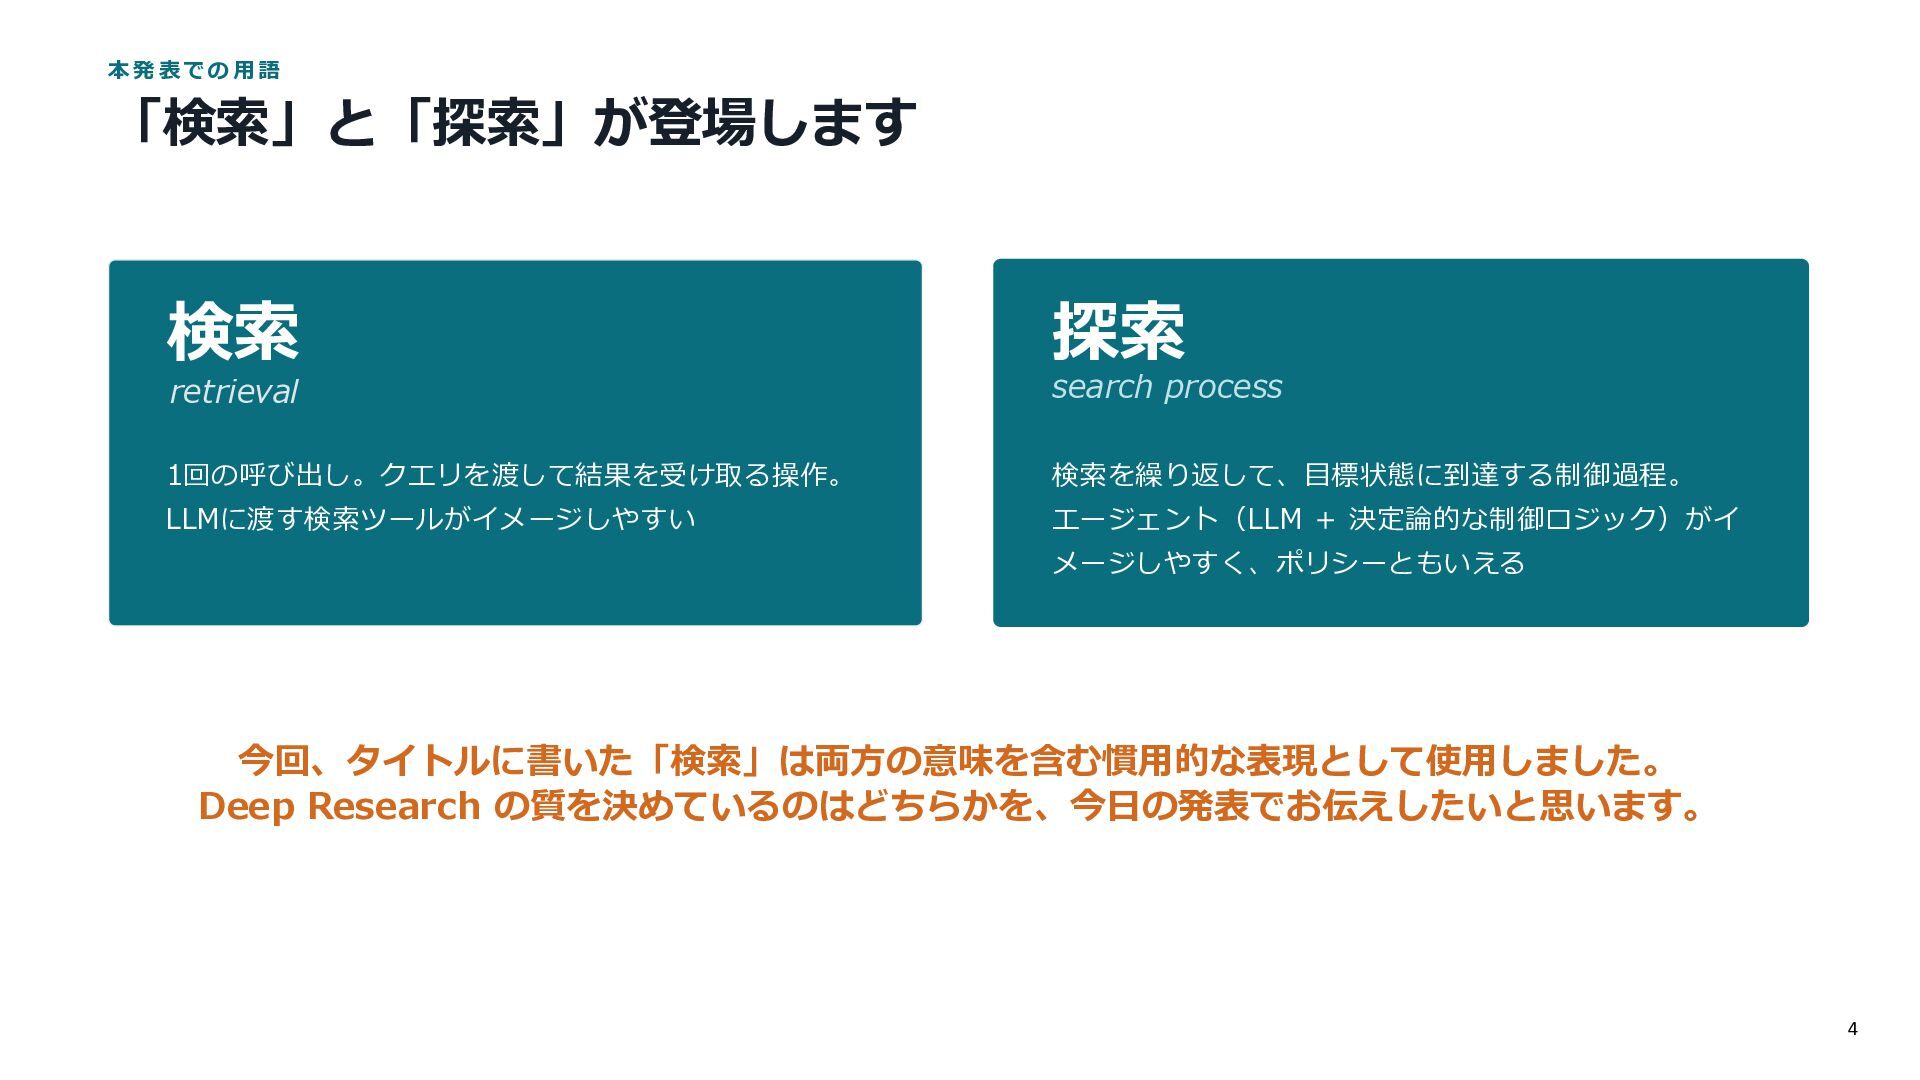
  5. 本発 表での 用語 「検索」と「探索」が登場します 検索 探索 retrieval search process 1回の呼び出し。クエリを渡して結果を受け取る操作。

    検索を繰り返して、目標状態に到達する制御過程。 LLMに渡す検索ツールがイメージしやすい エージェント(LLM + 決定論的な制御ロジック)がイ メージしやすく、ポリシーともいえる 今回、タイトルに書いた「検索」は両方の意味を含む慣用的な表現として使用しました。 Deep Research の質を決めているのはどちらかを、今日の発表でお伝えしたいと思います。 4
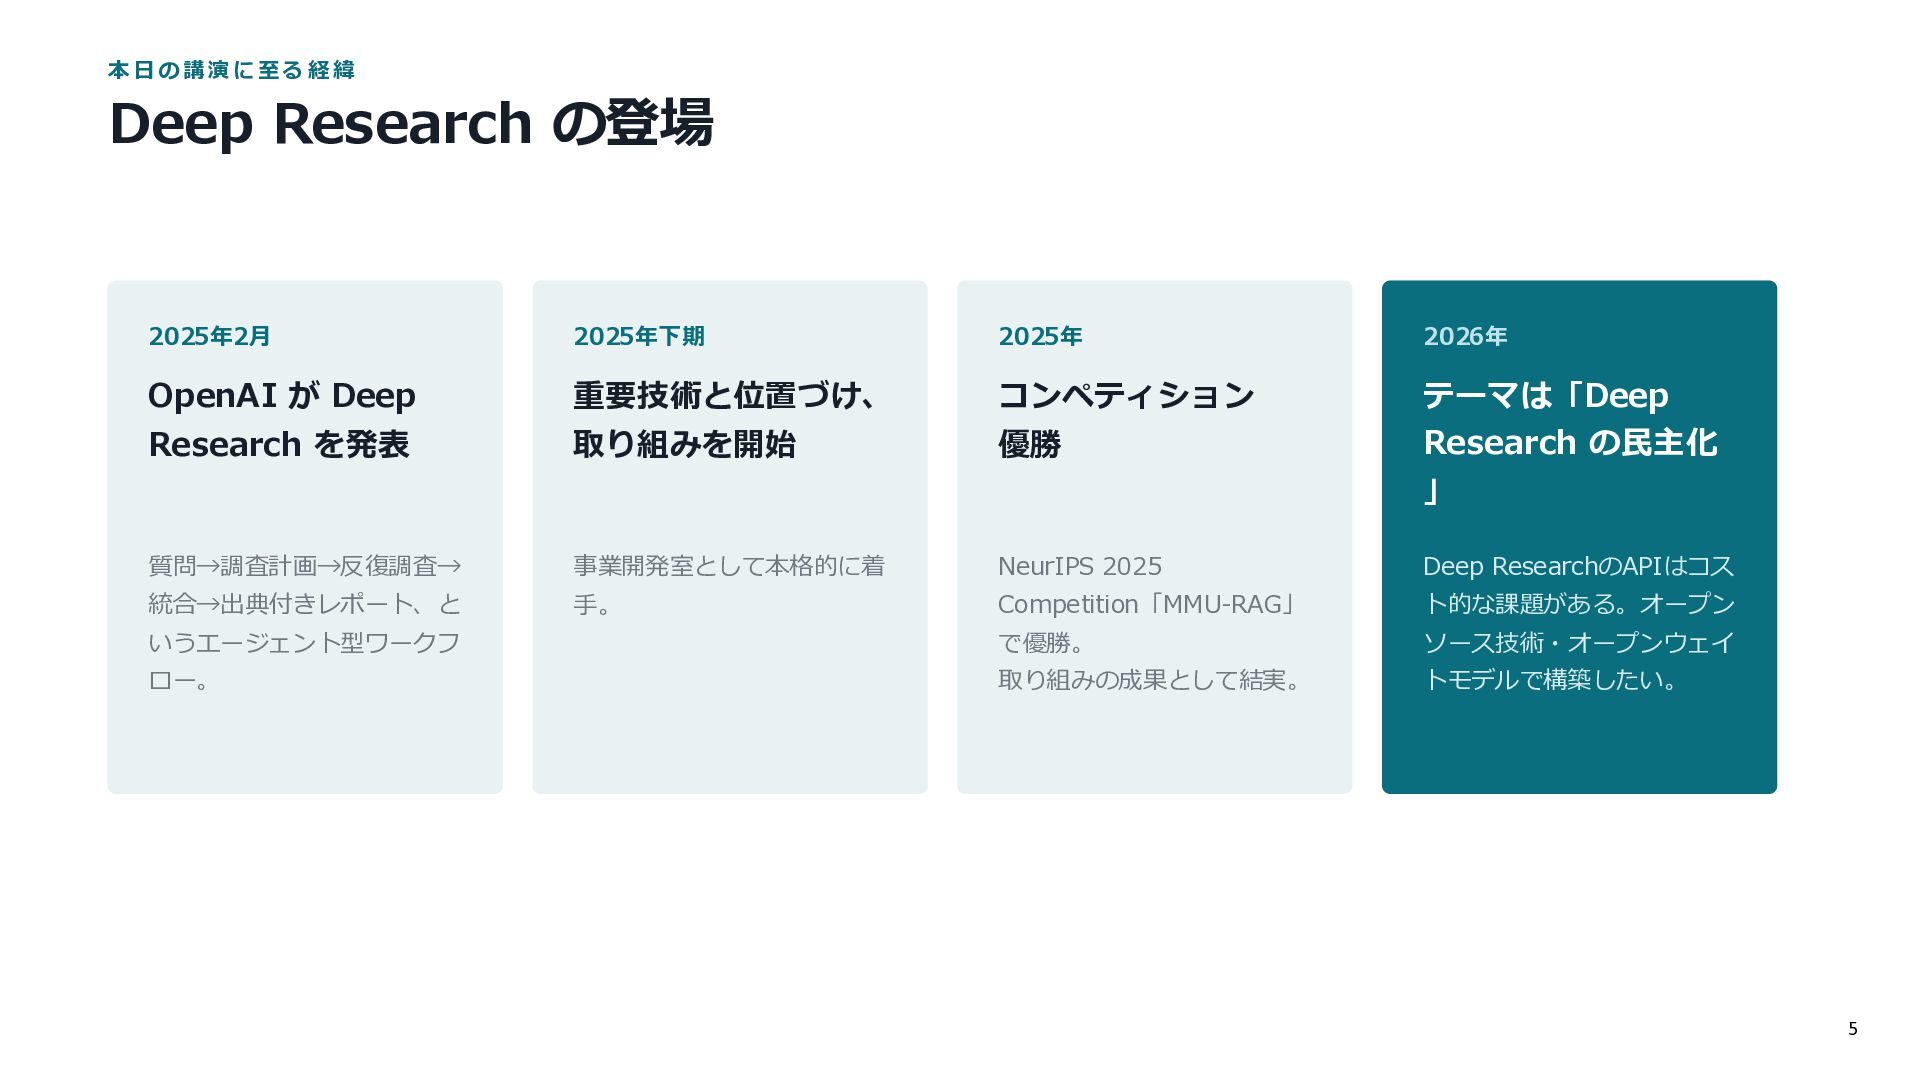
  6. 本日 の講演 に至る 経緯 Deep Research の登場 2025年2月 2025年下期 2025年

    2026年 OpenAI が Deep 重要技術と位置づけ、 コンペティション Research を発表 取り組みを開始 優勝 テーマは「Deep Research の民主化 」 質問→調査計画→反復調査→ 事業開発室として本格的に着 NeurIPS 2025 Deep ResearchのAPIはコス 統合→出典付きレポート、と 手。 Competition「MMU-RAG」 ト的な課題がある。オープン いうエージェント型ワークフ で優勝。 ソース技術・オープンウェイ ロー。 取り組みの成果として結実。 トモデルで構築したい。 5
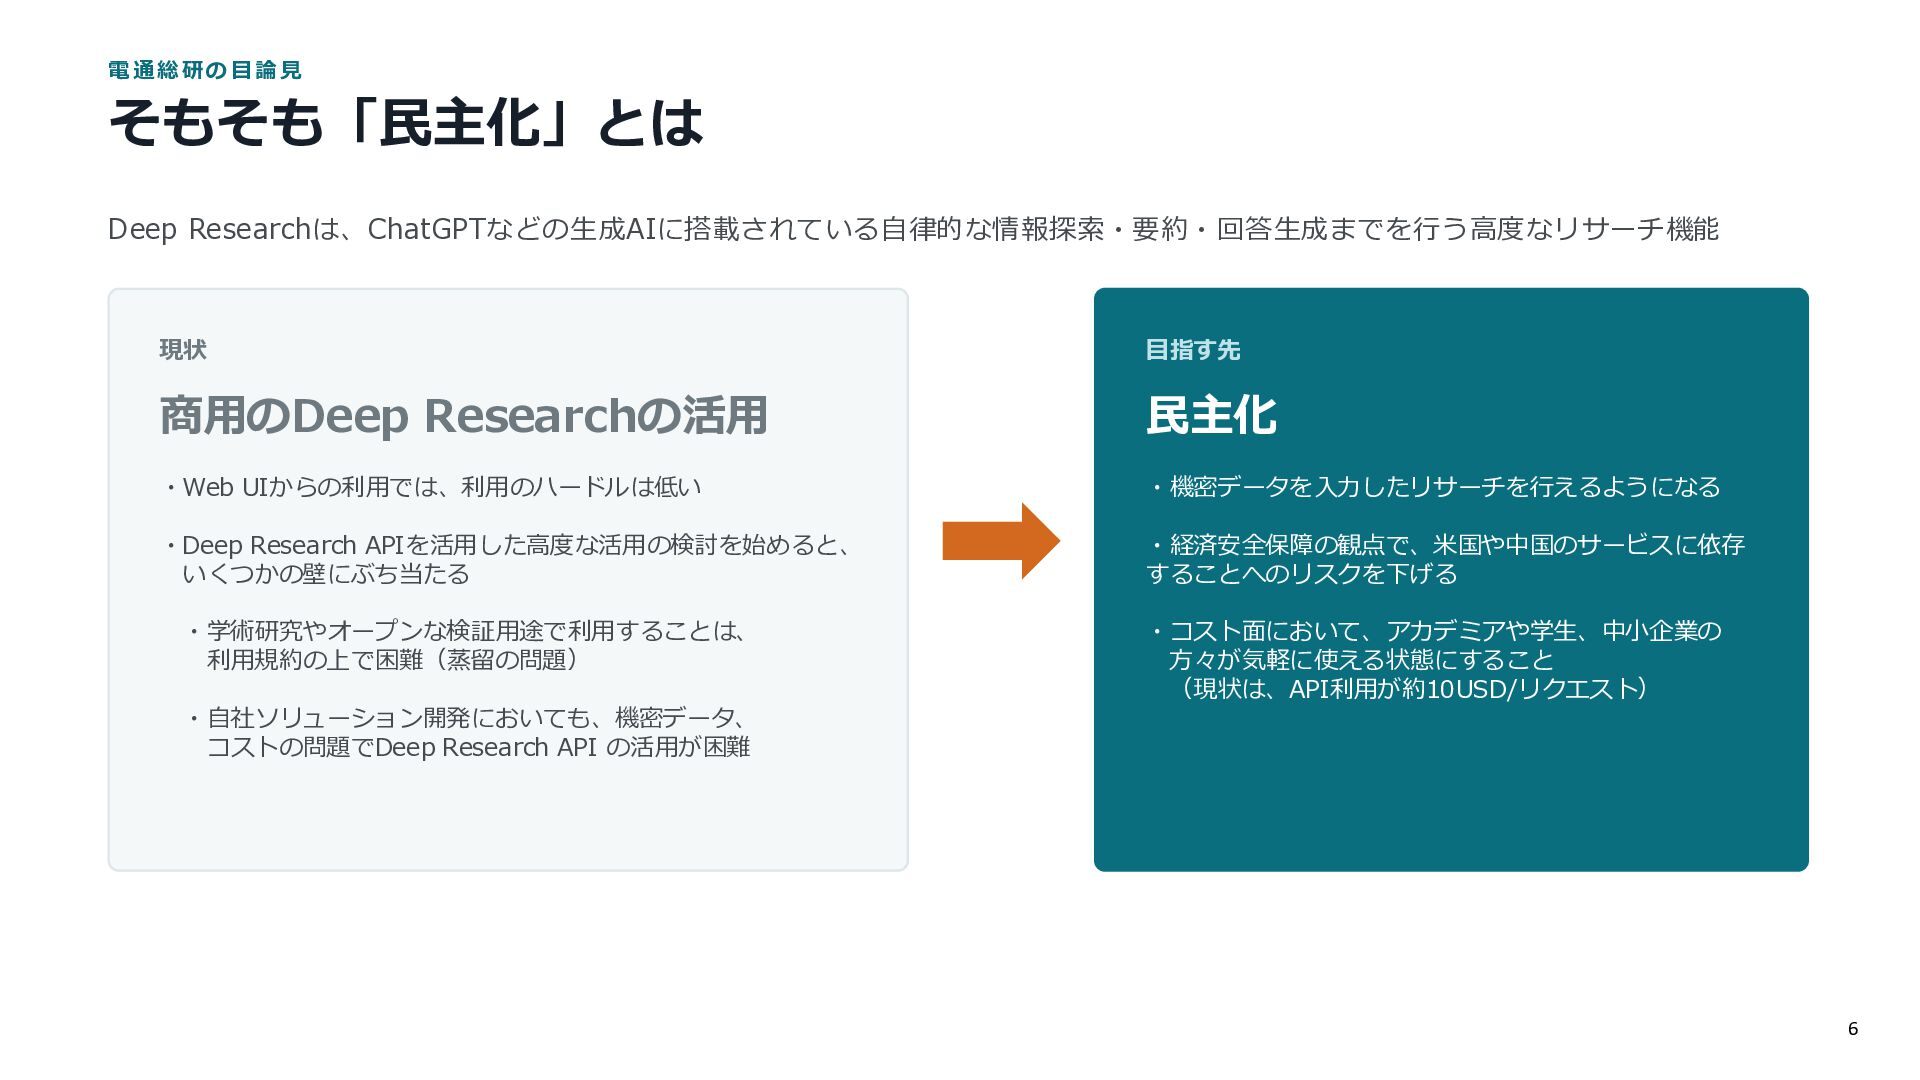
  7. 電通総研の目論見 そもそも「民主化」とは Deep Researchは、ChatGPTなどの生成AIに搭載されている自律的な情報探索・要約・回答生成までを行う高度なリサーチ機能 現状 目指す先 商用のDeep Researchの活用 民主化 ・Web

    UIからの利用では、利用のハードルは低い ・機密データを入力したリサーチを行えるようになる ・Deep Research APIを活用した高度な活用の検討を始めると、 いくつかの壁にぶち当たる ・経済安全保障の観点で、米国や中国のサービスに依存 することへのリスクを下げる ・学術研究やオープンな検証用途で利用することは、 利用規約の上で困難(蒸留の問題) ・自社ソリューション開発においても、機密データ、 コストの問題でDeep Research API の活用が困難 ・コスト面において、アカデミアや学生、中小企業の 方々が気軽に使える状態にすること (現状は、API利用が約10USD/リクエスト) 6
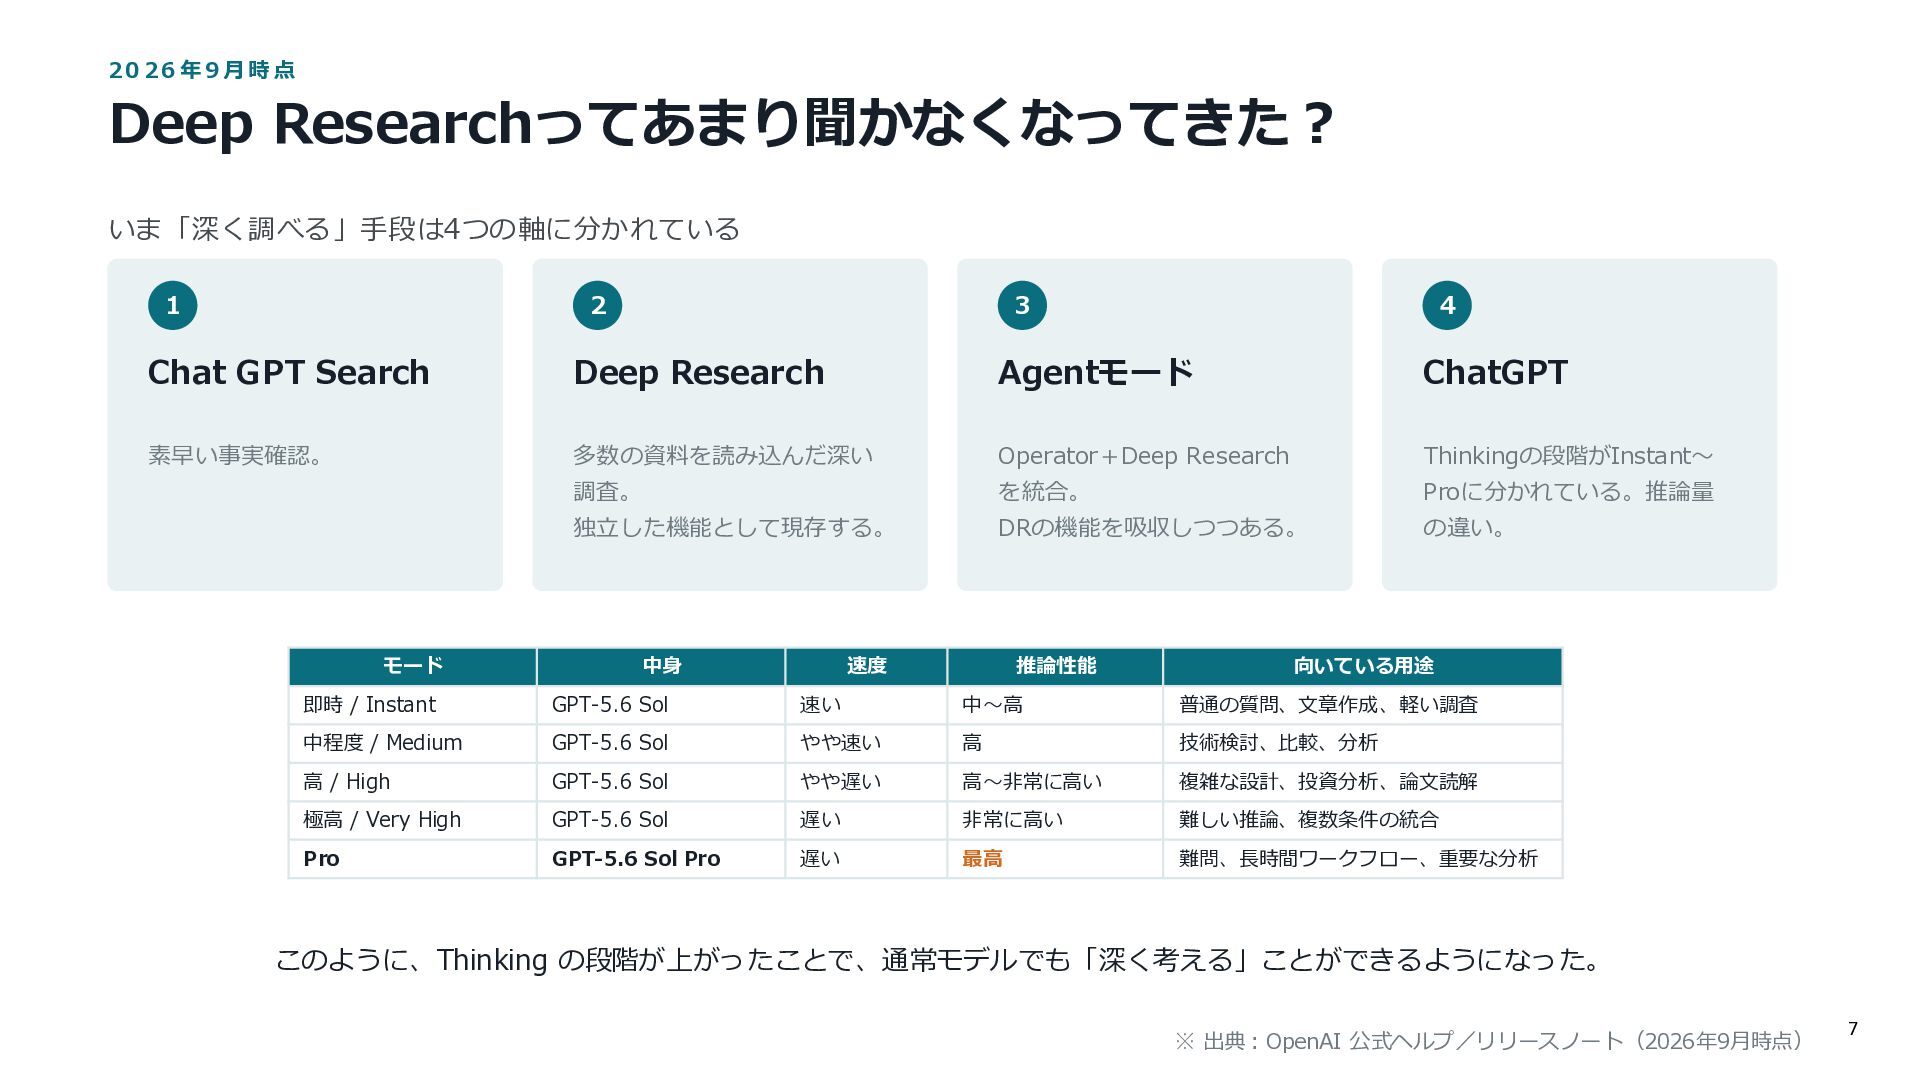
  8. 20 26 年9月時 点 Deep Researchってあまり聞かなくなってきた? いま「深く調べる」手段は4つの軸に分かれている 1 2 3

    4 Chat GPT Search Deep Research Agentモード ChatGPT 素早い事実確認。 多数の資料を読み込んだ深い Operator+Deep Research Thinkingの段階がInstant~ 調査。 を統合。 Proに分かれている。推論量 独立した機能として現存する。 DRの機能を吸収しつつある。 の違い。 モード 中身 速度 推論性能 向いている用途 即時 / Instant GPT-5.6 Sol 速い 中~高 普通の質問、文章作成、軽い調査 中程度 / Medium GPT-5.6 Sol やや速い 高 技術検討、比較、分析 高 / High GPT-5.6 Sol やや遅い 高~非常に高い 複雑な設計、投資分析、論文読解 極高 / Very High GPT-5.6 Sol 遅い 非常に高い 難しい推論、複数条件の統合 Pro GPT-5.6 Sol Pro 遅い 最高 難問、長時間ワークフロー、重要な分析 このように、Thinking の段階が上がったことで、通常モデルでも「深く考える」ことができるようになった。 ※ 出典:OpenAI 公式ヘルプ/リリースノート(2026年9月時点) 7
  9. 「 De ep Re s ea rch 」は どこへ 行った

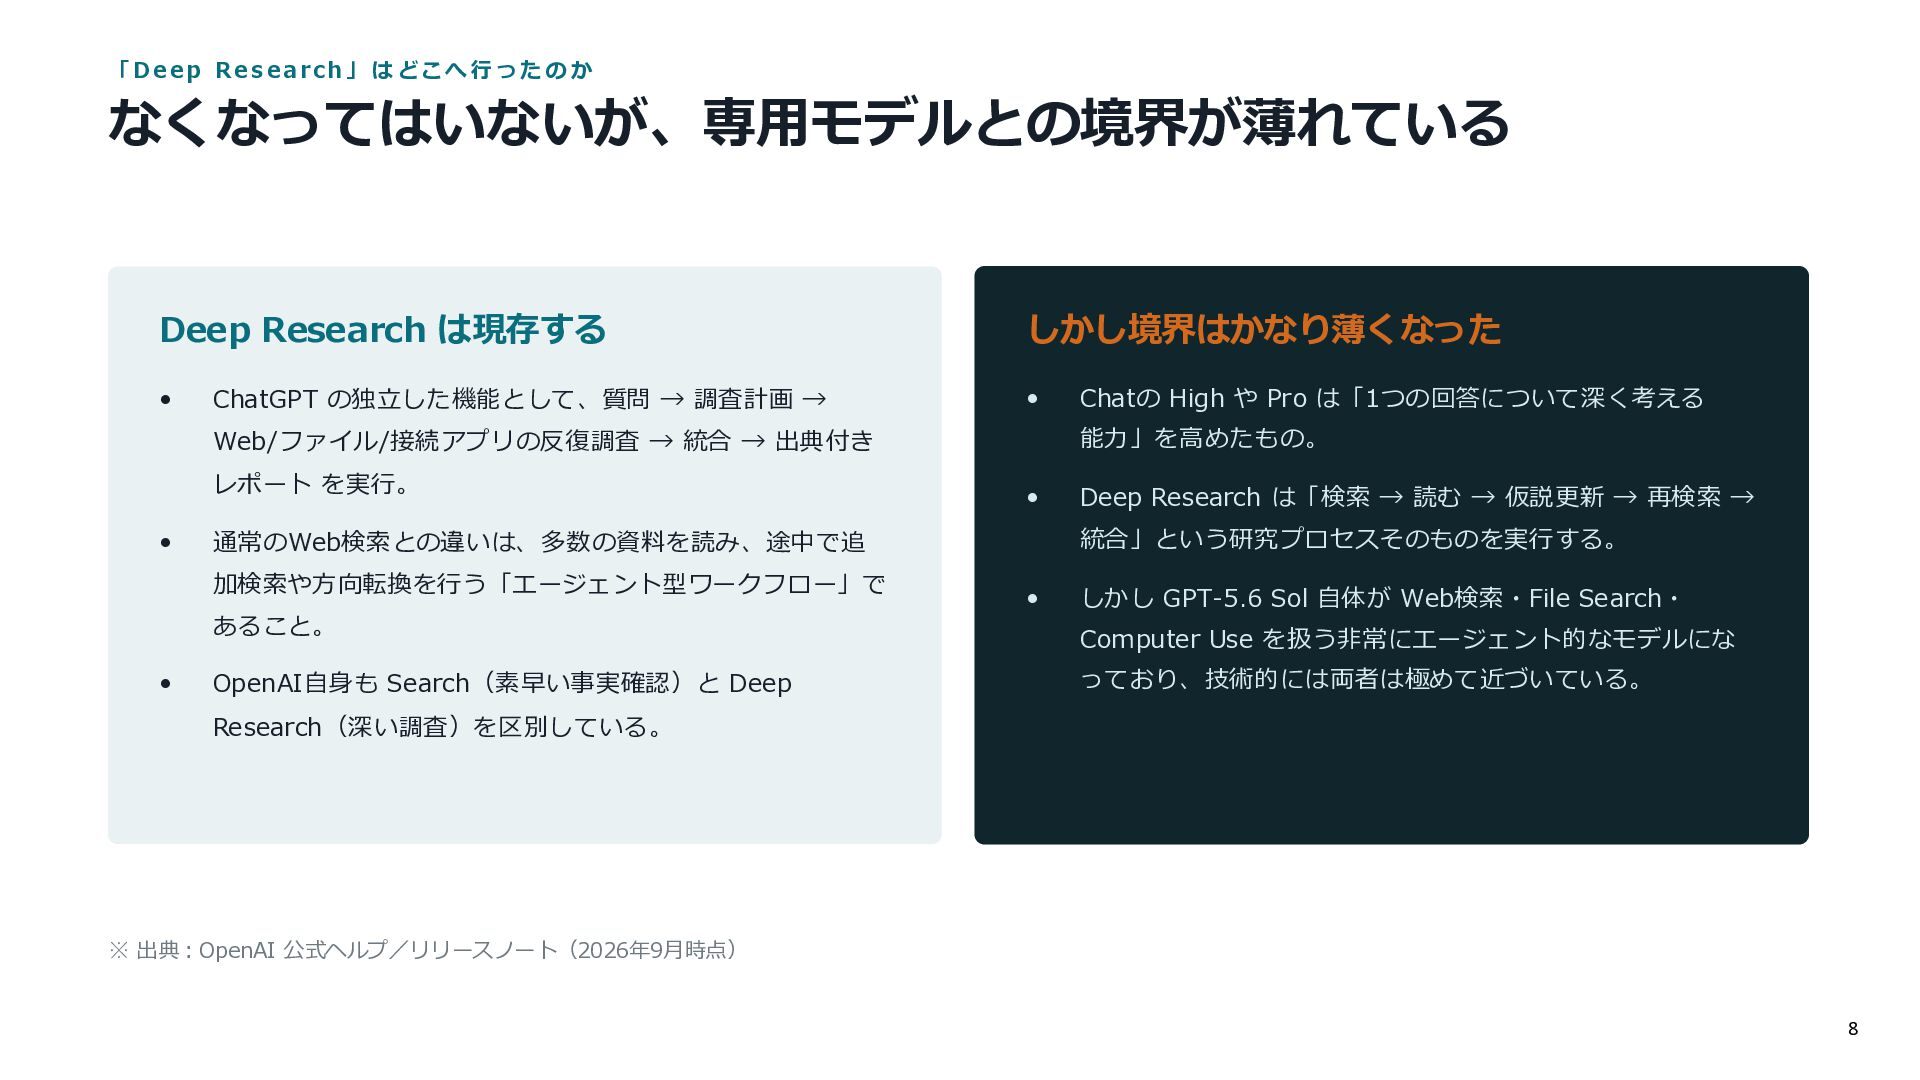
    のか なくなってはいないが、専用モデルとの境界が薄れている Deep Research は現存する しかし境界はかなり薄くなった • • ChatGPT の独立した機能として、質問 → 調査計画 → 能力」を高めたもの。 Web/ファイル/接続アプリの反復調査 → 統合 → 出典付き レポート を実行。 • あること。 • • OpenAI自身も Search(素早い事実確認)と Deep Deep Research は「検索 → 読む → 仮説更新 → 再検索 → 統合」という研究プロセスそのものを実行する。 通常のWeb検索との違いは、多数の資料を読み、途中で追 加検索や方向転換を行う「エージェント型ワークフロー」で Chatの High や Pro は「1つの回答について深く考える • しかし GPT-5.6 Sol 自体が Web検索・File Search・ Computer Use を扱う非常にエージェント的なモデルにな っており、技術的には両者は極めて近づいている。 Research(深い調査)を区別している。 ※ 出典:OpenAI 公式ヘルプ/リリースノート(2026年9月時点) 8
  10. 寄り 道:誰 もがミ レニ アム懸 賞問題 を解け るよう にな ったの

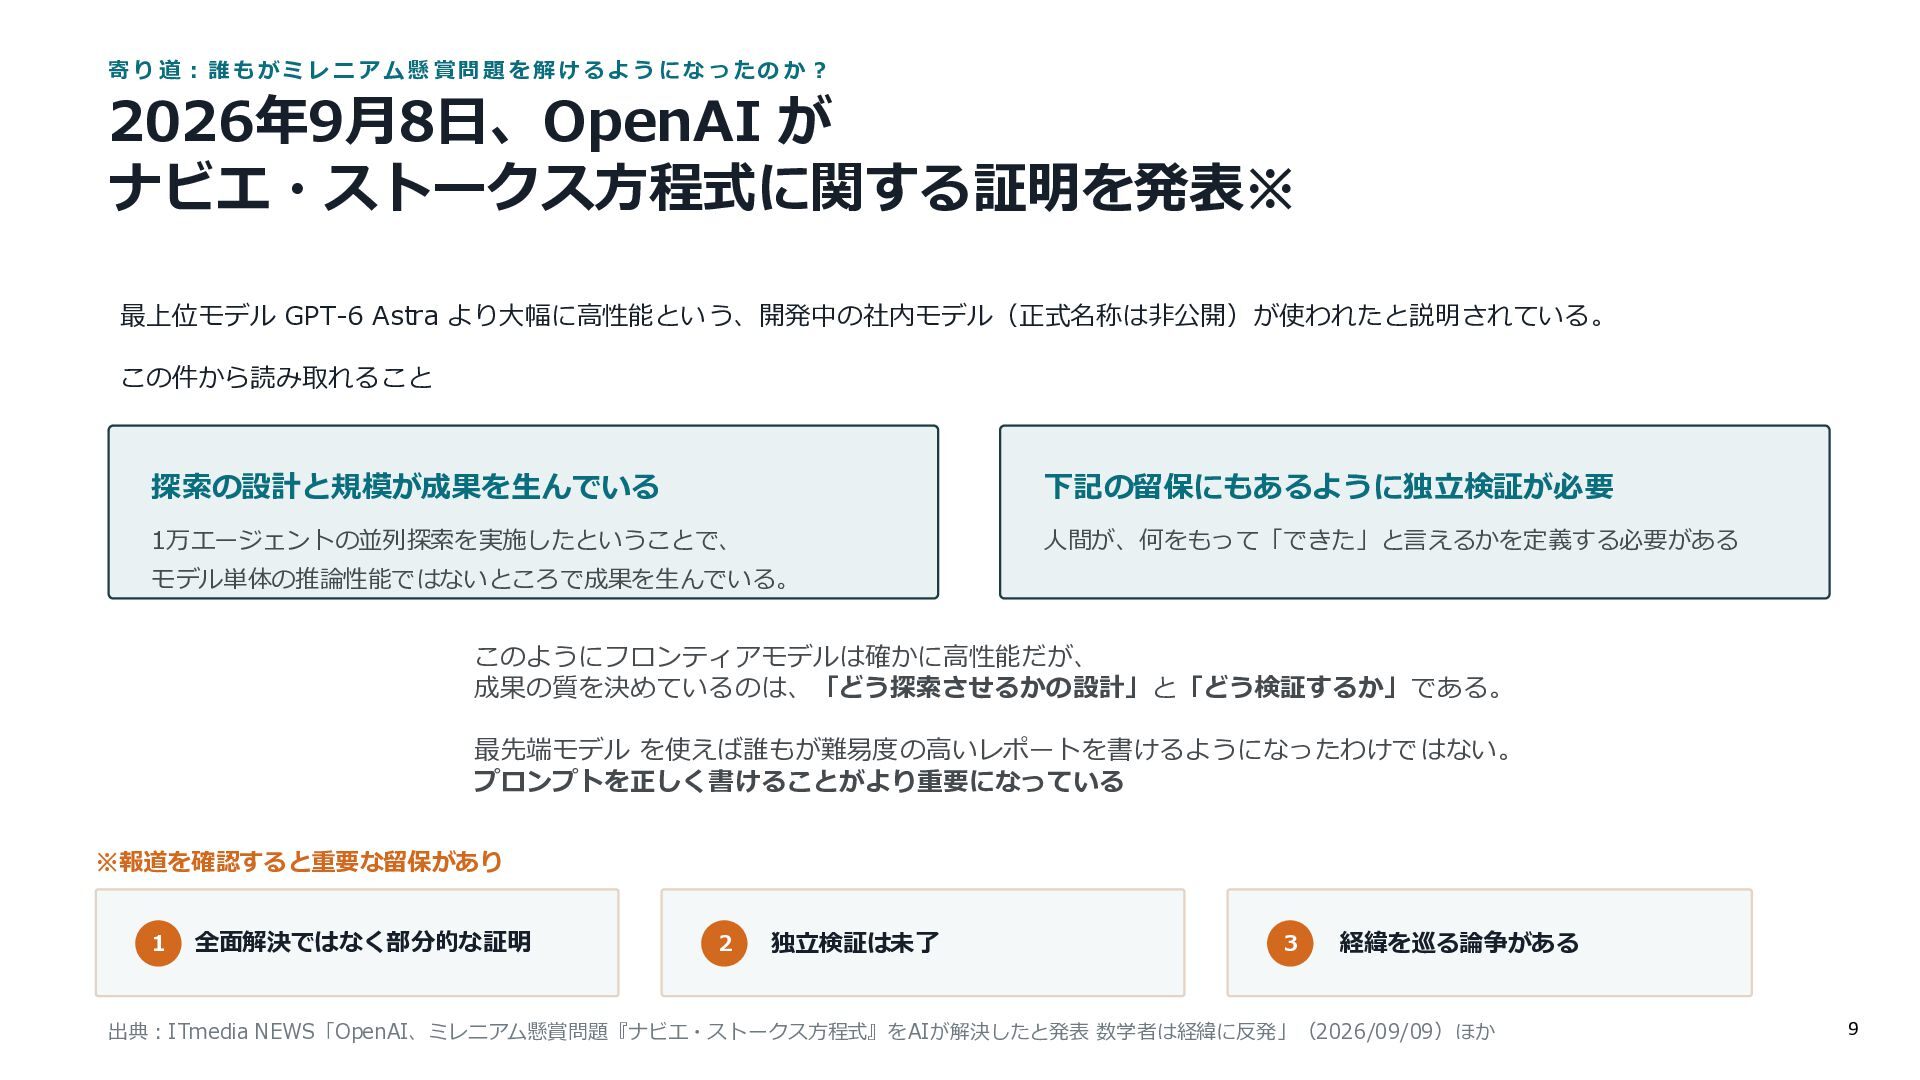
    か? 2026年9月8日、OpenAI が ナビエ・ストークス方程式に関する証明を発表※ 最上位モデル GPT-6 Astra より大幅に高性能という、開発中の社内モデル(正式名称は非公開)が使われたと説明されている。 この件から読み取れること 探索の設計と規模が成果を生んでいる 下記の留保にもあるように独立検証が必要 1万エージェントの並列探索を実施したということで、 人間が、何をもって「できた」と言えるかを定義する必要がある モデル単体の推論性能ではないところで成果を生んでいる。 このようにフロンティアモデルは確かに高性能だが、 成果の質を決めているのは、「どう探索させるかの設計」と「どう検証するか」である。 最先端モデル を使えば誰もが難易度の高いレポートを書けるようになったわけではない。 プロンプトを正しく書けることがより重要になっている ※報道を確認すると重要な留保があり 1 全面解決ではなく部分的な証明 2 独立検証は未了 3 経緯を巡る論争がある 出典:ITmedia NEWS「OpenAI、ミレニアム懸賞問題『ナビエ・ストークス方程式』をAIが解決したと発表 数学者は経緯に反発」(2026/09/09)ほか 9
  11. 電通 総研の 取り組 みの出発 点 「探索の設計と規模」が重要になりつつある 推論性能での差別化余地が縮んだ結果、残った差別化要因は「探索の設計と規模」 これまでの差別化軸 これからの差別化軸 推論の深さ

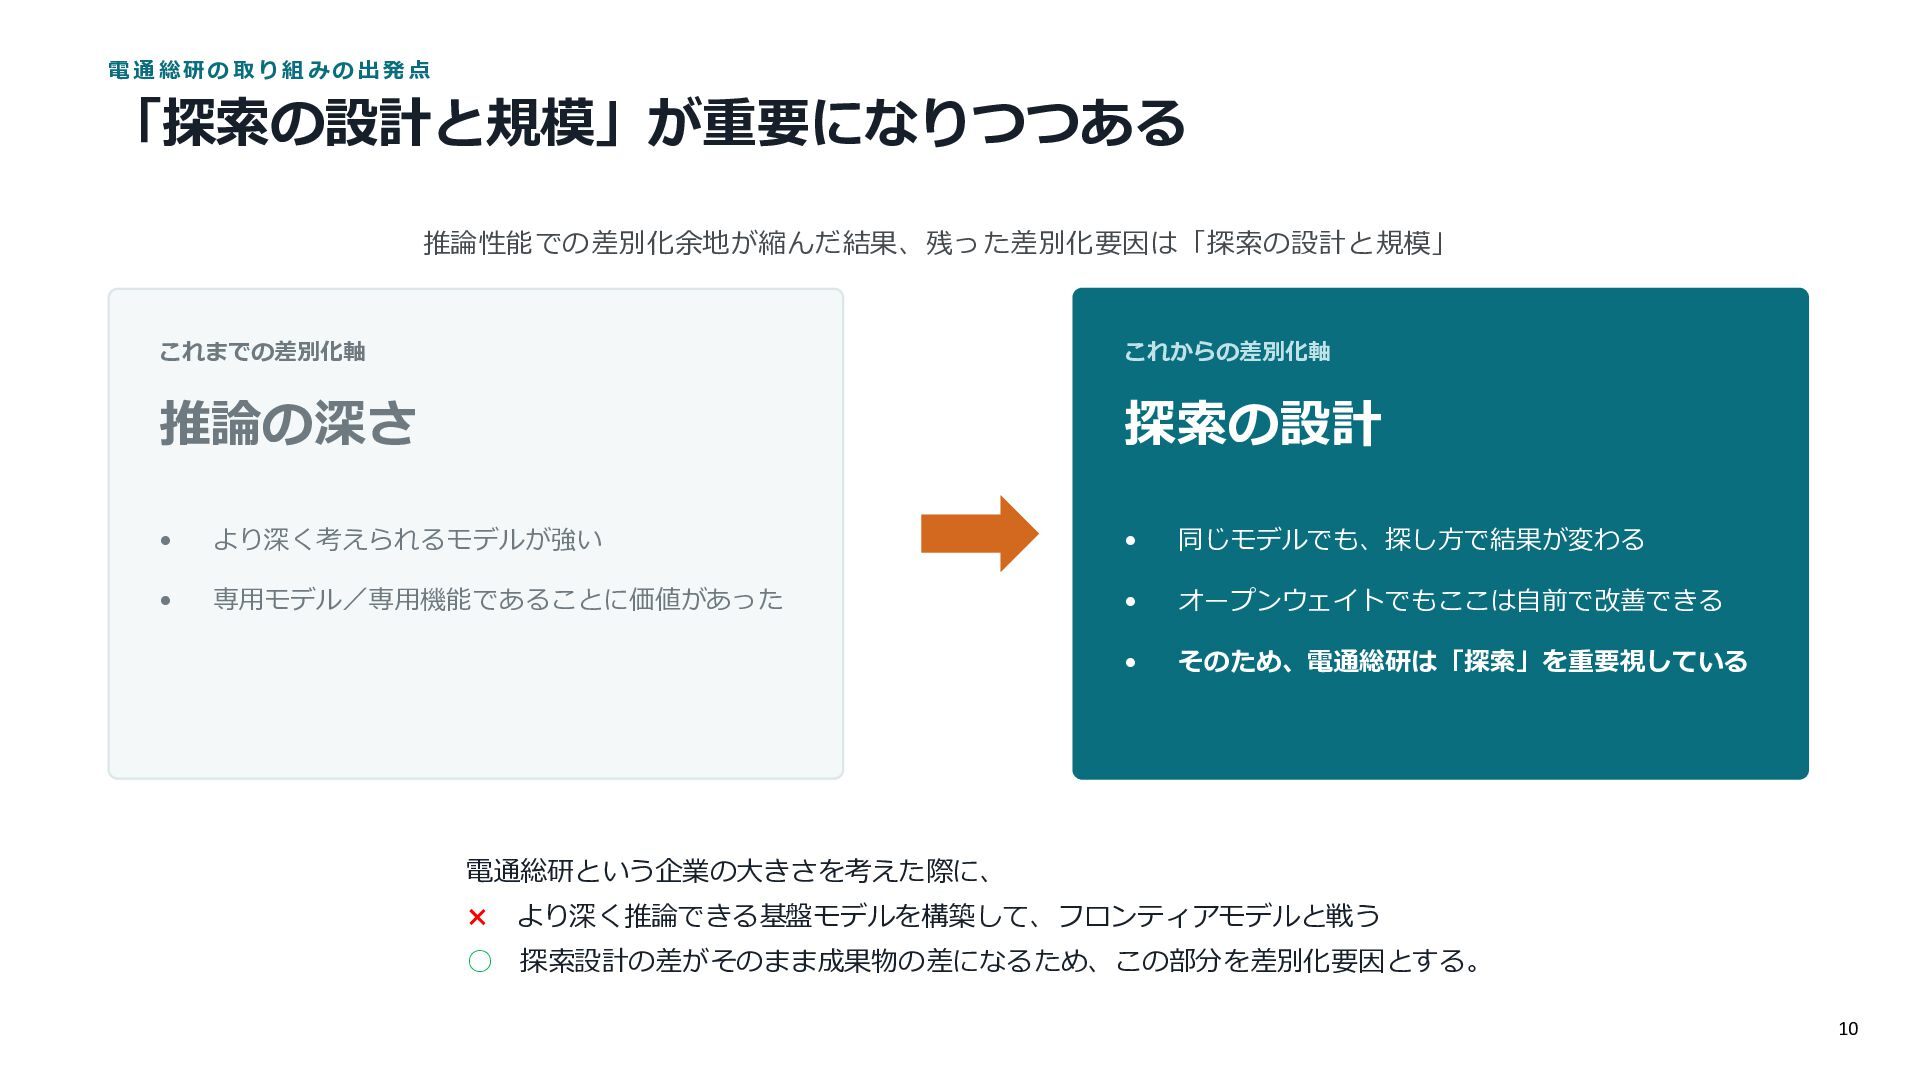
    探索の設計 • より深く考えられるモデルが強い • 同じモデルでも、探し方で結果が変わる • 専用モデル/専用機能であることに価値があった • オープンウェイトでもここは自前で改善できる • そのため、電通総研は「探索」を重要視している 電通総研という企業の大きさを考えた際に、 × より深く推論できる基盤モデルを構築して、フロンティアモデルと戦う ◦ 探索設計の差がそのまま成果物の差になるため、この部分を差別化要因とする。 10
  12. 正し いプロ ンプト とは ? 良いプロンプトは、徐々に変わってきている かつて ― Imperative(手続き型) いま

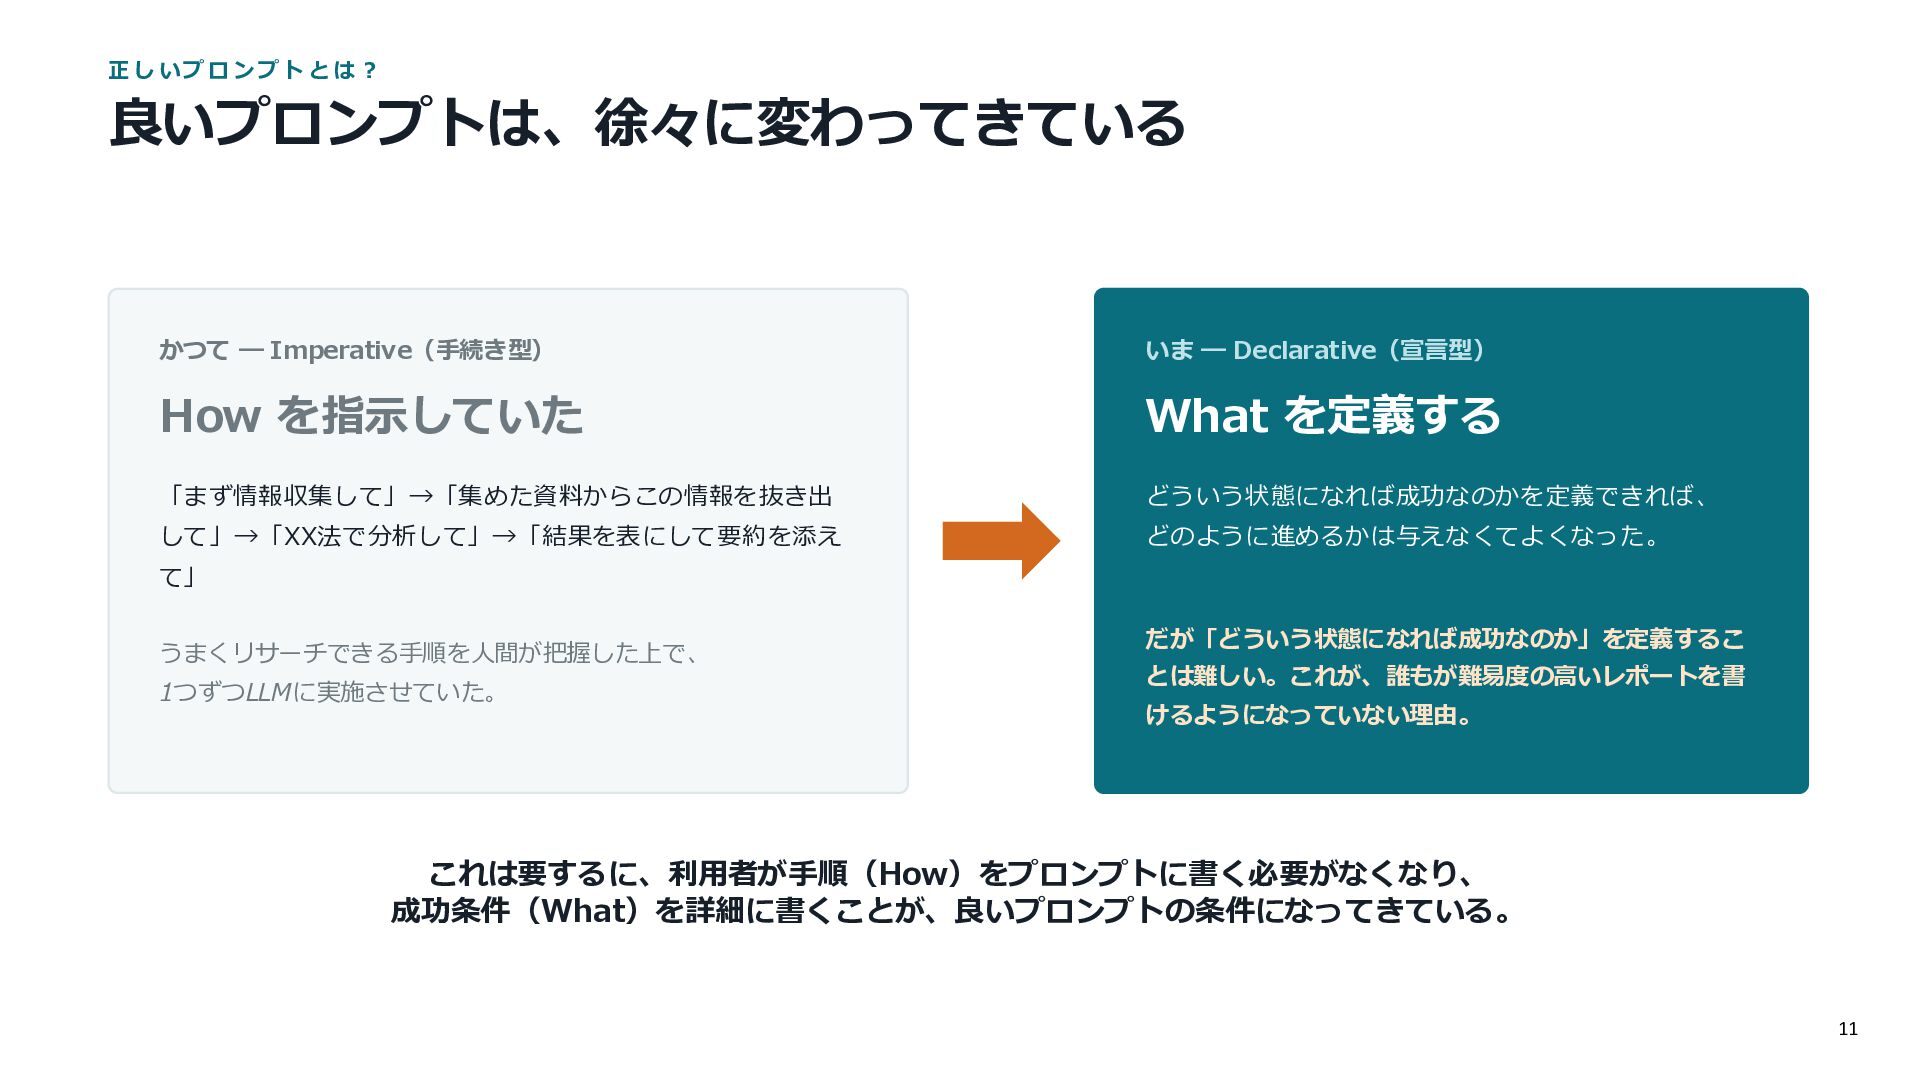
    ― Declarative(宣言型) How を指示していた What を定義する 「まず情報収集して」→「集めた資料からこの情報を抜き出 どういう状態になれば成功なのかを定義できれば、 して」→「XX法で分析して」→「結果を表にして要約を添え どのように進めるかは与えなくてよくなった。 て」 うまくリサーチできる手順を人間が把握した上で、 1つずつLLMに実施させていた。 だが「どういう状態になれば成功なのか」を定義するこ とは難しい。これが、誰もが難易度の高いレポートを書 けるようになっていない理由。 これは要するに、利用者が手順(How)をプロンプトに書く必要がなくなり、 成功条件(What)を詳細に書くことが、良いプロンプトの条件になってきている。 11
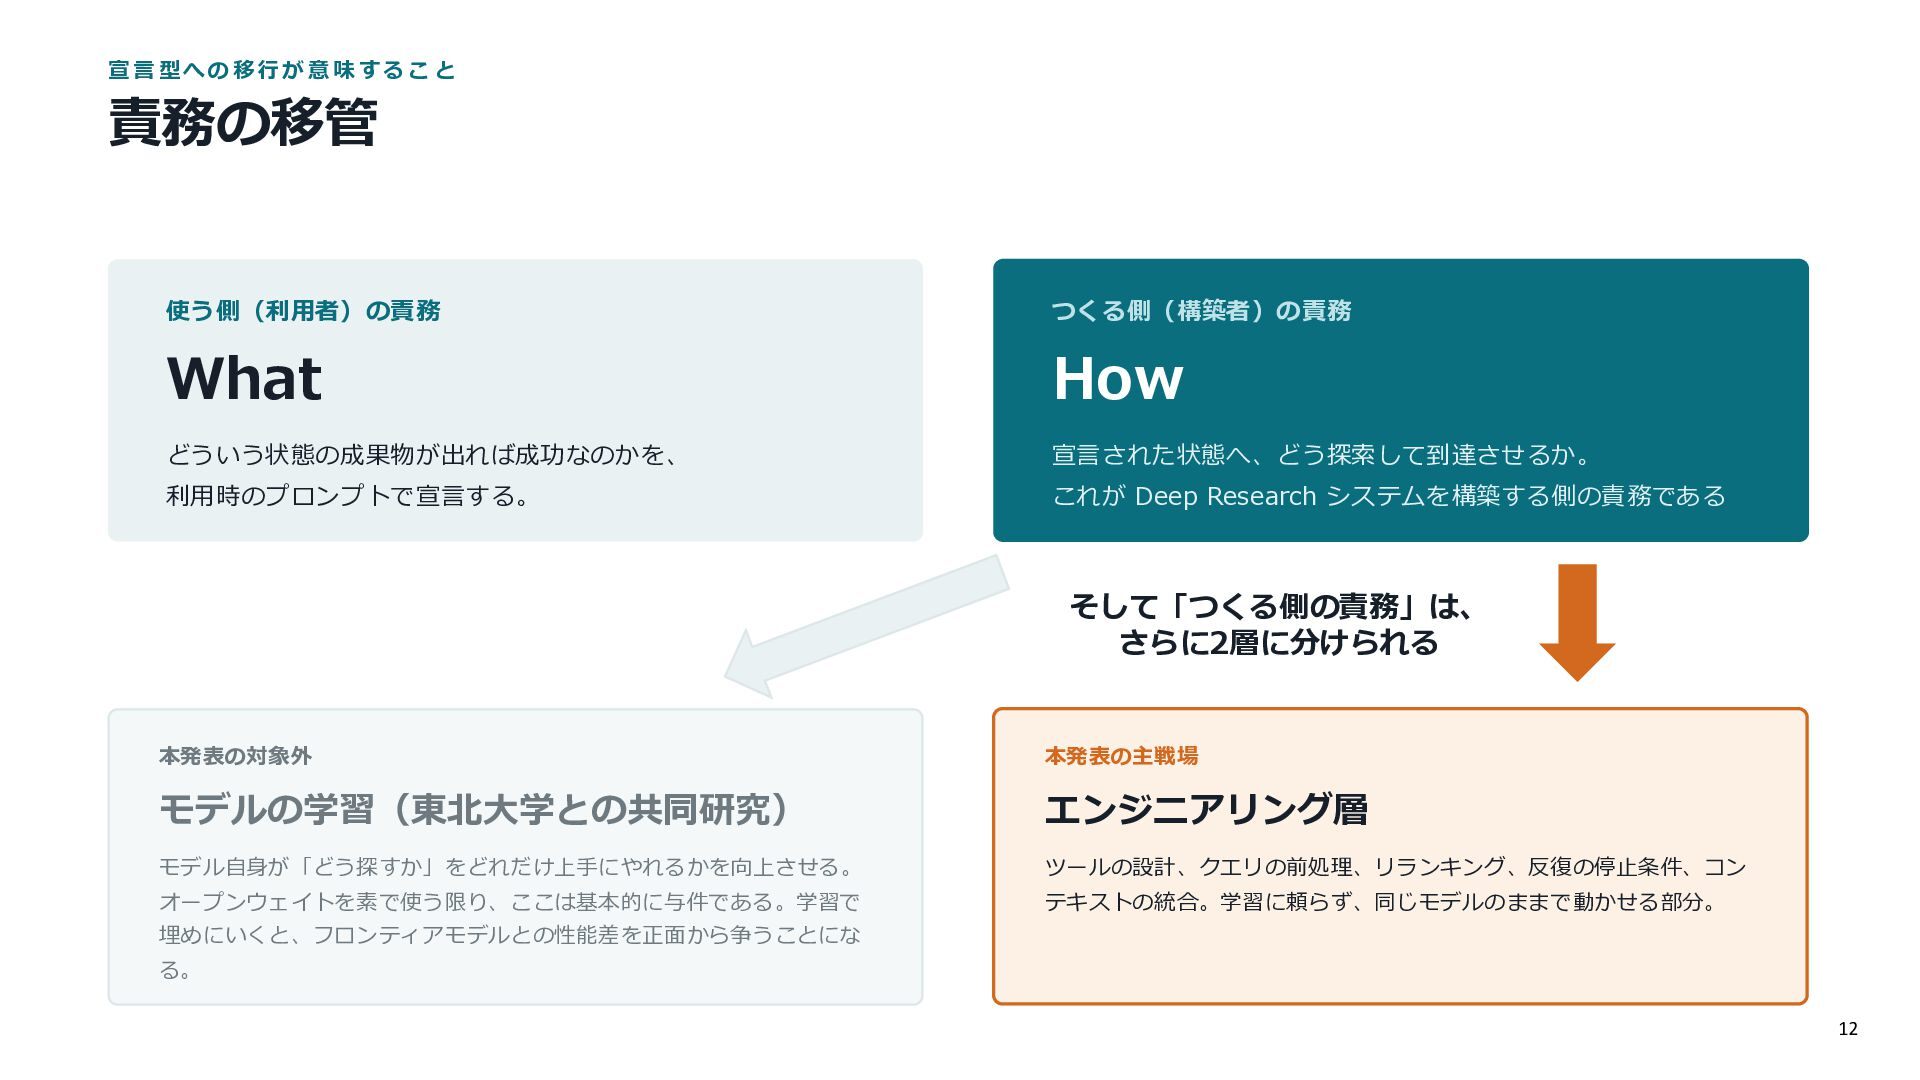
  13. 宣言 型への 移行が 意味 するこ と 責務の移管 使う側(利用者)の責務 つくる側(構築者)の責務 What

    How どういう状態の成果物が出れば成功なのかを、 宣言された状態へ、どう探索して到達させるか。 利用時のプロンプトで宣言する。 これが Deep Research システムを構築する側の責務である そして「つくる側の責務」は、 さらに2層に分けられる 本発表の対象外 本発表の主戦場 モデルの学習(東北大学との共同研究) エンジニアリング層 モデル自身が「どう探すか」をどれだけ上手にやれるかを向上させる。 ツールの設計、クエリの前処理、リランキング、反復の停止条件、コン オープンウェイトを素で使う限り、ここは基本的に与件である。学習で テキストの統合。学習に頼らず、同じモデルのままで動かせる部分。 埋めにいくと、フロンティアモデルとの性能差を正面から争うことにな る。 12
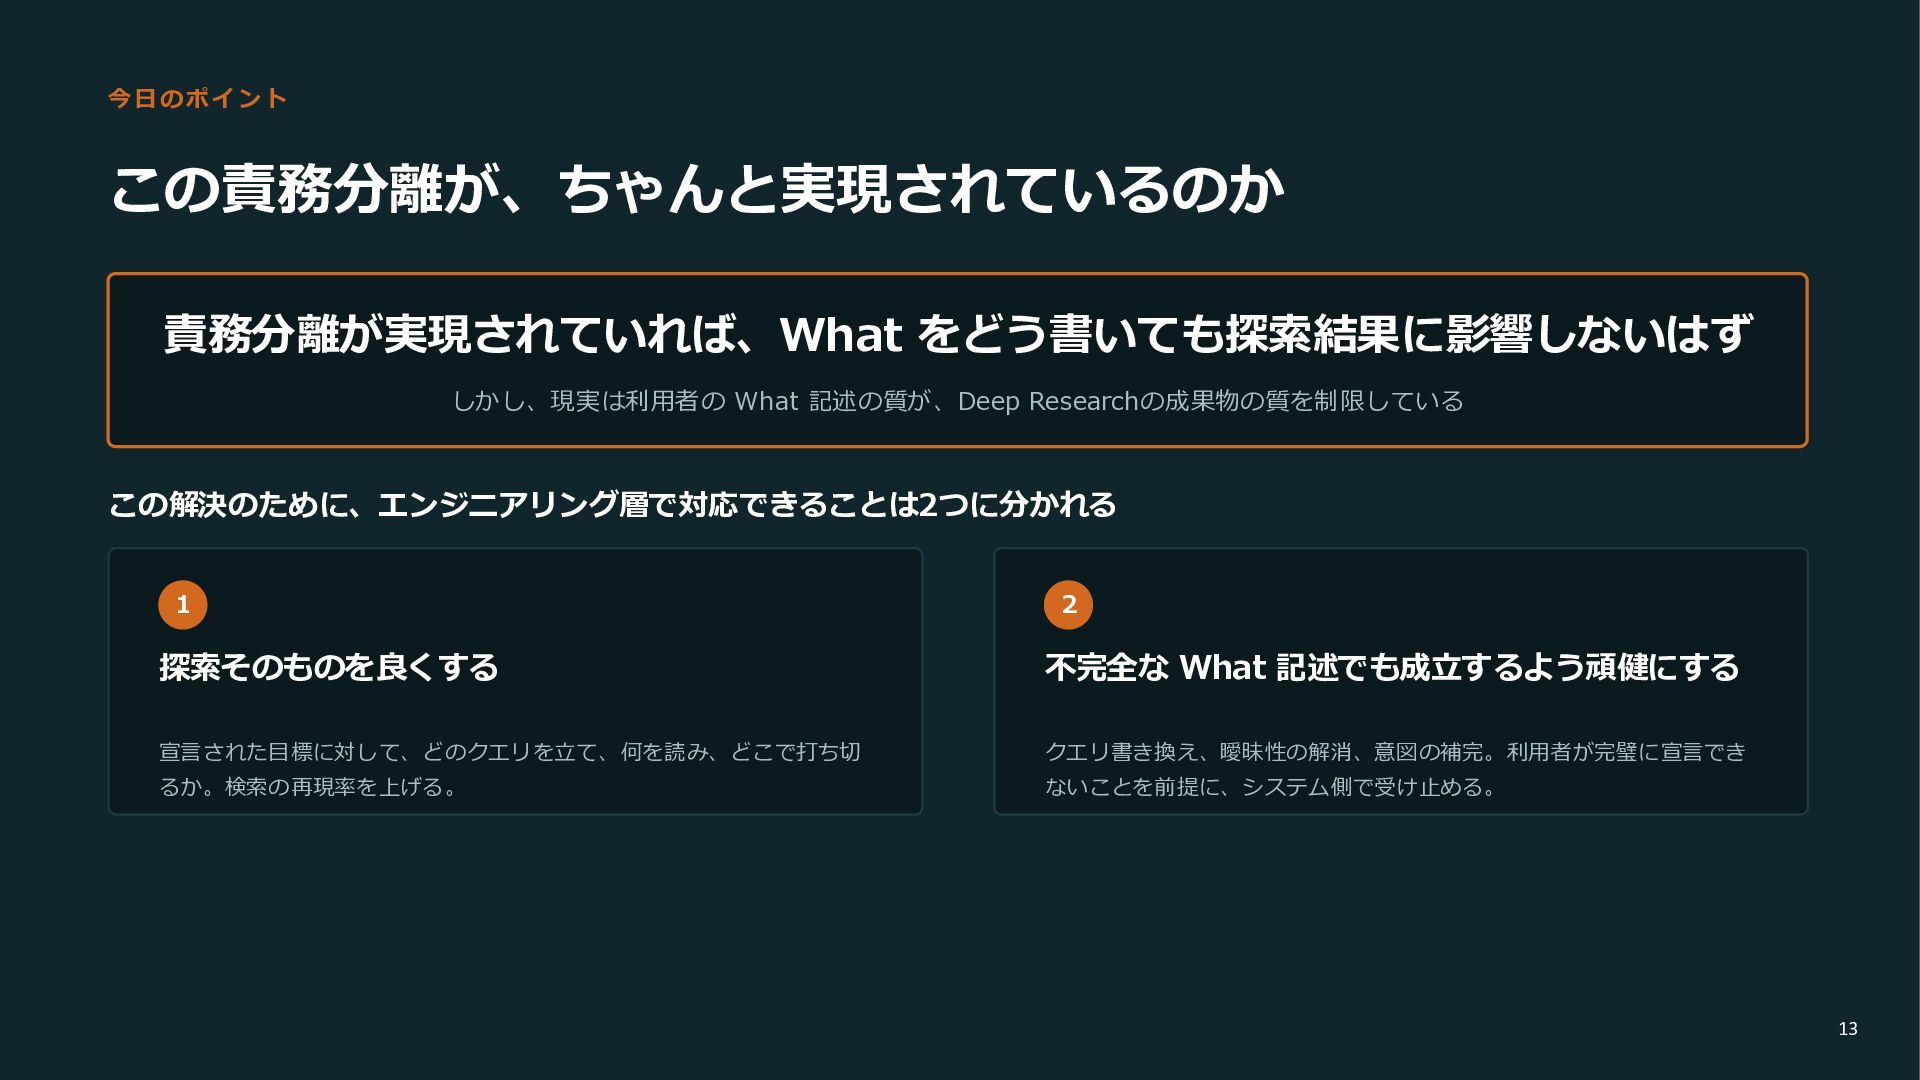
  14. 今日のポイント この責務分離が、ちゃんと実現されているのか 責務分離が実現されていれば、What をどう書いても探索結果に影響しないはず しかし、現実は利用者の What 記述の質が、Deep Researchの成果物の質を制限している この解決のために、エンジニアリング層で対応できることは2つに分かれる 1

    2 探索そのものを良くする 不完全な What 記述でも成立するよう頑健にする 宣言された目標に対して、どのクエリを立て、何を読み、どこで打ち切 クエリ書き換え、曖昧性の解消、意図の補完。利用者が完璧に宣言でき るか。検索の再現率を上げる。 ないことを前提に、システム側で受け止める。 13
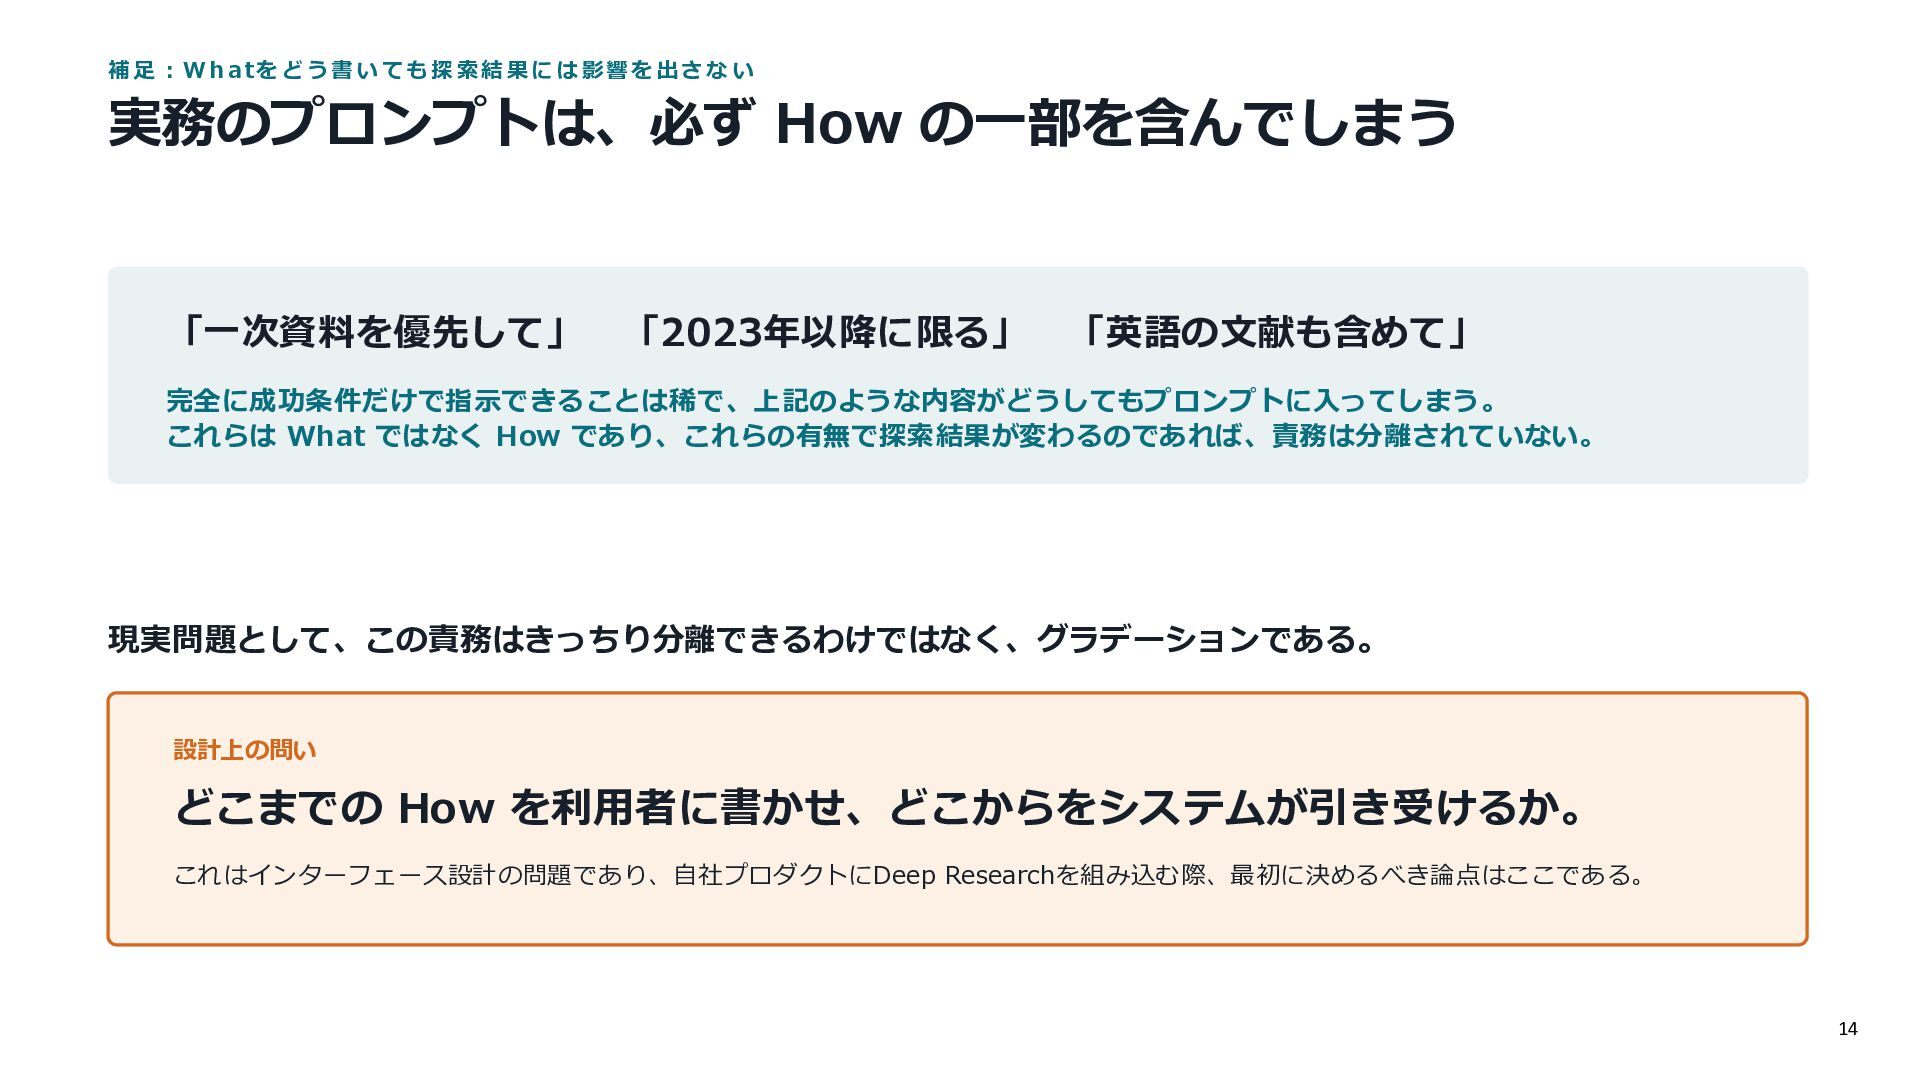
  15. 補足 : W h at をど う書い ても探 索結 果には

    影響を 出さな い 実務のプロンプトは、必ず How の一部を含んでしまう 「一次資料を優先して」 「2023年以降に限る」 「英語の文献も含めて」 完全に成功条件だけで指示できることは稀で、上記のような内容がどうしてもプロンプトに入ってしまう。 これらは What ではなく How であり、これらの有無で探索結果が変わるのであれば、責務は分離されていない。 現実問題として、この責務はきっちり分離できるわけではなく、グラデーションである。 設計上の問い どこまでの How を利用者に書かせ、どこからをシステムが引き受けるか。 これはインターフェース設計の問題であり、自社プロダクトにDeep Researchを組み込む際、最初に決めるべき論点はここである。 14
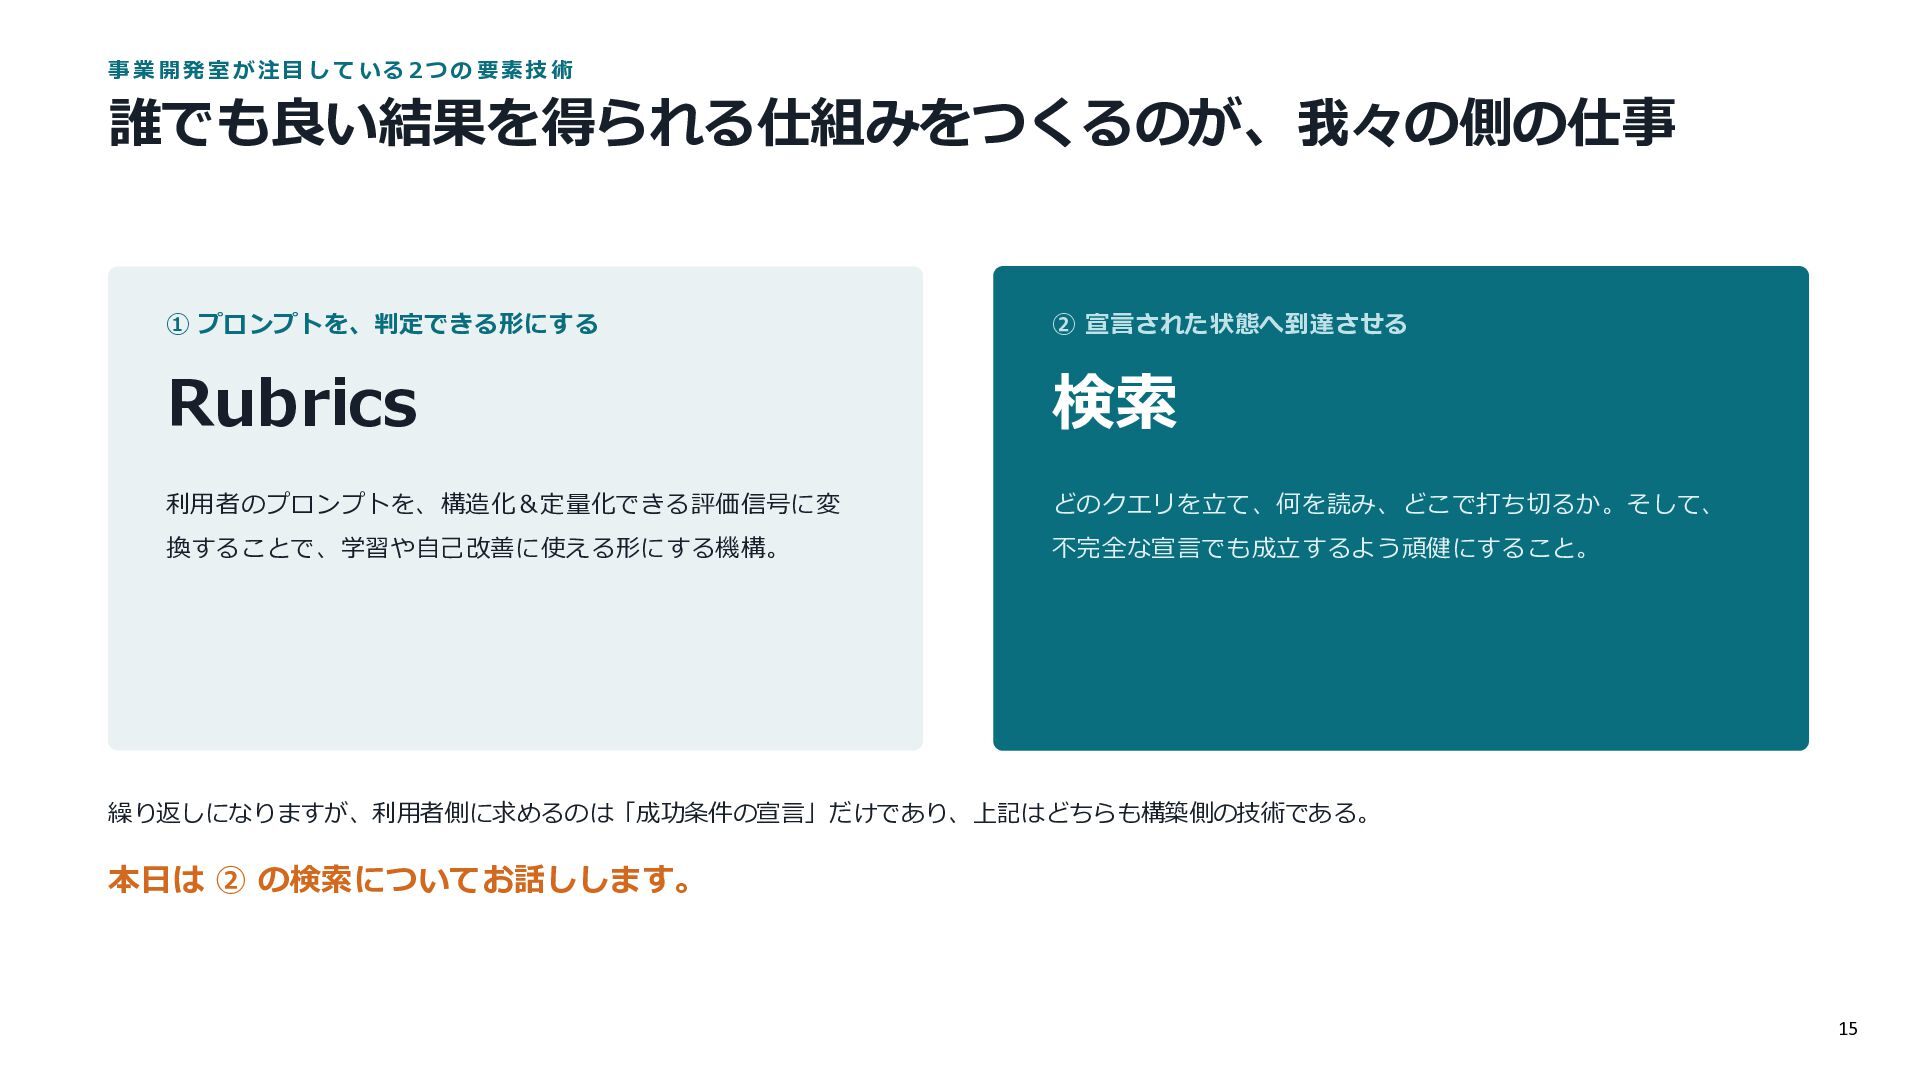
  16. 事業 開発室 が注目 して いる2つの 要素技 術 誰でも良い結果を得られる仕組みをつくるのが、我々の側の仕事 ① プロンプトを、判定できる形にする

    ② 宣言された状態へ到達させる Rubrics 検索 利用者のプロンプトを、構造化&定量化できる評価信号に変 どのクエリを立て、何を読み、どこで打ち切るか。そして、 換することで、学習や自己改善に使える形にする機構。 不完全な宣言でも成立するよう頑健にすること。 繰り返しになりますが、利用者側に求めるのは「成功条件の宣言」だけであり、上記はどちらも構築側の技術である。 本日は ② の検索についてお話しします。 15
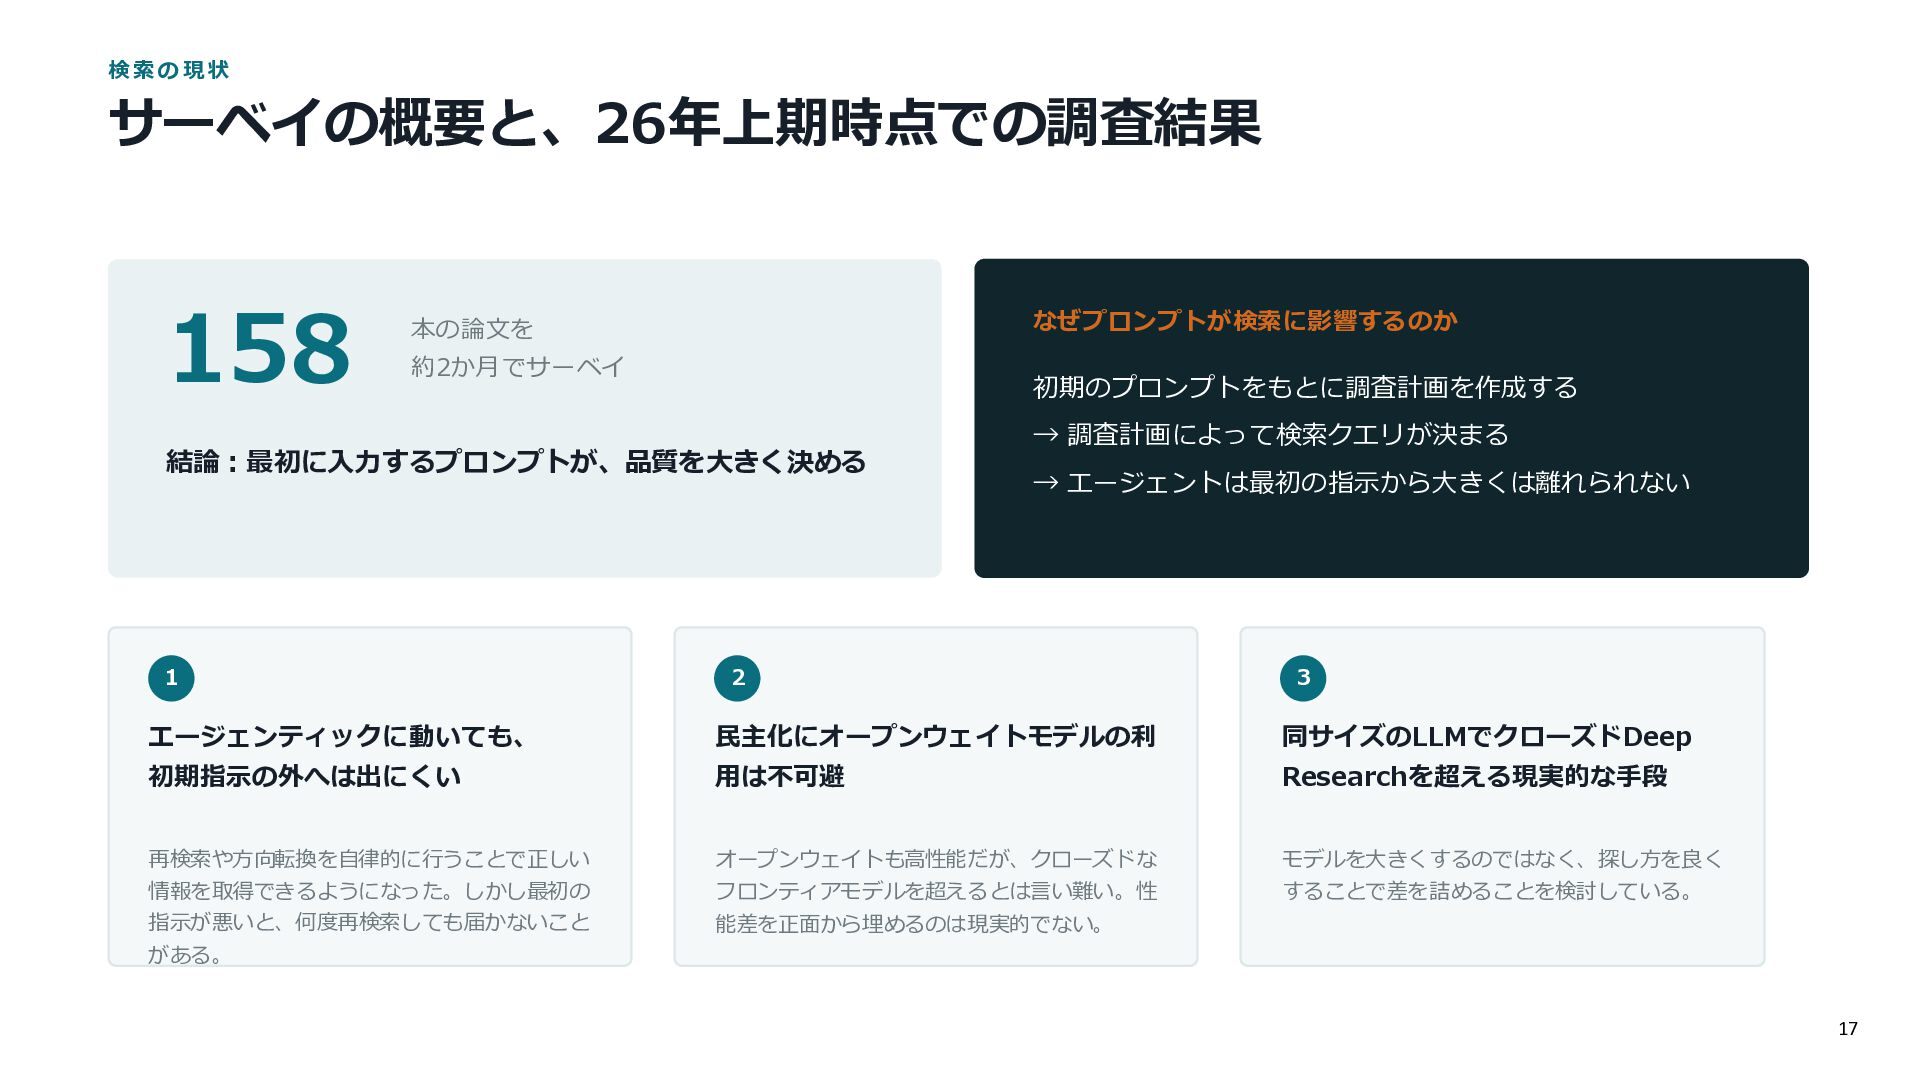
  17. 検索 の現 状 サーベイの概要と、26年上期時点での調査結果 158 なぜプロンプトが検索に影響するのか 本の論文を 約2か月でサーベイ 初期のプロンプトをもとに調査計画を作成する 結論:最初に入力するプロンプトが、品質を大きく決める

    1 → 調査計画によって検索クエリが決まる → エージェントは最初の指示から大きくは離れられない 2 3 エージェンティックに動いても、 民主化にオープンウェイトモデルの利 同サイズのLLMでクローズドDeep 初期指示の外へは出にくい 用は不可避 Researchを超える現実的な手段 再検索や方向転換を自律的に行うことで正しい 情報を取得できるようになった。しかし最初の 指示が悪いと、何度再検索しても届かないこと オープンウェイトも高性能だが、クローズドな フロンティアモデルを超えるとは言い難い。性 モデルを大きくするのではなく、探し方を良く することで差を詰めることを検討している。 能差を正面から埋めるのは現実的でない。 がある。 17
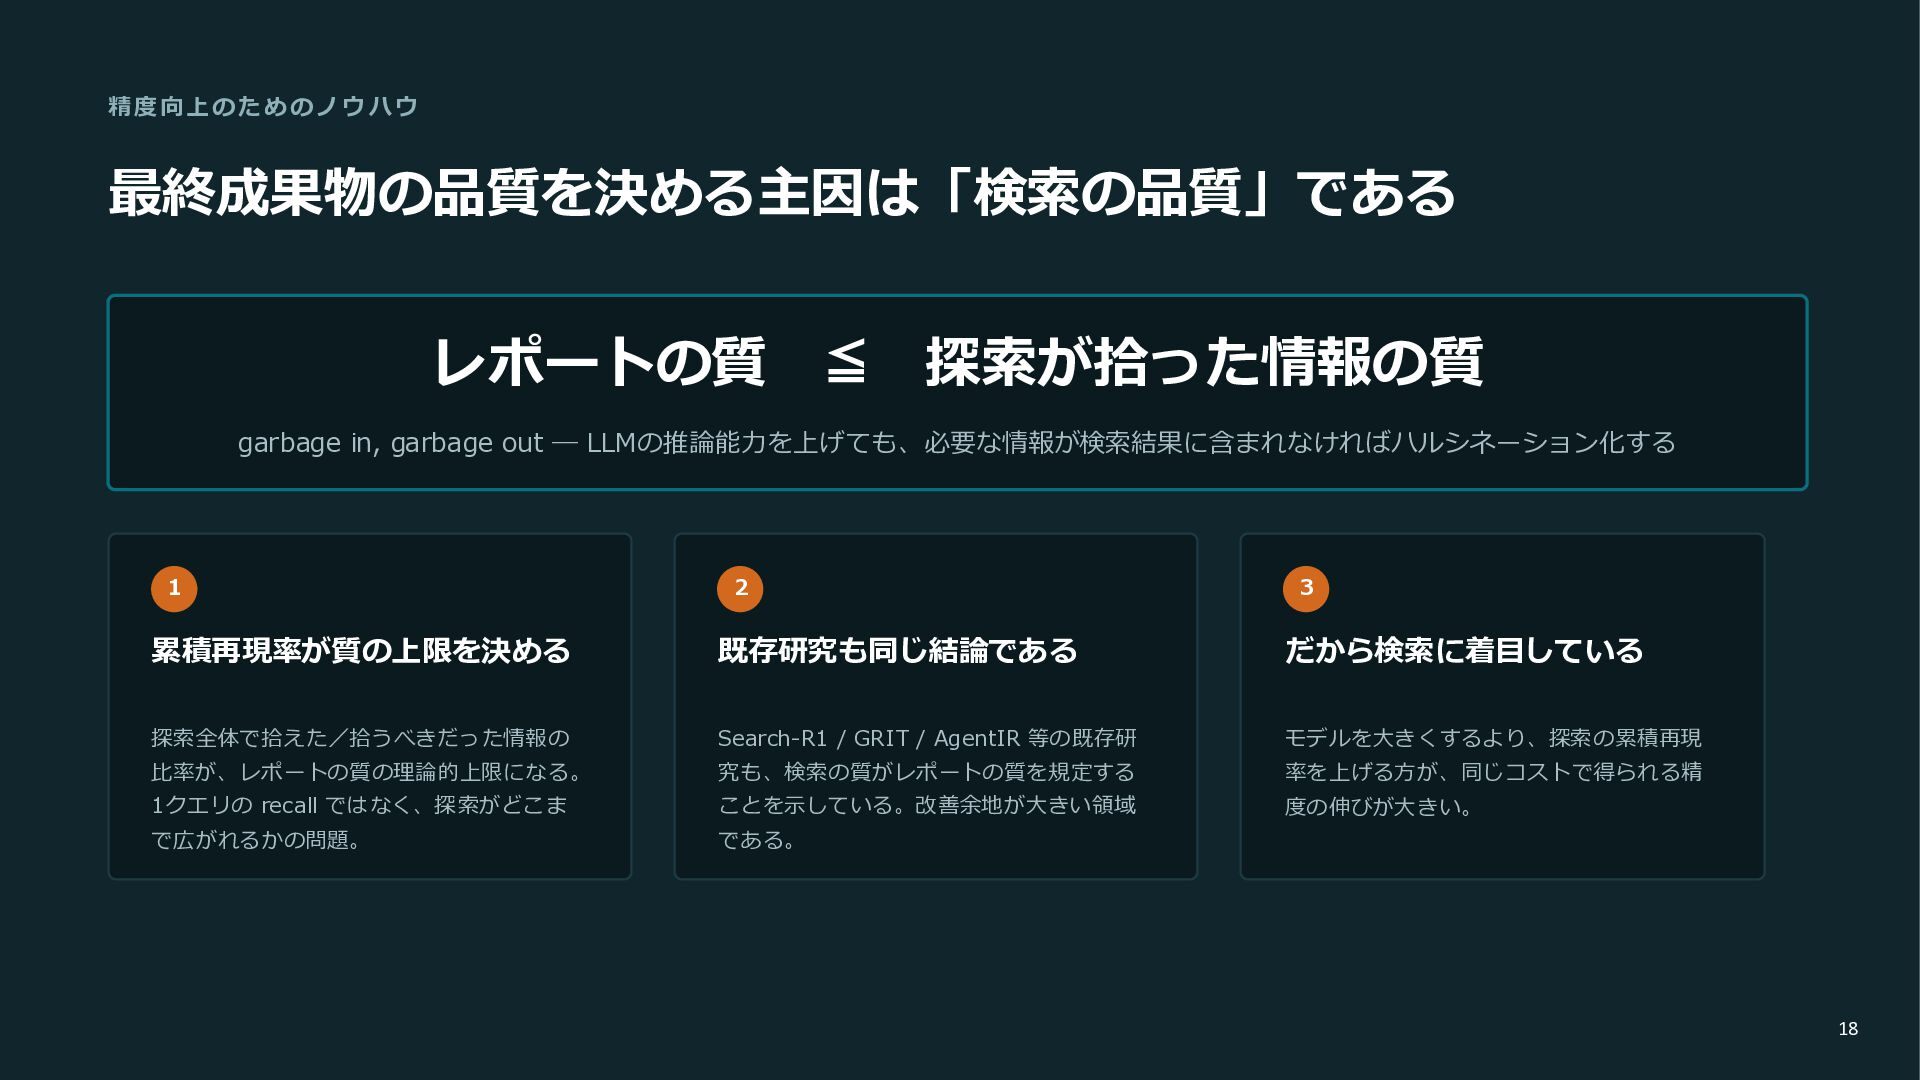
  18. 精度向上のためのノウ ハウ 最終成果物の品質を決める主因は「検索の品質」である レポートの質 ≦ 探索が拾った情報の質 garbage in, garbage out

    ― LLMの推論能力を上げても、必要な情報が検索結果に含まれなければハルシネーション化する 1 2 3 累積再現率が質の上限を決める 既存研究も同じ結論である だから検索に着目している 探索全体で拾えた/拾うべきだった情報の Search-R1 / GRIT / AgentIR 等の既存研 モデルを大きくするより、探索の累積再現 比率が、レポートの質の理論的上限になる。 究も、検索の質がレポートの質を規定する 率を上げる方が、同じコストで得られる精 1クエリの recall ではなく、探索がどこま ことを示している。改善余地が大きい領域 度の伸びが大きい。 で広がれるかの問題。 である。 18
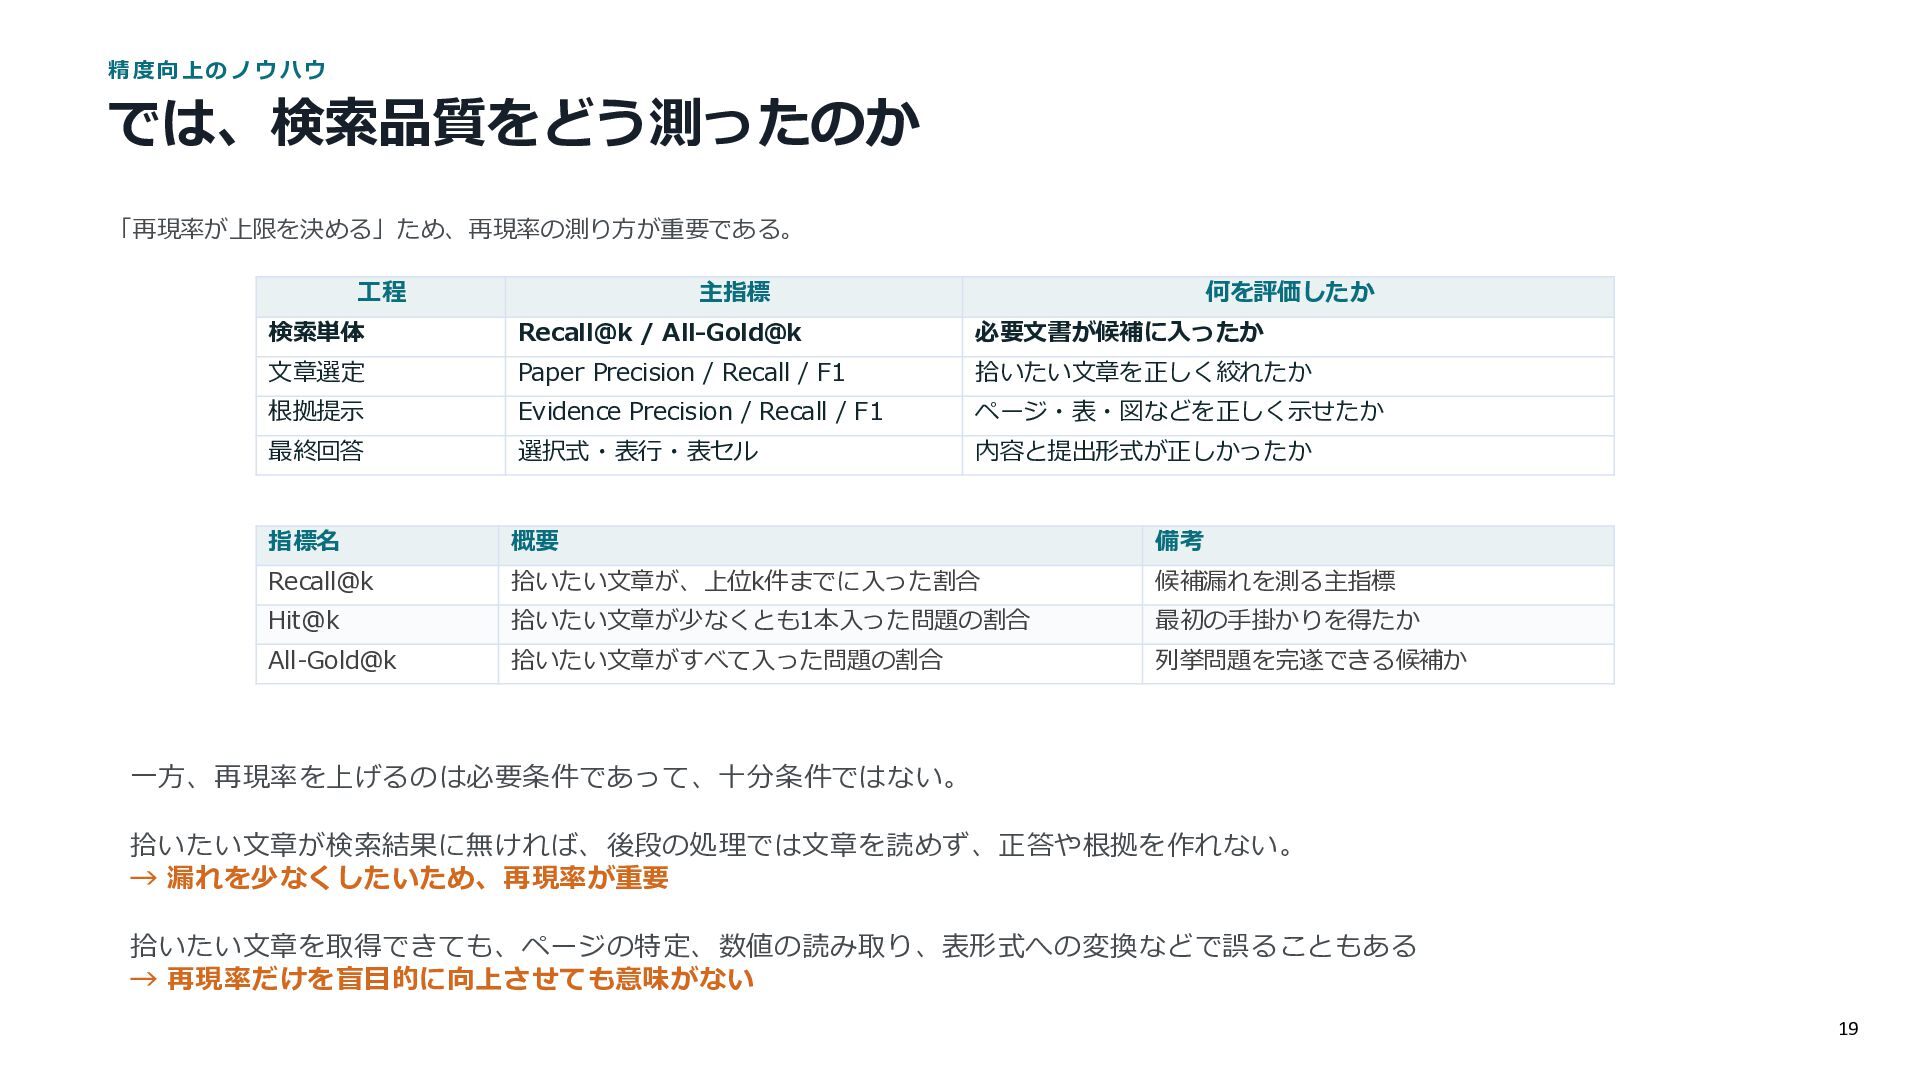
  19. 精度向上のノウハウ では、検索品質をどう測ったのか 「再現率が上限を決める」ため、再現率の測り方が重要である。 工程 主指標 何を評価したか 検索単体 Recall@k / All-Gold@k

    必要文書が候補に入ったか 文章選定 Paper Precision / Recall / F1 拾いたい文章を正しく絞れたか 根拠提示 Evidence Precision / Recall / F1 ページ・表・図などを正しく示せたか 最終回答 選択式・表行・表セル 内容と提出形式が正しかったか 指標名 概要 備考 Recall@k 拾いたい文章が、上位k件までに入った割合 候補漏れを測る主指標 Hit@k 拾いたい文章が少なくとも1本入った問題の割合 最初の手掛かりを得たか All-Gold@k 拾いたい文章がすべて入った問題の割合 列挙問題を完遂できる候補か 一方、再現率を上げるのは必要条件であって、十分条件ではない。 拾いたい文章が検索結果に無ければ、後段の処理では文章を読めず、正答や根拠を作れない。 → 漏れを少なくしたいため、再現率が重要 拾いたい文章を取得できても、ページの特定、数値の読み取り、表形式への変換などで誤ることもある → 再現率だけを盲目的に向上させても意味がない 19
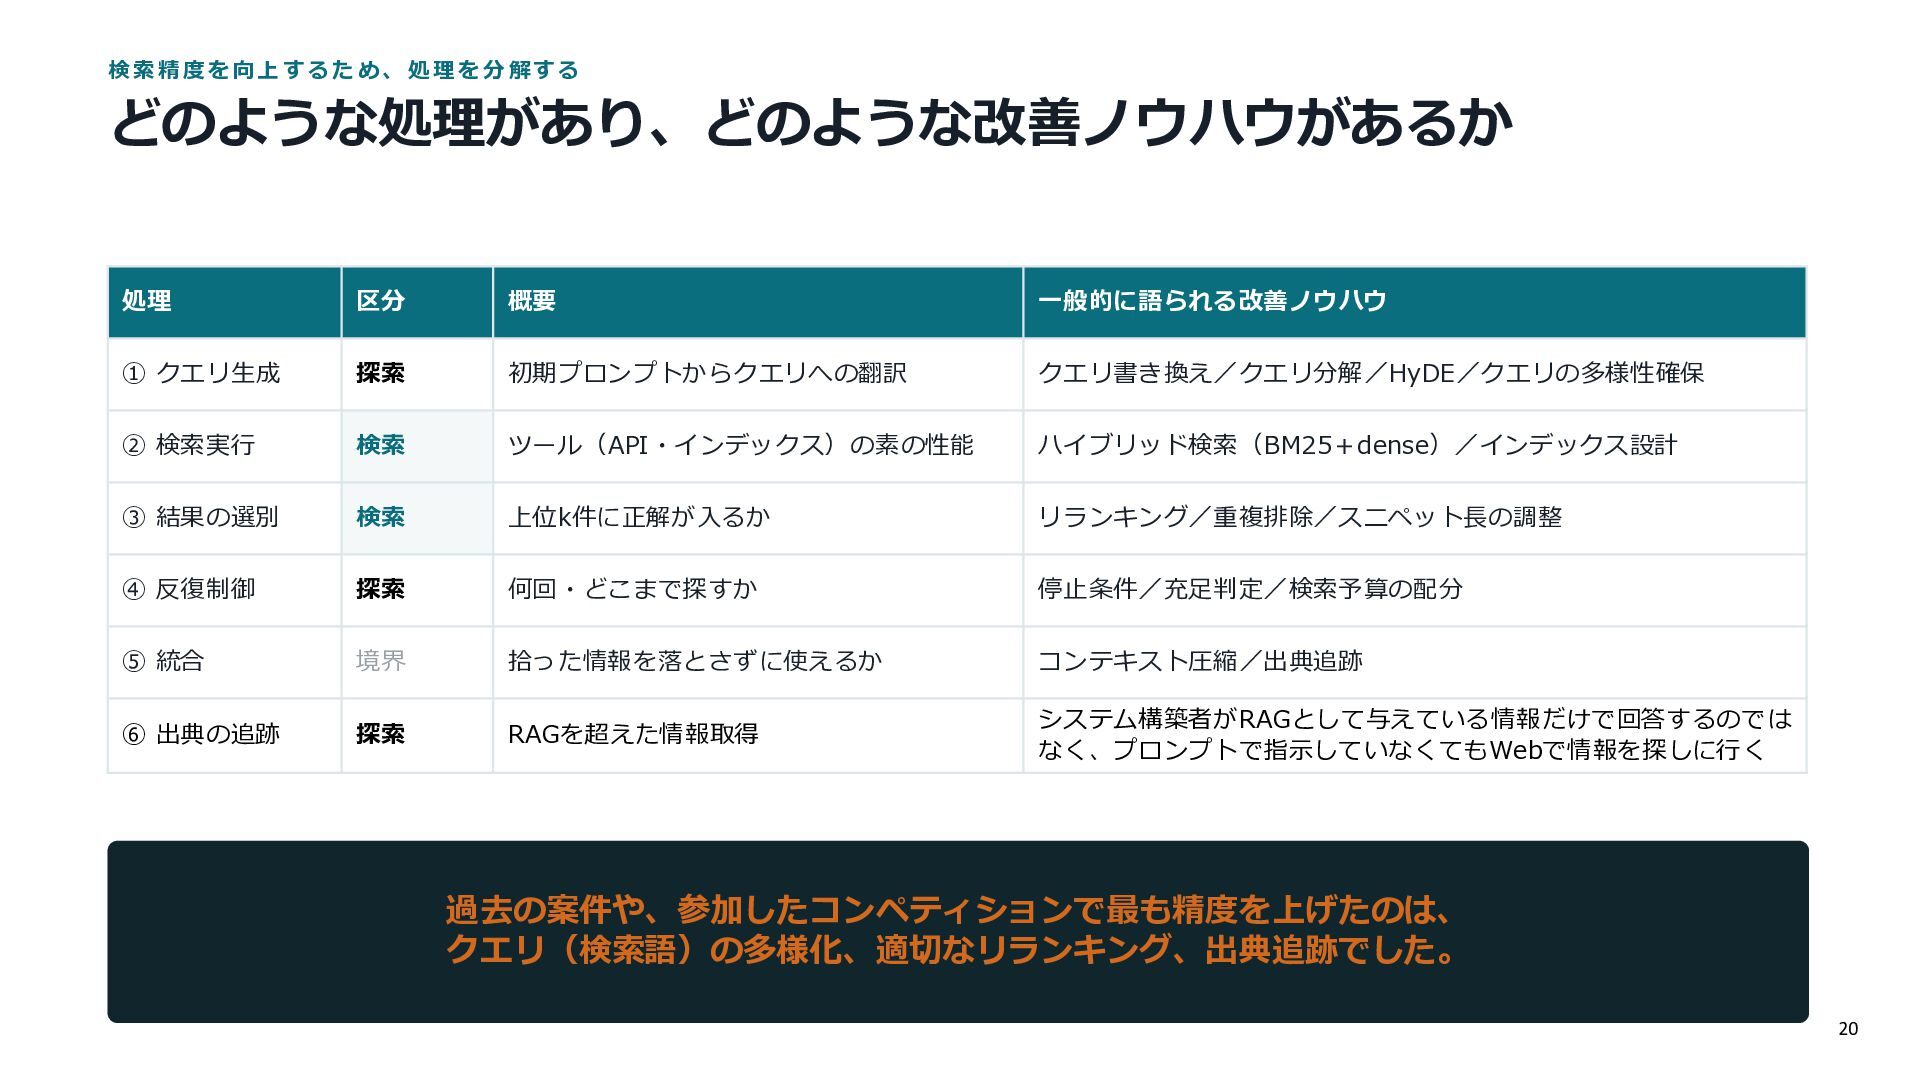
  20. 検索 精度 を向上 するた め、 処理 を分 解する どのような処理があり、どのような改善ノウハウがあるか 処理

    区分 概要 一般的に語られる改善ノウハウ ① クエリ生成 探索 初期プロンプトからクエリへの翻訳 クエリ書き換え/クエリ分解/HyDE/クエリの多様性確保 ② 検索実行 検索 ツール(API・インデックス)の素の性能 ハイブリッド検索(BM25+dense)/インデックス設計 ③ 結果の選別 検索 上位k件に正解が入るか リランキング/重複排除/スニペット長の調整 ④ 反復制御 探索 何回・どこまで探すか 停止条件/充足判定/検索予算の配分 ⑤ 統合 境界 拾った情報を落とさずに使えるか コンテキスト圧縮/出典追跡 ⑥ 出典の追跡 探索 RAGを超えた情報取得 システム構築者がRAGとして与えている情報だけで回答するのでは なく、プロンプトで指示していなくてもWebで情報を探しに行く 過去の案件や、参加したコンペティションで最も精度を上げたのは、 クエリ(検索語)の多様化、適切なリランキング、出典追跡でした。 20
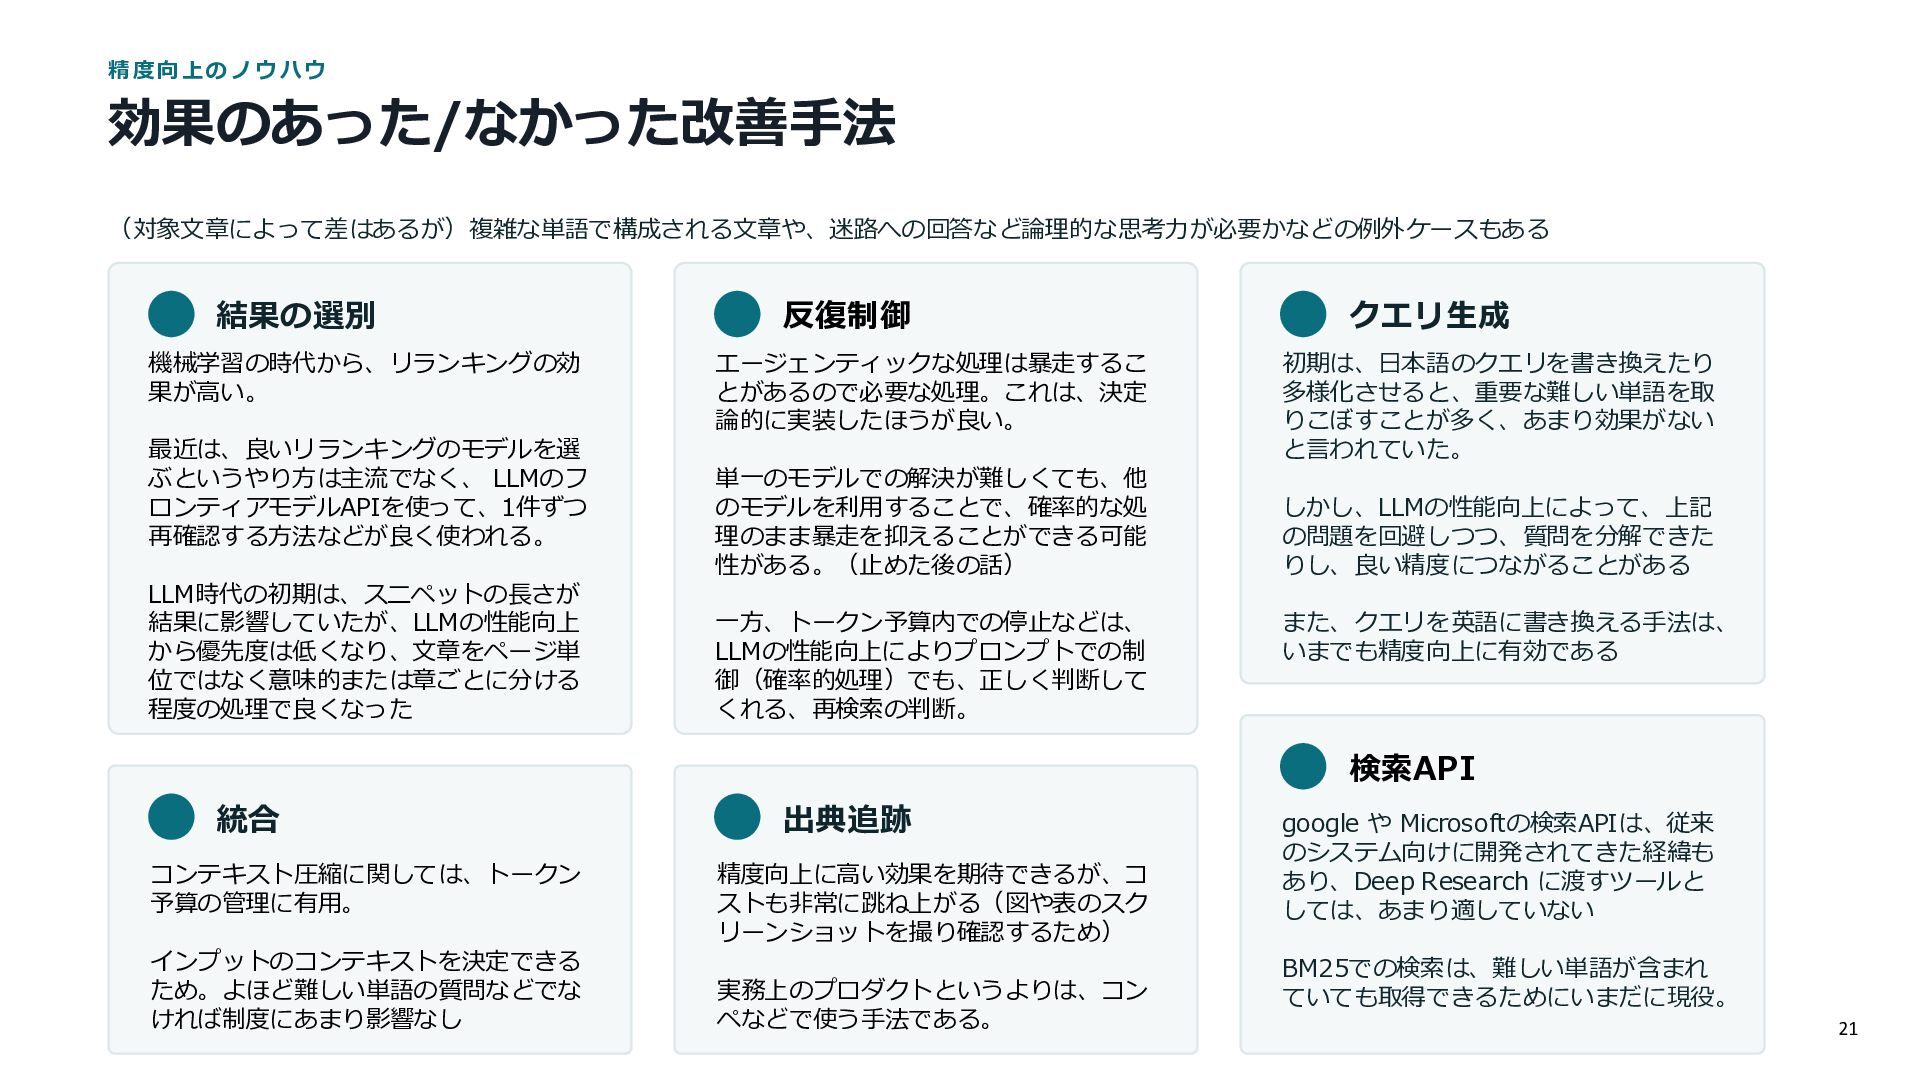
  21. 精度向上のノウハウ 効果のあった/なかった改善手法 (対象文章によって差はあるが)複雑な単語で構成される文章や、迷路への回答など論理的な思考力が必要かなどの例外ケースもある 結果の選別 機械学習の時代から、リランキングの効 果が高い。 最近は、良いリランキングのモデルを選 ぶというやり方は主流でなく、 LLMのフ ロンティアモデルAPIを使って、1件ずつ

    再確認する方法などが良く使われる。 LLM時代の初期は、スニペットの長さが 結果に影響していたが、LLMの性能向上 から優先度は低くなり、文章をページ単 位ではなく意味的または章ごとに分ける 程度の処理で良くなった 反復制御 エージェンティックな処理は暴走するこ とがあるので必要な処理。これは、決定 論的に実装したほうが良い。 単一のモデルでの解決が難しくても、他 のモデルを利用することで、確率的な処 理のまま暴走を抑えることができる可能 性がある。(止めた後の話) 一方、トークン予算内での停止などは、 LLMの性能向上によりプロンプトでの制 御(確率的処理)でも、正しく判断して くれる、再検索の判断。 クエリ生成 初期は、日本語のクエリを書き換えたり 多様化させると、重要な難しい単語を取 りこぼすことが多く、あまり効果がない と言われていた。 しかし、LLMの性能向上によって、上記 の問題を回避しつつ、質問を分解できた りし、良い精度につながることがある また、クエリを英語に書き換える手法は、 いまでも精度向上に有効である 検索API 統合 コンテキスト圧縮に関しては、トークン 予算の管理に有用。 インプットのコンテキストを決定できる ため。よほど難しい単語の質問などでな ければ制度にあまり影響なし 出典追跡 精度向上に高い効果を期待できるが、コ ストも非常に跳ね上がる(図や表のスク リーンショットを撮り確認するため) 実務上のプロダクトというよりは、コン ペなどで使う手法である。 google や Microsoftの検索APIは、従来 のシステム向けに開発されてきた経緯も あり、Deep Research に渡すツールと しては、あまり適していない BM25での検索は、難しい単語が含まれ ていても取得できるためにいまだに現役。 21
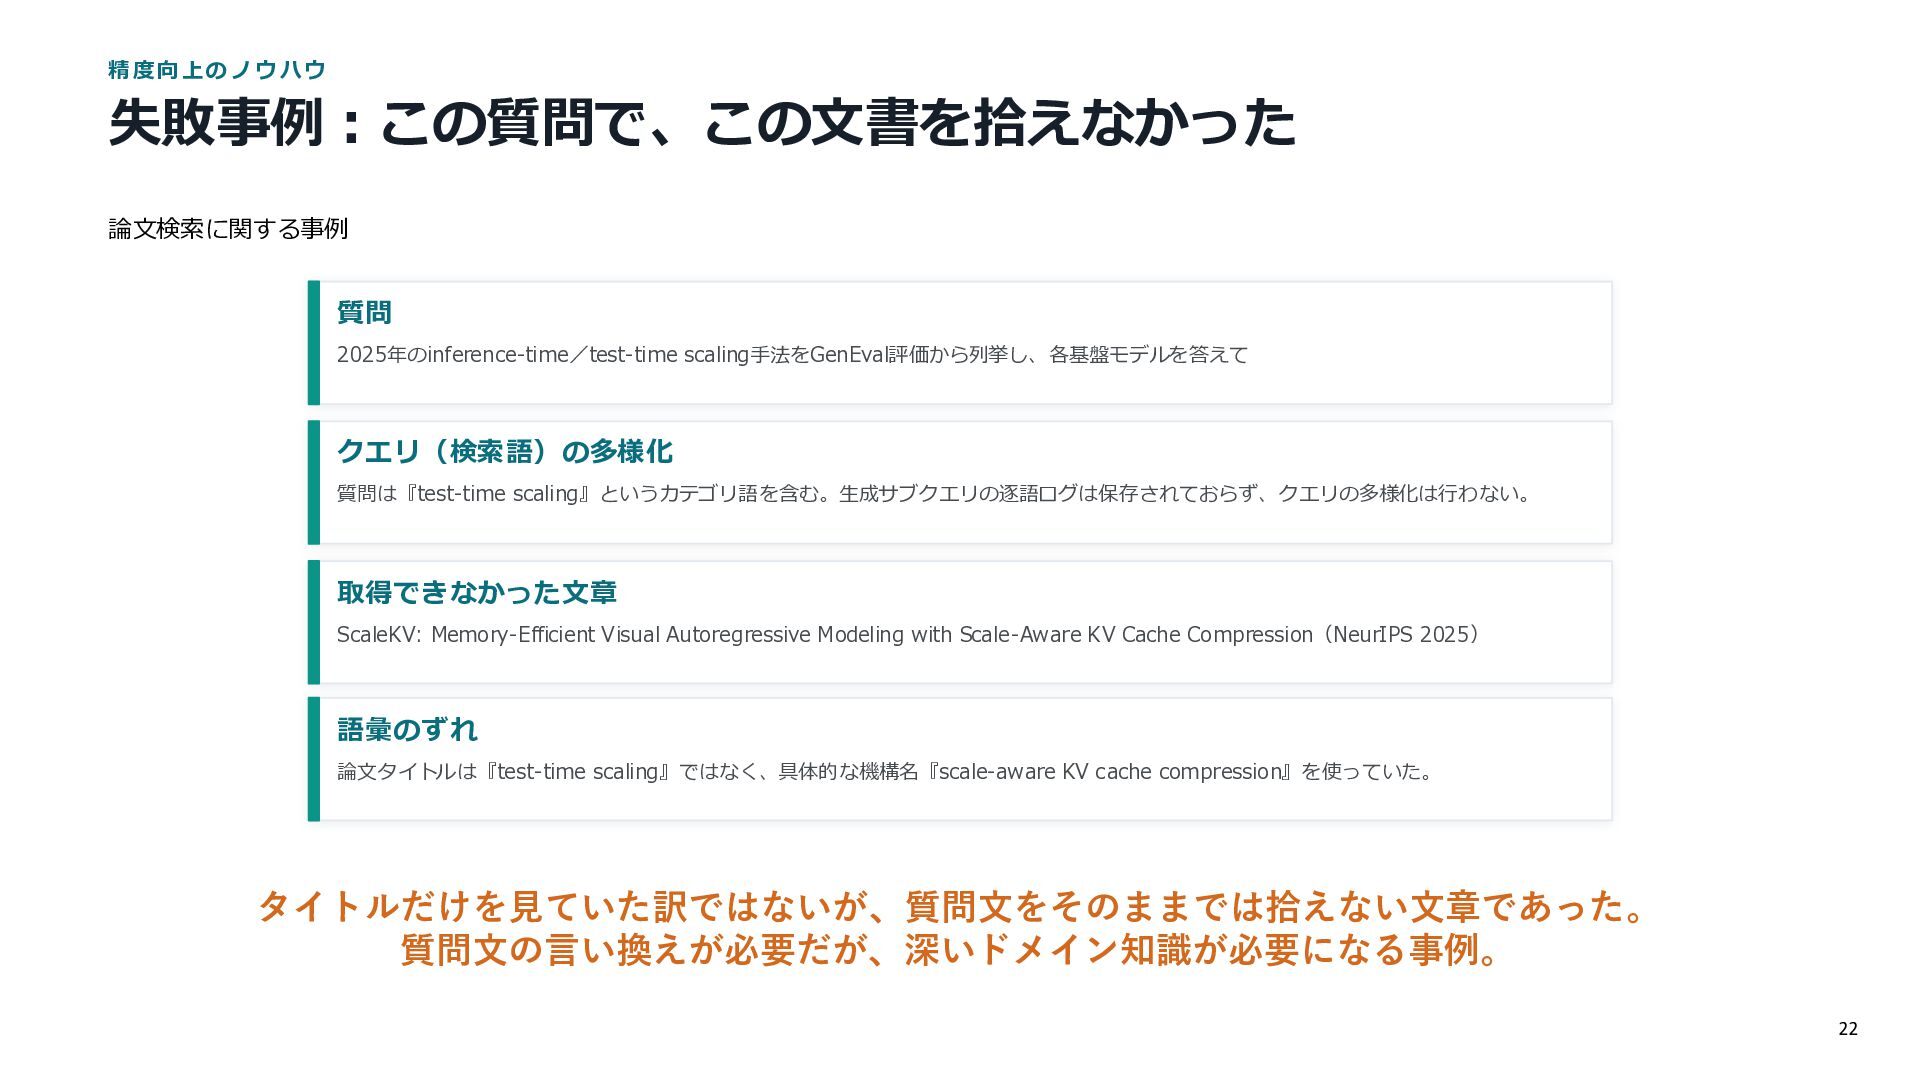
  22. 精度向上のノウハウ 失敗事例:この質問で、この文書を拾えなかった 論文検索に関する事例 質問 2025年のinference-time/test-time scaling手法をGenEval評価から列挙し、各基盤モデルを答えて クエリ(検索語)の多様化 質問は『test-time scaling』というカテゴリ語を含む。生成サブクエリの逐語ログは保存されておらず、クエリの多様化は行わない。 取得できなかった文章

    ScaleKV: Memory-Efficient Visual Autoregressive Modeling with Scale-Aware KV Cache Compression(NeurIPS 2025) 語彙のずれ 論文タイトルは『test-time scaling』ではなく、具体的な機構名『scale-aware KV cache compression』を使っていた。 タイトルだけを見ていた訳ではないが、質問文をそのままでは拾えない文章であった。 質問文の言い換えが必要だが、深いドメイン知識が必要になる事例。 22
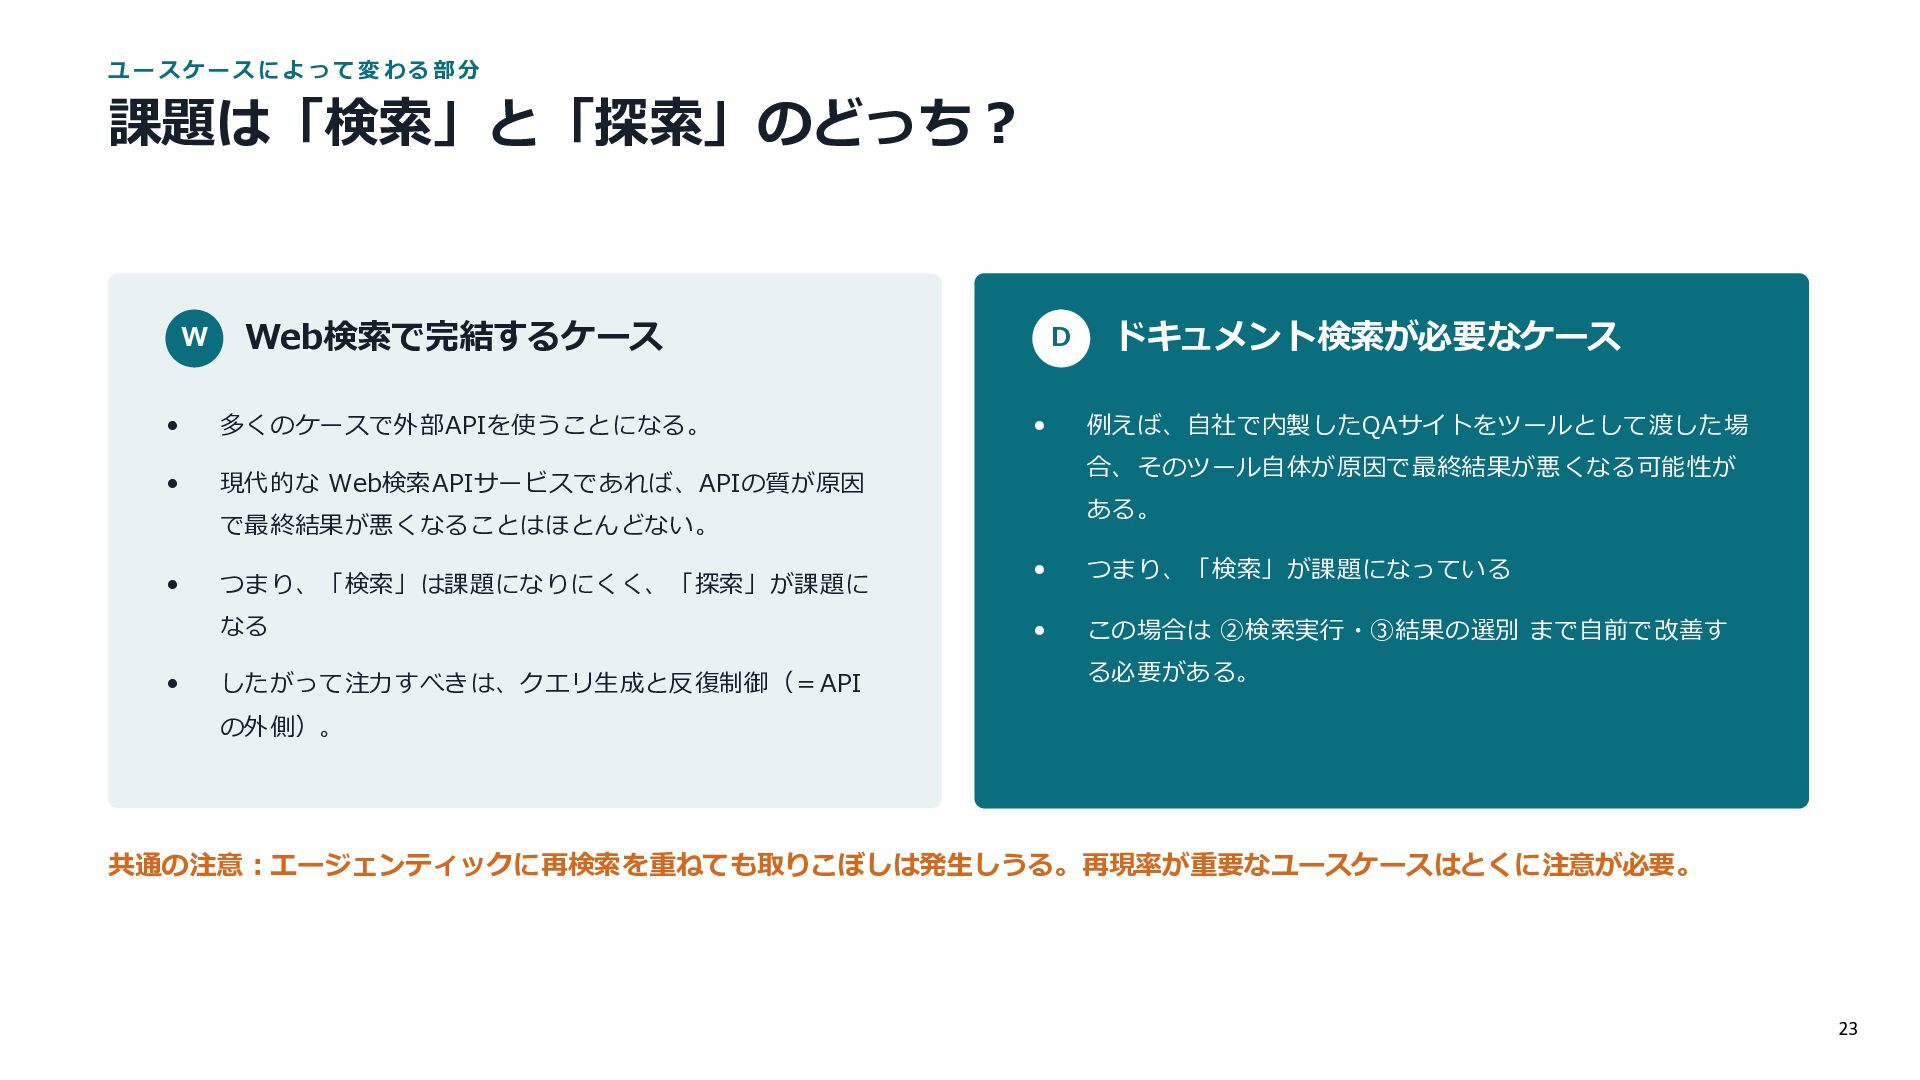
  23. ユー スケー スによ って変 わる部 分 課題は「検索」と「探索」のどっち? W Web検索で完結するケース •

    多くのケースで外部APIを使うことになる。 • 現代的な Web検索APIサービスであれば、APIの質が原因 D • つまり、「検索」は課題になりにくく、「探索」が課題に なる • したがって注力すべきは、クエリ生成と反復制御(=API 例えば、自社で内製したQAサイトをツールとして渡した場 合、そのツール自体が原因で最終結果が悪くなる可能性が ある。 で最終結果が悪くなることはほとんどない。 • ドキュメント検索が必要なケース • つまり、「検索」が課題になっている • この場合は ②検索実行・③結果の選別 まで自前で改善す る必要がある。 の外側)。 共通の注意:エージェンティックに再検索を重ねても取りこぼしは発生しうる。再現率が重要なユースケースはとくに注意が必要。 23
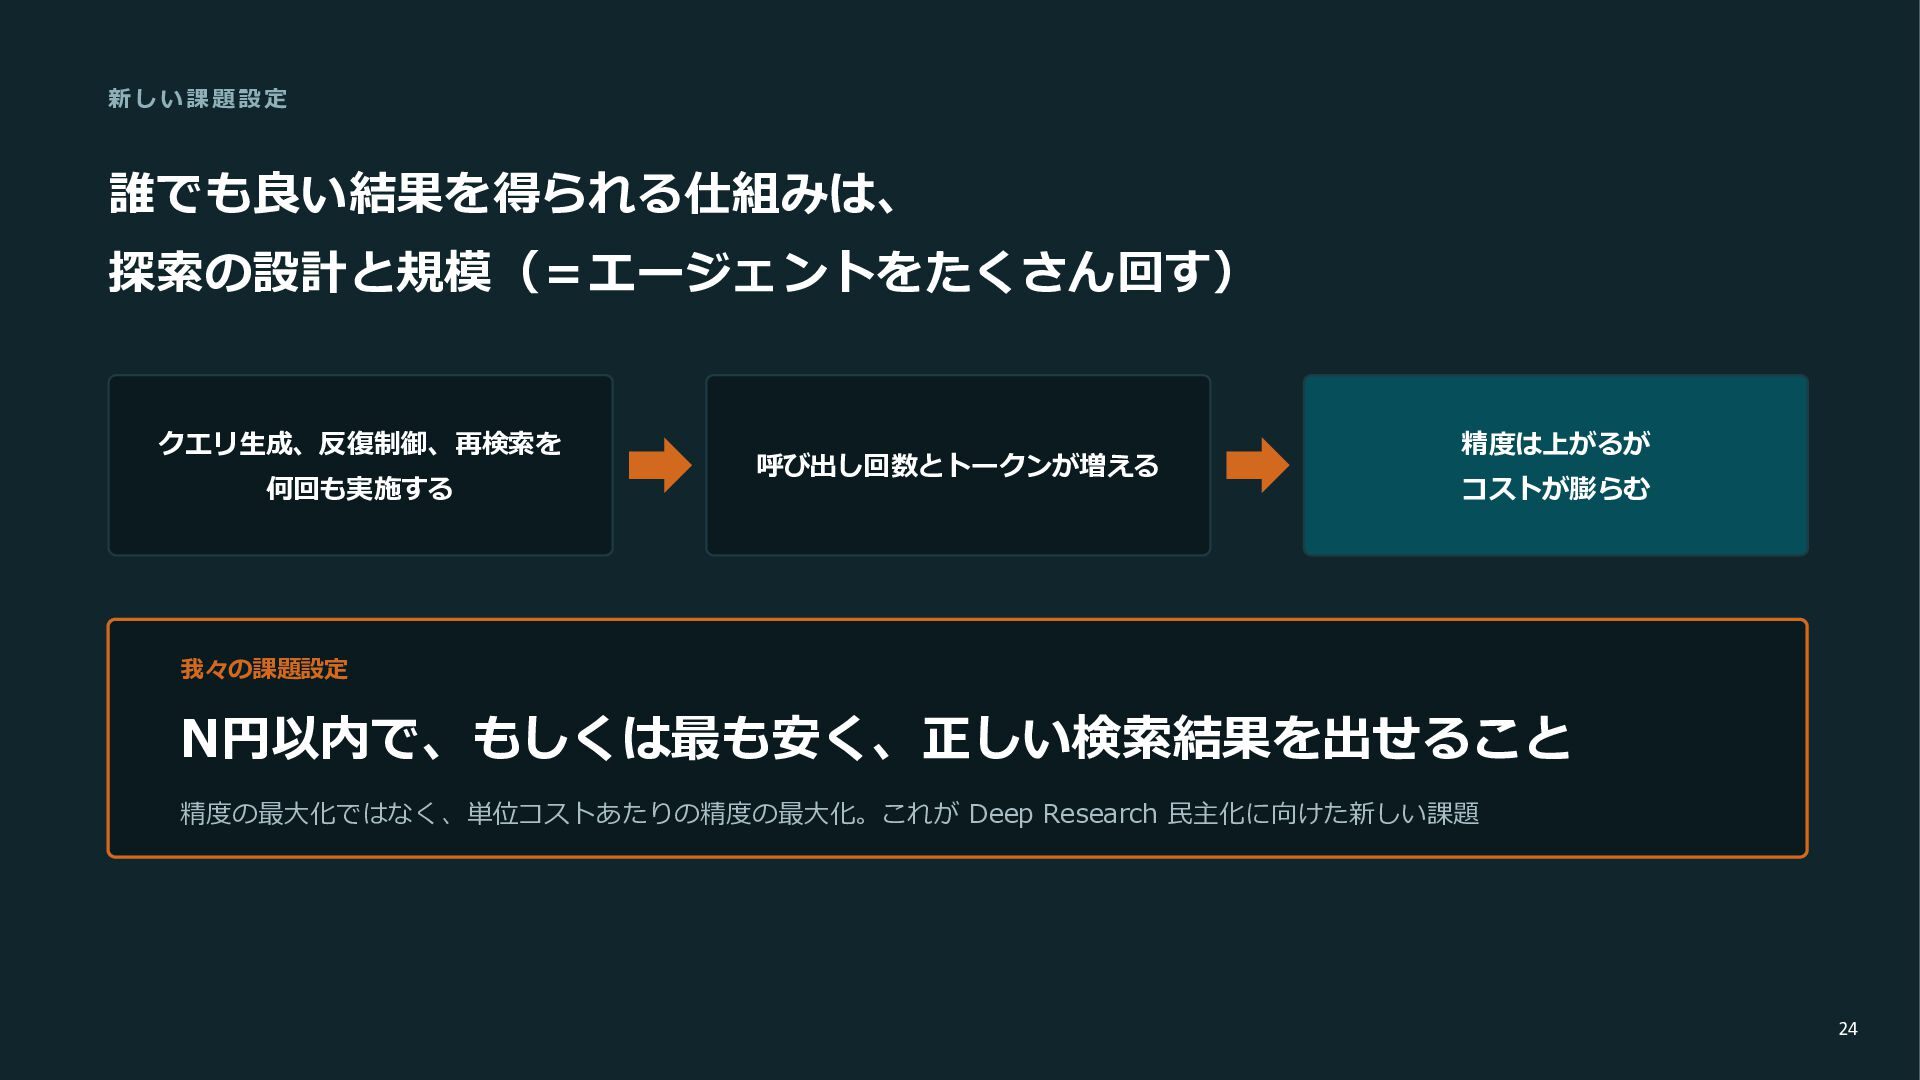
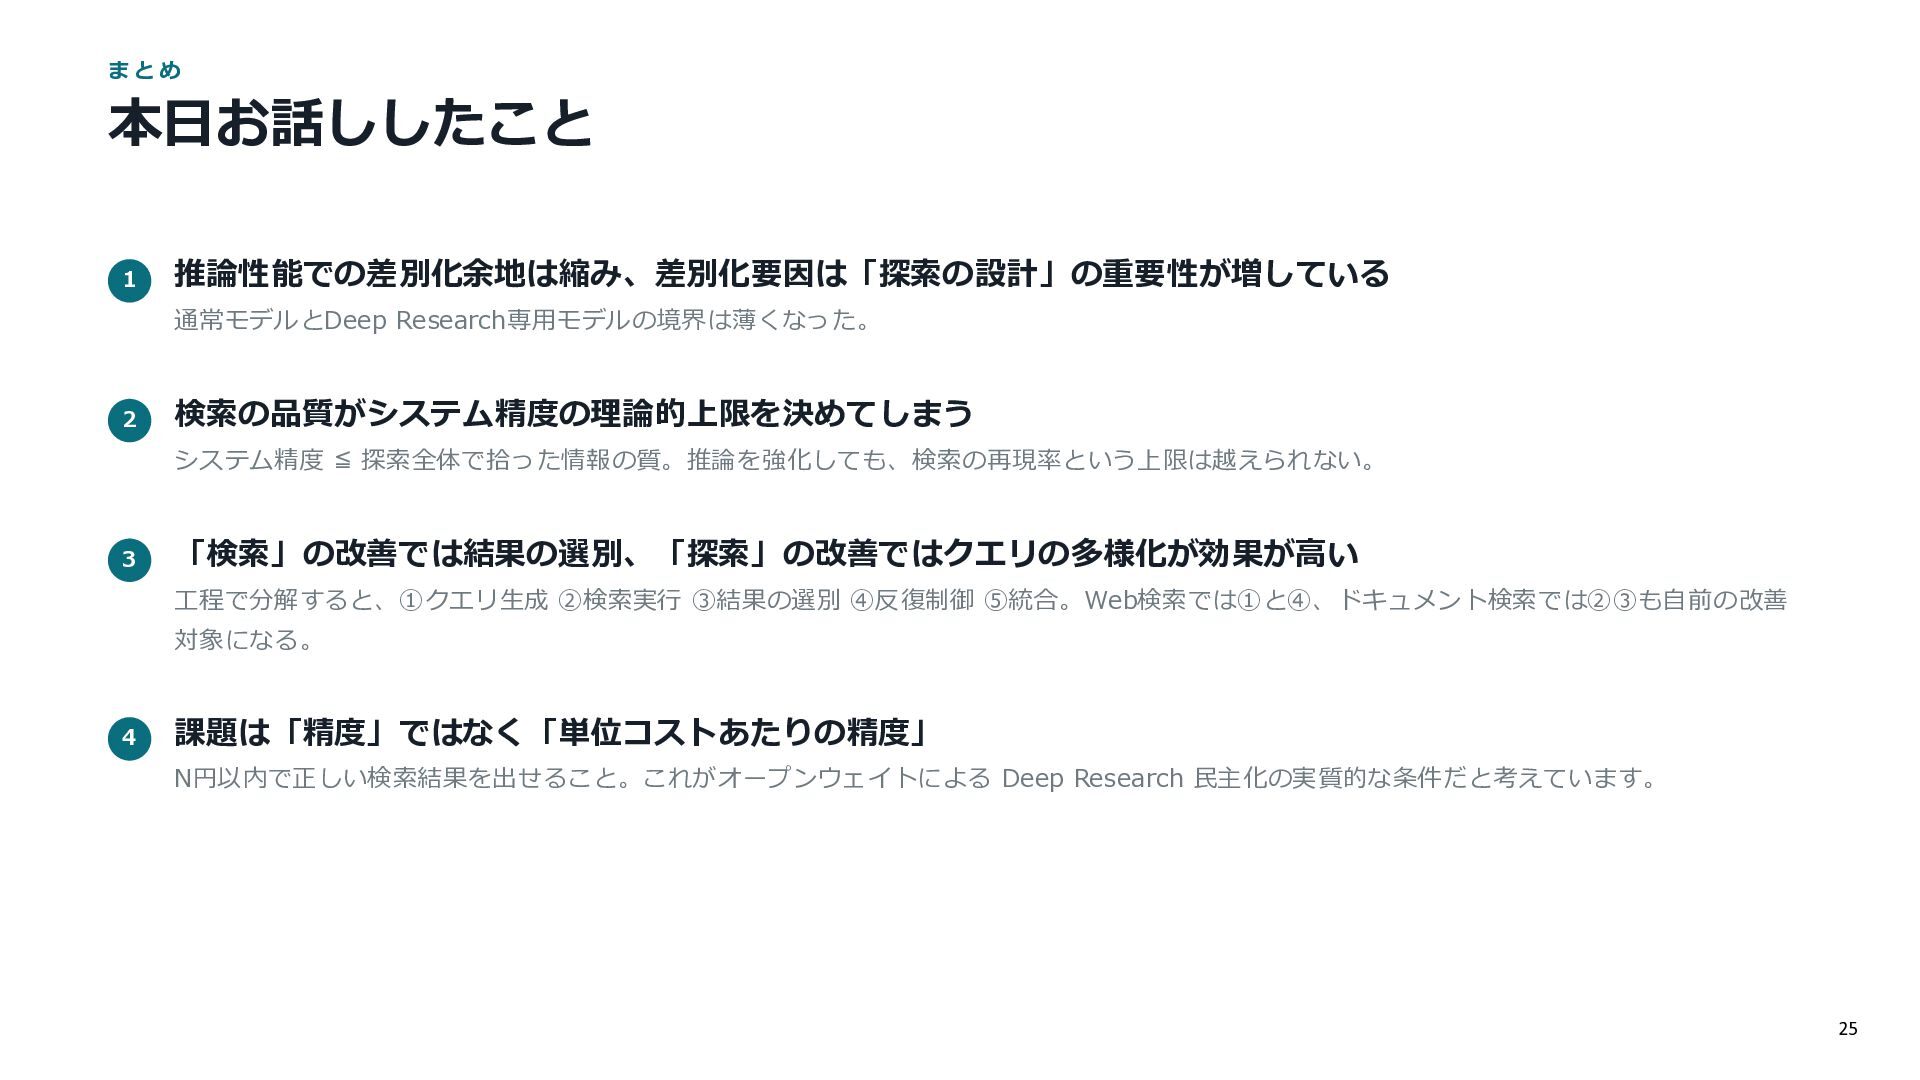
  24. まと め 本日お話ししたこと 1 推論性能での差別化余地は縮み、差別化要因は「探索の設計」の重要性が増している 通常モデルとDeep Research専用モデルの境界は薄くなった。 2 検索の品質がシステム精度の理論的上限を決めてしまう システム精度

    ≦ 探索全体で拾った情報の質。推論を強化しても、検索の再現率という上限は越えられない。 3 「検索」の改善では結果の選別、「探索」の改善ではクエリの多様化が効果が高い 工程で分解すると、①クエリ生成 ②検索実行 ③結果の選別 ④反復制御 ⑤統合。Web検索では①と④、ドキュメント検索では②③も自前の改善 対象になる。 4 課題は「精度」ではなく「単位コストあたりの精度」 N円以内で正しい検索結果を出せること。これがオープンウェイトによる Deep Research 民主化の実質的な条件だと考えています。 25
  25. W e a r e h ir in g 電通総研の新しい柱を一緒に作りませんか

    募集職種一覧はこちら 電通総研テックブログ https://www.career.dentsusoken.com/ https://tech.dentsusoken.com/ ただ今メンテナンス中のため、応募受付を一時停止しています。 再開は、9月29日頃を予定しております。それまでは、里中までご連絡ください。 26