Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
最先端NLP勉強会2026: How Memory Management Impacts LL...
Search
Ryuki Ida
August 14, 2026
180
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
最先端NLP勉強会2026: How Memory Management Impacts LLM Agents: An Empirical Study of Experience-Following Behavior
Ryuki Ida
August 14, 2026
More Decks by Ryuki Ida
See All by Ryuki Ida
ACL読み会2026@名大:AutoGraph-R1: End-to-End Reinforcement Learning for Knowledge Graph Construction
iryuki1110
0
80
ACL読み会2025@名大:A Theory of Response Sampling in LLMs: Part Descriptive and Part Prescriptive
iryuki1110
0
120
最先端NLP勉強会2025: Disentangling Memory and Reasoning Ability in Large Language Models
iryuki1110
0
210
ACL読み会2024@名大:SCIMON : Scientific Inspiration Machines Optimized for Novelty
iryuki1110
0
98
最先端NLP勉強会2024: TTM-RE Memory-Augmented Document-Level Relation Extraction
iryuki1110
0
200
Featured
See All Featured
Lessons Learnt from Crawling 1000+ Websites
charlesmeaden
PRO
1
1.6k
How to train your dragon (web standard)
notwaldorf
97
6.8k
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
250
How GitHub (no longer) Works
holman
316
150k
Max Prin - Stacking Signals: How International SEO Comes Together (And Falls Apart)
techseoconnect
PRO
0
470
jQuery: Nuts, Bolts and Bling
dougneiner
66
8.6k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8k
SEOcharity - Dark patterns in SEO and UX: How to avoid them and build a more ethical web
sarafernandez
0
290
The Power of CSS Pseudo Elements
geoffreycrofte
82
6.6k
Speed Design
sergeychernyshev
33
2.1k
The Cult of Friendly URLs
andyhume
79
7k
BBQ
matthewcrist
89
10k
Transcript
※ 図表は論⽂・発表スライドより引⽤ @ACL 2026 読み⼿: 井⽥ ⿓希(豊⽥⼯業⼤学 知識データ⼯学研究室D3) 第18回最先端NLP勉強会/ 2026年8⽉30‒31⽇
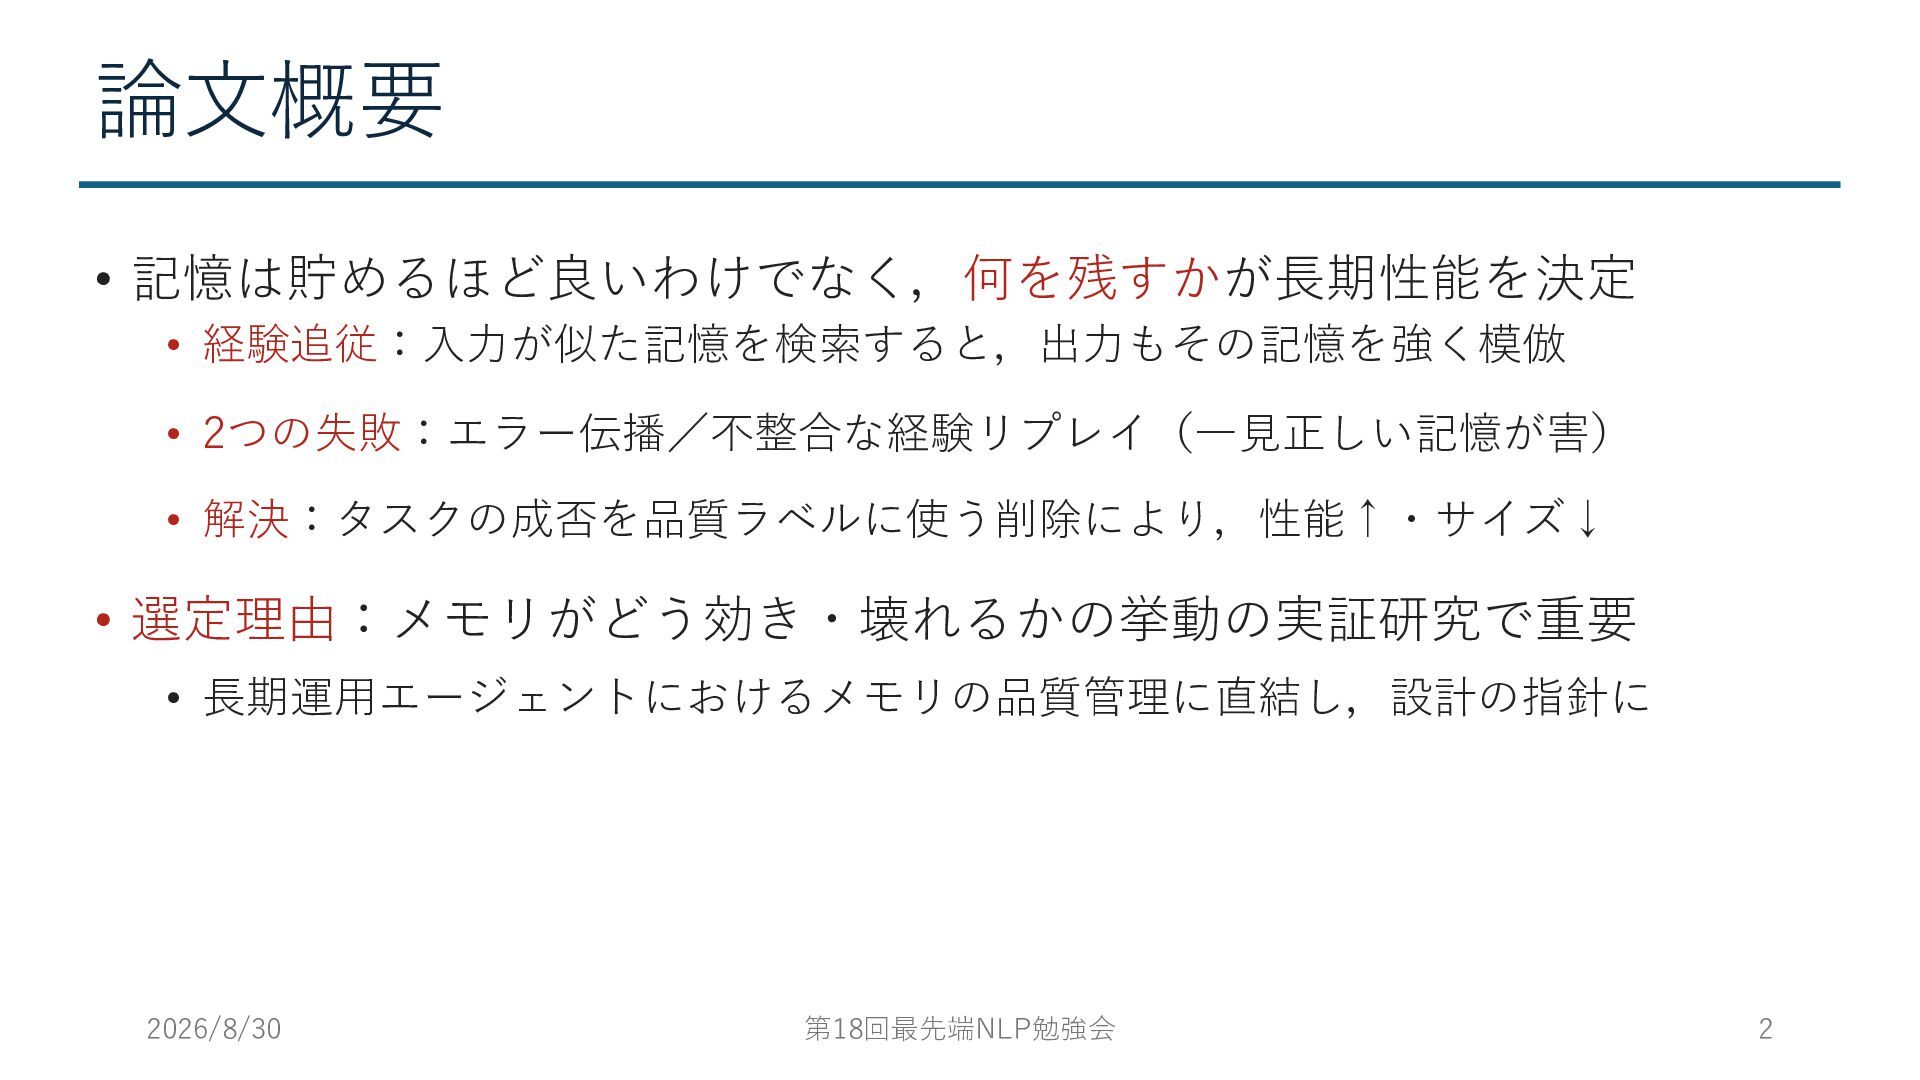
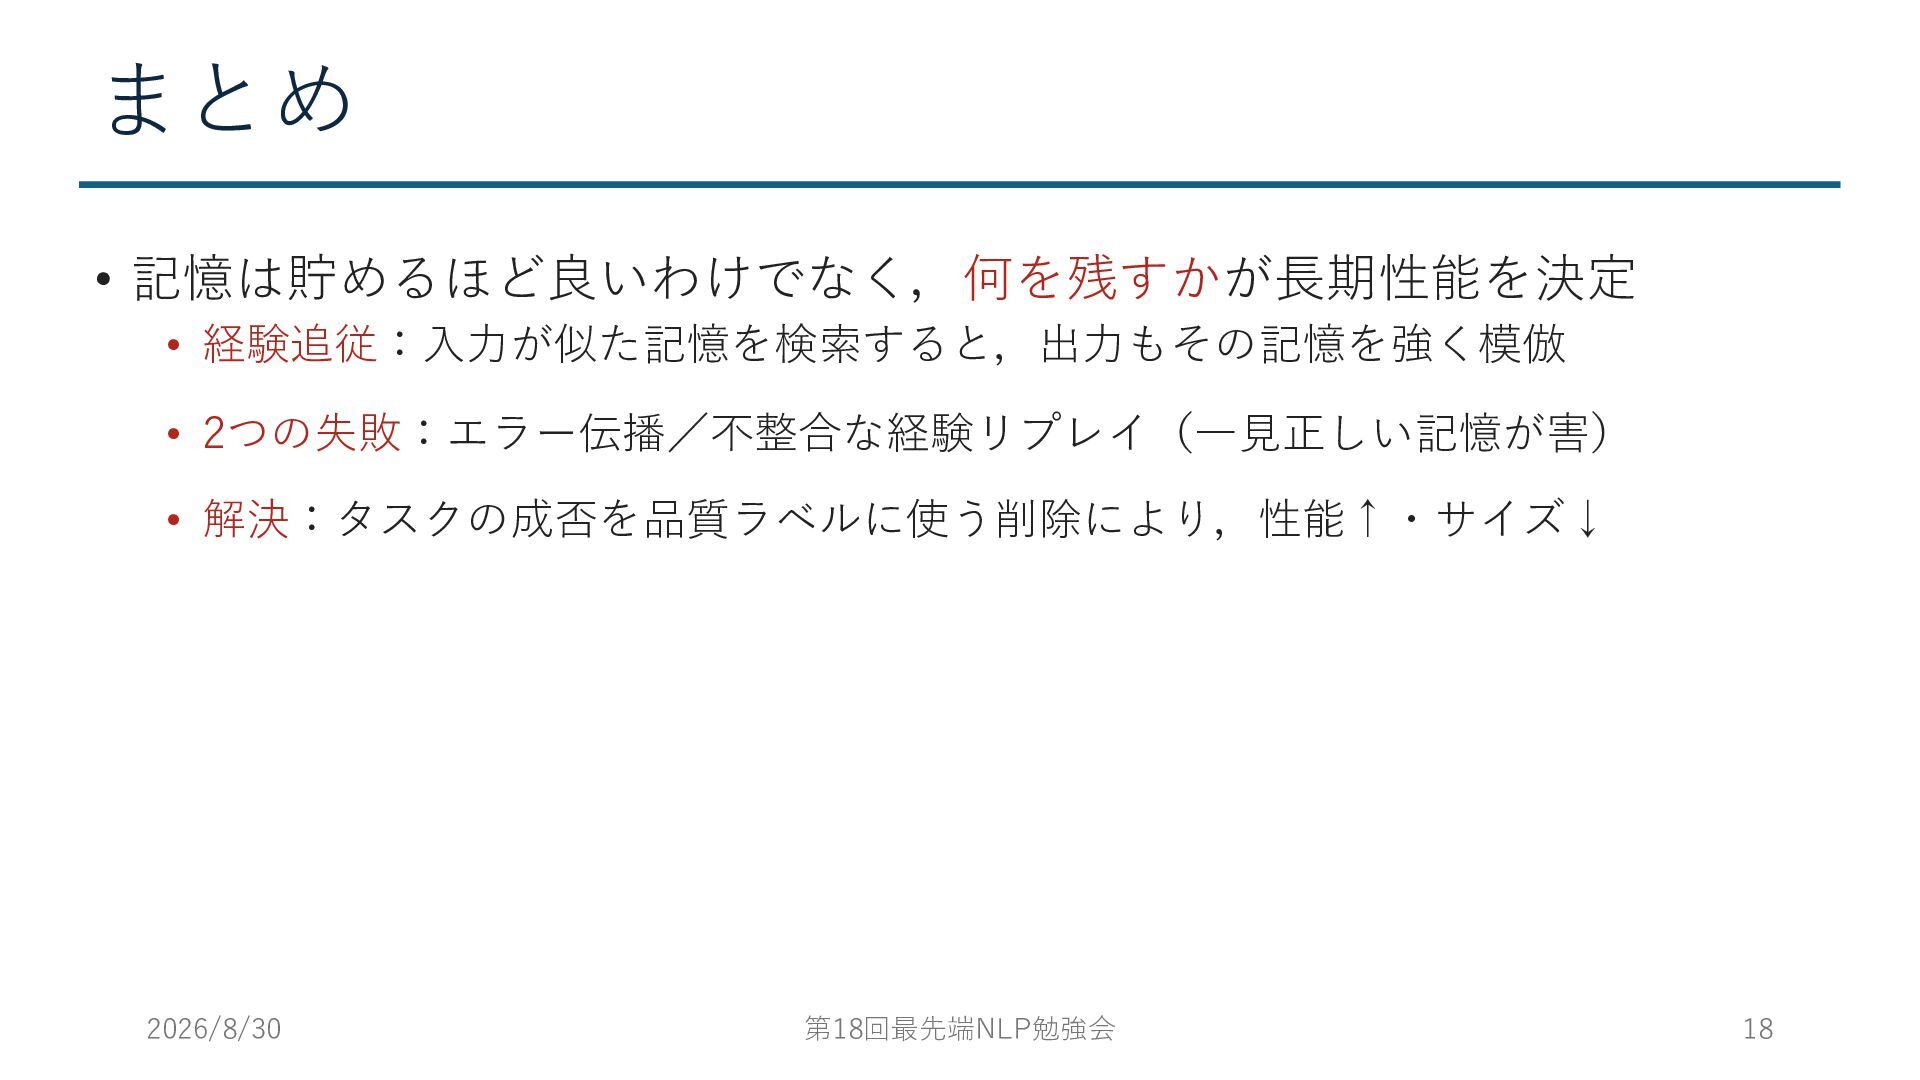
論⽂概要 • 記憶は貯めるほど良いわけでなく,何を残すかが⻑期性能を決定 • 経験追従:⼊⼒が似た記憶を検索すると,出⼒もその記憶を強く模倣 • 2つの失敗:エラー伝播/不整合な経験リプレイ(⼀⾒正しい記憶が害) • 解決:タスクの成否を品質ラベルに使う削除により,性能↑・サイズ↓ •
選定理由:メモリがどう効き・壊れるかの挙動の実証研究で重要 • ⻑期運⽤エージェントにおけるメモリの品質管理に直結し,設計の指針に 2026/8/30 第18回最先端NLP勉強会 2
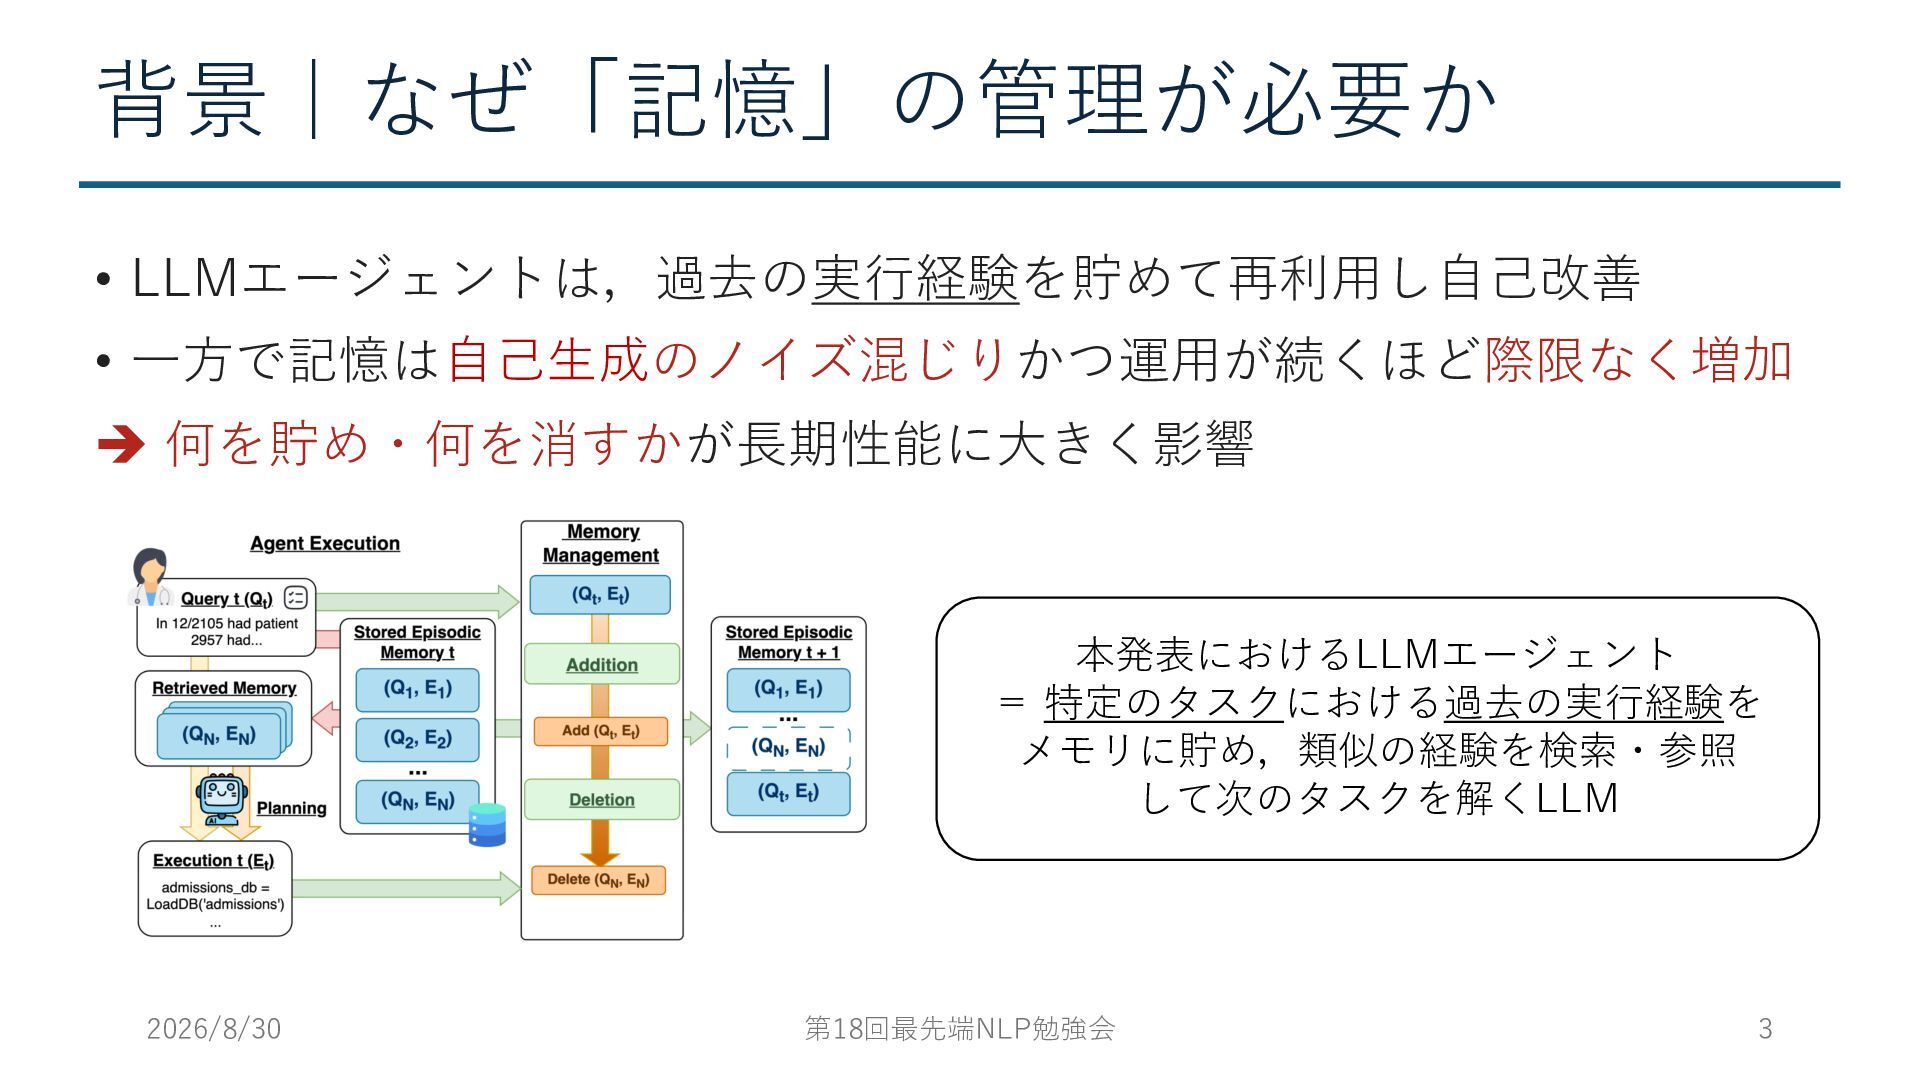
背景|なぜ「記憶」の管理が必要か • LLMエージェントは,過去の実⾏経験を貯めて再利⽤し⾃⼰改善 • ⼀⽅で記憶は⾃⼰⽣成のノイズ混じりかつ運⽤が続くほど際限なく増加 è 何を貯め・何を消すかが⻑期性能に⼤きく影響 本発表におけるLLMエージェント = 特定のタスクにおける過去の実⾏経験を
メモリに貯め,類似の経験を検索・参照 して次のタスクを解くLLM 2026/8/30 第18回最先端NLP勉強会 3
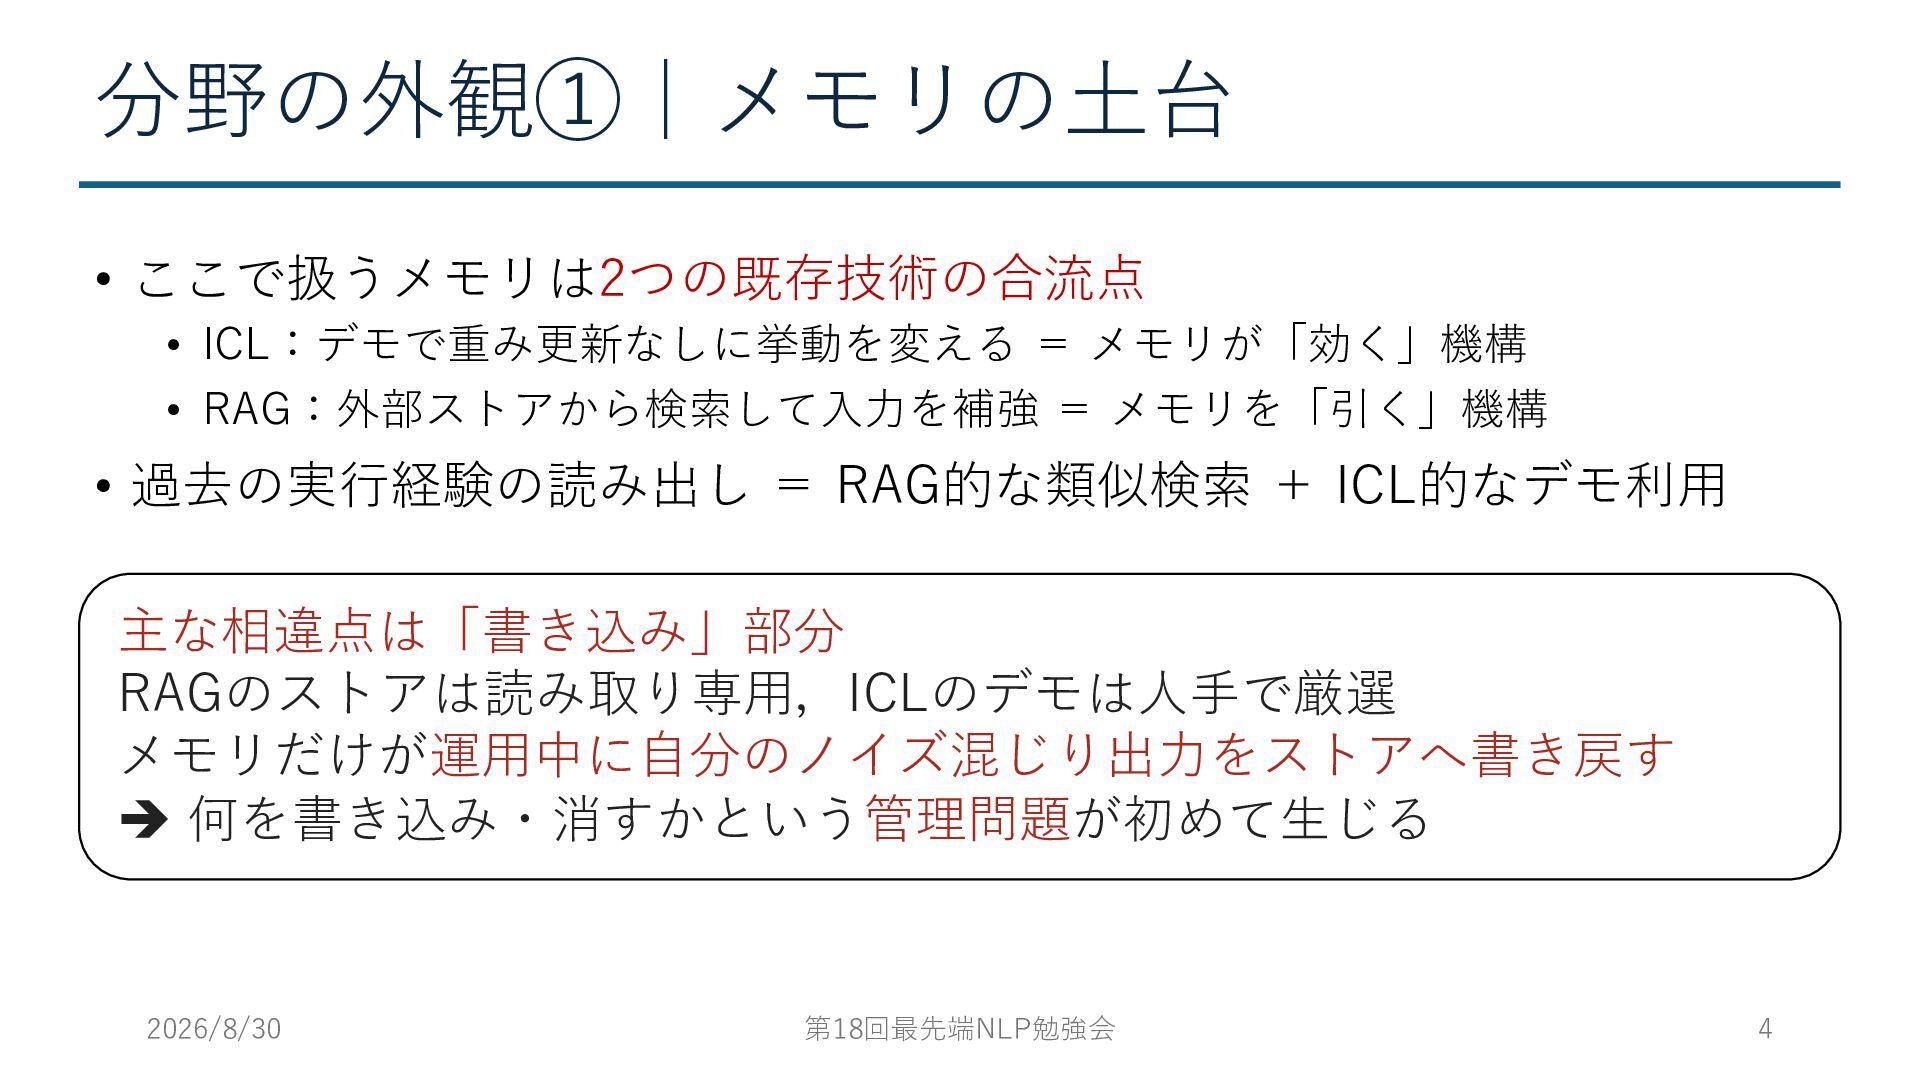
分野の外観①|メモリの⼟台 • ここで扱うメモリは2つの既存技術の合流点 • ICL:デモで重み更新なしに挙動を変える = メモリが「効く」機構 • RAG:外部ストアから検索して⼊⼒を補強 =
メモリを「引く」機構 • 過去の実⾏経験の読み出し = RAG的な類似検索 + ICL的なデモ利⽤ 主な相違点は「書き込み」部分 RAGのストアは読み取り専⽤,ICLのデモは⼈⼿で厳選 メモリだけが運⽤中に⾃分のノイズ混じり出⼒をストアへ書き戻す è 何を書き込み・消すかという管理問題が初めて⽣じる 2026/8/30 第18回最先端NLP勉強会 4
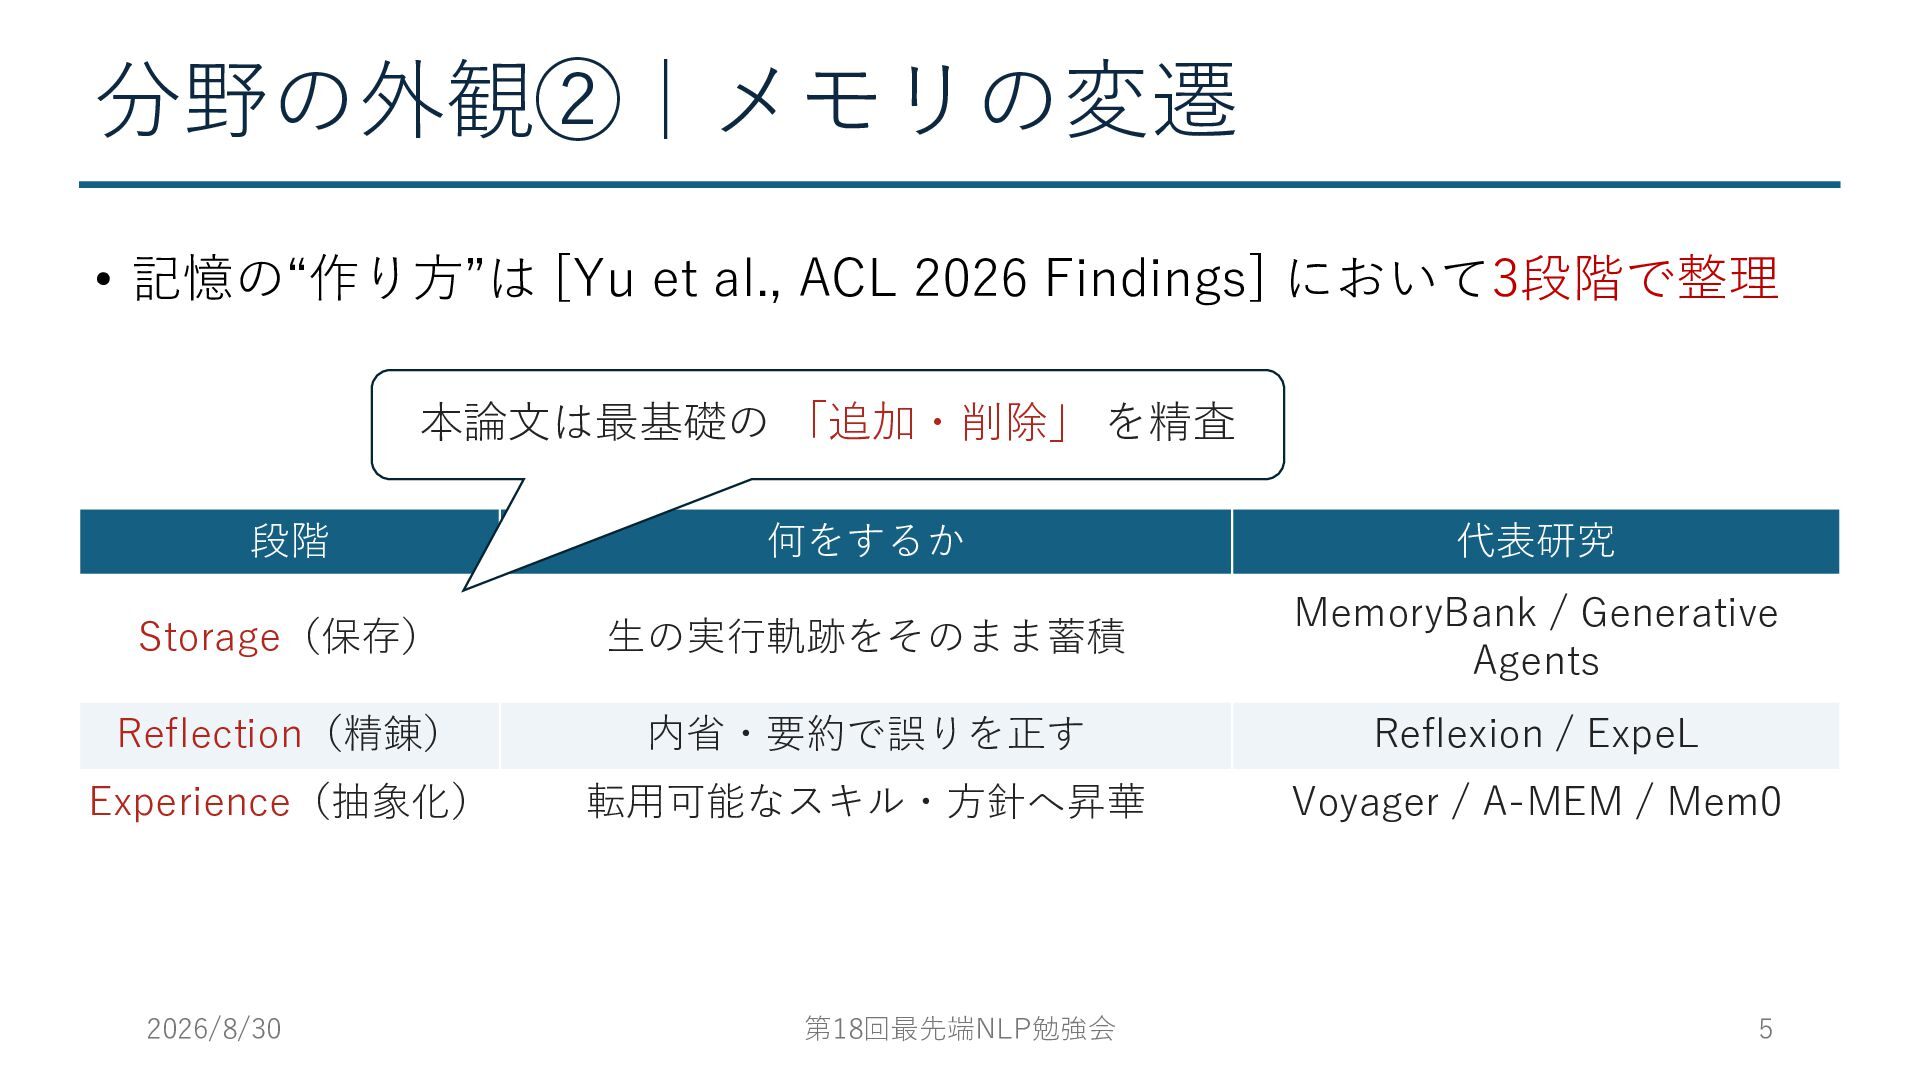
分野の外観②|メモリの変遷 • 記憶の“作り⽅”は [Yu et al., ACL 2026 Findings] において3段階で整理
本論⽂は最基礎の 「追加・削除」 を精査 段階 何をするか 代表研究 Storage(保存) ⽣の実⾏軌跡をそのまま蓄積 MemoryBank / Generative Agents Reflection(精錬) 内省・要約で誤りを正す Reflexion / ExpeL Experience(抽象化) 転⽤可能なスキル・⽅針へ昇華 Voyager / A-MEM / Mem0 2026/8/30 第18回最先端NLP勉強会 5
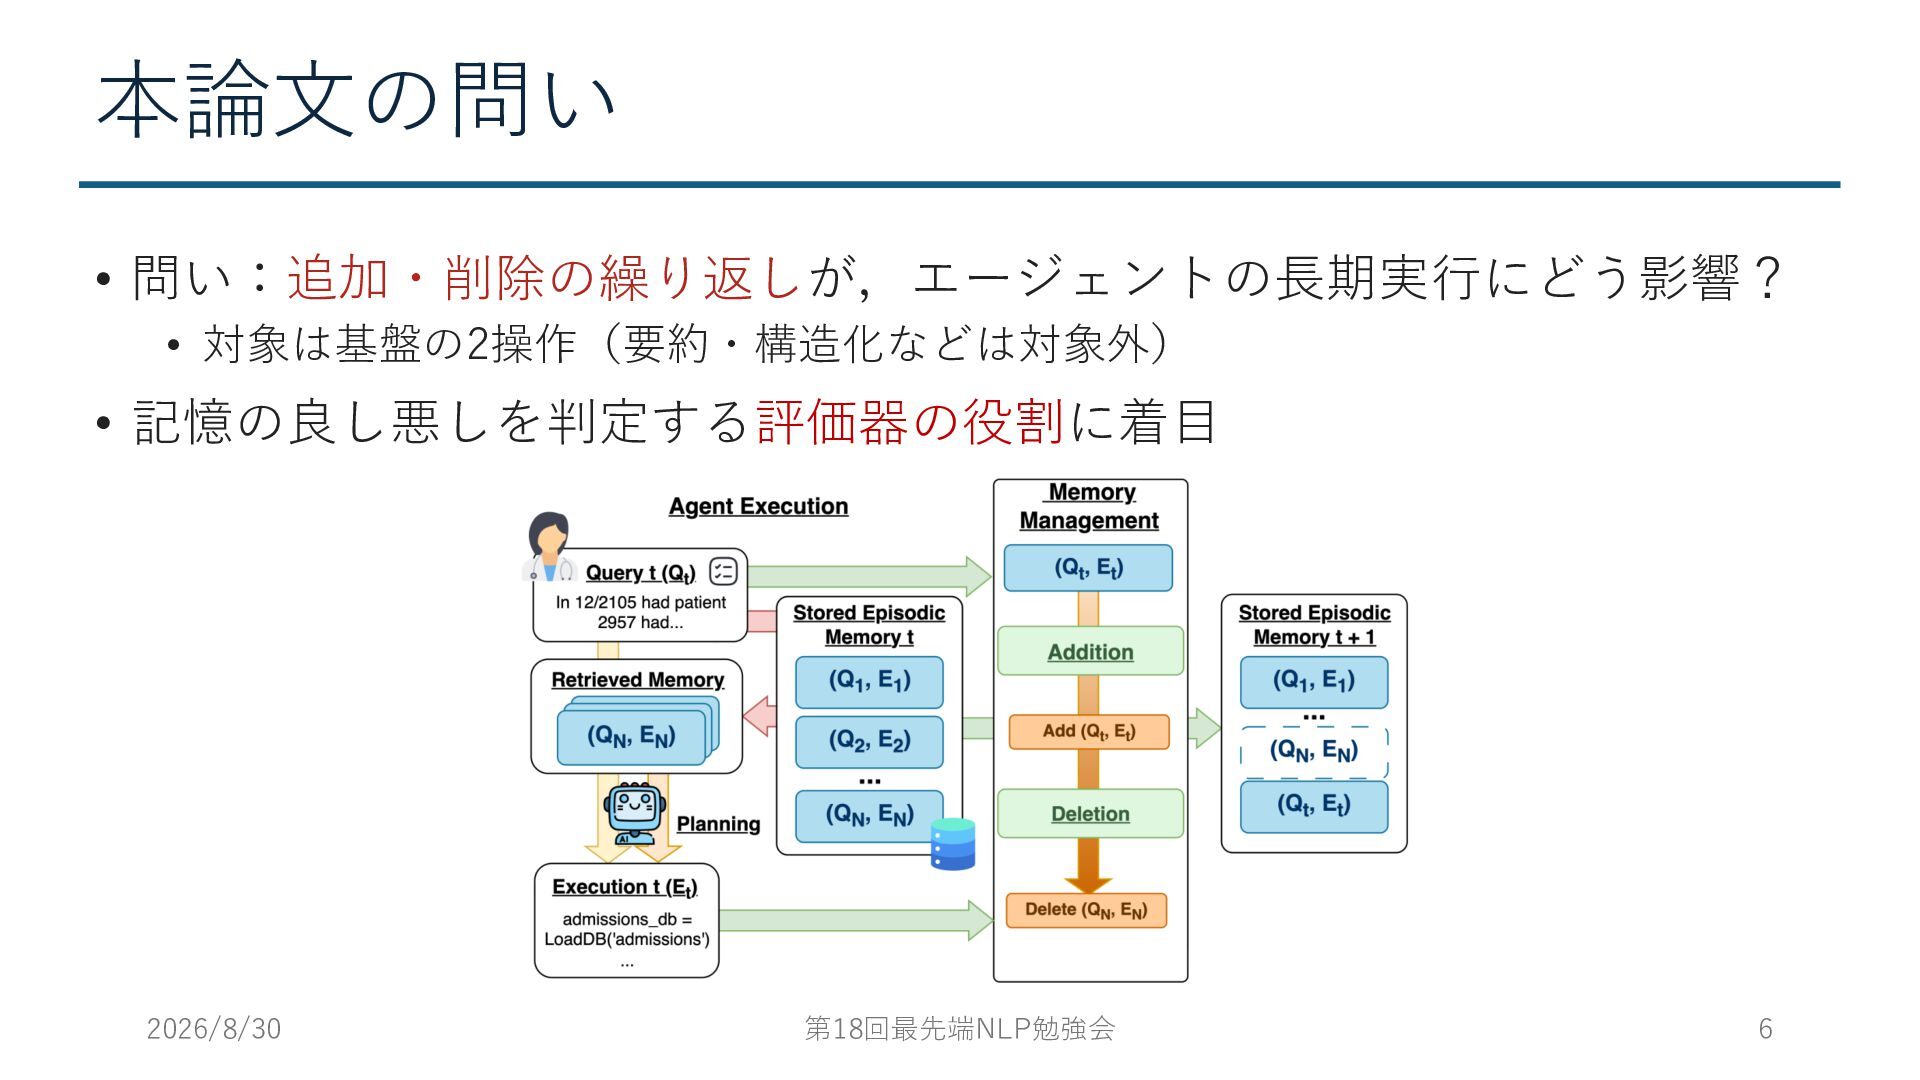
本論⽂の問い • 問い:追加・削除の繰り返しが,エージェントの⻑期実⾏にどう影響? • 対象は基盤の2操作(要約・構造化などは対象外) • 記憶の良し悪しを判定する評価器の役割に着⽬ 2026/8/30 第18回最先端NLP勉強会 6
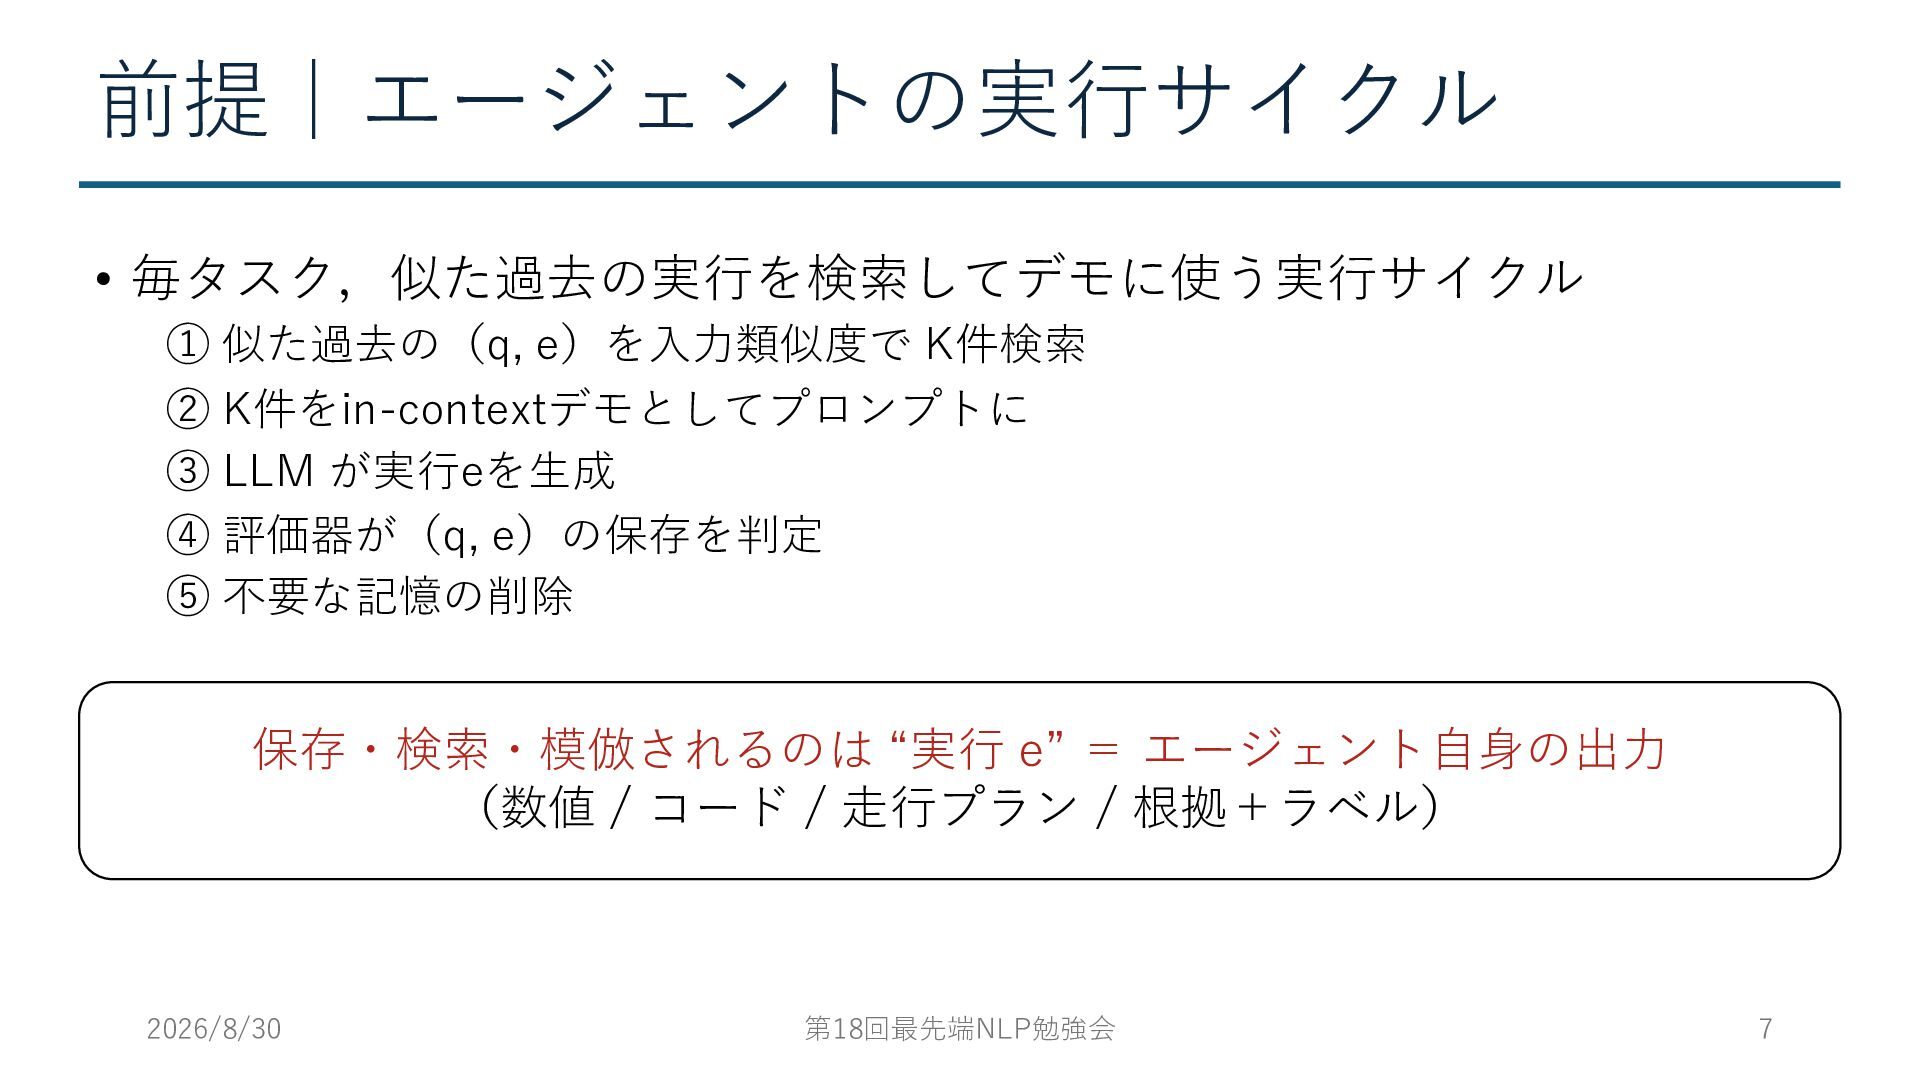
前提|エージェントの実⾏サイクル • 毎タスク,似た過去の実⾏を検索してデモに使う実⾏サイクル ① 似た過去の(q, e)を⼊⼒類似度で K件検索 ② K件をin-contextデモとしてプロンプトに ③
LLM が実⾏eを⽣成 ④ 評価器が(q, e)の保存を判定 ⑤ 不要な記憶の削除 保存・検索・模倣されるのは “実⾏ e” = エージェント⾃⾝の出⼒ (数値 / コード / ⾛⾏プラン / 根拠+ラベル) 2026/8/30 第18回最先端NLP勉強会 7
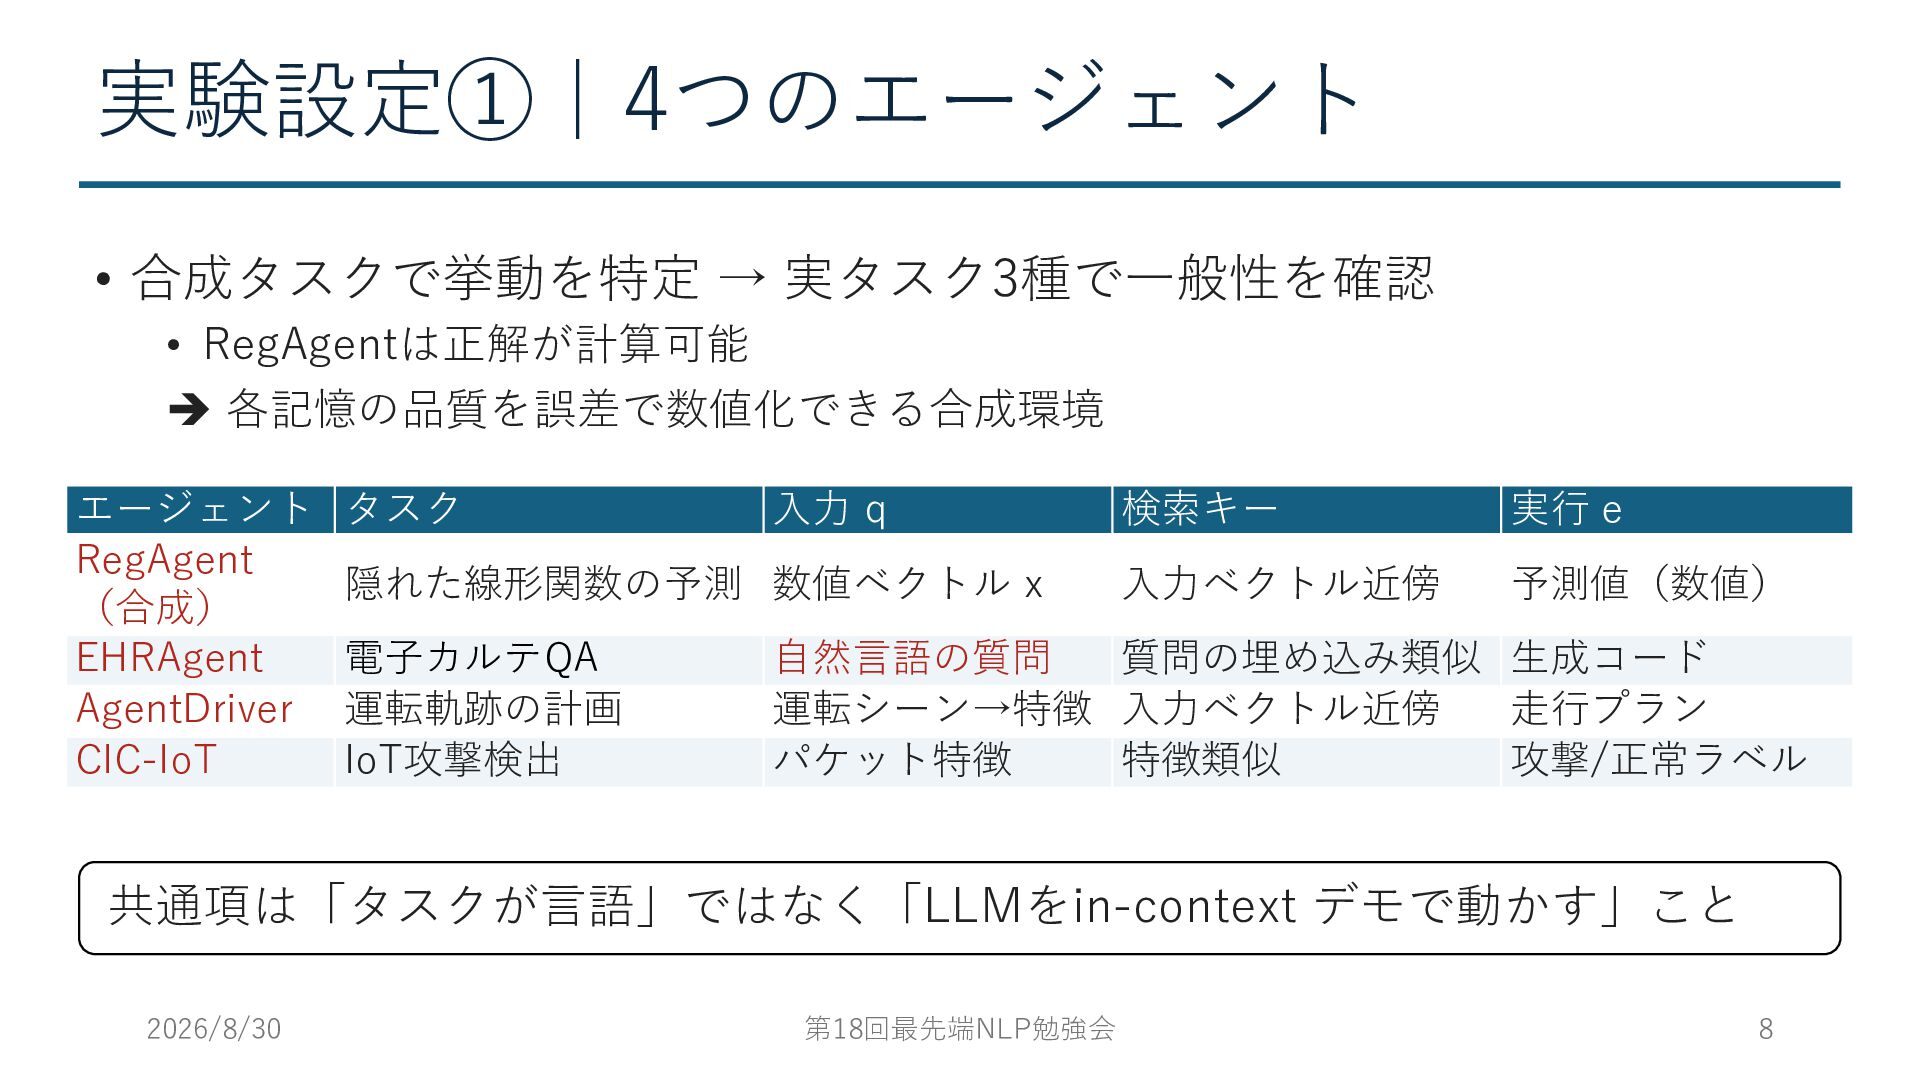
実験設定①|4つのエージェント • 合成タスクで挙動を特定 → 実タスク3種で⼀般性を確認 • RegAgentは正解が計算可能 è 各記憶の品質を誤差で数値化できる合成環境 エージェント
RegAgent (合成) EHRAgent AgentDriver CIC-IoT タスク ⼊⼒ q 隠れた線形関数の予測 数値ベクトル x 電⼦カルテQA 運転軌跡の計画 IoT攻撃検出 検索キー 実⾏ e ⼊⼒ベクトル近傍 予測値(数値) ⾃然⾔語の質問 質問の埋め込み類似 ⽣成コード 運転シーン→特徴 ⼊⼒ベクトル近傍 ⾛⾏プラン パケット特徴 特徴類似 攻撃/正常ラベル 共通項は「タスクが⾔語」ではなく「LLMをin-context デモで動かす」こと 2026/8/30 第18回最先端NLP勉強会 8
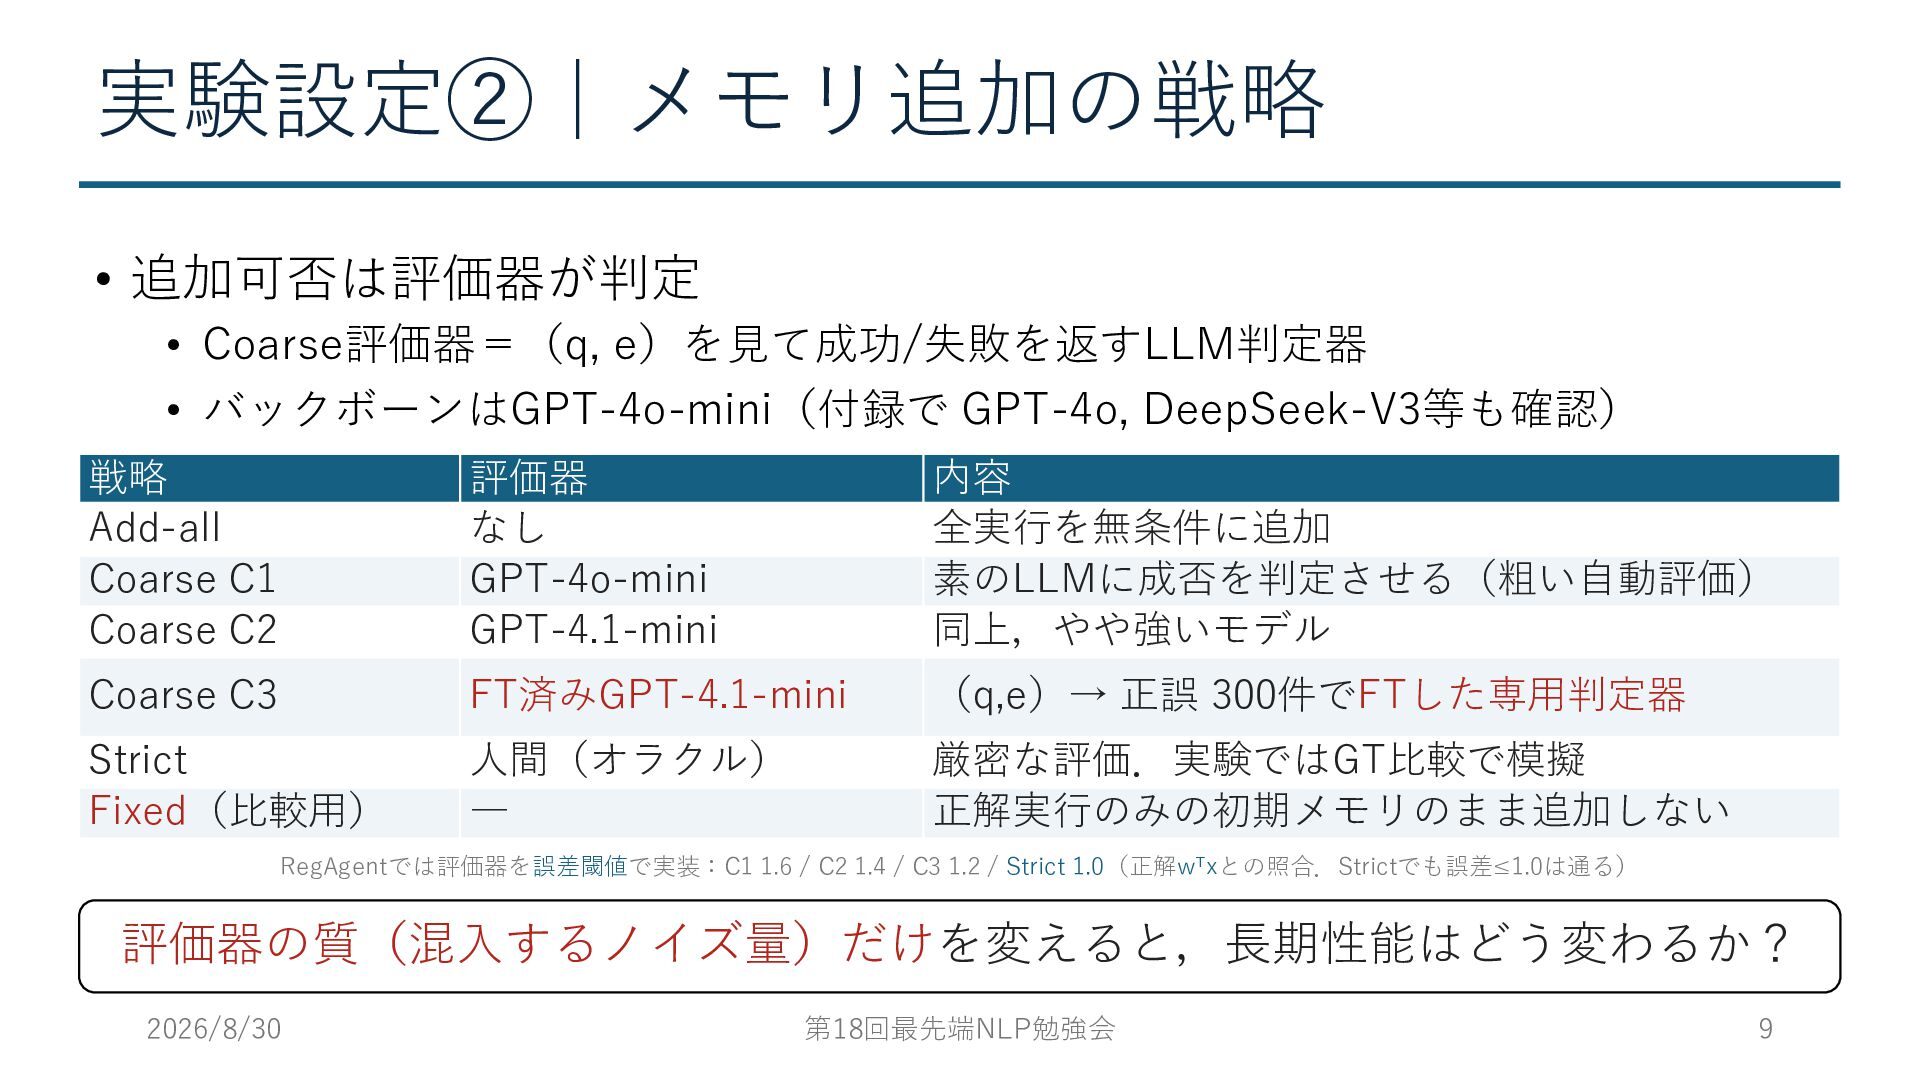
実験設定②|メモリ追加の戦略 • 追加可否は評価器が判定 • Coarse評価器=(q, e)を⾒て成功/失敗を返すLLM判定器 • バックボーンはGPT-4o-mini(付録で GPT-4o, DeepSeek-V3等も確認)
戦略 Add-all Coarse C1 Coarse C2 評価器 なし GPT-4o-mini GPT-4.1-mini 内容 全実⾏を無条件に追加 素のLLMに成否を判定させる(粗い⾃動評価) 同上,やや強いモデル Coarse C3 FT済みGPT-4.1-mini (q,e)→ 正誤 300件でFTした専⽤判定器 Strict Fixed(⽐較⽤) ⼈間(オラクル) ― 厳密な評価.実験ではGT⽐較で模擬 正解実⾏のみの初期メモリのまま追加しない RegAgentでは評価器を誤差閾値で実装:C1 1.6 / C2 1.4 / C3 1.2 / Strict 1.0(正解w⊤xとの照合.Strictでも誤差≤1.0は通る) 評価器の質(混⼊するノイズ量)だけを変えると,⻑期性能はどう変わるか? 2026/8/30 第18回最先端NLP勉強会 9
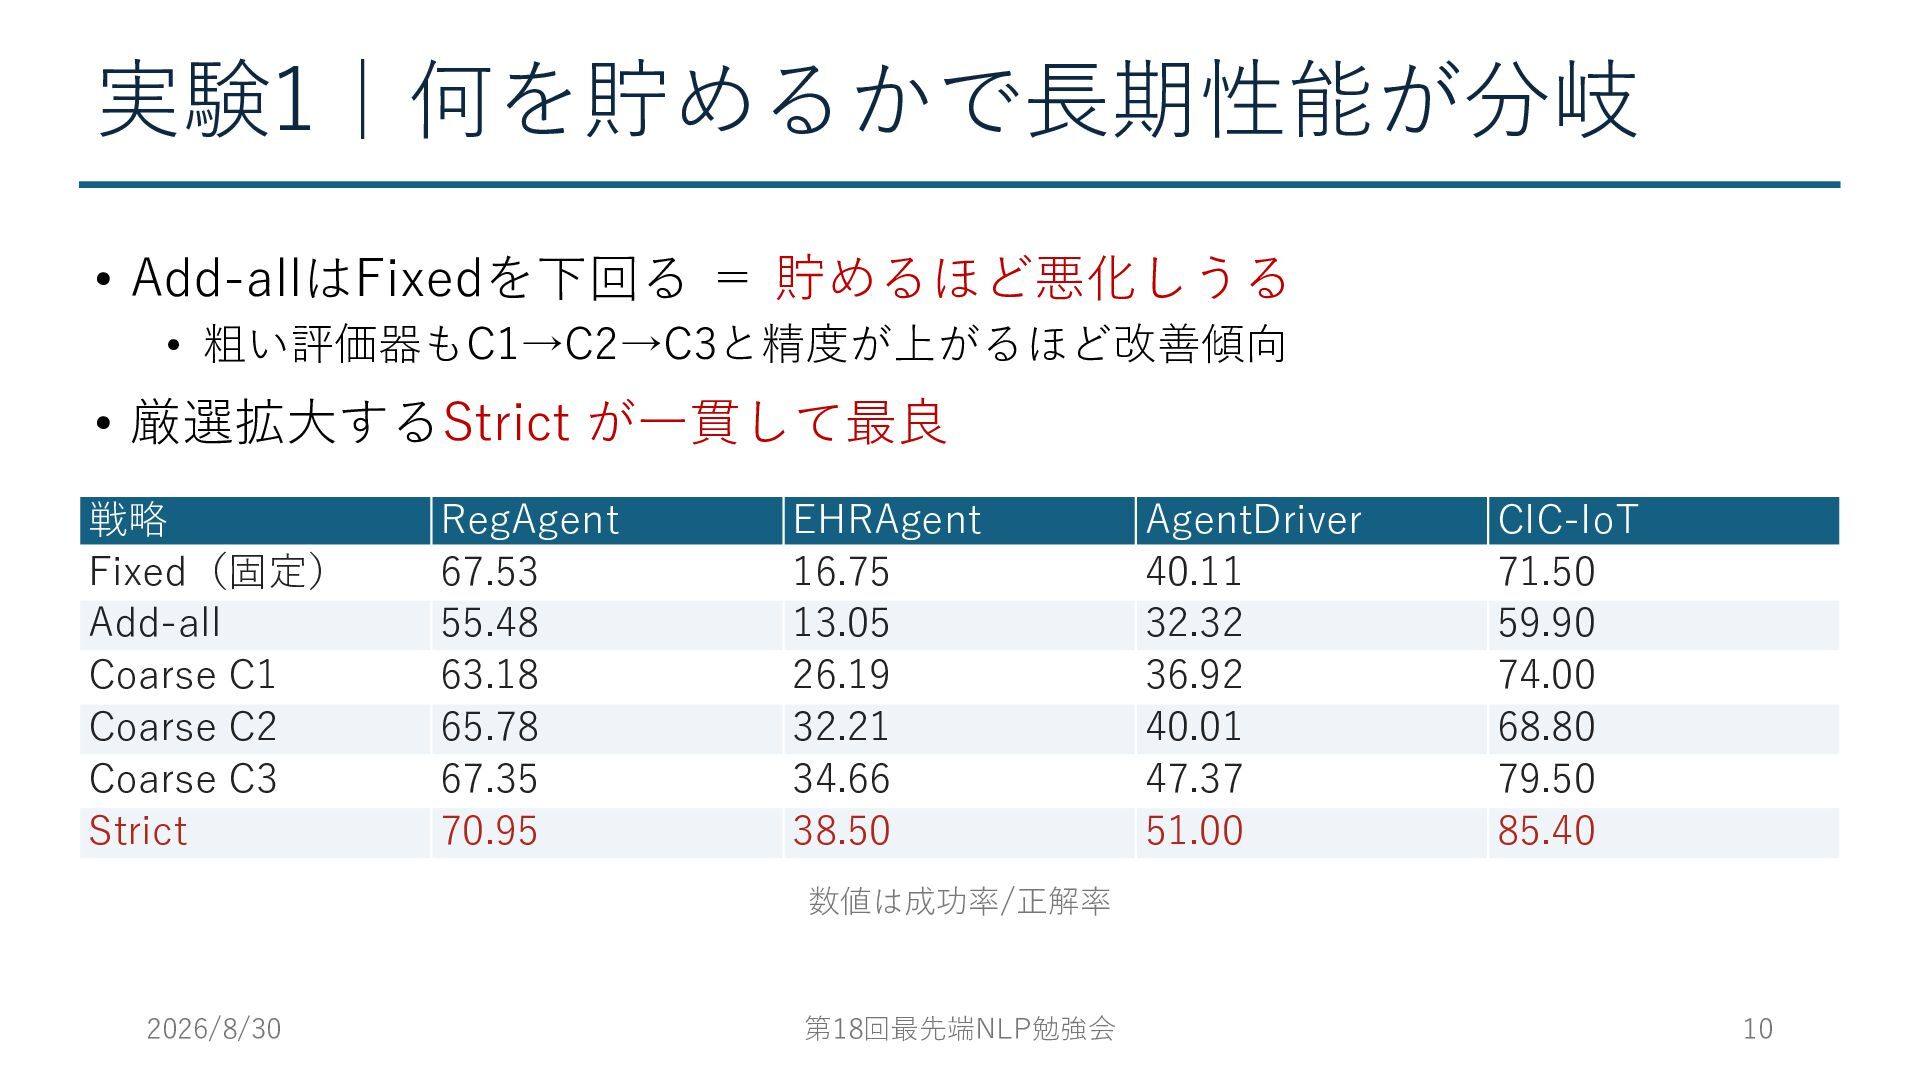
実験1|何を貯めるかで⻑期性能が分岐 • Add-allはFixedを下回る = 貯めるほど悪化しうる • 粗い評価器もC1→C2→C3と精度が上がるほど改善傾向 • 厳選拡⼤するStrict が⼀貫して最良
戦略 Fixed(固定) Add-all Coarse C1 Coarse C2 Coarse C3 Strict RegAgent 67.53 55.48 63.18 65.78 67.35 70.95 EHRAgent 16.75 13.05 26.19 32.21 34.66 38.50 AgentDriver 40.11 32.32 36.92 40.01 47.37 51.00 CIC-IoT 71.50 59.90 74.00 68.80 79.50 85.40 数値は成功率/正解率 2026/8/30 第18回最先端NLP勉強会 10
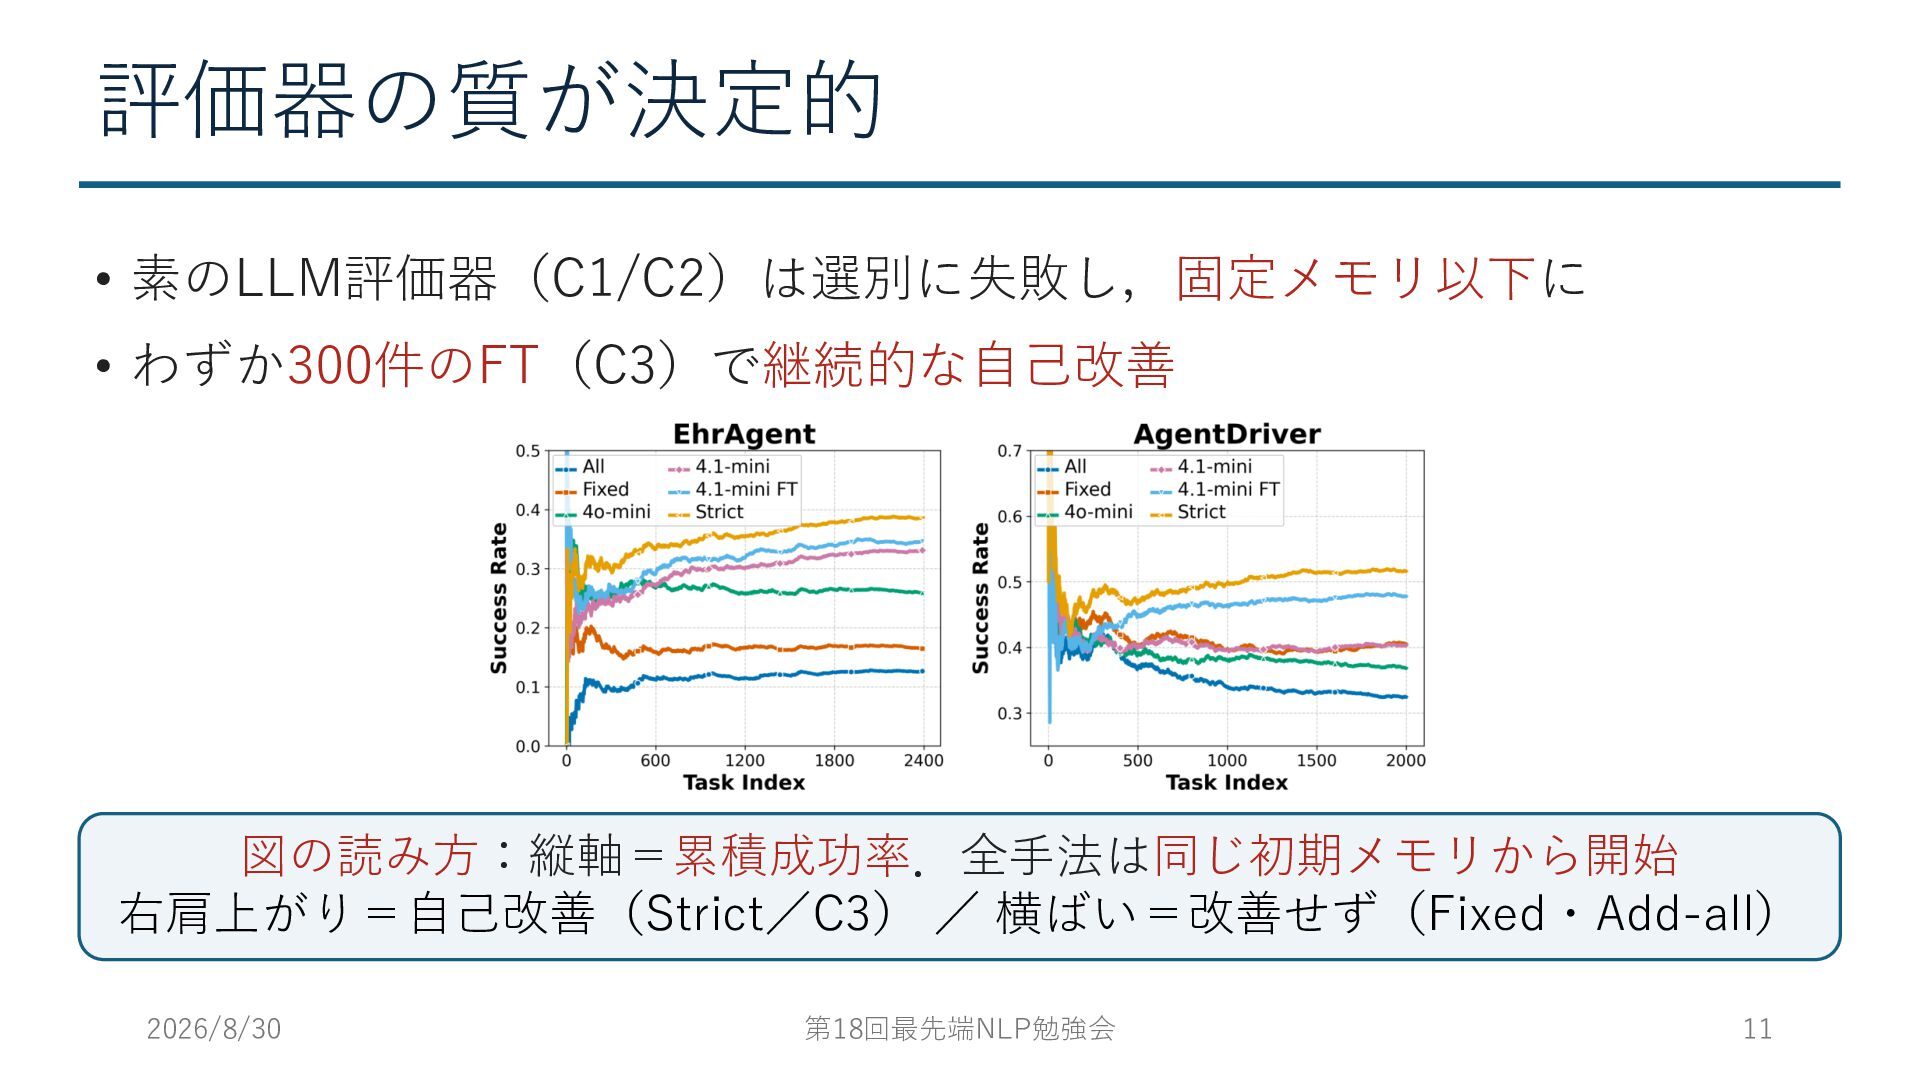
評価器の質が決定的 • 素のLLM評価器(C1/C2)は選別に失敗し,固定メモリ以下に • わずか300件のFT(C3)で継続的な⾃⼰改善 図の読み⽅:縦軸=累積成功率.全⼿法は同じ初期メモリから開始 右肩上がり=⾃⼰改善(Strict/C3) / 横ばい=改善せず(Fixed・Add-all) 2026/8/30
第18回最先端NLP勉強会 11
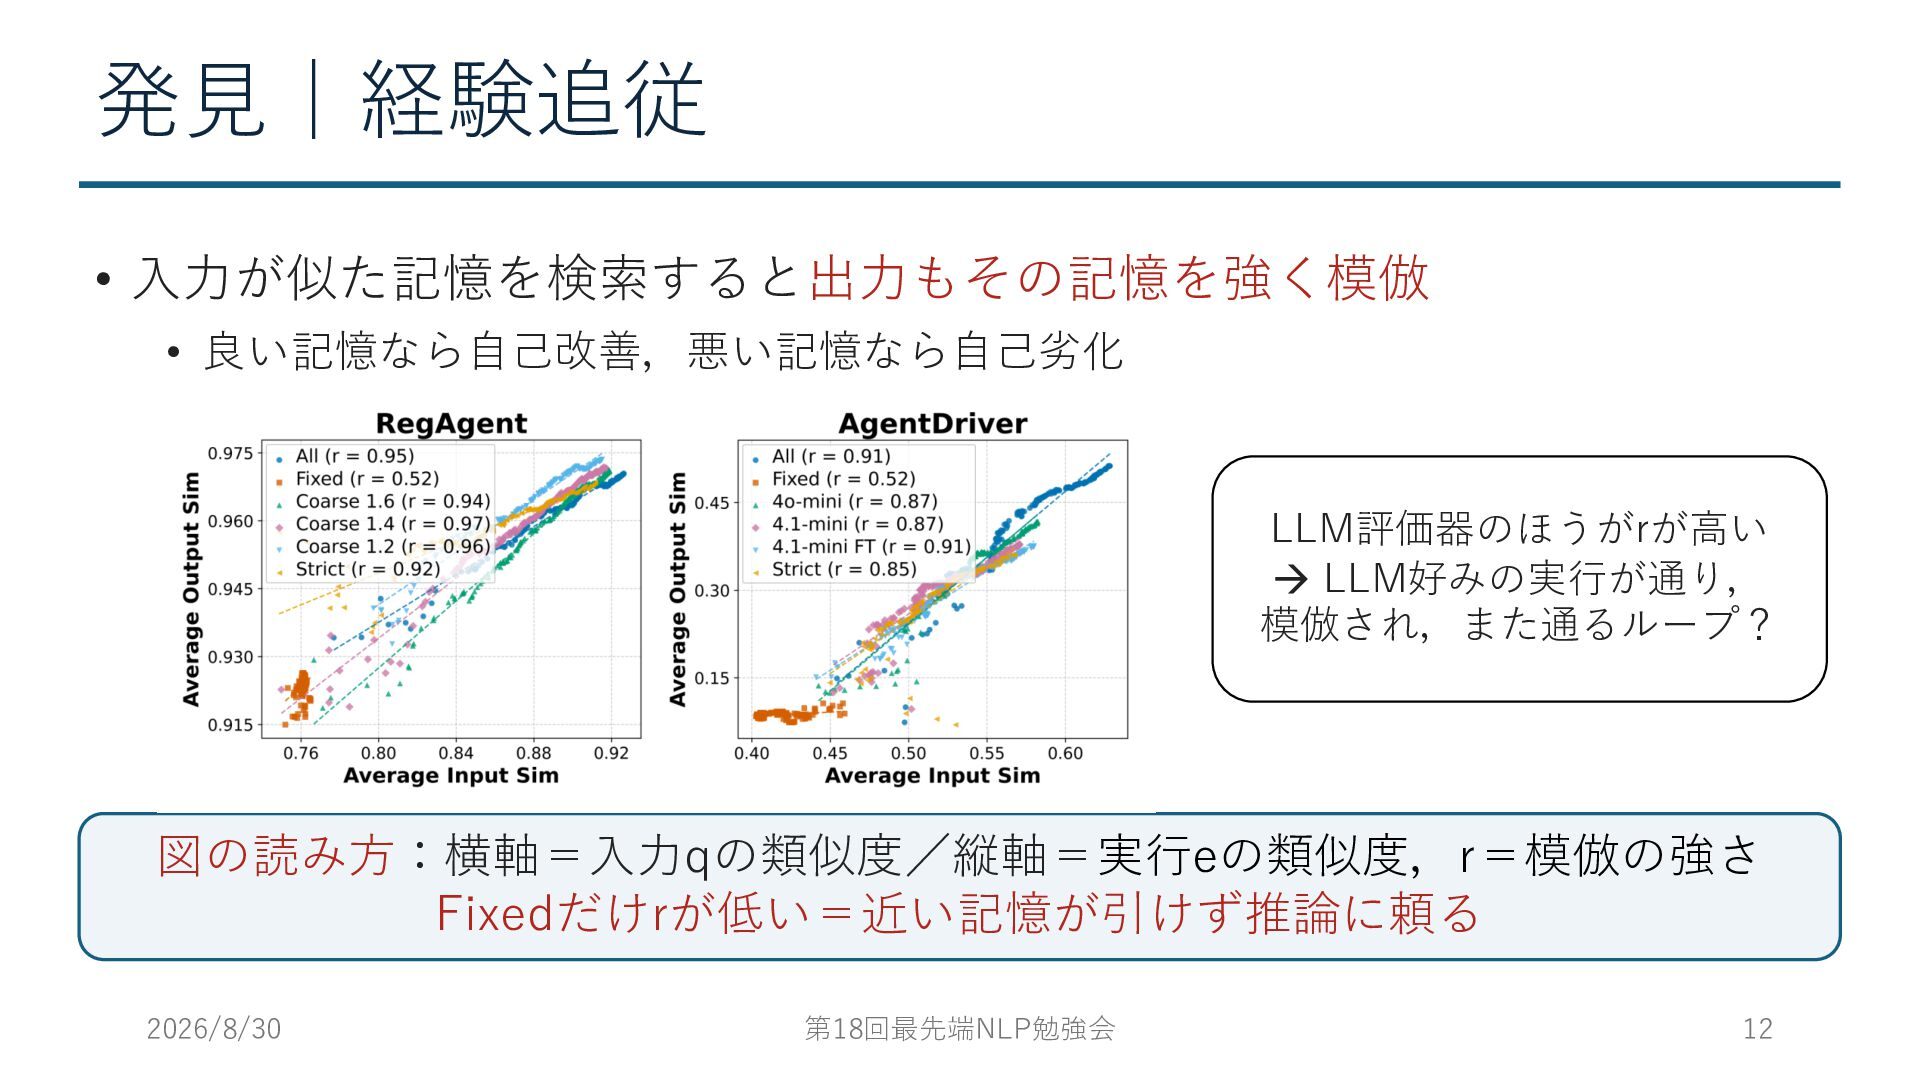
発⾒|経験追従 • ⼊⼒が似た記憶を検索すると出⼒もその記憶を強く模倣 • 良い記憶なら⾃⼰改善,悪い記憶なら⾃⼰劣化 LLM評価器のほうがrが⾼い à LLM好みの実⾏が通り, 模倣され,また通るループ? 図の読み⽅:横軸=⼊⼒qの類似度/縦軸=実⾏eの類似度,r=模倣の強さ
Fixedだけrが低い=近い記憶が引けず推論に頼る 2026/8/30 第18回最先端NLP勉強会 12
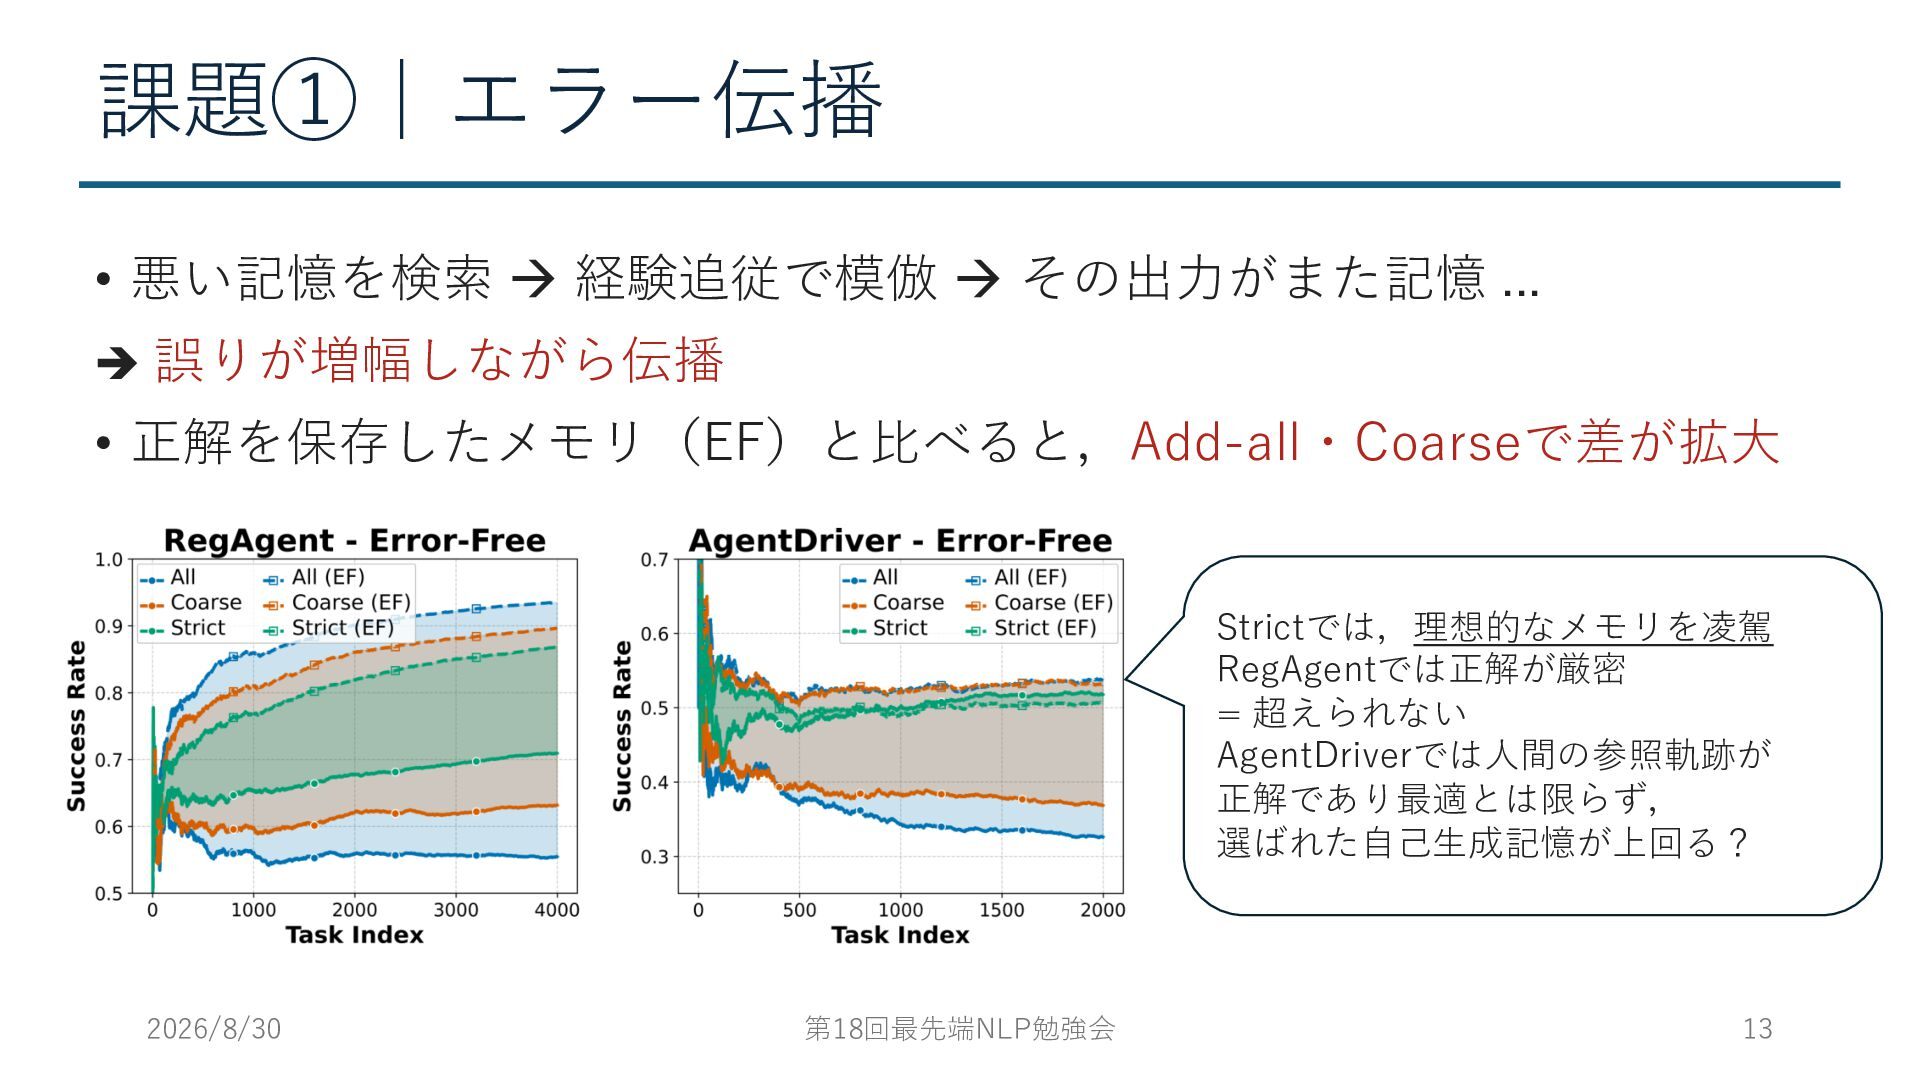
課題①|エラー伝播 • 悪い記憶を検索 à 経験追従で模倣 à その出⼒がまた記憶 ... è 誤りが増幅しながら伝播
• 正解を保存したメモリ(EF)と⽐べると,Add-all・Coarseで差が拡⼤ Strictでは,理想的なメモリを凌駕 RegAgentでは正解が厳密 = 超えられない AgentDriverでは⼈間の参照軌跡が 正解であり最適とは限らず, 選ばれた⾃⼰⽣成記憶が上回る? 2026/8/30 第18回最先端NLP勉強会 13
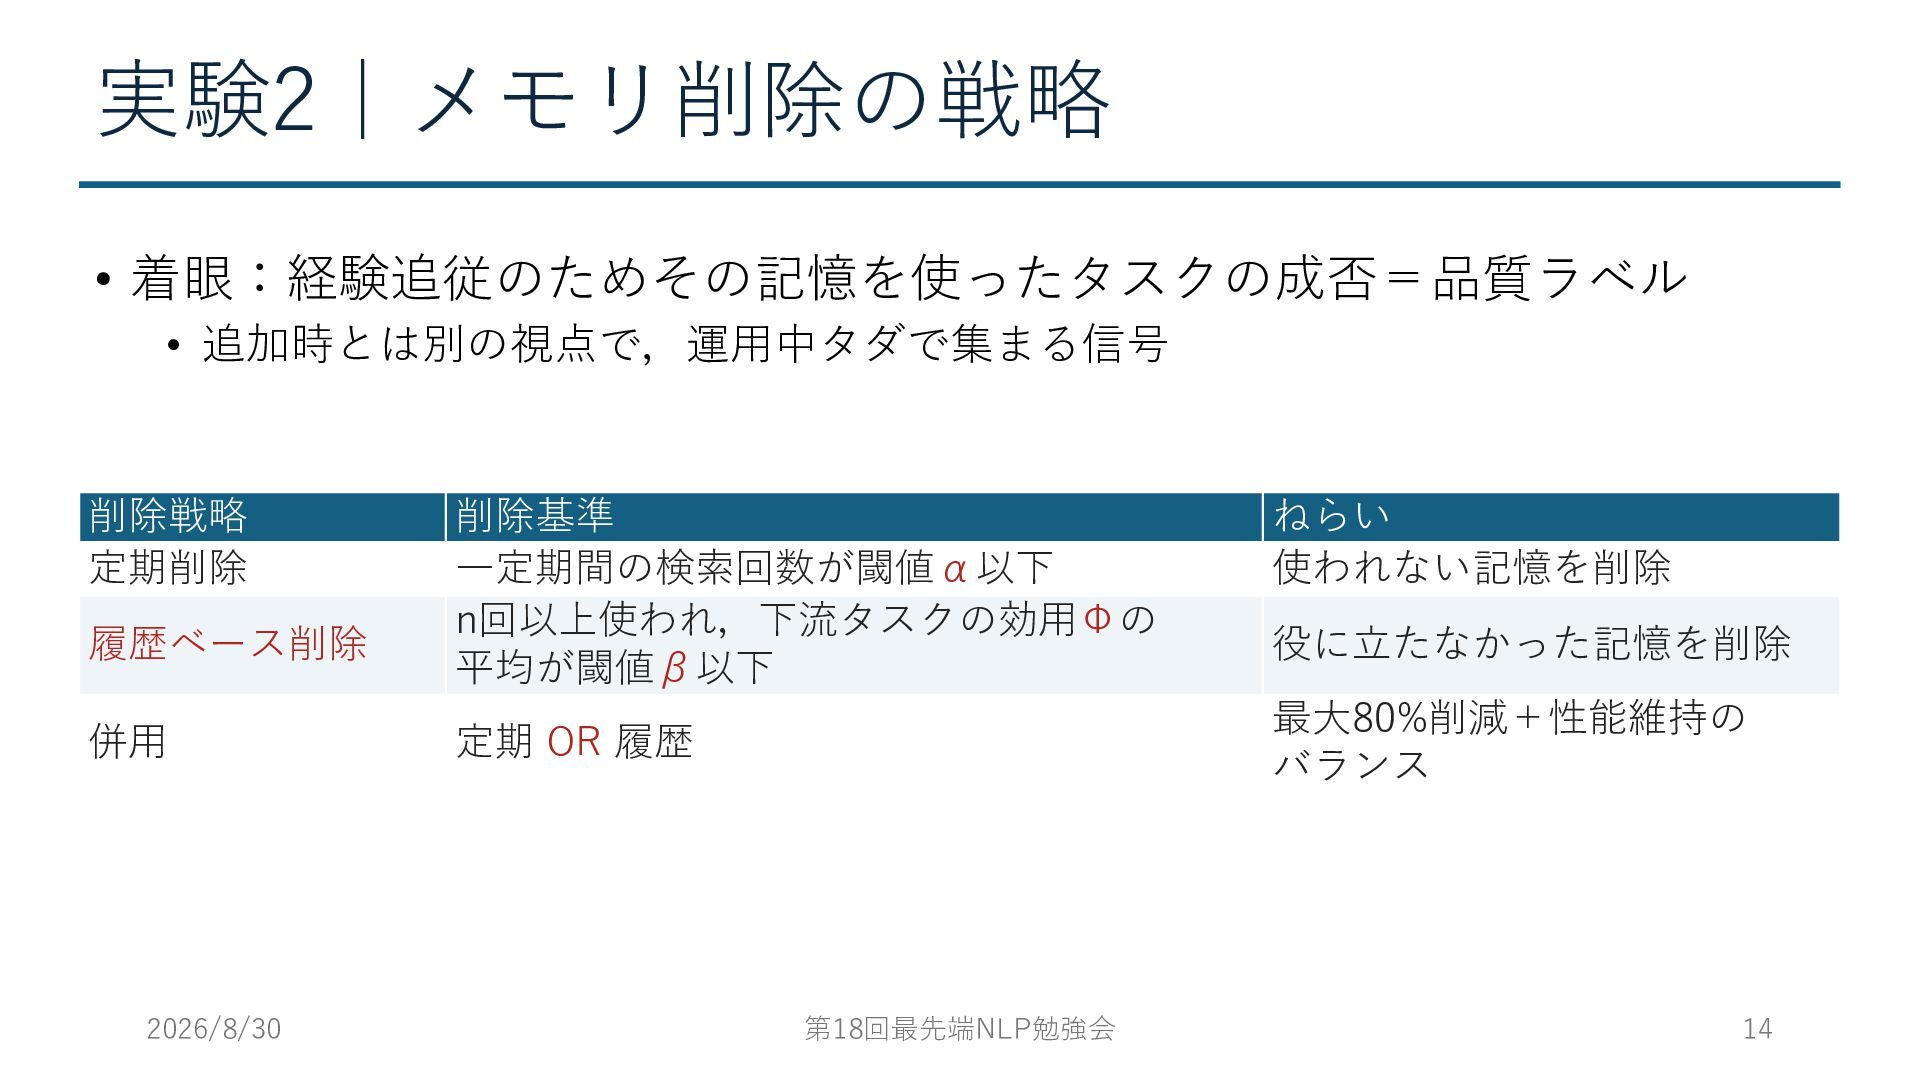
実験2|メモリ削除の戦略 • 着眼:経験追従のためその記憶を使ったタスクの成否=品質ラベル • 追加時とは別の視点で,運⽤中タダで集まる信号 削除戦略 定期削除 履歴ベース削除 併⽤ 2026/8/30
削除基準 ⼀定期間の検索回数が閾値α以下 n回以上使われ,下流タスクの効⽤Φの 平均が閾値β以下 ねらい 使われない記憶を削除 役に⽴たなかった記憶を削除 最⼤80%削減+性能維持の バランス 定期 OR 履歴 第18回最先端NLP勉強会 14
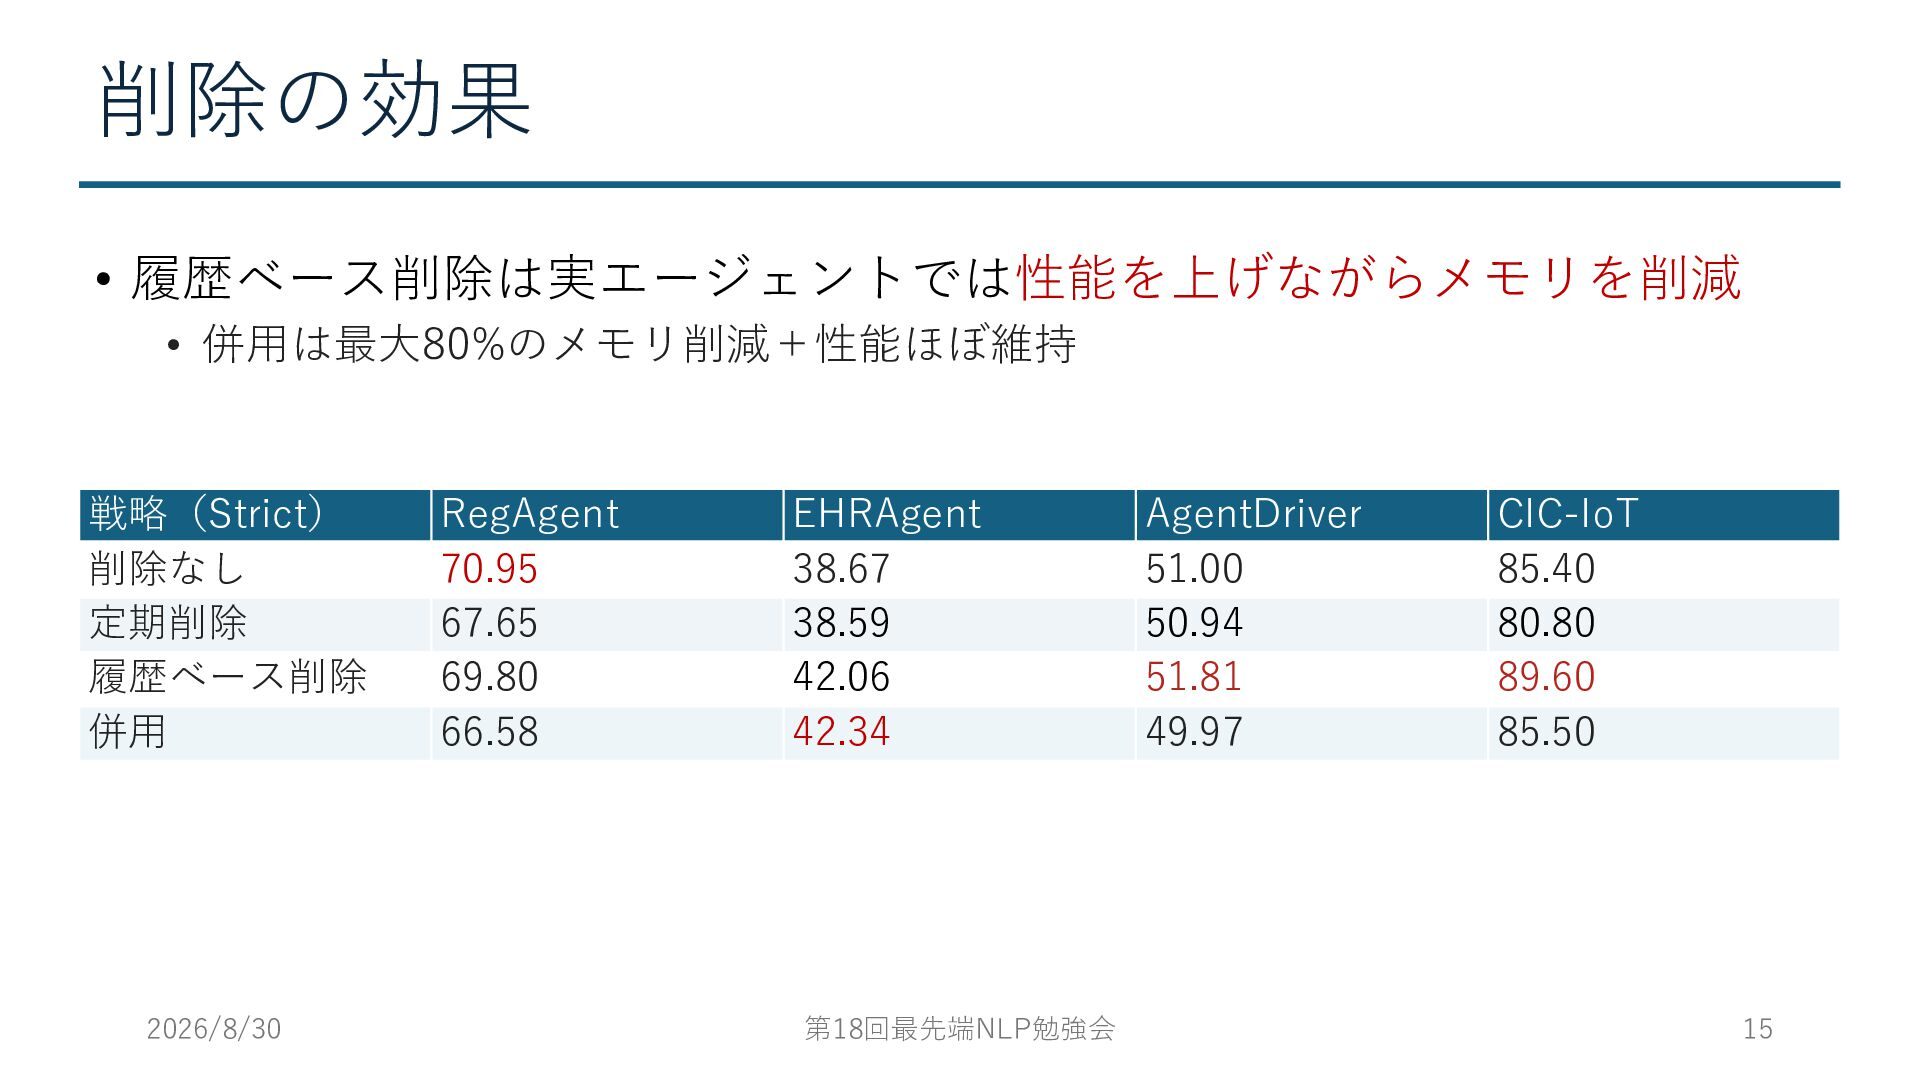
削除の効果 • 履歴ベース削除は実エージェントでは性能を上げながらメモリを削減 • 併⽤は最⼤80%のメモリ削減+性能ほぼ維持 戦略(Strict) 削除なし 定期削除 履歴ベース削除 併⽤
2026/8/30 RegAgent 70.95 67.65 69.80 66.58 EHRAgent 38.67 38.59 42.06 42.34 第18回最先端NLP勉強会 AgentDriver 51.00 50.94 51.81 49.97 CIC-IoT 85.40 80.80 89.60 85.50 15
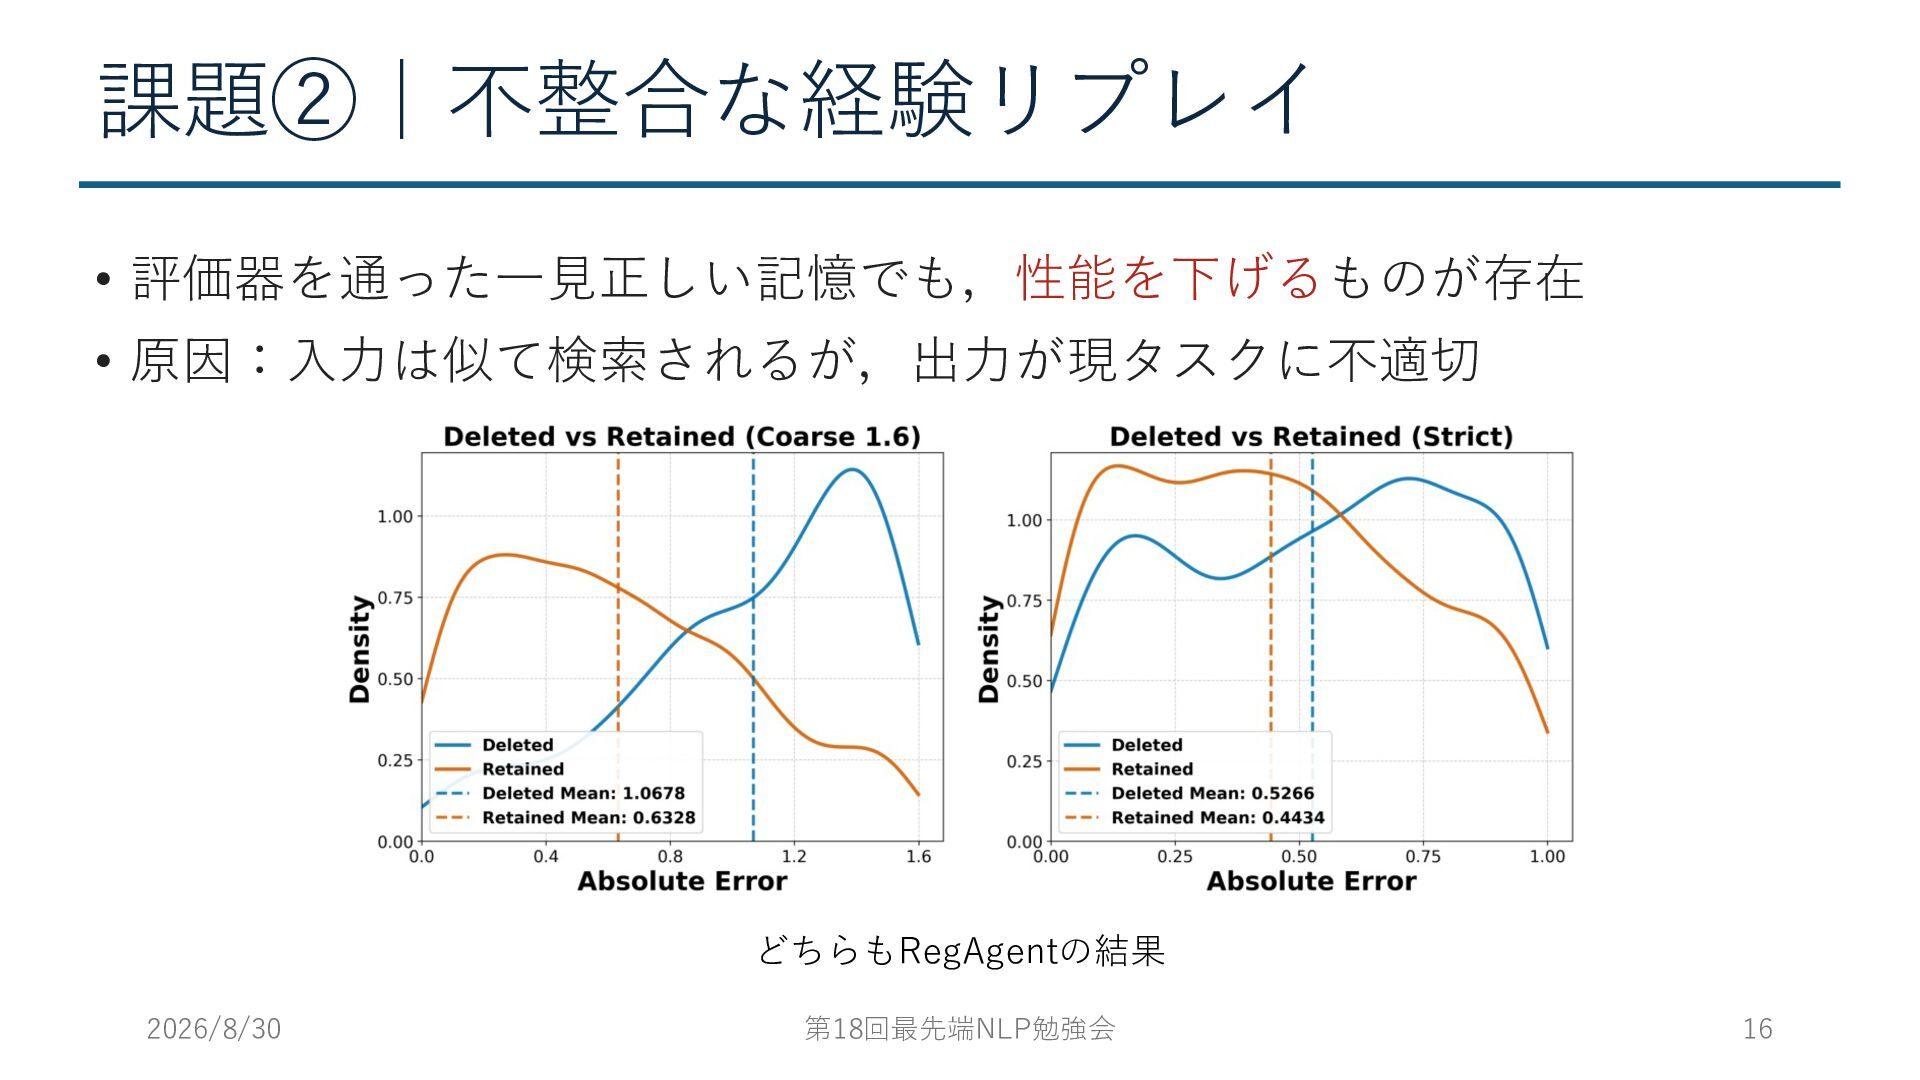
課題②|不整合な経験リプレイ • 評価器を通った⼀⾒正しい記憶でも,性能を下げるものが存在 • 原因:⼊⼒は似て検索されるが,出⼒が現タスクに不適切 どちらもRegAgentの結果 2026/8/30 第18回最先端NLP勉強会 16
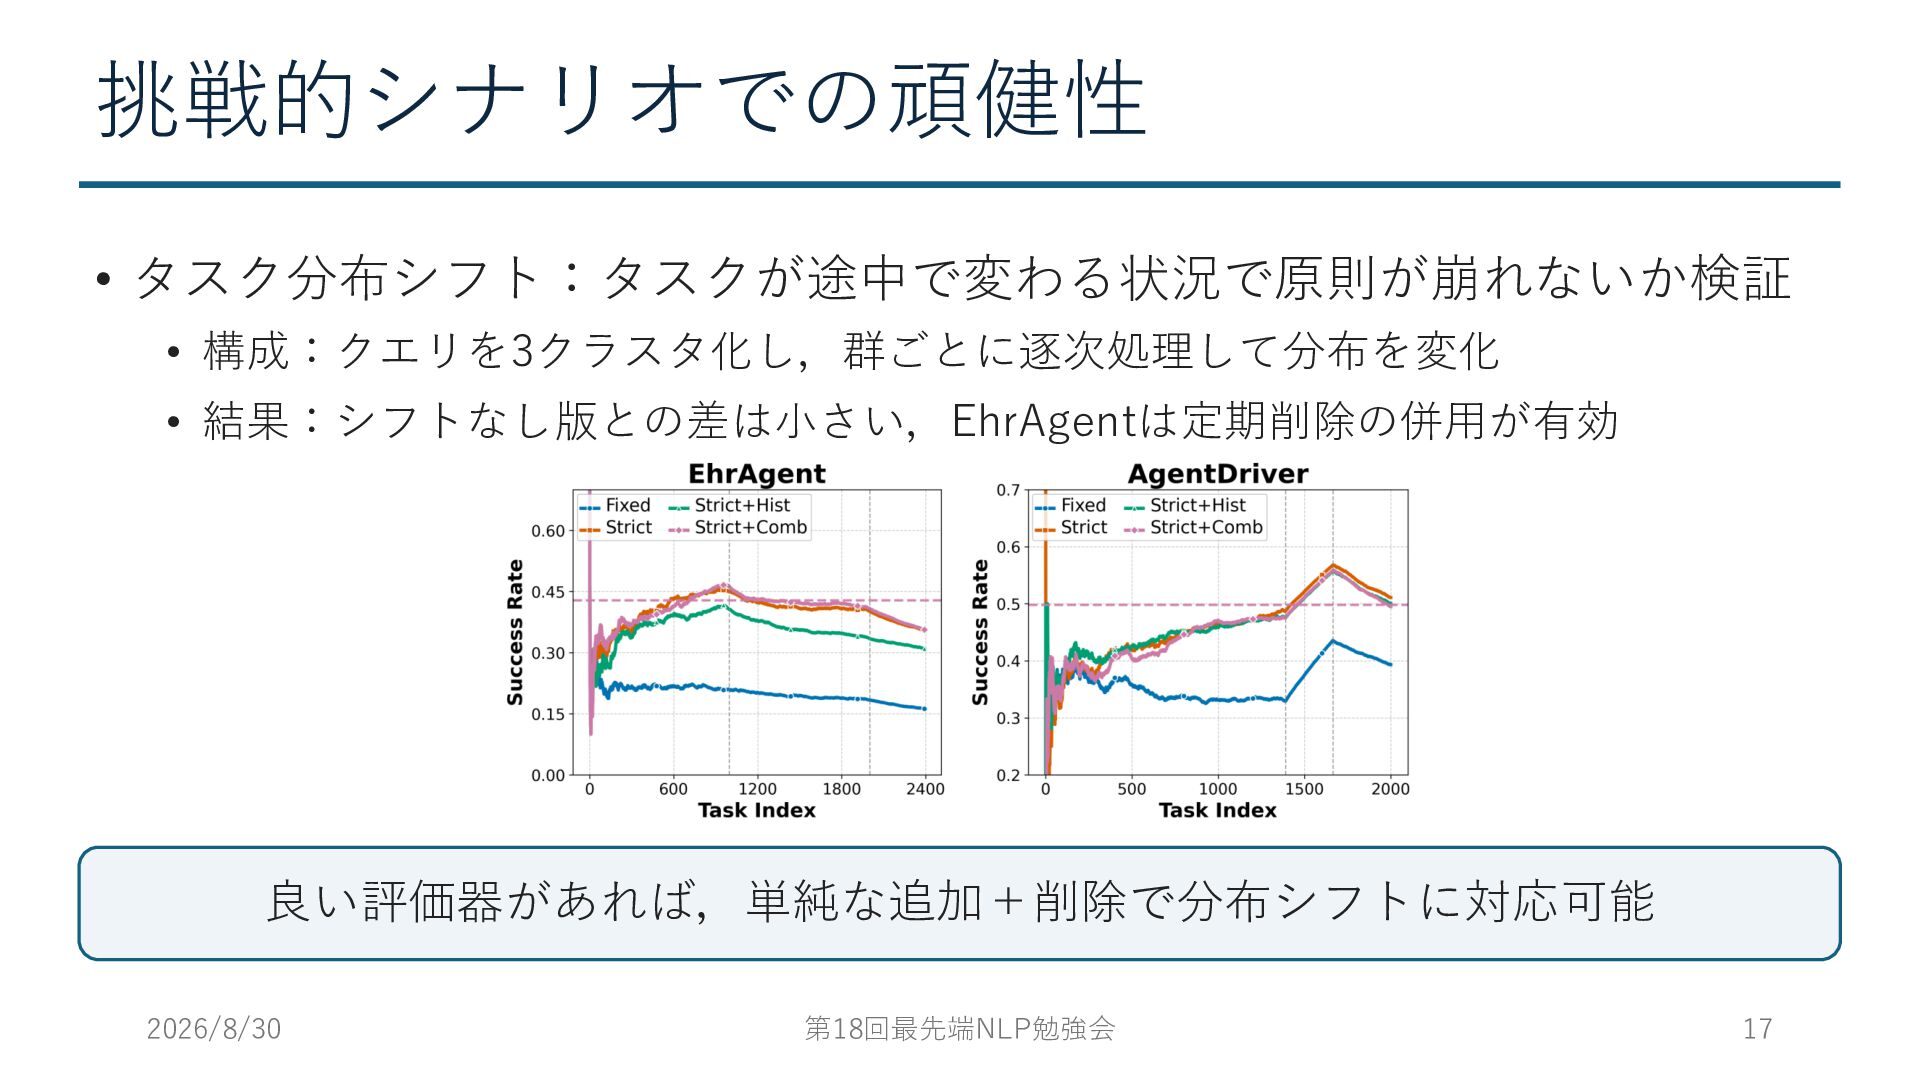
挑戦的シナリオでの頑健性 • タスク分布シフト:タスクが途中で変わる状況で原則が崩れないか検証 • 構成:クエリを3クラスタ化し,群ごとに逐次処理して分布を変化 • 結果:シフトなし版との差は⼩さい,EhrAgentは定期削除の併⽤が有効 良い評価器があれば,単純な追加+削除で分布シフトに対応可能 2026/8/30 第18回最先端NLP勉強会
17
まとめ • 記憶は貯めるほど良いわけでなく,何を残すかが⻑期性能を決定 • 経験追従:⼊⼒が似た記憶を検索すると,出⼒もその記憶を強く模倣 • 2つの失敗:エラー伝播/不整合な経験リプレイ(⼀⾒正しい記憶が害) • 解決:タスクの成否を品質ラベルに使う削除により,性能↑・サイズ↓ 2026/8/30
第18回最先端NLP勉強会 18
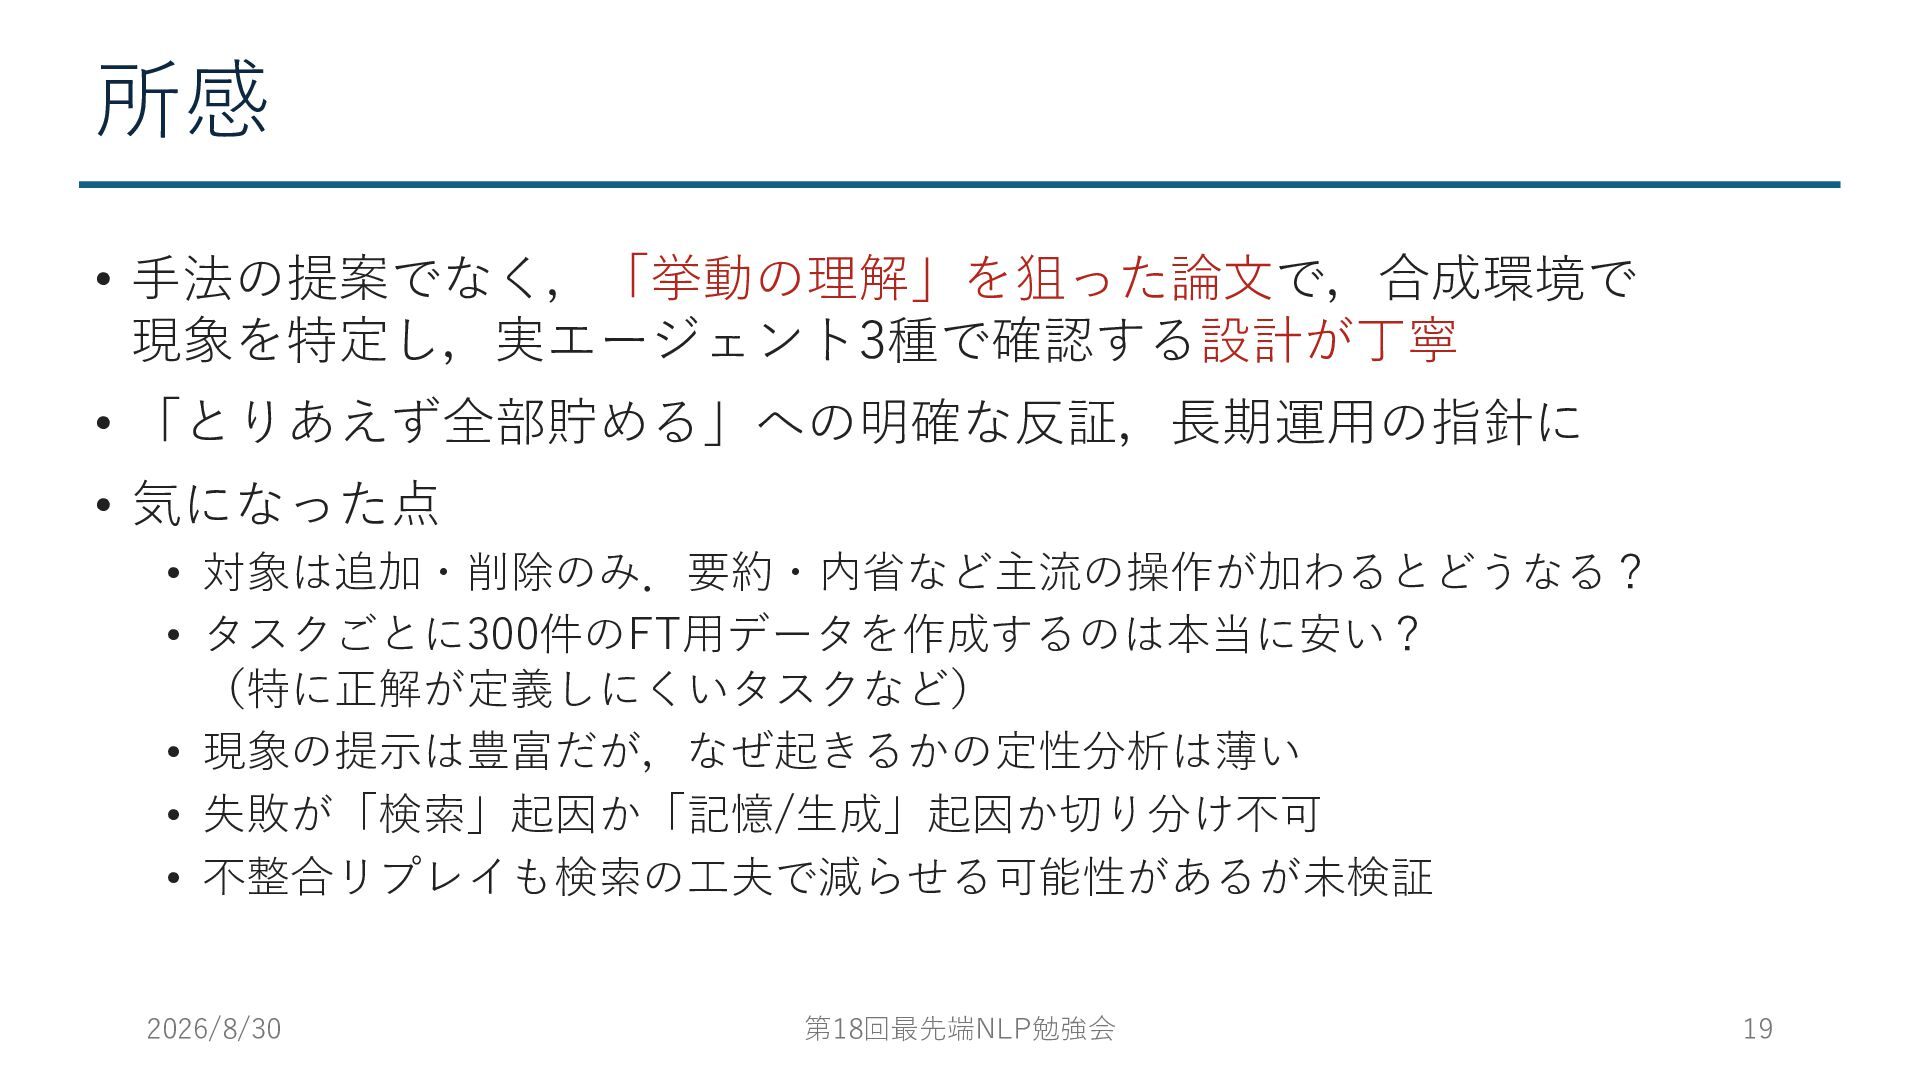
所感 • ⼿法の提案でなく,「挙動の理解」を狙った論⽂で,合成環境で 現象を特定し,実エージェント3種で確認する設計が丁寧 • 「とりあえず全部貯める」への明確な反証,⻑期運⽤の指針に • 気になった点 • 対象は追加・削除のみ.要約・内省など主流の操作が加わるとどうなる?
• タスクごとに300件のFT⽤データを作成するのは本当に安い? (特に正解が定義しにくいタスクなど) • 現象の提⽰は豊富だが,なぜ起きるかの定性分析は薄い • 失敗が「検索」起因か「記憶/⽣成」起因か切り分け不可 • 不整合リプレイも検索の⼯夫で減らせる可能性があるが未検証 2026/8/30 第18回最先端NLP勉強会 19
予備スライド
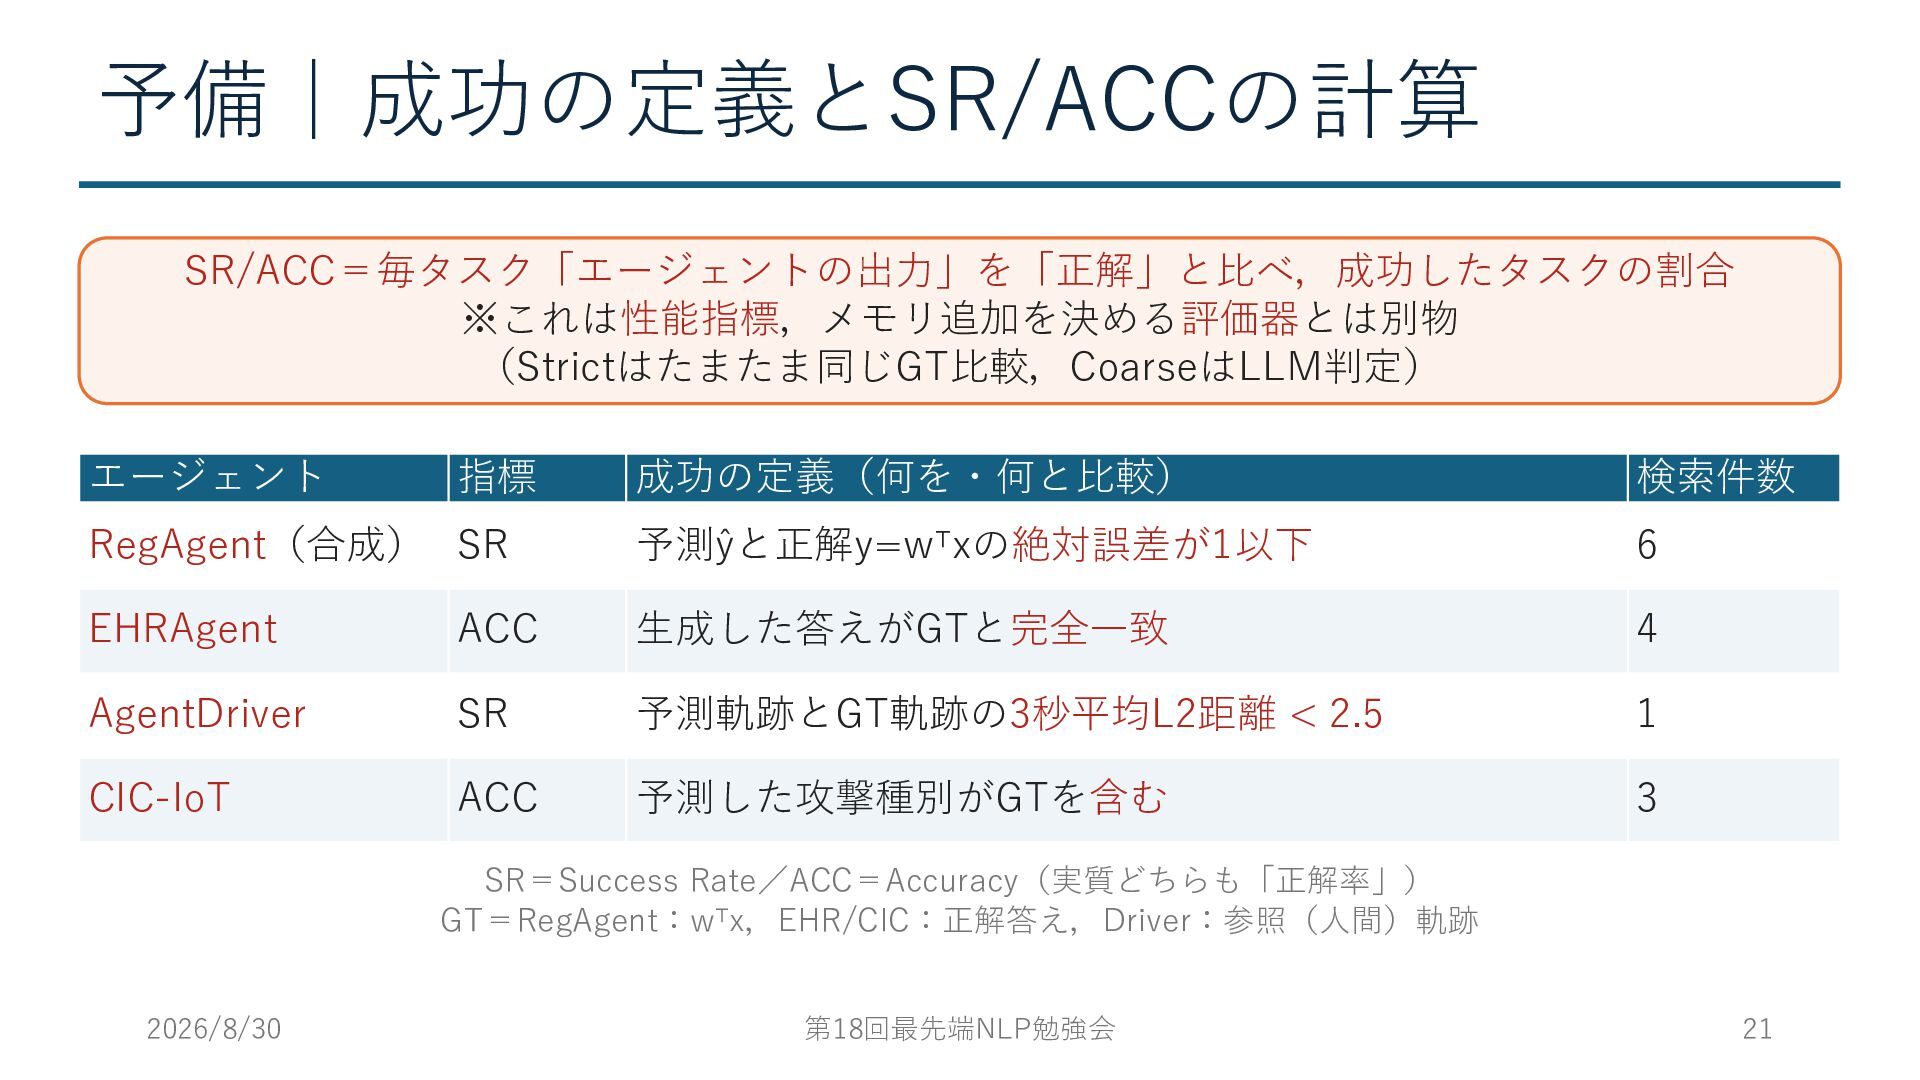
予備|成功の定義とSR/ACCの計算 SR/ACC=毎タスク「エージェントの出⼒」を「正解」と⽐べ,成功したタスクの割合 ※これは性能指標,メモリ追加を決める評価器とは別物 (Strictはたまたま同じGT⽐較,CoarseはLLM判定) エージェント 指標 成功の定義(何を・何と⽐較) 検索件数 RegAgent(合成) SR
予測ŷと正解y=w⊤xの絶対誤差が1以下 6 EHRAgent ACC ⽣成した答えがGTと完全⼀致 4 AgentDriver SR 予測軌跡とGT軌跡の3秒平均L2距離 < 2.5 1 CIC-IoT ACC 予測した攻撃種別がGTを含む 3 SR=Success Rate/ACC=Accuracy(実質どちらも「正解率」) GT=RegAgent:w⊤x,EHR/CIC:正解答え,Driver:参照(⼈間)軌跡 2026/8/30 第18回最先端NLP勉強会 21


 iryuki1110
 charlesmeaden
 notwaldorf
 davidcarrasco
 holman
 techseoconnect
 dougneiner
 aleyda
 sarafernandez
 geoffreycrofte
 sergeychernyshev
 andyhume
 matthewcrist