Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
10分で詰め込むHadoop
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
kanga333
April 02, 2018
Technology
170
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
10分で詰め込むHadoop
MicroAd 社内LT会資料
kanga333
April 02, 2018
More Decks by kanga333
See All by kanga333
Athenaを使ったバッチ処理のTIPS
kanga333
0
960
個々のアプリのリポジトリでTerraformを管理している話
kanga333
4
3.8k
docker_and_make
kanga333
1
440
CoreOS Container Linuxで始めるベアメタルKubernetes
kanga333
3
9.1k
ORCについて調べた
kanga333
0
270
burrow_monitoring
kanga333
0
890
j2hの紹介
kanga333
0
6.3k
Other Decks in Technology
See All in Technology
無理せず続ける、子育てエンジニアの学び
codmoninc
PRO
0
480
生成AIで高い生産性を求められて、 悩み、乗り越えた話
mot_techtalk
2
130
AI時代に必要な脅威モデリング― 変化の速度に負けない理解とリスク判断
masakane55
5
1.2k
今こそ知りたいAmplifyGen2
mkdev10
2
160
AgentCoreで実践するハーネスエンジニアリング
yakumo
1
290
メルペイ 会計システム概要と歴史
mewuto
0
190
DevelopersIO 2026 知識の地図を描く ─ オントロジーとは何か?
ishikawa_satoru
1
600
Essential architectural thinking (revised edition)
ufried
0
100
使いこなすために知っておきたい Azure SRE Agent アンチパターン
torumakabe
2
420
OR学会2026年秋期大会_機械学習と数理最適化の融合による、配合レシピ最適化システム開発事例
brainpadpr
0
110
freeeらしさをAIとともに作る / Creating the freee Experience with AI
ymrl
0
210
全人類(ほぼ)AWS Organizations の上でAWSを利用している、その世界を知る話
htan
1
130
Featured
See All Featured
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
[Rails World 2026] Durable orchestration on Rails: from continuation to workflow
palkan
1
500
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
940
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.7k
What Being in a Rock Band Can Teach Us About Real World SEO
427marketing
0
1.1k
Code Review Best Practice
trishagee
74
20k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
Darren the Foodie - Storyboard
khoart
PRO
4
4k
Rails Girls Zürich Keynote
gr2m
96
14k
HDC tutorial
michielstock
2
950
Navigating Weather and Climate Data
rabernat
0
550
Transcript
10分で詰め込むHadoop kagawa_shoichi
あらまし Hadoopとはなんぞやという話を10分で詰め込む ざっくり概要と用途について 厳密には違ったりするかもしれんけど、雰囲気伝わるの重視
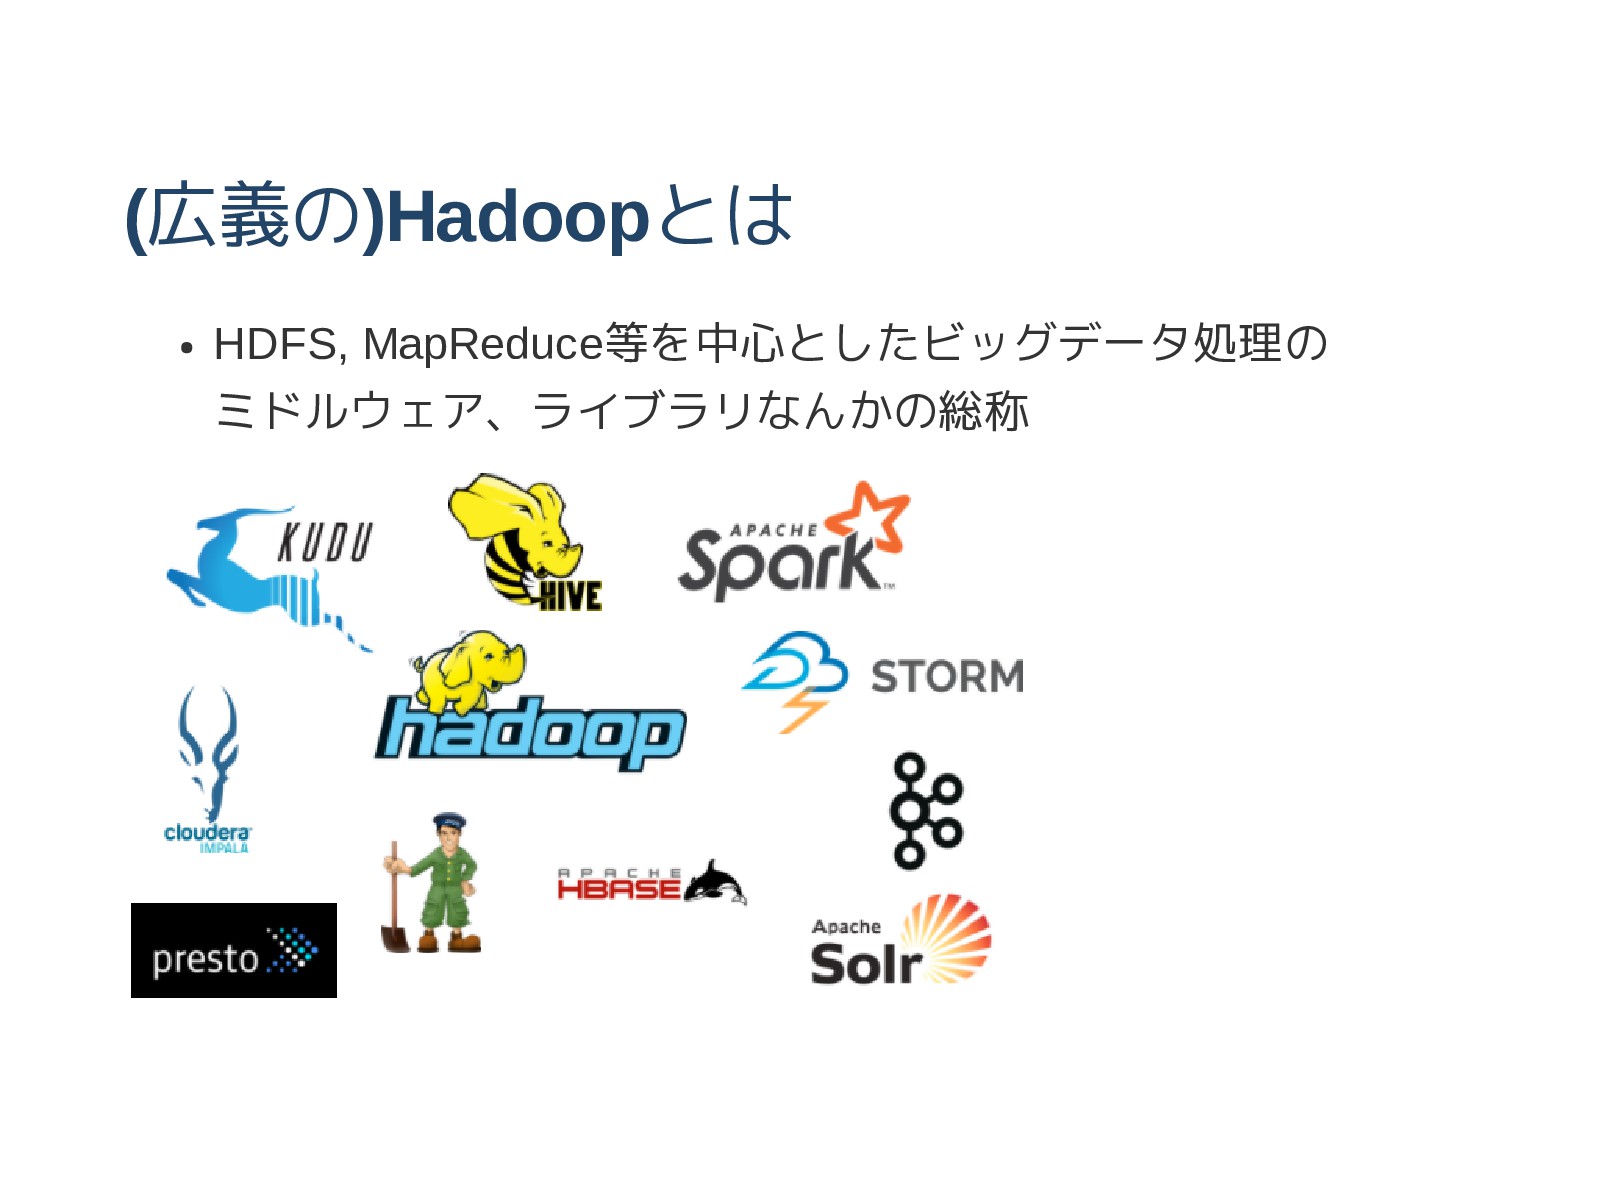
(広義の)Hadoopとは HDFS, MapReduce等を中心としたビッグデータ処理の ミドルウェア、ライブラリなんかの総称
(狭義の)Hadoopとは 巨大なデータに対するバッチ処理ミドルウェアである HDFS, YARN, MapReduceの事を示す それぞれについては後述
Hadoopのディストリビューション LinuxにおけるRedhat,Ubuntuと同様にHadoopにも ディストリビューションがある 普通はOSSのHadoopを直で使ったりせず なんらかディストリビューションのものを使う 主要なディストリビューションベンダー Cloudera (CDH) Hortonworks (HDP)
MAPR (MARP) Pivotal (Pivotal HD)
主要Hadoopコンポーネント HDFS YARN MapReduce Spark Hive ZooKeeper
HDFS Hadoop Distributed File System 分散ファイルシステム ファイルをブロックという単位で分割して複数サーバに保持 させる
YARN 分散環境のサーバ郡のリソーススケジューラー ジョブが投入された際に、そのジョブをどのサーバ達でどの くらいのCPU/メモリを割り当てて、実行するかを決定する
MapReduce map処理とreduce処理により大規模データを処理する フレームワーク map([ , , ], cook) => [
, , ] reduce([ , , ], eat) =>
Spark ひとまずは、洗練されたMapReduceくらいに思っておけばOK 中間データをオンメモリで持つから高速 MapとReduceのTaskを行うプロセスを区別せず使い回す 色んな便利ライブラリが付いている 機械学習: Spark ML リアルタイム処理: Spark
Streaming SQL: Spark SQL リアルタイム処理 with SQL: Spark Structured Streaming
Hive SQL処理エンジン SQLをMRやSparkなどのジョブに変換してデータを操作 ちなみにHive on SparkとSpark SQLは別物
Zookeeper 対障害性を高めた分散KVS Hadopコンポーネントのメタデータを管理する 分散環境において、どれがマスタなのか?などを管理
その他Hadoopコンポーネント解説 HBase Kudu Kafka Storm/SparkStreaming Impara/Presto
HBase オンメモリ分散列指向DB HDFSではできないデータの更新などができる ただし、メモリに乗り切るくらいのデータしか扱えない とはいえクラスタを組むのでスケールは可能
Kude 分散列指向ストレージ HDFSとHBaseのギャップを埋めるストレージ TB規模のデータをディスクとして持ちながら更新可能 とはいえ HBaseの方が早い HDFSの方が大規模データに対するスループットはある 用途 リアルタイムに更新などが発生する大規模データに対し て分析などのスキャン的な操作もしたい
Kafka 分散キューイングシステム スケール可能なFIFOでPubSubなキュー
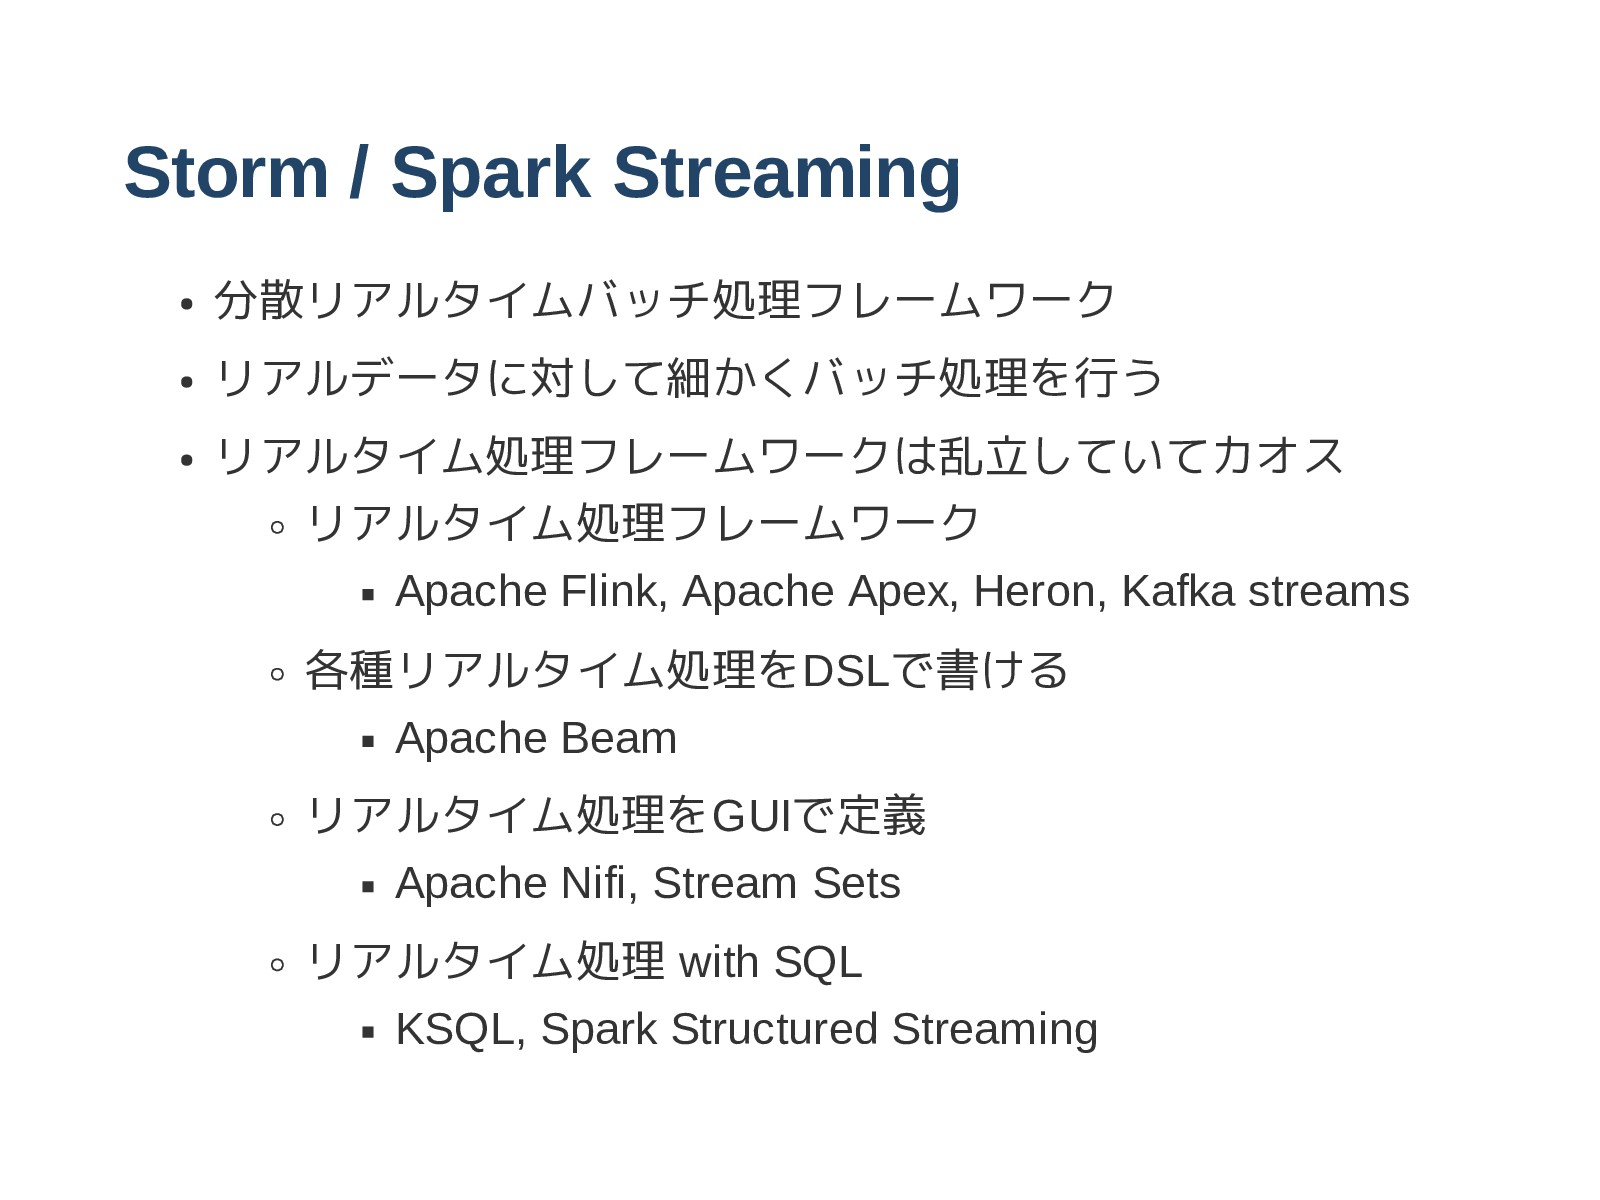
Storm / Spark Streaming 分散リアルタイムバッチ処理フレームワーク リアルデータに対して細かくバッチ処理を行う リアルタイム処理フレームワークは乱立していてカオス リアルタイム処理フレームワーク Apache Flink,
Apache Apex, Heron, Kafka streams 各種リアルタイム処理をDSLで書ける Apache Beam リアルタイム処理をGUIで定義 Apache Nifi, Stream Sets リアルタイム処理 with SQL KSQL, Spark Structured Streaming
Impara / Presto 高速な分散SQL処理エンジン SQLをMRやSparkに変換するHiveと比較してSQLを処理する ことに特化して作られており高速 基本的には耐障害性を犠牲にしてスループットを高める設計 データを全部メモリに乗せて処理する バッチよりアドホッククエリ向き 多分Imparaの方が早いし、CDHと親和性高いけど
Prestoの方が汎用性高い
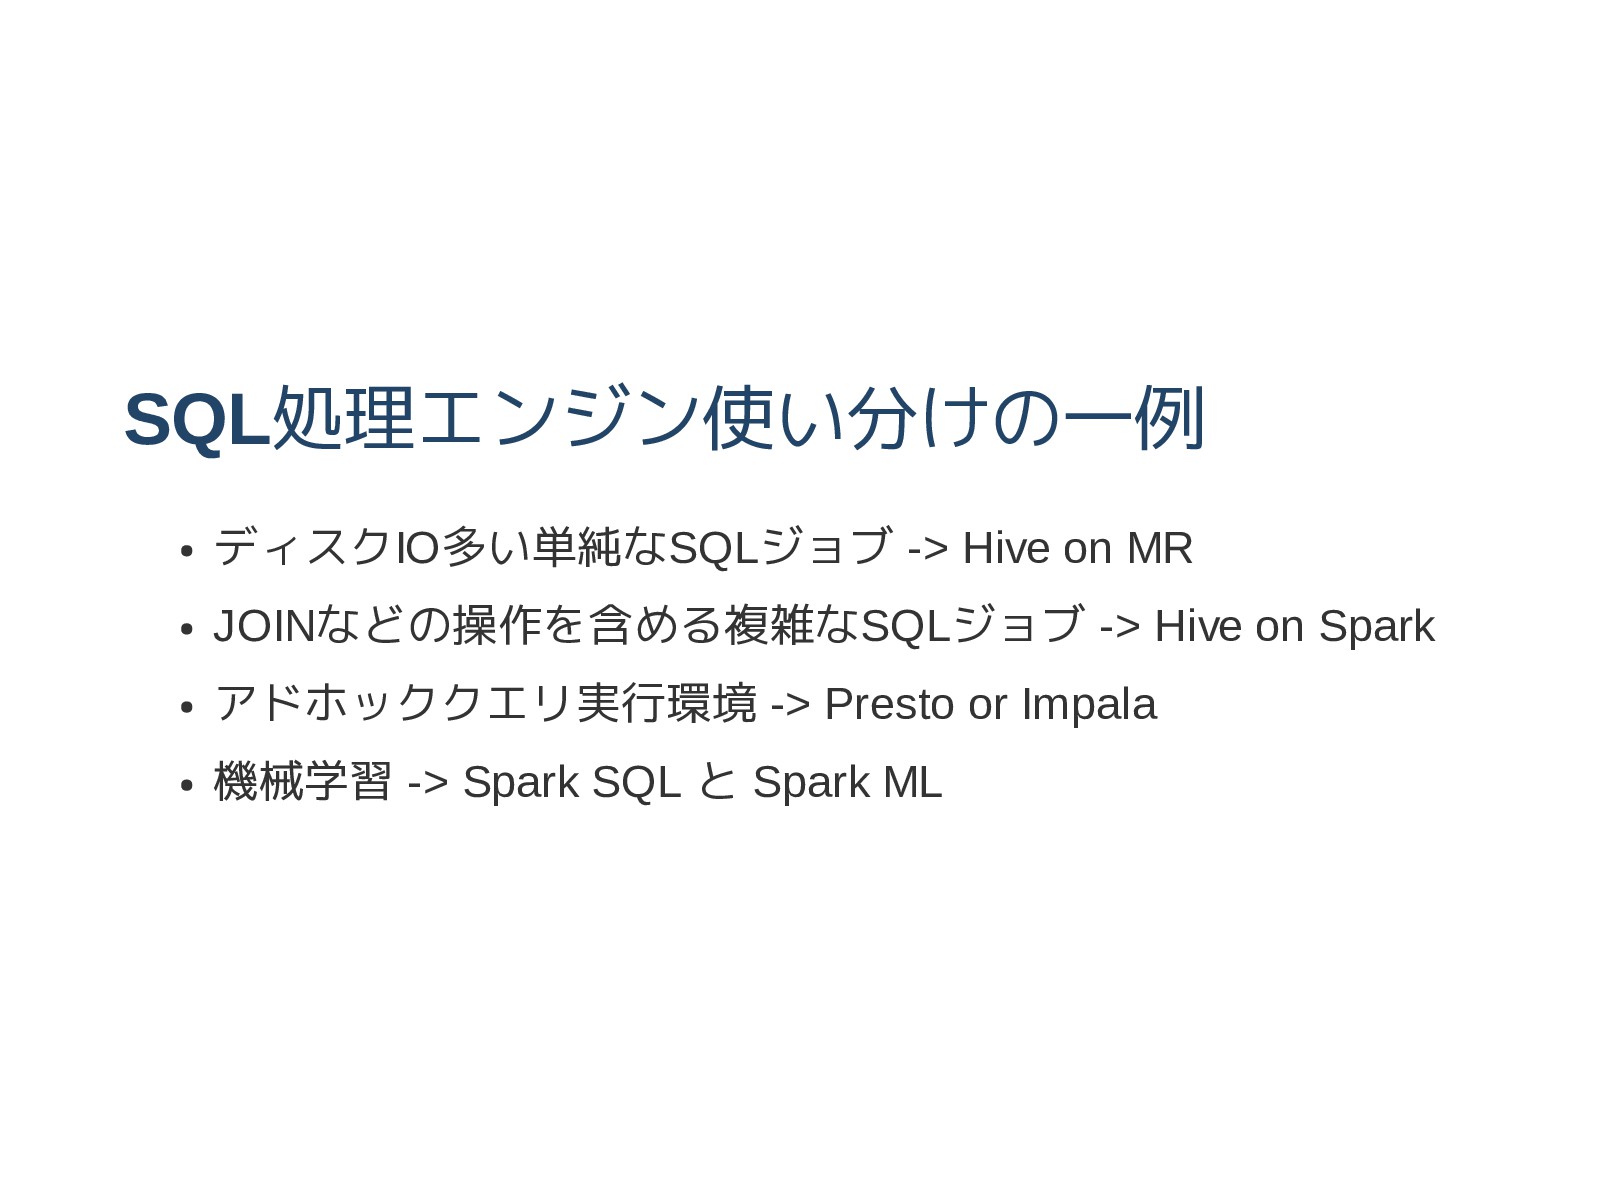
SQL処理エンジン使い分けの一例 ディスクIO多い単純なSQLジョブ > Hive on MR JOINなどの操作を含める複雑なSQLジョブ > Hive on
Spark アドホッククエリ実行環境 > Presto or Impala 機械学習 > Spark SQL と Spark ML
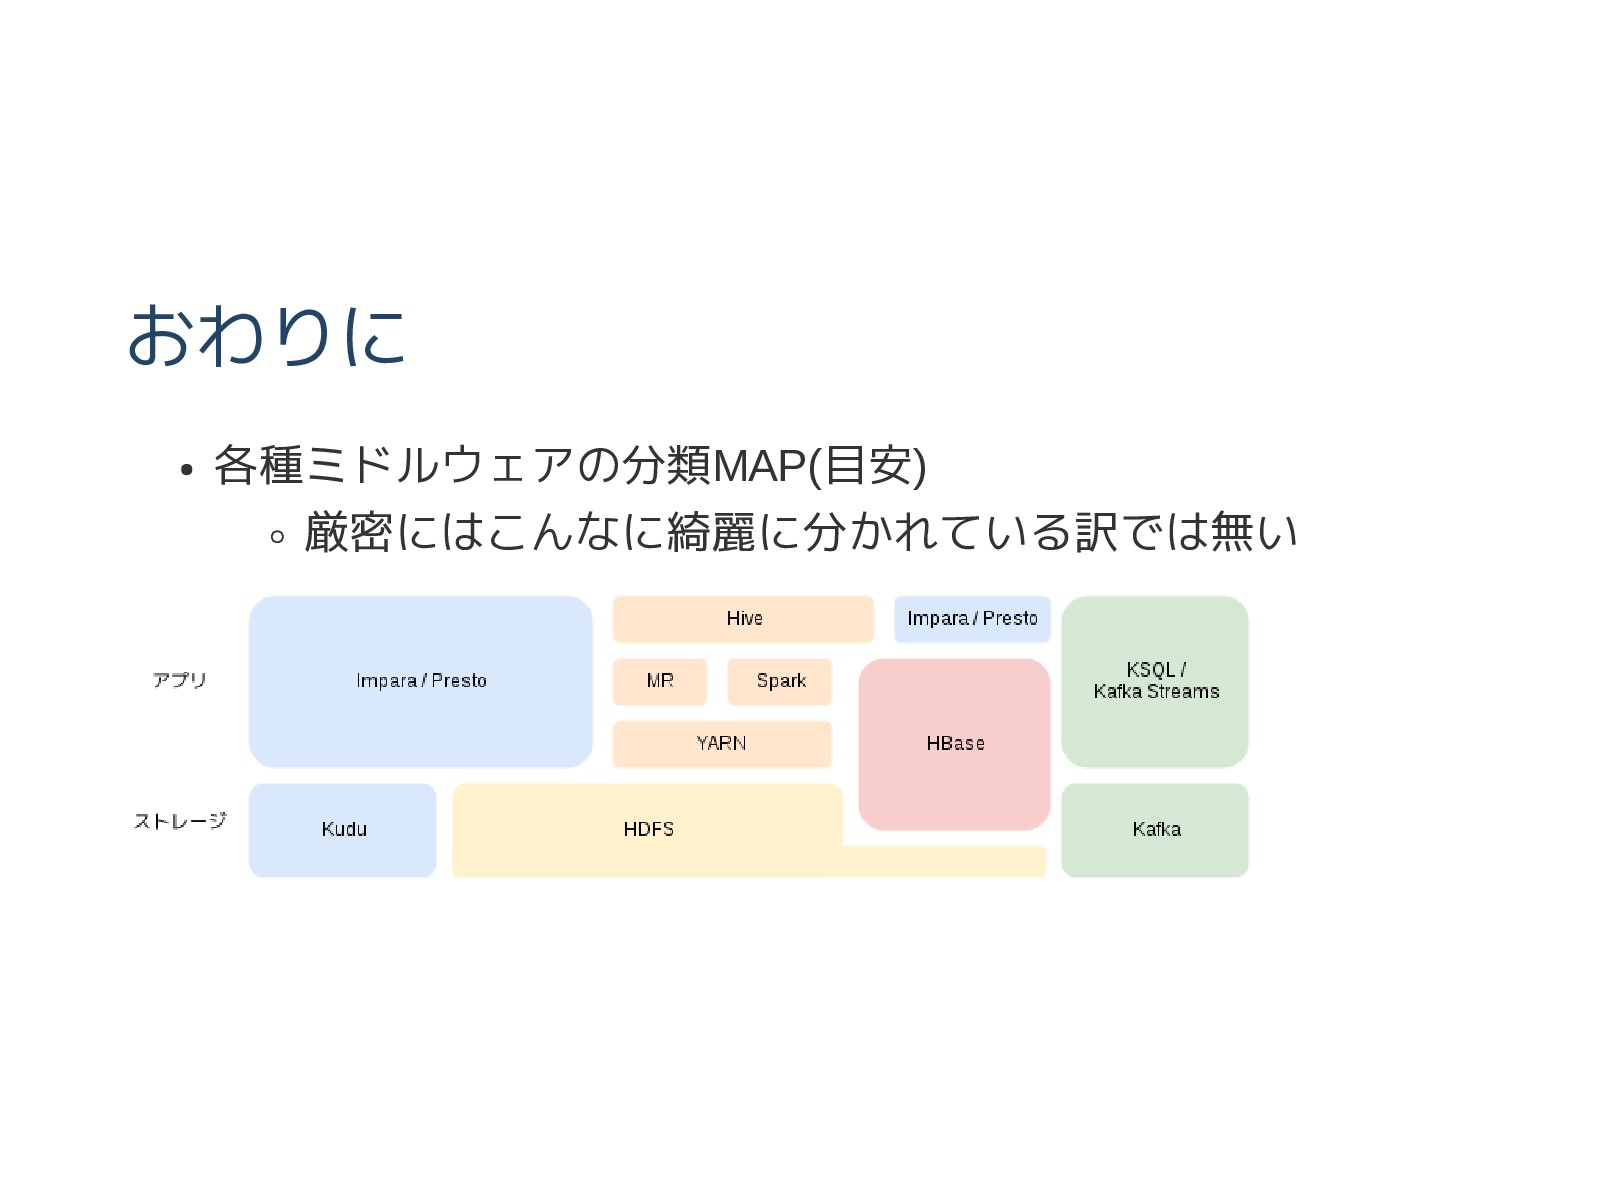
おわりに 各種ミドルウェアの分類MAP(目安) 厳密にはこんなに綺麗に分かれている訳では無い
None


 kanga333
 codmoninc
 mot_techtalk
 masakane55
 mkdev10
 yakumo
 mewuto
 ishikawa_satoru
 ufried
 torumakabe
 brainpadpr
 ymrl
 htan
 aleyda
 palkan
 tammyeverts
 nmsamuel
 eileencodes
 427marketing
 trishagee
 maggiecrowley
 khoart
 gr2m
 michielstock
 rabernat