Share
Embed
[Journal club] SeqTR: A Simple yet Universal Network for Visual Grounding
Semantic Machine Intelligence Lab., Keio Univ. PRO
July 31, 2023
Transcript
29 slides
-
SeqTR: A Simple yet Universal Network for Visual Grounding 慶應義塾大学杉浦孔明研究室
松田一起 Chaoyang Zhu1 , Yiyi Zhou1 , Yunhang Shen3 , Gen Luo1, Xingjia Pan3, Mingbao Lin3, Chao Chen3, Liujuan Cao1*, Xiaoshuai Sun1,4, Rongrong Ji1,2,4 1MAC Lab, Department of Artificial Intelligence, School of Informatics, Xiamen University. 2Institute of Energy Research, Jiangxi Academy of Sciences. 3Tencent Youtu Lab. 3Institute of Artificial Intelligence, Xiamen University. ECCV 2022 C. Zhu, Y. Zhou, Y. Shen, G. Luo, X. Pan, M. Lin, C. Chen, L. Cao, X. Sun, and R. Ji, “SeqTR: A Simple yet Universal Network for Visual Grounding,” in ECCV, 2022. -
2 背景 ✔ 参照表現理解(REC)と参照表現セグメンテーション(RES)における 既存手法は複雑なネットワーク構造や損失関数が用いられる →タスクに強く依存 提案手法:SeqTR ✔ BboxとSegmentation maskを離散的な座標のシーケンスとして扱う
✔ 言語モデリングの手法(自己回帰)でそれらの座標を得る 結果 ✔ シンプルな構造で複数タスクに用いることができるネットワーク ✔ RECタスクとRESタスクでSOTAを達成 概要 -
3 背景 – 既存手法は複雑でタスク依存のものが多い ✔ V&Lタスクにおいて既存手法はネットワーク設計や損失関数における専門知識が必要 ✔ 例えばMAttNet[Yu+, CVPR18]では言語表現をSubject, Location,
Relationshipのフレーズ に分け、対応する3つのAttention moduleを用いる MAttNet[Yu+, CVPR18] -
4 背景 – 既存手法は複雑でタスク依存のものが多い ✔ V&Lタスクにおいて既存手法はネットワーク設計や損失関数における専門知識が必要 ✔ 損失関数においてもタスクに依存したものや複雑なものが多い ✔ e.g.
GIoU loss[Rezatofighi+, CVPR19], focal loss[Lin+, CVPR20], dice loss[Milletari+, IEEE16],… -
5 関連研究 – Pix2Seq, MAttNet 手法 概要 Pix2Seq [Chen+, ICLR22]
Bboxを離散座標として表現, 言語モデリングの手法で物 体検出 MAttNet[Yu+, CVPR18] RECタスクにおいて3つのAttention moduleを用いる Pix2Seq [Chen+, ICLR22] MAttNet[Yu+, CVPR18] -
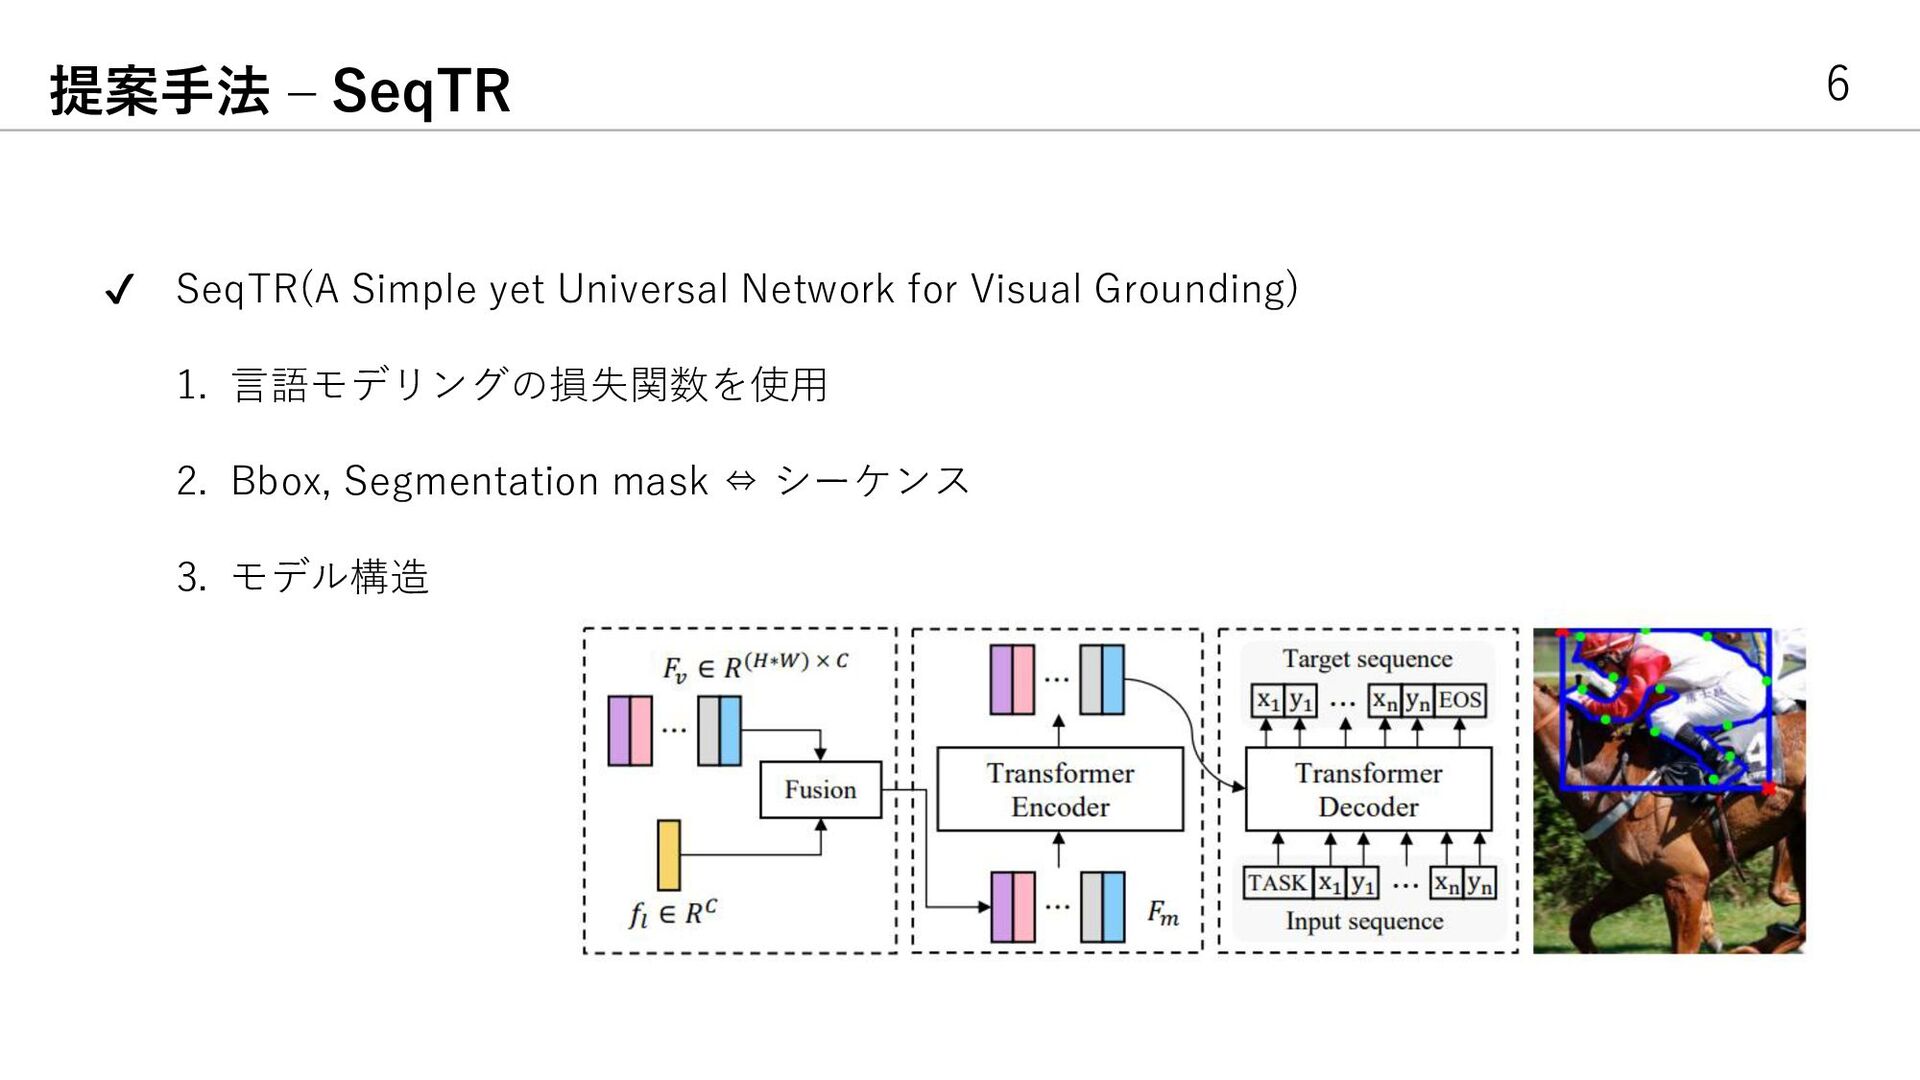
6 提案手法 – SeqTR ✔ SeqTR(A Simple yet Universal Network
for Visual Grounding) 1. 言語モデリングの損失関数を使用 2. Bbox, Segmentation mask ⇔ シーケンス 3. モデル構造 -
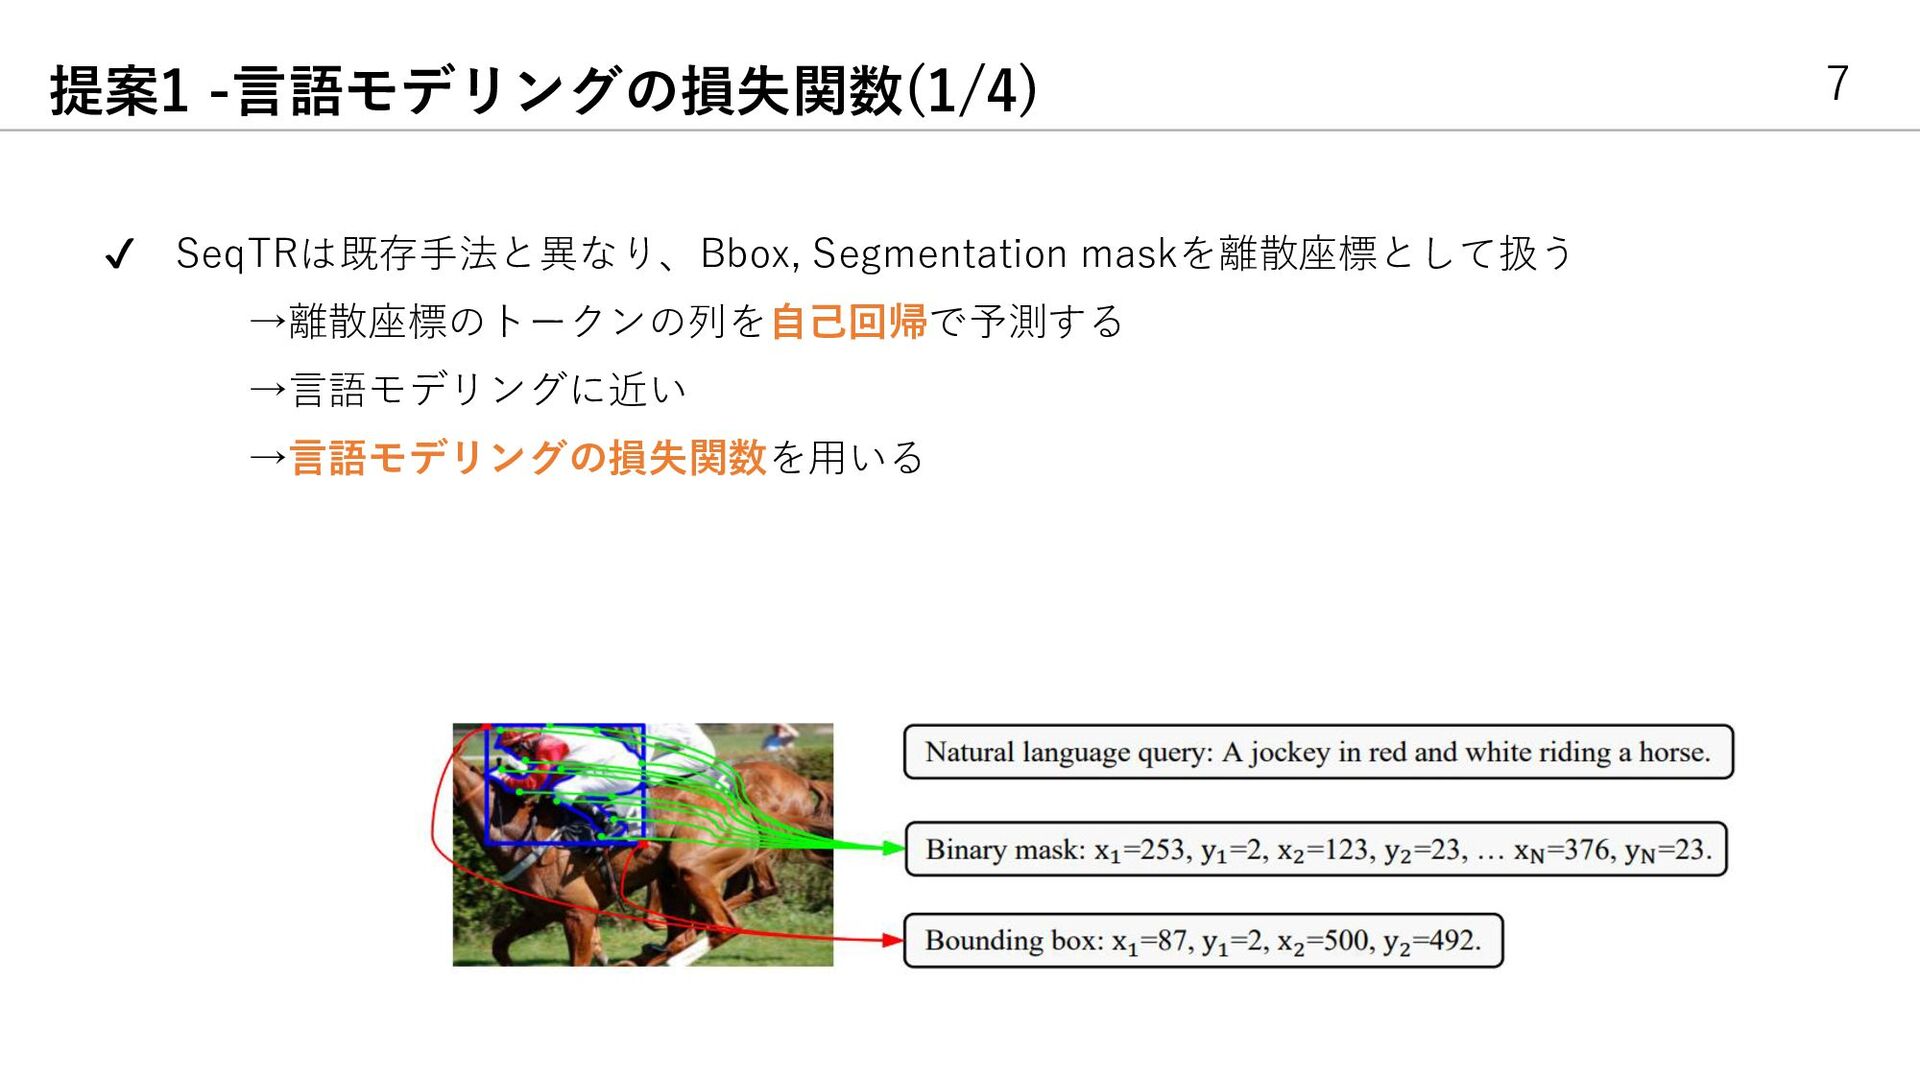
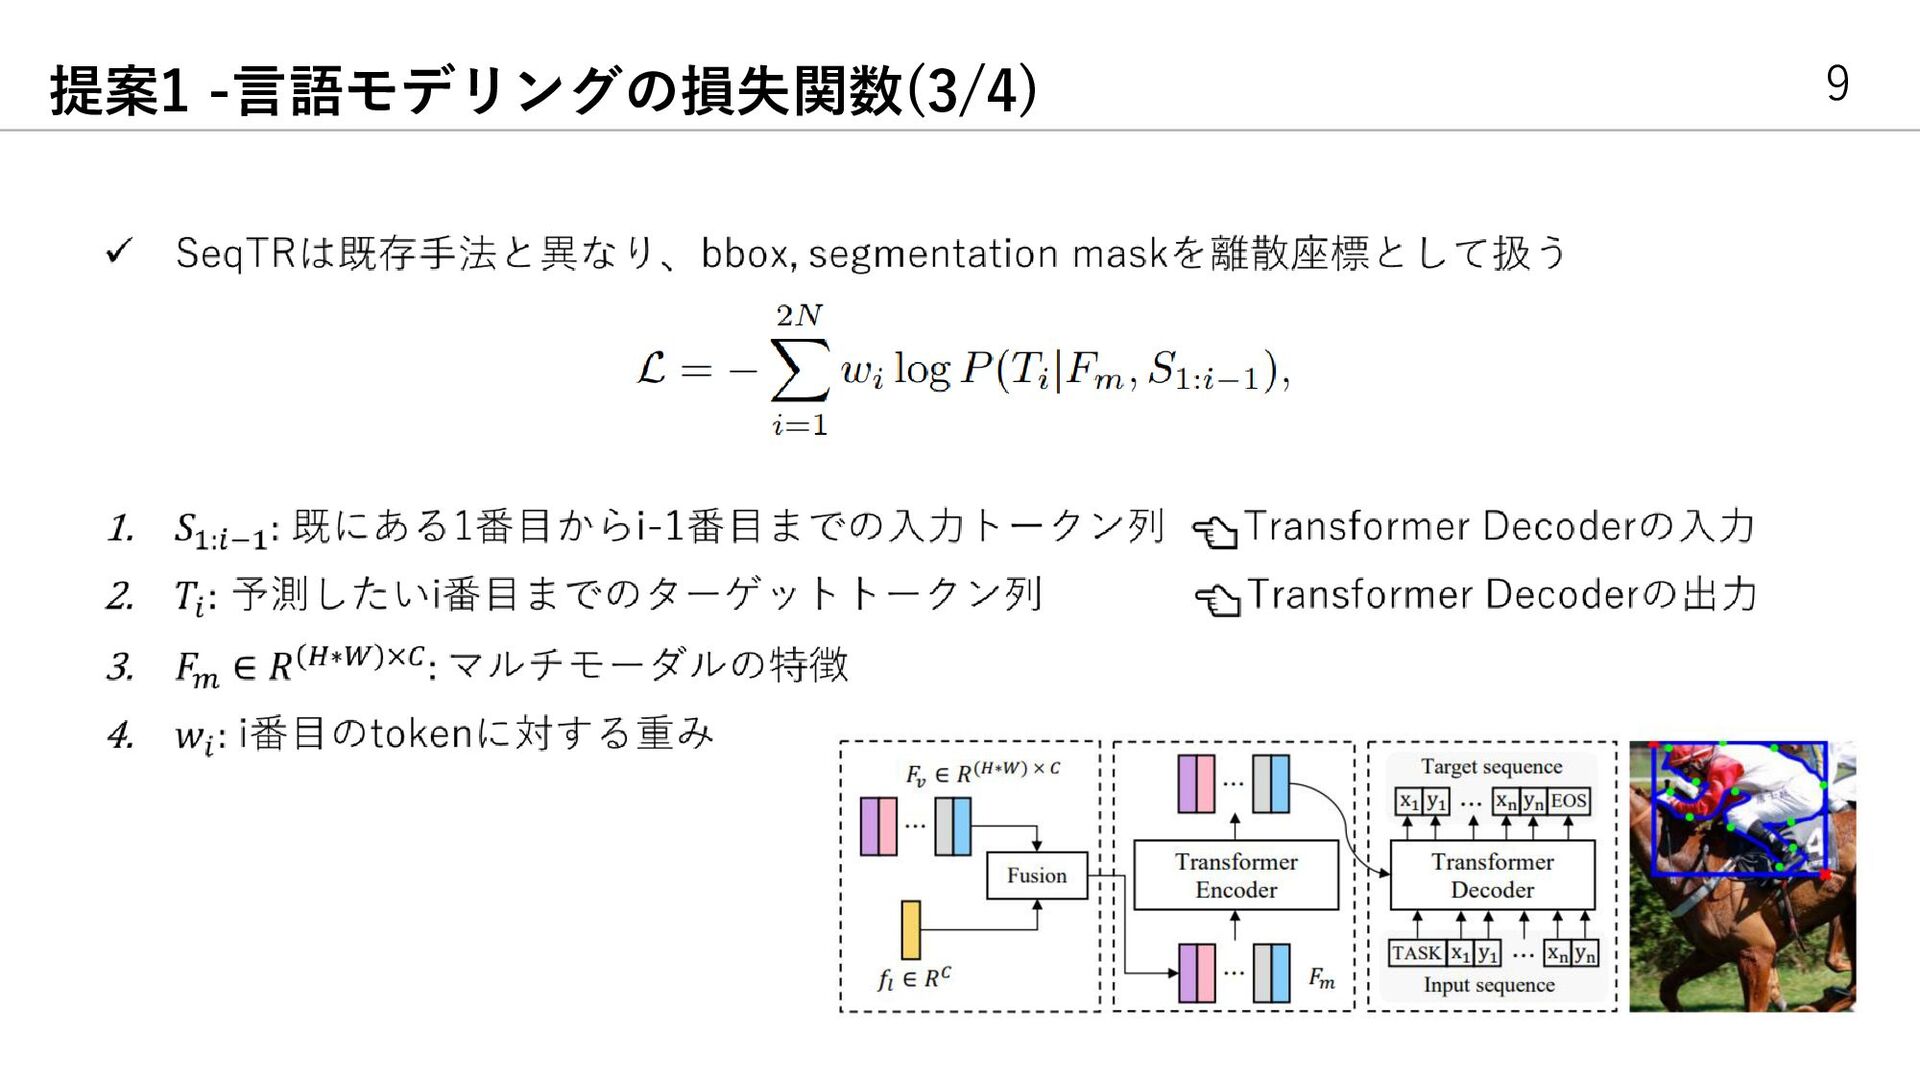
8 提案1 -言語モデリングの損失関数(2/4) ✔ SeqTRは既存手法と異なり、Bbox, Segmentation maskを離散座標として扱う ✔ [TASK]: シーケンスの始点&どのタスクに取り組んでいるか
→モデルがより単純、汎用的に ✔ [EOS]: シーケンスの終点 -
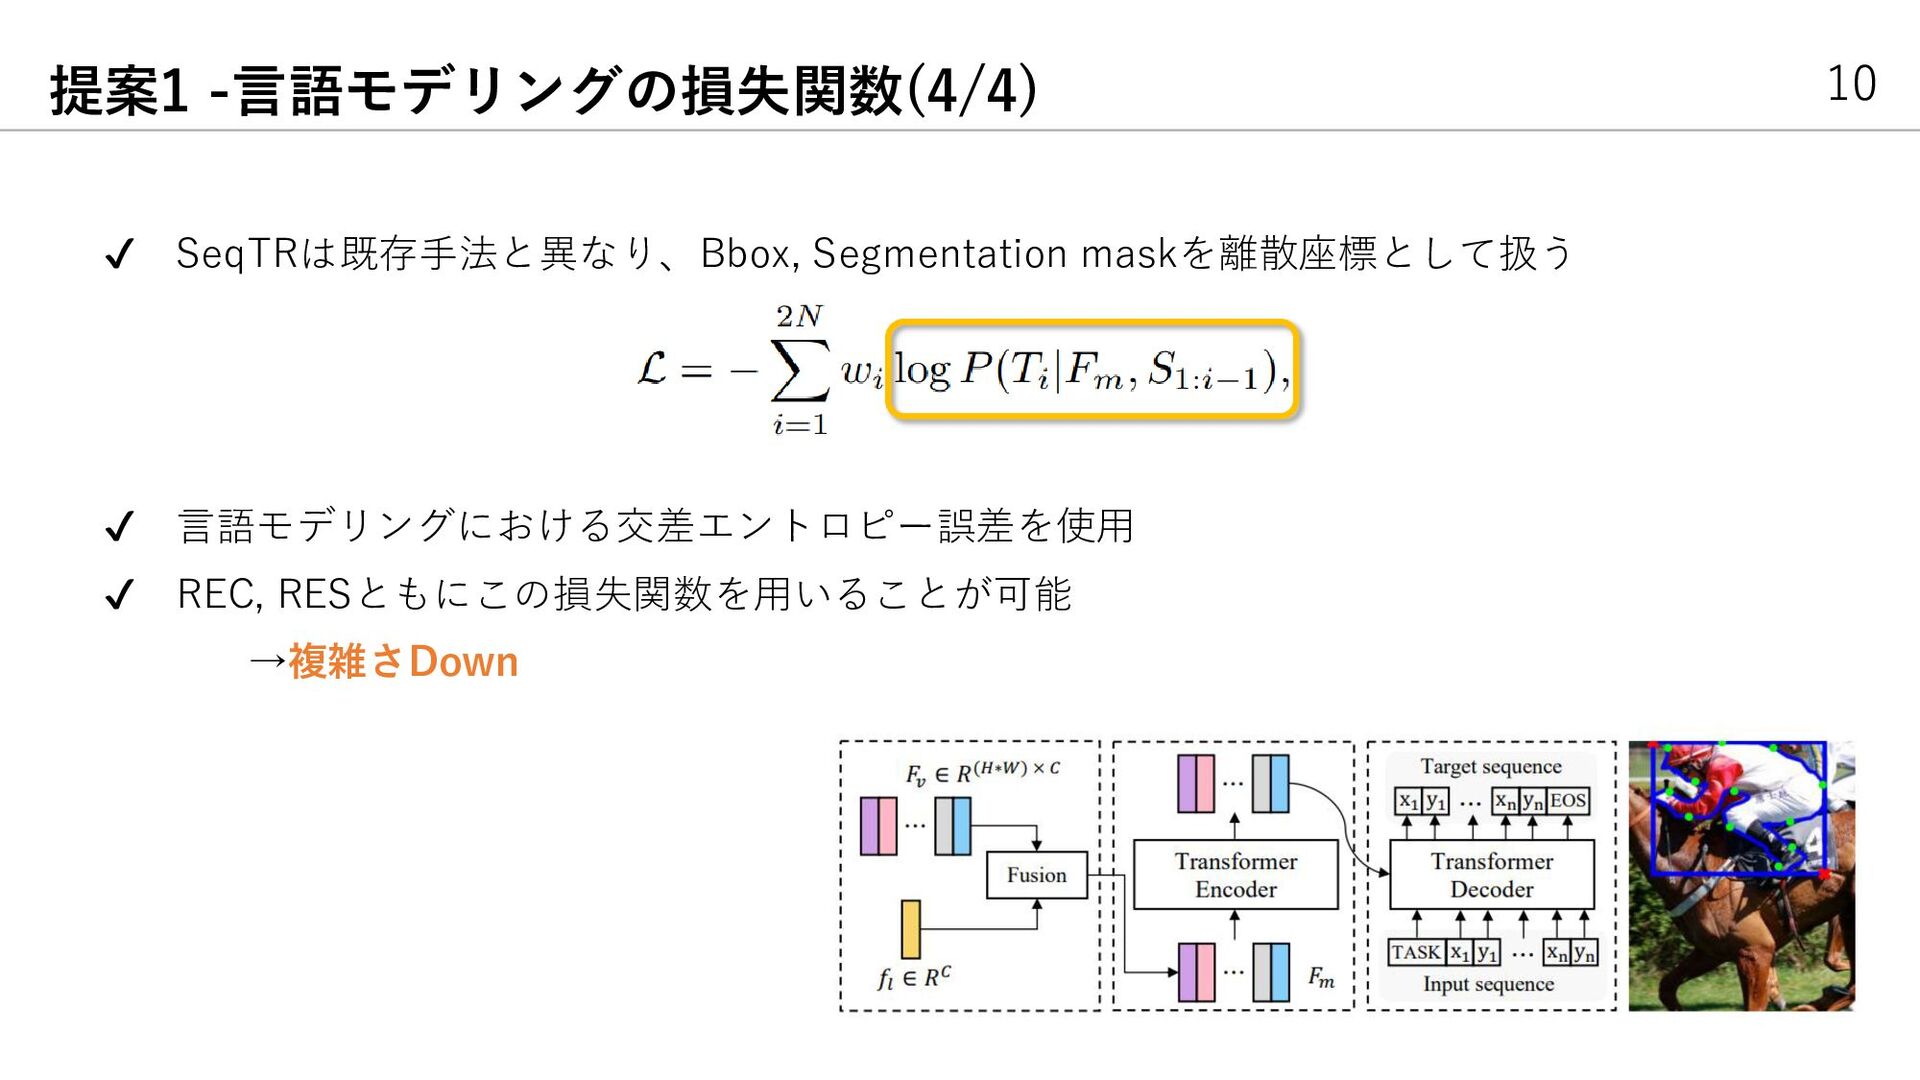
10 提案1 -言語モデリングの損失関数(4/4) ✔ SeqTRは既存手法と異なり、Bbox, Segmentation maskを離散座標として扱う ✔ 言語モデリングにおける交差エントロピー誤差を使用 ✔
REC, RESともにこの損失関数を用いることが可能 →複雑さDown -
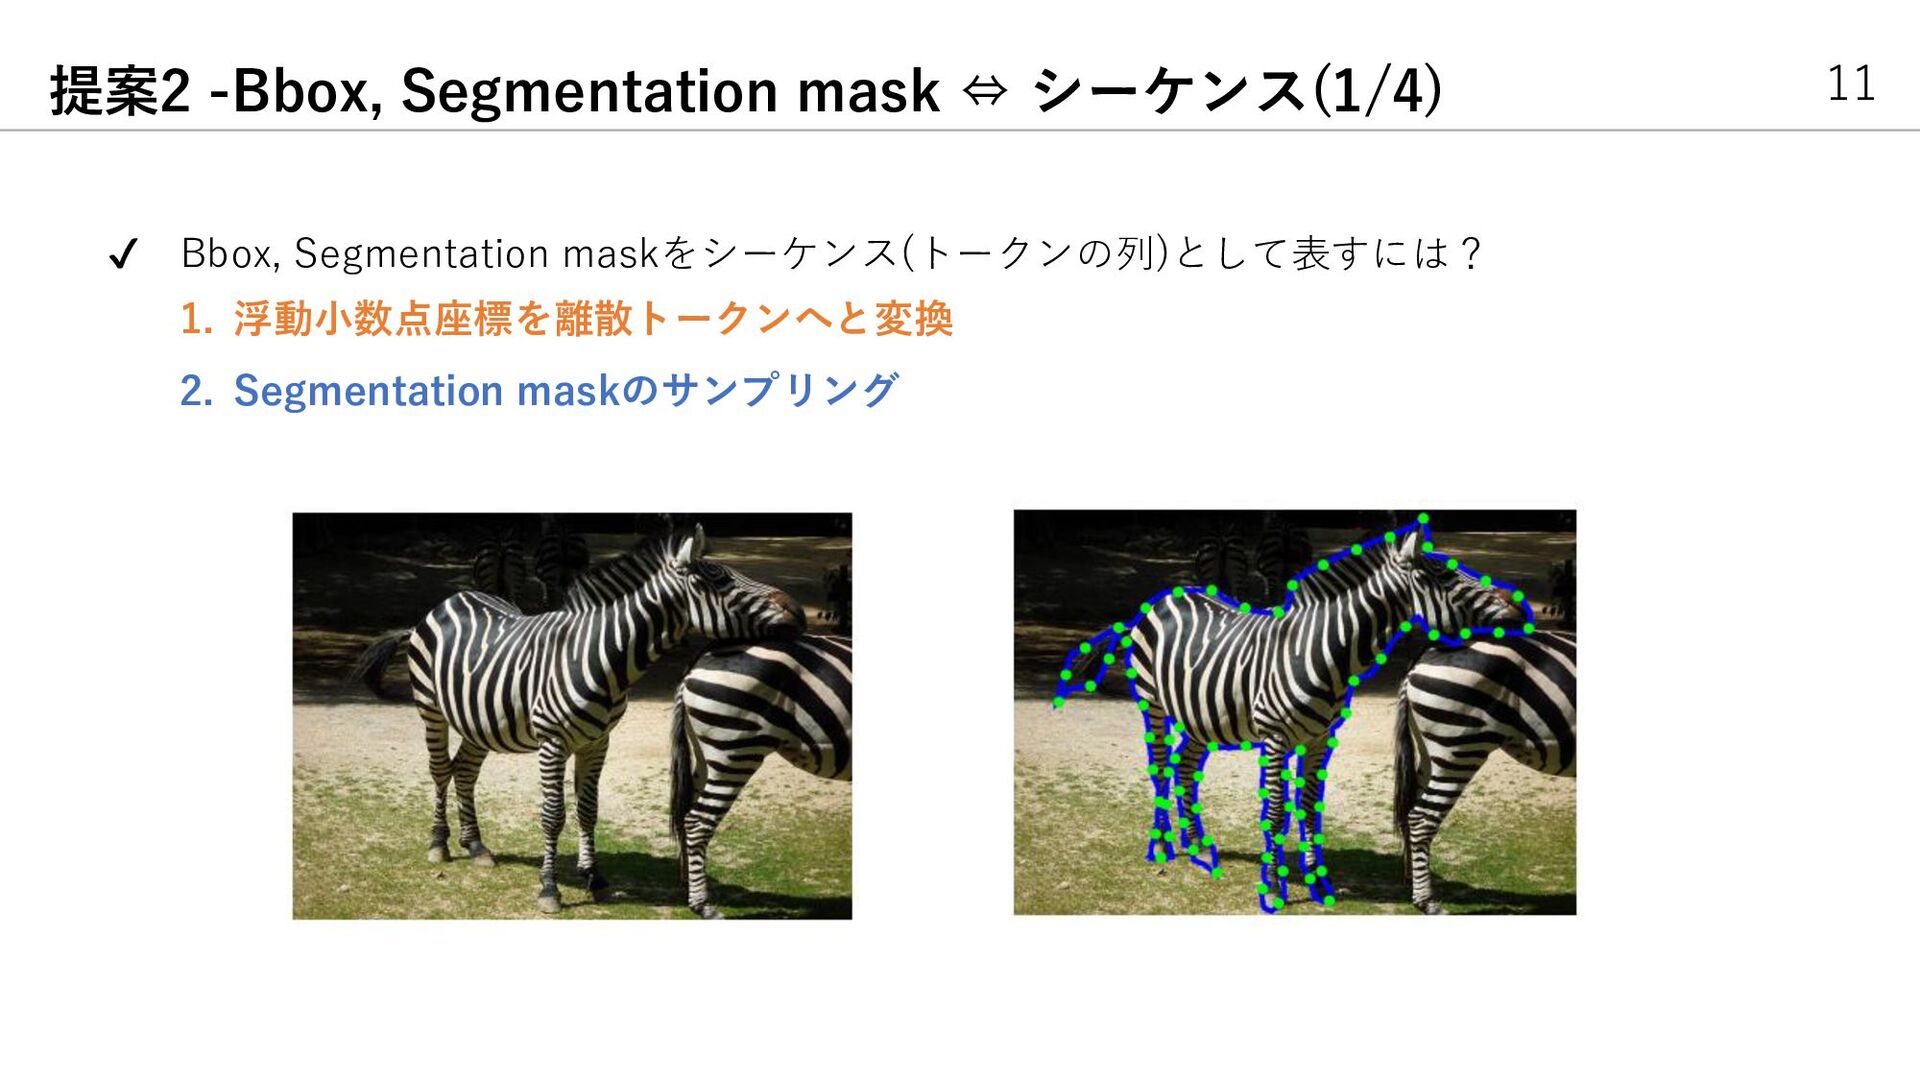
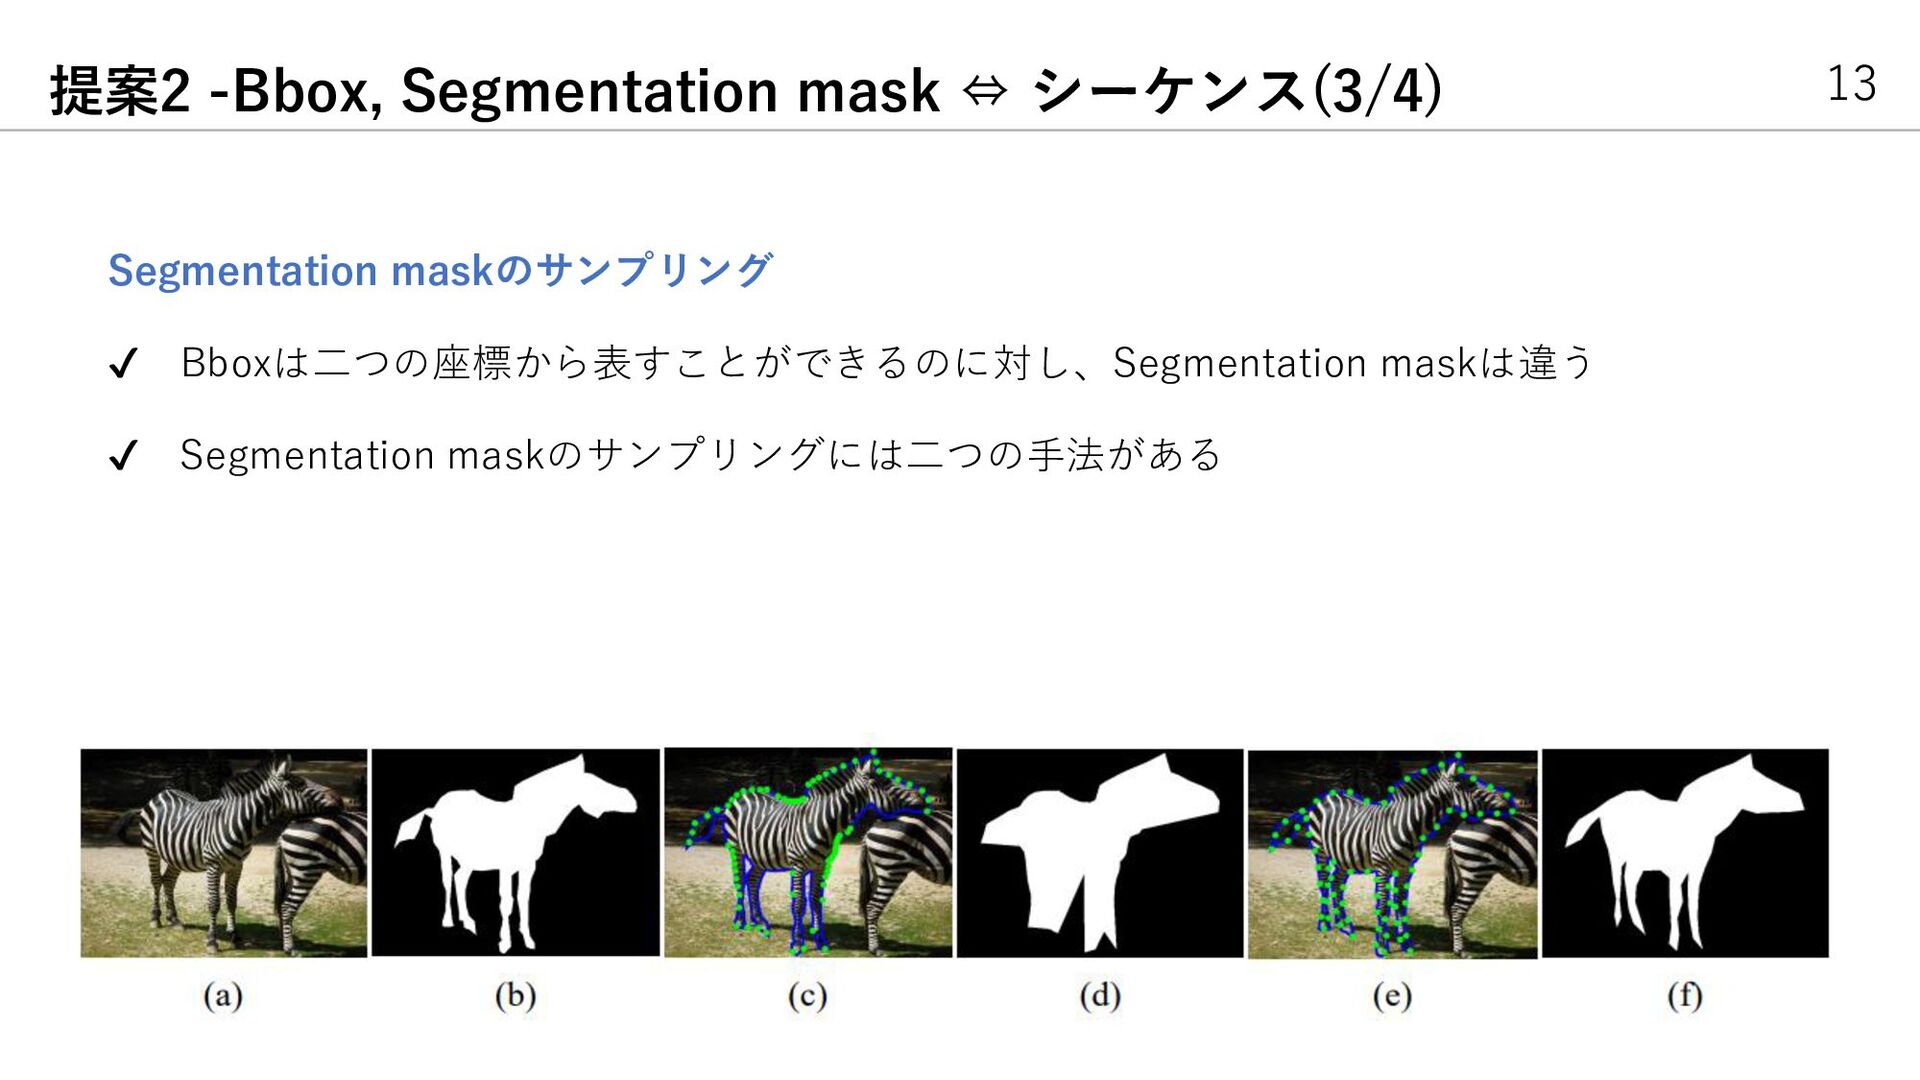
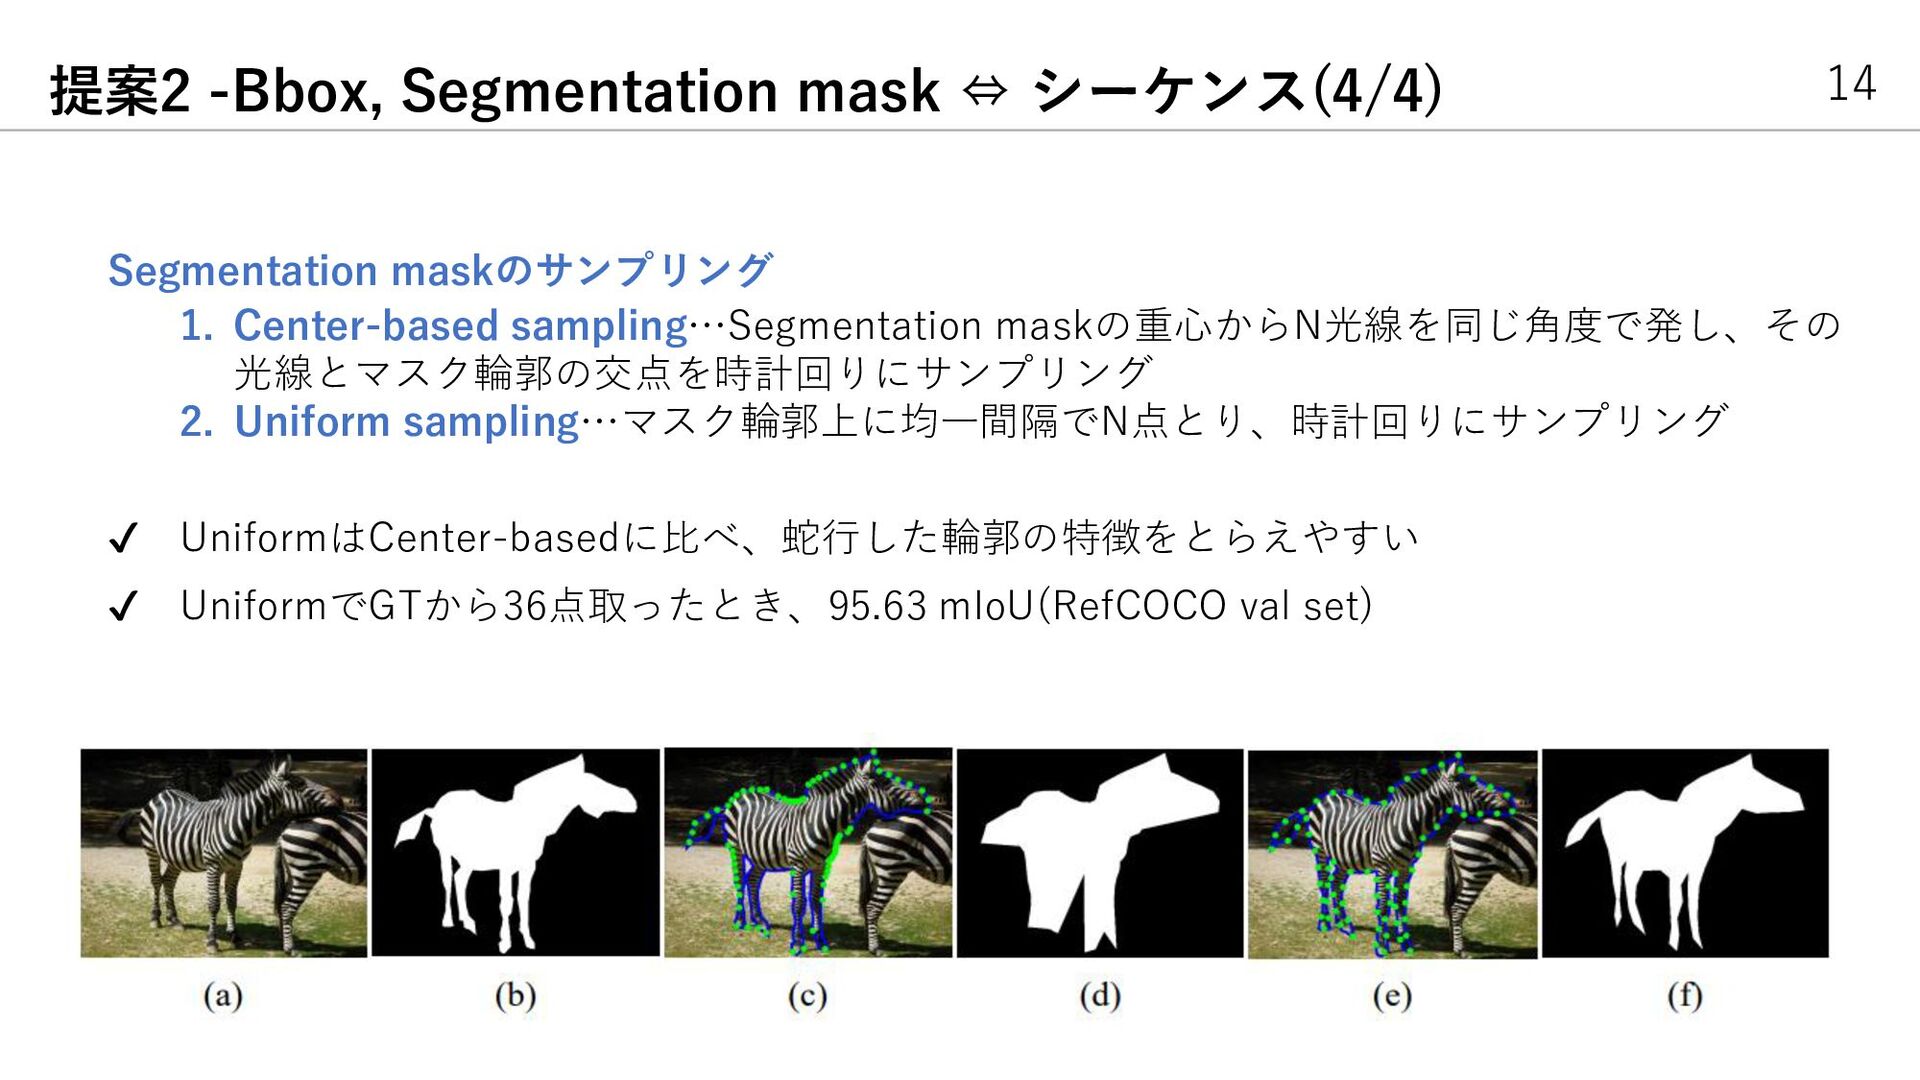
11 提案2 -Bbox, Segmentation mask ⇔ シーケンス(1/4) ✔ Bbox, Segmentation
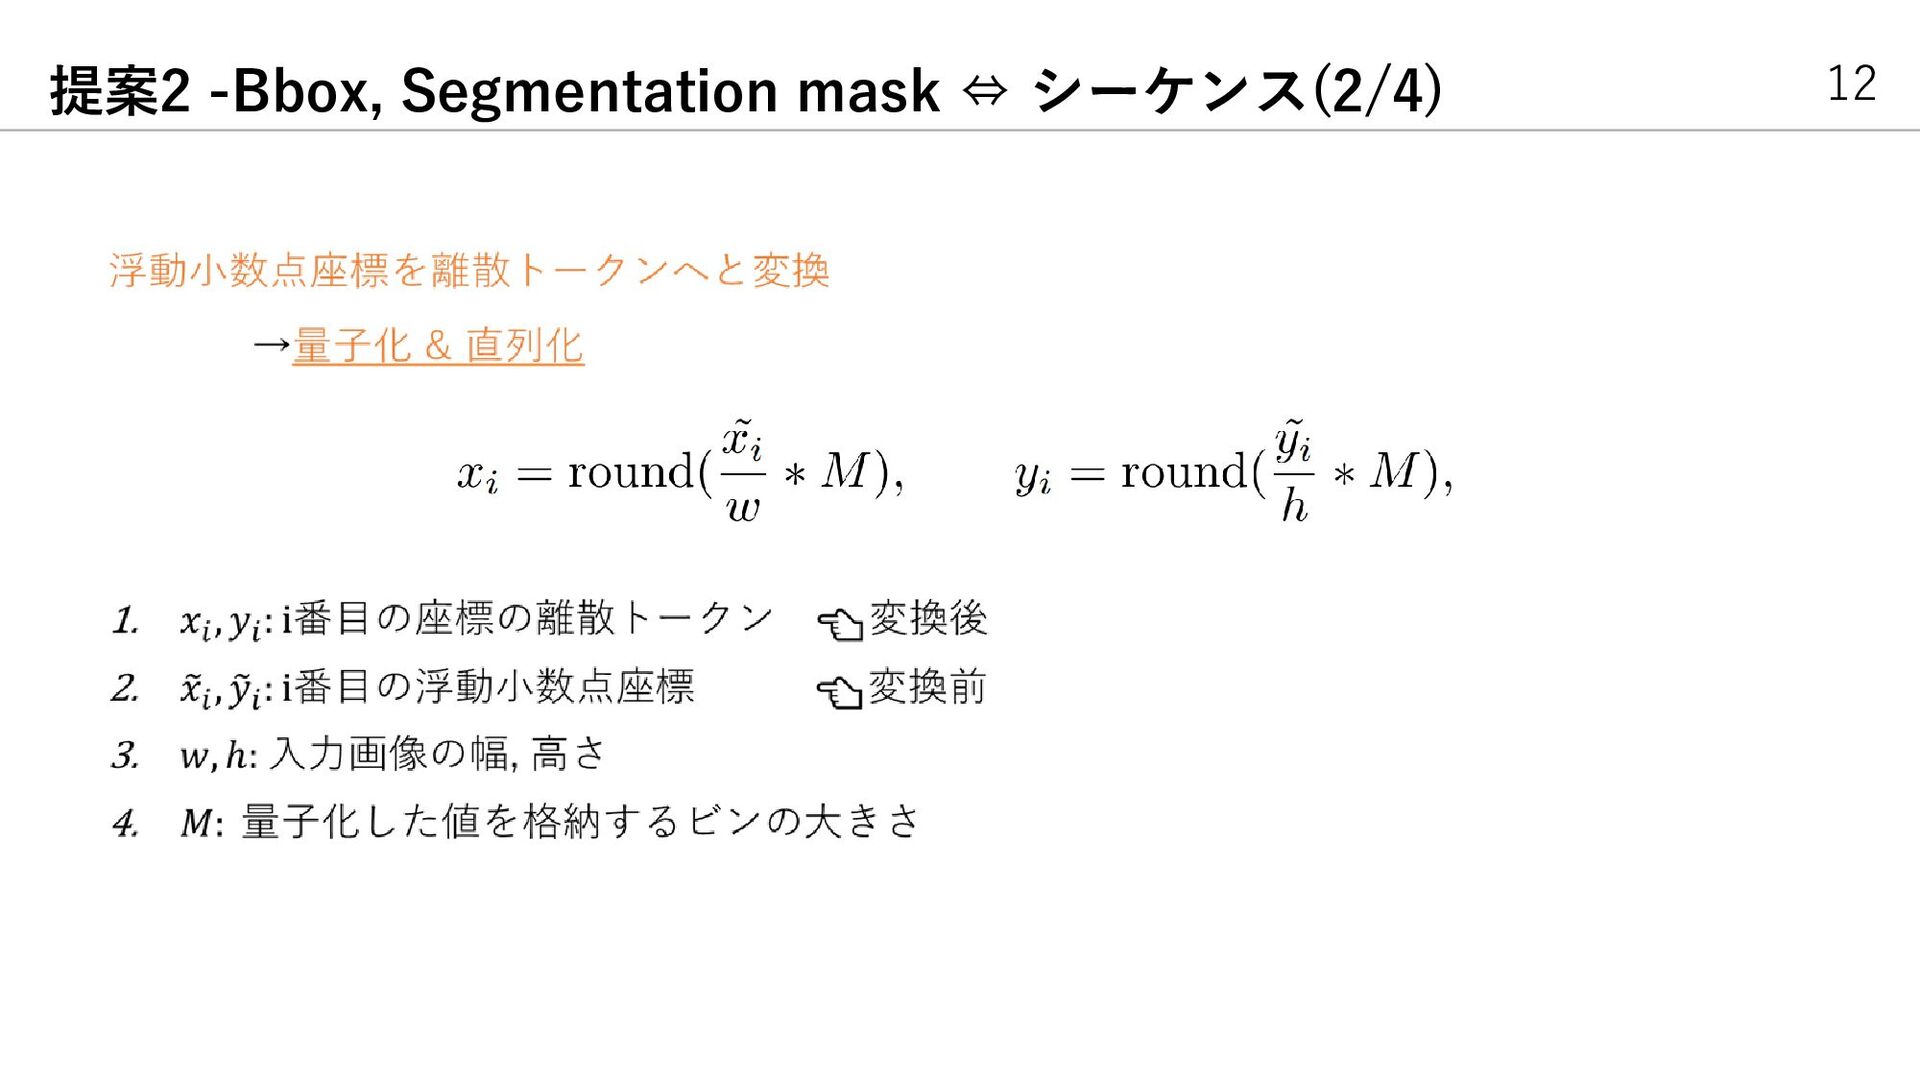
maskをシーケンス(トークンの列)として表すには? 1. 浮動小数点座標を離散トークンへと変換 2. Segmentation maskのサンプリング -
13 提案2 -Bbox, Segmentation mask ⇔ シーケンス(3/4) Segmentation maskのサンプリング ✔
Bboxは二つの座標から表すことができるのに対し、Segmentation maskは違う ✔ Segmentation maskのサンプリングには二つの手法がある -
14 提案2 -Bbox, Segmentation mask ⇔ シーケンス(4/4) Segmentation maskのサンプリング 1.
Center-based sampling…Segmentation maskの重心からN光線を同じ角度で発し、その 光線とマスク輪郭の交点を時計回りにサンプリング 2. Uniform sampling…マスク輪郭上に均一間隔でN点とり、時計回りにサンプリング ✔ UniformはCenter-basedに比べ、蛇行した輪郭の特徴をとらえやすい ✔ UniformでGTから36点取ったとき、95.63 mIoU(RefCOCO val set) -
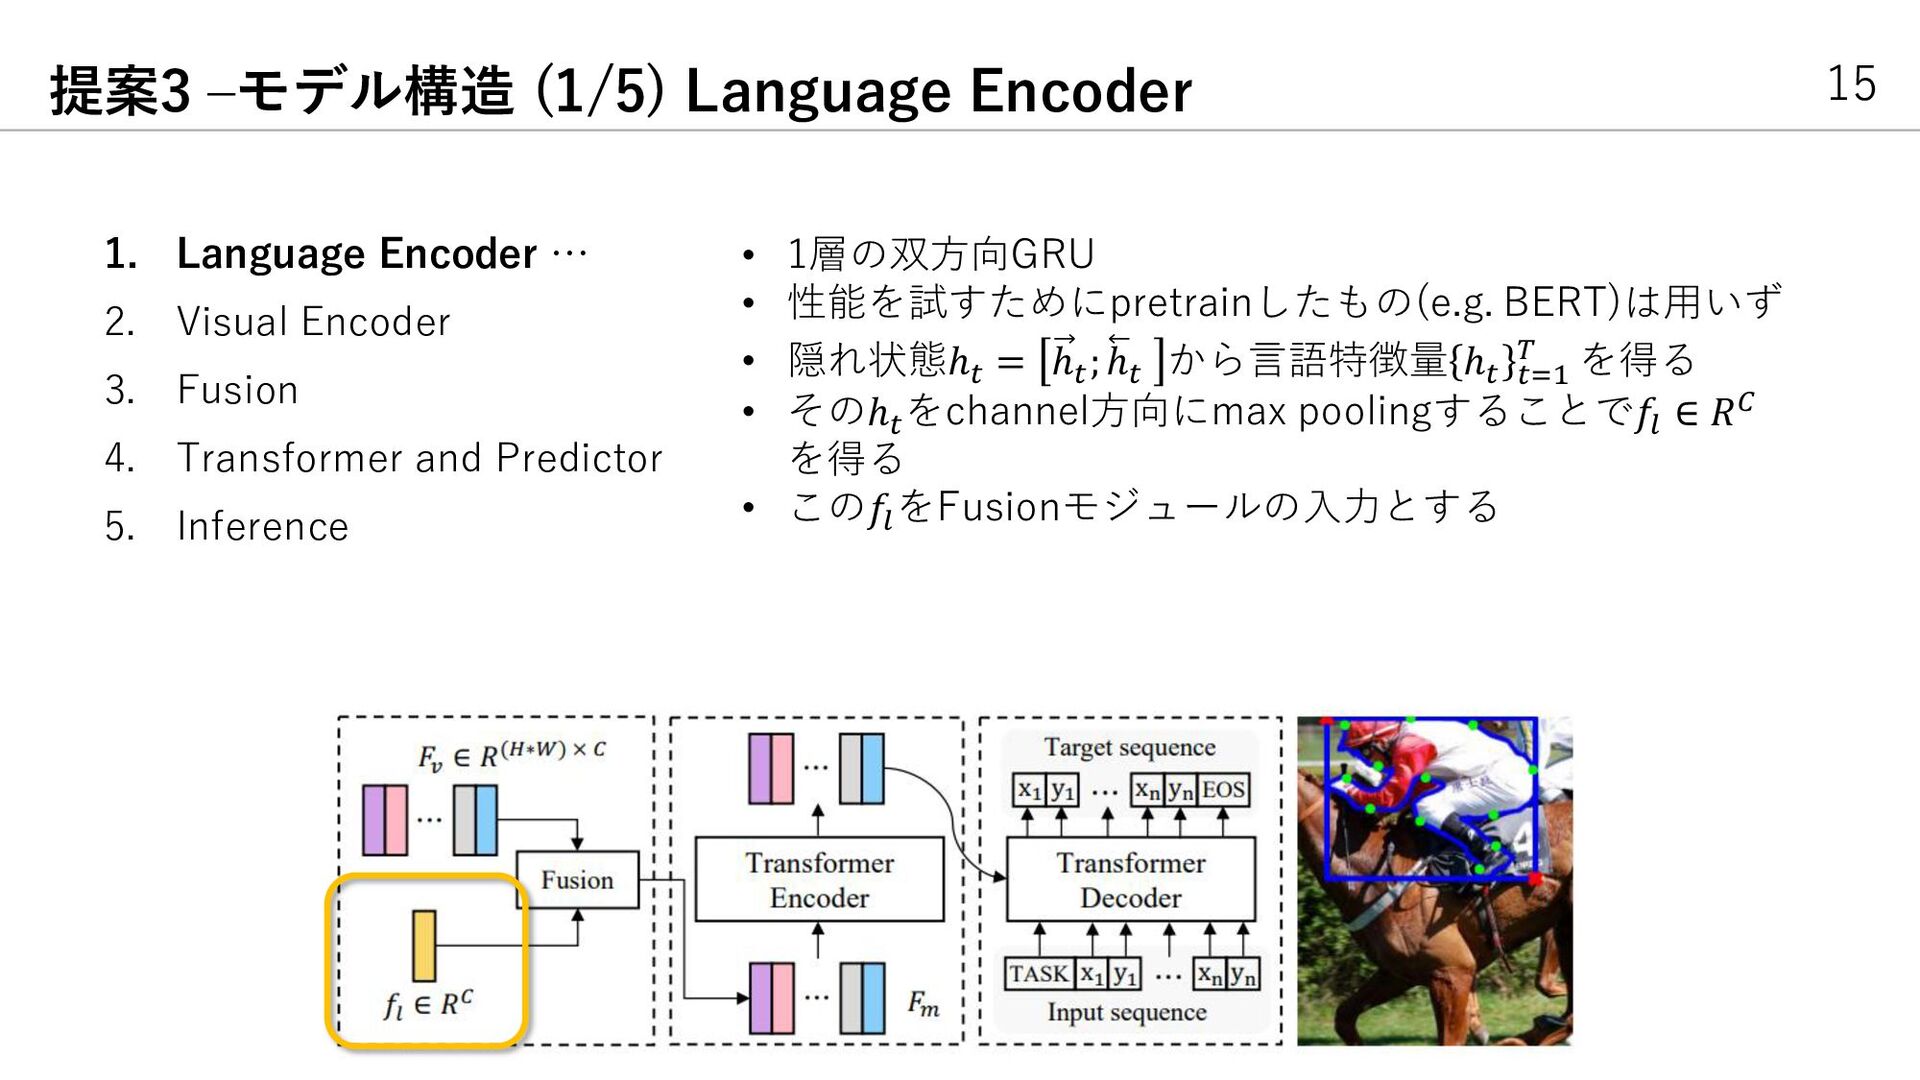
15 提案3 –モデル構造 (1/5) Language Encoder 1. Language Encoder …
2. Visual Encoder 3. Fusion 4. Transformer and Predictor 5. Inference -
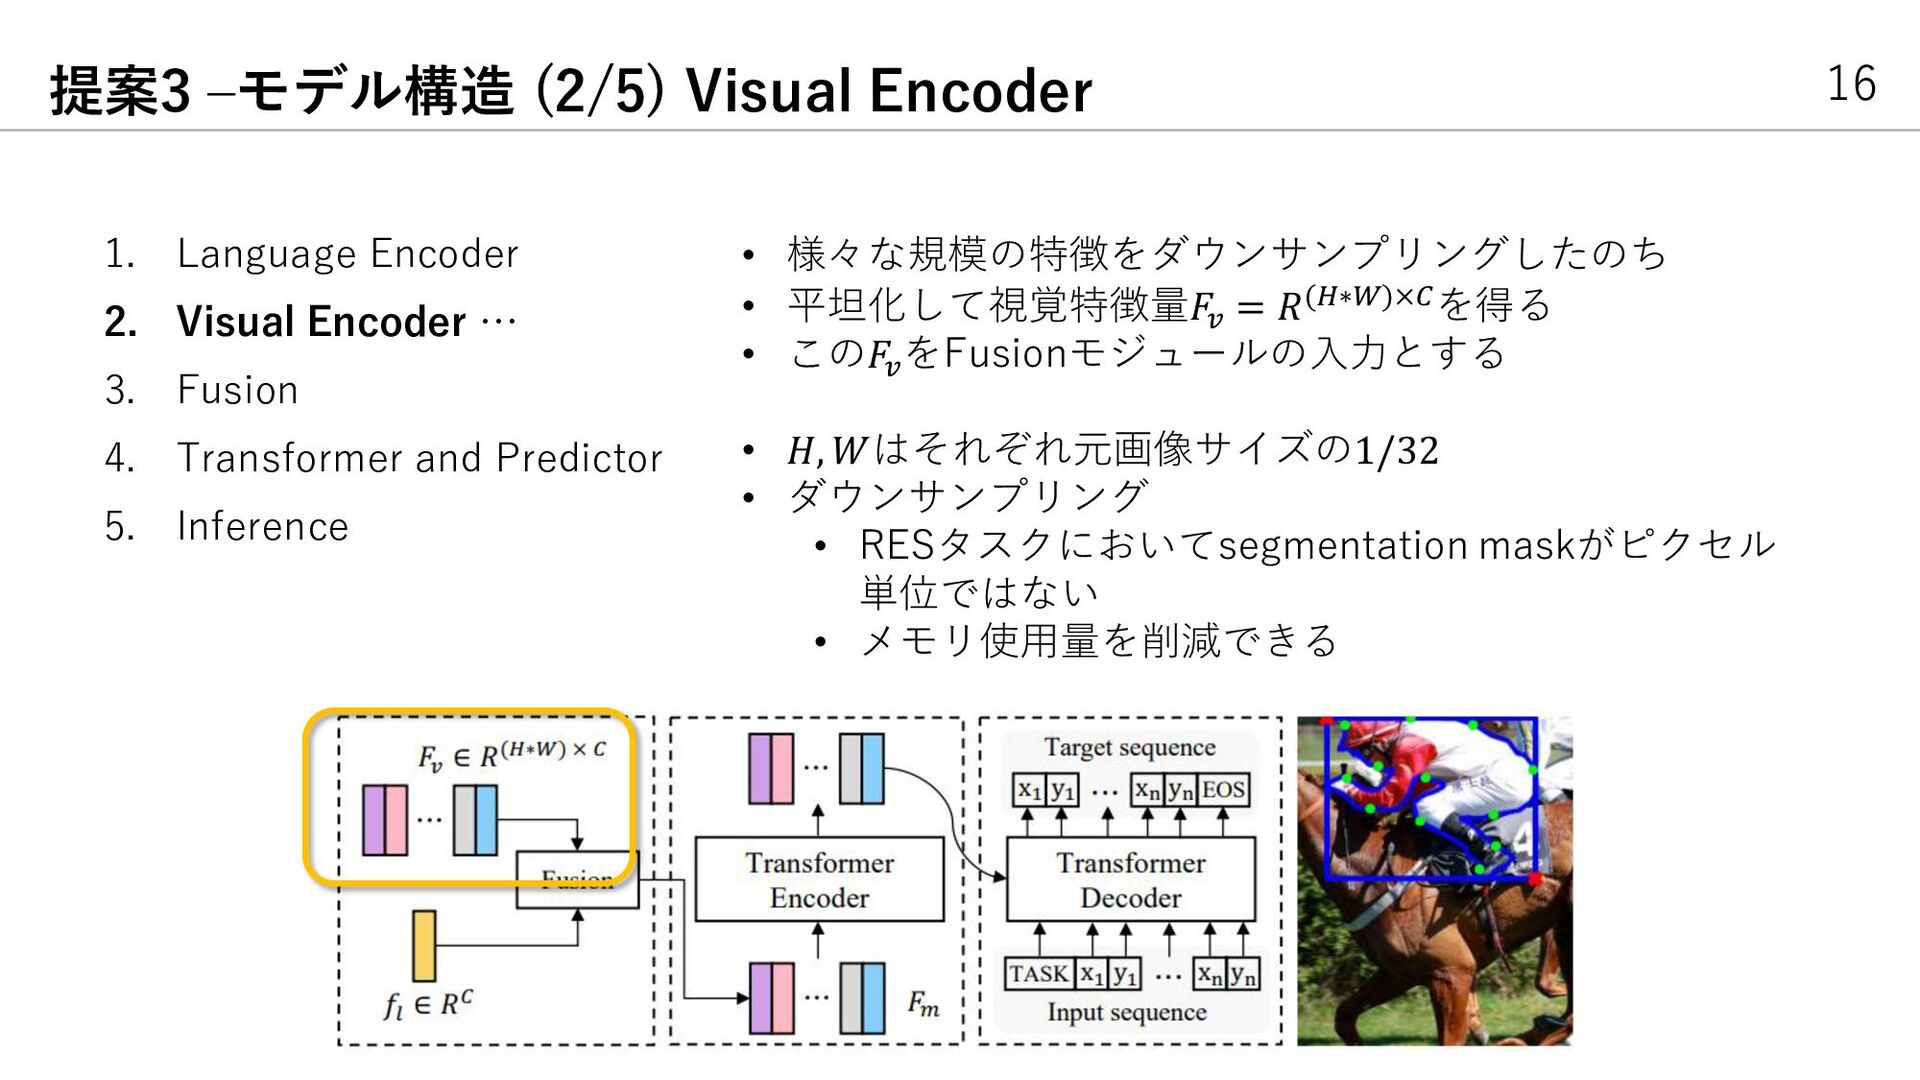
16 提案3 –モデル構造 (2/5) Visual Encoder 1. Language Encoder 2.
Visual Encoder … 3. Fusion 4. Transformer and Predictor 5. Inference -
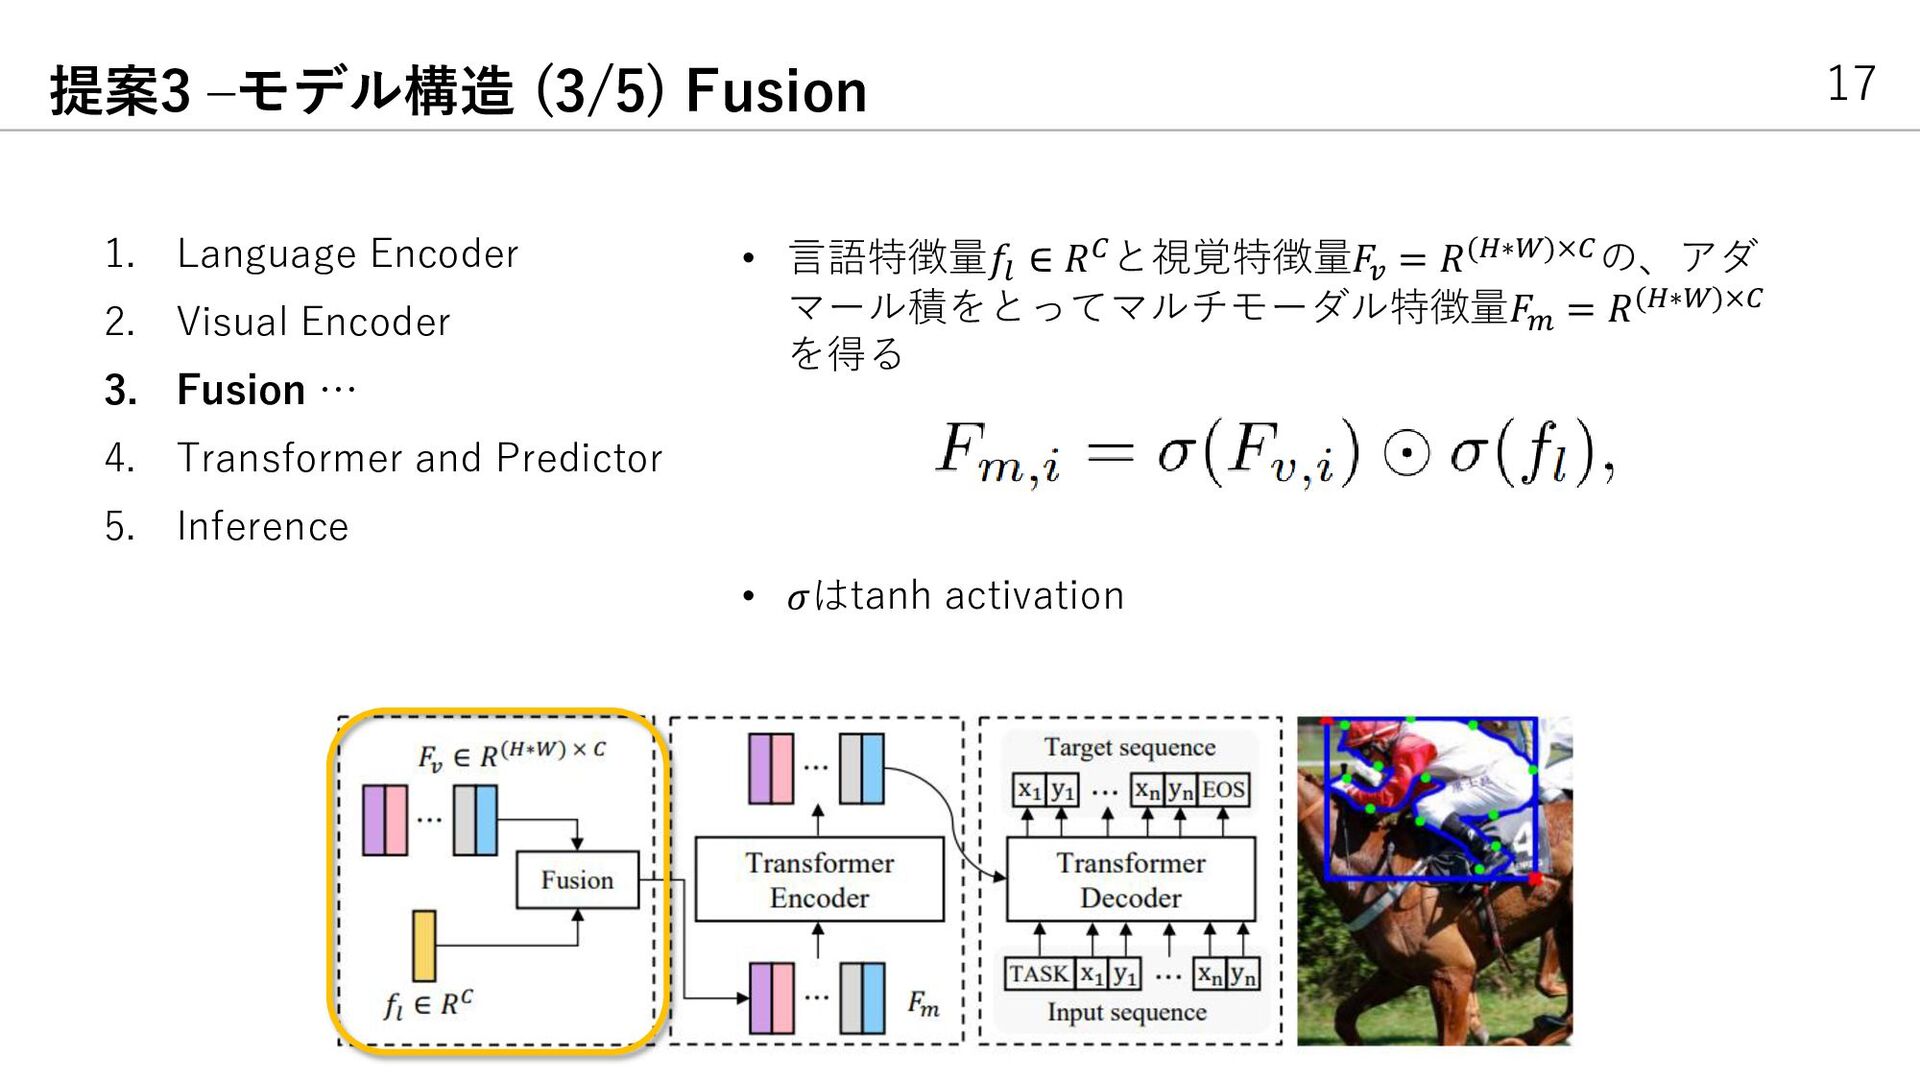
17 提案3 –モデル構造 (3/5) Fusion 1. Language Encoder 2. Visual
Encoder 3. Fusion … 4. Transformer and Predictor 5. Inference -
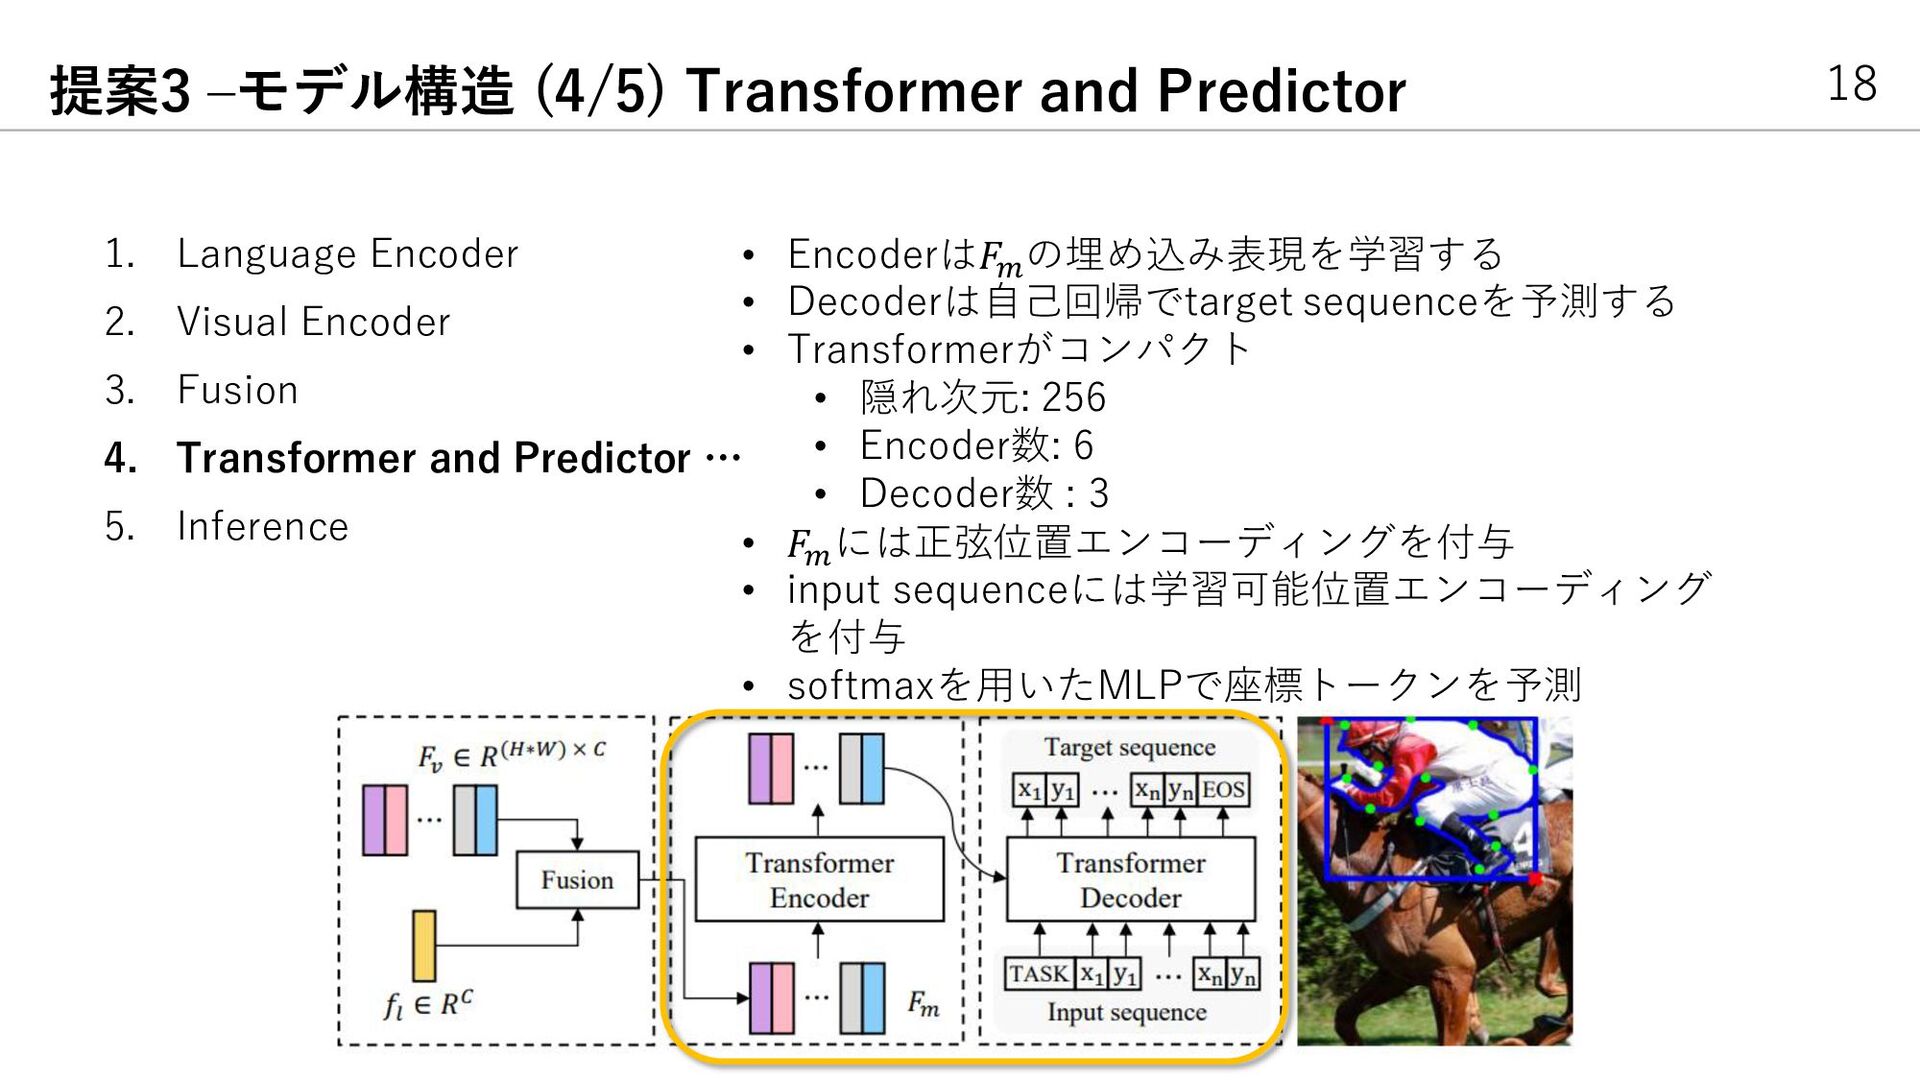
18 提案3 –モデル構造 (4/5) Transformer and Predictor 1. Language Encoder
2. Visual Encoder 3. Fusion 4. Transformer and Predictor … 5. Inference -
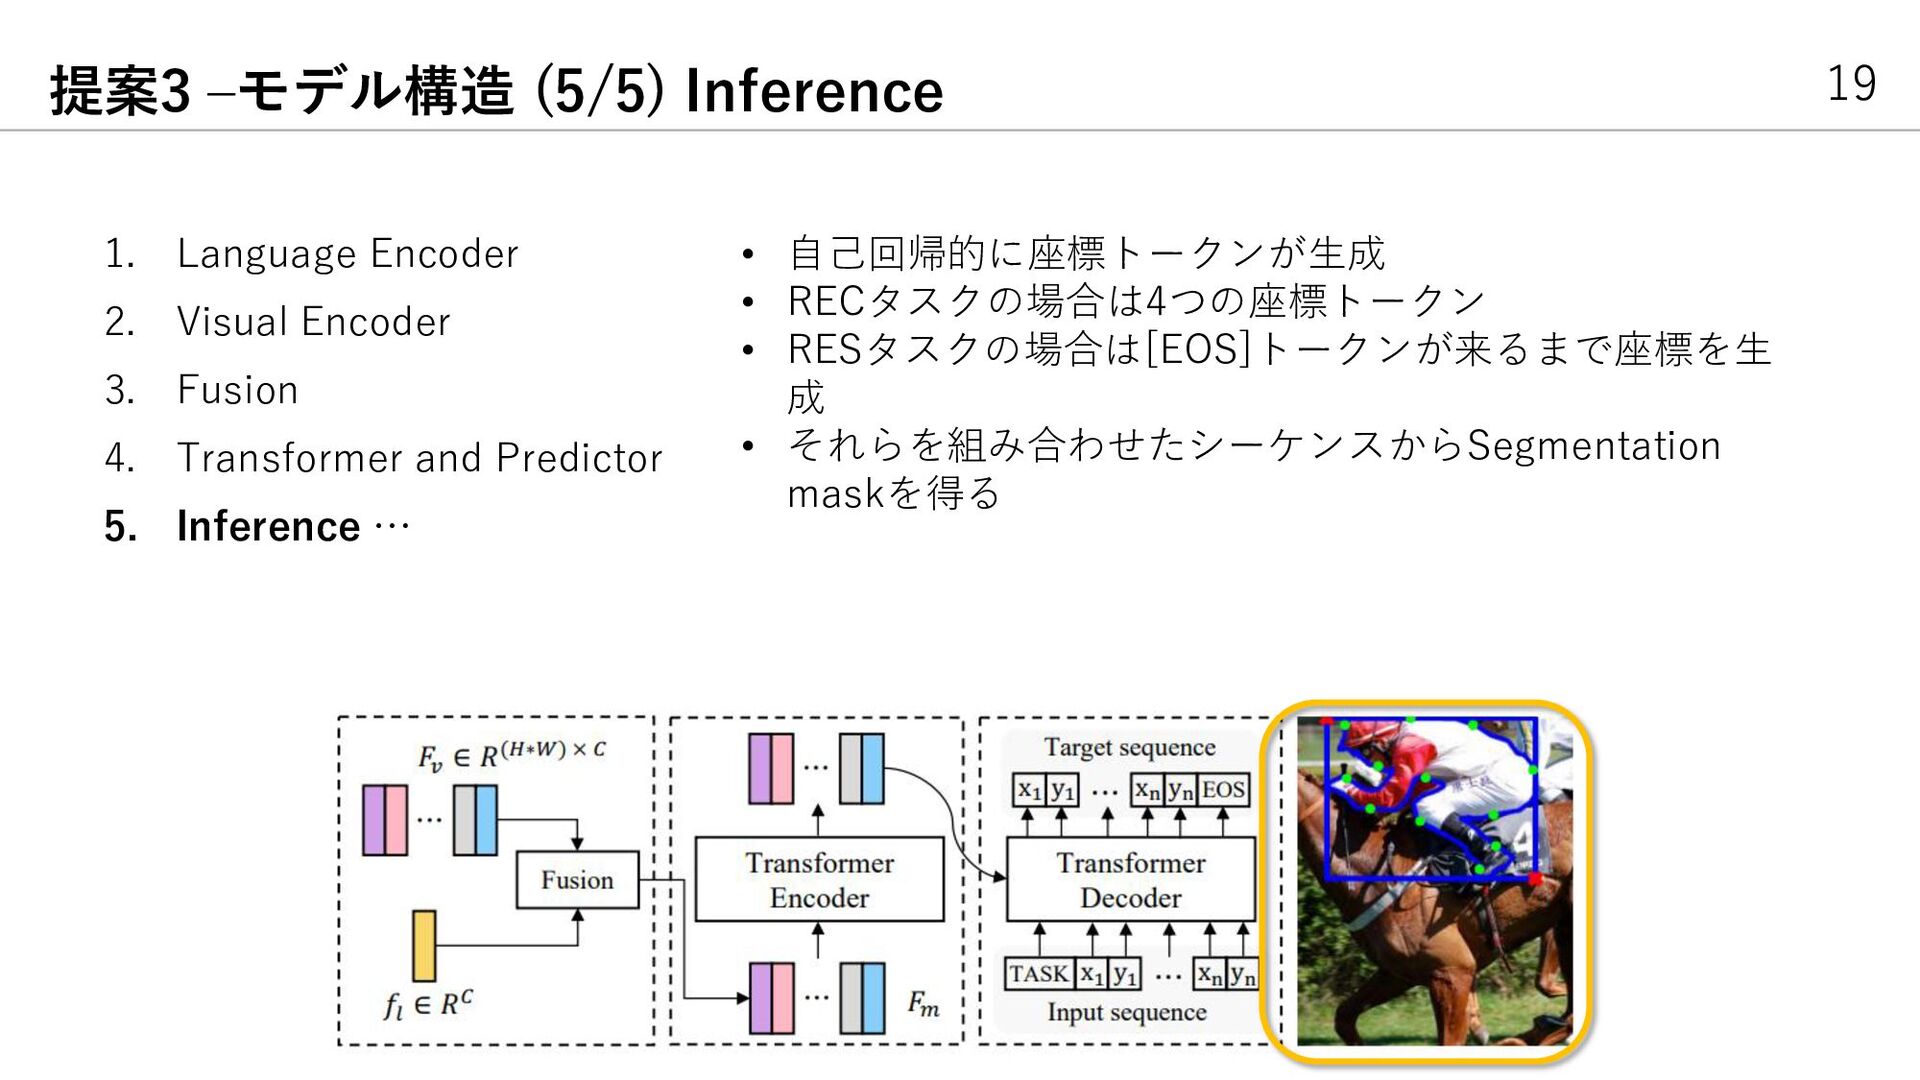
19 提案3 –モデル構造 (5/5) Inference 1. Language Encoder 2. Visual
Encoder 3. Fusion 4. Transformer and Predictor 5. Inference … • 自己回帰的に座標トークンが生成 • RECタスクの場合は4つの座標トークン • RESタスクの場合は[EOS]トークンが来るまで座標を生 成 • それらを組み合わせたシーケンスからSegmentation maskを得る -
20 実験設定 評価指標 ✔ REC(参照表現理解)タスク: [email protected] ✔ RES(参照表現セグメンテーション)タスク: mIoU データセット
✔ RefCOCO / RefCOCO+ / RefCOCOg ✔ ReferItGame / Flicker30K -
22 定量的結果 – 参照表現セグメンテーション(RES)でSOTA達成 ✔ 評価指標:mIoU ✔ SOTAであるVLT[Ding+, ICCV21]を超えた ✔
SeqTR*は大規模な言語データでpretrainしたモデル -
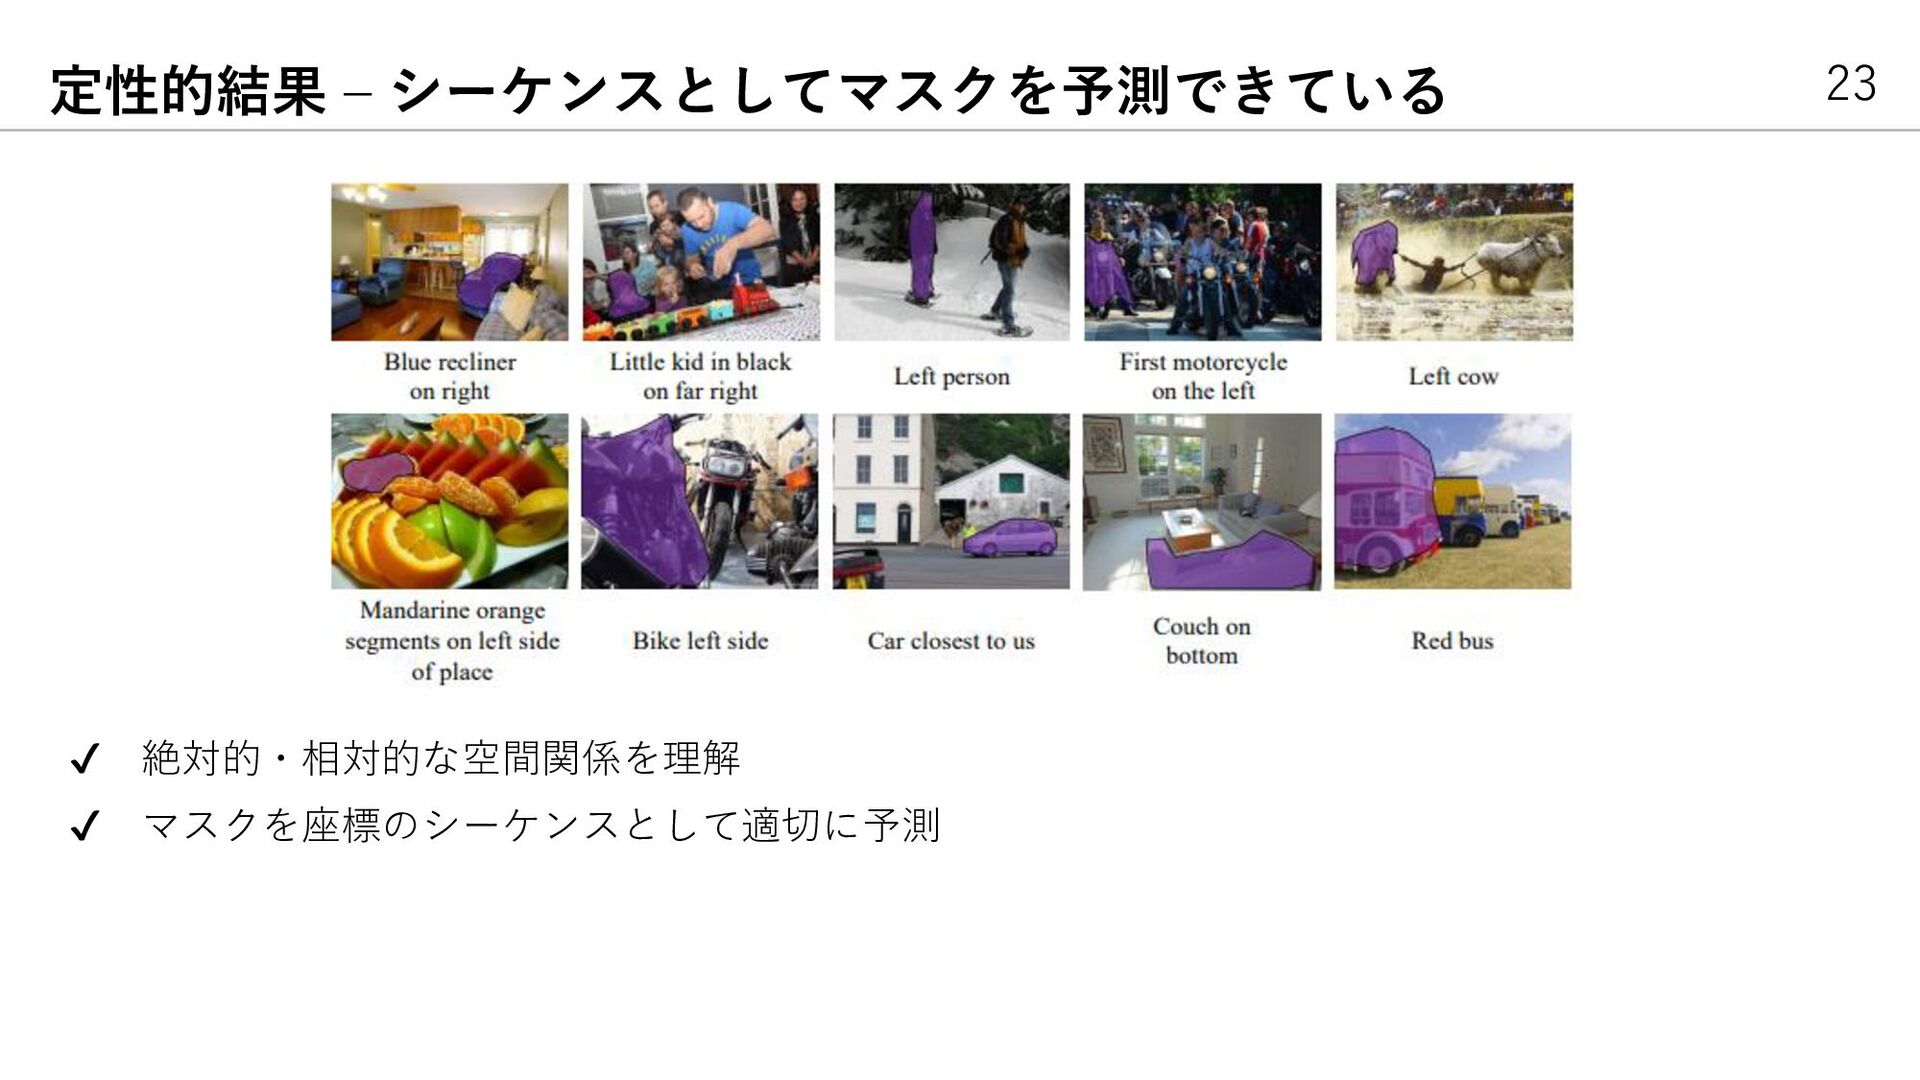
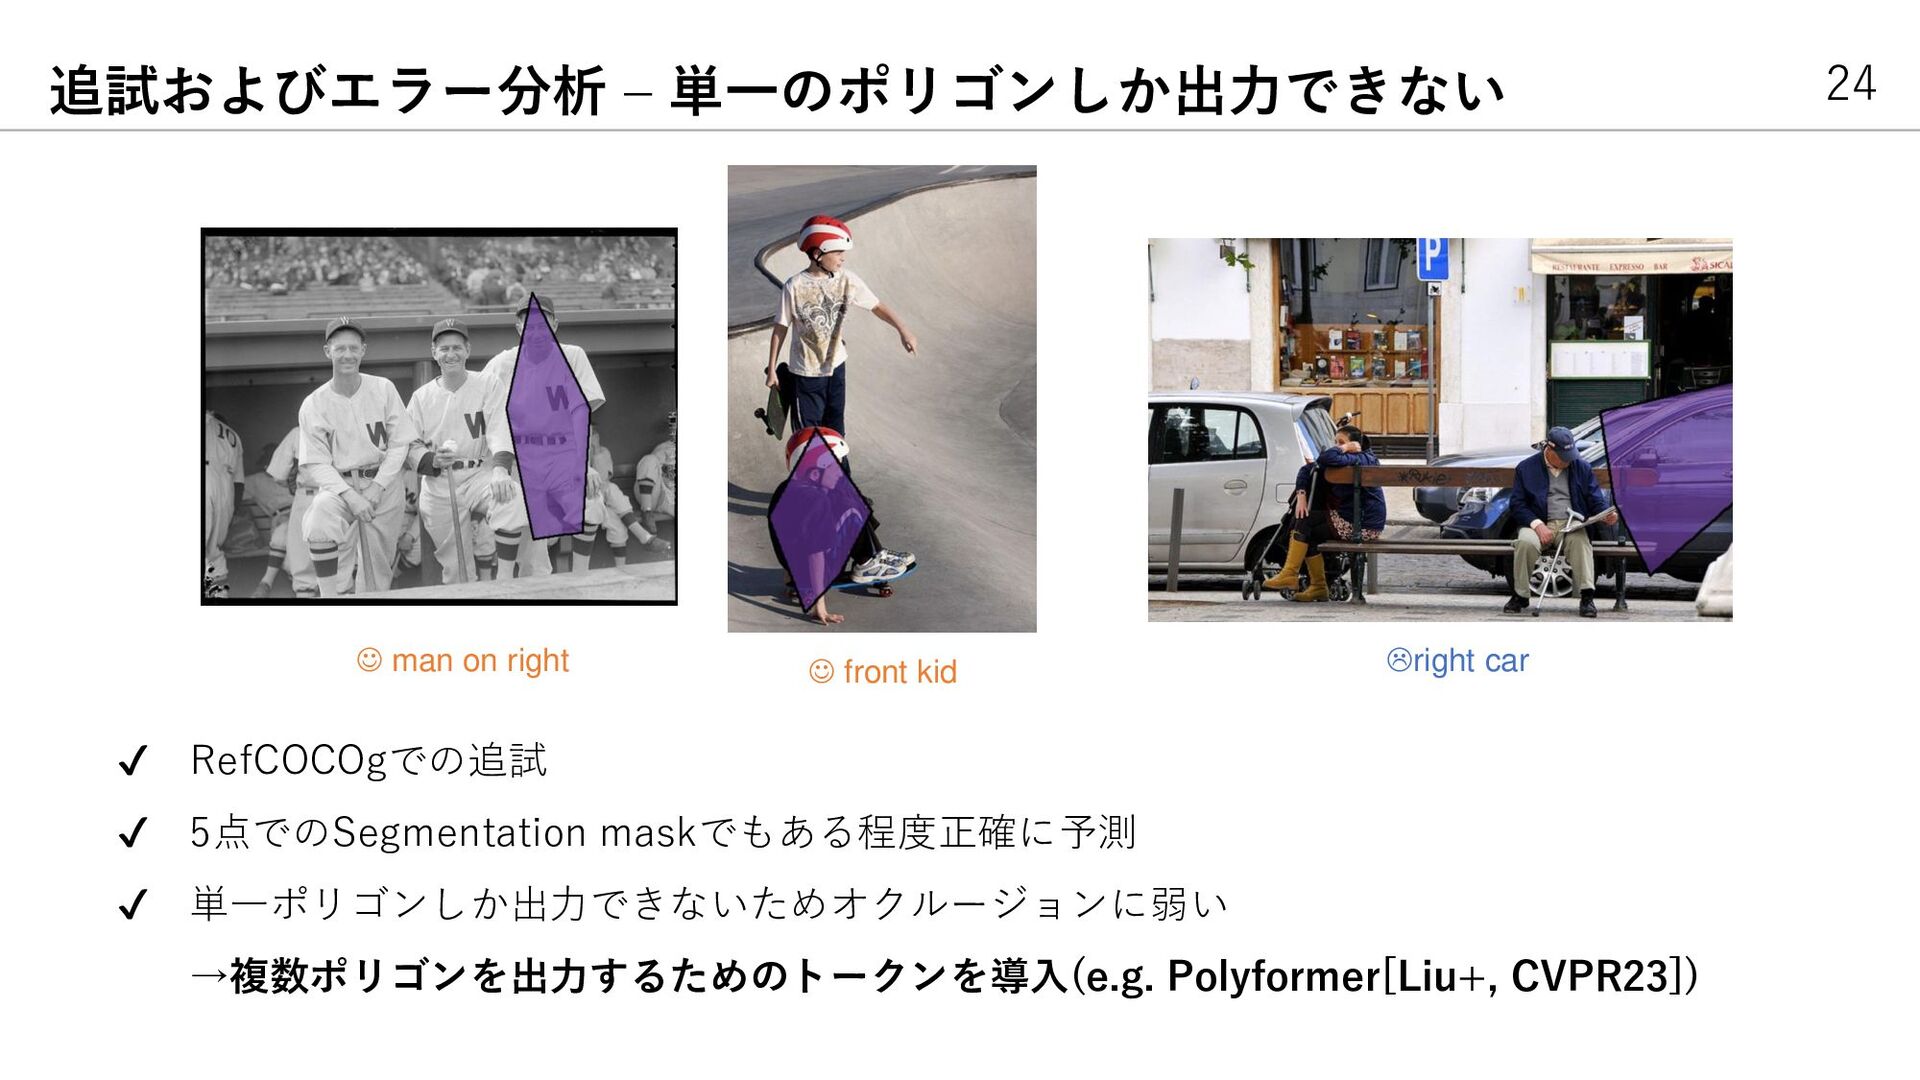
24 追試およびエラー分析 – 単一のポリゴンしか出力できない ✔ RefCOCOgでの追試 ✔ 5点でのSegmentation maskでもある程度正確に予測 ✔
単一ポリゴンしか出力できないためオクルージョンに弱い →複数ポリゴンを出力するためのトークンを導入(e.g. Polyformer[Liu+, CVPR23]) ☺ man on right ☺ front kid right car -
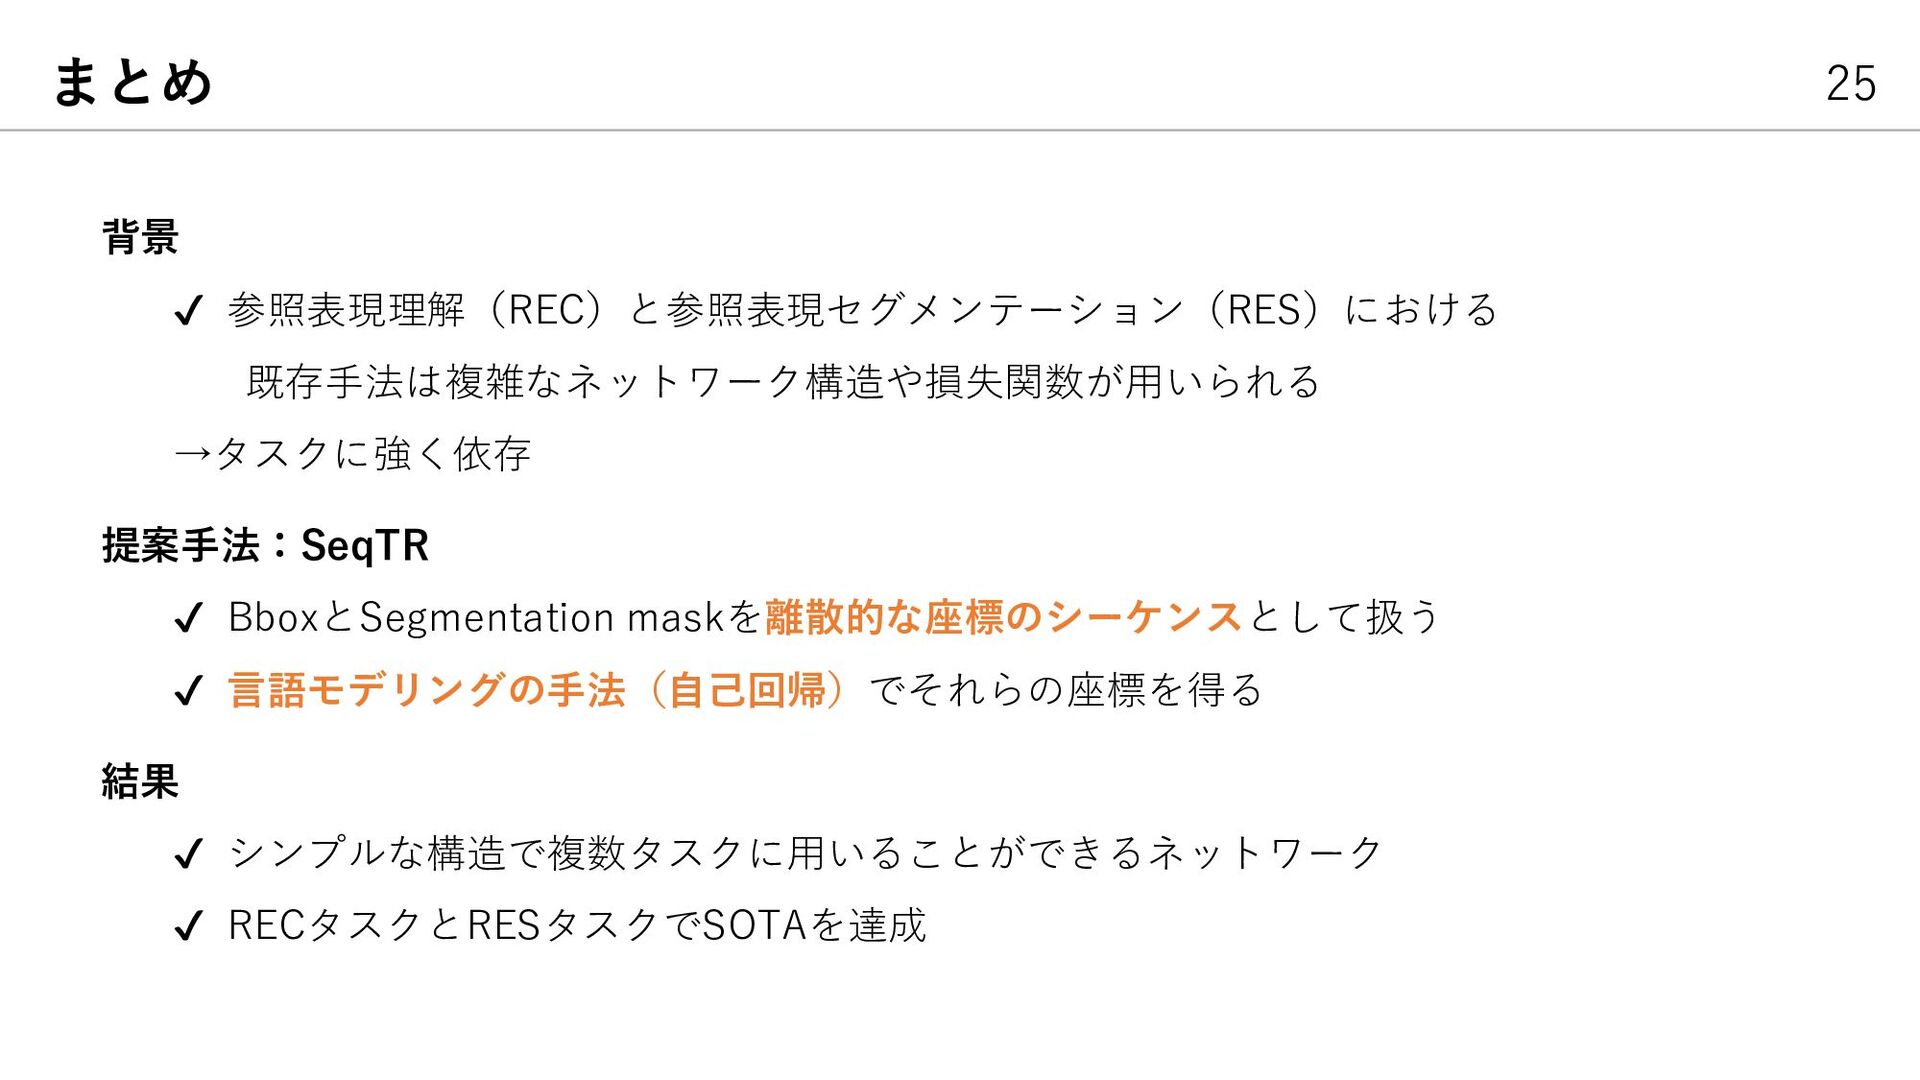
25 背景 ✔ 参照表現理解(REC)と参照表現セグメンテーション(RES)における 既存手法は複雑なネットワーク構造や損失関数が用いられる →タスクに強く依存 提案手法:SeqTR ✔ BboxとSegmentation maskを離散的な座標のシーケンスとして扱う
✔ 言語モデリングの手法(自己回帰)でそれらの座標を得る 結果 ✔ シンプルな構造で複数タスクに用いることができるネットワーク ✔ RECタスクとRESタスクでSOTAを達成 まとめ -
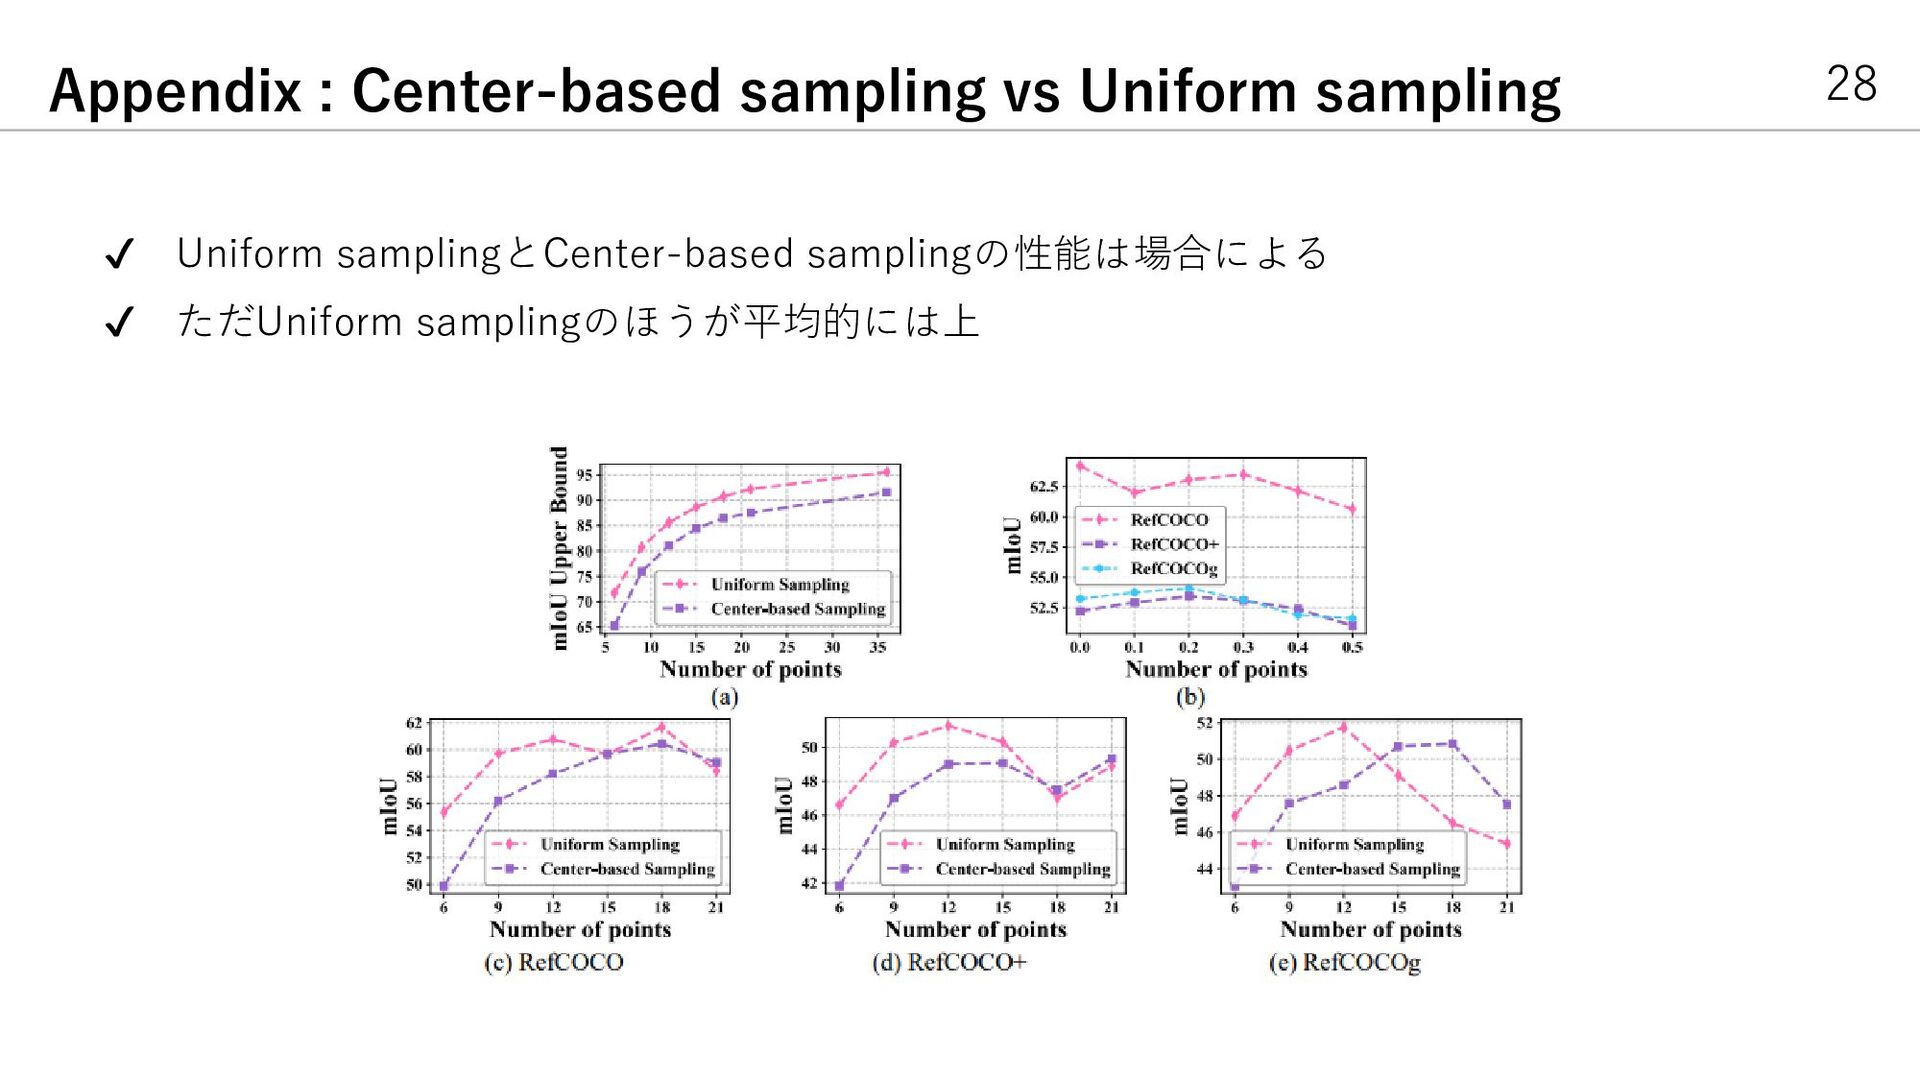
28 Appendix : Center-based sampling vs Uniform sampling ✔ Uniform
samplingとCenter-based samplingの性能は場合による ✔ ただUniform samplingのほうが平均的には上 -
29 Appendix : Token weight ✔ 最初のtoken weightを少し上げると精度が向上した →1st tokenは[TASK]トークン
→2nd~5th tokenは(x1, y1, x2, y2) -
30 Appendix : 参考資料 ✔ Paper: https://www.ecva.net/papers/eccv_2022/papers_ECCV/papers/136950593.pdf ✔ Code (Github):
https://github.com/sean-zhuh/SeqTR