Upgrade to Pro — share decks privately, control downloads, hide ads and more …

ローカルLLMの基本と近況 2611 / Local LLM basics and recen...

ローカルLLMの基本と近況 2611 / Local LLM basics and recent situation 2611

2026年11月13日に行われたローカルLLM勉強会での登壇資料です
https://lycorptech-jp.connpass.com/event/410845/

Naoki Kishida

November 13, 2026

Transcript

23 slides
  1. • • • きしだ なおき X(twitter): @kis blog: きしだのHatena •

    • 自己紹介 (nowokay.hatenablog.com) 「プロになるJava」というJavaの本を書いてます 2026/11/13 2
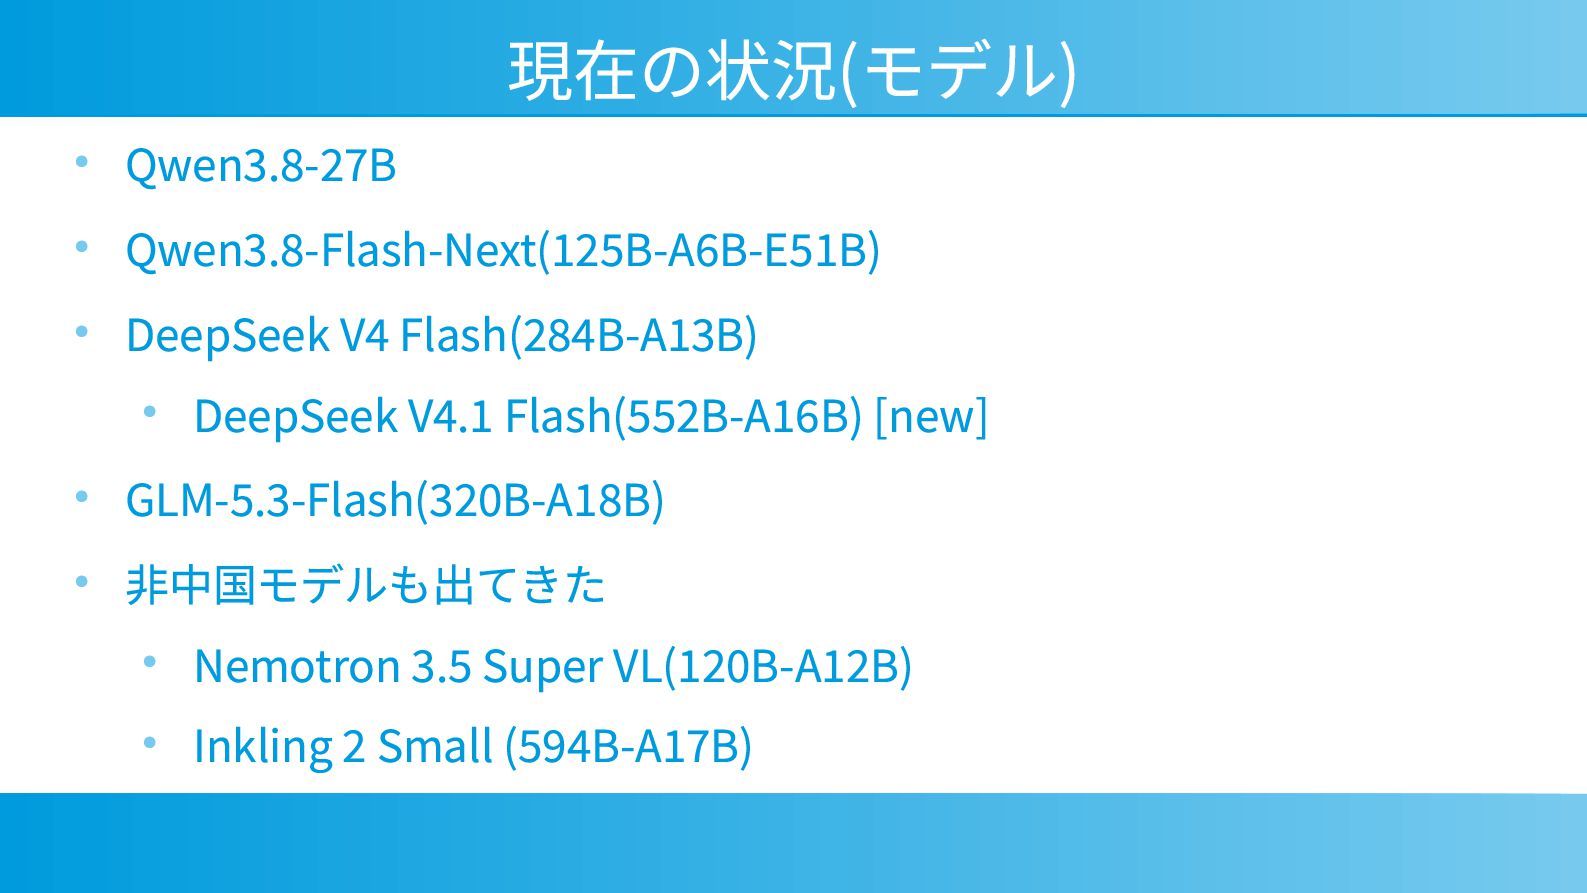
  2. 現在の状況(モデル) • • • Qwen3.8-27B Qwen3.8-Flash-Next(125B-A6B-E51B) DeepSeek V4 Flash(284B-A13B) DeepSeek

    V4.1 Flash(552B-A16B) [new] GLM-5.3-Flash(320B-A18B) 非中国モデルも出てきた Nemotron 3.5 Super VL(120B-A12B) Inkling 2 Small (594B-A17B) • • • • •
  3. 現在の状況(ビジネス的) • • • コーディングエージェント使い放題はコストがかさむ プロプラモデルは制限がきびしい プロプラモデルは値上がりする • • •

    サーバーが足りてない 新しい高性能モデルは高くなっていってる プロプラモデルはなんか性能さがってる
  4. • • オープンウェイトモデルの整理 G7デジタル技術大臣会合での整理 ウェイト利用可能AI • • なんらか利用条件のあるライセンス(モデル名明示など) ex: Qwen3.8-Flash-Next,

    Kimi-K3 オープンウェイトAI • オープンソースライセンス(Apache 2.0, MIT, OpenMDW 1.1) ex: Qwen3.8-27B, DeepSeek-V4-Flash, GLM-5.3-Flash • • オープンデータ付きオープンソースAI • • 学習データや学習スクリプトなど公開 ex: LLM-JP, Nemotron オープンソースAI • 学習データについて公開できないものは説明(該当なし)
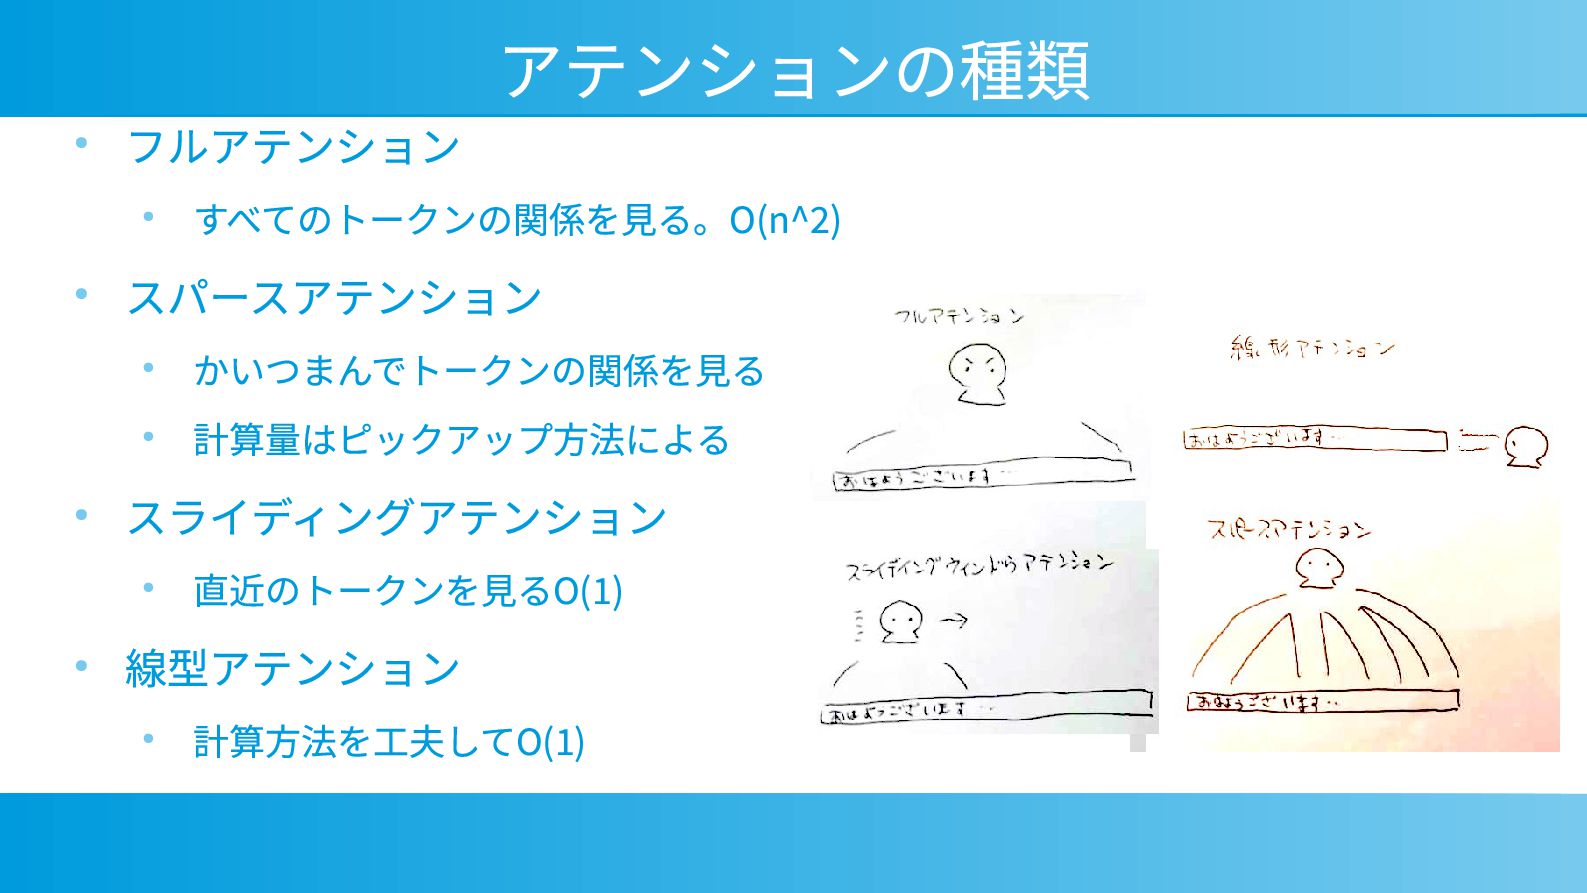
  5. • フルアテンション • • • かいつまんでトークンの関係を見る 計算量はピックアップ方法による スライディングアテンション • •

    すべてのトークンの関係を見る。O(n^2) スパースアテンション • • アテンションの種類 直近のトークンを見るO(1) 線型アテンション • 計算方法を工夫してO(1)
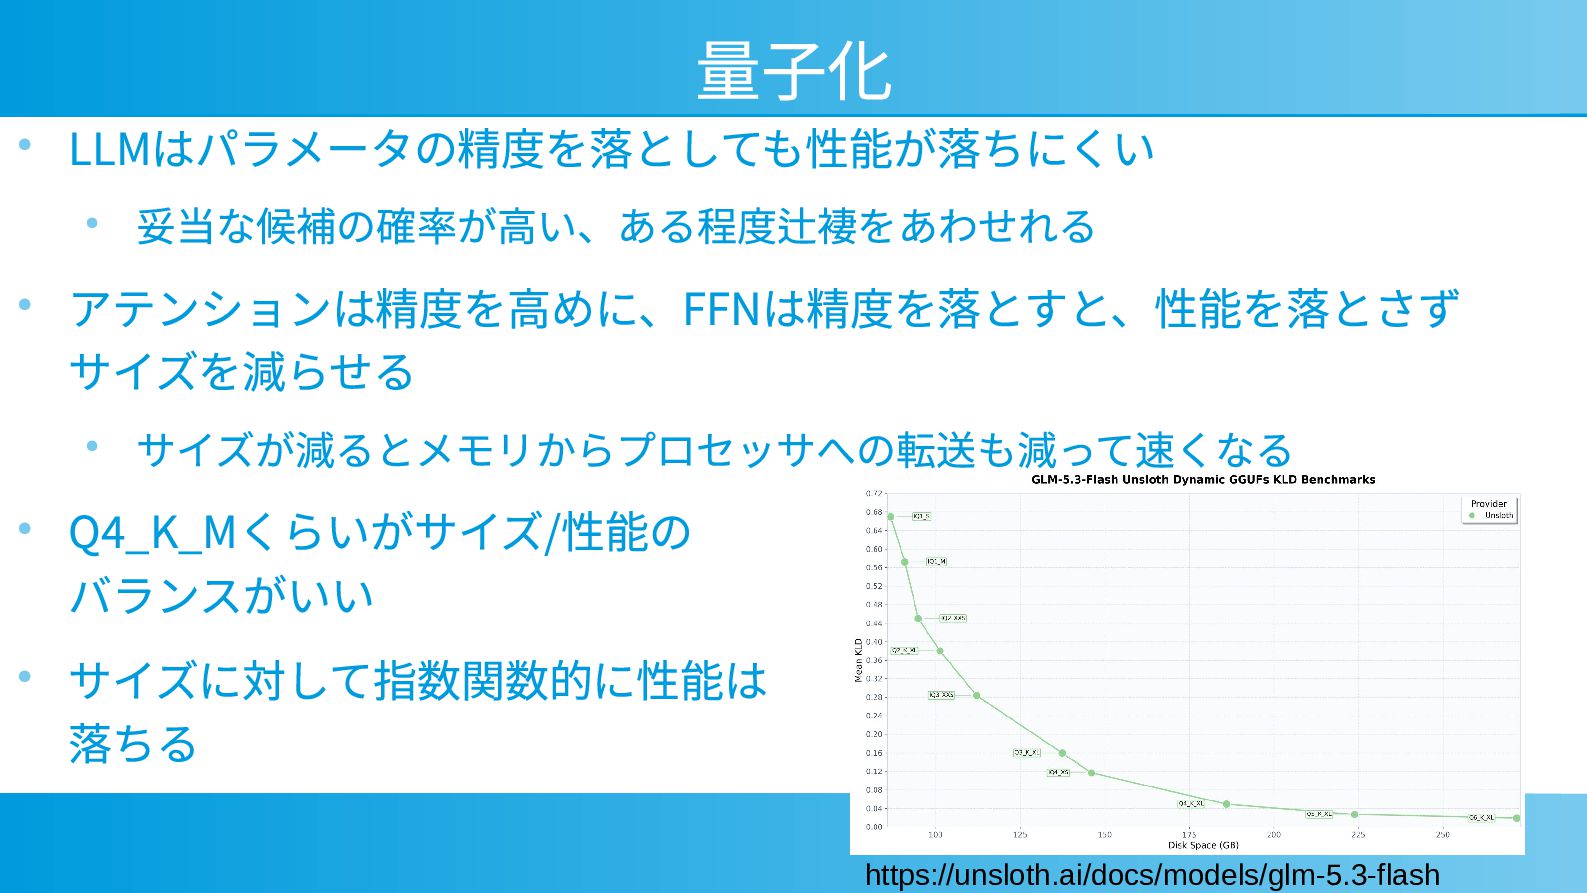
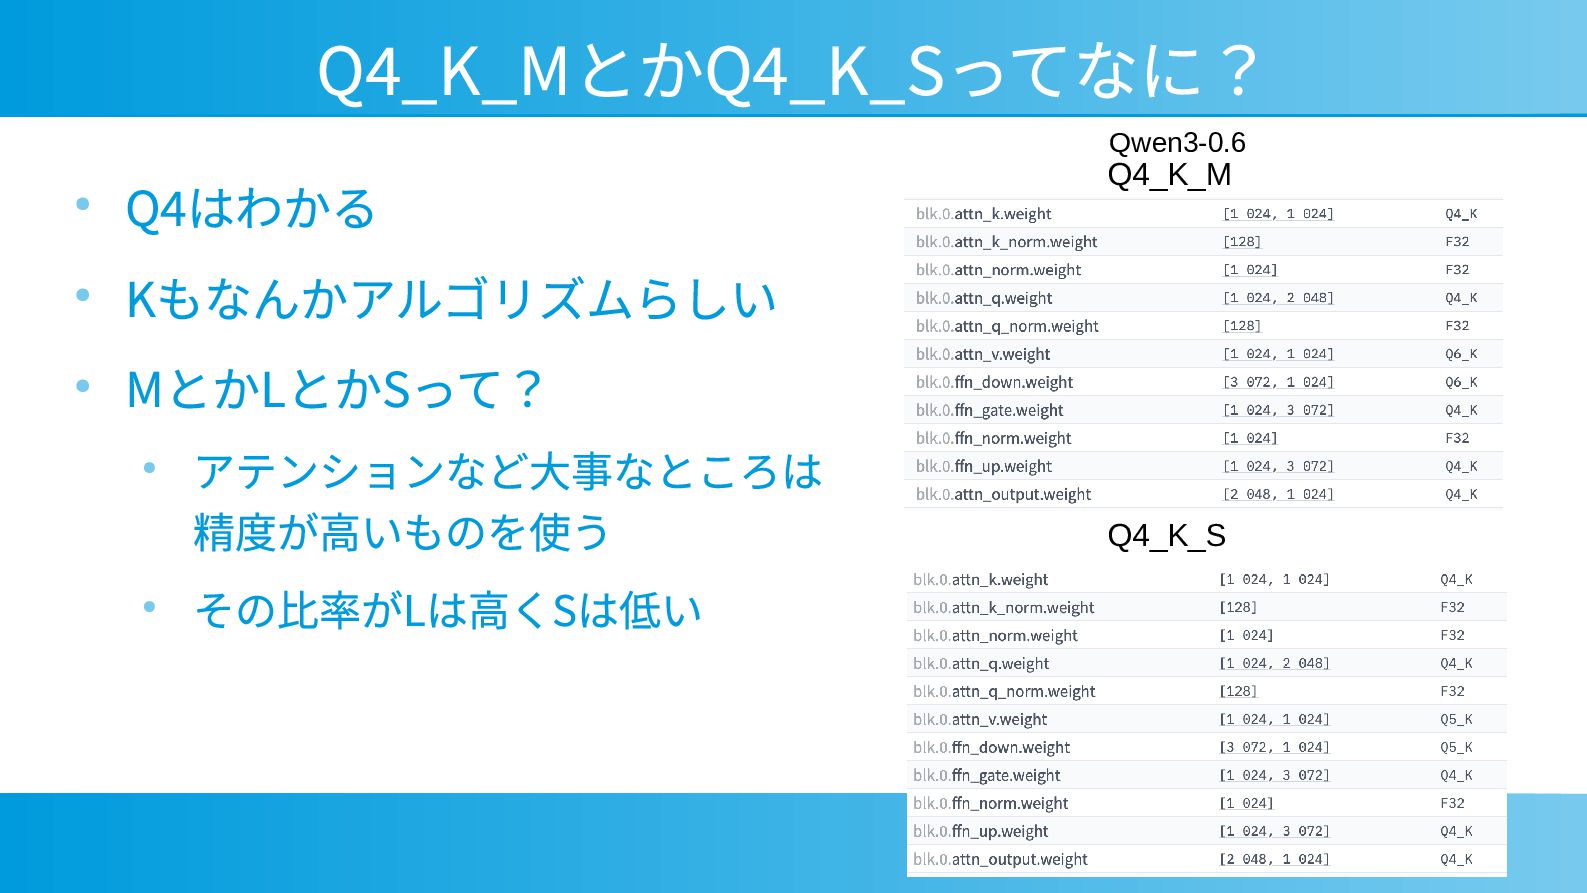
  6. • 量子化 LLMはパラメータの精度を落としても性能が落ちにくい • • アテンションは精度を高めに、FFNは精度を落とすと、性能を落とさず サイズを減らせる • • •

    妥当な候補の確率が高い、ある程度辻褄をあわせれる サイズが減るとメモリからプロセッサへの転送も減って速くなる Q4_K_Mくらいがサイズ/性能の バランスがいい サイズに対して指数関数的に性能は 落ちる https://unsloth.ai/docs/models/glm-5.3-flash
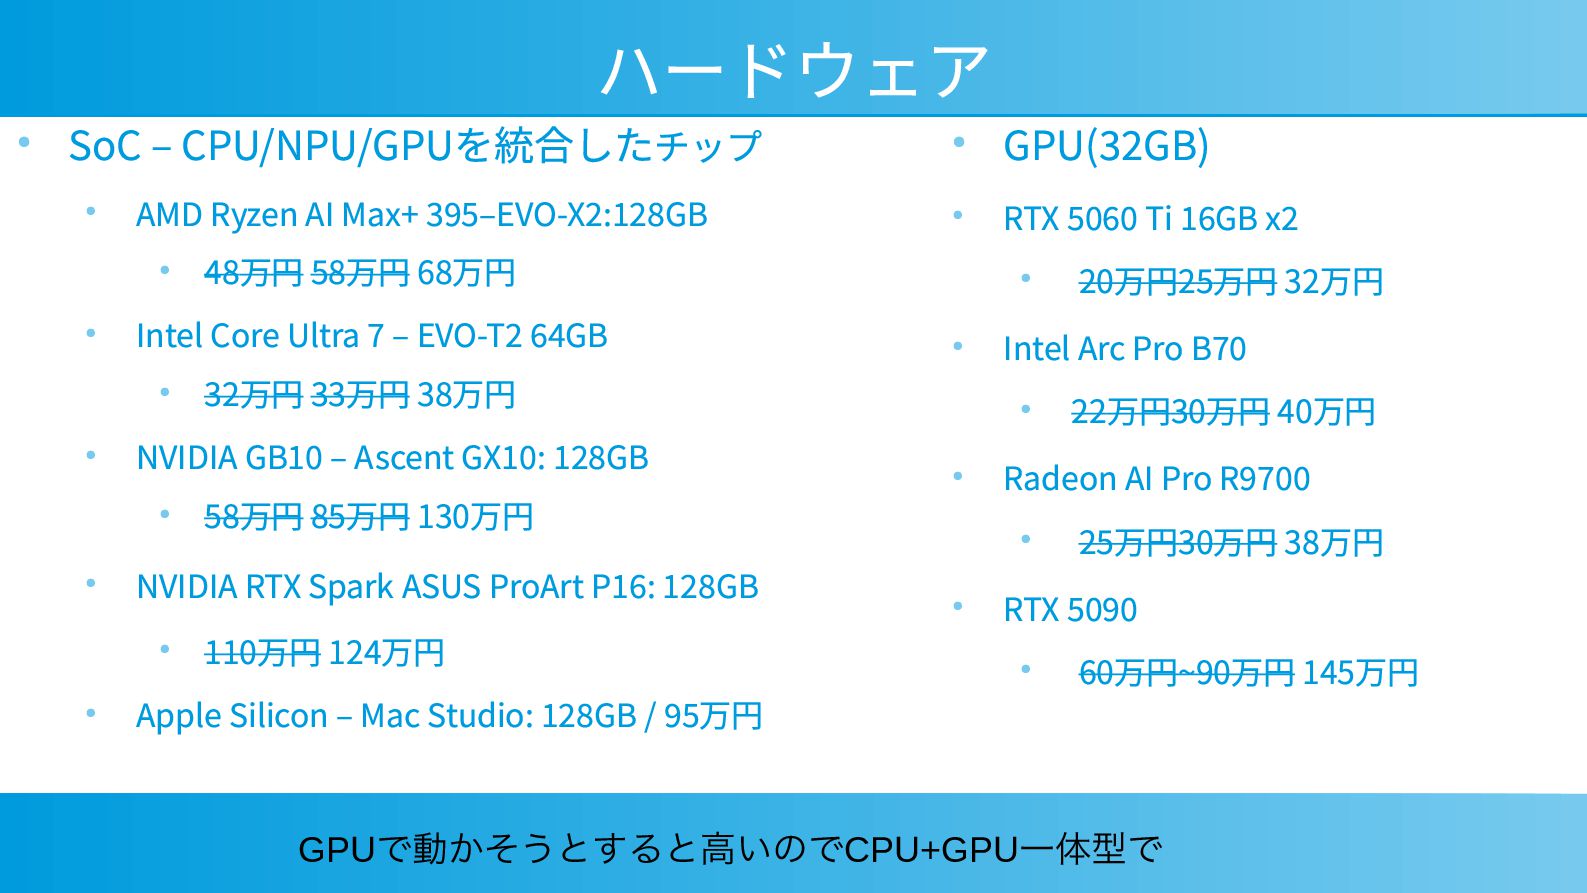
  7. • ハードウェア SoC – CPU/NPU/GPUを統合したチップ GPU(32GB) • AMD Ryzen AI

    Max+ 395–EVO-X2:128GB 48万円 58万円 68万円 Intel Core Ultra 7 – EVO-T2 64GB 32万円 33万円 38万円 NVIDIA GB10 – Ascent GX10: 128GB 58万円 85万円 130万円 NVIDIA RTX Spark ASUS ProArt P16: 128GB 110万円 124万円 Apple Silicon – Mac Studio: 128GB / 95万円 • • • • • • • • • • • • • • RTX 5060 Ti 16GB x2 20万円25万円 32万円 Intel Arc Pro B70 22万円30万円 40万円 Radeon AI Pro R9700 25万円30万円 38万円 RTX 5090 60万円~90万円 145万円 • • • GPUで動かそうとすると高いのでCPU+GPU一体型で
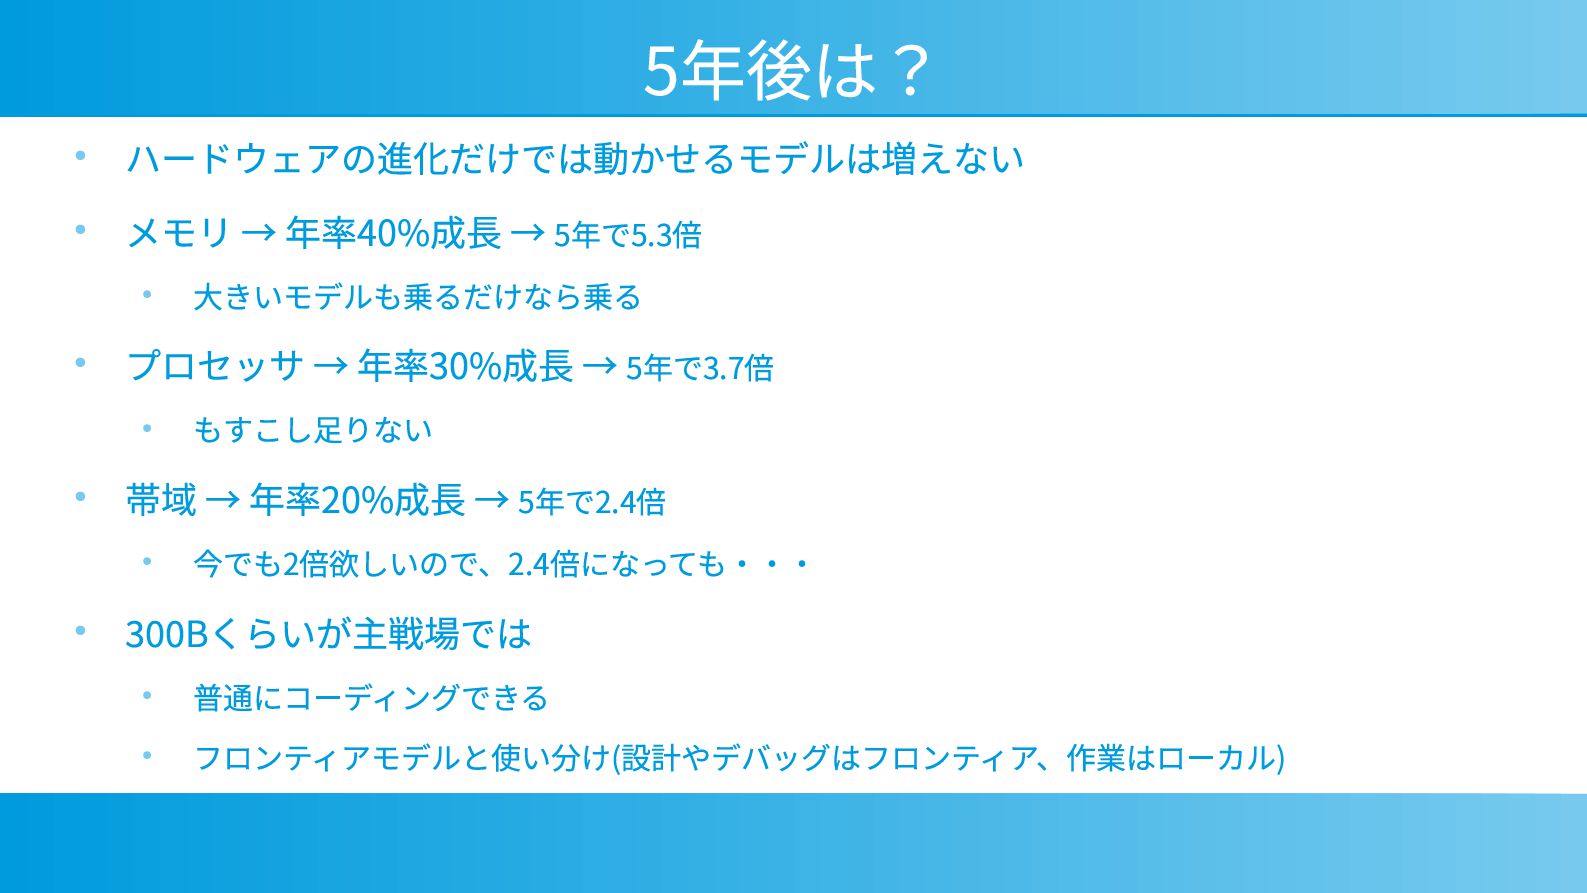
  8. 5年後は? • • ハードウェアの進化だけでは動かせるモデルは増えない メモリ → 年率40%成長 → 5年で5.3倍 大きいモデルも乗るだけなら乗る

    プロセッサ → 年率30%成長 → 5年で3.7倍 もすこし足りない 帯域 → 年率20%成長 → 5年で2.4倍 今でも2倍欲しいので、2.4倍になっても・・・ • • • • • • 300Bくらいが主戦場では • • 普通にコーディングできる フロンティアモデルと使い分け(設計やデバッグはフロンティア、作業はローカル)
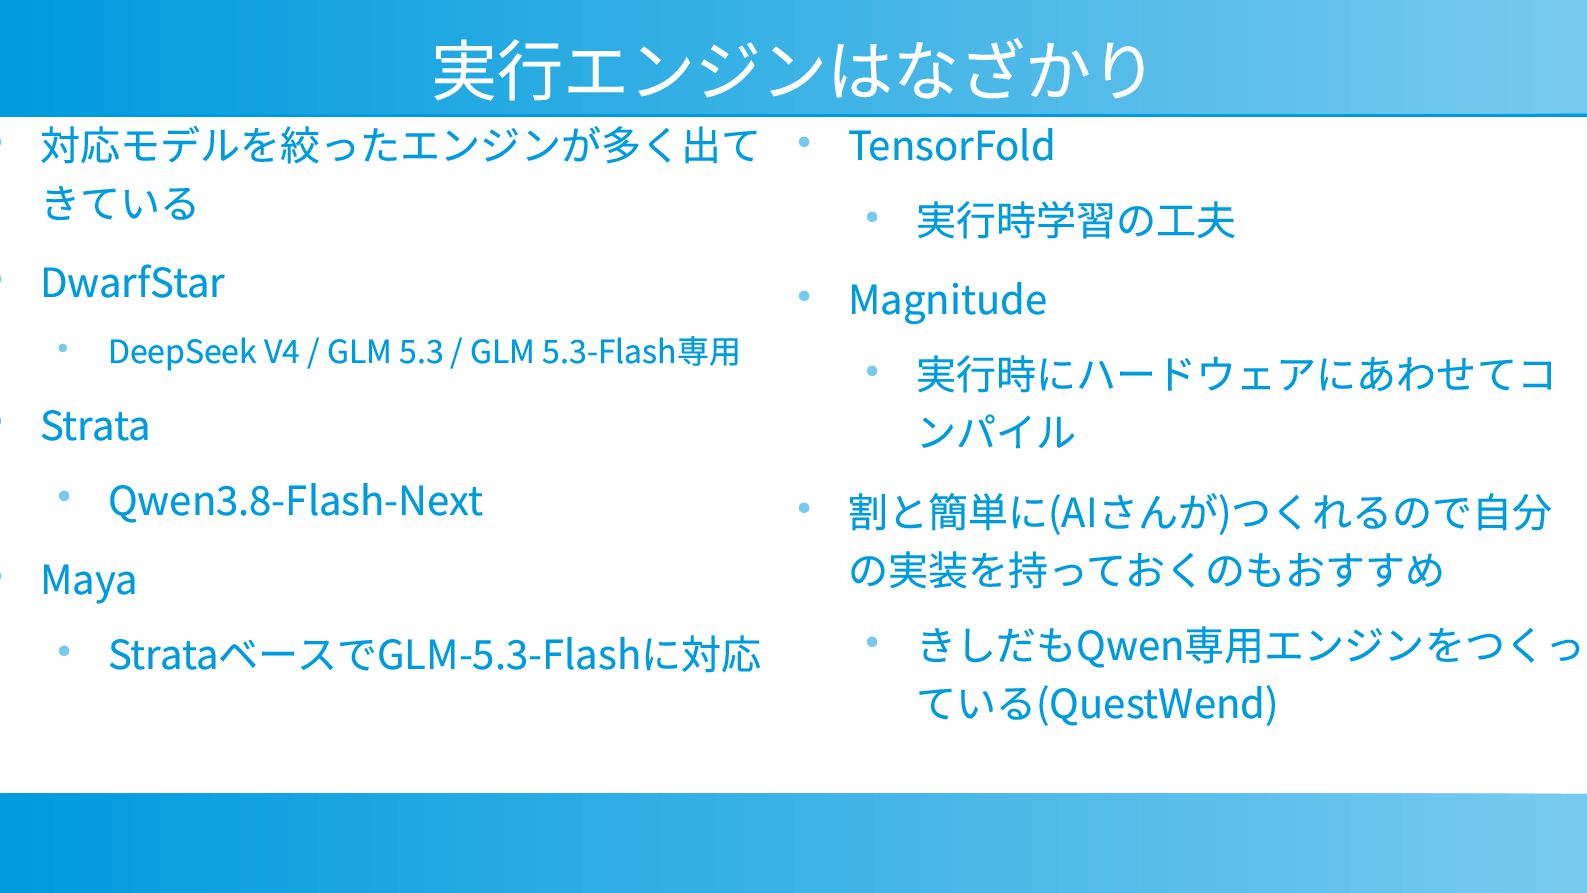
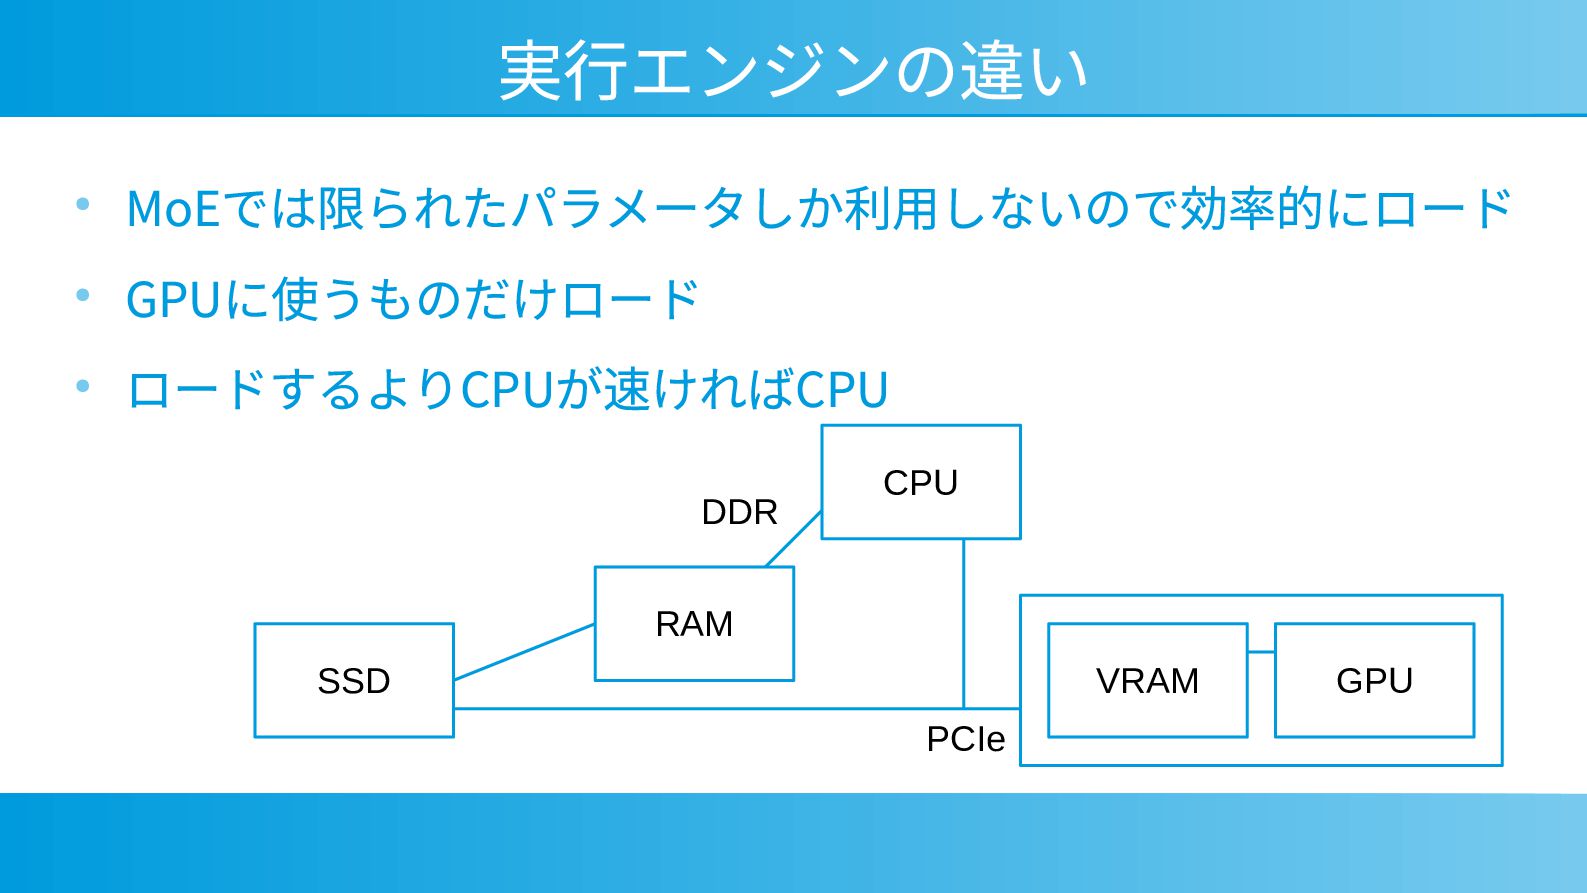
  9. • • • • 実行エンジンはなざかり 対応モデルを絞ったエンジンが多く出て TensorFold きている DwarfStar •

    DeepSeek V4 / GLM 5.3 / GLM 5.3-Flash専用 Strata Qwen3.8-Flash-Next Maya StrataベースでGLM-5.3-Flashに対応 • • • 実行時学習の工夫 Magnitude 実行時にハードウェアにあわせてコ ンパイル 割と簡単に(AIさんが)つくれるので自分 の実装を持っておくのもおすすめ きしだもQwen専用エンジンをつくっ ている(QuestWend) • • • • •
  10. なぜいま実行環境が乱立? • モデルが安定してきた • どんどん性能のいいモデルが出ていた • • 性能が十分になって、やはり大きいサイズが必要だとわかった • •

    「自分の手元で動くモデルが出ないかな」 「あのモデルを自分で動かしたい」 エージェントが賢くなってきた • Opus 4.8では組めなかった。 • • Fable 5がやってくれた Oput 5から組めるようになった
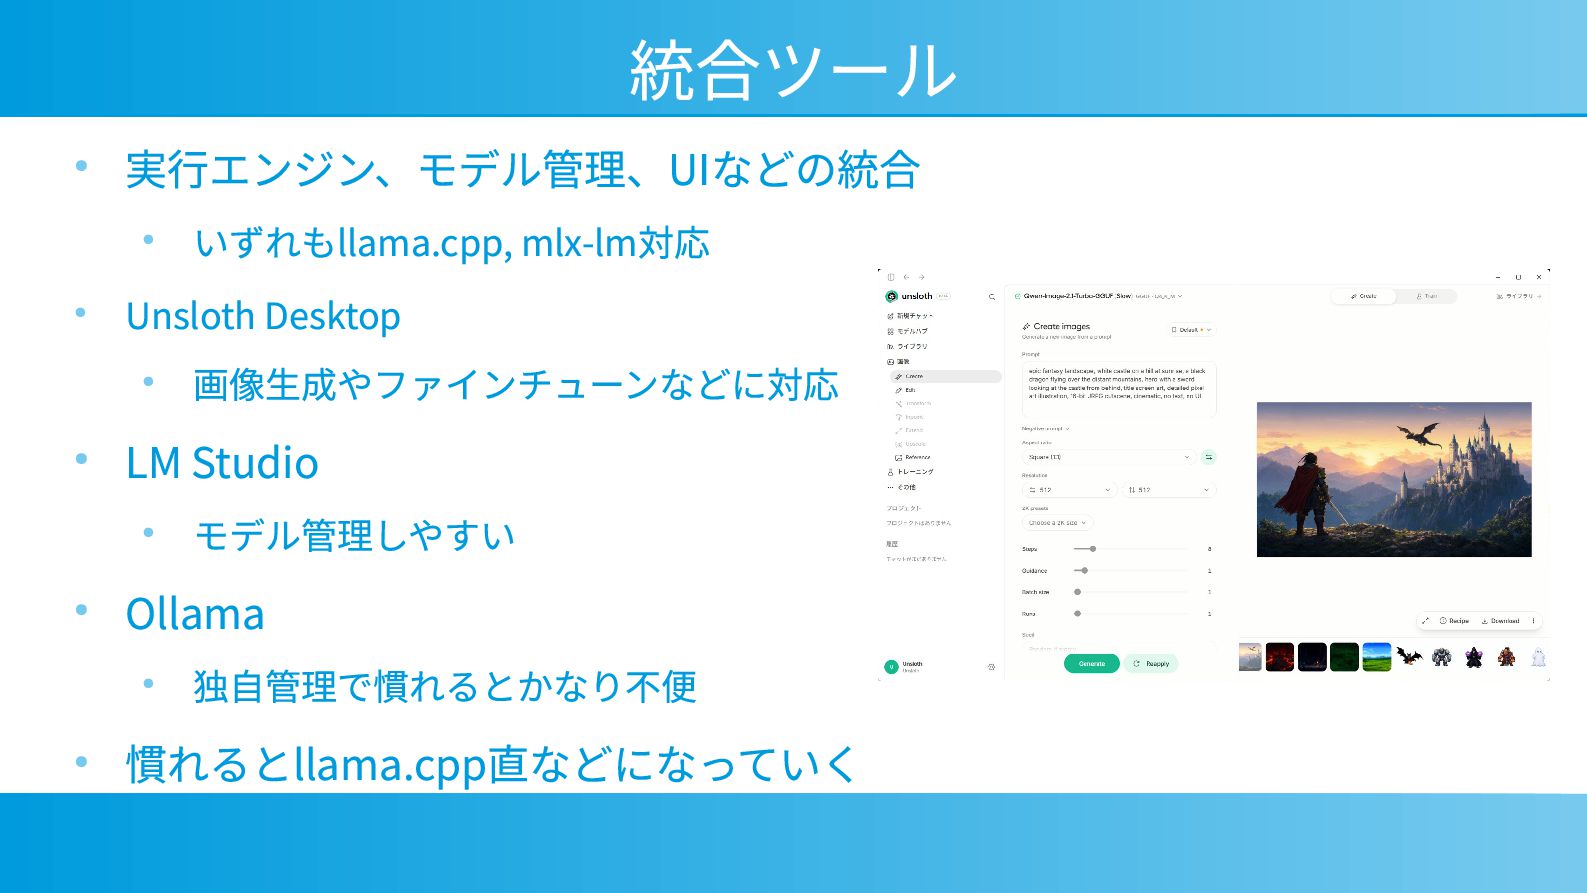
  11. 統合ツール • 実行エンジン、モデル管理、UIなどの統合 いずれもllama.cpp, mlx-lm対応 Unsloth Desktop 画像生成やファインチューンなどに対応 • •

    • • LM Studio • • Ollama • • モデル管理しやすい 独自管理で慣れるとかなり不便 慣れるとllama.cpp直などになっていく
  12. コーディングエージェント • オープンソース • • • • OpenCode Pi DeepSeek

    Herness クローズドツールも使える • • Codex Claude Code
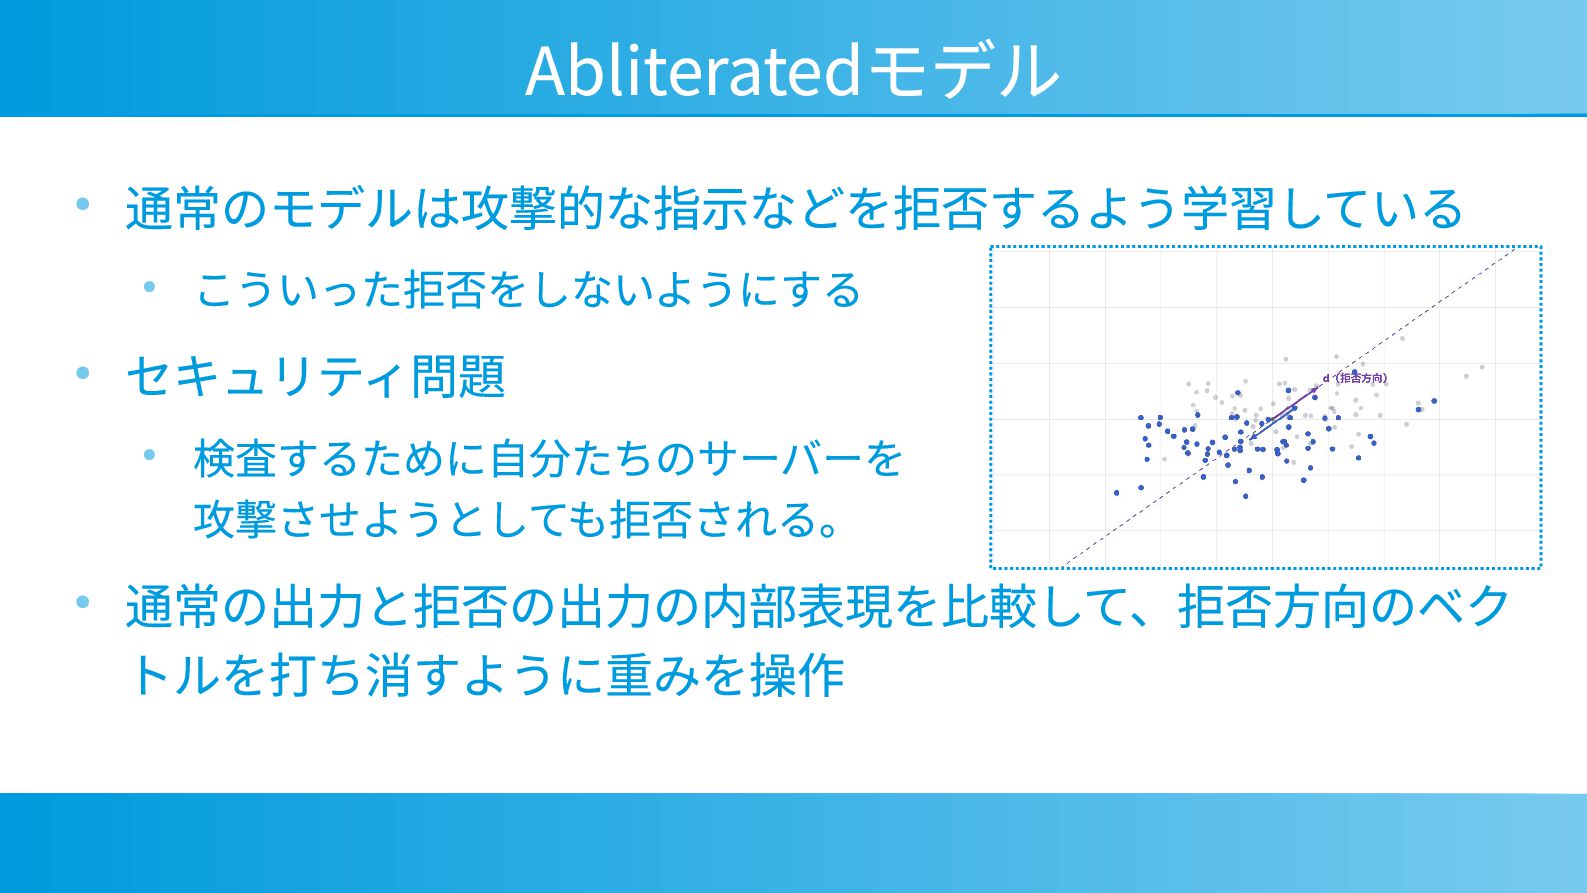
  13. Abliteratedモデル • 通常のモデルは攻撃的な指示などを拒否するよう学習している • • セキュリティ問題 • • こういった拒否をしないようにする 検査するために自分たちのサーバーを

    攻撃させようとしても拒否される。 通常の出力と拒否の出力の内部表現を比較して、拒否方向のベク トルを打ち消すように重みを操作

More Decks by Naoki Kishida

Other Decks in Programming