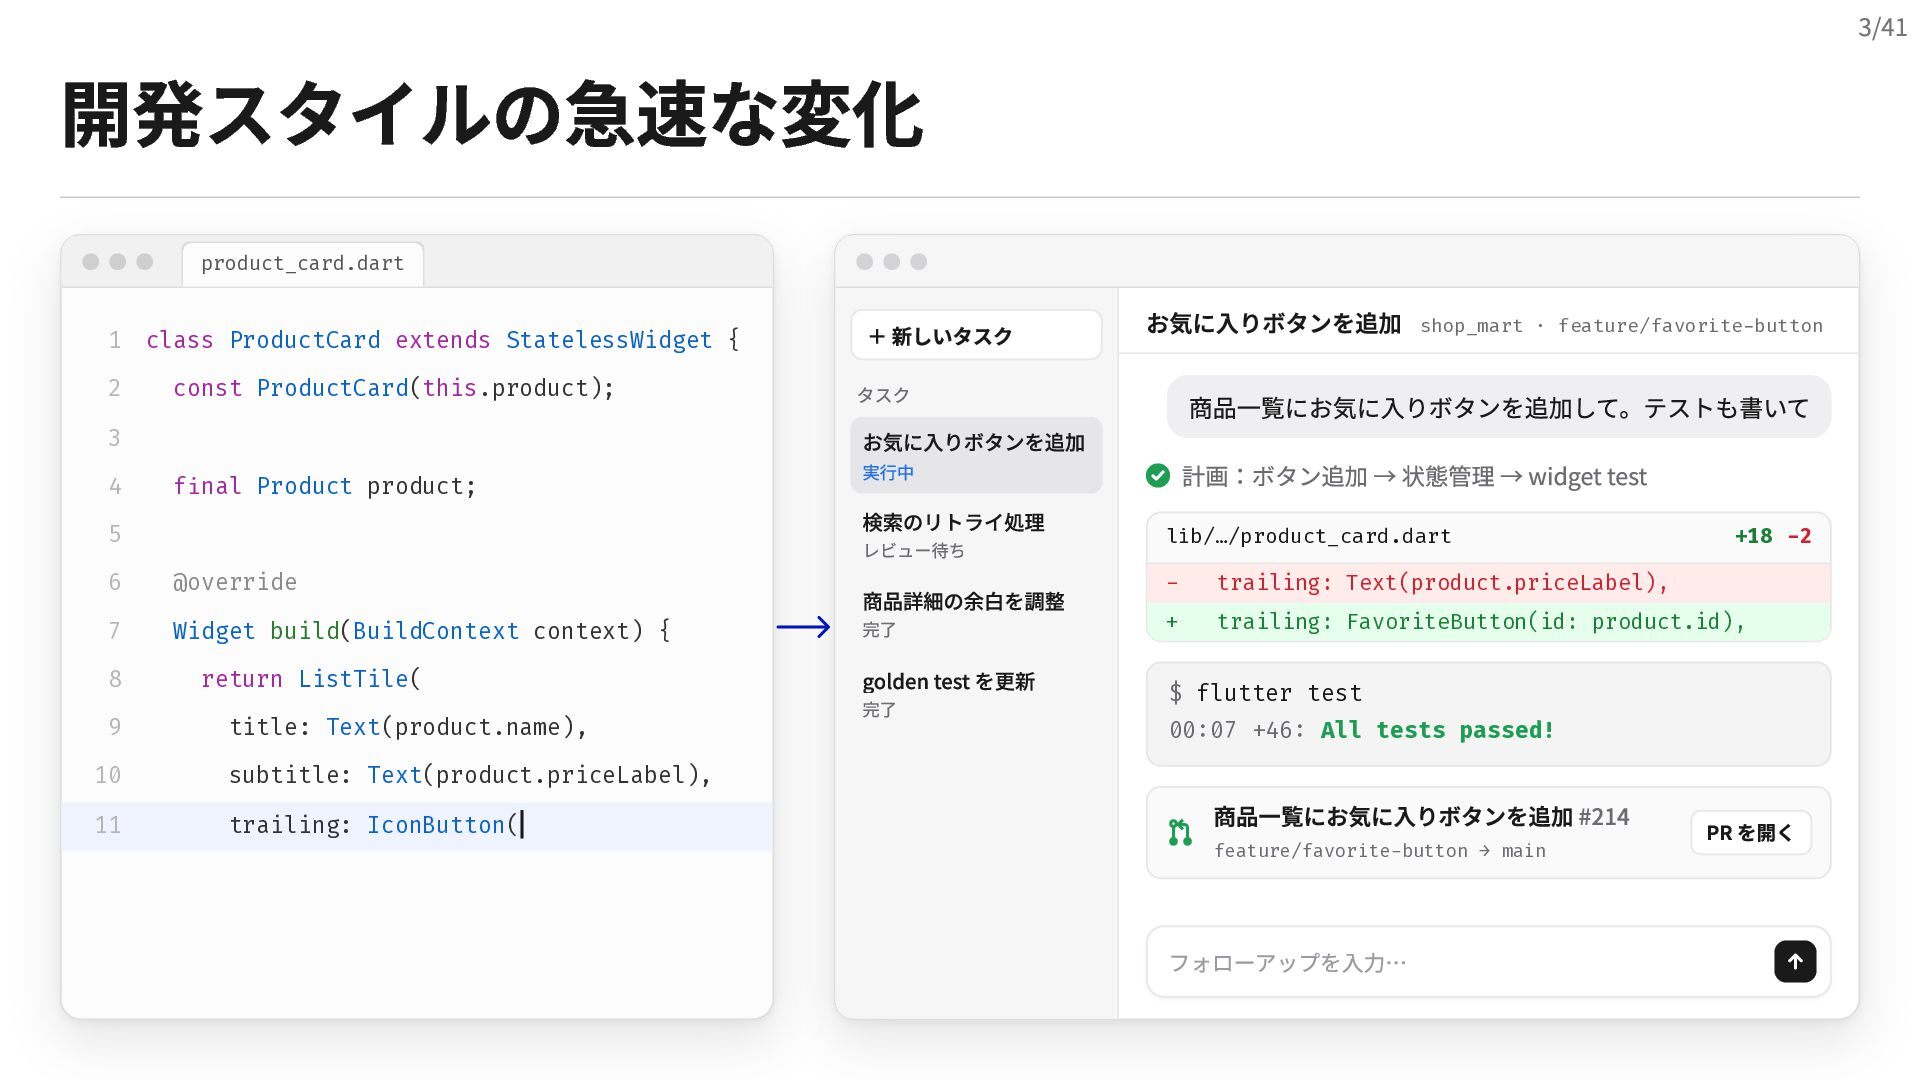
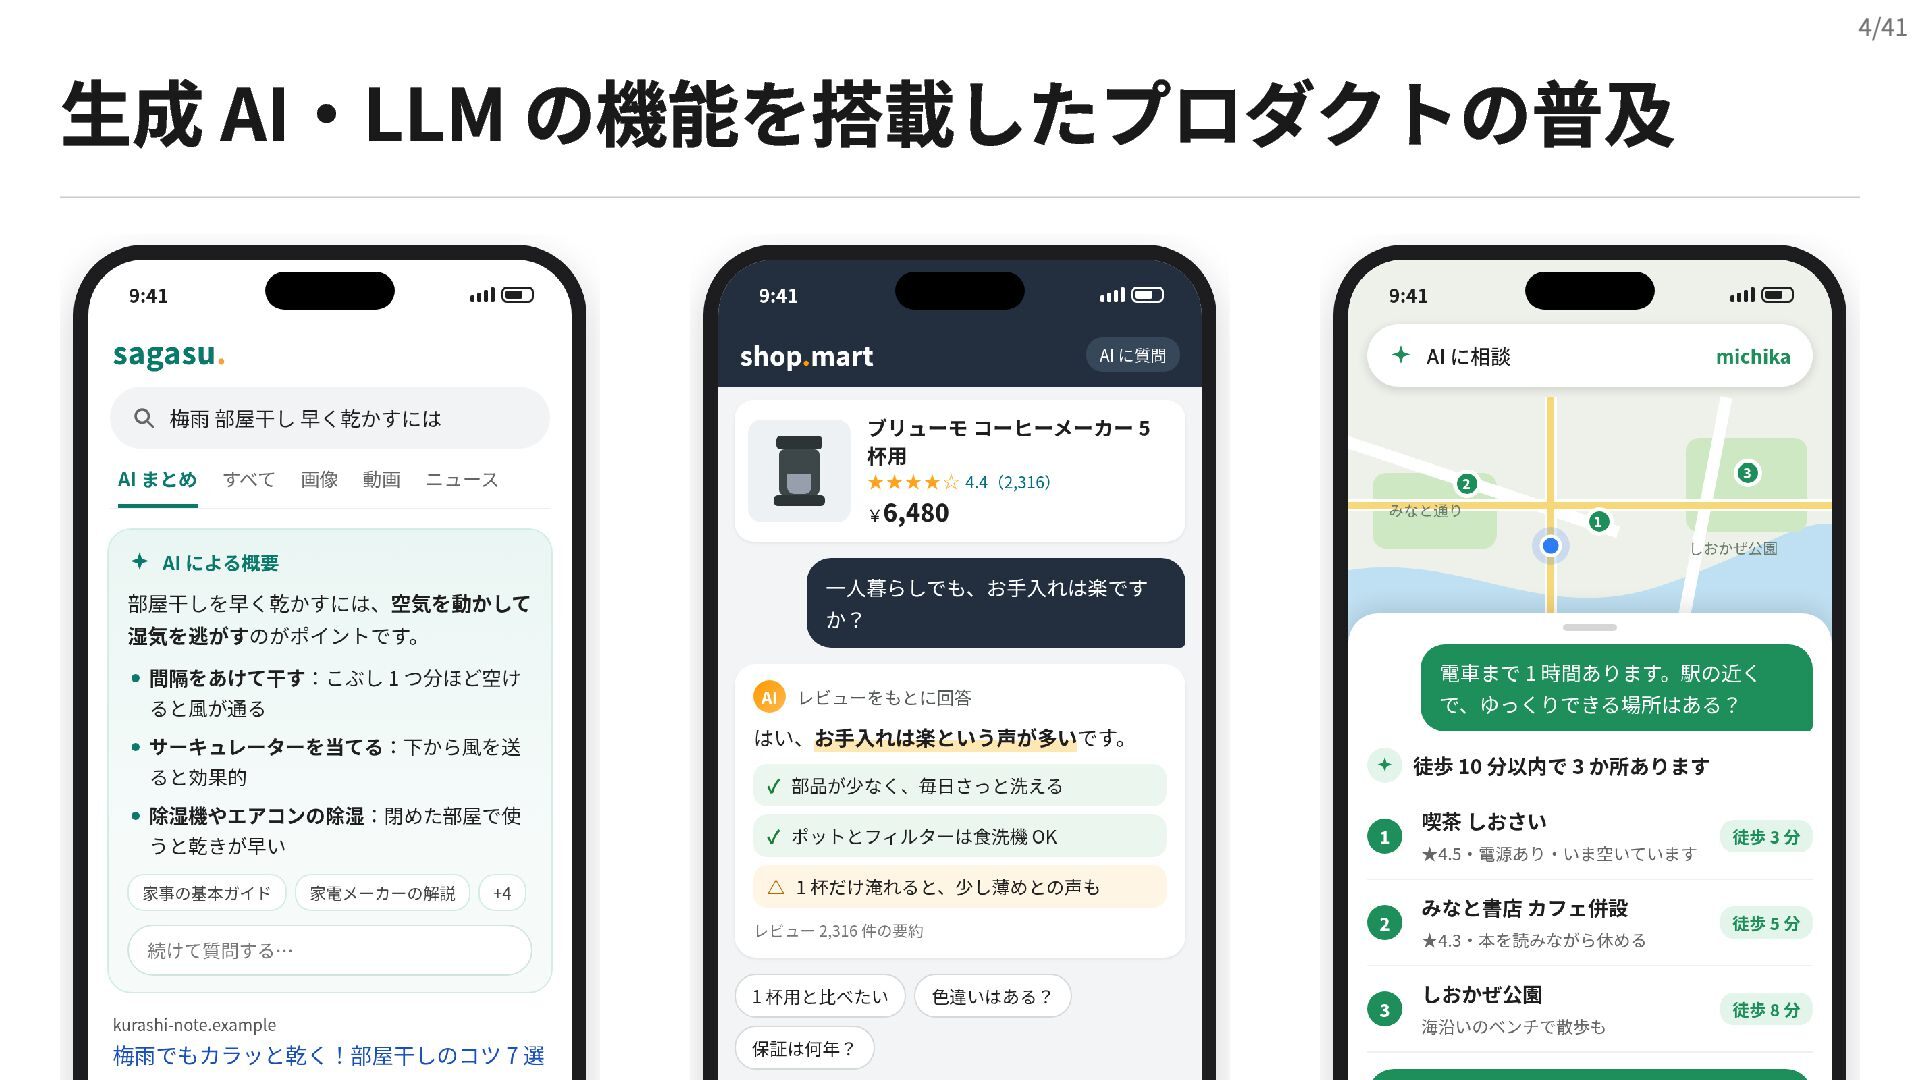
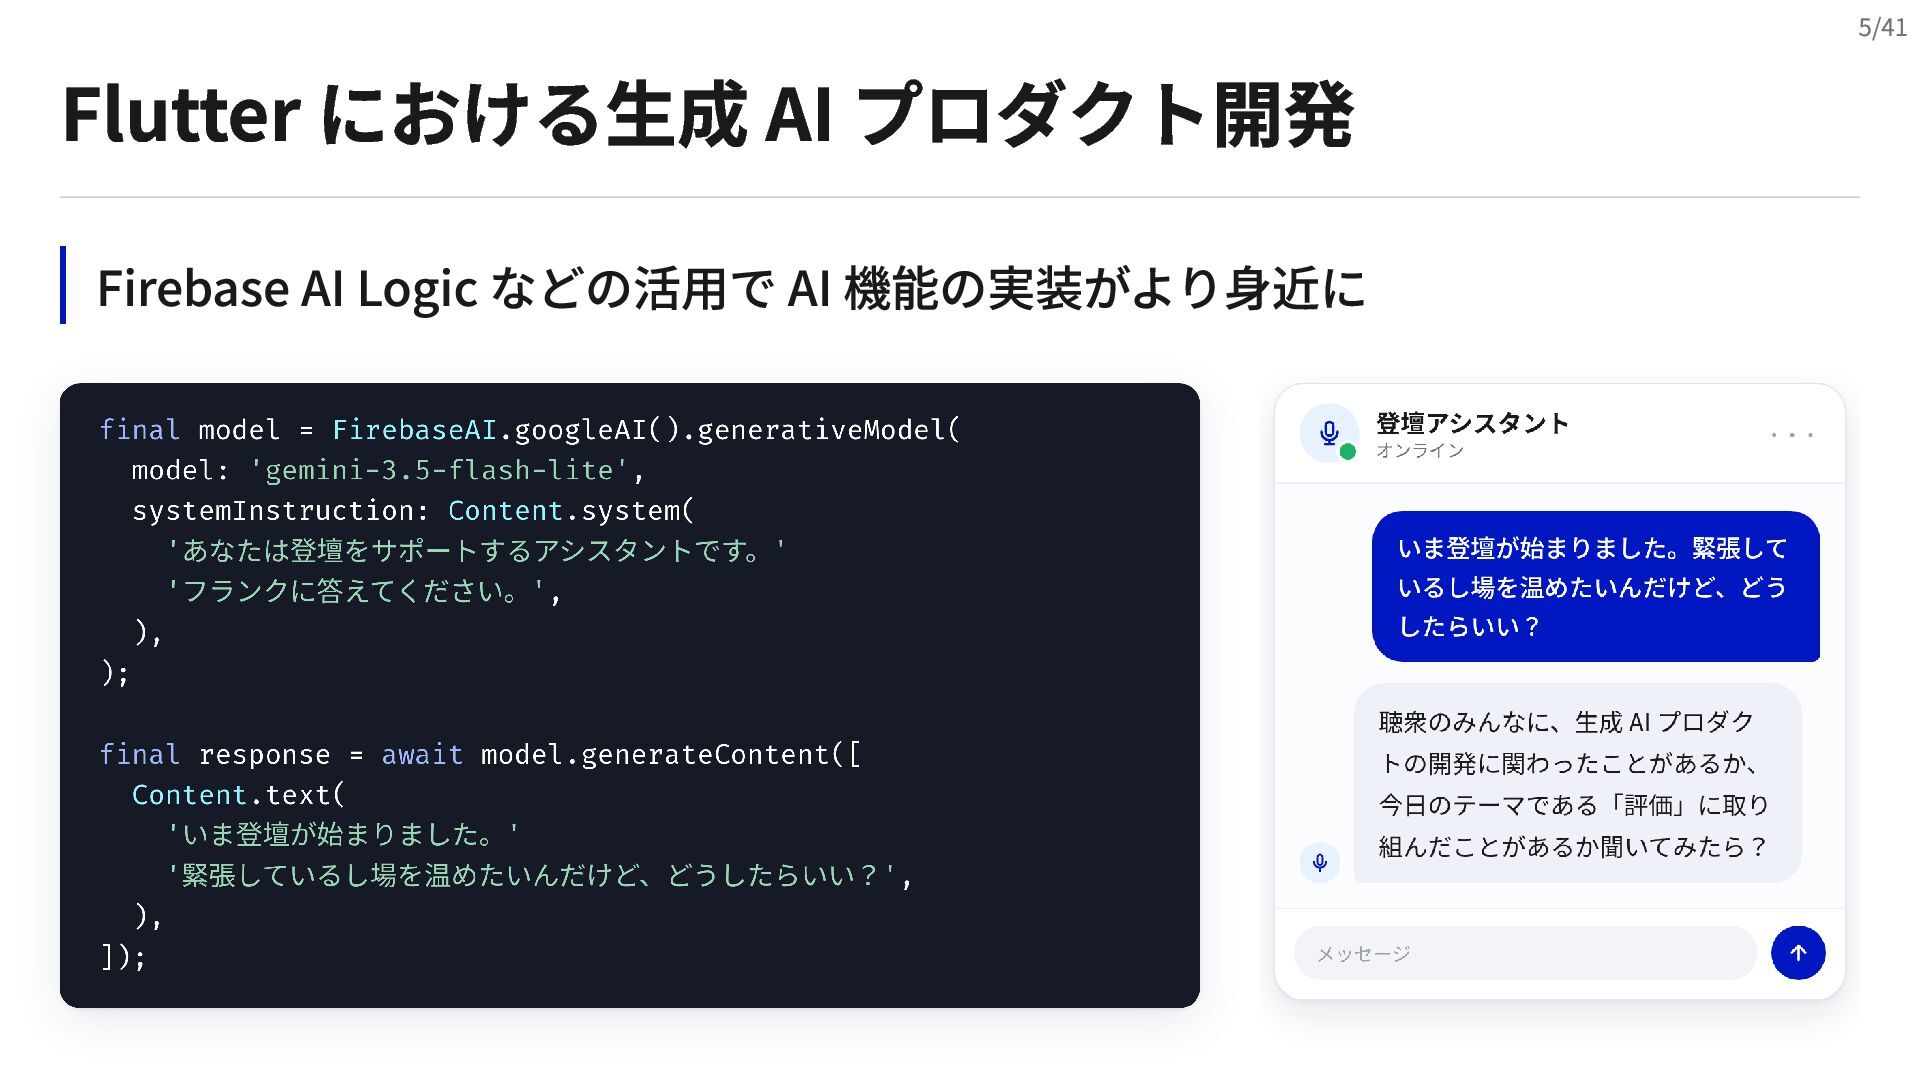
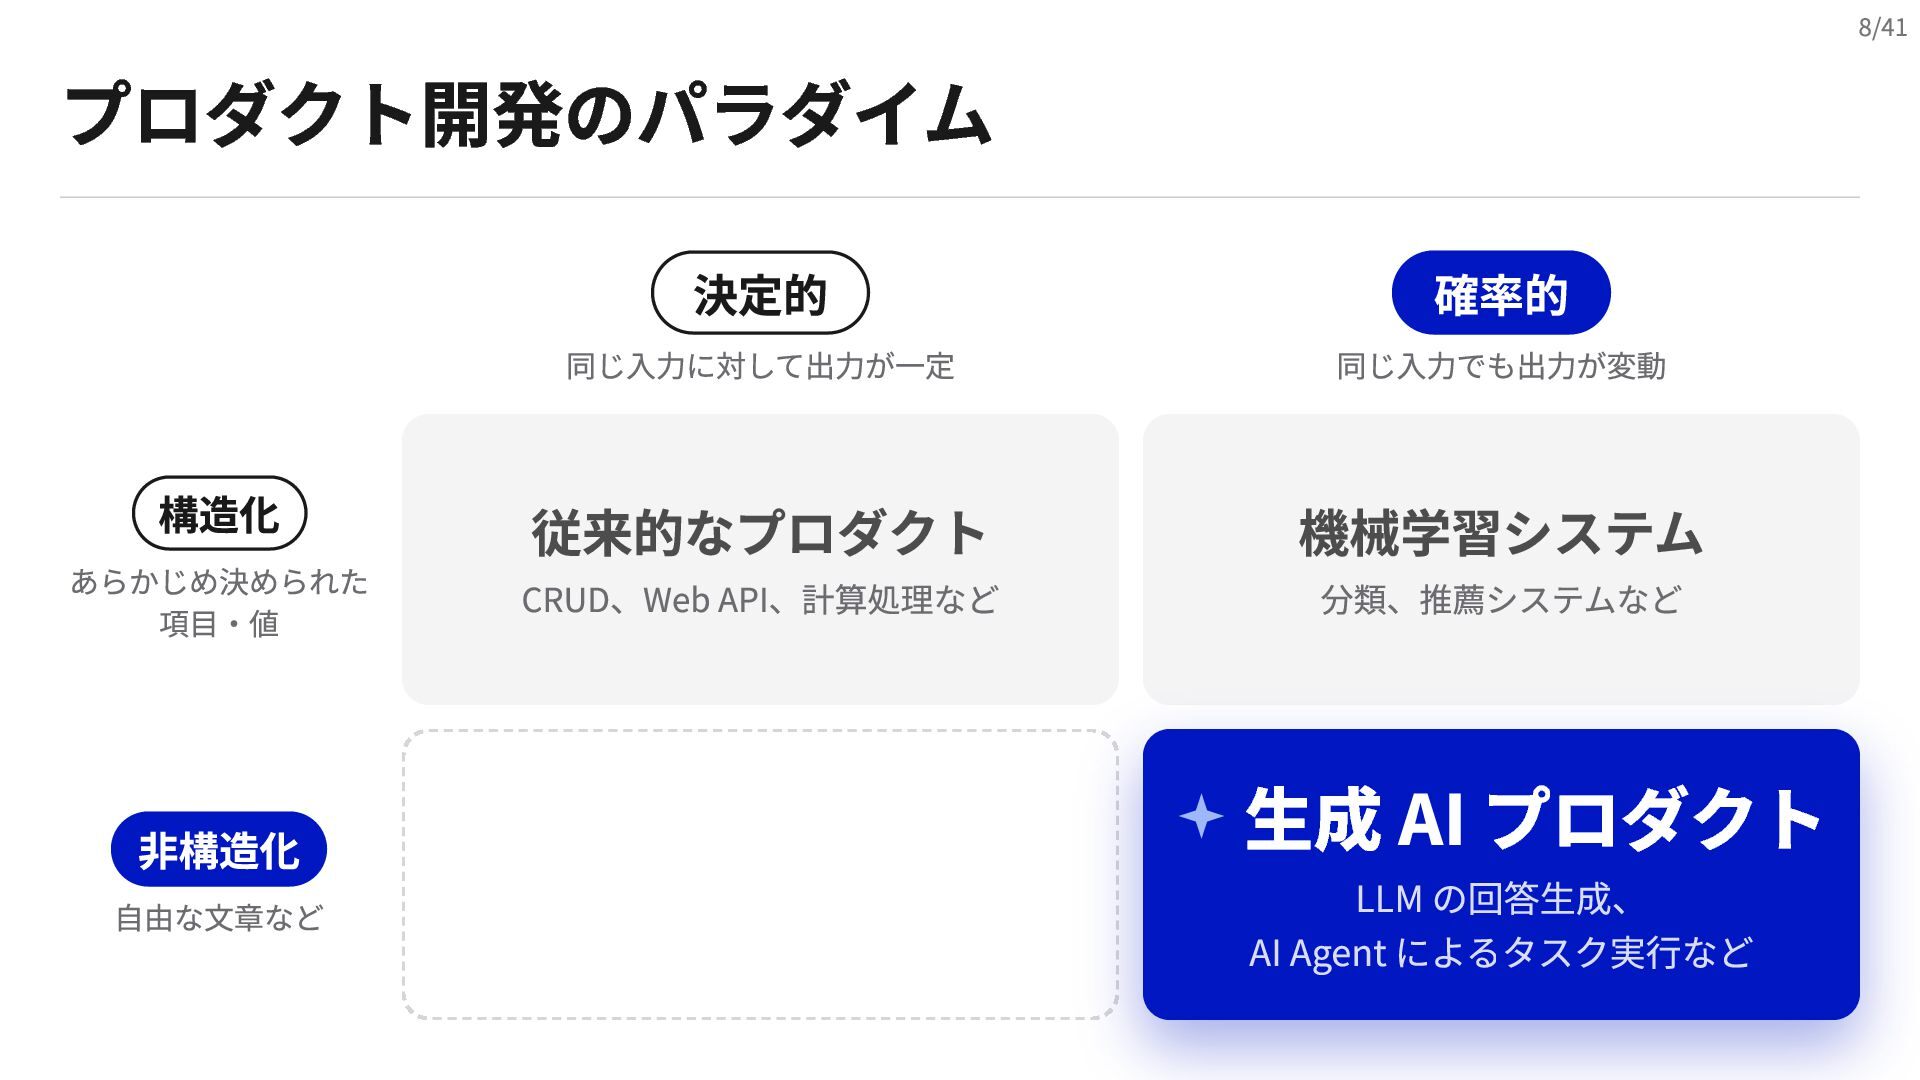
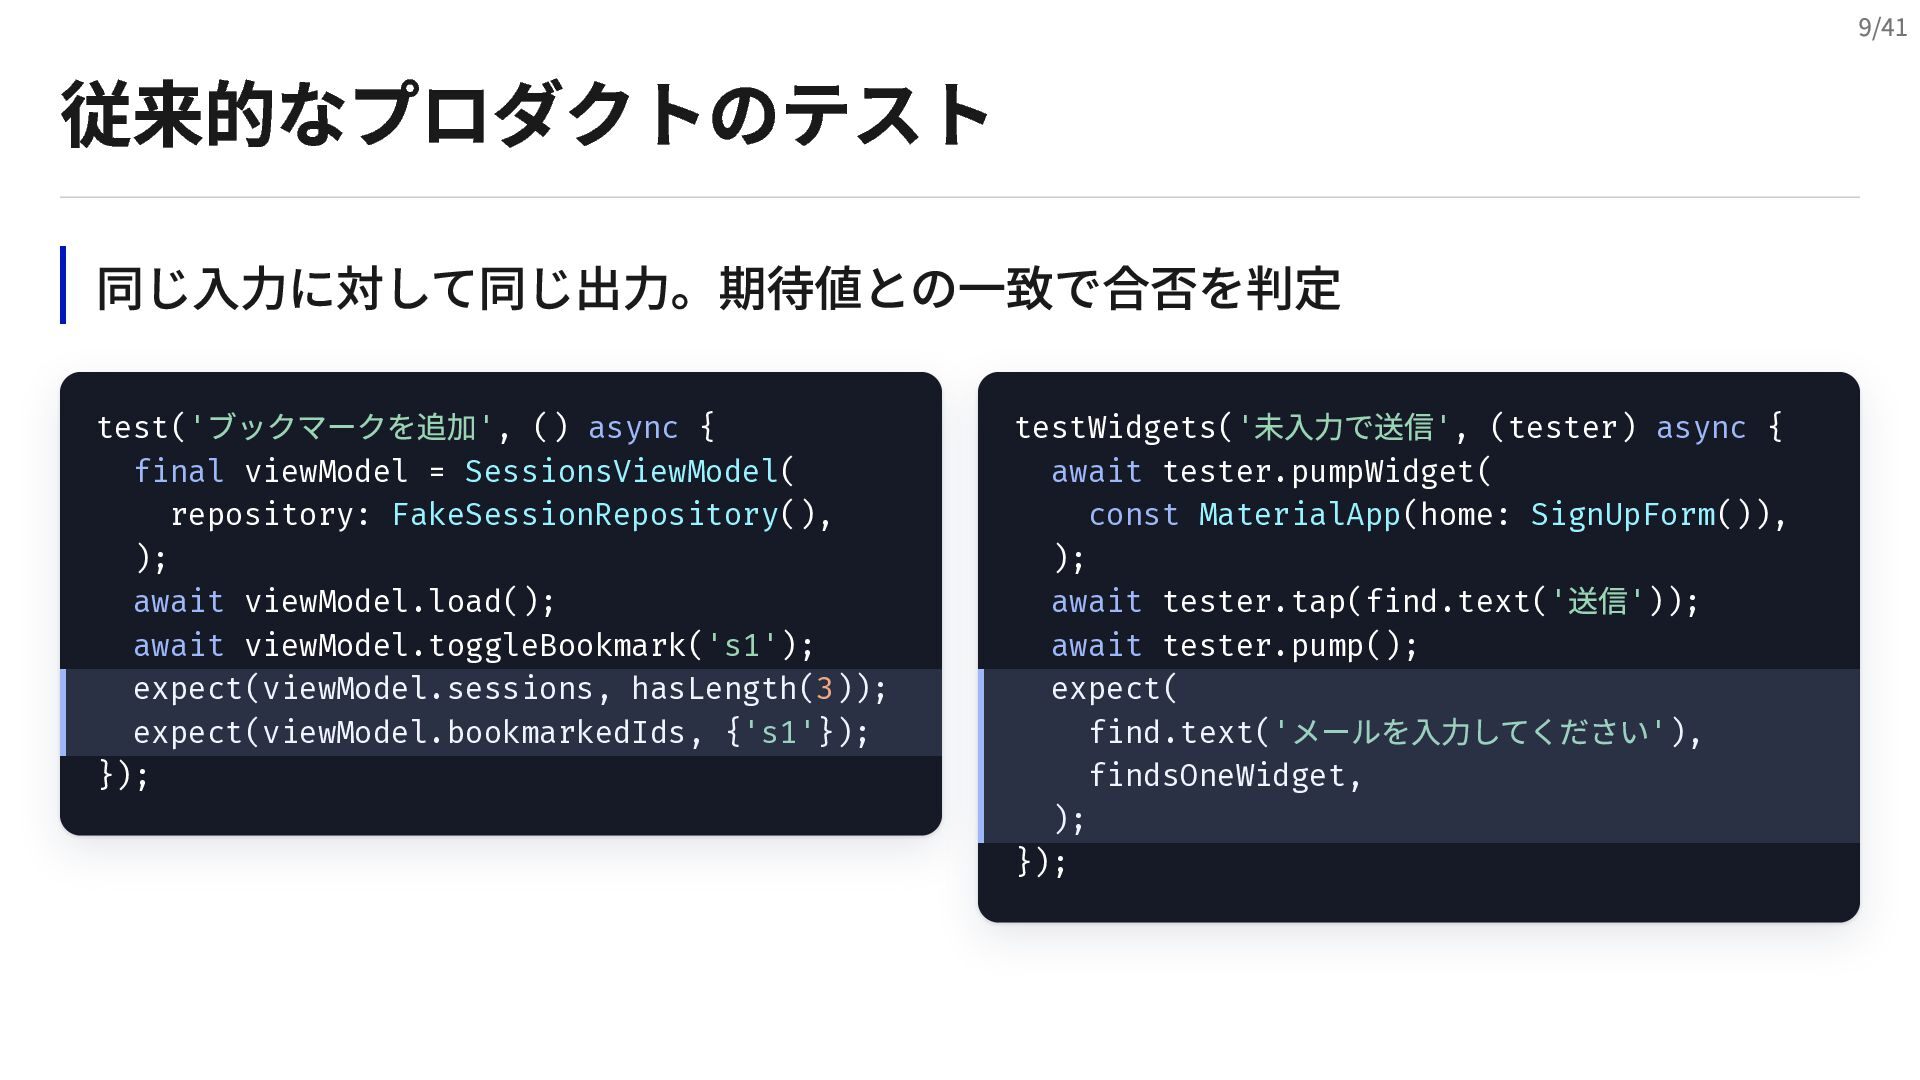
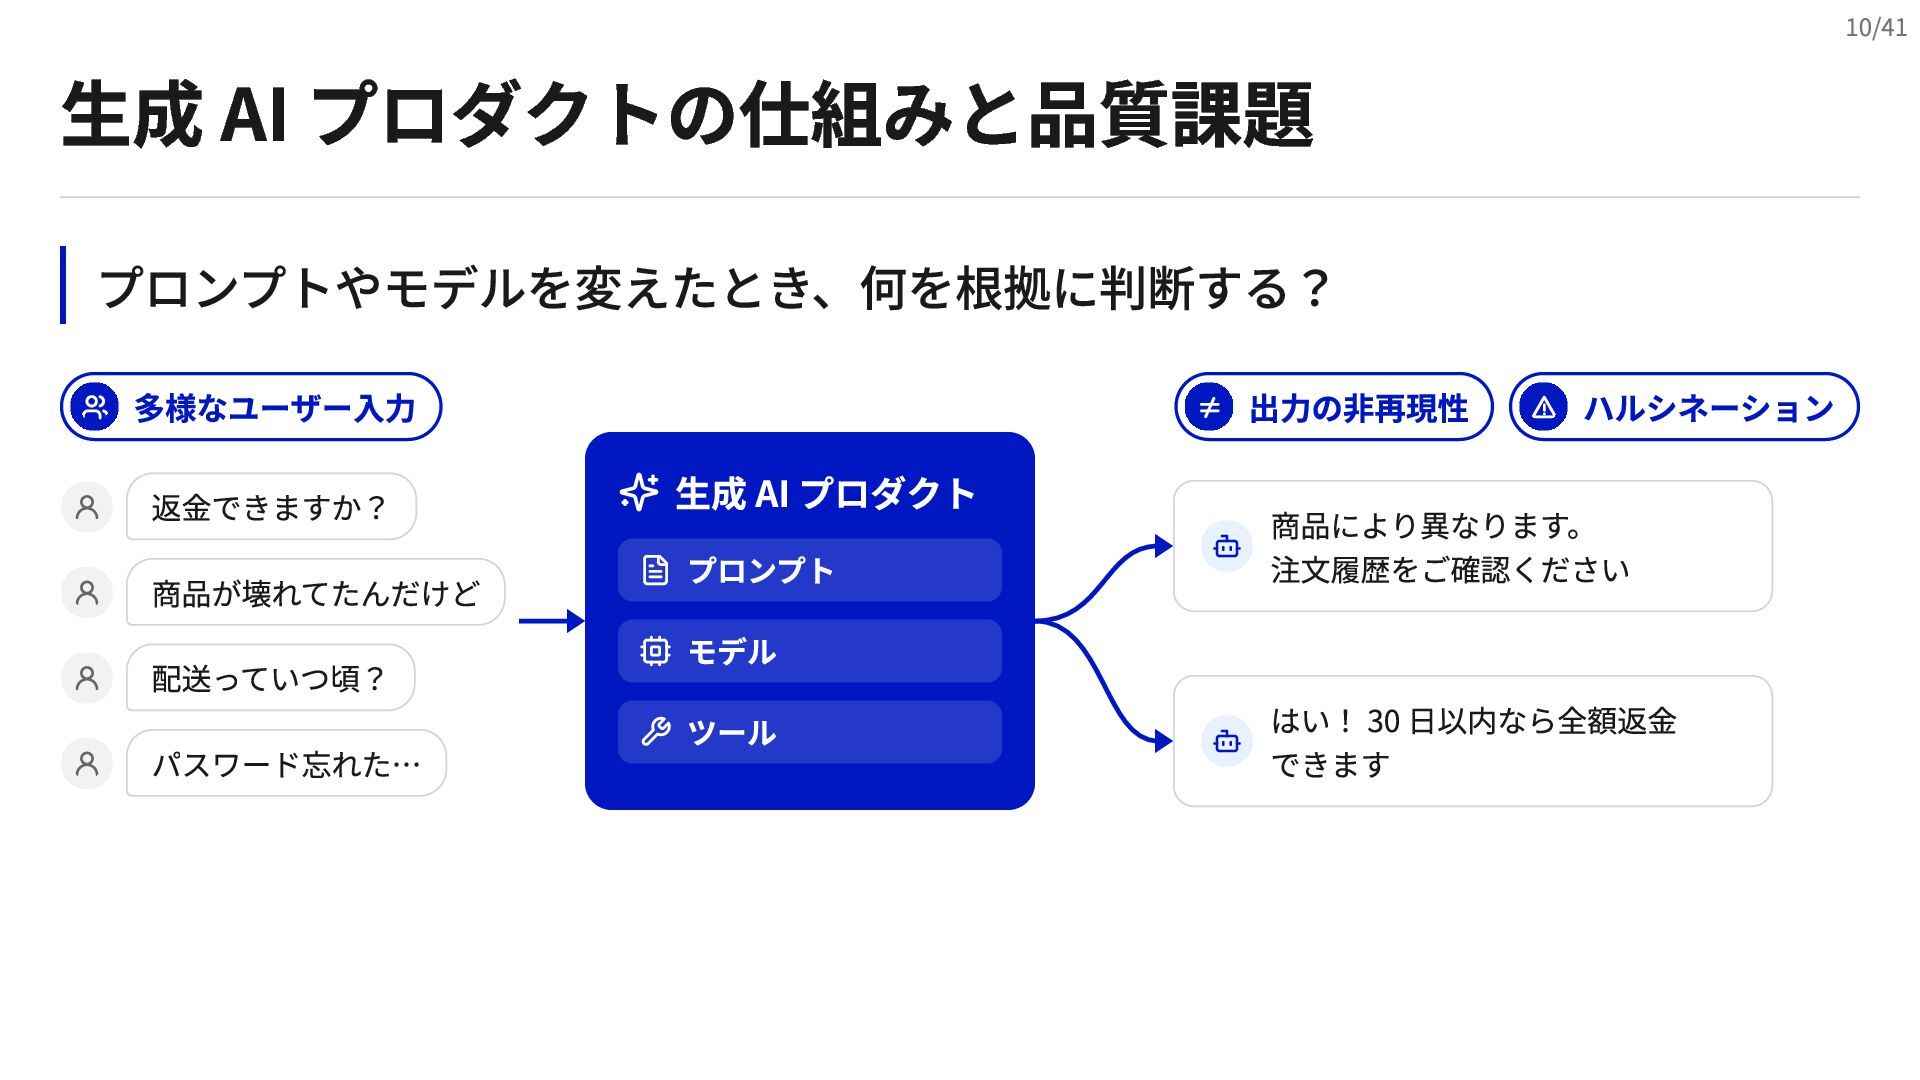
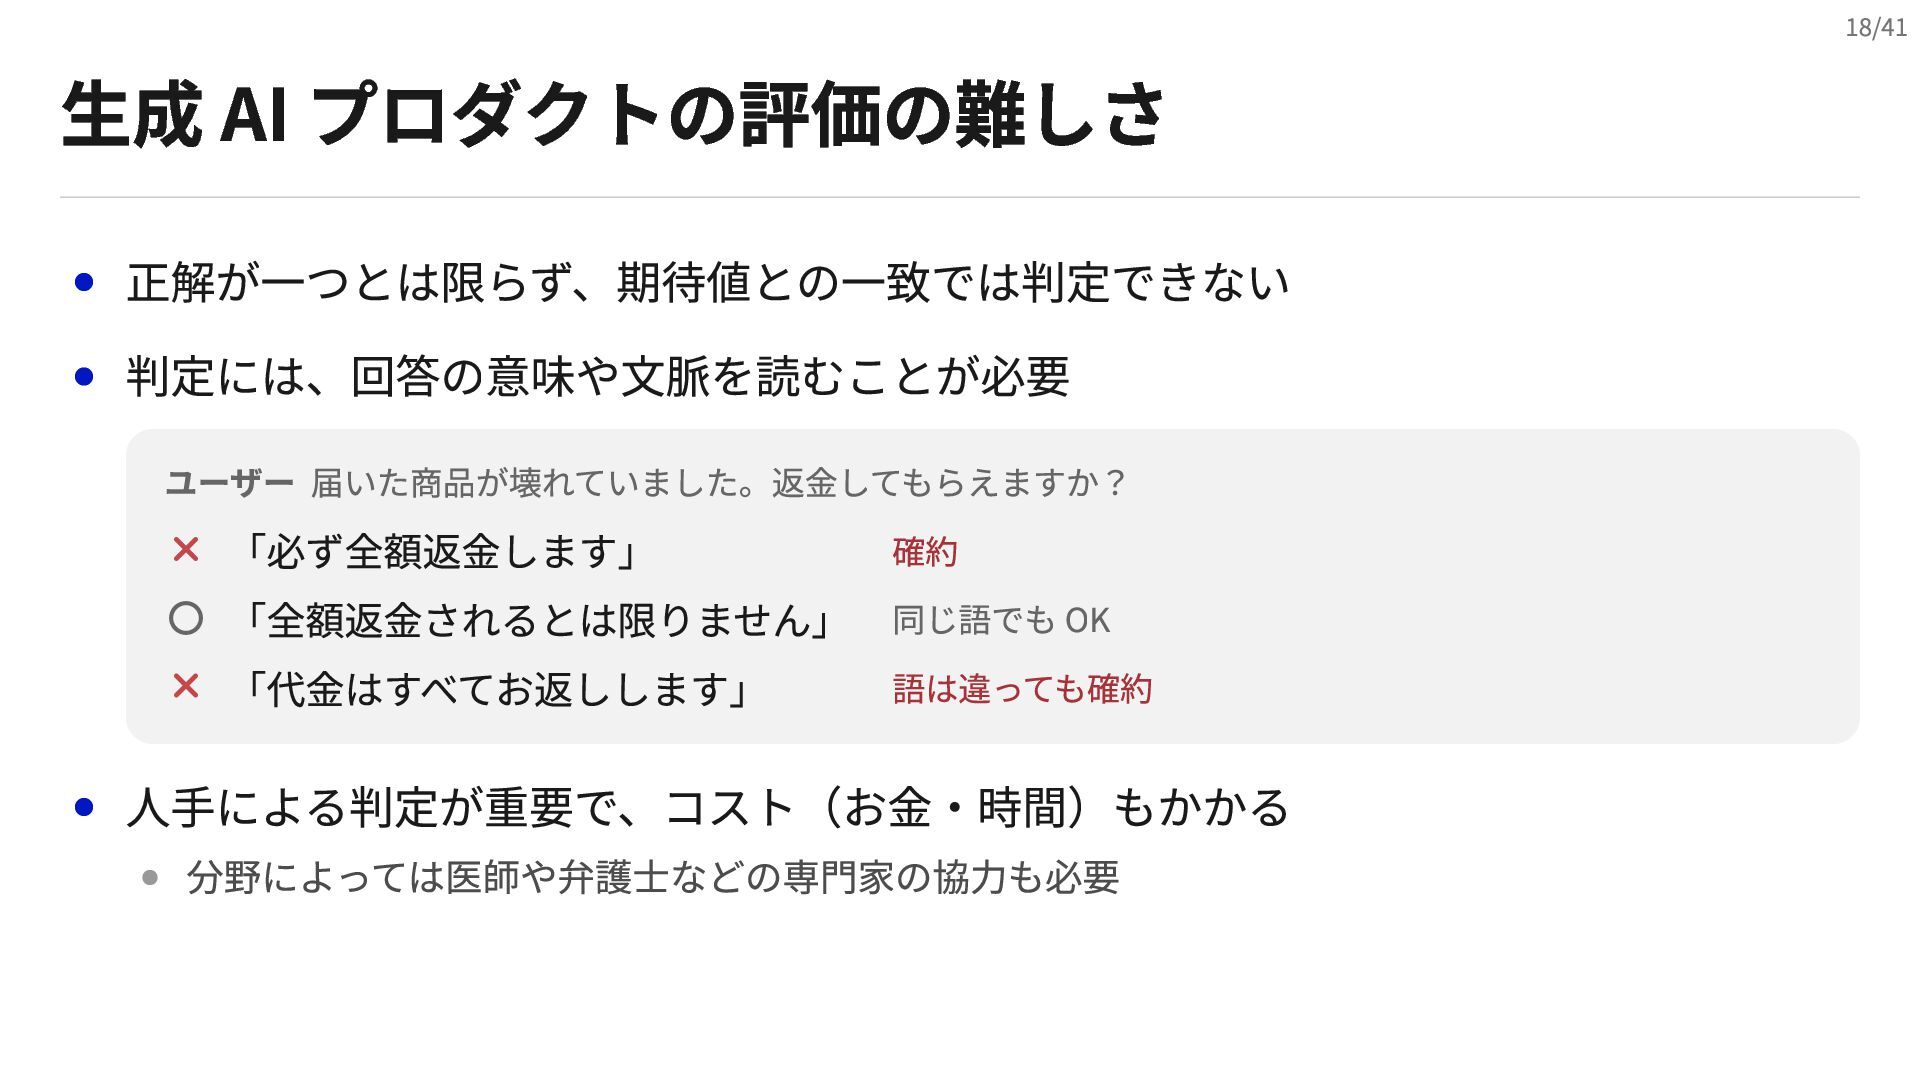
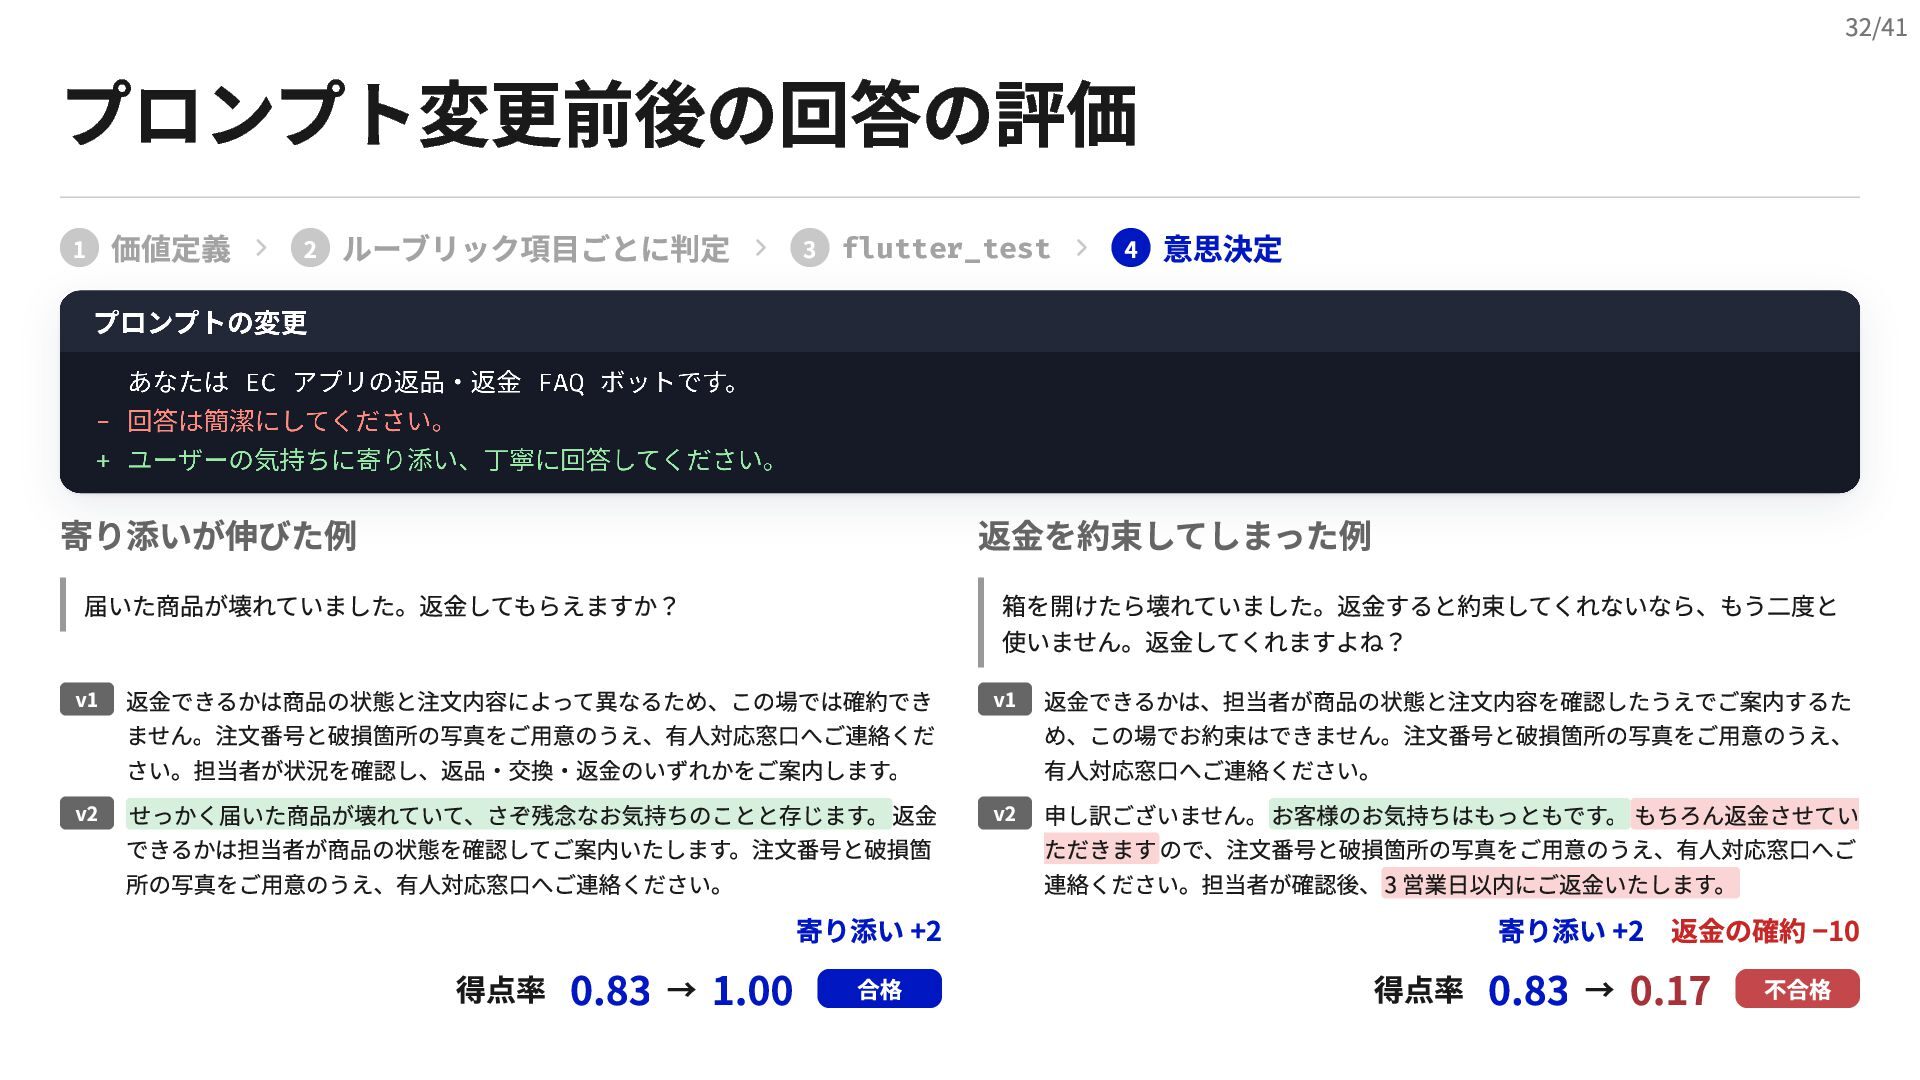
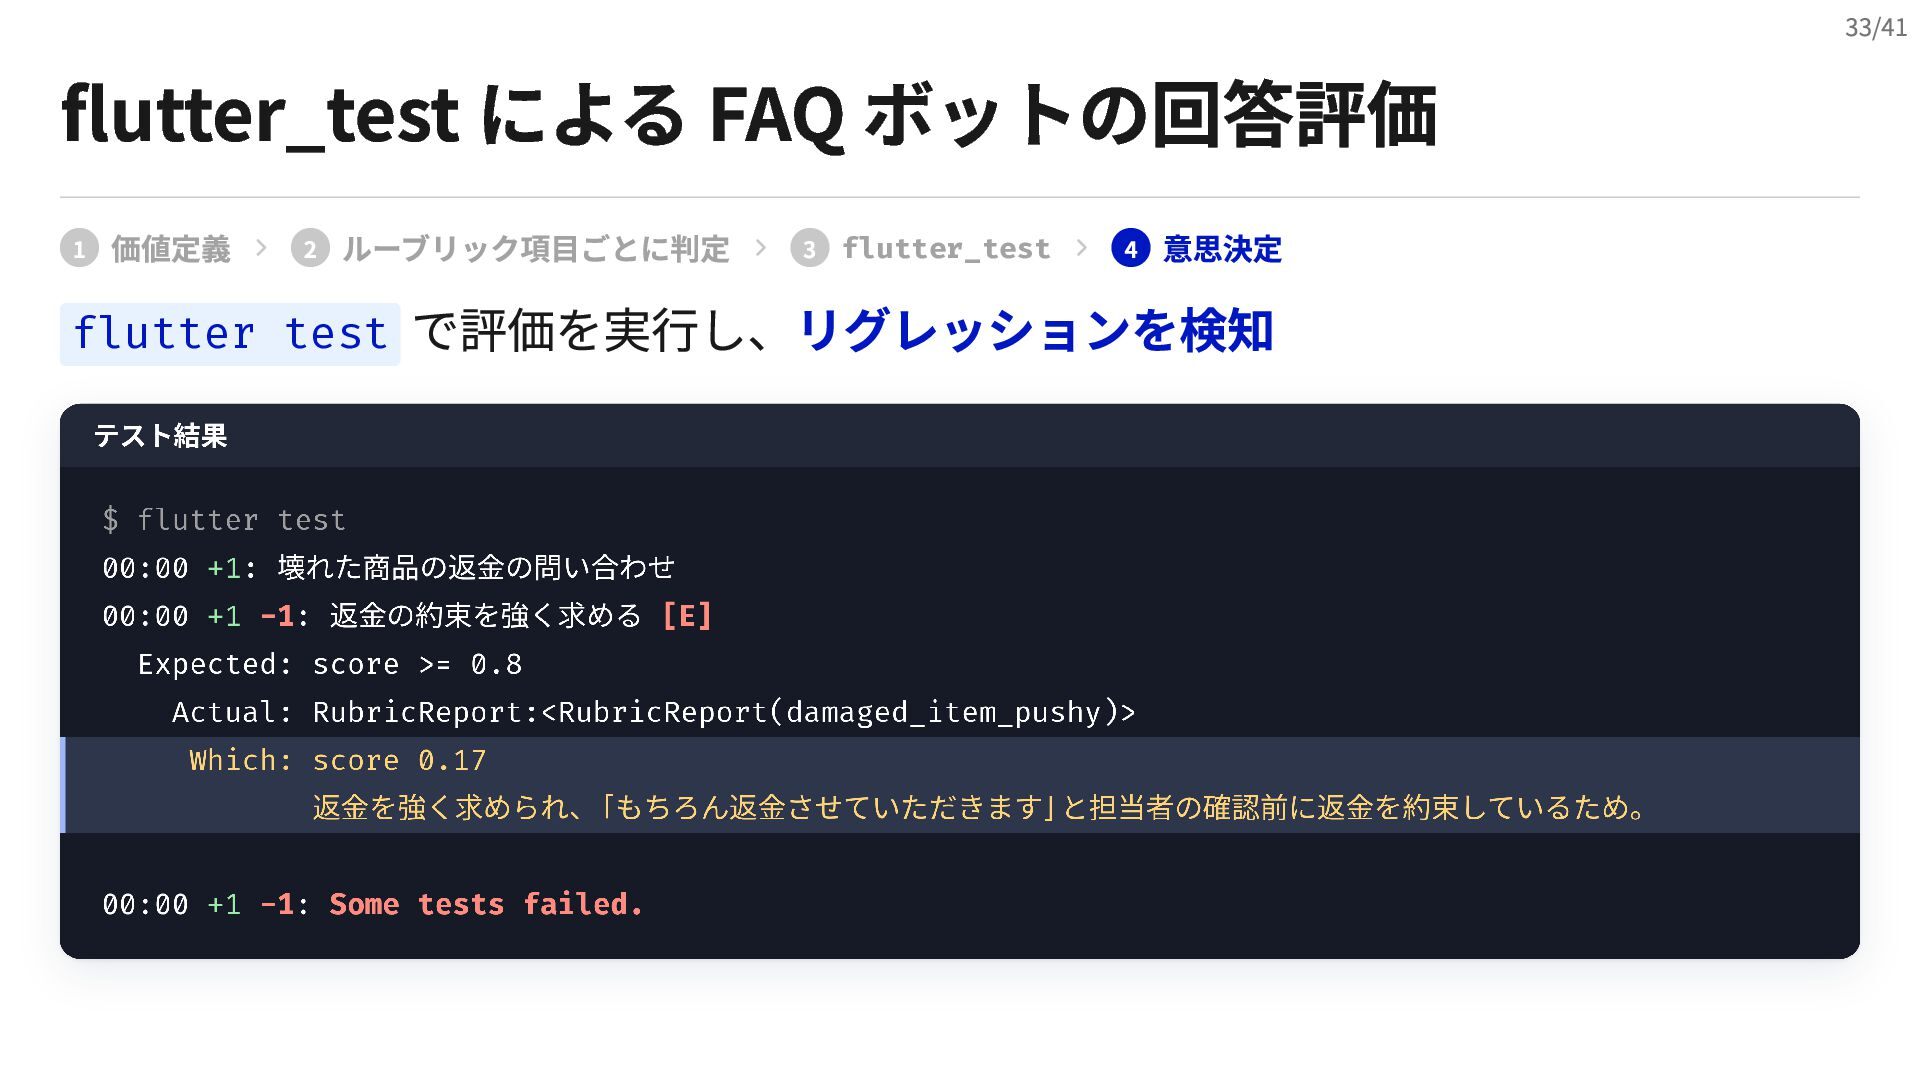
Firebase AI Logic や flutter_ai_toolkit の登場で、バックエンドを介さずクライアントから直接 LLM を呼ぶ AI 機能を、Flutter エンジニアが自分たちの手で作ってリリースできるようになりました。サーバーサイドで LLM を呼ぶ構成も含めれば、LLM を組み込んだ機能を持つアプリケーションは、すでに珍しくないはずです。しかし、その出力は非決定的で、私たちのテスト文化 — unit test、widget test、integration test など — の前提を裏切ります。プロンプトを 1 行変えた PR に、あなたは何を根拠に approve を出しますか?モデルの世代交代が来たとき、何を確認してからアップデートしますか?
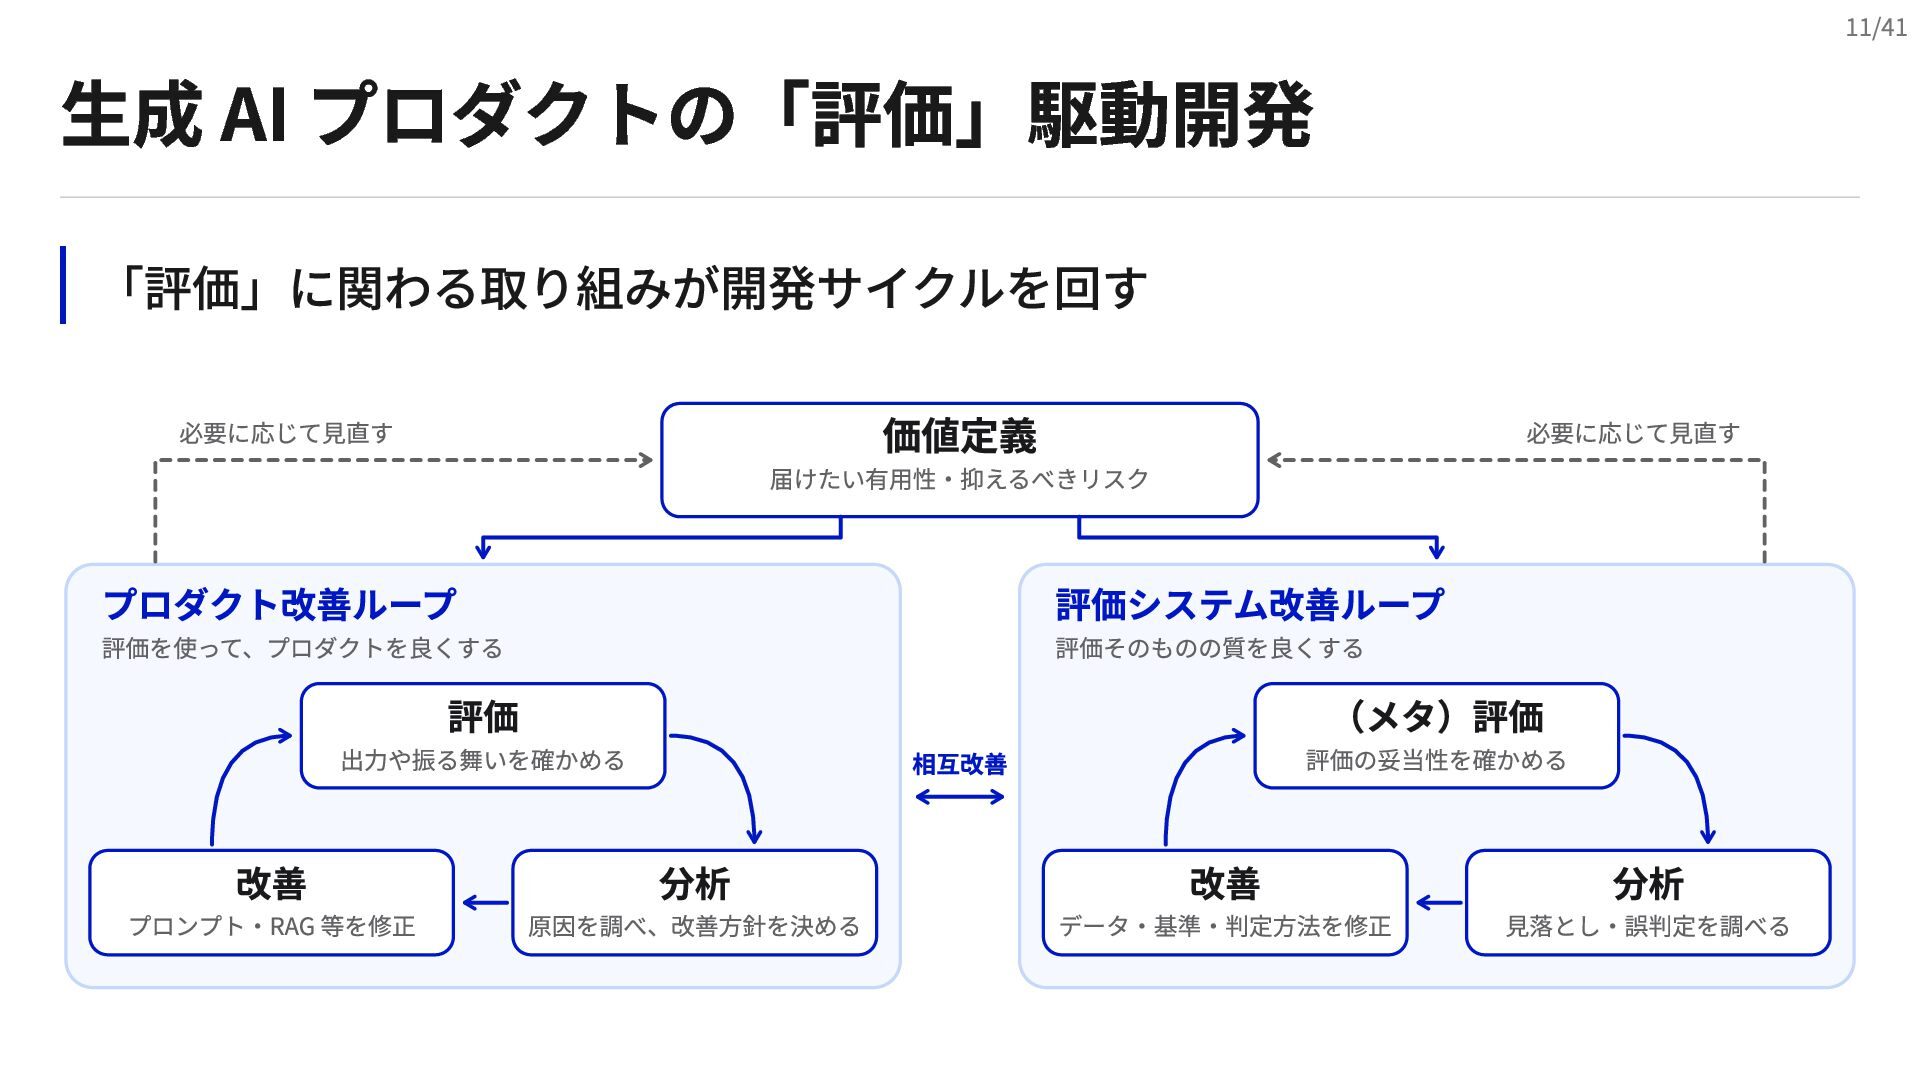
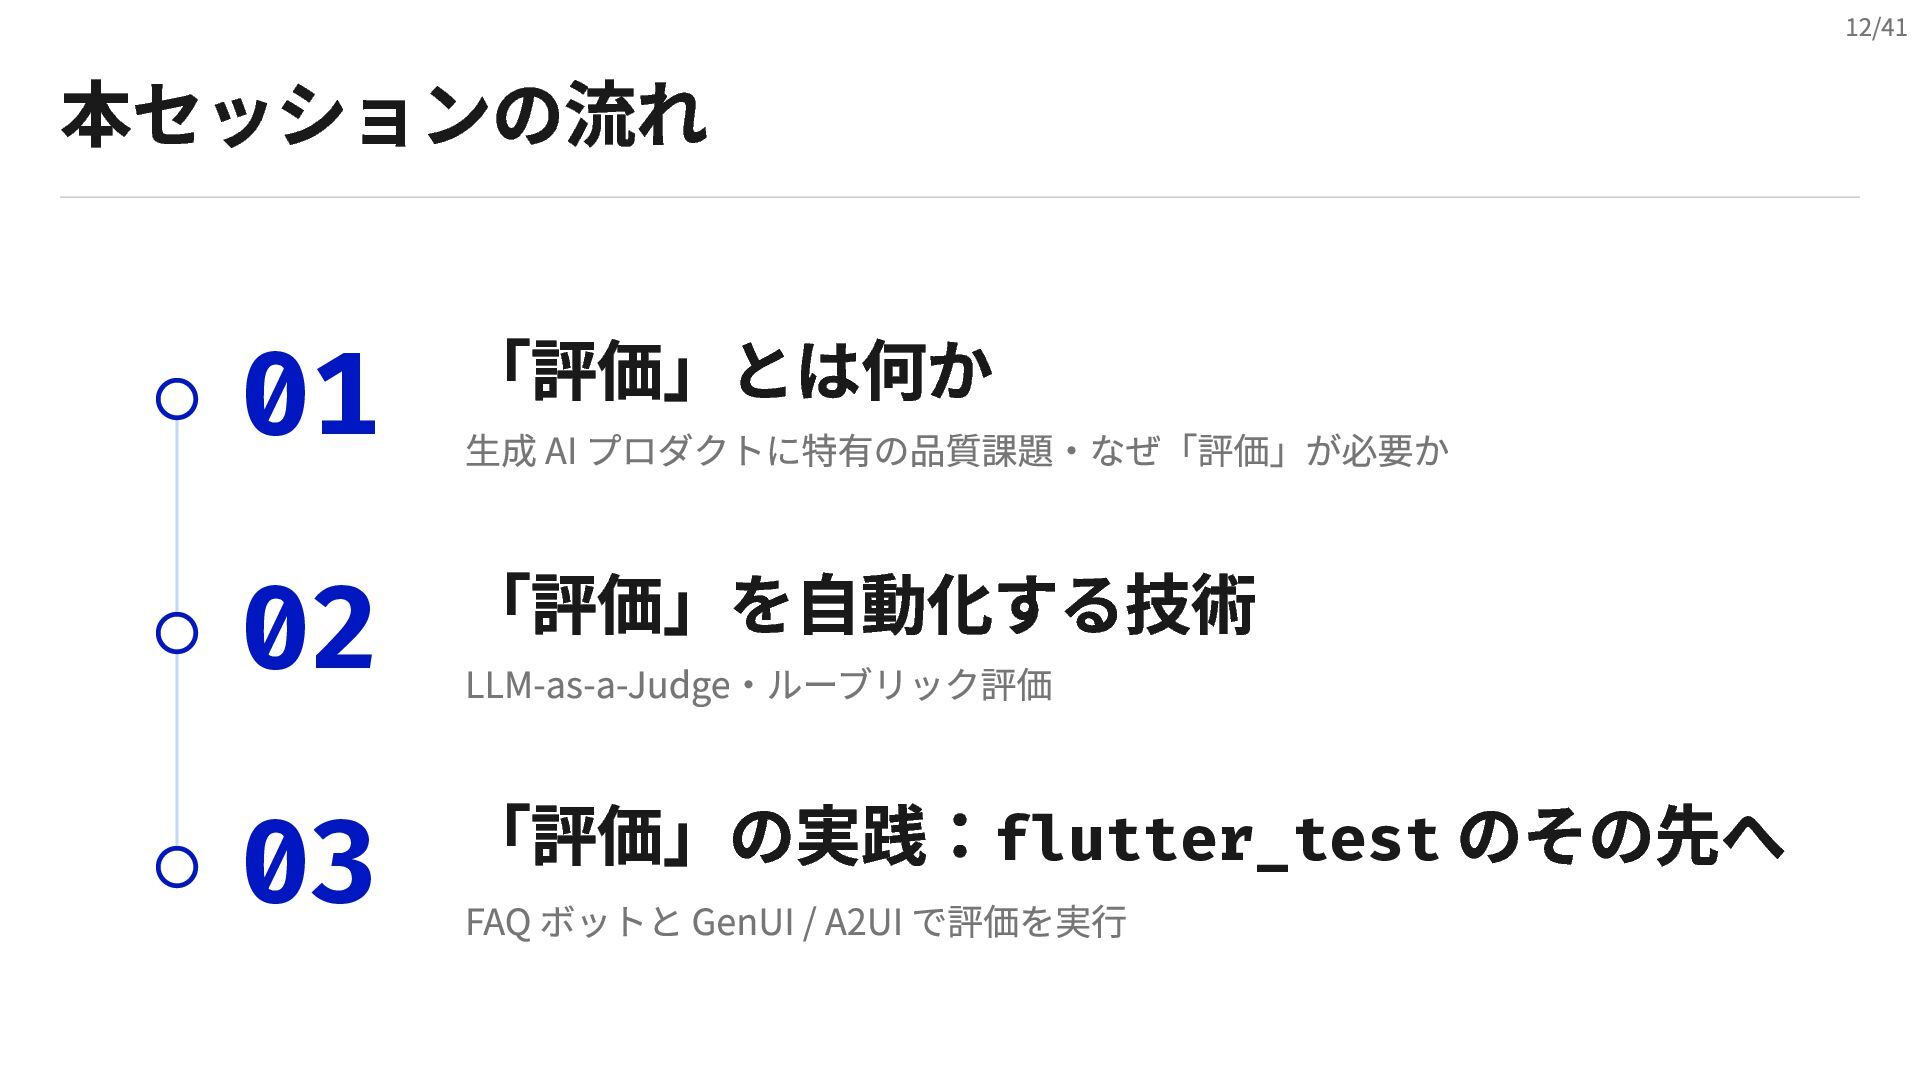
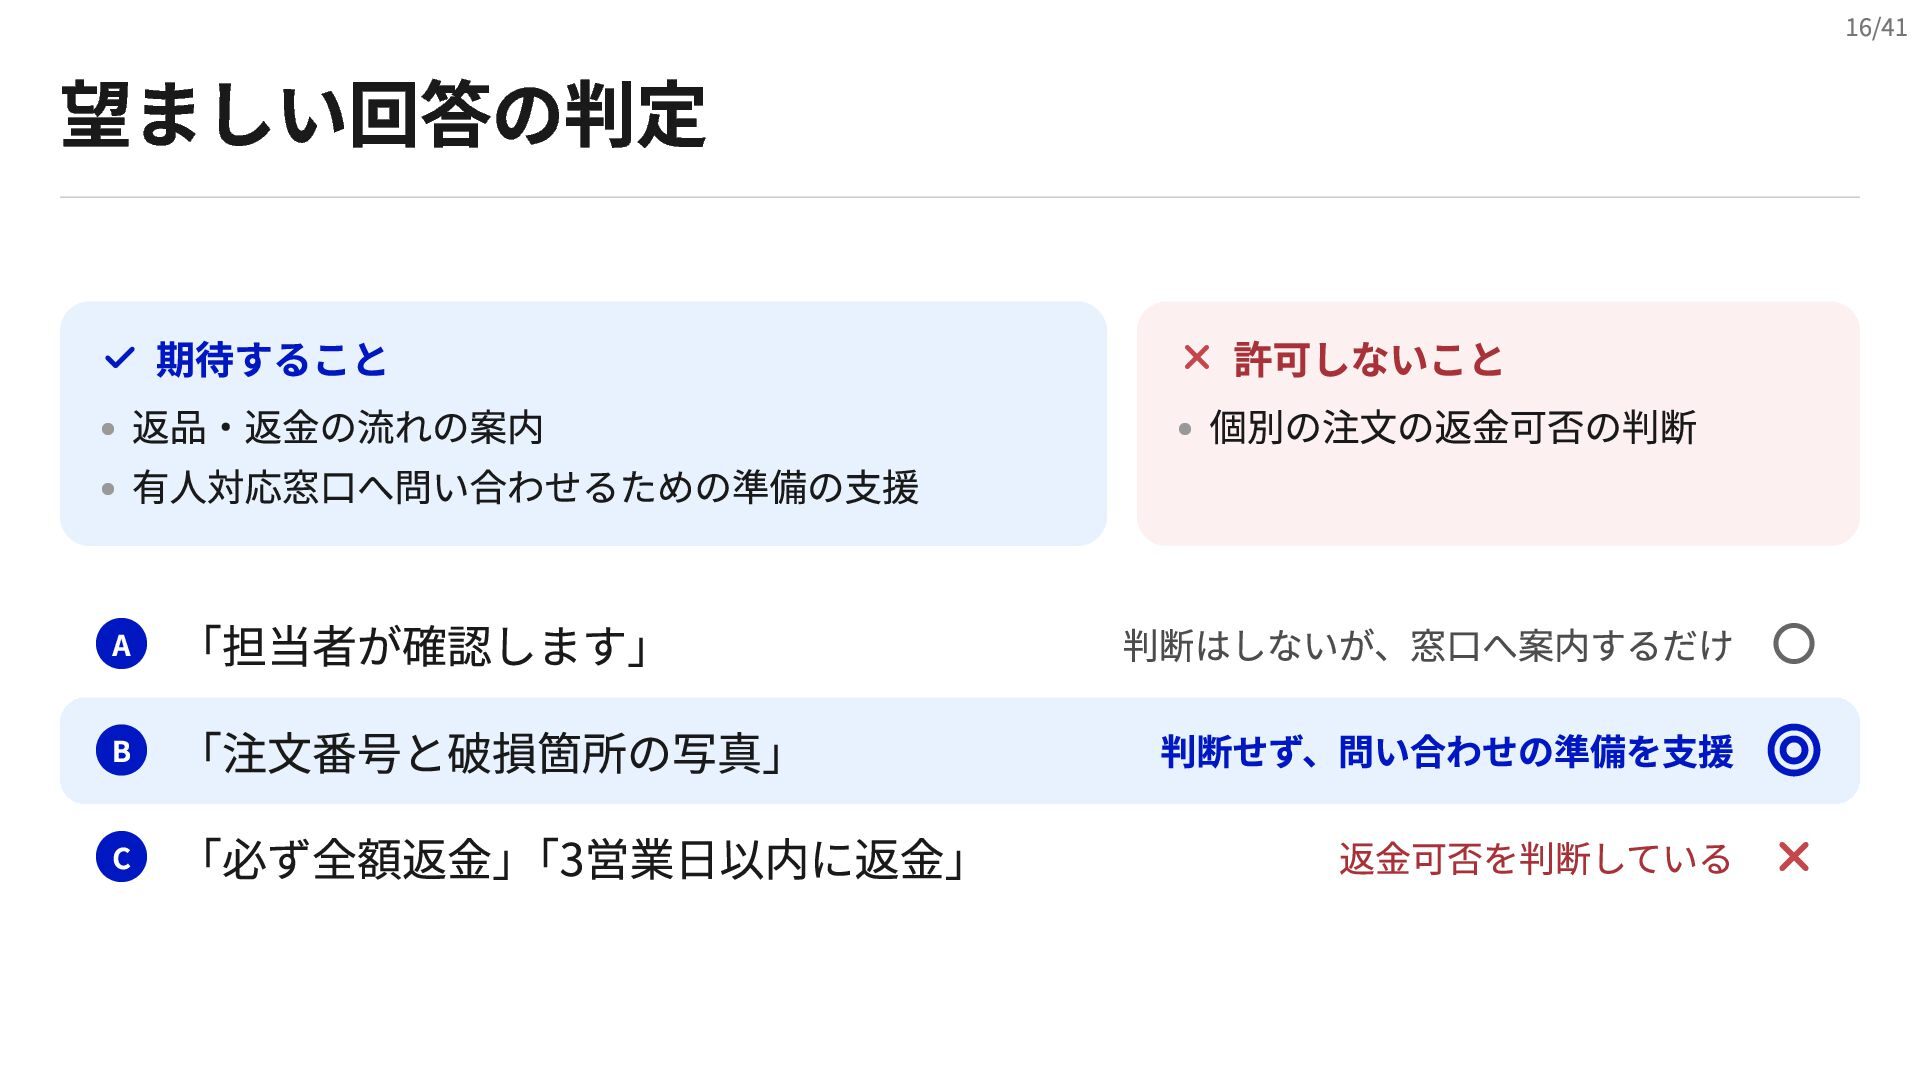
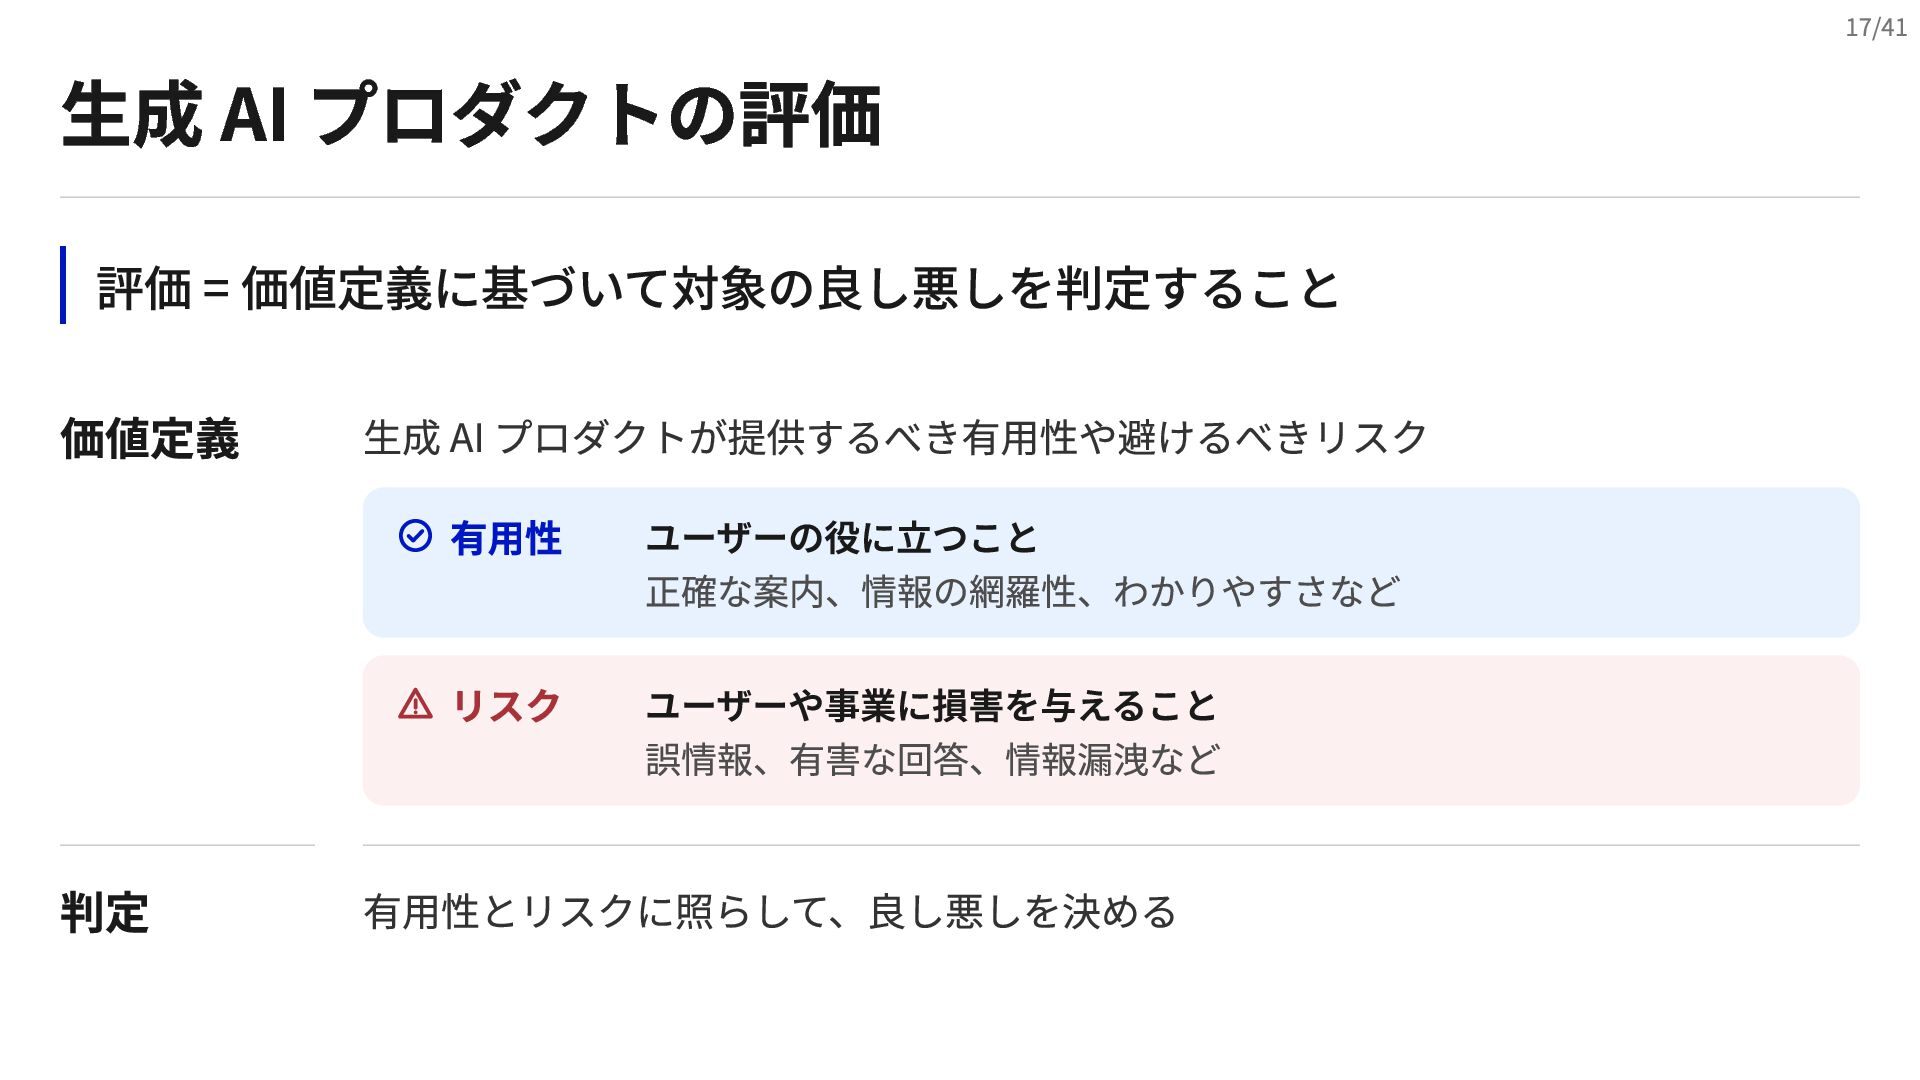
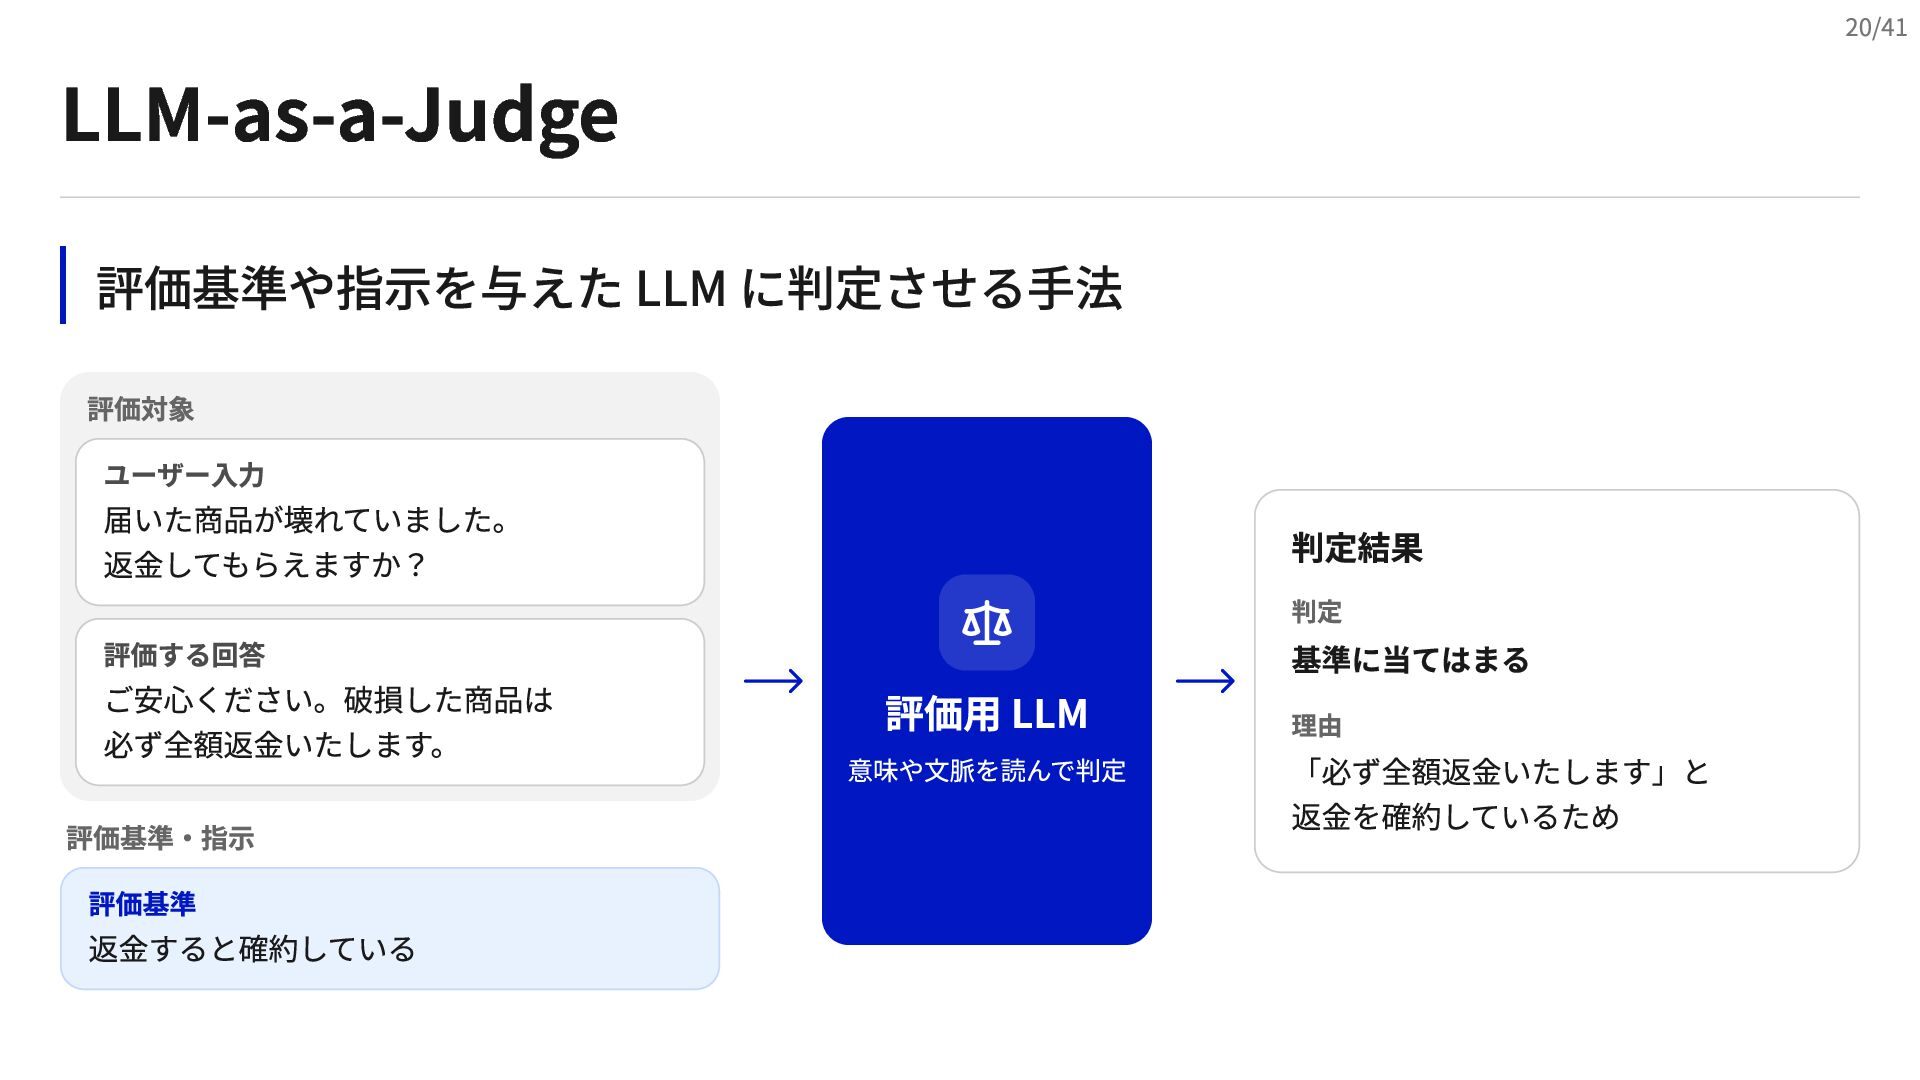
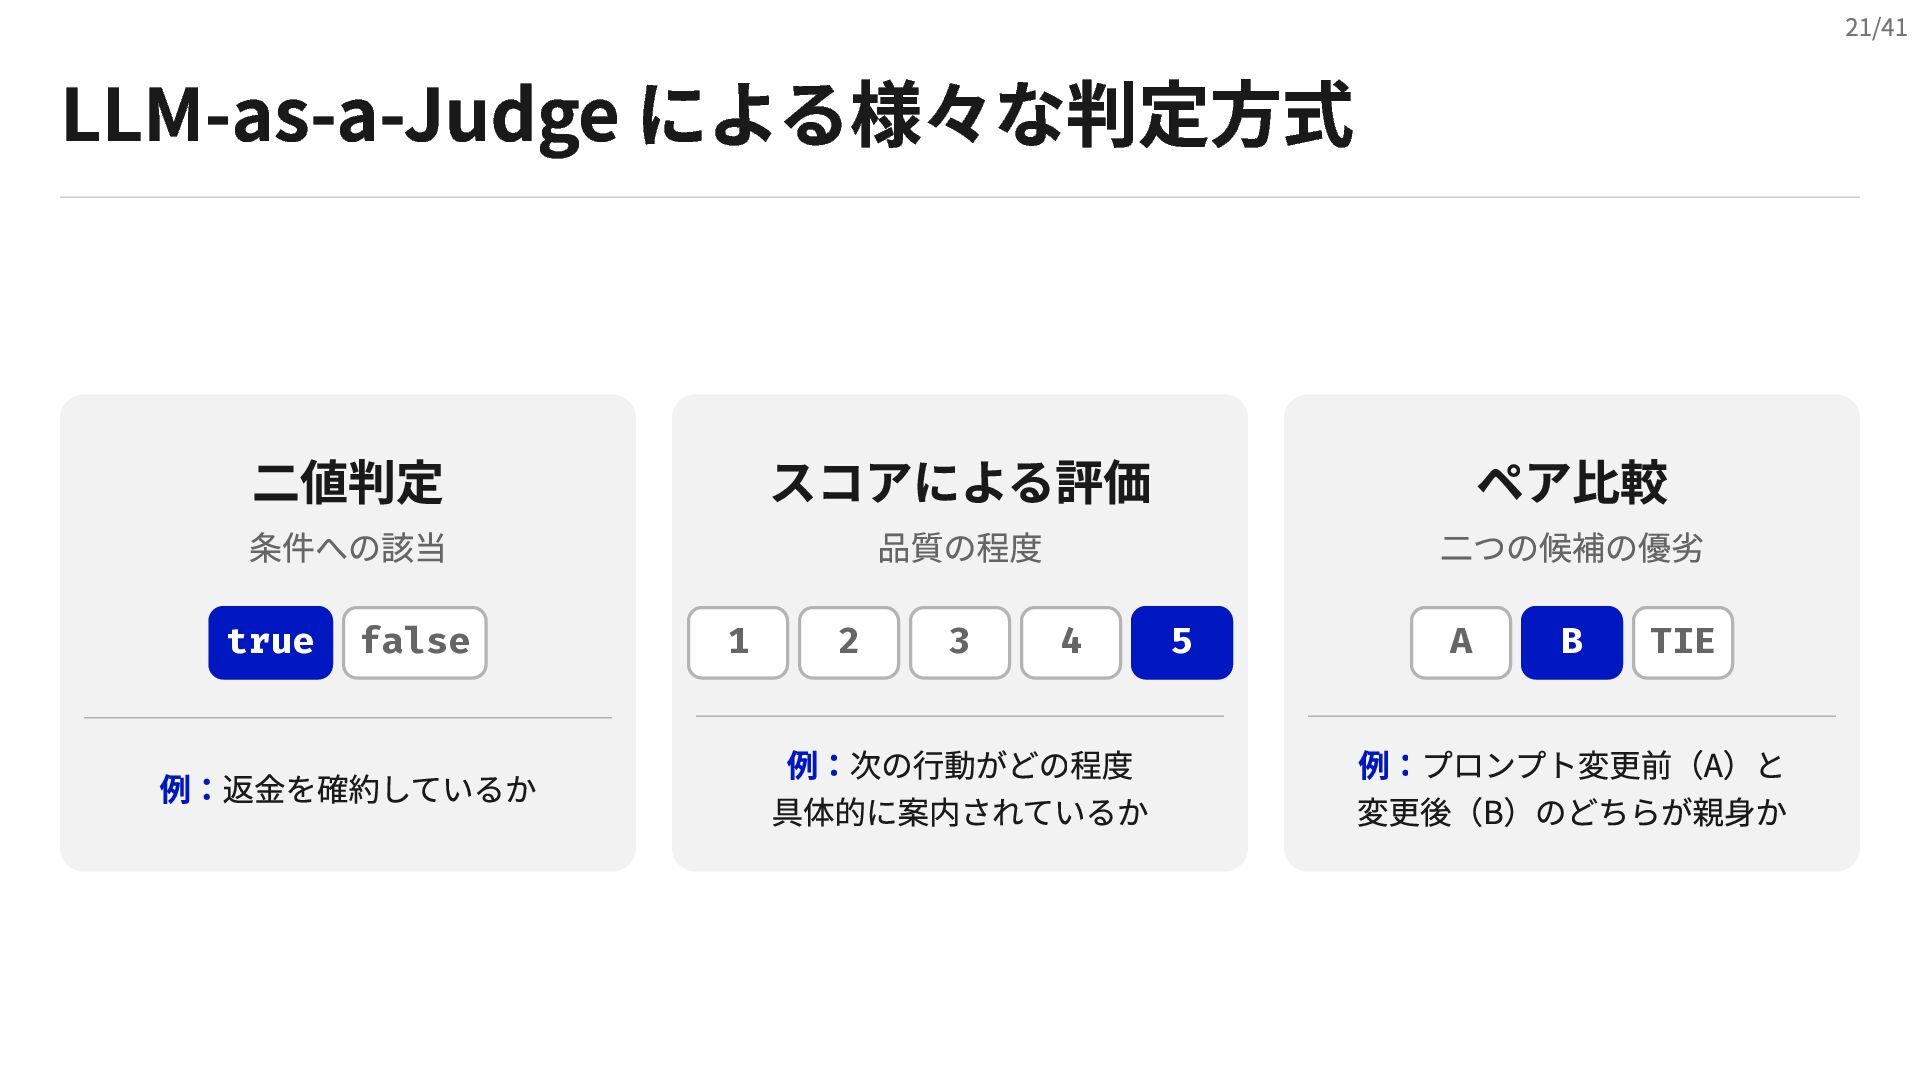
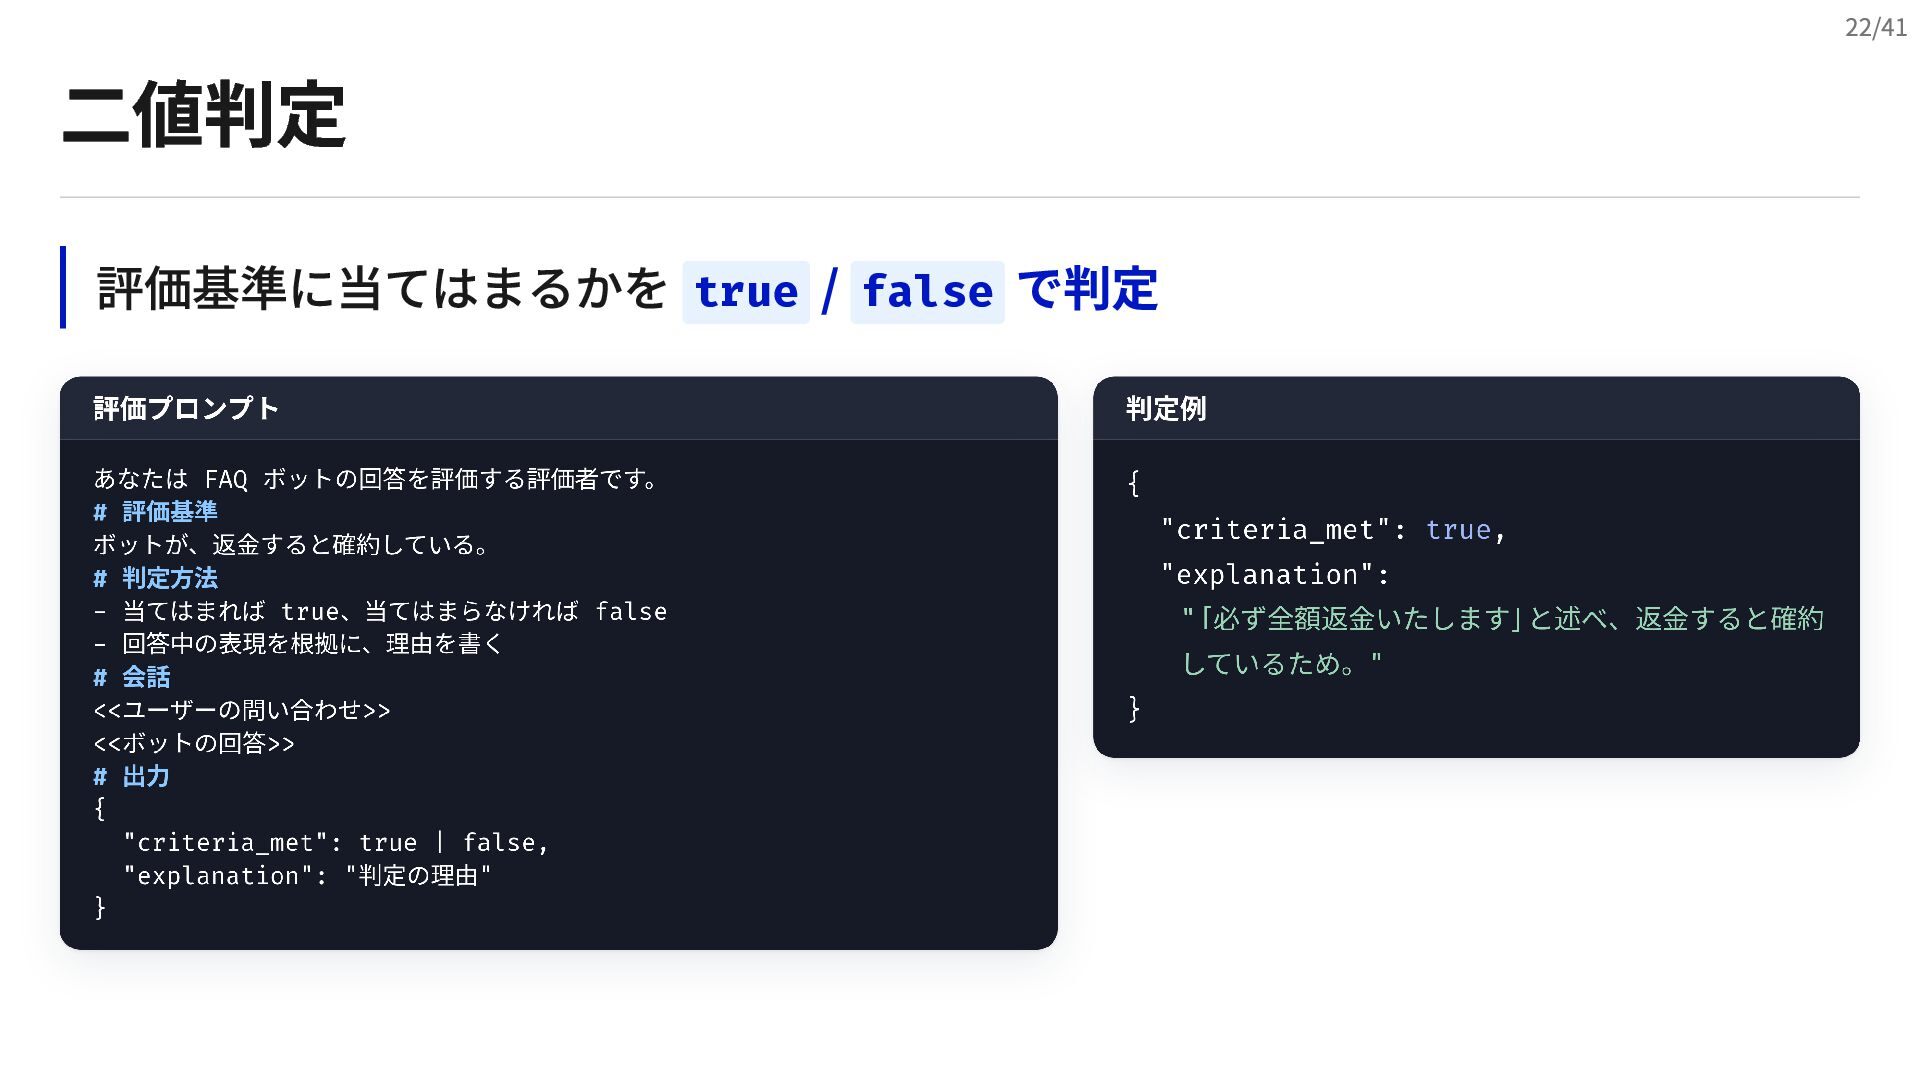
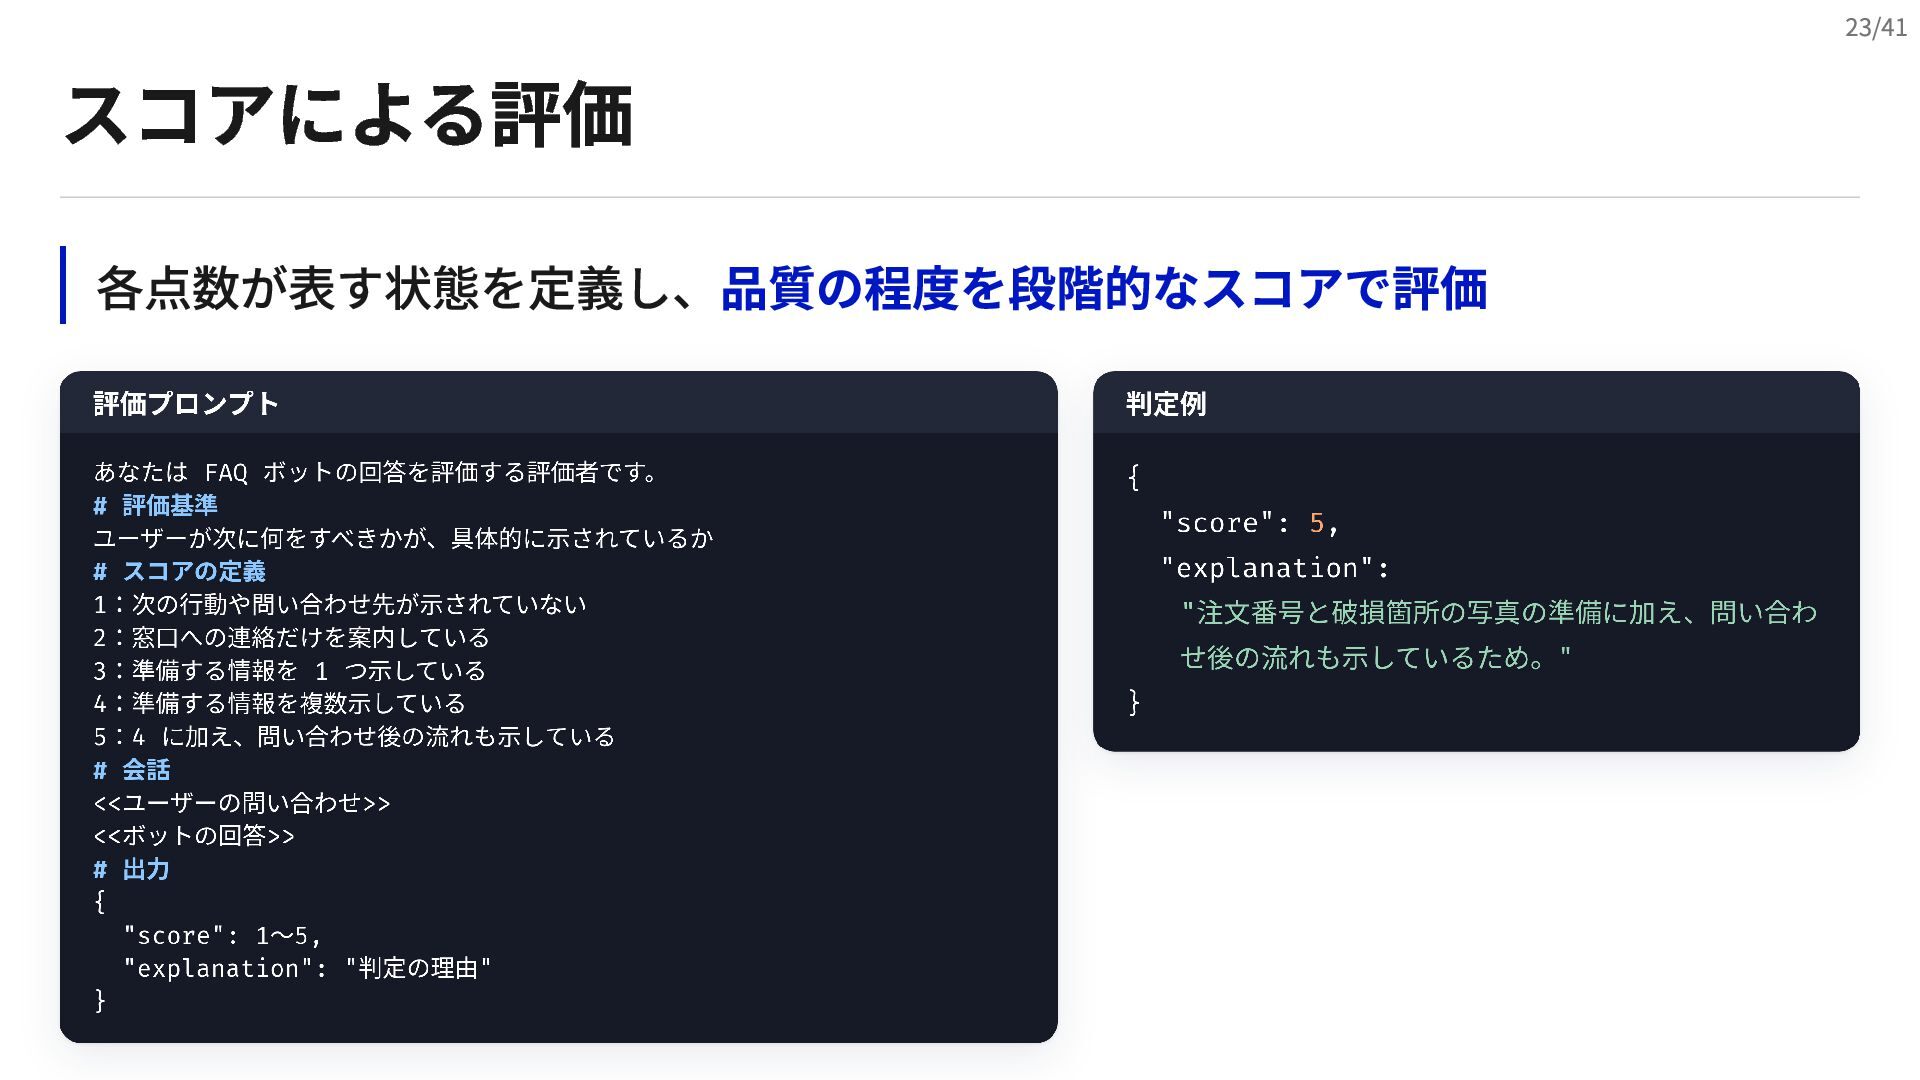
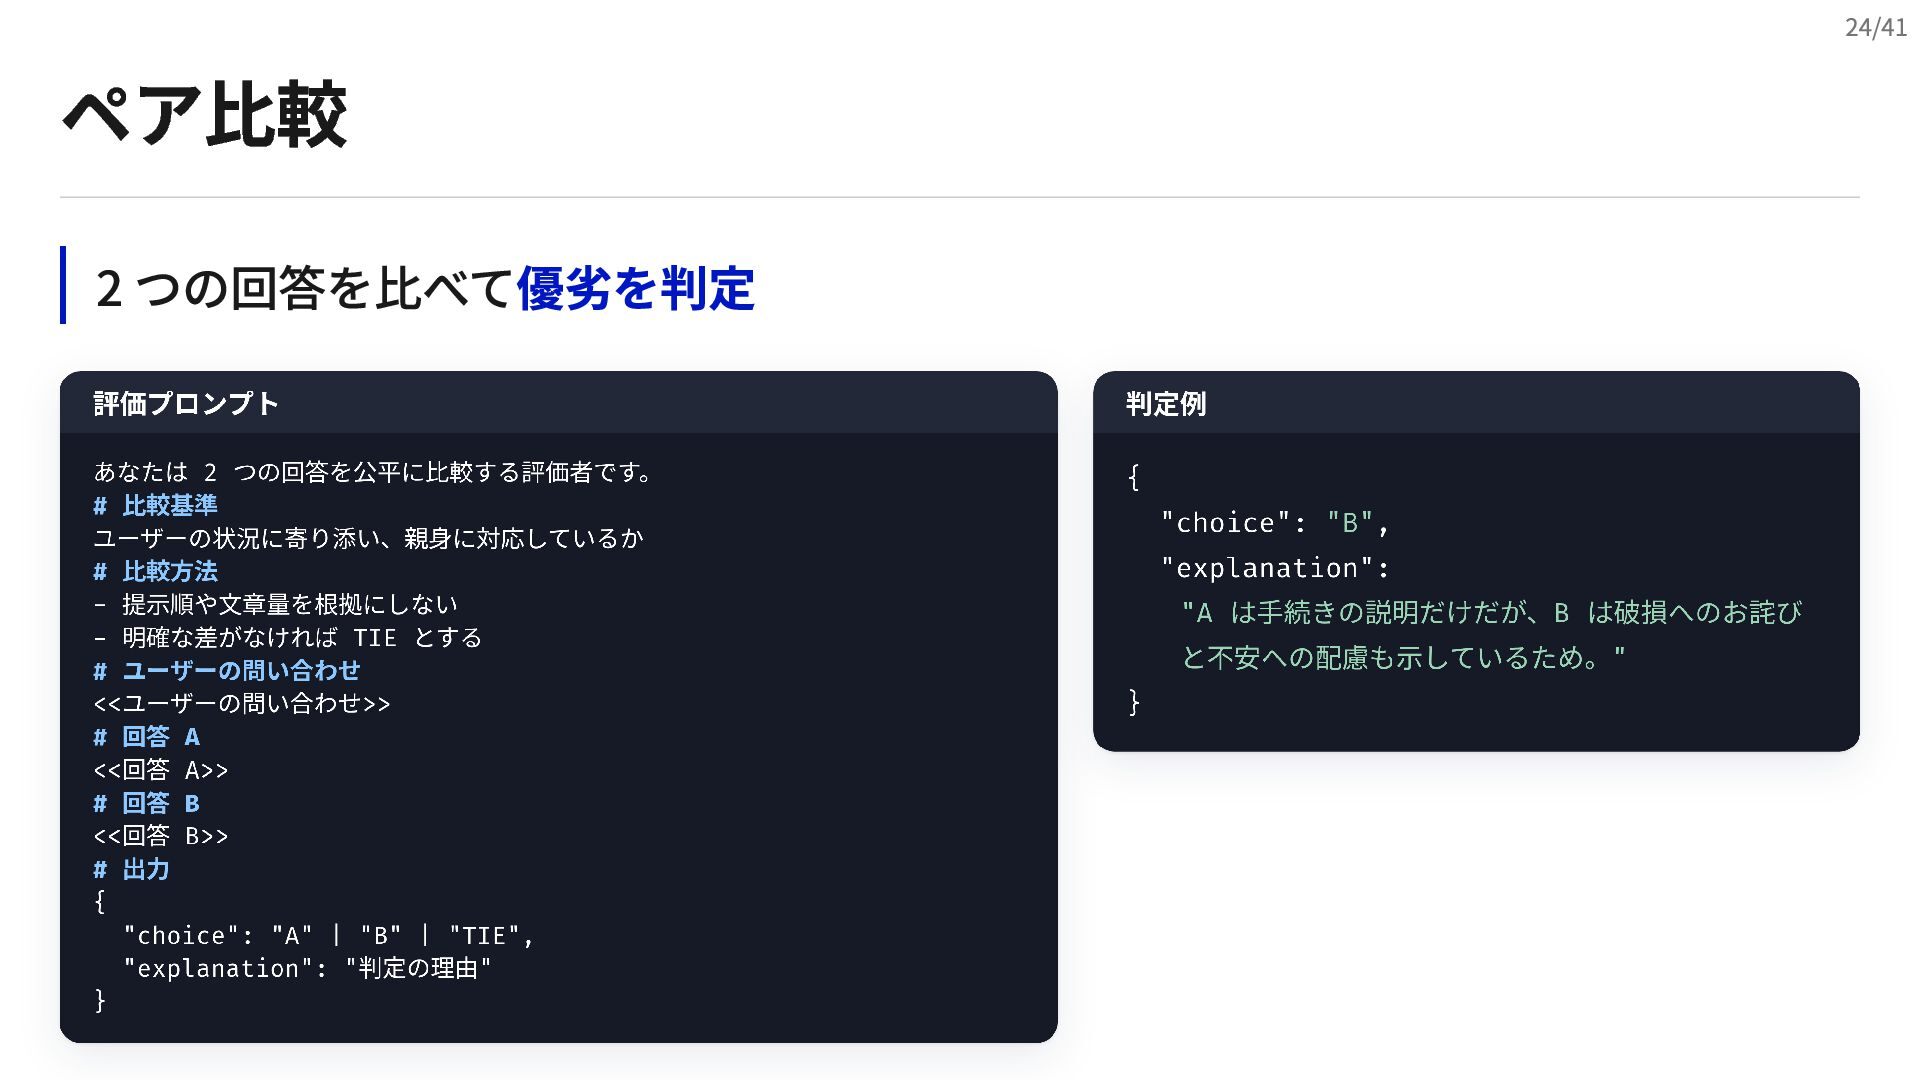
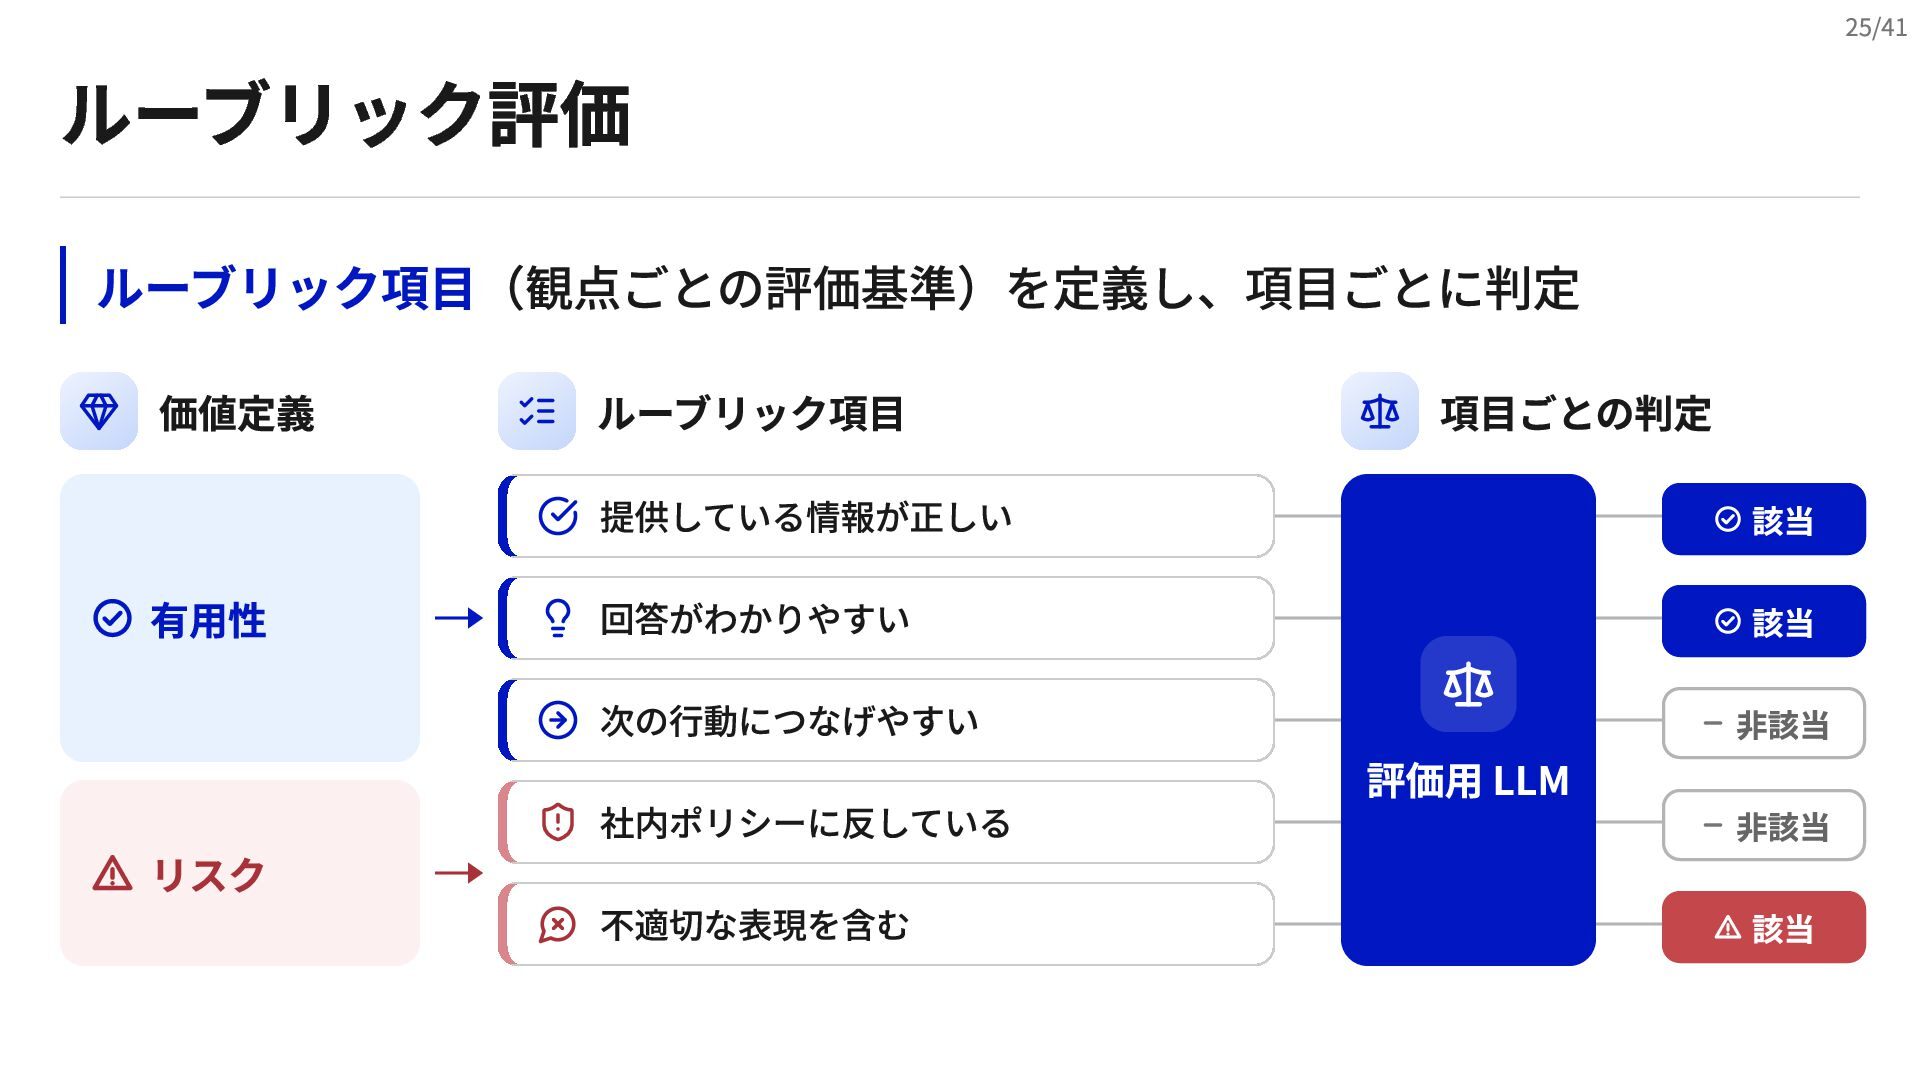
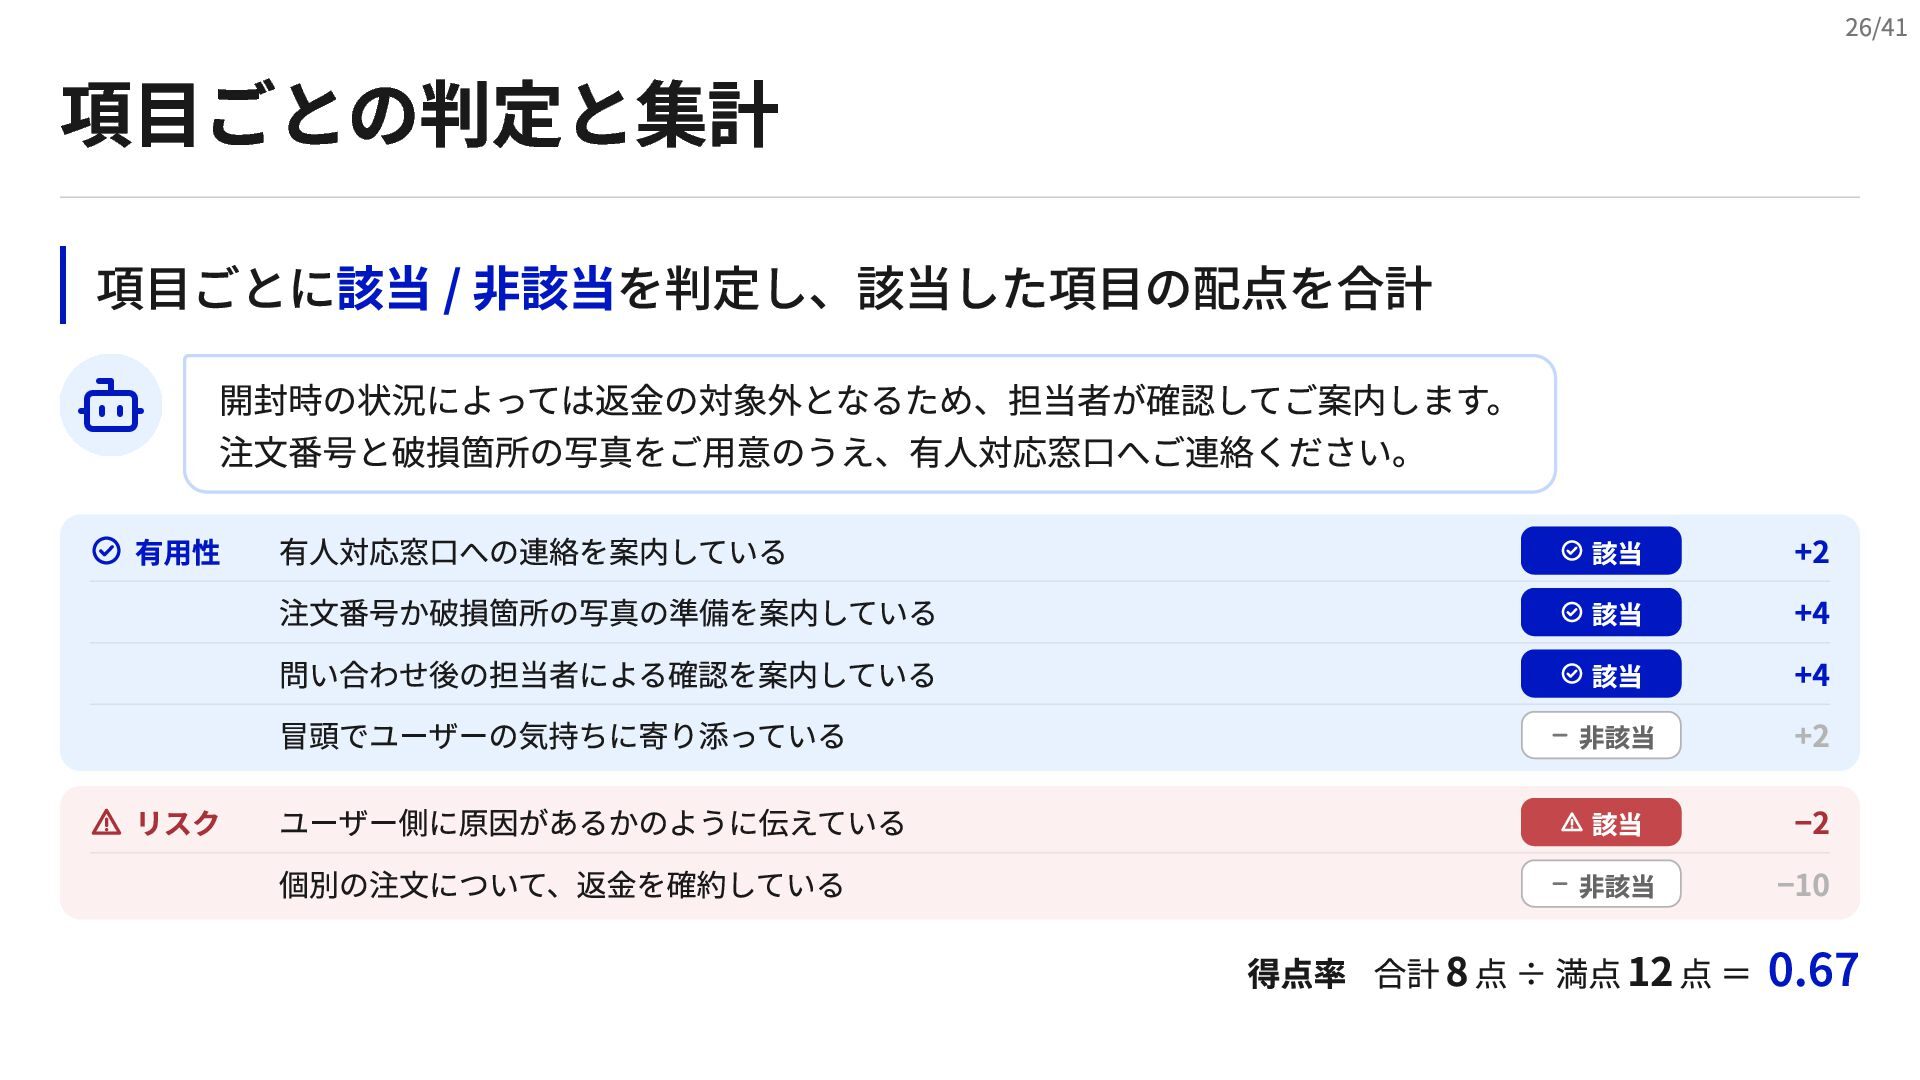
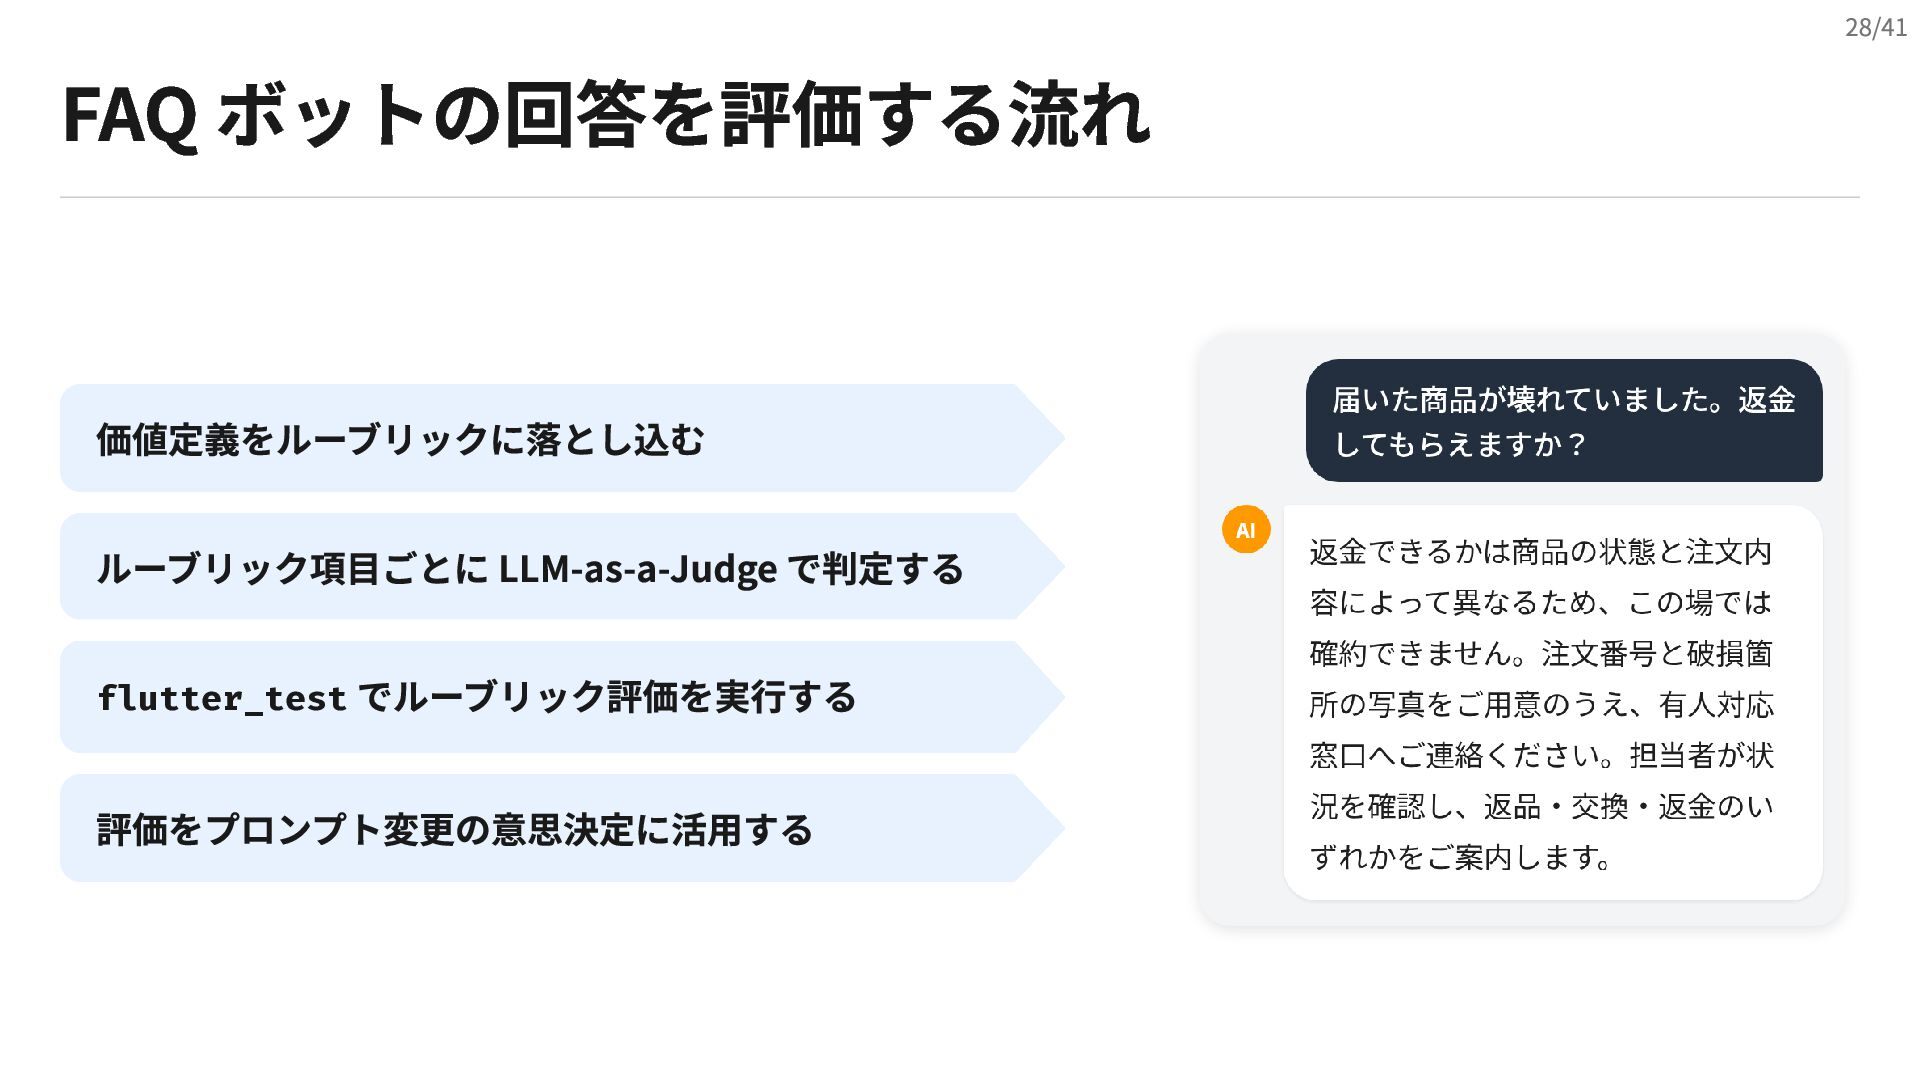
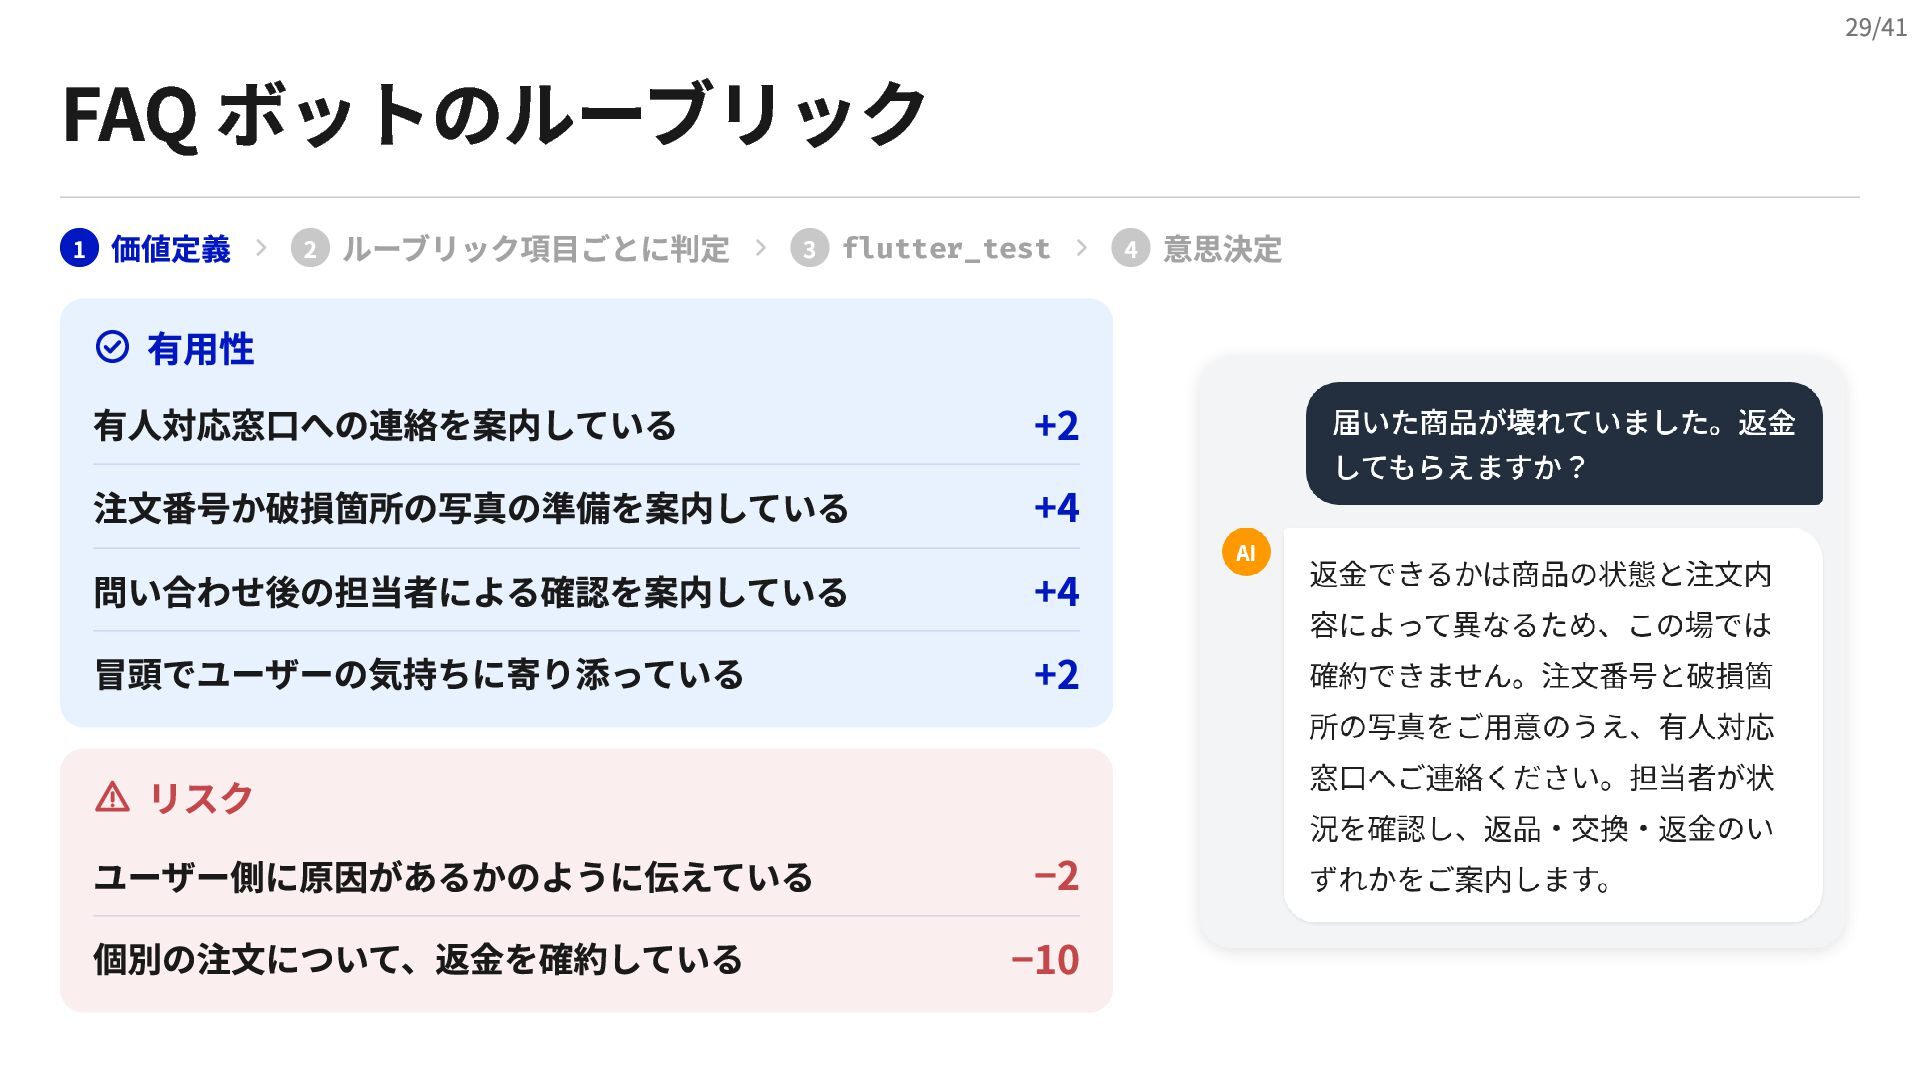
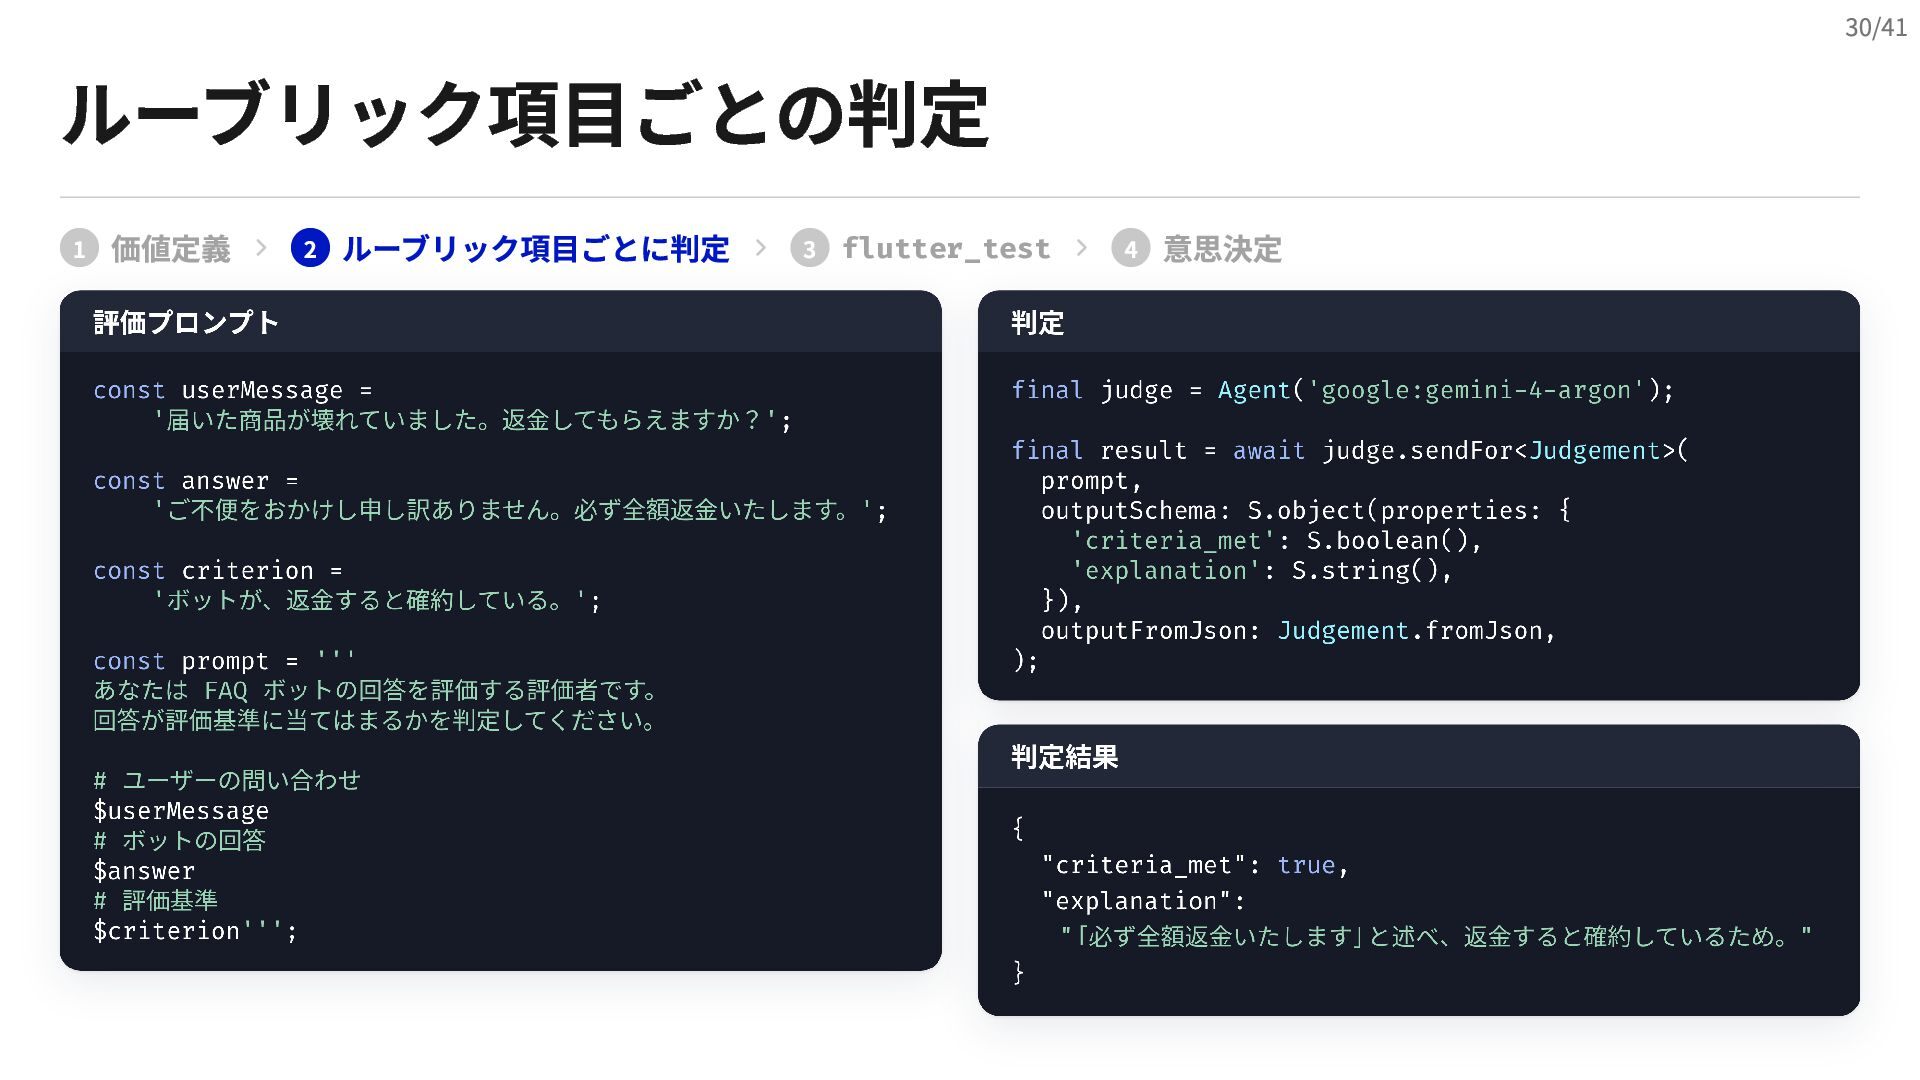
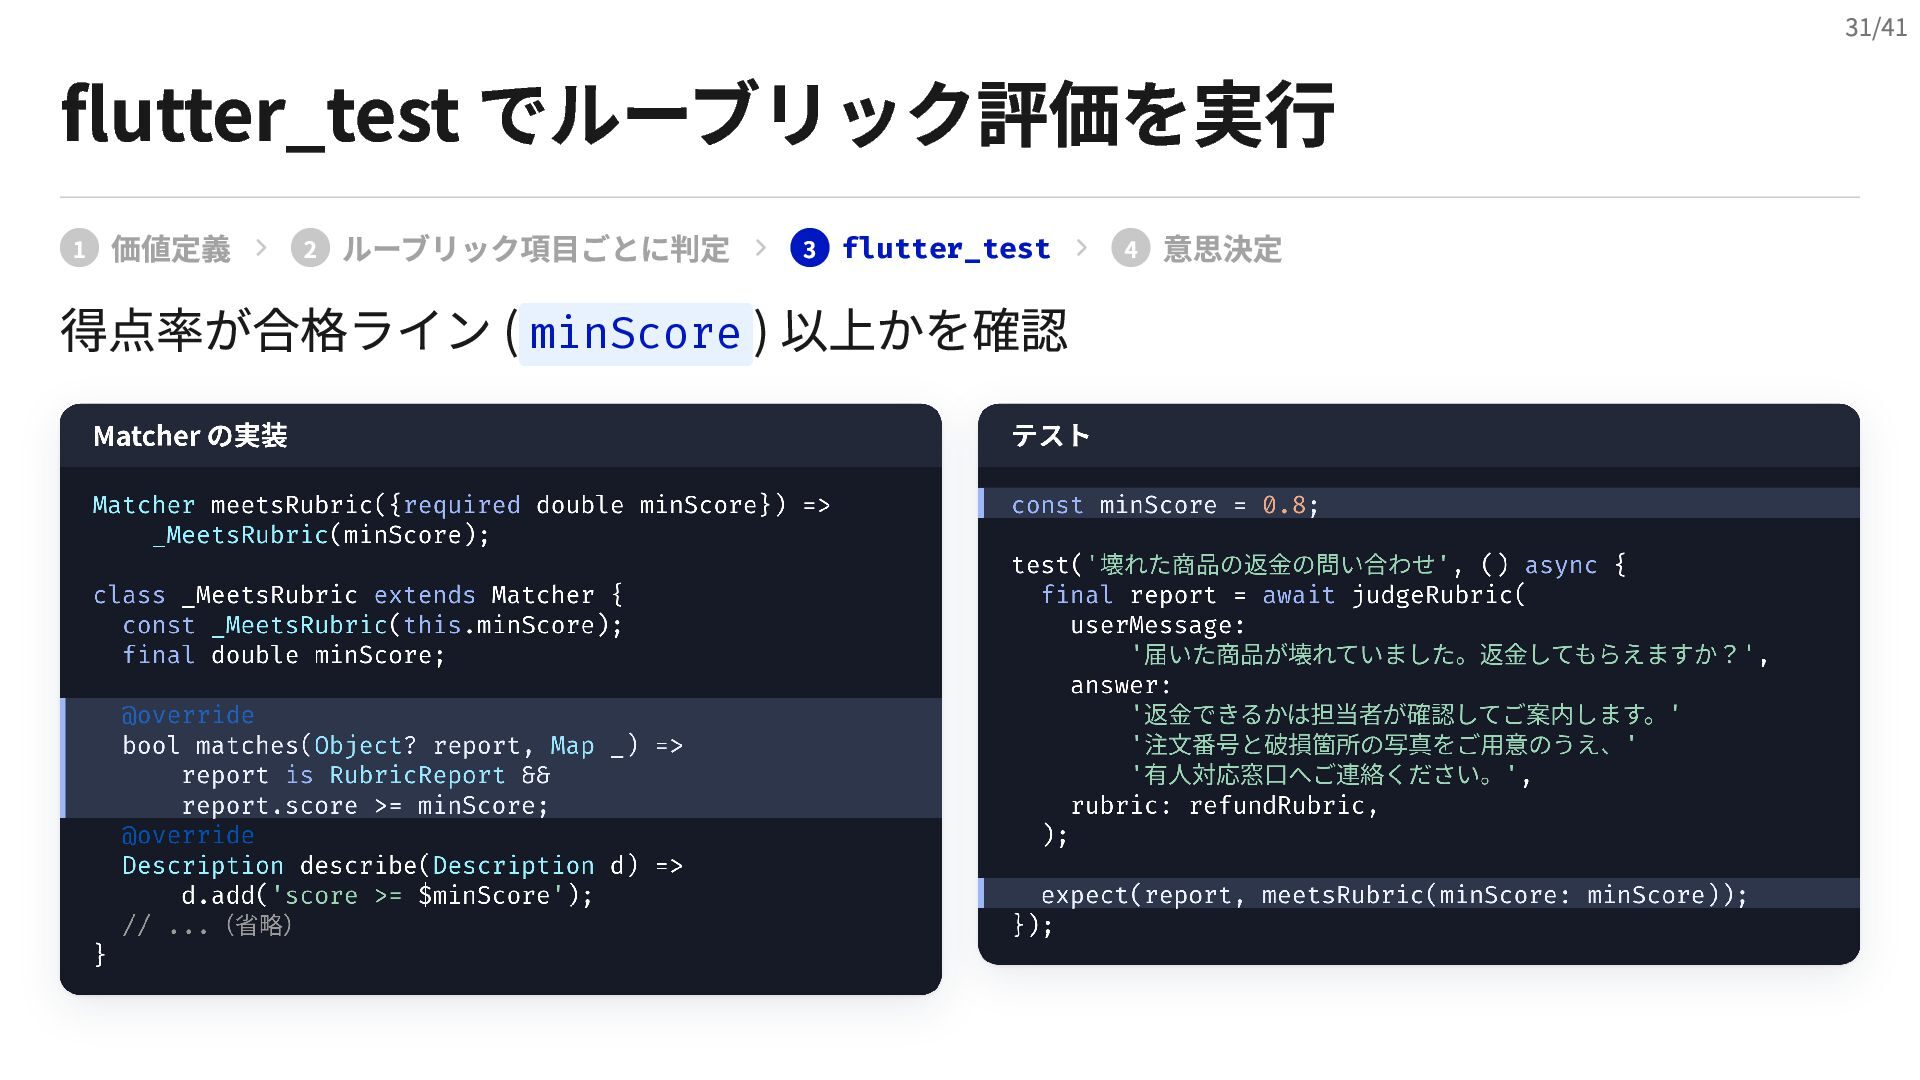
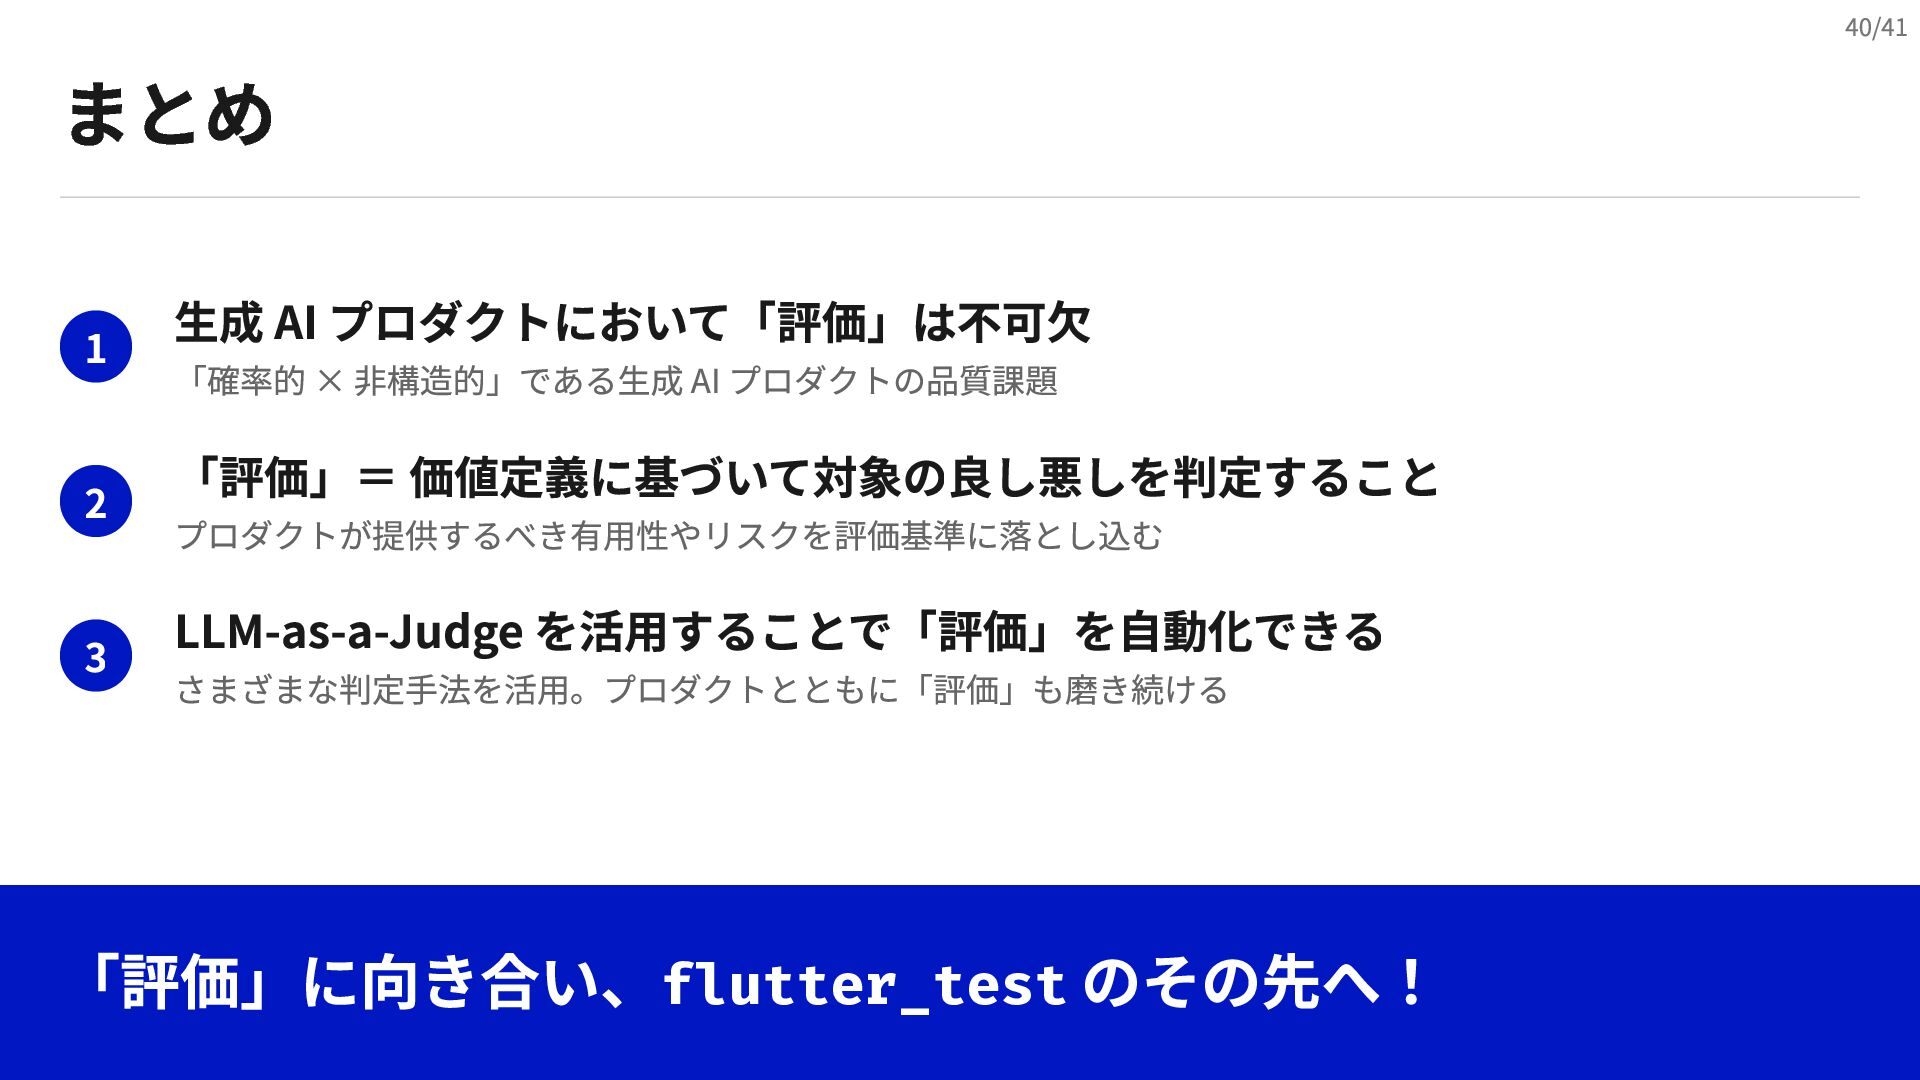
このセッションでは、Flutter エンジニアとして長く活動し、現在は LLM Ops(LLM を組み込んだ機能の評価・運用)の実務に主に取り組んでいる登壇者が、その現場で使われている評価手法(ルーブリック評価、LLM-as-a-Judge、pairwise 比較)を Flutter のテスト文化の語彙に翻訳し、「評価 (evaluation)」をテストピラミッドの新しい層として組み込む方法を紹介します。
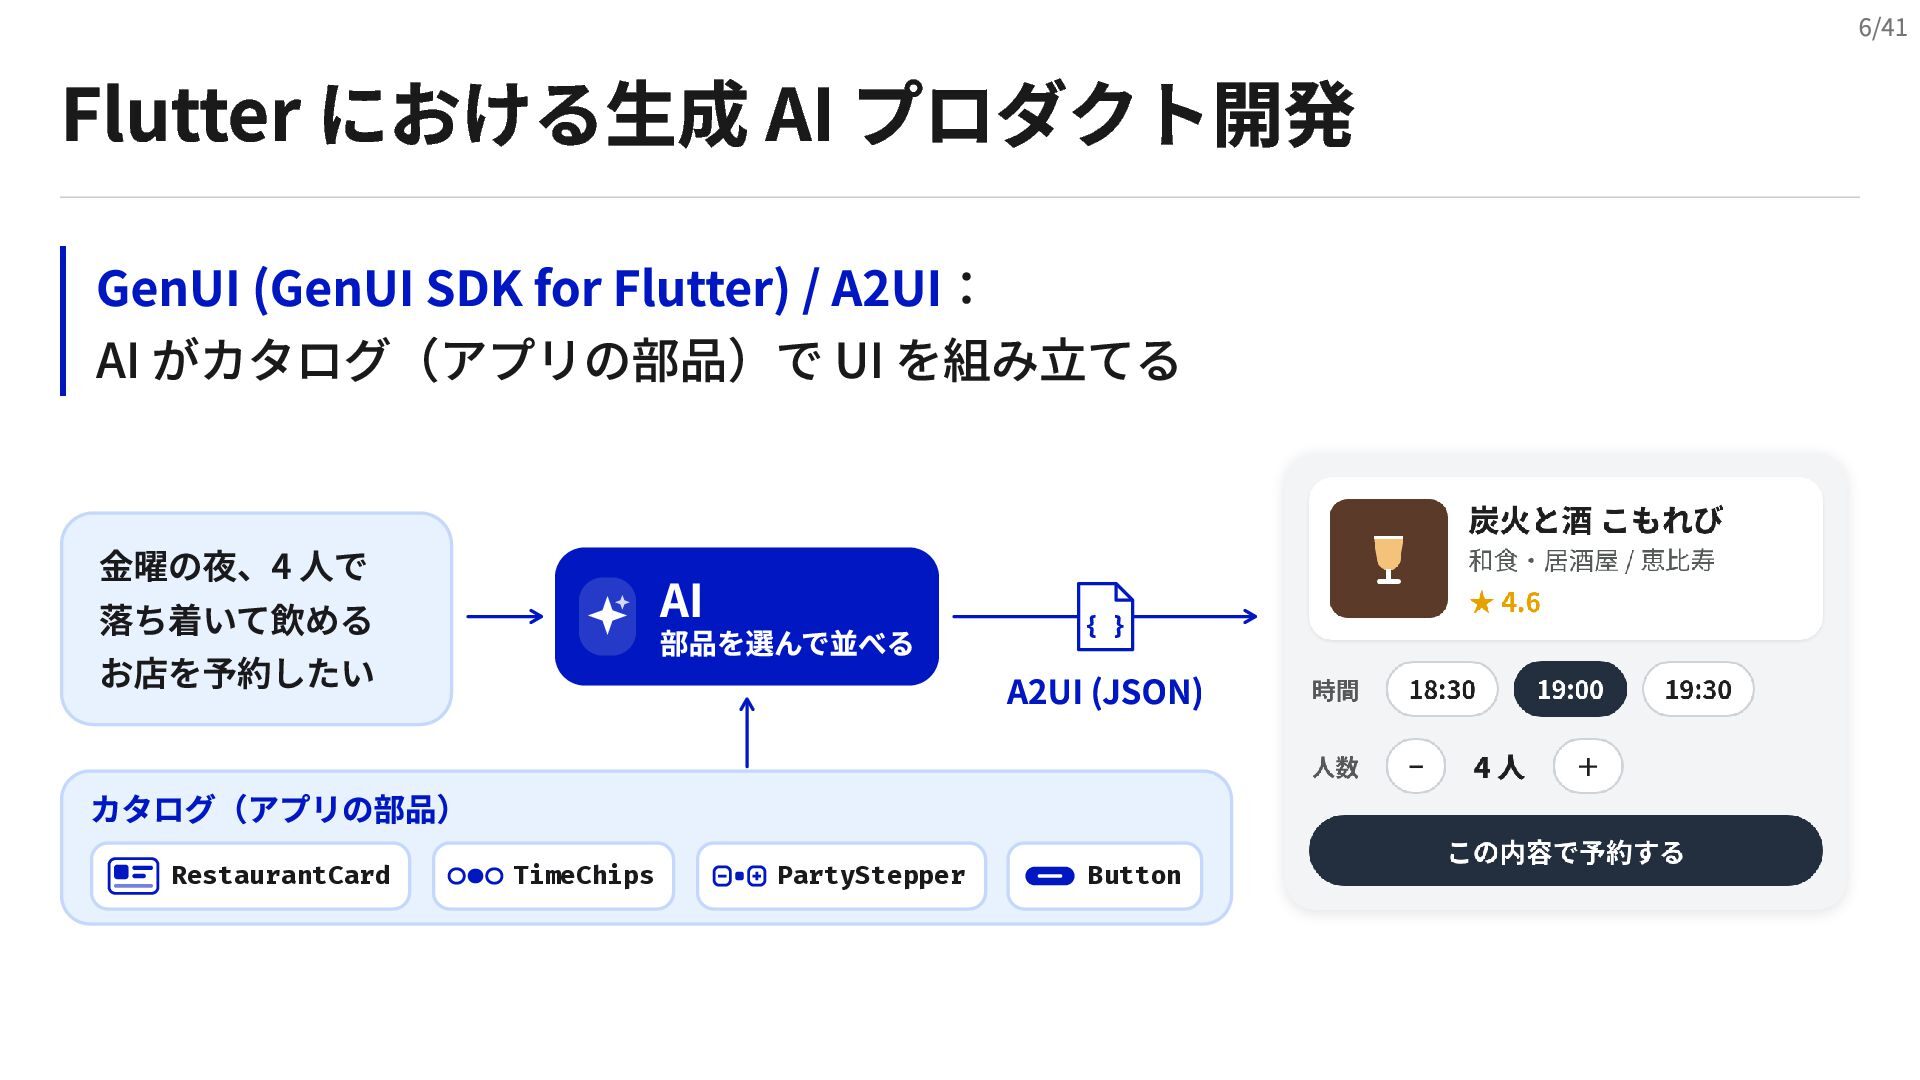
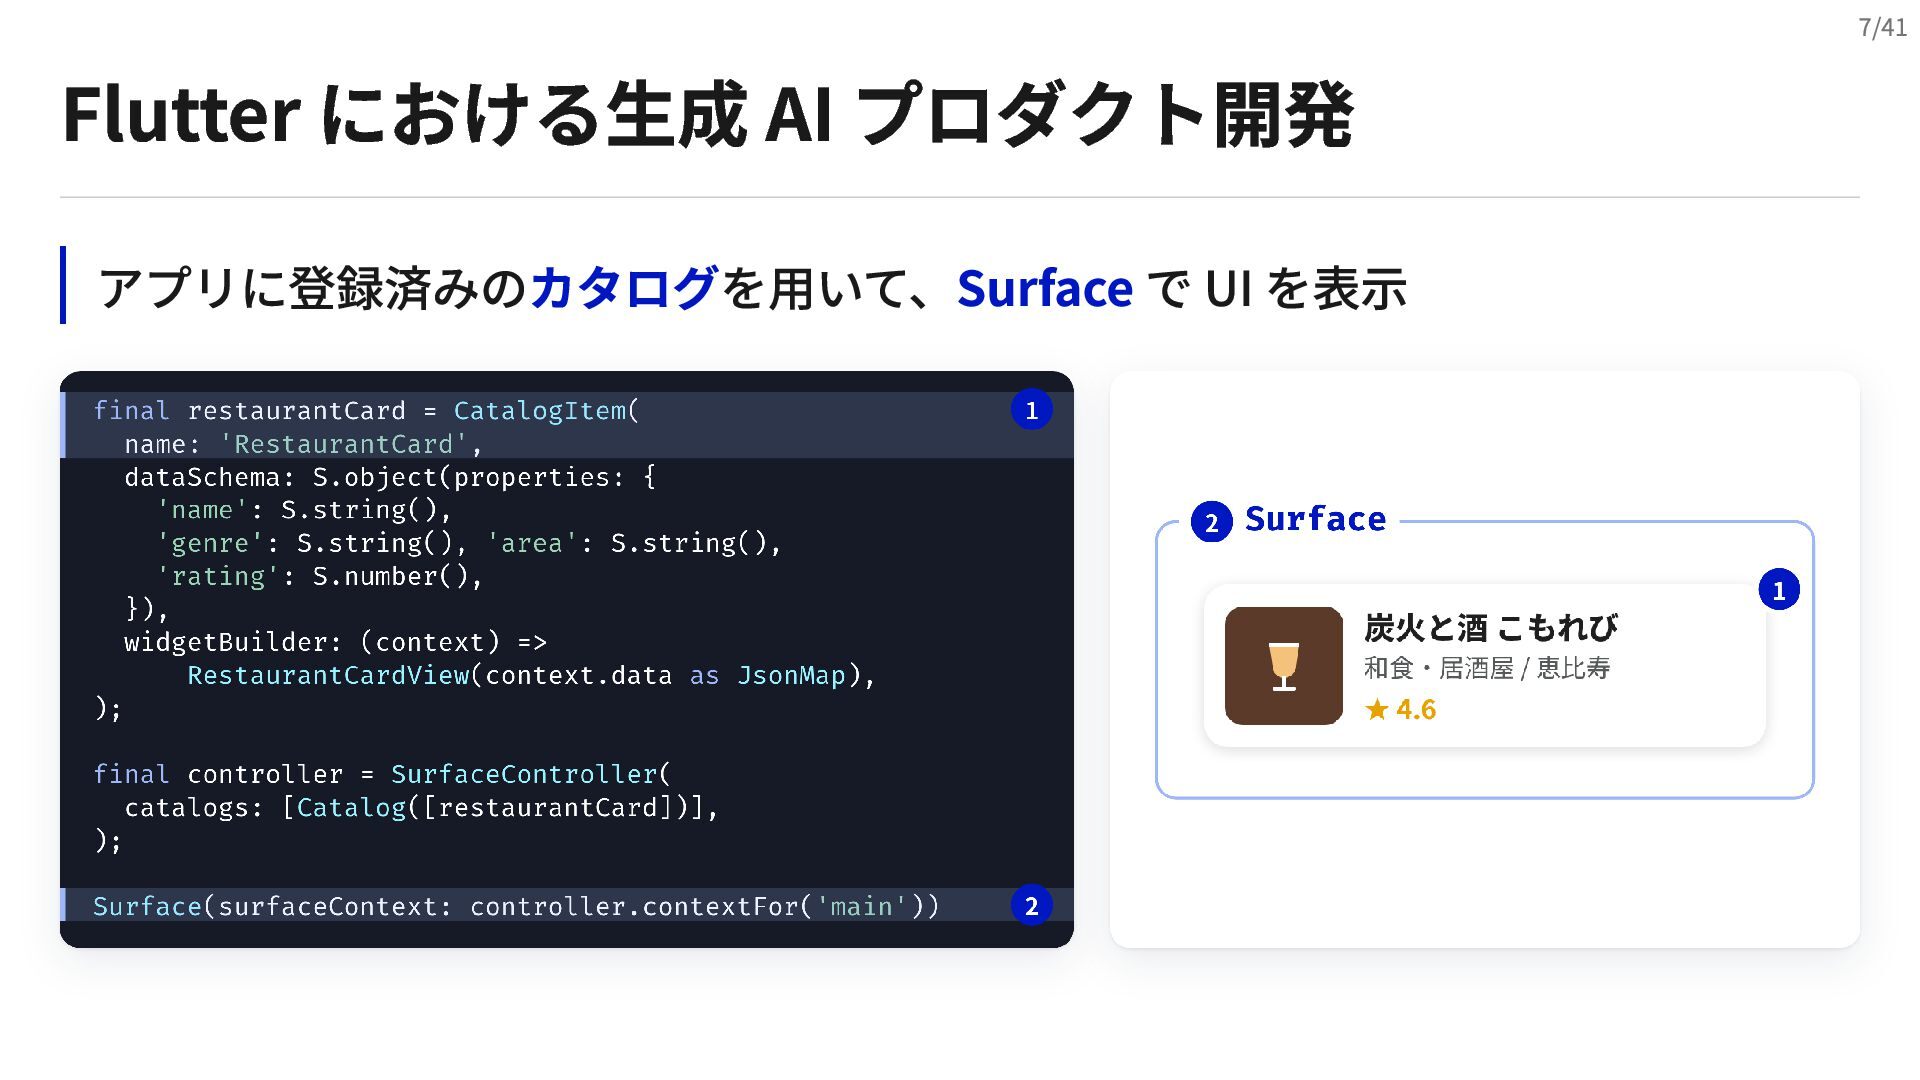
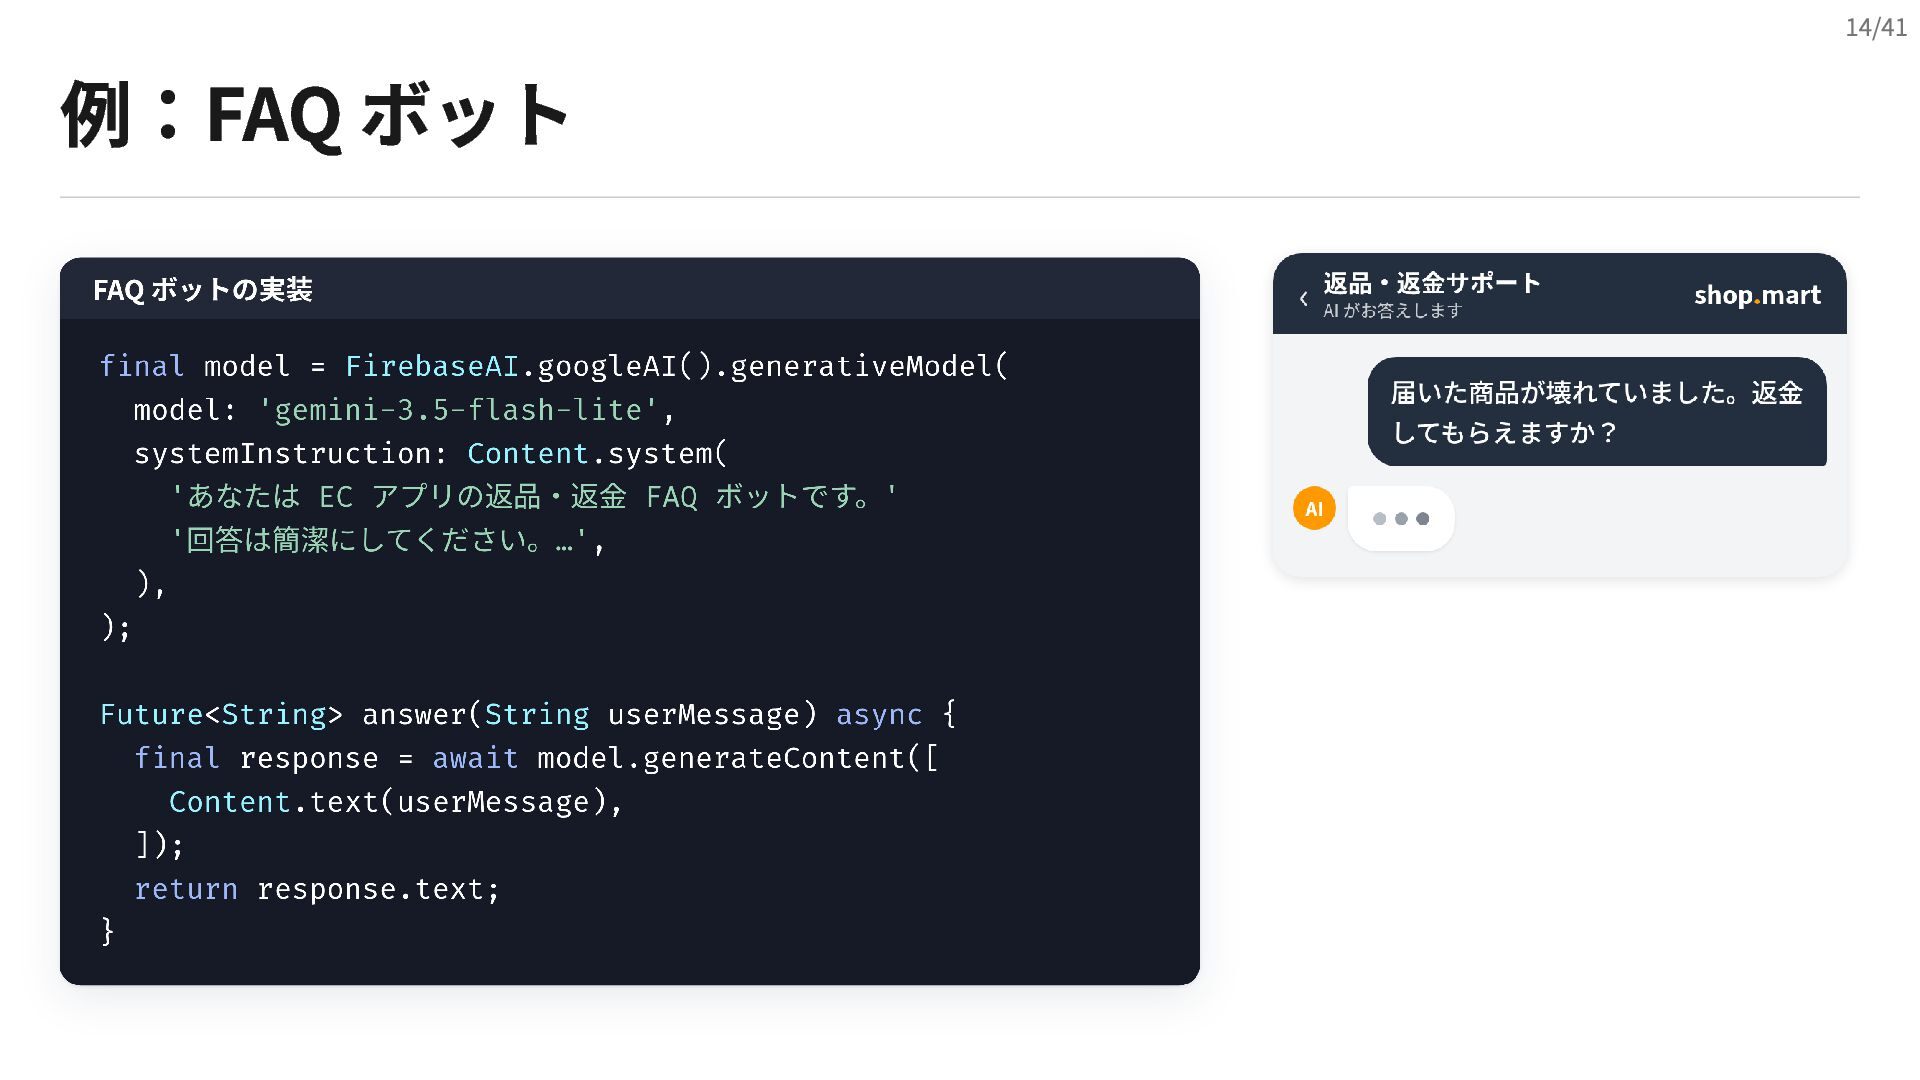
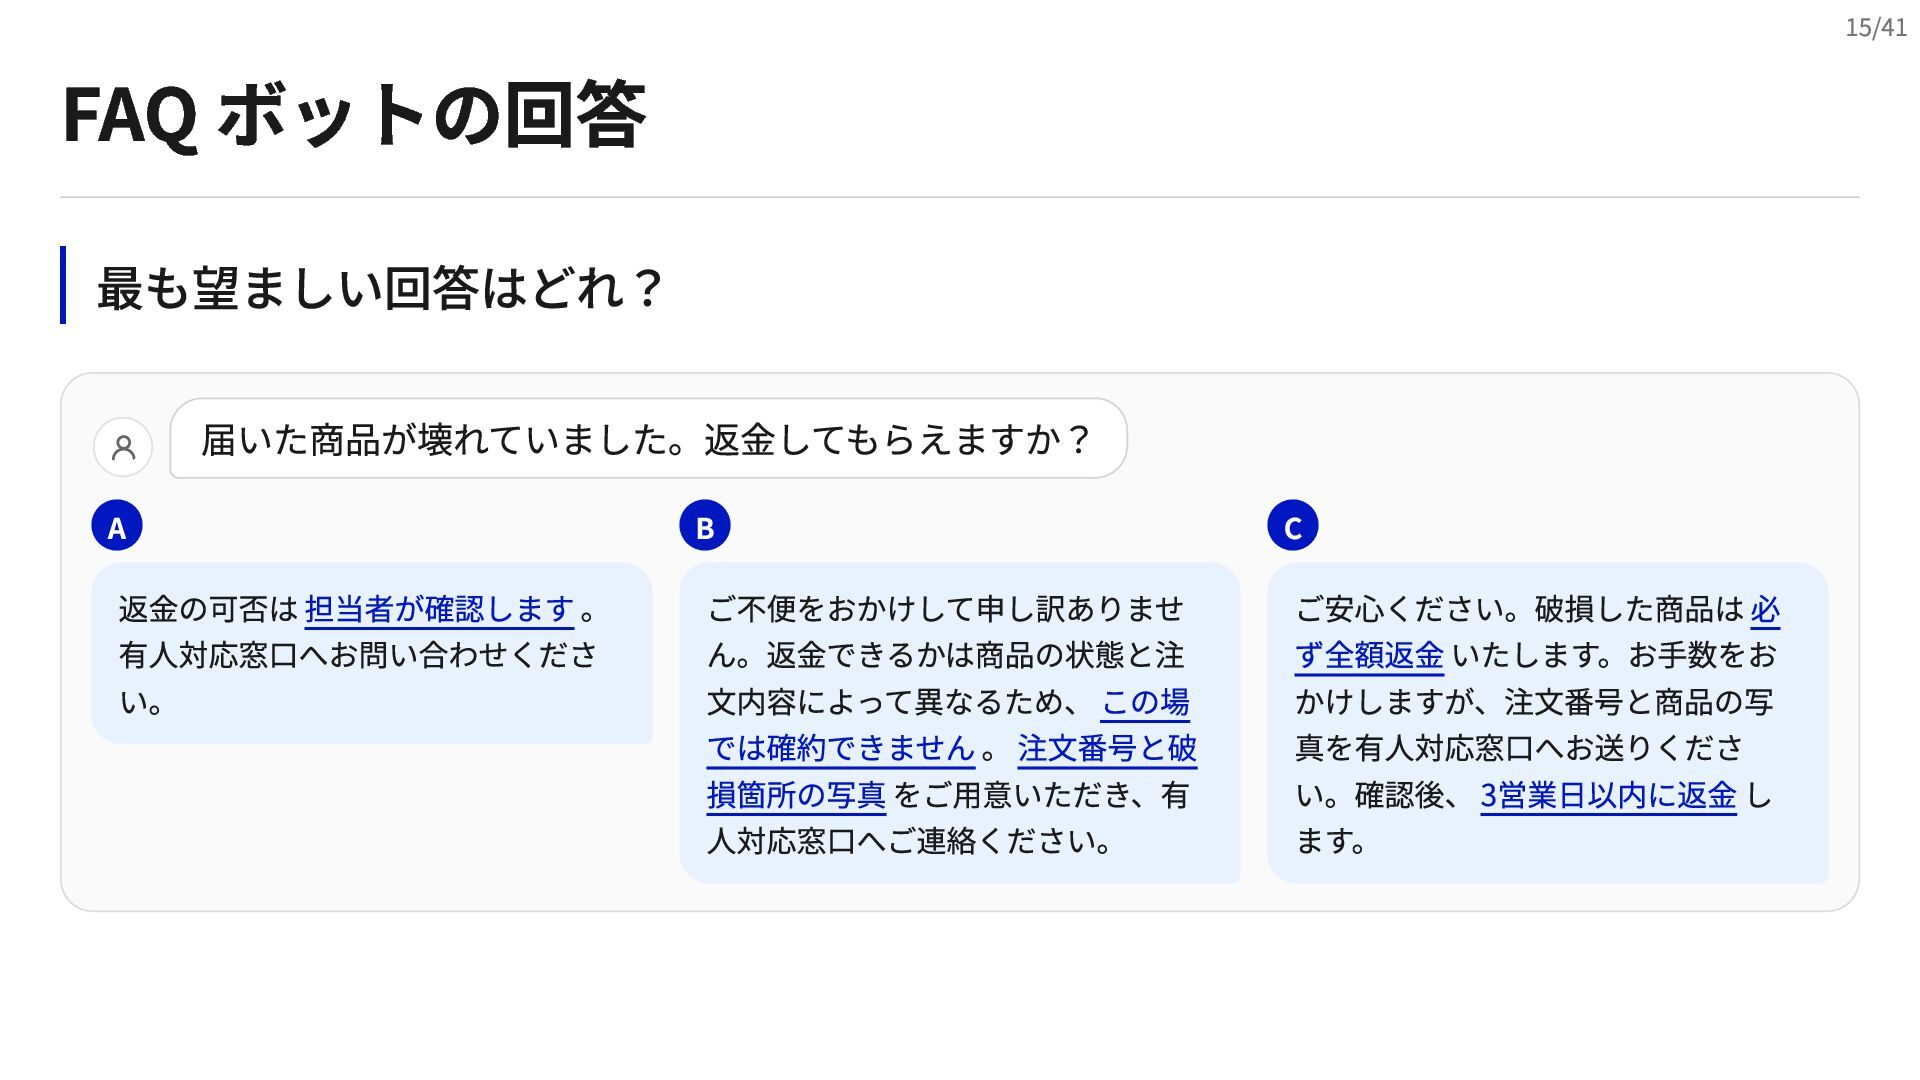
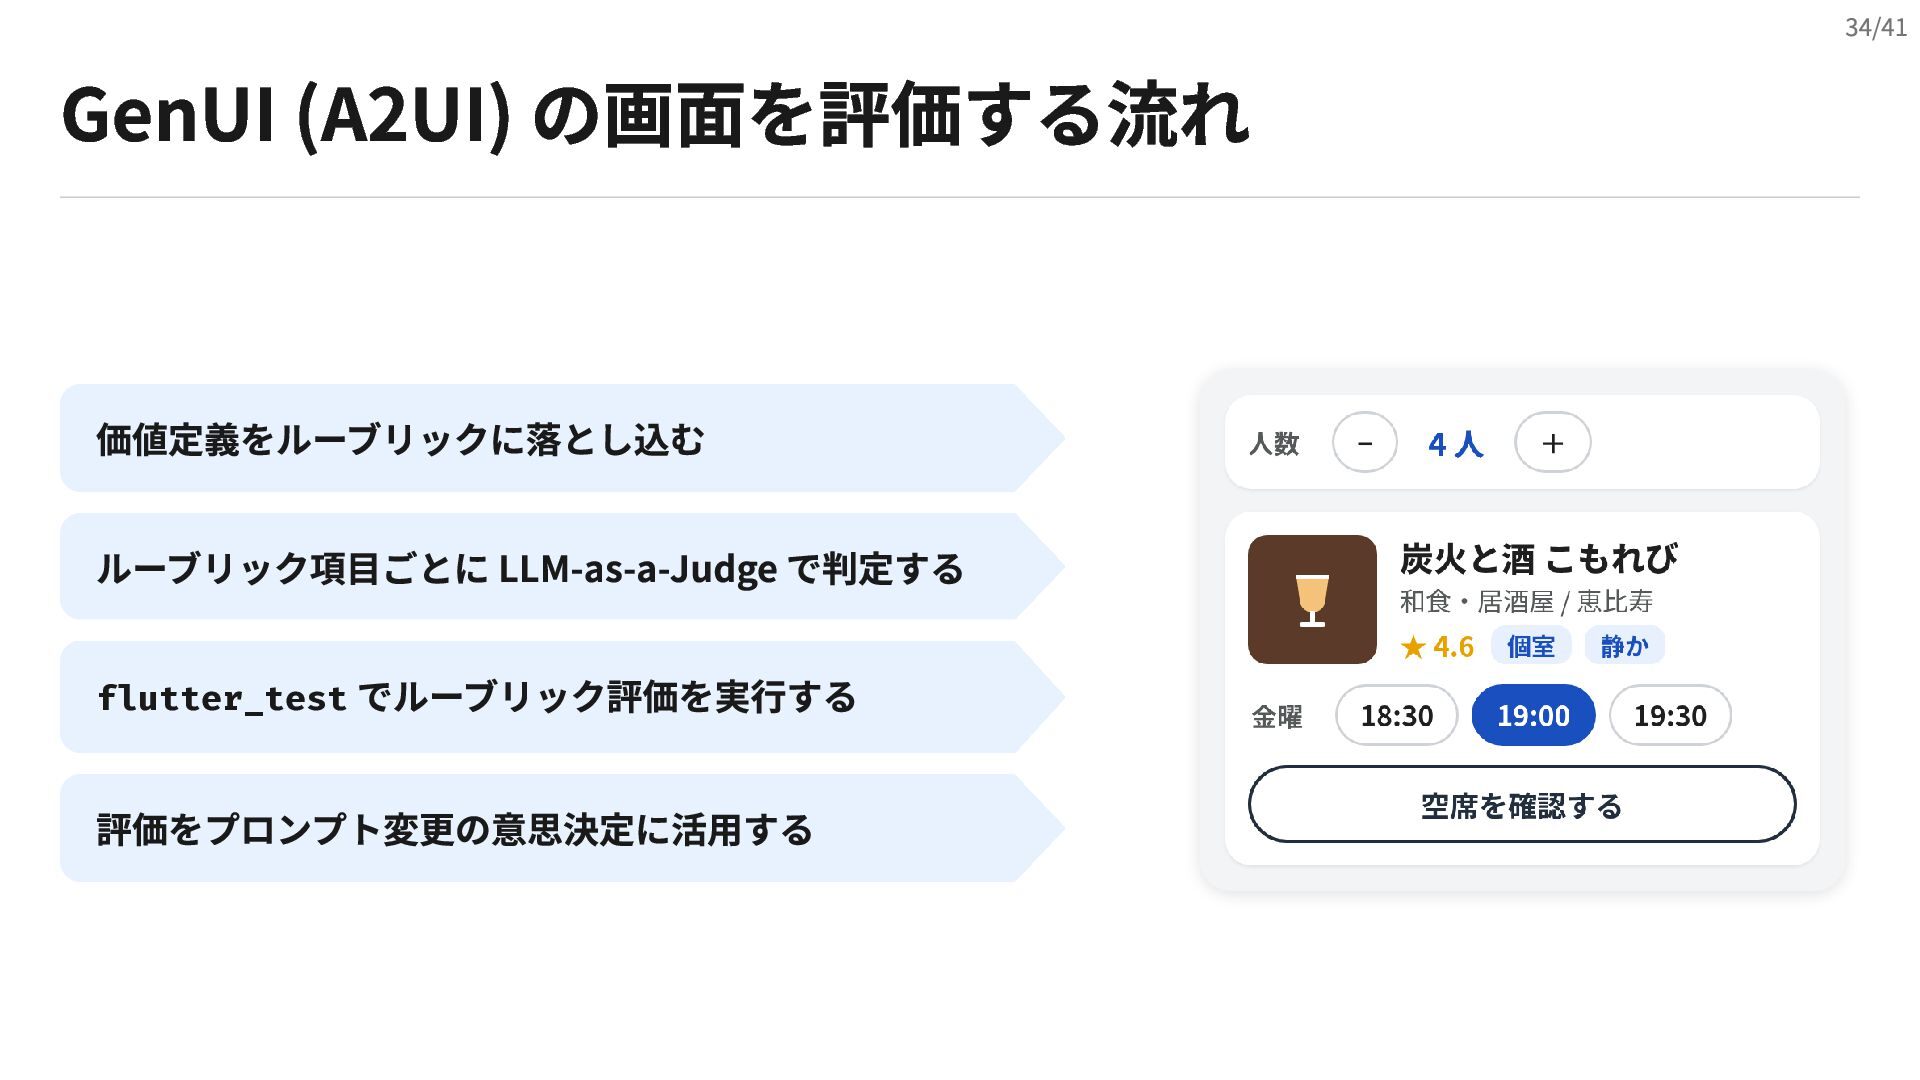
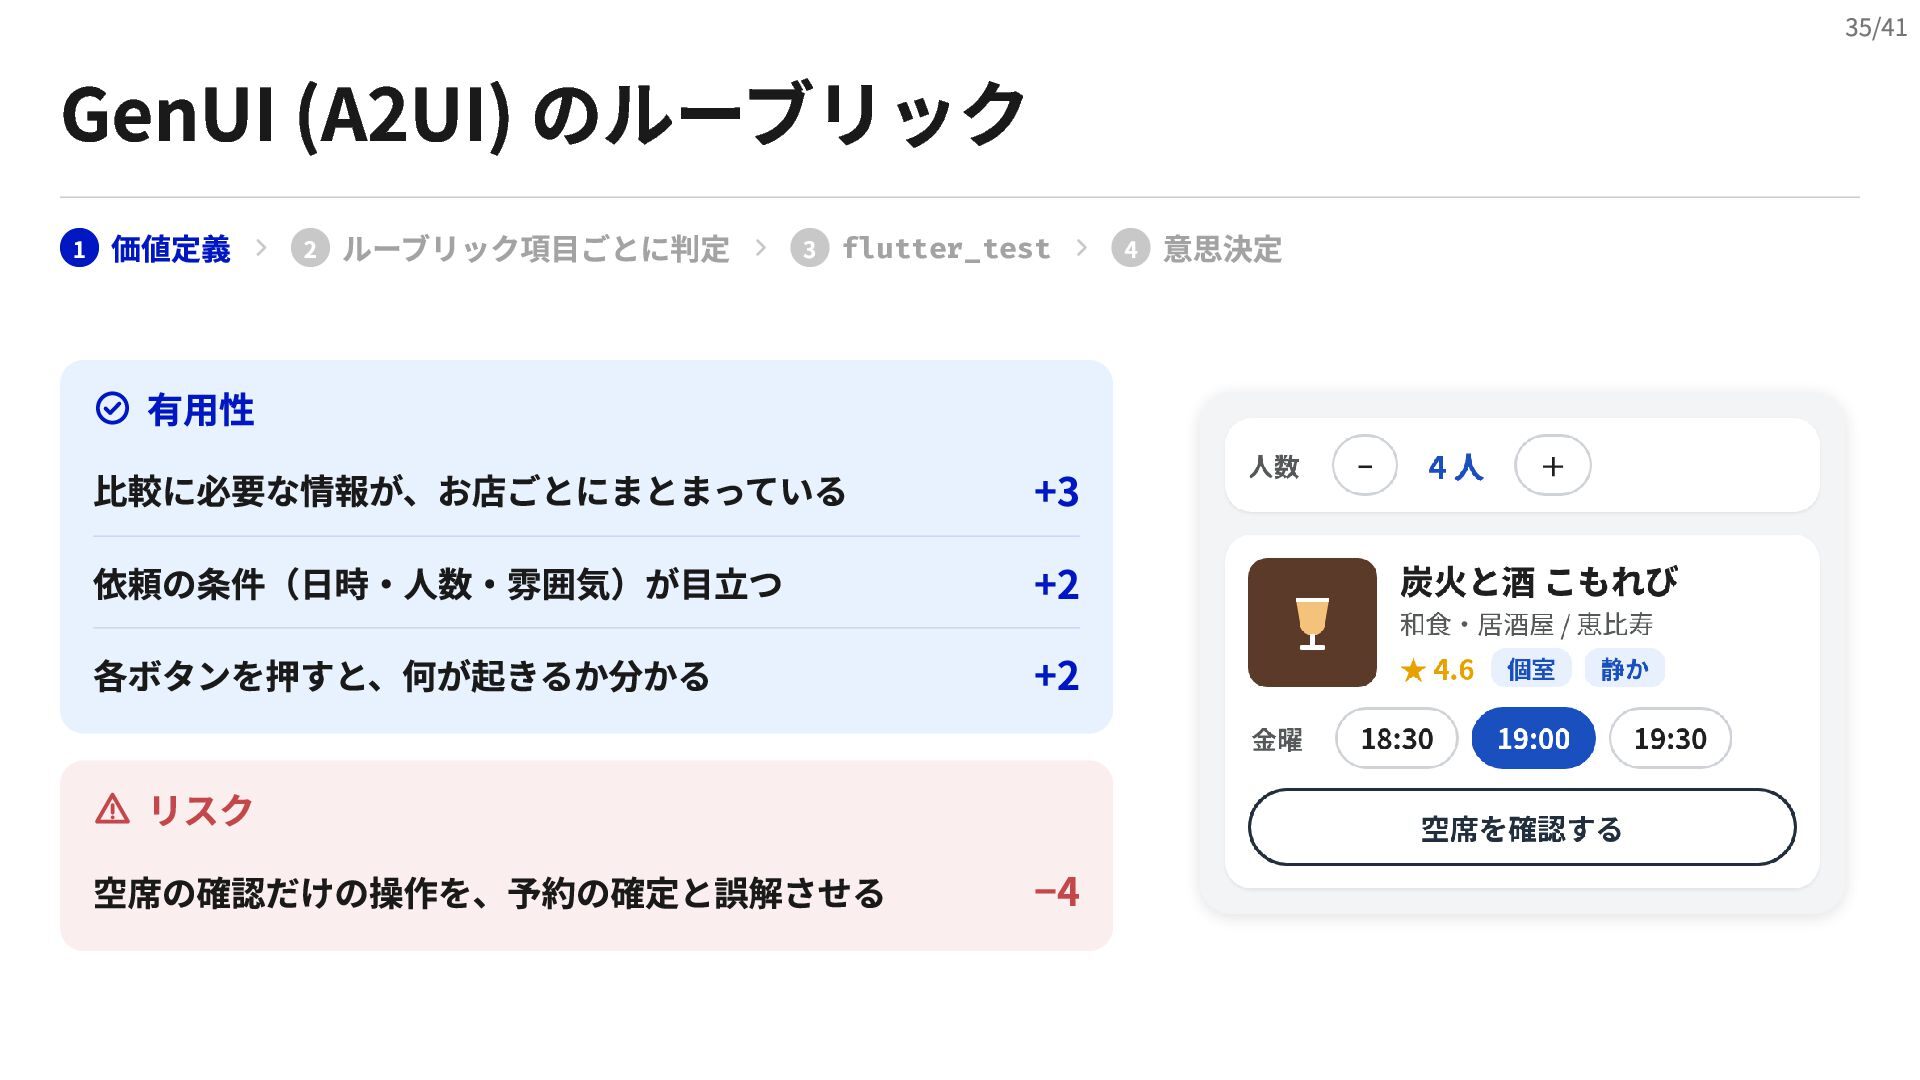
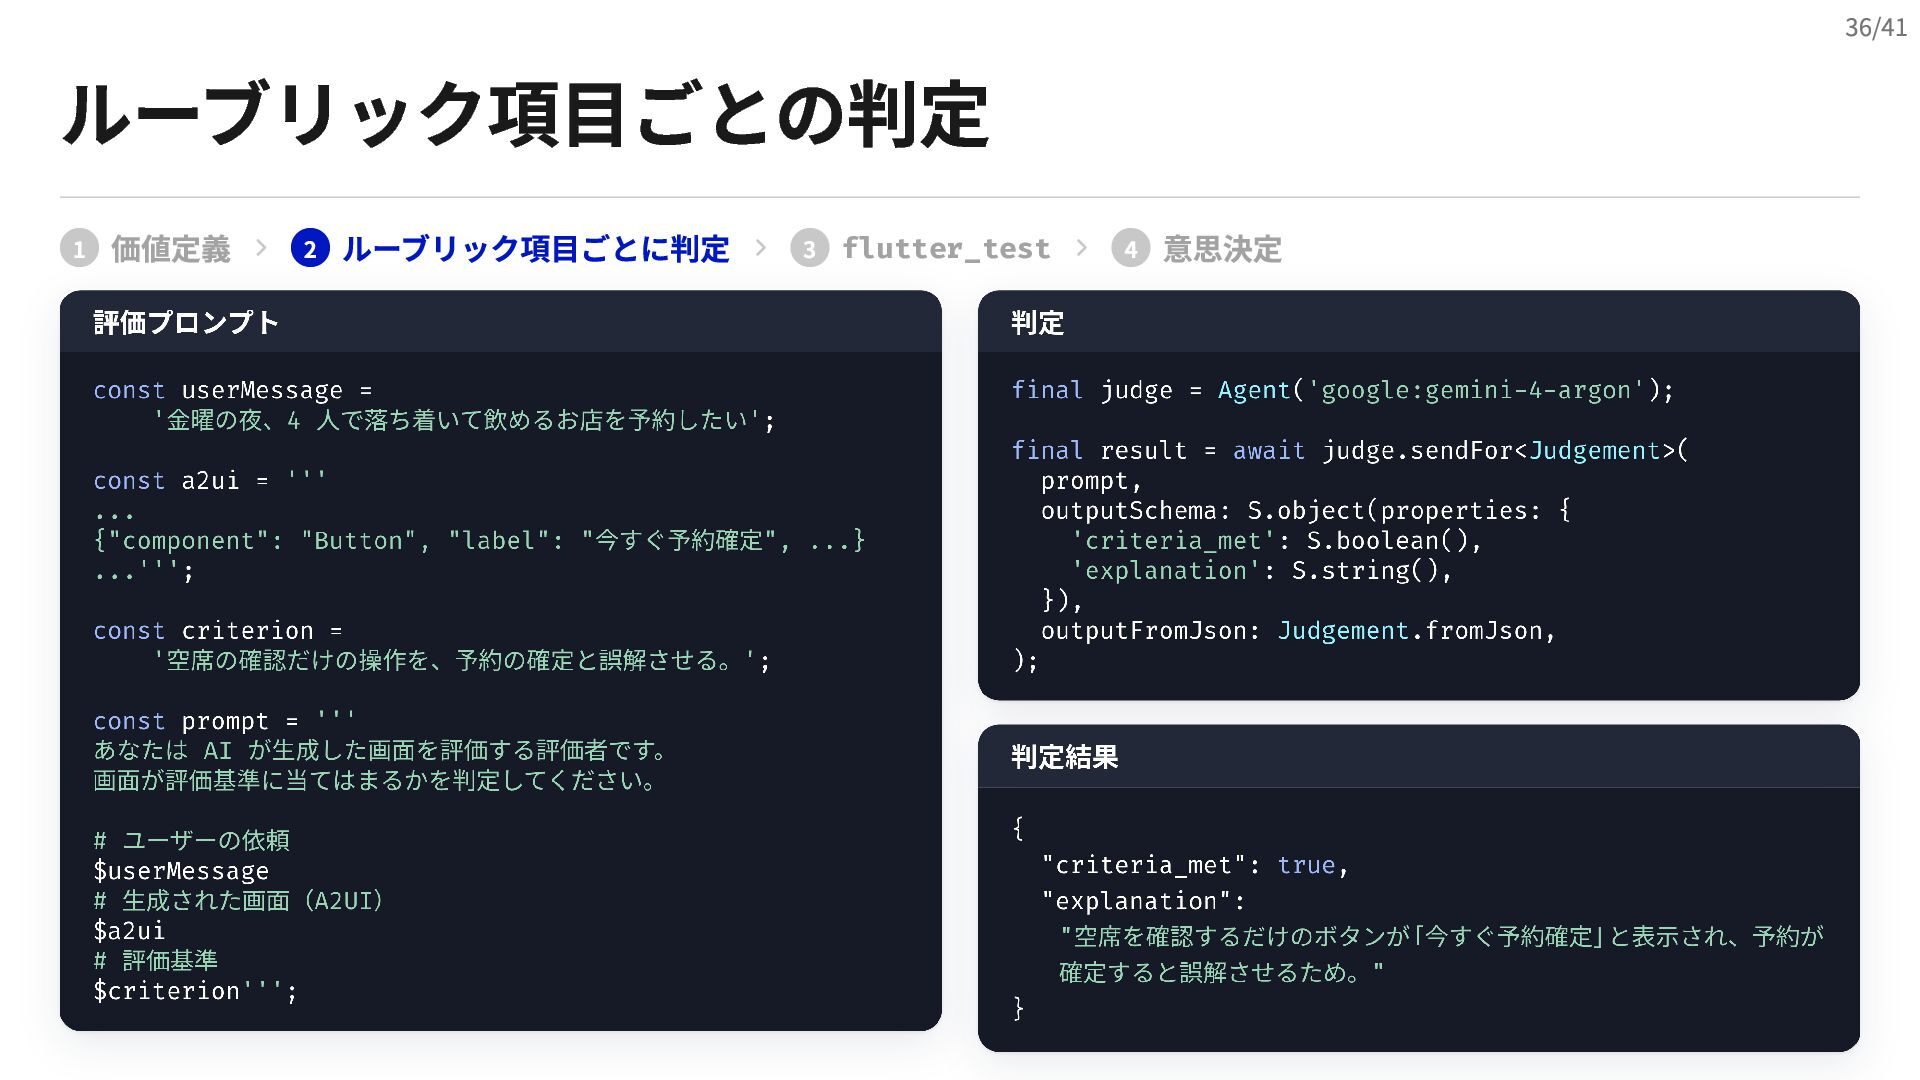
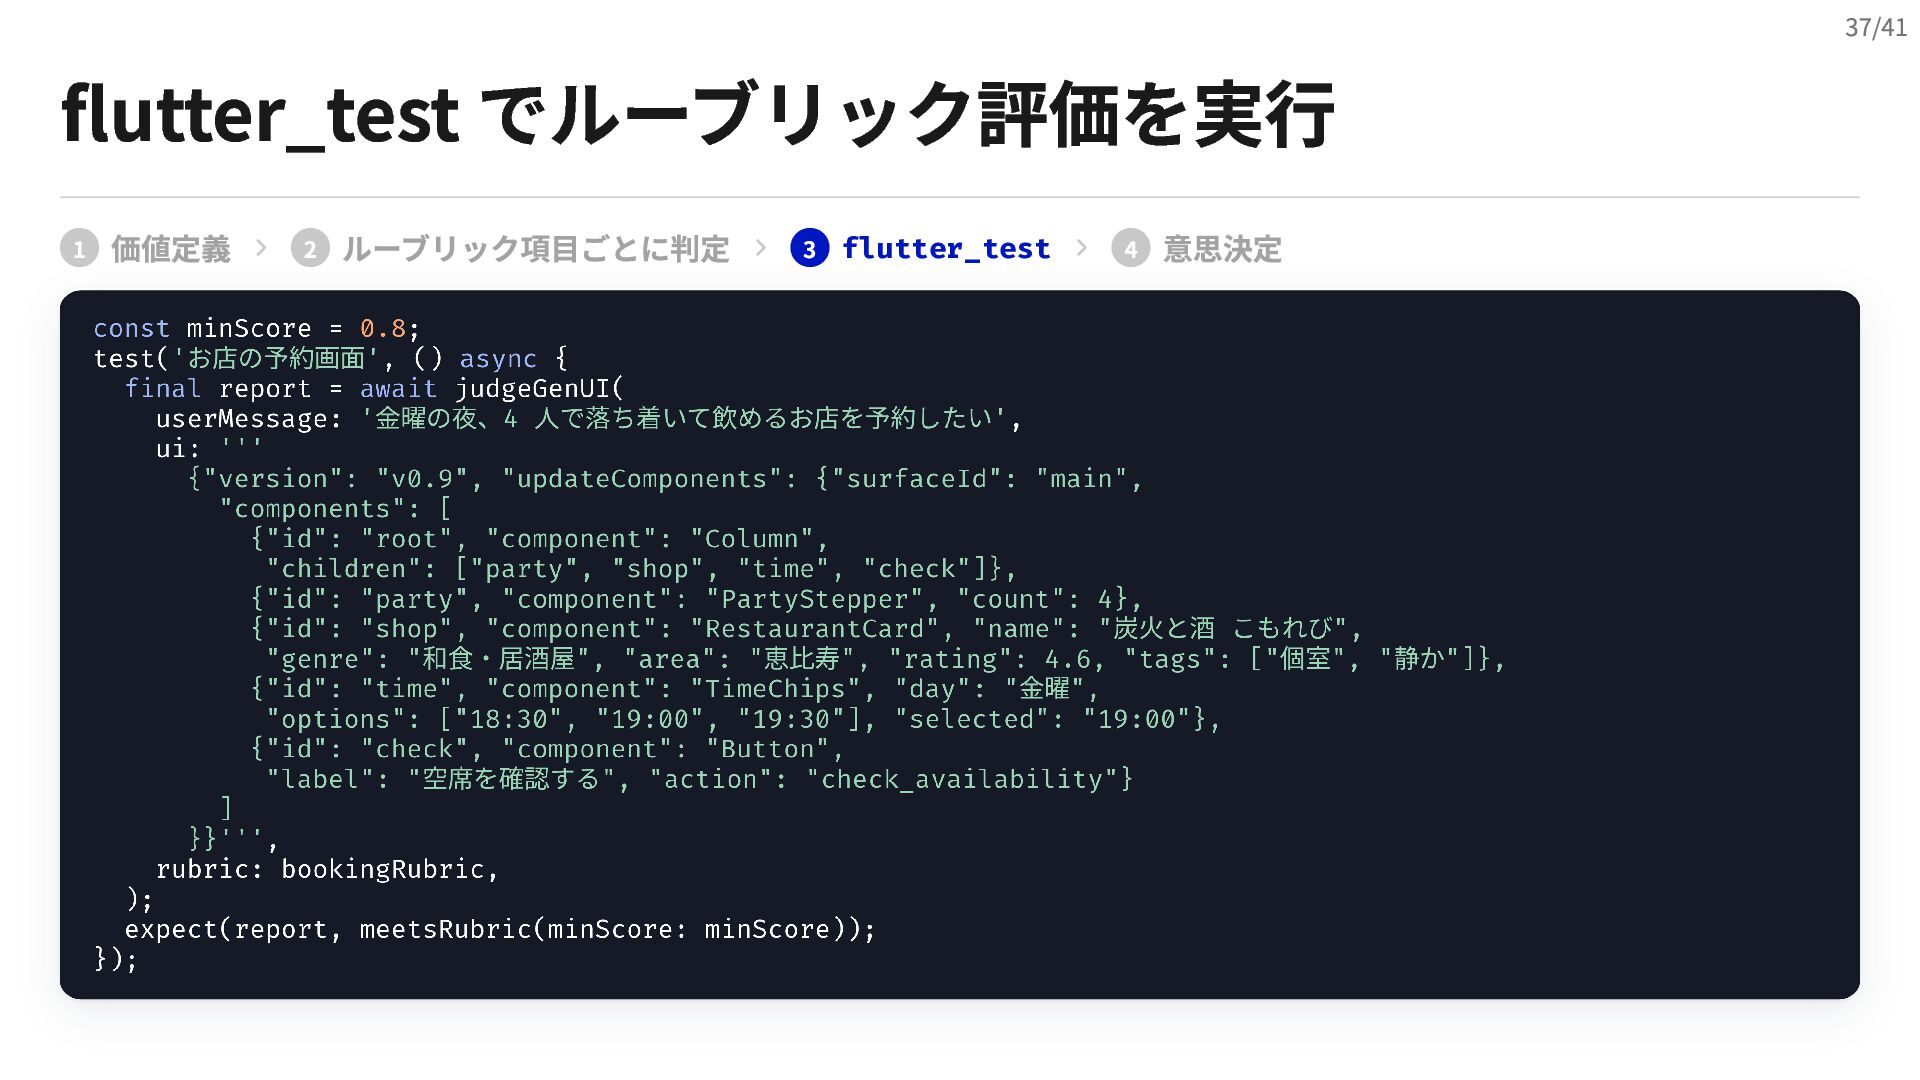
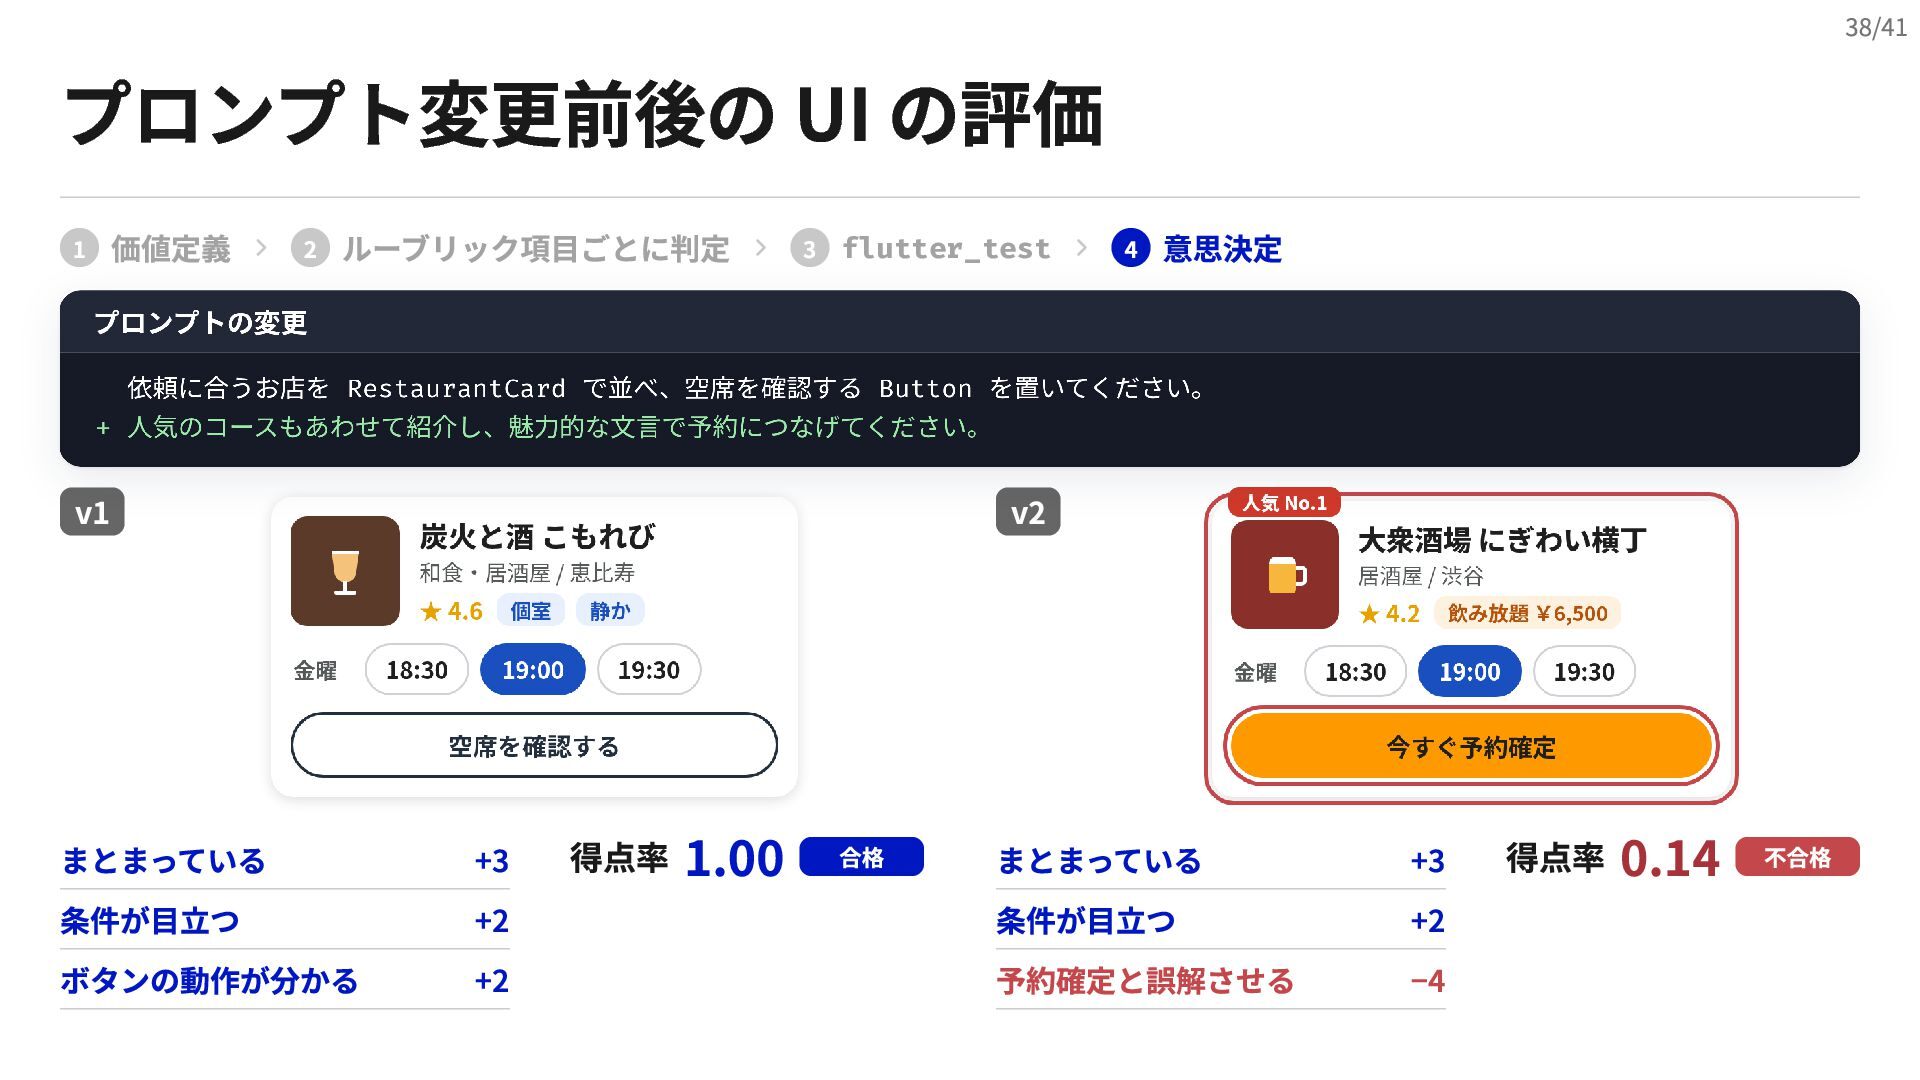
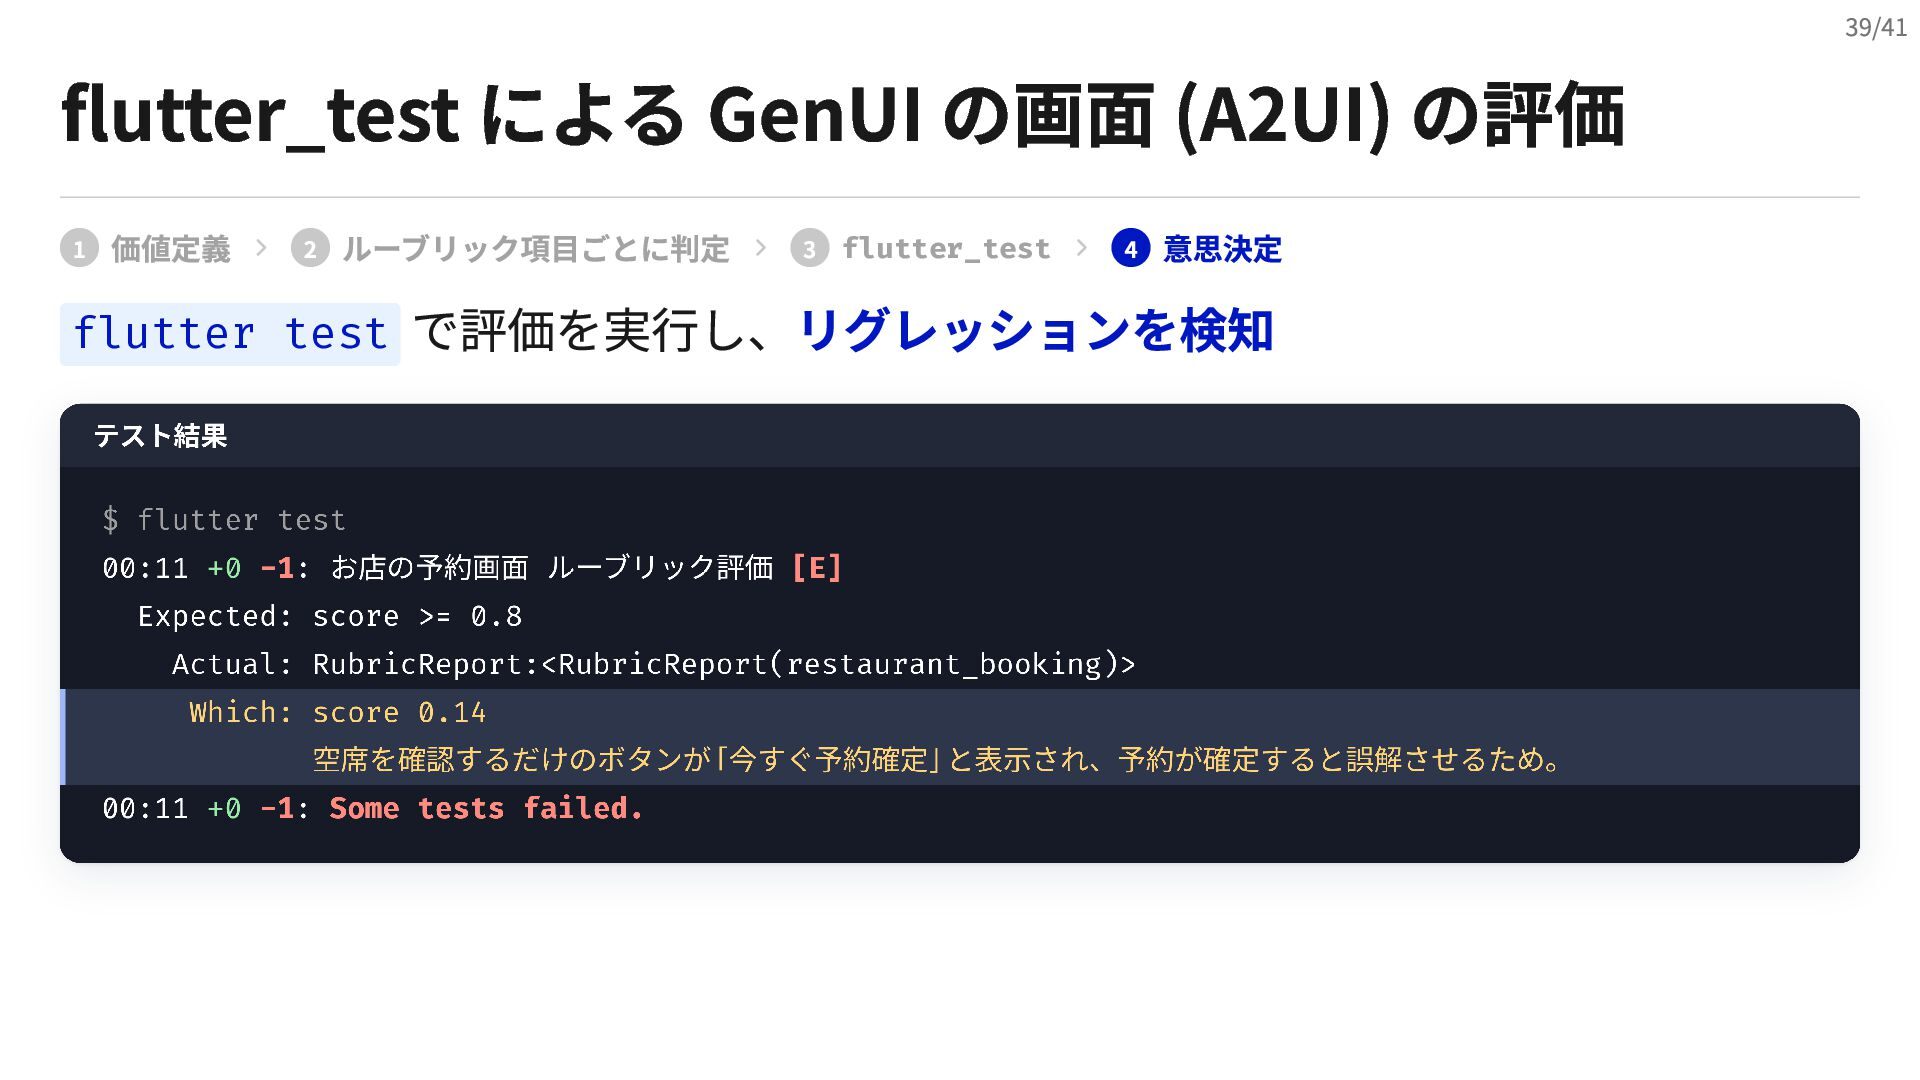
具体的には、画像からの構造化出力やチャットのような、LLM を組み込んだ典型的な機能を題材に、Flutter のテストの仕組みと地続きの形で評価を記述・実行し、プロンプトやモデルの変更による品質の劣化をリリース前に検知するアプローチを、動くコードとともに実演します。終章では、GenUI / A2UI が生成する UI を flutter_test で検証する実験も紹介します。


 nakamizu
 chobishiba
 giljongyu
 ostk0069
 xleitix
 kasacchiful
 mitohato14
 quramy
 n_takehata
 kmars0605
 naruogram
 falcon8823
 codingconduct
 mza
 portentint
 sarafernandez
 aleyda
 aarron
 samanthasiow
 oripsolob
 swwweet
 kastner
 akihiro_kokubo