Upgrade to Pro — share decks privately, control downloads, hide ads and more …

高速開発を止めずに 性能を上げる Flyleのシステム刷新と改善の歴史

azihsoyn
November 18, 2026

高速開発を止めずに 性能を上げる Flyleのシステム刷新と改善の歴史

# 高速開発を止めずに 性能を上げる

Flyleのシステム刷新と改善の歴史

CloudNative Days Winter 2026 / 株式会社フライル

---

# 自己紹介

Twitter(現X)

@azihsoyn

吉澤 直哉

株式会社フライル / Software Engineer

・アプリケーションエンジニア → パフォーマンス改善エンジニア

・2026年5月のクラウドネイティブ会議でも
性能改善の話をしました

・釣りが好き🎣

・GitHub: @azihsoyn

---

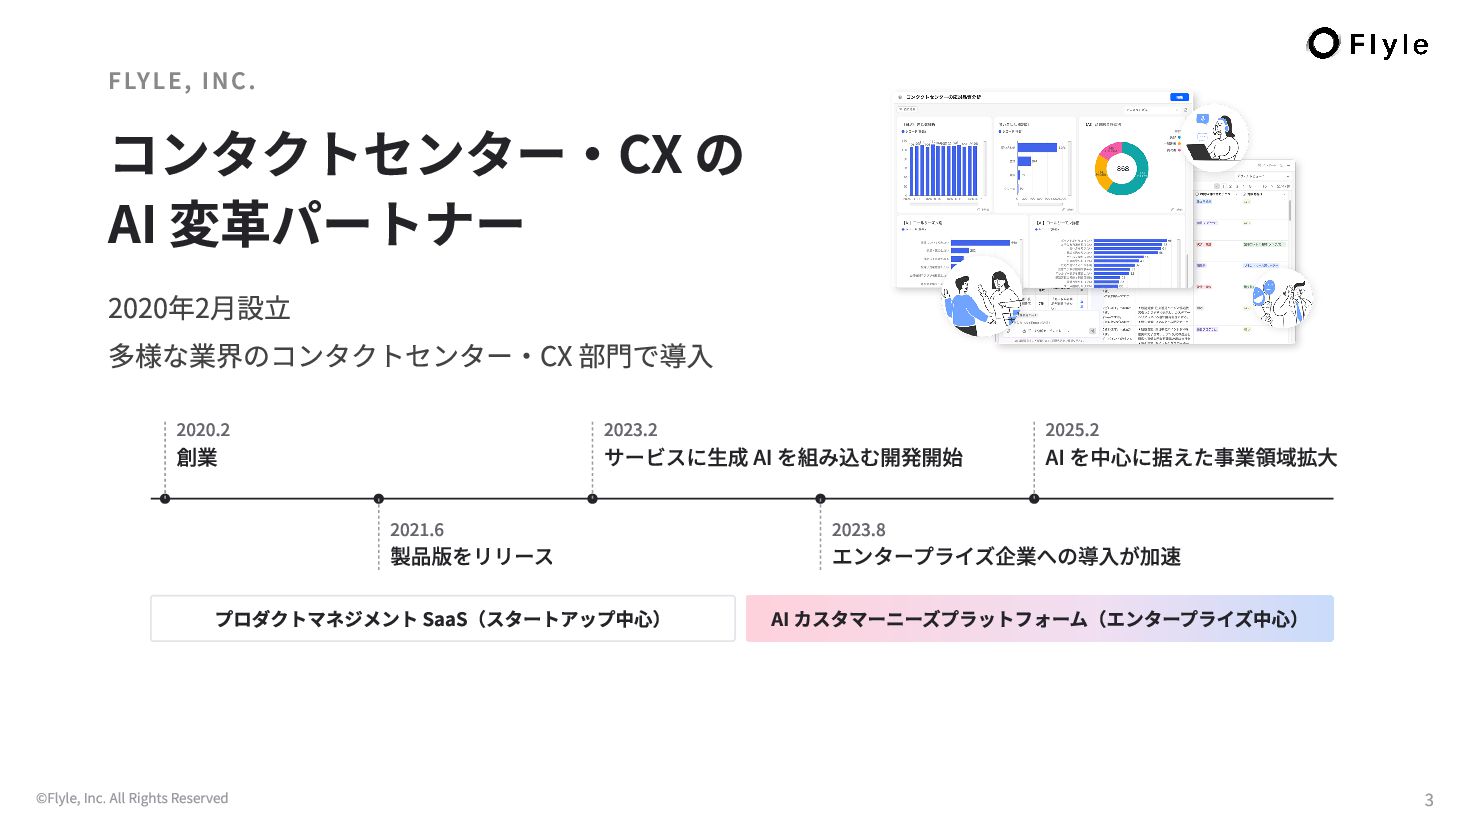
FLYLE, INC.

コンタクトセンター・CX の
AI 変革パートナー

2020年2月設立
多様な業界のコンタクトセンター・CX 部門で導入

---

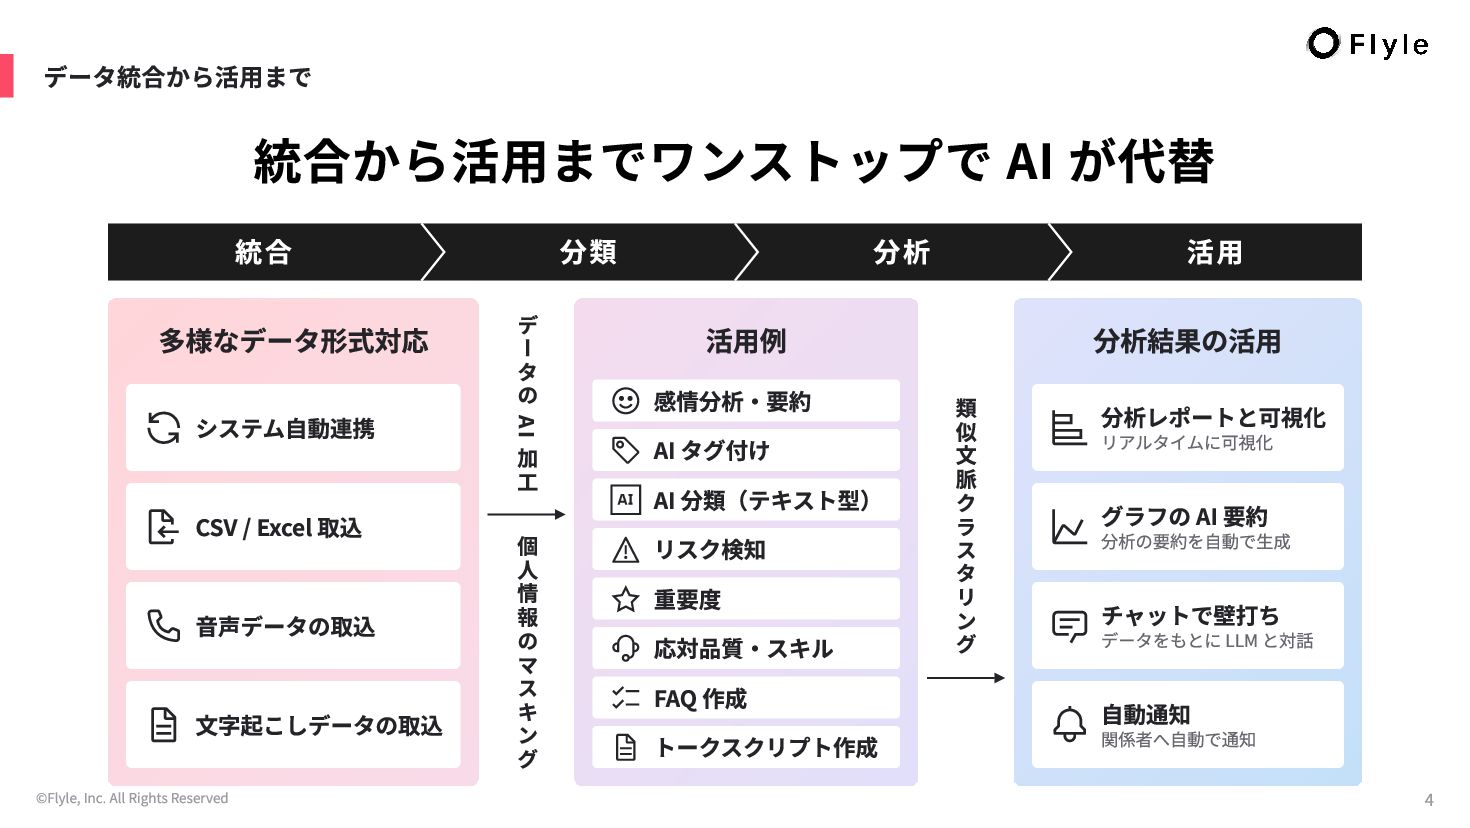
###### データ統合から活用まで

# 統合から活用までワンストップで AI が代替

多様なデータ形式対応

システム自動連携

CSV / Excel 取込

音声データの取込

文字起こしデータの取込

データの AI 加工

個人情報のマスキング

活用例

感情分析・要約

AI タグ付け

AI 分類(テキスト型)

リスク検知 重要度

応対品質・スキル

FAQ 作成

トークスクリプト作成

類似文脈クラスタリング

分析結果の活用

分析レポートと可視化

リアルタイムに可視化

グラフの AI 要約

分析の要約を自動で生成

チャットで壁打ち

データをもとに LLM と対話

自動通知

関係者へ自動で通知

---

###### 2026年5月 クラウドネイティブ会議

# 前回話したこと

speakerdeck.com/azihsoyn/cloudnative-conference-2026

---

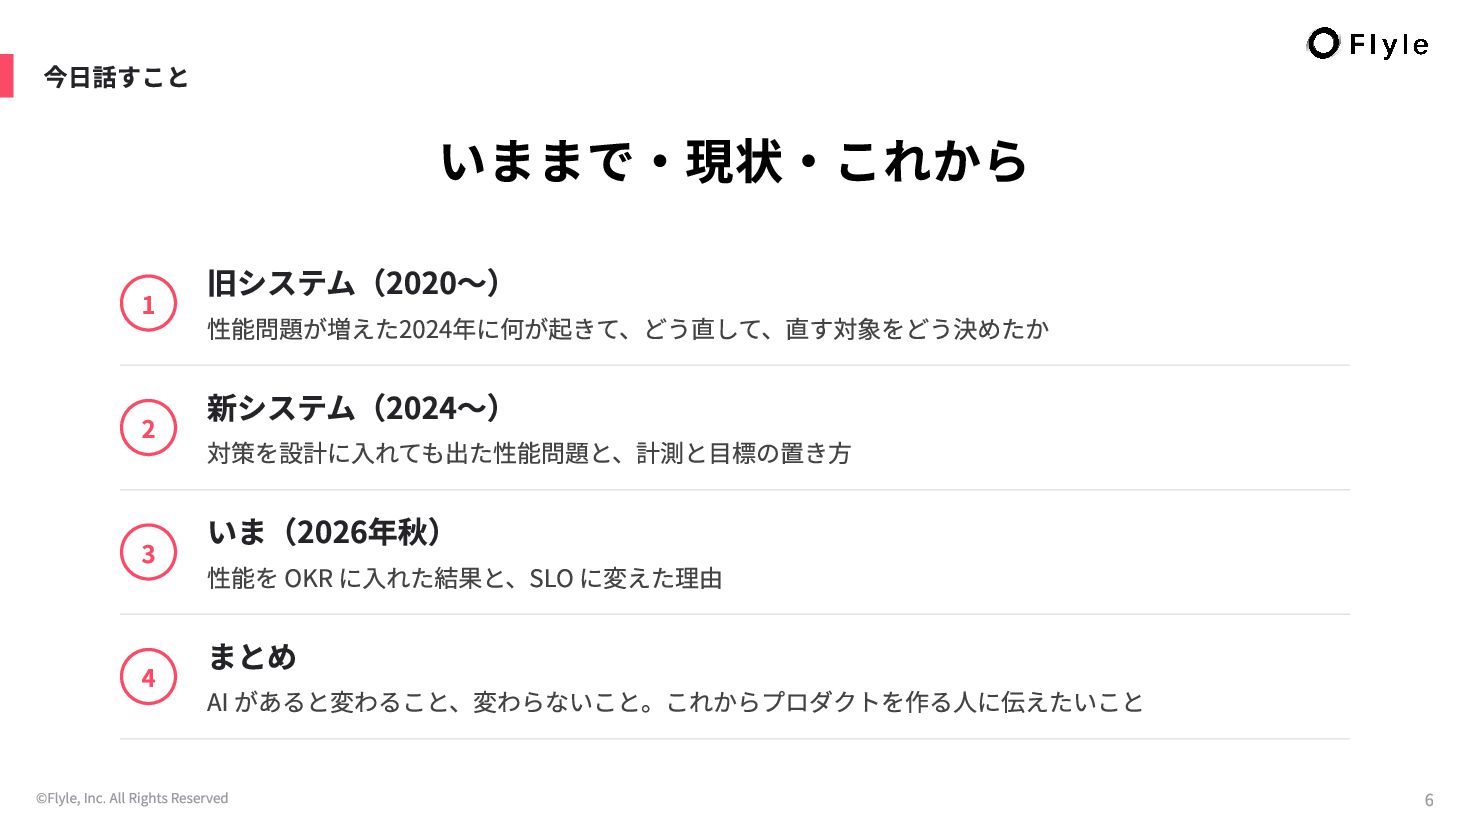
###### 今日話すこと

# いままで・現状・これから

1

旧システム(2020〜)

性能問題が増えた2024年に何が起きて、どう直して、直す対象をどう決めたか

2

新システム(2024〜)

対策を設計に入れても出た性能問題と、計測と目標の置き方

3

いま(2026年秋)

性能を OKR に入れた結果と、SLO に変えた理由

4 まとめ

AI があると変わること、変わらないこと。これからプロダクトを作る人に伝えたいこと

---

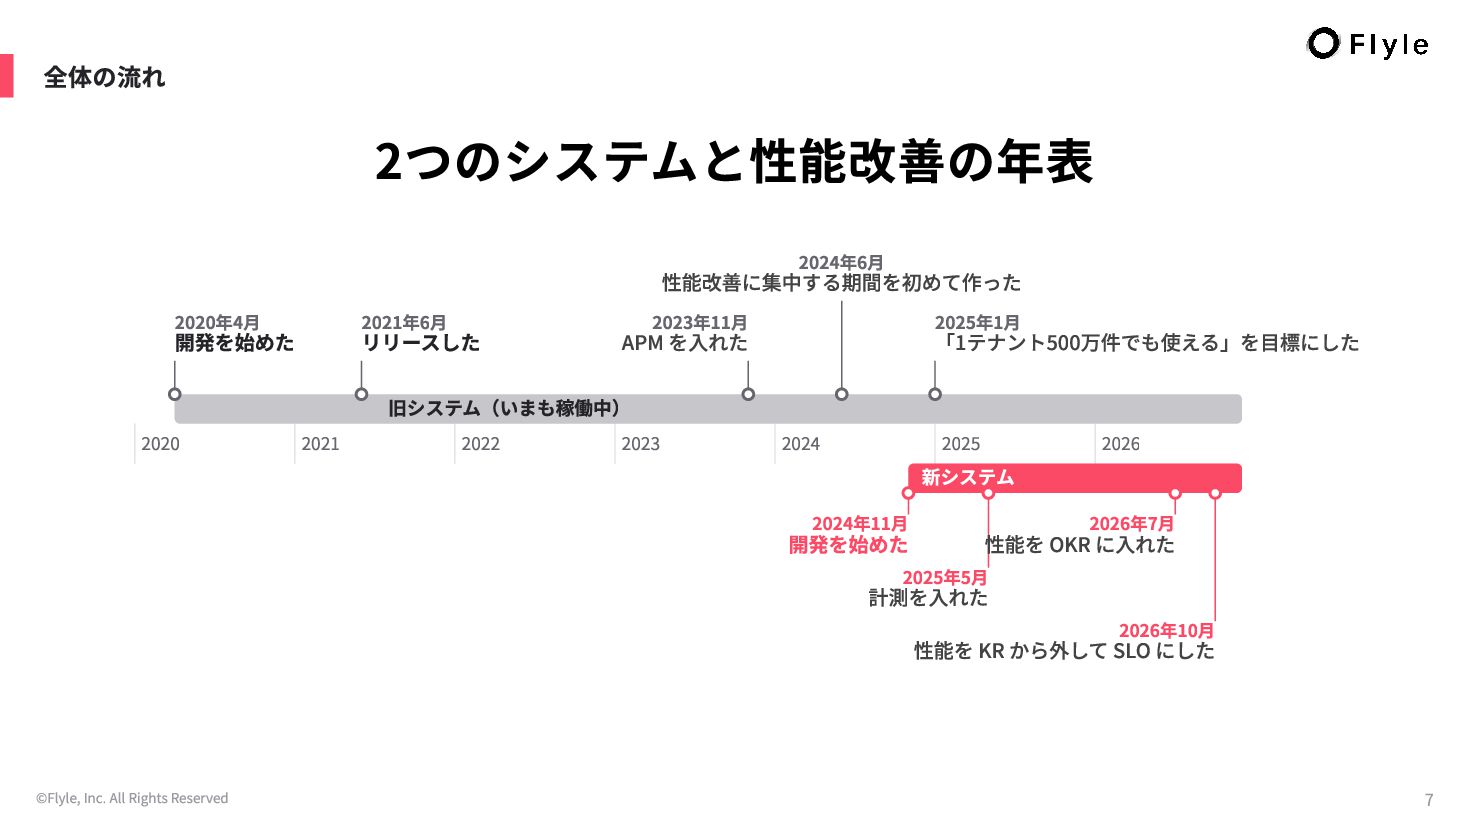
###### 全体の流れ

# 2つのシステムと性能改善の年表

---

###### 旧システム ・ 概要

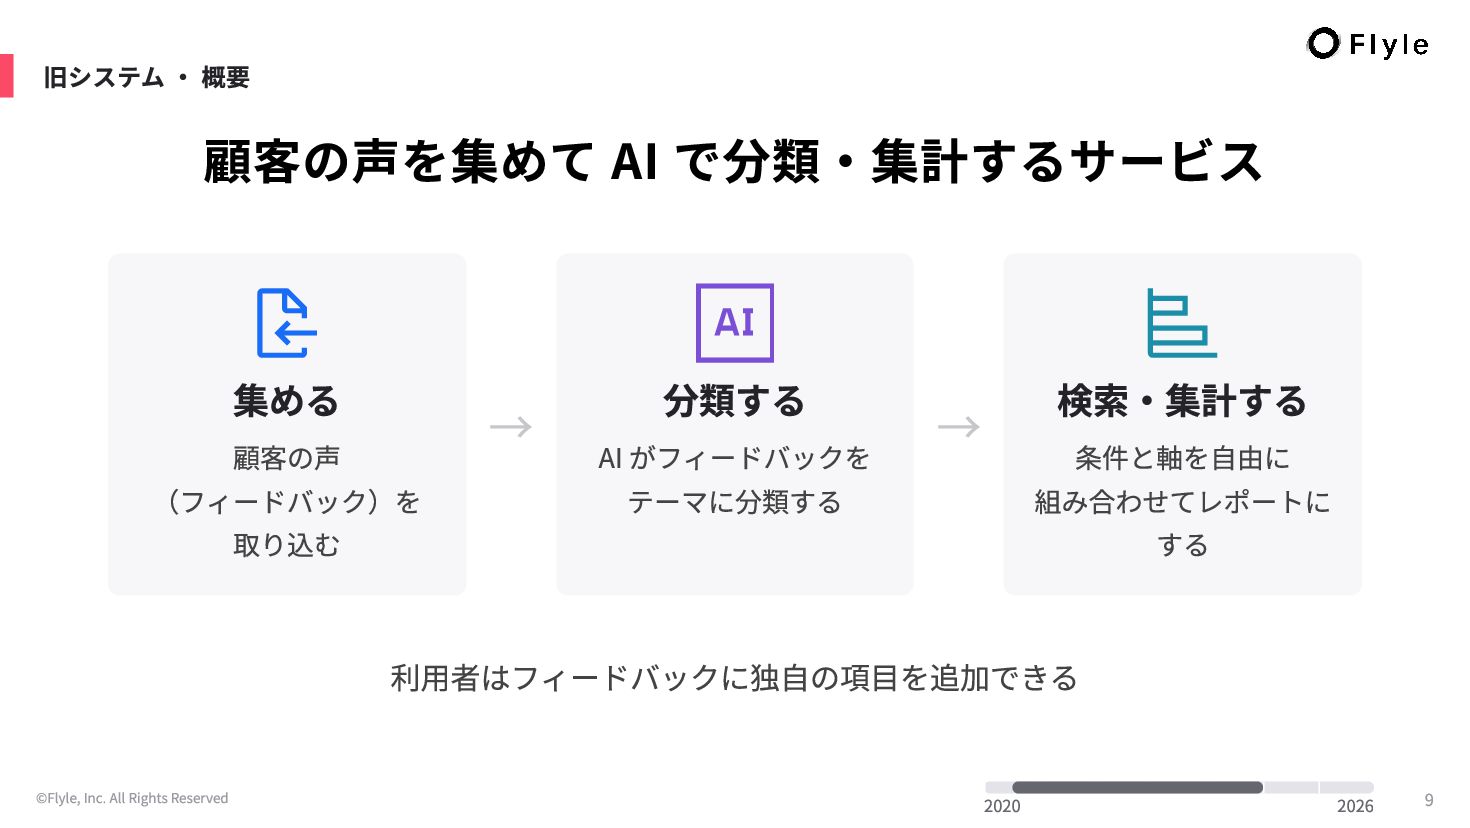
# 顧客の声を集めて AI で分類・集計するサービス

集める

顧客の声(フィードバック)を取り込む

→ 分類する

AI がフィードバックをテーマに分類する

→

検索・集計する

条件と軸を自由に組み合わせてレポートにする

利用者はフィードバックに独自の項目を追加できる

---

###### 旧システム ・ 構成(2024年時点)

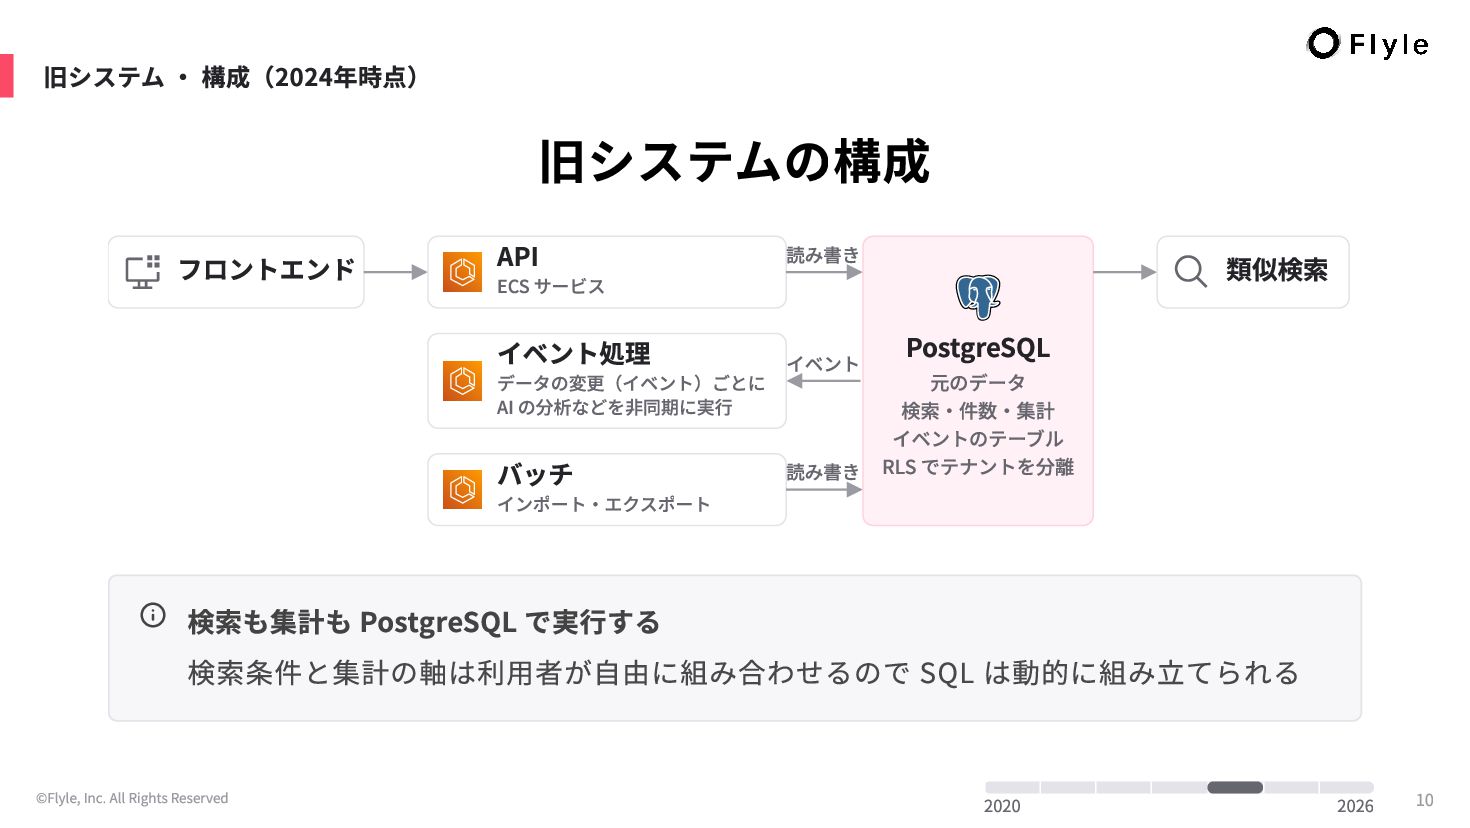
# 旧システムの構成

> **検索も集計も PostgreSQL で実行する**
>
> 検索条件と集計の軸は利用者が自由に組み合わせるので SQL は動的に組み立てられる

---

###### 旧システム ・ 起きたこと(2020〜2023)

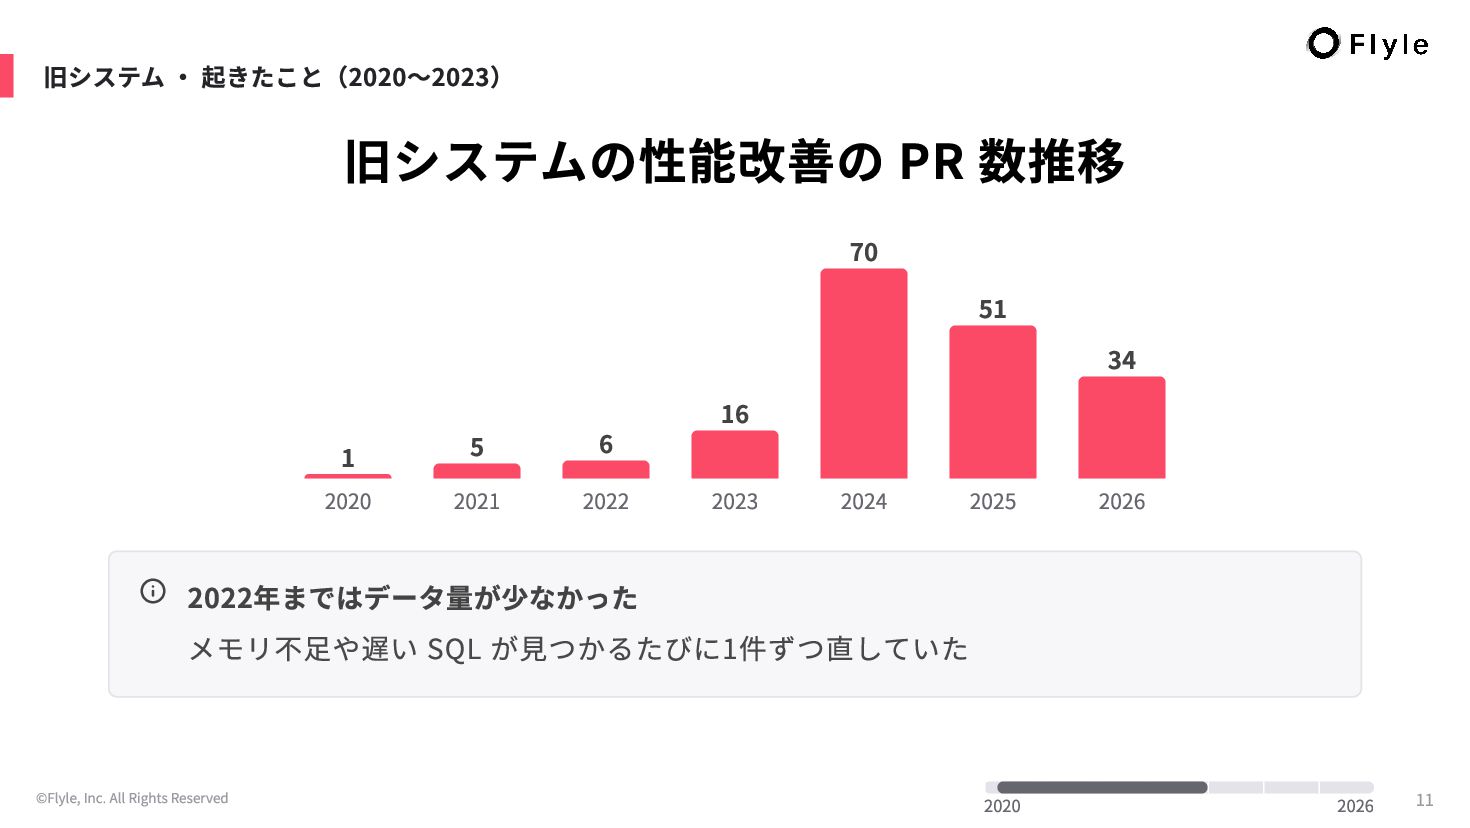
# 旧システムの性能改善の PR 数推移

1 5 6 16 70 51 34 2020 2021 2022 2023 2024 2025 2026

> **2022年まではデータ量が少なかった**
>
> メモリ不足や遅い SQL が見つかるたびに1件ずつ直していた

---

###### 旧システム ・ 起きたこと(2024)

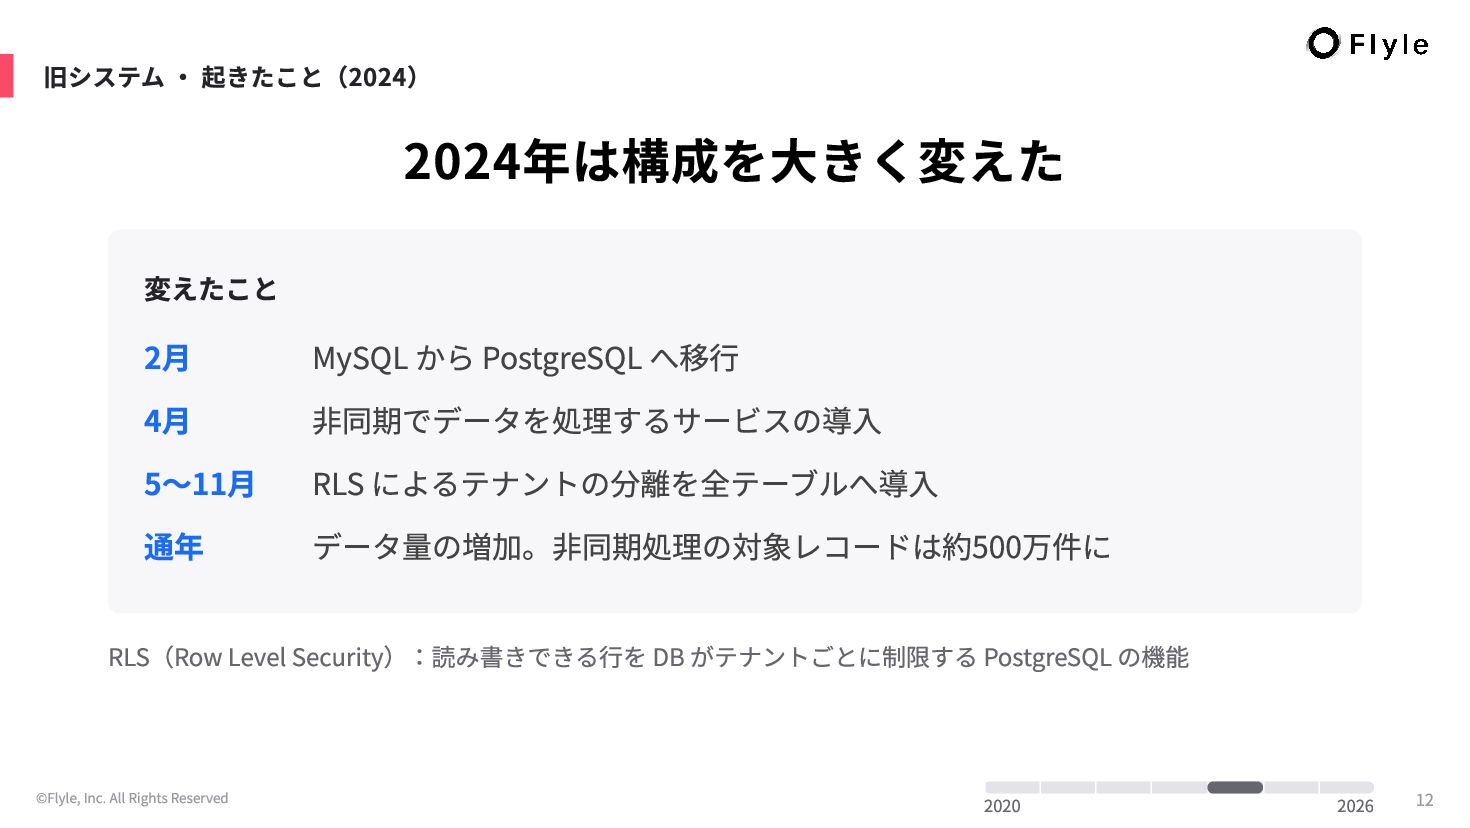
# 2024年は構成を大きく変えた

変えたこと 2月

MySQL から PostgreSQL へ移行

4月

非同期でデータを処理するサービスの導入

5〜11月

RLS によるテナントの分離を全テーブルへ導入

通年

データ量の増加。非同期処理の対象レコードは約500万件に

RLS(Row Level Security):読み書きできる行を DB がテナントごとに制限する PostgreSQL の機能

---

###### 旧システム ・ 起きたこと(2024)

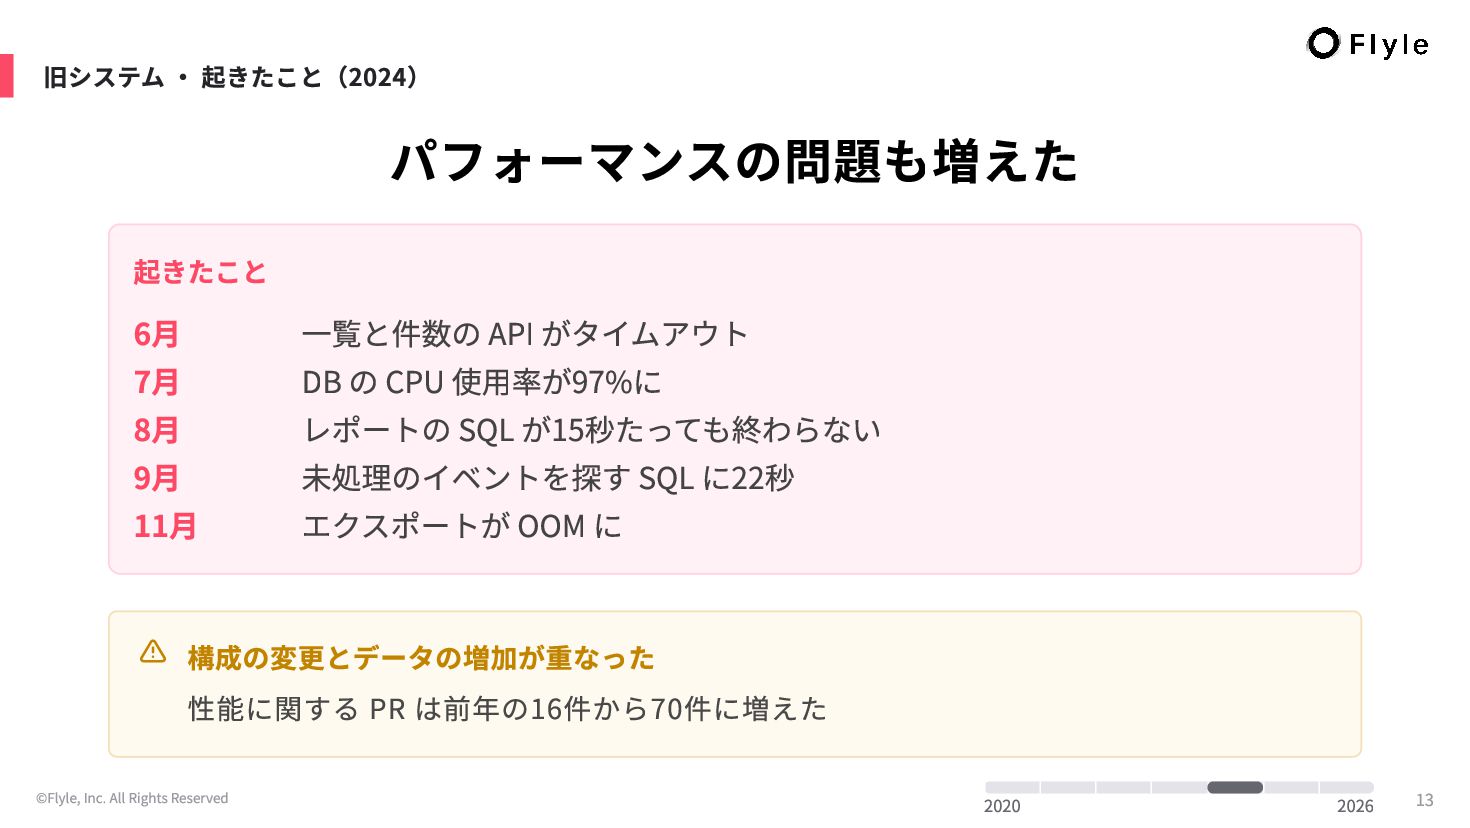
# パフォーマンスの問題も増えた

起きたこと 6月

一覧と件数の API がタイムアウト

7月

DB の CPU 使用率が97%に

8月

レポートの SQL が15秒たっても終わらない

9月

未処理のイベントを探す SQL に22秒

11月

エクスポートが OOM に

> **構成の変更とデータの増加が重なった**
>
> 性能に関する PR は前年の16件から70件に増えた

---

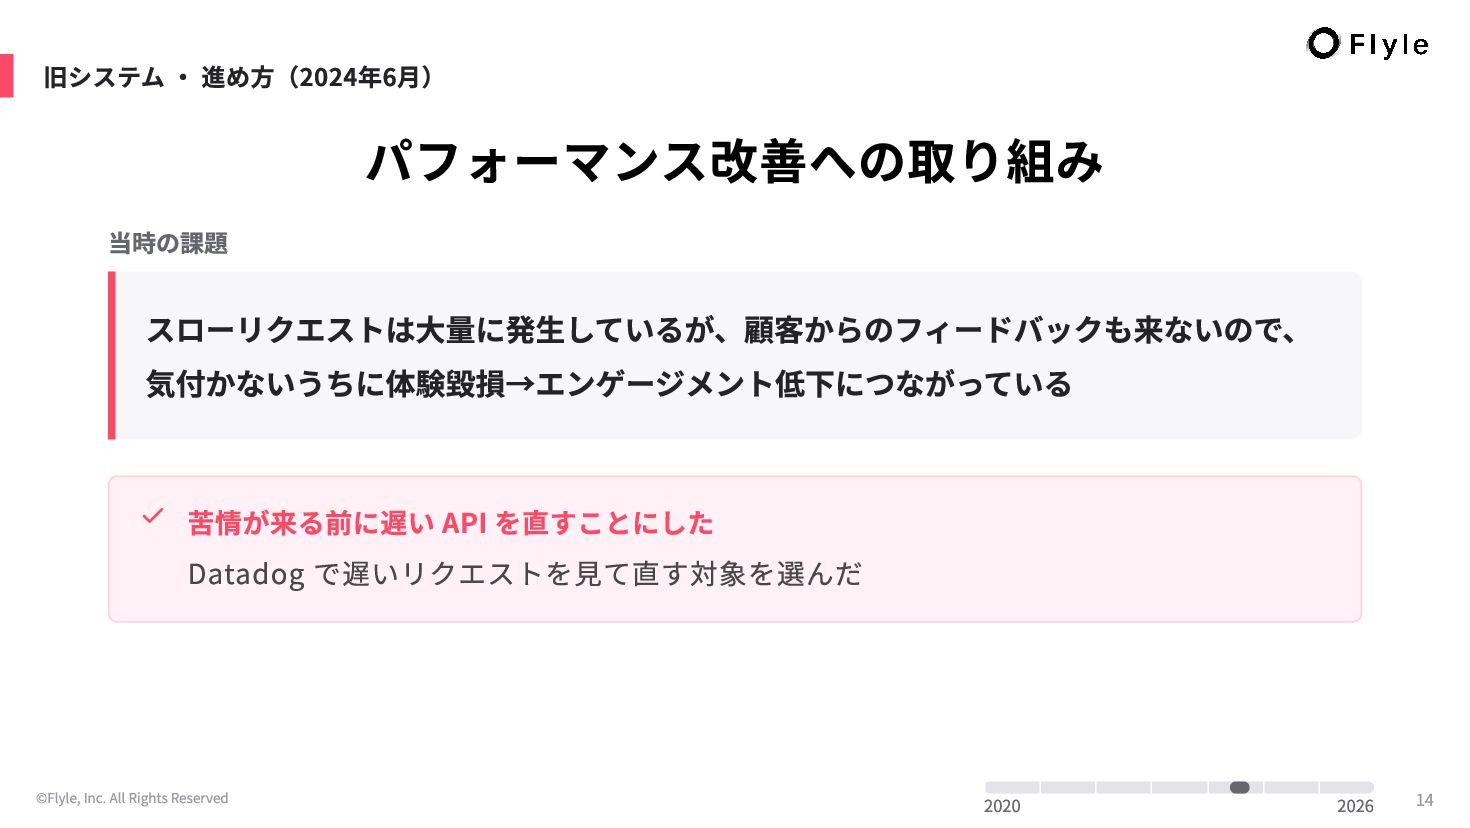
###### 旧システム ・ 進め方(2024年6月)

# パフォーマンス改善への取り組み

当時の課題

スローリクエストは大量に発生しているが、顧客からのフィードバックも来ないので、気付かないうちに体験毀損→エンゲージメント低下につながっている

> **苦情が来る前に遅い API を直すことにした**
>
> Datadog で遅いリクエストを見て直す対象を選んだ

---

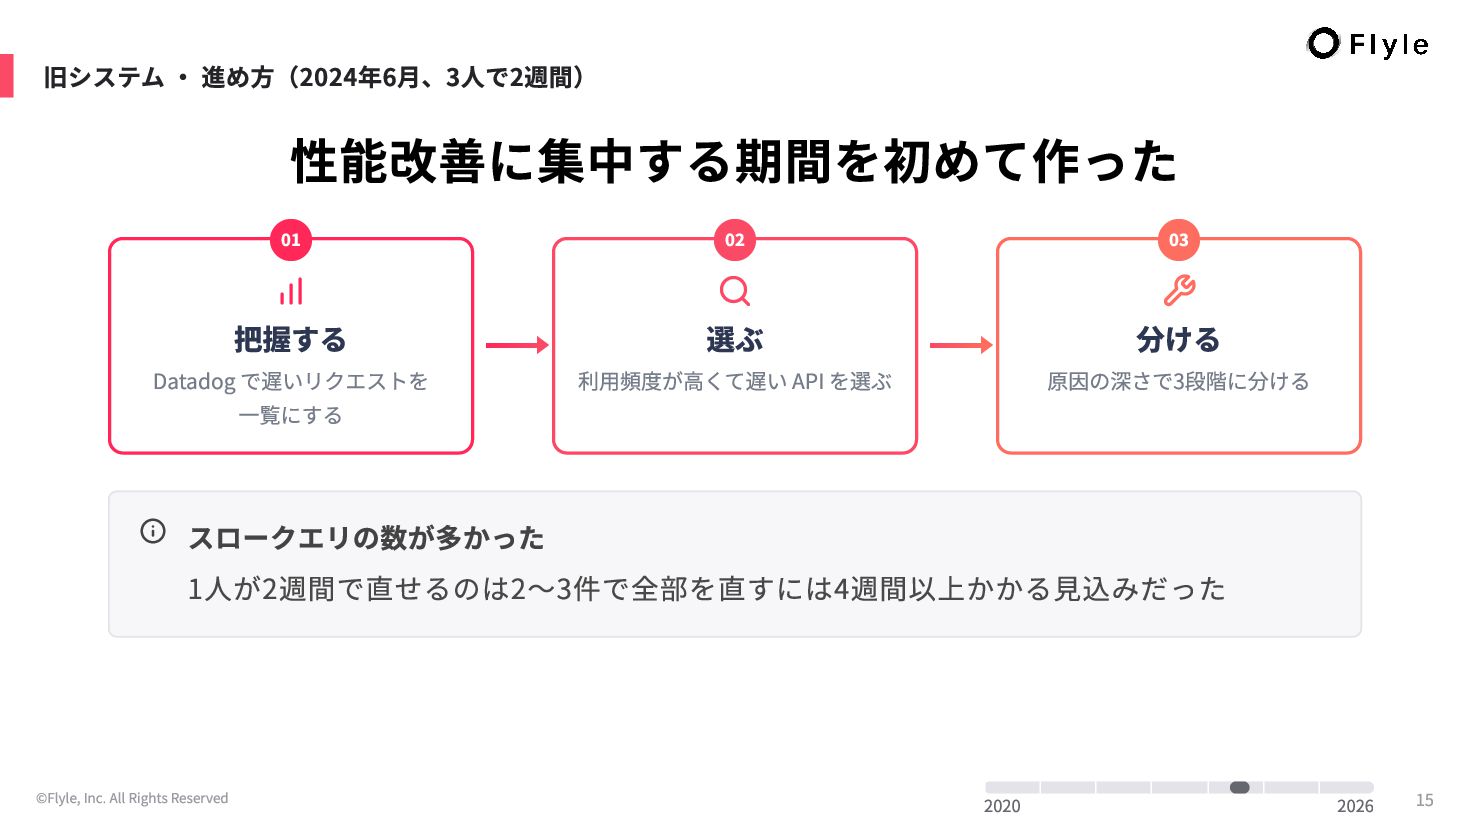
###### 旧システム ・ 進め方(2024年6月、3人で2週間)

# 性能改善に集中する期間を初めて作った

- 把握する — Datadog で遅いリクエストを一覧にする — chart
- 選ぶ — 利用頻度が高くて遅い API を選ぶ — search
- 分ける — 原因の深さで3段階に分ける — wrench

> **スロークエリの数が多かった**
>
> 1人が2週間で直せるのは2〜3件で全部を直すには4週間以上かかる見込みだった

---

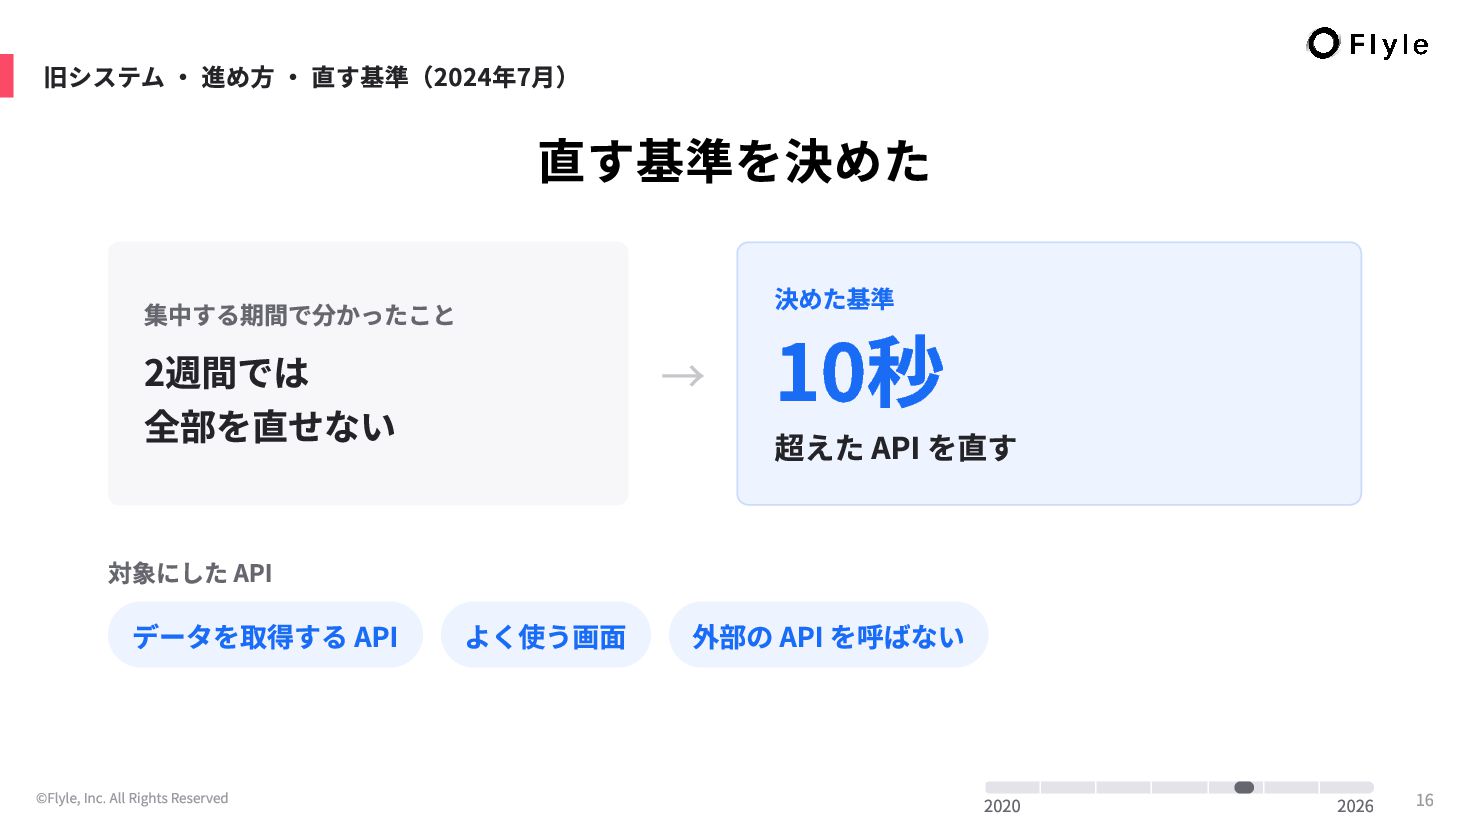
###### 旧システム ・ 進め方 ・ 直す基準(2024年7月)

# 直す基準を決めた

集中する期間で分かったこと

2週間では
全部を直せない

→ 決めた基準 10秒

超えた API を直す

対象にした API

データを取得する API

よく使う画面

外部の API を呼ばない

---

###### 旧システム ・ 直し方 ・ 例 1

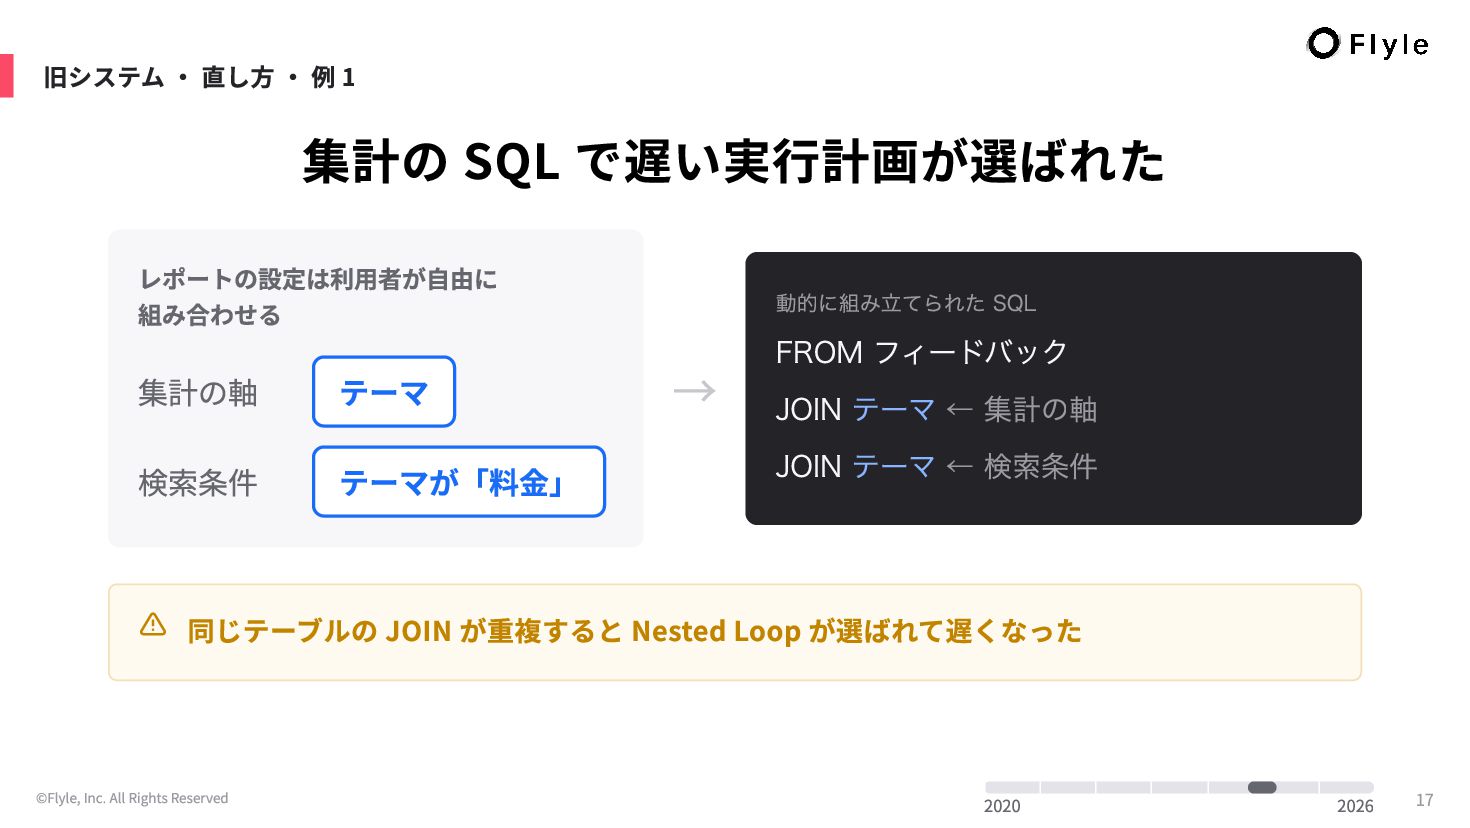
# 集計の SQL で遅い実行計画が選ばれた

レポートの設定は利用者が自由に組み合わせる

集計の軸 テーマ 検索条件

テーマが「料金」

→

動的に組み立てられた SQL

FROM フィードバック

JOIN テーマ ← 集計の軸

JOIN テーマ ← 検索条件

> **同じテーブルの JOIN が重複すると Nested Loop が選ばれて遅くなった**
>

---

###### 旧システム ・ 直し方 ・ 例 1

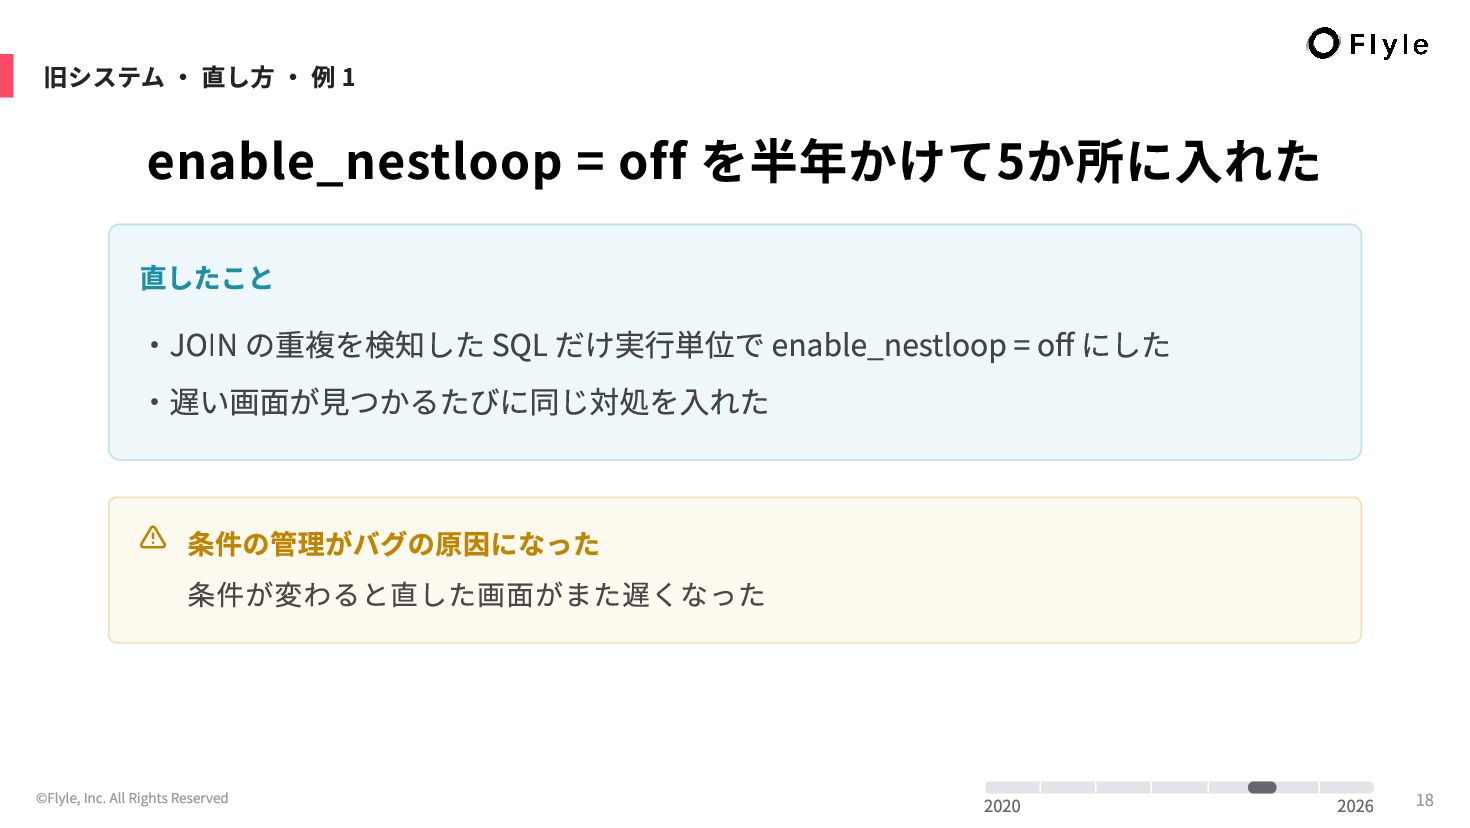
# enable_nestloop = off を半年かけて5か所に入れた

直したこと

・JOIN の重複を検知した SQL だけ実行単位で enable_nestloop = off にした

・遅い画面が見つかるたびに同じ対処を入れた

> **条件の管理がバグの原因になった**
>
> 条件が変わると直した画面がまた遅くなった

---

###### 旧システム ・ 直し方 ・ 例 2

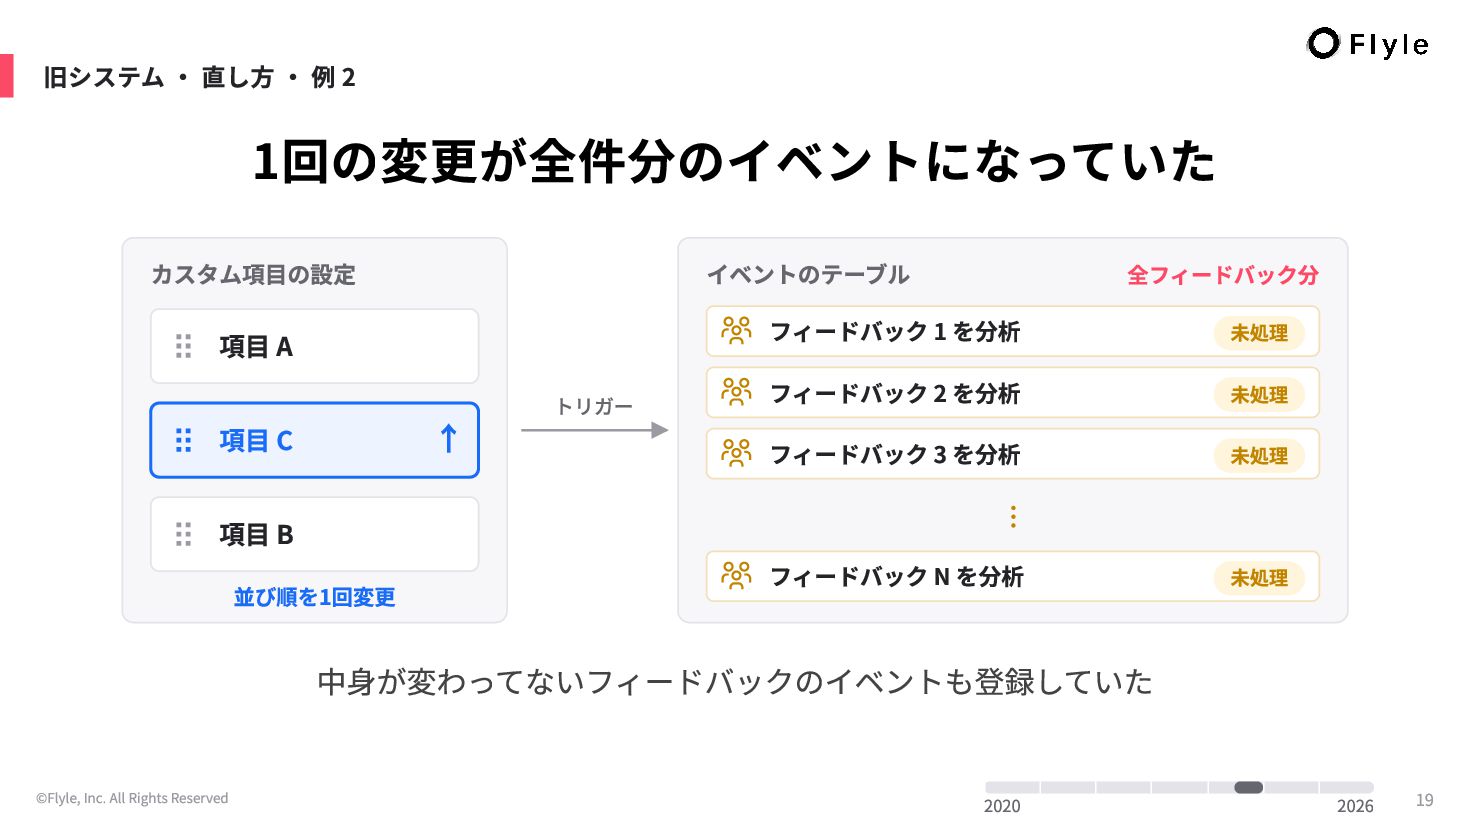
# 1回の変更が全件分のイベントになっていた

中身が変わってないフィードバックのイベントも登録していた

---

###### 旧システム ・ 直し方 ・ 例 2

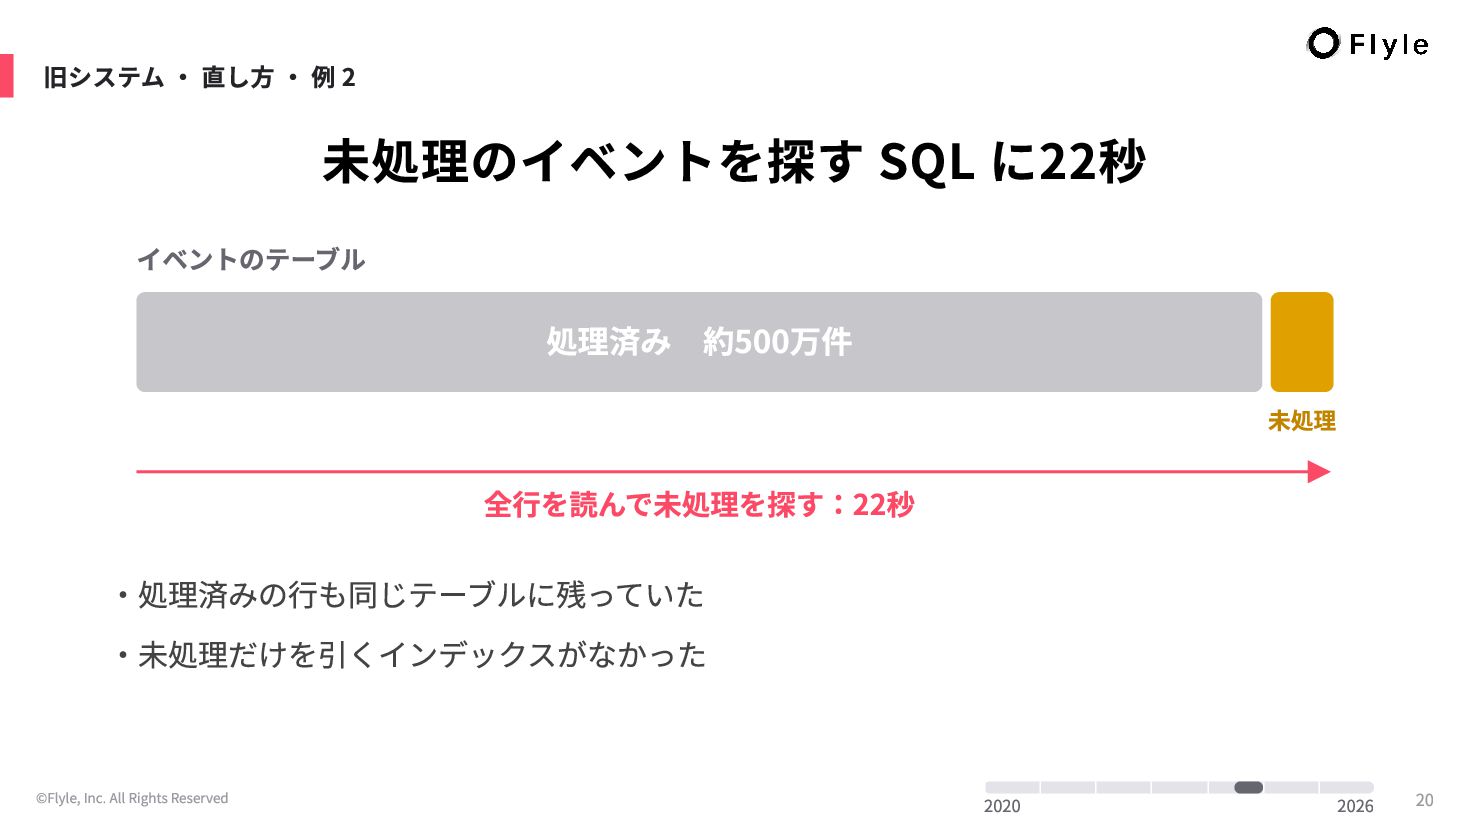
# 未処理のイベントを探す SQL に22秒

・処理済みの行も同じテーブルに残っていた

・未処理だけを引くインデックスがなかった

---

###### 旧システム ・ 直し方 ・ 例 2

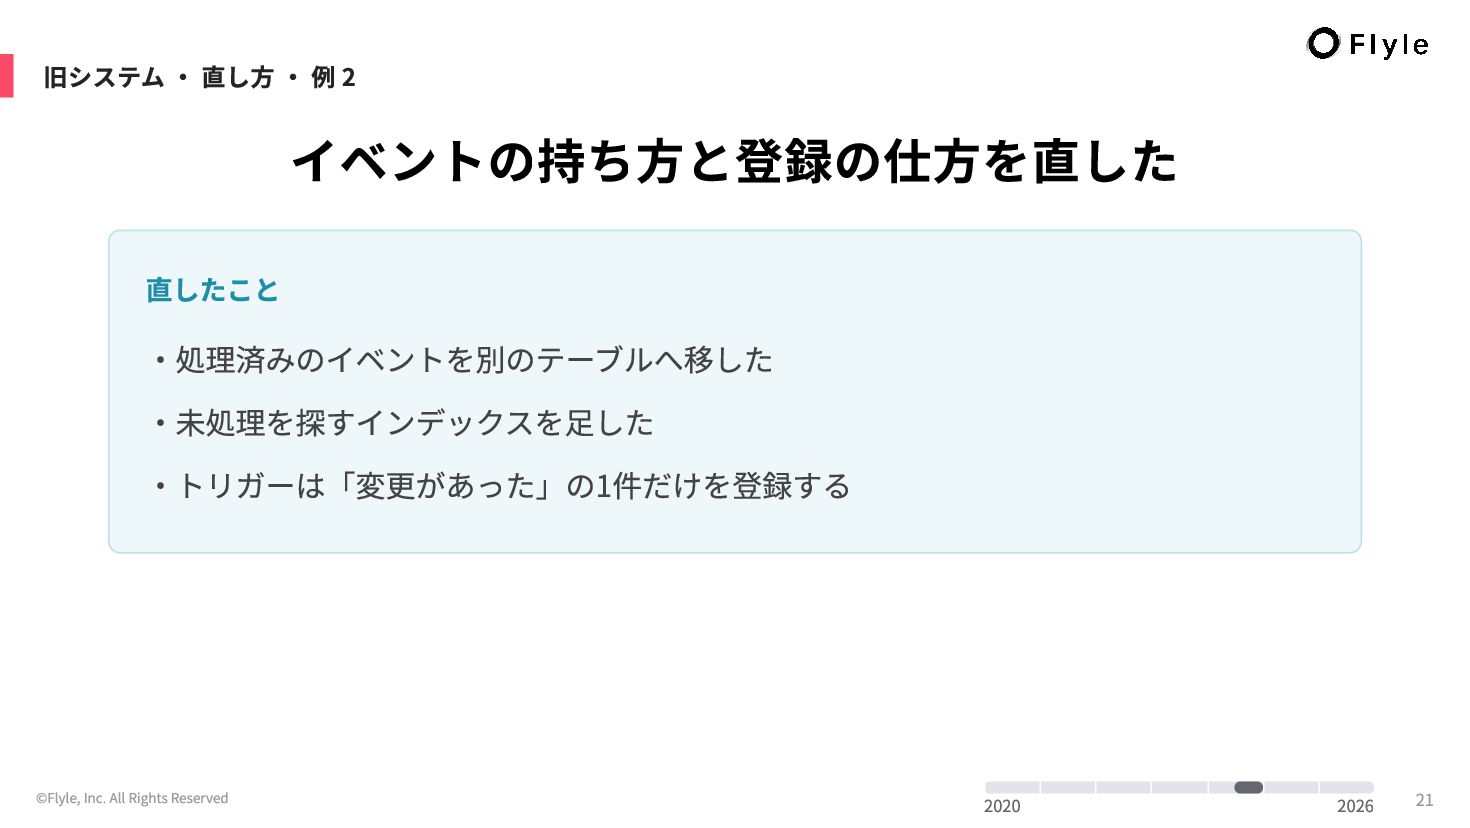
# イベントの持ち方と登録の仕方を直した

直したこと

・処理済みのイベントを別のテーブルへ移した

・未処理を探すインデックスを足した

・トリガーは「変更があった」の1件だけを登録する

---

###### 旧システム ・ 直し方 ・ 例 3

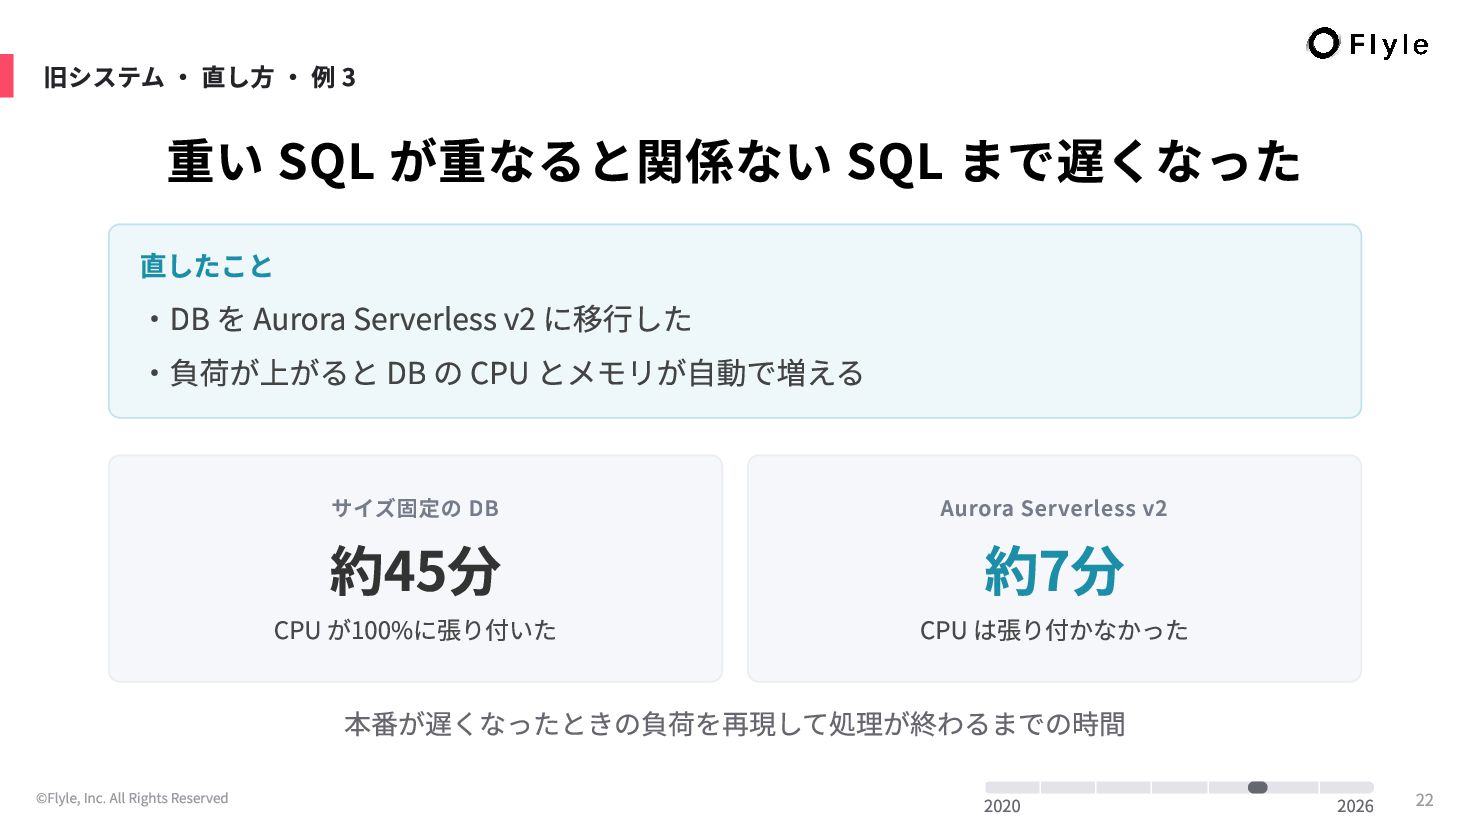
# 重い SQL が重なると関係ない SQL まで遅くなった

直したこと

・DB を Aurora Serverless v2 に移行した

・負荷が上がると DB の CPU とメモリが自動で増える

- 約45分 / サイズ固定の DB / CPU が100%に張り付いた
- 約7分 / Aurora Serverless v2 / CPU は張り付かなかった

本番が遅くなったときの負荷を再現して処理が終わるまでの時間

---

###### 旧システム ・ 直し方 ・ 分類

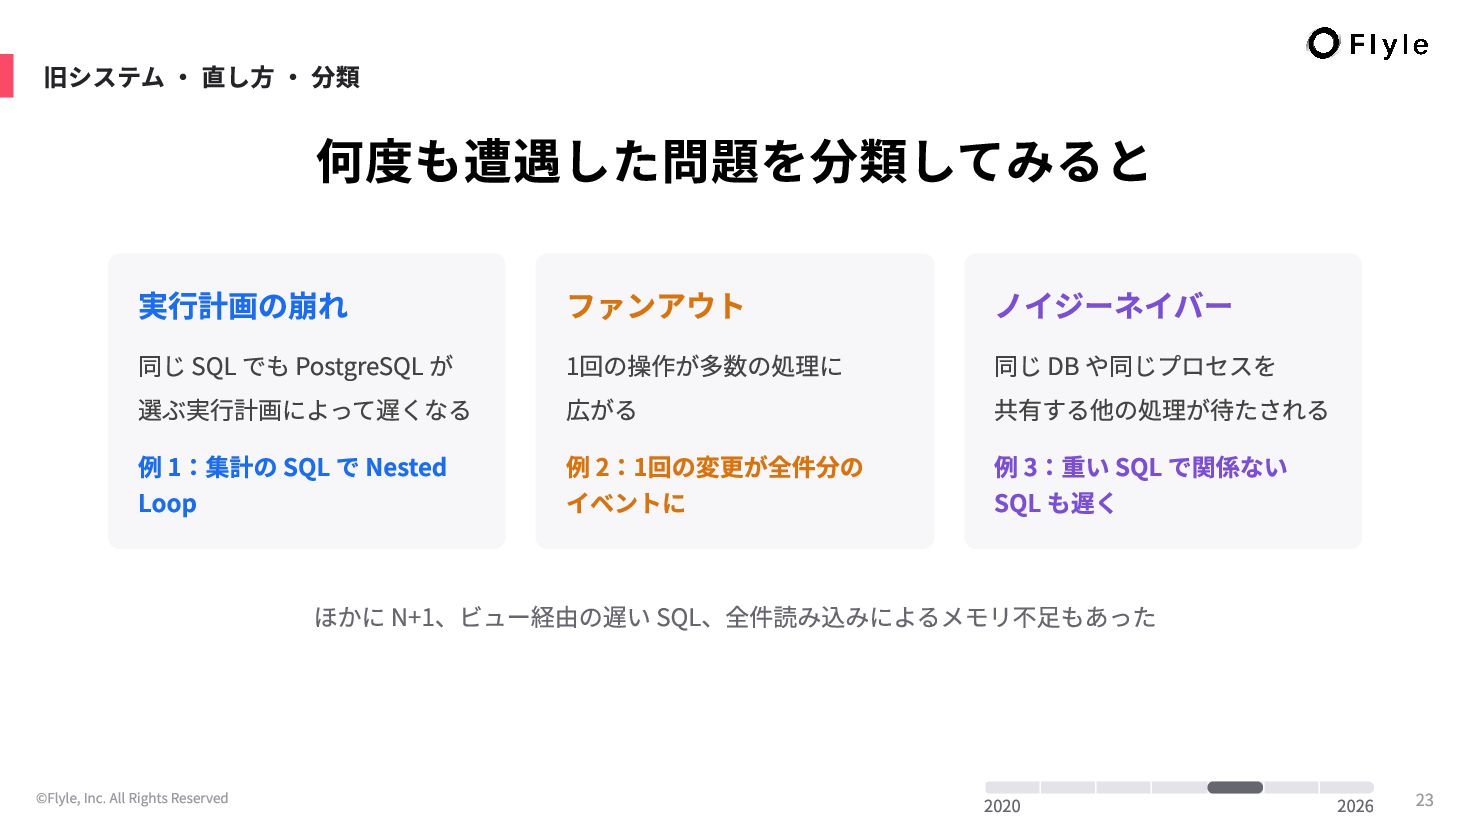
# 何度も遭遇した問題を分類してみると

実行計画の崩れ

同じ SQL でも PostgreSQL が選ぶ実行計画によって遅くなる

例 1:集計の SQL で Nested Loop

ファンアウト

1回の操作が多数の処理に広がる

例 2:1回の変更が全件分のイベントに

ノイジーネイバー

同じ DB や同じプロセスを共有する他の処理が待たされる

例 3:重い SQL で関係ない SQL も遅く

ほかに N+1、ビュー経由の遅い SQL、全件読み込みによるメモリ不足もあった

---

###### 旧システム ・ 直し方(2024年10月)

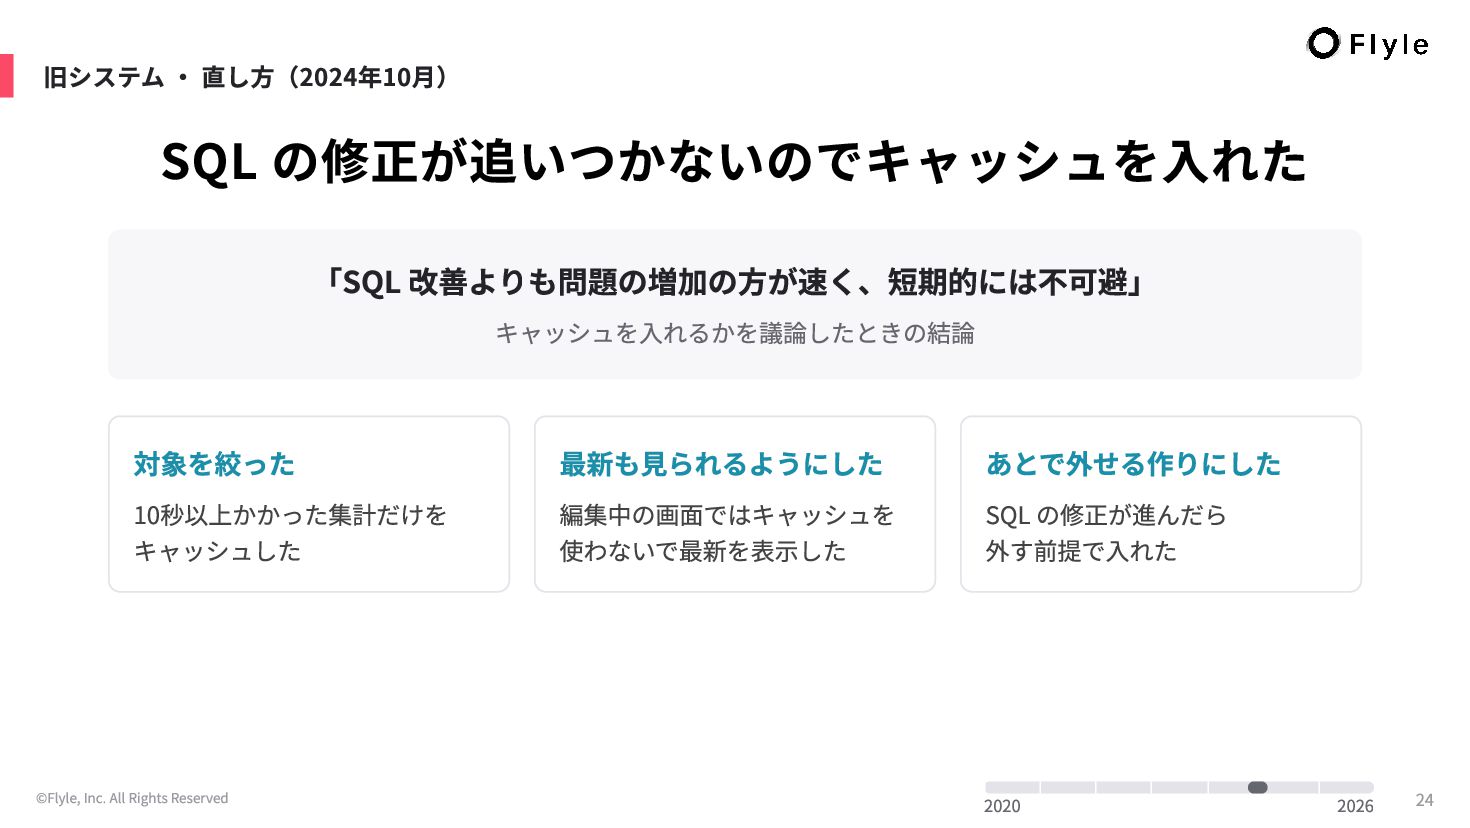
# SQL の修正が追いつかないのでキャッシュを入れた

「SQL 改善よりも問題の増加の方が速く、短期的には不可避」

キャッシュを入れるかを議論したときの結論

対象を絞った

10秒以上かかった集計だけをキャッシュした

最新も見られるようにした

編集中の画面ではキャッシュを使わないで最新を表示した

あとで外せる作りにした

SQL の修正が進んだら外す前提で入れた

---

###### 旧システム ・ 進め方 ・ 直す基準(2025年1月)

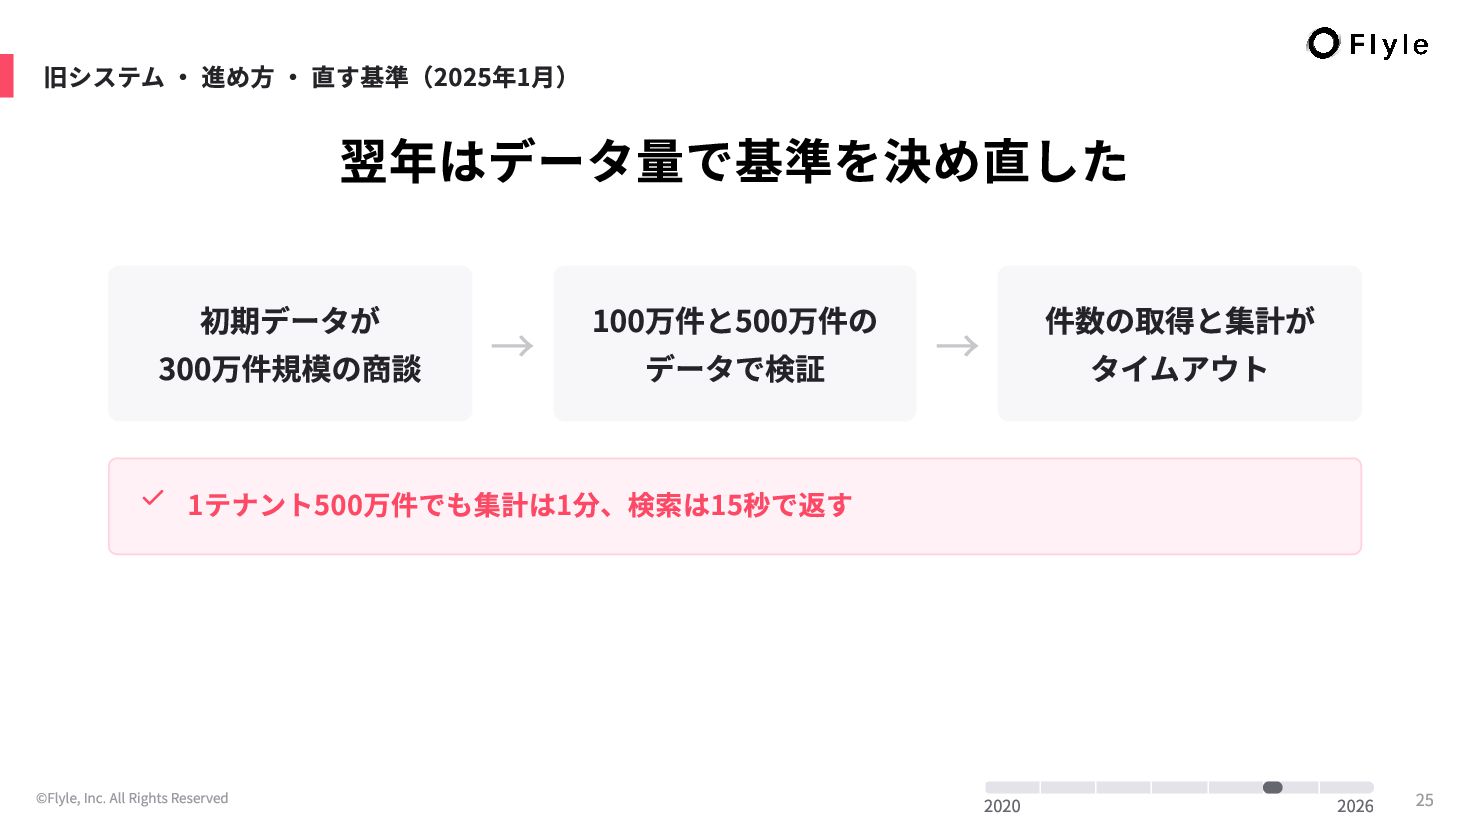
# 翌年はデータ量で基準を決め直した

初期データが
300万件規模の商談

→

100万件と500万件の
データで検証

→

件数の取得と集計が
タイムアウト

> **1テナント500万件でも集計は1分、検索は15秒で返す**
>

---

###### 旧システム ・ 進め方 ・ 検証

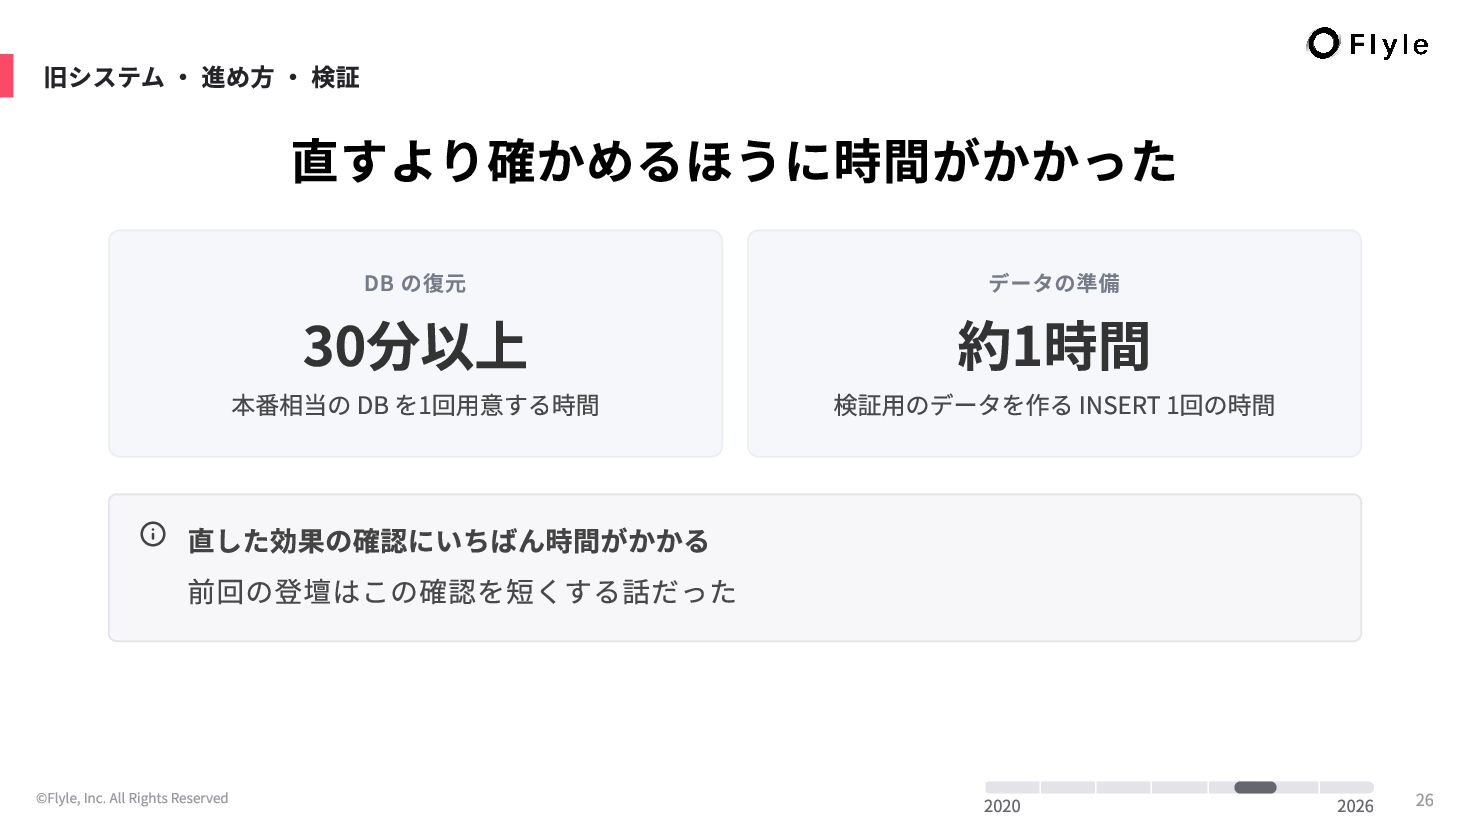
# 直すより確かめるほうに時間がかかった

- 30分以上 / DB の復元 / 本番相当の DB を1回用意する時間
- 約1時間 / データの準備 / 検証用のデータを作る INSERT 1回の時間

> **直した効果の確認にいちばん時間がかかる**
>
> 前回の登壇はこの確認を短くする話だった

---

###### 旧システム ・ まとめ

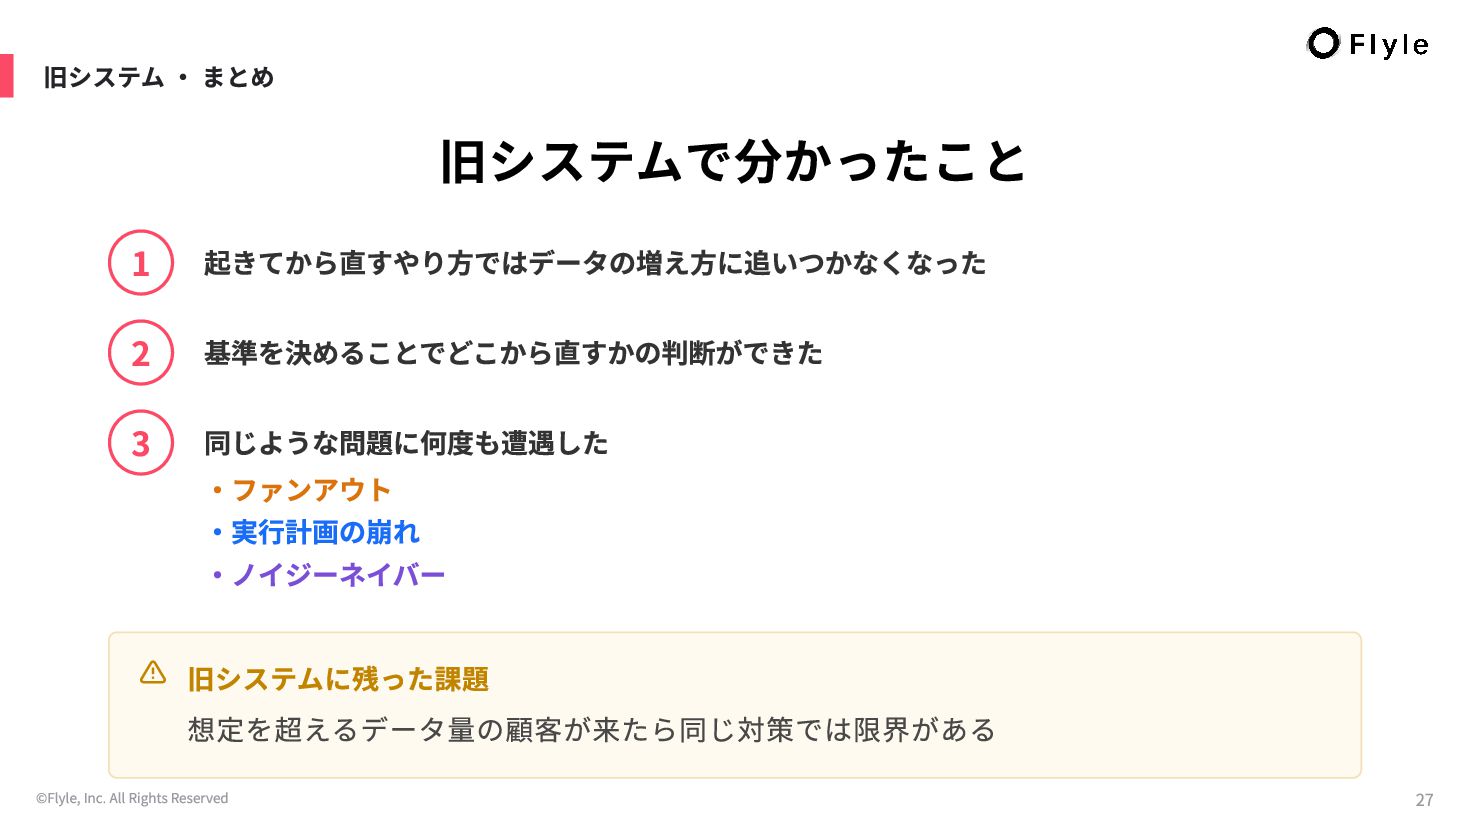
# 旧システムで分かったこと

1

起きてから直すやり方ではデータの増え方に追いつかなくなった

2

基準を決めることでどこから直すかの判断ができた

3

同じような問題に何度も遭遇した

・ファンアウト

・実行計画の崩れ

・ノイジーネイバー

> **旧システムに残った課題**
>
> 想定を超えるデータ量の顧客が来たら同じ対策では限界がある

---

###### 新システム ・ 背景

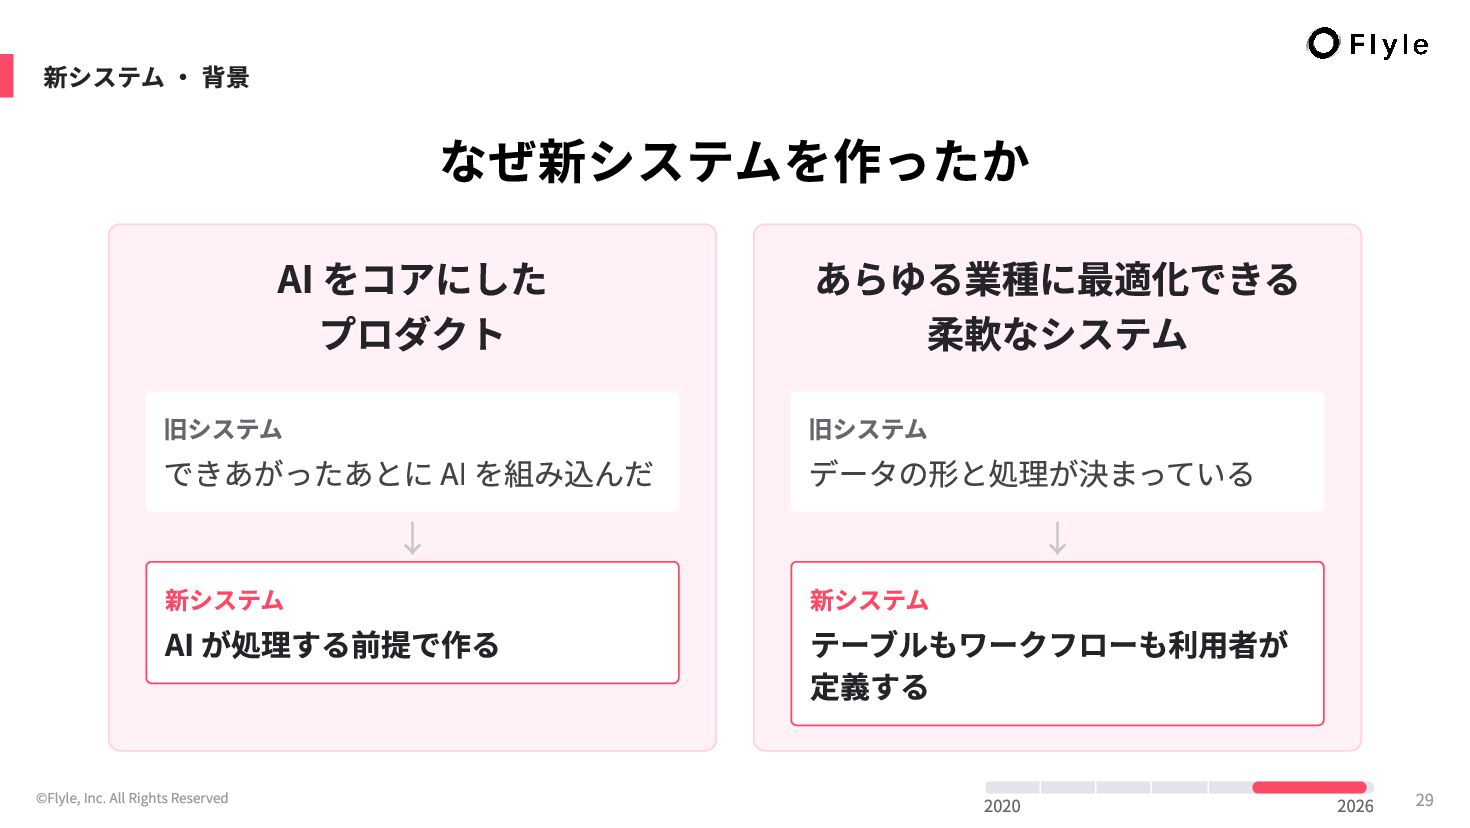
# なぜ新システムを作ったか

AI をコアにした
プロダクト

旧システム

できあがったあとに AI を組み込んだ

↓ 新システム

AI が処理する前提で作る

あらゆる業種に最適化できる
柔軟なシステム

旧システム

データの形と処理が決まっている

↓ 新システム

テーブルもワークフローも利用者が定義する

---

###### 新システム ・ 概要

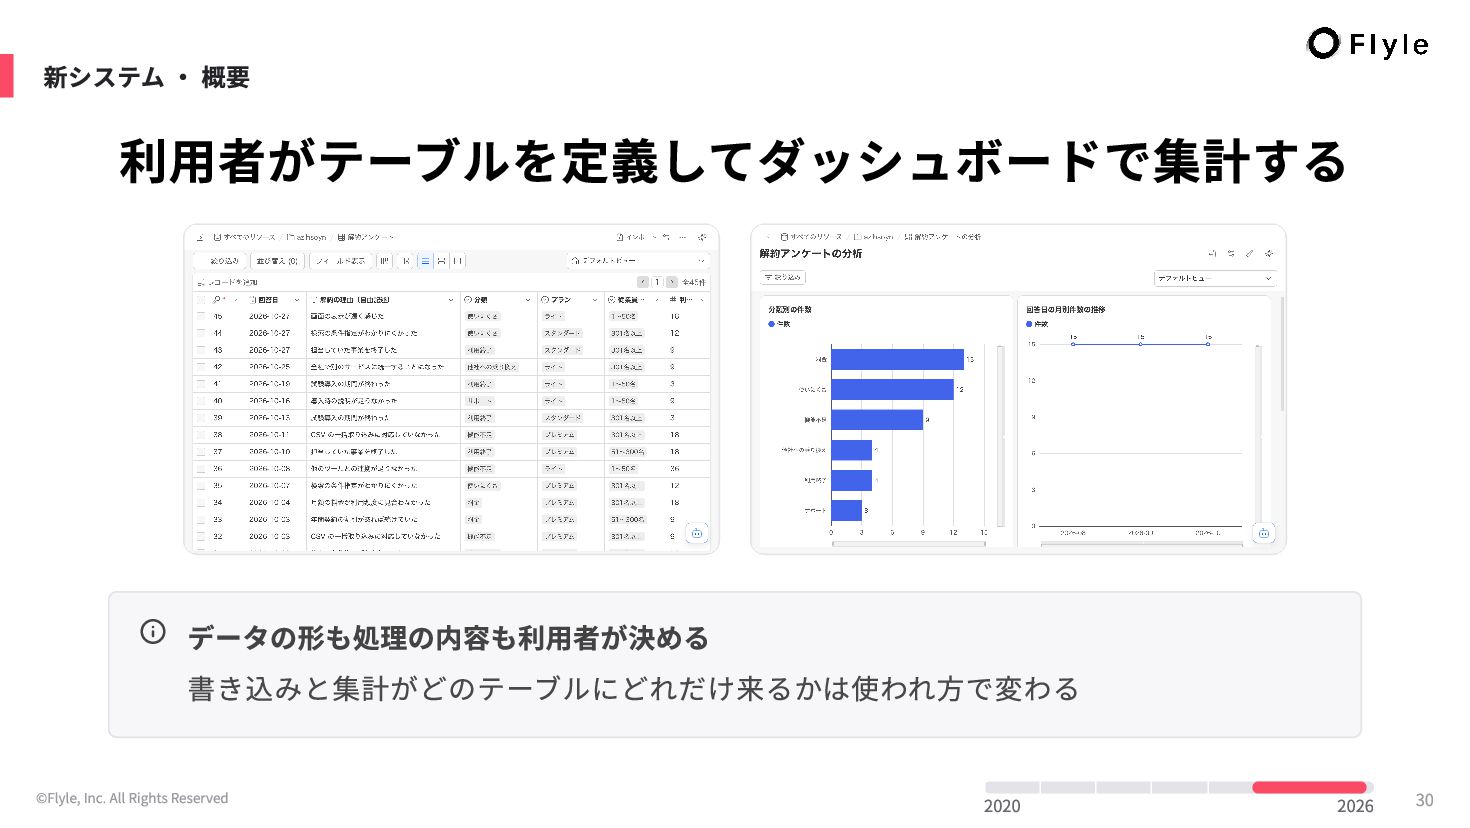
# 利用者がテーブルを定義してダッシュボードで集計する

> **データの形も処理の内容も利用者が決める**
>
> 書き込みと集計がどのテーブルにどれだけ来るかは使われ方で変わる

---

###### 新システム ・ 概要

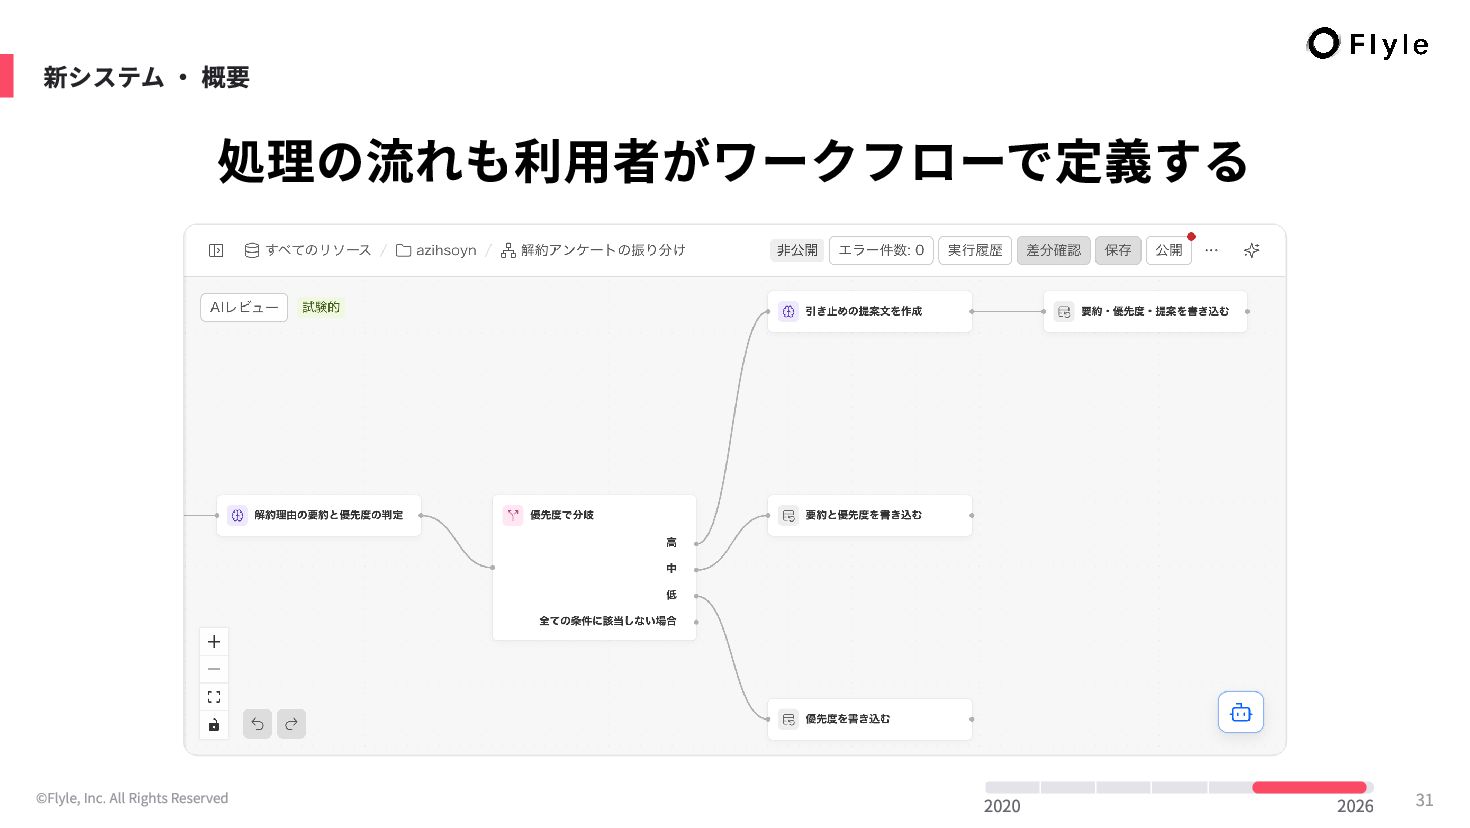
# 処理の流れも利用者がワークフローで定義する

---

###### 新システム ・ 構成

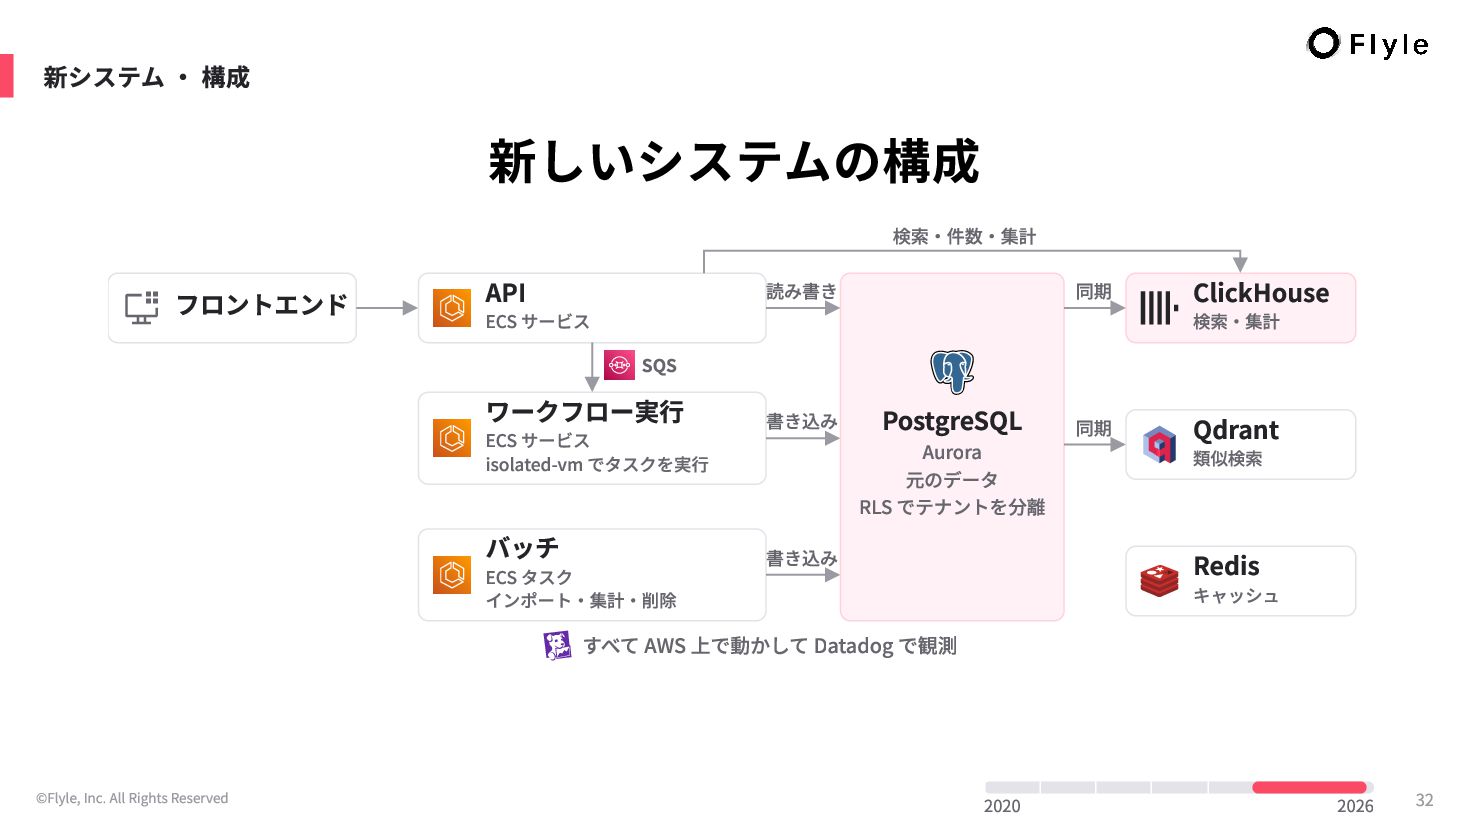
# 新しいシステムの構成

---

###### 新システム ・ 設計

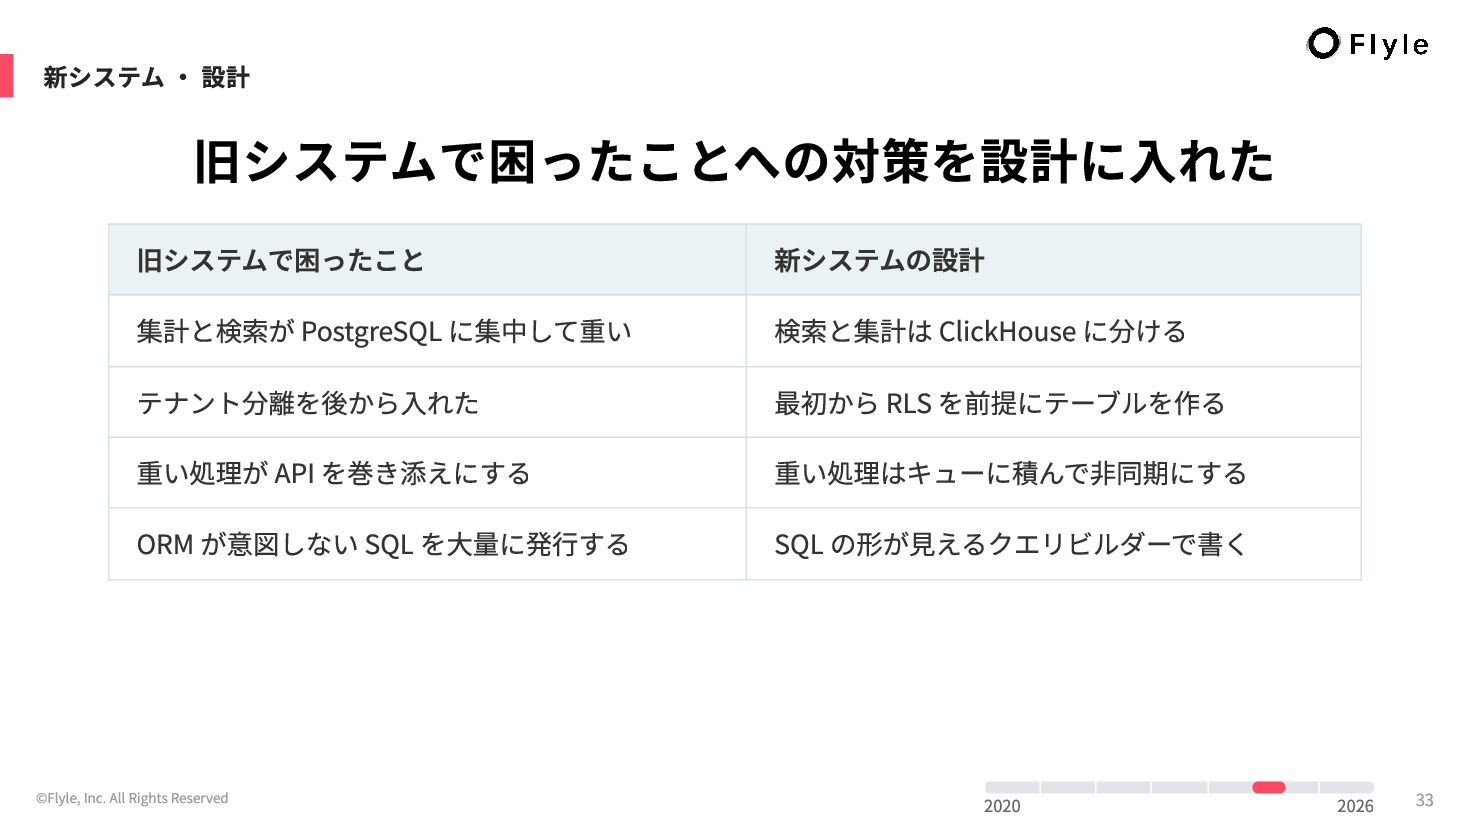
# 旧システムで困ったことへの対策を設計に入れた

| 旧システムで困ったこと | 新システムの設計 |
|---|---|
| 集計と検索が PostgreSQL に集中して重い | 検索と集計は ClickHouse に分ける |
| テナント分離を後から入れた | 最初から RLS を前提にテーブルを作る |
| 重い処理が API を巻き添えにする | 重い処理はキューに積んで非同期にする |
| ORM が意図しない SQL を大量に発行する | SQL の形が見えるクエリビルダーで書く |

---

###### 新システム ・ 起きたこと

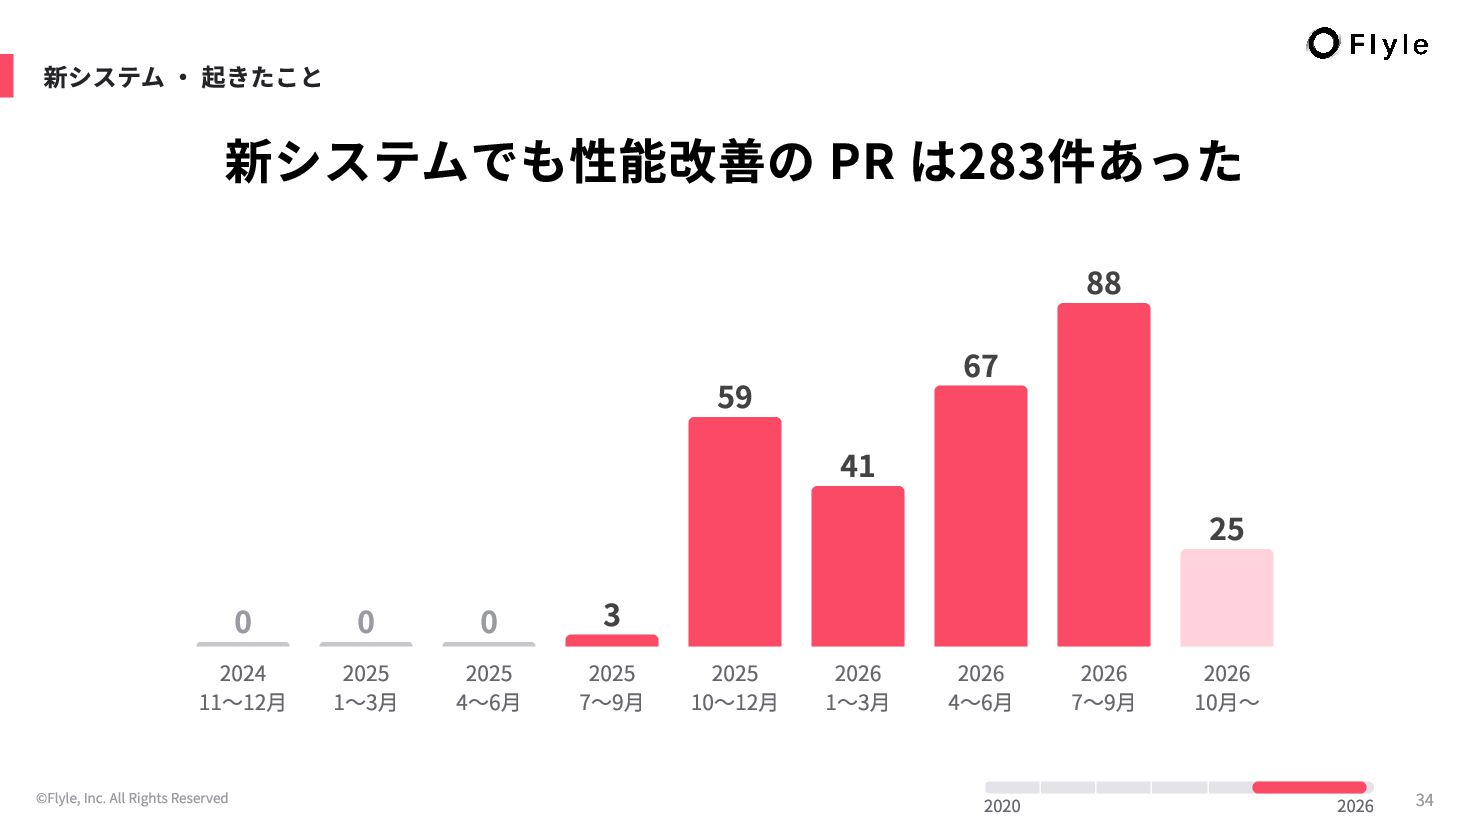
# 新システムでも性能改善の PR は283件あった

0 0 0 3 59 41 67 88 25

2024
11〜12月

2025
1〜3月

2025
4〜6月

2025
7〜9月

2025
10〜12月

2026
1〜3月

2026
4〜6月

2026
7〜9月

2026
10月〜

---

###### 新システム ・ 起きたこと

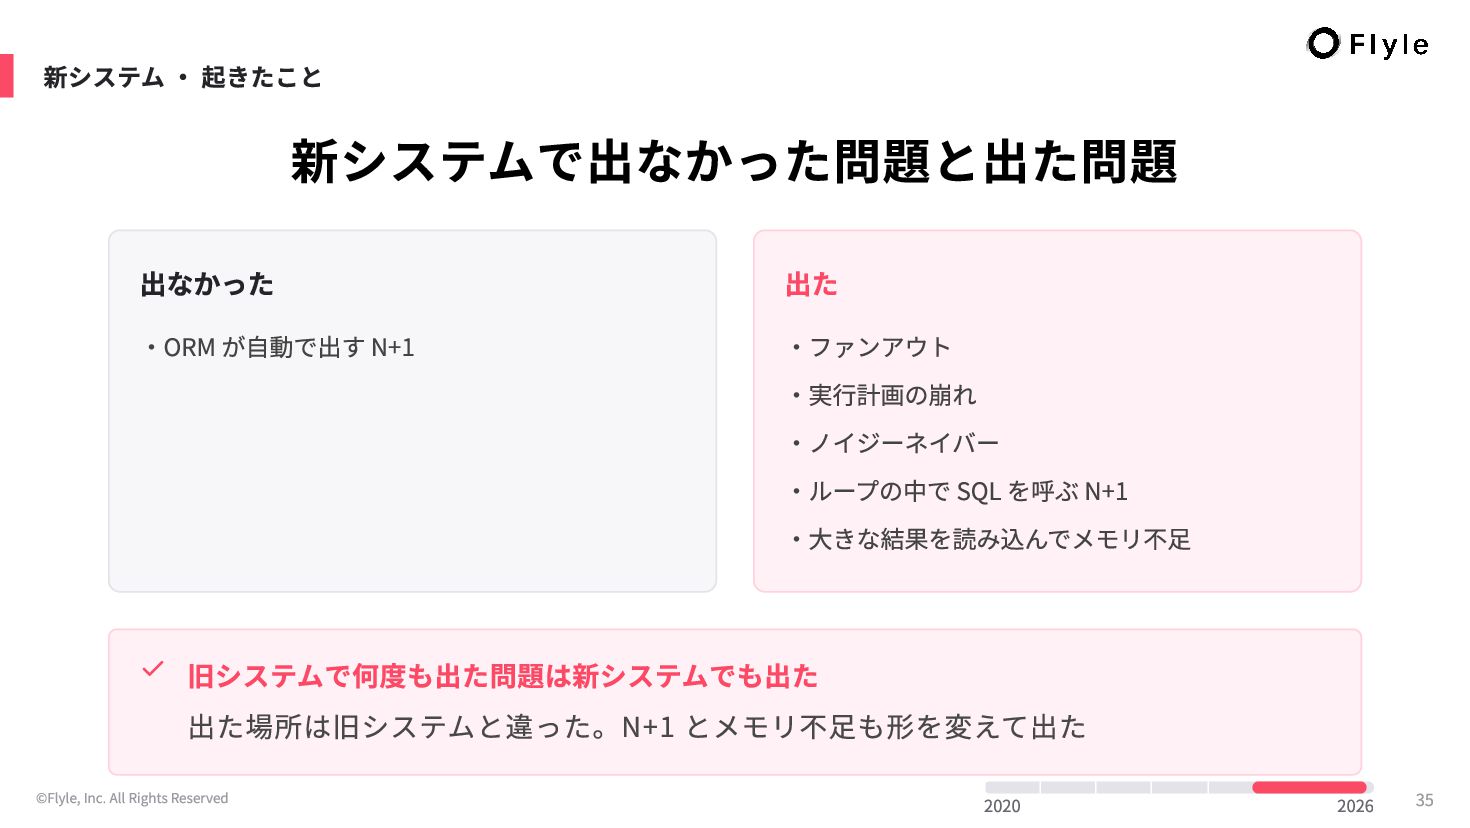
# 新システムで出なかった問題と出た問題

出なかった

・ORM が自動で出す N+1

出た

・ファンアウト

・実行計画の崩れ

・ノイジーネイバー

・ループの中で SQL を呼ぶ N+1

・大きな結果を読み込んでメモリ不足

> **旧システムで何度も出た問題は新システムでも出た**
>
> 出た場所は旧システムと違った。N+1 とメモリ不足も形を変えて出た

---

###### 新システム ・ 直し方

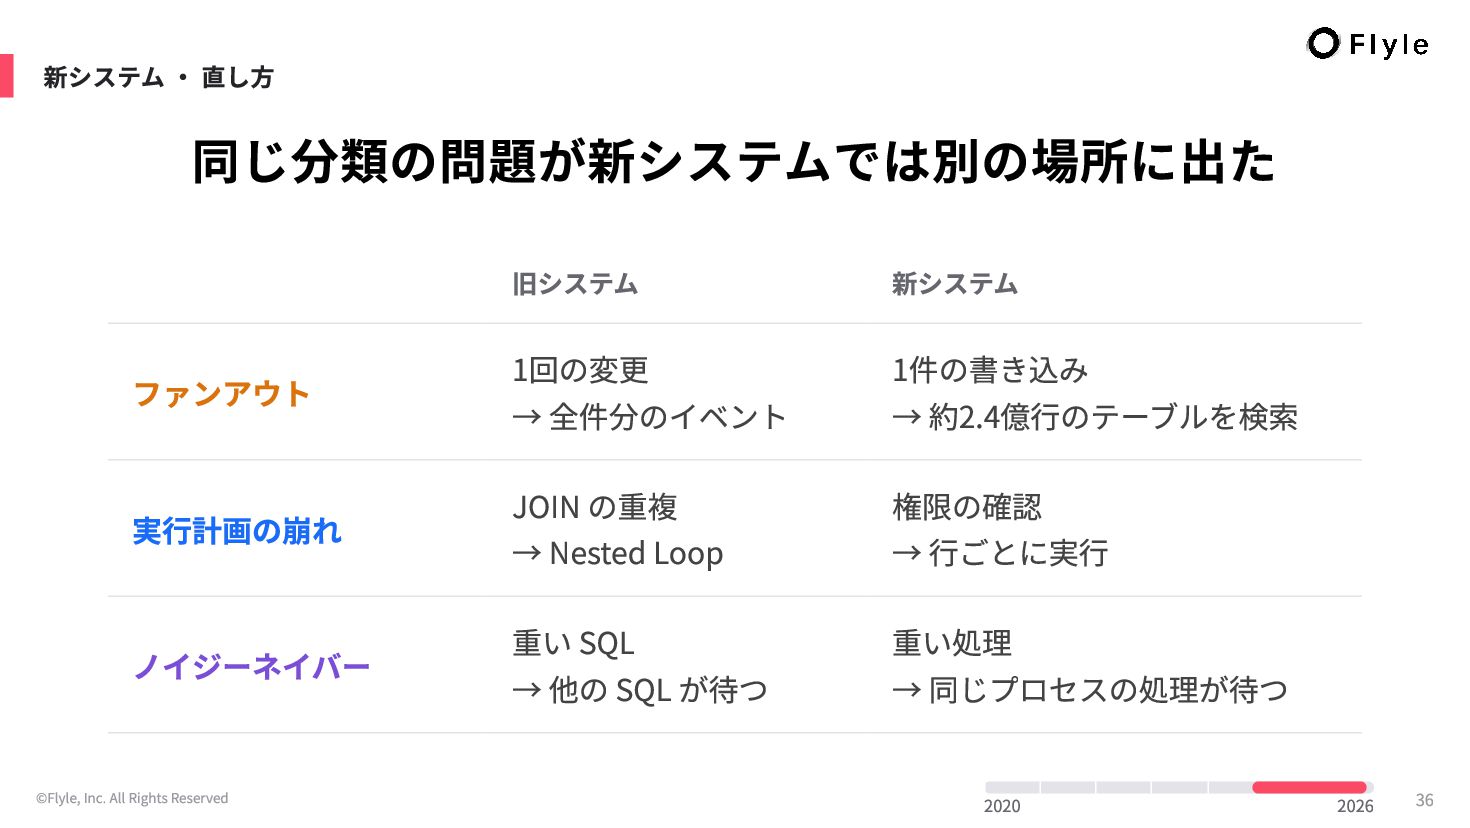
# 同じ分類の問題が新システムでは別の場所に出た

旧システム 新システム ファンアウト

1回の変更
→ 全件分のイベント

1件の書き込み
→ 約2.4億行のテーブルを検索

実行計画の崩れ

JOIN の重複
→ Nested Loop

権限の確認
→ 行ごとに実行

ノイジーネイバー

重い SQL
→ 他の SQL が待つ

重い処理
→ 同じプロセスの処理が待つ

---

###### 新システム ・ 直し方 ・ ファンアウトの例

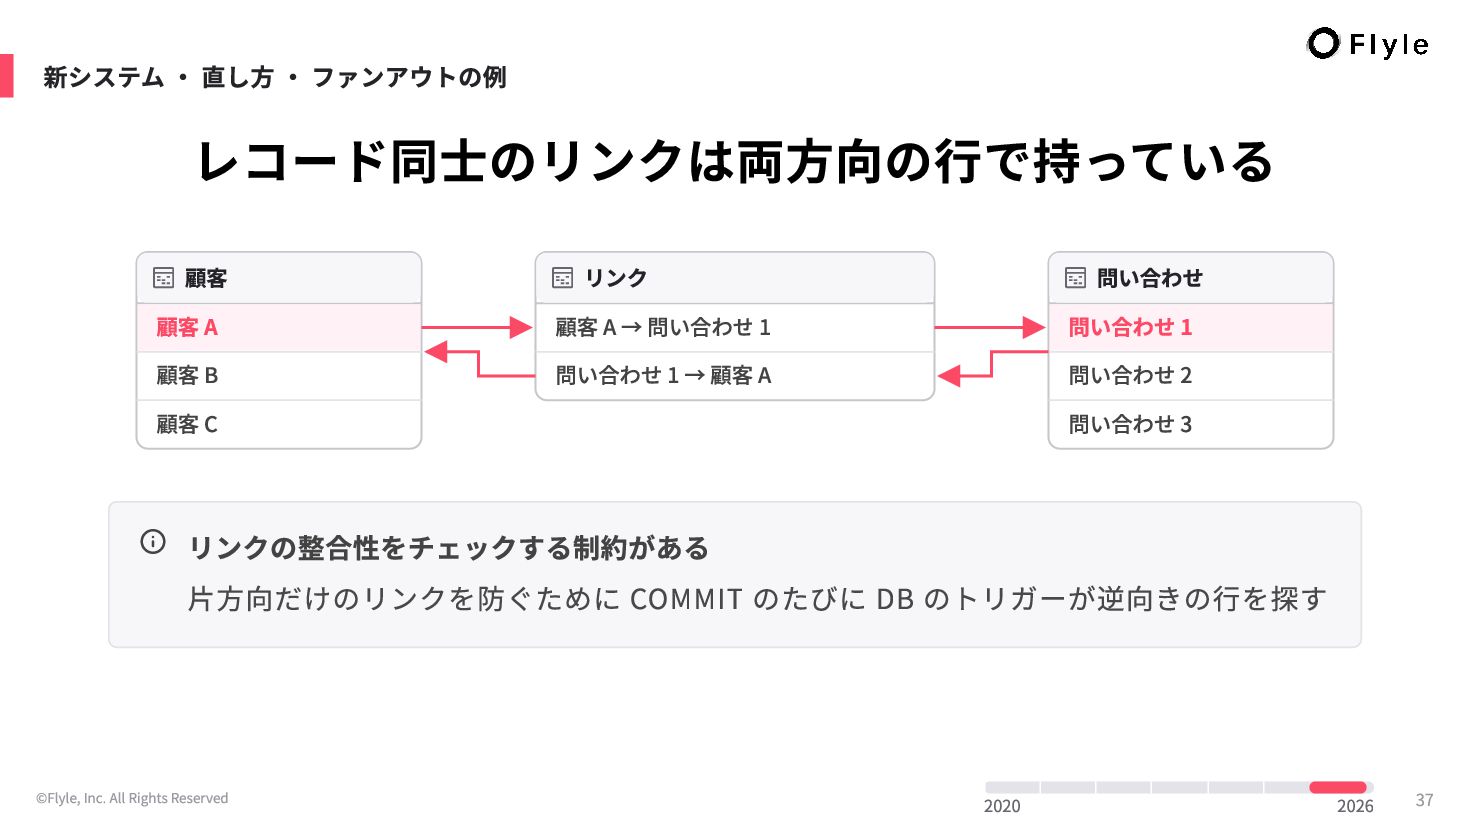
# レコード同士のリンクは両方向の行で持っている

> **リンクの整合性をチェックする制約がある**
>
> 片方向だけのリンクを防ぐために COMMIT のたびに DB のトリガーが逆向きの行を探す

---

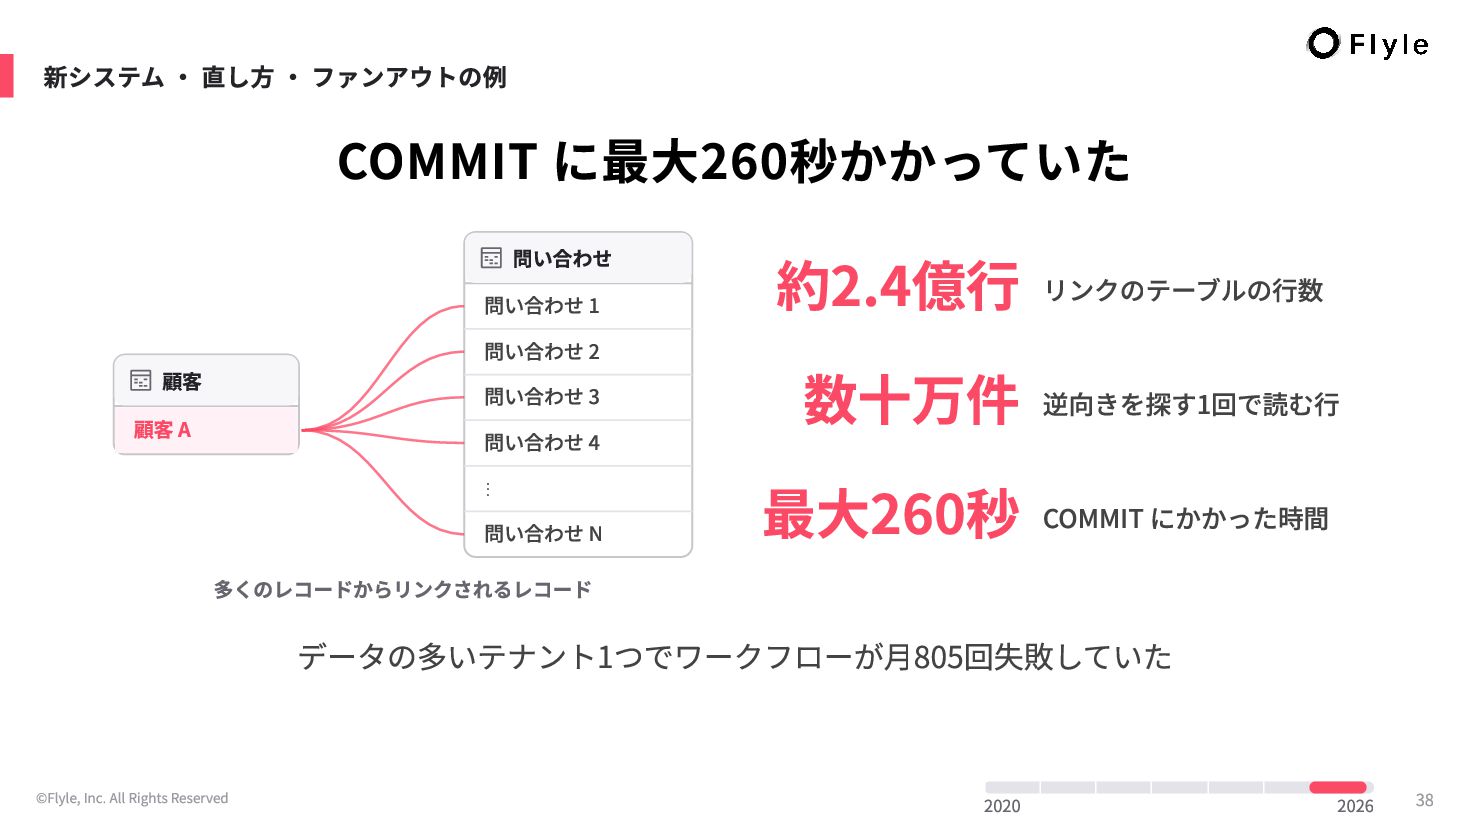
###### 新システム ・ 直し方 ・ ファンアウトの例

# COMMIT に最大260秒かかっていた

データの多いテナント1つでワークフローが月805回失敗していた

---

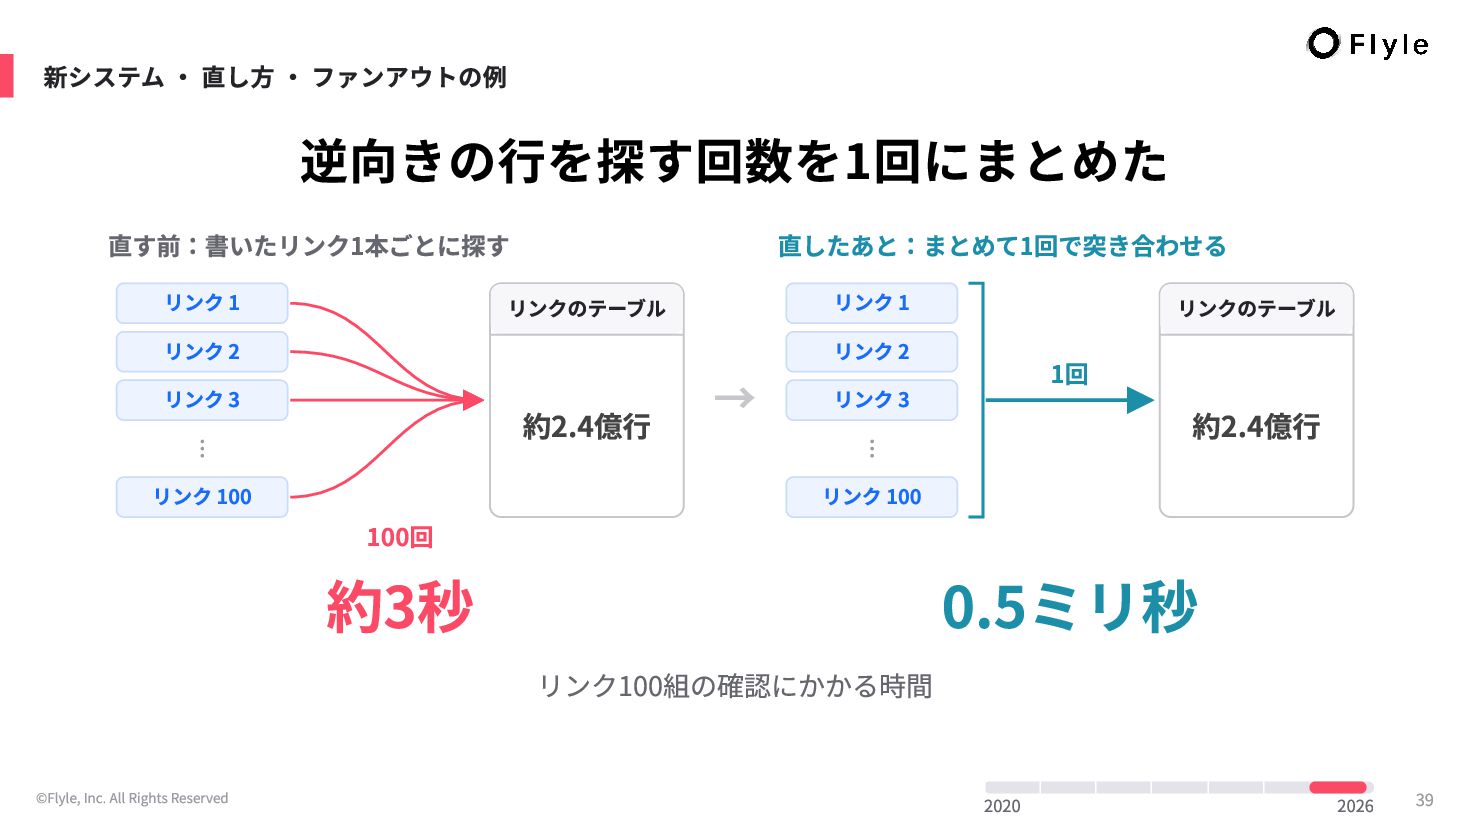
###### 新システム ・ 直し方 ・ ファンアウトの例

# 逆向きの行を探す回数を1回にまとめた

リンク100組の確認にかかる時間

---

###### 新システム ・ 直し方 ・ 実行計画の崩れの例 1

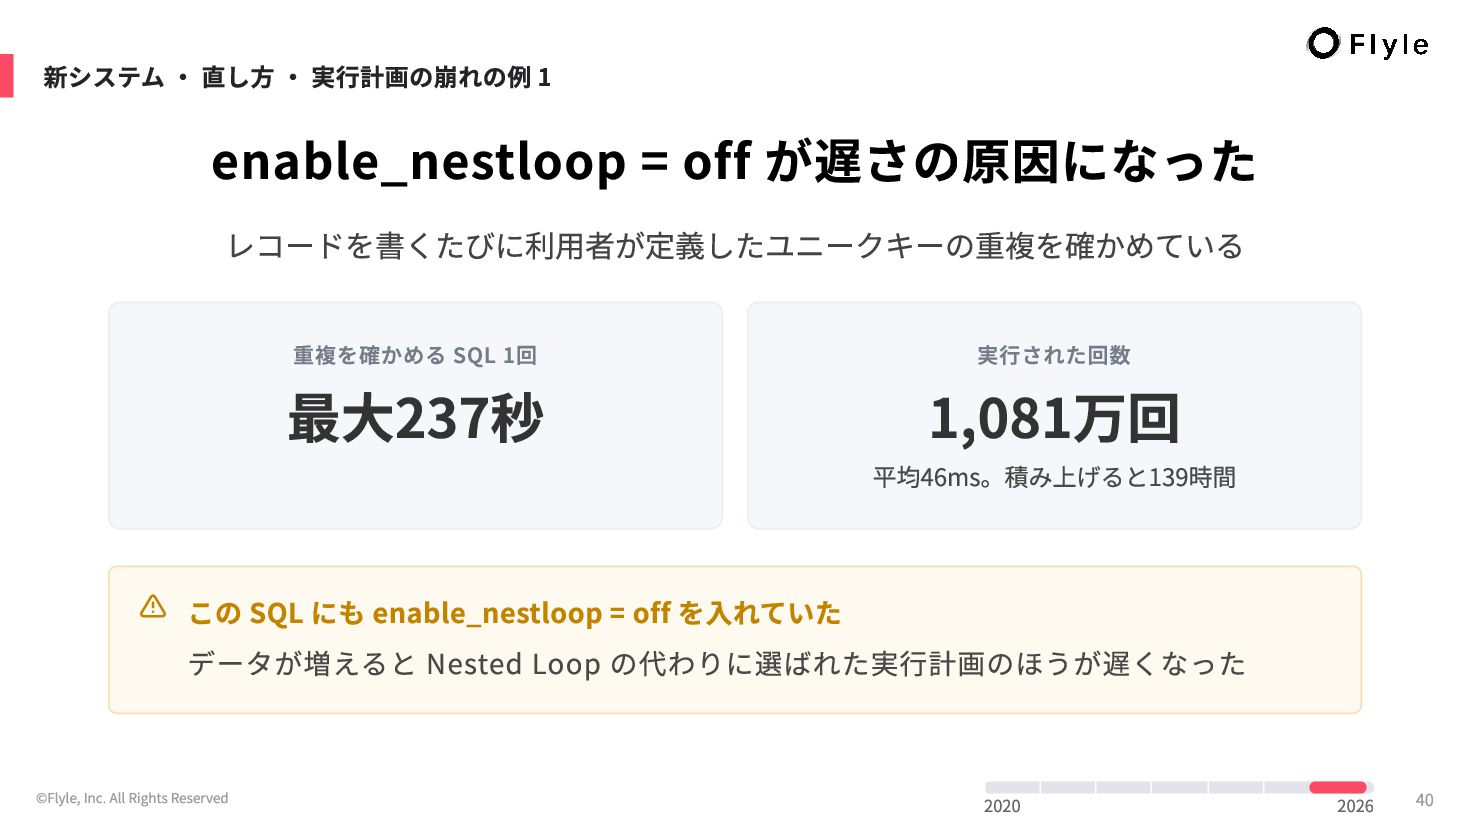
# enable_nestloop = off が遅さの原因になった

レコードを書くたびに利用者が定義したユニークキーの重複を確かめている

- 最大237秒 / 重複を確かめる SQL 1回
- 1,081万回 / 実行された回数 / 平均46ms。積み上げると139時間

> **この SQL にも enable_nestloop = off を入れていた**
>
> データが増えると Nested Loop の代わりに選ばれた実行計画のほうが遅くなった

---

###### 新システム ・ 直し方 ・ 実行計画の崩れの例 1

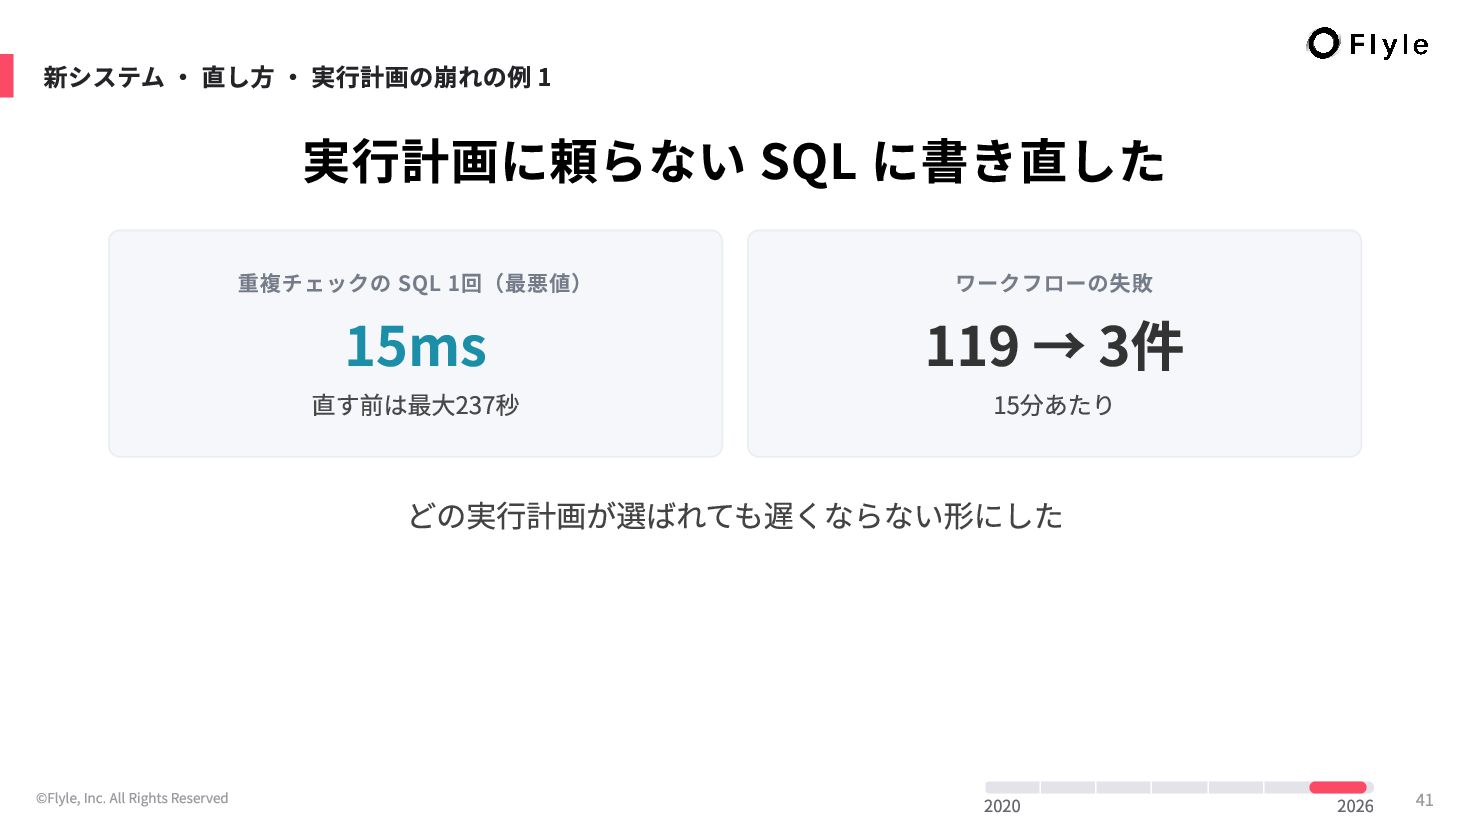
# 実行計画に頼らない SQL に書き直した

- 15ms / 重複チェックの SQL 1回(最悪値) / 直す前は最大237秒
- 119 → 3件 / ワークフローの失敗 / 15分あたり

どの実行計画が選ばれても遅くならない形にした

---

###### 新システム ・ 直し方 ・ 実行計画の崩れの例 2

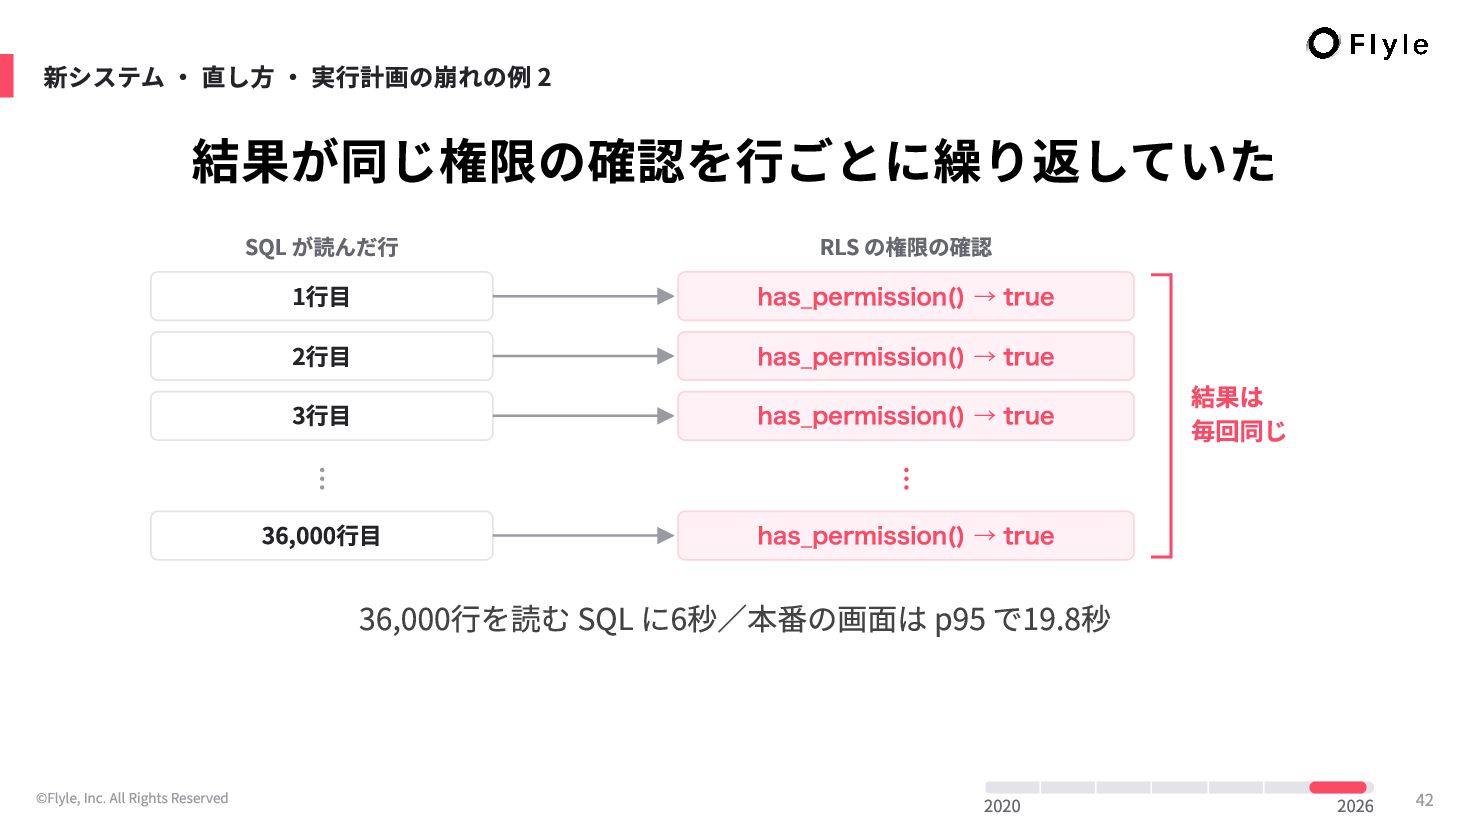
# 結果が同じ権限の確認を行ごとに繰り返していた

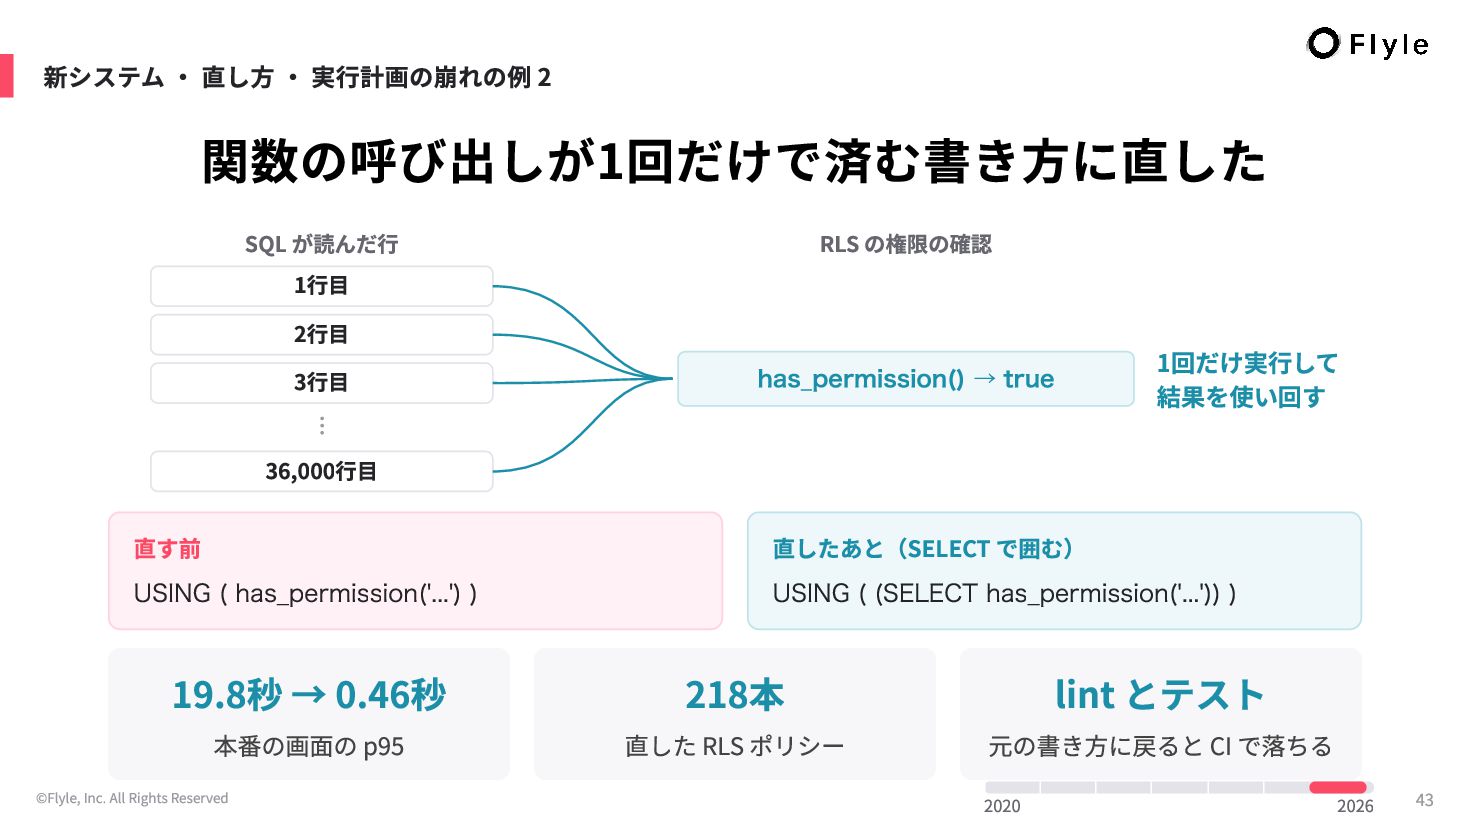
36,000行を読む SQL に6秒/本番の画面は p95 で19.8秒

---

###### 新システム ・ 直し方 ・ 実行計画の崩れの例 2

# 関数の呼び出しが1回だけで済む書き方に直した

直す前

USING ( has_permission('...') )

直したあと(SELECT で囲む)

USING ( (SELECT has_permission('...')) )

19.8秒 → 0.46秒

本番の画面の p95

218本

直した RLS ポリシー

lint とテスト

元の書き方に戻ると CI で落ちる

---

###### 新システム ・ 直し方 ・ ノイジーネイバーの例

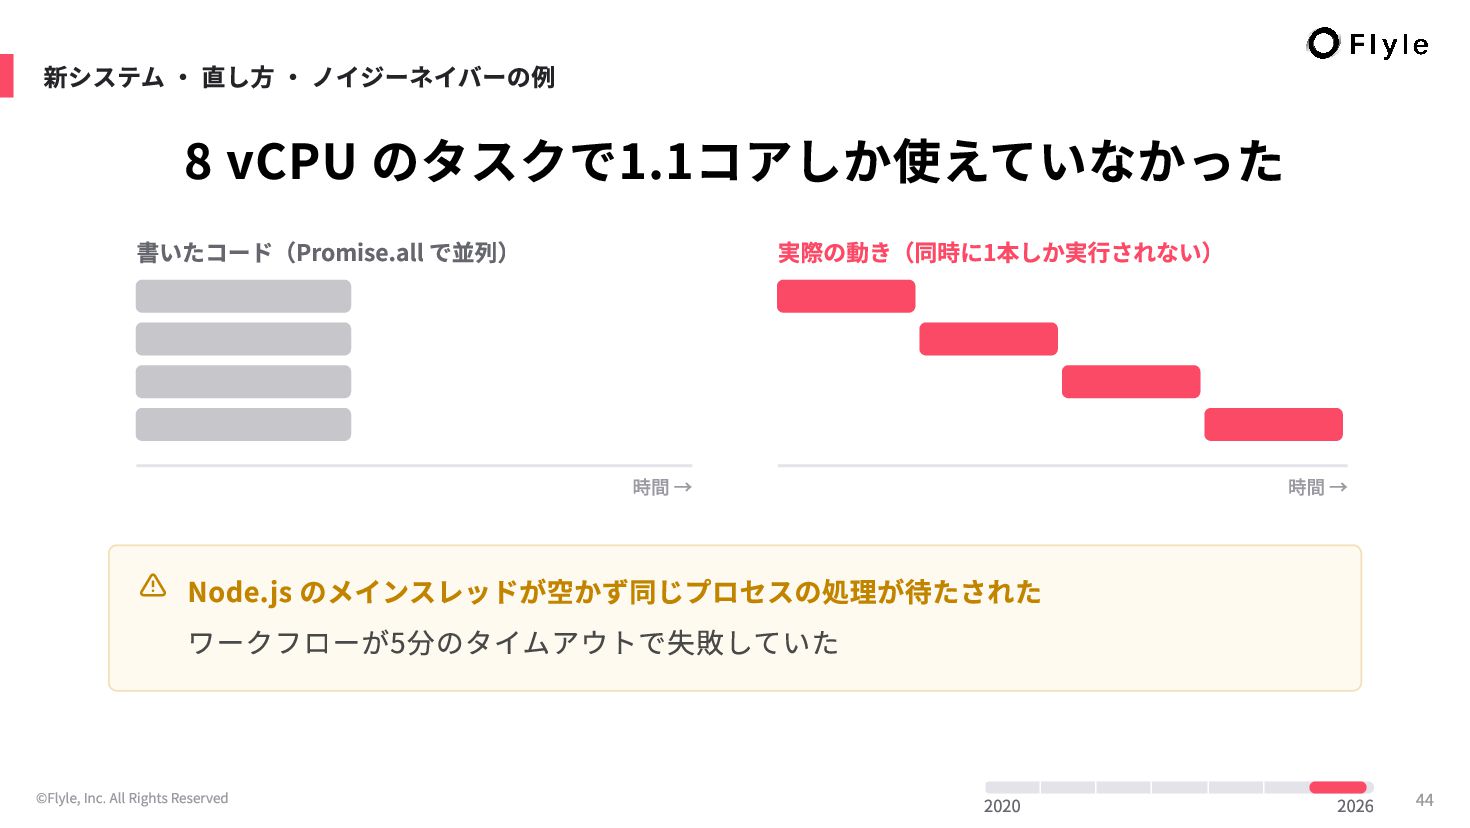
# 8 vCPU のタスクで1.1コアしか使えていなかった

> **Node.js のメインスレッドが空かず同じプロセスの処理が待たされた**
>
> ワークフローが5分のタイムアウトで失敗していた

---

###### 新システム ・ 直し方 ・ ノイジーネイバーの例

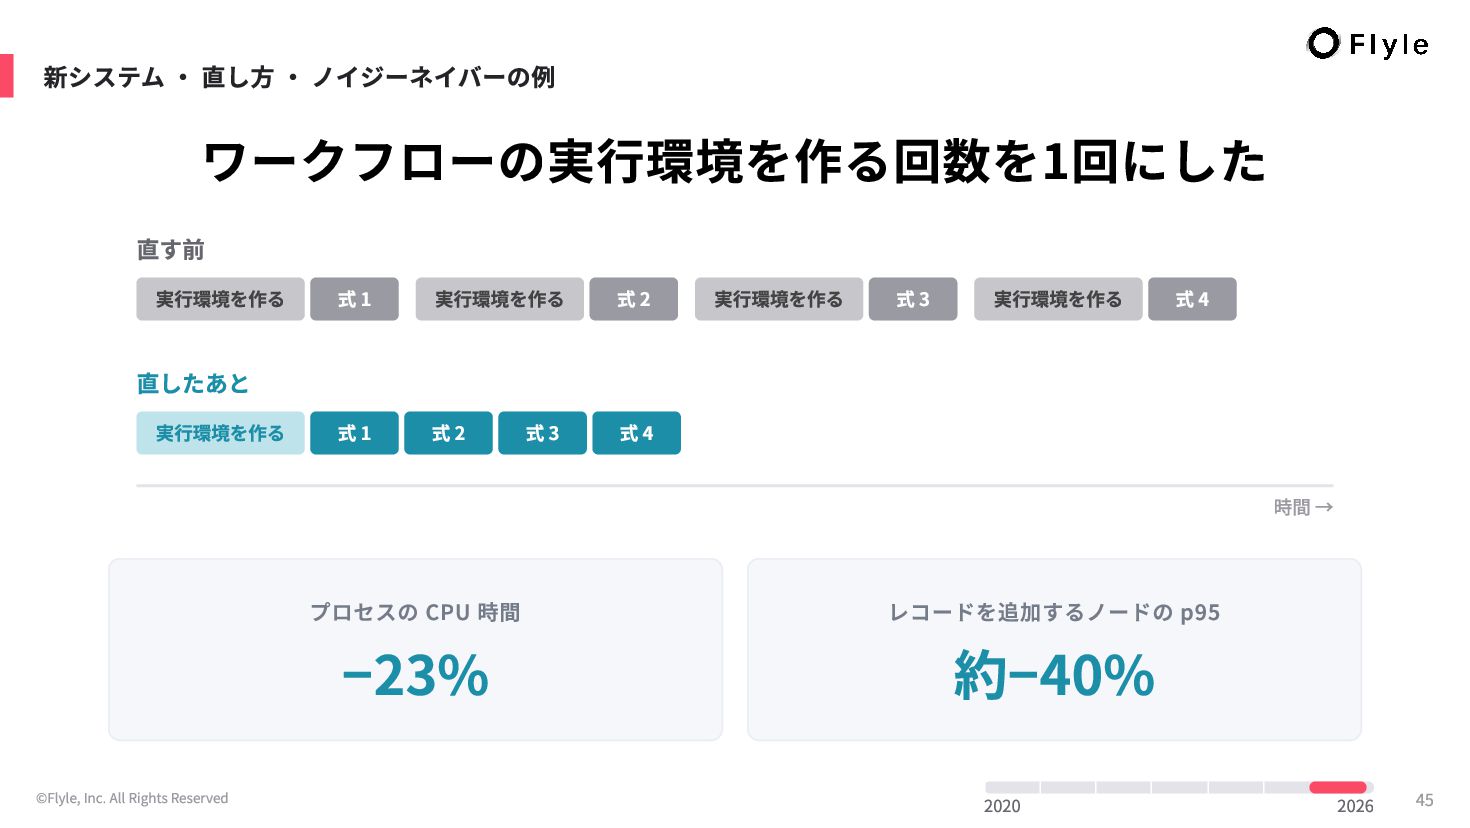
# ワークフローの実行環境を作る回数を1回にした

- −23% / プロセスの CPU 時間
- 約−40% / レコードを追加するノードの p95

---

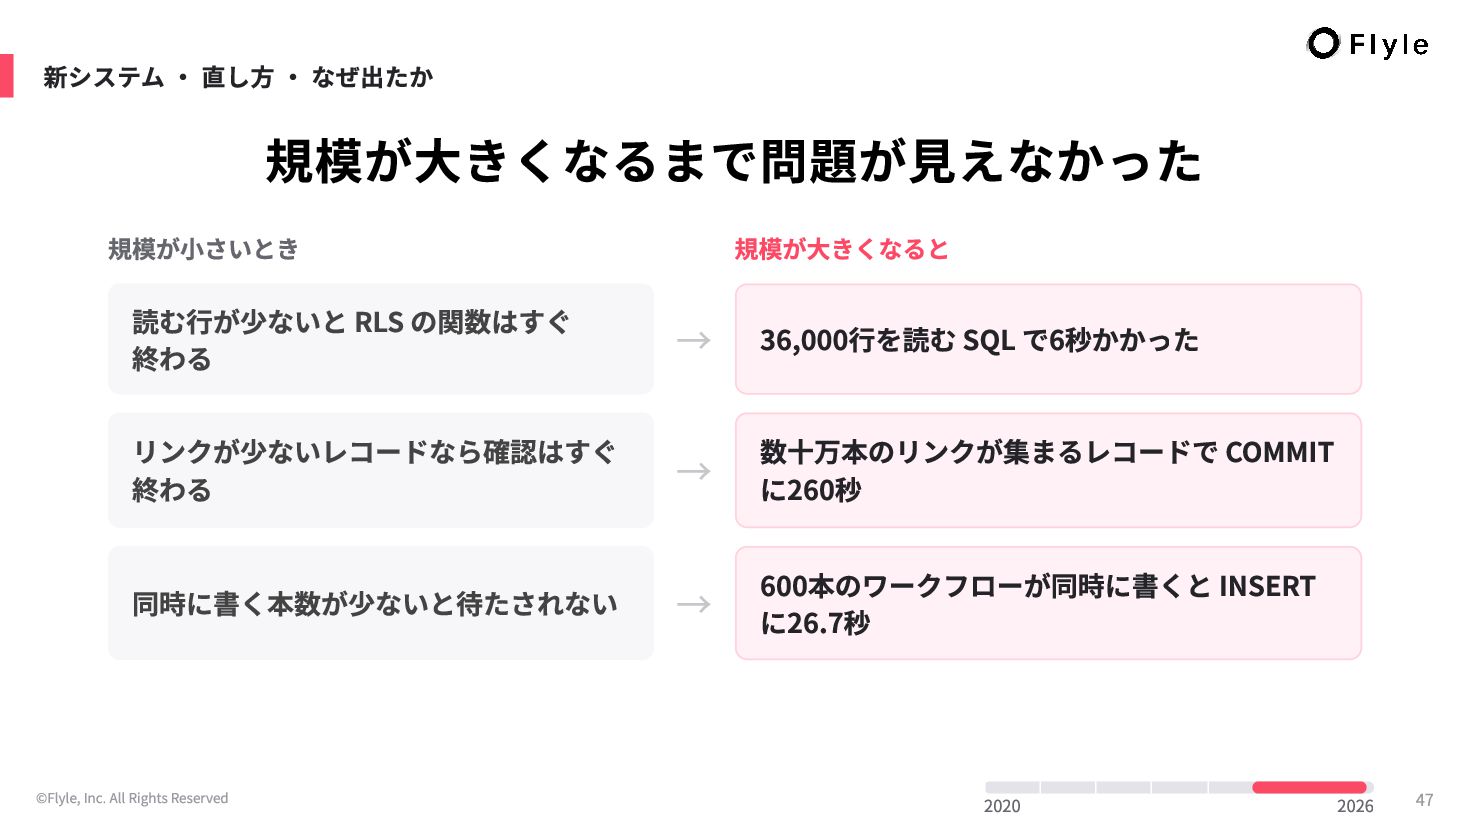
###### 新システム ・ 直し方 ・ なぜ出たか

# 規模が大きくなるまで問題が見えなかった

規模が小さいとき

規模が大きくなると

読む行が少ないと RLS の関数はすぐ終わる

→

36,000行を読む SQL で6秒かかった

リンクが少ないレコードなら確認はすぐ終わる

→

数十万本のリンクが集まるレコードで COMMIT に260秒

同時に書く本数が少ないと待たされない

→

600本のワークフローが同時に書くと INSERT に26.7秒

---

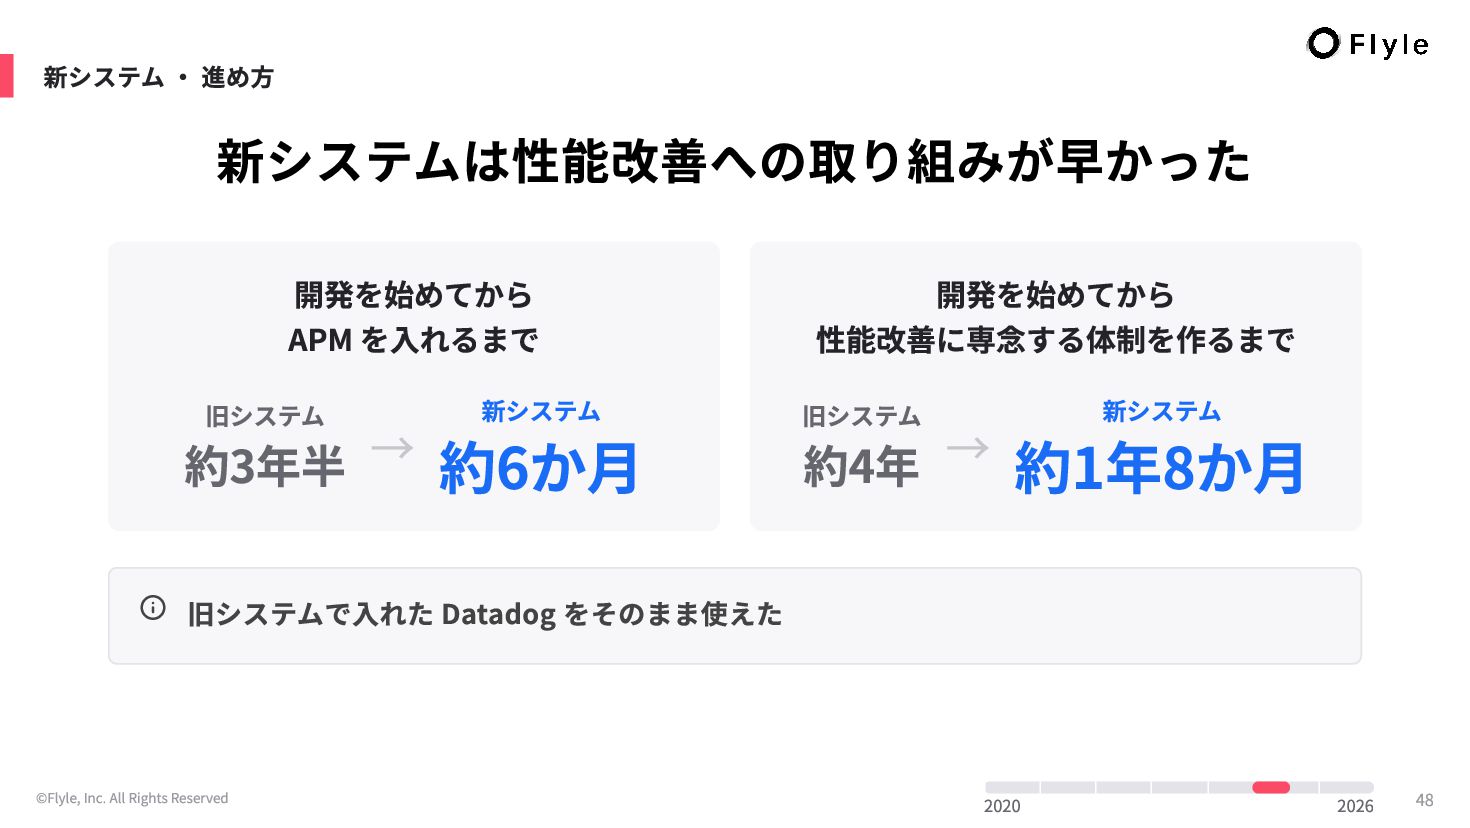
###### 新システム ・ 進め方

# 新システムは性能改善への取り組みが早かった

開発を始めてから
APM を入れるまで

旧システム 約3年半 → 新システム 約6か月

開発を始めてから
性能改善に専念する体制を作るまで

旧システム 約4年 → 新システム 約1年8か月

> **旧システムで入れた Datadog をそのまま使えた**
>

---

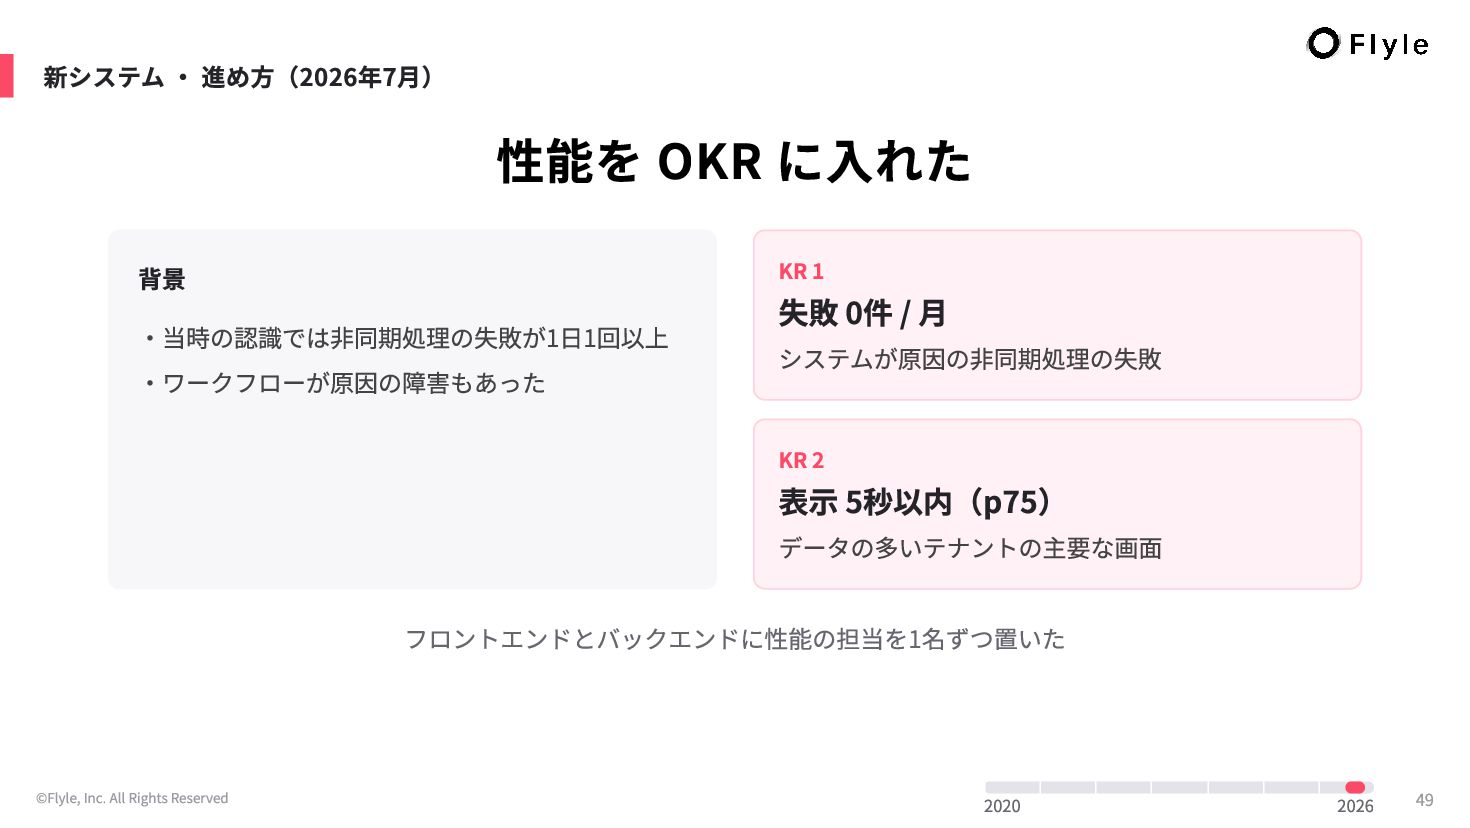
###### 新システム ・ 進め方(2026年7月)

# 性能を OKR に入れた

背景

・当時の認識では非同期処理の失敗が1日1回以上

・ワークフローが原因の障害もあった

KR 1

失敗 0件 / 月

システムが原因の非同期処理の失敗

KR 2

表示 5秒以内(p75)

データの多いテナントの主要な画面

フロントエンドとバックエンドに性能の担当を1名ずつ置いた

---

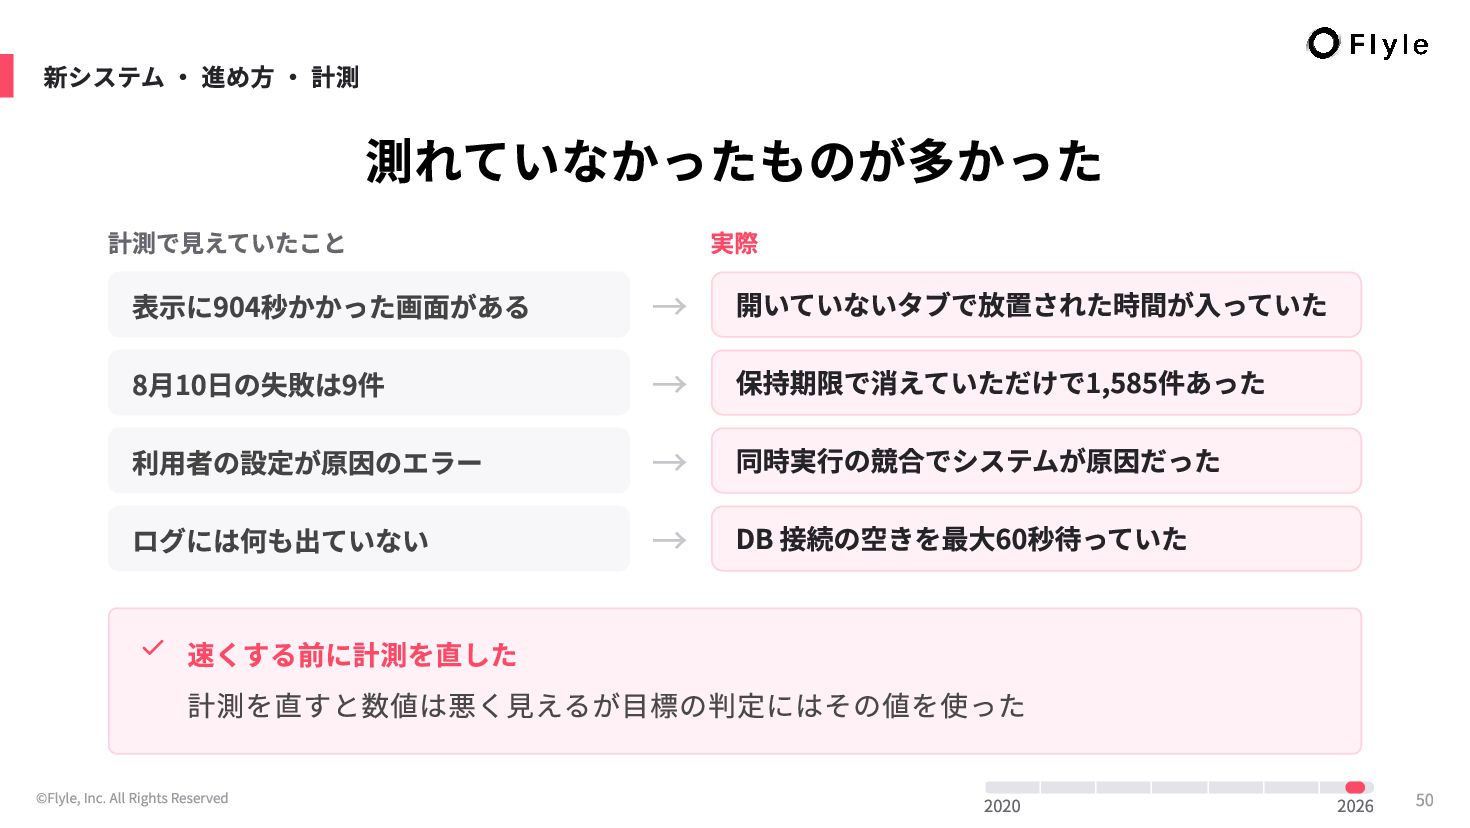
###### 新システム ・ 進め方 ・ 計測

# 測れていなかったものが多かった

計測で見えていたこと

実際

表示に904秒かかった画面がある

→

開いていないタブで放置された時間が入っていた

8月10日の失敗は9件

→

保持期限で消えていただけで1,585件あった

利用者の設定が原因のエラー

→

同時実行の競合でシステムが原因だった

ログには何も出ていない

→

DB 接続の空きを最大60秒待っていた

> **速くする前に計測を直した**
>
> 計測を直すと数値は悪く見えるが目標の判定にはその値を使った

---

###### いま ・ 開発の速さ

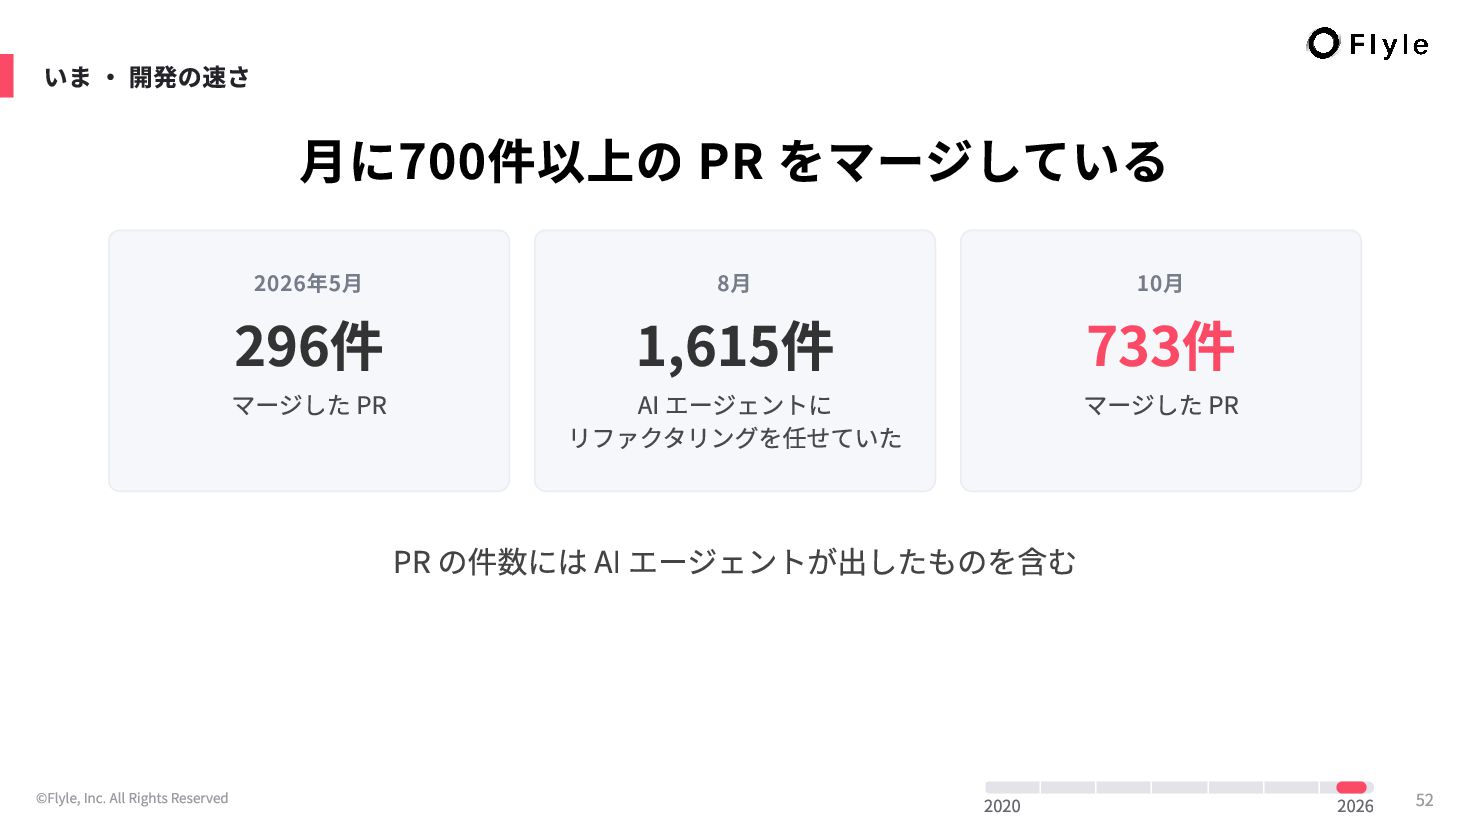
# 月に700件以上の PR をマージしている

- 296件 / 2026年5月 / マージした PR
- 1,615件 / 8月 / AI エージェントにリファクタリングを任せていた
- 733件 / 10月 / マージした PR

PR の件数には AI エージェントが出したものを含む

---

###### いま ・ 起きたこと(2026年9月末)

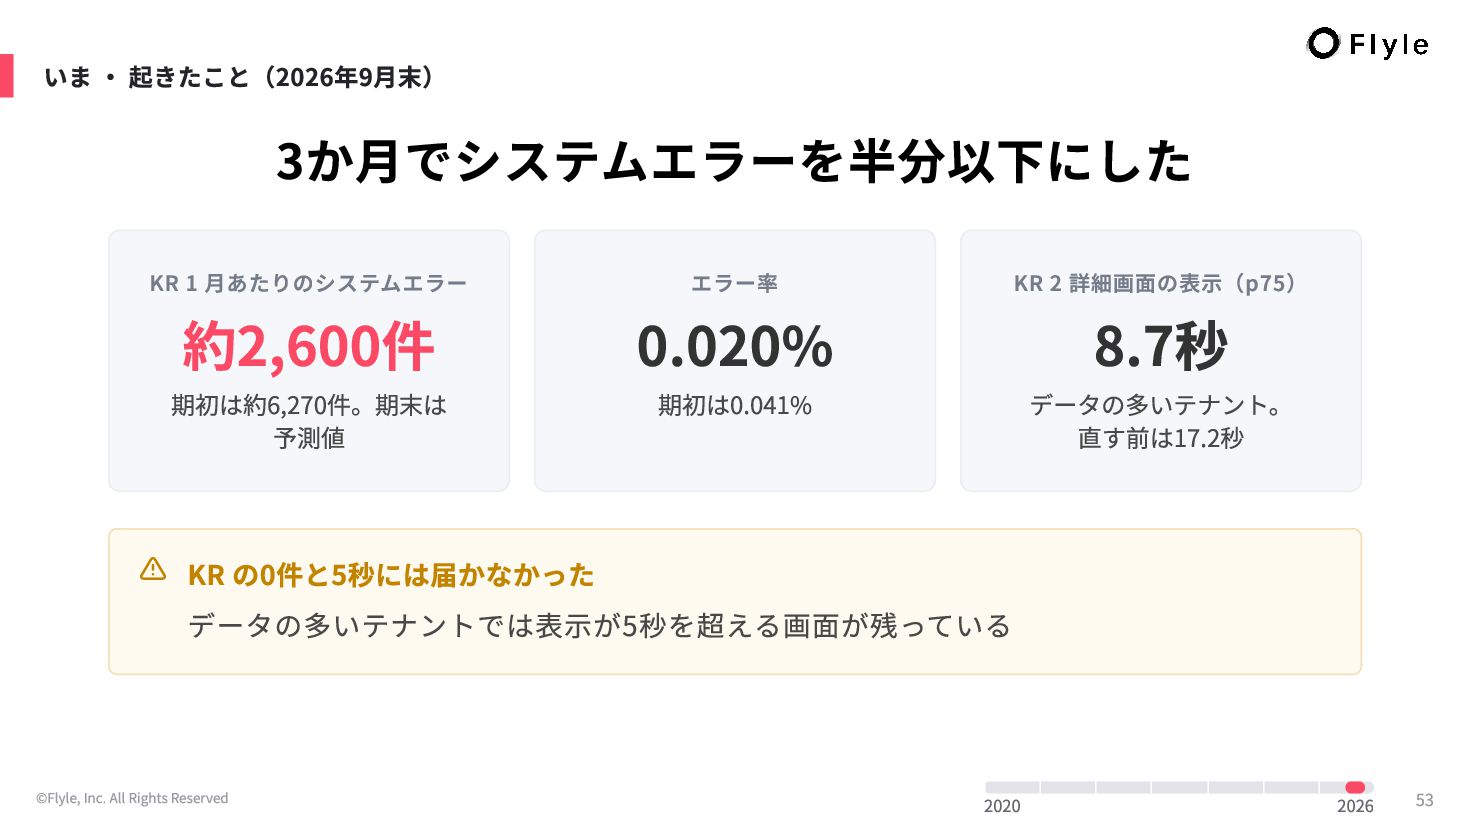
# 3か月でシステムエラーを半分以下にした

- 約2,600件 / KR 1 月あたりのシステムエラー / 期初は約6,270件。期末は予測値
- 0.020% / エラー率 / 期初は0.041%
- 8.7秒 / KR 2 詳細画面の表示(p75) / データの多いテナント。直す前は17.2秒

> **KR の0件と5秒には届かなかった**
>
> データの多いテナントでは表示が5秒を超える画面が残っている

---

###### いま ・ 直し方

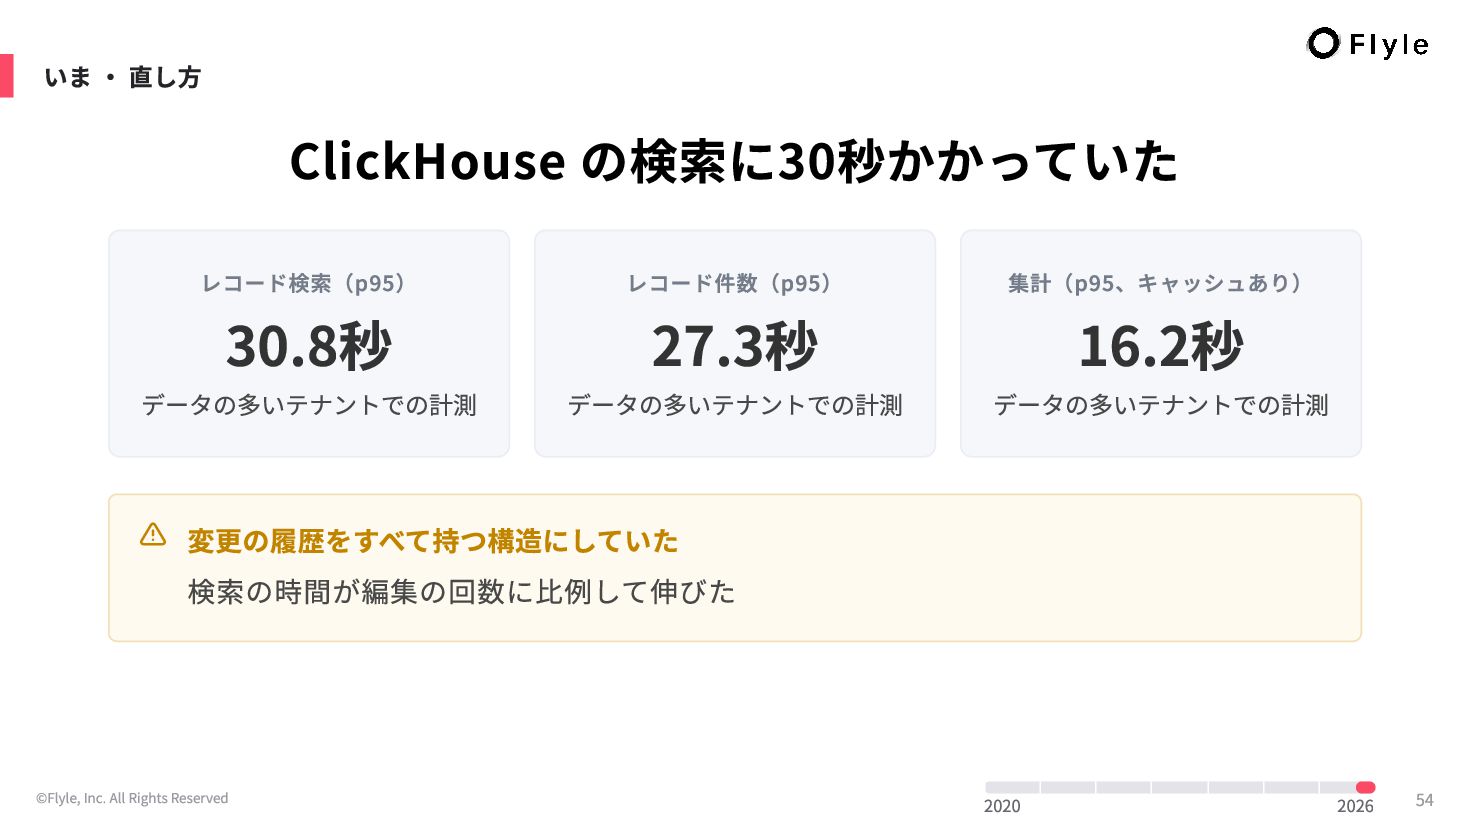
# ClickHouse の検索に30秒かかっていた

- 30.8秒 / レコード検索(p95) / データの多いテナントでの計測
- 27.3秒 / レコード件数(p95) / データの多いテナントでの計測
- 16.2秒 / 集計(p95、キャッシュあり) / データの多いテナントでの計測

> **変更の履歴をすべて持つ構造にしていた**
>
> 検索の時間が編集の回数に比例して伸びた

---

###### いま ・ 直し方

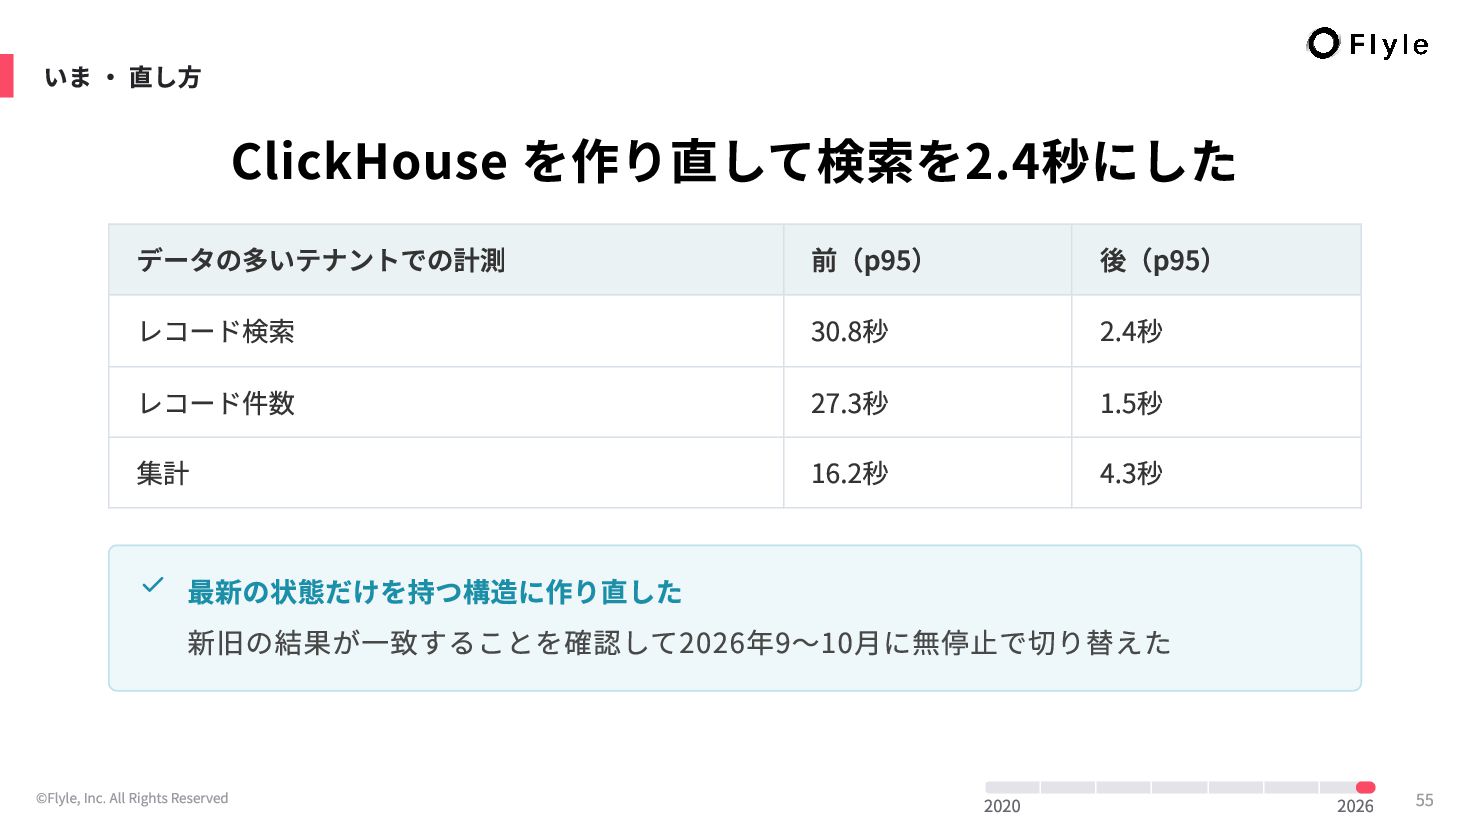
# ClickHouse を作り直して検索を2.4秒にした

| データの多いテナントでの計測 | 前(p95) | 後(p95) |
|---|---|---|
| レコード検索 | 30.8秒 | 2.4秒 |
| レコード件数 | 27.3秒 | 1.5秒 |
| 集計 | 16.2秒 | 4.3秒 |

> **最新の状態だけを持つ構造に作り直した**
>
> 新旧の結果が一致することを確認して2026年9〜10月に無停止で切り替えた

---

###### いま ・ 進め方 ・ 9月の振り返りから

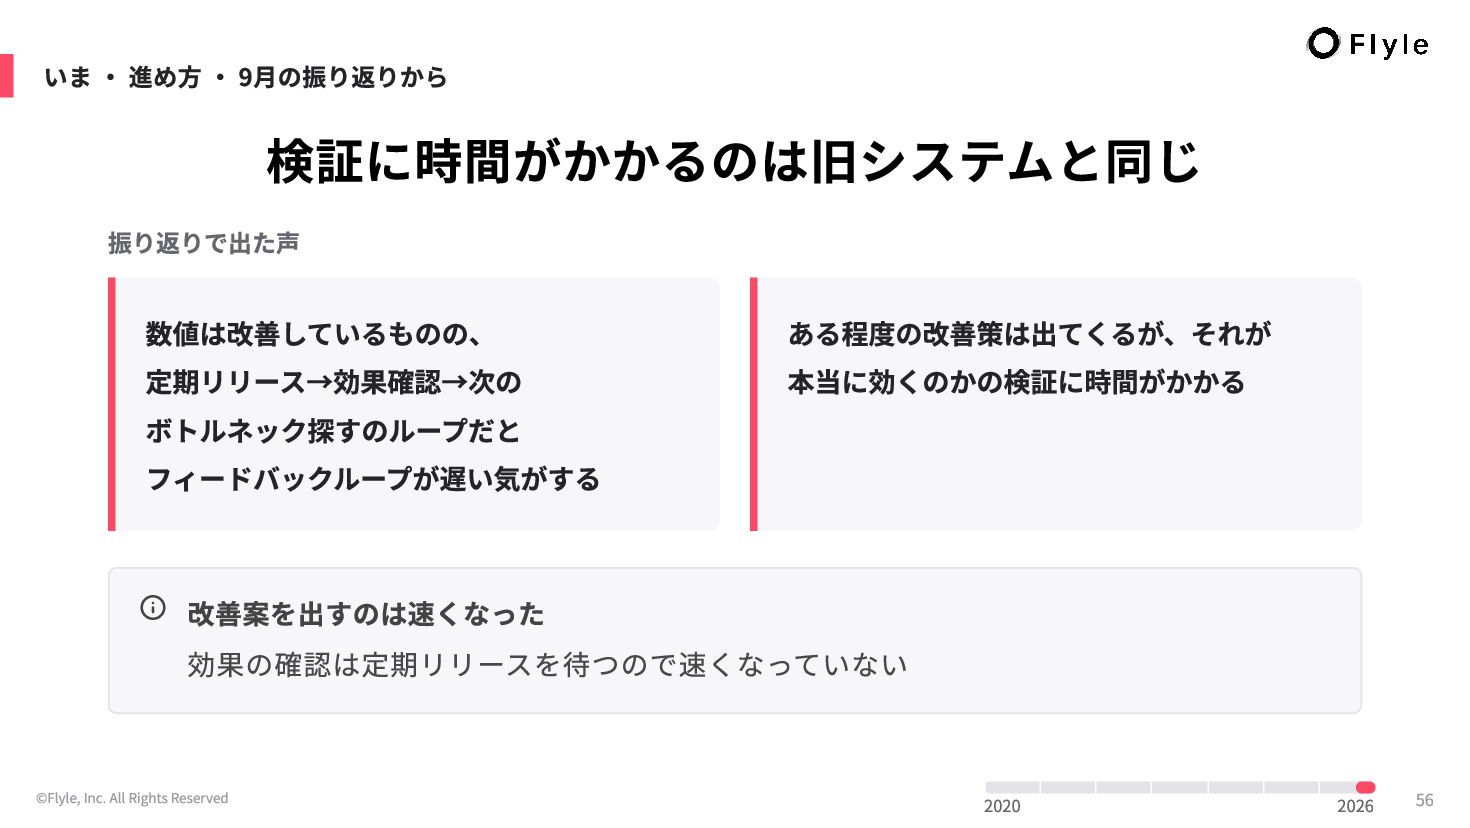
# 検証に時間がかかるのは旧システムと同じ

振り返りで出た声

数値は改善しているものの、定期リリース→効果確認→次のボトルネック探すのループだとフィードバックループが遅い気がする

ある程度の改善策は出てくるが、それが本当に効くのかの検証に時間がかかる

> **改善案を出すのは速くなった**
>
> 効果の確認は定期リリースを待つので速くなっていない

---

###### いま ・ 進め方(2026年10月)

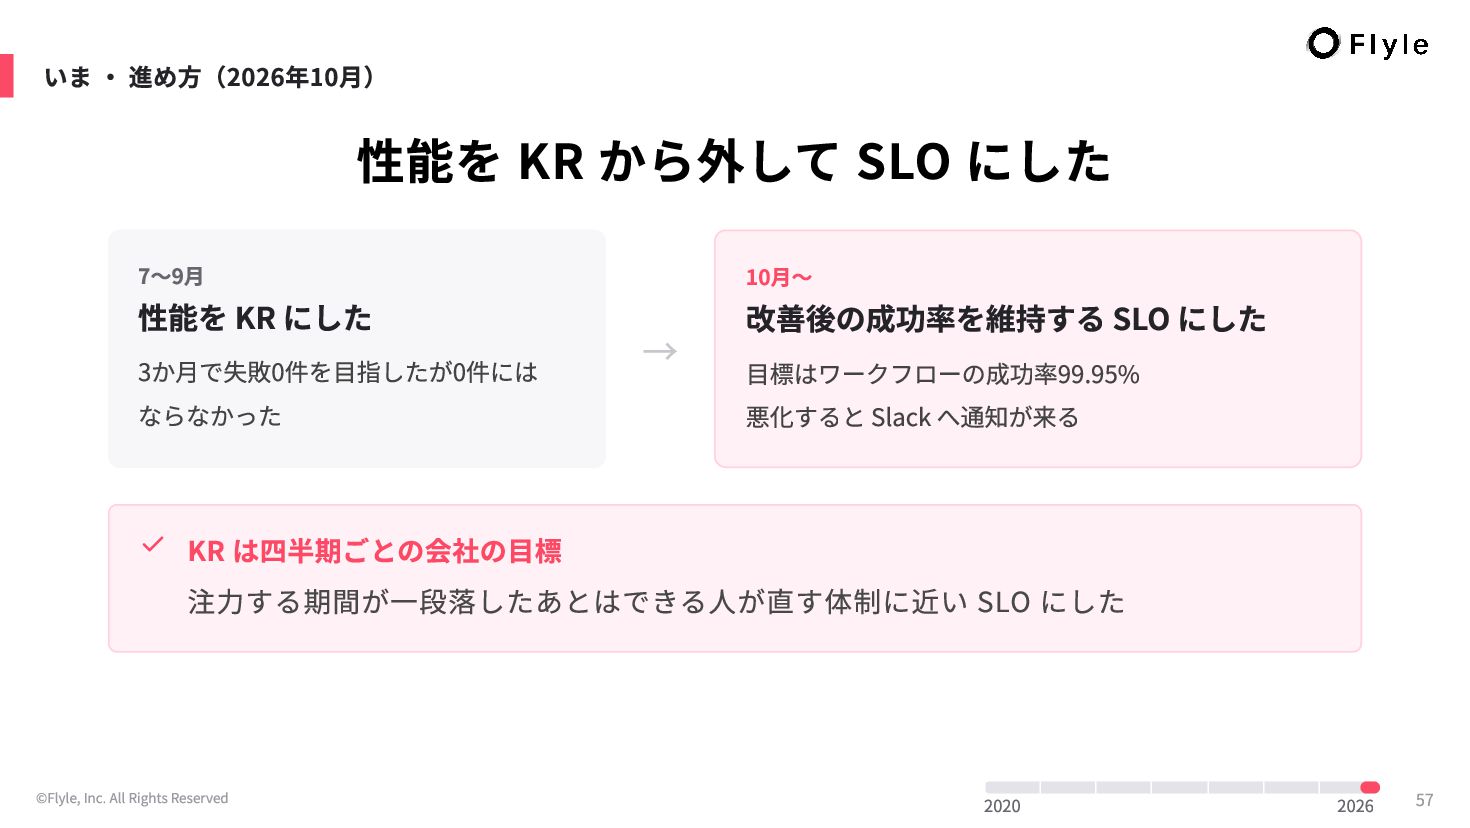
# 性能を KR から外して SLO にした

7〜9月

性能を KR にした

3か月で失敗0件を目指したが0件にはならなかった

→ 10月〜

改善後の成功率を維持する SLO にした

目標はワークフローの成功率99.95%
悪化すると Slack へ通知が来る

> **KR は四半期ごとの会社の目標**
>
> 注力する期間が一段落したあとはできる人が直す体制に近い SLO にした

---

###### いま ・ 進め方

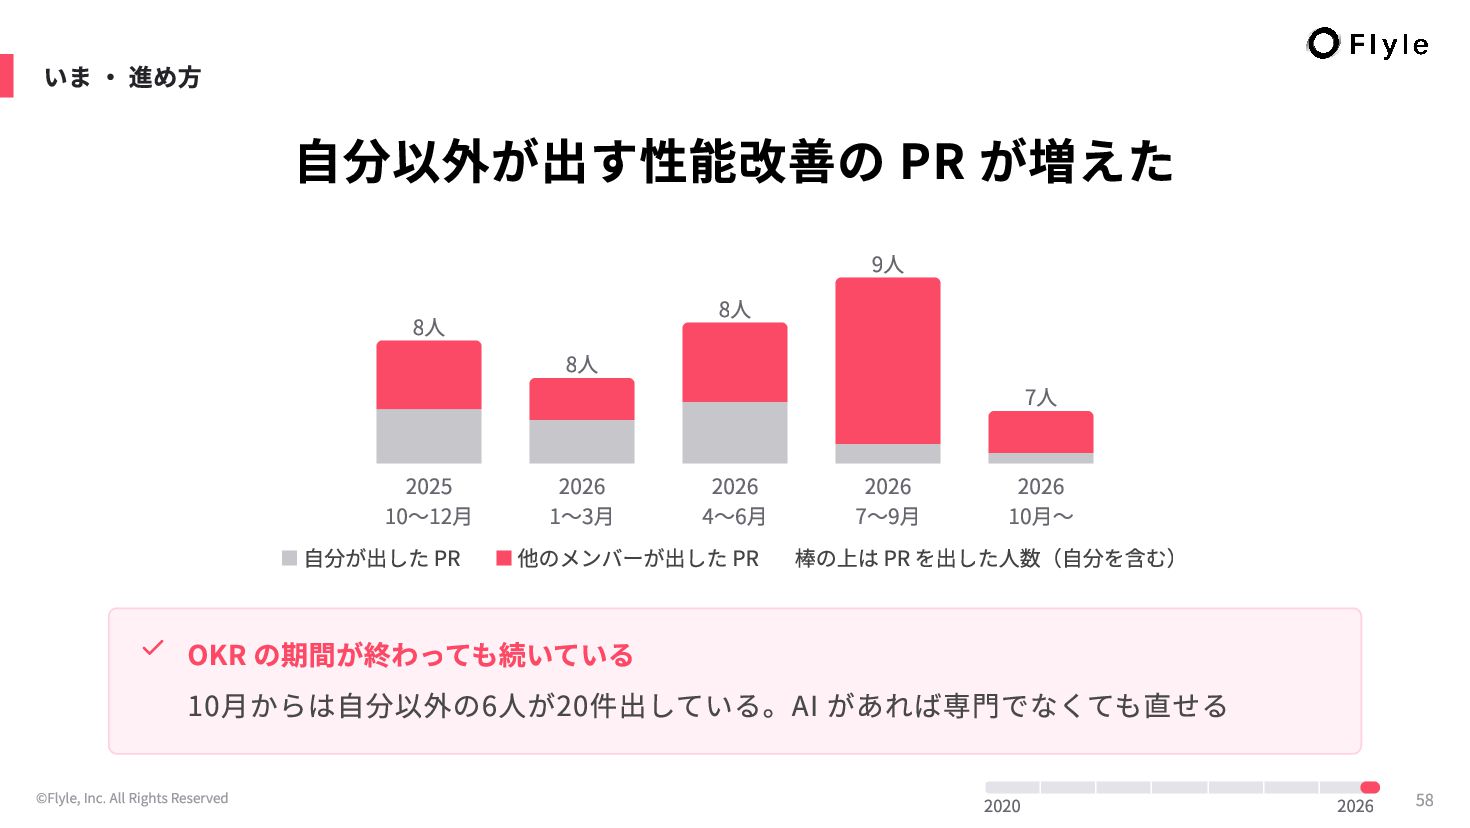
# 自分以外が出す性能改善の PR が増えた

8人 8人 8人 9人 7人

2025
10〜12月

2026
1〜3月

2026
4〜6月

2026
7〜9月

2026
10月〜

自分が出した PR

他のメンバーが出した PR

棒の上は PR を出した人数(自分を含む)

> **OKR の期間が終わっても続いている**
>
> 10月からは自分以外の6人が20件出している。AI があれば専門でなくても直せる

---

###### いま ・ 進め方 ・ 最近の例

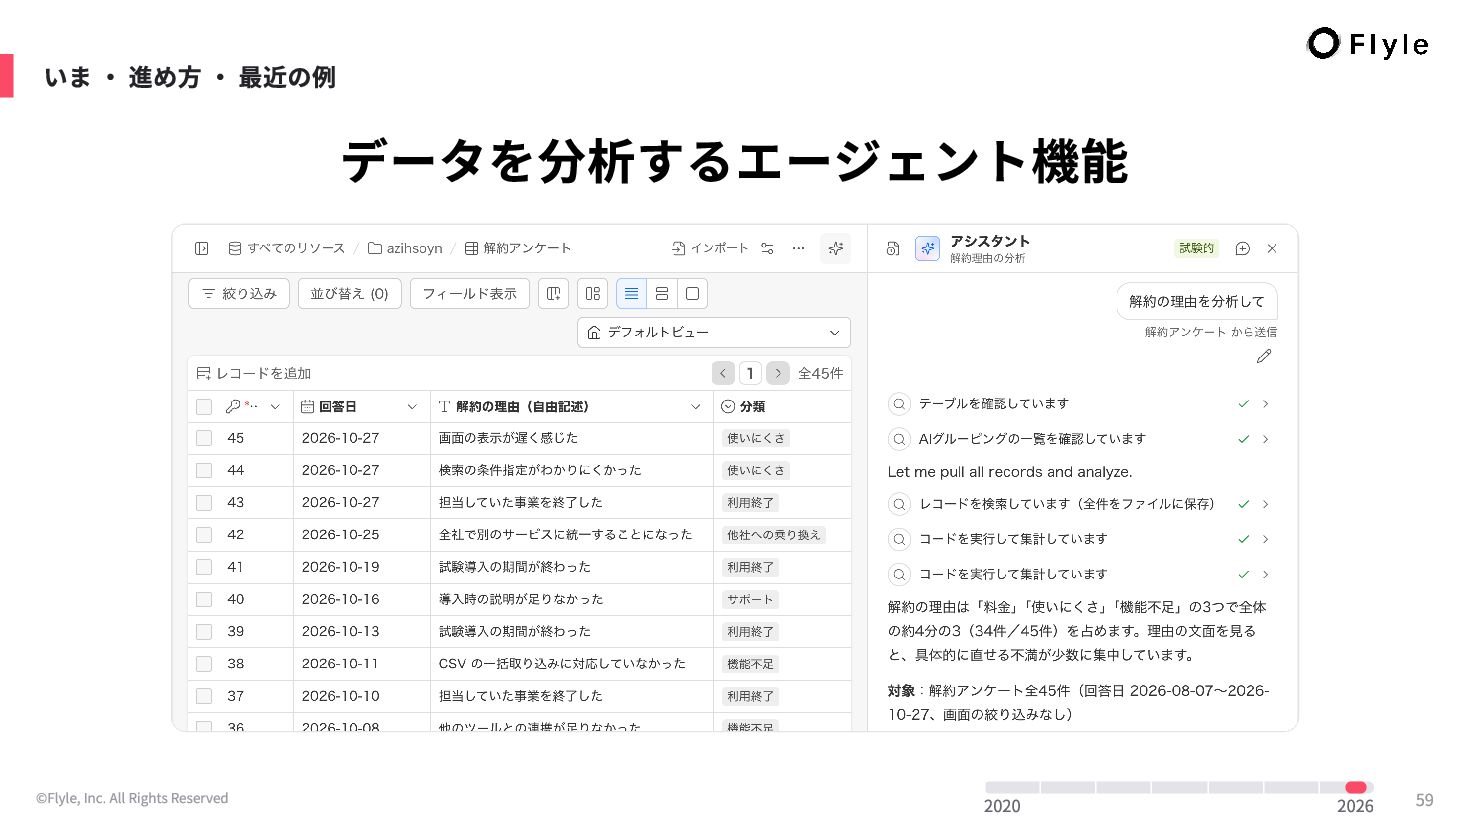
# データを分析するエージェント機能

---

###### いま ・ 進め方 ・ 最近の例

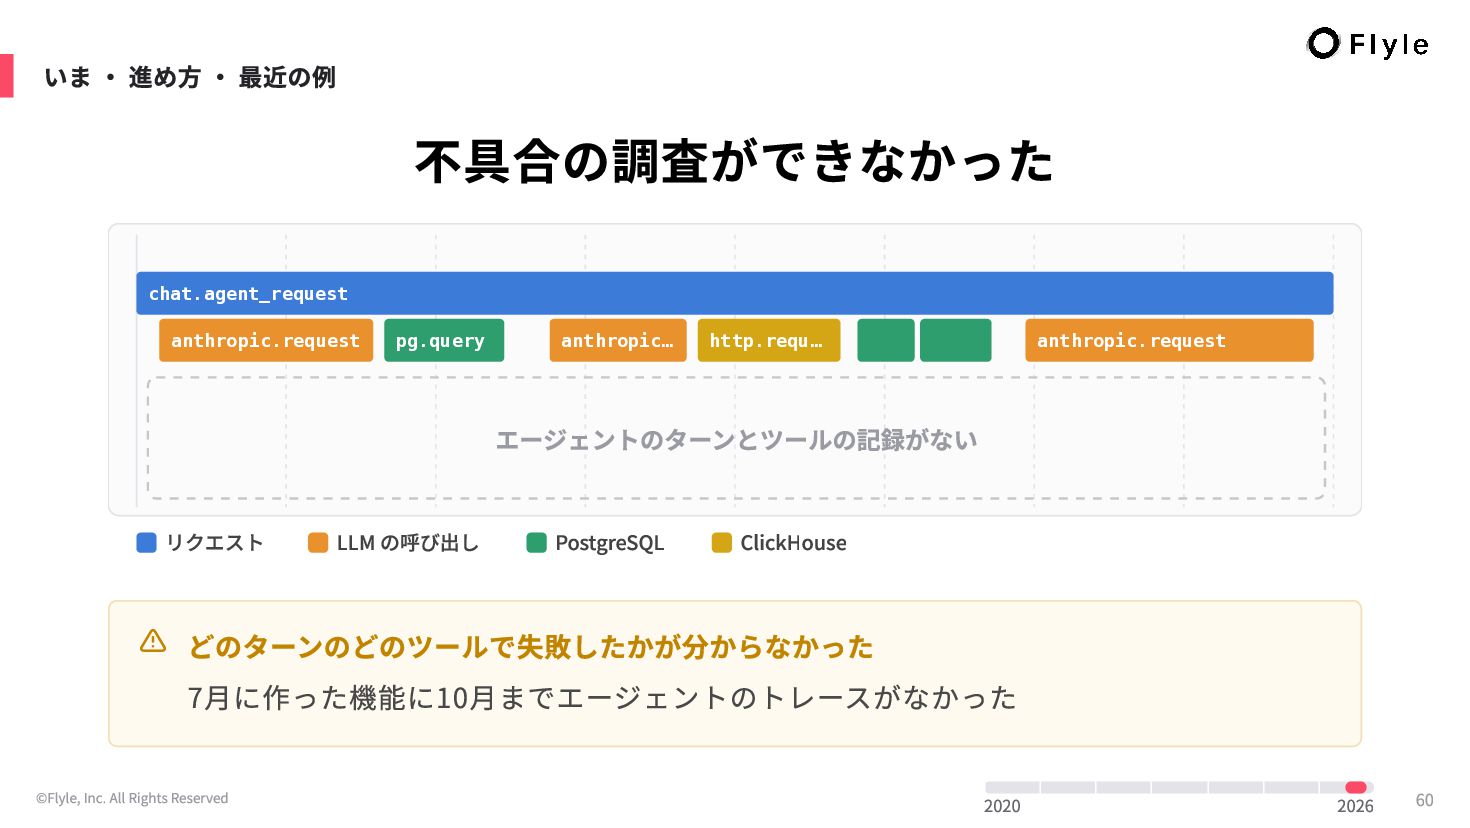
# 不具合の調査ができなかった

> **どのターンのどのツールで失敗したかが分からなかった**
>
> 7月に作った機能に10月までエージェントのトレースがなかった

---

###### いま ・ 進め方 ・ 最近の例

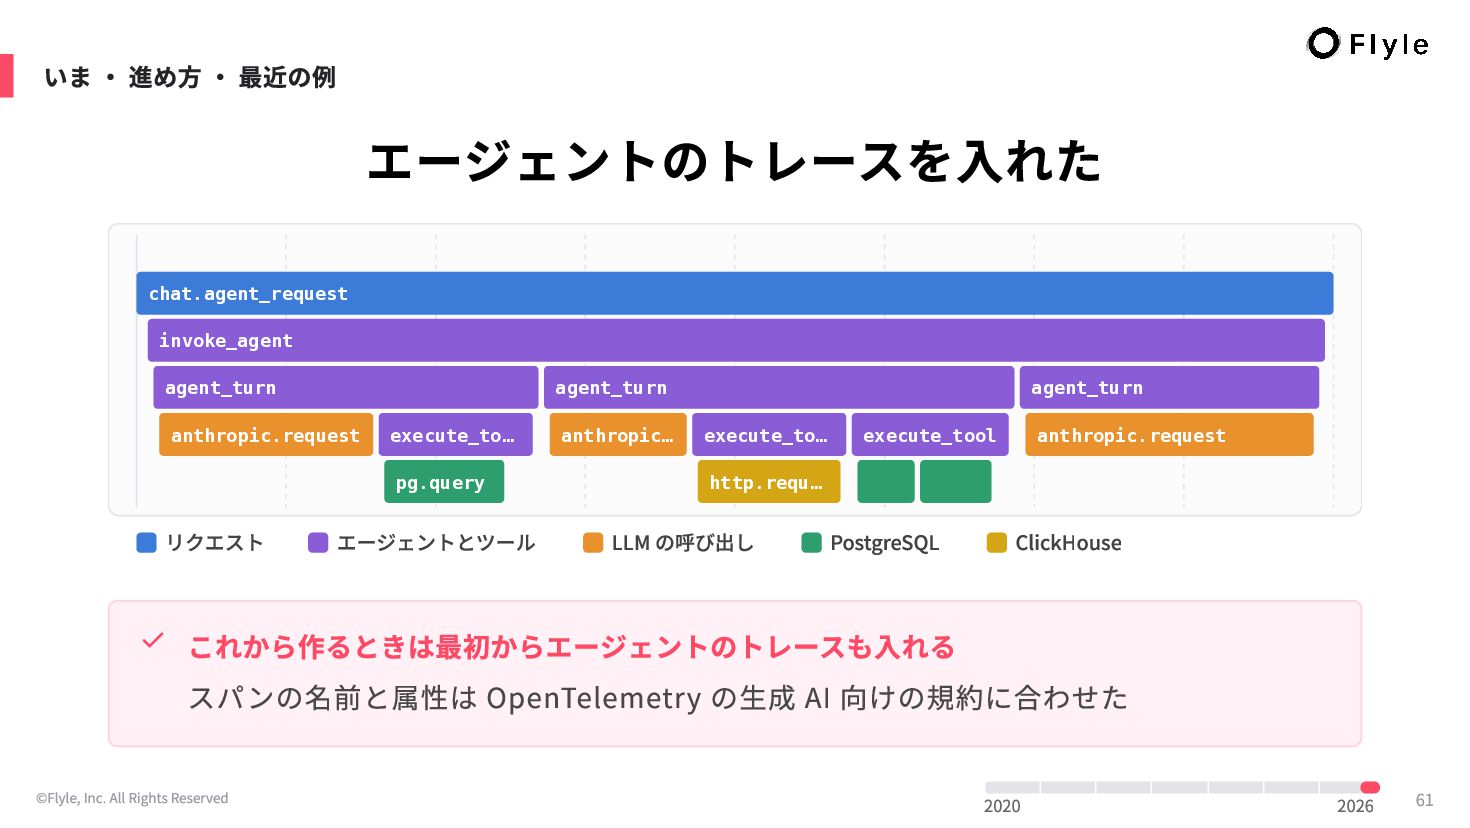
# エージェントのトレースを入れた

> **これから作るときは最初からエージェントのトレースも入れる**
>
> スパンの名前と属性は OpenTelemetry の生成 AI 向けの規約に合わせた

---

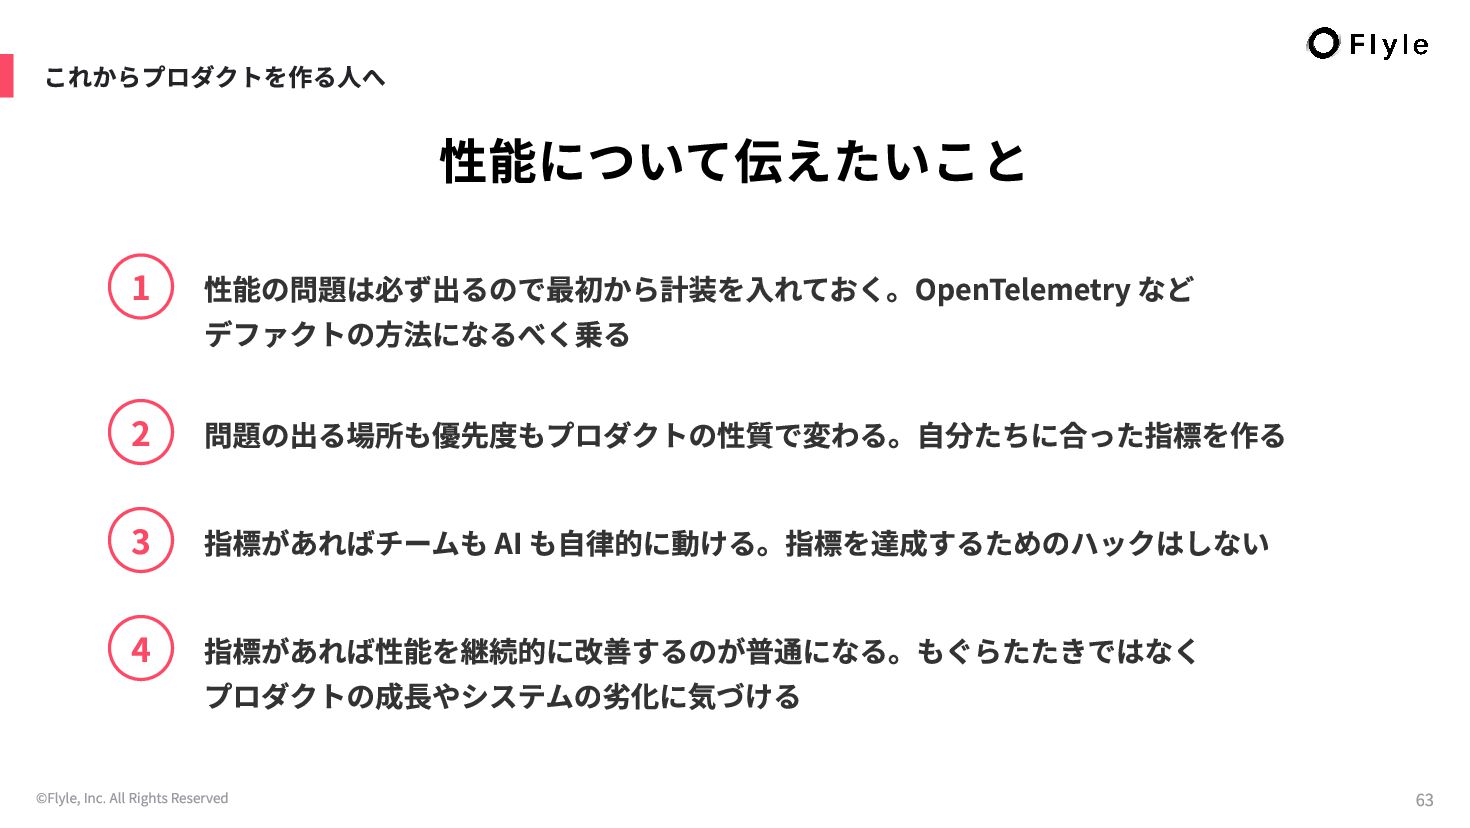
###### これからプロダクトを作る人へ

# 性能について伝えたいこと

1. 性能の問題は必ず出るので最初から計装を入れておく。OpenTelemetry などデファクトの方法になるべく乗る
2. 問題の出る場所も優先度もプロダクトの性質で変わる。自分たちに合った指標を作る
3. 指標があればチームも AI も自律的に動ける。指標を達成するためのハックはしない
4. 指標があれば性能を継続的に改善するのが普通になる。もぐらたたきではなくプロダクトの成長やシステムの劣化に気づける

---

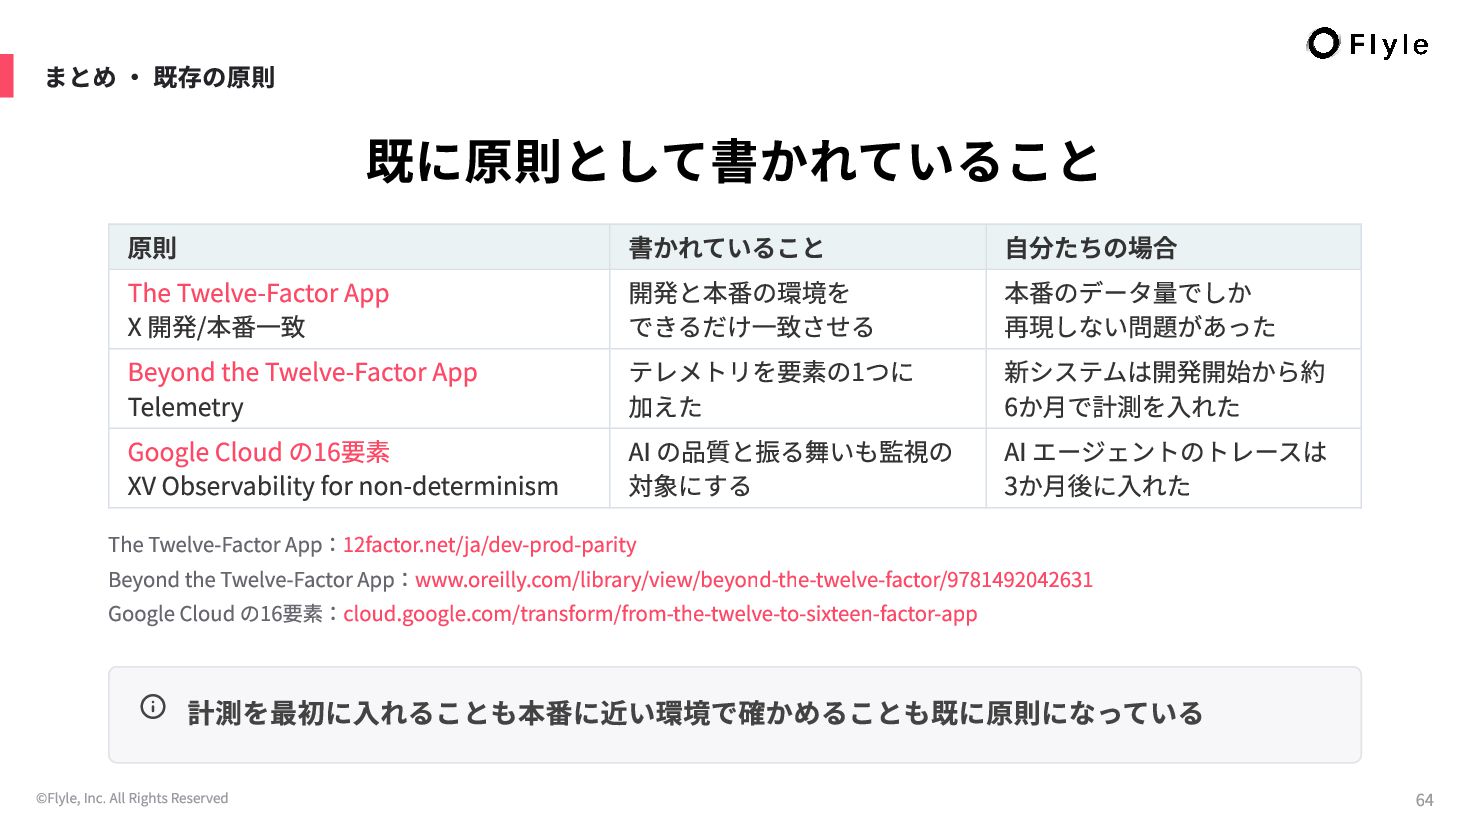
###### まとめ ・ 既存の原則

# 既に原則として書かれていること

| 原則 | 書かれていること | 自分たちの場合 |
|---|---|---|
| [The Twelve-Factor App](https://12factor.net/ja/dev-prod-parity)
X 開発/本番一致 | 開発と本番の環境をできるだけ一致させる | 本番のデータ量でしか再現しない問題があった |
| [Beyond the Twelve-Factor App](https://www.oreilly.com/library/view/beyond-the-twelve-factor/9781492042631/)
Telemetry | テレメトリを要素の1つに加えた | 新システムは開発開始から約6か月で計測を入れた |
| [Google Cloud の16要素](https://cloud.google.com/transform/from-the-twelve-to-sixteen-factor-app)
XV Observability for non-determinism | AI の品質と振る舞いも監視の対象にする | AI エージェントのトレースは3か月後に入れた |

The Twelve-Factor App: 12factor.net/ja/dev-prod-parity

Beyond the Twelve-Factor App: www.oreilly.com/library/view/beyond-the-twelve-factor/9781492042631

Google Cloud の16要素: cloud.google.com/transform/from-the-twelve-to-sixteen-factor-app

> **計測を最初に入れることも本番に近い環境で確かめることも既に原則になっている**
>

---

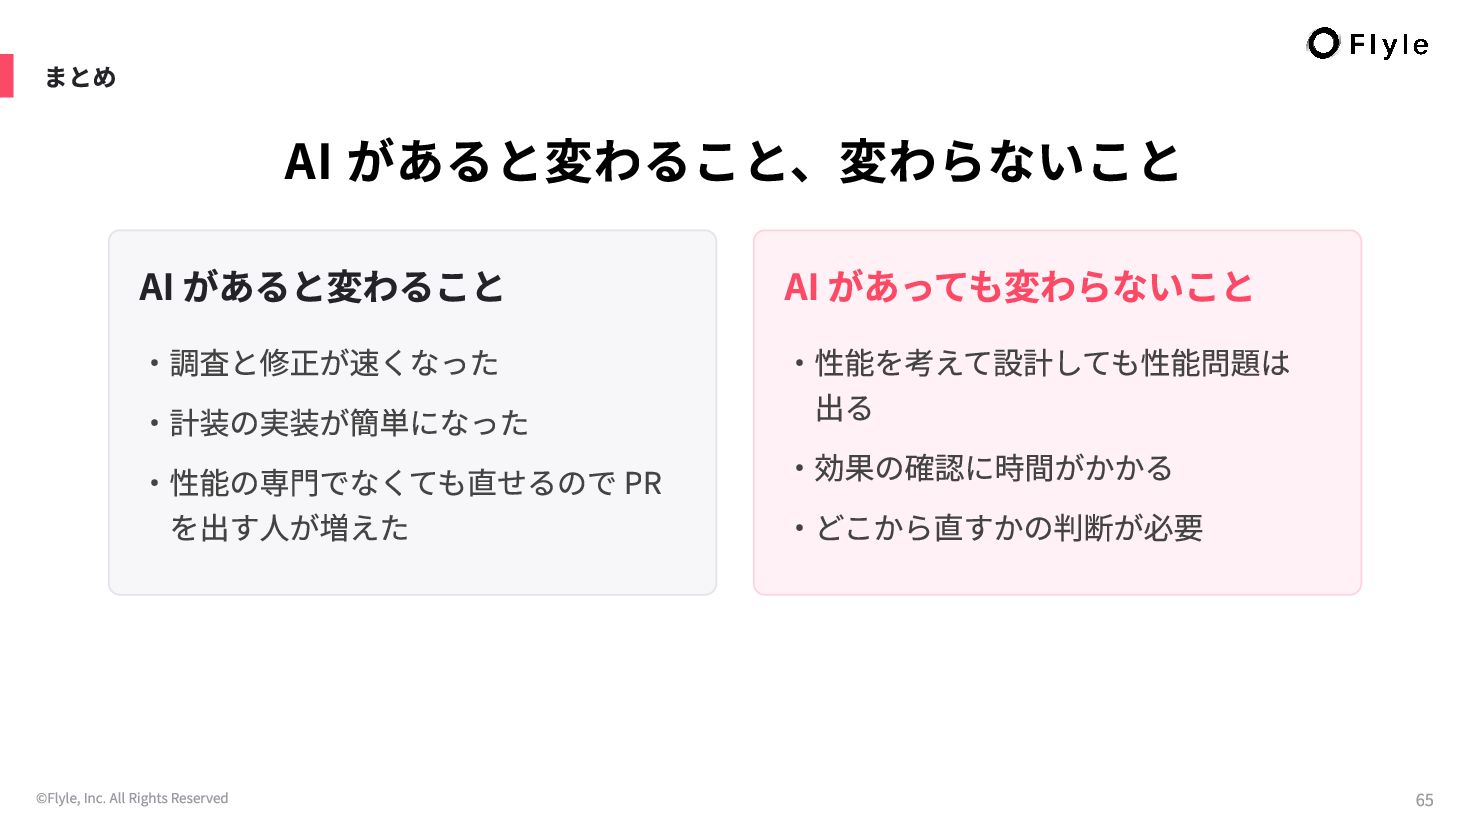
###### まとめ

# AI があると変わること、変わらないこと

AI があると変わること

・調査と修正が速くなった

・計装の実装が簡単になった

・性能の専門でなくても直せるので PR を出す人が増えた

AI があっても変わらないこと

・性能を考えて設計しても性能問題は出る

・効果の確認に時間がかかる

・どこから直すかの判断が必要

---

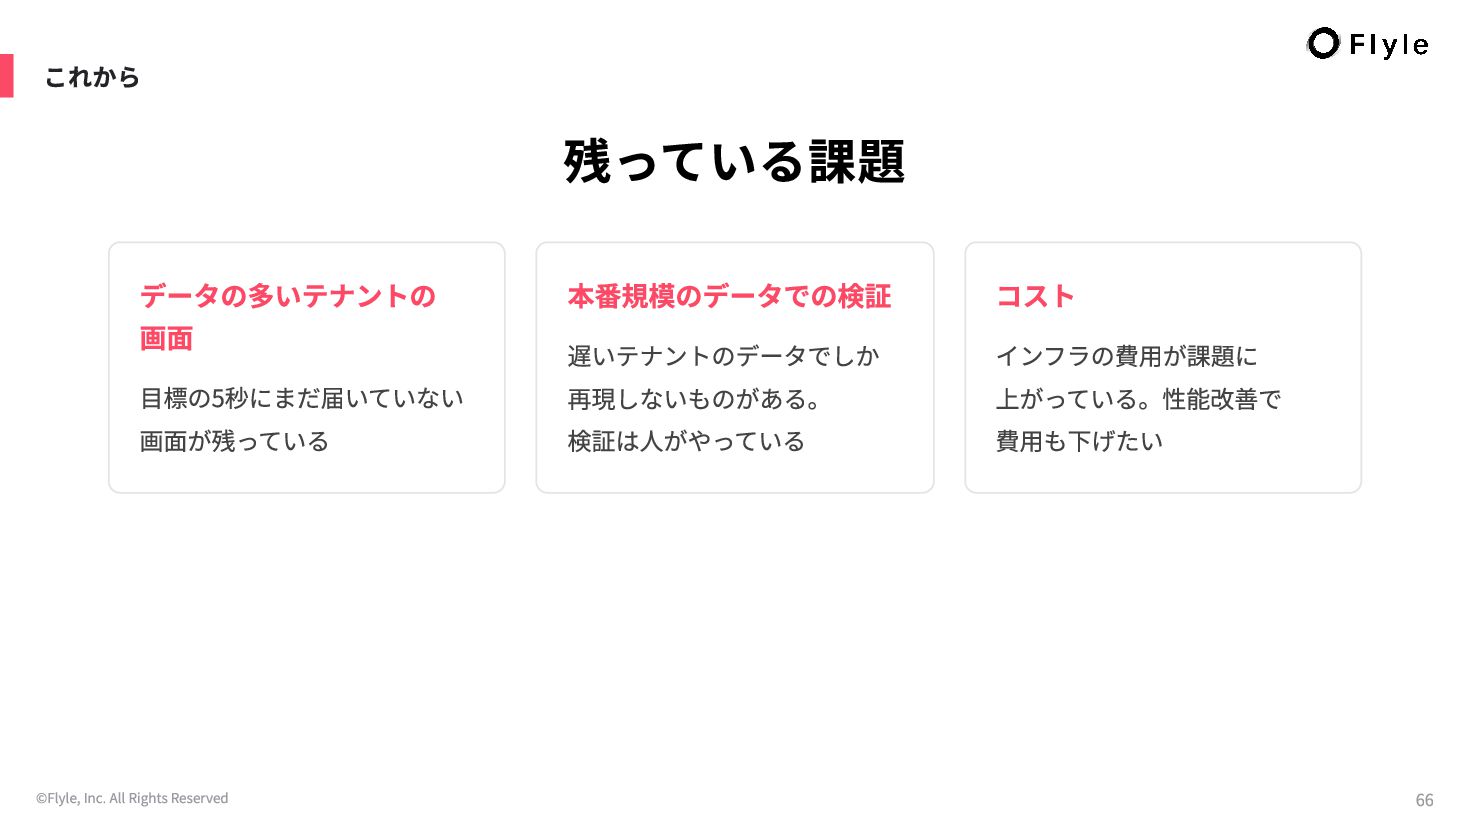
###### これから

# 残っている課題

データの多いテナントの画面

目標の5秒にまだ届いていない画面が残っている

本番規模のデータでの検証

遅いテナントのデータでしか再現しないものがある。検証は人がやっている

コスト

インフラの費用が課題に上がっている。性能改善で費用も下げたい

---

# 一緒に性能改善に取り組んでくれる仲間を募集中

### こんな人に来てほしい
- 大規模データとマルチテナントのスケール課題に挑みたい
- 個人技より仕組みや道具で解くのが好き
- DB・API・キャッシュ・フロントなど領域をまたいで動ける
- 試しながら進めていくのを楽しめる

recruit.flyle.io

azihsoyn

November 18, 2026

Transcript

68 slides
  1. 吉澤 直哉 Twitter(現X) @azihsoyn ©Flyle, Inc. All Rights Reserved 自己紹介
    株式会社フライル / Software Engineer ・アプリケーションエンジニア → パフォーマンス改善エンジニア ・2026年5月のクラウドネイティブ会議でも 性能改善の話をしました ・釣りが好き🎣 ・GitHub: @azihsoyn 2
  2. FLYLE, INC. コンタクトセンター・CX の AI 変革パートナー 2020年2月設立 多様な業界のコンタクトセンター・CX 部門で導入 2020.2

    2023.2 創業 サービスに生成 AI を組み込む開発開始 2021.6 製品版をリリース プロダクトマネジメント SaaS(スタートアップ中心) ©Flyle, Inc. All Rights Reserved 2025.2 AI を中心に据えた事業領域拡大 2023.8 エンタープライズ企業への導入が加速 AI カスタマーニーズプラットフォーム(エンタープライズ中心) 3
  3. データ統合から活用まで 統合から活用までワンストップで AI が代替 統合 システム自動連携 CSV / Excel 取込

    音声データの取込 文字起こしデータの取込 ©Flyle, Inc. All Rights Reserved デ ー タ の 加 工 IA 多様なデータ形式対応 分類 個 人 情 報 の マ ス キ ン グ 分析 活用 活用例 感情分析・要約 AI タグ付け AI 分類(テキスト型) リスク検知 重要度 応対品質・スキル FAQ 作成 トークスクリプト作成 分析結果の活用 類 似 文 脈 ク ラ ス タ リ ン グ 分析レポートと可視化 リアルタイムに可視化 グラフの AI 要約 分析の要約を自動で生成 チャットで壁打ち データをもとに LLM と対話 自動通知 関係者へ自動で通知 4
  4. 今日話すこと いままで・現状・これから 1 旧システム(2020〜) 2 新システム(2024〜) 3 いま(2026年秋) 4 まとめ

    性能問題が増えた2024年に何が起きて、どう直して、直す対象をどう決めたか 対策を設計に入れても出た性能問題と、計測と目標の置き方 性能を OKR に入れた結果と、SLO に変えた理由 AI があると変わること、変わらないこと。これからプロダクトを作る人に伝えたいこと ©Flyle, Inc. All Rights Reserved 6
  5. 全体の流れ 2つのシステムと性能改善の年表 2024年6月 2020年4月 2021年6月 開発を始めた 2020 性能改善に集中する期間を初めて作った リリースした 2021

    2023年11月 旧システム(いまも稼働中) 2022 2025年1月 APM を入れた 2023 「1テナント500万件でも使える」を目標にした 2024 2024年11月 2025 新システム 2026 2026年7月 開発を始めた 性能を OKR に入れた 2025年5月 計測を入れた 2026年10月 性能を KR から外して SLO にした ©Flyle, Inc. All Rights Reserved 7
  6. 旧システム ・ 概要 顧客の声を集めて AI で分類・集計するサービス 集める 顧客の声 (フィードバック)を 取り込む

    → 分類する AI がフィードバックを テーマに分類する 検索・集計する → 条件と軸を自由に 組み合わせてレポートに する 利用者はフィードバックに独自の項目を追加できる ©Flyle, Inc. All Rights Reserved 2020 2026 9
  7. 旧システム ・ 構成(2024年時点) フロントエンド 旧システムの構成 API 読み書き イベント処理 イベント ECS

    サービス データの変更(イベント)ごとに AI の分析などを非同期に実行 バッチ インポート・エクスポート 類似検索 PostgreSQL 元のデータ 検索・件数・集計 イベントのテーブル 読み書き RLS でテナントを分離 検索も集計も PostgreSQL で実行する 検索条件と集計の軸は利用者が自由に組み合わせるので SQL は動的に組み立てられる ©Flyle, Inc. All Rights Reserved 2020 2026 10
  8. 旧システム ・ 起きたこと(2020〜2023) 旧システムの性能改善の PR 数推移 70 1 2020 5

    2021 6 2022 51 16 2023 2024 2025 34 2026 2022年まではデータ量が少なかった メモリ不足や遅い SQL が見つかるたびに1件ずつ直していた ©Flyle, Inc. All Rights Reserved 2020 2026 11
  9. 旧システム ・ 起きたこと(2024) 2024年は構成を大きく変えた 変えたこと 2月 4月 5〜11月 通年 MySQL

    から PostgreSQL へ移行 非同期でデータを処理するサービスの導入 RLS によるテナントの分離を全テーブルへ導入 データ量の増加。非同期処理の対象レコードは約500万件に RLS(Row Level Security):読み書きできる行を DB がテナントごとに制限する PostgreSQL の機能 ©Flyle, Inc. All Rights Reserved 2020 2026 12
  10. 旧システム ・ 起きたこと(2024) パフォーマンスの問題も増えた 起きたこと 6月 7月 8月 9月 11月

    一覧と件数の API がタイムアウト DB の CPU 使用率が97%に レポートの SQL が15秒たっても終わらない 未処理のイベントを探す SQL に22秒 エクスポートが OOM に 構成の変更とデータの増加が重なった 性能に関する PR は前年の16件から70件に増えた ©Flyle, Inc. All Rights Reserved 2020 2026 13
  11. 旧システム ・ 進め方(2024年6月、3人で2週間) 性能改善に集中する期間を初めて作った 01 02 03 把握する 選ぶ 分ける

    Datadog で遅いリクエストを 一覧にする 利用頻度が高くて遅い API を選ぶ 原因の深さで3段階に分ける スロークエリの数が多かった 1人が2週間で直せるのは2〜3件で全部を直すには4週間以上かかる見込みだった ©Flyle, Inc. All Rights Reserved 2020 2026 15
  12. 旧システム ・ 進め方 ・ 直す基準(2024年7月) 直す基準を決めた 集中する期間で分かったこと → 2週間では 全部を直せない

    対象にした API データを取得する API ©Flyle, Inc. All Rights Reserved よく使う画面 10秒 決めた基準 超えた API を直す 外部の API を呼ばない 2020 2026 16
  13. 旧システム ・ 直し方 ・ 例 1 集計の SQL で遅い実行計画が選ばれた レポートの設定は利用者が自由に

    組み合わせる 集計の軸 検索条件 テーマ テーマが「料金」 → 動的に組み立てられた SQL FROM フィードバック JOIN テーマ ← 集計の軸 JOIN テーマ ← 検索条件 同じテーブルの JOIN が重複すると Nested Loop が選ばれて遅くなった ©Flyle, Inc. All Rights Reserved 2020 2026 17
  14. 旧システム ・ 直し方 ・ 例 1 enable_nestloop = off を半年かけて5か所に入れた

    直したこと ・JOIN の重複を検知した SQL だけ実行単位で enable_nestloop = off にした ・遅い画面が見つかるたびに同じ対処を入れた 条件の管理がバグの原因になった 条件が変わると直した画面がまた遅くなった ©Flyle, Inc. All Rights Reserved 2020 2026 18
  15. 旧システム ・ 直し方 ・ 例 2 1回の変更が全件分のイベントになっていた カスタム項目の設定 項目 A

    ↑ 項目 C 項目 B トリガー イベントのテーブル フィードバック 1 を分析 フィードバック 2 を分析 フィードバック 3 を分析 全フィードバック分 未処理 未処理 未処理 ⋮ 並び順を1回変更 フィードバック N を分析 未処理 中身が変わってないフィードバックのイベントも登録していた ©Flyle, Inc. All Rights Reserved 2020 2026 19
  16. 旧システム ・ 直し方 ・ 例 2 未処理のイベントを探す SQL に22秒 イベントのテーブル

    処理済み 約500万件 未処理 全行を読んで未処理を探す:22秒 ・処理済みの行も同じテーブルに残っていた ・未処理だけを引くインデックスがなかった ©Flyle, Inc. All Rights Reserved 2020 2026 20
  17. 旧システム ・ 直し方 ・ 例 3 重い SQL が重なると関係ない SQL

    まで遅くなった 直したこと ・DB を Aurora Serverless v2 に移行した ・負荷が上がると DB の CPU とメモリが自動で増える サイズ固定の DB 約45分 CPU が100%に張り付いた Aurora Serverless v2 約7分 CPU は張り付かなかった 本番が遅くなったときの負荷を再現して処理が終わるまでの時間 ©Flyle, Inc. All Rights Reserved 2020 2026 22
  18. 旧システム ・ 直し方 ・ 分類 何度も遭遇した問題を分類してみると 実行計画の崩れ 同じ SQL でも

    PostgreSQL が 選ぶ実行計画によって遅くなる 例 1:集計の SQL で Nested Loop ファンアウト 1回の操作が多数の処理に 広がる 例 2:1回の変更が全件分の イベントに ノイジーネイバー 同じ DB や同じプロセスを 共有する他の処理が待たされる 例 3:重い SQL で関係ない SQL も遅く ほかに N+1、ビュー経由の遅い SQL、全件読み込みによるメモリ不足もあった ©Flyle, Inc. All Rights Reserved 2020 2026 23
  19. 旧システム ・ 直し方(2024年10月) SQL の修正が追いつかないのでキャッシュを入れた 「SQL 改善よりも問題の増加の方が速く、短期的には不可避」 キャッシュを入れるかを議論したときの結論 対象を絞った 10秒以上かかった集計だけを

    キャッシュした ©Flyle, Inc. All Rights Reserved 最新も見られるようにした 編集中の画面ではキャッシュを 使わないで最新を表示した あとで外せる作りにした SQL の修正が進んだら 外す前提で入れた 2020 2026 24
  20. 旧システム ・ 進め方 ・ 直す基準(2025年1月) 翌年はデータ量で基準を決め直した 初期データが 300万件規模の商談 → 100万件と500万件の

    データで検証 件数の取得と集計が タイムアウト → 1テナント500万件でも集計は1分、検索は15秒で返す ©Flyle, Inc. All Rights Reserved 2020 2026 25
  21. 旧システム ・ 進め方 ・ 検証 直すより確かめるほうに時間がかかった DB の復元 30分以上 本番相当の

    DB を1回用意する時間 データの準備 約1時間 検証用のデータを作る INSERT 1回の時間 直した効果の確認にいちばん時間がかかる 前回の登壇はこの確認を短くする話だった ©Flyle, Inc. All Rights Reserved 2020 2026 26
  22. 旧システム ・ まとめ 旧システムで分かったこと 1 起きてから直すやり方ではデータの増え方に追いつかなくなった 2 基準を決めることでどこから直すかの判断ができた 3 同じような問題に何度も遭遇した

    ・ファンアウト ・実行計画の崩れ ・ノイジーネイバー 旧システムに残った課題 想定を超えるデータ量の顧客が来たら同じ対策では限界がある ©Flyle, Inc. All Rights Reserved 27
  23. 新システム ・ 背景 なぜ新システムを作ったか AI をコアにした プロダクト 旧システム できあがったあとに AI

    を組み込んだ 新システム ↓ AI が処理する前提で作る ©Flyle, Inc. All Rights Reserved あらゆる業種に最適化できる 柔軟なシステム 旧システム データの形と処理が決まっている ↓ 新システム テーブルもワークフローも利用者が 定義する 2020 2026 29
  24. 新システム ・ 構成 フロントエンド 新しいシステムの構成 検索・件数・集計 API ECS サービス 読み書き

    SQS ワークフロー実行 書き込み バッチ 書き込み ECS サービス isolated-vm でタスクを実行 ECS タスク インポート・集計・削除 PostgreSQL Aurora 元のデータ RLS でテナントを分離 同期 ClickHouse 同期 Qdrant 検索・集計 類似検索 Redis キャッシュ すべて AWS 上で動かして Datadog で観測 ©Flyle, Inc. All Rights Reserved 2020 2026 32
  25. 新システム ・ 設計 旧システムで困ったことへの対策を設計に入れた 旧システムで困ったこと 集計と検索が PostgreSQL に集中して重い テナント分離を後から入れた 重い処理が

    API を巻き添えにする ORM が意図しない SQL を大量に発行する ©Flyle, Inc. All Rights Reserved 新システムの設計 検索と集計は ClickHouse に分ける 最初から RLS を前提にテーブルを作る 重い処理はキューに積んで非同期にする SQL の形が見えるクエリビルダーで書く 2020 2026 33
  26. 新システム ・ 起きたこと 新システムでも性能改善の PR は283件あった 88 59 0 2024

    11〜12月 ©Flyle, Inc. All Rights Reserved 0 2025 1〜3月 0 2025 4〜6月 3 2025 7〜9月 2025 10〜12月 67 41 2026 1〜3月 25 2026 4〜6月 2020 2026 7〜9月 2026 10月〜 2026 34
  27. 新システム ・ 起きたこと 新システムで出なかった問題と出た問題 出なかった ・ORM が自動で出す N+1 出た ・ファンアウト

    ・実行計画の崩れ ・ノイジーネイバー ・ループの中で SQL を呼ぶ N+1 ・大きな結果を読み込んでメモリ不足 旧システムで何度も出た問題は新システムでも出た 出た場所は旧システムと違った。N+1 とメモリ不足も形を変えて出た ©Flyle, Inc. All Rights Reserved 2020 2026 35
  28. 新システム ・ 直し方 同じ分類の問題が新システムでは別の場所に出た ファンアウト 実行計画の崩れ ノイジーネイバー ©Flyle, Inc. All

    Rights Reserved 旧システム 新システム 1回の変更 → 全件分のイベント JOIN の重複 → Nested Loop 重い SQL → 他の SQL が待つ 1件の書き込み → 約2.4億行のテーブルを検索 権限の確認 → 行ごとに実行 重い処理 → 同じプロセスの処理が待つ 2020 2026 36
  29. 新システム ・ 直し方 ・ ファンアウトの例 レコード同士のリンクは両方向の行で持っている 顧客 顧客 A 顧客

    B 顧客 C リンク 顧客 A → 問い合わせ 1 問い合わせ 1 → 顧客 A 問い合わせ 問い合わせ 1 問い合わせ 2 問い合わせ 3 リンクの整合性をチェックする制約がある 片方向だけのリンクを防ぐために COMMIT のたびに DB のトリガーが逆向きの行を探す ©Flyle, Inc. All Rights Reserved 2020 2026 37
  30. 新システム ・ 直し方 ・ ファンアウトの例 COMMIT に最大260秒かかっていた 問い合わせ 問い合わせ 1

    問い合わせ 2 問い合わせ 3 問い合わせ 4 顧客 顧客 A ⋮ 問い合わせ N 多くのレコードからリンクされるレコード 約2.4億行 リンクのテーブルの行数 数十万件 逆向きを探す1回で読む行 最大260秒 COMMIT にかかった時間 データの多いテナント1つでワークフローが月805回失敗していた ©Flyle, Inc. All Rights Reserved 2020 2026 38
  31. 新システム ・ 直し方 ・ ファンアウトの例 逆向きの行を探す回数を1回にまとめた 直す前:書いたリンク1本ごとに探す リンク 1 リンク

    2 リンク 3 リンクのテーブル 約2.4億行 ⋮ リンク 100 100回 約3秒 ©Flyle, Inc. All Rights Reserved 直したあと:まとめて1回で突き合わせる → リンク 1 リンク 2 リンク 3 リンクのテーブル 1回 ⋮ 約2.4億行 リンク 100 リンク100組の確認にかかる時間 0.5ミリ秒 2020 2026 39
  32. 新システム ・ 直し方 ・ 実行計画の崩れの例 1 enable_nestloop = off が遅さの原因になった

    レコードを書くたびに利用者が定義したユニークキーの重複を確かめている 重複を確かめる SQL 1回 最大237秒 実行された回数 1,081万回 平均46ms。積み上げると139時間 この SQL にも enable_nestloop = off を入れていた データが増えると Nested Loop の代わりに選ばれた実行計画のほうが遅くなった ©Flyle, Inc. All Rights Reserved 2020 2026 40
  33. 新システム ・ 直し方 ・ 実行計画の崩れの例 1 実行計画に頼らない SQL に書き直した 重複チェックの

    SQL 1回(最悪値) 15ms 直す前は最大237秒 ワークフローの失敗 11915分あたり → 3件 どの実行計画が選ばれても遅くならない形にした ©Flyle, Inc. All Rights Reserved 2020 2026 41
  34. 新システム ・ 直し方 ・ 実行計画の崩れの例 2 結果が同じ権限の確認を行ごとに繰り返していた SQL が読んだ行 RLS

    の権限の確認 1行目 2行目 3行目 has_permission() → true has_permission() → true has_permission() → true ⋮ ⋮ 36,000行目 has_permission() → true 結果は 毎回同じ 36,000行を読む SQL に6秒/本番の画面は p95 で19.8秒 ©Flyle, Inc. All Rights Reserved 2020 2026 42
  35. 新システム ・ 直し方 ・ 実行計画の崩れの例 2 関数の呼び出しが1回だけで済む書き方に直した SQL が読んだ行 1行目

    2行目 3行目 RLS の権限の確認 1回だけ実行して 結果を使い回す has_permission() → true ⋮ 36,000行目 直す前 USING ( has_permission('...') ) 19.8秒 → 0.46秒 本番の画面の p95 ©Flyle, Inc. All Rights Reserved 直したあと(SELECT で囲む) USING ( (SELECT has_permission('...')) ) 218本 直した RLS ポリシー lint とテスト 元の書き方に戻ると CI で落ちる 2020 2026 43
  36. 新システム ・ 直し方 ・ ノイジーネイバーの例 8 vCPU のタスクで1.1コアしか使えていなかった 書いたコード(Promise.all で並列)

    実際の動き(同時に1本しか実行されない) 時間 → 時間 → Node.js のメインスレッドが空かず同じプロセスの処理が待たされた ワークフローが5分のタイムアウトで失敗していた ©Flyle, Inc. All Rights Reserved 2020 2026 44
  37. 新システム ・ 直し方 ・ ノイジーネイバーの例 ワークフローの実行環境を作る回数を1回にした 直す前 実行環境を作る 直したあと 実行環境を作る

    式1 実行環境を作る 式2 式1 式2 式4 式3 実行環境を作る 式3 実行環境を作る 式4 時間 → プロセスの CPU 時間 −23% ©Flyle, Inc. All Rights Reserved レコードを追加するノードの p95 約−40% 2020 2026 45
  38. 新システム ・ 直し方 ・ なぜ出たか 規模が大きくなるまで問題が見えなかった 規模が小さいとき 規模が大きくなると 読む行が少ないと RLS

    の関数はすぐ 終わる → 36,000行を読む SQL で6秒かかった リンクが少ないレコードなら確認はすぐ 終わる COMMIT → 数十万本のリンクが集まるレコードで に260秒 同時に書く本数が少ないと待たされない INSERT → 600本のワークフローが同時に書くと に26.7秒 ©Flyle, Inc. All Rights Reserved 2020 2026 47
  39. 新システム ・ 進め方 新システムは性能改善への取り組みが早かった 開発を始めてから APM を入れるまで 旧システム 新システム 約3年半

    → 約6か月 開発を始めてから 性能改善に専念する体制を作るまで 新システム 旧システム 約4年 → 約1年8か月 旧システムで入れた Datadog をそのまま使えた ©Flyle, Inc. All Rights Reserved 2020 2026 48
  40. 新システム ・ 進め方(2026年7月) 性能を OKR に入れた 背景 ・当時の認識では非同期処理の失敗が1日1回以上 ・ワークフローが原因の障害もあった KR

    1 失敗 0件 / 月 システムが原因の非同期処理の失敗 KR 2 表示 5秒以内(p75) データの多いテナントの主要な画面 フロントエンドとバックエンドに性能の担当を1名ずつ置いた ©Flyle, Inc. All Rights Reserved 2020 2026 49
  41. 新システム ・ 進め方 ・ 計測 計測で見えていたこと 測れていなかったものが多かった 表示に904秒かかった画面がある 8月10日の失敗は9件 利用者の設定が原因のエラー

    ログには何も出ていない 実際 → 開いていないタブで放置された時間が入っていた → 保持期限で消えていただけで1,585件あった → 同時実行の競合でシステムが原因だった → DB 接続の空きを最大60秒待っていた 速くする前に計測を直した 計測を直すと数値は悪く見えるが目標の判定にはその値を使った ©Flyle, Inc. All Rights Reserved 2020 2026 50
  42. いま ・ 開発の速さ 月に700件以上の PR をマージしている 2026年5月 296件 マージした PR

    8月 10月 1,615件 AI エージェントに 733件 マージした PR リファクタリングを任せていた PR の件数には AI エージェントが出したものを含む ©Flyle, Inc. All Rights Reserved 2020 2026 52
  43. いま ・ 起きたこと(2026年9月末) 3か月でシステムエラーを半分以下にした KR 1 月あたりのシステムエラー 約2,600件 期初は約6,270件。期末は 予測値

    エラー率 KR 2 詳細画面の表示(p75) 0.020% 期初は0.041% 8.7秒 データの多いテナント。 直す前は17.2秒 KR の0件と5秒には届かなかった データの多いテナントでは表示が5秒を超える画面が残っている ©Flyle, Inc. All Rights Reserved 2020 2026 53
  44. いま ・ 直し方 ClickHouse の検索に30秒かかっていた レコード検索(p95) 30.8秒 データの多いテナントでの計測 レコード件数(p95) 27.3秒

    データの多いテナントでの計測 集計(p95、キャッシュあり) 16.2秒 データの多いテナントでの計測 変更の履歴をすべて持つ構造にしていた 検索の時間が編集の回数に比例して伸びた ©Flyle, Inc. All Rights Reserved 2020 2026 54
  45. いま ・ 直し方 ClickHouse を作り直して検索を2.4秒にした データの多いテナントでの計測 レコード検索 レコード件数 集計 前(p95)

    30.8秒 27.3秒 16.2秒 後(p95) 2.4秒 1.5秒 4.3秒 最新の状態だけを持つ構造に作り直した 新旧の結果が一致することを確認して2026年9〜10月に無停止で切り替えた ©Flyle, Inc. All Rights Reserved 2020 2026 55
  46. いま ・ 進め方 ・ 9月の振り返りから 検証に時間がかかるのは旧システムと同じ 振り返りで出た声 数値は改善しているものの、 定期リリース→効果確認→次の ボトルネック探すのループだと

    フィードバックループが遅い気がする ある程度の改善策は出てくるが、それが 本当に効くのかの検証に時間がかかる 改善案を出すのは速くなった 効果の確認は定期リリースを待つので速くなっていない ©Flyle, Inc. All Rights Reserved 2020 2026 56
  47. いま ・ 進め方(2026年10月) 性能を KR から外して SLO にした 7〜9月 性能を

    KR にした 3か月で失敗0件を目指したが0件には ならなかった → 10月〜 改善後の成功率を維持する SLO にした 目標はワークフローの成功率99.95% 悪化すると Slack へ通知が来る KR は四半期ごとの会社の目標 注力する期間が一段落したあとはできる人が直す体制に近い SLO にした ©Flyle, Inc. All Rights Reserved 2020 2026 57
  48. いま ・ 進め方 自分以外が出す性能改善の PR が増えた 8人 2025 10〜12月 自分が出した

    PR 8人 9人 8人 7人 2026 2026 2026 2026 1〜3月 4〜6月 7〜9月 10月〜 他のメンバーが出した PR 棒の上は PR を出した人数(自分を含む) OKR の期間が終わっても続いている 10月からは自分以外の6人が20件出している。AI があれば専門でなくても直せる ©Flyle, Inc. All Rights Reserved 2020 2026 58
  49. いま ・ 進め方 ・ 最近の例 ©Flyle, Inc. All Rights Reserved

    データを分析するエージェント機能 2020 2026 59
  50. いま ・ 進め方 ・ 最近の例 不具合の調査ができなかった chat.agent_request anthropic.request pg.query anthropic…

    http.requ… anthropic.request エージェントのターンとツールの記録がない リクエスト LLM の呼び出し PostgreSQL ClickHouse どのターンのどのツールで失敗したかが分からなかった 7月に作った機能に10月までエージェントのトレースがなかった ©Flyle, Inc. All Rights Reserved 2020 2026 60
  51. いま ・ 進め方 ・ 最近の例 エージェントのトレースを入れた chat.agent_request invoke_agent agent_turn agent_turn

    anthropic.request execute_to… pg.query リクエスト エージェントとツール anthropic… agent_turn execute_to… execute_tool anthropic.request http.requ… LLM の呼び出し PostgreSQL ClickHouse これから作るときは最初からエージェントのトレースも入れる スパンの名前と属性は OpenTelemetry の生成 AI 向けの規約に合わせた ©Flyle, Inc. All Rights Reserved 2020 2026 61
  52. これからプロダクトを作る人へ 性能について伝えたいこと 1 性能の問題は必ず出るので最初から計装を入れておく。OpenTelemetry など デファクトの方法になるべく乗る 2 問題の出る場所も優先度もプロダクトの性質で変わる。自分たちに合った指標を作る 3 指標があればチームも

    AI も自律的に動ける。指標を達成するためのハックはしない 4 指標があれば性能を継続的に改善するのが普通になる。もぐらたたきではなく プロダクトの成長やシステムの劣化に気づける ©Flyle, Inc. All Rights Reserved 63
  53. まとめ ・ 既存の原則 既に原則として書かれていること 原則 The Twelve-Factor App X 開発/本番一致

    Beyond the Twelve-Factor App Telemetry Google Cloud の16要素 XV Observability for non-determinism 書かれていること 開発と本番の環境を できるだけ一致させる テレメトリを要素の1つに 加えた AI の品質と振る舞いも監視の 対象にする 自分たちの場合 本番のデータ量でしか 再現しない問題があった 新システムは開発開始から約 6か月で計測を入れた AI エージェントのトレースは 3か月後に入れた The Twelve-Factor App:12factor.net/ja/dev-prod-parity Beyond the Twelve-Factor App:www.oreilly.com/library/view/beyond-the-twelve-factor/9781492042631 Google Cloud の16要素:cloud.google.com/transform/from-the-twelve-to-sixteen-factor-app 計測を最初に入れることも本番に近い環境で確かめることも既に原則になっている ©Flyle, Inc. All Rights Reserved 64
  54. まとめ AI があると変わること、変わらないこと AI があると変わること ・調査と修正が速くなった ・計装の実装が簡単になった ・性能の専門でなくても直せるので PR を出す人が増えた

    ©Flyle, Inc. All Rights Reserved AI があっても変わらないこと ・性能を考えて設計しても性能問題は 出る ・効果の確認に時間がかかる ・どこから直すかの判断が必要 65
  55. これから データの多いテナントの 画面 目標の5秒にまだ届いていない 画面が残っている ©Flyle, Inc. All Rights Reserved

    残っている課題 本番規模のデータでの検証 遅いテナントのデータでしか 再現しないものがある。 検証は人がやっている コスト インフラの費用が課題に 上がっている。性能改善で 費用も下げたい 66

More Decks by azihsoyn

Other Decks in Programming