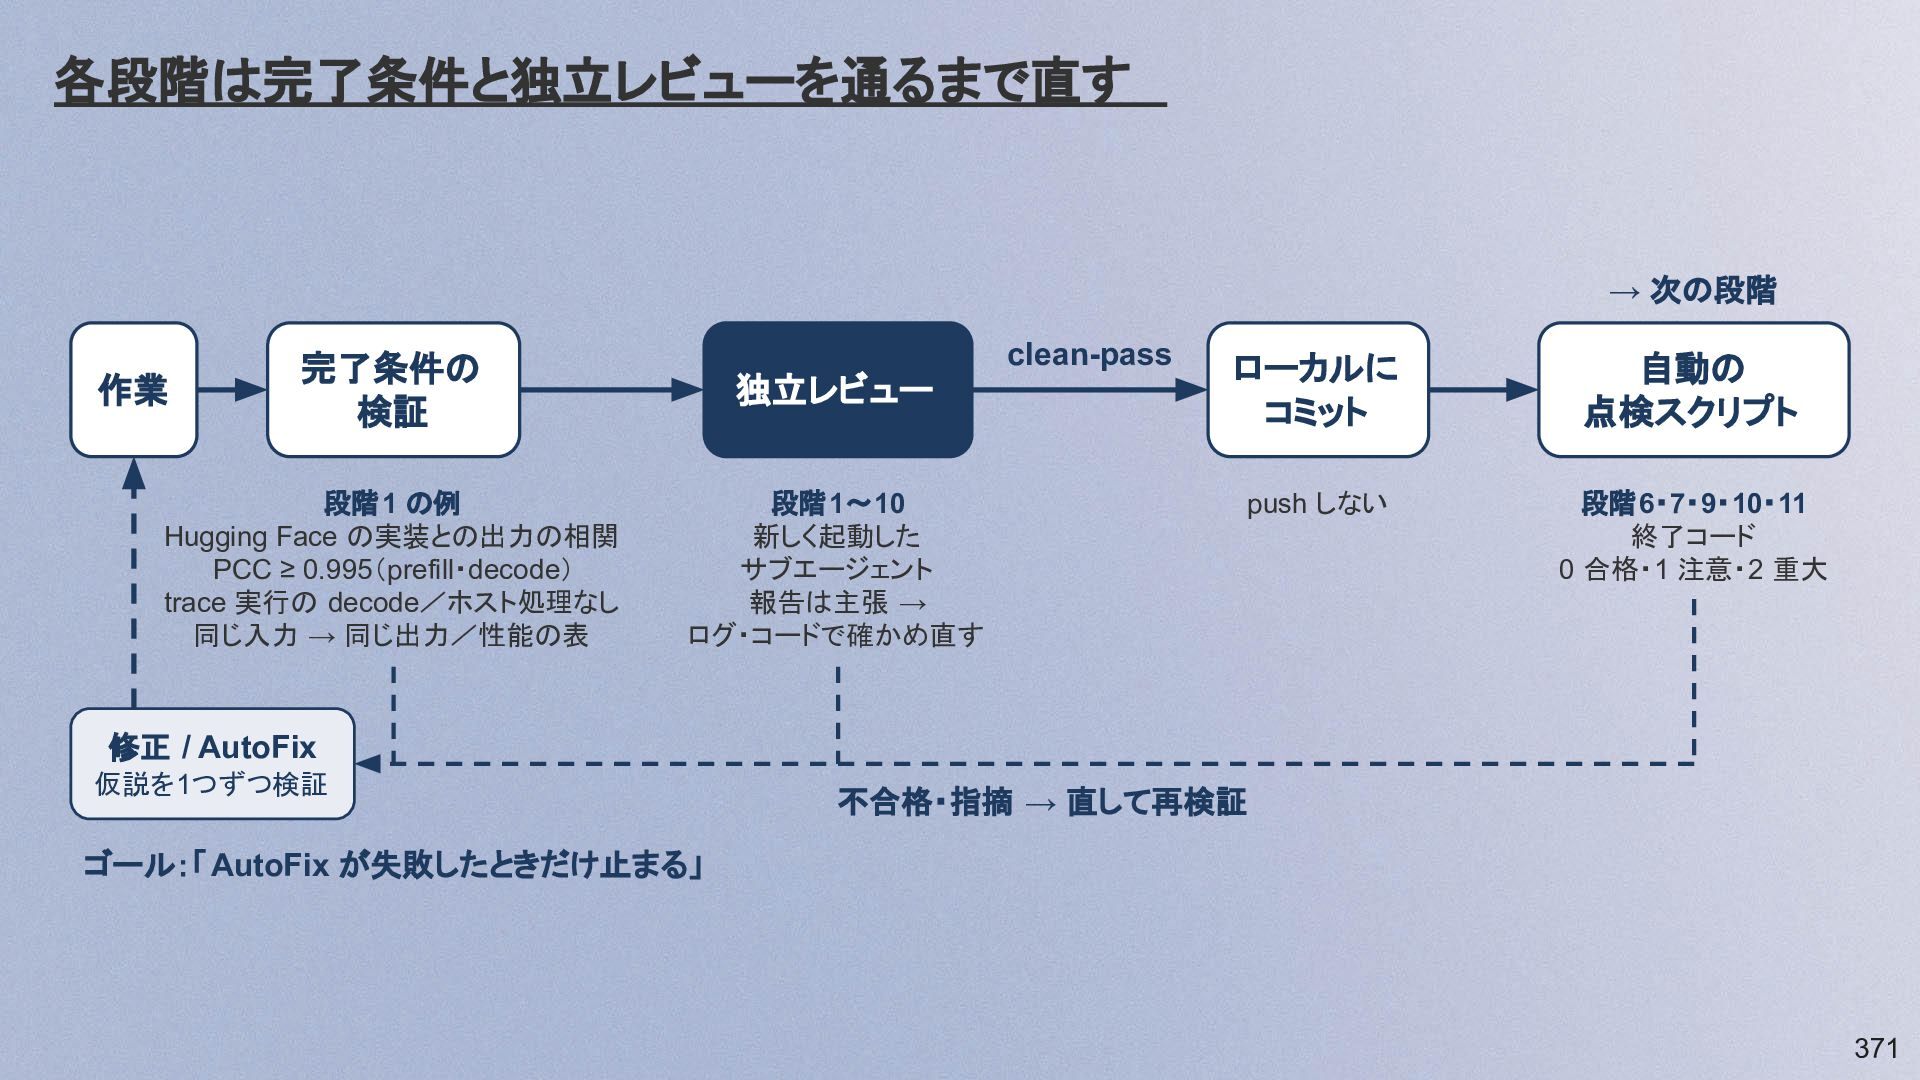
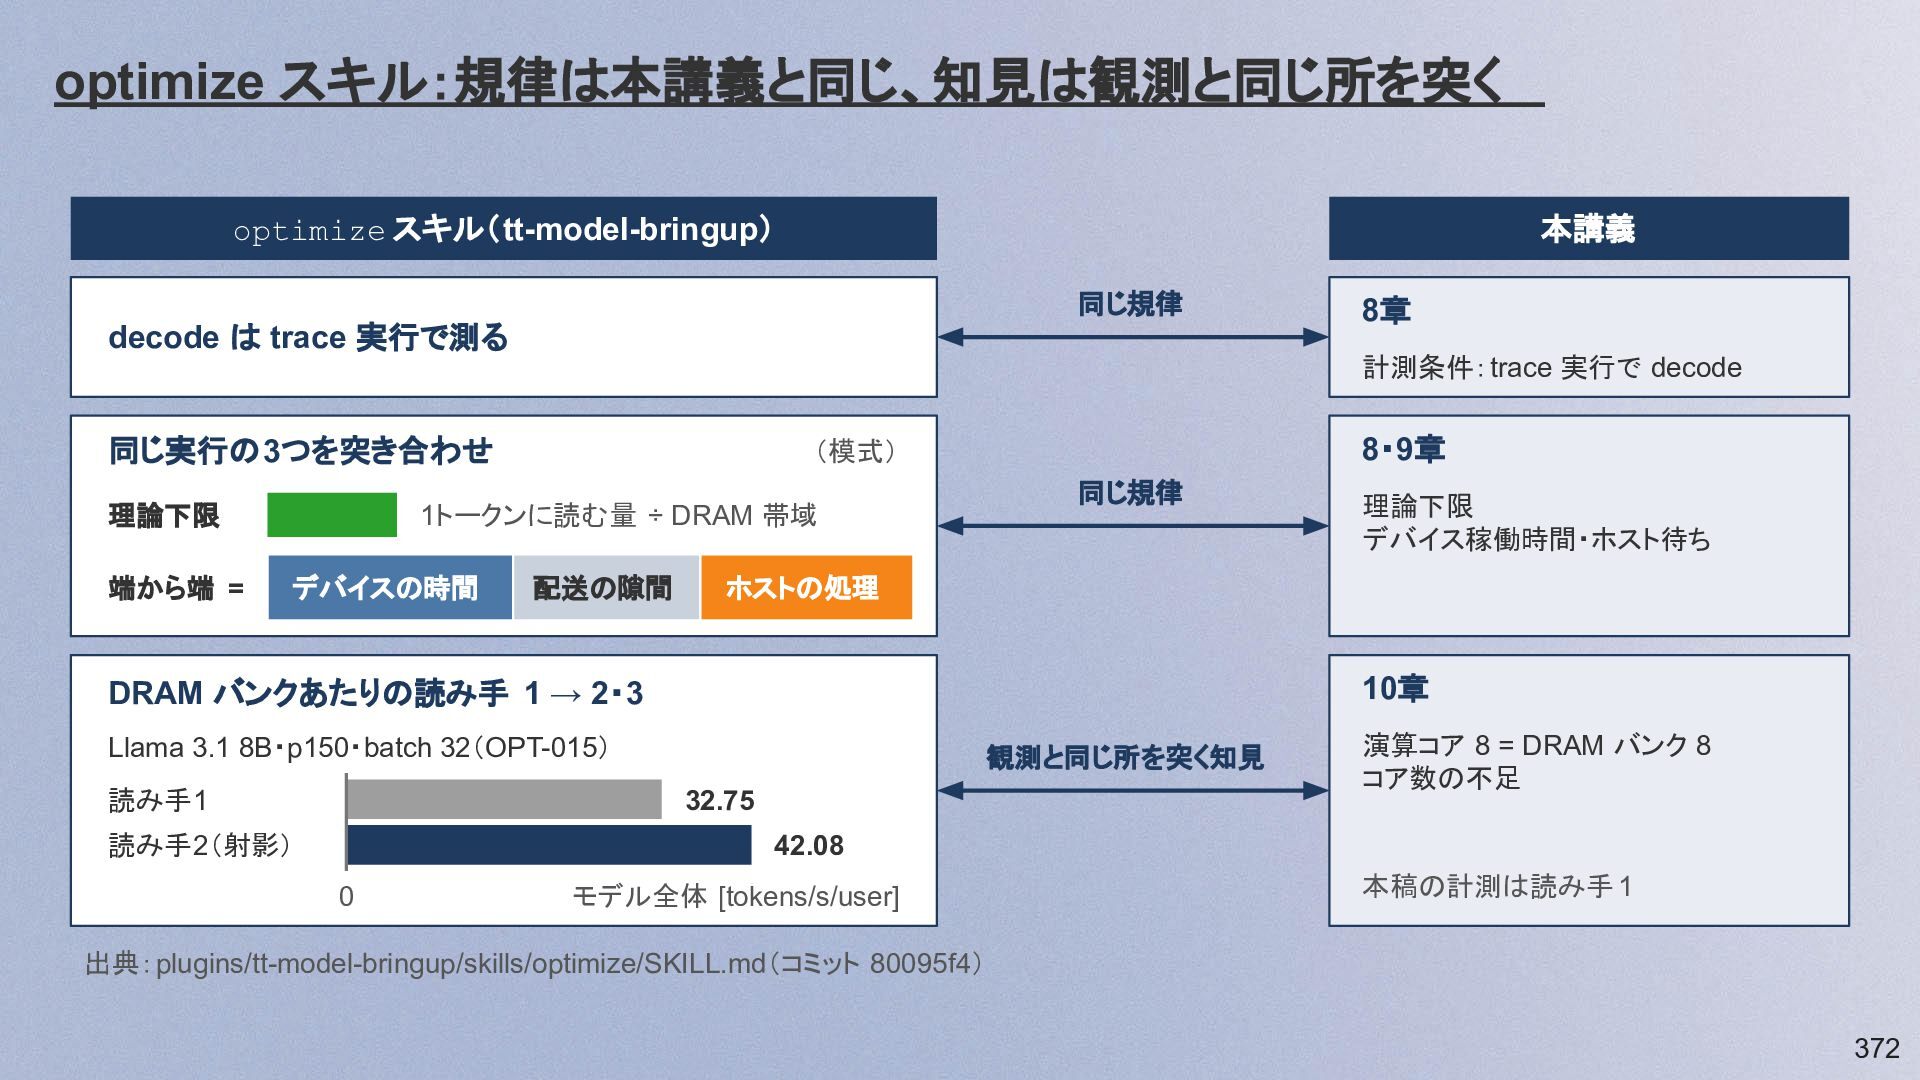
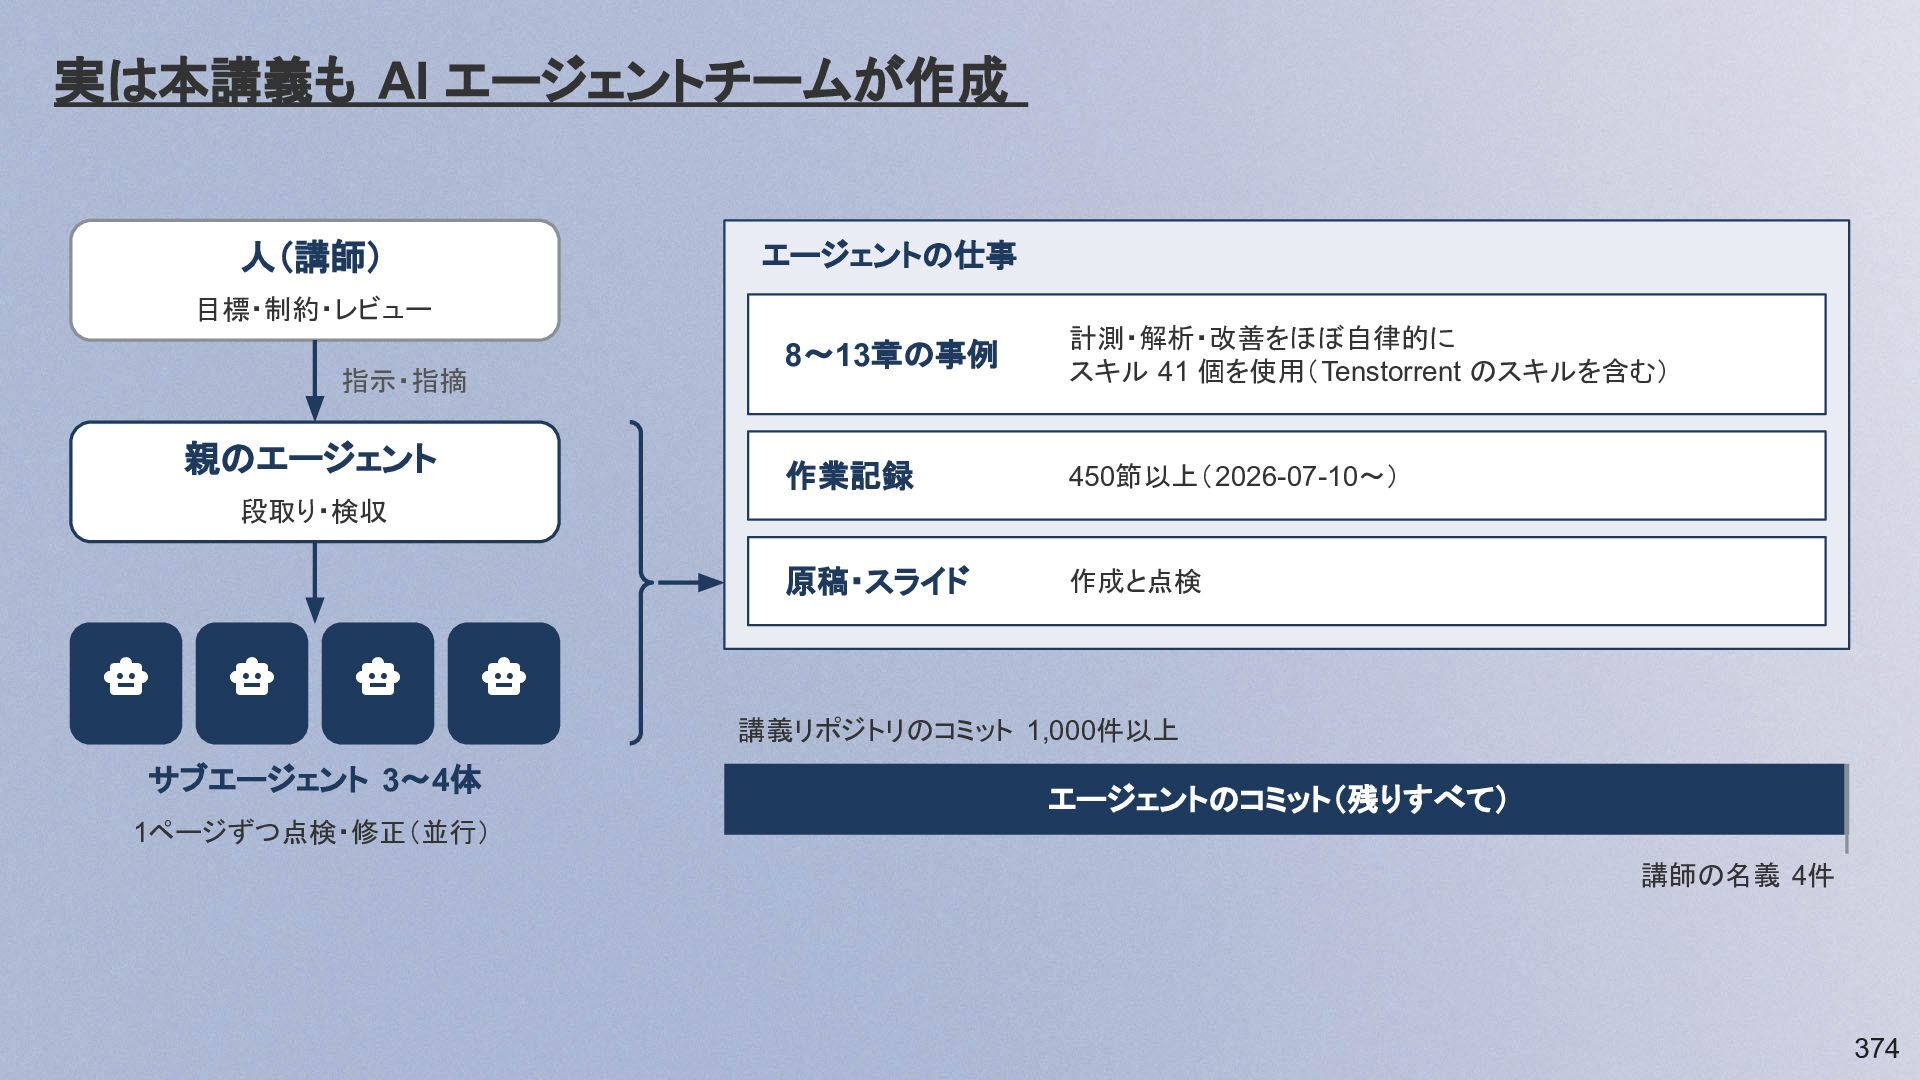
AIパフォーマンスエンジニアリングの最前線
 Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→

Share
AIパフォーマンスエンジニアリングの最前線
2026/10/09開催の「第23回物理屋のための機械学習講義」 https://akio-tomiya.github.io/lectures4mlphys/#%E7%AC%AC23%E5%9B%9E の講義資料です。
日時: 2026/10/9 (金) 13:00-17:00 JST
講師: 吉藤 尚生 (テンストレントジャパン株式会社)
講演題目: AIパフォーマンスエンジニアリングの最前線
開催方法: 対面とオンラインのハイブリッド
場所: 筑波大学東京キャンパス 118講義室
概要:
近年、機械学習およびAIモデルの急速な大規模化・複雑化に伴い、計算資源を効率的に活用し処理を高速化するための「パフォーマンスエンジニアリング」の重要性がますます高まっています。本講義では、書籍『実践的パフォーマンスエンジニアリングによるAI高速化』の内容をベースに、AIパフォーマンスエンジニアリングの基礎から最前線までを概観します。
まず前半では基礎編として、AIパフォーマンスエンジニアリングの歴史や全体像、そしてパフォーマンス計測およびパフォーマンス改善の基本的な手法について整理します。具体事例として大規模言語モデル(LLM)推論や自動運転AI推論も取り上げ、特に利用頻度の高いGPU上での実践的なパフォーマンスエンジアリング手法を解説します。
後半では発展編として、現在のAIパフォーマンスエンジニアリングの最新状況および将来展望を紹介し、特に重要となる2つの具体的な方法論について紹介します。まずはじめに、異なるハードウェアアーキテクチャによるパフォーマンスエンジニアリング手法の違いを解説します。具体的には、オープンなアーキテクチャ(Tenstorrent Blackholeなど)上で前半の事例などを実行し、仕様がオープンであるからこそ可能になる、よりきめ細やかなパフォーマンスエンジニアリングの事例を紹介します。最後に、こうした高度なパフォーマンスエンジニアリングをAIエージェントに実行させる最新の取り組みについて触れ、オープンなアーキテクチャがいかに「今後のパフォーマンスエンジニアリング」と親和性が高いかを議論します。
受講に際して書籍『実践的パフォーマンスエンジニアリングによるAI高速化』(技術評論社)は必須ではありませんが、事前に予習として目を通しておく、あるいは講義中に触れられなかった詳細について確認しながら受講すると、より理解を深めることができます。

YOSHIFUJI Naoki @Tenstorrent
Transcript
271 slides
-
Disclaimer The views and opinions expressed in this presentation are
those of the speaker and do not necessarily reflect the official policy or position of Tenstorrent. 2 -
自己紹介 吉藤 尚生 YOSHIFUJI Naoki (@LWisteria) • テンストレントジャパン Field Application
Engineer (2026-) • フィックスターズ リードエンジニア・ディレクター (2013-2025) ◦ LLM事業推進室 室長 (2023-2024) ◦ パフォーマンスエンジニアリング・ラボ ラボ長 (2025) (Online avatar) [主な業績] • 『実践的パフォーマンスエンジニアリングによるAI高速化』筆頭編 著者 • LLM/AIの事業立ち上げ・展開 • HWの特性を活かしたSW開発・高速化の支援 • HPC・LLM・計算土木力学分野にて論文投稿・学会発表 3 -
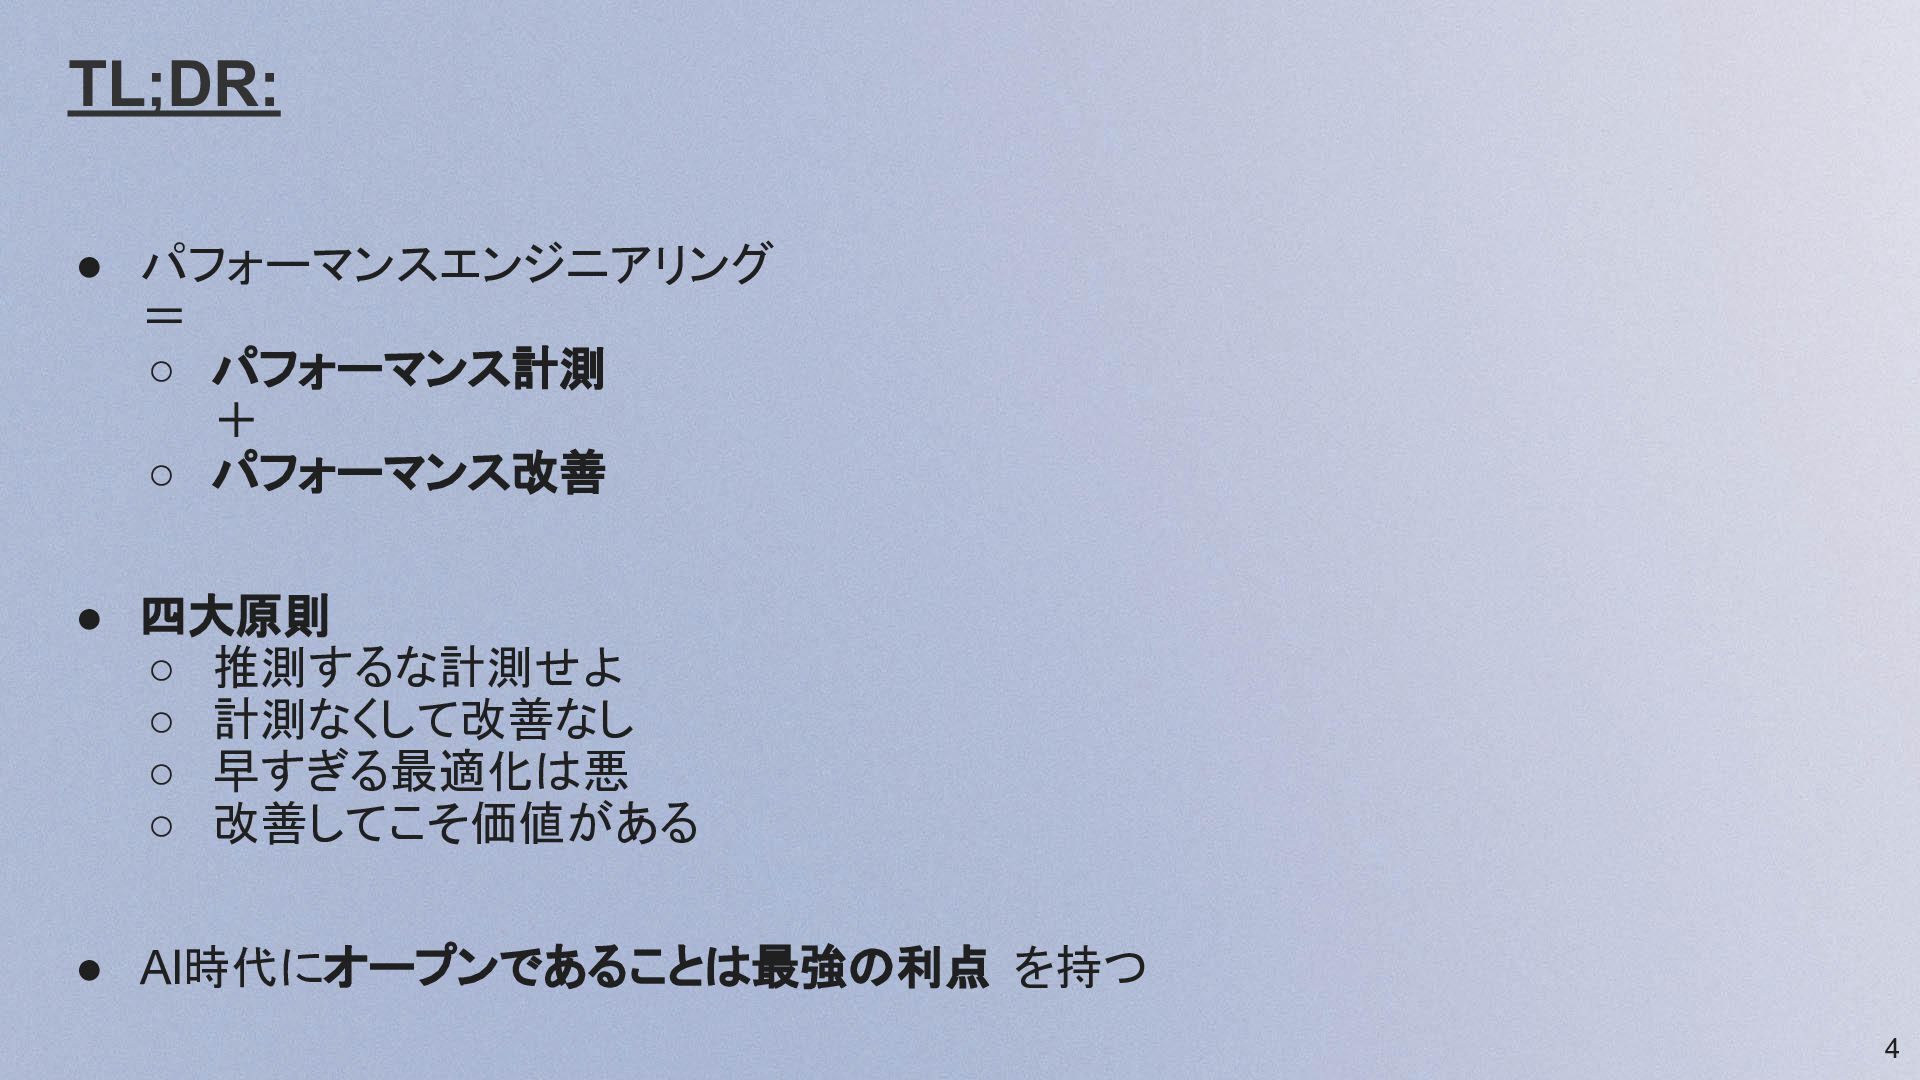
TL;DR: • パフォーマンスエンジニアリング = ◦ パフォーマンス計測 + ◦ パフォーマンス改善 •
四大原則 ◦ 推測するな計測せよ ◦ 計測なくして改善なし ◦ 早すぎる最適化は悪 ◦ 改善してこそ価値がある • AI時代にオープンであることは最強の利点 を持つ 4 -
目次 1. 本日の概要 (20分) 2. 理論編(1時間) 1. パフォーマンス計測 2. パフォーマンス改善
(休憩5分) 3. 実践編(1時間) 1. LLM推論の事例 2. 自動運転AIの事例 (休憩5分) 4. 発展編(1.5時間) 1. オープンアーキテクチャとの親和性実例 2. AIエージェントによる開発 6 -
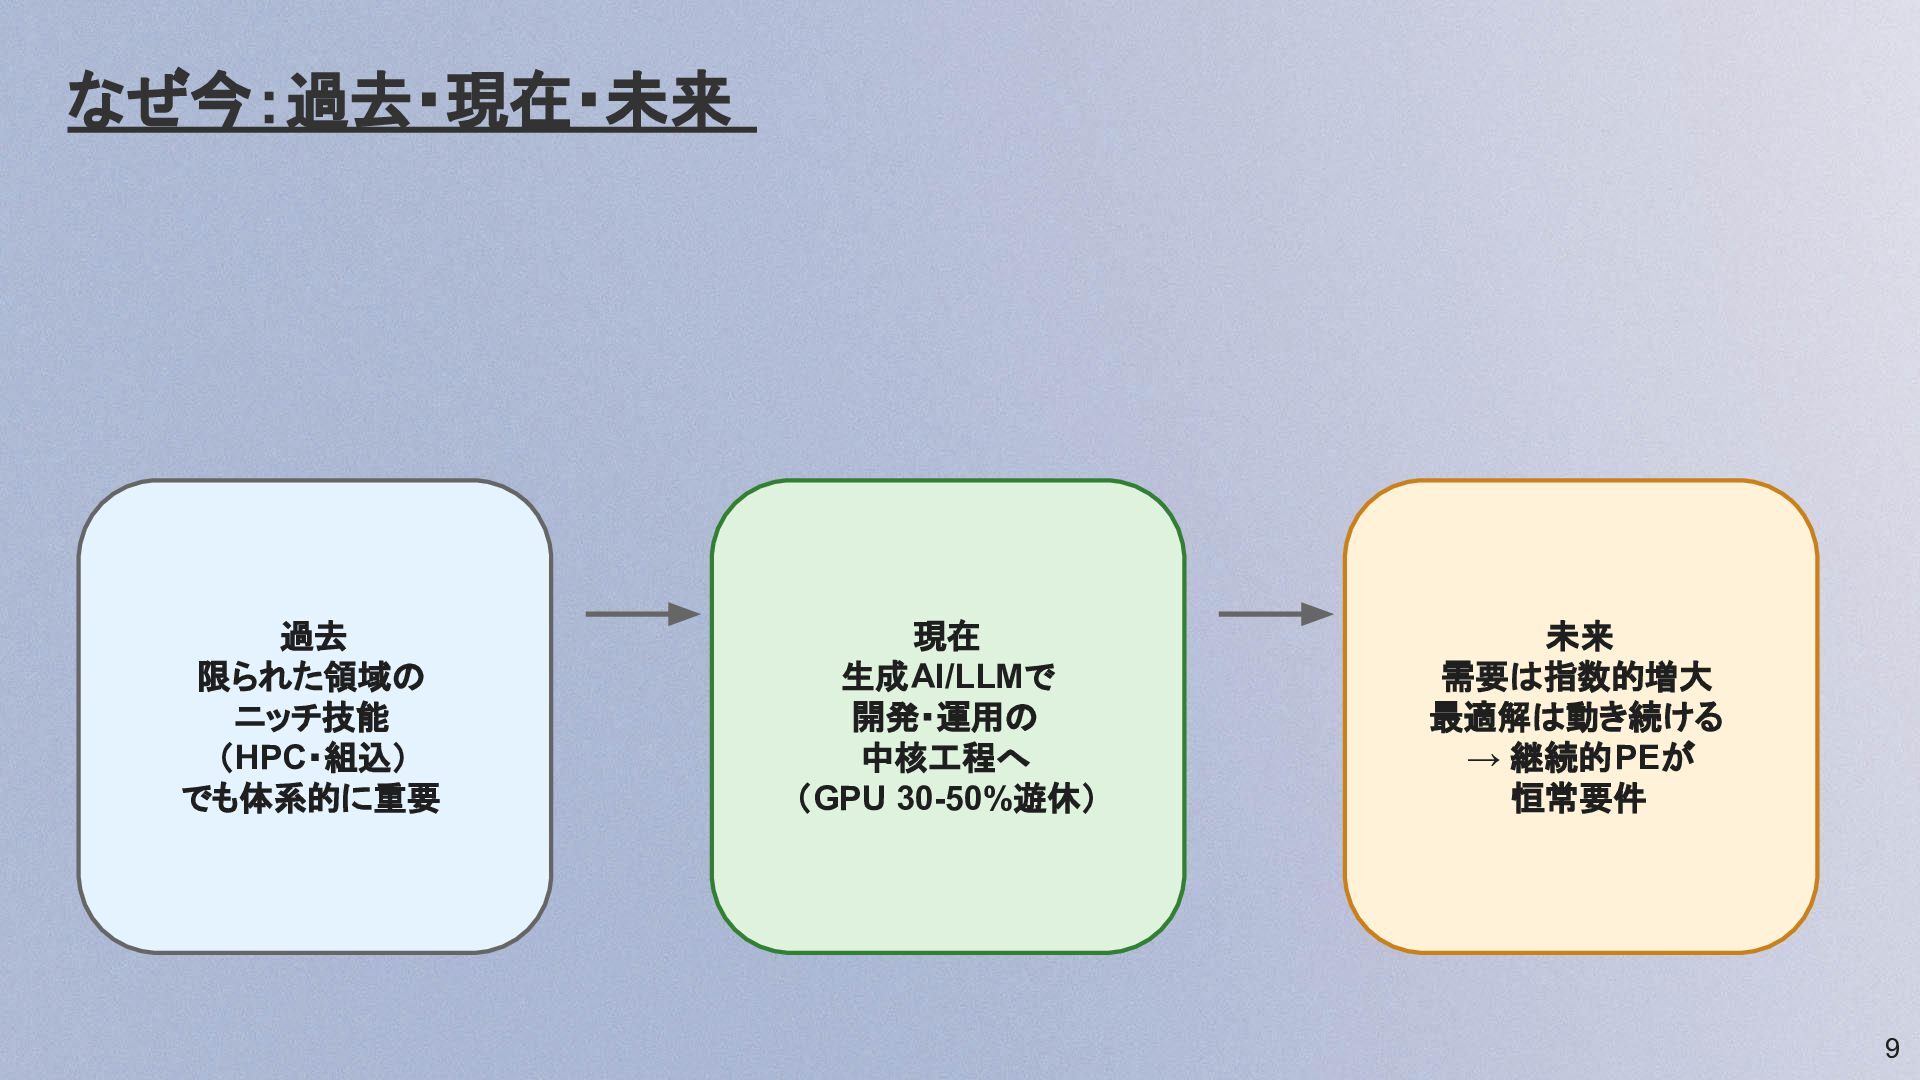
なぜ今:過去・現在・未来 過去 限られた領域の ニッチ技能 (HPC・組込) でも体系的に重要 現在 生成AI/LLMで 開発・運用の 中核工程へ
(GPU 30-50%遊休) 未来 需要は指数的増大 最適解は動き続ける → 継続的PEが 恒常要件 9 -
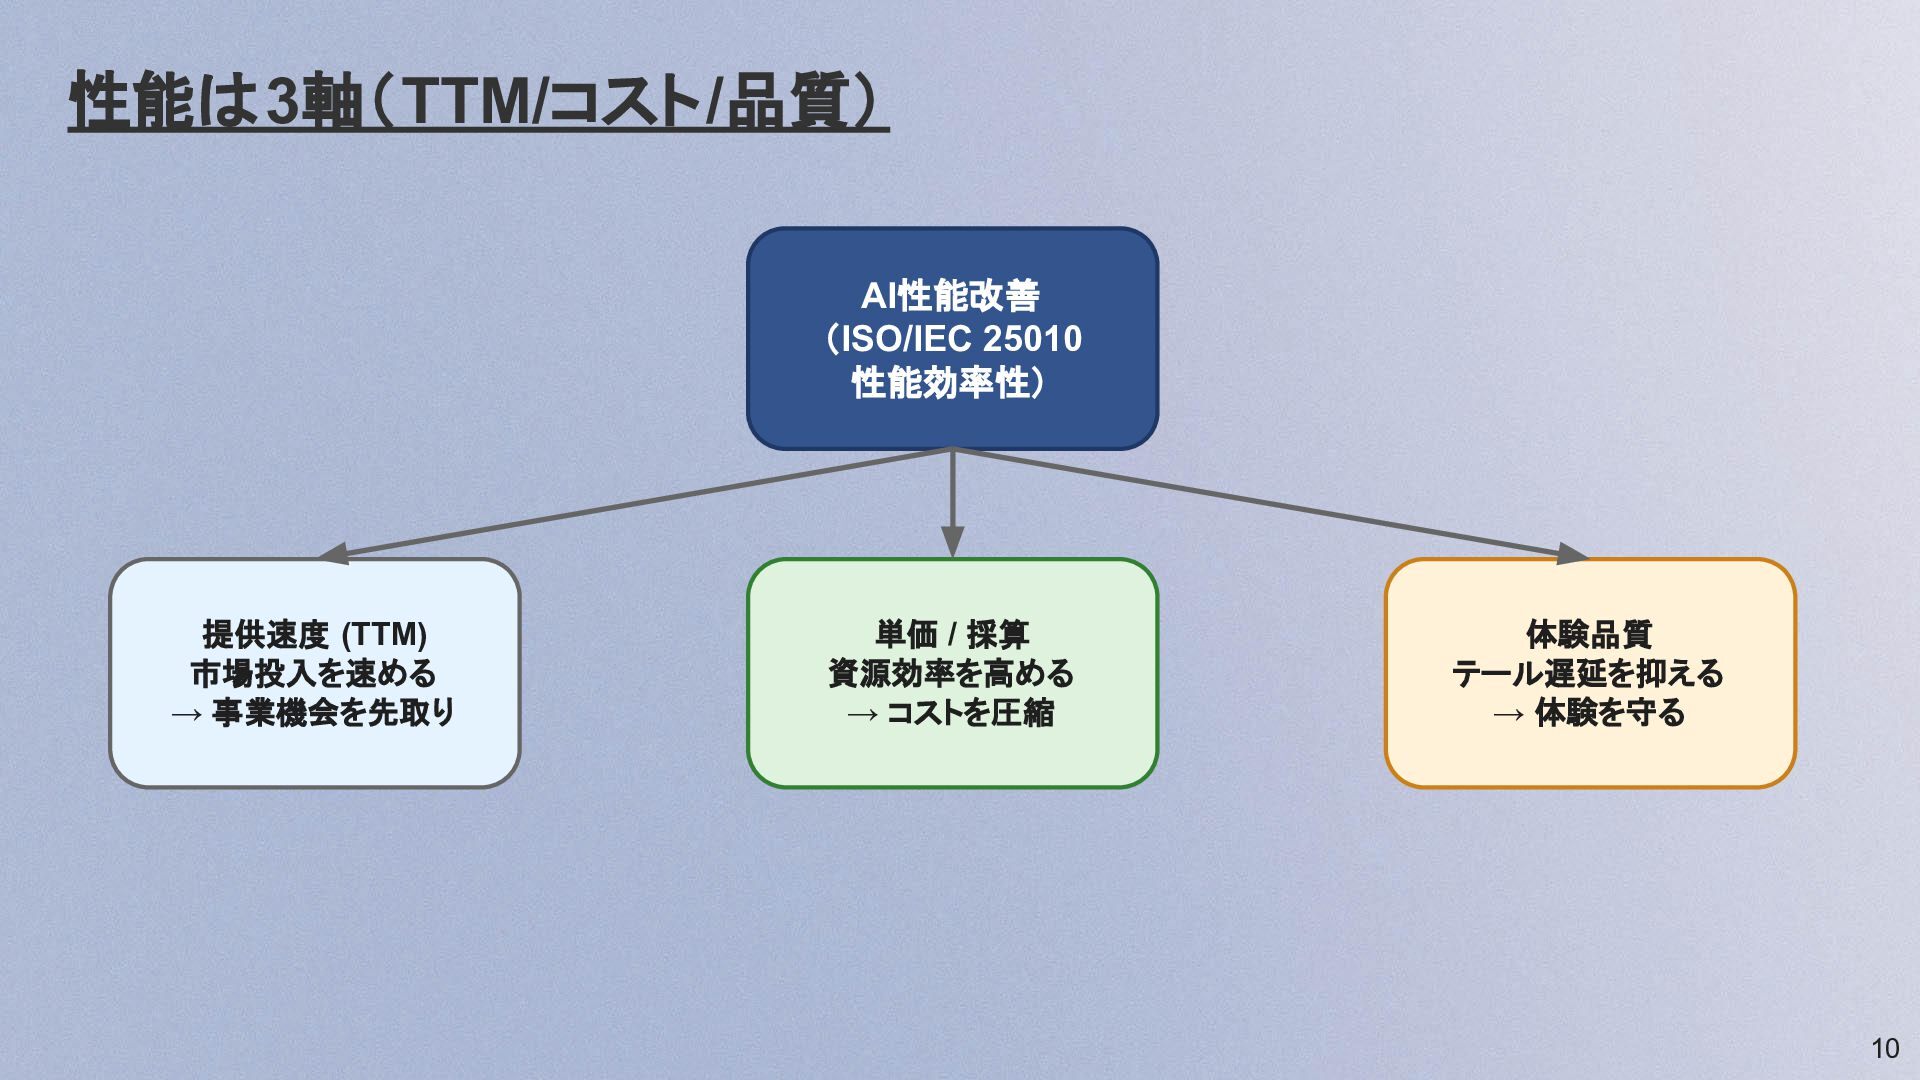
性能は3軸(TTM/コスト/品質) AI性能改善 (ISO/IEC 25010 性能効率性) 提供速度 (TTM) 市場投入を速める → 事業機会を先取り
単価 / 採算 資源効率を高める → コストを圧縮 体験品質 テール遅延を抑える → 体験を守る 10 -
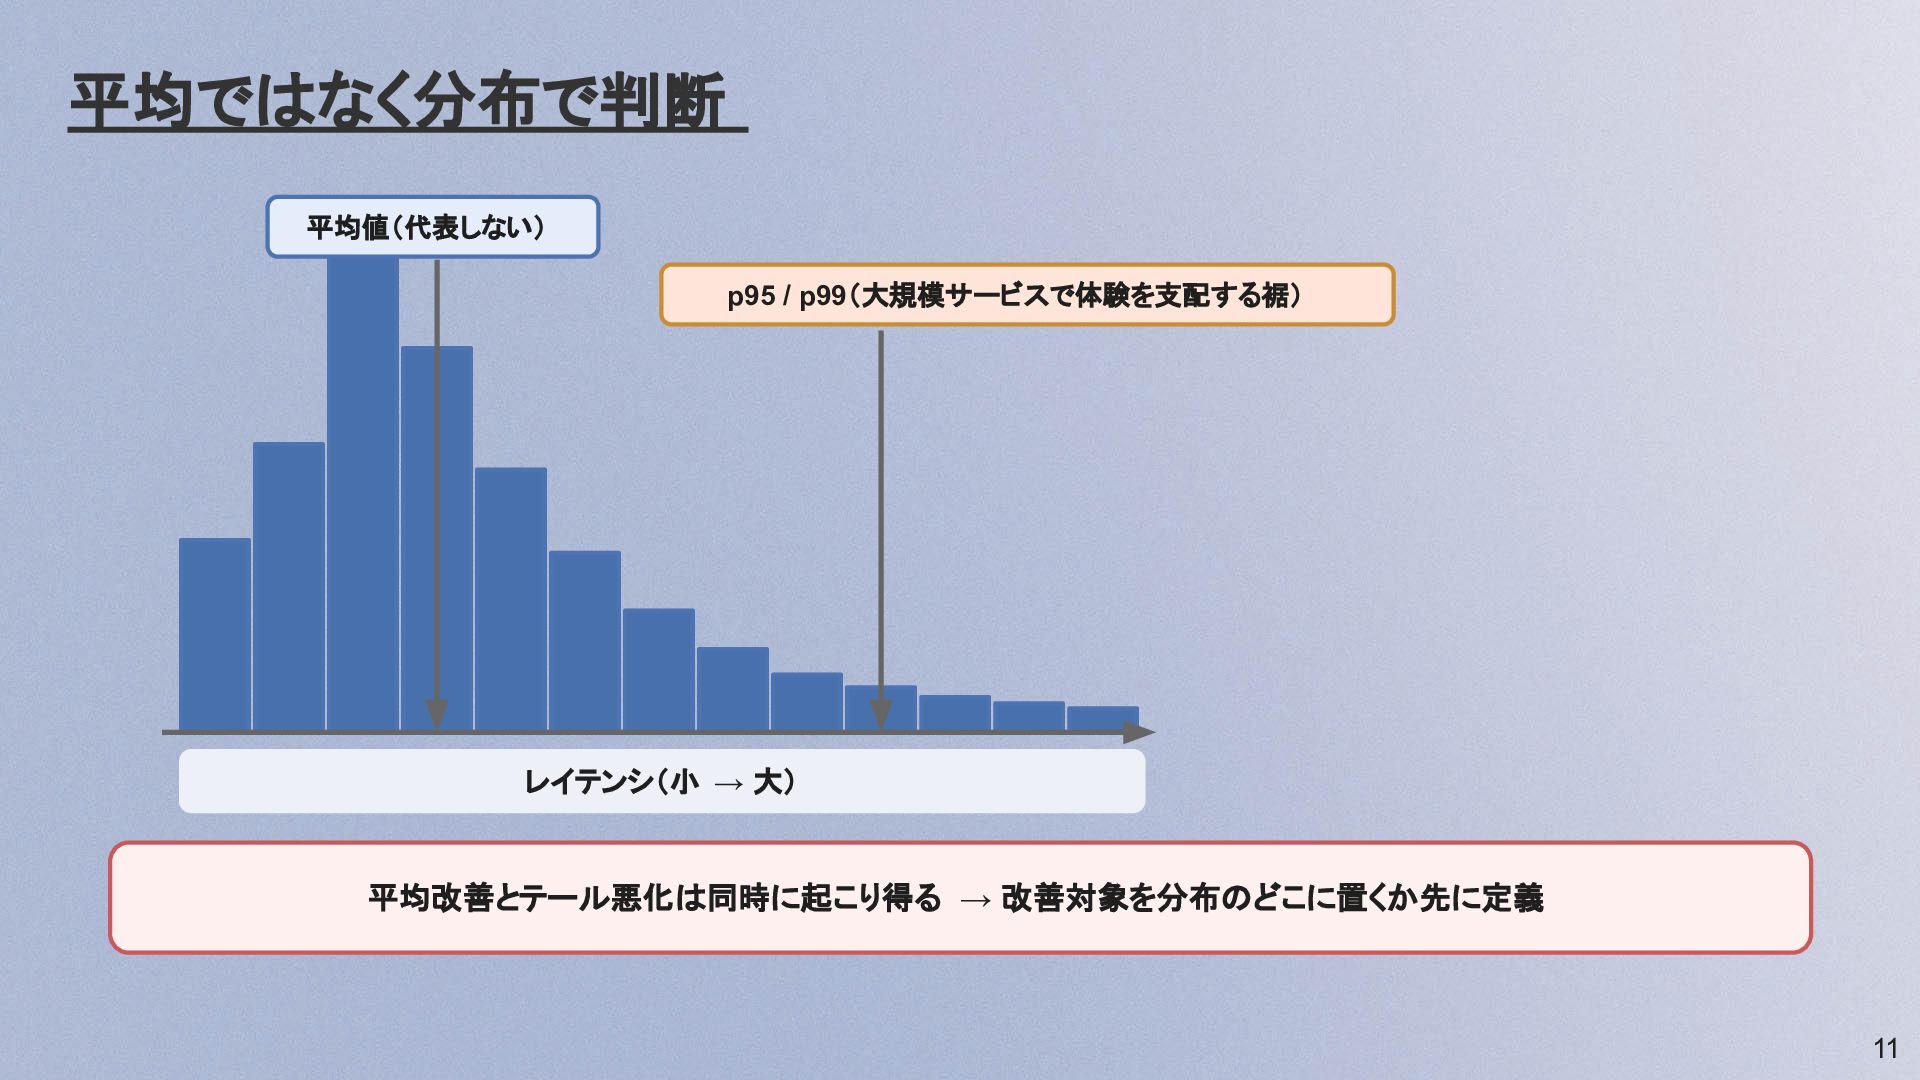
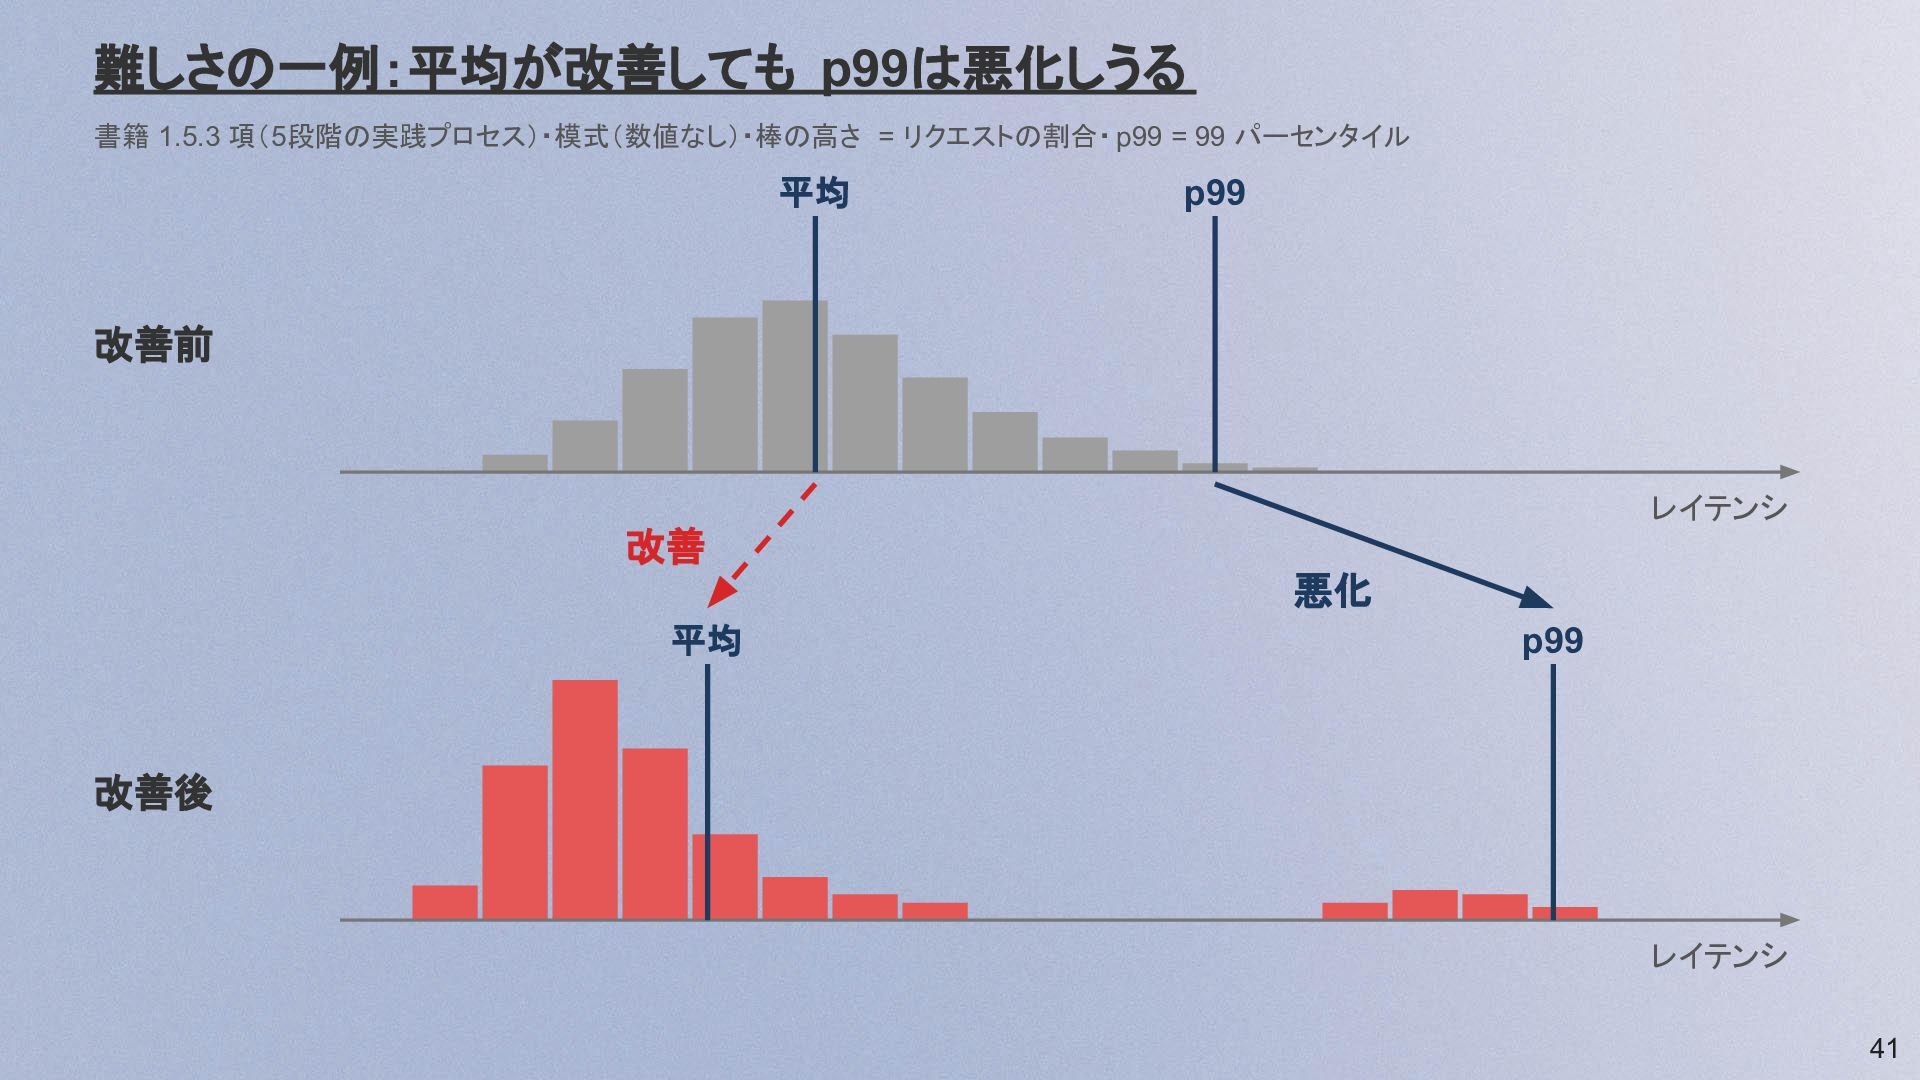
平均ではなく分布で判断 平均値(代表しない) p95 / p99(大規模サービスで体験を支配する裾) レイテンシ(小 → 大) 平均改善とテール悪化は同時に起こり得る →
改善対象を分布のどこに置くか先に定義 11 -
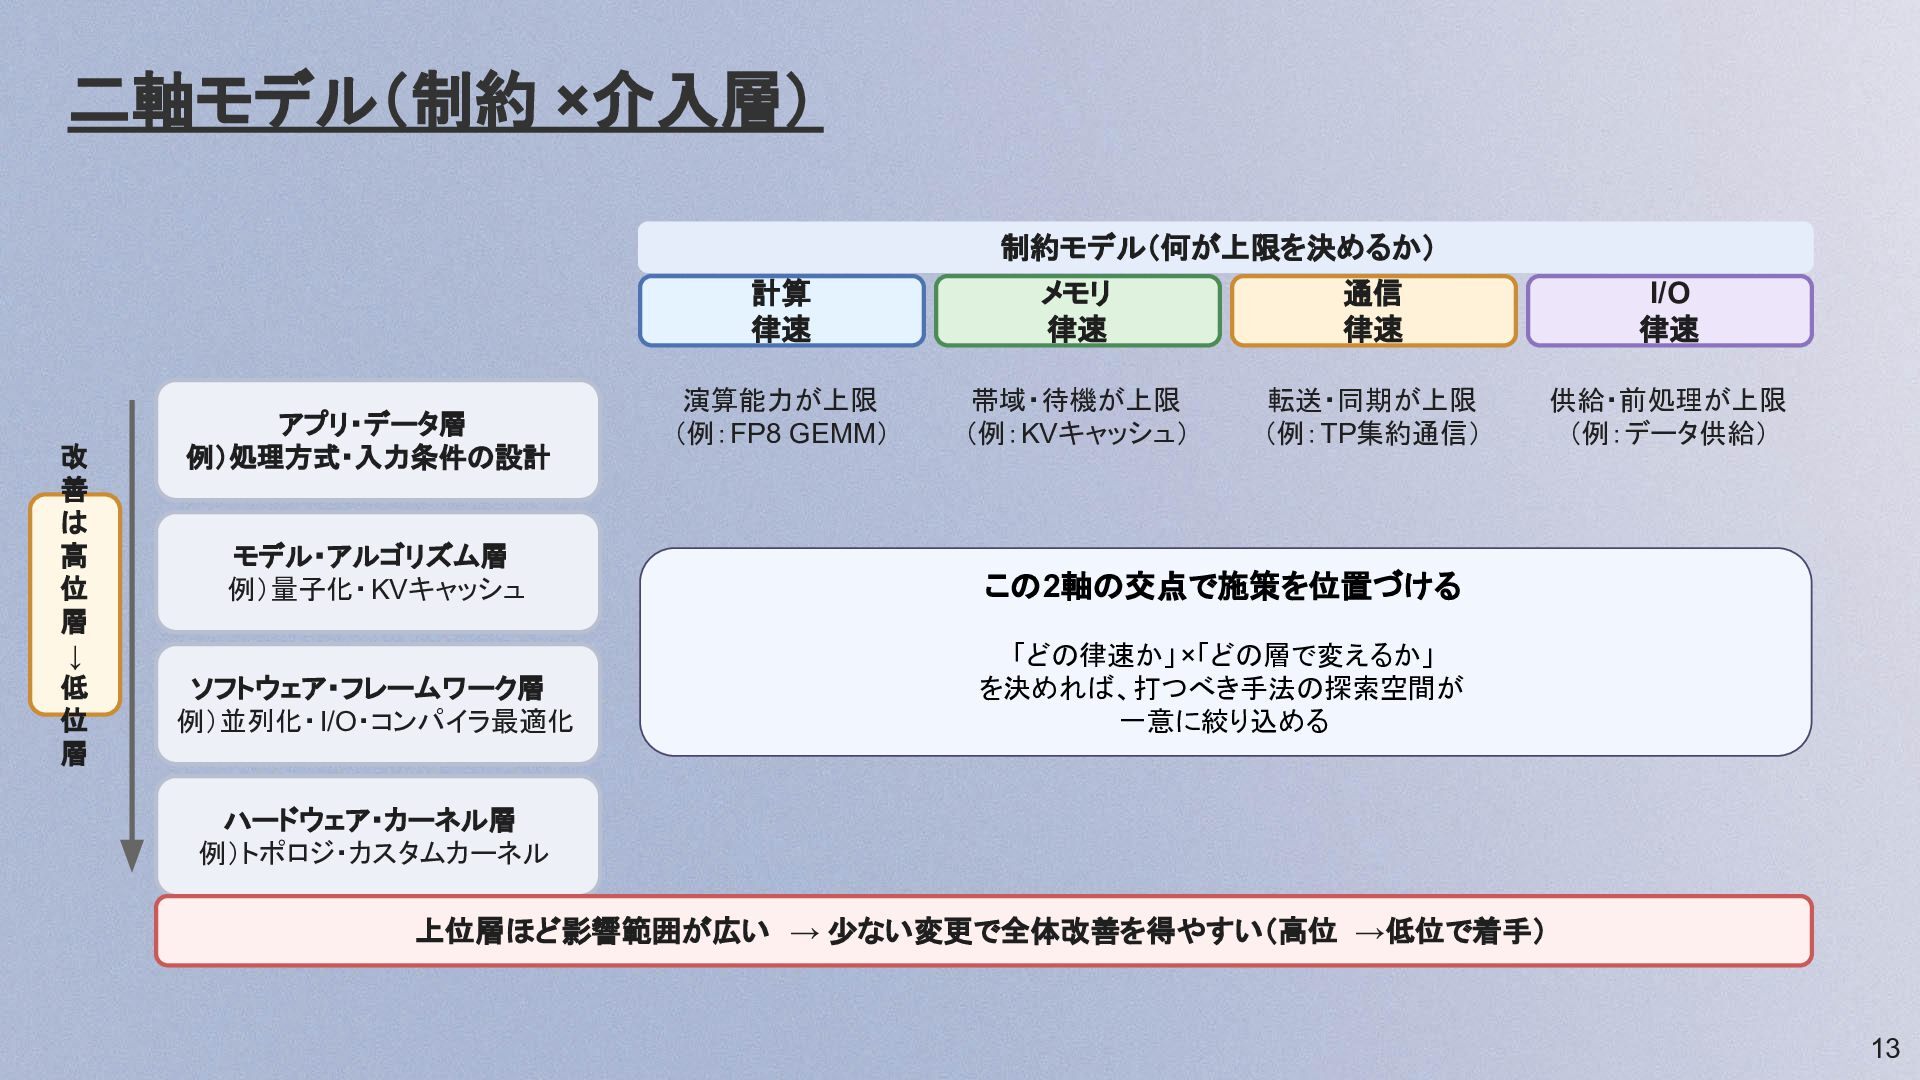
二軸モデル(制約 ×介入層) 制約モデル(何が上限を決めるか) 改 善 は 高 位 層 ↓
低 位 層 アプリ・データ層 例)処理方式・入力条件の設計 計算 律速 メモリ 律速 通信 律速 I/O 律速 演算能力が上限 (例:FP8 GEMM) 帯域・待機が上限 (例:KVキャッシュ) 転送・同期が上限 (例:TP集約通信) 供給・前処理が上限 (例:データ供給) モデル・アルゴリズム層 例)量子化・KVキャッシュ この2軸の交点で施策を位置づける ソフトウェア・フレームワーク層 例)並列化・I/O・コンパイラ最適化 「どの律速か」 ×「どの層で変えるか」 を決めれば、打つべき手法の探索空間が 一意に絞り込める ハードウェア・カーネル層 例)トポロジ・カスタムカーネル 上位層ほど影響範囲が広い → 少ない変更で全体改善を得やすい(高位 →低位で着手) 13 -
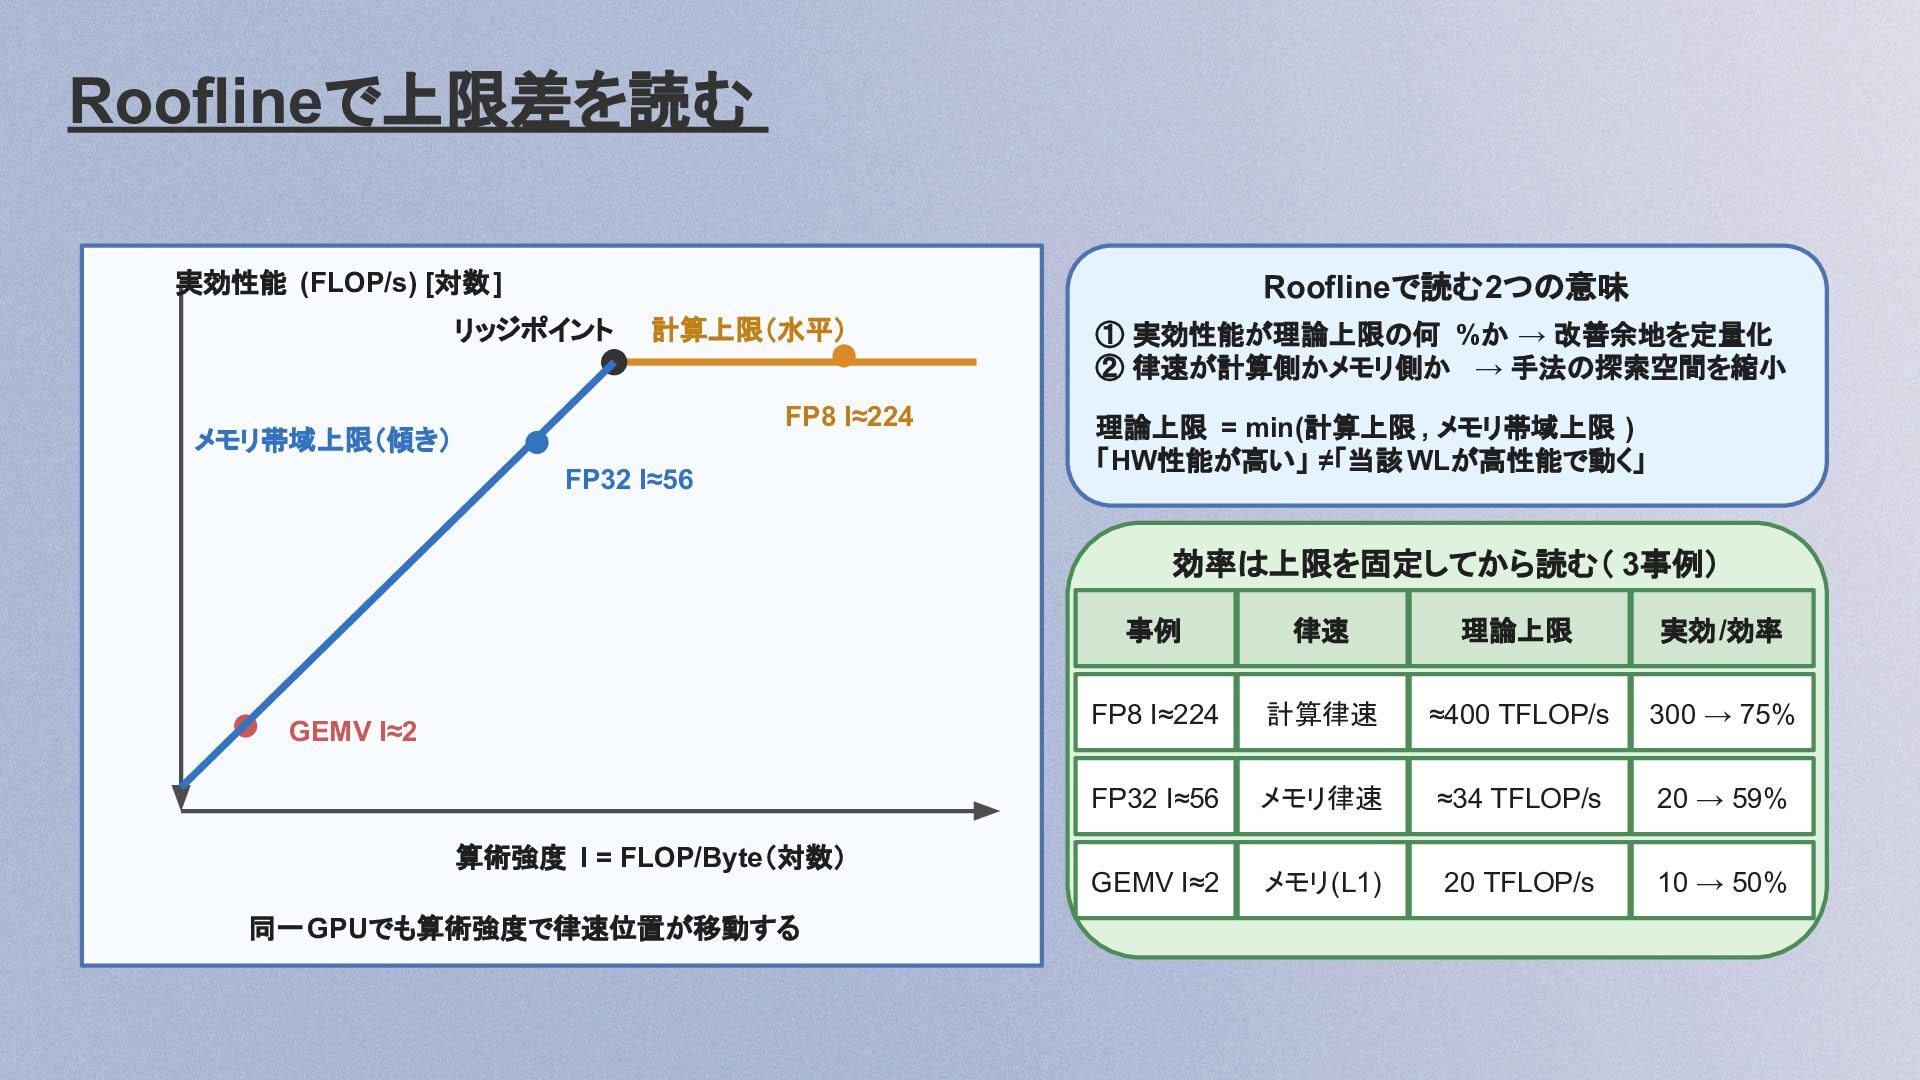
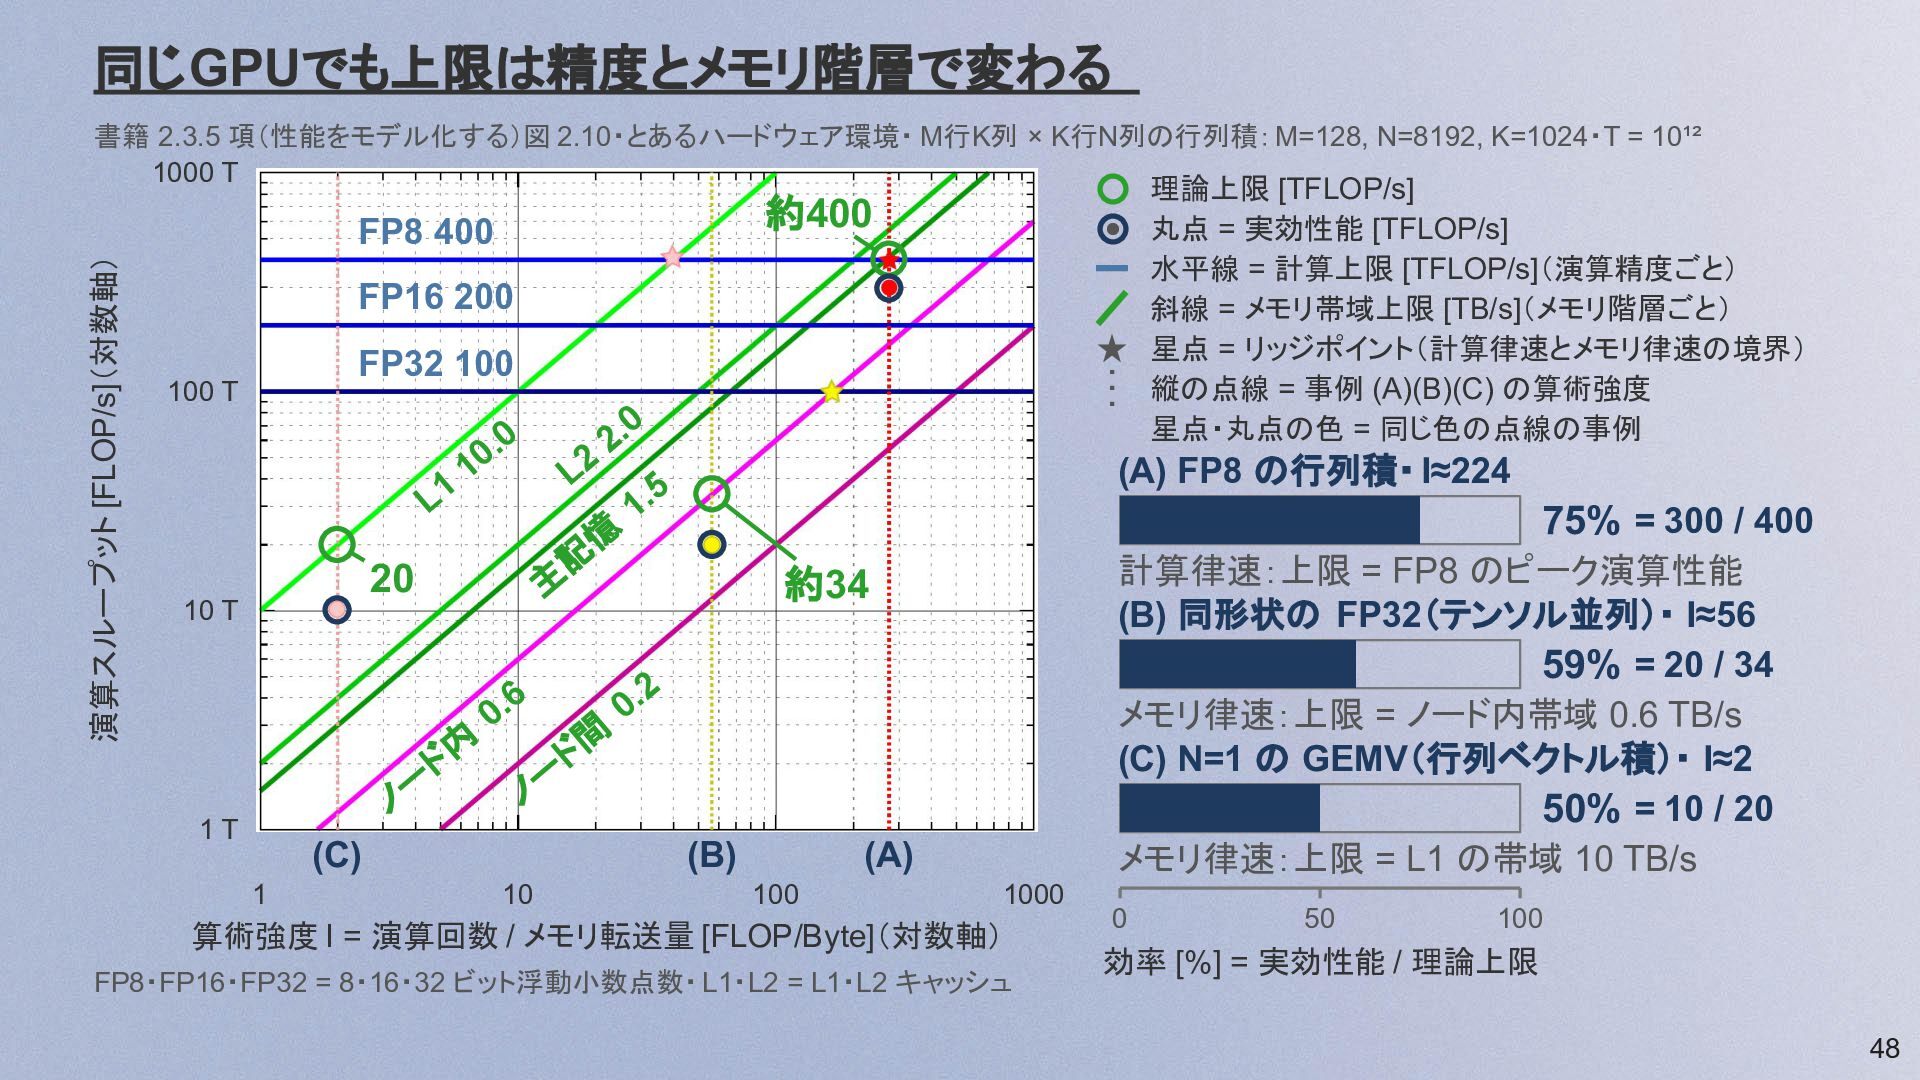
Rooflineで上限差を読む 実効性能 (FLOP/s) [対数] Rooflineで読む2つの意味 リッジポイント 計算上限(水平) FP8 I≈224 メモリ帯域上限(傾き)
FP32 I≈56 ① 実効性能が理論上限の何 %か → 改善余地を定量化 ② 律速が計算側かメモリ側か → 手法の探索空間を縮小 理論上限 = min(計算上限 , メモリ帯域上限 ) 「HW性能が高い」 ≠「当該 WLが高性能で動く」 効率は上限を固定してから読む( 3事例) GEMV I≈2 算術強度 I = FLOP/Byte(対数) 同一GPUでも算術強度で律速位置が移動する 事例 律速 理論上限 実効/効率 FP8 I≈224 計算律速 ≈400 TFLOP/s 300 → 75% FP32 I≈56 メモリ律速 ≈34 TFLOP/s 20 → 59% GEMV I≈2 メモリ(L1) 20 TFLOP/s 10 → 50% -
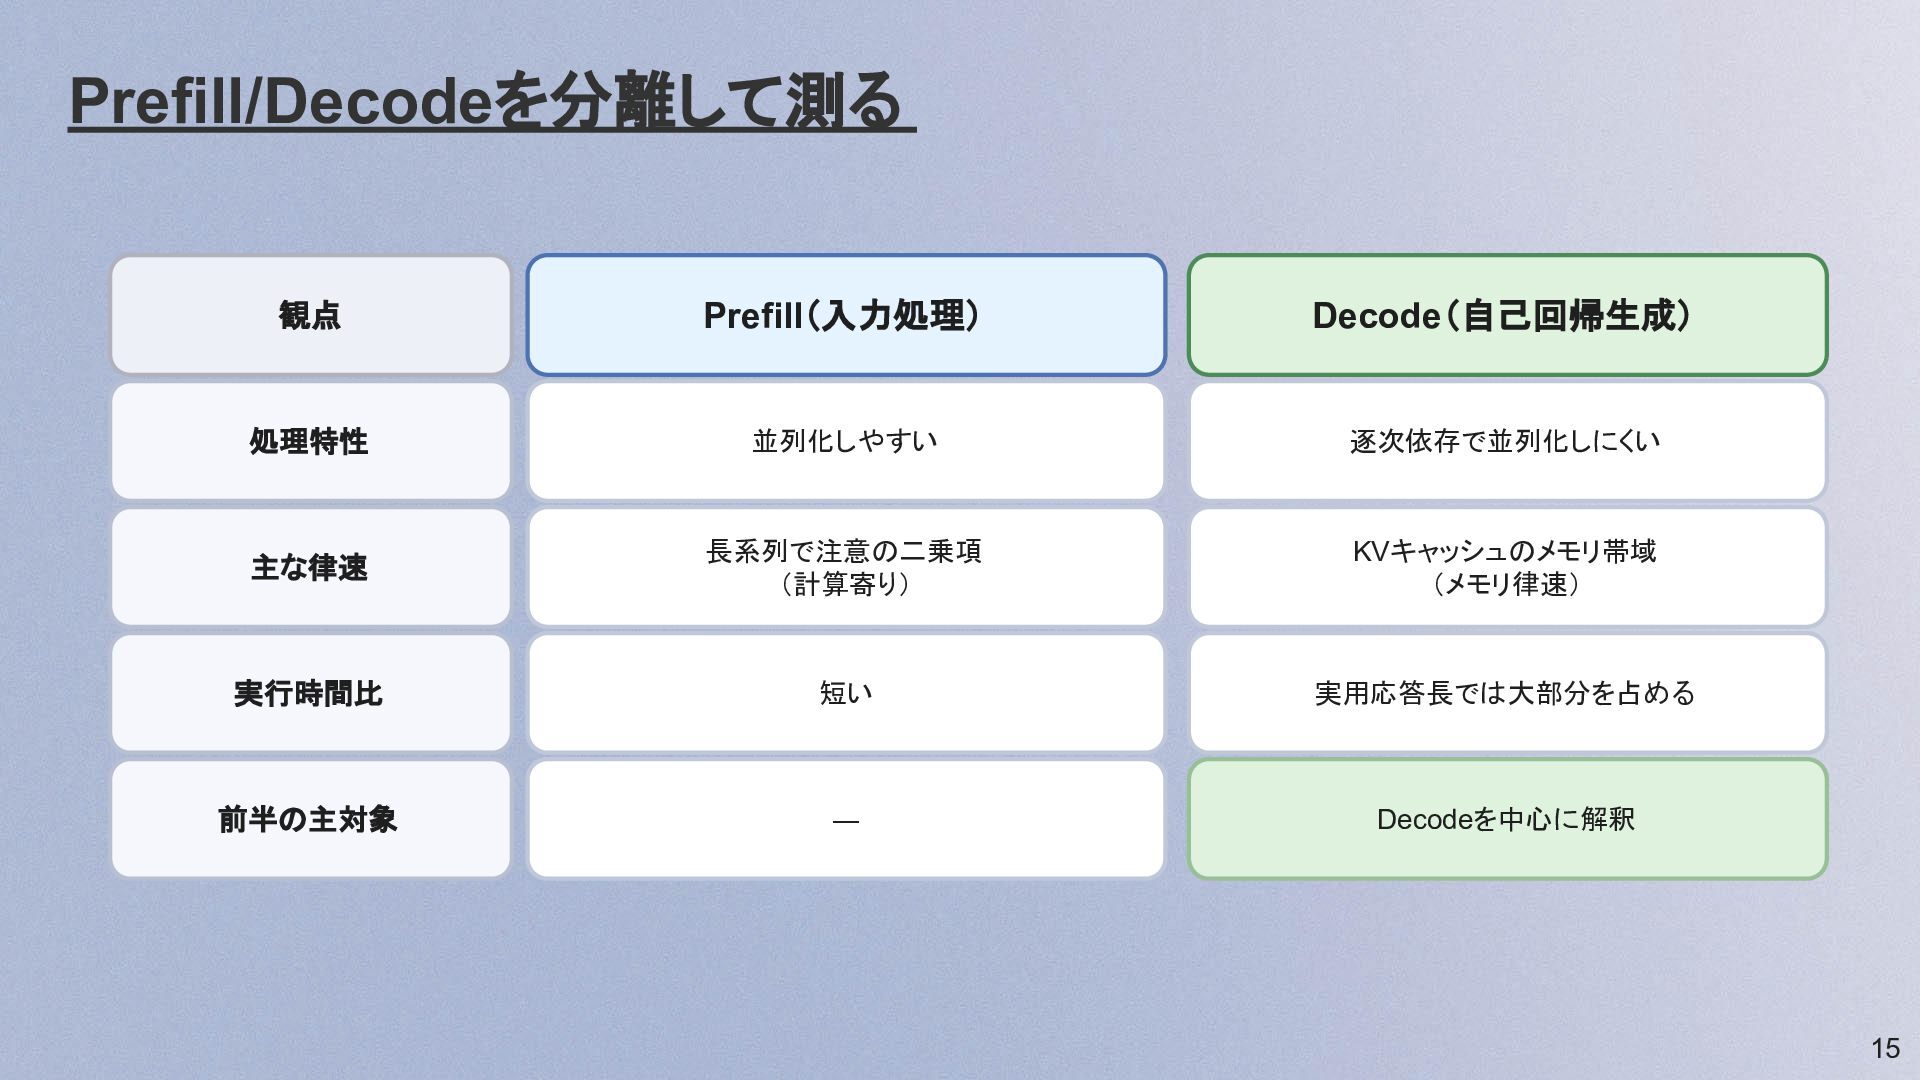
Prefill/Decodeを分離して測る 観点 Prefill(入力処理) Decode(自己回帰生成) 処理特性 並列化しやすい 逐次依存で並列化しにくい 主な律速 長系列で注意の二乗項 (計算寄り)
KVキャッシュのメモリ帯域 (メモリ律速) 実行時間比 短い 実用応答長では大部分を占める 前半の主対象 ― Decodeを中心に解釈 15 -
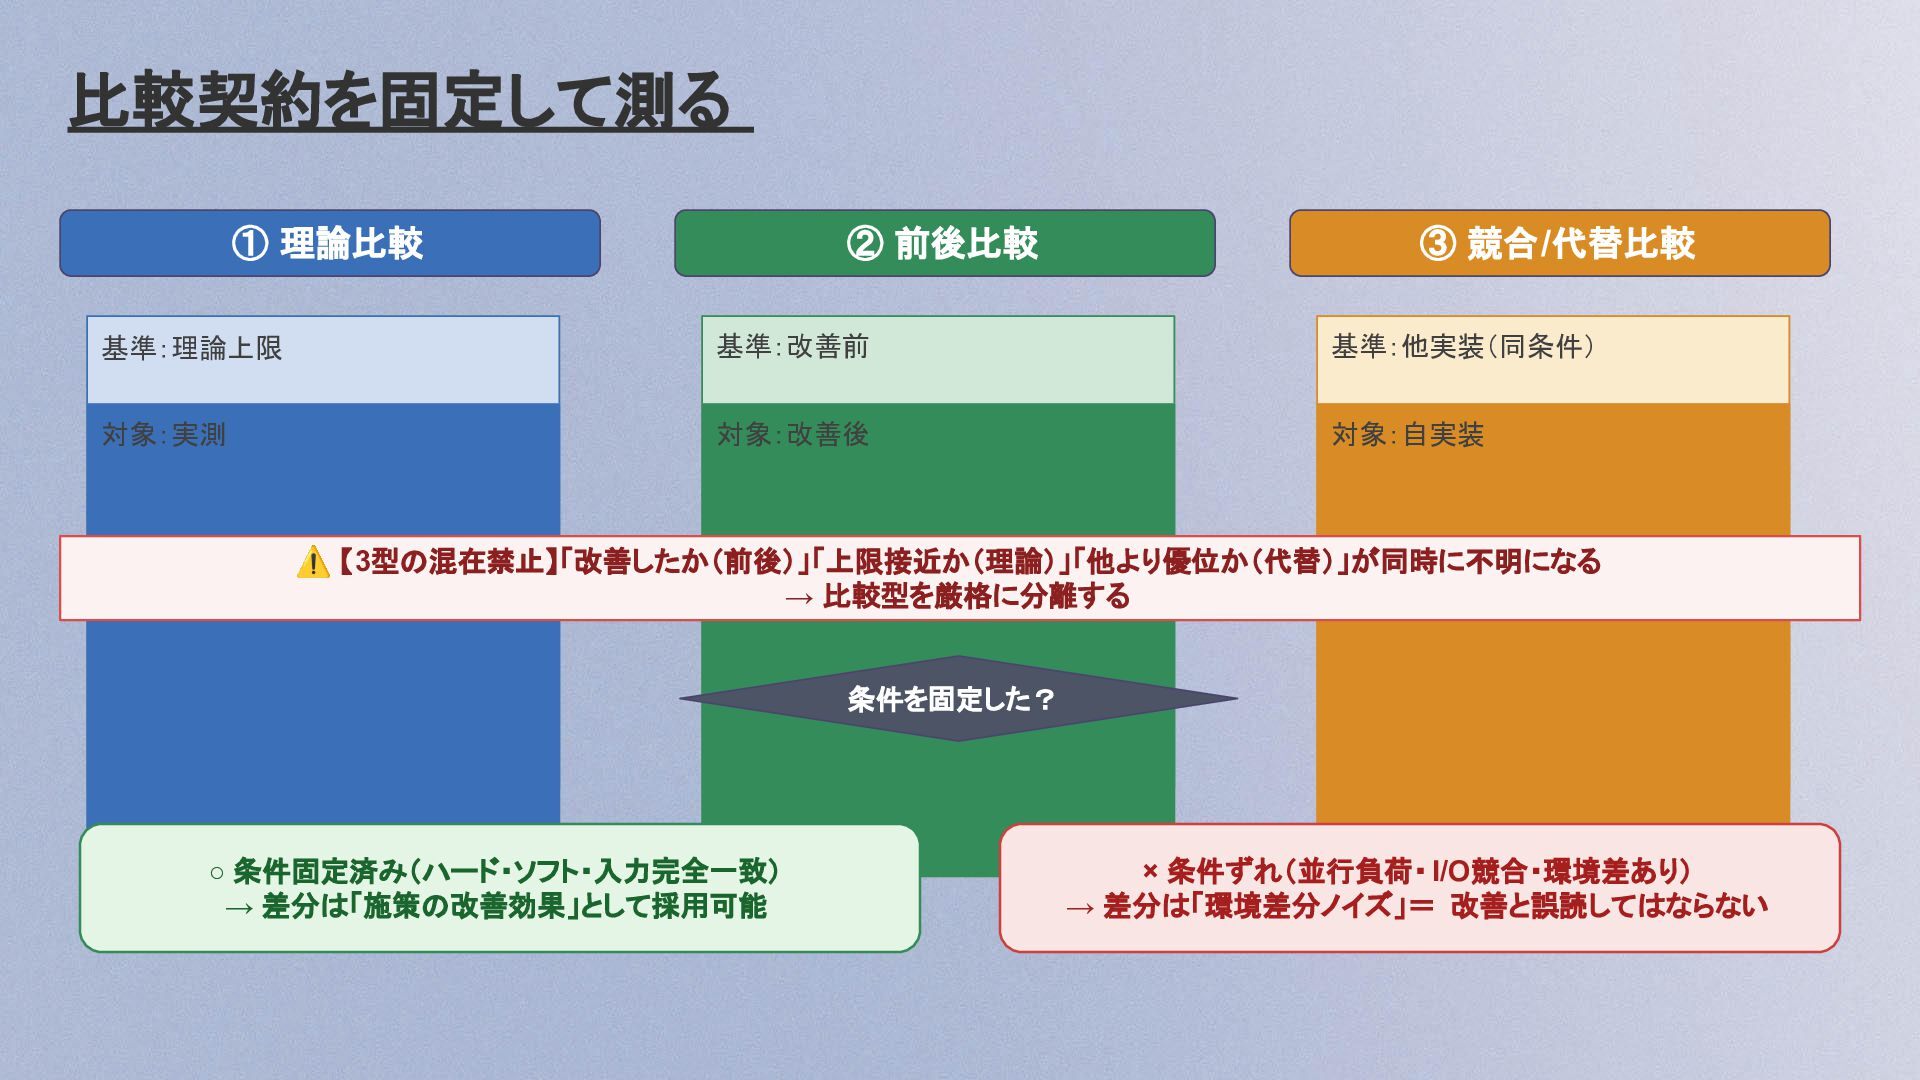
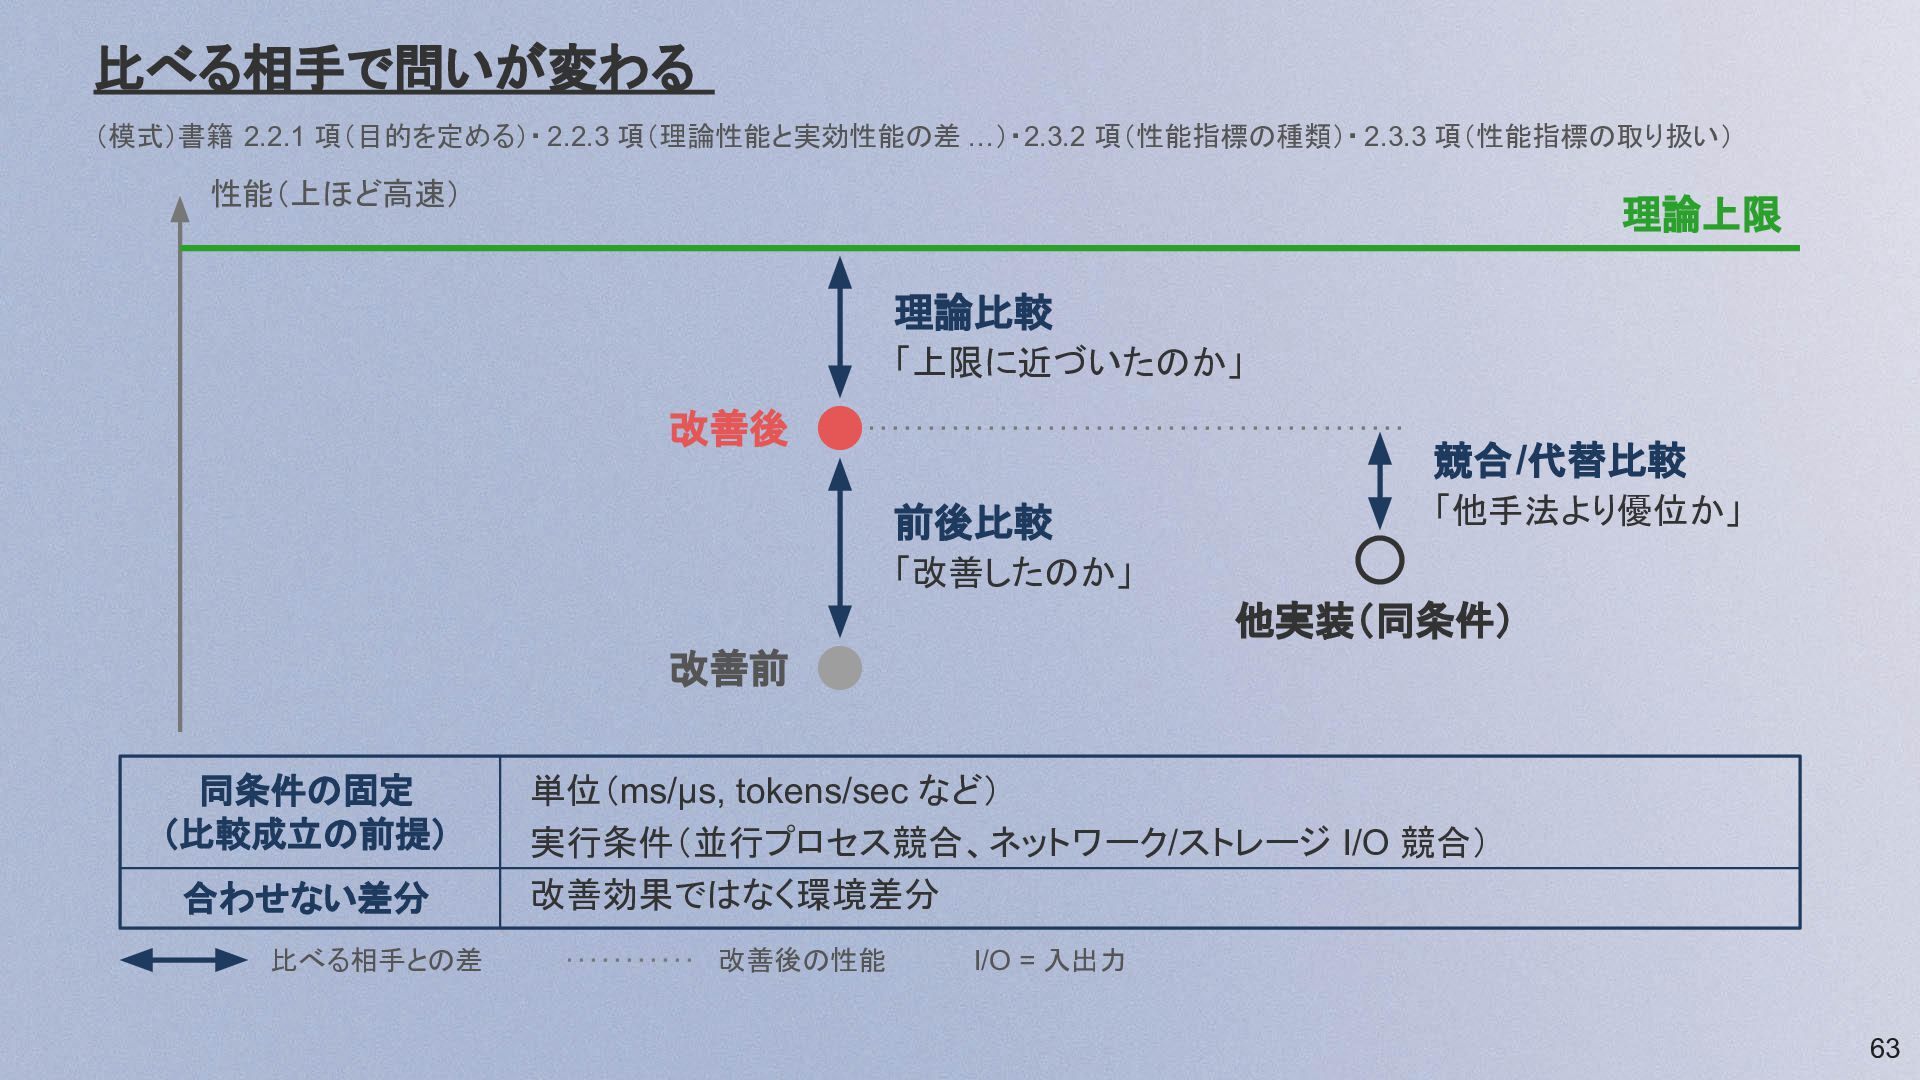
比較契約を固定して測る ① 理論比較 ② 前後比較 ③ 競合/代替比較 基準:理論上限 基準:改善前 基準:他実装(同条件)
対象:実測 対象:改善後 対象:自実装 Δ = 上限との差 → 「上限に近づい Δ = 前後差 → 「改善したのか」 Δ = 実装差 → 「他より優位か」 たか」 ⚠ 【3型の混在禁止】「改善したか(前後)」「上限接近か(理論)」「他より優位か(代替)」が同時に不明になる → 比較型を厳格に分離する 条件を固定した? ◦ 条件固定済み(ハード・ソフト・入力完全一致) → 差分は「施策の改善効果」として採用可能 × 条件ずれ(並行負荷・ I/O競合・環境差あり) → 差分は「環境差分ノイズ」= 改善と誤読してはならない -
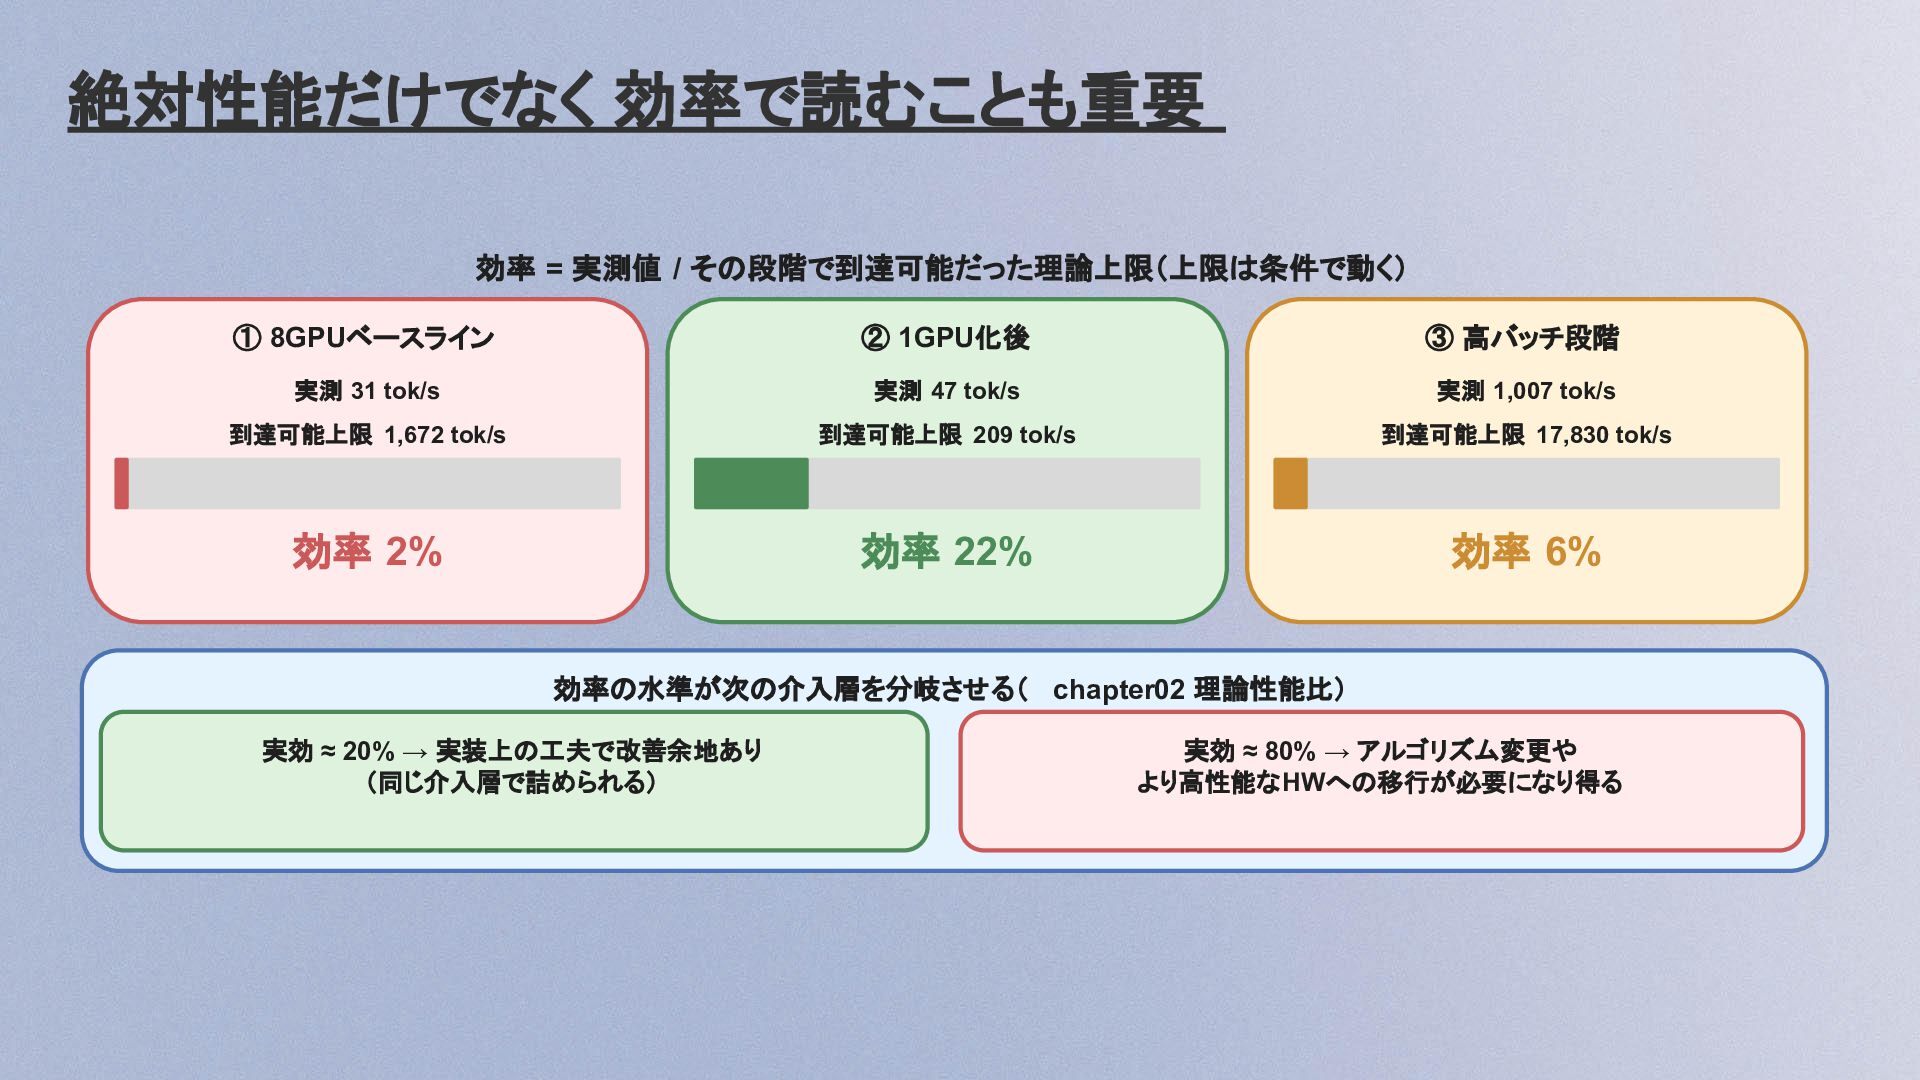
絶対性能だけでなく 効率で読むことも重要 効率 = 実測値 / その段階で到達可能だった理論上限(上限は条件で動く) ① 8GPUベースライン ②
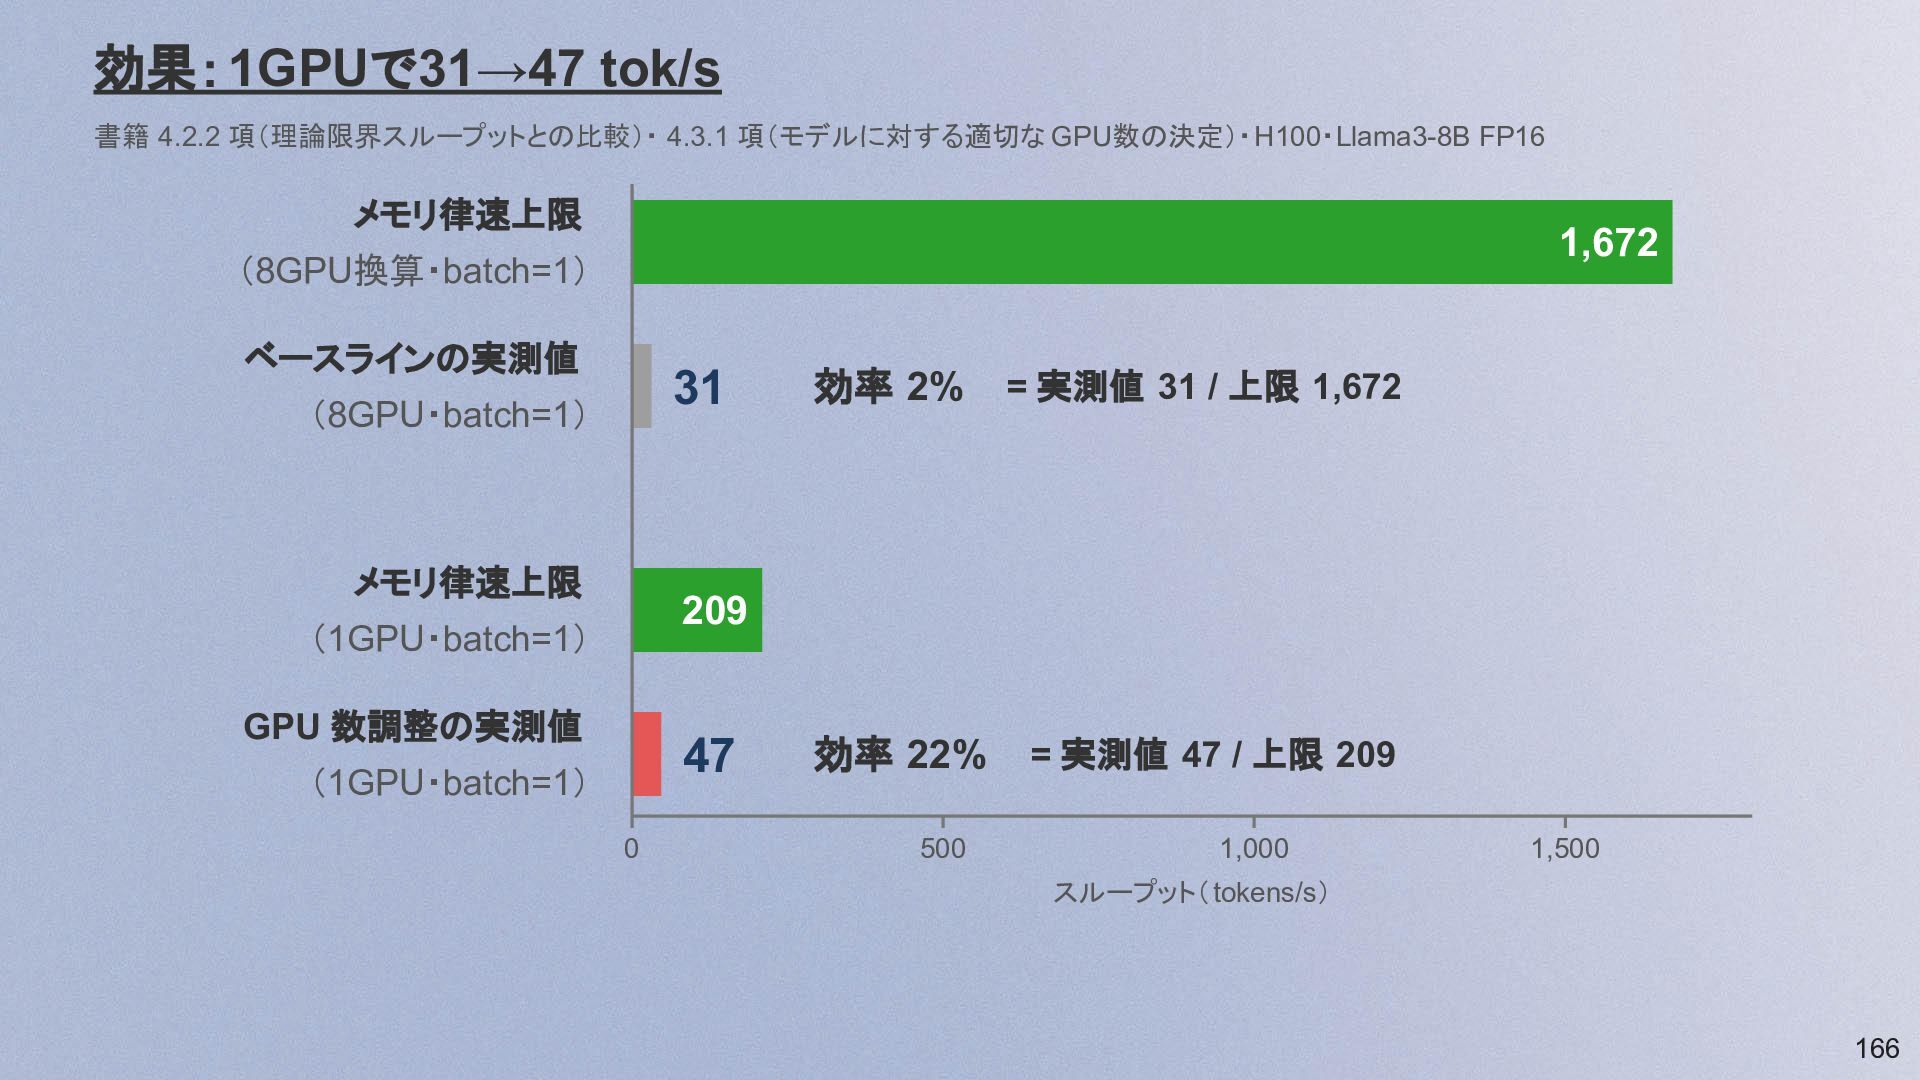
1GPU化後 ③ 高バッチ段階 実測 31 tok/s 実測 47 tok/s 実測 1,007 tok/s 到達可能上限 1,672 tok/s 到達可能上限 209 tok/s 到達可能上限 17,830 tok/s 効率 2% 効率 22% 効率 6% 効率の水準が次の介入層を分岐させる( chapter02 理論性能比) 実効 ≈ 20% → 実装上の工夫で改善余地あり (同じ介入層で詰められる) 実効 ≈ 80% → アルゴリズム変更や より高性能なHWへの移行が必要になり得る -
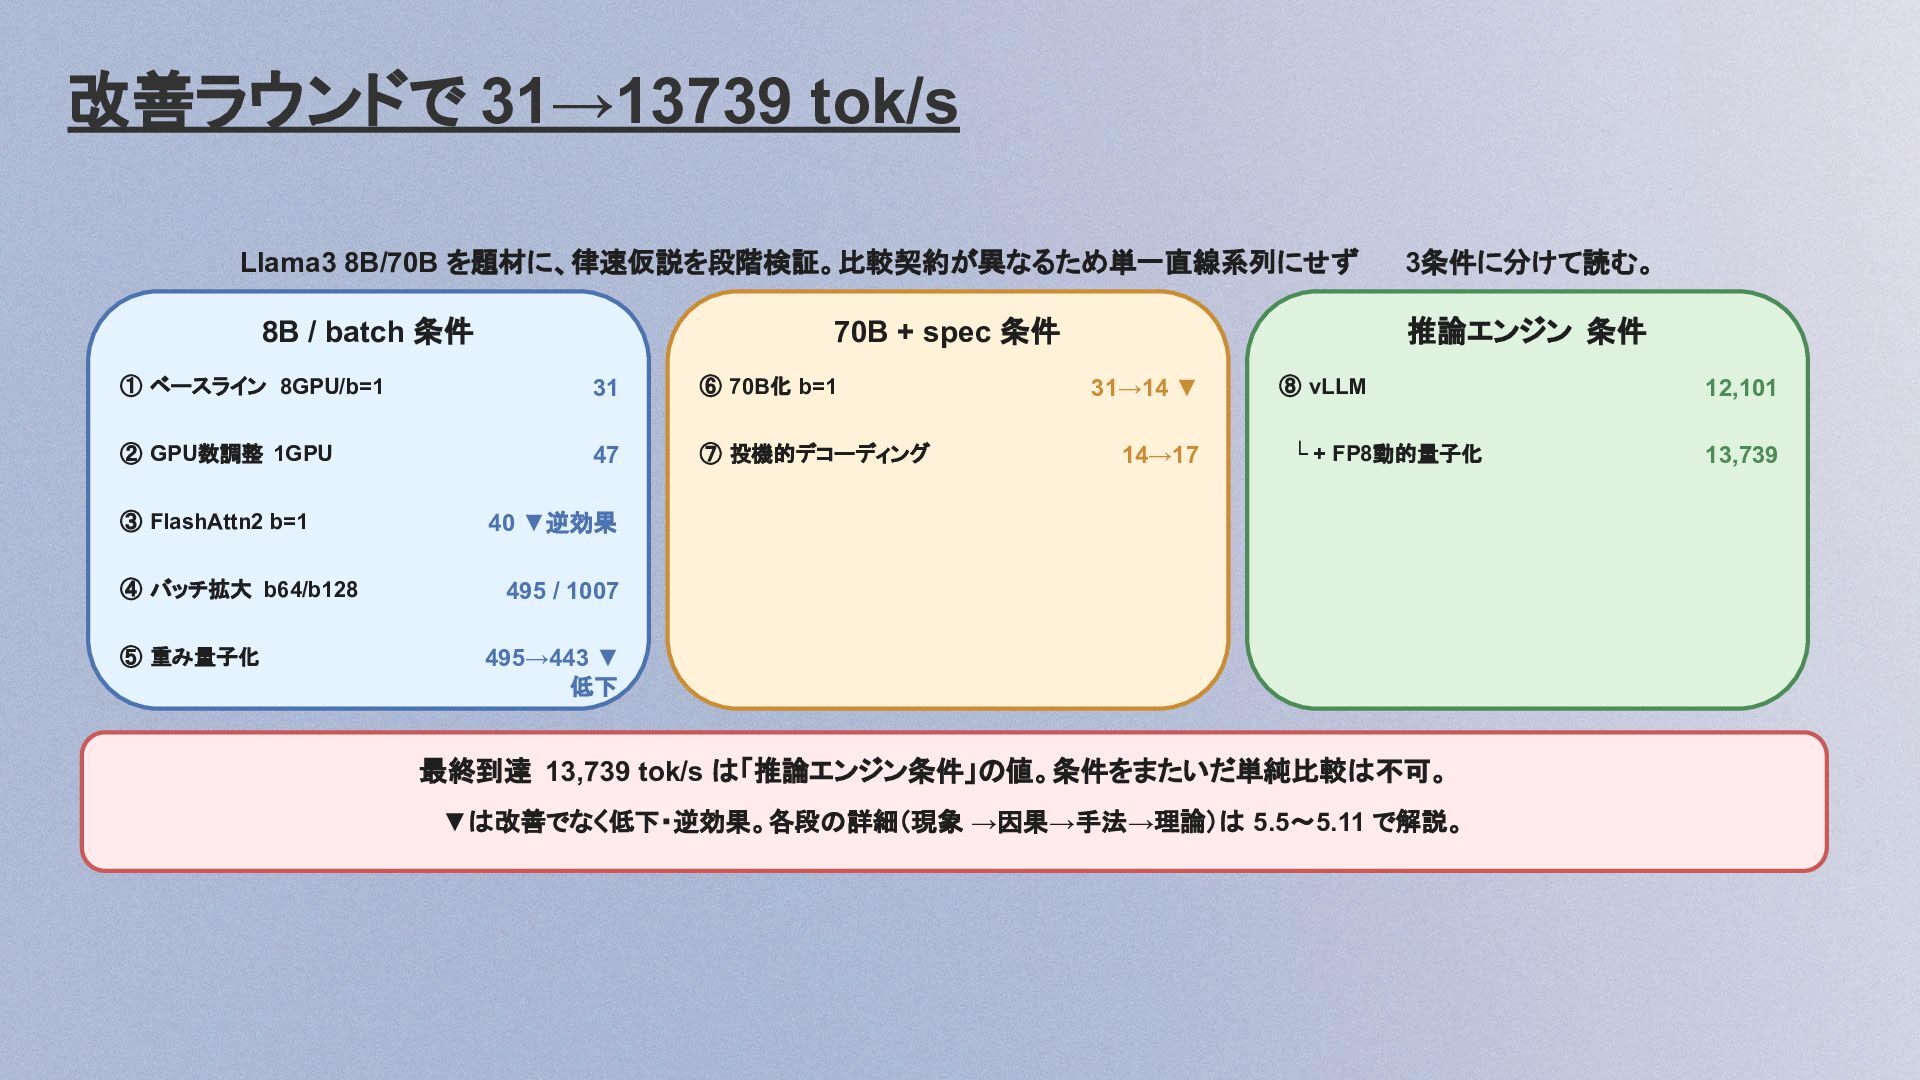
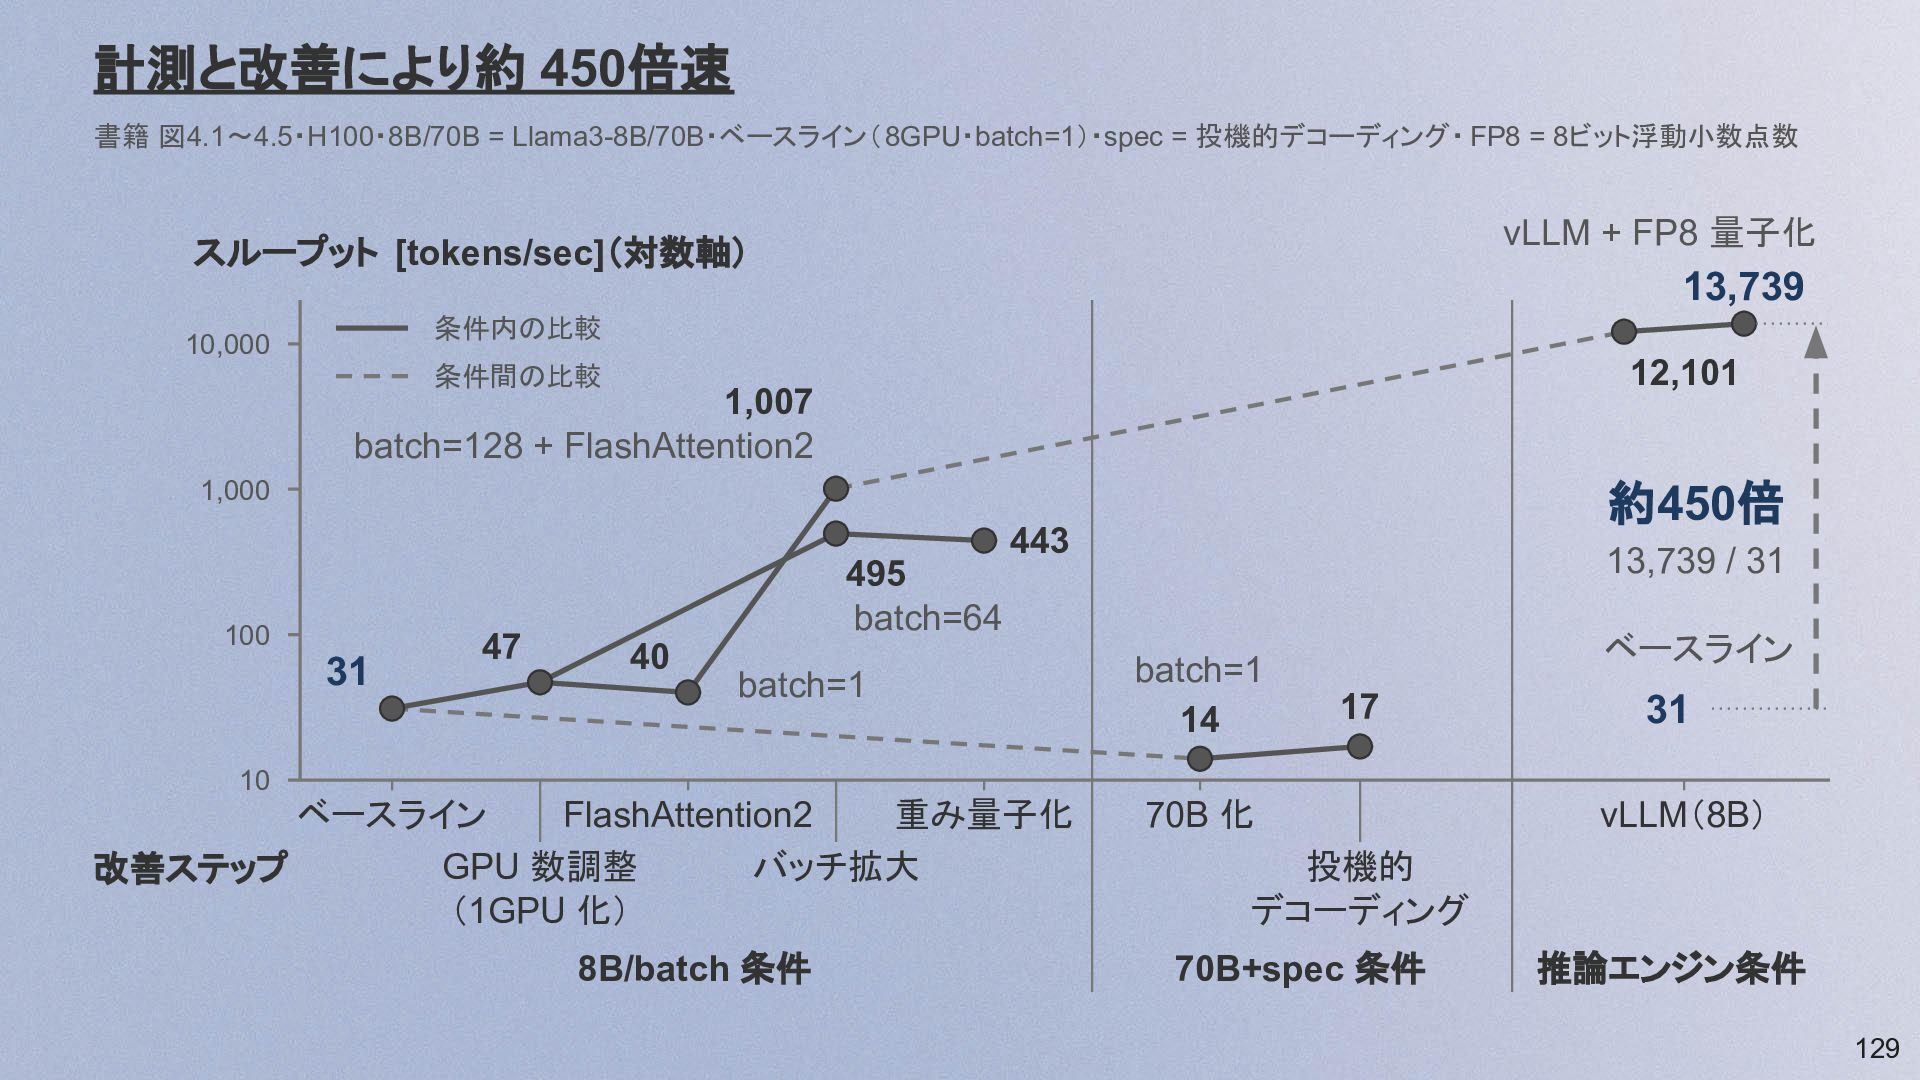
改善ラウンドで 31→13739 tok/s Llama3 8B/70B を題材に、律速仮説を段階検証。比較契約が異なるため単一直線系列にせず 8B / batch 条件
70B + spec 条件 ① ベースライン 8GPU/b=1 31 ⑥ 70B化 b=1 ② GPU数調整 1GPU 47 ⑦ 投機的デコーディング ③ FlashAttn2 b=1 ④ バッチ拡大 b64/b128 ⑤ 重み量子化 3条件に分けて読む。 推論エンジン 条件 31→14 ▼ 14→17 ⑧ vLLM 12,101 └ + FP8動的量子化 13,739 40 ▼逆効果 495 / 1007 495→443 ▼ 低下 最終到達 13,739 tok/s は「推論エンジン条件」の値。条件をまたいだ単純比較は不可。 ▼は改善でなく低下・逆効果。各段の詳細(現象 →因果→手法→理論)は 5.5〜5.11 で解説。 -
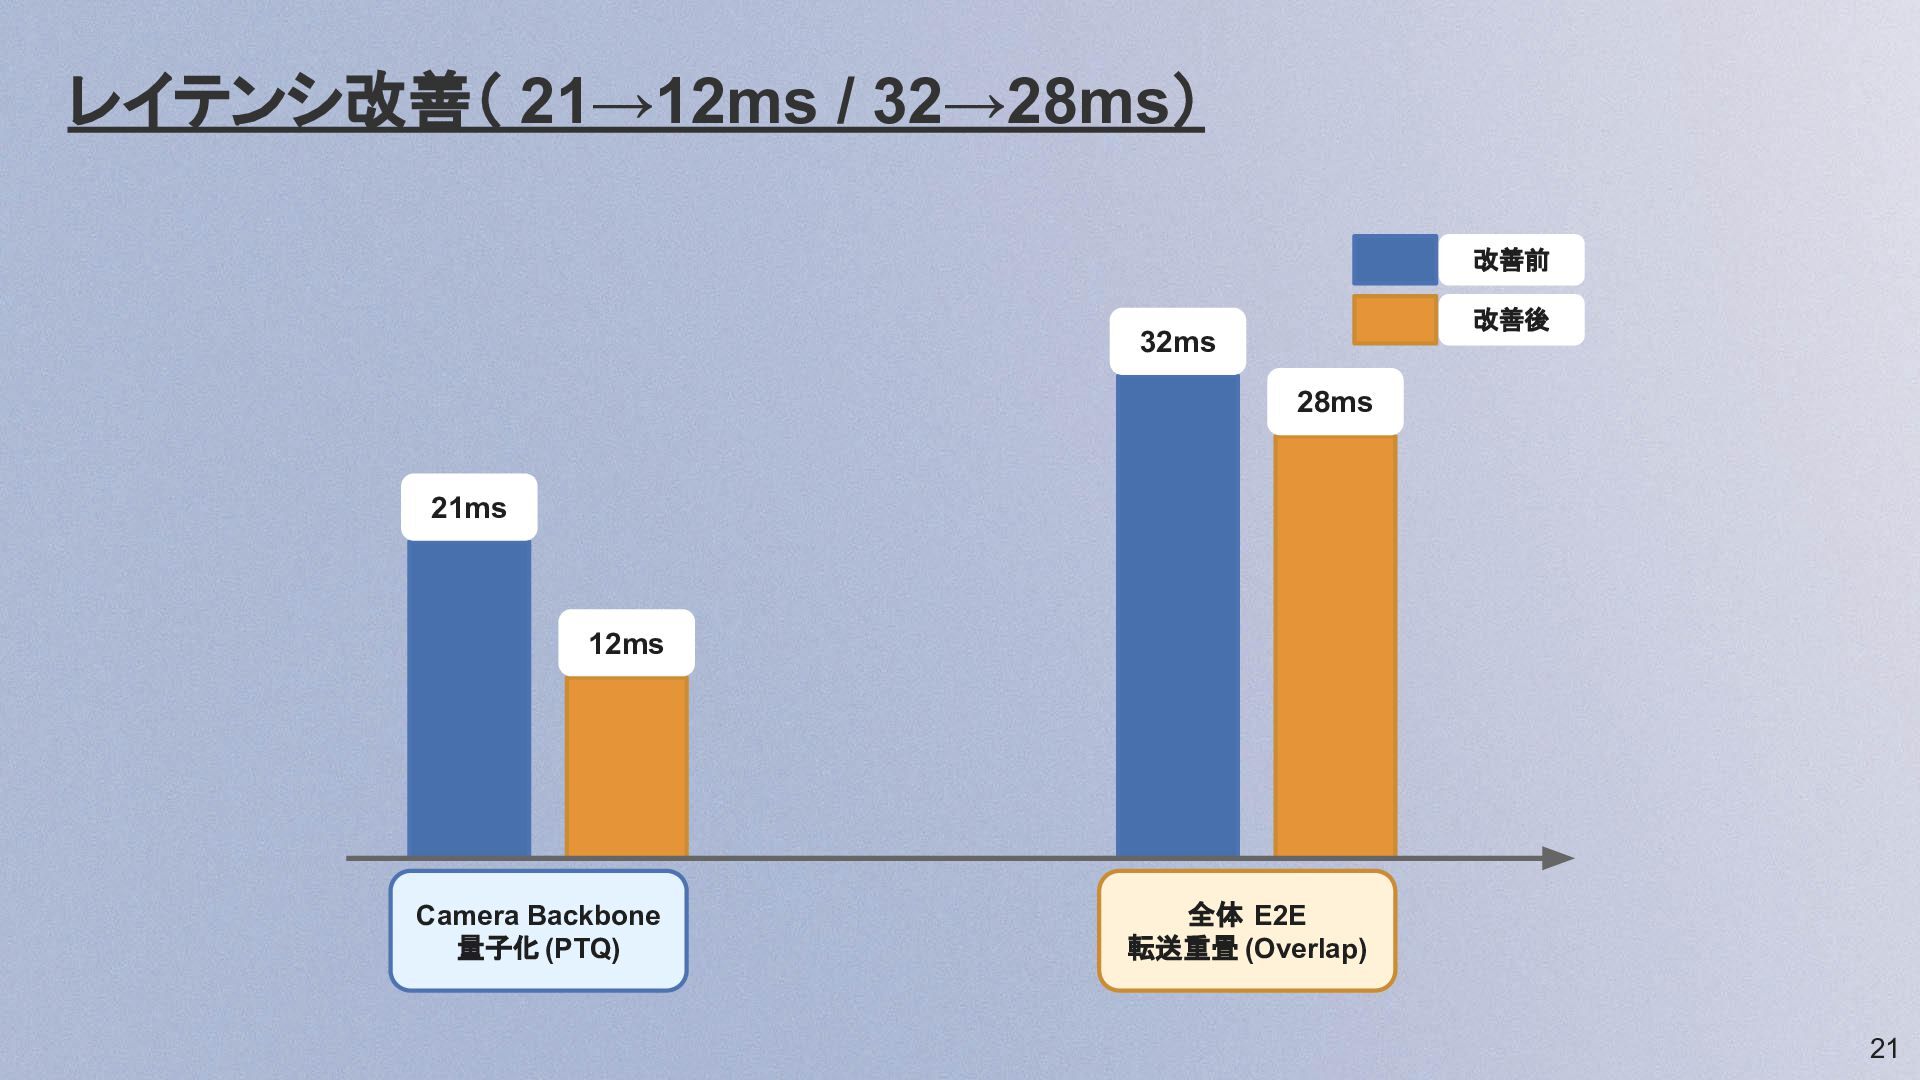
レイテンシ改善( 21→12ms / 32→28ms) 改善前 改善後 32ms 28ms 21ms 12ms
Camera Backbone 量子化 (PTQ) 全体 E2E 転送重畳 (Overlap) 21 -
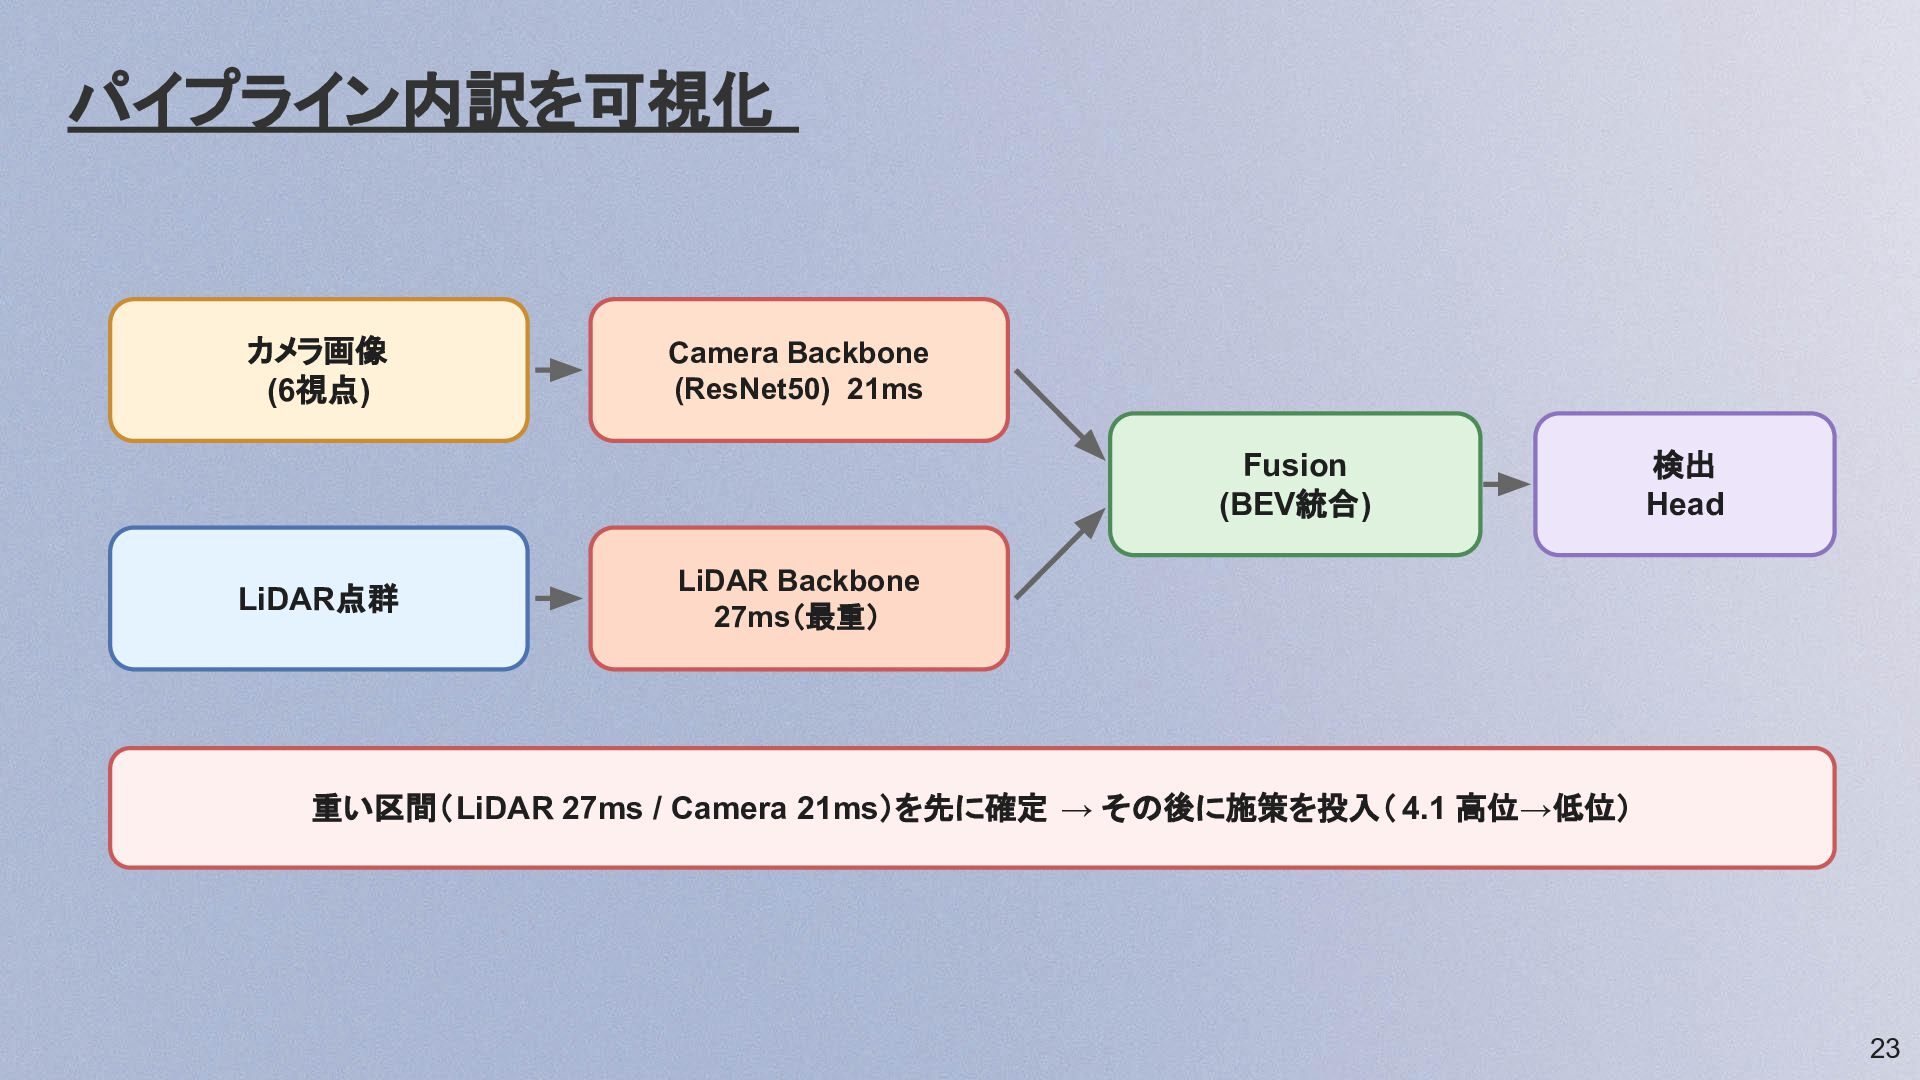
パイプライン内訳を可視化 カメラ画像 (6視点) Camera Backbone (ResNet50) 21ms Fusion (BEV統合) LiDAR点群
検出 Head LiDAR Backbone 27ms(最重) 重い区間(LiDAR 27ms / Camera 21ms)を先に確定 → その後に施策を投入( 4.1 高位→低位) 23 -
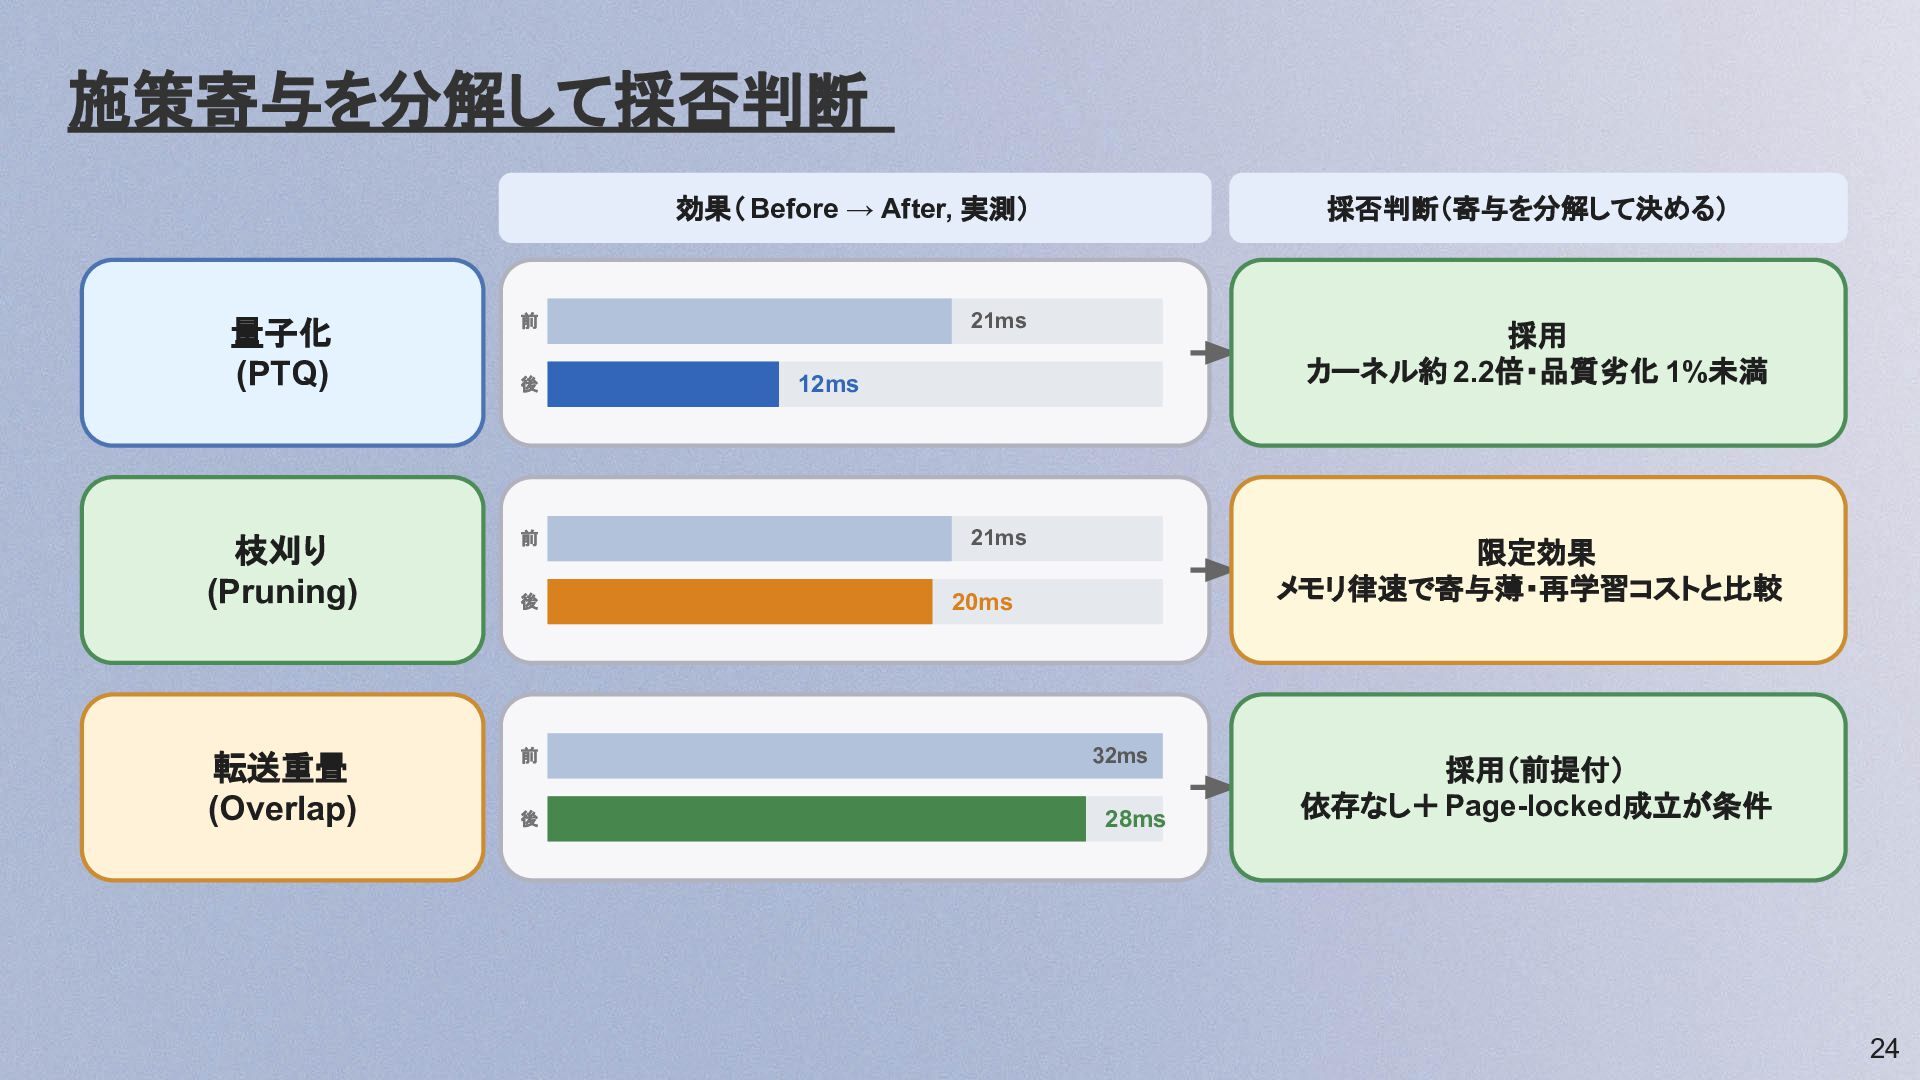
施策寄与を分解して採否判断 効果( Before → After, 実測) 量子化 (PTQ) 前 枝刈り
(Pruning) 前 転送重畳 (Overlap) 前 後 後 後 採否判断(寄与を分解して決める) 21ms 採用 カーネル約 2.2倍・品質劣化 1%未満 21ms 限定効果 メモリ律速で寄与薄・再学習コストと比較 12ms 20ms 32ms 28ms 採用(前提付) 依存なし+ Page-locked成立が条件 24 -
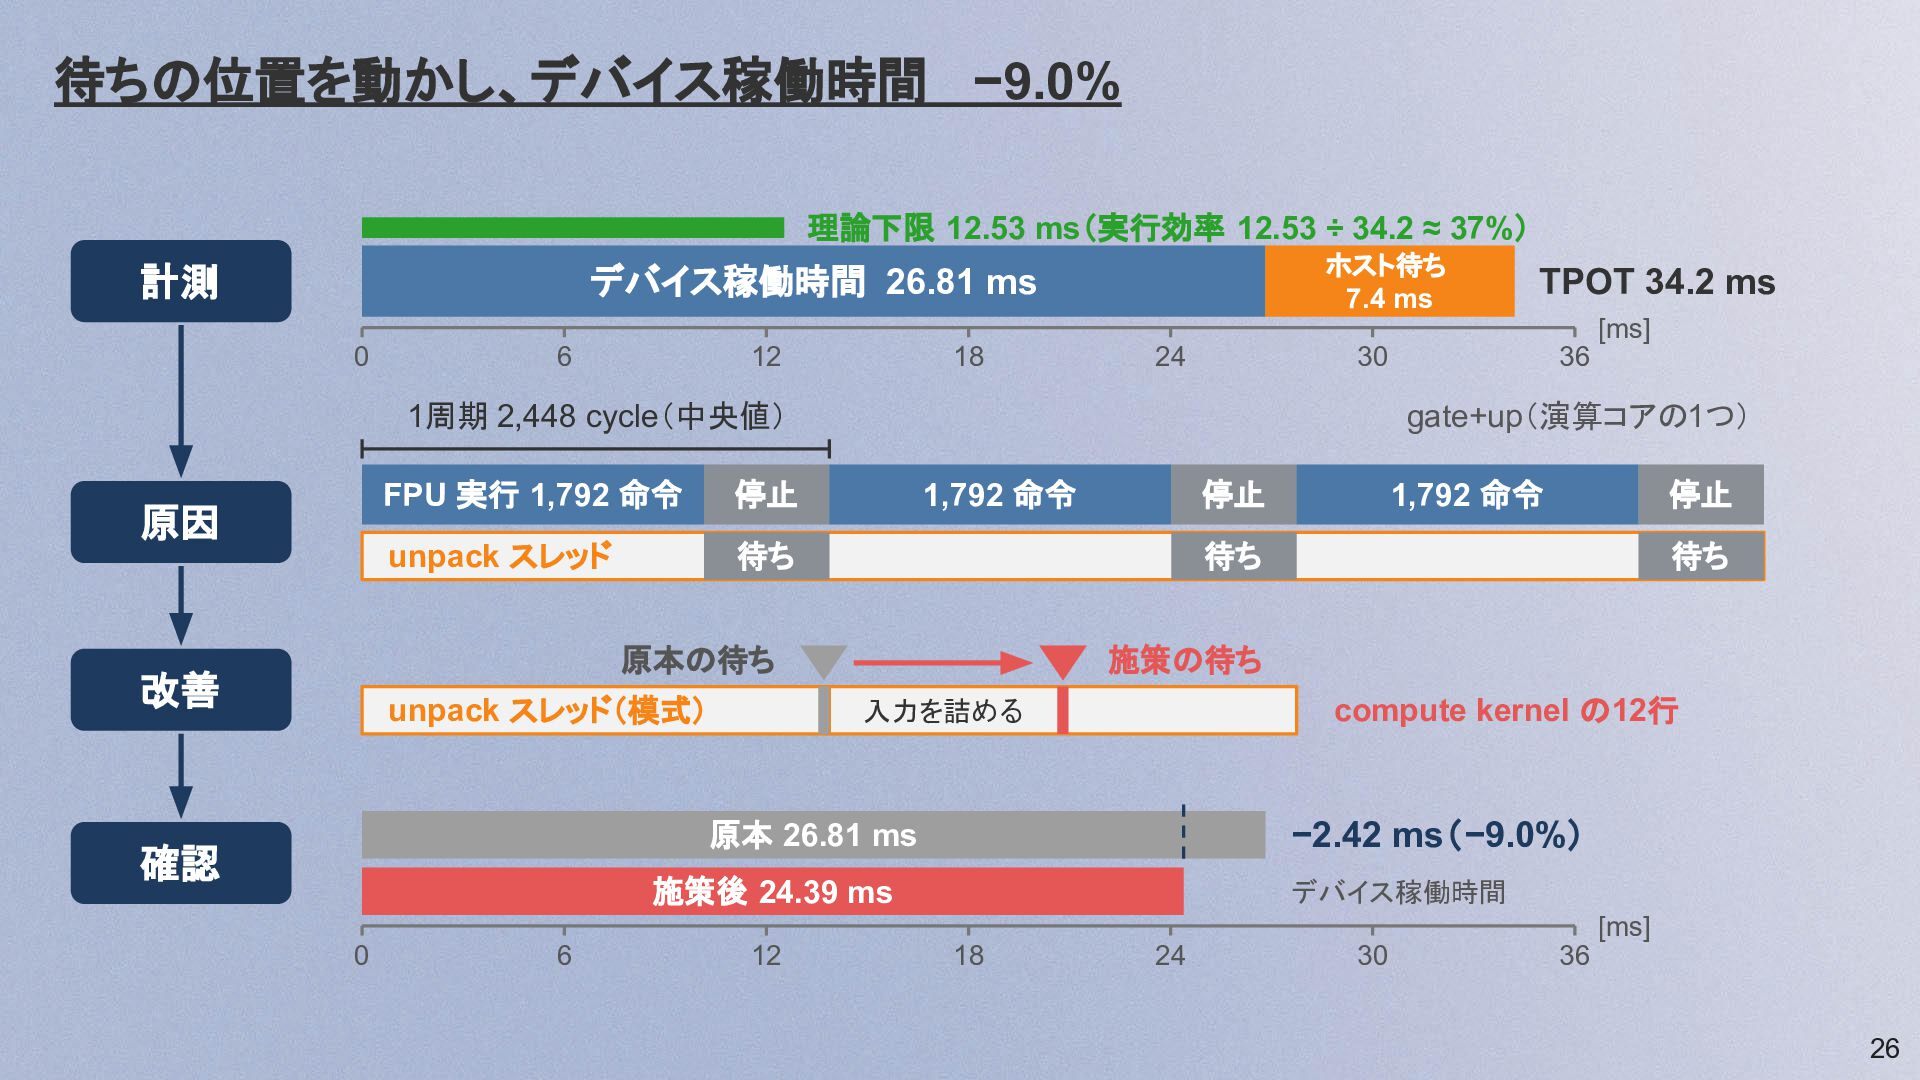
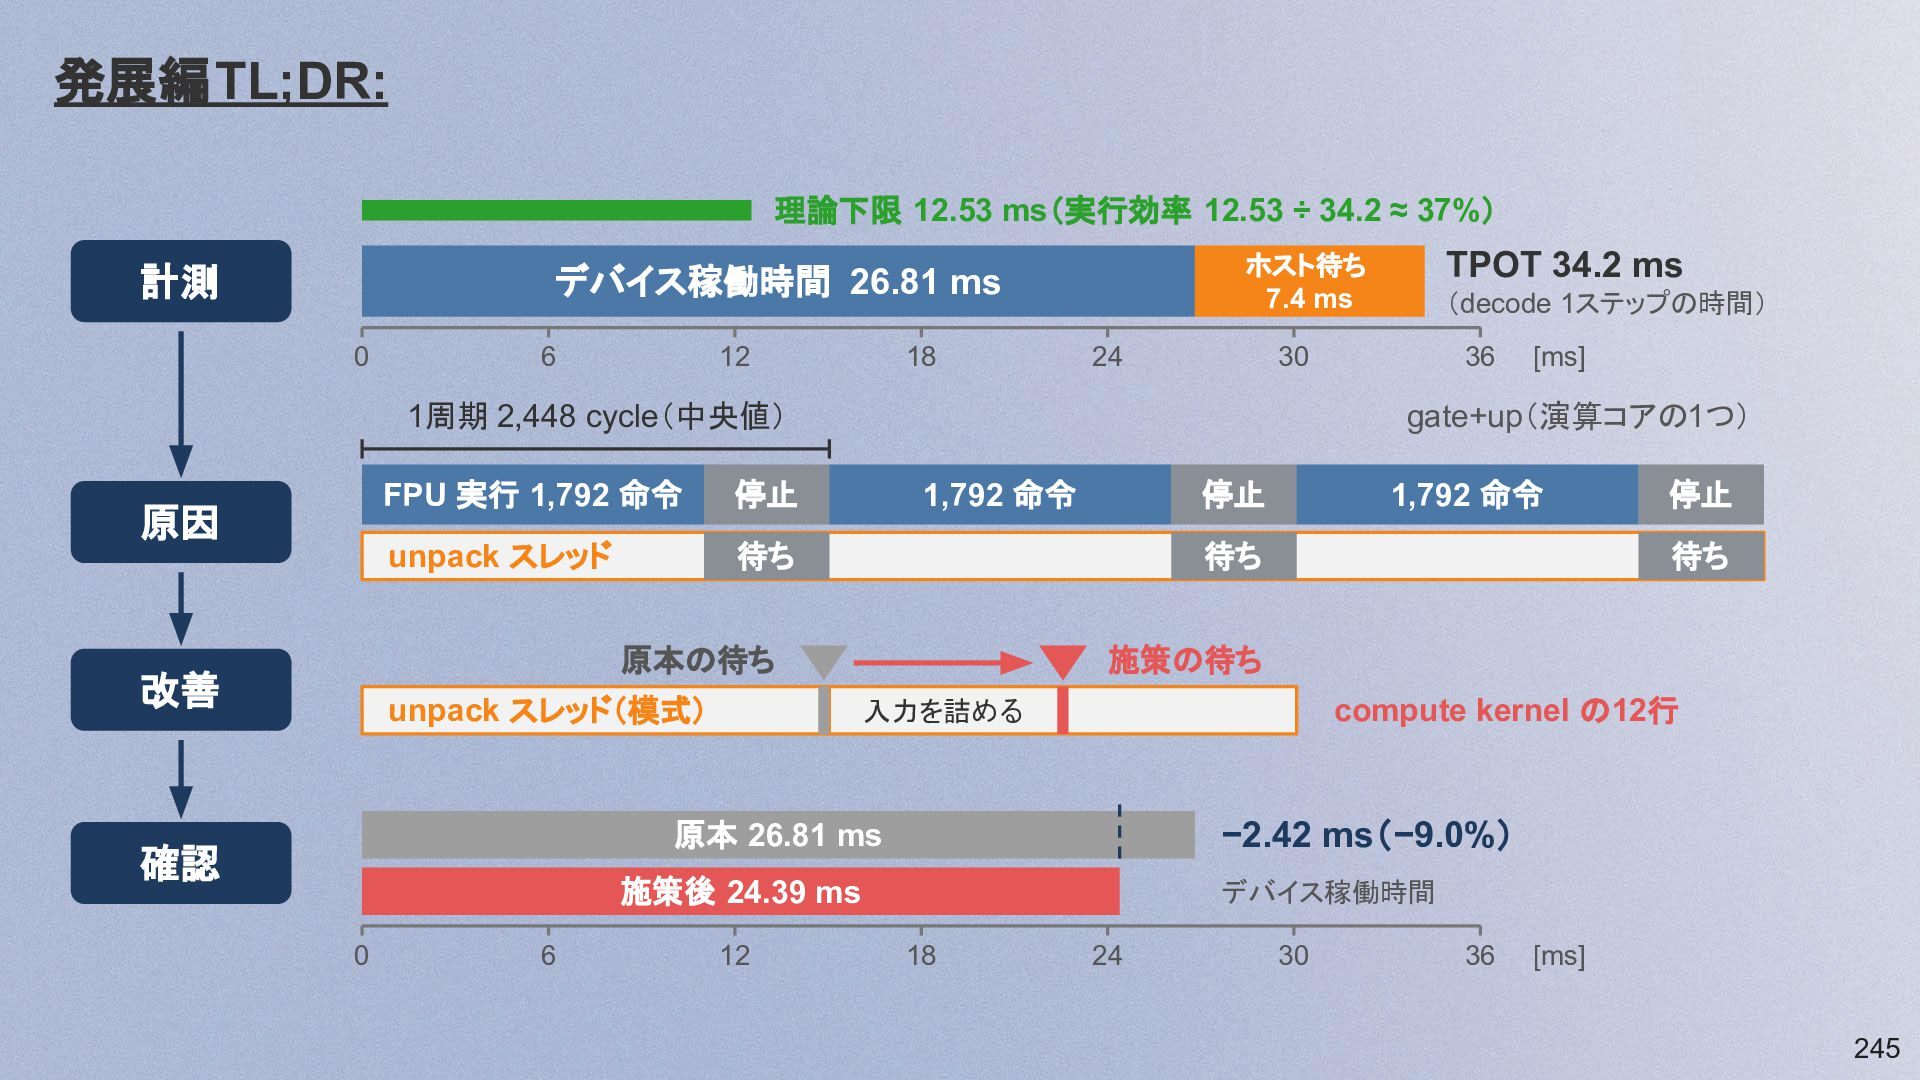
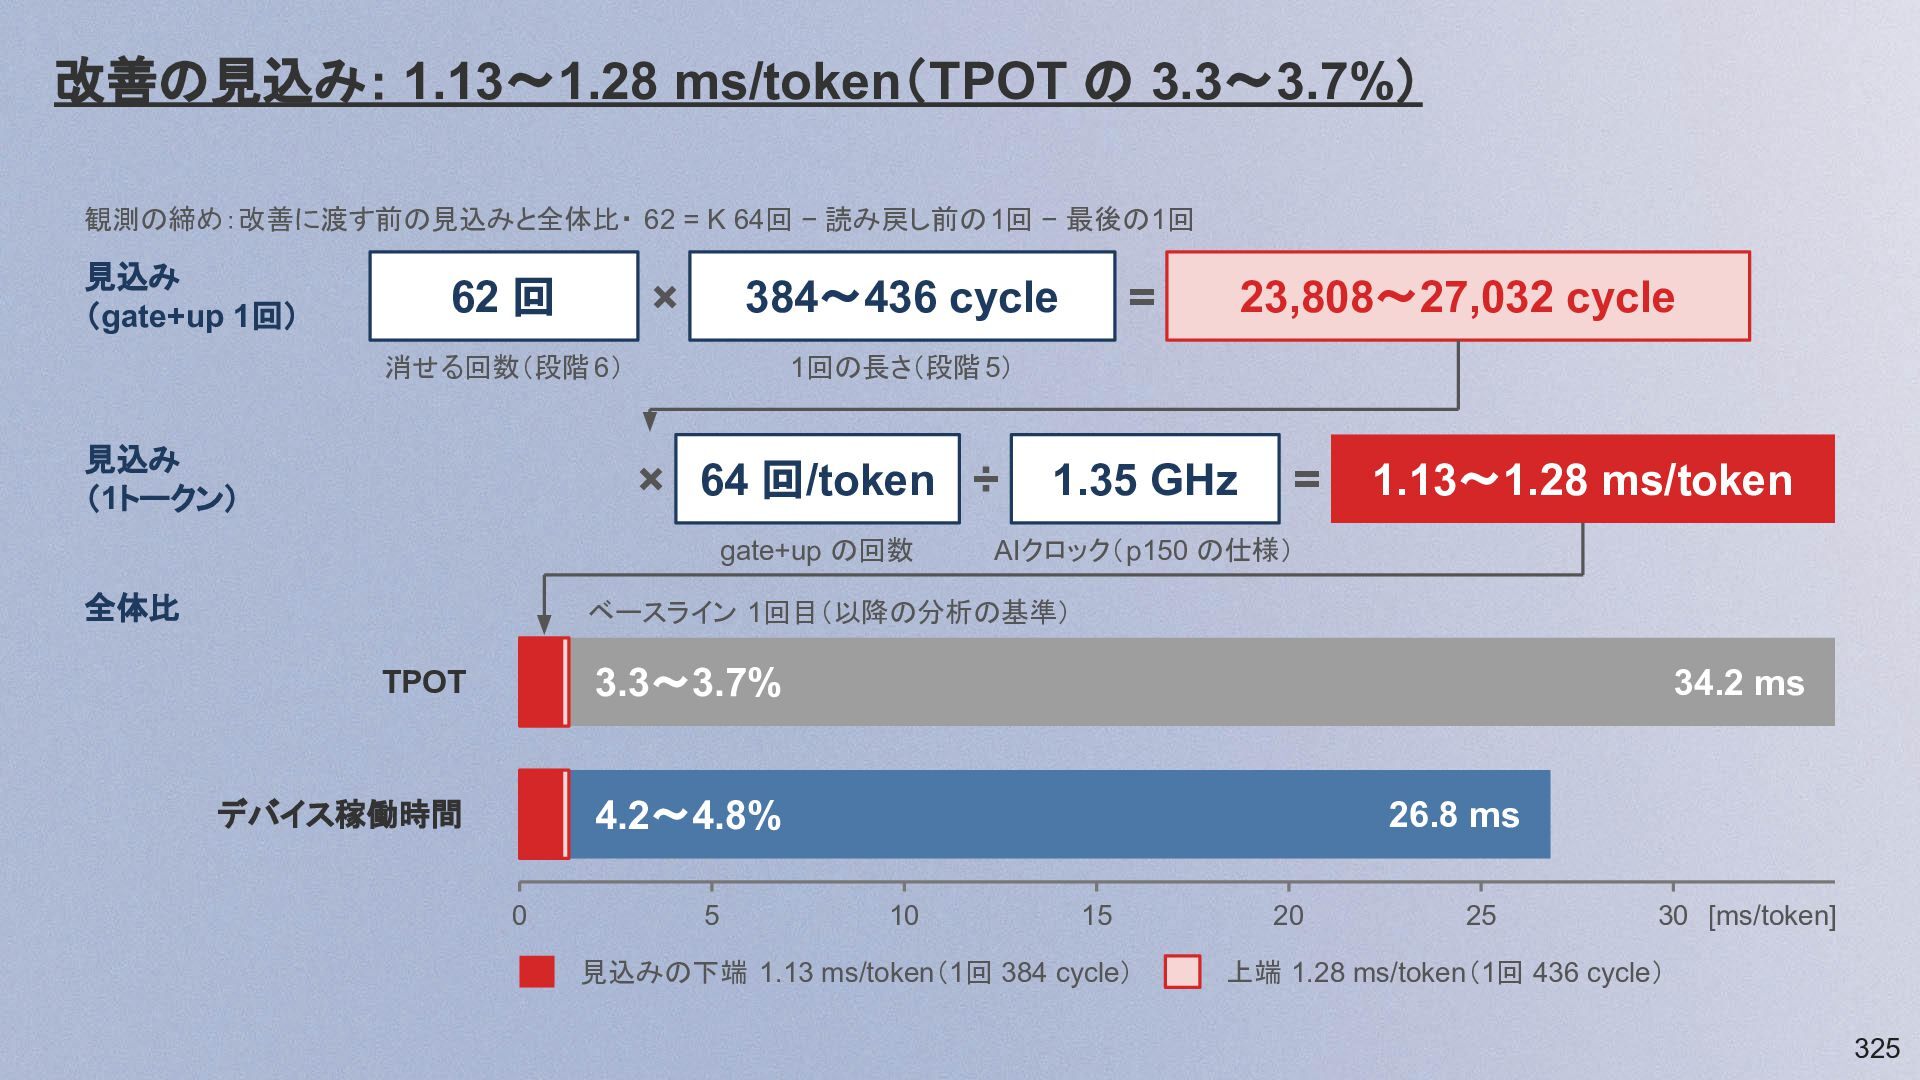
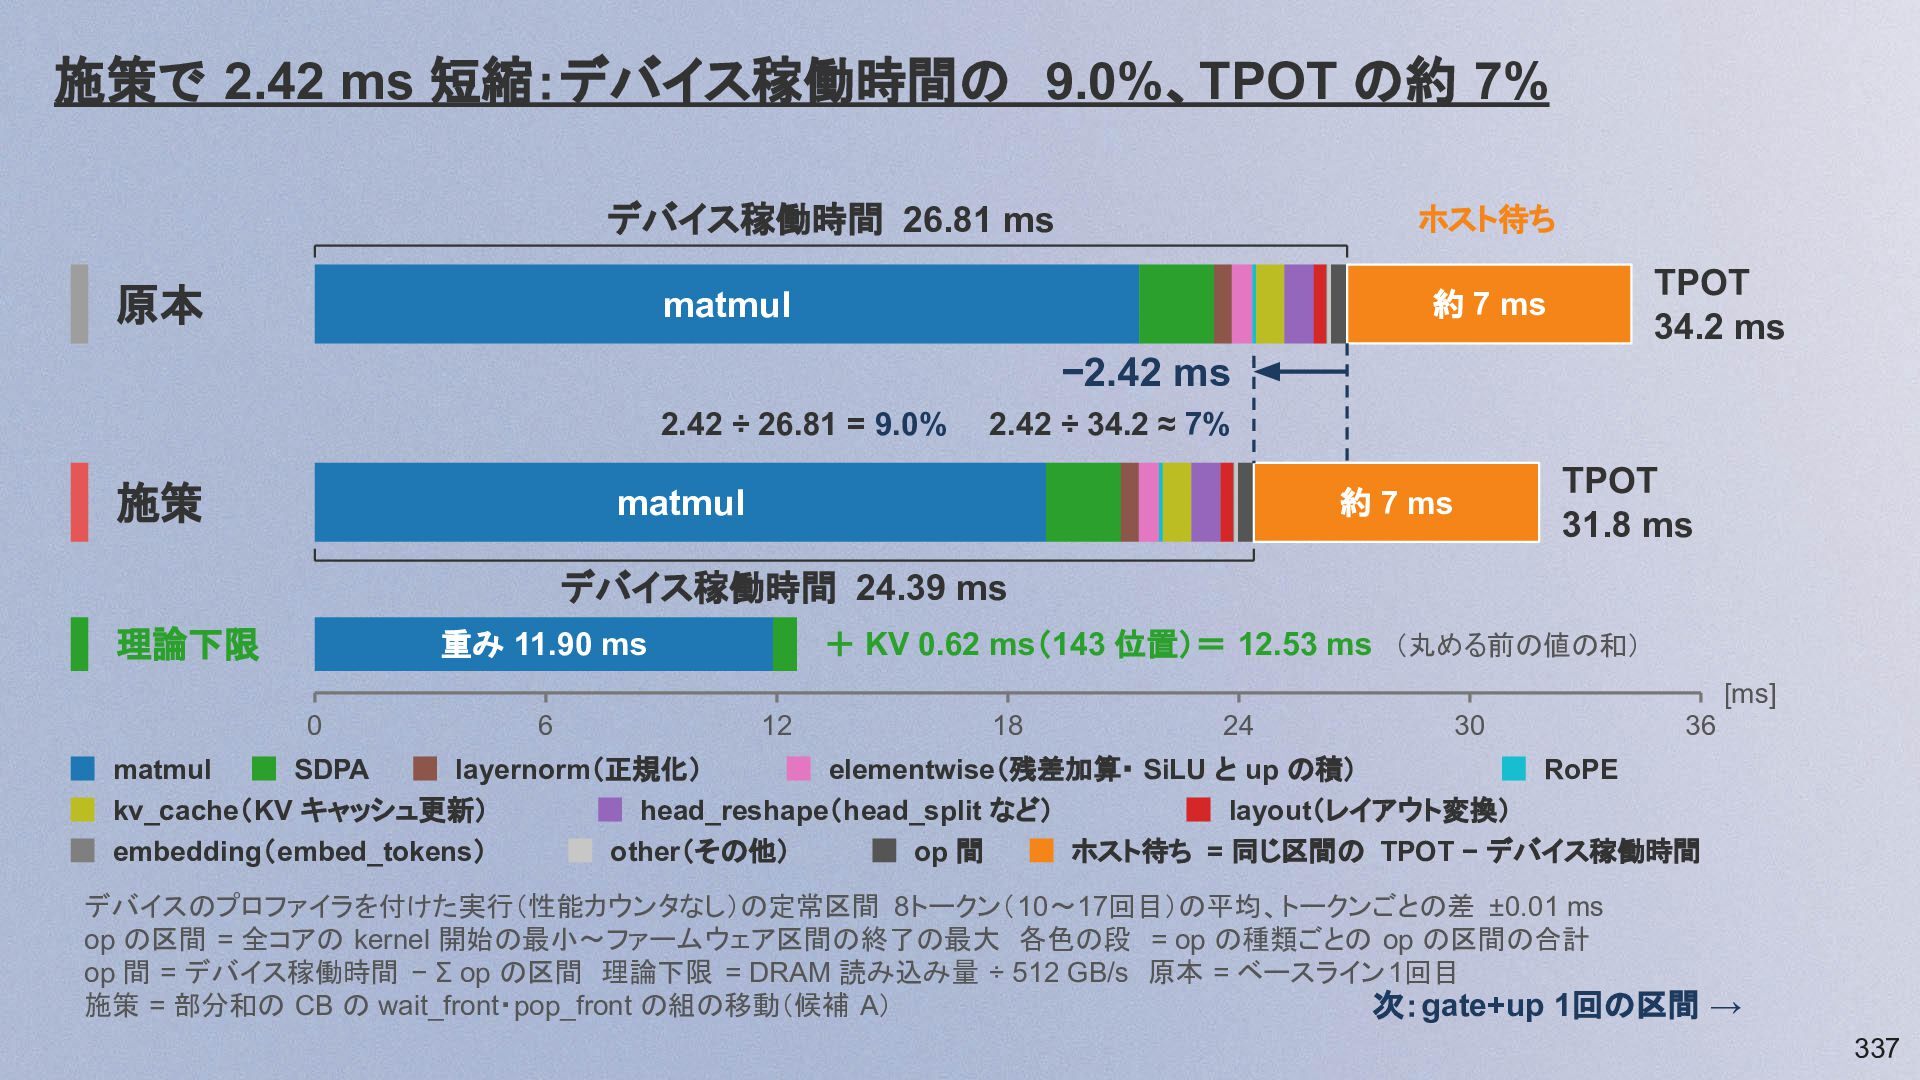
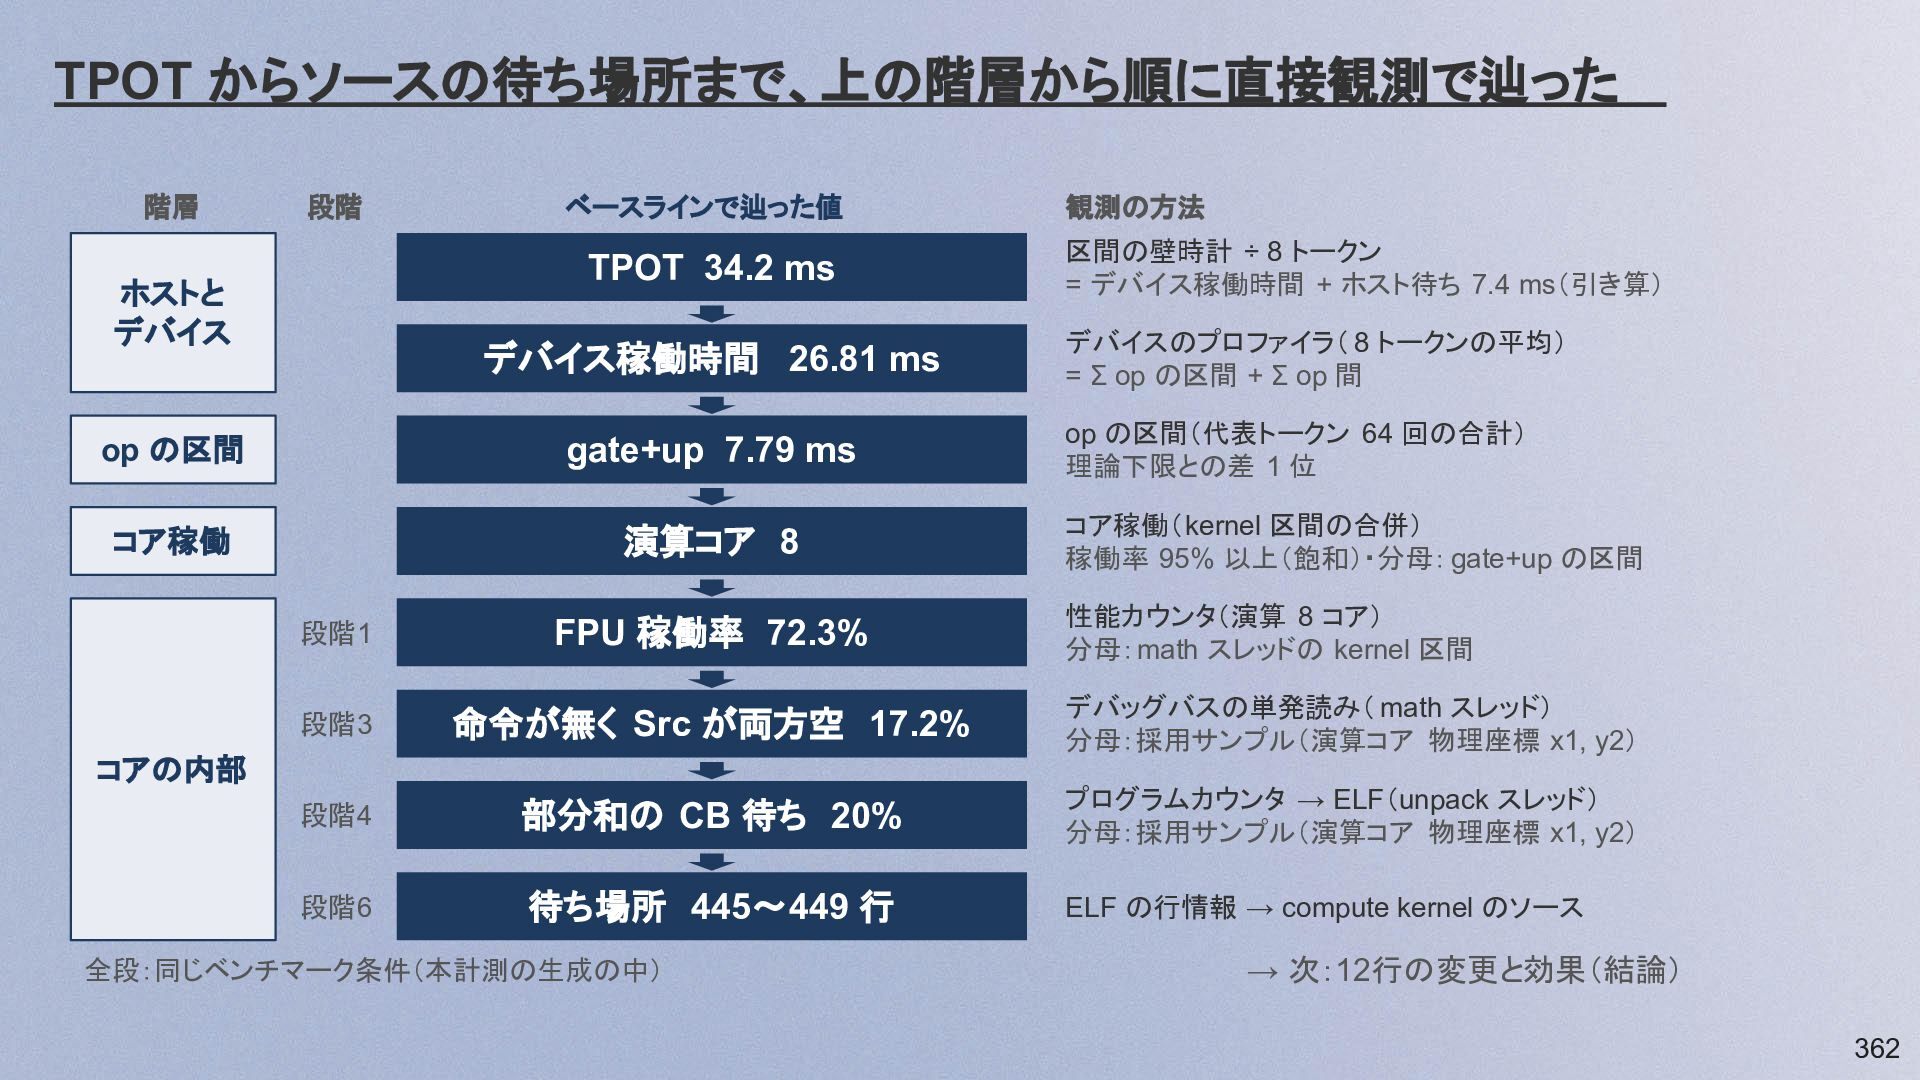
待ちの位置を動かし、デバイス稼働時間 −9.0% 理論下限 12.53 ms(実行効率 12.53 ÷ 34.2 ≈ 37%)
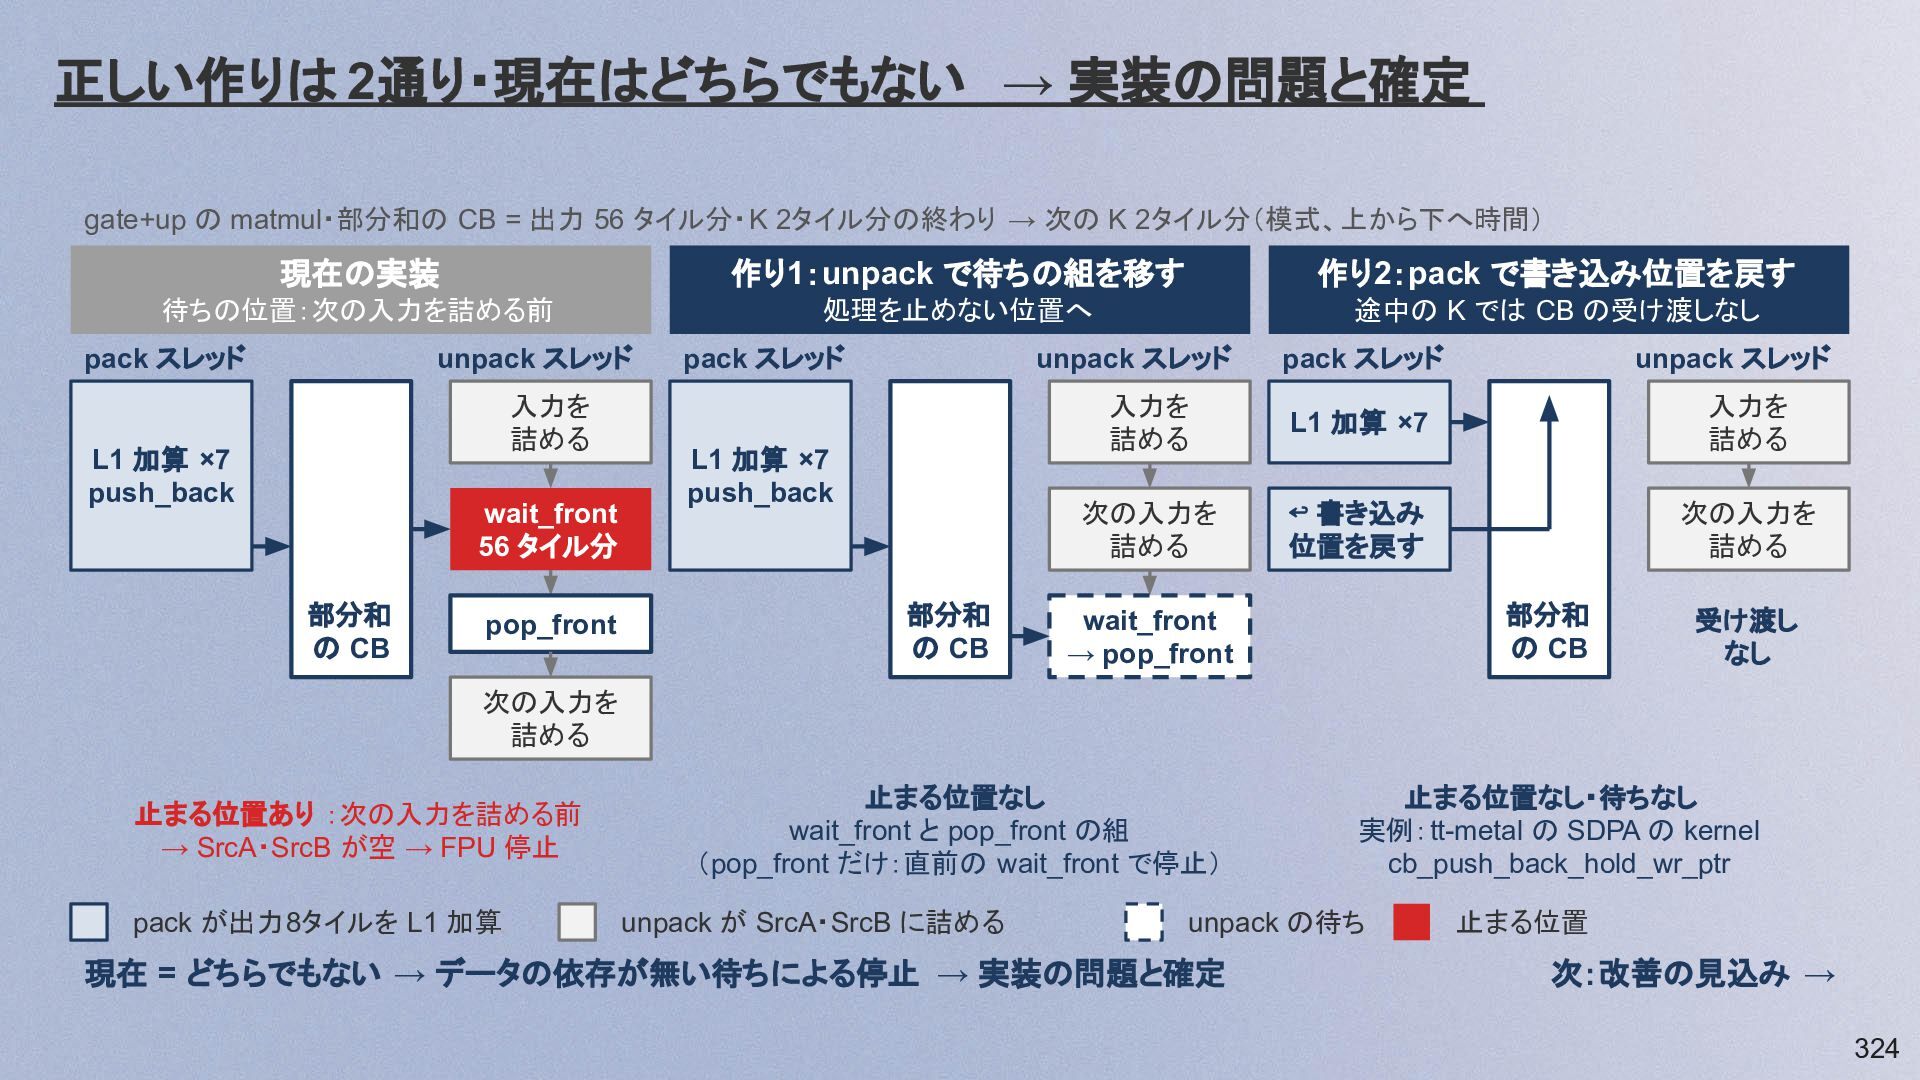
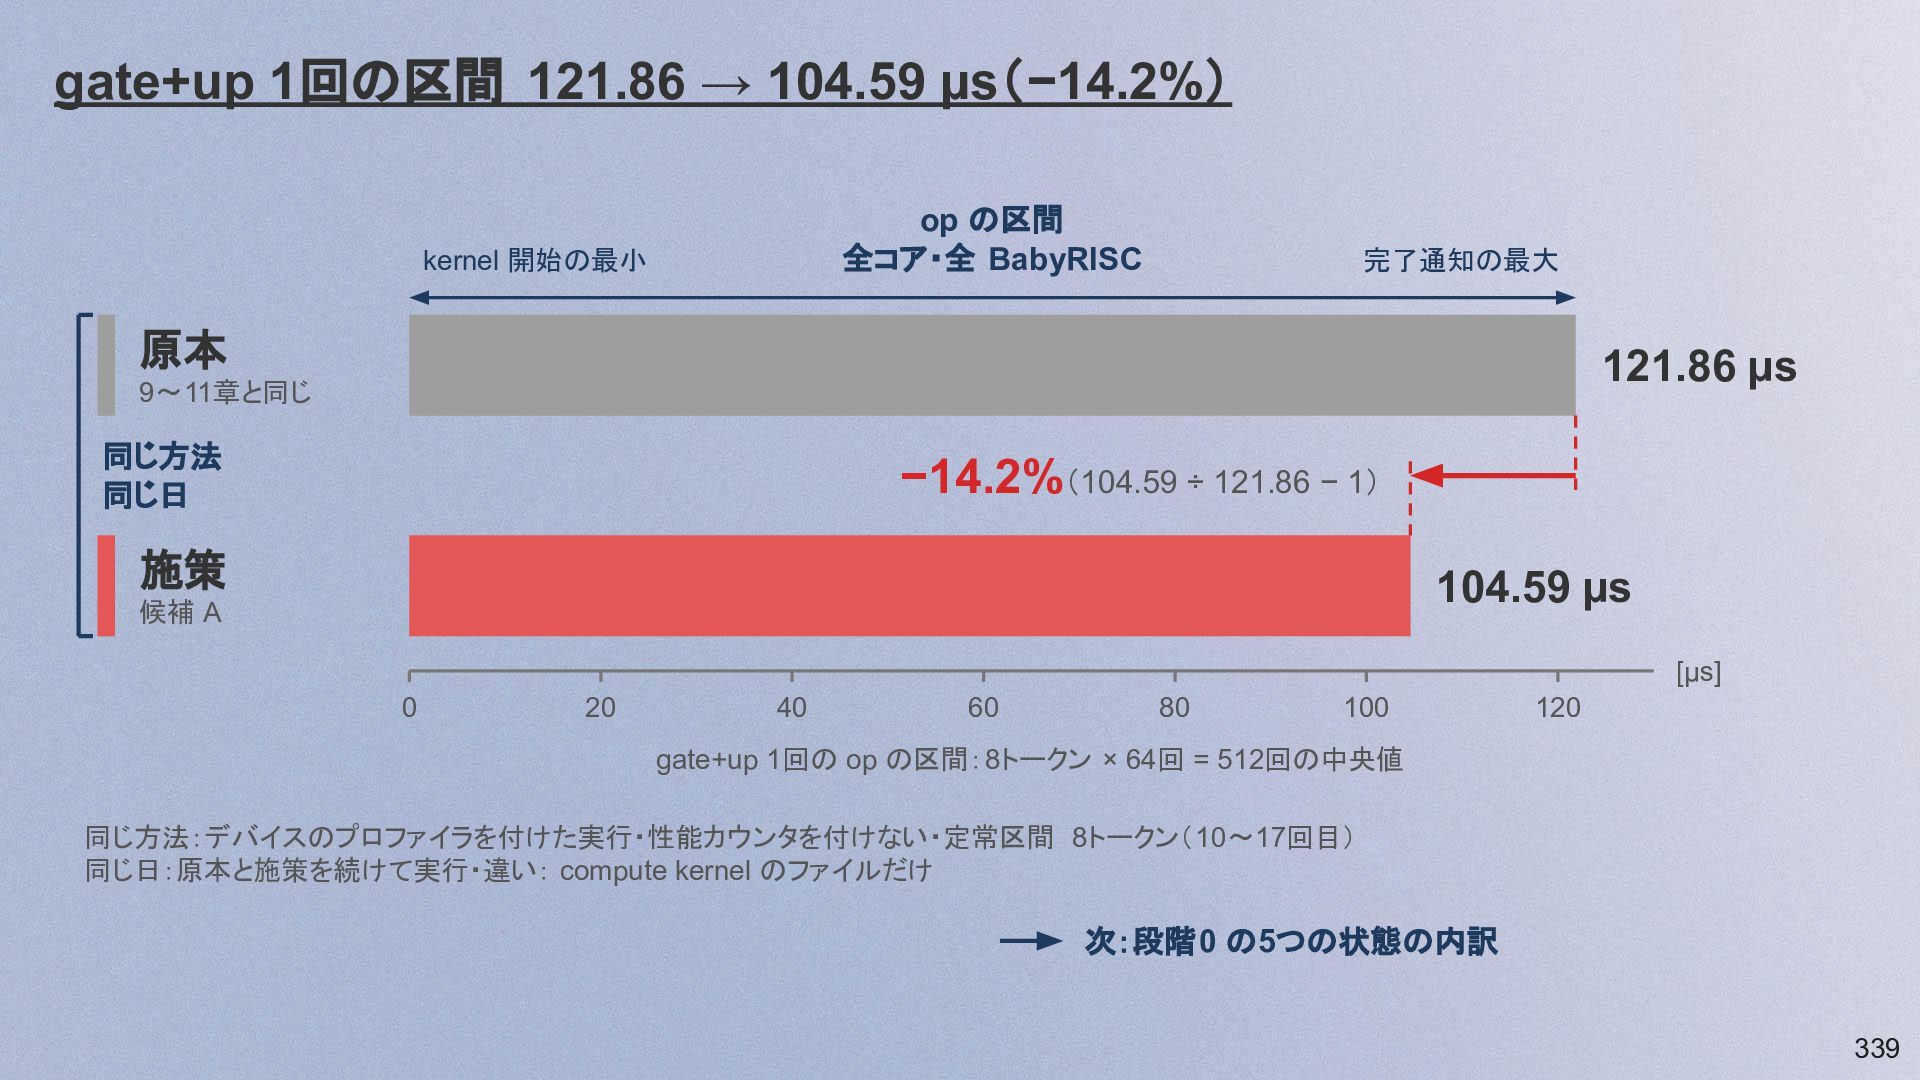
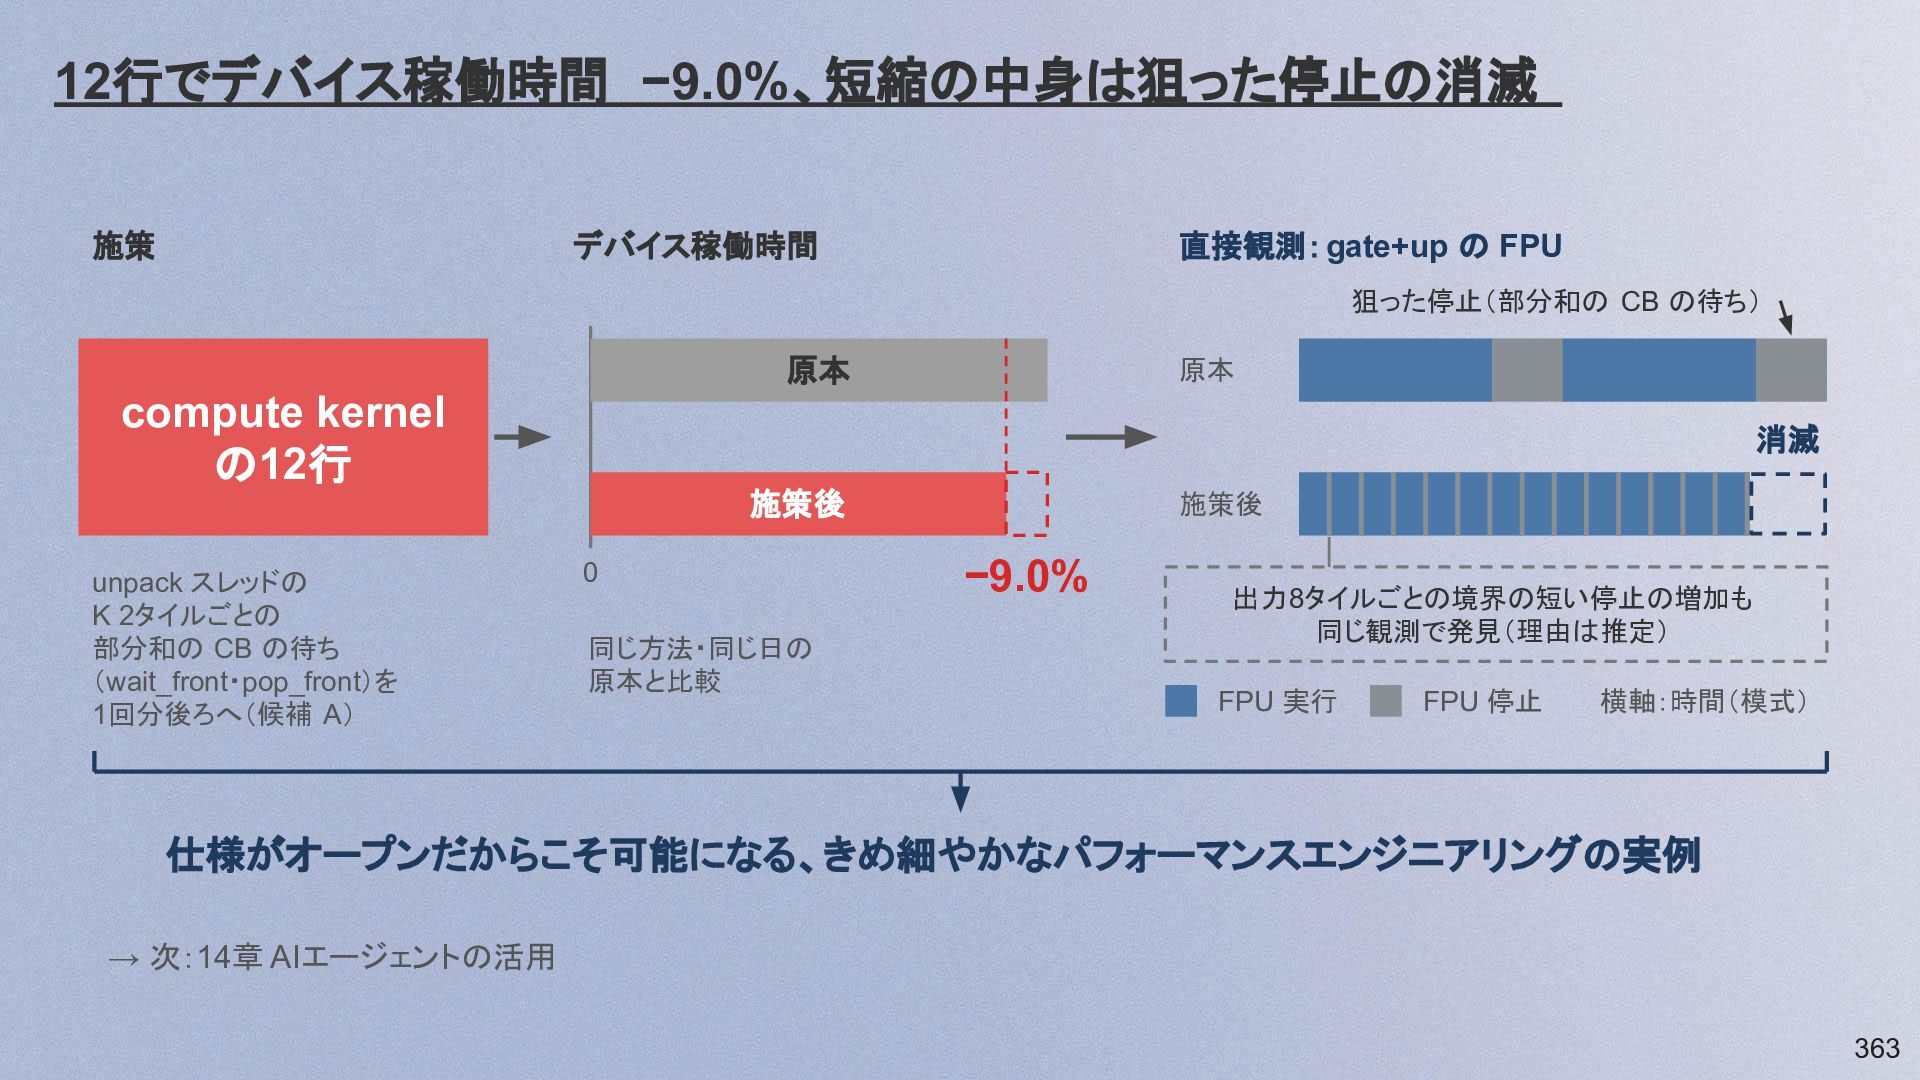
計測 ホスト待ち 7.4 ms デバイス稼働時間 26.81 ms TPOT 34.2 ms [ms] 0 6 12 18 24 30 1周期 2,448 cycle(中央値) 原因 改善 gate+up(演算コアの1つ) FPU 実行 1,792 命令 停止 unpack スレッド 待ち 待ち 原本の待ち 施策の待ち unpack スレッド(模式) 1,792 命令 停止 1,792 命令 停止 待ち compute kernel の12行 入力を詰める 原本 26.81 ms 確認 36 −2.42 ms(−9.0%) 施策後 24.39 ms デバイス稼働時間 [ms] 0 6 12 18 24 30 36 26 -
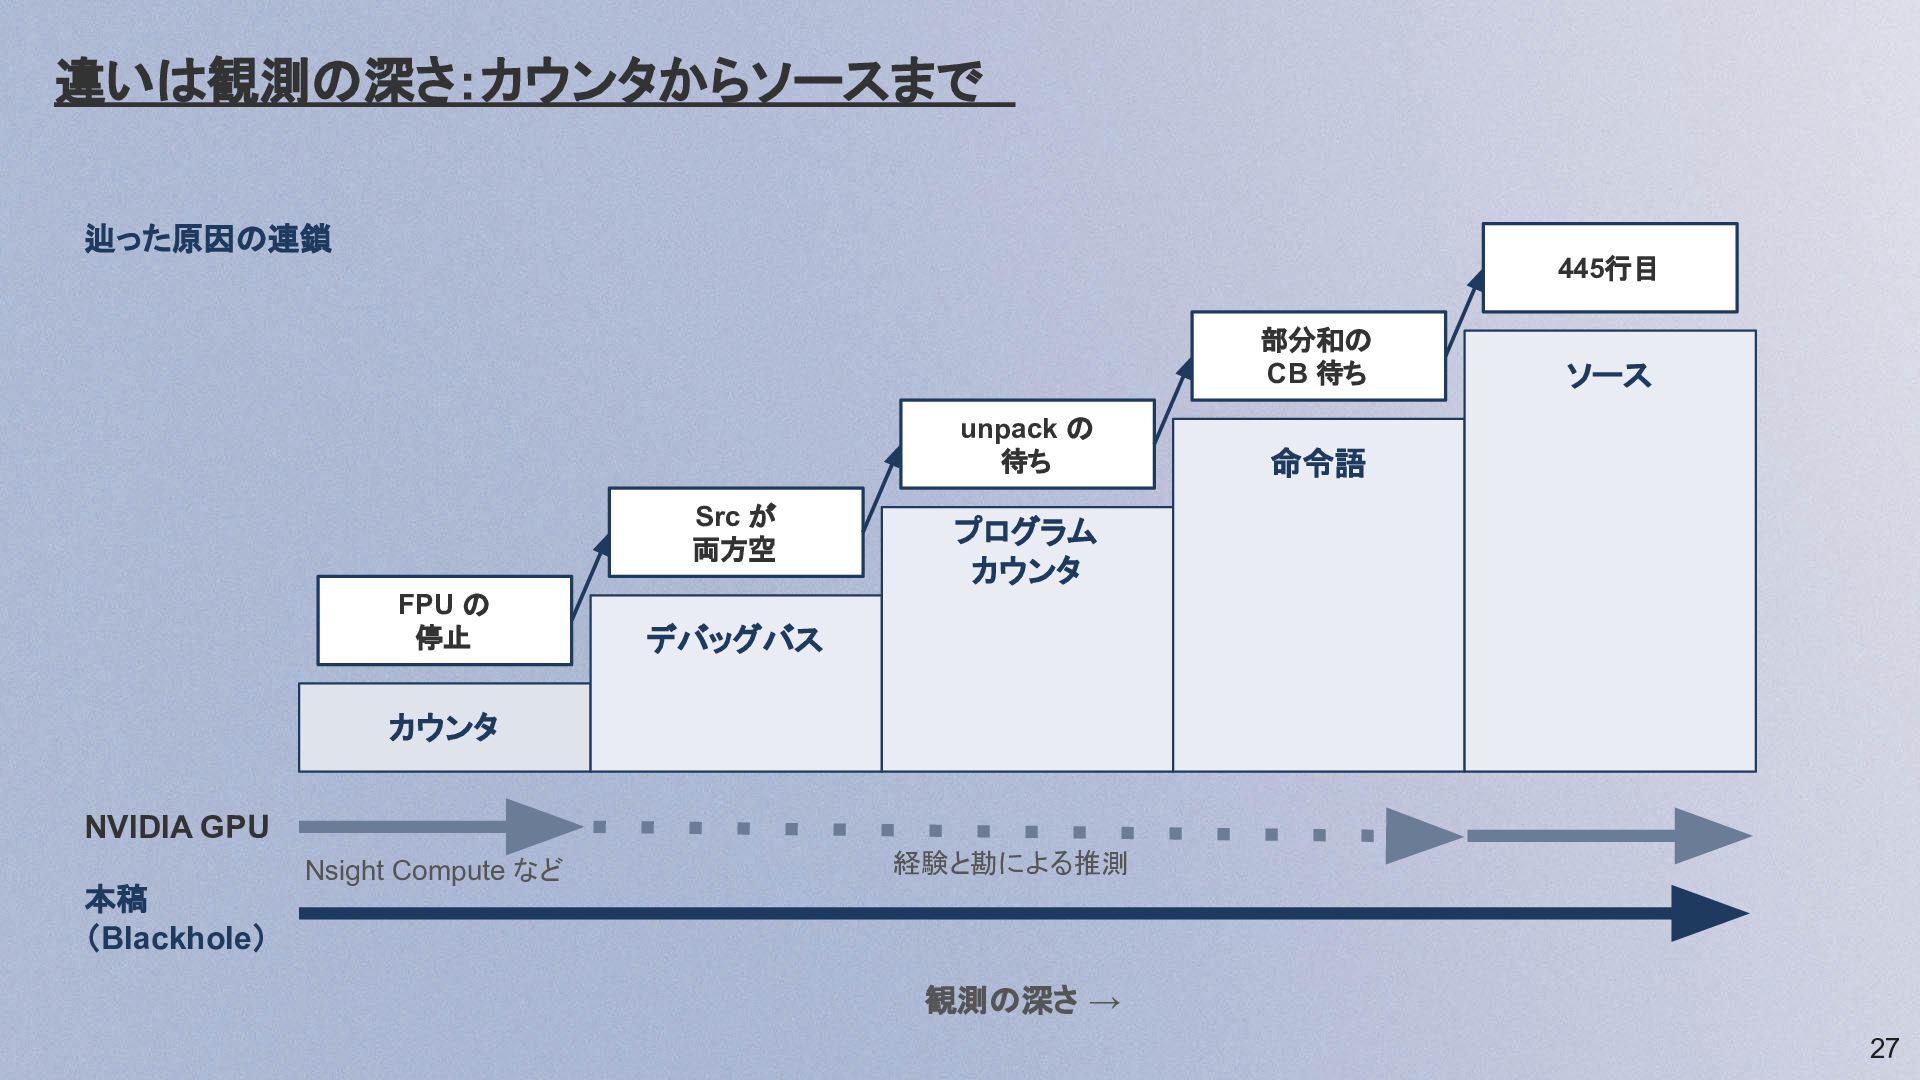
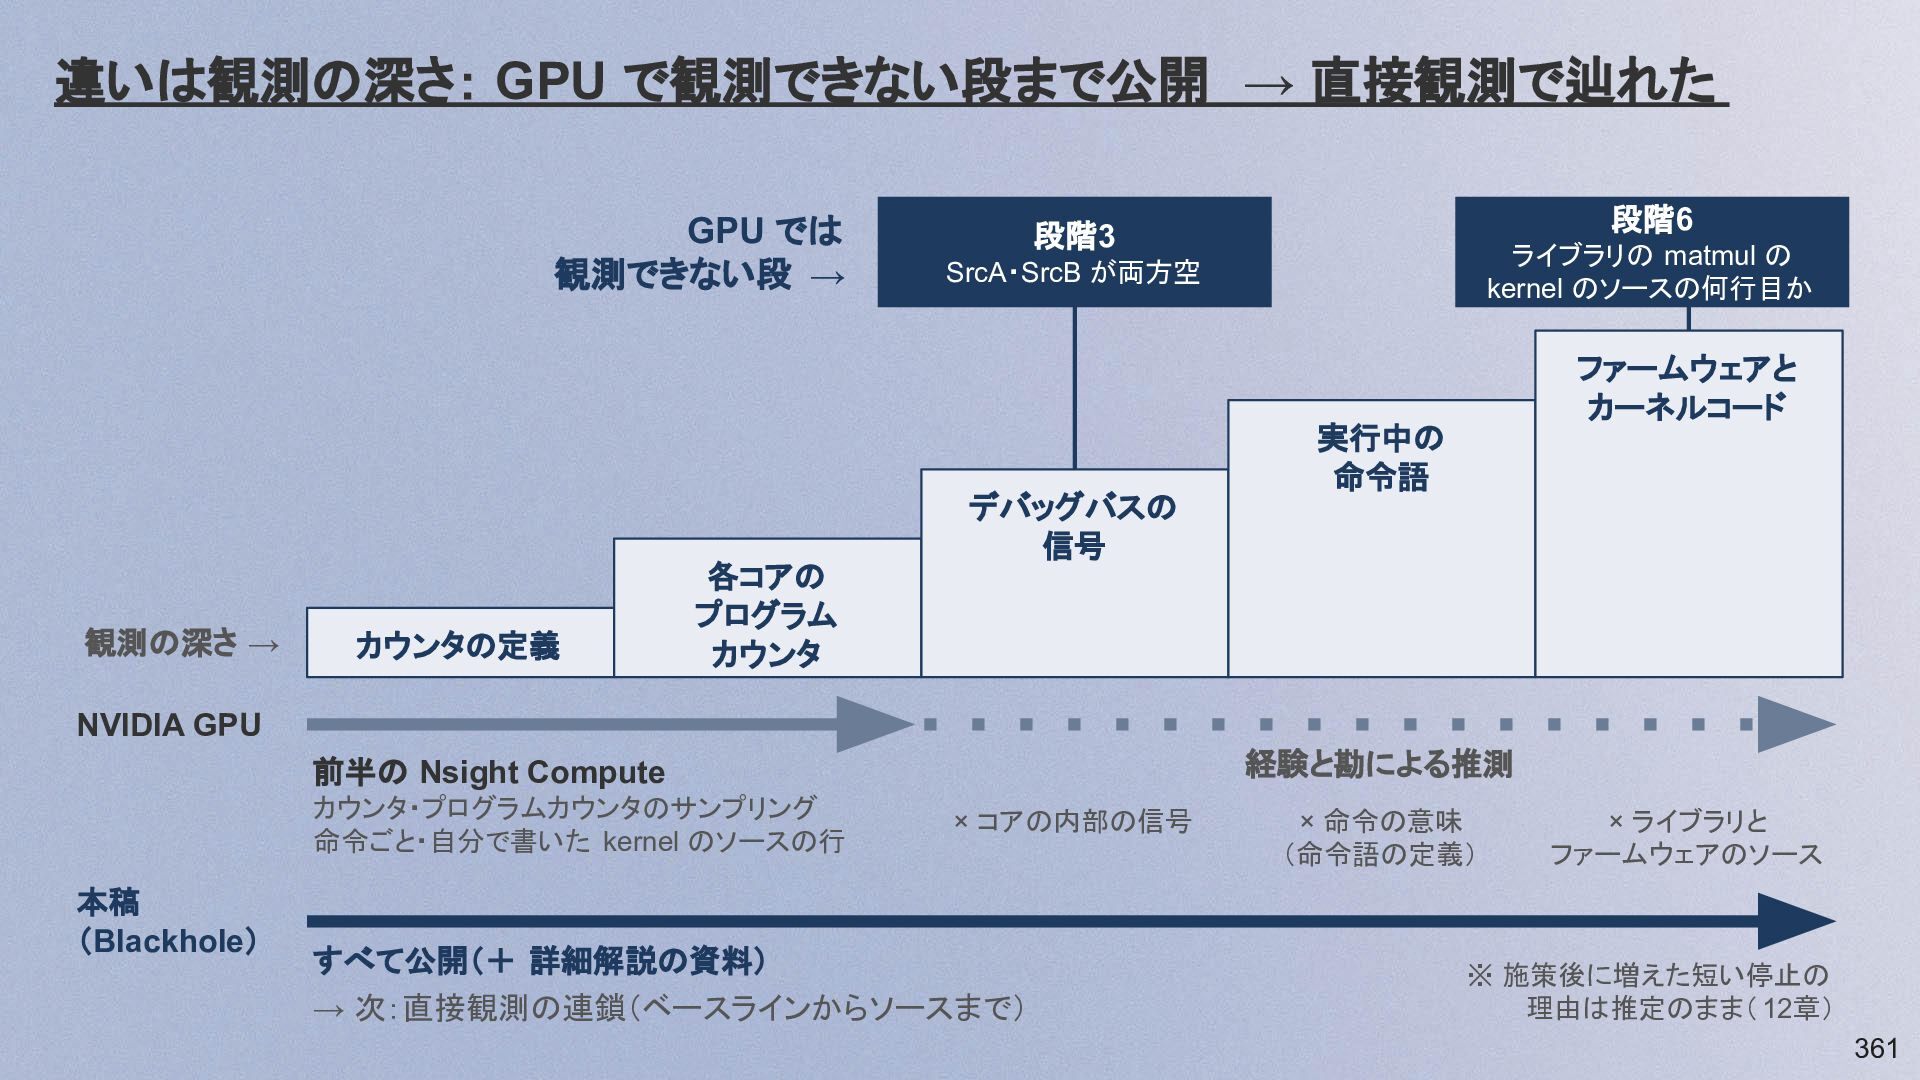
違いは観測の深さ:カウンタからソースまで 辿った原因の連鎖 445行目 部分和の CB 待ち unpack の 待ち Src
が 両方空 FPU の 停止 ソース 命令語 プログラム カウンタ デバッグバス カウンタ NVIDIA GPU 本稿 (Blackhole) Nsight Compute など 経験と勘による推測 観測の深さ → 27 -
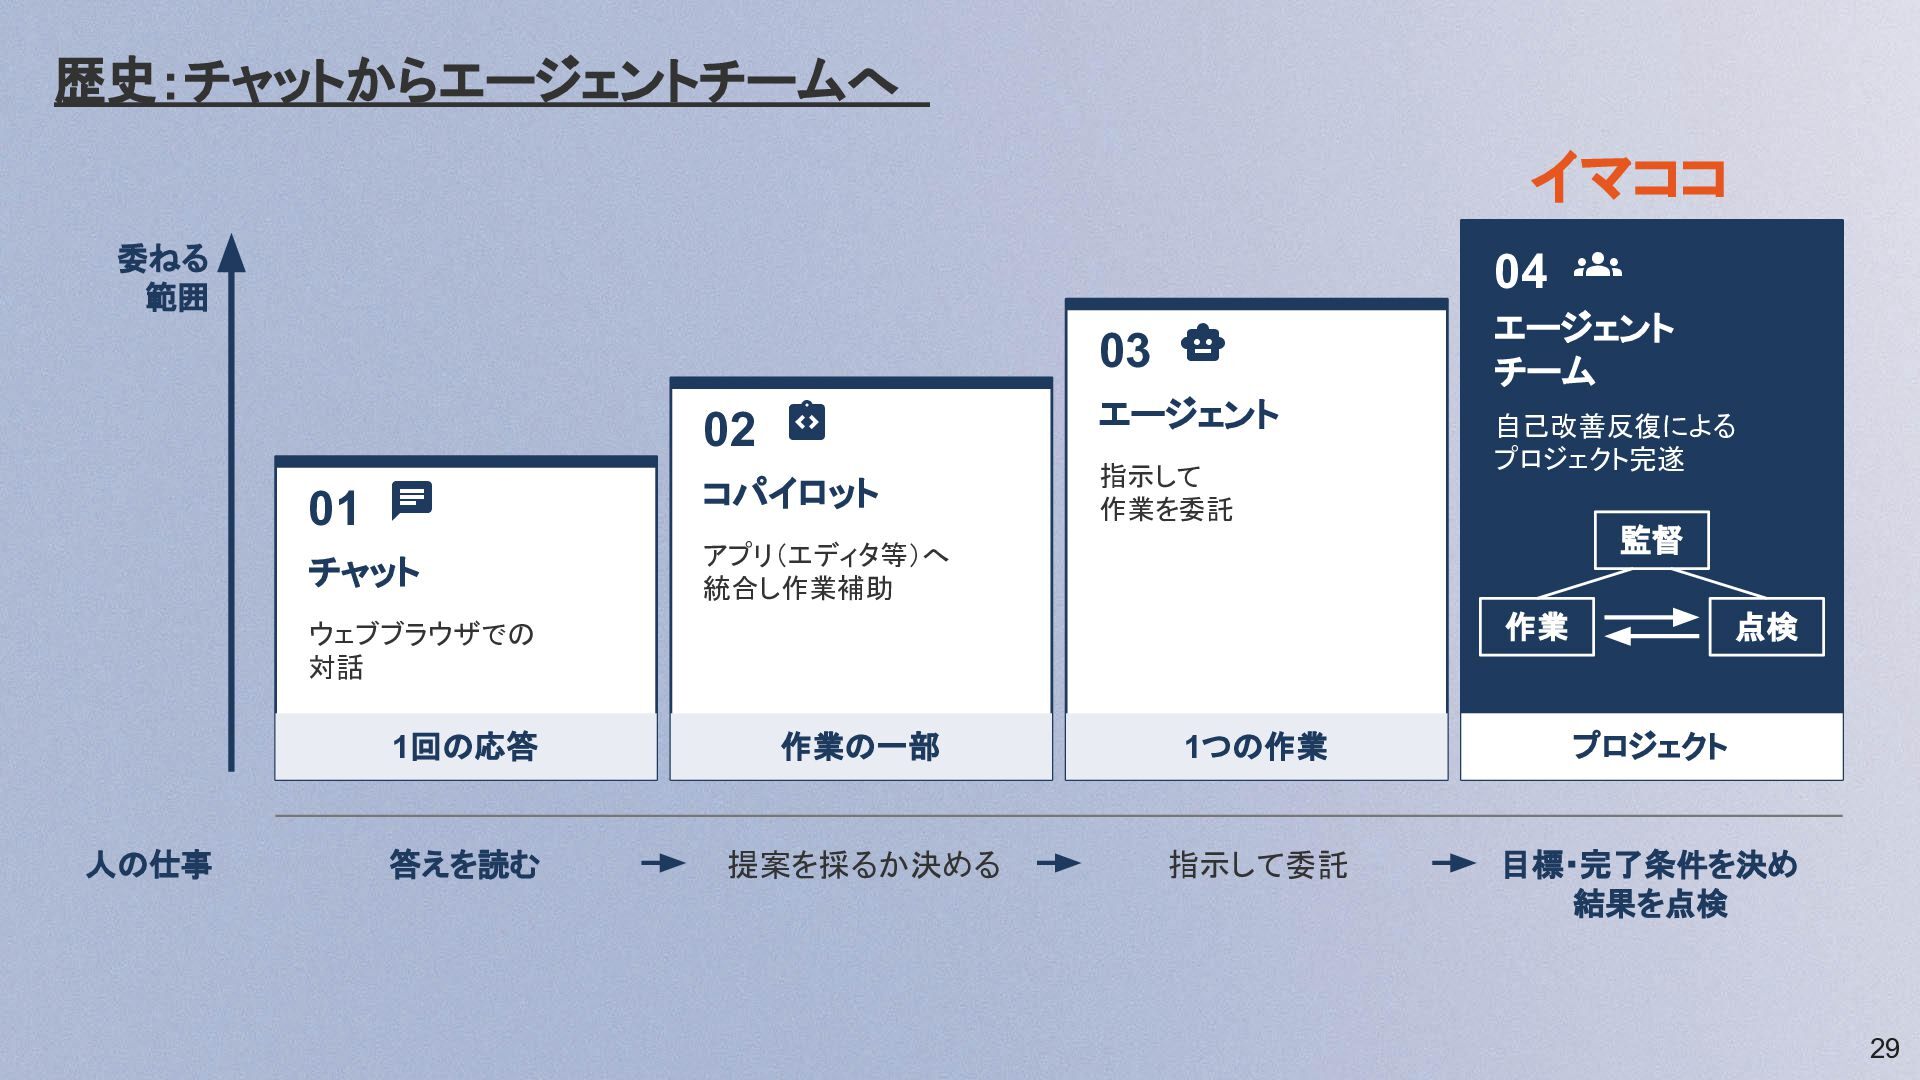
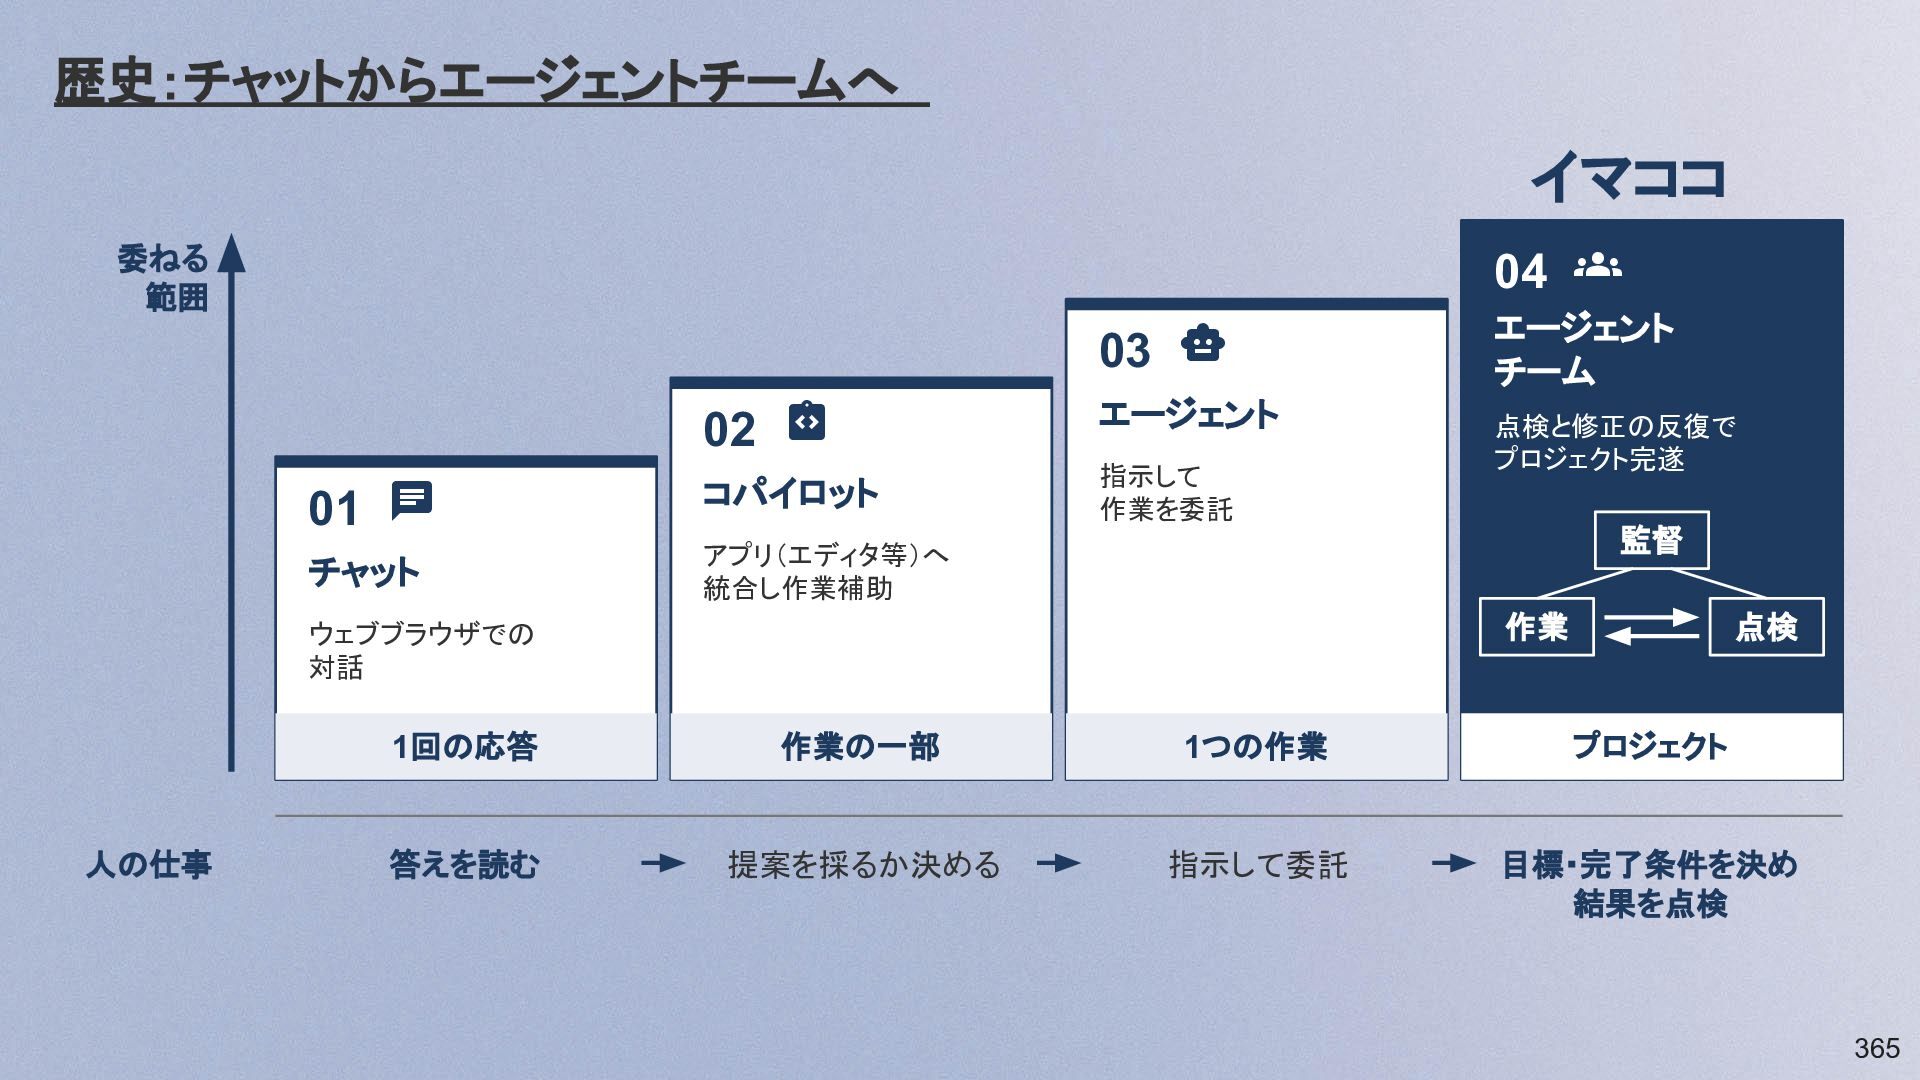
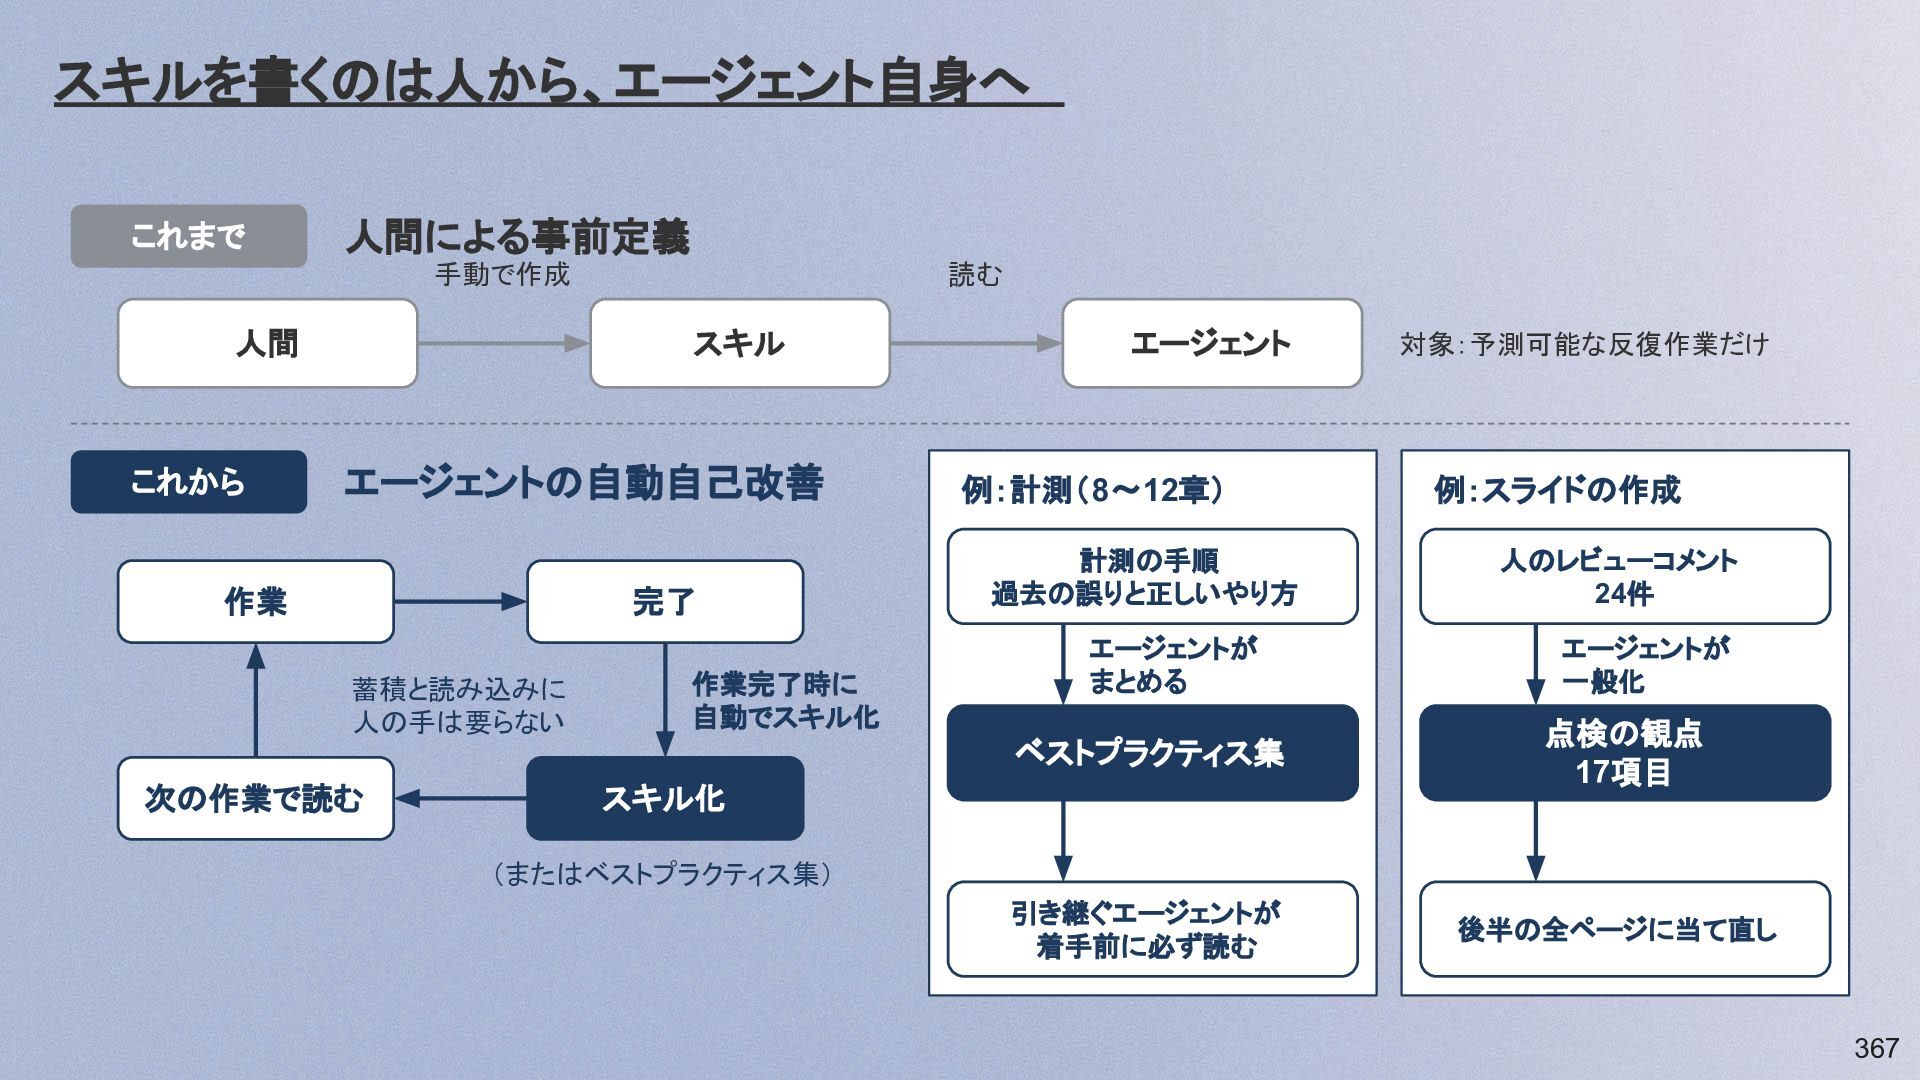
歴史:チャットからエージェントチームへ イマココ 04 委ねる 範囲 03 02
01 チャット コパイロット エージェント 指示して 作業を委託 自己改善反復による プロジェクト完遂 監督 アプリ(エディタ等)へ 統合し作業補助 作業 ウェブブラウザでの 対話 人の仕事 エージェント チーム 点検 1回の応答 作業の一部 1つの作業 プロジェクト 答えを読む 提案を採るか決める 指示して委託 目標・完了条件を決め 結果を点検 29 -
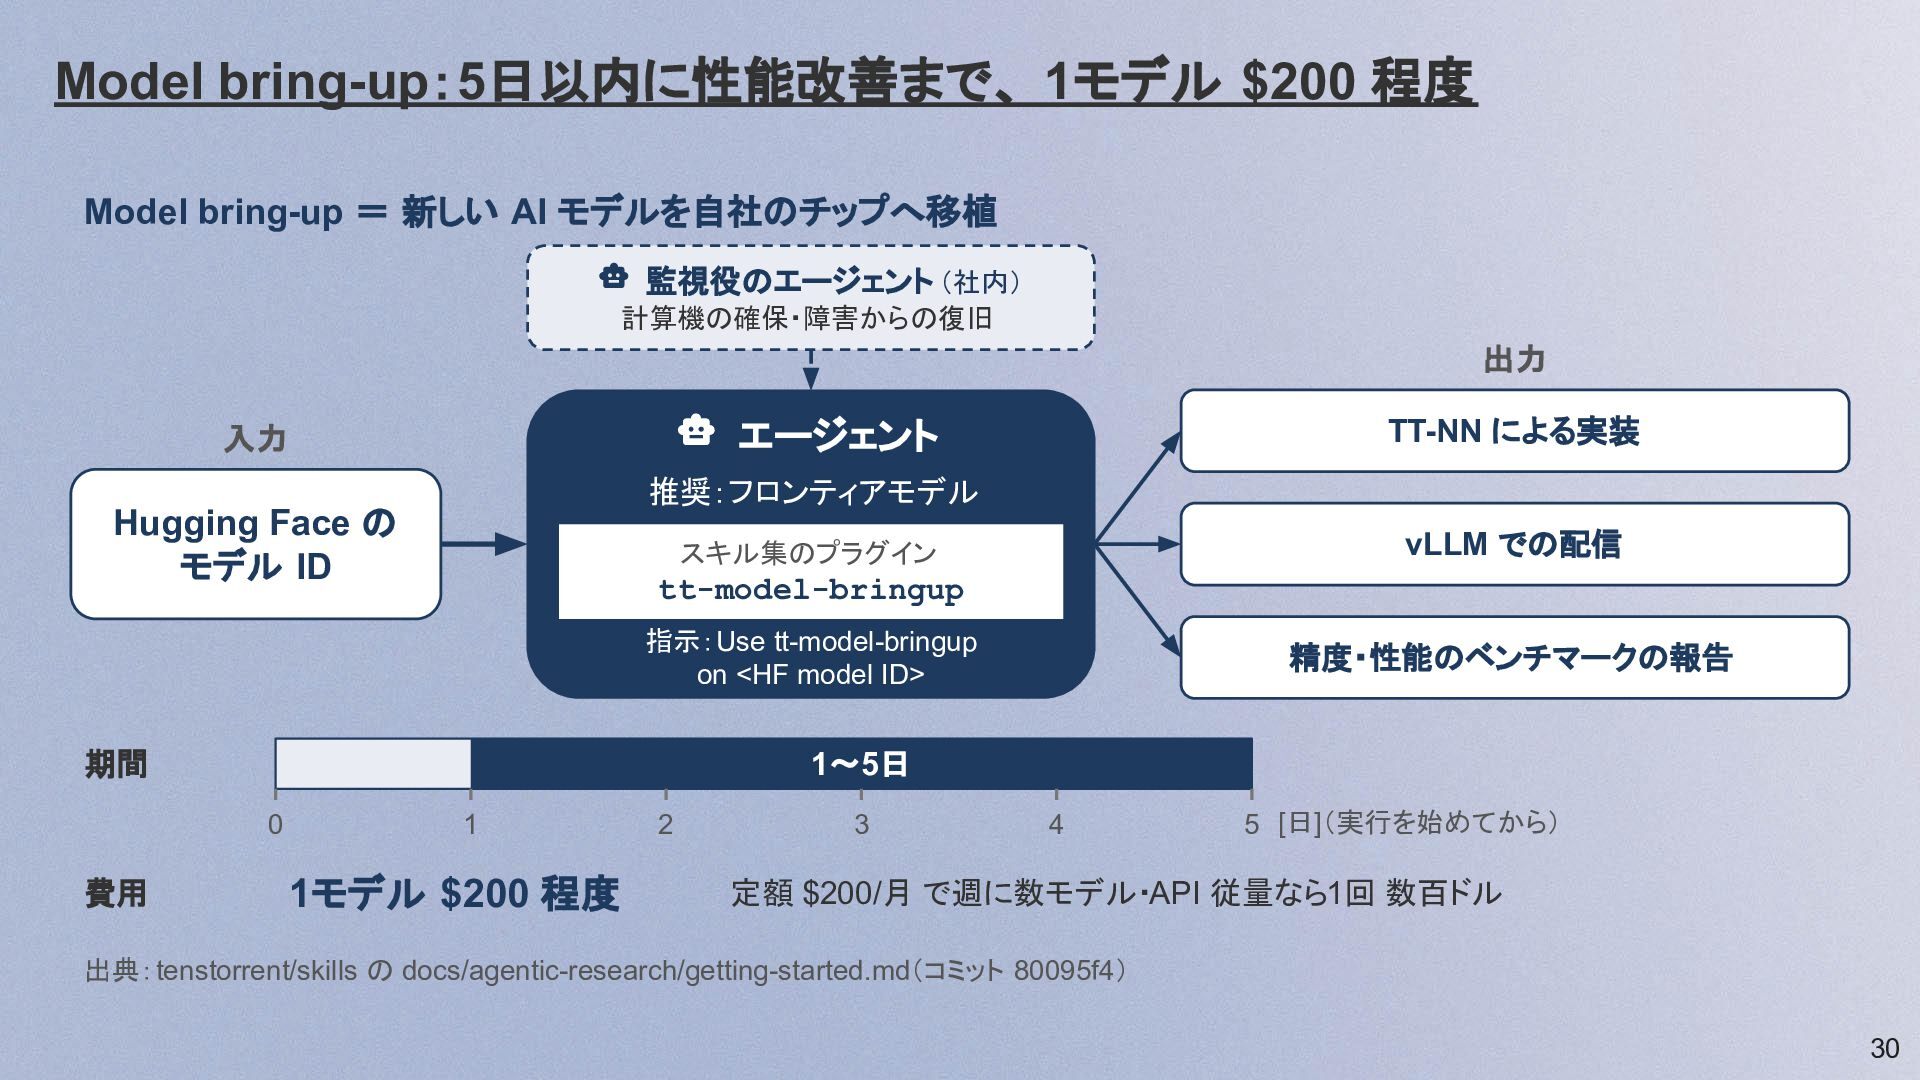
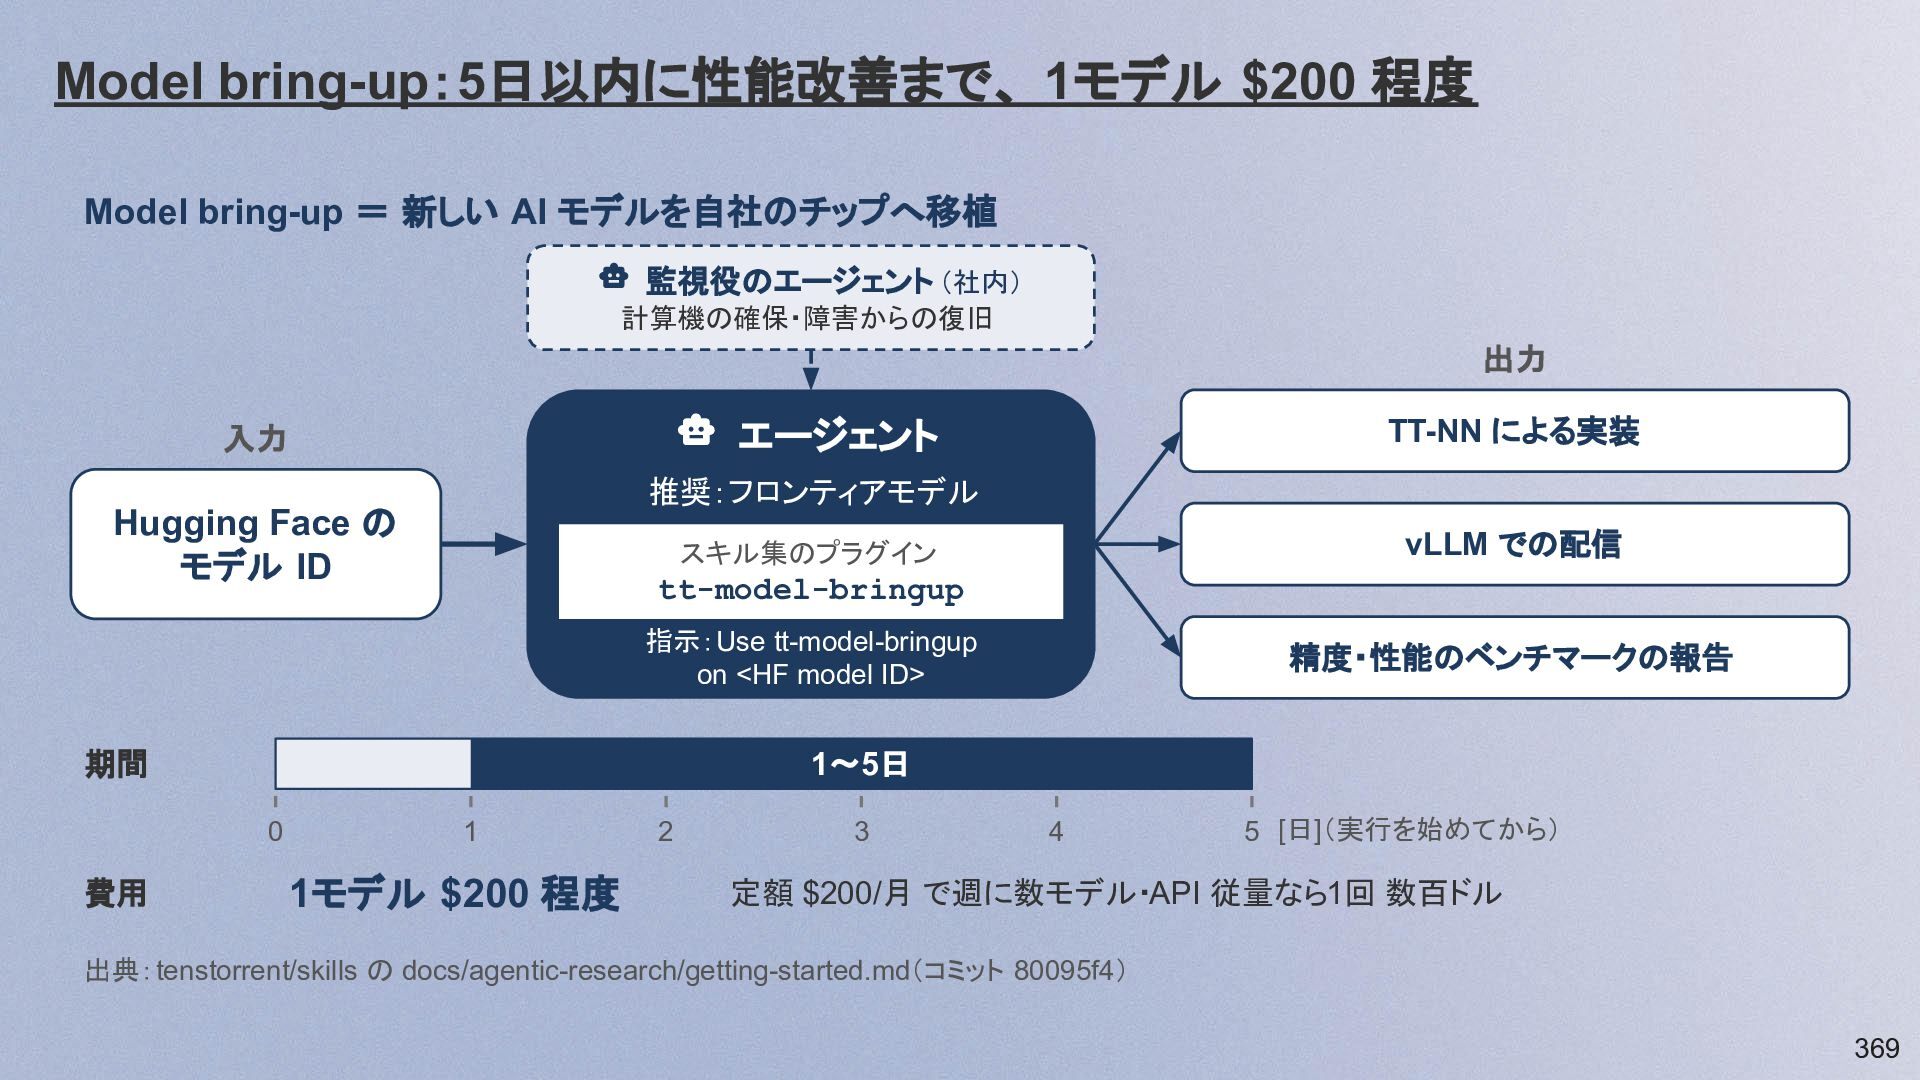
Model bring-up:5日以内に性能改善まで、 1モデル $200 程度 Model bring-up = 新しい AI
モデルを自社のチップへ移植 監視役のエージェント (社内) 計算機の確保・障害からの復旧 出力 エージェント 入力 TT-NN による実装 推奨:フロンティアモデル Hugging Face の モデル ID vLLM での配信 スキル集のプラグイン tt-model-bringup 指示:Use tt-model-bringup on <HF model ID> 期間 1〜5日 0 費用 精度・性能のベンチマークの報告 1 1モデル $200 程度 2 3 4 5 [日](実行を始めてから) 定額 $200/月 で週に数モデル・API 従量なら1回 数百ドル 出典:tenstorrent/skills の docs/agentic-research/getting-started.md(コミット 80095f4) 30 -
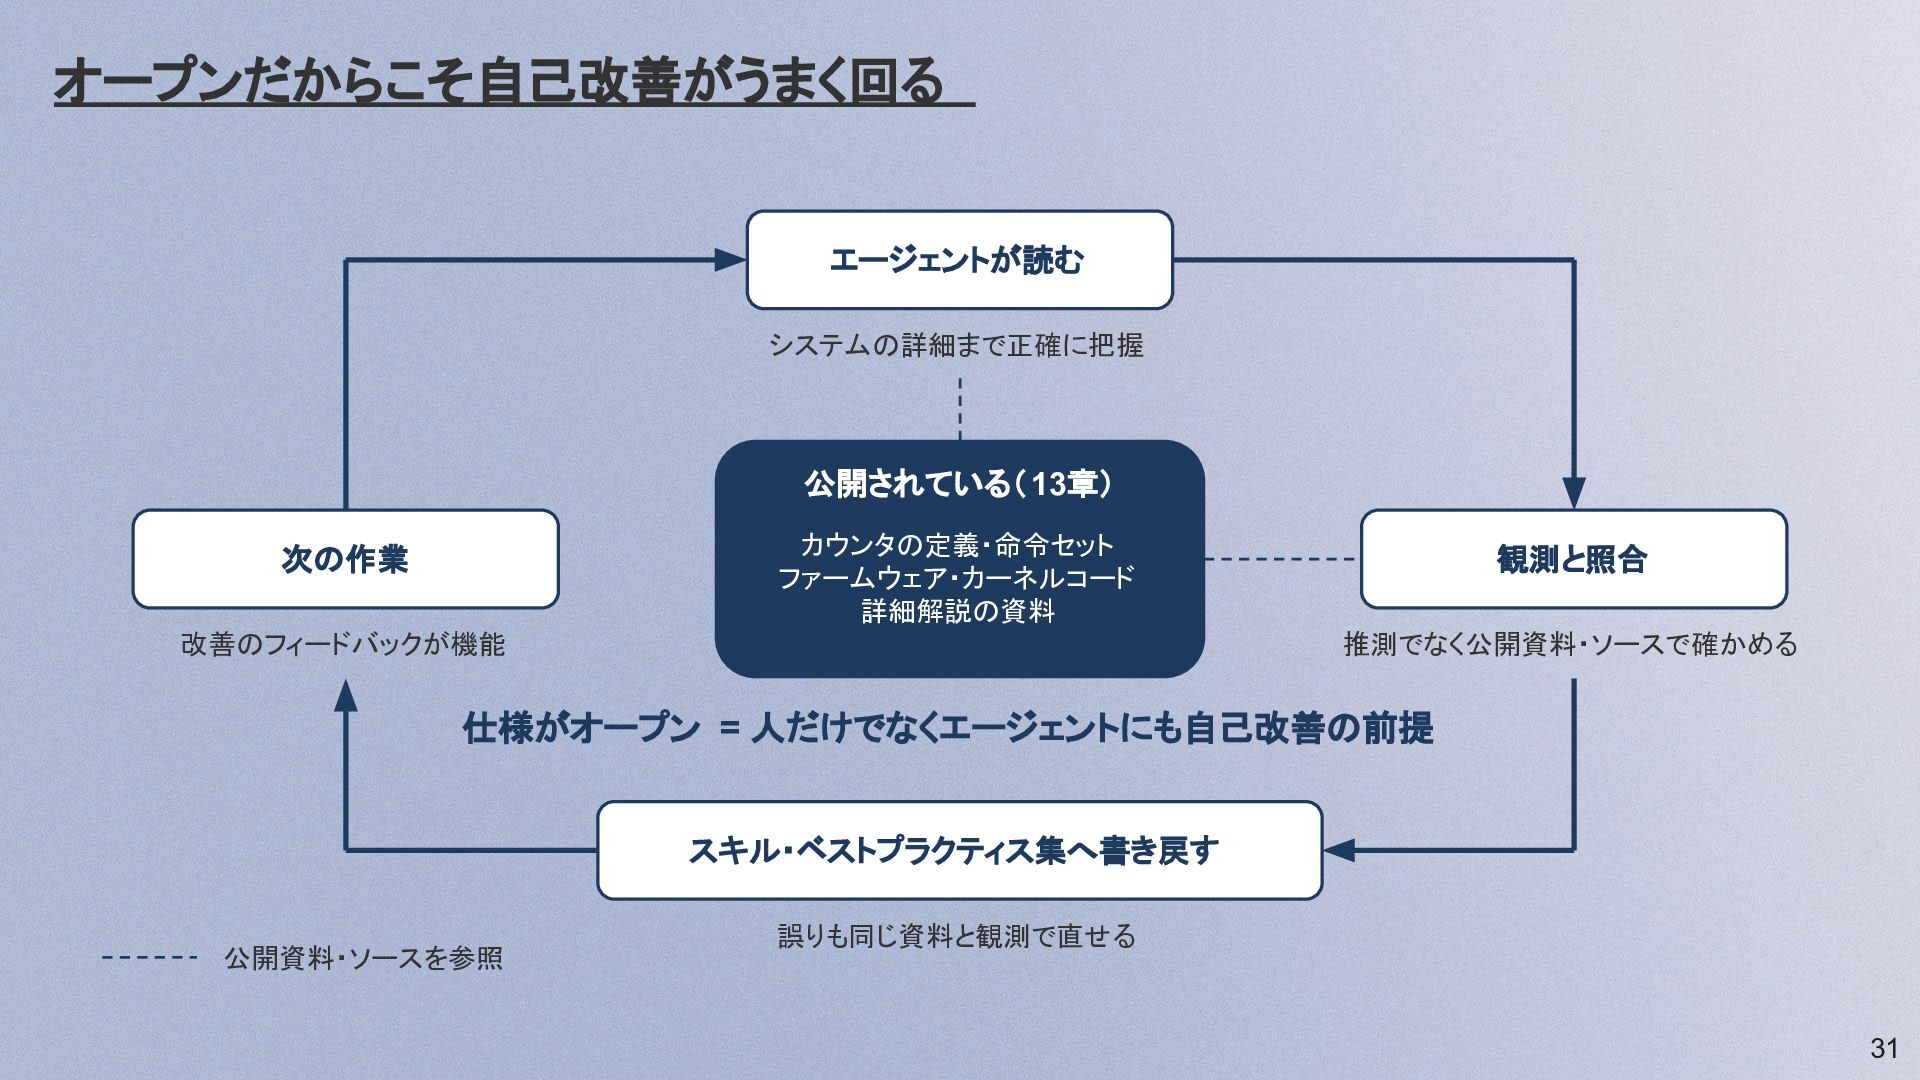
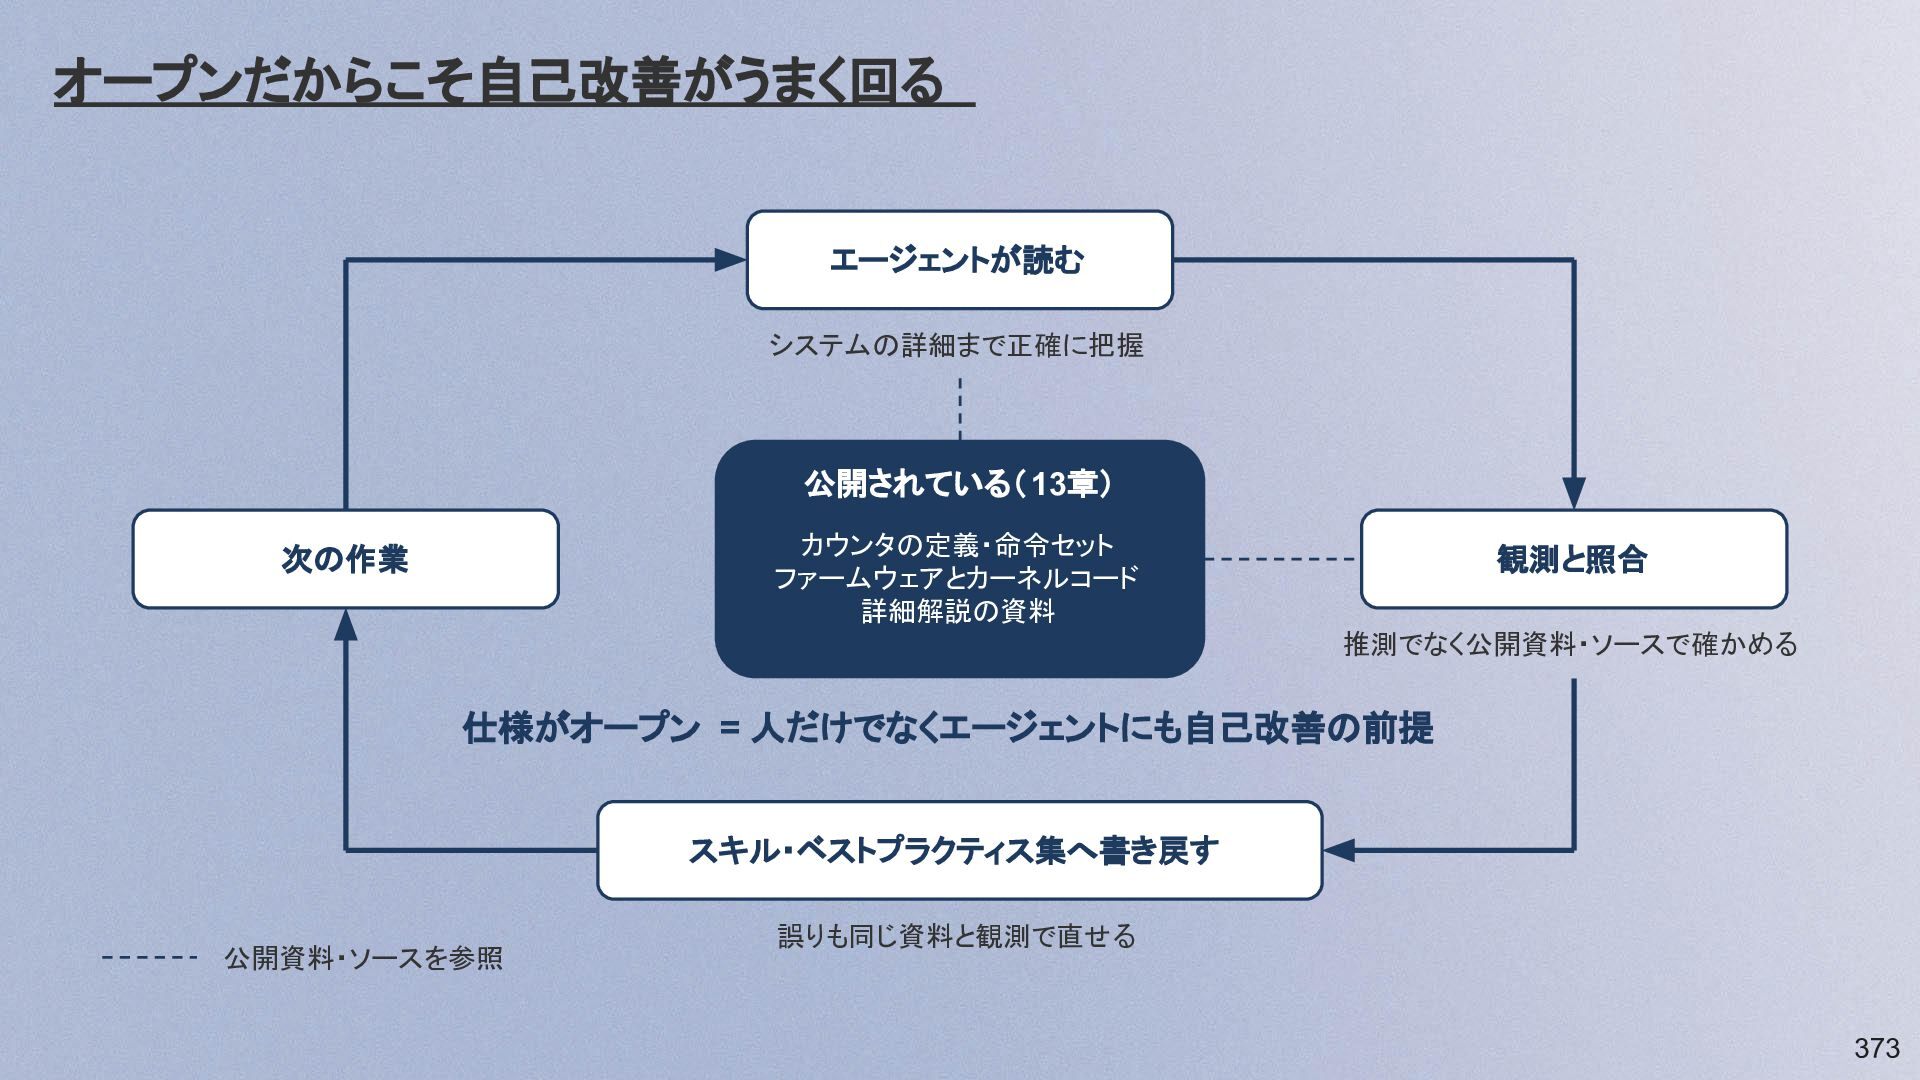
オープンだからこそ自己改善がうまく回る エージェントが読む システムの詳細まで正確に把握 公開されている( 13章) カウンタの定義・命令セット ファームウェア・カーネルコード 詳細解説の資料 次の作業 改善のフィードバックが機能
観測と照合 推測でなく公開資料・ソースで確かめる 仕様がオープン = 人だけでなくエージェントにも自己改善の前提 スキル・ベストプラクティス集へ書き戻す 公開資料・ソースを参照 誤りも同じ資料と観測で直せる 31 -
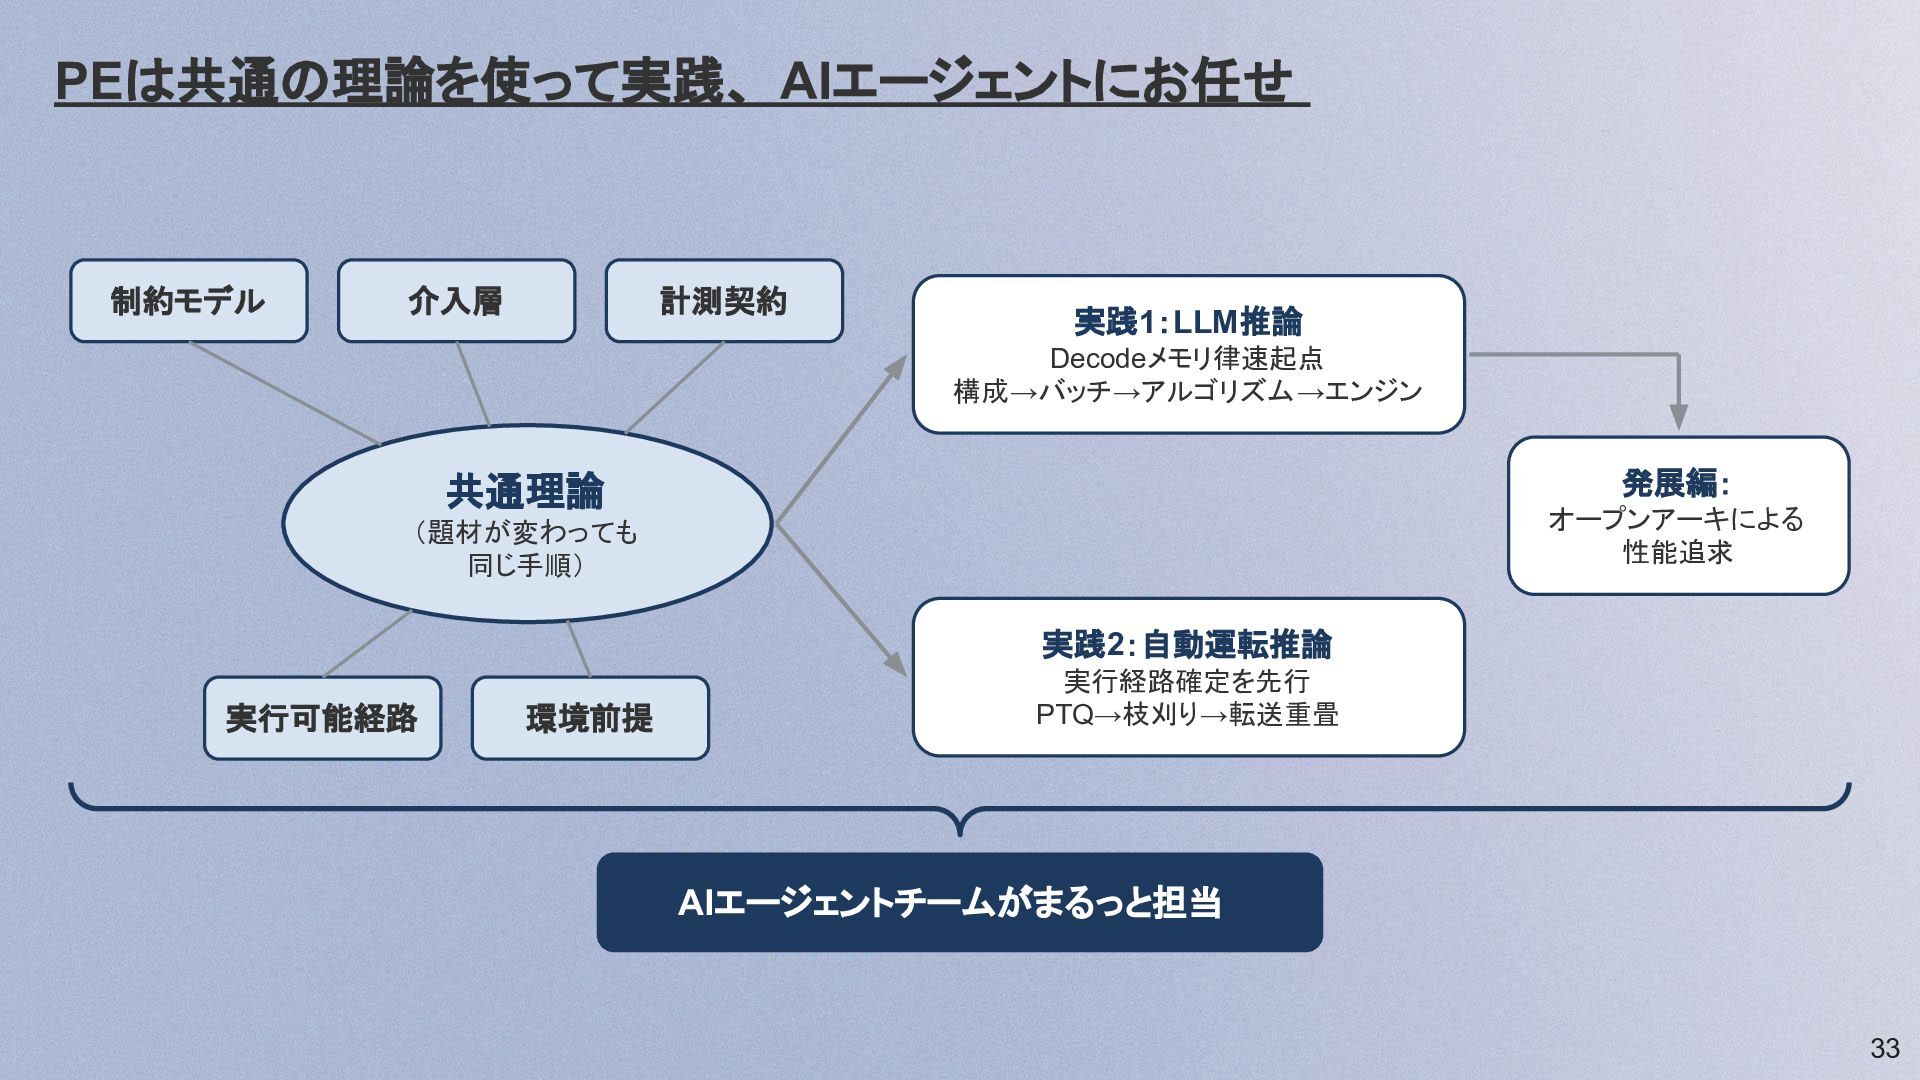
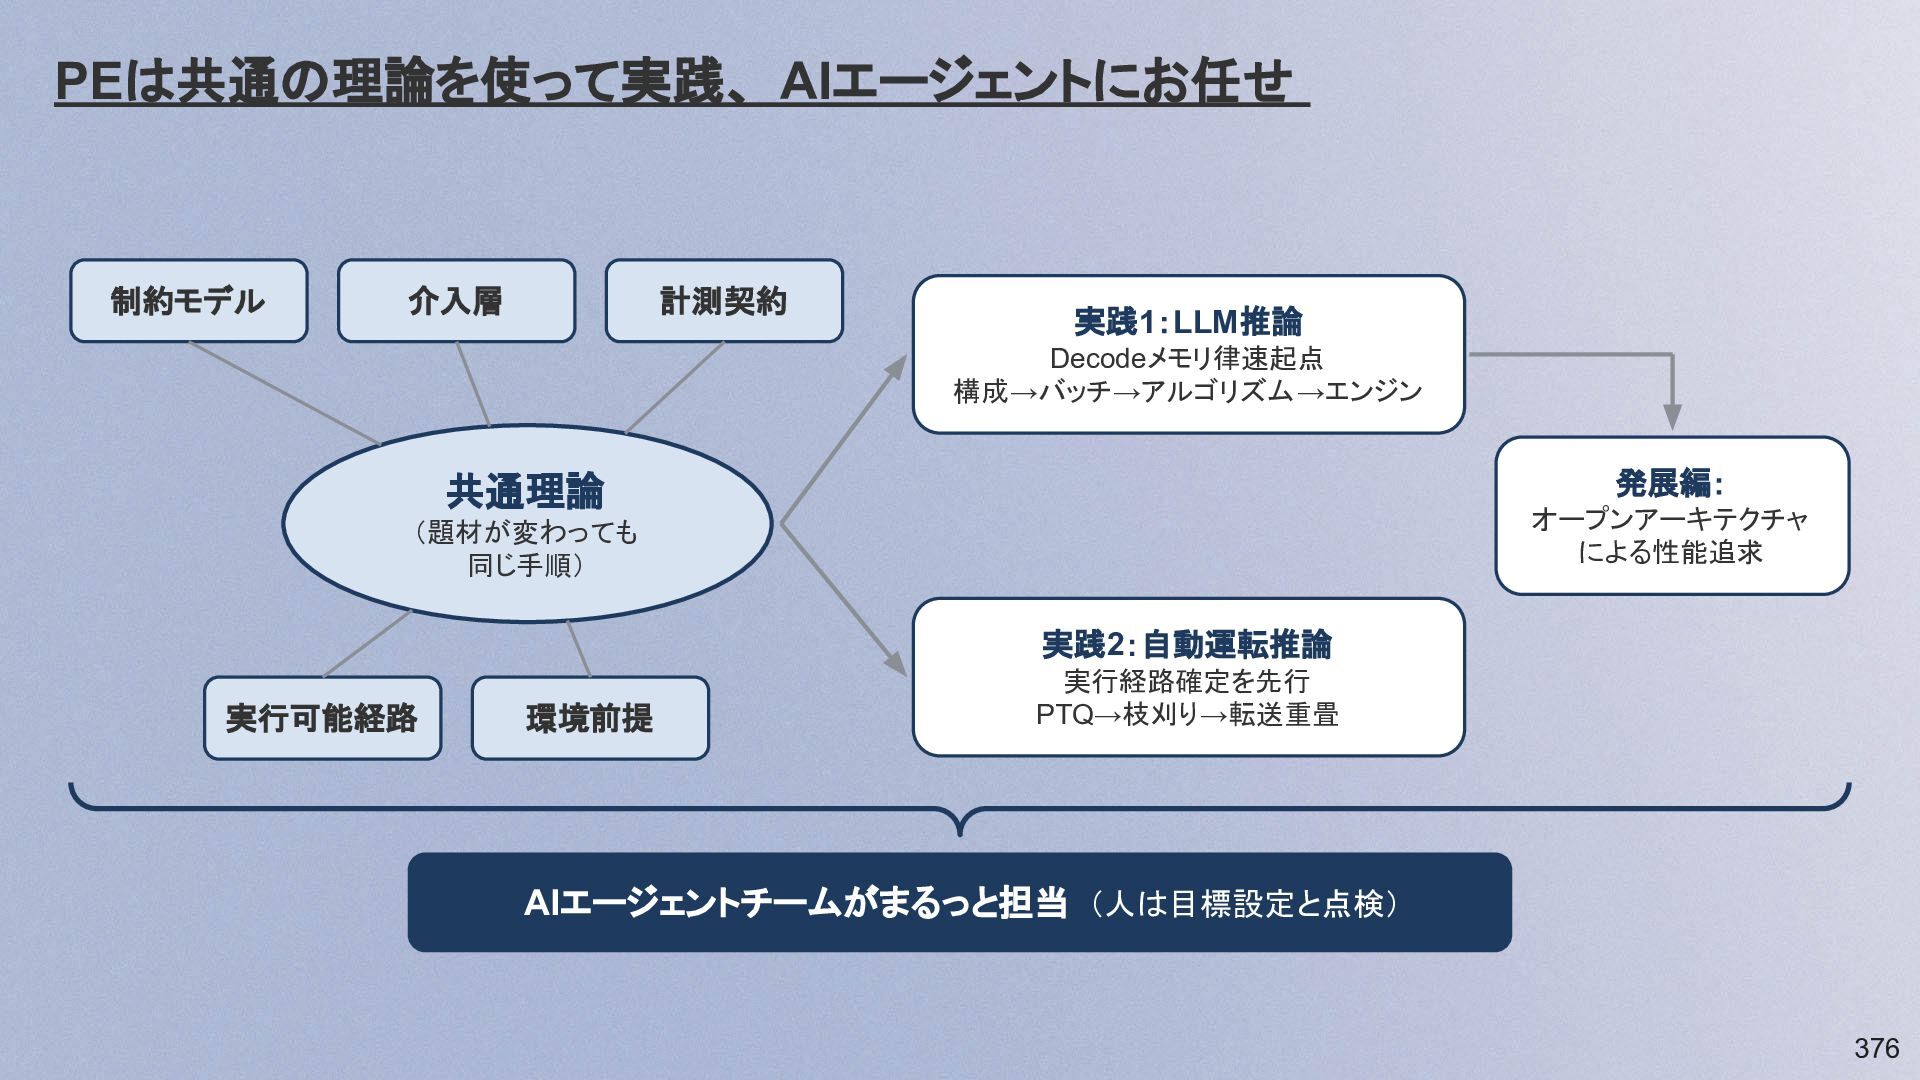
PEは共通の理論を使って実践、 AIエージェントにお任せ 制約モデル 介入層 計測契約 実践1:LLM推論 Decodeメモリ律速起点 構成→バッチ→アルゴリズム →エンジン 発展編:
共通理論 オープンアーキによる 性能追求 (題材が変わっても 同じ手順) 実践2:自動運転推論 実行可能経路 環境前提 実行経路確定を先行 PTQ→枝刈り→転送重畳 AIエージェントチームがまるっと担当 33 -
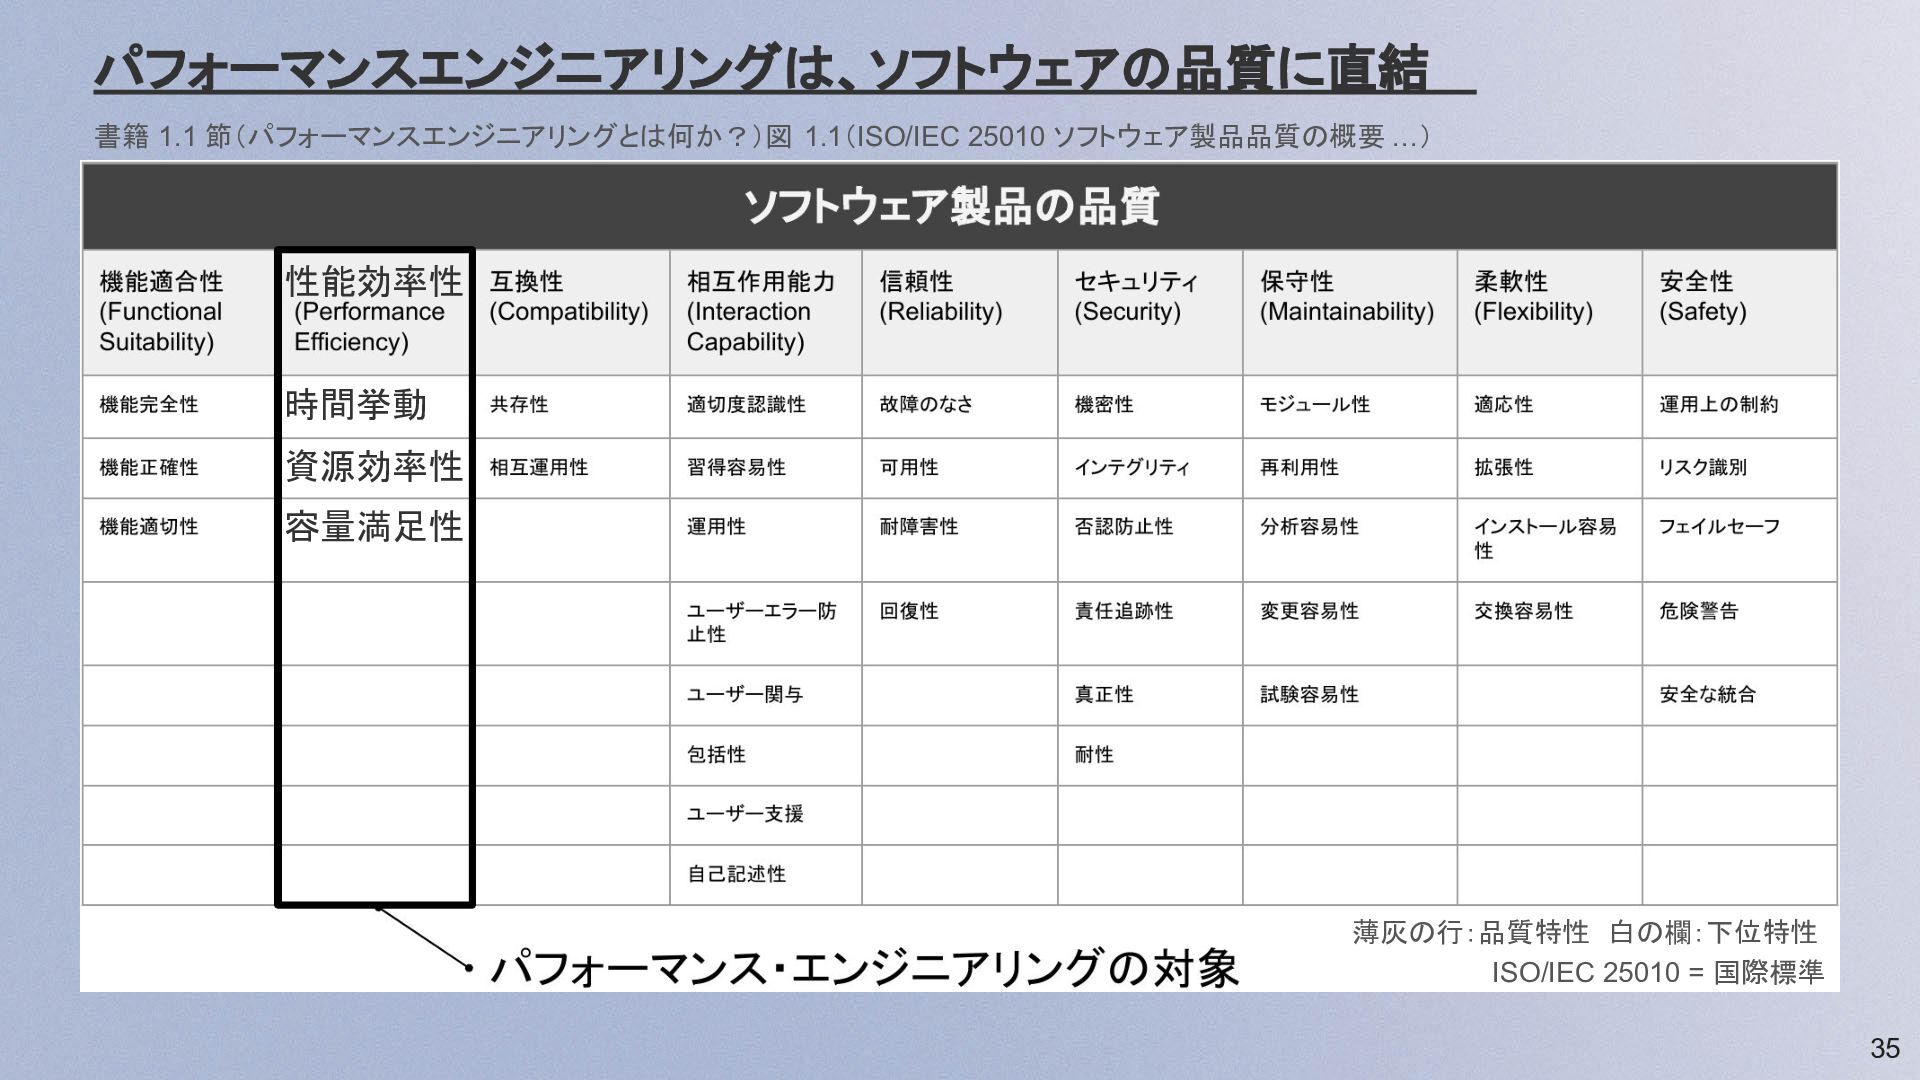
パフォーマンスエンジニアリングは、ソフトウェアの品質に直結 書籍 1.1 節(パフォーマンスエンジニアリングとは何か?)図 1.1(ISO/IEC 25010 ソフトウェア製品品質の概要 …) 性能効率性 時間挙動
資源効率性 容量満足性 薄灰の行:品質特性 白の欄:下位特性 ISO/IEC 25010 = 国際標準 35 -
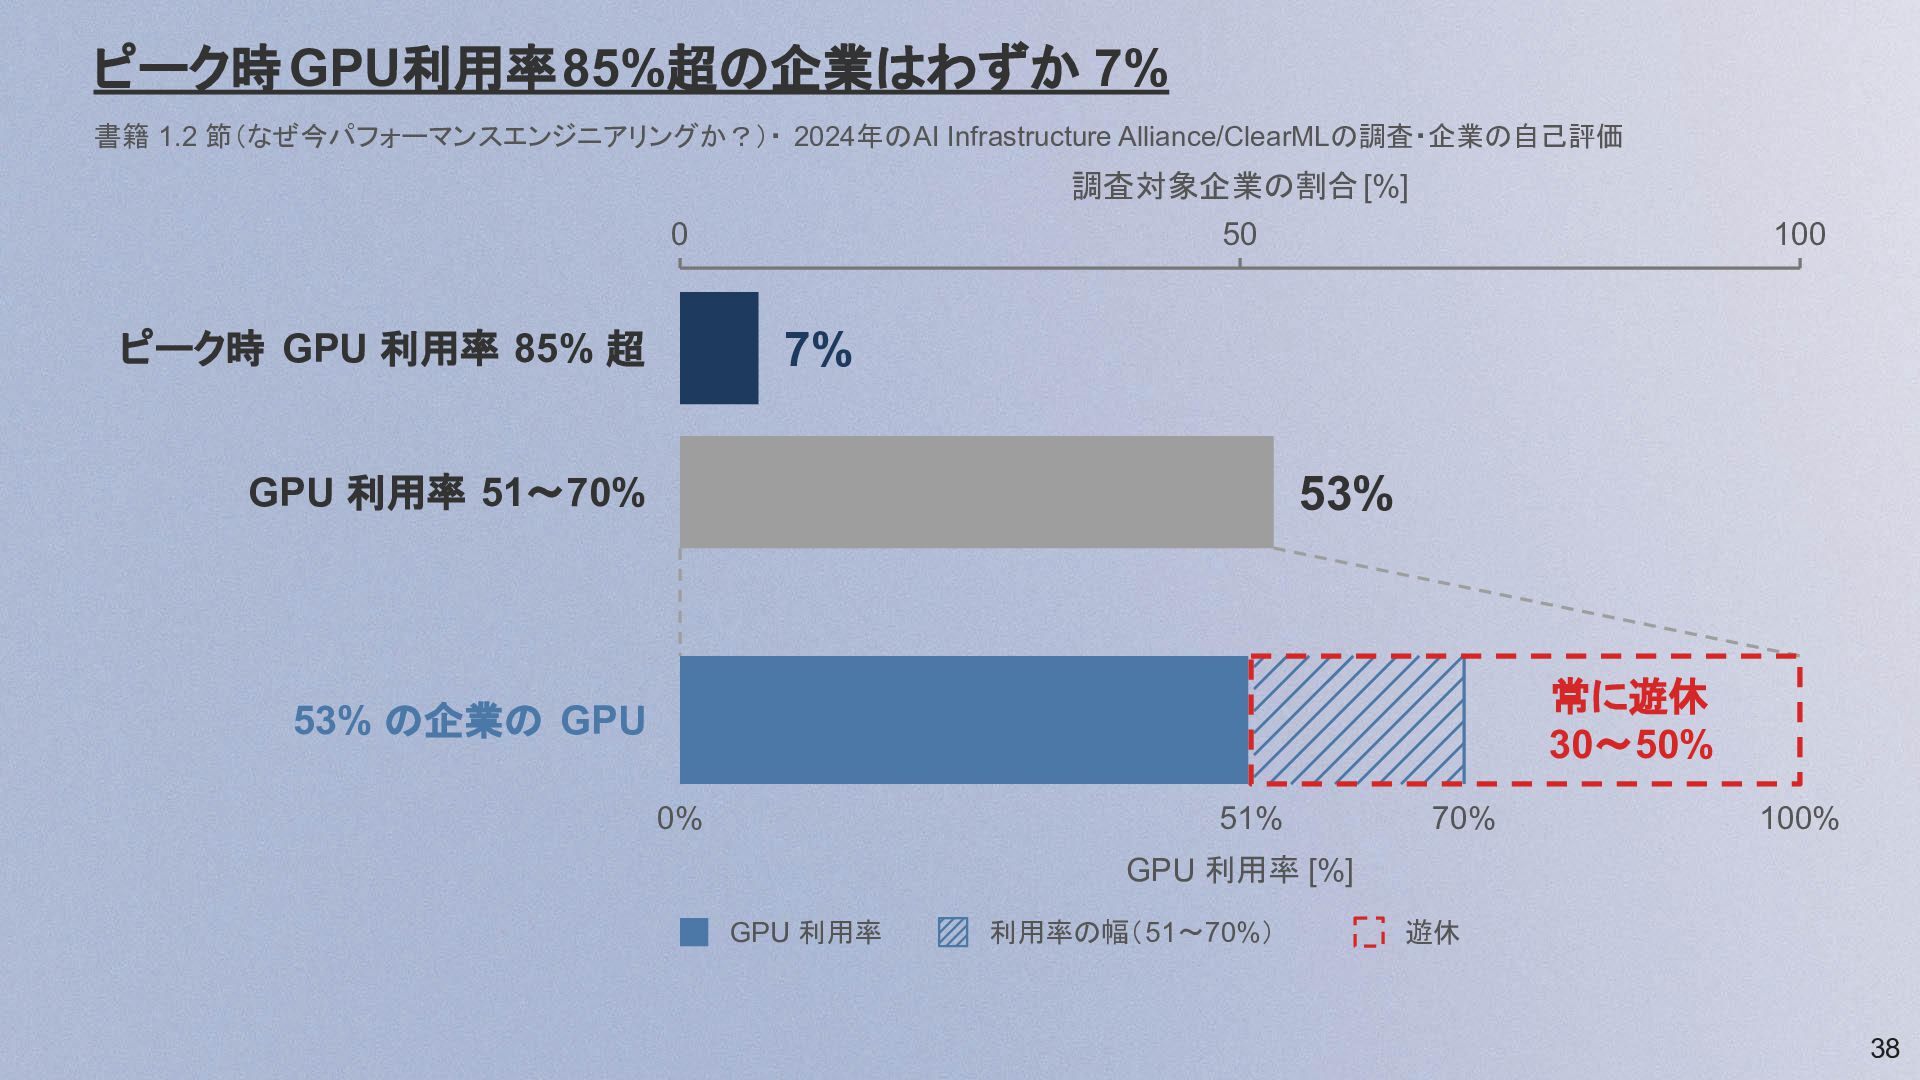
ピーク時 GPU利用率85%超の企業はわずか 7% 書籍 1.2 節(なぜ今パフォーマンスエンジニアリングか?)・ 2024年のAI Infrastructure Alliance/ClearMLの調査・企業の自己評価 調査対象企業の割合
[%] 50 0 ピーク時 GPU 利用率 85% 超 100 7% GPU 利用率 51〜70% 53% 常に遊休 30〜50% 53% の企業の GPU 0% 51% 70% 100% GPU 利用率 [%] GPU 利用率 利用率の幅(51〜70%) 遊休 38 -
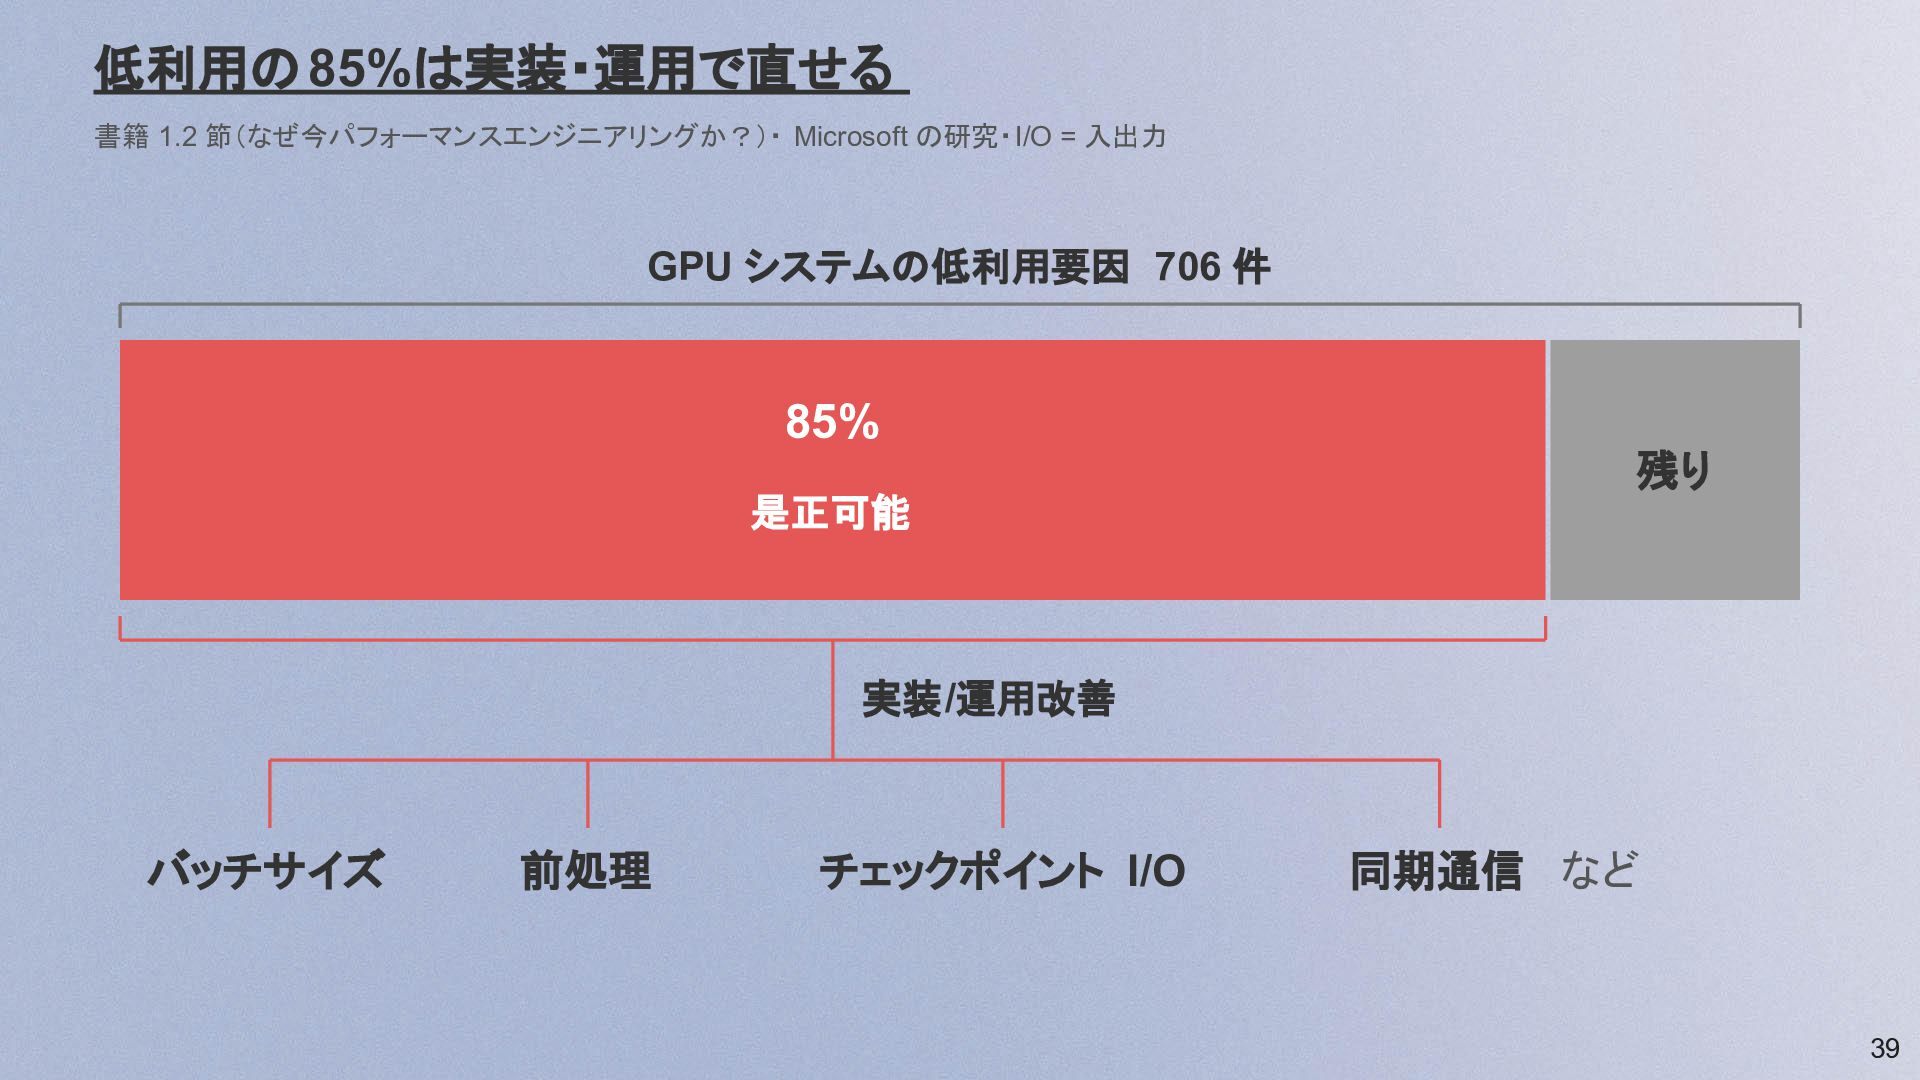
低利用の 85%は実装・運用で直せる 書籍 1.2 節(なぜ今パフォーマンスエンジニアリングか?)・ Microsoft の研究・I/O = 入出力 GPU
システムの低利用要因 706 件 85% 是正可能 残り 実装/運用改善 バッチサイズ 前処理 チェックポイント I/O 同期通信 など 39 -
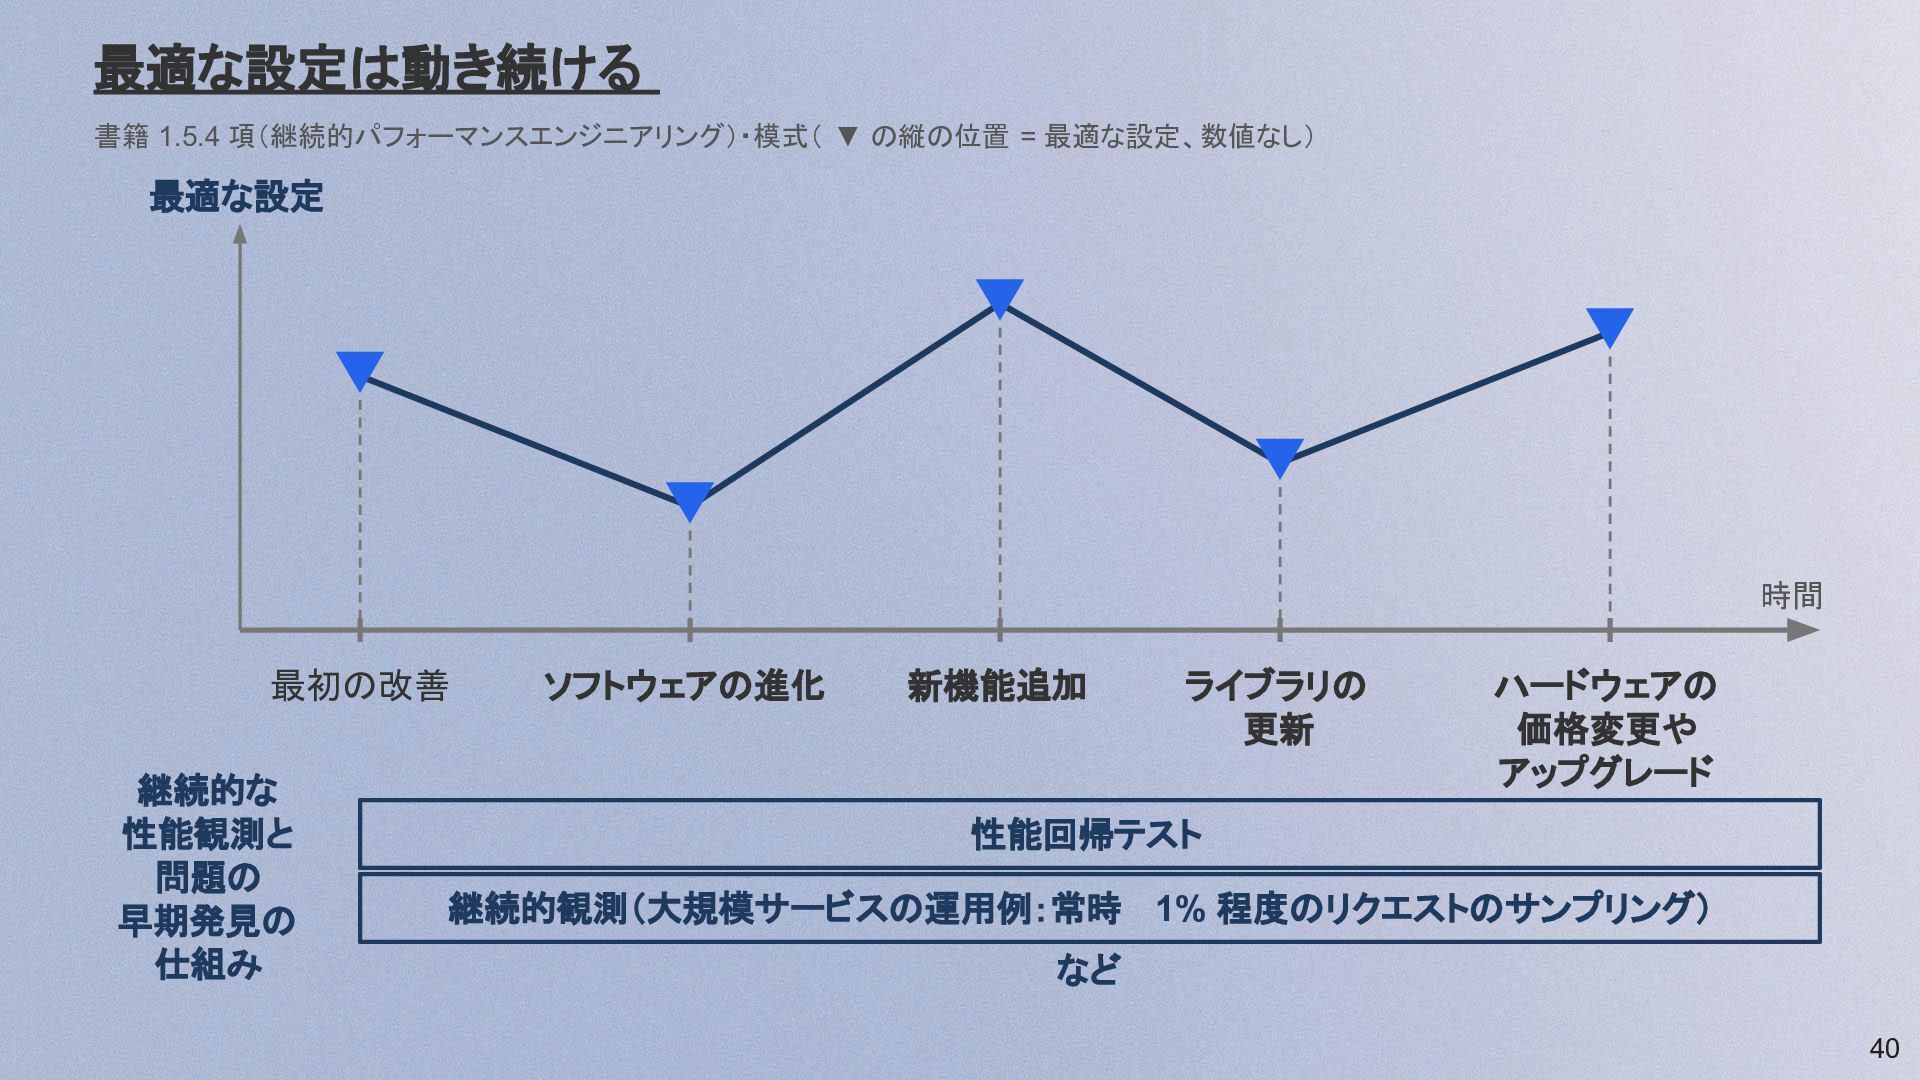
最適な設定は動き続ける 書籍 1.5.4 項(継続的パフォーマンスエンジニアリング)・模式( ▼ の縦の位置 = 最適な設定、数値なし) 最適な設定 時間
最初の改善 継続的な 性能観測と 問題の 早期発見の 仕組み ソフトウェアの進化 新機能追加 ライブラリの 更新 ハードウェアの 価格変更や アップグレード 性能回帰テスト 継続的観測(大規模サービスの運用例:常時 1% 程度のリクエストのサンプリング) など 40 -
難しさの一例:平均が改善しても p99は悪化しうる 書籍 1.5.3 項(5段階の実践プロセス)・模式(数値なし)・棒の高さ = リクエストの割合・ p99 = 99
パーセンタイル 平均 p99 改善前 レイテンシ 改善 悪化 平均 p99 改善後 レイテンシ 41 -
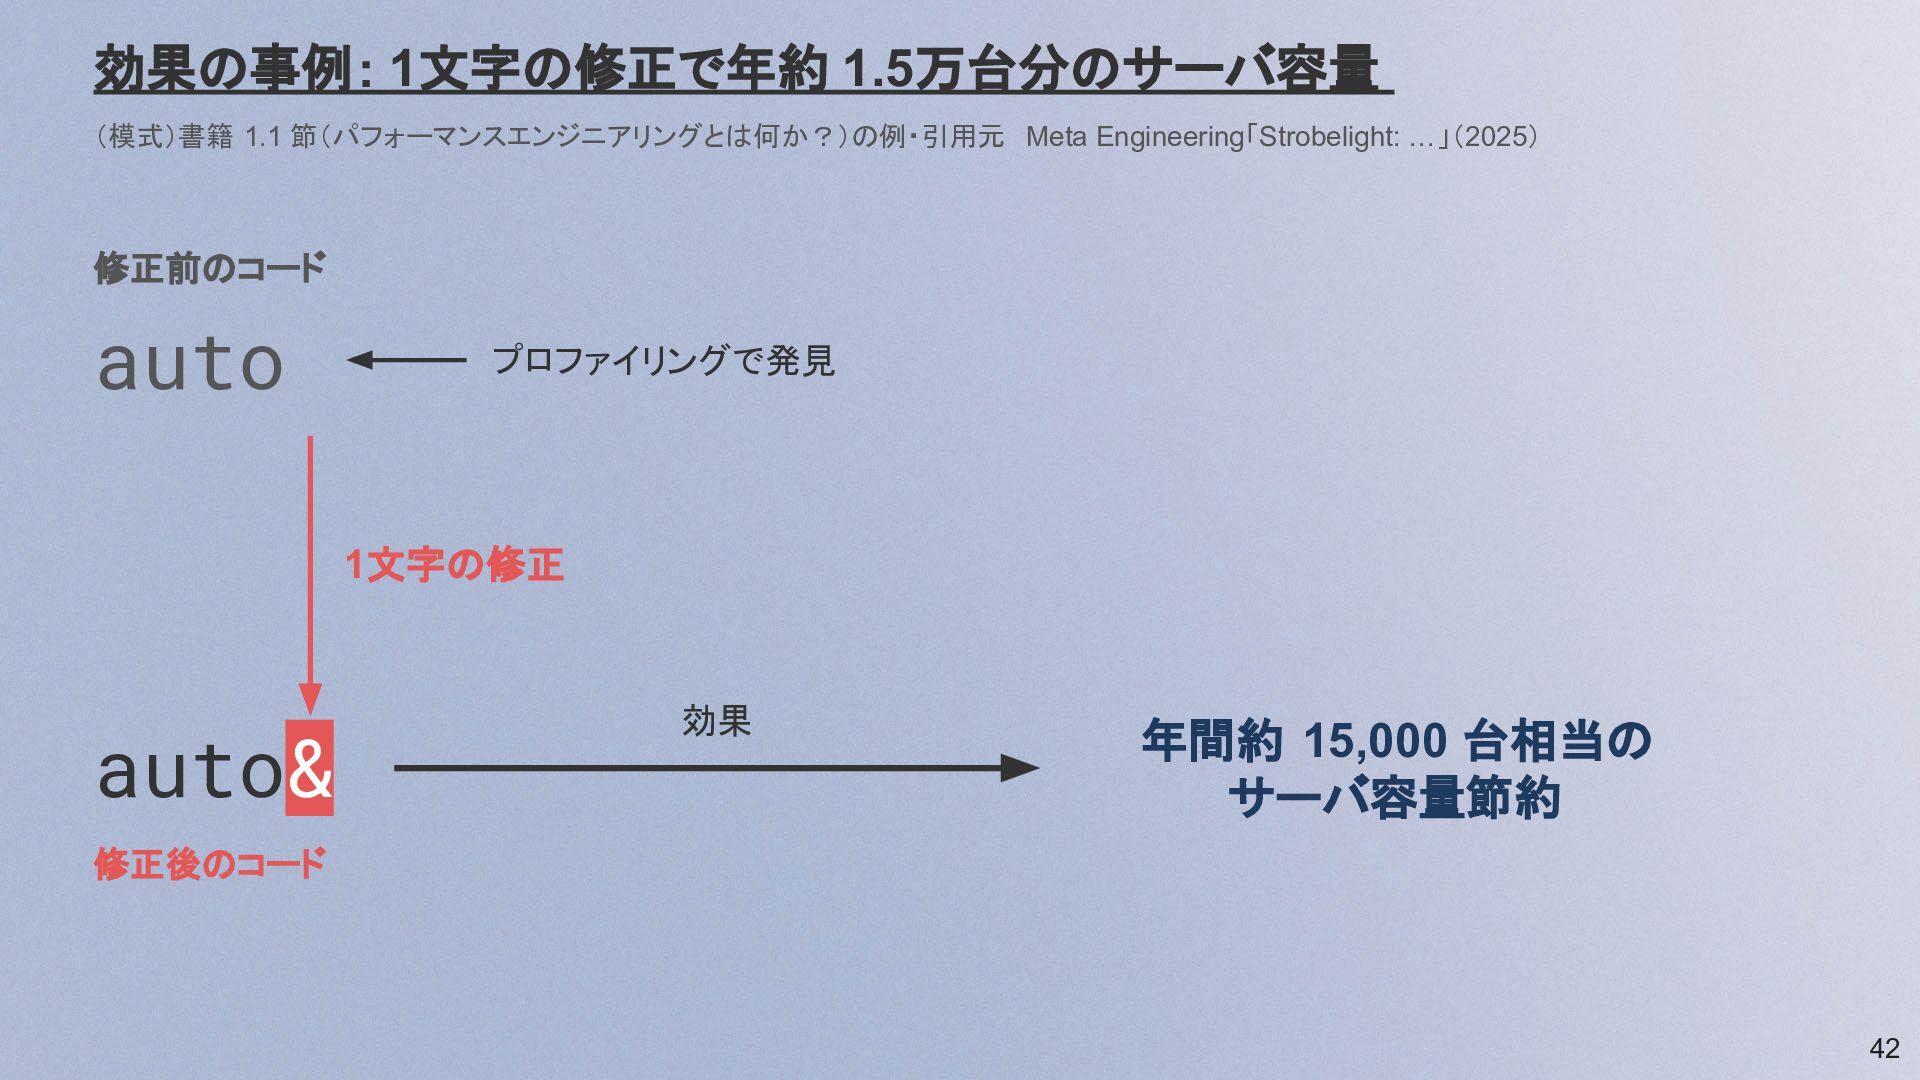
効果の事例: 1文字の修正で年約 1.5万台分のサーバ容量 (模式)書籍 1.1 節(パフォーマンスエンジニアリングとは何か?)の例・引用元 Meta Engineering「Strobelight: …」(2025) 修正前のコード
auto プロファイリングで発見 1文字の修正 auto& 効果 年間約 15,000 台相当の サーバ容量節約 修正後のコード 42 -
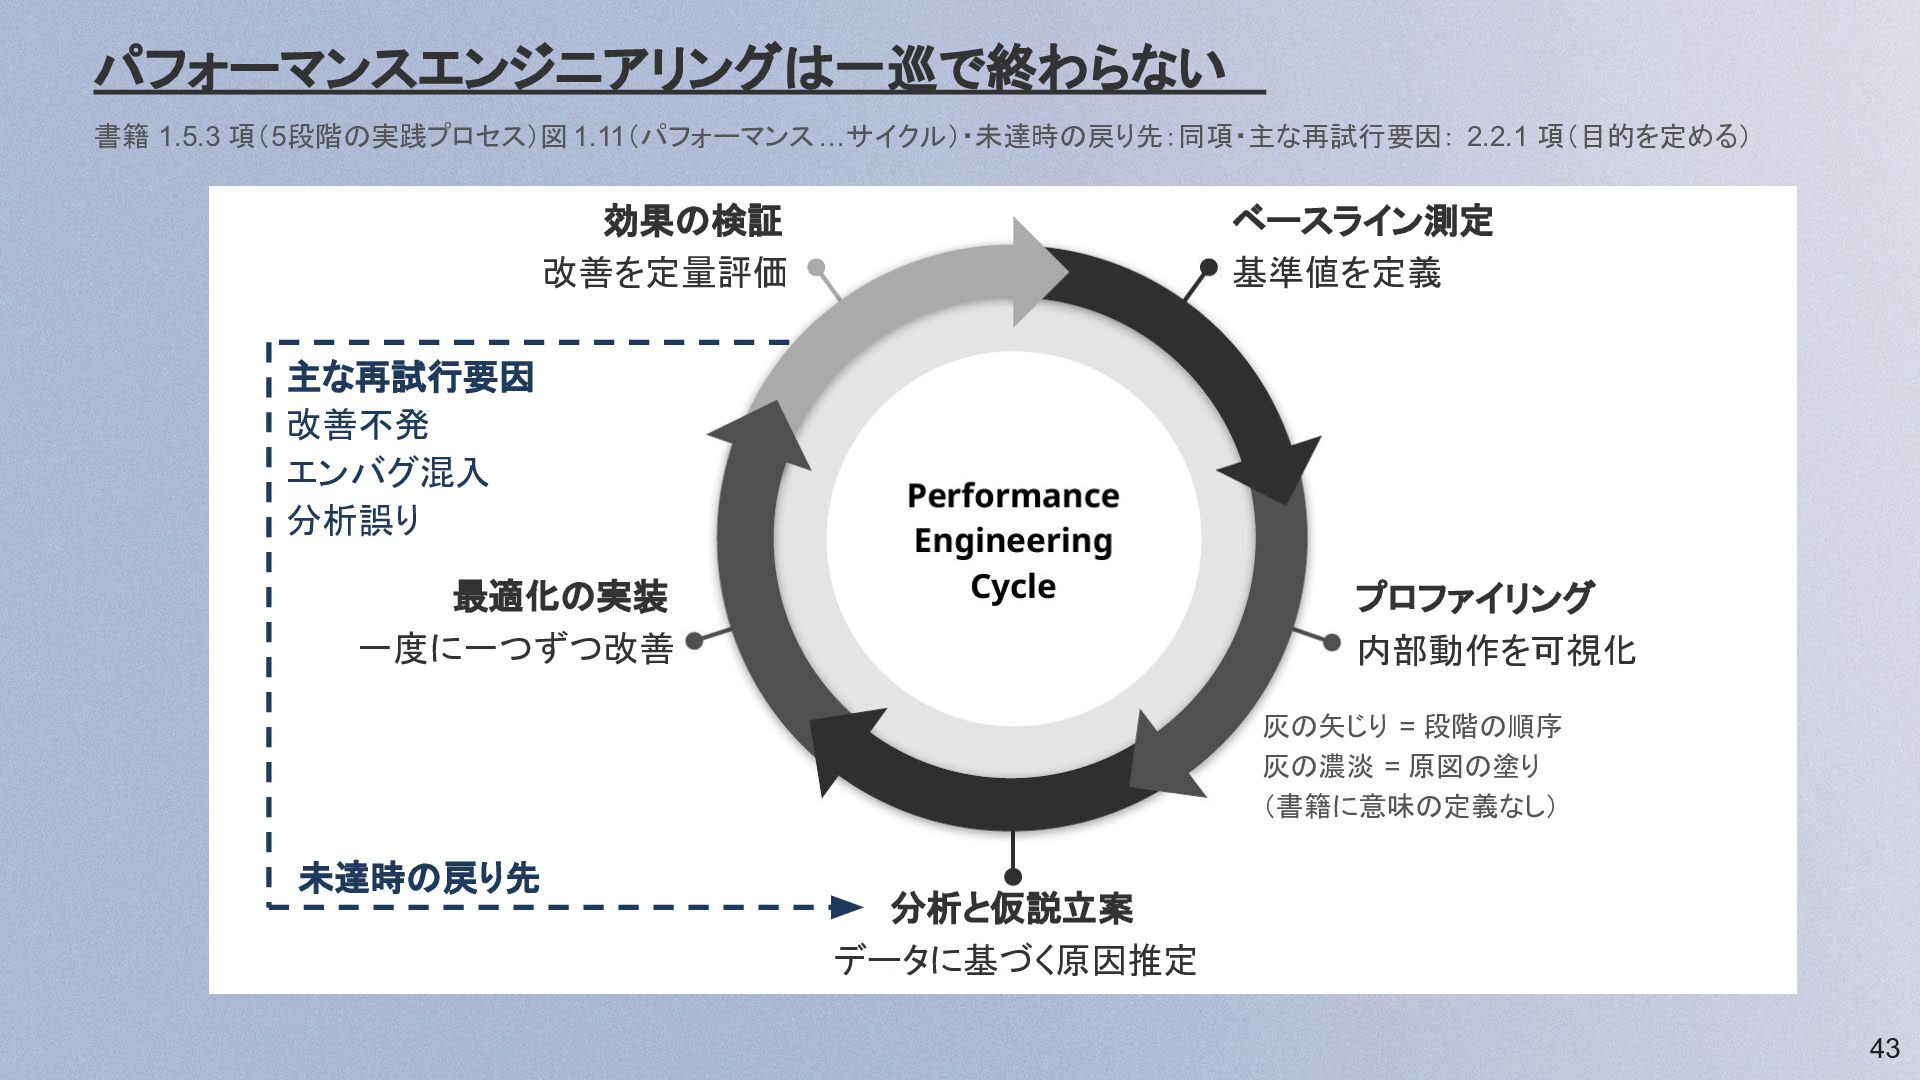
パフォーマンスエンジニアリングは一巡で終わらない 書籍 1.5.3 項(5段階の実践プロセス)図 1.11(パフォーマンス …サイクル)・未達時の戻り先:同項・主な再試行要因: 2.2.1 項(目的を定める) 効果の検証 改善を定量評価
ベースライン測定 基準値を定義 主な再試行要因 改善不発 エンバグ混入 分析誤り 最適化の実装 一度に一つずつ改善 プロファイリング 内部動作を可視化 灰の矢じり = 段階の順序 灰の濃淡 = 原図の塗り (書籍に意味の定義なし) 未達時の戻り先 分析と仮説立案 データに基づく原因推定 43 -
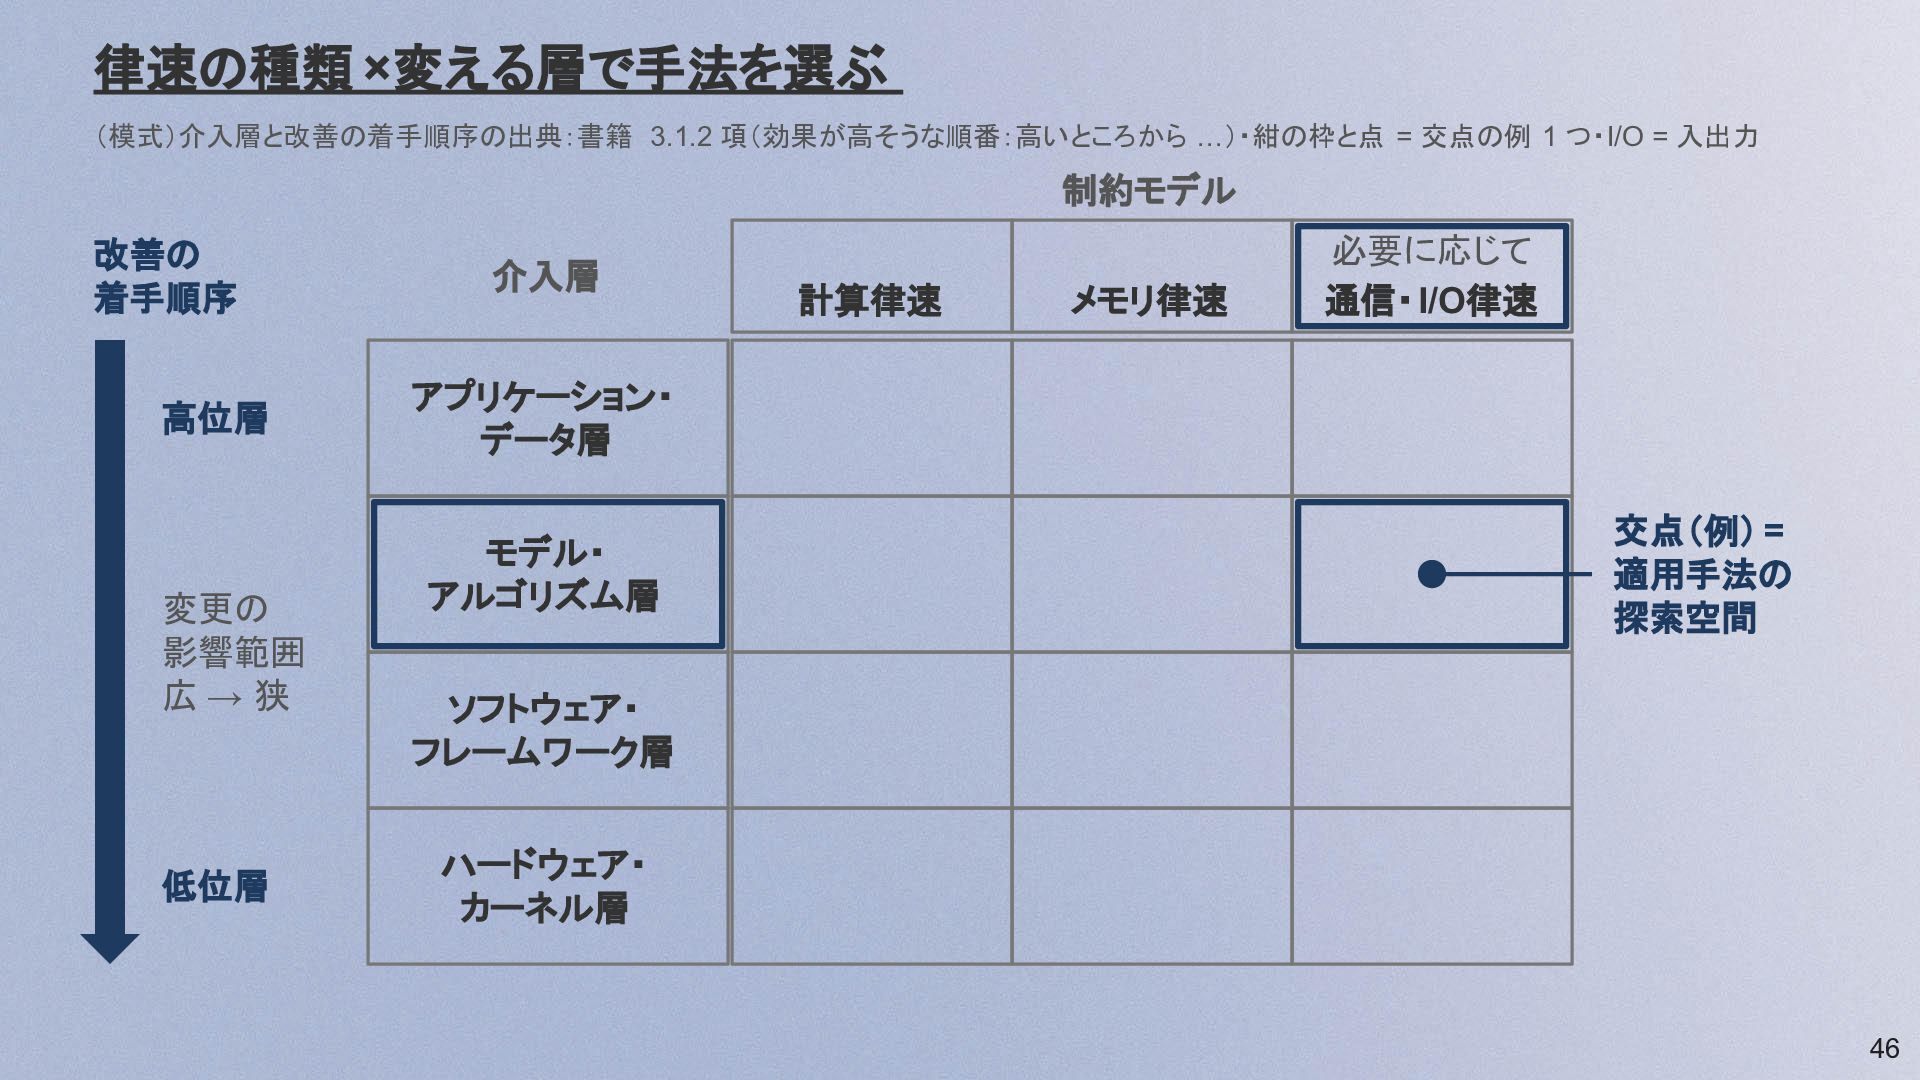
律速の種類 ×変える層で手法を選ぶ (模式)介入層と改善の着手順序の出典:書籍 3.1.2 項(効果が高そうな順番:高いところから …)・紺の枠と点 = 交点の例 1 つ・I/O
= 入出力 制約モデル 改善の 着手順序 高位層 変更の 影響範囲 広→狭 低位層 介入層 計算律速 メモリ律速 必要に応じて 通信・I/O律速 アプリケーション・ データ層 モデル・ アルゴリズム層 交点(例) = 適用手法の 探索空間 ソフトウェア・ フレームワーク層 ハードウェア・ カーネル層 46 -
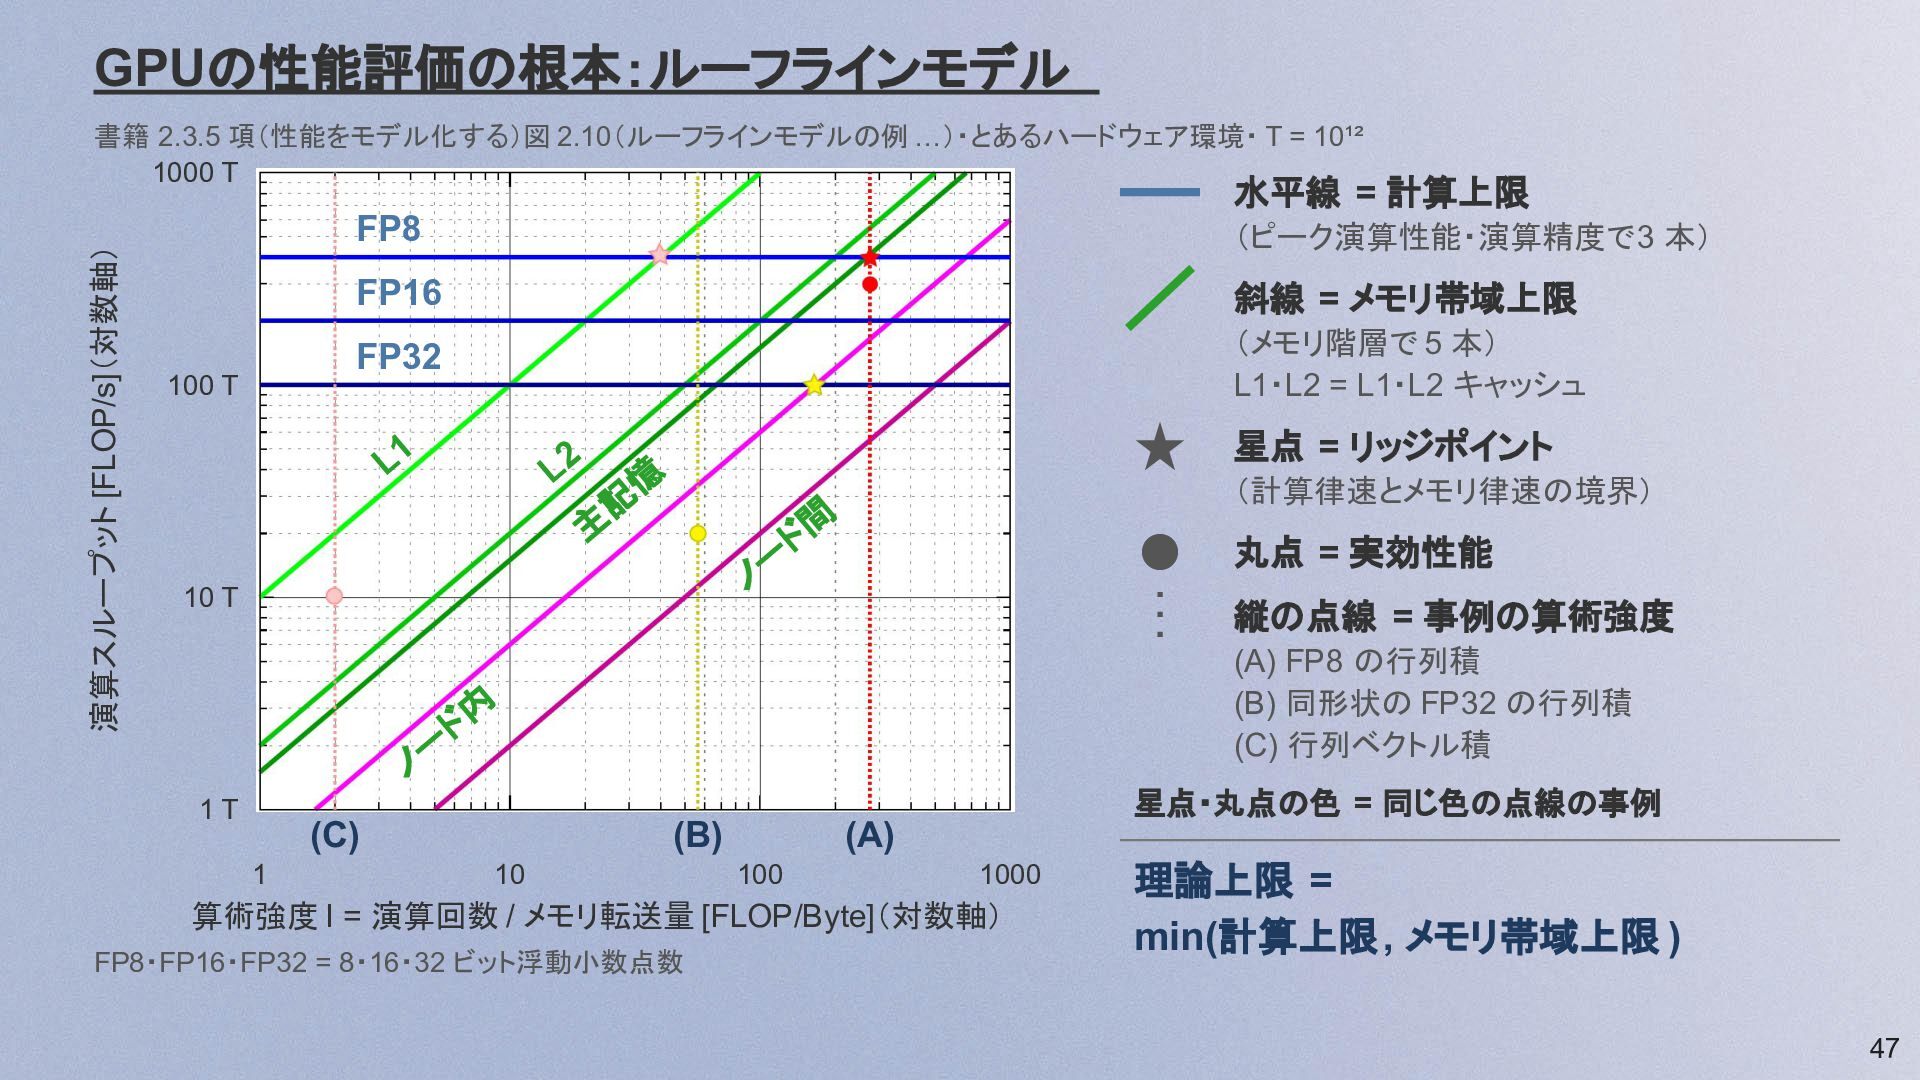
GPUの性能評価の根本:ルーフラインモデル 書籍 2.3.5 項(性能をモデル化する)図 2.10(ルーフラインモデルの例 …)・とあるハードウェア環境・ T = 10¹² 1000
T 演算スループット [FLOP/s](対数軸) 水平線 = 計算上限 100 T FP8 (ピーク演算性能・演算精度で 3 本) FP16 斜線 = メモリ帯域上限 FP32 (メモリ階層で 5 本) L1・L2 = L1・L2 キャッシュ L1 L2 星点 = リッジポイント 憶 記 (計算律速とメモリ律速の境界) ド間 ノー 主 10 T 丸点 = 実効性能 縦の点線 = 事例の算術強度 (A) FP8 の行列積 (B) 同形状の FP32 の行列積 (C) 行列ベクトル積 ド内 ノー 1T (C) 1 (B) 10 星点・丸点の色 = 同じ色の点線の事例 (A) 100 1000 算術強度 I = 演算回数 / メモリ転送量 [FLOP/Byte](対数軸) FP8・FP16・FP32 = 8・16・32 ビット浮動小数点数 理論上限 = min(計算上限 , メモリ帯域上限 ) 47 -
同じGPUでも上限は精度とメモリ階層で変わる 書籍 2.3.5 項(性能をモデル化する)図 2.10・とあるハードウェア環境・ M行K列 × K行N列の行列積:M=128, N=8192, K=1024・T
= 10¹² 1000 T 約400 FP8 400 演算スループット [FLOP/s](対数軸) 理論上限 [TFLOP/s] 丸点 = 実効性能 [TFLOP/s] 水平線 = 計算上限 [TFLOP/s](演算精度ごと) 斜線 = メモリ帯域上限 [TB/s](メモリ階層ごと) 星点 = リッジポイント(計算律速とメモリ律速の境界) 縦の点線 = 事例 (A)(B)(C) の算術強度 星点・丸点の色 = 同じ色の点線の事例 FP16 200 FP32 100 100 T L1 1 ノー 75% = 300 / 400 計算律速:上限 = FP8 のピーク演算性能 (B) 同形状の FP32(テンソル並列)・ I≈56 59% = 20 / 34 メモリ律速:上限 = ノード内帯域 0.6 TB/s (C) N=1 の GEMV(行列ベクトル積)・ I≈2 50% = 10 / 20 メモリ律速:上限 = L1 の帯域 10 TB/s 約34 2 6 0. ド間 0. ノー (C) 1 (A) FP8 の行列積・ I≈224 5 1. 記 主 ド内 1T L2 2. 憶 20 10 T 0 0 0. (B) 10 (A) 100 1000 算術強度 I = 演算回数 / メモリ転送量 [FLOP/Byte](対数軸) FP8・FP16・FP32 = 8・16・32 ビット浮動小数点数・ L1・L2 = L1・L2 キャッシュ 0 50 100 効率 [%] = 実効性能 / 理論上限 48 -
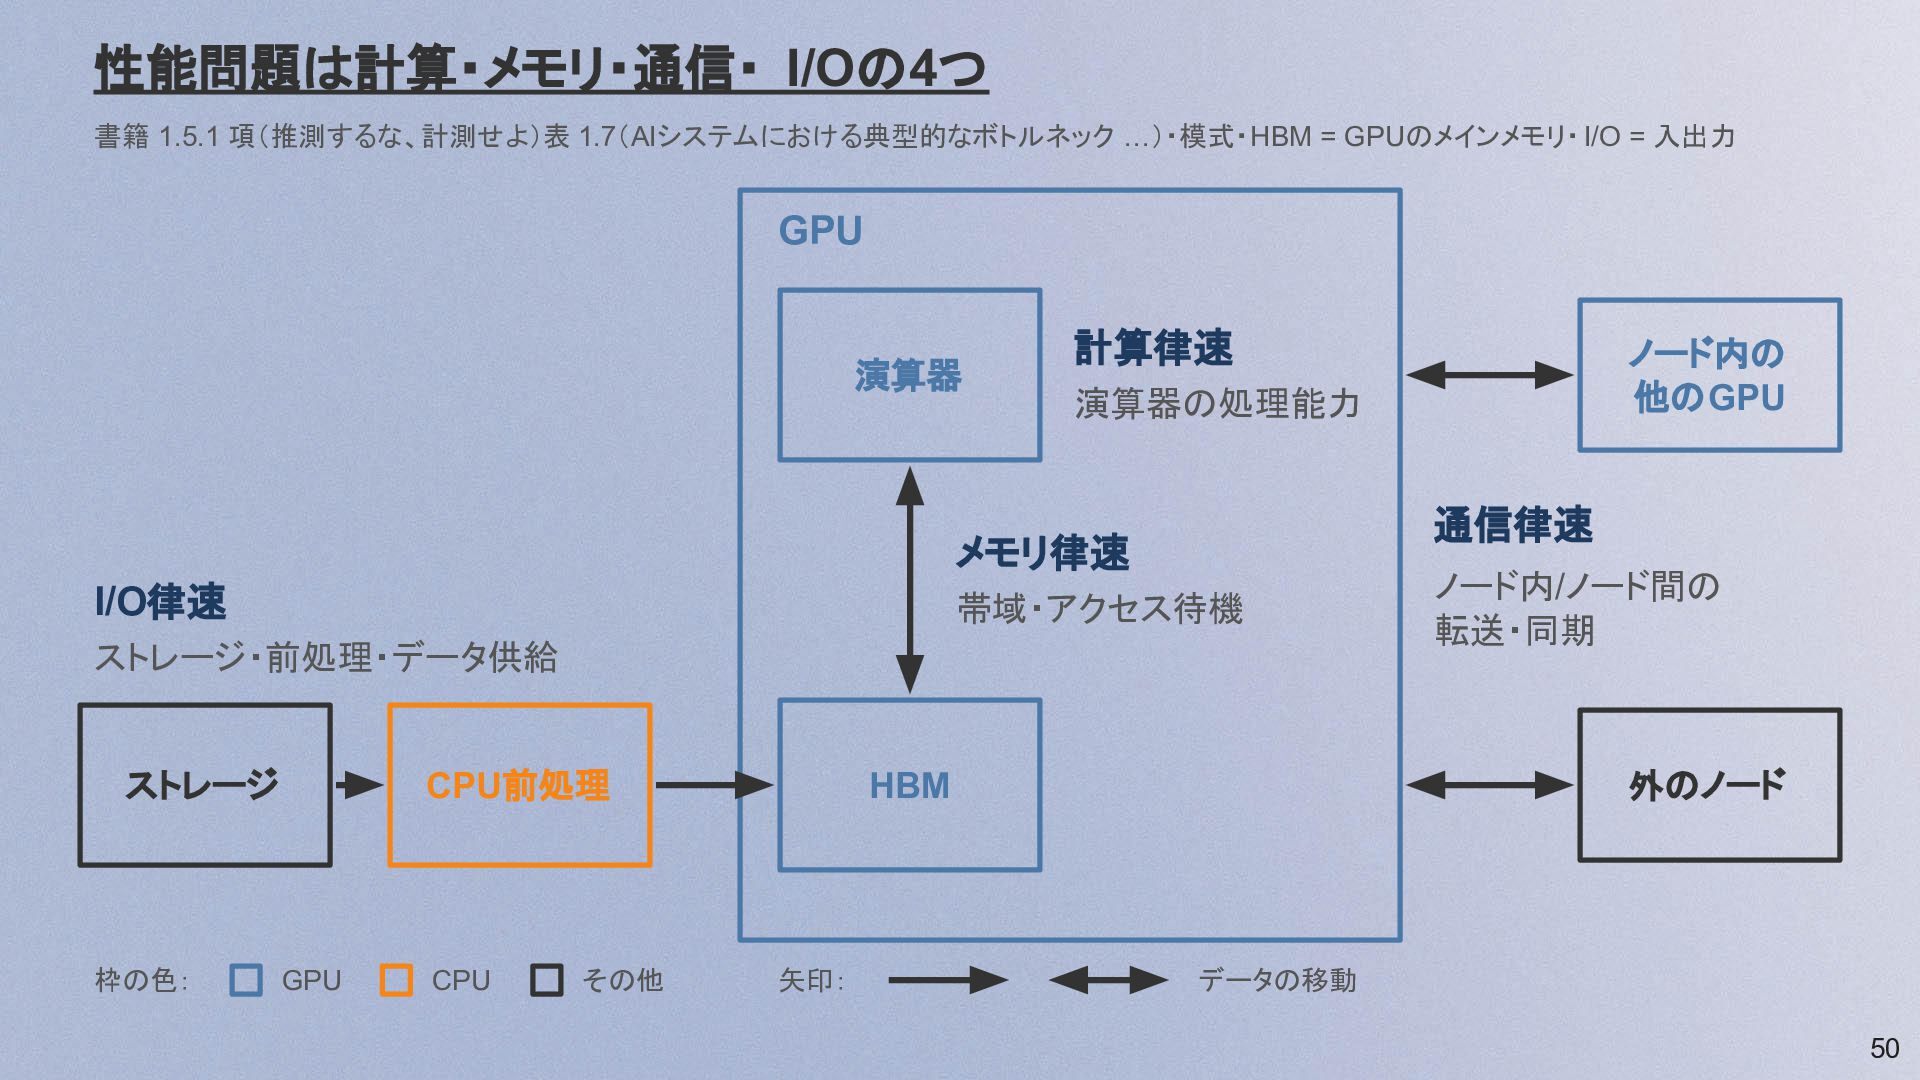
性能問題は計算・メモリ・通信・ I/Oの4つ 書籍 1.5.1 項(推測するな、計測せよ)表 1.7(AIシステムにおける典型的なボトルネック …)・模式・HBM = GPUのメインメモリ・ I/O
= 入出力 GPU 演算器 計算律速 演算器の処理能力 通信律速 メモリ律速 I/O律速 帯域・アクセス待機 ストレージ・前処理・データ供給 ストレージ 枠の色: GPU CPU その他 矢印: ノード内/ノード間の 転送・同期 外のノード HBM CPU前処理 ノード内の 他のGPU データの移動 50 -
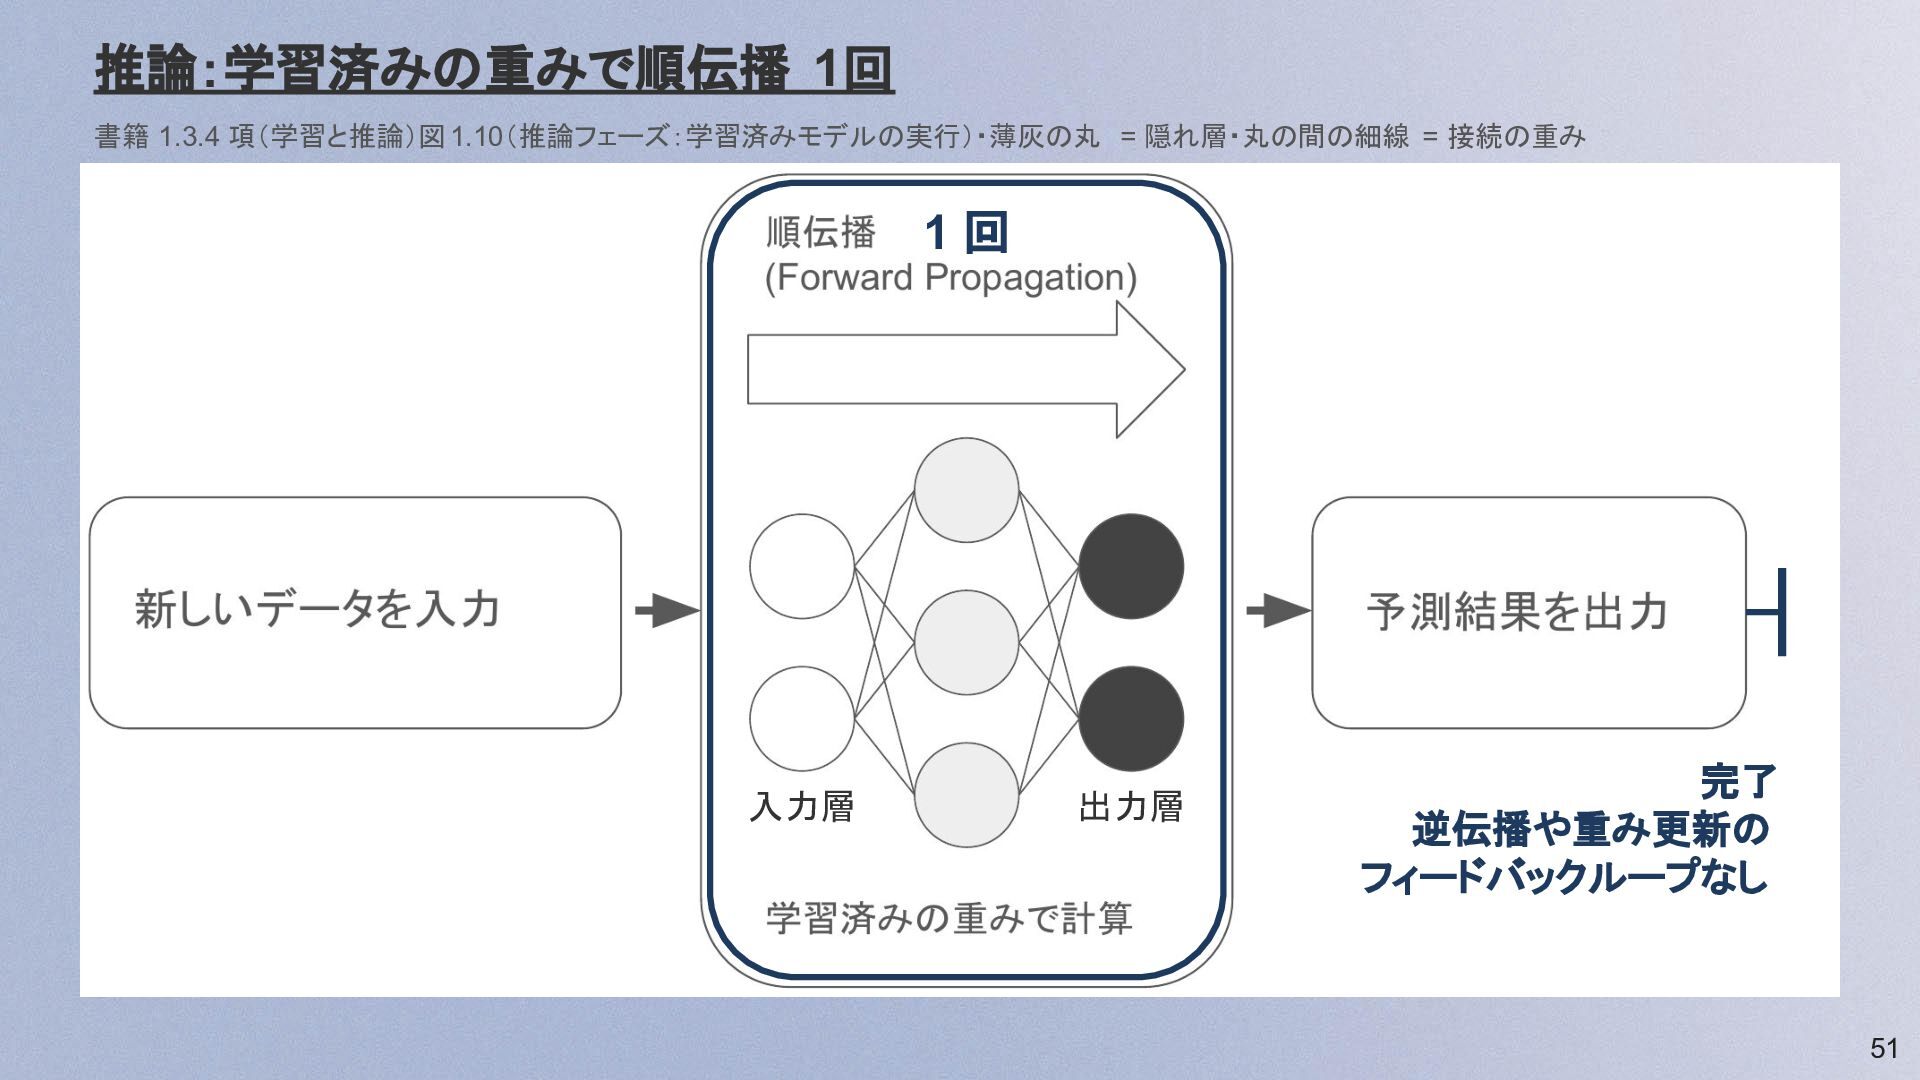
推論:学習済みの重みで順伝播 1回 書籍 1.3.4 項(学習と推論)図 1.10(推論フェーズ:学習済みモデルの実行)・薄灰の丸 = 隠れ層・丸の間の細線 = 接続の重み
1回 入力層 出力層 完了 逆伝播や重み更新の フィードバックループなし 51 -
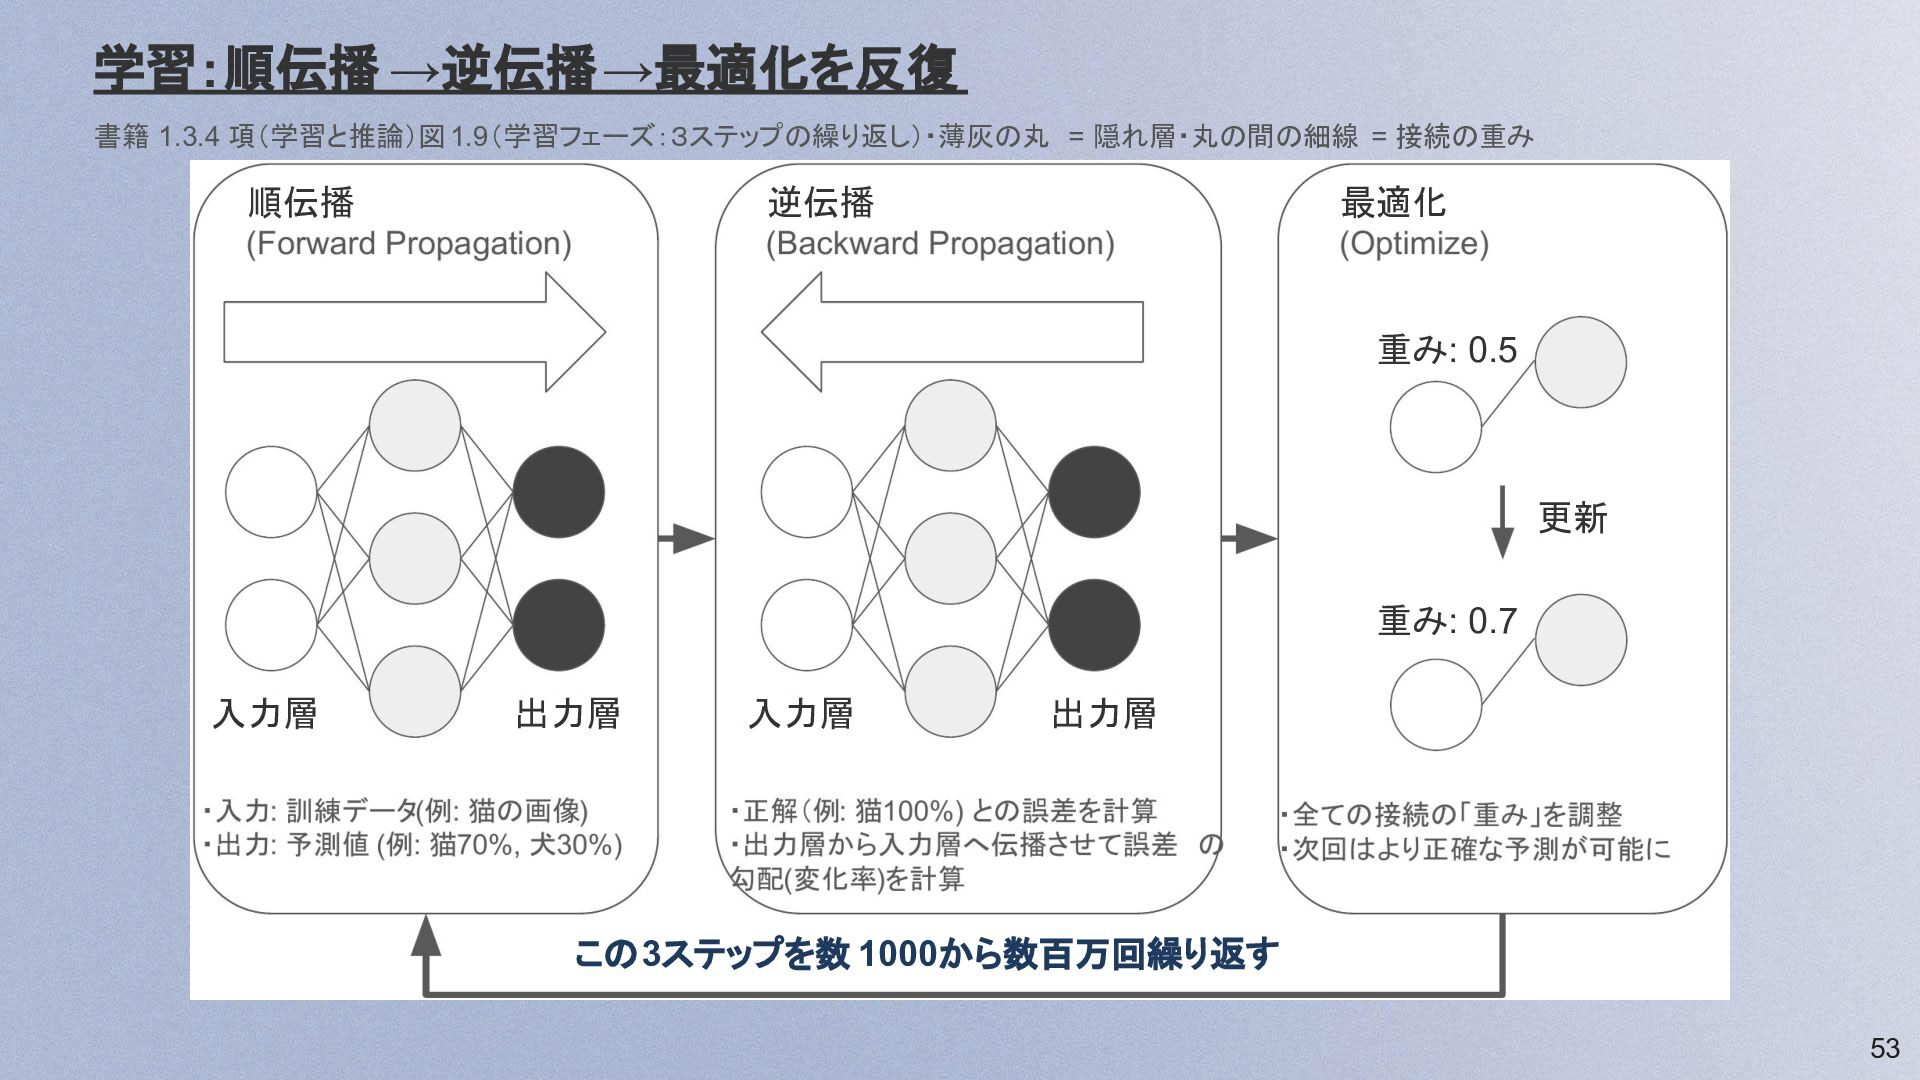
学習:順伝播 →逆伝播→最適化を反復 書籍 1.3.4 項(学習と推論)図 1.9(学習フェーズ:3ステップの繰り返し)・薄灰の丸 = 隠れ層・丸の間の細線 = 接続の重み
順伝播 逆伝播 最適化 重み: 0.5 更新 重み: 0.7 入力層 出力層 入力層 出力層 この3ステップを数 1000から数百万回繰り返す 53 -
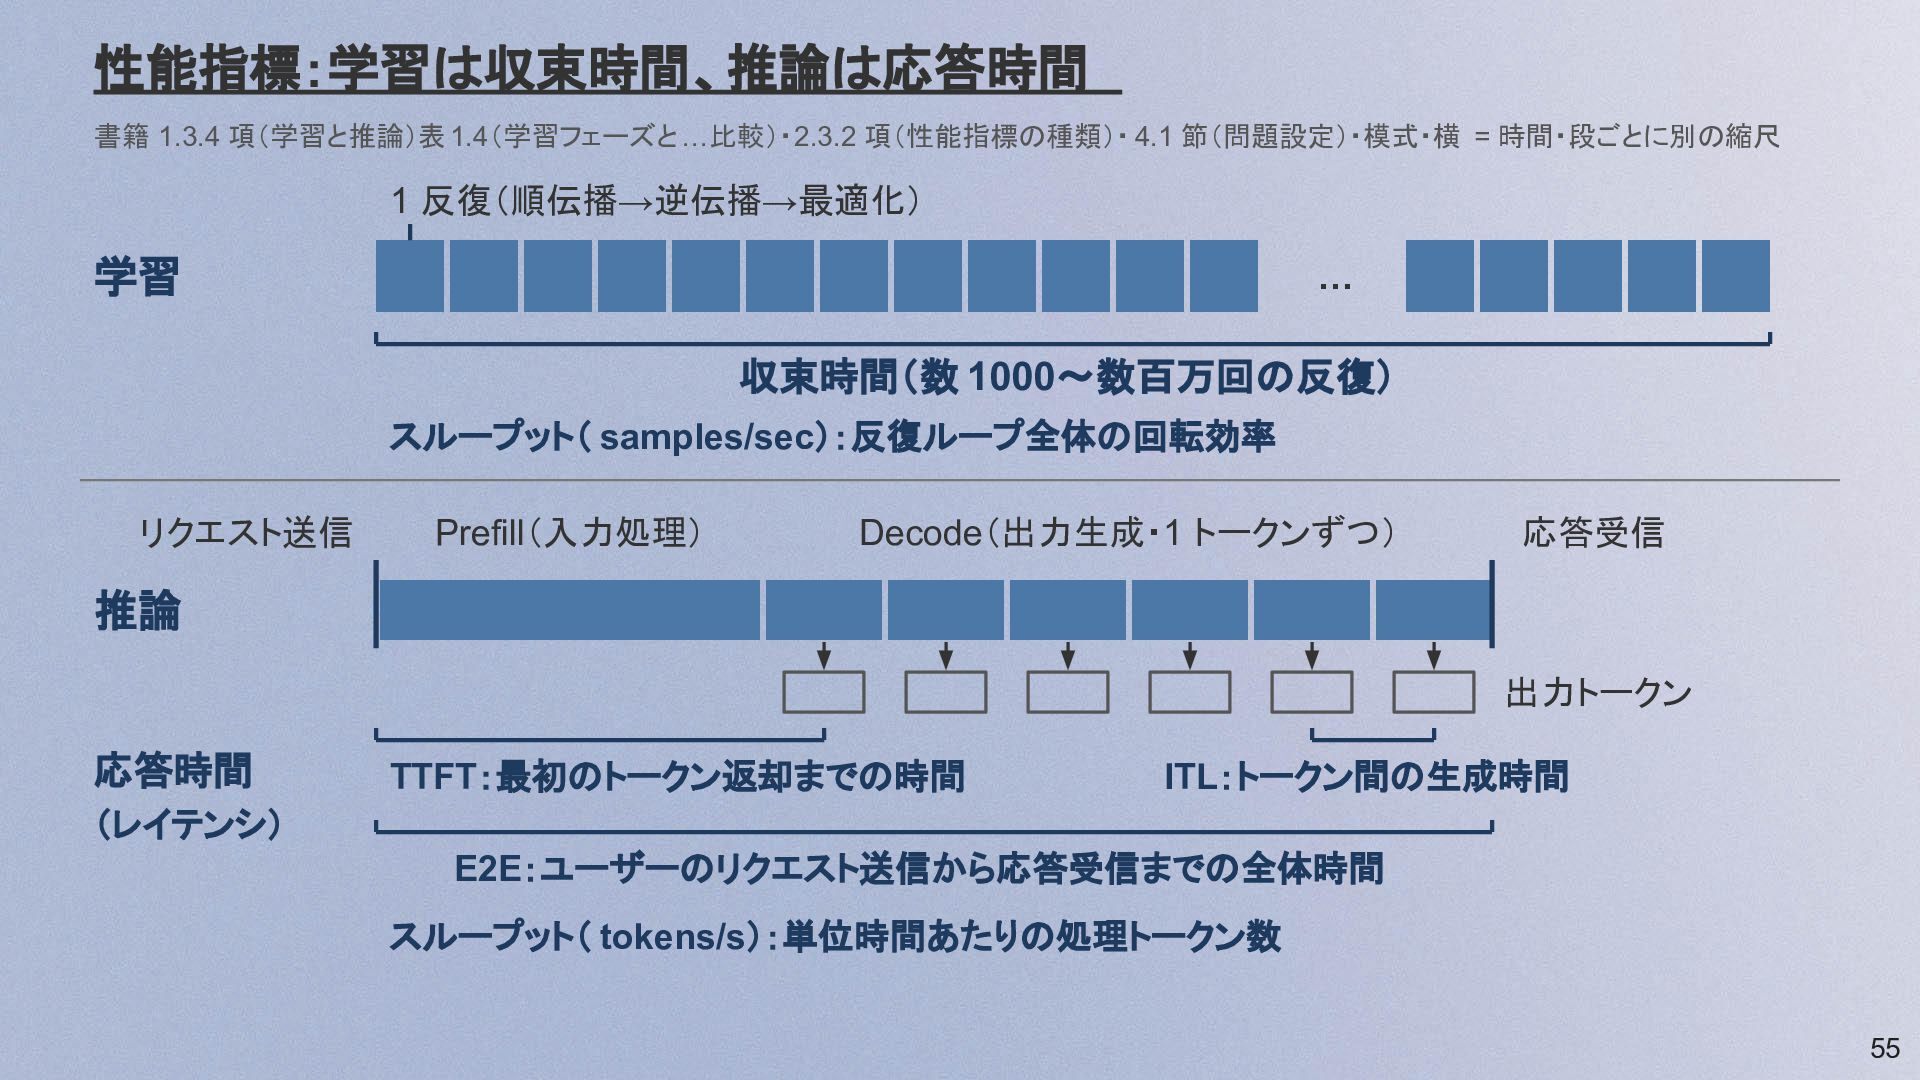
性能指標:学習は収束時間、推論は応答時間 書籍 1.3.4 項(学習と推論)表 1.4(学習フェーズと …比較)・2.3.2 項(性能指標の種類)・ 4.1 節(問題設定)・模式・横 =
時間・段ごとに別の縮尺 1 反復(順伝播→逆伝播→最適化) 学習 … 収束時間(数 1000〜数百万回の反復) スループット( samples/sec):反復ループ全体の回転効率 リクエスト送信 Prefill(入力処理) Decode(出力生成・1 トークンずつ) 応答受信 推論 出力トークン 応答時間 TTFT:最初のトークン返却までの時間 ITL:トークン間の生成時間 (レイテンシ) E2E:ユーザーのリクエスト送信から応答受信までの全体時間 スループット( tokens/s):単位時間あたりの処理トークン数 55 -
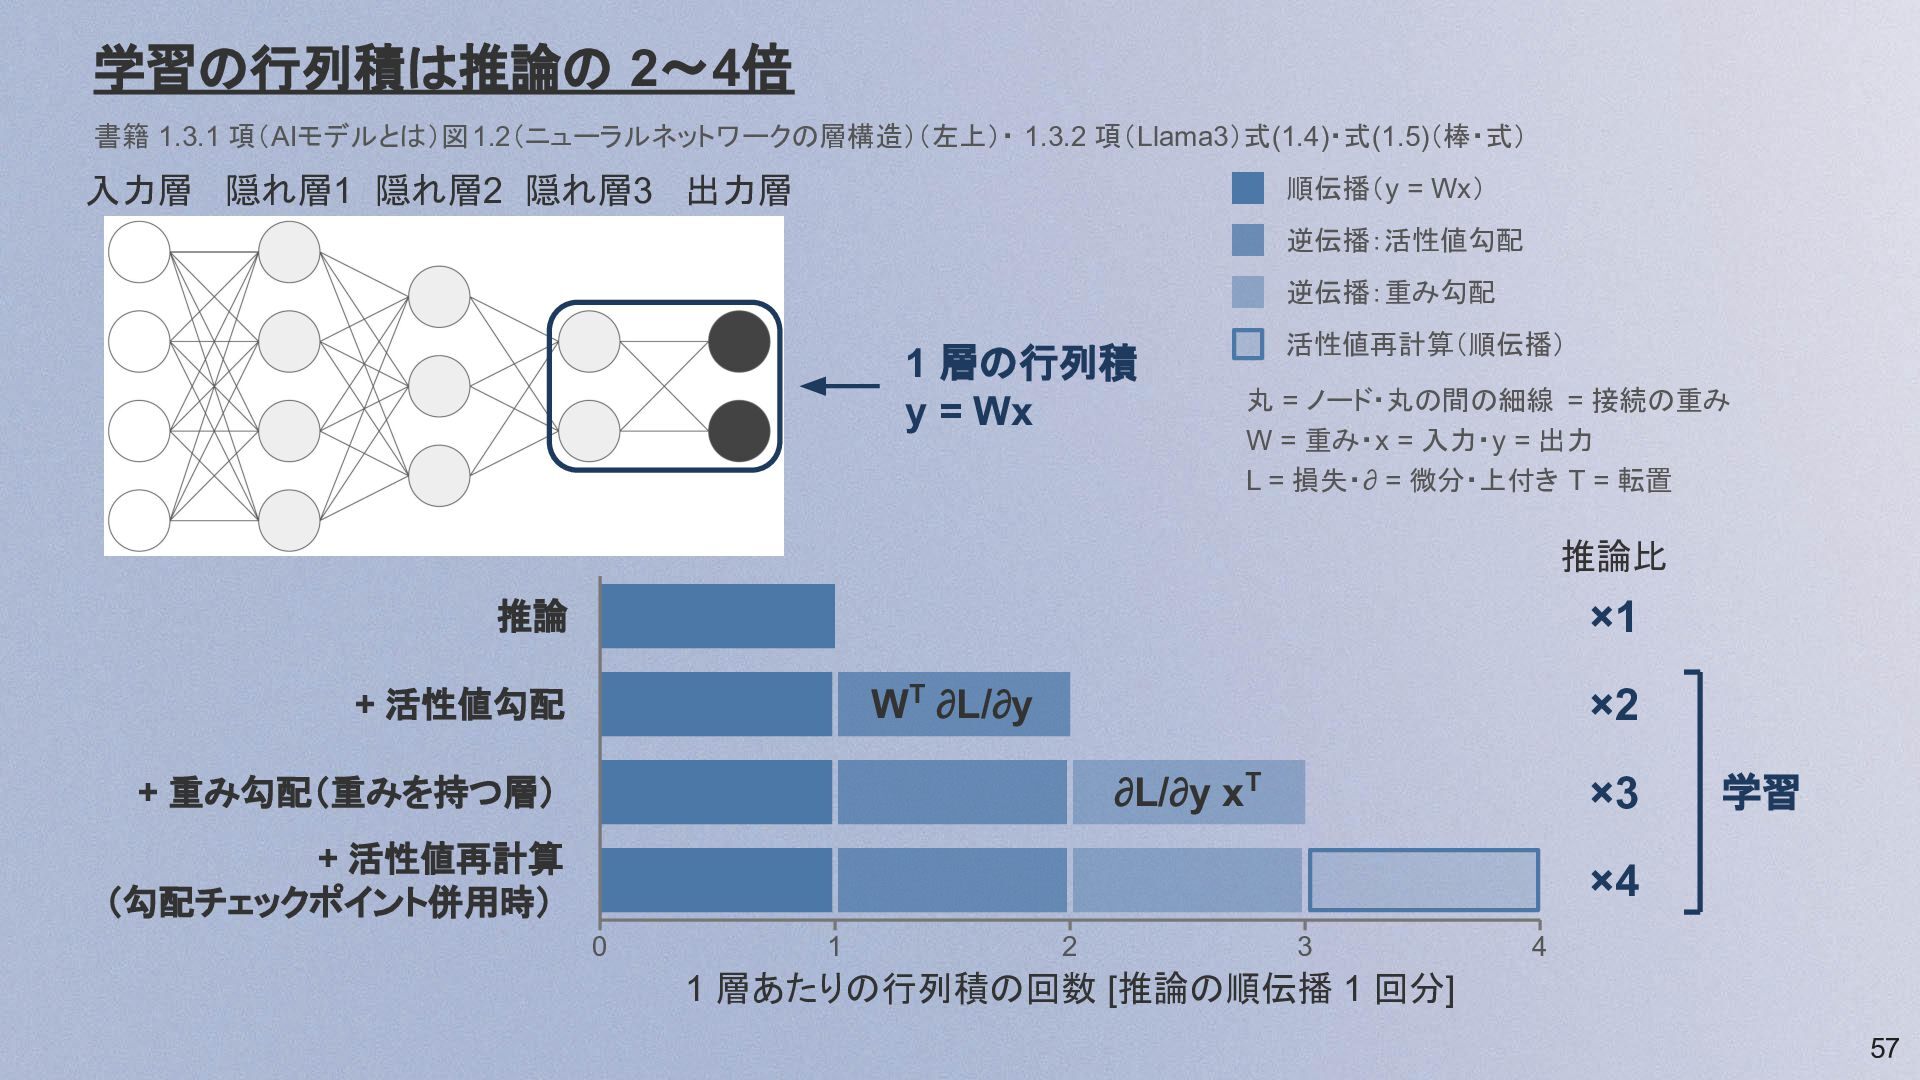
学習の行列積は推論の 2〜4倍 書籍 1.3.1 項(AIモデルとは)図 1.2(ニューラルネットワークの層構造)(左上)・ 1.3.2 項(Llama3)式(1.4)・式(1.5)(棒・式) 入力層 隠れ層1
隠れ層2 隠れ層3 出力層 順伝播(y = Wx) 逆伝播:活性値勾配 逆伝播:重み勾配 1 層の行列積 y = Wx 活性値再計算(順伝播) 丸 = ノード・丸の間の細線 = 接続の重み W = 重み・x = 入力・y = 出力 L = 損失・∂ = 微分・上付き T = 転置 推論比 推論 ×1 WT ∂L/∂y + 活性値勾配 ×2 ∂L/∂y xT + 重み勾配(重みを持つ層) ×3 + 活性値再計算 (勾配チェックポイント併用時) 学習 ×4 0 1 2 3 4 1 層あたりの行列積の回数 [推論の順伝播 1 回分] 57 -
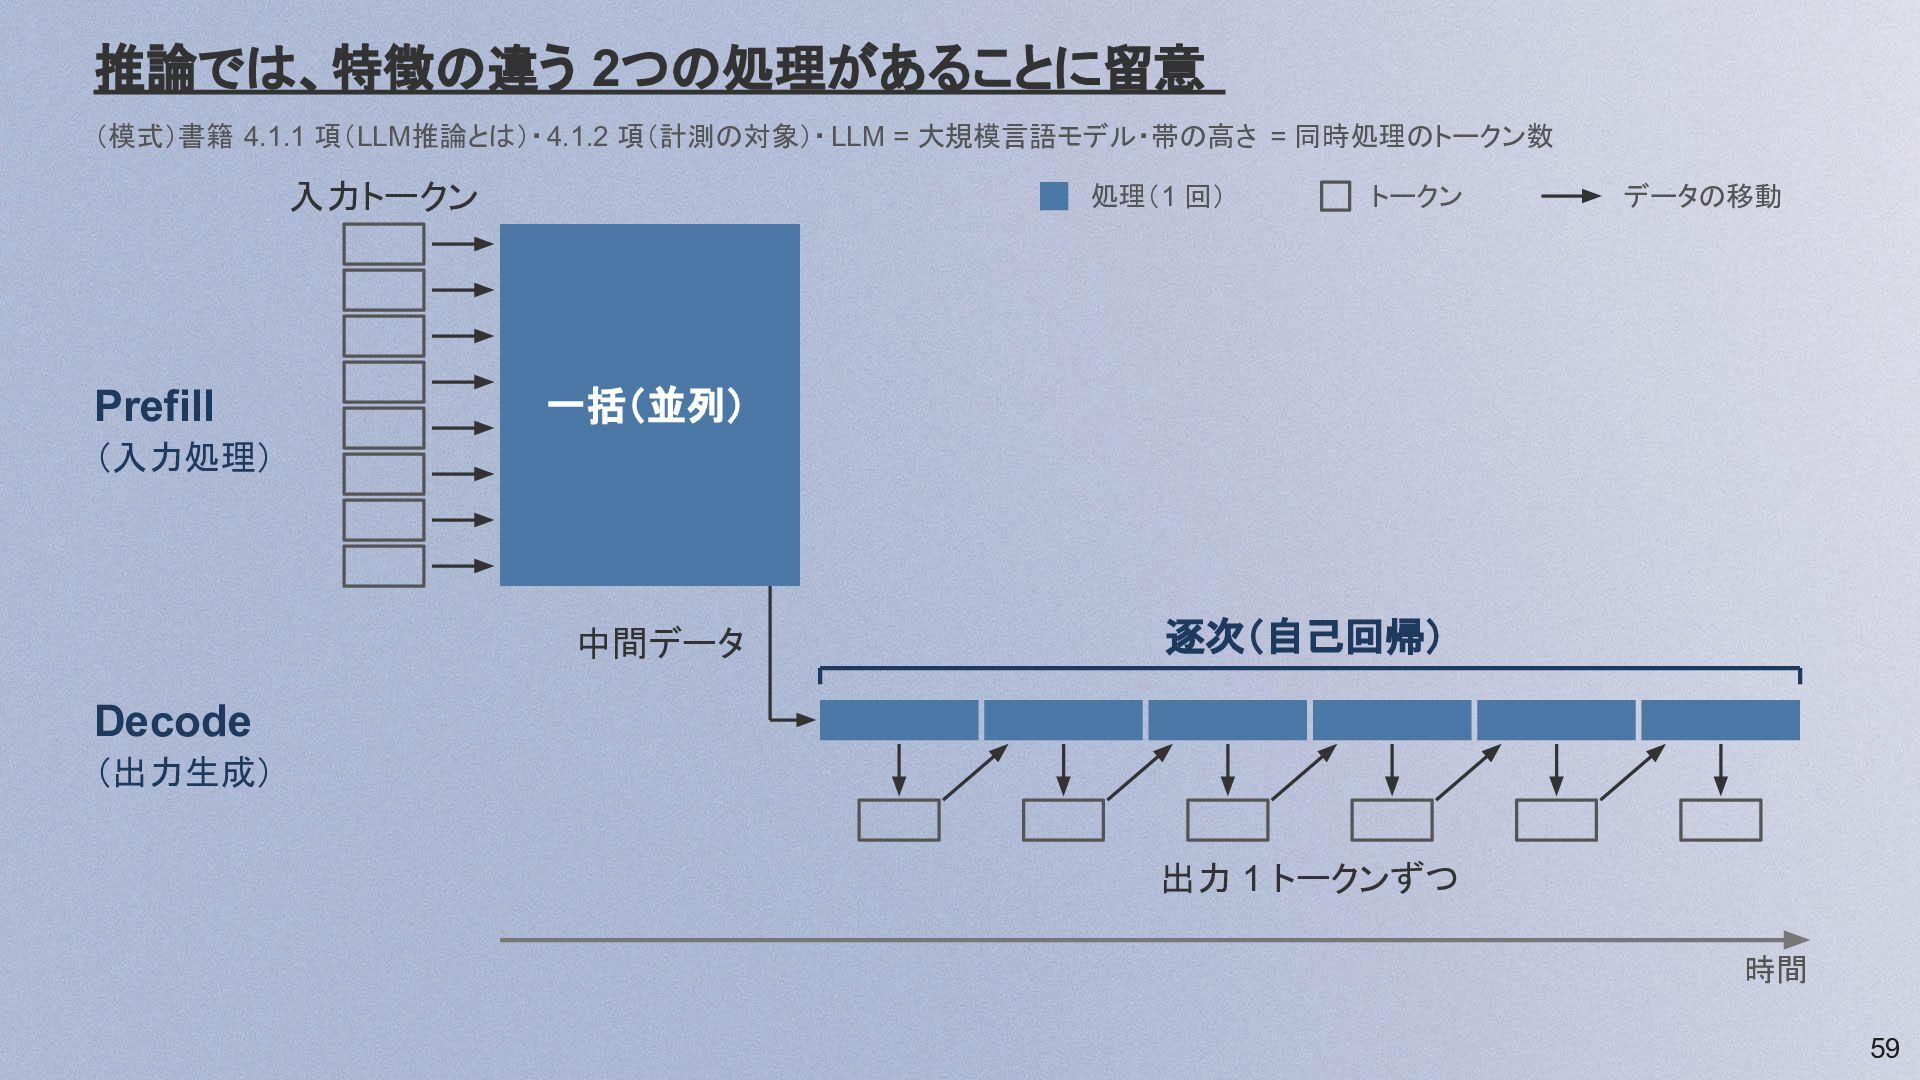
推論では、特徴の違う 2つの処理があることに留意 (模式)書籍 4.1.1 項(LLM推論とは)・4.1.2 項(計測の対象)・ LLM = 大規模言語モデル・帯の高さ =
同時処理のトークン数 入力トークン Prefill 処理(1 回) トークン データの移動 一括(並列) (入力処理) 中間データ 逐次(自己回帰) Decode (出力生成) 出力 1 トークンずつ 時間 59 -
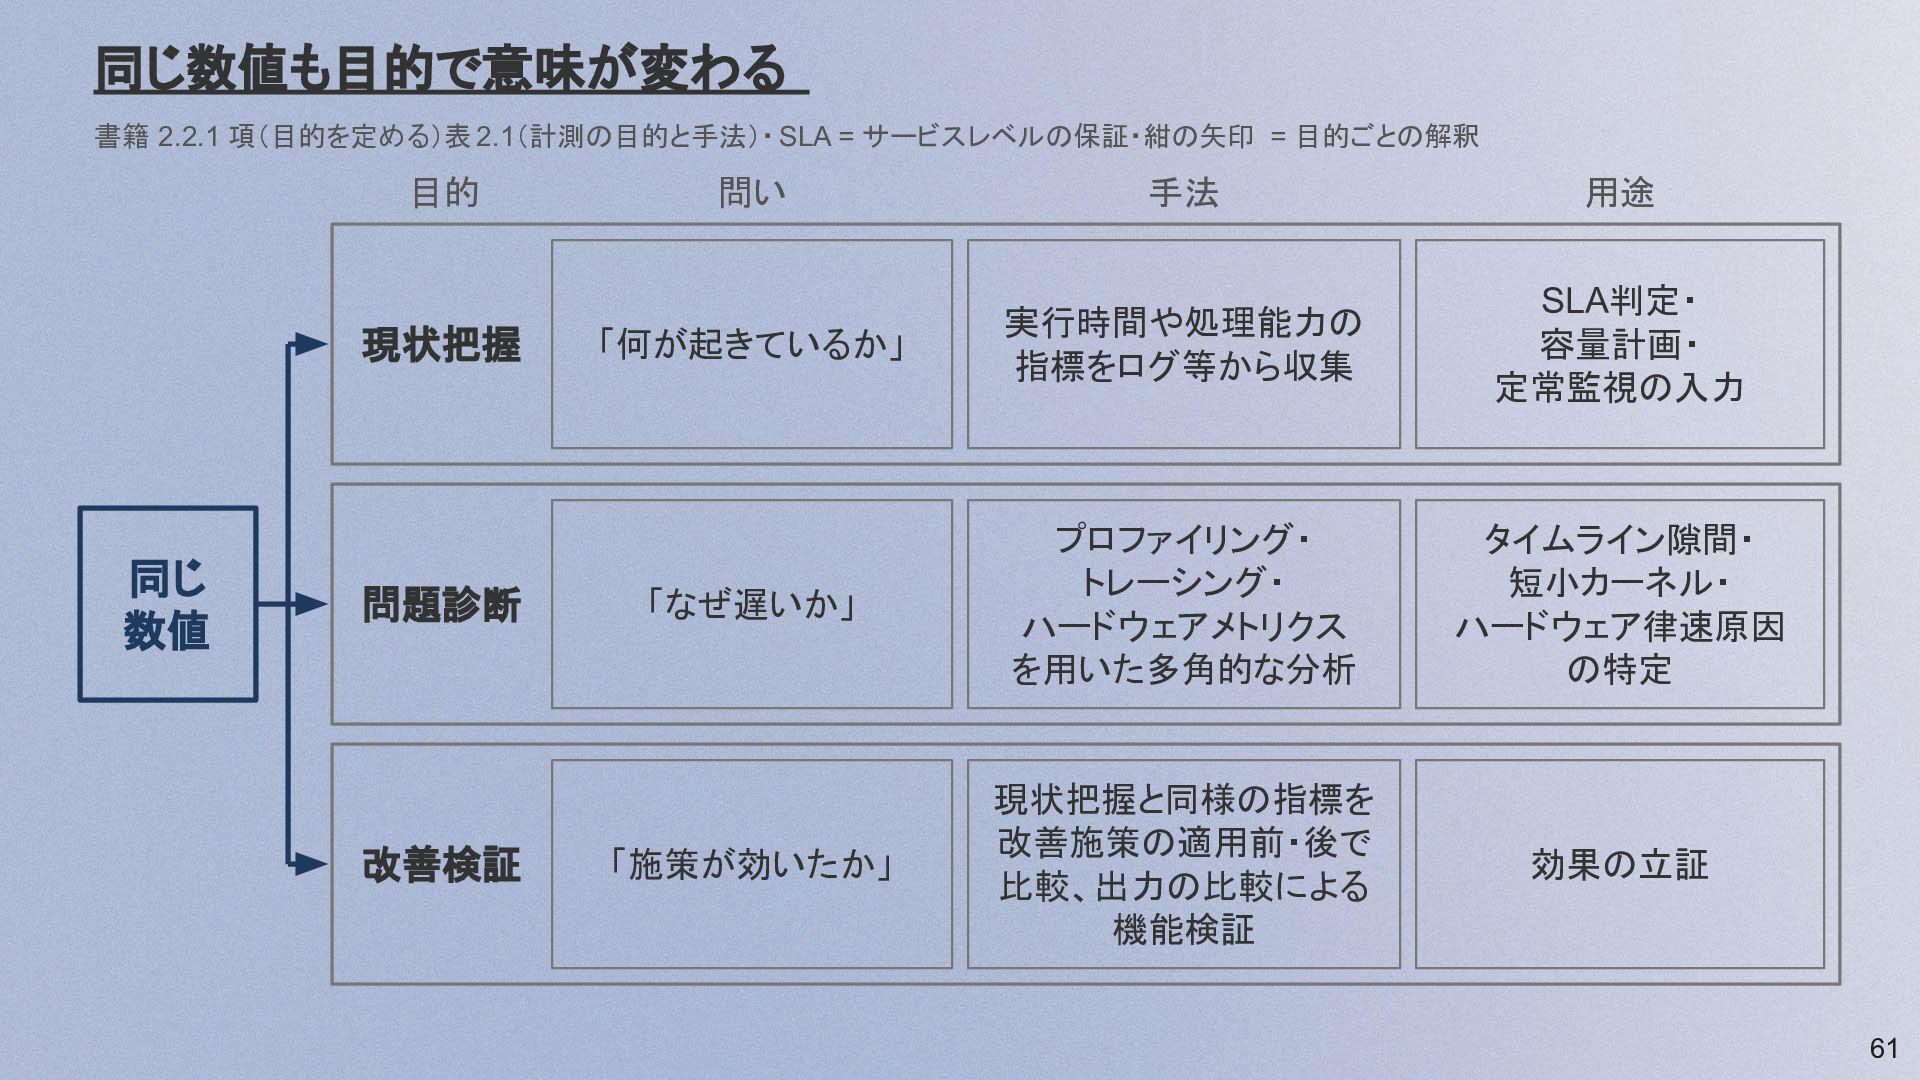
同じ数値も目的で意味が変わる 書籍 2.2.1 項(目的を定める)表 2.1(計測の目的と手法)・ SLA = サービスレベルの保証・紺の矢印 = 目的ごとの解釈
目的 現状把握 同じ 数値 問題診断 改善検証 問い 手法 用途 「何が起きているか」 実行時間や処理能力の 指標をログ等から収集 SLA判定・ 容量計画・ 定常監視の入力 「なぜ遅いか」 プロファイリング・ トレーシング・ ハードウェアメトリクス を用いた多角的な分析 タイムライン隙間・ 短小カーネル・ ハードウェア律速原因 の特定 「施策が効いたか」 現状把握と同様の指標を 改善施策の適用前・後で 比較、出力の比較による 機能検証 効果の立証 61 -
比べる相手で問いが変わる (模式)書籍 2.2.1 項(目的を定める)・ 2.2.3 項(理論性能と実効性能の差 …)・2.3.2 項(性能指標の種類)・ 2.3.3 項(性能指標の取り扱い)
性能(上ほど高速) 理論上限 理論比較 「上限に近づいたのか」 改善後 競合/代替比較 前後比較 「他手法より優位か」 「改善したのか」 他実装(同条件) 改善前 同条件の固定 (比較成立の前提) 合わせない差分 比べる相手との差 単位(ms/µs, tokens/sec など) 実行条件(並行プロセス競合、ネットワーク/ストレージ I/O 競合) 改善効果ではなく環境差分 改善後の性能 I/O = 入出力 63 -
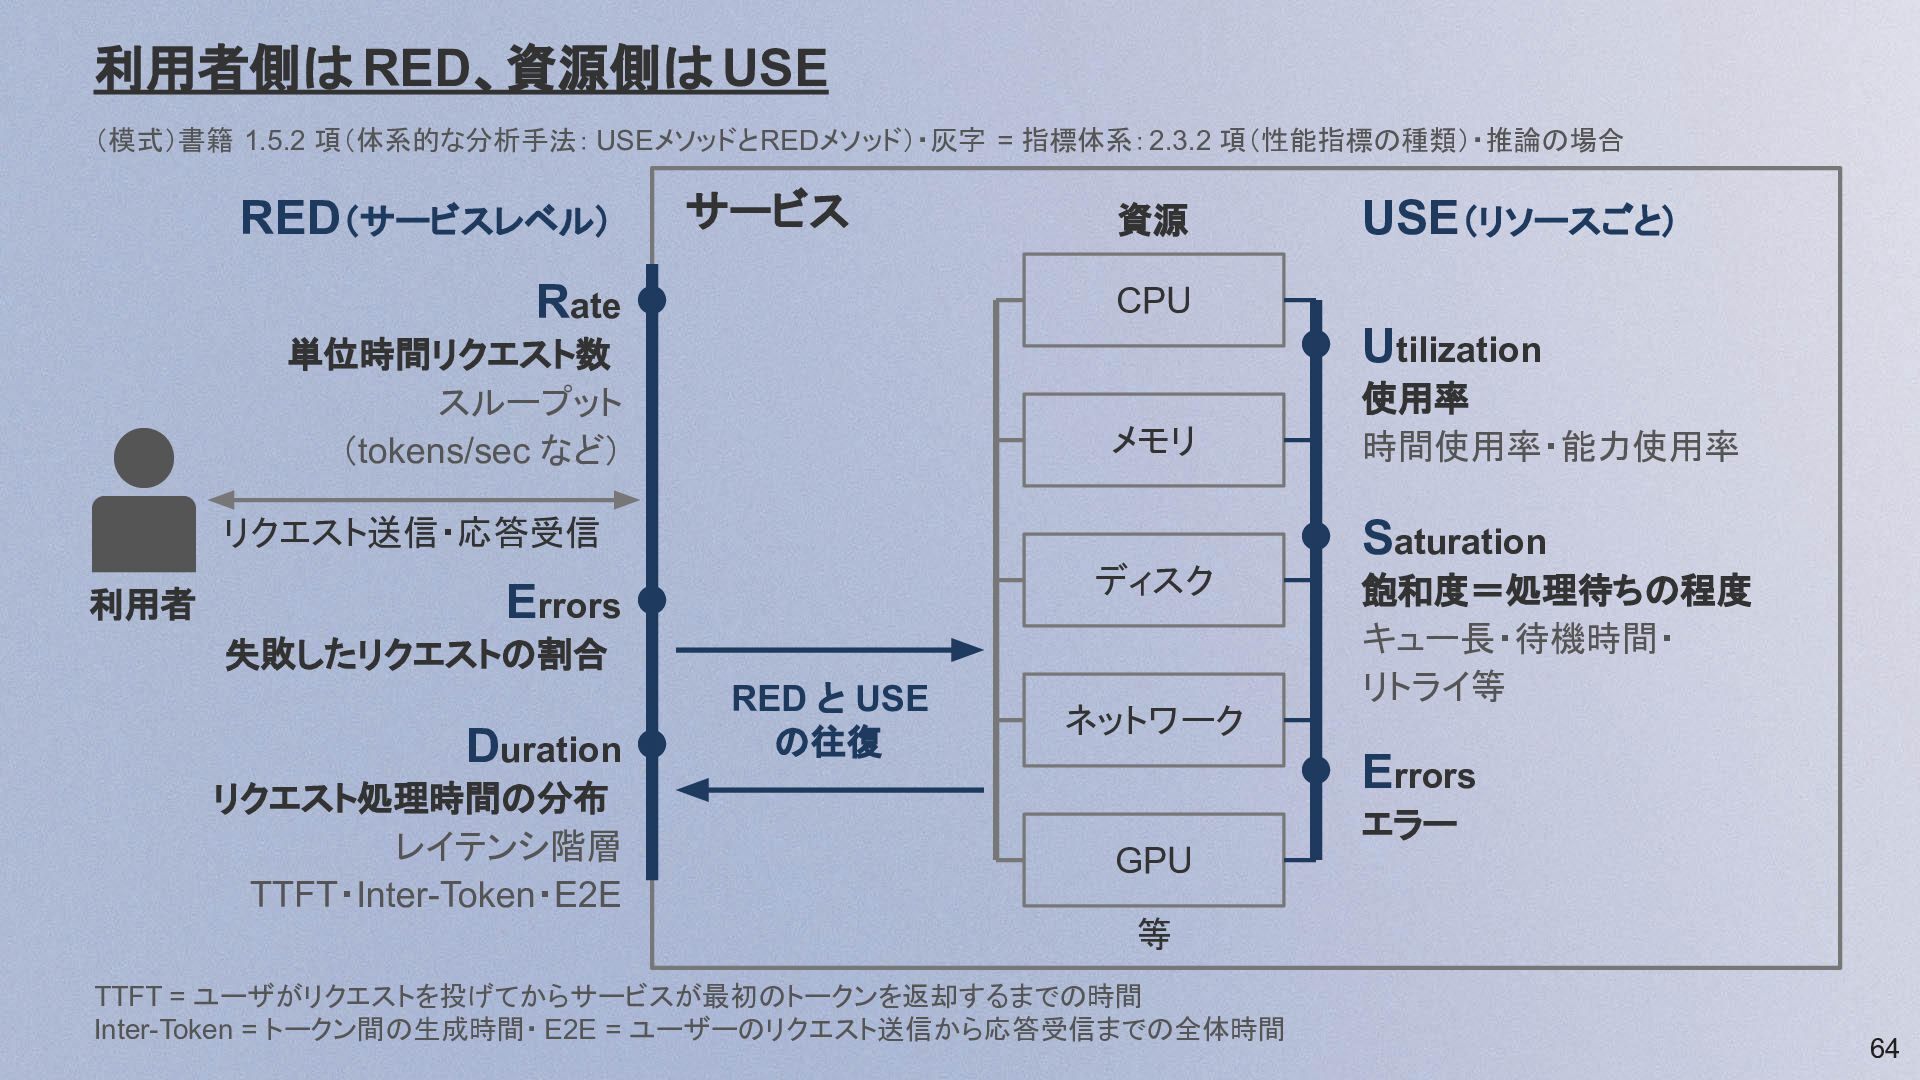
利用者側は RED、資源側は USE (模式)書籍 1.5.2 項(体系的な分析手法: USEメソッドとREDメソッド)・灰字 = 指標体系:2.3.2 項(性能指標の種類)・推論の場合
RED(サービスレベル) サービス Rate 資源 CPU Utilization 単位時間リクエスト数 スループット (tokens/sec など) メモリ リクエスト送信・応答受信 利用者 ディスク Errors 失敗したリクエストの割合 Duration リクエスト処理時間の分布 レイテンシ階層 TTFT・Inter-Token・E2E USE(リソースごと) RED と USE の往復 ネットワーク 使用率 時間使用率・能力使用率 Saturation 飽和度=処理待ちの程度 キュー長・待機時間・ リトライ等 Errors エラー GPU 等 TTFT = ユーザがリクエストを投げてからサービスが最初のトークンを返却するまでの時間 Inter-Token = トークン間の生成時間・ E2E = ユーザーのリクエスト送信から応答受信までの全体時間 64 -
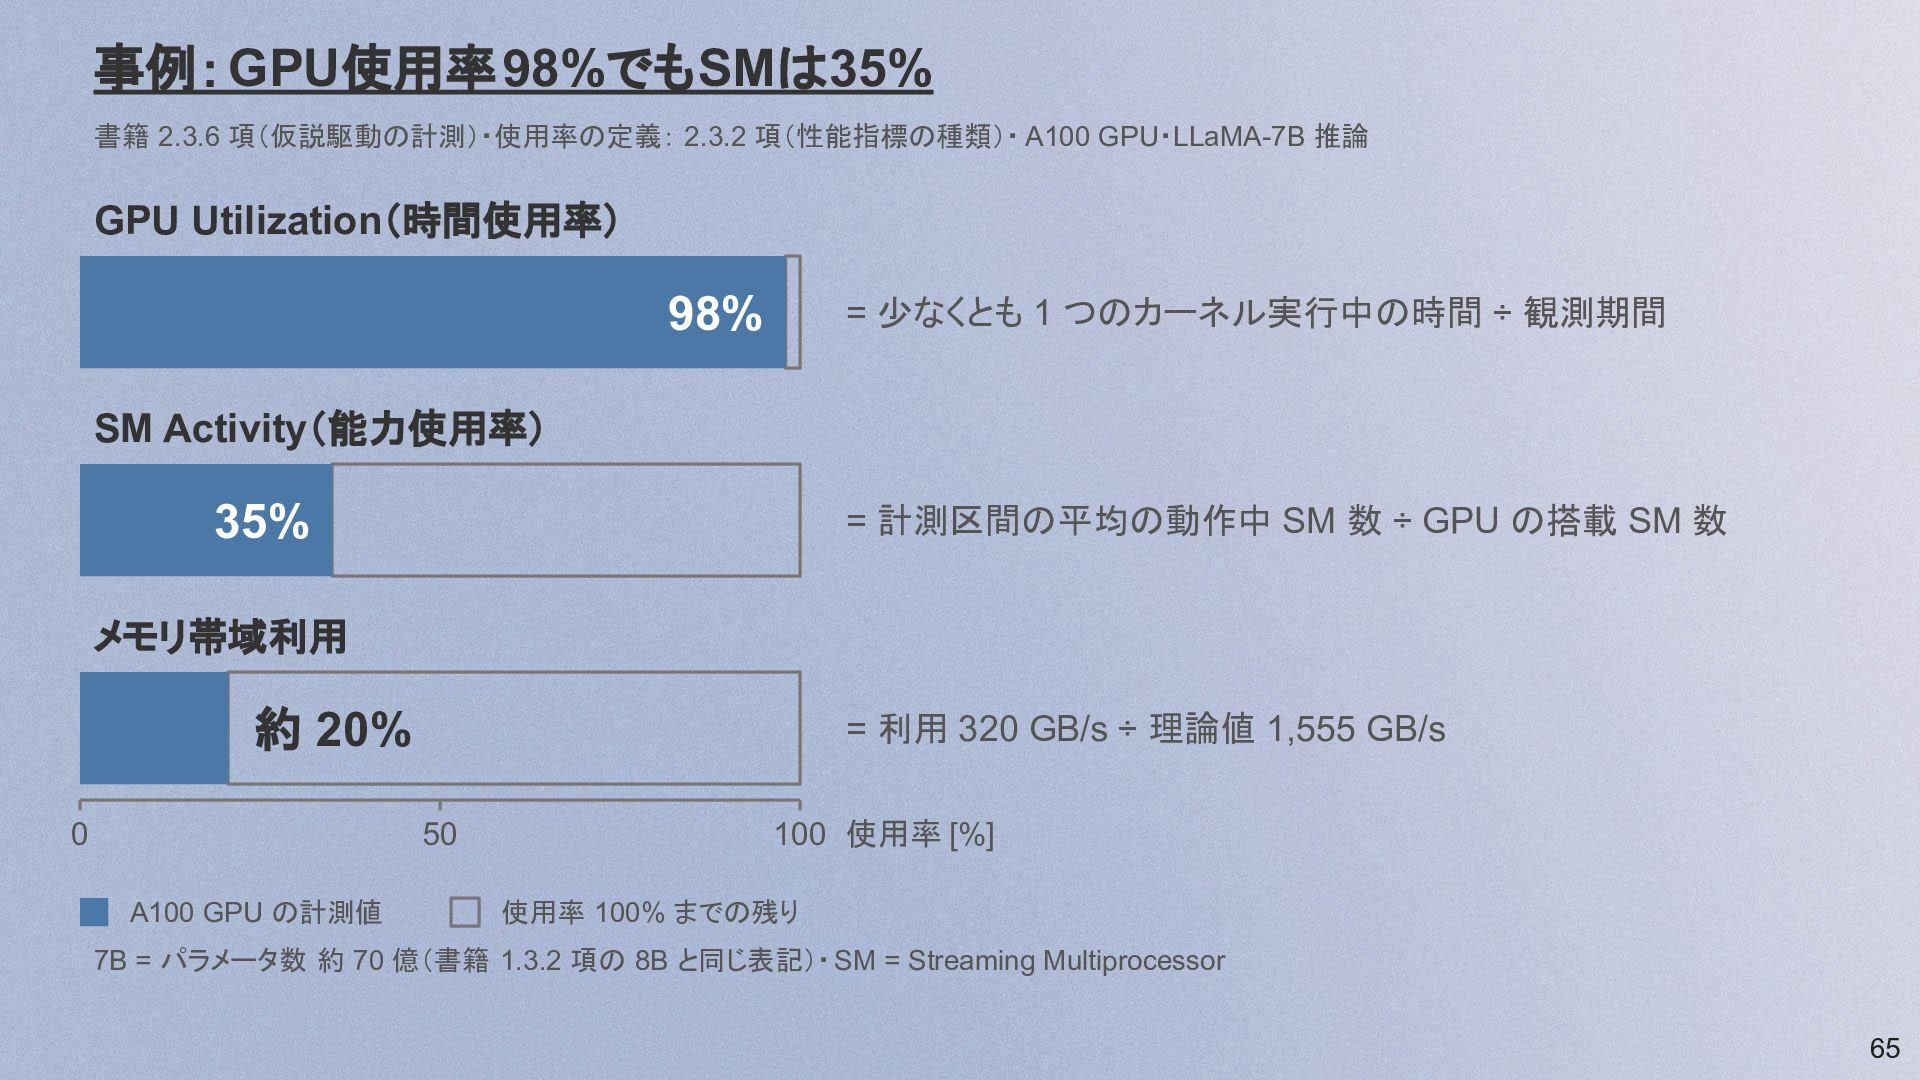
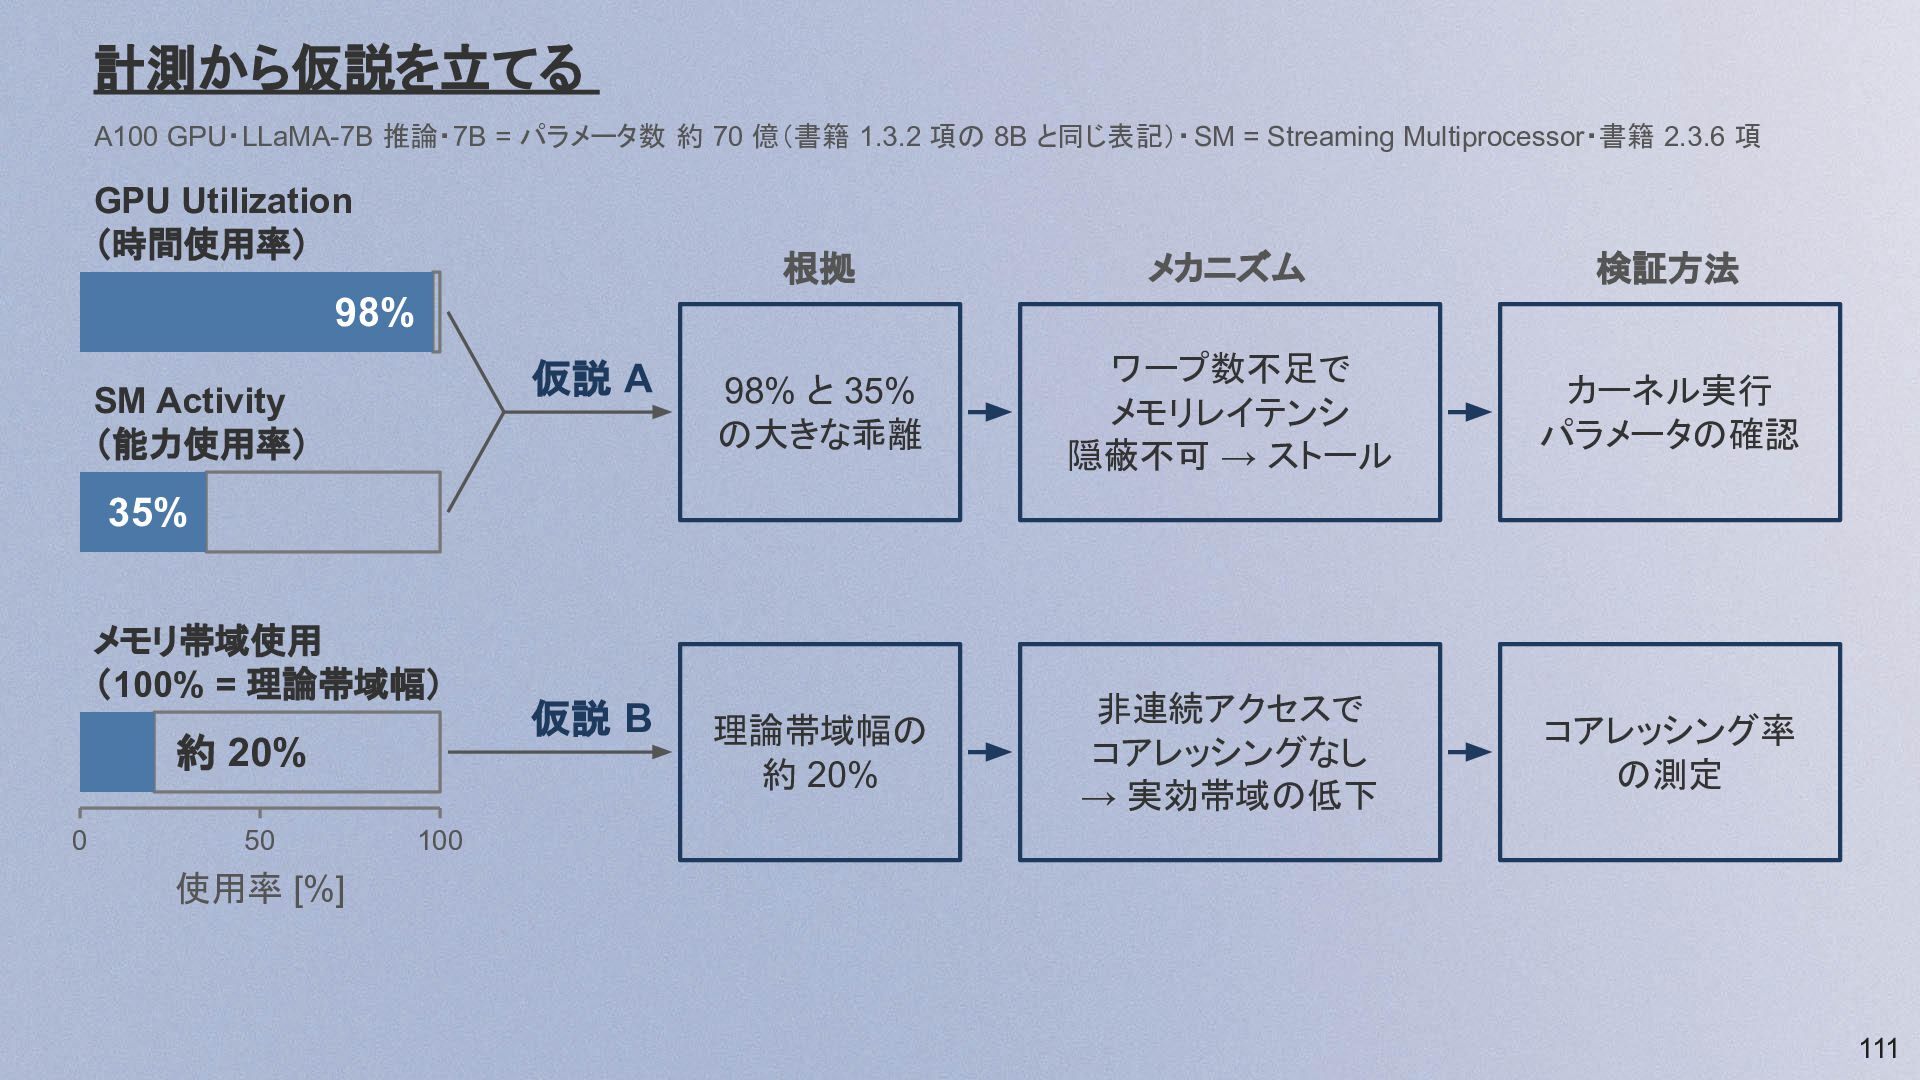
事例:GPU使用率98%でもSMは35% 書籍 2.3.6 項(仮説駆動の計測)・使用率の定義: 2.3.2 項(性能指標の種類)・ A100 GPU・LLaMA-7B 推論 GPU
Utilization(時間使用率) = 少なくとも 1 つのカーネル実行中の時間 ÷ 観測期間 98% SM Activity(能力使用率) = 計測区間の平均の動作中 SM 数 ÷ GPU の搭載 SM 数 35% メモリ帯域利用 約 20% 0 = 利用 320 GB/s ÷ 理論値 1,555 GB/s 50 A100 GPU の計測値 100 使用率 [%] 使用率 100% までの残り 7B = パラメータ数 約 70 億(書籍 1.3.2 項の 8B と同じ表記)・ SM = Streaming Multiprocessor 65 -
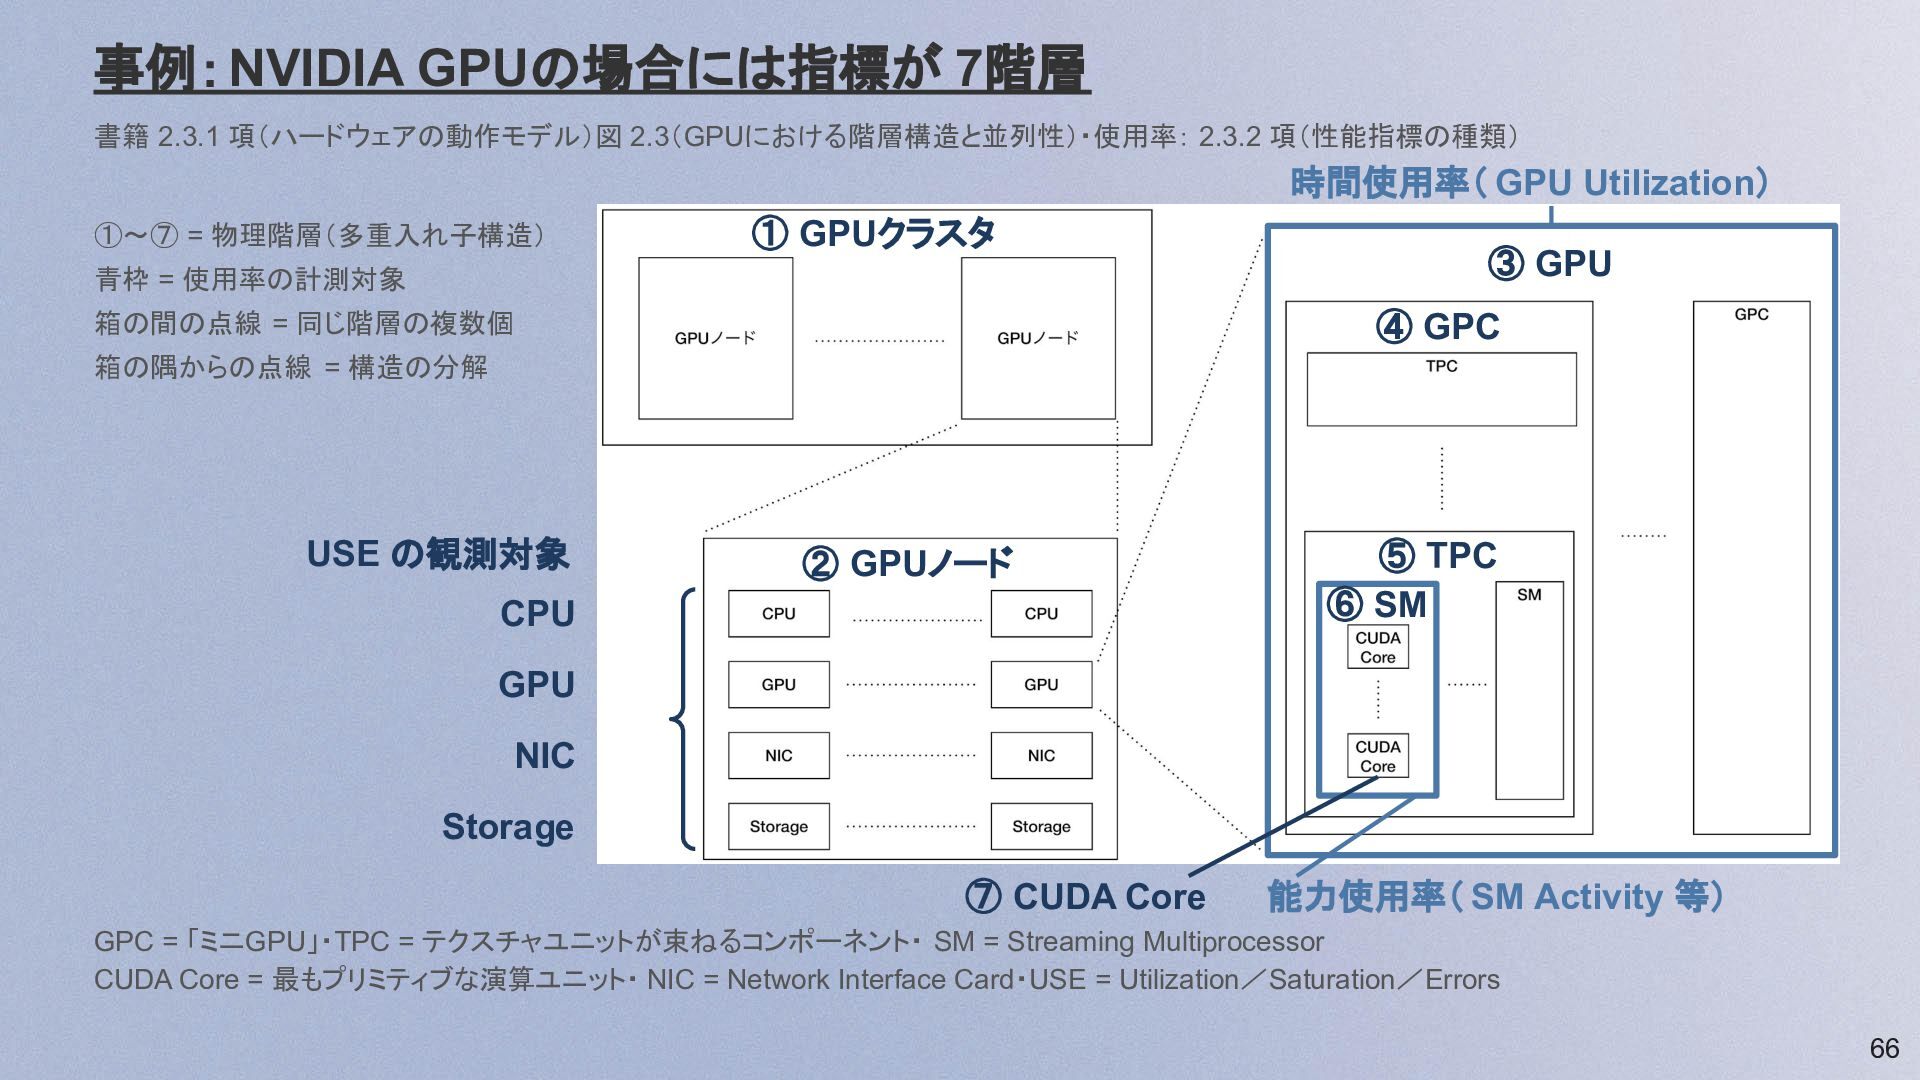
事例:NVIDIA GPUの場合には指標が 7階層 書籍 2.3.1 項(ハードウェアの動作モデル)図 2.3(GPUにおける階層構造と並列性)・使用率: 2.3.2 項(性能指標の種類) 時間使用率(
GPU Utilization) ①〜⑦ = 物理階層(多重入れ子構造) ① GPUクラスタ 青枠 = 使用率の計測対象 ③ GPU ④ GPC 箱の間の点線 = 同じ階層の複数個 箱の隅からの点線 = 構造の分解 USE の観測対象 ② GPUノード CPU ⑤ TPC ⑥ SM GPU NIC Storage ⑦ CUDA Core 能力使用率( SM Activity 等) GPC = 「ミニGPU」・TPC = テクスチャユニットが束ねるコンポーネント・ SM = Streaming Multiprocessor CUDA Core = 最もプリミティブな演算ユニット・ NIC = Network Interface Card・USE = Utilization/Saturation/Errors 66 -
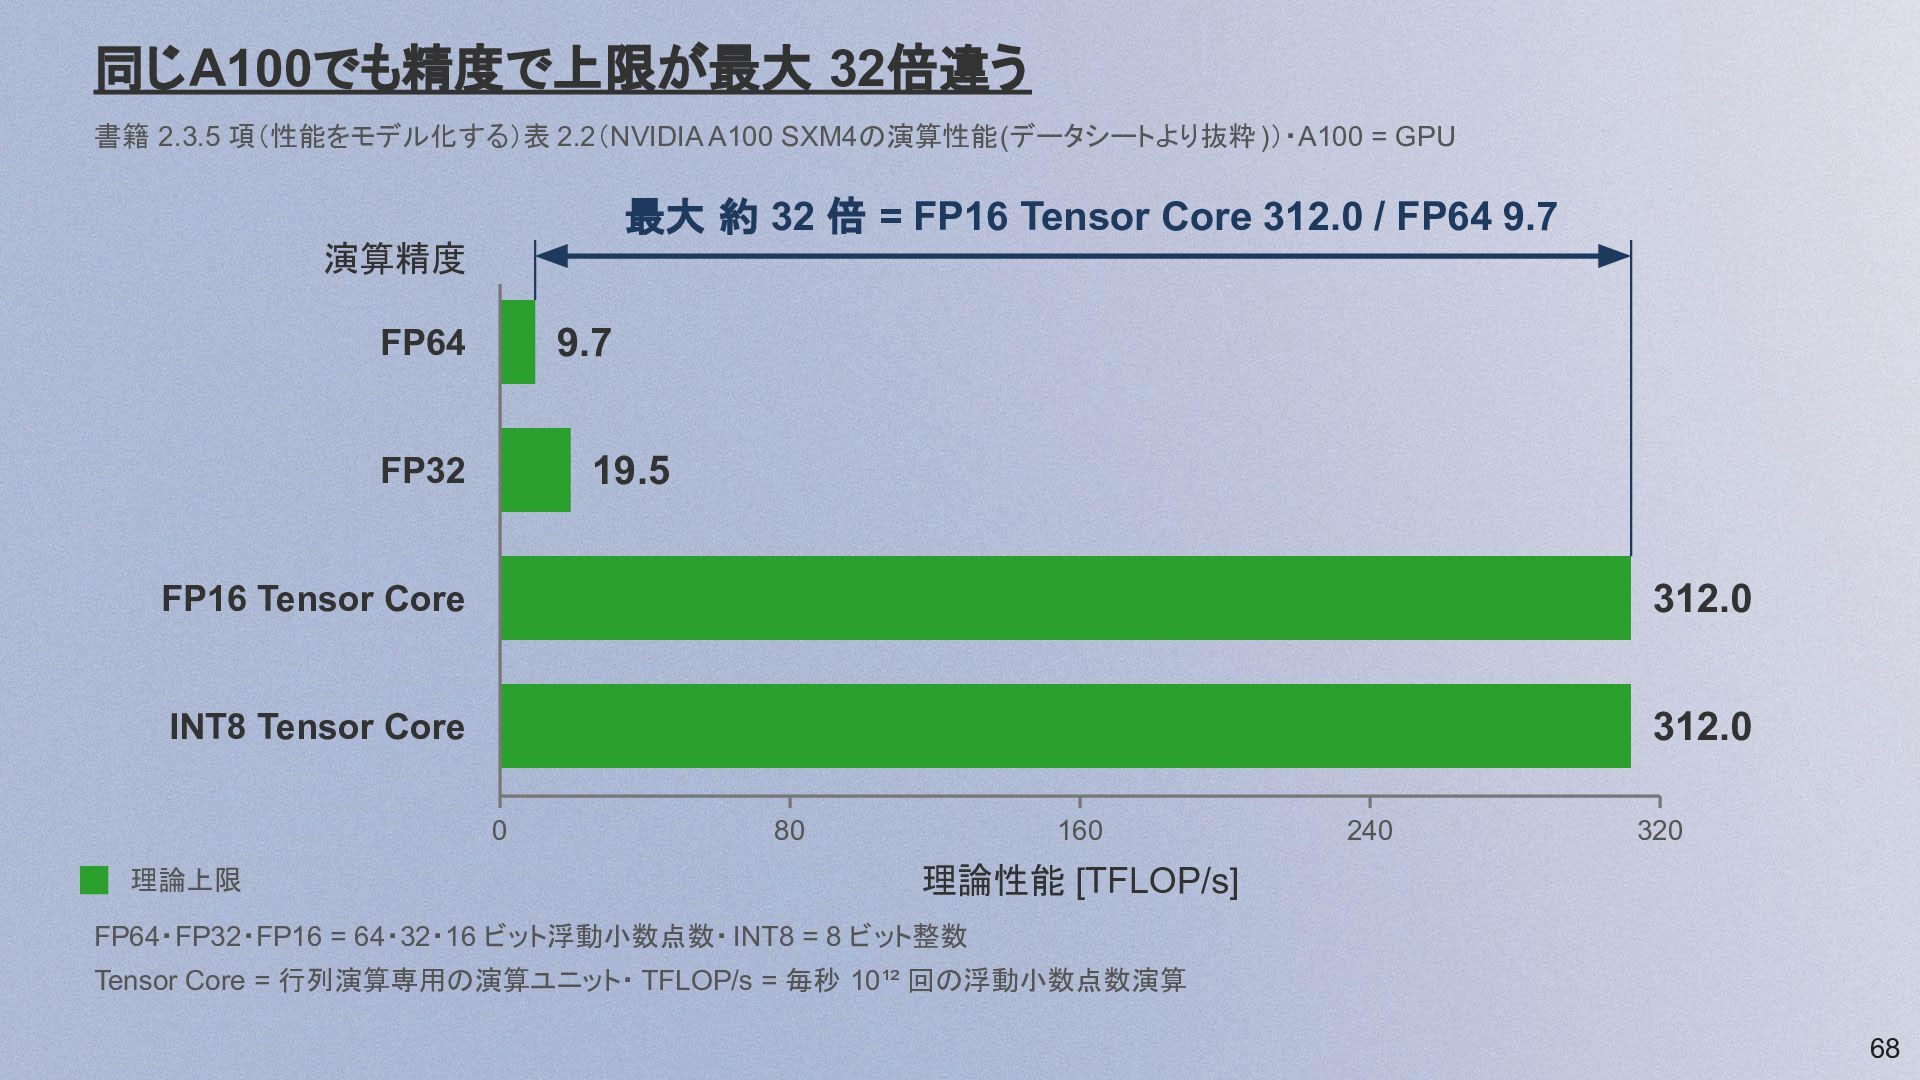
同じA100でも精度で上限が最大 32倍違う 書籍 2.3.5 項(性能をモデル化する)表 2.2(NVIDIA A100 SXM4の演算性能(データシートより抜粋 ))・A100 =
GPU 最大 約 32 倍 = FP16 Tensor Core 312.0 / FP64 9.7 演算精度 9.7 FP64 19.5 FP32 FP16 Tensor Core 312.0 INT8 Tensor Core 312.0 0 理論上限 80 160 240 320 理論性能 [TFLOP/s] FP64・FP32・FP16 = 64・32・16 ビット浮動小数点数・ INT8 = 8 ビット整数 Tensor Core = 行列演算専用の演算ユニット・ TFLOP/s = 毎秒 10¹² 回の浮動小数点数演算 68 -
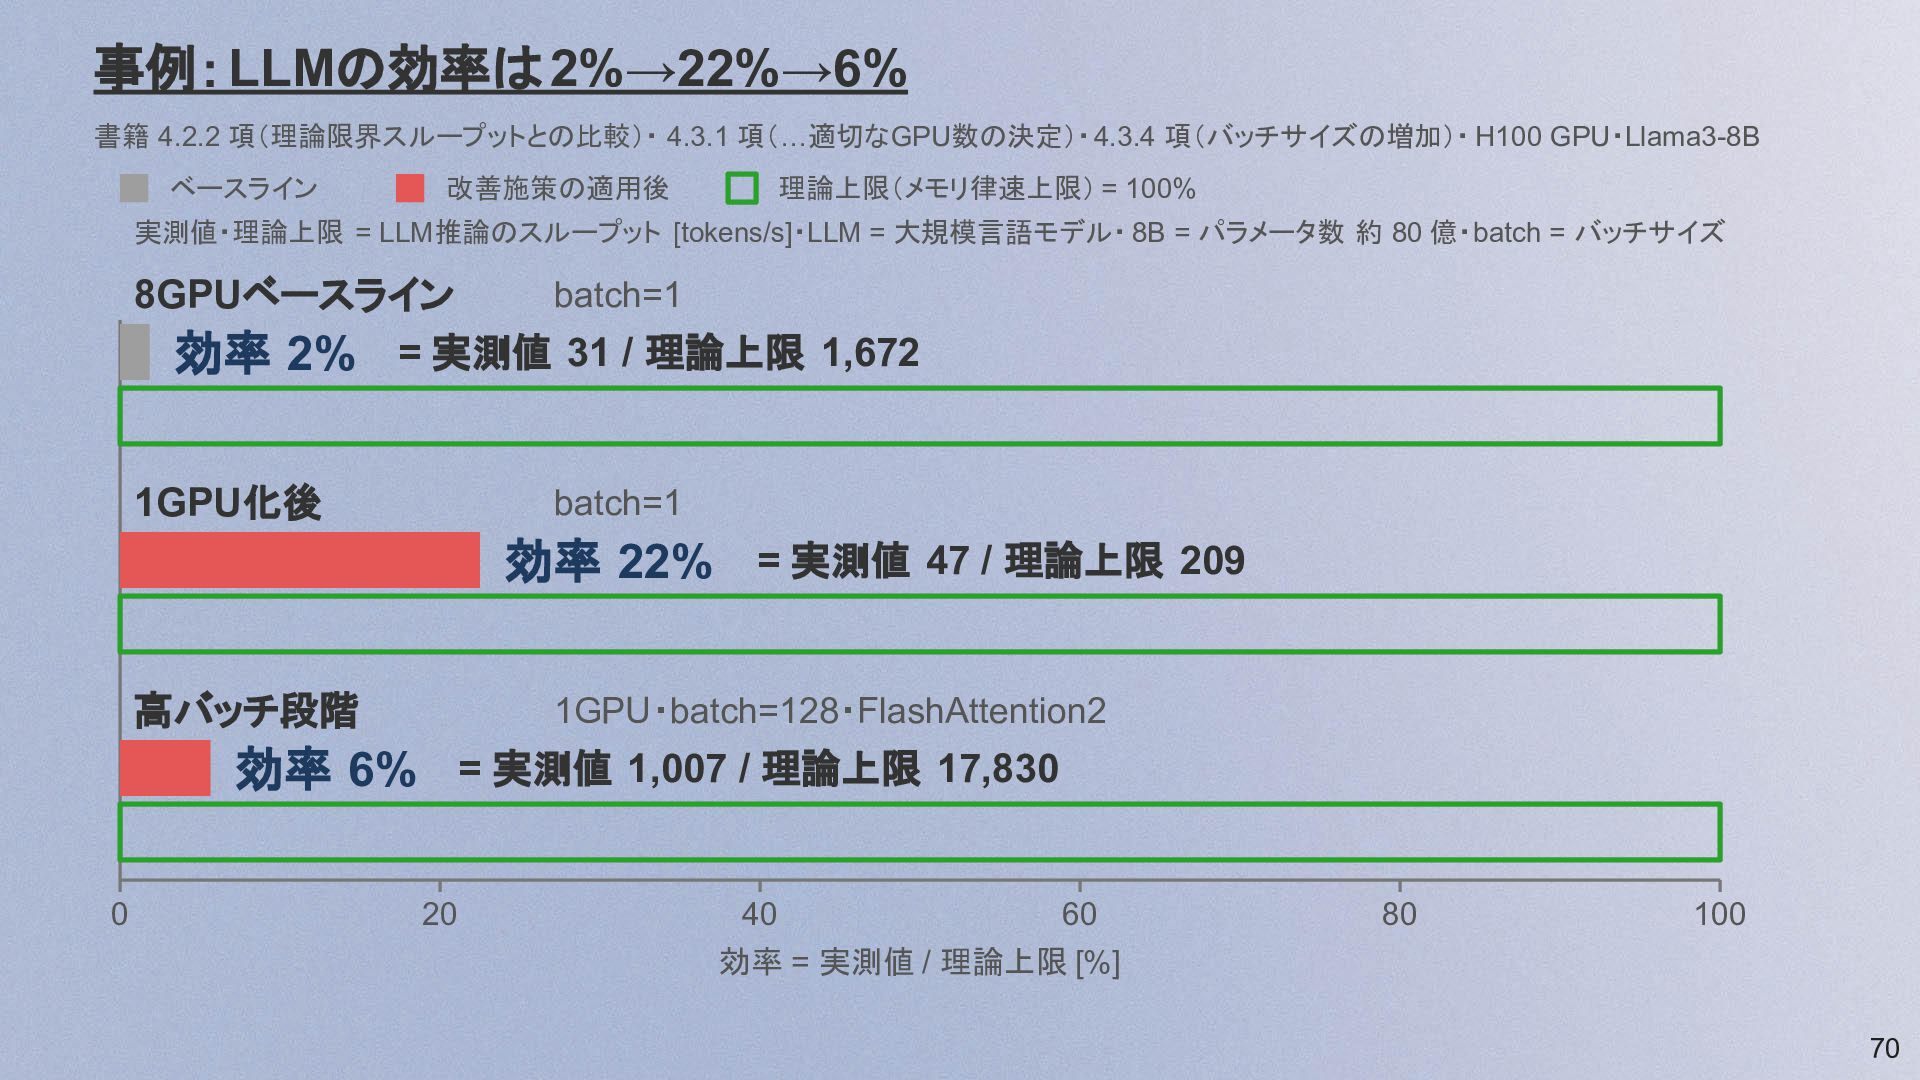
事例:LLMの効率は 2%→22%→6% 書籍 4.2.2 項(理論限界スループットとの比較)・ 4.3.1 項(…適切なGPU数の決定)・4.3.4 項(バッチサイズの増加)・ H100 GPU・Llama3-8B
ベースライン 改善施策の適用後 理論上限(メモリ律速上限) = 100% 実測値・理論上限 = LLM推論のスループット [tokens/s]・LLM = 大規模言語モデル・ 8B = パラメータ数 約 80 億・batch = バッチサイズ batch=1 8GPUベースライン 効率 2% = 実測値 31 / 理論上限 1,672 1GPU化後 batch=1 効率 22% = 実測値 47 / 理論上限 209 高バッチ段階 1GPU・batch=128・FlashAttention2 効率 6% = 実測値 1,007 / 理論上限 17,830 0 20 40 60 効率 = 実測値 / 理論上限 [%] 80 100 70 -
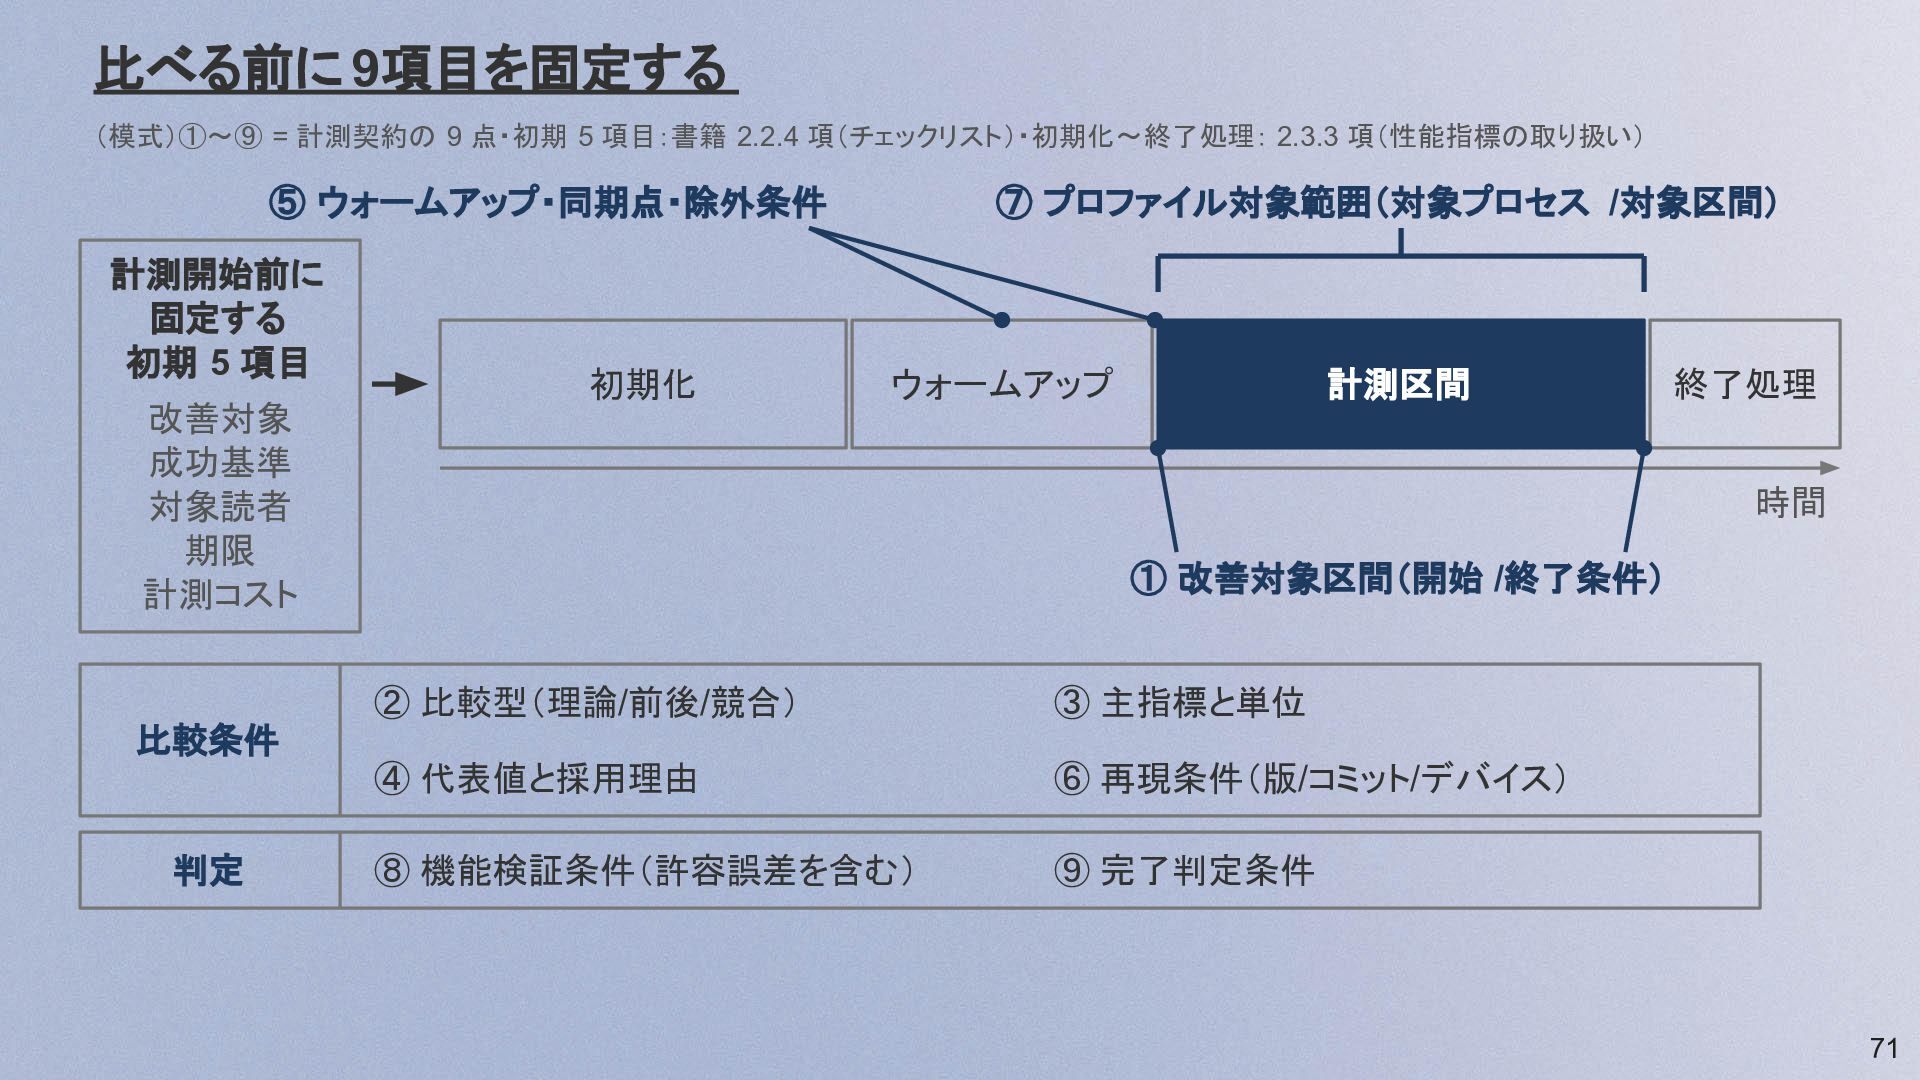
比べる前に 9項目を固定する (模式)①〜⑨ = 計測契約の 9 点・初期 5 項目:書籍 2.2.4
項(チェックリスト)・初期化〜終了処理: 2.3.3 項(性能指標の取り扱い) ⑤ ウォームアップ・同期点・除外条件 計測開始前に 固定する 初期 5 項目 改善対象 成功基準 対象読者 期限 計測コスト 初期化 ⑦ プロファイル対象範囲(対象プロセス /対象区間) ウォームアップ 計測区間 終了処理 時間 ① 改善対象区間(開始 /終了条件) ② 比較型(理論/前後/競合) ③ 主指標と単位 ④ 代表値と採用理由 ⑥ 再現条件(版/コミット/デバイス) ⑧ 機能検証条件(許容誤差を含む) ⑨ 完了判定条件 比較条件 判定 71 -
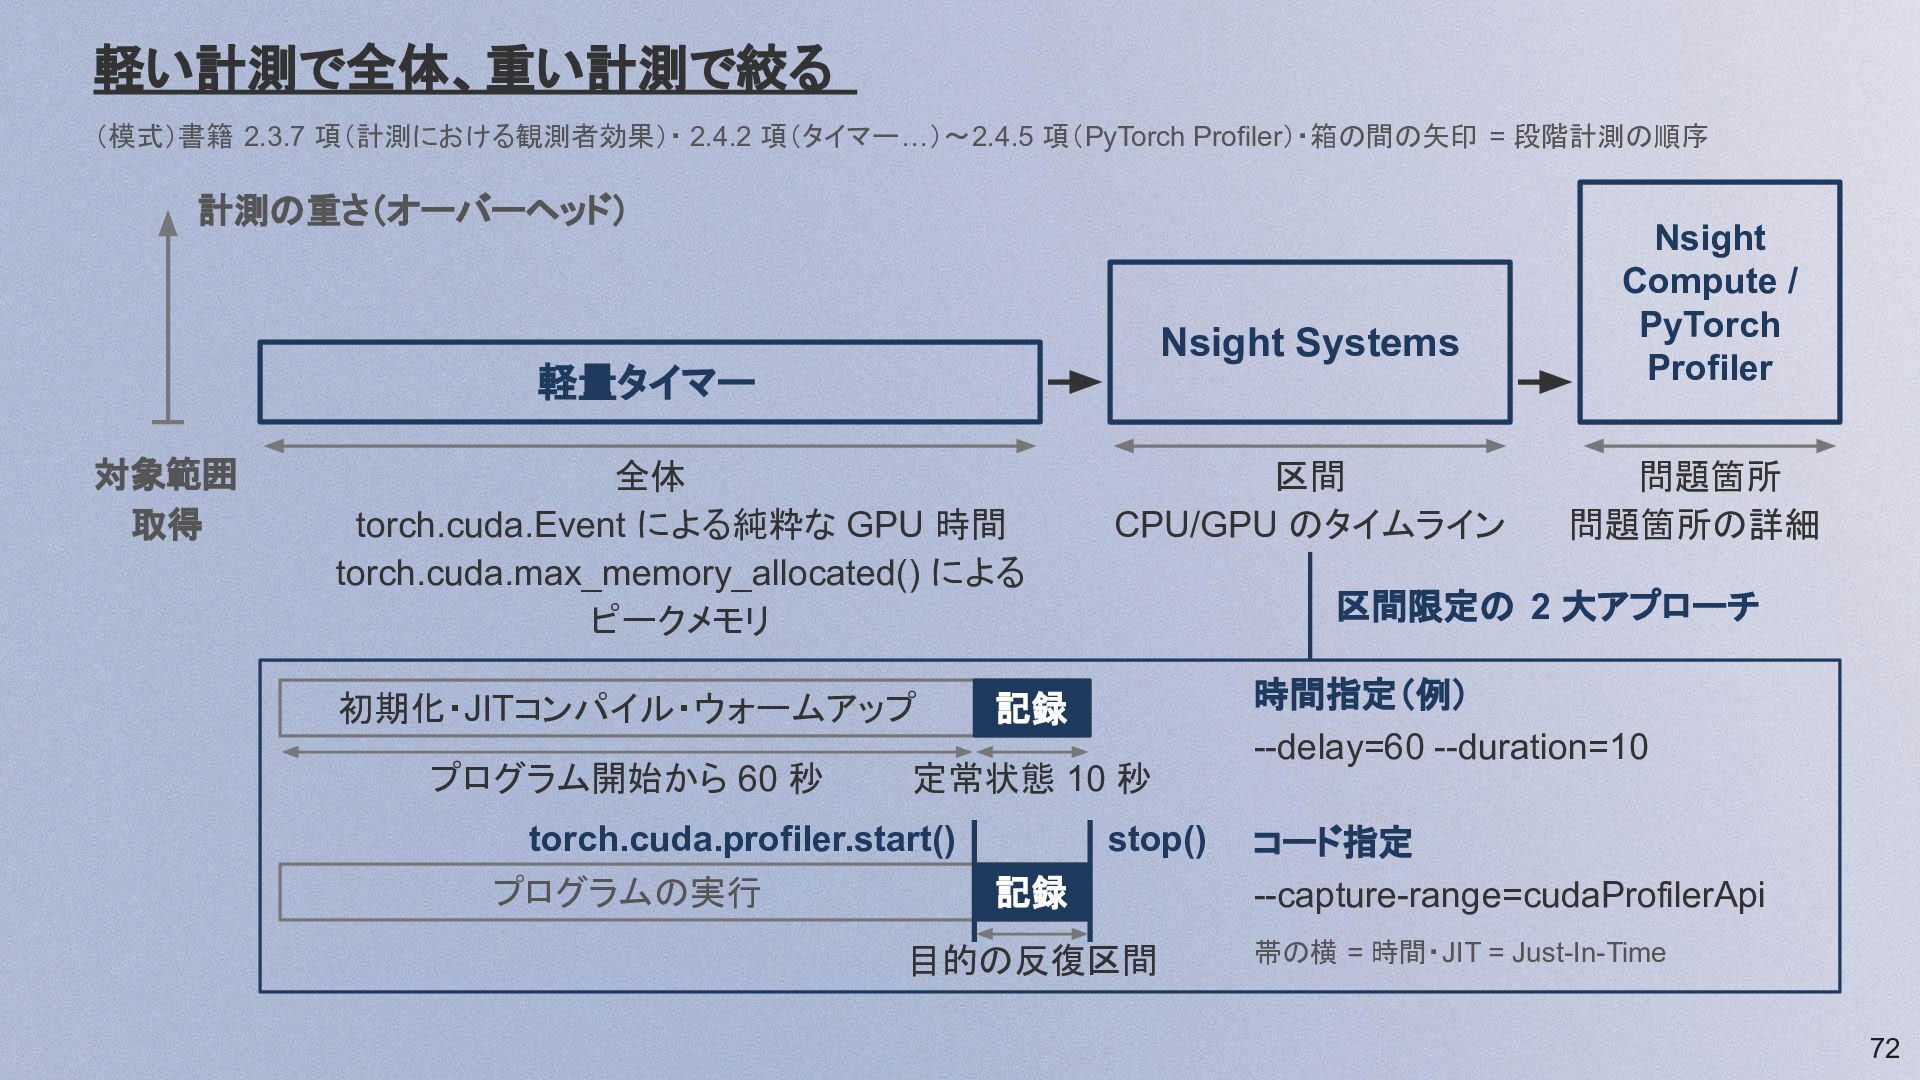
軽い計測で全体、重い計測で絞る (模式)書籍 2.3.7 項(計測における観測者効果)・ 2.4.2 項(タイマー…)〜2.4.5 項(PyTorch Profiler)・箱の間の矢印 = 段階計測の順序
計測の重さ(オーバーヘッド) Nsight Systems 軽量タイマー 対象範囲 取得 全体 torch.cuda.Event による純粋な GPU 時間 torch.cuda.max_memory_allocated() による ピークメモリ 初期化・JITコンパイル・ウォームアップ プログラム開始から 60 秒 区間 CPU/GPU のタイムライン 問題箇所 問題箇所の詳細 区間限定の 2 大アプローチ 記録 定常状態 10 秒 torch.cuda.profiler.start() プログラムの実行 Nsight Compute / PyTorch Profiler stop() 記録 目的の反復区間 時間指定(例) --delay=60 --duration=10 コード指定 --capture-range=cudaProfilerApi 帯の横 = 時間・JIT = Just-In-Time 72 -
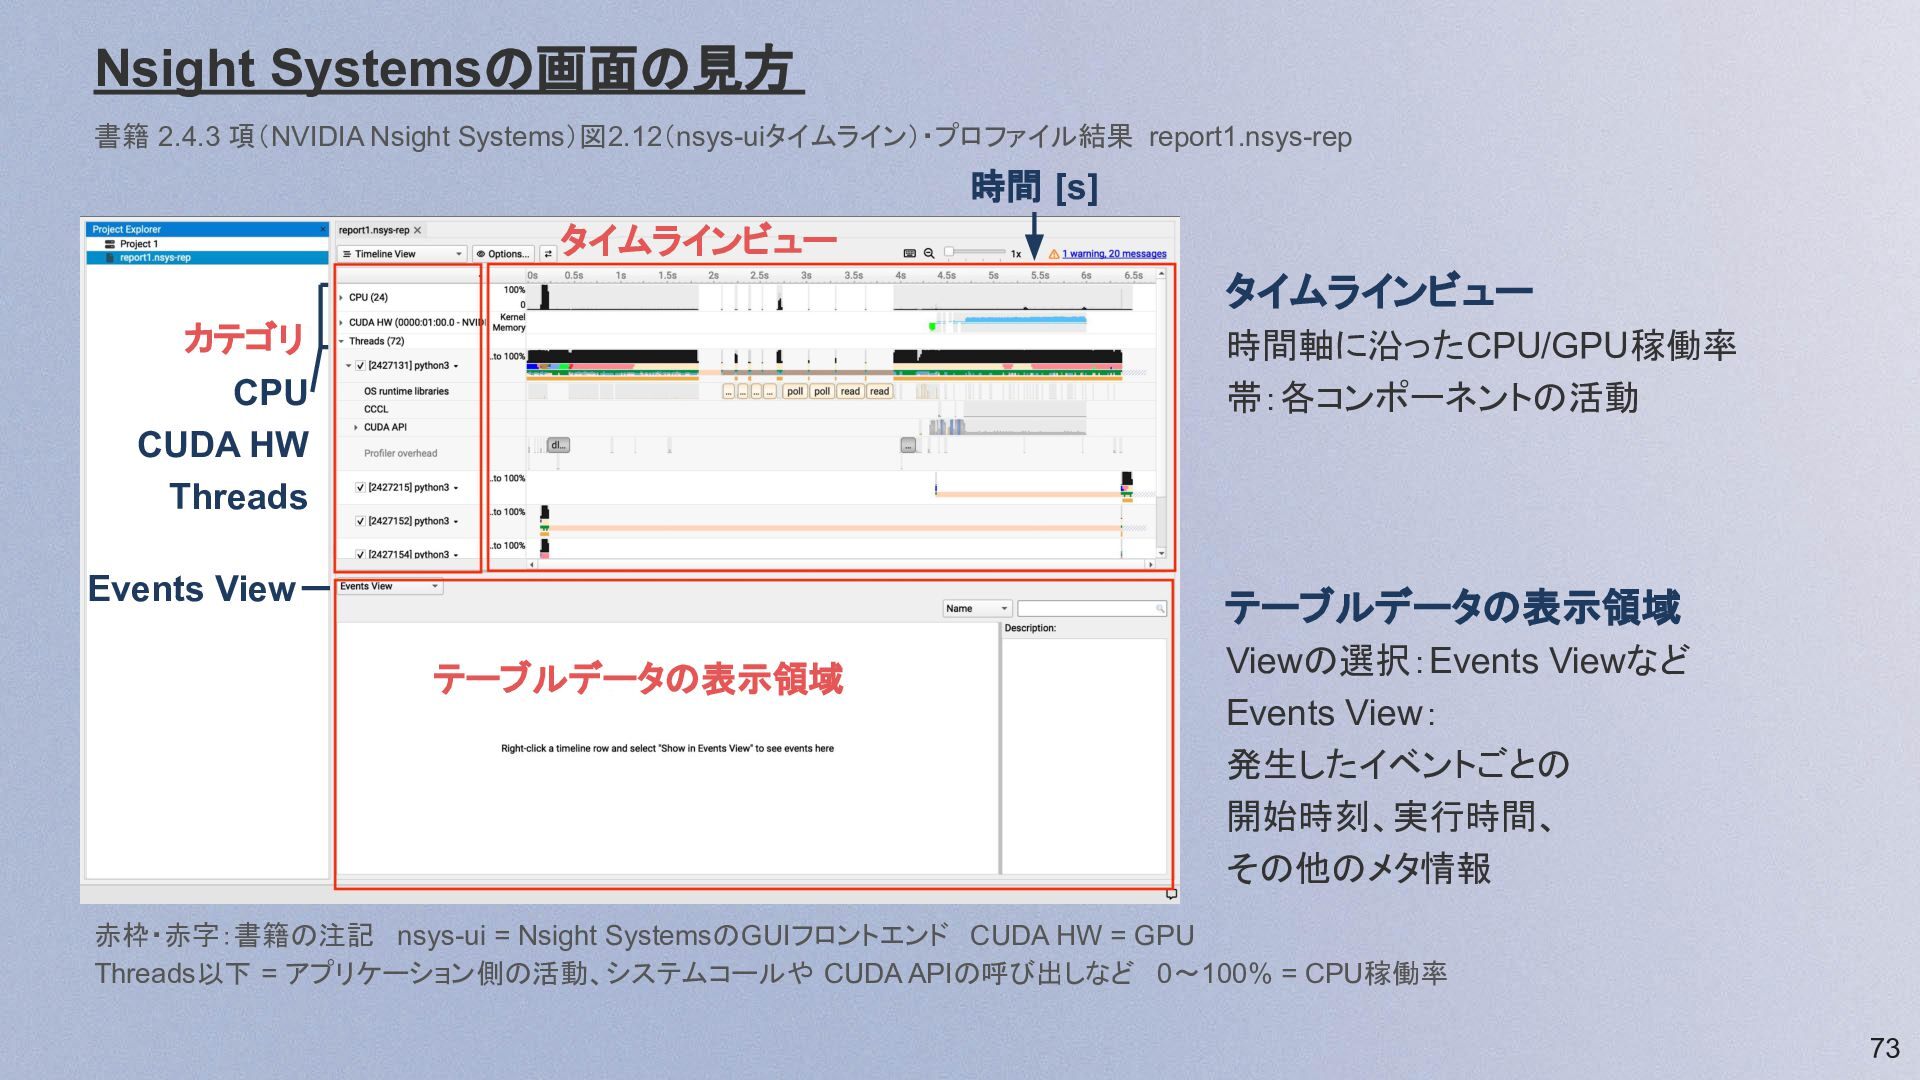
Nsight Systemsの画面の見方 書籍 2.4.3 項(NVIDIA Nsight Systems)図2.12(nsys-uiタイムライン)・プロファイル結果 report1.nsys-rep 時間 [s]
タイムラインビュー タイムラインビュー カテゴリ CPU CUDA HW Threads 時間軸に沿ったCPU/GPU稼働率 帯:各コンポーネントの活動 Events View テーブルデータの表示領域 テーブルデータの表示領域 Viewの選択:Events Viewなど Events View: 発生したイベントごとの 開始時刻、実行時間、 その他のメタ情報 赤枠・赤字:書籍の注記 nsys-ui = Nsight SystemsのGUIフロントエンド CUDA HW = GPU Threads以下 = アプリケーション側の活動、システムコールや CUDA APIの呼び出しなど 0〜100% = CPU稼働率 73 -
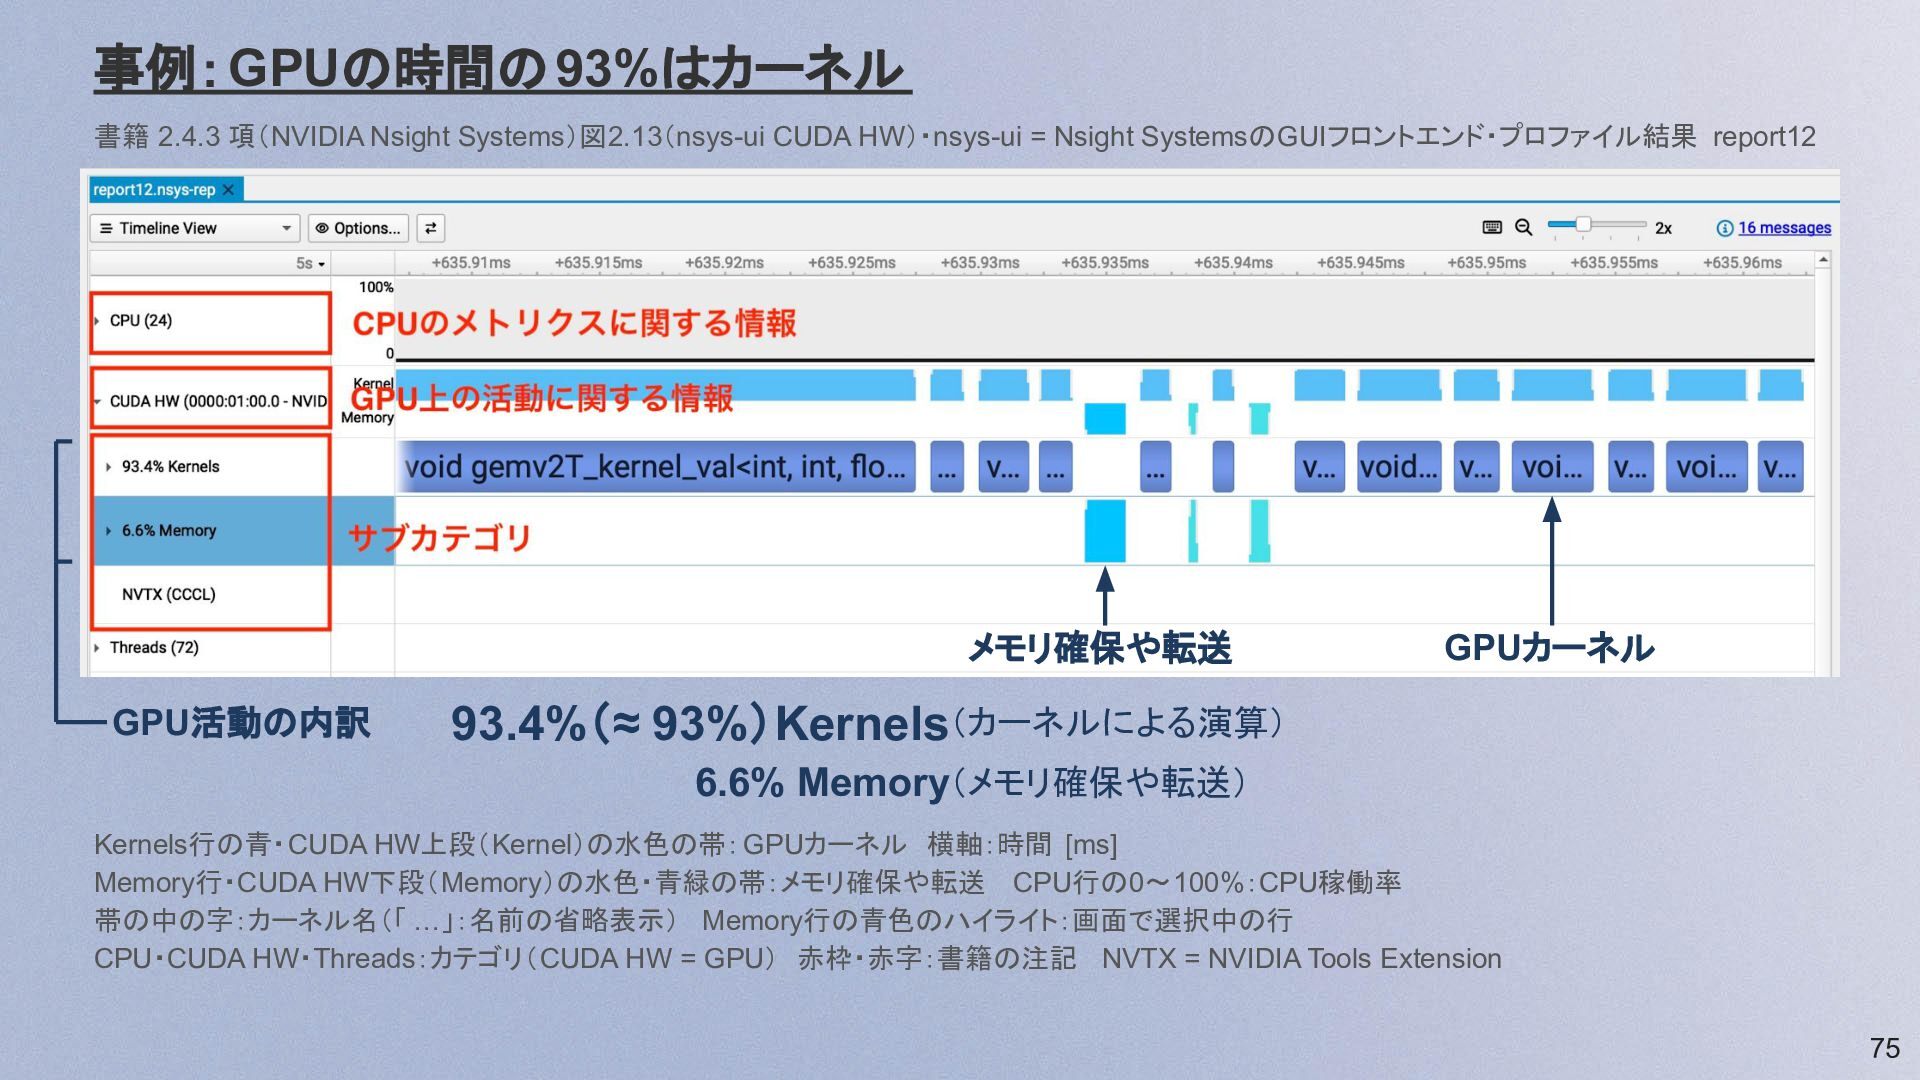
事例:GPUの時間の 93%はカーネル 書籍 2.4.3 項(NVIDIA Nsight Systems)図2.13(nsys-ui CUDA HW)・nsys-ui =
Nsight SystemsのGUIフロントエンド・プロファイル結果 report12 メモリ確保や転送 GPU活動の内訳 GPUカーネル 93.4%(≈ 93%)Kernels(カーネルによる演算) 6.6% Memory(メモリ確保や転送) Kernels行の青・CUDA HW上段(Kernel)の水色の帯: GPUカーネル 横軸:時間 [ms] Memory行・CUDA HW下段(Memory)の水色・青緑の帯:メモリ確保や転送 CPU行の0〜100%:CPU稼働率 帯の中の字:カーネル名(「 …」:名前の省略表示) Memory行の青色のハイライト:画面で選択中の行 CPU・CUDA HW・Threads:カテゴリ(CUDA HW = GPU) 赤枠・赤字:書籍の注記 NVTX = NVIDIA Tools Extension 75 -
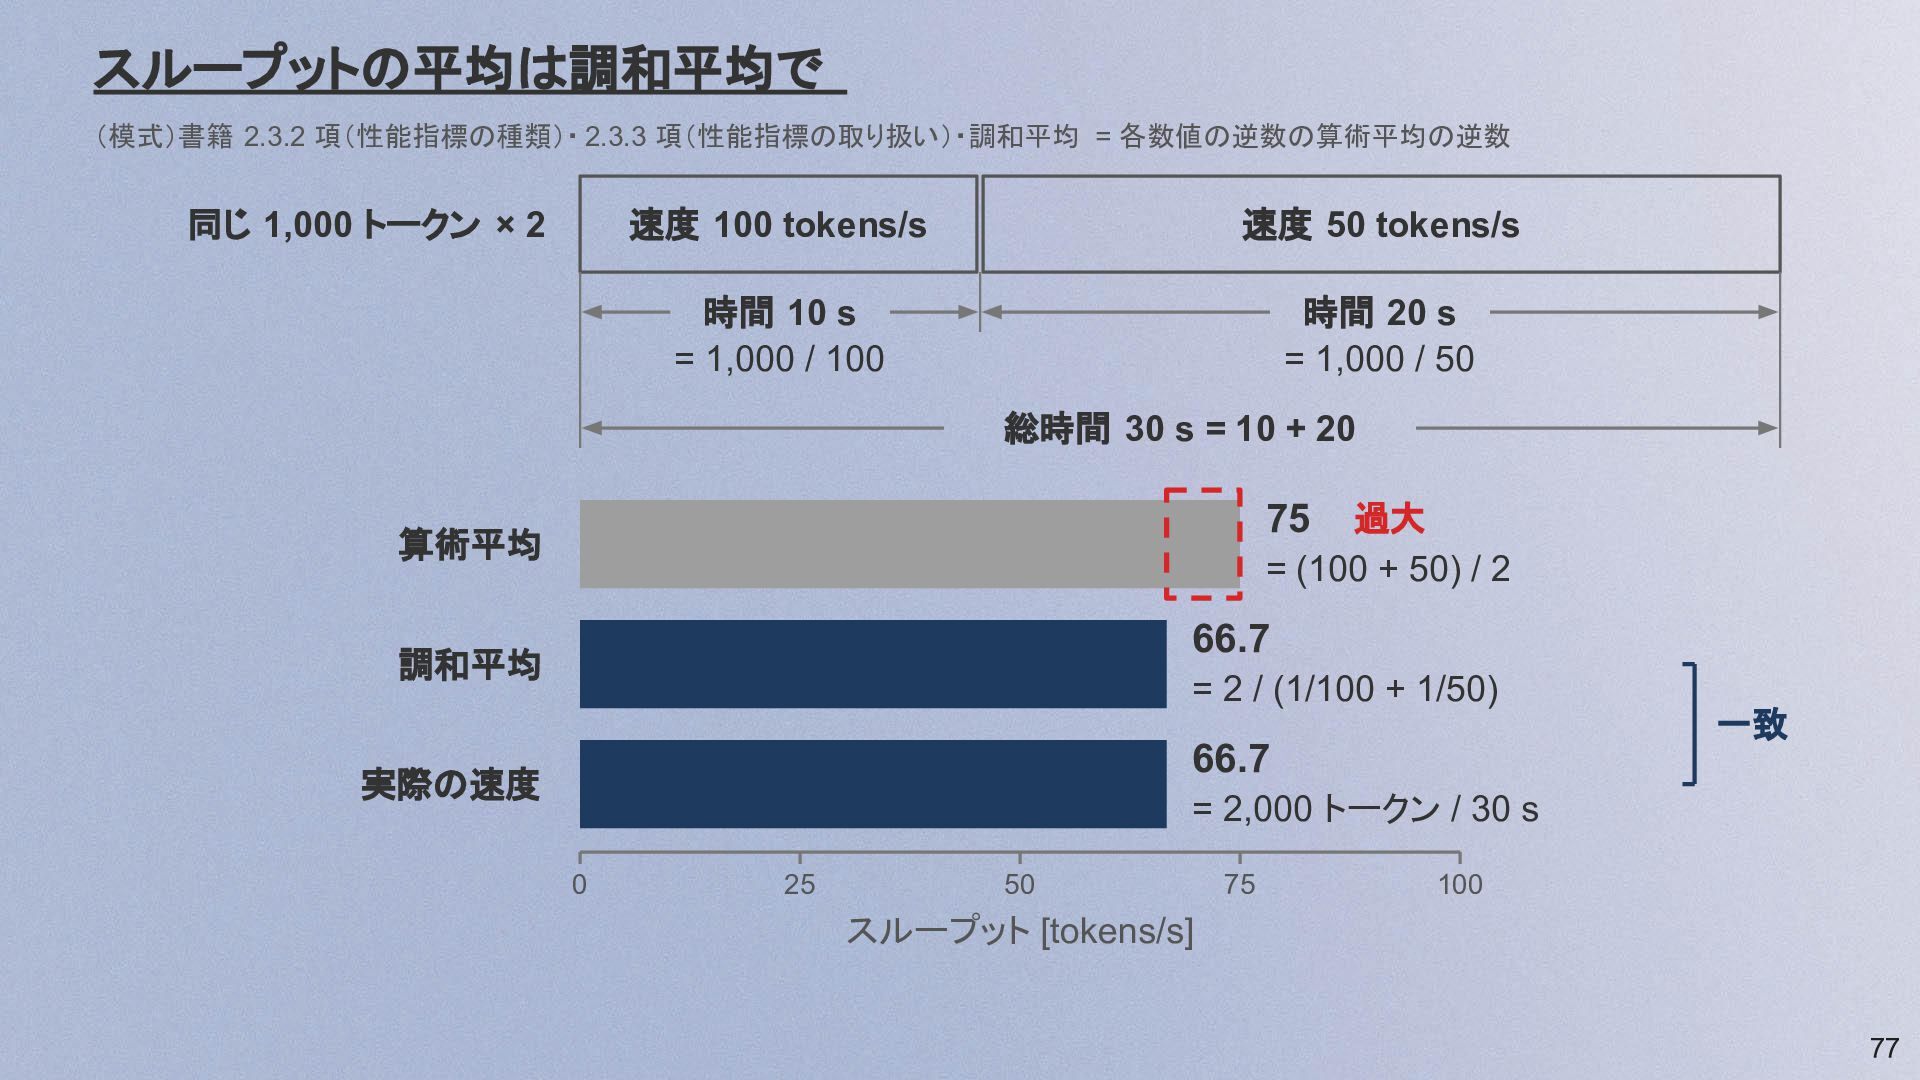
スループットの平均は調和平均で (模式)書籍 2.3.2 項(性能指標の種類)・ 2.3.3 項(性能指標の取り扱い)・調和平均 = 各数値の逆数の算術平均の逆数 同じ 1,000
トークン × 2 速度 100 tokens/s 速度 50 tokens/s 時間 10 s = 1,000 / 100 時間 20 s = 1,000 / 50 総時間 30 s = 10 + 20 過大 = (100 + 50) / 2 75 算術平均 66.7 調和平均 = 2 / (1/100 + 1/50) 一致 66.7 実際の速度 = 2,000 トークン / 30 s 0 25 50 75 100 スループット [tokens/s] 77 -
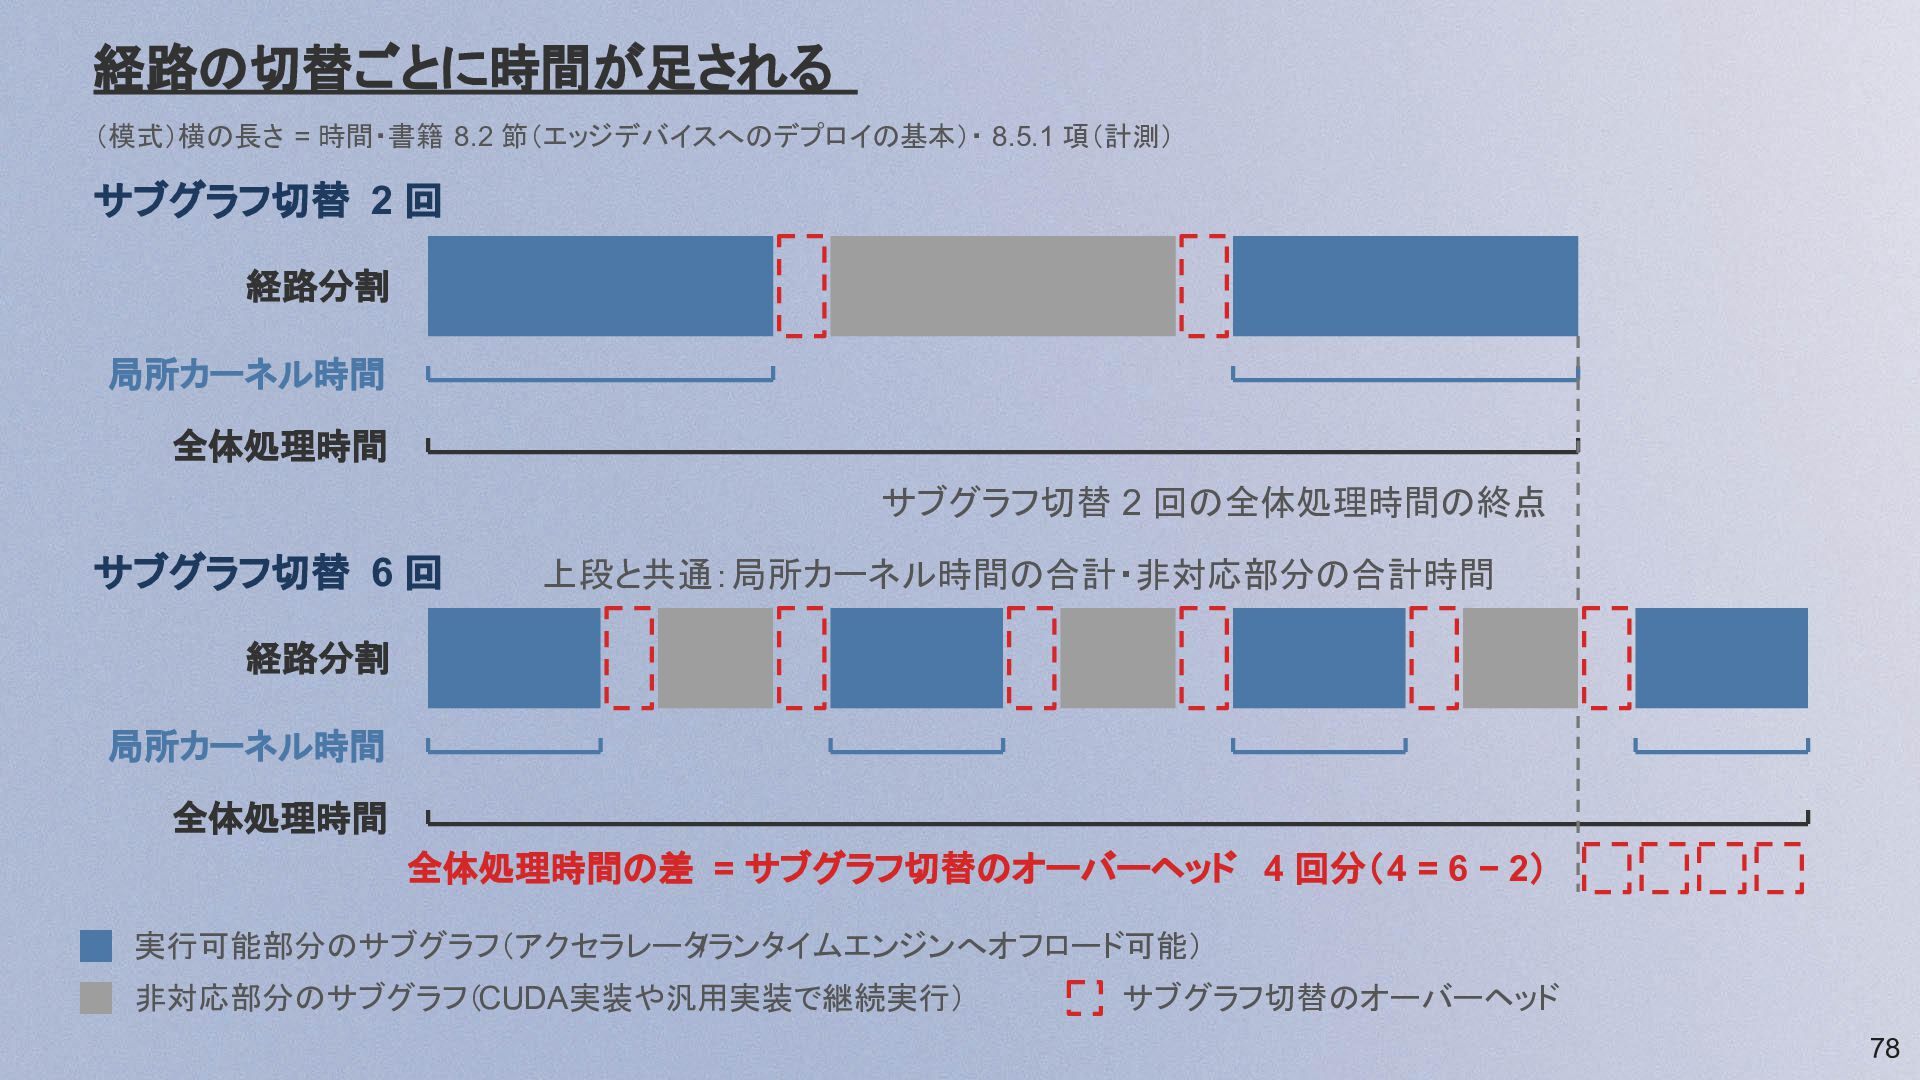
経路の切替ごとに時間が足される (模式)横の長さ = 時間・書籍 8.2 節(エッジデバイスへのデプロイの基本)・ 8.5.1 項(計測) サブグラフ切替 2
回 経路分割 局所カーネル時間 全体処理時間 サブグラフ切替 2 回の全体処理時間の終点 サブグラフ切替 6 回 上段と共通:局所カーネル時間の合計・非対応部分の合計時間 経路分割 局所カーネル時間 全体処理時間 全体処理時間の差 = サブグラフ切替のオーバーヘッド 4 回分(4 = 6 − 2) 実行可能部分のサブグラフ(アクセラレータ/ランタイムエンジンへオフロード可能) 非対応部分のサブグラフ(CUDA実装や汎用実装で継続実行) サブグラフ切替のオーバーヘッド 78 -
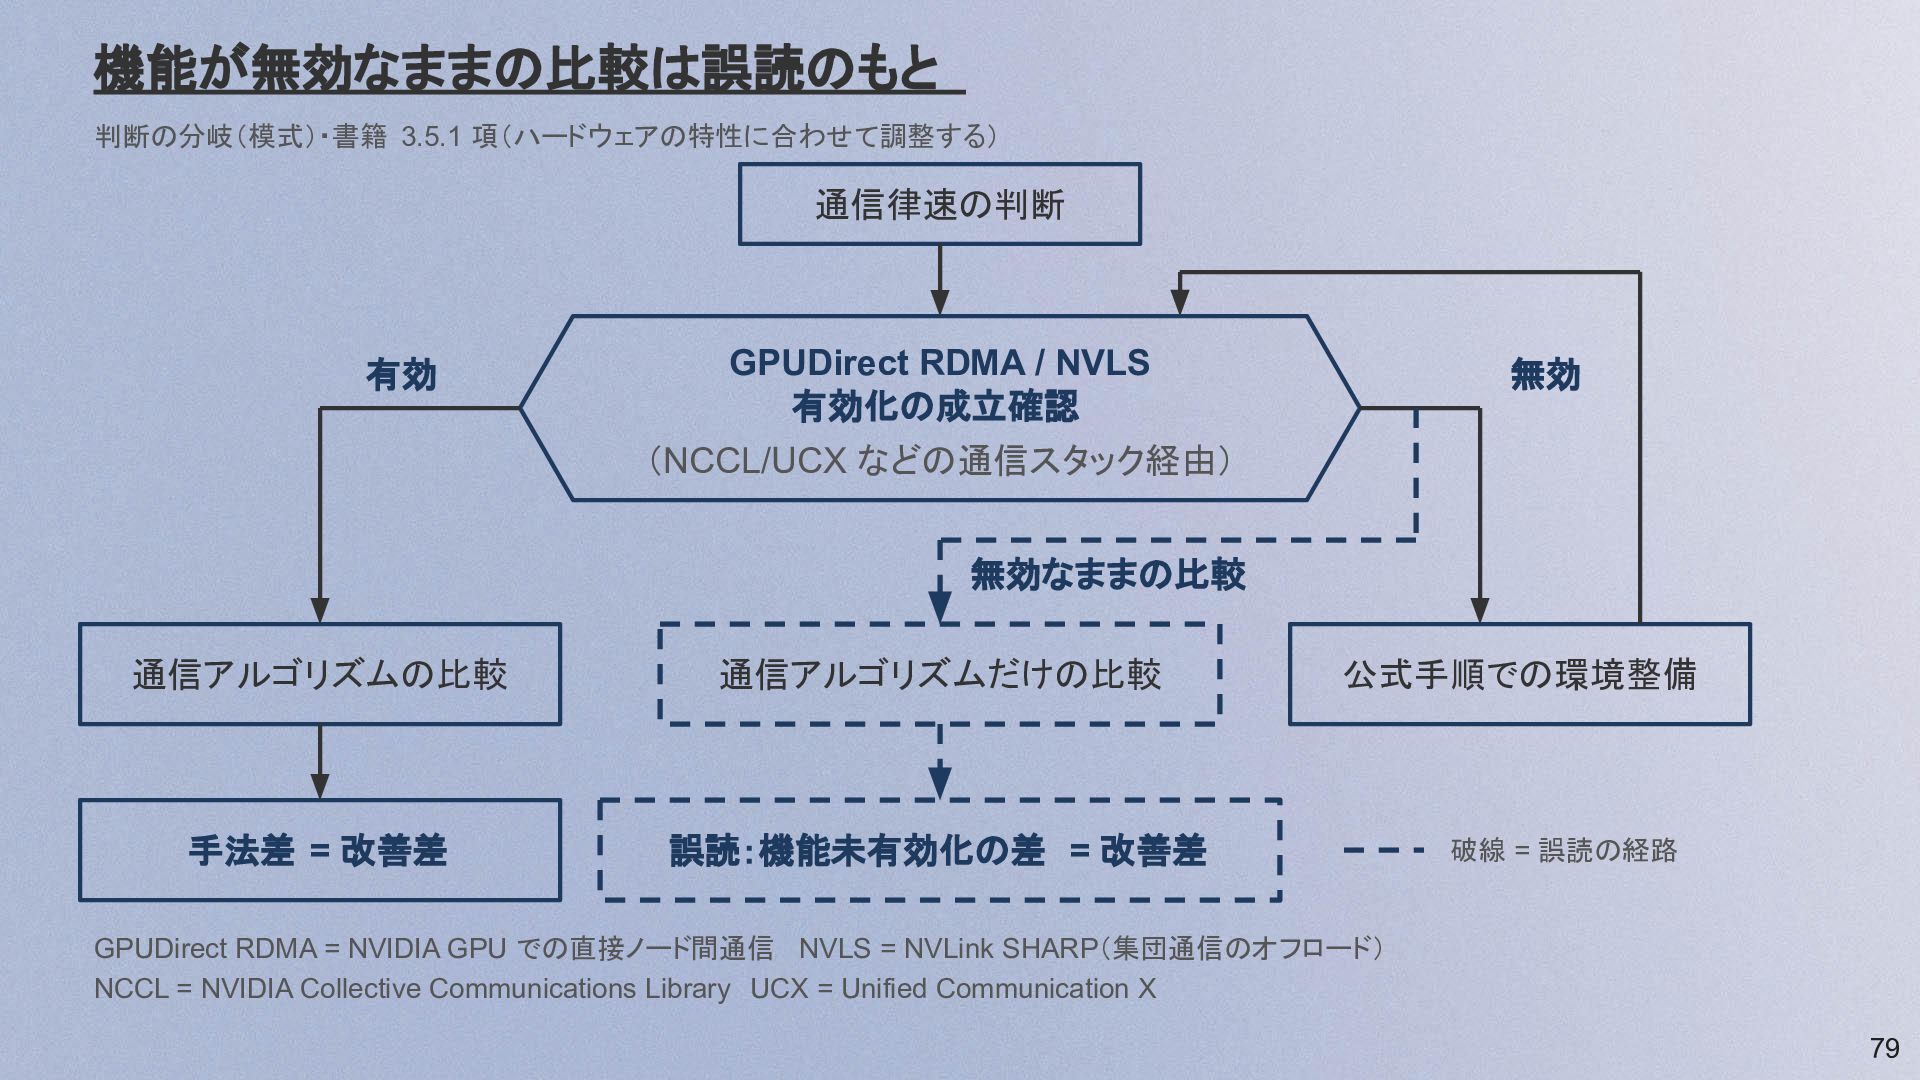
機能が無効なままの比較は誤読のもと 判断の分岐(模式)・書籍 3.5.1 項(ハードウェアの特性に合わせて調整する) 通信律速の判断 有効 GPUDirect RDMA / NVLS
有効化の成立確認 無効 (NCCL/UCX などの通信スタック経由) 無効なままの比較 通信アルゴリズムの比較 通信アルゴリズムだけの比較 手法差 = 改善差 誤読:機能未有効化の差 = 改善差 公式手順での環境整備 破線 = 誤読の経路 GPUDirect RDMA = NVIDIA GPU での直接ノード間通信 NVLS = NVLink SHARP(集団通信のオフロード) NCCL = NVIDIA Collective Communications Library UCX = Unified Communication X 79 -
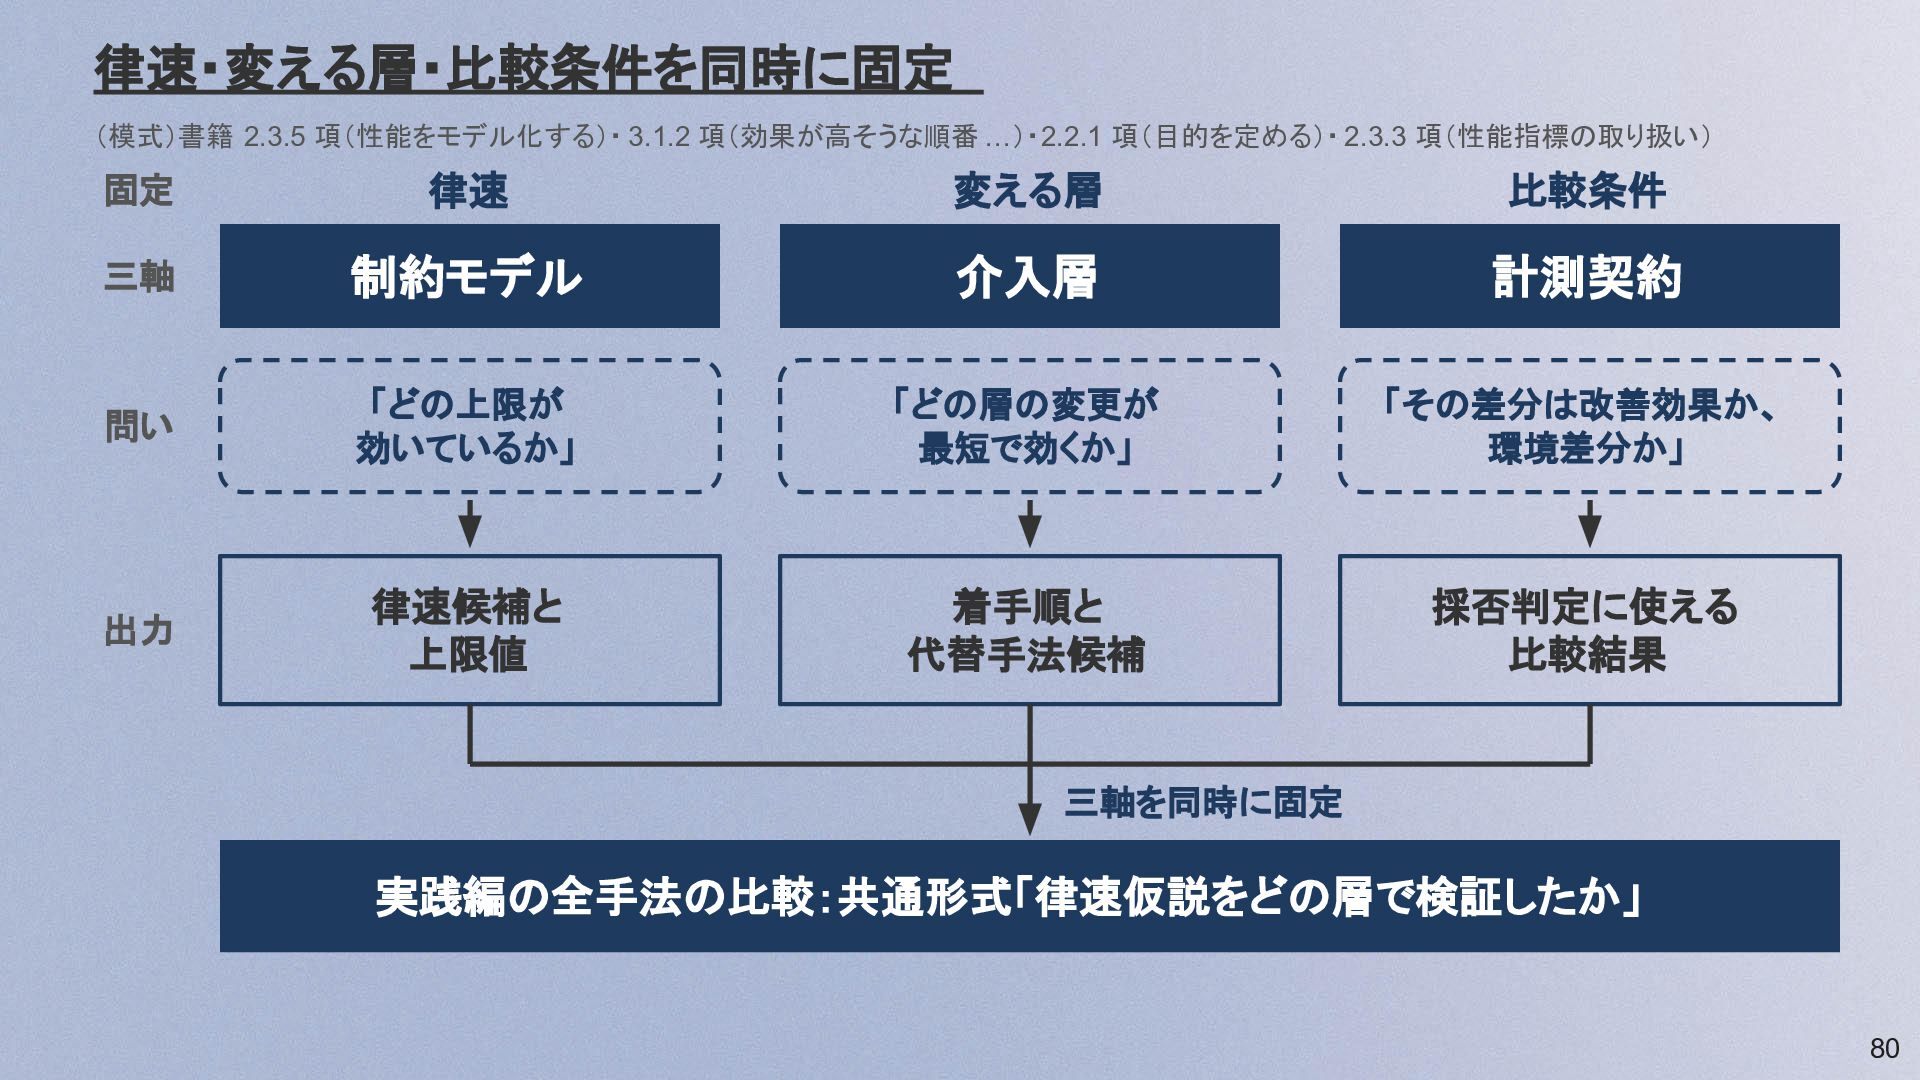
律速・変える層・比較条件を同時に固定 (模式)書籍 2.3.5 項(性能をモデル化する)・ 3.1.2 項(効果が高そうな順番 …)・2.2.1 項(目的を定める)・ 2.3.3 項(性能指標の取り扱い)
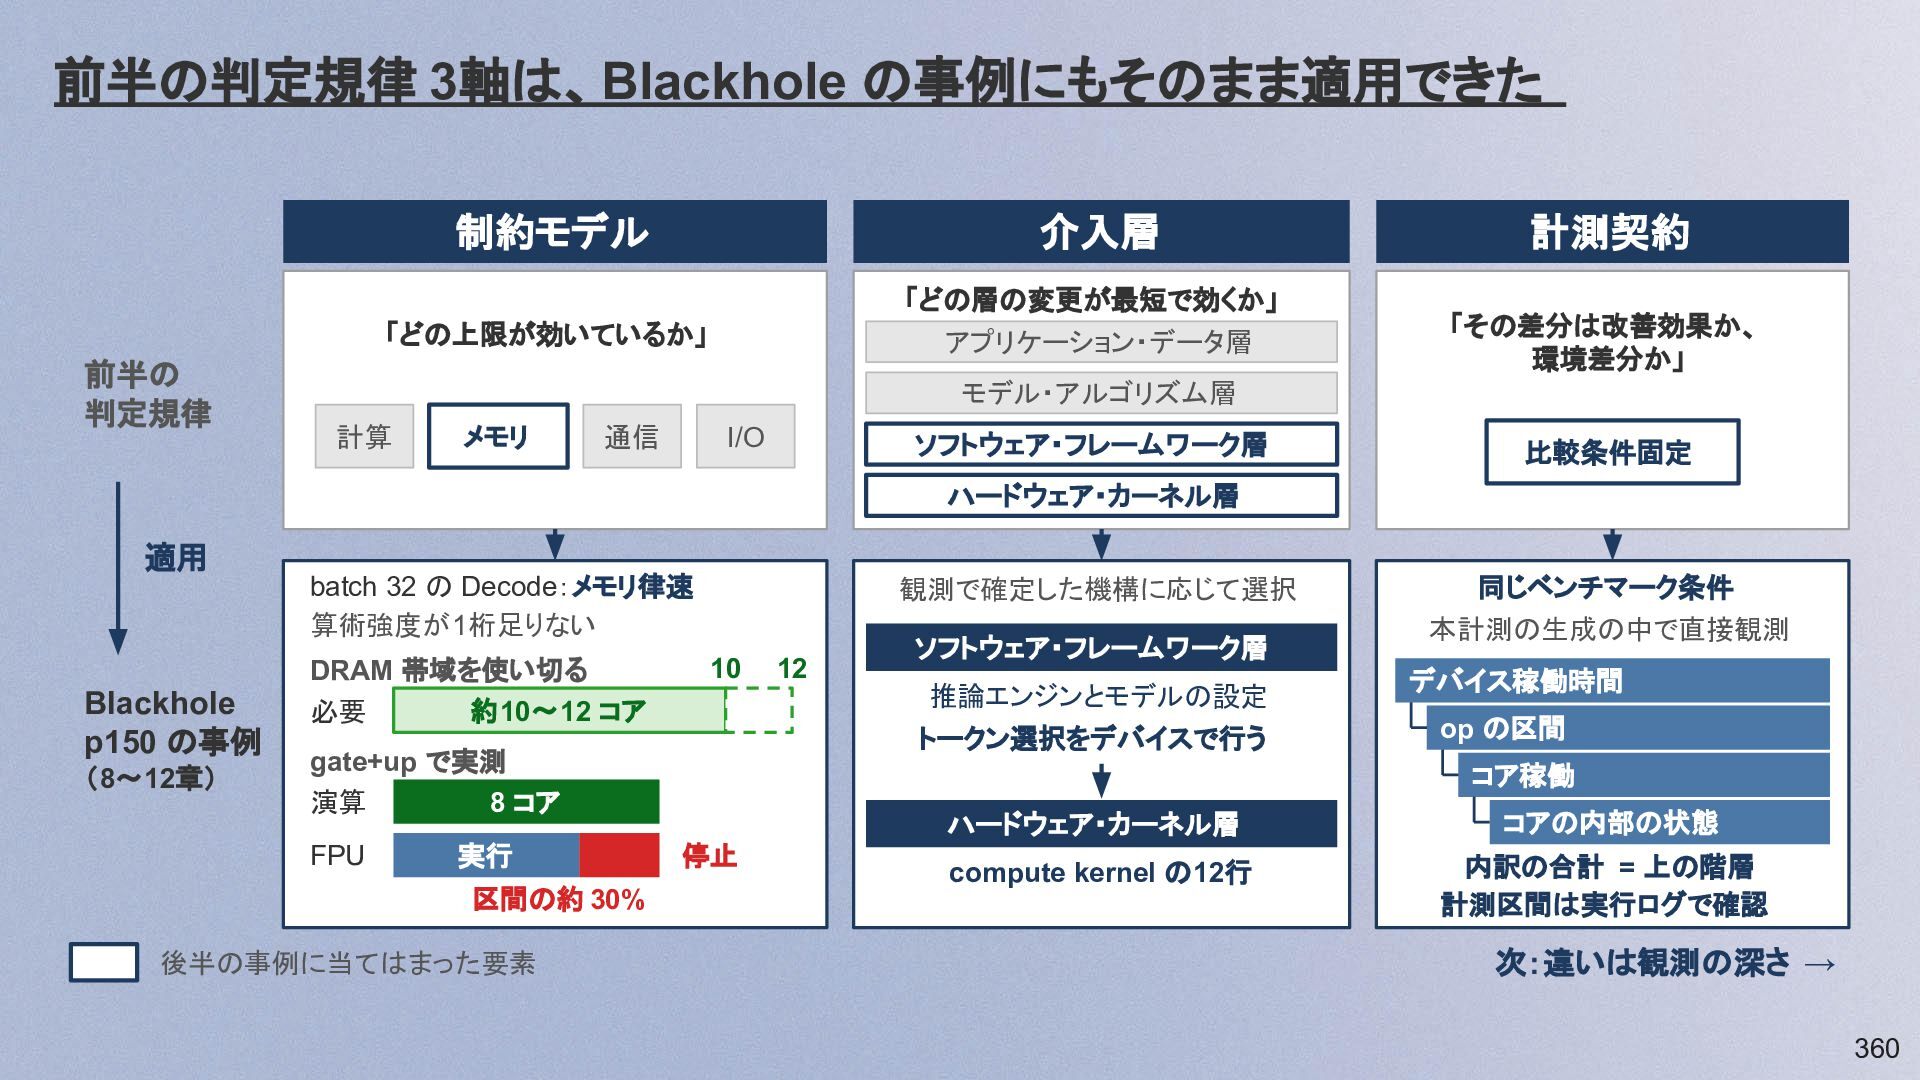
固定 律速 変える層 比較条件 三軸 制約モデル 介入層 計測契約 問い 「どの上限が 効いているか」 「どの層の変更が 最短で効くか」 「その差分は改善効果か、 環境差分か」 出力 律速候補と 上限値 着手順と 代替手法候補 採否判定に使える 比較結果 三軸を同時に固定 実践編の全手法の比較:共通形式「律速仮説をどの層で検証したか」 80 -
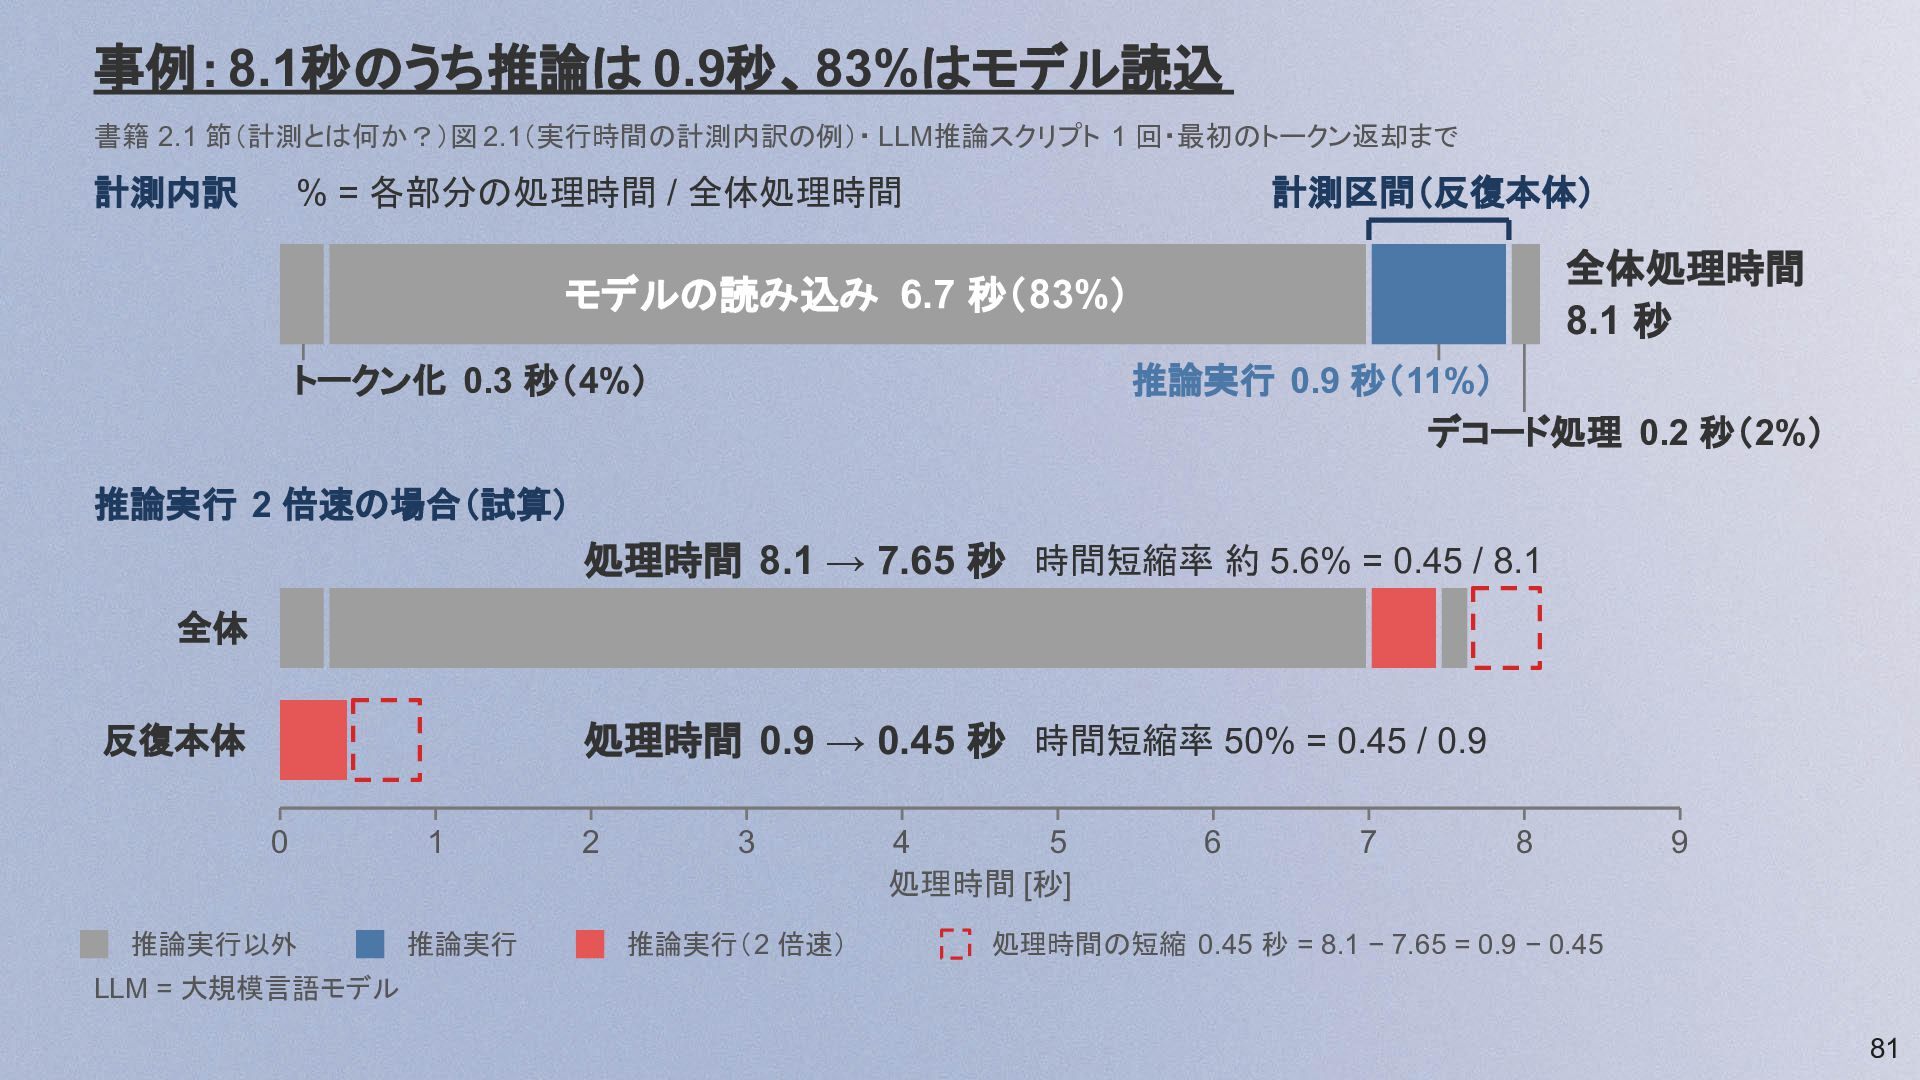
事例:8.1秒のうち推論は 0.9秒、83%はモデル読込 書籍 2.1 節(計測とは何か?)図 2.1(実行時間の計測内訳の例)・ LLM推論スクリプト 1 回・最初のトークン返却まで 計測内訳
% = 各部分の処理時間 / 全体処理時間 計測区間(反復本体) 全体処理時間 8.1 秒 モデルの読み込み 6.7 秒(83%) トークン化 0.3 秒(4%) 推論実行 0.9 秒(11%) デコード処理 0.2 秒(2%) 推論実行 2 倍速の場合(試算) 処理時間 8.1 → 7.65 秒 時間短縮率 約 5.6% = 0.45 / 8.1 全体 処理時間 0.9 → 0.45 秒 時間短縮率 50% = 0.45 / 0.9 反復本体 0 推論実行以外 1 推論実行 2 3 推論実行(2 倍速) 4 5 処理時間 [秒] 6 7 8 9 処理時間の短縮 0.45 秒 = 8.1 − 7.65 = 0.9 − 0.45 LLM = 大規模言語モデル 81 -
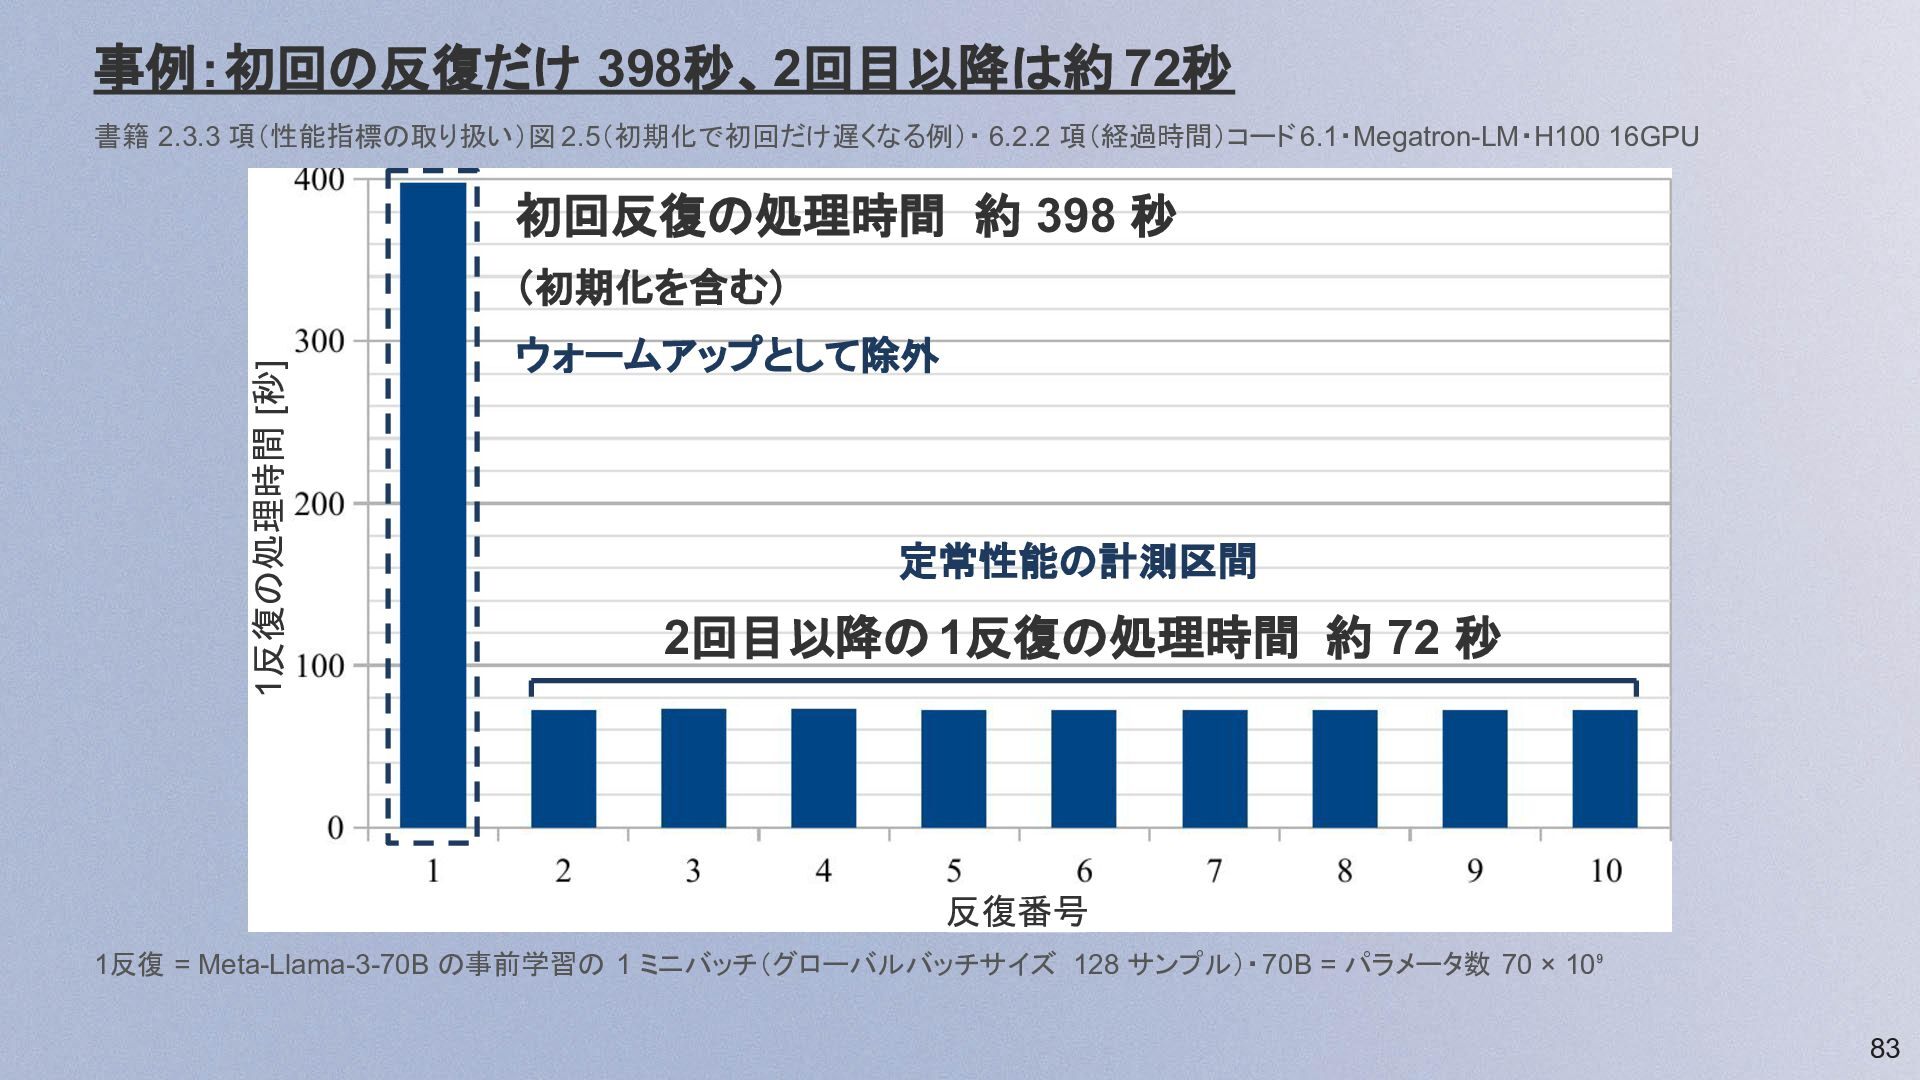
事例:初回の反復だけ 398秒、2回目以降は約 72秒 書籍 2.3.3 項(性能指標の取り扱い)図 2.5(初期化で初回だけ遅くなる例)・ 6.2.2 項(経過時間)コード 6.1・Megatron-LM・H100
16GPU 初回反復の処理時間 約 398 秒 1反復の処理時間 [秒] (初期化を含む) ウォームアップとして除外 定常性能の計測区間 2回目以降の 1反復の処理時間 約 72 秒 反復番号 1反復 = Meta-Llama-3-70B の事前学習の 1 ミニバッチ(グローバルバッチサイズ 128 サンプル)・70B = パラメータ数 70 × 10⁹ 83 -
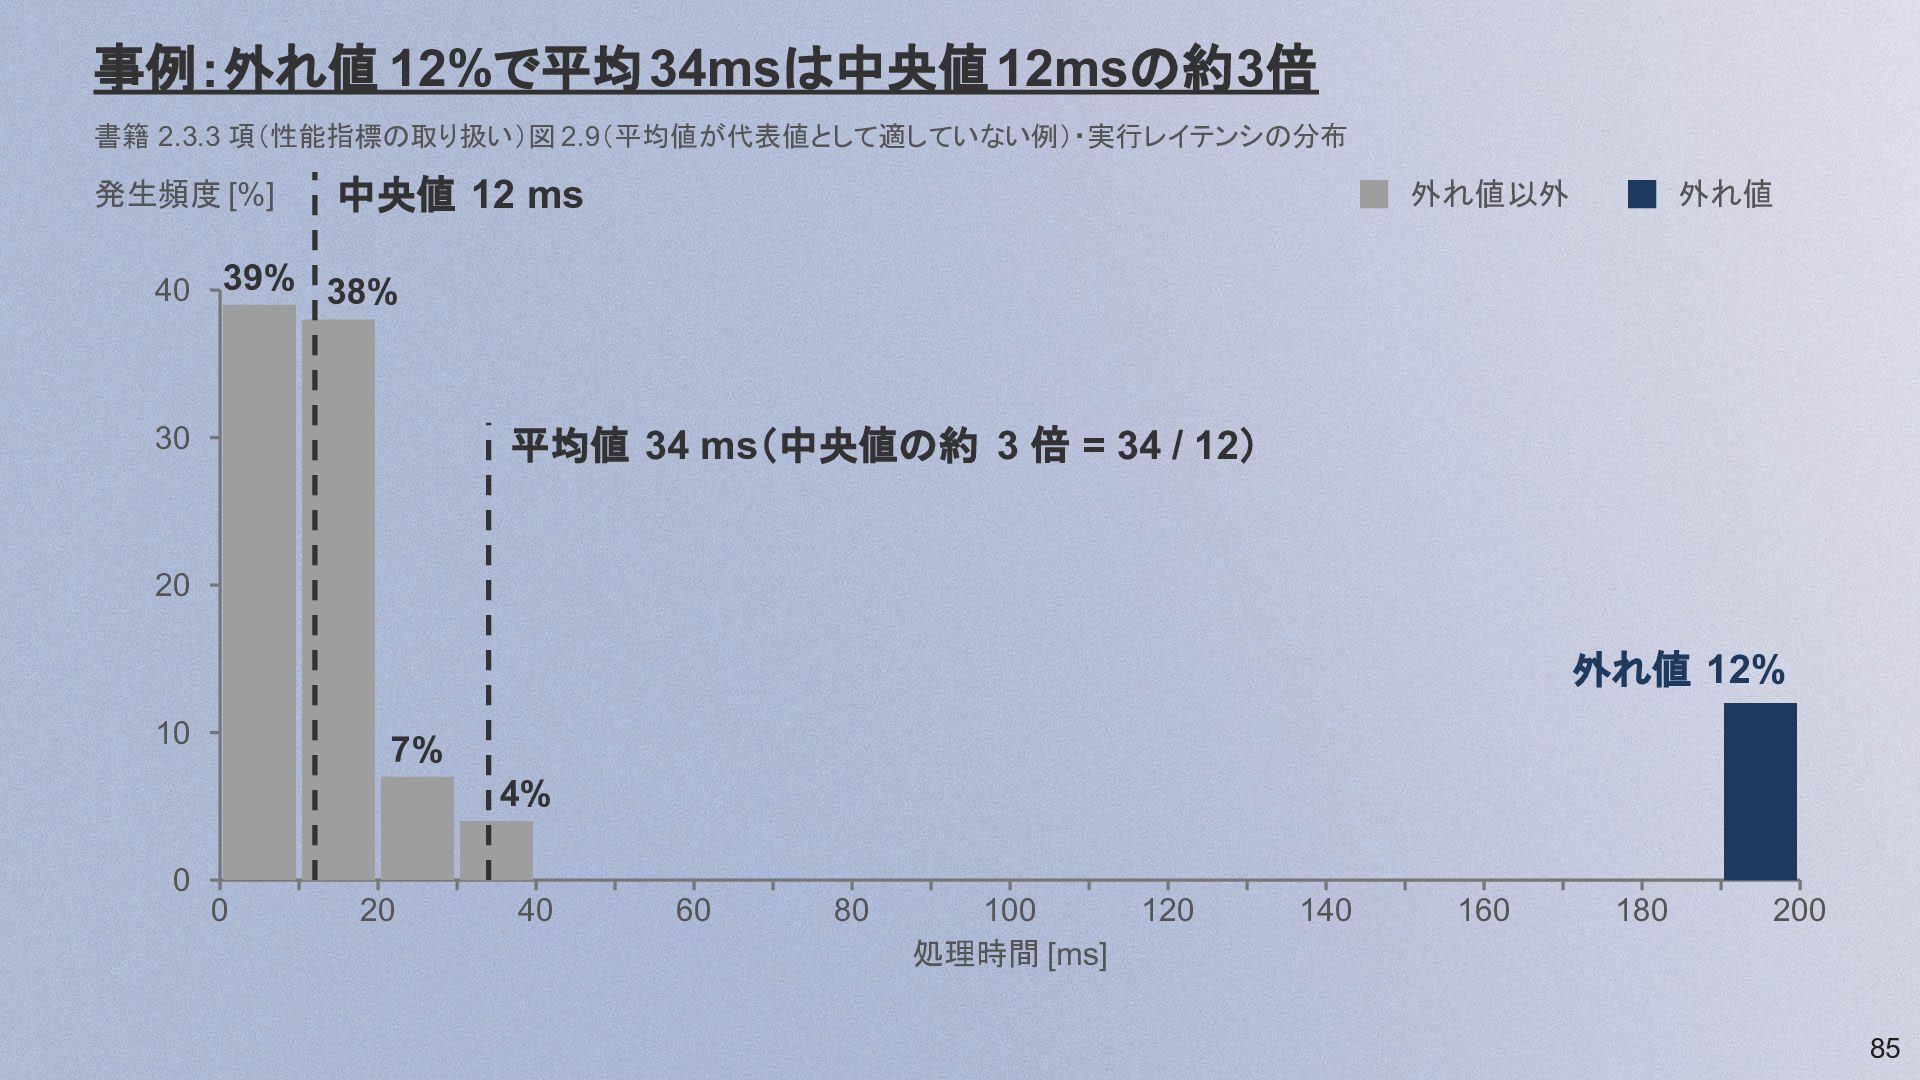
事例:外れ値 12%で平均34msは中央値 12msの約3倍 書籍 2.3.3 項(性能指標の取り扱い)図 2.9(平均値が代表値として適していない例)・実行レイテンシの分布 発生頻度 [%] 40
中央値 12 ms 外れ値以外 外れ値 39% 38% 平均値 34 ms(中央値の約 3 倍 = 34 / 12) 30 20 外れ値 12% 10 7% 4% 0 0 20 40 60 80 100 処理時間 [ms] 120 140 160 180 200 85 -
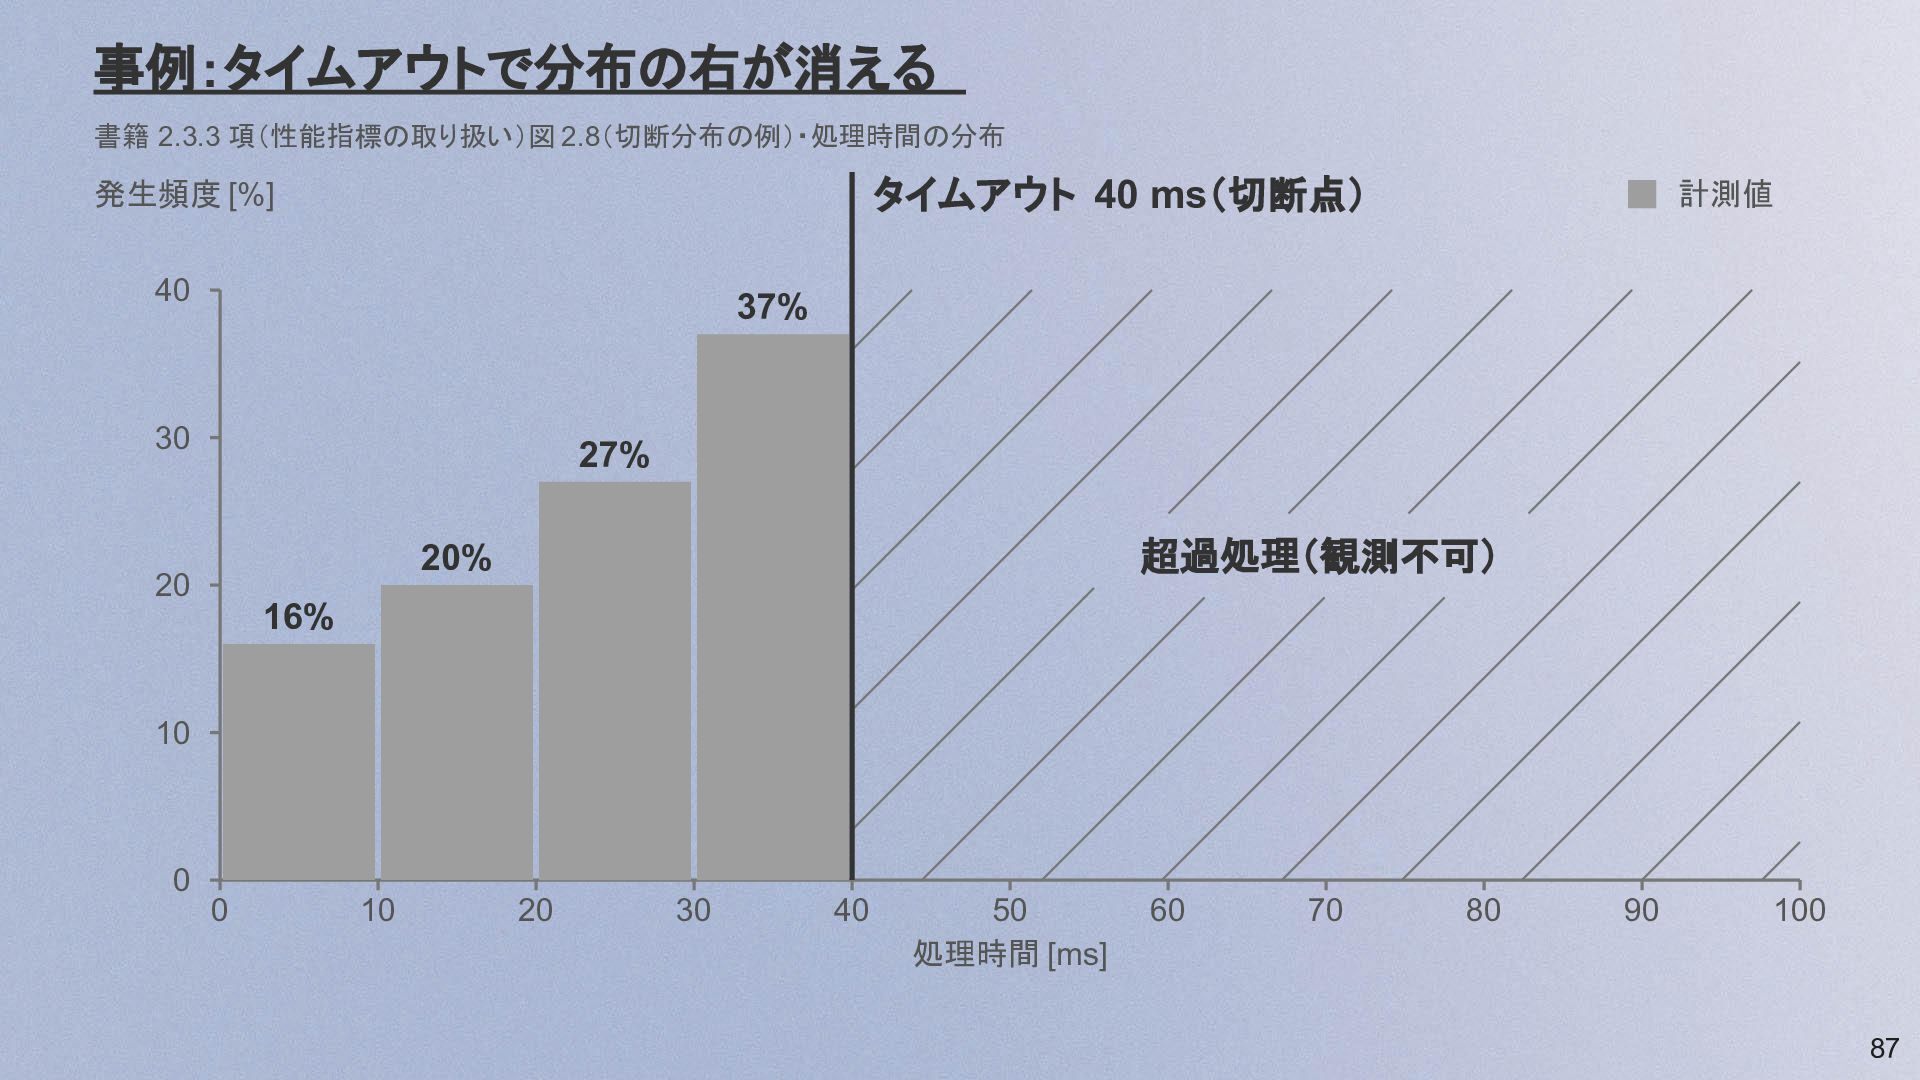
事例:タイムアウトで分布の右が消える 書籍 2.3.3 項(性能指標の取り扱い)図 2.8(切断分布の例)・処理時間の分布 タイムアウト 40 ms(切断点) 発生頻度 [%]
40 計測値 37% 30 27% 超過処理(観測不可) 20% 20 16% 10 0 0 10 20 30 40 50 処理時間 [ms] 60 70 80 90 100 87 -
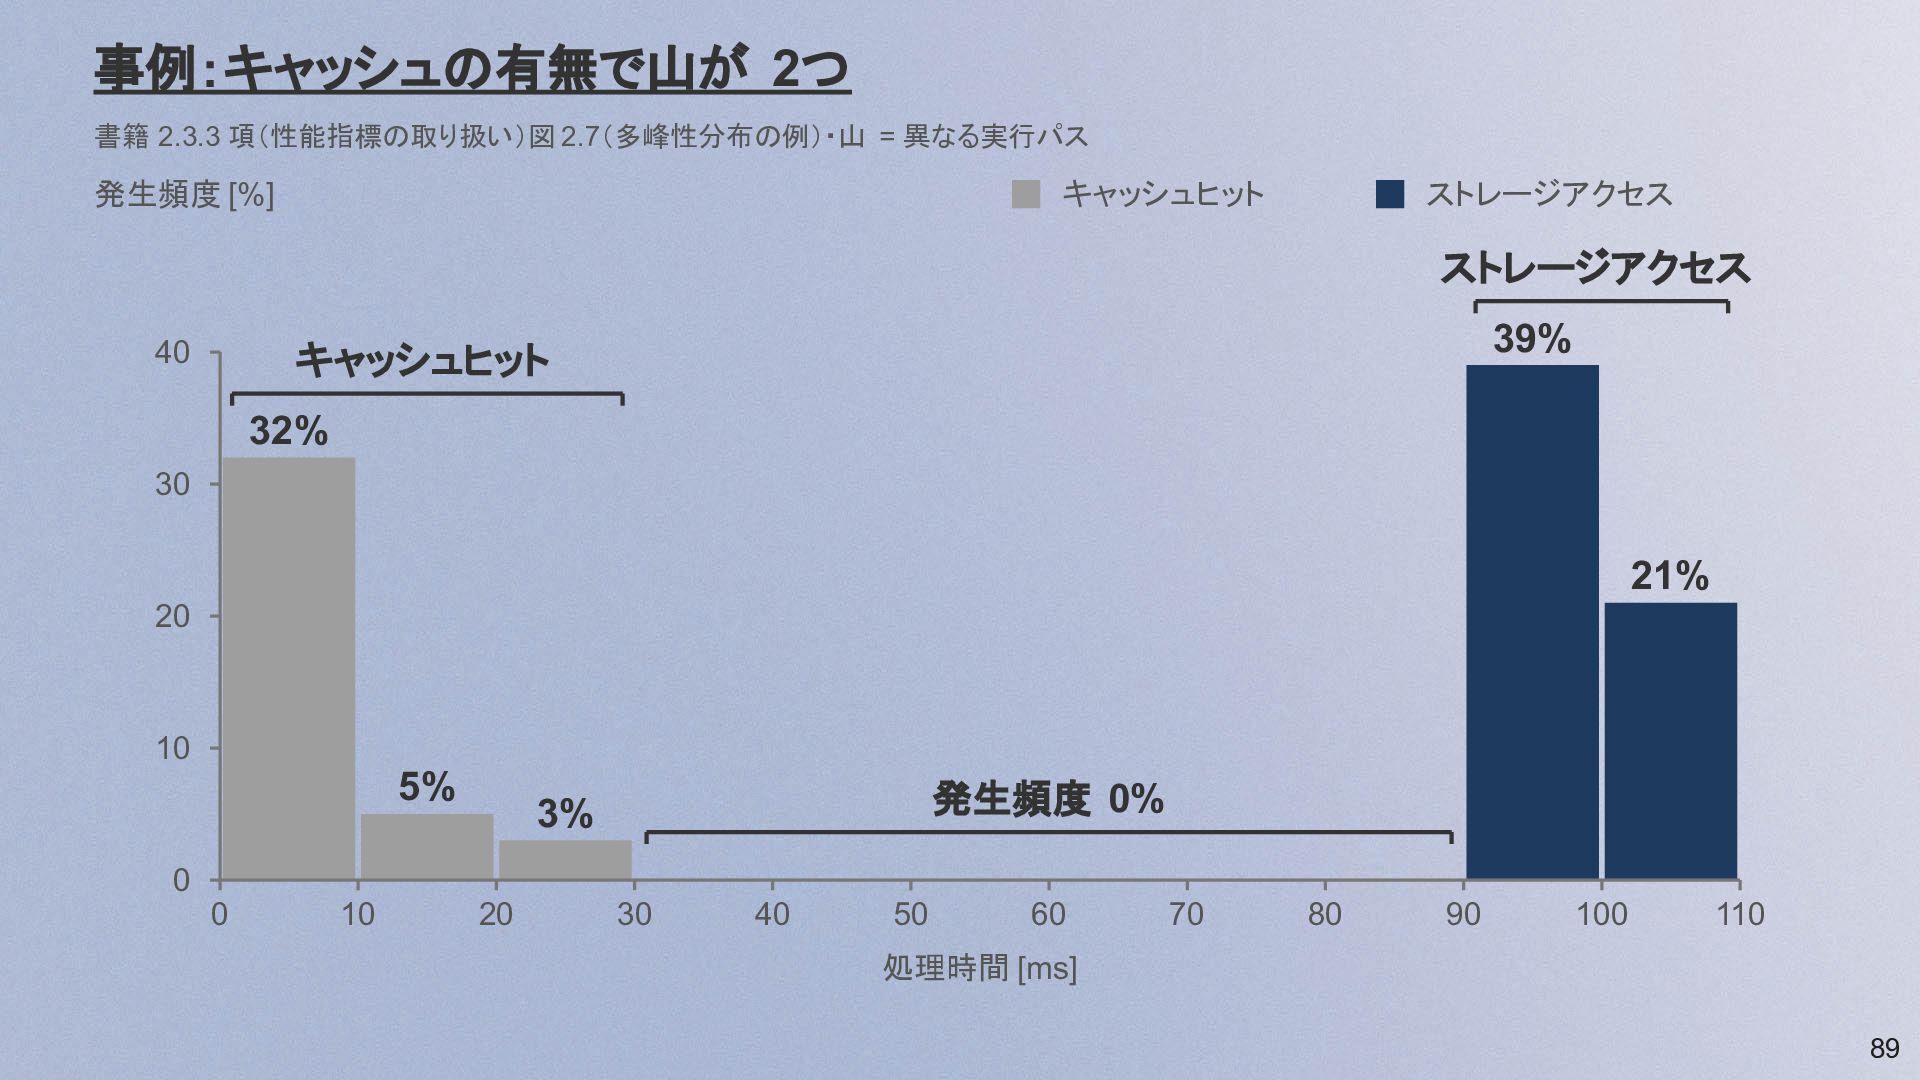
事例:キャッシュの有無で山が 2つ 書籍 2.3.3 項(性能指標の取り扱い)図 2.7(多峰性分布の例)・山 = 異なる実行パス キャッシュヒット 発生頻度
[%] ストレージアクセス ストレージアクセス 39% キャッシュヒット 40 32% 30 21% 20 10 5% 発生頻度 0% 3% 0 0 10 20 30 40 50 60 70 80 90 100 110 処理時間 [ms] 89 -
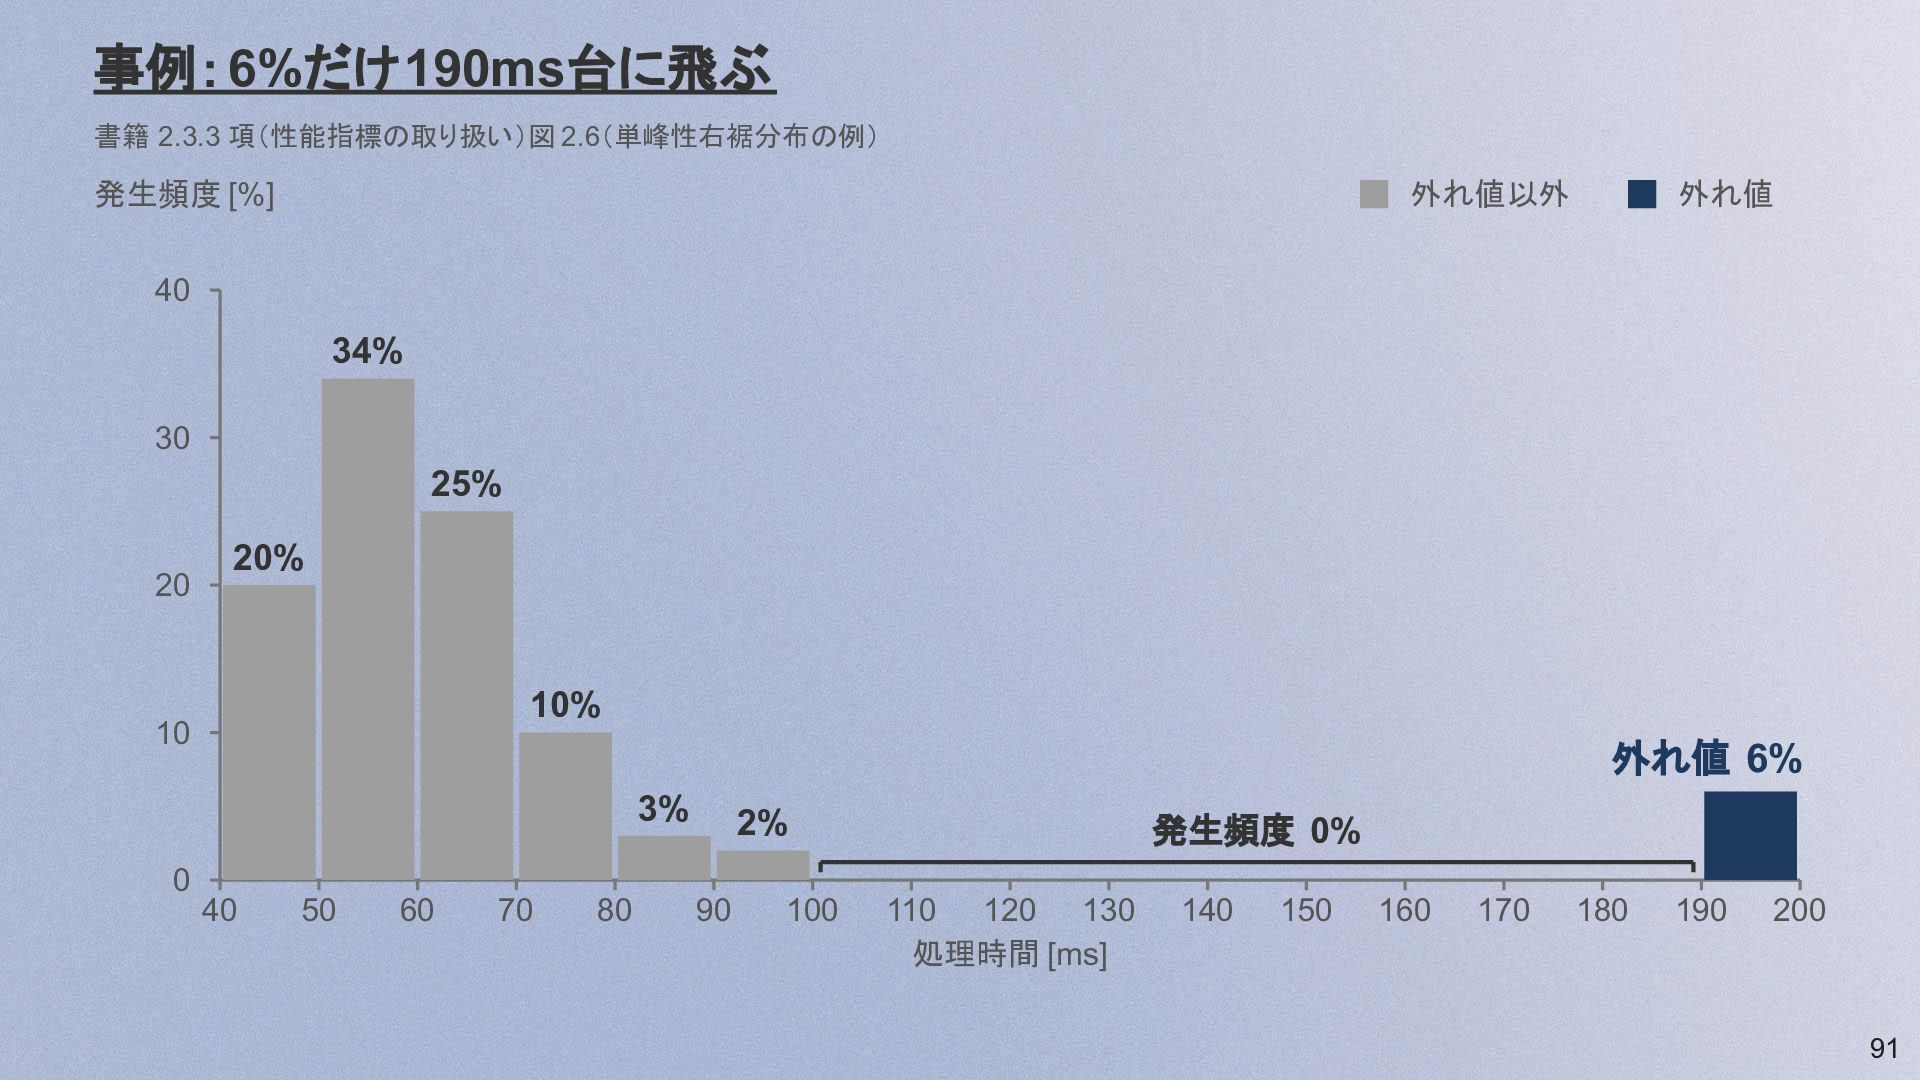
事例:6%だけ190ms台に飛ぶ 書籍 2.3.3 項(性能指標の取り扱い)図 2.6(単峰性右裾分布の例) 外れ値以外 発生頻度 [%] 外れ値 40
34% 30 25% 20 20% 10% 10 外れ値 6% 3% 0 40 50 60 70 80 2% 90 100 発生頻度 0% 110 120 130 処理時間 [ms] 140 150 160 170 180 190 200 91 -
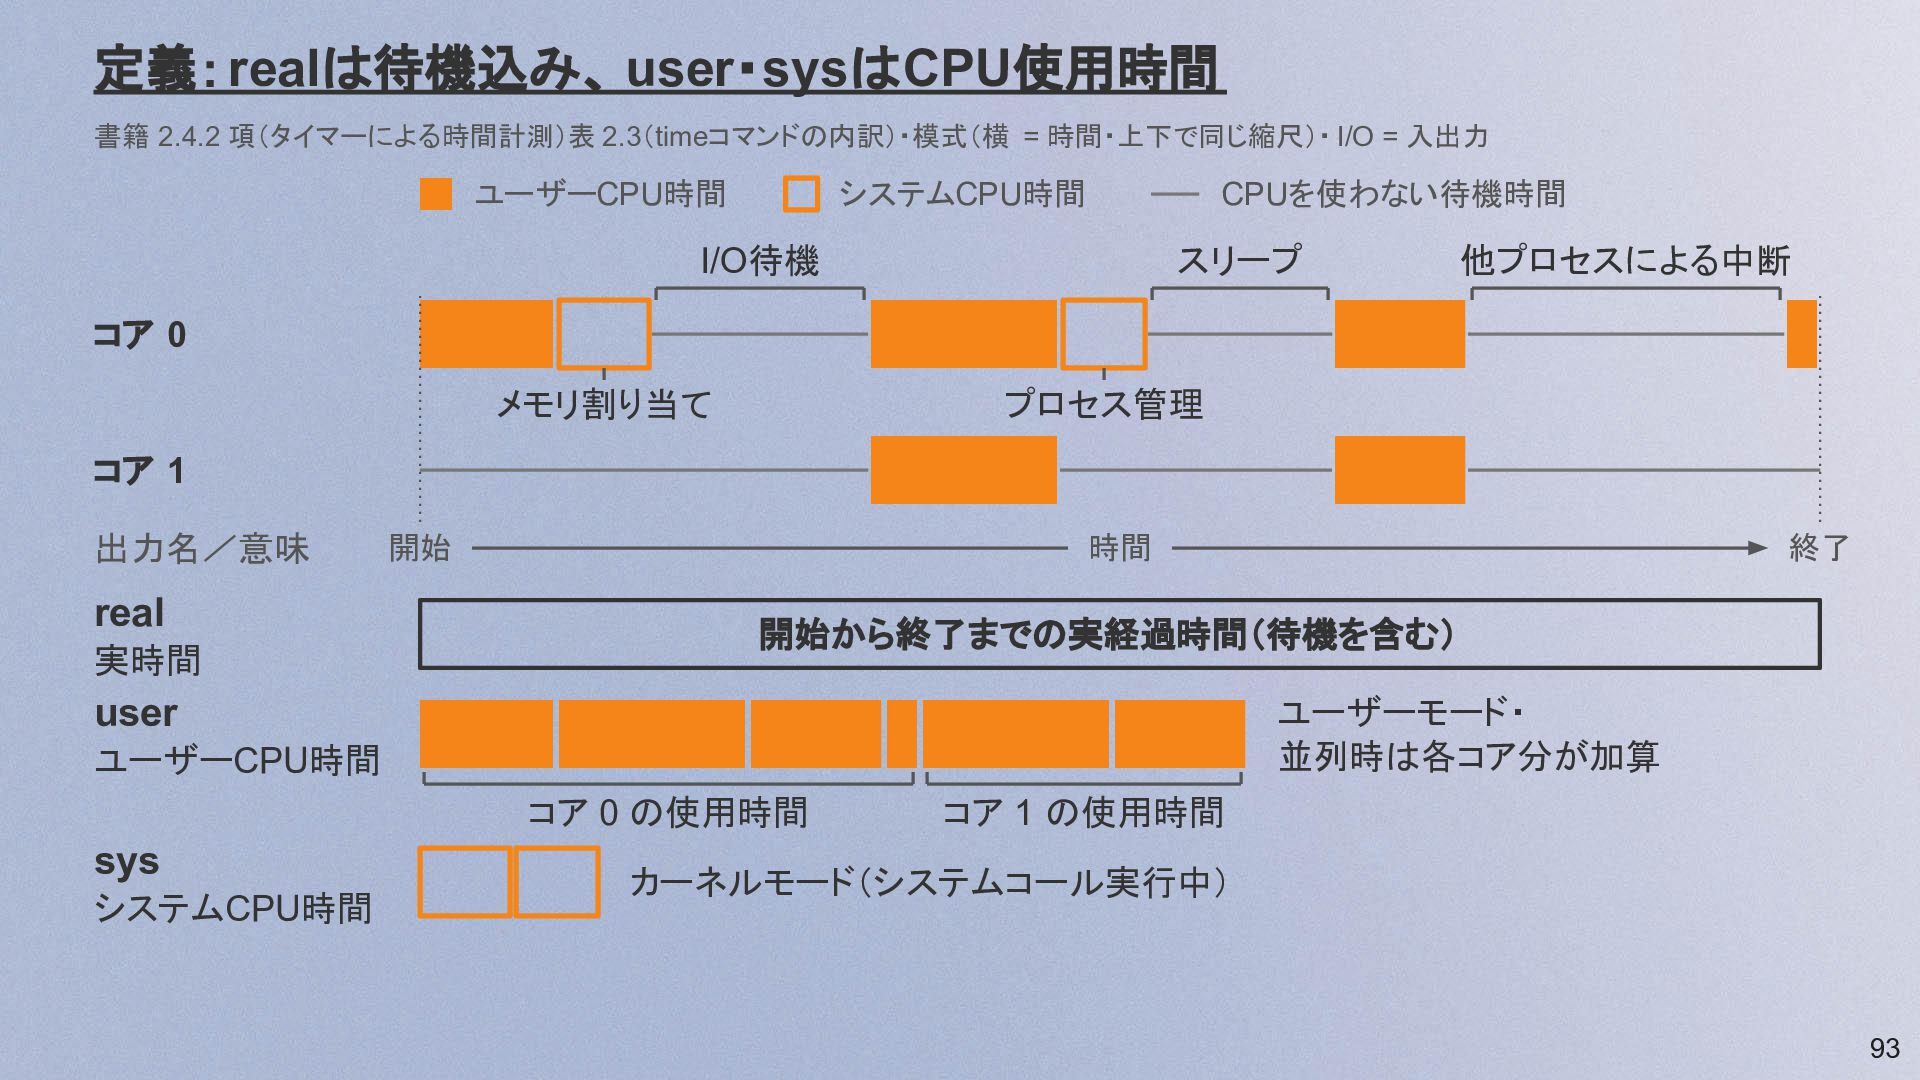
定義:realは待機込み、 user・sysはCPU使用時間 書籍 2.4.2 項(タイマーによる時間計測)表 2.3(timeコマンドの内訳)・模式(横 = 時間・上下で同じ縮尺)・ I/O =
入出力 ユーザーCPU時間 システムCPU時間 CPUを使わない待機時間 スリープ I/O待機 他プロセスによる中断 コア 0 メモリ割り当て プロセス管理 コア 1 出力名/意味 real 実時間 開始 時間 開始から終了までの実経過時間(待機を含む) ユーザーモード・ 並列時は各コア分が加算 user ユーザーCPU時間 コア 0 の使用時間 sys システムCPU時間 終了 コア 1 の使用時間 カーネルモード(システムコール実行中) 93 -
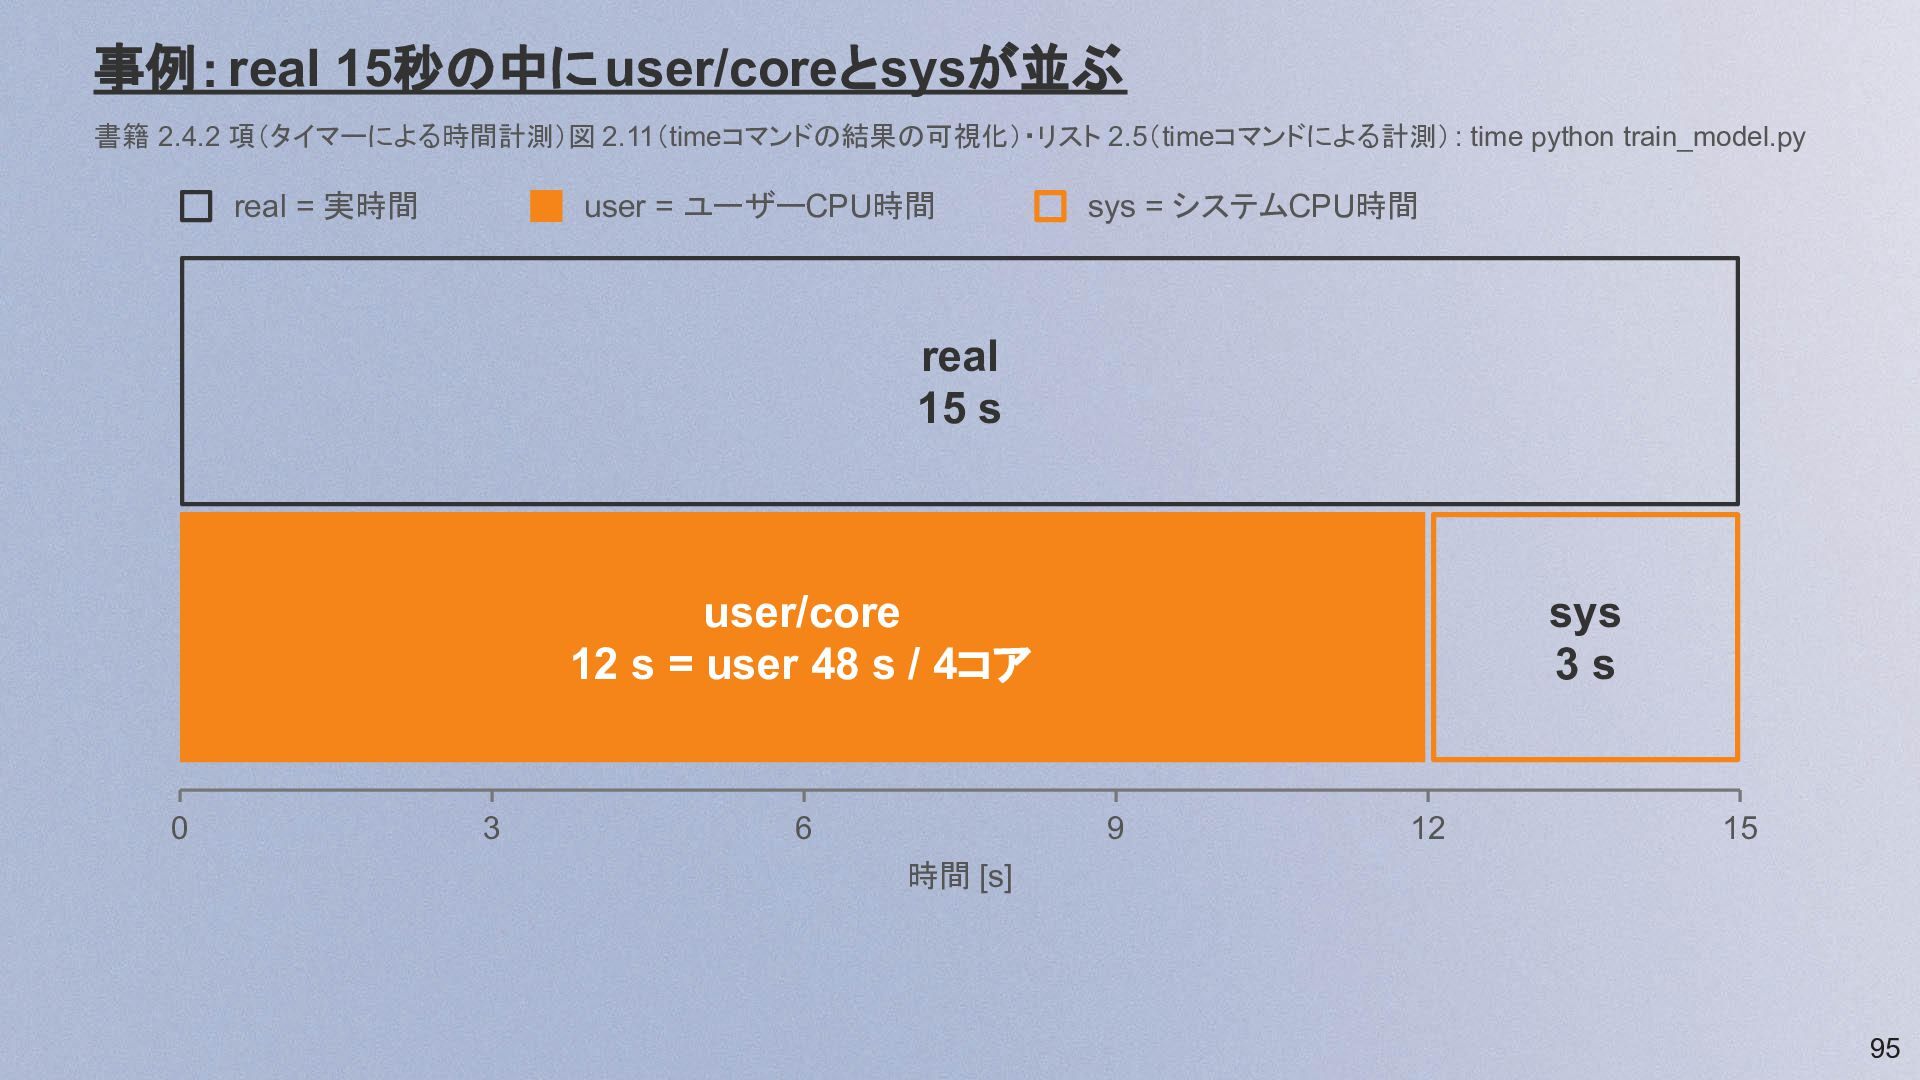
事例:real 15秒の中に user/coreとsysが並ぶ 書籍 2.4.2 項(タイマーによる時間計測)図 2.11(timeコマンドの結果の可視化)・リスト 2.5(timeコマンドによる計測) : time
python train_model.py real = 実時間 user = ユーザーCPU時間 sys = システムCPU時間 real 15 s sys 3s user/core 12 s = user 48 s / 4コア 0 3 6 9 12 15 時間 [s] 95 -
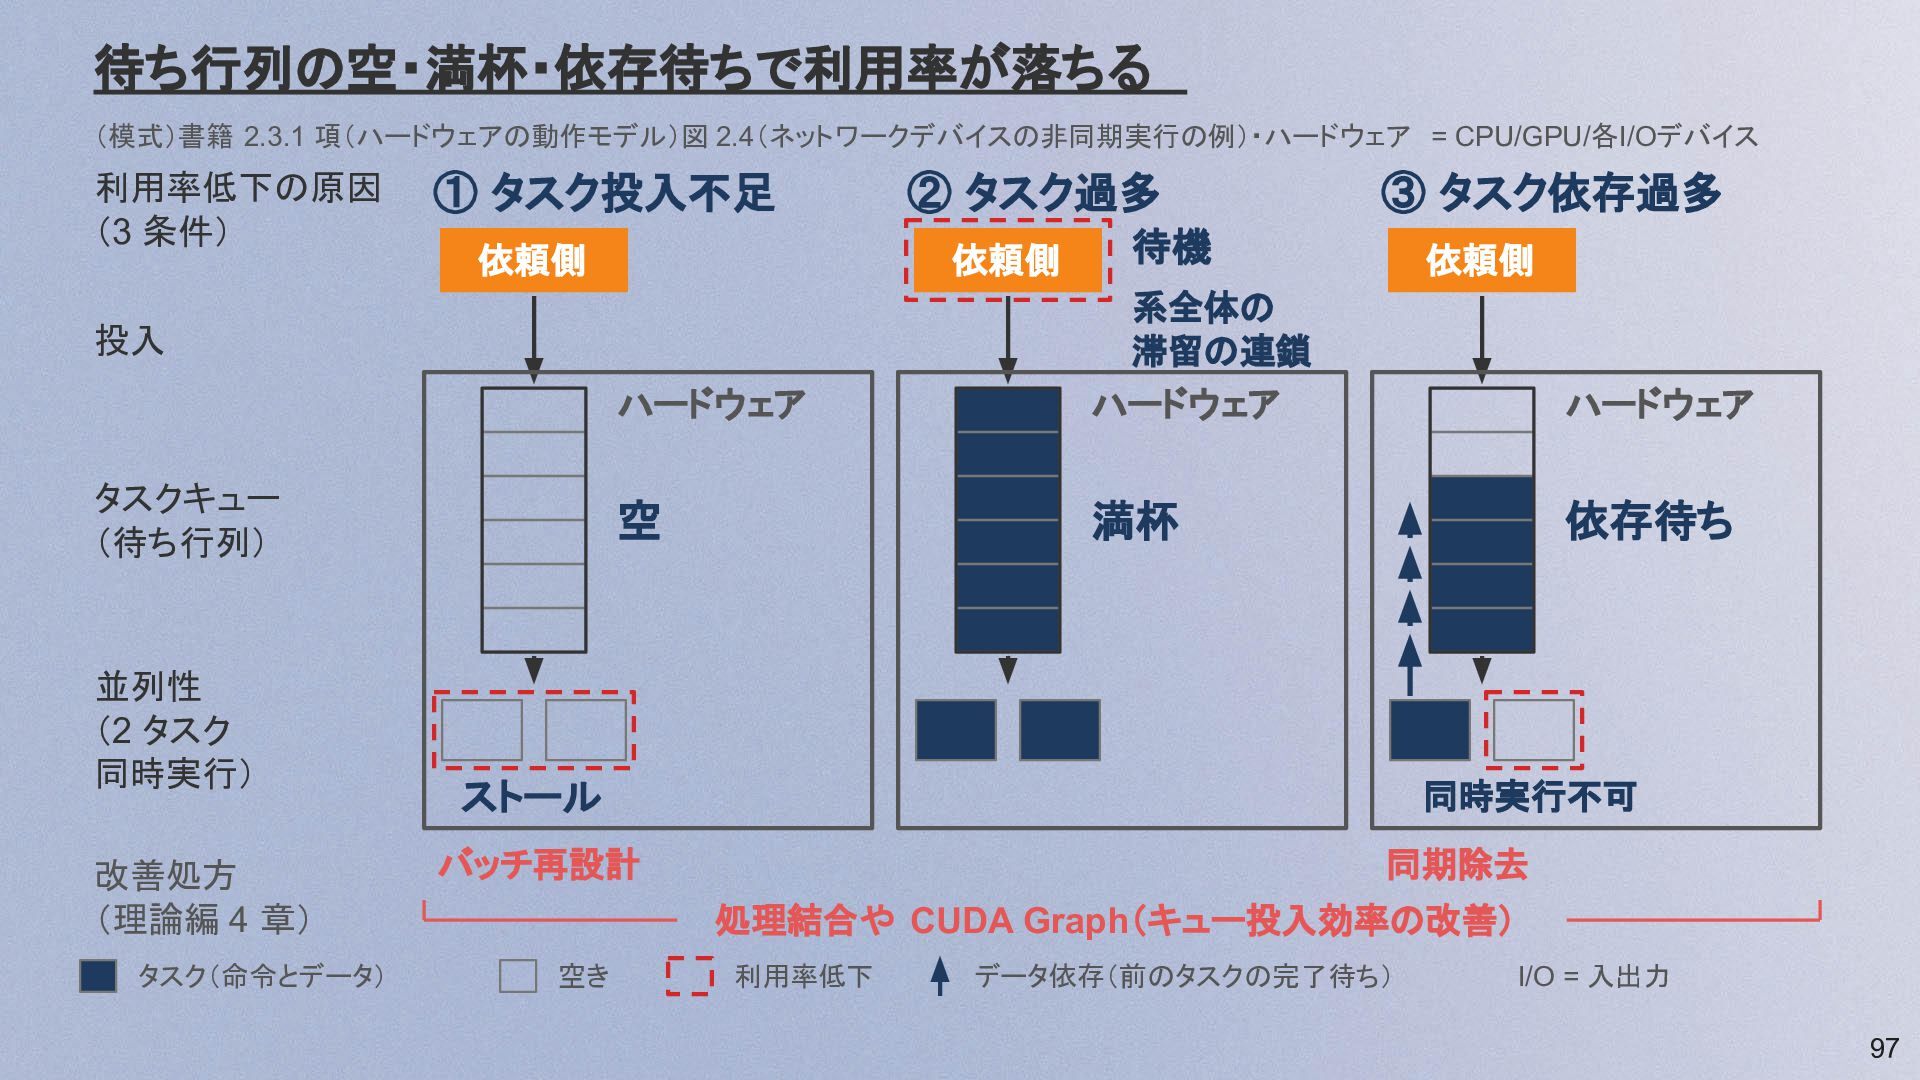
待ち行列の空・満杯・依存待ちで利用率が落ちる (模式)書籍 2.3.1 項(ハードウェアの動作モデル)図 2.4(ネットワークデバイスの非同期実行の例)・ハードウェア = CPU/GPU/各I/Oデバイス 利用率低下の原因 (3 条件)
① タスク投入不足 依頼側 依頼側 並列性 (2 タスク 同時実行) 改善処方 (理論編 4 章) タスク(命令とデータ) ③ タスク依存過多 待機 依頼側 ハードウェア 系全体の 滞留の連鎖 ハードウェア ハードウェア 空 満杯 依存待ち 投入 タスクキュー (待ち行列) ② タスク過多 ストール 同時実行不可 バッチ再設計 同期除去 処理結合や CUDA Graph(キュー投入効率の改善) 空き 利用率低下 データ依存(前のタスクの完了待ち) I/O = 入出力 97 -
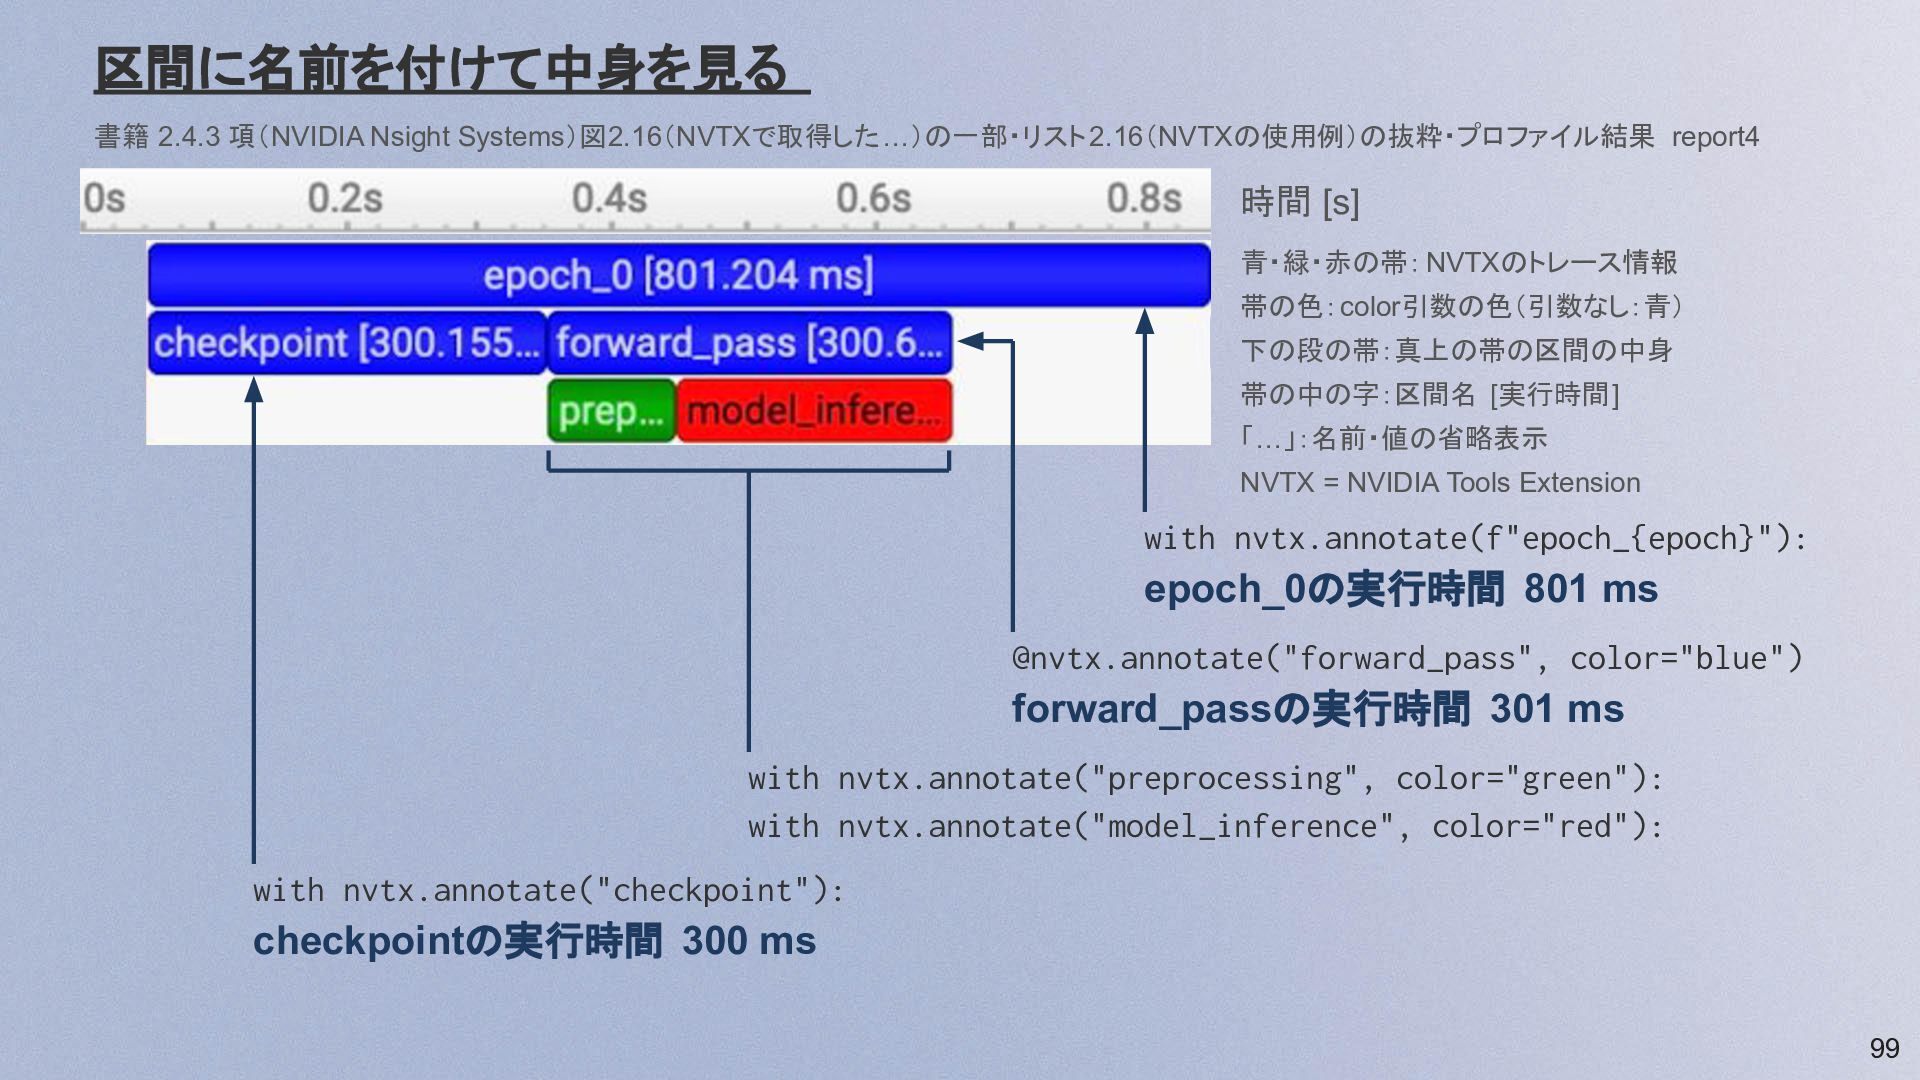
区間に名前を付けて中身を見る 書籍 2.4.3 項(NVIDIA Nsight Systems)図2.16(NVTXで取得した…)の一部・リスト 2.16(NVTXの使用例)の抜粋・プロファイル結果 report4 時間 [s]
青・緑・赤の帯: NVTXのトレース情報 帯の色:color引数の色(引数なし:青) 下の段の帯:真上の帯の区間の中身 帯の中の字:区間名 [実行時間] 「…」:名前・値の省略表示 NVTX = NVIDIA Tools Extension with nvtx.annotate(f"epoch_{epoch}"): epoch_0の実行時間 801 ms @nvtx.annotate("forward_pass", color="blue") forward_passの実行時間 301 ms with nvtx.annotate("preprocessing", color="green"): with nvtx.annotate("model_inference", color="red"): with nvtx.annotate("checkpoint"): checkpointの実行時間 300 ms 99 -
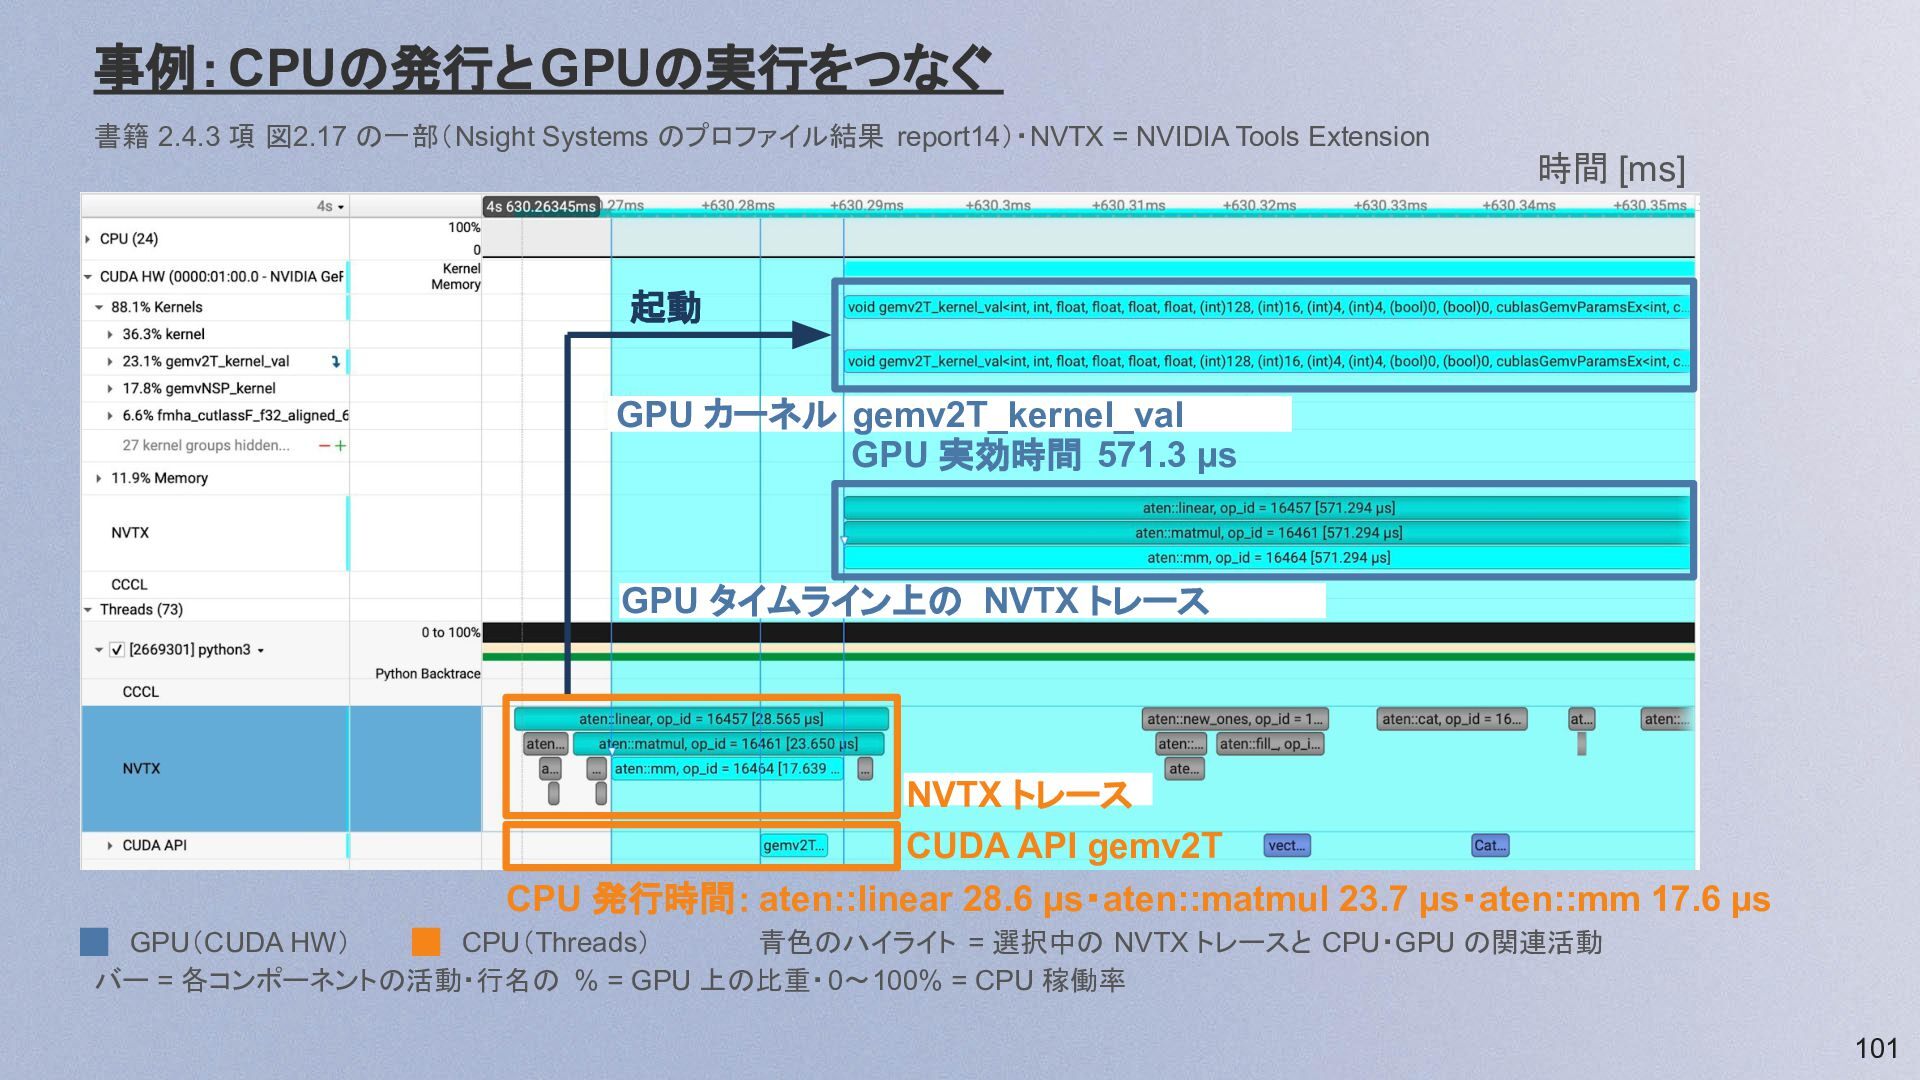
事例:CPUの発行と GPUの実行をつなぐ 書籍 2.4.3 項 図2.17 の一部(Nsight Systems のプロファイル結果 report14)・NVTX
= NVIDIA Tools Extension 時間 [ms] 起動 GPU カーネル gemv2T_kernel_val GPU 実効時間 571.3 µs GPU タイムライン上の NVTX トレース NVTX トレース CUDA API gemv2T CPU 発行時間: aten::linear 28.6 µs・aten::matmul 23.7 µs・aten::mm 17.6 µs GPU(CUDA HW) CPU(Threads) 青色のハイライト = 選択中の NVTX トレースと CPU・GPU の関連活動 バー = 各コンポーネントの活動・行名の % = GPU 上の比重・0〜100% = CPU 稼働率 101 -
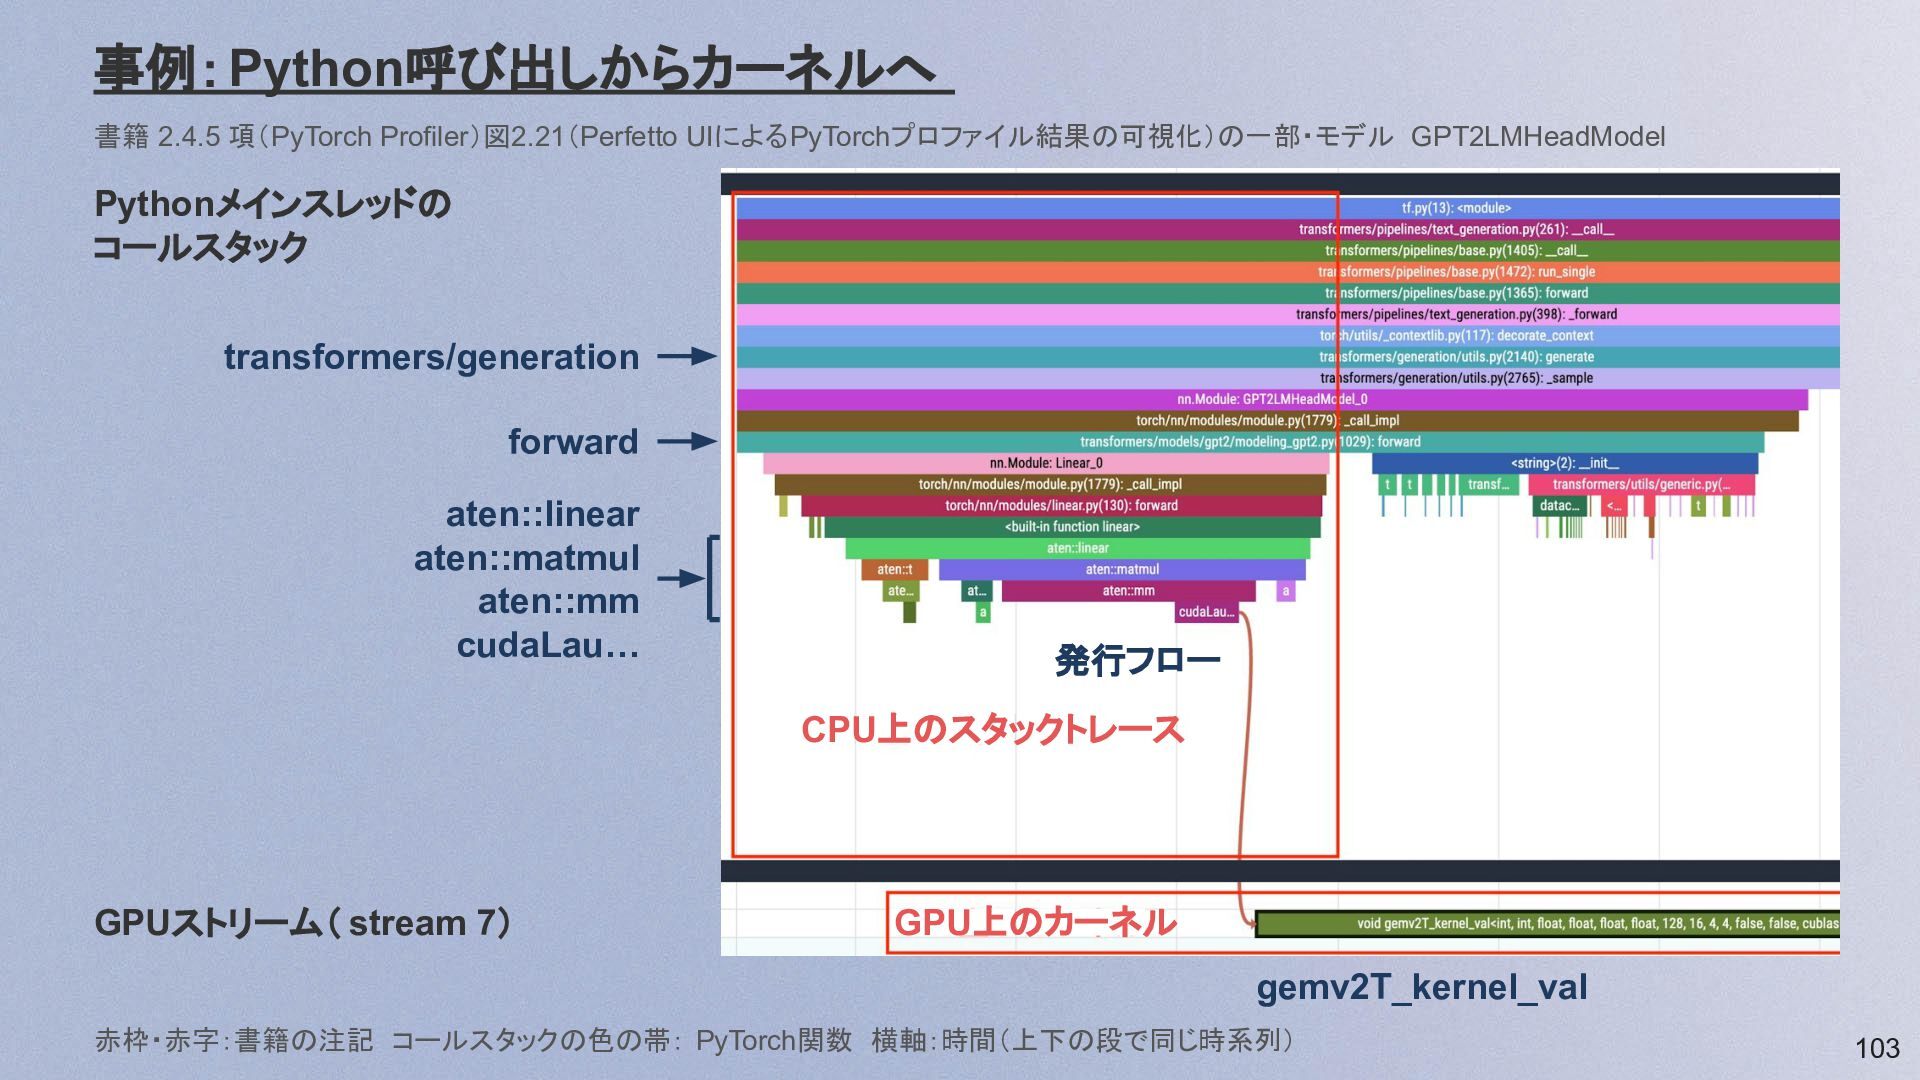
事例:Python呼び出しからカーネルへ 書籍 2.4.5 項(PyTorch Profiler)図2.21(Perfetto UIによるPyTorchプロファイル結果の可視化)の一部・モデル GPT2LMHeadModel Pythonメインスレッドの コールスタック transformers/generation
forward aten::linear aten::matmul aten::mm cudaLau… 発行フロー CPU上のスタックトレース GPUストリーム( stream 7) GPU上のカーネル gemv2T_kernel_val 赤枠・赤字:書籍の注記 コールスタックの色の帯: PyTorch関数 横軸:時間(上下の段で同じ時系列) 103 -
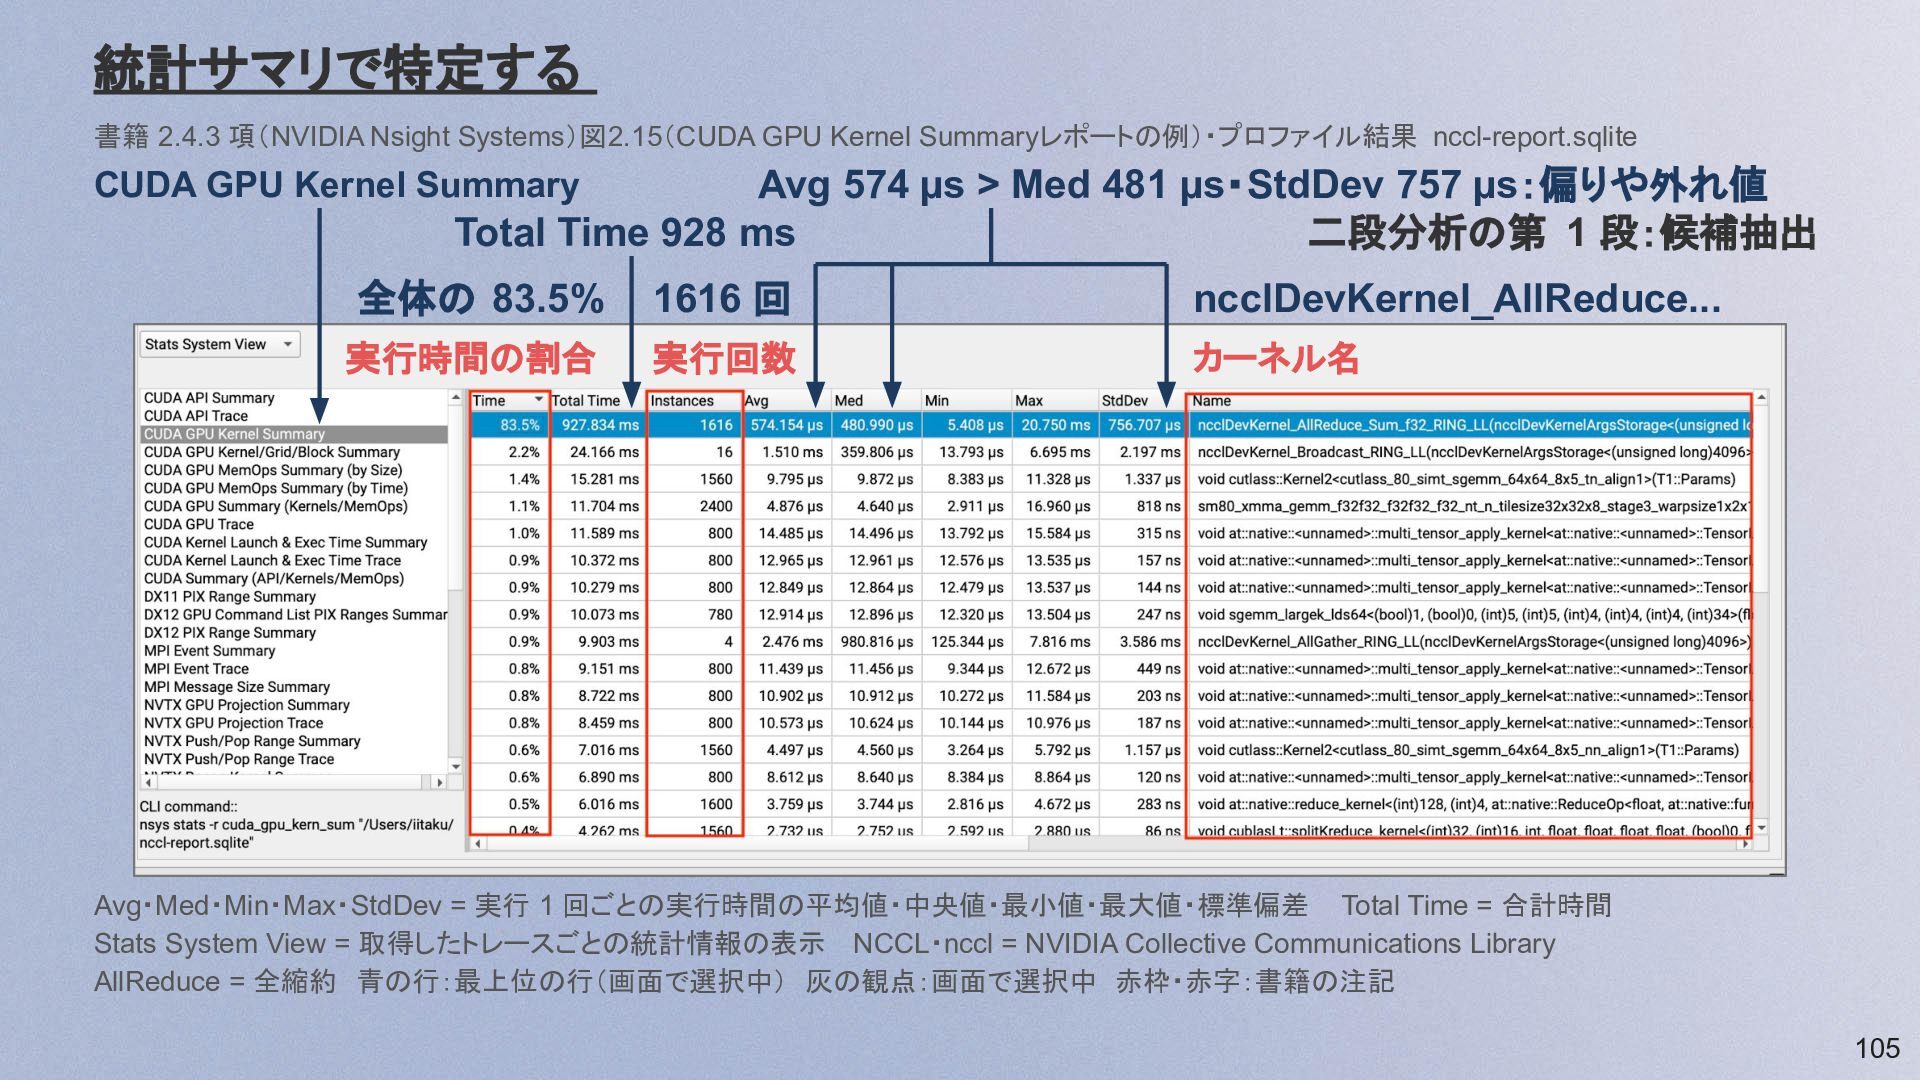
統計サマリで特定する 書籍 2.4.3 項(NVIDIA Nsight Systems)図2.15(CUDA GPU Kernel Summaryレポートの例)・プロファイル結果 nccl-report.sqlite
Avg 574 µs > Med 481 µs・StdDev 757 µs:偏りや外れ値 Total Time 928 ms 二段分析の第 1 段:候補抽出 CUDA GPU Kernel Summary 全体の 83.5% 1616 回 ncclDevKernel_AllReduce... 実行時間の割合 実行回数 カーネル名 Avg・Med・Min・Max・StdDev = 実行 1 回ごとの実行時間の平均値・中央値・最小値・最大値・標準偏差 Total Time = 合計時間 Stats System View = 取得したトレースごとの統計情報の表示 NCCL・nccl = NVIDIA Collective Communications Library AllReduce = 全縮約 青の行:最上位の行(画面で選択中) 灰の観点:画面で選択中 赤枠・赤字:書籍の注記 105 -
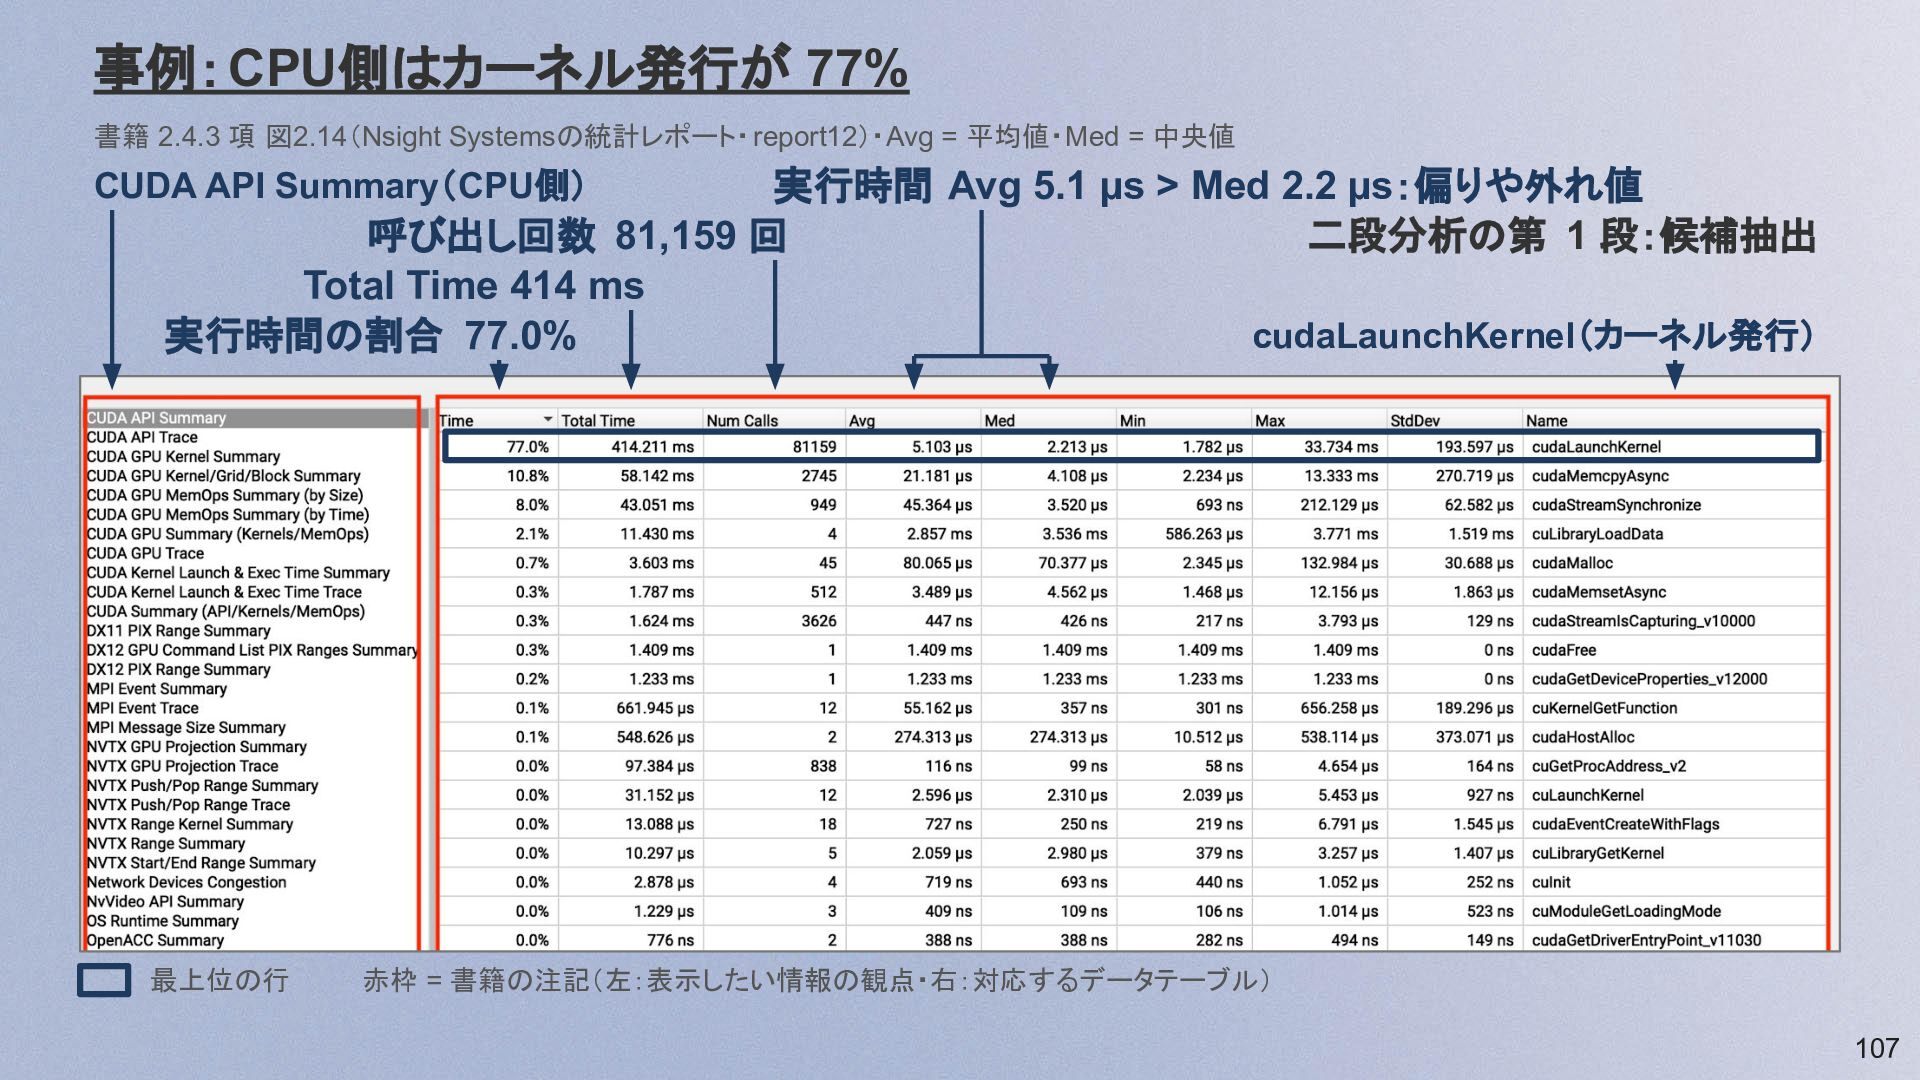
事例:CPU側はカーネル発行が 77% 書籍 2.4.3 項 図2.14(Nsight Systemsの統計レポート・ report12)・Avg = 平均値・Med
= 中央値 実行時間 Avg 5.1 µs > Med 2.2 µs:偏りや外れ値 呼び出し回数 81,159 回 二段分析の第 1 段:候補抽出 Total Time 414 ms cudaLaunchKernel(カーネル発行) 実行時間の割合 77.0% CUDA API Summary(CPU側) 最上位の行 赤枠 = 書籍の注記(左:表示したい情報の観点・右:対応するデータテーブル) 107 -
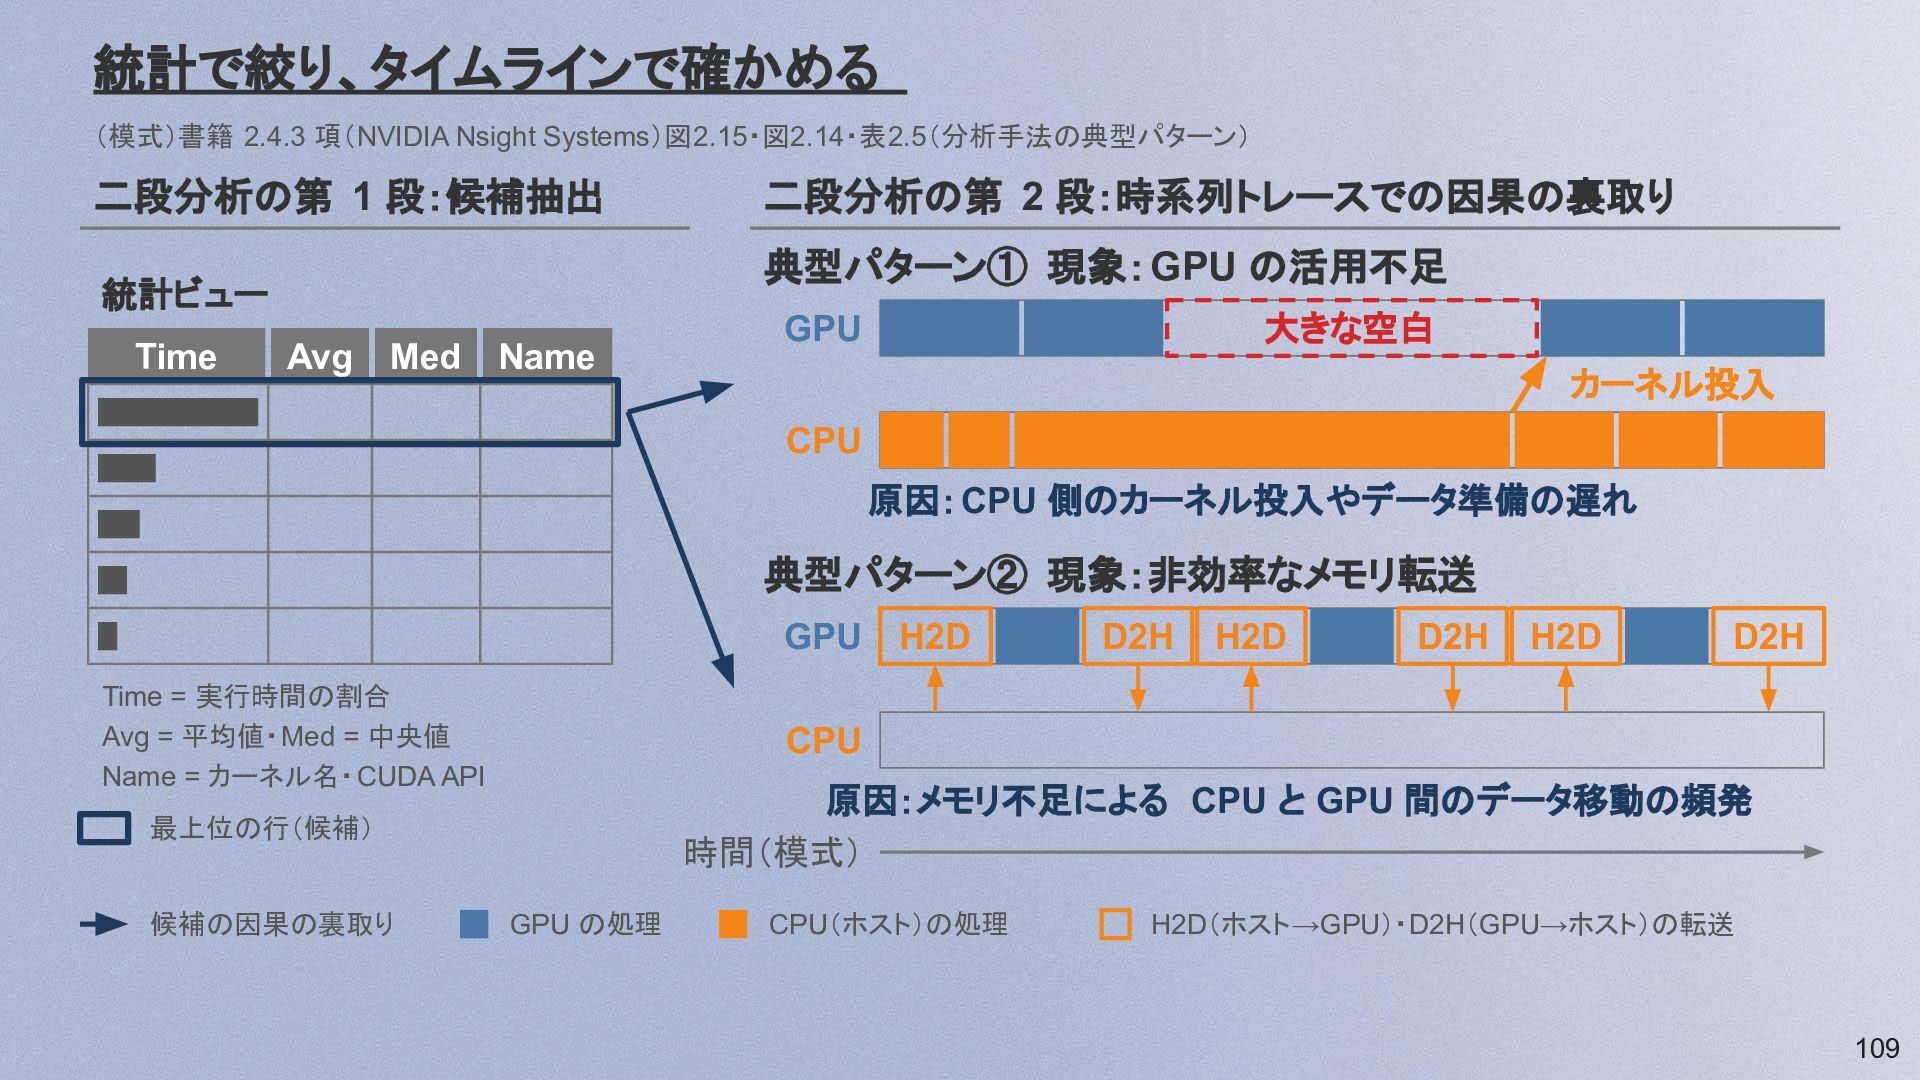
統計で絞り、タイムラインで確かめる (模式)書籍 2.4.3 項(NVIDIA Nsight Systems)図2.15・図2.14・表2.5(分析手法の典型パターン) 二段分析の第 1 段:候補抽出 典型パターン①
現象:GPU の活用不足 統計ビュー Time 二段分析の第 2 段:時系列トレースでの因果の裏取り Avg Med Name 大きな空白 GPU カーネル投入 CPU 原因:CPU 側のカーネル投入やデータ準備の遅れ 典型パターン② 現象:非効率なメモリ転送 GPU Time = 実行時間の割合 Avg = 平均値・Med = 中央値 Name = カーネル名・CUDA API D2H H2D D2H H2D D2H CPU 原因:メモリ不足による CPU と GPU 間のデータ移動の頻発 時間(模式) 最上位の行(候補) 候補の因果の裏取り H2D GPU の処理 CPU(ホスト)の処理 H2D(ホスト→GPU)・D2H(GPU→ホスト)の転送 109 -
計測から仮説を立てる A100 GPU・LLaMA-7B 推論・7B = パラメータ数 約 70 億(書籍 1.3.2
項の 8B と同じ表記)・ SM = Streaming Multiprocessor・書籍 2.3.6 項 GPU Utilization (時間使用率) 根拠 メカニズム 検証方法 仮説 A 98% と 35% の大きな乖離 ワープ数不足で メモリレイテンシ 隠蔽不可 → ストール カーネル実行 パラメータの確認 仮説 B 理論帯域幅の 約 20% 非連続アクセスで コアレッシングなし → 実効帯域の低下 コアレッシング率 の測定 98% SM Activity (能力使用率) 35% メモリ帯域使用 (100% = 理論帯域幅) 約 20% 0 50 100 使用率 [%] 111 -
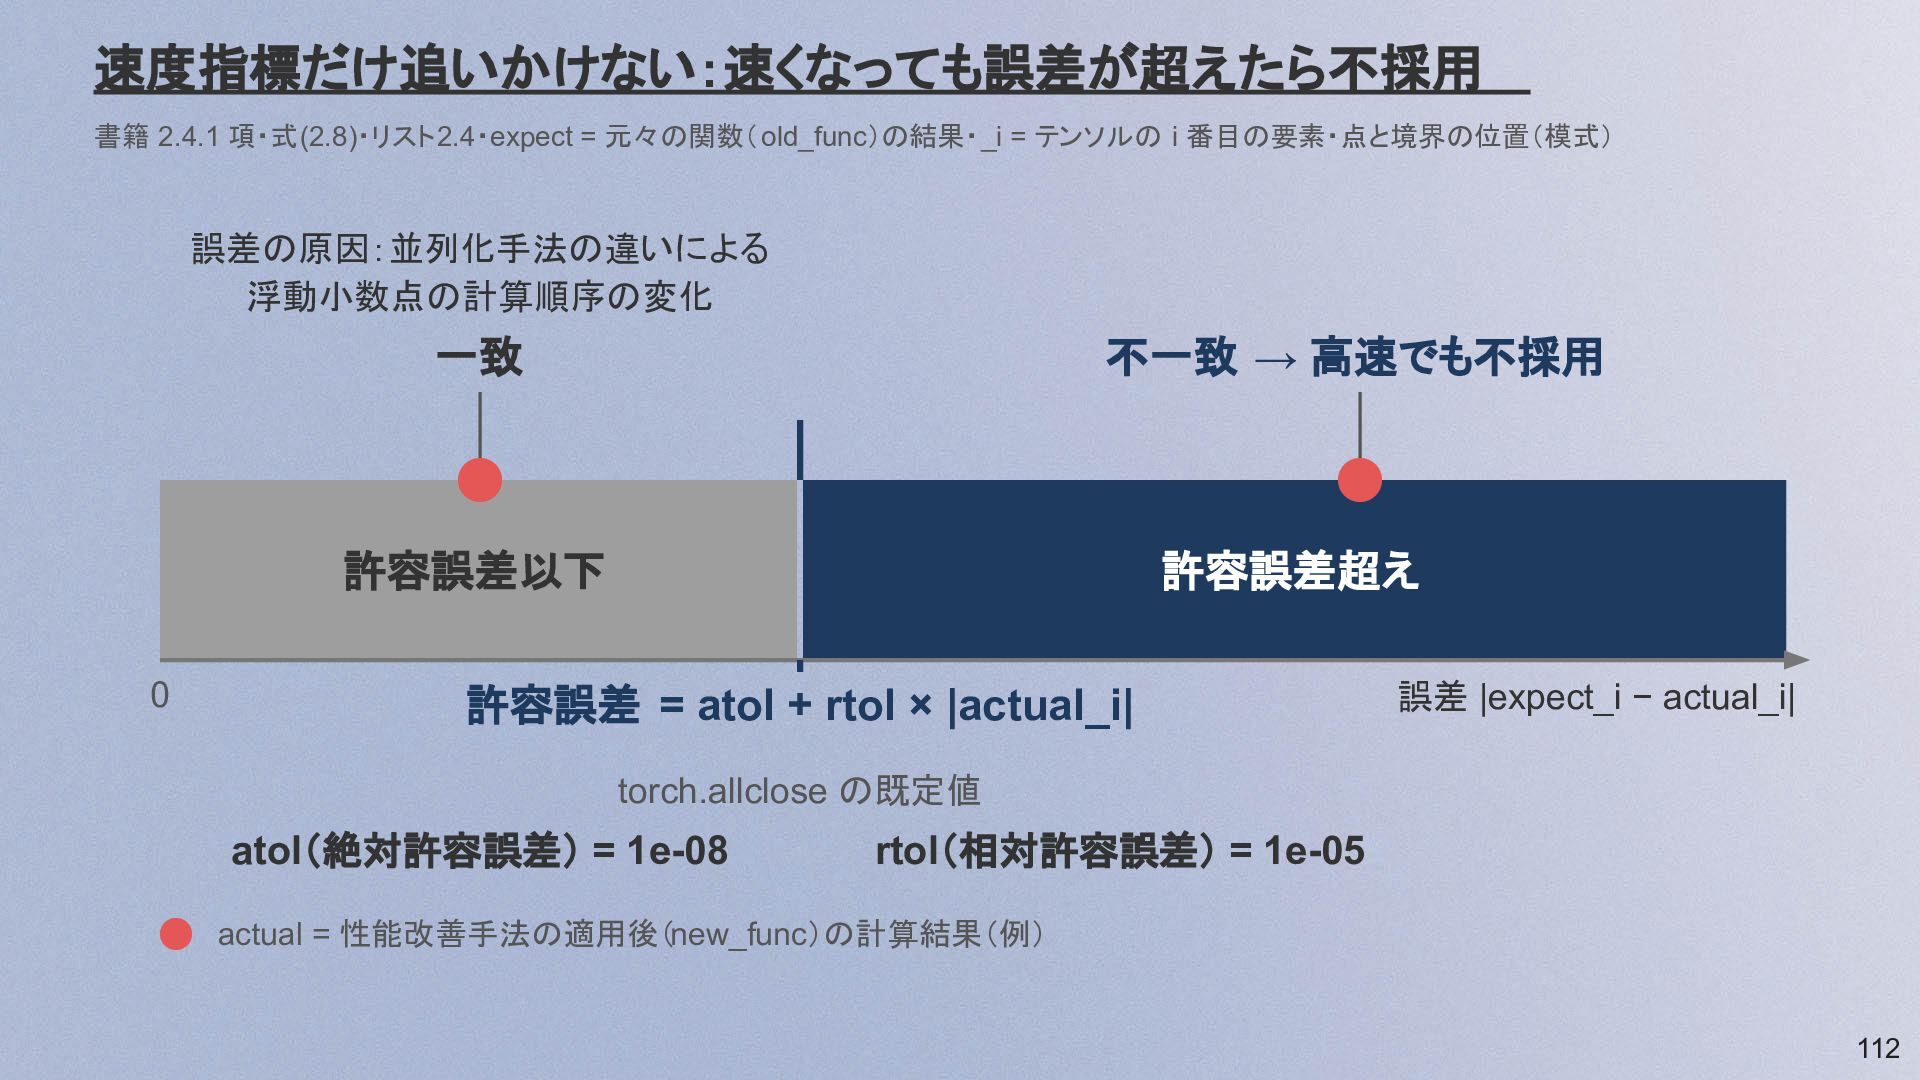
速度指標だけ追いかけない:速くなっても誤差が超えたら不採用 書籍 2.4.1 項・式(2.8)・リスト2.4・expect = 元々の関数(old_func)の結果・_i = テンソルの i 番目の要素・点と境界の位置(模式)
誤差の原因:並列化手法の違いによる 浮動小数点の計算順序の変化 一致 不一致 → 高速でも不採用 許容誤差以下 0 許容誤差超え 許容誤差 = atol + rtol × |actual_i| 誤差 |expect_i − actual_i| torch.allclose の既定値 atol(絶対許容誤差) = 1e-08 rtol(相対許容誤差) = 1e-05 actual = 性能改善手法の適用後(new_func)の計算結果(例) 112 -
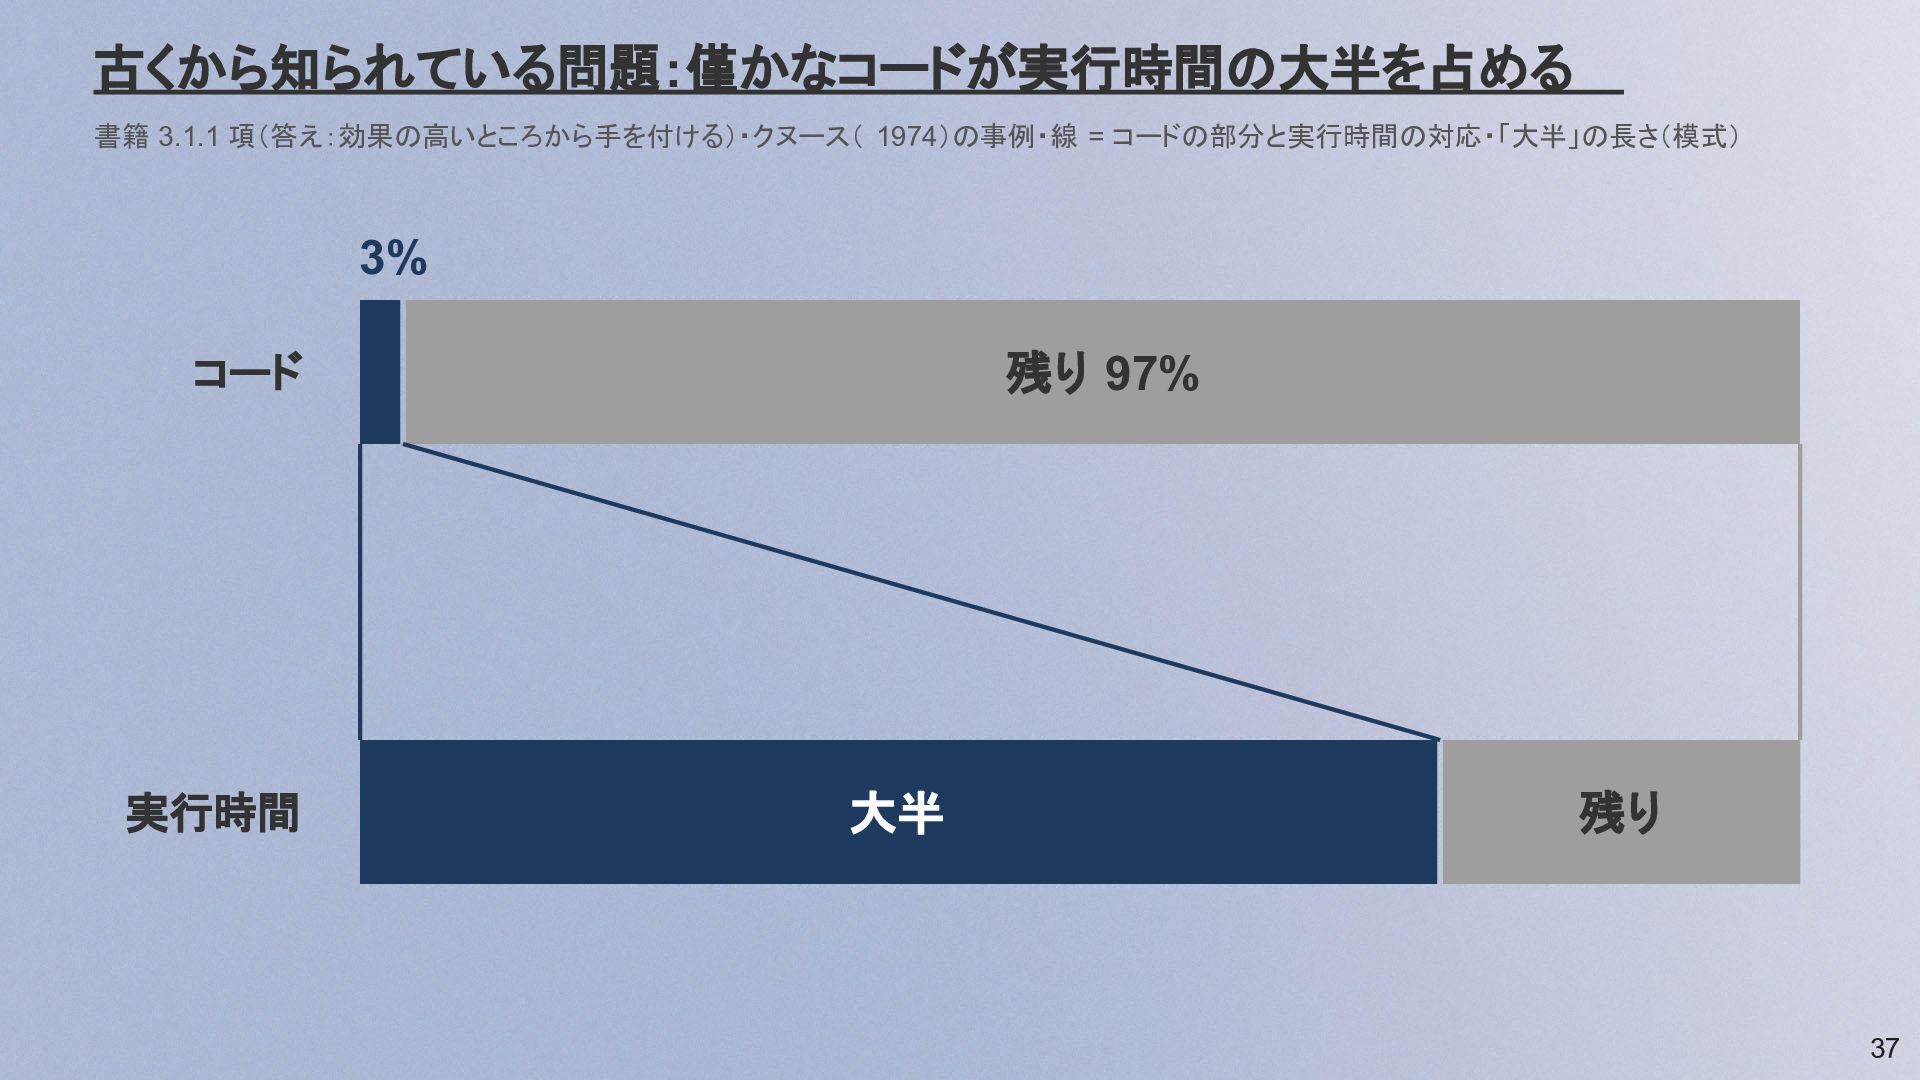
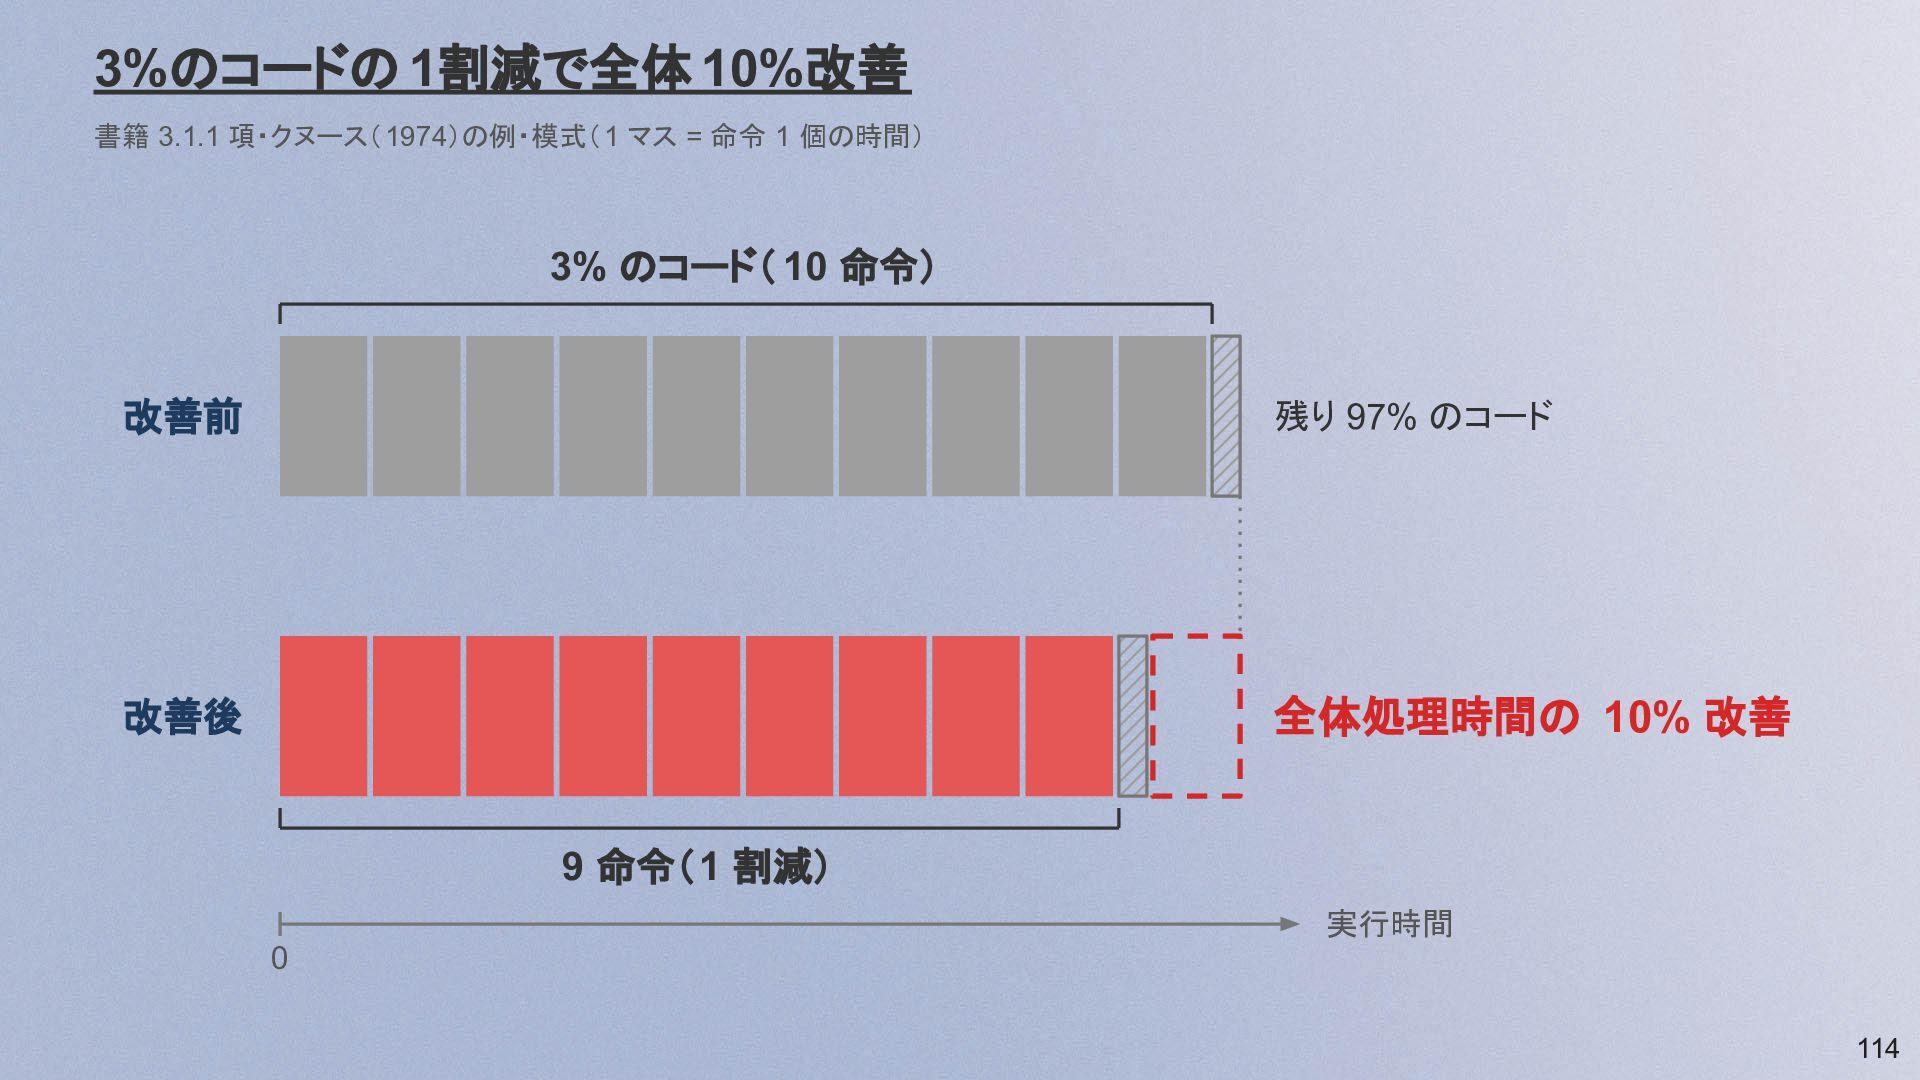
3%のコードの 1割減で全体 10%改善 書籍 3.1.1 項・クヌース( 1974)の例・模式(1 マス = 命令
1 個の時間) 3% のコード( 10 命令) 改善前 残り 97% のコード 改善後 全体処理時間の 10% 改善 9 命令(1 割減) 実行時間 0 114 -
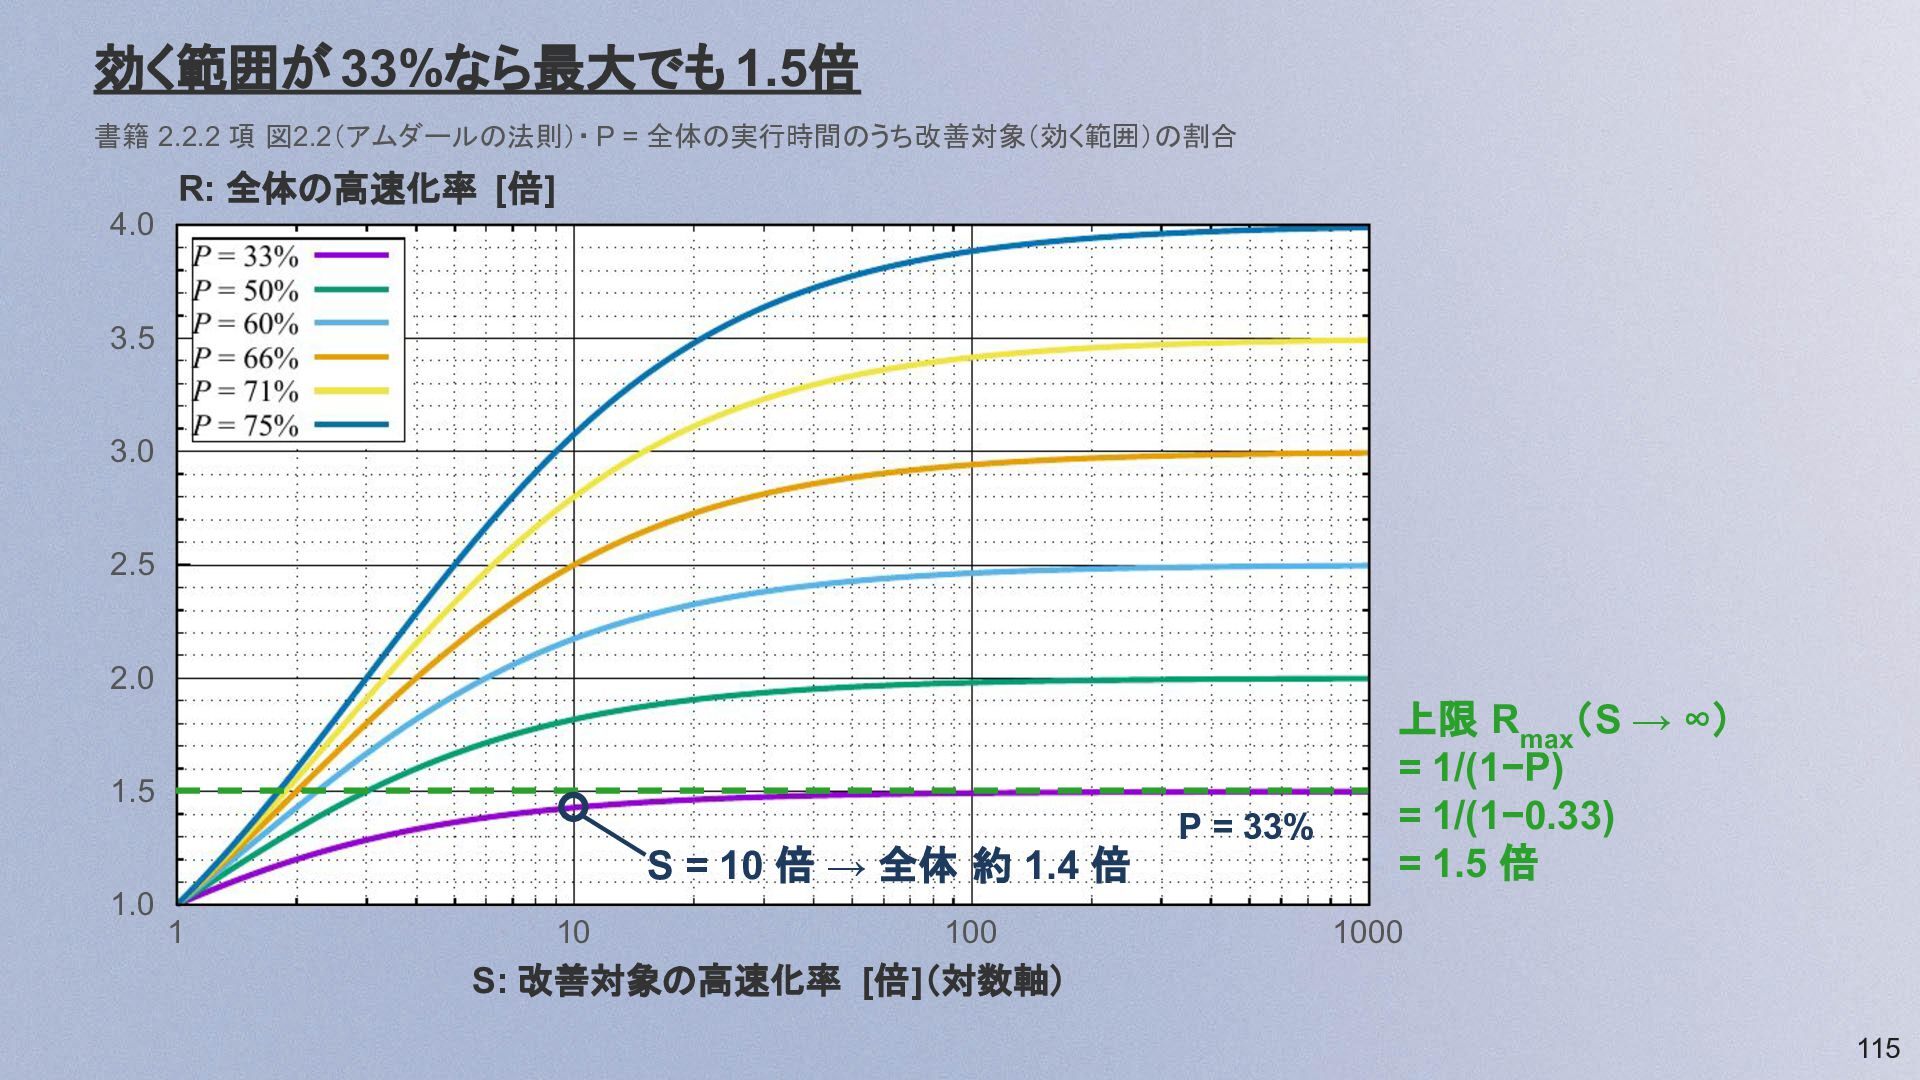
効く範囲が 33%なら最大でも 1.5倍 書籍 2.2.2 項 図2.2(アムダールの法則)・ P = 全体の実行時間のうち改善対象(効く範囲)の割合
R: 全体の高速化率 [倍] 4.0 3.5 3.0 2.5 2.0 1.5 S = 10 倍 → 全体 約 1.4 倍 1.0 1 10 100 P = 33% 上限 Rmax(S → ∞) = 1/(1−P) = 1/(1−0.33) = 1.5 倍 1000 S: 改善対象の高速化率 [倍](対数軸) 115 -
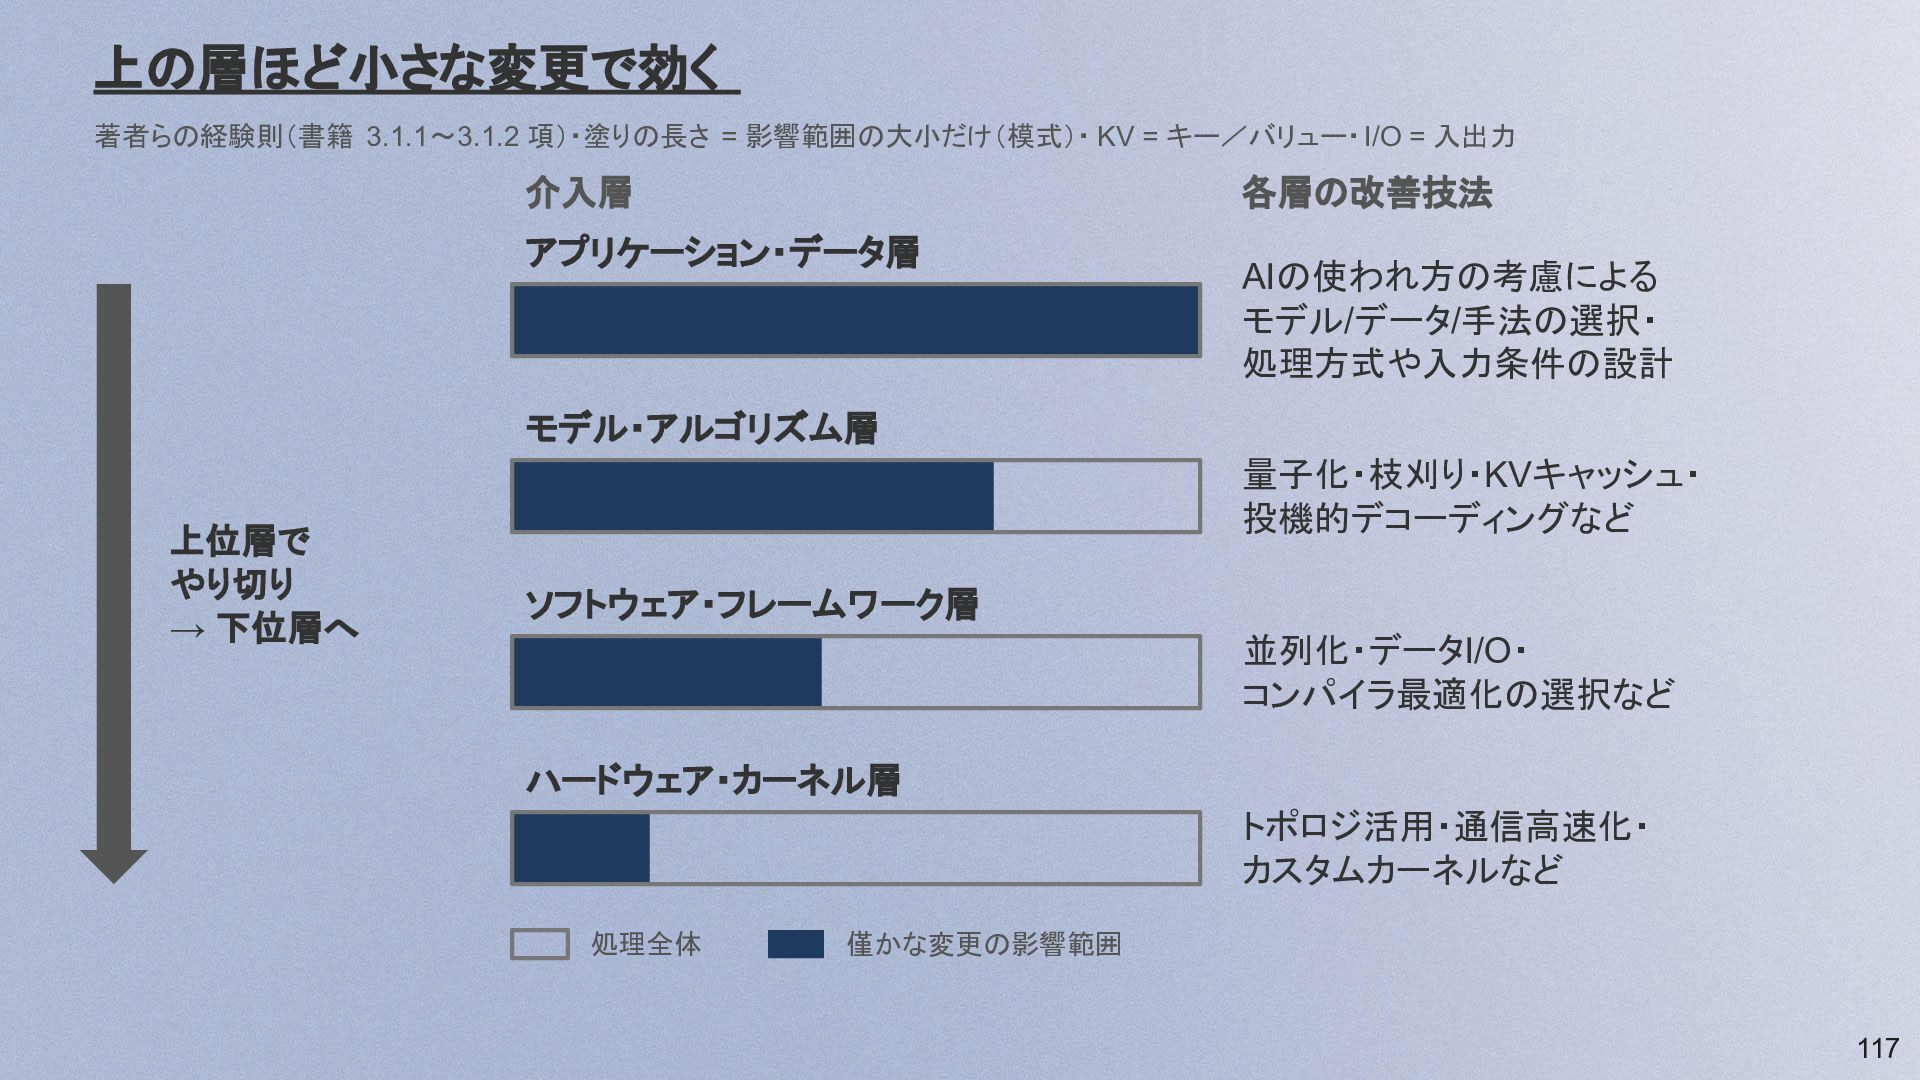
上の層ほど小さな変更で効く 著者らの経験則(書籍 3.1.1〜3.1.2 項)・塗りの長さ = 影響範囲の大小だけ(模式)・ KV = キー/バリュー・ I/O
= 入出力 介入層 各層の改善技法 アプリケーション・データ層 AIの使われ方の考慮による モデル/データ/手法の選択・ 処理方式や入力条件の設計 モデル・アルゴリズム層 上位層で やり切り → 下位層へ 量子化・枝刈り・KVキャッシュ・ 投機的デコーディングなど ソフトウェア・フレームワーク層 並列化・データI/O・ コンパイラ最適化の選択など ハードウェア・カーネル層 トポロジ活用・通信高速化・ カスタムカーネルなど 処理全体 僅かな変更の影響範囲 117 -
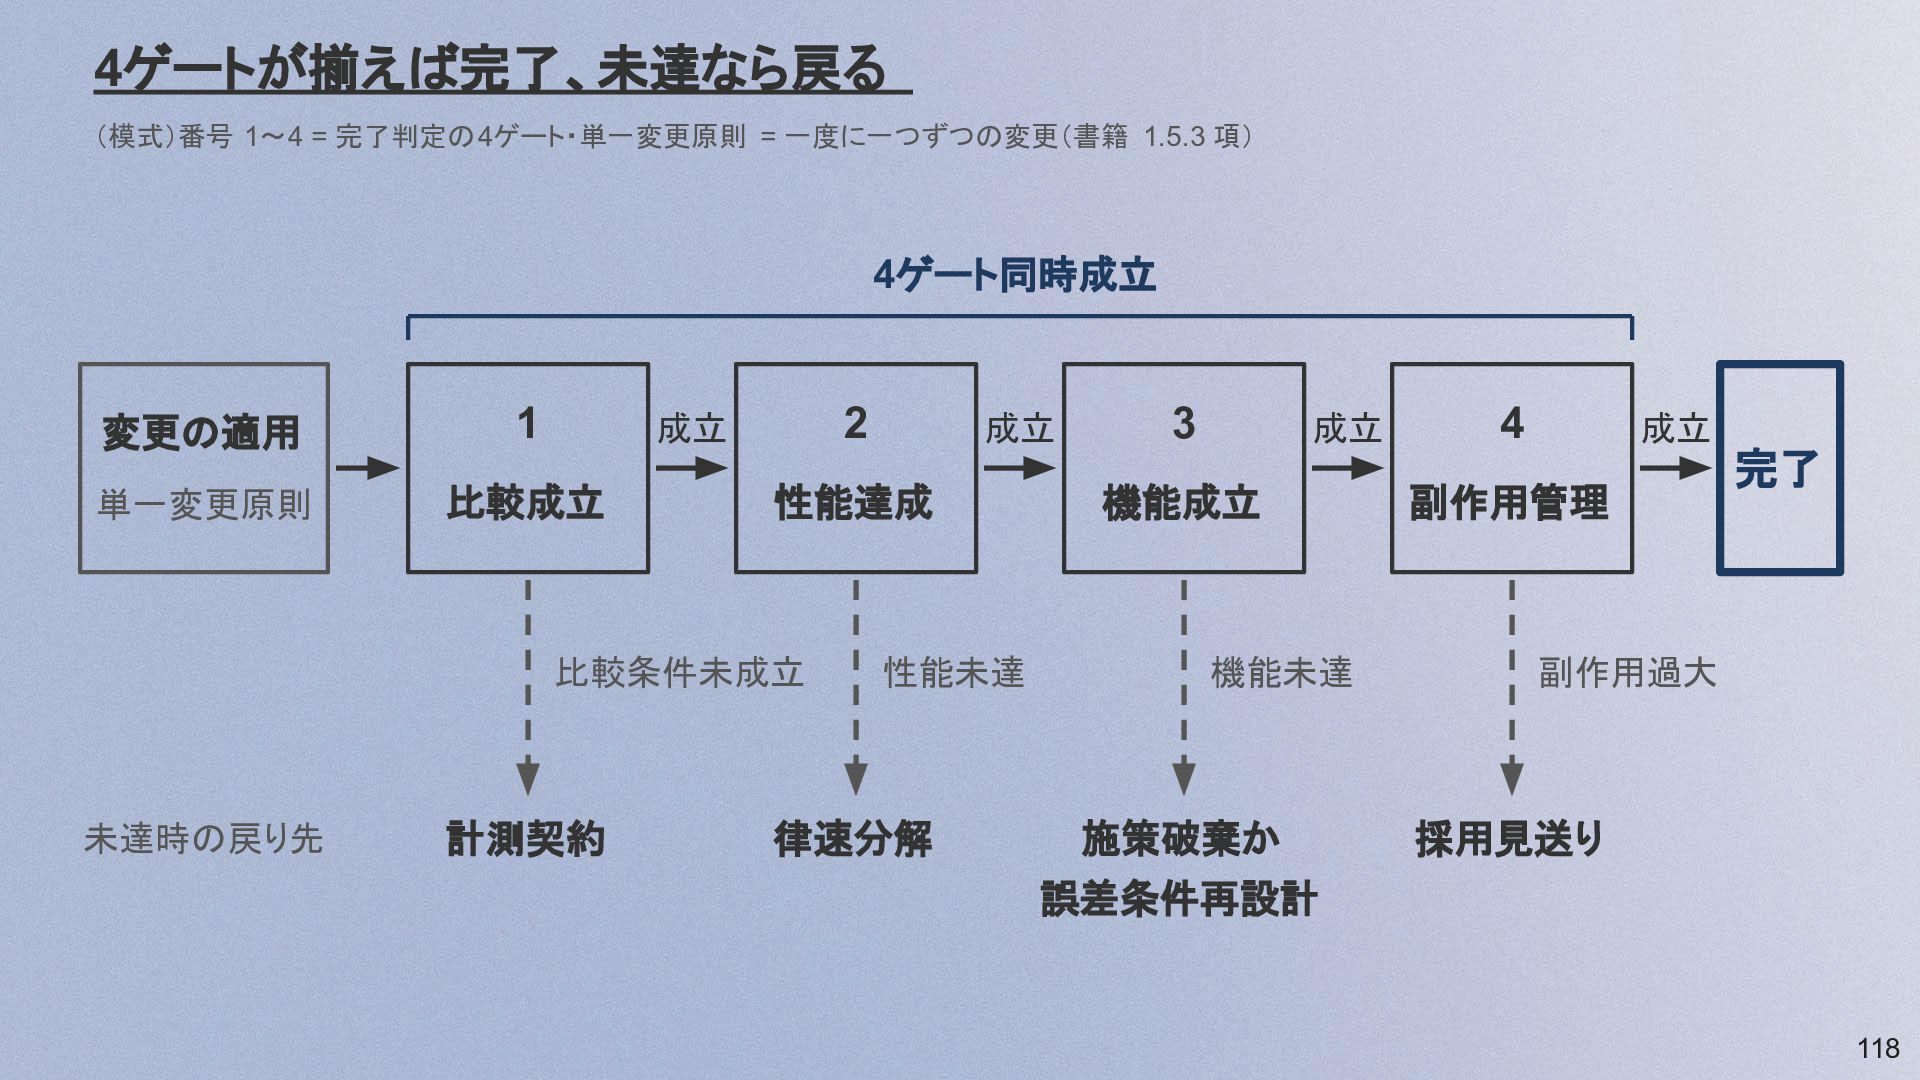
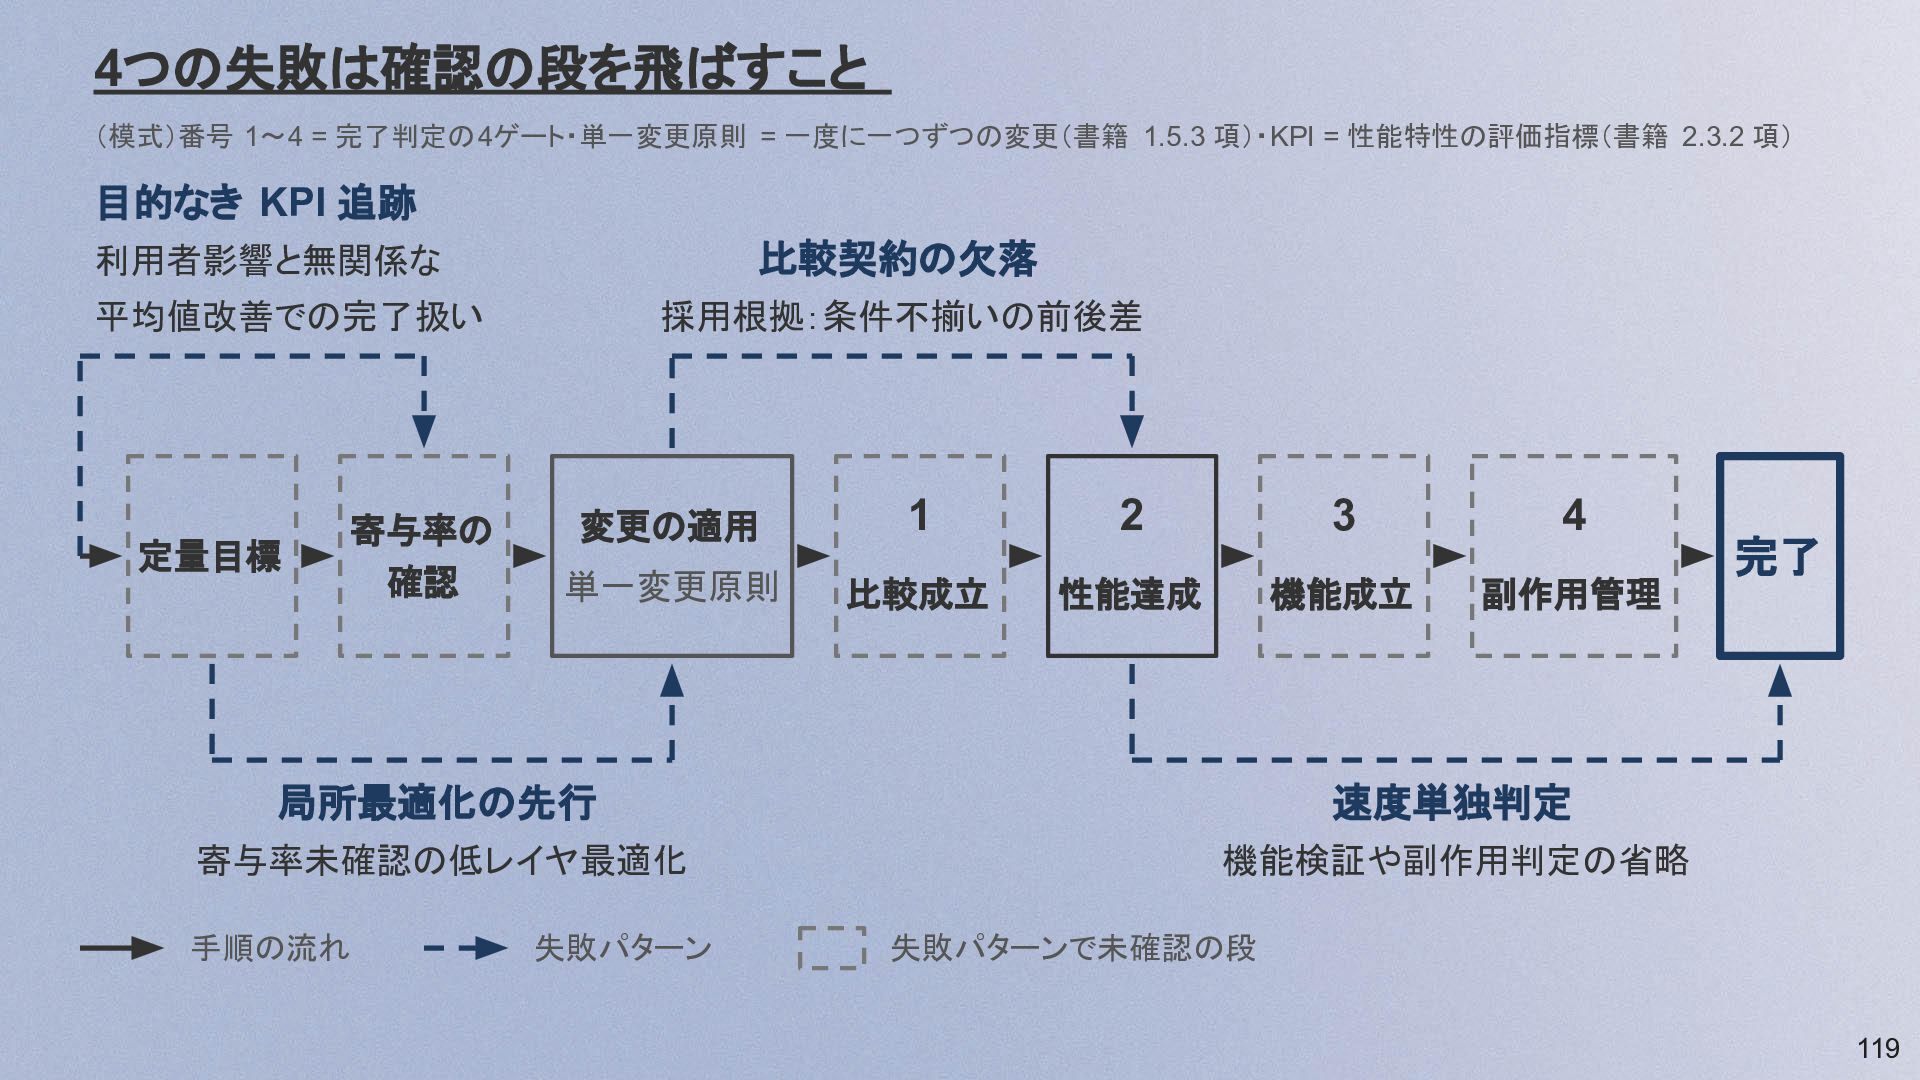
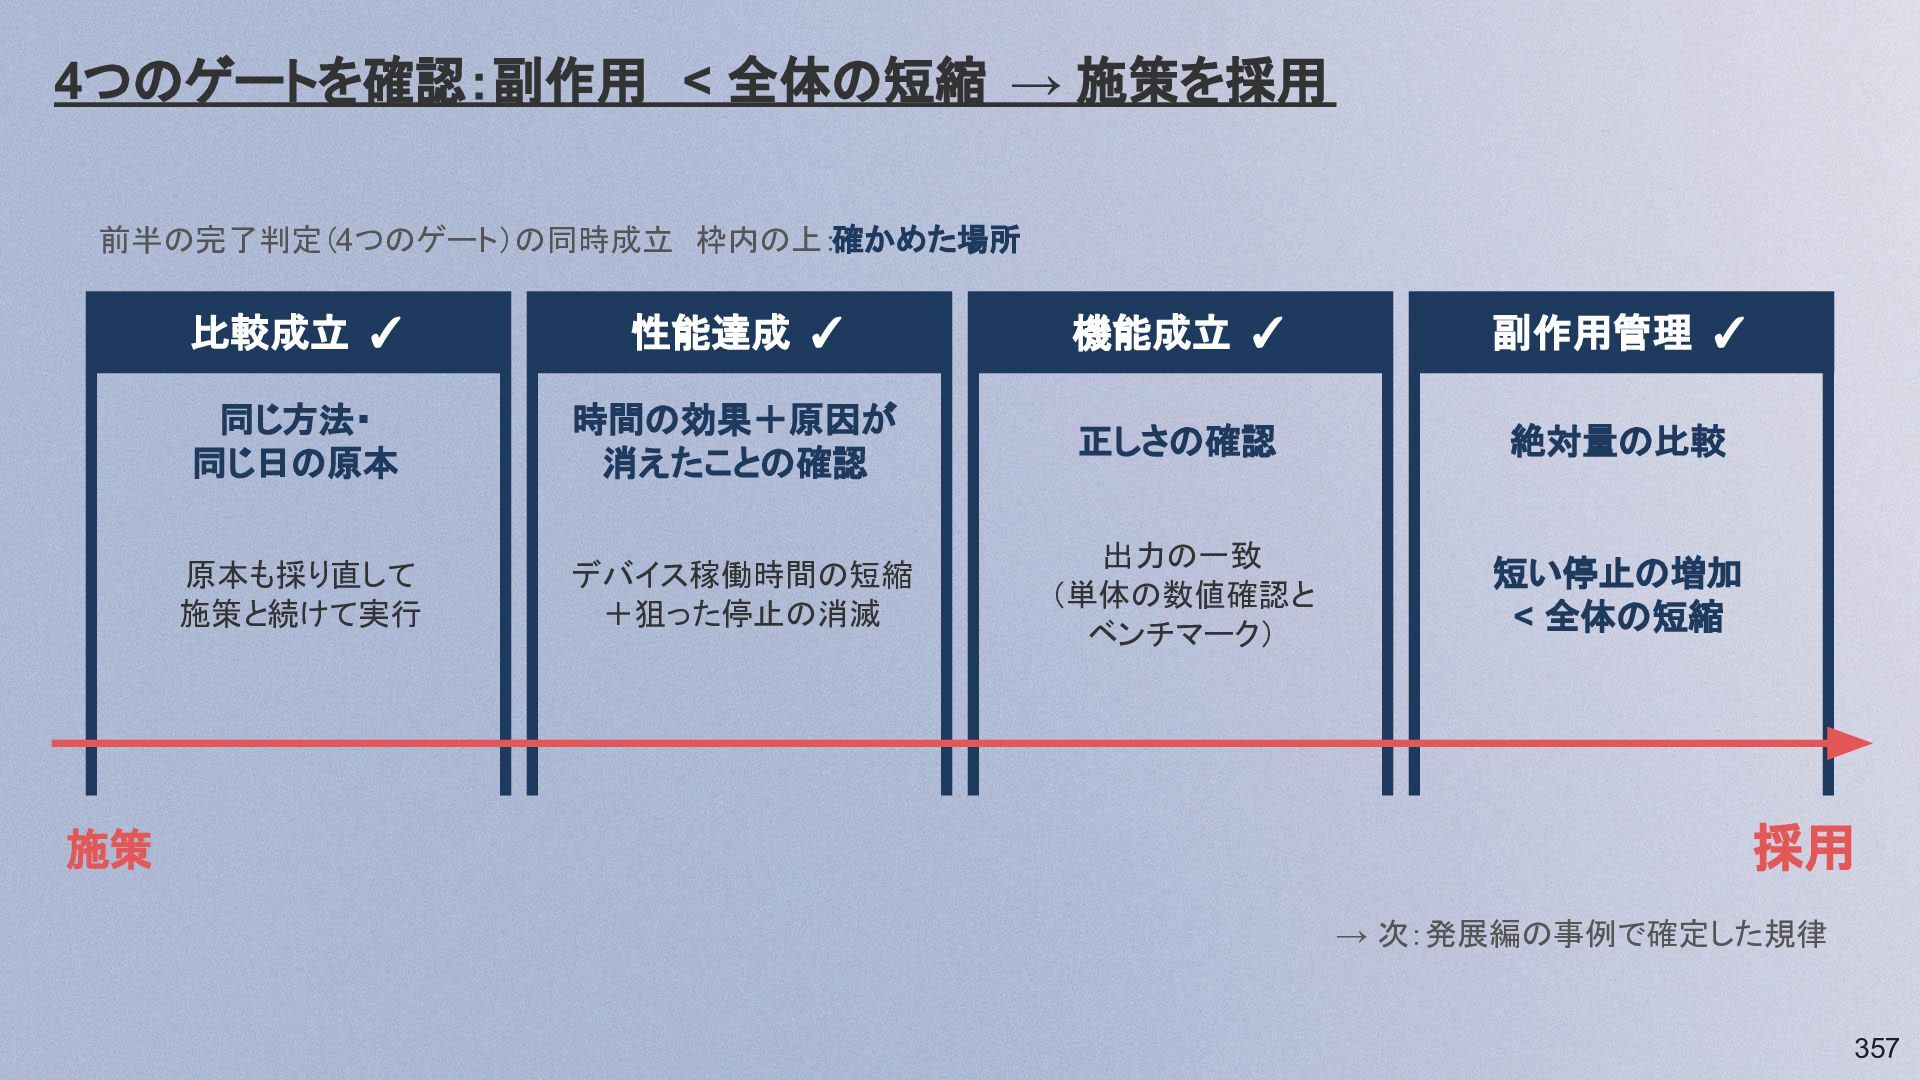
4ゲートが揃えば完了、未達なら戻る (模式)番号 1〜4 = 完了判定の4ゲート・単一変更原則 = 一度に一つずつの変更(書籍 1.5.3 項) 4ゲート同時成立
変更の適用 1 単一変更原則 比較成立 2 成立 性能達成 比較条件未成立 未達時の戻り先 計測契約 成立 性能未達 律速分解 3 成立 機能成立 機能未達 施策破棄か 4 成立 副作用管理 完了 副作用過大 採用見送り 誤差条件再設計 118 -
4つの失敗は確認の段を飛ばすこと (模式)番号 1〜4 = 完了判定の4ゲート・単一変更原則 = 一度に一つずつの変更(書籍 1.5.3 項)・KPI =
性能特性の評価指標(書籍 2.3.2 項) 目的なき KPI 追跡 利用者影響と無関係な 比較契約の欠落 平均値改善での完了扱い 採用根拠:条件不揃いの前後差 定量目標 寄与率の 確認 変更の適用 1 2 3 4 単一変更原則 比較成立 性能達成 機能成立 副作用管理 局所最適化の先行 速度単独判定 寄与率未確認の低レイヤ最適化 機能検証や副作用判定の省略 手順の流れ 失敗パターン 完了 失敗パターンで未確認の段 119 -
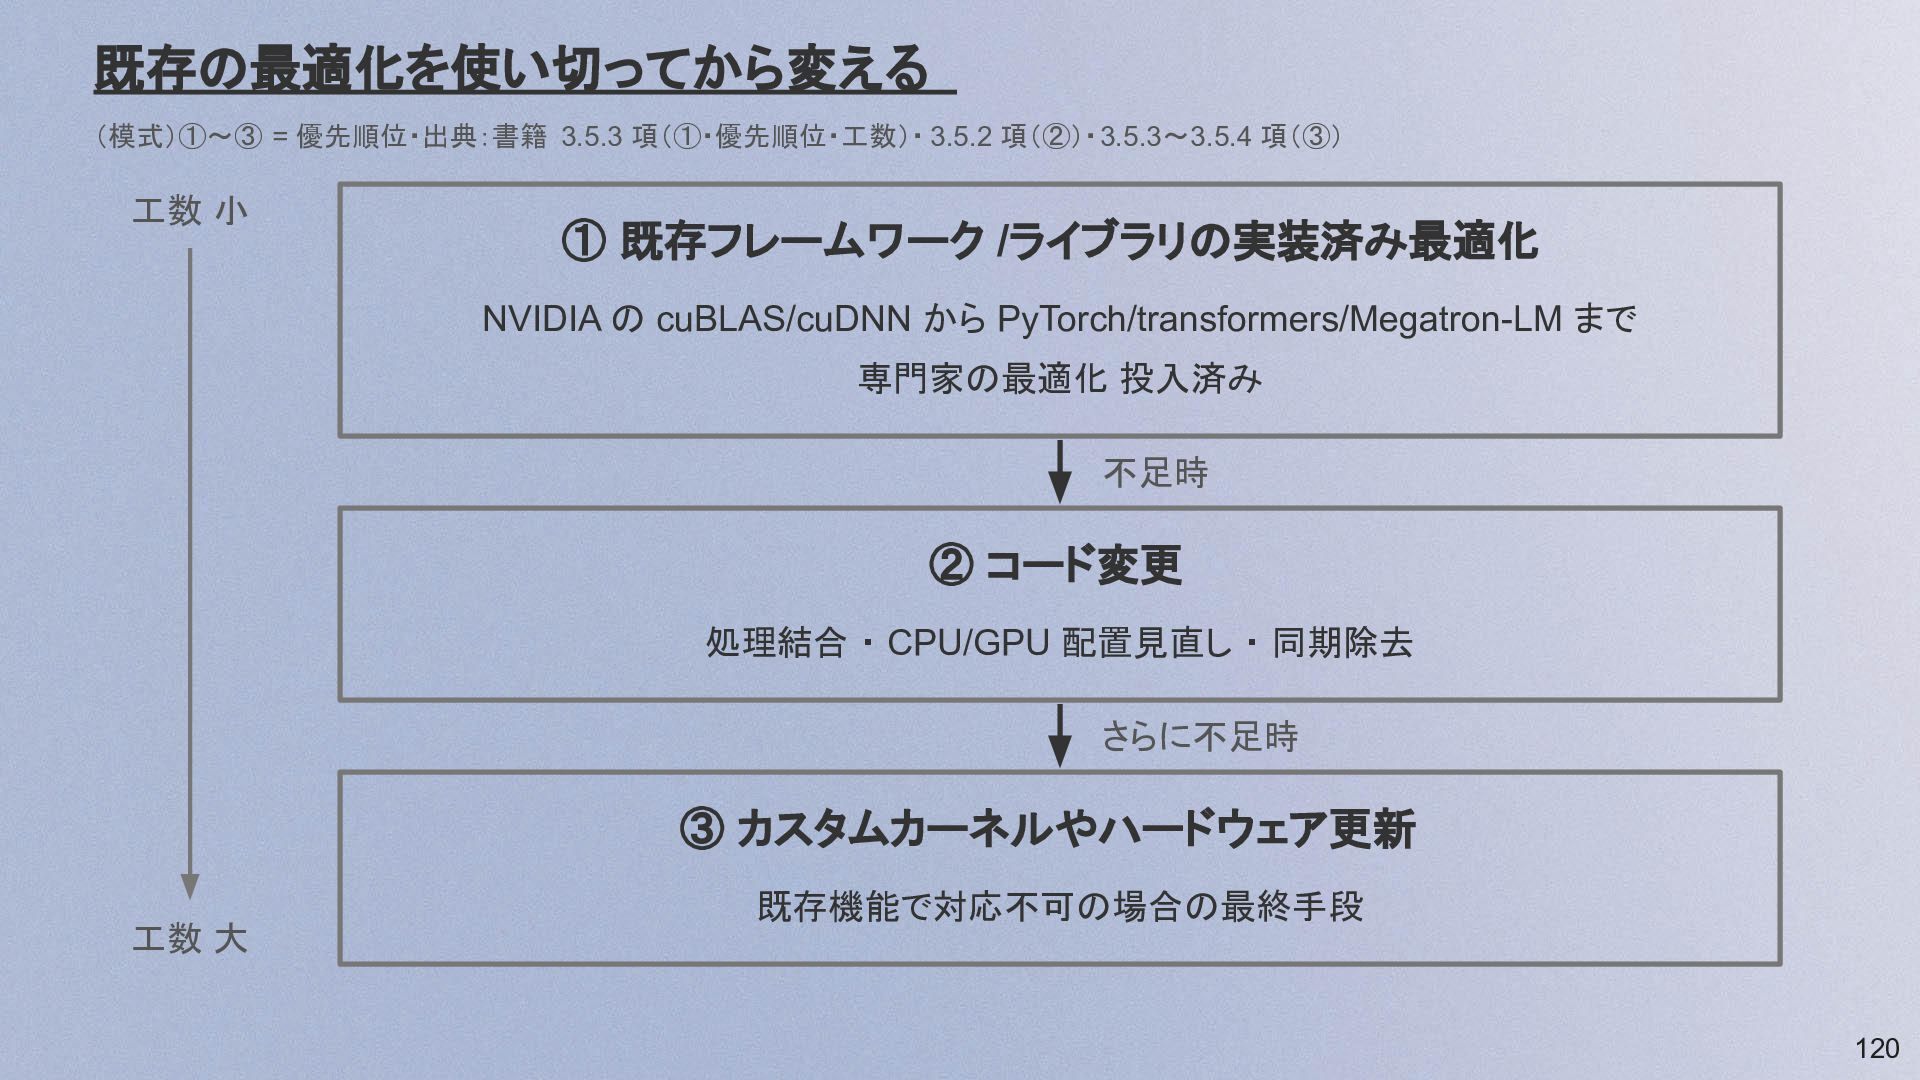
既存の最適化を使い切ってから変える (模式)①〜③ = 優先順位・出典:書籍 3.5.3 項(①・優先順位・工数)・ 3.5.2 項(②)・3.5.3〜3.5.4 項(③) 工数
小 ① 既存フレームワーク /ライブラリの実装済み最適化 NVIDIA の cuBLAS/cuDNN から PyTorch/transformers/Megatron-LM まで 専門家の最適化 投入済み 不足時 ② コード変更 処理結合 ・ CPU/GPU 配置見直し ・ 同期除去 さらに不足時 ③ カスタムカーネルやハードウェア更新 工数 大 既存機能で対応不可の場合の最終手段 120 -
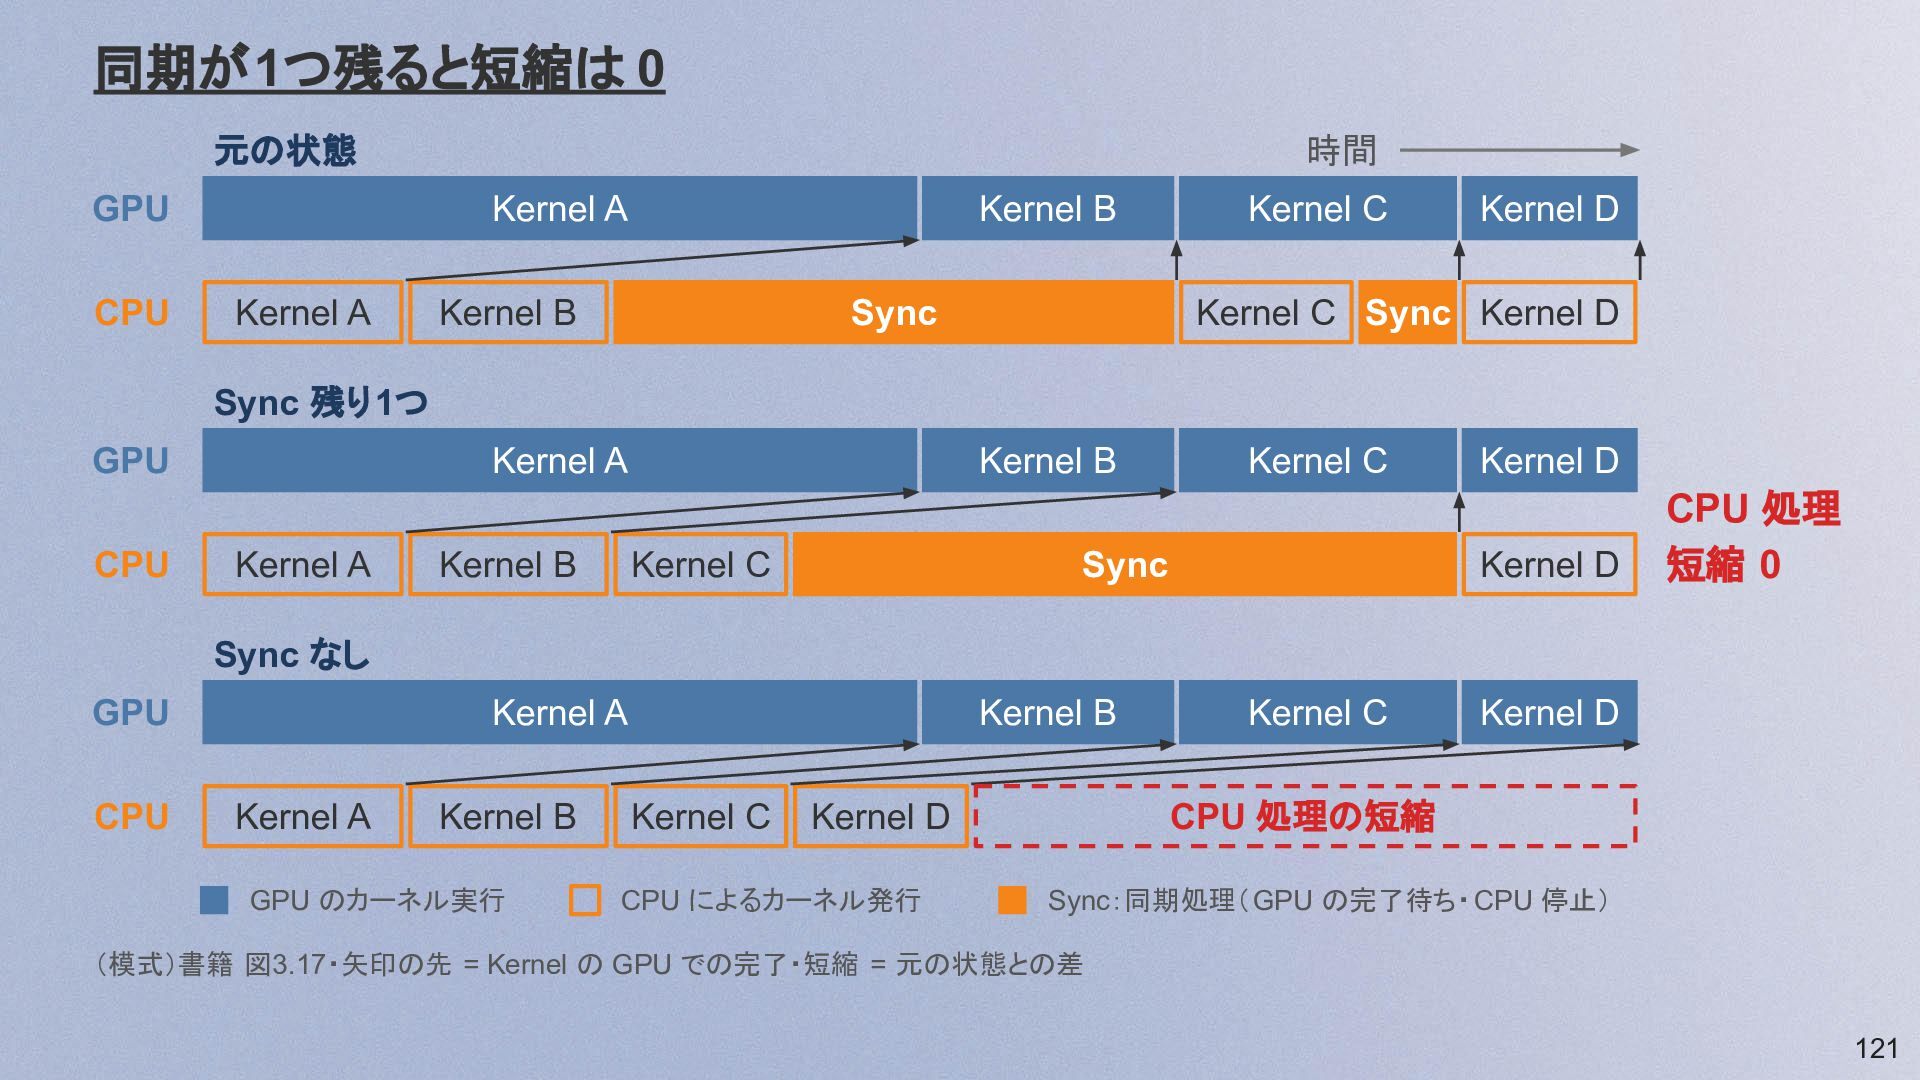
同期が1つ残ると短縮は 0 元の状態 GPU CPU 時間 Kernel A Kernel A
Kernel B Kernel B Sync Kernel C Kernel D Kernel C Sync Kernel D Sync 残り1つ GPU CPU Kernel A Kernel A Kernel B Kernel B Kernel C Kernel C Sync Kernel D Kernel D CPU 処理 短縮 0 Sync なし GPU CPU Kernel A Kernel A Kernel B GPU のカーネル実行 Kernel B Kernel C Kernel D CPU 処理の短縮 Kernel D CPU によるカーネル発行 Kernel C Sync:同期処理(GPU の完了待ち・CPU 停止) (模式)書籍 図3.17・矢印の先 = Kernel の GPU での完了・短縮 = 元の状態との差 121 -
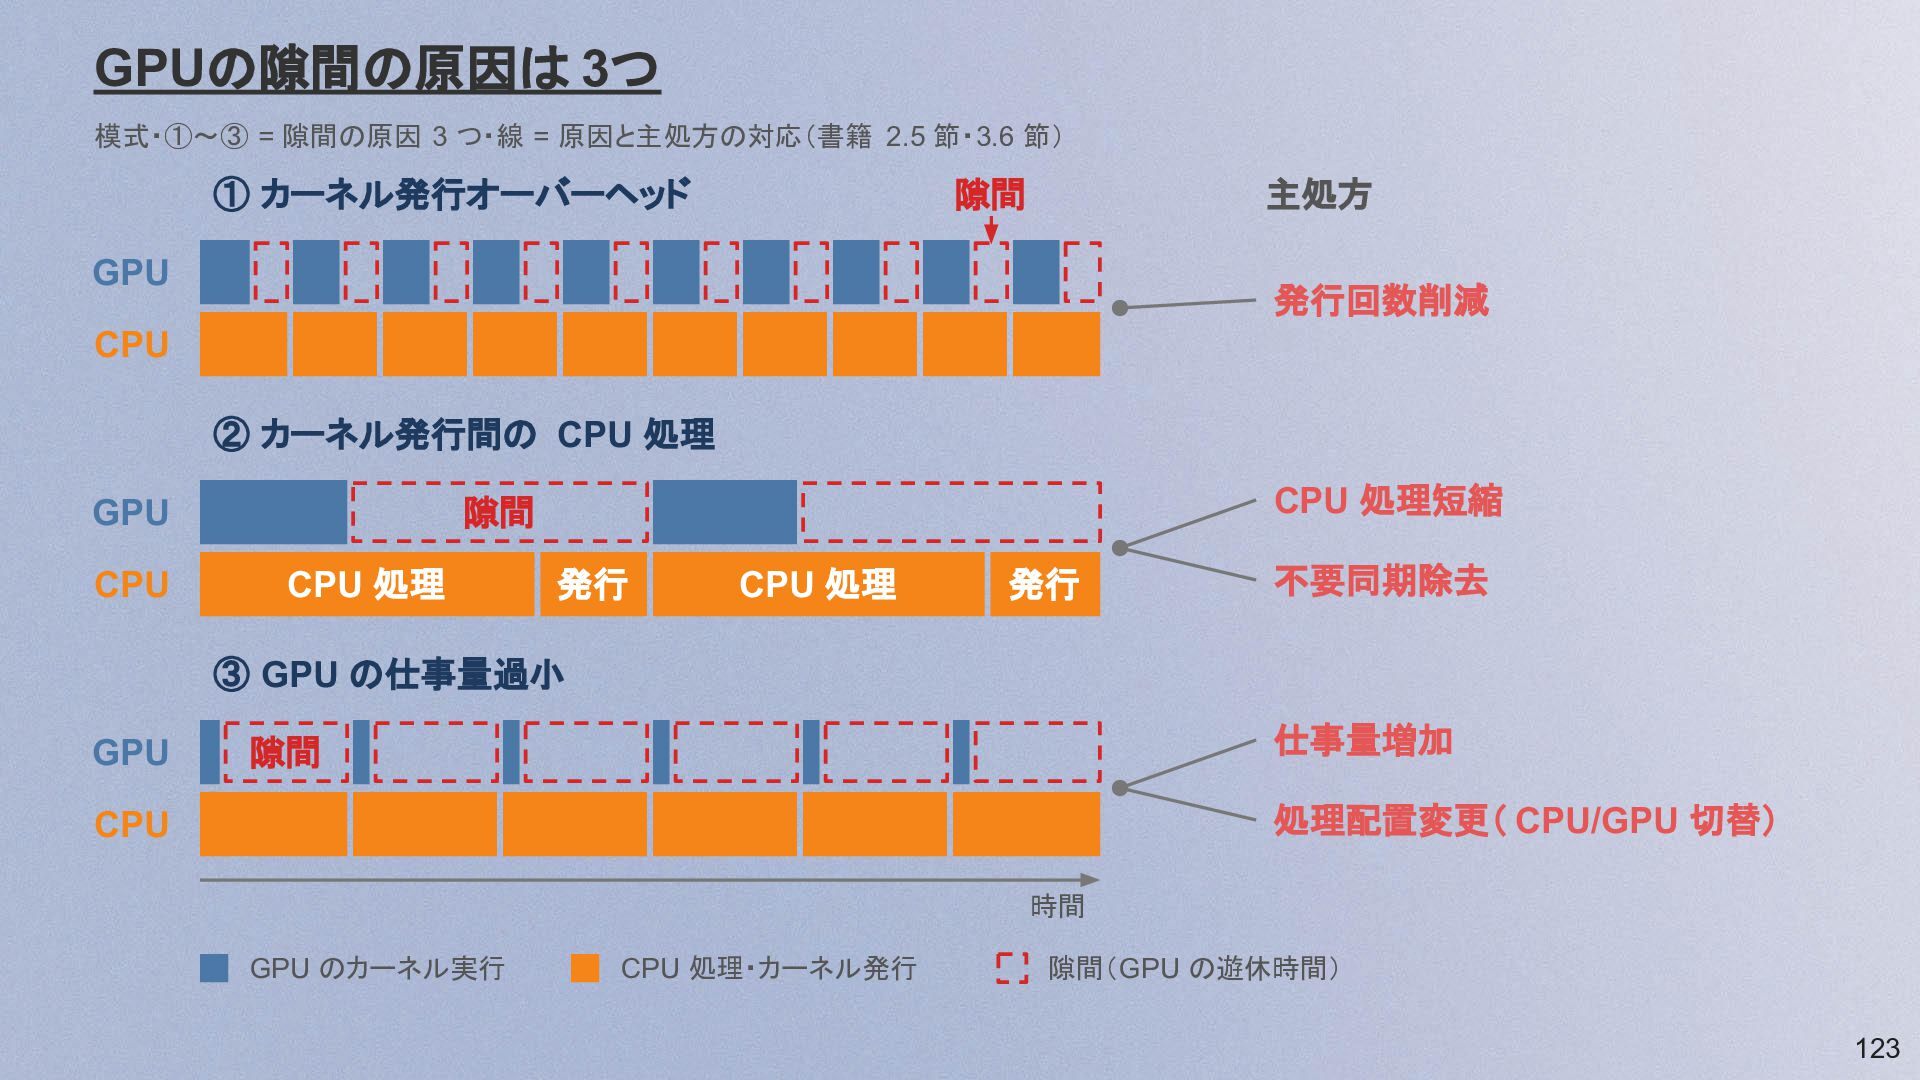
GPUの隙間の原因は 3つ 模式・①〜③ = 隙間の原因 3 つ・線 = 原因と主処方の対応(書籍 2.5
節・3.6 節) ① カーネル発行オーバーヘッド 隙間 主処方 GPU 発行回数削減 CPU ② カーネル発行間の CPU 処理 CPU CPU 処理短縮 隙間 GPU CPU 処理 発行 CPU 処理 発行 不要同期除去 ③ GPU の仕事量過小 GPU 仕事量増加 隙間 処理配置変更( CPU/GPU 切替) CPU 時間 GPU のカーネル実行 CPU 処理・カーネル発行 隙間(GPU の遊休時間) 123 -
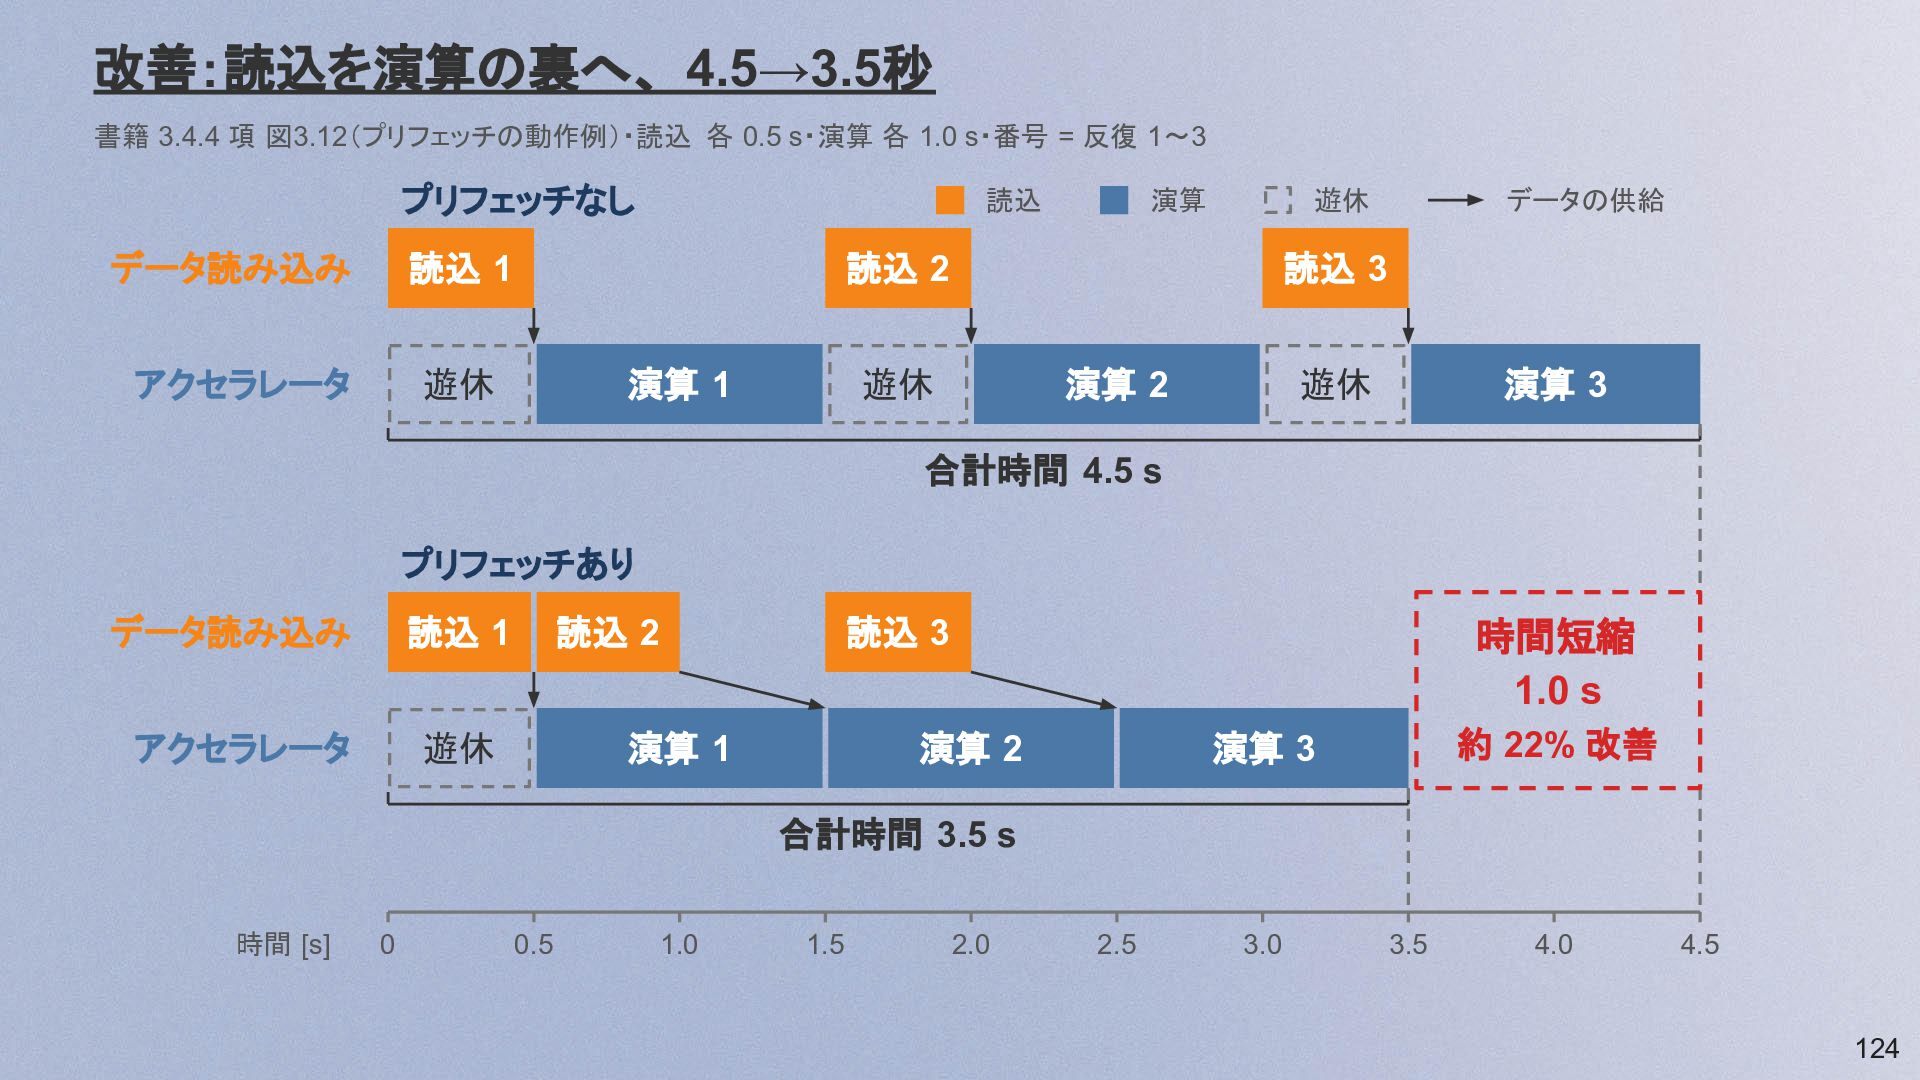
改善:読込を演算の裏へ、 4.5→3.5秒 書籍 3.4.4 項 図3.12(プリフェッチの動作例)・読込 各 0.5 s・演算 各
1.0 s・番号 = 反復 1〜3 プリフェッチなし データ読み込み 読込 1 アクセラレータ 遊休 読込 演算 遊休 読込 2 演算 1 データの供給 読込 3 演算 2 遊休 演算 3 遊休 合計時間 4.5 s プリフェッチあり データ読み込み 読込 1 アクセラレータ 遊休 読込 2 読込 3 演算 1 時間短縮 1.0 s 演算 2 約 22% 改善 演算 3 合計時間 3.5 s 時間 [s] 0 0.5 1.0 1.5 2.0 2.5 3.0 3.5 4.0 4.5 124 -
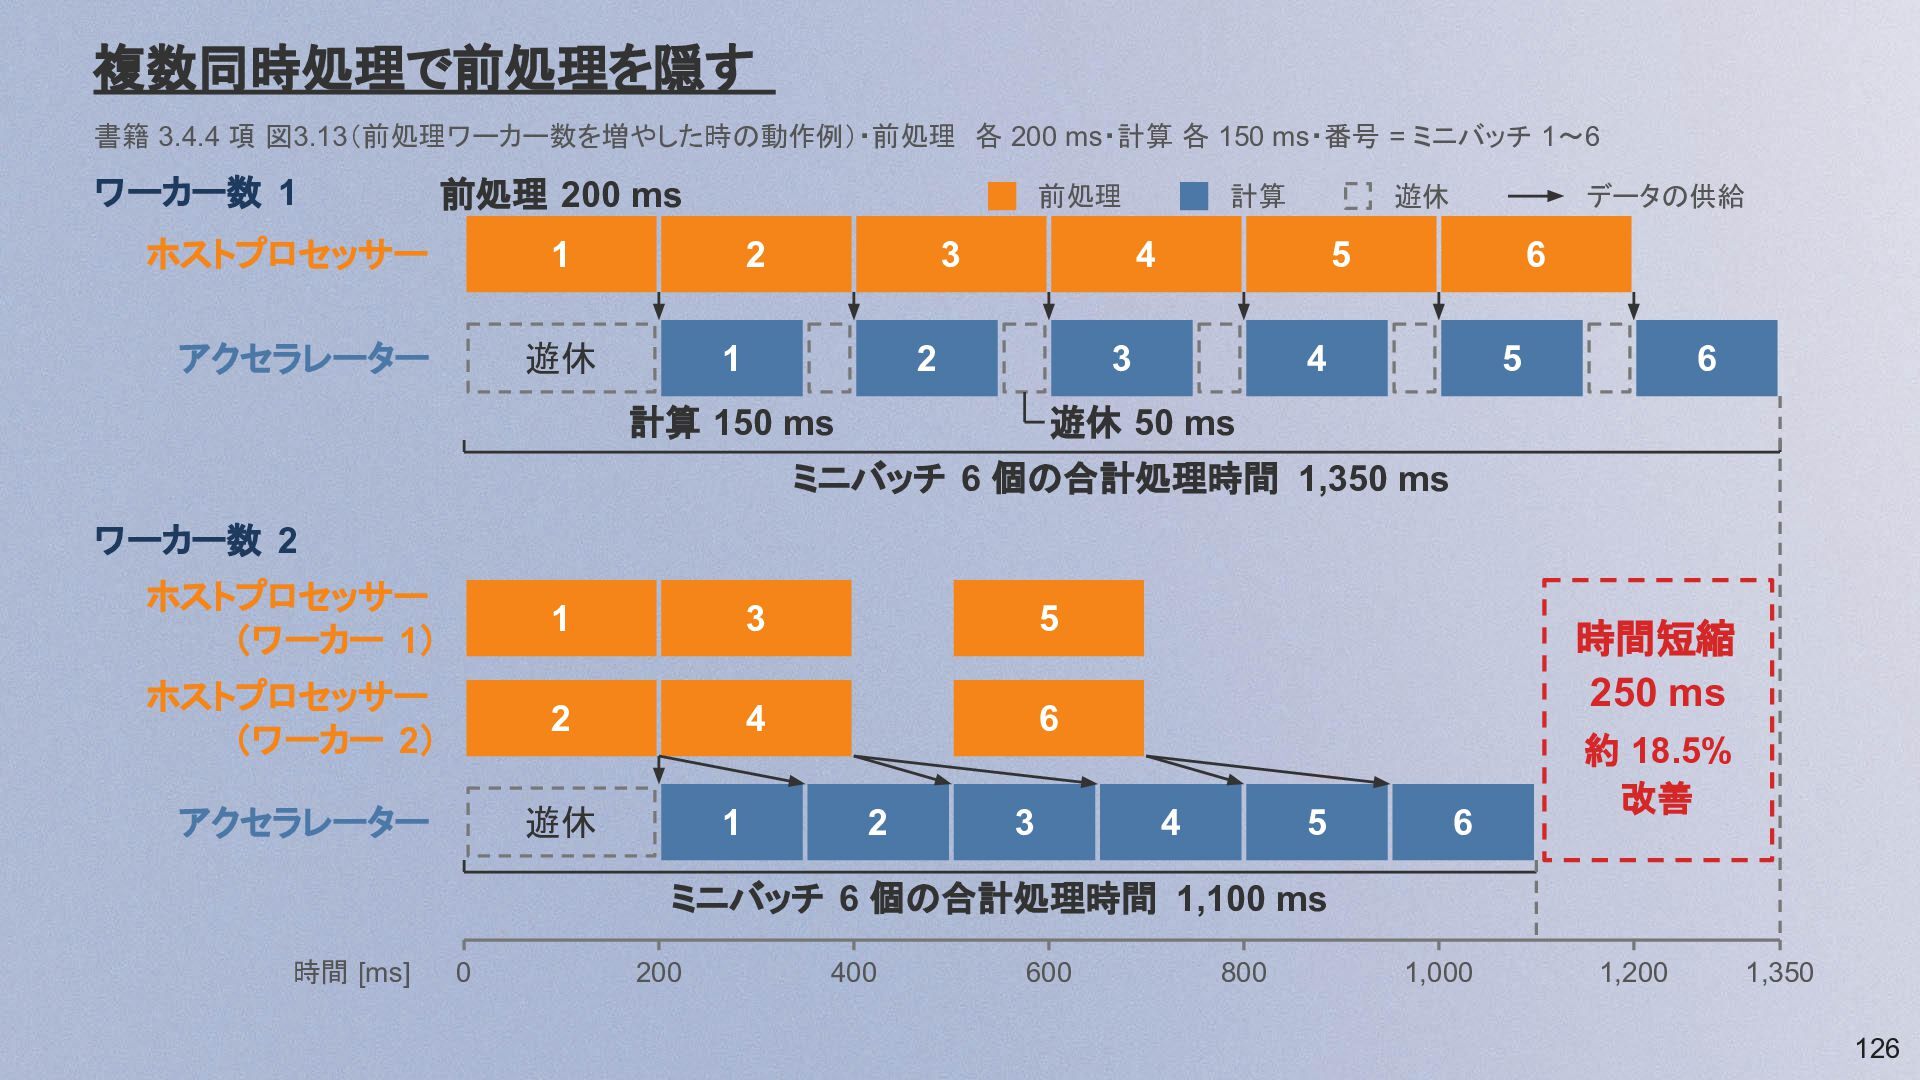
複数同時処理で前処理を隠す 書籍 3.4.4 項 図3.13(前処理ワーカー数を増やした時の動作例)・前処理 各 200 ms・計算 各 150
ms・番号 = ミニバッチ 1〜6 ワーカー数 1 前処理 200 ms ホストプロセッサー 1 アクセラレーター 遊休 前処理 2 3 1 計算 遊休 4 2 5 3 計算 150 ms データの供給 6 4 5 6 遊休 50 ms ミニバッチ 6 個の合計処理時間 1,350 ms ワーカー数 2 ホストプロセッサー (ワーカー 1) 1 3 5 ホストプロセッサー (ワーカー 2) 2 4 6 アクセラレーター 遊休 1 2 3 時間短縮 250 ms 4 5 6 約 18.5% 改善 ミニバッチ 6 個の合計処理時間 1,100 ms 時間 [ms] 0 200 400 600 800 1,000 1,200 1,350 126 -
計測と改善により約 450倍速 書籍 図4.1〜4.5・H100・8B/70B = Llama3-8B/70B・ベースライン( 8GPU・batch=1)・spec = 投機的デコーディング・ FP8
= 8ビット浮動小数点数 vLLM + FP8 量子化 スループット [tokens/sec](対数軸) 13,739 条件内の比較 10,000 12,101 条件間の比較 1,007 batch=128 + FlashAttention2 約450倍 1,000 100 31 47 495 batch=64 40 443 batch=1 10 ベースライン FlashAttention2 重み量子化 バッチ拡大 GPU 数調整 改善ステップ (1GPU 化) 8B/batch 条件 13,739 / 31 batch=1 14 ベースライン 17 70B 化 31 vLLM(8B) 投機的 デコーディング 70B+spec 条件 推論エンジン条件 129 -
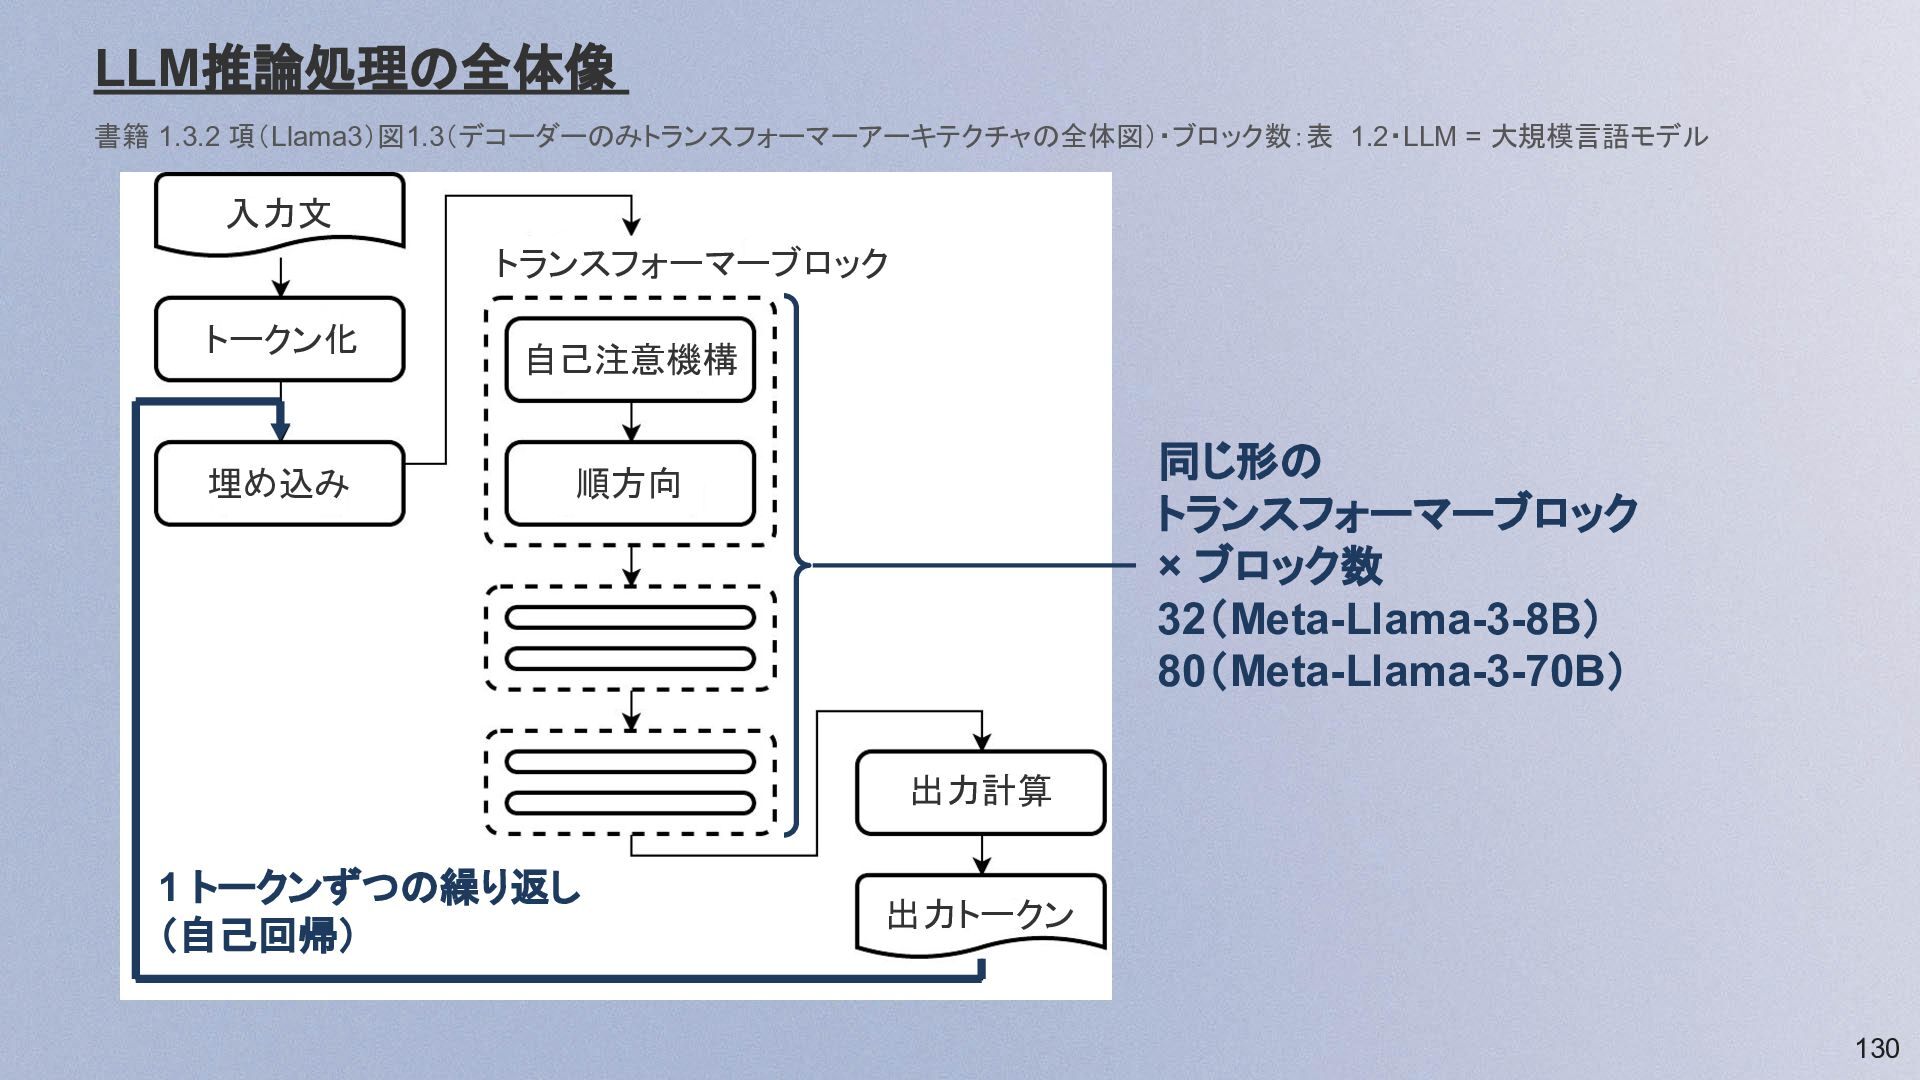
LLM推論処理の全体像 書籍 1.3.2 項(Llama3)図1.3(デコーダーのみトランスフォーマーアーキテクチャの全体図)・ブロック数:表 1.2・LLM = 大規模言語モデル 入力文 トランスフォーマーブロック トークン化
埋め込み 自己注意機構 同じ形の トランスフォーマーブロック × ブロック数 32(Meta-Llama-3-8B) 80(Meta-Llama-3-70B) 順方向 出力計算 1 トークンずつの繰り返し (自己回帰) 出力トークン 130 -
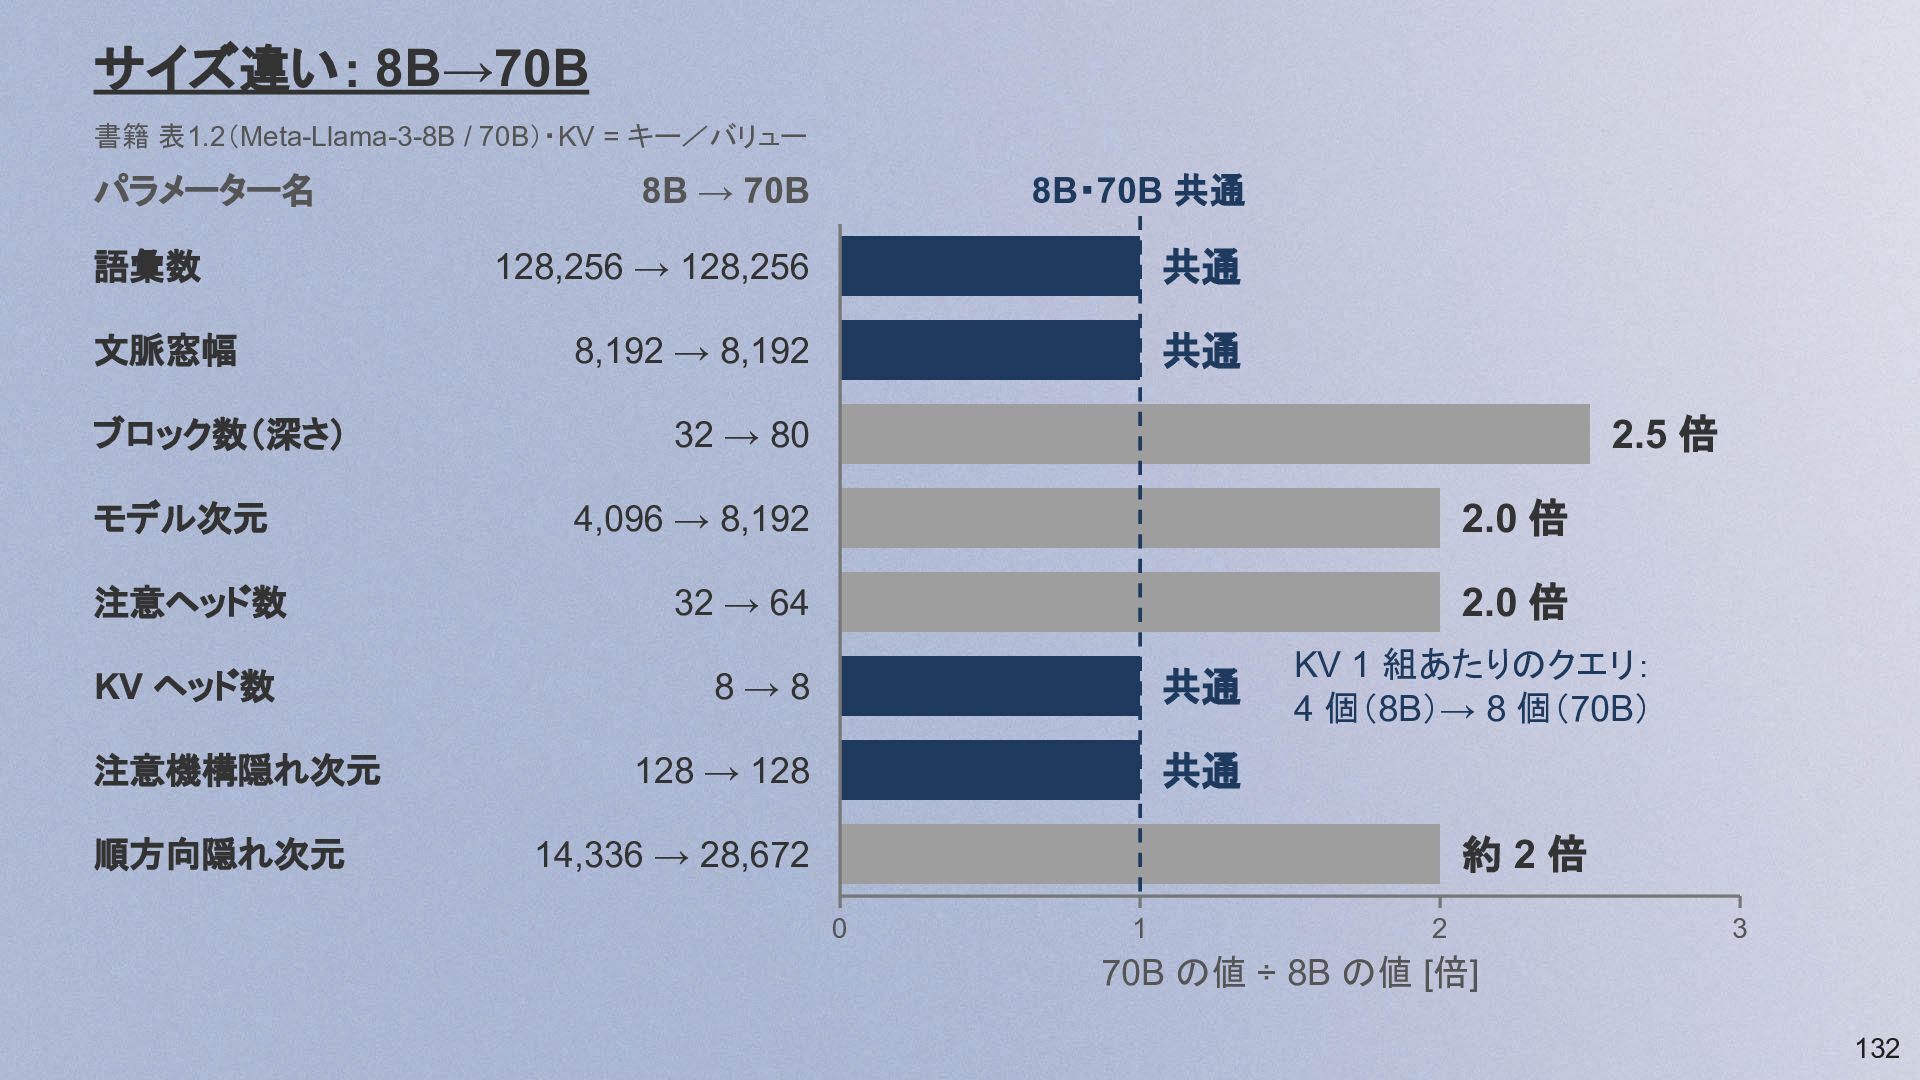
サイズ違い: 8B→70B 書籍 表1.2(Meta-Llama-3-8B / 70B)・KV = キー/バリュー パラメーター名 語彙数
文脈窓幅 ブロック数(深さ) 8B → 70B 8B・70B 共通 128,256 → 128,256 共通 8,192 → 8,192 共通 2.5 倍 32 → 80 モデル次元 4,096 → 8,192 2.0 倍 注意ヘッド数 32 → 64 2.0 倍 KV ヘッド数 8→8 共通 128 → 128 共通 注意機構隠れ次元 順方向隠れ次元 KV 1 組あたりのクエリ: 4 個(8B)→ 8 個(70B) 約2倍 14,336 → 28,672 0 1 2 3 70B の値 ÷ 8B の値 [倍] 132 -
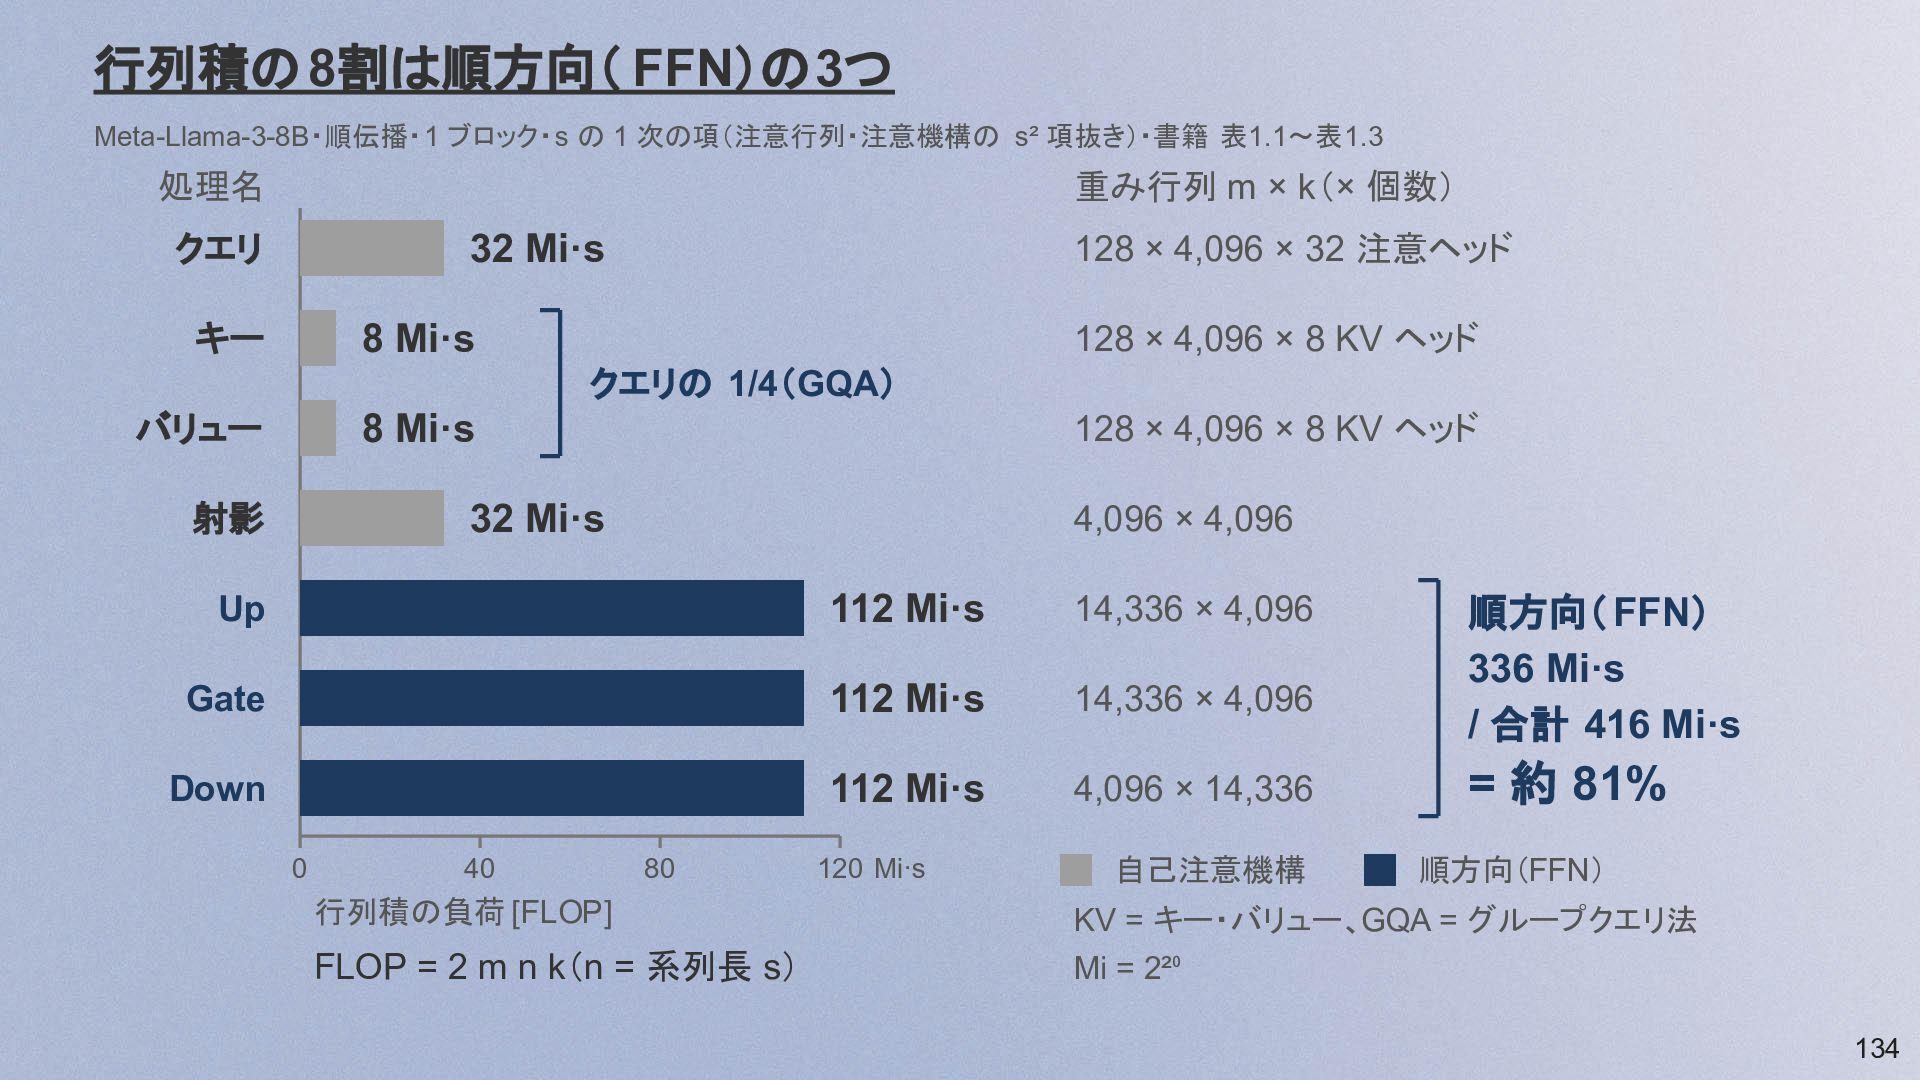
行列積の 8割は順方向( FFN)の3つ Meta-Llama-3-8B・順伝播・1 ブロック・s の 1 次の項(注意行列・注意機構の s² 項抜き)・書籍
表1.1〜表1.3 処理名 重み行列 m × k(× 個数) クエリ 128 × 4,096 × 32 注意ヘッド 32 Mi·s キー 128 × 4,096 × 8 KV ヘッド 8 Mi·s クエリの 1/4(GQA) バリュー 128 × 4,096 × 8 KV ヘッド 8 Mi·s 射影 32 Mi·s 4,096 × 4,096 Up 112 Mi·s 14,336 × 4,096 Gate 112 Mi·s 14,336 × 4,096 Down 112 Mi·s 4,096 × 14,336 0 40 80 行列積の負荷 [FLOP] FLOP = 2 m n k(n = 系列長 s) 120 Mi·s 自己注意機構 順方向( FFN) 336 Mi·s / 合計 416 Mi·s = 約 81% 順方向(FFN) KV = キー・バリュー、GQA = グループクエリ法 Mi = 2²⁰ 134 -
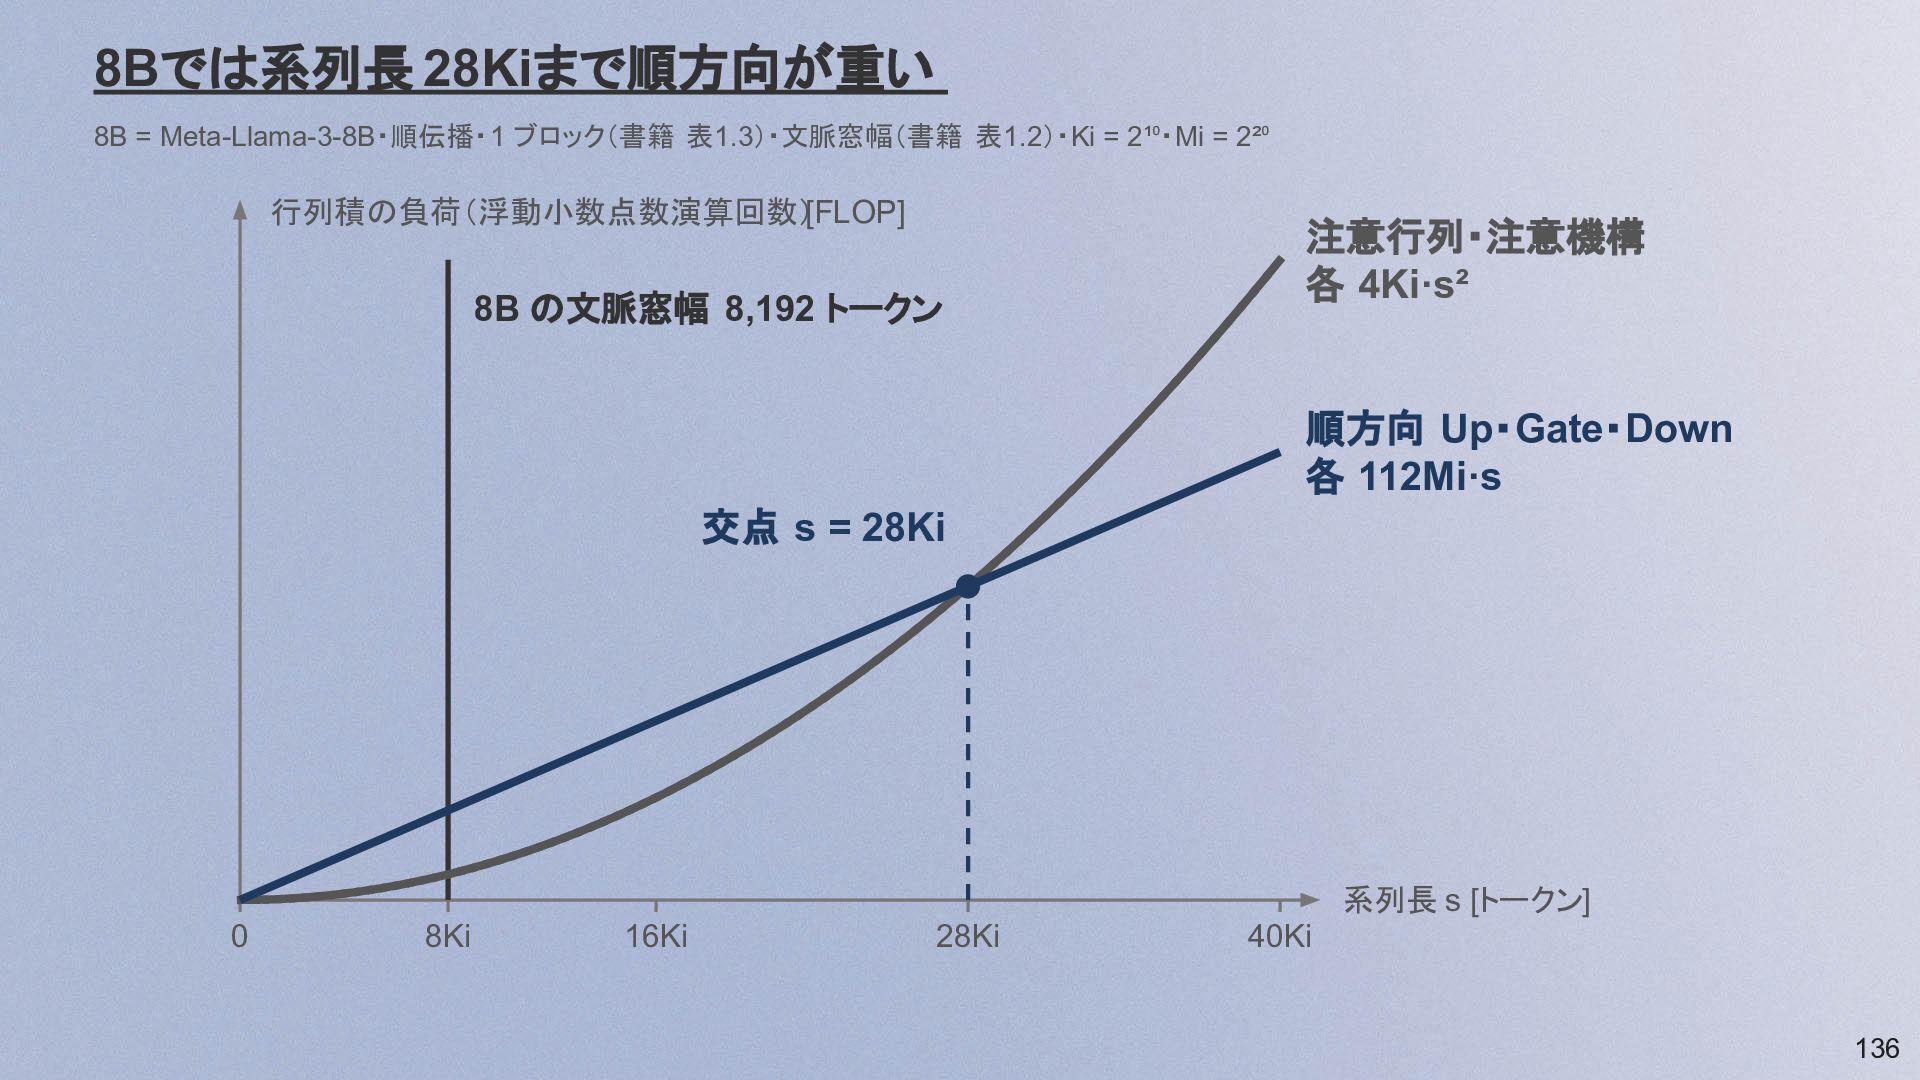
8Bでは系列長 28Kiまで順方向が重い 8B = Meta-Llama-3-8B・順伝播・1 ブロック(書籍 表1.3)・文脈窓幅(書籍 表1.2)・Ki = 2¹⁰・Mi
= 2²⁰ 行列積の負荷(浮動小数点数演算回数)[FLOP] 8B の文脈窓幅 8,192 トークン 注意行列・注意機構 各 4Ki·s² 順方向 Up・Gate・Down 各 112Mi·s 交点 s = 28Ki 系列長 s [トークン] 0 8Ki 16Ki 28Ki 40Ki 136 -
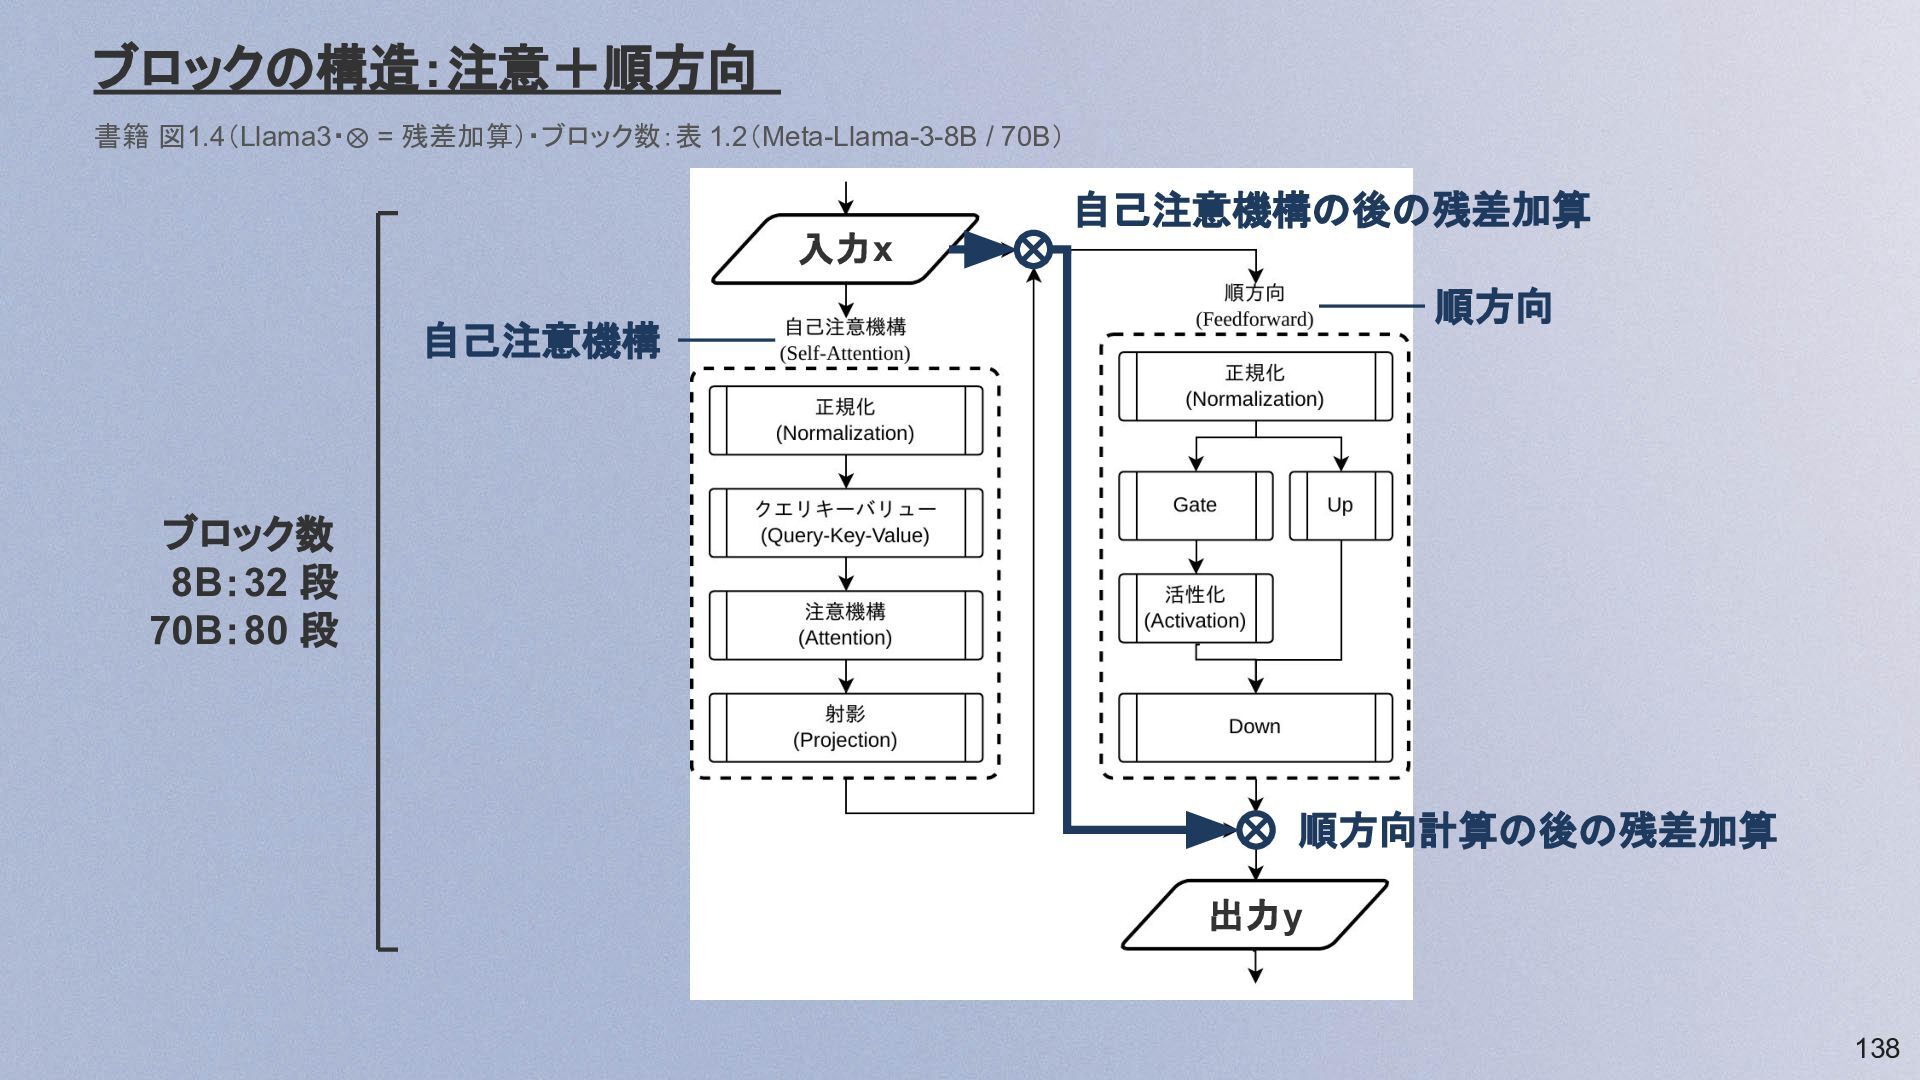
ブロックの構造:注意+順方向 書籍 図1.4(Llama3・⊗ = 残差加算)・ブロック数:表 1.2(Meta-Llama-3-8B / 70B) 自己注意機構の後の残差加算 入力x
順方向 自己注意機構 ブロック数 8B:32 段 70B:80 段 順方向計算の後の残差加算 出力y 138 -
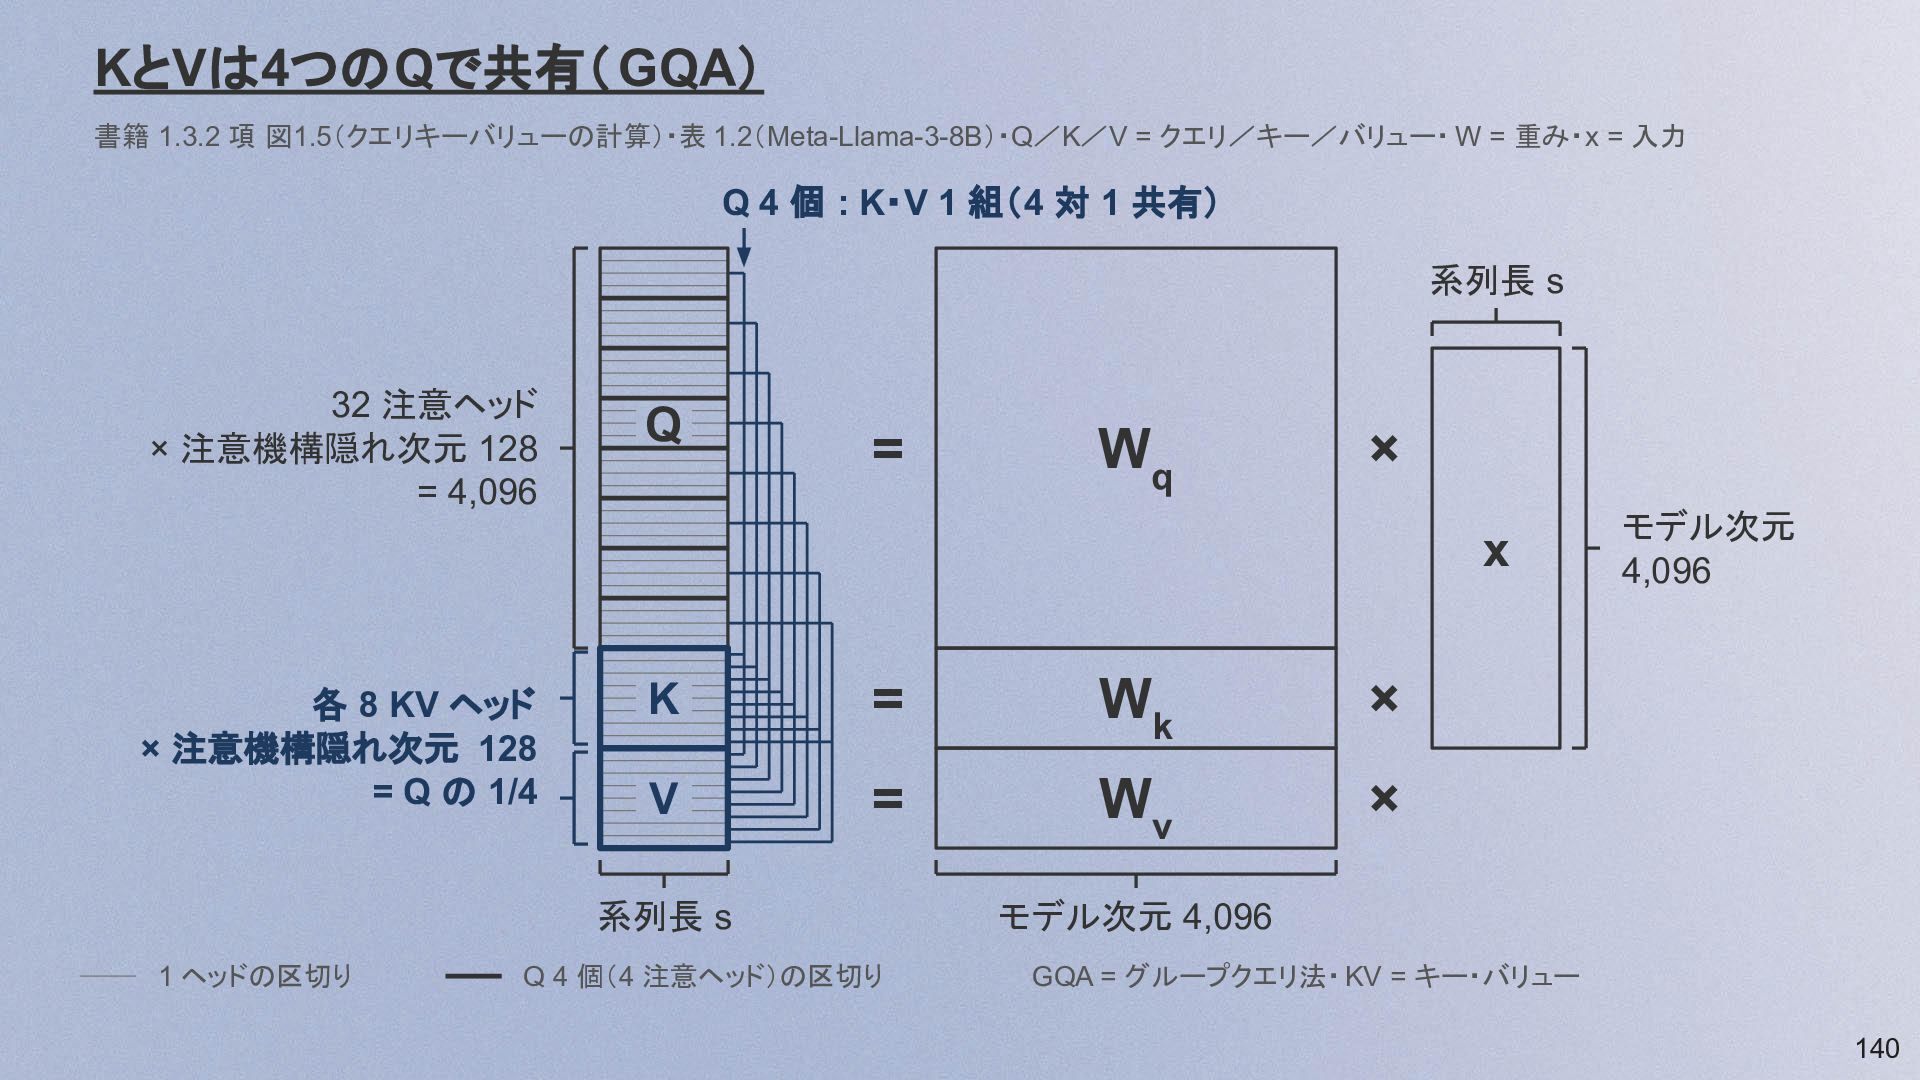
KとVは4つのQで共有( GQA) 書籍 1.3.2 項 図1.5(クエリキーバリューの計算)・表 1.2(Meta-Llama-3-8B)・Q/K/V = クエリ/キー/バリュー・ W
= 重み・x = 入力 Q 4 個 : K・V 1 組(4 対 1 共有) 系列長 s 32 注意ヘッド × 注意機構隠れ次元 128 = 4,096 Q = Wq × x 各 8 KV ヘッド × 注意機構隠れ次元 128 = Q の 1/4 K = Wk × V = Wv × 系列長 s 1 ヘッドの区切り Q 4 個(4 注意ヘッド)の区切り モデル次元 4,096 モデル次元 4,096 GQA = グループクエリ法・ KV = キー・バリュー 140 -
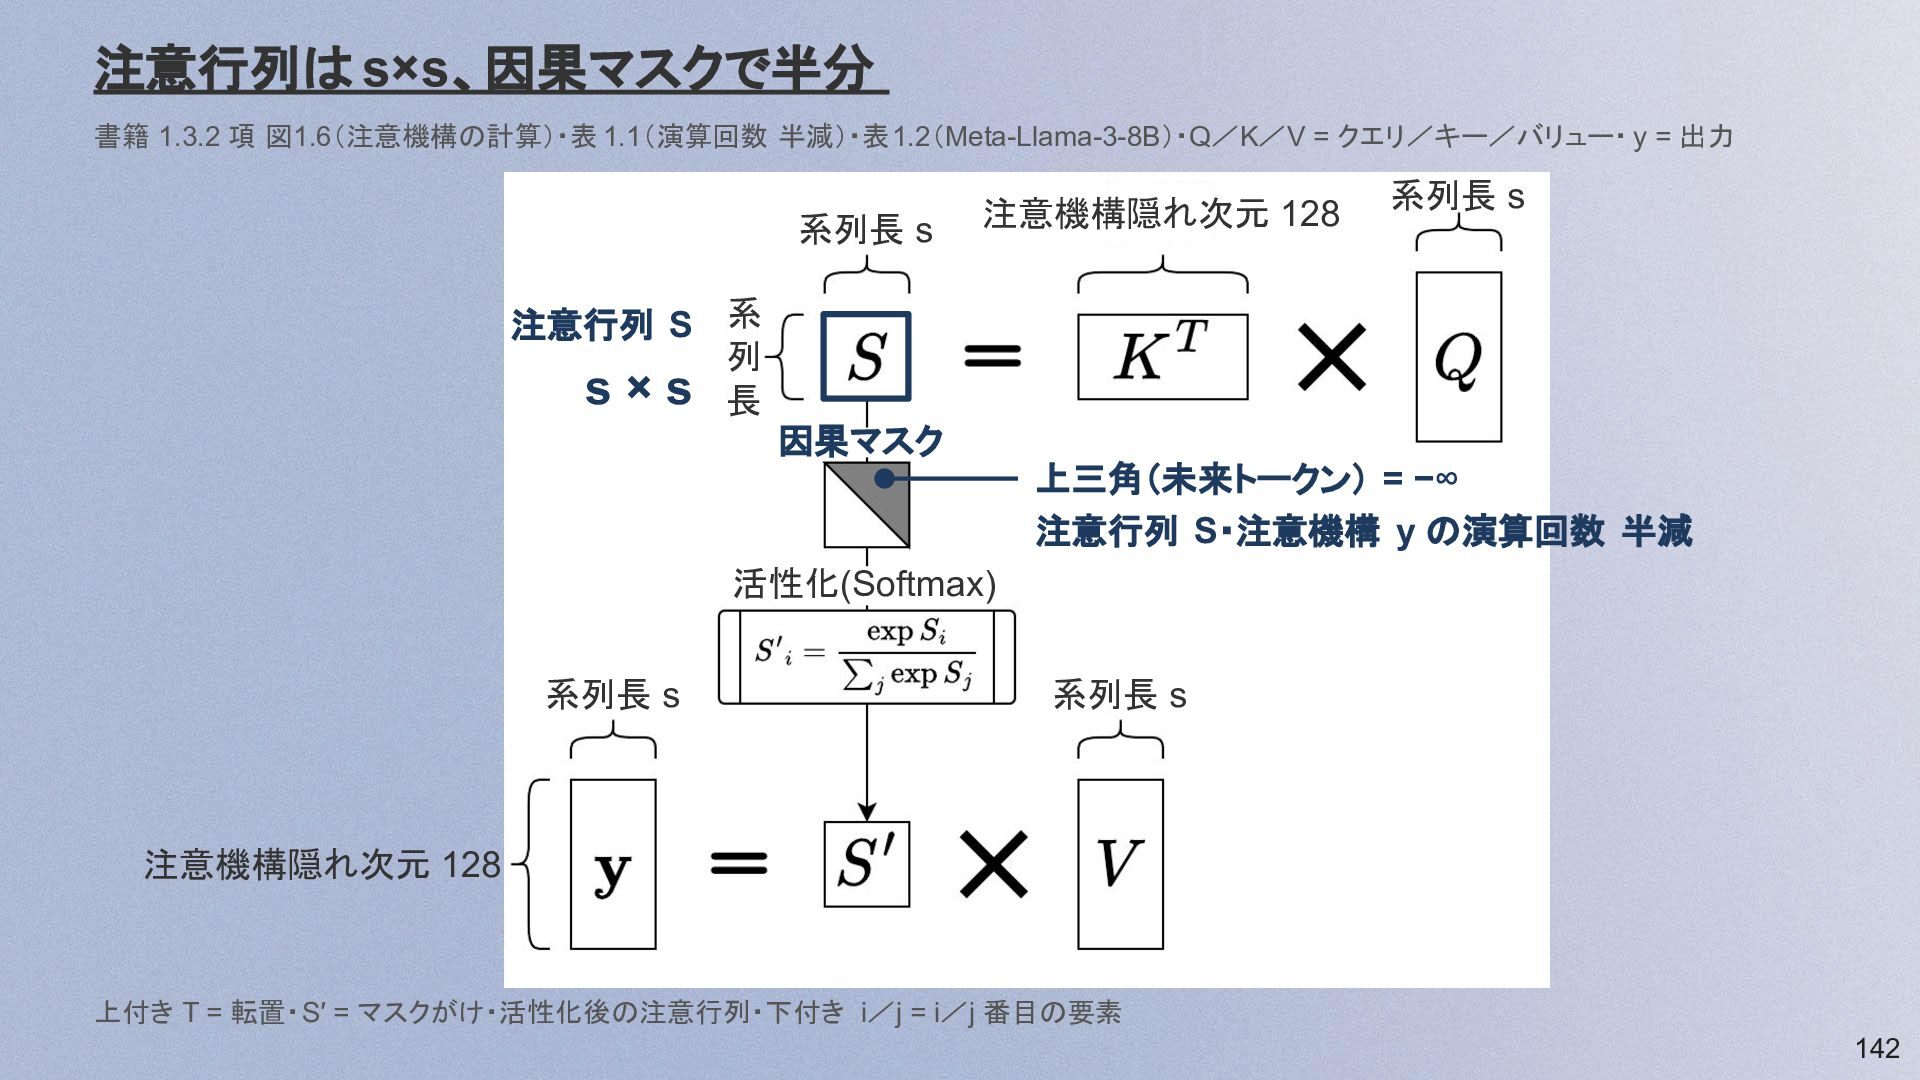
注意行列は s×s、因果マスクで半分 書籍 1.3.2 項 図1.6(注意機構の計算)・表 1.1(演算回数 半減)・表1.2(Meta-Llama-3-8B)・Q/K/V = クエリ/キー/バリュー・
y = 出力 系列長 s 注意機構隠れ次元 128 系列長 s 注意行列 S 系 列 s×s 長 因果マスク 上三角(未来トークン) = −∞ 注意行列 S・注意機構 y の演算回数 半減 活性化(Softmax) 系列長 s 系列長 s 注意機構隠れ次元 128 上付き T = 転置・S′ = マスクがけ・活性化後の注意行列・下付き i/j = i/j 番目の要素 142 -
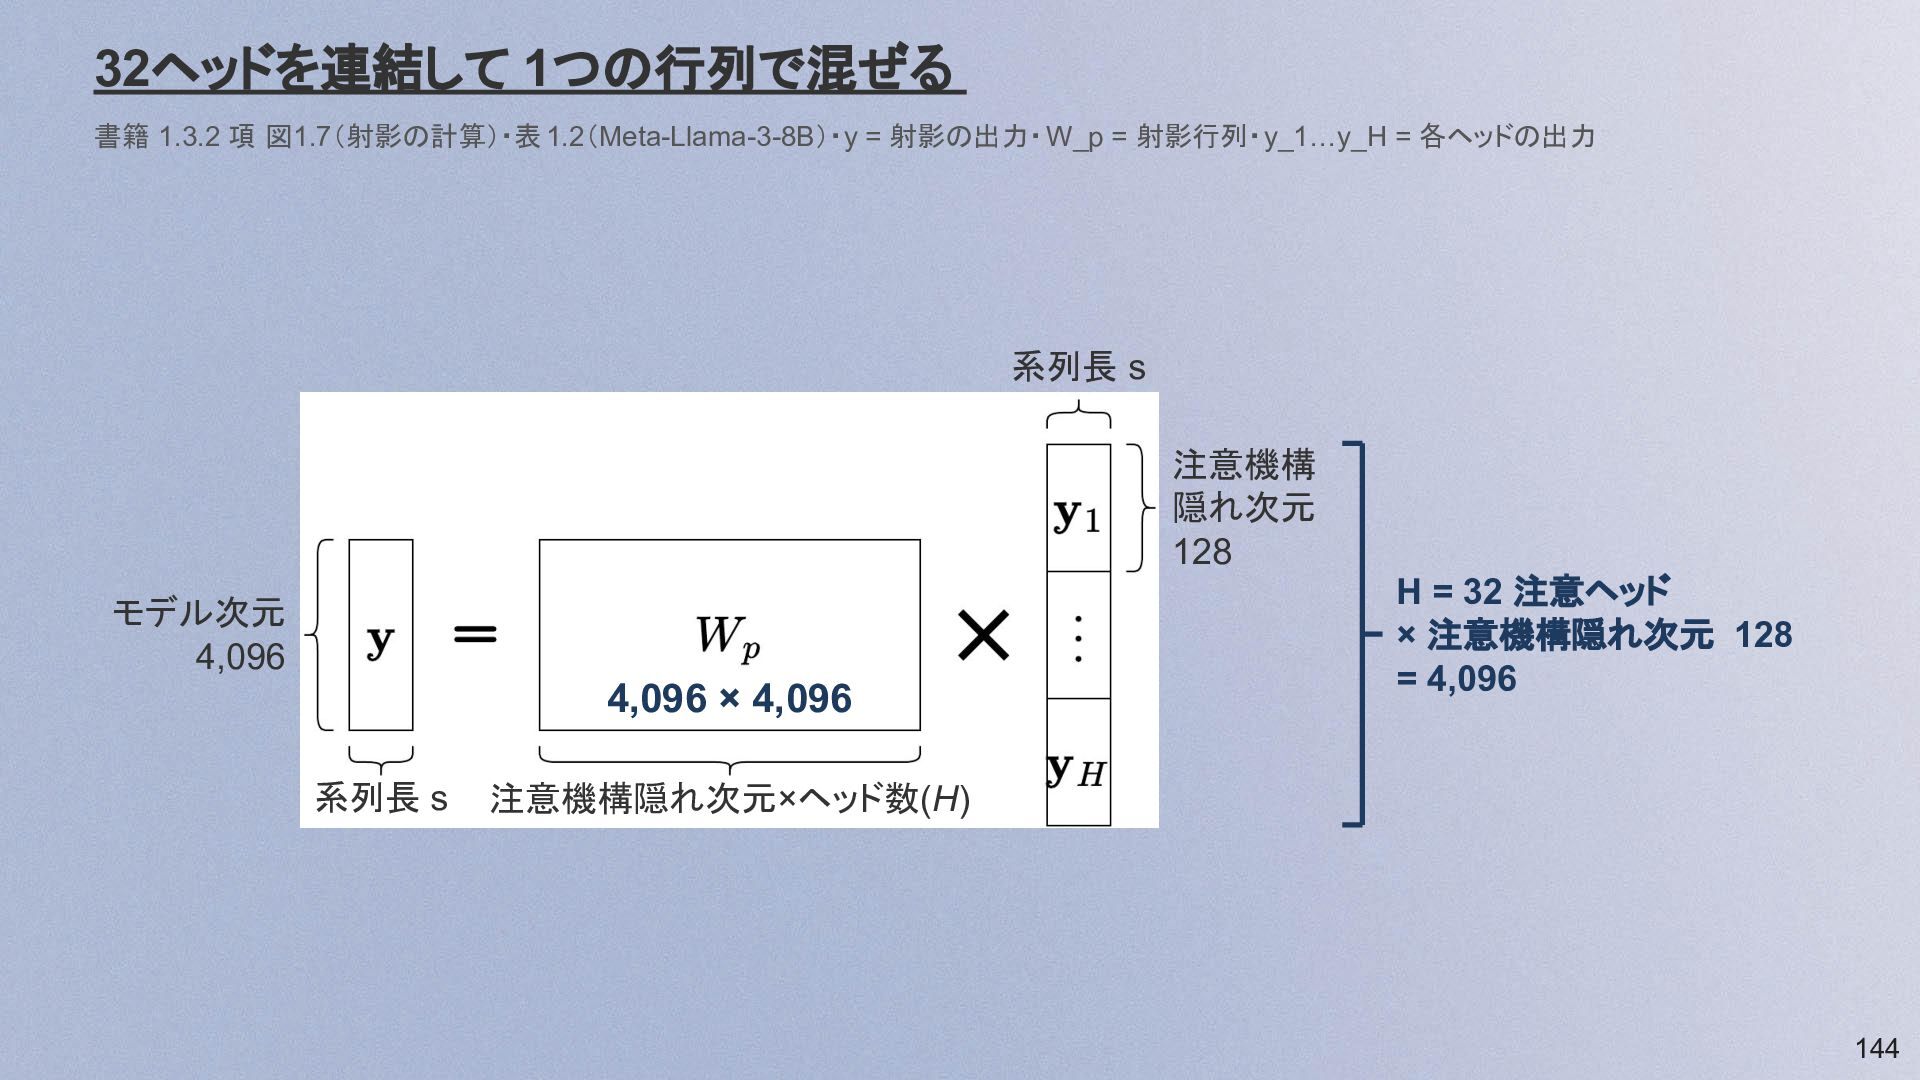
32ヘッドを連結して 1つの行列で混ぜる 書籍 1.3.2 項 図1.7(射影の計算)・表 1.2(Meta-Llama-3-8B)・y = 射影の出力・W_p =
射影行列・y_1…y_H = 各ヘッドの出力 系列長 s 注意機構 隠れ次元 128 モデル次元 4,096 4,096 × 4,096 系列長 s H = 32 注意ヘッド × 注意機構隠れ次元 128 = 4,096 注意機構隠れ次元×ヘッド数(H) 144 -
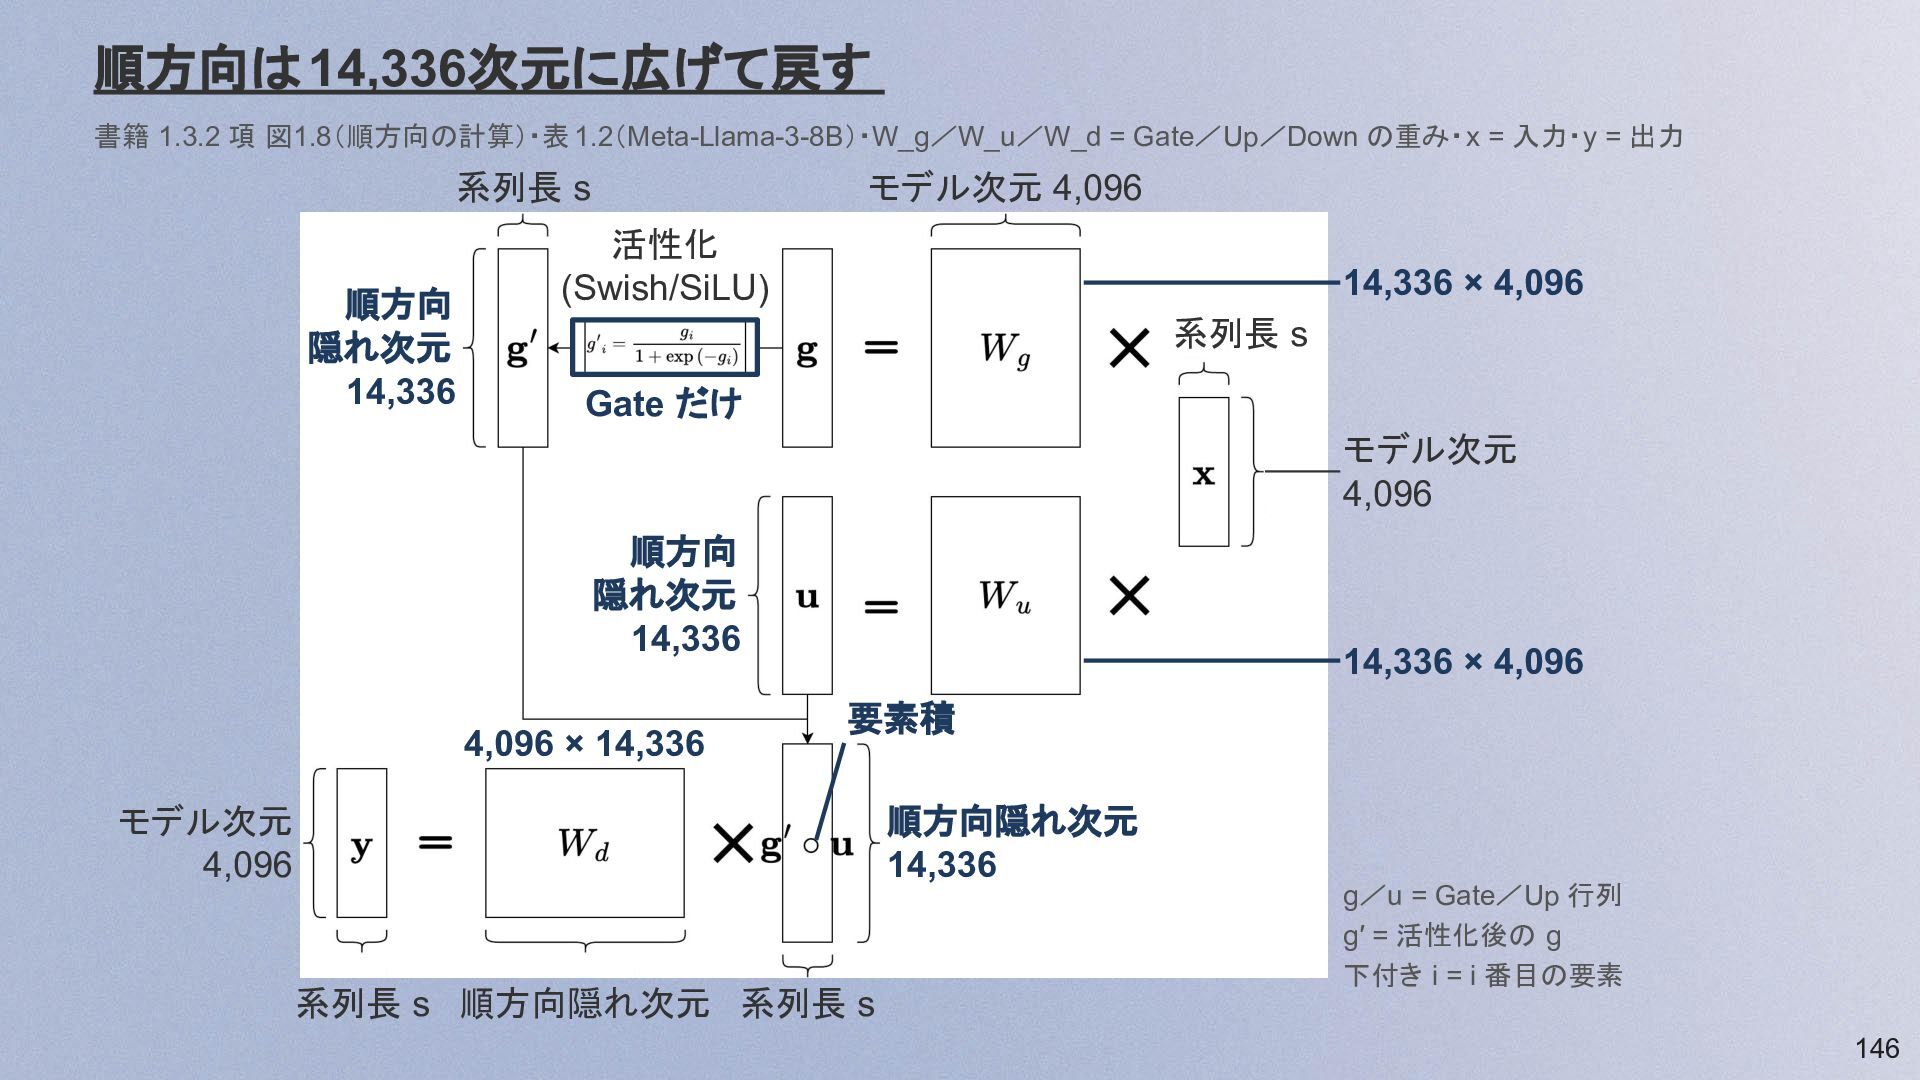
順方向は 14,336次元に広げて戻す 書籍 1.3.2 項 図1.8(順方向の計算)・表 1.2(Meta-Llama-3-8B)・W_g/W_u/W_d = Gate/Up/Down の重み・x
= 入力・y = 出力 系列長 s 順方向 隠れ次元 14,336 モデル次元 4,096 活性化 (Swish/SiLU) 14,336 × 4,096 系列長 s Gate だけ モデル次元 4,096 順方向 隠れ次元 14,336 4,096 × 14,336 14,336 × 4,096 要素積 モデル次元 4,096 順方向隠れ次元 14,336 系列長 s 順方向隠れ次元 系列長 s g/u = Gate/Up 行列 g′ = 活性化後の g 下付き i = i 番目の要素 146 -
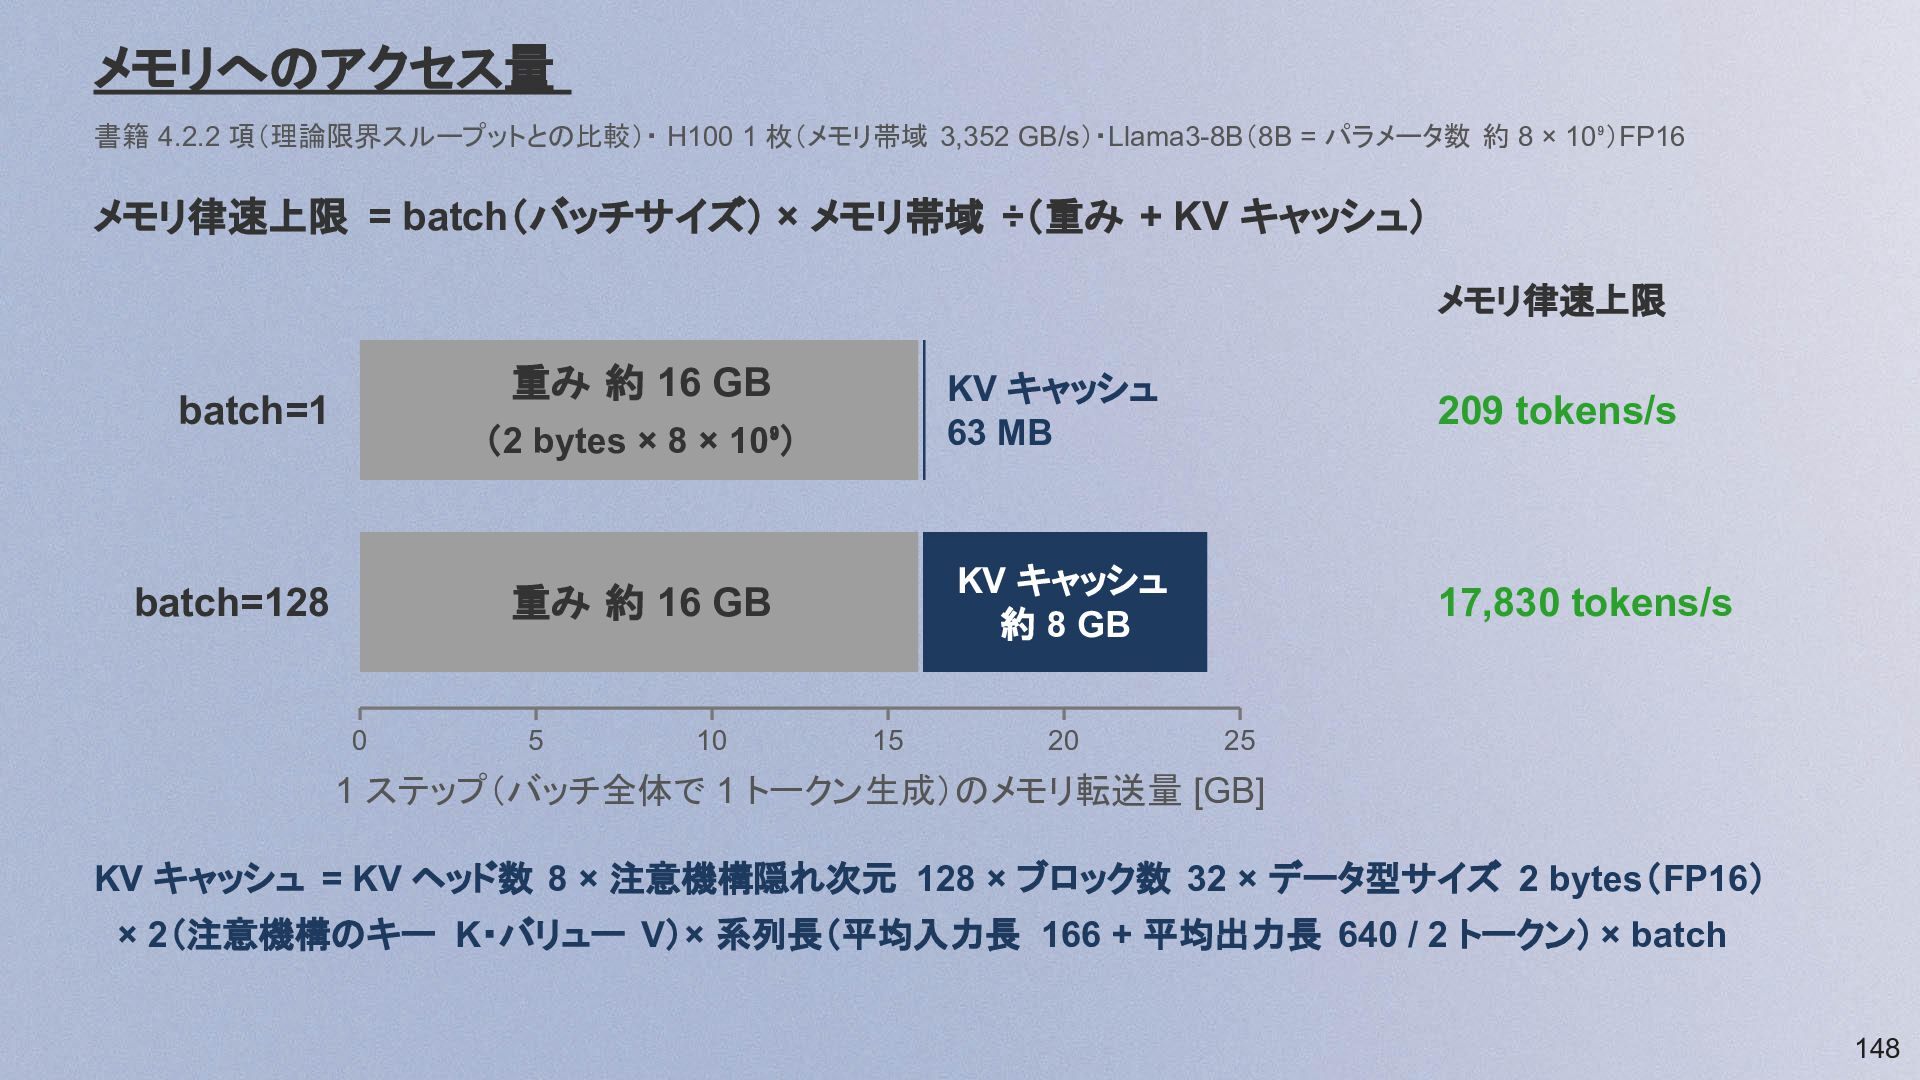
メモリへのアクセス量 書籍 4.2.2 項(理論限界スループットとの比較)・ H100 1 枚(メモリ帯域 3,352 GB/s)・Llama3-8B(8B =
パラメータ数 約 8 × 10⁹)FP16 メモリ律速上限 = batch(バッチサイズ) × メモリ帯域 ÷(重み + KV キャッシュ) メモリ律速上限 重み 約 16 GB batch=1 (2 bytes × 8 × 10⁹) 重み 約 16 GB batch=128 0 5 10 15 KV キャッシュ 63 MB 209 tokens/s KV キャッシュ 約 8 GB 17,830 tokens/s 20 25 1 ステップ(バッチ全体で 1 トークン生成)のメモリ転送量 [GB] KV キャッシュ = KV ヘッド数 8 × 注意機構隠れ次元 128 × ブロック数 32 × データ型サイズ 2 bytes(FP16) × 2(注意機構のキー K・バリュー V)× 系列長(平均入力長 166 + 平均出力長 640 / 2 トークン) × batch 148 -
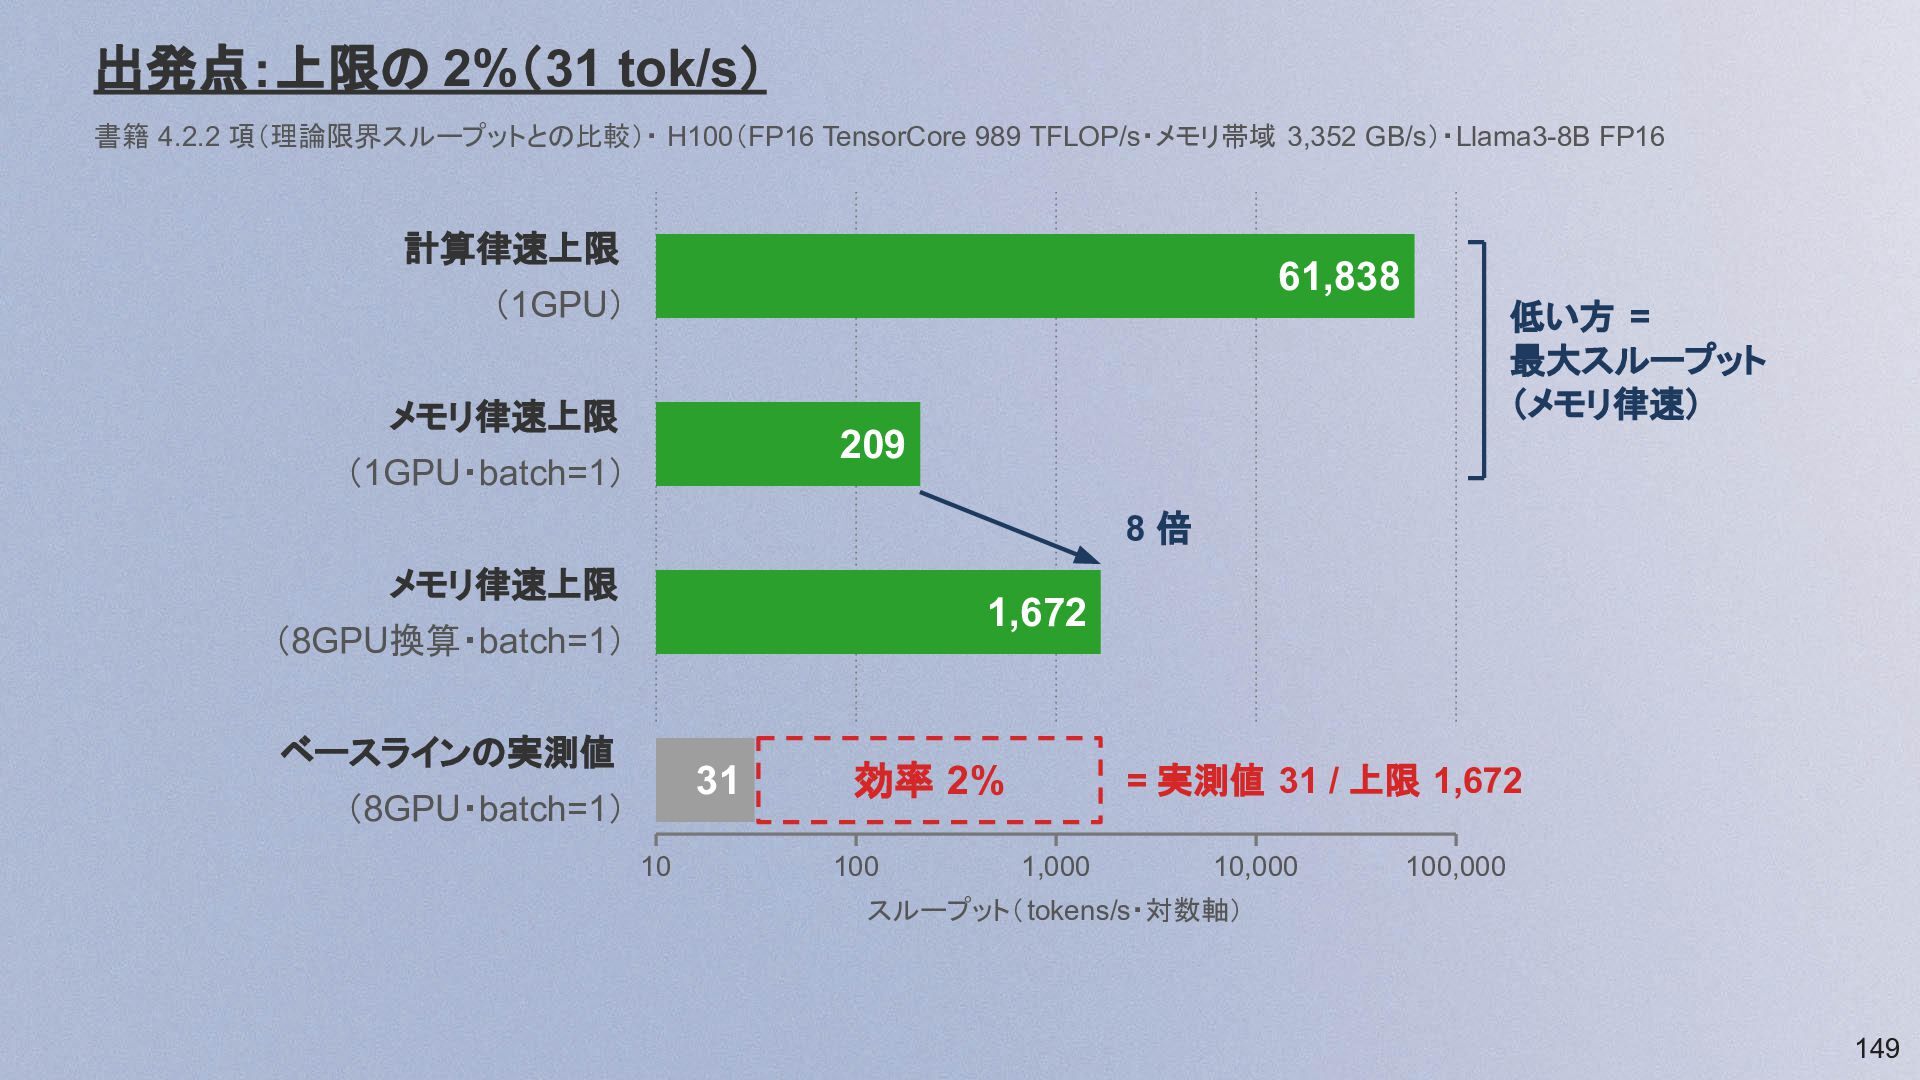
出発点:上限の 2%(31 tok/s) 書籍 4.2.2 項(理論限界スループットとの比較)・ H100(FP16 TensorCore 989 TFLOP/s・メモリ帯域
3,352 GB/s)・Llama3-8B FP16 計算律速上限 61,838 (1GPU) メモリ律速上限 低い方 = 最大スループット (メモリ律速) 209 (1GPU・batch=1) 8倍 メモリ律速上限 1,672 (8GPU換算・batch=1) ベースラインの実測値 31 (8GPU・batch=1) 10 効率 2% 100 = 実測値 31 / 上限 1,672 1,000 10,000 100,000 スループット( tokens/s・対数軸) 149 -
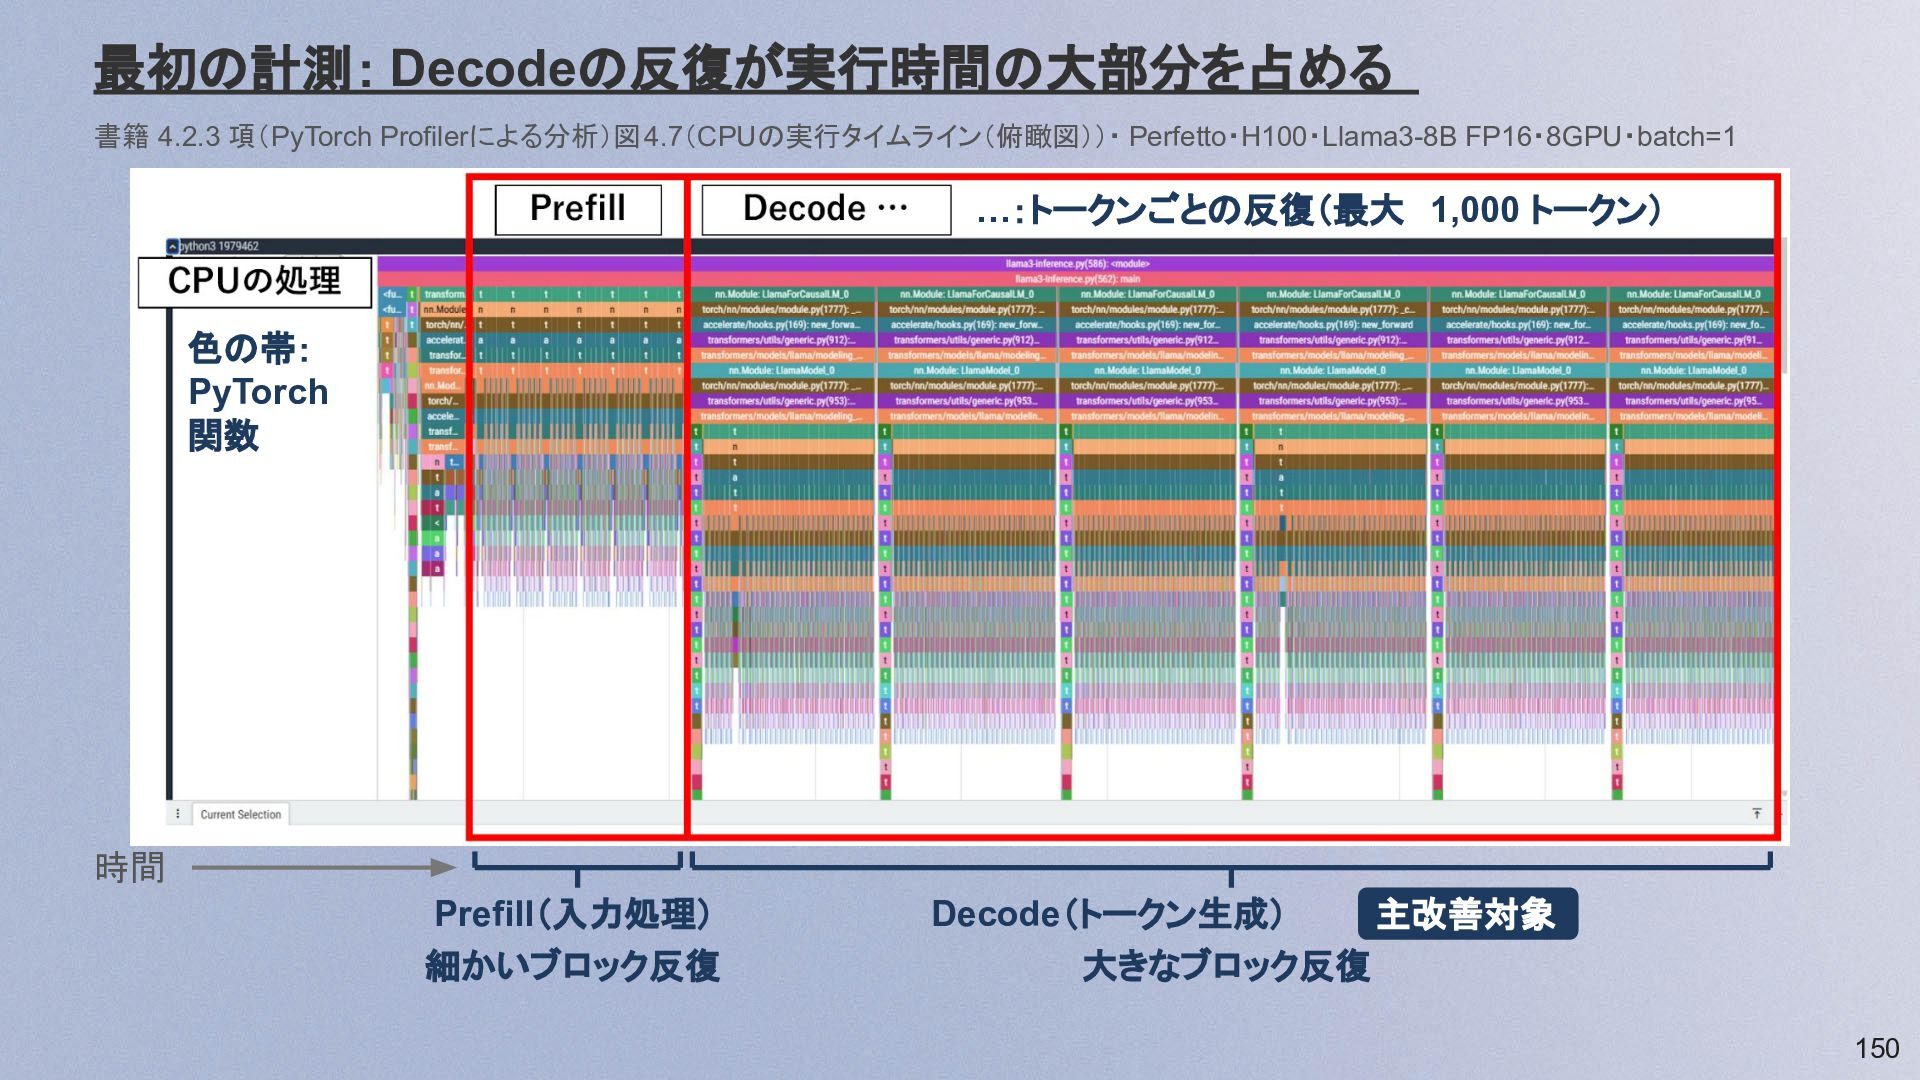
最初の計測: Decodeの反復が実行時間の大部分を占める 書籍 4.2.3 項(PyTorch Profilerによる分析)図 4.7(CPUの実行タイムライン(俯瞰図))・ Perfetto・H100・Llama3-8B FP16・8GPU・batch=1 …:トークンごとの反復(最大
1,000 トークン) 色の帯: PyTorch 関数 時間 Prefill(入力処理) 細かいブロック反復 Decode(トークン生成) 主改善対象 大きなブロック反復 150 -
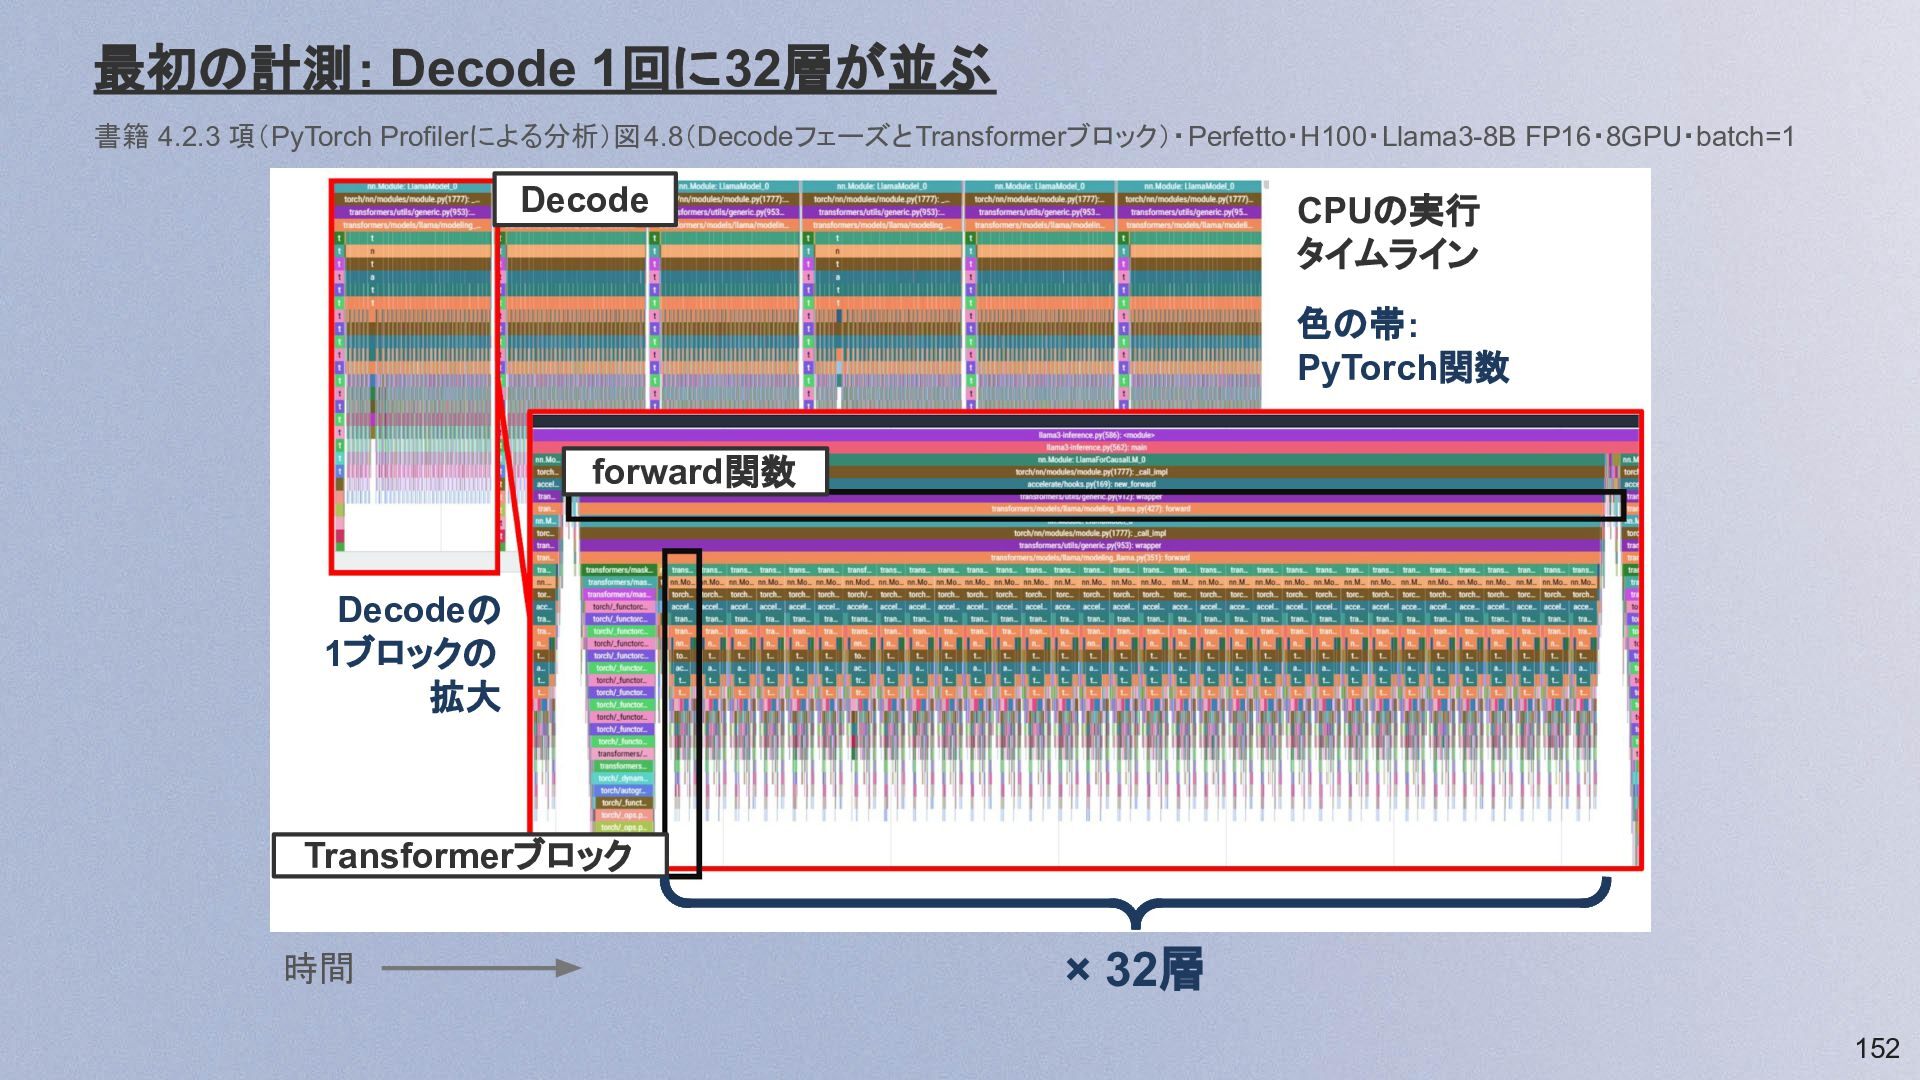
最初の計測: Decode 1回に32層が並ぶ 書籍 4.2.3 項(PyTorch Profilerによる分析)図 4.8(DecodeフェーズとTransformerブロック)・Perfetto・H100・Llama3-8B FP16・8GPU・batch=1 Decode
CPUの実行 タイムライン 色の帯: PyTorch関数 forward関数 Decodeの 1ブロックの 拡大 Transformerブロック 時間 × 32層 152 -
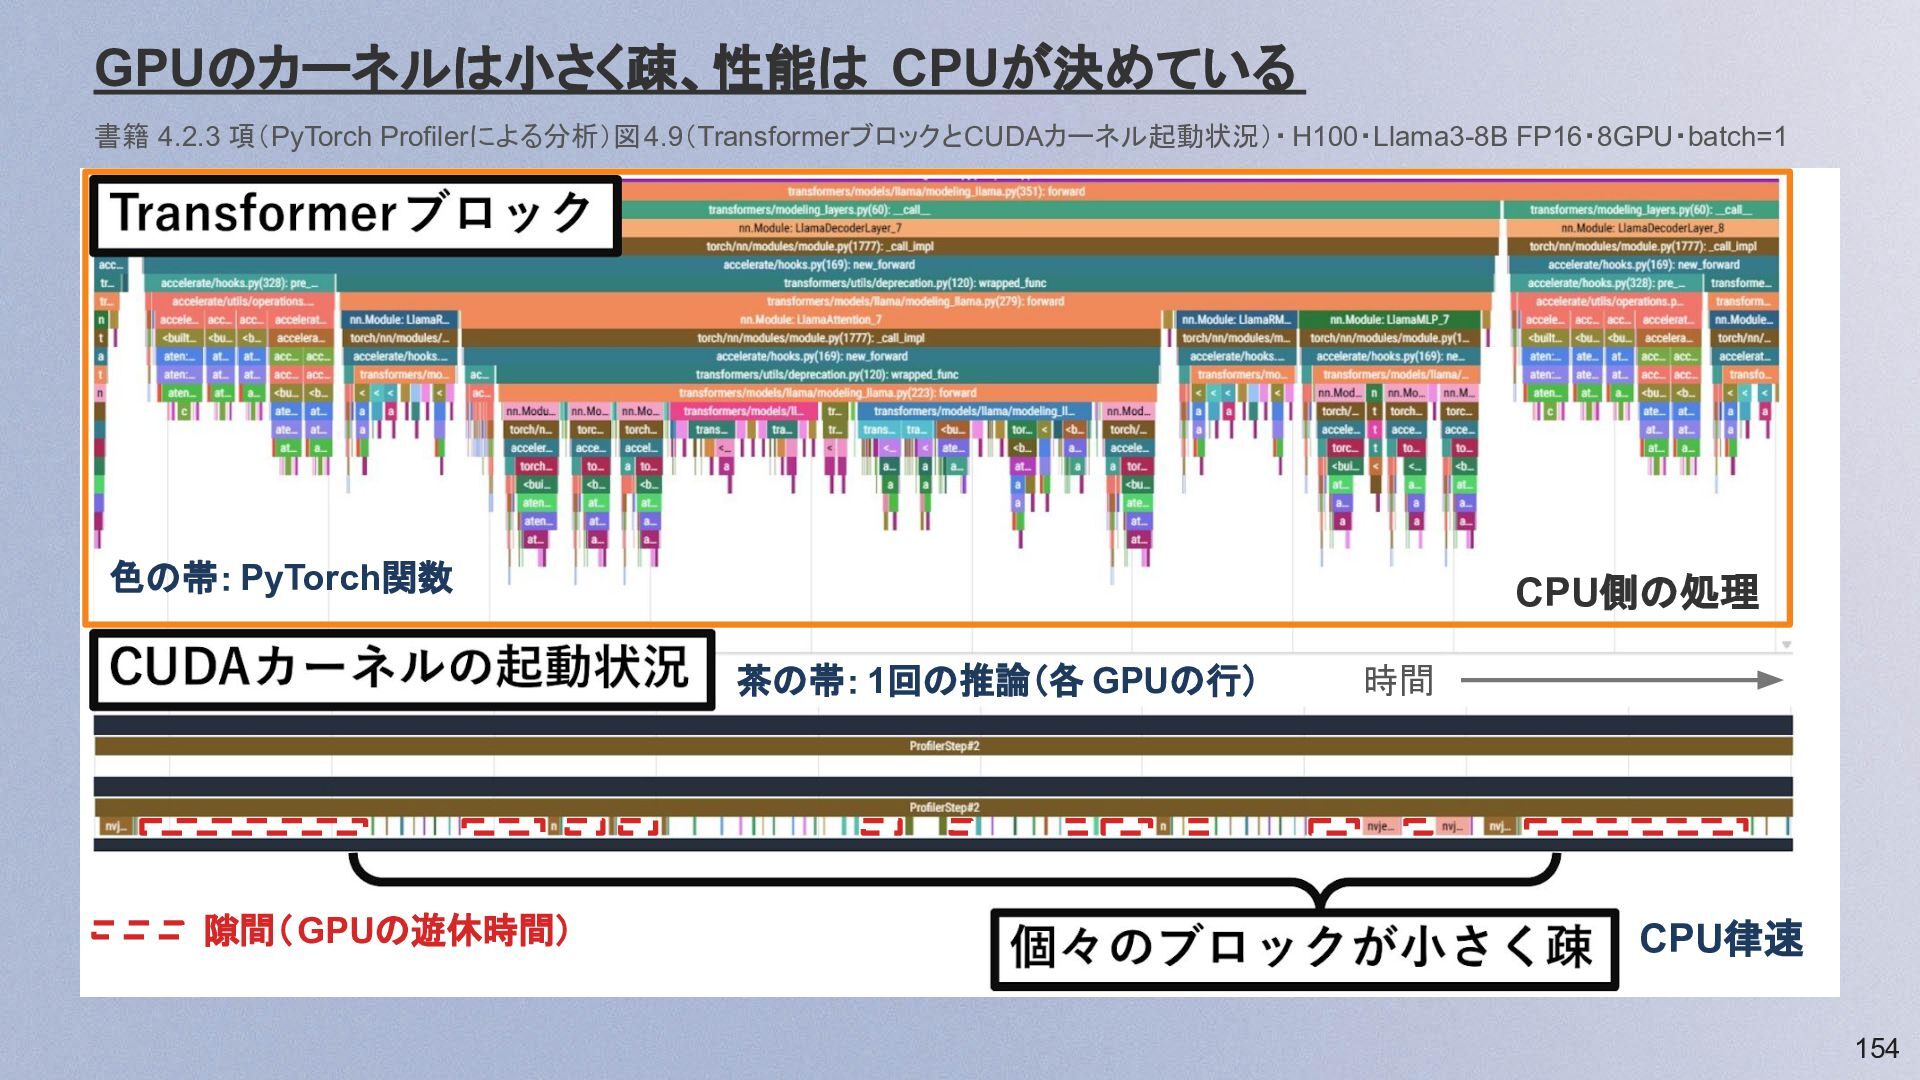
GPUのカーネルは小さく疎、性能は CPUが決めている 書籍 4.2.3 項(PyTorch Profilerによる分析)図 4.9(TransformerブロックとCUDAカーネル起動状況)・ H100・Llama3-8B FP16・8GPU・batch=1 色の帯:
PyTorch関数 CPU側の処理 茶の帯: 1回の推論(各 GPUの行) 隙間(GPUの遊休時間) 時間 CPU律速 154 -
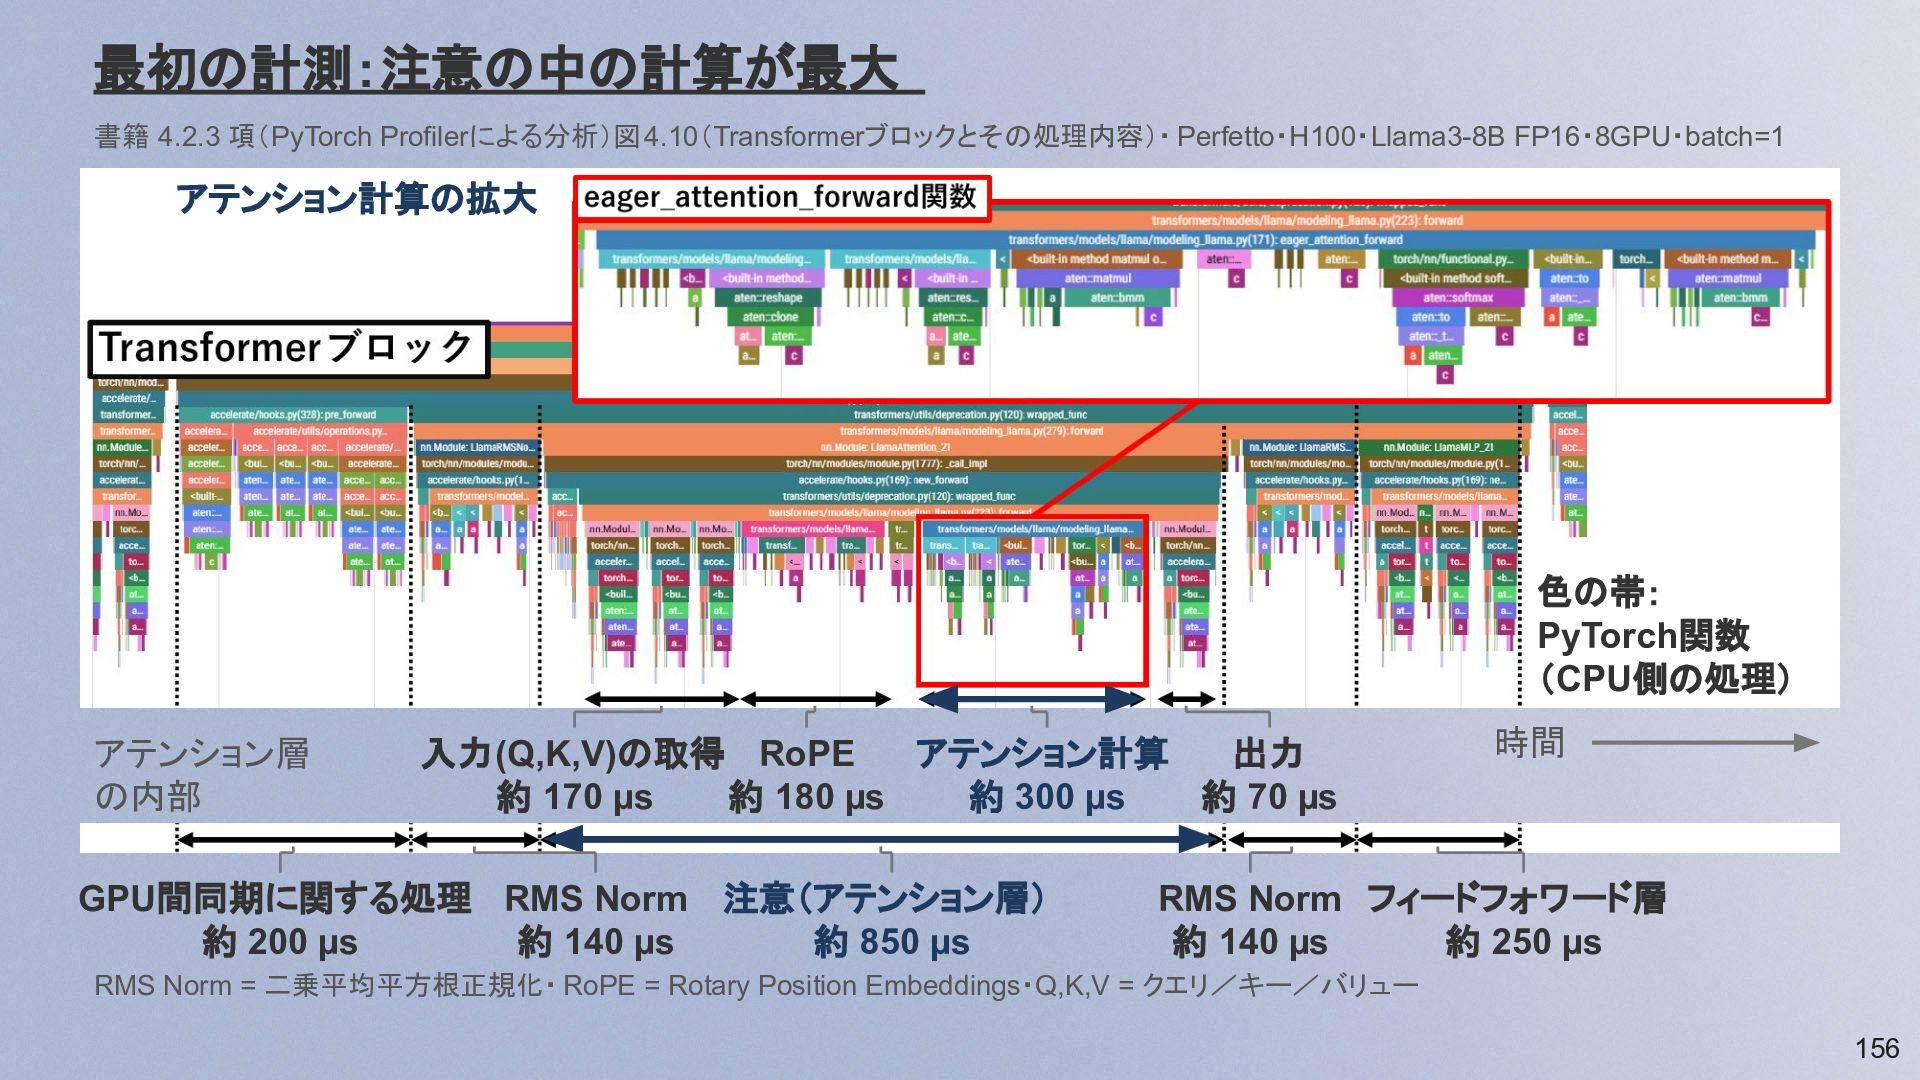
最初の計測:注意の中の計算が最大 書籍 4.2.3 項(PyTorch Profilerによる分析)図 4.10(Transformerブロックとその処理内容)・ Perfetto・H100・Llama3-8B FP16・8GPU・batch=1 アテンション計算の拡大 色の帯:
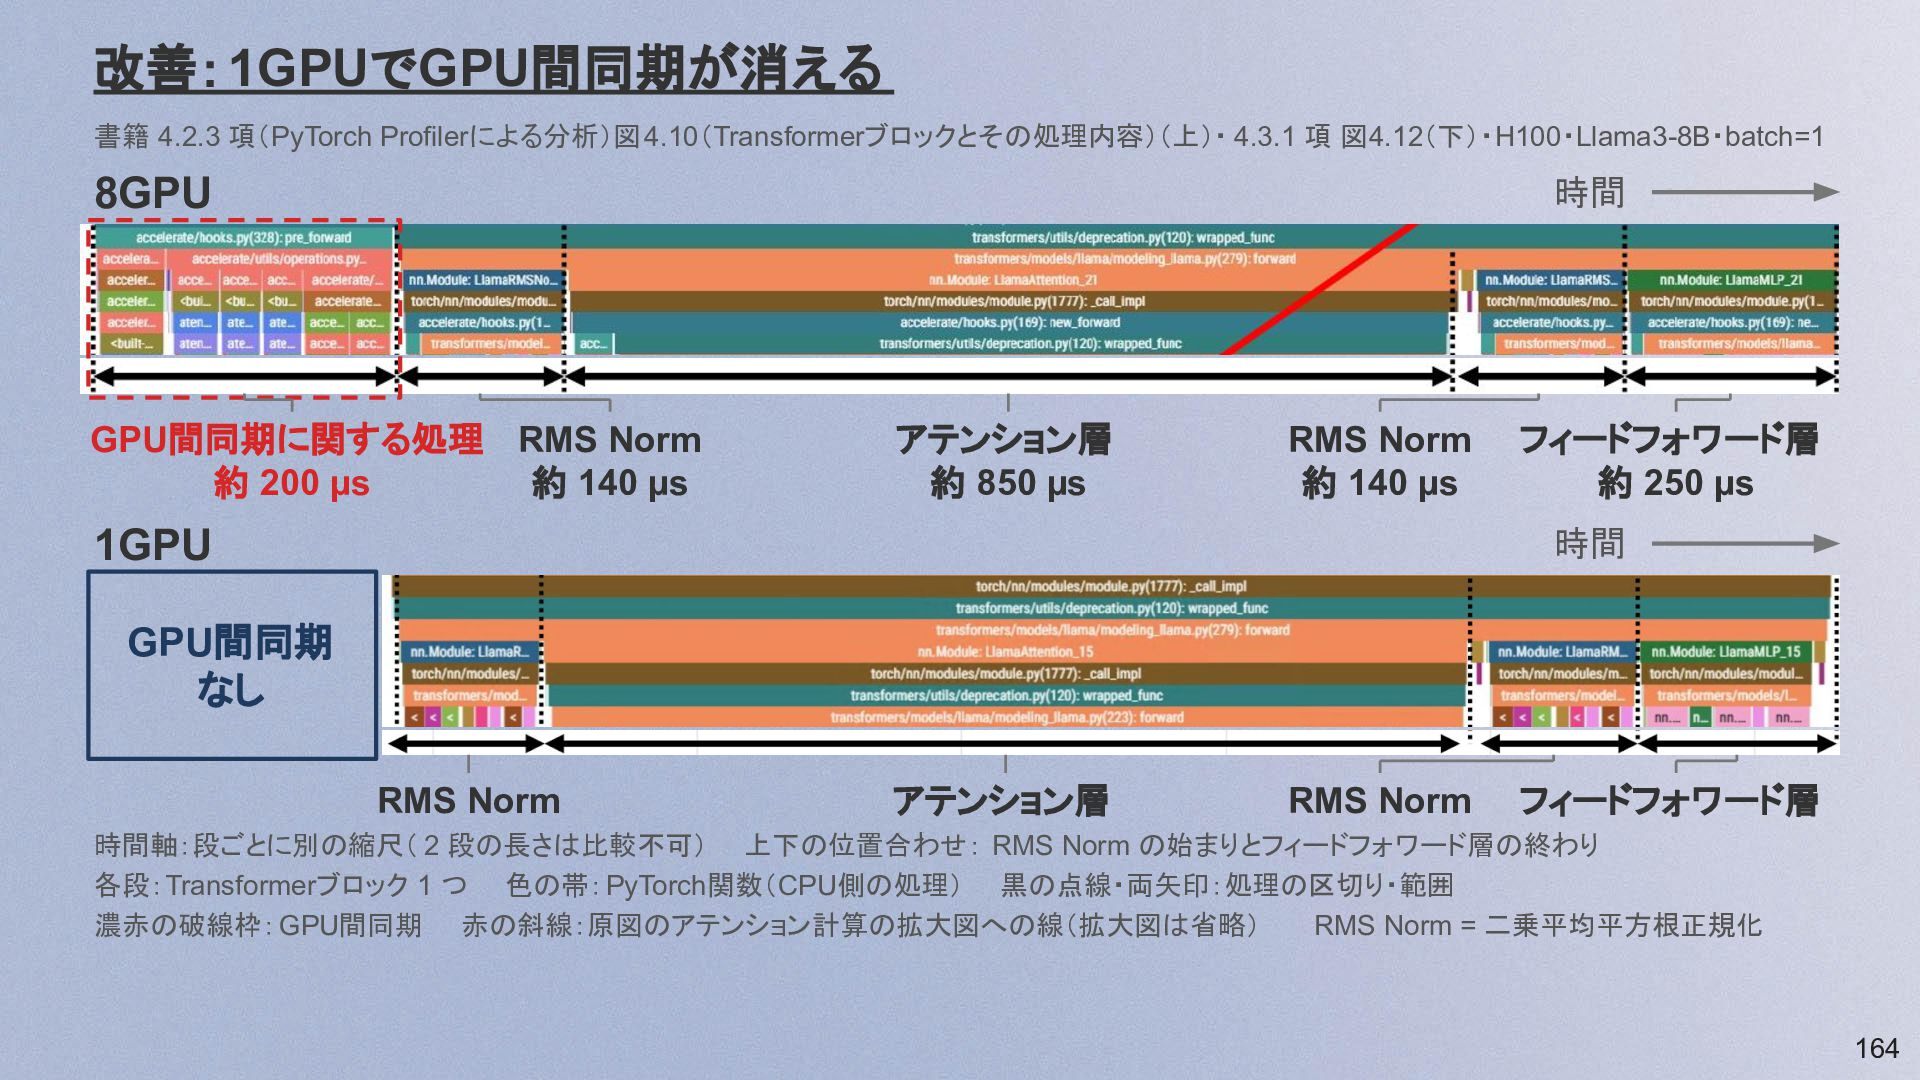
PyTorch関数 (CPU側の処理) アテンション層 の内部 入力(Q,K,V)の取得 RoPE アテンション計算 出力 約 170 µs 約 180 µs 約 300 µs 約 70 µs GPU間同期に関する処理 RMS Norm 注意(アテンション層) 約 200 µs 約 140 µs 約 850 µs 時間 RMS Norm フィードフォワード層 約 140 µs 約 250 µs RMS Norm = 二乗平均平方根正規化・ RoPE = Rotary Position Embeddings・Q,K,V = クエリ/キー/バリュー 156 -
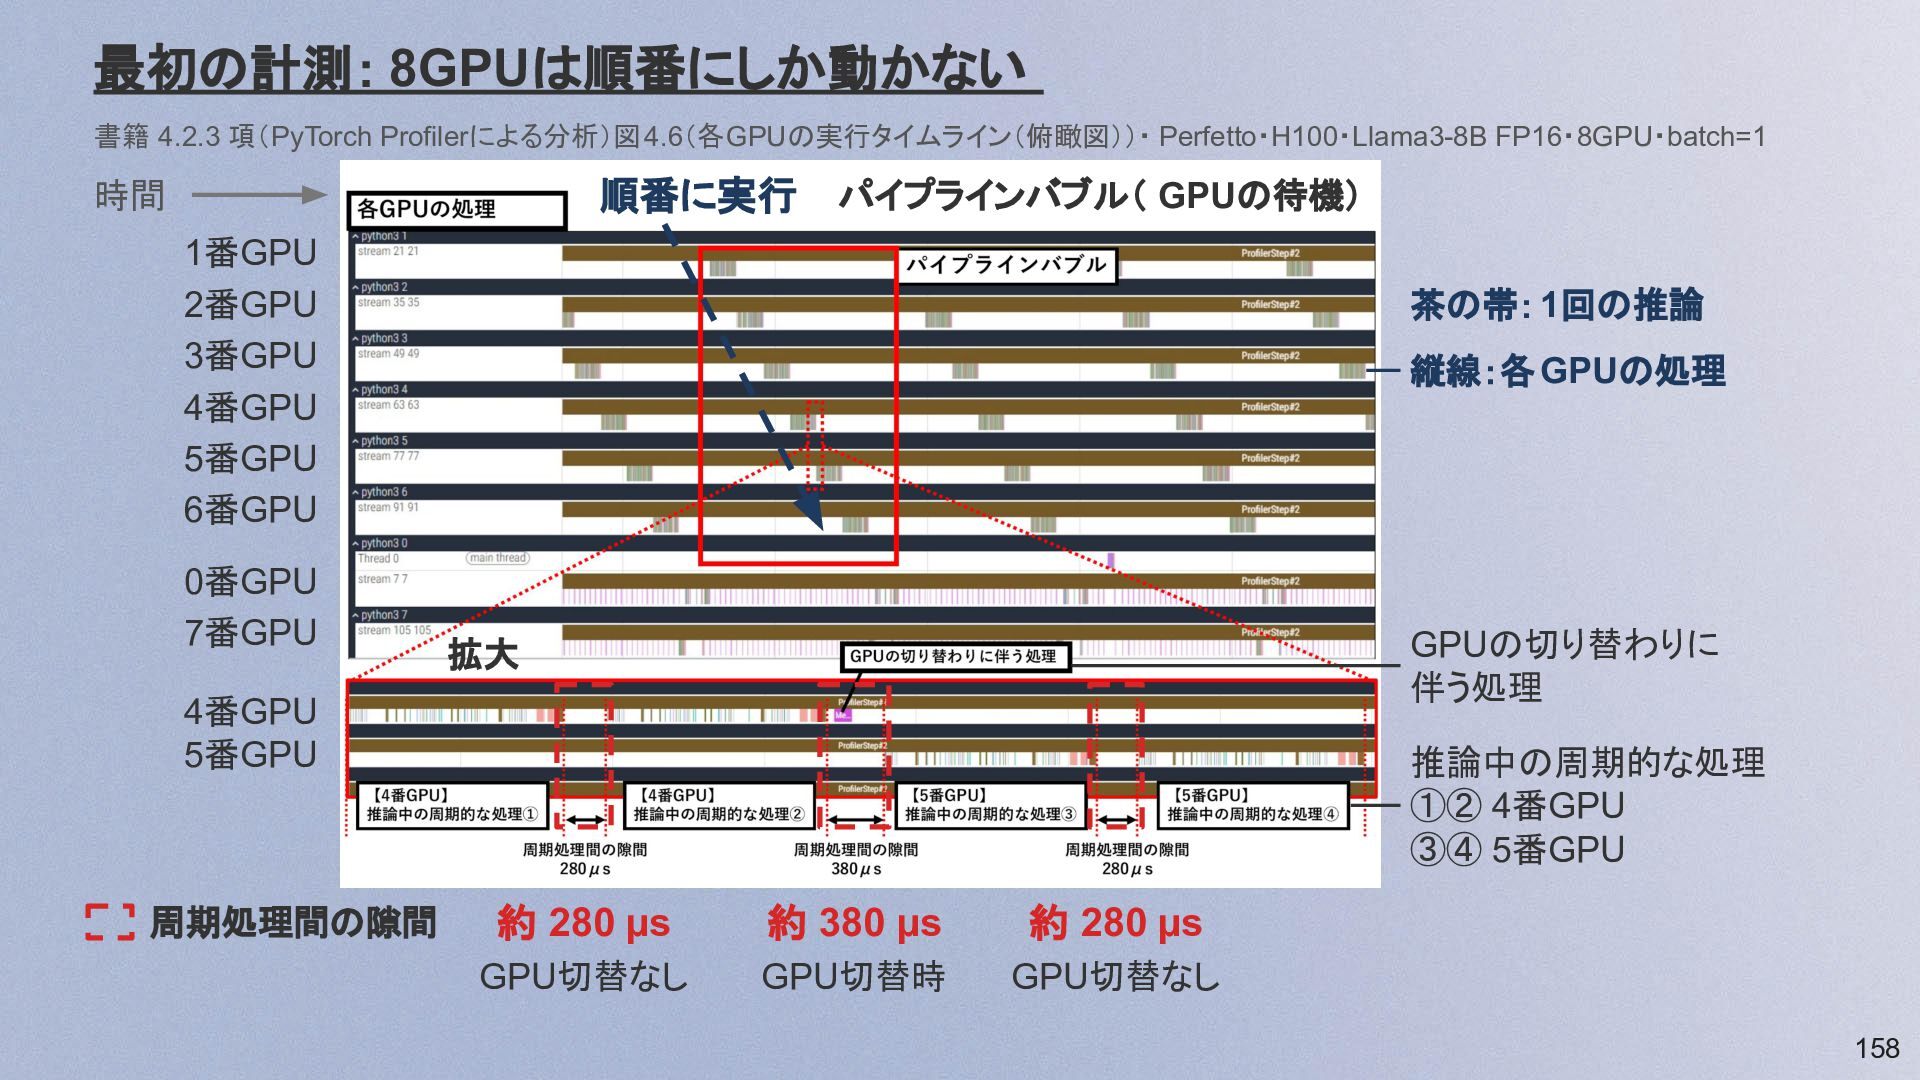
最初の計測: 8GPUは順番にしか動かない 書籍 4.2.3 項(PyTorch Profilerによる分析)図 4.6(各GPUの実行タイムライン(俯瞰図))・ Perfetto・H100・Llama3-8B FP16・8GPU・batch=1 順番に実行
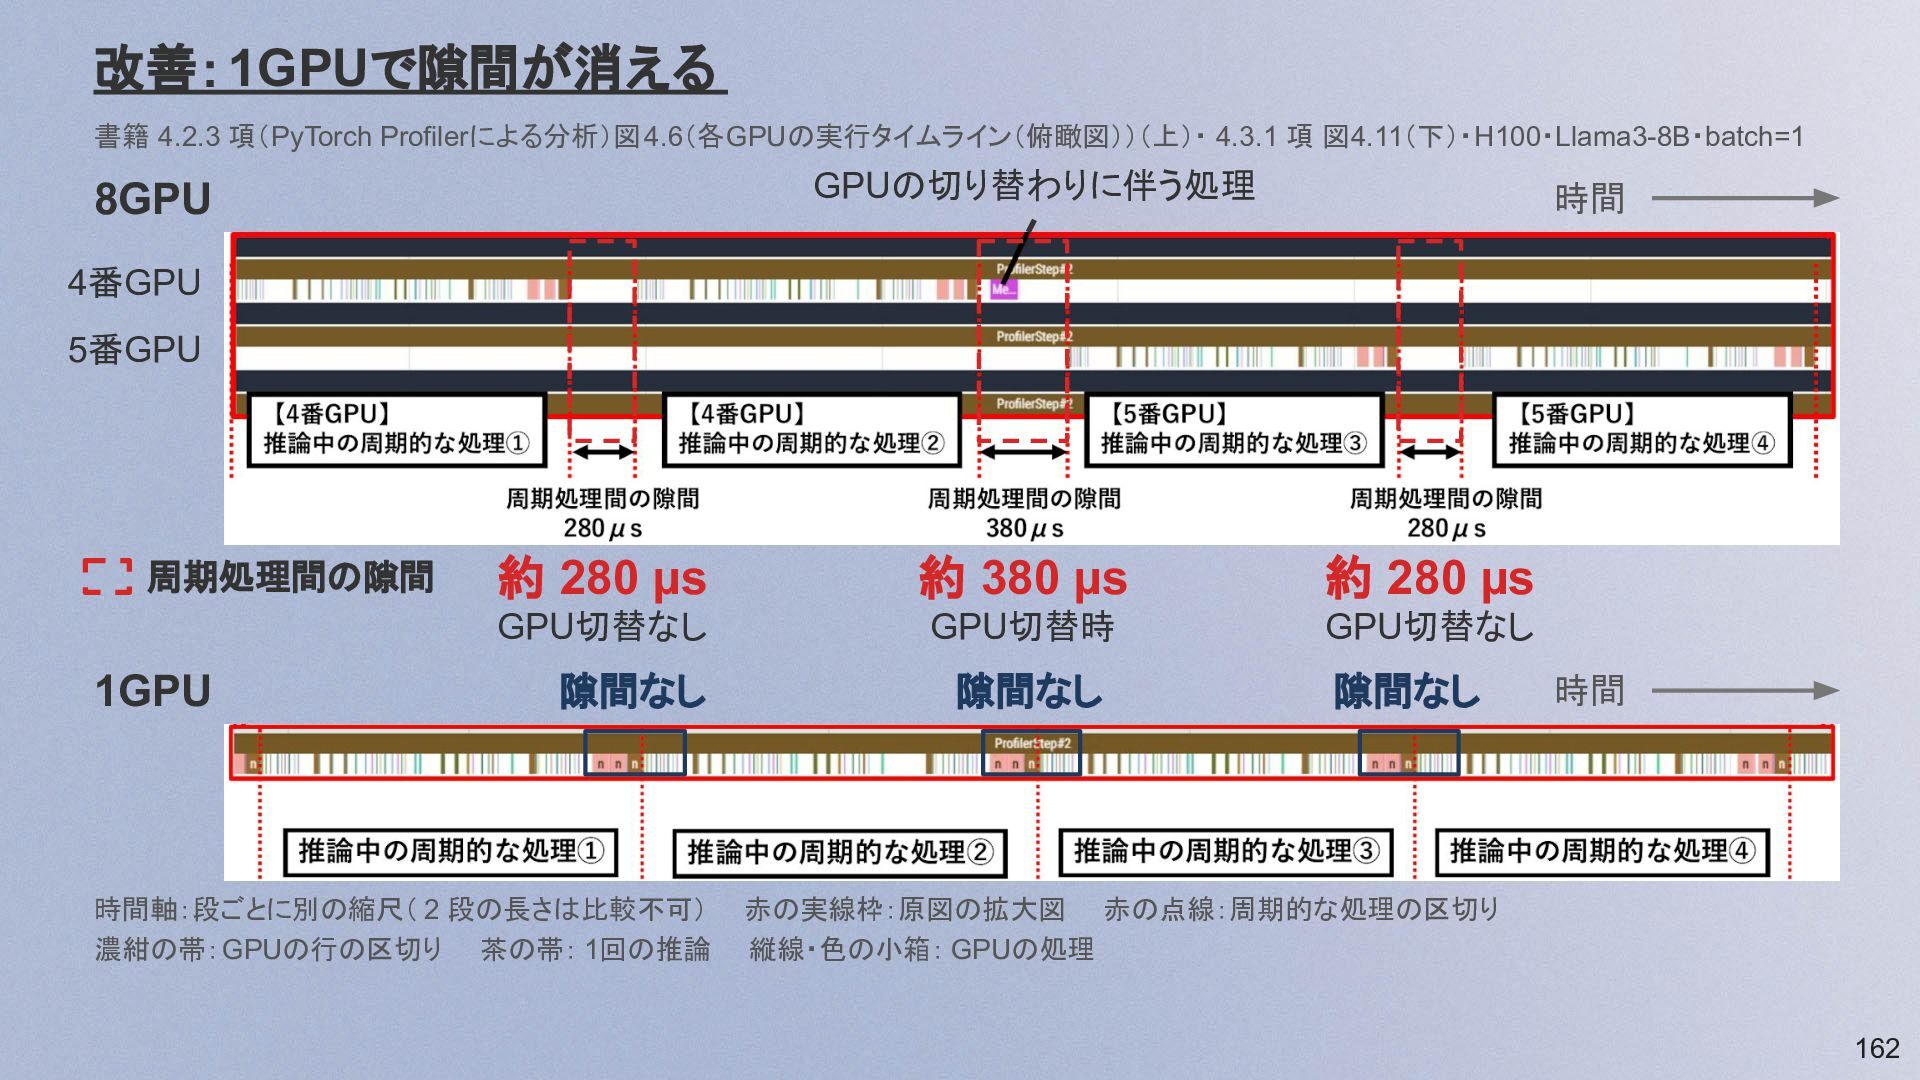
時間 パイプラインバブル( GPUの待機) 1番GPU 2番GPU 3番GPU 4番GPU 5番GPU 6番GPU 0番GPU 7番GPU 茶の帯: 1回の推論 縦線:各 GPUの処理 GPUの切り替わりに 伴う処理 拡大 4番GPU 5番GPU 周期処理間の隙間 推論中の周期的な処理 ①② 4番GPU ③④ 5番GPU 約 280 µs 約 380 µs 約 280 µs GPU切替なし GPU切替時 GPU切替なし 158 -
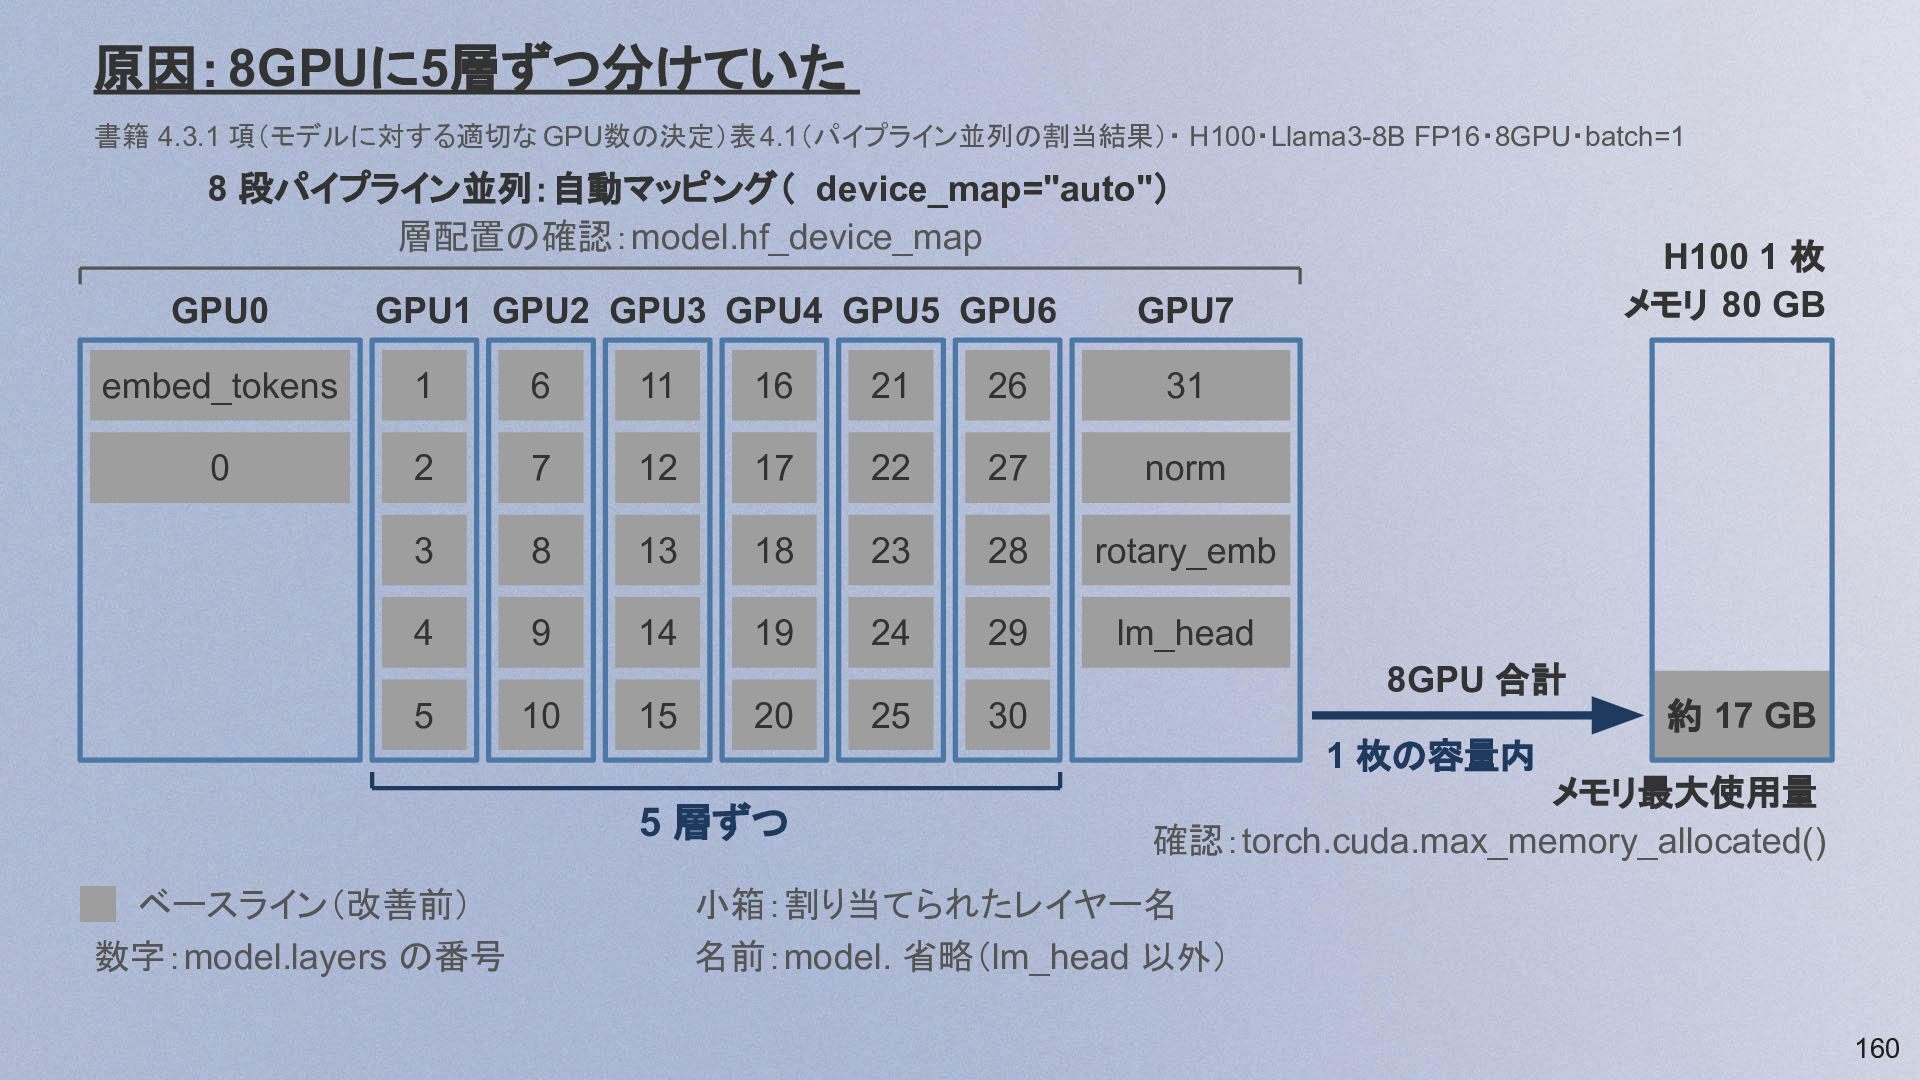
原因:8GPUに5層ずつ分けていた 書籍 4.3.1 項(モデルに対する適切な GPU数の決定)表4.1(パイプライン並列の割当結果)・ H100・Llama3-8B FP16・8GPU・batch=1 8 段パイプライン並列:自動マッピング( device_map="auto")
層配置の確認:model.hf_device_map GPU0 GPU1 GPU2 GPU3 GPU4 GPU5 GPU6 H100 1 枚 メモリ 80 GB GPU7 embed_tokens 1 6 11 16 21 26 31 0 2 7 12 17 22 27 norm 3 8 13 18 23 28 rotary_emb 4 9 14 19 24 29 lm_head 8GPU 合計 5 10 15 20 25 30 約 17 GB 1 枚の容量内 5 層ずつ ベースライン(改善前) 数字:model.layers の番号 メモリ最大使用量 確認:torch.cuda.max_memory_allocated() 小箱:割り当てられたレイヤー名 名前:model. 省略(lm_head 以外) 160 -
改善:1GPUで隙間が消える 書籍 4.2.3 項(PyTorch Profilerによる分析)図 4.6(各GPUの実行タイムライン(俯瞰図))(上)・ 4.3.1 項 図4.11(下)・H100・Llama3-8B・batch=1 GPUの切り替わりに伴う処理
8GPU 時間 4番GPU 5番GPU 周期処理間の隙間 1GPU 約 280 µs 約 380 µs 約 280 µs GPU切替なし GPU切替時 GPU切替なし 隙間なし 隙間なし 隙間なし 時間軸:段ごとに別の縮尺( 2 段の長さは比較不可) 濃紺の帯:GPUの行の区切り 茶の帯: 1回の推論 時間 赤の実線枠:原図の拡大図 赤の点線:周期的な処理の区切り 縦線・色の小箱: GPUの処理 162 -
改善:1GPUでGPU間同期が消える 書籍 4.2.3 項(PyTorch Profilerによる分析)図 4.10(Transformerブロックとその処理内容)(上)・ 4.3.1 項 図4.12(下)・H100・Llama3-8B・batch=1 時間
8GPU GPU間同期に関する処理 RMS Norm 約 200 µs 約 140 µs アテンション層 約 850 µs RMS Norm 約 140 µs フィードフォワード層 約 250 µs 時間 1GPU GPU間同期 なし RMS Norm アテンション層 RMS Norm フィードフォワード層 時間軸:段ごとに別の縮尺( 2 段の長さは比較不可) 上下の位置合わせ: RMS Norm の始まりとフィードフォワード層の終わり 各段:Transformerブロック 1 つ 色の帯: PyTorch関数(CPU側の処理) 黒の点線・両矢印:処理の区切り・範囲 濃赤の破線枠: GPU間同期 赤の斜線:原図のアテンション計算の拡大図への線(拡大図は省略) RMS Norm = 二乗平均平方根正規化 164 -
効果:1GPUで31→47 tok/s 書籍 4.2.2 項(理論限界スループットとの比較)・ 4.3.1 項(モデルに対する適切な GPU数の決定)・H100・Llama3-8B FP16 メモリ律速上限
1,672 (8GPU換算・batch=1) ベースラインの実測値 31 (8GPU・batch=1) メモリ律速上限 効率 2% = 実測値 31 / 上限 1,672 効率 22% = 実測値 47 / 上限 209 209 (1GPU・batch=1) GPU 数調整の実測値 47 (1GPU・batch=1) 0 500 1,000 1,500 スループット( tokens/s) 166 -
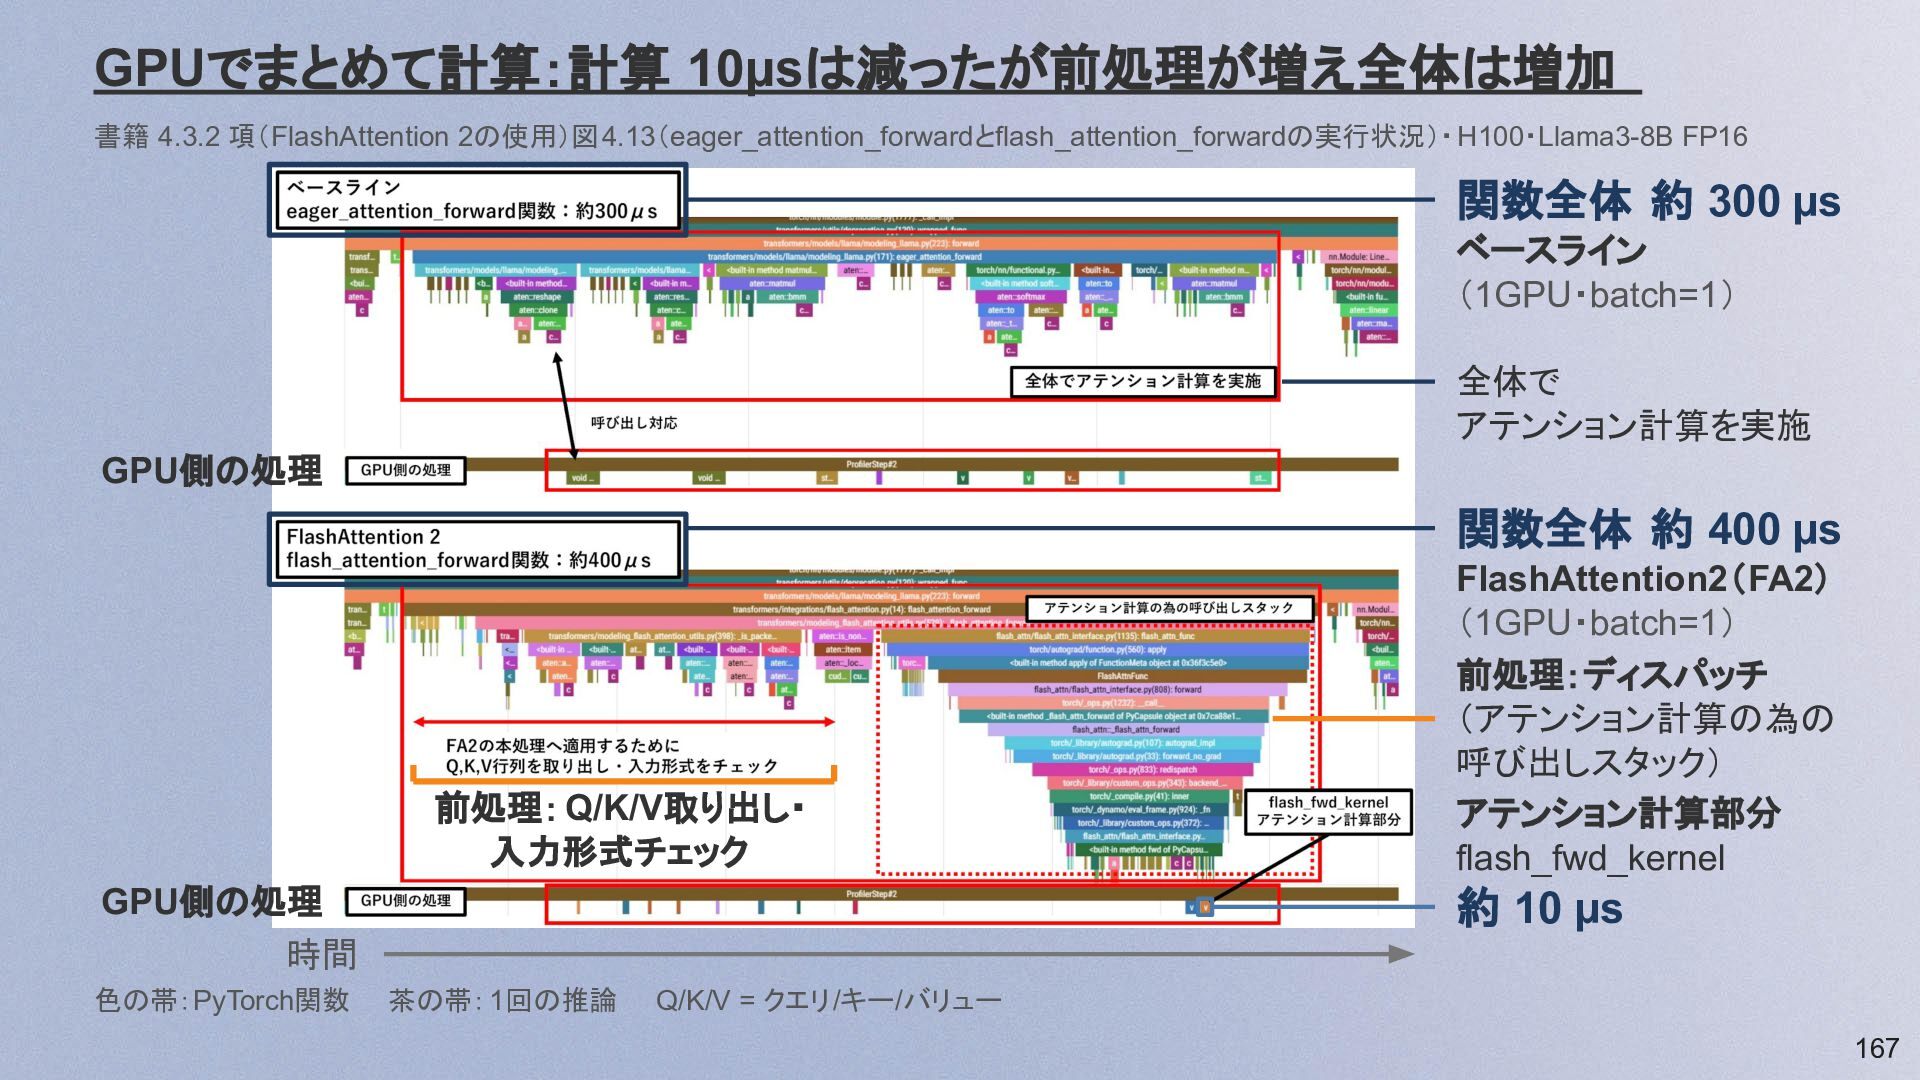
GPUでまとめて計算:計算 10µsは減ったが前処理が増え全体は増加 書籍 4.3.2 項(FlashAttention 2の使用)図4.13(eager_attention_forwardとflash_attention_forwardの実行状況)・ H100・Llama3-8B FP16 関数全体 約
300 µs ベースライン (1GPU・batch=1) 全体で アテンション計算を実施 GPU側の処理 関数全体 約 400 µs 前処理: Q/K/V取り出し・ 入力形式チェック 約 10 µs GPU側の処理 時間 色の帯:PyTorch関数 FlashAttention2(FA2) (1GPU・batch=1) 前処理:ディスパッチ (アテンション計算の為の 呼び出しスタック) アテンション計算部分 flash_fwd_kernel 茶の帯: 1回の推論 Q/K/V = クエリ/キー/バリュー 167 -
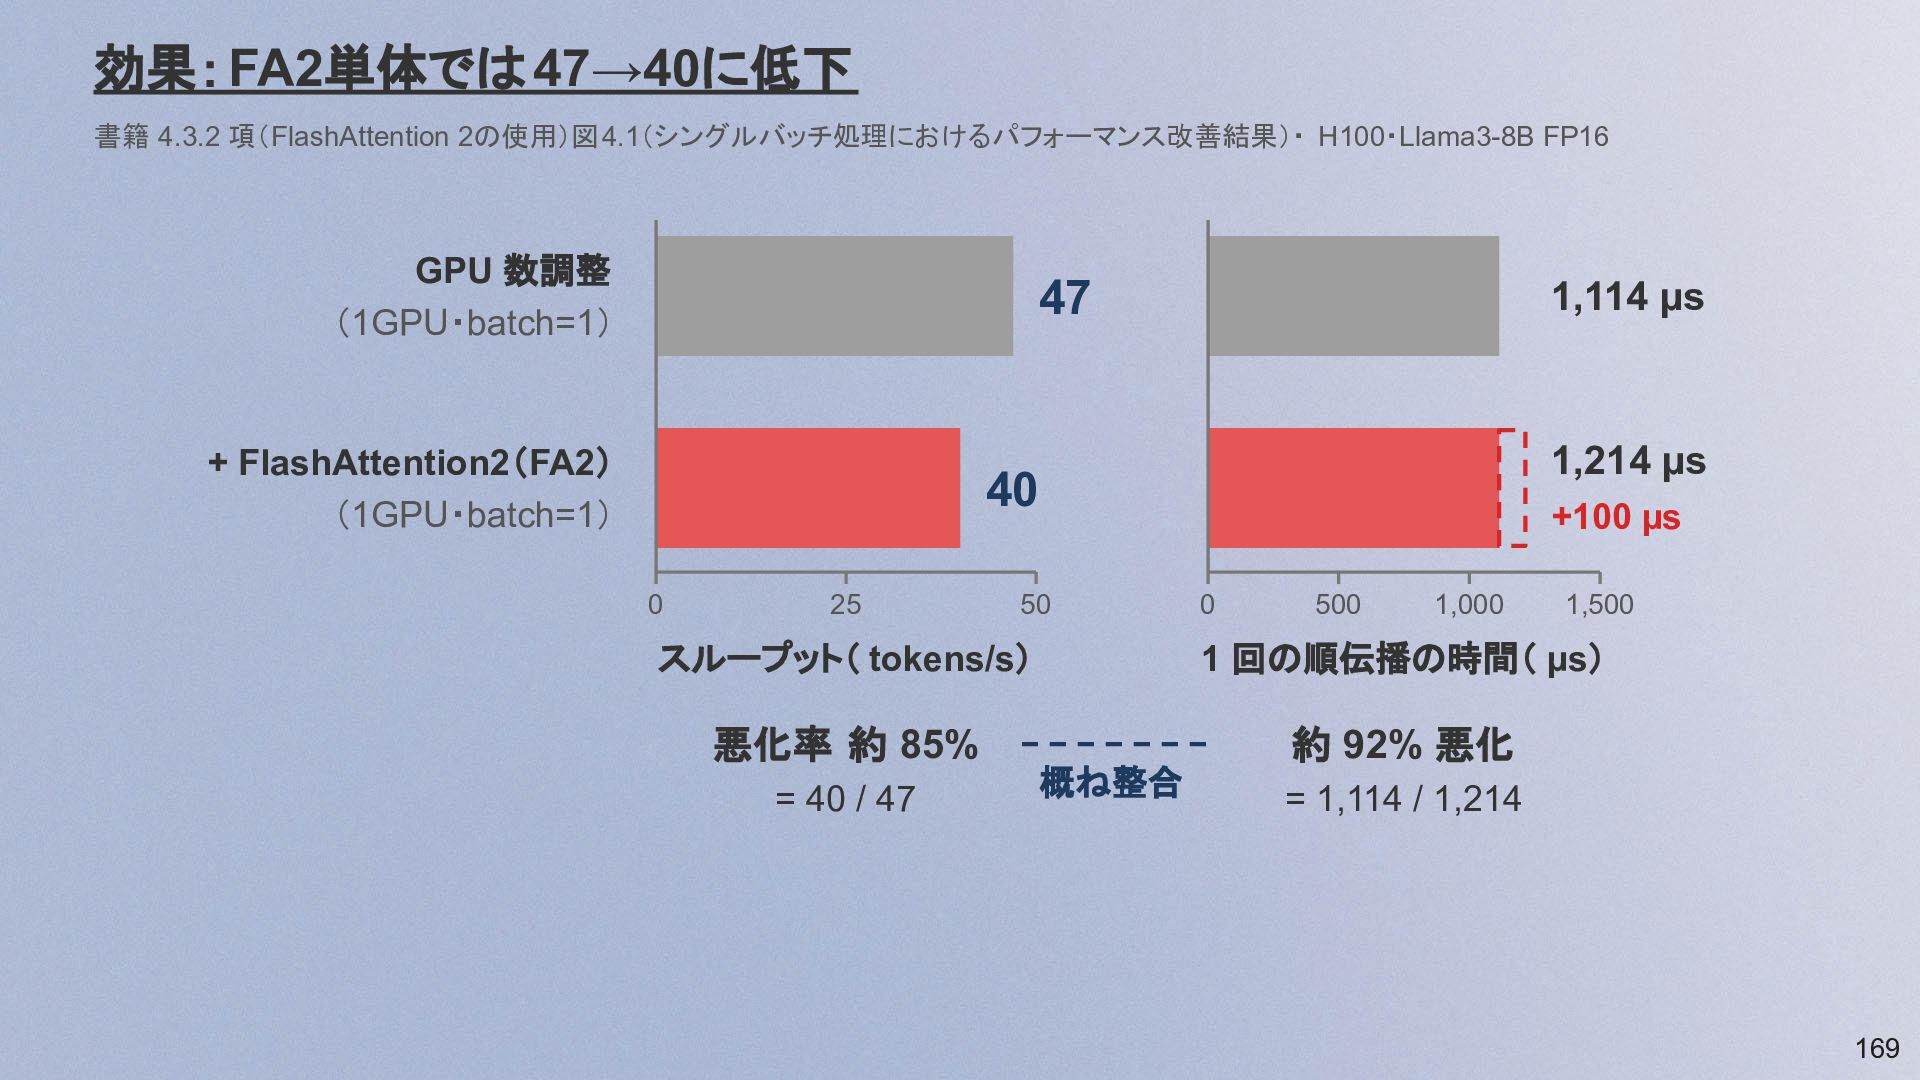
効果:FA2単体では 47→40に低下 書籍 4.3.2 項(FlashAttention 2の使用)図4.1(シングルバッチ処理におけるパフォーマンス改善結果)・ H100・Llama3-8B FP16 GPU 数調整
(1GPU・batch=1) 47 + FlashAttention2(FA2) (1GPU・batch=1) 1,114 µs 1,214 µs 40 0 25 +100 µs 50 0 500 1,000 1,500 スループット( tokens/s) 1 回の順伝播の時間( µs) 悪化率 約 85% 約 92% 悪化 = 40 / 47 概ね整合 = 1,114 / 1,214 169 -
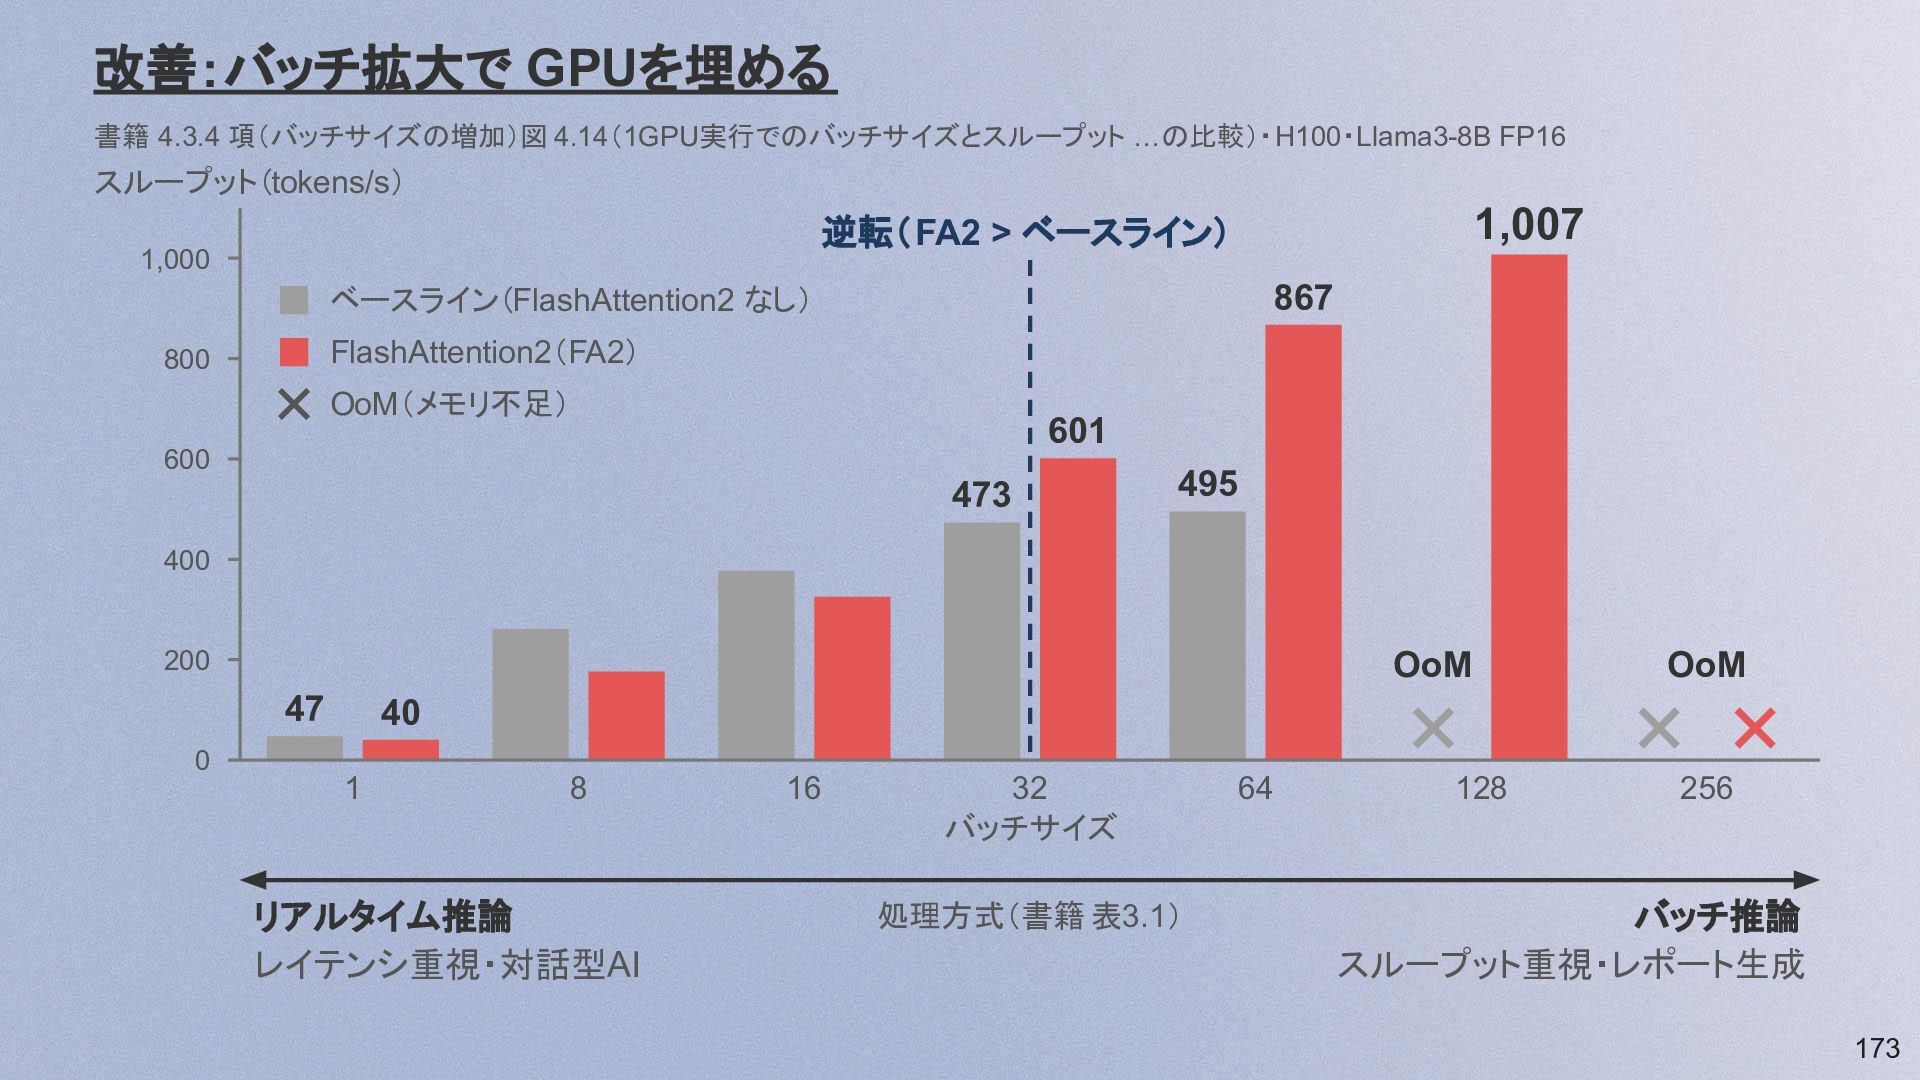
改善:バッチ拡大で GPUを埋める 書籍 4.3.4 項(バッチサイズの増加)図 4.14(1GPU実行でのバッチサイズとスループット …の比較)・H100・Llama3-8B FP16 スループット(tokens/s) 1,007
逆転(FA2 > ベースライン) 1,000 867 ベースライン(FlashAttention2 なし) FlashAttention2(FA2) 800 OoM(メモリ不足) 601 600 473 495 400 200 OoM 47 0 OoM 40 1 8 リアルタイム推論 レイテンシ重視・対話型AI 16 32 バッチサイズ 処理方式(書籍 表3.1) 64 128 256 バッチ推論 スループット重視・レポート生成 173 -
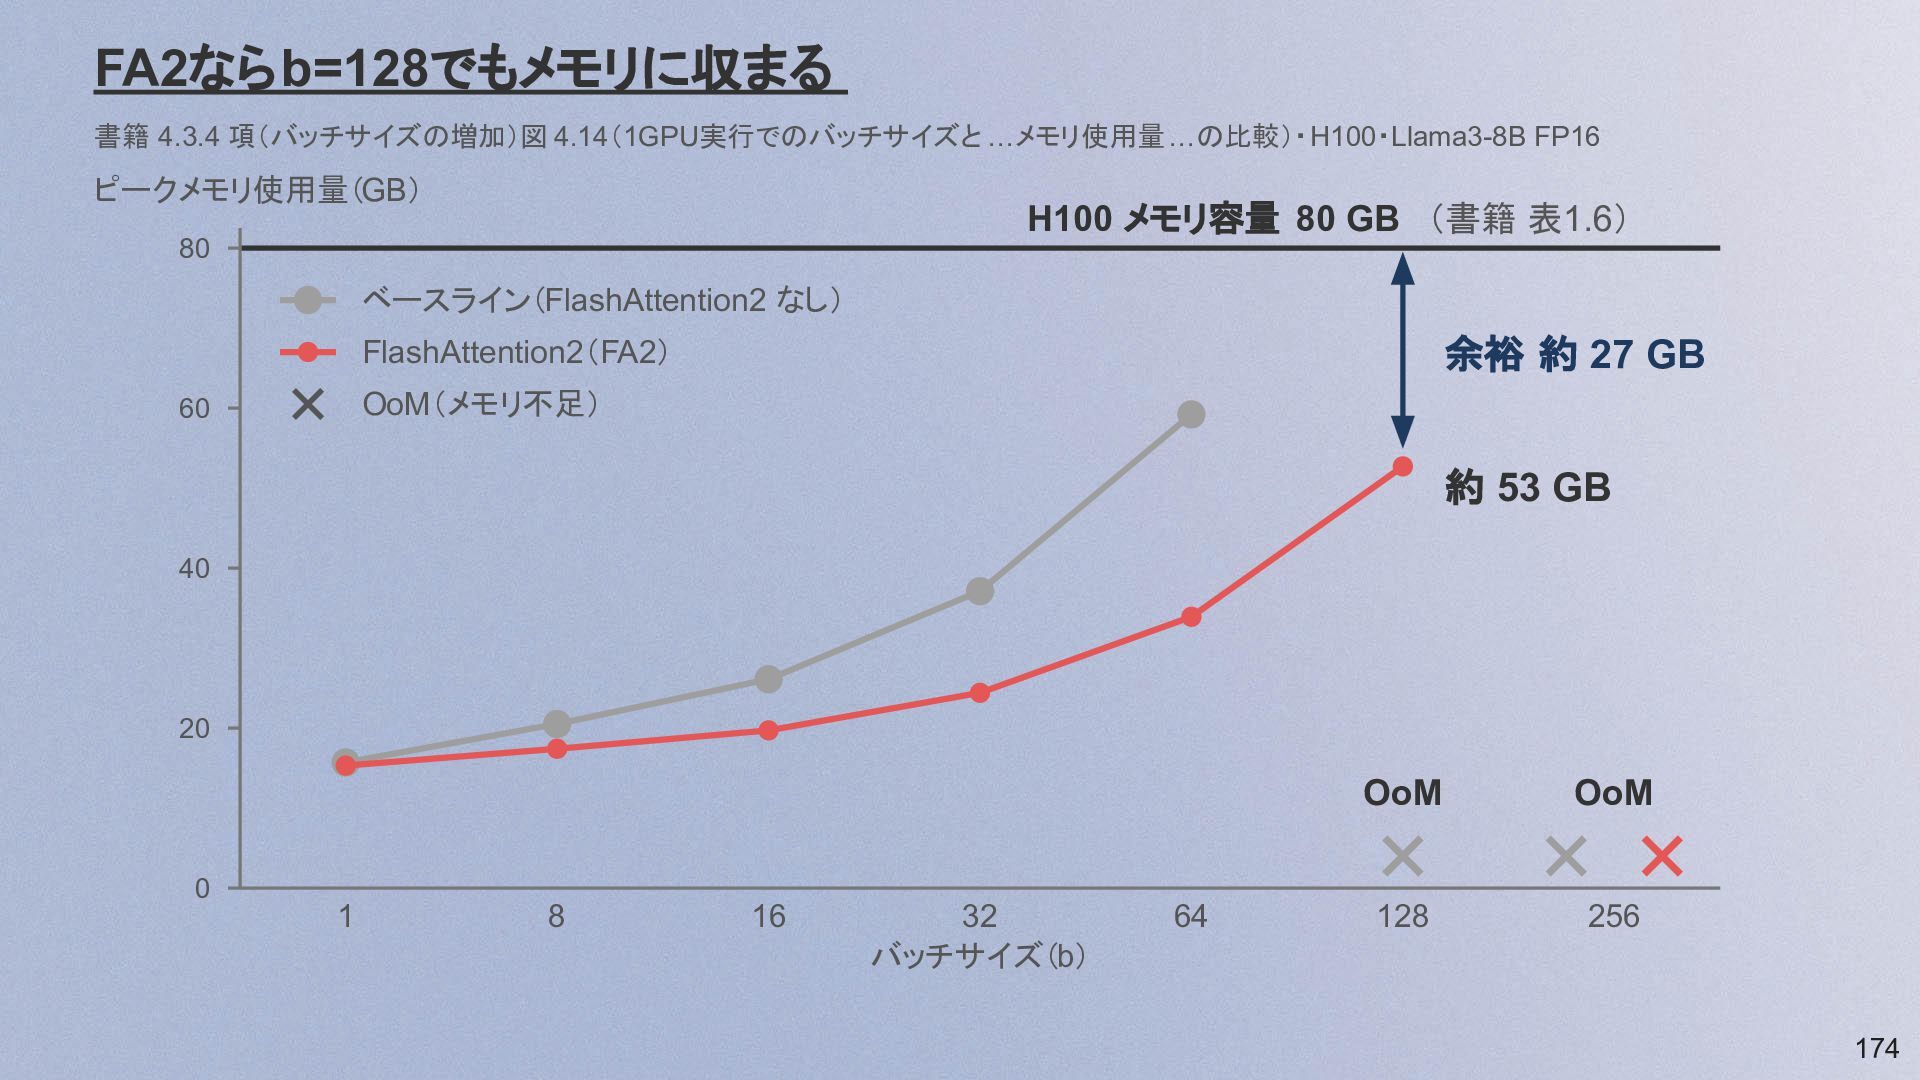
FA2ならb=128でもメモリに収まる 書籍 4.3.4 項(バッチサイズの増加)図 4.14(1GPU実行でのバッチサイズと …メモリ使用量…の比較)・H100・Llama3-8B FP16 ピークメモリ使用量(GB) H100 メモリ容量
80 GB (書籍 表1.6) 80 ベースライン(FlashAttention2 なし) 余裕 約 27 GB FlashAttention2(FA2) OoM(メモリ不足) 60 約 53 GB 40 20 0 1 8 16 32 バッチサイズ(b) 64 OoM OoM 128 256 174 -
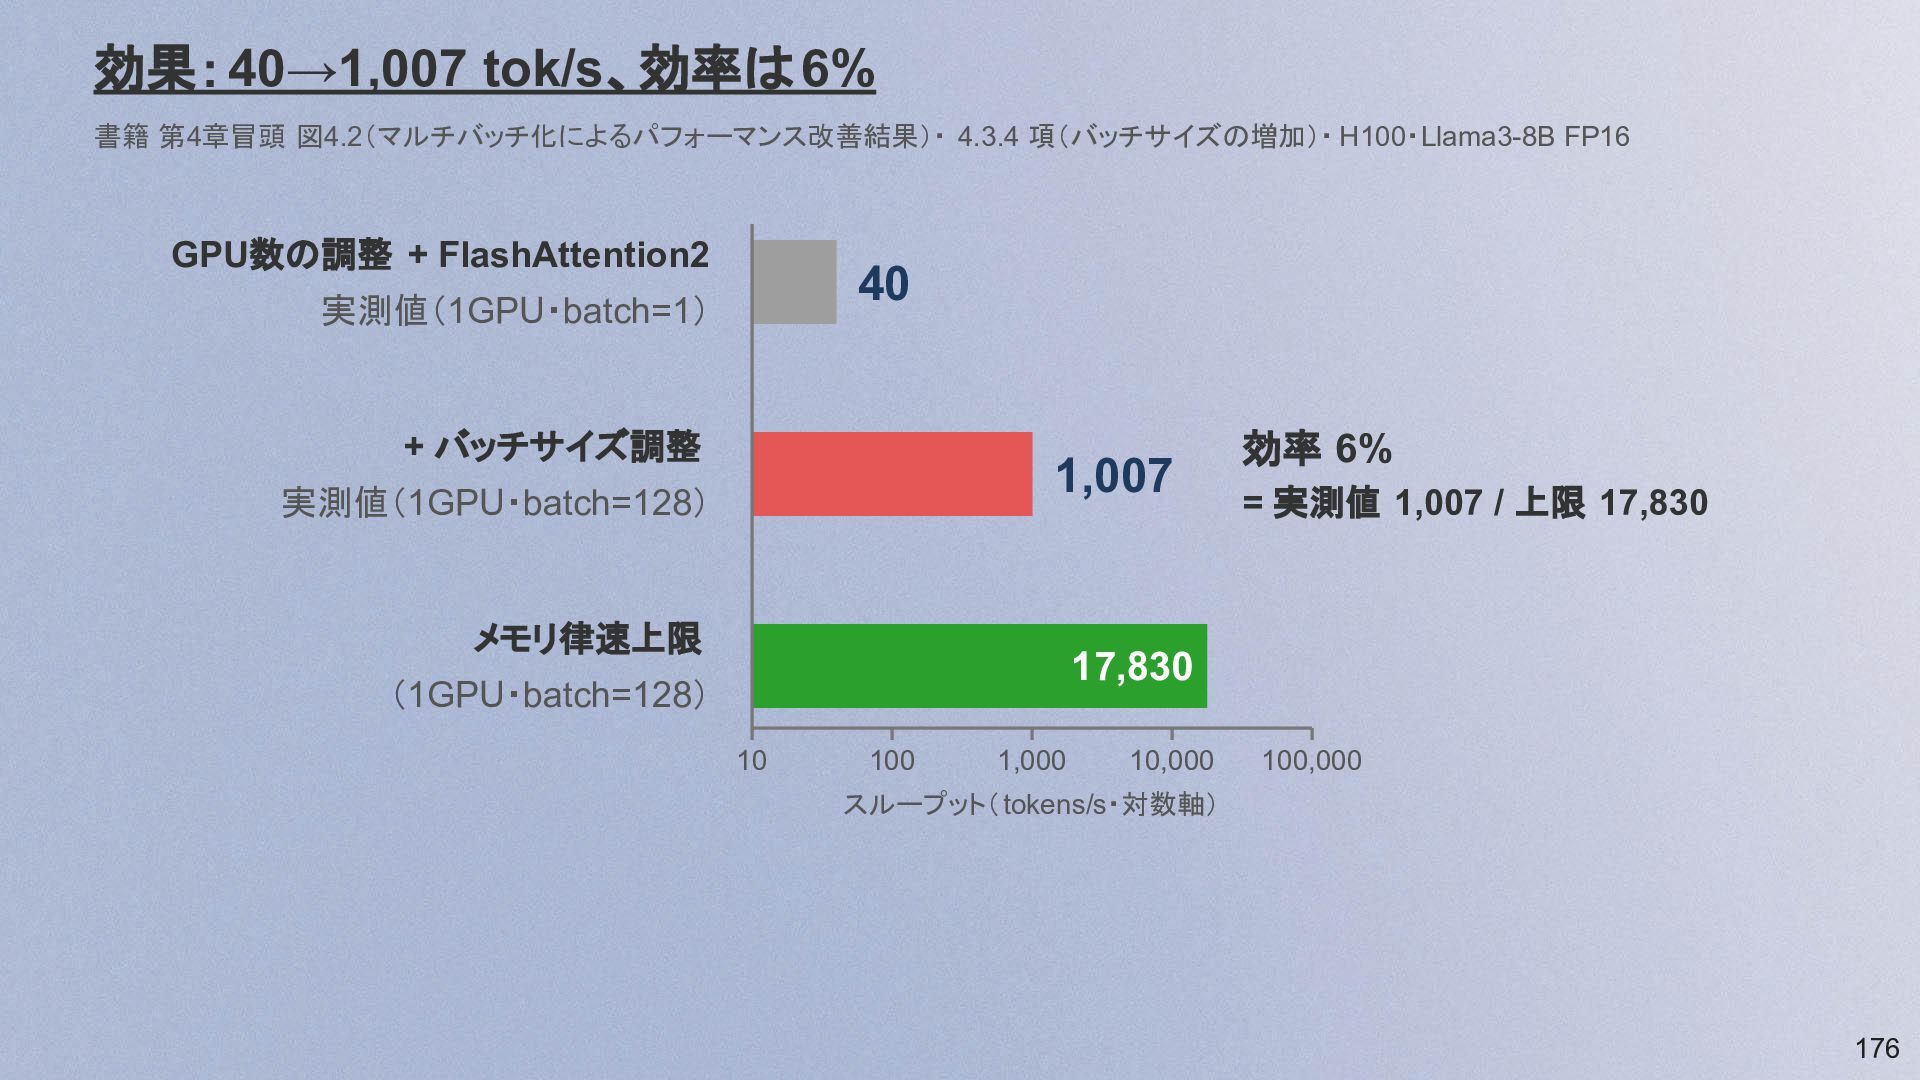
効果:40→1,007 tok/s、効率は 6% 書籍 第4章冒頭 図4.2(マルチバッチ化によるパフォーマンス改善結果)・ 4.3.4 項(バッチサイズの増加)・ H100・Llama3-8B FP16
GPU数の調整 + FlashAttention2 40 実測値(1GPU・batch=1) + バッチサイズ調整 1,007 実測値(1GPU・batch=128) メモリ律速上限 効率 6% = 実測値 1,007 / 上限 17,830 17,830 (1GPU・batch=128) 10 100 1,000 10,000 100,000 スループット( tokens/s・対数軸) 176 -
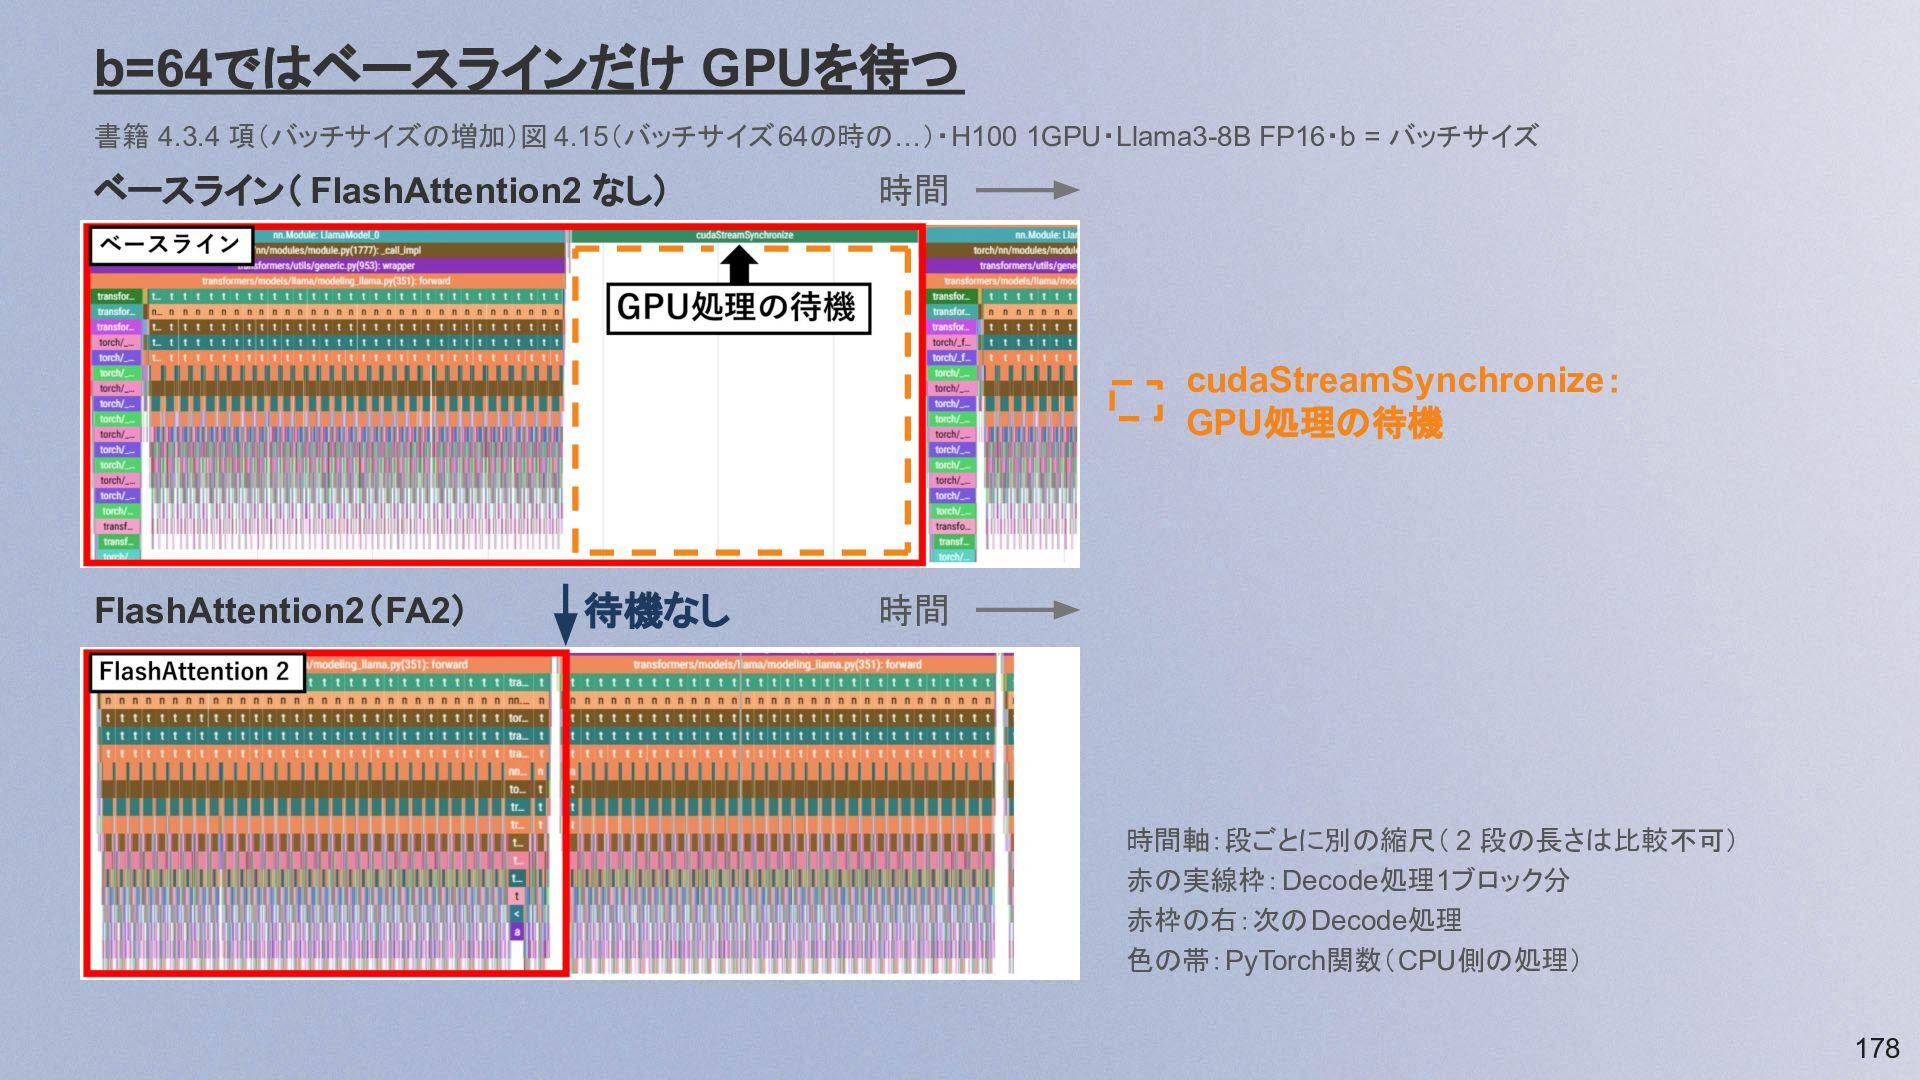
b=64ではベースラインだけ GPUを待つ 書籍 4.3.4 項(バッチサイズの増加)図 4.15(バッチサイズ 64の時の…)・H100 1GPU・Llama3-8B FP16・b =
バッチサイズ ベースライン( FlashAttention2 なし) 時間 cudaStreamSynchronize: GPU処理の待機 FlashAttention2(FA2) 待機なし 時間 時間軸:段ごとに別の縮尺( 2 段の長さは比較不可) 赤の実線枠:Decode処理1ブロック分 赤枠の右:次の Decode処理 色の帯:PyTorch関数(CPU側の処理) 178 -
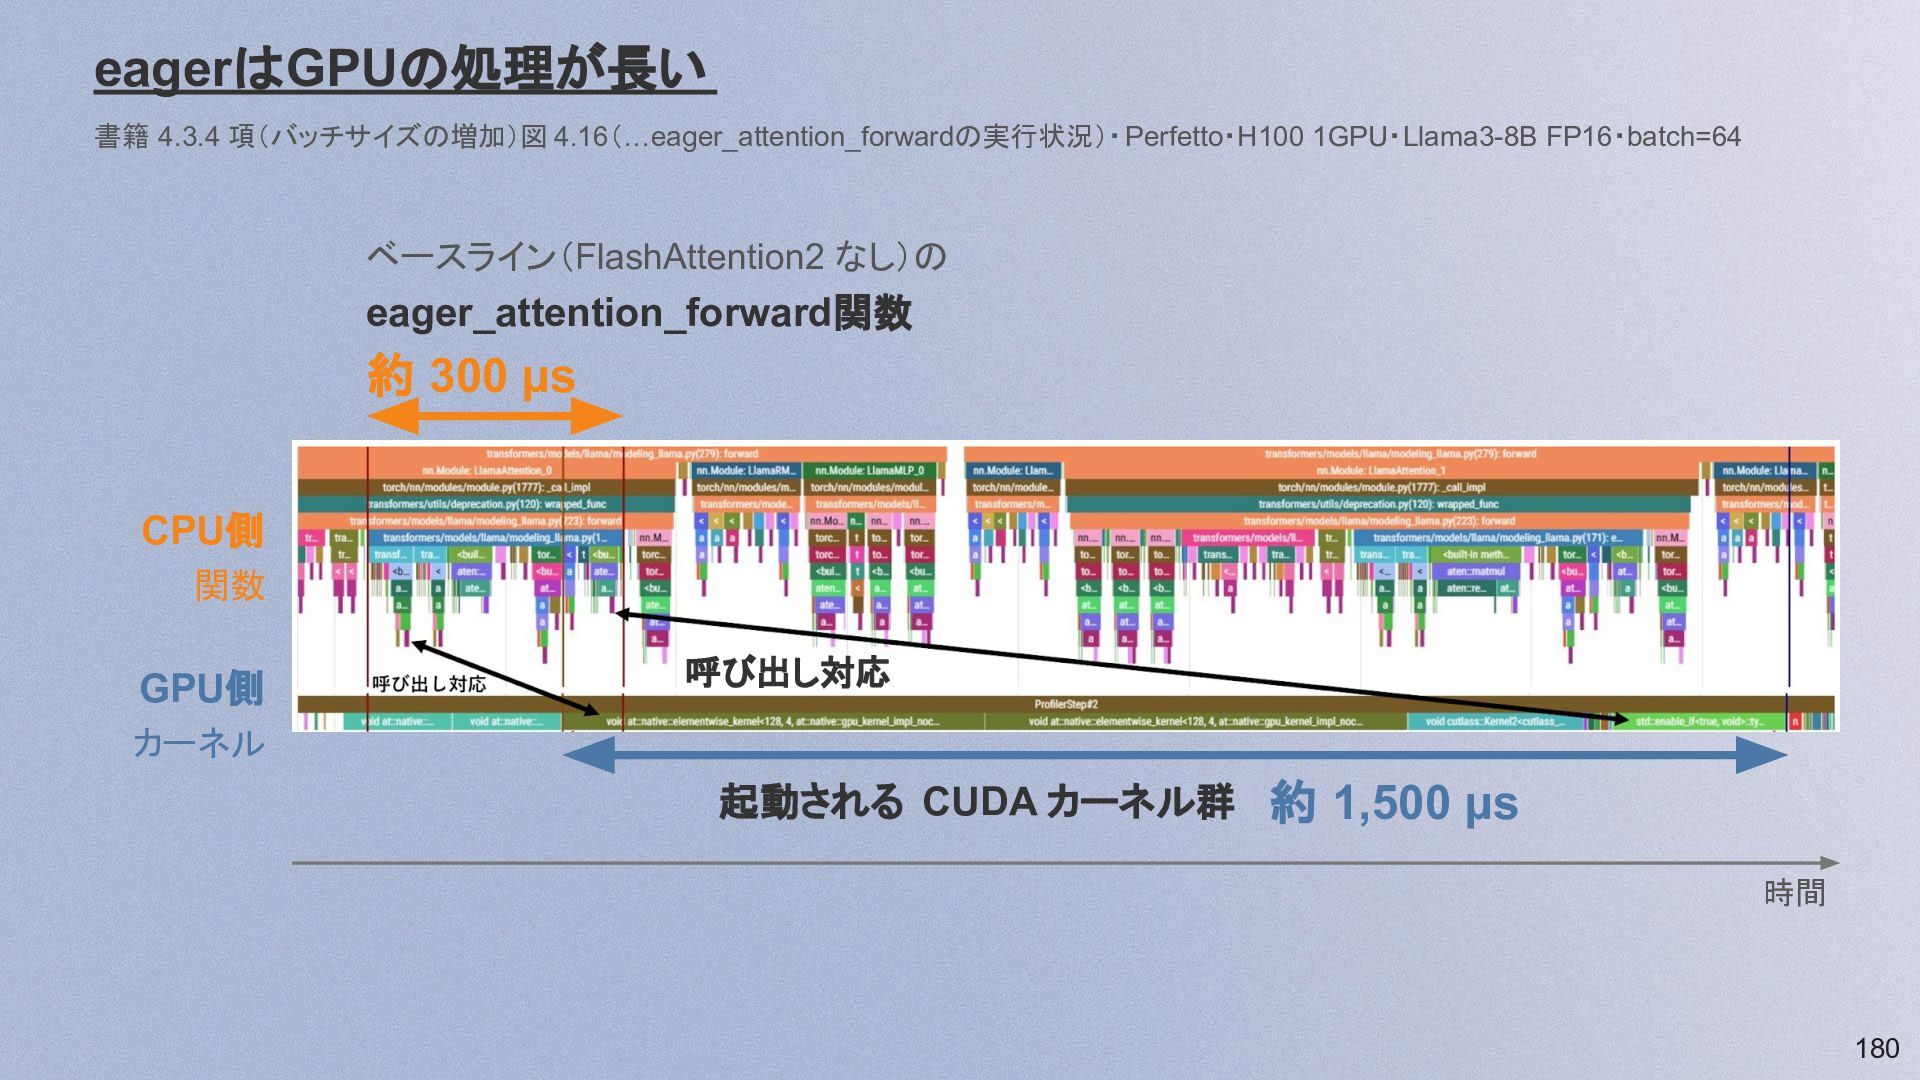
eagerはGPUの処理が長い 書籍 4.3.4 項(バッチサイズの増加)図 4.16(…eager_attention_forwardの実行状況)・ Perfetto・H100 1GPU・Llama3-8B FP16・batch=64 ベースライン(FlashAttention2 なし)の
eager_attention_forward関数 約 300 µs CPU側 関数 GPU側 呼び出し対応 カーネル 起動される CUDA カーネル群 約 1,500 µs 時間 180 -
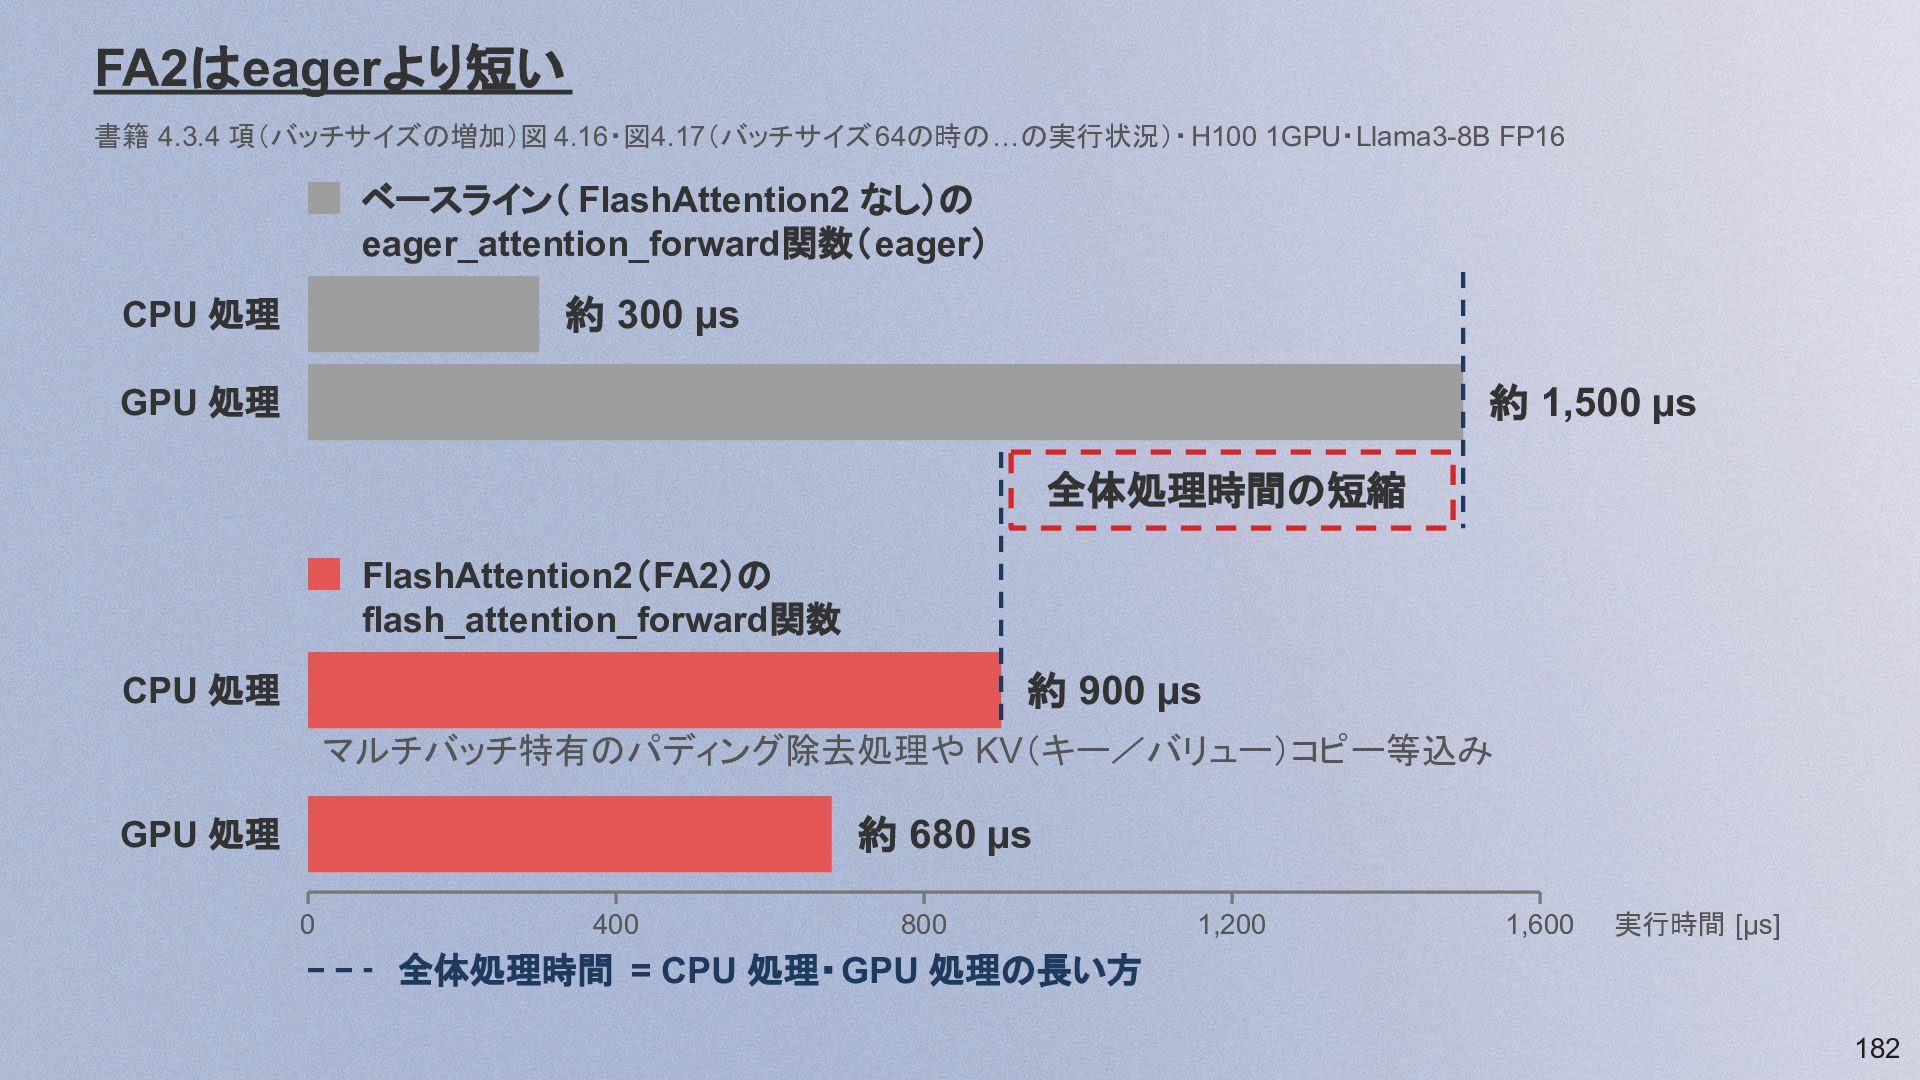
FA2はeagerより短い 書籍 4.3.4 項(バッチサイズの増加)図 4.16・図4.17(バッチサイズ 64の時の…の実行状況)・ H100 1GPU・Llama3-8B FP16 ベースライン(
FlashAttention2 なし)の eager_attention_forward関数(eager) 約 300 µs CPU 処理 約 1,500 µs GPU 処理 全体処理時間の短縮 FlashAttention2(FA2)の flash_attention_forward関数 約 900 µs CPU 処理 マルチバッチ特有のパディング除去処理や KV(キー/バリュー)コピー等込み 約 680 µs GPU 処理 0 400 800 1,200 1,600 実行時間 [µs] 全体処理時間 = CPU 処理・GPU 処理の長い方 182 -
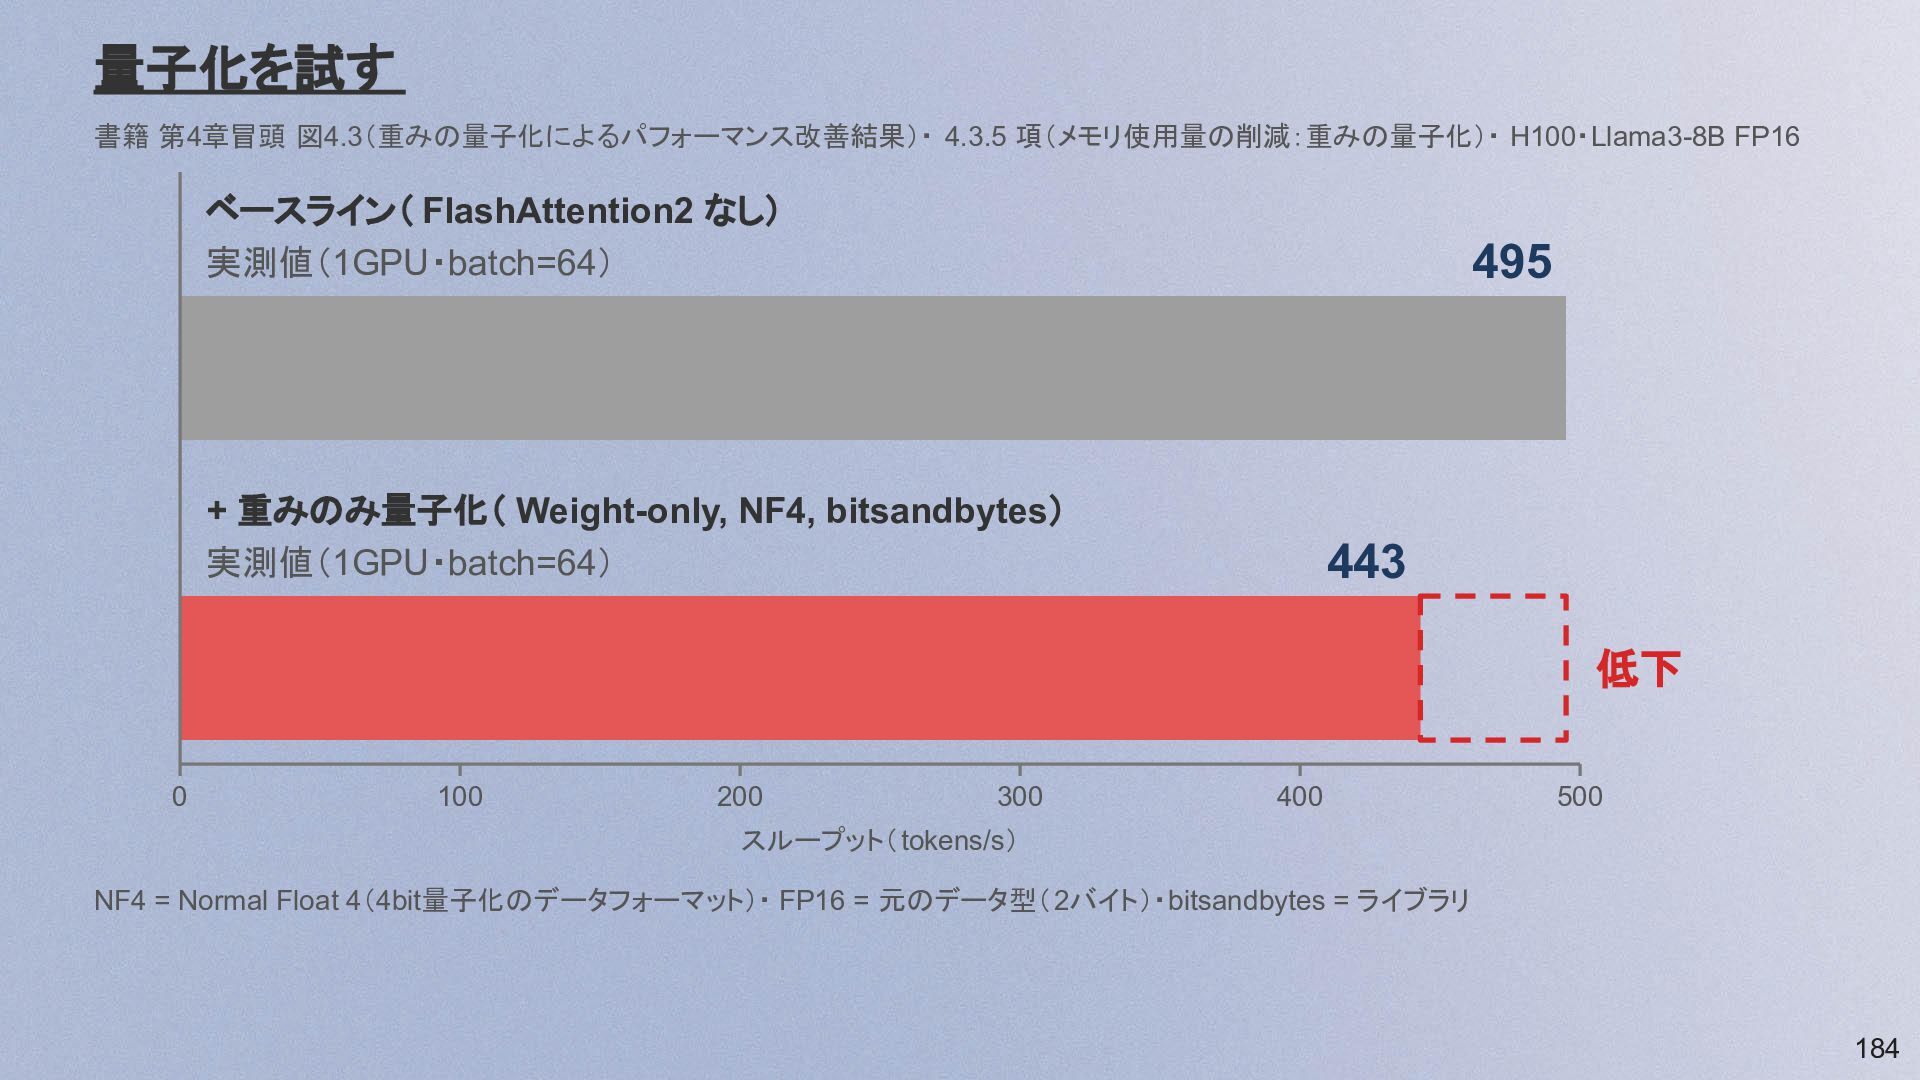
量子化を試す 書籍 第4章冒頭 図4.3(重みの量子化によるパフォーマンス改善結果)・ 4.3.5 項(メモリ使用量の削減:重みの量子化)・ H100・Llama3-8B FP16 ベースライン( FlashAttention2
なし) 実測値(1GPU・batch=64) 495 + 重みのみ量子化( Weight-only, NF4, bitsandbytes) 実測値(1GPU・batch=64) 443 低下 0 100 200 300 400 500 スループット( tokens/s) NF4 = Normal Float 4(4bit量子化のデータフォーマット)・ FP16 = 元のデータ型( 2バイト)・bitsandbytes = ライブラリ 184 -
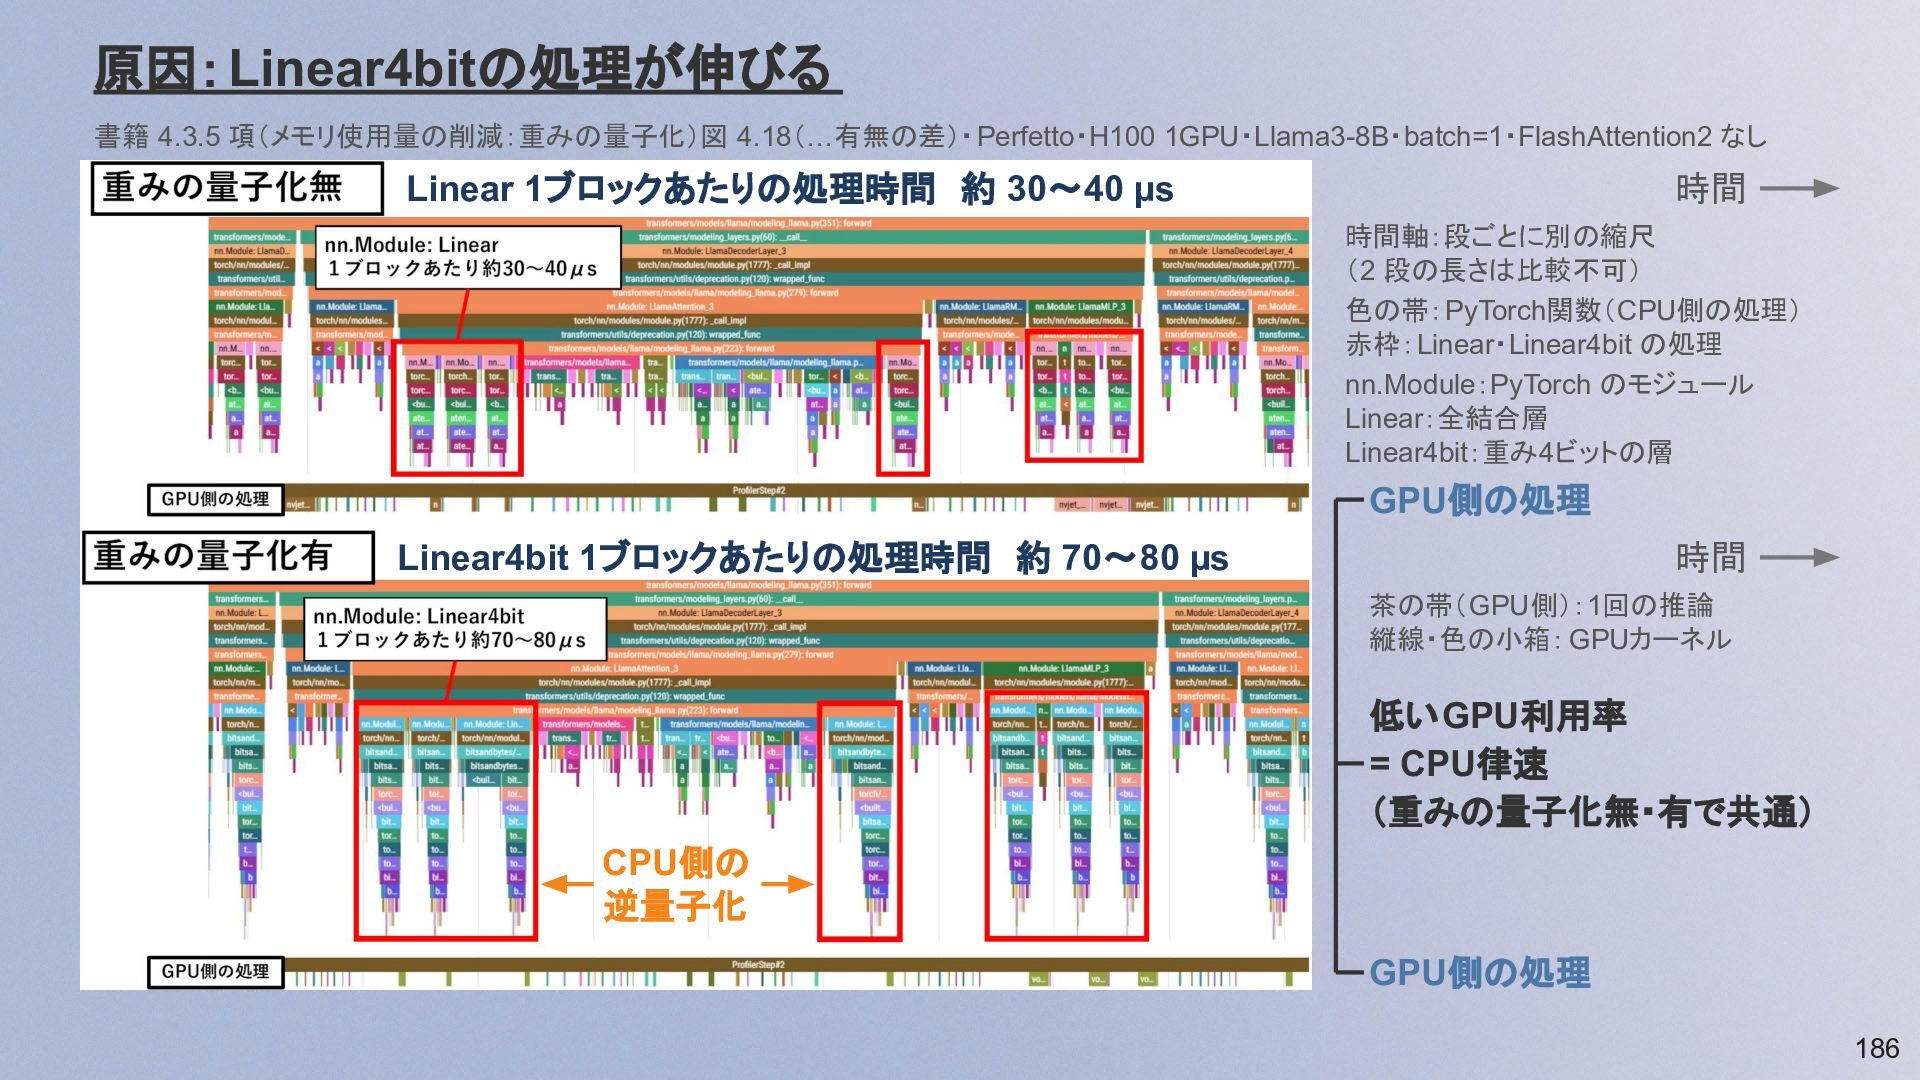
原因:Linear4bitの処理が伸びる 書籍 4.3.5 項(メモリ使用量の削減:重みの量子化)図 4.18(…有無の差)・Perfetto・H100 1GPU・Llama3-8B・batch=1・FlashAttention2 なし Linear 1ブロックあたりの処理時間 約
30〜40 µs 時間 時間軸:段ごとに別の縮尺 (2 段の長さは比較不可) 色の帯:PyTorch関数(CPU側の処理) 赤枠:Linear・Linear4bit の処理 nn.Module:PyTorch のモジュール Linear:全結合層 Linear4bit:重み4ビットの層 GPU側の処理 Linear4bit 1ブロックあたりの処理時間 約 70〜80 µs 時間 茶の帯(GPU側):1回の推論 縦線・色の小箱: GPUカーネル 低いGPU利用率 = CPU律速 (重みの量子化無・有で共通) CPU側の 逆量子化 GPU側の処理 186 -
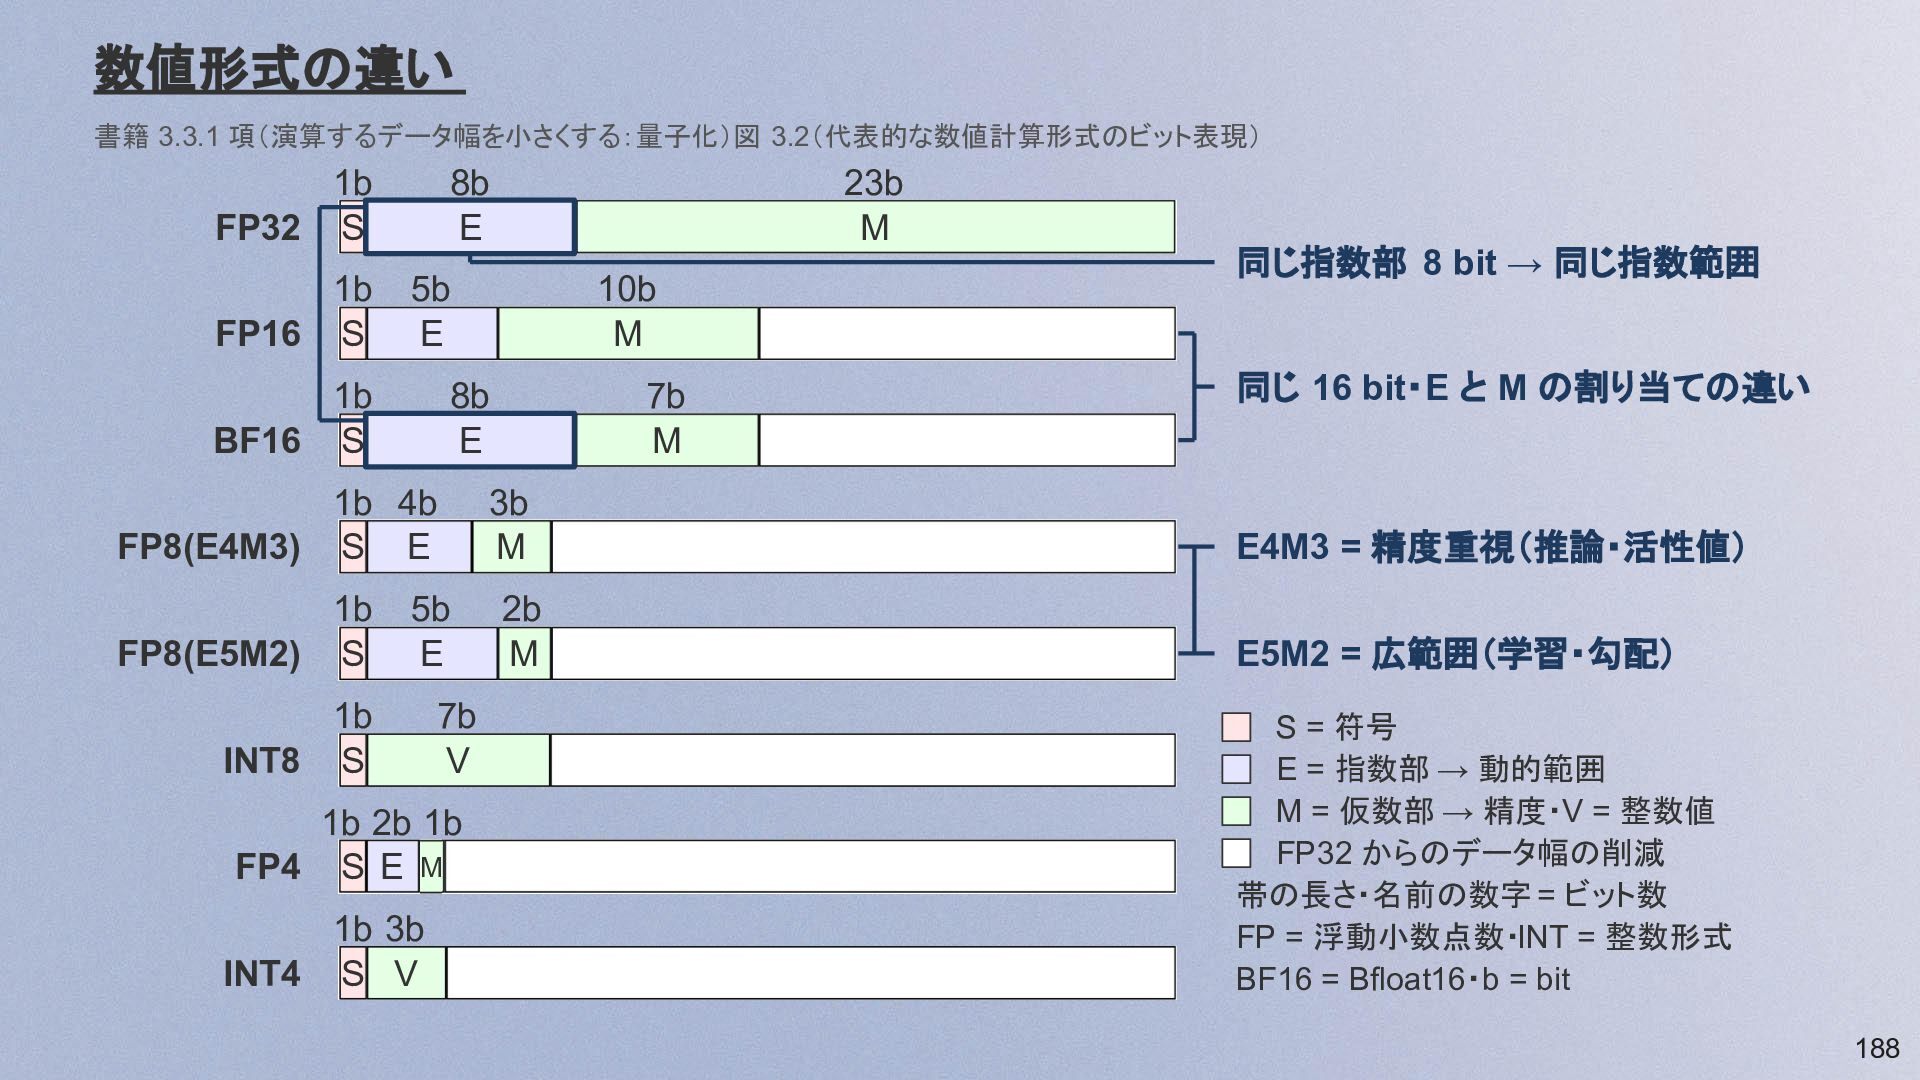
数値形式の違い 書籍 3.3.1 項(演算するデータ幅を小さくする:量子化)図 3.2(代表的な数値計算形式のビット表現) 1b FP32 S 1b FP16
S 8b E 23b M 5b E 1b BF16 S 10b M 8b E 7b M 同じ指数部 8 bit → 同じ指数範囲 同じ 16 bit・E と M の割り当ての違い 1b 4b FP8(E4M3) S E 3b M E4M3 = 精度重視(推論・活性値) 1b FP8(E5M2) S 2b M E5M2 = 広範囲(学習・勾配) 5b E 1b INT8 S 7b V 1b 2b 1b FP4 S E M 1b 3b INT4 S V S = 符号 E = 指数部 → 動的範囲 M = 仮数部 → 精度・V = 整数値 FP32 からのデータ幅の削減 帯の長さ・名前の数字 = ビット数 FP = 浮動小数点数・INT = 整数形式 BF16 = Bfloat16・b = bit 188 -
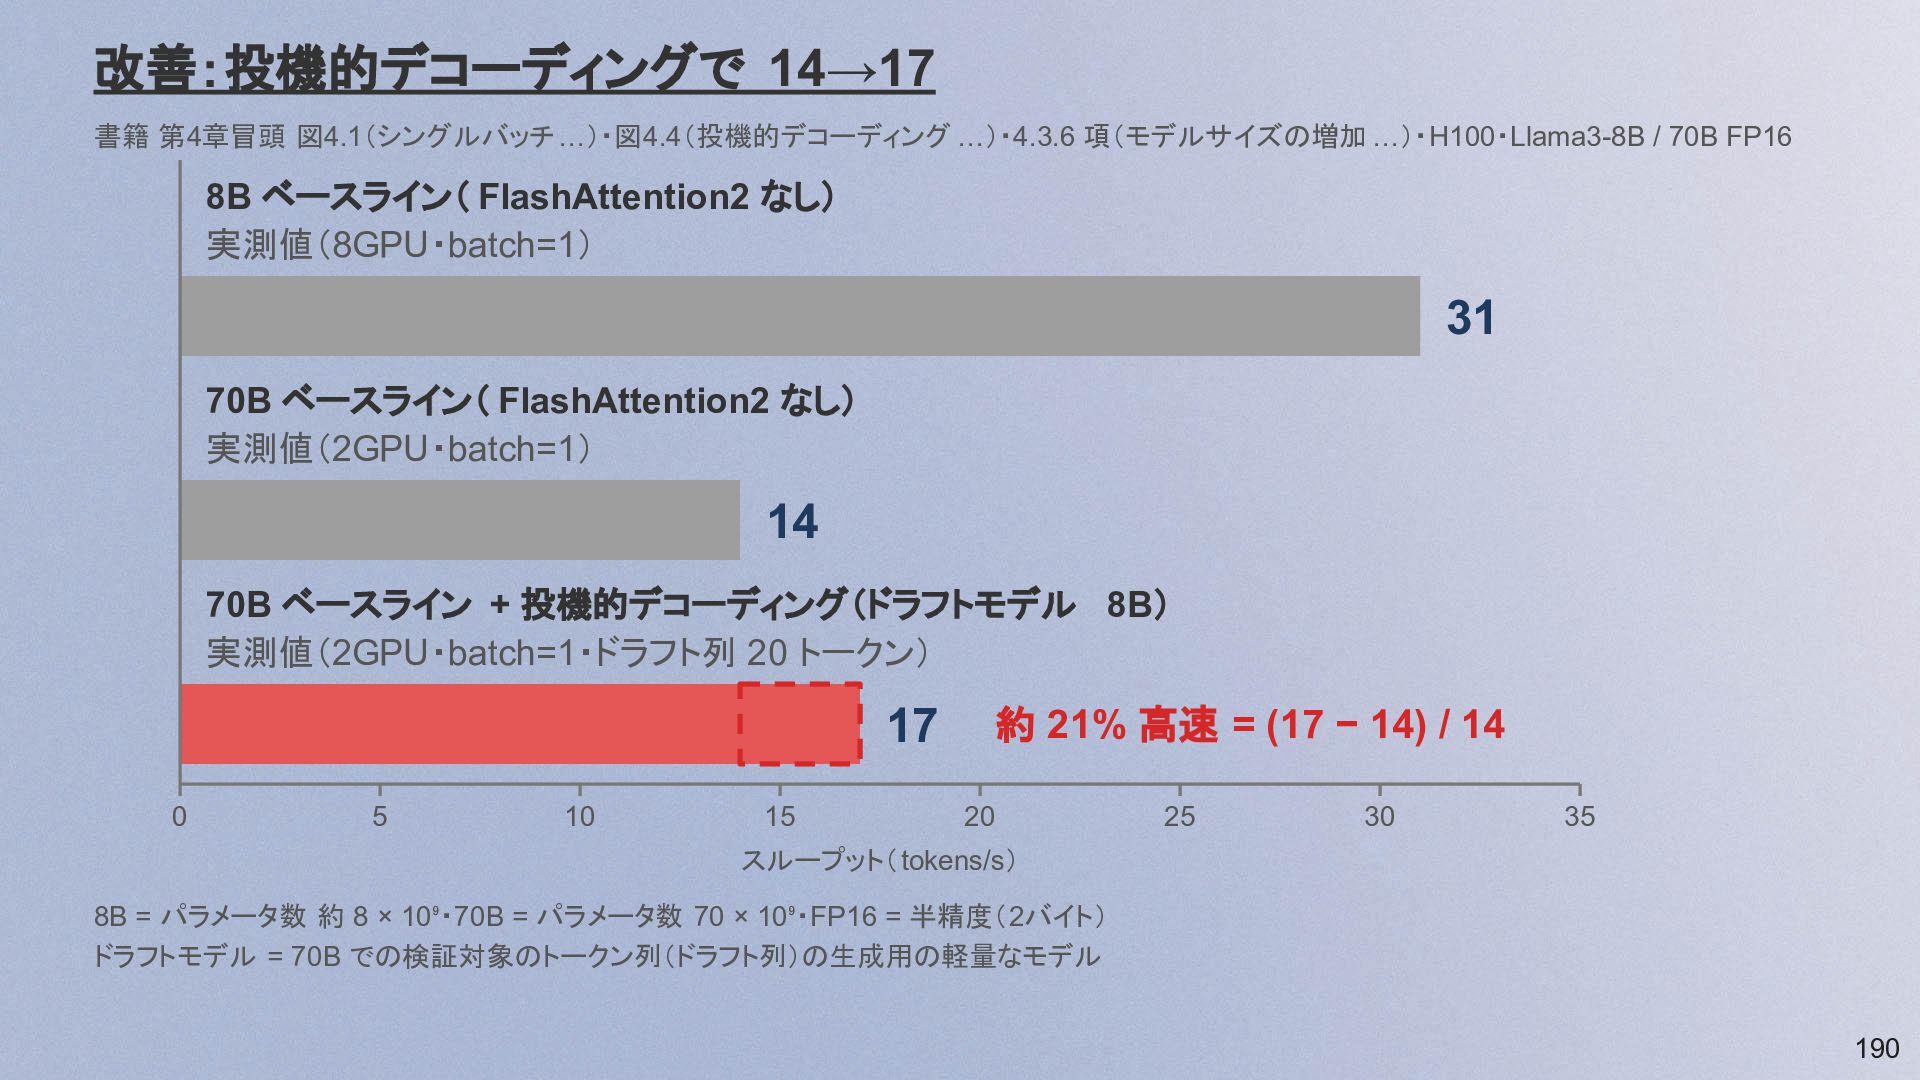
改善:投機的デコーディングで 14→17 書籍 第4章冒頭 図4.1(シングルバッチ …)・図4.4(投機的デコーディング …)・4.3.6 項(モデルサイズの増加 …)・H100・Llama3-8B /
70B FP16 8B ベースライン( FlashAttention2 なし) 実測値(8GPU・batch=1) 31 70B ベースライン( FlashAttention2 なし) 実測値(2GPU・batch=1) 14 70B ベースライン + 投機的デコーディング(ドラフトモデル 8B) 実測値(2GPU・batch=1・ドラフト列 20 トークン) 17 0 5 10 15 約 21% 高速 = (17 − 14) / 14 20 25 30 35 スループット( tokens/s) 8B = パラメータ数 約 8 × 10⁹・70B = パラメータ数 70 × 10⁹・FP16 = 半精度(2バイト) ドラフトモデル = 70B での検証対象のトークン列(ドラフト列)の生成用の軽量なモデル 190 -
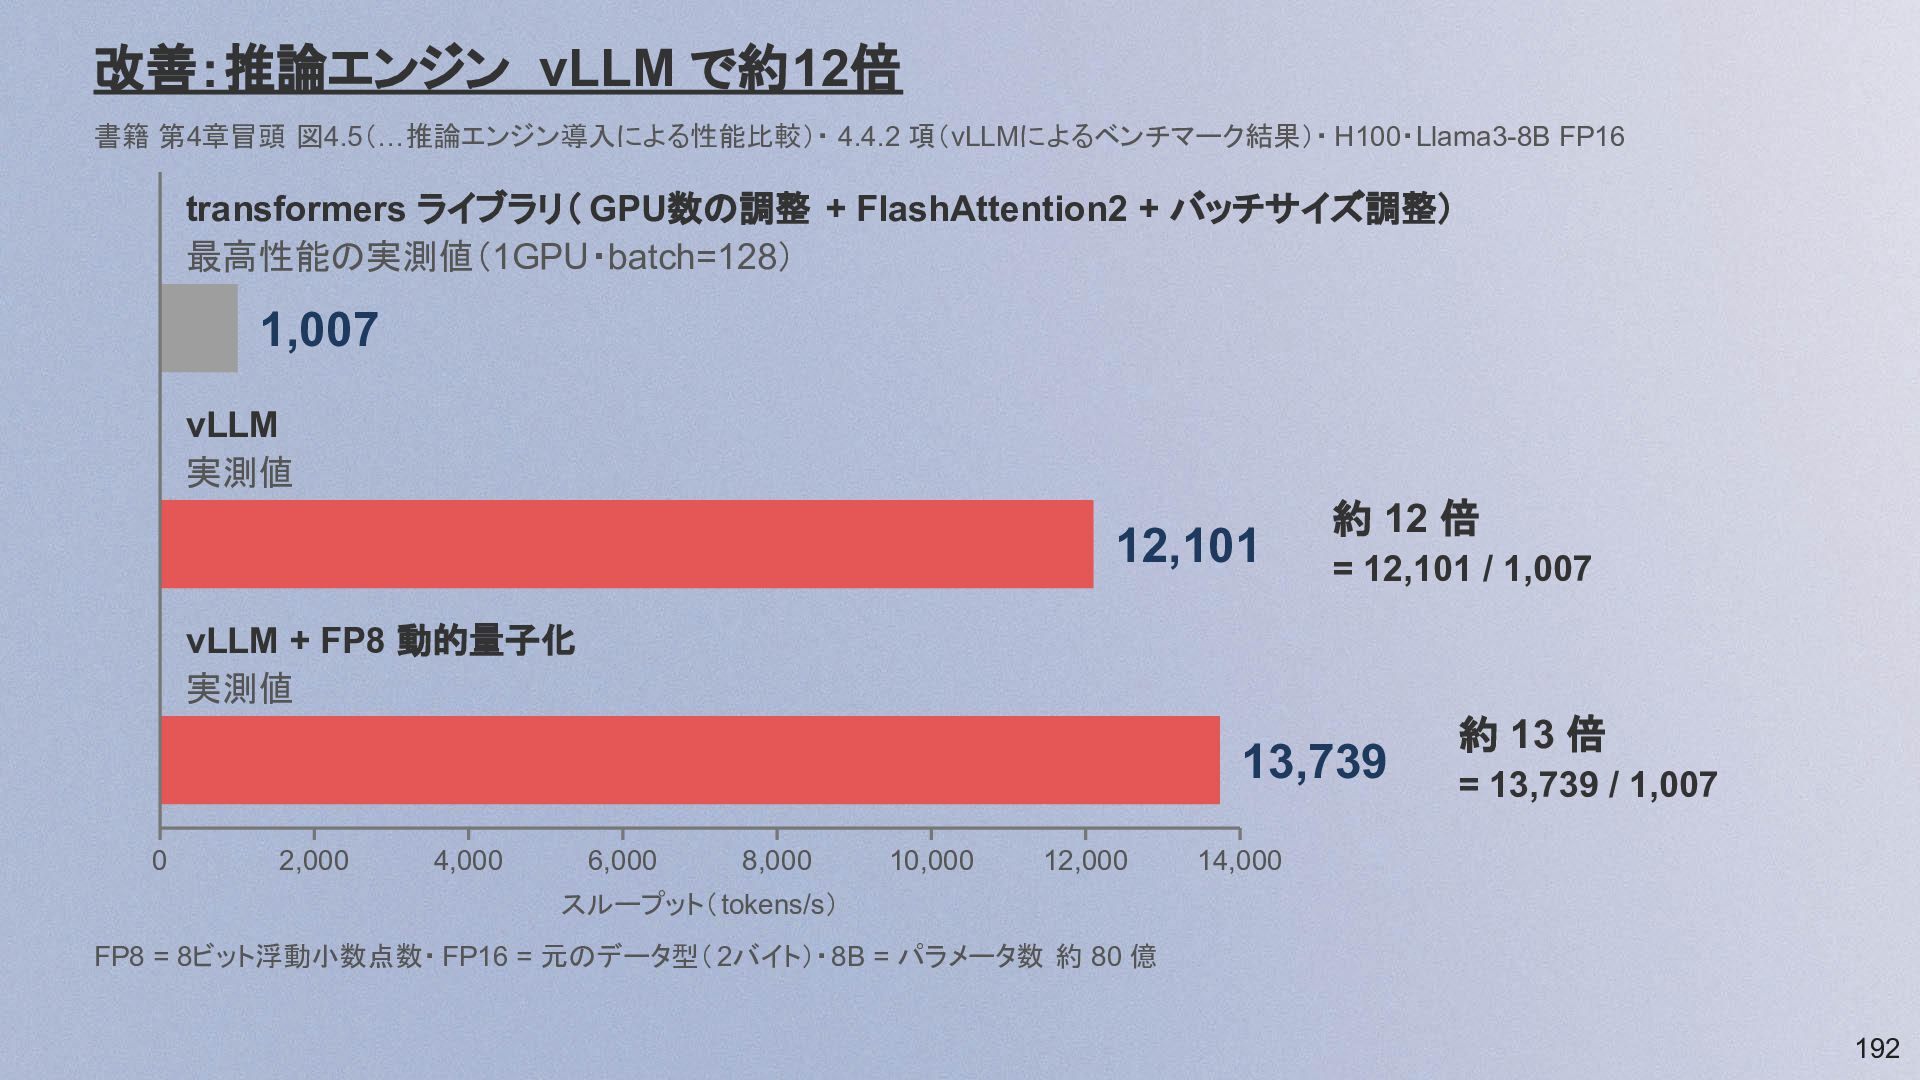
改善:推論エンジン vLLM で約12倍 書籍 第4章冒頭 図4.5(…推論エンジン導入による性能比較)・ 4.4.2 項(vLLMによるベンチマーク結果)・ H100・Llama3-8B FP16
transformers ライブラリ( GPU数の調整 + FlashAttention2 + バッチサイズ調整) 最高性能の実測値(1GPU・batch=128) 1,007 vLLM 実測値 12,101 約 12 倍 = 12,101 / 1,007 vLLM + FP8 動的量子化 実測値 13,739 0 2,000 4,000 6,000 8,000 10,000 12,000 約 13 倍 = 13,739 / 1,007 14,000 スループット( tokens/s) FP8 = 8ビット浮動小数点数・ FP16 = 元のデータ型( 2バイト)・8B = パラメータ数 約 80 億 192 -
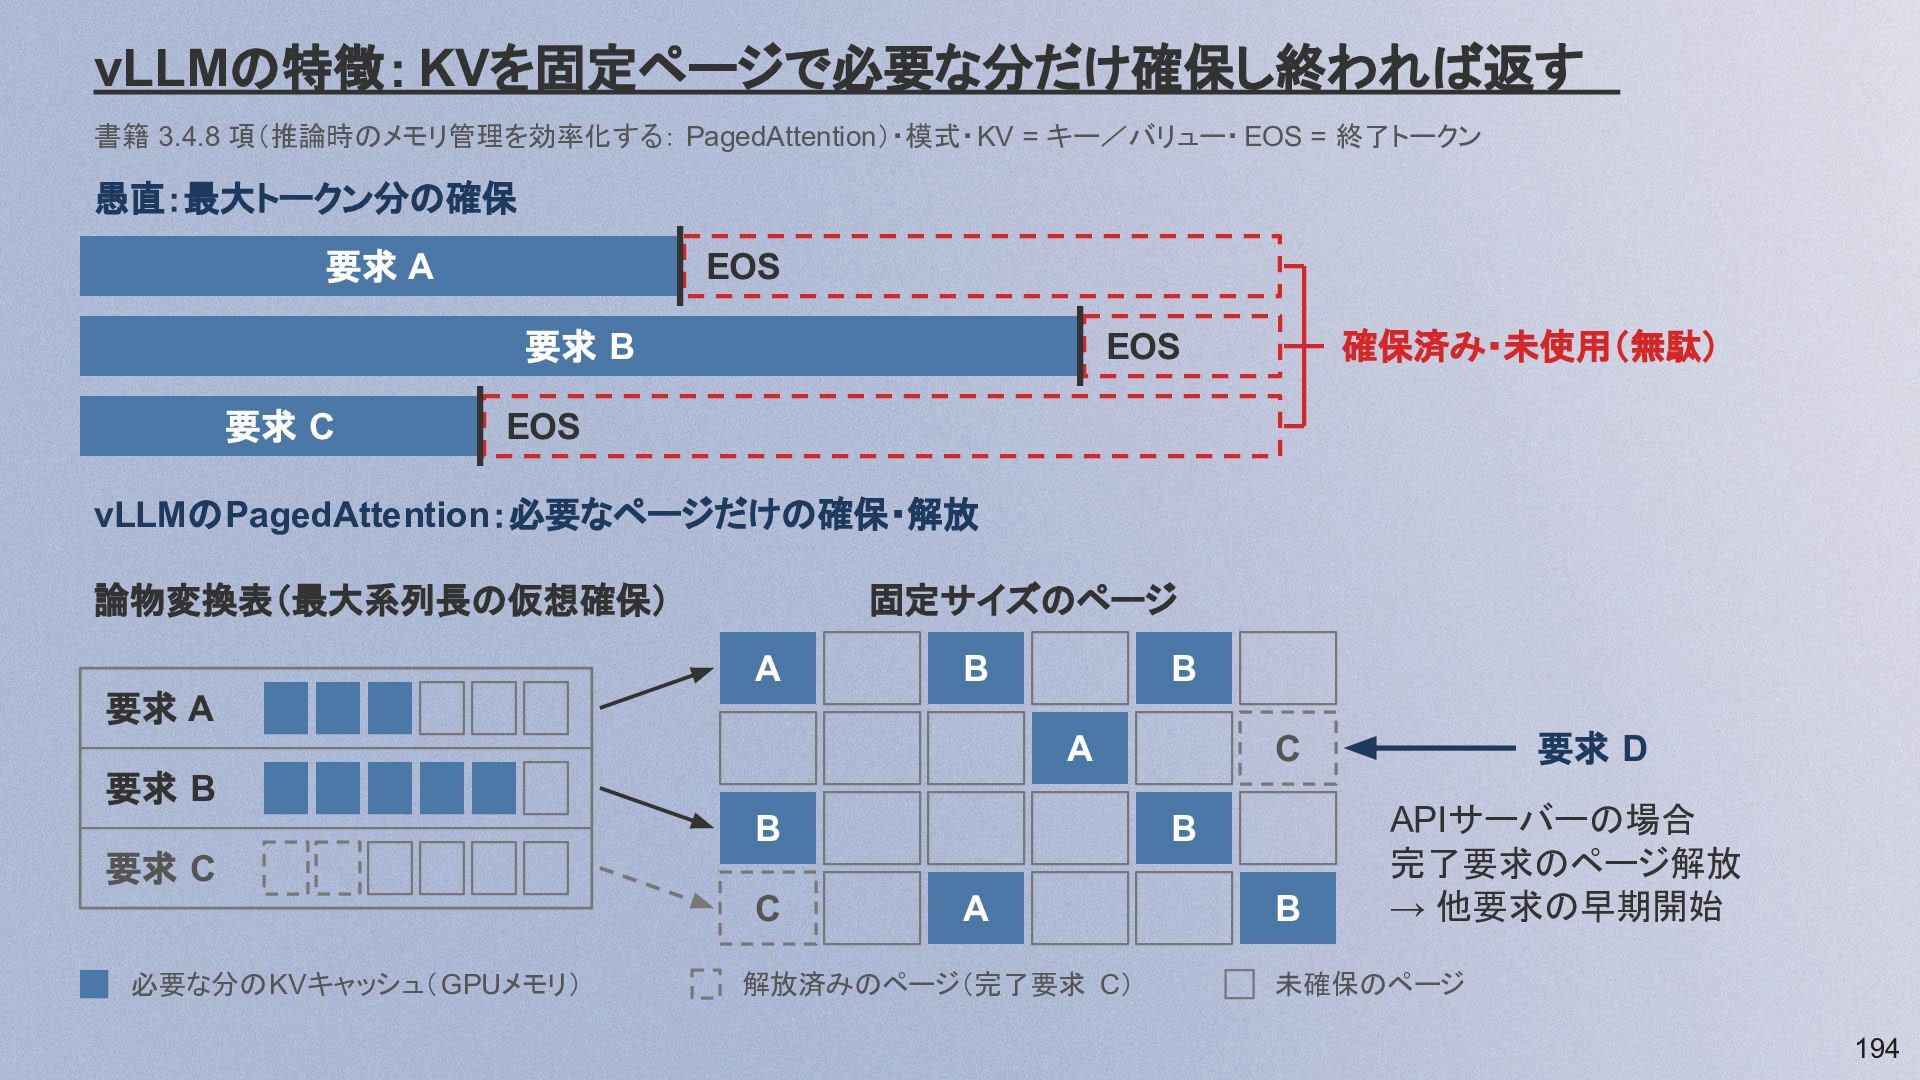
vLLMの特徴: KVを固定ページで必要な分だけ確保し終われば返す 書籍 3.4.8 項(推論時のメモリ管理を効率化する: PagedAttention)・模式・KV = キー/バリュー・ EOS =
終了トークン 愚直:最大トークン分の確保 要求 A EOS 要求 B 要求 C 確保済み・未使用(無駄) EOS EOS vLLMのPagedAttention:必要なページだけの確保・解放 論物変換表(最大系列長の仮想確保) 固定サイズのページ A B B 要求 A A 要求 B B B 要求 C C 必要な分のKVキャッシュ(GPUメモリ) A 解放済みのページ(完了要求 C) 要求 D C B APIサーバーの場合 完了要求のページ解放 → 他要求の早期開始 未確保のページ 194 -
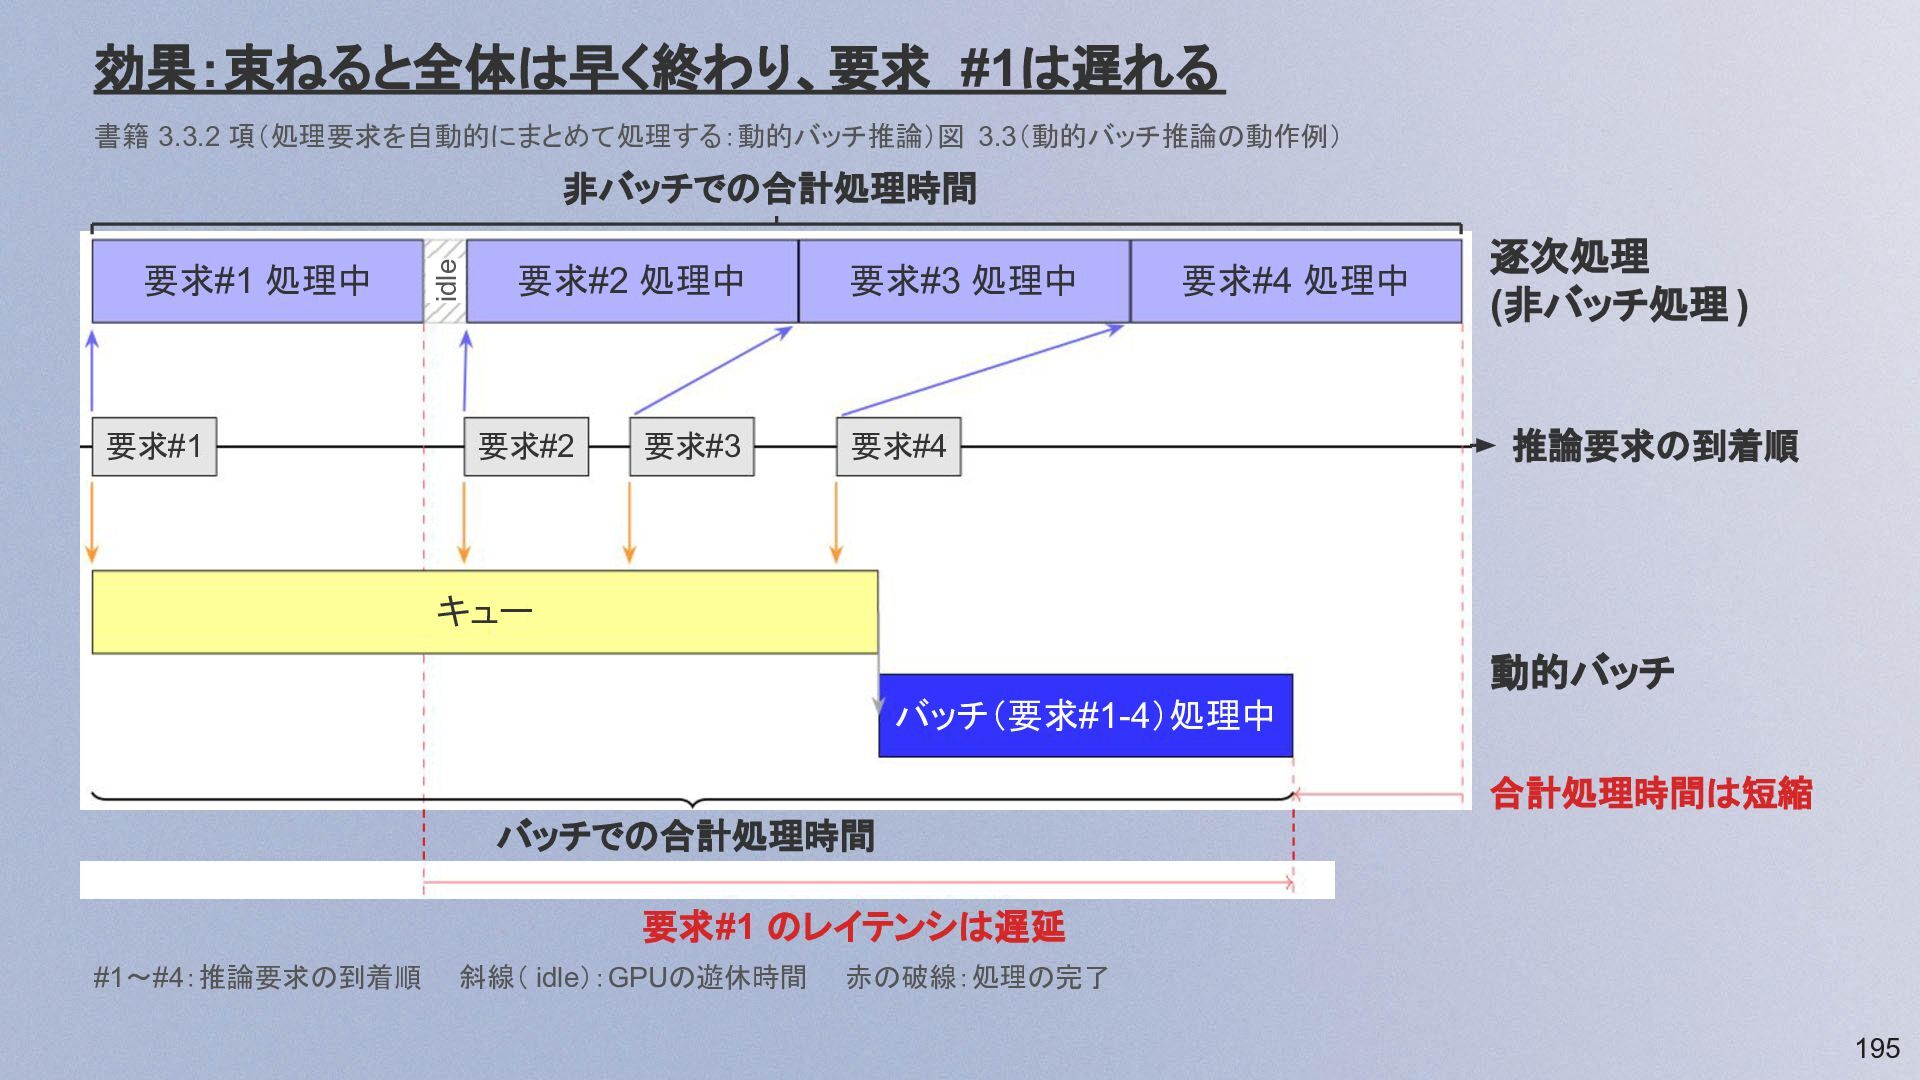
効果:束ねると全体は早く終わり、要求 #1は遅れる 書籍 3.3.2 項(処理要求を自動的にまとめて処理する:動的バッチ推論)図 3.3(動的バッチ推論の動作例) 要求#1 処理中 要求#1 idle
非バッチでの合計処理時間 要求#2 処理中 要求#2 要求#3 要求#3 処理中 要求#4 処理中 要求#4 逐次処理 (非バッチ処理 ) 推論要求の到着順 キュー 動的バッチ バッチ(要求#1-4)処理中 合計処理時間は短縮 バッチでの合計処理時間 要求#1 のレイテンシは遅延 #1〜#4:推論要求の到着順 斜線( idle):GPUの遊休時間 赤の破線:処理の完了 195 -
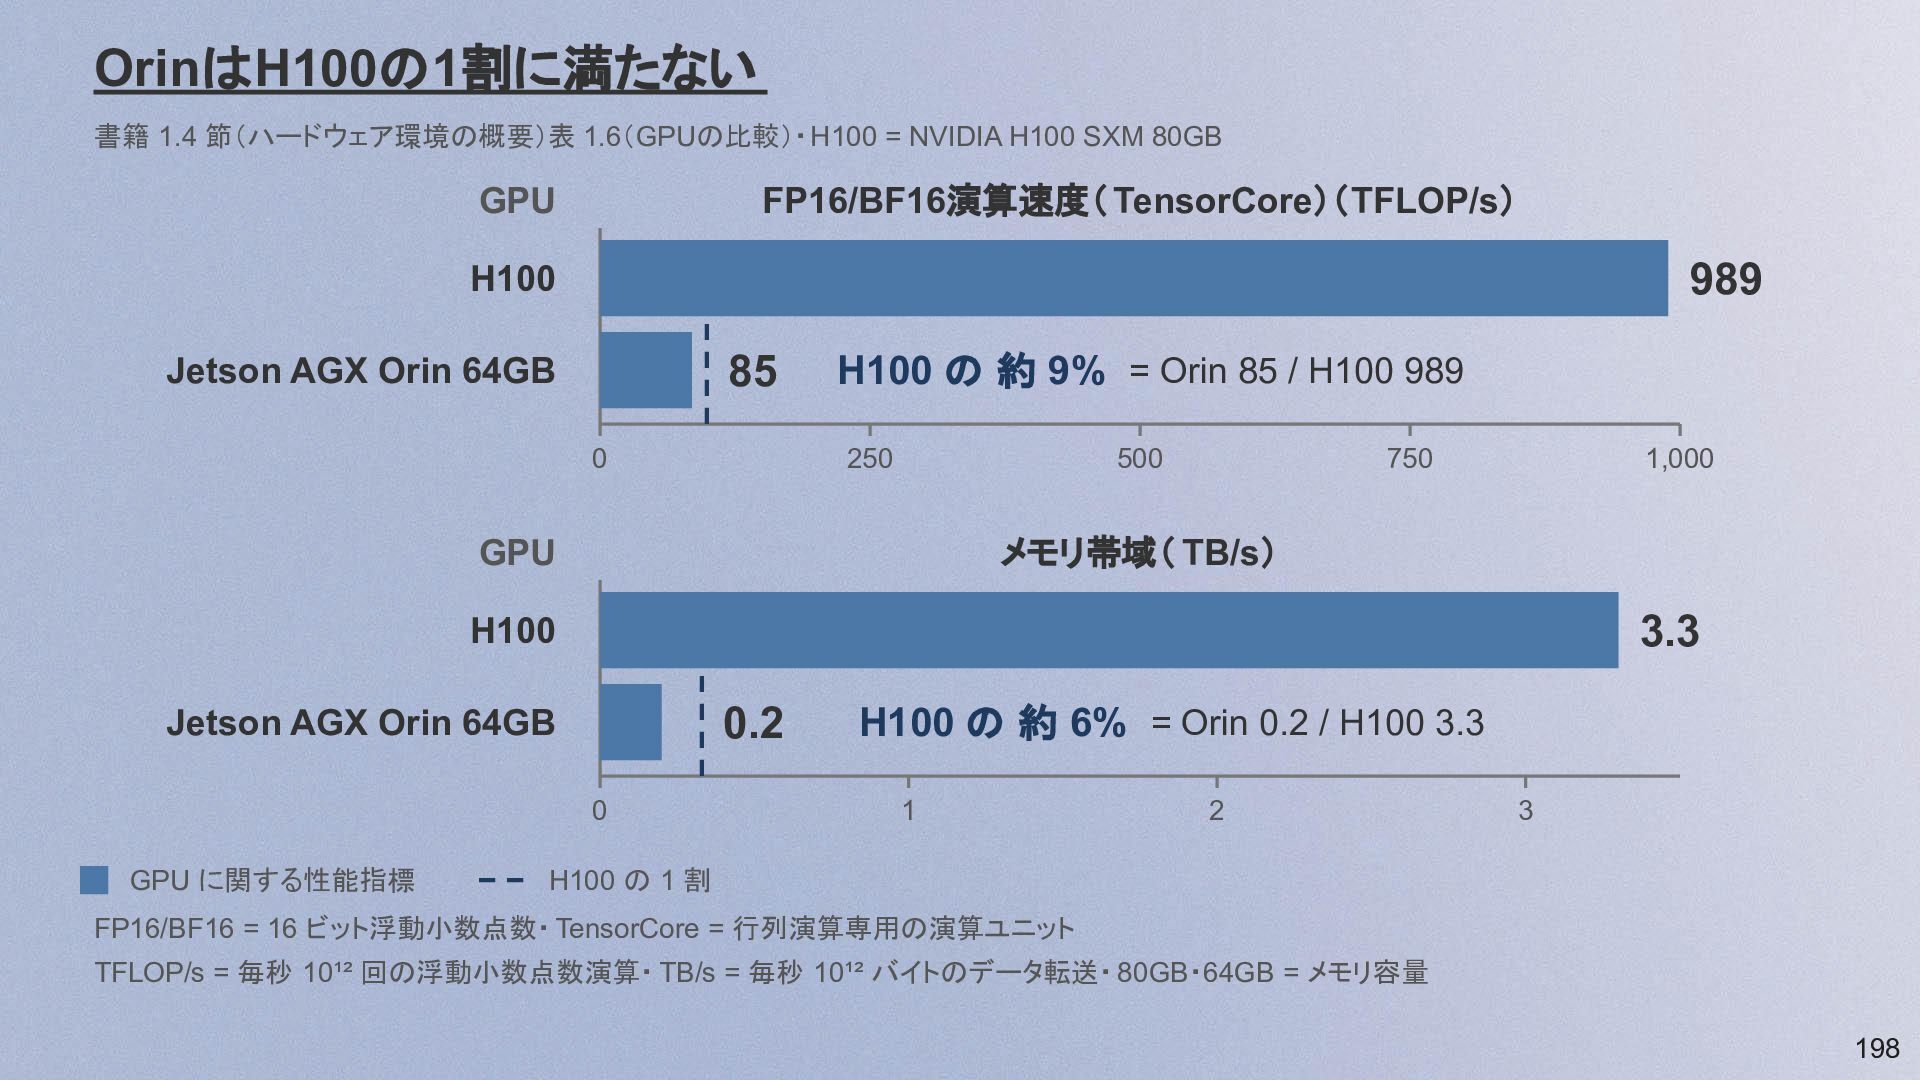
OrinはH100の1割に満たない 書籍 1.4 節(ハードウェア環境の概要)表 1.6(GPUの比較)・H100 = NVIDIA H100 SXM 80GB
GPU FP16/BF16演算速度( TensorCore)(TFLOP/s) 989 H100 85 Jetson AGX Orin 64GB 0 H100 の 約 9% = Orin 85 / H100 989 250 500 750 1,000 メモリ帯域( TB/s) GPU 3.3 H100 0.2 Jetson AGX Orin 64GB 0 GPU に関する性能指標 H100 の 約 6% = Orin 0.2 / H100 3.3 1 2 3 H100 の 1 割 FP16/BF16 = 16 ビット浮動小数点数・ TensorCore = 行列演算専用の演算ユニット TFLOP/s = 毎秒 10¹² 回の浮動小数点数演算・ TB/s = 毎秒 10¹² バイトのデータ転送・ 80GB・64GB = メモリ容量 198 -
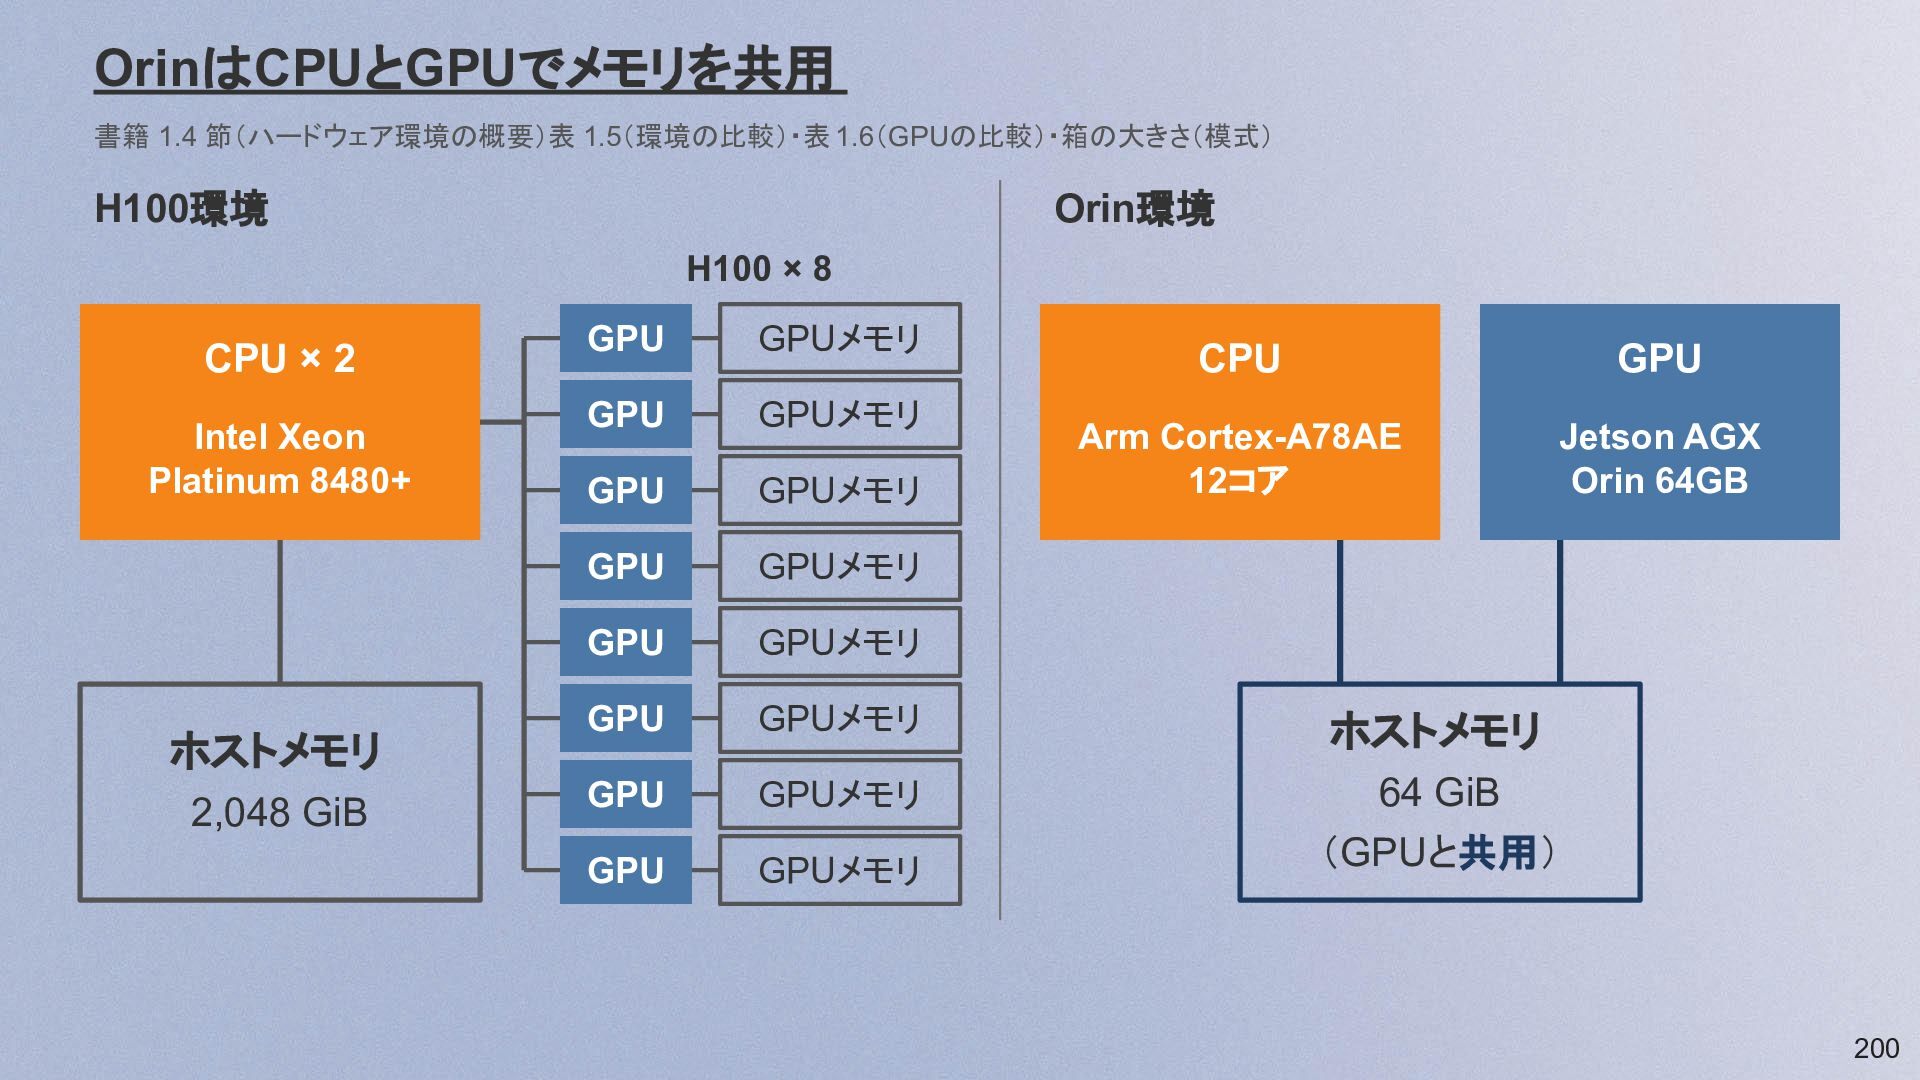
OrinはCPUとGPUでメモリを共用 書籍 1.4 節(ハードウェア環境の概要)表 1.5(環境の比較)・表 1.6(GPUの比較)・箱の大きさ(模式) H100環境 Orin環境 H100 ×
8 CPU × 2 Intel Xeon Platinum 8480+ ホストメモリ 2,048 GiB GPU GPUメモリ GPU GPUメモリ GPU GPUメモリ GPU GPUメモリ GPU GPUメモリ GPU GPUメモリ ホストメモリ GPU GPUメモリ GPU GPUメモリ 64 GiB (GPUと共用) CPU GPU Arm Cortex-A78AE 12コア Jetson AGX Orin 64GB 200 -
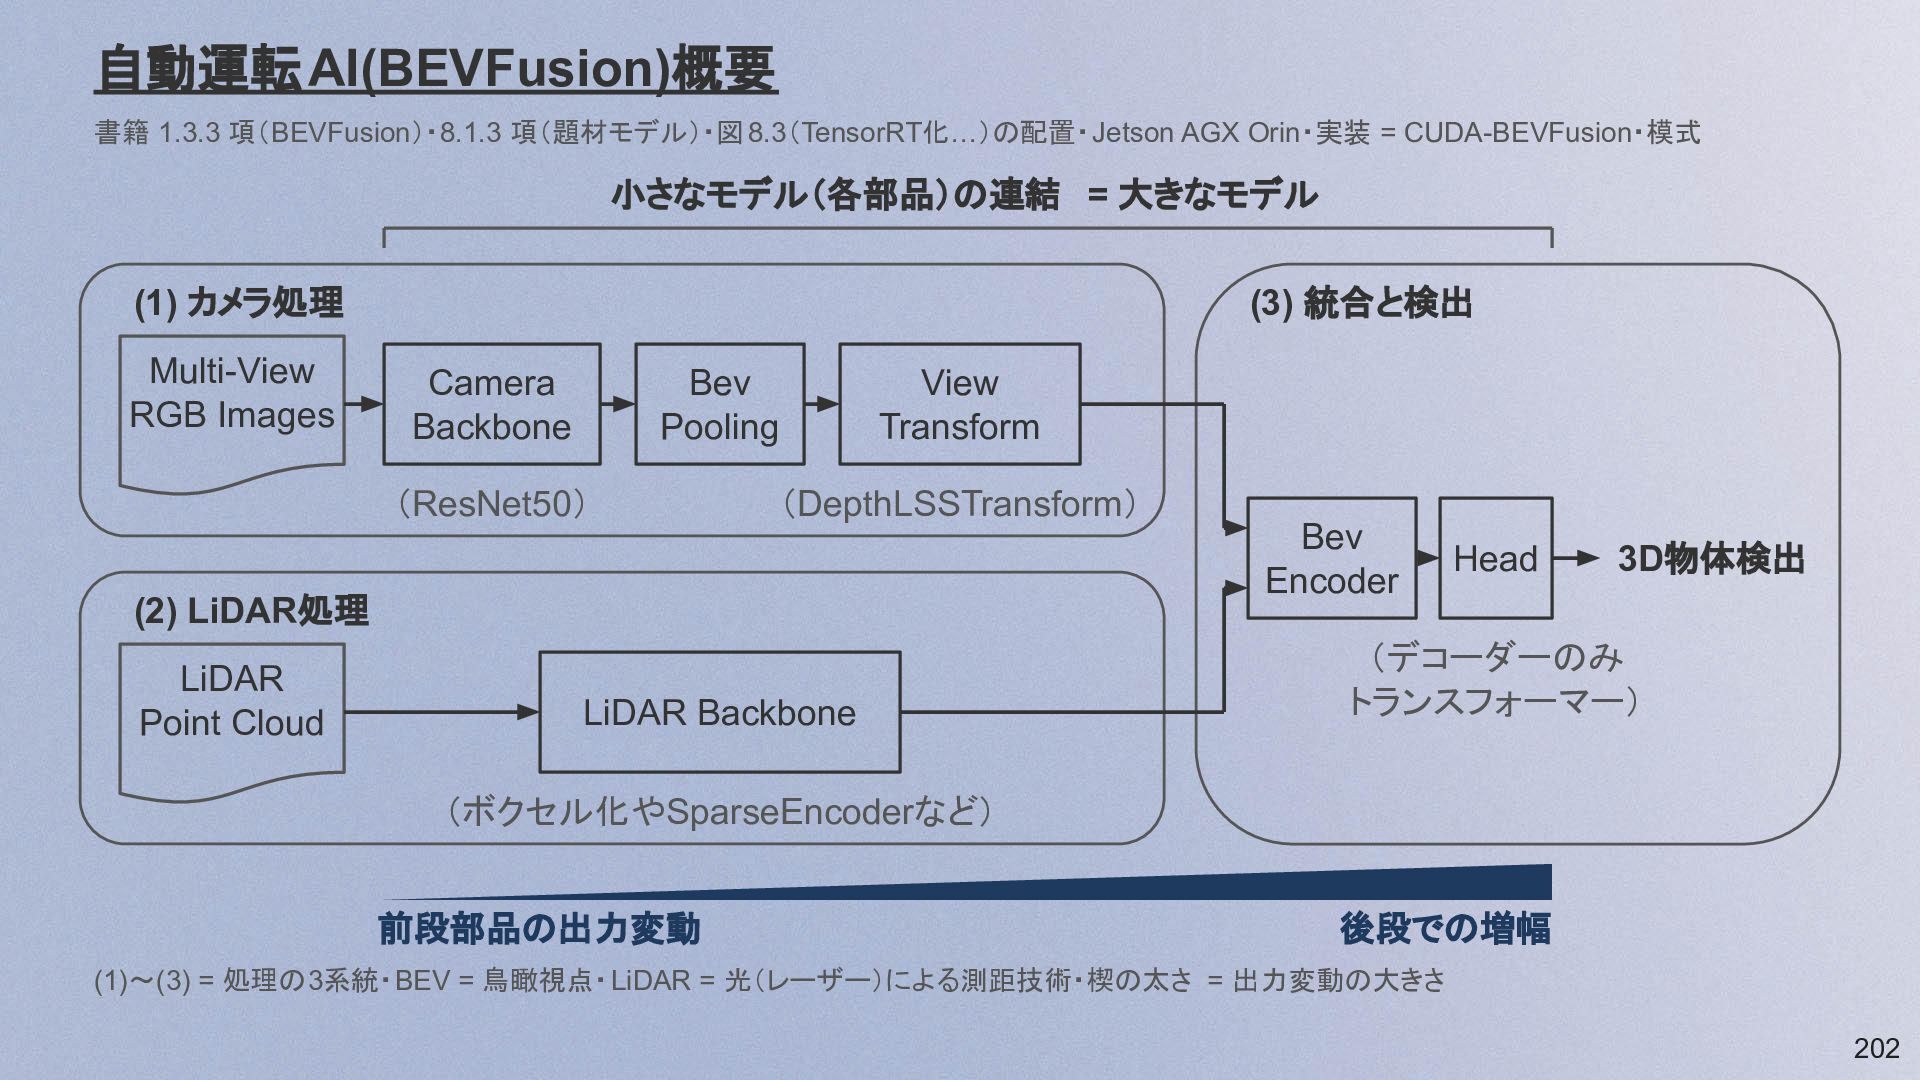
自動運転 AI(BEVFusion)概要 書籍 1.3.3 項(BEVFusion)・8.1.3 項(題材モデル)・図 8.3(TensorRT化…)の配置・Jetson AGX Orin・実装 =
CUDA-BEVFusion・模式 小さなモデル(各部品)の連結 = 大きなモデル (1) カメラ処理 Multi-View RGB Images (3) 統合と検出 Camera Backbone Bev Pooling (ResNet50) View Transform (DepthLSSTransform) Bev Encoder (2) LiDAR処理 LiDAR Point Cloud LiDAR Backbone Head 3D物体検出 (デコーダーのみ トランスフォーマー) (ボクセル化やSparseEncoderなど) 前段部品の出力変動 後段での増幅 (1)〜(3) = 処理の3系統・BEV = 鳥瞰視点・LiDAR = 光(レーザー)による測距技術・楔の太さ = 出力変動の大きさ 202 -
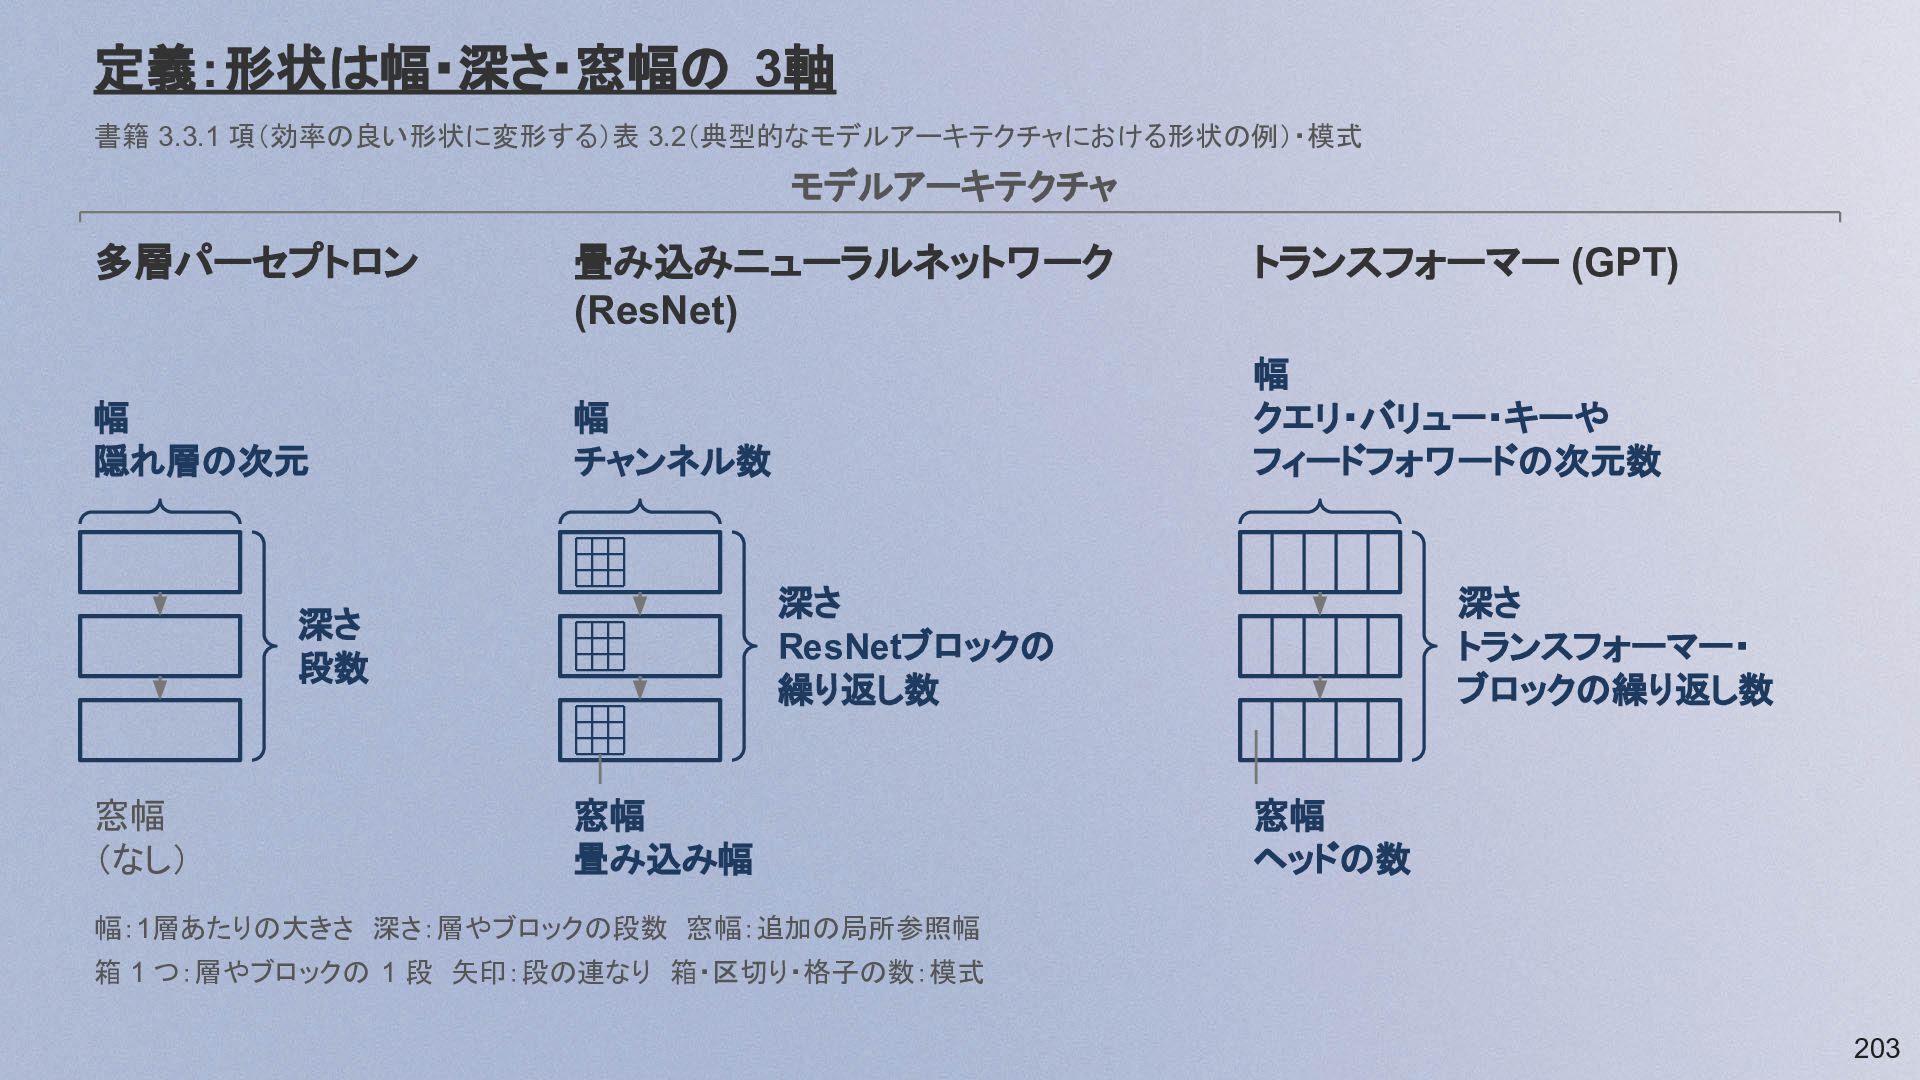
定義:形状は幅・深さ・窓幅の 3軸 書籍 3.3.1 項(効率の良い形状に変形する)表 3.2(典型的なモデルアーキテクチャにおける形状の例)・模式 モデルアーキテクチャ 多層パーセプトロン 幅 隠れ層の次元
畳み込みニューラルネットワーク (ResNet) 幅 クエリ・バリュー・キーや フィードフォワードの次元数 幅 チャンネル数 深さ ResNetブロックの 繰り返し数 深さ 段数 窓幅 (なし) トランスフォーマー (GPT) 窓幅 畳み込み幅 深さ トランスフォーマー・ ブロックの繰り返し数 窓幅 ヘッドの数 幅:1層あたりの大きさ 深さ:層やブロックの段数 窓幅:追加の局所参照幅 箱 1 つ:層やブロックの 1 段 矢印:段の連なり 箱・区切り・格子の数:模式 203 -
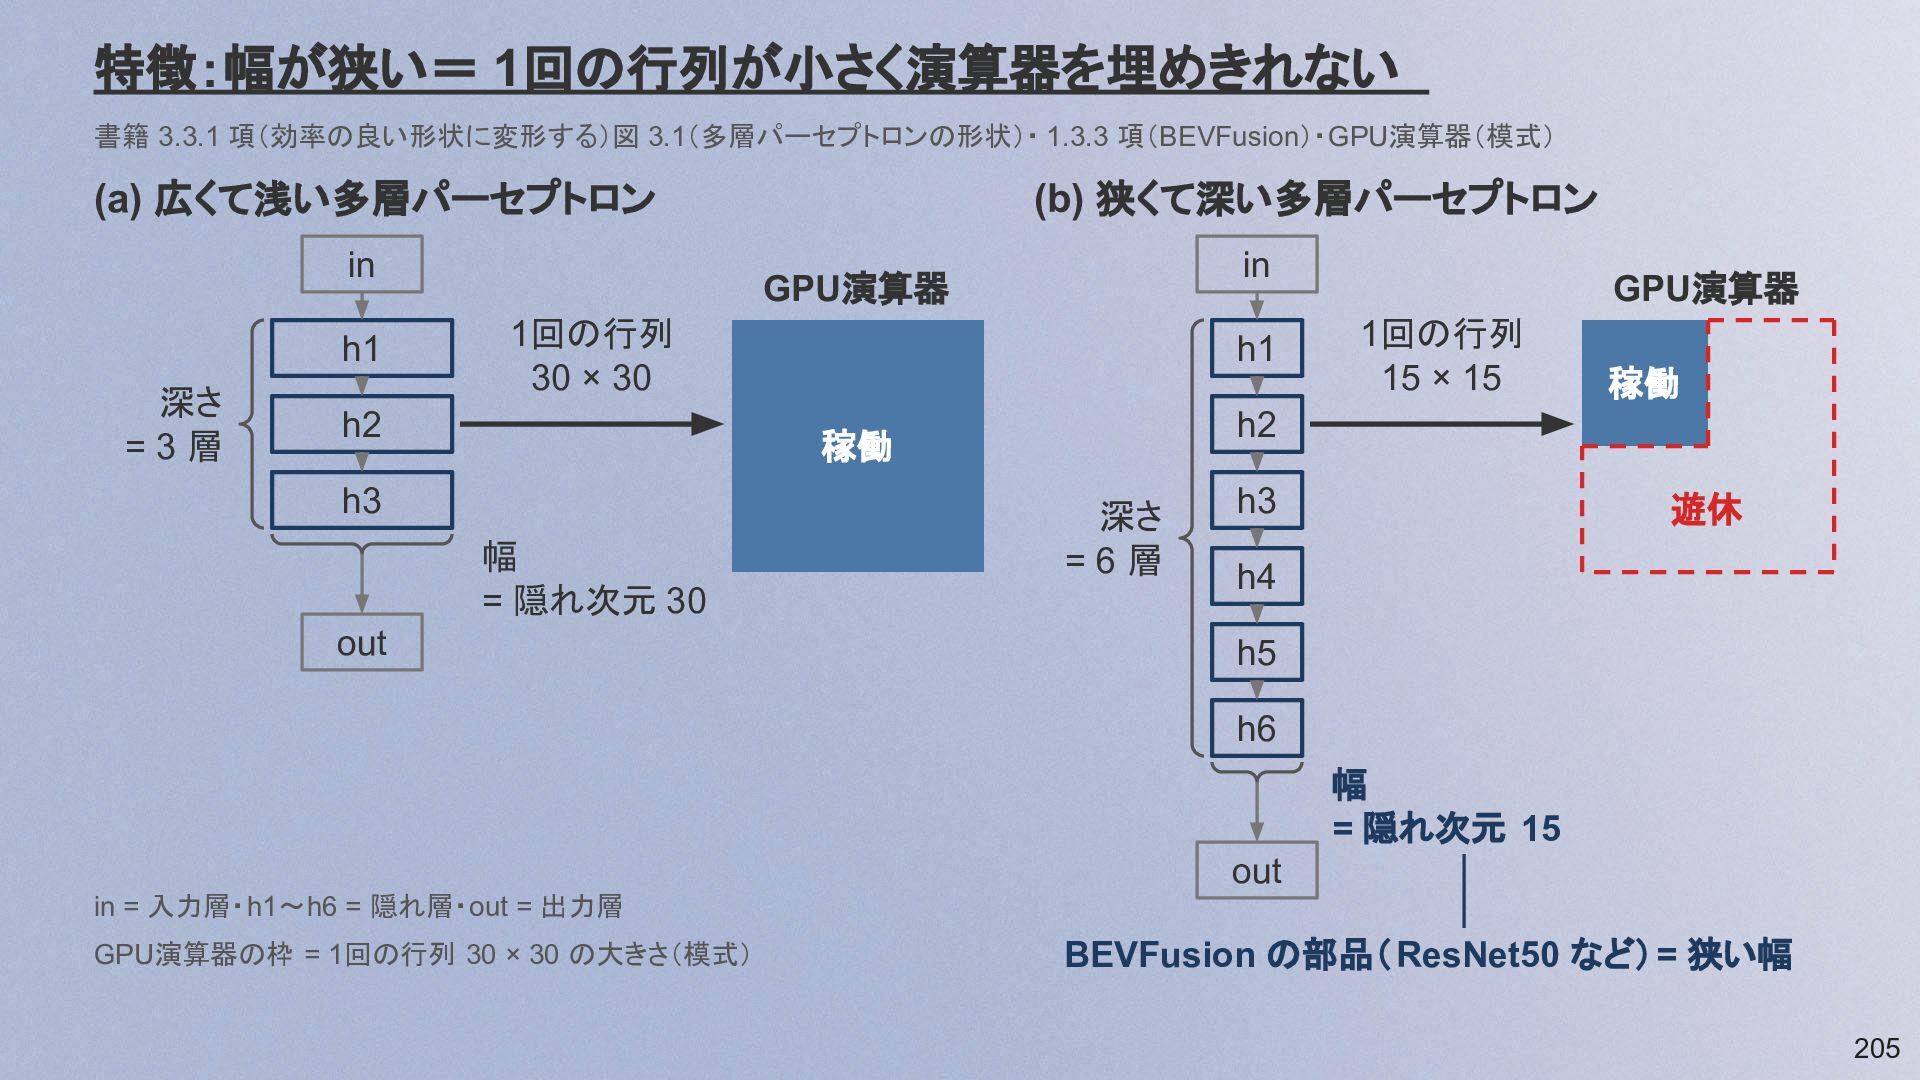
特徴:幅が狭い= 1回の行列が小さく演算器を埋めきれない 書籍 3.3.1 項(効率の良い形状に変形する)図 3.1(多層パーセプトロンの形状)・ 1.3.3 項(BEVFusion)・GPU演算器(模式) (a) 広くて浅い多層パーセプトロン
in h1 深さ =3層 (b) 狭くて深い多層パーセプトロン in GPU演算器 1回の行列 30 × 30 h2 h1 幅 = 隠れ次元 30 out 1回の行列 15 × 15 稼働 h2 稼働 h3 GPU演算器 深さ =6層 h3 遊休 h4 h5 h6 幅 = 隠れ次元 15 out in = 入力層・h1〜h6 = 隠れ層・out = 出力層 GPU演算器の枠 = 1回の行列 30 × 30 の大きさ(模式) BEVFusion の部品( ResNet50 など)= 狭い幅 205 -
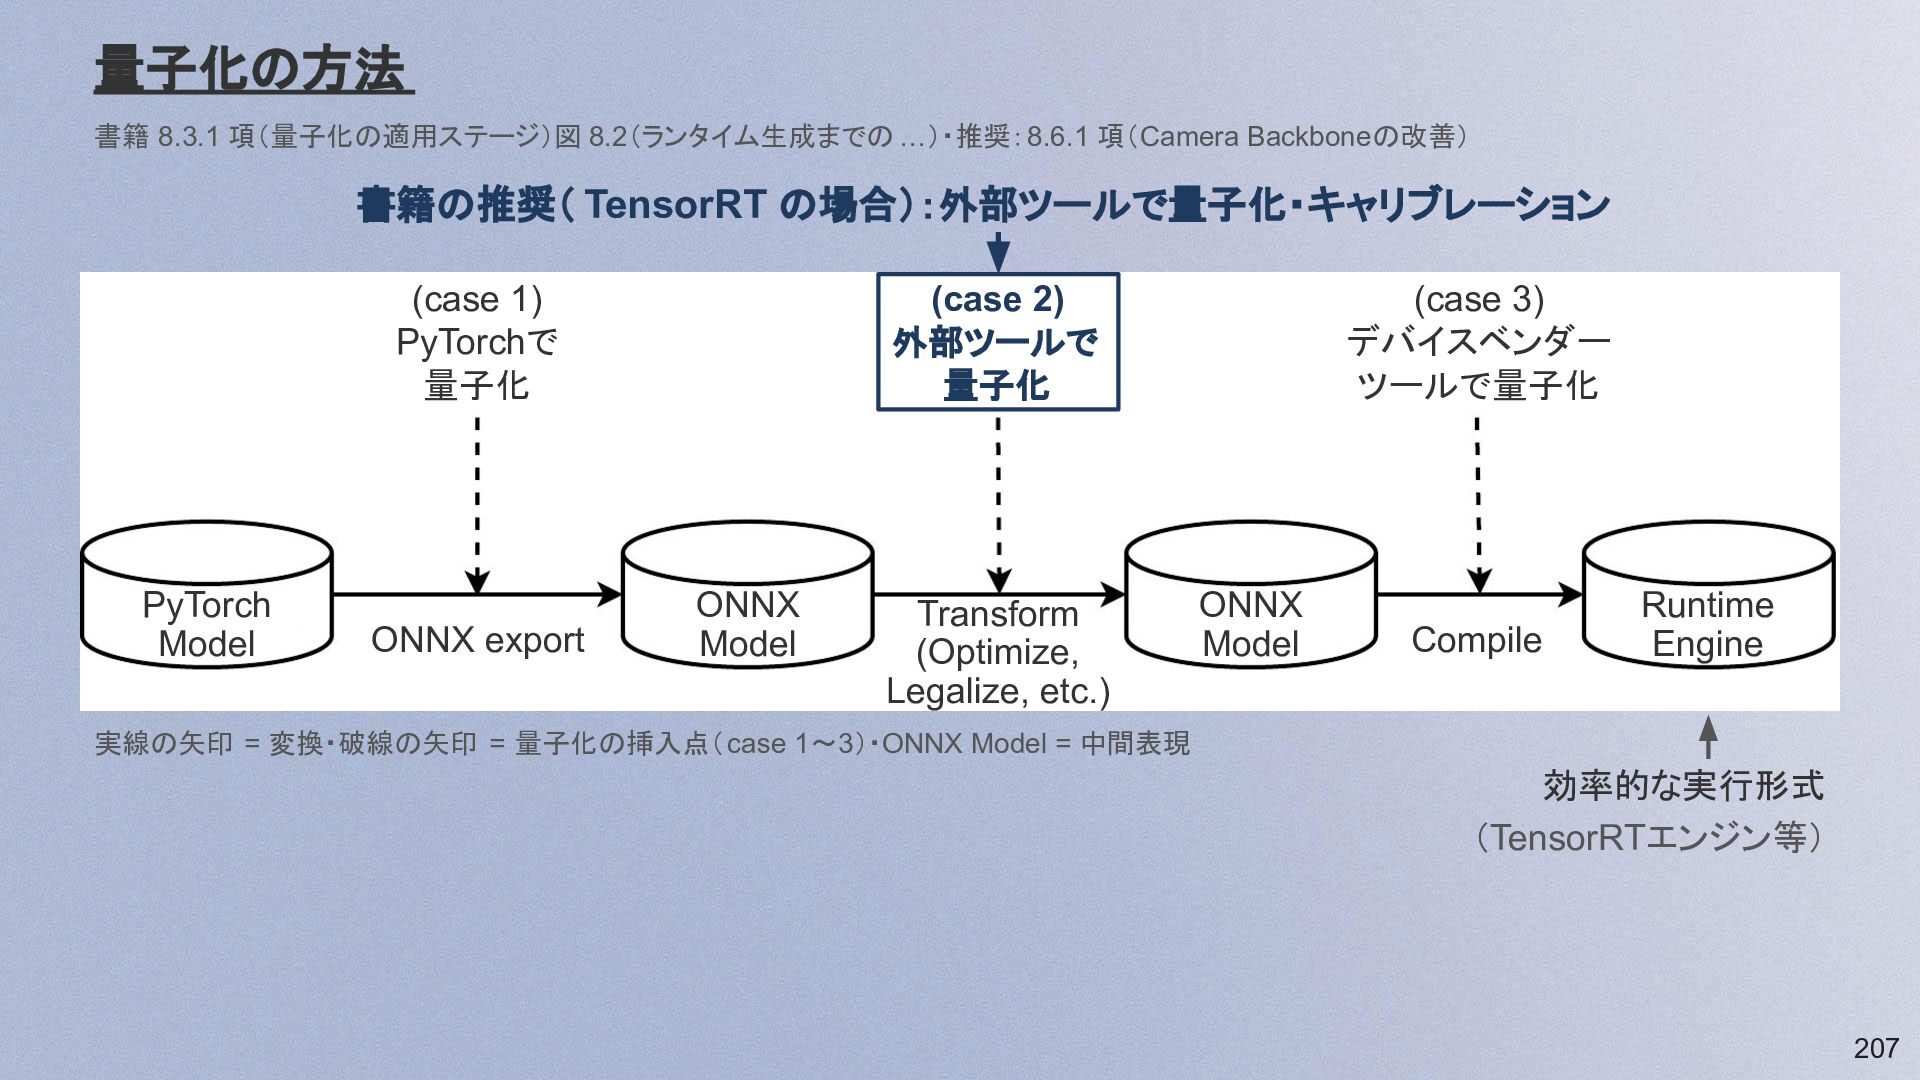
量子化の方法 書籍 8.3.1 項(量子化の適用ステージ)図 8.2(ランタイム生成までの …)・推奨:8.6.1 項(Camera Backboneの改善) 書籍の推奨( TensorRT
の場合):外部ツールで量子化・キャリブレーション (case 1) PyTorchで 量子化 PyTorch Model ONNX export (case 2) 外部ツールで 量子化 ONNX Model Transform (Optimize, Legalize, etc.) (case 3) デバイスベンダー ツールで量子化 ONNX Model Compile Runtime Engine 実線の矢印 = 変換・破線の矢印 = 量子化の挿入点( case 1〜3)・ONNX Model = 中間表現 効率的な実行形式 (TensorRTエンジン等) 207 -
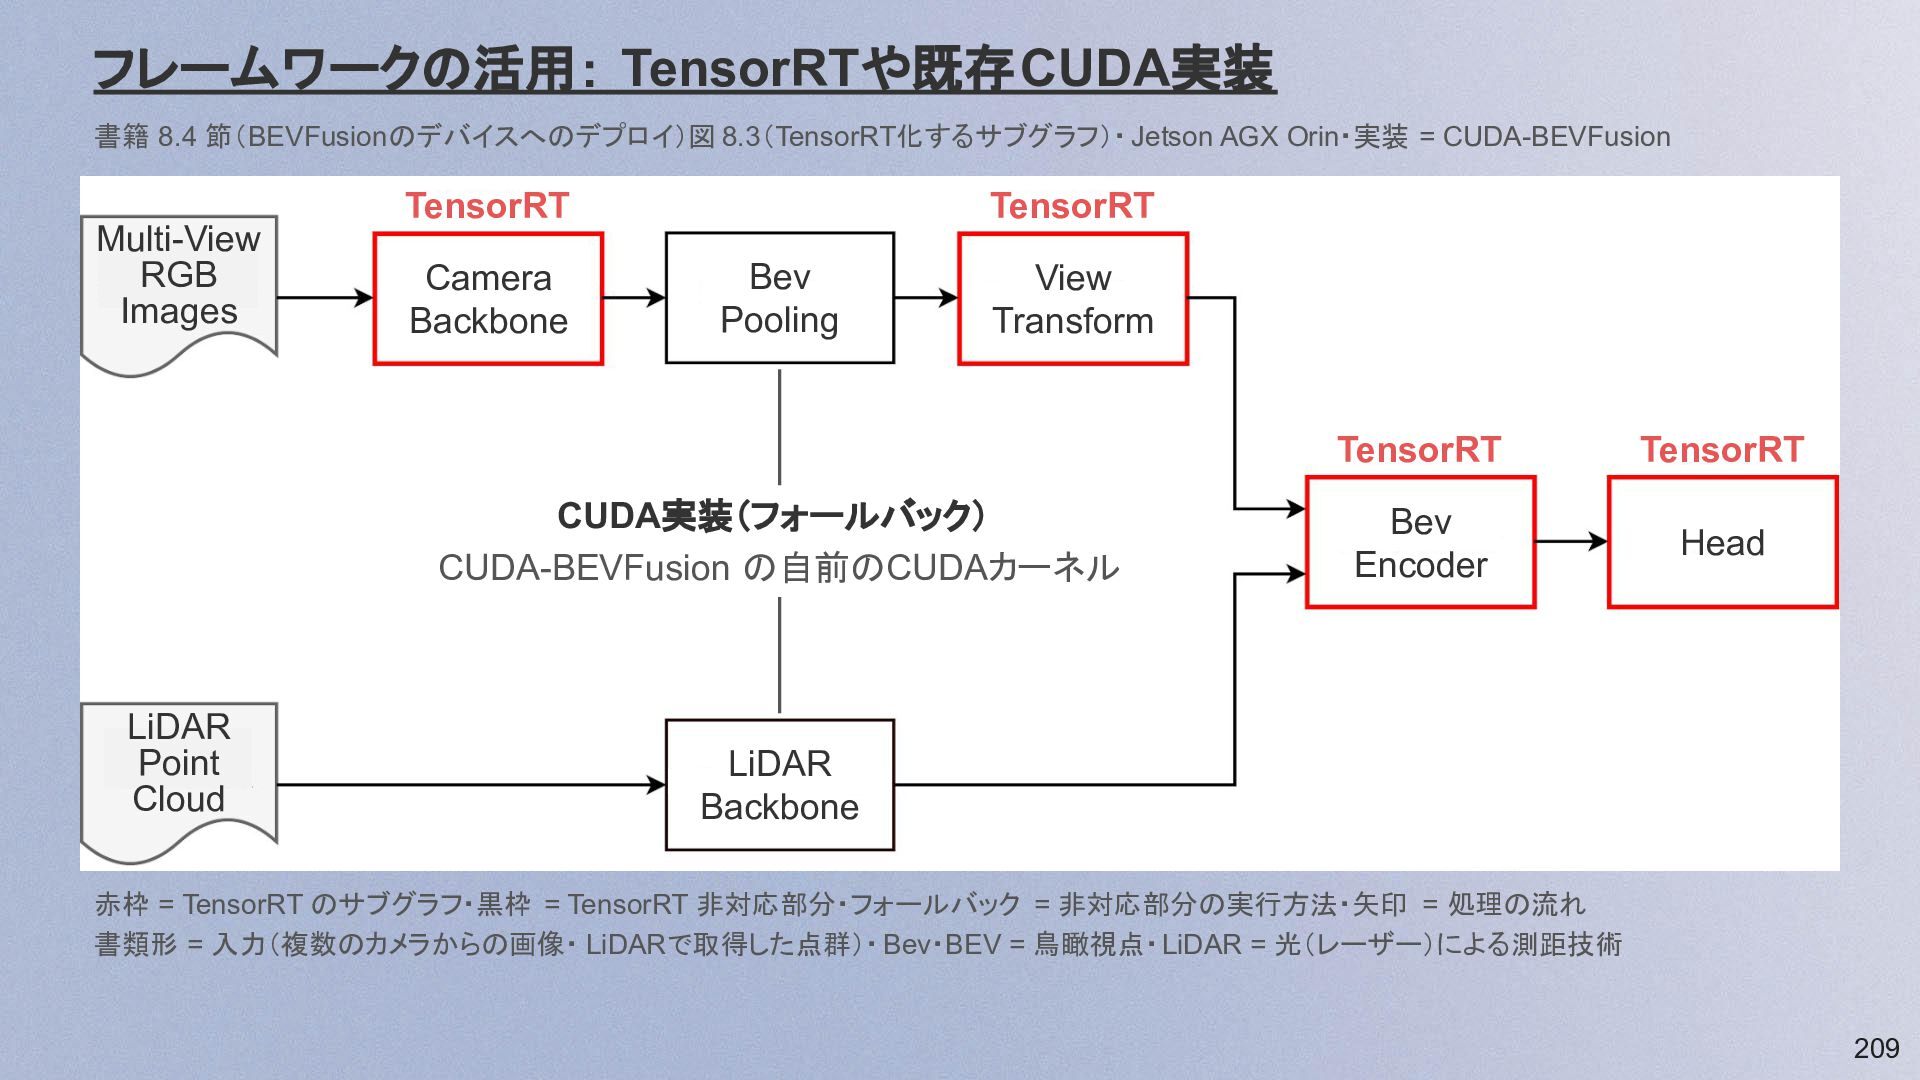
フレームワークの活用: TensorRTや既存CUDA実装 書籍 8.4 節(BEVFusionのデバイスへのデプロイ)図 8.3(TensorRT化するサブグラフ)・ Jetson AGX Orin・実装 =
CUDA-BEVFusion Multi-View RGB Images TensorRT Camera Backbone TensorRT Bev Pooling View Transform CUDA実装(フォールバック) CUDA-BEVFusion の自前のCUDAカーネル LiDAR Point Cloud TensorRT TensorRT Bev Encoder Head LiDAR Backbone 赤枠 = TensorRT のサブグラフ・黒枠 = TensorRT 非対応部分・フォールバック = 非対応部分の実行方法・矢印 = 処理の流れ 書類形 = 入力(複数のカメラからの画像・ LiDARで取得した点群)・ Bev・BEV = 鳥瞰視点・LiDAR = 光(レーザー)による測距技術 209 -
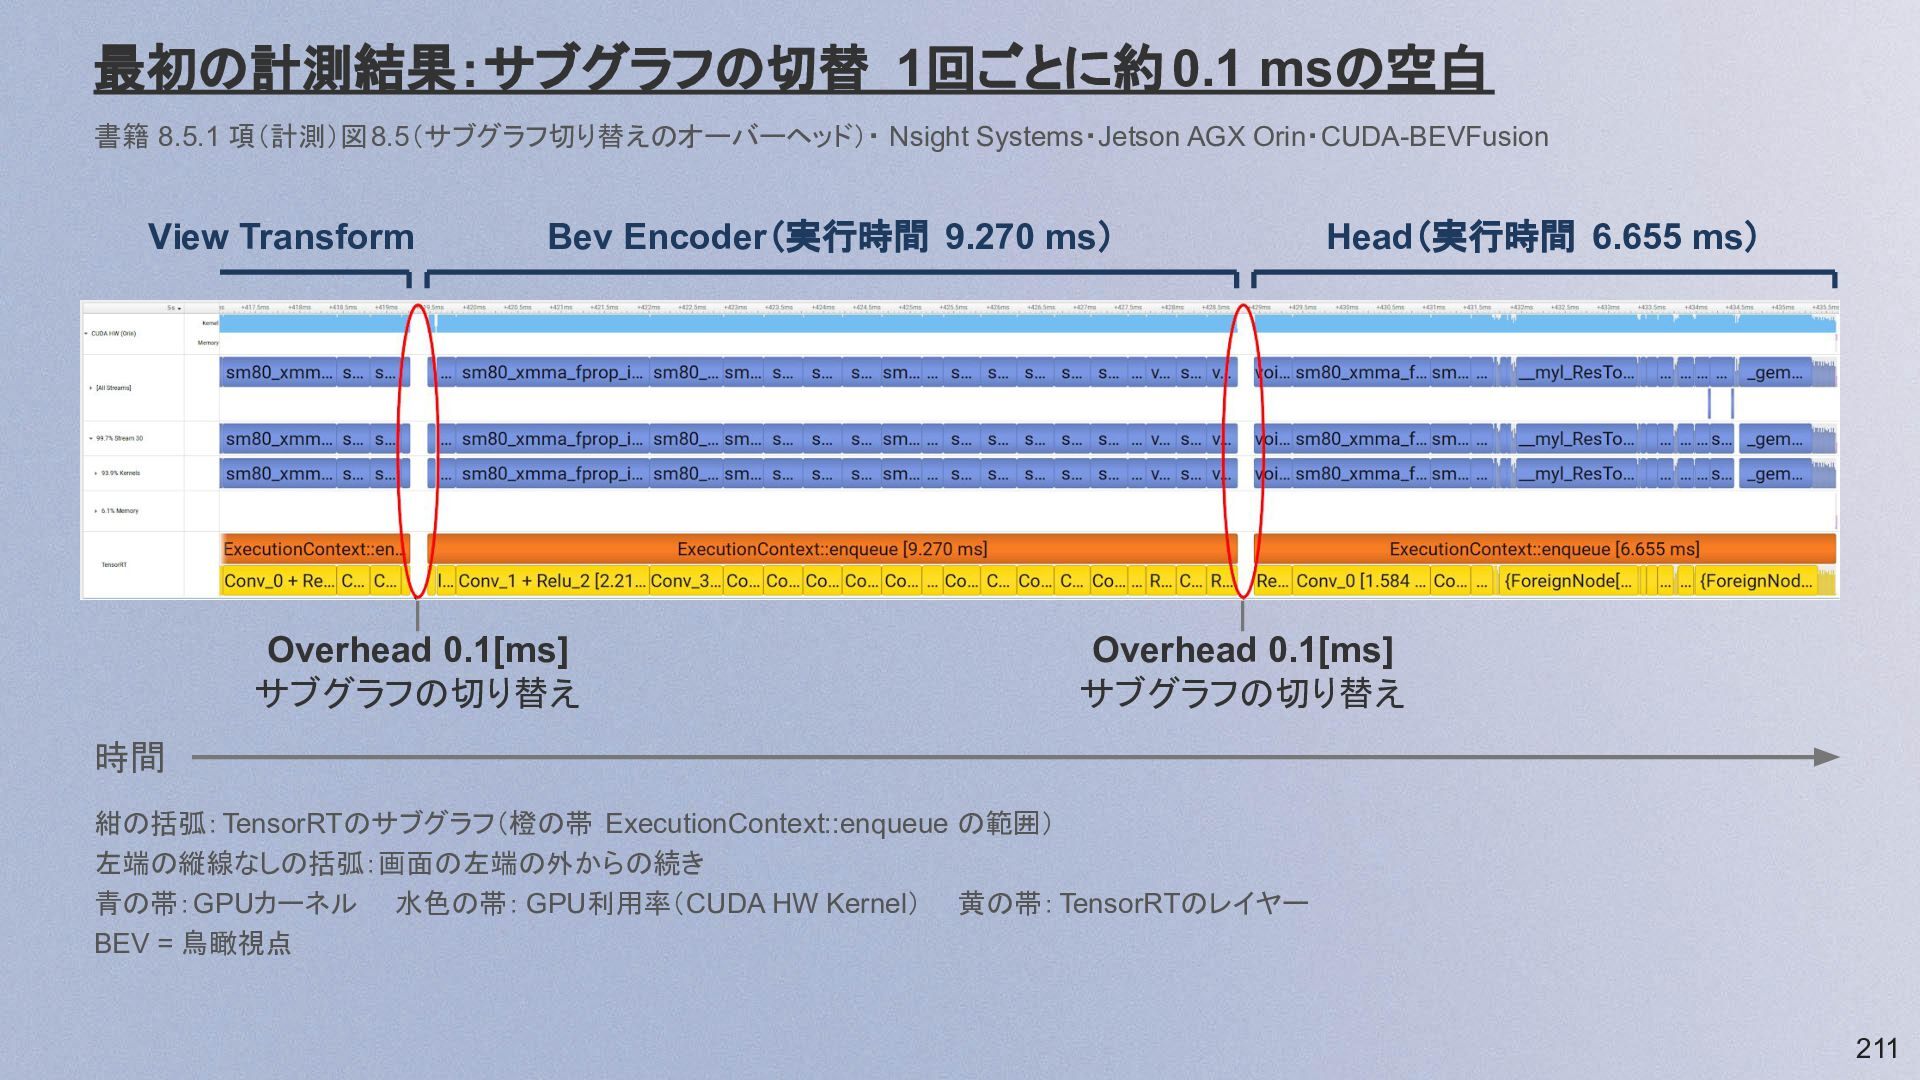
最初の計測結果:サブグラフの切替 1回ごとに約 0.1 msの空白 書籍 8.5.1 項(計測)図8.5(サブグラフ切り替えのオーバーヘッド)・ Nsight Systems・Jetson AGX
Orin・CUDA-BEVFusion View Transform Bev Encoder(実行時間 9.270 ms) Overhead 0.1[ms] サブグラフの切り替え Head(実行時間 6.655 ms) Overhead 0.1[ms] サブグラフの切り替え 時間 紺の括弧:TensorRTのサブグラフ(橙の帯 ExecutionContext::enqueue の範囲) 左端の縦線なしの括弧:画面の左端の外からの続き 青の帯:GPUカーネル 水色の帯: GPU利用率(CUDA HW Kernel) 黄の帯:TensorRTのレイヤー BEV = 鳥瞰視点 211 -
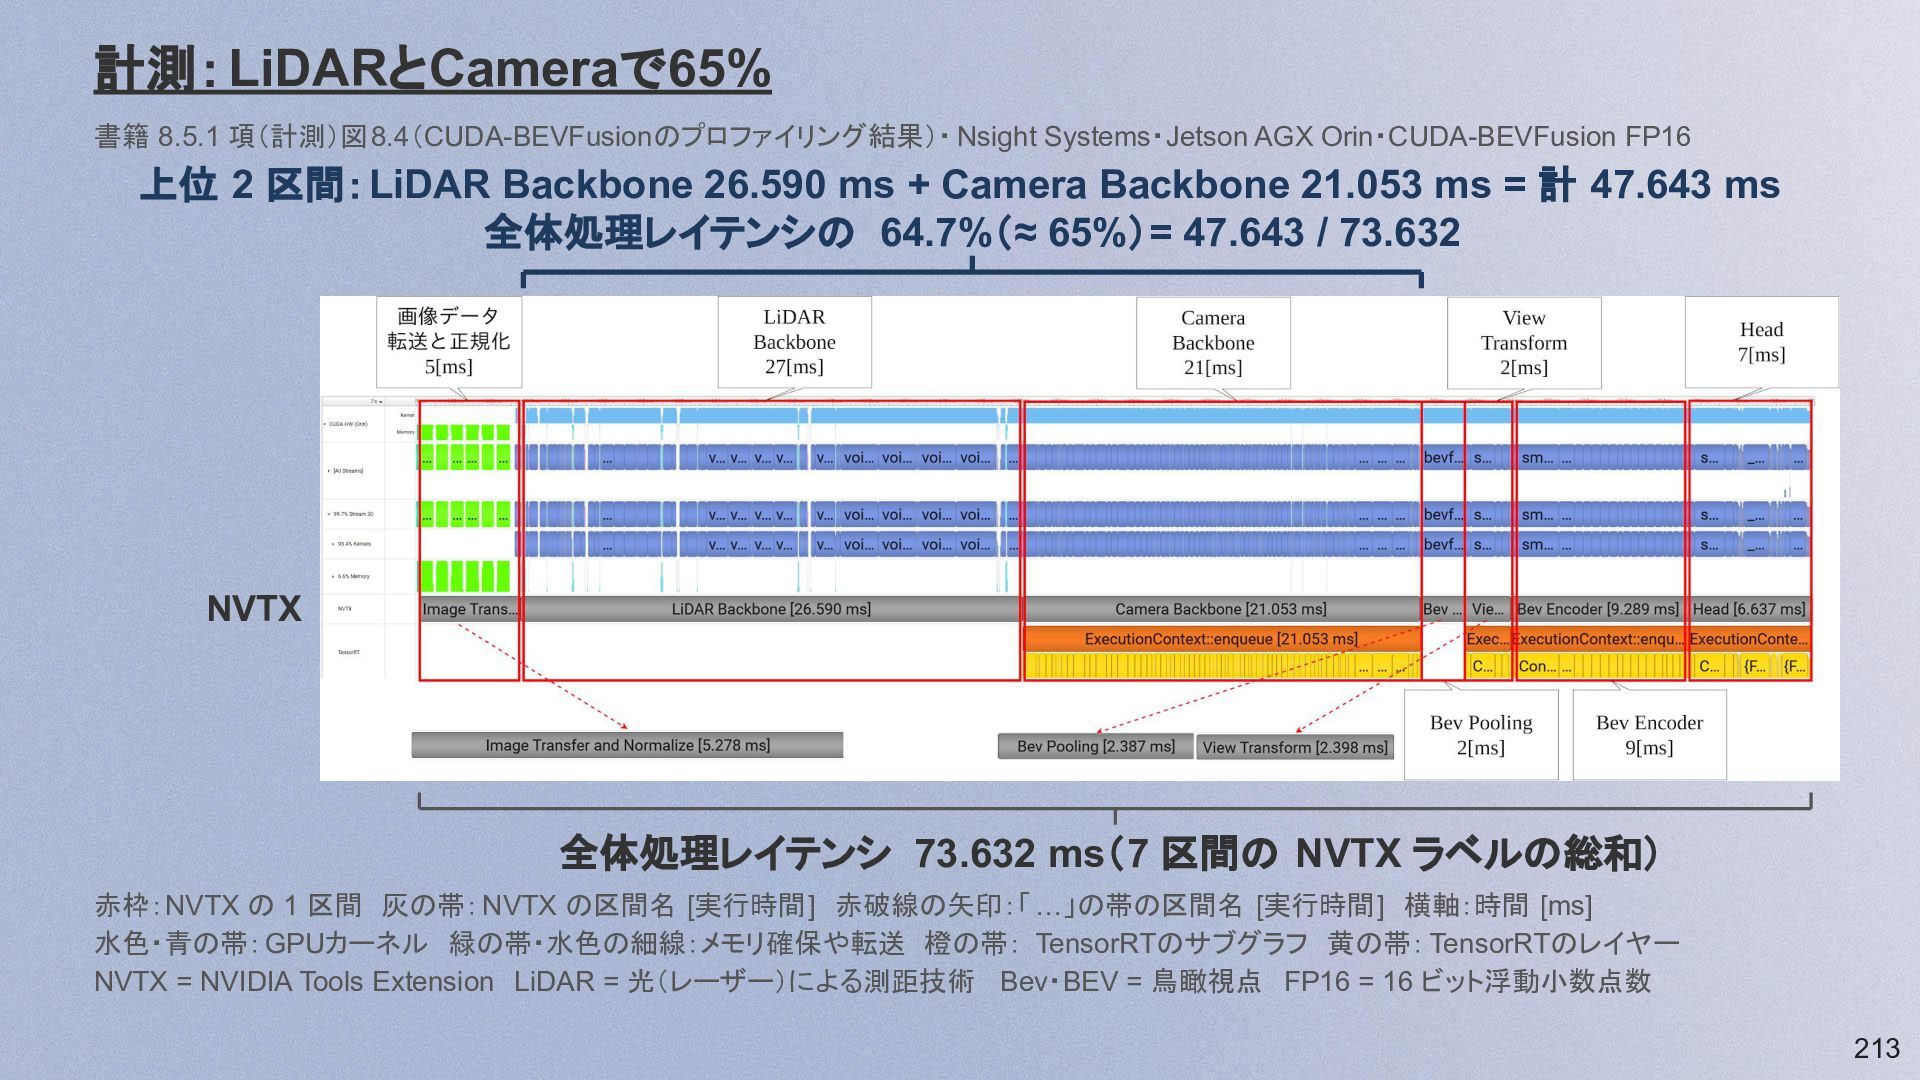
計測:LiDARとCameraで65% 書籍 8.5.1 項(計測)図8.4(CUDA-BEVFusionのプロファイリング結果)・ Nsight Systems・Jetson AGX Orin・CUDA-BEVFusion FP16 上位
2 区間:LiDAR Backbone 26.590 ms + Camera Backbone 21.053 ms = 計 47.643 ms 全体処理レイテンシの 64.7%(≈ 65%)= 47.643 / 73.632 NVTX 全体処理レイテンシ 73.632 ms(7 区間の NVTX ラベルの総和) 赤枠:NVTX の 1 区間 灰の帯: NVTX の区間名 [実行時間] 赤破線の矢印:「 …」の帯の区間名 [実行時間] 横軸:時間 [ms] 水色・青の帯: GPUカーネル 緑の帯・水色の細線:メモリ確保や転送 橙の帯: TensorRTのサブグラフ 黄の帯: TensorRTのレイヤー NVTX = NVIDIA Tools Extension LiDAR = 光(レーザー)による測距技術 Bev・BEV = 鳥瞰視点 FP16 = 16 ビット浮動小数点数 213 -
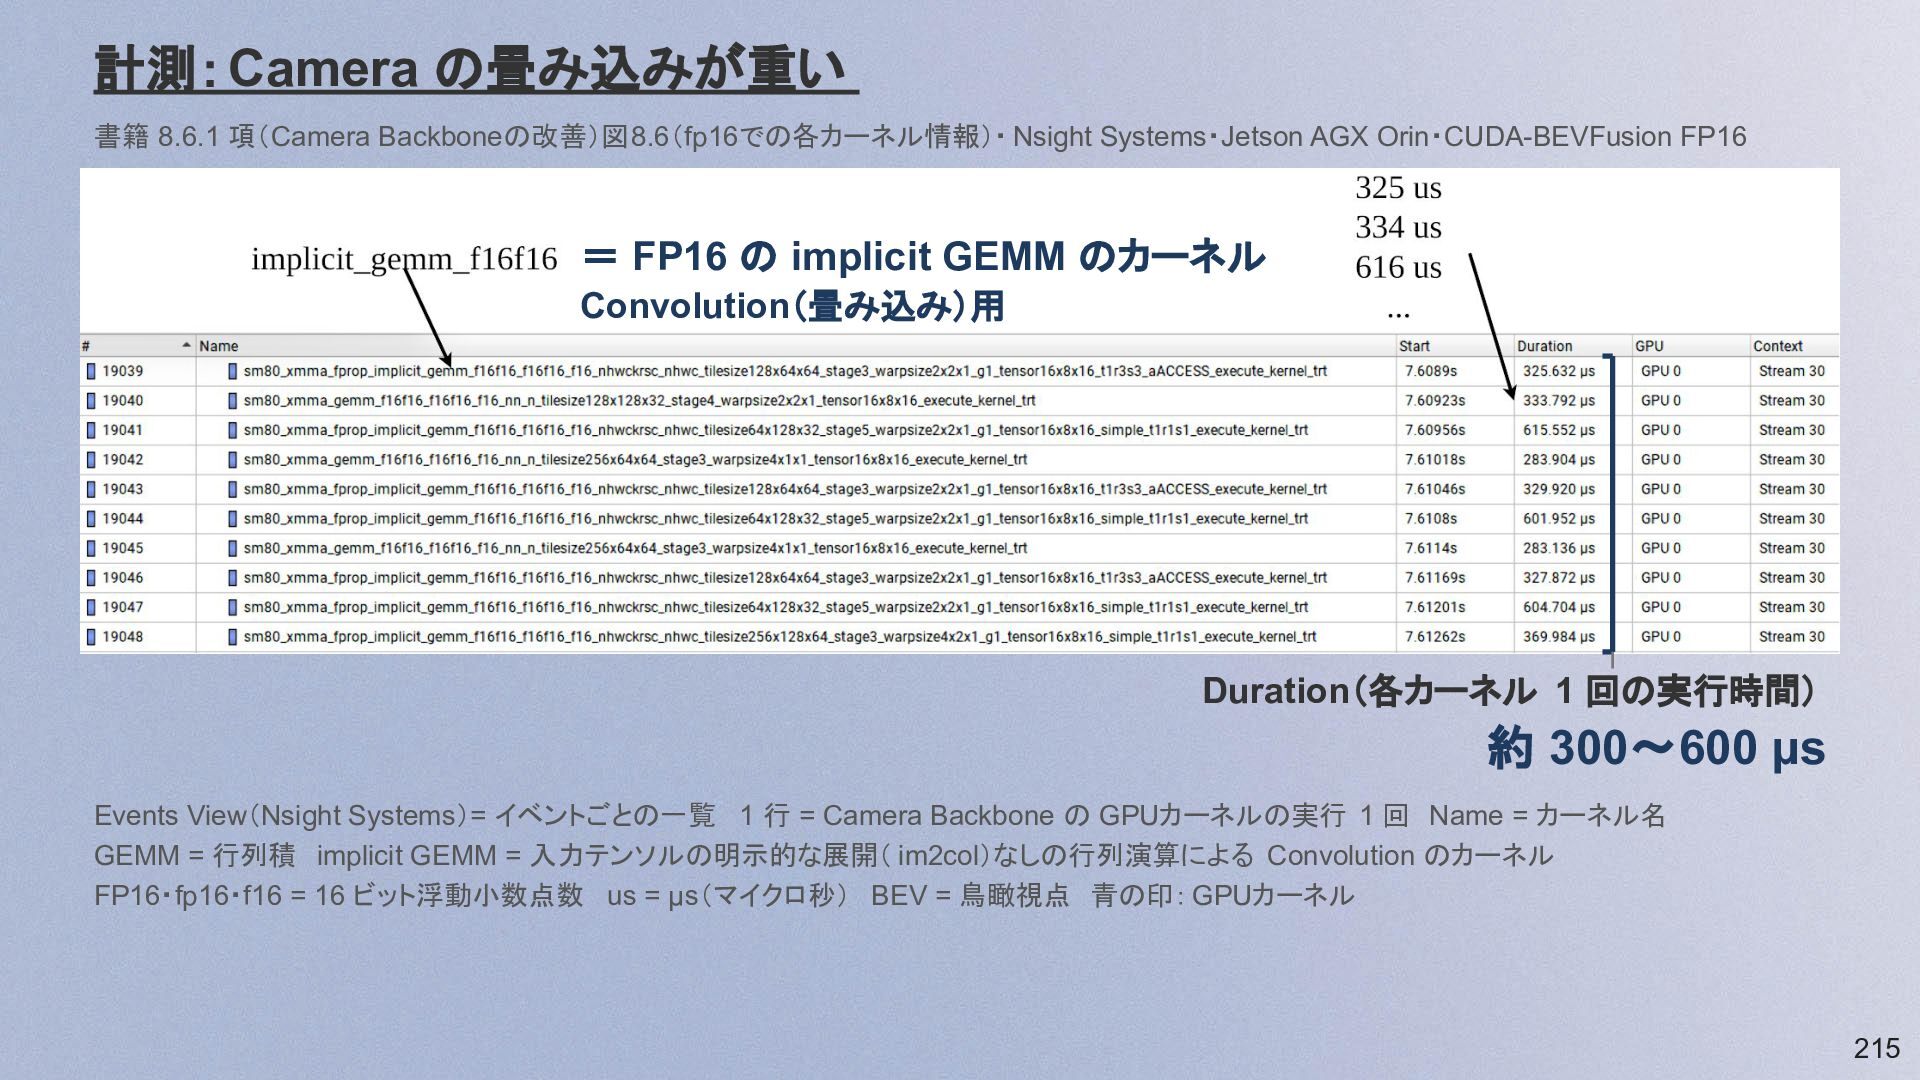
計測:Camera の畳み込みが重い 書籍 8.6.1 項(Camera Backboneの改善)図8.6(fp16での各カーネル情報)・ Nsight Systems・Jetson AGX Orin・CUDA-BEVFusion
FP16 = FP16 の implicit GEMM のカーネル Convolution(畳み込み)用 Duration(各カーネル 1 回の実行時間) 約 300〜600 µs Events View(Nsight Systems)= イベントごとの一覧 1 行 = Camera Backbone の GPUカーネルの実行 1 回 Name = カーネル名 GEMM = 行列積 implicit GEMM = 入力テンソルの明示的な展開( im2col)なしの行列演算による Convolution のカーネル FP16・fp16・f16 = 16 ビット浮動小数点数 us = µs(マイクロ秒) BEV = 鳥瞰視点 青の印: GPUカーネル 215 -
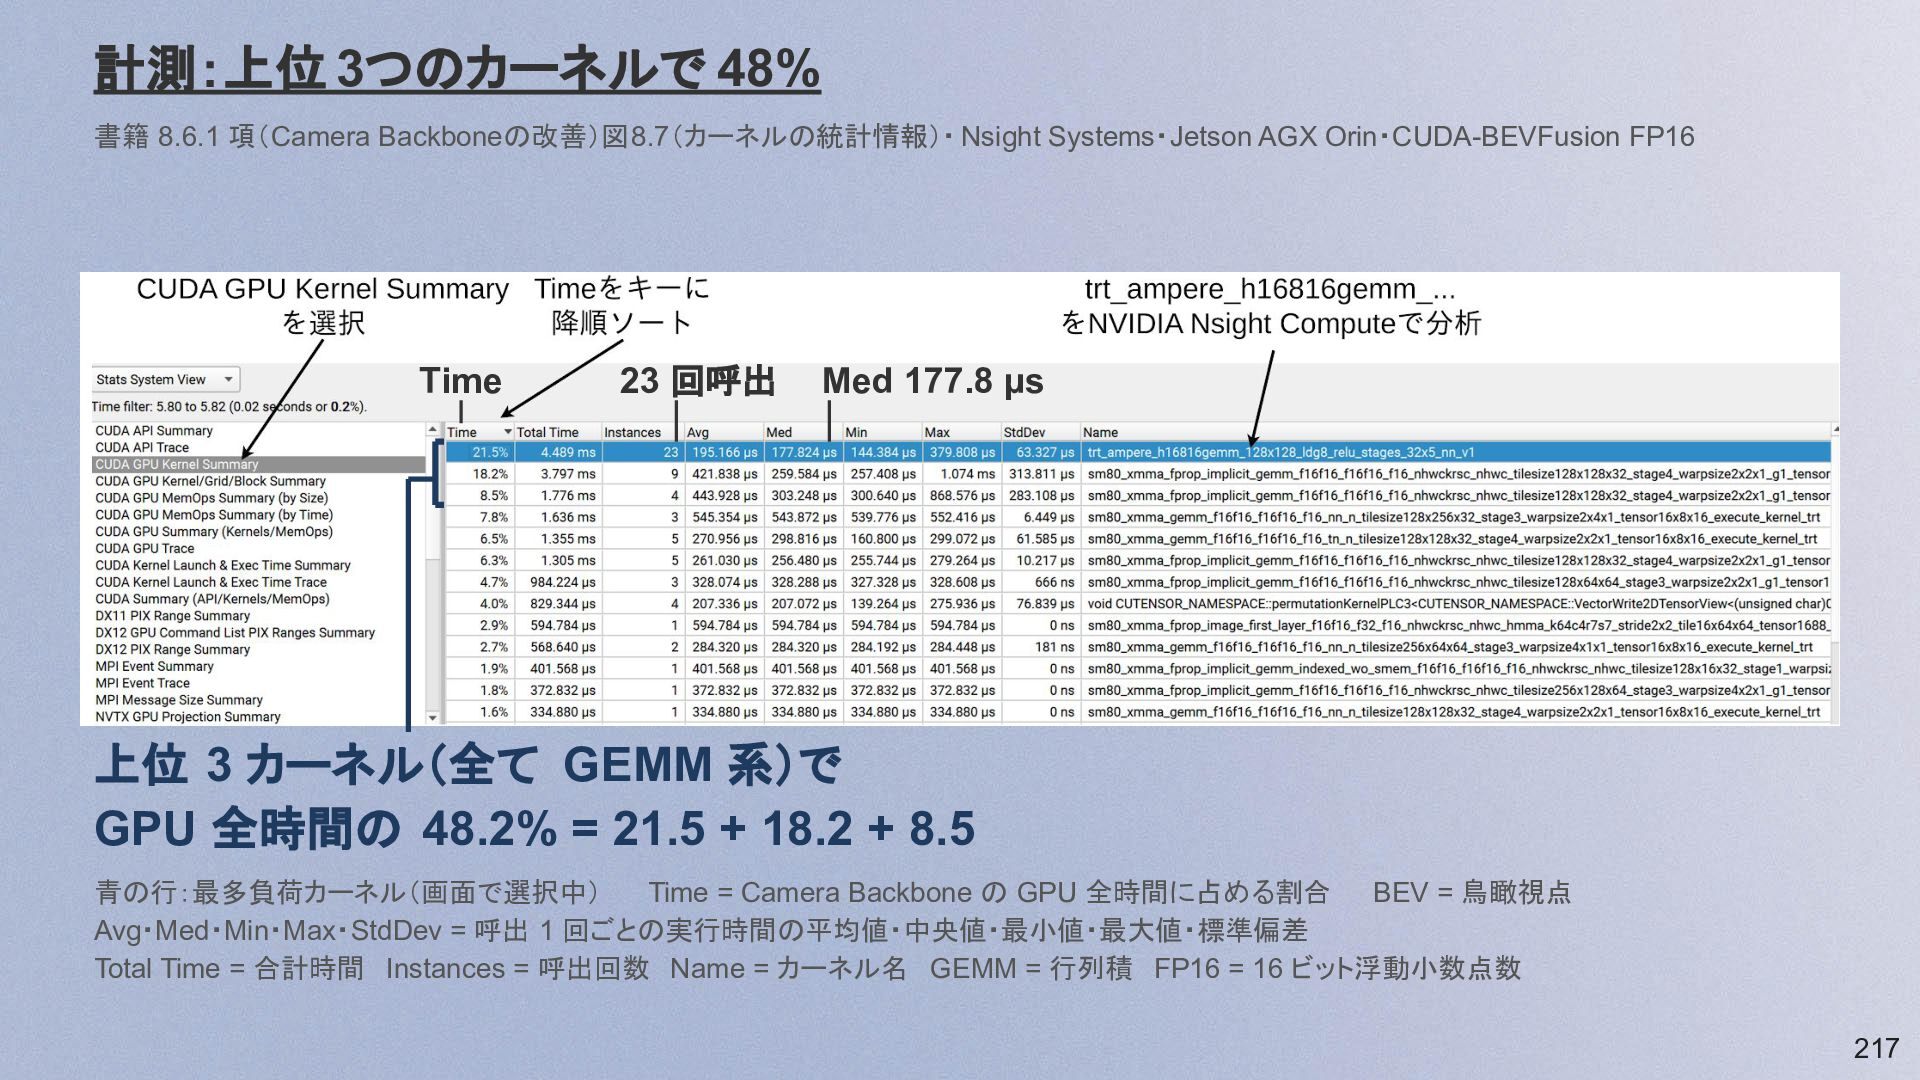
計測:上位 3つのカーネルで 48% 書籍 8.6.1 項(Camera Backboneの改善)図8.7(カーネルの統計情報)・ Nsight Systems・Jetson AGX
Orin・CUDA-BEVFusion FP16 Time 23 回呼出 Med 177.8 µs 上位 3 カーネル(全て GEMM 系)で GPU 全時間の 48.2% = 21.5 + 18.2 + 8.5 青の行:最多負荷カーネル(画面で選択中) Time = Camera Backbone の GPU 全時間に占める割合 BEV = 鳥瞰視点 Avg・Med・Min・Max・StdDev = 呼出 1 回ごとの実行時間の平均値・中央値・最小値・最大値・標準偏差 Total Time = 合計時間 Instances = 呼出回数 Name = カーネル名 GEMM = 行列積 FP16 = 16 ビット浮動小数点数 217 -
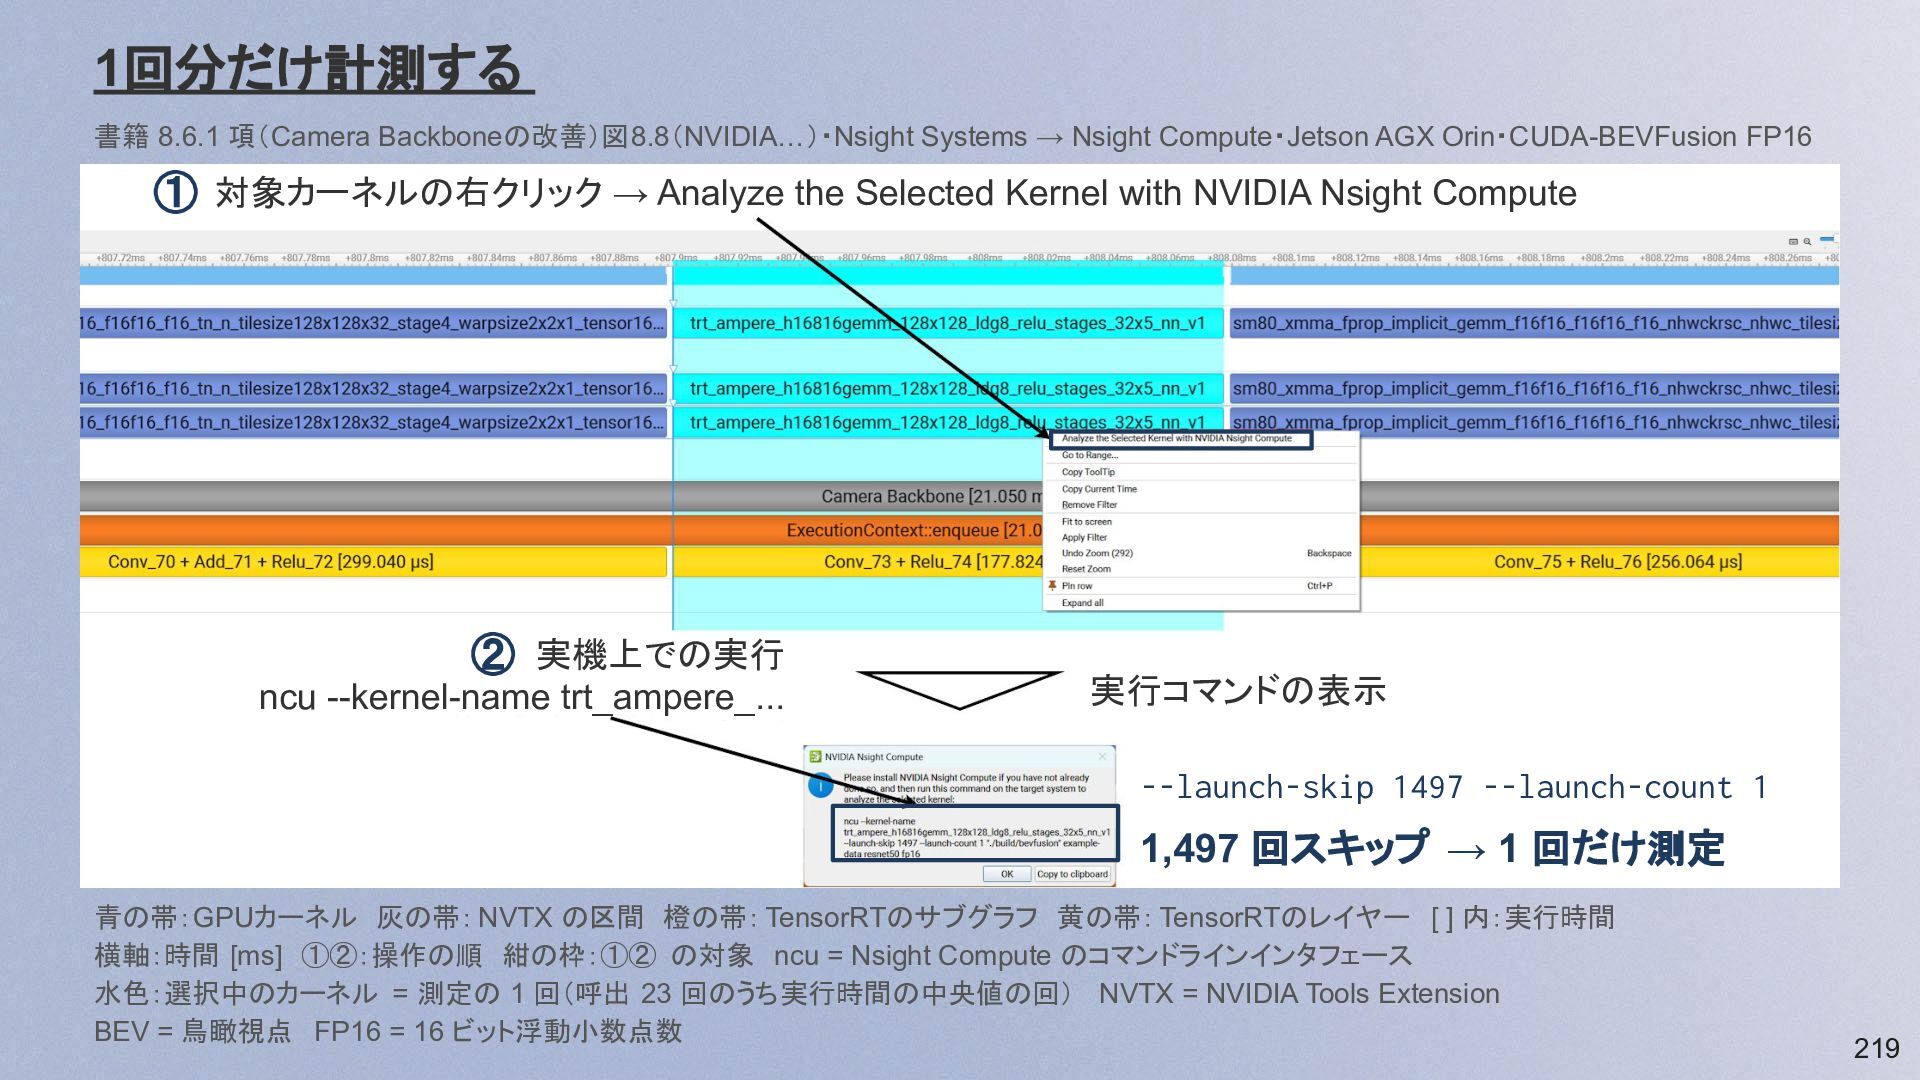
1回分だけ計測する 書籍 8.6.1 項(Camera Backboneの改善)図8.8(NVIDIA…)・Nsight Systems → Nsight Compute・Jetson AGX
Orin・CUDA-BEVFusion FP16 ① 対象カーネルの右クリック → Analyze the Selected Kernel with NVIDIA Nsight Compute ② 実機上での実行 ncu --kernel-name trt_ampere_... 実行コマンドの表示 --launch-skip 1497 --launch-count 1 1,497 回スキップ → 1 回だけ測定 青の帯:GPUカーネル 灰の帯: NVTX の区間 橙の帯: TensorRTのサブグラフ 黄の帯: TensorRTのレイヤー [ ] 内:実行時間 横軸:時間 [ms] ①②:操作の順 紺の枠:①② の対象 ncu = Nsight Compute のコマンドラインインタフェース 水色:選択中のカーネル = 測定の 1 回(呼出 23 回のうち実行時間の中央値の回) NVTX = NVIDIA Tools Extension BEV = 鳥瞰視点 FP16 = 16 ビット浮動小数点数 219 -
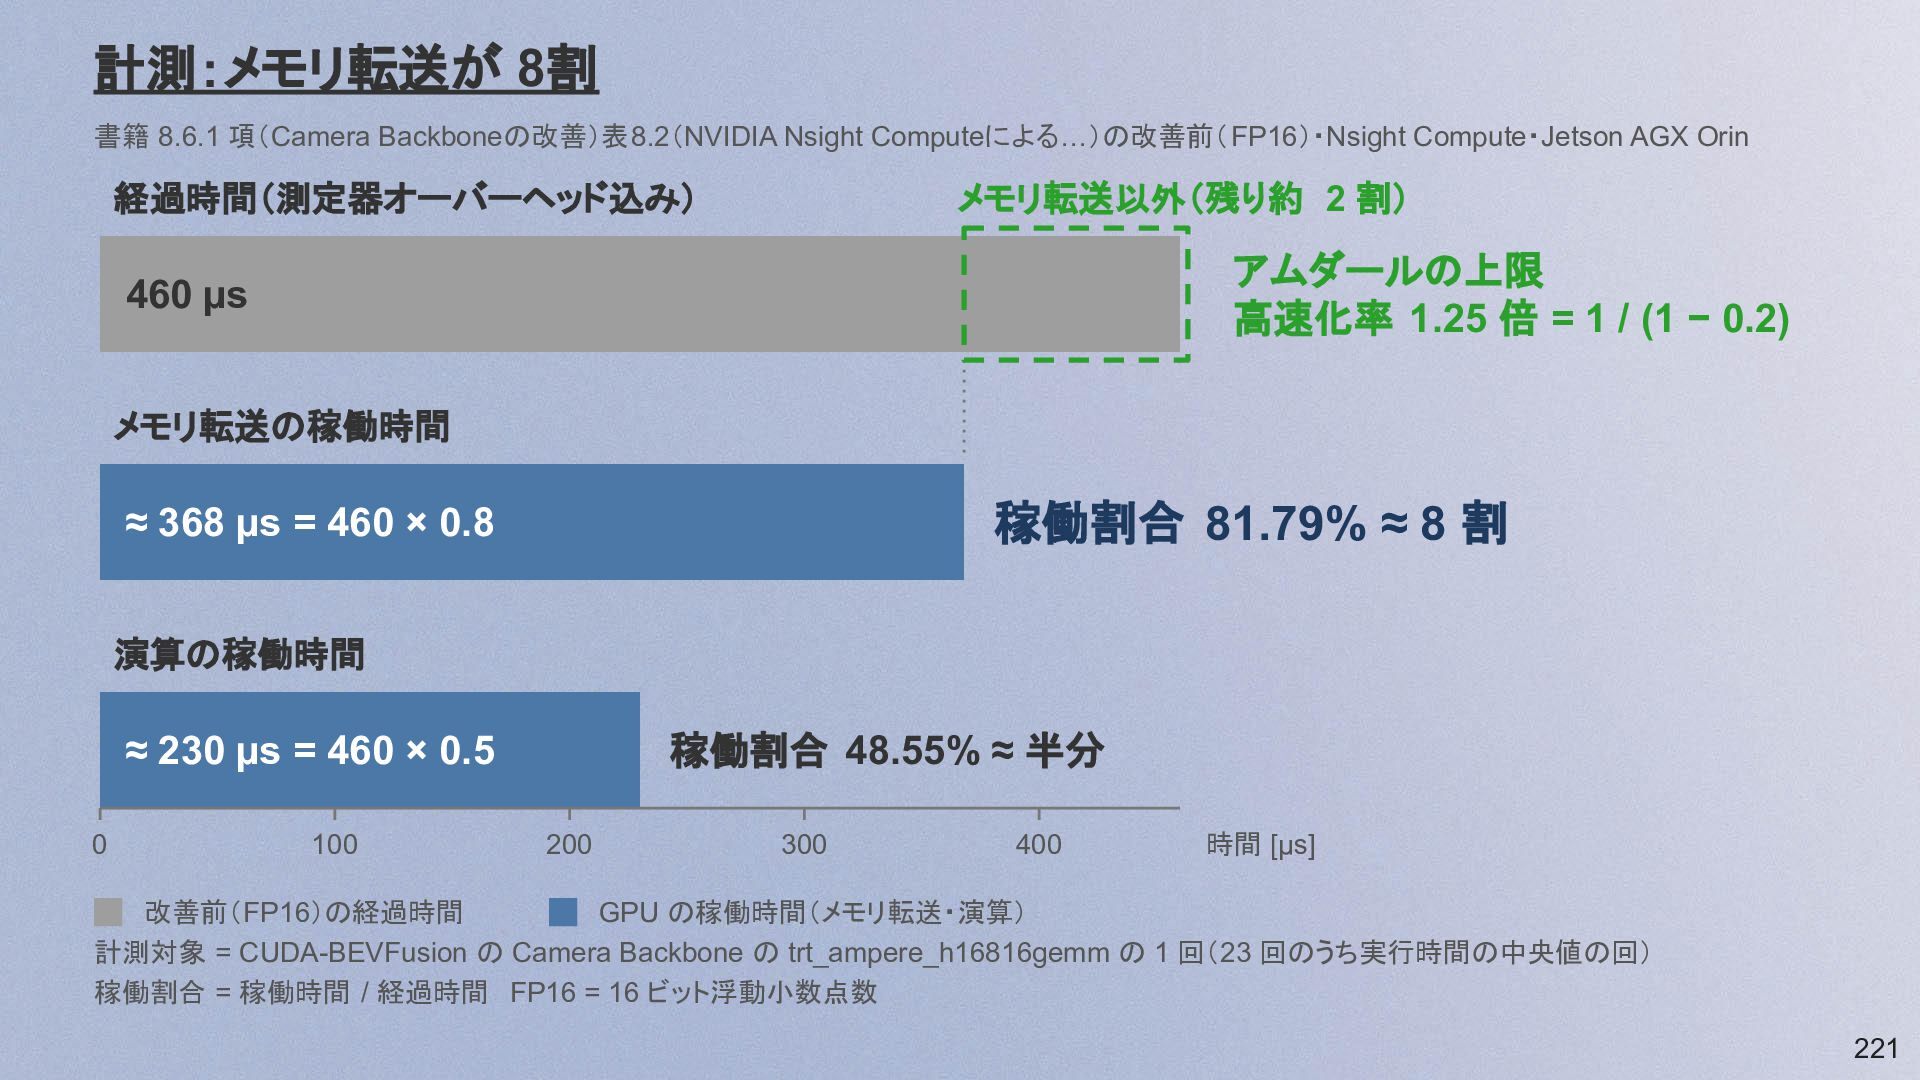
計測:メモリ転送が 8割 書籍 8.6.1 項(Camera Backboneの改善)表8.2(NVIDIA Nsight Computeによる…)の改善前(FP16)・Nsight Compute・Jetson AGX
Orin 経過時間(測定器オーバーヘッド込み) メモリ転送以外(残り約 2 割) アムダールの上限 高速化率 1.25 倍 = 1 / (1 − 0.2) 460 µs メモリ転送の稼働時間 稼働割合 81.79% ≈ 8 割 ≈ 368 µs = 460 × 0.8 演算の稼働時間 稼働割合 48.55% ≈ 半分 ≈ 230 µs = 460 × 0.5 0 100 200 300 400 時間 [µs] 改善前(FP16)の経過時間 GPU の稼働時間(メモリ転送・演算) 計測対象 = CUDA-BEVFusion の Camera Backbone の trt_ampere_h16816gemm の 1 回(23 回のうち実行時間の中央値の回) 稼働割合 = 稼働時間 / 経過時間 FP16 = 16 ビット浮動小数点数 221 -
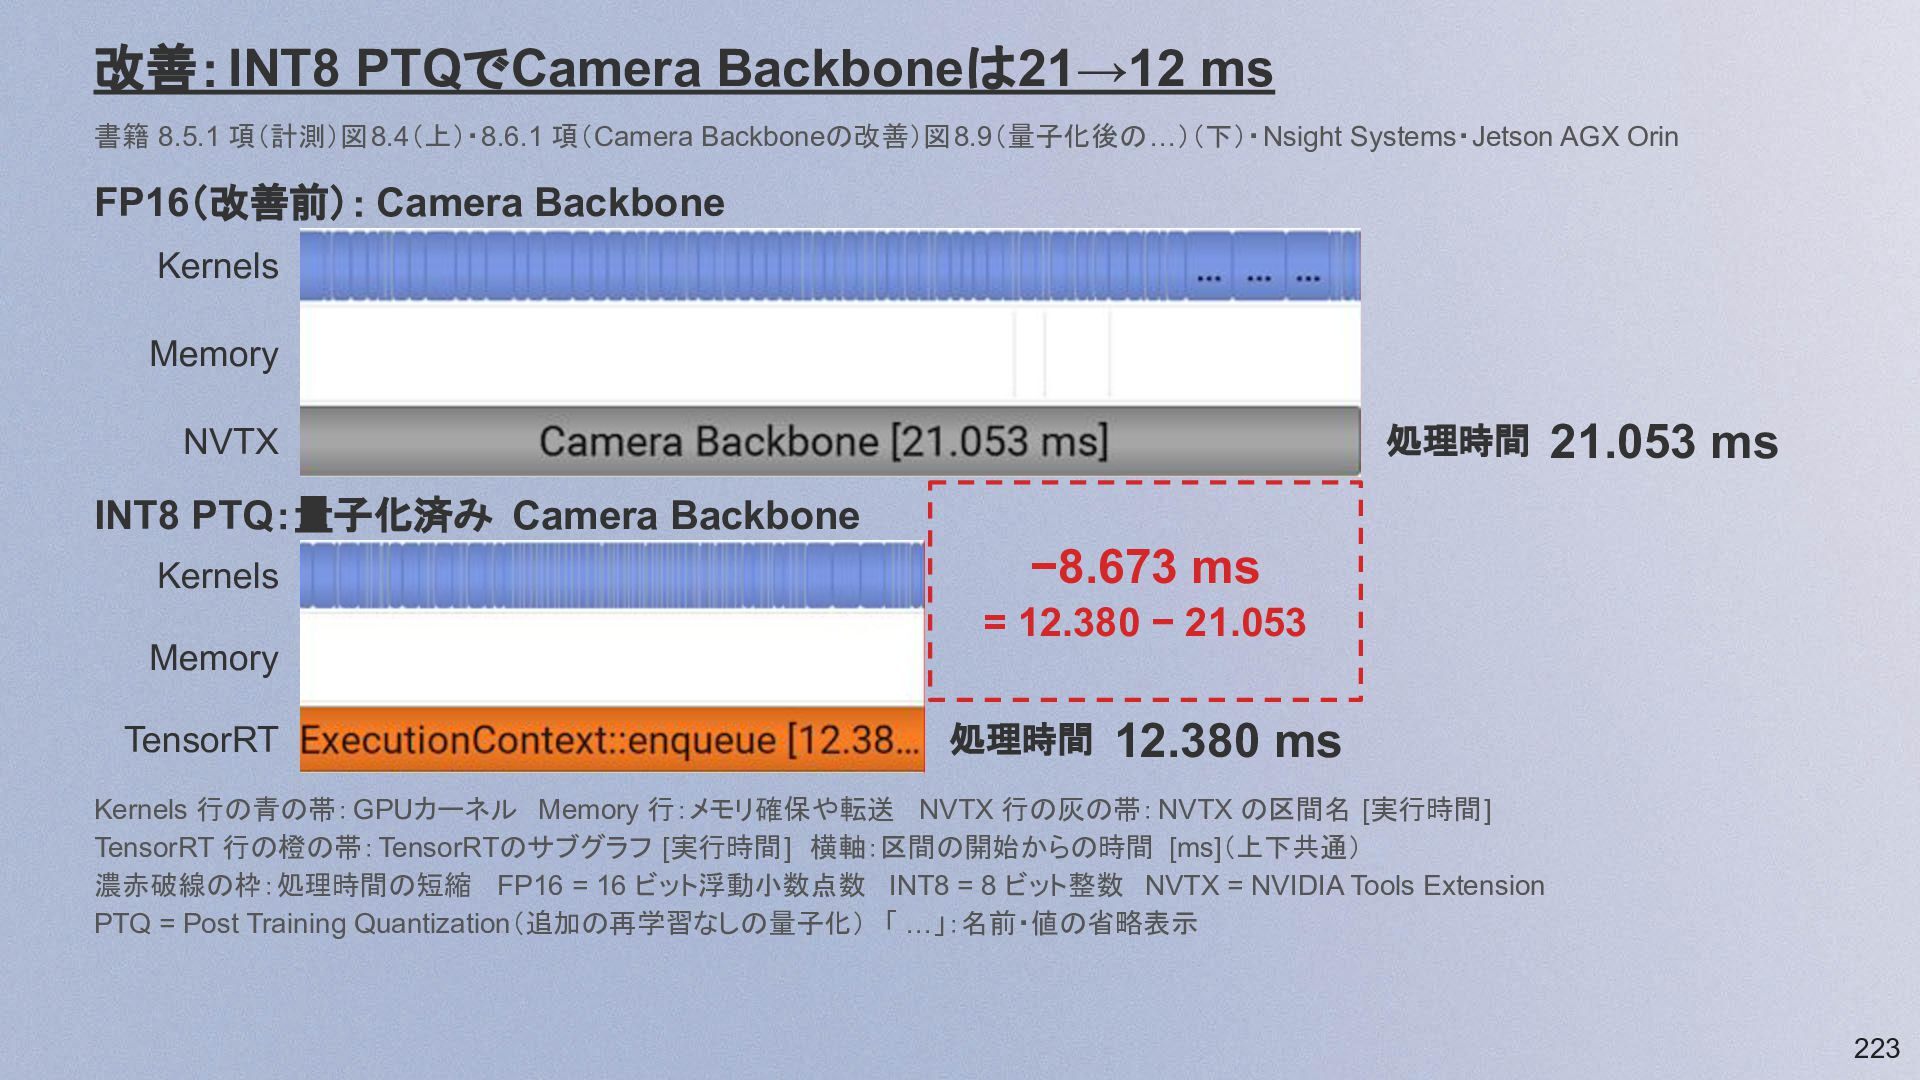
改善:INT8 PTQでCamera Backboneは21→12 ms 書籍 8.5.1 項(計測)図8.4(上)・8.6.1 項(Camera Backboneの改善)図8.9(量子化後の…)(下)・Nsight Systems・Jetson
AGX Orin FP16(改善前): Camera Backbone Kernels Memory 処理時間 21.053 ms NVTX INT8 PTQ:量子化済み Camera Backbone Kernels Memory TensorRT −8.673 ms = 12.380 − 21.053 処理時間 12.380 ms Kernels 行の青の帯:GPUカーネル Memory 行:メモリ確保や転送 NVTX 行の灰の帯:NVTX の区間名 [実行時間] TensorRT 行の橙の帯:TensorRTのサブグラフ [実行時間] 横軸:区間の開始からの時間 [ms](上下共通) 濃赤破線の枠:処理時間の短縮 FP16 = 16 ビット浮動小数点数 INT8 = 8 ビット整数 NVTX = NVIDIA Tools Extension PTQ = Post Training Quantization(追加の再学習なしの量子化) 「 …」:名前・値の省略表示 223 -
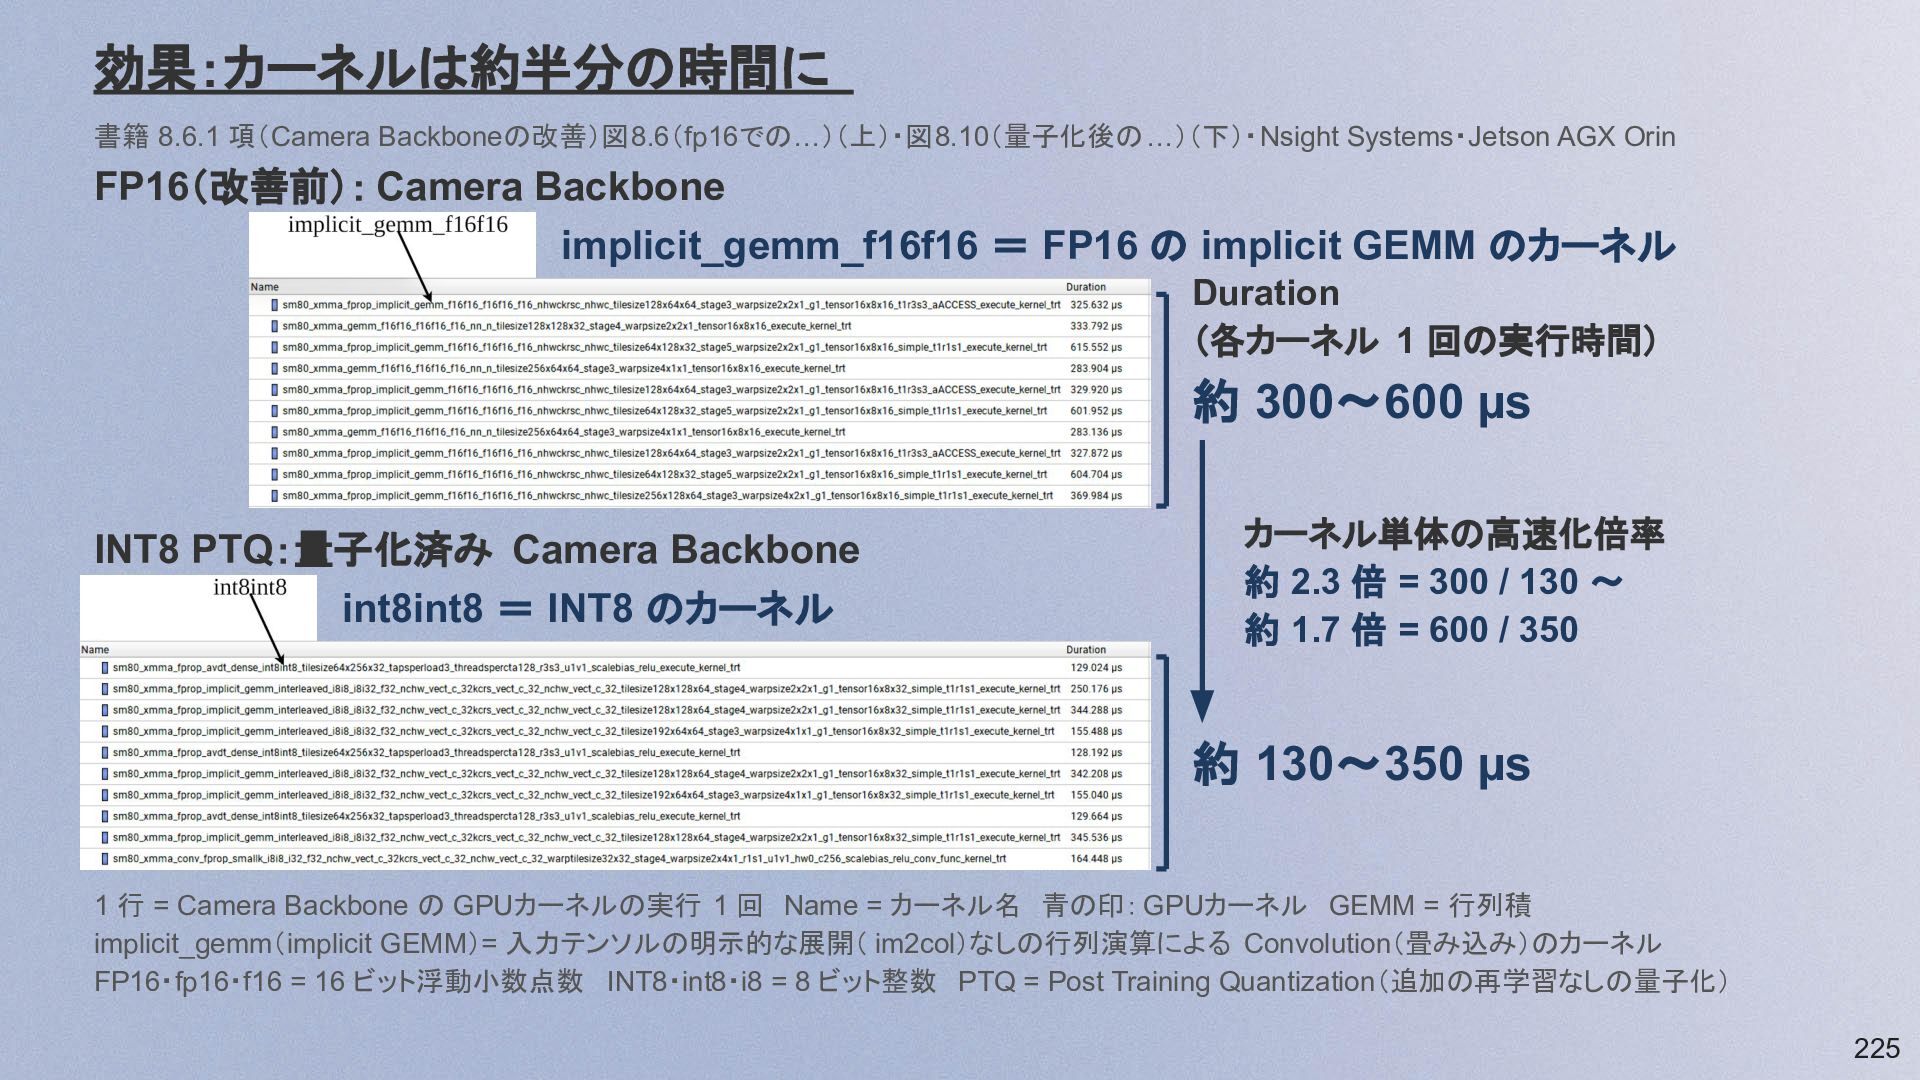
効果:カーネルは約半分の時間に 書籍 8.6.1 項(Camera Backboneの改善)図8.6(fp16での…)(上)・図8.10(量子化後の…)(下)・Nsight Systems・Jetson AGX Orin FP16(改善前): Camera
Backbone implicit_gemm_f16f16 = FP16 の implicit GEMM のカーネル Duration (各カーネル 1 回の実行時間) 約 300〜600 µs INT8 PTQ:量子化済み Camera Backbone int8int8 = INT8 のカーネル カーネル単体の高速化倍率 約 2.3 倍 = 300 / 130 〜 約 1.7 倍 = 600 / 350 約 130〜350 µs 1 行 = Camera Backbone の GPUカーネルの実行 1 回 Name = カーネル名 青の印: GPUカーネル GEMM = 行列積 implicit_gemm(implicit GEMM)= 入力テンソルの明示的な展開( im2col)なしの行列演算による Convolution(畳み込み)のカーネル FP16・fp16・f16 = 16 ビット浮動小数点数 INT8・int8・i8 = 8 ビット整数 PTQ = Post Training Quantization(追加の再学習なしの量子化) 225 -
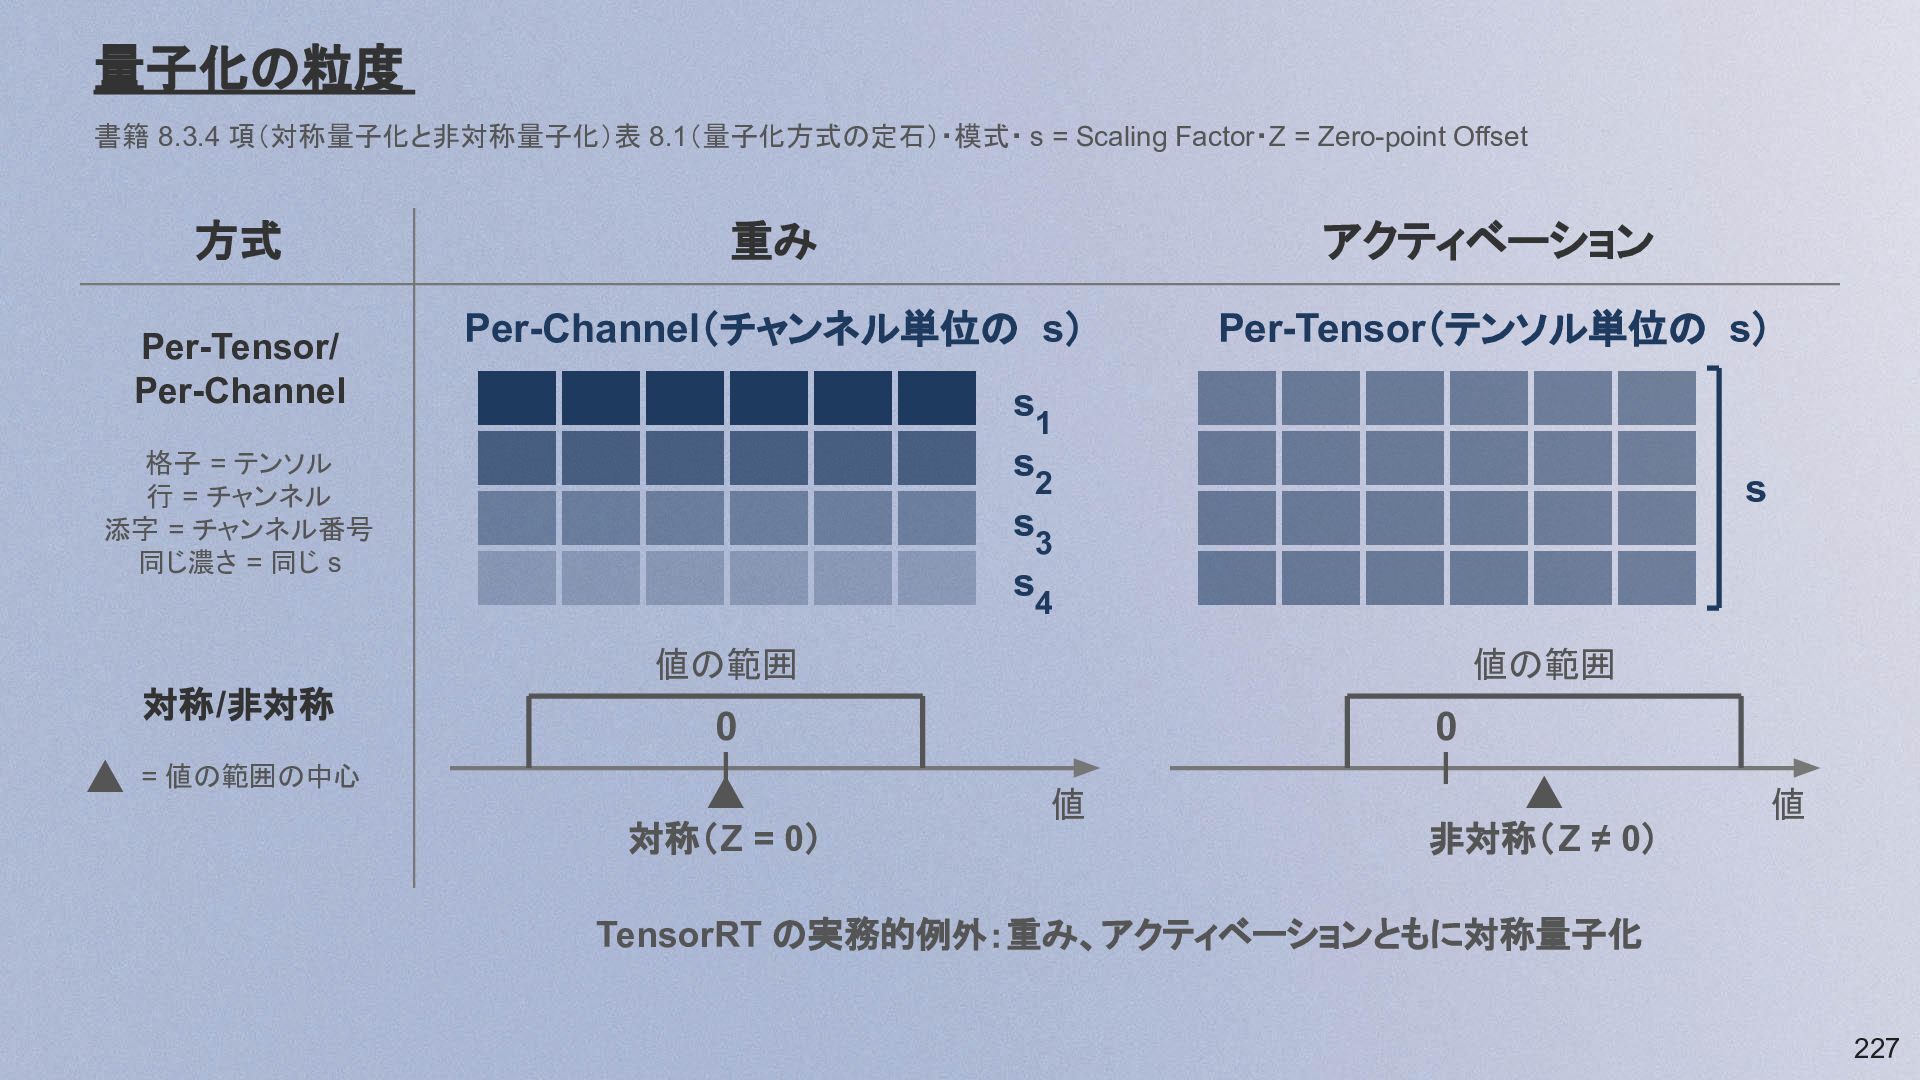
量子化の粒度 書籍 8.3.4 項(対称量子化と非対称量子化)表 8.1(量子化方式の定石)・模式・ s = Scaling Factor・Z =
Zero-point Offset 方式 Per-Tensor/ Per-Channel 重み アクティベーション Per-Channel(チャンネル単位の s) Per-Tensor(テンソル単位の s) s1 s2 格子 = テンソル 行 = チャンネル 添字 = チャンネル番号 同じ濃さ = 同じ s s s3 s4 値の範囲 対称/非対称 値の範囲 0 = 値の範囲の中心 対称(Z = 0) 0 値 非対称( Z ≠ 0) 値 TensorRT の実務的例外:重み、アクティベーションともに対称量子化 227 -
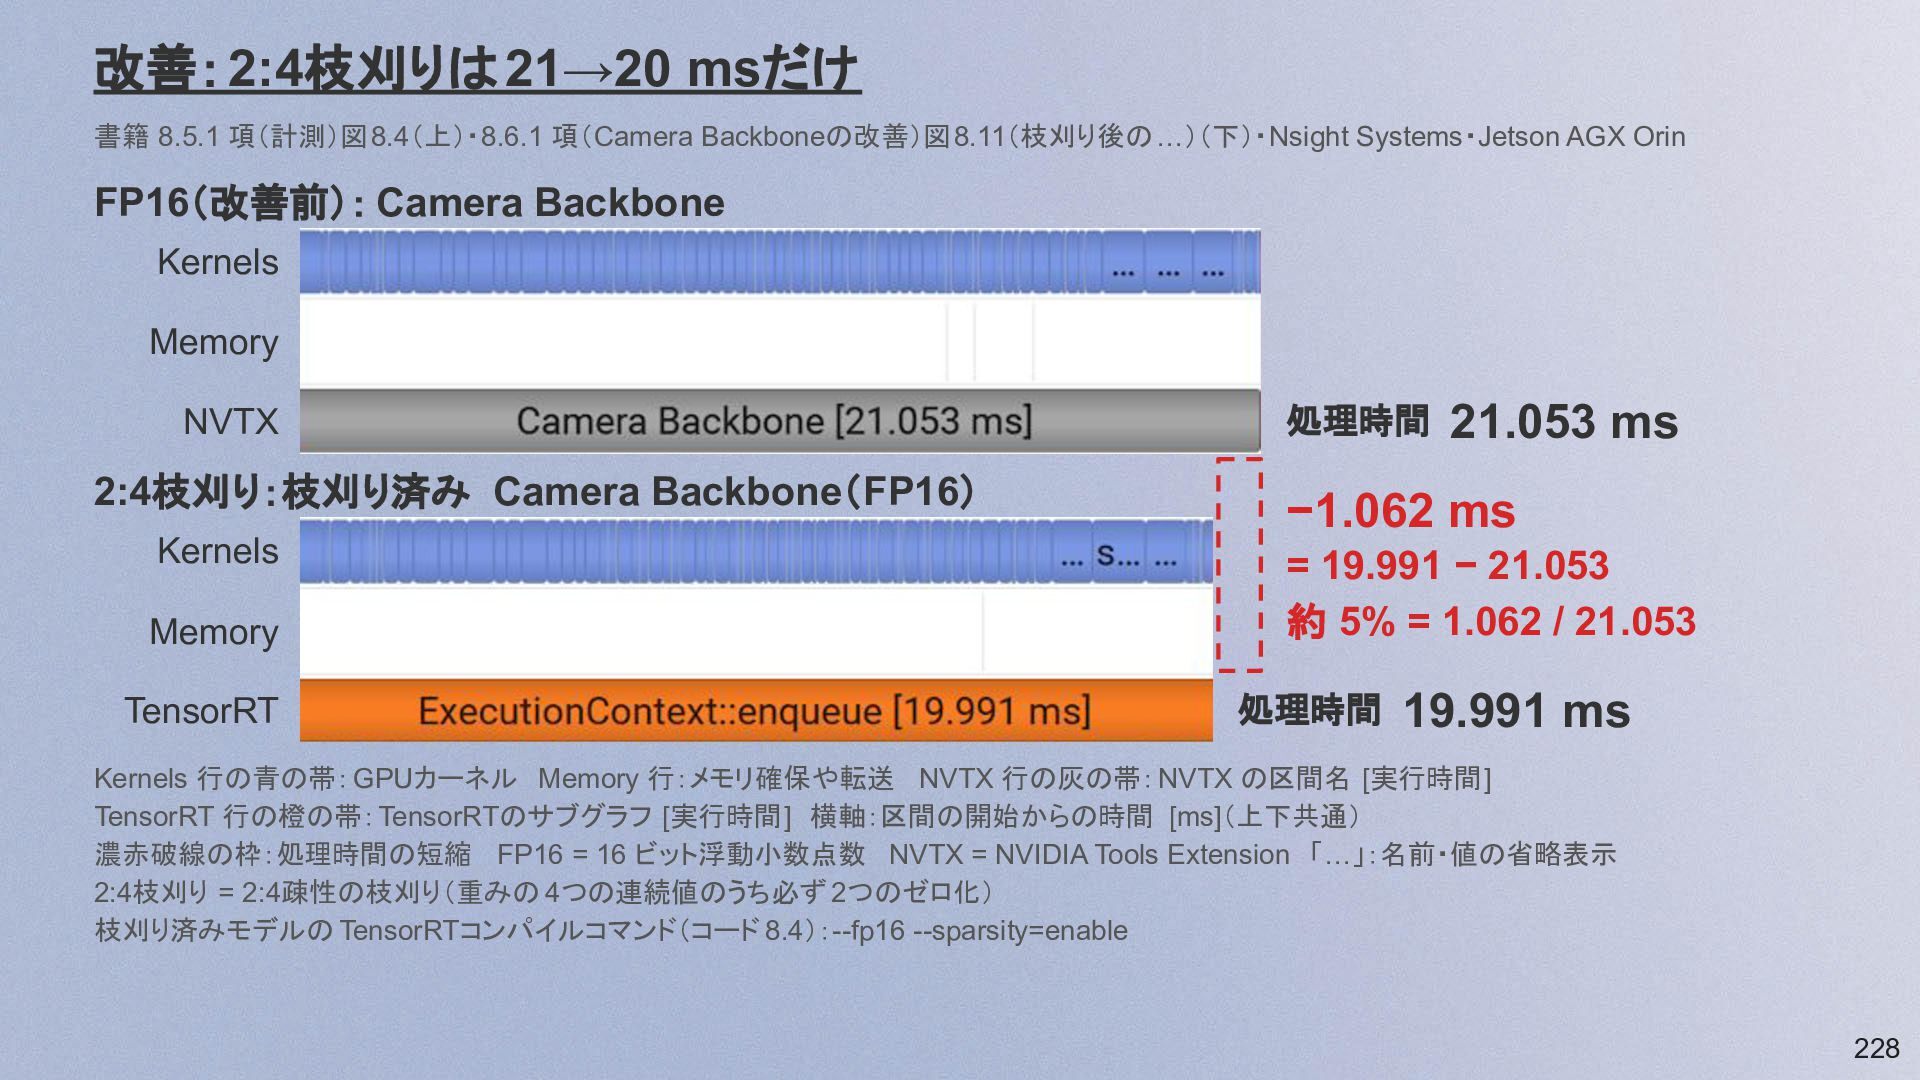
改善:2:4枝刈りは 21→20 msだけ 書籍 8.5.1 項(計測)図8.4(上)・8.6.1 項(Camera Backboneの改善)図8.11(枝刈り後の…)(下)・Nsight Systems・Jetson AGX
Orin FP16(改善前): Camera Backbone Kernels Memory NVTX 2:4枝刈り:枝刈り済み Camera Backbone(FP16) Kernels Memory TensorRT 処理時間 21.053 ms −1.062 ms = 19.991 − 21.053 約 5% = 1.062 / 21.053 処理時間 19.991 ms Kernels 行の青の帯:GPUカーネル Memory 行:メモリ確保や転送 NVTX 行の灰の帯:NVTX の区間名 [実行時間] TensorRT 行の橙の帯:TensorRTのサブグラフ [実行時間] 横軸:区間の開始からの時間 [ms](上下共通) 濃赤破線の枠:処理時間の短縮 FP16 = 16 ビット浮動小数点数 NVTX = NVIDIA Tools Extension 「…」:名前・値の省略表示 2:4枝刈り = 2:4疎性の枝刈り(重みの 4つの連続値のうち必ず 2つのゼロ化) 枝刈り済みモデルの TensorRTコンパイルコマンド(コード 8.4):--fp16 --sparsity=enable 228 -
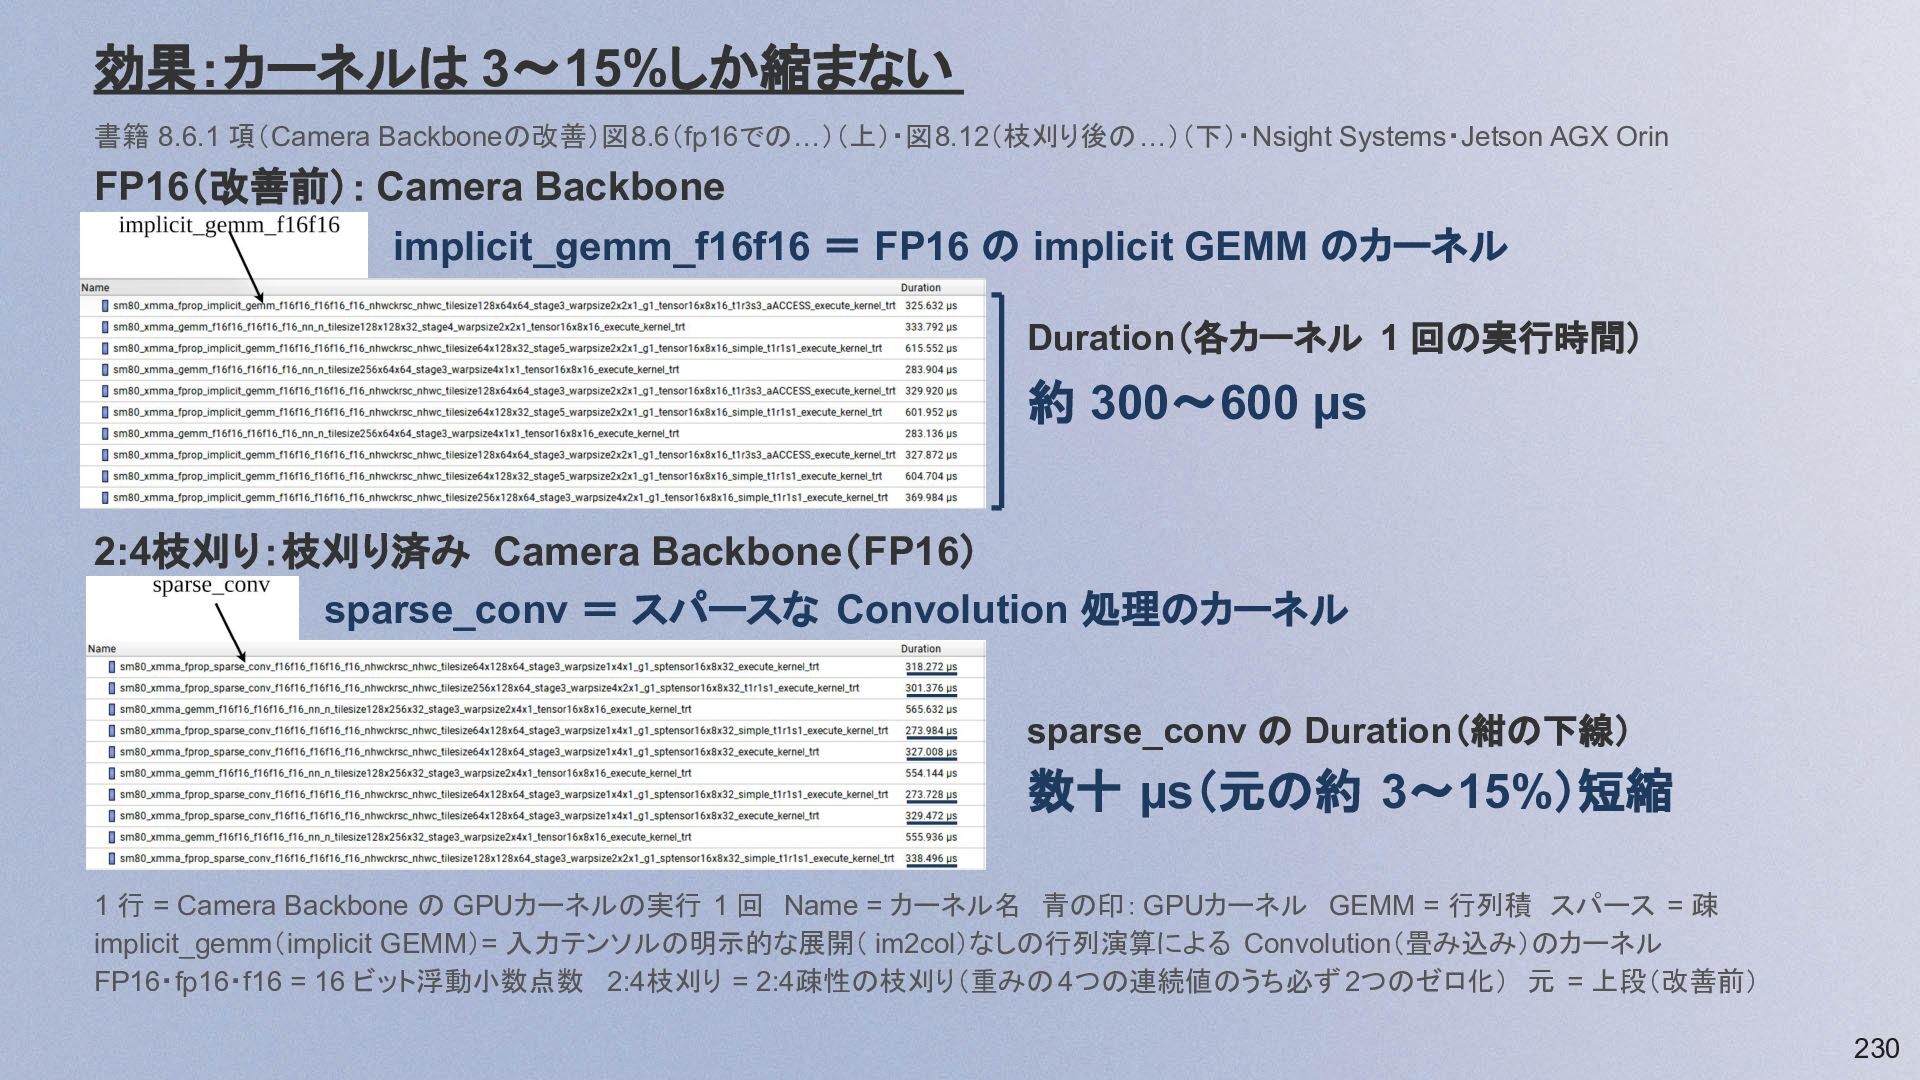
効果:カーネルは 3〜15%しか縮まない 書籍 8.6.1 項(Camera Backboneの改善)図8.6(fp16での…)(上)・図8.12(枝刈り後の…)(下)・Nsight Systems・Jetson AGX Orin FP16(改善前):
Camera Backbone implicit_gemm_f16f16 = FP16 の implicit GEMM のカーネル Duration(各カーネル 1 回の実行時間) 約 300〜600 µs 2:4枝刈り:枝刈り済み Camera Backbone(FP16) sparse_conv = スパースな Convolution 処理のカーネル sparse_conv の Duration(紺の下線) 数十 µs(元の約 3〜15%)短縮 1 行 = Camera Backbone の GPUカーネルの実行 1 回 Name = カーネル名 青の印: GPUカーネル GEMM = 行列積 スパース = 疎 implicit_gemm(implicit GEMM)= 入力テンソルの明示的な展開( im2col)なしの行列演算による Convolution(畳み込み)のカーネル FP16・fp16・f16 = 16 ビット浮動小数点数 2:4枝刈り = 2:4疎性の枝刈り(重みの 4つの連続値のうち必ず 2つのゼロ化) 元 = 上段(改善前) 230 -
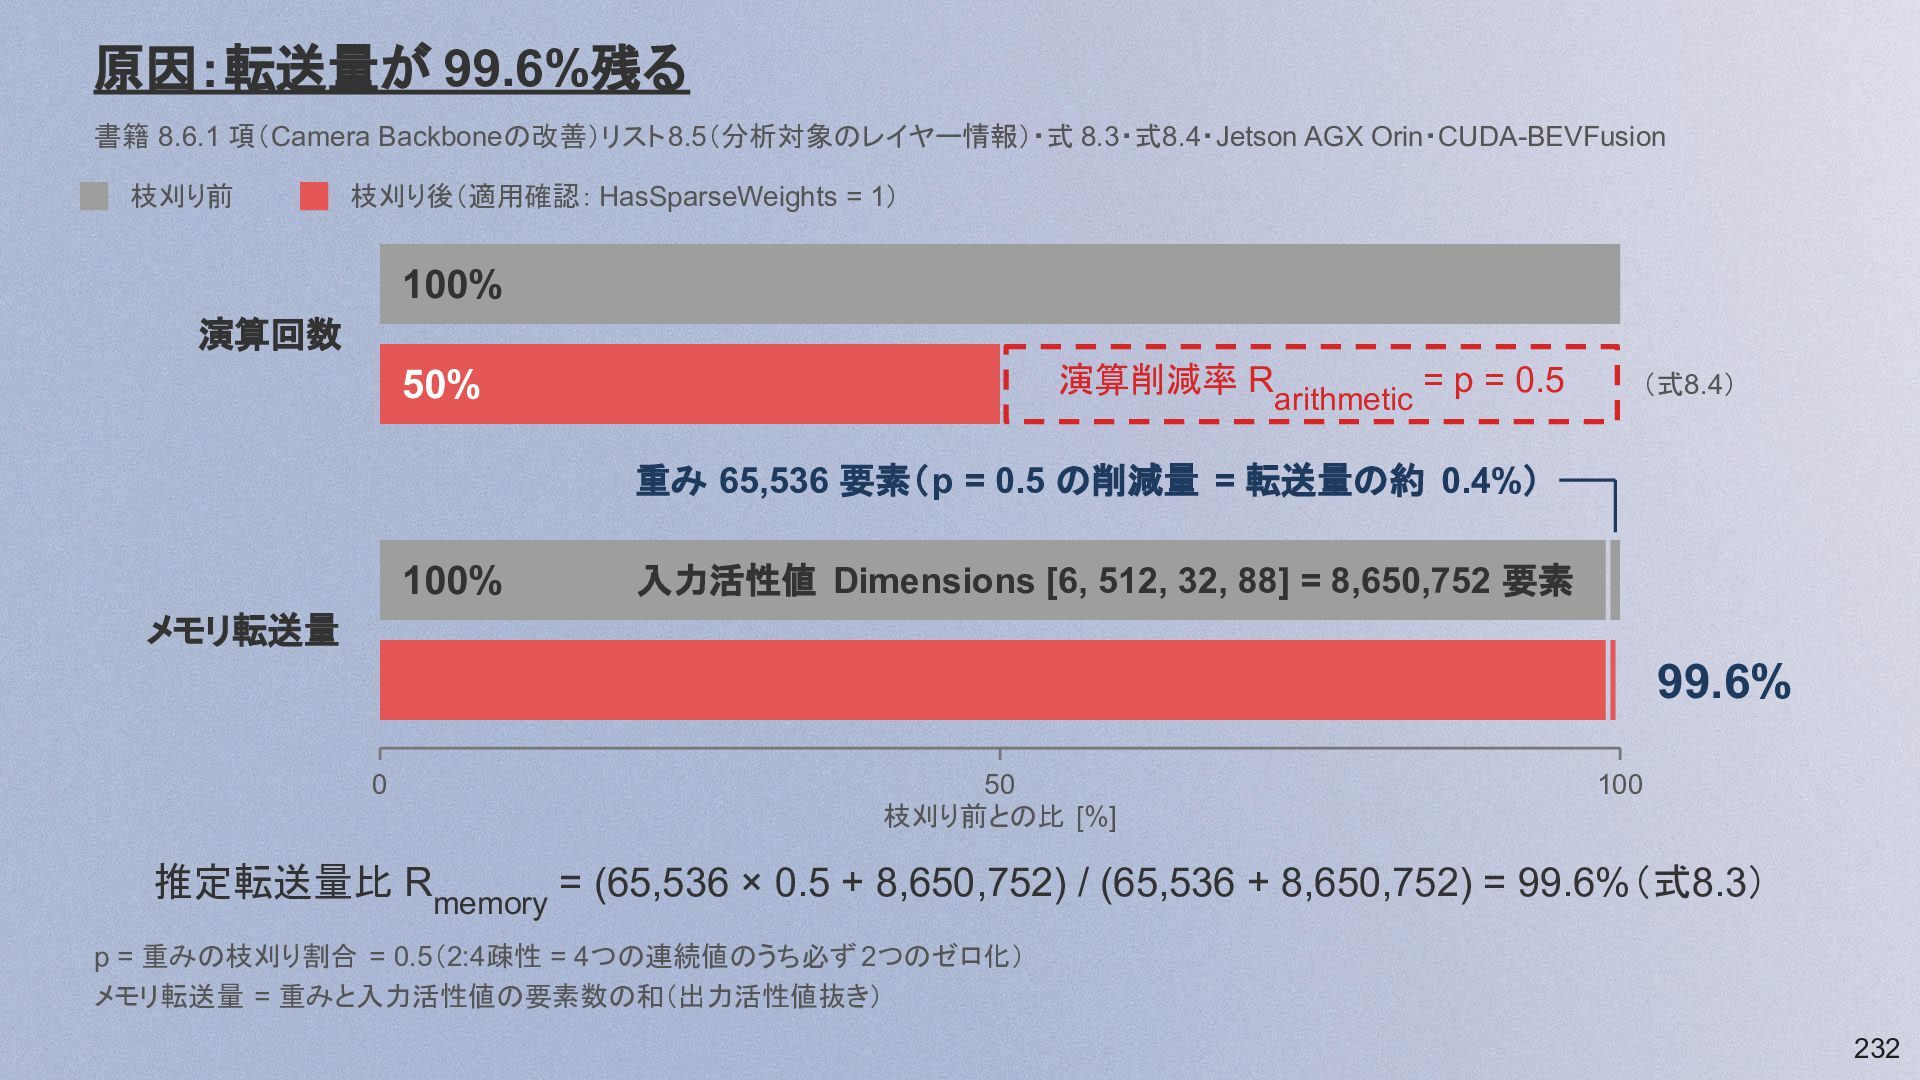
原因:転送量が 99.6%残る 書籍 8.6.1 項(Camera Backboneの改善)リスト 8.5(分析対象のレイヤー情報)・式 8.3・式8.4・Jetson AGX Orin・CUDA-BEVFusion
枝刈り前 枝刈り後(適用確認: HasSparseWeights = 1) 100% 演算回数 演算削減率 R 50% arithmetic = p = 0.5 (式8.4) 重み 65,536 要素(p = 0.5 の削減量 = 転送量の約 0.4%) 100% 入力活性値 Dimensions [6, 512, 32, 88] = 8,650,752 要素 メモリ転送量 99.6% 0 50 枝刈り前との比 [%] 100 推定転送量比 Rmemory = (65,536 × 0.5 + 8,650,752) / (65,536 + 8,650,752) = 99.6%(式8.3) p = 重みの枝刈り割合 = 0.5(2:4疎性 = 4つの連続値のうち必ず 2つのゼロ化) メモリ転送量 = 重みと入力活性値の要素数の和(出力活性値抜き) 232 -
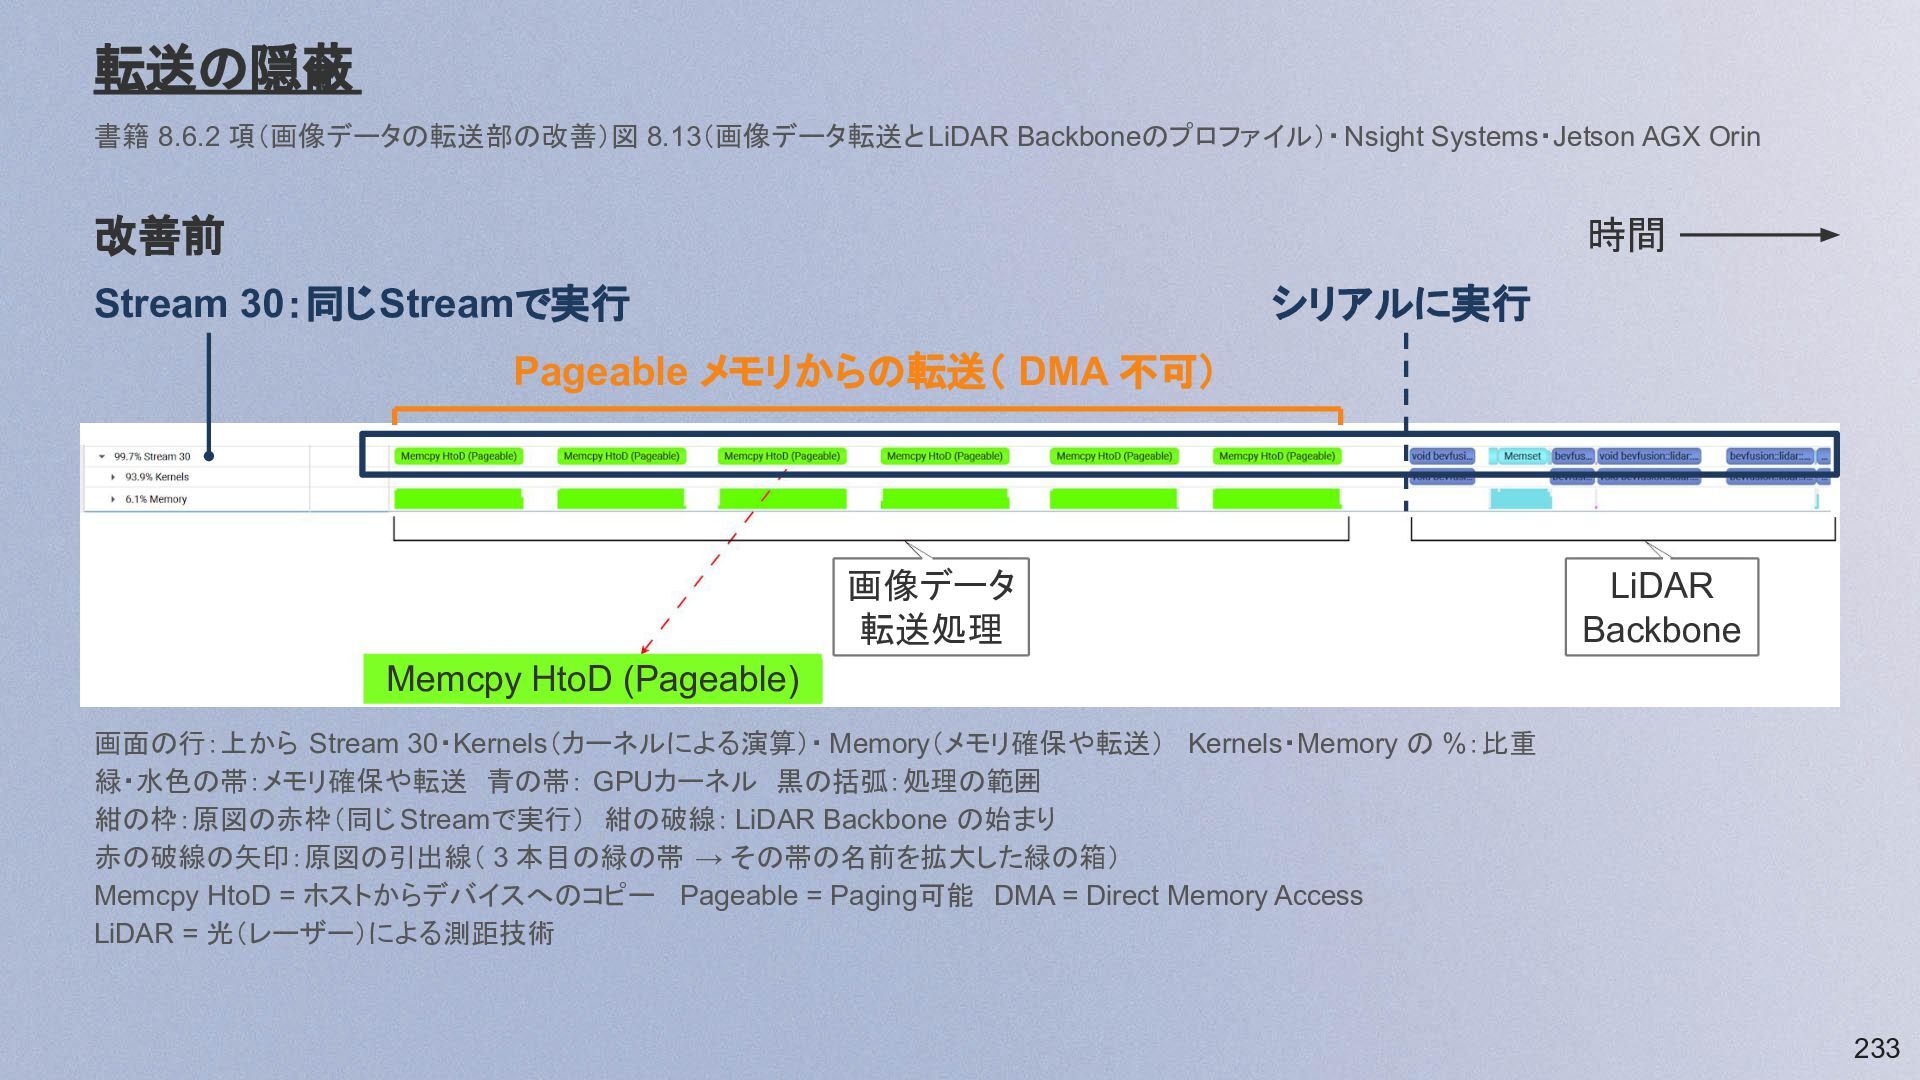
転送の隠蔽 書籍 8.6.2 項(画像データの転送部の改善)図 8.13(画像データ転送と LiDAR Backboneのプロファイル)・ Nsight Systems・Jetson AGX
Orin 改善前 時間 シリアルに実行 Stream 30:同じStreamで実行 Pageable メモリからの転送( DMA 不可) 画像データ 転送処理 LiDAR Backbone Memcpy HtoD (Pageable) 画面の行:上から Stream 30・Kernels(カーネルによる演算)・ Memory(メモリ確保や転送) Kernels・Memory の %:比重 緑・水色の帯:メモリ確保や転送 青の帯: GPUカーネル 黒の括弧:処理の範囲 紺の枠:原図の赤枠(同じ Streamで実行) 紺の破線: LiDAR Backbone の始まり 赤の破線の矢印:原図の引出線( 3 本目の緑の帯 → その帯の名前を拡大した緑の箱) Memcpy HtoD = ホストからデバイスへのコピー Pageable = Paging可能 DMA = Direct Memory Access LiDAR = 光(レーザー)による測距技術 233 -
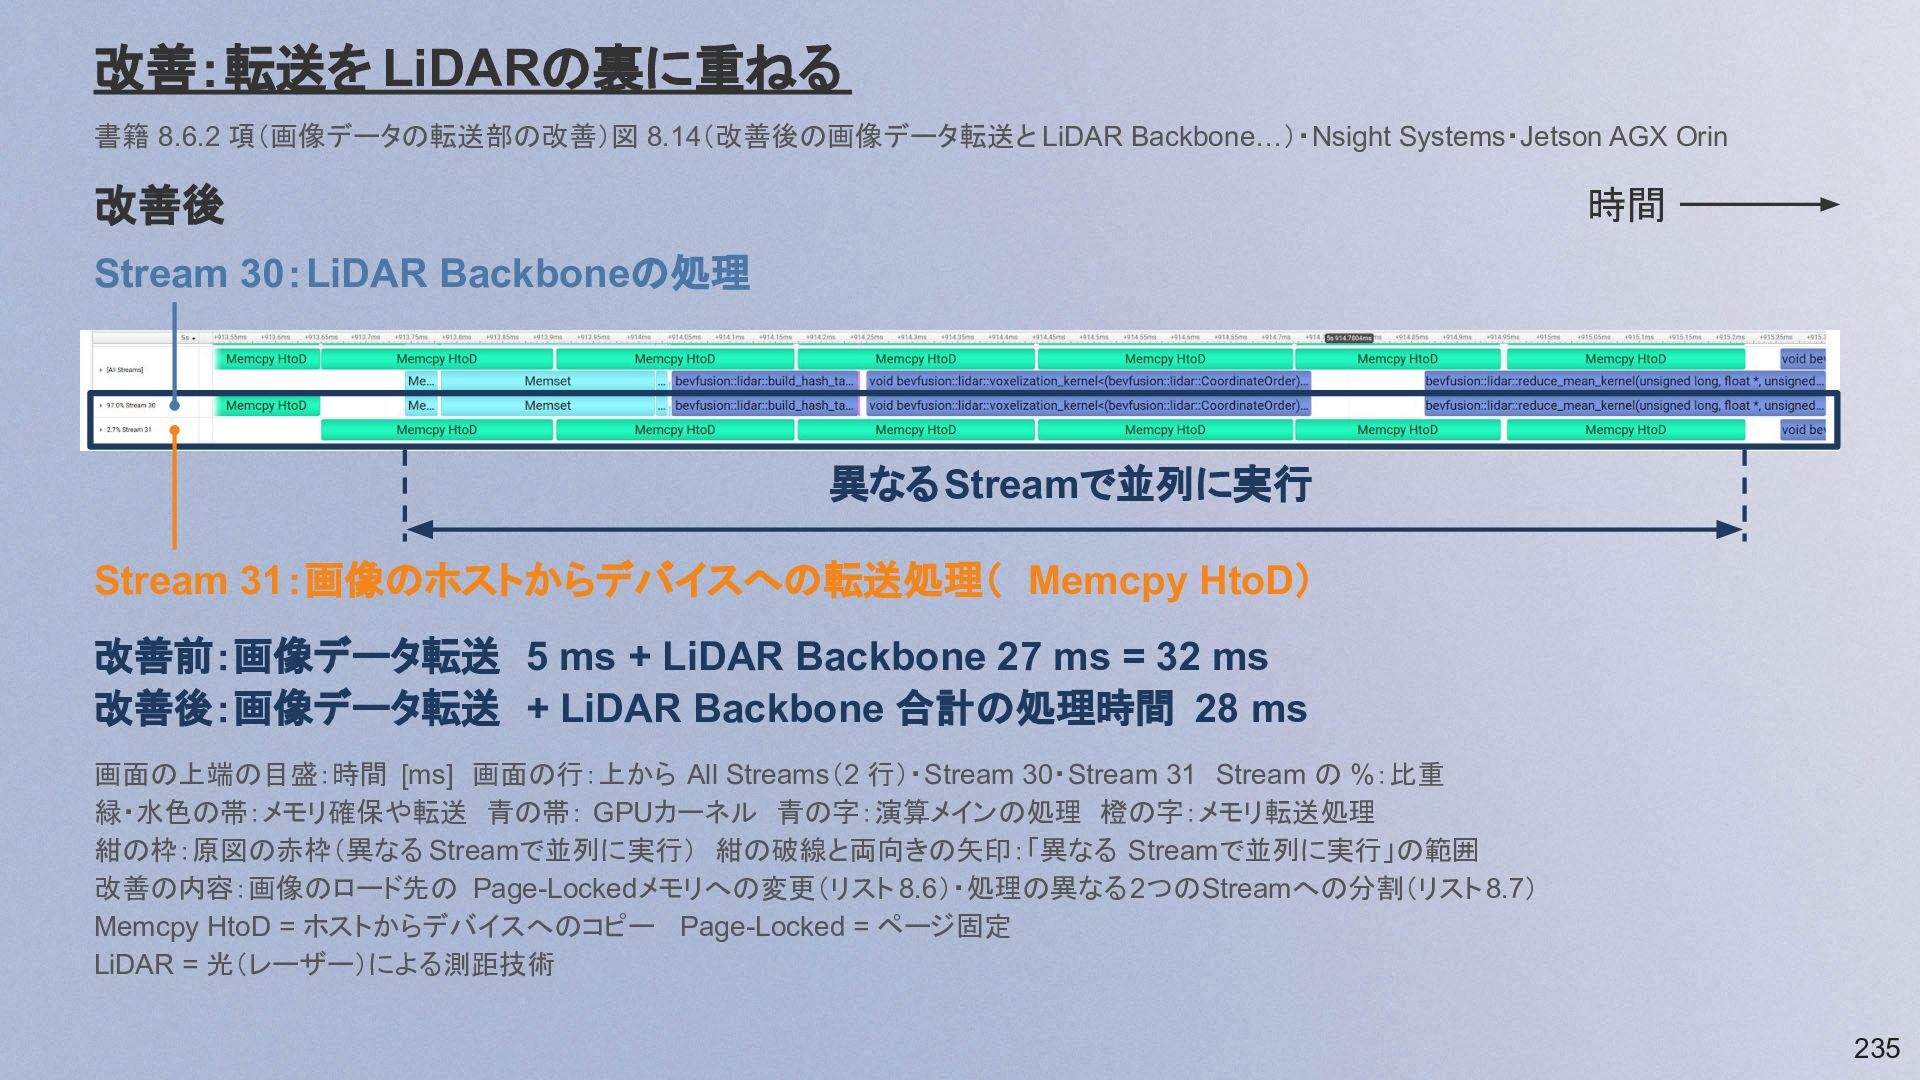
改善:転送を LiDARの裏に重ねる 書籍 8.6.2 項(画像データの転送部の改善)図 8.14(改善後の画像データ転送と LiDAR Backbone…)・Nsight Systems・Jetson AGX
Orin 改善後 時間 Stream 30:LiDAR Backboneの処理 異なるStreamで並列に実行 Stream 31:画像のホストからデバイスへの転送処理( Memcpy HtoD) 改善前:画像データ転送 5 ms + LiDAR Backbone 27 ms = 32 ms 改善後:画像データ転送 + LiDAR Backbone 合計の処理時間 28 ms 画面の上端の目盛:時間 [ms] 画面の行:上から All Streams(2 行)・Stream 30・Stream 31 Stream の %:比重 緑・水色の帯:メモリ確保や転送 青の帯: GPUカーネル 青の字:演算メインの処理 橙の字:メモリ転送処理 紺の枠:原図の赤枠(異なる Streamで並列に実行) 紺の破線と両向きの矢印:「異なる Streamで並列に実行」の範囲 改善の内容:画像のロード先の Page-Lockedメモリへの変更(リスト 8.6)・処理の異なる 2つのStreamへの分割(リスト 8.7) Memcpy HtoD = ホストからデバイスへのコピー Page-Locked = ページ固定 LiDAR = 光(レーザー)による測距技術 235 -
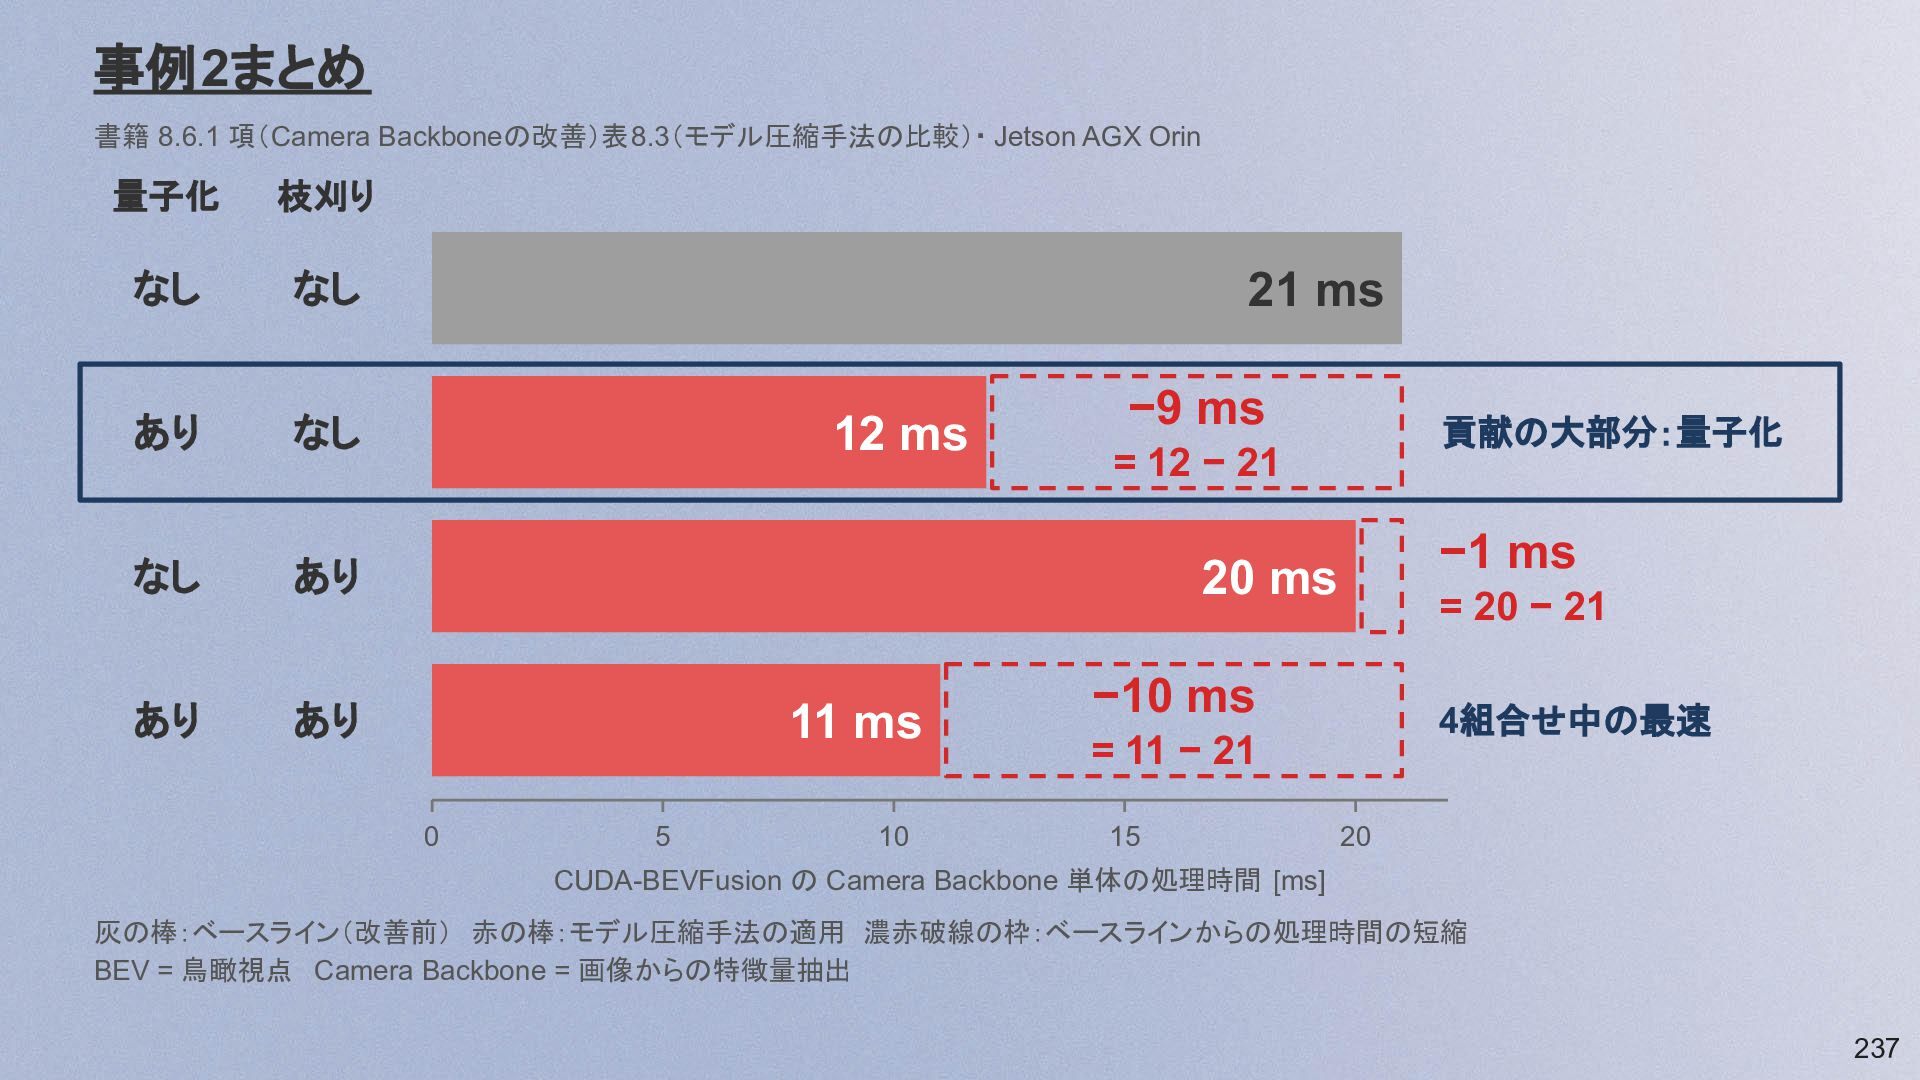
事例2まとめ 書籍 8.6.1 項(Camera Backboneの改善)表8.3(モデル圧縮手法の比較)・ Jetson AGX Orin 量子化 枝刈り
なし なし あり なし なし あり あり あり 21 ms 12 ms −9 ms 貢献の大部分:量子化 = 12 − 21 −1 ms 20 ms 11 ms 0 5 10 = 20 − 21 −10 ms 4組合せ中の最速 = 11 − 21 15 20 CUDA-BEVFusion の Camera Backbone 単体の処理時間 [ms] 灰の棒:ベースライン(改善前) 赤の棒:モデル圧縮手法の適用 濃赤破線の枠:ベースラインからの処理時間の短縮 BEV = 鳥瞰視点 Camera Backbone = 画像からの特徴量抽出 237 -
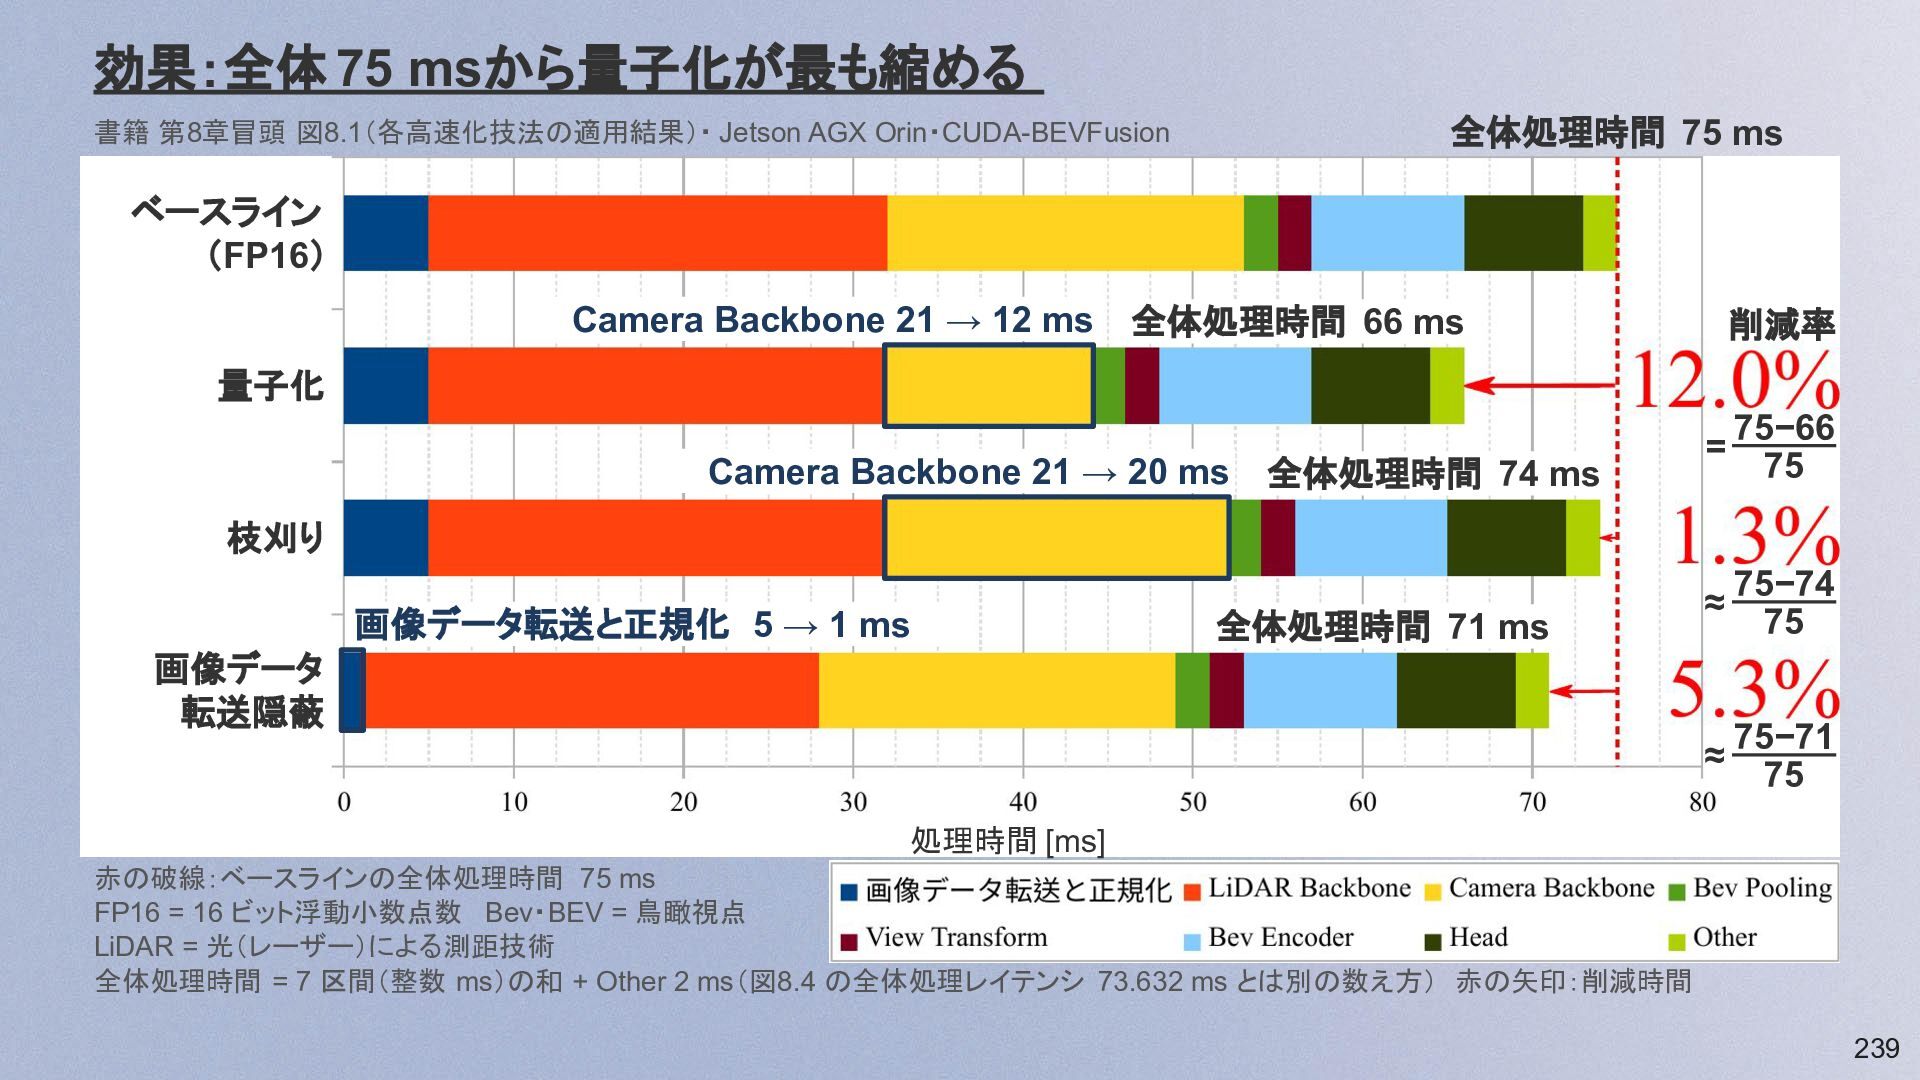
効果:全体 75 msから量子化が最も縮める 全体処理時間 75 ms 書籍 第8章冒頭 図8.1(各高速化技法の適用結果)・ Jetson
AGX Orin・CUDA-BEVFusion ベースライン (FP16) Camera Backbone 21 → 12 ms 全体処理時間 66 ms 削減率 量子化 Camera Backbone 21 → 20 ms 全体処理時間 74 ms = 75−66 75 ≈ 75−74 75 ≈ 75−71 75 枝刈り 画像データ転送と正規化 5 → 1 ms 全体処理時間 71 ms 画像データ 転送隠蔽 処理時間 [ms] 赤の破線:ベースラインの全体処理時間 75 ms FP16 = 16 ビット浮動小数点数 Bev・BEV = 鳥瞰視点 LiDAR = 光(レーザー)による測距技術 全体処理時間 = 7 区間(整数 ms)の和 + Other 2 ms(図8.4 の全体処理レイテンシ 73.632 ms とは別の数え方) 赤の矢印:削減時間 239 -
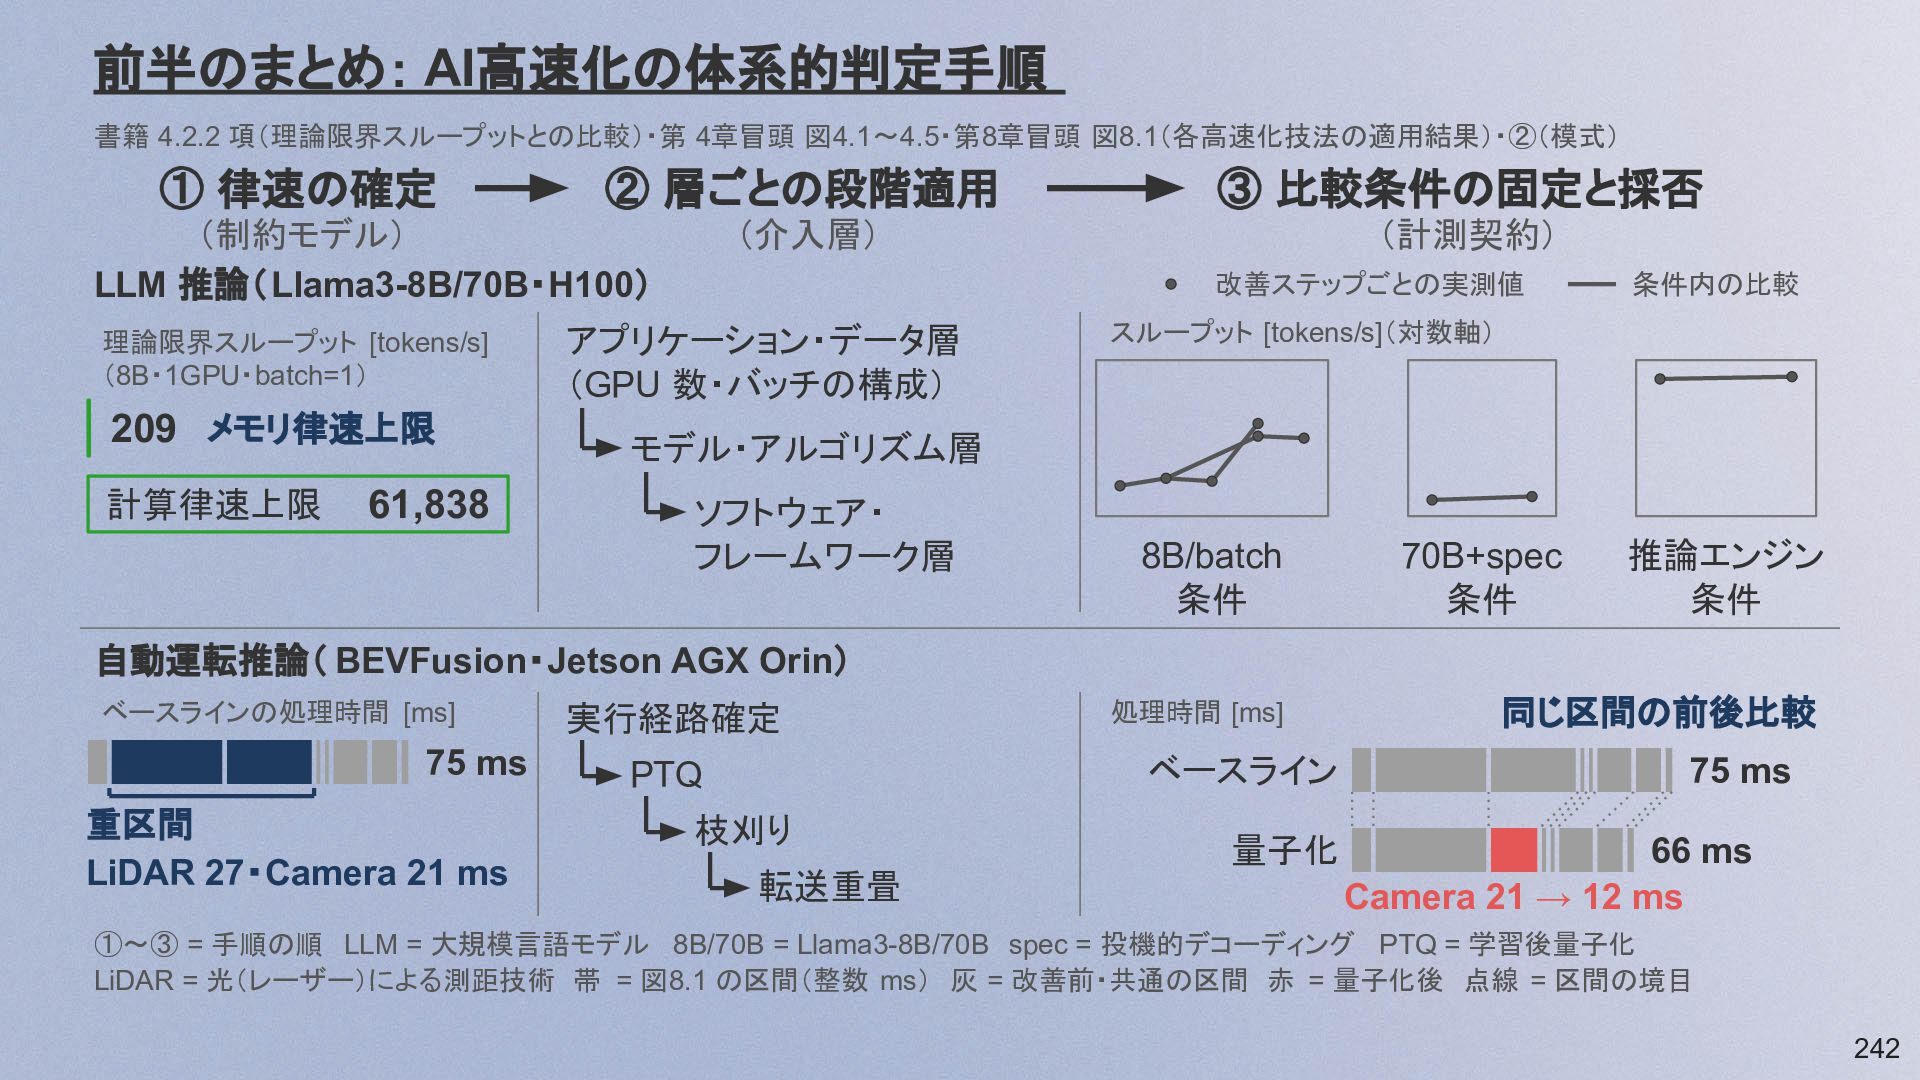
前半のまとめ: AI高速化の体系的判定手順 書籍 4.2.2 項(理論限界スループットとの比較)・第 4章冒頭 図4.1〜4.5・第8章冒頭 図8.1(各高速化技法の適用結果)・②(模式) ① 律速の確定
② 層ごとの段階適用 (制約モデル) LLM 推論(Llama3-8B/70B・H100) 理論限界スループット [tokens/s] (8B・1GPU・batch=1) 209 メモリ律速上限 計算律速上限 61,838 ③ 比較条件の固定と採否 (介入層) (計測契約) 改善ステップごとの実測値 アプリケーション・データ層 (GPU 数・バッチの構成) 条件内の比較 スループット [tokens/s](対数軸) モデル・アルゴリズム層 ソフトウェア・ フレームワーク層 8B/batch 条件 70B+spec 条件 推論エンジン 条件 自動運転推論( BEVFusion・Jetson AGX Orin) ベースラインの処理時間 [ms] 75 ms 重区間 LiDAR 27・Camera 21 ms 実行経路確定 処理時間 [ms] ベースライン PTQ 枝刈り 転送重畳 量子化 同じ区間の前後比較 75 ms 66 ms Camera 21 → 12 ms ①〜③ = 手順の順 LLM = 大規模言語モデル 8B/70B = Llama3-8B/70B spec = 投機的デコーディング PTQ = 学習後量子化 LiDAR = 光(レーザー)による測距技術 帯 = 図8.1 の区間(整数 ms) 灰 = 改善前・共通の区間 赤 = 量子化後 点線 = 区間の境目 242 -
発展編TL;DR: 理論下限 12.53 ms(実行効率 12.53 ÷ 34.2 ≈ 37%) 計測
ホスト待ち 7.4 ms デバイス稼働時間 26.81 ms 0 6 12 18 24 改善 停止 unpack スレッド 待ち 待ち 原本の待ち 施策の待ち 1,792 命令 停止 6 12 停止 待ち compute kernel の12行 −2.42 ms(−9.0%) 施策後 24.39 ms 0 [ms] 1,792 命令 入力を詰める 原本 26.81 ms 確認 36 gate+up(演算コアの1つ) FPU 実行 1,792 命令 unpack スレッド(模式) (decode 1ステップの時間) 30 1周期 2,448 cycle(中央値) 原因 TPOT 34.2 ms デバイス稼働時間 18 24 30 36 [ms] 245 -
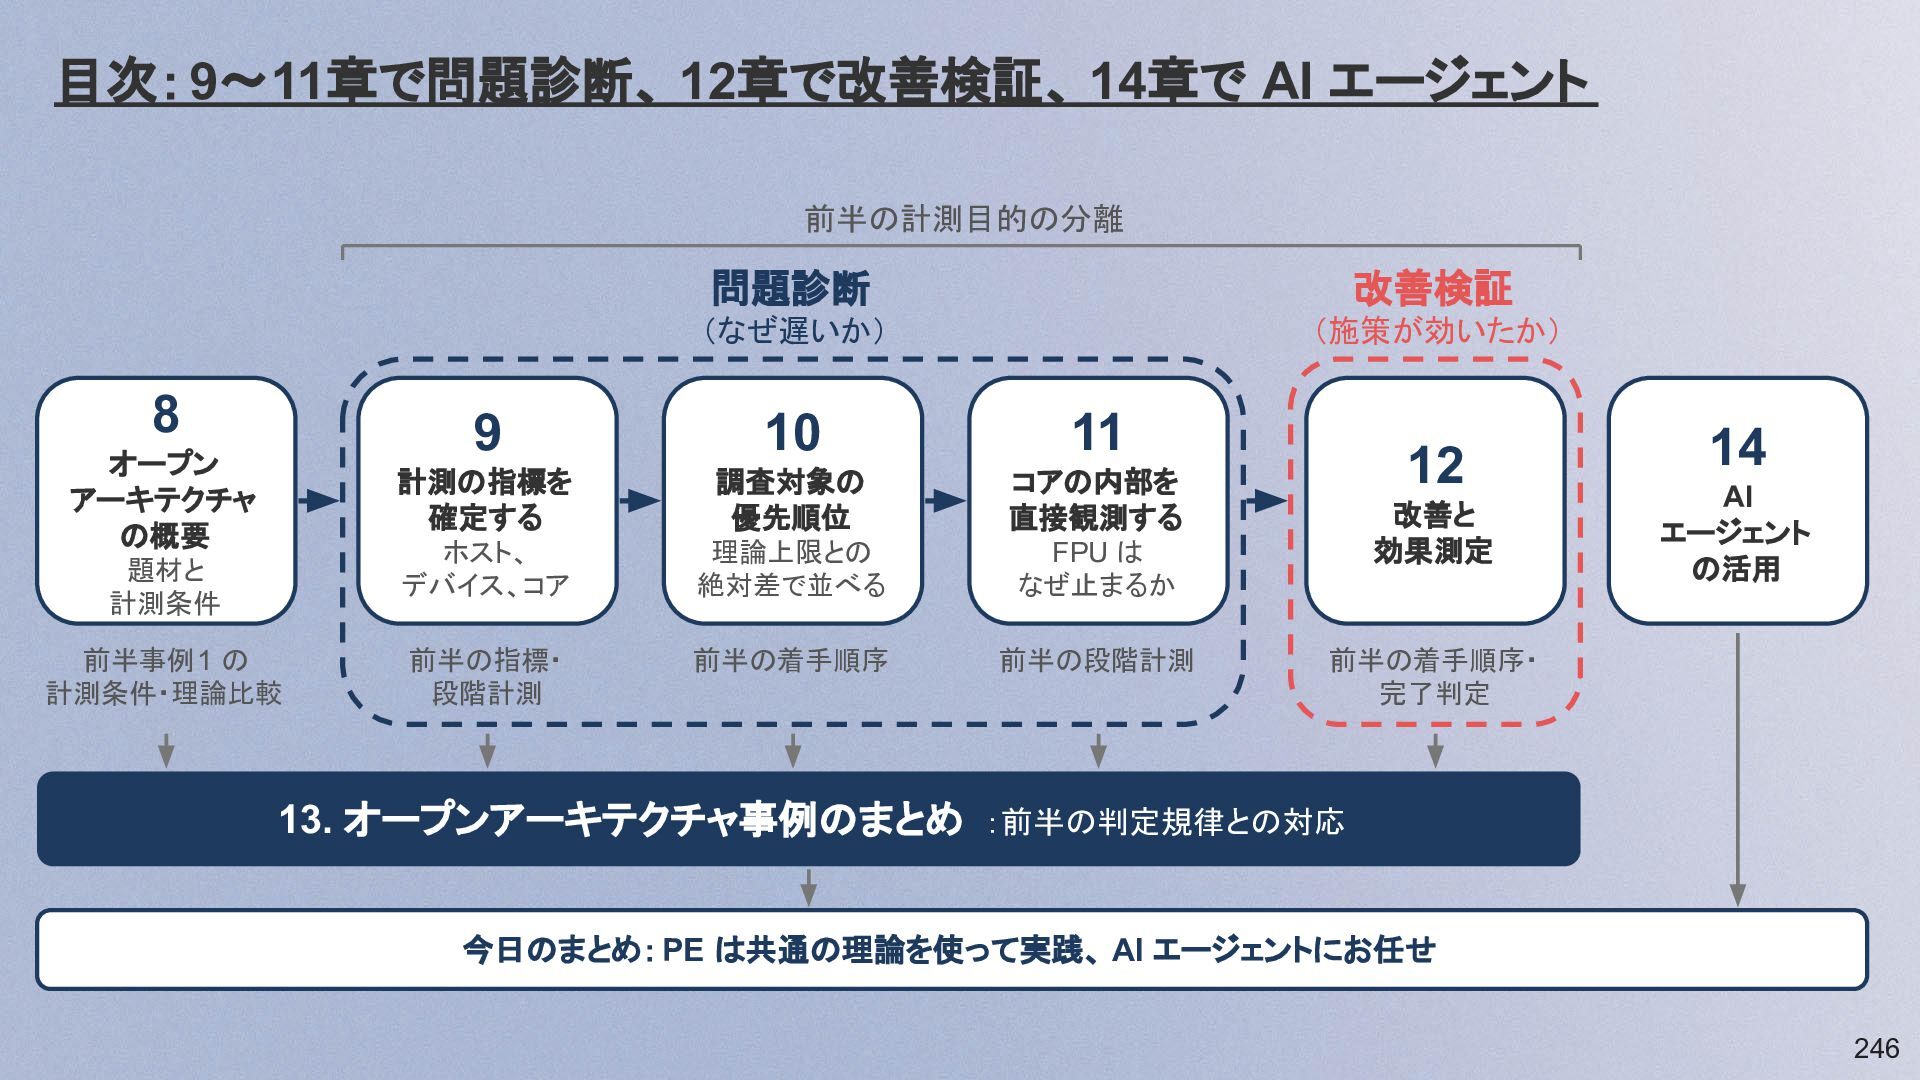
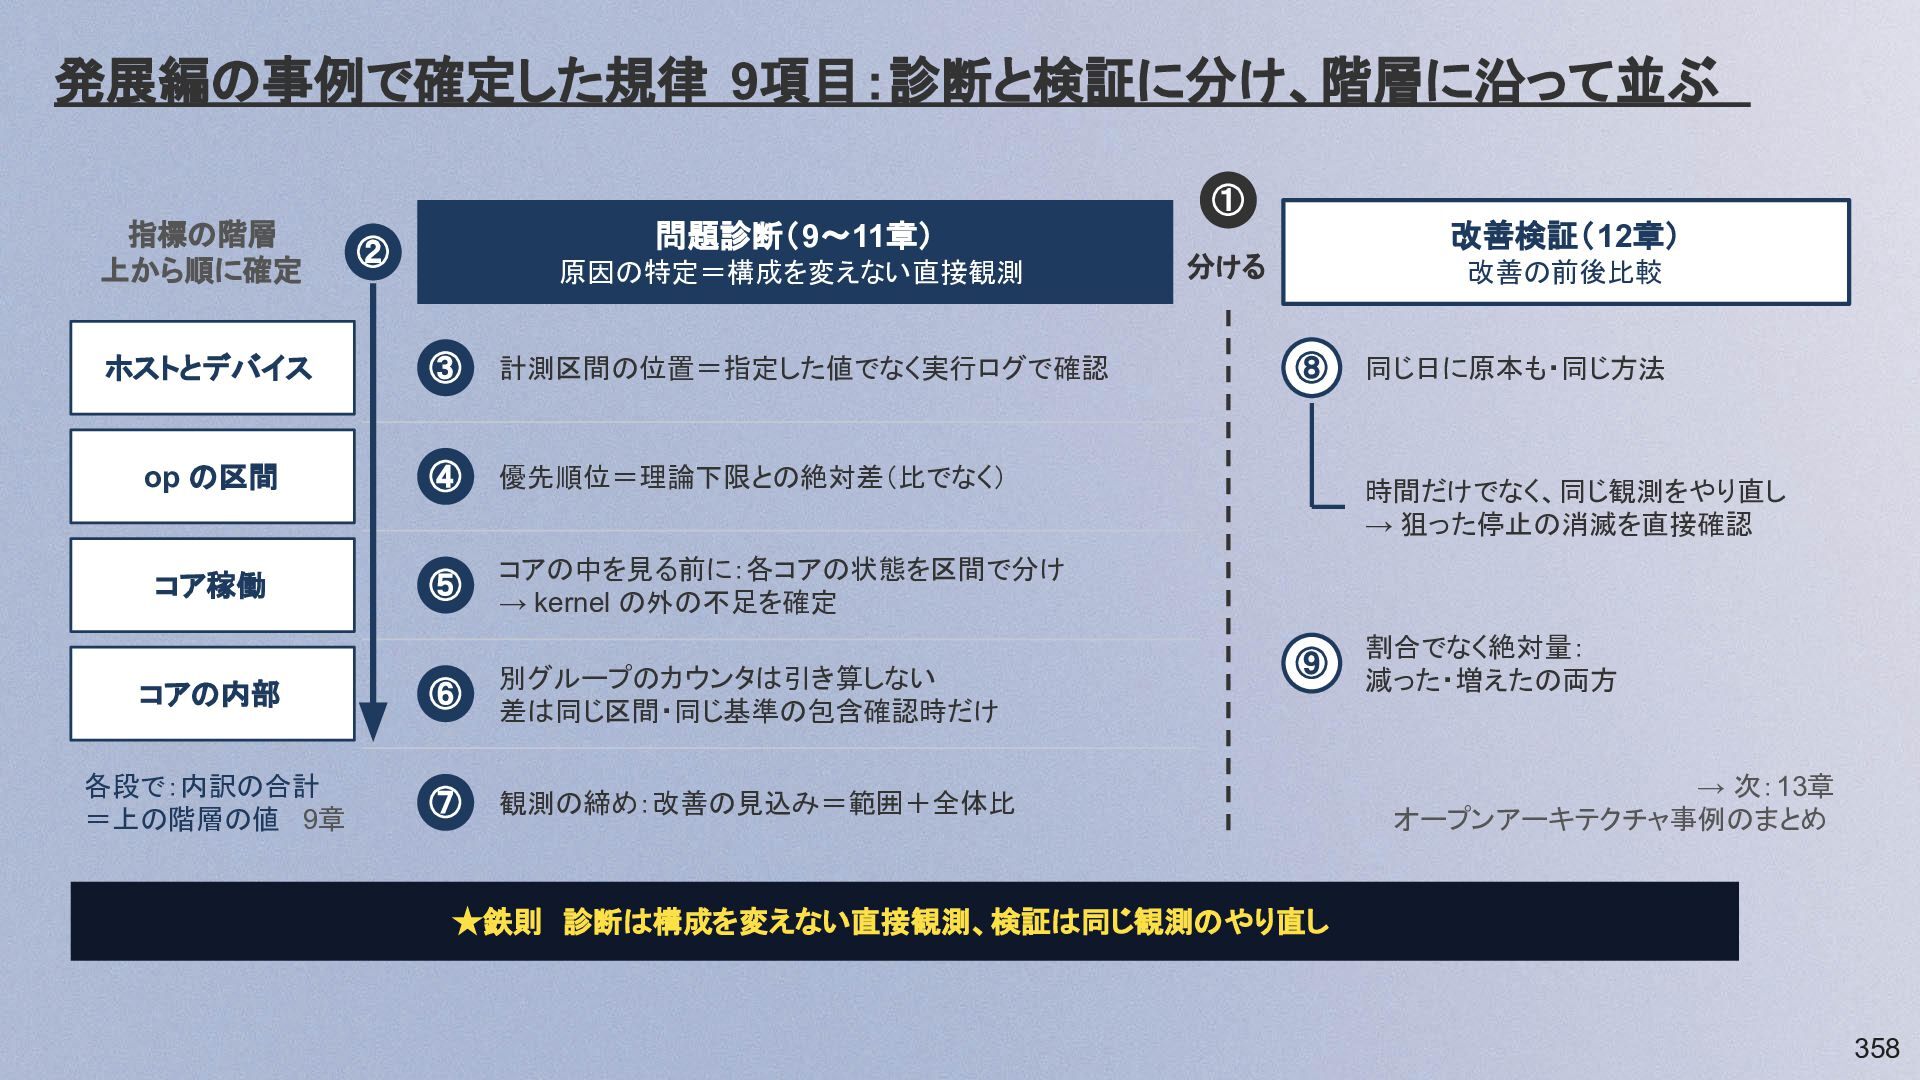
目次:9〜11章で問題診断、 12章で改善検証、 14章で AI エージェント 前半の計測目的の分離 8 オープン アーキテクチャ の概要
題材と 計測条件 前半事例1 の 計測条件・理論比較 問題診断 改善検証 (なぜ遅いか) (施策が効いたか) 9 10 11 計測の指標を 確定する 調査対象の 優先順位 コアの内部を 直接観測する ホスト、 デバイス、コア 理論上限との 絶対差で並べる FPU は なぜ止まるか 前半の指標・ 段階計測 前半の着手順序 前半の段階計測 12 改善と 効果測定 14 AI エージェント の活用 前半の着手順序・ 完了判定 13. オープンアーキテクチャ事例のまとめ :前半の判定規律との対応 今日のまとめ: PE は共通の理論を使って実践、 AI エージェントにお任せ 246 -
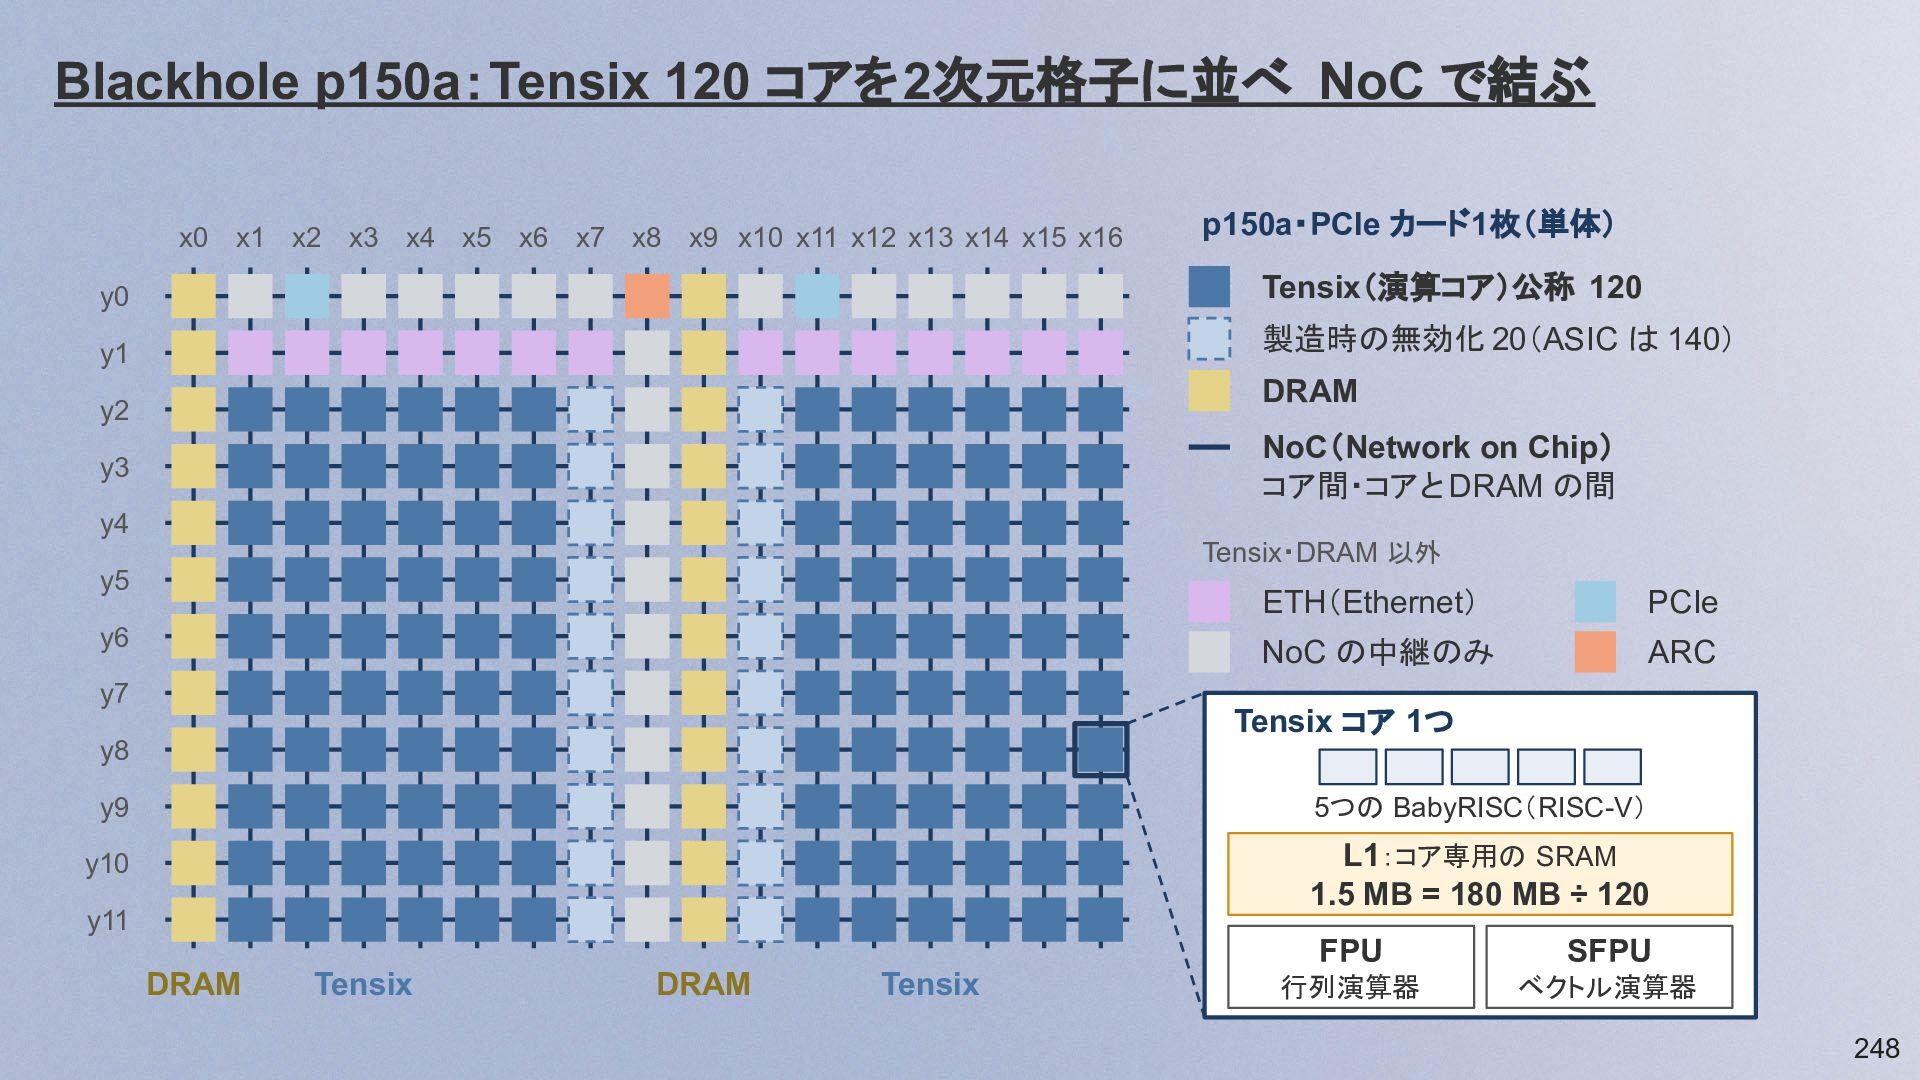
Blackhole p150a:Tensix 120 コアを2次元格子に並べ NoC で結ぶ x0 x1 x2 x3
x4 x5 x6 x7 x8 x9 x10 x11 x12 x13 x14 x15 x16 p150a・PCIe カード1枚(単体) y0 Tensix(演算コア)公称 120 y1 製造時の無効化 20(ASIC は 140) DRAM y2 NoC(Network on Chip) コア間・コアと DRAM の間 y3 y4 Tensix・DRAM 以外 y5 y6 y7 ETH(Ethernet) PCIe NoC の中継のみ ARC Tensix コア 1つ y8 y9 5つの BabyRISC(RISC-V) y10 L1:コア専用の SRAM 1.5 MB = 180 MB ÷ 120 y11 DRAM Tensix DRAM Tensix FPU SFPU 行列演算器 ベクトル演算器 248 -
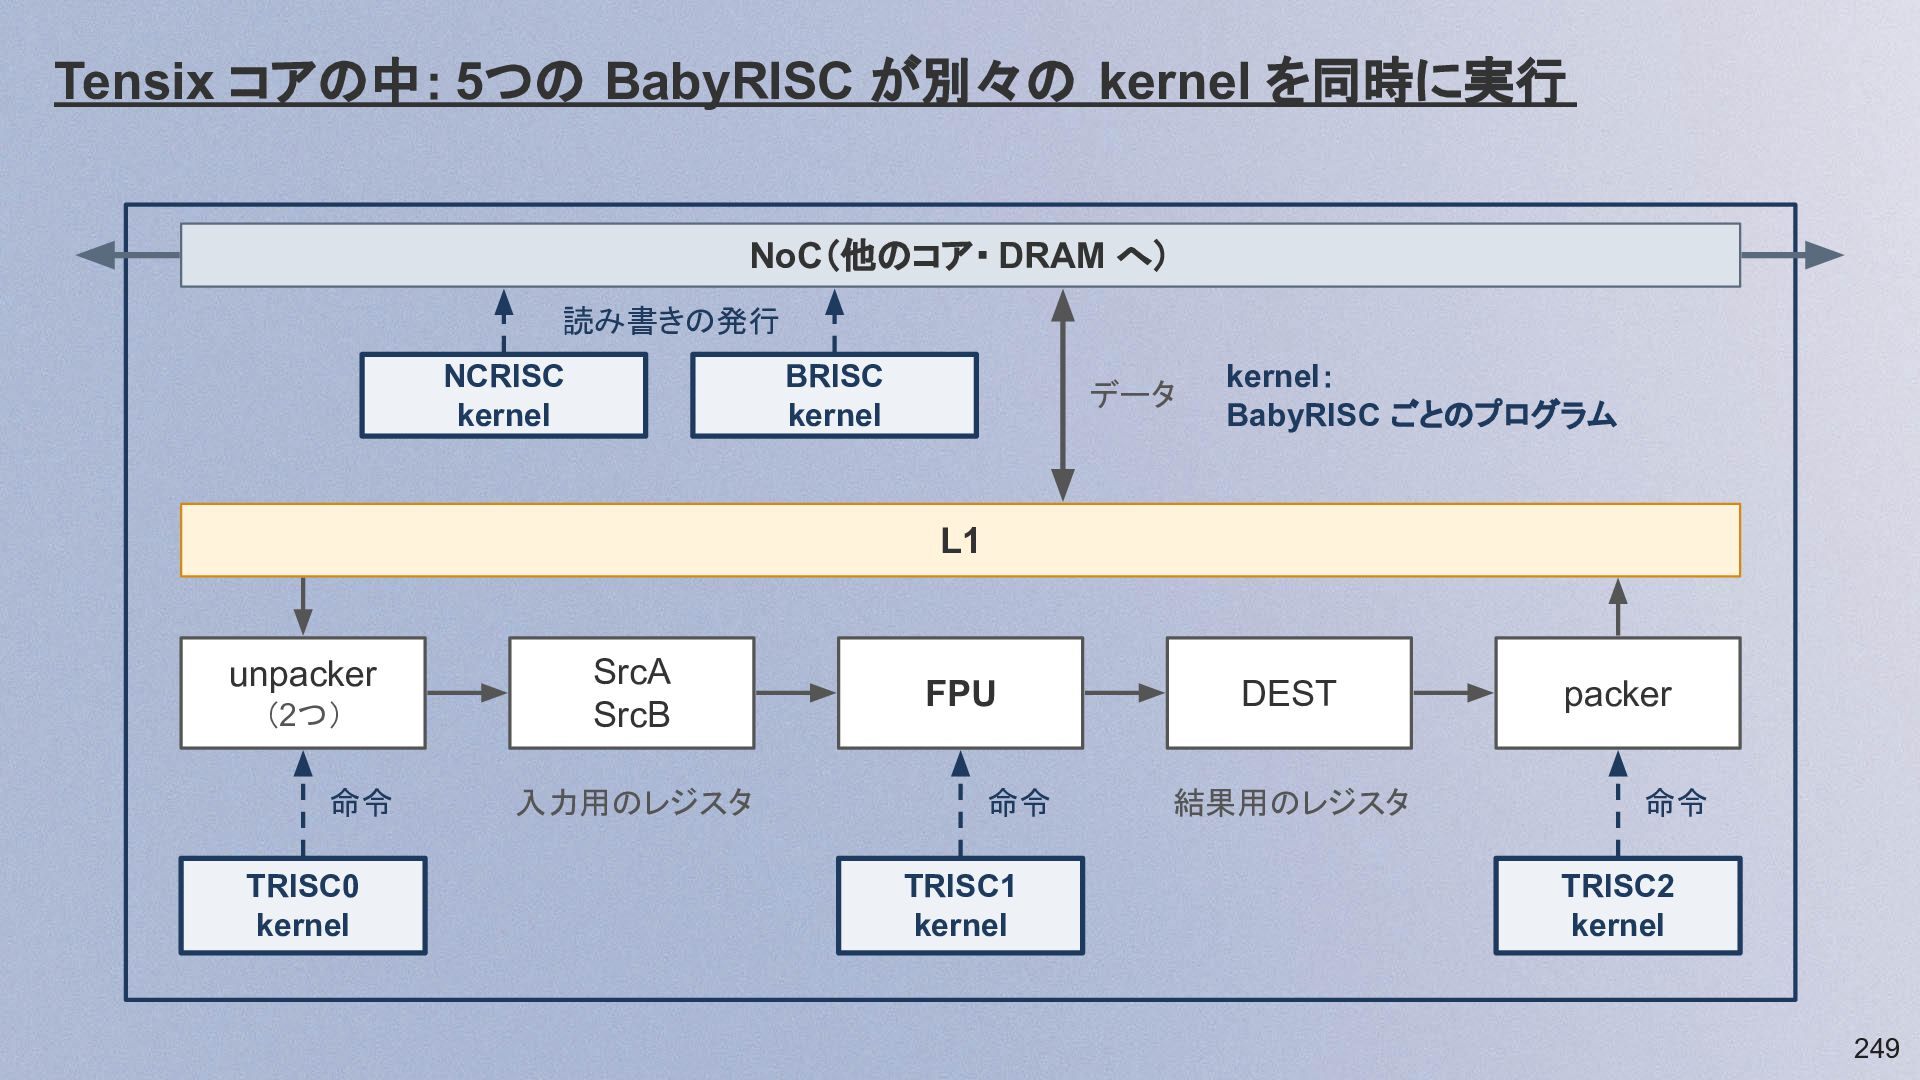
Tensix コアの中: 5つの BabyRISC が別々の kernel を同時に実行 NoC(他のコア・ DRAM へ)
読み書きの発行 NCRISC kernel BRISC kernel データ kernel: BabyRISC ごとのプログラム L1 unpacker (2つ) 命令 TRISC0 kernel SrcA SrcB 入力用のレジスタ FPU 命令 TRISC1 kernel DEST 結果用のレジスタ packer 命令 TRISC2 kernel 249 -
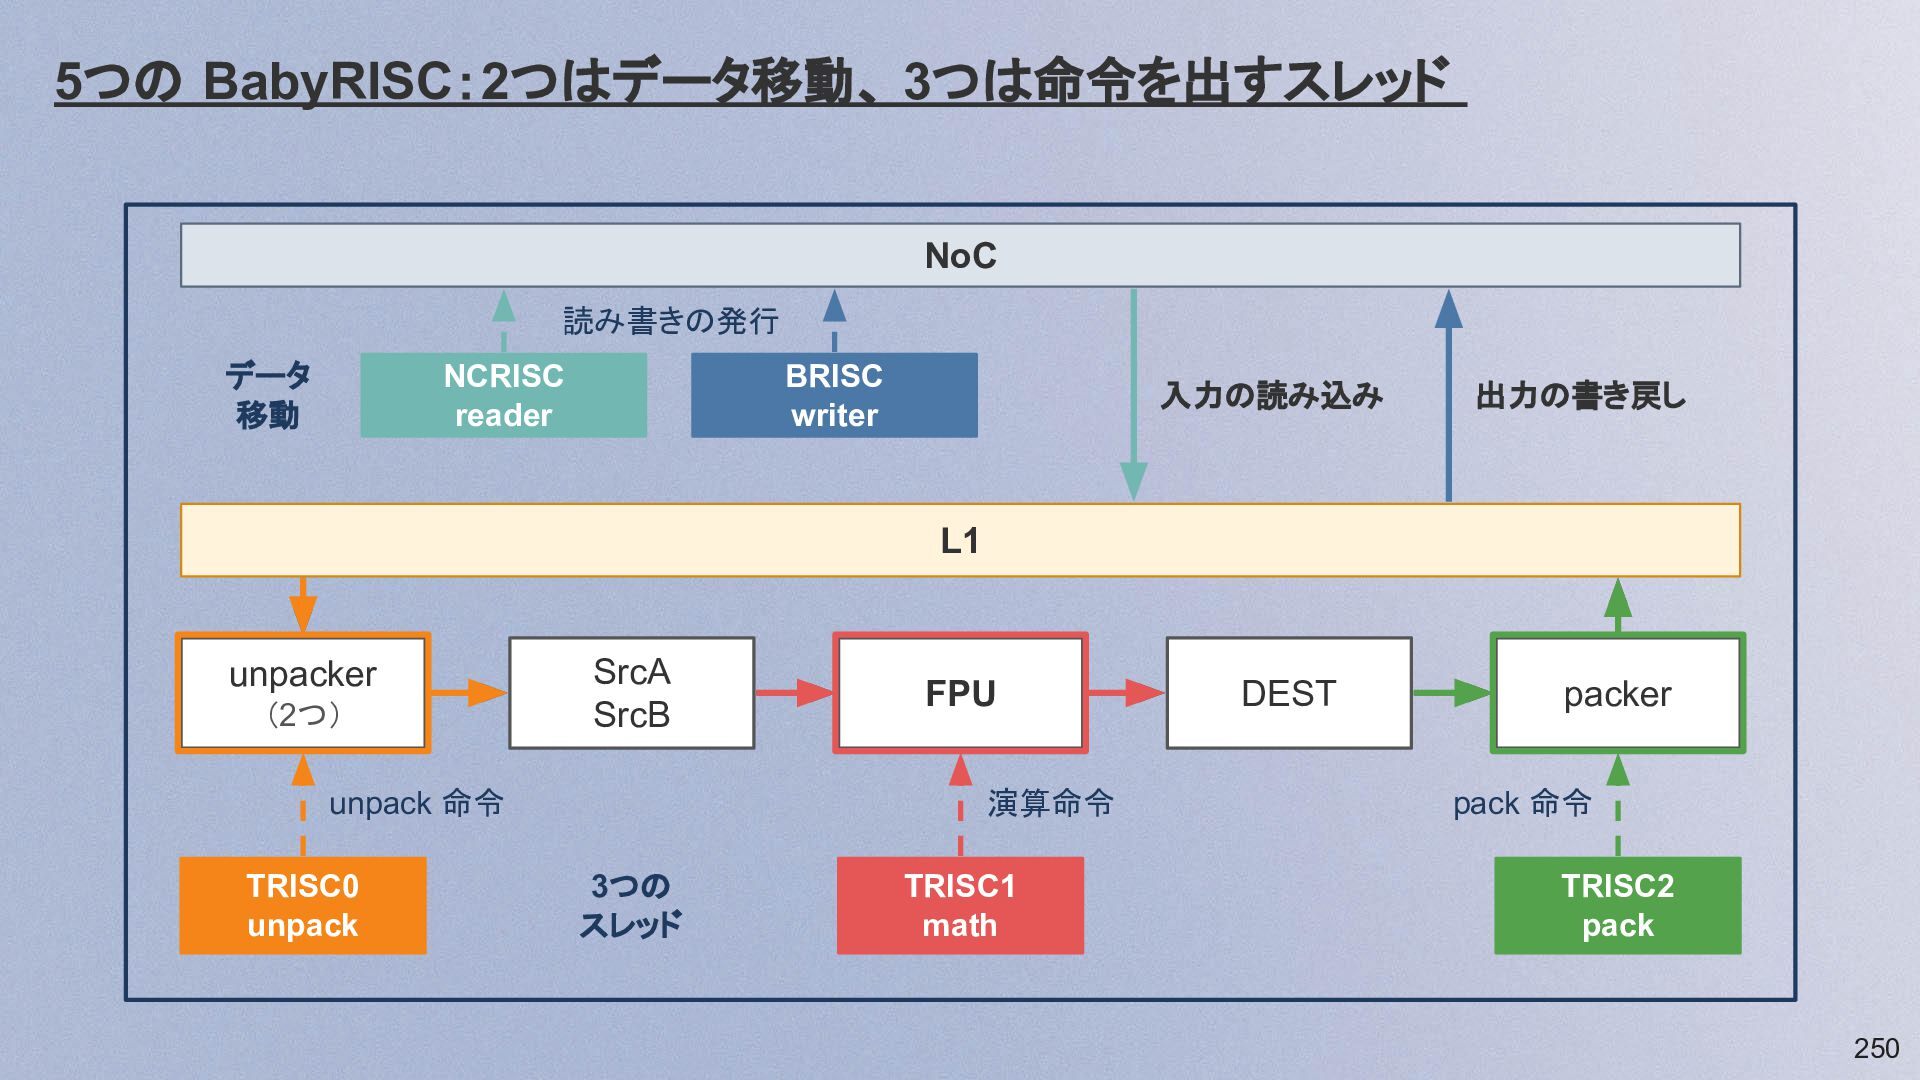
5つの BabyRISC:2つはデータ移動、 3つは命令を出すスレッド NoC 読み書きの発行 データ 移動 NCRISC reader BRISC
writer 入力の読み込み 出力の書き戻し L1 unpacker (2つ) SrcA SrcB unpack 命令 TRISC0 unpack FPU 演算命令 3つの スレッド TRISC1 math DEST packer pack 命令 TRISC2 pack 250 -
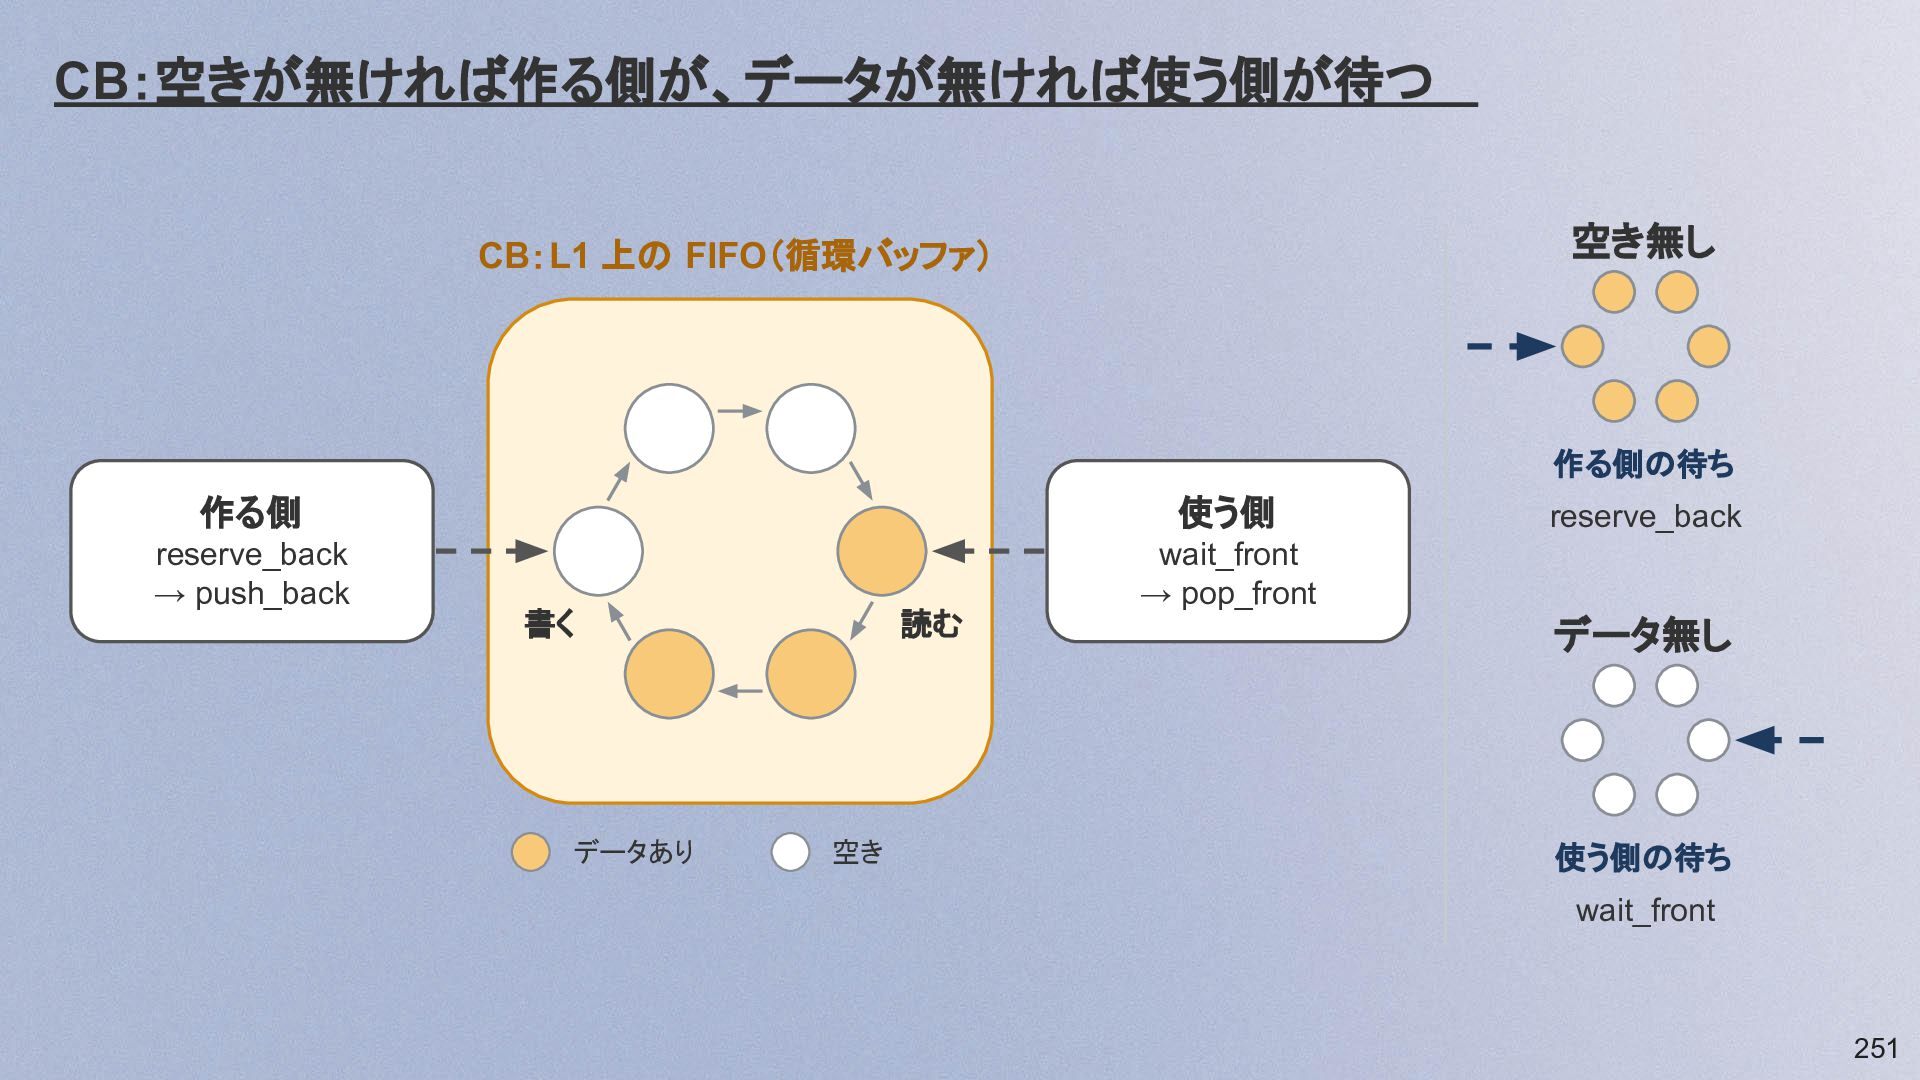
CB:空きが無ければ作る側が、データが無ければ使う側が待つ 空き無し CB:L1 上の FIFO(循環バッファ) 作る側の待ち 作る側 使う側 reserve_back →
push_back wait_front → pop_front 書く データあり 読む 空き reserve_back データ無し 使う側の待ち wait_front 251 -
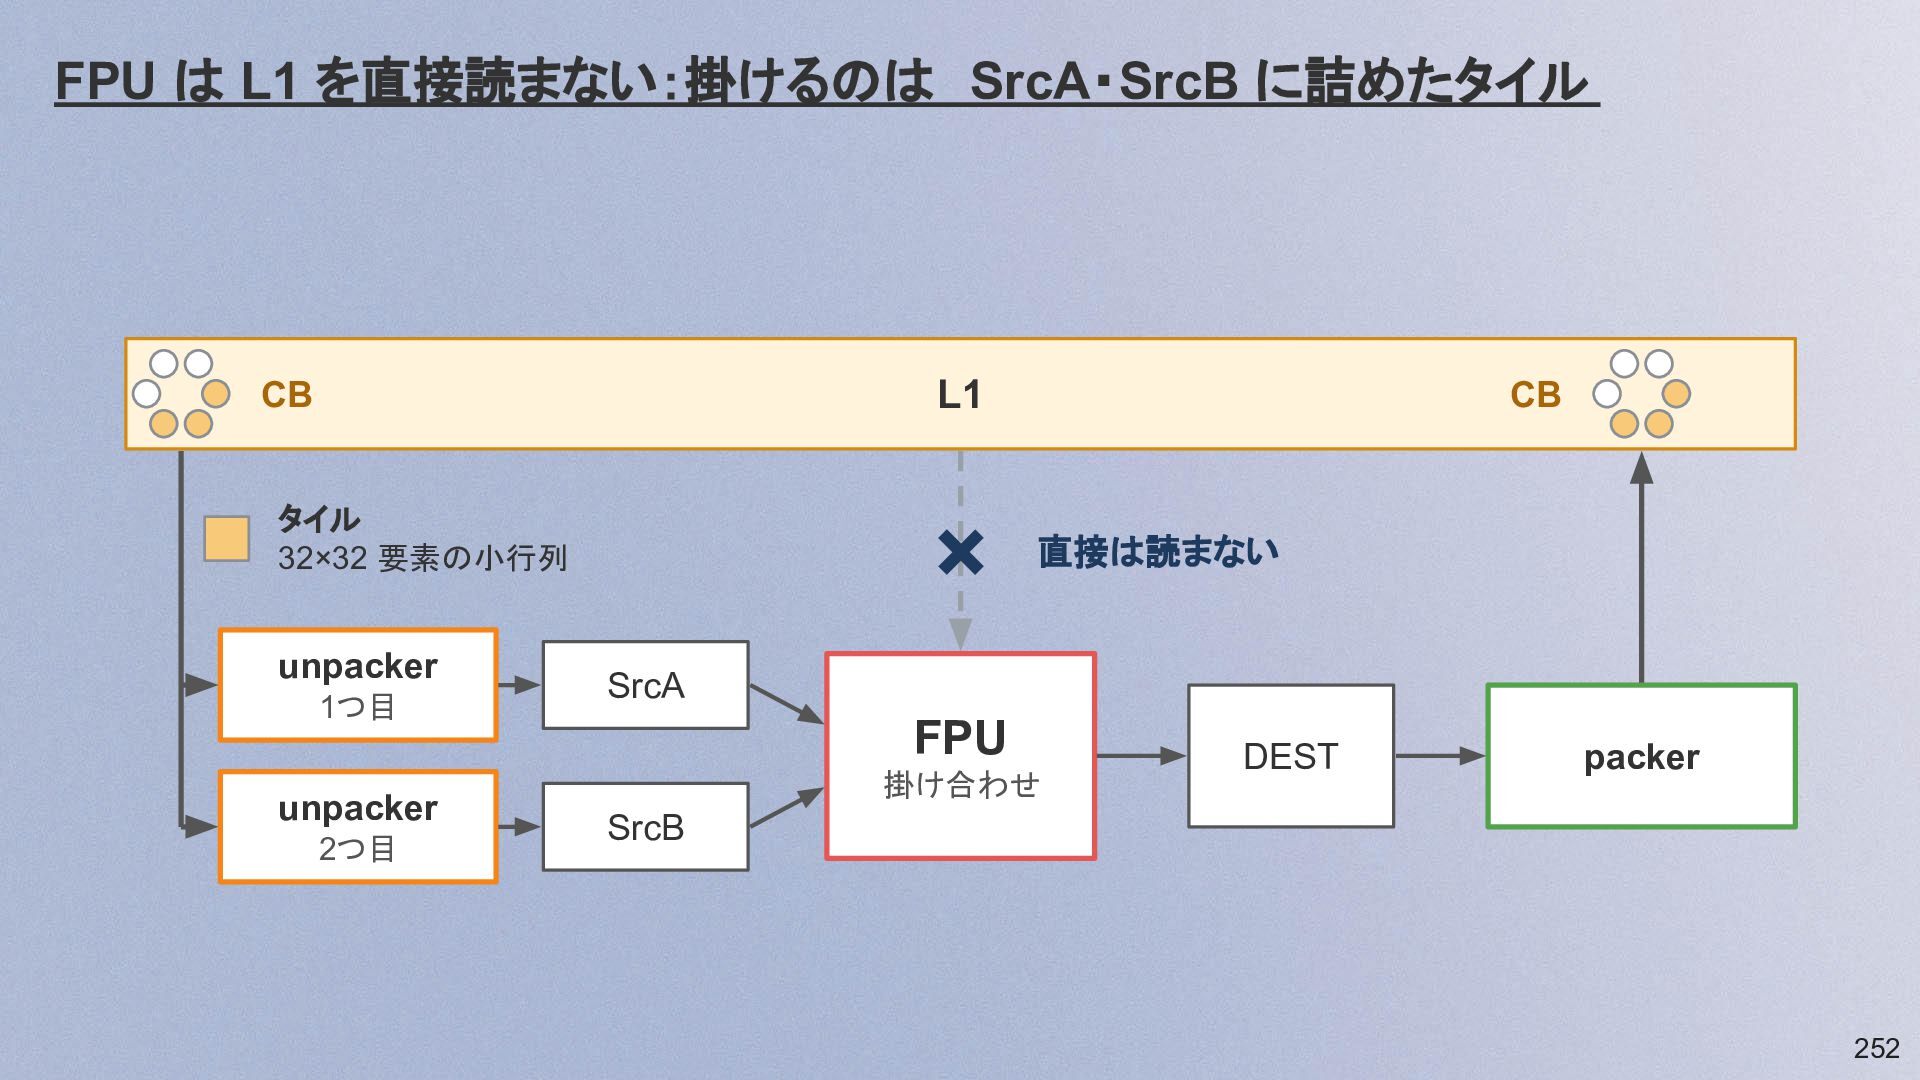
FPU は L1 を直接読まない:掛けるのは SrcA・SrcB に詰めたタイル CB L1 タイル 32×32
要素の小行列 × unpacker 1つ目 unpacker 2つ目 CB 直接は読まない SrcA FPU 掛け合わせ DEST packer SrcB 252 -
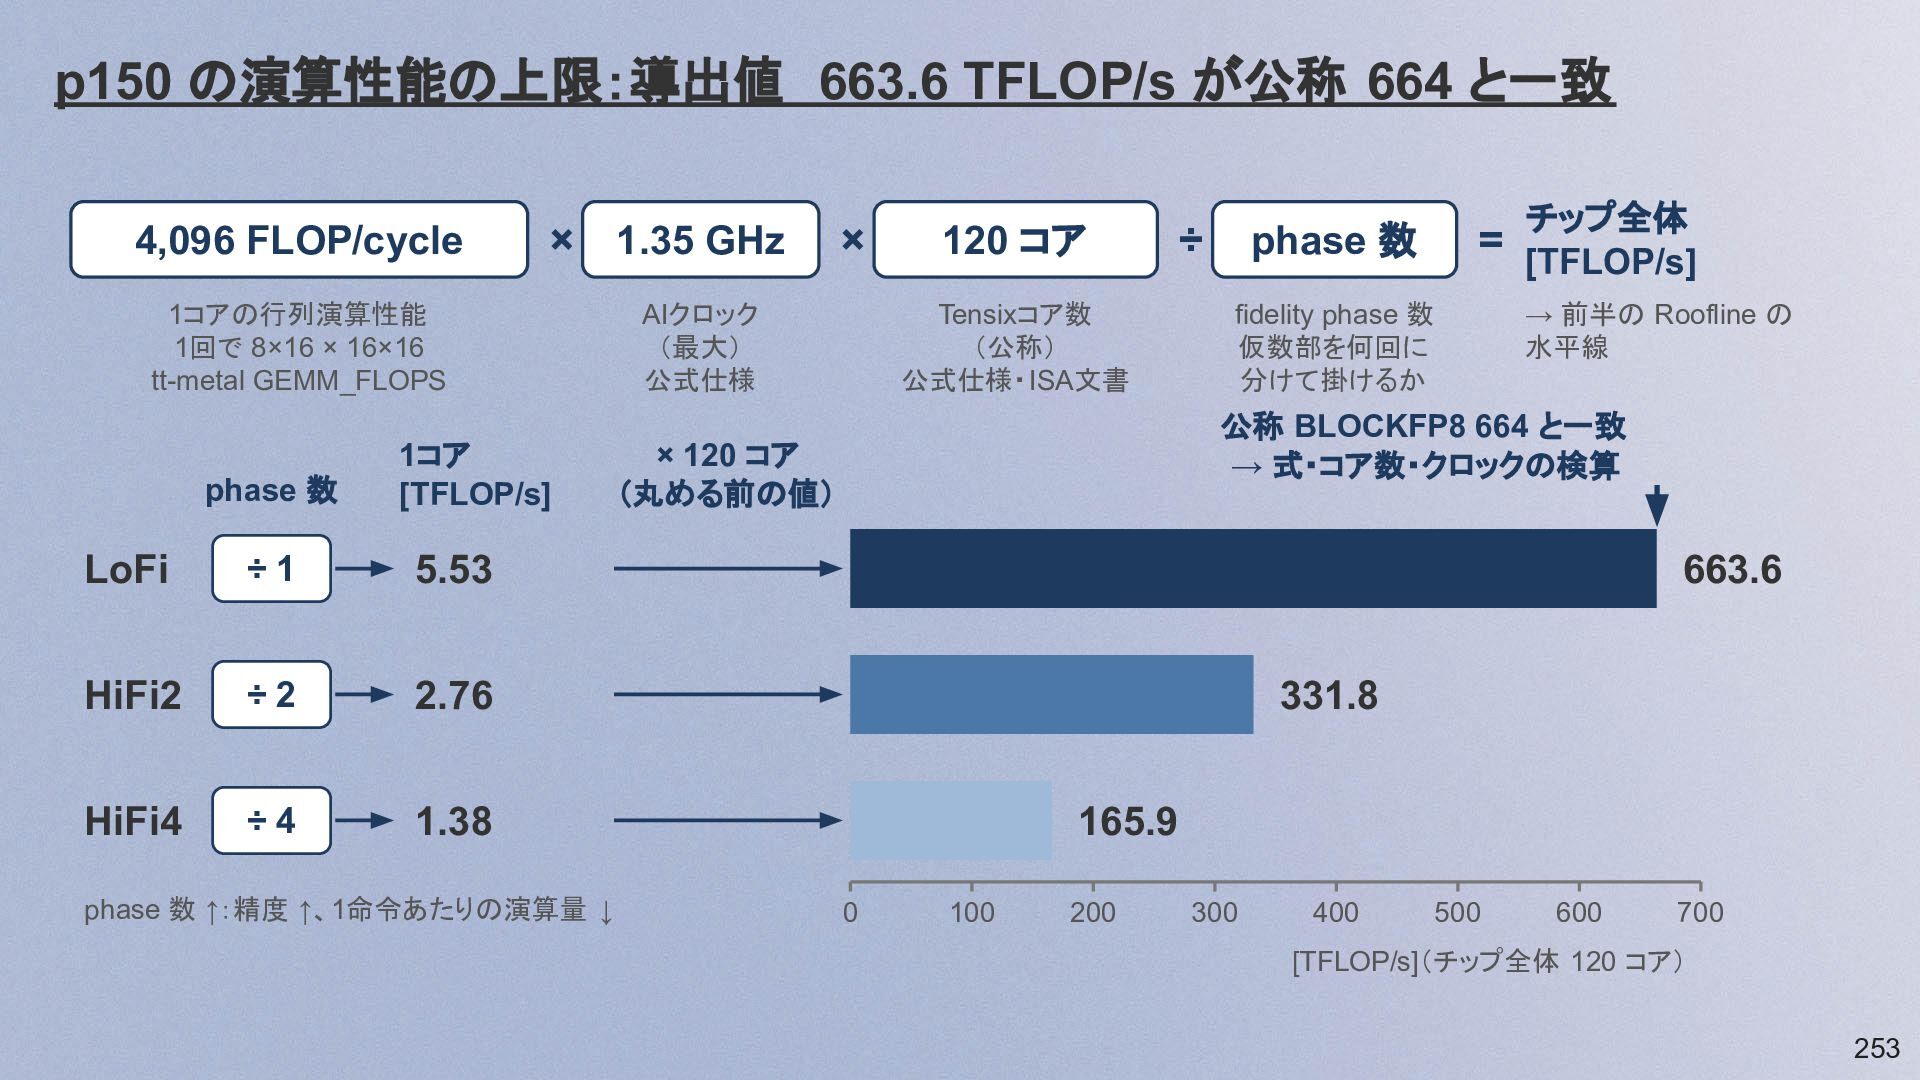
p150 の演算性能の上限:導出値 663.6 TFLOP/s が公称 664 と一致 4,096 FLOP/cycle ×
1.35 GHz 1コアの行列演算性能 1回で 8×16 × 16×16 tt-metal GEMM_FLOPS phase 数 1コア [TFLOP/s] LoFi ÷1 5.53 HiFi2 ÷2 2.76 HiFi4 ÷4 1.38 phase 数 ↑:精度 ↑、1命令あたりの演算量 ↓ × AIクロック (最大) 公式仕様 120 コア Tensixコア数 (公称) 公式仕様・ISA文書 phase 数 ÷ チップ全体 = [TFLOP/s] fidelity phase 数 仮数部を何回に 分けて掛けるか → 前半の Roofline の 水平線 公称 BLOCKFP8 664 と一致 → 式・コア数・クロックの検算 × 120 コア (丸める前の値) 663.6 331.8 165.9 0 100 200 300 400 500 600 700 [TFLOP/s](チップ全体 120 コア) 253 -
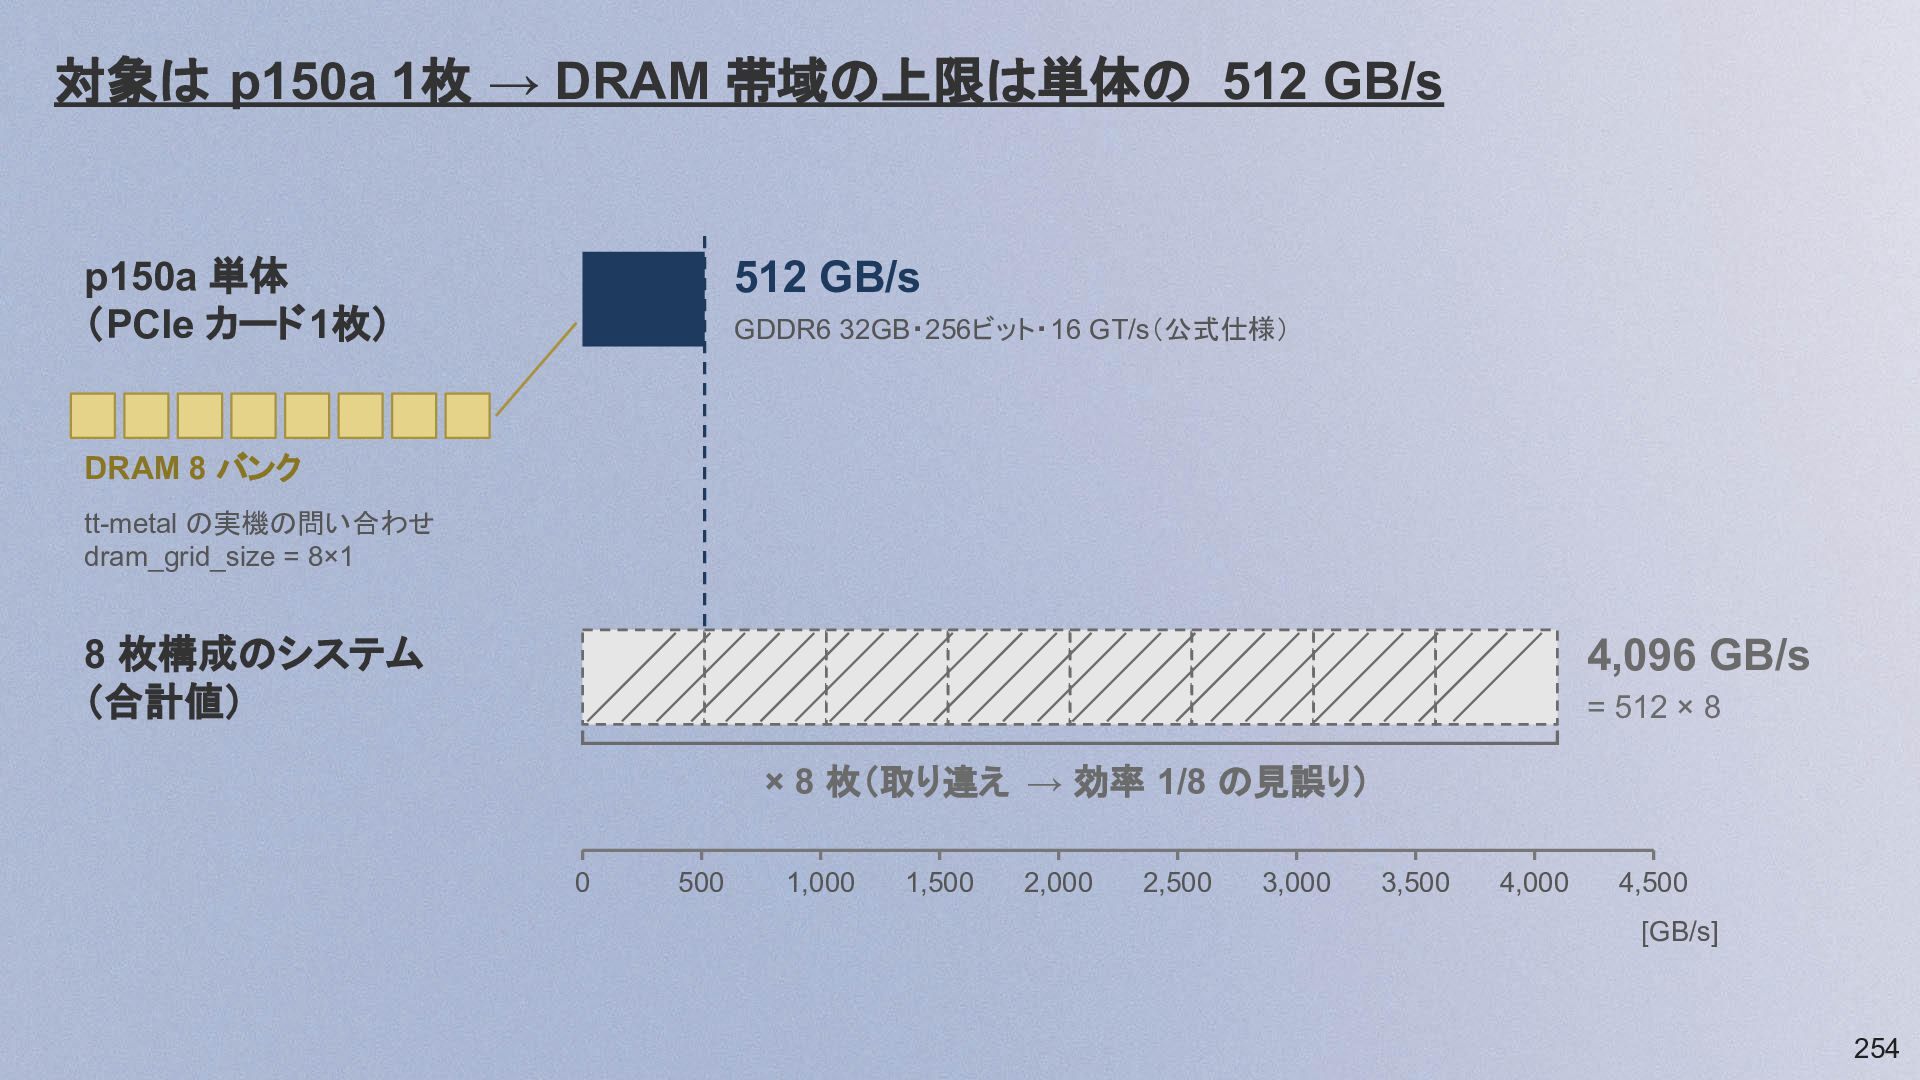
対象は p150a 1枚 → DRAM 帯域の上限は単体の 512 GB/s p150a 単体
(PCIe カード1枚) 512 GB/s GDDR6 32GB・256ビット・16 GT/s(公式仕様) DRAM 8 バンク tt-metal の実機の問い合わせ dram_grid_size = 8×1 8 枚構成のシステム (合計値) 4,096 GB/s = 512 × 8 × 8 枚(取り違え → 効率 1/8 の見誤り) 0 500 1,000 1,500 2,000 2,500 3,000 3,500 4,000 4,500 [GB/s] 254 -
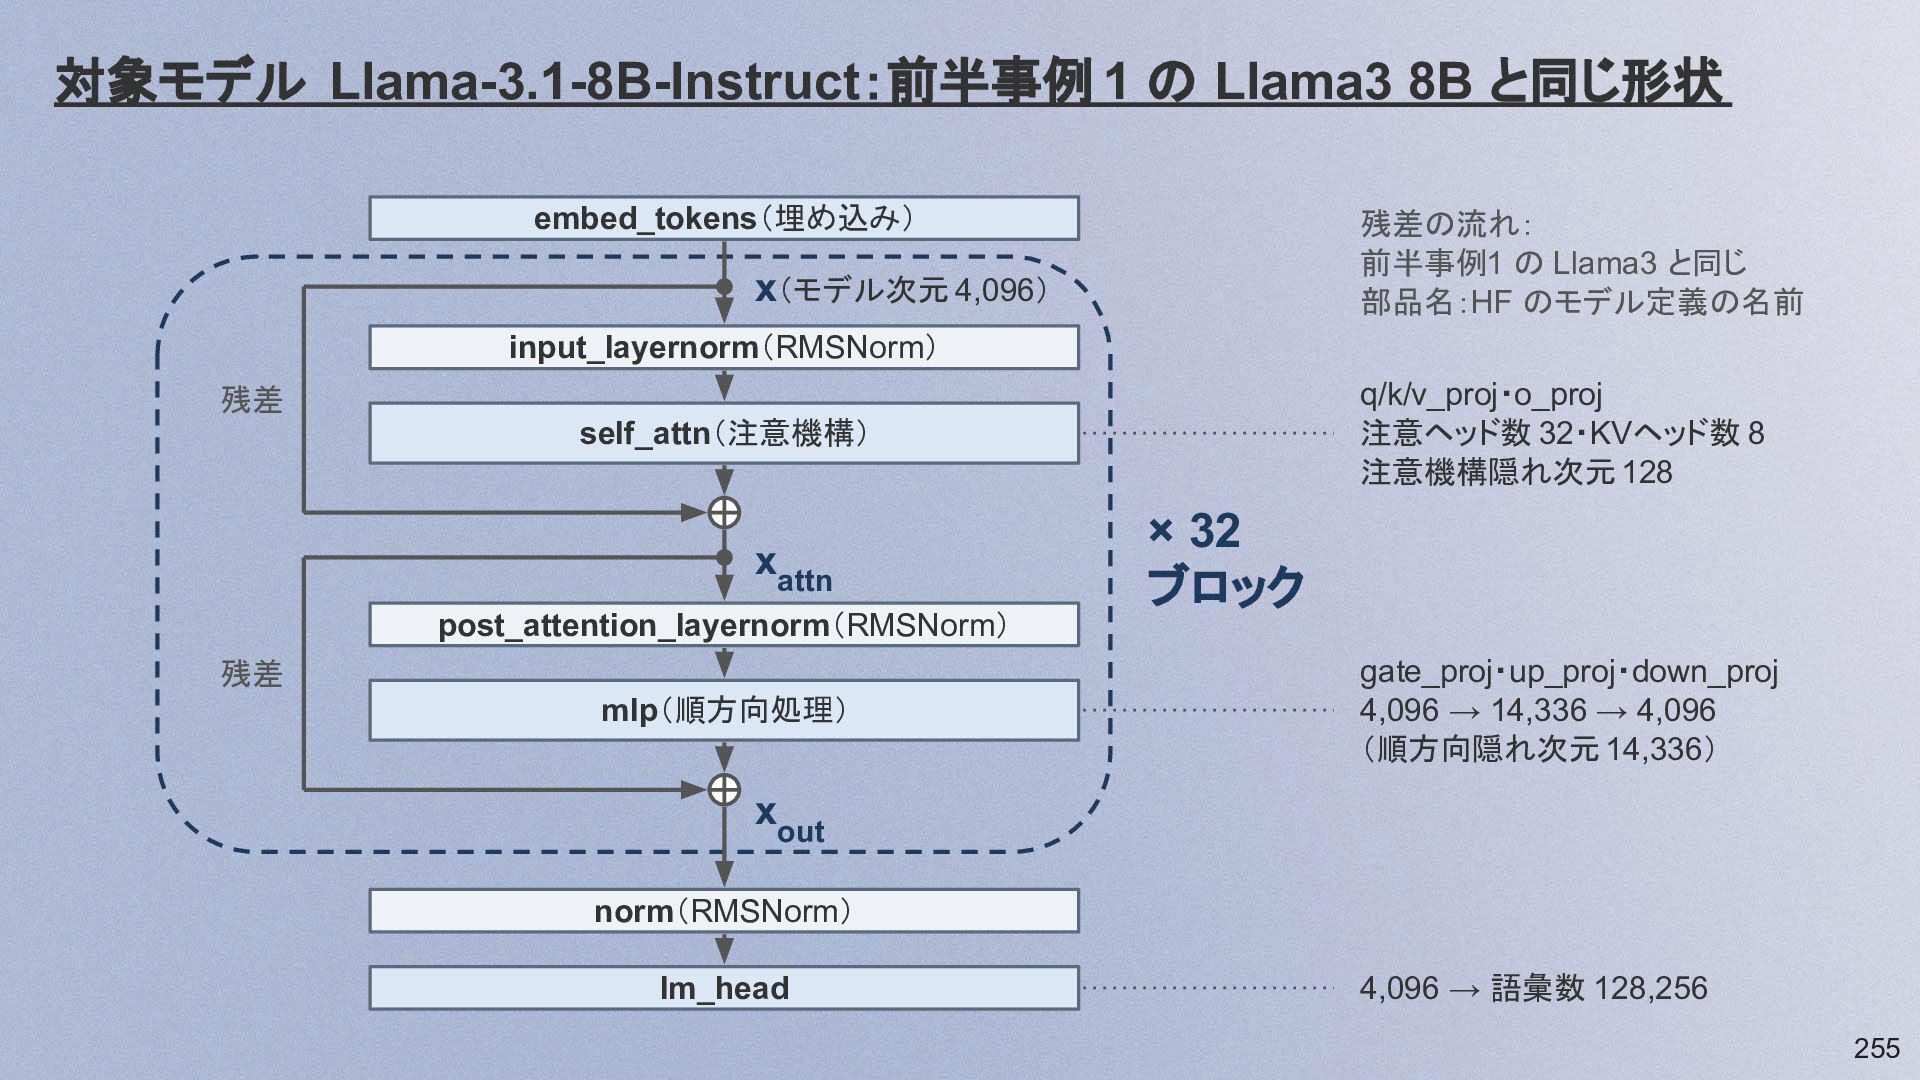
対象モデル Llama-3.1-8B-Instruct:前半事例 1 の Llama3 8B と同じ形状 embed_tokens(埋め込み) 残差の流れ: 前半事例1
の Llama3 と同じ 部品名:HF のモデル定義の名前 x(モデル次元 4,096) input_layernorm(RMSNorm) q/k/v_proj・o_proj 注意ヘッド数 32・KVヘッド数 8 注意機構隠れ次元 128 残差 self_attn(注意機構) xattn × 32 ブロック post_attention_layernorm(RMSNorm) 残差 mlp(順方向処理) gate_proj・up_proj・down_proj 4,096 → 14,336 → 4,096 (順方向隠れ次元 14,336) xout norm(RMSNorm) lm_head 4,096 → 語彙数 128,256 255 -
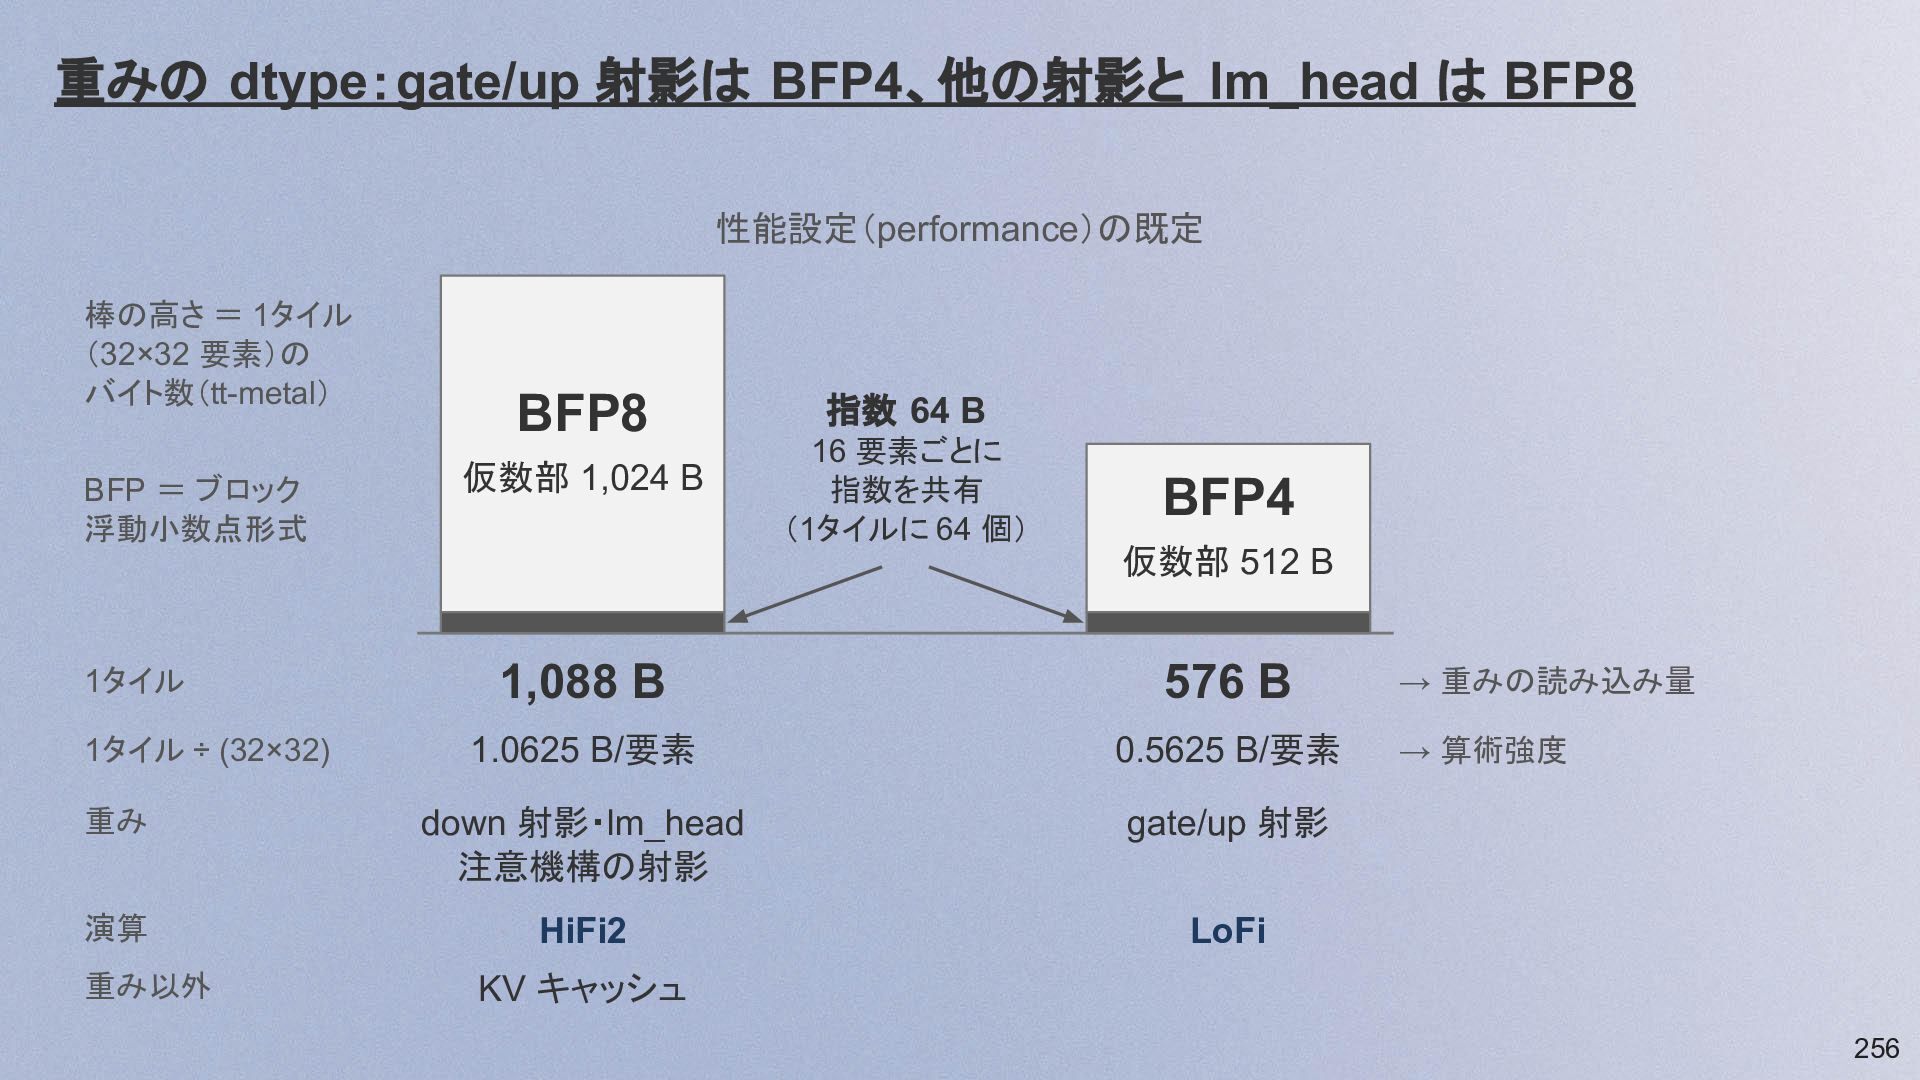
重みの dtype:gate/up 射影は BFP4、他の射影と lm_head は BFP8 性能設定(performance)の既定 棒の高さ =
1タイル (32×32 要素)の バイト数(tt-metal) BFP = ブロック 浮動小数点形式 BFP8 仮数部 1,024 B 指数 64 B 16 要素ごとに 指数を共有 (1タイルに 64 個) BFP4 仮数部 512 B 1,088 B 576 B 1.0625 B/要素 0.5625 B/要素 重み down 射影・lm_head 注意機構の射影 gate/up 射影 演算 HiFi2 LoFi 1タイル 1タイル ÷ (32×32) 重み以外 → 重みの読み込み量 → 算術強度 KV キャッシュ 256 -
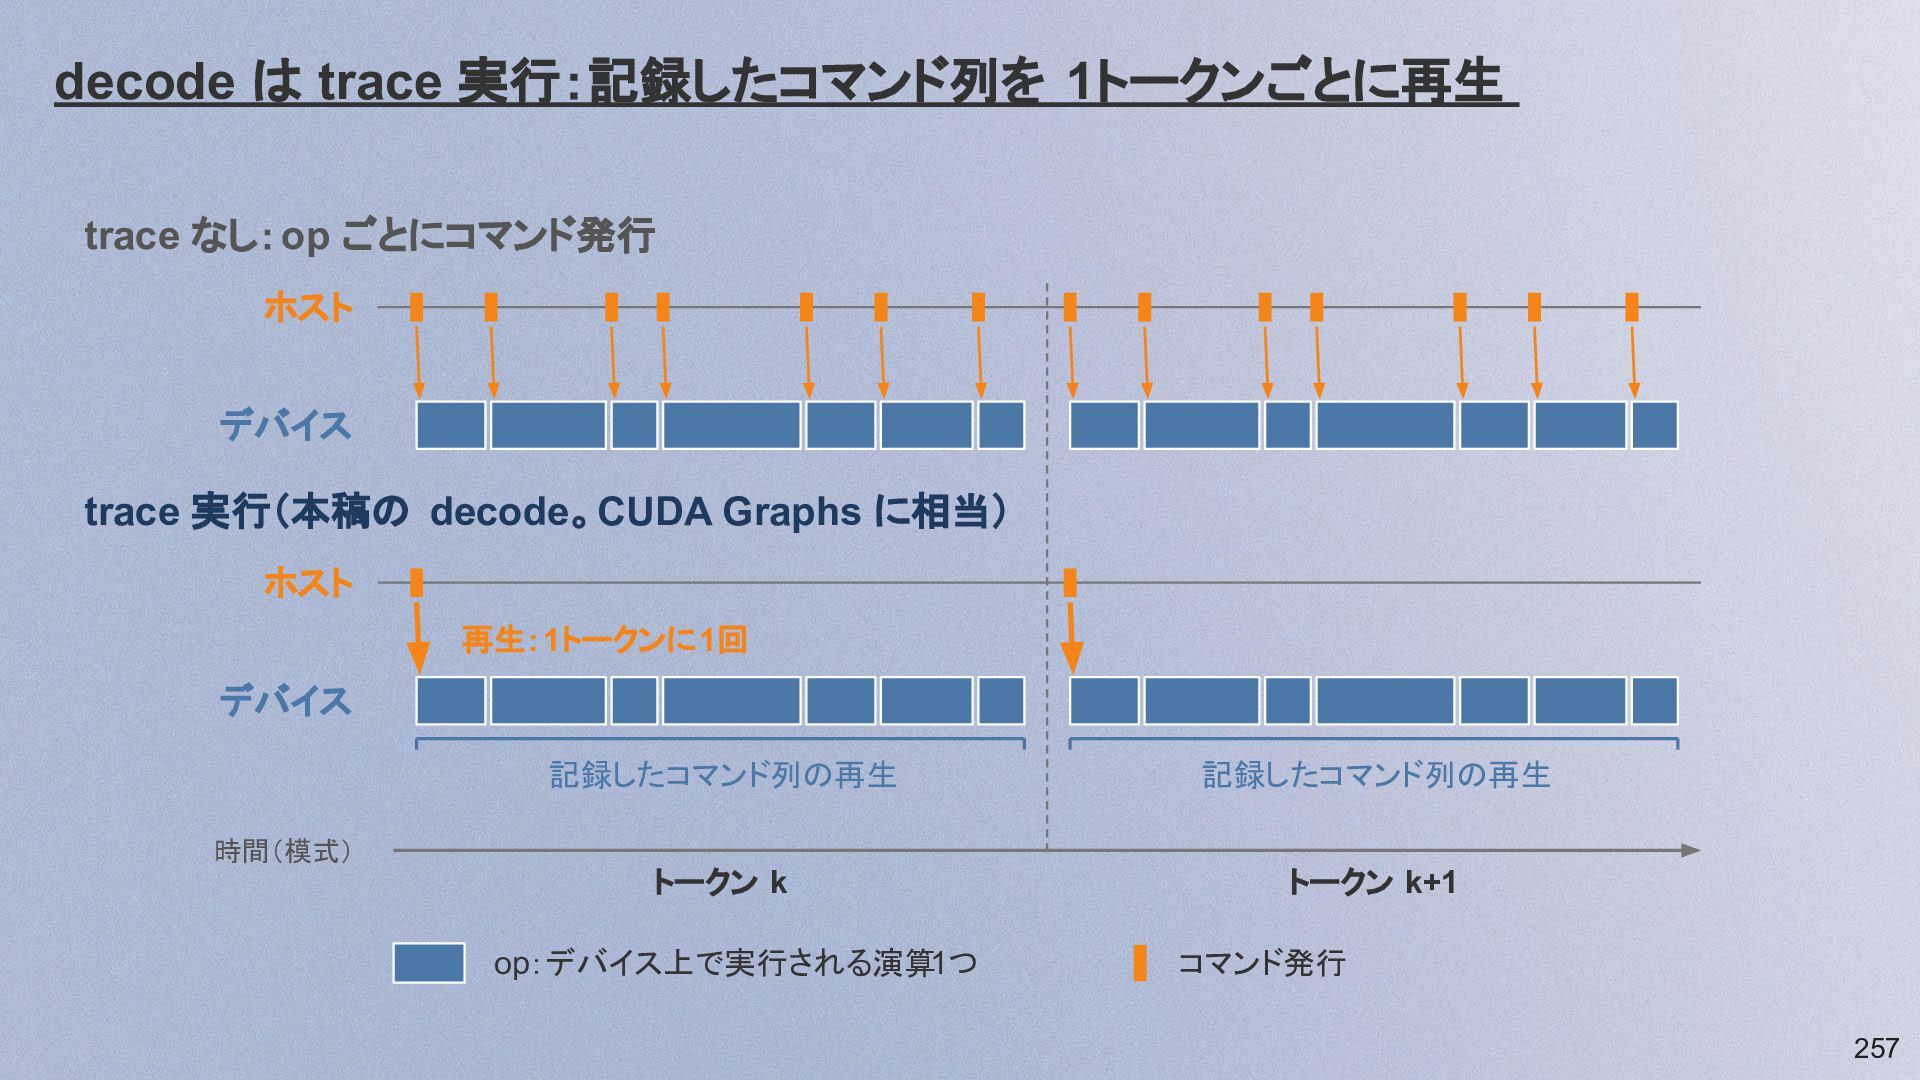
decode は trace 実行:記録したコマンド列を 1トークンごとに再生 trace なし:op ごとにコマンド発行 ホスト デバイス
trace 実行(本稿の decode。CUDA Graphs に相当) ホスト 再生:1トークンに1回 デバイス 記録したコマンド列の再生 記録したコマンド列の再生 トークン k トークン k+1 時間(模式) op:デバイス上で実行される演算1つ コマンド発行 257 -
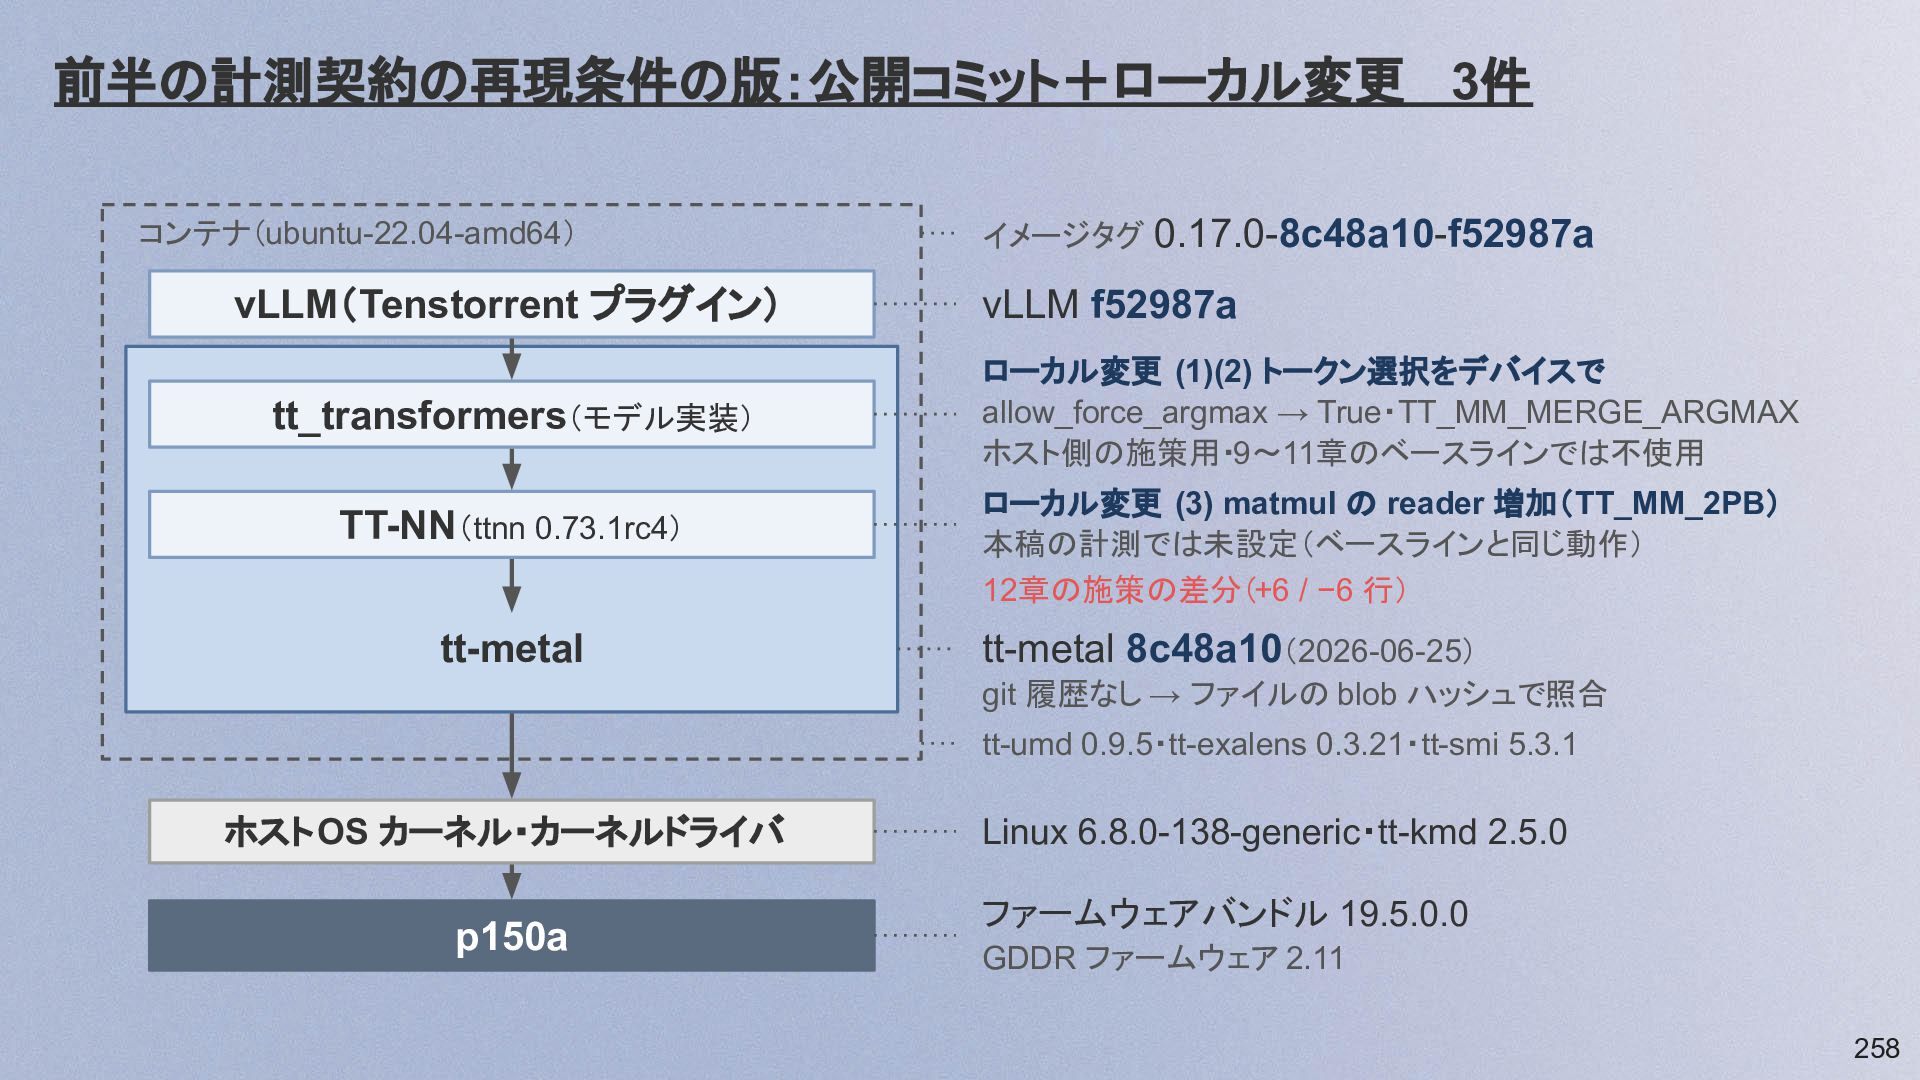
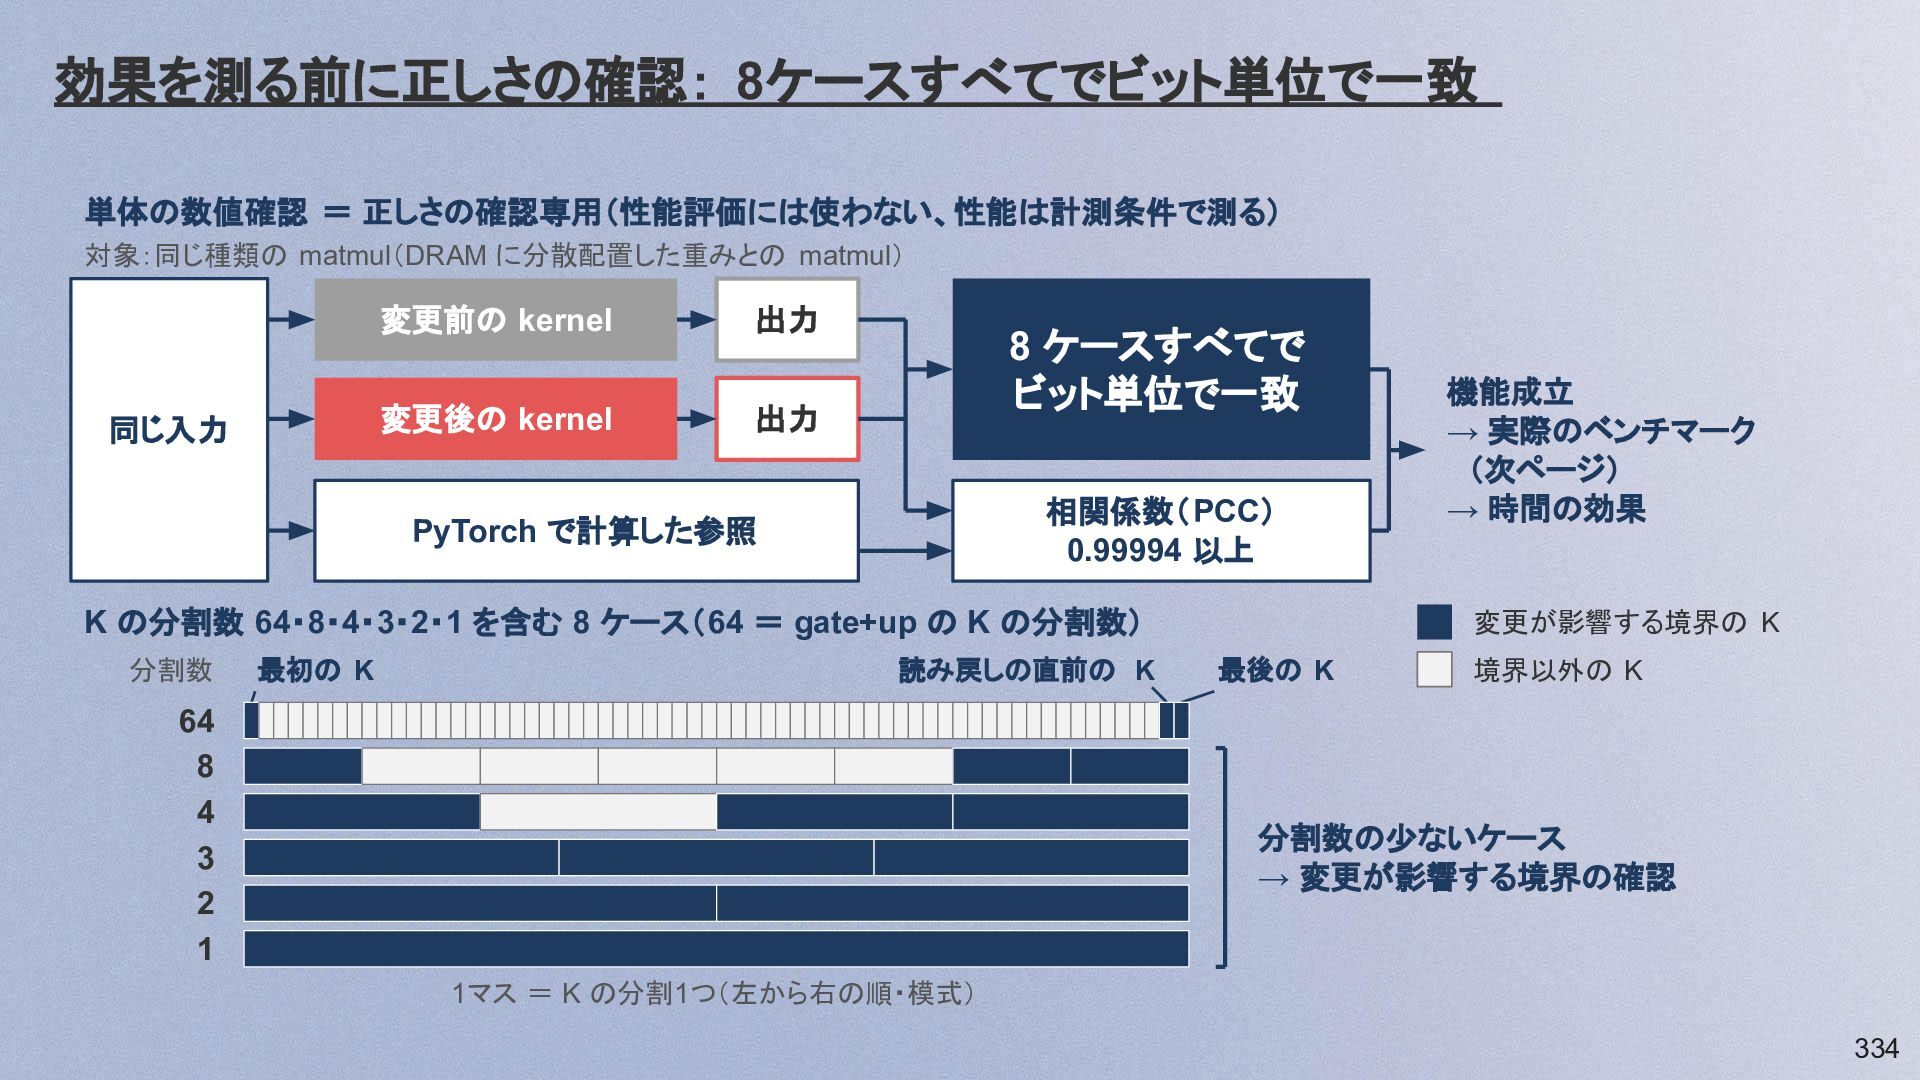
前半の計測契約の再現条件の版:公開コミット+ローカル変更 3件 コンテナ(ubuntu-22.04-amd64) vLLM(Tenstorrent プラグイン) tt_transformers(モデル実装) TT-NN(ttnn 0.73.1rc4) tt-metal イメージタグ
0.17.0-8c48a10-f52987a vLLM f52987a ローカル変更 (1)(2) トークン選択をデバイスで allow_force_argmax → True・TT_MM_MERGE_ARGMAX ホスト側の施策用・9〜11章のベースラインでは不使用 ローカル変更 (3) matmul の reader 増加(TT_MM_2PB) 本稿の計測では未設定(ベースラインと同じ動作) 12章の施策の差分(+6 / −6 行) tt-metal 8c48a10(2026-06-25) git 履歴なし → ファイルの blob ハッシュで照合 tt-umd 0.9.5・tt-exalens 0.3.21・tt-smi 5.3.1 ホストOS カーネル・カーネルドライバ p150a Linux 6.8.0-138-generic・tt-kmd 2.5.0 ファームウェアバンドル 19.5.0.0 GDDR ファームウェア 2.11 258 -
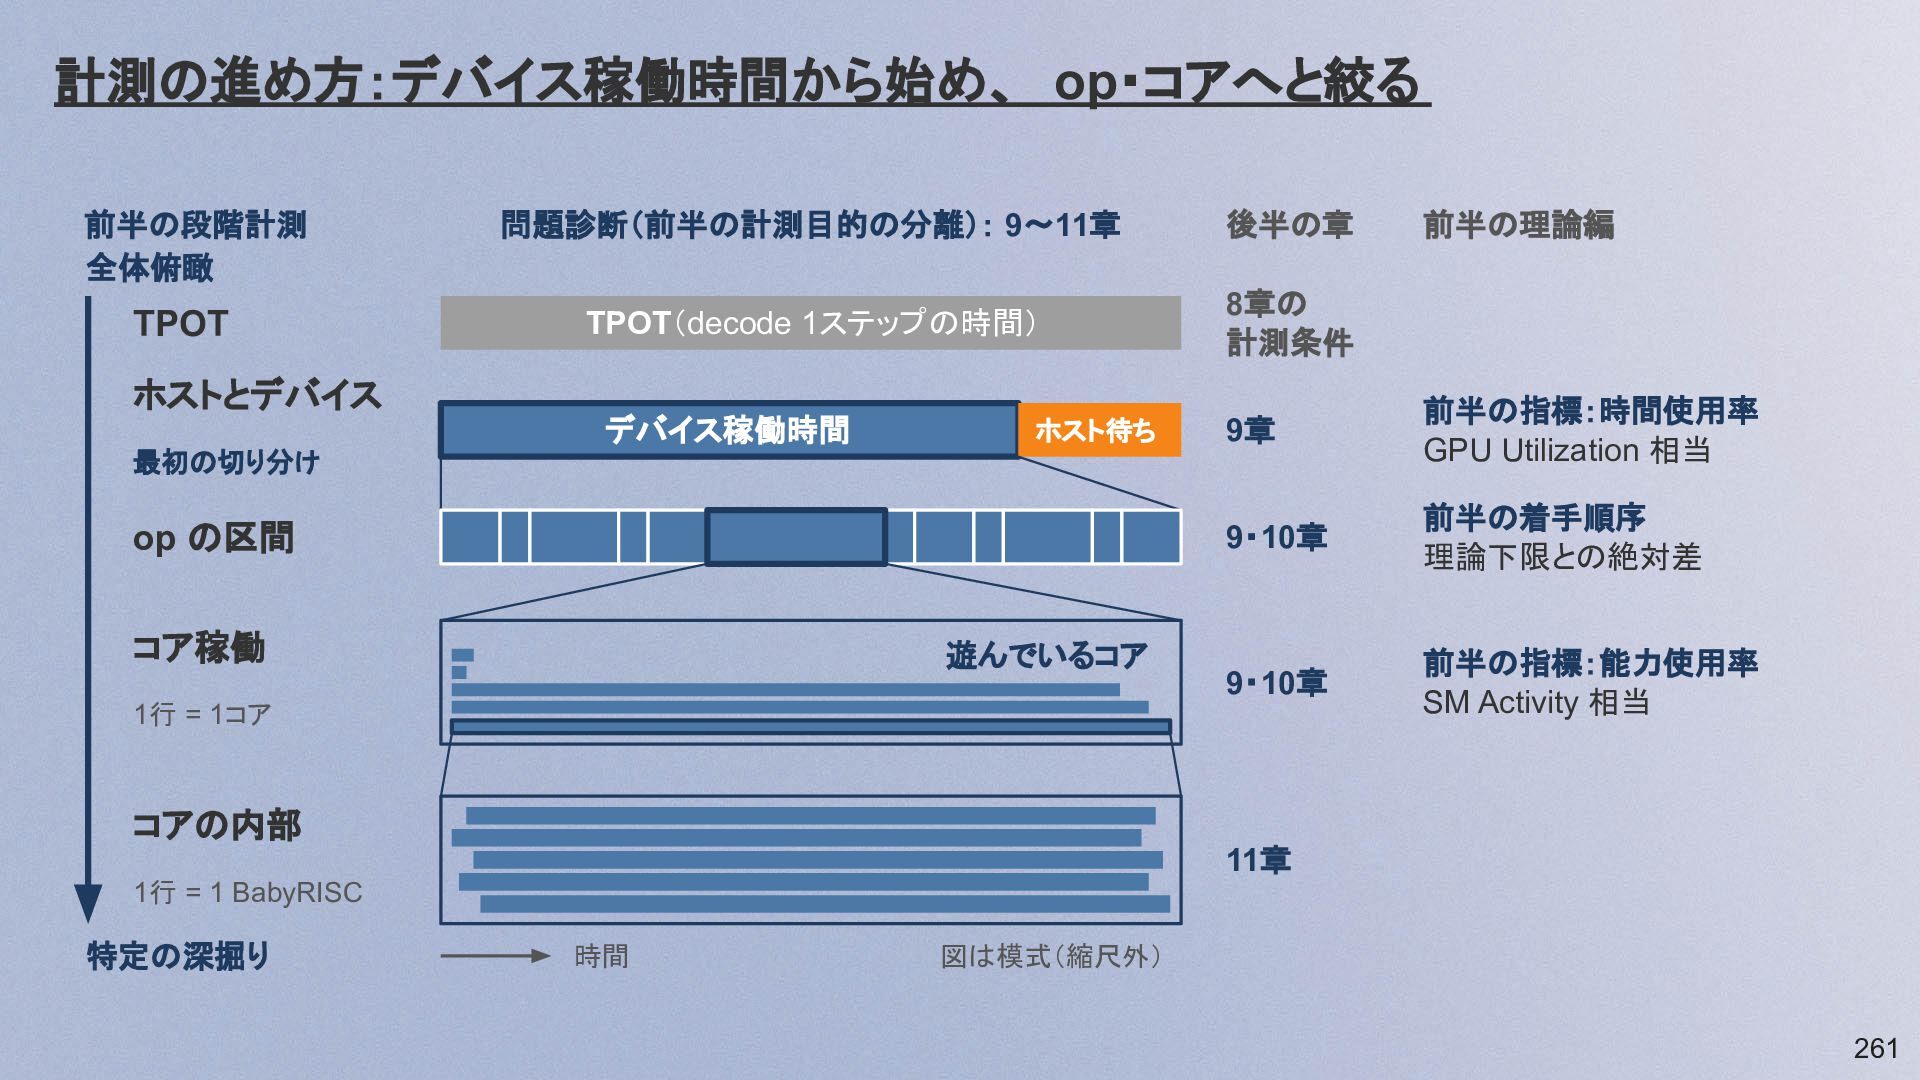
計測の進め方:デバイス稼働時間から始め、 op・コアへと絞る 前半の段階計測 全体俯瞰 問題診断(前半の計測目的の分離): 9〜11章 後半の章 TPOT TPOT(decode 1ステップの時間)
8章の 計測条件 デバイス稼働時間 9章 前半の指標:時間使用率 GPU Utilization 相当 9・10章 前半の着手順序 理論下限との絶対差 9・10章 前半の指標:能力使用率 SM Activity 相当 ホストとデバイス ホスト待ち 最初の切り分け op の区間 コア稼働 遊んでいるコア 1行 = 1コア 前半の理論編 コアの内部 11章 1行 = 1 BabyRISC 特定の深掘り 時間 図は模式(縮尺外) 261 -
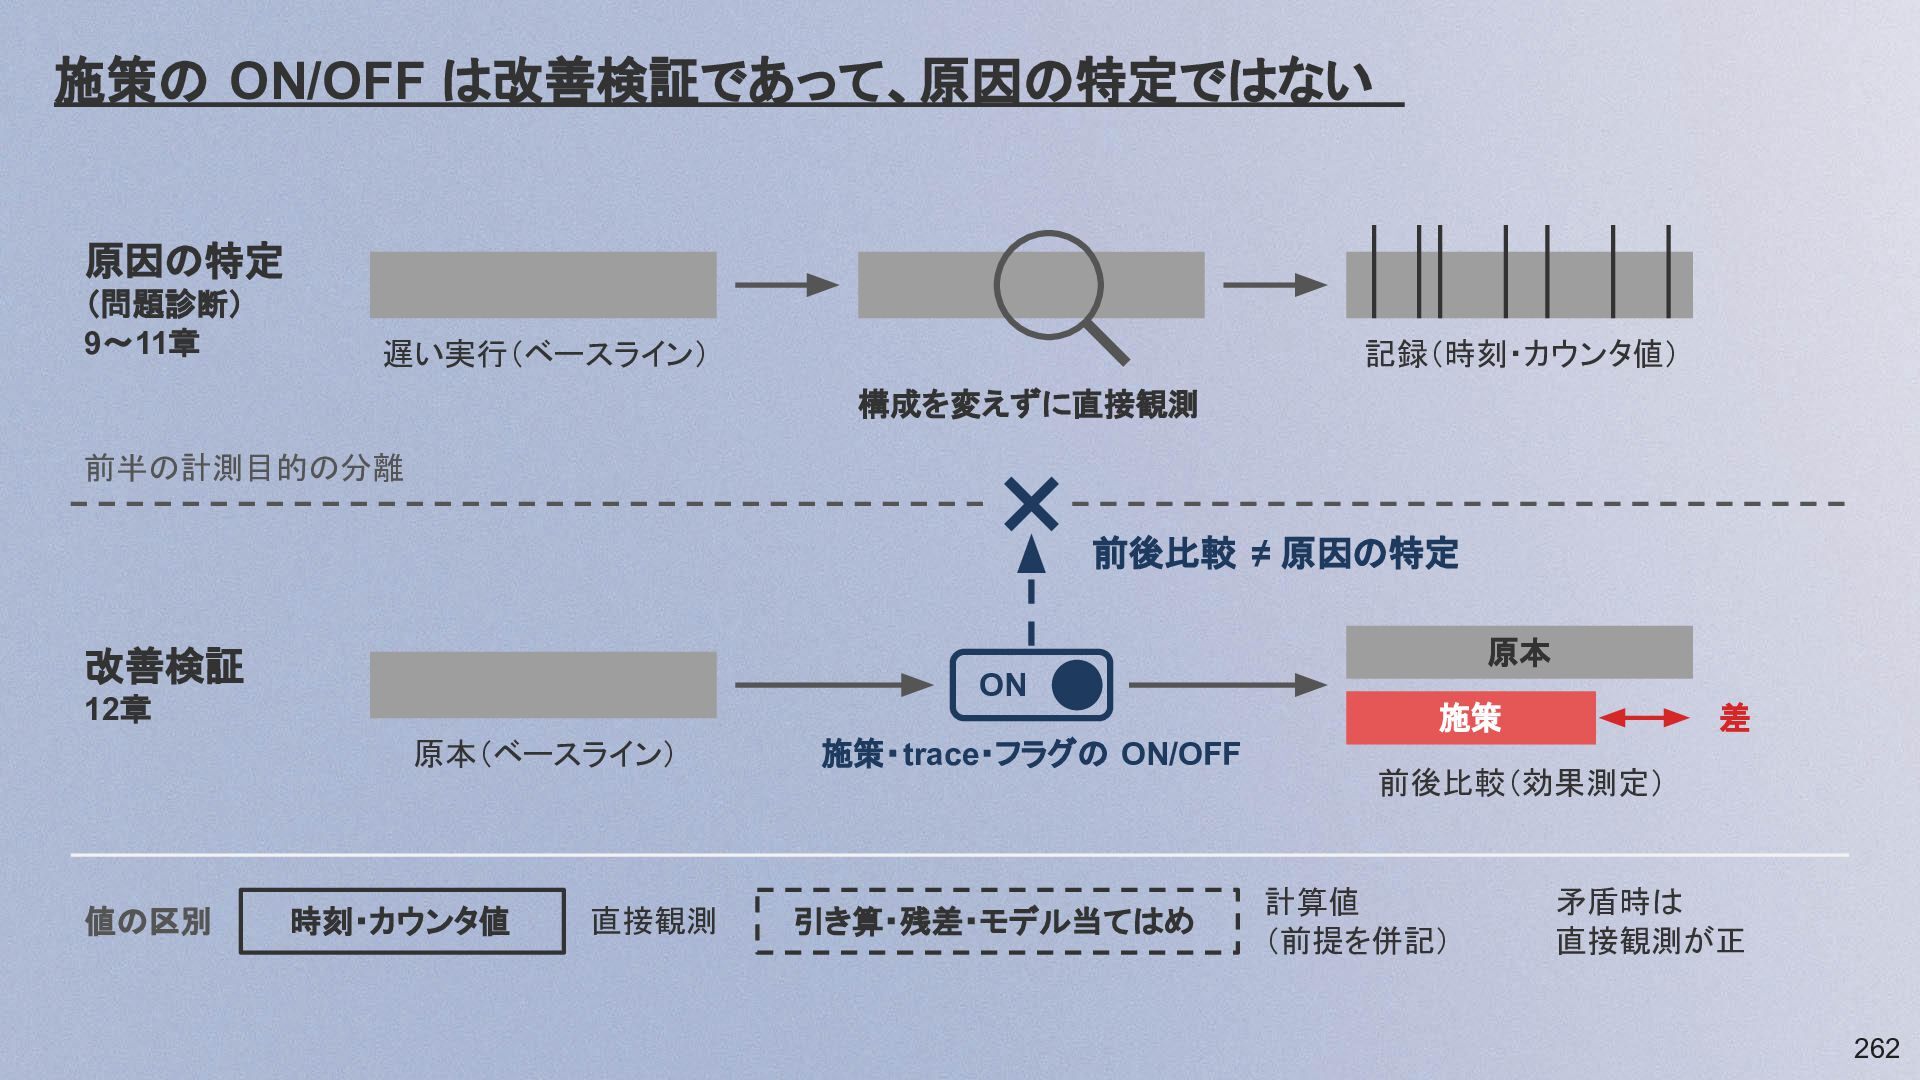
施策の ON/OFF は改善検証であって、原因の特定ではない 原因の特定 (問題診断) 9〜11章 遅い実行(ベースライン) 記録(時刻・カウンタ値) 構成を変えずに直接観測 前半の計測目的の分離
前後比較 ≠ 原因の特定 原本 改善検証 ON 12章 原本(ベースライン) 値の区別 時刻・カウンタ値 直接観測 施策・trace・フラグの ON/OFF 引き算・残差・モデル当てはめ 施策 差 前後比較(効果測定) 計算値 (前提を併記) 矛盾時は 直接観測が正 262 -
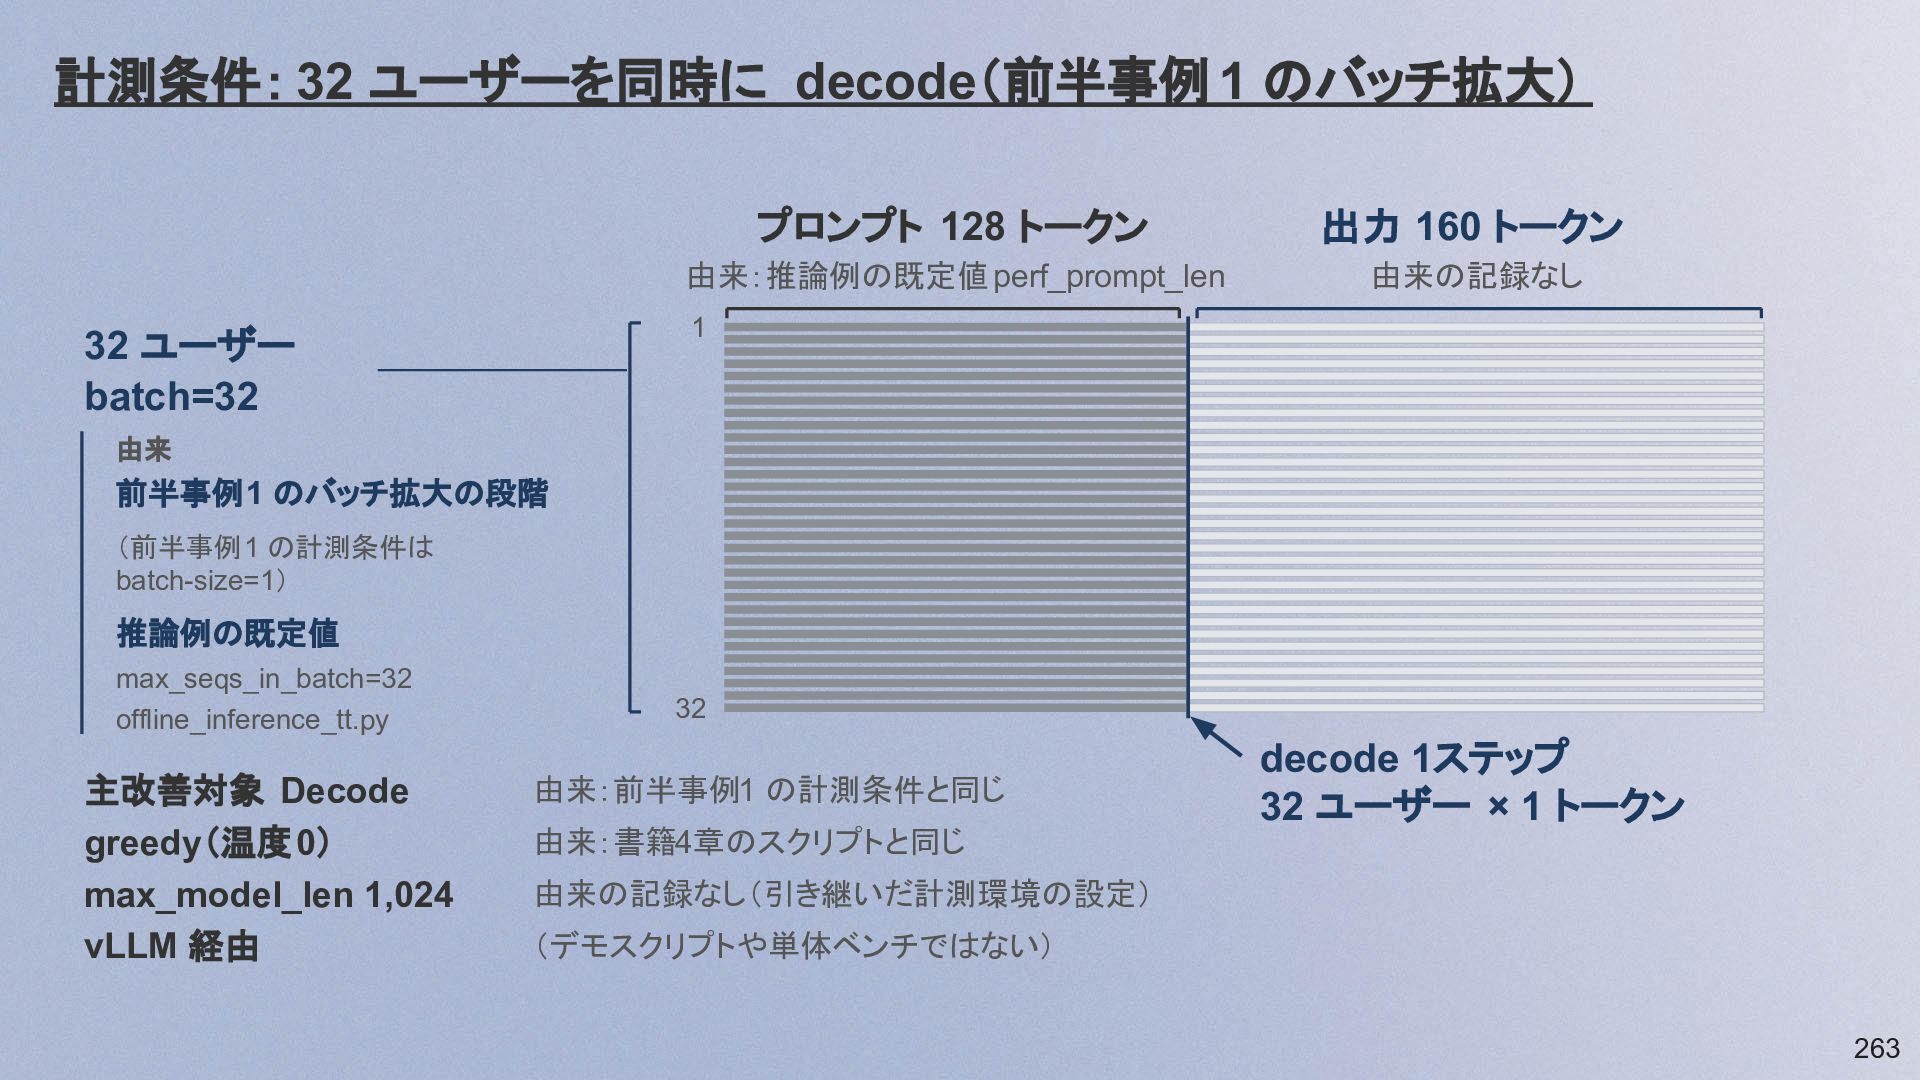
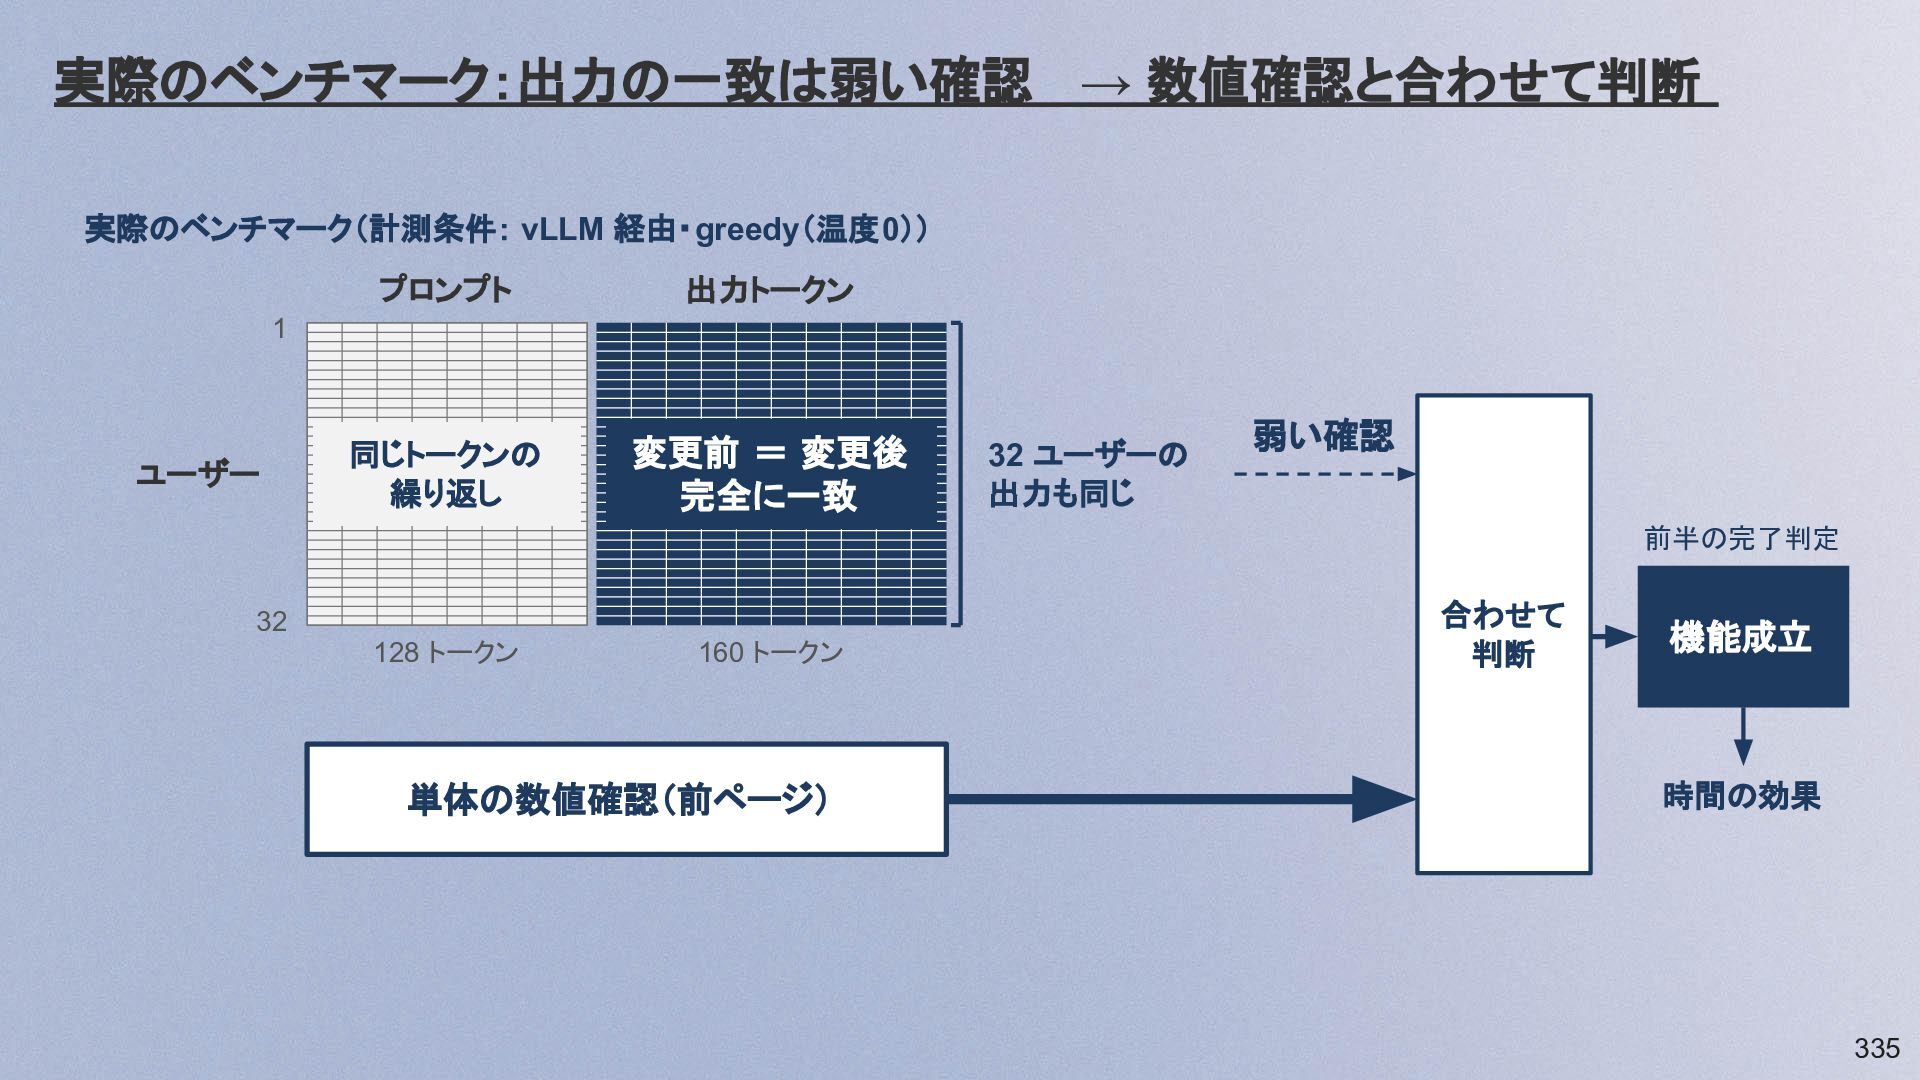
計測条件: 32 ユーザーを同時に decode(前半事例 1 のバッチ拡大) プロンプト 128 トークン 出力
160 トークン 由来:推論例の既定値 perf_prompt_len 由来の記録なし 1 32 ユーザー batch=32 由来 前半事例1 のバッチ拡大の段階 (前半事例1 の計測条件は batch-size=1) 推論例の既定値 max_seqs_in_batch=32 offline_inference_tt.py 主改善対象 Decode greedy(温度0) max_model_len 1,024 vLLM 経由 32 由来:前半事例1 の計測条件と同じ 由来:書籍4章のスクリプトと同じ decode 1ステップ 32 ユーザー × 1 トークン 由来の記録なし(引き継いだ計測環境の設定) (デモスクリプトや単体ベンチではない) 263 -
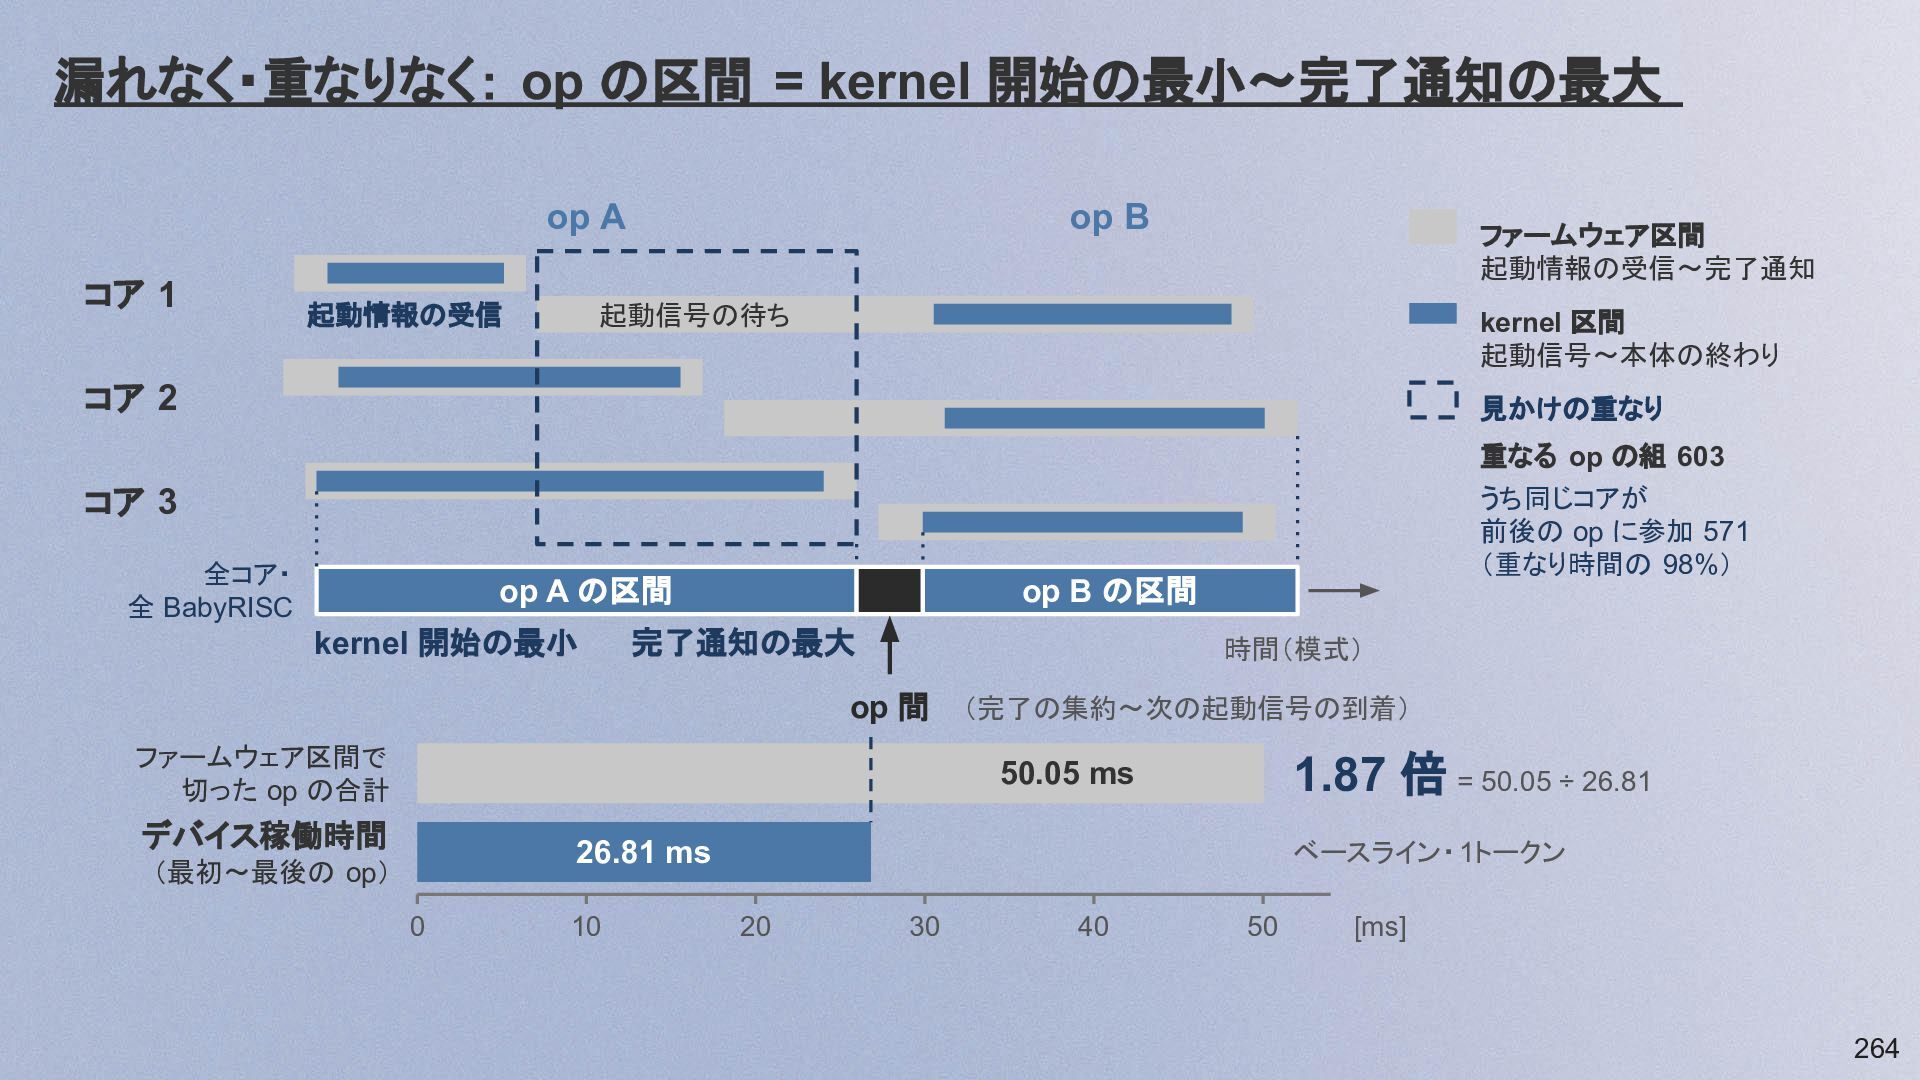
漏れなく・重なりなく: op の区間 = kernel 開始の最小〜完了通知の最大 op A コア 1
起動情報の受信 op B ファームウェア区間 起動情報の受信〜完了通知 起動信号の待ち kernel 区間 起動信号〜本体の終わり コア 2 見かけの重なり 重なる op の組 603 コア 3 全コア・ 全 BabyRISC op A の区間 kernel 開始の最小 うち同じコアが 前後の op に参加 571 (重なり時間の 98%) op B の区間 完了通知の最大 時間(模式) op 間 ファームウェア区間で 切った op の合計 (完了の集約〜次の起動信号の到着) 1.87 倍 = 50.05 ÷ 26.81 50.05 ms デバイス稼働時間 ベースライン・ 1トークン 26.81 ms (最初〜最後の op) 0 10 20 30 40 50 [ms] 264 -
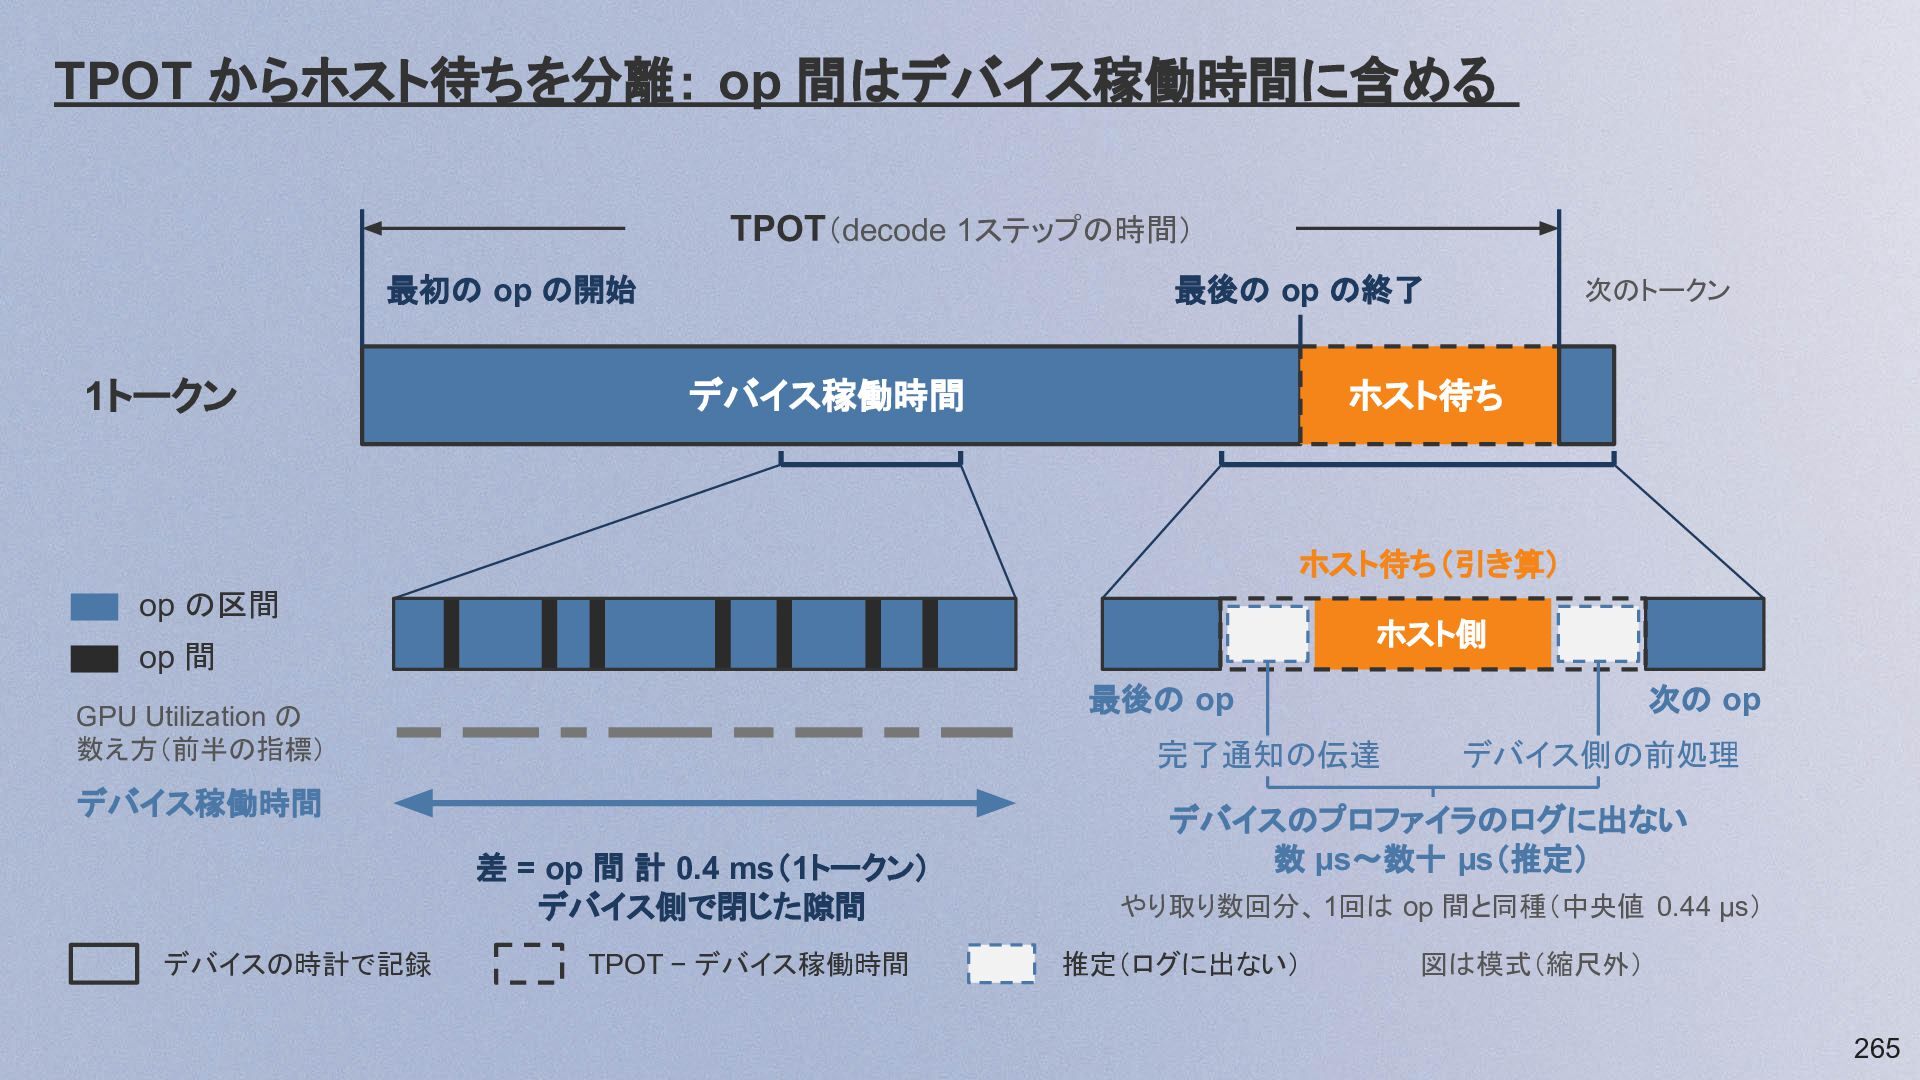
TPOT からホスト待ちを分離: op 間はデバイス稼働時間に含める TPOT(decode 1ステップの時間) 最初の op の開始 1トークン
最後の op の終了 デバイス稼働時間 次のトークン ホスト待ち ホスト待ち(引き算) op の区間 ホスト側 op 間 最後の op GPU Utilization の 数え方(前半の指標) 完了通知の伝達 デバイス稼働時間 差 = op 間 計 0.4 ms(1トークン) デバイス側で閉じた隙間 デバイスの時計で記録 TPOT − デバイス稼働時間 次の op デバイス側の前処理 デバイスのプロファイラのログに出ない 数 µs〜数十 µs(推定) やり取り数回分、 1回は op 間と同種(中央値 0.44 µs) 推定(ログに出ない) 図は模式(縮尺外) 265 -
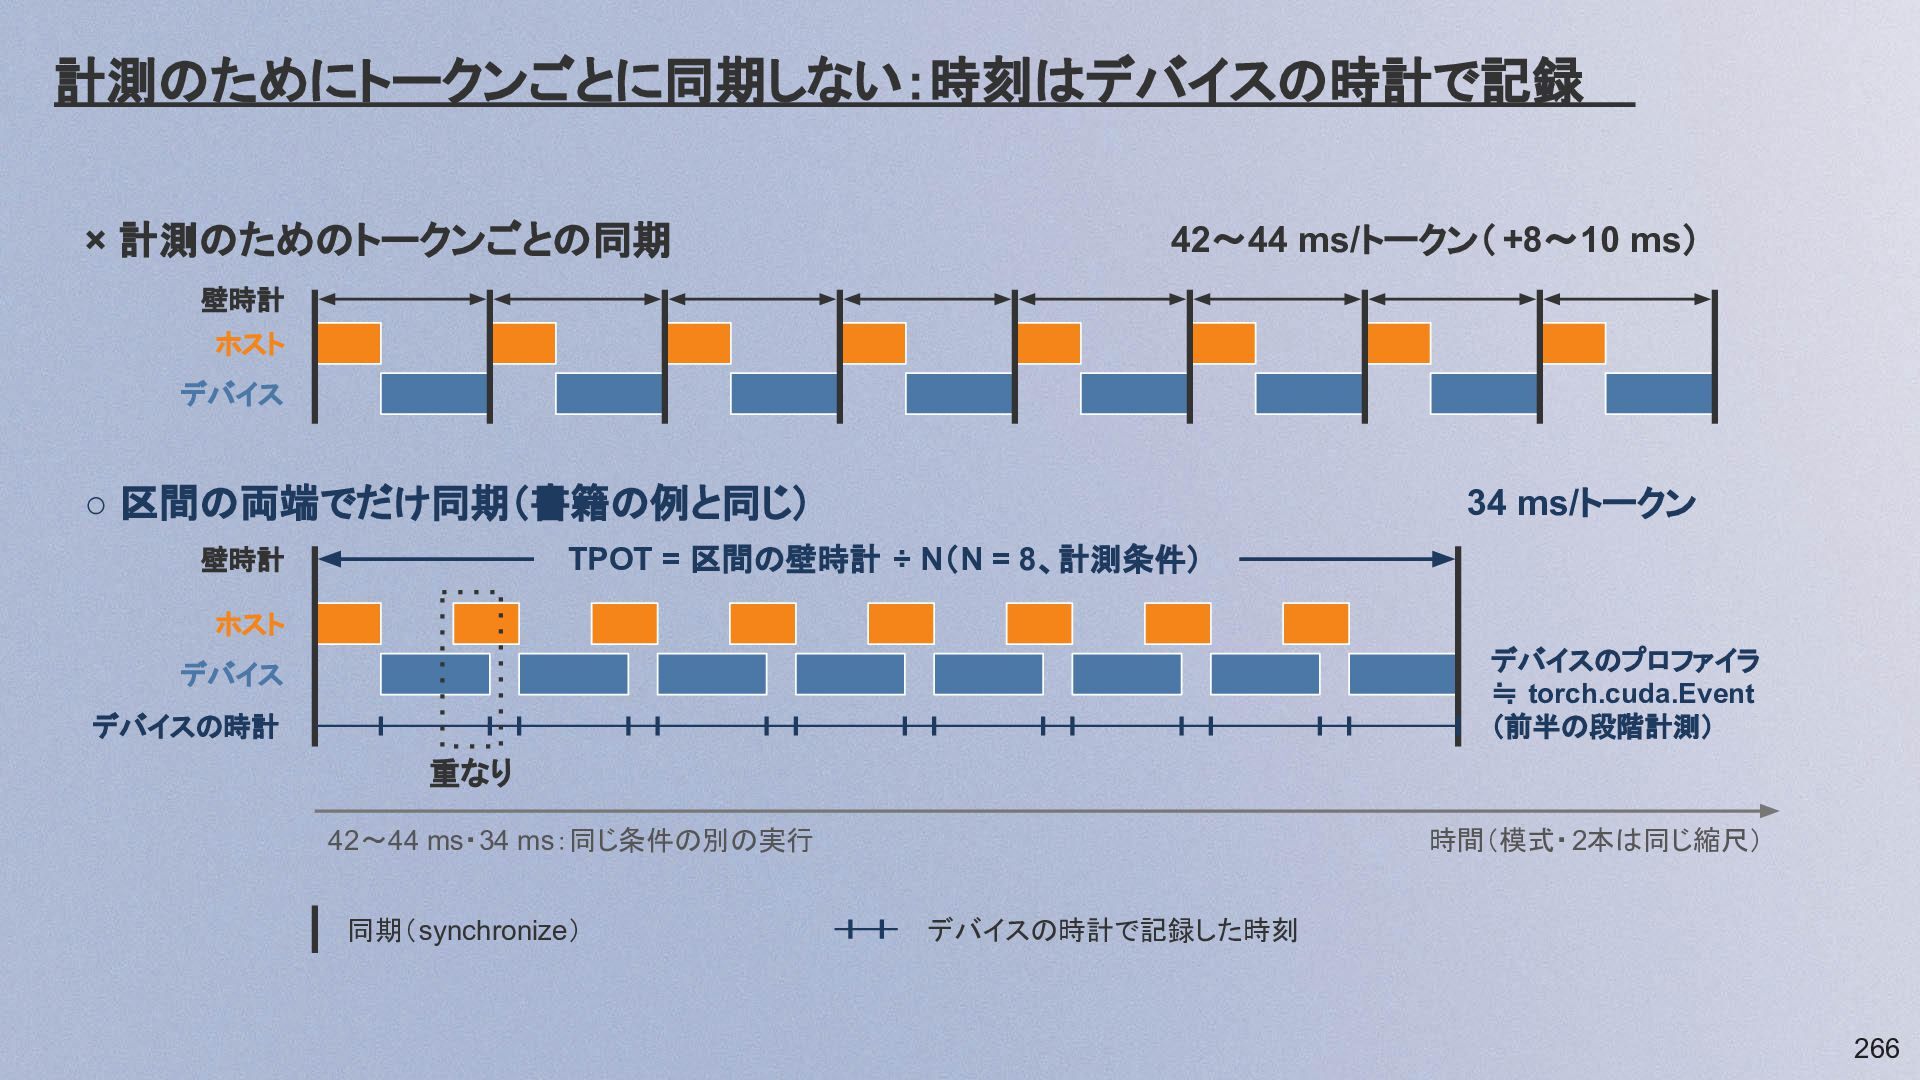
計測のためにトークンごとに同期しない:時刻はデバイスの時計で記録 × 計測のためのトークンごとの同期 42〜44 ms/トークン( +8〜10 ms) 壁時計 ホスト デバイス
◦ 区間の両端でだけ同期(書籍の例と同じ) 34 ms/トークン TPOT = 区間の壁時計 ÷ N(N = 8、計測条件) 壁時計 ホスト デバイスのプロファイラ ≒ torch.cuda.Event (前半の段階計測) デバイス デバイスの時計 重なり 時間(模式・2本は同じ縮尺) 42〜44 ms・34 ms:同じ条件の別の実行 同期(synchronize) デバイスの時計で記録した時刻 266 -
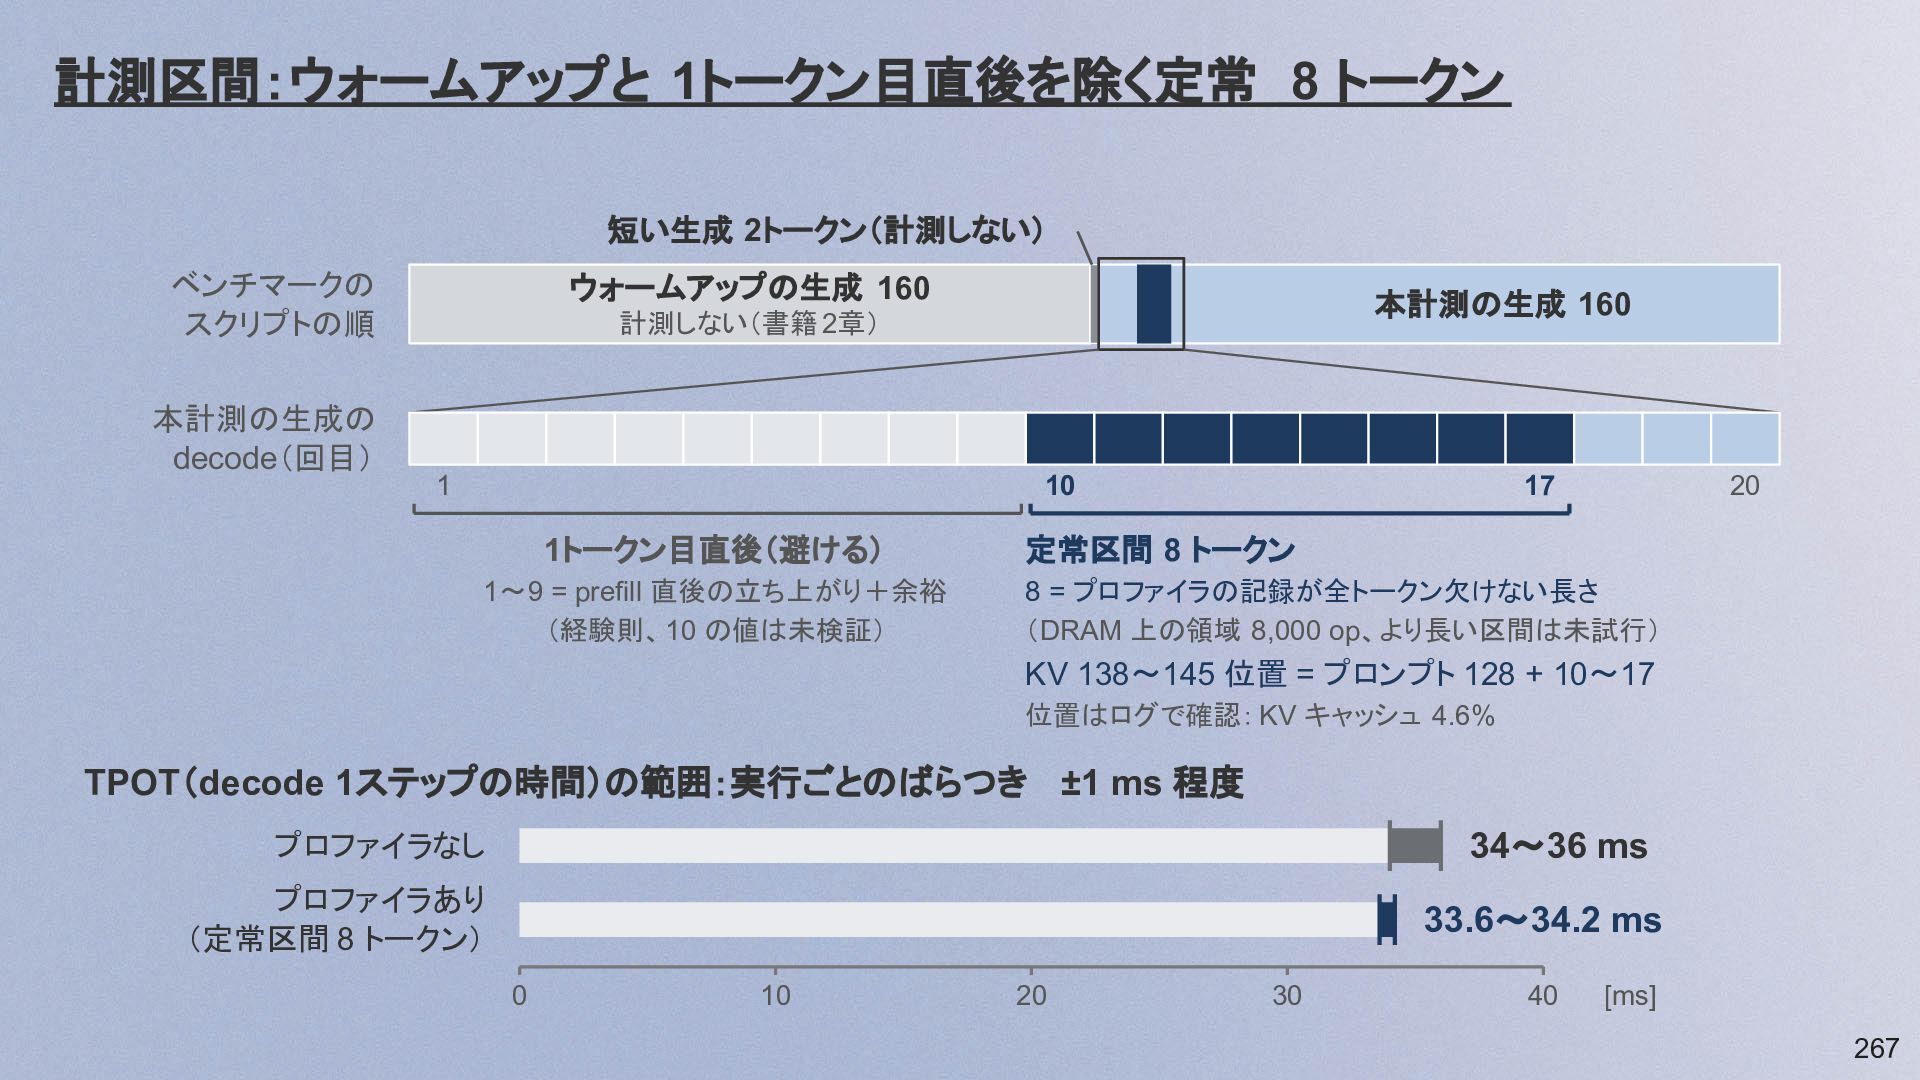
計測区間:ウォームアップと 1トークン目直後を除く定常 8 トークン 短い生成 2トークン(計測しない) ベンチマークの スクリプトの順 本計測の生成の decode(回目)
ウォームアップの生成 160 本計測の生成 160 計測しない(書籍 2章) 1 10 1トークン目直後(避ける) 1〜9 = prefill 直後の立ち上がり+余裕 (経験則、10 の値は未検証) 17 20 定常区間 8 トークン 8 = プロファイラの記録が全トークン欠けない長さ (DRAM 上の領域 8,000 op、より長い区間は未試行) KV 138〜145 位置 = プロンプト 128 + 10〜17 位置はログで確認: KV キャッシュ 4.6% TPOT(decode 1ステップの時間)の範囲:実行ごとのばらつき ±1 ms 程度 プロファイラなし 34〜36 ms プロファイラあり (定常区間 8 トークン) 33.6〜34.2 ms 0 10 20 30 40 [ms] 267 -
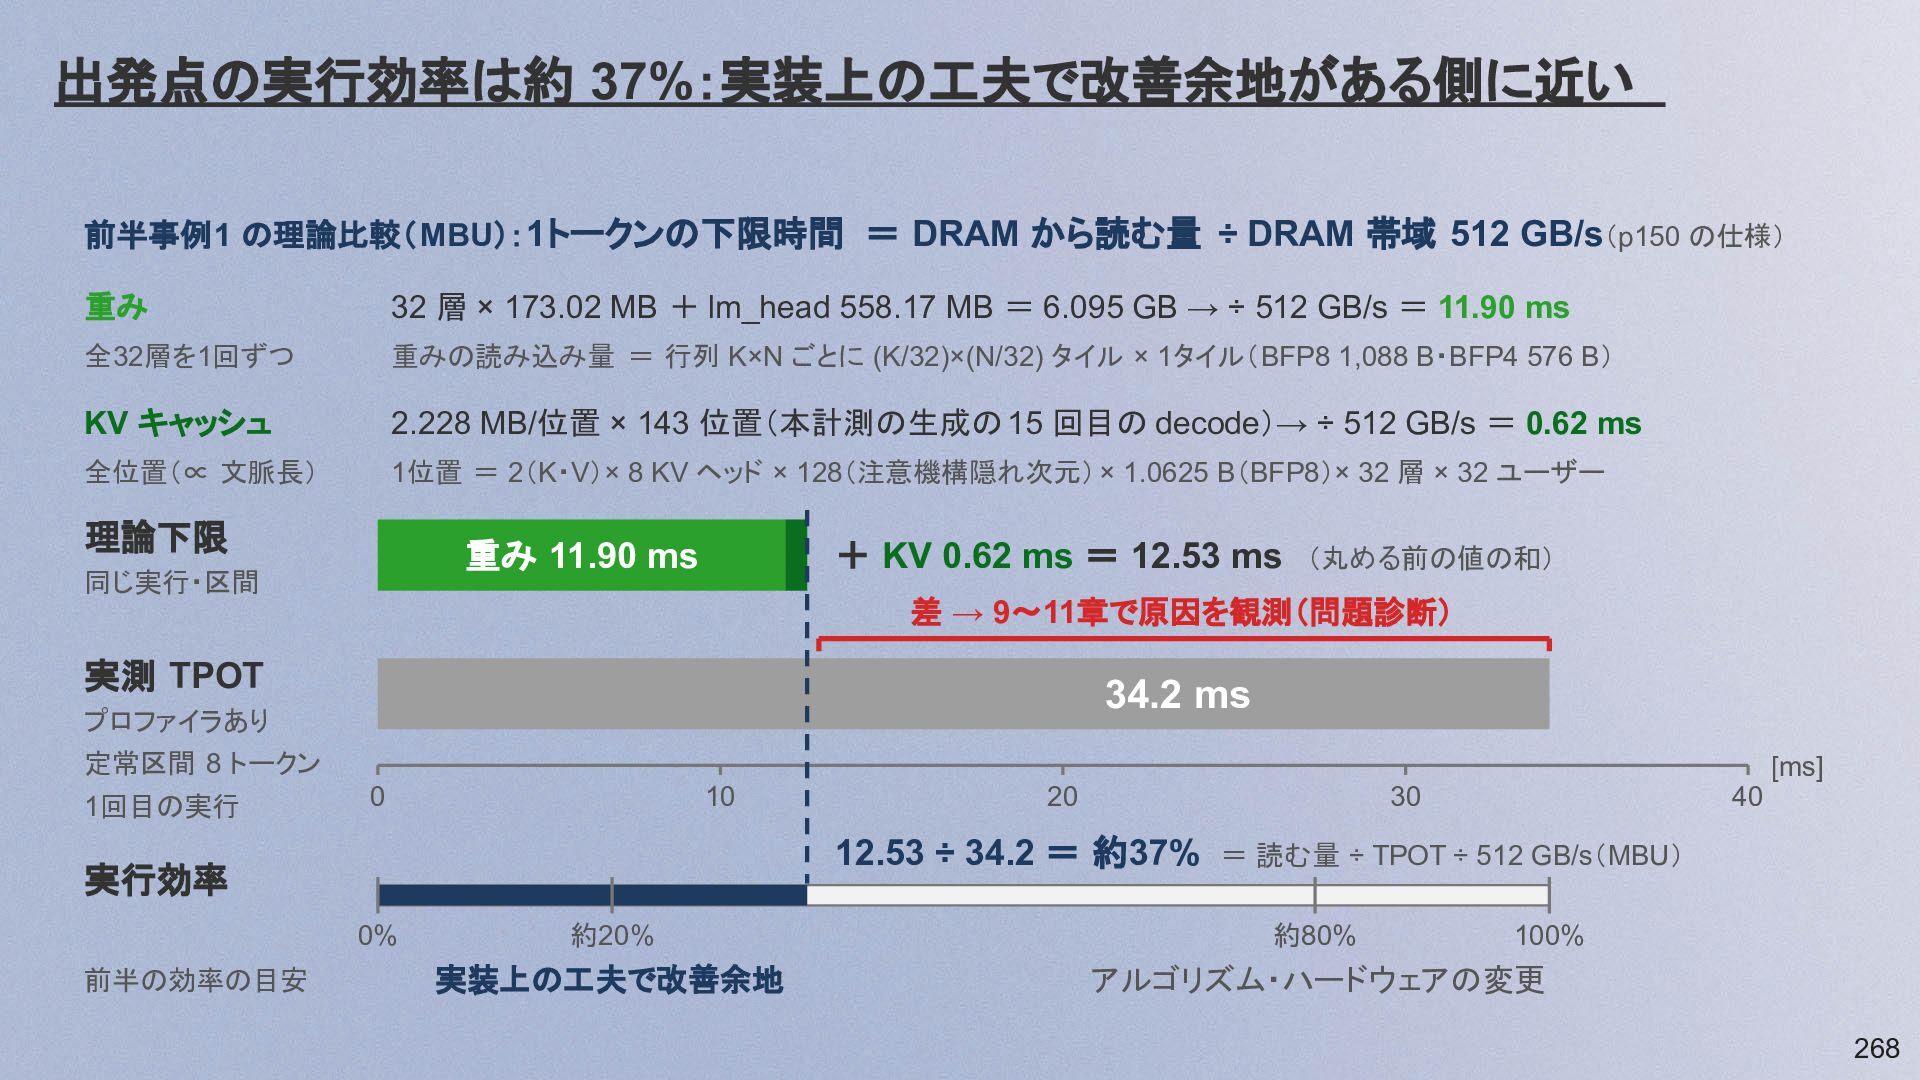
出発点の実行効率は約 37%:実装上の工夫で改善余地がある側に近い 前半事例1 の理論比較(MBU): 1トークンの下限時間 = DRAM から読む量 ÷ DRAM
帯域 512 GB/s(p150 の仕様) 重み 32 層 × 173.02 MB + lm_head 558.17 MB = 6.095 GB → ÷ 512 GB/s = 11.90 ms 全32層を1回ずつ 重みの読み込み量 = 行列 K×N ごとに (K/32)×(N/32) タイル × 1タイル(BFP8 1,088 B・BFP4 576 B) KV キャッシュ 2.228 MB/位置 × 143 位置(本計測の生成の 15 回目の decode)→ ÷ 512 GB/s = 0.62 ms 全位置(∝ 文脈長) 1位置 = 2(K・V)× 8 KV ヘッド × 128(注意機構隠れ次元) × 1.0625 B(BFP8)× 32 層 × 32 ユーザー 理論下限 重み 11.90 ms 同じ実行・区間 + KV 0.62 ms = 12.53 ms (丸める前の値の和) 差 → 9〜11章で原因を観測(問題診断) 実測 TPOT 34.2 ms プロファイラあり 定常区間 8 トークン 1回目の実行 [ms] 0 10 30 40 12.53 ÷ 34.2 = 約37% = 読む量 ÷ TPOT ÷ 512 GB/s(MBU) 実行効率 0% 前半の効率の目安 20 約20% 約80% 実装上の工夫で改善余地 アルゴリズム・ハードウェアの変更 100% 268 -
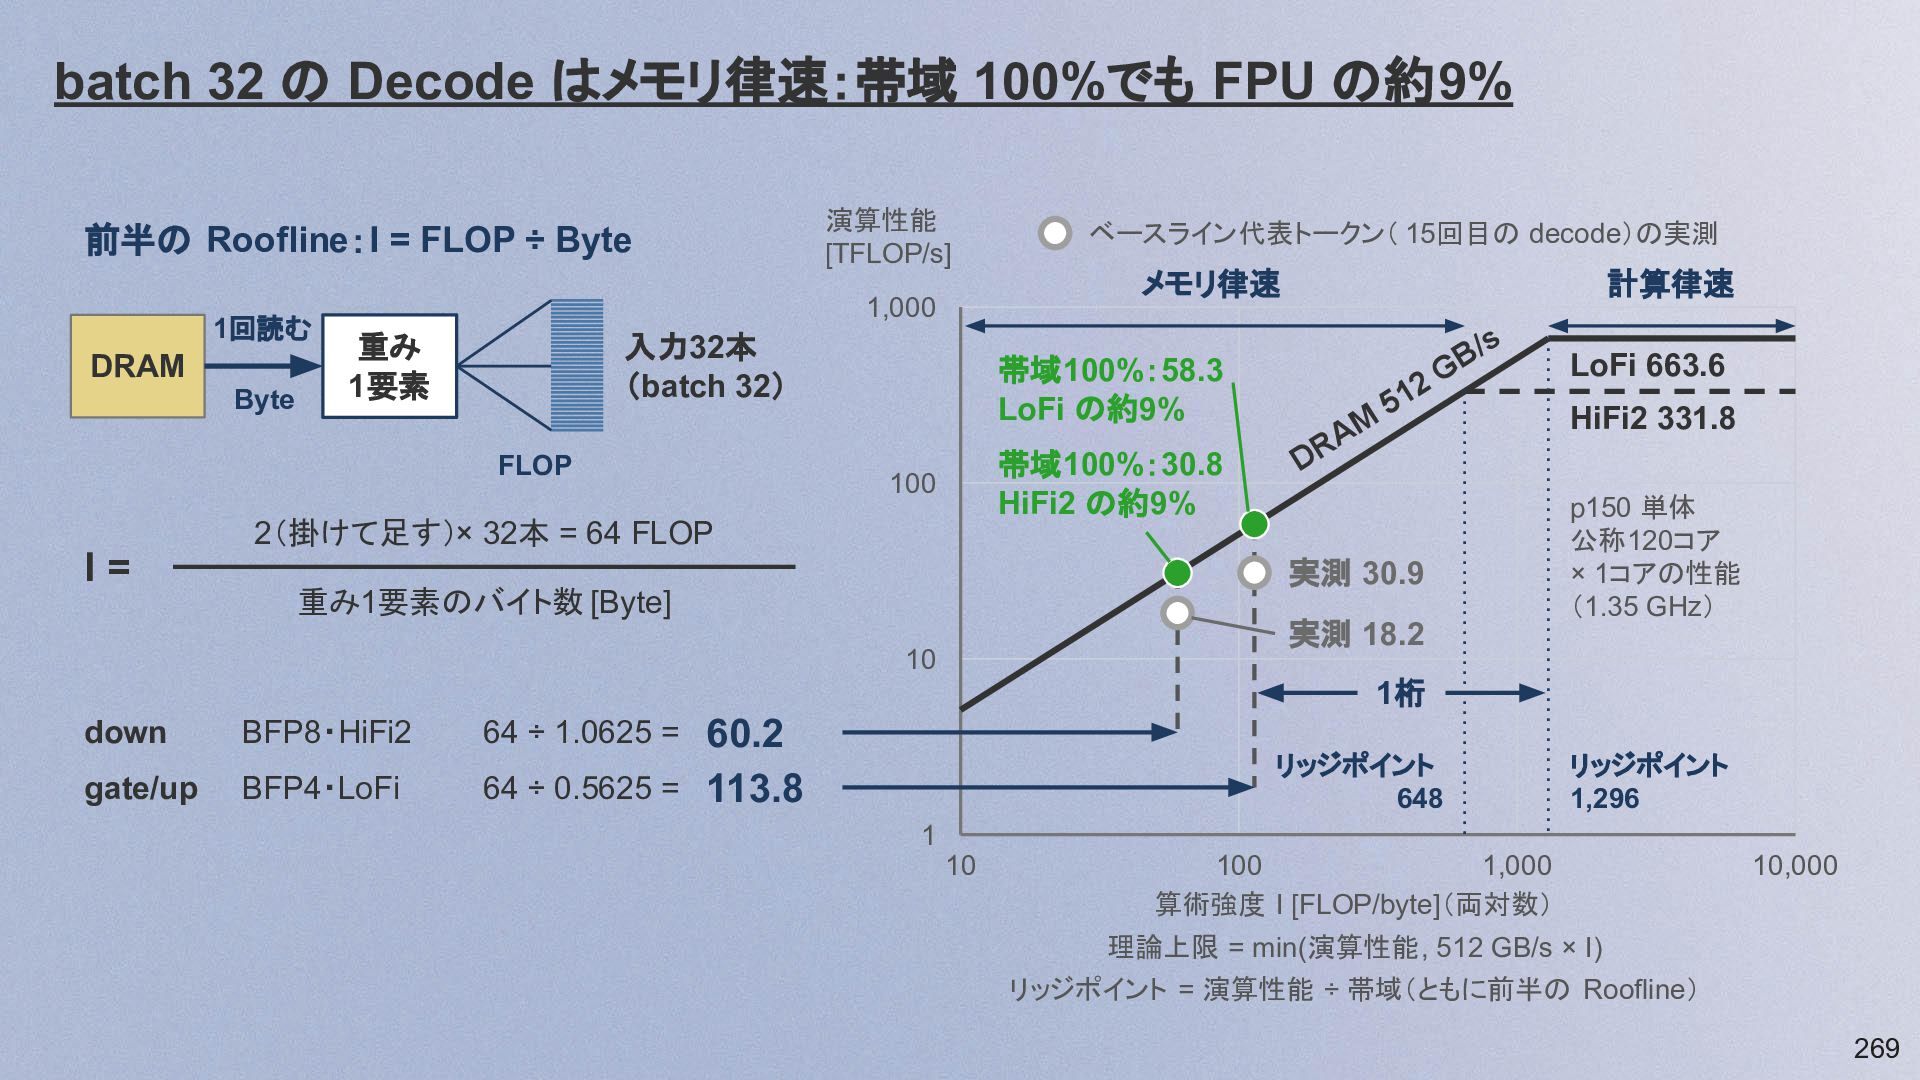
batch 32 の Decode はメモリ律速:帯域 100%でも FPU の約9% 前半の Roofline:I
= FLOP ÷ Byte 1回読む DRAM Byte 演算性能 [TFLOP/s] 1,000 入力32本 (batch 32) 重み 1要素 FLOP メモリ律速 計算律速 /s B 2G 帯域100%:58.3 LoFi の約9% 帯域100%:30.8 HiFi2 の約9% 100 2(掛けて足す)× 32本 = 64 FLOP I= ベースライン代表トークン( 15回目の decode)の実測 M RA 51 実測 18.2 10 HiFi2 331.8 D 実測 30.9 重み1要素のバイト数 [Byte] LoFi 663.6 p150 単体 公称120コア × 1コアの性能 (1.35 GHz) 1桁 down BFP8・HiFi2 gate/up BFP4・LoFi 60.2 64 ÷ 0.5625 = 113.8 64 ÷ 1.0625 = リッジポイント 648 リッジポイント 1,296 1 10 100 1,000 算術強度 I [FLOP/byte](両対数) 10,000 理論上限 = min(演算性能, 512 GB/s × I) リッジポイント = 演算性能 ÷ 帯域(ともに前半の Roofline) 269 -
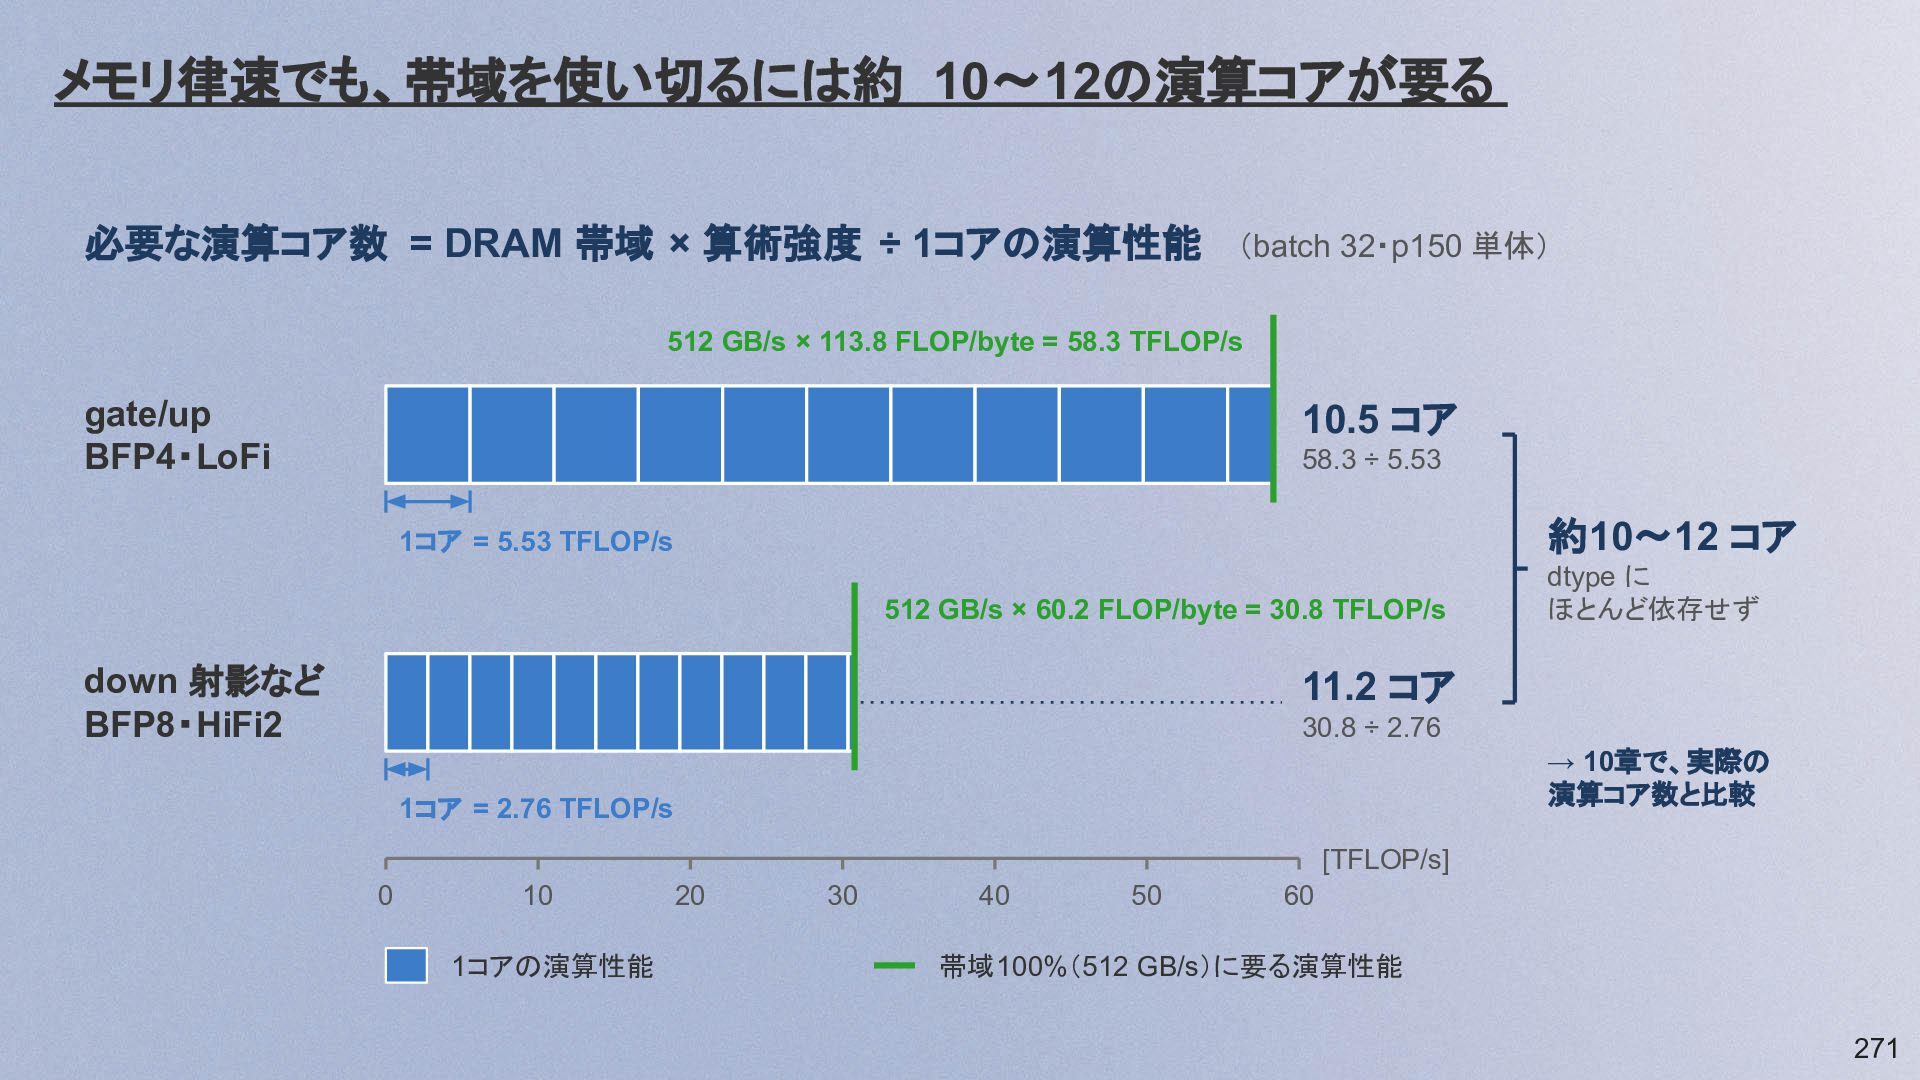
メモリ律速でも、帯域を使い切るには約 10〜12の演算コアが要る 必要な演算コア数 = DRAM 帯域 × 算術強度 ÷ 1コアの演算性能
(batch 32・p150 単体) 512 GB/s × 113.8 FLOP/byte = 58.3 TFLOP/s 10.5 コア gate/up BFP4・LoFi 58.3 ÷ 5.53 約10〜12 コア 1コア = 5.53 TFLOP/s 512 GB/s × 60.2 FLOP/byte = 30.8 TFLOP/s down 射影など BFP8・HiFi2 dtype に ほとんど依存せず 11.2 コア 30.8 ÷ 2.76 → 10章で、実際の 演算コア数と比較 1コア = 2.76 TFLOP/s [TFLOP/s] 0 10 1コアの演算性能 20 30 40 50 60 帯域100%(512 GB/s)に要る演算性能 271 -
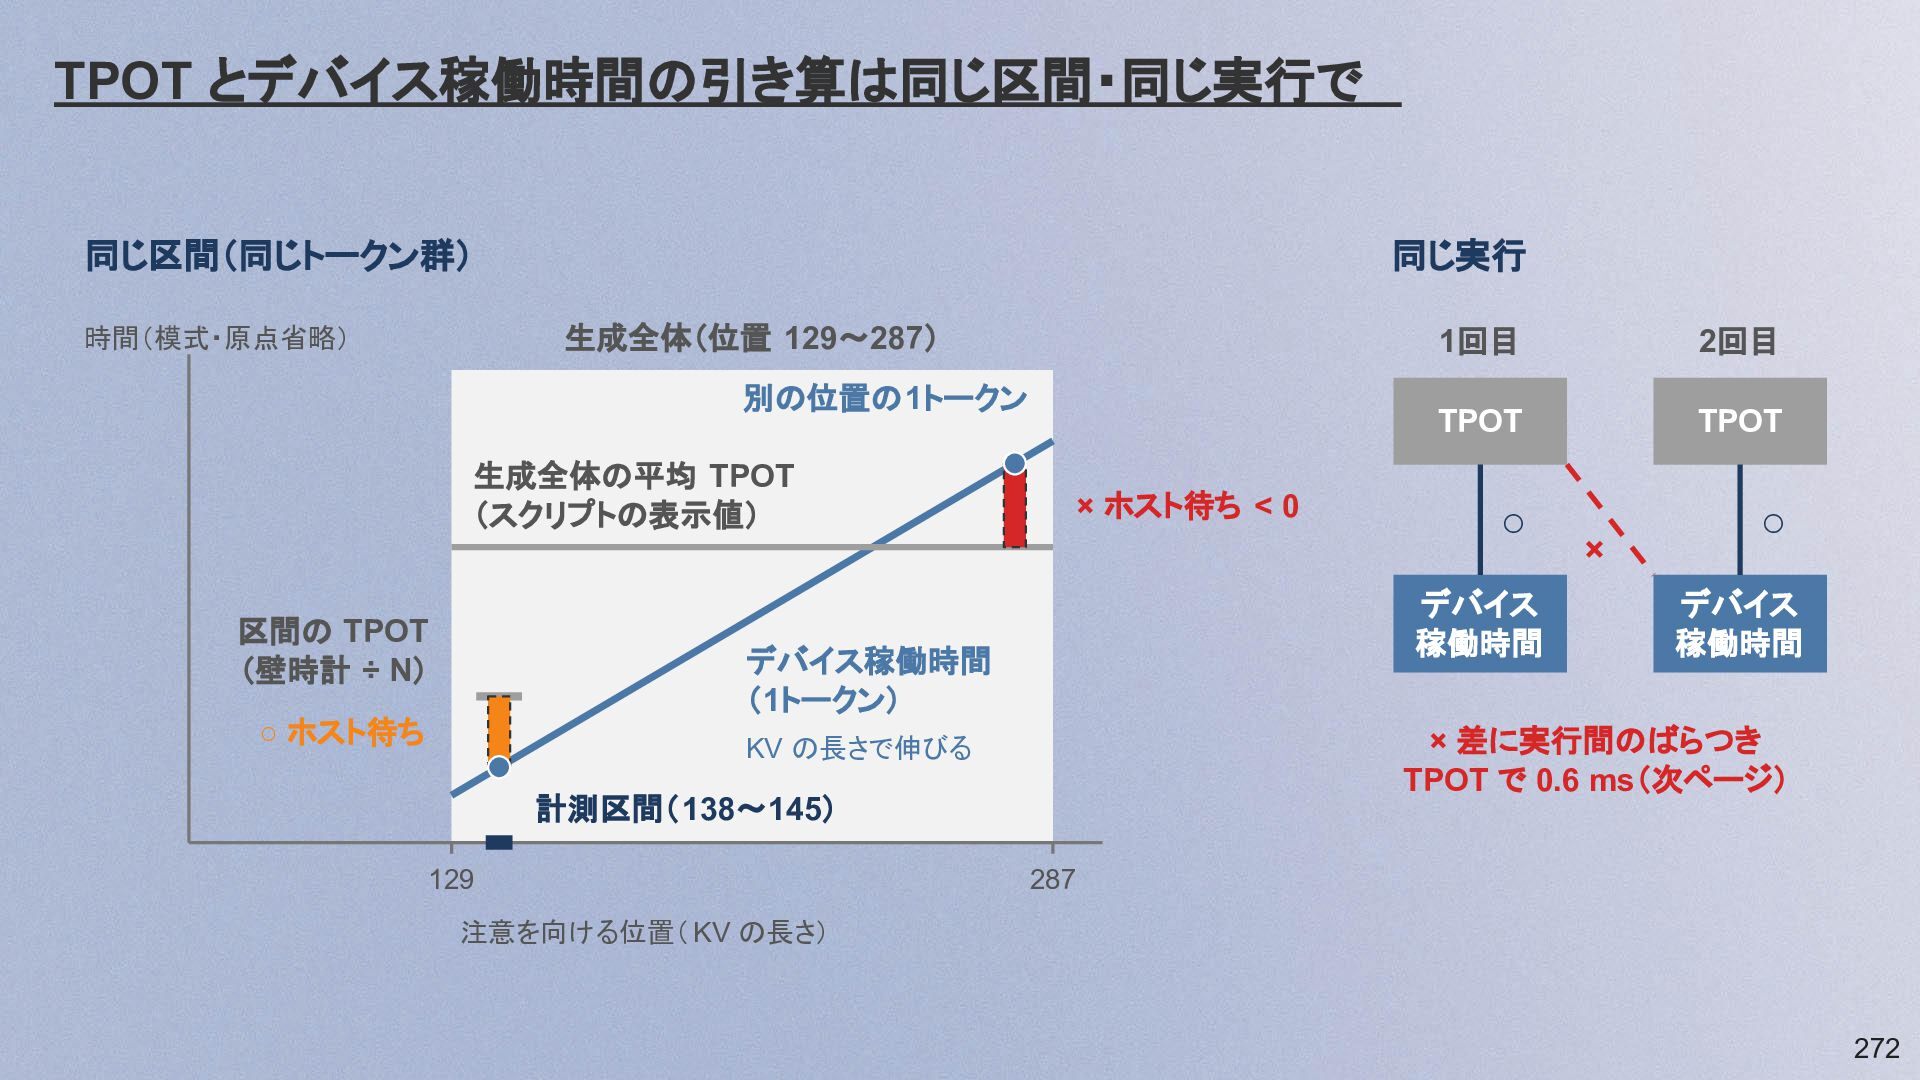
TPOT とデバイス稼働時間の引き算は同じ区間・同じ実行で 同じ区間(同じトークン群) 同じ実行 生成全体(位置 129〜287) 時間(模式・原点省略) 別の位置の1トークン 生成全体の平均 TPOT
(スクリプトの表示値) 区間の TPOT (壁時計 ÷ N) × ホスト待ち < 0 TPOT TPOT ◦ ◦ × デバイス 稼働時間 × 差に実行間のばらつき TPOT で 0.6 ms(次ページ) KV の長さで伸びる 計測区間(138〜145) 129 2回目 デバイス 稼働時間 デバイス稼働時間 (1トークン) ◦ ホスト待ち 1回目 287 注意を向ける位置( KV の長さ) 272 -
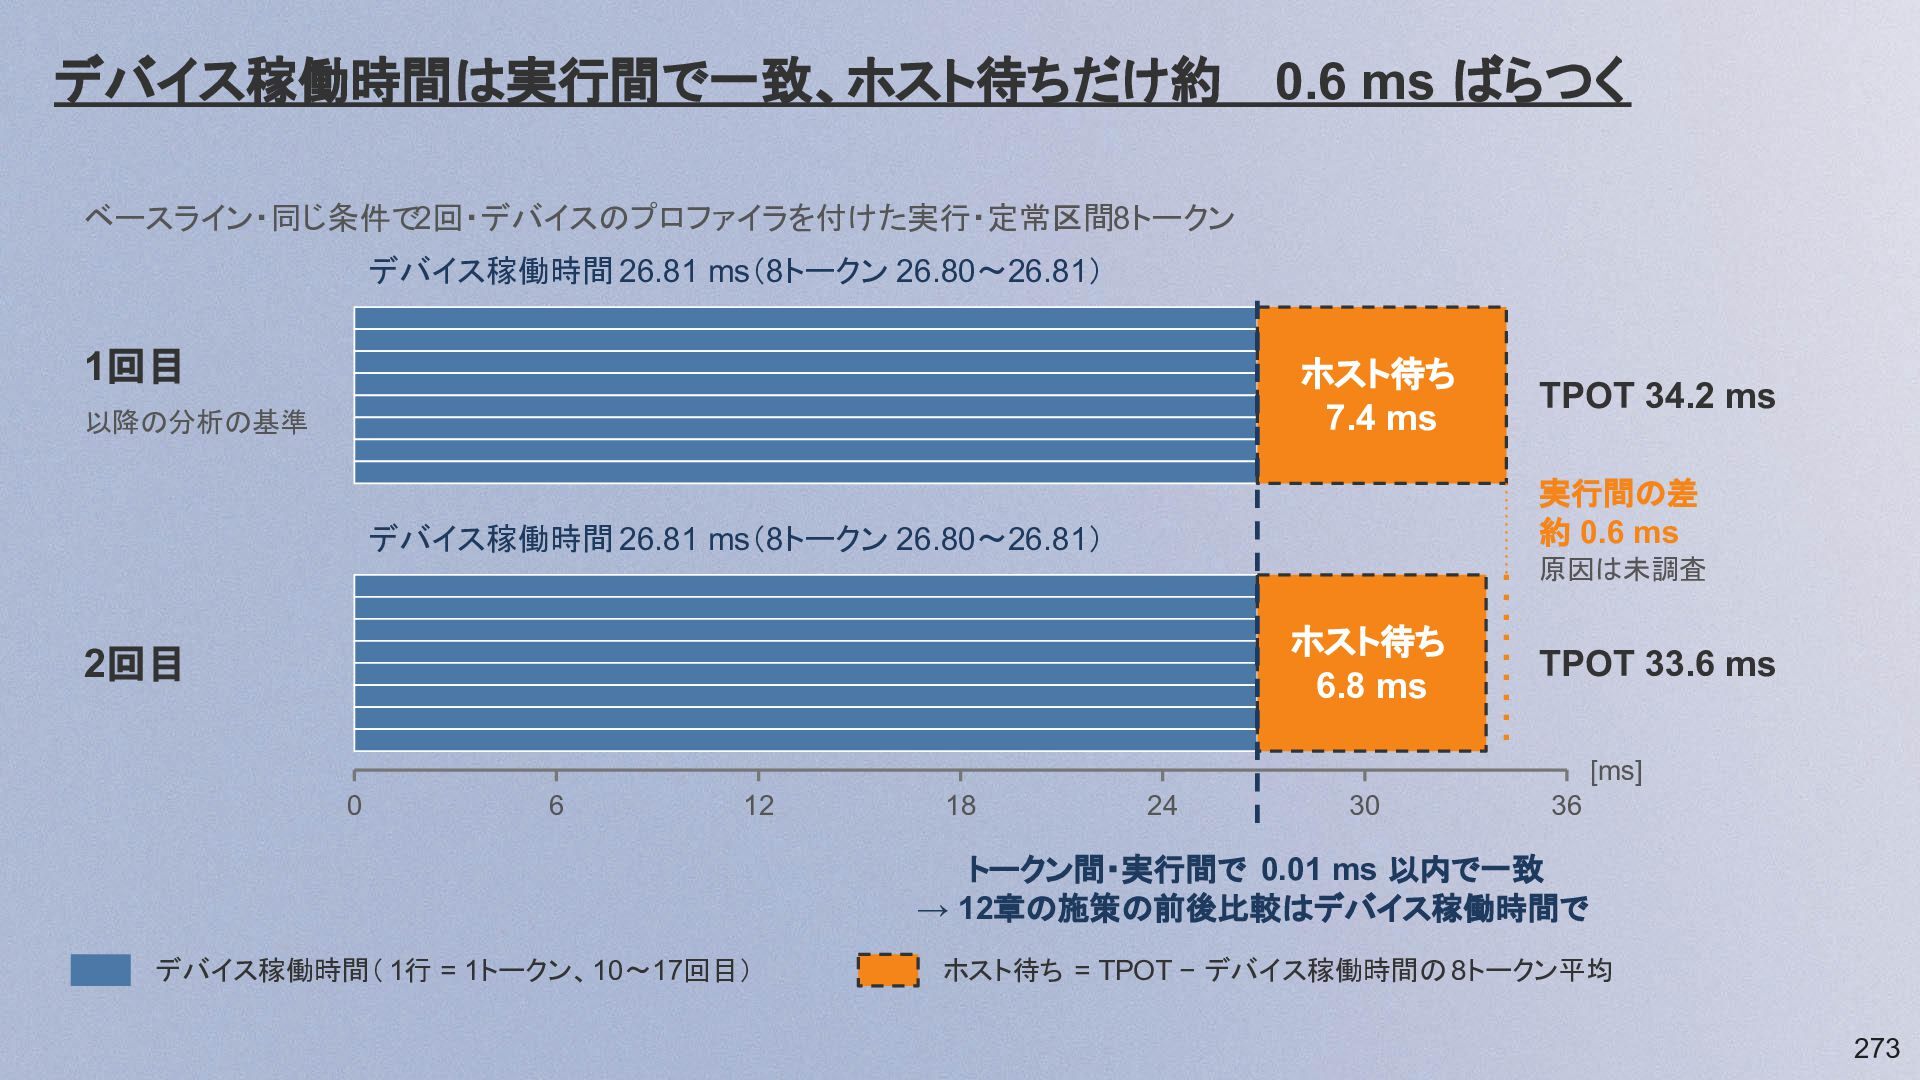
デバイス稼働時間は実行間で一致、ホスト待ちだけ約 0.6 ms ばらつく ベースライン・同じ条件で2回・デバイスのプロファイラを付けた実行・定常区間8トークン デバイス稼働時間 26.81 ms(8トークン 26.80〜26.81) 1回目
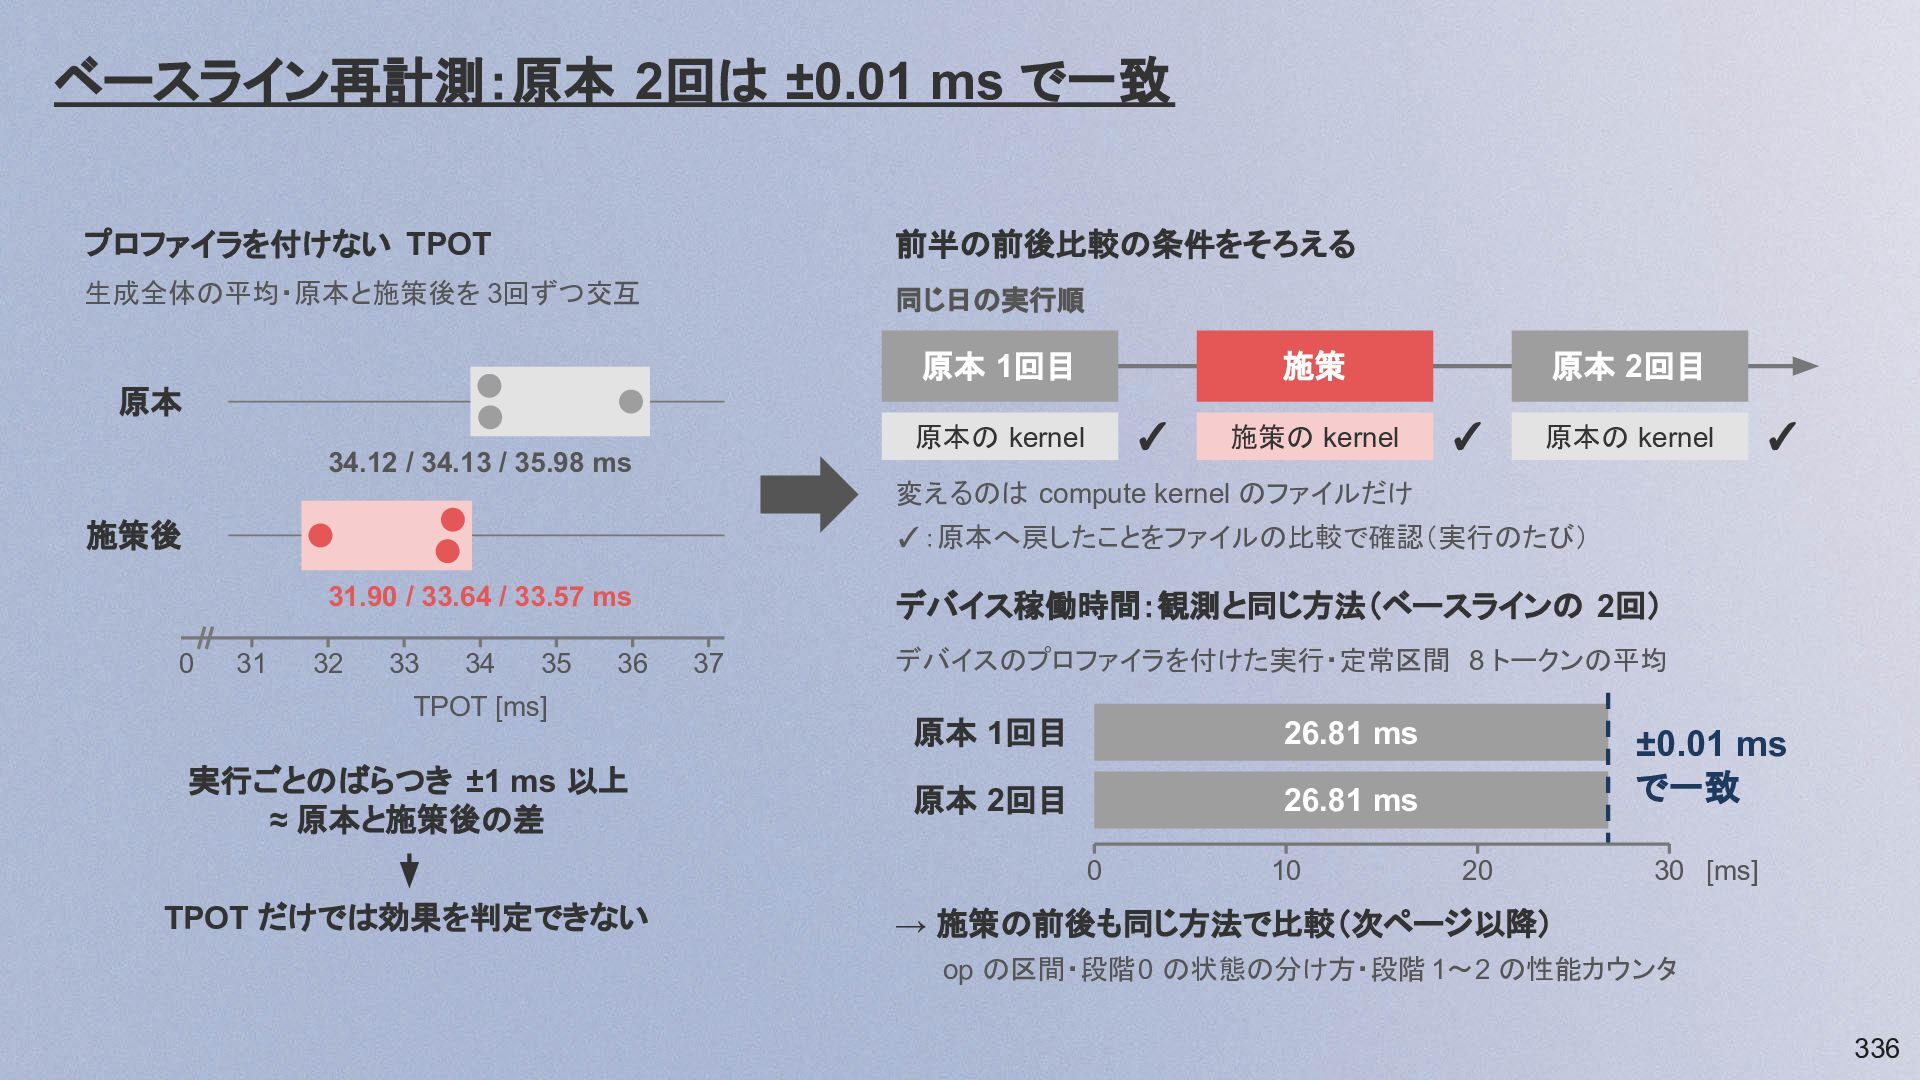
ホスト待ち 7.4 ms 以降の分析の基準 TPOT 34.2 ms 実行間の差 約 0.6 ms デバイス稼働時間 26.81 ms(8トークン 26.80〜26.81) 原因は未調査 ホスト待ち 6.8 ms 2回目 TPOT 33.6 ms [ms] 0 6 12 18 24 30 36 トークン間・実行間で 0.01 ms 以内で一致 → 12章の施策の前後比較はデバイス稼働時間で デバイス稼働時間( 1行 = 1トークン、10〜17回目) ホスト待ち = TPOT − デバイス稼働時間の 8トークン平均 273 -
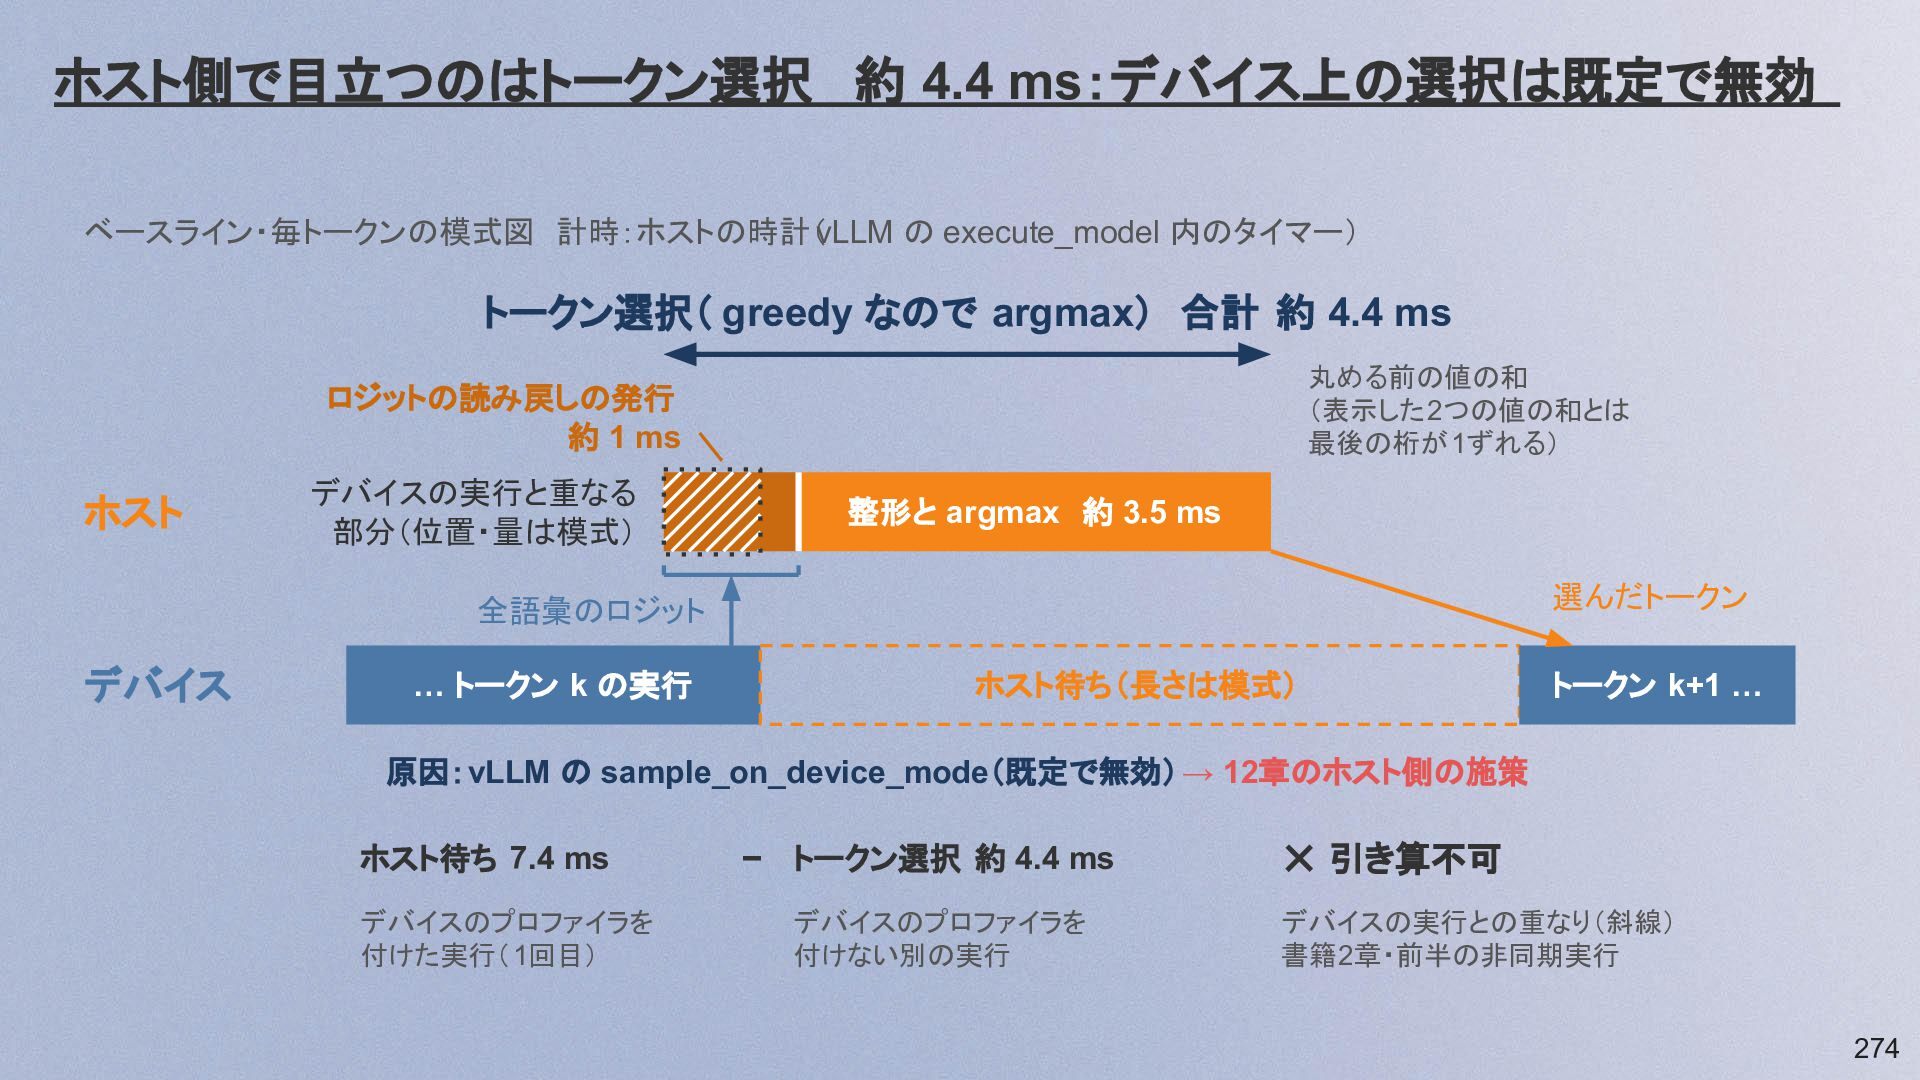
ホスト側で目立つのはトークン選択 約 4.4 ms:デバイス上の選択は既定で無効 ベースライン・毎トークンの模式図 計時:ホストの時計(vLLM の execute_model 内のタイマー) トークン選択(
greedy なので argmax) 合計 約 4.4 ms 丸める前の値の和 (表示した2つの値の和とは 最後の桁が1ずれる) ロジットの読み戻しの発行 約 1 ms ホスト デバイスの実行と重なる 部分(位置・量は模式) 整形と argmax 約 3.5 ms 選んだトークン 全語彙のロジット デバイス … トークン k の実行 ホスト待ち(長さは模式) トークン k+1 … 原因:vLLM の sample_on_device_mode(既定で無効) → 12章のホスト側の施策 ホスト待ち 7.4 ms デバイスのプロファイラを 付けた実行(1回目) − トークン選択 約 4.4 ms デバイスのプロファイラを 付けない別の実行 ✕ 引き算不可 デバイスの実行との重なり(斜線) 書籍2章・前半の非同期実行 274 -
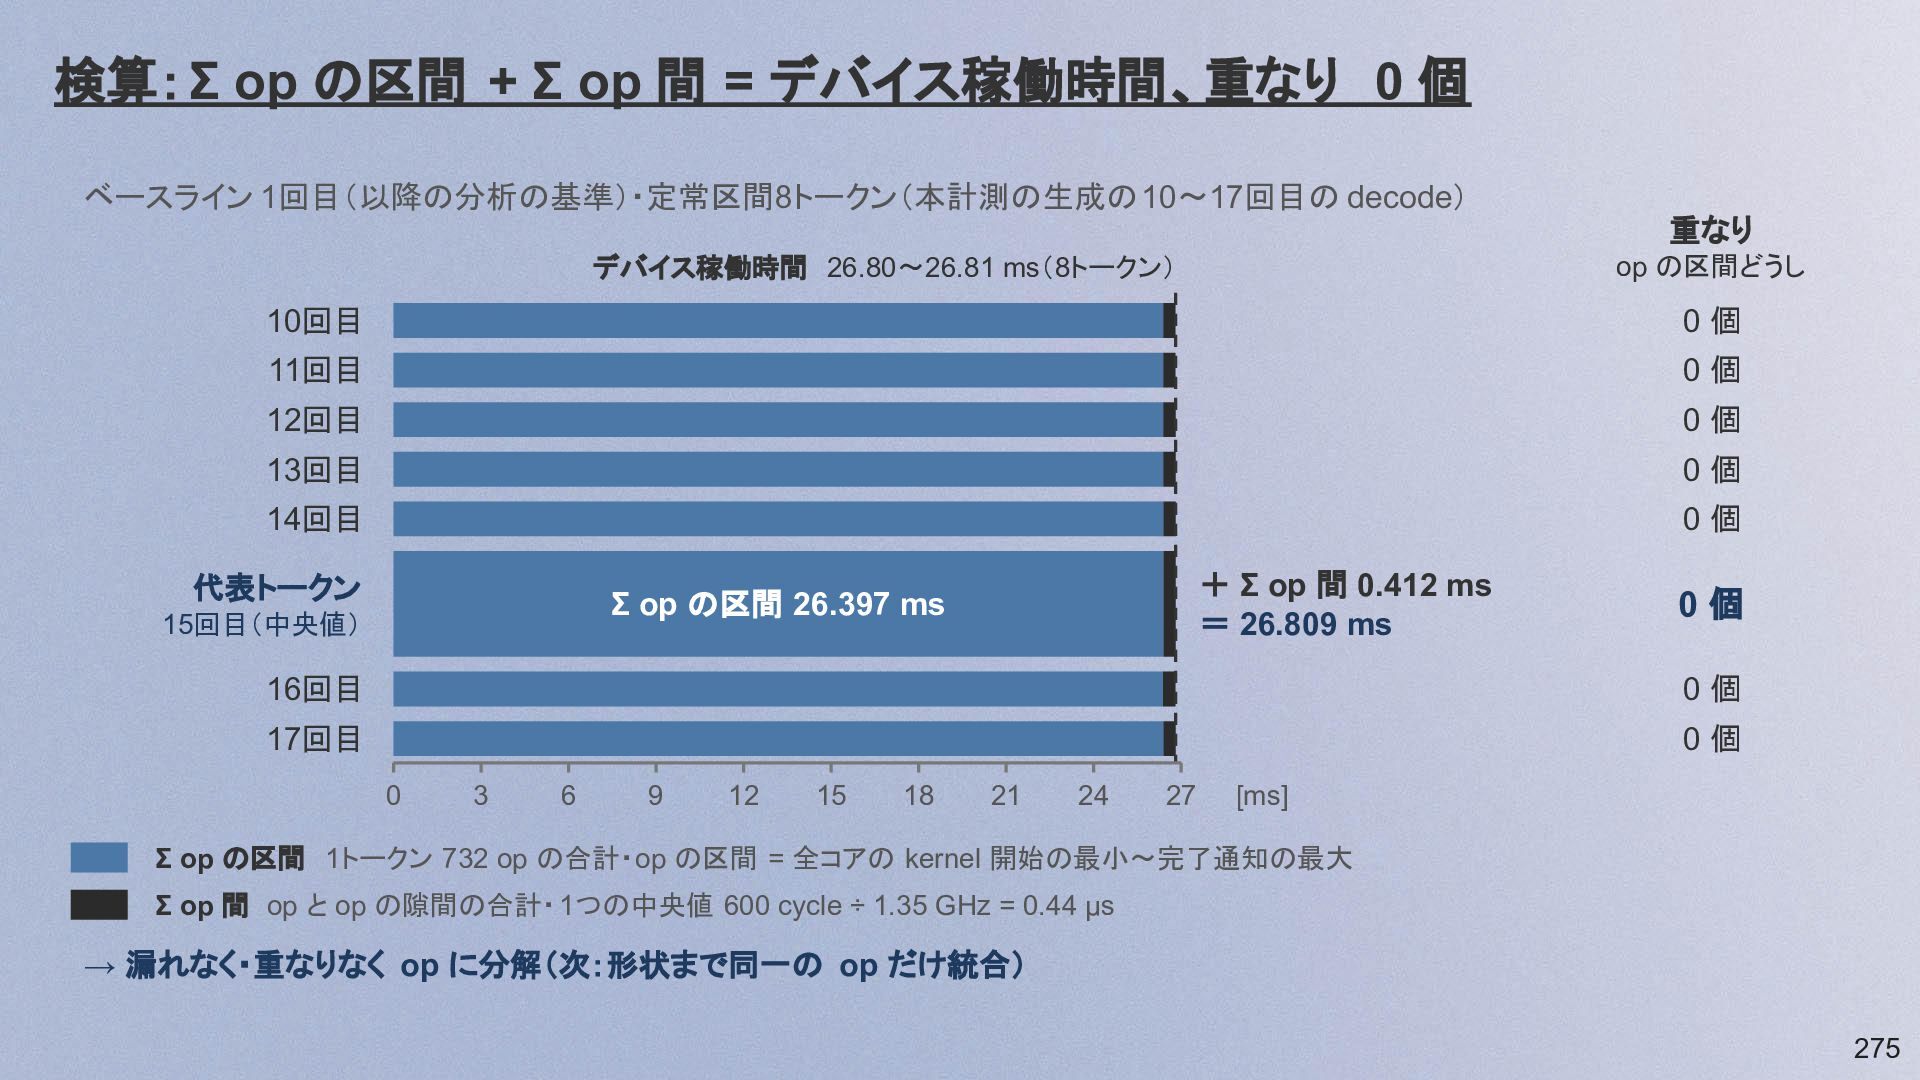
検算:Σ op の区間 + Σ op 間 = デバイス稼働時間、重なり 0
個 ベースライン 1回目(以降の分析の基準)・定常区間 8トークン(本計測の生成の 10〜17回目の decode) 重なり op の区間どうし デバイス稼働時間 26.80〜26.81 ms(8トークン) 10回目 0個 11回目 0個 12回目 0個 13回目 0個 14回目 0個 代表トークン + Σ op 間 0.412 ms = 26.809 ms Σ op の区間 26.397 ms 15回目(中央値) 0個 16回目 0個 17回目 0個 0 3 6 9 12 15 18 21 24 27 [ms] Σ op の区間 1トークン 732 op の合計・op の区間 = 全コアの kernel 開始の最小〜完了通知の最大 Σ op 間 op と op の隙間の合計・ 1つの中央値 600 cycle ÷ 1.35 GHz = 0.44 µs → 漏れなく・重なりなく op に分解(次:形状まで同一の op だけ統合) 275 -
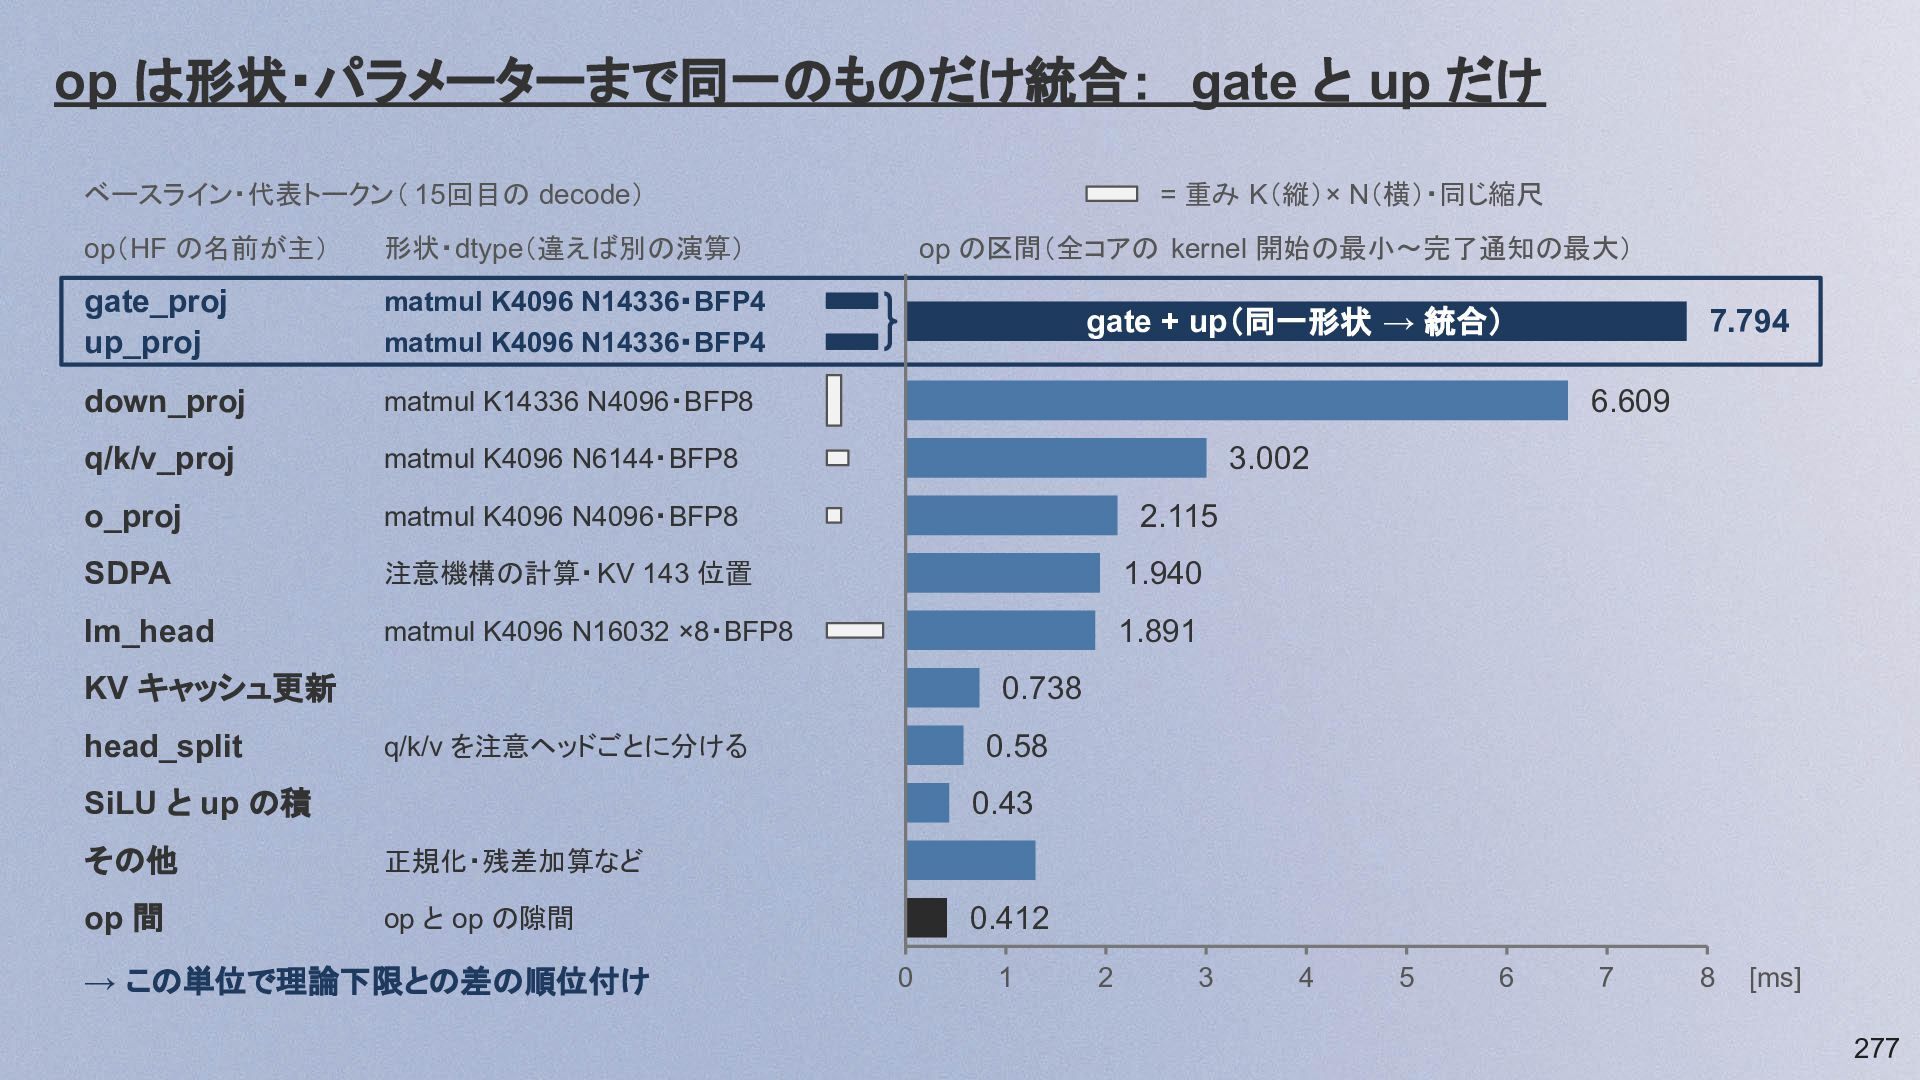
op は形状・パラメーターまで同一のものだけ統合: gate と up だけ ベースライン・代表トークン( 15回目の decode) =
重み K(縦)× N(横)・同じ縮尺 op(HF の名前が主) 形状・dtype(違えば別の演算) op の区間(全コアの kernel 開始の最小〜完了通知の最大) gate_proj up_proj matmul K4096 N14336・BFP4 matmul K4096 N14336・BFP4 gate + up(同一形状 → 統合) down_proj matmul K14336 N4096・BFP8 q/k/v_proj matmul K4096 N6144・BFP8 o_proj matmul K4096 N4096・BFP8 2.115 SDPA 注意機構の計算・ KV 143 位置 1.940 lm_head matmul K4096 N16032 ×8・BFP8 1.891 6.609 3.002 KV キャッシュ更新 head_split 7.794 0.738 q/k/v を注意ヘッドごとに分ける 0.58 SiLU と up の積 0.43 その他 正規化・残差加算など op 間 op と op の隙間 → この単位で理論下限との差の順位付け 0.412 0 1 2 3 4 5 6 7 8 [ms] 277 -
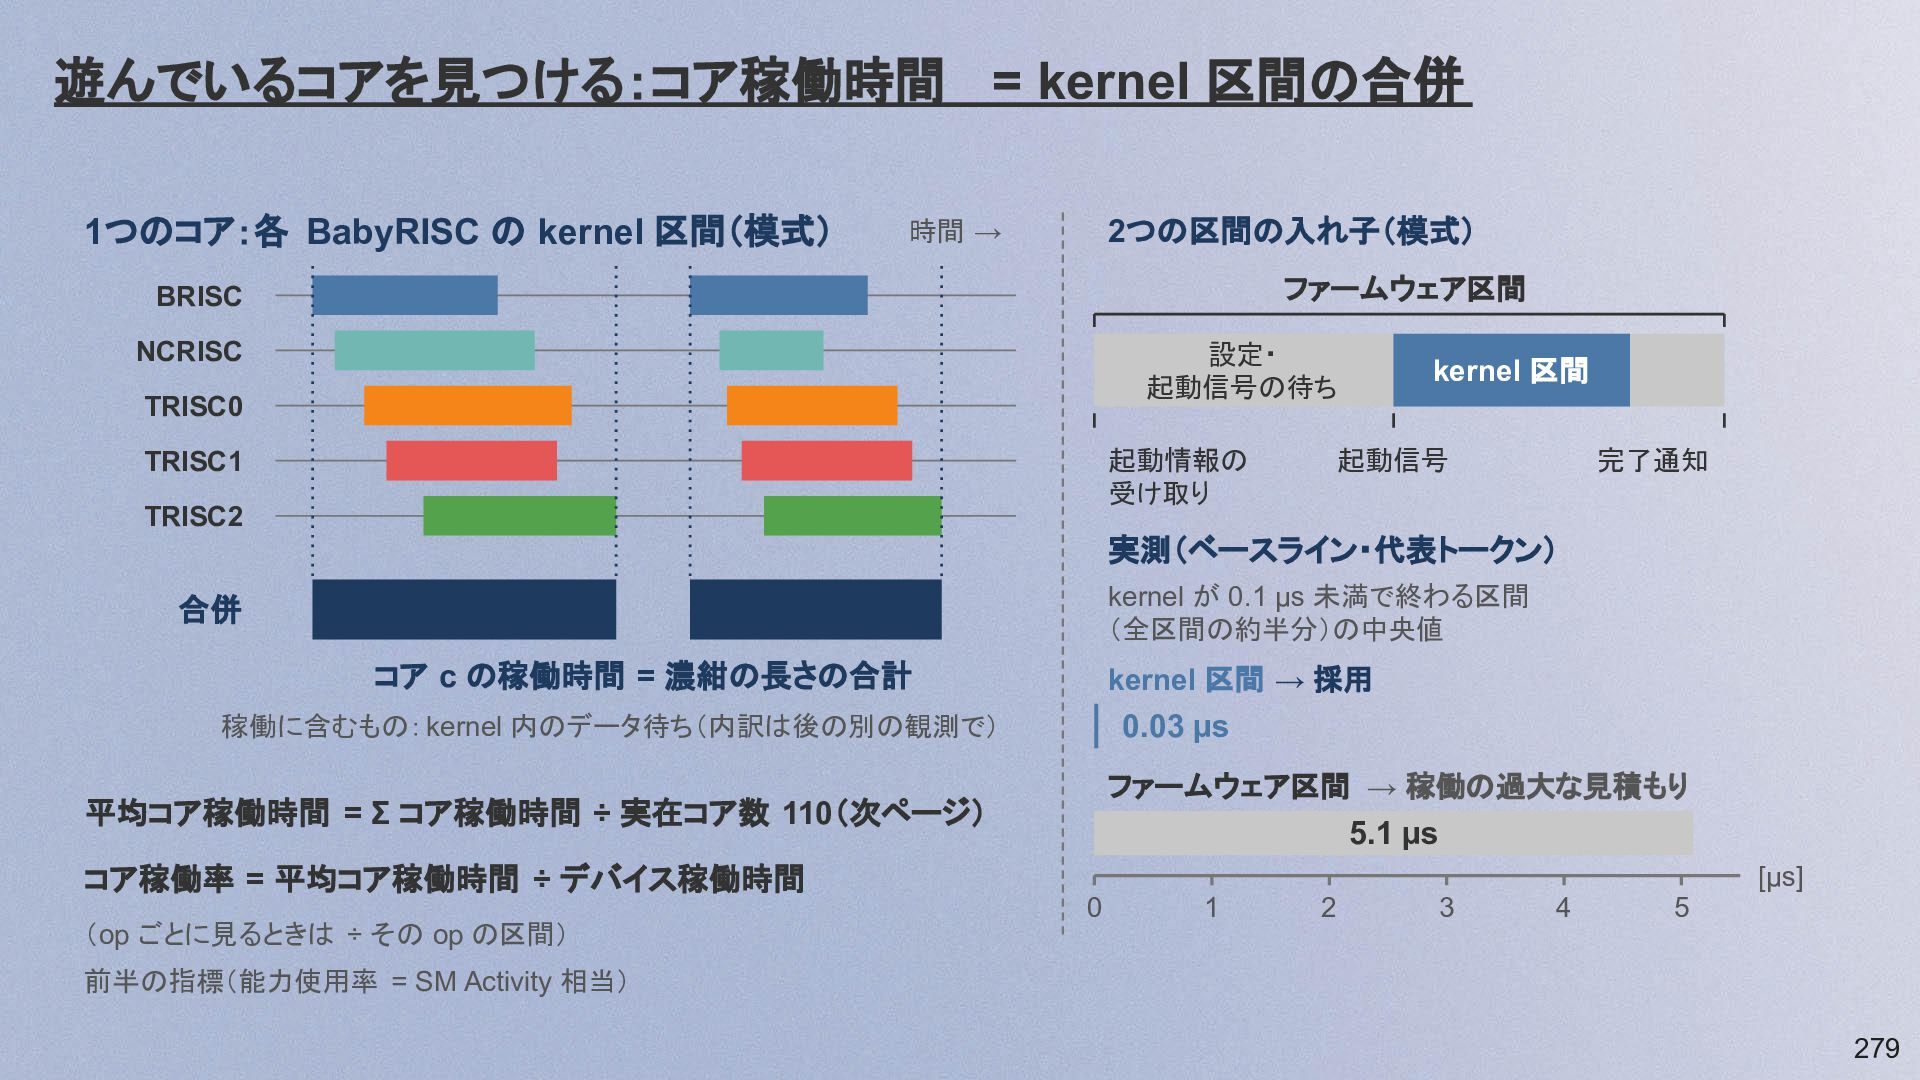
遊んでいるコアを見つける:コア稼働時間 = kernel 区間の合併 1つのコア:各 BabyRISC の kernel 区間(模式) 時間
→ 2つの区間の入れ子(模式) ファームウェア区間 BRISC 設定・ 起動信号の待ち NCRISC TRISC0 起動情報の 受け取り TRISC1 TRISC2 kernel 区間 起動信号 完了通知 実測(ベースライン・代表トークン) kernel が 0.1 µs 未満で終わる区間 (全区間の約半分)の中央値 合併 コア c の稼働時間 = 濃紺の長さの合計 kernel 区間 → 採用 稼働に含むもの: kernel 内のデータ待ち(内訳は後の別の観測で) 0.03 µs ファームウェア区間 → 稼働の過大な見積もり 平均コア稼働時間 = Σ コア稼働時間 ÷ 実在コア数 110(次ページ) 5.1 µs コア稼働率 = 平均コア稼働時間 ÷ デバイス稼働時間 (op ごとに見るときは ÷ その op の区間) [µs] 0 1 2 3 4 5 前半の指標(能力使用率 = SM Activity 相当) 279 -
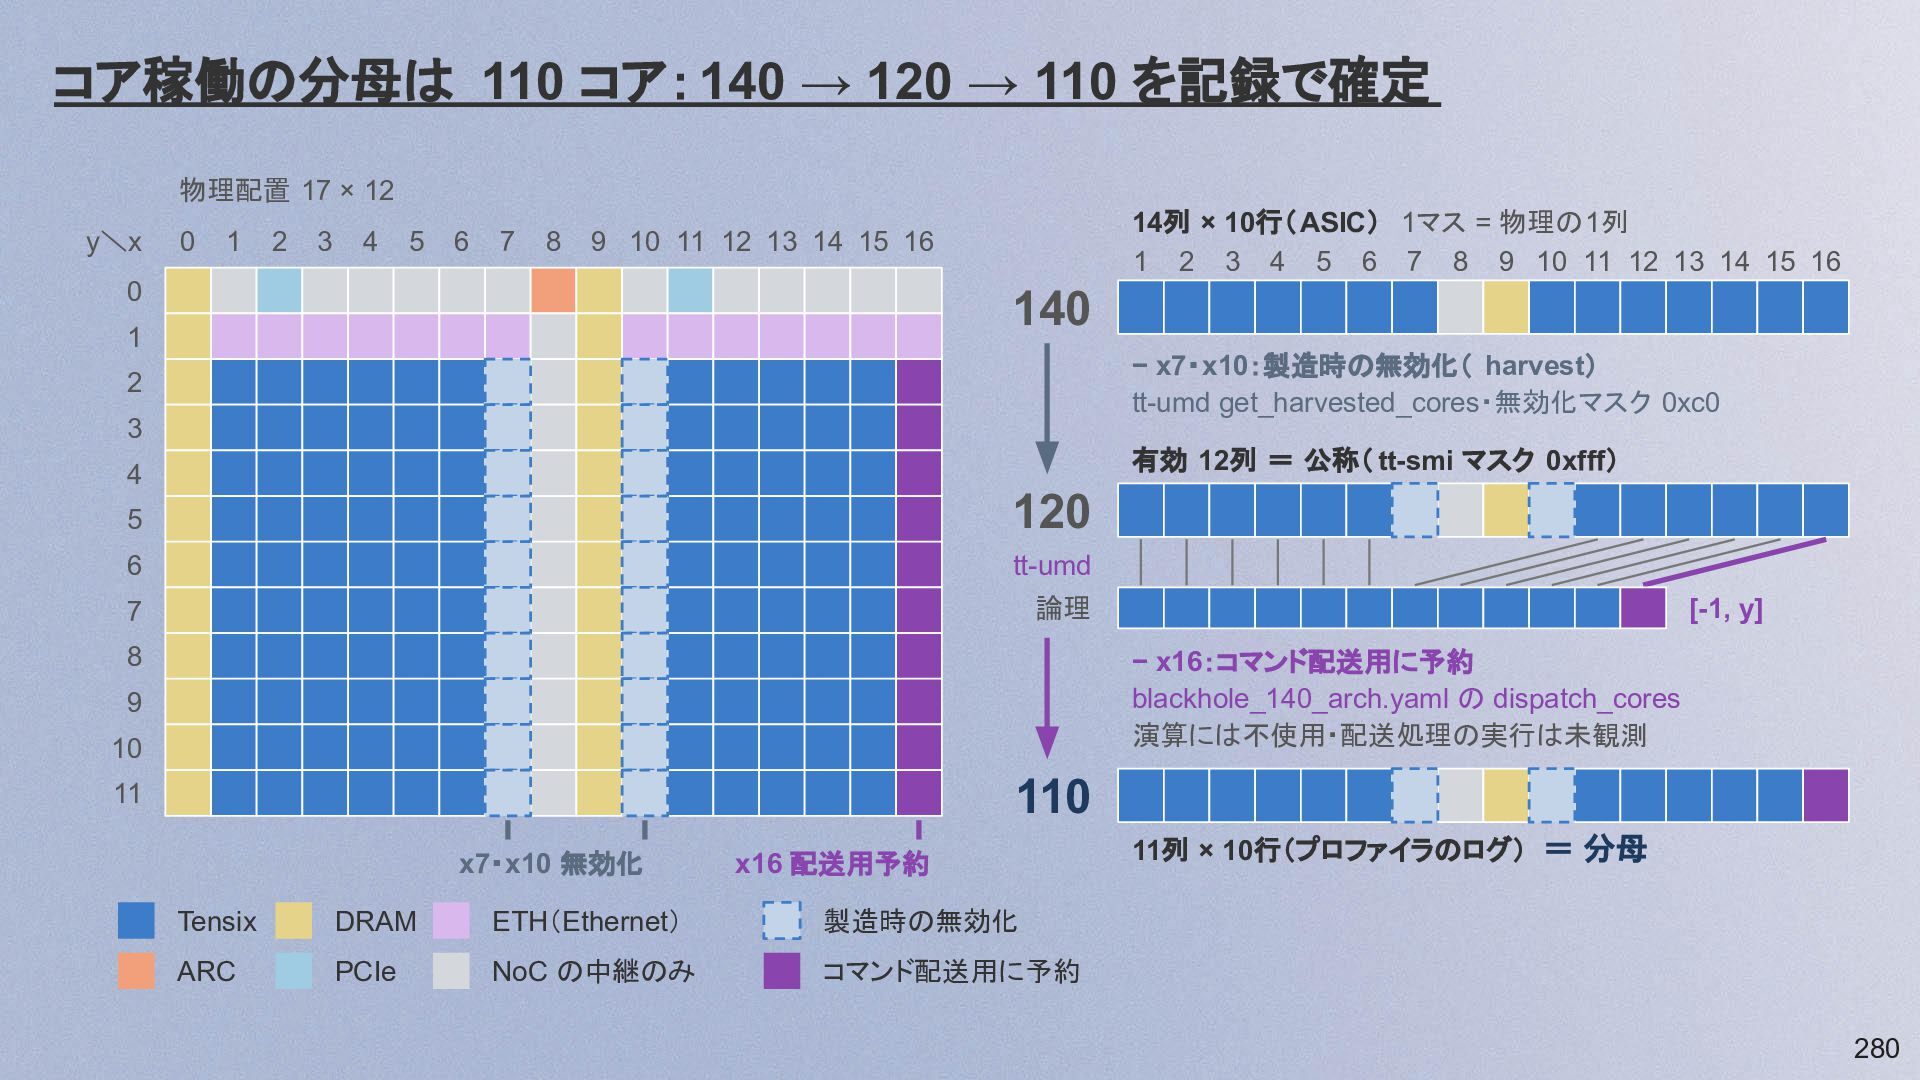
コア稼働の分母は 110 コア:140 → 120 → 110 を記録で確定 物理配置 17
× 12 y\x 0 1 2 3 4 5 6 7 8 14列 × 10行(ASIC) 1マス = 物理の1列 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 9 10 11 12 13 14 15 16 0 140 1 − x7・x10:製造時の無効化( harvest) tt-umd get_harvested_cores・無効化マスク 0xc0 2 3 有効 12列 = 公称( tt-smi マスク 0xfff) 4 5 120 6 tt-umd 7 論理 8 [-1, y] − x16:コマンド配送用に予約 blackhole_140_arch.yaml の dispatch_cores 演算には不使用・配送処理の実行は未観測 9 10 110 11 x7・x10 無効化 x16 配送用予約 Tensix DRAM ETH(Ethernet) 製造時の無効化 ARC PCIe NoC の中継のみ コマンド配送用に予約 11列 × 10行(プロファイラのログ) = 分母 280 -
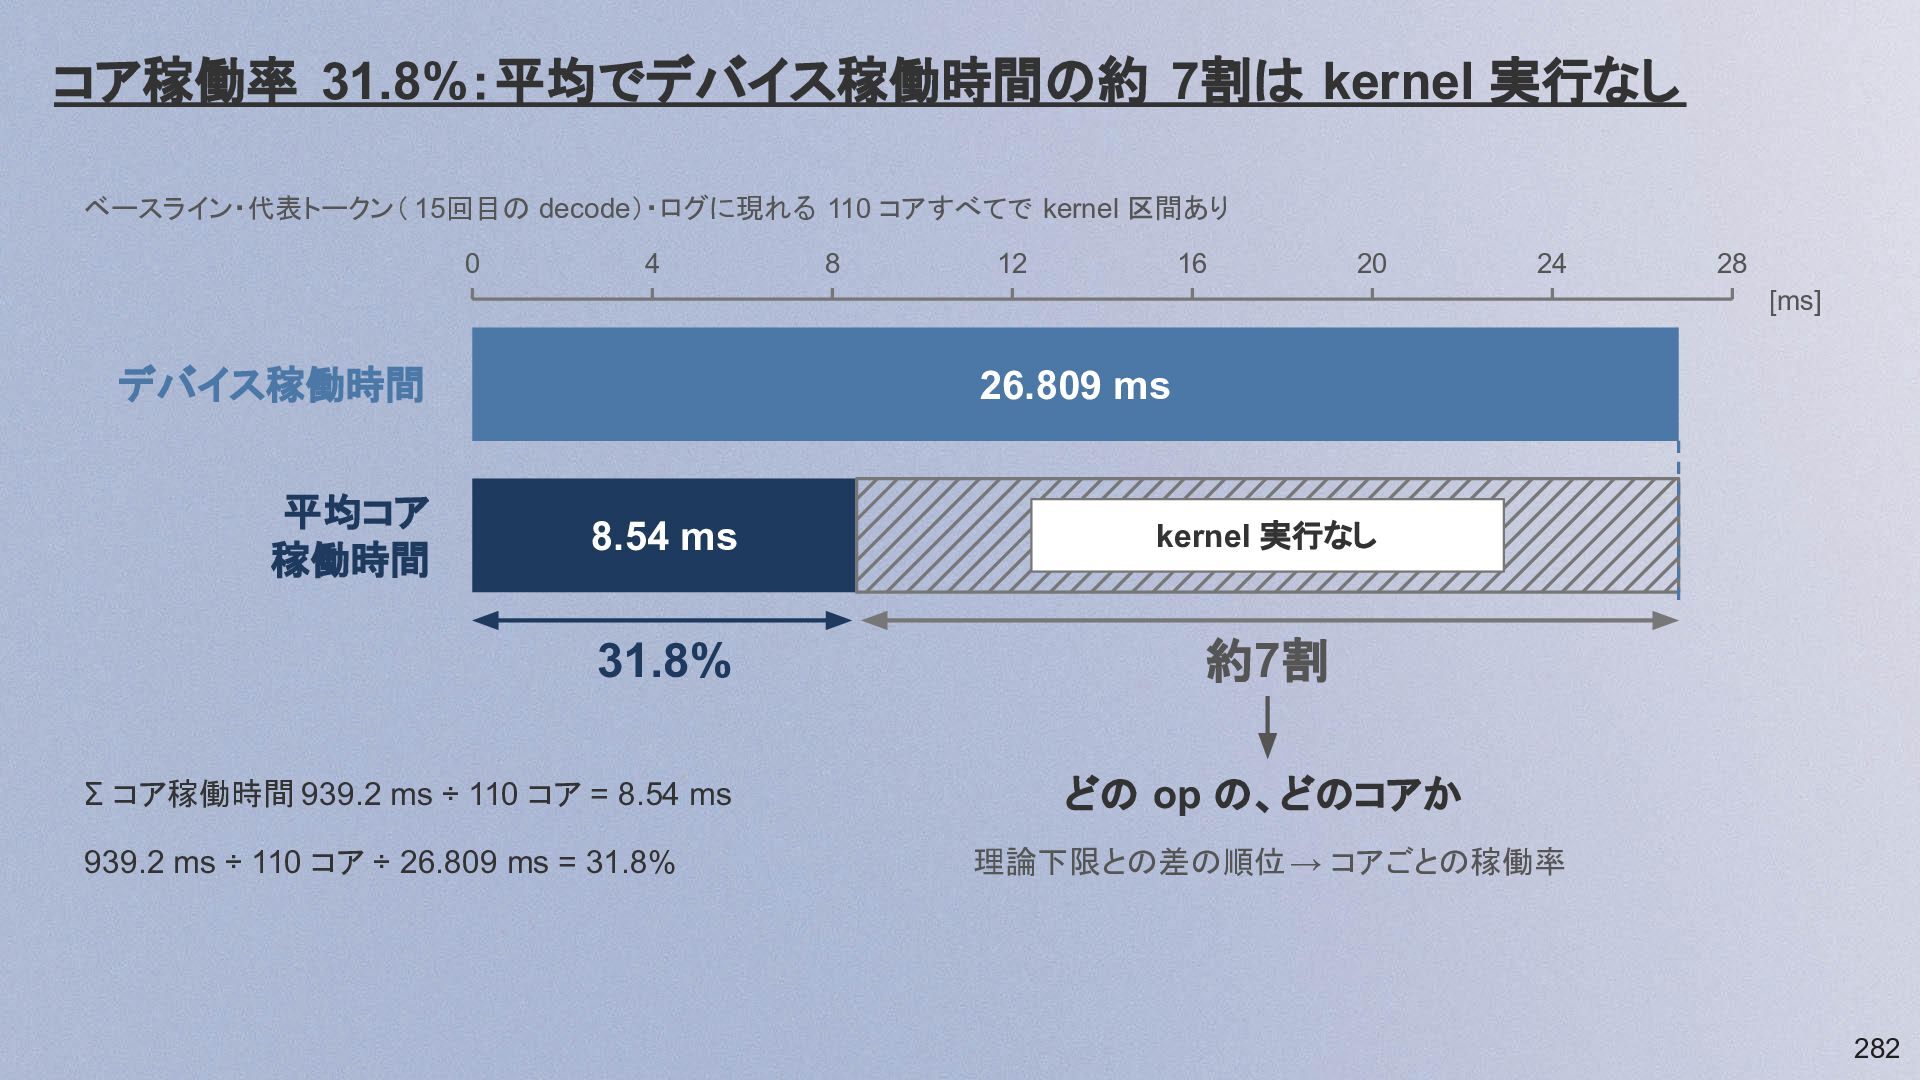
コア稼働率 31.8%:平均でデバイス稼働時間の約 7割は kernel 実行なし ベースライン・代表トークン( 15回目の decode)・ログに現れる 110 コアすべてで
kernel 区間あり 0 4 8 12 16 20 24 28 [ms] デバイス稼働時間 平均コア 稼働時間 26.809 ms 8.54 ms kernel 実行なし 31.8% 約7割 Σ コア稼働時間 939.2 ms ÷ 110 コア = 8.54 ms 939.2 ms ÷ 110 コア ÷ 26.809 ms = 31.8% どの op の、どのコアか 理論下限との差の順位 → コアごとの稼働率 282 -
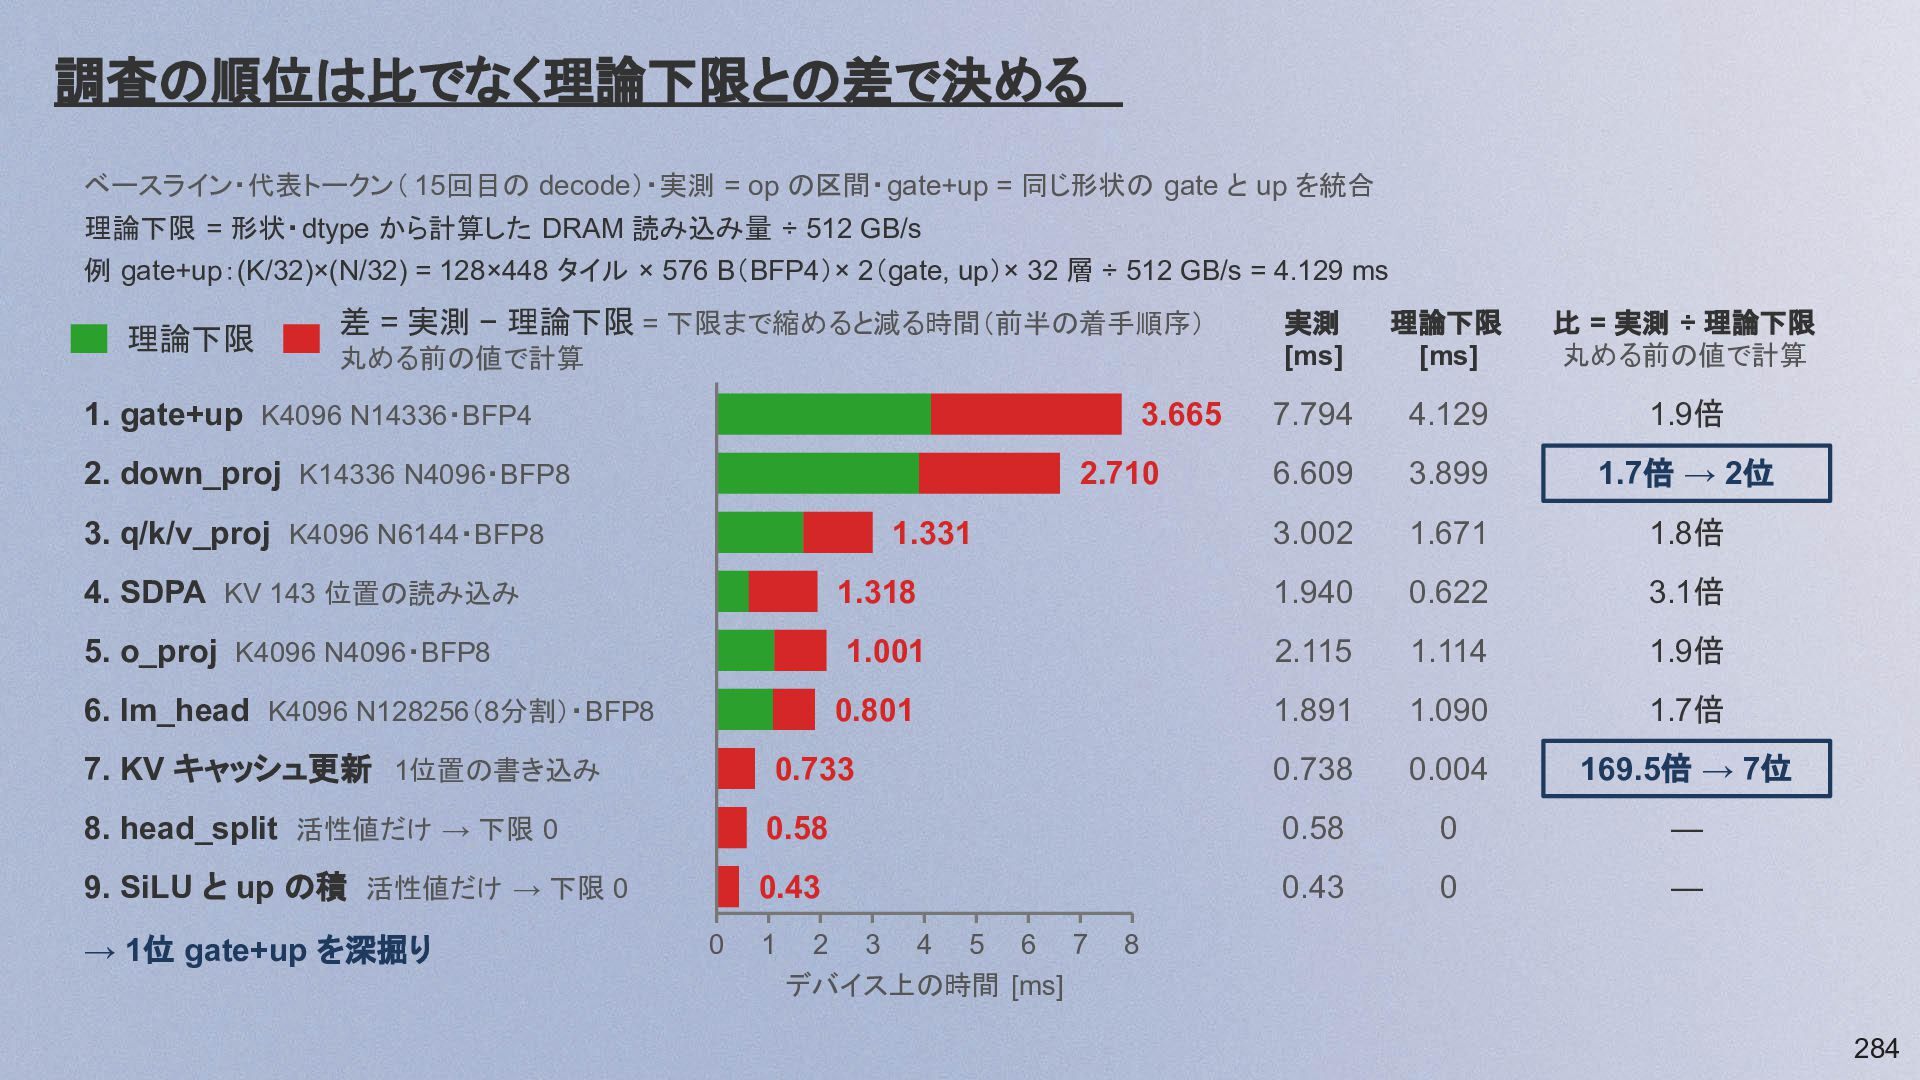
調査の順位は比でなく理論下限との差で決める ベースライン・代表トークン( 15回目の decode)・実測 = op の区間・gate+up = 同じ形状の gate
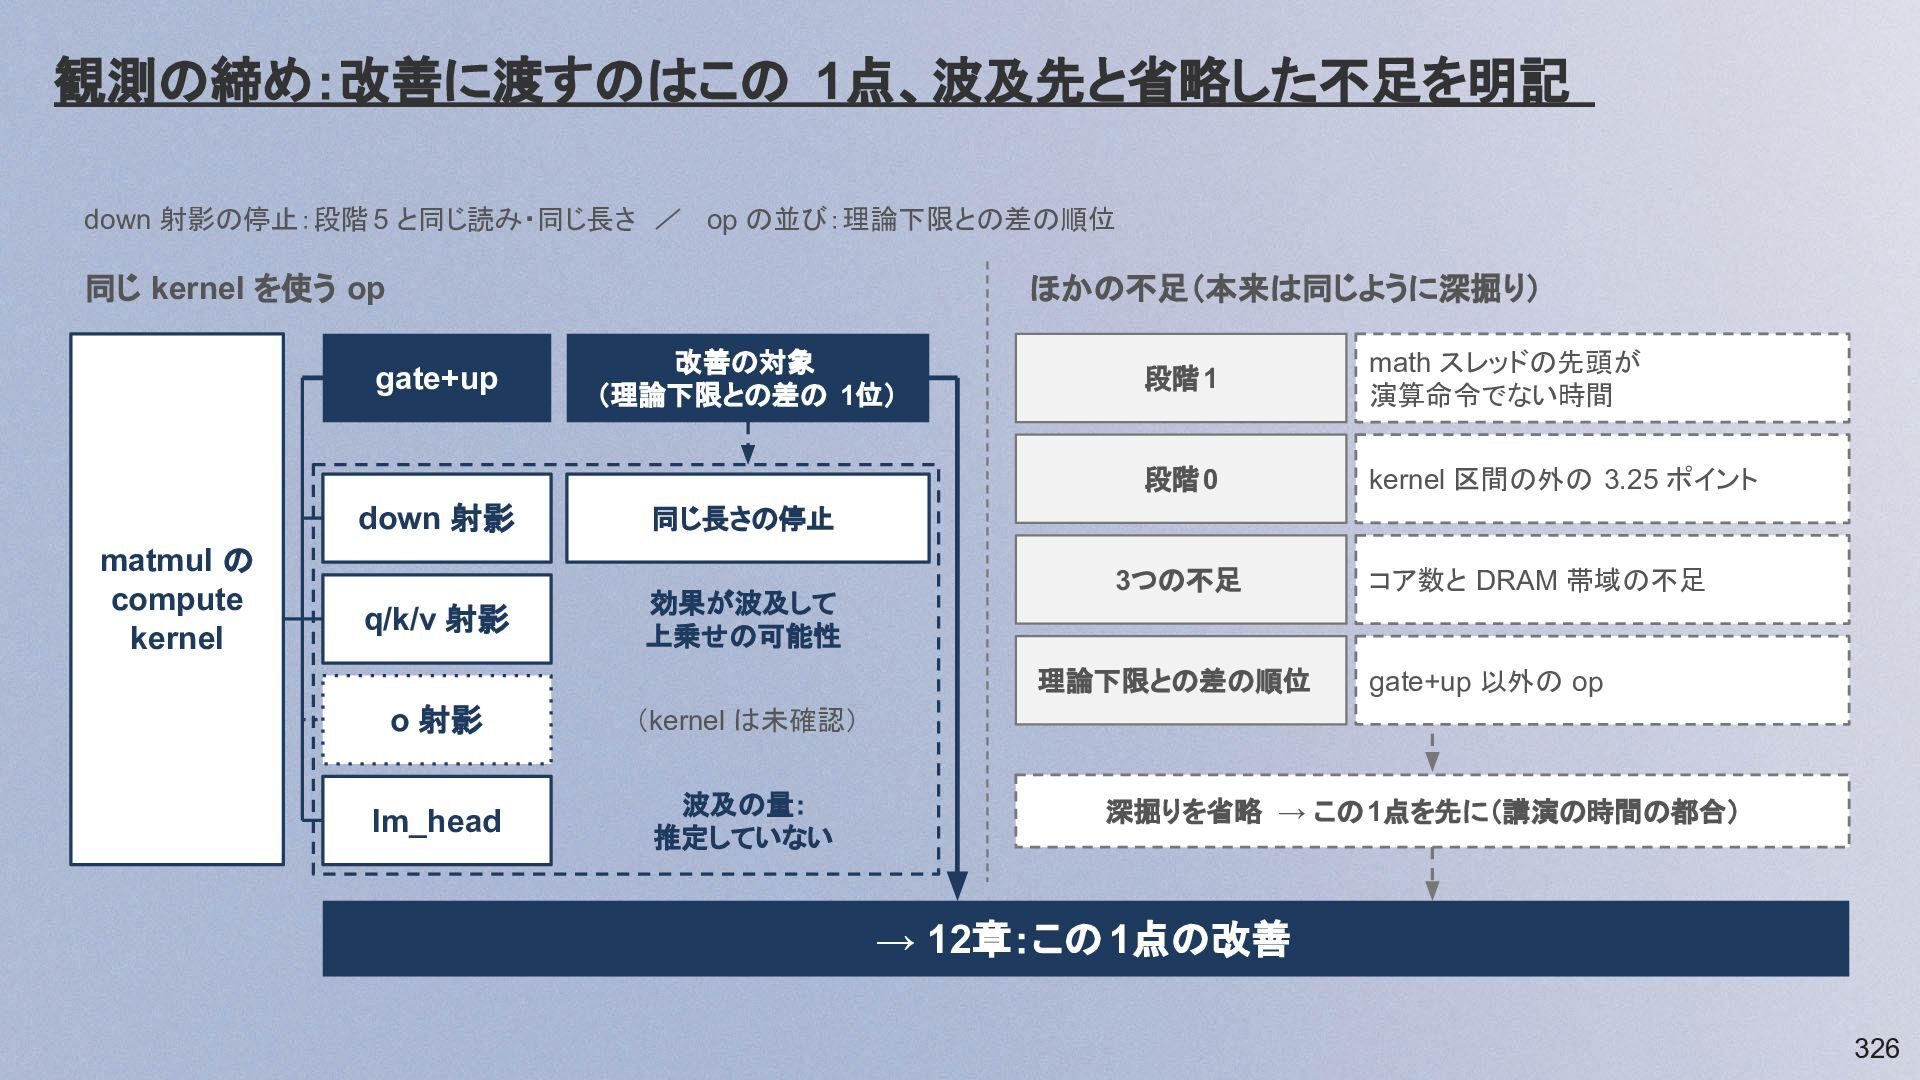
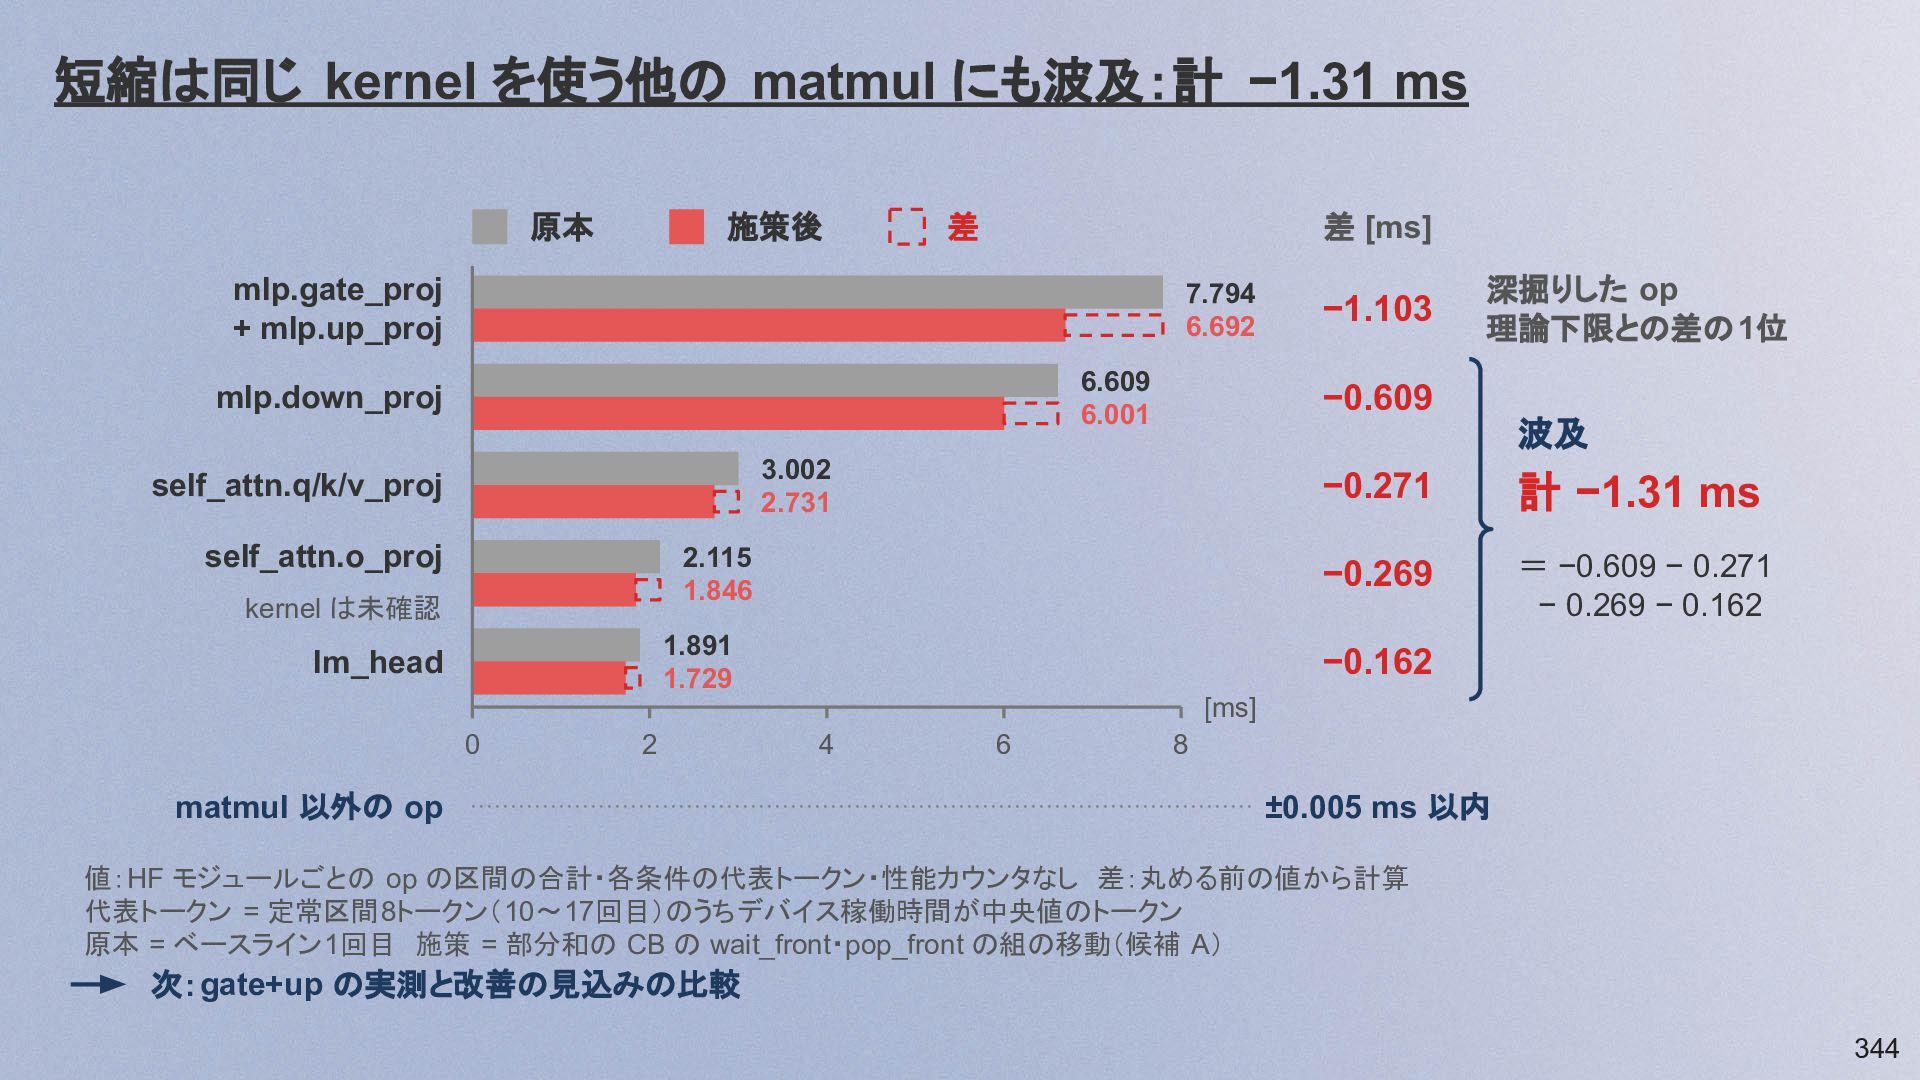
と up を統合 理論下限 = 形状・dtype から計算した DRAM 読み込み量 ÷ 512 GB/s 例 gate+up:(K/32)×(N/32) = 128×448 タイル × 576 B(BFP4)× 2(gate, up)× 32 層 ÷ 512 GB/s = 4.129 ms 理論下限 差 = 実測 − 理論下限 = 下限まで縮めると減る時間(前半の着手順序) 丸める前の値で計算 1. gate+up K4096 N14336・BFP4 3.665 2. down_proj K14336 N4096・BFP8 2.710 3. q/k/v_proj K4096 N6144・BFP8 1.331 実測 [ms] 理論下限 [ms] 比 = 実測 ÷ 理論下限 丸める前の値で計算 7.794 4.129 1.9倍 6.609 3.899 1.7倍 → 2位 3.002 1.671 1.8倍 4. SDPA KV 143 位置の読み込み 1.318 1.940 0.622 3.1倍 5. o_proj K4096 N4096・BFP8 1.001 2.115 1.114 1.9倍 6. lm_head K4096 N128256(8分割)・BFP8 0.801 1.891 1.090 1.7倍 7. KV キャッシュ更新 1位置の書き込み 0.733 0.738 0.004 169.5倍 → 7位 8. head_split 活性値だけ → 下限 0 0.58 0.58 0 — 9. SiLU と up の積 活性値だけ → 下限 0 0.43 0.43 0 — → 1位 gate+up を深掘り 0 1 2 3 4 5 6 7 デバイス上の時間 [ms] 8 284 -
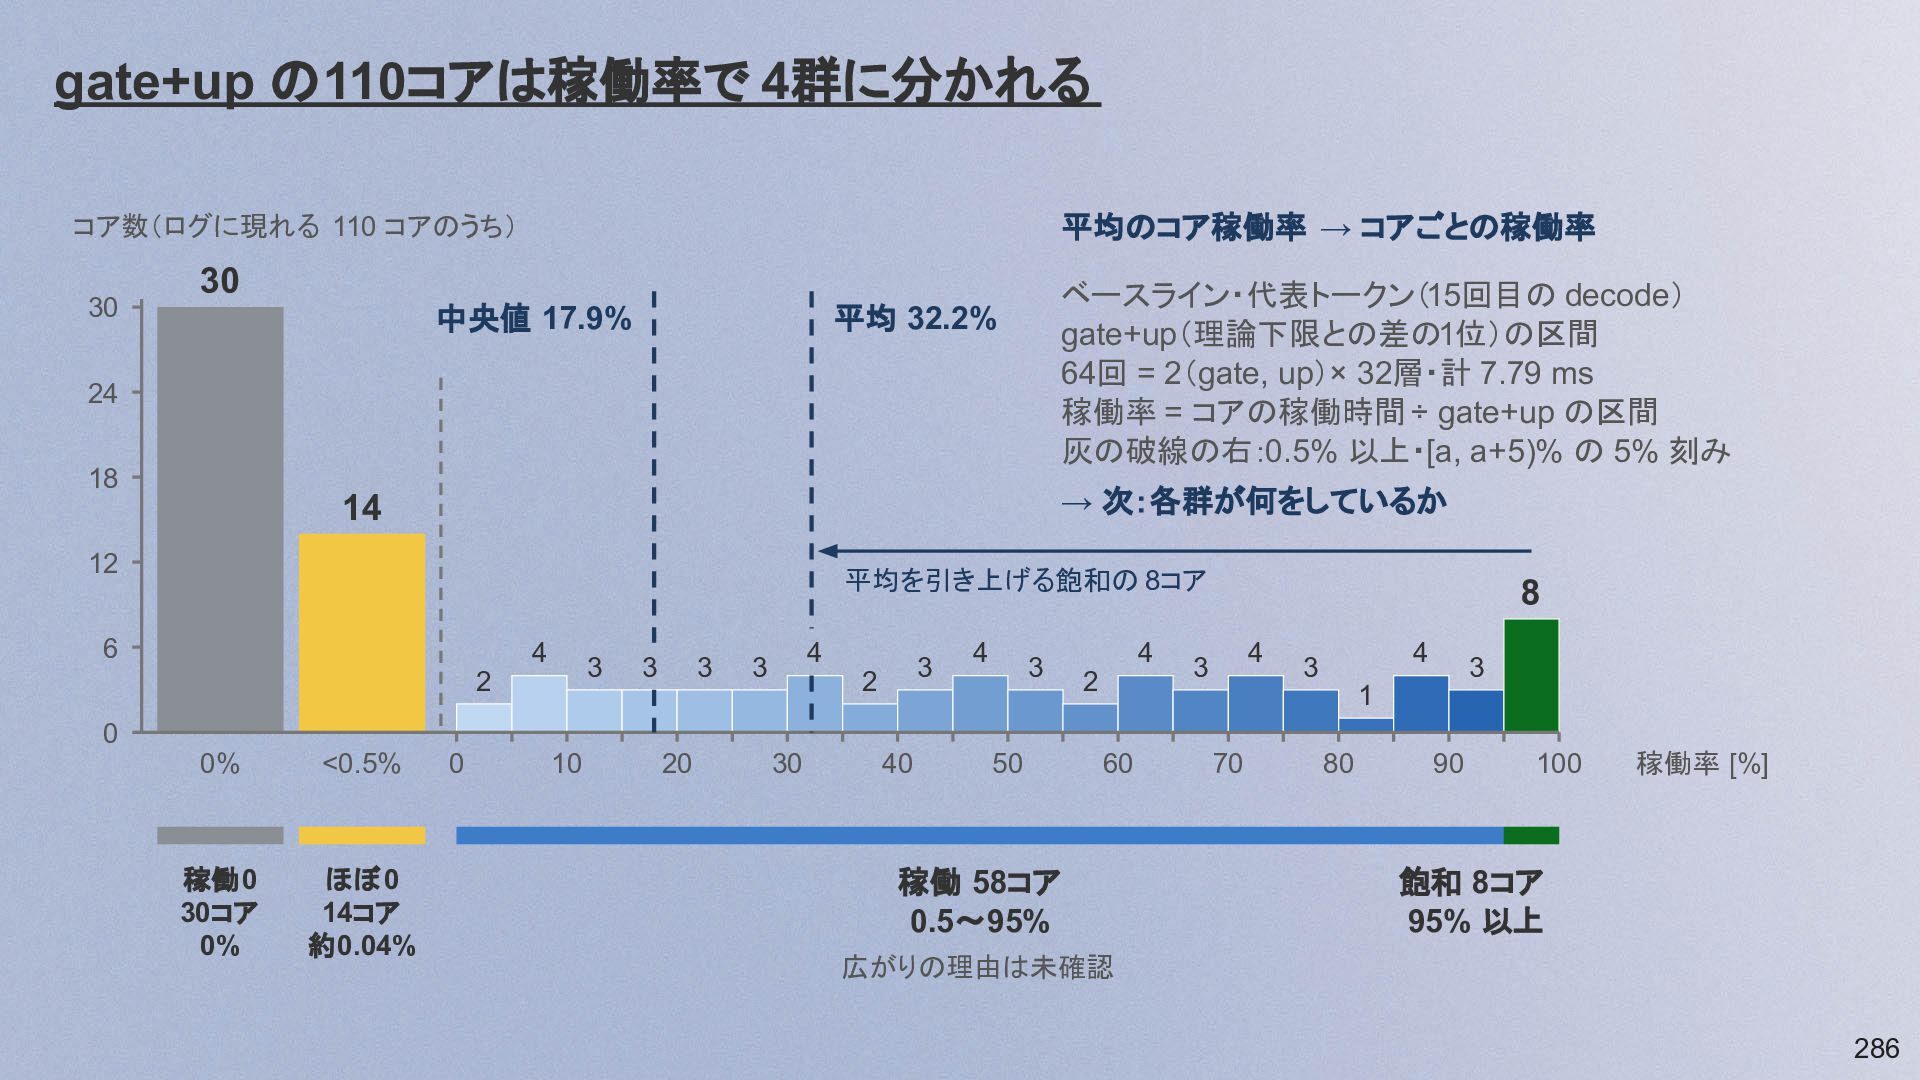
gate+up の110コアは稼働率で 4群に分かれる 平均のコア稼働率 → コアごとの稼働率 コア数(ログに現れる 110 コアのうち) 30
30 中央値 17.9% ベースライン・代表トークン(15回目の decode) gate+up(理論下限との差の1位)の区間 64回 = 2(gate, up)× 32層・計 7.79 ms 稼働率 = コアの稼働時間 ÷ gate+up の区間 灰の破線の右:0.5% 以上・[a, a+5)% の 5% 刻み 平均 32.2% 24 18 → 次:各群が何をしているか 14 12 平均を引き上げる飽和の 8コア 6 4 3 2 3 3 4 3 3 2 4 3 4 2 8 4 3 4 3 3 1 0 0% <0.5% 稼働0 30コア 0% ほぼ0 14コア 約0.04% 0 10 20 30 40 50 60 稼働 58コア 0.5〜95% 70 80 90 100 稼働率 [%] 飽和 8コア 95% 以上 広がりの理由は未確認 286 -
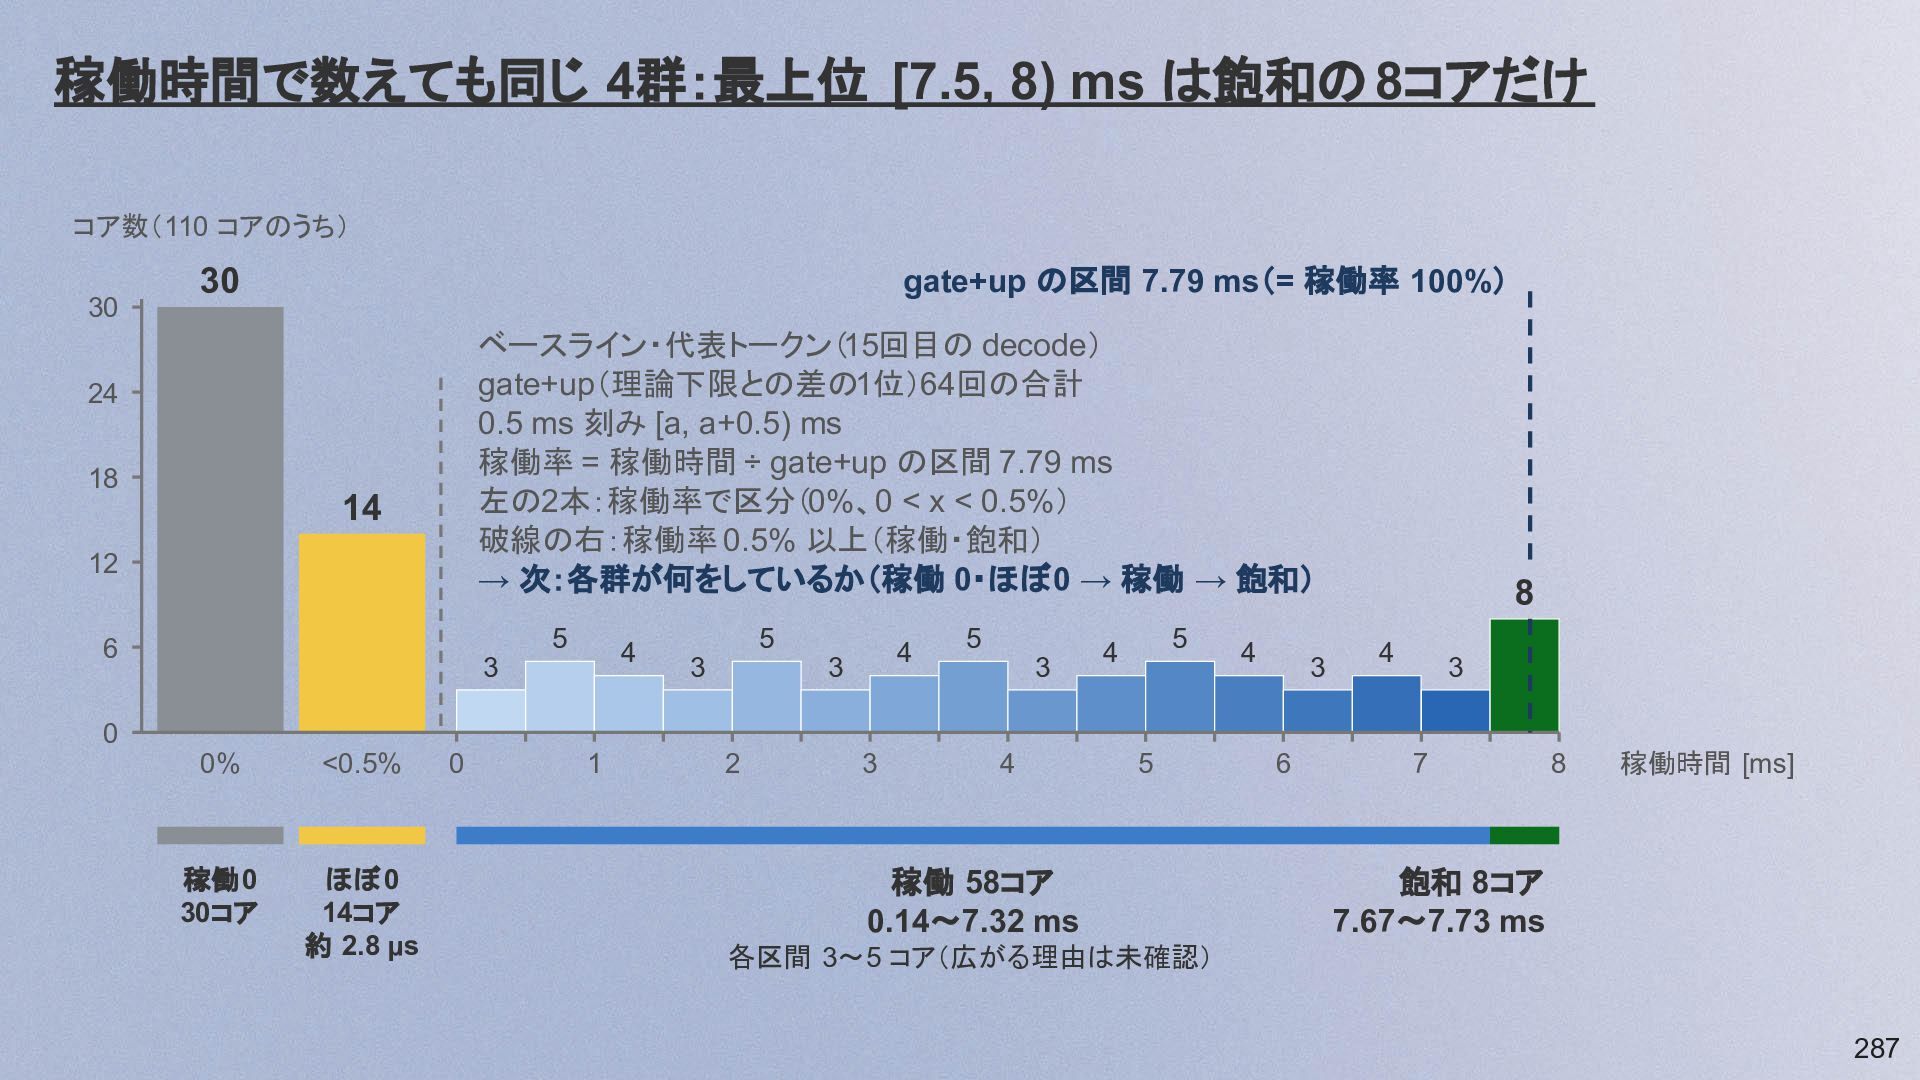
稼働時間で数えても同じ 4群:最上位 [7.5, 8) ms は飽和の 8コアだけ コア数(110 コアのうち) 30
gate+up の区間 7.79 ms(= 稼働率 100%) 30 ベースライン・代表トークン(15回目の decode) gate+up(理論下限との差の1位)64回の合計 0.5 ms 刻み [a, a+0.5) ms 稼働率 = 稼働時間 ÷ gate+up の区間 7.79 ms 左の2本:稼働率で区分(0%、0 < x < 0.5%) 破線の右:稼働率 0.5% 以上(稼働・飽和) → 次:各群が何をしているか(稼働 0・ほぼ0 → 稼働 → 飽和) 24 18 14 12 5 6 4 3 5 3 4 3 5 3 5 4 4 3 8 4 3 0 0% <0.5% 稼働0 30コア ほぼ0 14コア 約 2.8 µs 0 1 2 3 4 5 稼働 58コア 0.14〜7.32 ms 6 7 8 稼働時間 [ms] 飽和 8コア 7.67〜7.73 ms 各区間 3〜5 コア(広がる理由は未確認) 287 -
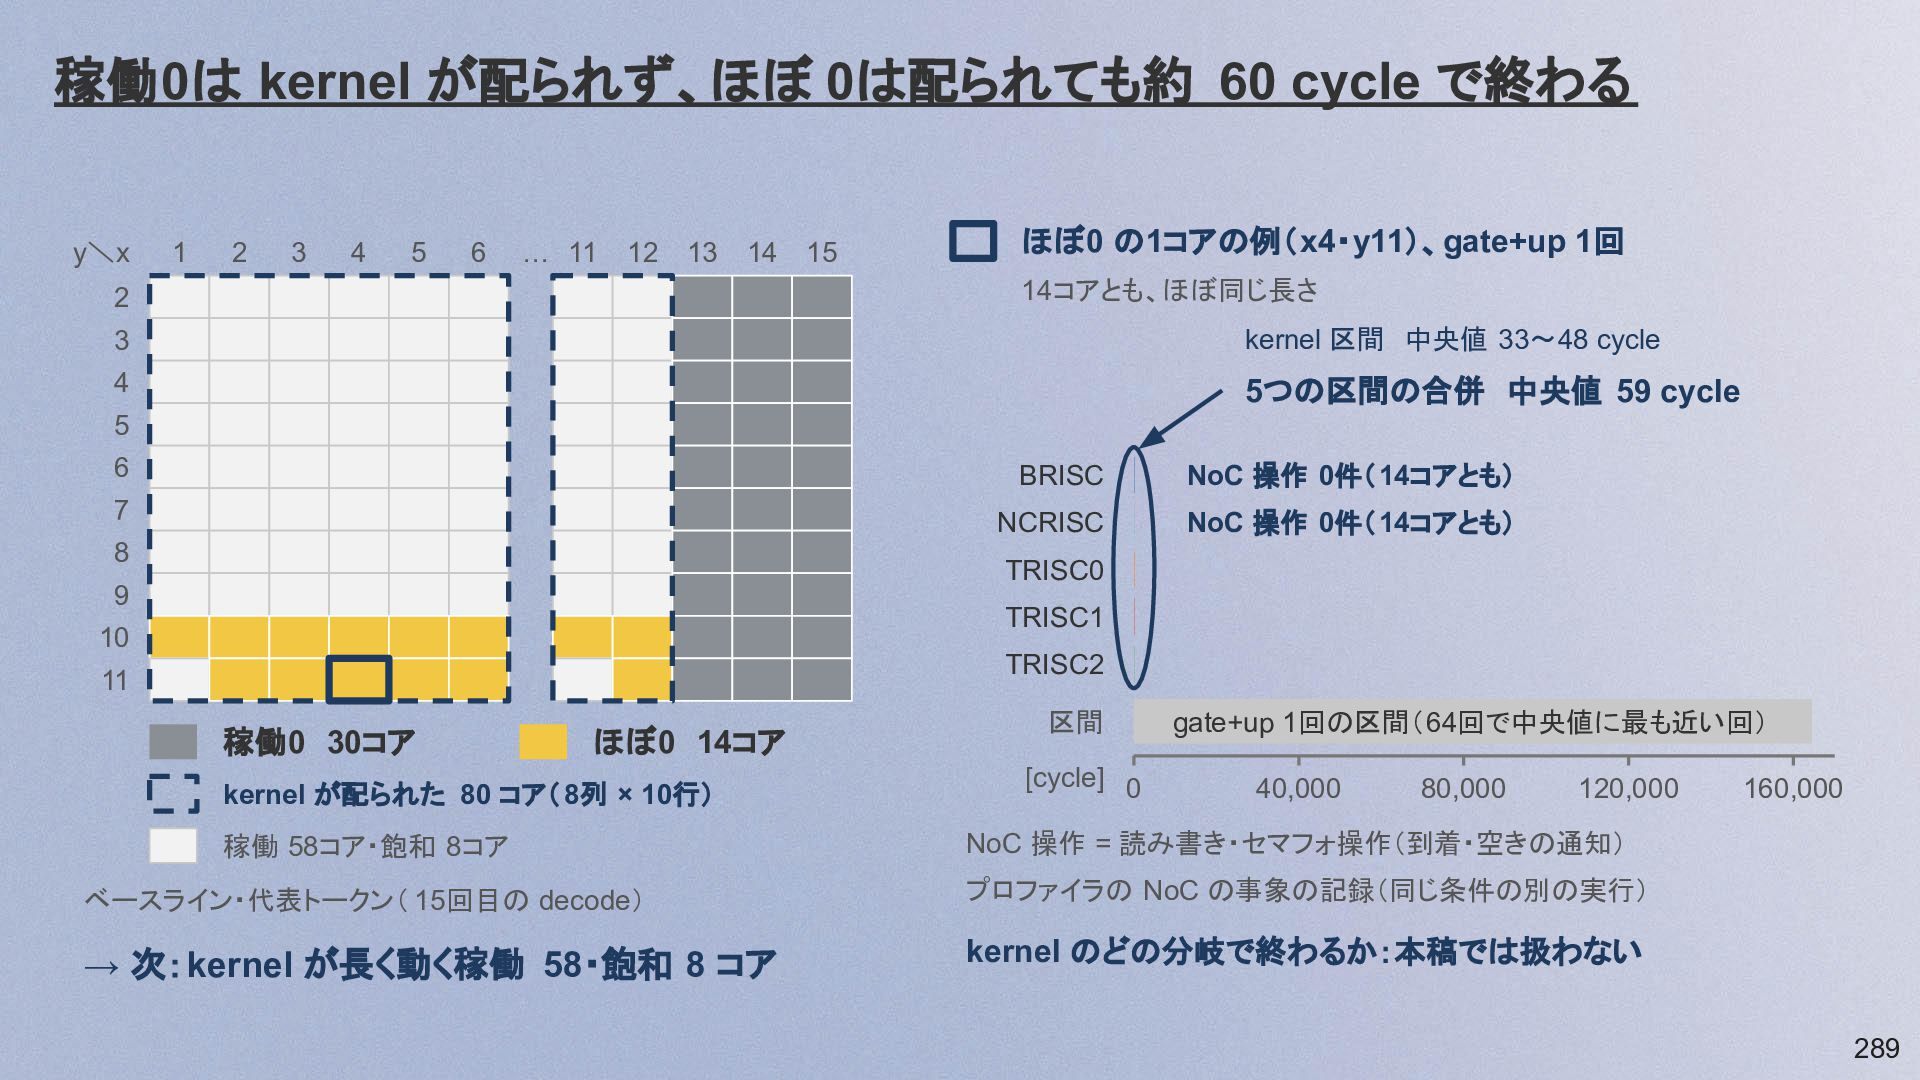
稼働0は kernel が配られず、ほぼ 0は配られても約 60 cycle で終わる y\x 1 2
3 4 5 6 … 11 12 13 14 15 ほぼ0 の1コアの例(x4・y11)、gate+up 1回 14コアとも、ほぼ同じ長さ 2 3 kernel 区間 中央値 33〜48 cycle 4 5つの区間の合併 中央値 59 cycle 5 6 BRISC NoC 操作 0件(14コアとも) 7 NCRISC NoC 操作 0件(14コアとも) 8 TRISC0 9 TRISC1 10 TRISC2 11 稼働0 30コア ほぼ0 14コア kernel が配られた 80 コア( 8列 × 10行) 区間 [cycle] 0 gate+up 1回の区間(64回で中央値に最も近い回) 40,000 80,000 120,000 稼働 58コア・飽和 8コア NoC 操作 = 読み書き・セマフォ操作(到着・空きの通知) ベースライン・代表トークン( 15回目の decode) プロファイラの NoC の事象の記録(同じ条件の別の実行) → 次:kernel が長く動く稼働 58・飽和 8 コア kernel のどの分岐で終わるか:本稿では扱わない 160,000 289 -
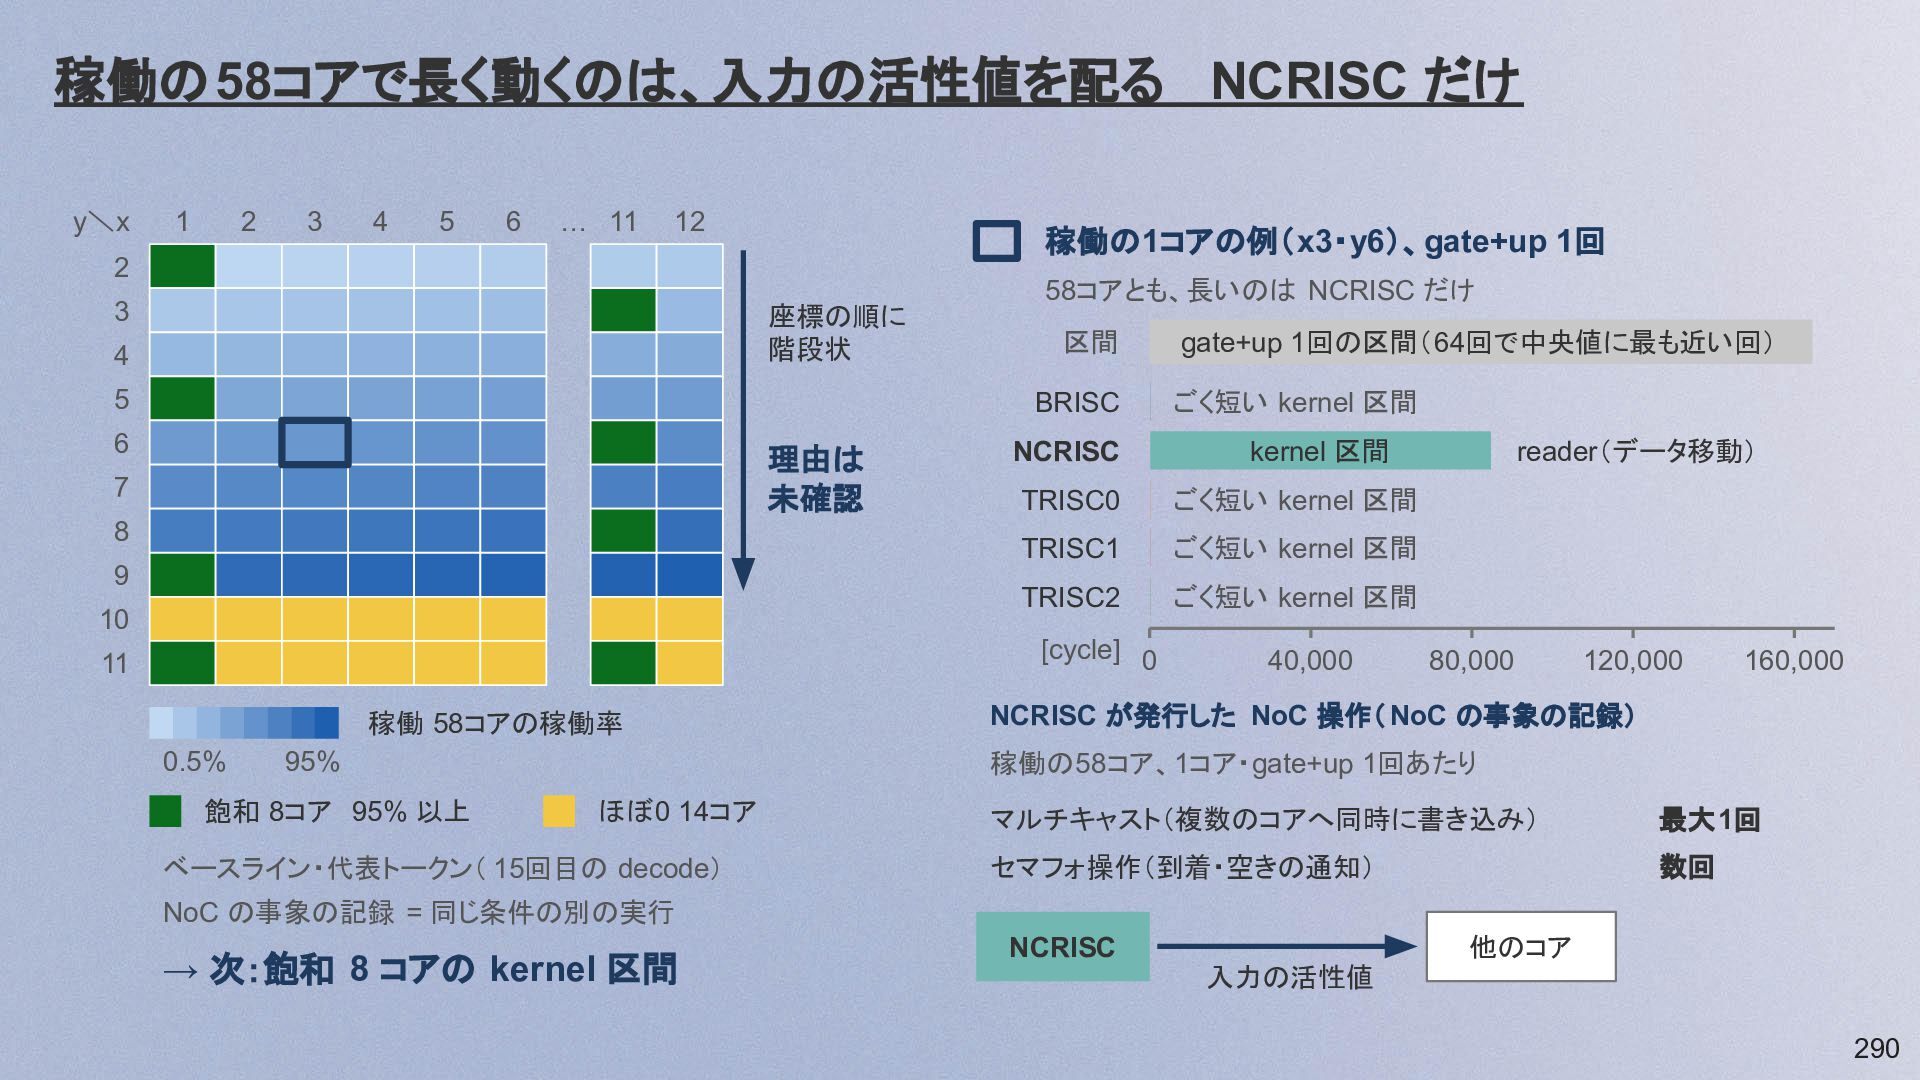
稼働の58コアで長く動くのは、入力の活性値を配る NCRISC だけ y\x 1 2 3 4 5 6
… 11 12 稼働の1コアの例(x3・y6)、gate+up 1回 2 3 座標の順に 階段状 4 5 58コアとも、長いのは NCRISC だけ 区間 BRISC 6 理由は 未確認 7 8 9 10 NCRISC 稼働 58コアの稼働率 0.5% kernel 区間 ごく短い kernel 区間 TRISC1 ごく短い kernel 区間 TRISC2 ごく短い kernel 区間 40,000 reader(データ移動) 80,000 120,000 160,000 NCRISC が発行した NoC 操作( NoC の事象の記録) 稼働の58コア、1コア・gate+up 1回あたり 95% 飽和 8コア 95% 以上 ごく短い kernel 区間 TRISC0 [cycle] 0 11 gate+up 1回の区間(64回で中央値に最も近い回) ほぼ0 14コア ベースライン・代表トークン( 15回目の decode) マルチキャスト(複数のコアへ同時に書き込み) 最大1回 セマフォ操作(到着・空きの通知) 数回 NoC の事象の記録 = 同じ条件の別の実行 → 次:飽和 8 コアの kernel 区間 NCRISC 他のコア 入力の活性値 290 -
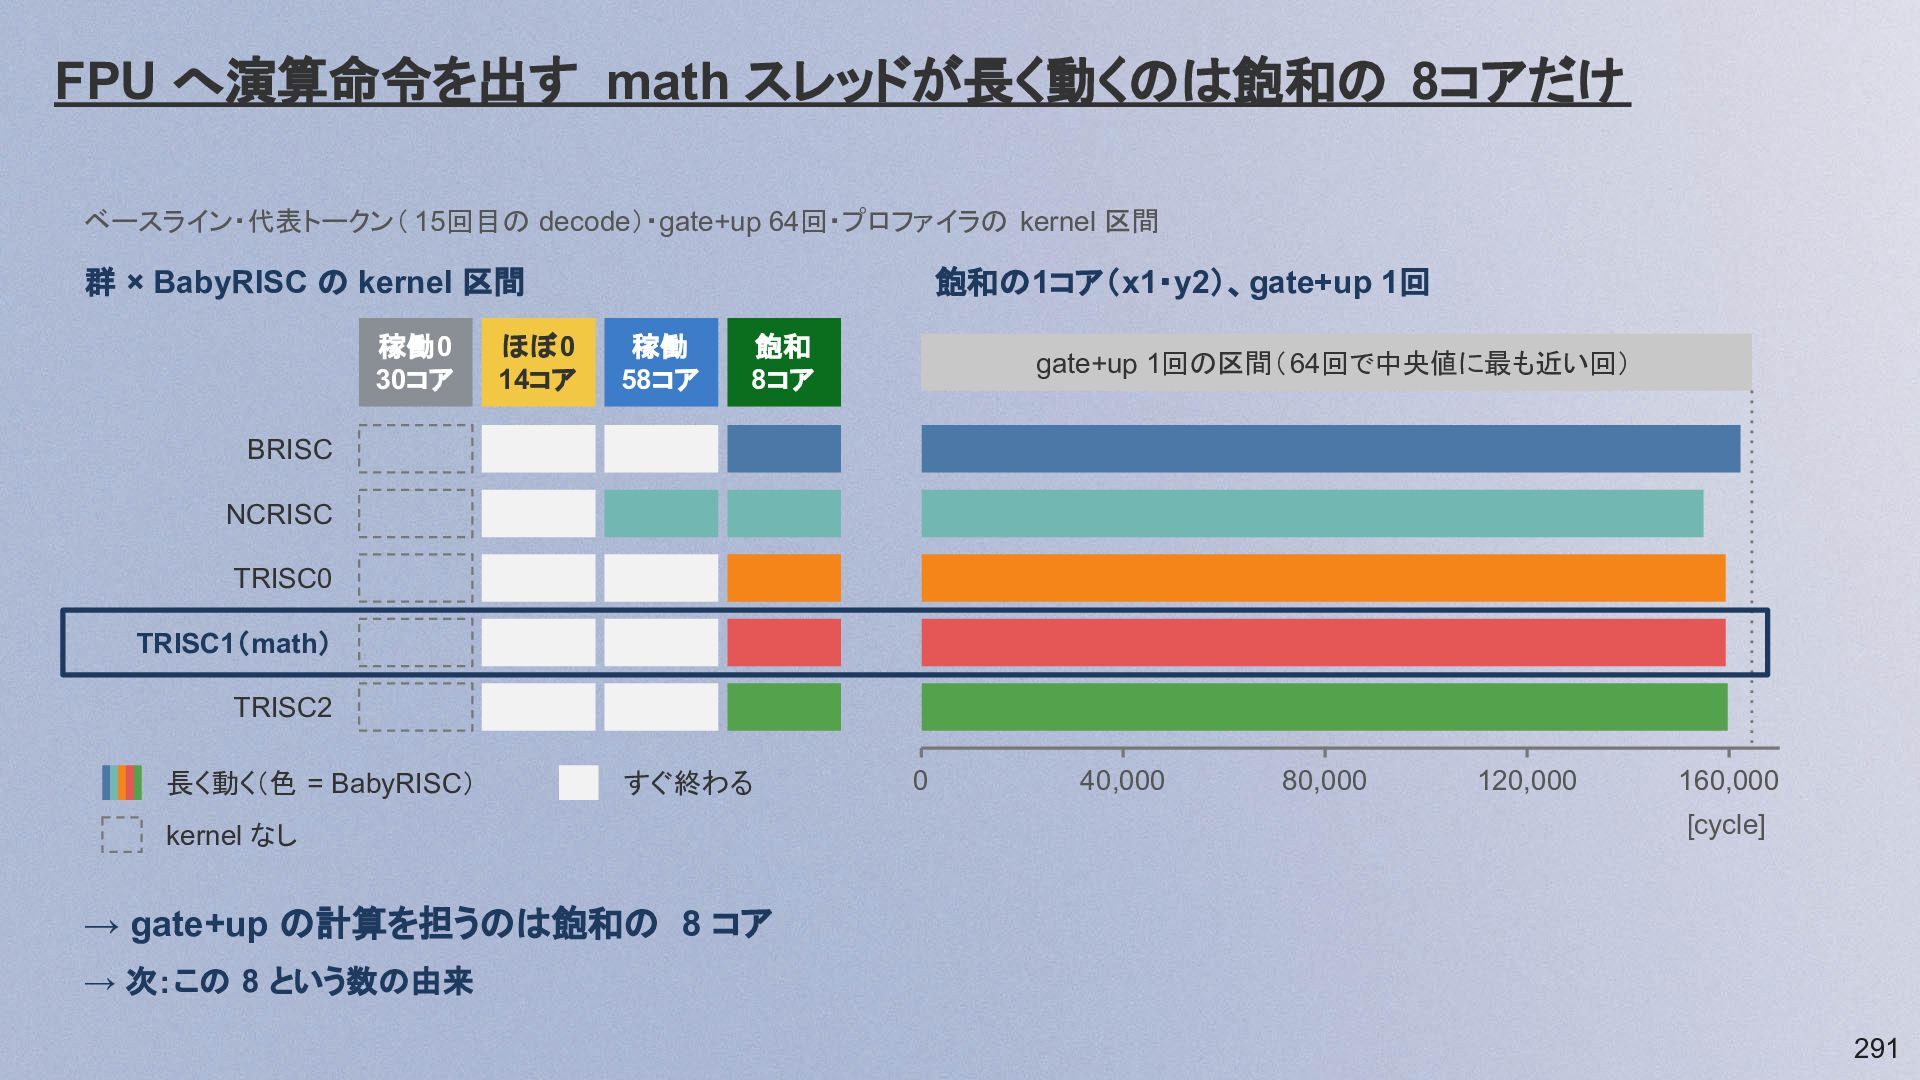
FPU へ演算命令を出す math スレッドが長く動くのは飽和の 8コアだけ ベースライン・代表トークン( 15回目の decode)・gate+up 64回・プロファイラの kernel
区間 群 × BabyRISC の kernel 区間 稼働0 30コア ほぼ0 14コア 飽和の1コア(x1・y2)、gate+up 1回 稼働 58コア 飽和 8コア gate+up 1回の区間(64回で中央値に最も近い回) BRISC NCRISC TRISC0 TRISC1(math) TRISC2 長く動く(色 = BabyRISC) すぐ終わる kernel なし 0 40,000 80,000 120,000 160,000 [cycle] → gate+up の計算を担うのは飽和の 8 コア → 次:この 8 という数の由来 291 -
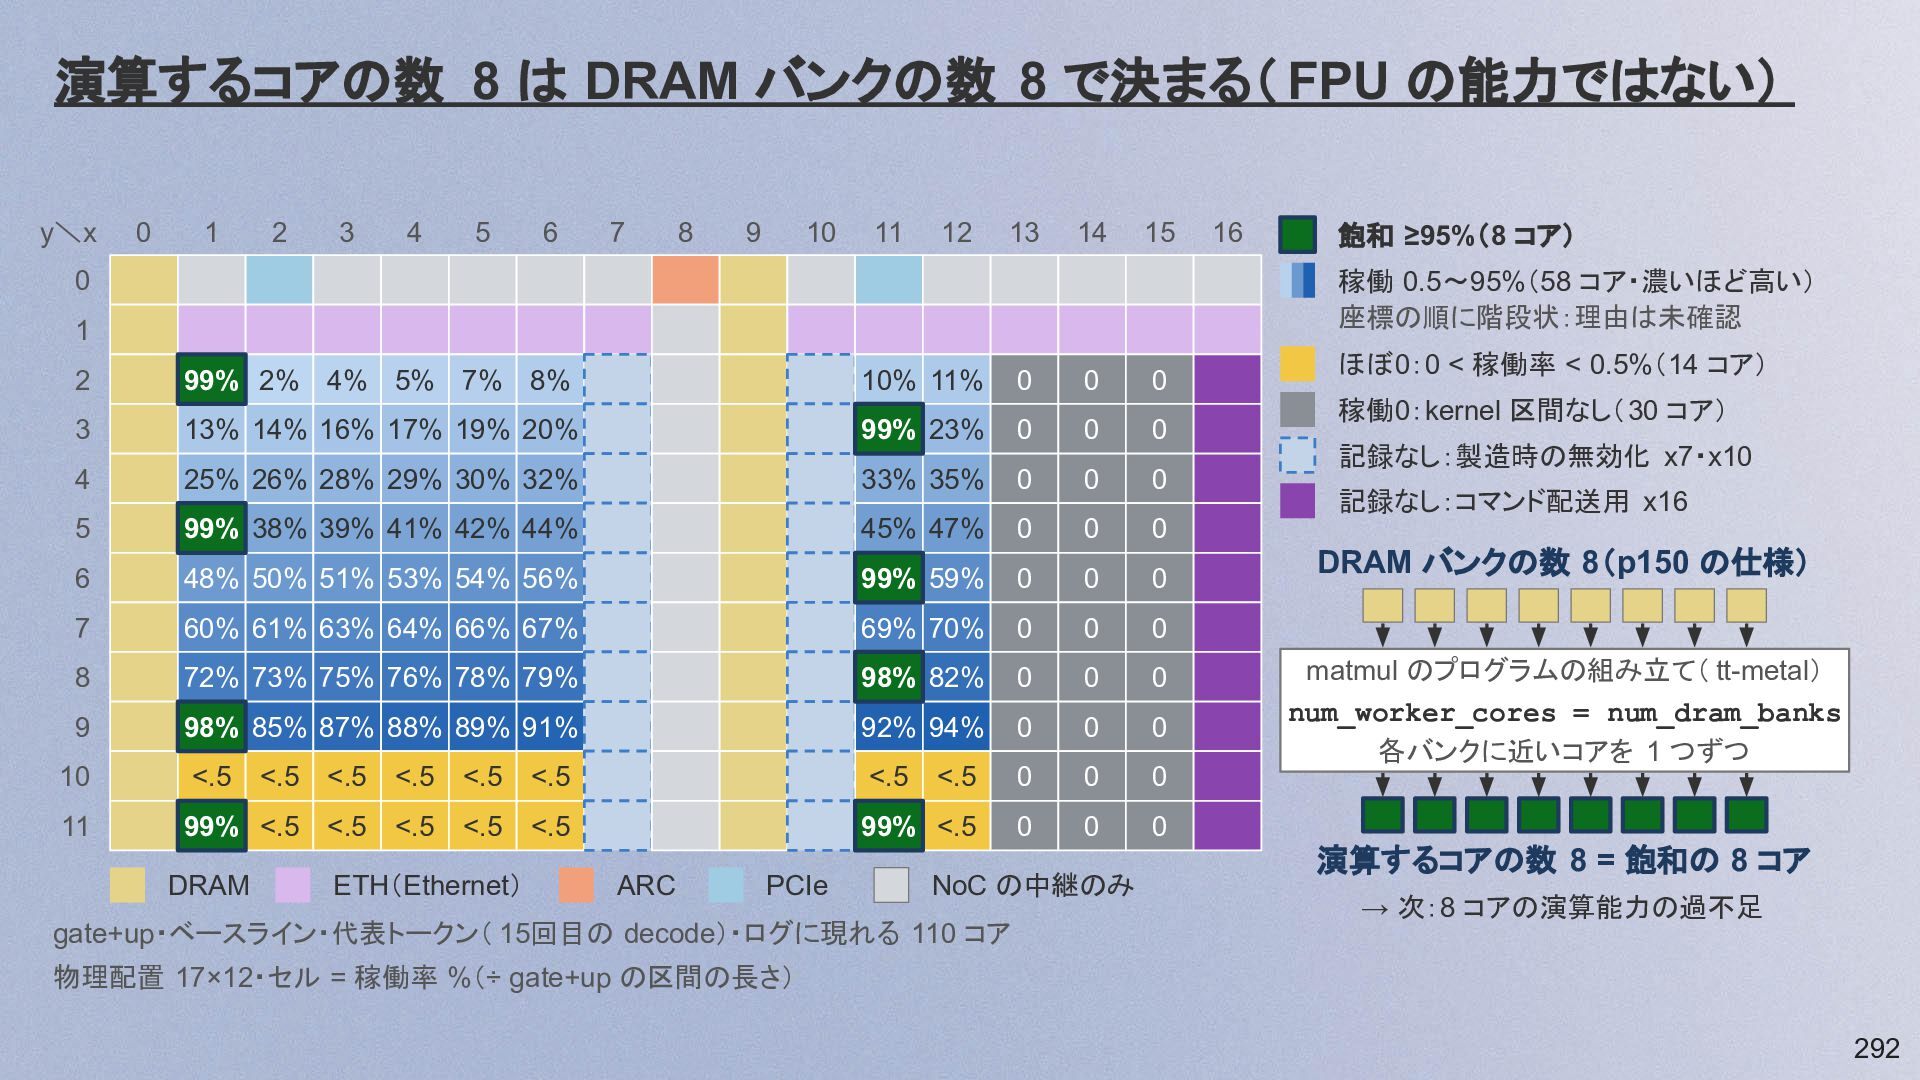
演算するコアの数 8 は DRAM バンクの数 8 で決まる( FPU の能力ではない) y\x
0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 飽和 ≥95%(8 コア) 稼働 0.5〜95%(58 コア・濃いほど高い) 座標の順に階段状:理由は未確認 0 1 2 99% 2% 4% 5% 7% 8% 10% 11% 0 0 0 3 13% 14% 16% 17% 19% 20% 99% 23% 0 0 0 4 25% 26% 28% 29% 30% 32% 33% 35% 0 0 0 5 99% 38% 39% 41% 42% 44% 45% 47% 0 0 0 6 48% 50% 51% 53% 54% 56% 99% 59% 0 0 0 7 60% 61% 63% 64% 66% 67% 69% 70% 0 0 0 8 72% 73% 75% 76% 78% 79% 98% 82% 0 0 0 9 98% 85% 87% 88% 89% 91% 92% 94% 0 0 0 10 <.5 <.5 <.5 <.5 <.5 <.5 <.5 <.5 0 0 0 11 99% <.5 <.5 <.5 <.5 <.5 99% <.5 0 0 0 DRAM ETH(Ethernet) ARC PCIe NoC の中継のみ gate+up・ベースライン・代表トークン( 15回目の decode)・ログに現れる 110 コア ほぼ0:0 < 稼働率 < 0.5%(14 コア) 稼働0:kernel 区間なし(30 コア) 記録なし:製造時の無効化 x7・x10 記録なし:コマンド配送用 x16 DRAM バンクの数 8(p150 の仕様) matmul のプログラムの組み立て( tt-metal) num_worker_cores = num_dram_banks 各バンクに近いコアを 1 つずつ 演算するコアの数 8 = 飽和の 8 コア → 次:8 コアの演算能力の過不足 物理配置 17×12・セル = 稼働率 %(÷ gate+up の区間の長さ) 292 -
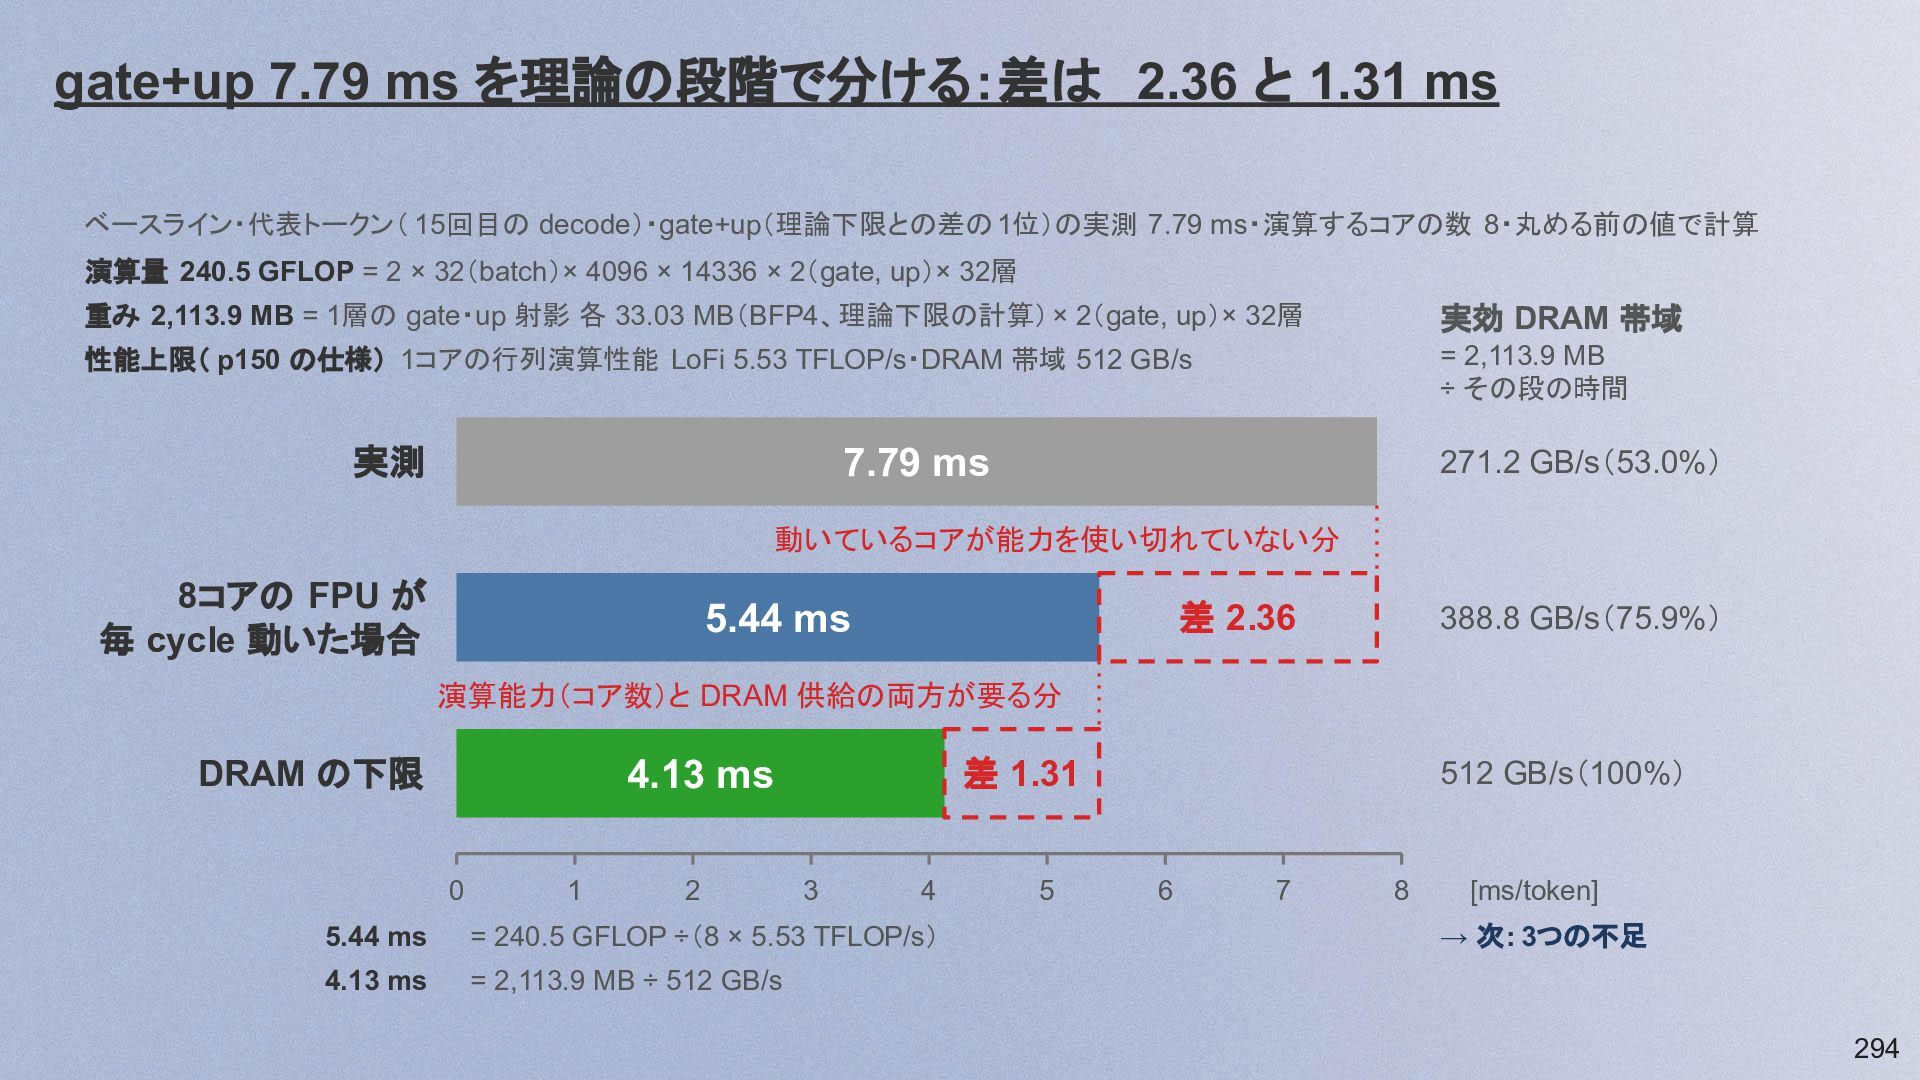
gate+up 7.79 ms を理論の段階で分ける:差は 2.36 と 1.31 ms ベースライン・代表トークン( 15回目の
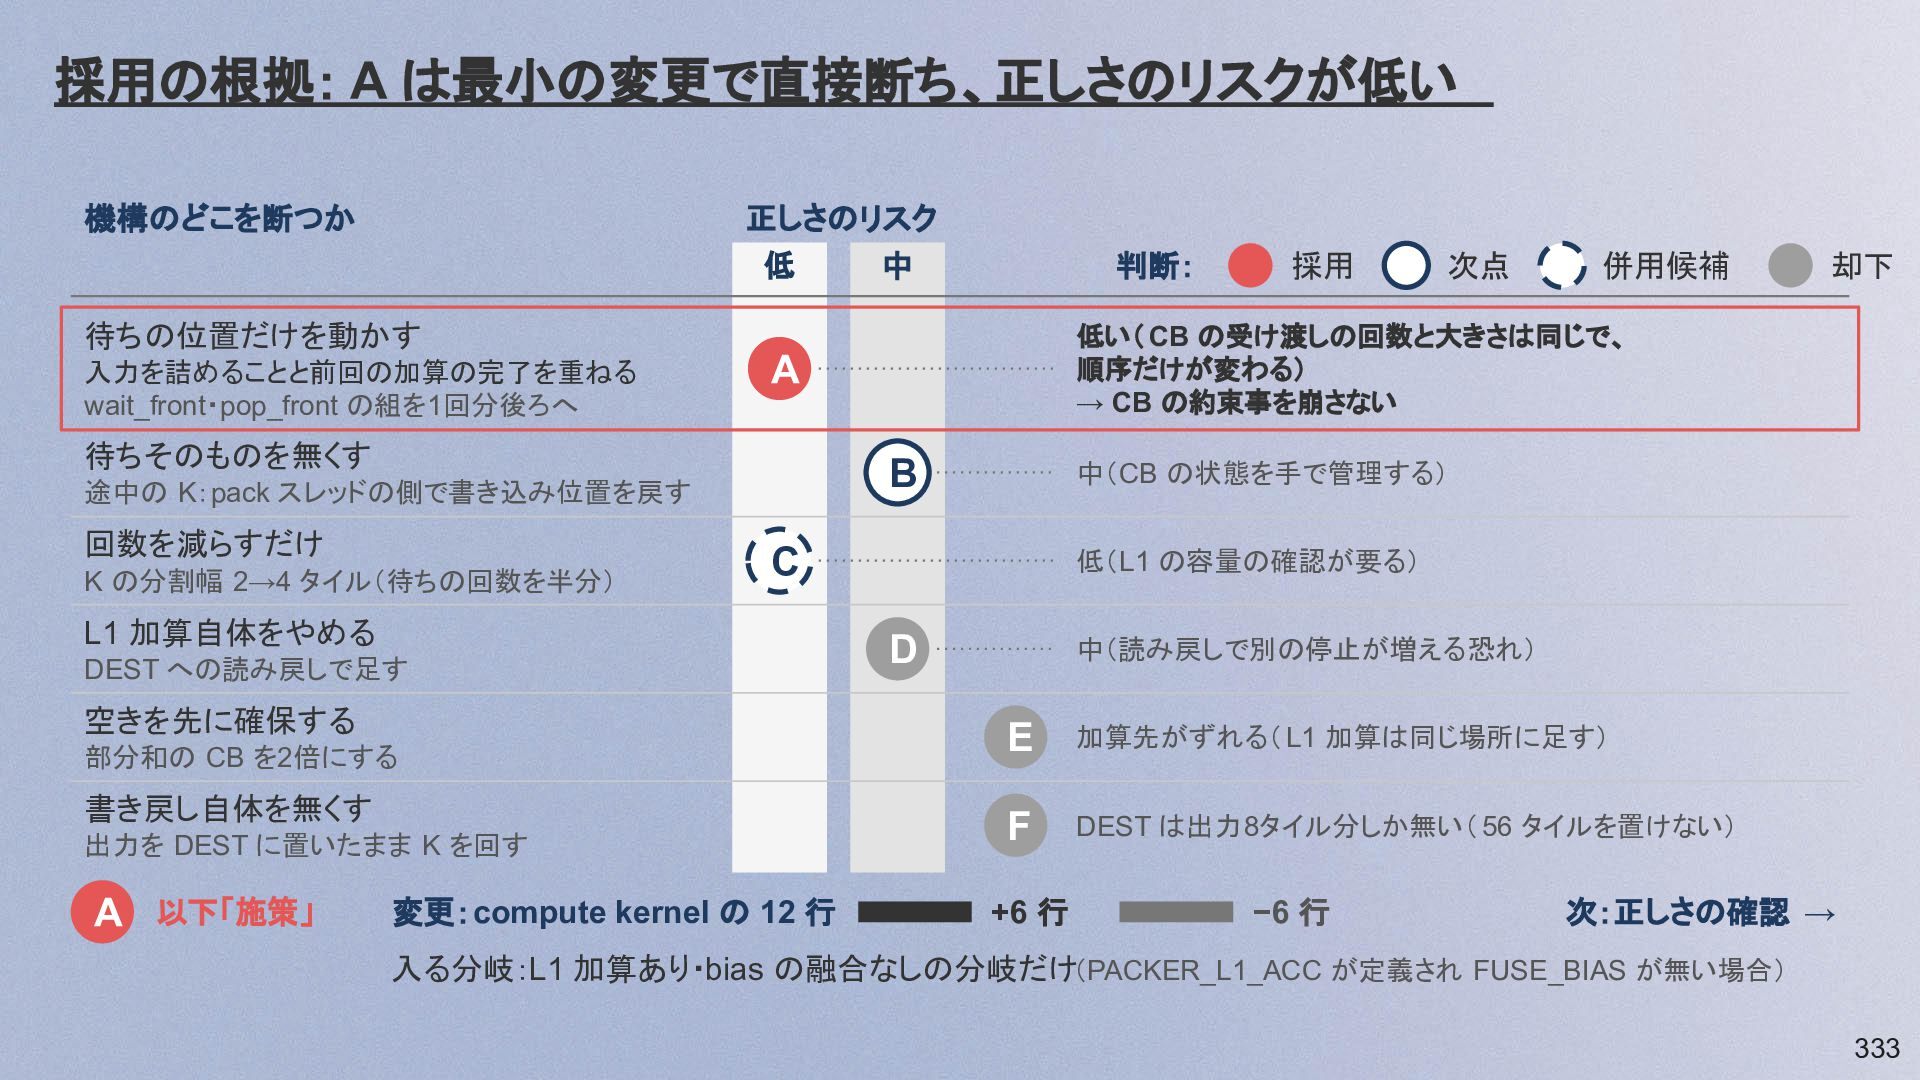
decode)・gate+up(理論下限との差の 1位)の実測 7.79 ms・演算するコアの数 8・丸める前の値で計算 演算量 240.5 GFLOP = 2 × 32(batch)× 4096 × 14336 × 2(gate, up)× 32層 重み 2,113.9 MB = 1層の gate・up 射影 各 33.03 MB(BFP4、理論下限の計算) × 2(gate, up)× 32層 実効 DRAM 帯域 性能上限( p150 の仕様) 1コアの行列演算性能 LoFi 5.53 TFLOP/s・DRAM 帯域 512 GB/s = 2,113.9 MB ÷ その段の時間 実測 7.79 ms 271.2 GB/s(53.0%) 動いているコアが能力を使い切れていない分 8コアの FPU が 毎 cycle 動いた場合 差 2.36 5.44 ms 388.8 GB/s(75.9%) 演算能力(コア数)と DRAM 供給の両方が要る分 DRAM の下限 差 1.31 4.13 ms 0 1 2 3 4 5.44 ms = 240.5 GFLOP ÷(8 × 5.53 TFLOP/s) 4.13 ms = 2,113.9 MB ÷ 512 GB/s 5 512 GB/s(100%) 6 7 8 [ms/token] → 次:3つの不足 294 -
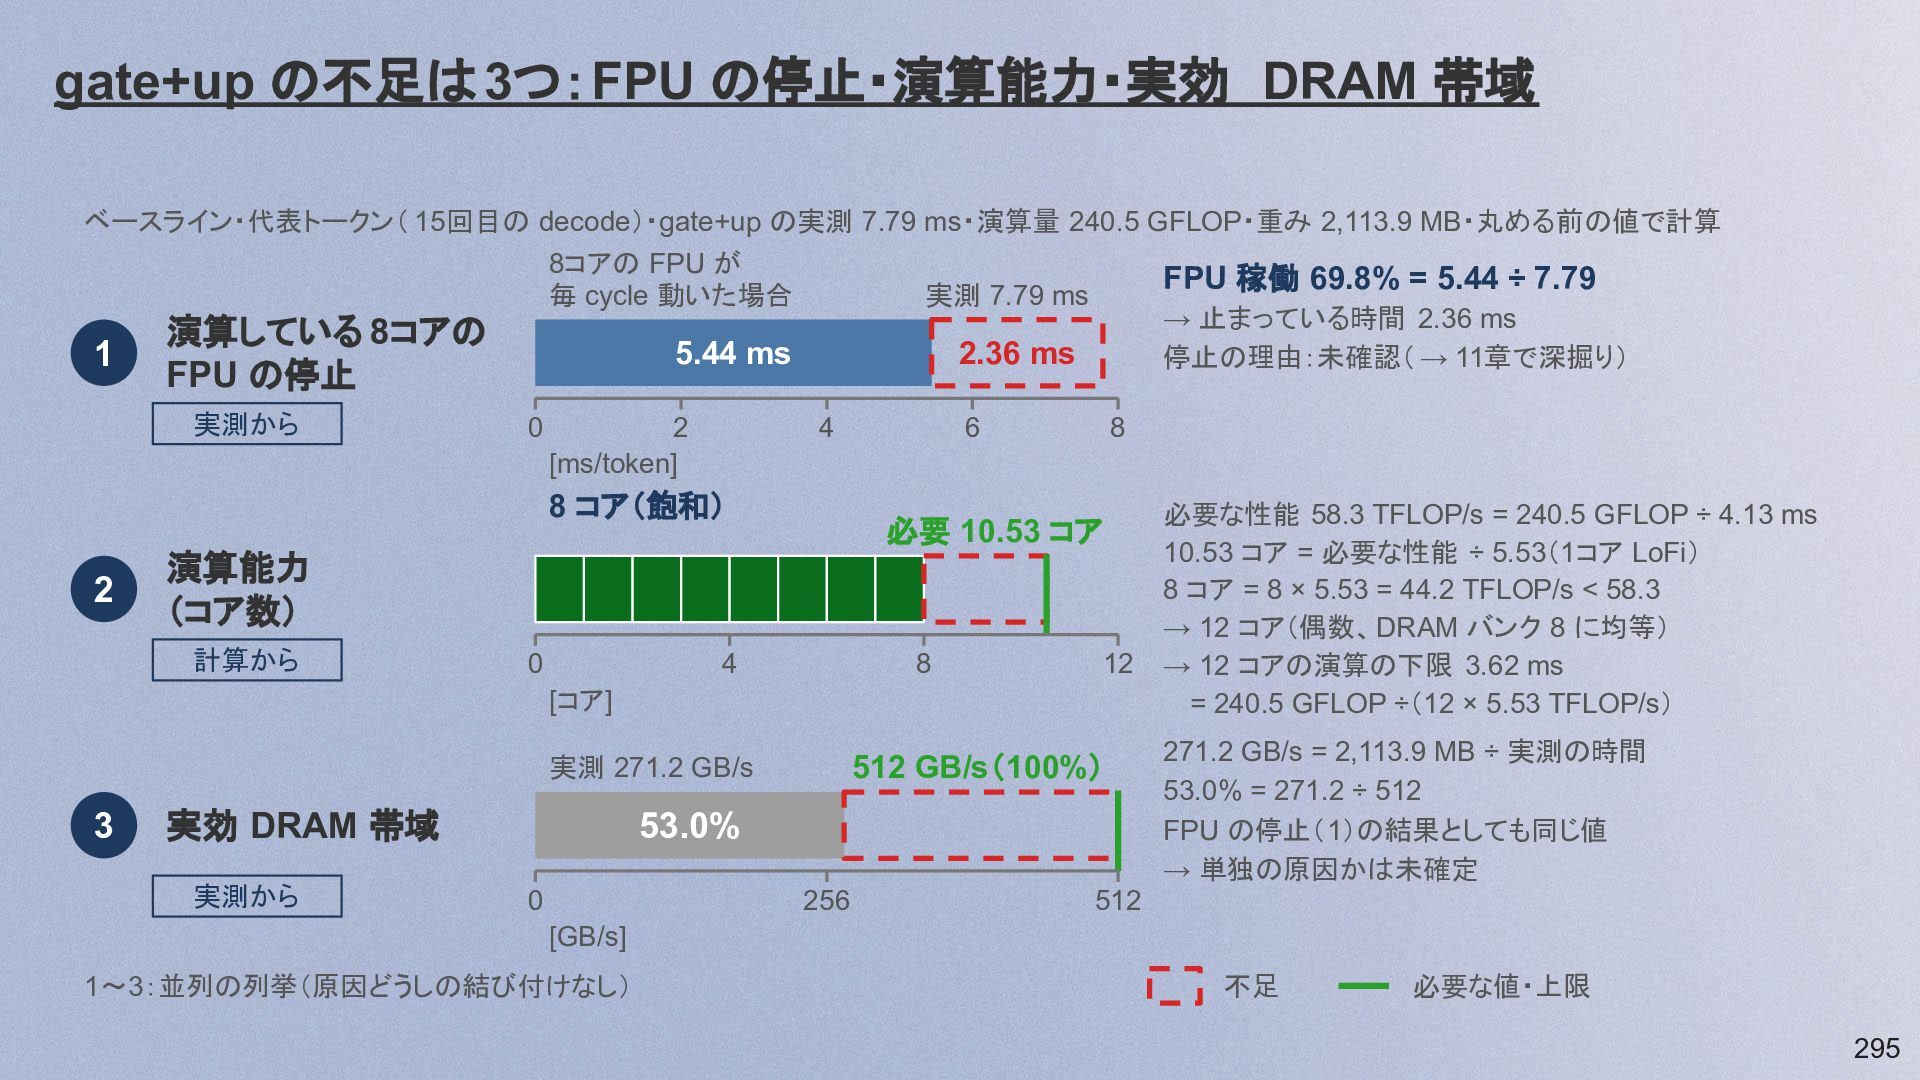
gate+up の不足は 3つ:FPU の停止・演算能力・実効 DRAM 帯域 ベースライン・代表トークン( 15回目の decode)・gate+up の実測
7.79 ms・演算量 240.5 GFLOP・重み 2,113.9 MB・丸める前の値で計算 1 8コアの FPU が 毎 cycle 動いた場合 実測 7.79 ms 5.44 ms 2.36 ms 演算している 8コアの FPU の停止 実測から 0 2 [ms/token] 4 8 コア(飽和) 2 FPU 稼働 69.8% = 5.44 ÷ 7.79 → 止まっている時間 2.36 ms 停止の理由:未確認( → 11章で深掘り) 6 8 必要 10.53 コア 演算能力 (コア数) 計算から 0 4 8 12 [コア] 実測 271.2 GB/s 3 実効 DRAM 帯域 実測から 512 GB/s(100%) 53.0% 0 256 必要な性能 58.3 TFLOP/s = 240.5 GFLOP ÷ 4.13 ms 10.53 コア = 必要な性能 ÷ 5.53(1コア LoFi) 8 コア = 8 × 5.53 = 44.2 TFLOP/s < 58.3 → 12 コア(偶数、DRAM バンク 8 に均等) → 12 コアの演算の下限 3.62 ms = 240.5 GFLOP ÷(12 × 5.53 TFLOP/s) 271.2 GB/s = 2,113.9 MB ÷ 実測の時間 53.0% = 271.2 ÷ 512 FPU の停止(1)の結果としても同じ値 → 単独の原因かは未確定 512 [GB/s] 1〜3:並列の列挙(原因どうしの結び付けなし) 不足 必要な値・上限 295 -
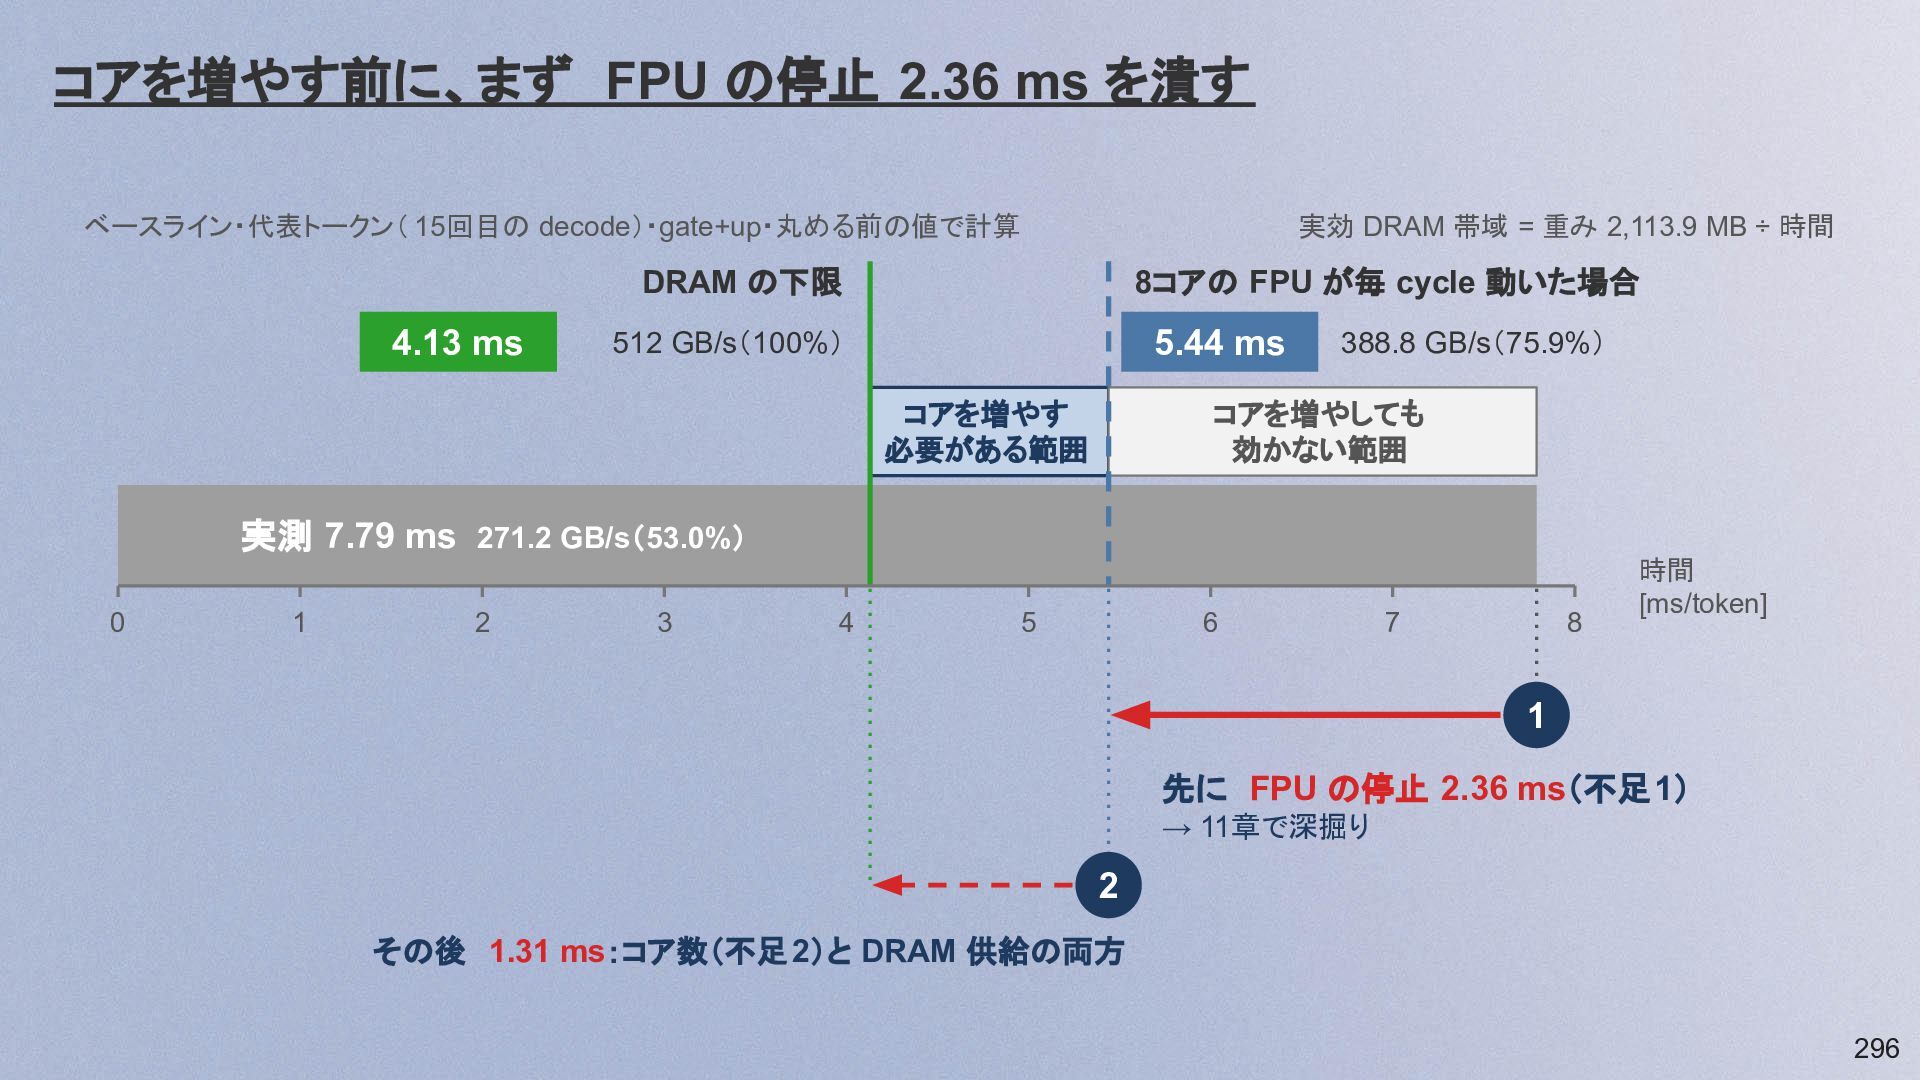
コアを増やす前に、まず FPU の停止 2.36 ms を潰す ベースライン・代表トークン( 15回目の decode)・gate+up・丸める前の値で計算 実効
DRAM 帯域 = 重み 2,113.9 MB ÷ 時間 DRAM の下限 4.13 ms 8コアの FPU が毎 cycle 動いた場合 5.44 ms 512 GB/s(100%) コアを増やす 必要がある範囲 388.8 GB/s(75.9%) コアを増やしても 効かない範囲 実測 7.79 ms 271.2 GB/s(53.0%) 0 1 2 3 4 5 6 7 8 時間 [ms/token] 1 先に FPU の停止 2.36 ms(不足1) → 11章で深掘り 2 その後 1.31 ms:コア数(不足 2)と DRAM 供給の両方 296 -
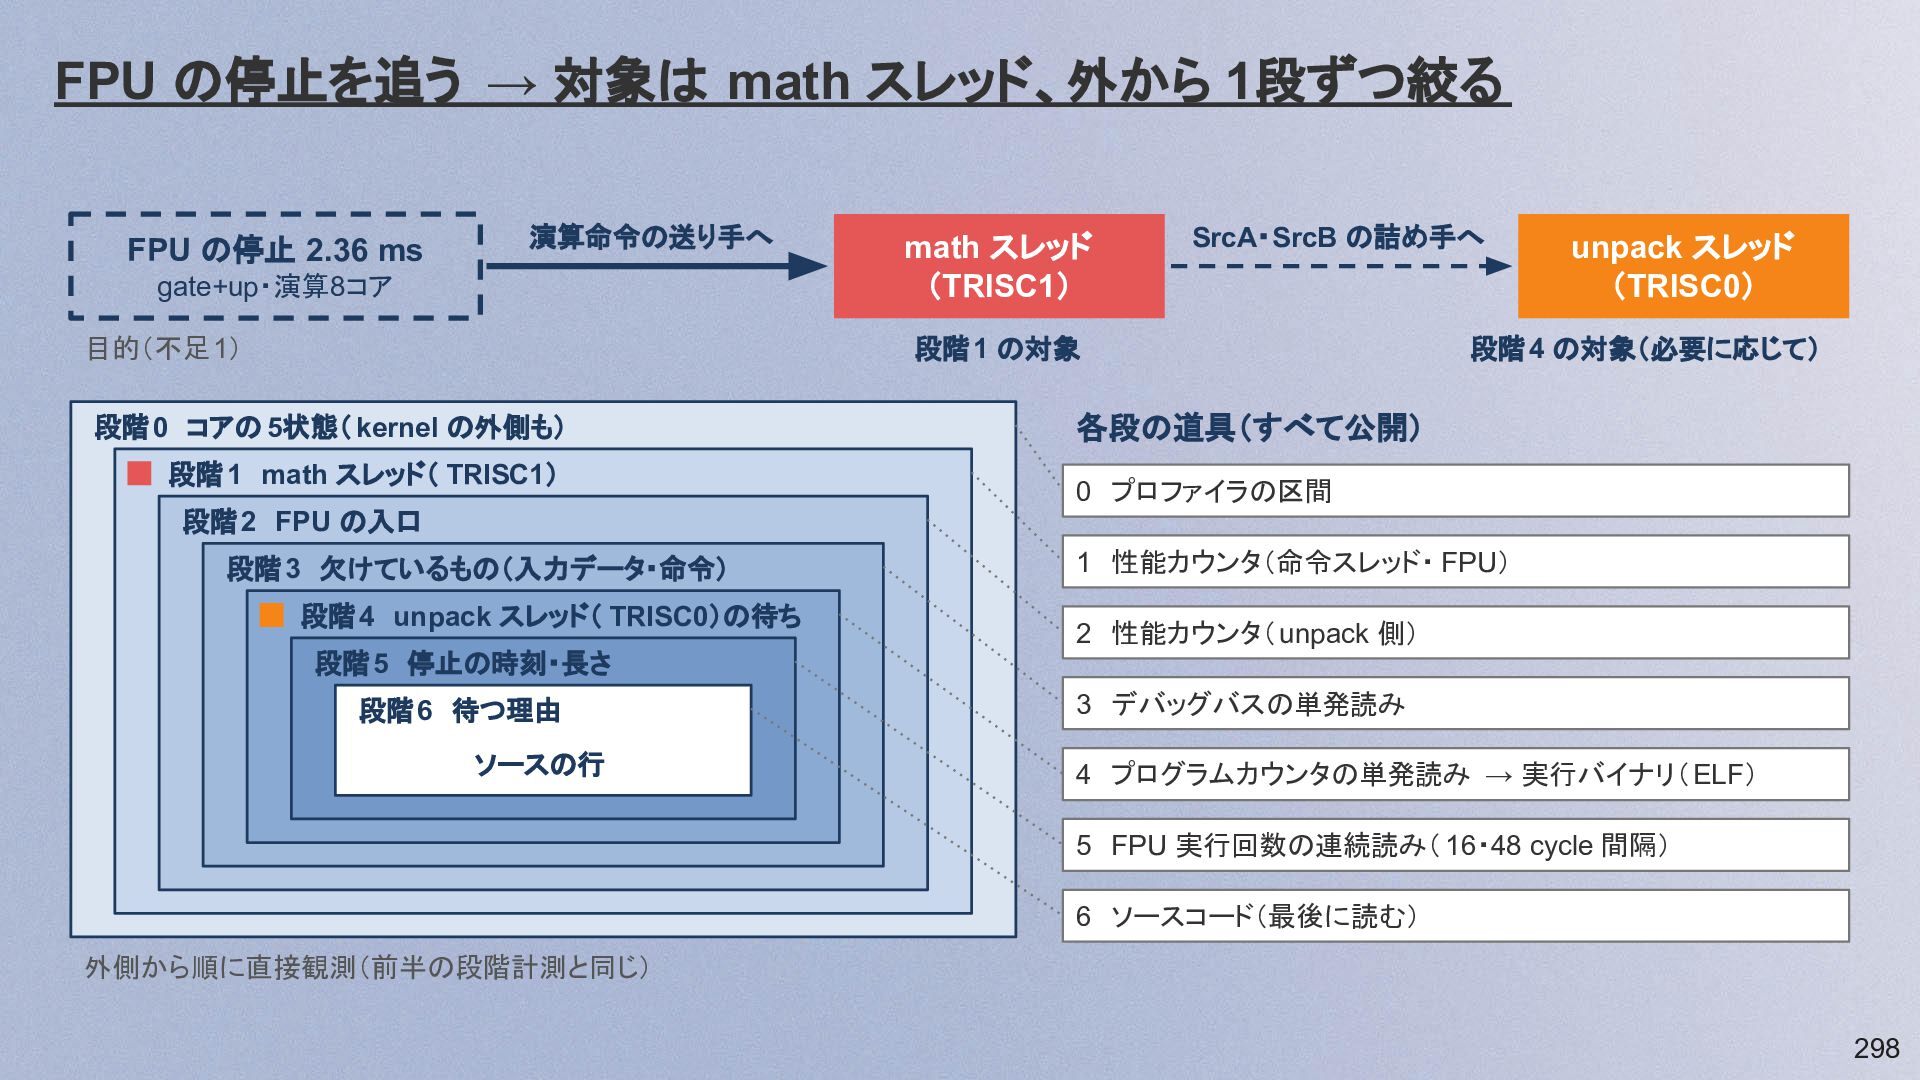
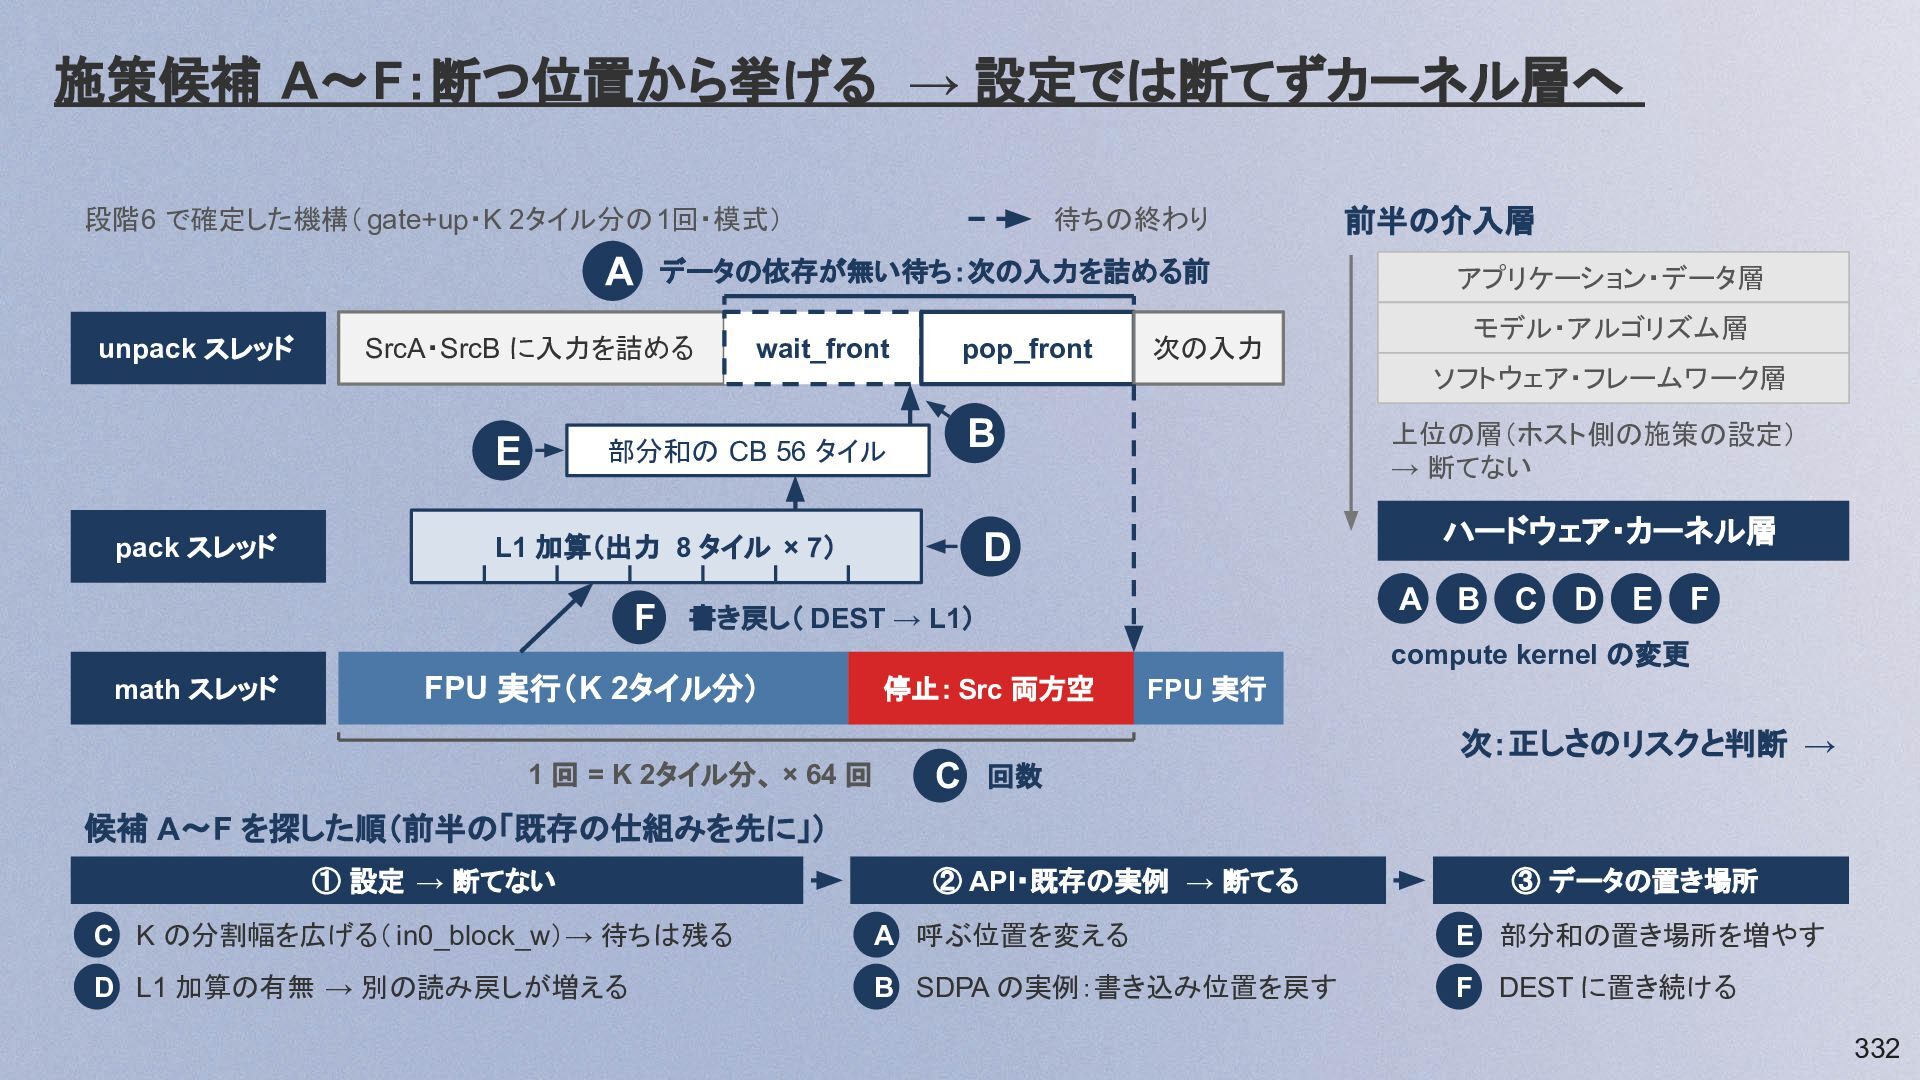
FPU の停止を追う → 対象は math スレッド、外から 1段ずつ絞る FPU の停止 2.36
ms 演算命令の送り手へ gate+up・演算8コア 目的(不足1) math スレッド (TRISC1) SrcA・SrcB の詰め手へ 段階1 の対象 段階0 コアの 5状態( kernel の外側も) 段階1 math スレッド( TRISC1) unpack スレッド (TRISC0) 段階4 の対象(必要に応じて) 各段の道具(すべて公開) 0 プロファイラの区間 段階2 FPU の入口 段階3 欠けているもの(入力データ・命令) 段階4 unpack スレッド( TRISC0)の待ち 1 性能カウンタ(命令スレッド・ FPU) 2 性能カウンタ( unpack 側) 段階5 停止の時刻・長さ 段階6 待つ理由 ソースの行 3 デバッグバスの単発読み 4 プログラムカウンタの単発読み → 実行バイナリ( ELF) 5 FPU 実行回数の連続読み( 16・48 cycle 間隔) 6 ソースコード(最後に読む) 外側から順に直接観測(前半の段階計測と同じ) 298 -
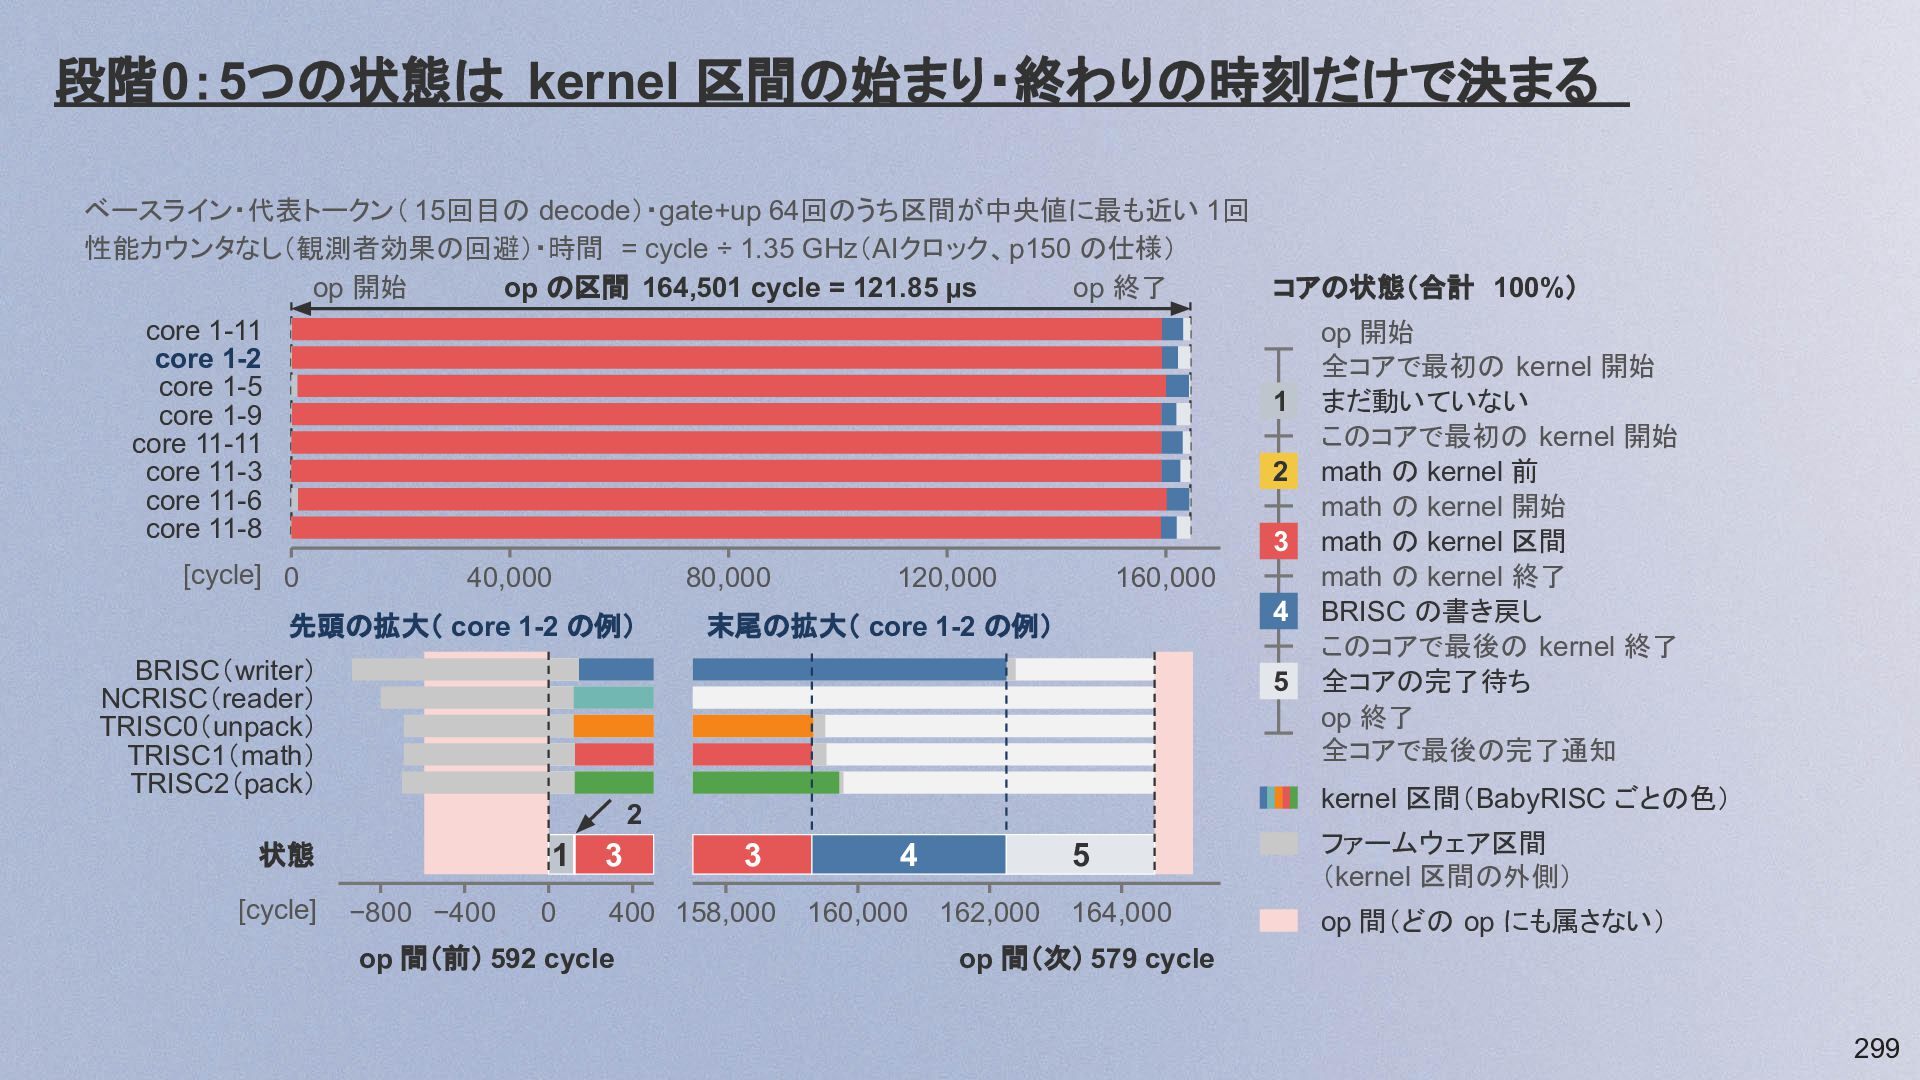
段階0:5つの状態は kernel 区間の始まり・終わりの時刻だけで決まる ベースライン・代表トークン( 15回目の decode)・gate+up 64回のうち区間が中央値に最も近い 1回 性能カウンタなし(観測者効果の回避)・時間 =
cycle ÷ 1.35 GHz(AIクロック、p150 の仕様) op 開始 op の区間 164,501 cycle = 121.85 µs op 終了 コアの状態(合計 100%) core 1-11 core 1-2 core 1-5 core 1-9 core 11-11 core 11-3 core 11-6 core 11-8 1 2 3 [cycle] 0 40,000 80,000 先頭の拡大( core 1-2 の例) 120,000 160,000 4 末尾の拡大( core 1-2 の例) BRISC(writer) NCRISC(reader) TRISC0(unpack) TRISC1(math) TRISC2(pack) 5 kernel 区間(BabyRISC ごとの色) 2 状態 [cycle] −800 −400 1 3 3 4 0 400 158,000 160,000 op 間(前) 592 cycle op 開始 全コアで最初の kernel 開始 まだ動いていない このコアで最初の kernel 開始 math の kernel 前 math の kernel 開始 math の kernel 区間 math の kernel 終了 BRISC の書き戻し このコアで最後の kernel 終了 全コアの完了待ち op 終了 全コアで最後の完了通知 162,000 5 ファームウェア区間 (kernel 区間の外側) 164,000 op 間(どの op にも属さない) op 間(次) 579 cycle 299 -
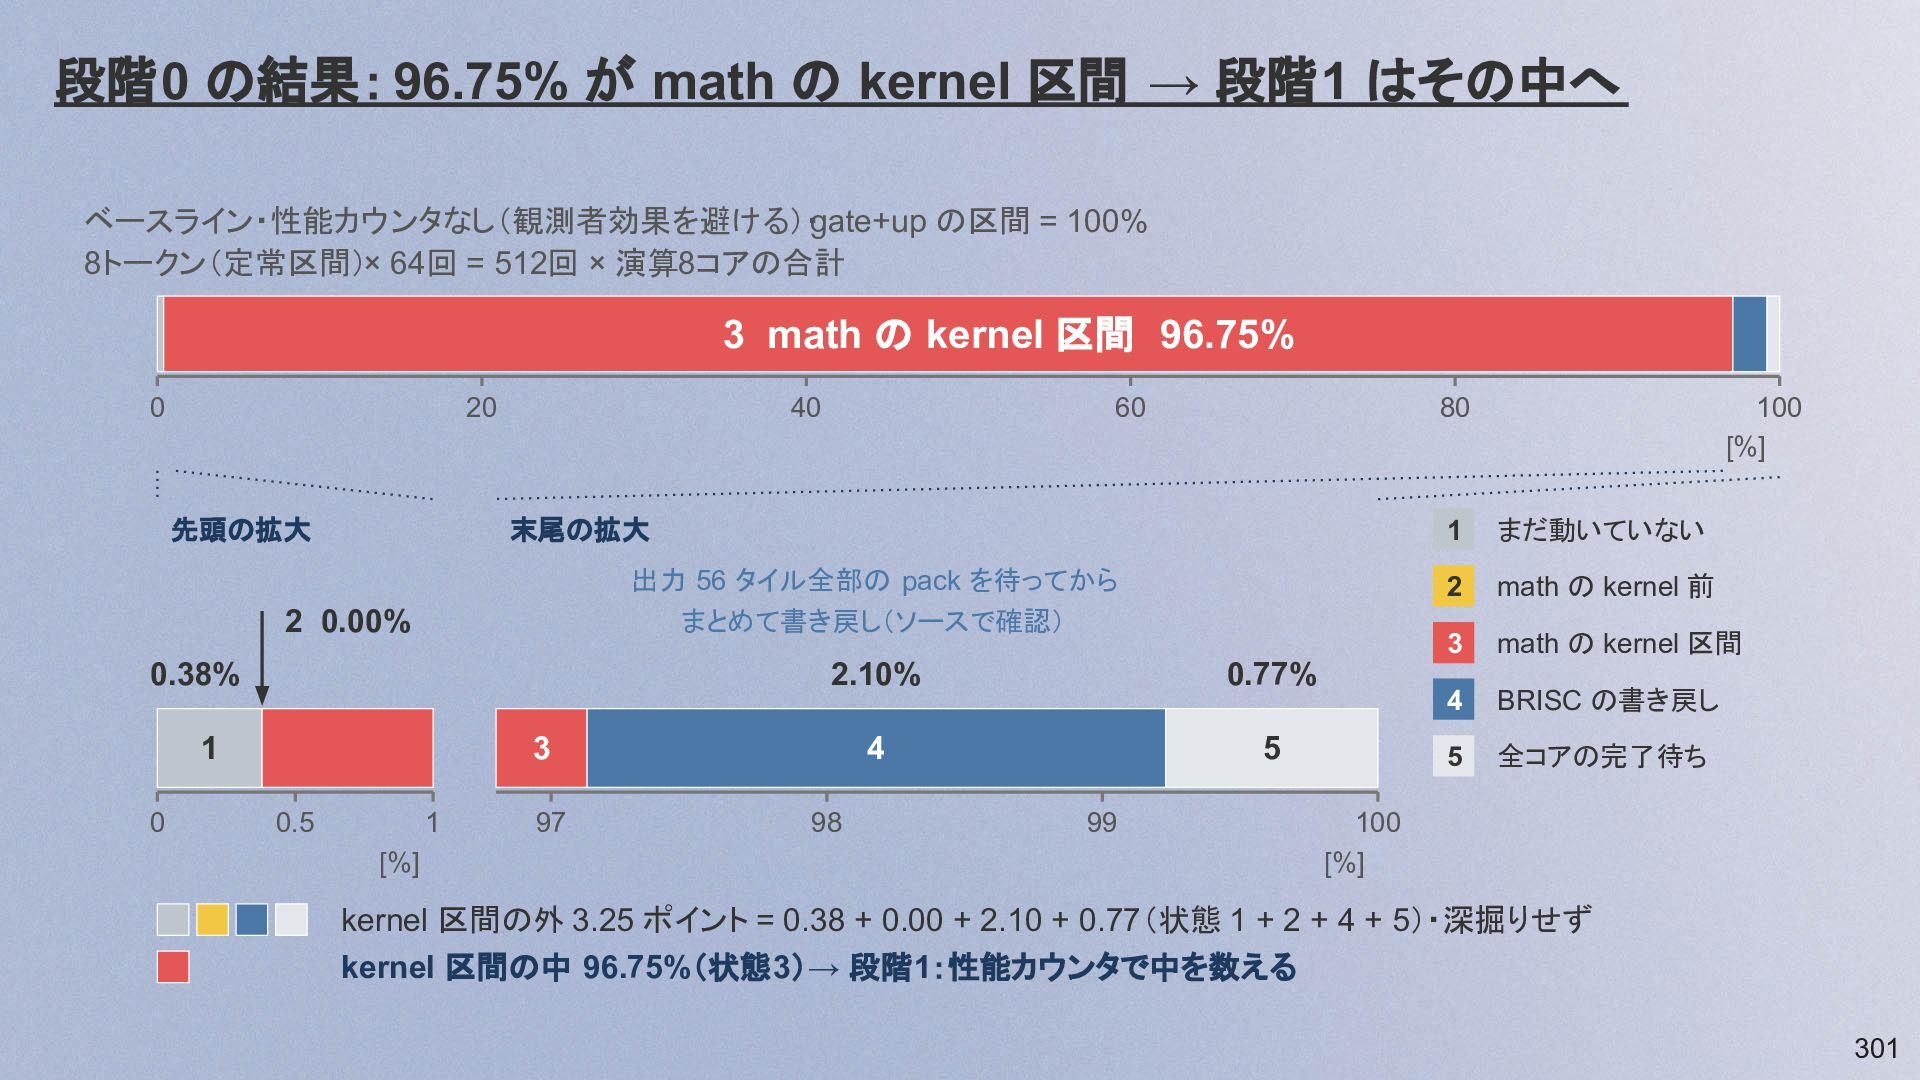
段階0 の結果: 96.75% が math の kernel 区間 → 段階1
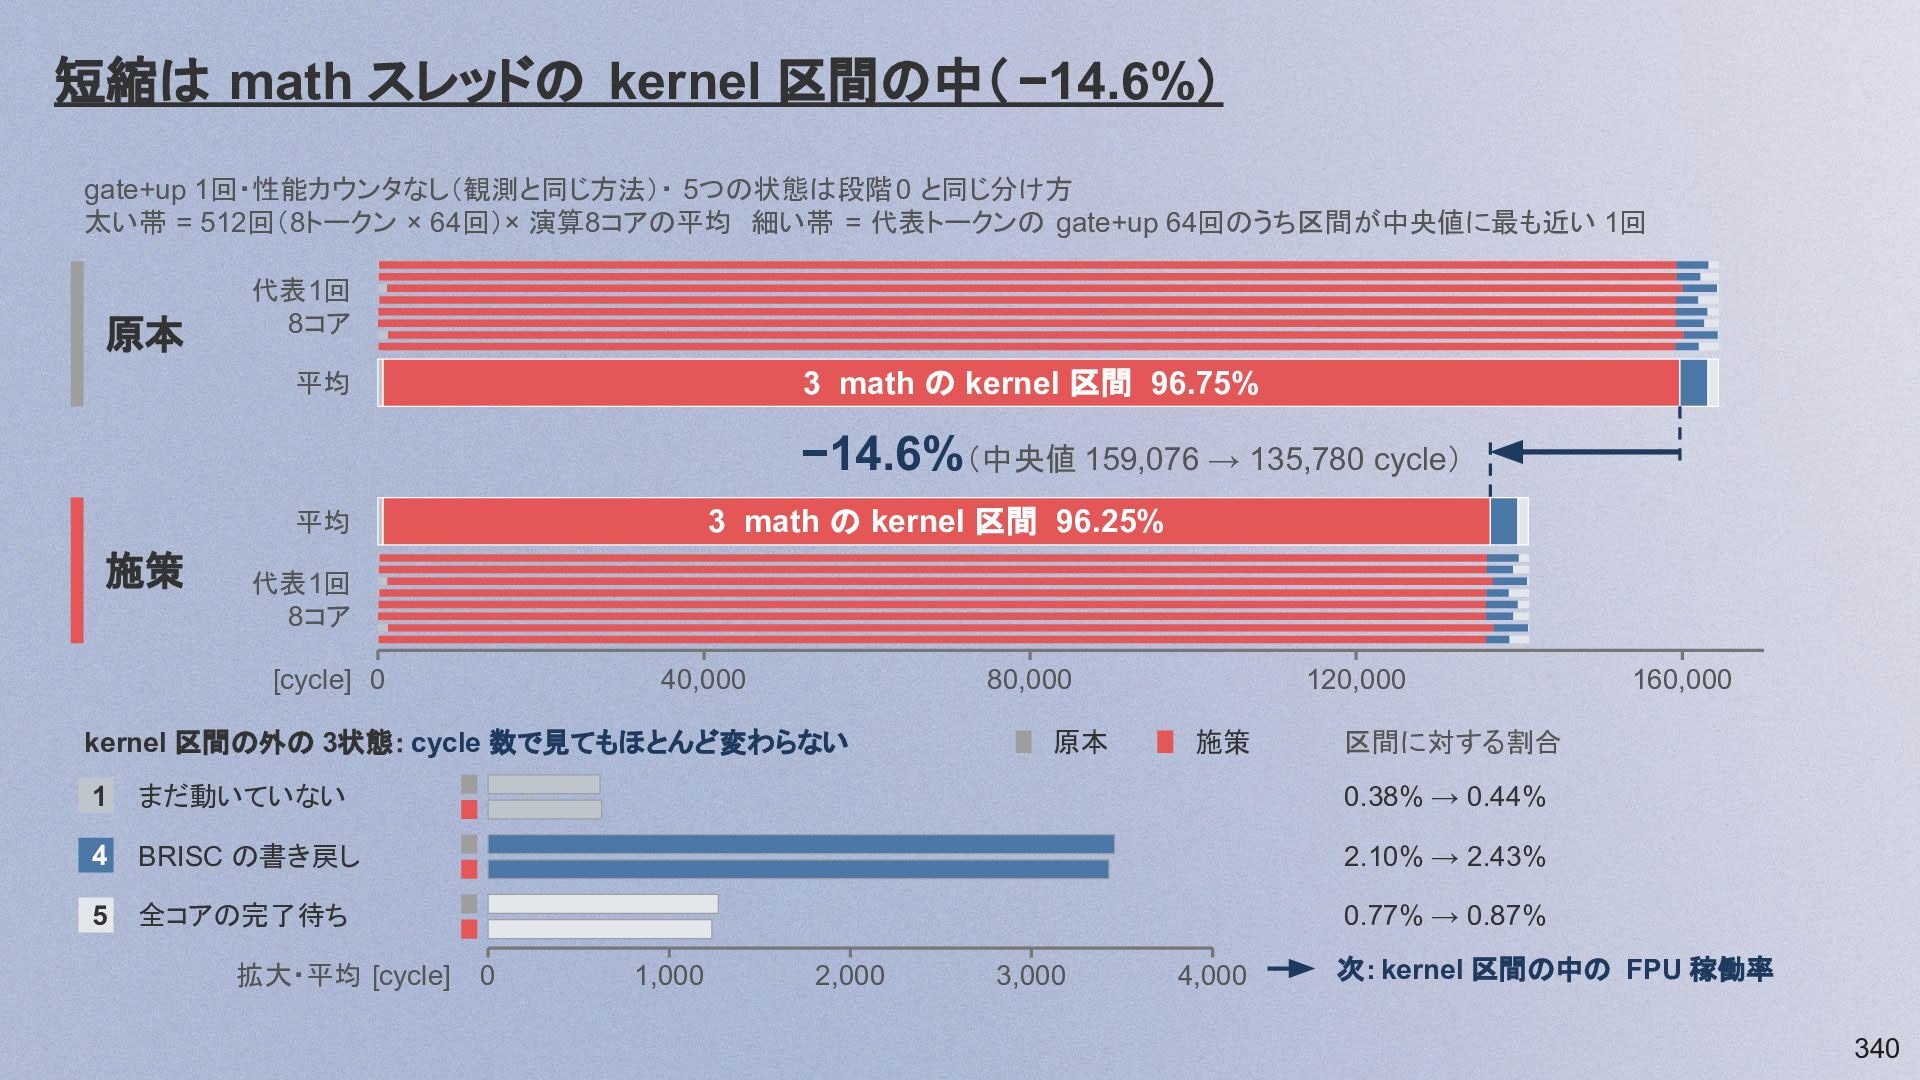
はその中へ ベースライン・性能カウンタなし(観測者効果を避ける)・gate+up の区間 = 100% 8トークン(定常区間)× 64回 = 512回 × 演算8コアの合計 3 math の kernel 区間 96.75% 0 20 先頭の拡大 40 80 末尾の拡大 出力 56 タイル全部の pack を待ってから まとめて書き戻し(ソースで確認) 2 0.00% 0.38% 1 0 60 2.10% 0.77% 4 5 3 0.5 1 [%] 97 98 99 100 [%] 1 まだ動いていない 2 math の kernel 前 3 math の kernel 区間 4 BRISC の書き戻し 5 全コアの完了待ち 100 [%] kernel 区間の外 3.25 ポイント = 0.38 + 0.00 + 2.10 + 0.77(状態 1 + 2 + 4 + 5)・深掘りせず kernel 区間の中 96.75%(状態3)→ 段階1:性能カウンタで中を数える 301 -
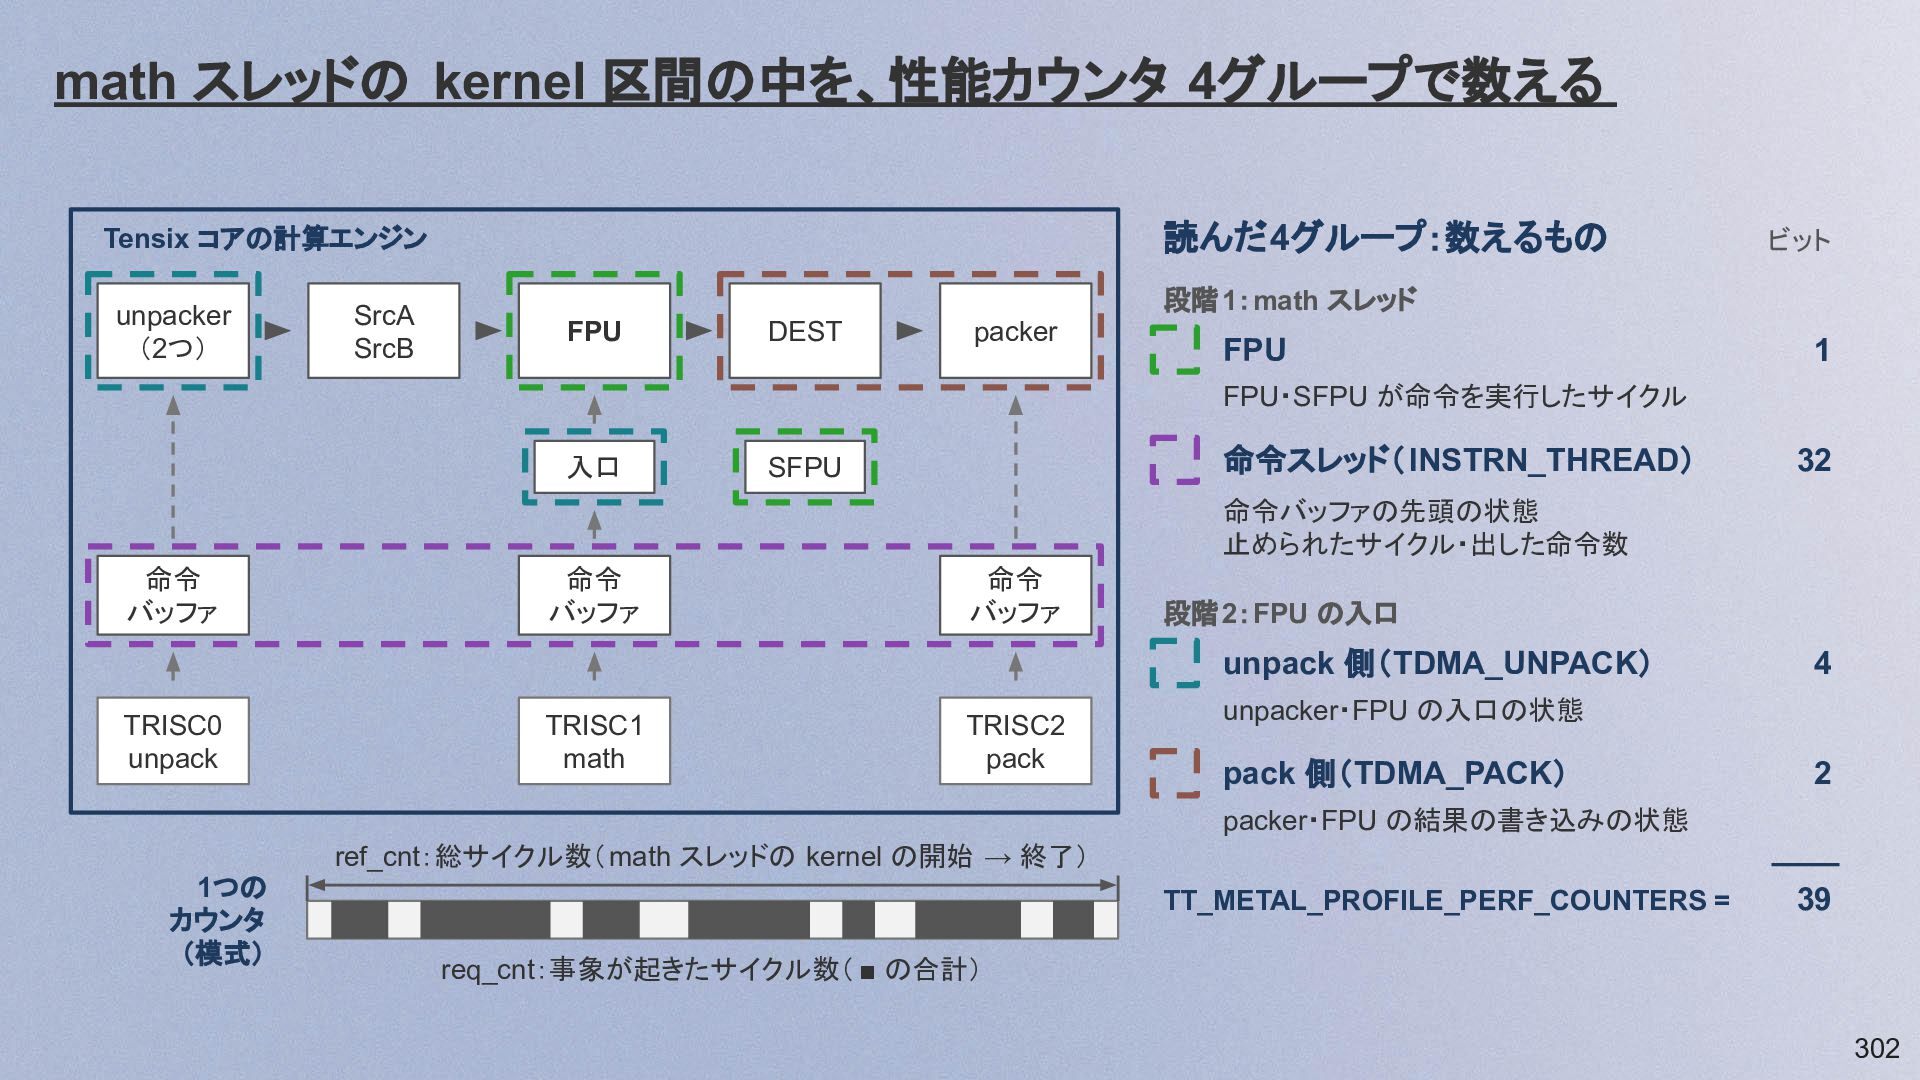
math スレッドの kernel 区間の中を、性能カウンタ 4グループで数える 読んだ4グループ:数えるもの Tensix コアの計算エンジン unpacker (2つ)
SrcA SrcB ビット 段階1:math スレッド FPU DEST packer FPU 1 FPU・SFPU が命令を実行したサイクル 入口 命令スレッド( INSTRN_THREAD) SFPU 32 命令バッファの先頭の状態 止められたサイクル・出した命令数 命令 バッファ 命令 バッファ 命令 バッファ 段階2:FPU の入口 unpack 側(TDMA_UNPACK) TRISC0 unpack TRISC1 math TRISC2 pack 4 unpacker・FPU の入口の状態 pack 側(TDMA_PACK) 2 packer・FPU の結果の書き込みの状態 ref_cnt:総サイクル数( math スレッドの kernel の開始 → 終了) 1つの カウンタ (模式) TT_METAL_PROFILE_PERF_COUNTERS = 39 req_cnt:事象が起きたサイクル数( ▪ の合計) 302 -
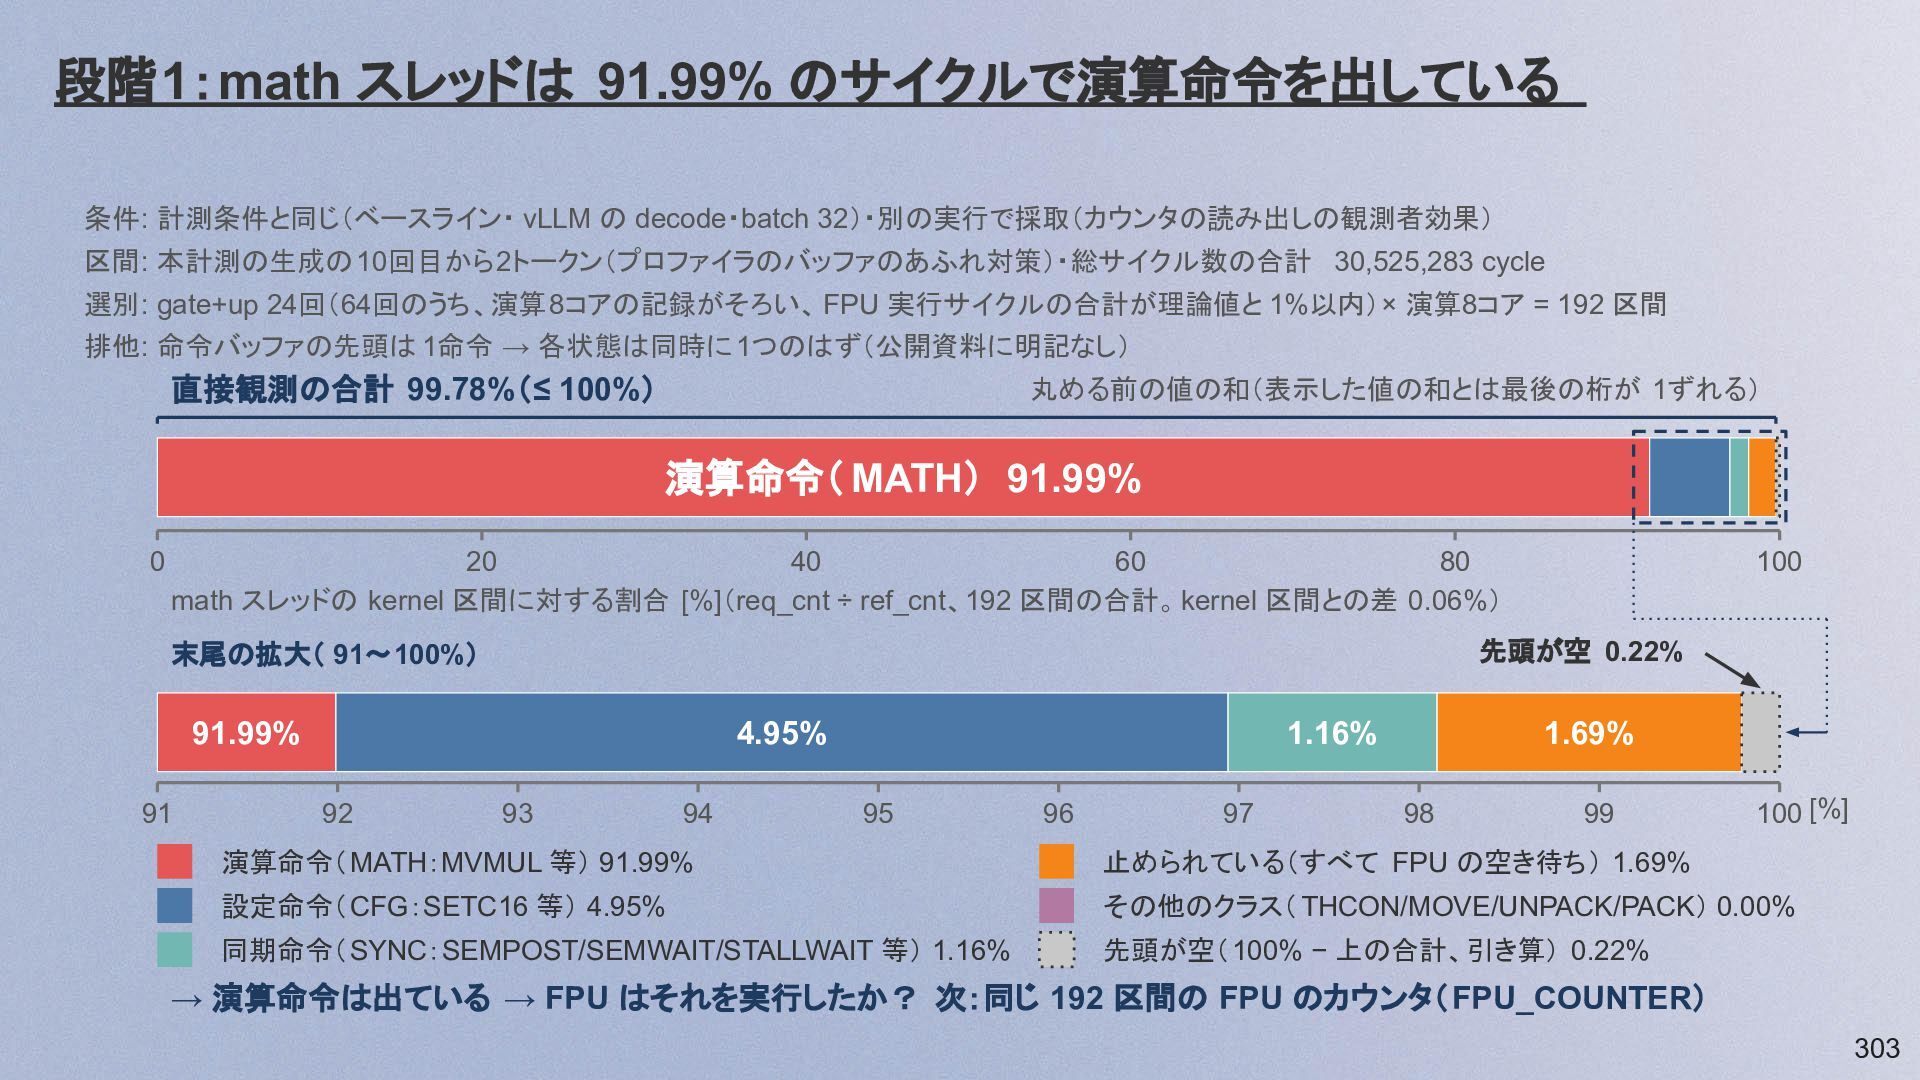
段階1:math スレッドは 91.99% のサイクルで演算命令を出している 条件: 計測条件と同じ(ベースライン・ vLLM の decode・batch 32)・別の実行で採取(カウンタの読み出しの観測者効果)
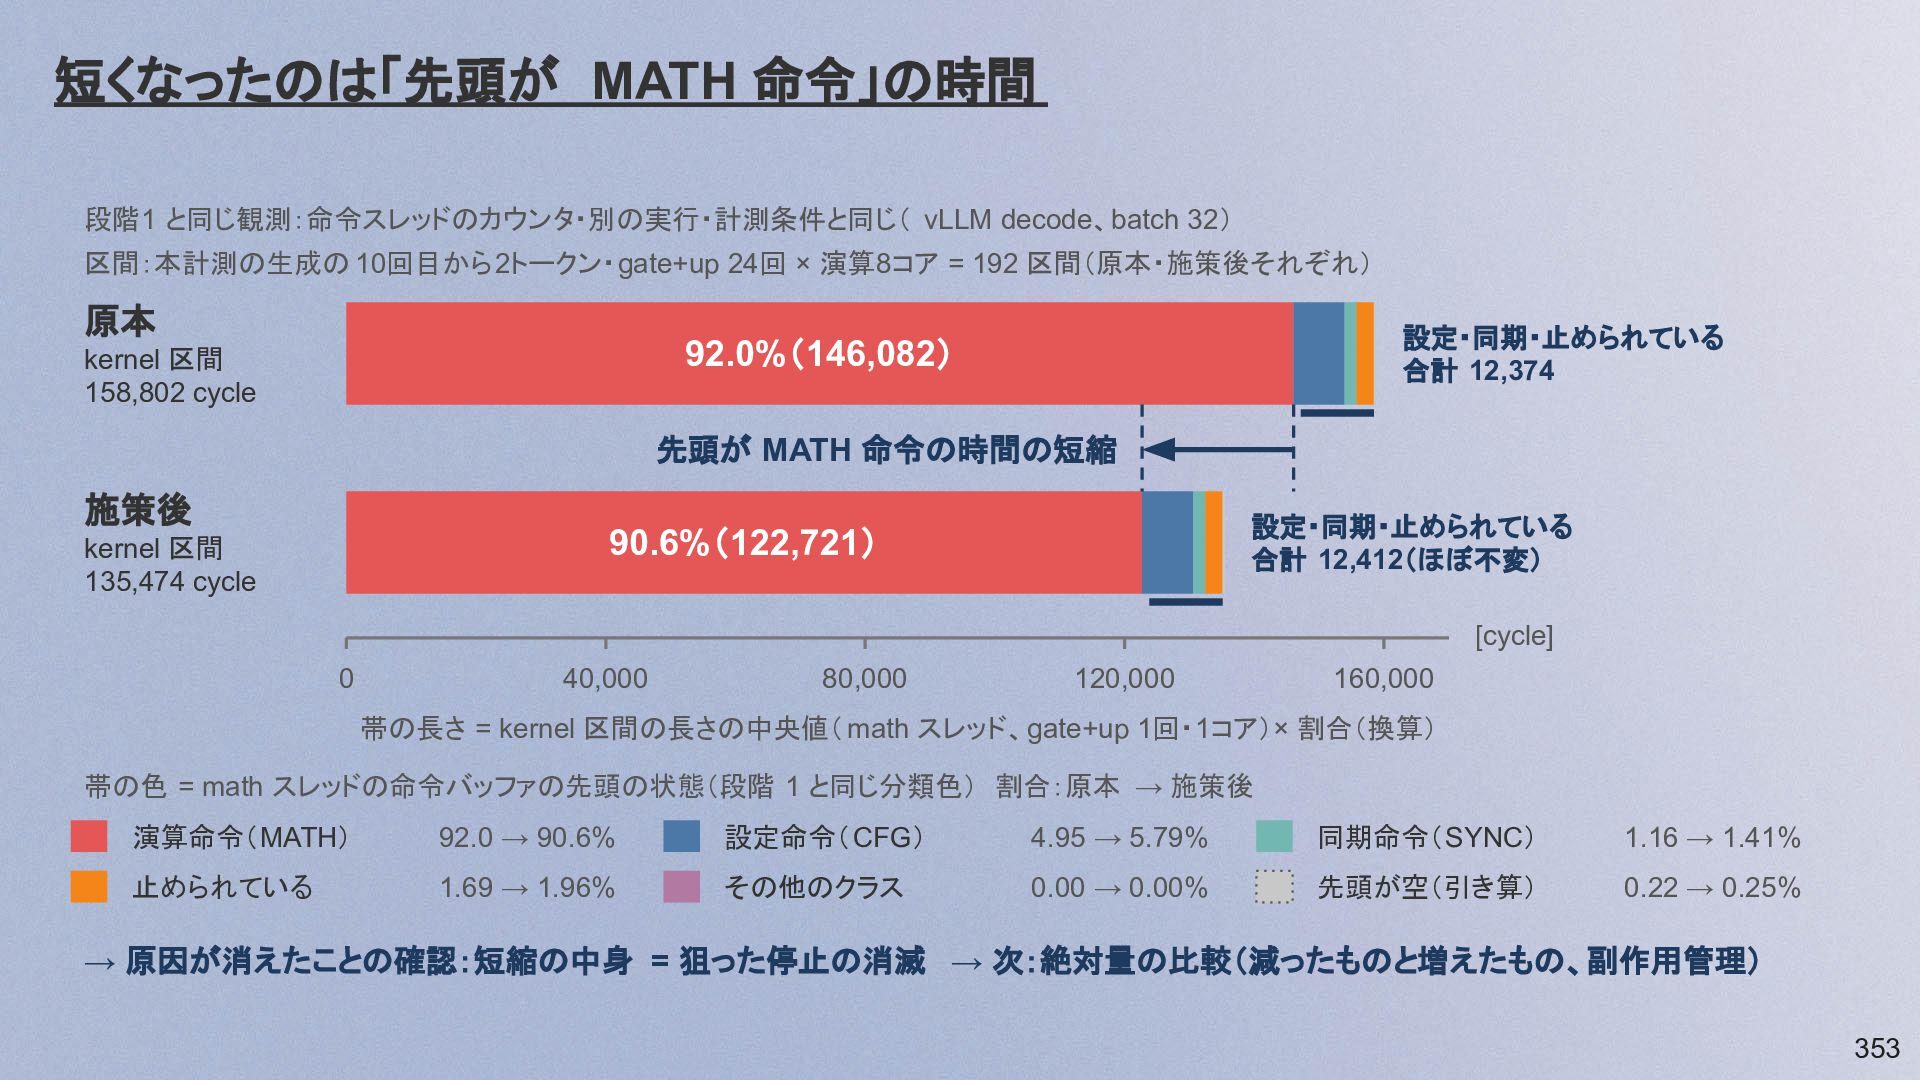
区間: 本計測の生成の 10回目から2トークン(プロファイラのバッファのあふれ対策)・総サイクル数の合計 30,525,283 cycle 選別: gate+up 24回(64回のうち、演算 8コアの記録がそろい、 FPU 実行サイクルの合計が理論値と 1%以内)× 演算8コア = 192 区間 排他: 命令バッファの先頭は 1命令 → 各状態は同時に 1つのはず(公開資料に明記なし) 直接観測の合計 99.78%(≤ 100%) 丸める前の値の和(表示した値の和とは最後の桁が 1ずれる) 演算命令( MATH) 91.99% 0 20 40 60 80 math スレッドの kernel 区間に対する割合 [%](req_cnt ÷ ref_cnt、192 区間の合計。 kernel 区間との差 0.06%) 先頭が空 0.22% 末尾の拡大( 91〜100%) 91.99% 91 4.95% 92 100 93 94 1.16% 95 96 97 1.69% 98 99 100 [%] 演算命令(MATH:MVMUL 等) 91.99% 止められている(すべて FPU の空き待ち) 1.69% 設定命令(CFG:SETC16 等) 4.95% その他のクラス( THCON/MOVE/UNPACK/PACK) 0.00% 同期命令(SYNC:SEMPOST/SEMWAIT/STALLWAIT 等) 1.16% 先頭が空(100% − 上の合計、引き算) 0.22% → 演算命令は出ている → FPU はそれを実行したか? 次:同じ 192 区間の FPU のカウンタ( FPU_COUNTER) 303 -
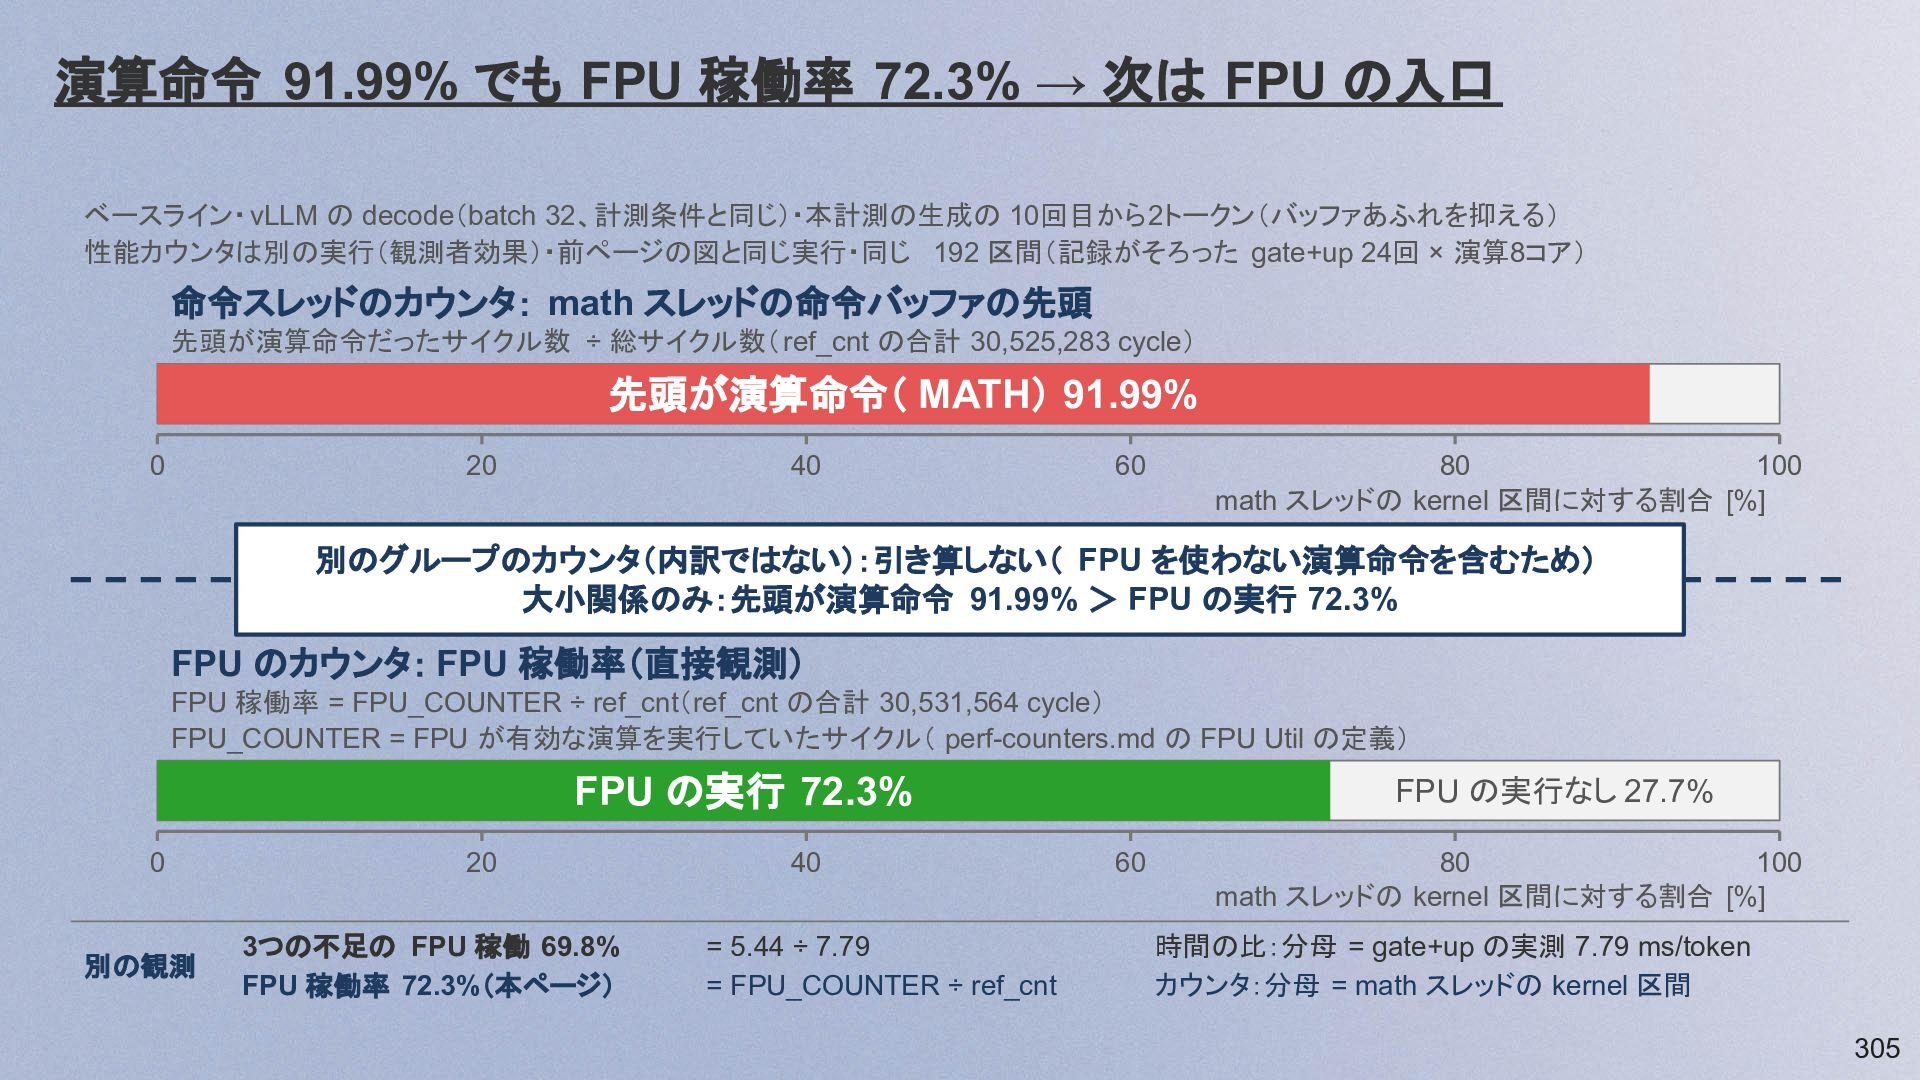
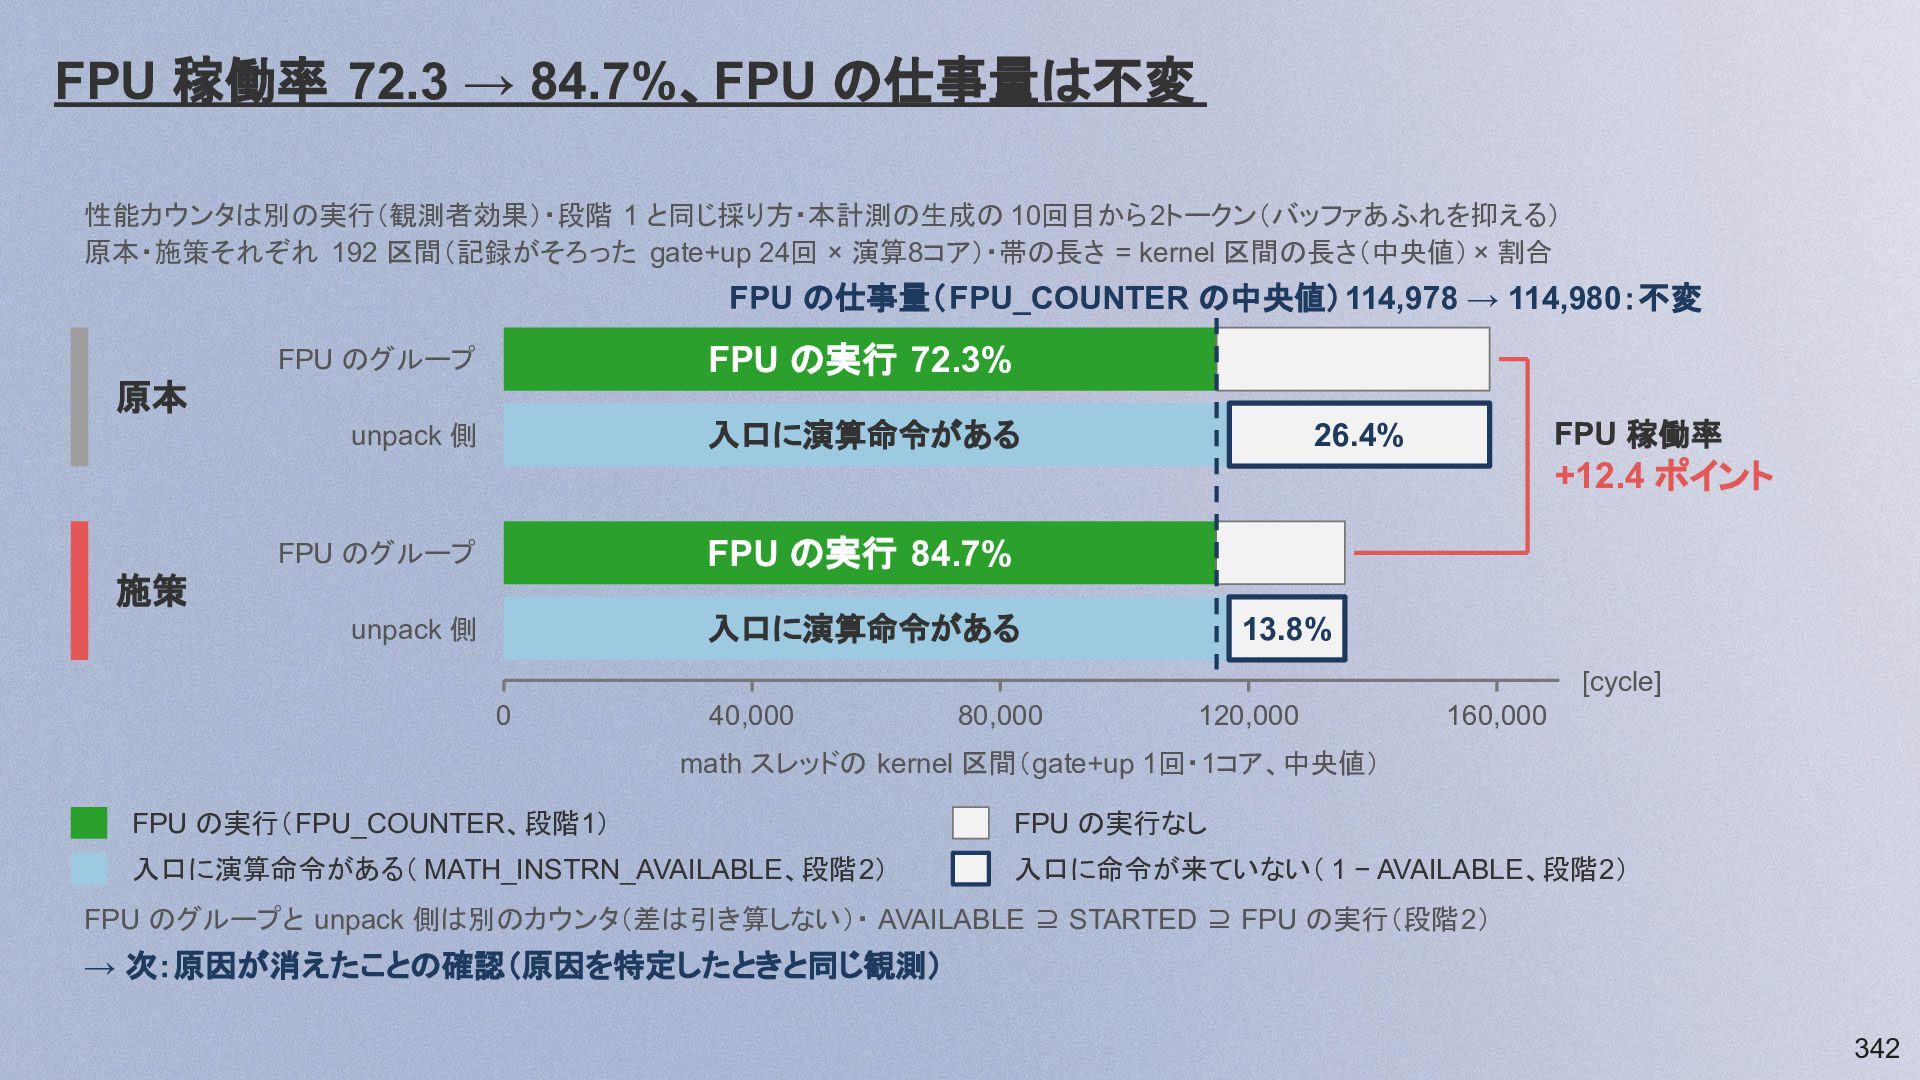
演算命令 91.99% でも FPU 稼働率 72.3% → 次は FPU の入口
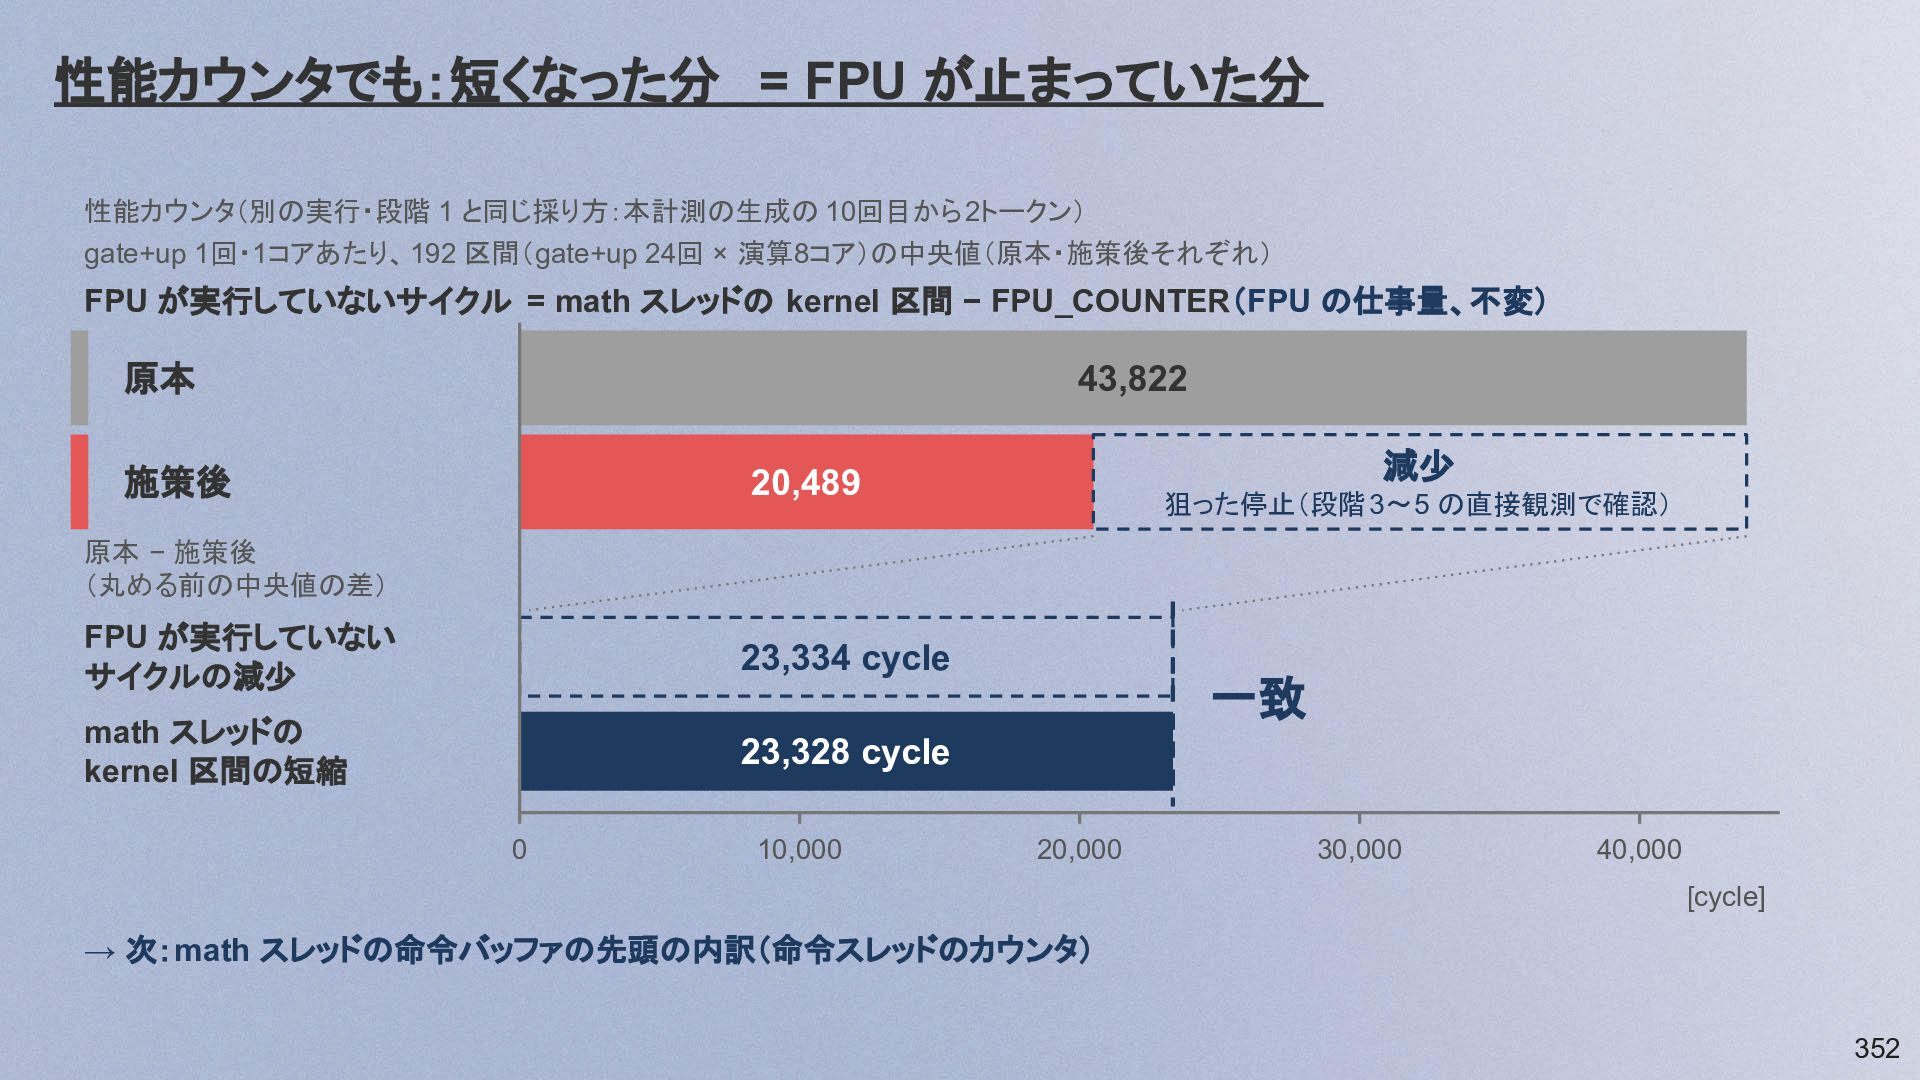
ベースライン・ vLLM の decode(batch 32、計測条件と同じ)・本計測の生成の 10回目から2トークン(バッファあふれを抑える) 性能カウンタは別の実行(観測者効果)・前ページの図と同じ実行・同じ 192 区間(記録がそろった gate+up 24回 × 演算8コア) 命令スレッドのカウンタ: math スレッドの命令バッファの先頭 先頭が演算命令だったサイクル数 ÷ 総サイクル数( ref_cnt の合計 30,525,283 cycle) 先頭が演算命令( MATH) 91.99% 0 20 40 60 80 100 math スレッドの kernel 区間に対する割合 [%] 別のグループのカウンタ(内訳ではない):引き算しない( FPU を使わない演算命令を含むため) 大小関係のみ:先頭が演算命令 91.99% > FPU の実行 72.3% FPU のカウンタ: FPU 稼働率(直接観測) FPU 稼働率 = FPU_COUNTER ÷ ref_cnt(ref_cnt の合計 30,531,564 cycle) FPU_COUNTER = FPU が有効な演算を実行していたサイクル( perf-counters.md の FPU Util の定義) FPU の実行 72.3% 0 別の観測 20 3つの不足の FPU 稼働 69.8% FPU 稼働率 72.3%(本ページ) 40 = 5.44 ÷ 7.79 = FPU_COUNTER ÷ ref_cnt FPU の実行なし 27.7% 60 80 100 math スレッドの kernel 区間に対する割合 [%] 時間の比:分母 = gate+up の実測 7.79 ms/token カウンタ:分母 = math スレッドの kernel 区間 305 -
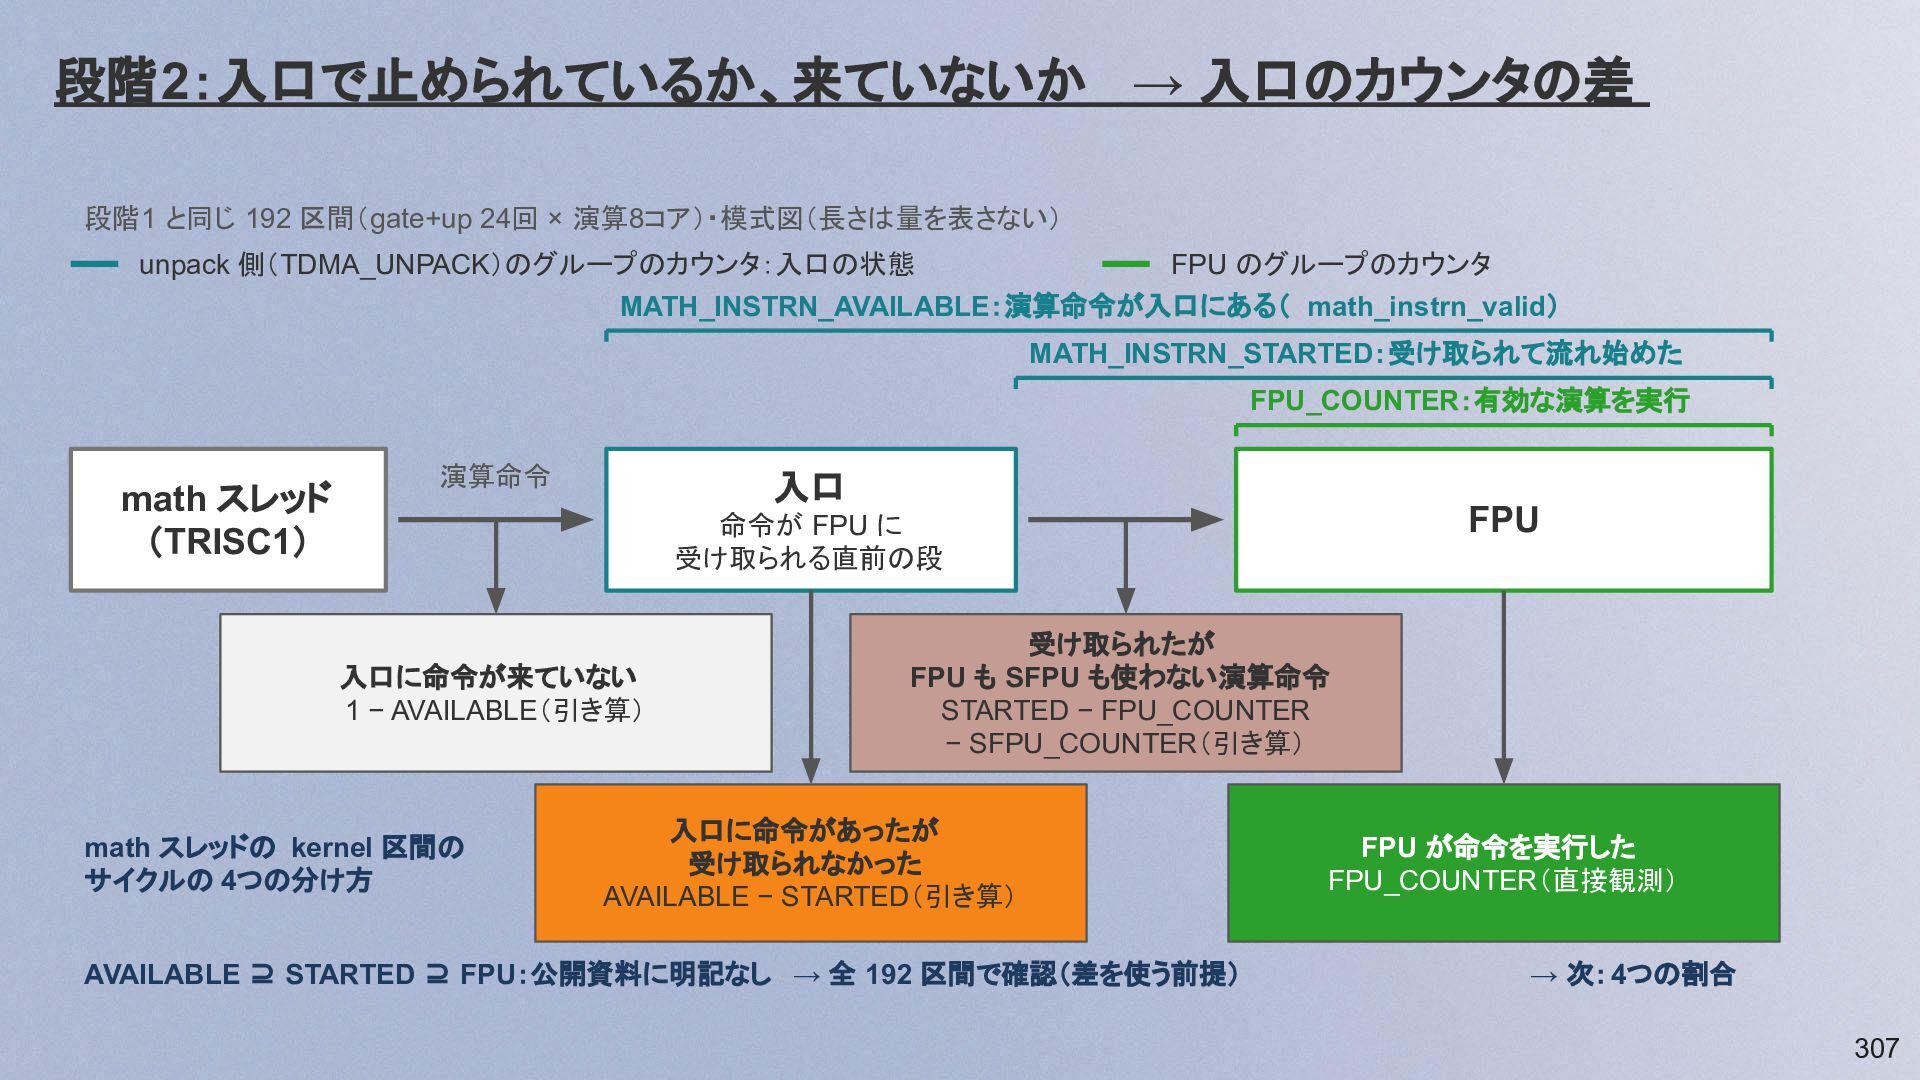
段階2:入口で止められているか、来ていないか → 入口のカウンタの差 段階1 と同じ 192 区間(gate+up 24回 × 演算8コア)・模式図(長さは量を表さない)
unpack 側(TDMA_UNPACK)のグループのカウンタ:入口の状態 FPU のグループのカウンタ MATH_INSTRN_AVAILABLE:演算命令が入口にある( math_instrn_valid) MATH_INSTRN_STARTED:受け取られて流れ始めた FPU_COUNTER:有効な演算を実行 math スレッド (TRISC1) 演算命令 入口 FPU 命令が FPU に 受け取られる直前の段 入口に命令が来ていない 1 − AVAILABLE(引き算) math スレッドの kernel 区間の サイクルの 4つの分け方 受け取られたが FPU も SFPU も使わない演算命令 STARTED − FPU_COUNTER − SFPU_COUNTER(引き算) 入口に命令があったが 受け取られなかった AVAILABLE − STARTED(引き算) AVAILABLE ⊇ STARTED ⊇ FPU:公開資料に明記なし → 全 192 区間で確認(差を使う前提) FPU が命令を実行した FPU_COUNTER(直接観測) → 次:4つの割合 307 -
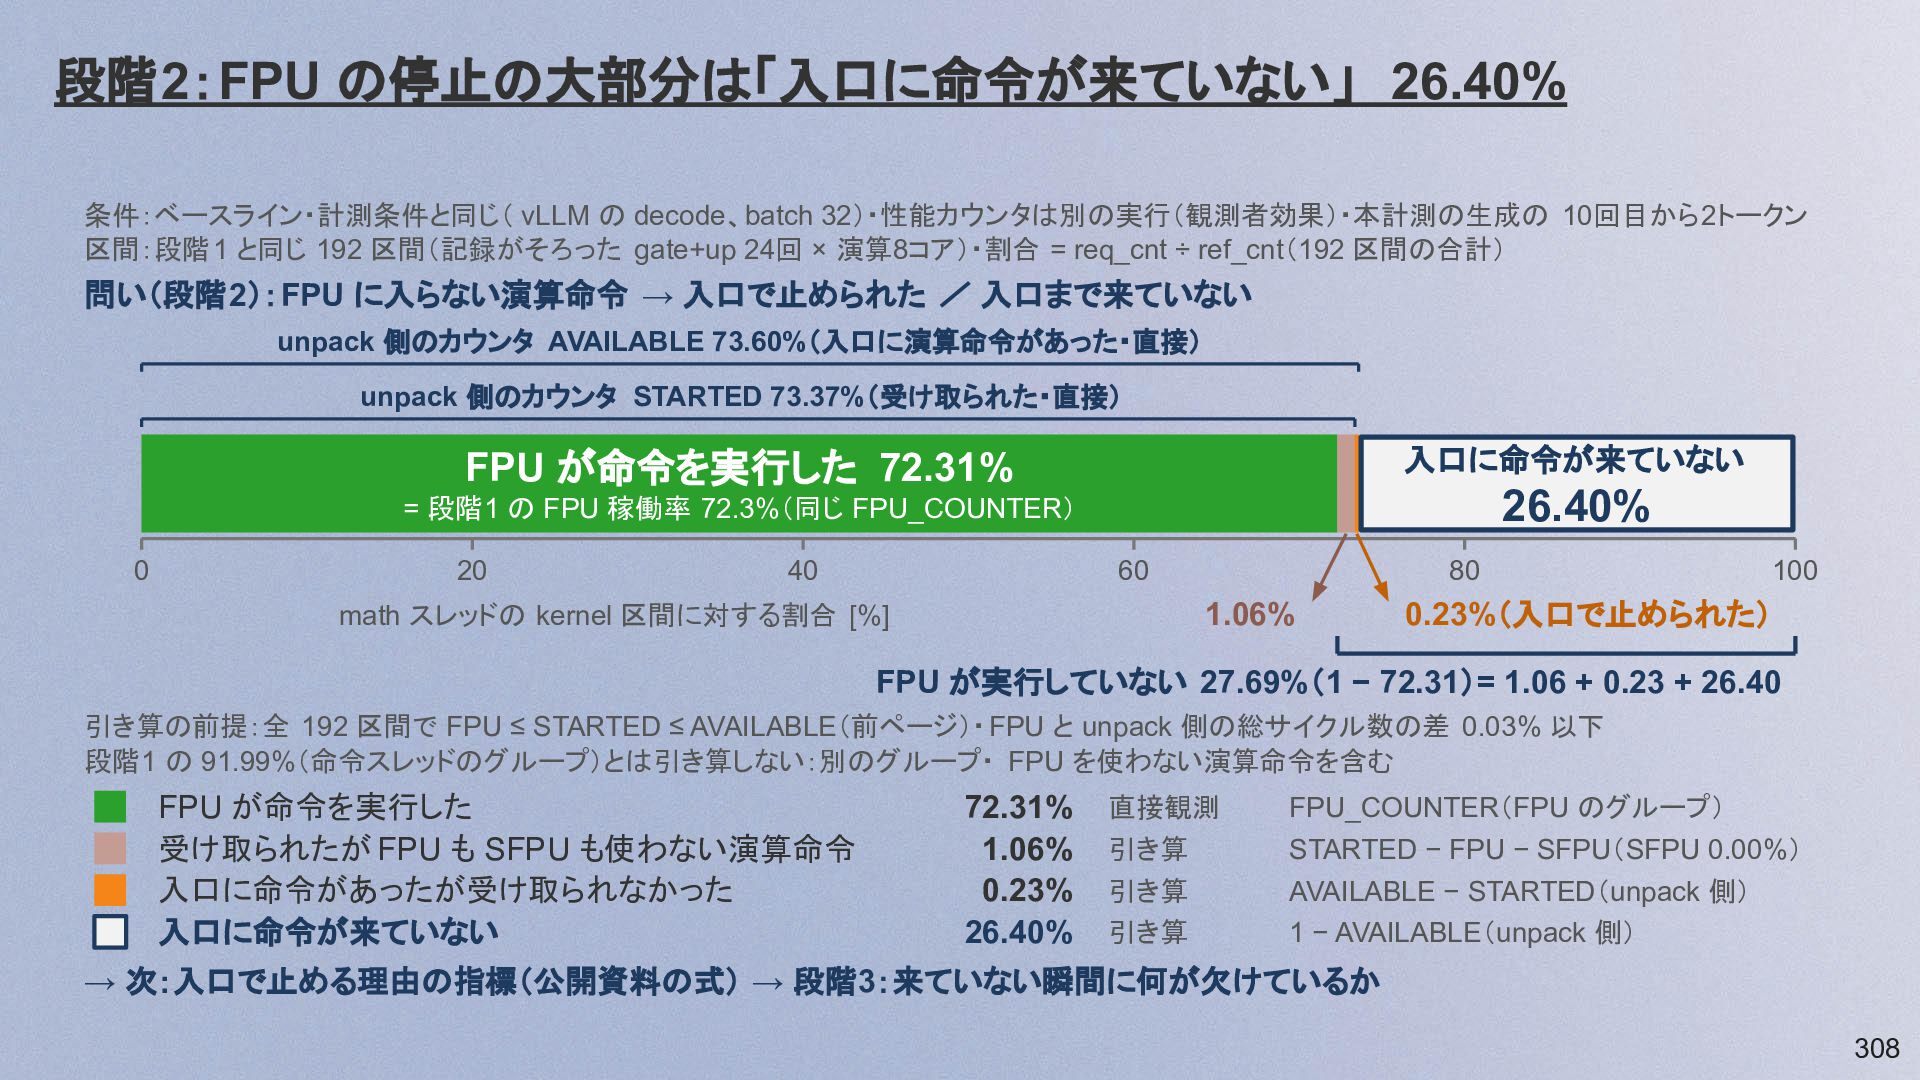
段階2:FPU の停止の大部分は「入口に命令が来ていない」 26.40% 条件:ベースライン・計測条件と同じ( vLLM の decode、batch 32)・性能カウンタは別の実行(観測者効果)・本計測の生成の 10回目から2トークン 区間:段階1
と同じ 192 区間(記録がそろった gate+up 24回 × 演算8コア)・割合 = req_cnt ÷ ref_cnt(192 区間の合計) 問い(段階2):FPU に入らない演算命令 → 入口で止められた / 入口まで来ていない unpack 側のカウンタ AVAILABLE 73.60%(入口に演算命令があった・直接) unpack 側のカウンタ STARTED 73.37%(受け取られた・直接) 入口に命令が来ていない FPU が命令を実行した 72.31% 26.40% = 段階1 の FPU 稼働率 72.3%(同じ FPU_COUNTER) 0 20 40 60 math スレッドの kernel 区間に対する割合 [%] 80 1.06% 100 0.23%(入口で止められた) FPU が実行していない 27.69%(1 − 72.31)= 1.06 + 0.23 + 26.40 引き算の前提:全 192 区間で FPU ≤ STARTED ≤ AVAILABLE(前ページ)・FPU と unpack 側の総サイクル数の差 0.03% 以下 段階1 の 91.99%(命令スレッドのグループ)とは引き算しない:別のグループ・ FPU を使わない演算命令を含む FPU が命令を実行した 受け取られたが FPU も SFPU も使わない演算命令 入口に命令があったが受け取られなかった 入口に命令が来ていない 72.31% 1.06% 0.23% 26.40% 直接観測 引き算 引き算 引き算 FPU_COUNTER(FPU のグループ) STARTED − FPU − SFPU(SFPU 0.00%) AVAILABLE − STARTED(unpack 側) 1 − AVAILABLE(unpack 側) → 次:入口で止める理由の指標(公開資料の式) → 段階3:来ていない瞬間に何が欠けているか 308 -
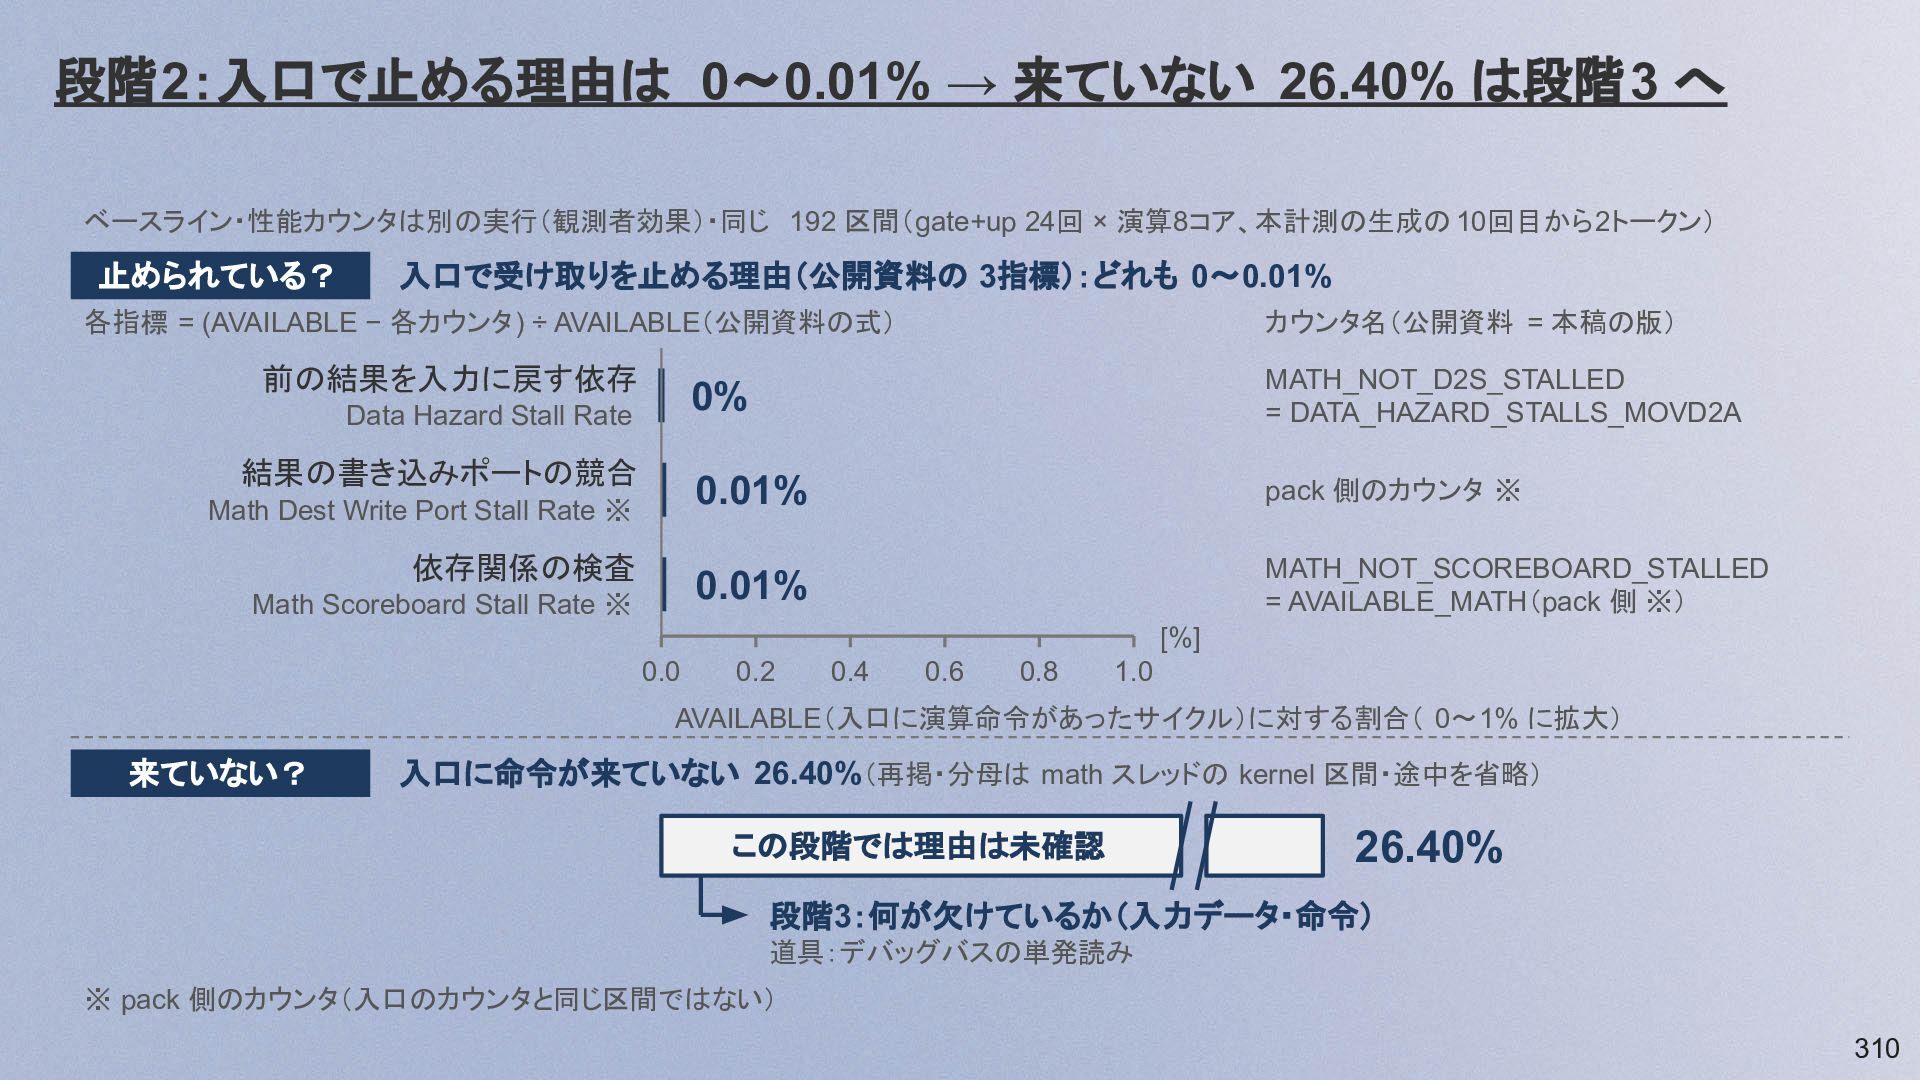
段階2:入口で止める理由は 0〜0.01% → 来ていない 26.40% は段階3 へ ベースライン・性能カウンタは別の実行(観測者効果)・同じ 192 区間(gate+up
24回 × 演算8コア、本計測の生成の 10回目から2トークン) 止められている? 入口で受け取りを止める理由(公開資料の 3指標):どれも 0〜0.01% 各指標 = (AVAILABLE − 各カウンタ) ÷ AVAILABLE(公開資料の式) 前の結果を入力に戻す依存 Data Hazard Stall Rate 結果の書き込みポートの競合 Math Dest Write Port Stall Rate ※ 依存関係の検査 Math Scoreboard Stall Rate ※ カウンタ名(公開資料 = 本稿の版) 0% MATH_NOT_D2S_STALLED = DATA_HAZARD_STALLS_MOVD2A 0.01% pack 側のカウンタ ※ 0.01% MATH_NOT_SCOREBOARD_STALLED = AVAILABLE_MATH(pack 側 ※) [%] 0.0 0.2 0.4 0.6 0.8 1.0 AVAILABLE(入口に演算命令があったサイクル)に対する割合( 0〜1% に拡大) 来ていない? 入口に命令が来ていない 26.40%(再掲・分母は math スレッドの kernel 区間・途中を省略) この段階では理由は未確認 26.40% 段階3:何が欠けているか(入力データ・命令) 道具:デバッグバスの単発読み ※ pack 側のカウンタ(入口のカウンタと同じ区間ではない) 310 -
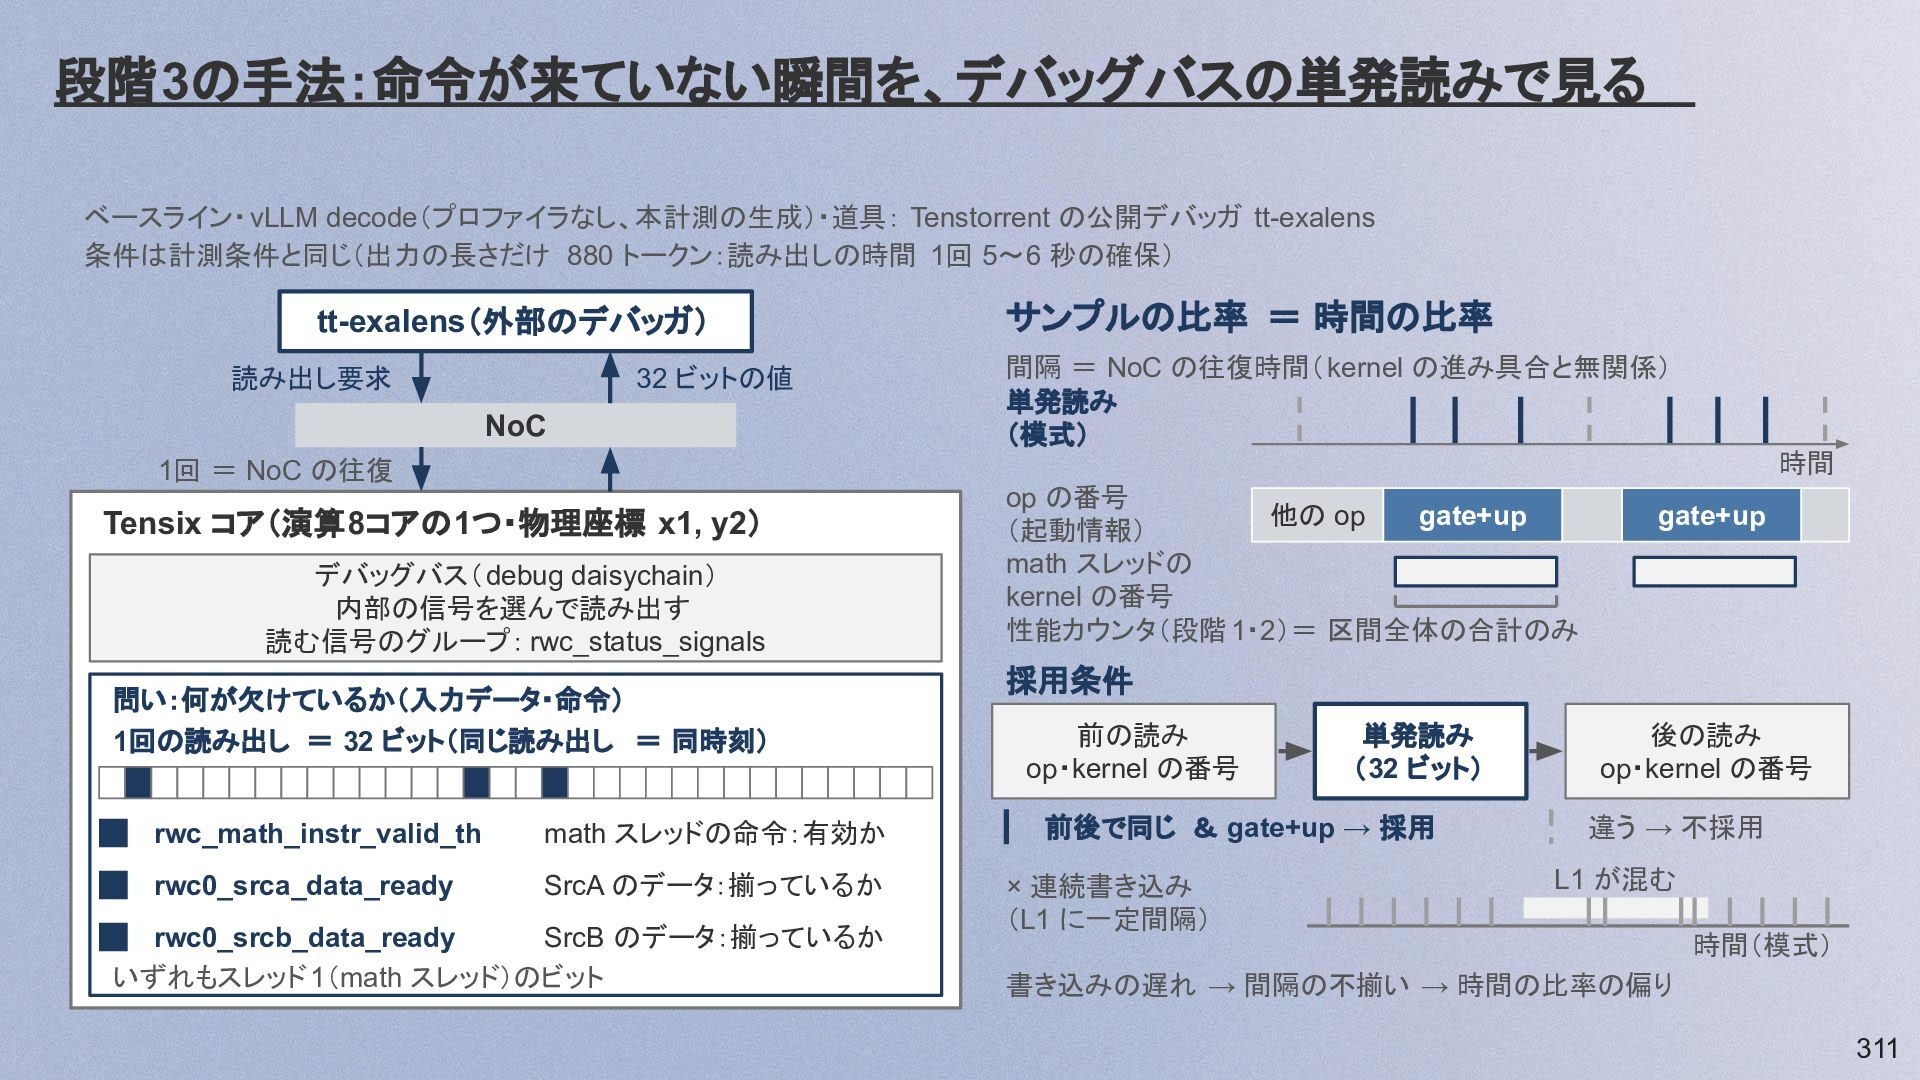
段階3の手法:命令が来ていない瞬間を、デバッグバスの単発読みで見る ベースライン・ vLLM decode(プロファイラなし、本計測の生成)・道具: Tenstorrent の公開デバッガ tt-exalens 条件は計測条件と同じ(出力の長さだけ 880 トークン:読み出しの時間
1回 5〜6 秒の確保) tt-exalens(外部のデバッガ) 読み出し要求 32 ビットの値 NoC サンプルの比率 = 時間の比率 間隔 = NoC の往復時間(kernel の進み具合と無関係) 単発読み (模式) 時間 1回 = NoC の往復 Tensix コア(演算8コアの1つ・物理座標 x1, y2) デバッグバス( debug daisychain) 内部の信号を選んで読み出す 読む信号のグループ: rwc_status_signals 問い:何が欠けているか(入力データ・命令) 1回の読み出し = 32 ビット(同じ読み出し = 同時刻) rwc_math_instr_valid_th math スレッドの命令:有効か rwc0_srca_data_ready SrcA のデータ:揃っているか rwc0_srcb_data_ready SrcB のデータ:揃っているか いずれもスレッド 1(math スレッド)のビット op の番号 他の op gate+up (起動情報) math スレッドの kernel の番号 性能カウンタ(段階 1・2)= 区間全体の合計のみ gate+up 採用条件 前の読み op・kernel の番号 単発読み (32 ビット) 前後で同じ & gate+up → 採用 × 連続書き込み (L1 に一定間隔) 後の読み op・kernel の番号 違う → 不採用 L1 が混む 時間(模式) 書き込みの遅れ → 間隔の不揃い → 時間の比率の偏り 311 -
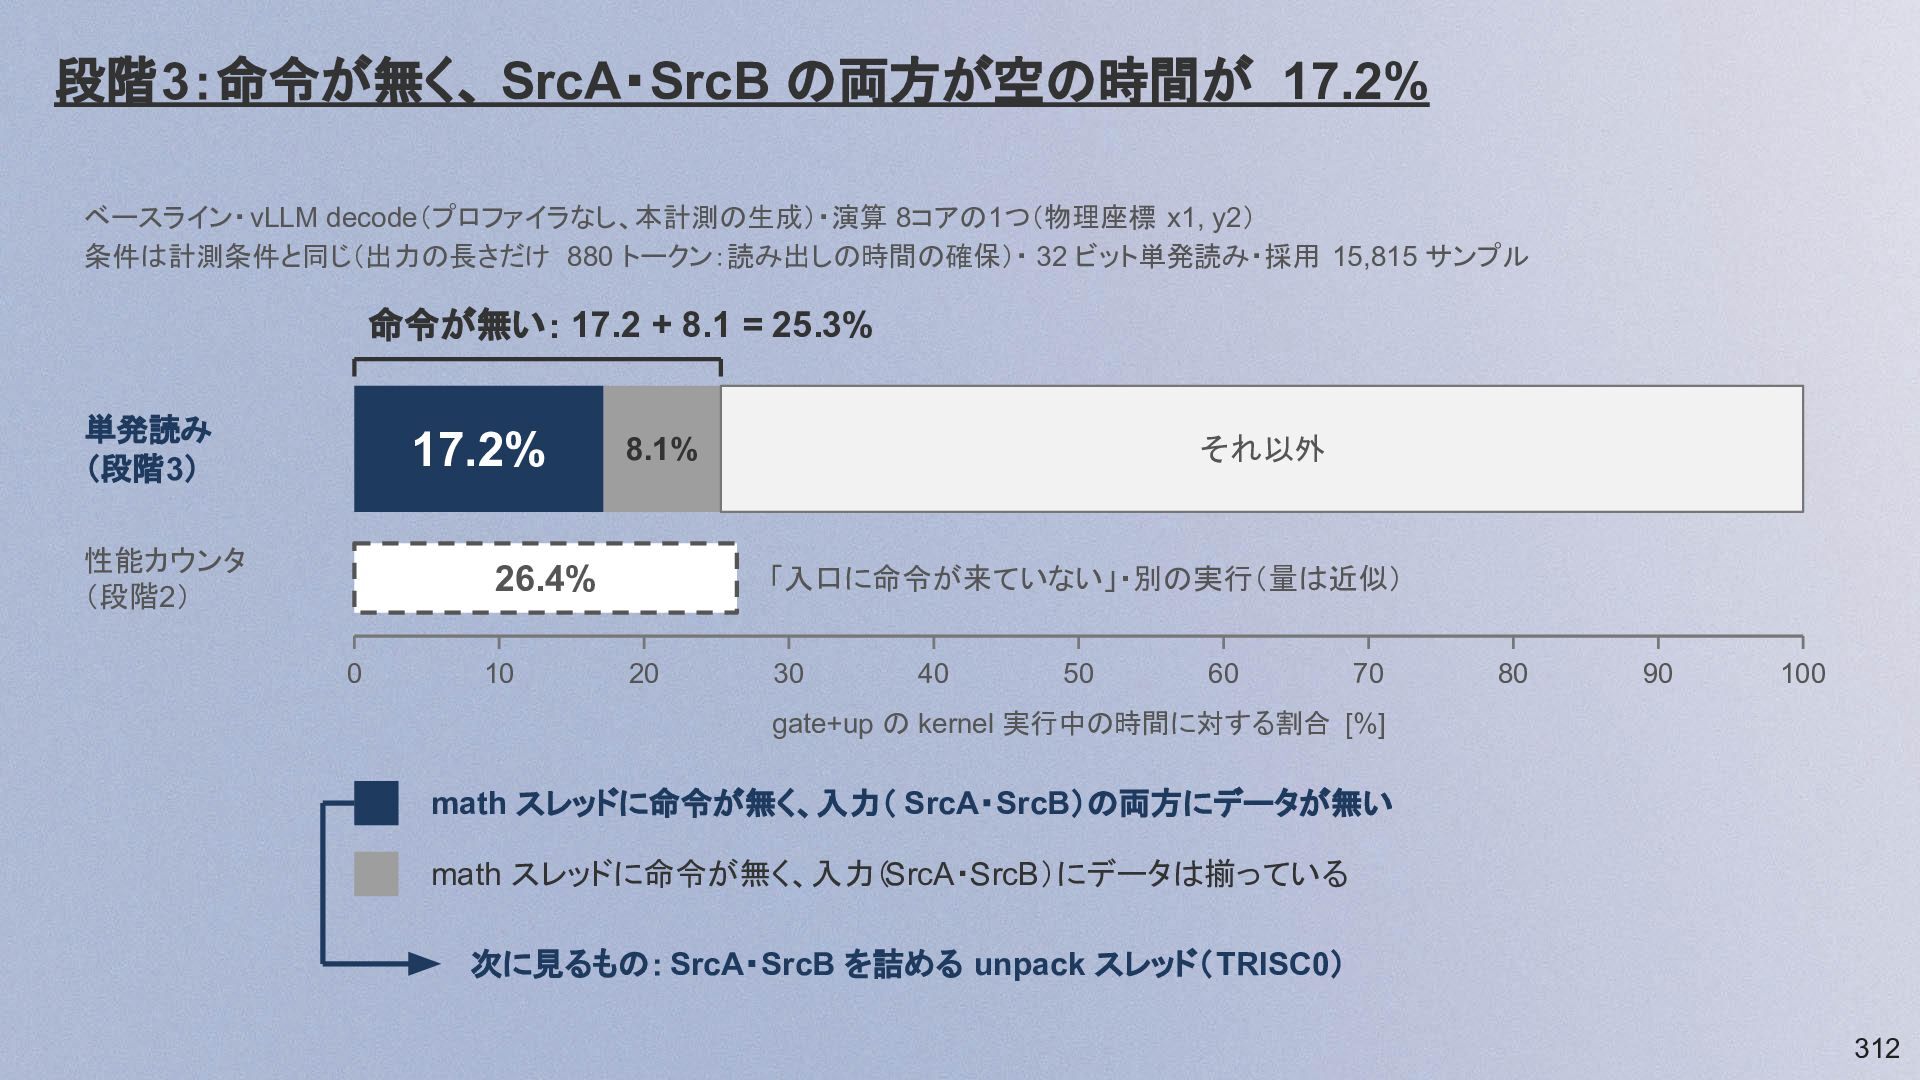
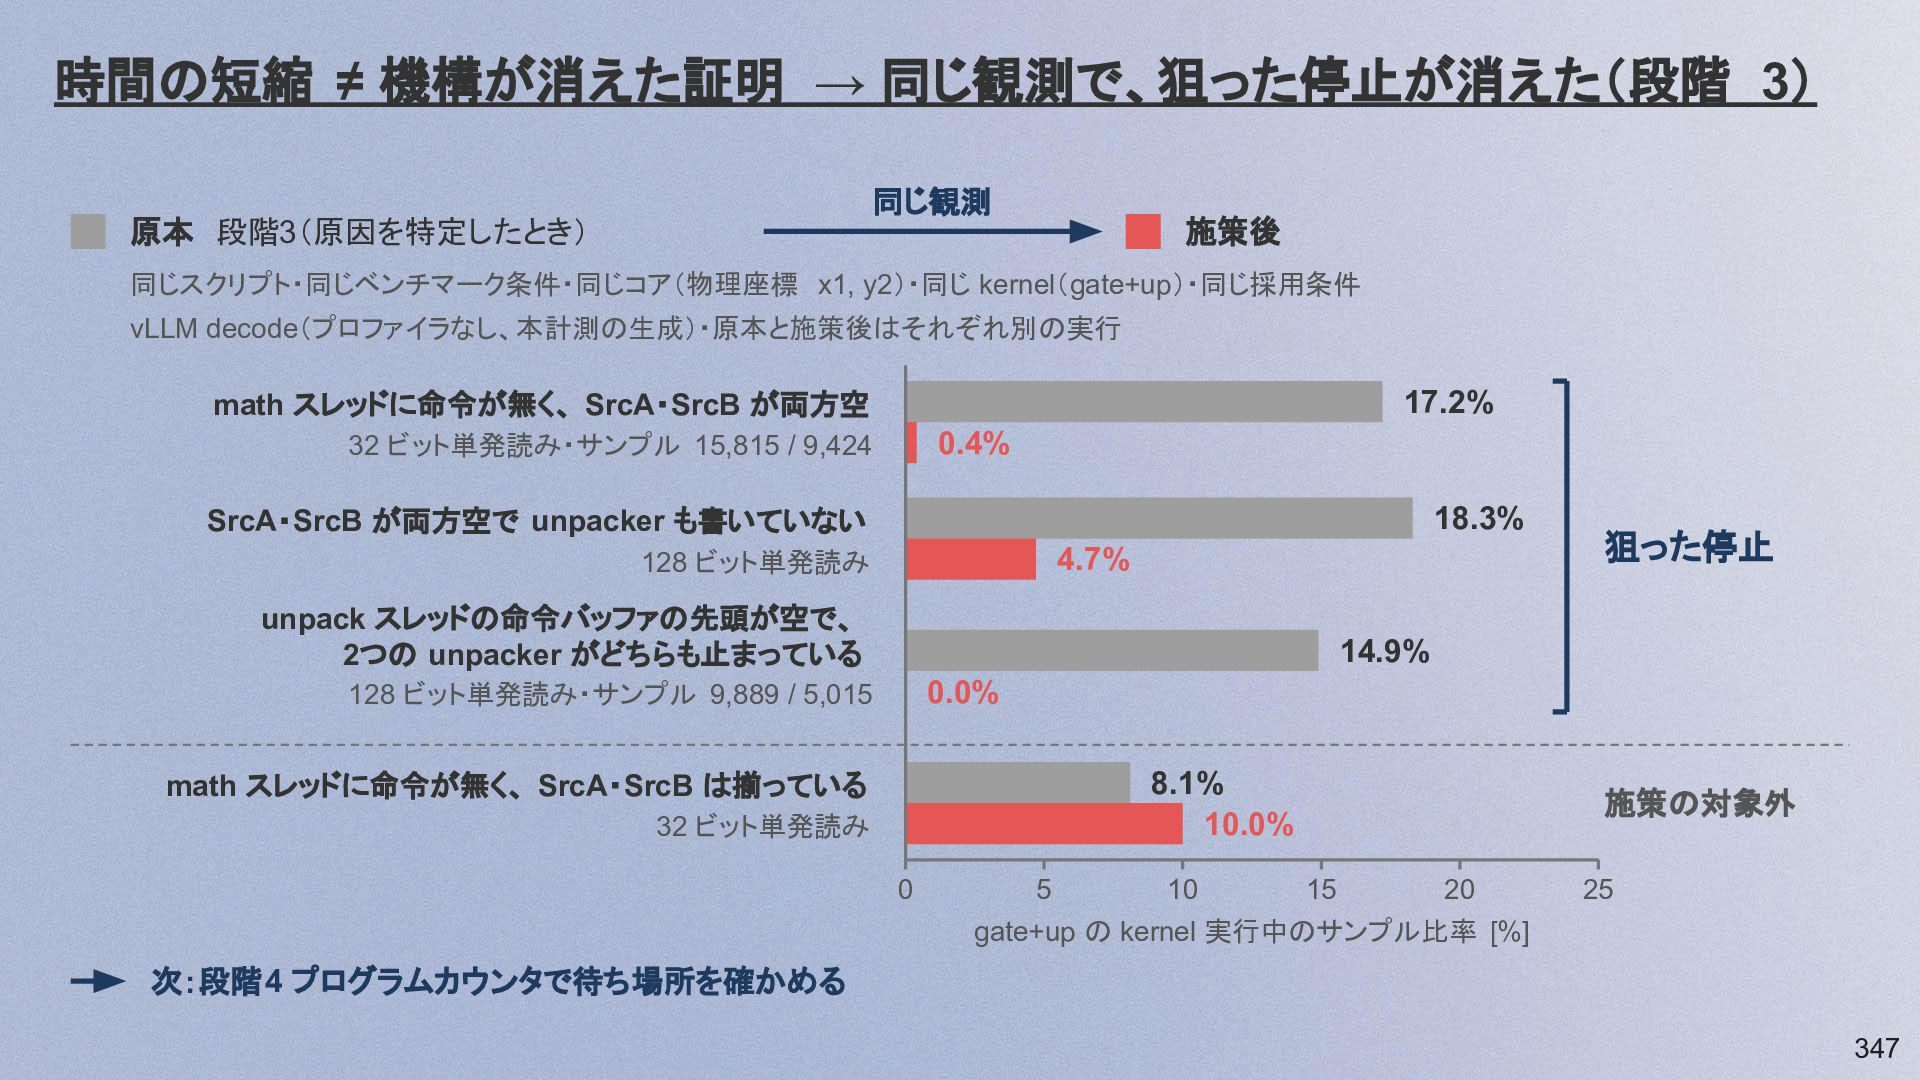
段階3:命令が無く、 SrcA・SrcB の両方が空の時間が 17.2% ベースライン・ vLLM decode(プロファイラなし、本計測の生成)・演算 8コアの1つ(物理座標 x1, y2)
条件は計測条件と同じ(出力の長さだけ 880 トークン:読み出しの時間の確保)・ 32 ビット単発読み・採用 15,815 サンプル 命令が無い: 17.2 + 8.1 = 25.3% 単発読み (段階3) 17.2% 性能カウンタ (段階2) 「入口に命令が来ていない」・別の実行(量は近似) 26.4% 0 10 それ以外 8.1% 20 30 40 50 60 70 80 90 100 gate+up の kernel 実行中の時間に対する割合 [%] math スレッドに命令が無く、入力( SrcA・SrcB)の両方にデータが無い math スレッドに命令が無く、入力(SrcA・SrcB)にデータは揃っている 次に見るもの: SrcA・SrcB を詰める unpack スレッド(TRISC0) 312 -
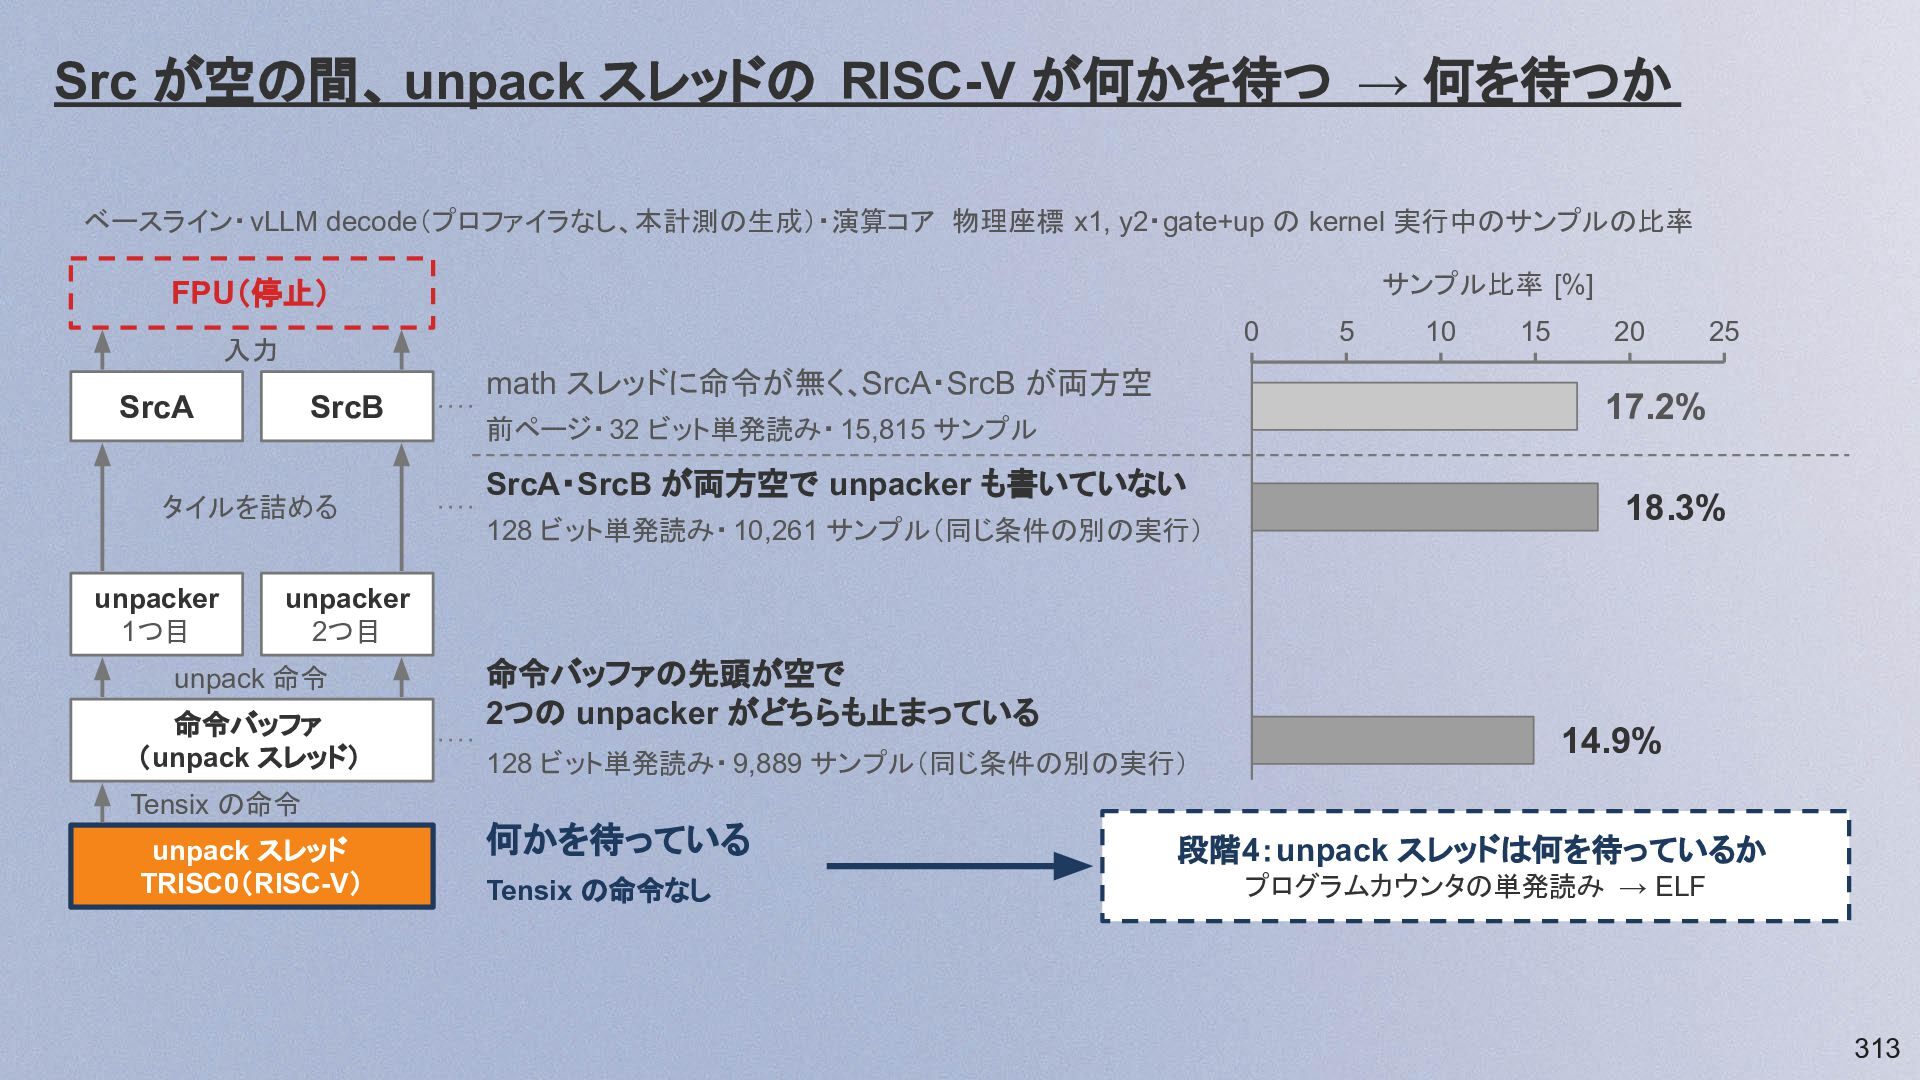
Src が空の間、 unpack スレッドの RISC-V が何かを待つ → 何を待つか ベースライン・ vLLM
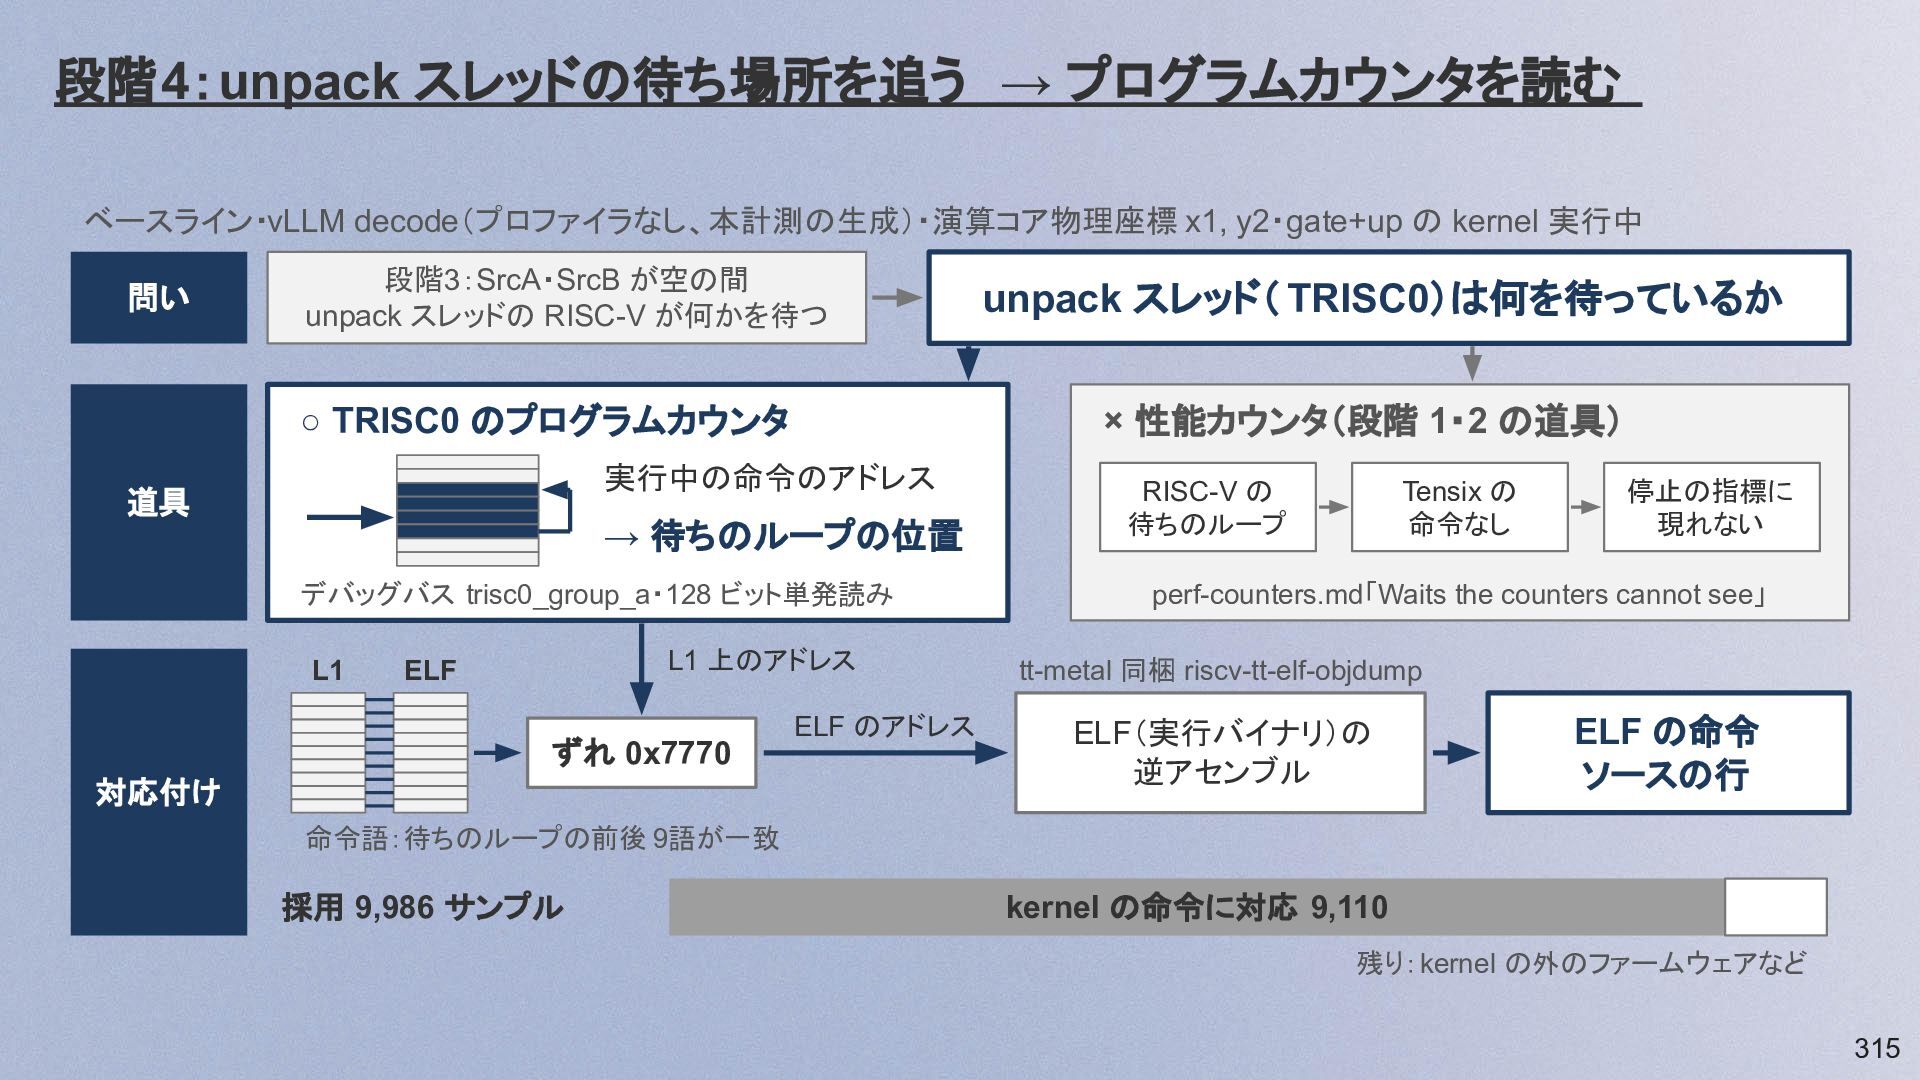
decode(プロファイラなし、本計測の生成)・演算コア 物理座標 x1, y2・gate+up の kernel 実行中のサンプルの比率 サンプル比率 [%] FPU(停止) 0 入力 SrcA SrcB タイルを詰める unpacker 1つ目 math スレッドに命令が無く、SrcA・SrcB が両方空 5 10 15 20 25 17.2% 前ページ・32 ビット単発読み・ 15,815 サンプル SrcA・SrcB が両方空で unpacker も書いていない 128 ビット単発読み・ 10,261 サンプル(同じ条件の別の実行) 18.3% unpacker 2つ目 unpack 命令 命令バッファ (unpack スレッド) 命令バッファの先頭が空で 2つの unpacker がどちらも止まっている 128 ビット単発読み・ 9,889 サンプル(同じ条件の別の実行) 14.9% Tensix の命令 unpack スレッド TRISC0(RISC-V) 何かを待っている Tensix の命令なし 段階4:unpack スレッドは何を待っているか プログラムカウンタの単発読み → ELF 313 -
段階4:unpack スレッドの待ち場所を追う → プログラムカウンタを読む ベースライン・vLLM decode(プロファイラなし、本計測の生成)・演算コア物理座標 x1, y2・gate+up の kernel
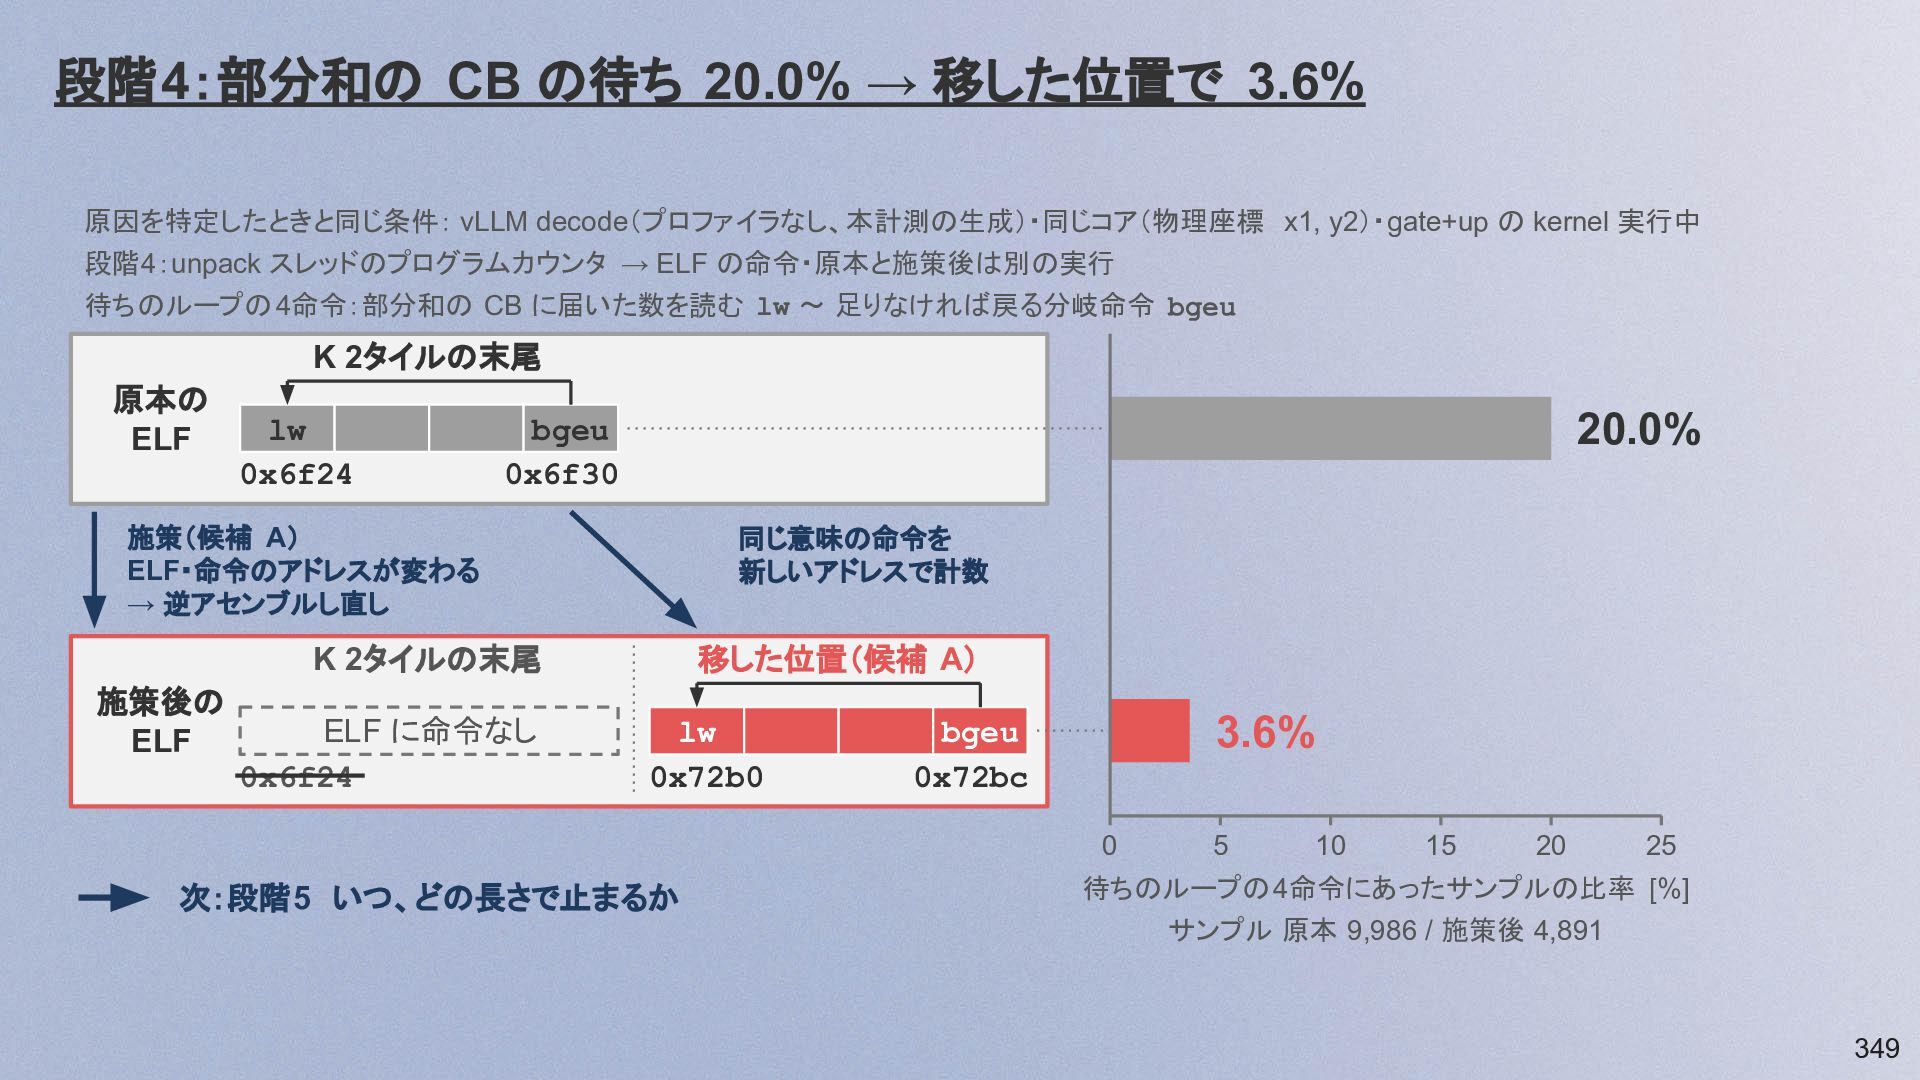
実行中 問い 段階3:SrcA・SrcB が空の間 unpack スレッドの RISC-V が何かを待つ ◦ TRISC0 のプログラムカウンタ × 性能カウンタ(段階 1・2 の道具) 実行中の命令のアドレス 道具 → 待ちのループの位置 デバッグバス trisc0_group_a・128 ビット単発読み L1 L1 上のアドレス ELF ずれ 0x7770 対応付け unpack スレッド( TRISC0)は何を待っているか ELF のアドレス RISC-V の 待ちのループ Tensix の 命令なし 停止の指標に 現れない perf-counters.md「Waits the counters cannot see」 tt-metal 同梱 riscv-tt-elf-objdump ELF(実行バイナリ)の 逆アセンブル ELF の命令 ソースの行 命令語:待ちのループの前後 9語が一致 採用 9,986 サンプル kernel の命令に対応 9,110 残り:kernel の外のファームウェアなど 315 -
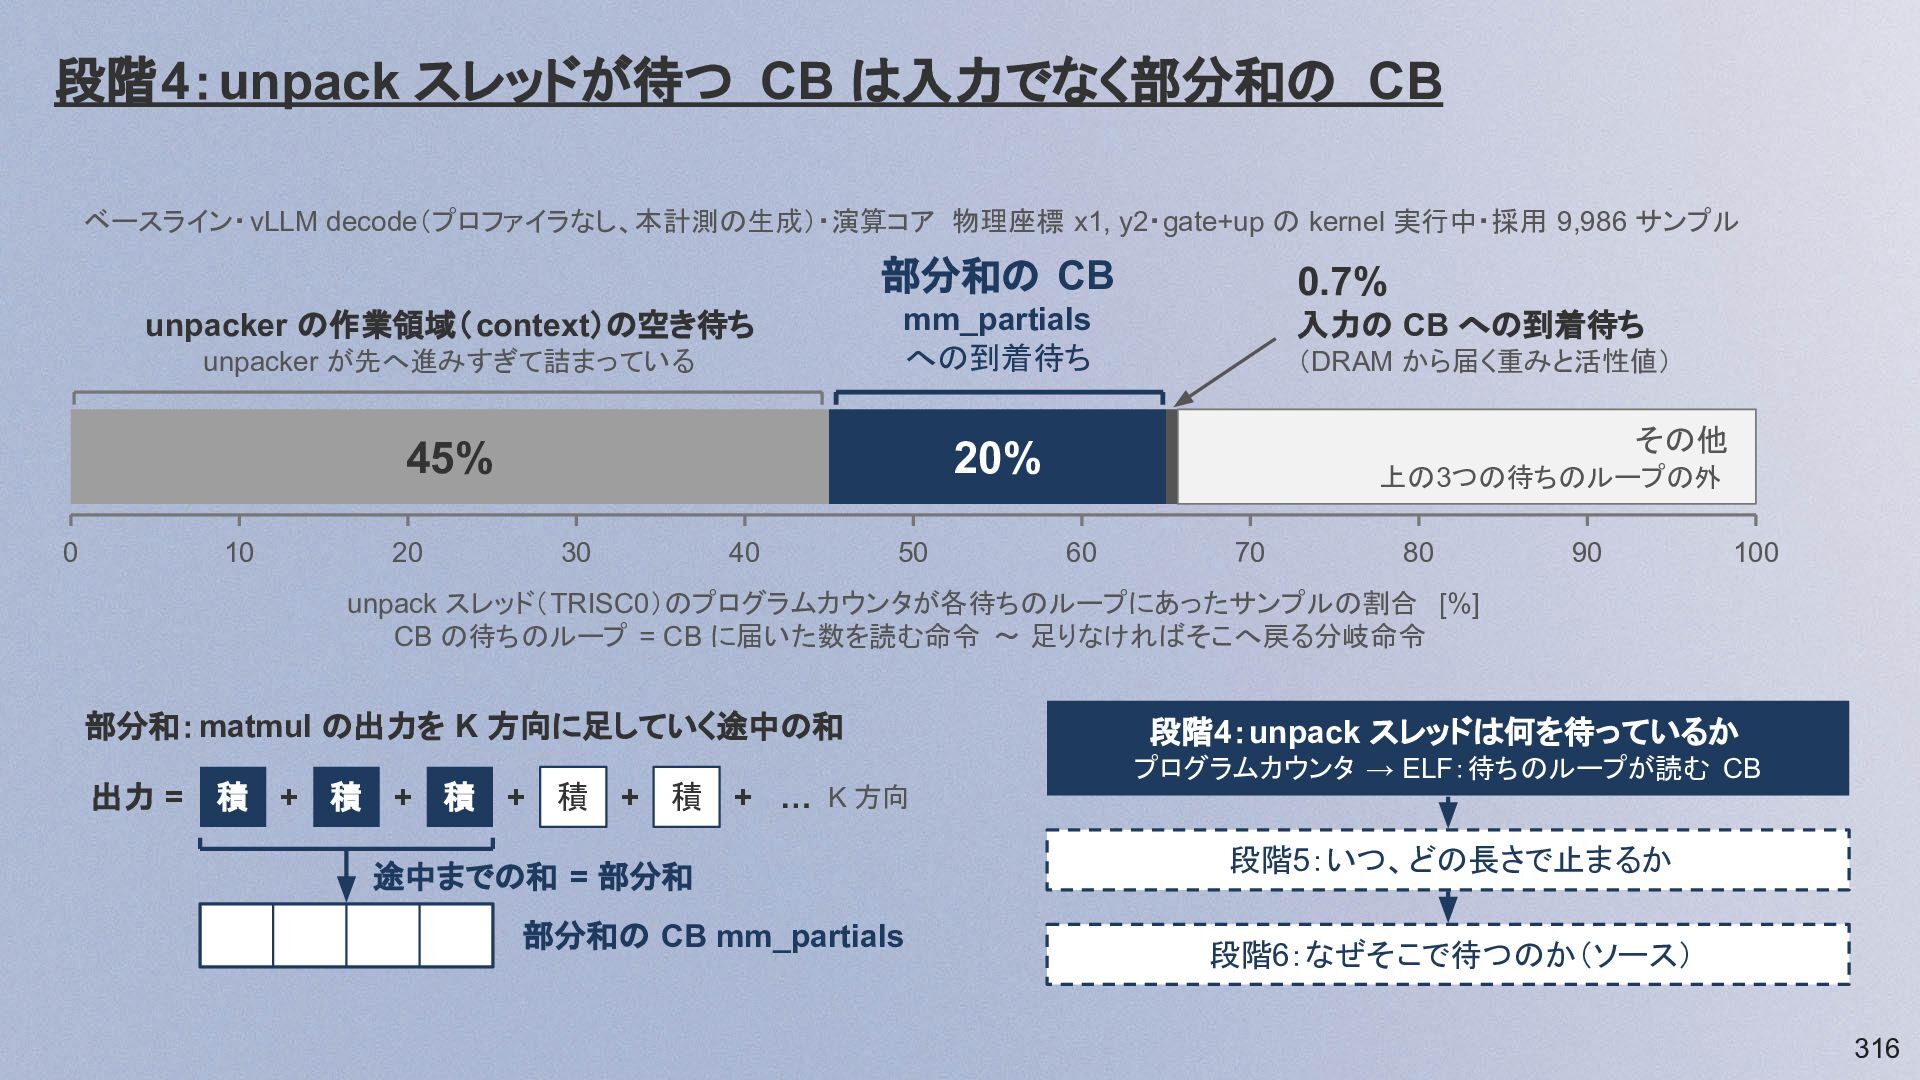
段階4:unpack スレッドが待つ CB は入力でなく部分和の CB ベースライン・ vLLM decode(プロファイラなし、本計測の生成)・演算コア 物理座標 x1,
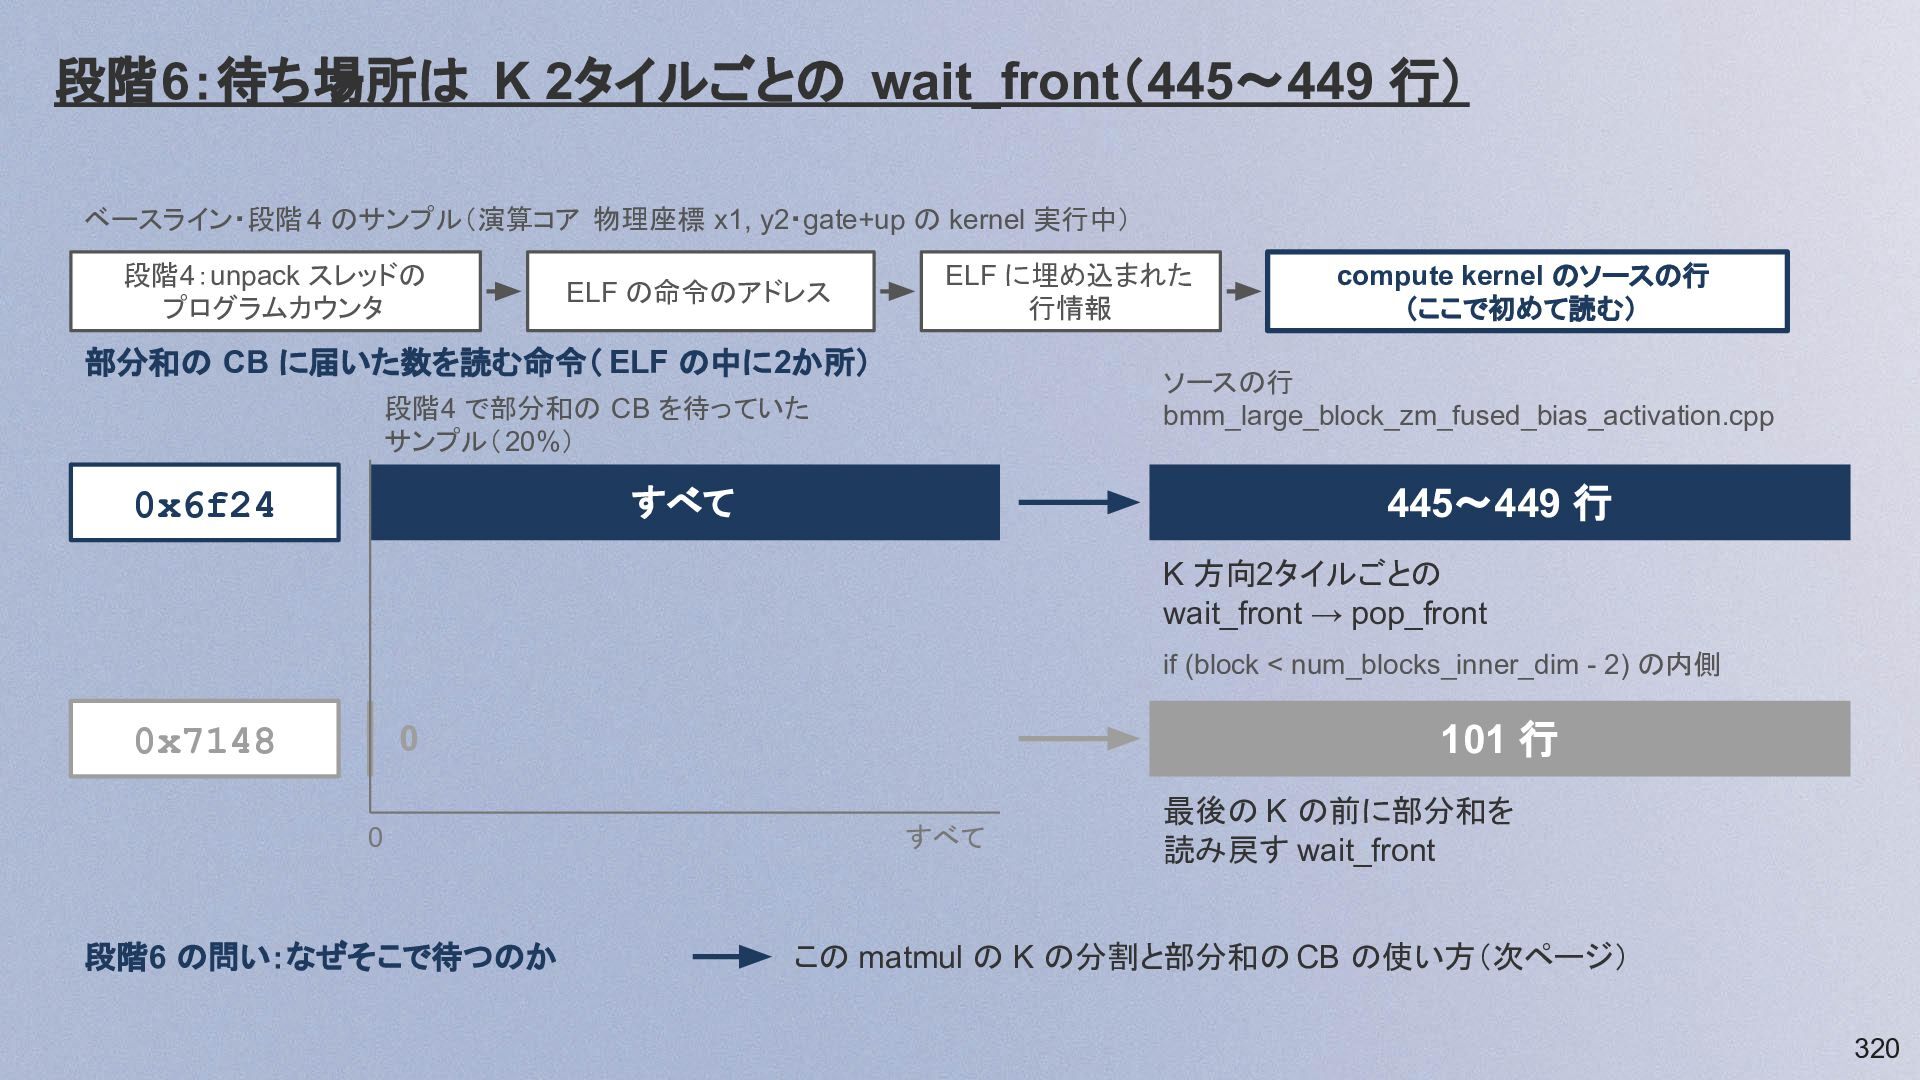
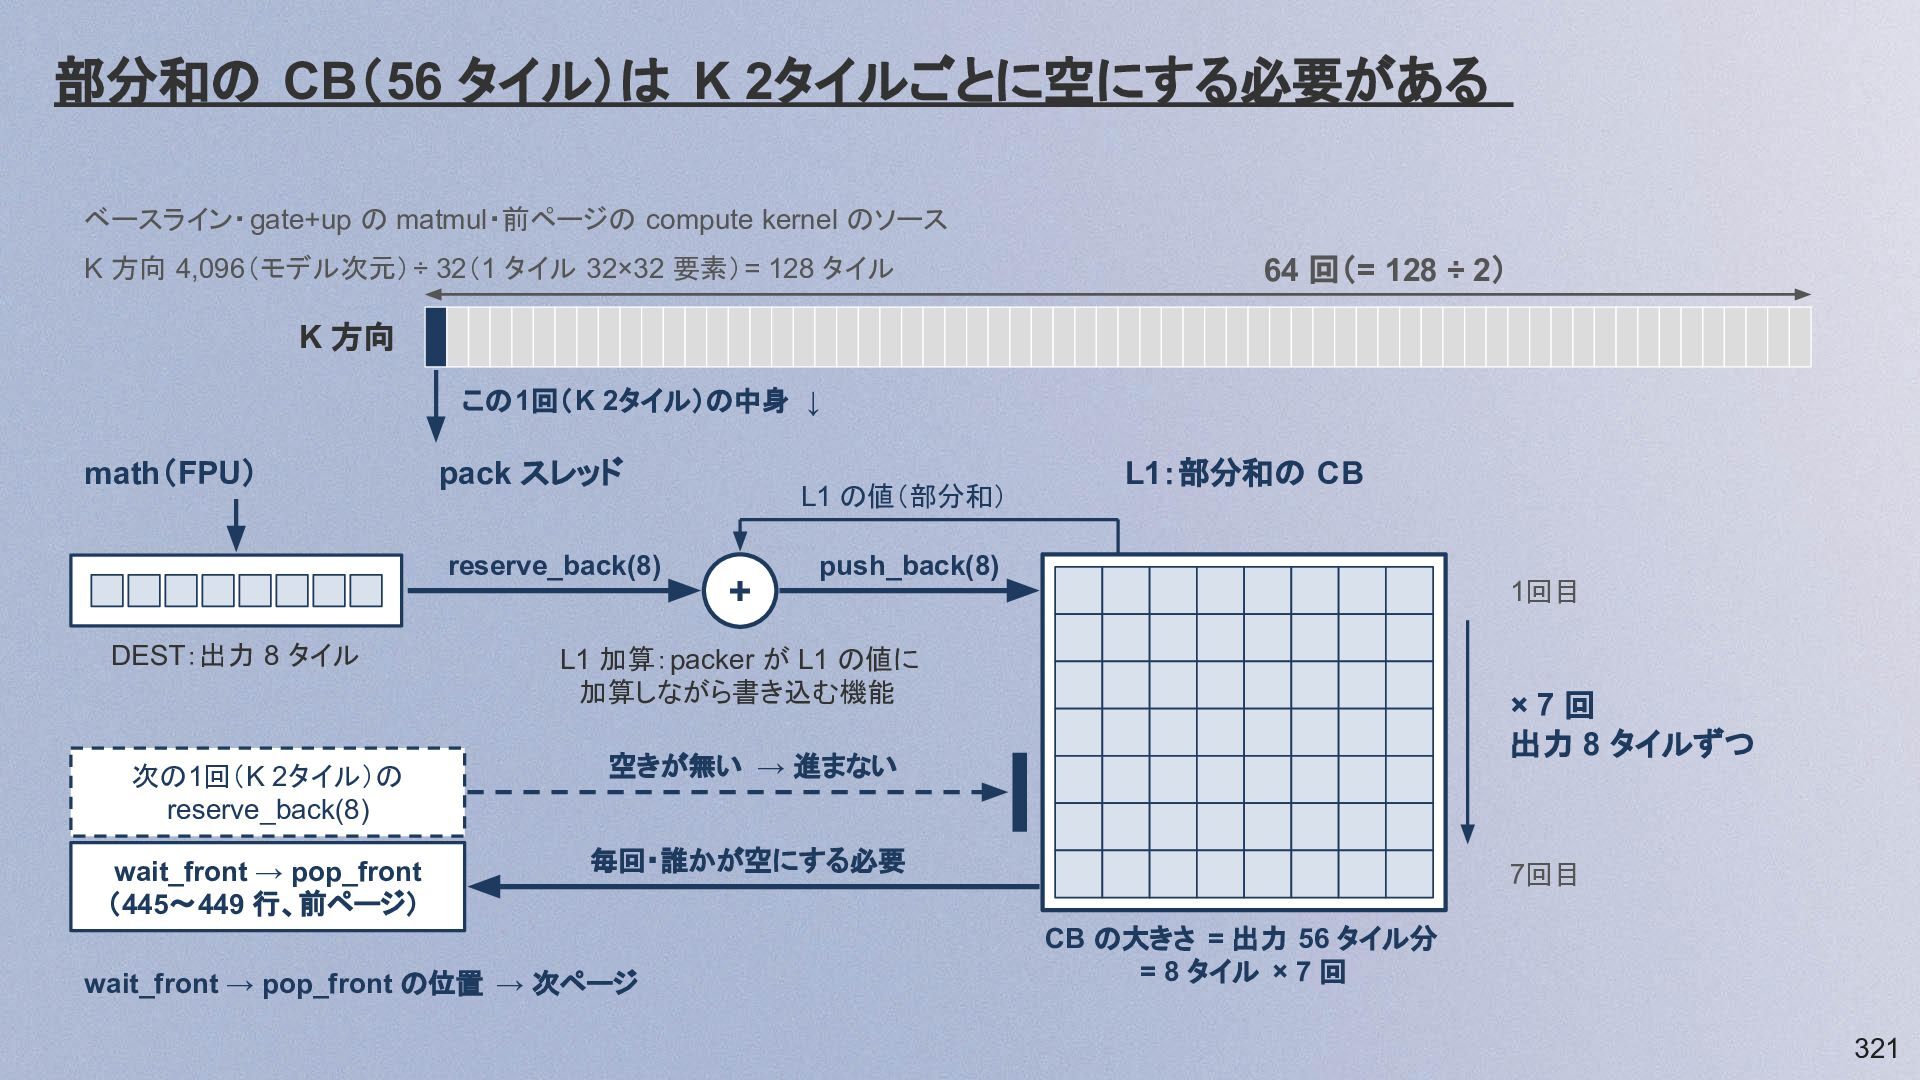
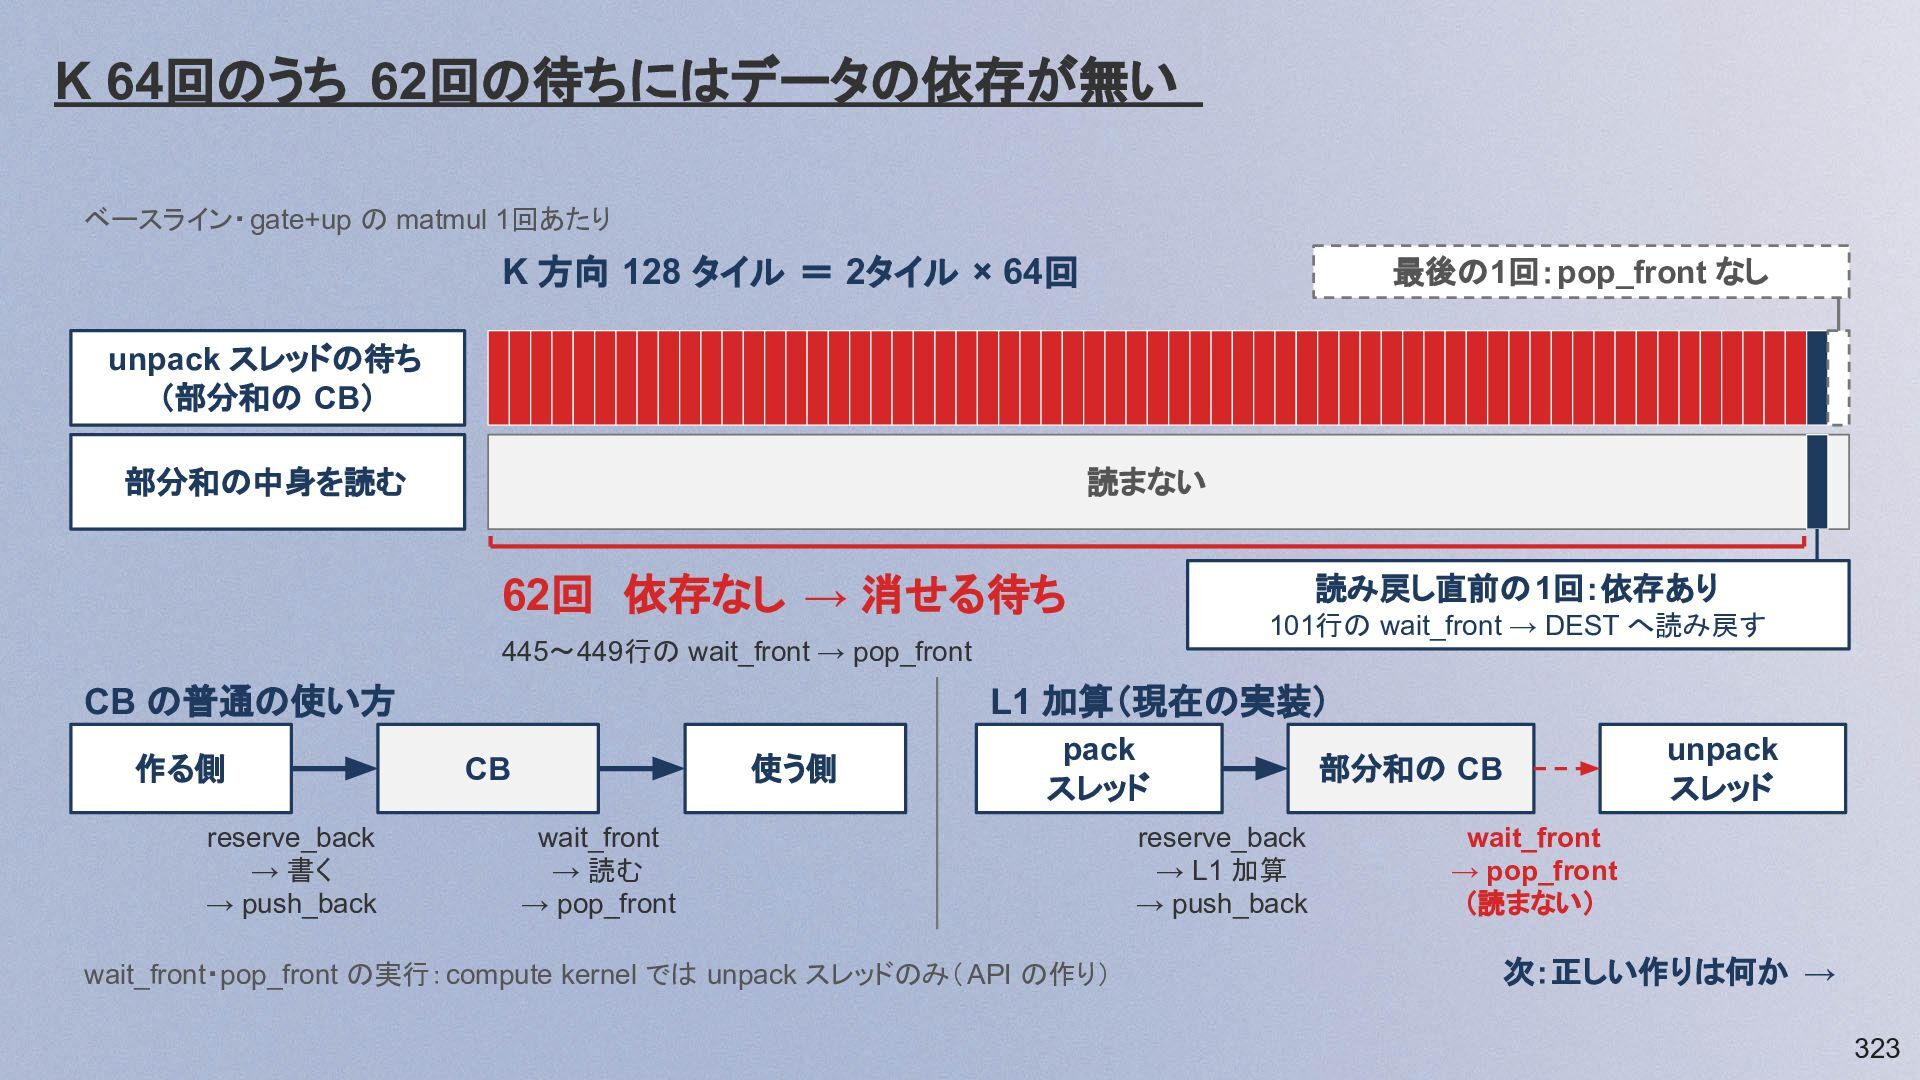
y2・gate+up の kernel 実行中・採用 9,986 サンプル 部分和の CB unpacker が先へ進みすぎて詰まっている mm_partials への到着待ち 45% 20% unpacker の作業領域(context)の空き待ち 0 10 20 30 40 50 0.7% 入力の CB への到着待ち (DRAM から届く重みと活性値) その他 上の3つの待ちのループの外 60 70 80 90 100 unpack スレッド(TRISC0)のプログラムカウンタが各待ちのループにあったサンプルの割合 [%] CB の待ちのループ = CB に届いた数を読む命令 〜 足りなければそこへ戻る分岐命令 部分和:matmul の出力を K 方向に足していく途中の和 出力 = 積 + 積 + 積 + 積 + 積 + … K 方向 途中までの和 = 部分和 部分和の CB mm_partials 段階4:unpack スレッドは何を待っているか プログラムカウンタ → ELF:待ちのループが読む CB 段階5:いつ、どの長さで止まるか 段階6:なぜそこで待つのか(ソース) 316 -
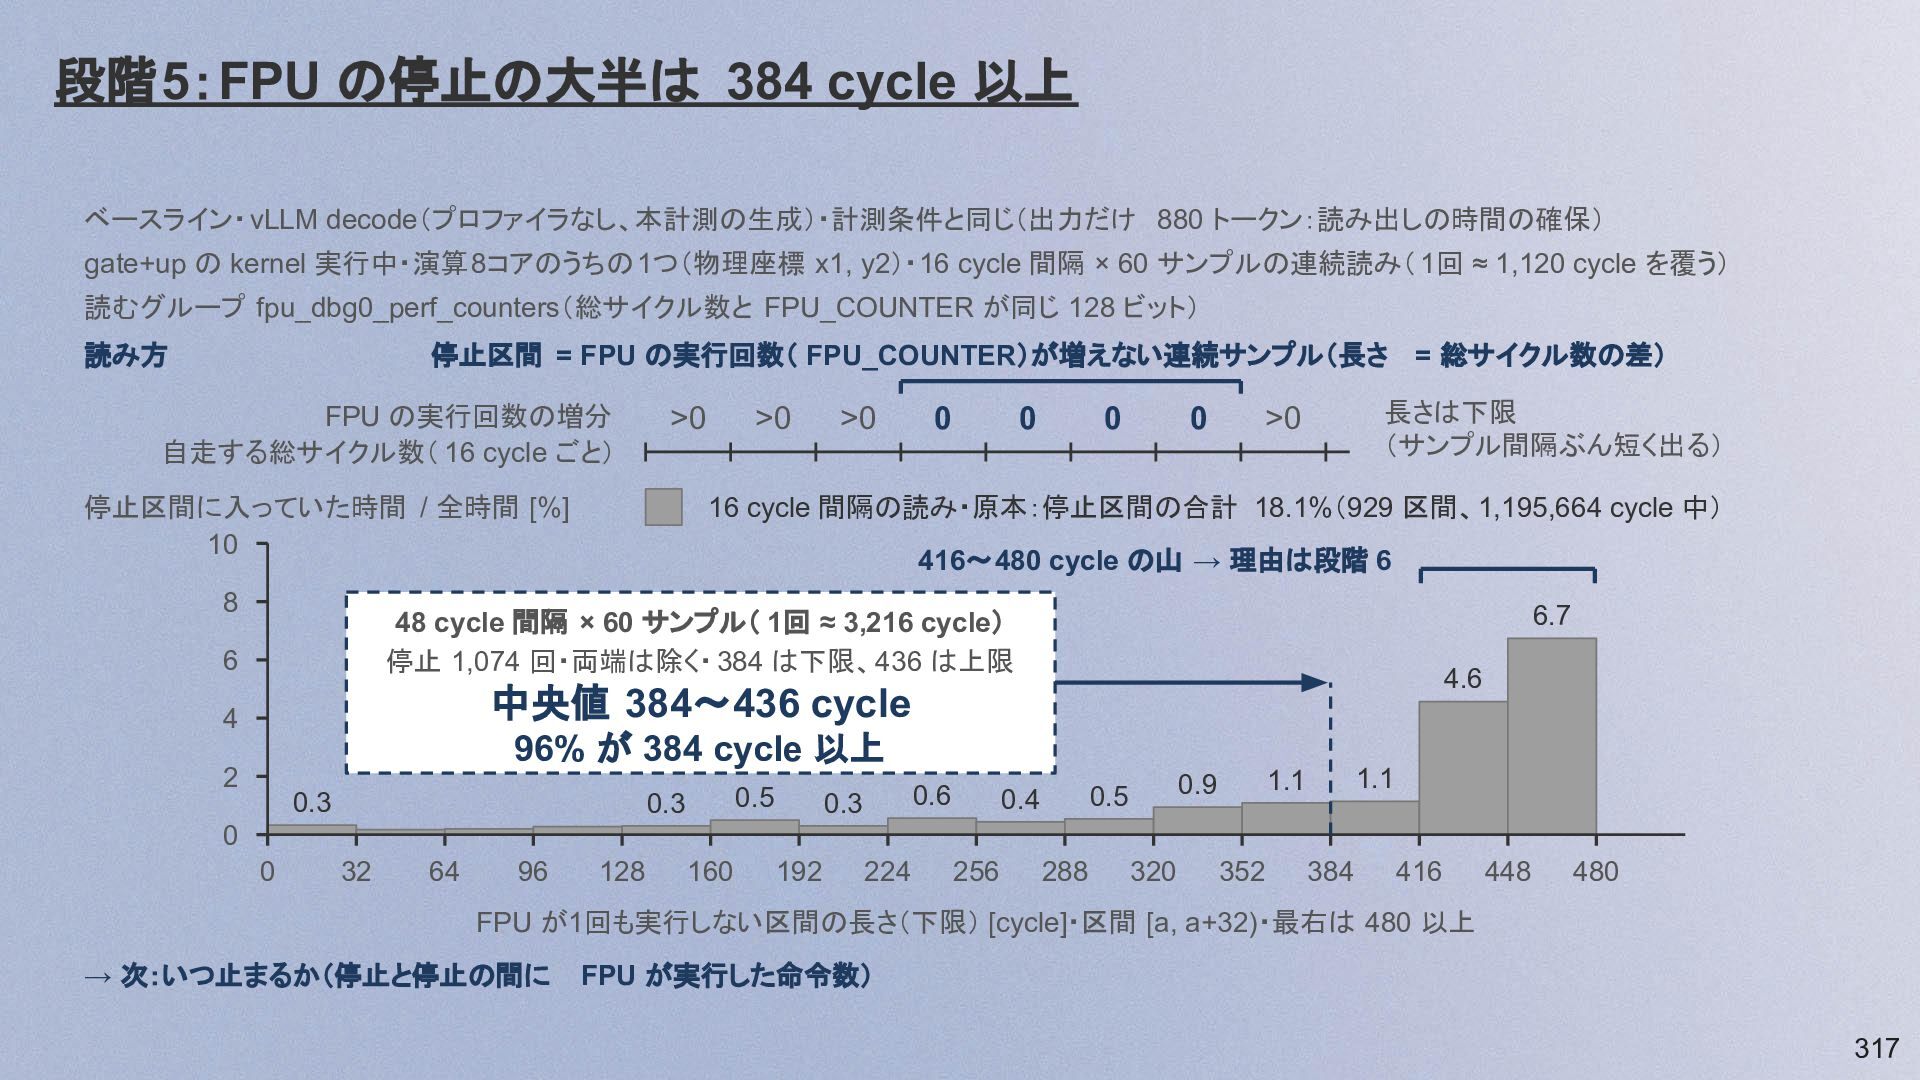
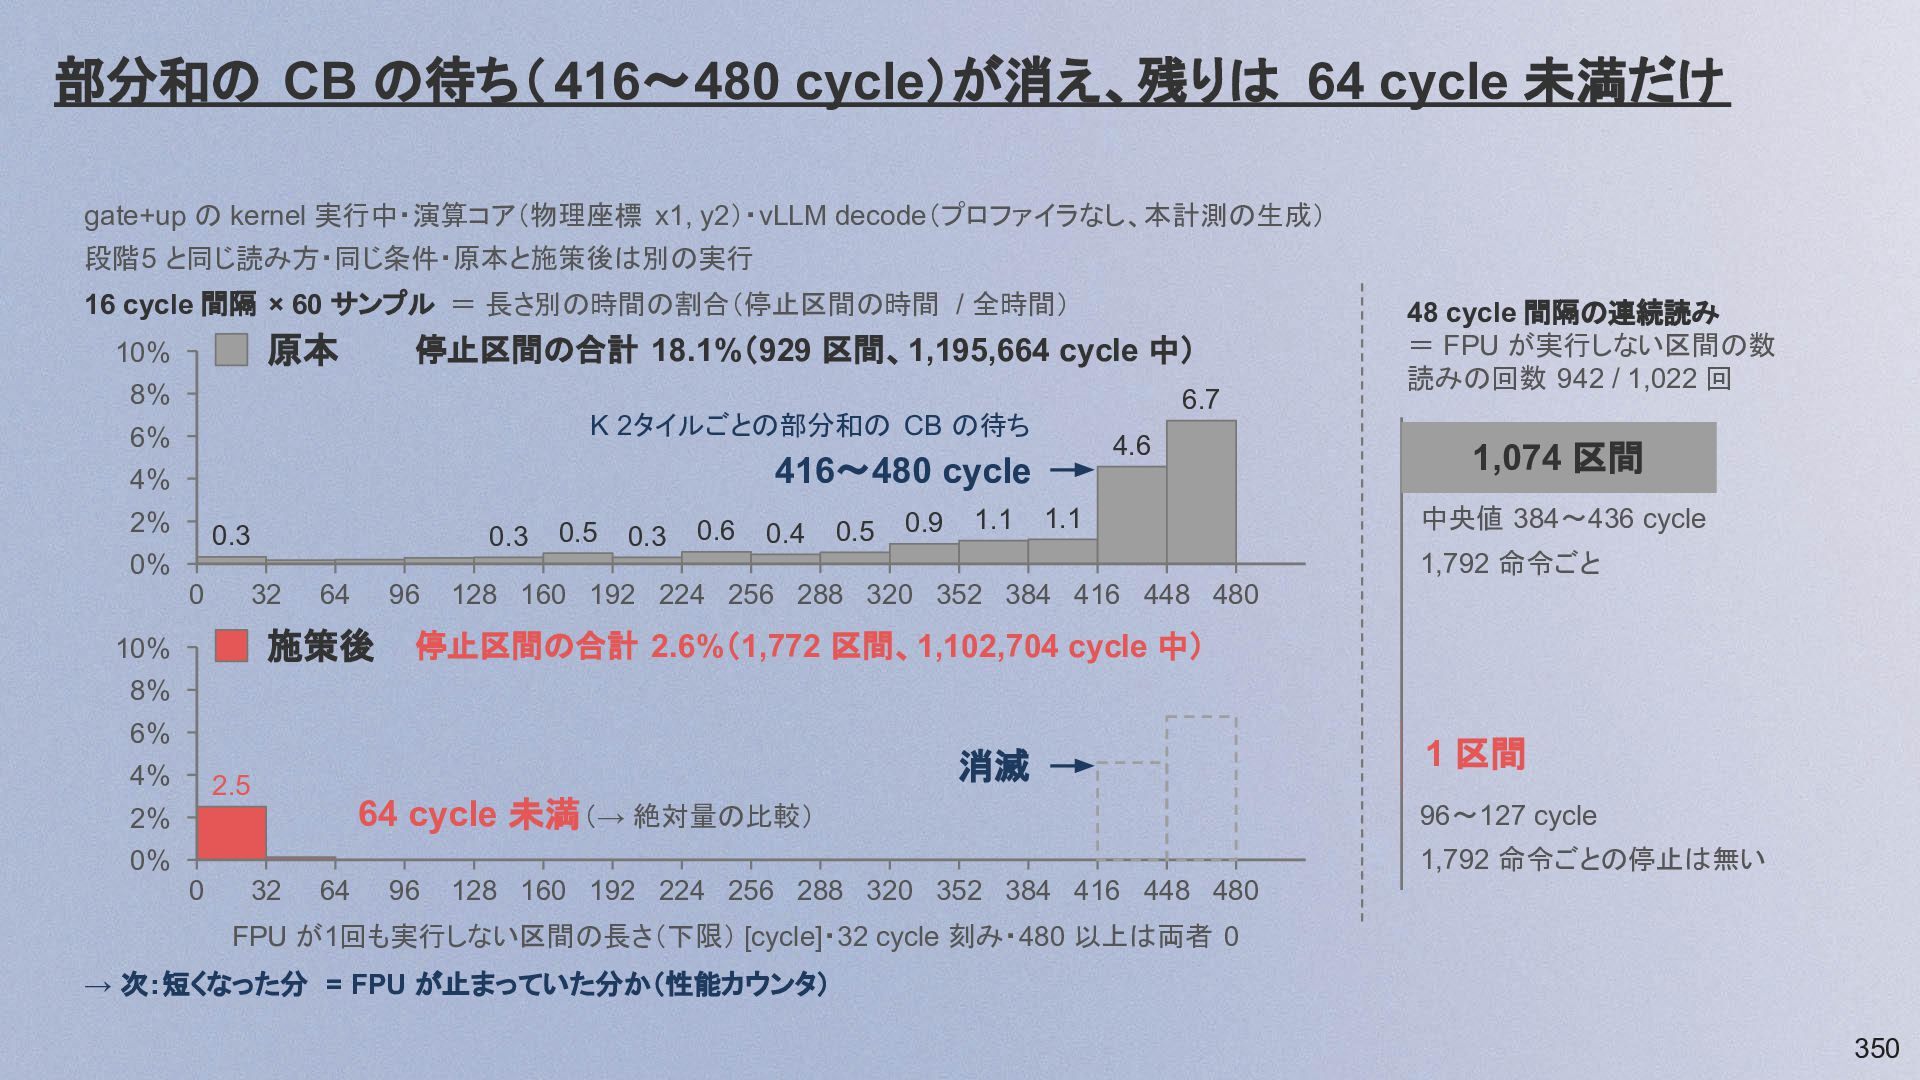
段階5:FPU の停止の大半は 384 cycle 以上 ベースライン・ vLLM decode(プロファイラなし、本計測の生成)・計測条件と同じ(出力だけ 880 トークン:読み出しの時間の確保)
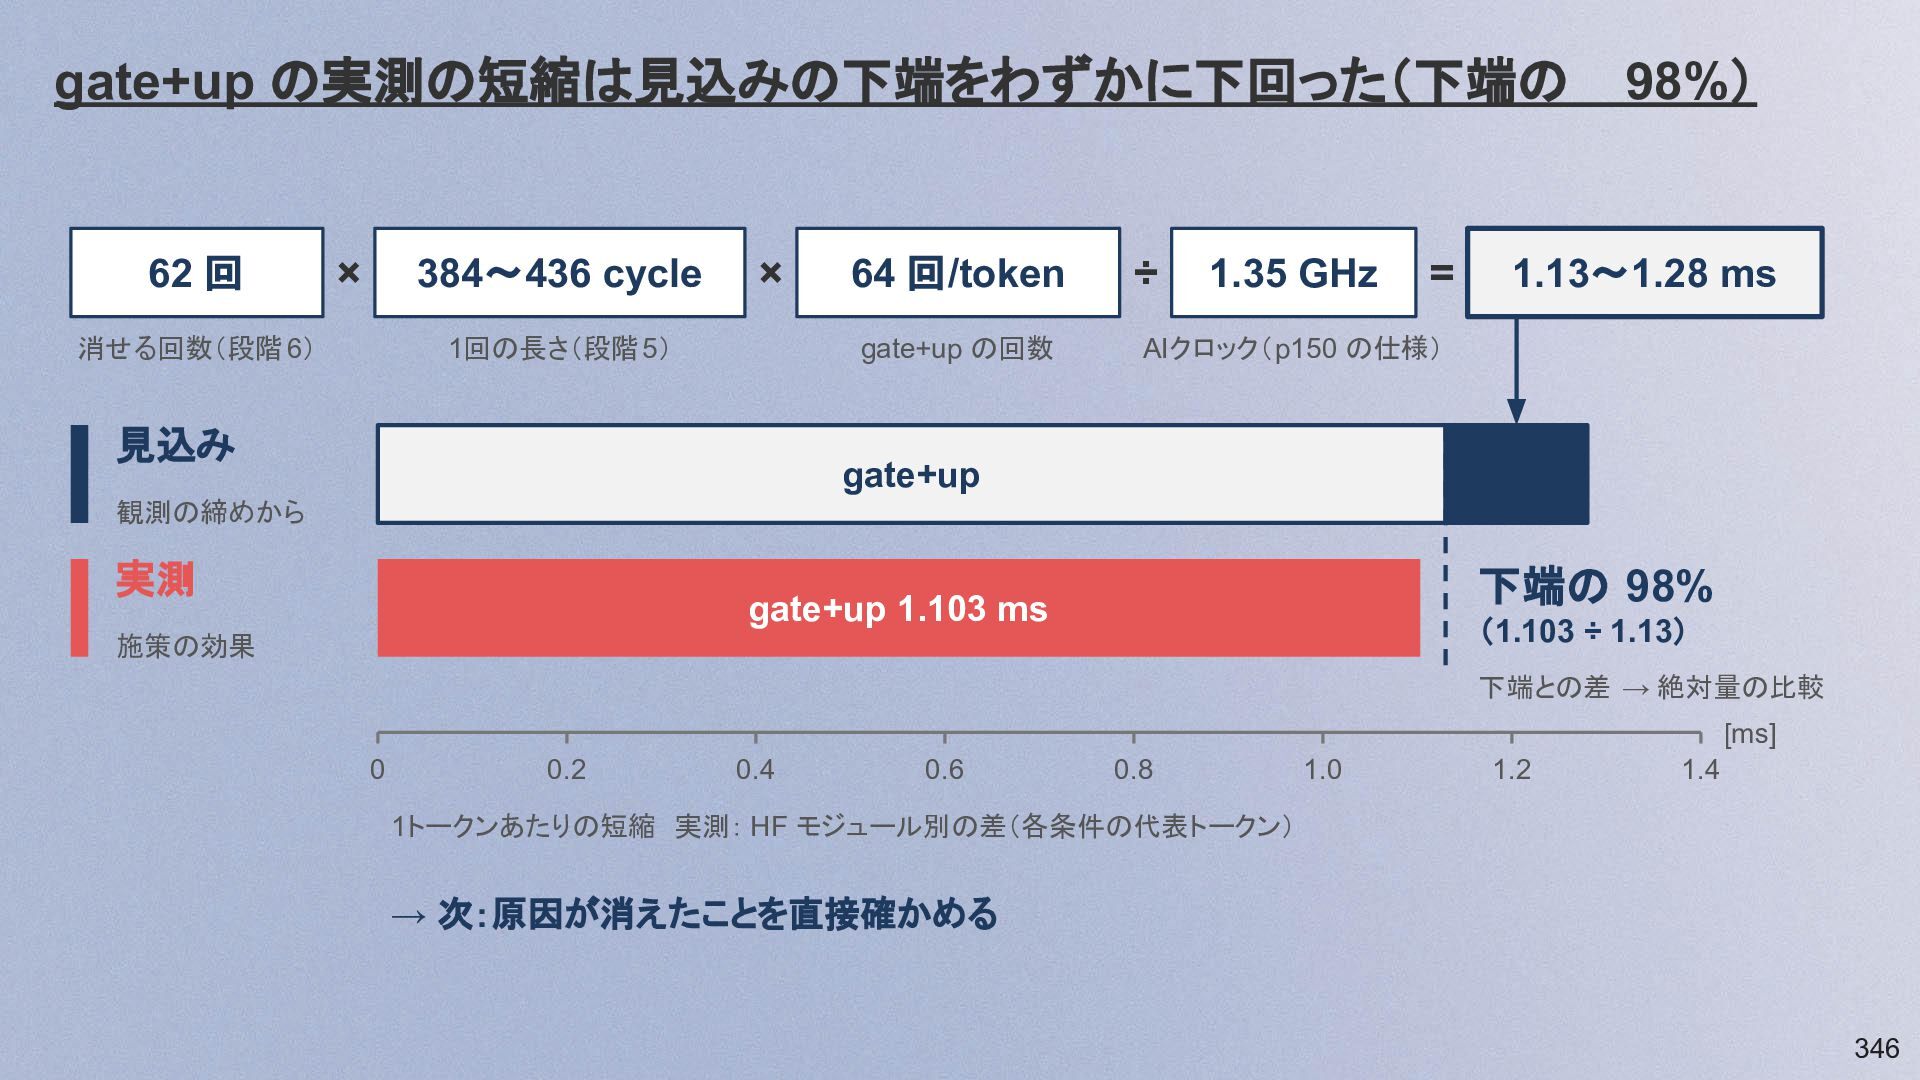
gate+up の kernel 実行中・演算8コアのうちの1つ(物理座標 x1, y2)・16 cycle 間隔 × 60 サンプルの連続読み( 1回 ≈ 1,120 cycle を覆う) 読むグループ fpu_dbg0_perf_counters(総サイクル数と FPU_COUNTER が同じ 128 ビット) 読み方 停止区間 = FPU の実行回数( FPU_COUNTER)が増えない連続サンプル(長さ = 総サイクル数の差) FPU の実行回数の増分 自走する総サイクル数( 16 cycle ごと) >0 停止区間に入っていた時間 / 全時間 [%] 10 8 >0 >0 0 0 0 0 長さは下限 (サンプル間隔ぶん短く出る) >0 16 cycle 間隔の読み・原本:停止区間の合計 18.1%(929 区間、1,195,664 cycle 中) 416〜480 cycle の山 → 理由は段階 6 6 48 cycle 間隔 × 60 サンプル( 1回 ≈ 3,216 cycle) 停止 1,074 回・両端は除く・ 384 は下限、436 は上限 4 中央値 384〜436 cycle 6.7 4.6 96% が 384 cycle 以上 2 0.3 0.5 0.3 0.6 0.3 1.1 1.1 0.9 0.5 0.4 0 0 32 64 96 128 160 192 224 256 288 320 352 384 416 448 480 FPU が1回も実行しない区間の長さ(下限) [cycle]・区間 [a, a+32)・最右は 480 以上 → 次:いつ止まるか(停止と停止の間に FPU が実行した命令数) 317 -
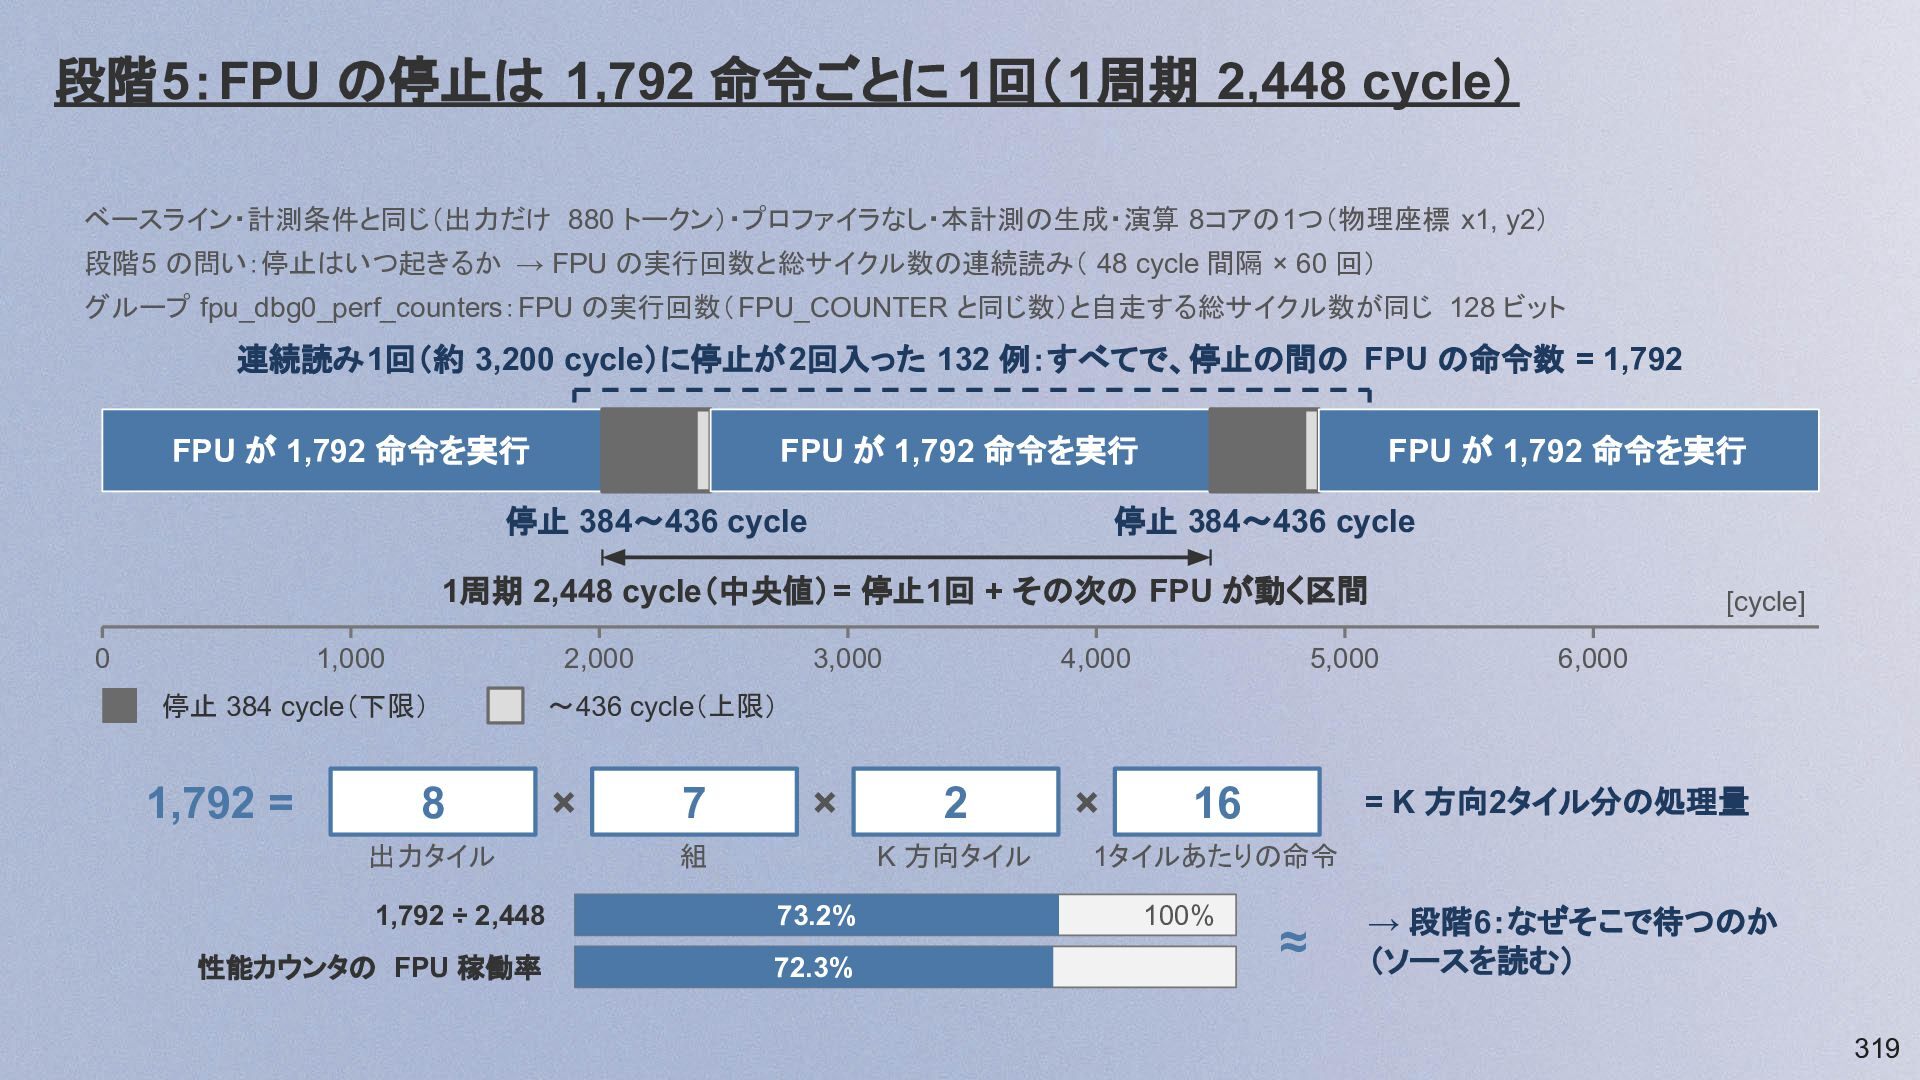
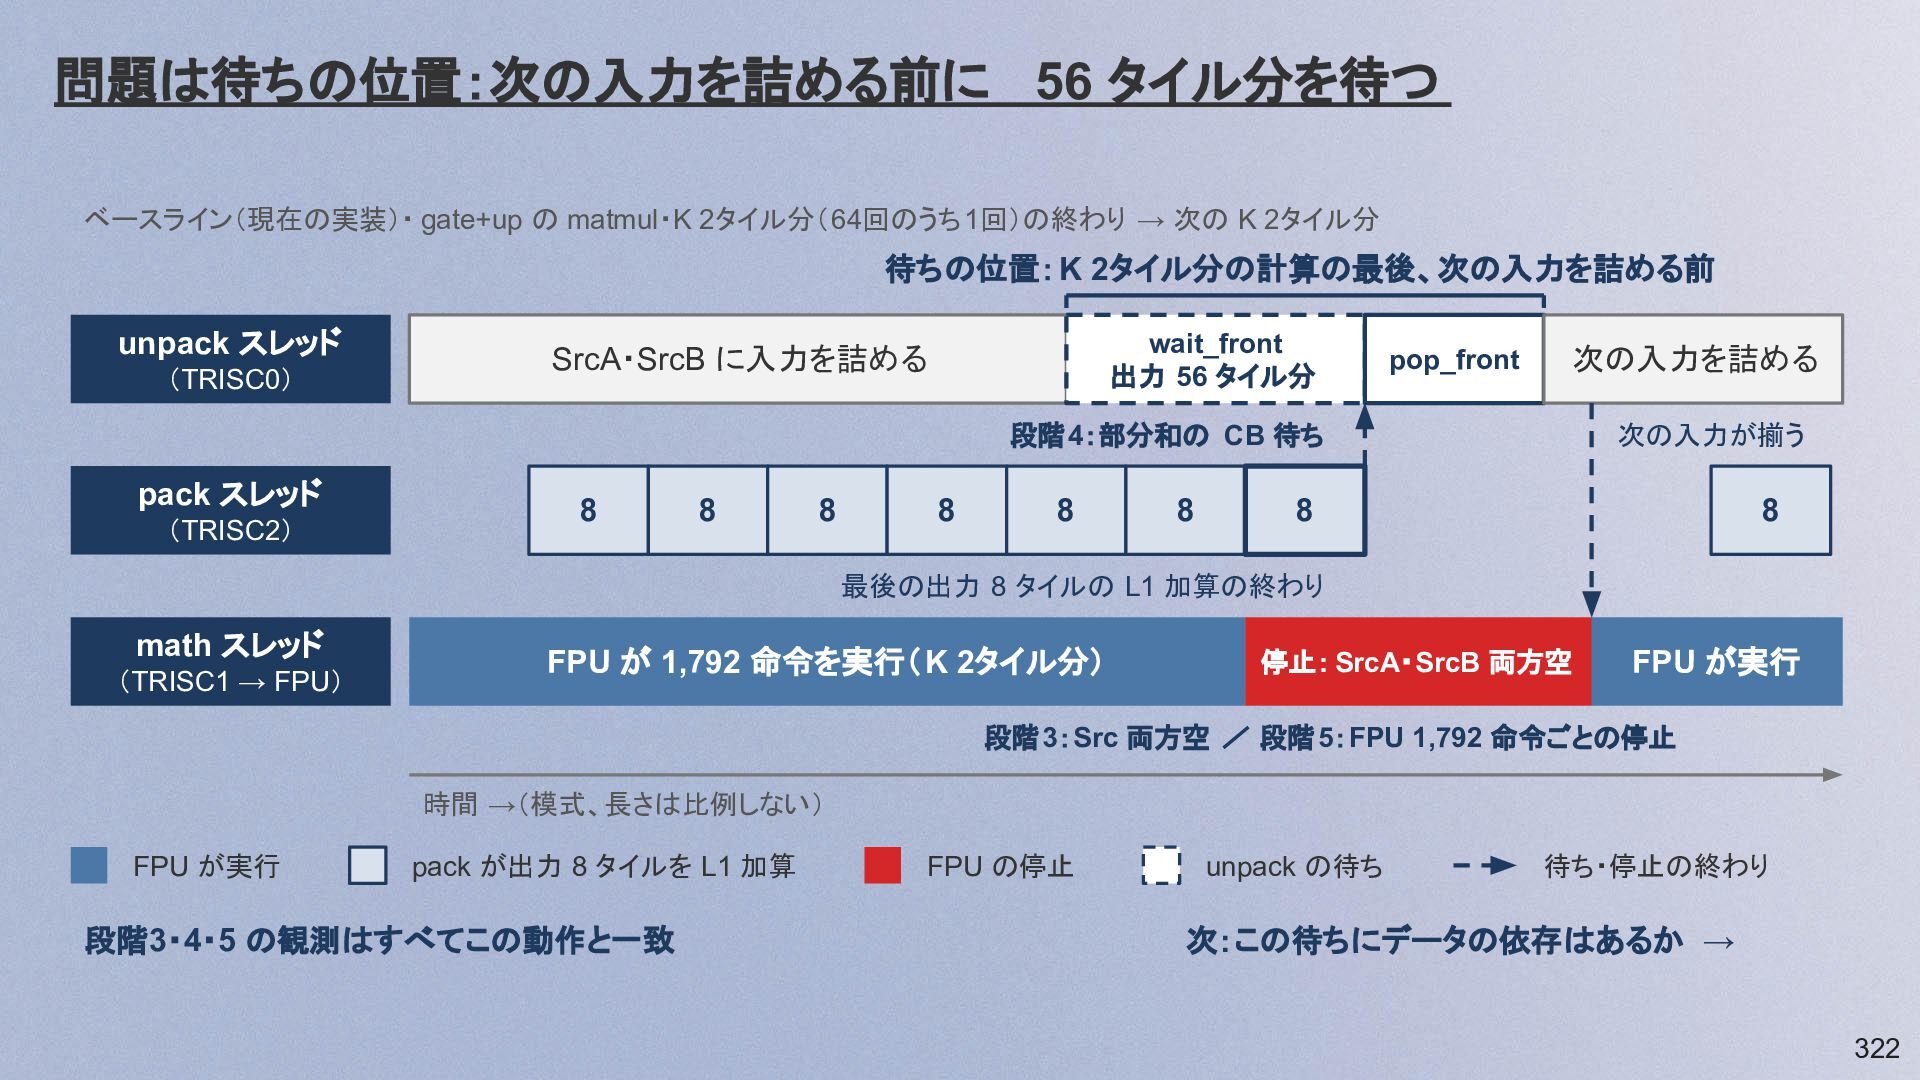
段階5:FPU の停止は 1,792 命令ごとに 1回(1周期 2,448 cycle) ベースライン・計測条件と同じ(出力だけ 880 トークン)・プロファイラなし・本計測の生成・演算
8コアの1つ(物理座標 x1, y2) 段階5 の問い:停止はいつ起きるか → FPU の実行回数と総サイクル数の連続読み( 48 cycle 間隔 × 60 回) グループ fpu_dbg0_perf_counters:FPU の実行回数(FPU_COUNTER と同じ数)と自走する総サイクル数が同じ 128 ビット 連続読み1回(約 3,200 cycle)に停止が2回入った 132 例:すべてで、停止の間の FPU の命令数 = 1,792 FPU が 1,792 命令を実行 FPU が 1,792 命令を実行 停止 384〜436 cycle FPU が 1,792 命令を実行 停止 384〜436 cycle 1周期 2,448 cycle(中央値)= 停止1回 + その次の FPU が動く区間 0 1,000 2,000 3,000 停止 384 cycle(下限) 〜436 cycle(上限) 1,792 = × 8 出力タイル 7 × 組 4,000 2 K 方向タイル 1,792 ÷ 2,448 73.2% 性能カウンタの FPU 稼働率 72.3% × 5,000 [cycle] 6,000 = K 方向2タイル分の処理量 16 1タイルあたりの命令 100% ≈ → 段階6:なぜそこで待つのか (ソースを読む) 319 -
段階6:待ち場所は K 2タイルごとの wait_front(445〜449 行) ベースライン・段階 4 のサンプル(演算コア 物理座標 x1,
y2・gate+up の kernel 実行中) 段階4:unpack スレッドの プログラムカウンタ ELF の命令のアドレス ELF に埋め込まれた 行情報 部分和の CB に届いた数を読む命令( ELF の中に2か所) ソースの行 bmm_large_block_zm_fused_bias_activation.cpp 段階4 で部分和の CB を待っていた サンプル(20%) 445〜449 行 すべて 0x6f24 compute kernel のソースの行 (ここで初めて読む) K 方向2タイルごとの wait_front → pop_front if (block < num_blocks_inner_dim - 2) の内側 101 行 0 0x7148 0 段階6 の問い:なぜそこで待つのか すべて 最後の K の前に部分和を 読み戻す wait_front この matmul の K の分割と部分和の CB の使い方(次ページ) 320 -
部分和の CB(56 タイル)は K 2タイルごとに空にする必要がある ベースライン・ gate+up の matmul・前ページの compute
kernel のソース K 方向 4,096(モデル次元) ÷ 32(1 タイル 32×32 要素)= 128 タイル 64 回(= 128 ÷ 2) K 方向 この1回(K 2タイル)の中身 ↓ math(FPU) pack スレッド reserve_back(8) DEST:出力 8 タイル L1 の値(部分和) + L1:部分和の CB push_back(8) 1回目 L1 加算:packer が L1 の値に 加算しながら書き込む機能 次の1回(K 2タイル)の reserve_back(8) 空きが無い → 進まない wait_front → pop_front (445〜449 行、前ページ) 毎回・誰かが空にする必要 wait_front → pop_front の位置 → 次ページ ×7回 出力 8 タイルずつ 7回目 CB の大きさ = 出力 56 タイル分 = 8 タイル × 7 回 321 -
問題は待ちの位置:次の入力を詰める前に 56 タイル分を待つ ベースライン(現在の実装)・ gate+up の matmul・K 2タイル分(64回のうち1回)の終わり → 次の
K 2タイル分 待ちの位置: K 2タイル分の計算の最後、次の入力を詰める前 unpack スレッド (TRISC0) wait_front 出力 56 タイル分 SrcA・SrcB に入力を詰める pop_front 次の入力を詰める 段階4:部分和の CB 待ち pack スレッド (TRISC2) 8 8 8 8 8 8 次の入力が揃う 8 8 最後の出力 8 タイルの L1 加算の終わり math スレッド (TRISC1 → FPU) FPU が 1,792 命令を実行( K 2タイル分) 停止: SrcA・SrcB 両方空 FPU が実行 段階3:Src 両方空 / 段階5:FPU 1,792 命令ごとの停止 時間 →(模式、長さは比例しない) FPU が実行 pack が出力 8 タイルを L1 加算 段階3・4・5 の観測はすべてこの動作と一致 FPU の停止 unpack の待ち 待ち・停止の終わり 次:この待ちにデータの依存はあるか → 322 -
K 64回のうち 62回の待ちにはデータの依存が無い ベースライン・ gate+up の matmul 1回あたり K 方向
128 タイル = 2タイル × 64回 最後の1回:pop_front なし unpack スレッドの待ち (部分和の CB) 部分和の中身を読む 読まない 62回 依存なし → 消せる待ち 読み戻し直前の 1回:依存あり 101行の wait_front → DEST へ読み戻す 445〜449行の wait_front → pop_front CB の普通の使い方 作る側 reserve_back → 書く → push_back L1 加算(現在の実装) 使う側 CB pack スレッド wait_front → 読む → pop_front wait_front・pop_front の実行:compute kernel では unpack スレッドのみ( API の作り) reserve_back → L1 加算 → push_back 部分和の CB unpack スレッド wait_front → pop_front (読まない) 次:正しい作りは何か → 323 -
正しい作りは 2通り・現在はどちらでもない → 実装の問題と確定 gate+up の matmul・部分和の CB = 出力
56 タイル分・K 2タイル分の終わり → 次の K 2タイル分(模式、上から下へ時間) 現在の実装 作り1:unpack で待ちの組を移す 作り2:pack で書き込み位置を戻す 待ちの位置:次の入力を詰める前 処理を止めない位置へ 途中の K では CB の受け渡しなし pack スレッド unpack スレッド 入力を 詰める L1 加算 ×7 push_back wait_front 56 タイル分 部分和 の CB pop_front pack スレッド L1 加算 ×7 push_back 部分和 の CB unpack スレッド pack スレッド unpack スレッド 入力を 詰める L1 加算 ×7 入力を 詰める 次の入力を 詰める ↩ 書き込み 位置を戻す 次の入力を 詰める 部分和 の CB wait_front → pop_front 受け渡し なし 次の入力を 詰める 止まる位置あり :次の入力を詰める前 → SrcA・SrcB が空 → FPU 停止 pack が出力8タイルを L1 加算 止まる位置なし wait_front と pop_front の組 (pop_front だけ:直前の wait_front で停止) unpack が SrcA・SrcB に詰める 止まる位置なし・待ちなし 実例:tt-metal の SDPA の kernel cb_push_back_hold_wr_ptr unpack の待ち 現在 = どちらでもない → データの依存が無い待ちによる停止 → 実装の問題と確定 止まる位置 次:改善の見込み → 324 -
改善の見込み: 1.13〜1.28 ms/token(TPOT の 3.3〜3.7%) 観測の締め:改善に渡す前の見込みと全体比・ 62 = K 64回
− 読み戻し前の 1回 − 最後の1回 見込み (gate+up 1回) 62 回 × 消せる回数(段階 6) 見込み (1トークン) 23,808〜27,032 cycle 1回の長さ(段階 5) × 64 回/token ÷ gate+up の回数 全体比 = 384〜436 cycle 1.35 GHz = 1.13〜1.28 ms/token AIクロック(p150 の仕様) ベースライン 1回目(以降の分析の基準) TPOT 3.3〜3.7% デバイス稼働時間 4.2〜4.8% 0 5 34.2 ms 26.8 ms 10 15 見込みの下端 1.13 ms/token(1回 384 cycle) 20 25 30 [ms/token] 上端 1.28 ms/token(1回 436 cycle) 325 -
観測の締め:改善に渡すのはこの 1点、波及先と省略した不足を明記 down 射影の停止:段階 5 と同じ読み・同じ長さ / op の並び:理論下限との差の順位 同じ
kernel を使う op ほかの不足(本来は同じように深掘り) gate+up matmul の compute kernel 改善の対象 (理論下限との差の 1位) down 射影 同じ長さの停止 q/k/v 射影 効果が波及して 上乗せの可能性 段階1 math スレッドの先頭が 演算命令でない時間 段階0 kernel 区間の外の 3.25 ポイント 3つの不足 理論下限との差の順位 o 射影 (kernel は未確認) lm_head 波及の量: 推定していない コア数と DRAM 帯域の不足 gate+up 以外の op 深掘りを省略 → この1点を先に(講演の時間の都合) → 12章:この 1点の改善 326 -
改善の進め方:上位の層から、 1つずつ入れ、 4つのゲートで判定 改善検証(前半の計測目的の分離): 12章 上位の層(推論エンジンの設定) 施策の選び方 後半の節 ホスト側の施策 上位の層で断てない機構
→ この層で介入 ハードウェア・カーネル層( compute kernel) 前半の理論編 施策候補 A〜F 前半の着手順序・ 「既存の仕組みを先に」 既存の仕組みを先に、自前の変更は最後に ホスト側の施策 1つずつ入れる 原本 gate+up の施策 比較の基準 完了の判定 比較成立 性能達成 機能成立 副作用管理 ホスト側の施策・ 時間の効果 前半の単一変更原則 正しさの確認〜 絶対量の比較 前半の完了判定 4つのゲートの同時成立 328 -
トークン選択は既存の仕組みでデバイスへ:設定と 1行の変更 1トークンのデータの流れ(計測条件の batch 32・greedy) 矢印の太さ = ホストへ渡すデータの量(模式) ロジットの読み戻し batch
32 × 語彙 128,256 デバイス( p150) 変更前 lm_head argmax デバイスが選んだ トークンだけ( 32 個) デバイス( p150) 変更後 lm_head ホスト ホスト argmax なし argmax 9章で観測した ホスト側の大きな処理 既存の仕組み → 効果:次の 2ページ (性能/機能・副作用) 既存の仕組みが有効になる条件(上位の層 = 推論エンジンの設定:前半の着手順序・「既存の仕組みを先に」) True vLLM の Tenstorrent プラグインの設定 sample_on_device_mode: decode_only 既定:無効 = ホストで argmax 有効 tt-metal の モデル設定 allow_force_argmax (model_config.py) greedy のときの 経路の分岐 Galaxy 構成のみ (多数のチップを束ねた構成) → argmax だけをデバイスで行う経路 施策:False → True(1行の変更) → p150 でも argmax の経路へ False それ以外の構成(p150 を含む) → 1コアで動く汎用の上位 k 個の選択 1回 約 16 ms(参考値、デモスクリプト) 329 -
ホスト待ち 7.4 → 0.1 ms、TPOT 34.2 → 27.6 ms 変更前
デバイス稼働時間 26.81 ms ホスト待ち 7.4 ms argmax 以外の op:±0.01 ms 以内 → デバイス稼働時間とホスト待ちの分け方の確認 デバイスに移った argmax(0.72 ms) 変更後 TPOT 34.2 ms TPOT 34.2 → 27.6 ms argmax 以外の op ホスト待ち 0.1 ms デバイス稼働時間 26.81 → 27.52 ms(+0.71 ms) [ms] 0 6 12 18 24 30 36 ベースラインと同じ方法:デバイスのプロファイラを付けた実行、本計測の生成の定常区間 8トークン ホスト待ち = TPOT − デバイス稼働時間 別の計測:ホストの時計(プロファイラを付けない別の実行) 変更前 変更後 4.42 ms 0.21 ms ロジットの読み戻しの発行 + ホストでの整形・ argmax の合計(9章のホスト側の区間と同じ) 330 -
argmax の結果は torch.argmax と一致、 0.72 ms がデバイス側に移る 機能 同じロジット batch
32 × 語彙 128,256 デバイスの argmax PyTorch の torch.argmax (このモデルの形状) 副作用 ✓ 一致 単体の数値確認 (正しさの確認専用) デバイス側に移る argmax:0.72 ms 1トークンごとの trace の再生(模式) decode の trace TPOT(プロファイラを付けない実行、 3回ずつ交互の平均) argmax の trace argmax を別の trace として毎トークン追加で再生 27.96 ms argmax argmax を decode の trace に入れて1回の再生 27.81 ms decode の trace 本稿の計測:再現条件の版のローカル変更 (2) 0 4 8 12 16 20 24 28 32 [ms] → TPOT は変わらず(実行ごとのばらつき ±1 ms 程度) 原本(比較の基準) 9〜11章と同じ = ホスト側の施策を入れる前 ホスト側の施策:トークン選択をデバイスで 以降:デバイス側の gate+up の施策 331 -
施策候補 A〜F:断つ位置から挙げる → 設定では断てずカーネル層へ 段階6 で確定した機構( gate+up・K 2タイル分の1回・模式) 待ちの終わり 前半の介入層
A データの依存が無い待ち:次の入力を詰める前 unpack スレッド SrcA・SrcB に入力を詰める wait_front pop_front アプリケーション・データ層 モデル・アルゴリズム層 次の入力 ソフトウェア・フレームワーク層 E pack スレッド B 部分和の CB 56 タイル ハードウェア・カーネル層 D L1 加算(出力 8 タイル × 7) F 上位の層(ホスト側の施策の設定) → 断てない A 書き戻し( DEST → L1) B C D E F compute kernel の変更 math スレッド FPU 実行(K 2タイル分) 1 回 = K 2タイル分、 × 64 回 停止: Src 両方空 FPU 実行 次:正しさのリスクと判断 → C 回数 候補 A〜F を探した順(前半の「既存の仕組みを先に」) ① 設定 → 断てない ② API・既存の実例 → 断てる ③ データの置き場所 C K の分割幅を広げる( in0_block_w)→ 待ちは残る A 呼ぶ位置を変える E 部分和の置き場所を増やす D L1 加算の有無 → 別の読み戻しが増える B SDPA の実例:書き込み位置を戻す F DEST に置き続ける 332 -
採用の根拠: A は最小の変更で直接断ち、正しさのリスクが低い 機構のどこを断つか 正しさのリスク 低 中 判断: 待ちの位置だけを動かす 入力を詰めることと前回の加算の完了を重ねる
wait_front・pop_front の組を1回分後ろへ B 途中の K:pack スレッドの側で書き込み位置を戻す 回数を減らすだけ K の分割幅 2→4 タイル(待ちの回数を半分) DEST への読み戻しで足す 空きを先に確保する 併用候補 低(L1 の容量の確認が要る) D 中(読み戻しで別の停止が増える恐れ) E 加算先がずれる( L1 加算は同じ場所に足す) 出力を DEST に置いたまま K を回す F DEST は出力8タイル分しか無い( 56 タイルを置けない) A 以下「施策」 +6 行 部分和の CB を2倍にする 書き戻し自体を無くす 変更:compute kernel の 12 行 却下 中(CB の状態を手で管理する) C L1 加算自体をやめる 次点 低い( CB の受け渡しの回数と大きさは同じで、 順序だけが変わる) → CB の約束事を崩さない A 待ちそのものを無くす 採用 −6 行 次:正しさの確認 → 入る分岐:L1 加算あり・bias の融合なしの分岐だけ(PACKER_L1_ACC が定義され FUSE_BIAS が無い場合) 333 -
効果を測る前に正しさの確認: 8ケースすべてでビット単位で一致 単体の数値確認 = 正しさの確認専用(性能評価には使わない、性能は計測条件で測る) 対象:同じ種類の matmul(DRAM に分散配置した重みとの matmul) 同じ入力
変更前の kernel 出力 変更後の kernel 出力 8 ケースすべてで ビット単位で一致 相関係数(PCC) 0.99994 以上 PyTorch で計算した参照 K の分割数 64・8・4・3・2・1 を含む 8 ケース(64 = gate+up の K の分割数) 分割数 最初の K 読み戻しの直前の K 64 8 4 3 2 1 機能成立 → 実際のベンチマーク (次ページ) → 時間の効果 変更が影響する境界の K 最後の K 境界以外の K 分割数の少ないケース → 変更が影響する境界の確認 1マス = K の分割1つ(左から右の順・模式) 334 -
実際のベンチマーク:出力の一致は弱い確認 → 数値確認と合わせて判断 実際のベンチマーク(計測条件: vLLM 経由・greedy(温度0)) プロンプト 出力トークン 同じトークンの 繰り返し
変更前 = 変更後 完全に一致 1 ユーザー 32 ユーザーの 出力も同じ 弱い確認 前半の完了判定 32 128 トークン 160 トークン 単体の数値確認(前ページ) 合わせて 判断 機能成立 時間の効果 335 -
ベースライン再計測:原本 2回は ±0.01 ms で一致 プロファイラを付けない TPOT 前半の前後比較の条件をそろえる 生成全体の平均・原本と施策後を 3回ずつ交互
同じ日の実行順 原本 1回目 施策 原本 2回目 原本 ✓ 原本の kernel 34.12 / 34.13 / 35.98 ms 施策の kernel ✓ 原本の kernel ✓ 変えるのは compute kernel のファイルだけ 施策後 ✓:原本へ戻したことをファイルの比較で確認(実行のたび) 31.90 / 33.64 / 33.57 ms 0 31 32 33 34 35 36 TPOT [ms] 実行ごとのばらつき ±1 ms 以上 ≈ 原本と施策後の差 デバイス稼働時間:観測と同じ方法(ベースラインの 2回) 37 デバイスのプロファイラを付けた実行・定常区間 8 トークンの平均 原本 1回目 26.81 ms 原本 2回目 26.81 ms 0 TPOT だけでは効果を判定できない 10 ±0.01 ms で一致 20 30 [ms] → 施策の前後も同じ方法で比較(次ページ以降) op の区間・段階0 の状態の分け方・段階 1〜2 の性能カウンタ 336 -
施策で 2.42 ms 短縮:デバイス稼働時間の 9.0%、TPOT の約 7% デバイス稼働時間 26.81 ms
原本 ホスト待ち TPOT 34.2 ms 約 7 ms matmul −2.42 ms 2.42 ÷ 26.81 = 9.0% 施策 2.42 ÷ 34.2 ≈ 7% TPOT 31.8 ms 約 7 ms matmul デバイス稼働時間 24.39 ms 理論下限 重み 11.90 ms + KV 0.62 ms(143 位置)= 12.53 ms (丸める前の値の和) [ms] 0 6 12 18 24 30 36 matmul SDPA layernorm(正規化) elementwise(残差加算・ SiLU と up の積) RoPE kv_cache(KV キャッシュ更新) head_reshape(head_split など) layout(レイアウト変換) embedding(embed_tokens) other(その他) op 間 ホスト待ち = 同じ区間の TPOT − デバイス稼働時間 デバイスのプロファイラを付けた実行(性能カウンタなし)の定常区間 8トークン(10〜17回目)の平均、トークンごとの差 ±0.01 ms op の区間 = 全コアの kernel 開始の最小〜ファームウェア区間の終了の最大 各色の段 = op の種類ごとの op の区間の合計 op 間 = デバイス稼働時間 − Σ op の区間 理論下限 = DRAM 読み込み量 ÷ 512 GB/s 原本 = ベースライン1回目 施策 = 部分和の CB の wait_front・pop_front の組の移動(候補 A) 次:gate+up 1回の区間 → 337 -
gate+up 1回の区間 121.86 → 104.59 µs(−14.2%) op の区間 全コア・全 BabyRISC
kernel 開始の最小 完了通知の最大 原本 121.86 µs 9〜11章と同じ 同じ方法 同じ日 −14.2%(104.59 ÷ 121.86 − 1) 施策 104.59 µs 候補 A [µs] 0 20 40 60 80 100 120 gate+up 1回の op の区間:8トークン × 64回 = 512回の中央値 同じ方法:デバイスのプロファイラを付けた実行・性能カウンタを付けない・定常区間 8トークン(10〜17回目) 同じ日:原本と施策を続けて実行・違い: compute kernel のファイルだけ 次:段階0 の5つの状態の内訳 339 -
短縮は math スレッドの kernel 区間の中( −14.6%) gate+up 1回・性能カウンタなし(観測と同じ方法)・ 5つの状態は段階 0
と同じ分け方 太い帯 = 512回(8トークン × 64回)× 演算8コアの平均 細い帯 = 代表トークンの gate+up 64回のうち区間が中央値に最も近い 1回 原本 代表1回 8コア 3 math の kernel 区間 96.75% 平均 −14.6%(中央値 159,076 → 135,780 cycle) 3 math の kernel 区間 96.25% 平均 施策 代表1回 8コア [cycle] 0 40,000 80,000 kernel 区間の外の 3状態: cycle 数で見てもほとんど変わらない 原本 120,000 施策 区間に対する割合 1 まだ動いていない 0.38% → 0.44% 4 BRISC の書き戻し 2.10% → 2.43% 5 全コアの完了待ち 0.77% → 0.87% 拡大・平均 [cycle] 0 1,000 2,000 3,000 4,000 160,000 次:kernel 区間の中の FPU 稼働率 340 -
FPU 稼働率 72.3 → 84.7%、FPU の仕事量は不変 性能カウンタは別の実行(観測者効果)・段階 1 と同じ採り方・本計測の生成の 10回目から2トークン(バッファあふれを抑える)
原本・施策それぞれ 192 区間(記録がそろった gate+up 24回 × 演算8コア)・帯の長さ = kernel 区間の長さ(中央値) × 割合 FPU の仕事量(FPU_COUNTER の中央値)114,978 → 114,980:不変 FPU のグループ FPU の実行 72.3% unpack 側 入口に演算命令がある 原本 FPU 稼働率 26.4% +12.4 ポイント FPU のグループ FPU の実行 84.7% unpack 側 入口に演算命令がある 施策 13.8% [cycle] 0 40,000 80,000 120,000 160,000 math スレッドの kernel 区間(gate+up 1回・1コア、中央値) FPU の実行(FPU_COUNTER、段階1) FPU の実行なし 入口に演算命令がある( MATH_INSTRN_AVAILABLE、段階2) 入口に命令が来ていない( 1 − AVAILABLE、段階2) FPU のグループと unpack 側は別のカウンタ(差は引き算しない)・ AVAILABLE ⊇ STARTED ⊇ FPU の実行(段階2) → 次:原因が消えたことの確認(原因を特定したときと同じ観測) 342 -
短縮は同じ kernel を使う他の matmul にも波及:計 −1.31 ms 原本 施策後 差
差 [ms] mlp.gate_proj + mlp.up_proj 7.794 6.692 6.609 6.001 mlp.down_proj self_attn.o_proj 2.115 1.846 kernel は未確認 1.891 1.729 lm_head 深掘りした op 理論下限との差の 1位 −0.609 3.002 2.731 self_attn.q/k/v_proj −1.103 波及 −0.271 計 −1.31 ms −0.269 = −0.609 − 0.271 − 0.269 − 0.162 −0.162 [ms] 0 2 matmul 以外の op 4 6 8 ±0.005 ms 以内 値:HF モジュールごとの op の区間の合計・各条件の代表トークン・性能カウンタなし 差:丸める前の値から計算 代表トークン = 定常区間8トークン(10〜17回目)のうちデバイス稼働時間が中央値のトークン 原本 = ベースライン1回目 施策 = 部分和の CB の wait_front・pop_front の組の移動(候補 A) 次:gate+up の実測と改善の見込みの比較 344 -
gate+up の実測の短縮は見込みの下端をわずかに下回った(下端の 62 回 × 384〜436 cycle 消せる回数(段階 6) ×
1回の長さ(段階 5) 見込み 64 回/token ÷ gate+up の回数 AIクロック(p150 の仕様) 1.35 GHz = 98%) 1.13〜1.28 ms gate+up 観測の締めから 実測 下端の 98% gate+up 1.103 ms (1.103 ÷ 1.13) 施策の効果 下端との差 → 絶対量の比較 [ms] 0 0.2 0.4 0.6 0.8 1.0 1.2 1.4 1トークンあたりの短縮 実測: HF モジュール別の差(各条件の代表トークン) → 次:原因が消えたことを直接確かめる 346 -
時間の短縮 ≠ 機構が消えた証明 → 同じ観測で、狙った停止が消えた(段階 3) 同じ観測 原本 段階3(原因を特定したとき) 施策後
同じスクリプト・同じベンチマーク条件・同じコア(物理座標 x1, y2)・同じ kernel(gate+up)・同じ採用条件 vLLM decode(プロファイラなし、本計測の生成)・原本と施策後はそれぞれ別の実行 math スレッドに命令が無く、 SrcA・SrcB が両方空 17.2% 0.4% 32 ビット単発読み・サンプル 15,815 / 9,424 SrcA・SrcB が両方空で unpacker も書いていない 18.3% 4.7% 128 ビット単発読み unpack スレッドの命令バッファの先頭が空で、 2つの unpacker がどちらも止まっている 狙った停止 14.9% 0.0% 128 ビット単発読み・サンプル 9,889 / 5,015 math スレッドに命令が無く、 SrcA・SrcB は揃っている 8.1% 10.0% 32 ビット単発読み 0 5 10 15 20 gate+up の kernel 実行中のサンプル比率 [%] 施策の対象外 25 次:段階4 プログラムカウンタで待ち場所を確かめる 347 -
段階4:部分和の CB の待ち 20.0% → 移した位置で 3.6% 原因を特定したときと同じ条件: vLLM decode(プロファイラなし、本計測の生成)・同じコア(物理座標
x1, y2)・gate+up の kernel 実行中 段階4:unpack スレッドのプログラムカウンタ → ELF の命令・原本と施策後は別の実行 待ちのループの 4命令:部分和の CB に届いた数を読む lw 〜 足りなければ戻る分岐命令 bgeu K 2タイルの末尾 原本の ELF lw 0x6f24 20.0% bgeu 0x6f30 施策(候補 A) ELF・命令のアドレスが変わる → 逆アセンブルし直し 同じ意味の命令を 新しいアドレスで計数 移した位置(候補 A) K 2タイルの末尾 施策後の ELF ELF に命令なし 0x6f24 lw 0x72b0 3.6% bgeu 0x72bc 0 次:段階5 いつ、どの長さで止まるか 5 10 15 20 25 待ちのループの 4命令にあったサンプルの比率 [%] サンプル 原本 9,986 / 施策後 4,891 349 -
部分和の CB の待ち( 416〜480 cycle)が消え、残りは 64 cycle 未満だけ gate+up の
kernel 実行中・演算コア(物理座標 x1, y2)・vLLM decode(プロファイラなし、本計測の生成) 段階5 と同じ読み方・同じ条件・原本と施策後は別の実行 16 cycle 間隔 × 60 サンプル = 長さ別の時間の割合(停止区間の時間 / 全時間) 原本 10% 停止区間の合計 18.1%(929 区間、1,195,664 cycle 中) 8% 6% K 2タイルごとの部分和の CB の待ち 4% 416〜480 cycle 2% 0.3 0.3 0.5 0.3 0.6 0.4 0.5 0.9 1.1 6.7 4.6 1.1 32 64 96 施策後 10% 1,074 区間 中央値 384〜436 cycle 1,792 命令ごと 0% 0 48 cycle 間隔の連続読み = FPU が実行しない区間の数 読みの回数 942 / 1,022 回 128 160 192 224 256 288 320 352 384 416 448 480 停止区間の合計 2.6%(1,772 区間、1,102,704 cycle 中) 8% 6% 4% 消滅 2.5 64 cycle 未満 (→ 絶対量の比較) 2% 1 区間 96〜127 cycle 1,792 命令ごとの停止は無い 0% 0 32 64 96 128 160 192 224 256 288 320 352 384 416 448 480 FPU が1回も実行しない区間の長さ(下限) [cycle]・32 cycle 刻み・480 以上は両者 0 → 次:短くなった分 = FPU が止まっていた分か(性能カウンタ) 350 -
性能カウンタでも:短くなった分 = FPU が止まっていた分 性能カウンタ(別の実行・段階 1 と同じ採り方:本計測の生成の 10回目から2トークン) gate+up 1回・1コアあたり、192
区間(gate+up 24回 × 演算8コア)の中央値(原本・施策後それぞれ) FPU が実行していないサイクル = math スレッドの kernel 区間 − FPU_COUNTER(FPU の仕事量、不変) 原本 43,822 施策後 減少 20,489 狙った停止(段階 3〜5 の直接観測で確認) 原本 − 施策後 (丸める前の中央値の差) FPU が実行していない サイクルの減少 23,334 cycle math スレッドの kernel 区間の短縮 23,328 cycle 0 10,000 一致 20,000 30,000 40,000 [cycle] → 次:math スレッドの命令バッファの先頭の内訳(命令スレッドのカウンタ) 352 -
短くなったのは「先頭が MATH 命令」の時間 段階1 と同じ観測:命令スレッドのカウンタ・別の実行・計測条件と同じ( vLLM decode、batch 32) 区間:本計測の生成の 10回目から2トークン・gate+up
24回 × 演算8コア = 192 区間(原本・施策後それぞれ) 原本 設定・同期・止められている 合計 12,374 92.0%(146,082) kernel 区間 158,802 cycle 先頭が MATH 命令の時間の短縮 施策後 設定・同期・止められている 合計 12,412(ほぼ不変) 90.6%(122,721) kernel 区間 135,474 cycle [cycle] 0 40,000 80,000 120,000 160,000 帯の長さ = kernel 区間の長さの中央値( math スレッド、gate+up 1回・1コア)× 割合(換算) 帯の色 = math スレッドの命令バッファの先頭の状態(段階 1 と同じ分類色) 割合:原本 → 施策後 演算命令(MATH) 92.0 → 90.6% 設定命令(CFG) 4.95 → 5.79% 同期命令(SYNC) 1.16 → 1.41% 止められている 1.69 → 1.96% その他のクラス 0.00 → 0.00% 先頭が空(引き算) 0.22 → 0.25% → 原因が消えたことの確認:短縮の中身 = 狙った停止の消滅 → 次:絶対量の比較(減ったものと増えたもの、副作用管理) 353 -
割合でなく絶対量( cycle に換算)で並べる → 純減ではなかった 換算値 [cycle] = 観測した割合 ×
math スレッドの kernel 区間の長さ(中央値) (≠ 直接の観測値) kernel 区間の長さ(施策で変わる分母):原本 158,802 → 施策後 135,474 cycle(性能カウンタの実行) 項目 原本 → 施策後 [cycle] 64 cycle 以上続いた FPU の停止 27,943 → 0 段階5・16 cycle 間隔(長さは下限) math スレッドに命令が無く、 Src が両方空 28,419 → 2,901 段階3 と同じグループの 128 ビット単発読み※ ← 減った 増えた(副作用) → −27,943 −25,518 64 cycle 未満の FPU の停止 +2,784 788 → 3,572 段階5・16 cycle 間隔 math スレッドに命令が無く、 SrcA は揃っているが SrcB だけ空 +4,540 464 → 5,004 128 ビット単発読み※ math スレッドの先頭が設定命令・同期命令・止められている ほぼ不変 12,374 → 12,412 段階1 の性能カウンタ 差 = 施策後 − 原本 [cycle](gate+up 1回・1コアあたり) −30,000 −20,000 −10,000 0 +10,000 +20,000 +30,000 ※ 128 ビット単発読み:段階 3 の 32 ビット単発読みとは別の実行・全スレッド共通の信号 → Src が両方空の原本 17.9%(段階3 は 17.2%) 次:増えた短い停止は何か 355 -
出力8タイルの境界の短い停止 1.8 → 8.0 cycle:見込みの下端との差を説明 出力8タイルの組 (K の1回分) 原本 FPU
1 2 3 4 5 停止 1.8 6 停止 8.0 cycle 施策後 unpack スレッド 移した wait_front・pop_front の判定の命令 → 次の組の最初の SrcB(活性値1タイル)の遅れ (換算値) ≈ 実際の短縮 境界1回あたりの平均 2 4 推定(未確認) 6 8 10 境界からの時間 [cycle](模式) 差し引き 約 25,200(丸める前の値の差) 増えた短い停止 約 2,800 ≈(8.0 − 1.8)× 448 回 kernel 区間の短縮 23,328 = 64 cycle 未満の 停止の合計 ÷ 448 回 FPU が実行 消えた長い停止 約 27,900 停止の増減 (gate+up 1回あたり) FPU が実行 施策後 FPU 0 境界 境界:7組 × K の64回 = 448 回 7 12 [cycle]、gate+up 1回・1コアあたり ≈ は近似: 停止の長さは読み間隔のため下限・ 別の実行の値の換算 → 増加分で見込みの下端をわずかに下回った 次の作業:wait_front・pop_front の組の置き場所をさらに変えた版・施策候補 B で同じ観測 → SrcB だけが空の短い停止が元に戻るか(推定の確かめ) 次:前半の完了判定( 4つのゲート)で採否 356 -
4つのゲートを確認:副作用 < 全体の短縮 → 施策を採用 前半の完了判定(4つのゲート)の同時成立 枠内の上:確かめた場所 施策 比較成立 ✓
性能達成 ✓ 機能成立 ✓ 副作用管理 ✓ 同じ方法・ 同じ日の原本 時間の効果+原因が 消えたことの確認 正しさの確認 絶対量の比較 原本も採り直して 施策と続けて実行 デバイス稼働時間の短縮 +狙った停止の消滅 出力の一致 (単体の数値確認と ベンチマーク) 短い停止の増加 < 全体の短縮 採用 → 次:発展編の事例で確定した規律 357 -
発展編の事例で確定した規律 9項目:診断と検証に分け、階層に沿って並ぶ ① 指標の階層 上から順に確定 問題診断(9〜11章) ② 原因の特定=構成を変えない直接観測 ホストとデバイス ③
計測区間の位置=指定した値でなく実行ログで確認 op の区間 ④ 優先順位=理論下限との絶対差(比でなく) コア稼働 ⑤ コアの中を見る前に:各コアの状態を区間で分け → kernel の外の不足を確定 コアの内部 ⑥ 別グループのカウンタは引き算しない 差は同じ区間・同じ基準の包含確認時だけ 各段で:内訳の合計 =上の階層の値 9章 ⑦ 観測の締め:改善の見込み=範囲+全体比 改善検証(12章) 分ける 改善の前後比較 ⑧ 同じ日に原本も・同じ方法 時間だけでなく、同じ観測をやり直し → 狙った停止の消滅を直接確認 ⑨ 割合でなく絶対量: 減った・増えたの両方 → 次:13章 オープンアーキテクチャ事例のまとめ ★鉄則 診断は構成を変えない直接観測、検証は同じ観測のやり直し 358 -
前半の判定規律 3軸は、Blackhole の事例にもそのまま適用できた 制約モデル 介入層 「どの層の変更が最短で効くか」 「どの上限が効いているか」 前半の 判定規律 アプリケーション・データ層
計測契約 「その差分は改善効果か、 環境差分か」 モデル・アルゴリズム層 計算 メモリ 通信 I/O ソフトウェア・フレームワーク層 比較条件固定 ハードウェア・カーネル層 適用 Blackhole p150 の事例 (8〜12章) batch 32 の Decode:メモリ律速 算術強度が1桁足りない DRAM 帯域を使い切る 必要 約10〜12 コア 観測で確定した機構に応じて選択 10 実行 区間の約 30% 後半の事例に当てはまった要素 ソフトウェア・フレームワーク層 推論エンジンとモデルの設定 トークン選択をデバイスで行う gate+up で実測 演算 8 コア FPU 12 同じベンチマーク条件 本計測の生成の中で直接観測 デバイス稼働時間 op の区間 コア稼働 停止 ハードウェア・カーネル層 コアの内部の状態 compute kernel の12行 内訳の合計 = 上の階層 計測区間は実行ログで確認 次:違いは観測の深さ → 360 -
違いは観測の深さ: GPU で観測できない段まで公開 → 直接観測で辿れた GPU では 観測できない段 → 観測の深さ
→ カウンタの定義 各コアの プログラム カウンタ 段階6 段階3 ライブラリの matmul の kernel のソースの何行目か SrcA・SrcB が両方空 デバッグバスの 信号 ファームウェアと カーネルコード 実行中の 命令語 NVIDIA GPU 経験と勘による推測 前半の Nsight Compute カウンタ・プログラムカウンタのサンプリング 命令ごと・自分で書いた kernel のソースの行 本稿 (Blackhole) × コアの内部の信号 すべて公開(+ 詳細解説の資料) → 次:直接観測の連鎖(ベースラインからソースまで) × 命令の意味 (命令語の定義) × ライブラリと ファームウェアのソース ※ 施策後に増えた短い停止の 理由は推定のまま( 12章) 361 -
TPOT からソースの待ち場所まで、上の階層から順に直接観測で辿った 階層 段階 ベースラインで辿った値 TPOT 34.2 ms ホストと デバイス
デバイス稼働時間 26.81 ms op の区間 gate+up 7.79 ms コア稼働 演算コア 8 観測の方法 区間の壁時計 ÷ 8 トークン = デバイス稼働時間 + ホスト待ち 7.4 ms(引き算) デバイスのプロファイラ( 8 トークンの平均) = Σ op の区間 + Σ op 間 op の区間(代表トークン 64 回の合計) 理論下限との差 1 位 コア稼働(kernel 区間の合併) 稼働率 95% 以上(飽和)・分母: gate+up の区間 性能カウンタ(演算 8 コア) 分母:math スレッドの kernel 区間 段階1 FPU 稼働率 72.3% 段階3 命令が無く Src が両方空 17.2% デバッグバスの単発読み( math スレッド) 分母:採用サンプル(演算コア 物理座標 x1, y2) 段階4 部分和の CB 待ち 20% プログラムカウンタ → ELF(unpack スレッド) 分母:採用サンプル(演算コア 物理座標 x1, y2) 段階6 待ち場所 445〜449 行 ELF の行情報 → compute kernel のソース コアの内部 全段:同じベンチマーク条件(本計測の生成の中) → 次:12行の変更と効果(結論) 362 -
12行でデバイス稼働時間 −9.0%、短縮の中身は狙った停止の消滅 施策 デバイス稼働時間 直接観測:gate+up の FPU 狙った停止(部分和の CB の待ち)
原本 原本 compute kernel の12行 消滅 施策後 unpack スレッドの K 2タイルごとの 部分和の CB の待ち (wait_front・pop_front)を 1回分後ろへ(候補 A) 0 同じ方法・同じ日の 原本と比較 施策後 −9.0% 出力8タイルごとの境界の短い停止の増加も 同じ観測で発見(理由は推定) FPU 実行 FPU 停止 横軸:時間(模式) 仕様がオープンだからこそ可能になる、きめ細やかなパフォーマンスエンジニアリングの実例 → 次:14章 AIエージェントの活用 363 -
歴史:チャットからエージェントチームへ イマココ 04 委ねる 範囲 03 02
01 チャット コパイロット エージェント 指示して 作業を委託 点検と修正の反復で プロジェクト完遂 監督 アプリ(エディタ等)へ 統合し作業補助 作業 ウェブブラウザでの 対話 人の仕事 エージェント チーム 点検 1回の応答 作業の一部 1つの作業 プロジェクト 答えを読む 提案を採るか決める 指示して委託 目標・完了条件を決め 結果を点検 365 -
スキル=作業のやり方を 1フォルダに、段階的に読むので多く入れても使える 入れておいた多くのスキル スキルのフォルダ 1 SKILL.md 先頭:名前・「いつ使うか」の説明 1 本文:手順・守るべき条件 2
詳しい資料 … 2 3 1 ふだん:名前・説明だけ 2 作業に合うとき:本文 3 さらに必要なときだけ:詳しい資料 3 スクリプト 読む部分 読まない部分 出典:Codex の skill-creator スキルの説明( Claude Code も同じ形式) 366 -
スキルを書くのは人から、エージェント自身へ これまで 人間による事前定義 手動で作成 人間 これから 読む スキル エージェントの自動自己改善 作業
完了 蓄積と読み込みに 人の手は要らない 次の作業で読む 作業完了時に 自動でスキル化 エージェント 例:計測(8〜12章) 計測の手順 過去の誤りと正しいやり方 エージェントが まとめる 対象:予測可能な反復作業だけ 例:スライドの作成 人のレビューコメント 24件 エージェントが 一般化 ベストプラクティス集 点検の観点 17項目 引き継ぐエージェントが 着手前に必ず読む 後半の全ページに当て直し スキル化 (またはベストプラクティス集) 367 -
Tenstorrent の事例:スキル集が GitHub で公開( 6プラグイン・ 47スキル) 社内で実際に使うスキルを、ここで集約・更新 github.com/tenstorrent/skills プラグイン tt-review-skills
PR のレビュー tt-model-bringup モデルの移植( Model bring-up) tt-debug-tools デバッグツールの操作 tt-buddy コーディングの補助 tt-autodebug 不具合の調査と修理 tt-skills 15 14 → 次ページ 9 5 3 プラグインの案内 1 0 5 10 15 スキルの数 = skills/ の下の SKILL.md の数 計 47、コミット 80095f4 368 -
Model bring-up:5日以内に性能改善まで、 1モデル $200 程度 Model bring-up = 新しい AI
モデルを自社のチップへ移植 監視役のエージェント (社内) 計算機の確保・障害からの復旧 出力 エージェント 入力 TT-NN による実装 推奨:フロンティアモデル Hugging Face の モデル ID vLLM での配信 スキル集のプラグイン tt-model-bringup 指示:Use tt-model-bringup on <HF model ID> 期間 1〜5日 0 費用 精度・性能のベンチマークの報告 1 1モデル $200 程度 2 3 4 5 [日](実行を始めてから) 定額 $200/月 で週に数モデル・API 従量なら1回 数百ドル 出典:tenstorrent/skills の docs/agentic-research/getting-started.md(コミット 80095f4) 369 -
中身:11段階で規模を広げ、そのたびに最適化 各段階 = エージェントに渡すゴール(目標・完了条件) 規模 デコーダ1層 複数チップ モデル全体 配信 全段階で共通
別のプラグイン まず正しく動かす 次に最適化(4回) 1 動く実装 2 演算の融合 3 最適化 functional-decoder graph-fusing optimize 4 複数チップへの分割 5 最適化 multichip optimize 6 全層の組み立て 7 最適化 8 データ型の選定 full-model optimize datatype-sweep 9 vLLM への組み込み 10 最適化 11 ベンチマーク vllm-integration optimize benchmark-model 装置の安全な使い方 tt-device-usage trace 実行 tt-enable-tracing 生成文の質の確認 qualitative-check 独立レビュー stage-review 不具合の調査と修理:tt-autodebug(AutoDebug・AutoTriage・AutoFix) コードと試験: models/autoports/< モデル名>/ 出典:plugins/tt-model-bringup/skills/model-bringup/SKILL.md (コミット 80095f4) 370 -
各段階は完了条件と独立レビューを通るまで直す → 次の段階 clean-pass 完了条件の 検証 独立レビュー 段階1 の例 Hugging
Face の実装との出力の相関 PCC ≥ 0.995(prefill・decode) trace 実行の decode/ホスト処理なし 同じ入力 → 同じ出力/性能の表 段階1〜10 新しく起動した サブエージェント 報告は主張 → ログ・コードで確かめ直す 作業 ローカルに コミット 自動の 点検スクリプト push しない 段階6・7・9・10・11 終了コード 0 合格・1 注意・2 重大 修正 / AutoFix 仮説を1つずつ検証 不合格・指摘 → 直して再検証 ゴール:「AutoFix が失敗したときだけ止まる」 371 -
optimize スキル:規律は本講義と同じ、知見は観測と同じ所を突く optimize スキル(tt-model-bringup) 本講義 同じ規律 decode は trace 実行で測る
計測条件:trace 実行で decode 同じ実行の3つを突き合わせ 理論下限 端から端 = (模式) 1トークンに読む量 ÷ DRAM 帯域 デバイスの時間 配送の隙間 8・9章 同じ規律 10章 Llama 3.1 8B・p150・batch 32(OPT-015) 観測と同じ所を突く知見 32.75 読み手2(射影) 理論下限 デバイス稼働時間・ホスト待ち ホストの処理 DRAM バンクあたりの読み手 1 → 2・3 読み手1 8章 演算コア 8 = DRAM バンク 8 コア数の不足 42.08 0 モデル全体 [tokens/s/user] 本稿の計測は読み手 1 出典:plugins/tt-model-bringup/skills/optimize/SKILL.md(コミット 80095f4) 372 -
オープンだからこそ自己改善がうまく回る エージェントが読む システムの詳細まで正確に把握 公開されている( 13章) カウンタの定義・命令セット ファームウェアとカーネルコード 詳細解説の資料 次の作業 観測と照合
推測でなく公開資料・ソースで確かめる 仕様がオープン = 人だけでなくエージェントにも自己改善の前提 スキル・ベストプラクティス集へ書き戻す 公開資料・ソースを参照 誤りも同じ資料と観測で直せる 373 -
実は本講義も AI エージェントチームが作成 人(講師) エージェントの仕事 目標・制約・レビュー 指示・指摘 親のエージェント 8〜13章の事例 計測・解析・改善をほぼ自律的に
スキル 41 個を使用(Tenstorrent のスキルを含む) 作業記録 450節以上(2026-07-10〜) 原稿・スライド 作成と点検 段取り・検収 サブエージェント 3〜4体 講義リポジトリのコミット 1,000件以上 エージェントのコミット(残りすべて) 1ページずつ点検・修正(並行) 講師の名義 4件 374 -
PEは共通の理論を使って実践、 AIエージェントにお任せ 制約モデル 介入層 計測契約 実践1:LLM推論 Decodeメモリ律速起点 構成→バッチ→アルゴリズム →エンジン 発展編:
共通理論 オープンアーキテクチャ による性能追求 (題材が変わっても 同じ手順) 実践2:自動運転推論 実行可能経路 環境前提 実行経路確定を先行 PTQ→枝刈り→転送重畳 AIエージェントチームがまるっと担当 (人は目標設定と点検) 376
 minorun365
 sioncojp
 oidfj
 sat
 sergicalsix
 kota2and3kan
 sansantech
 rist
 tomoaki25
 grimoh
 hagino3000
 bengo4com
 smashingmag
 techseoconnect
 sabderemane
 mongodb
 reverentgeek
 akademiya2063
 lemiorhan
 jnunemaker
 cromwellryan
 eileencodes
 uxyall
 chrisshort