Upgrade to Pro — share decks privately, control downloads, hide ads and more …

監視・分析・拡張性を一手に:TiDBが支えるmixi2のデータ基盤

 監視・分析・拡張性を一手に:TiDBが支えるmixi2のデータ基盤

開発生産性 Conference 2025 Day 2 Hall B で発表した時の資料です。

Avatar for Atsuya

Atsuya

July 04, 2025

Other Decks in Technology

Transcript

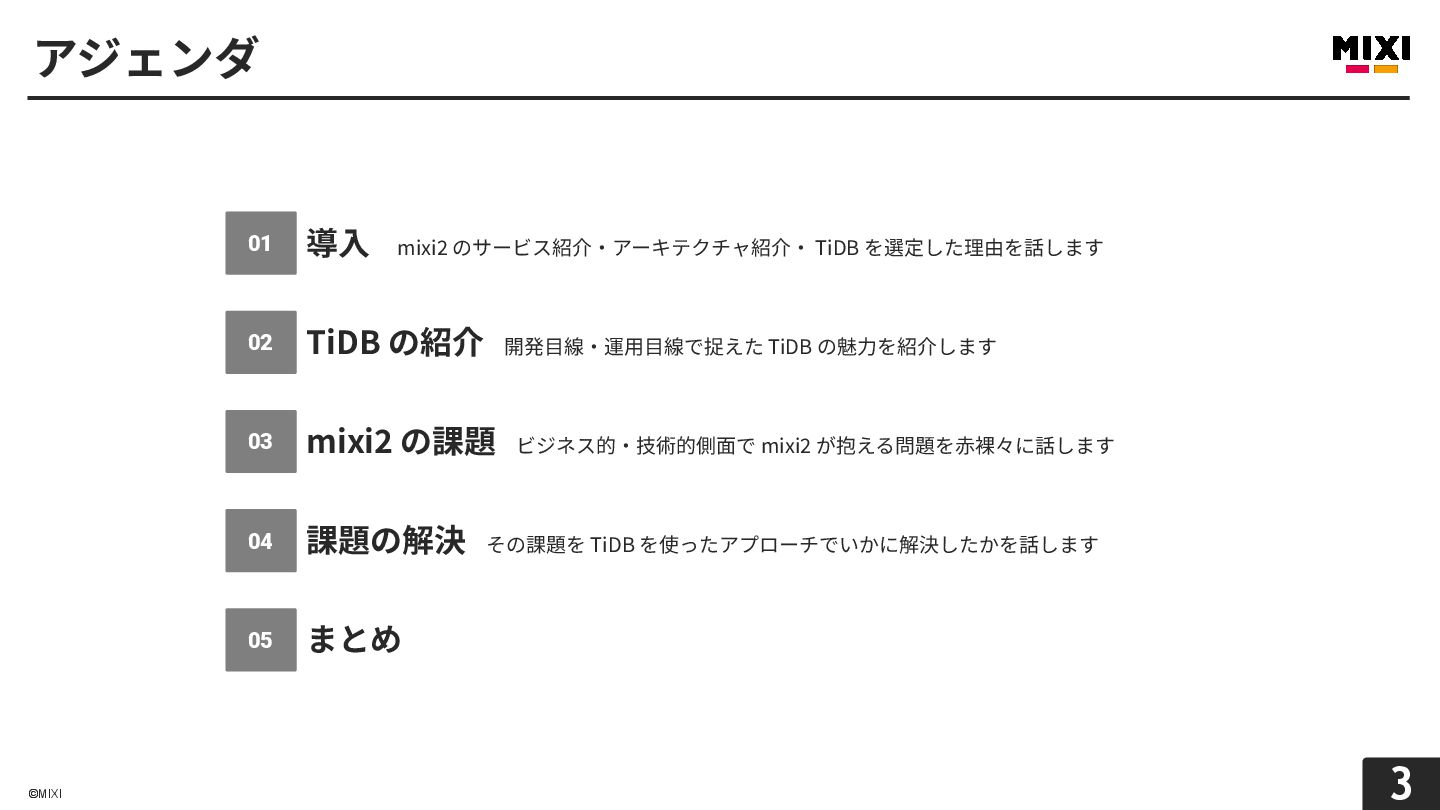
  1. ©MIXI 3 アジェンダ 導⼊  mixi2 のサービス紹介‧アーキテクチャ紹介‧ TiDB を選定した理由を話します 01 TiDB

    の紹介 開発⽬線‧運⽤⽬線で捉えた TiDB の魅⼒を紹介します 02 mixi2 の課題 ビジネス的‧技術的側⾯で mixi2 が抱える問題を⾚裸々に話します 03 課題の解決 その課題を TiDB を使ったアプローチでいかに解決したかを話します 04 まとめ  05
  2. ©MIXI 4 アジェンダ 導⼊  mixi2 のサービス紹介‧アーキテクチャ紹介‧ TiDB を選定した理由を話します 01 TiDB

    の紹介 開発⽬線‧運⽤⽬線で捉えた TiDB の魅⼒を紹介します 02 mixi2 の課題 ビジネス的‧技術的側⾯で mixi2 が抱える問題を⾚裸々に話します 03 課題の解決 その課題を TiDB を使ったアプローチでいかに解決したかを話します 04 まとめ  05
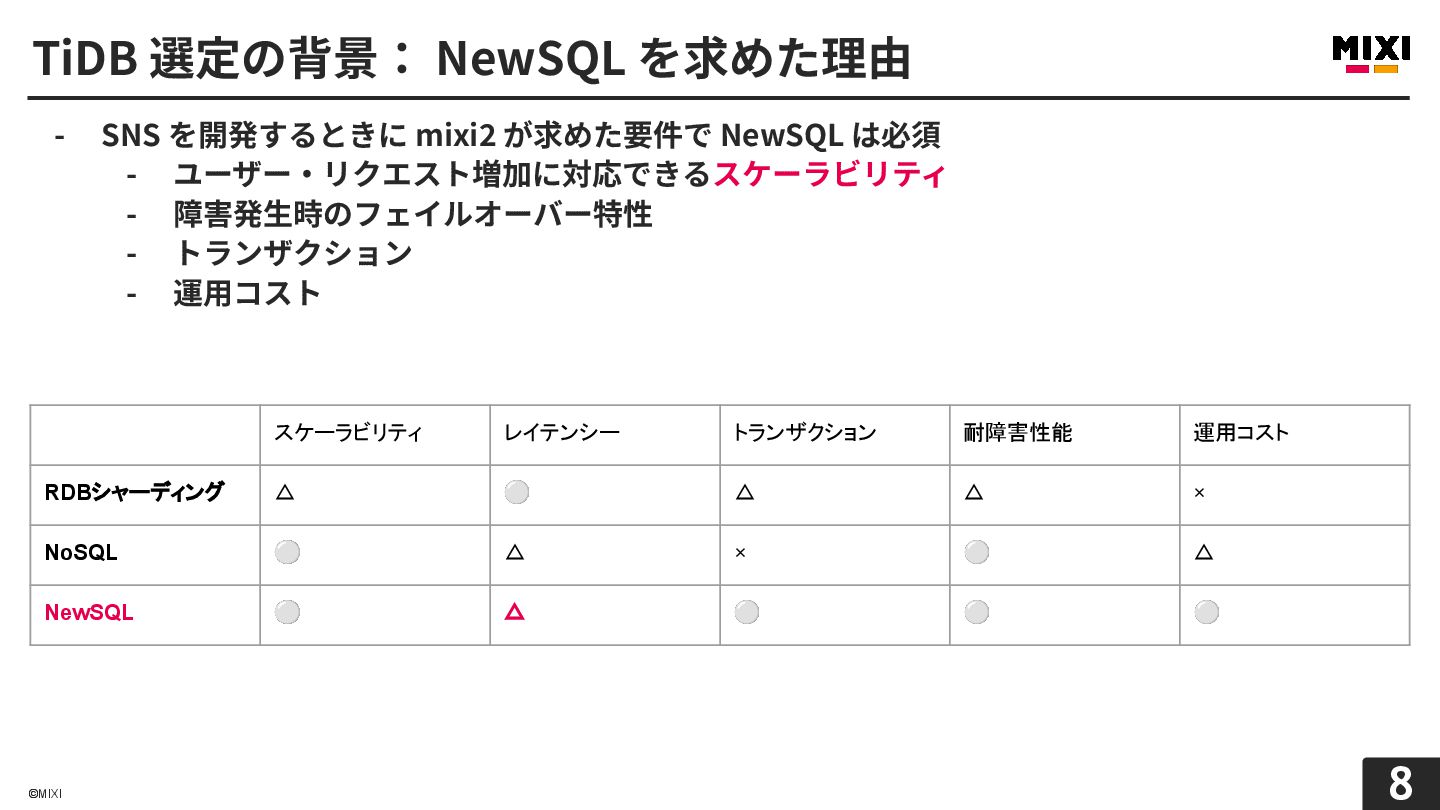
  3. ©MIXI 8 - SNS を開発するときに mixi2 が求めた要件で NewSQL は必須 -

    ユーザー‧リクエスト増加に対応できるスケーラビリティ - 障害発⽣時のフェイルオーバー特性 - トランザクション - 運⽤コスト TiDB 選定の背景: NewSQL を求めた理由 スケーラビリティ レイテンシー トランザクション 耐障害性能 運用コスト RDBシャーディング △ ⚪ △ △ × NoSQL ⚪ △ × ⚪ △ NewSQL ⚪ △ ⚪ ⚪ ⚪
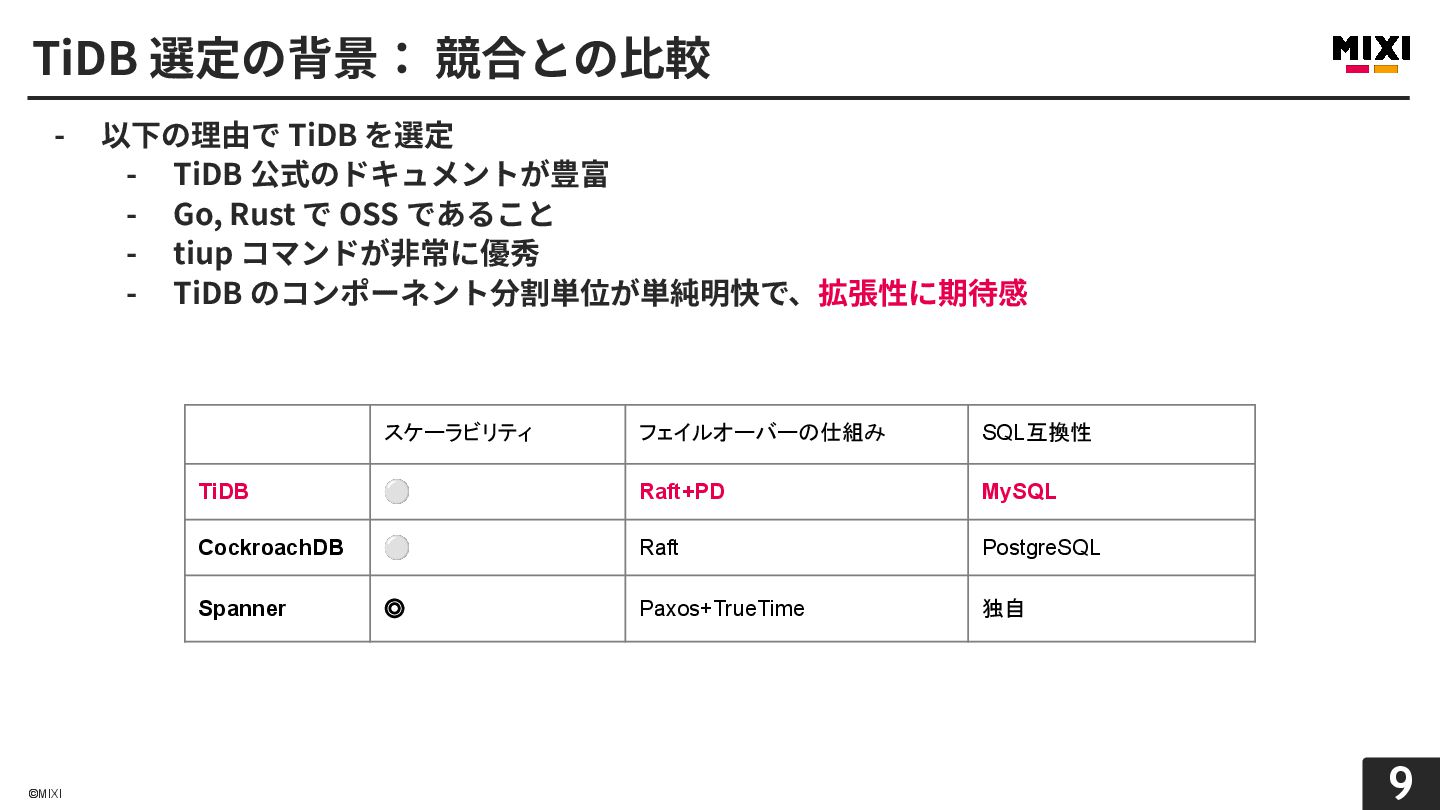
  4. ©MIXI 9 - 以下の理由で TiDB を選定 - TiDB 公式のドキュメントが豊富 -

    Go, Rust で OSS であること - tiup コマンドが⾮常に優秀 - TiDB のコンポーネント分割単位が単純明快で、拡張性に期待感 TiDB 選定の背景: 競合との⽐較 スケーラビリティ フェイルオーバーの仕組み SQL互換性 TiDB ⚪ Raft+PD MySQL CockroachDB ⚪ Raft PostgreSQL Spanner ◎ Paxos+TrueTime 独自
  5. ©MIXI 10 アジェンダ 導⼊  mixi2 のサービス紹介‧アーキテクチャ紹介‧ TiDB を選定した理由を話します 01 TiDB

    の紹介 開発⽬線‧運⽤⽬線で捉えた TiDB の魅⼒を紹介します 02 mixi2 の課題 ビジネス的‧技術的側⾯で mixi2 が抱える問題を⾚裸々に話します 03 課題の解決 その課題を TiDB を使ったアプローチでいかに解決したかを話します 04 まとめ  05
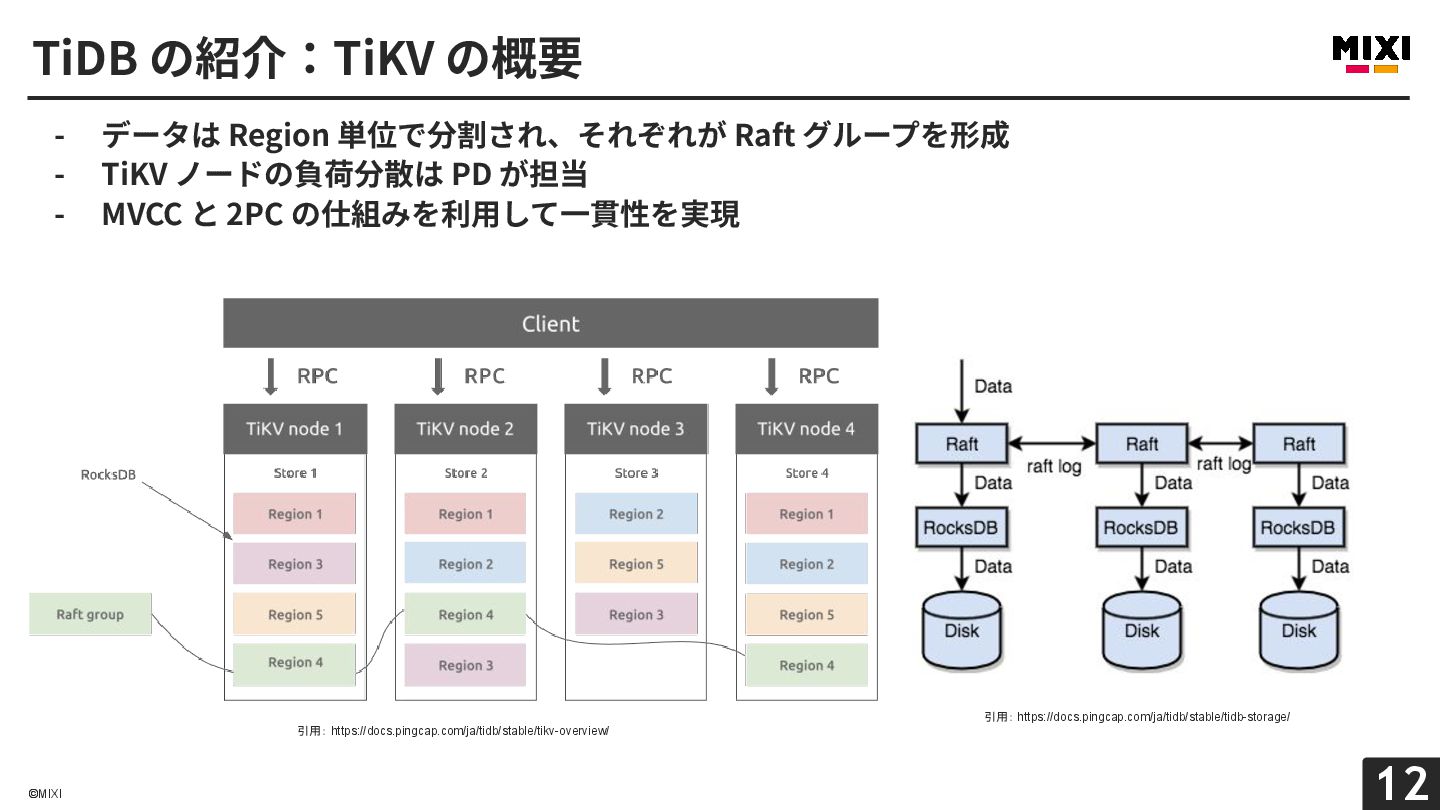
  6. ©MIXI 12 - データは Region 単位で分割され、それぞれが Raft グループを形成 - TiKV

    ノードの負荷分散は PD が担当 - MVCC と 2PC の仕組みを利⽤して⼀貫性を実現 TiDB の紹介:TiKV の概要 引用: https://docs.pingcap.com/ja/tidb/stable/tikv-overview/ 引用: https://docs.pingcap.com/ja/tidb/stable/tidb-storage/
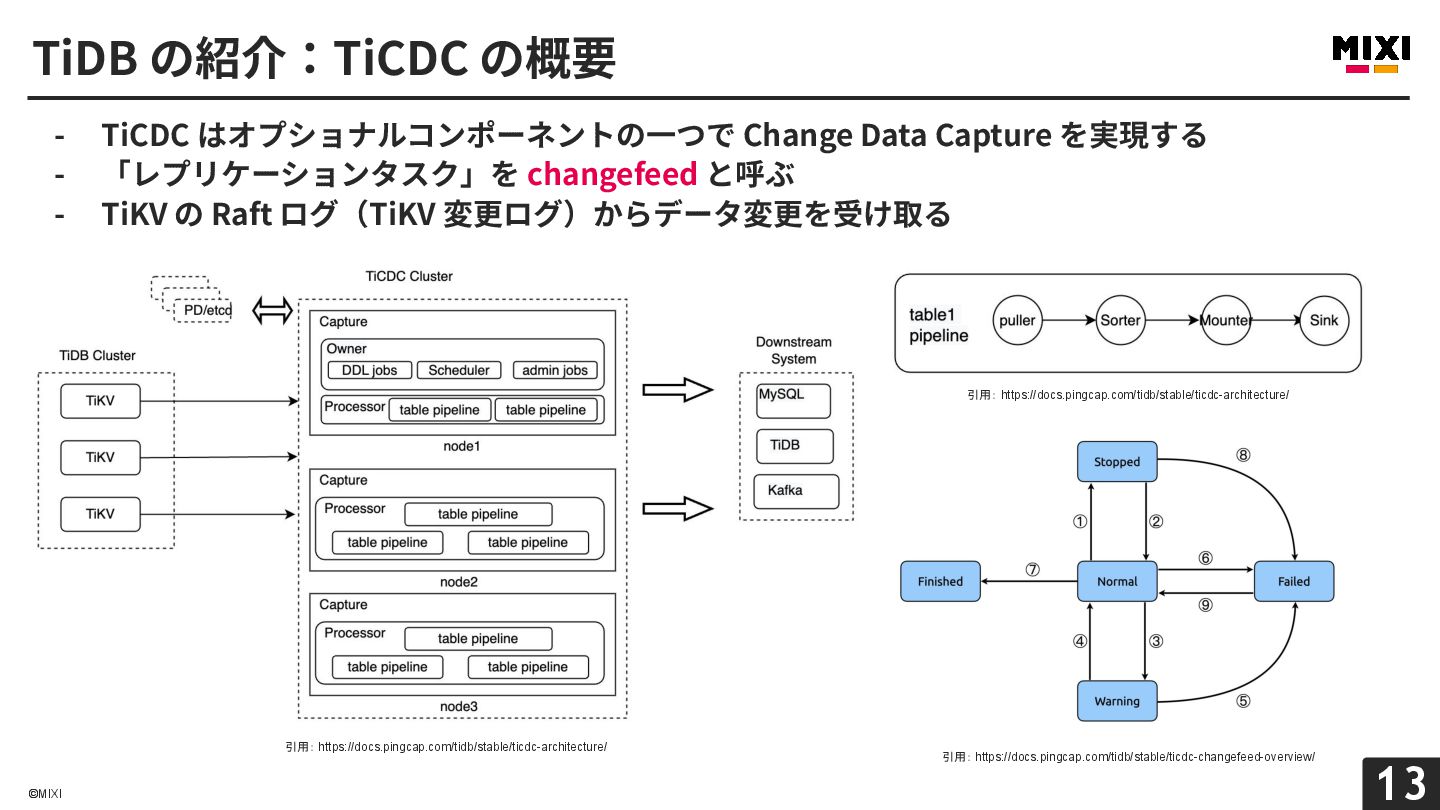
  7. ©MIXI 13 - TiCDC はオプショナルコンポーネントの⼀つで Change Data Capture を実現する -

    「レプリケーションタスク」を changefeed と呼ぶ - TiKV の Raft ログ(TiKV 変更ログ)からデータ変更を受け取る TiDB の紹介:TiCDC の概要 引用: https://docs.pingcap.com/tidb/stable/ticdc-architecture/ 引用: https://docs.pingcap.com/tidb/stable/ticdc-architecture/ 引用: https://docs.pingcap.com/tidb/stable/ticdc-changefeed-overview/
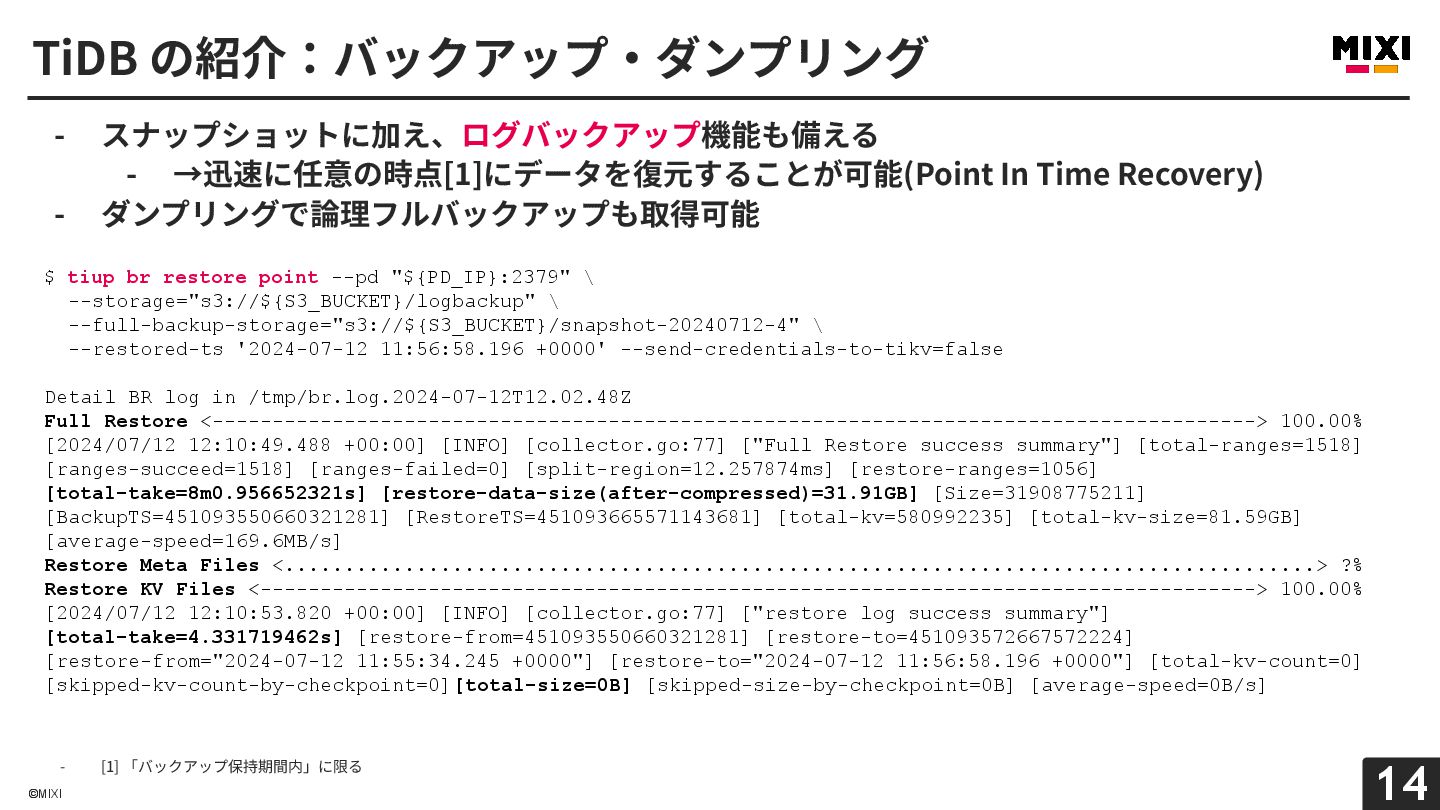
  8. ©MIXI 14 - [1] 「バックアップ保持期間内」に限る - スナップショットに加え、ログバックアップ機能も備える - →迅速に任意の時点[1]にデータを復元することが可能(Point In

    Time Recovery) - ダンプリングで論理フルバックアップも取得可能 TiDB の紹介:バックアップ‧ダンプリング $ tiup br restore point --pd "${PD_IP}:2379" \ --storage="s3://${S3_BUCKET}/logbackup" \ --full-backup-storage="s3://${S3_BUCKET}/snapshot-20240712-4" \ --restored-ts '2024-07-12 11:56:58.196 +0000' --send-credentials-to-tikv=false Detail BR log in /tmp/br.log.2024-07-12T12.02.48Z Full Restore <---------------------------------------------------------------------------------------> 100.00% [2024/07/12 12:10:49.488 +00:00] [INFO] [collector.go:77] ["Full Restore success summary"] [total-ranges=1518] [ranges-succeed=1518] [ranges-failed=0] [split-region=12.257874ms] [restore-ranges=1056] [total-take=8m0.956652321s] [restore-data-size(after-compressed)=31.91GB] [Size=31908775211] [BackupTS=451093550660321281] [RestoreTS=451093665571143681] [total-kv=580992235] [total-kv-size=81.59GB] [average-speed=169.6MB/s] Restore Meta Files <......................................................................................> ?% Restore KV Files <-----------------------------------------------------------------------------------> 100.00% [2024/07/12 12:10:53.820 +00:00] [INFO] [collector.go:77] ["restore log success summary"] [total-take=4.331719462s] [restore-from=451093550660321281] [restore-to=451093572667572224] [restore-from="2024-07-12 11:55:34.245 +0000"] [restore-to="2024-07-12 11:56:58.196 +0000"] [total-kv-count=0] [skipped-kv-count-by-checkpoint=0] [total-size=0B] [skipped-size-by-checkpoint=0B] [average-speed=0B/s]
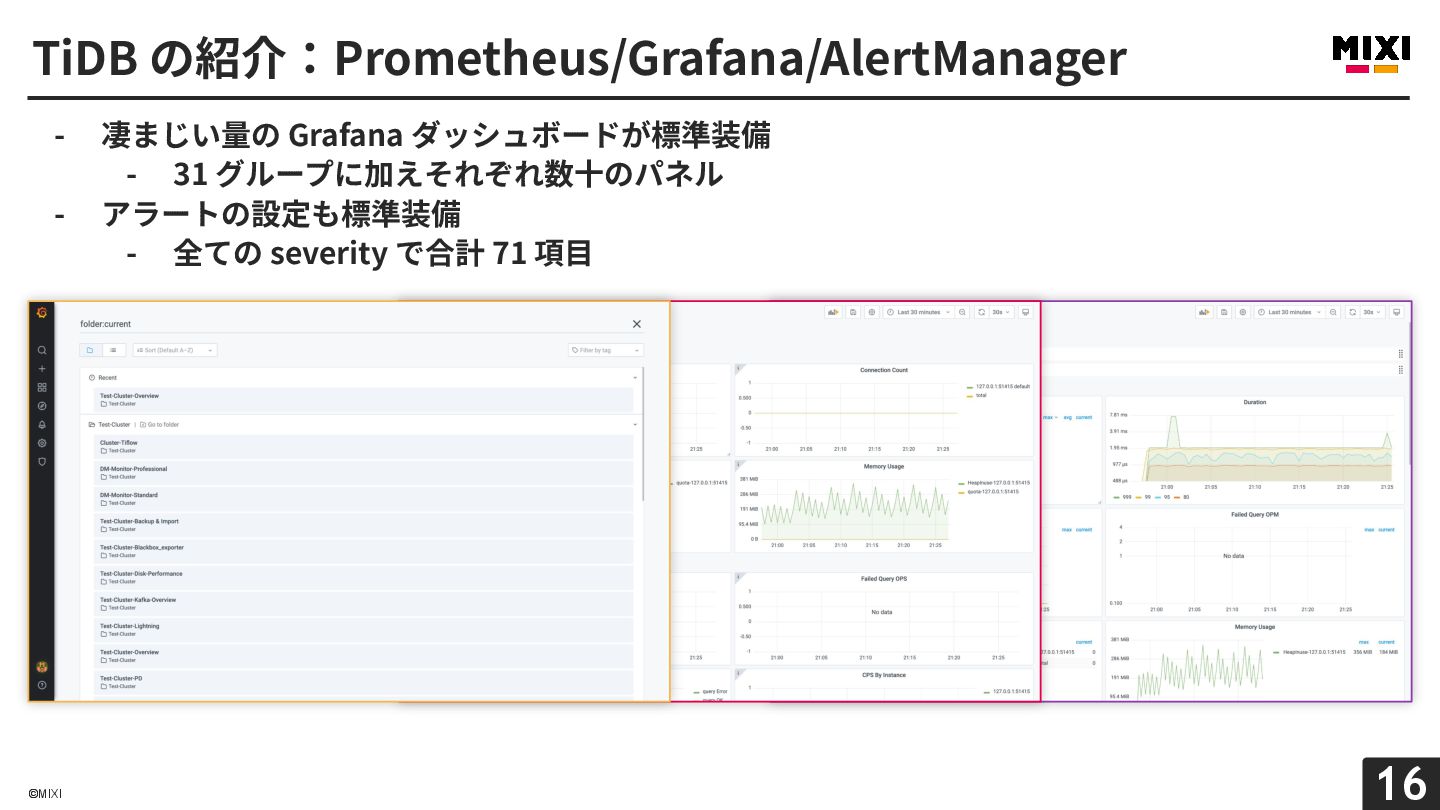
  9. ©MIXI 16 - 凄まじい量の Grafana ダッシュボードが標準装備 - 31 グループに加えそれぞれ数⼗のパネル -

    アラートの設定も標準装備 - 全ての severity で合計 71 項⽬ TiDB の紹介:Prometheus/Grafana/AlertManager
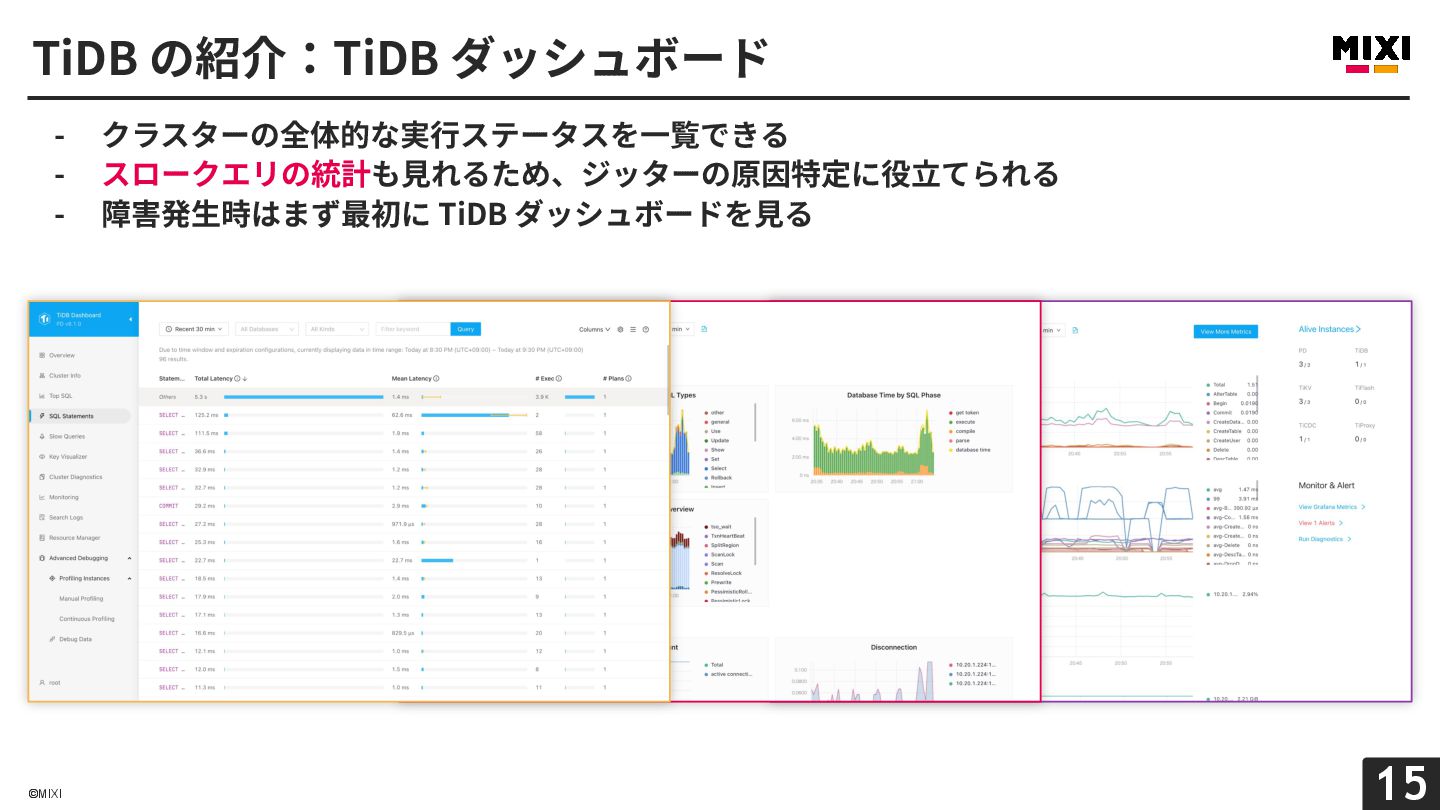
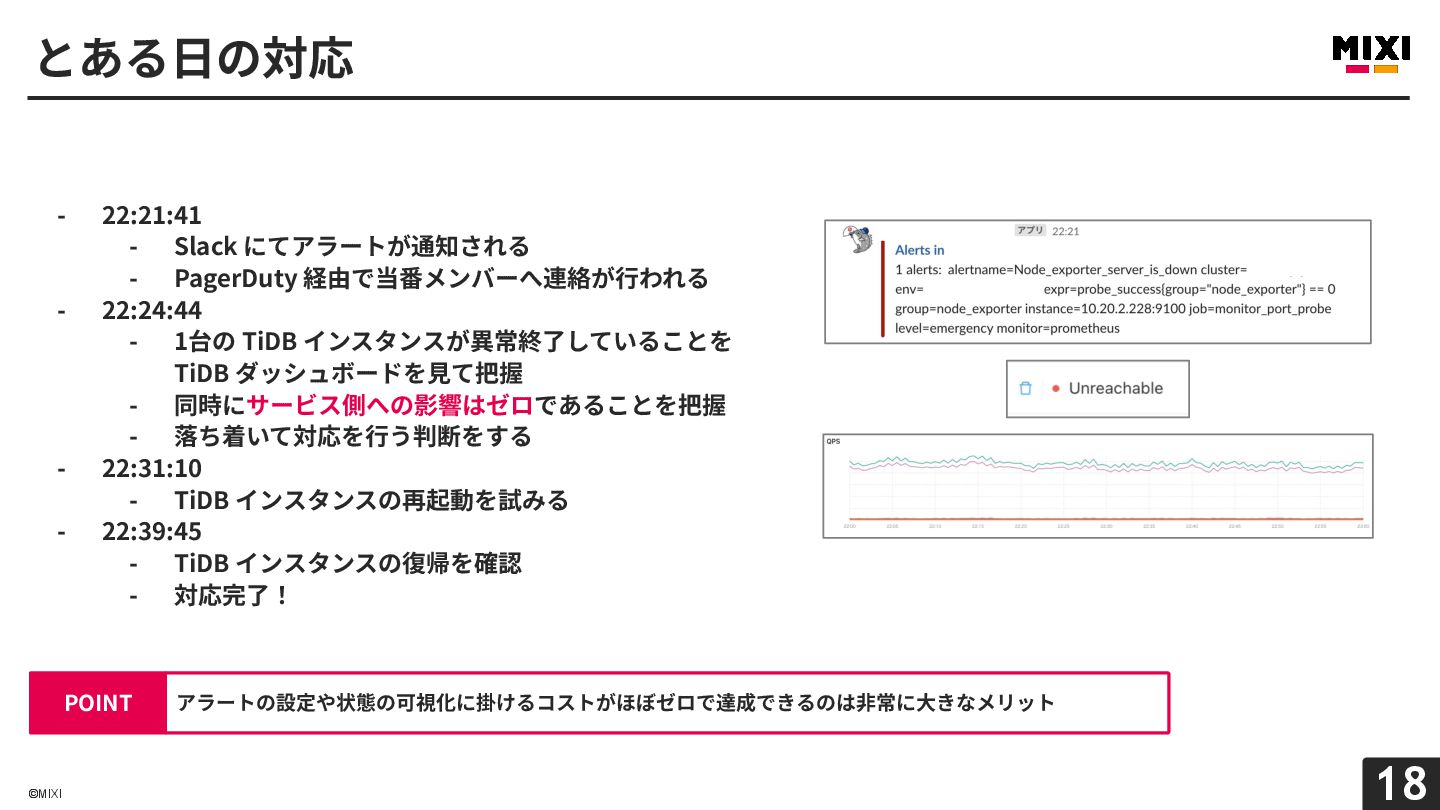
  10. ©MIXI 18 - 22:21:41 - Slack にてアラートが通知される - PagerDuty 経由で当番メンバーへ連絡が⾏われる

    - 22:24:44 - 1台の TiDB インスタンスが異常終了していることを TiDB ダッシュボードを⾒て把握 - 同時にサービス側への影響はゼロであることを把握 - 落ち着いて対応を⾏う判断をする - 22:31:10 - TiDB インスタンスの再起動を試みる - 22:39:45 - TiDB インスタンスの復帰を確認 - 対応完了! とある⽇の対応 アラートの設定や状態の可視化に掛けるコストがほぼゼロで達成できるのは⾮常に⼤きなメリット POINT
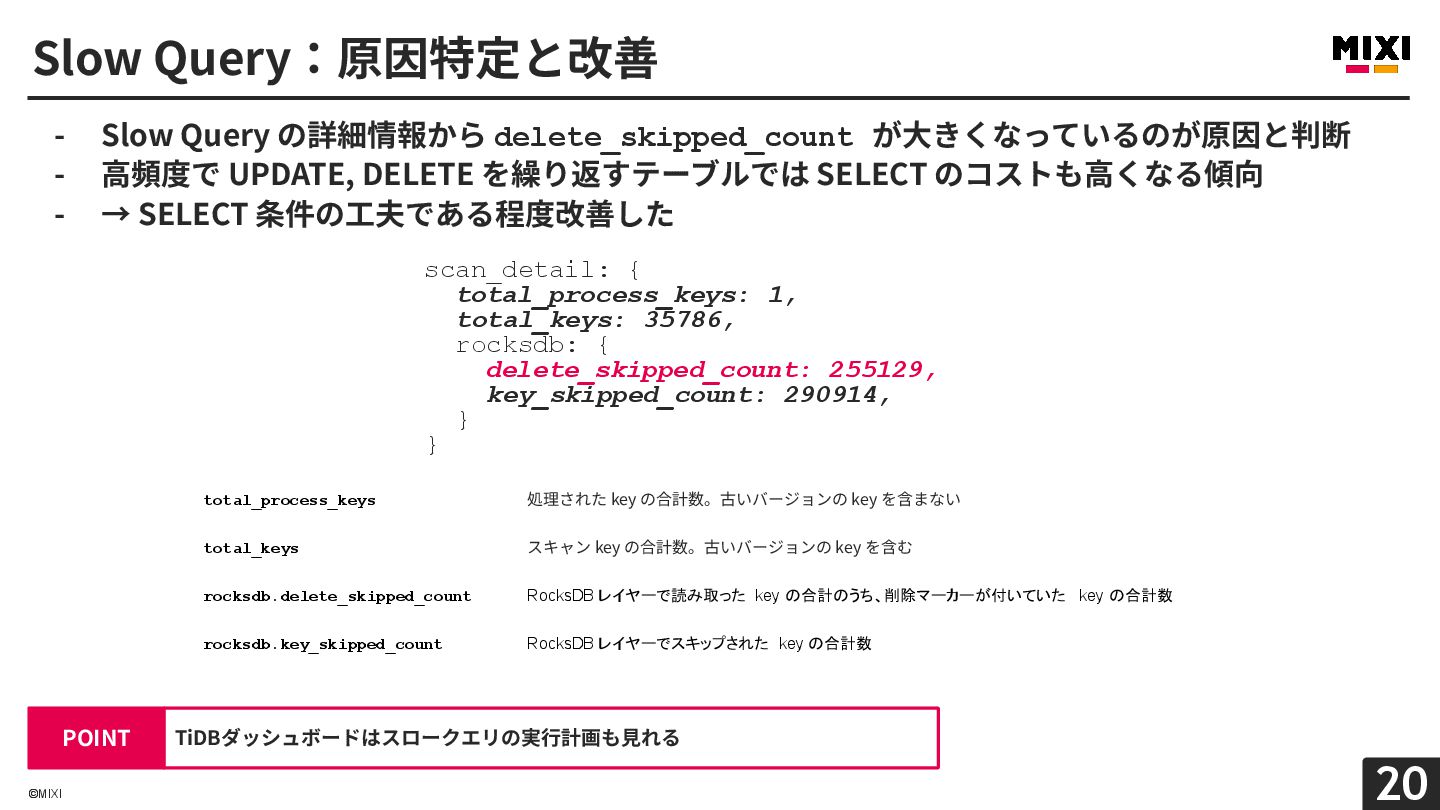
  11. ©MIXI 20 Slow Query:原因特定と改善 - Slow Query の詳細情報から delete_skipped_count が⼤きくなっているのが原因と判断

    - ⾼頻度で UPDATE, DELETE を繰り返すテーブルでは SELECT のコストも⾼くなる傾向 - → SELECT 条件の⼯夫である程度改善した scan_detail: { total_process_keys: 1, total_keys: 35786, rocksdb: { delete_skipped_count: 255129, key_skipped_count: 290914, } } total_process_keys 処理された key の合計数。古いバージョンの key を含まない total_keys スキャン key の合計数。古いバージョンの key を含む rocksdb.delete_skipped_count RocksDB レイヤーで読み取った key の合計のうち、削除マーカーが付いていた key の合計数 rocksdb.key_skipped_count RocksDB レイヤーでスキップされた key の合計数 TiDBダッシュボードはスロークエリの実⾏計画も⾒れる POINT
  12. ©MIXI 21 アジェンダ 導⼊  mixi2 のサービス紹介‧アーキテクチャ紹介‧ TiDB を選定した理由を話します 01 TiDB

    の紹介 開発⽬線‧運⽤⽬線で捉えた TiDB の魅⼒を紹介します 02 mixi2 の課題 ビジネス的‧技術的側⾯で mixi2 が抱える問題を⾚裸々に話します 03 課題の解決 その課題を TiDB を使ったアプローチでいかに解決したかを話します 04 まとめ  05
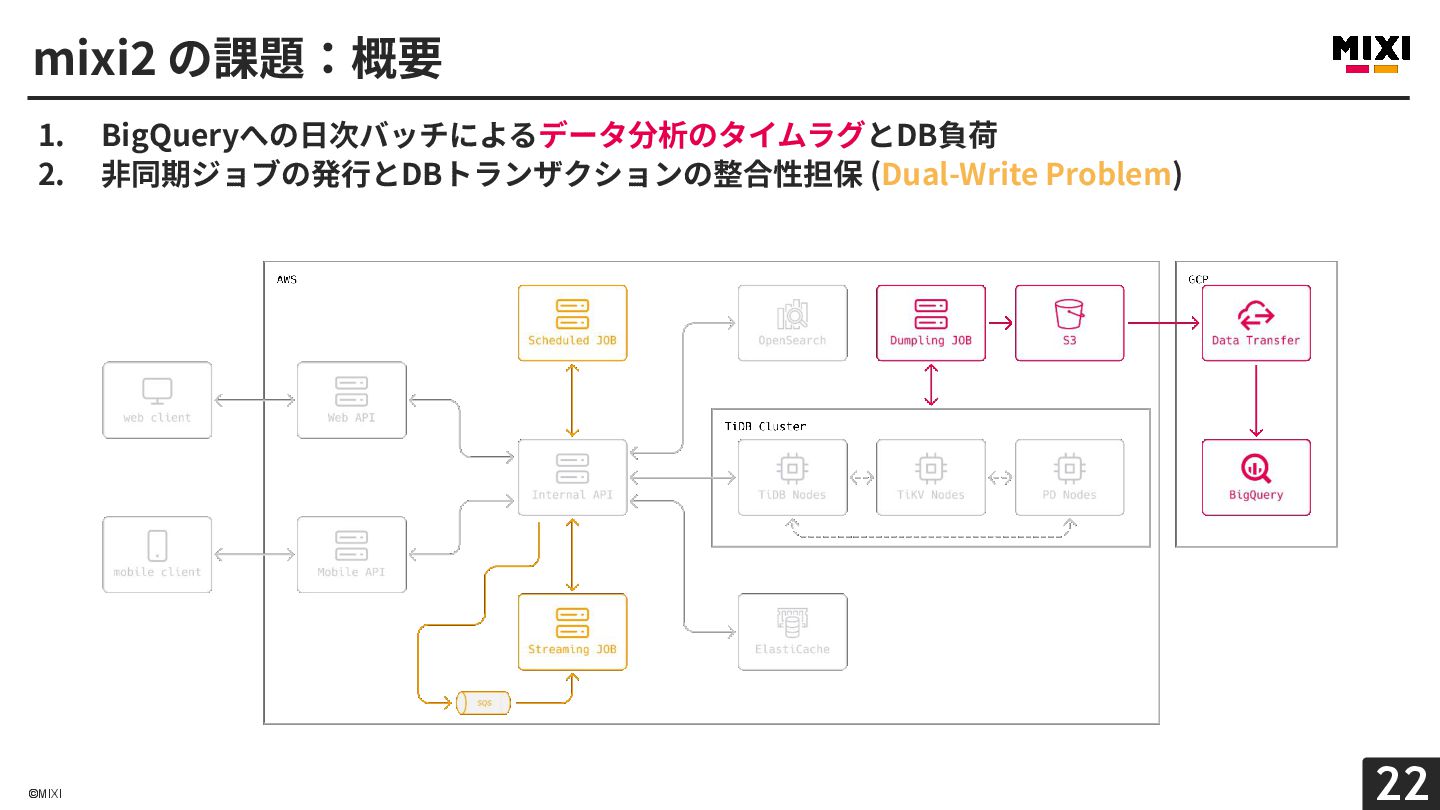
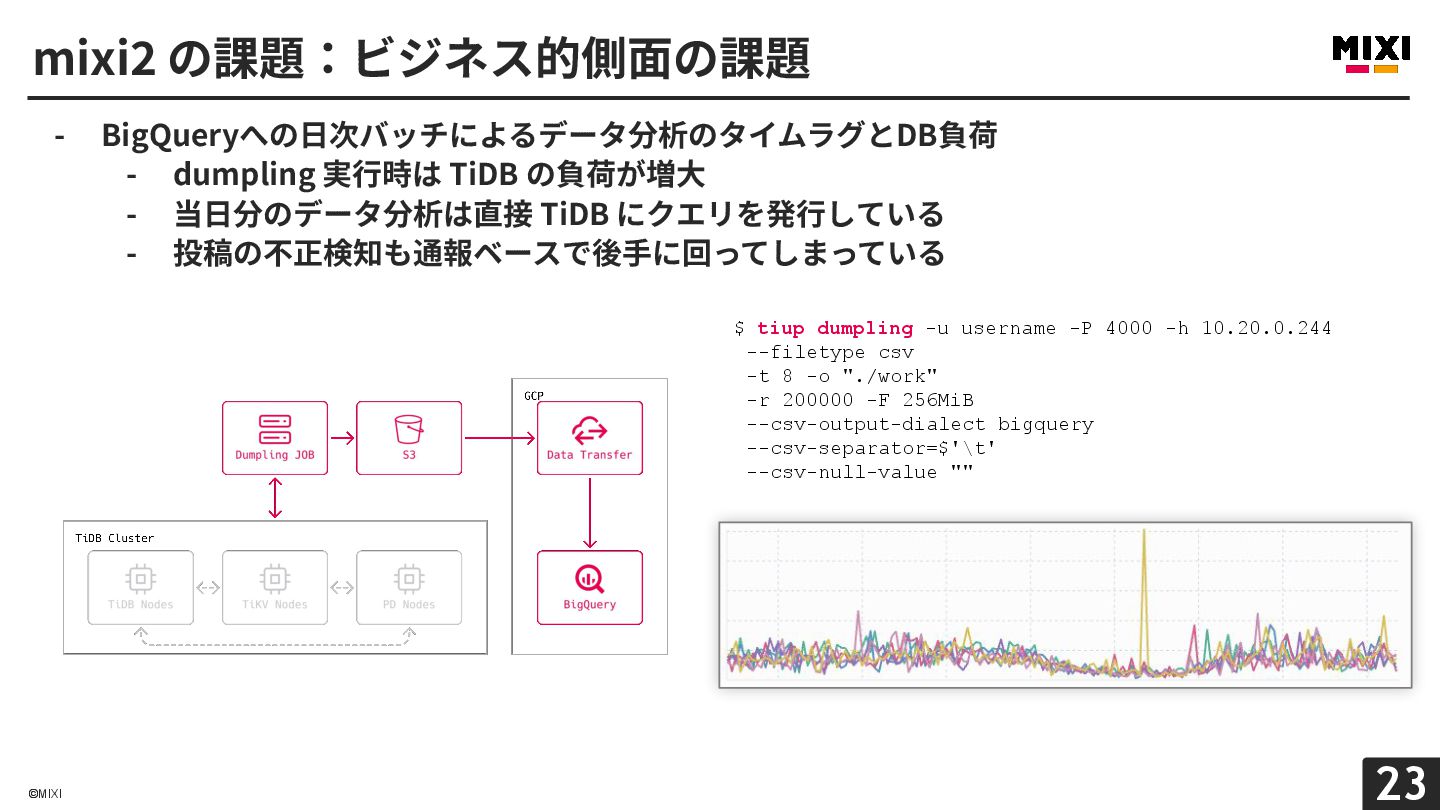
  13. ©MIXI 23 - BigQueryへの⽇次バッチによるデータ分析のタイムラグとDB負荷 - dumpling 実⾏時は TiDB の負荷が増⼤ -

    当⽇分のデータ分析は直接 TiDB にクエリを発⾏している - 投稿の不正検知も通報ベースで後⼿に回ってしまっている $ tiup dumpling -u username -P 4000 -h 10.20.0.244 --filetype csv -t 8 -o "./work" -r 200000 -F 256MiB --csv-output-dialect bigquery --csv-separator=$'\t' --csv-null-value "" mixi2 の課題:ビジネス的側⾯の課題
  14. ©MIXI 25 アジェンダ 導⼊  mixi2 のサービス紹介‧アーキテクチャ紹介‧ TiDB を選定した理由を話します 01 TiDB

    の紹介 開発⽬線‧運⽤⽬線で捉えた TiDB の魅⼒を紹介します 02 mixi2 の課題 ビジネス的‧技術的側⾯で mixi2 が抱える問題を⾚裸々に話します 03 課題の解決 その課題を TiDB を使ったアプローチでいかに解決したかを話します 04 まとめ  05
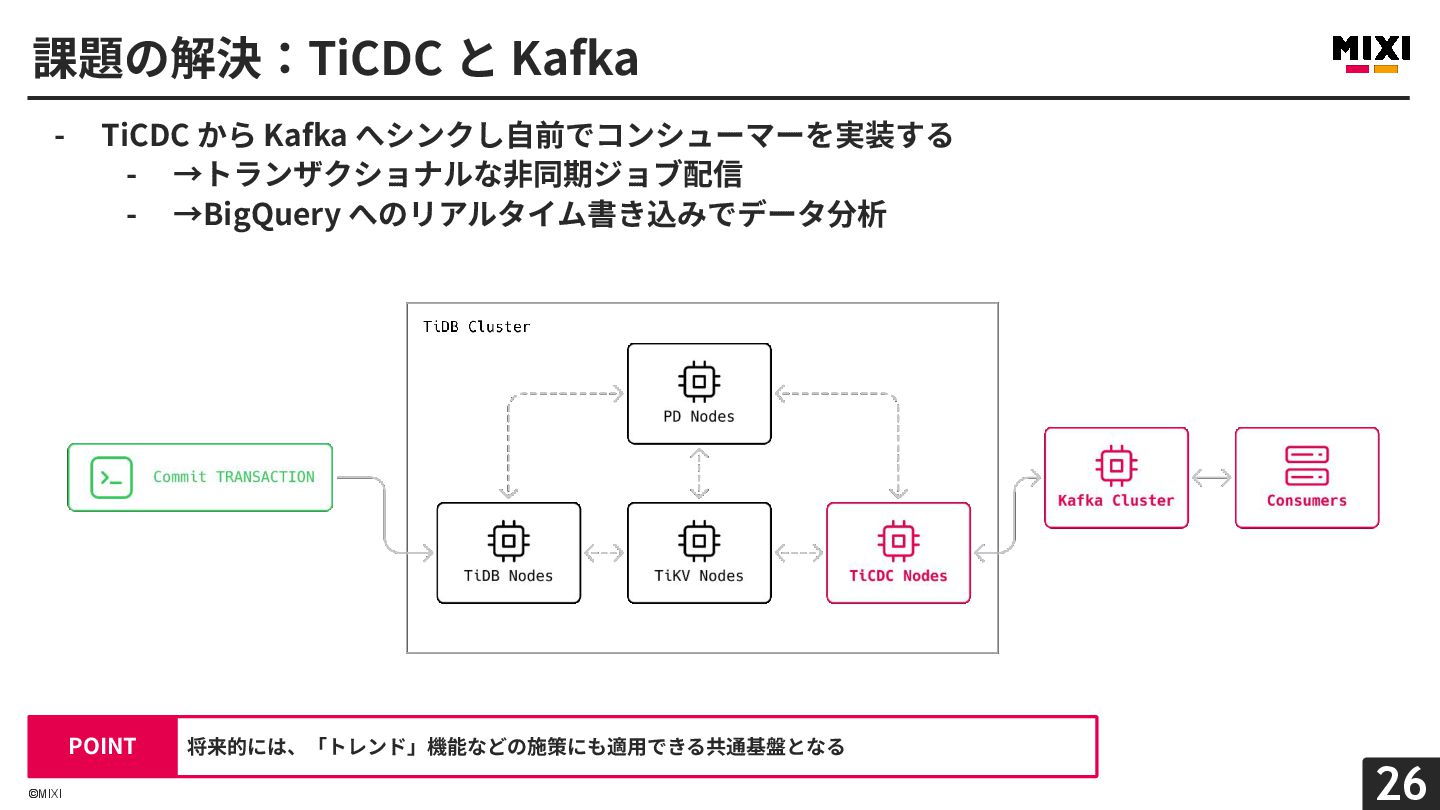
  15. ©MIXI 26 - TiCDC から Kafka へシンクし⾃前でコンシューマーを実装する - →トランザクショナルな⾮同期ジョブ配信 -

    →BigQuery へのリアルタイム書き込みでデータ分析 課題の解決:TiCDC と Kafka 将来的には、「トレンド」機能などの施策にも適⽤できる共通基盤となる POINT
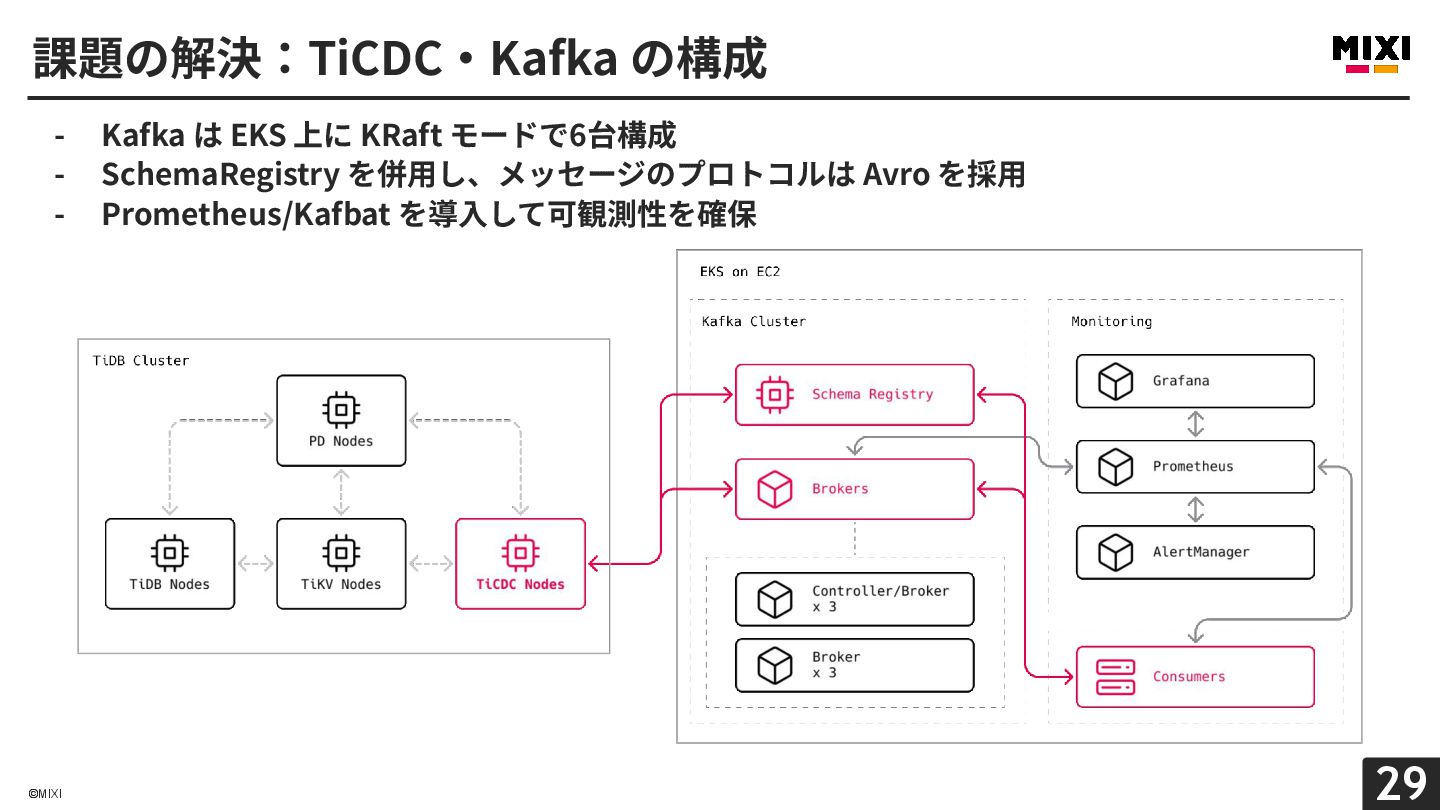
  16. ©MIXI 29 - Kafka は EKS 上に KRaft モードで6台構成 -

    SchemaRegistry を併⽤し、メッセージのプロトコルは Avro を採⽤ - Prometheus/Kafbat を導⼊して可観測性を確保 課題の解決:TiCDC‧Kafka の構成
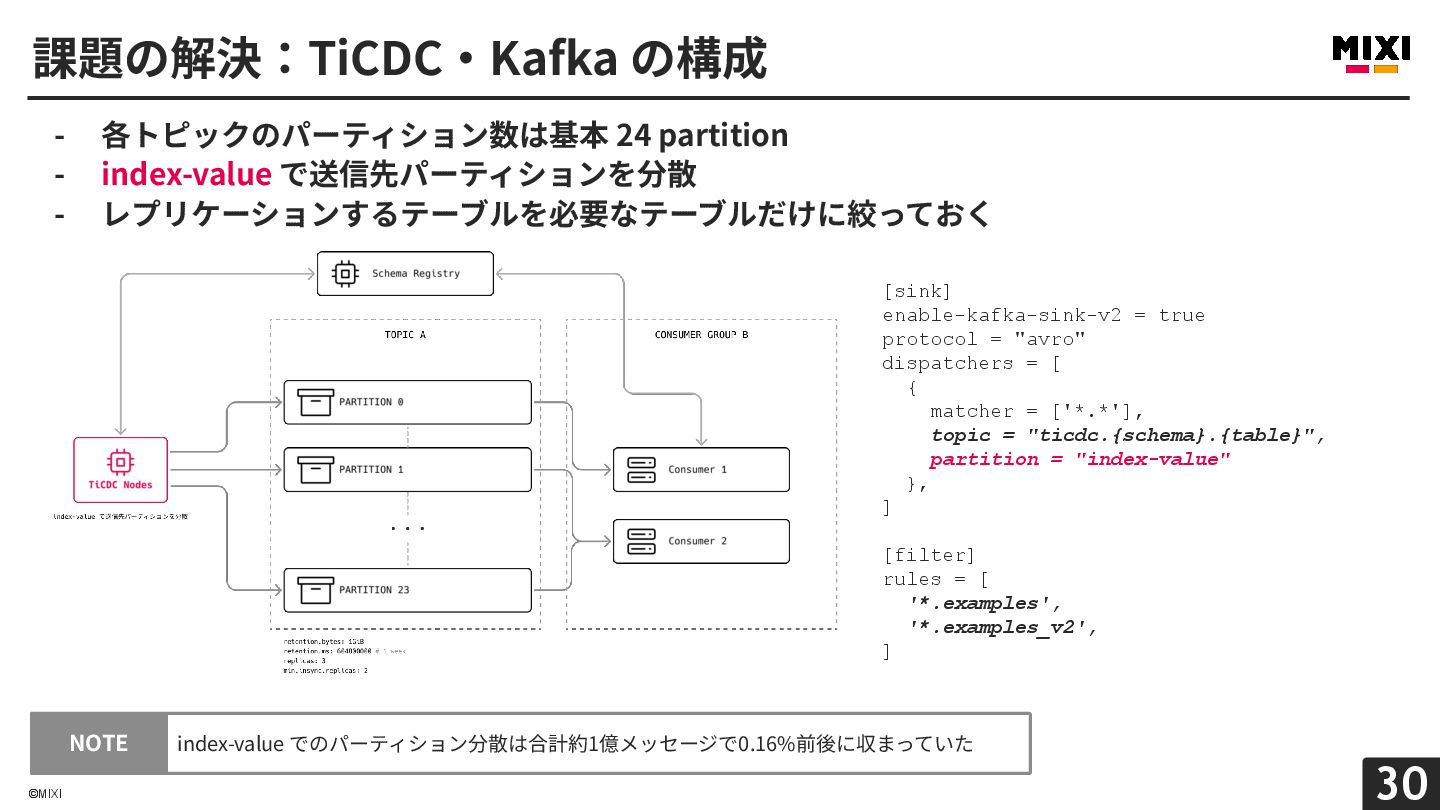
  17. ©MIXI 30 - 各トピックのパーティション数は基本 24 partition - index-value で送信先パーティションを分散 -

    レプリケーションするテーブルを必要なテーブルだけに絞っておく 課題の解決:TiCDC‧Kafka の構成 [sink] enable-kafka-sink-v2 = true protocol = "avro" dispatchers = [ { matcher = ['*.*'], topic = "ticdc.{schema}.{table}", partition = "index-value" }, ] [filter] rules = [ '*.examples', '*.examples_v2', ] index-value でのパーティション分散は合計約1億メッセージで0.16%前後に収まっていた NOTE
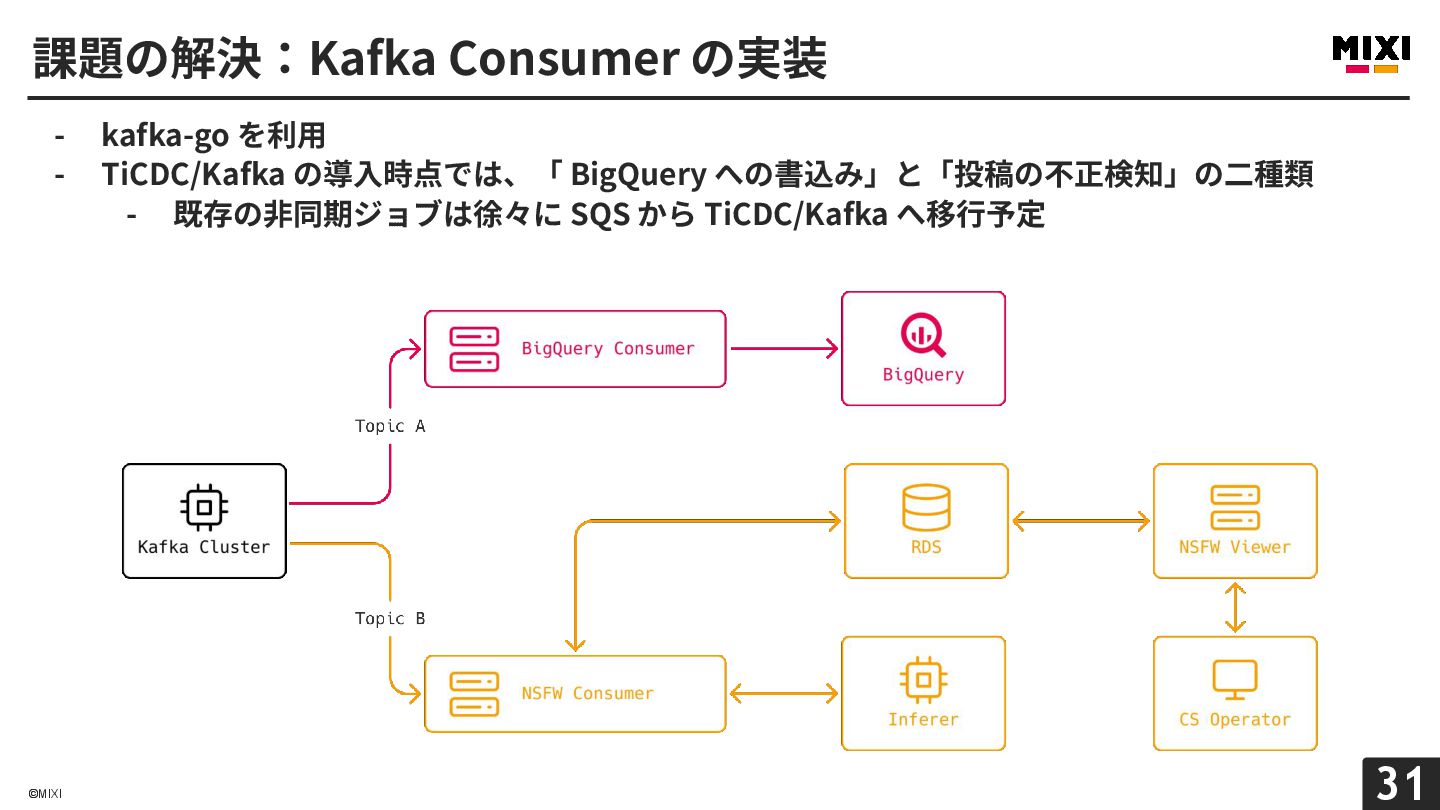
  18. ©MIXI 31 - kafka-go を利⽤ - TiCDC/Kafka の導⼊時点では、「 BigQuery への書込み」と「投稿の不正検知」の⼆種類

    - 既存の⾮同期ジョブは徐々に SQS から TiCDC/Kafka へ移⾏予定 課題の解決:Kafka Consumer の実装
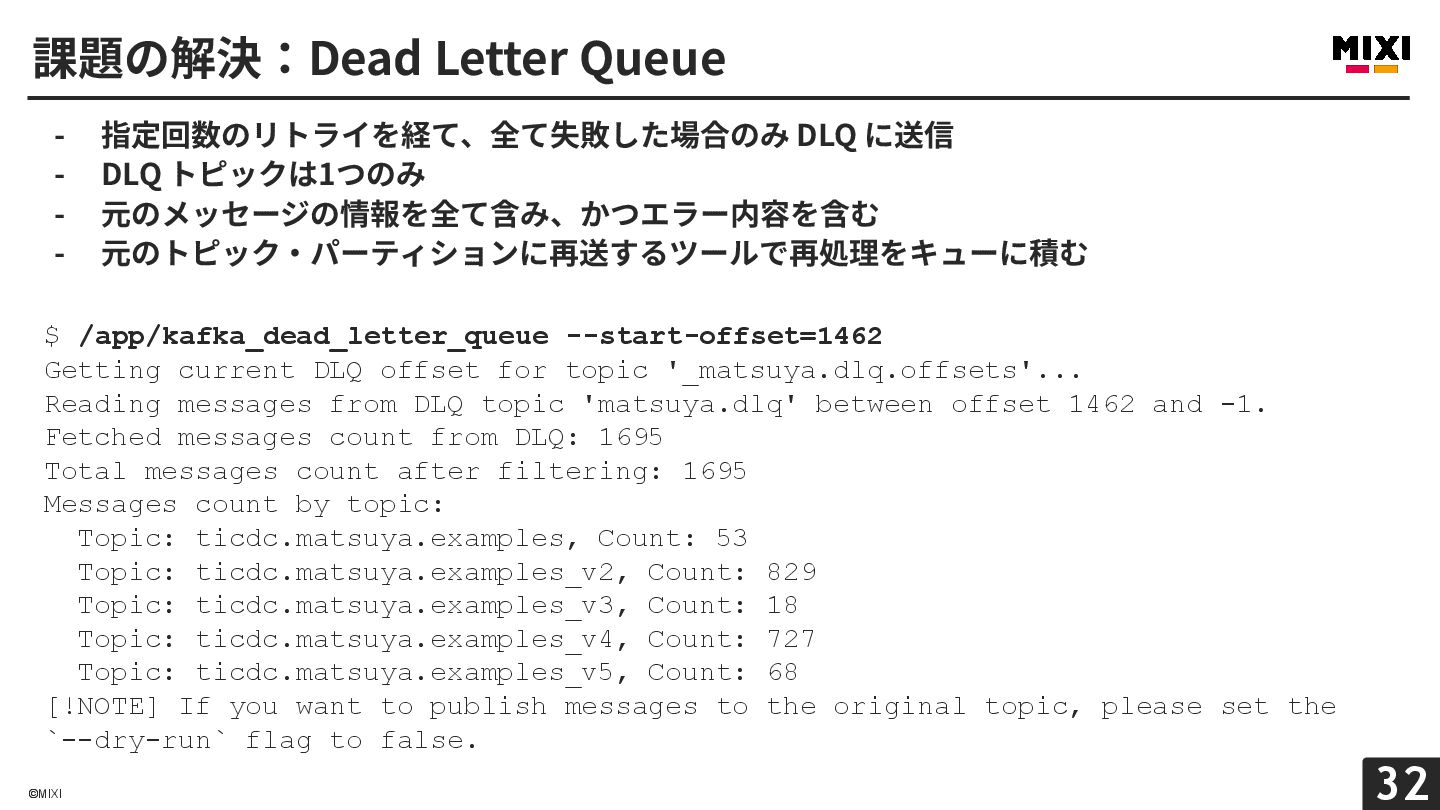
  19. ©MIXI 32 - 指定回数のリトライを経て、全て失敗した場合のみ DLQ に送信 - DLQ トピックは1つのみ -

    元のメッセージの情報を全て含み、かつエラー内容を含む - 元のトピック‧パーティションに再送するツールで再処理をキューに積む 課題の解決:Dead Letter Queue $ /app/kafka_dead_letter_queue --start-offset=1462 Getting current DLQ offset for topic '_matsuya.dlq.offsets'... Reading messages from DLQ topic 'matsuya.dlq' between offset 1462 and -1. Fetched messages count from DLQ: 1695 Total messages count after filtering: 1695 Messages count by topic: Topic: ticdc.matsuya.examples, Count: 53 Topic: ticdc.matsuya.examples_v2, Count: 829 Topic: ticdc.matsuya.examples_v3, Count: 18 Topic: ticdc.matsuya.examples_v4, Count: 727 Topic: ticdc.matsuya.examples_v5, Count: 68 [!NOTE] If you want to publish messages to the original topic, please set the `--dry-run` flag to false.
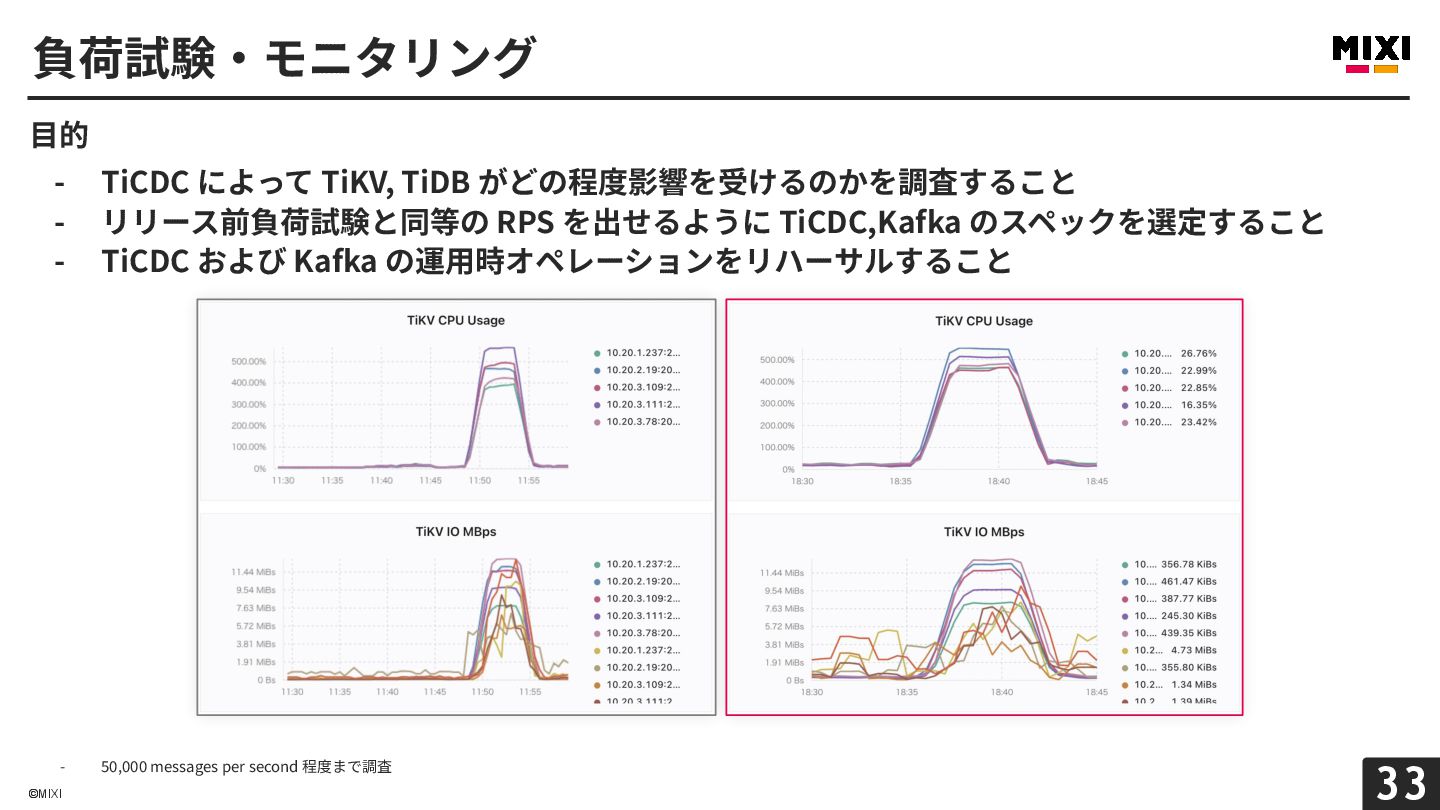
  20. ©MIXI 33 ⽬的 - TiCDC によって TiKV, TiDB がどの程度影響を受けるのかを調査すること -

    リリース前負荷試験と同等の RPS を出せるように TiCDC,Kafka のスペックを選定すること - TiCDC および Kafka の運⽤時オペレーションをリハーサルすること 負荷試験‧モニタリング - 50,000 messages per second 程度まで調査
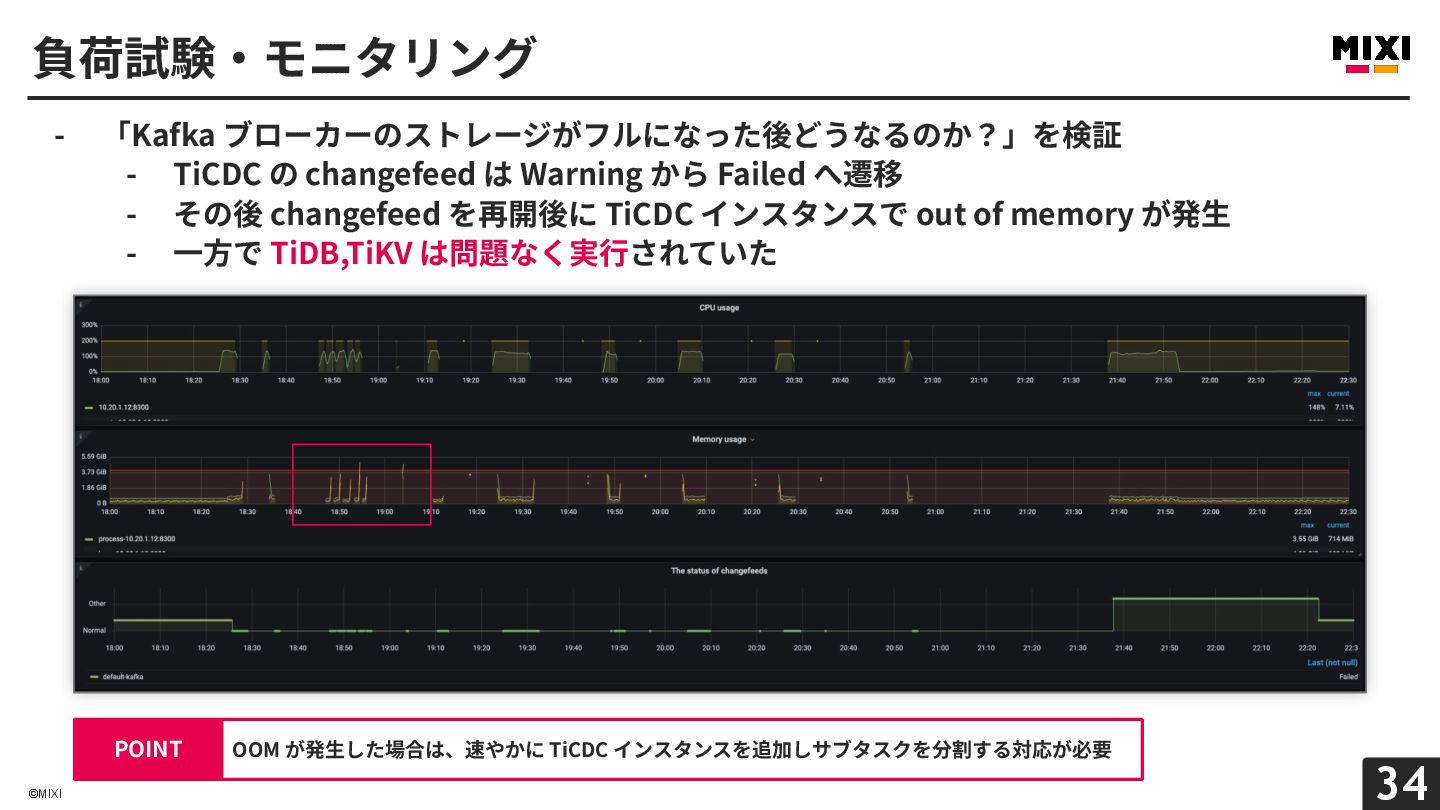
  21. ©MIXI 34 - 「Kafka ブローカーのストレージがフルになった後どうなるのか?」を検証 - TiCDC の changefeed は

    Warning から Failed へ遷移 - その後 changefeed を再開後に TiCDC インスタンスで out of memory が発⽣ - ⼀⽅で TiDB,TiKV は問題なく実⾏されていた 負荷試験‧モニタリング OOM が発⽣した場合は、速やかに TiCDC インスタンスを追加しサブタスクを分割する対応が必要 POINT
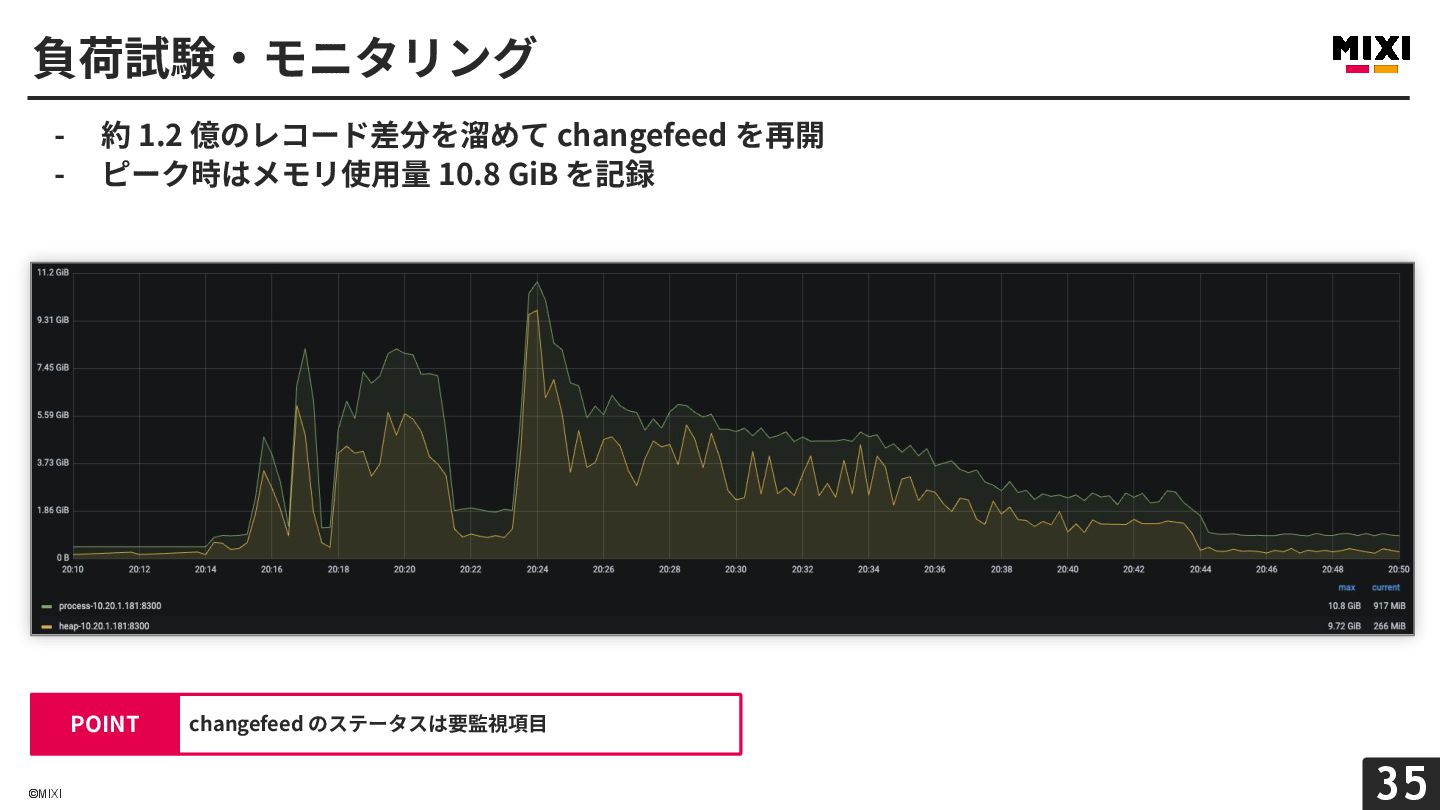
  22. ©MIXI 35 - 約 1.2 億のレコード差分を溜めて changefeed を再開 - ピーク時はメモリ使⽤量

    10.8 GiB を記録 負荷試験‧モニタリング changefeed のステータスは要監視項⽬ POINT
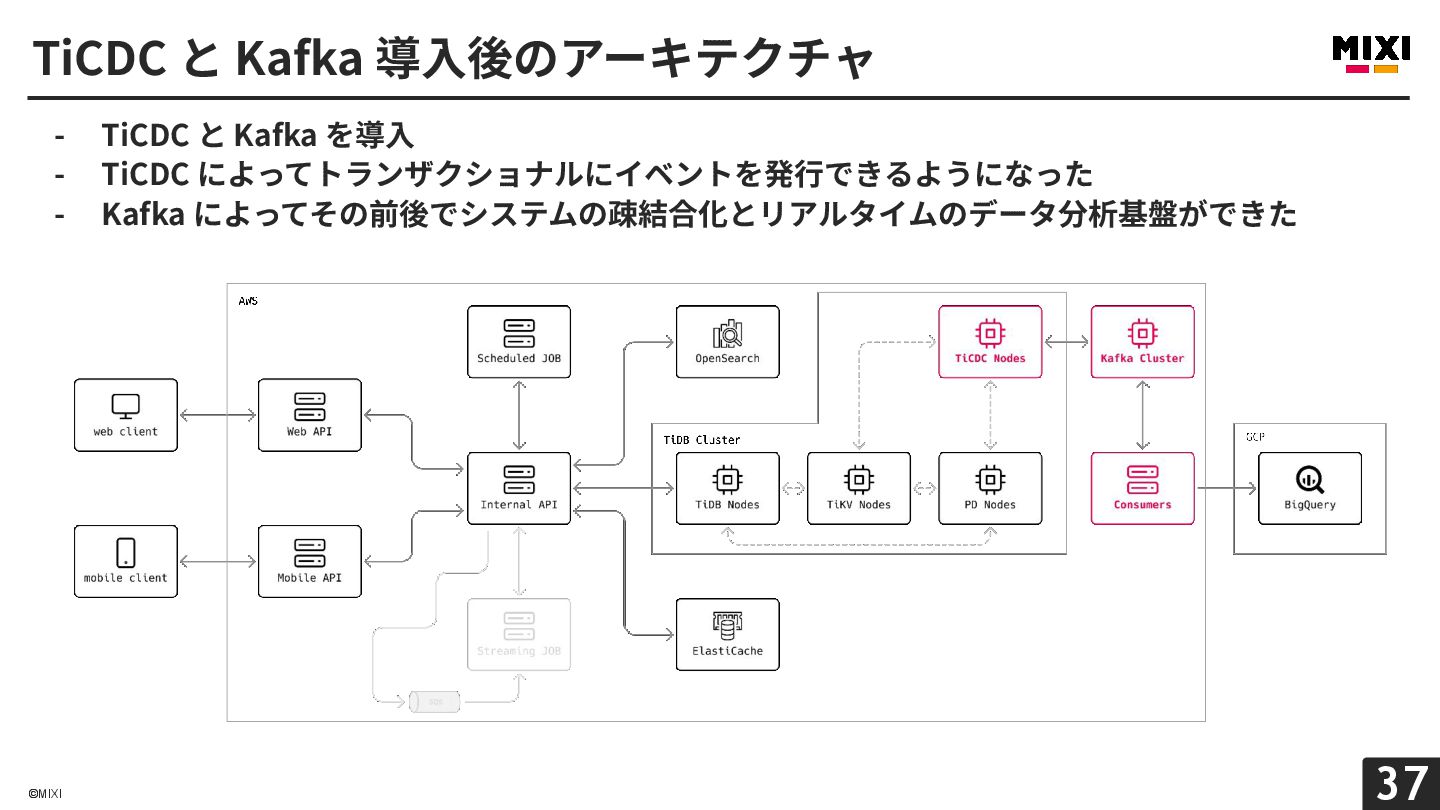
  23. ©MIXI 37 - TiCDC と Kafka を導⼊ - TiCDC によってトランザクショナルにイベントを発⾏できるようになった

    - Kafka によってその前後でシステムの疎結合化とリアルタイムのデータ分析基盤ができた TiCDC と Kafka 導⼊後のアーキテクチャ
  24. ©MIXI 38 アジェンダ 導⼊  mixi2 のサービス紹介‧アーキテクチャ紹介‧ TiDB を選定した理由を話します 01 TiDB

    の紹介 開発⽬線‧運⽤⽬線で捉えた TiDB の魅⼒を紹介します 02 mixi2 の課題 ビジネス的‧技術的側⾯で mixi2 が抱える問題を⾚裸々に話します 03 課題の解決 その課題を TiDB を使ったアプローチでいかに解決したかを話します 04 まとめ  05