Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Jev勉強会
Search
Takeshi Kato
September 28, 2026
Technology
14
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Jev勉強会
Takeshi Kato
September 28, 2026
Other Decks in Technology
See All in Technology
実践!Cloud Run ハンズオン!! / Cloud Run handson
y0hgi
2
280
ソフトウェア ファクトリー - 再現性のあるソフトウェアの工場づくり / Software factory
iktakahiro
6
4.9k
自作バイナリを動かす「入口」8選
puhitaku
2
1.3k
DevelopersIO 2026 知識の地図を描く ─ オントロジーとは何か?
ishikawa_satoru
1
1.7k
re:Invent初参加で変わったこと、2回目にやってみたいこと(JAWS-UG彩の国埼玉 #12)
mhrtech
2
220
QA4AI 2026-Oct 生成AI時代の品質保証
tokuty
1
860
「Docker Desktop不要の時代」は 来たのか?
ueponx
0
770
Tofu-Controller lightning talk @ Containerday 2026
gionn
0
100
脆弱性診断って、何をしているの? 〜弱点を見つけて、会社の改善につなげるまで〜
keeg
0
920
Claude の新機能を、 出た日に触って社内に届けるまで
rfdnxbro
1
170
Running Kotlin + Quarkus with Lambda
nealle
1
3.7k
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
140
Featured
See All Featured
Building Flexible Design Systems
yeseniaperezcruz
330
41k
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.9k
Tips & Tricks on How to Get Your First Job In Tech
honzajavorek
1
800
The Mindset for Success: Future Career Progression
greggifford
PRO
0
540
Test your architecture with Archunit
thirion
2
2.4k
Mobile First: as difficult as doing things right
swwweet
225
10k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
sira's awesome portfolio website redesign presentation
elsirapls
0
450
Accessibility Awareness
sabderemane
1
250
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
530
Transcript
Jev ——文章を書かないAIで、エージェントの「判定」を速く安くする
9月15日、新しい種類のAIが出た Jev ジェブ。TypeSafe AI、9月15日公開 ChatGPT や Claude とは、やることが違うAIです。 2
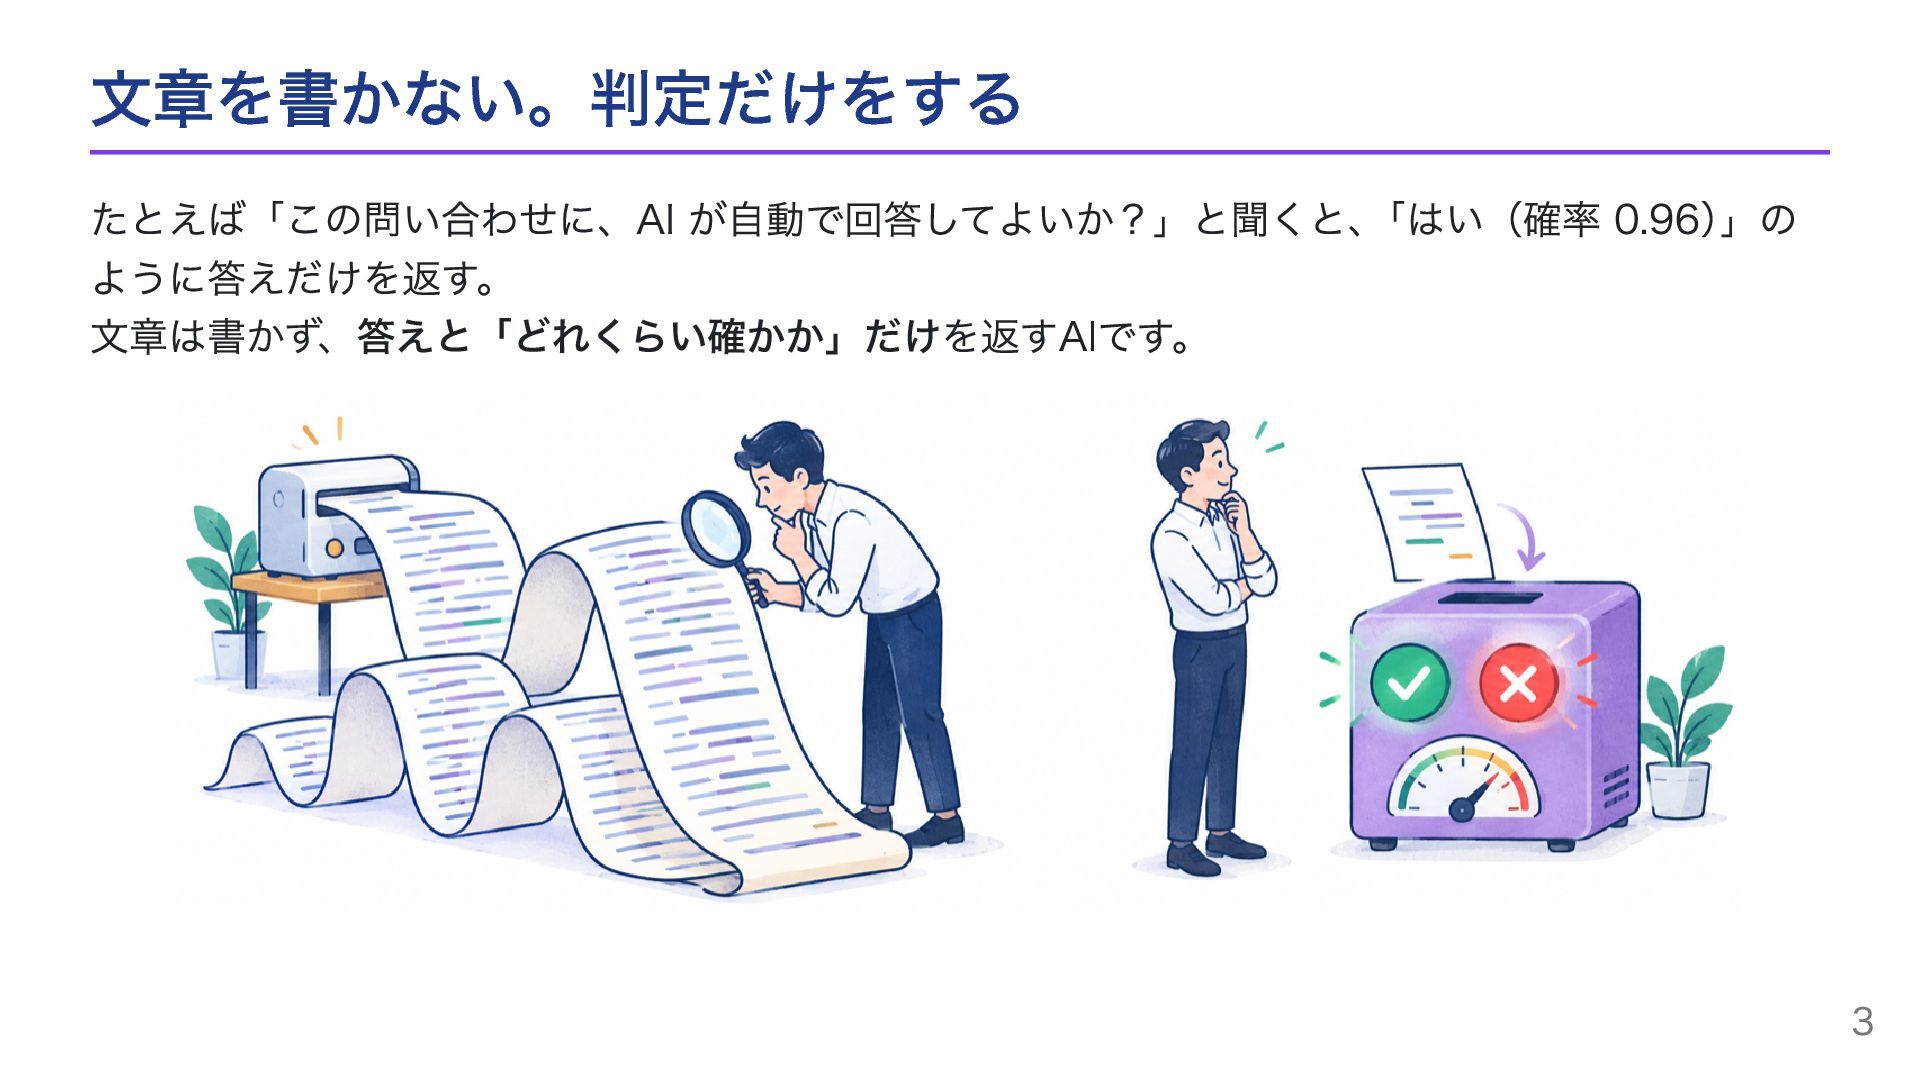
文章を書かない。判定だけをする たとえば「この問い合わせに、AI が自動で回答してよいか?」と聞くと、「はい(確率 0.96)」の ように答えだけを返す。 文章は書かず、答えと「どれくらい確かか」だけを返すAIです。 3
いま、話題になっている 公開から1週間で、AI開発の主な基盤サービス(Vercel、Cloudflare、LangChain)が対応。 Qiita では公式イベントが開かれ、1週間で 76本 の「試してみた」記事。 「文章を書かないAI」が、なぜこんなに注目されているのか。今日はそこから話します 4
今日の流れ 1. なぜうれしいのか —— AIエージェント(AIに仕事を任せる仕組み)の中の「判定」の問題 2. どう使われているか —— 実際のユースケース 3.
仕組みの解説 4. 公開1週間で真似された。この先どうなるか 5
第1部 なぜうれしいのか —— エージェントの「判定」の問題 6
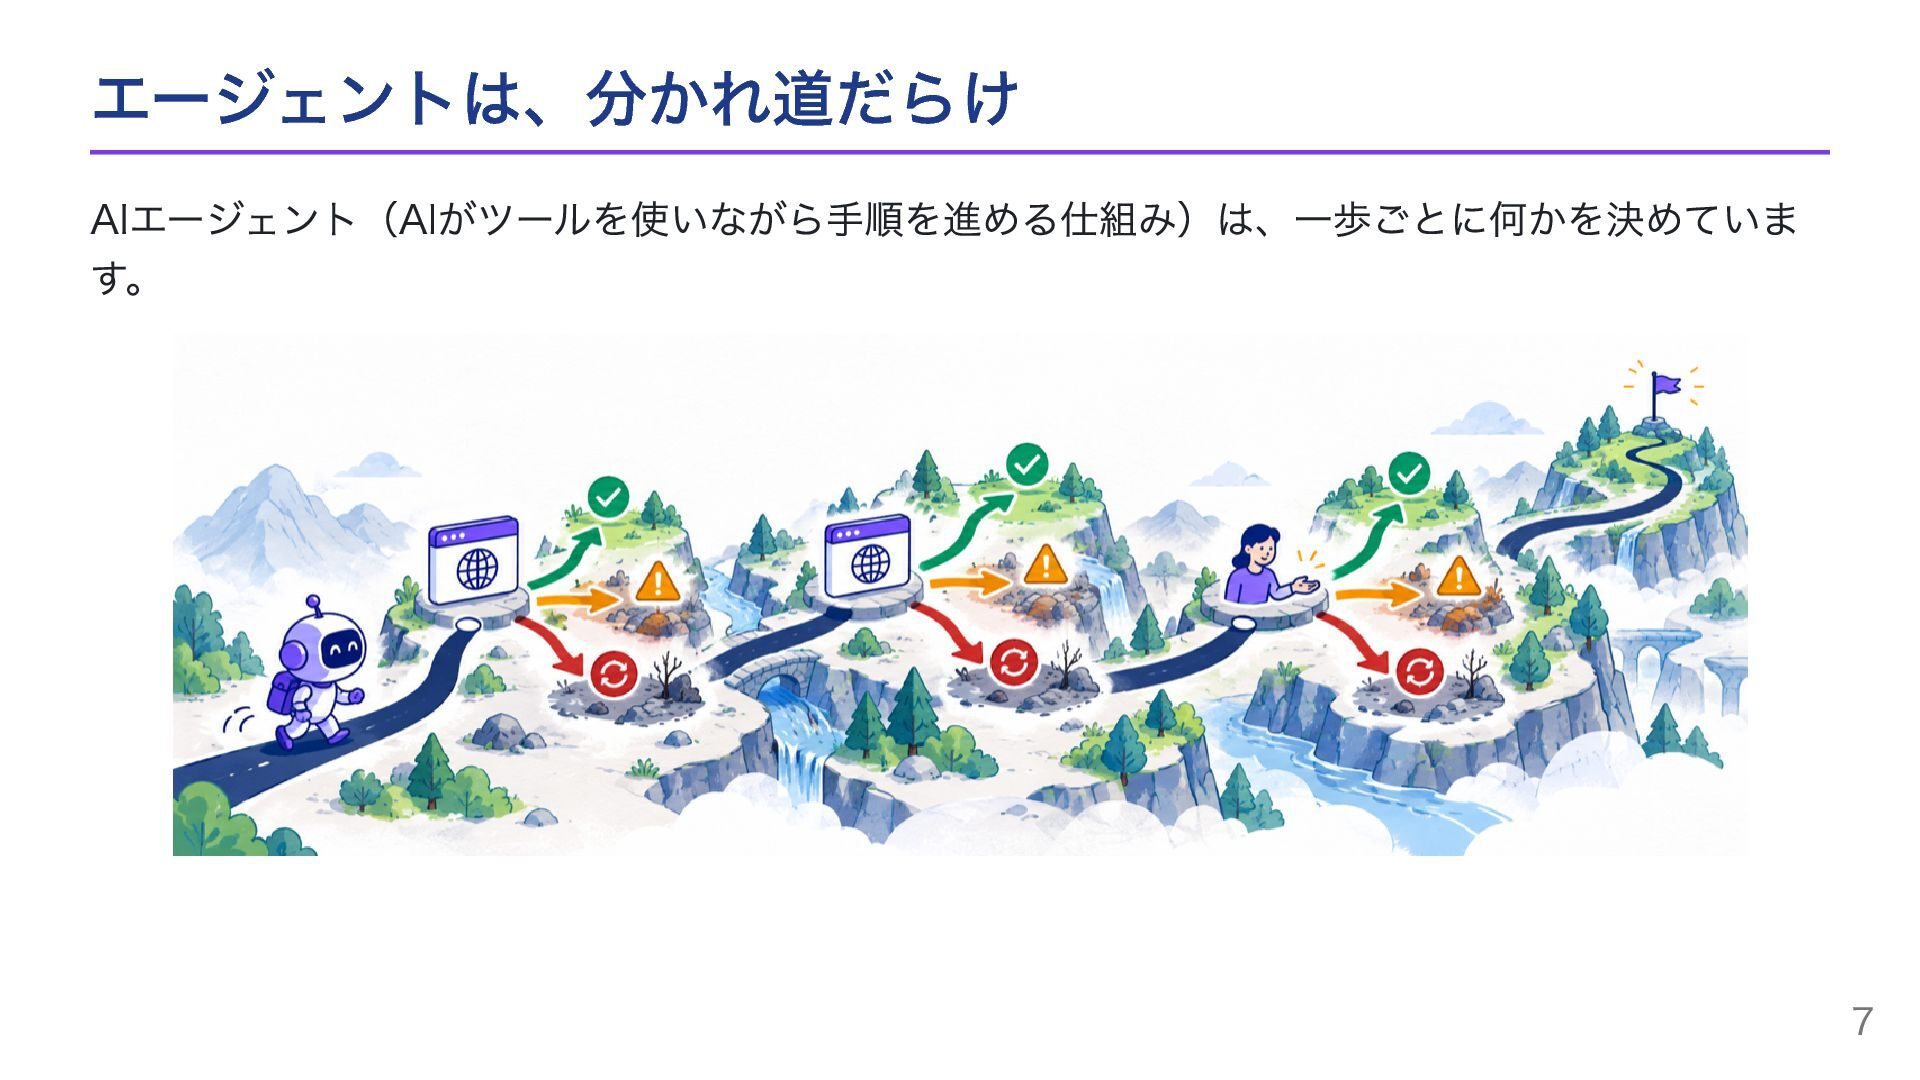
エージェントは、分かれ道だらけ AIエージェント(AIがツールを使いながら手順を進める仕組み)は、一歩ごとに何かを決めていま す。 7
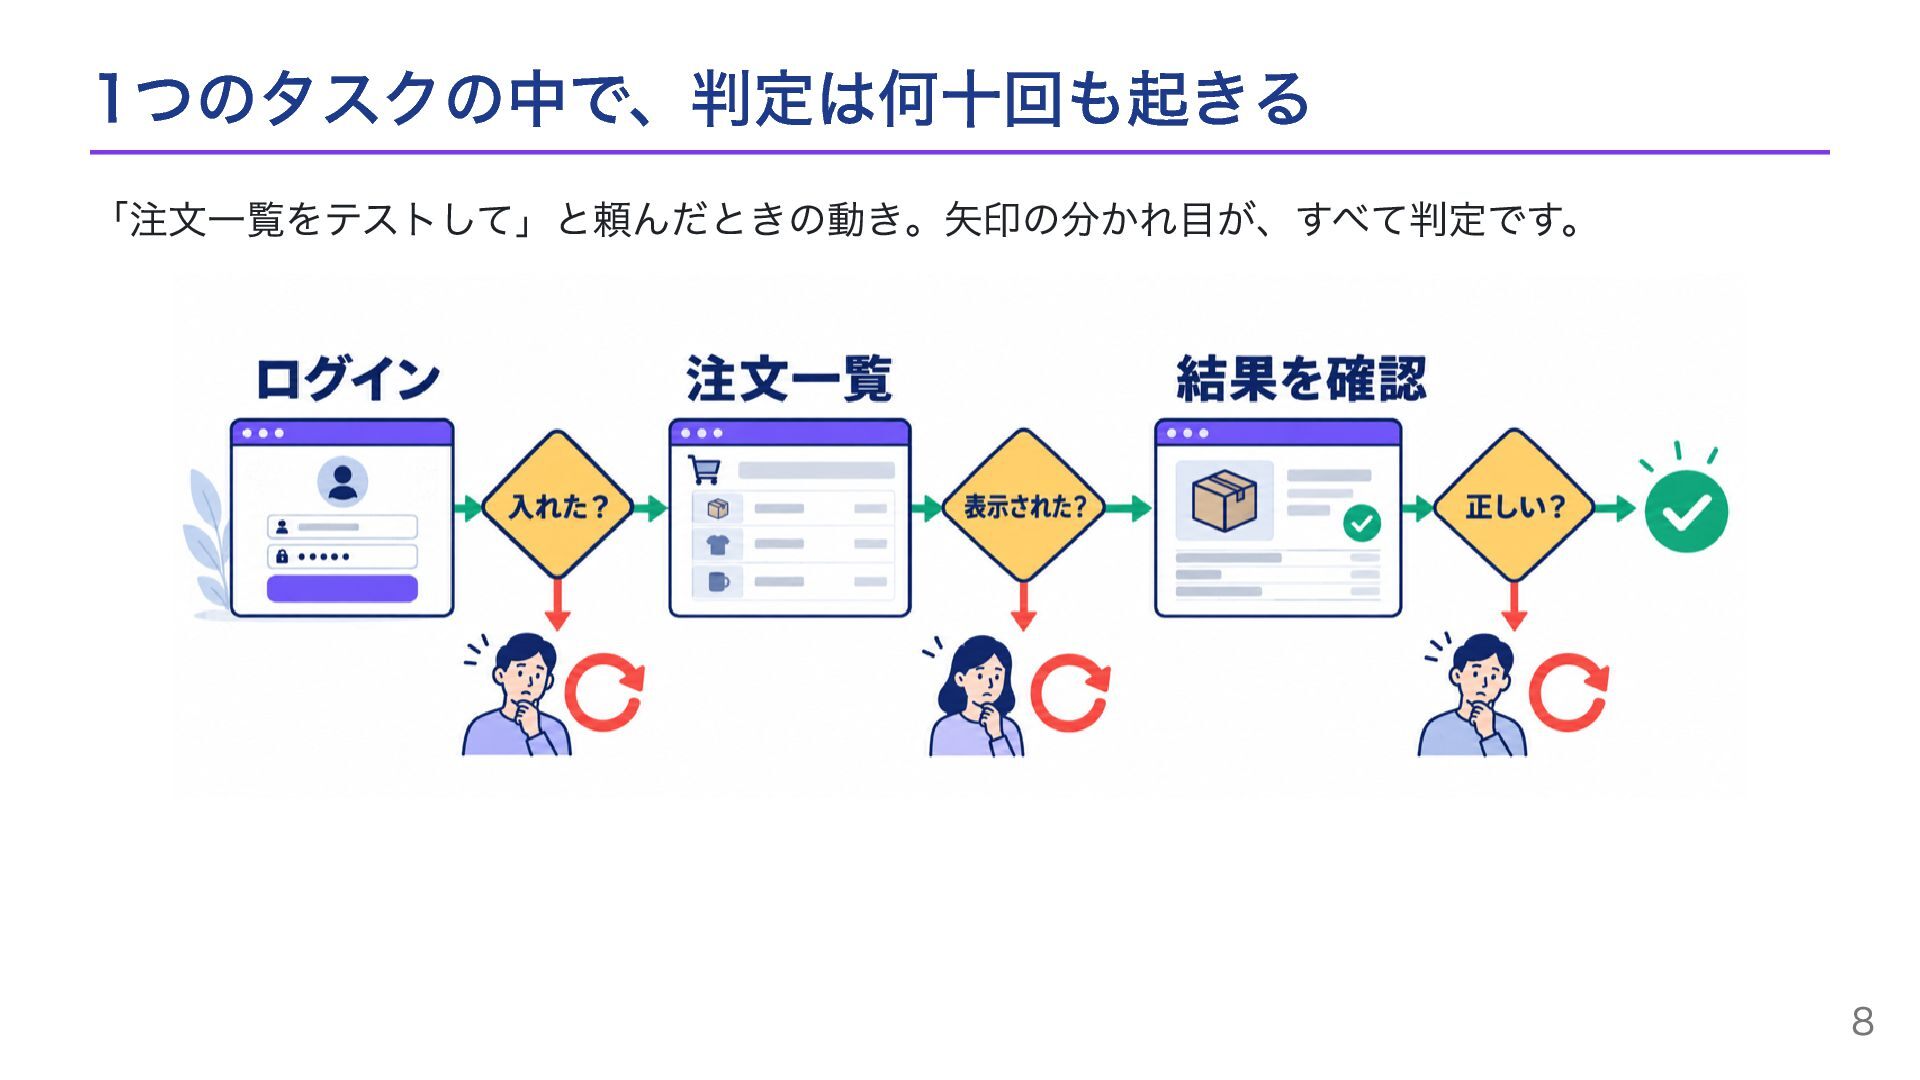
1つのタスクの中で、判定は何十回も起きる 「注文一覧をテストして」と頼んだときの動き。矢印の分かれ目が、すべて判定です。 8
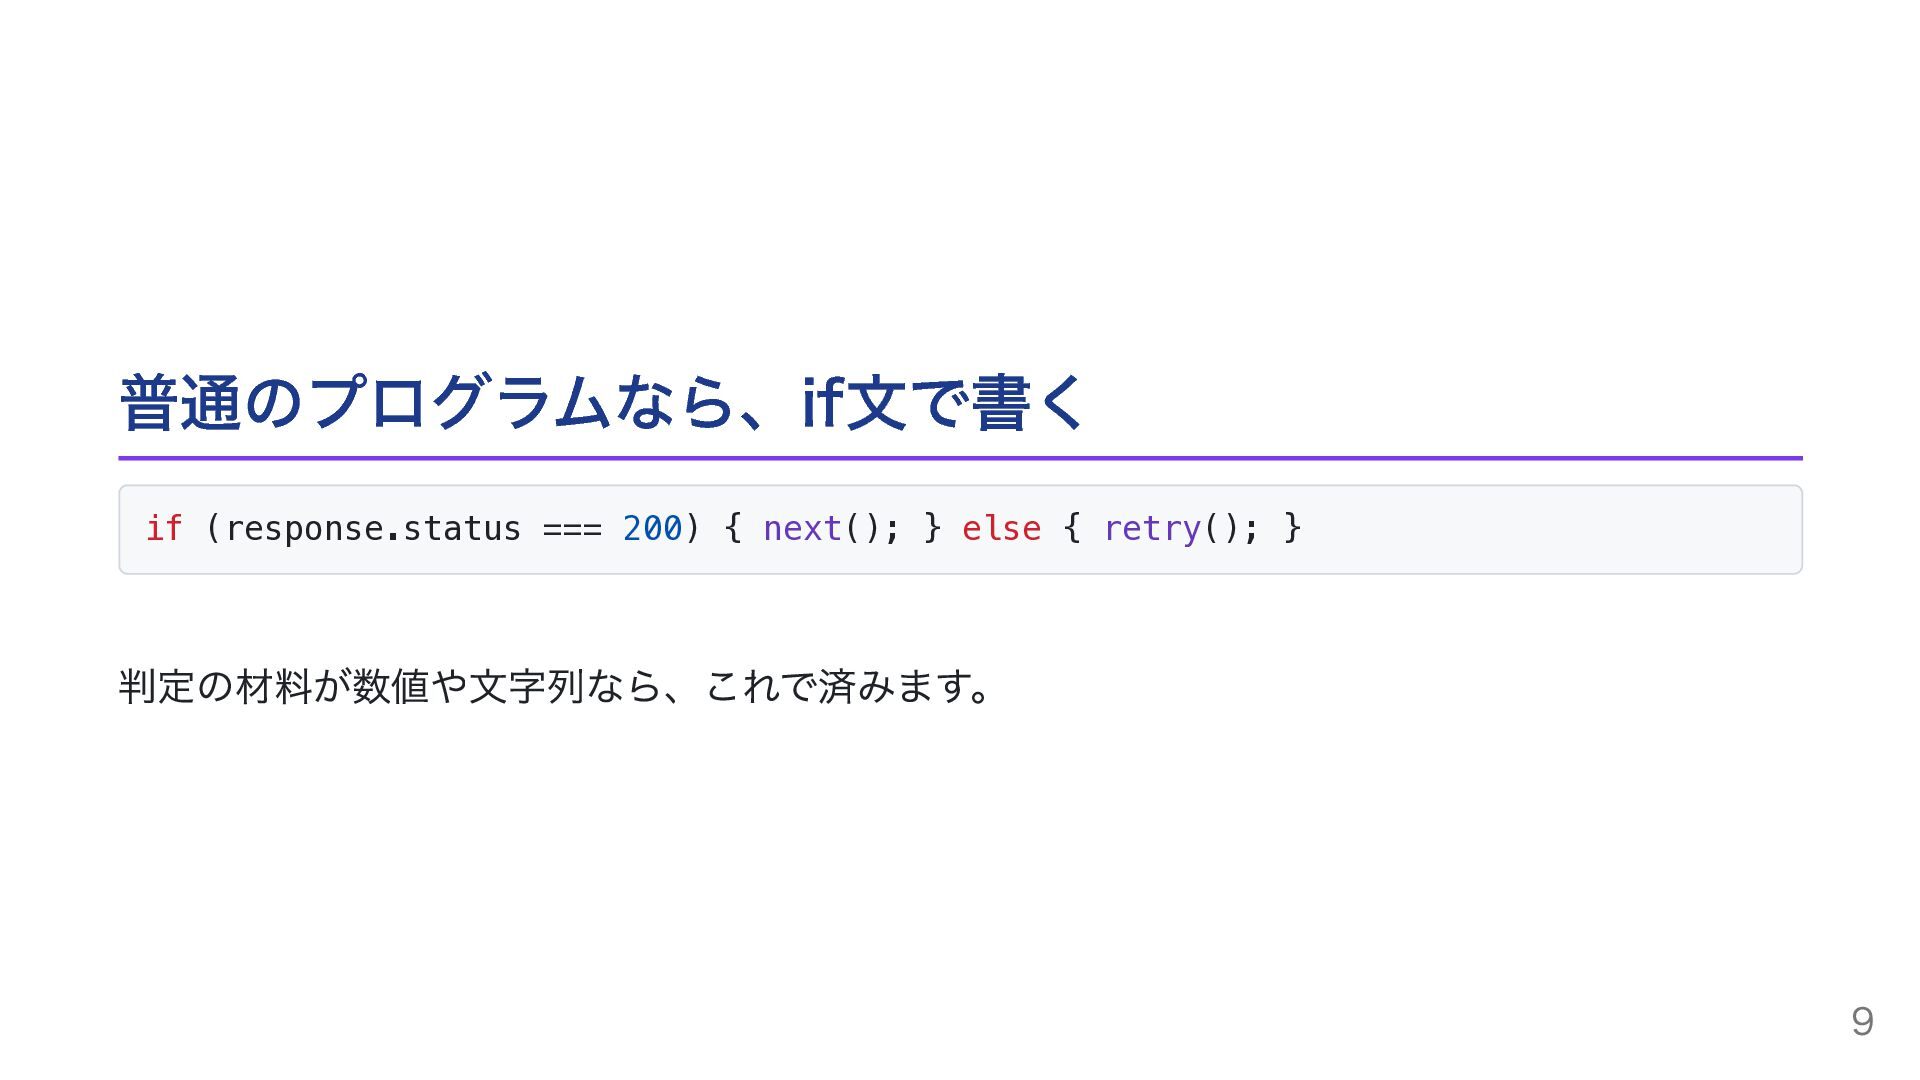
普通のプログラムなら、if文で書く if (response.status === 200) { next(); } else {
retry(); } 判定の材料が数値や文字列なら、これで済みます。 9
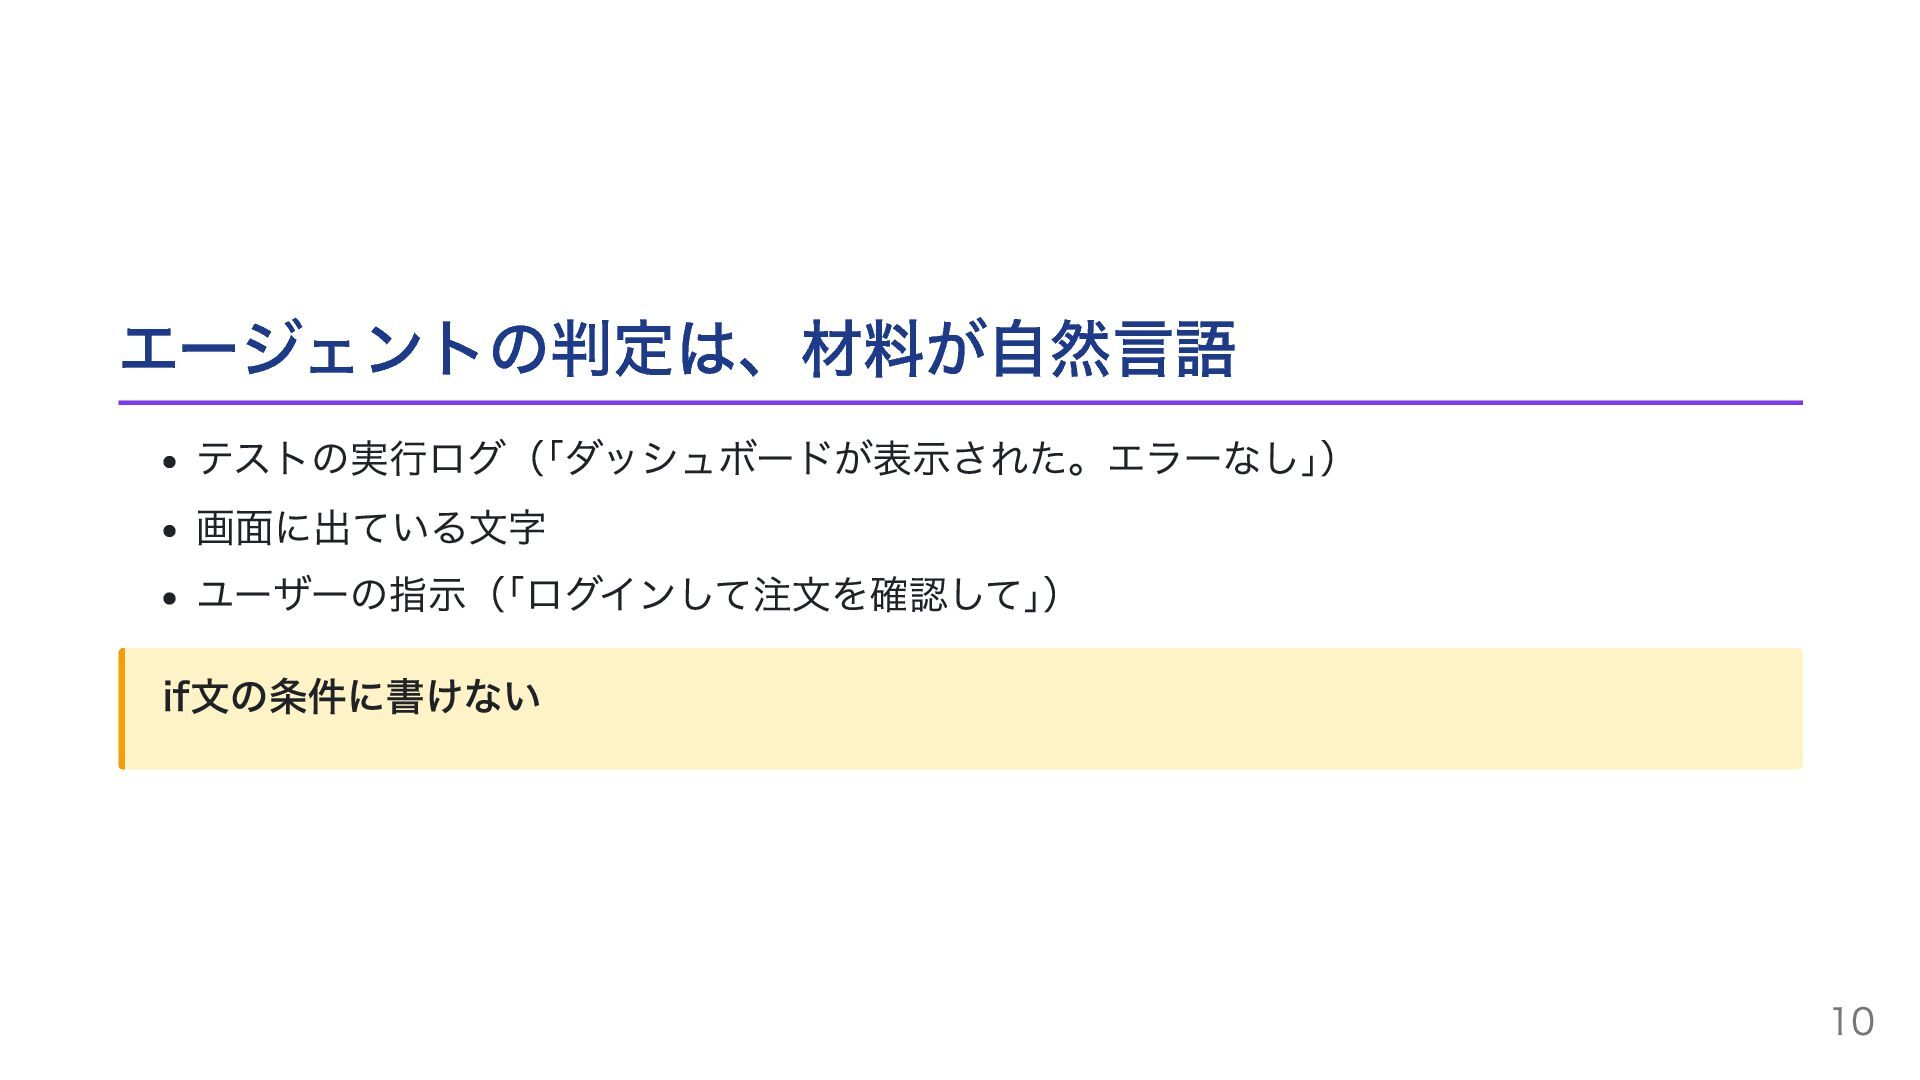
エージェントの判定は、材料が自然言語 テストの実行ログ(「ダッシュボードが表示された。エラーなし」) 画面に出ている文字 ユーザーの指示(「ログインして注文を確認して」) if文の条件に書けない 10
そこで、LLMに文章で聞いてきた LLM(ChatGPT や Claude のような、文章を生成するAI)に読ませて、答えを文章で返させ る。 11
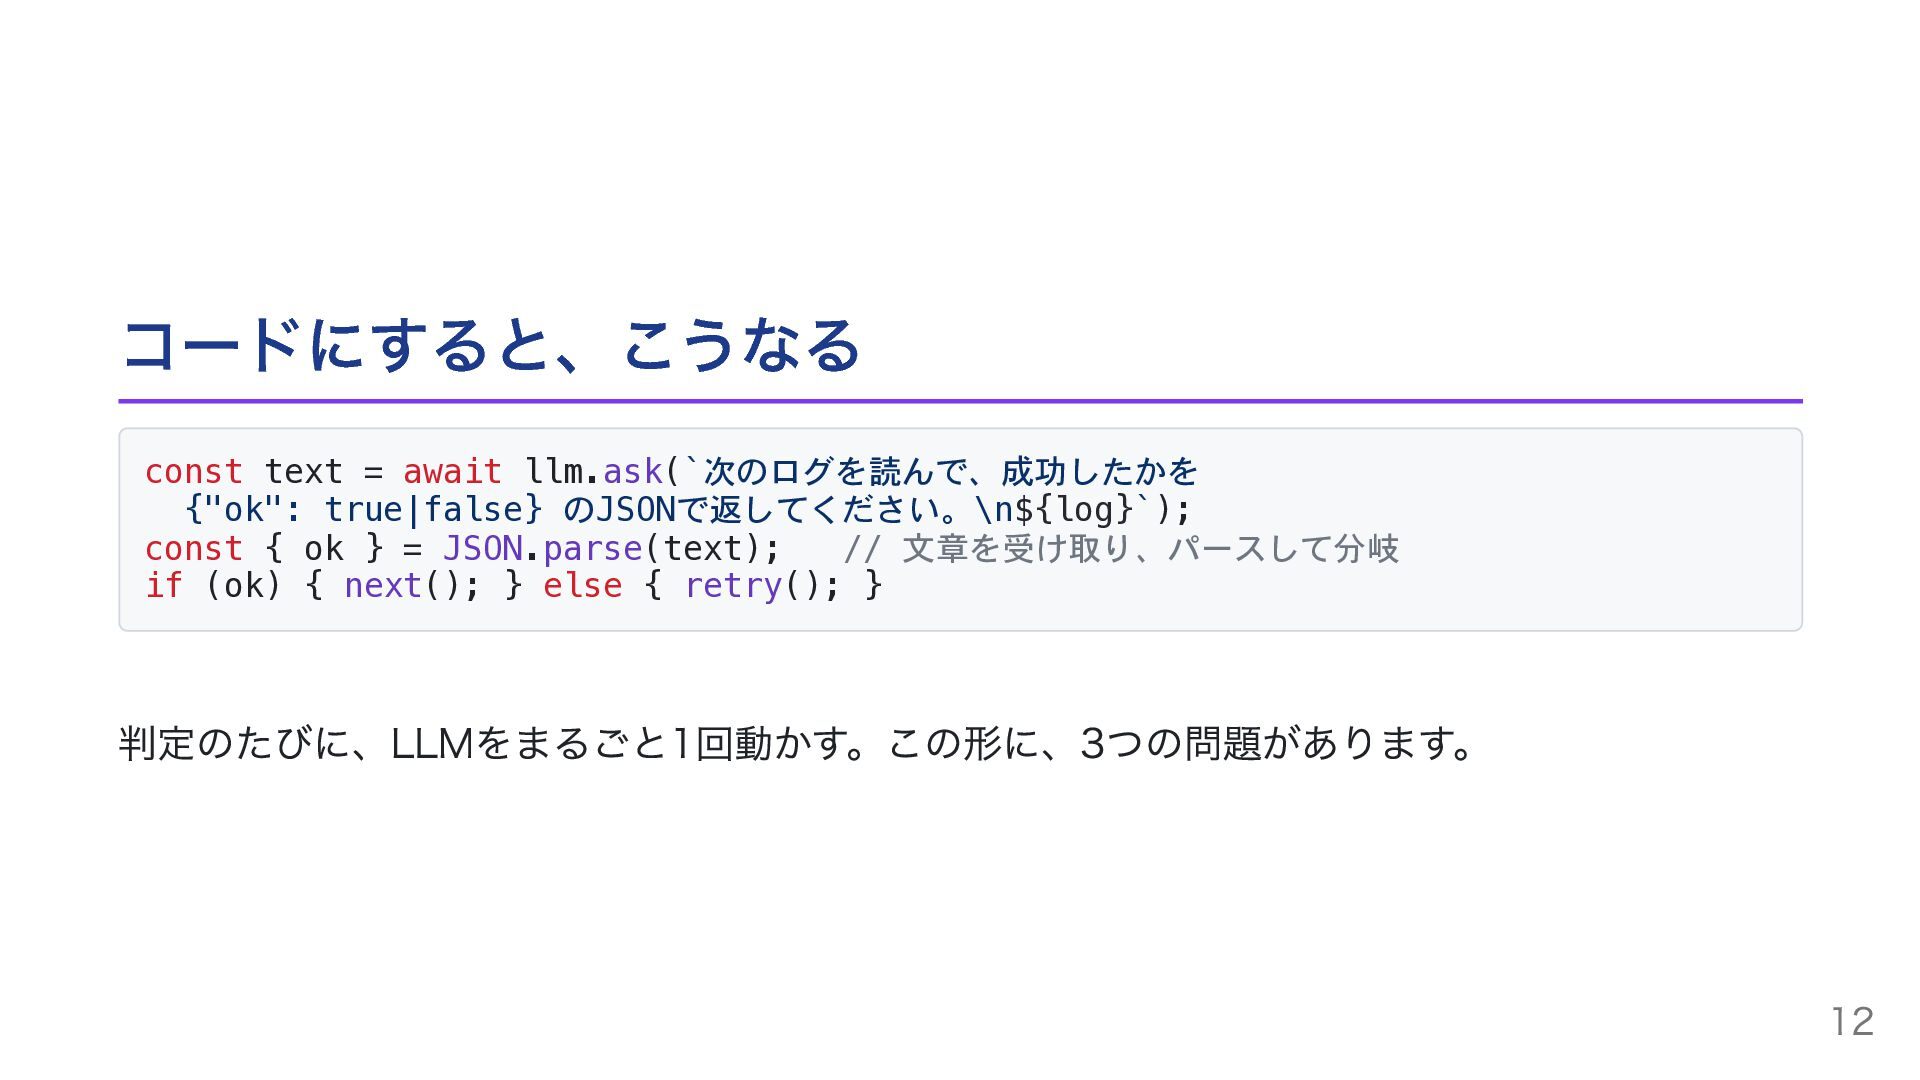
コードにすると、こうなる const text = await llm.ask(`次のログを読んで、成功したかを {"ok": true|false} のJSONで返してください。\n${log}`); const
{ ok } = JSON.parse(text); // 文章を受け取り、パースして分岐 if (ok) { next(); } else { retry(); } 判定のたびに、LLMをまるごと1回動かす。この形に、3つの問題があります。 12
ところで、この判定1回に 何秒かかると思いますか? 「成功したか」を LLM に聞くだけの処理です 13
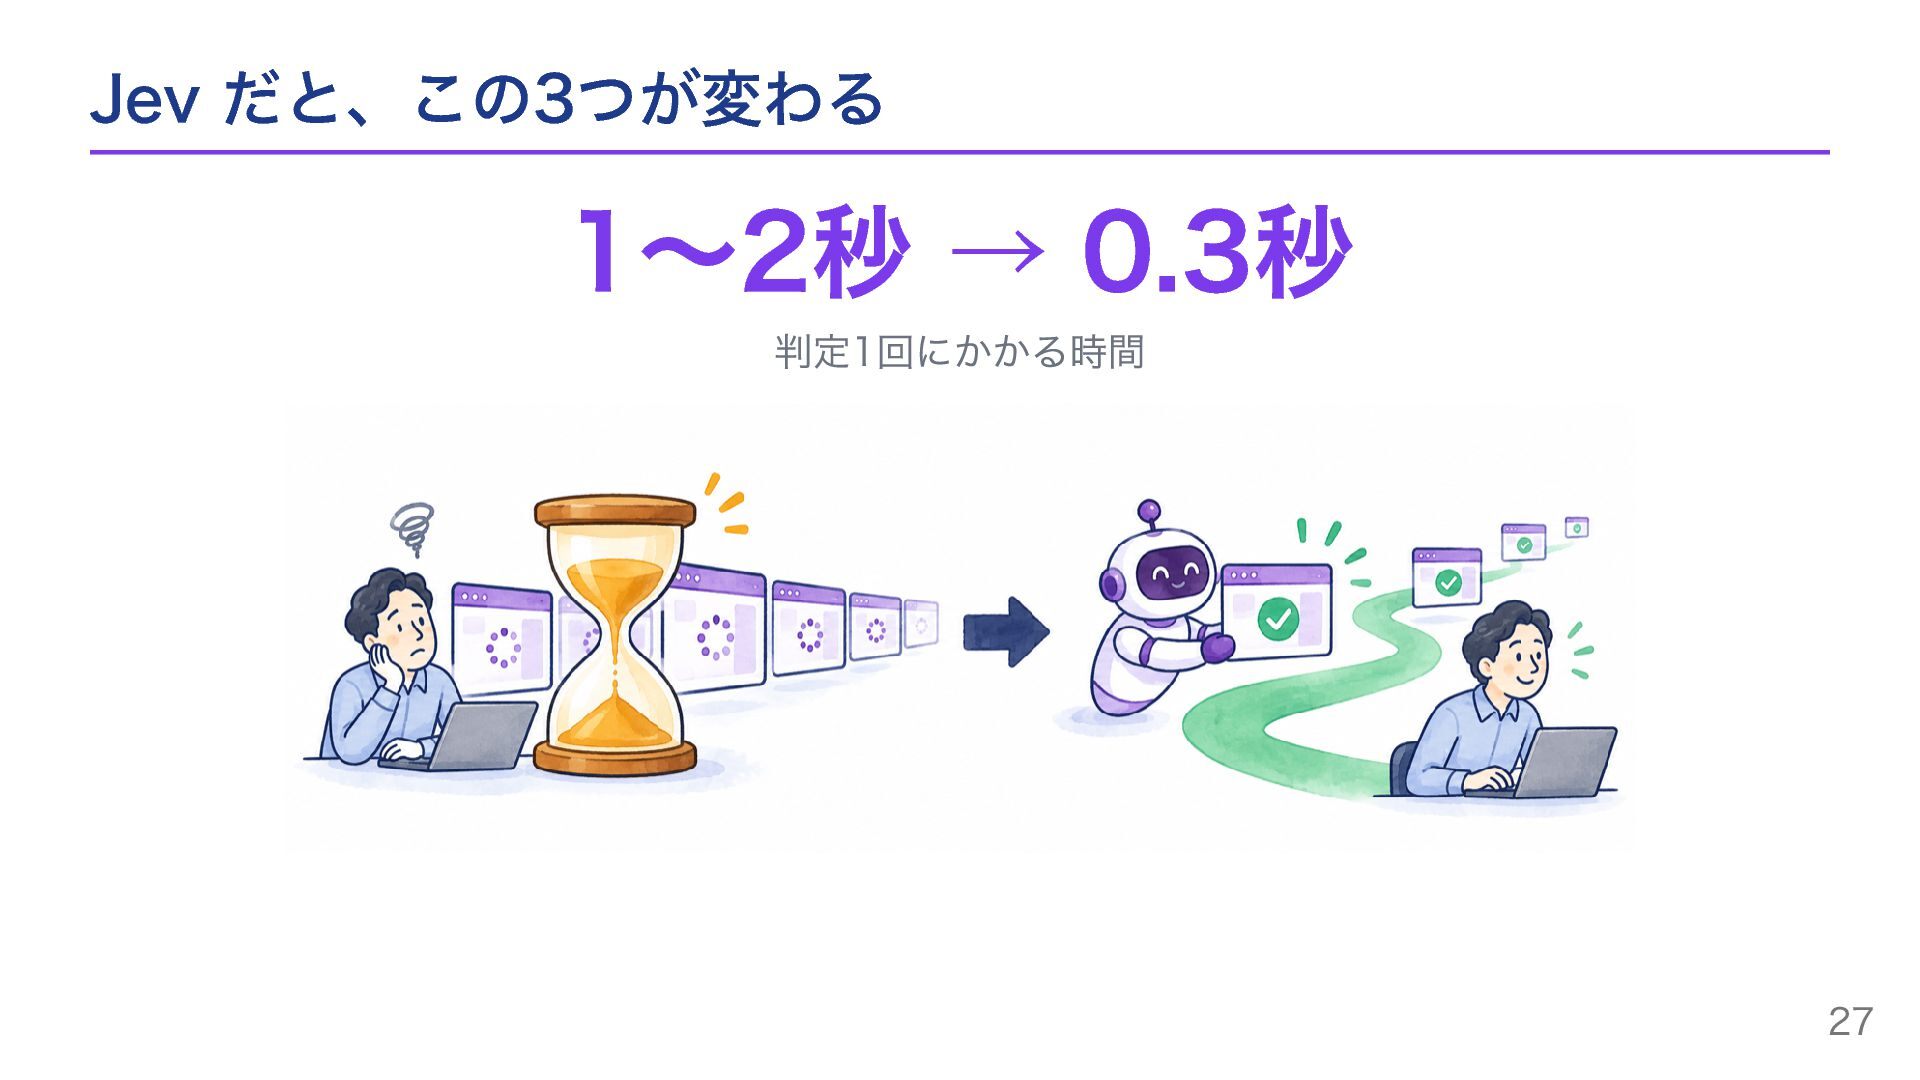
問題①: 遅い 1〜2秒 答えが一言でも、入力を読んで文章を生成するのに時間がかかる 14
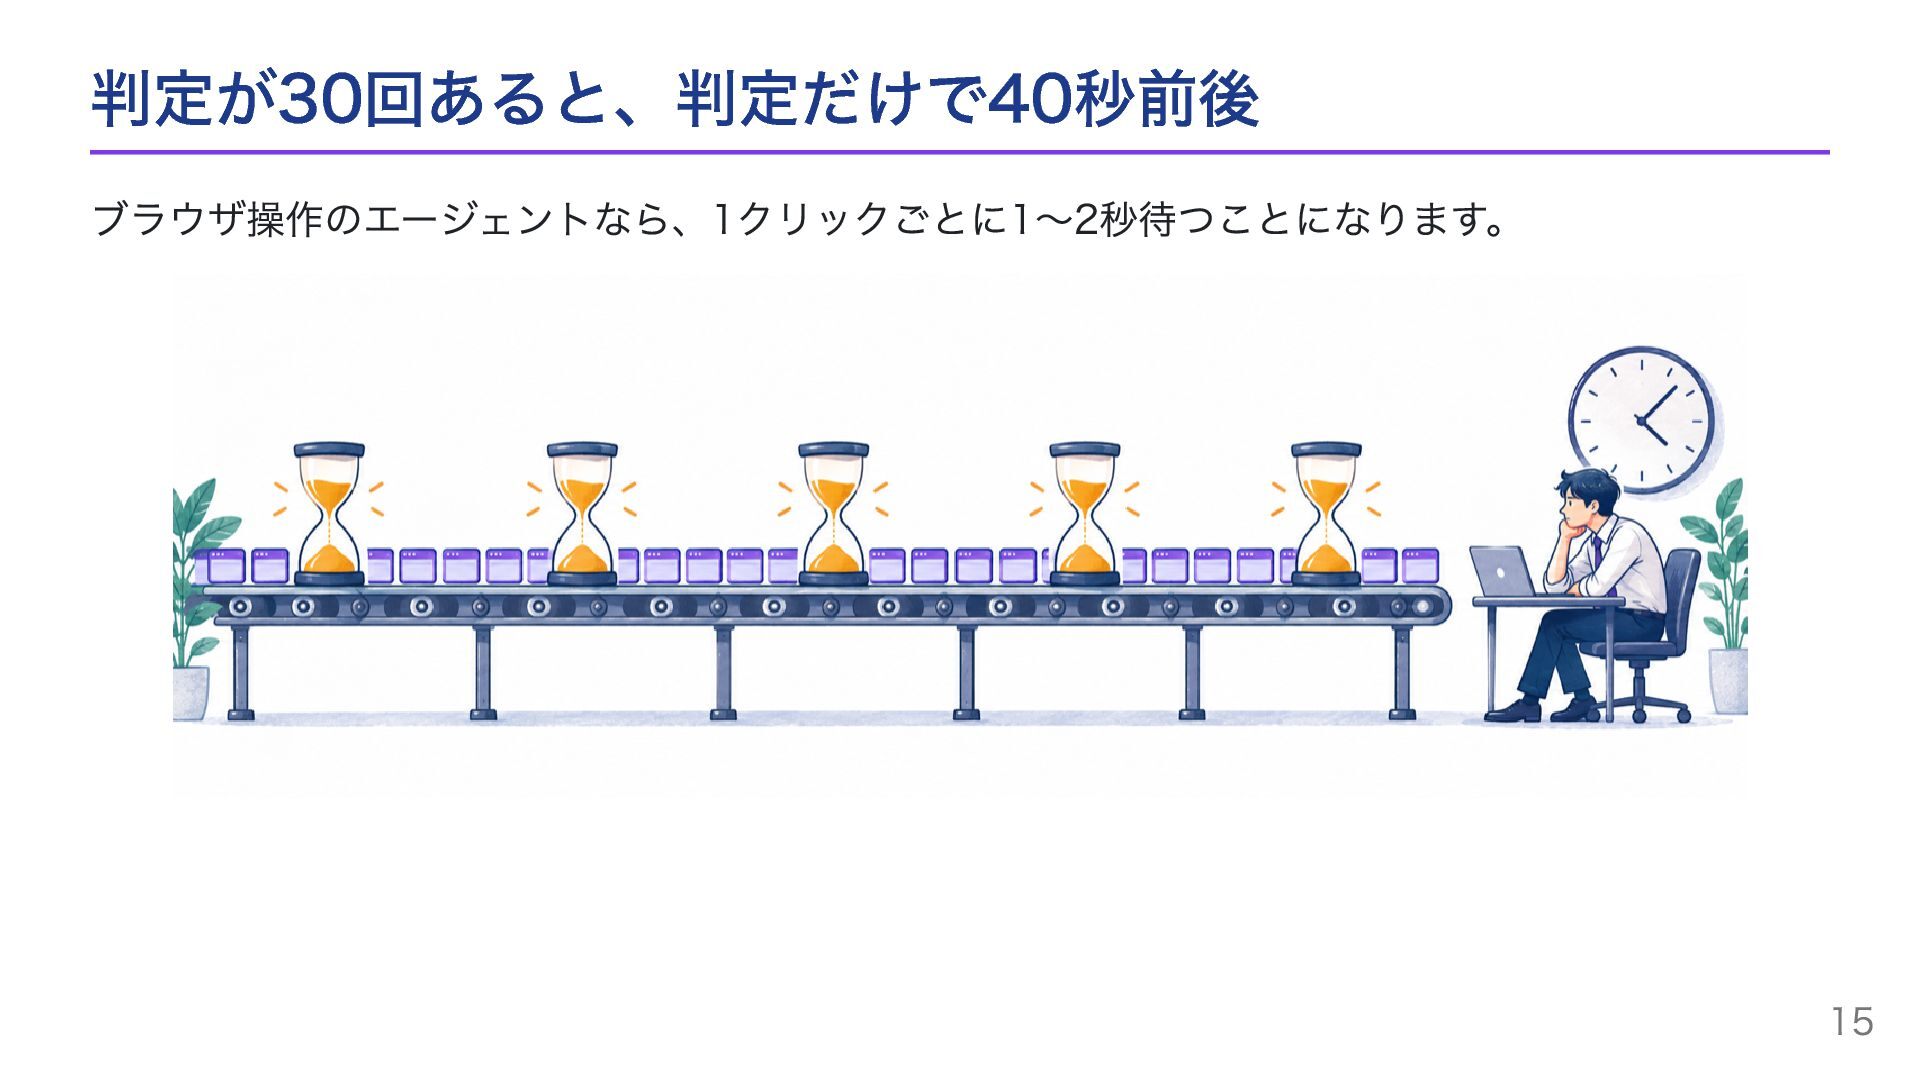
判定が30回あると、判定だけで40秒前後 ブラウザ操作のエージェントなら、1クリックごとに1〜2秒待つことになります。 15
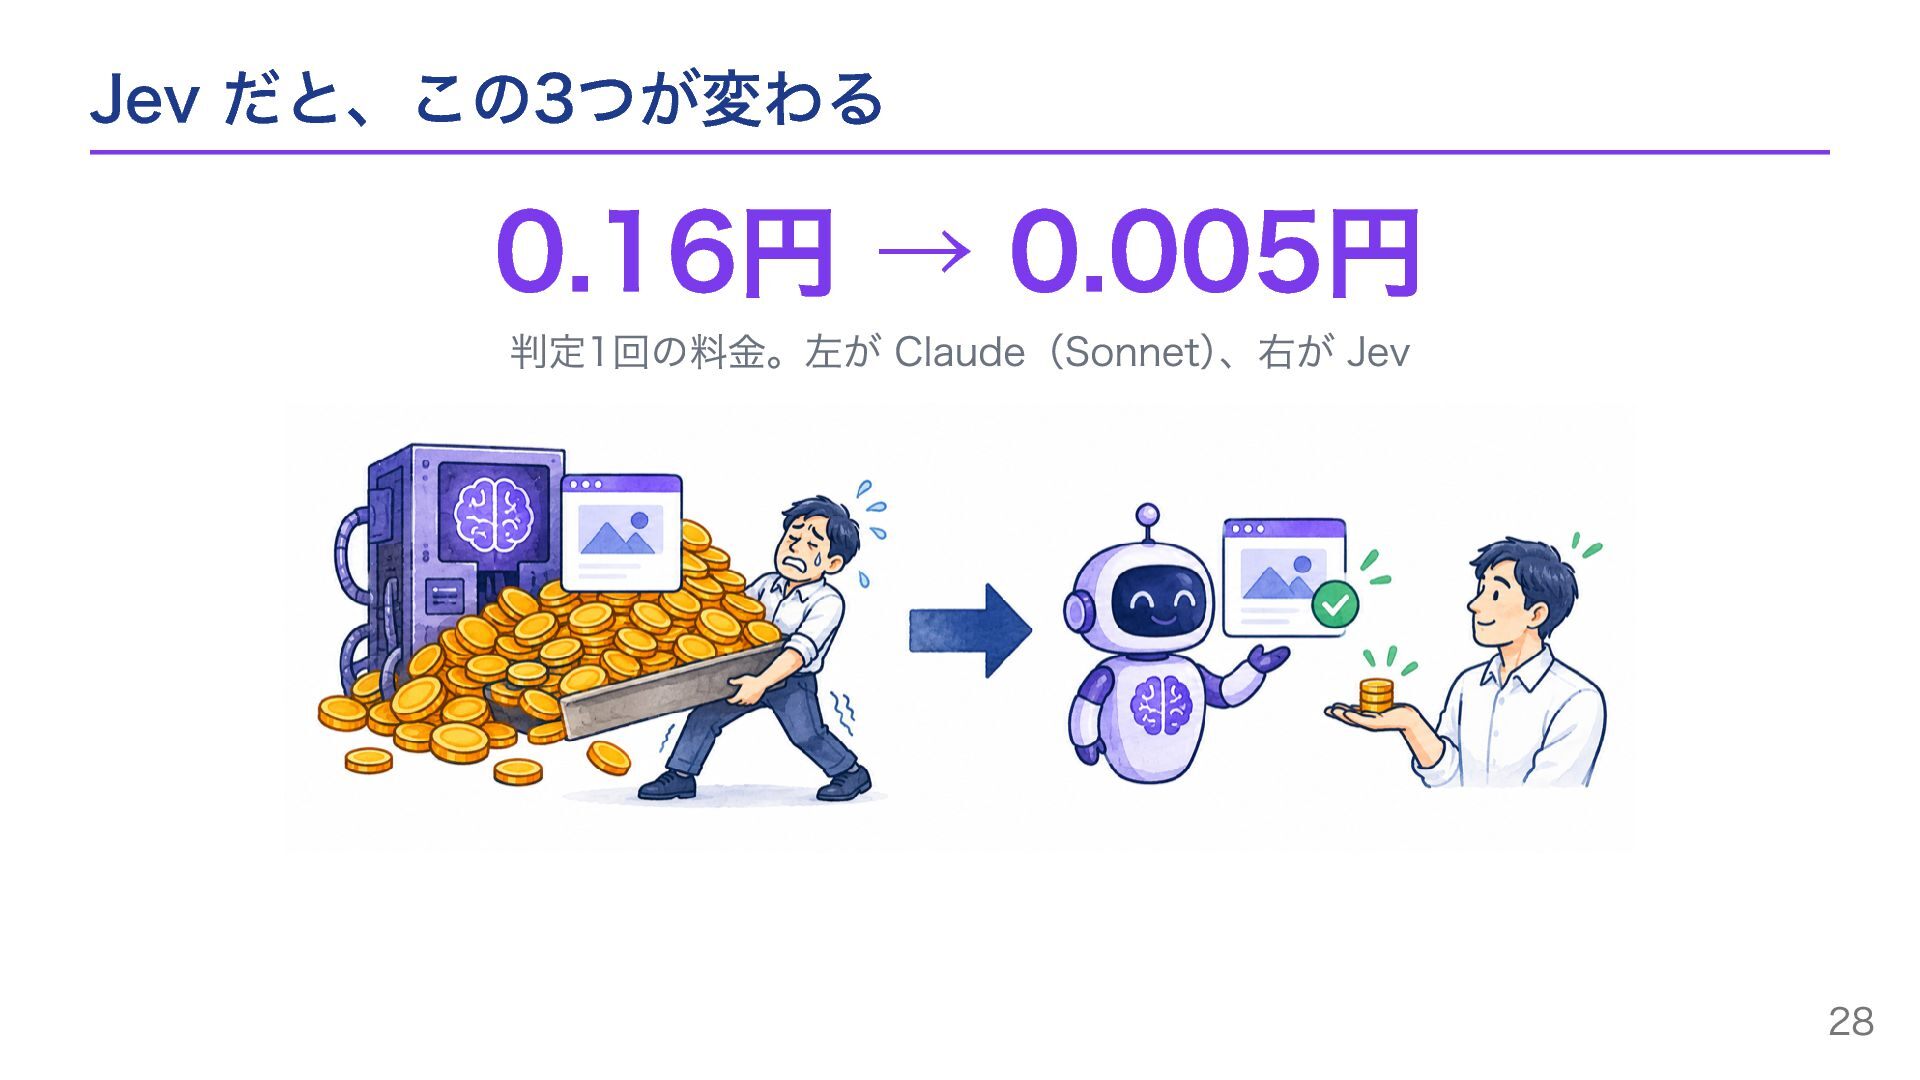
問題②: 高い Claude(Sonnet)で判定すると、1回は約0.16円。安く見えますが、1タスク30回 × 1日 1,000タスクで、月に約15万円。 16
問題③: 「どれくらい確かか」が取れない LLM の答えは「成功」か「失敗」かだけ。その答えにどれくらい自信があるのかは、教えてく れません。 「確率も書いて」と頼めば数字は返ってきます。でも、その数字は当てになりません 17
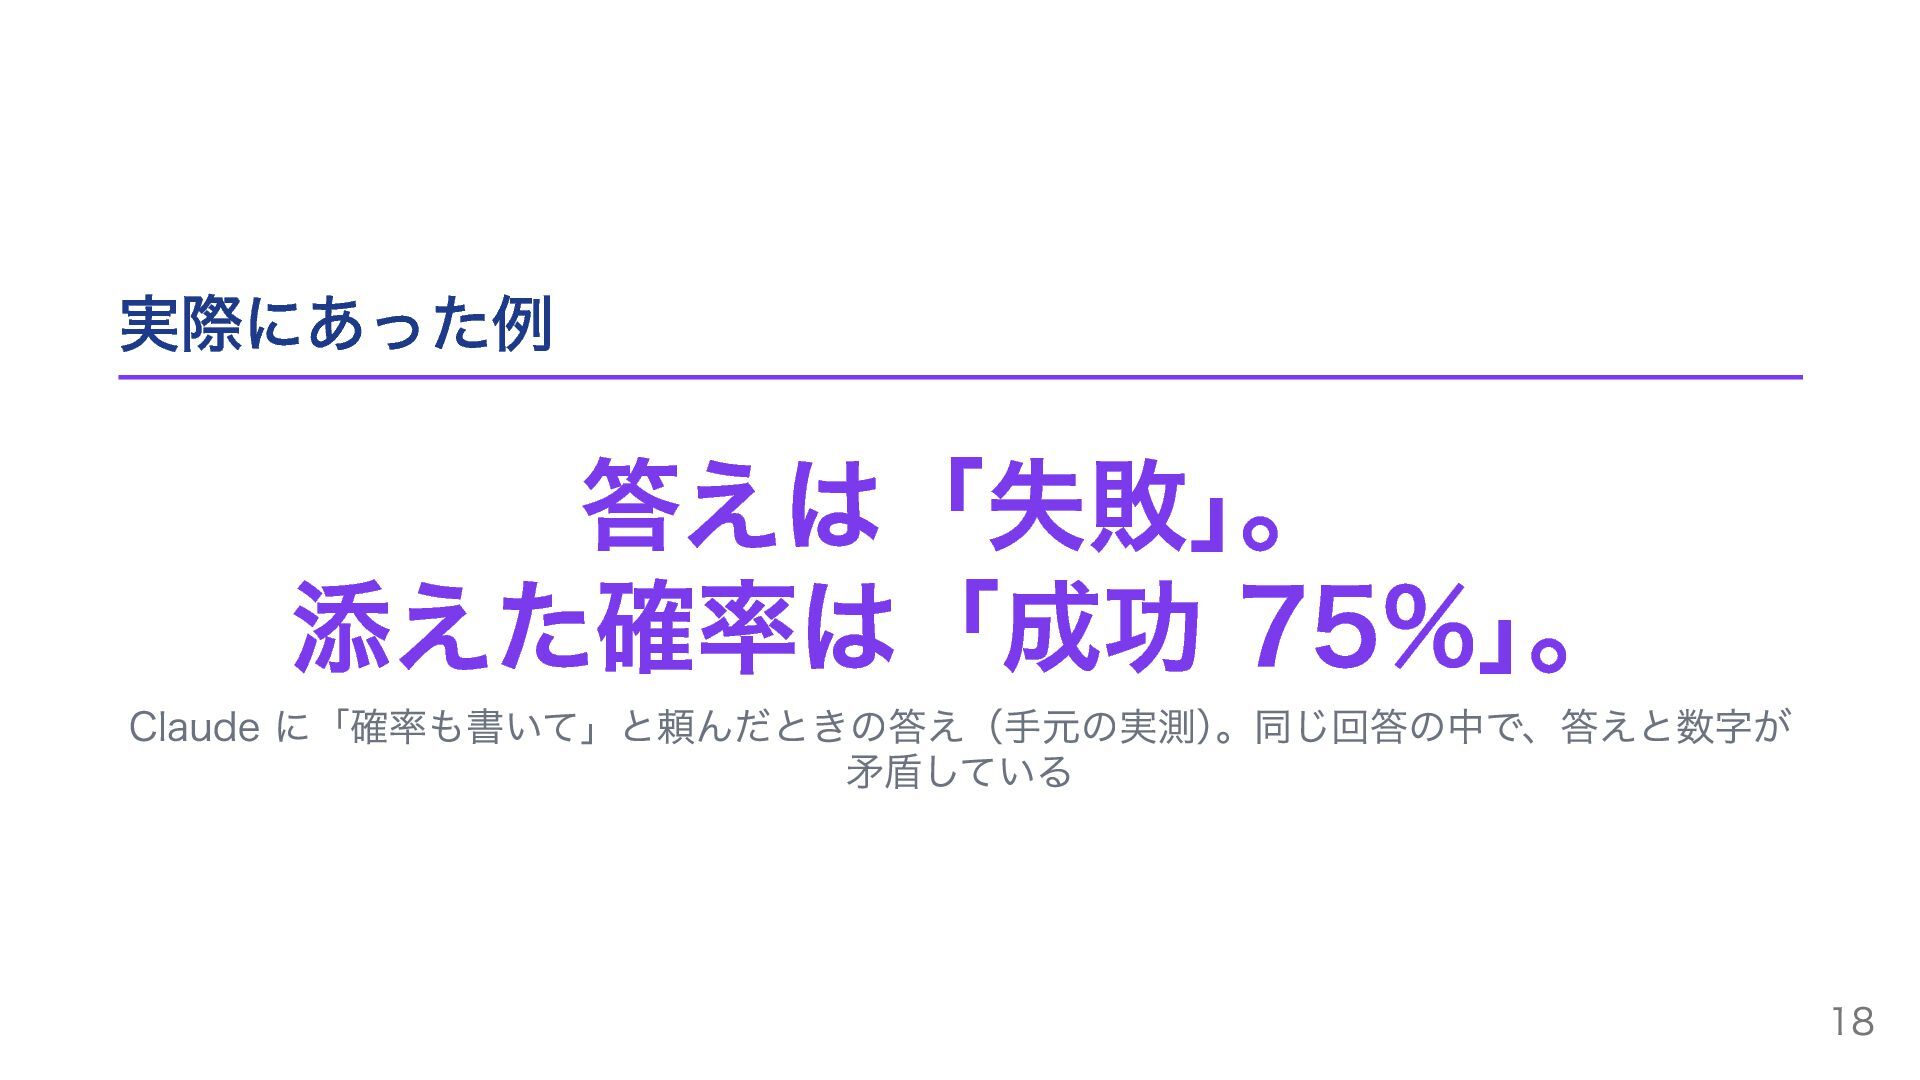
実際にあった例 答えは「失敗」。 添えた確率は「成功 75%」。 Claude に「確率も書いて」と頼んだときの答え(手元の実測)。同じ回答の中で、答えと数字が 矛盾している 18
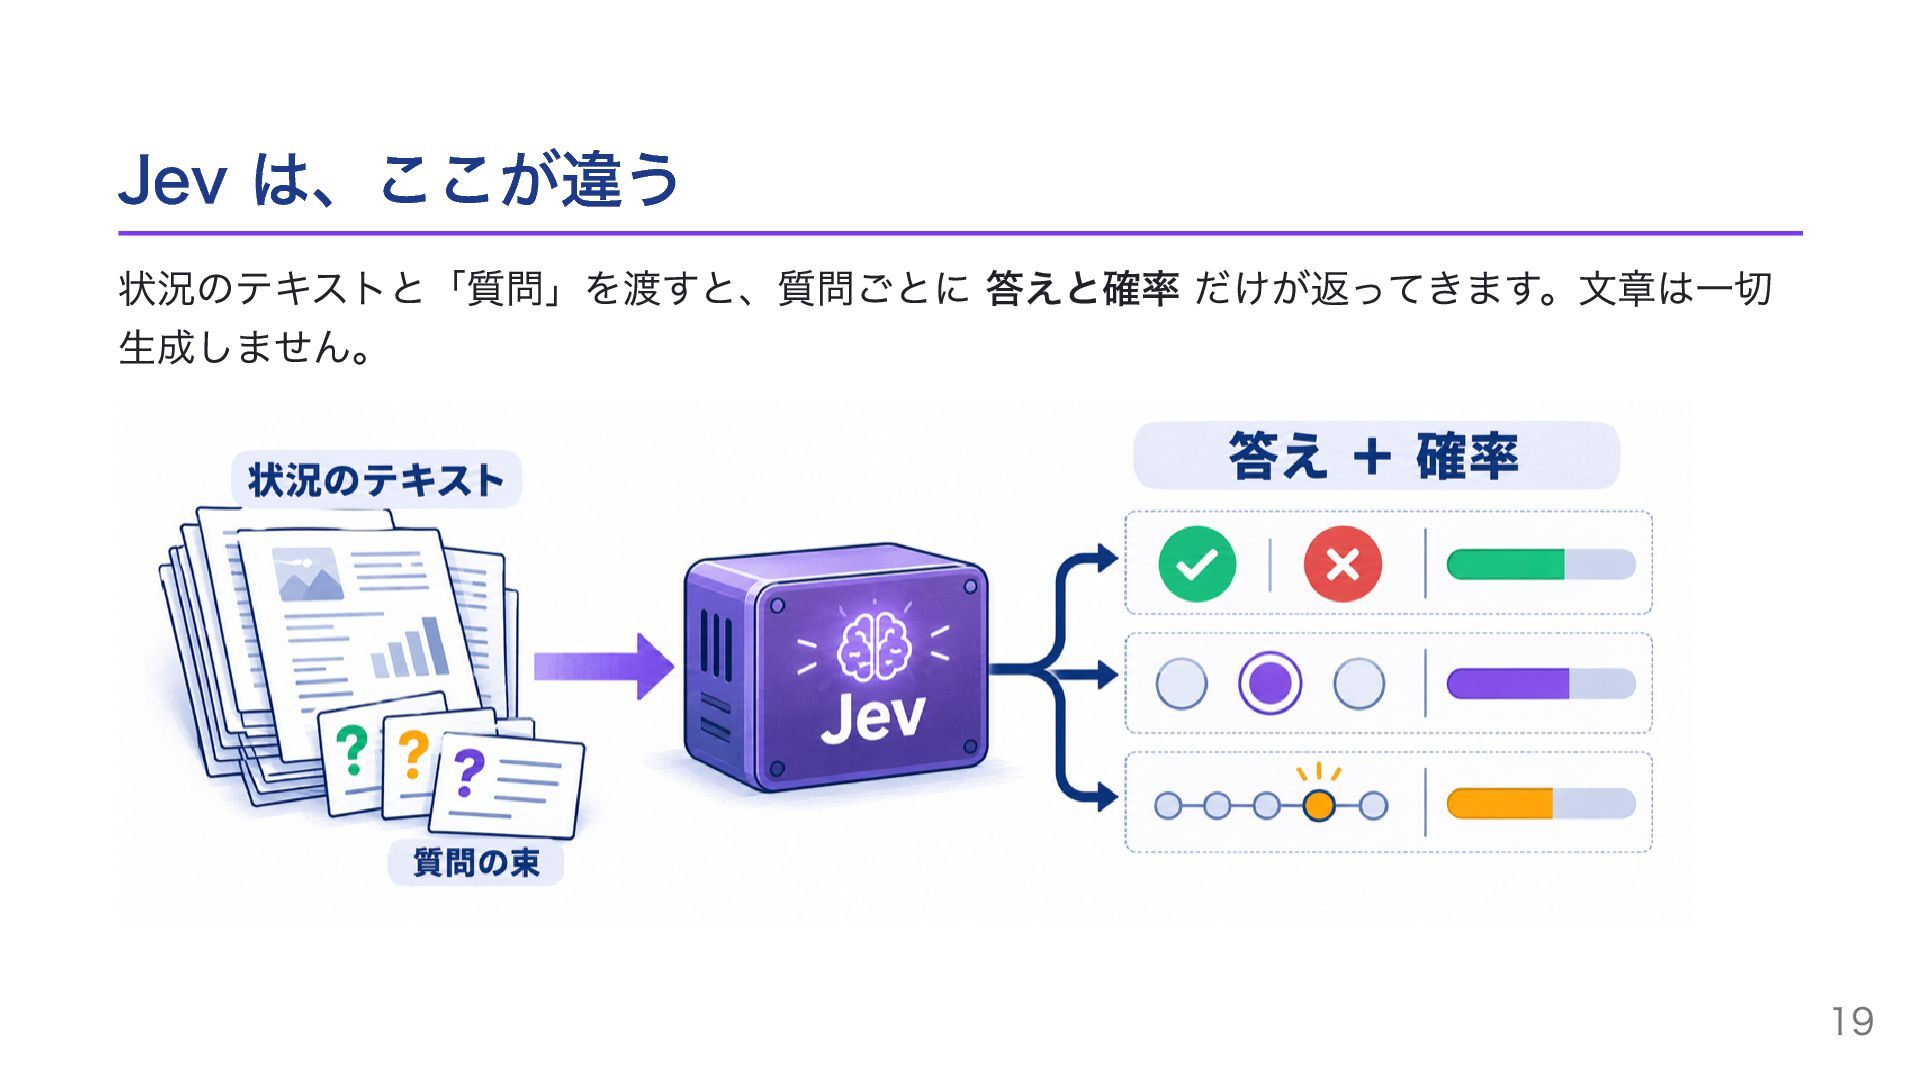
Jev は、ここが違う 状況のテキストと「質問」を渡すと、質問ごとに 答えと確率 だけが返ってきます。文章は一切 生成しません。 19
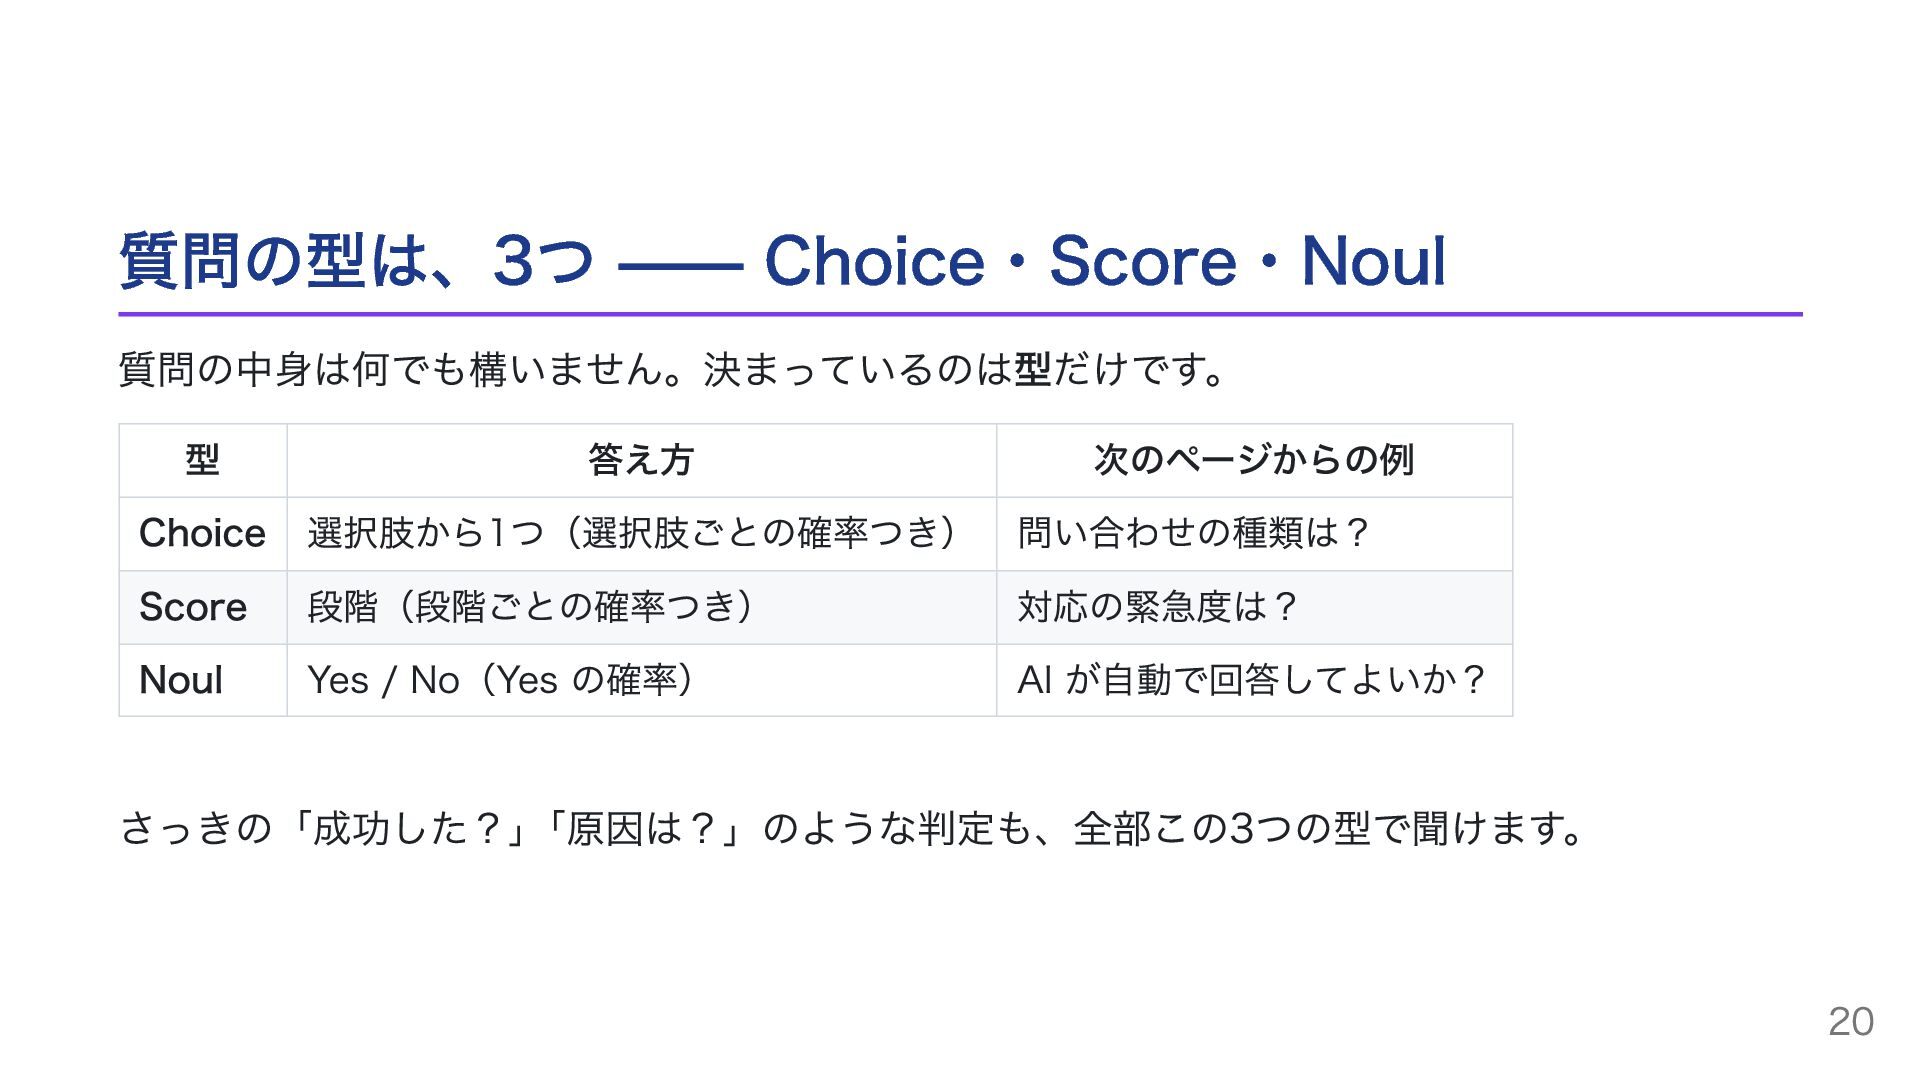
質問の型は、3つ —— Choice・Score・Noul 質問の中身は何でも構いません。決まっているのは型だけです。 型 答え方 次のページからの例 Choice 選択肢から1つ(選択肢ごとの確率つき) 問い合わせの種類は?
Score 段階(段階ごとの確率つき) 対応の緊急度は? Noul Yes / No(Yes の確率) AI が自動で回答してよいか? さっきの「成功した?」「原因は?」のような判定も、全部この3つの型で聞けます。 20
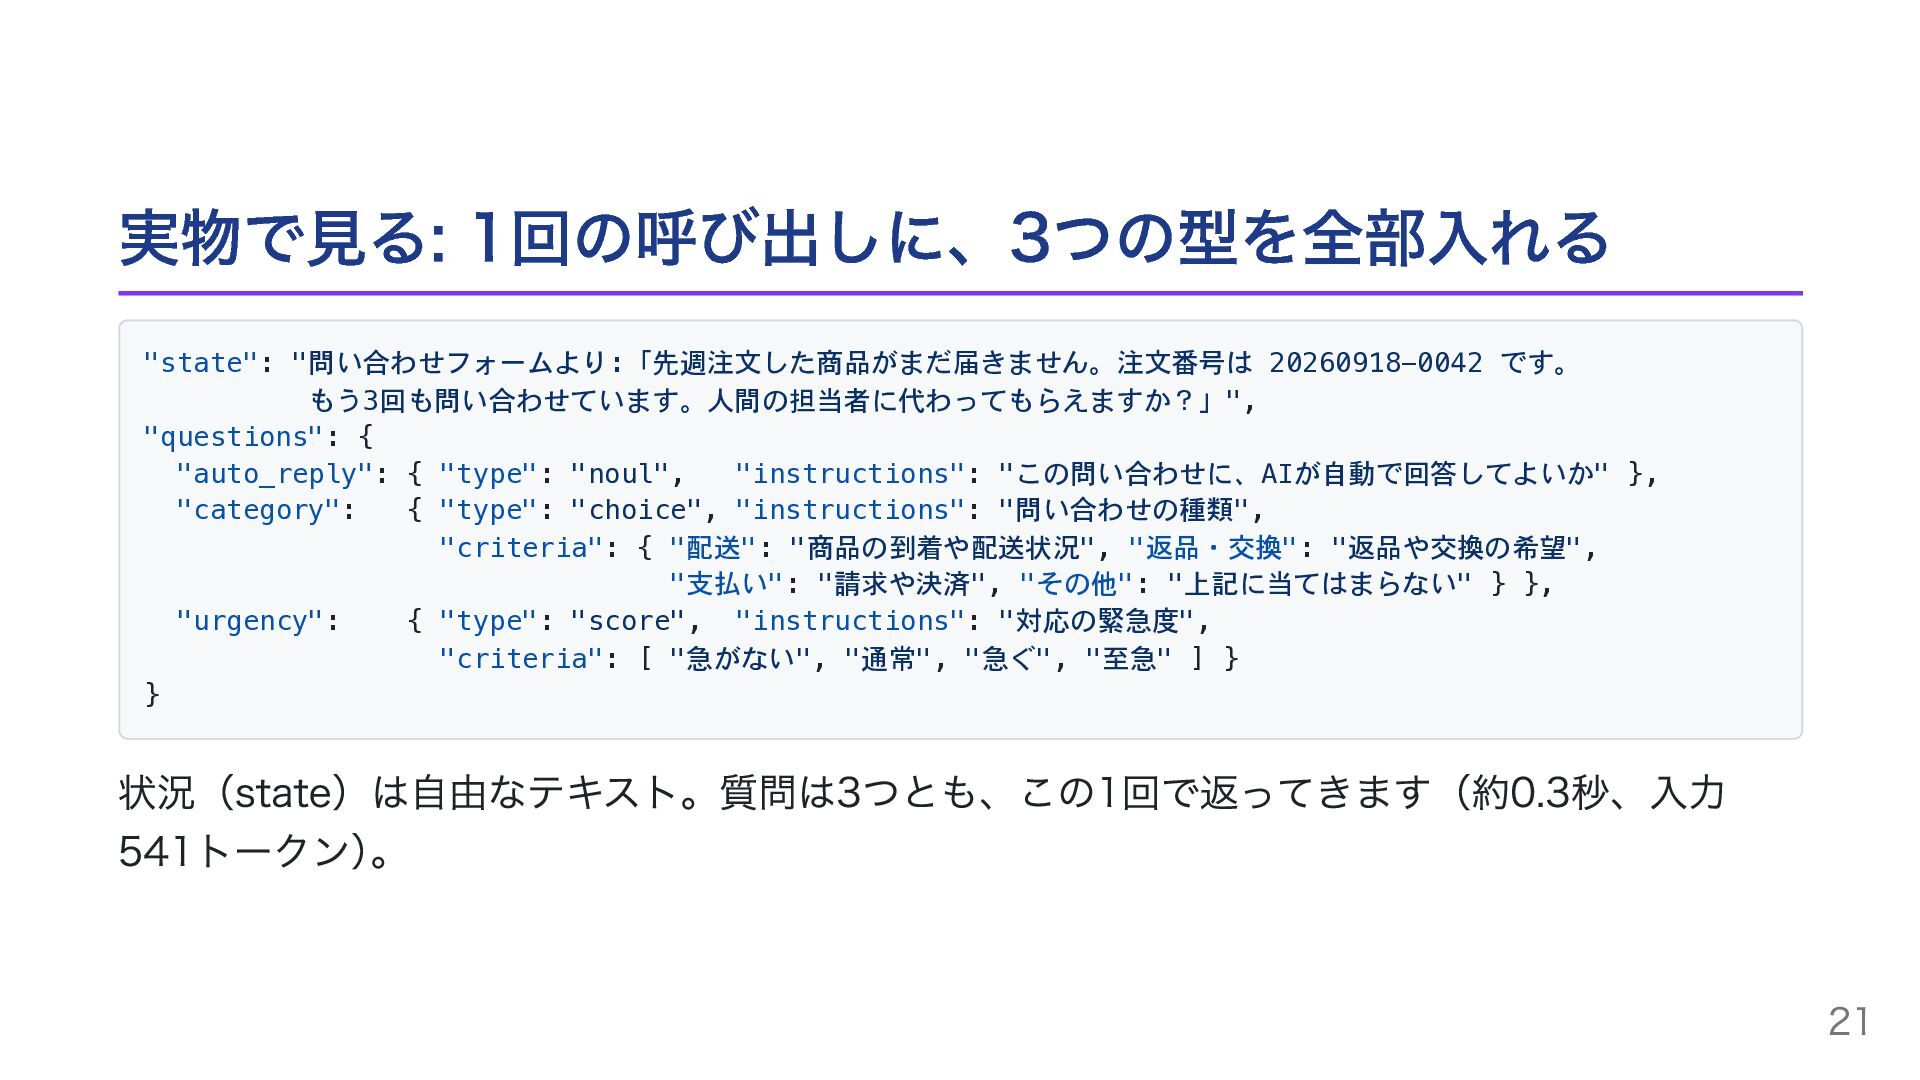
実物で見る: 1回の呼び出しに、3つの型を全部入れる "state": "問い合わせフォームより:「先週注文した商品がまだ届きません。注文番号は 20260918-0042 です。 もう3回も問い合わせています。人間の担当者に代わってもらえますか?」", "questions": { "auto_reply":
{ "type": "noul", "instructions": "この問い合わせに、AIが自動で回答してよいか" }, "category": { "type": "choice", "instructions": "問い合わせの種類", "criteria": { "配送": "商品の到着や配送状況", "返品・交換": "返品や交換の希望", "支払い": "請求や決済", "その他": "上記に当てはまらない" } }, "urgency": { "type": "score", "instructions": "対応の緊急度", "criteria": [ "急がない", "通常", "急ぐ", "至急" ] } } 状況(state)は自由なテキスト。質問は3つとも、この1回で返ってきます(約0.3秒、入力 541トークン)。 21
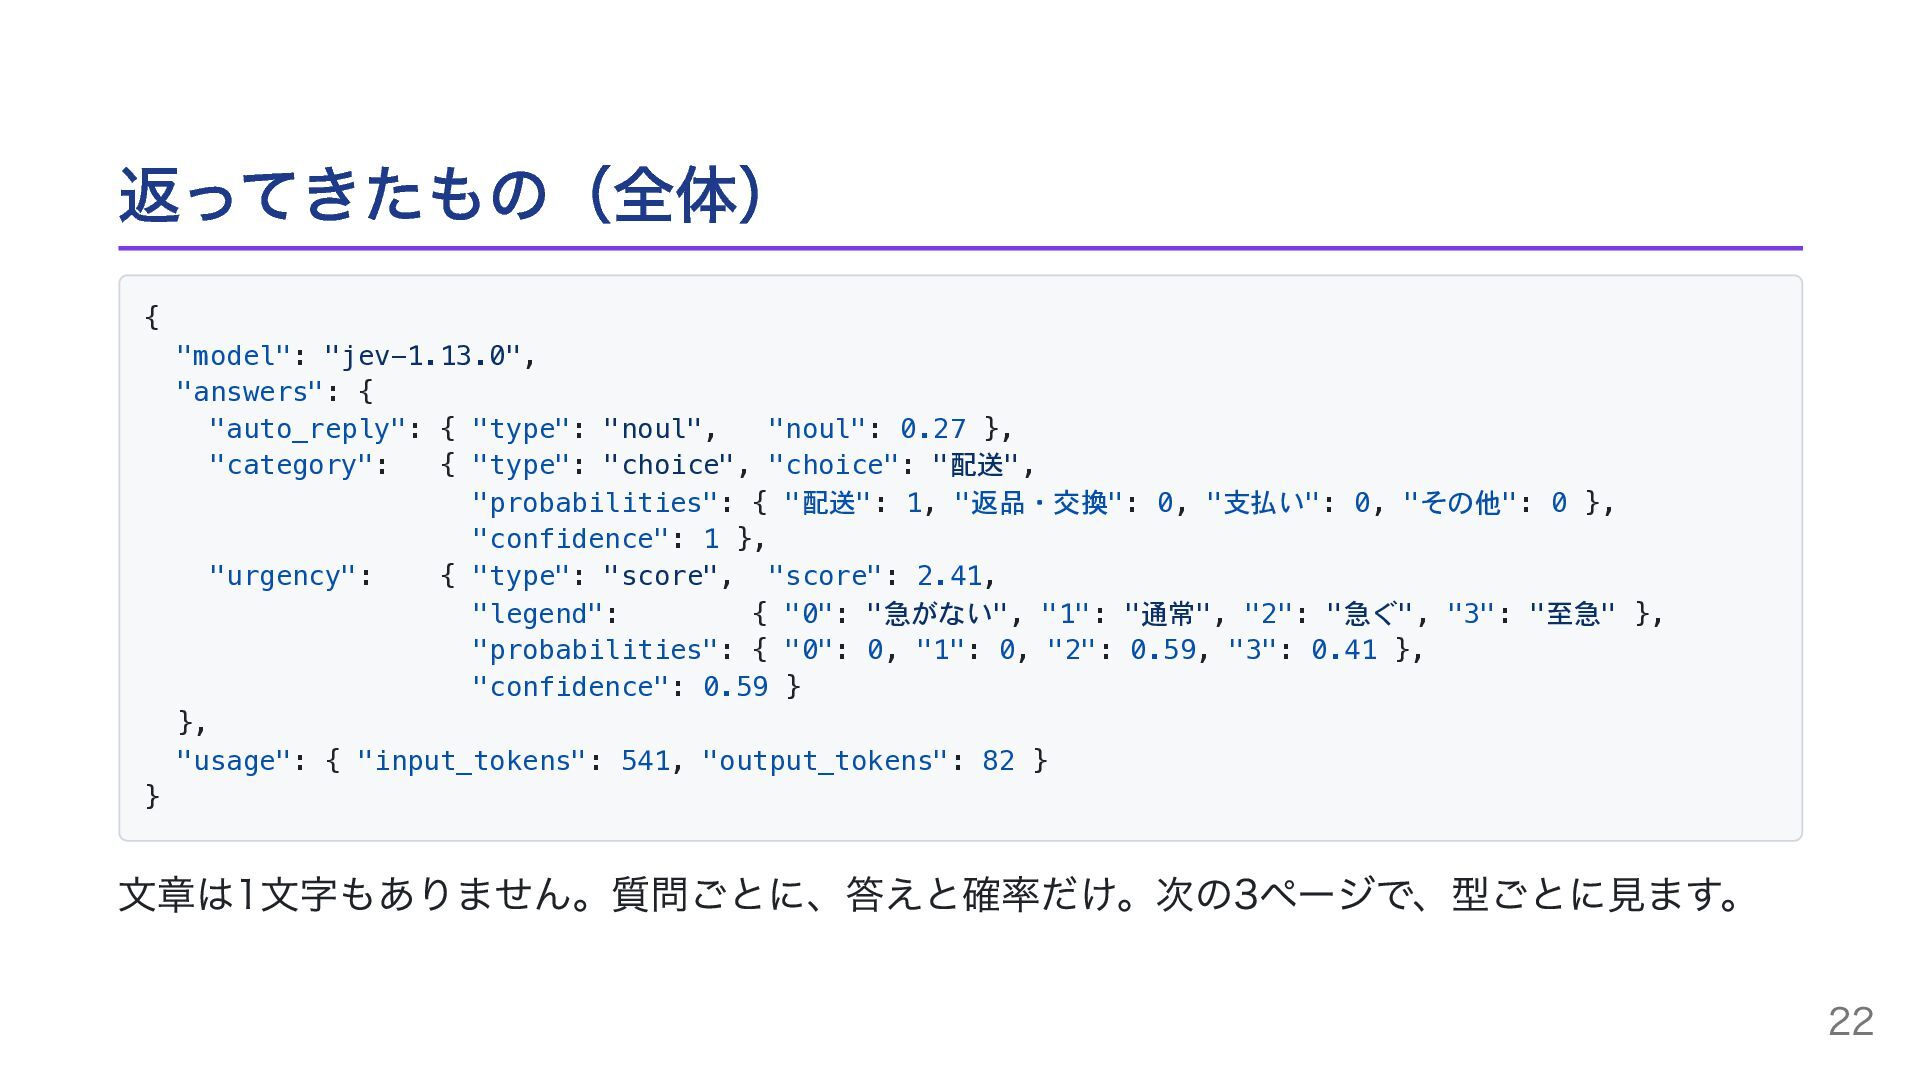
返ってきたもの(全体) { "model": "jev-1.13.0", "answers": { "auto_reply": { "type": "noul",
"noul": 0.27 }, "category": { "type": "choice", "choice": "配送", "probabilities": { "配送": 1, "返品・交換": 0, "支払い": 0, "その他": 0 }, "confidence": 1 }, "urgency": { "type": "score", "score": 2.41, "legend": { "0": "急がない", "1": "通常", "2": "急ぐ", "3": "至急" }, "probabilities": { "0": 0, "1": 0, "2": 0.59, "3": 0.41 }, "confidence": 0.59 } }, "usage": { "input_tokens": 541, "output_tokens": 82 } } 文章は1文字もありません。質問ごとに、答えと確率だけ。次の3ページで、型ごとに見ます。 22
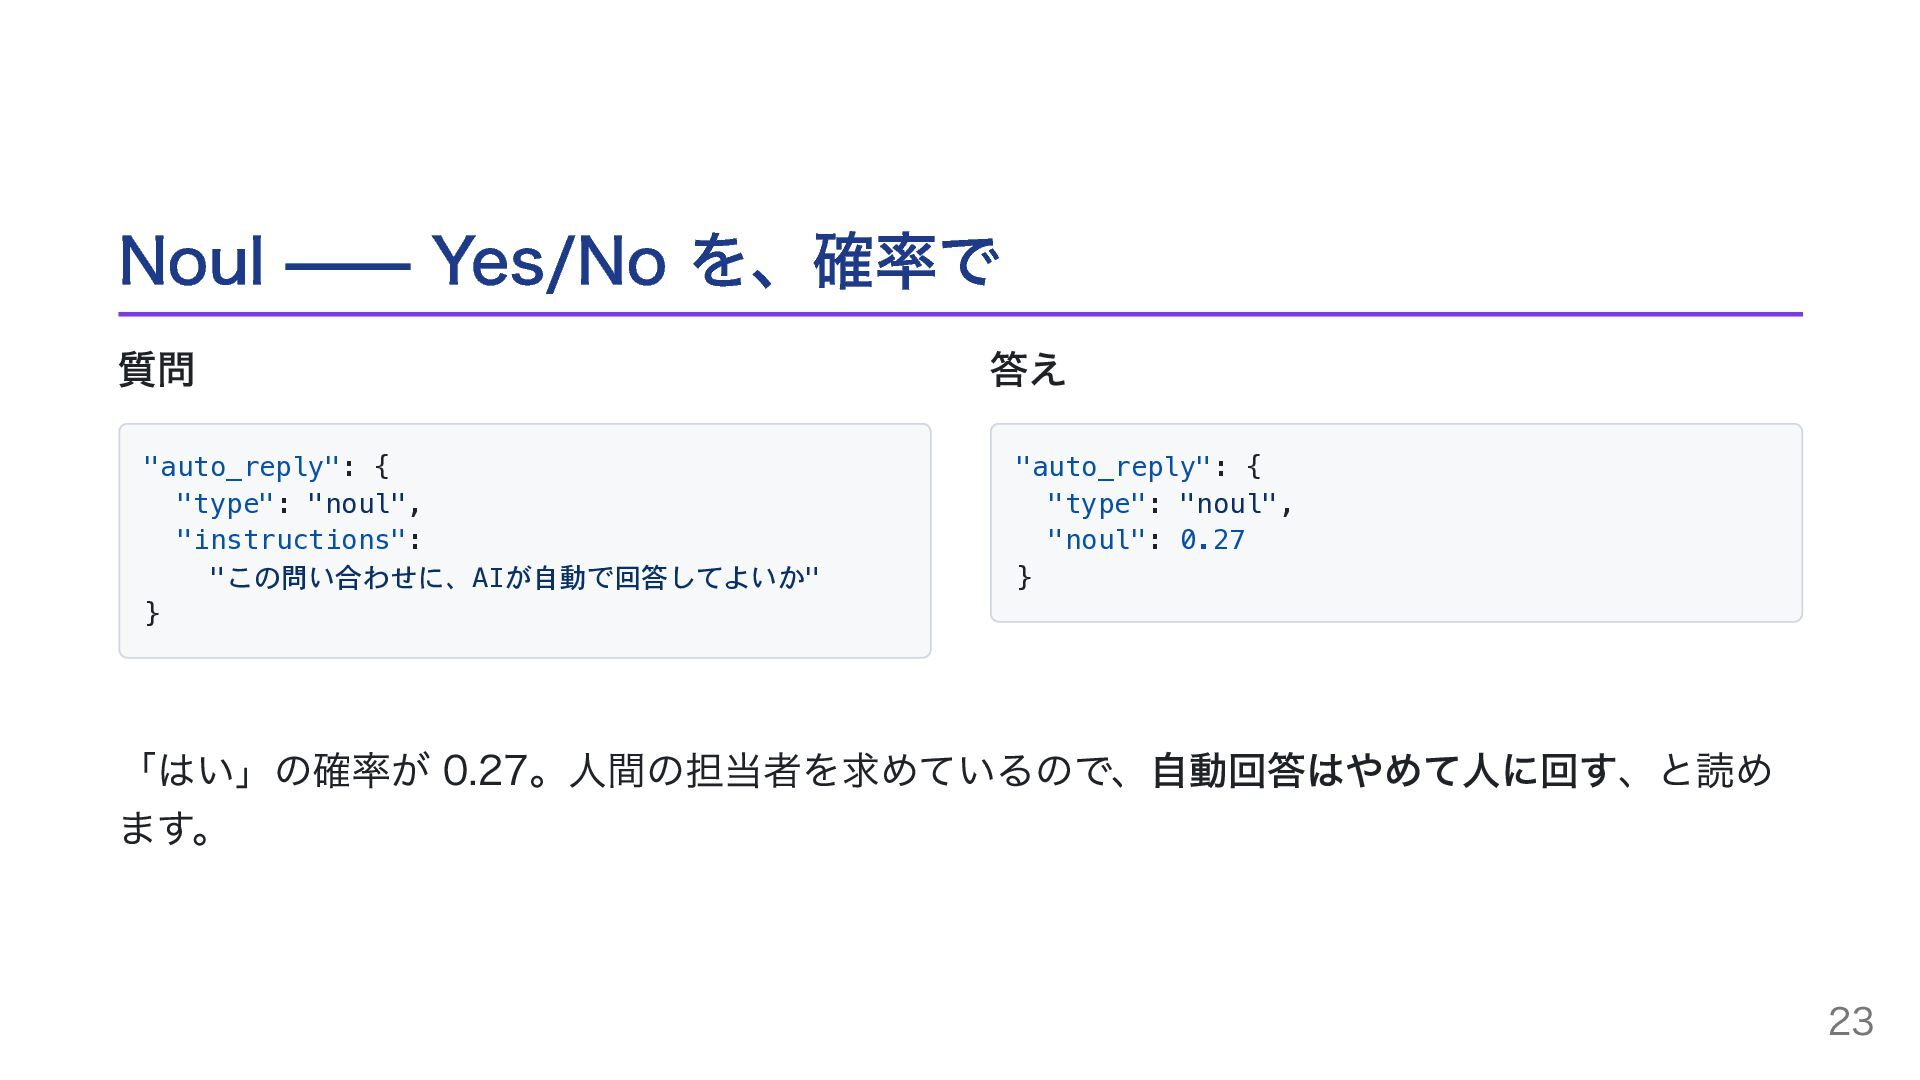
Noul —— Yes/No を、確率で 質問 "auto_reply": { "type": "noul", "instructions":
"この問い合わせに、AIが自動で回答してよいか" } 答え "auto_reply": { "type": "noul", "noul": 0.27 } 「はい」の確率が 0.27。人間の担当者を求めているので、自動回答はやめて人に回す、と読め ます。 23
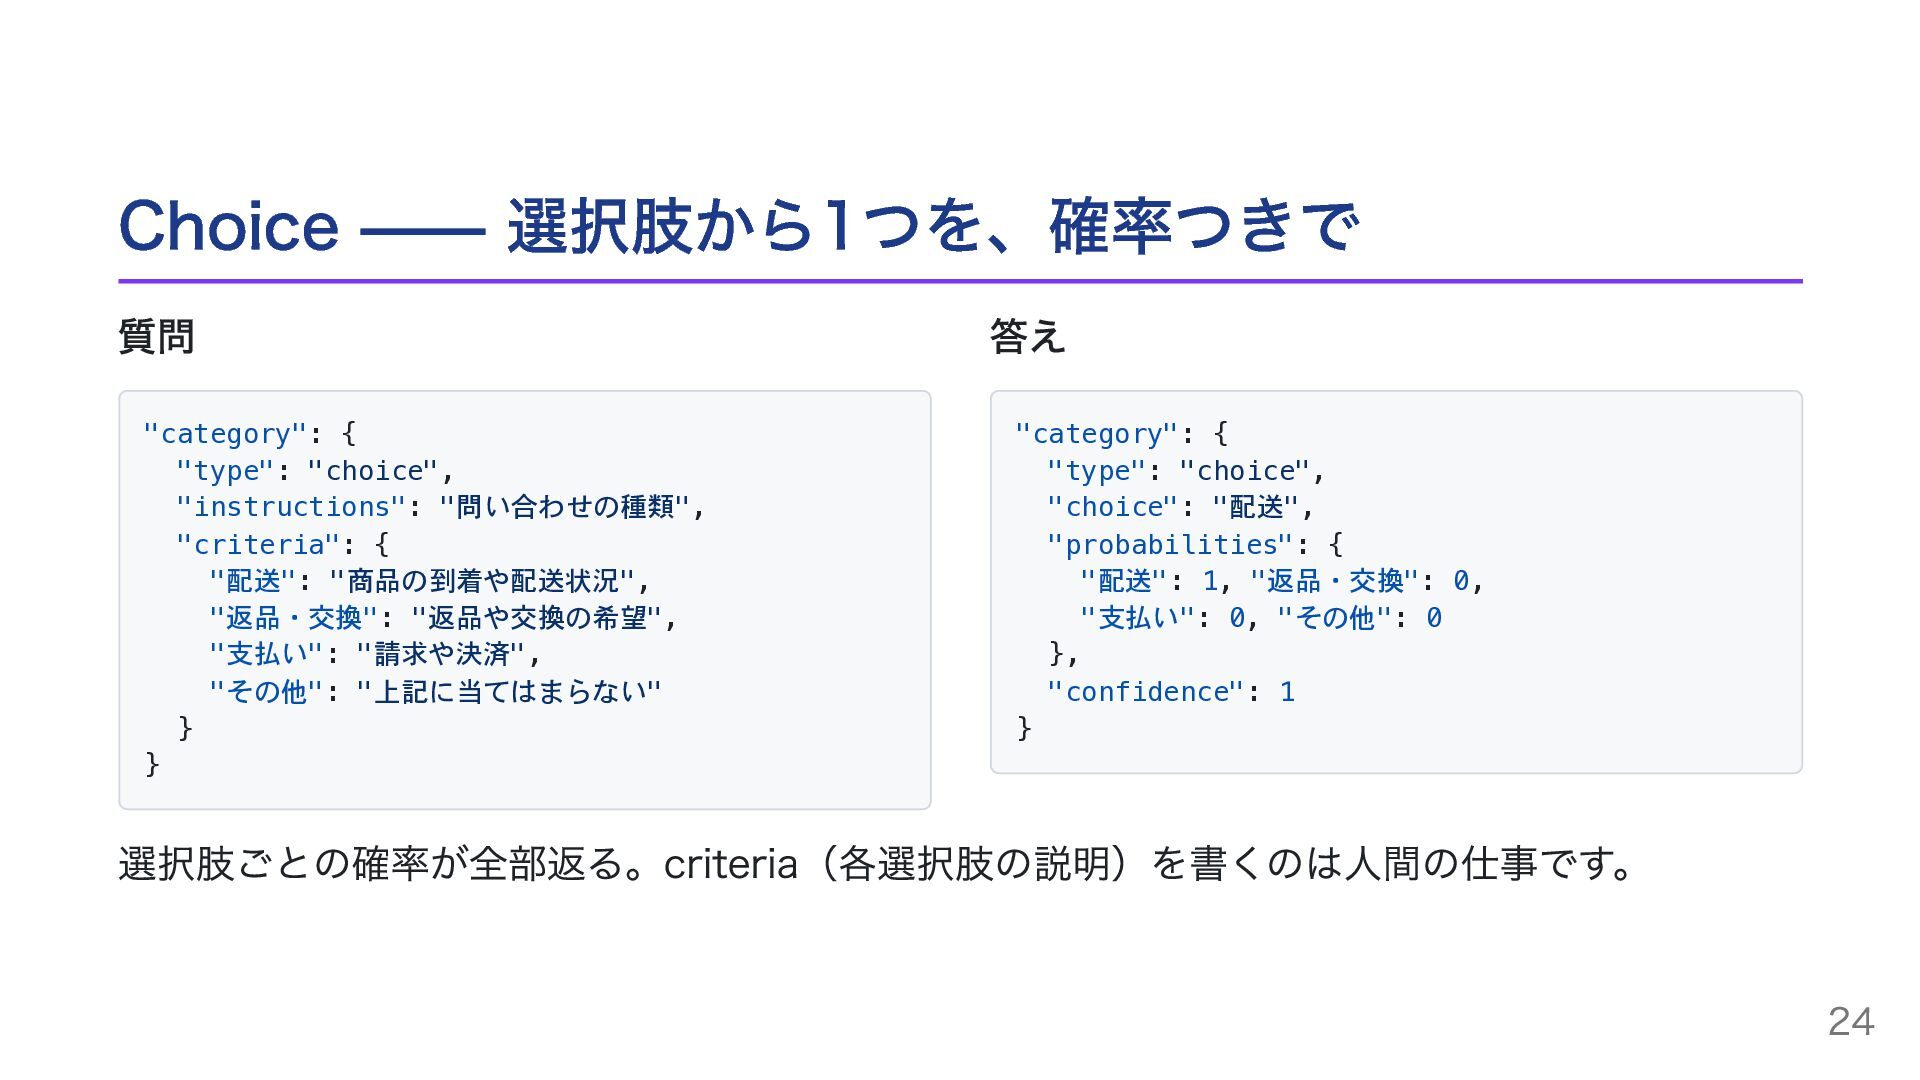
Choice —— 選択肢から1つを、確率つきで 質問 "category": { "type": "choice", "instructions": "問い合わせの種類",
"criteria": { "配送": "商品の到着や配送状況", "返品・交換": "返品や交換の希望", "支払い": "請求や決済", "その他": "上記に当てはまらない" } } 答え "category": { "type": "choice", "choice": "配送", "probabilities": { "配送": 1, "返品・交換": 0, "支払い": 0, "その他": 0 }, "confidence": 1 } 選択肢ごとの確率が全部返る。criteria(各選択肢の説明)を書くのは人間の仕事です。 24
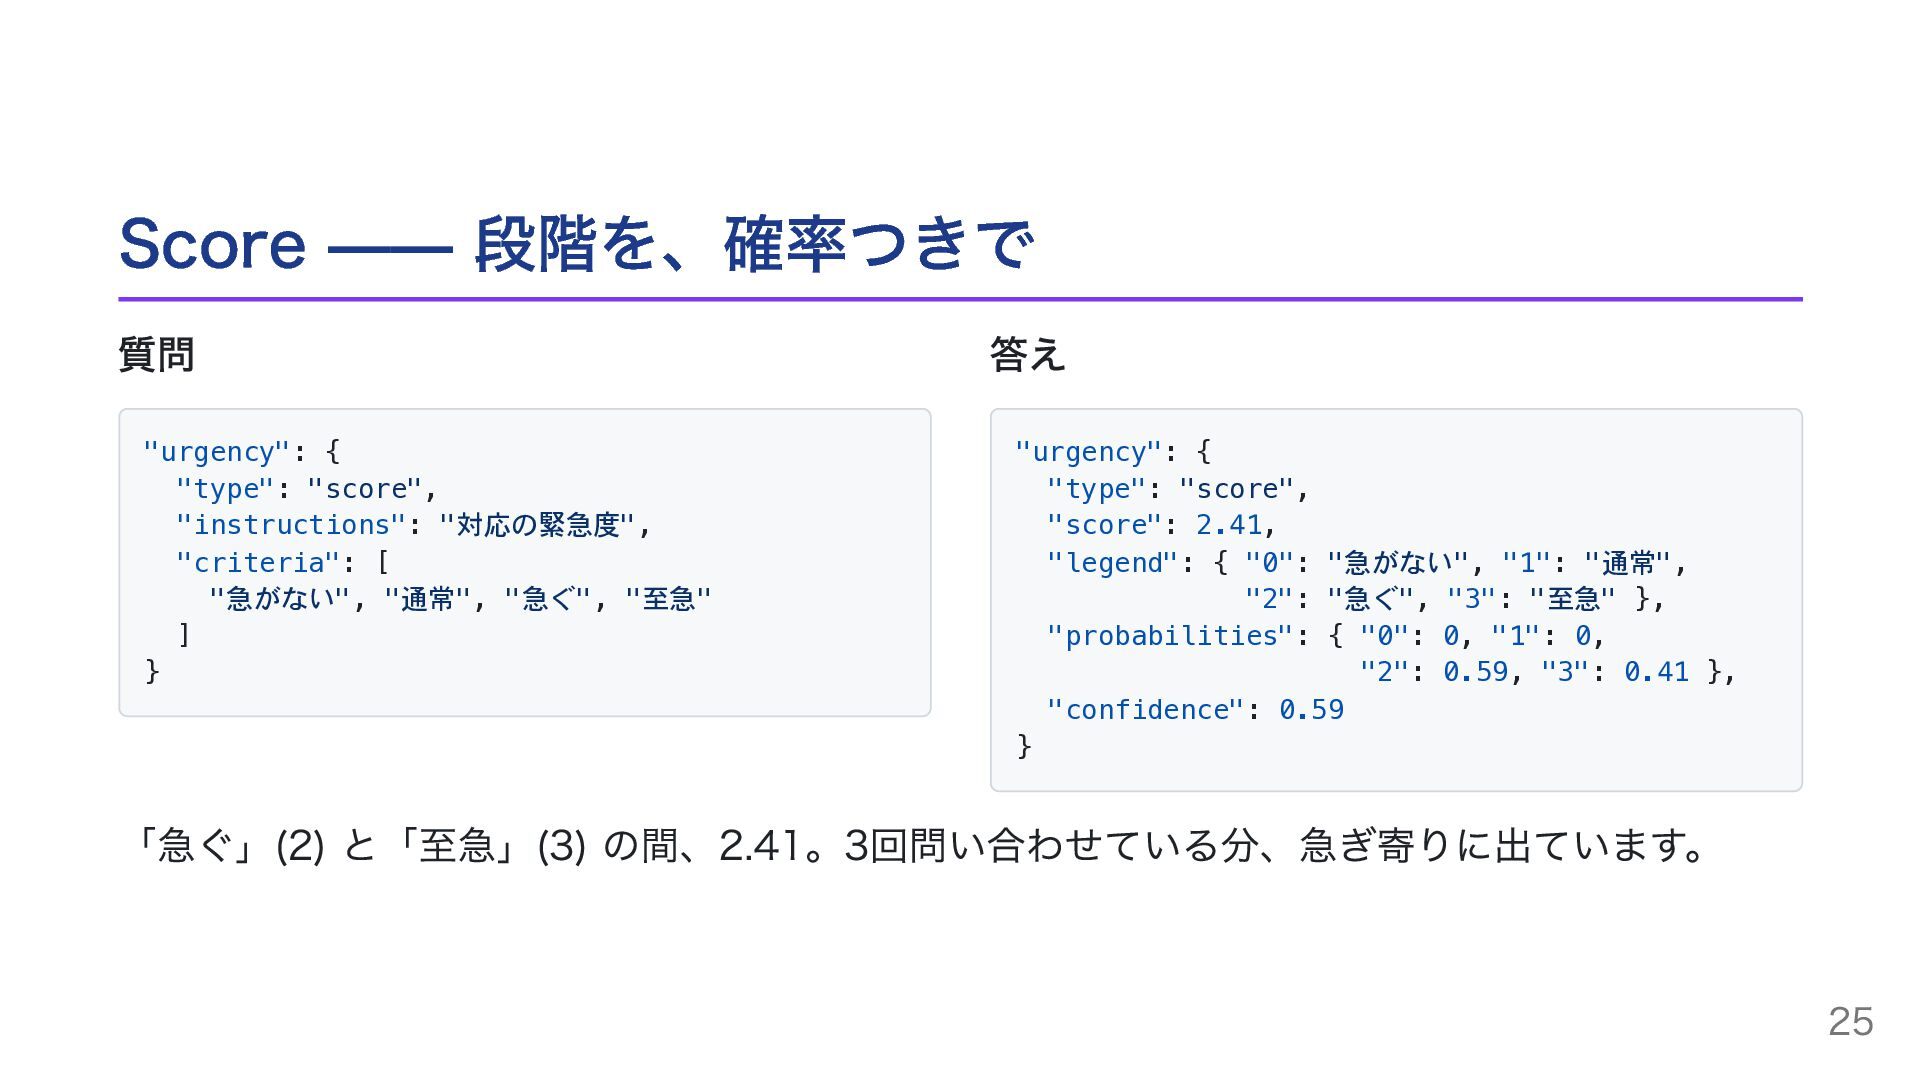
Score —— 段階を、確率つきで 質問 "urgency": { "type": "score", "instructions": "対応の緊急度",
"criteria": [ "急がない", "通常", "急ぐ", "至急" ] } 答え "urgency": { "type": "score", "score": 2.41, "legend": { "0": "急がない", "1": "通常", "2": "急ぐ", "3": "至急" }, "probabilities": { "0": 0, "1": 0, "2": 0.59, "3": 0.41 }, "confidence": 0.59 } 「急ぐ」(2) と「至急」(3) の間、2.41。3回問い合わせている分、急ぎ寄りに出ています。 25
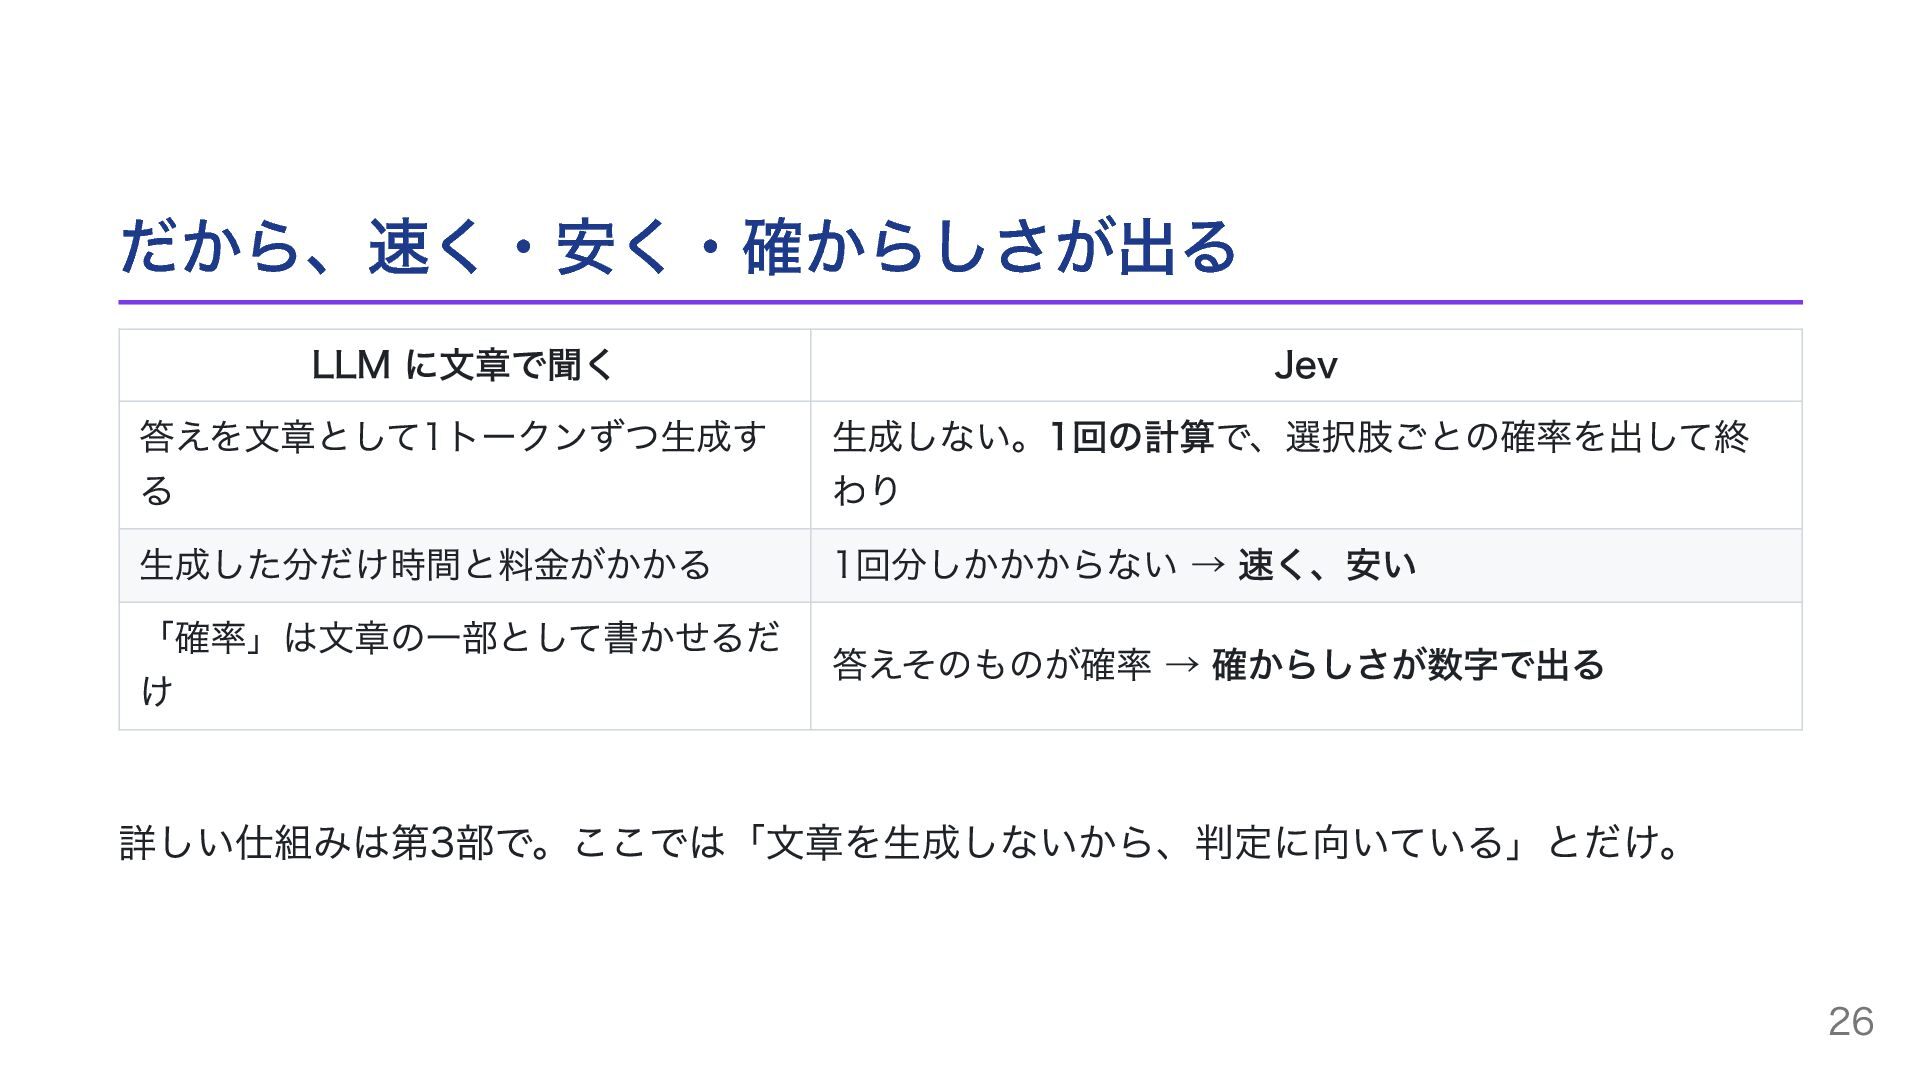
だから、速く・安く・確からしさが出る LLM に文章で聞く 答えを文章として1トークンずつ生成す る 生成した分だけ時間と料金がかかる 「確率」は文章の一部として書かせるだ け Jev 生成しない。1回の計算で、選択肢ごとの確率を出して終
わり 1回分しかかからない → 速く、安い 答えそのものが確率 → 確からしさが数字で出る 詳しい仕組みは第3部で。ここでは「文章を生成しないから、判定に向いている」とだけ。 26
Jev だと、この3つが変わる 1〜2秒 → 0.3秒 判定1回にかかる時間 27
Jev だと、この3つが変わる 0.16円 → 0.005円 判定1回の料金。左が Claude(Sonnet)、右が Jev 28
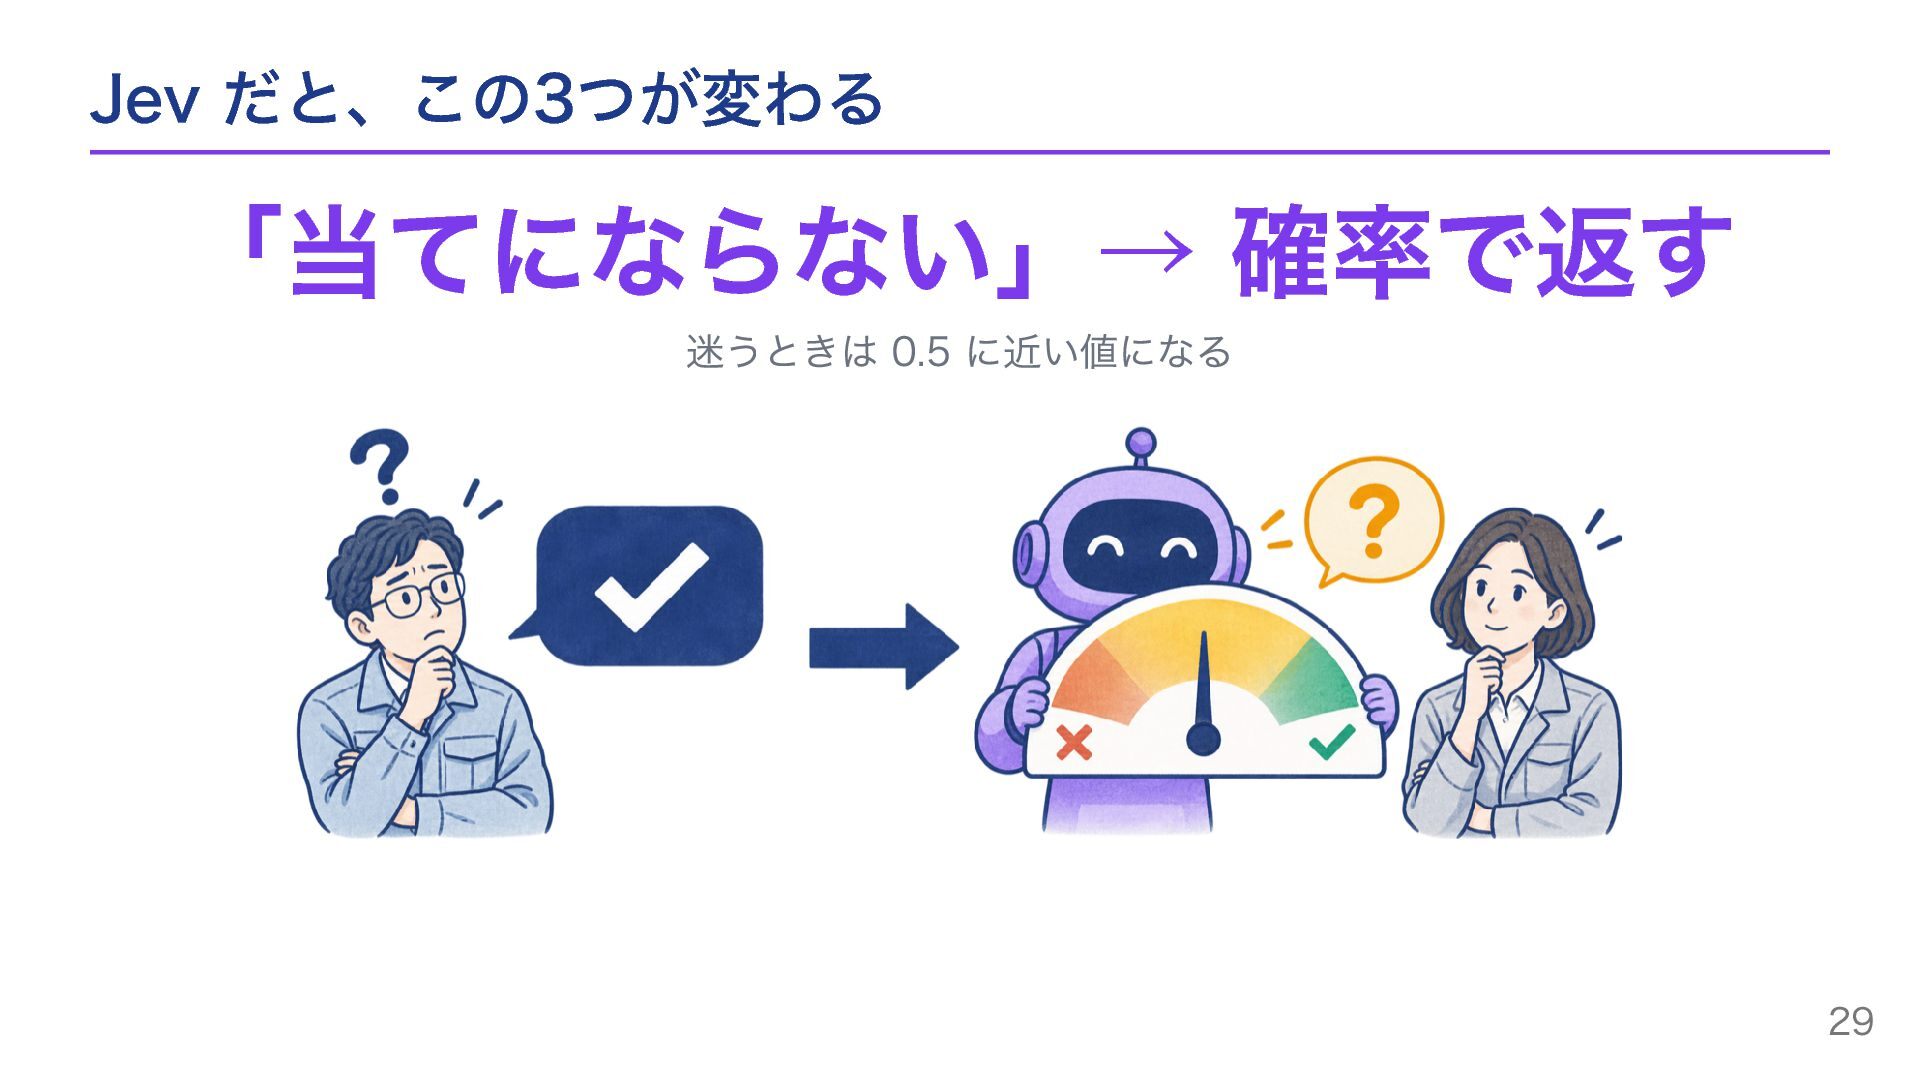
Jev だと、この3つが変わる 「当てにならない」→ 確率で返す 迷うときは 0.5 に近い値になる 29
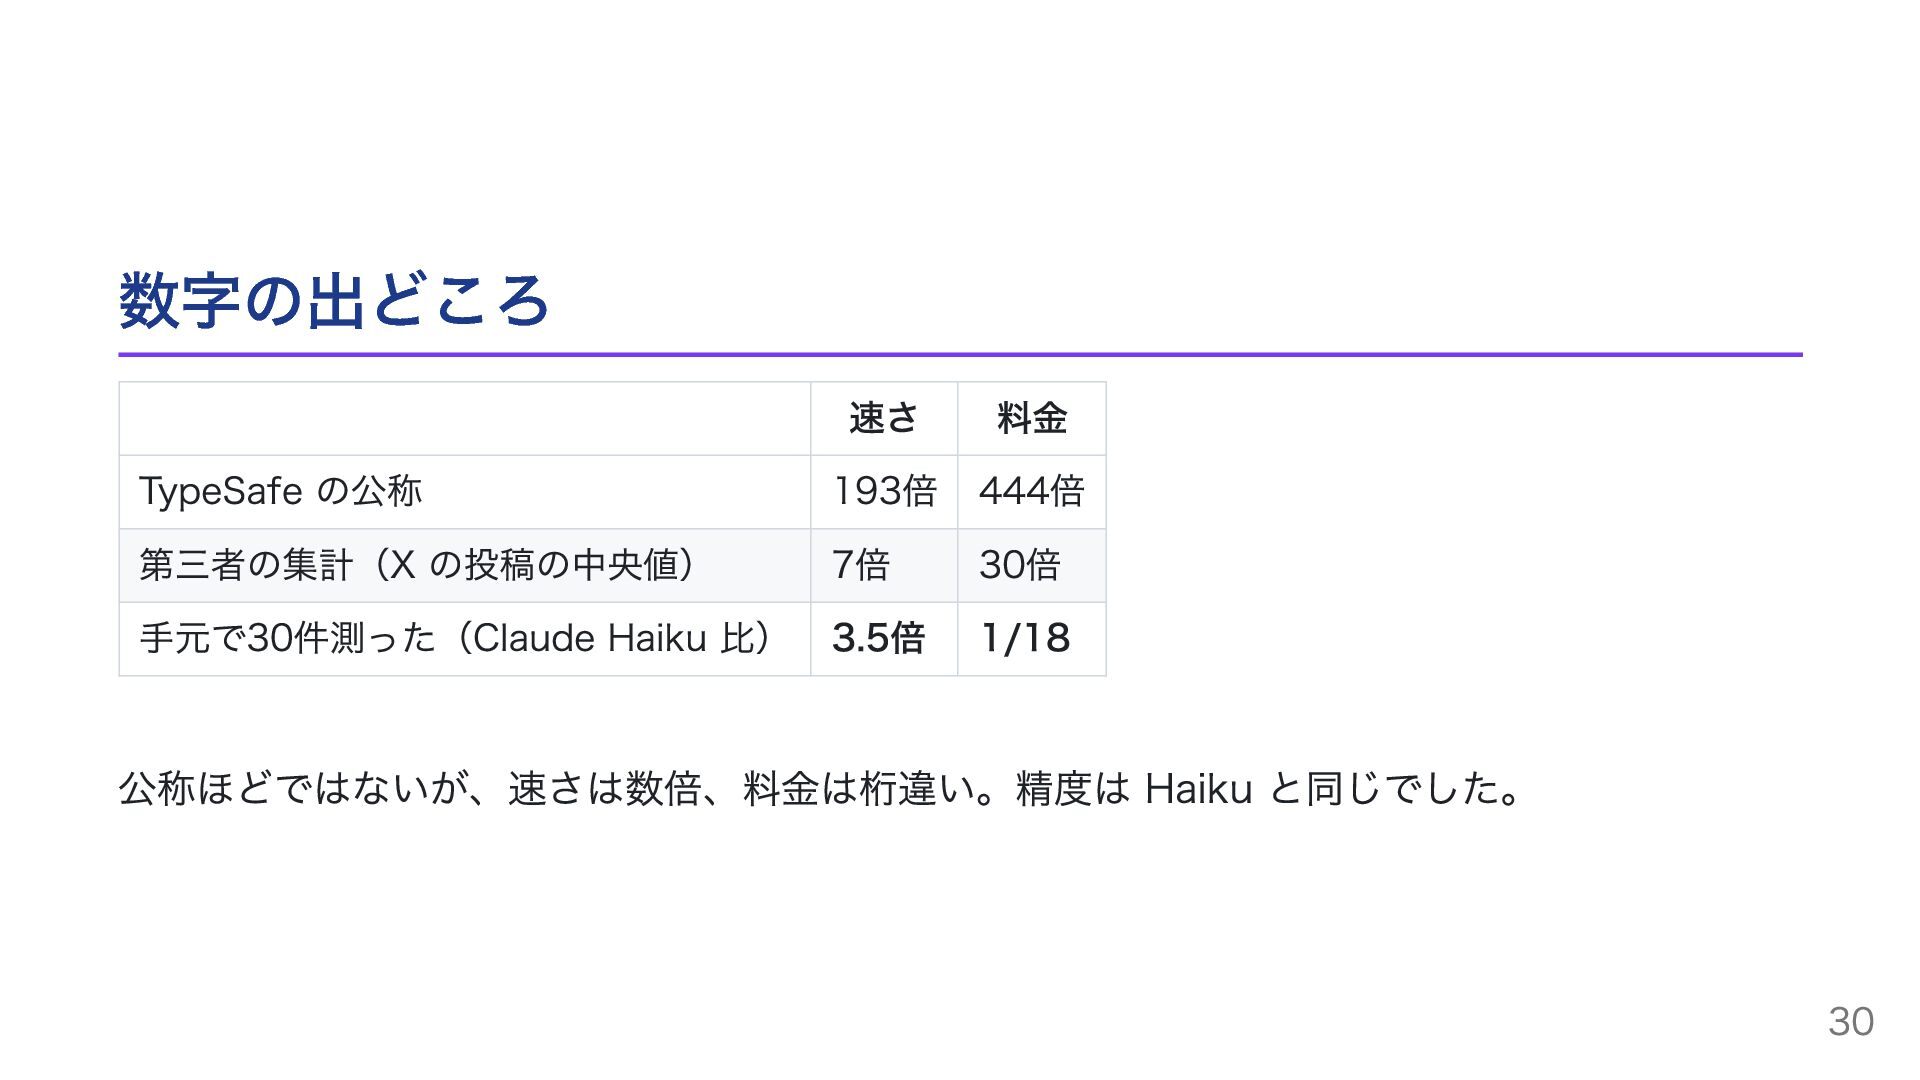
数字の出どころ 速さ 料金 TypeSafe の公称 193倍 444倍 第三者の集計(X の投稿の中央値) 7倍
30倍 手元で30件測った(Claude Haiku 比) 3.5倍 1/18 公称ほどではないが、速さは数倍、料金は桁違い。精度は Haiku と同じでした。 30
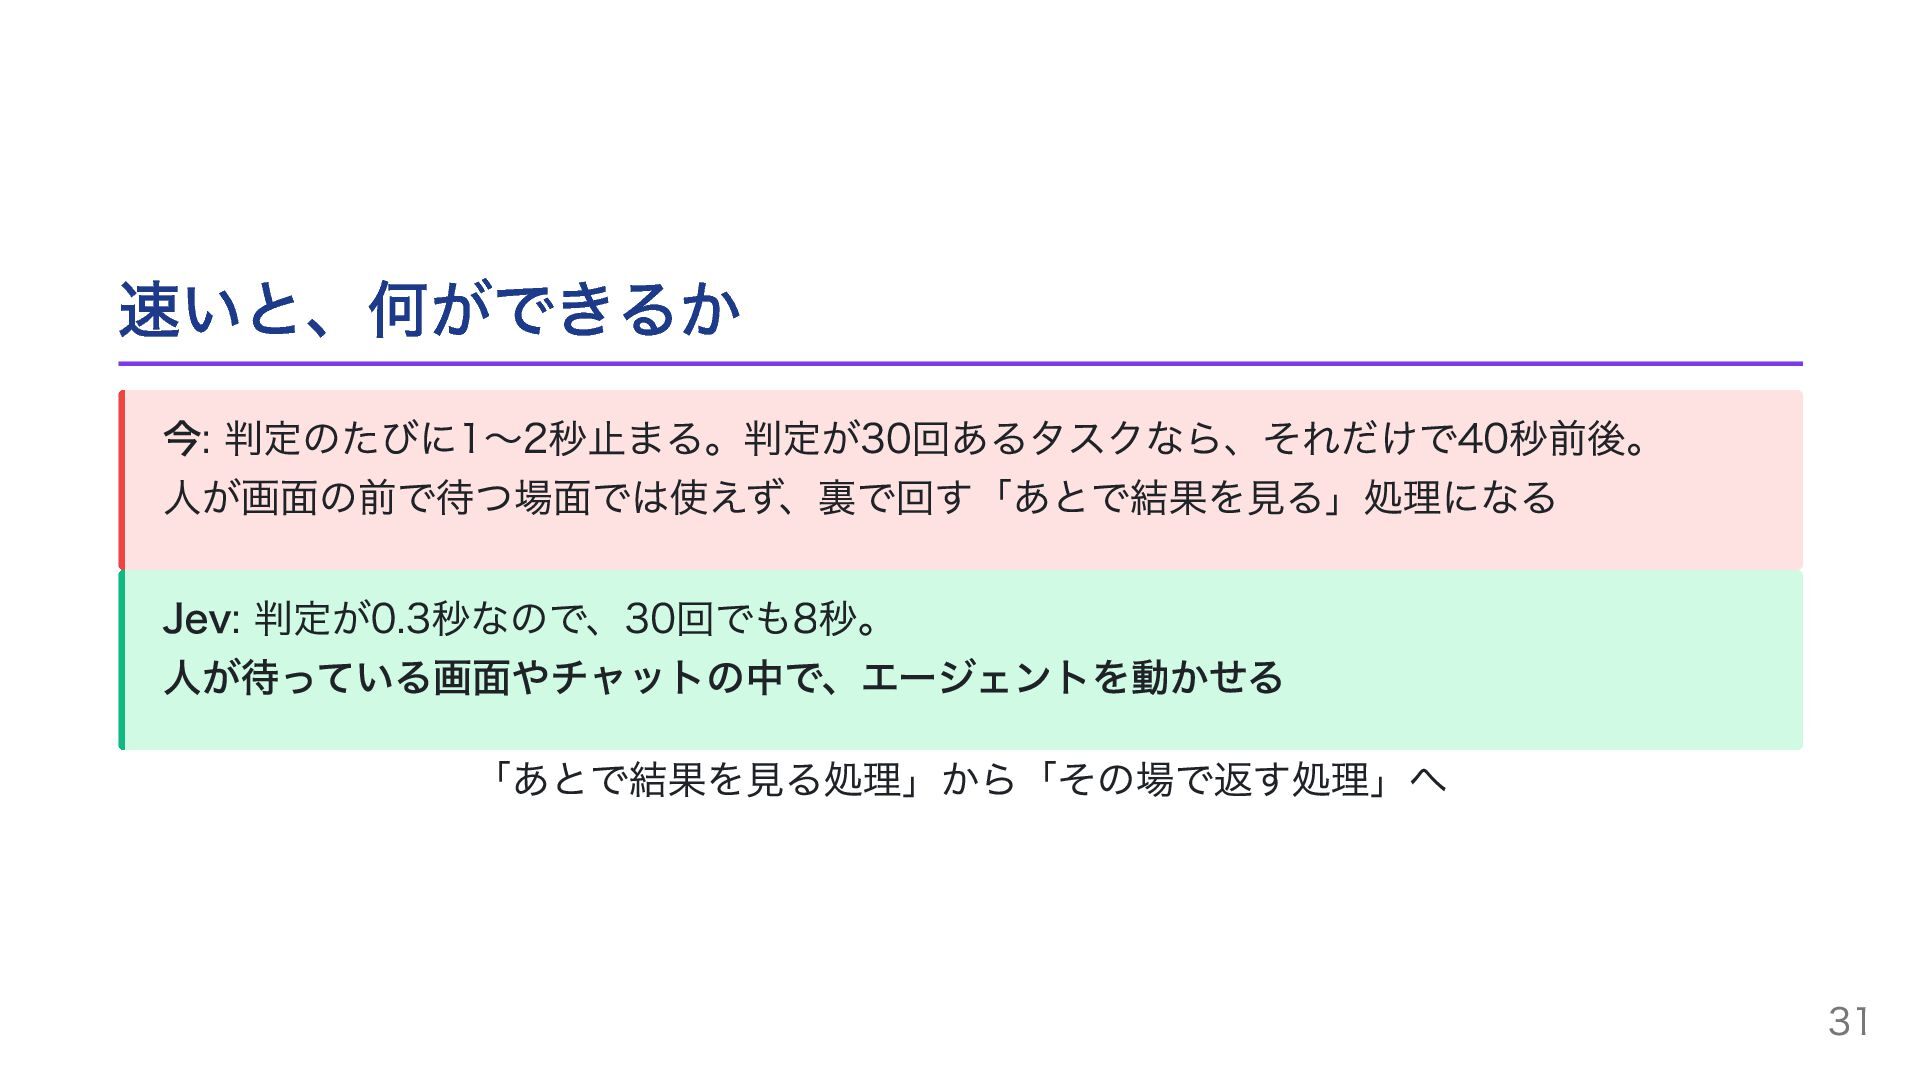
速いと、何ができるか 今: 判定のたびに1〜2秒止まる。判定が30回あるタスクなら、それだけで40秒前後。 人が画面の前で待つ場面では使えず、裏で回す「あとで結果を見る」処理になる Jev: 判定が0.3秒なので、30回でも8秒。 人が待っている画面やチャットの中で、エージェントを動かせる 「あとで結果を見る処理」から「その場で返す処理」へ 31
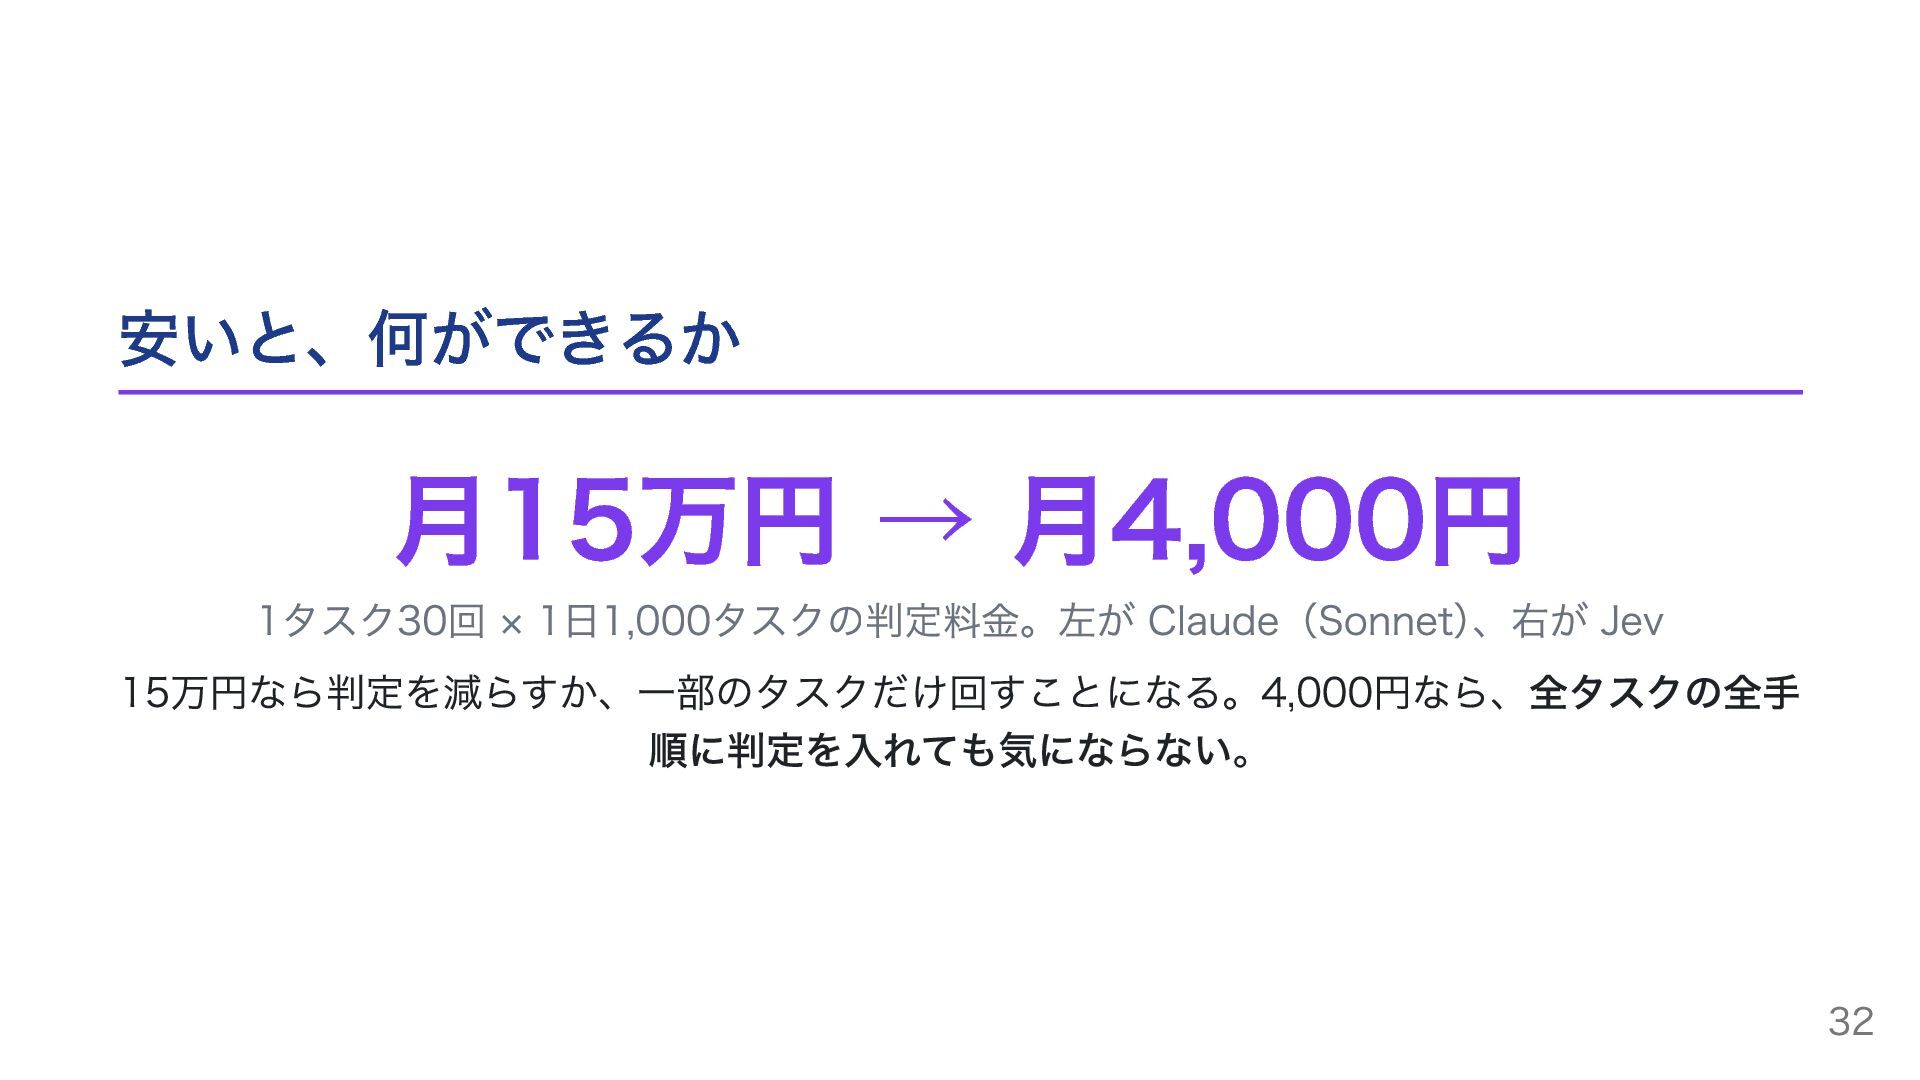
安いと、何ができるか 月15万円 → 月4,000円 1タスク30回 × 1日1,000タスクの判定料金。左が Claude(Sonnet)、右が Jev 15万円なら判定を減らすか、一部のタスクだけ回すことになる。4,000円なら、全タスクの全手
順に判定を入れても気にならない。 32
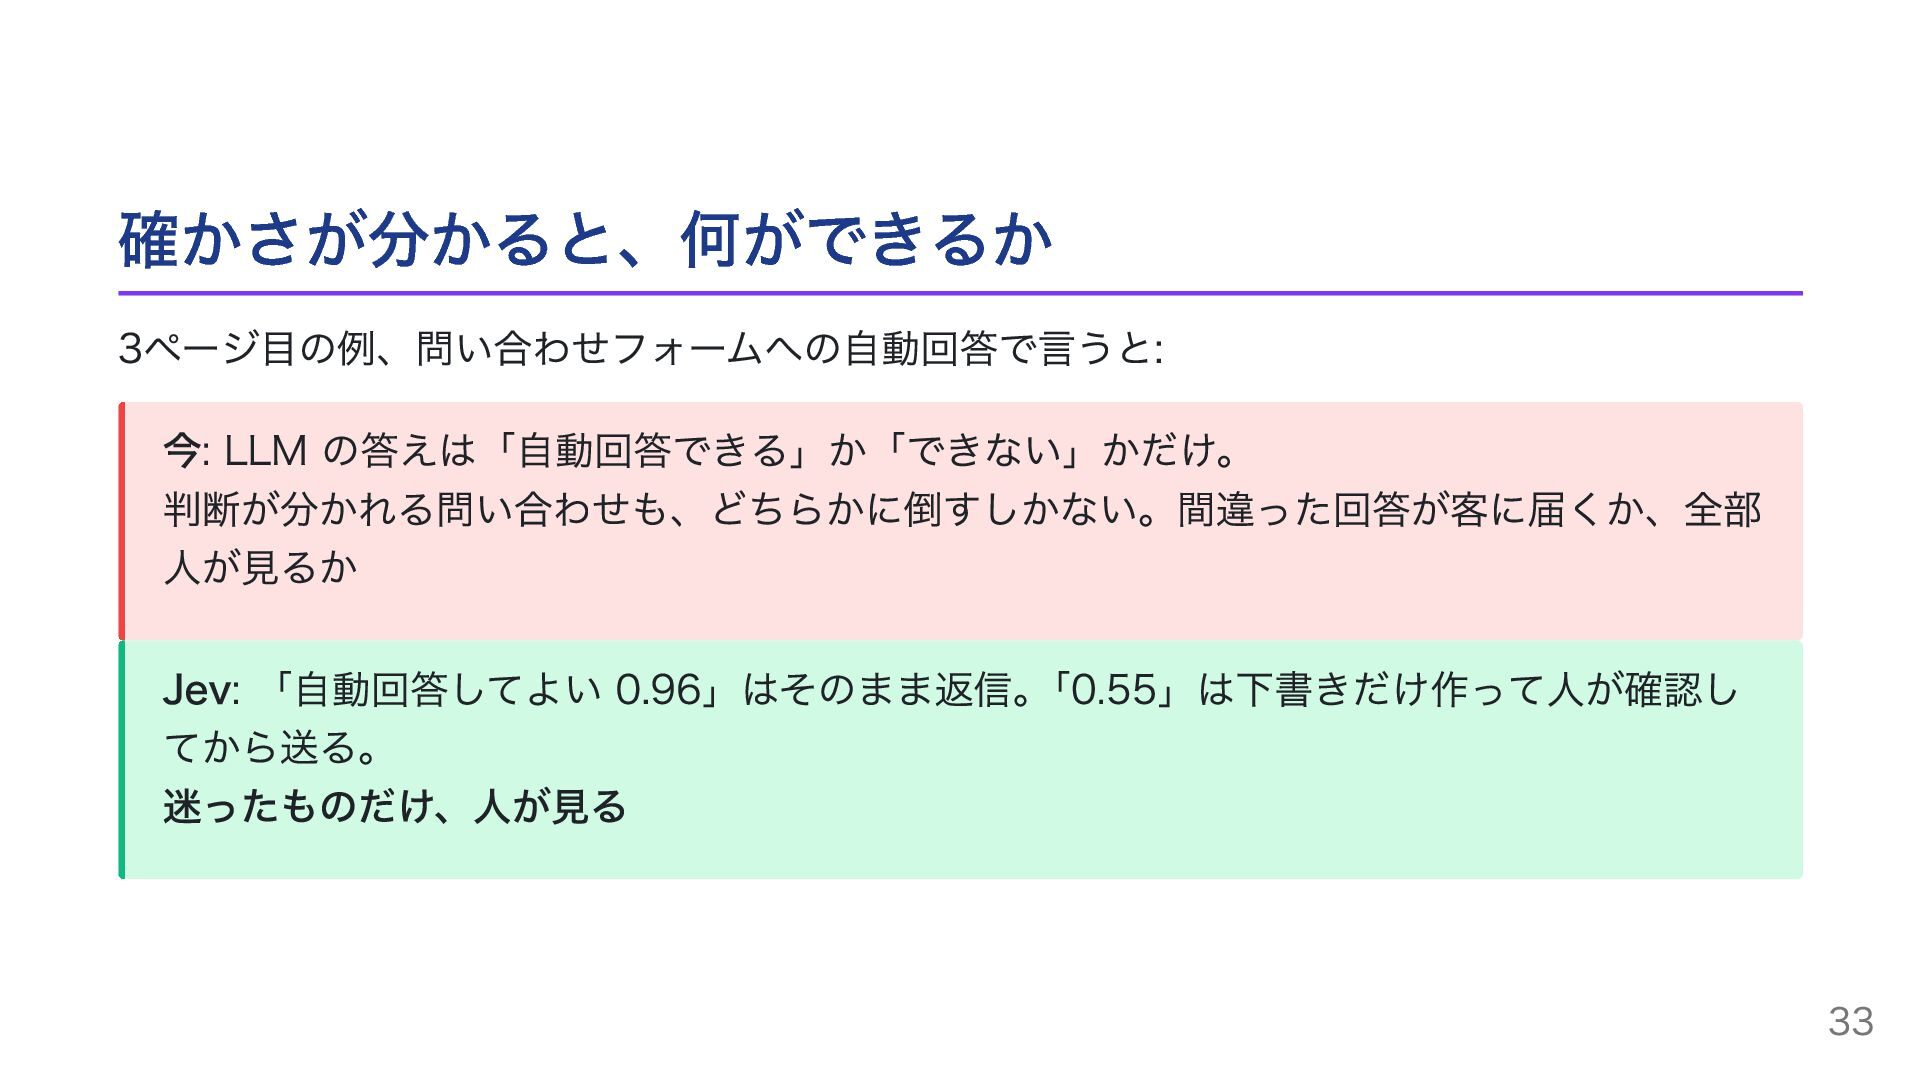
確かさが分かると、何ができるか 3ページ目の例、問い合わせフォームへの自動回答で言うと: 今: LLM の答えは「自動回答できる」か「できない」かだけ。 判断が分かれる問い合わせも、どちらかに倒すしかない。間違った回答が客に届くか、全部 人が見るか Jev: 「自動回答してよい 0.96」はそのまま返信。「0.55」は下書きだけ作って人が確認し
てから送る。 迷ったものだけ、人が見る 33
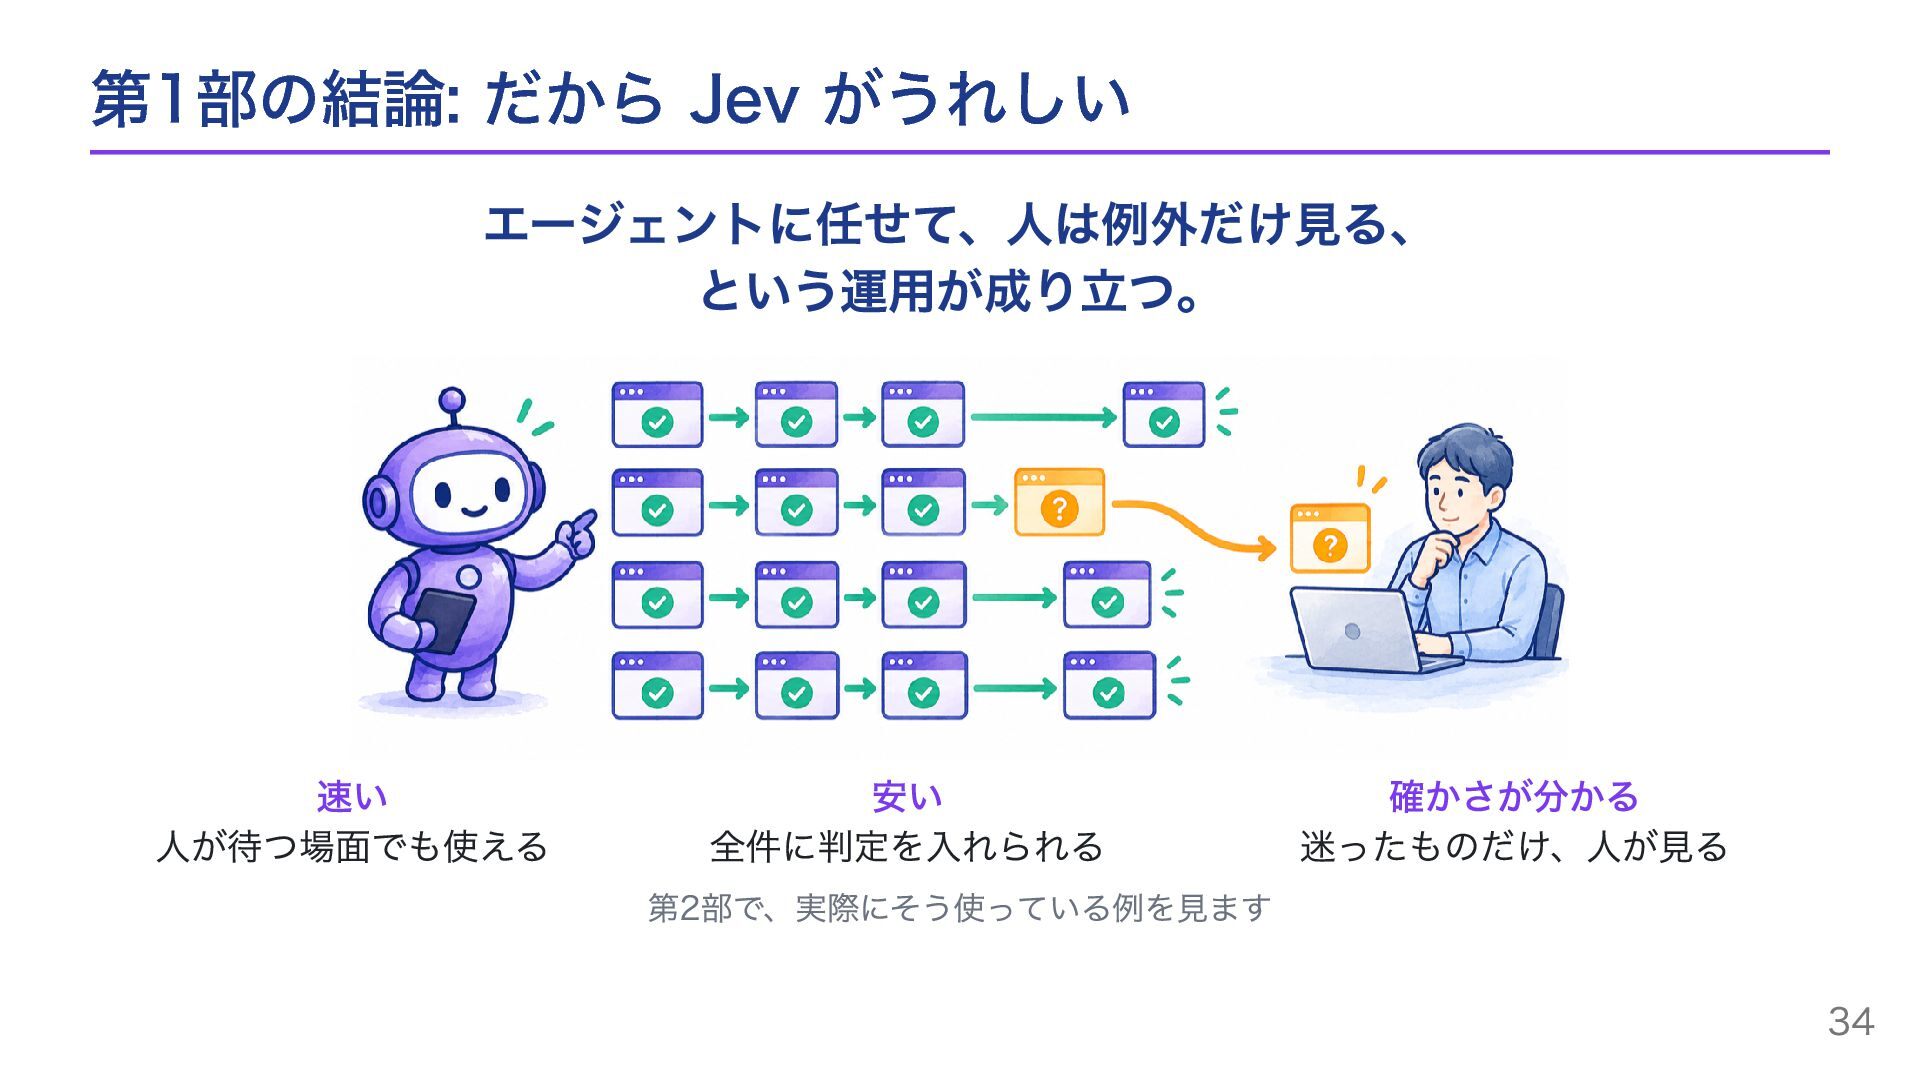
第1部の結論: だから Jev がうれしい エージェントに任せて、人は例外だけ見る、 という運用が成り立つ。 速い 人が待つ場面でも使える 安い 全件に判定を入れられる
第2部で、実際にそう使っている例を見ます 確かさが分かる 迷ったものだけ、人が見る 34
第2部 どう使われているか —— 実際のユースケース 35
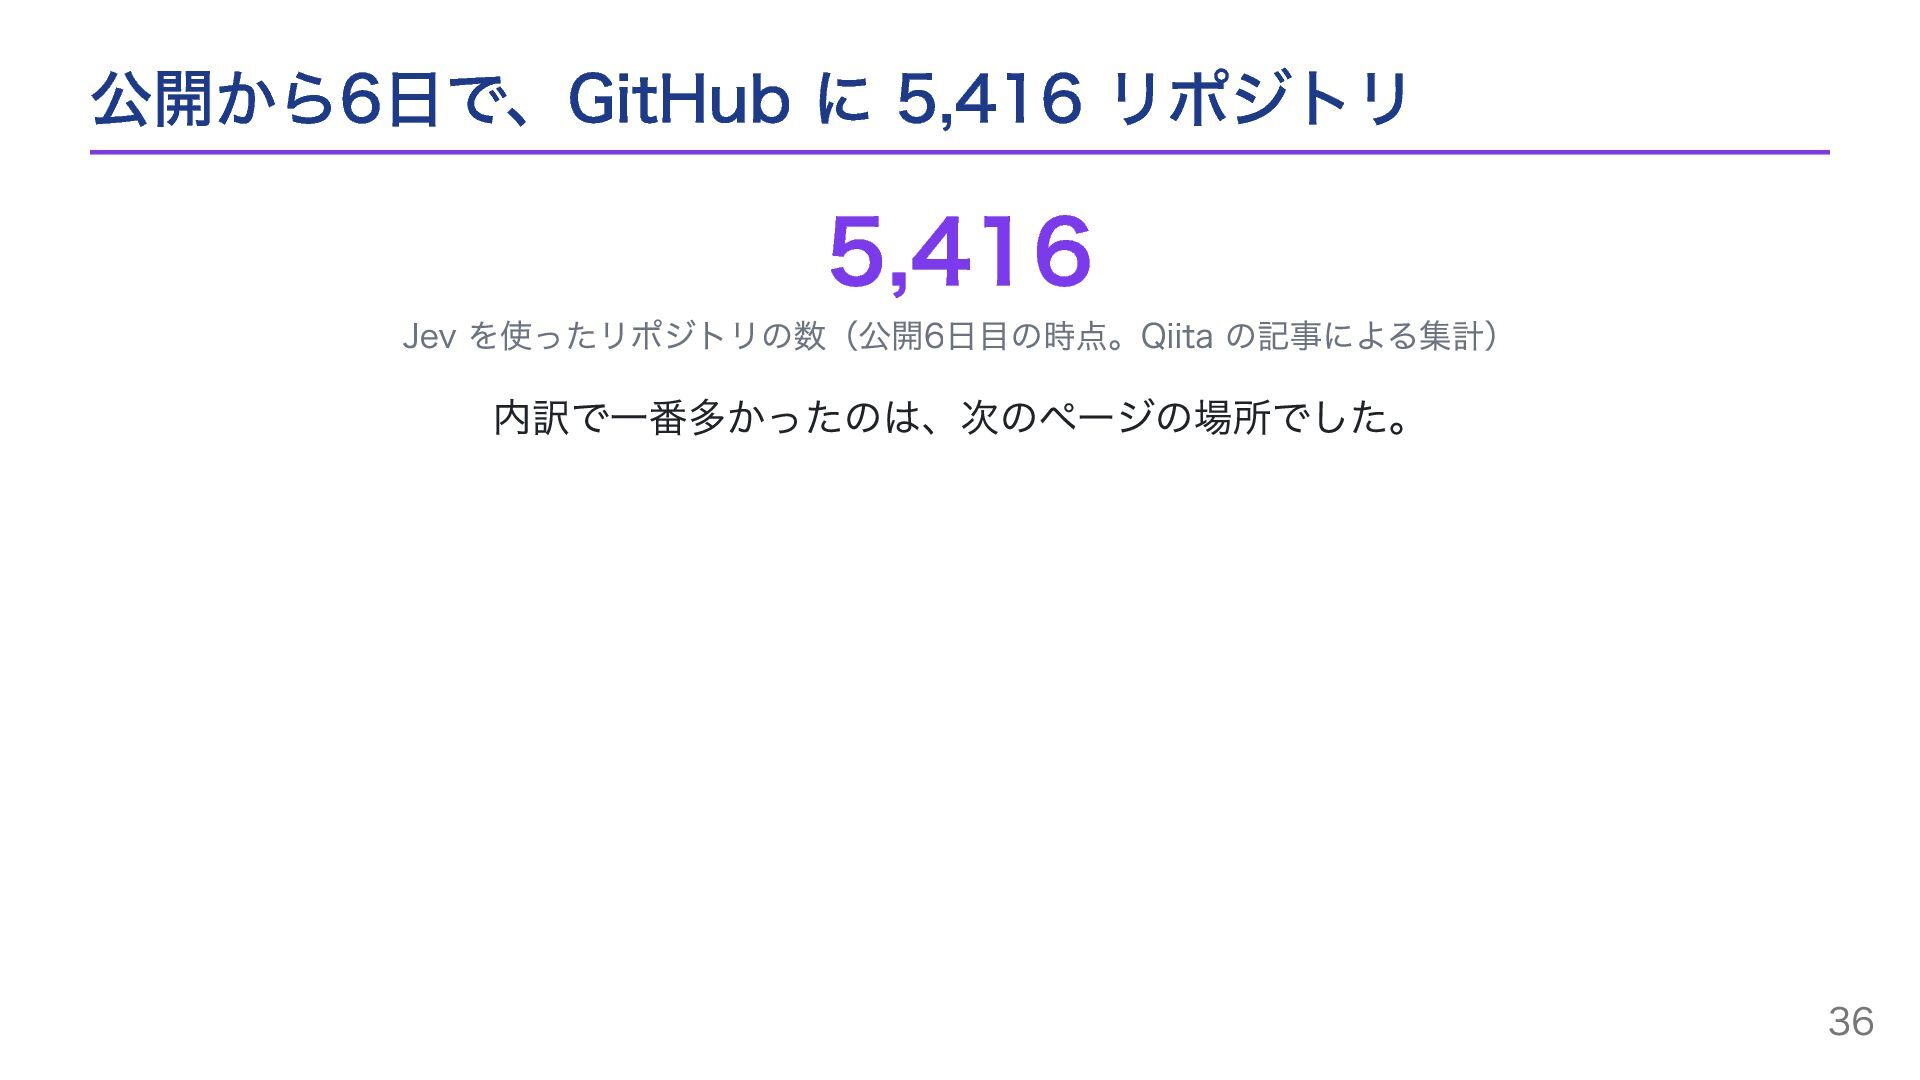
公開から6日で、GitHub に 5,416 リポジトリ 5,416 Jev を使ったリポジトリの数(公開6日目の時点。Qiita の記事による集計) 内訳で一番多かったのは、次のページの場所でした。 36
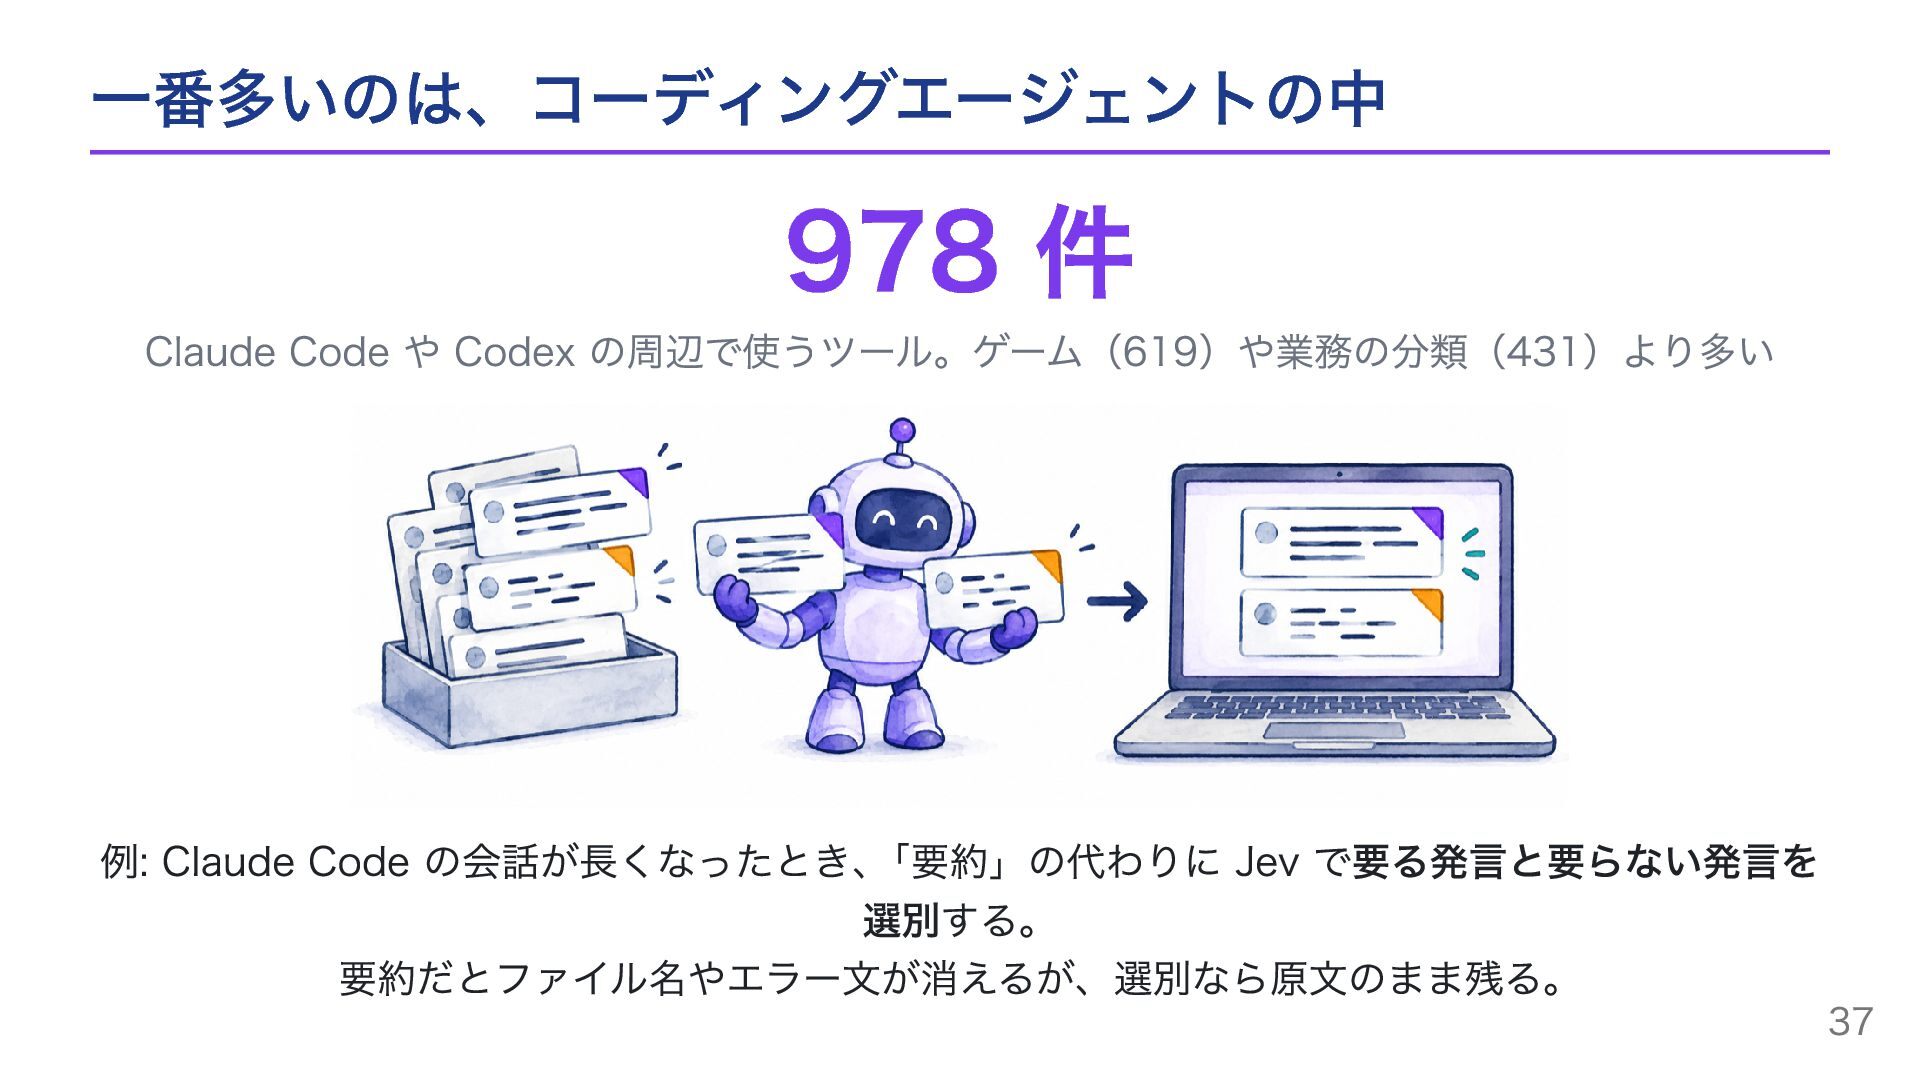
一番多いのは、コーディングエージェントの中 978 件 Claude Code や Codex の周辺で使うツール。ゲーム(619)や業務の分類(431)より多い 例: Claude
Code の会話が長くなったとき、「要約」の代わりに Jev で要る発言と要らない発言を 選別する。 要約だとファイル名やエラー文が消えるが、選別なら原文のまま残る。 37
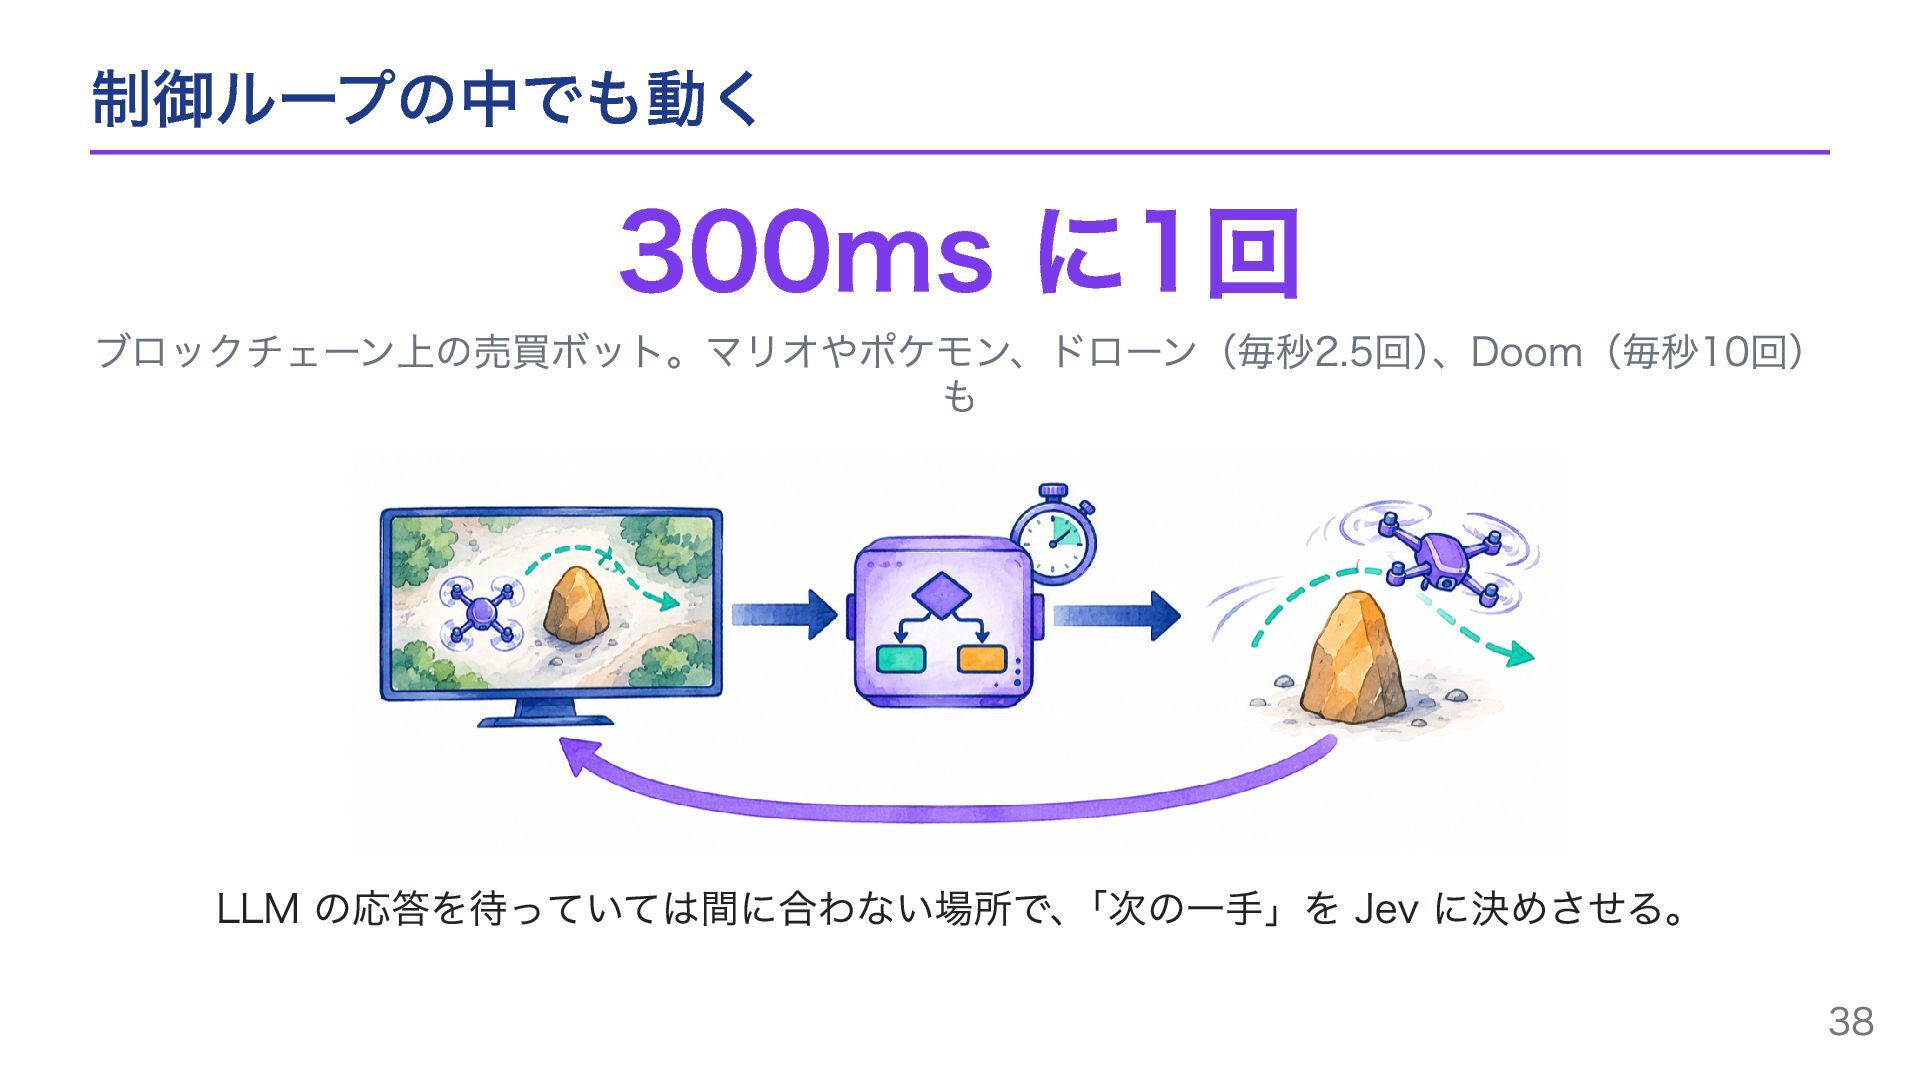
制御ループの中でも動く 300ms に1回 ブロックチェーン上の売買ボット。マリオやポケモン、ドローン(毎秒2.5回)、Doom(毎秒10回) も LLM の応答を待っていては間に合わない場所で、「次の一手」を Jev に決めさせる。 38
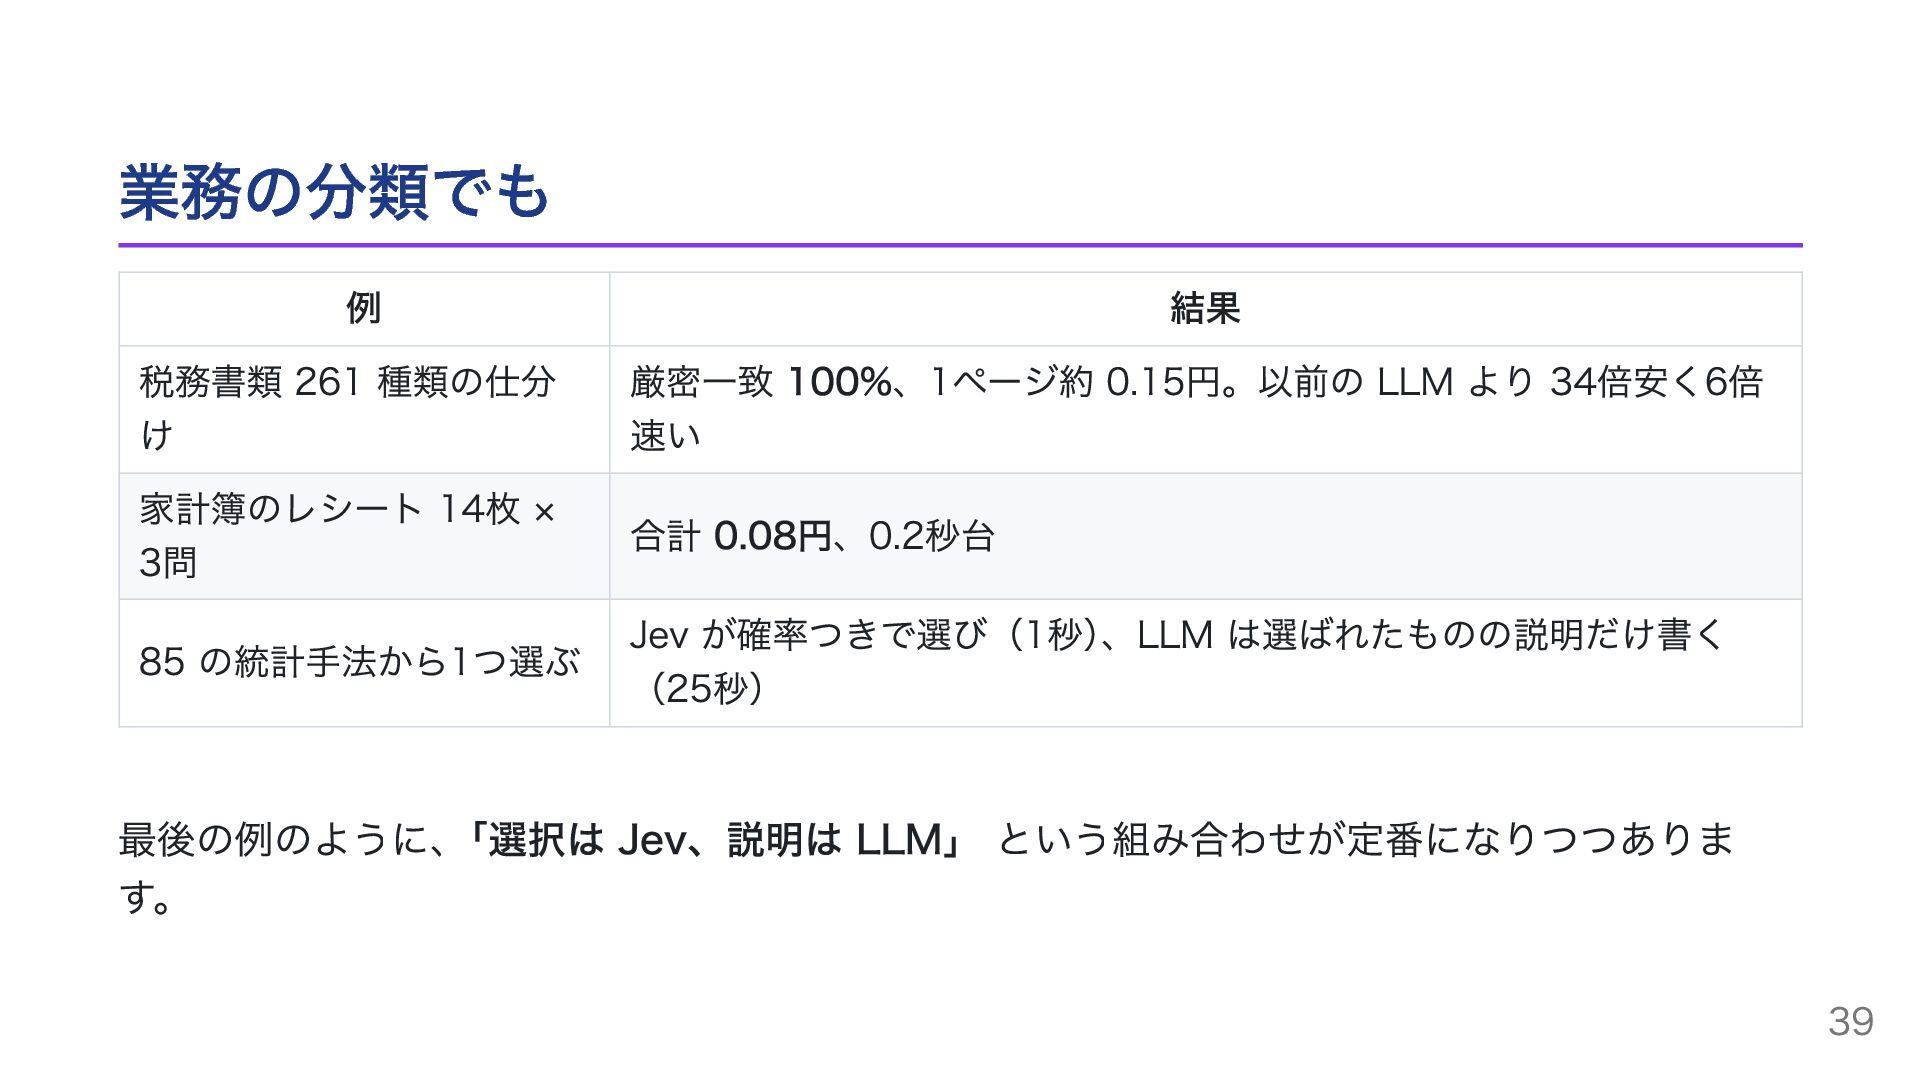
業務の分類でも 例 結果 税務書類 261 種類の仕分 厳密一致 100%、1ページ約 0.15円。以前の LLM
より 34倍安く6倍 け 速い 家計簿のレシート 14枚 × 合計 0.08円、0.2秒台 3問 Jev が確率つきで選び(1秒) 、LLM は選ばれたものの説明だけ書く 85 の統計手法から1つ選ぶ (25秒) 最後の例のように、「選択は Jev、説明は LLM」 という組み合わせが定番になりつつありま す。 39
危険な操作を止める —— Vercel 5〜18倍速く Vercel(Web開発の基盤サービス)が、AI が実行するコマンドの安全確認を Jev に置き換えた結果 The Next
Web 2026-09-22 40
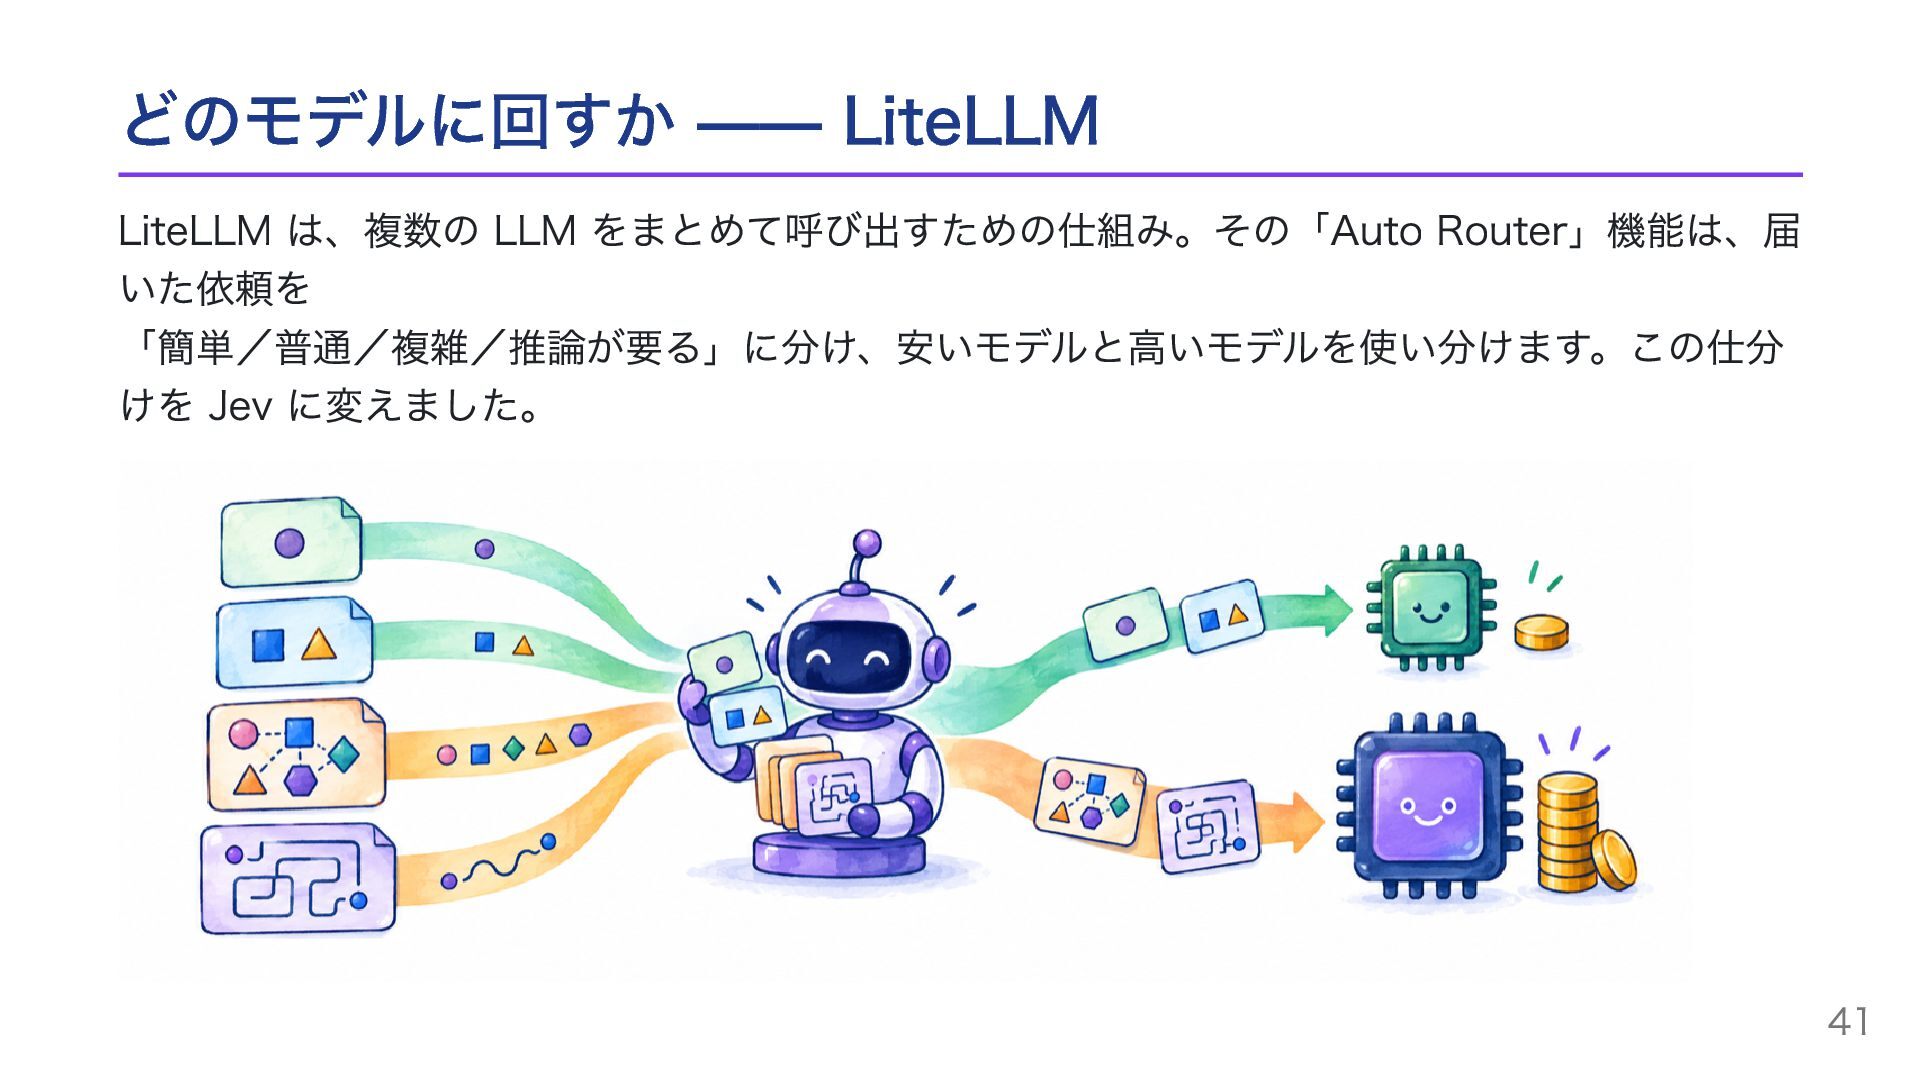
どのモデルに回すか —— LiteLLM LiteLLM は、複数の LLM をまとめて呼び出すための仕組み。その「Auto Router」機能は、届 いた依頼を 「簡単/普通/複雑/推論が要る」に分け、安いモデルと高いモデルを使い分けます。この仕分
けを Jev に変えました。 41
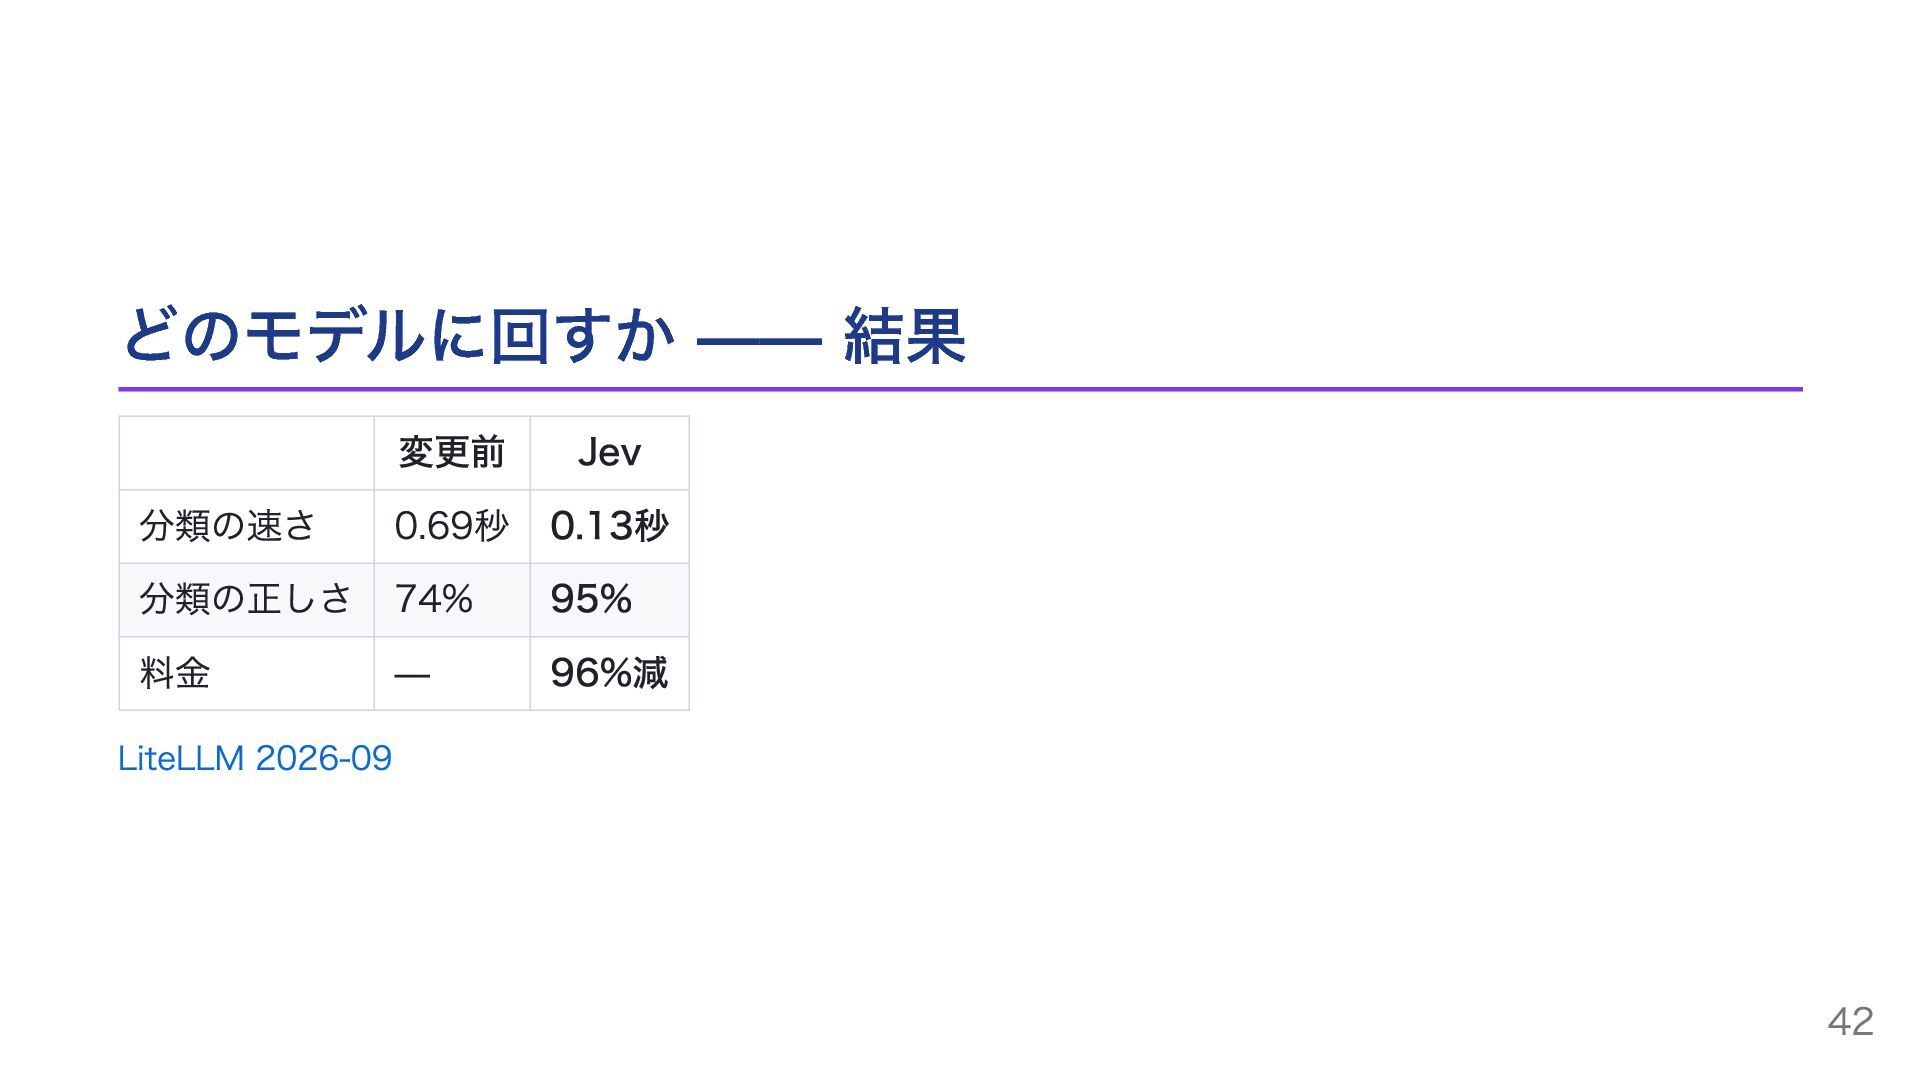
どのモデルに回すか —— 結果 変更前 Jev 分類の速さ 0.69秒 0.13秒 分類の正しさ 74%
95% 料金 — 96%減 LiteLLM 2026-09 42
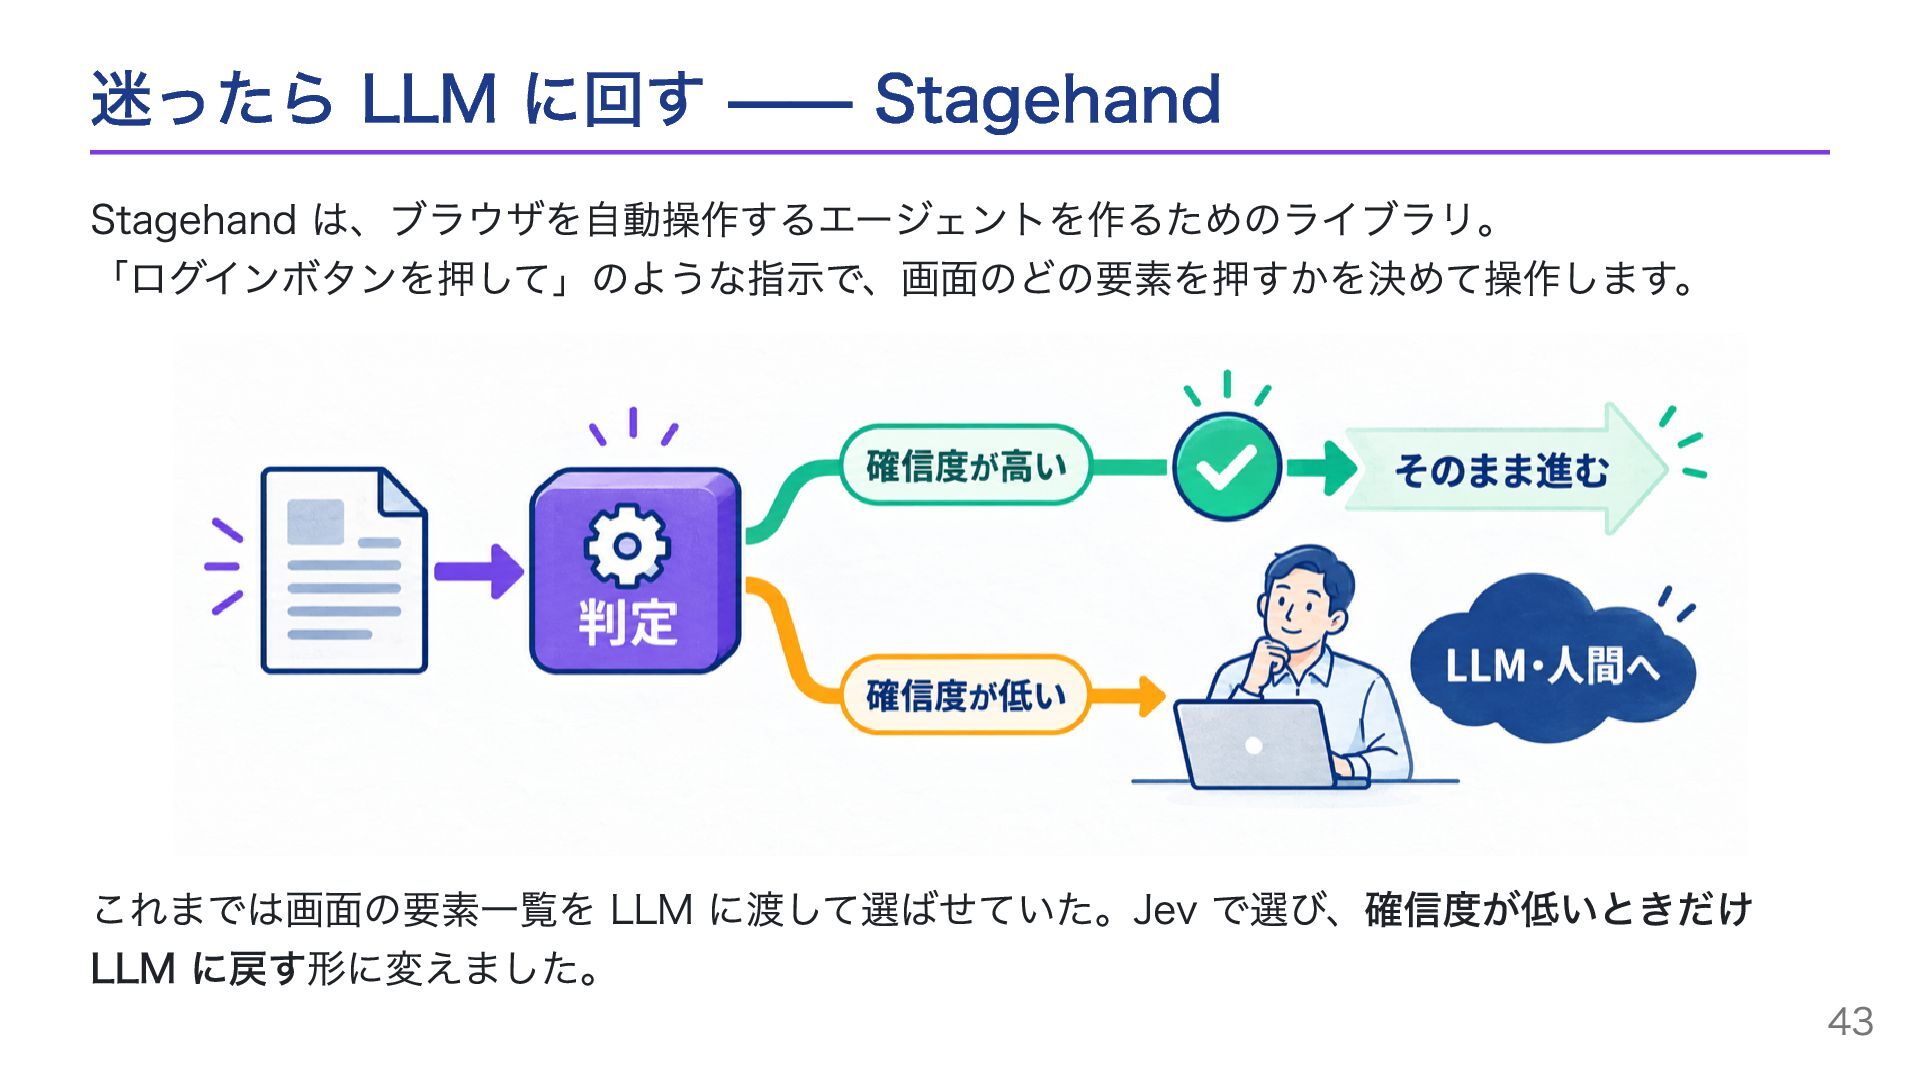
迷ったら LLM に回す —— Stagehand Stagehand は、ブラウザを自動操作するエージェントを作るためのライブラリ。 「ログインボタンを押して」のような指示で、画面のどの要素を押すかを決めて操作します。 これまでは画面の要素一覧を LLM
に渡して選ばせていた。Jev で選び、確信度が低いときだけ LLM に戻す形に変えました。 43
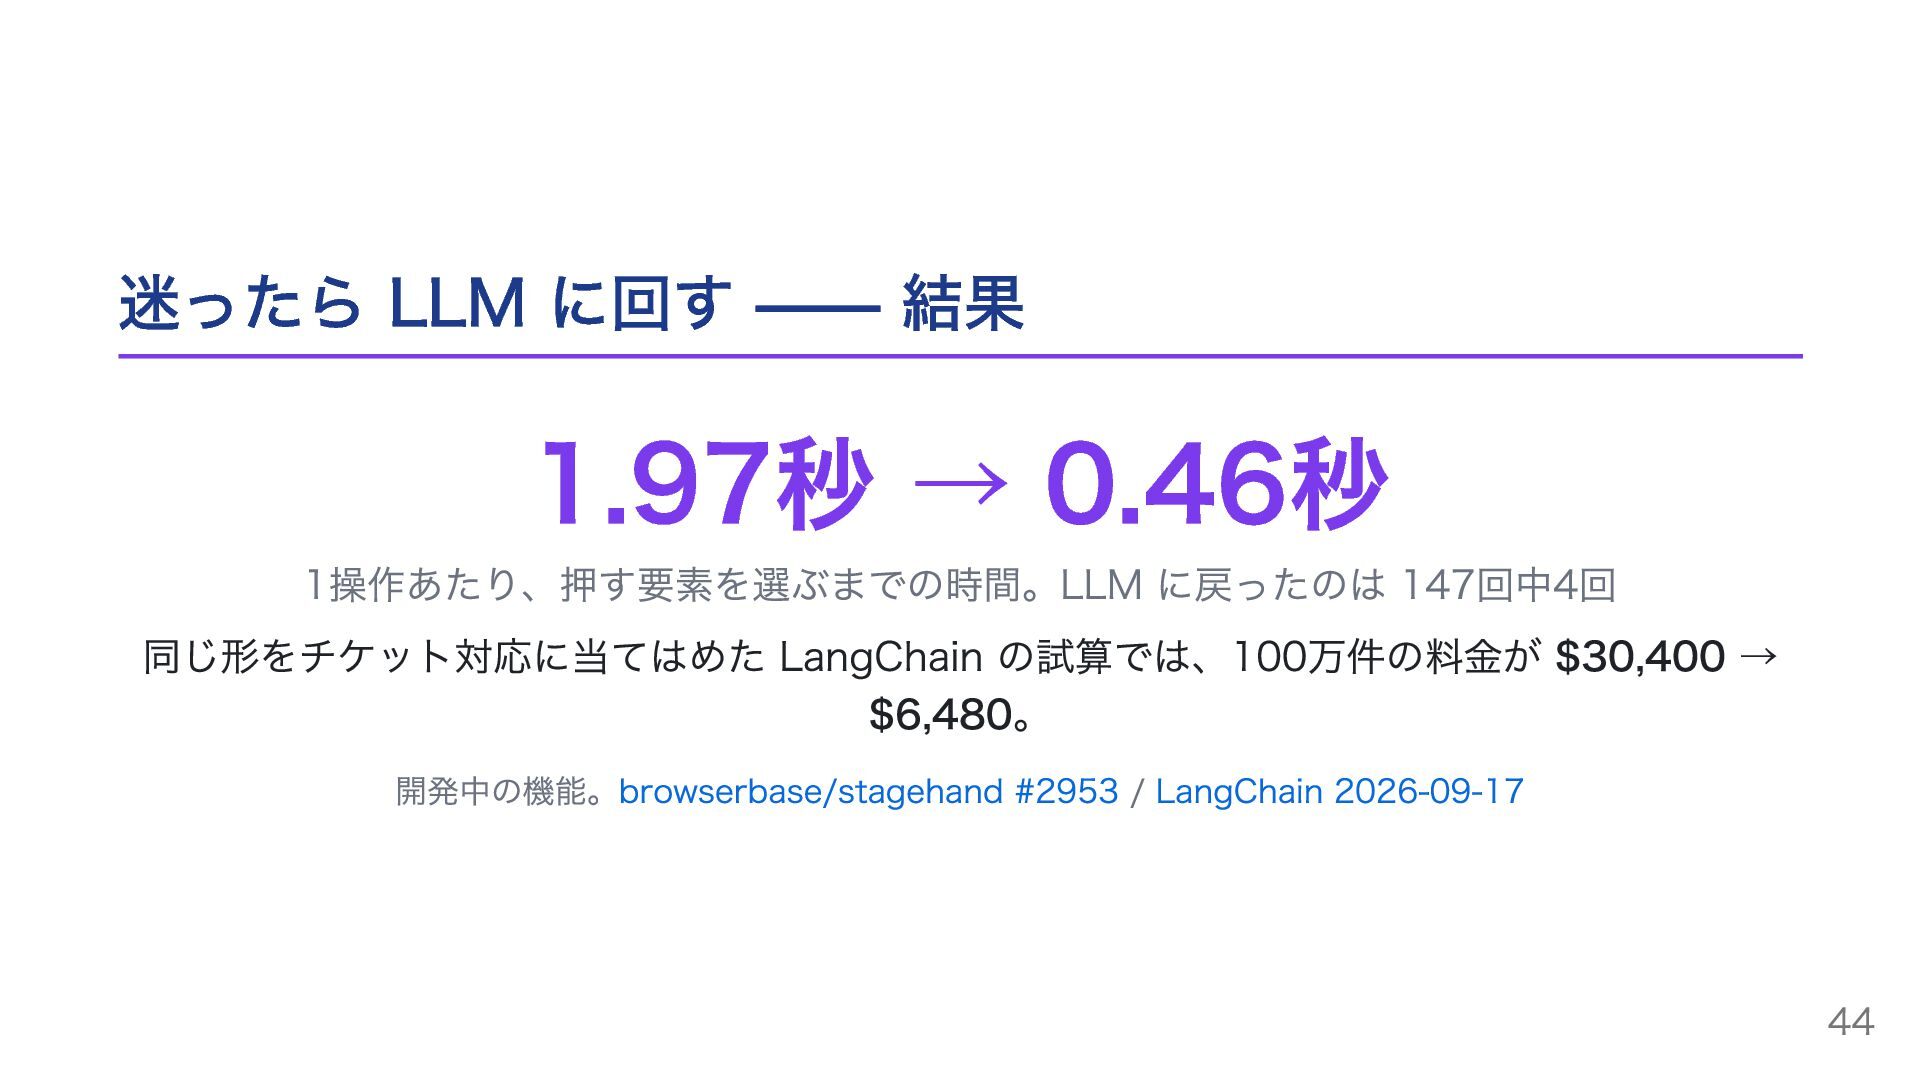
迷ったら LLM に回す —— 結果 1.97秒 → 0.46秒 1操作あたり、押す要素を選ぶまでの時間。LLM に戻ったのは
147回中4回 同じ形をチケット対応に当てはめた LangChain の試算では、100万件の料金が $30,400 → $6,480。 開発中の機能。browserbase/stagehand #2953 / LangChain 2026-09-17 44
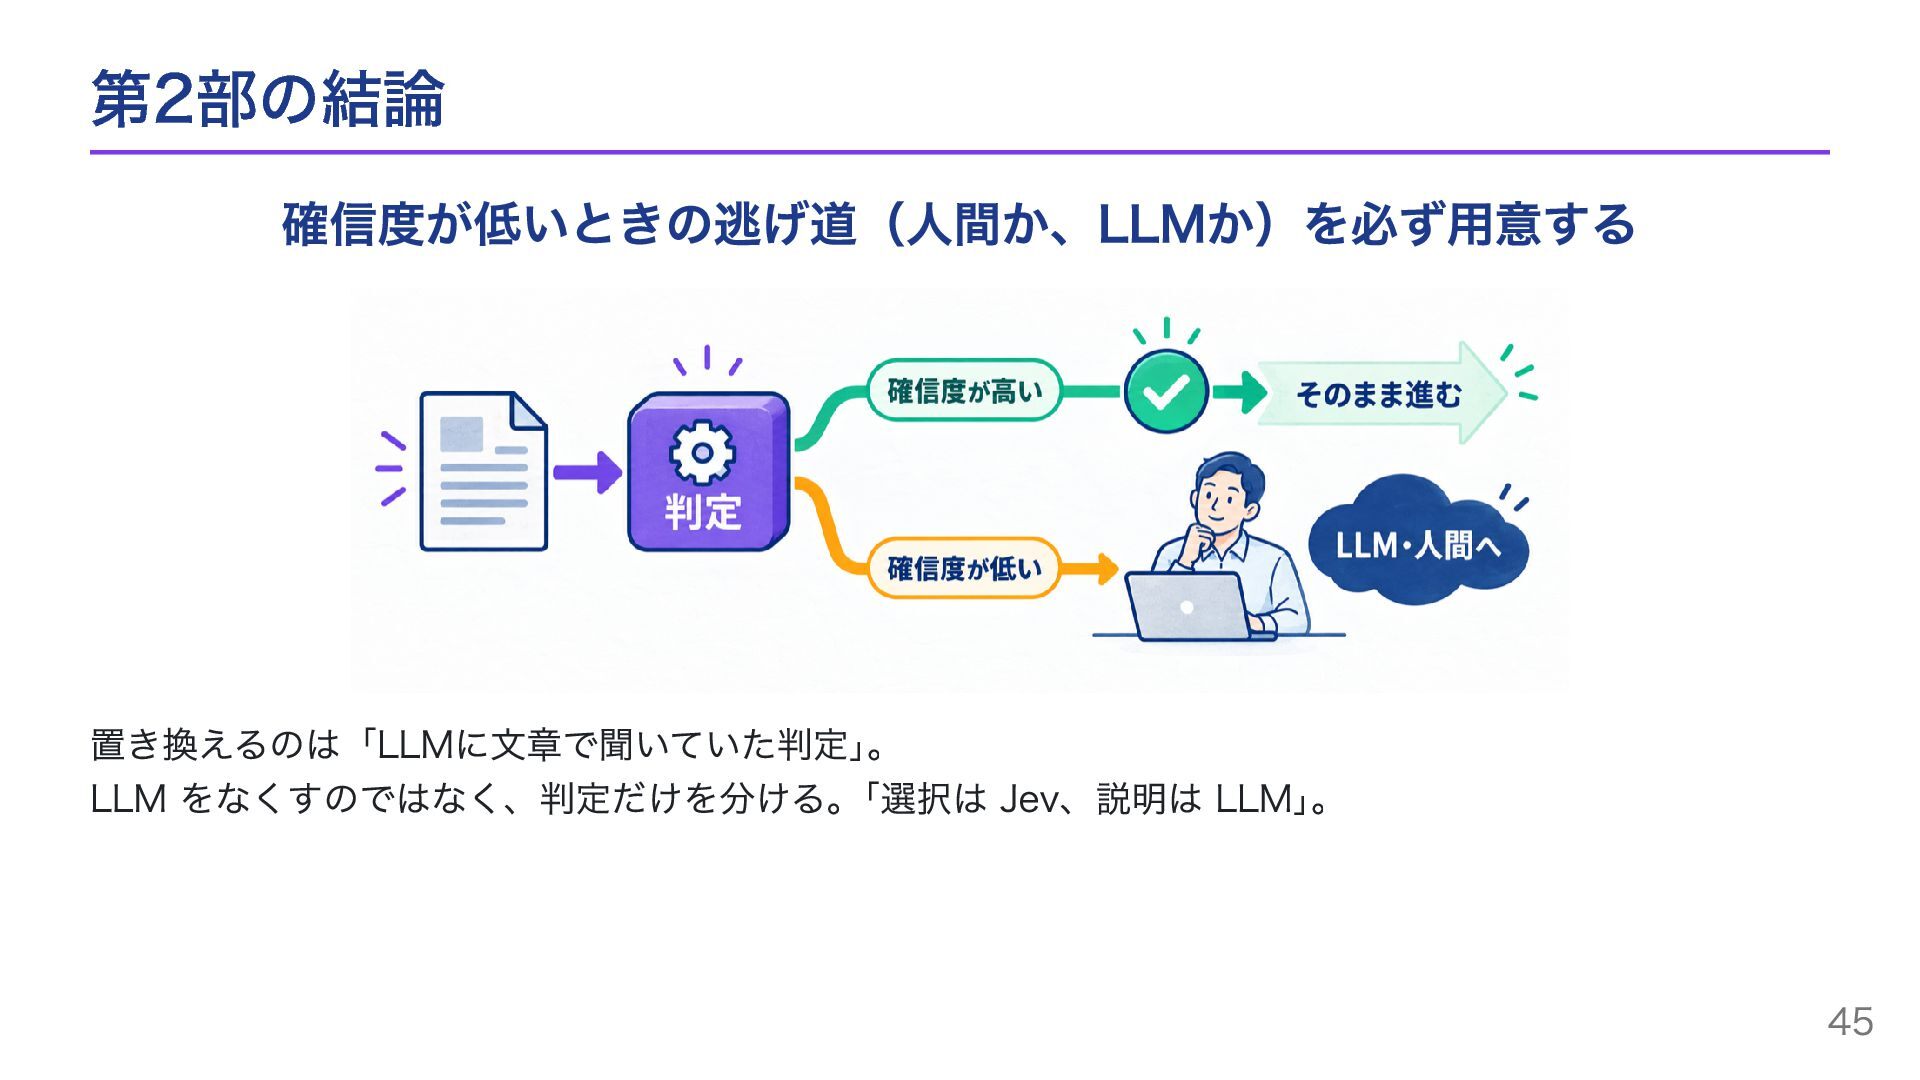
第2部の結論 確信度が低いときの逃げ道(人間か、LLMか)を必ず用意する 置き換えるのは「LLMに文章で聞いていた判定」。 LLM をなくすのではなく、判定だけを分ける。「選択は Jev、説明は LLM」。 45
第3部 仕組みの解説 46
誰が作ったか 作ったのは TypeSafe AI。創業者は元 OpenAI で、ChatGPT の研究に関わった人です。 TypeSafe はこれを「System One
Model(直感で即答するモデル)」と呼び、 LLM とは別の種類のモデルだと位置づけています 47
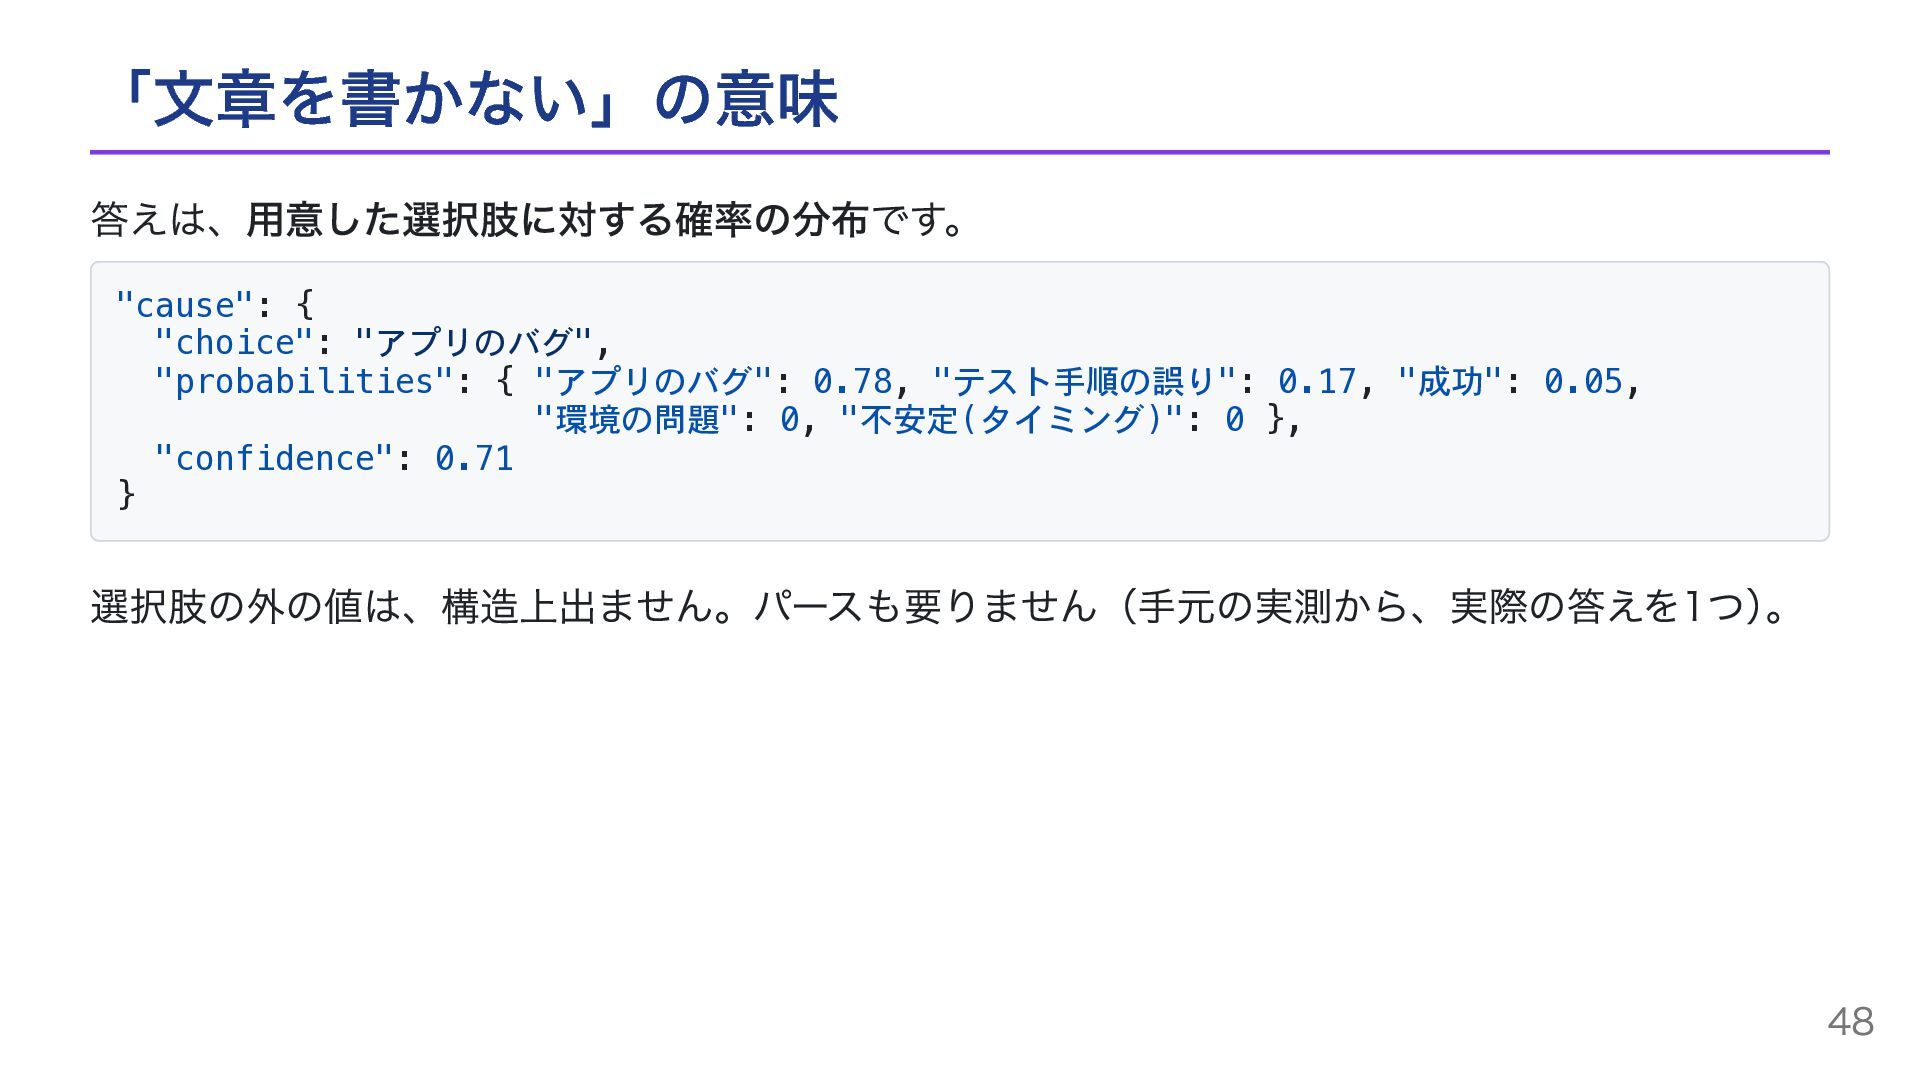
「文章を書かない」の意味 答えは、用意した選択肢に対する確率の分布です。 "cause": { "choice": "アプリのバグ", "probabilities": { "アプリのバグ": 0.78,
"テスト手順の誤り": 0.17, "成功": 0.05, "環境の問題": 0, "不安定(タイミング)": 0 }, "confidence": 0.71 } 選択肢の外の値は、構造上出ません。パースも要りません(手元の実測から、実際の答えを1つ)。 48
何十問でも、同時に聞ける "questions": { "ok": { "type": "noul", "instructions": "この手順は成功したか" },
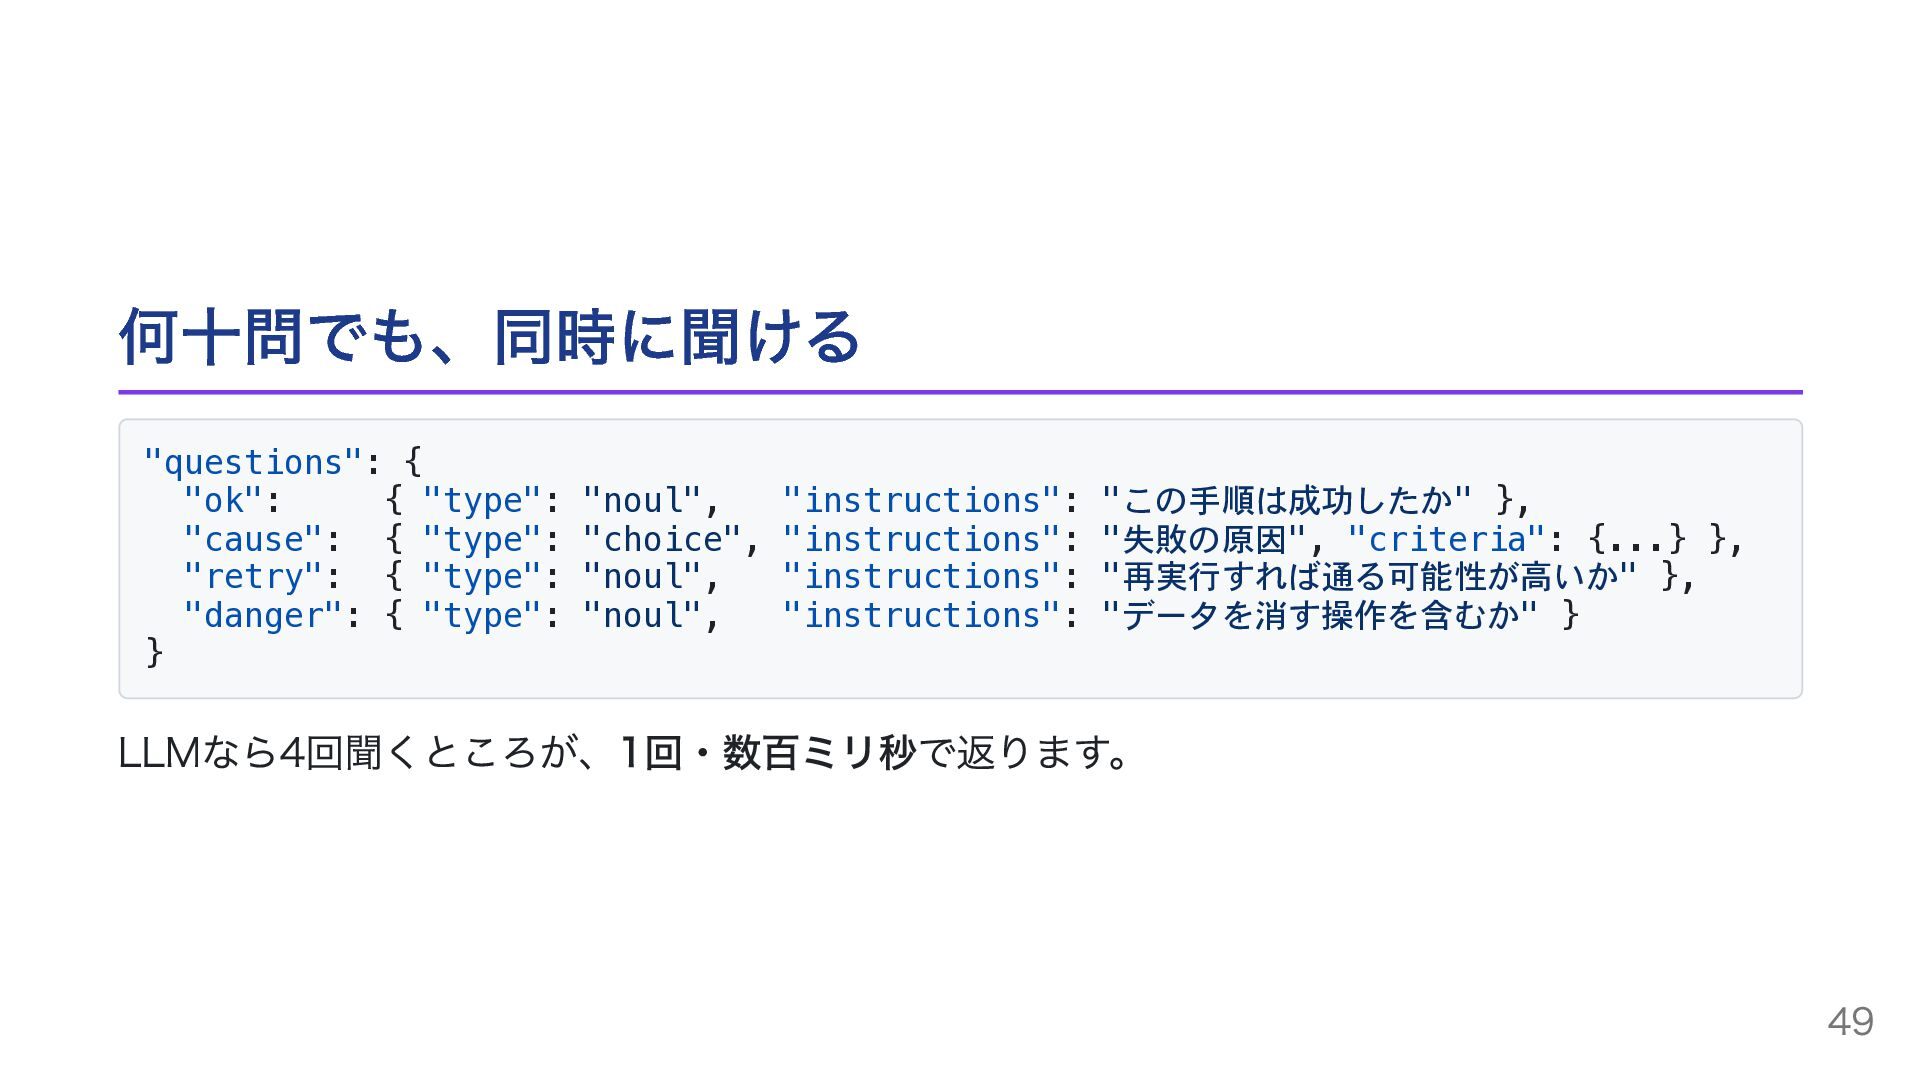
"cause": { "type": "choice", "instructions": "失敗の原因", "criteria": {...} }, "retry": { "type": "noul", "instructions": "再実行すれば通る可能性が高いか" }, "danger": { "type": "noul", "instructions": "データを消す操作を含むか" } } LLMなら4回聞くところが、1回・数百ミリ秒で返ります。 49
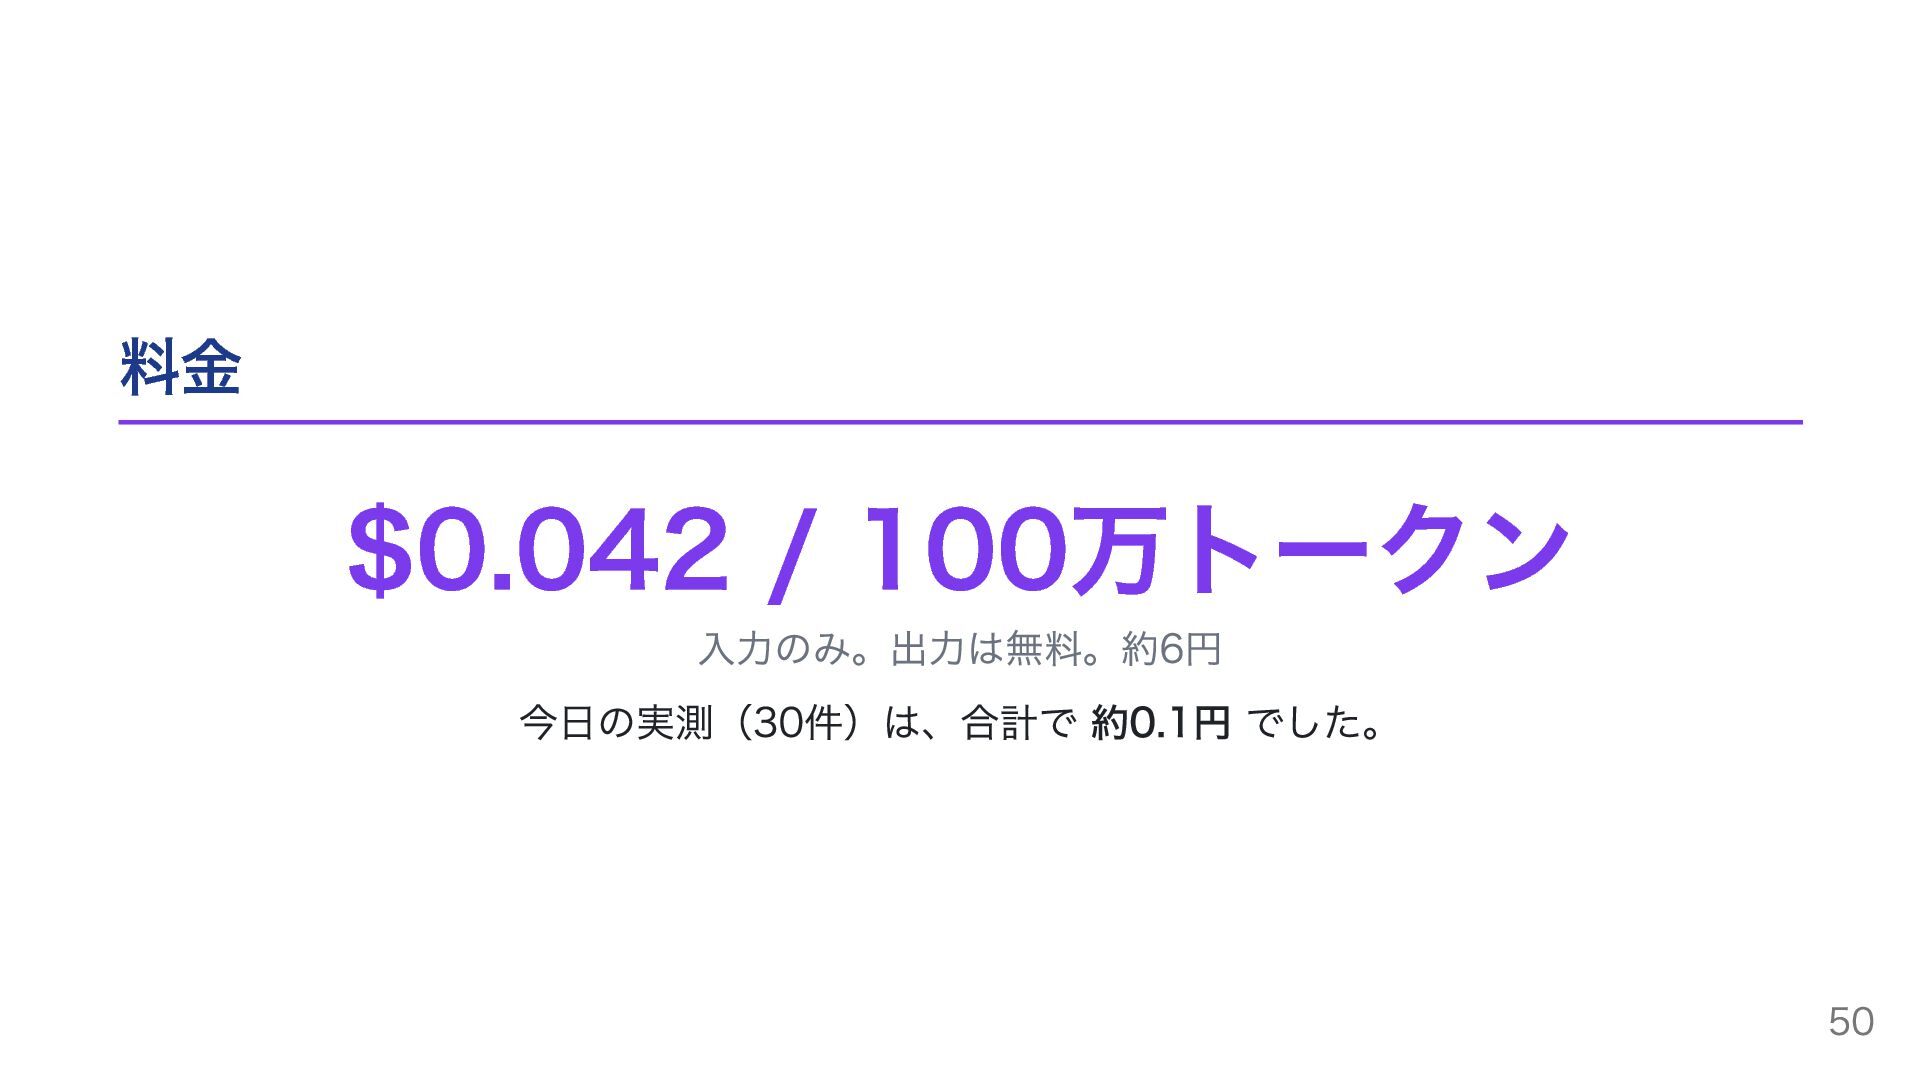
料金 $0.042 / 100万トークン 入力のみ。出力は無料。約6円 今日の実測(30件)は、合計で 約0.1円 でした。 50
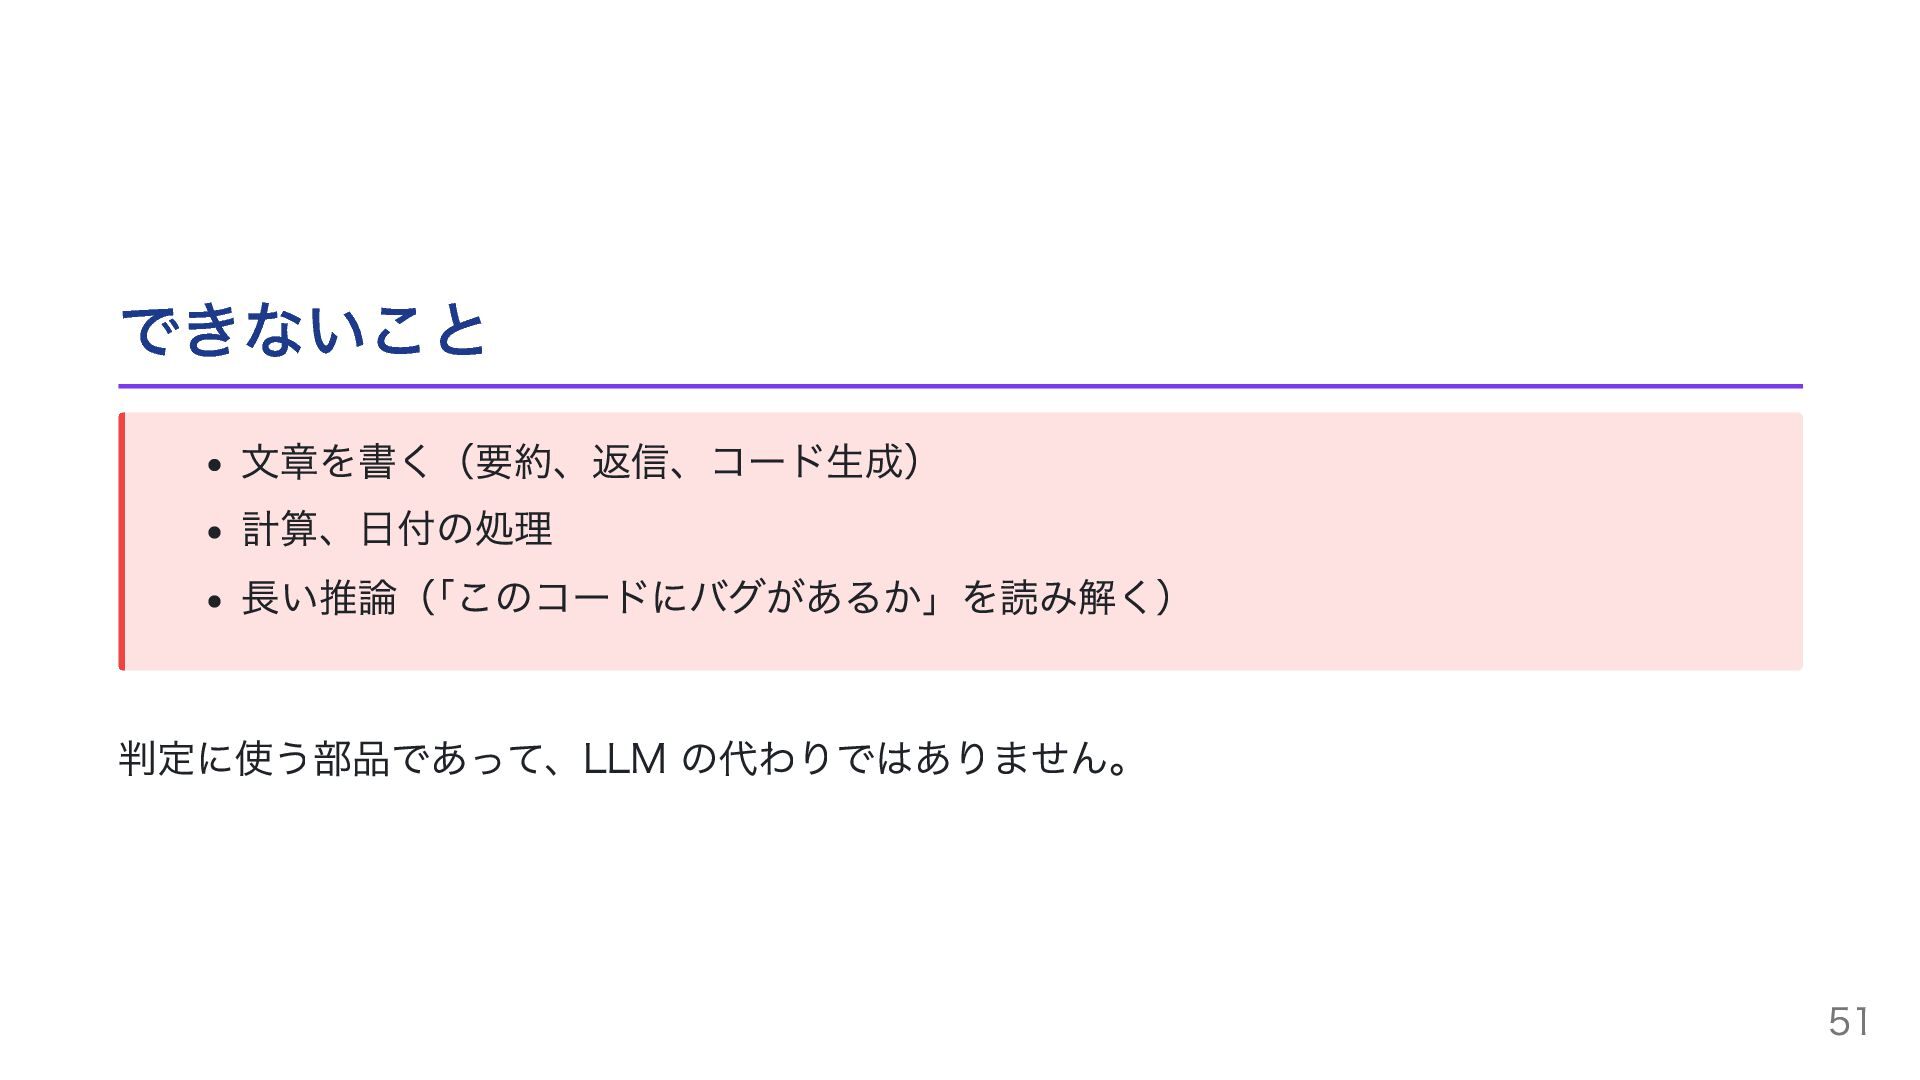
できないこと 文章を書く(要約、返信、コード生成) 計算、日付の処理 長い推論(「このコードにバグがあるか」を読み解く) 判定に使う部品であって、LLM の代わりではありません。 51
「ハルシネーションゼロ」の意味 TypeSafe は「ハルシネーションしない」と表現しています。 意味は「選択肢の外を答えない」であって、「判定を間違えない」ではない 間違えることはあります。ただし手元の実測では、間違えるときは確信度が下がっていました。 52
うまくいかなかった問いもある 22 / 30 件が「必要」 「人間の確認が必要か」と直接聞いたときの答え(手元の実測)。確率もばらばらで、境界なし この問いは使えず、「判定そのものの確信度」を使うほうが良かった。 53
問い方で、精度が変わる 第三者の検証。迷惑メール2,000通を「これは迷惑メールか」と1問で聞くと 62.6%。 「リンク先が短縮URLや無料ホスティングか」「組織を名乗りながら送信者が無料メールアドレス か」のような 5つの具体的な問いに分け、重みをつけて合算すると 95.0%。 1つの大きな問いより、答えやすい小さな問いに分ける。分け方を考えるのは人間の仕事です The Daily
Brief 2026-09 54
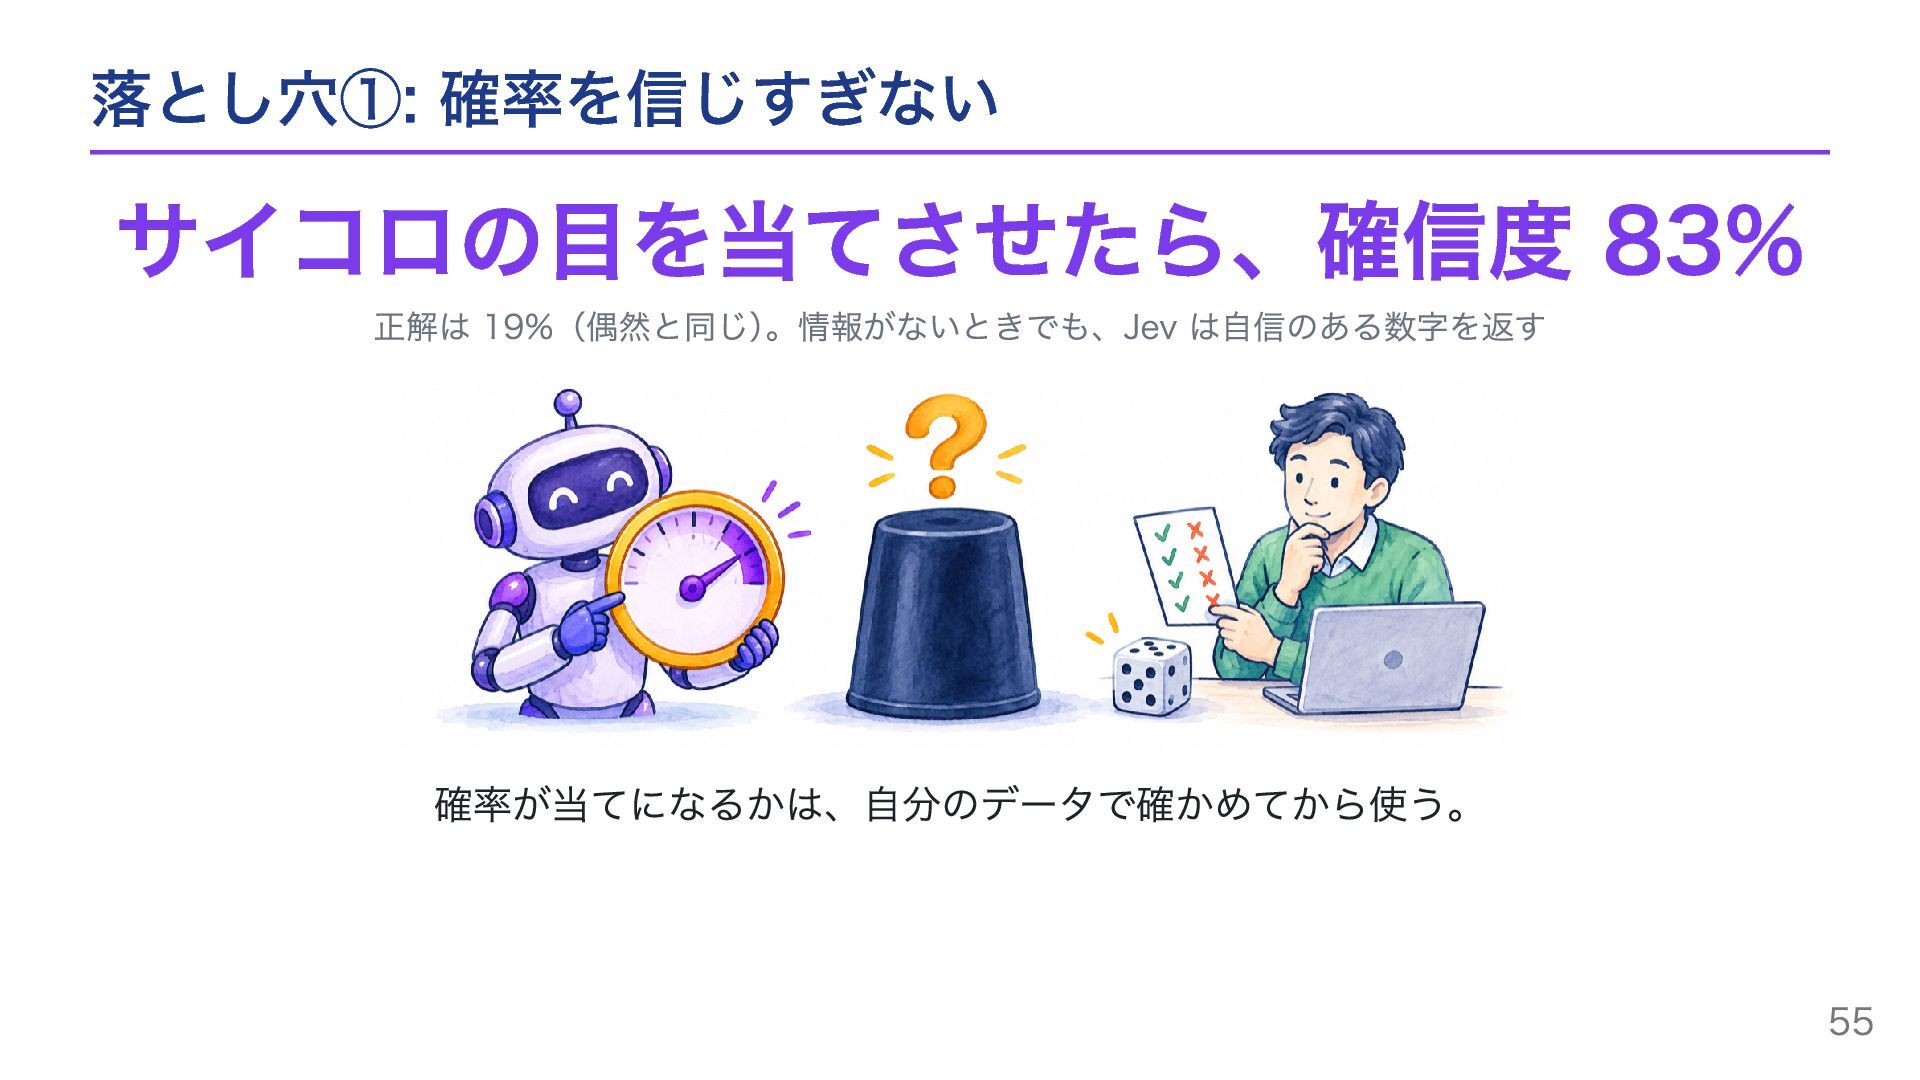
落とし穴①: 確率を信じすぎない サイコロの目を当てさせたら、確信度 83% 正解は 19%(偶然と同じ)。情報がないときでも、Jev は自信のある数字を返す 確率が当てになるかは、自分のデータで確かめてから使う。 55
落とし穴②: 書いたことしか見ない。1回で決めない 選択肢の説明(criteria)に書いていない観点は、判定に入らない。「言語化がすべて」 同じコードを Jev に3回採点させたら、47点・48点・49点と少しずつ違い、判定は 「要注意」「要注意」「不合格」に割れた。境目の近くでは、1点のぶれで結論が変わる 使っている人の対処: 観点は全部書く。境目に近いものは何度か聞くか、人に回す。 56
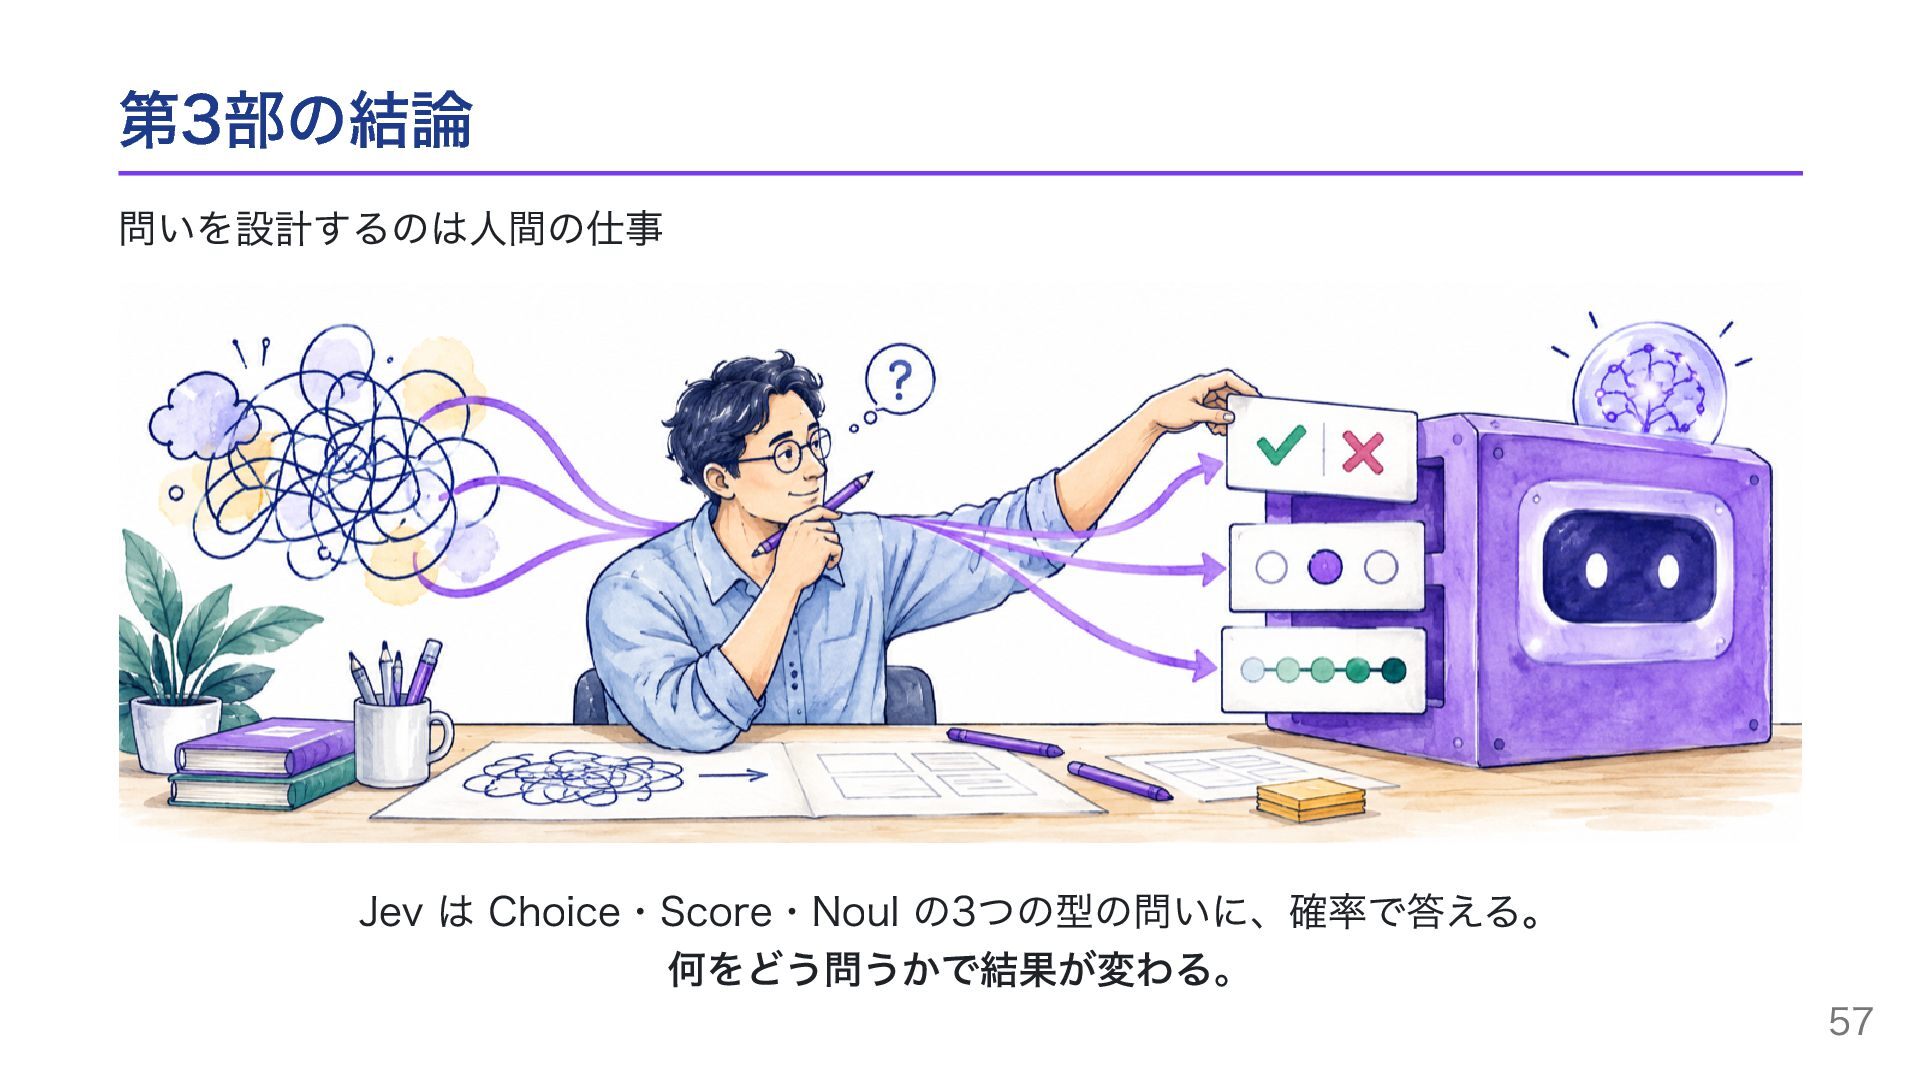
第3部の結論 問いを設計するのは人間の仕事 Jev は Choice・Score・Noul の3つの型の問いに、確率で答える。 何をどう問うかで結果が変わる。 57
第4部 公開1週間で真似された。この先どうなるか 58
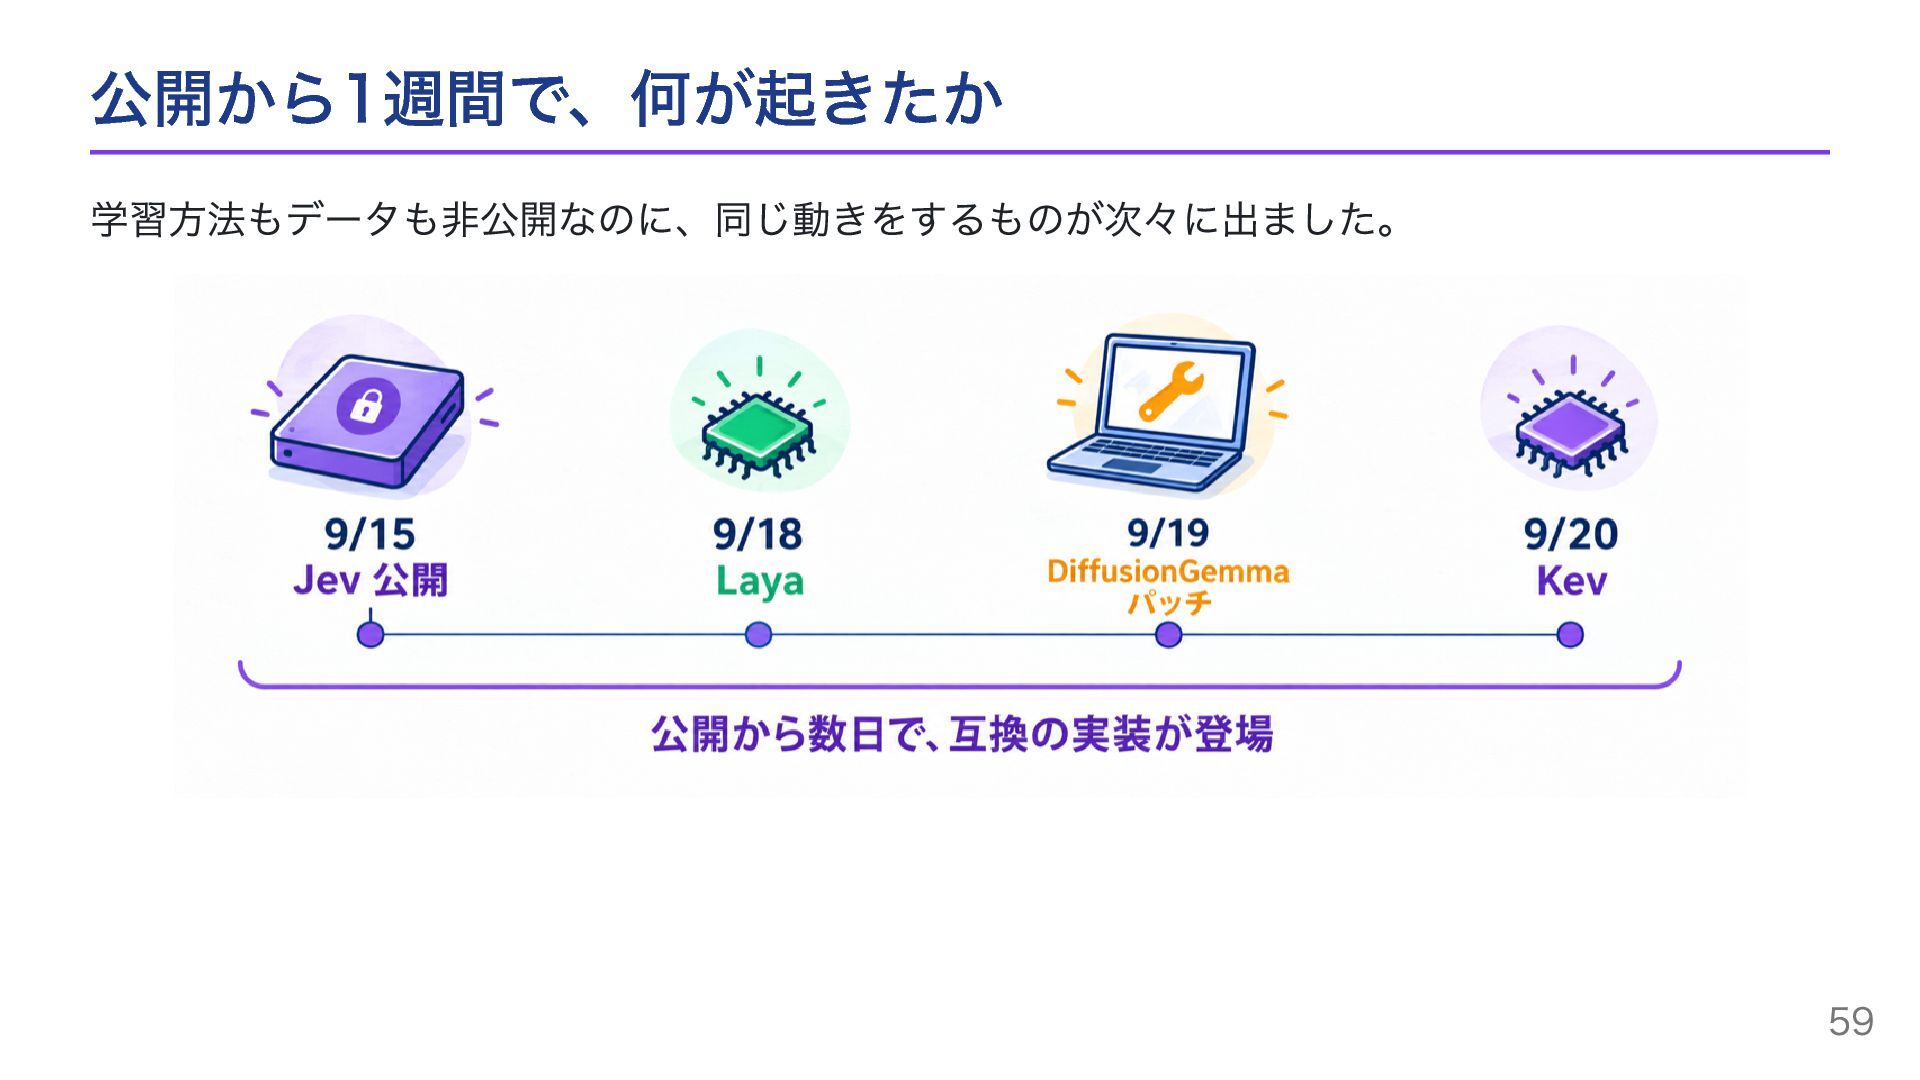
公開から1週間で、何が起きたか 学習方法もデータも非公開なのに、同じ動きをするものが次々に出ました。 59
中身は非公開。 なぜ、1週間で真似できたのか? 60
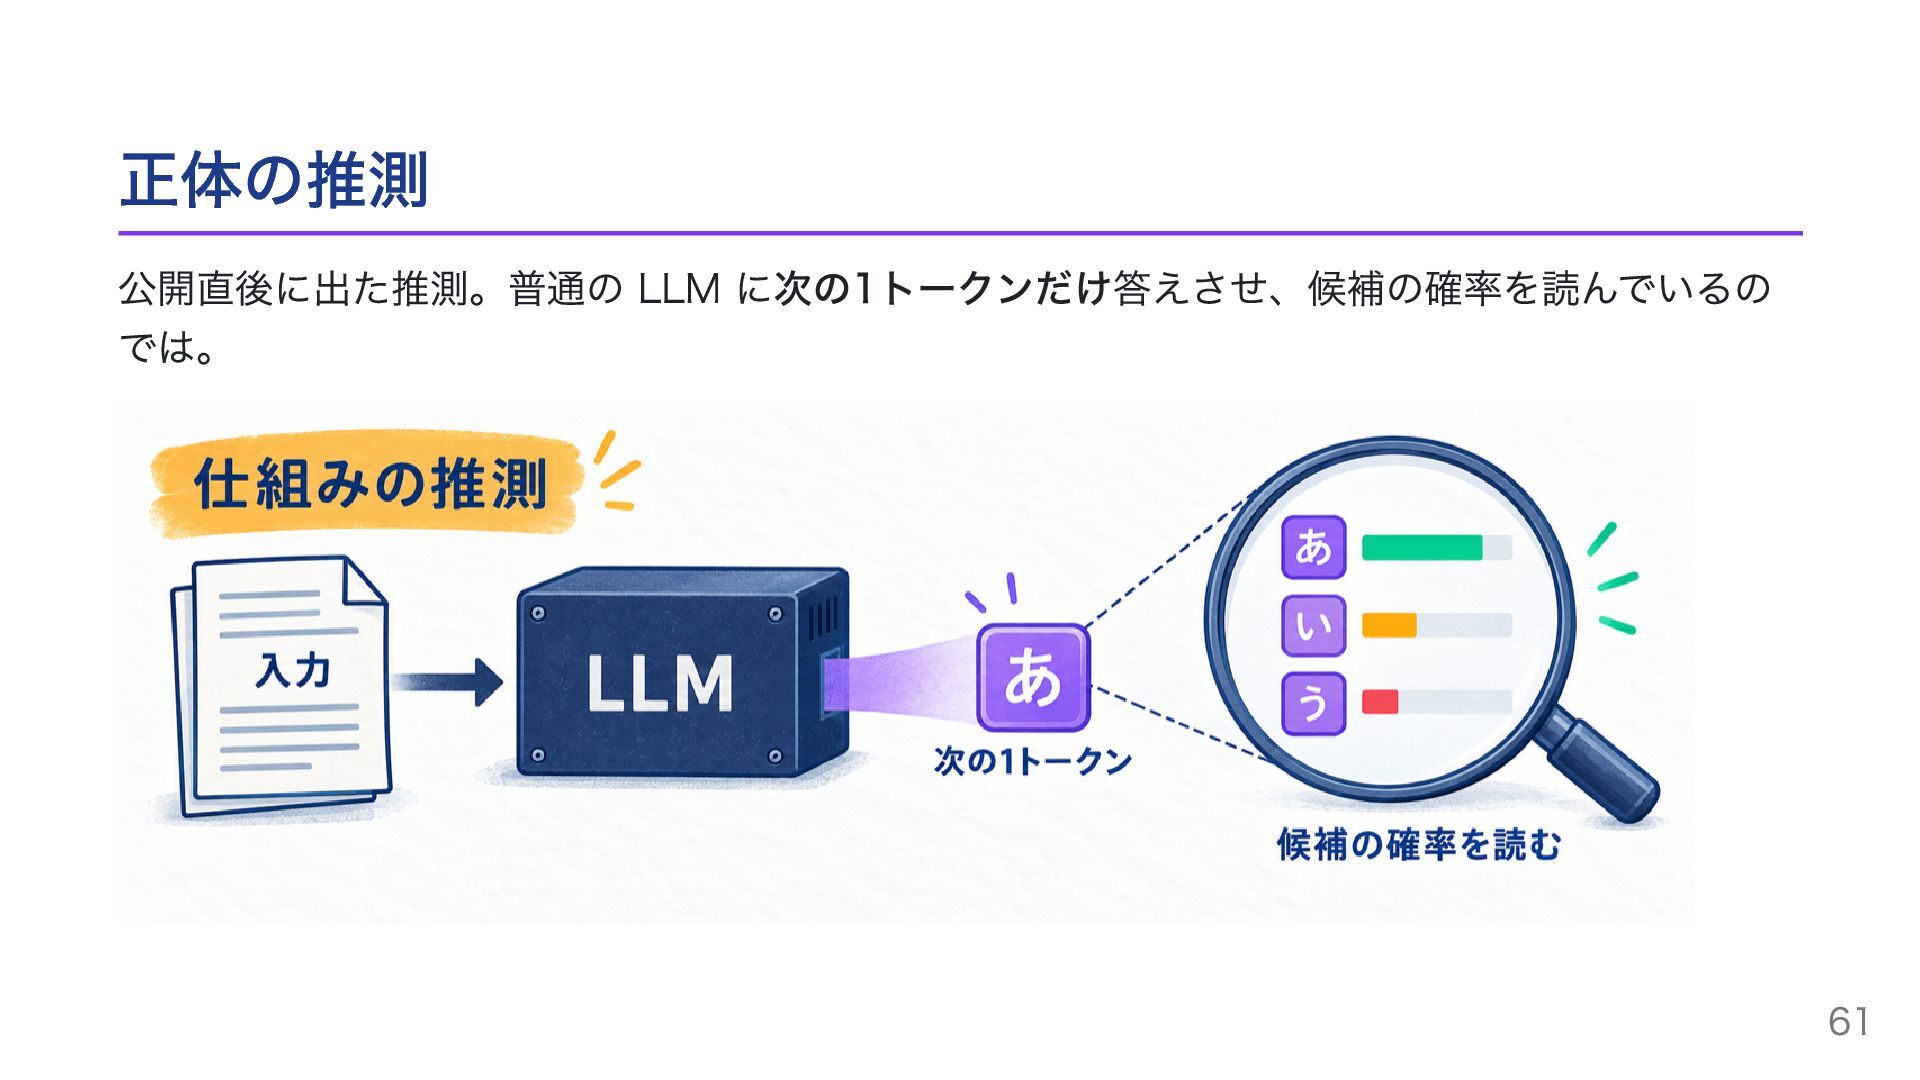
正体の推測 公開直後に出た推測。普通の LLM に次の1トークンだけ答えさせ、候補の確率を読んでいるの では。 61
TypeSafe の答え: 「差はデータ」 創業者の回答は、この推測を否定していません。 「ボトルネックはアーキテクチャではなく、校正のための学習データ」 TypeSafe は自分たちを「データの研究所」と呼んでいて、仕組みは真似できるがデータは真似 しにくい、という主張です。 実際、この計算のやり方自体は 2020年ごろの研究にあったもので、新しいのは「製品として
API にした」ことです。 62
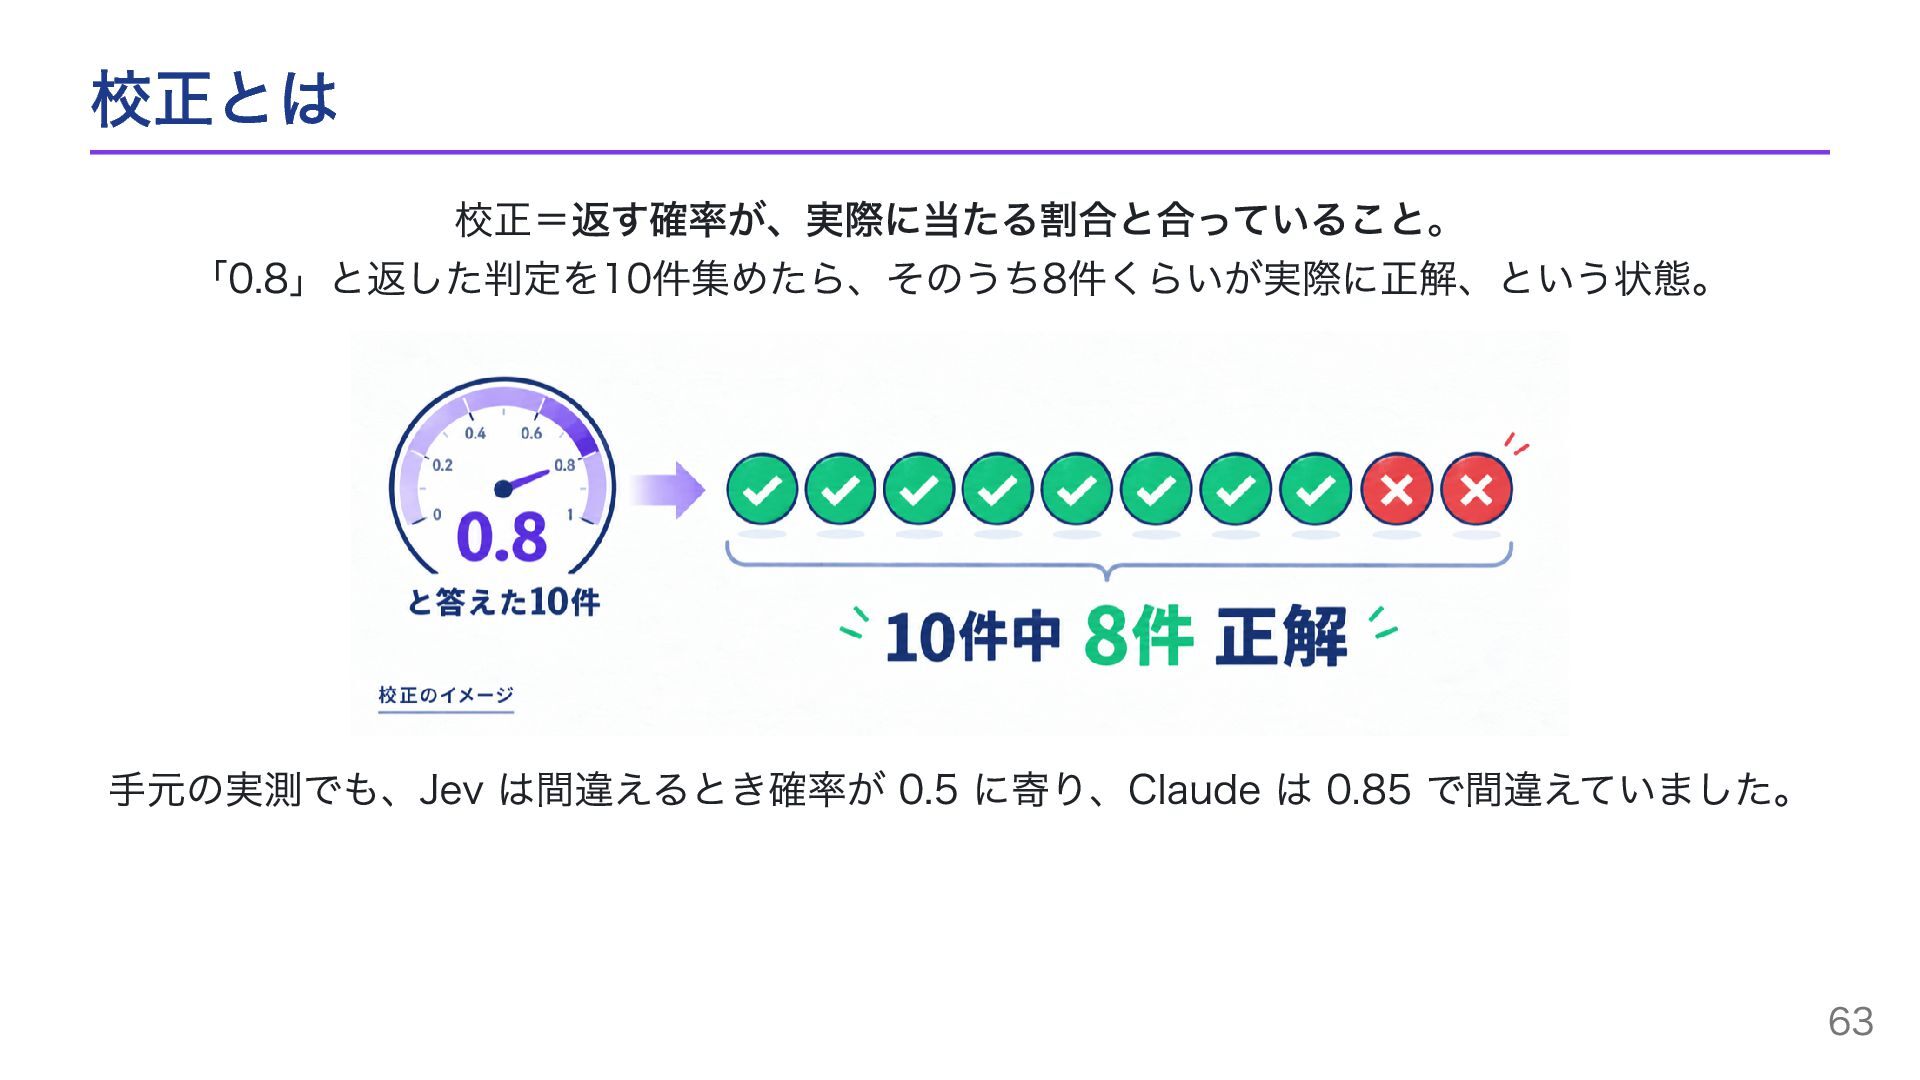
校正とは 校正=返す確率が、実際に当たる割合と合っていること。 「0.8」と返した判定を10件集めたら、そのうち8件くらいが実際に正解、という状態。 手元の実測でも、Jev は間違えるとき確率が 0.5 に寄り、Claude は 0.85 で間違えていました。
63
4日後: Google の公開モデルで、同じ動き Google の公開モデル(DiffusionGemma)を Jev と同じ動きにするパッチが出ました。 作者の確認では、精度は Jev とほぼ互角。手元で動かす分、Jev
より速かった X での投稿は「We have Jev at home(Jev なら家にある)」。 開発中。vllm-project/vllm #57250 64
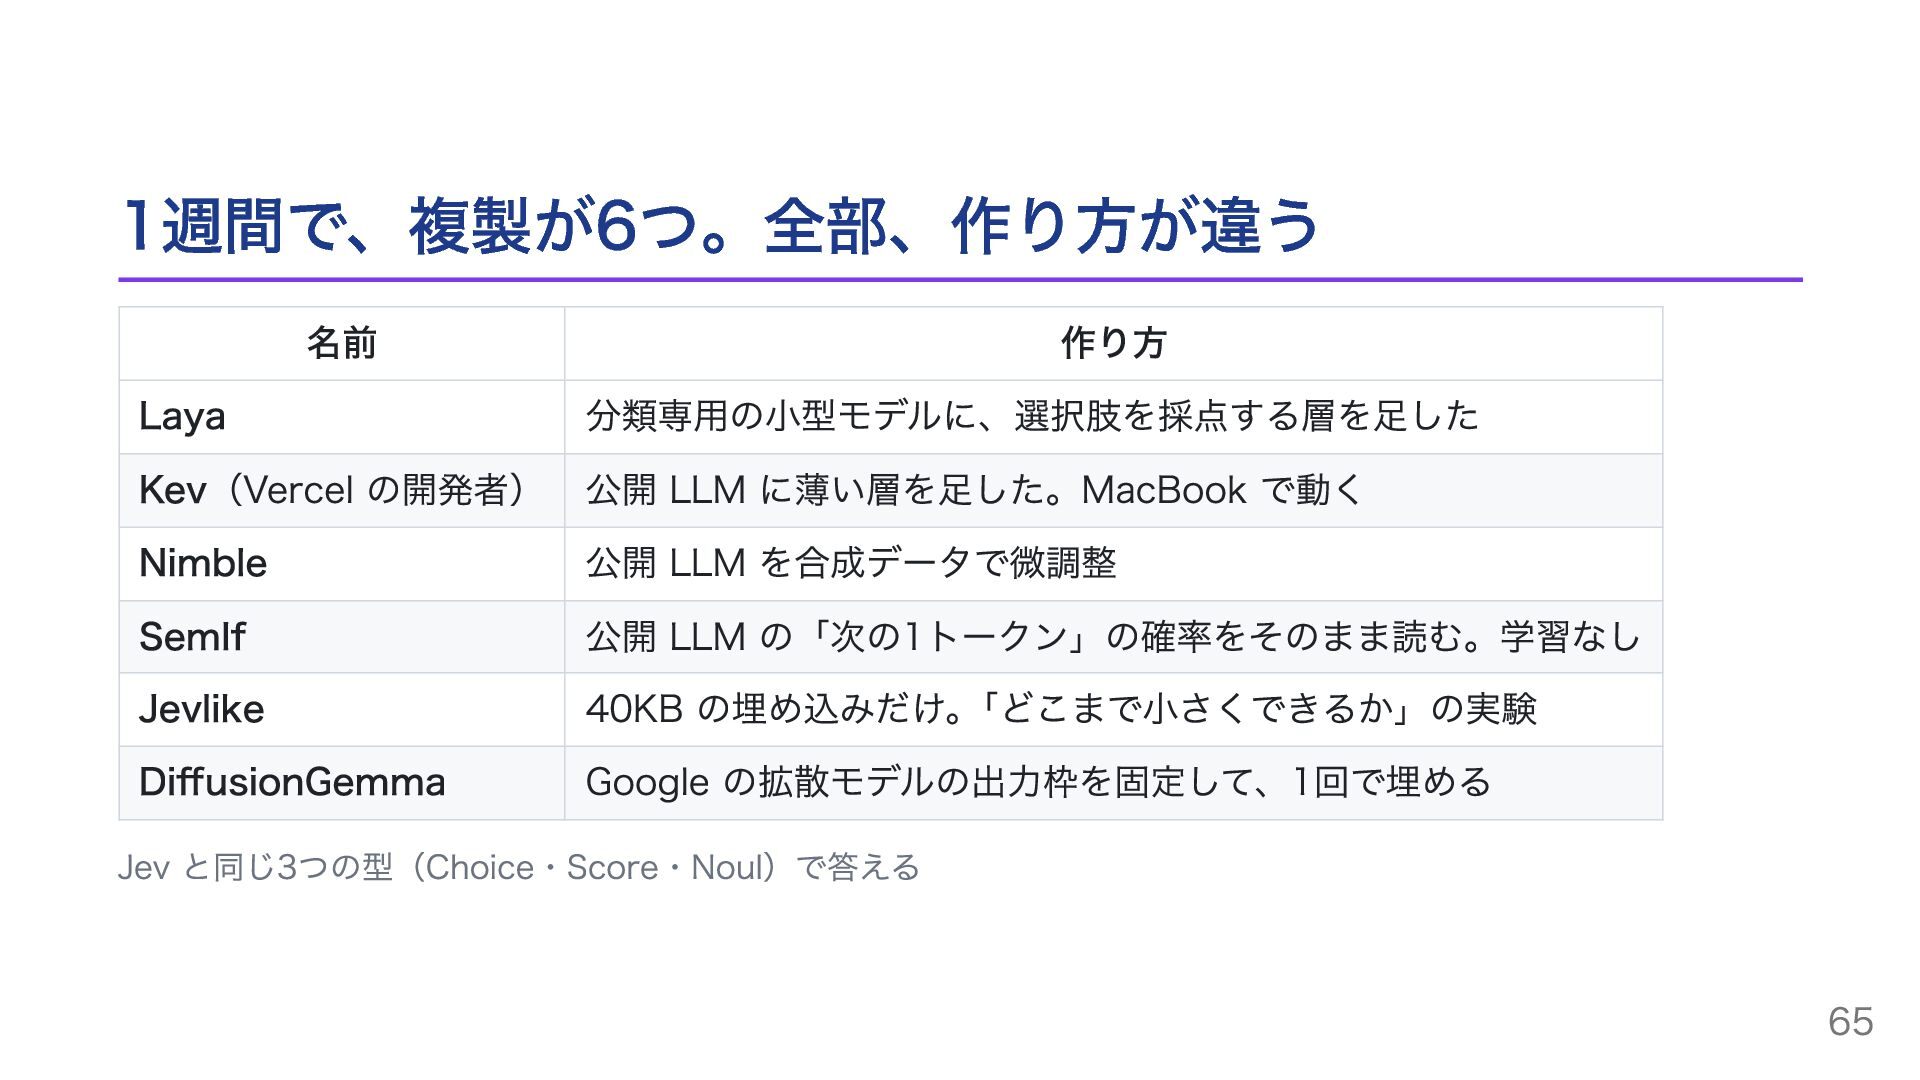
1週間で、複製が6つ。全部、作り方が違う 名前 作り方 Laya 分類専用の小型モデルに、選択肢を採点する層を足した Kev(Vercel の開発者) 公開 LLM に薄い層を足した。MacBook
で動く Nimble 公開 LLM を合成データで微調整 SemIf 公開 LLM の「次の1トークン」の確率をそのまま読む。学習なし Jevlike 40KB の埋め込みだけ。「どこまで小さくできるか」の実験 DiffusionGemma Google の拡散モデルの出力枠を固定して、1回で埋める Jev と同じ3つの型(Choice・Score・Noul)で答える 65
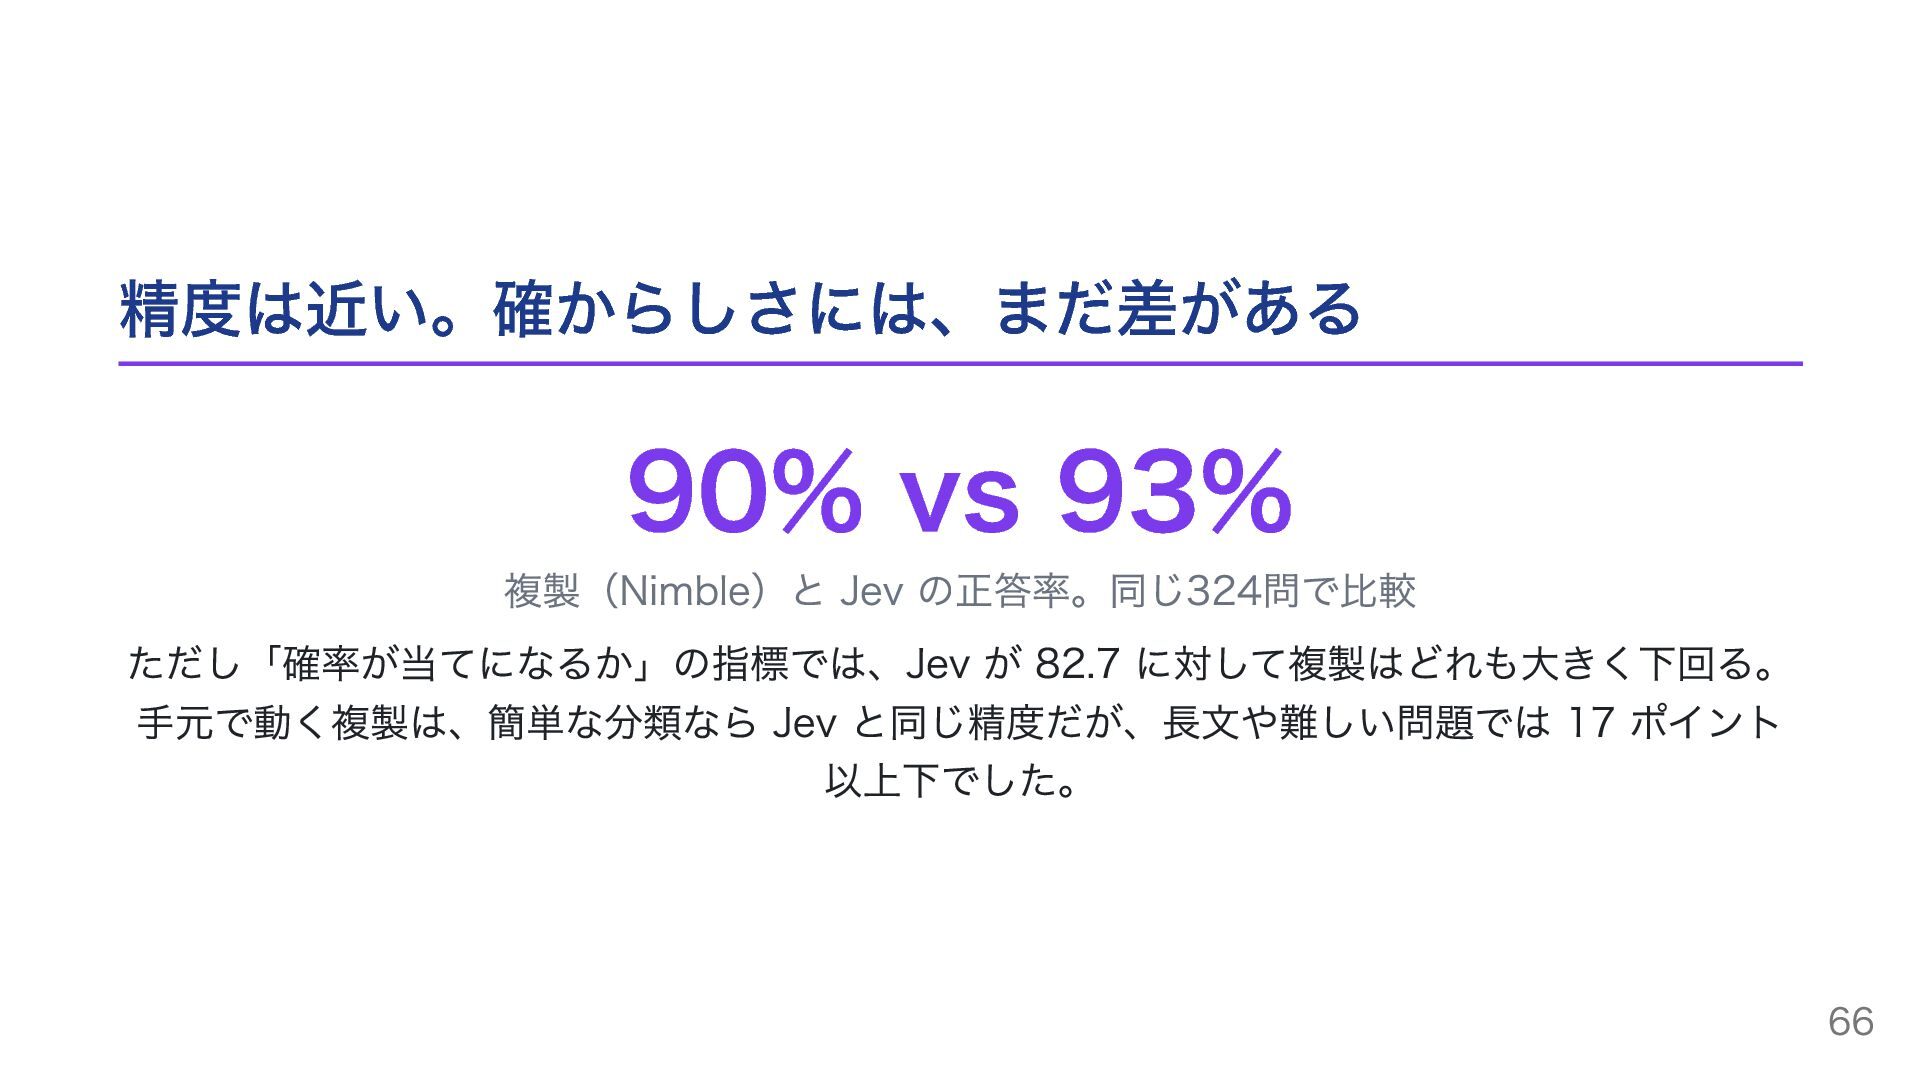
精度は近い。確からしさには、まだ差がある 90% vs 93% 複製(Nimble)と Jev の正答率。同じ324問で比較 ただし「確率が当てになるか」の指標では、Jev が 82.7
に対して複製はどれも大きく下回る。 手元で動く複製は、簡単な分類なら Jev と同じ精度だが、長文や難しい問題では 17 ポイント 以上下でした。 66
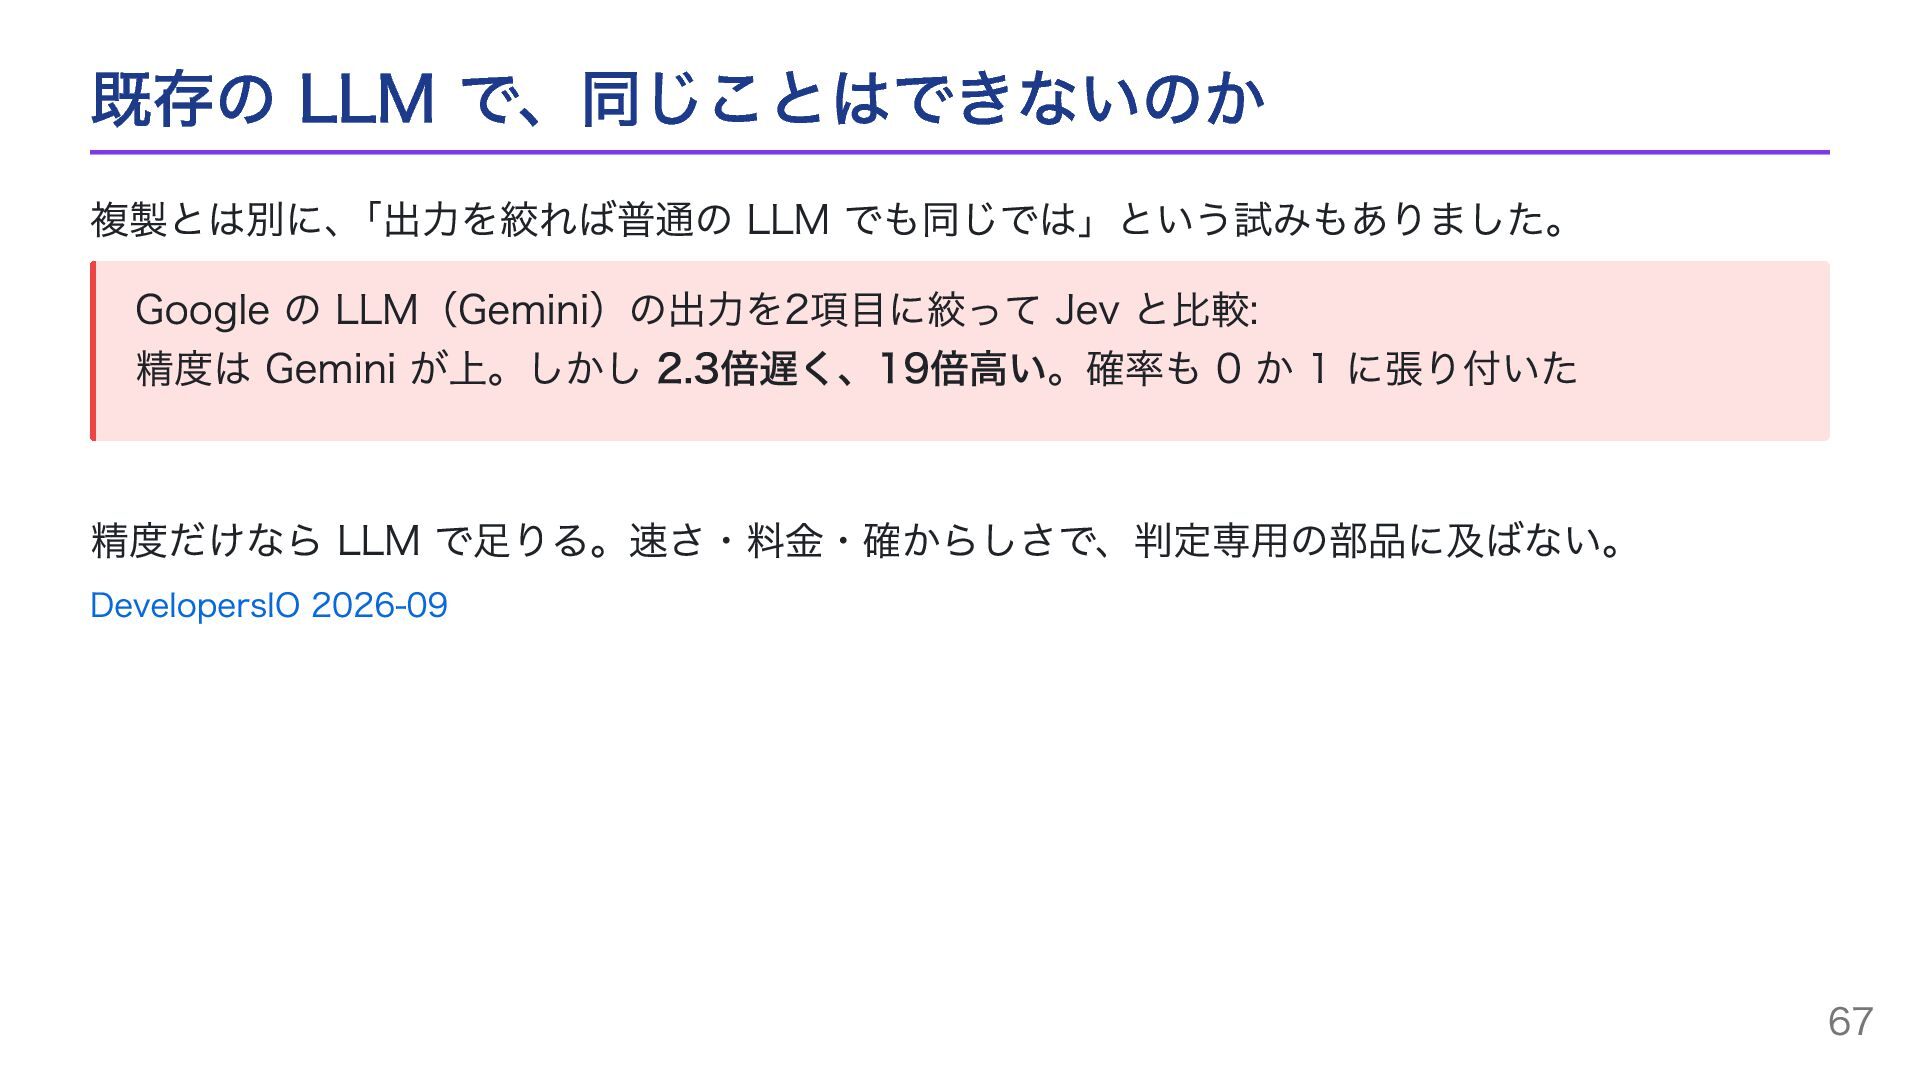
既存の LLM で、同じことはできないのか 複製とは別に、「出力を絞れば普通の LLM でも同じでは」という試みもありました。 Google の LLM(Gemini)の出力を2項目に絞って Jev
と比較: 精度は Gemini が上。しかし 2.3倍遅く、19倍高い。確率も 0 か 1 に張り付いた 精度だけなら LLM で足りる。速さ・料金・確からしさで、判定専用の部品に及ばない。 DevelopersIO 2026-09 67
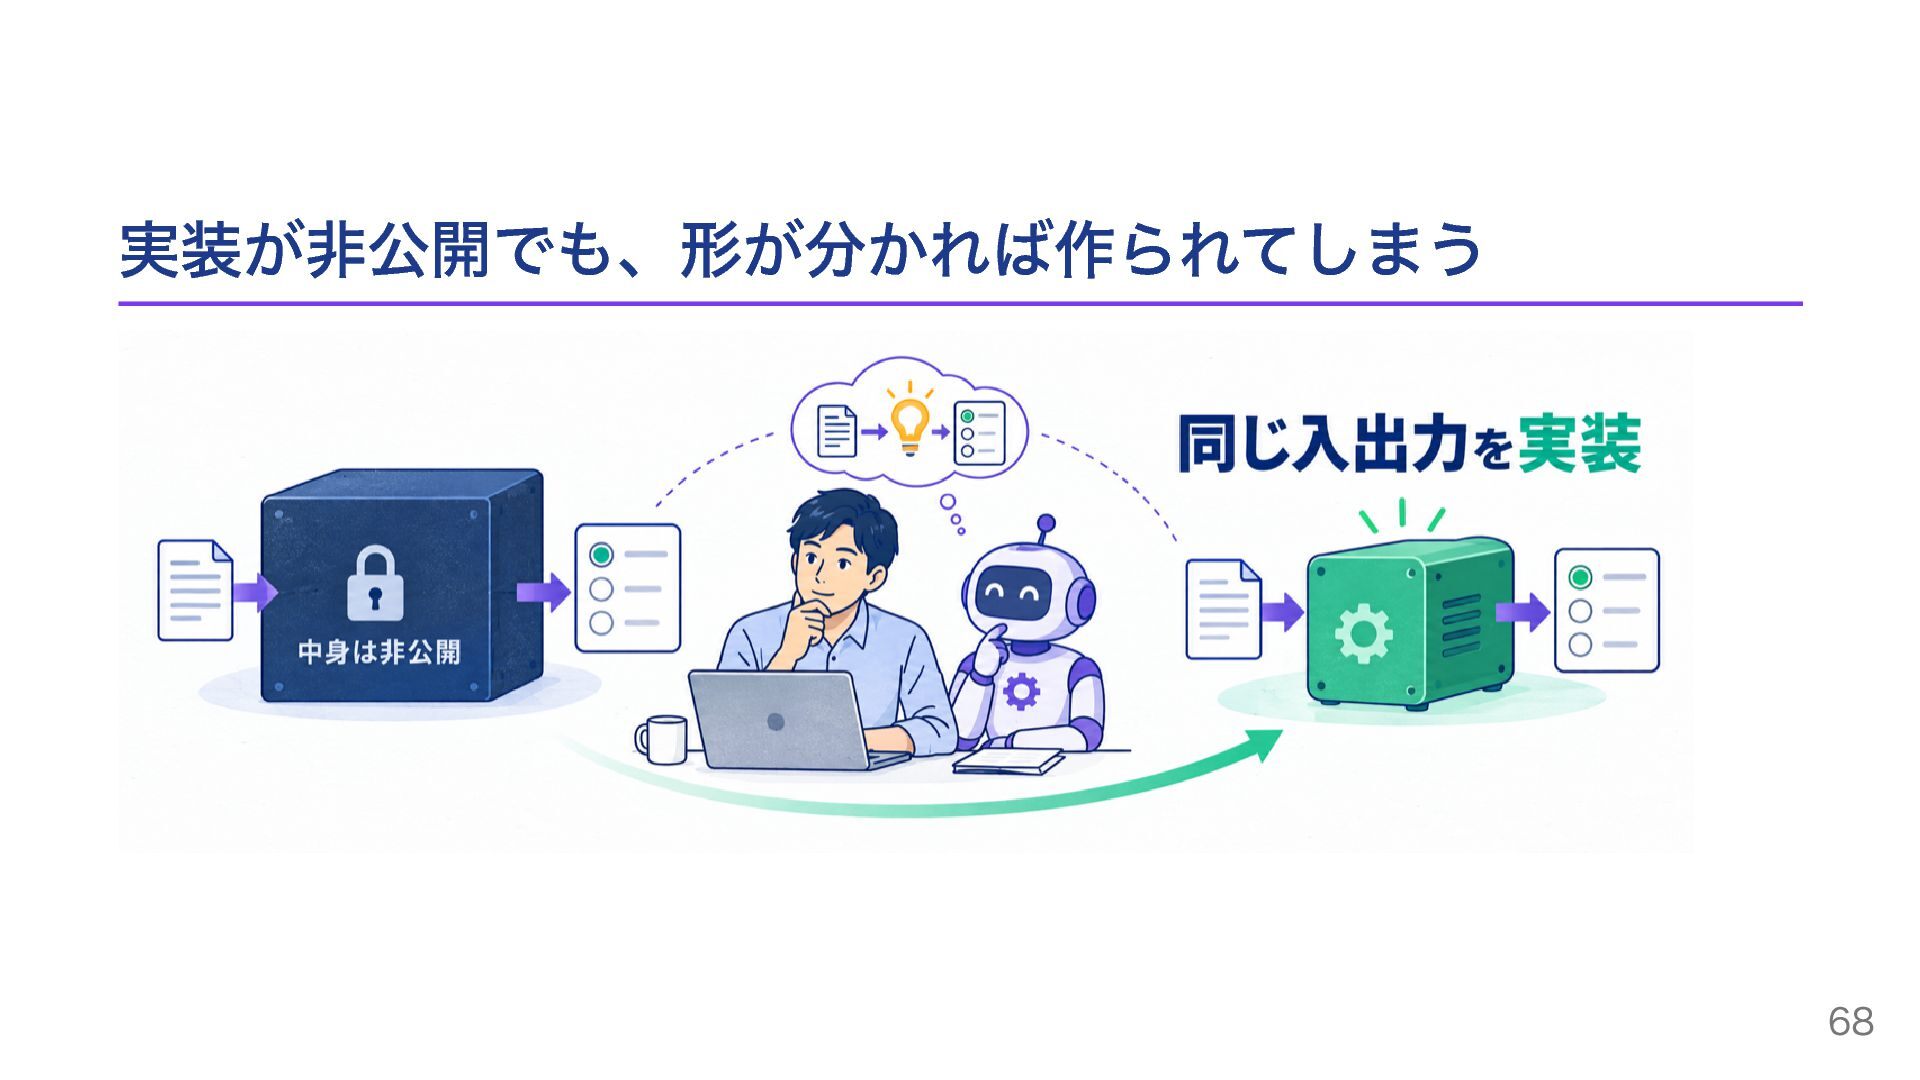
実装が非公開でも、形が分かれば作られてしまう 68
参入障壁が、崩れつつある Jev の学習方法もデータも非公開。公開されたのは「入力と出力の形」と「成り立つ」という事 実だけ。 それでも3日後から複製が次々に出ました。 これまでは「どう作るか」の設計と実装が参入障壁だった。 いまは「何を作るか」が分かれば、「どう作るか」は AI と一緒に埋められる DiffusionGemma
のパッチは、1人の開発者が数日で書いたもの。共著者には Claude が入って います。 69
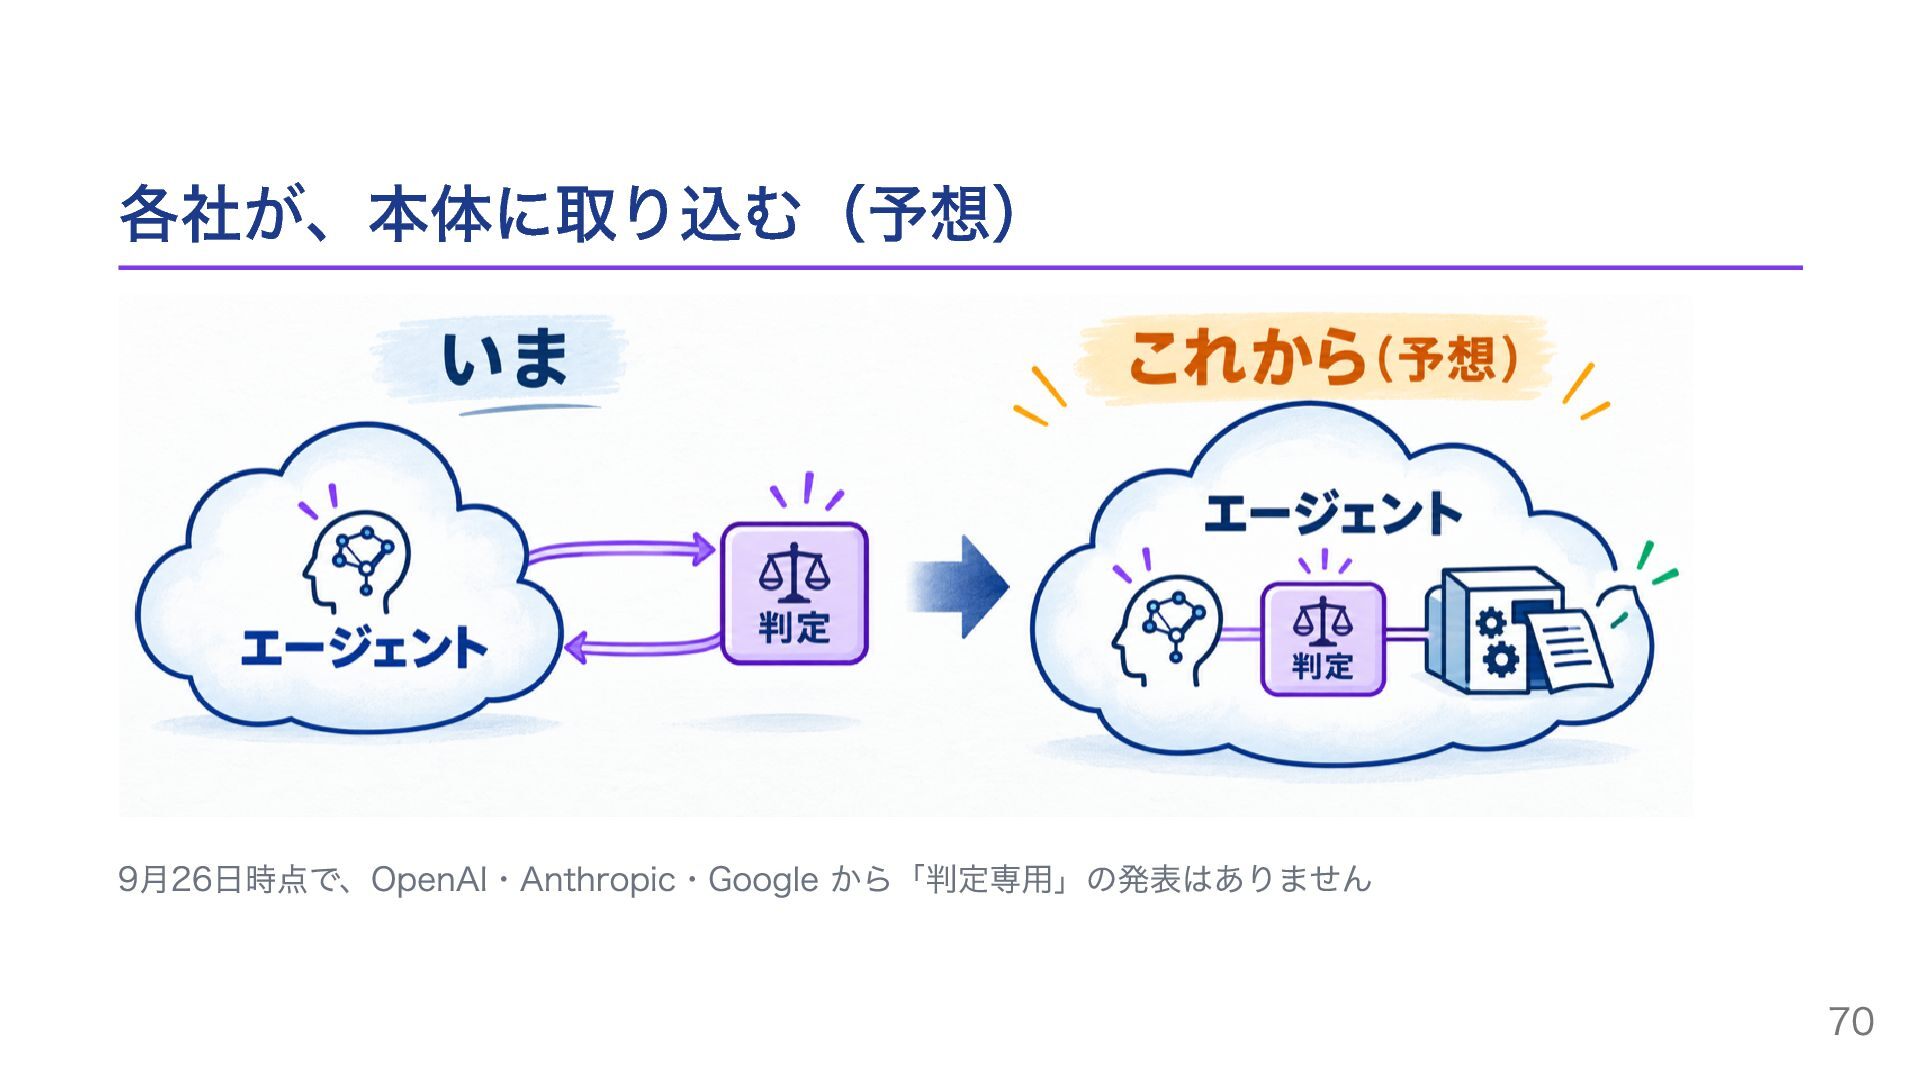
各社が、本体に取り込む(予想) 9月26日時点で、OpenAI・Anthropic・Google から「判定専用」の発表はありません 70
根拠は3つ 1. LLM はツール呼び出しの判断で、すでに内部で「1トークンの分類」をしている。外に出す だけ 2. Claude Code の Auto
モードは、すでに同じ場所に分類器を挟んでいる 3. TypeSafe 自身が「差はデータ」と言っている。大手はデータを作れる Claude や Codex のようなコーディングエージェントも、内部の分岐(次に何をするか、 止まるか、危険か)を この経路で処理し、全体が速く安くなる 71
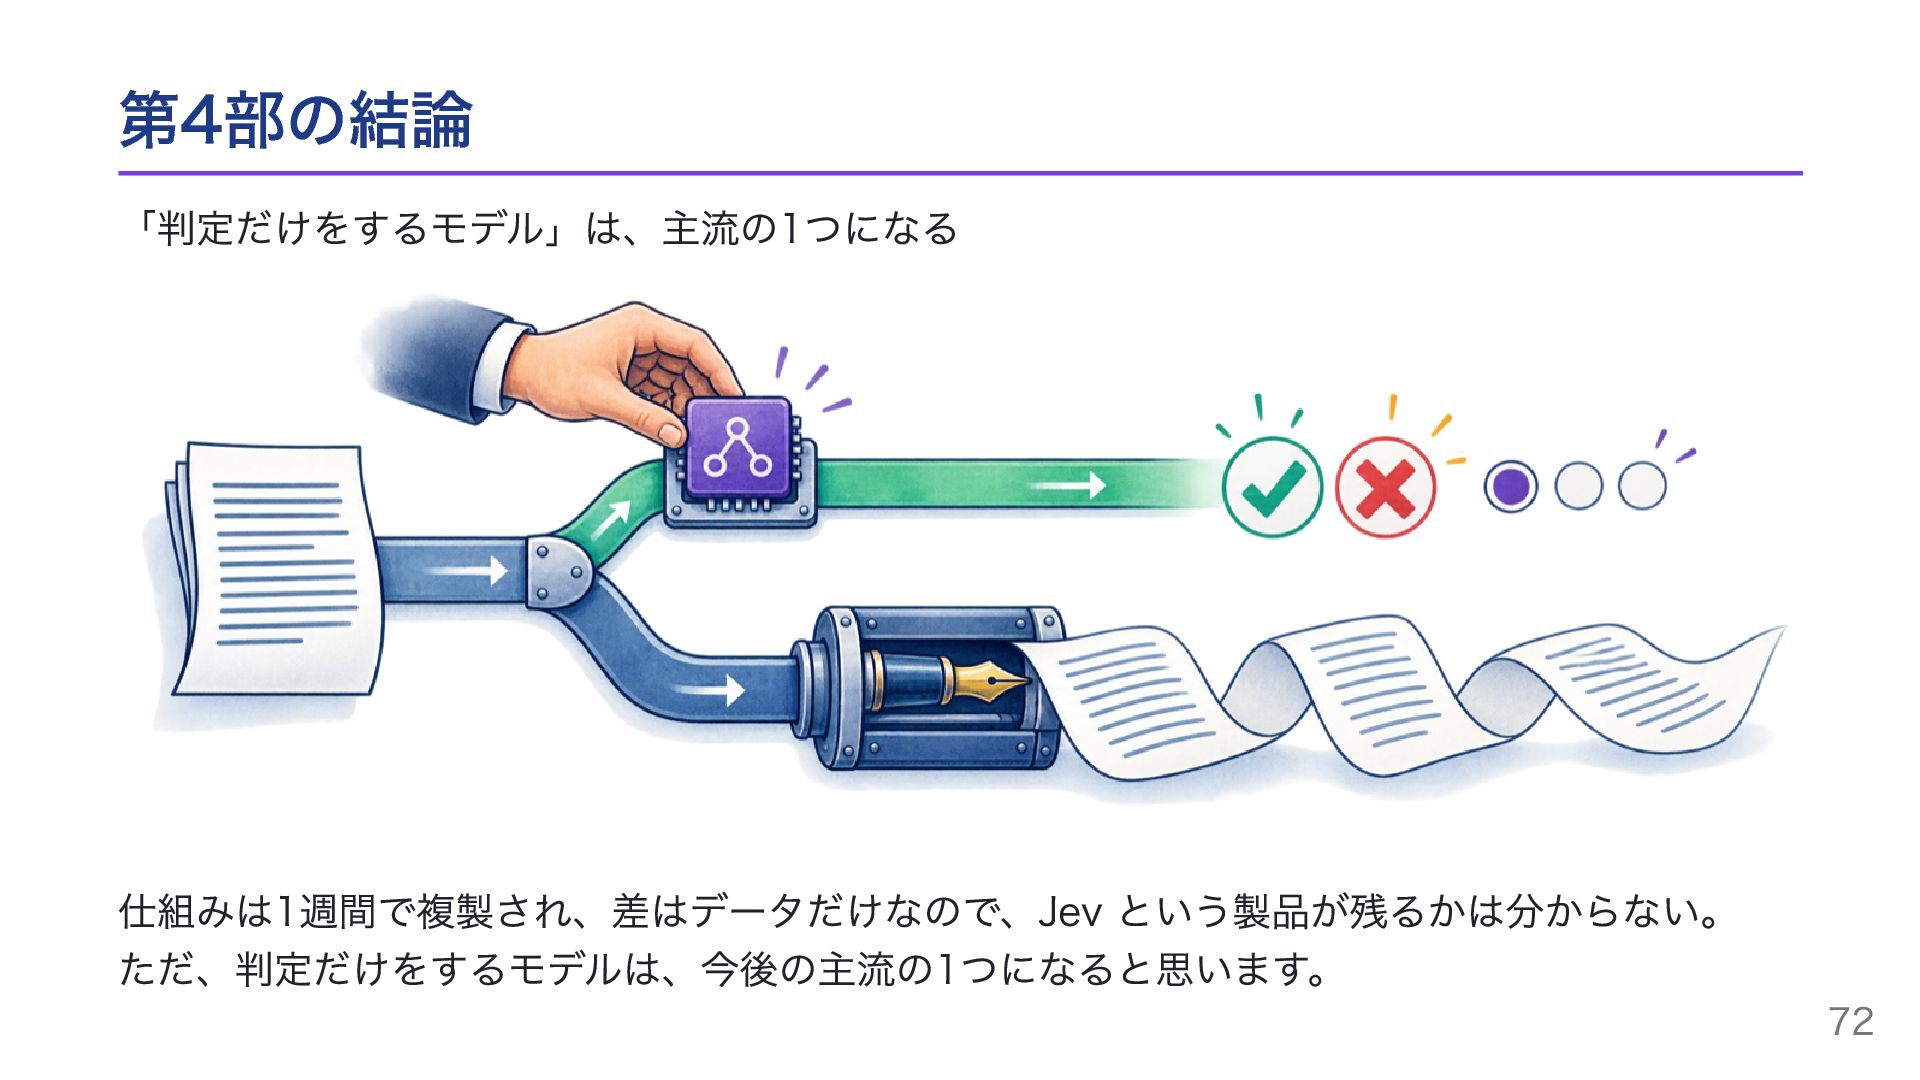
第4部の結論 「判定だけをするモデル」は、主流の1つになる 仕組みは1週間で複製され、差はデータだけなので、Jev という製品が残るかは分からない。 ただ、判定だけをするモデルは、今後の主流の1つになると思います。 72
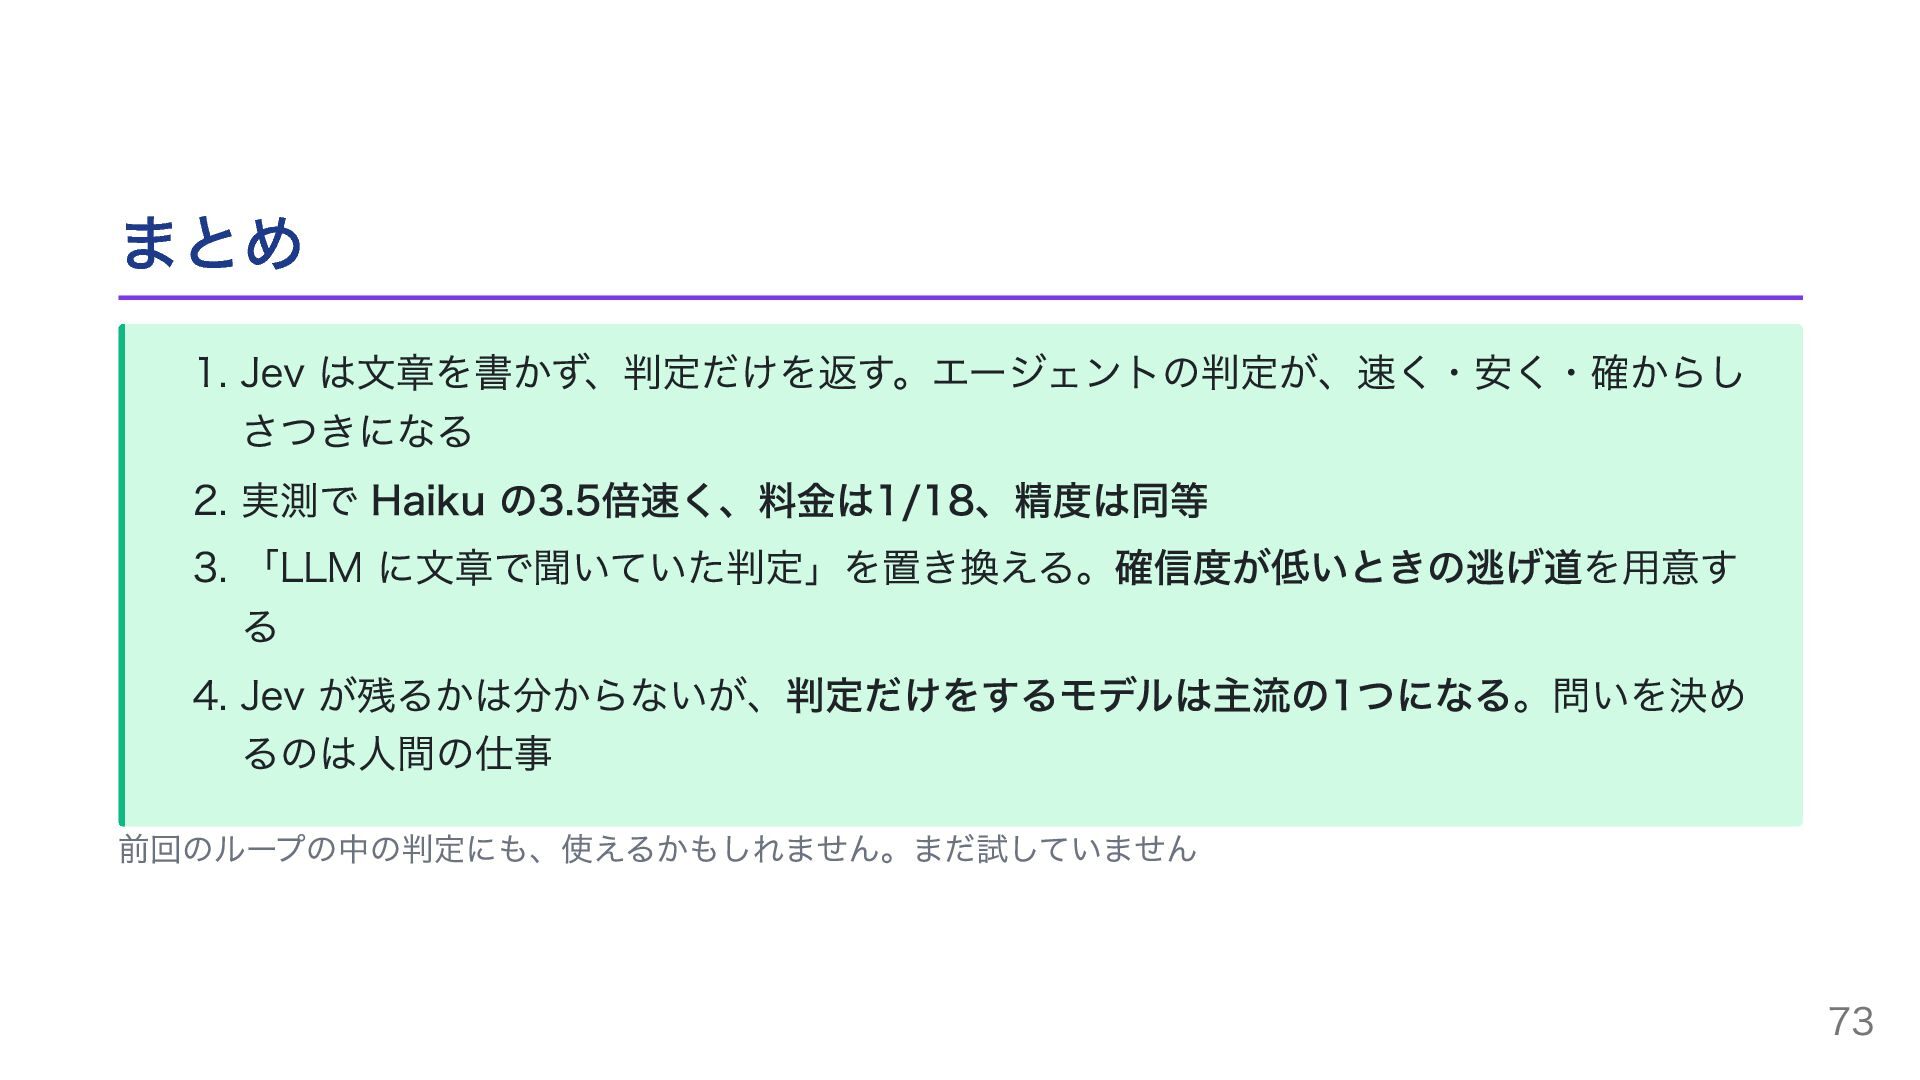
まとめ 1. Jev は文章を書かず、判定だけを返す。エージェントの判定が、速く・安く・確からし さつきになる 2. 実測で Haiku の3.5倍速く、料金は1/18、精度は同等 3.
「LLM に文章で聞いていた判定」を置き換える。確信度が低いときの逃げ道を用意す る 4. Jev が残るかは分からないが、判定だけをするモデルは主流の1つになる。問いを決め るのは人間の仕事 前回のループの中の判定にも、使えるかもしれません。まだ試していません 73
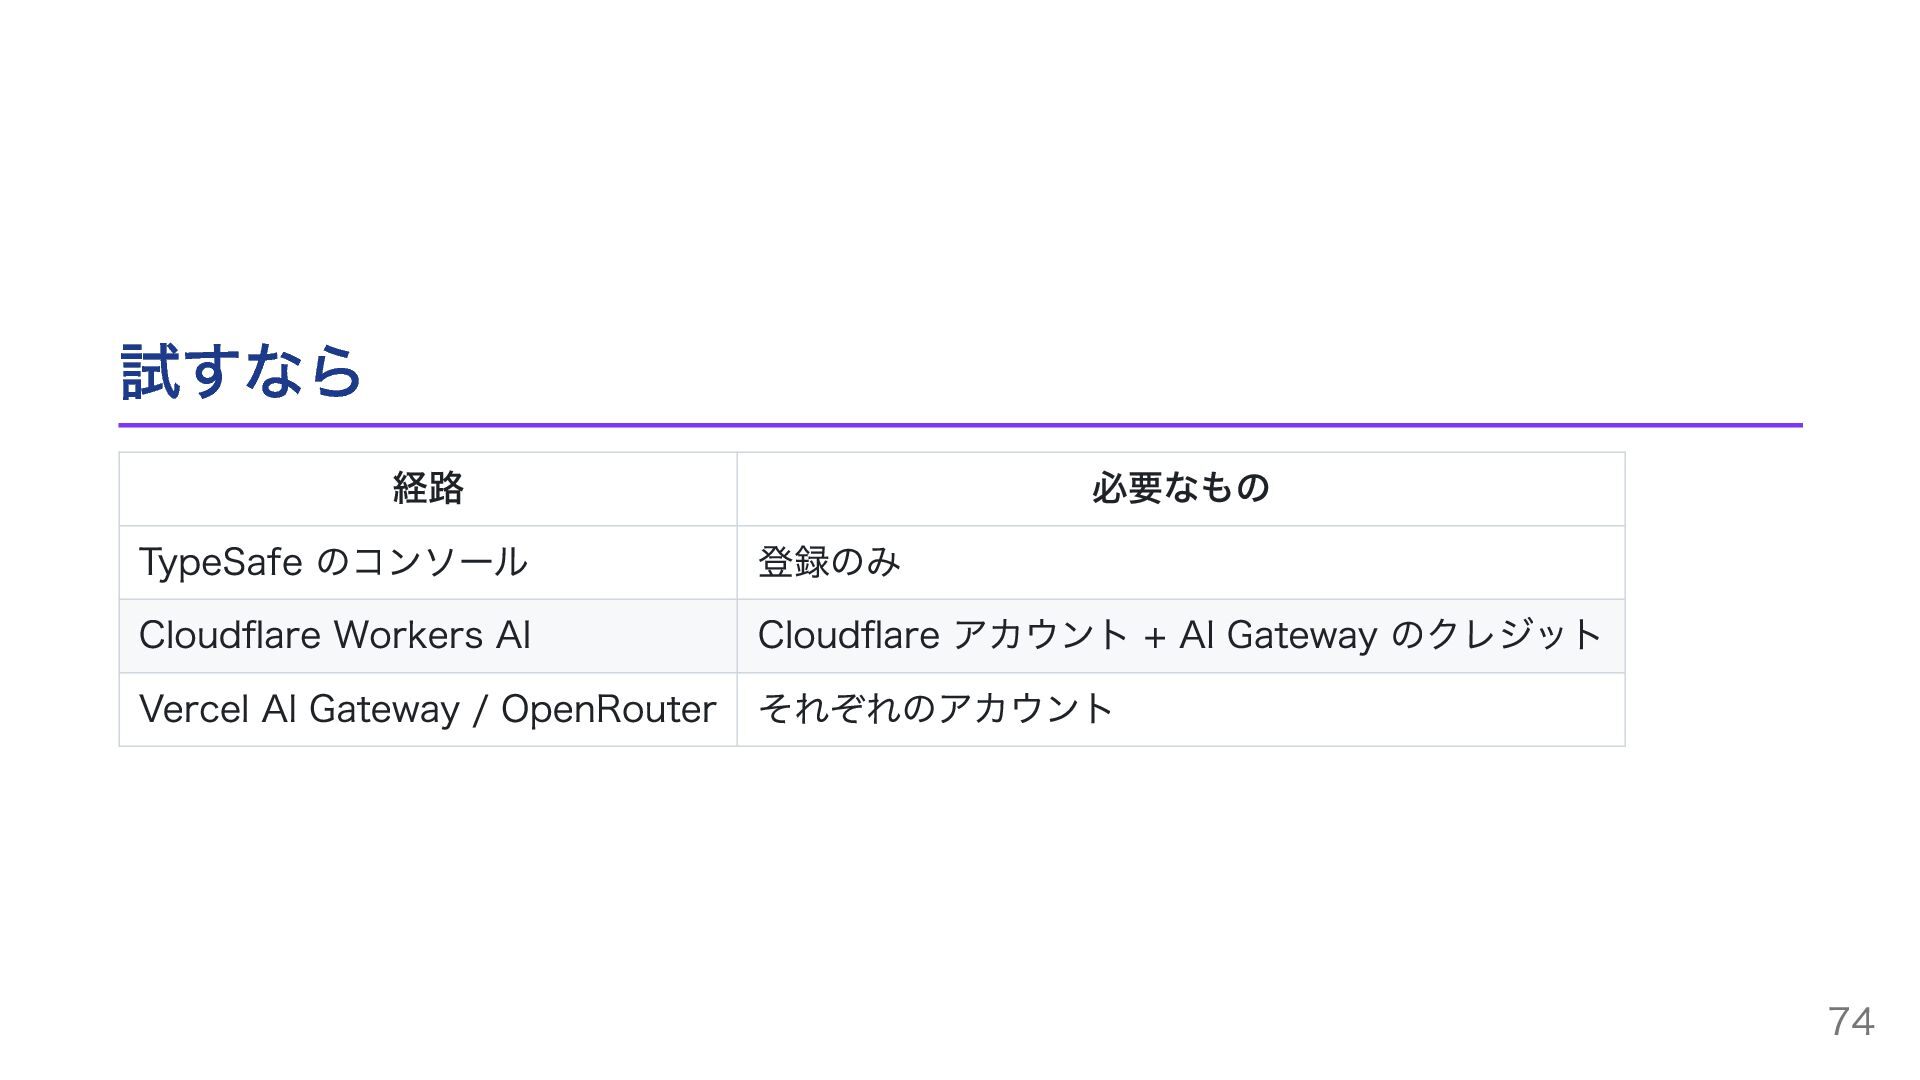
試すなら 経路 必要なもの TypeSafe のコンソール 登録のみ Cloudflare Workers AI Cloudflare
アカウント + AI Gateway のクレジット Vercel AI Gateway / OpenRouter それぞれのアカウント 74
おわり


 y0hgi
 iktakahiro
 puhitaku
 ishikawa_satoru
 mhrtech
 tokuty
 ueponx
 gionn
 keeg
 rfdnxbro
 nealle
 jtakeda
 yeseniaperezcruz
 tammyeverts
 honzajavorek
 greggifford
 thirion
 swwweet
 honnibal
 addyosmani
 codingconduct
 elsirapls
 sabderemane
 jct