Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
第6回 AI Edge Contest に参加したけど全然だめだった話
Search
nearwisteria
March 04, 2023
Programming
130
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
第6回 AI Edge Contest に参加したけど全然だめだった話
第6回 AI Edge Contestに参加したが、全然だめだった結果を供養するスライドです。
nearwisteria
March 04, 2023
Other Decks in Programming
See All in Programming
AWS CDKのカスタムリソースでContinuum(旧Security Agent)を実装した話 | Implementing Continuum (formerly Security Agent) via AWS CDK Custom Resource
akihisaikeda
2
150
當我們開始不讀 Code - AI Agent 時代,Code Review 與 Clean Code 還剩下什麼?
jame2408
1
260
dotNET_vulnclicker_intro.pdf
deka_morita
0
140
月間100万人のサービス刷新で、 技術選定をHonoに振り切った話
yutobara
8
6.7k
Apple Intelligence を用いた個人情報誤送信防止、及びユーザーリクエスト体験の改善について
yukiny
0
350
SalesForceを内製化!? ~ HR事業を支える顧客管理基盤のインフラを大公開 ~
oku053
0
180
npm との違いを手がかりにGo の依存管理を理解したい
optim
0
800
HTML-in-Canvasで作る未来のWeb UI表現
clockmaker
5
5.2k
Simple Storage Service(S3) is not simple
iwatsukayura
0
290
[JA] Domain Modeling with Vanilla Rails: 「操作」から再考するRailsの設計論
yasaichi
3
440
IBM Bob Dojo #1 仕様駆動開発入門
oniak3ibm
PRO
0
400
Unity6 URPによる海底をテーマにしたVJシステムの解説 | Unity Shader 完全に理解した 勉強会
gam0022
0
370
Featured
See All Featured
The Invisible Side of Design
smashingmag
301
52k
So, you think you're a good person
axbom
PRO
2
2.2k
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
280
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
Optimizing for Happiness
mojombo
378
71k
How to make the Groovebox
asonas
2
2.5k
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3.1k
Facilitating Awesome Meetings
lara
57
7.2k
Typedesign – Prime Four
hannesfritz
42
3.2k
Money Talks: Using Revenue to Get Sh*t Done
nikkihalliwell
0
520
Code Reviewing Like a Champion
maltzj
529
40k
The browser strikes back
jonoalderson
0
1.8k
Transcript
第6回 AI Edge Contest に参加したけど全然だめだった話 nearwisteria
はじめに • 第6回 AI Edge Contestに参加したが、全然だめだった結果を供養するスライドです。 ◦ 残念ながら、認識率が雑魚、かつ、速度も雑魚だった。 • 第6回
AI Edge Contestについて ◦ https://signate.jp/competitions/732 ◦ (開発)車両前方の画像および全方位の点群データから、3D物体検出を行うアルゴリズムを作成 ◦ (実装)開発したアルゴリズムを、RISC-Vを搭載したプラットフォームに実装 2
概要 • 以下のアプローチで取り組んだ ◦ 認識: 点群データを鳥瞰図に変換し、NNで認識 ◦ 実装: C+RTLのスクラッチ実装 ▪
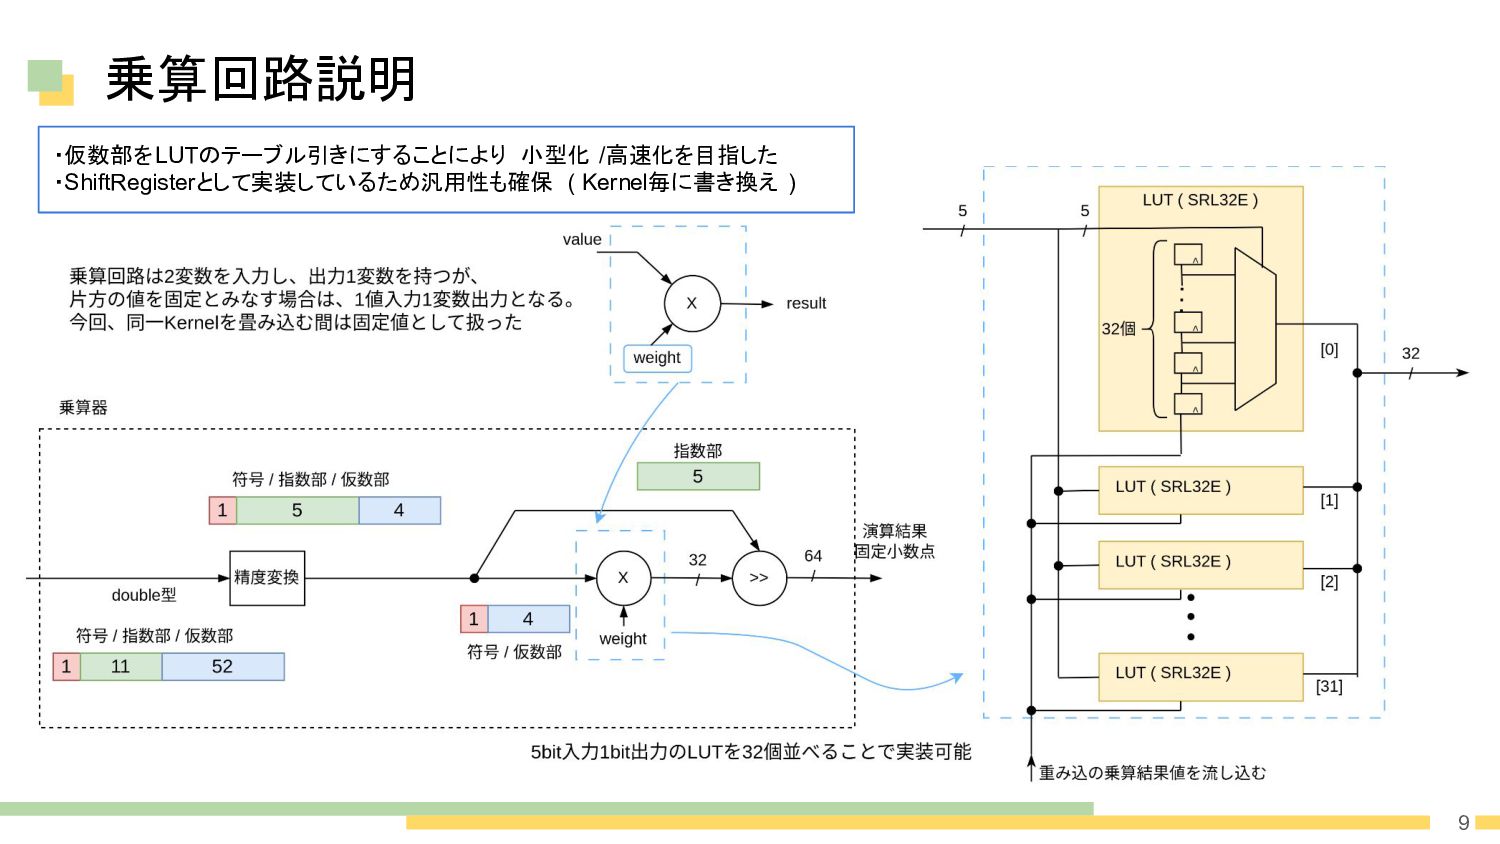
畳み込み演算部分をAccelerate ▪ RISC-Vは、OpenSourceを流用 ◦ 独自点 ▪ Accelerateの浮動小数点演算をLUT構造を意識したテーブル引きにて実装 ▪ ShiftRegister実装により、テーブルの値を書き換えられるようにしている • 使用するKernelの前にテーブル値を設定する ▪ テーブル引きを実現するために、独自制度の浮動小数点を採用 • 符号 1bit / 指数部5bits / 仮数部 4bits ( 以降、float10 と呼びます ) 3
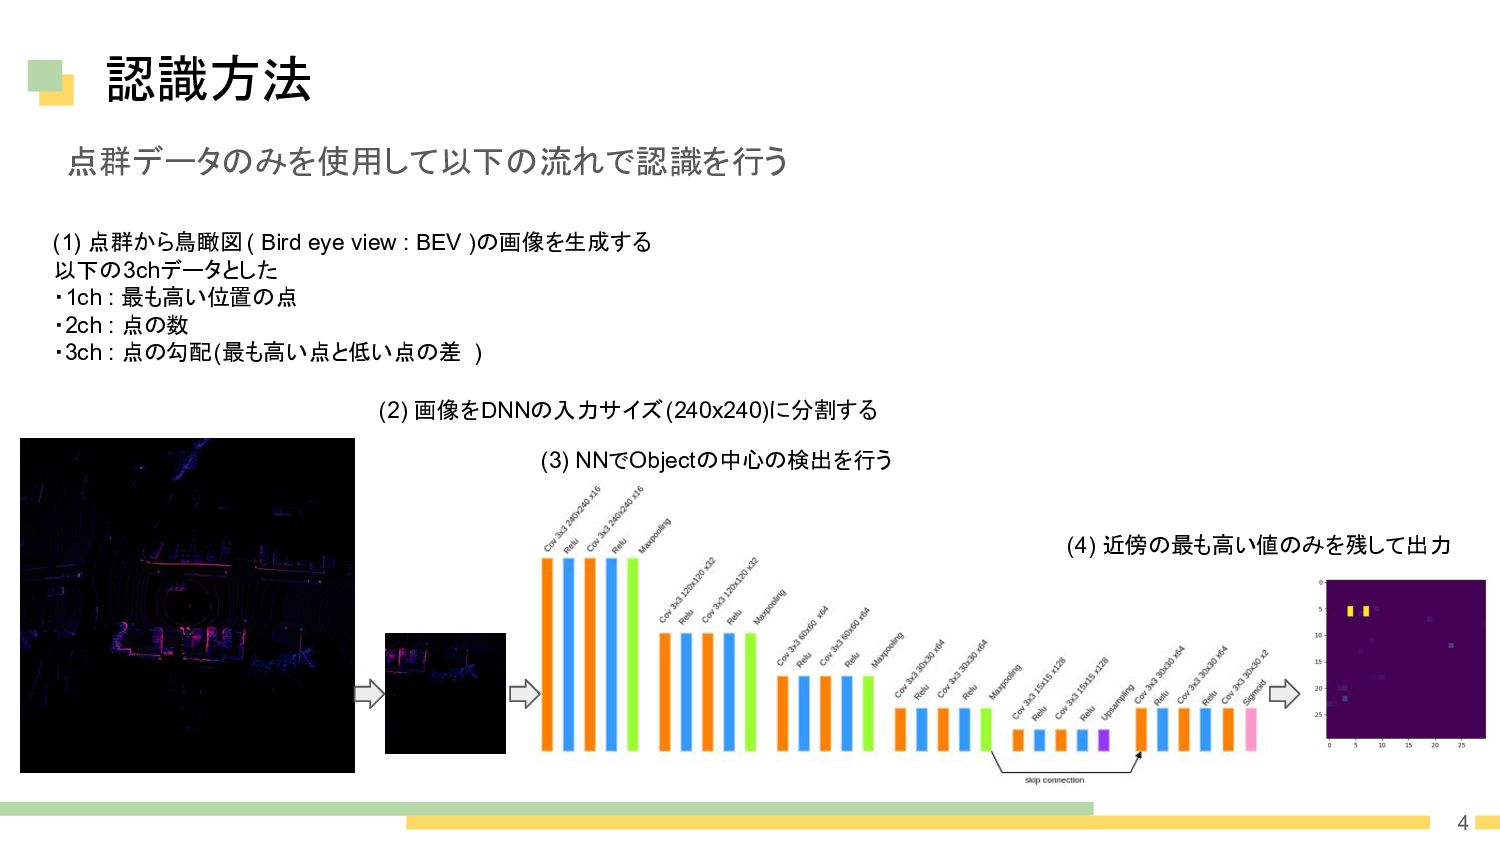
認識方法 点群データのみを使用して以下の流れで認識を行う 4 (1) 点群から鳥瞰図 ( Bird eye view :
BEV )の画像を生成する 以下の3chデータとした ・1ch : 最も高い位置の点 ・2ch : 点の数 ・3ch : 点の勾配(最も高い点と低い点の差 ) (2) 画像をDNNの入力サイズ(240x240)に分割する (3) NNでObjectの中心の検出を行う (4) 近傍の最も高い値のみを残して出力
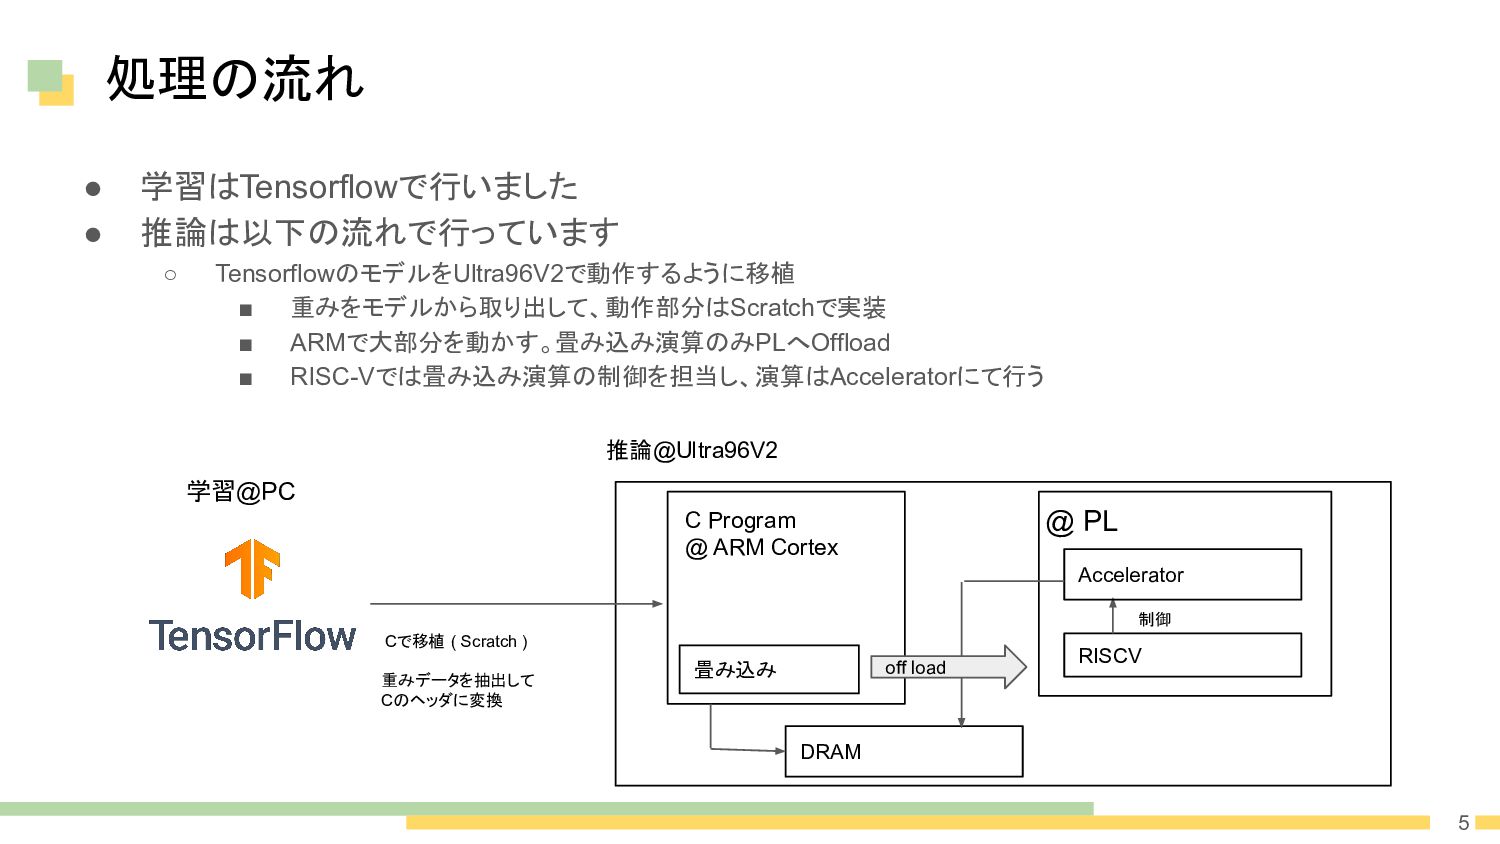
処理の流れ • 学習はTensorflowで行いました • 推論は以下の流れで行っています ◦ TensorflowのモデルをUltra96V2で動作するように移植 ▪ 重みをモデルから取り出して、動作部分はScratchで実装 ▪
ARMで大部分を動かす。畳み込み演算のみPLへOffload ▪ RISC-Vでは畳み込み演算の制御を担当し、演算はAcceleratorにて行う 5 学習@PC 推論@Ultra96V2 重みデータを抽出して Cのヘッダに変換 Cで移植 ( Scratch ) 畳み込み @ PL RISCV Accelerator C Program @ ARM Cortex 制御 DRAM off load
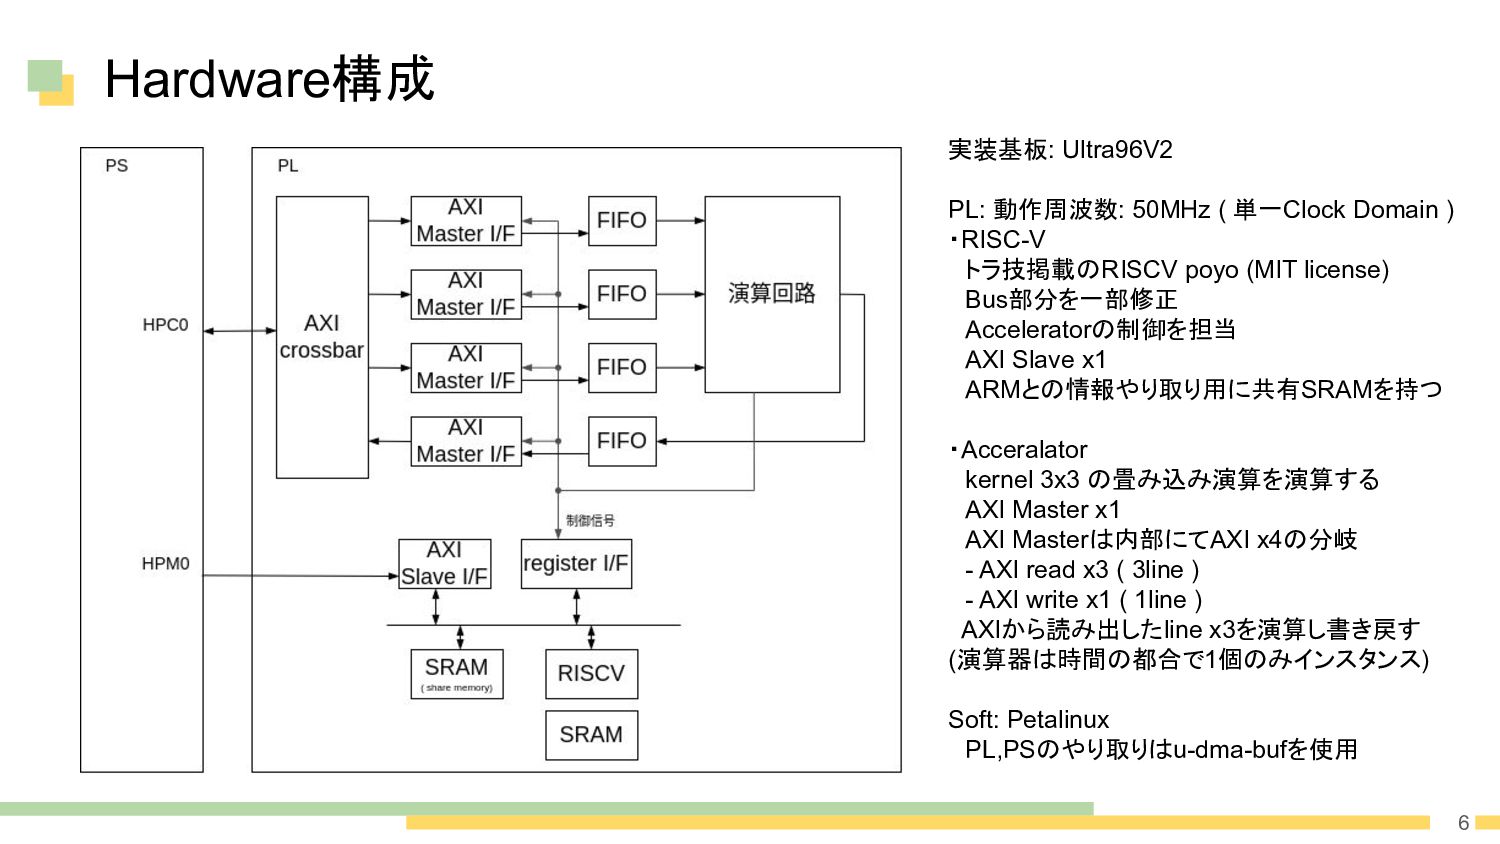
Hardware構成 6 実装基板: Ultra96V2 PL: 動作周波数: 50MHz ( 単一Clock Domain
) ・RISC-V トラ技掲載のRISCV poyo (MIT license) Bus部分を一部修正 Acceleratorの制御を担当 AXI Slave x1 ARMとの情報やり取り用に共有SRAMを持つ ・Acceralator kernel 3x3 の畳み込み演算を演算する AXI Master x1 AXI Masterは内部にてAXI x4の分岐 - AXI read x3 ( 3line ) - AXI write x1 ( 1line ) AXIから読み出したline x3を演算し書き戻す (演算器は時間の都合で1個のみインスタンス) Soft: Petalinux PL,PSのやり取りはu-dma-bufを使用
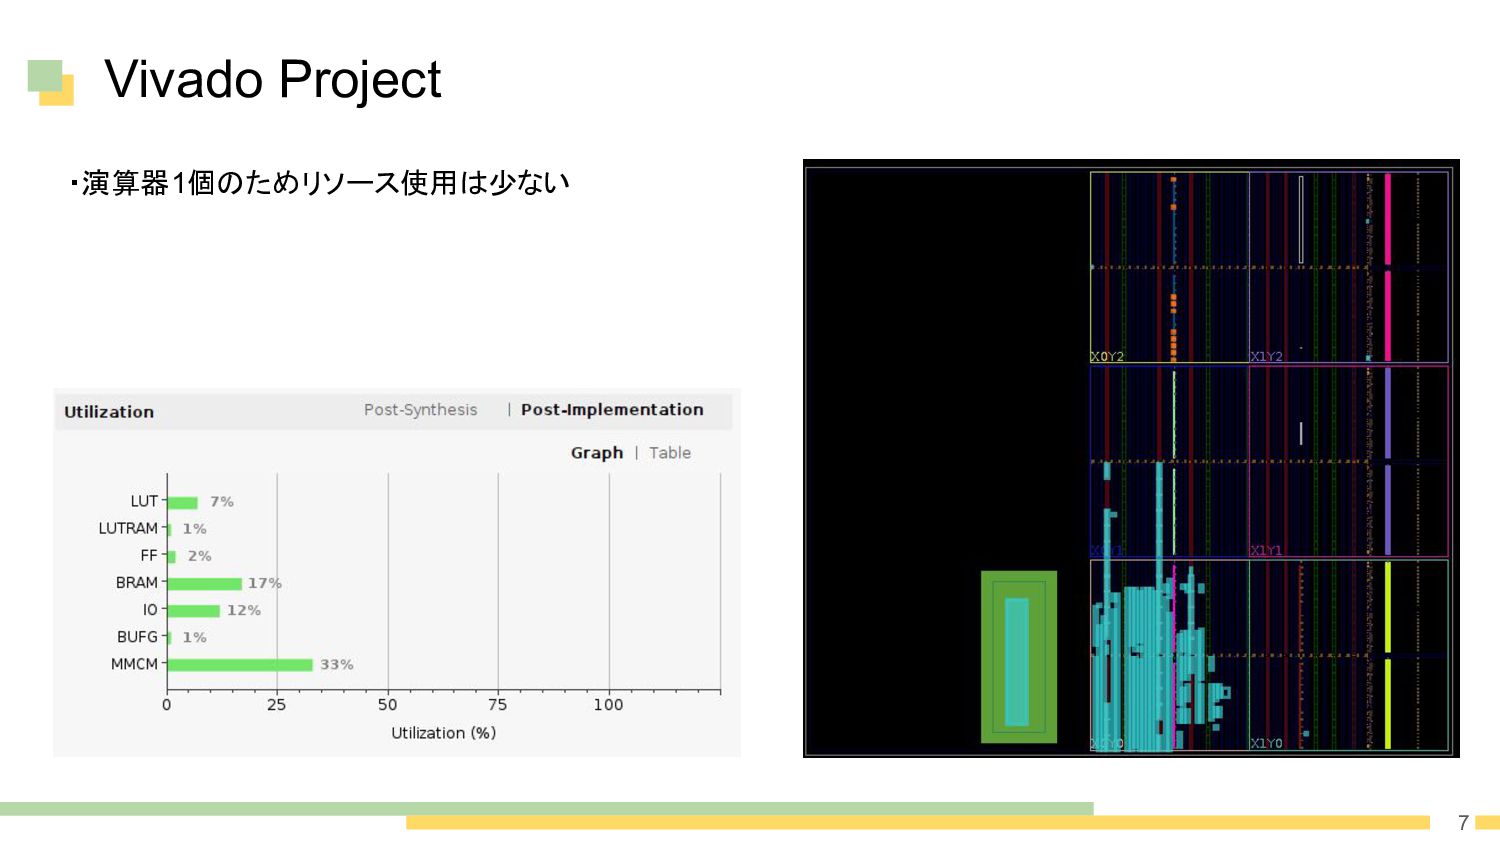
Vivado Project 7 ・演算器1個のためリソース使用は少ない
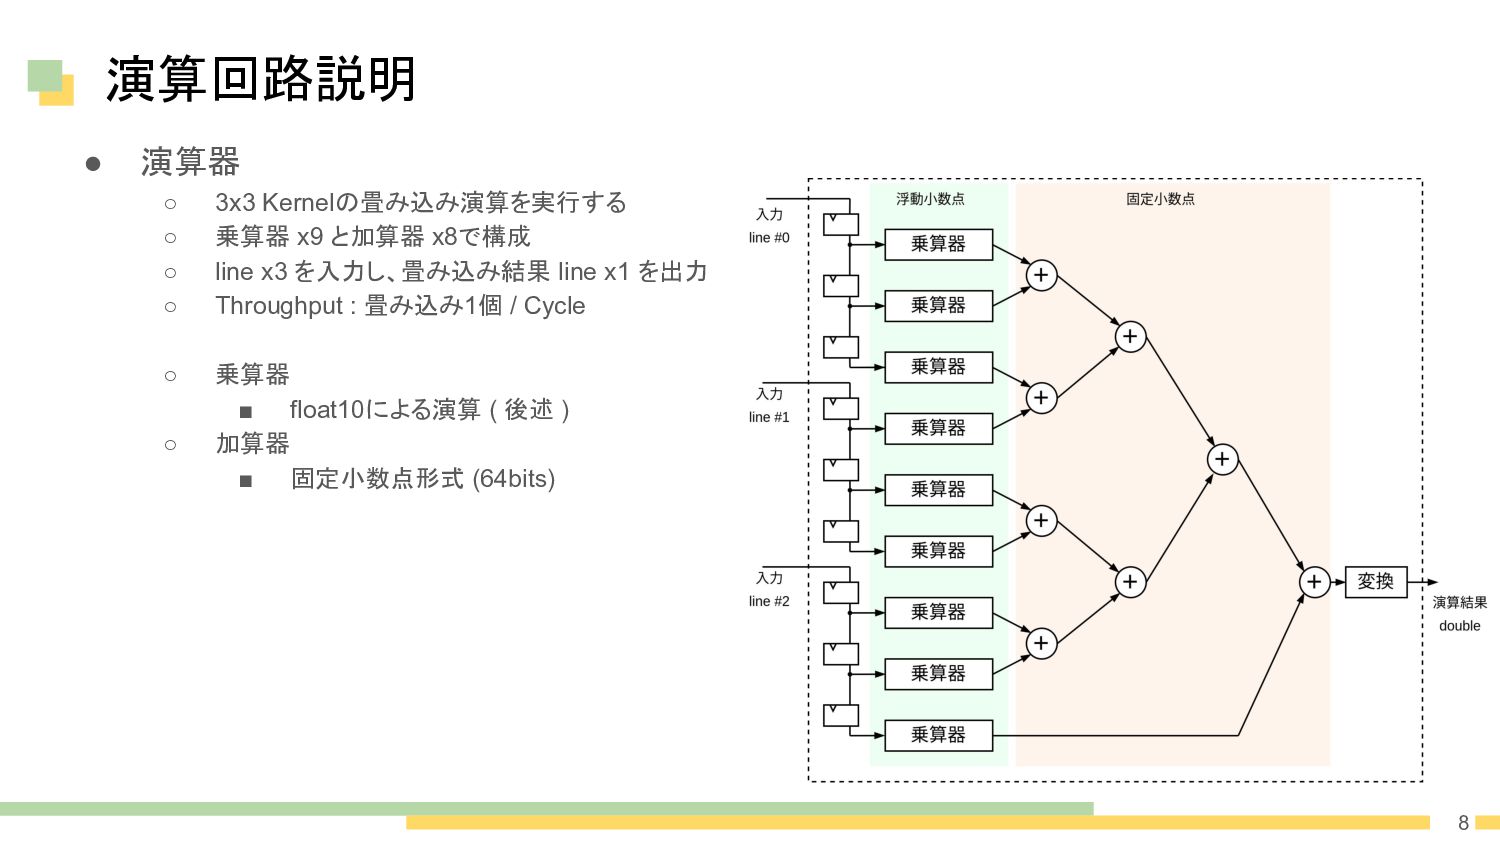
演算回路説明 • 演算器 ◦ 3x3 Kernelの畳み込み演算を実行する ◦ 乗算器 x9 と加算器
x8で構成 ◦ line x3 を入力し、畳み込み結果 line x1 を出力 ◦ Throughput : 畳み込み1個 / Cycle ◦ 乗算器 ▪ float10による演算 ( 後述 ) ◦ 加算器 ▪ 固定小数点形式 (64bits) 8
乗算回路説明 9 ・仮数部をLUTのテーブル引きにすることにより 小型化 /高速化を目指した ・ShiftRegisterとして実装しているため汎用性も確保 ( Kernel毎に書き換え )
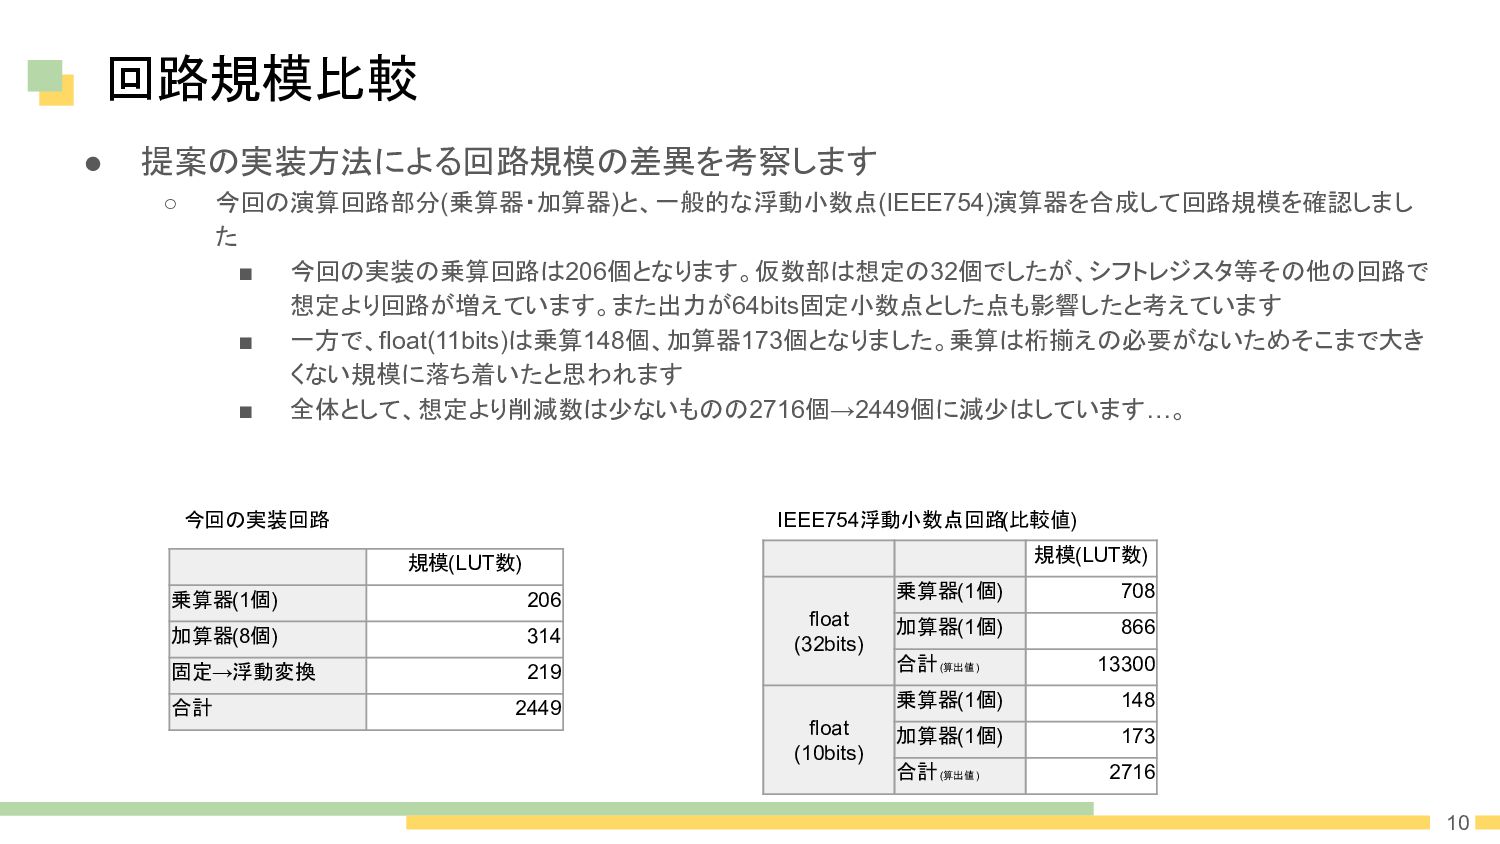
回路規模比較 • 提案の実装方法による回路規模の差異を考察します ◦ 今回の演算回路部分(乗算器・加算器)と、一般的な浮動小数点(IEEE754)演算器を合成して回路規模を確認しまし た ▪ 今回の実装の乗算回路は206個となります。仮数部は想定の32個でしたが、シフトレジスタ等その他の回路で 想定より回路が増えています。また出力が64bits固定小数点とした点も影響したと考えています ▪
一方で、float(11bits)は乗算148個、加算器173個となりました。乗算は桁揃えの必要がないためそこまで大き くない規模に落ち着いたと思われます ▪ 全体として、想定より削減数は少ないものの2716個→2449個に減少はしています…。 規模(LUT数) 乗算器(1個) 206 加算器(8個) 314 固定→浮動変換 219 合計 2449 今回の実装回路 規模(LUT数) float (32bits) 乗算器(1個) 708 加算器(1個) 866 合計 (算出値 ) 13300 float (10bits) 乗算器(1個) 148 加算器(1個) 173 合計 (算出値 ) 2716 IEEE754浮動小数点回路(比較値) 10
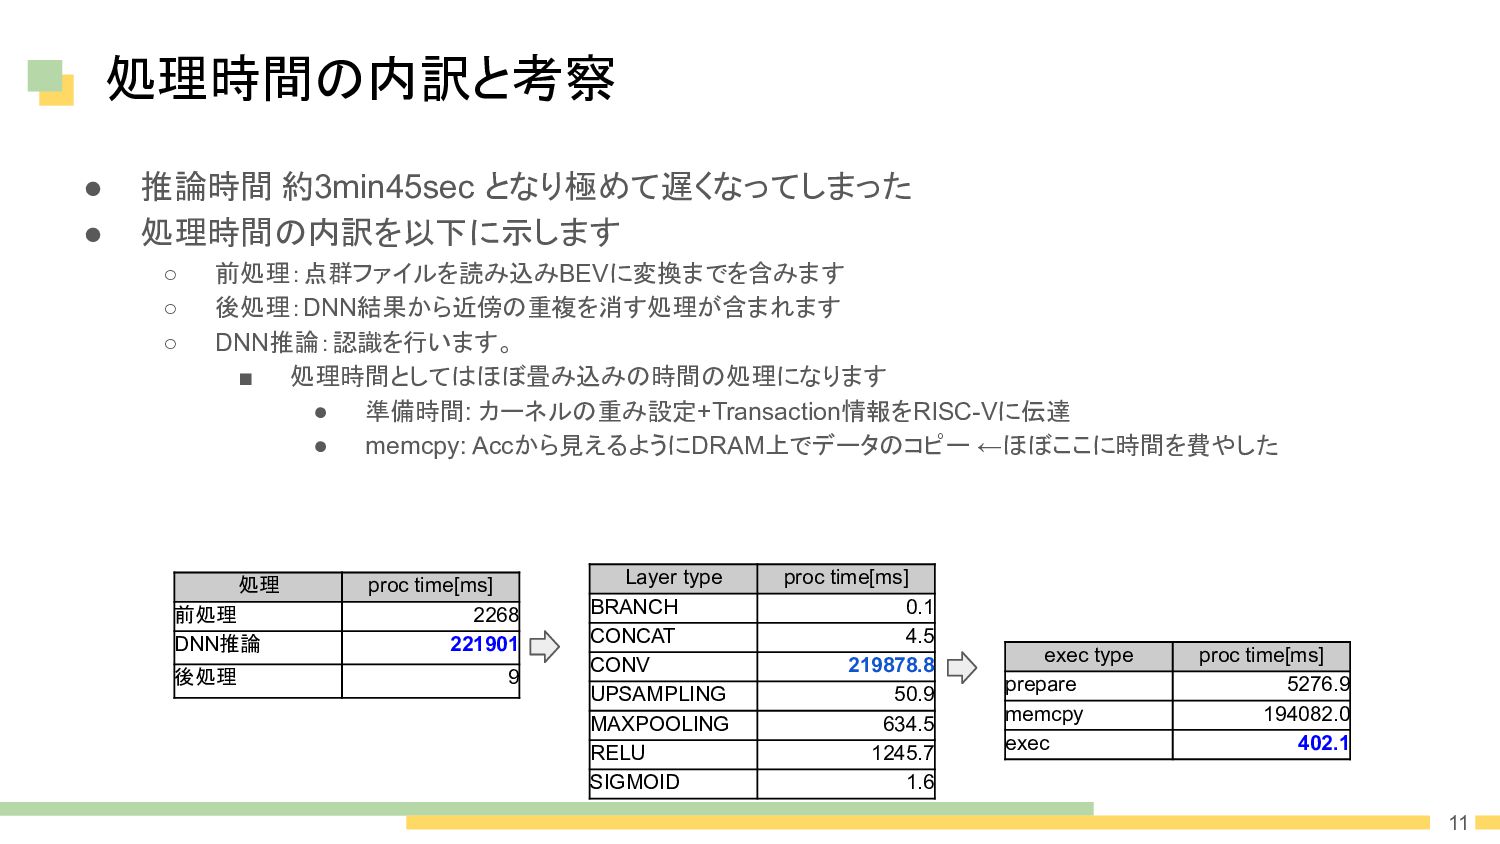
処理時間の内訳と考察 • 推論時間 約3min45sec となり極めて遅くなってしまった • 処理時間の内訳を以下に示します ◦ 前処理:点群ファイルを読み込みBEVに変換までを含みます ◦
後処理:DNN結果から近傍の重複を消す処理が含まれます ◦ DNN推論:認識を行います。 ▪ 処理時間としてはほぼ畳み込みの時間の処理になります • 準備時間: カーネルの重み設定+Transaction情報をRISC-Vに伝達 • memcpy: Accから見えるようにDRAM上でデータのコピー ←ほぼここに時間を費やした Layer type proc time[ms] BRANCH 0.1 CONCAT 4.5 CONV 219878.8 UPSAMPLING 50.9 MAXPOOLING 634.5 RELU 1245.7 SIGMOID 1.6 処理 proc time[ms] 前処理 2268 DNN推論 221901 後処理 9 exec type proc time[ms] prepare 5276.9 memcpy 194082.0 exec 402.1 11
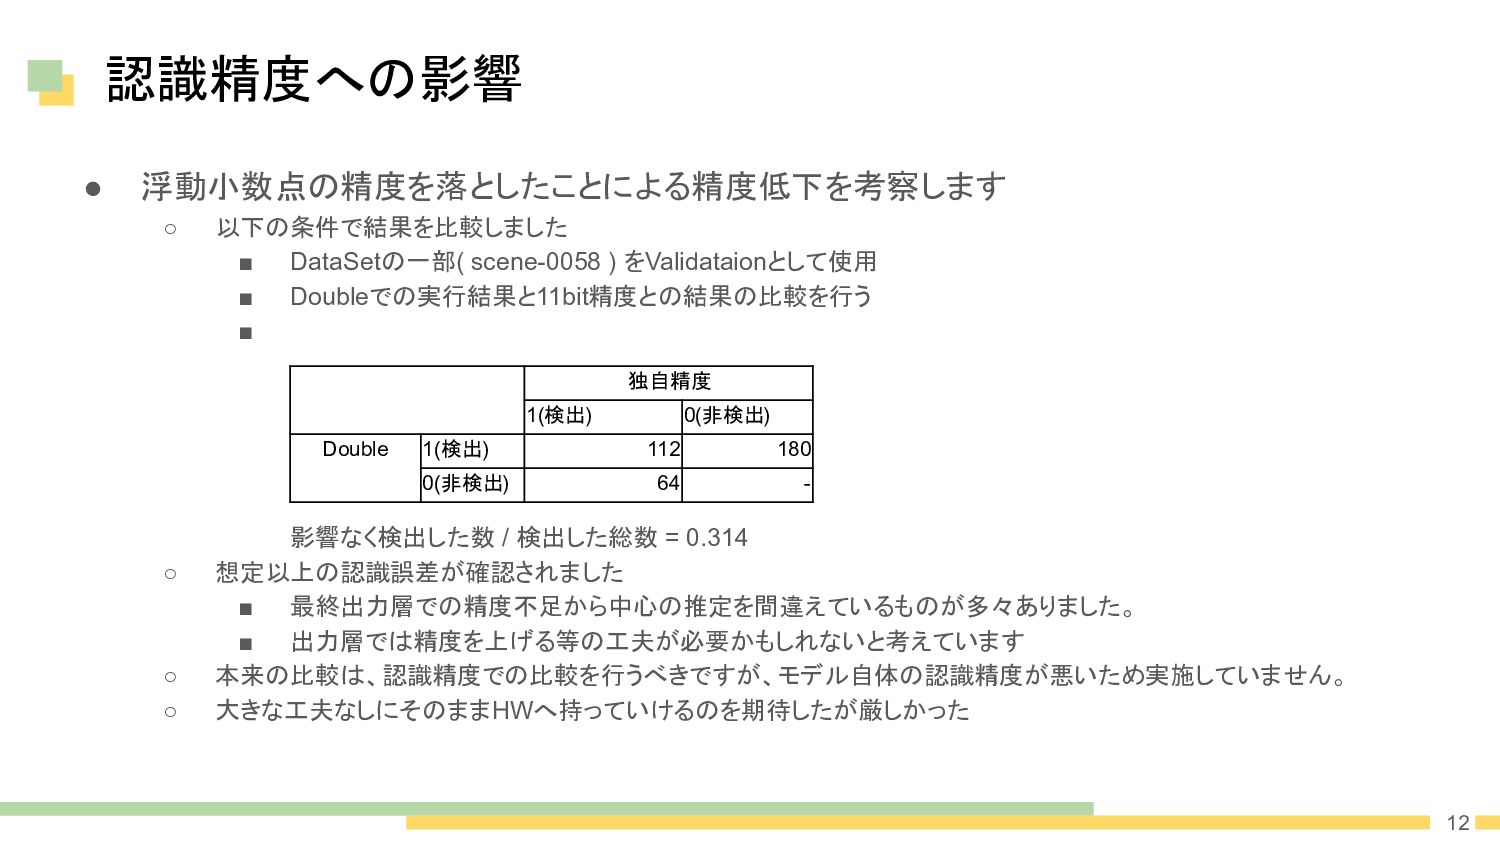
認識精度への影響 • 浮動小数点の精度を落としたことによる精度低下を考察します ◦ 以下の条件で結果を比較しました ▪ DataSetの一部( scene-0058 ) をValidataionとして使用
▪ Doubleでの実行結果と11bit精度との結果の比較を行う ▪ 影響なく検出した数 / 検出した総数 = 0.314 ◦ 想定以上の認識誤差が確認されました ▪ 最終出力層での精度不足から中心の推定を間違えているものが多々ありました。 ▪ 出力層では精度を上げる等の工夫が必要かもしれないと考えています ◦ 本来の比較は、認識精度での比較を行うべきですが、モデル自体の認識精度が悪いため実施していません。 ◦ 大きな工夫なしにそのままHWへ持っていけるのを期待したが厳しかった 独自精度 1(検出) 0(非検出) Double 1(検出) 112 180 0(非検出) 64 - 12
認識精度考察 • 今回の手法では認識精度が著しく低い結果となっています。 • 認識精度が極めて低いことについて考察します ◦ Annotation状態による問題 ▪ 点群データをBEV変換し一部領域を切り抜き、教師データとしています。ただ、点群データの一部は前方方向 のみAnnotationしか適切にAnnotationされてないため、切り出し部分によってはfalse-negativeが頻出します
• 切り出した段階でAnotationが全く存在しないデータは削除 • false-negativeの場合の誤差を、0.1乗算し誤差を小さくさせて学習 ◦ ただし、このため学習モデルに誤検出が頻発する結果となってしまった ◦ Network Modelによる起因 ▪ 出力するmatrixでの精度しか認識できず中点を適切に判断できない ( 1m x 1m ) • このためPedestrianは諦めて、Carのみ出力 ▪ z-軸方向の認識を諦め、決め打ちで補間した。( 時間切れ ) 13
まとめ • 結果 ◦ 認識率が悪く、かつ、速度が遅いものができた • 反省点 ◦ 認識の点 ▪
根本のモデルの精度が低いため、float10による精度影響がまともに見積もれてない ◦ 実装の点 ▪ インスタンス数を増やせなかったため、本当の実力が不明 ▪ インスタンス数を増やし、別のボトルネックの解析が行えていない ◦ 作業時間不足 ▪ すべての作業で時間が不足しており、これからいいところという状況で時間切れ ▪ C+RTLの構成ですべてスクラッチ開発はアプローチとしては微妙だった • (主目的はスキルアップなのでその点では間違ってないのかもだが…) • 所感 ◦ かなり疲れた…。 14
最終スライド 15


 akihisaikeda
 jame2408
 deka_morita
 yutobara
 yukiny
 oku053
 optim
 clockmaker
 iwatsukayura
 yasaichi
 oniak3ibm
 gam0022
 smashingmag
 axbom
 davidcarrasco
 chriscoyier
 mojombo
 asonas
 eileencodes
 lara
 hannesfritz
 nikkihalliwell
 maltzj
 jonoalderson