Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ASRは精度だけでは足りない − 専門用語の誤認識にどう向き合うか
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Nishika-Inc
August 05, 2026
130
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ASRは精度だけでは足りない − 専門用語の誤認識にどう向き合うか
現場で使える音声認識・LLM (Nishika AI Product Lab #1)
Nishika-Inc
August 05, 2026
More Decks by Nishika-Inc
See All by Nishika-Inc
Slack + Notion + AIで作る不具合対応ワークフロー
nishikainc
0
34
AIプロダクト開発におけるClaudeCode活用ガイド
nishikainc
0
43
会議AIエージェント「SecureMemo」シリーズ紹介 − なぜ私たちは精度に一番こだわるのか
nishikainc
0
95
会議AIエージェントに話者認識AIを乗せる難しさと重要性
nishikainc
0
140
Nishika_テックチーム_ご紹介資料 / Nishika_TechTeam_Introduction
nishikainc
0
1.9k
Nishika_Bussei_大好きオフトゥン_1st_solution.pdf
nishikainc
0
250
Nishika_Bussei_mi-solution_3rd_solution.pdf
nishikainc
0
460
Nishika_Sleep_TYS_1st_Solution.pdf
nishikainc
0
280
Nishika_Sleep_Condor_3rd_Solution.pdf
nishikainc
0
250
Featured
See All Featured
Organizational Design Perspectives: An Ontology of Organizational Design Elements
kimpetersen
PRO
1
840
16th Malabo Montpellier Forum Presentation
akademiya2063
PRO
0
400
Building AI with AI
inesmontani
PRO
1
1.3k
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
42k
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
69
66k
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
350
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
350
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
260
Git: the NoSQL Database
bkeepers
PRO
433
67k
個人開発の失敗を避けるイケてる考え方 / tips for indie hackers
panda_program
123
22k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
First, design no harm
axbom
PRO
2
1.3k
Transcript
ASR(音声認識)は精度だけでは足りない 専門用語の誤認識にどう向き合うか 2026-08-05 © Nishika, Inc
Nishika AI Lab #1 自己紹介 ▪ プリンシパルAIエンジニア ▪ プロダクトのAI機能(音声認識・要約)まわりを担当 ▪
サウナがマイブーム © Nishika, Inc 2
Nishika AI Lab #1 アジェンダ 1. ASR の現在地 2. プロダクトにおける音声認識の課題意識
3. 課題に向き合う © Nishika, Inc 3
1. ASR の現在地 © Nishika, Inc 4
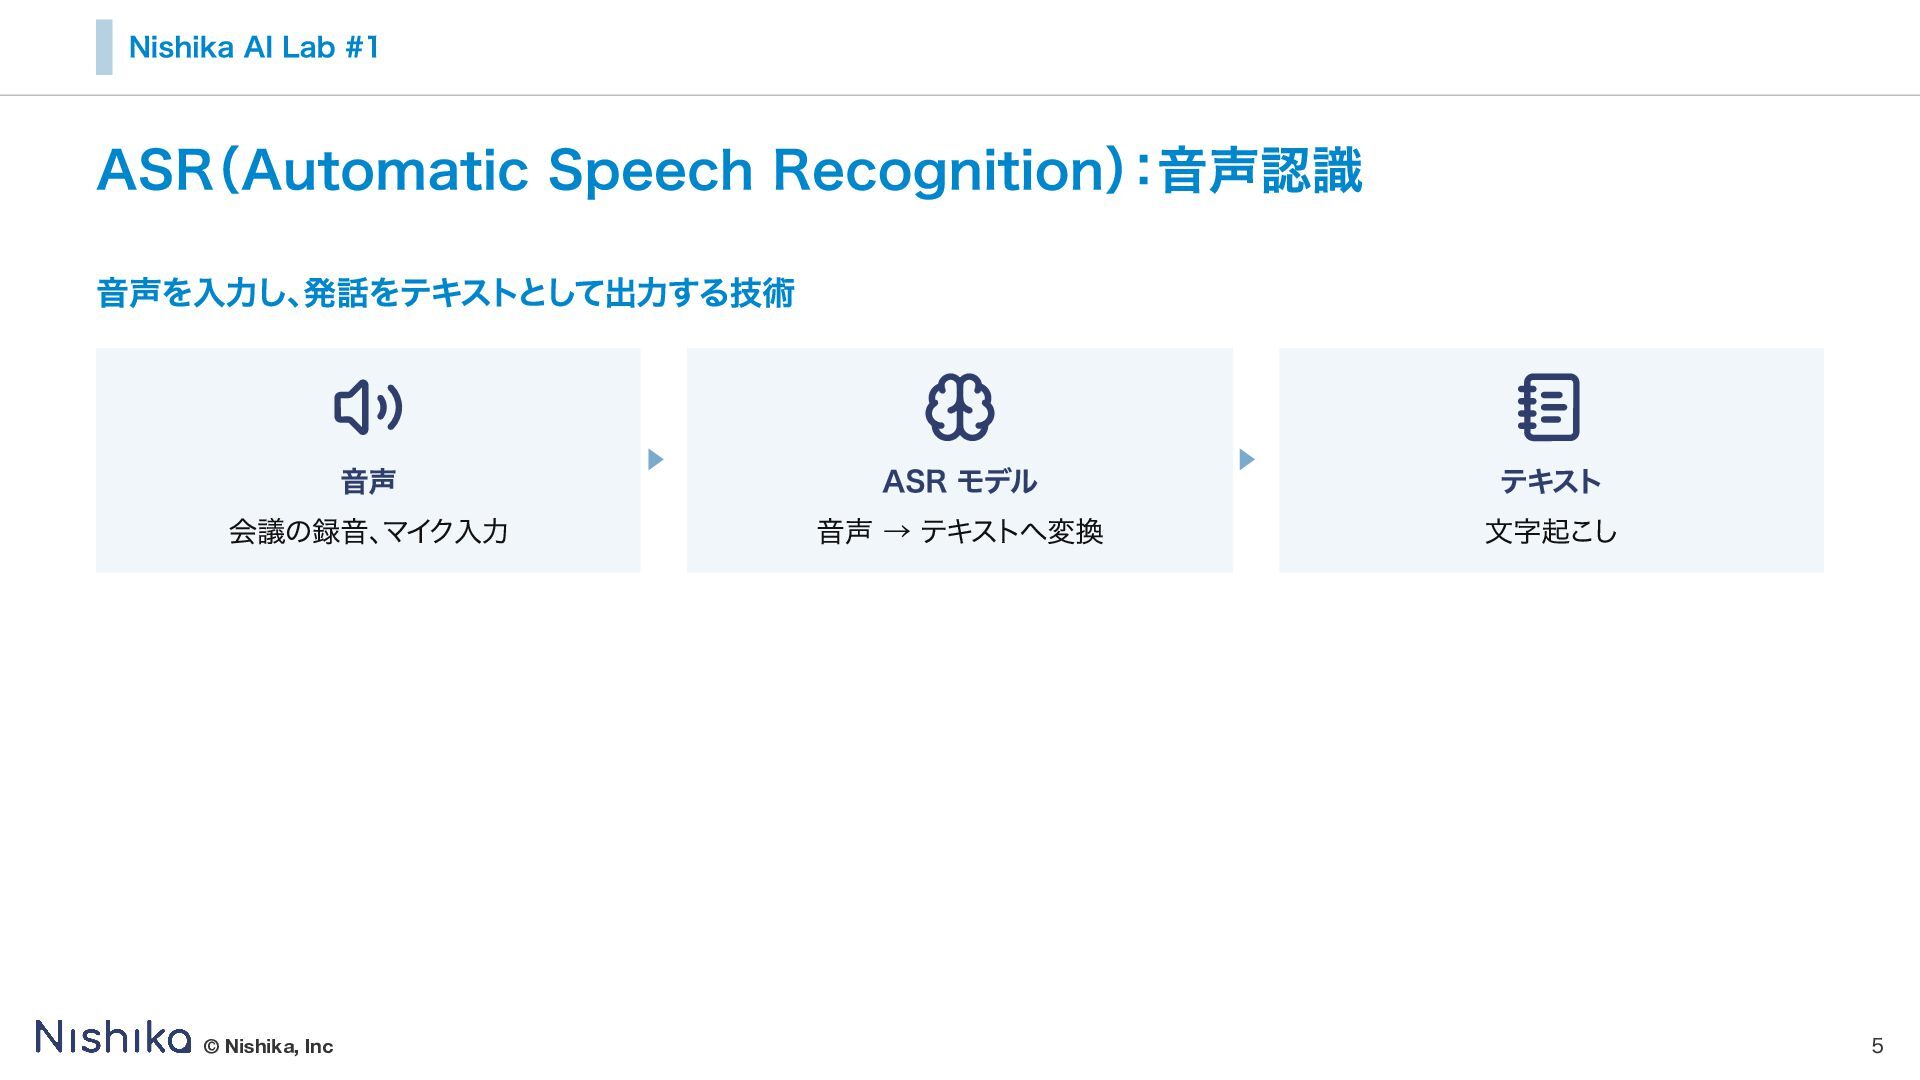
Nishika AI Lab #1 ASR(Automatic Speech Recognition):音声認識 音声を入力し、発話をテキストとして出力する技術 音声 会議の録音、マイク入力
© Nishika, Inc ▶ ASR モデル 音声 → テキストへ変換 ▶ テキスト 文字起こし 5
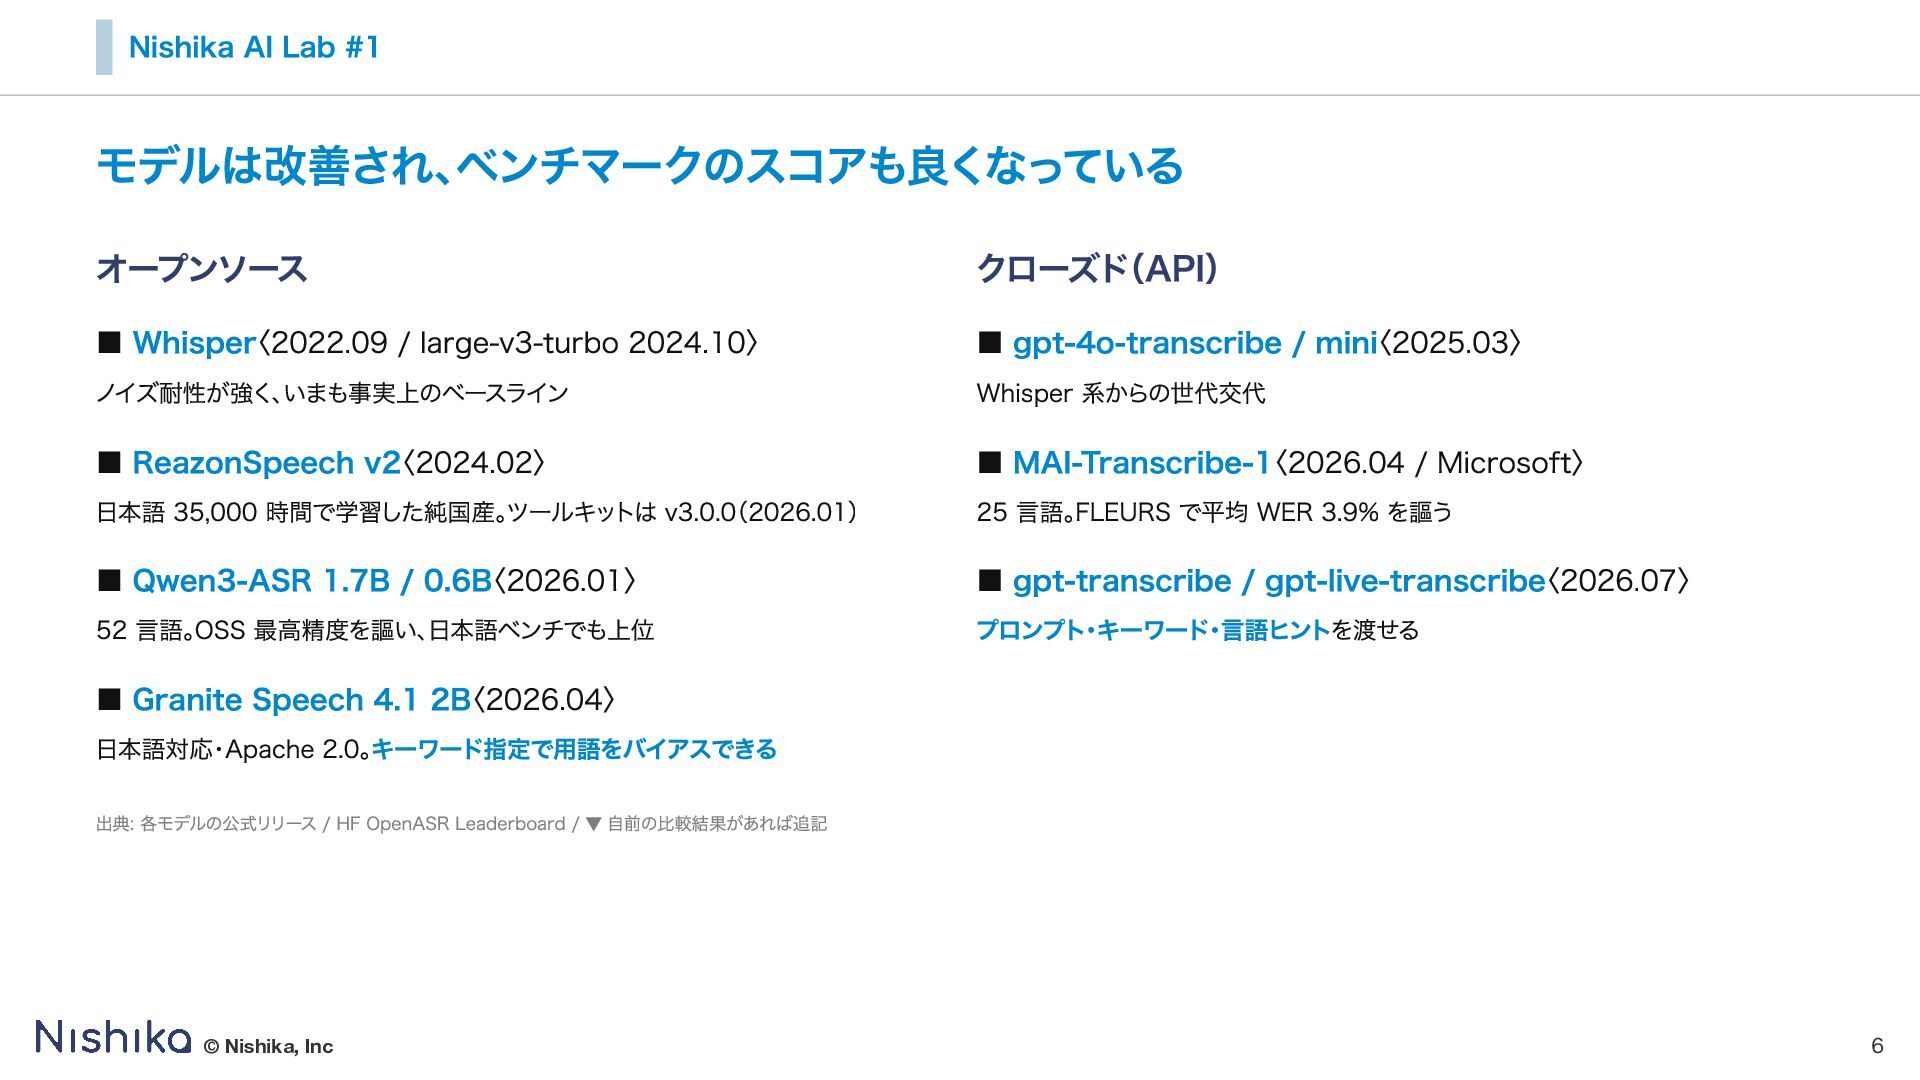
Nishika AI Lab #1 モデルは改善され、ベンチマークのスコアも良くなっている オープンソース クローズド(API) ノイズ耐性が強く、いまも事実上のベースライン Whisper 系からの世代交代
▪ Whisper〈2022.09 / large-v3-turbo 2024.10〉 ▪ gpt-4o-transcribe / mini〈2025.03〉 ▪ ReazonSpeech v2〈2024.02〉 ▪ MAI-Transcribe-1〈2026.04 / Microsoft〉 ▪ Qwen3-ASR 1.7B / 0.6B〈2026.01〉 ▪ gpt-transcribe / gpt-live-transcribe〈2026.07〉 日本語 35,000 時間で学習した純国産。ツールキットは v3.0.0(2026.01) 52 言語。OSS 最高精度を謳い、日本語ベンチでも上位 25 言語。FLEURS で平均 WER 3.9% を謳う プロンプト・キーワード・言語ヒントを渡せる ▪ Granite Speech 4.1 2B〈2026.04〉 日本語対応・Apache 2.0。キーワード指定で用語をバイアスできる 出典: 各モデルの公式リリース / HF OpenASR Leaderboard / ▼ 自前の比較結果があれば追記 © Nishika, Inc 6
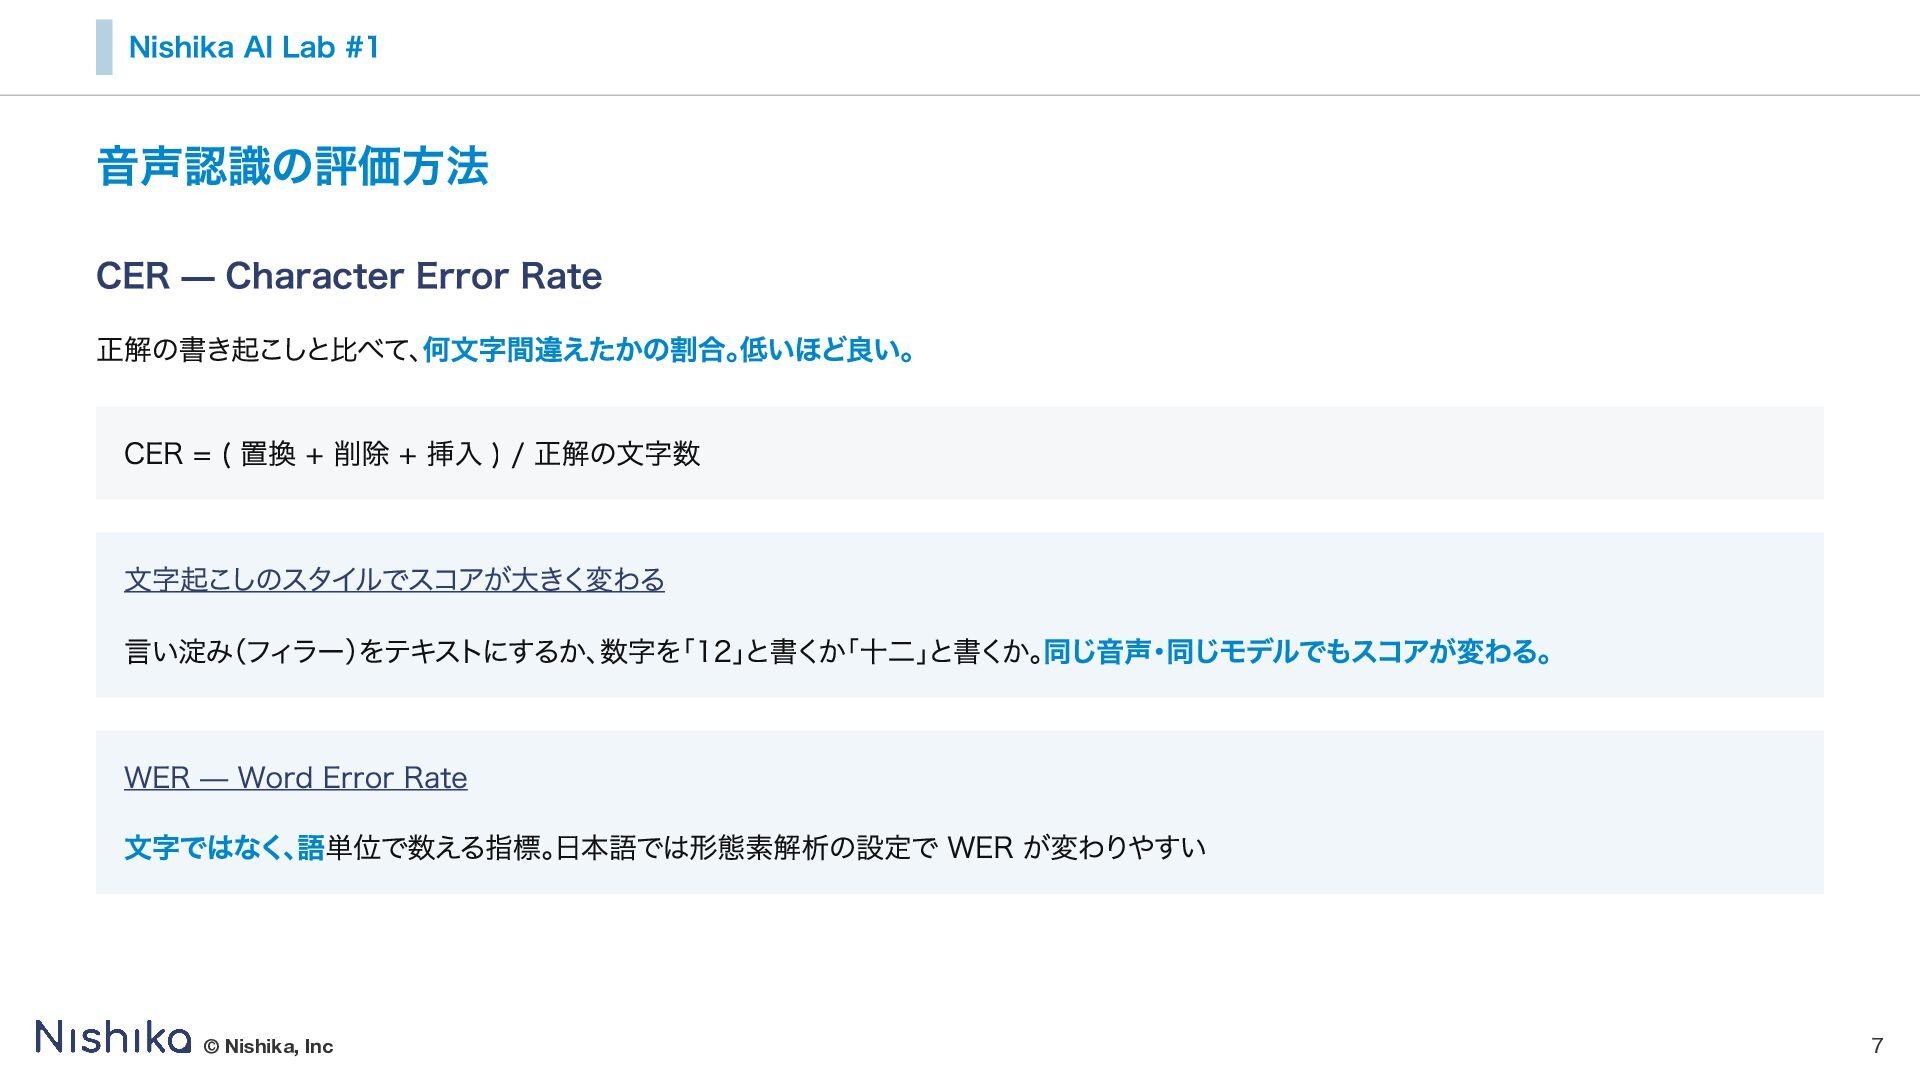
Nishika AI Lab #1 音声認識の評価方法 CER — Character Error Rate
正解の書き起こしと比べて、何文字間違えたかの割合。低いほど良い。 CER = ( 置換 + 削除 + 挿入 ) / 正解の文字数 文字起こしのスタイルでスコアが大きく変わる 言い淀み(フィラー)をテキストにするか、数字を「12」と書くか「十二」と書くか。同じ音声・同じモデルでもスコアが変わる。 WER — Word Error Rate 文字ではなく、語単位で数える指標。日本語では形態素解析の設定で WER が変わりやすい © Nishika, Inc 7
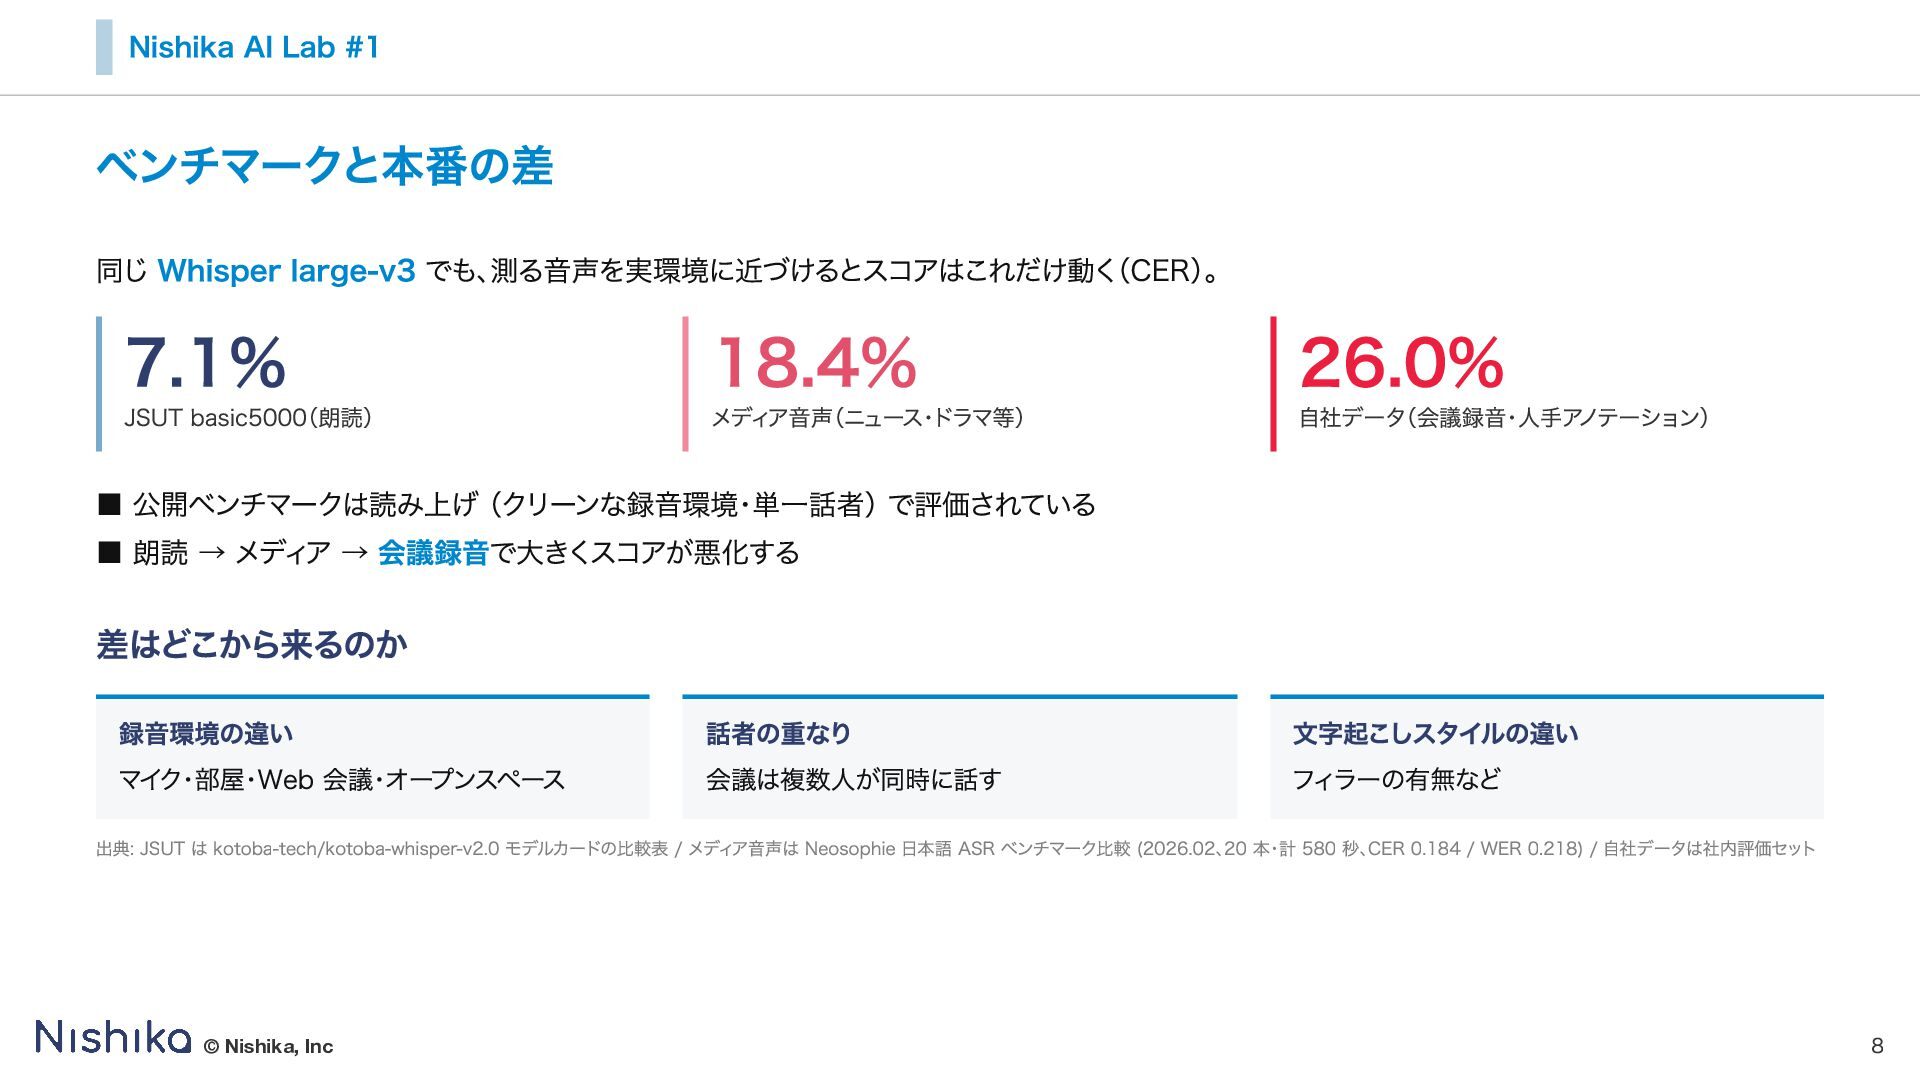
Nishika AI Lab #1 ベンチマークと本番の差 同じ Whisper large-v3 でも、測る音声を実環境に近づけるとスコアはこれだけ動く(CER)。 7.1%
JSUT basic5000(朗読) 18.4% メディア音声(ニュース・ドラマ等) 26.0% 自社データ(会議録音・人手アノテーション) ▪ 公開ベンチマークは読み上げ(クリーンな録音環境・単一話者)で評価されている ▪ 朗読 → メディア → 会議録音で大きくスコアが悪化する 差はどこから来るのか 録音環境の違い マイク・部屋・Web 会議・オープンスペース 話者の重なり 会議は複数人が同時に話す 文字起こしスタイルの違い フィラーの有無など 出典: JSUT は kotoba-tech/kotoba-whisper-v2.0 モデルカードの比較表 / メディア音声は Neosophie 日本語 ASR ベンチマーク比較 (2026.02、20 本・計 580 秒、CER 0.184 / WER 0.218) / 自社データは社内評価セット © Nishika, Inc 8
2. プロダクトにおける音声認識の課題 © Nishika, Inc 9
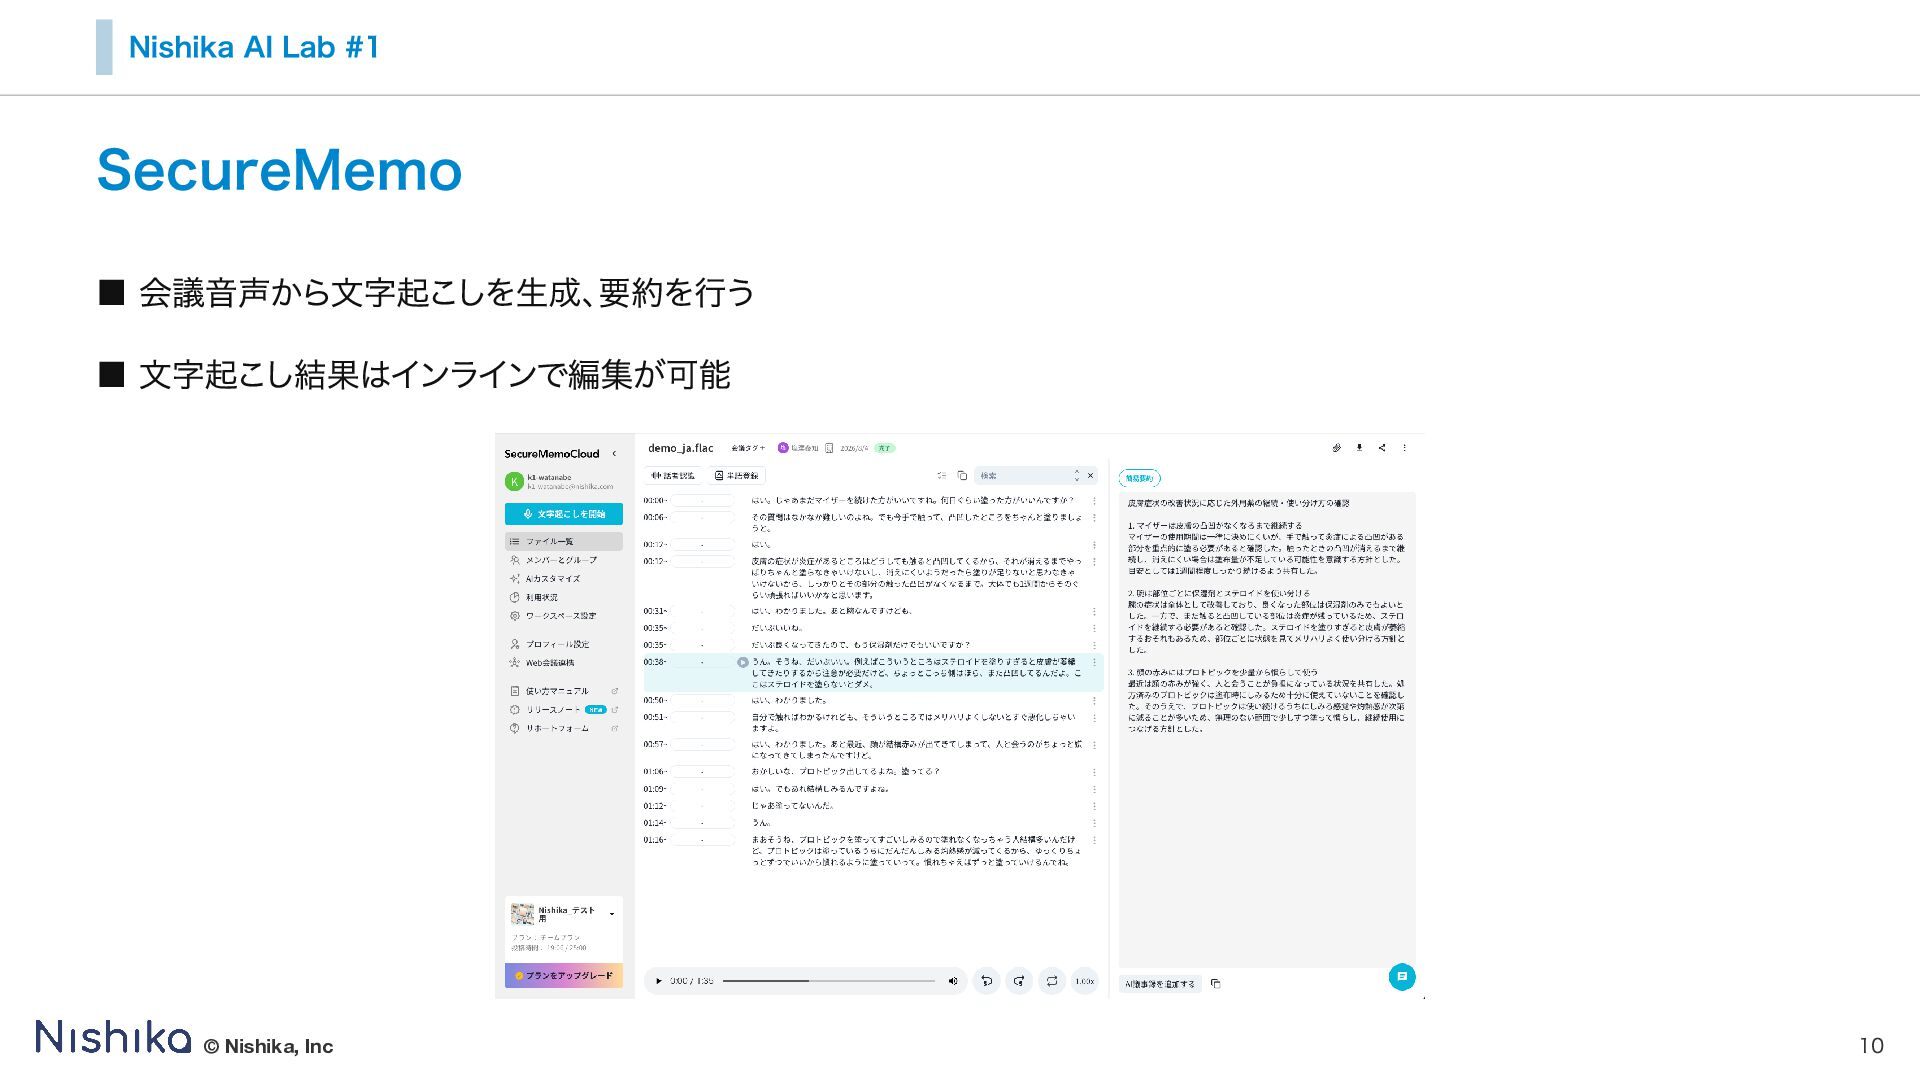
Nishika AI Lab #1 SecureMemo ▪ 会議音声から文字起こしを生成、要約を行う ▪ 文字起こし結果はインラインで編集が可能 ©
Nishika, Inc 10
最も大きな課題は「名詞」の間違い © Nishika, Inc 11
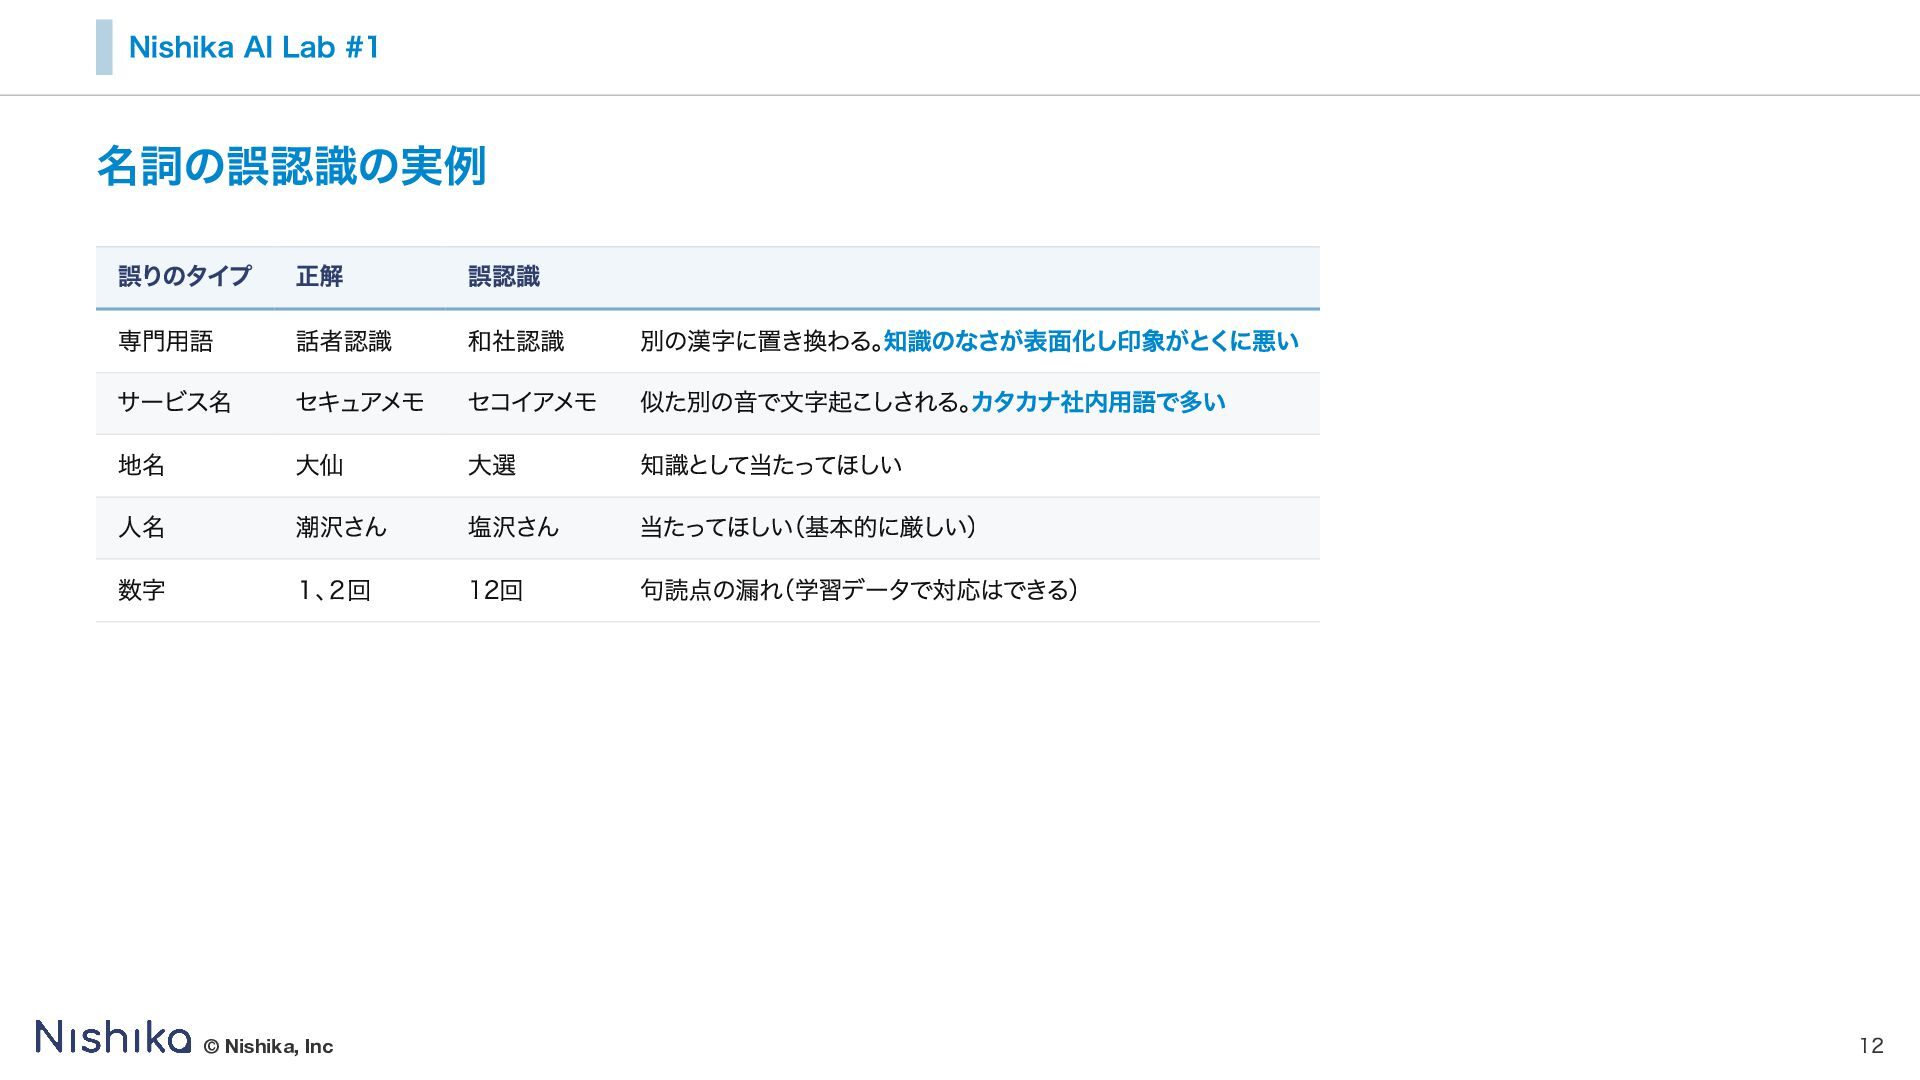
Nishika AI Lab #1 名詞の誤認識の実例 誤りのタイプ 専門用語 サービス名 地名 人名
数字 正解 話者認識 セキュアメモ 大仙 潮沢さん 1、2回 © Nishika, Inc 誤認識 和社認識 セコイアメモ 大選 塩沢さん 12回 別の漢字に置き換わる。知識のなさが表面化し印象がとくに悪い 似た別の音で文字起こしされる。カタカナ社内用語で多い 知識として当たってほしい 当たってほしい(基本的に厳しい) 句読点の漏れ(学習データで対応はできる) 12
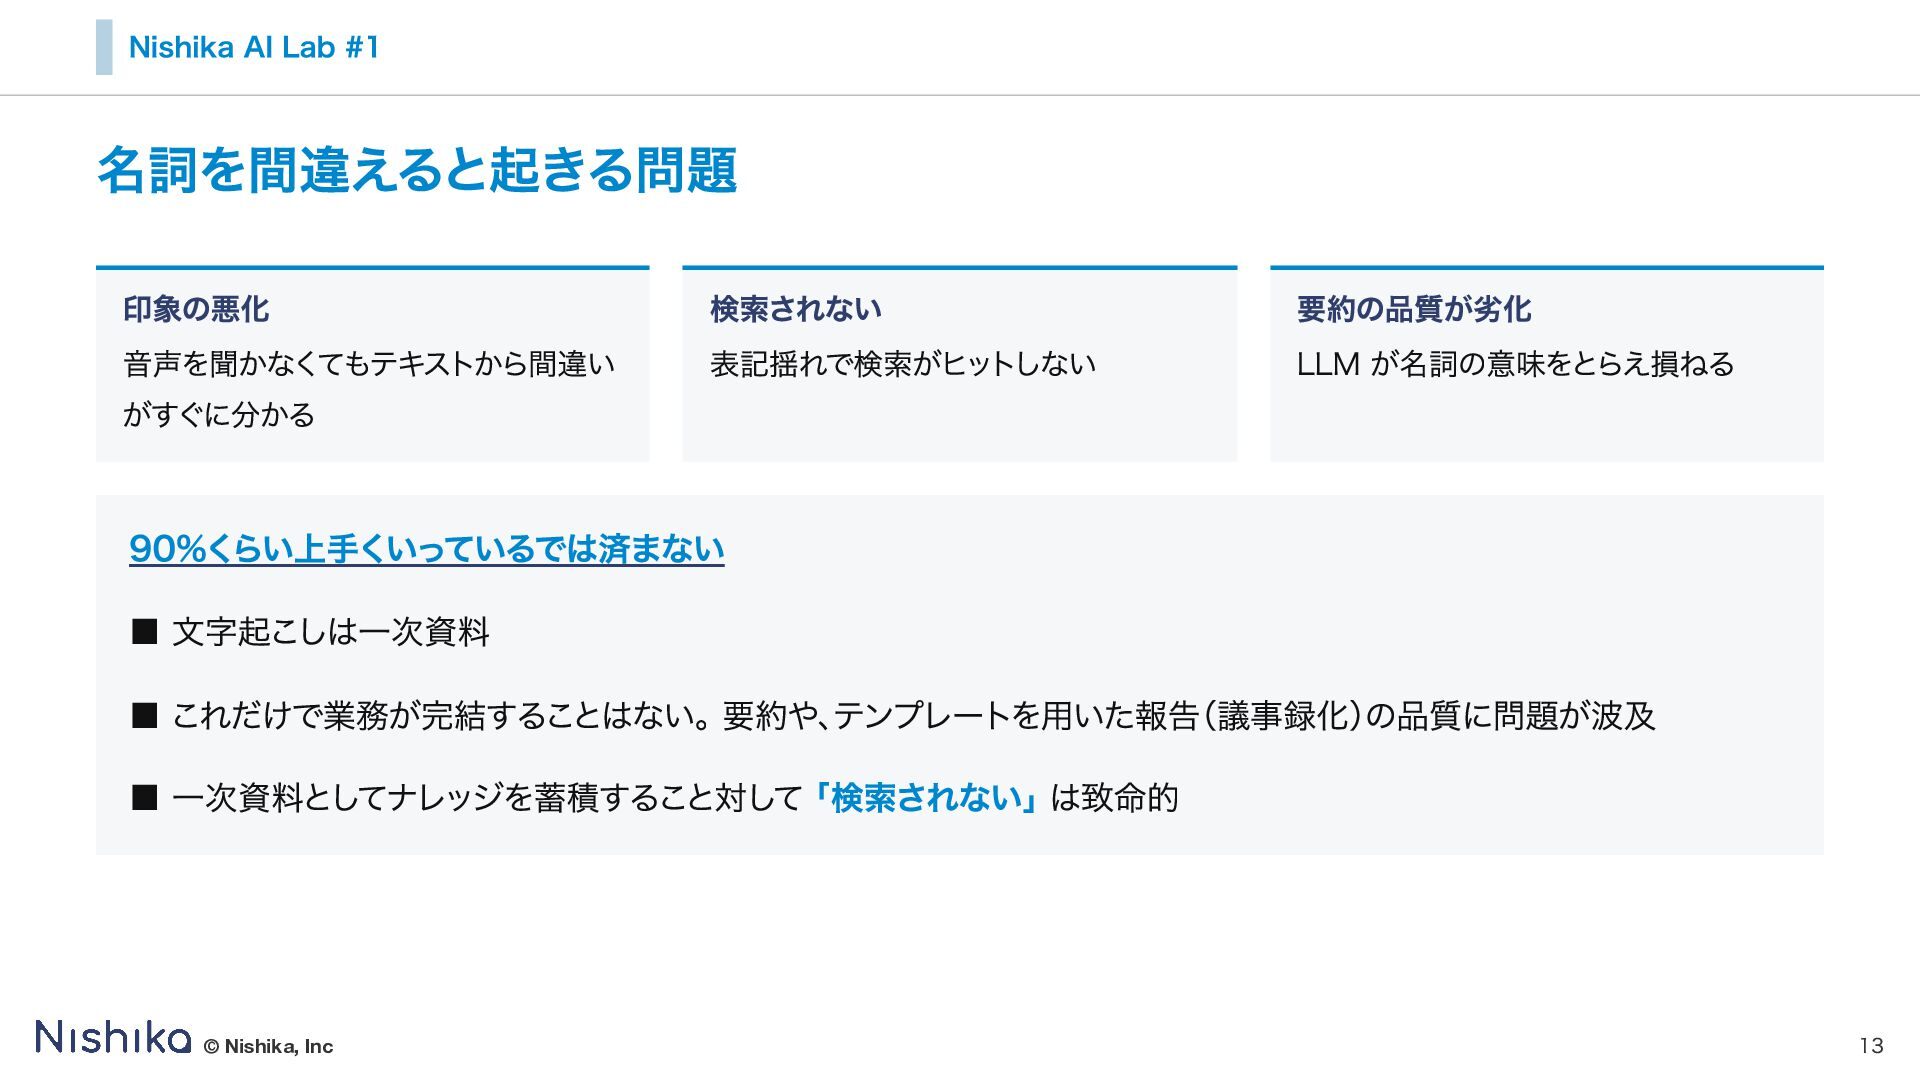
Nishika AI Lab #1 名詞を間違えると起きる問題 印象の悪化 音声を聞かなくてもテキストから間違い がすぐに分かる 検索されない 表記揺れで検索がヒットしない
要約の品質が劣化 LLM が名詞の意味をとらえ損ねる 90%くらい上手くいっているでは済まない ▪ 文字起こしは一次資料 ▪ これだけで業務が完結することはない。要約や、テンプレートを用いた報告(議事録化)の品質に問題が波及 ▪ 一次資料としてナレッジを蓄積すること対して「検索されない」は致命的 © Nishika, Inc 13
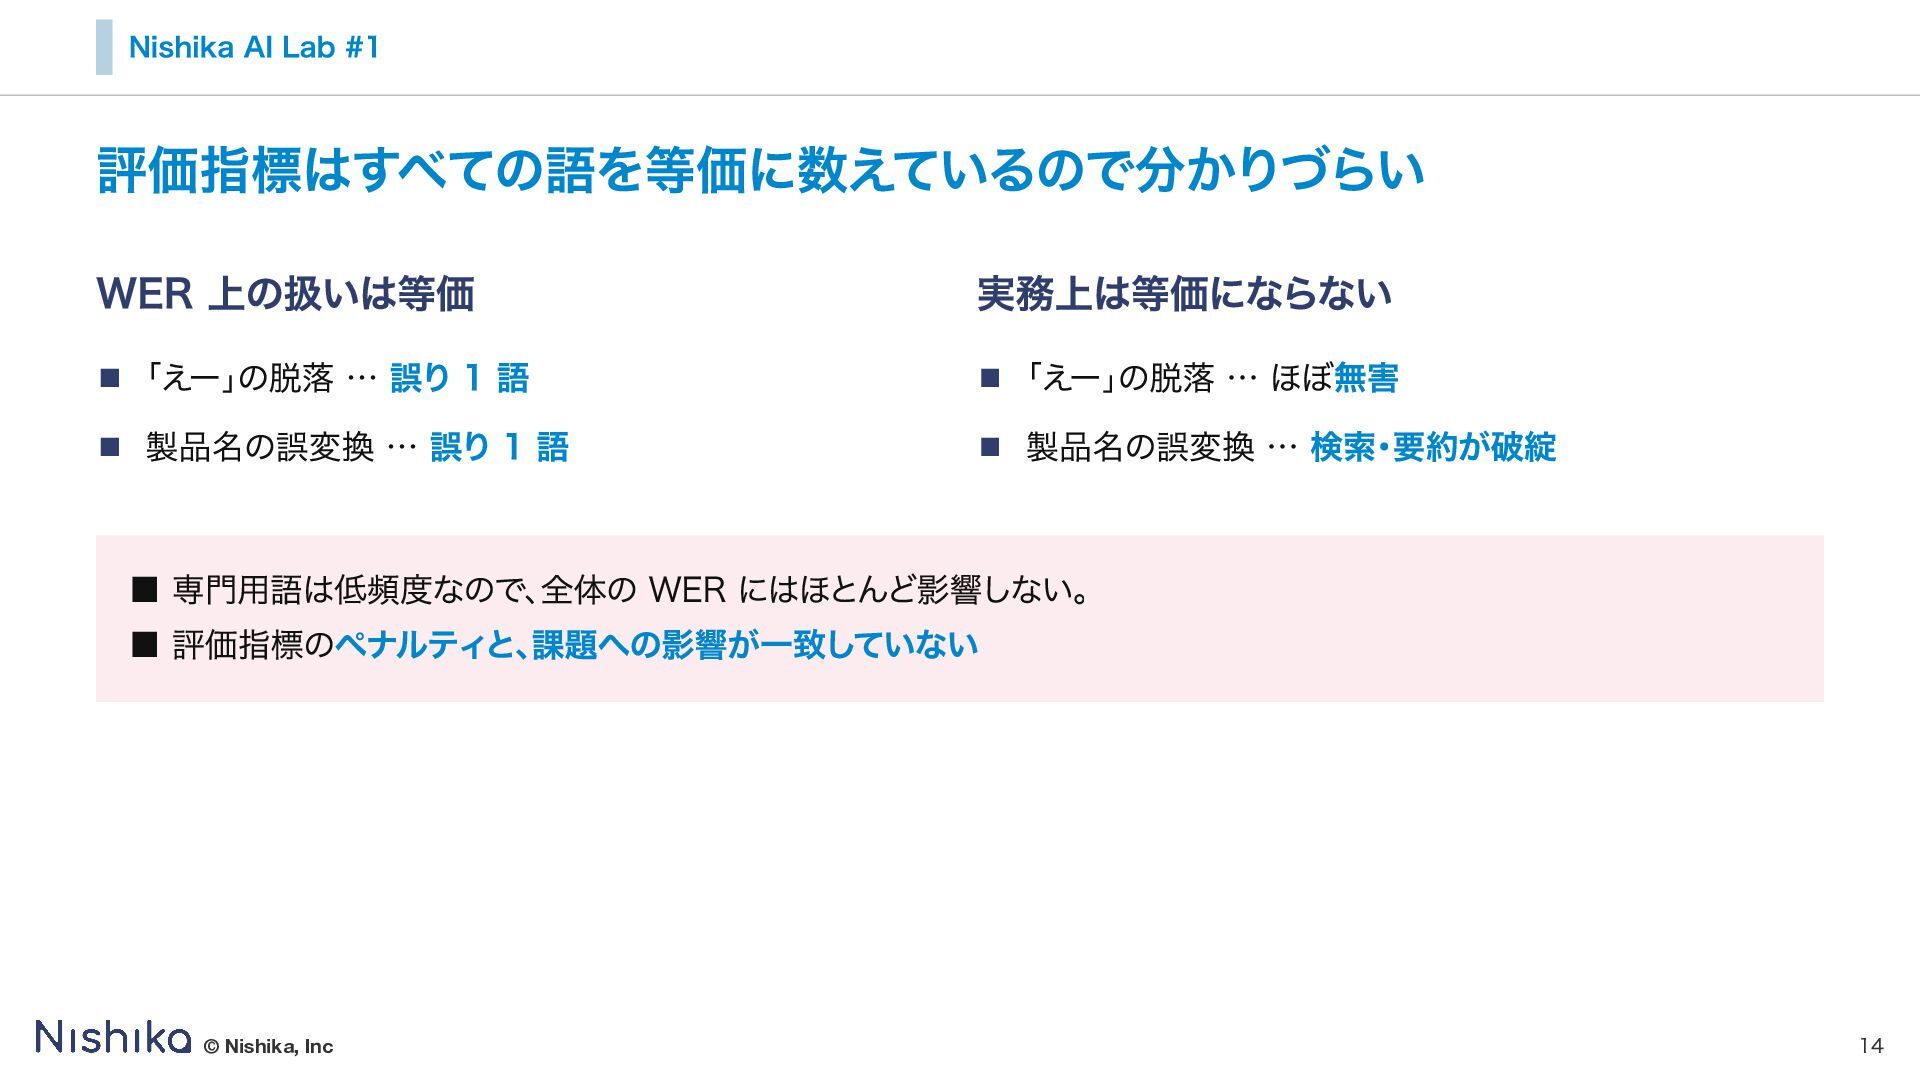
Nishika AI Lab #1 評価指標はすべての語を等価に数えているので分かりづらい WER 上の扱いは等価 ▪ 「えー」の脱落 …
誤り 1 語 ▪ 製品名の誤変換 … 誤り 1 語 実務上は等価にならない ▪ 「えー」の脱落 … ほぼ無害 ▪ 製品名の誤変換 … 検索・要約が破綻 ▪ 専門用語は低頻度なので、全体の WER にはほとんど影響しない。 ▪ 評価指標のペナルティと、課題への影響が一致していない © Nishika, Inc 14
3. 名詞の間違いに向き合う © Nishika, Inc 15
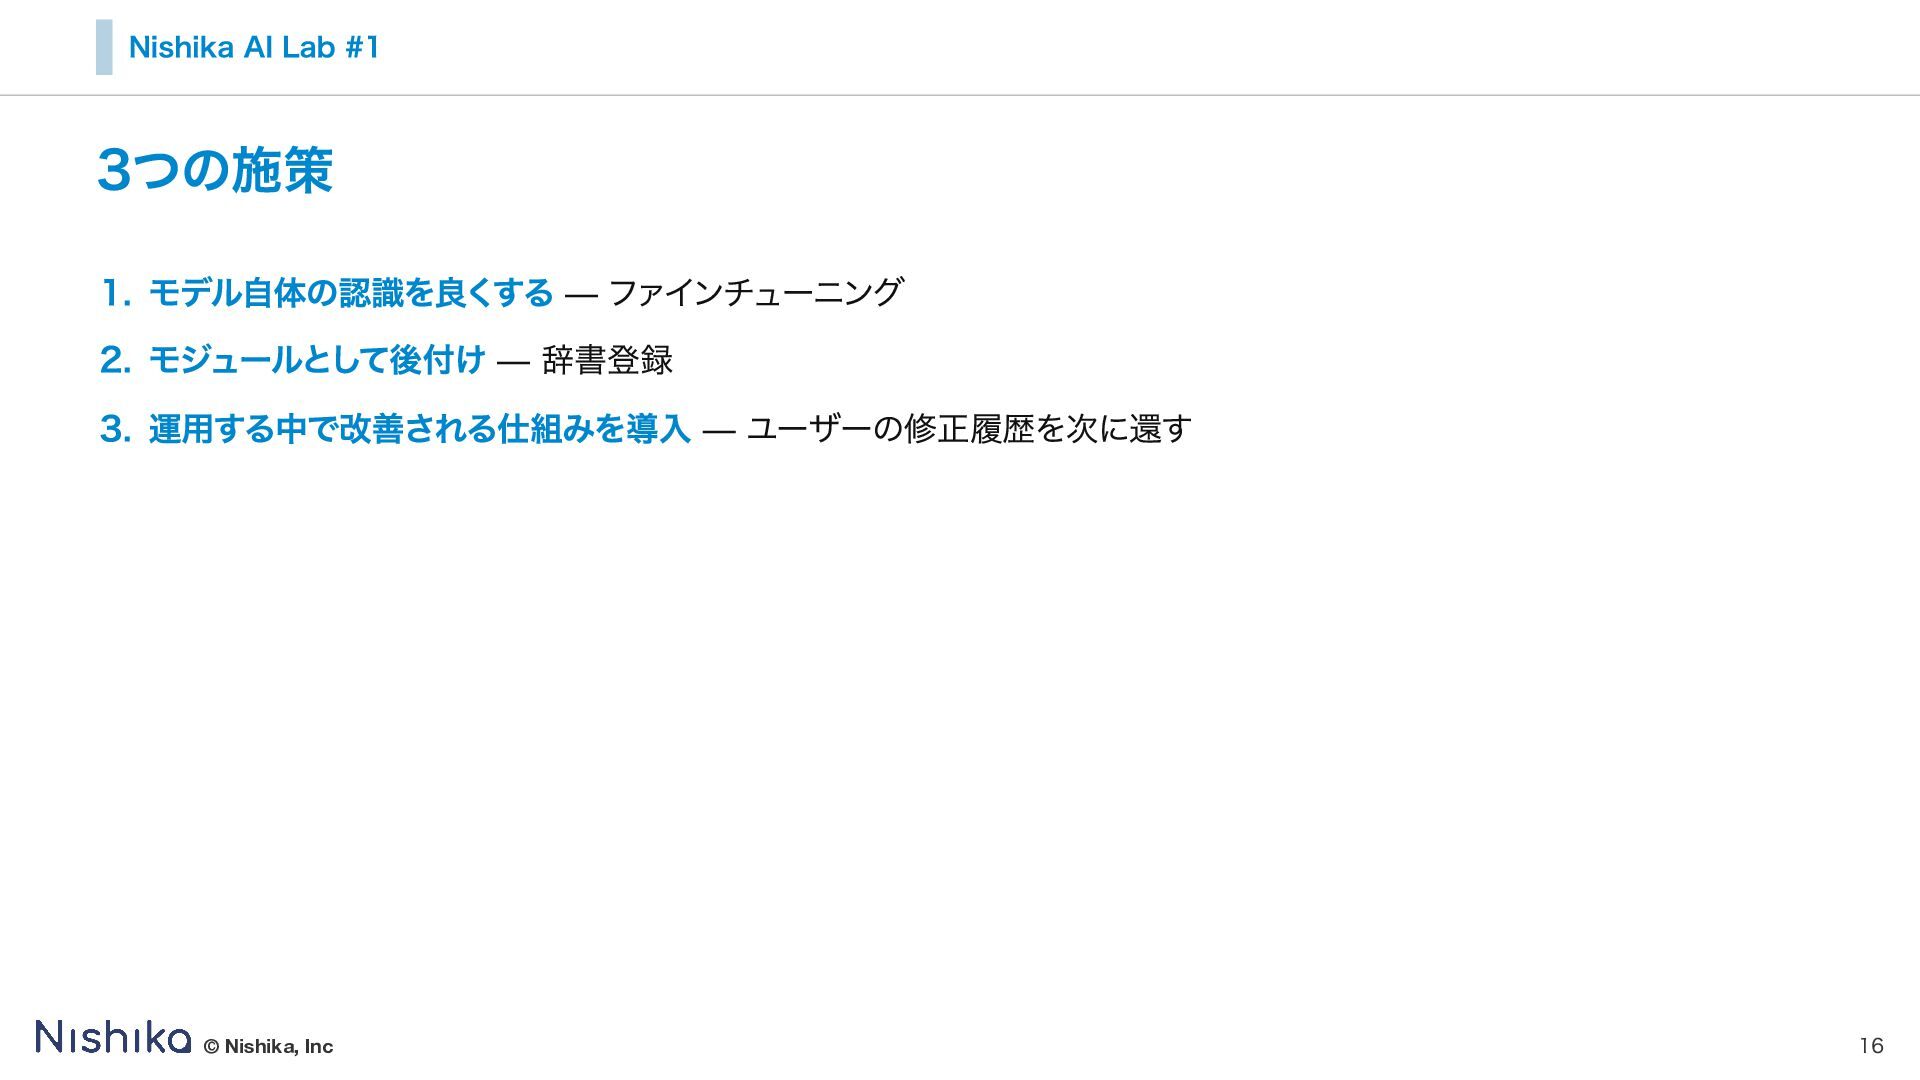
Nishika AI Lab #1 3つの施策 1. モデル自体の認識を良くする — ファインチューニング 2.
モジュールとして後付け — 辞書登録 3. 運用する中で改善される仕組みを導入 — ユーザーの修正履歴を次に還す © Nishika, Inc 16
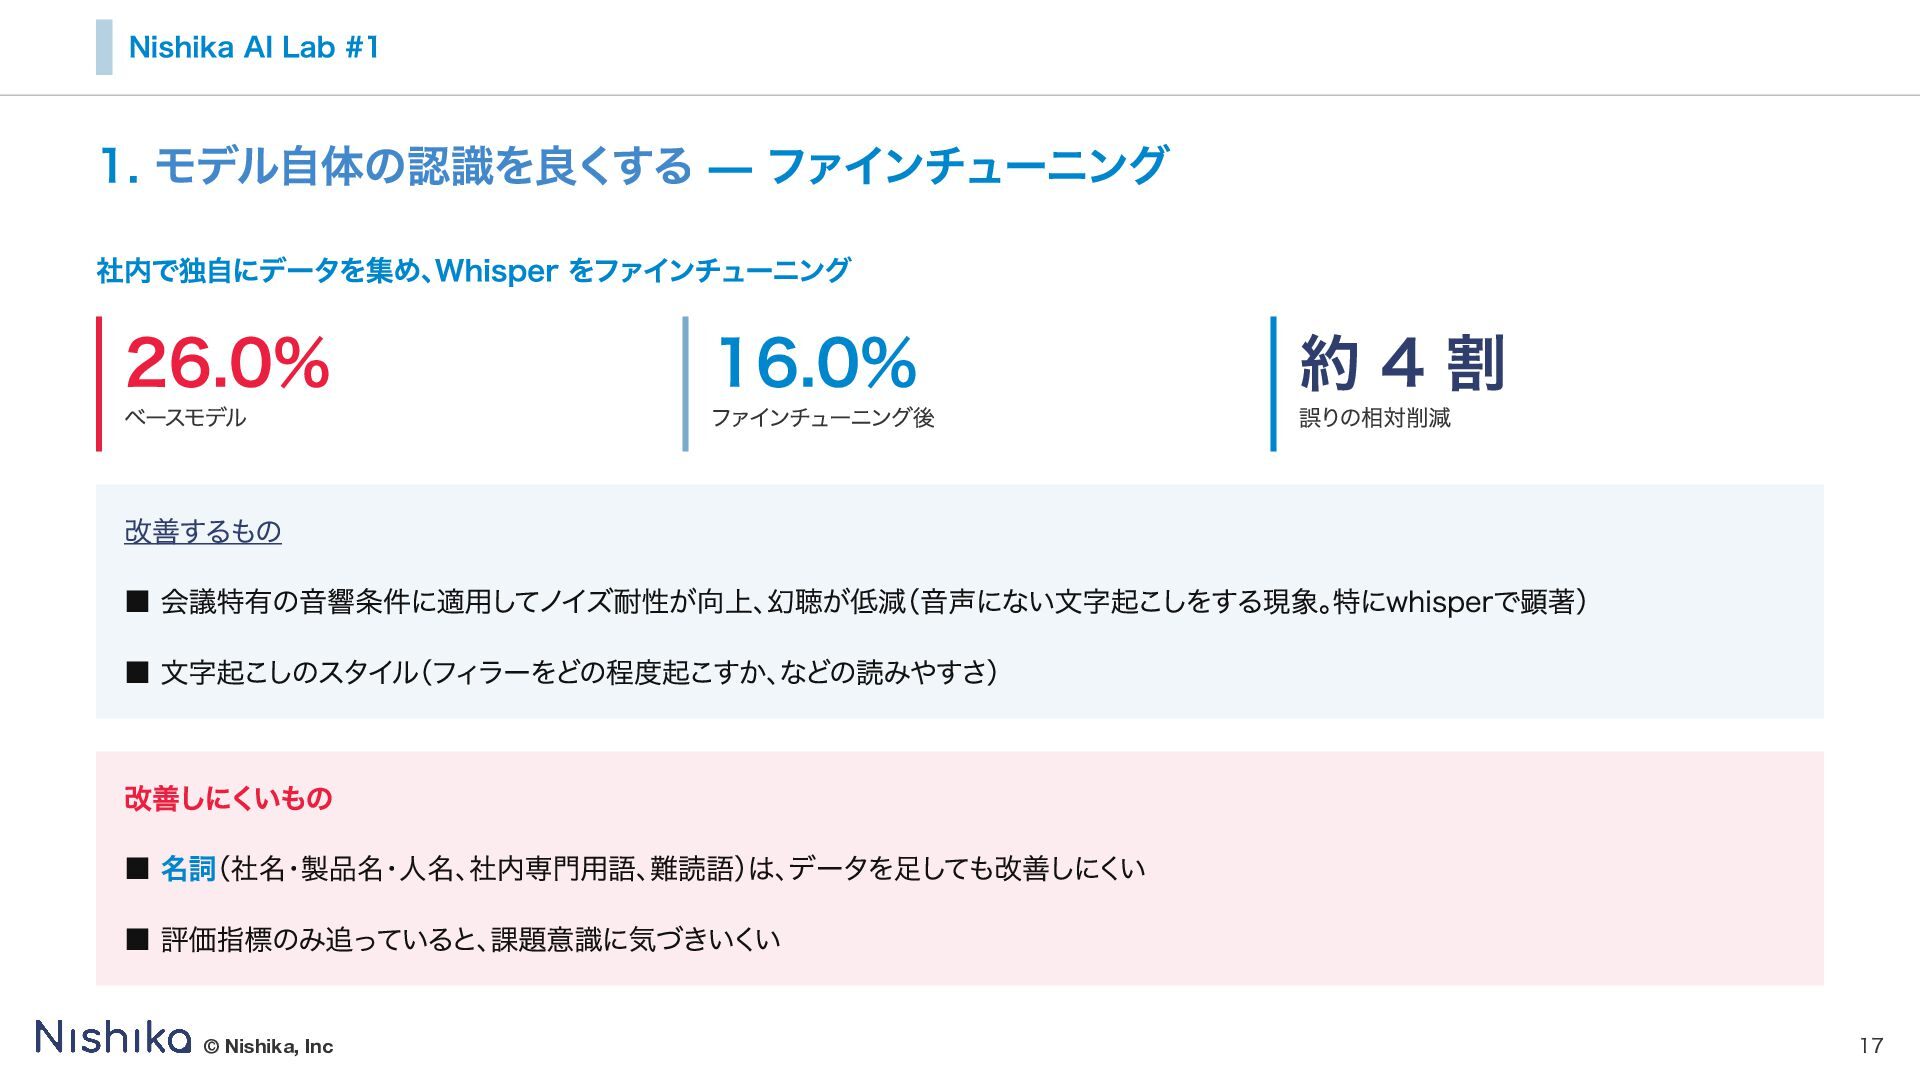
Nishika AI Lab #1 1. モデル自体の認識を良くする — ファインチューニング 社内で独自にデータを集め、Whisper をファインチューニング
26.0% ベースモデル 16.0% ファインチューニング後 約4割 誤りの相対削減 改善するもの ▪ 会議特有の音響条件に適用してノイズ耐性が向上、幻聴が低減(音声にない文字起こしをする現象。特にwhisperで顕著) ▪ 文字起こしのスタイル(フィラーをどの程度起こすか、などの読みやすさ) 改善しにくいもの ▪ 名詞(社名・製品名・人名、社内専門用語、難読語)は、データを足しても改善しにくい ▪ 評価指標のみ追っていると、課題意識に気づきいくい © Nishika, Inc 17
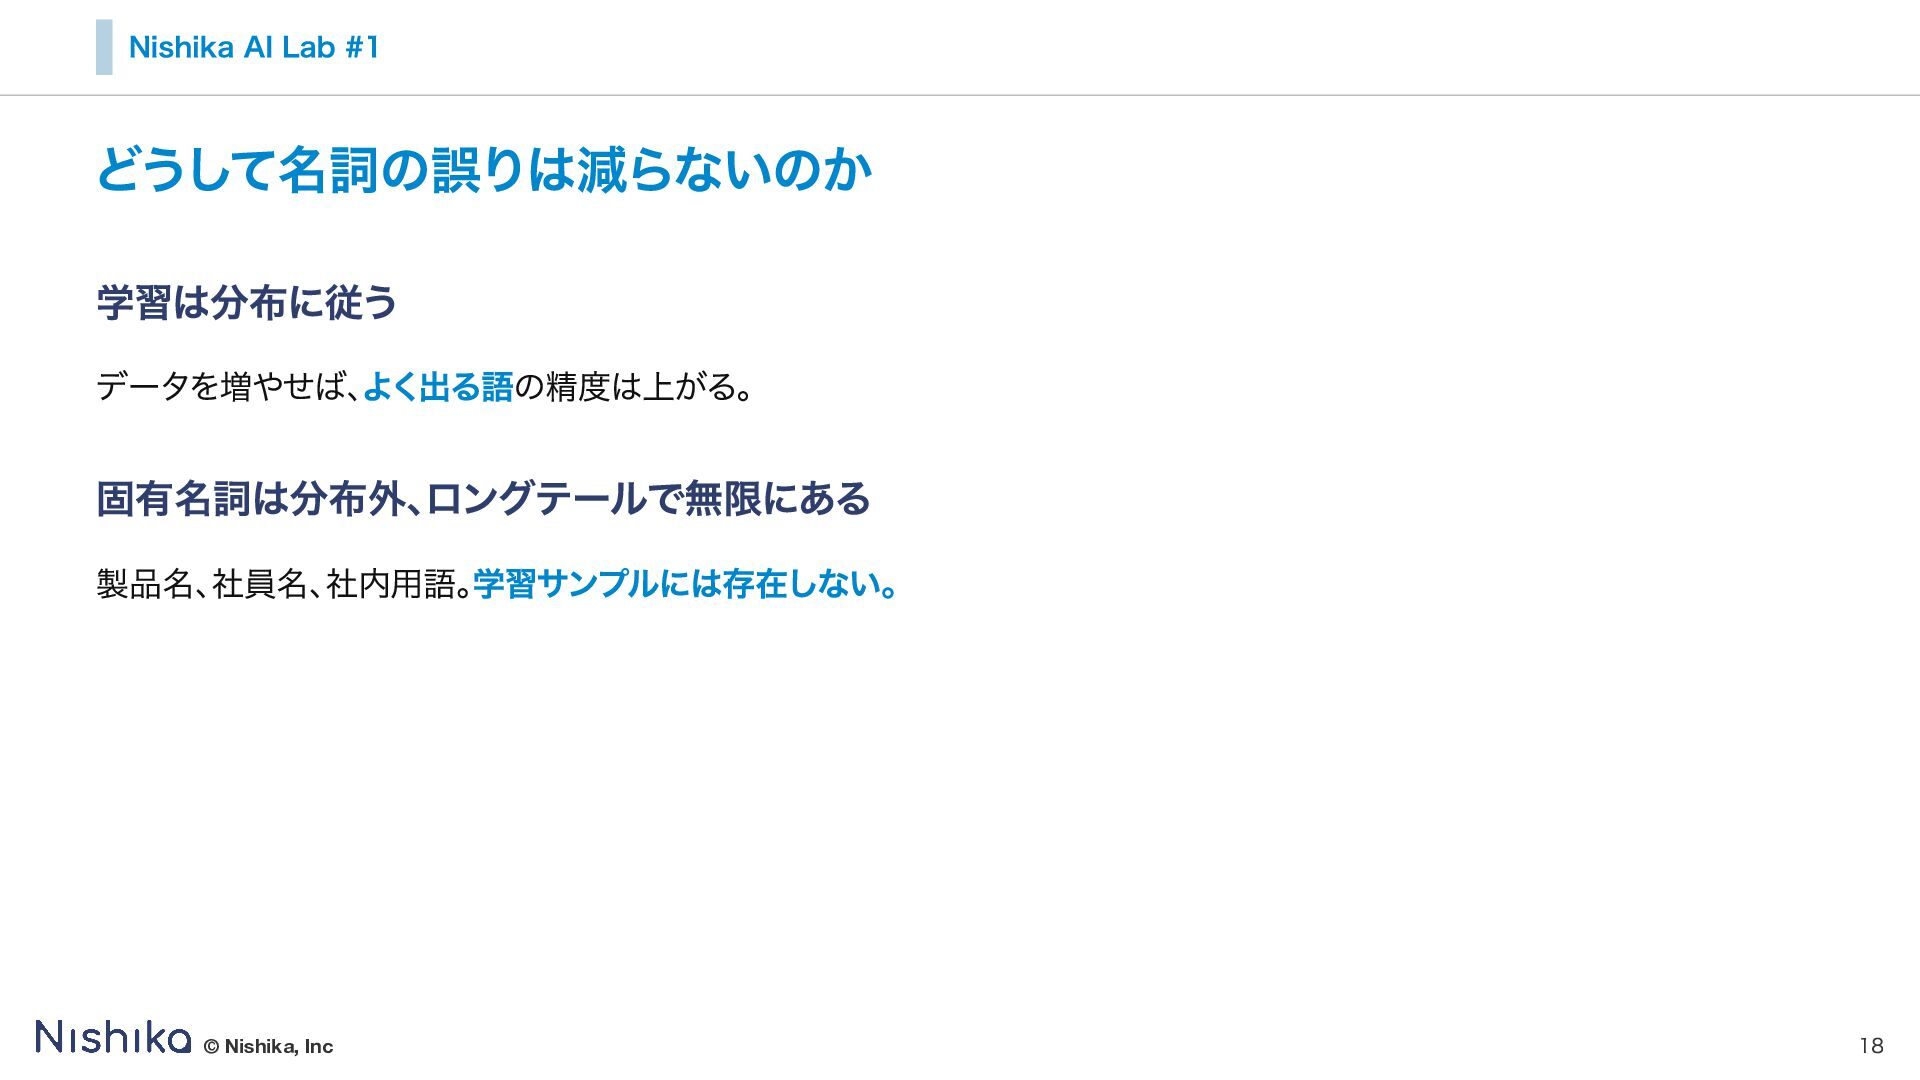
Nishika AI Lab #1 どうして名詞の誤りは減らないのか 学習は分布に従う データを増やせば、よく出る語の精度は上がる。 固有名詞は分布外、ロングテールで無限にある 製品名、社員名、社内用語。学習サンプルには存在しない。 ©
Nishika, Inc 18
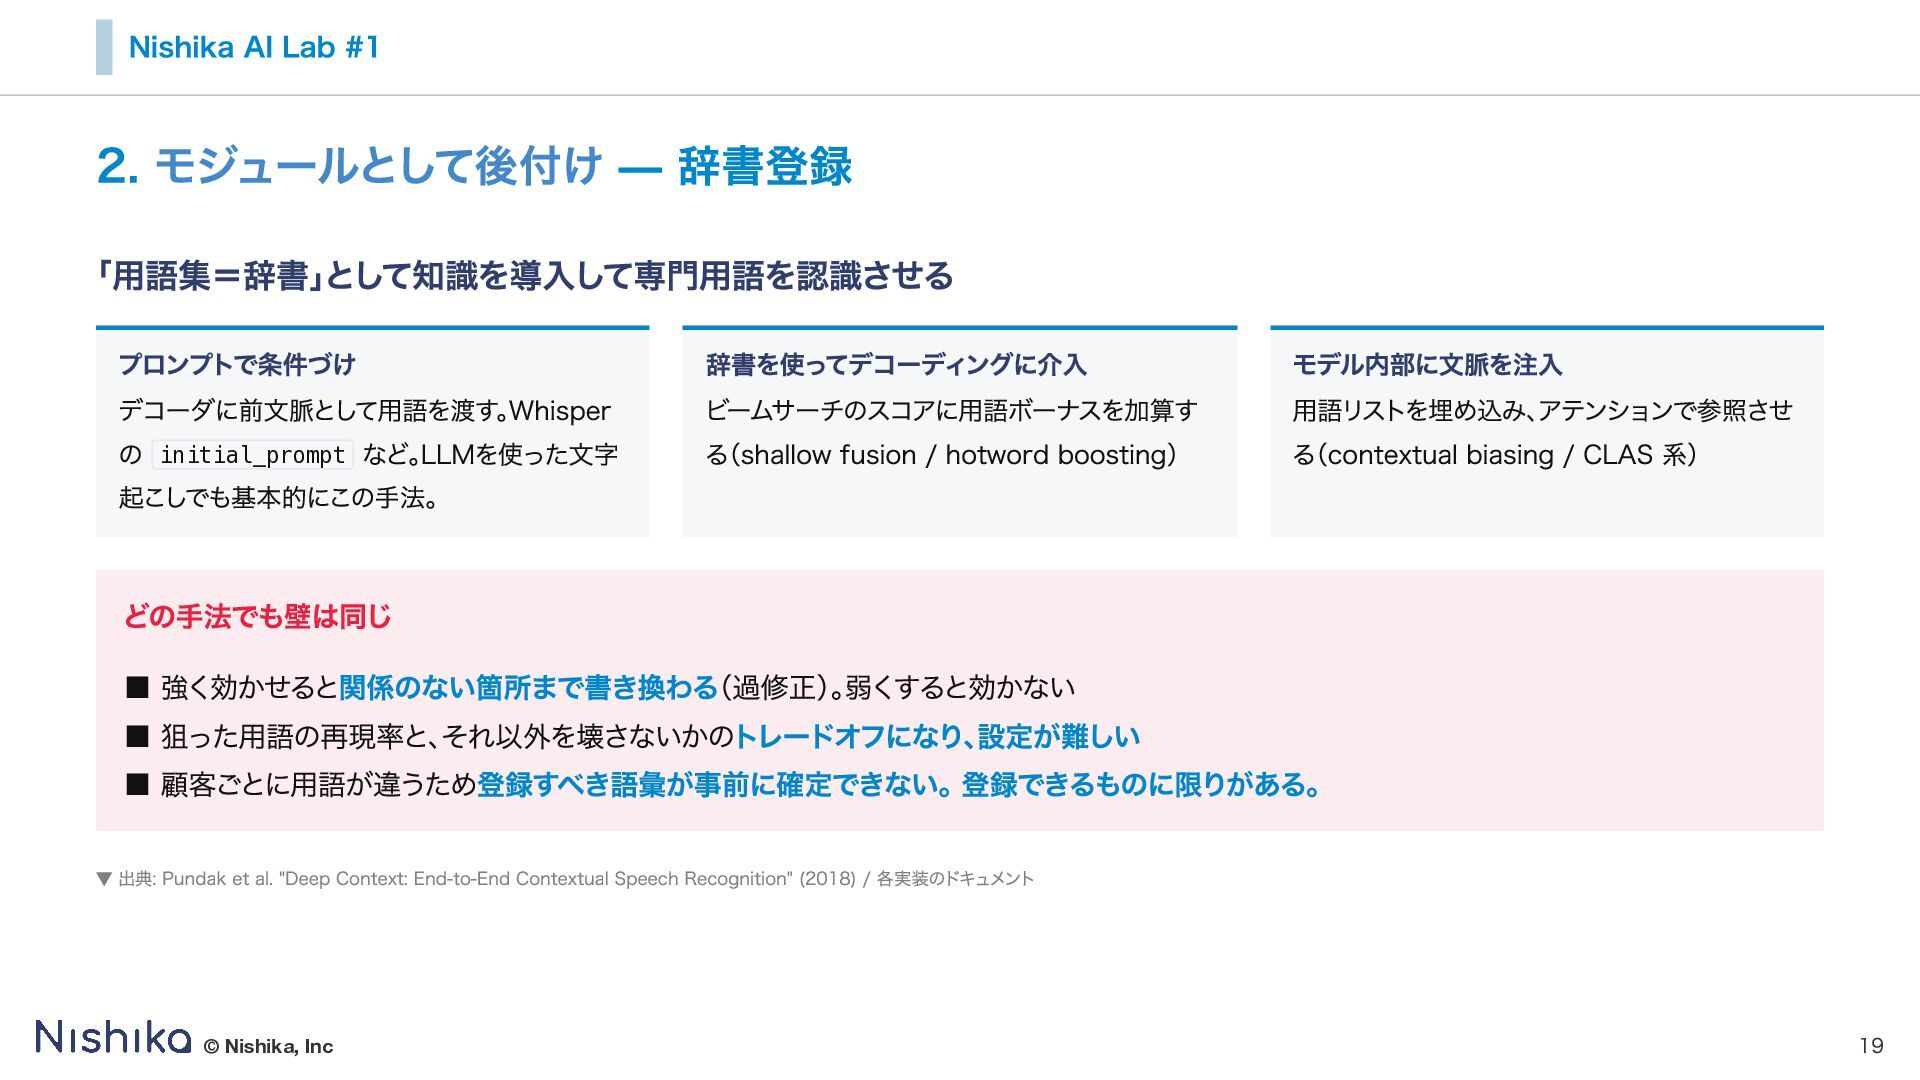
Nishika AI Lab #1 2. モジュールとして後付け — 辞書登録 「用語集=辞書」として知識を導入して専門用語を認識させる プロンプトで条件づけ
デコーダに前文脈として用語を渡す。Whisper の initial_prompt など。LLMを使った文字 起こしでも基本的にこの手法。 辞書を使ってデコーディングに介入 ビームサーチのスコアに用語ボーナスを加算す る(shallow fusion / hotword boosting) モデル内部に文脈を注入 用語リストを埋め込み、アテンションで参照させ る(contextual biasing / CLAS 系) どの手法でも壁は同じ ▪ 強く効かせると関係のない箇所まで書き換わる(過修正)。弱くすると効かない ▪ 狙った用語の再現率と、それ以外を壊さないかのトレードオフになり、設定が難しい ▪ 顧客ごとに用語が違うため登録すべき語彙が事前に確定できない。登録できるものに限りがある。 ▼ 出典: Pundak et al. "Deep Context: End-to-End Contextual Speech Recognition" (2018) / 各実装のドキュメント © Nishika, Inc 19
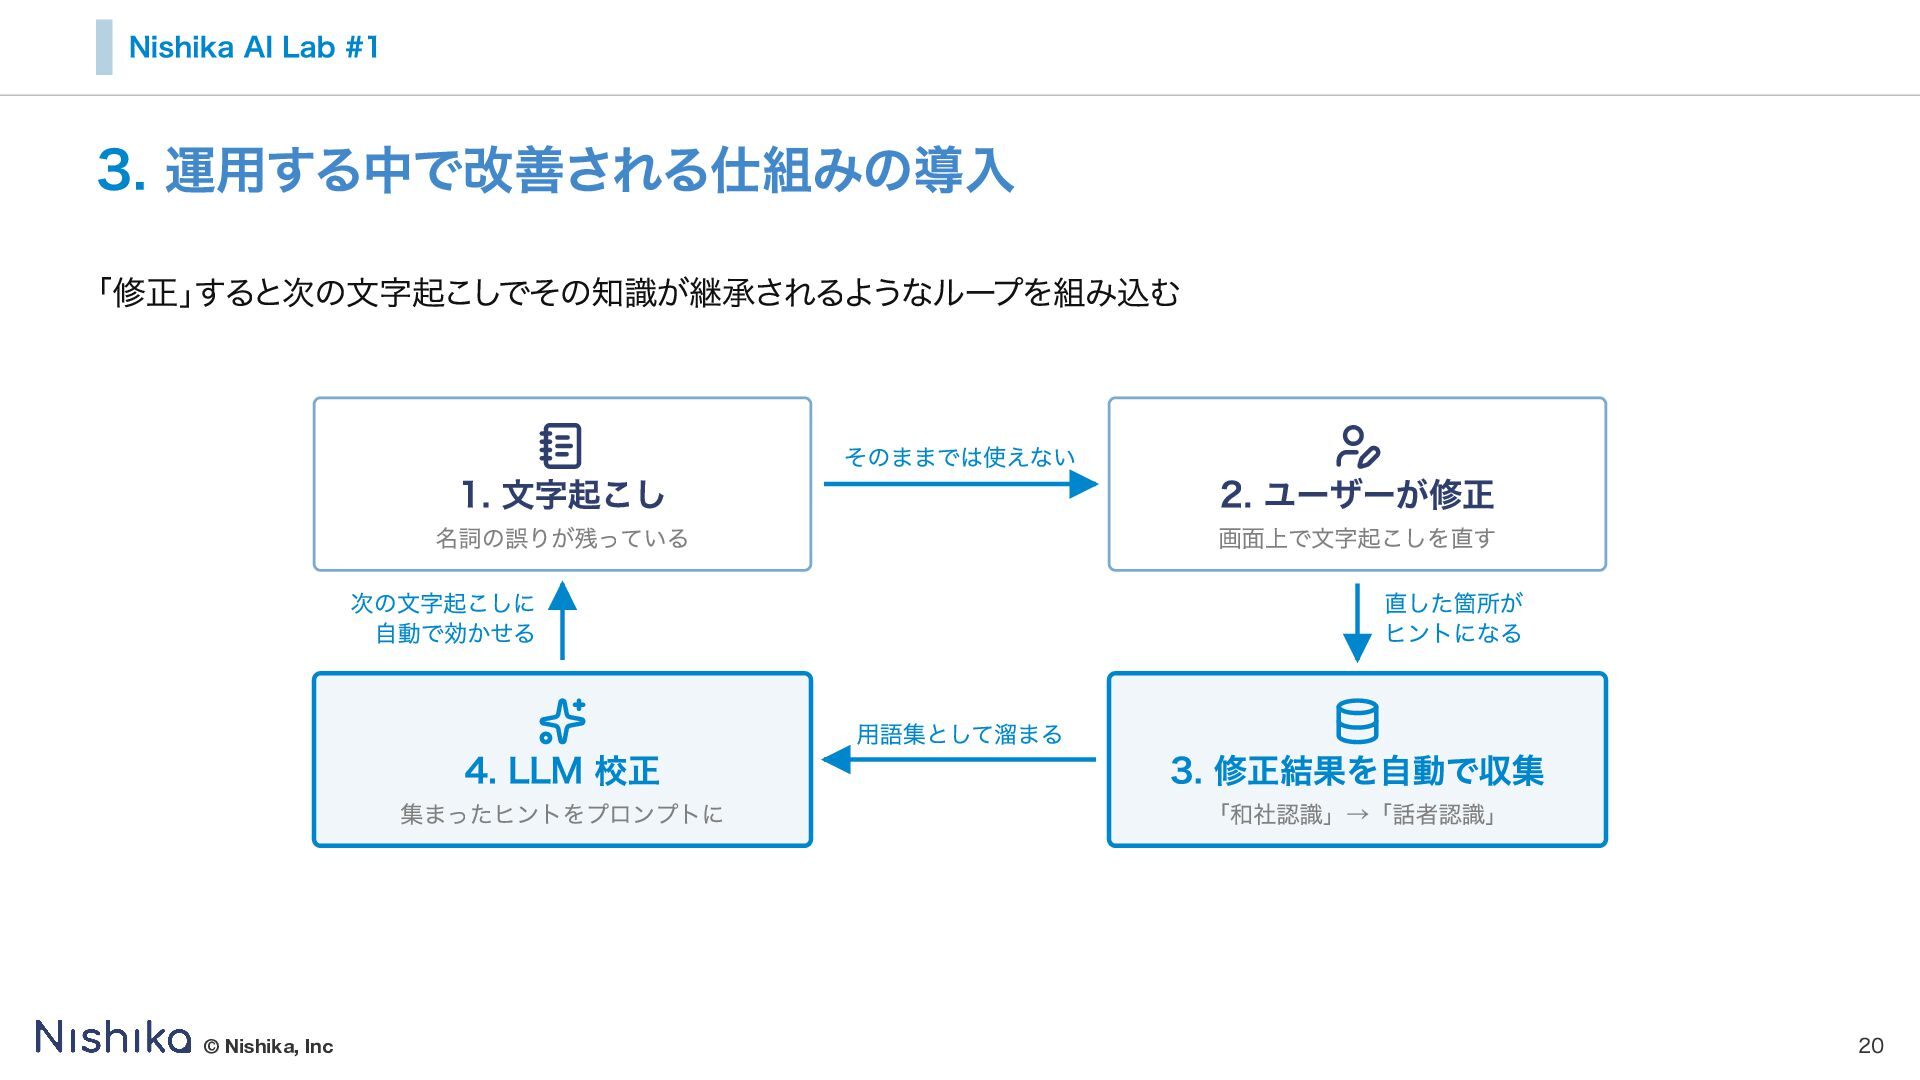
Nishika AI Lab #1 3. 運用する中で改善される仕組みの導入 「修正」すると次の文字起こしでその知識が継承されるようなループを組み込む 1. ⽂字起こし そのままでは使えない
4. LLM 校正 ⽤語集として溜まる 名詞の誤りが残っている 次の⽂字起こしに ⾃動で効かせる 集まったヒントをプロンプトに © Nishika, Inc 2. ユーザーが修正 画⾯上で⽂字起こしを直す 直した箇所が ヒントになる 3. 修正結果を⾃動で収集 「和社認識」→「話者認識」 20
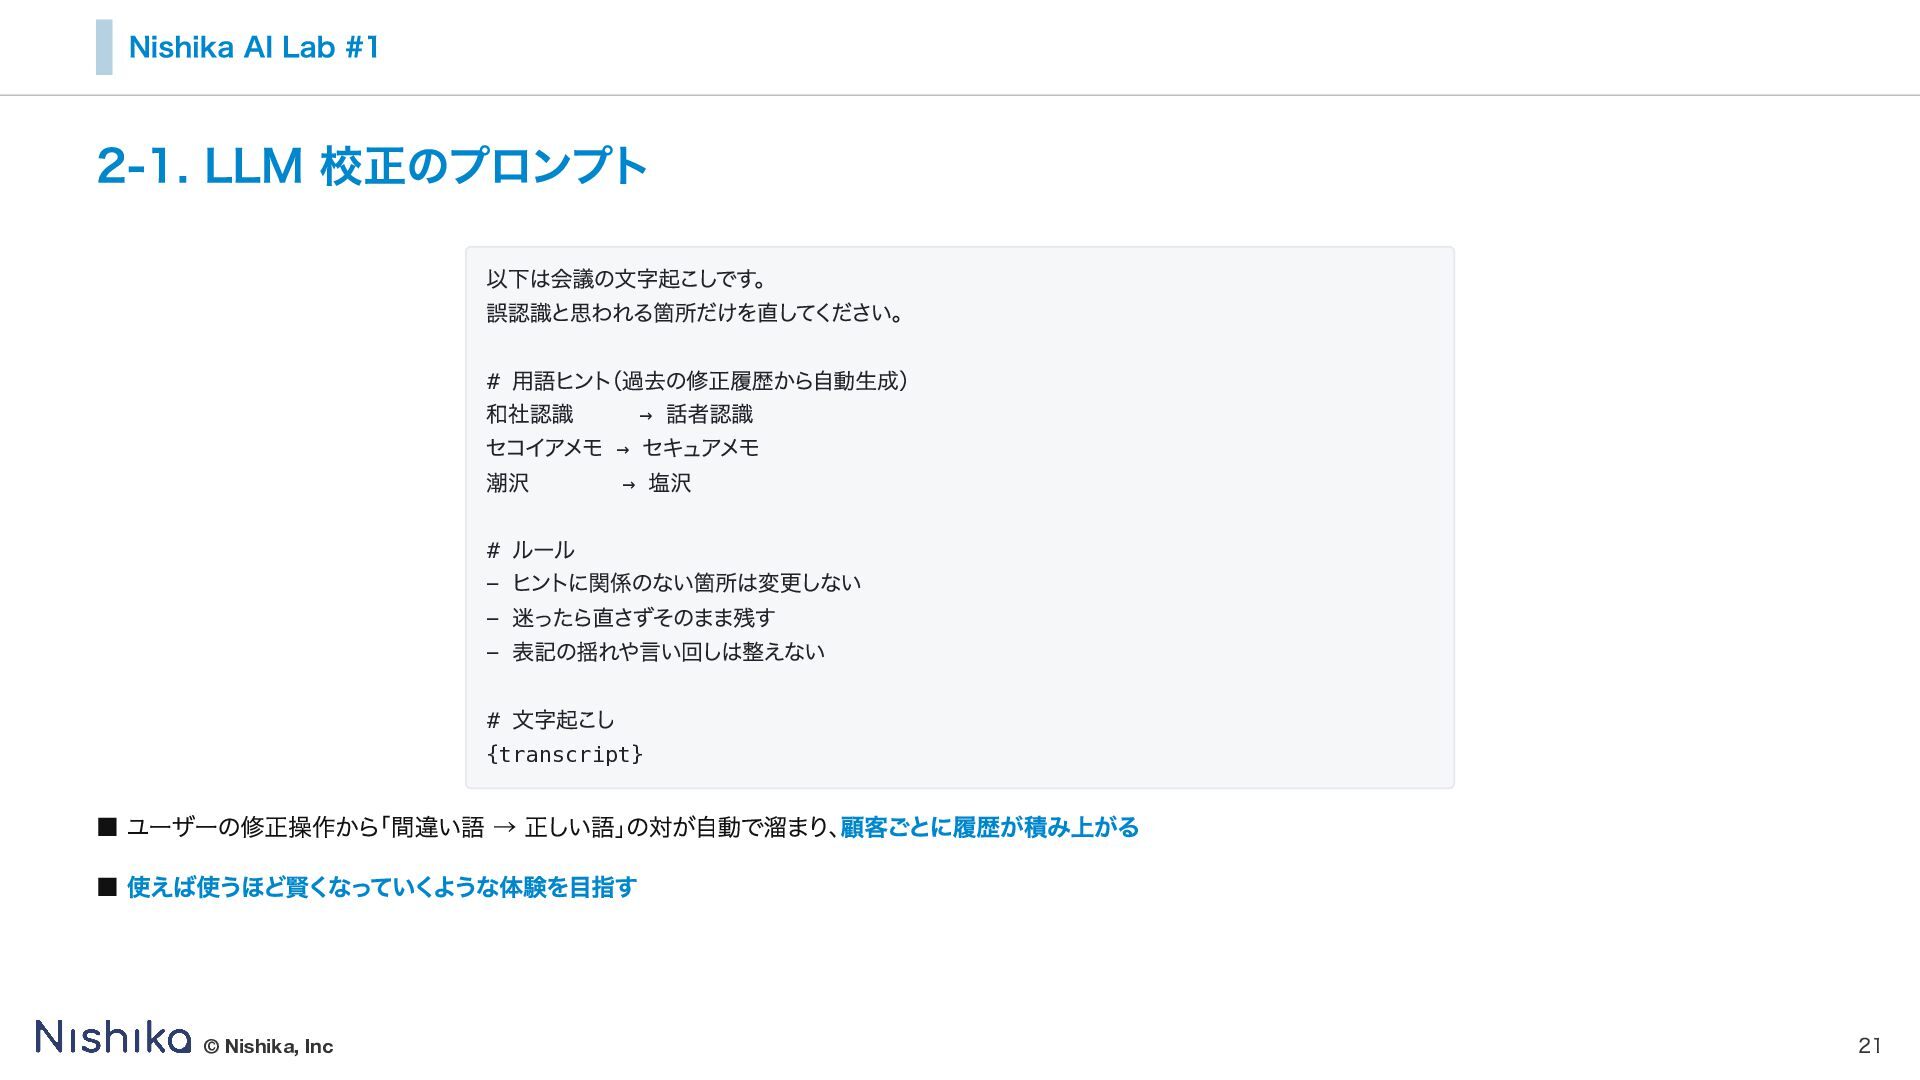
Nishika AI Lab #1 2-1. LLM 校正のプロンプト 以下は会議の文字起こしです。 誤認識と思われる箇所だけを直してください。 用語ヒント(過去の修正履歴から自動生成)
和社認識 → 話者認識 セコイアメモ → セキュアメモ 潮沢 → 塩沢 # ルール - ヒントに関係のない箇所は変更しない - 迷ったら直さずそのまま残す - 表記の揺れや言い回しは整えない # # 文字起こし {transcript} ▪ ユーザーの修正操作から「間違い語 → 正しい語」の対が自動で溜まり、顧客ごとに履歴が積み上がる ▪ 使えば使うほど賢くなっていくような体験を目指す © Nishika, Inc 21
Nishika AI Lab #1 それでも残る課題 1. コールドスタート — 顧客ごとに認識したい専門用語が違う。初回導入時は情報がない。反映までの時間差 2.
過剰な修正、見逃し — LLM でも過剰な修正や見逃しは残り、100%にはならない 3. 評価の困難さ — 専門用語、それに対する修正パターンは多岐にわたる © Nishika, Inc 22
Nishika AI Lab #1 まとめ 1. ベンチマークと本番は違う — Whisper large-v3
で ベンチマーク: CER 7.1% → 社内アノテーション: 26.0% 2.「名詞」という課題意識 — 社名・製品名・人名・専門用語。印象が悪く、検索されず、要約まで壊れる 3. 銀の弾丸はない — ファインチューニングでは顧客ごとの専門用語・社内用語の精度は上がらない 4. 仕組みで解決を目指す — ユーザーの修正を自動で集め、LLMによって修正を自動化させる © Nishika, Inc 23
Appendix © Nishika, Inc 24
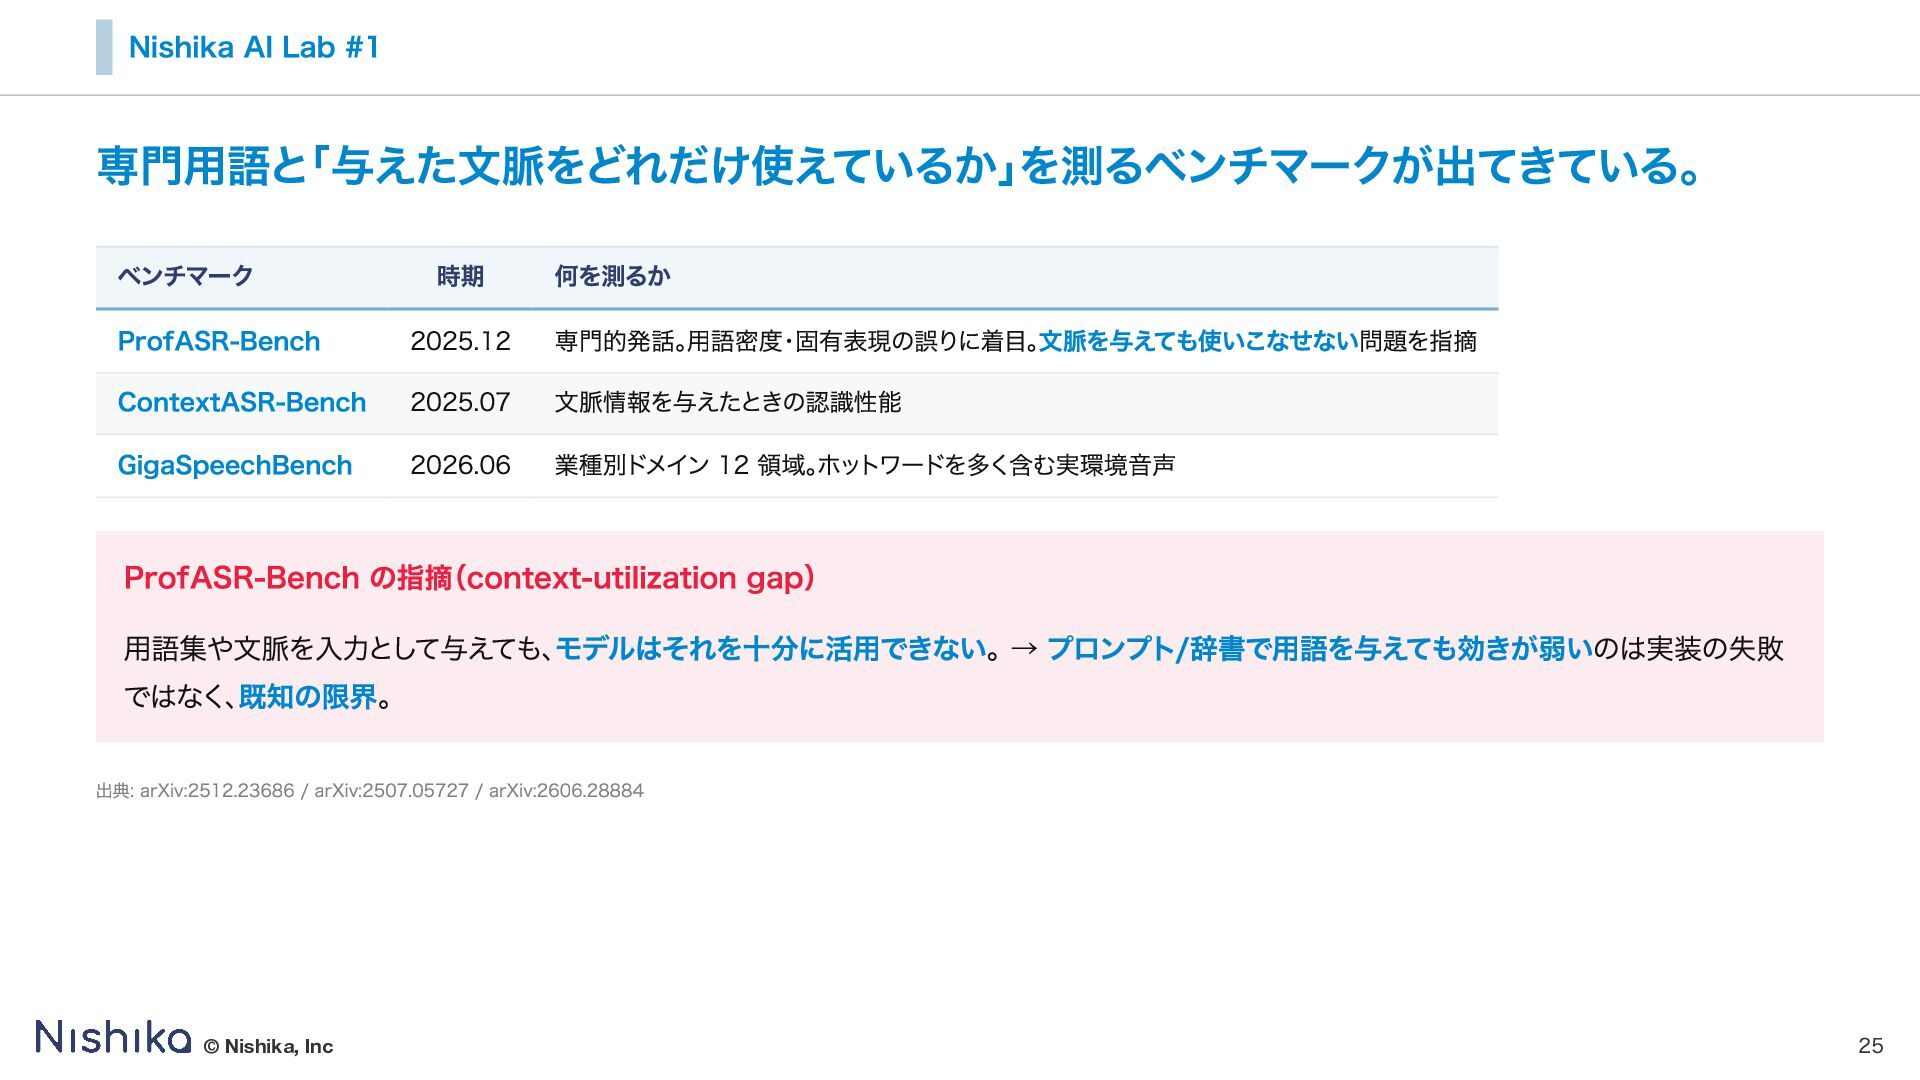
Nishika AI Lab #1 専門用語と「与えた文脈をどれだけ使えているか」を測るベンチマークが出てきている。 ベンチマーク 時期 何を測るか ProfASR-Bench 2025.12
専門的発話。用語密度・固有表現の誤りに着目。文脈を与えても使いこなせない問題を指摘 ContextASR-Bench 2025.07 文脈情報を与えたときの認識性能 GigaSpeechBench 2026.06 業種別ドメイン 12 領域。ホットワードを多く含む実環境音声 ProfASR-Bench の指摘(context-utilization gap) 用語集や文脈を入力として与えても、モデルはそれを十分に活用できない。→ プロンプト/辞書で用語を与えても効きが弱いのは実装の失敗 ではなく、既知の限界。 出典: arXiv:2512.23686 / arXiv:2507.05727 / arXiv:2606.28884 © Nishika, Inc 25


 nishikainc
 kimpetersen
 akademiya2063
 inesmontani
 akihiro_kokubo
 madoxten
 greggifford
 dugsong
 tmiket
 bkeepers
 panda_program
 codingconduct
 axbom