Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AWS を使った 全社横断データ基盤の安定性とガバナンスの両立

AWS を使った 全社横断データ基盤の安定性とガバナンスの両立

2026年6月26日 AWS Summit 2026にて、 Lightning talk でお話した内容のスライドです。

登壇者:松ノ下 広騎
部門:データサイエンスグループ データエンジニア

Avatar for Netprotections Engineers

Netprotections Engineers

July 05, 2026

Other Decks in Technology

Transcript

  1. Copyright(C) Net Protections,Inc. All Rights Reserved. 2 AWS を使った 全社横断データ基盤の安定性とガバナンスの両立

    松ノ下 広騎 株式会社ネットプロテクションズ データサイエンスグループ データエンジニア 2026年6月26日 AWS Summit 2026 Lightning talk Hall 7 :Theater 02
  2. Copyright(C) Net Protections,Inc. All Rights Reserved. アジェンダ 3 自己紹介 &

    会社紹介 データ基盤のBefore/After パフォーマンスの課題と解決策 ガバナンスの課題と解決策 まとめ
  3. Copyright(C) Net Protections,Inc. All Rights Reserved. 2022年新卒入社。 入社2年目よりデータエンジニアリング領域に従事。 データ基盤のアーキテクチャ設計・開発をリード。 4

    松ノ下 広騎 Koki Matsunoshita 株式会社ネットプロテクションズ データサイエンスグループ/データエンジニア 自己紹介
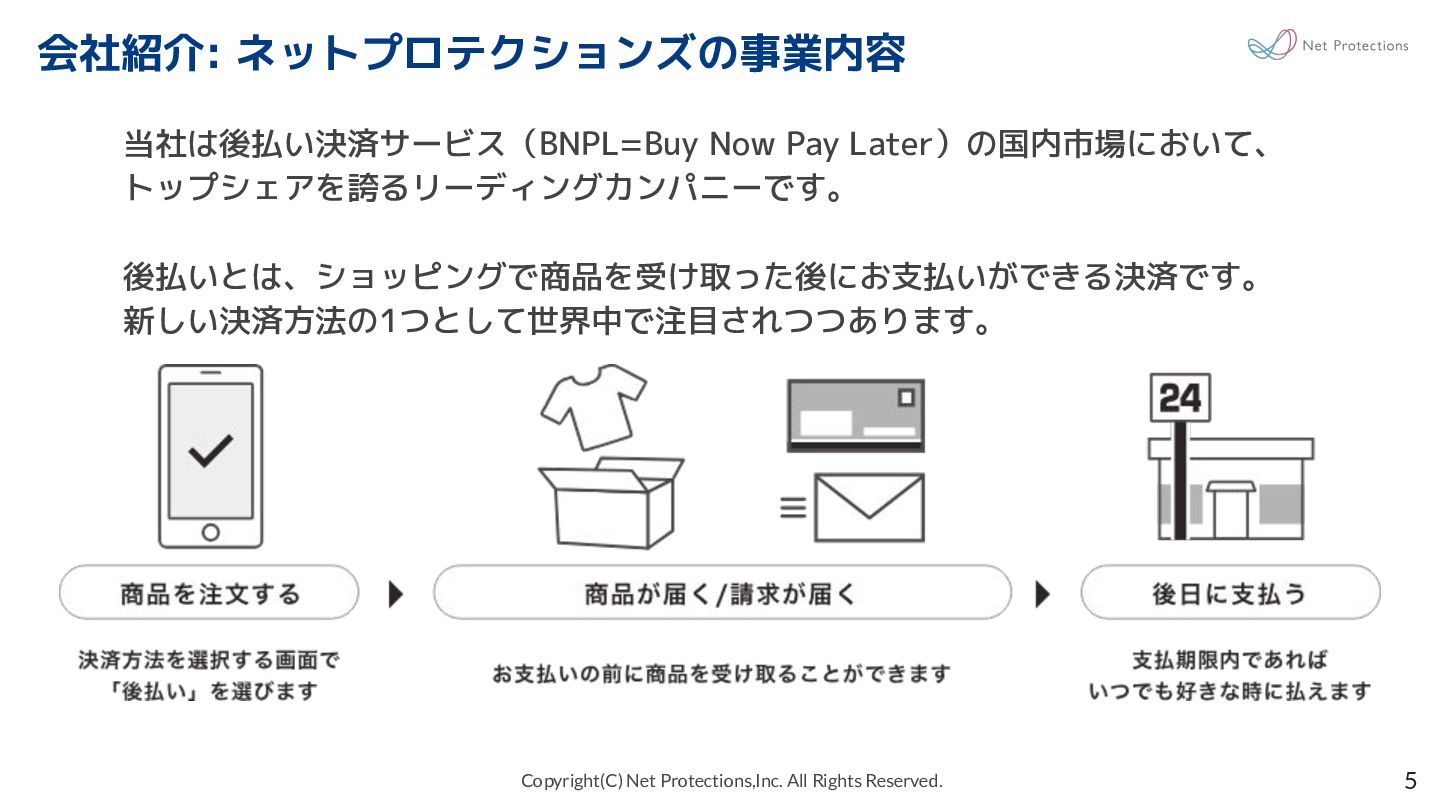
  4. Copyright(C) Net Protections,Inc. All Rights Reserved. 5 会社紹介: ネットプロテクションズの事業内容 当社は後払い決済サービス(BNPL=Buy

    Now Pay Later)の国内市場において、 トップシェアを誇るリーディングカンパニーです。 後払いとは、ショッピングで商品を受け取った後にお支払いができる決済です。 新しい決済方法の1つとして世界中で注目されつつあります。
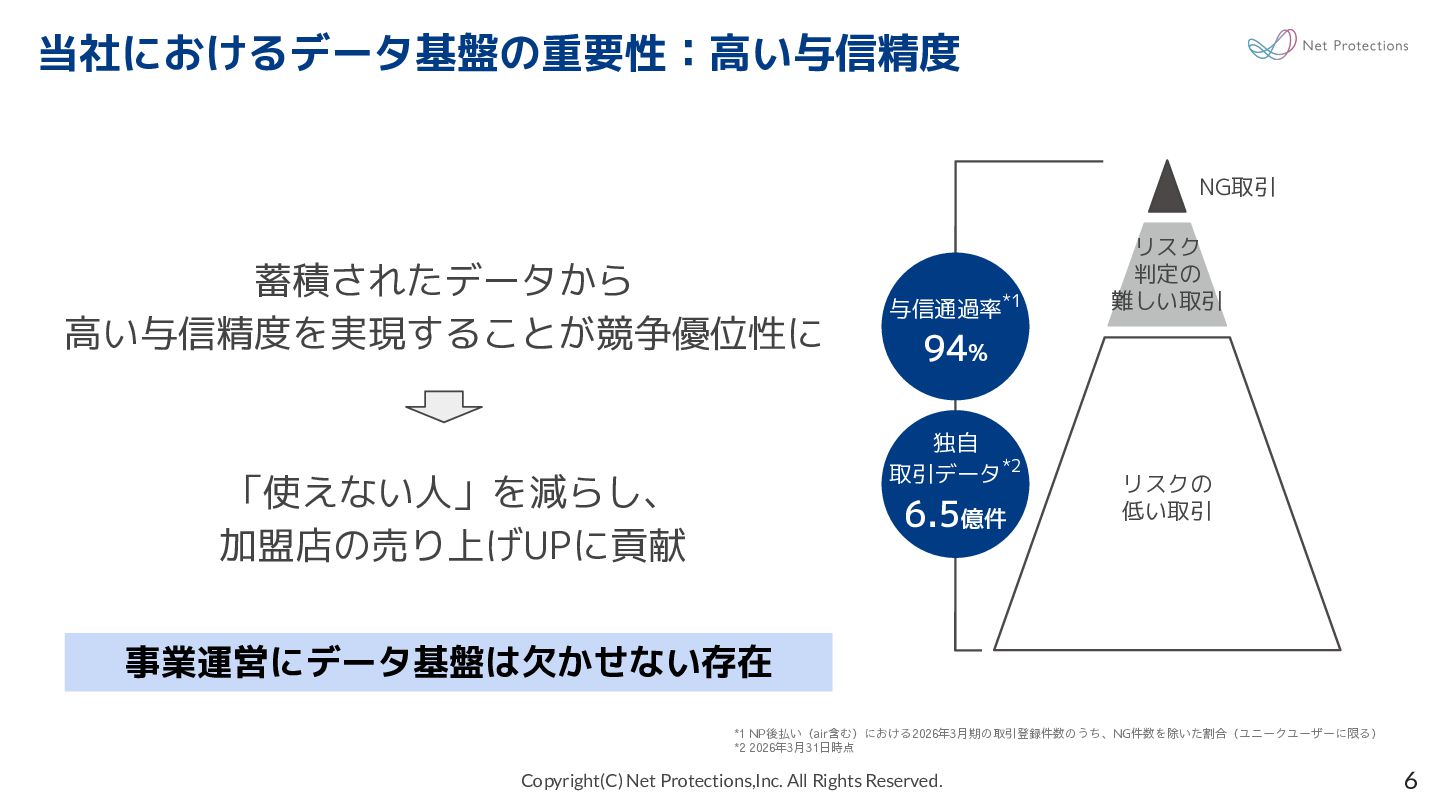
  5. Copyright(C) Net Protections,Inc. All Rights Reserved. 蓄積されたデータから 高い与信精度を実現することが競争優位性に 6 *1

    NP後払い(air含む)における2026年3月期の取引登録件数のうち、NG件数を除いた割合(ユニークユーザーに限る) *2 2026年3月31日時点 「使えない人」を減らし、 加盟店の売り上げUPに貢献 NG取引 リスク 判定の 難しい取引 リスクの 低い取引 独自 取引データ*2 6.5億件 与信通過率*1 94% 当社におけるデータ基盤の重要性:高い与信精度 事業運営にデータ基盤は欠かせない存在
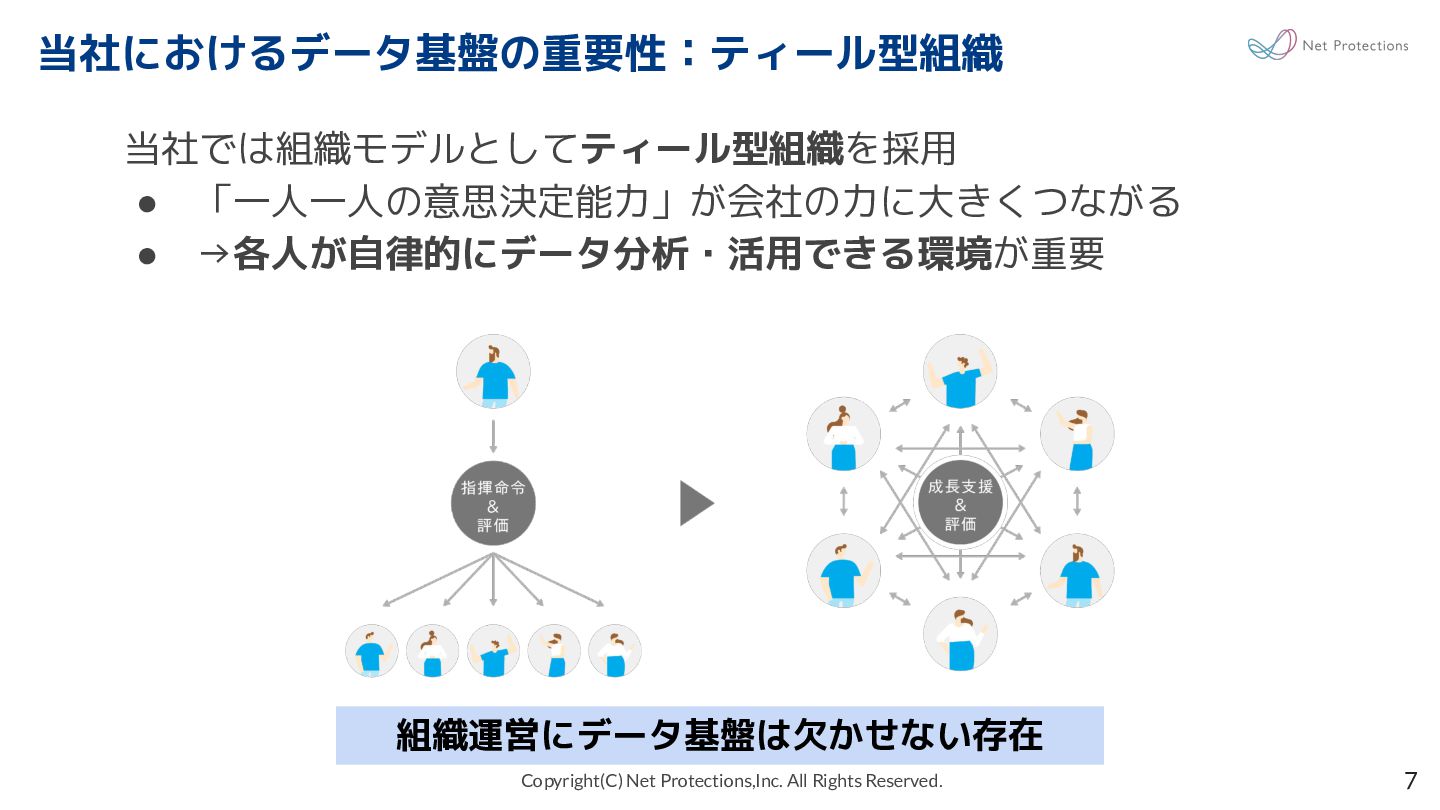
  6. Copyright(C) Net Protections,Inc. All Rights Reserved. 当社におけるデータ基盤の重要性:ティール型組織 7 当社では組織モデルとしてティール型組織を採用 •

    「一人一人の意思決定能力」が会社の力に大きくつながる • →各人が自律的にデータ分析・活用できる環境が重要 組織運営にデータ基盤は欠かせない存在
  7. Copyright(C) Net Protections,Inc. All Rights Reserved. アジェンダ 8 自己紹介 &

    会社紹介 データ基盤のBefore/After パフォーマンスの課題と解決策 ガバナンスの課題と解決策 まとめ
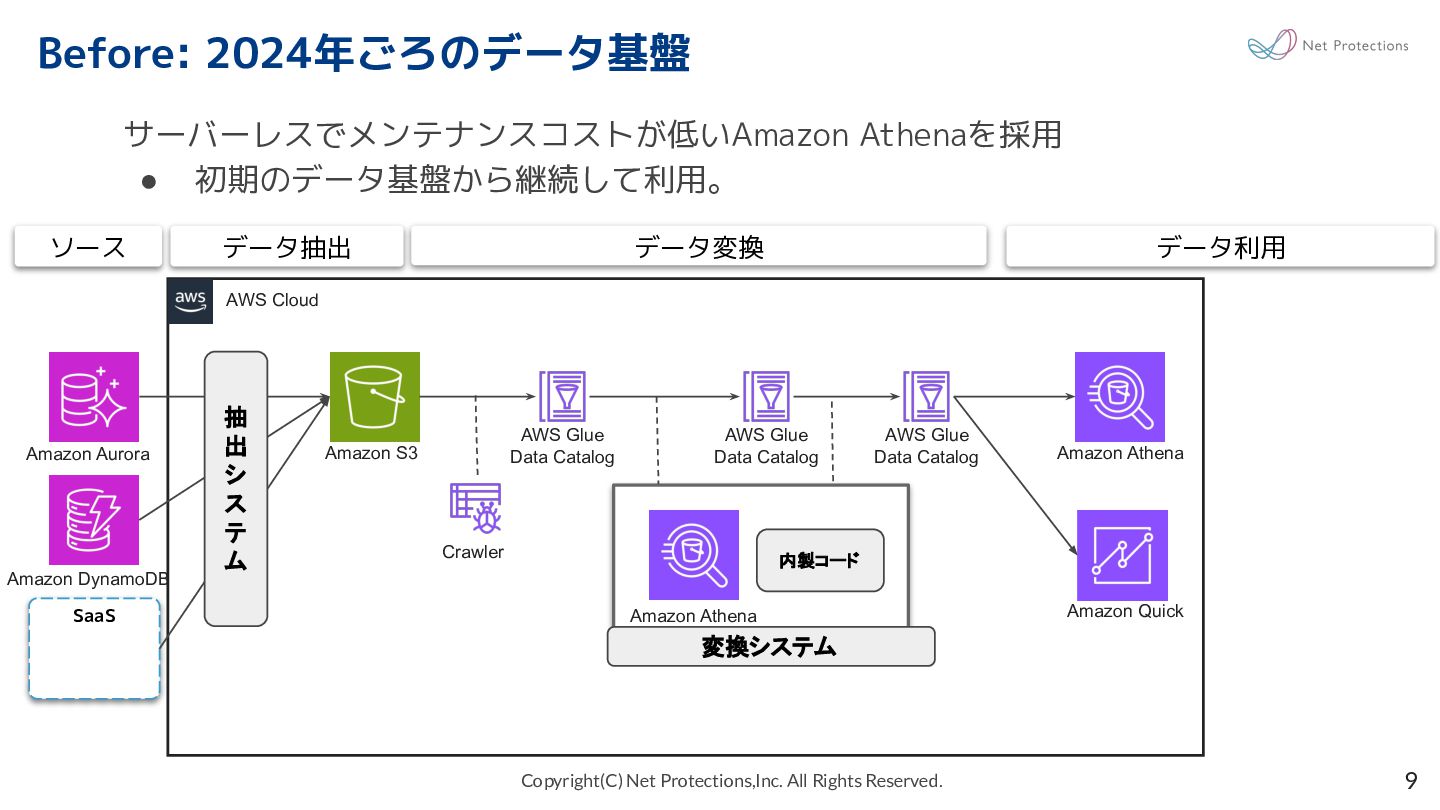
  8. Copyright(C) Net Protections,Inc. All Rights Reserved. サーバーレスでメンテナンスコストが低いAmazon Athenaを採用 • 初期のデータ基盤から継続して利用。

    AWS Cloud Before: 2024年ごろのデータ基盤 9 データ利用 データ抽出 ソース データ変換 AWS Glue Data Catalog Amazon Athena Amazon Quick Crawler AWS Glue Data Catalog AWS Glue Data Catalog SaaS 抽 出 シ ス テ ム Amazon Aurora Amazon DynamoDB Amazon S3 Amazon Athena 内製コード 変換システム
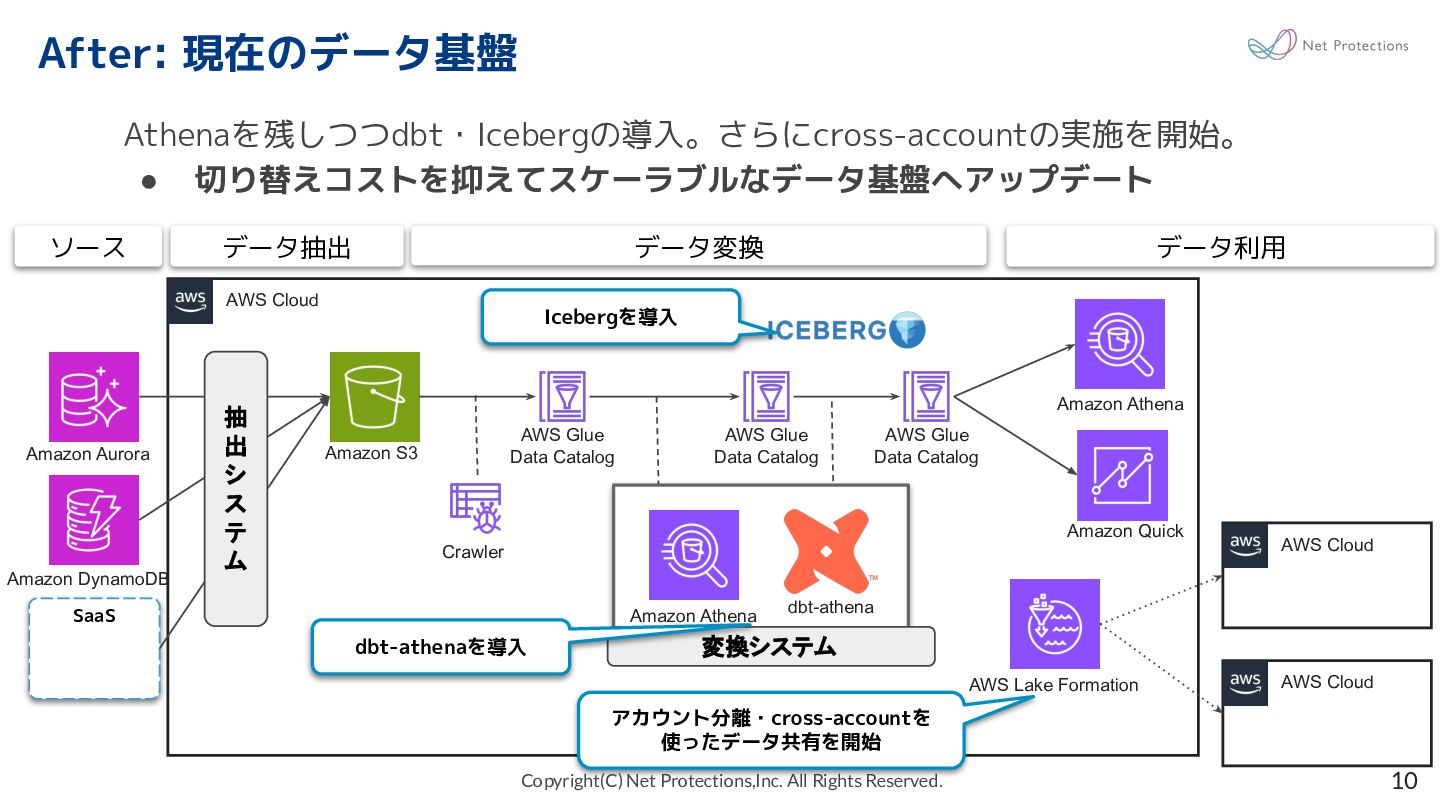
  9. Copyright(C) Net Protections,Inc. All Rights Reserved. AWS Cloud After: 現在のデータ基盤

    10 データ利用 データ抽出 ソース データ変換 AWS Glue Data Catalog Amazon Athena Amazon Quick Crawler AWS Glue Data Catalog AWS Glue Data Catalog SaaS 抽 出 シ ス テ ム Amazon Aurora Amazon DynamoDB Amazon Athena 変換システム AWS Lake Formation AWS Cloud AWS Cloud dbt-athena dbt-athenaを導入 アカウント分離・cross-accountを 使ったデータ共有を開始 Amazon S3 Icebergを導入 Athenaを残しつつdbt・Icebergの導入。さらにcross-accountの実施を開始。 • 切り替えコストを抑えてスケーラブルなデータ基盤へアップデート
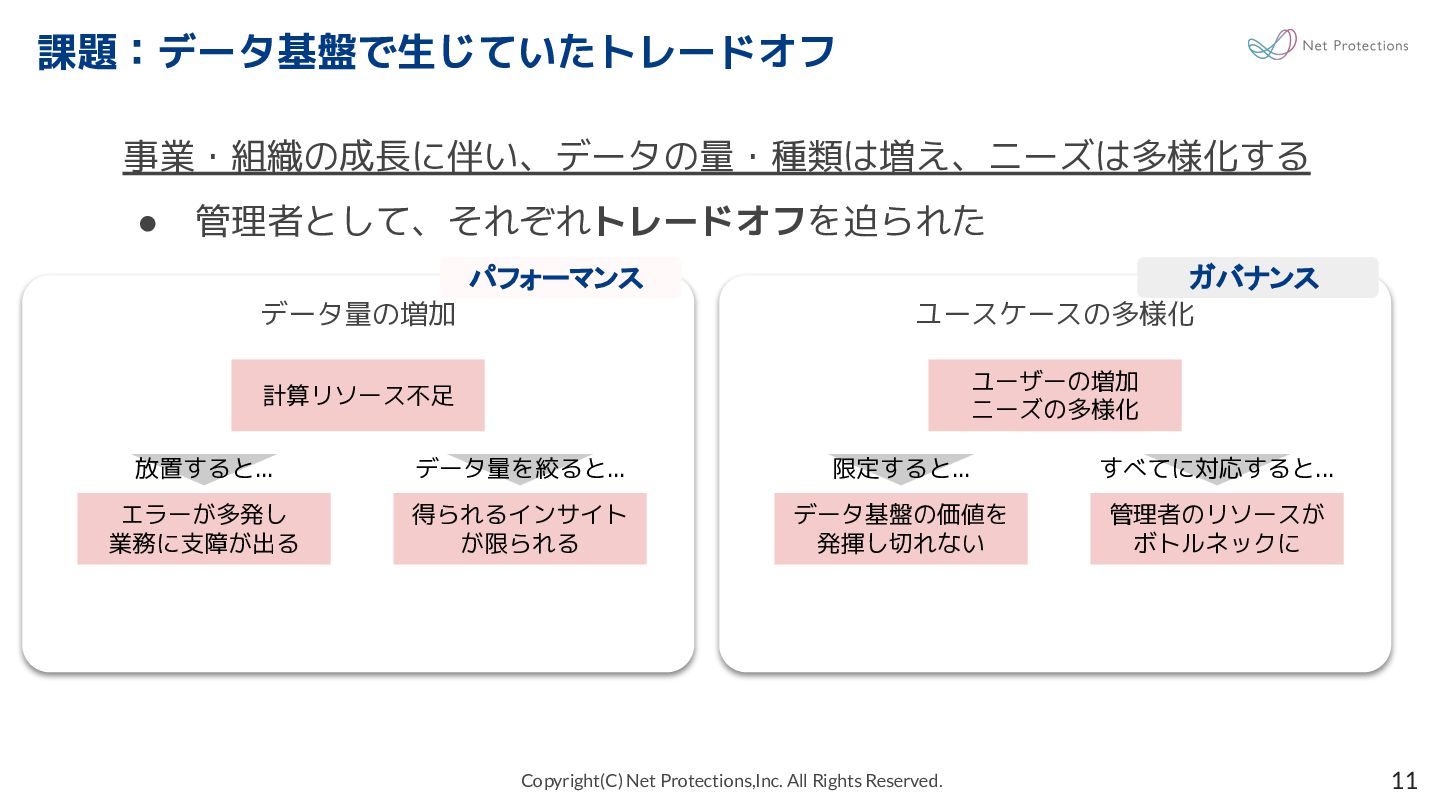
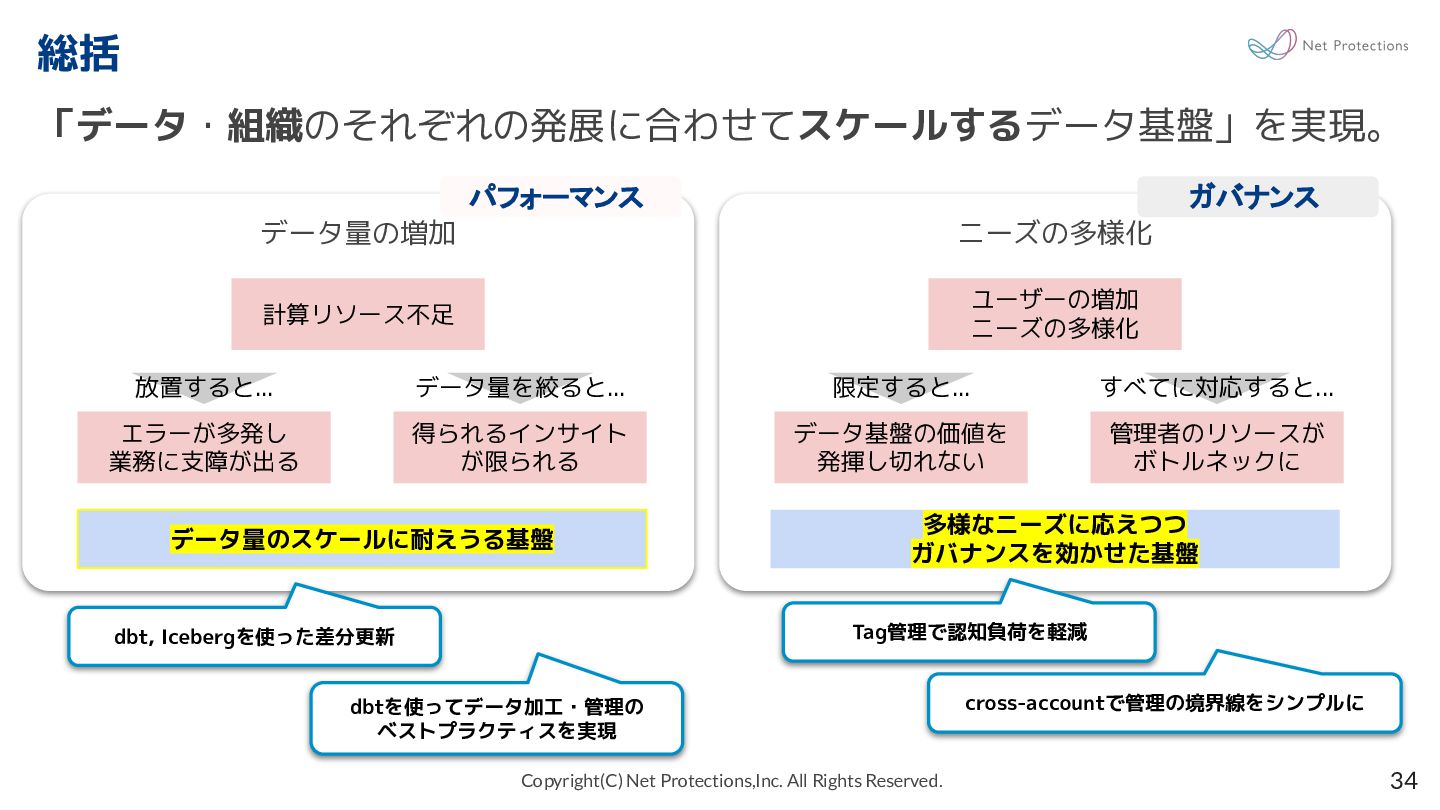
  10. Copyright(C) Net Protections,Inc. All Rights Reserved. 課題:データ基盤で生じていたトレードオフ 11 事業・組織の成長に伴い、データの量・種類は増え、ニーズは多様化する •

    管理者として、それぞれトレードオフを迫られた ユースケースの多様化 ユーザーの増加 ニーズの多様化 管理者のリソースが ボトルネックに データ基盤の価値を 発揮し切れない データ量の増加 計算リソース不足 得られるインサイト が限られる エラーが多発し 業務に支障が出る 放置すると... データ量を絞ると... すべてに対応すると... 限定すると... パフォーマンス ガバナンス
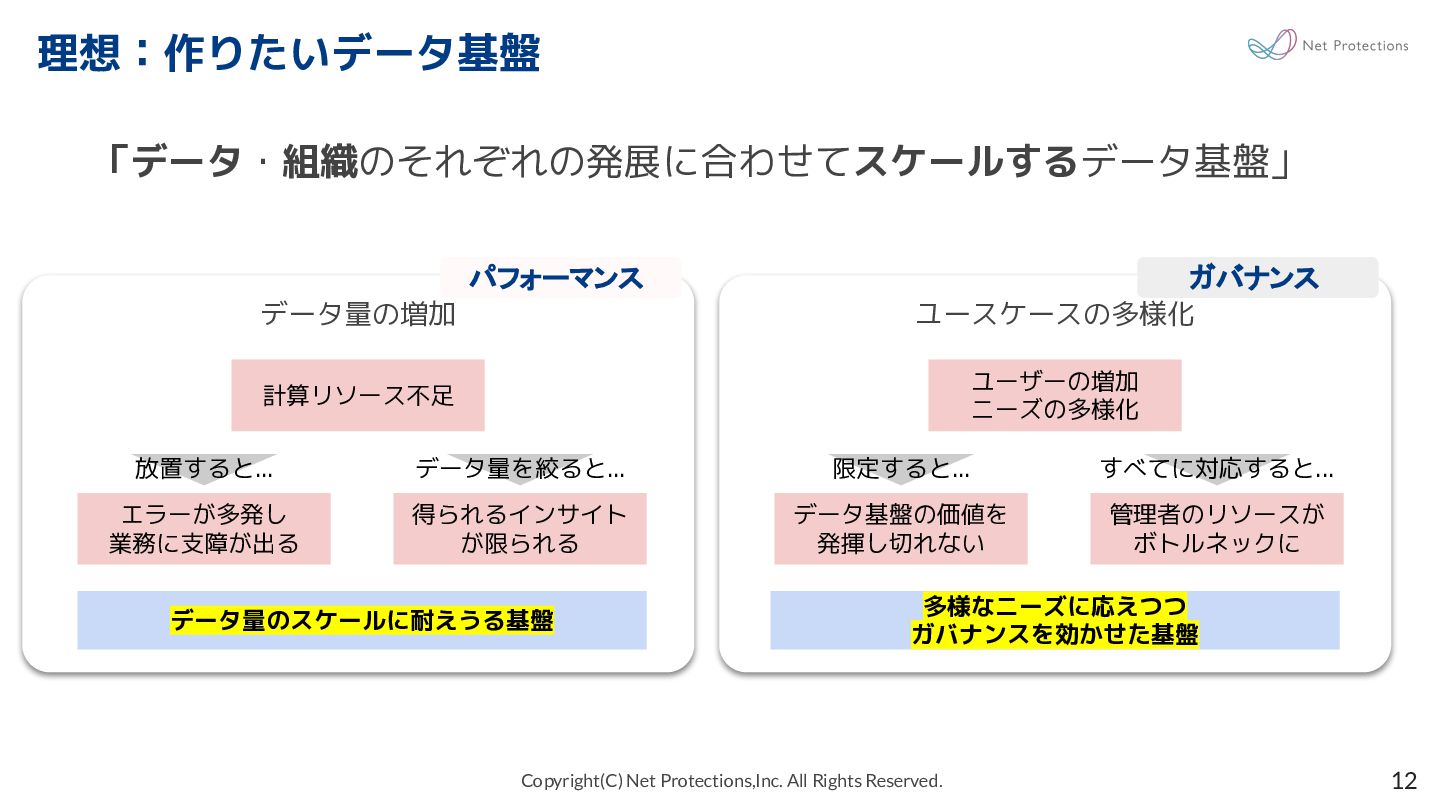
  11. Copyright(C) Net Protections,Inc. All Rights Reserved. ユースケースの多様化 理想:作りたいデータ基盤 12 ユーザーの増加

    ニーズの多様化 管理者のリソースが ボトルネックに データ基盤の価値を 発揮し切れない データ量の増加 計算リソース不足 得られるインサイト が限られる エラーが多発し 業務に支障が出る 放置すると... データ量を絞ると... すべてに対応すると... 限定すると... データ量のスケールに耐えうる基盤 多様なニーズに応えつつ ガバナンスを効かせた基盤 「データ・組織のそれぞれの発展に合わせてスケールするデータ基盤」 パフォーマンス ガバナンス
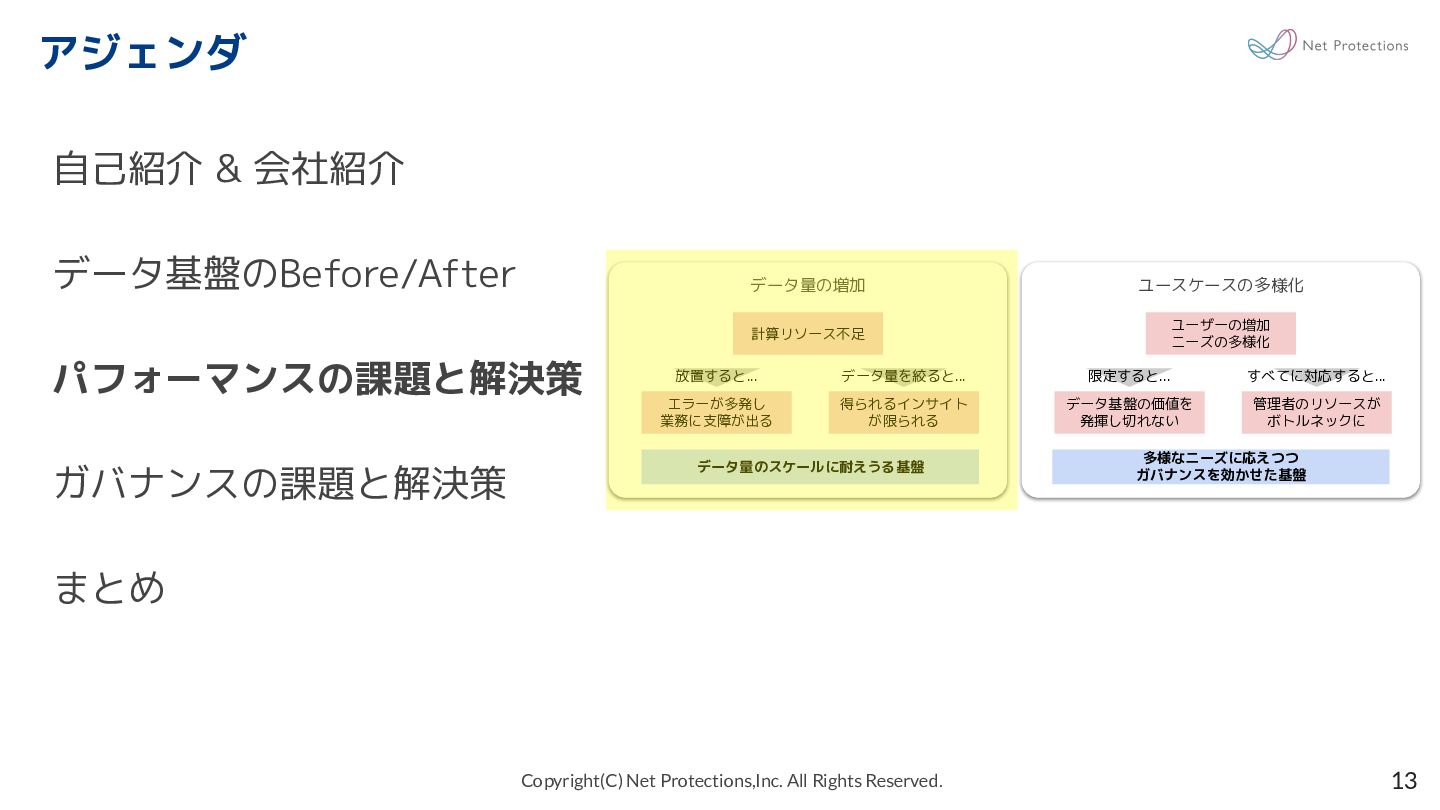
  12. Copyright(C) Net Protections,Inc. All Rights Reserved. アジェンダ 13 ユースケースの多様化 ユーザーの増加

    ニーズの多様化 管理者のリソースが ボトルネックに データ基盤の価値を 発揮し切れない データ量の増加 計算リソース不足 得られるインサイト が限られる エラーが多発し 業務に支障が出る 放置すると... データ量を絞ると... すべてに対応すると... 限定すると... 多様なニーズに応えつつ ガバナンスを効かせた基盤 データ量のスケールに耐えうる基盤 自己紹介 & 会社紹介 データ基盤のBefore/After パフォーマンスの課題と解決策 ガバナンスの課題と解決策 まとめ
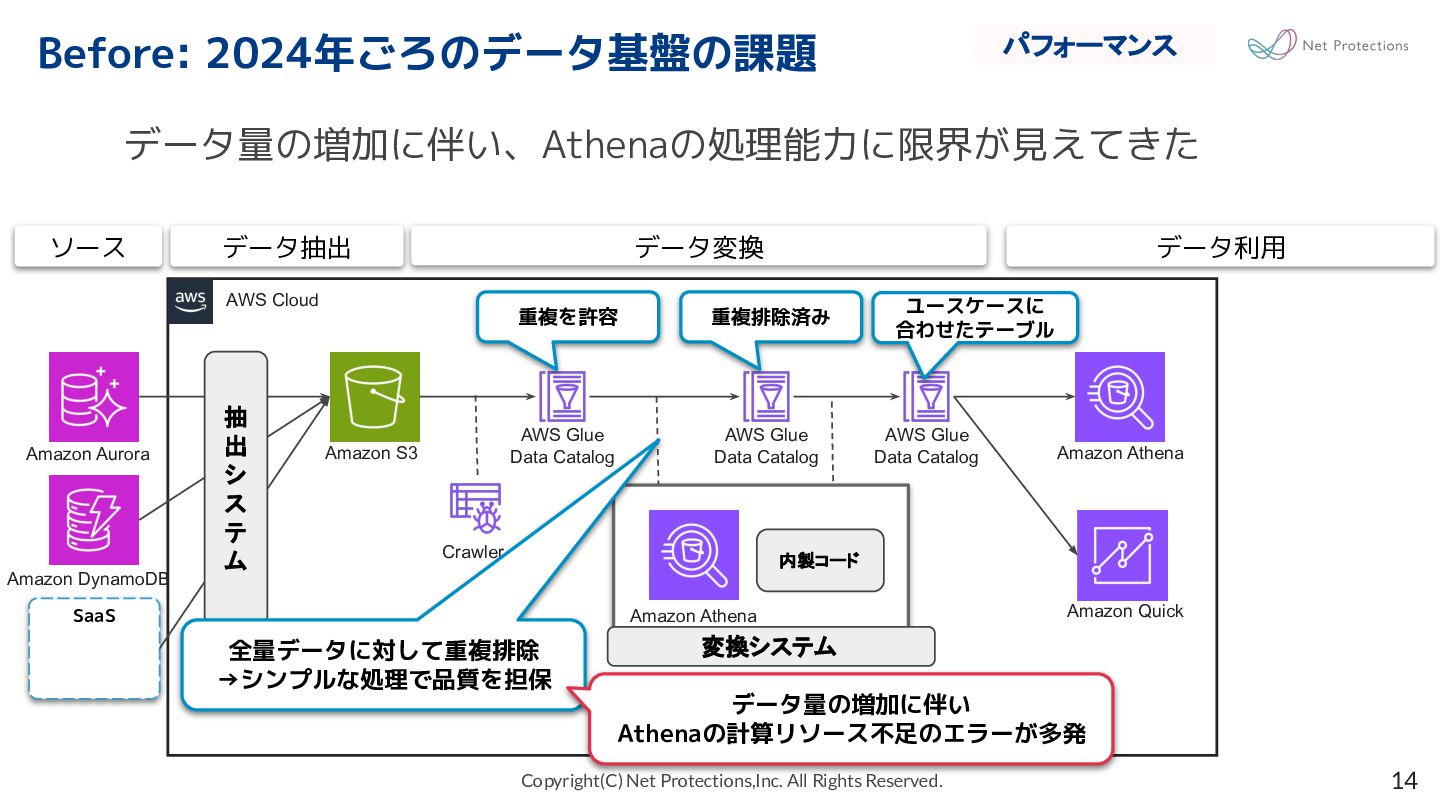
  13. Copyright(C) Net Protections,Inc. All Rights Reserved. AWS Cloud Before: 2024年ごろのデータ基盤の課題

    14 データ利用 データ抽出 ソース データ変換 AWS Glue Data Catalog Amazon Athena Amazon Quick Crawler AWS Glue Data Catalog AWS Glue Data Catalog SaaS 抽 出 シ ス テ ム Amazon Aurora Amazon DynamoDB Amazon Athena 内製コード 全量データに対して重複排除 →シンプルな処理で品質を担保 変換システム データ量の増加に伴い Athenaの計算リソース不足のエラーが多発 データ量の増加に伴い、Athenaの処理能力に限界が見えてきた パフォーマンス 重複を許容 重複排除済み ユースケースに 合わせたテーブル Amazon S3
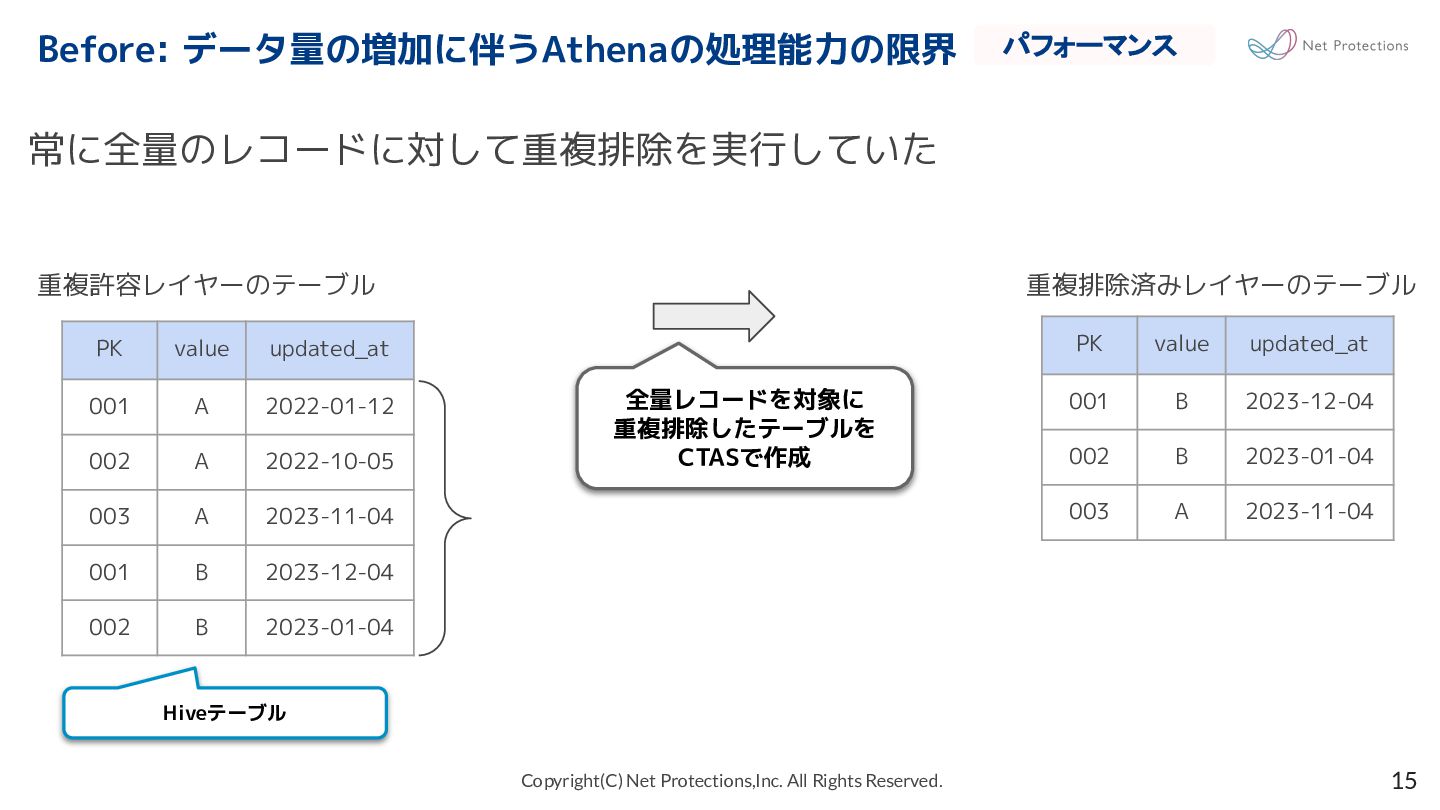
  14. Copyright(C) Net Protections,Inc. All Rights Reserved. 常に全量のレコードに対して重複排除を実行していた Before: データ量の増加に伴うAthenaの処理能力の限界 15

    重複許容レイヤーのテーブル 重複排除済みレイヤーのテーブル PK value updated_at 001 B 2023-12-04 002 B 2023-01-04 003 A 2023-11-04 全量レコードを対象に 重複排除したテーブルを CTASで作成 PK value updated_at 001 A 2022-01-12 002 A 2022-10-05 003 A 2023-11-04 001 B 2023-12-04 002 B 2023-01-04 パフォーマンス Hiveテーブル
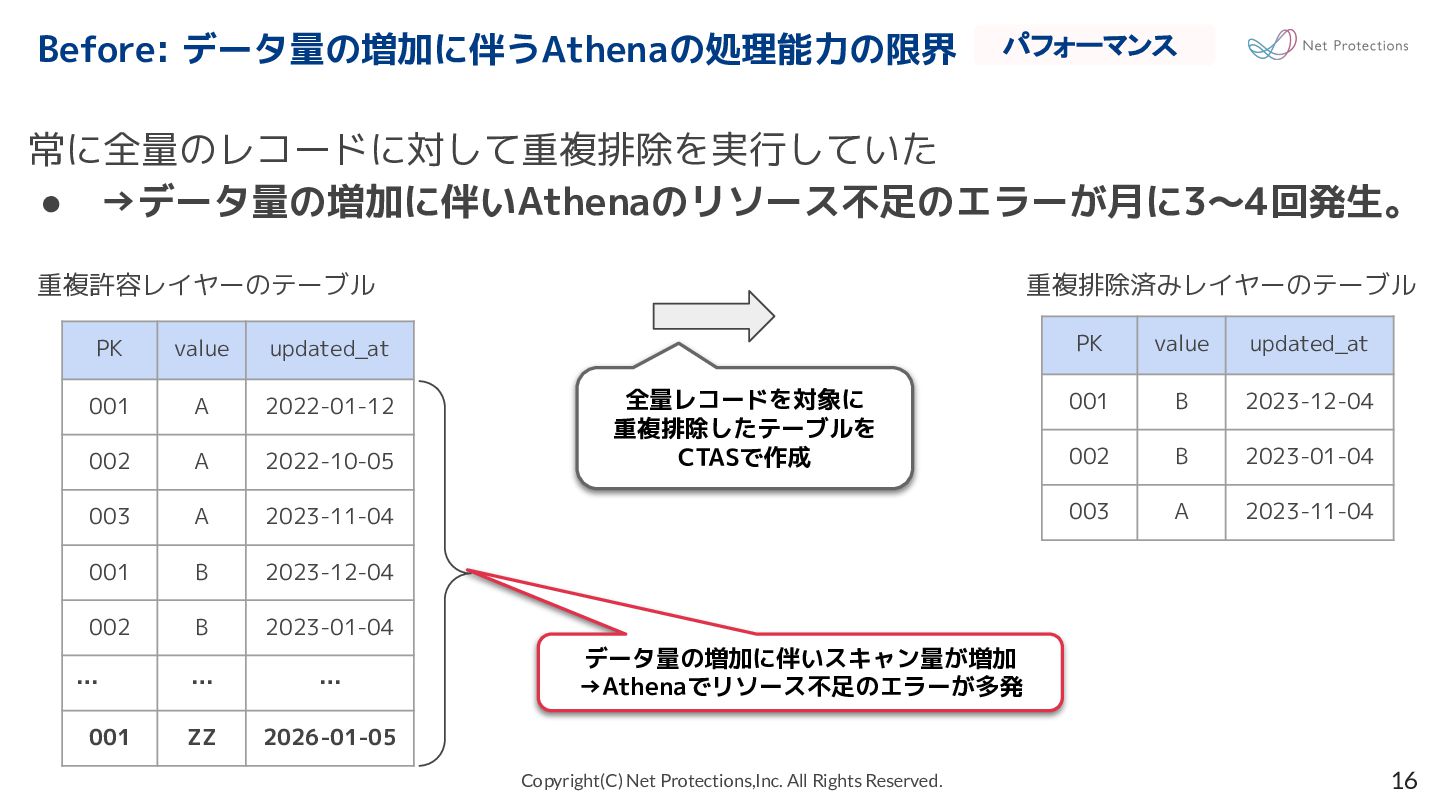
  15. Copyright(C) Net Protections,Inc. All Rights Reserved. 常に全量のレコードに対して重複排除を実行していた • →データ量の増加に伴いAthenaのリソース不足のエラーが月に3〜4回発生。 16

    重複許容レイヤーのテーブル 重複排除済みレイヤーのテーブル PK value updated_at 001 B 2023-12-04 002 B 2023-01-04 003 A 2023-11-04 全量レコードを対象に 重複排除したテーブルを CTASで作成 データ量の増加に伴いスキャン量が増加 →Athenaでリソース不足のエラーが多発 PK value updated_at 001 A 2022-01-12 002 A 2022-10-05 003 A 2023-11-04 001 B 2023-12-04 002 B 2023-01-04 … … … 001 ZZ 2026-01-05 パフォーマンス Before: データ量の増加に伴うAthenaの処理能力の限界
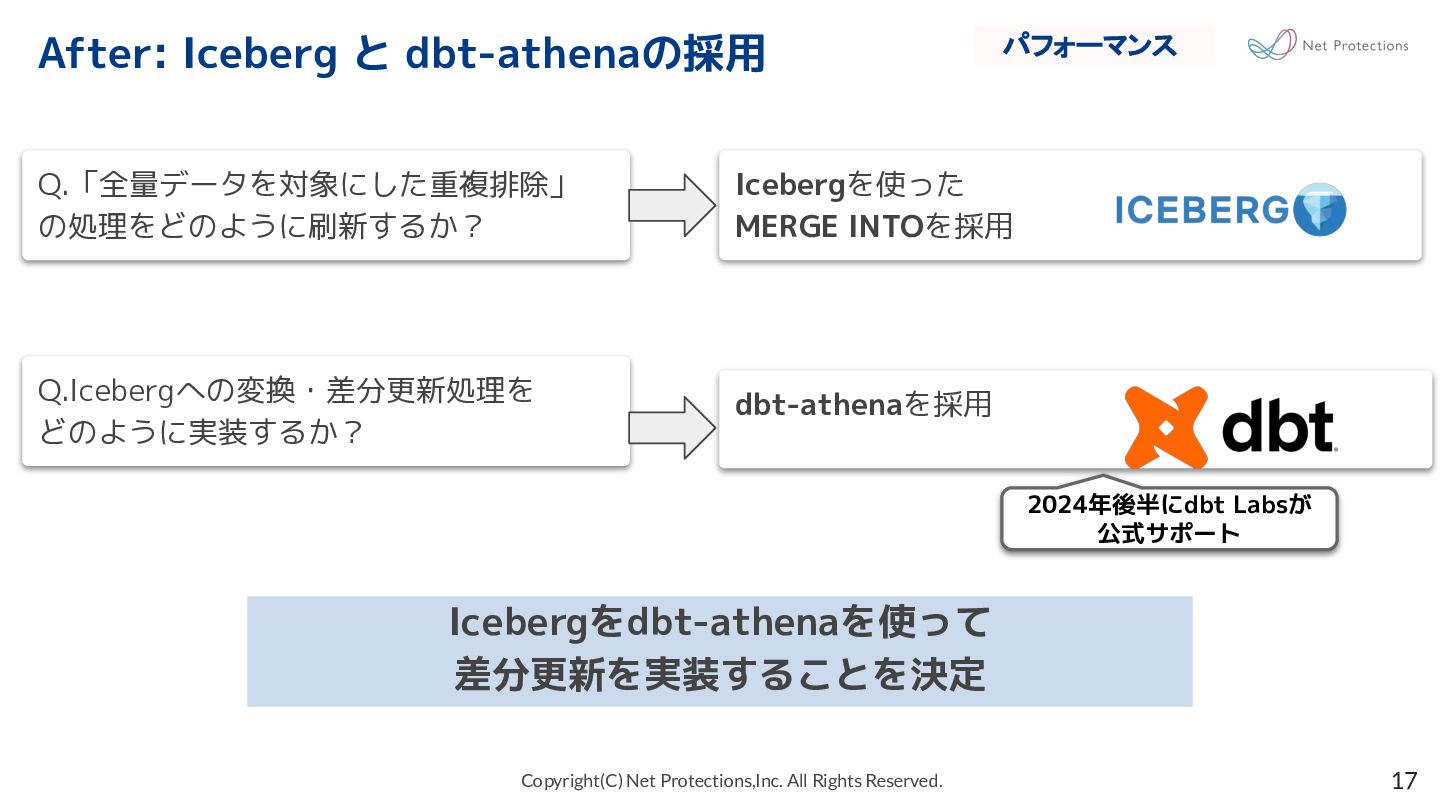
  16. Copyright(C) Net Protections,Inc. All Rights Reserved. After: Iceberg と dbt-athenaの採用

    17 パフォーマンス Q.「全量データを対象にした重複排除」 の処理をどのように刷新するか? Q.Icebergへの変換・差分更新処理を どのように実装するか? Icebergをdbt-athenaを使って 差分更新を実装することを決定 Icebergを使った MERGE INTOを採用 dbt-athenaを採用 2024年後半にdbt Labsが 公式サポート
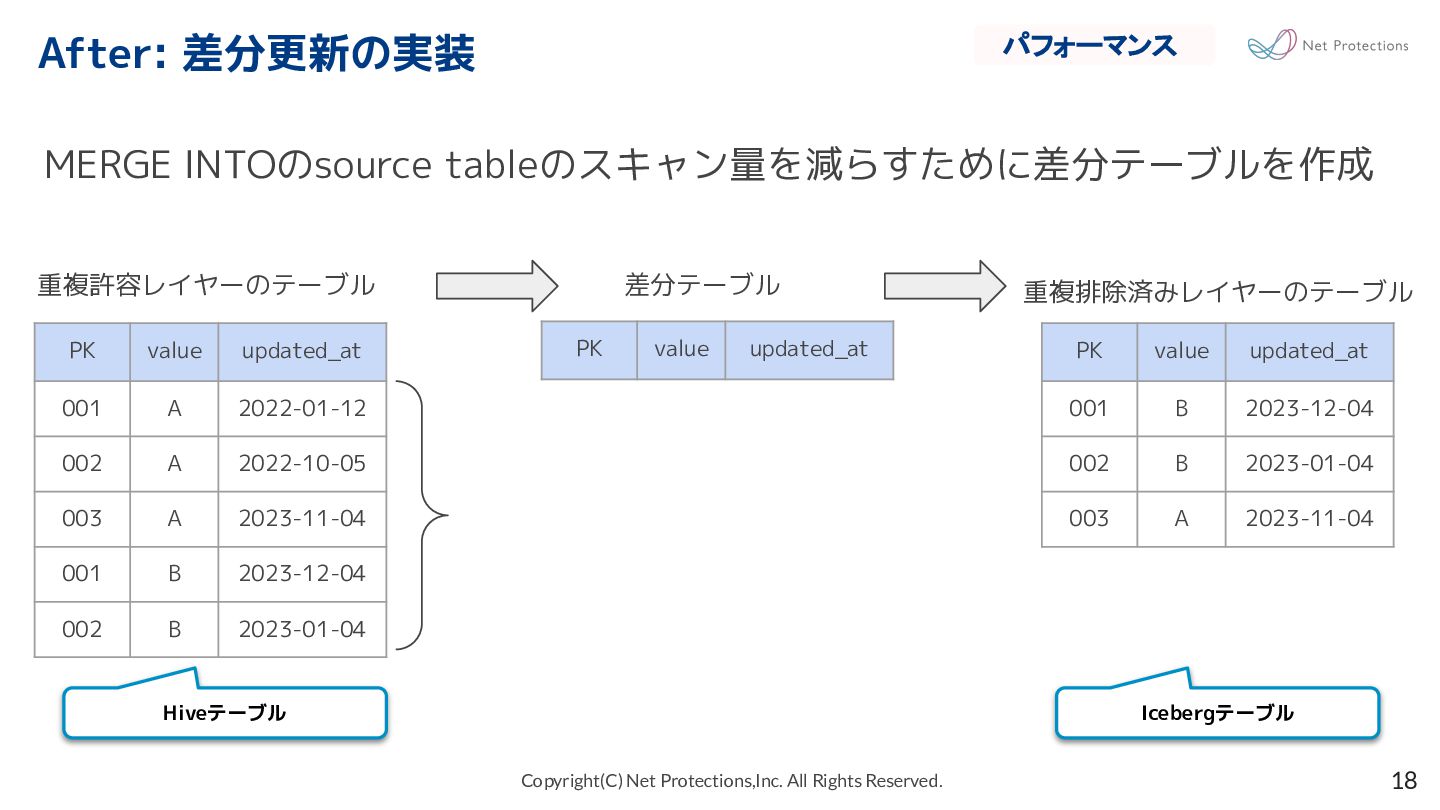
  17. Copyright(C) Net Protections,Inc. All Rights Reserved. MERGE INTOのsource tableのスキャン量を減らすために差分テーブルを作成 After:

    差分更新の実装 18 PK value updated_at 差分テーブル 重複許容レイヤーのテーブル 重複排除済みレイヤーのテーブル PK value updated_at 001 A 2022-01-12 002 A 2022-10-05 003 A 2023-11-04 001 B 2023-12-04 002 B 2023-01-04 PK value updated_at 001 B 2023-12-04 002 B 2023-01-04 003 A 2023-11-04 パフォーマンス Hiveテーブル Icebergテーブル
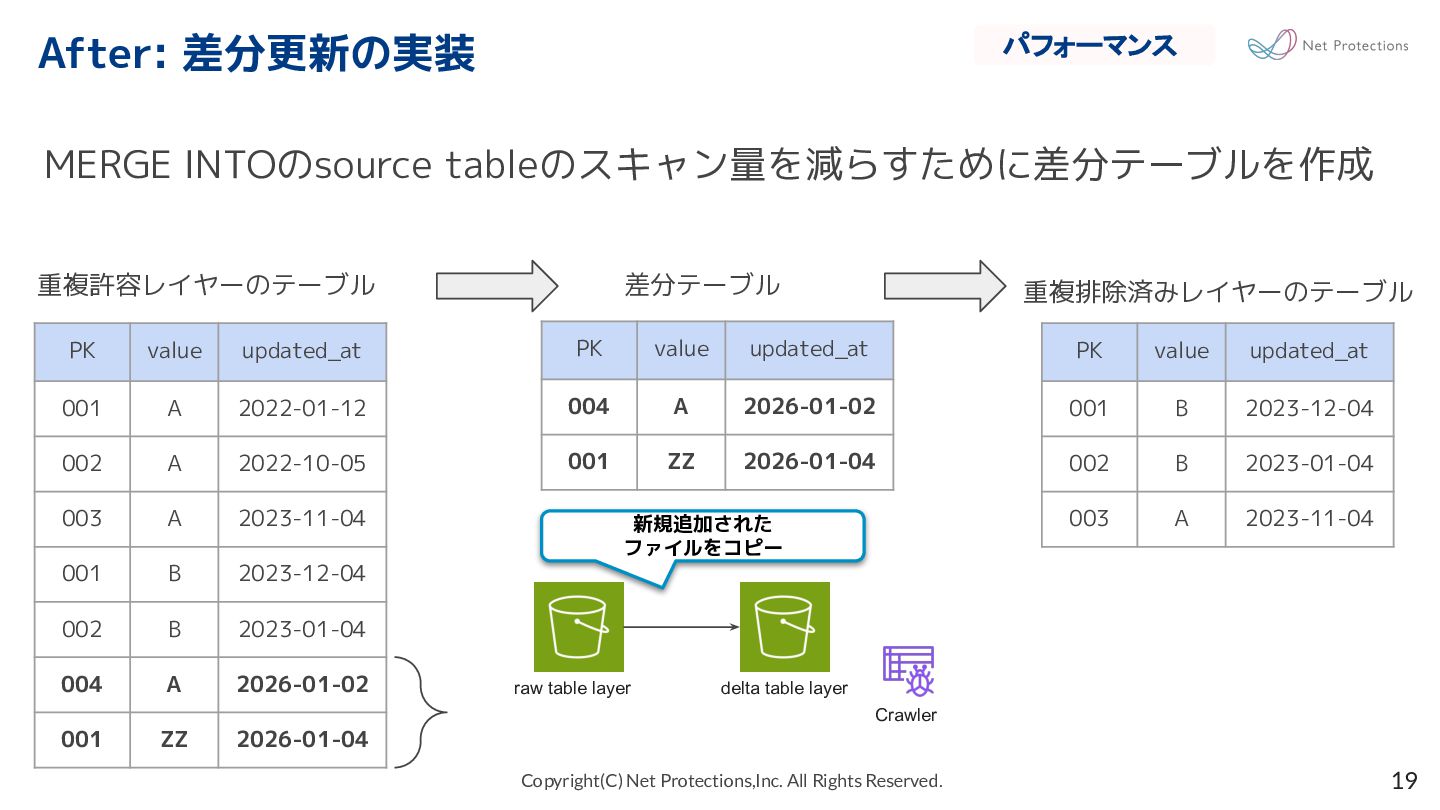
  18. Copyright(C) Net Protections,Inc. All Rights Reserved. 19 PK value updated_at

    004 A 2026-01-02 001 ZZ 2026-01-04 重複許容レイヤーのテーブル 重複排除済みレイヤーのテーブル PK value updated_at 001 A 2022-01-12 002 A 2022-10-05 003 A 2023-11-04 001 B 2023-12-04 002 B 2023-01-04 004 A 2026-01-02 001 ZZ 2026-01-04 PK value updated_at 001 B 2023-12-04 002 B 2023-01-04 003 A 2023-11-04 新規追加された ファイルをコピー raw table layer delta table layer 差分テーブル パフォーマンス MERGE INTOのsource tableのスキャン量を減らすために差分テーブルを作成 After: 差分更新の実装 Crawler
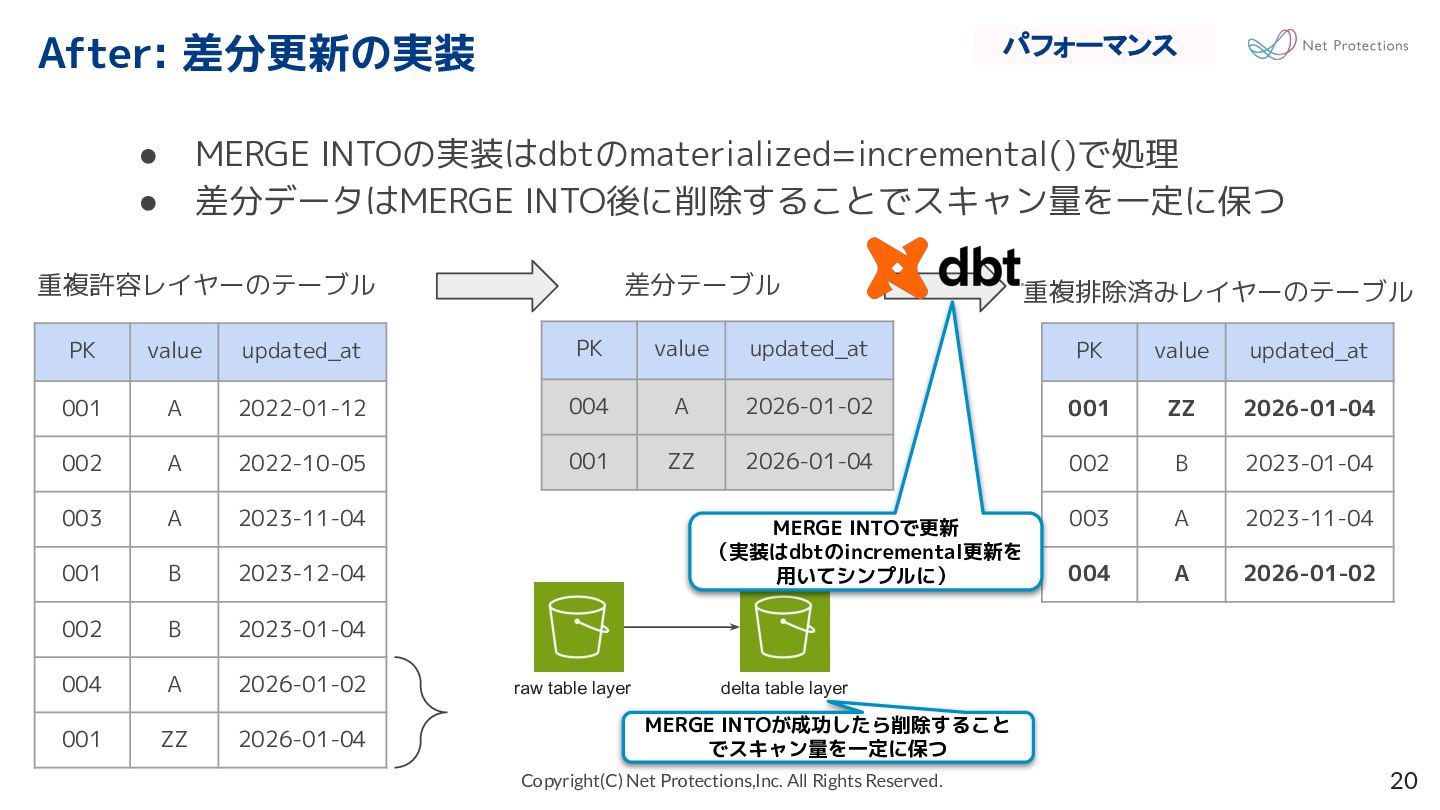
  19. Copyright(C) Net Protections,Inc. All Rights Reserved. • MERGE INTOの実装はdbtのmaterialized=incremental()で処理 •

    差分データはMERGE INTO後に削除することでスキャン量を一定に保つ 20 PK value updated_at 004 A 2026-01-02 001 ZZ 2026-01-04 重複許容レイヤーのテーブル 重複排除済みレイヤーのテーブル PK value updated_at 001 A 2022-01-12 002 A 2022-10-05 003 A 2023-11-04 001 B 2023-12-04 002 B 2023-01-04 004 A 2026-01-02 001 ZZ 2026-01-04 PK value updated_at 001 ZZ 2026-01-04 002 B 2023-01-04 003 A 2023-11-04 004 A 2026-01-02 MERGE INTOが成功したら削除すること でスキャン量を一定に保つ raw table layer delta table layer MERGE INTOで更新 (実装はdbtのincremental更新を 用いてシンプルに) 差分テーブル パフォーマンス After: 差分更新の実装
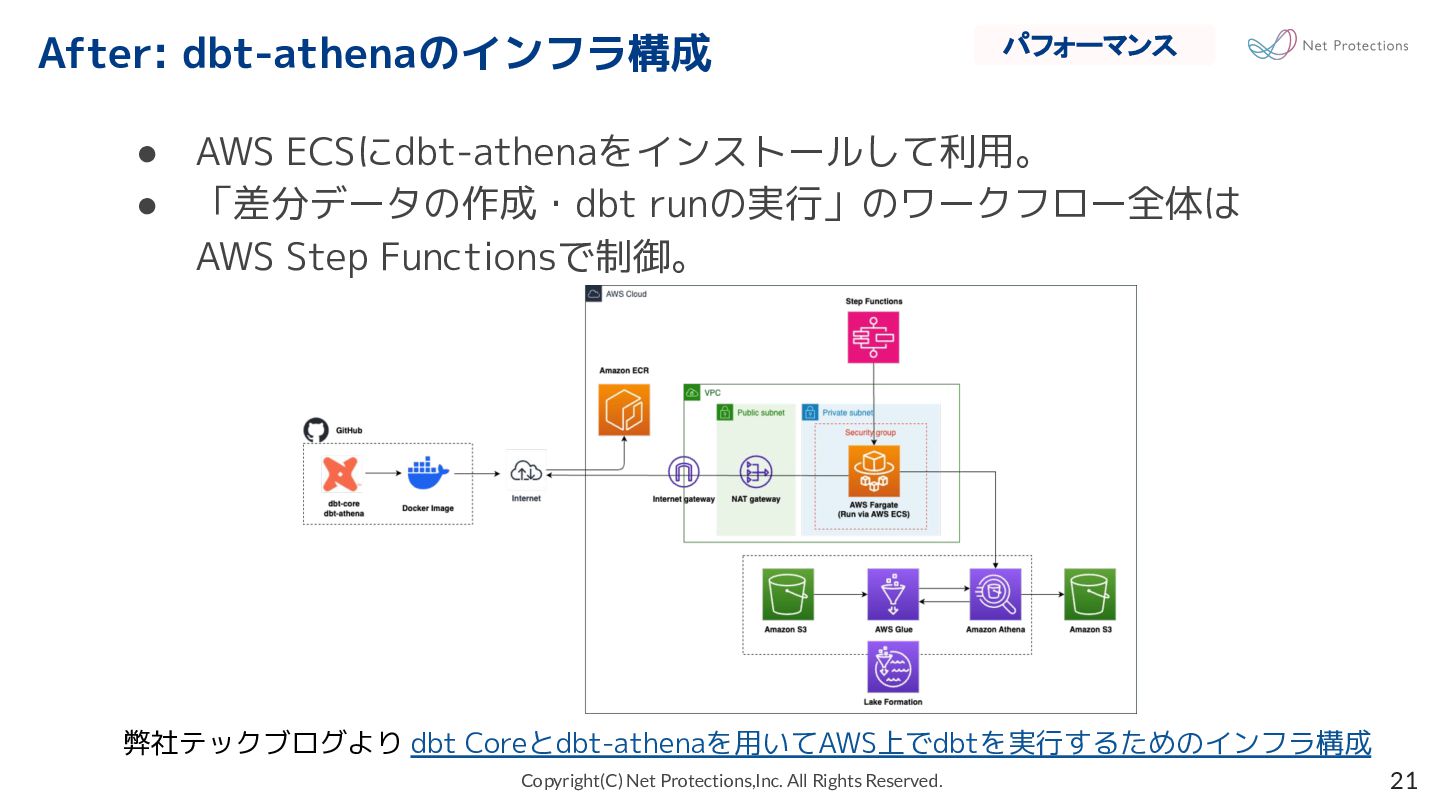
  20. Copyright(C) Net Protections,Inc. All Rights Reserved. • AWS ECSにdbt-athenaをインストールして利用。 •

    「差分データの作成・dbt runの実行」のワークフロー全体は AWS Step Functionsで制御。 After: dbt-athenaのインフラ構成 21 パフォーマンス 弊社テックブログより dbt Coreとdbt-athenaを用いてAWS上でdbtを実行するためのインフラ構成
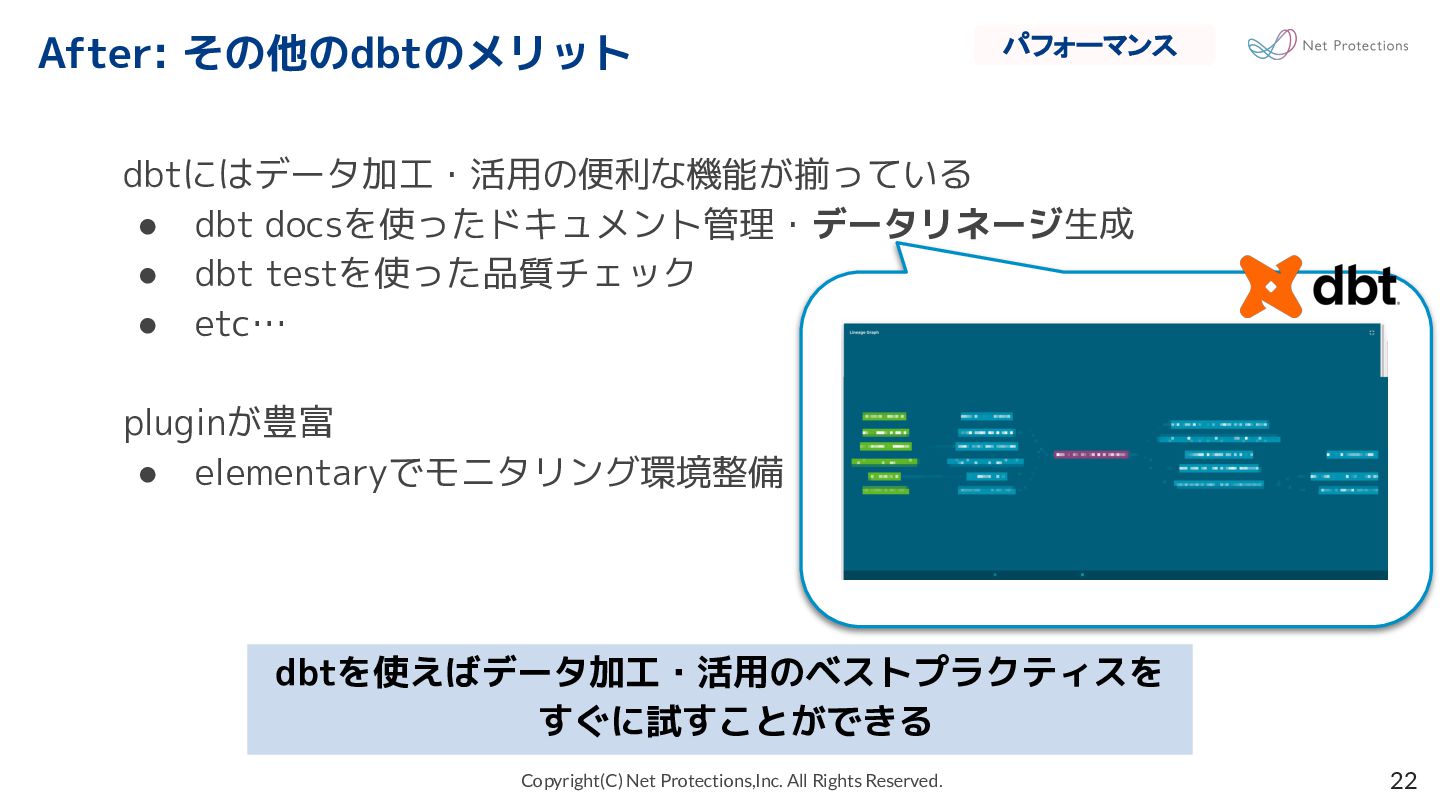
  21. Copyright(C) Net Protections,Inc. All Rights Reserved. dbtにはデータ加工・活用の便利な機能が揃っている • dbt docsを使ったドキュメント管理・データリネージ生成

    • dbt testを使った品質チェック • etc… pluginが豊富 • elementaryでモニタリング環境整備 After: その他のdbtのメリット 22 パフォーマンス dbtを使えばデータ加工・活用のベストプラクティスを すぐに試すことができる
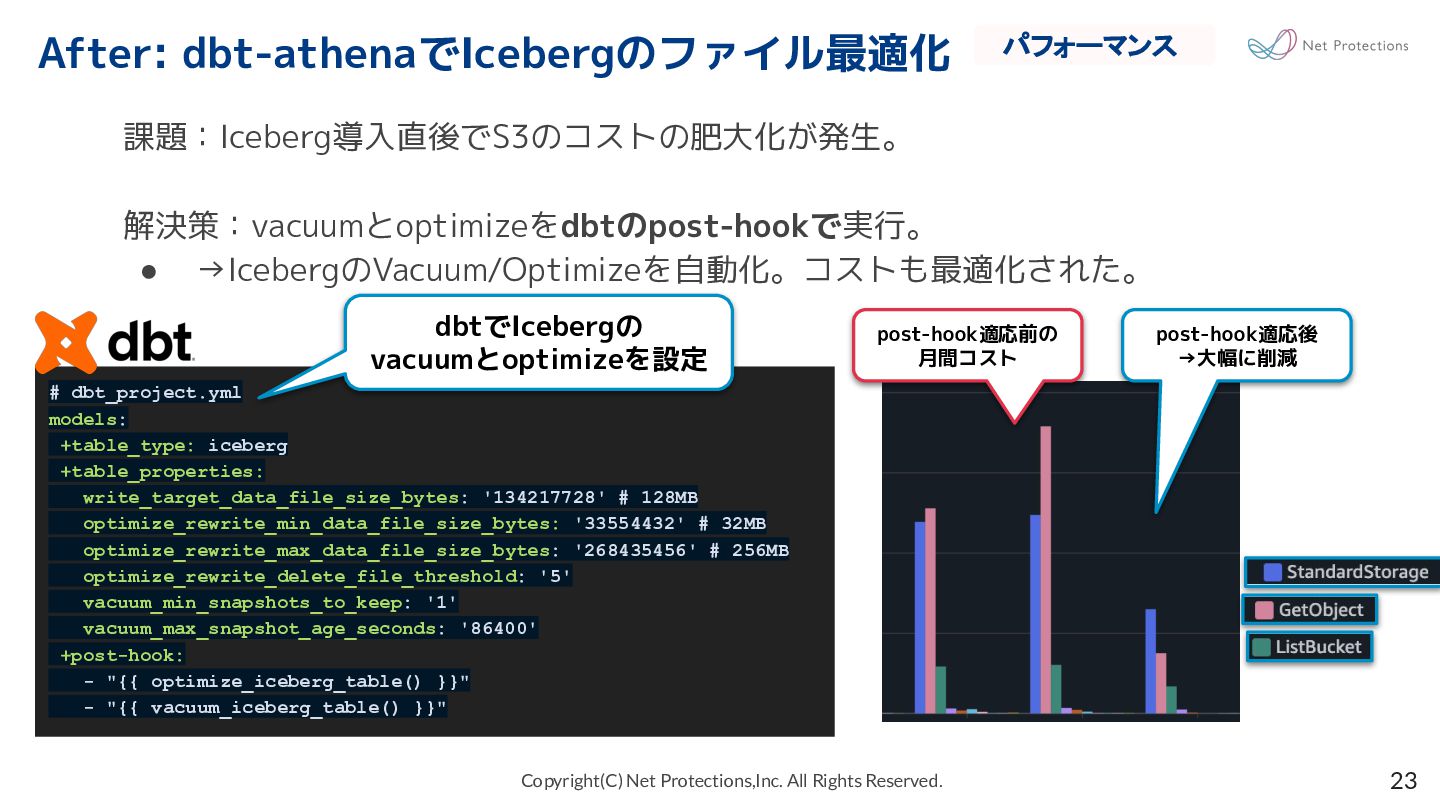
  22. Copyright(C) Net Protections,Inc. All Rights Reserved. 課題:Iceberg導入直後でS3のコストの肥大化が発生。 解決策:vacuumとoptimizeをdbtのpost-hookで実行。 • →IcebergのVacuum/Optimizeを自動化。コストも最適化された。

    After: dbt-athenaでIcebergのファイル最適化 23 # dbt_project.yml models: +table_type: iceberg +table_properties: write_target_data_file_size_bytes: '134217728' # 128MB optimize_rewrite_min_data_file_size_bytes: '33554432' # 32MB optimize_rewrite_max_data_file_size_bytes: '268435456' # 256MB optimize_rewrite_delete_file_threshold: '5' vacuum_min_snapshots_to_keep: '1' vacuum_max_snapshot_age_seconds: '86400' +post-hook: - "{{ optimize_iceberg_table() }}" - "{{ vacuum_iceberg_table() }}" post-hook適応前の 月間コスト post-hook適応後 →大幅に削減 パフォーマンス dbtでIcebergの vacuumとoptimizeを設定
  23. Copyright(C) Net Protections,Inc. All Rights Reserved. まとめ:パフォーマンスのBefore/After Before • 全量更新がAthenaの計算リソース不足により月に3〜4回失敗

    & 障害対応。 • 内製システムでの複雑なデータ変換処理のメンテナンスの限界。 After • Iceberg + MERGE INTOを使った差分更新で計算リソース不足のエラーを回避。 ◦ エラーは数ヶ月に1回程度 • dbtによる安定した処理が実現。内製システムのメンテナンスが楽に。 • dbtの機能・エコシステムが豊富。 パフォーマンス データ量のスケールに耐えうる基盤を実現。 dbtを使ったデータ加工のベストプラクティスを踏襲可能に。
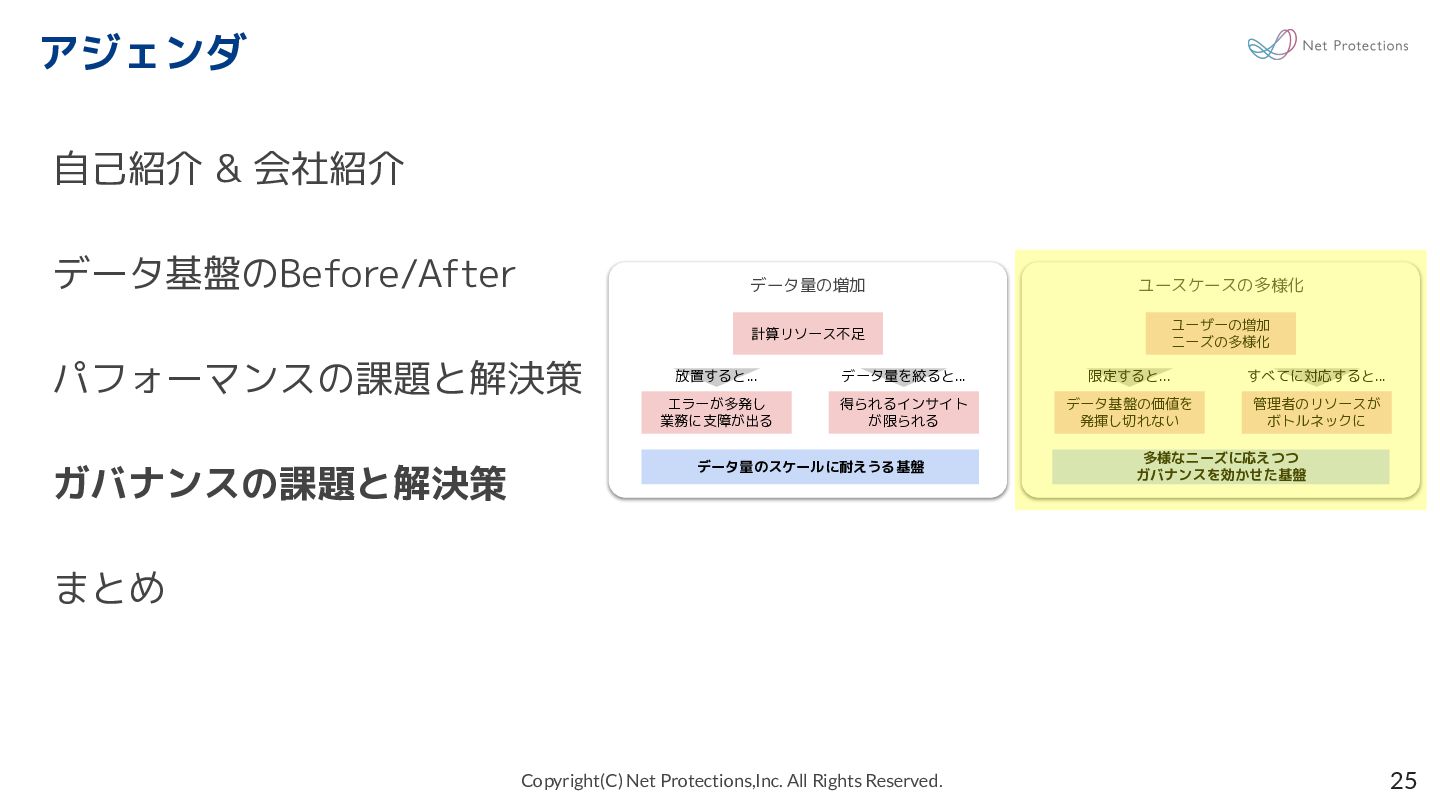
  24. Copyright(C) Net Protections,Inc. All Rights Reserved. アジェンダ 25 ユースケースの多様化 ユーザーの増加

    ニーズの多様化 管理者のリソースが ボトルネックに データ基盤の価値を 発揮し切れない データ量の増加 計算リソース不足 得られるインサイト が限られる エラーが多発し 業務に支障が出る 放置すると... データ量を絞ると... すべてに対応すると... 限定すると... 多様なニーズに応えつつ ガバナンスを効かせた基盤 データ量のスケールに耐えうる基盤 自己紹介 & 会社紹介 データ基盤のBefore/After パフォーマンスの課題と解決策 ガバナンスの課題と解決策 まとめ
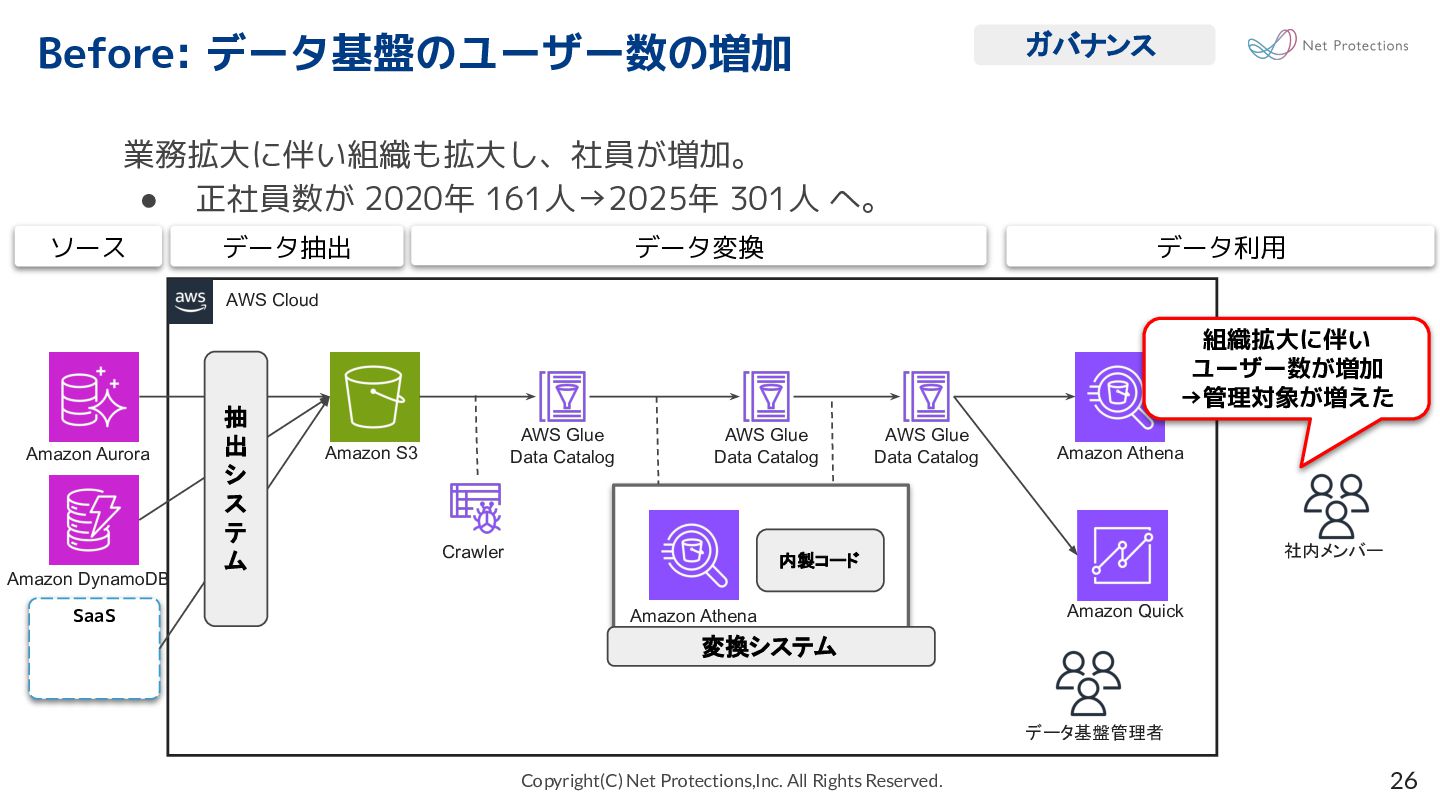
  25. Copyright(C) Net Protections,Inc. All Rights Reserved. 業務拡大に伴い組織も拡大し、社員が増加。 • 正社員数が 2020年

    161人→2025年 301人 へ。 AWS Cloud Before: データ基盤のユーザー数の増加 26 データ利用 データ抽出 ソース データ変換 AWS Glue Data Catalog Amazon Athena Amazon Quick Crawler AWS Glue Data Catalog AWS Glue Data Catalog SaaS 抽 出 シ ス テ ム Amazon Aurora Amazon DynamoDB Amazon Athena 内製コード 変換システム データ基盤管理者 社内メンバー 組織拡大に伴い ユーザー数が増加 →管理対象が増えた ガバナンス Amazon S3
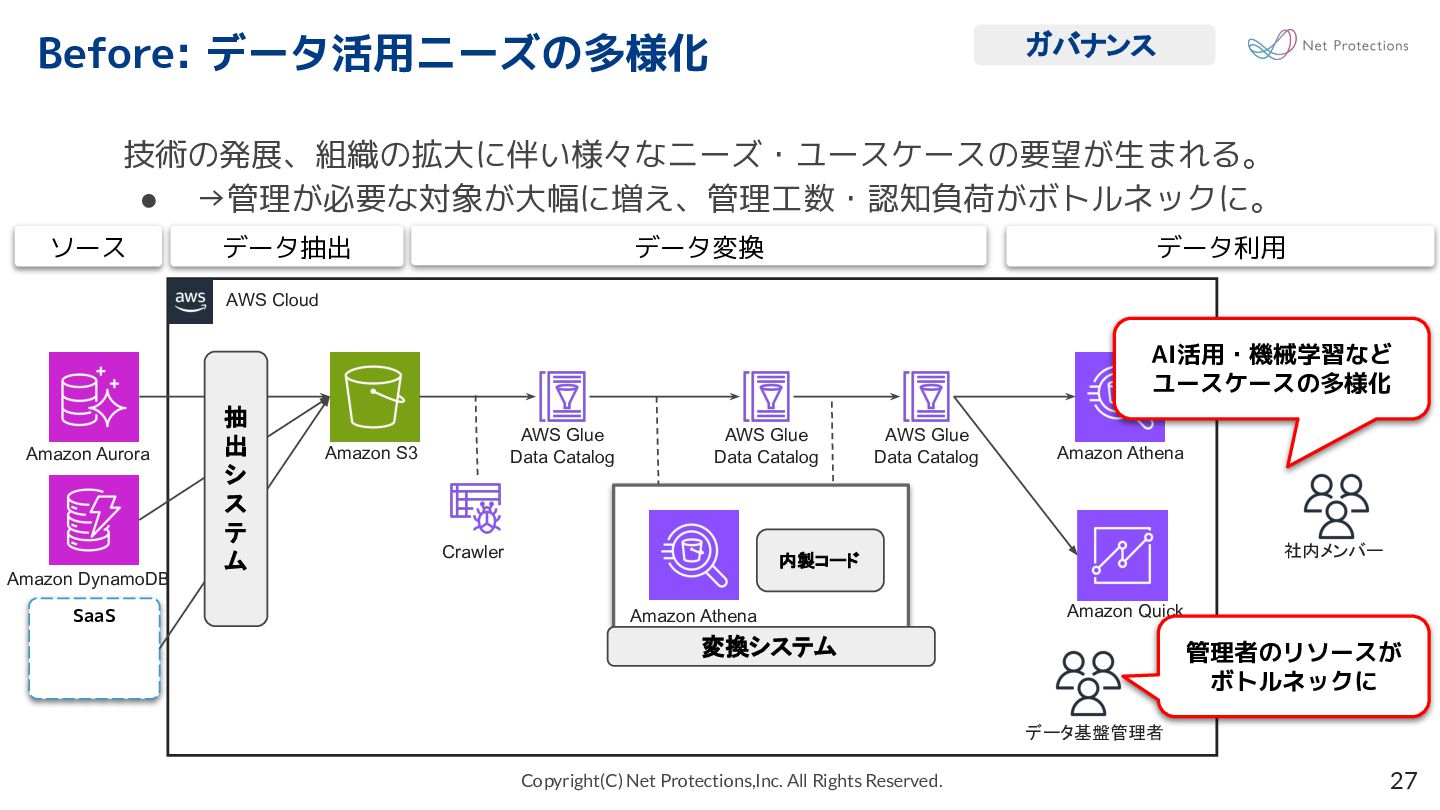
  26. Copyright(C) Net Protections,Inc. All Rights Reserved. 技術の発展、組織の拡大に伴い様々なニーズ・ユースケースの要望が生まれる。 • →管理が必要な対象が大幅に増え、管理工数・認知負荷がボトルネックに。 AWS

    Cloud Before: データ活用ニーズの多様化 27 データ利用 データ抽出 ソース データ変換 AWS Glue Data Catalog Amazon Athena Amazon Quick Crawler AWS Glue Data Catalog AWS Glue Data Catalog SaaS 抽 出 シ ス テ ム Amazon Aurora Amazon DynamoDB Amazon Athena 内製コード 変換システム データ基盤管理者 社内メンバー AI活用・機械学習など ユースケースの多様化 管理者のリソースが ボトルネックに ガバナンス Amazon S3
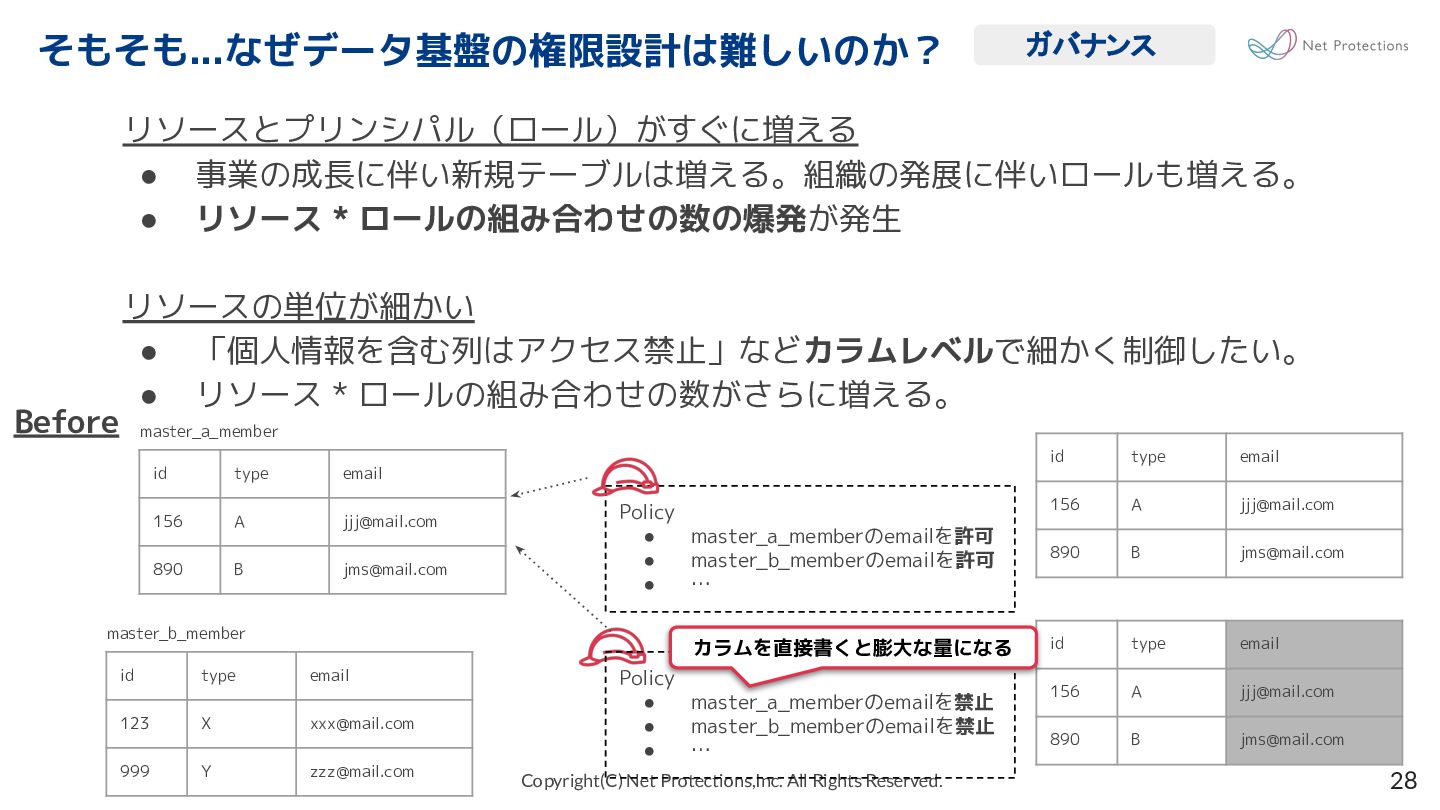
  27. Copyright(C) Net Protections,Inc. All Rights Reserved. リソースとプリンシパル(ロール)がすぐに増える • 事業の成長に伴い新規テーブルは増える。組織の発展に伴いロールも増える。 •

    リソース * ロールの組み合わせの数の爆発が発生 リソースの単位が細かい • 「個人情報を含む列はアクセス禁止」などカラムレベルで細かく制御したい。 • リソース * ロールの組み合わせの数がさらに増える。 そもそも...なぜデータ基盤の権限設計は難しいのか? 28 id type email 156 A [email protected] 890 B [email protected] id type email 156 A [email protected] 890 B [email protected] Policy • master_a_memberのemailを許可 • master_b_memberのemailを許可 • … id type email 156 A [email protected] 890 B [email protected] master_a_member id type email 123 X [email protected] 999 Y [email protected] master_b_member ガバナンス Policy • master_a_memberのemailを禁止 • master_b_memberのemailを禁止 • … カラムを直接書くと膨大な量になる Before
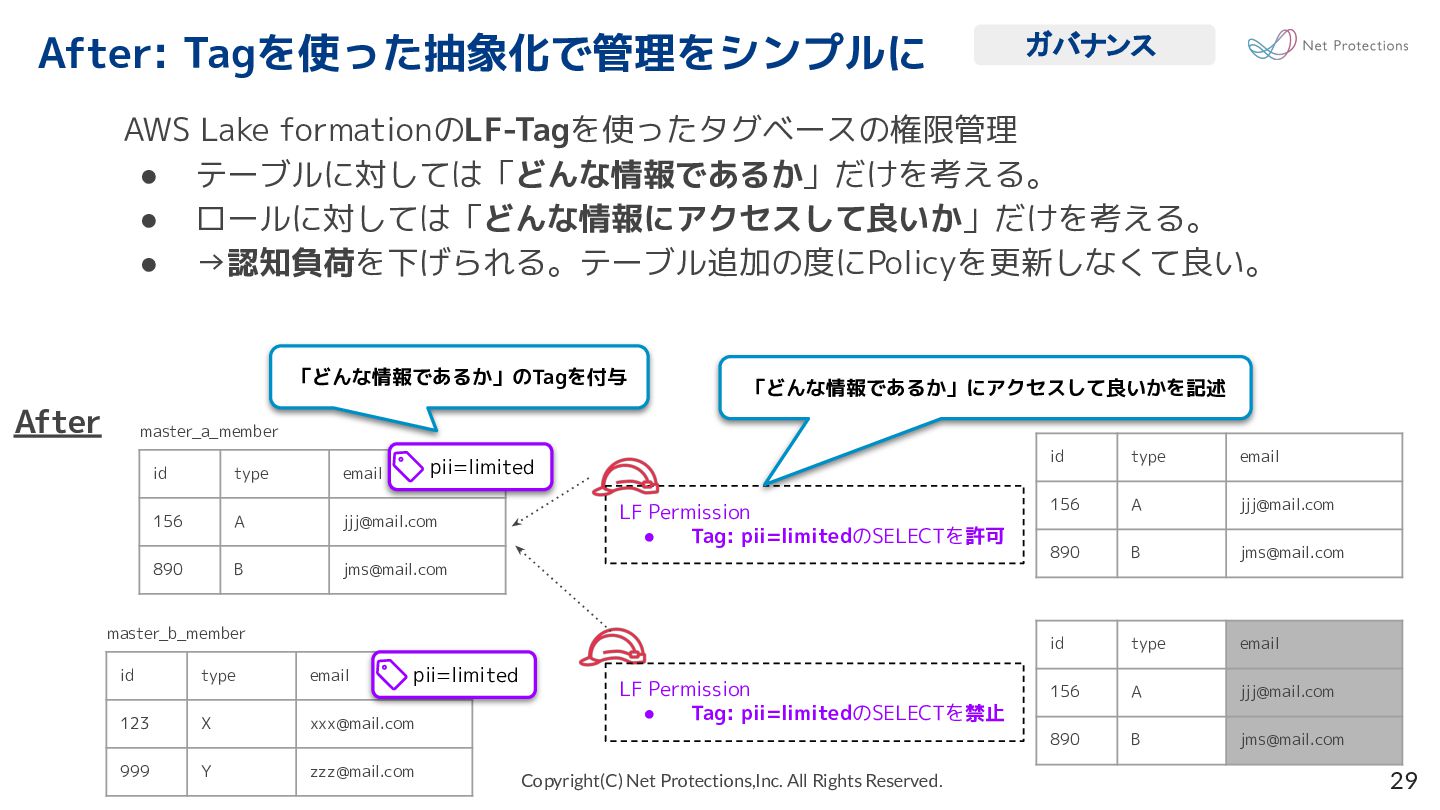
  28. Copyright(C) Net Protections,Inc. All Rights Reserved. AWS Lake formationのLF-Tagを使ったタグベースの権限管理 •

    テーブルに対しては「どんな情報であるか」だけを考える。 • ロールに対しては「どんな情報にアクセスして良いか」だけを考える。 • →認知負荷を下げられる。テーブル追加の度にPolicyを更新しなくて良い。 After: Tagを使った抽象化で管理をシンプルに 29 id type email 156 A [email protected] 890 B [email protected] id type email 156 A [email protected] 890 B [email protected] id type email 156 A [email protected] 890 B [email protected] master_a_member id type email 123 X [email protected] 999 Y [email protected] master_b_member 「どんな情報であるか」のTagを付与 ガバナンス LF Permission • Tag: pii=limitedのSELECTを許可 LF Permission • Tag: pii=limitedのSELECTを禁止 pii=limited pii=limited 「どんな情報であるか」にアクセスして良いかを記述 After
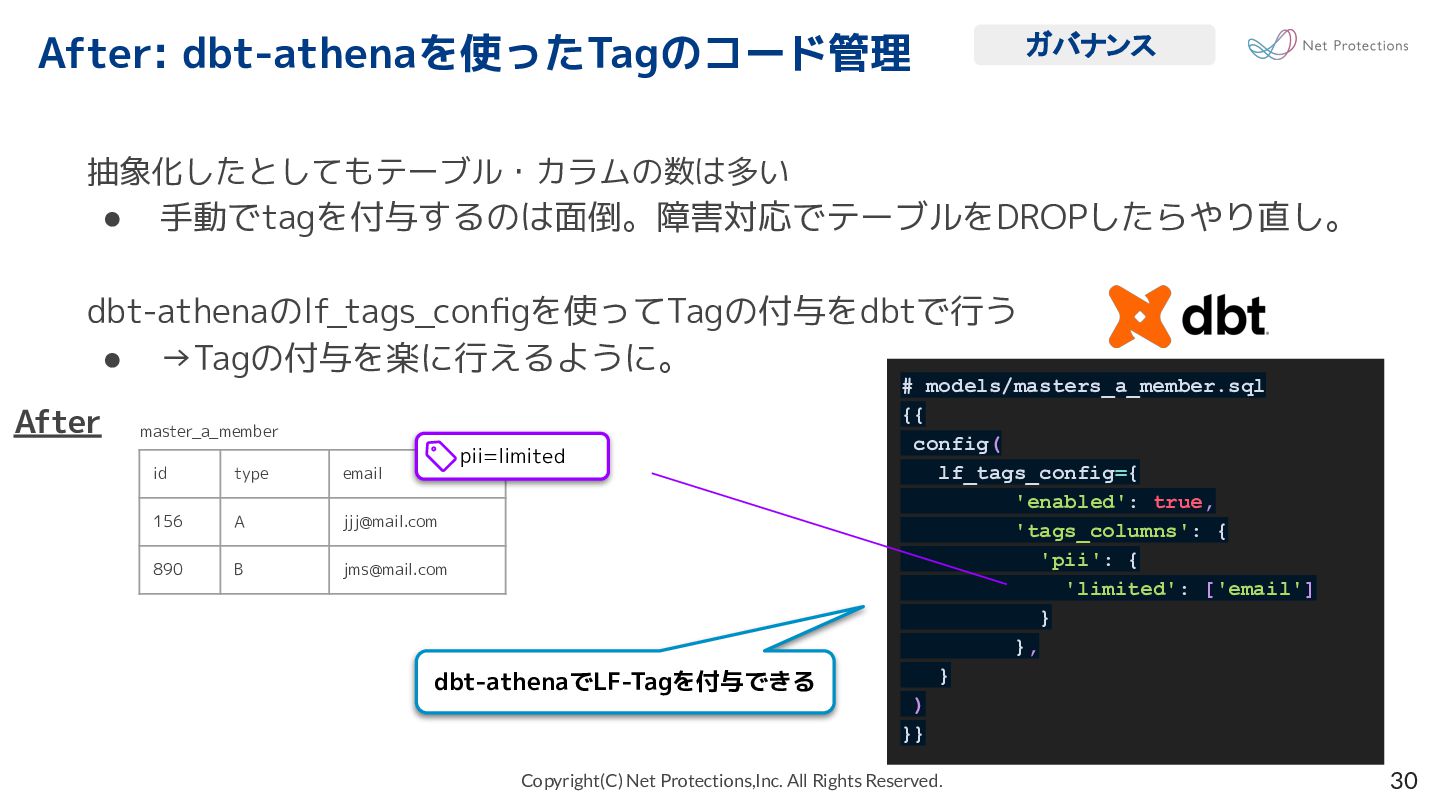
  29. Copyright(C) Net Protections,Inc. All Rights Reserved. 抽象化したとしてもテーブル・カラムの数は多い • 手動でtagを付与するのは面倒。障害対応でテーブルをDROPしたらやり直し。 dbt-athenaのlf_tags_configを使ってTagの付与をdbtで行う

    • →Tagの付与を楽に行えるように。 After: dbt-athenaを使ったTagのコード管理 30 # models/masters_a_member.sql {{ config( lf_tags_config={ 'enabled': true, 'tags_columns': { 'pii': { 'limited': ['email'] } }, } ) }} id type email 156 A [email protected] 890 B [email protected] master_a_member pii=limited ガバナンス dbt-athenaでLF-Tagを付与できる After
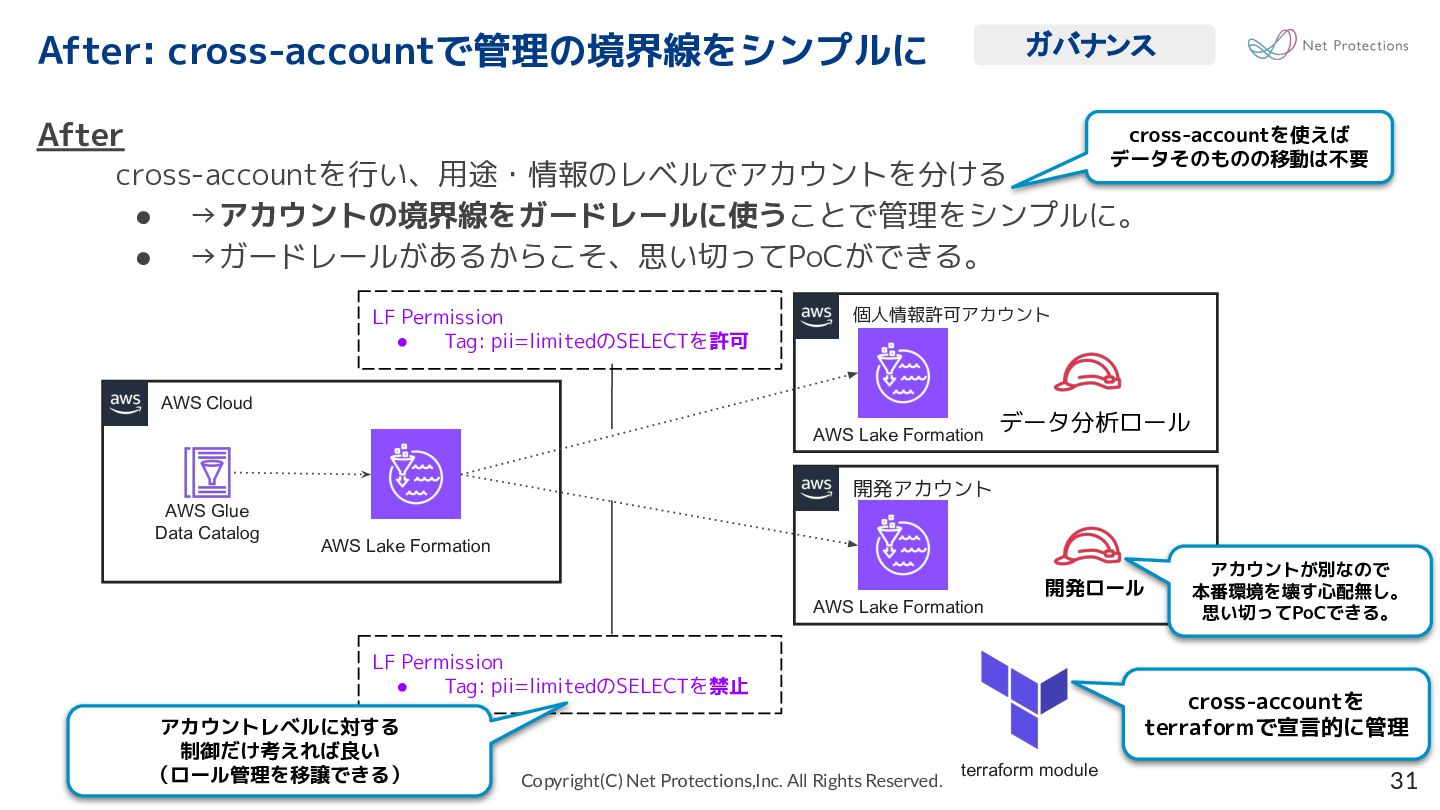
  30. Copyright(C) Net Protections,Inc. All Rights Reserved. cross-accountを行い、用途・情報のレベルでアカウントを分ける • →アカウントの境界線をガードレールに使うことで管理をシンプルに。 •

    →ガードレールがあるからこそ、思い切ってPoCができる。 個人情報許可アカウント AWS Cloud After: cross-accountで管理の境界線をシンプルに 31 AWS Glue Data Catalog AWS Lake Formation AWS Lake Formation 開発アカウント AWS Lake Formation アカウントが別なので 本番環境を壊す心配無し。 思い切ってPoCできる。 ガバナンス LF Permission • Tag: pii=limitedのSELECTを禁止 LF Permission • Tag: pii=limitedのSELECTを許可 開発ロール アカウントレベルに対する 制御だけ考えれば良い (ロール管理を移譲できる) After データ分析ロール cross-accountを使えば データそのものの移動は不要 terraform module cross-accountを terraformで宣言的に管理
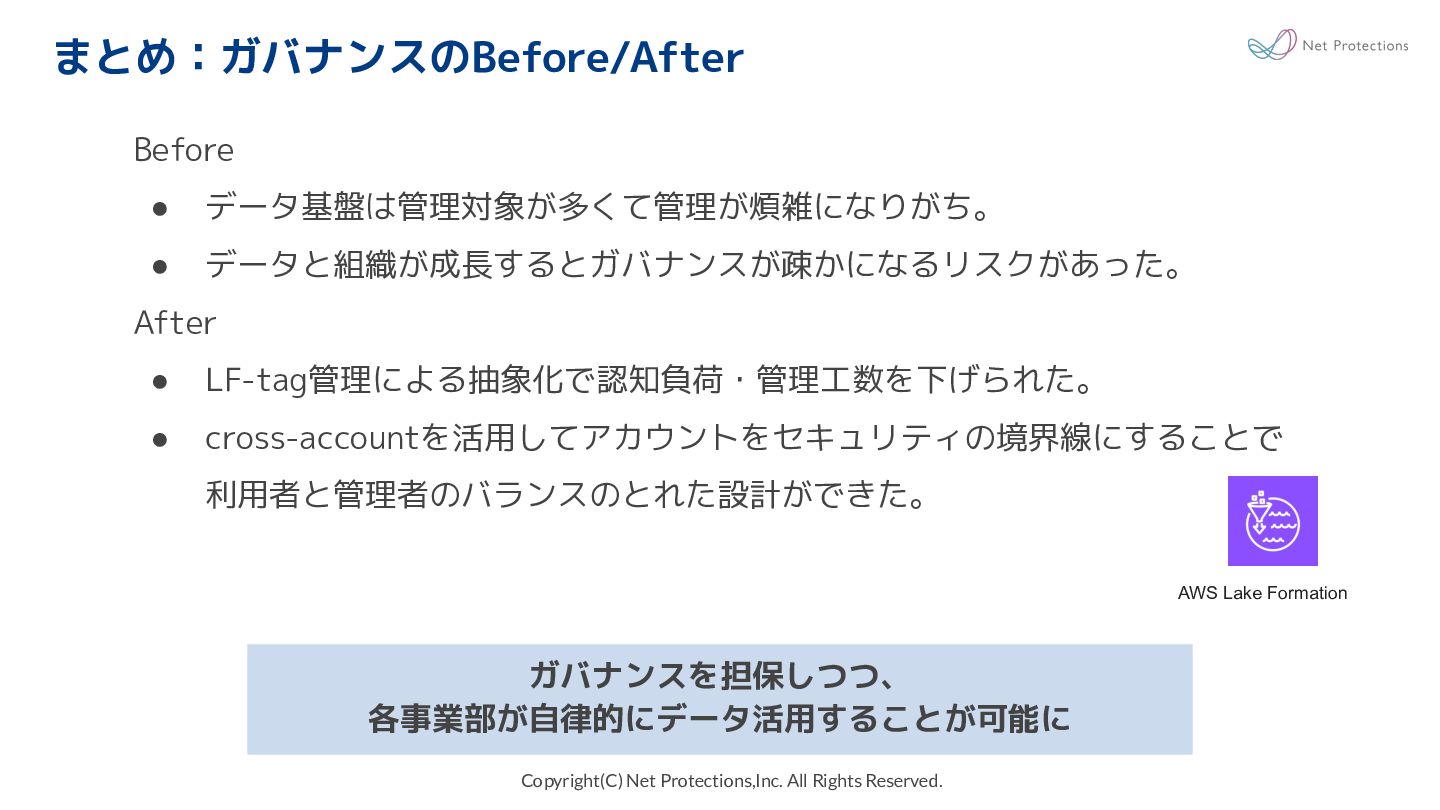
  31. Copyright(C) Net Protections,Inc. All Rights Reserved. まとめ:ガバナンスのBefore/After Before • データ基盤は管理対象が多くて管理が煩雑になりがち。

    • データと組織が成長するとガバナンスが疎かになるリスクがあった。 After • LF-tag管理による抽象化で認知負荷・管理工数を下げられた。 • cross-accountを活用してアカウントをセキュリティの境界線にすることで 利用者と管理者のバランスのとれた設計ができた。 ガバナンスを担保しつつ、 各事業部が自律的にデータ活用することが可能に AWS Lake Formation
  32. Copyright(C) Net Protections,Inc. All Rights Reserved. アジェンダ 33 自己紹介 &

    会社紹介 データ基盤のBefore/After パフォーマンスの課題と解決策 ガバナンスの課題と解決策 まとめ
  33. Copyright(C) Net Protections,Inc. All Rights Reserved. ニーズの多様化 総括 34 ユーザーの増加

    ニーズの多様化 管理者のリソースが ボトルネックに データ基盤の価値を 発揮し切れない データ量の増加 計算リソース不足 得られるインサイト が限られる エラーが多発し 業務に支障が出る 放置すると... データ量を絞ると... すべてに対応すると... 限定すると... データ量のスケールに耐えうる基盤 多様なニーズに応えつつ ガバナンスを効かせた基盤 dbt, Icebergを使った差分更新 dbtを使ってデータ加工・管理の ベストプラクティスを実現 Tag管理で認知負荷を軽減 cross-accountで管理の境界線をシンプルに パフォーマンス ガバナンス 「データ・組織のそれぞれの発展に合わせてスケールするデータ基盤」を実現。
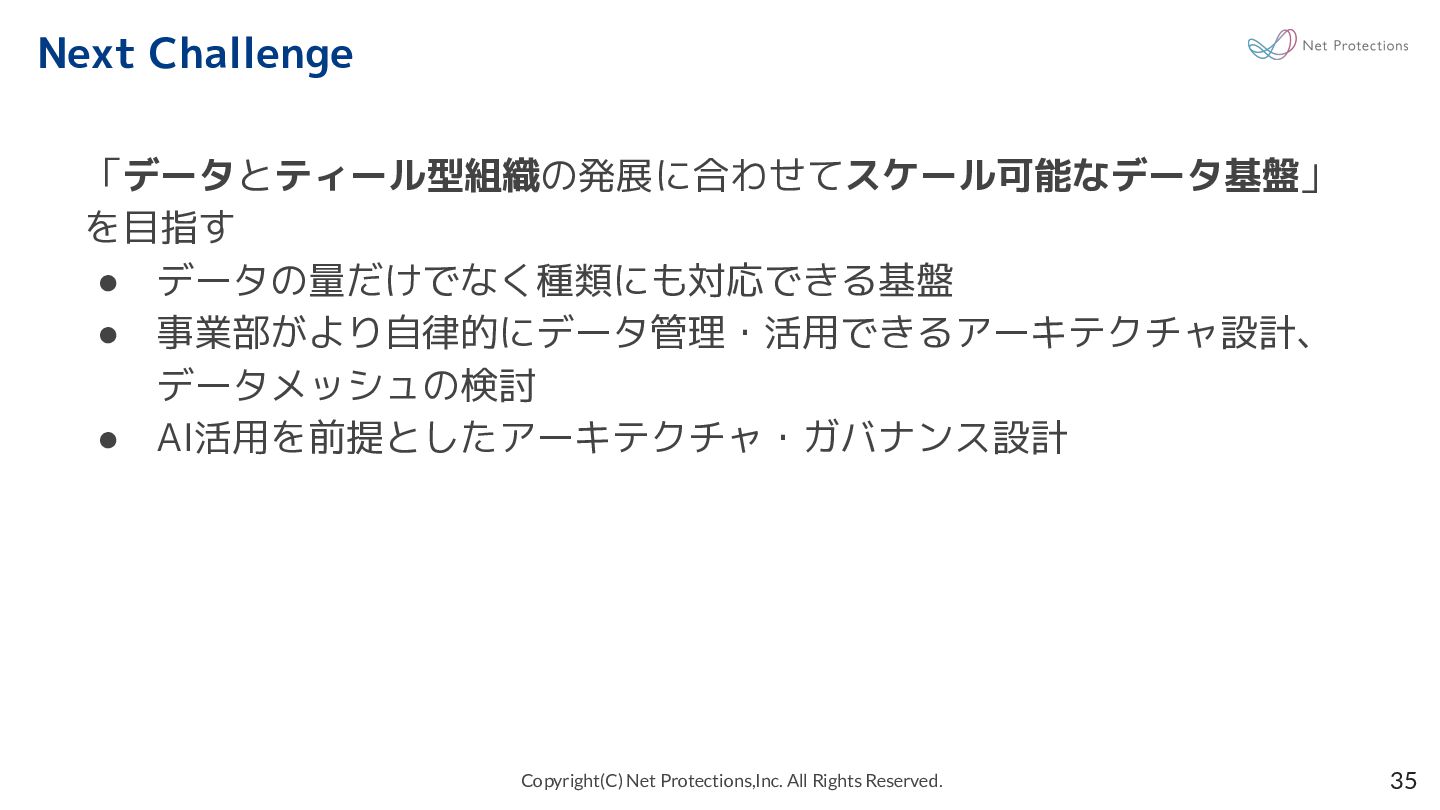
  34. Copyright(C) Net Protections,Inc. All Rights Reserved. 「データとティール型組織の発展に合わせてスケール可能なデータ基盤」 を目指す • データの量だけでなく種類にも対応できる基盤

    • 事業部がより自律的にデータ管理・活用できるアーキテクチャ設計、 データメッシュの検討 • AI活用を前提としたアーキテクチャ・ガバナンス設計 Next Challenge 35