Upgrade to Pro — share decks privately, control downloads, hide ads and more …

World 2 で、World 2 の Database を作る

Avatar for Satomi N Satomi N
September 17, 2026

World 2 で、World 2 の Database を作る

https://storesinc.tech/conf/2026

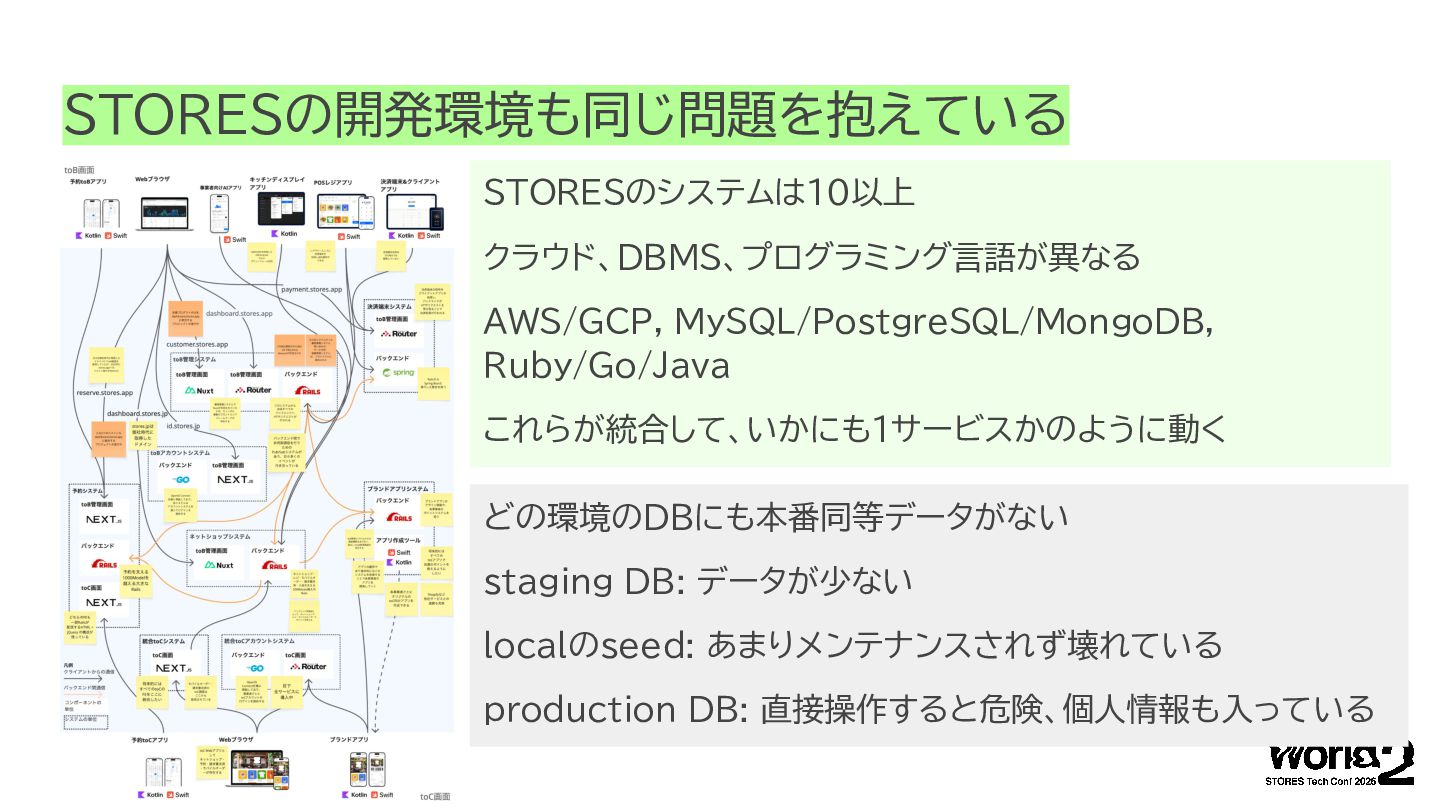
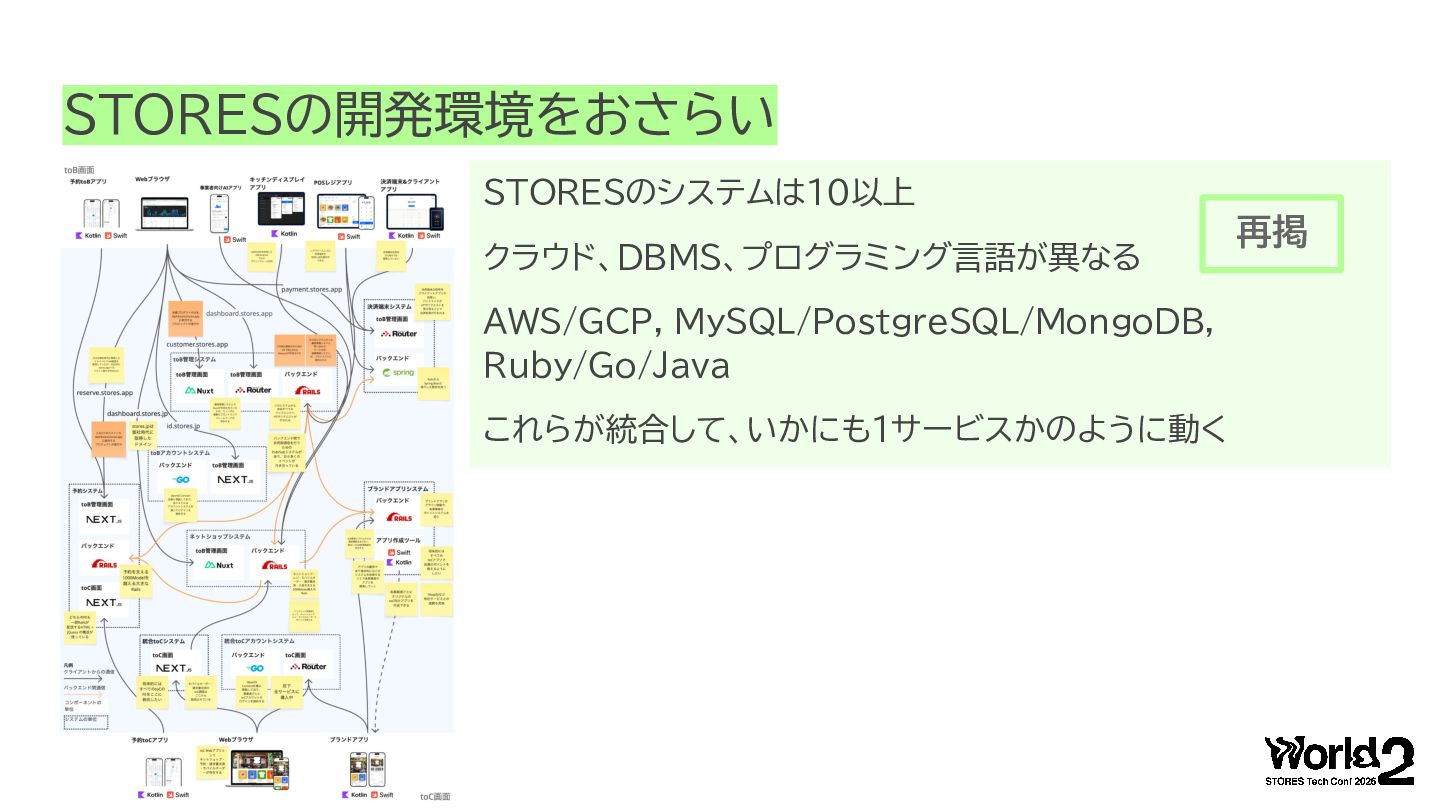
STORES には10個以上のシステムがあり、クラウド、DBMS、プログラミング言語がそれぞれ異なります。開発環境の初期データは十分にメンテナンスされておらず、また staging 環境にもデータが少ないため、本番環境と同等の動作検証が困難でした。これは以前からの課題ですが、AI が実装から検証まで自律的に行う World 2 において、特にボトルネックとなりました。

そこで Mirage DB という、本番環境と同等、かつ安全に触れるデータベースを開発しました。これにより AI エージェントや開発者が、オンデマンドで個人情報をマスクしたデータベースを払い出し、本番同等のデータで動作検証できるようになりました。

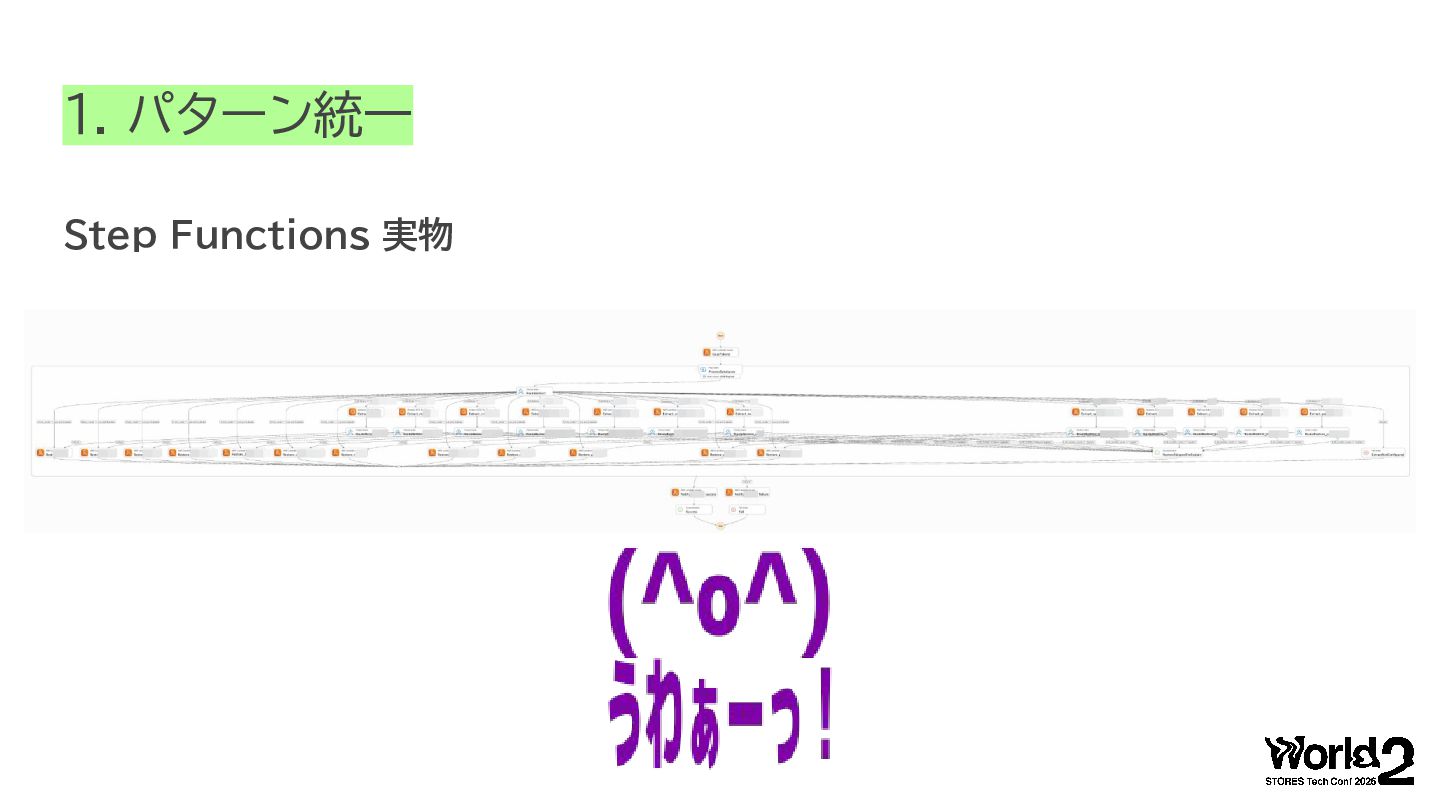
World 2 で求められる AI 自律開発環境、Mirage DB の具体的な技術設計、そして人間として私がした仕事についてお話します。

Avatar for Satomi N

Satomi N

September 17, 2026

More Decks by Satomi N

Other Decks in Technology

Transcript

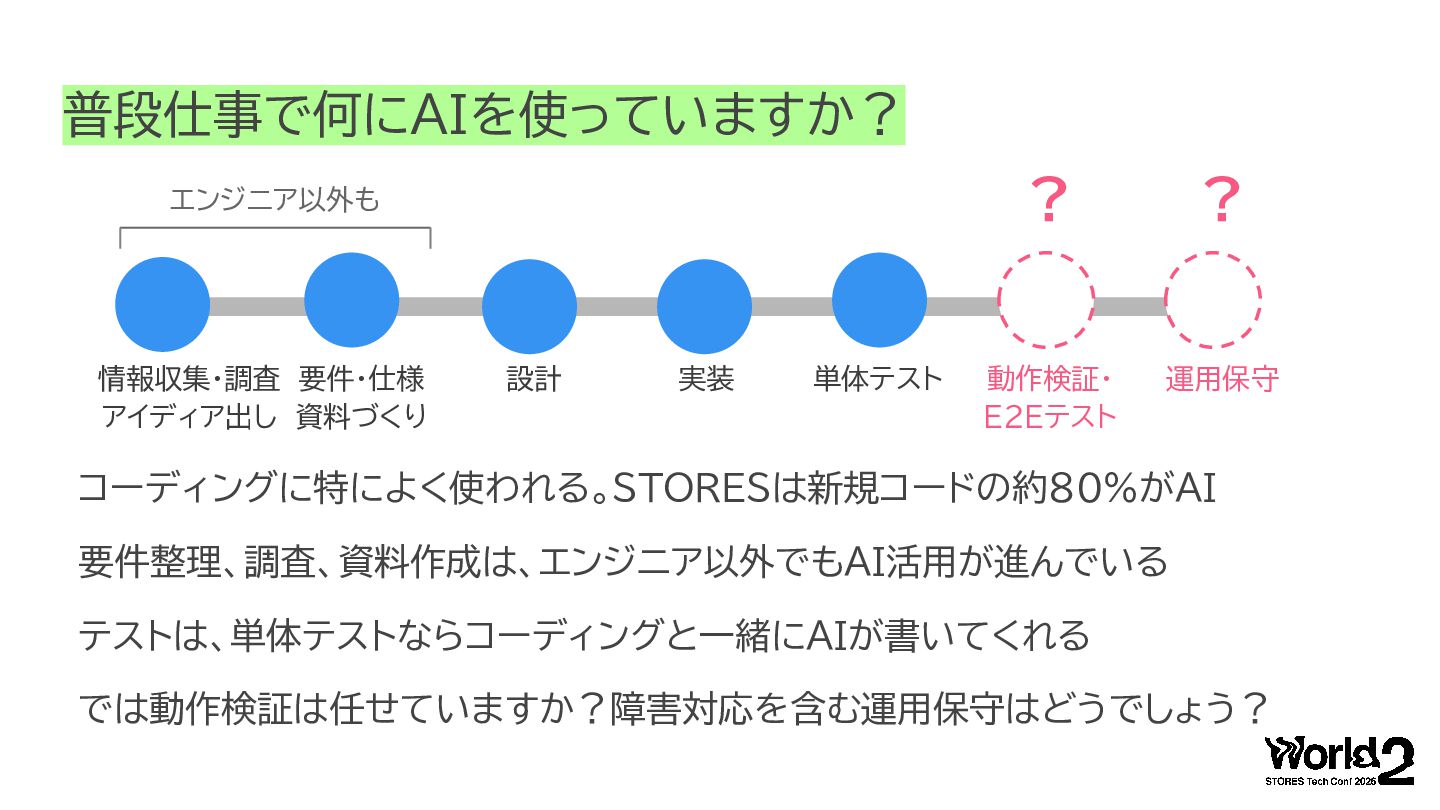
  1. 普段仕事で何にAIを使っていますか? エンジニア以外も 情報収集・調査 要件・仕様 アイディア出し 資料づくり 設計 実装 単体テスト ?

    ? 動作検証・ E2Eテスト 運用保守 コーディングに特によく使われる。STORESは新規コードの約80%がAI 要件整理、調査、資料作成は、エンジニア以外でもAI活用が進んでいる テストは、単体テストならコーディングと一緒にAIが書いてくれる では動作検証は任せていますか?障害対応を含む運用保守はどうでしょう?
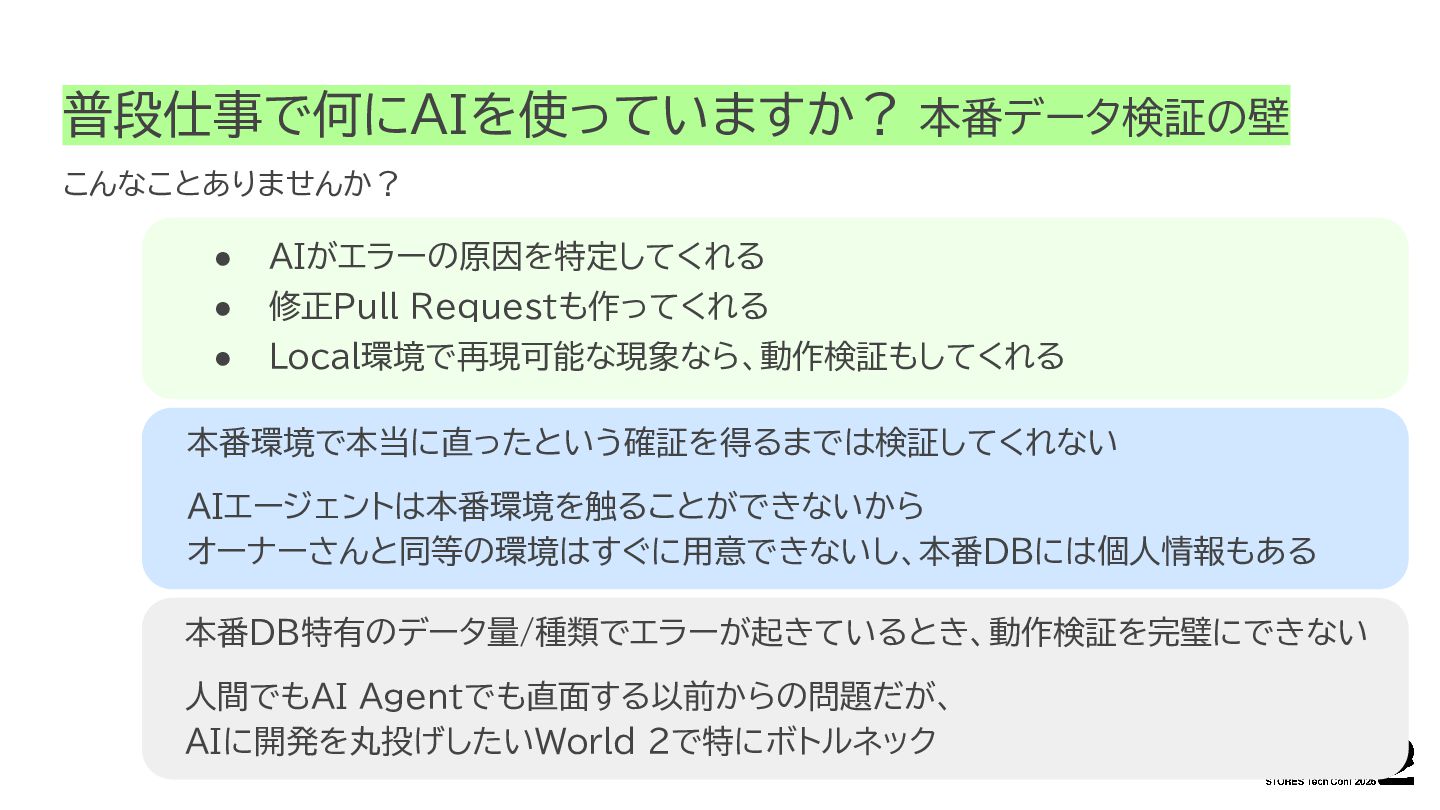
  2. 普段仕事で何にAIを使っていますか? 本番データ検証の壁 こんなことありませんか? • AIがエラーの原因を特定してくれる �� • 修正Pull Requestも作ってくれる •

    Local環境で再現可能な現象なら、動作検証もしてくれる 本番環境で本当に直ったという確証を得るまでは検証してくれない �� AIエージェントは本番環境を触ることができないから オーナーさんと同等の環境はすぐに用意できないし、本番DBには個人情報もある 本番DB特有のデータ量/種類でエラーが起きているとき、動作検証を完璧にできない ��人間でもAI Agentでも直面する以前からの問題だが、 AIに開発を丸投げしたいWorld 2で特にボトルネック
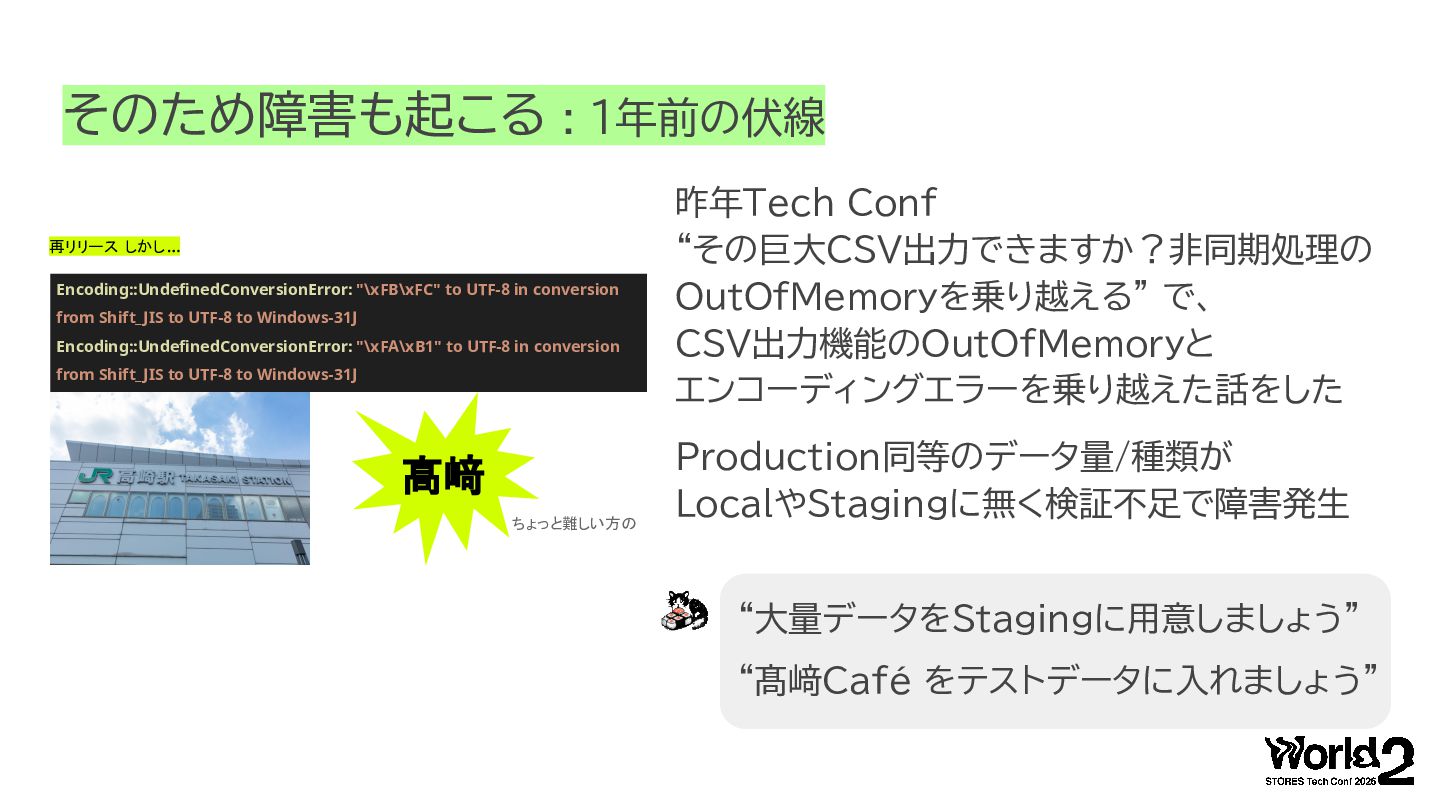
  3. そのため障害も起こる : 1年前の伏線 再リリース しかし … Encoding::UndefinedConversionError: "\xFB\xFC" to UTF-8

    in conversion from Shift_JIS to UTF-8 to Windows-31J Encoding::UndefinedConversionError: "\xFA\xB1" to UTF-8 in conversion from Shift_JIS to UTF-8 to Windows-31J 髙﨑 ちょっと難しい方の 昨年Tech Conf “その巨大CSV出力できますか?非同期処理の OutOfMemoryを乗り越える” で、 CSV出力機能のOutOfMemoryと エンコーディングエラーを乗り越えた話をした Production同等のデータ量/種類が LocalやStagingに無く検証不足で障害発生 “大量データをStagingに用意しましょう” “髙﨑Café をテストデータに入れましょう”
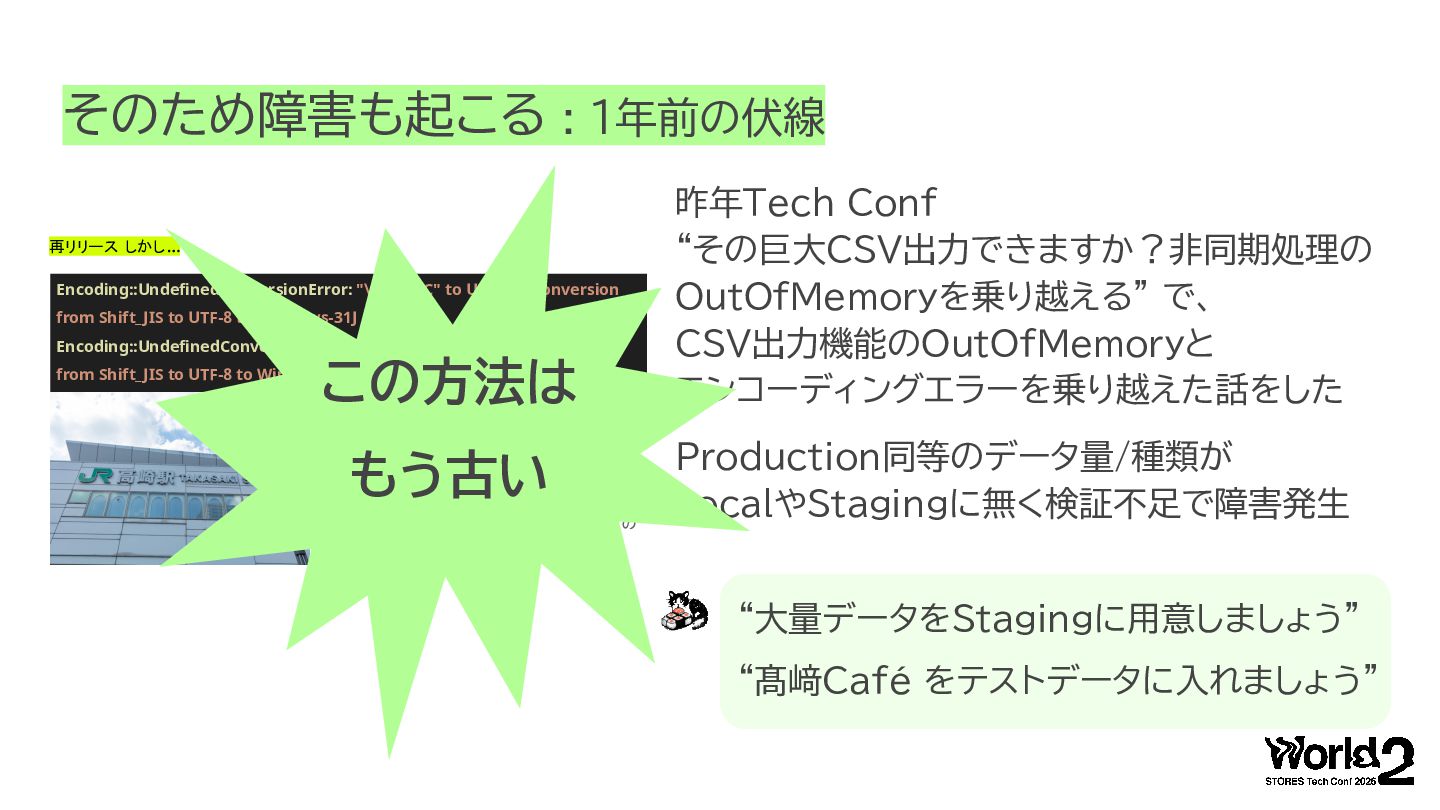
  4. そのため障害も起こる : 1年前の伏線 再リリース しかし … Encoding::UndefinedConversionError: "\xFB\xFC" to UTF-8

    in conversion from Shift_JIS to UTF-8 to Windows-31J Encoding::UndefinedConversionError: "\xFA\xB1" to UTF-8 in conversion この方法は from Shift_JIS to UTF-8 to Windows-31J 髙﨑 もう古い ちょっと難しい方の 昨年Tech Conf “その巨大CSV出力できますか?非同期処理の OutOfMemoryを乗り越える” で、 CSV出力機能のOutOfMemoryと エンコーディングエラーを乗り越えた話をした Production同等のデータ量/種類が LocalやStagingに無く検証不足で障害発生 “大量データをStagingに用意しましょう” “髙﨑Café をテストデータに入れましょう”
  5. 本番同等で安全なDatabaseを作れないか? どの環境のDBにも本番同等データがない staging DB: データが少ない localのseed: あまりメンテナンスされず壊れている production DB: 直接操作すると危険、個人情報も入っている

    では作れないか? 本番同等かつ個人情報がマスキングされたDatabaseと、 そのDatabaseにつながった開発環境を作れば、 AIに本番同等の動作検証まで丸投げできる 人間は、開発したいものは何か?という課題設定や意思決定 人間同士のコミュニケーションに集中できる 再掲
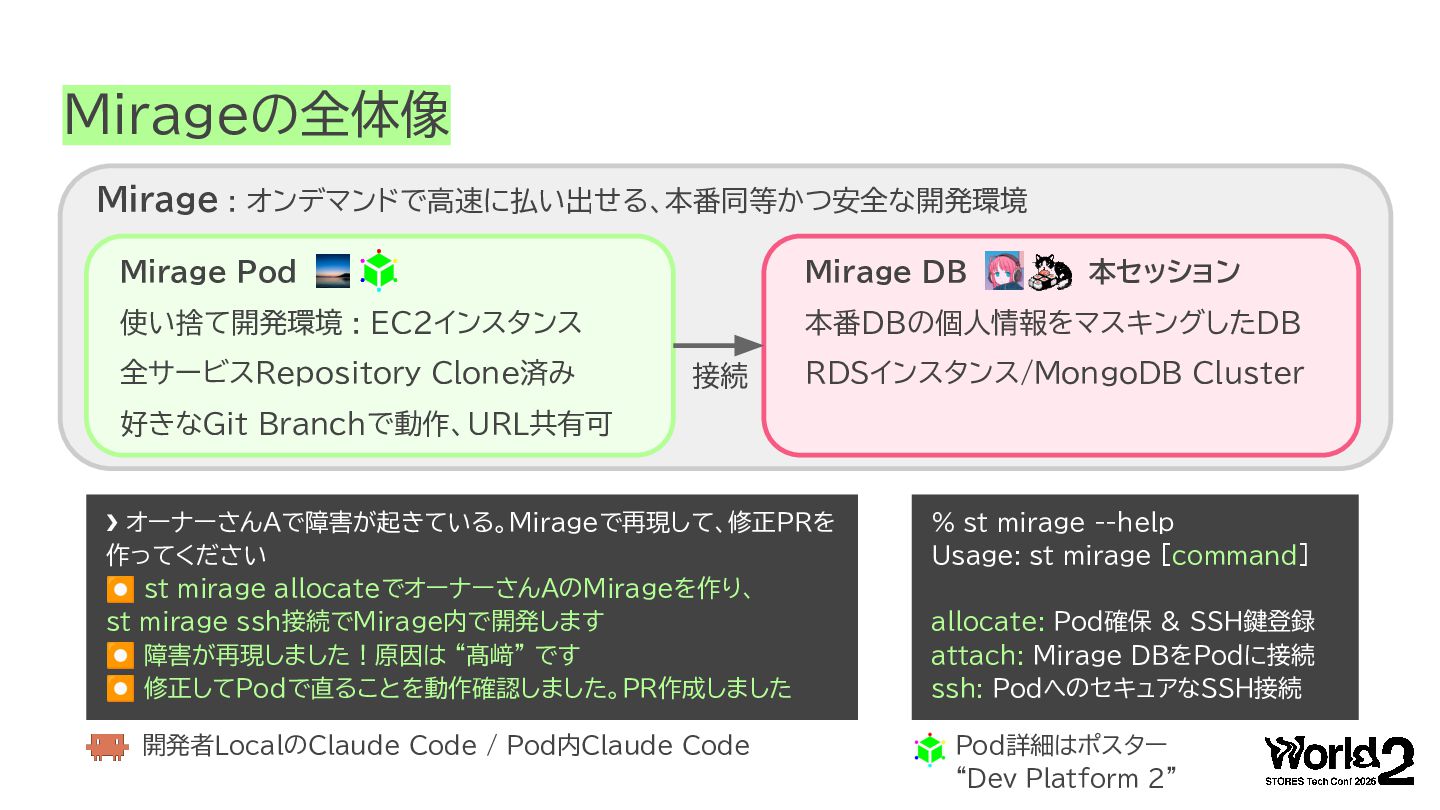
  6. Mirageの全体像 Mirage : オンデマンドで高速に払い出せる、本番同等かつ安全な開発環境 Mirage Pod Mirage DB 使い捨て開発環境 :

    EC2インスタンス 本番DBの個人情報をマスキングしたDB 全サービスRepository Clone済み 接続 本セッション RDSインスタンス/MongoDB Cluster 好きなGit Branchで動作、URL共有可 ❯ オーナーさんAで障害が起きている。Mirageで再現して、修正PRを 作ってください ⏺ st mirage allocateでオーナーさんAのMirageを作り、 st mirage ssh接続でMirage内で開発します ⏺ 障害が再現しました!原因は “髙﨑” です ⏺ 修正してPodで直ることを動作確認しました。PR作成しました 開発者LocalのClaude Code / Pod内Claude Code % st mirage --help Usage: st mirage [command] allocate: Pod確保 & SSH鍵登録 attach: Mirage DBをPodに接続 ssh: PodへのセキュアなSSH接続 Pod詳細はポスター “Dev Platform 2”
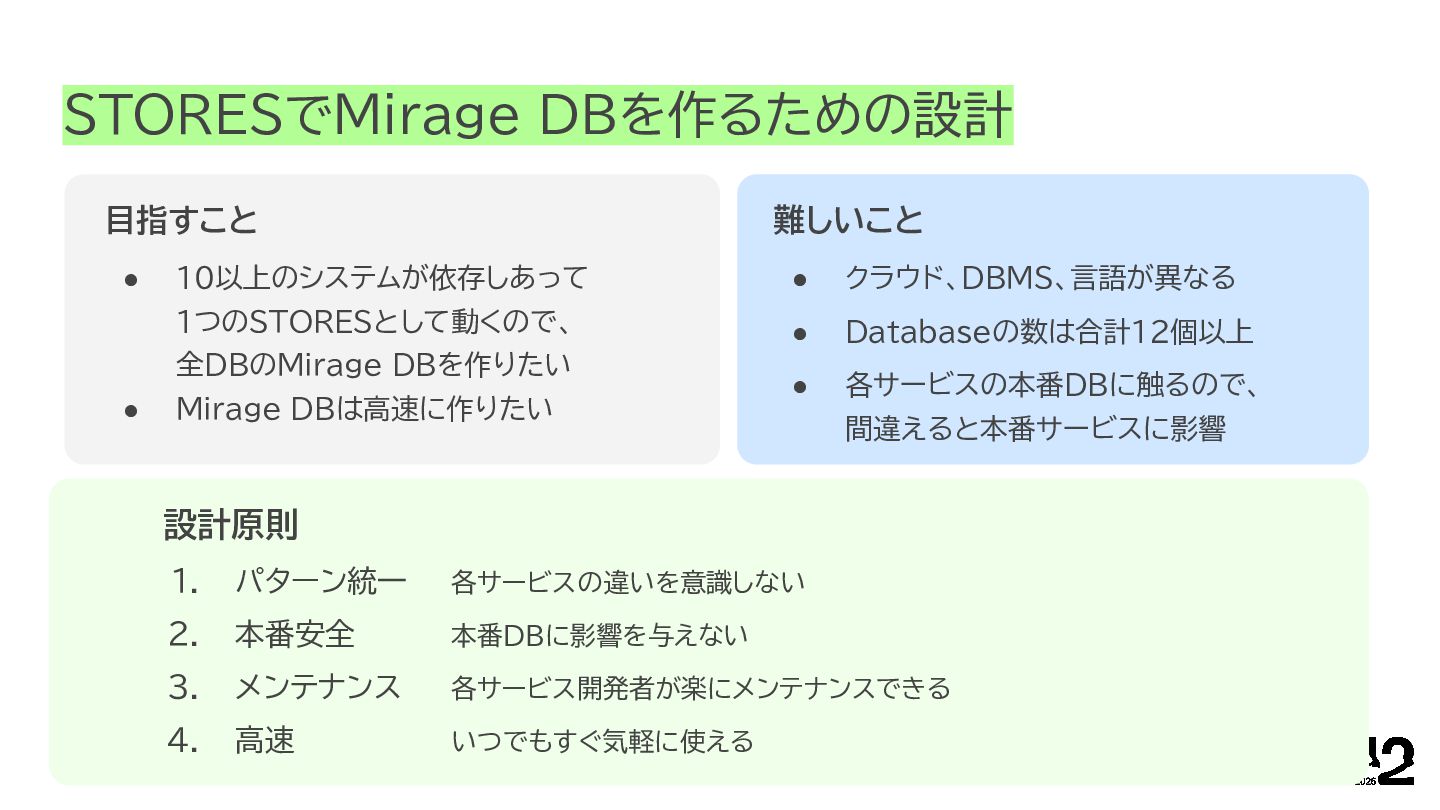
  7. STORESでMirage DBを作るための設計 目指すこと • 難しいこと 10以上のシステムが依存しあって • クラウド、DBMS、言語が異なる 1つのSTORESとして動くので、 •

    Databaseの数は合計12個以上 • 各サービスの本番DBに触るので、 全DBのMirage DBを作りたい • Mirage DBは高速に作りたい 間違えると本番サービスに影響 設計原則 1. パターン統一 各サービスの違いを意識しない 2. 本番安全 本番DBに影響を与えない 3. メンテナンス 各サービス開発者が楽にメンテナンスできる 4. 高速 いつでもすぐ気軽に使える
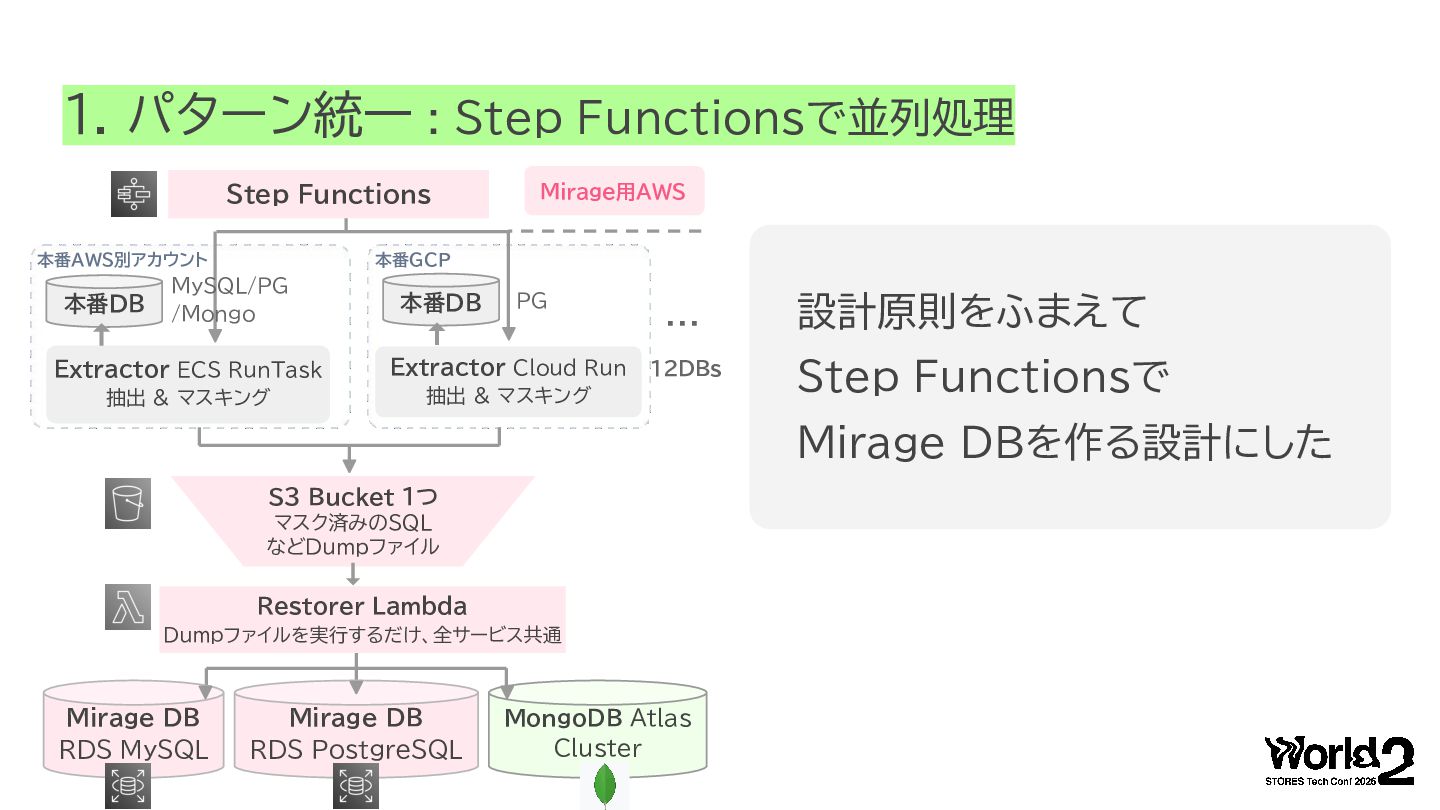
  8. 1. パターン統一 : Step Functionsで並列処理 Step Functions 本番AWS別アカウント 本番DB Mirage用AWS

    本番GCP MySQL/PG /Mongo 本番DB PG Extractor ECS RunTask Extractor Cloud Run 抽出 & マスキング 抽出 & マスキング … 12DBs 設計原則をふまえて Step Functionsで Mirage DBを作る設計にした S3 Bucket 1つ マスク済みのSQL などDumpファイル Restorer Lambda Dumpファイルを実行するだけ、全サービス共通 Mirage DB RDS MySQL Mirage DB RDS PostgreSQL MongoDB Atlas Cluster
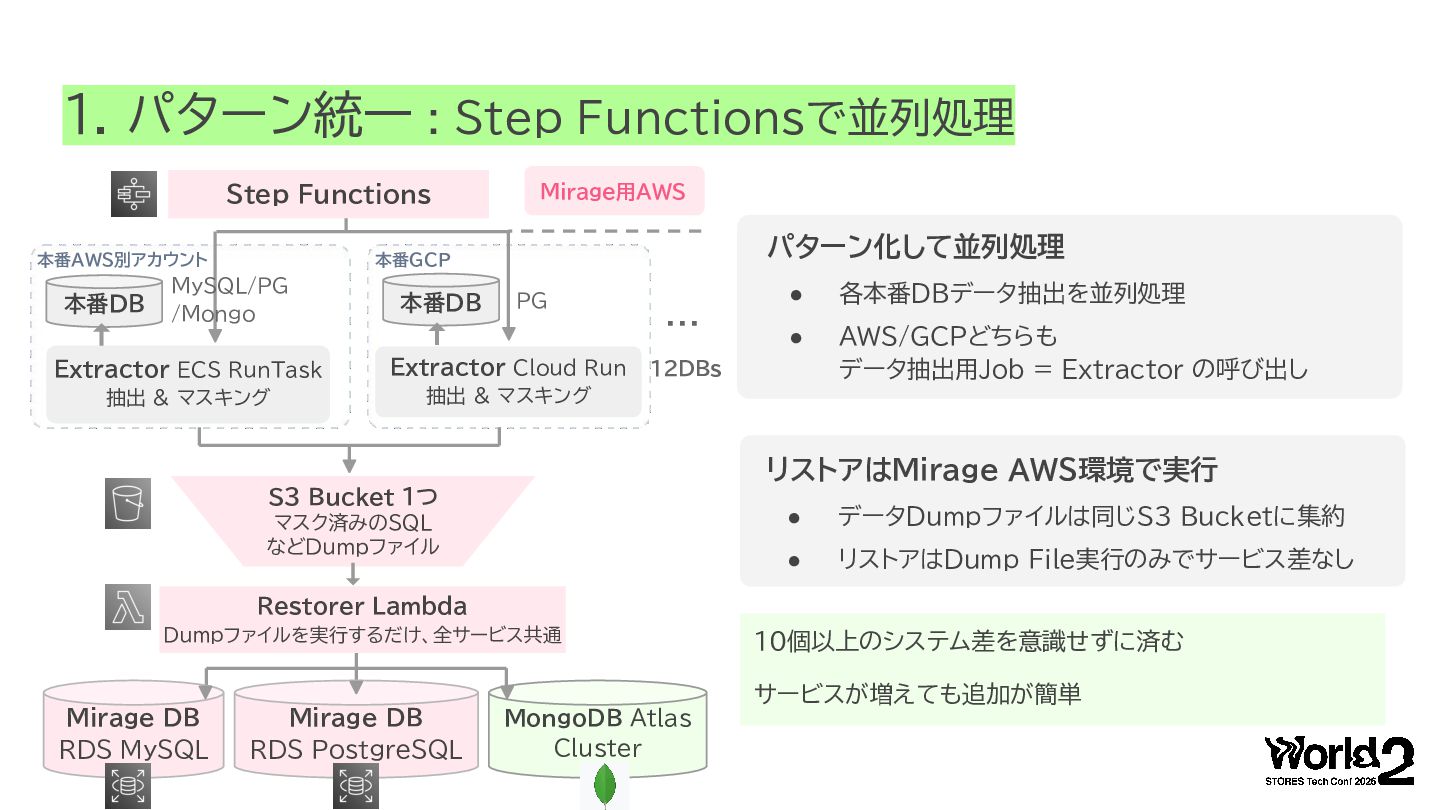
  9. 1. パターン統一 : Step Functionsで並列処理 Step Functions 本番AWS別アカウント 本番DB Mirage用AWS

    パターン化して並列処理 本番GCP MySQL/PG /Mongo 本番DB PG Extractor ECS RunTask Extractor Cloud Run 抽出 & マスキング 抽出 & マスキング … • 各本番DBデータ抽出を並列処理 • AWS/GCPどちらも データ抽出用Job = Extractor の呼び出し 12DBs リストアはMirage AWS環境で実行 S3 Bucket 1つ マスク済みのSQL などDumpファイル • データDumpファイルは同じS3 Bucketに集約 • リストアはDump File実行のみでサービス差なし Restorer Lambda Dumpファイルを実行するだけ、全サービス共通 Mirage DB RDS MySQL Mirage DB RDS PostgreSQL 10個以上のシステム差を意識せずに済む サービスが増えても追加が簡単 MongoDB Atlas Cluster
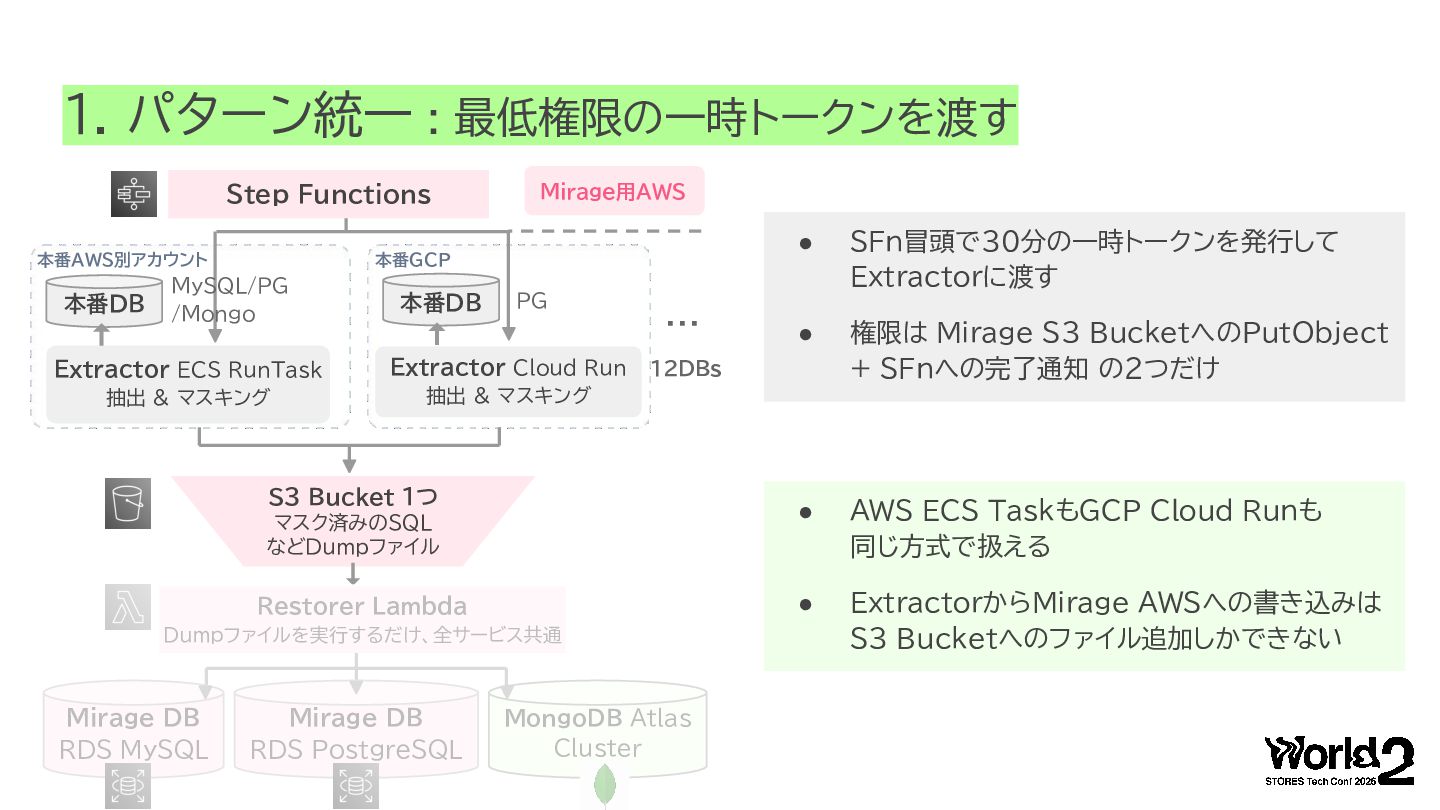
  10. 1. パターン統一 : 最低権限の一時トークンを渡す Step Functions 本番AWS別アカウント 本番DB Mirage用AWS 本番GCP

    MySQL/PG /Mongo 本番DB PG Extractor ECS RunTask Extractor Cloud Run 抽出 & マスキング 抽出 & マスキング … マスク済みのSQL などDumpファイル Restorer Lambda Dumpファイルを実行するだけ、全サービス共通 Mirage DB RDS PostgreSQL SFn冒頭で30分の一時トークンを発行して Extractorに渡す • 権限は Mirage S3 BucketへのPutObject + SFnへの完了通知 の2つだけ • AWS ECS TaskもGCP Cloud Runも 同じ方式で扱える • ExtractorからMirage AWSへの書き込みは S3 Bucketへのファイル追加しかできない 12DBs S3 Bucket 1つ Mirage DB RDS MySQL • MongoDB Atlas Cluster
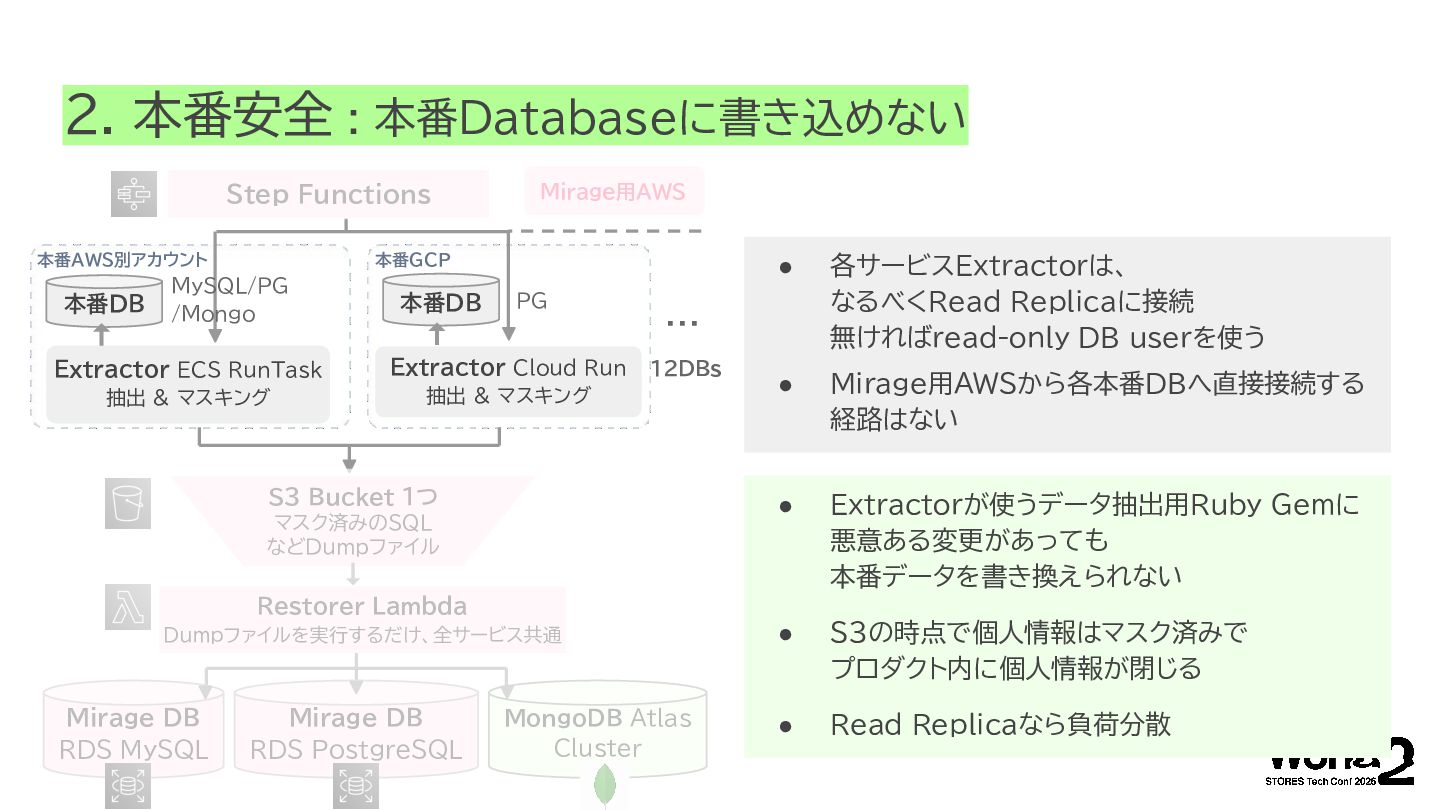
  11. 2. 本番安全 : 本番Databaseに書き込めない Step Functions 本番AWS別アカウント 本番DB Mirage用AWS 本番GCP

    MySQL/PG /Mongo 本番DB PG Extractor ECS RunTask Extractor Cloud Run 抽出 & マスキング 抽出 & マスキング • 各サービスExtractorは、 なるべくRead Replicaに接続 無ければread-only DB userを使う • Mirage用AWSから各本番DBへ直接接続する 経路はない • Extractorが使うデータ抽出用Ruby Gemに 悪意ある変更があっても 本番データを書き換えられない • S3の時点で個人情報はマスク済みで プロダクト内に個人情報が閉じる • Read Replicaなら負荷分散 … 12DBs S3 Bucket 1つ マスク済みのSQL などDumpファイル Restorer Lambda Dumpファイルを実行するだけ、全サービス共通 Mirage DB RDS MySQL Mirage DB RDS PostgreSQL MongoDB Atlas Cluster
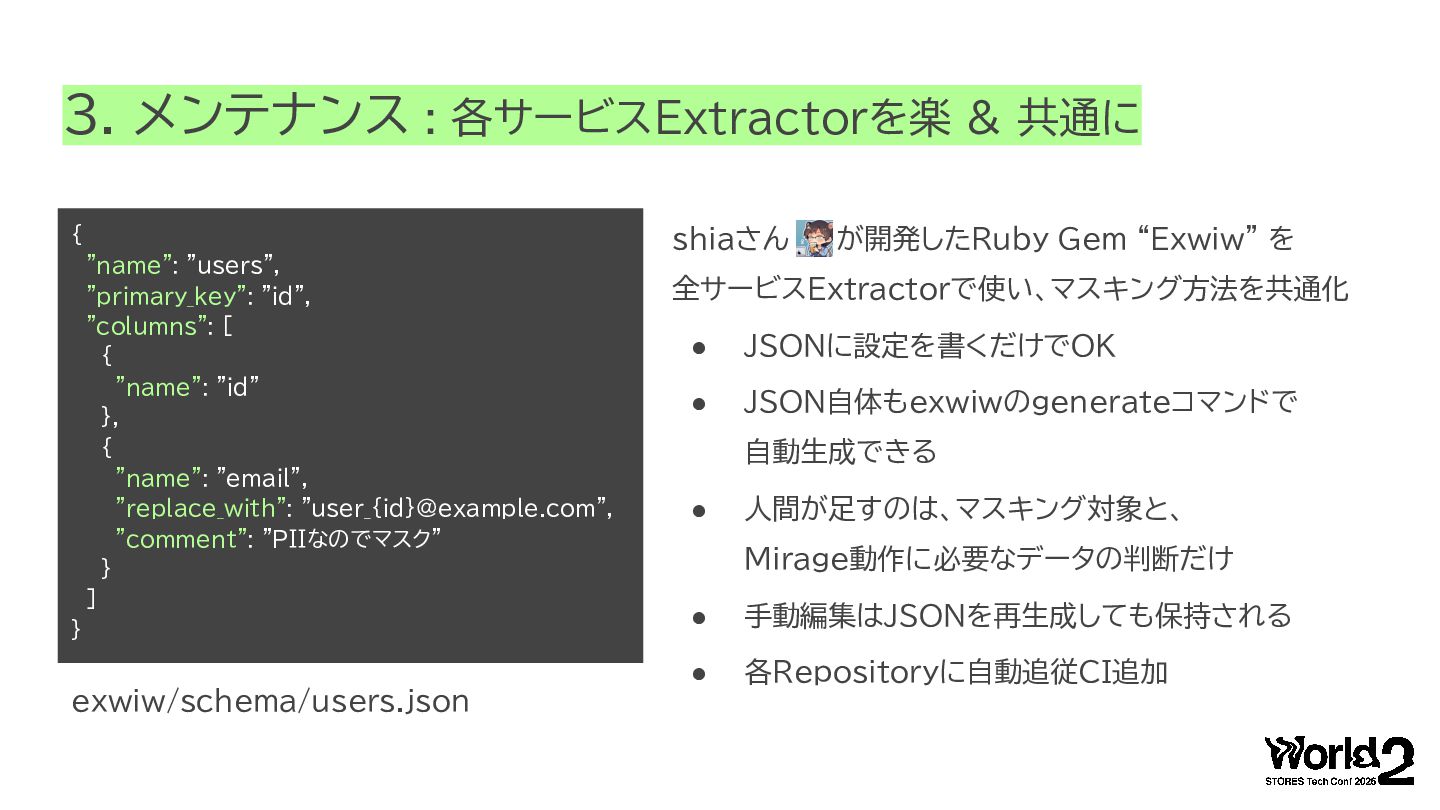
  12. 3. メンテナンス : 各サービスExtractorを楽 & 共通に { shiaさん "name": "users",

    "primary_key": "id", "columns": [ { "name": "id" }, { "name": "email", "replace_with": "user_{id}@example.com", "comment": "PIIなのでマスク" } ] } exwiw/schema/users.json が開発したRuby Gem “Exwiw” を 全サービスExtractorで使い、マスキング方法を共通化 • JSONに設定を書くだけでOK • JSON自体もexwiwのgenerateコマンドで 自動生成できる • 人間が足すのは、マスキング対象と、 Mirage動作に必要なデータの判断だけ • 手動編集はJSONを再生成しても保持される • 各Repositoryに自動追従CI追加
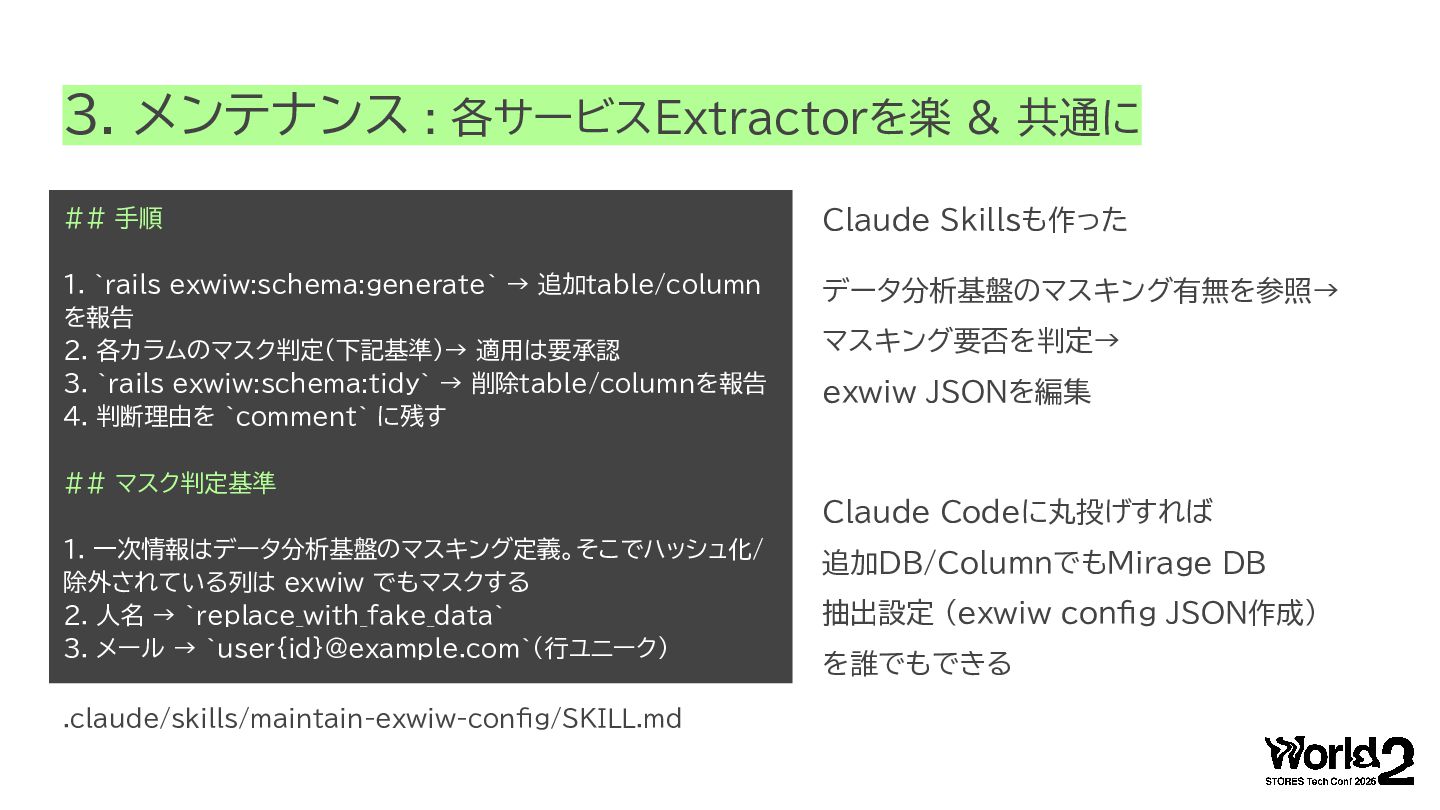
  13. 3. メンテナンス : 各サービスExtractorを楽 & 共通に ## 手順 Claude Skillsも作った

    1. `rails exwiw:schema:generate` → 追加table/column を報告 2. 各カラムのマスク判定(下記基準)→ 適用は要承認 3. `rails exwiw:schema:tidy` → 削除table/columnを報告 4. 判断理由を `comment` に残す データ分析基盤のマスキング有無を参照→ マスキング要否を判定→ exwiw JSONを編集 ## マスク判定基準 Claude Codeに丸投げすれば 1. 一次情報はデータ分析基盤のマスキング定義。そこでハッシュ化/ 除外されている列は exwiw でもマスクする 2. 人名 → `replace_with_fake_data` 3. メール → `user{id}@example.com`(行ユニーク) .claude/skills/maintain-exwiw-config/SKILL.md 追加DB/ColumnでもMirage DB 抽出設定 (exwiw config JSON作成) を誰でもできる
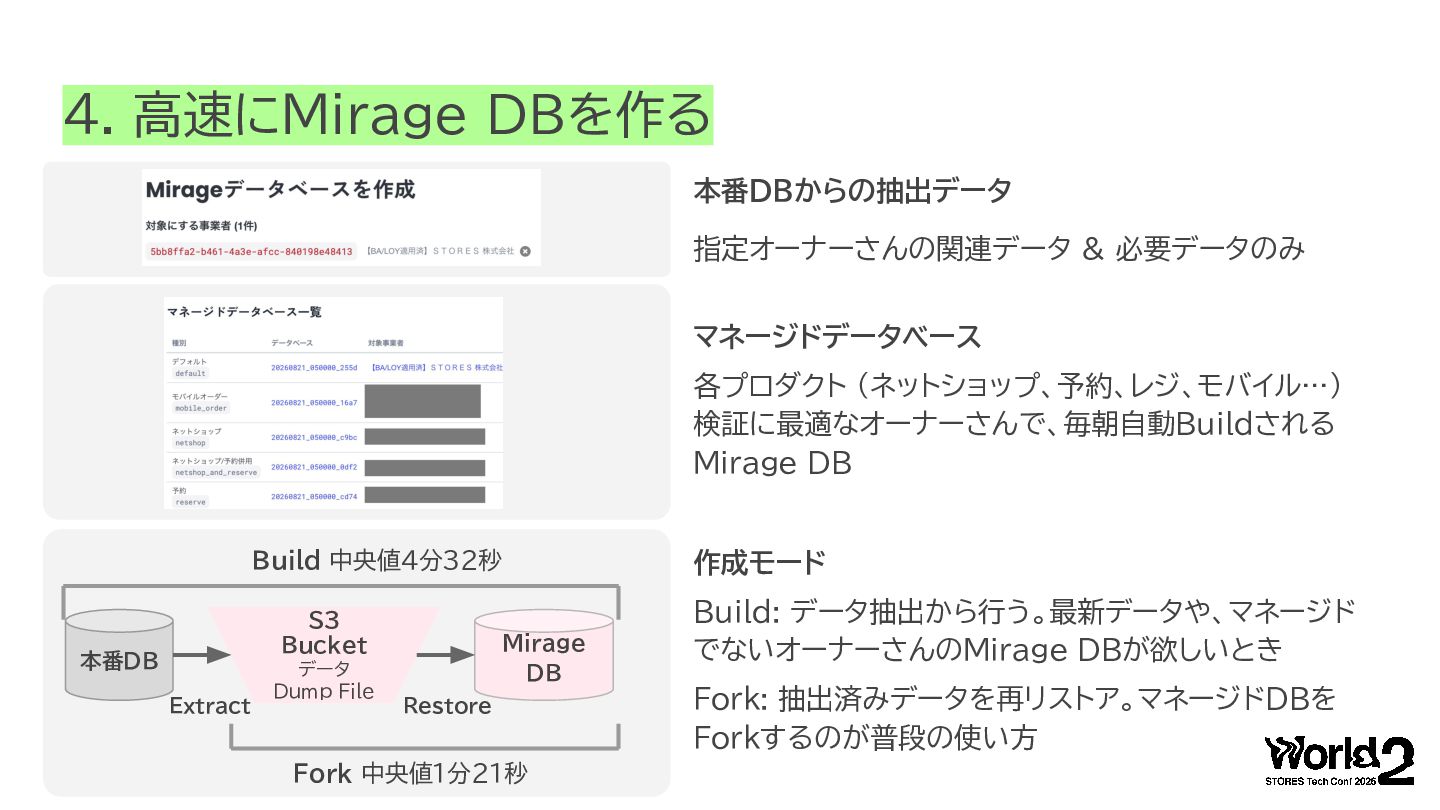
  14. 4. 高速にMirage DBを作る 本番DBからの抽出データ 指定オーナーさんの関連データ & 必要データのみ マネージドデータベース 各プロダクト (ネットショップ、予約、レジ、モバイル…)

    検証に最適なオーナーさんで、毎朝自動Buildされる Mirage DB Build 中央値4分32秒 S3 Bucket 本番DB Extract データ Dump File 作成モード Mirage DB Restore Fork 中央値1分21秒 Build: データ抽出から行う。最新データや、マネージド でないオーナーさんのMirage DBが欲しいとき Fork: 抽出済みデータを再リストア。マネージドDBを Forkするのが普段の使い方
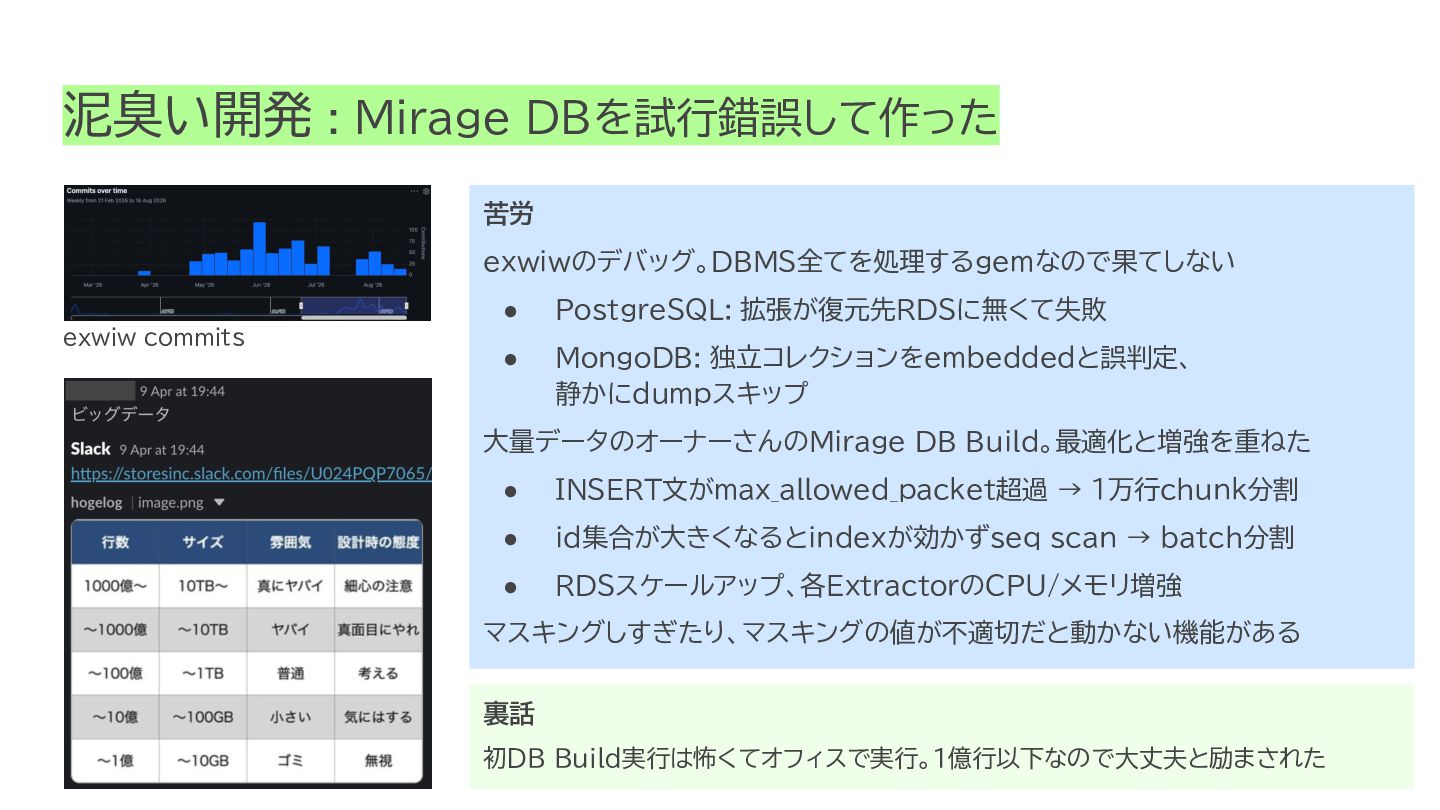
  15. 泥臭い開発 : Mirage DBを試行錯誤して作った 苦労 exwiwのデバッグ。DBMS全てを処理するgemなので果てしない • PostgreSQL: 拡張が復元先RDSに無くて失敗 •

    MongoDB: 独立コレクションをembeddedと誤判定、 静かにdumpスキップ exwiw commits 大量データのオーナーさんのMirage DB Build。最適化と増強を重ねた • INSERT文がmax_allowed_packet超過 → 1万行chunk分割 • id集合が大きくなるとindexが効かずseq scan → batch分割 • RDSスケールアップ、各ExtractorのCPU/メモリ増強 マスキングしすぎたり、マスキングの値が不適切だと動かない機能がある 裏話 初DB Build実行は怖くてオフィスで実行。1億行以下なので大丈夫と励まされた
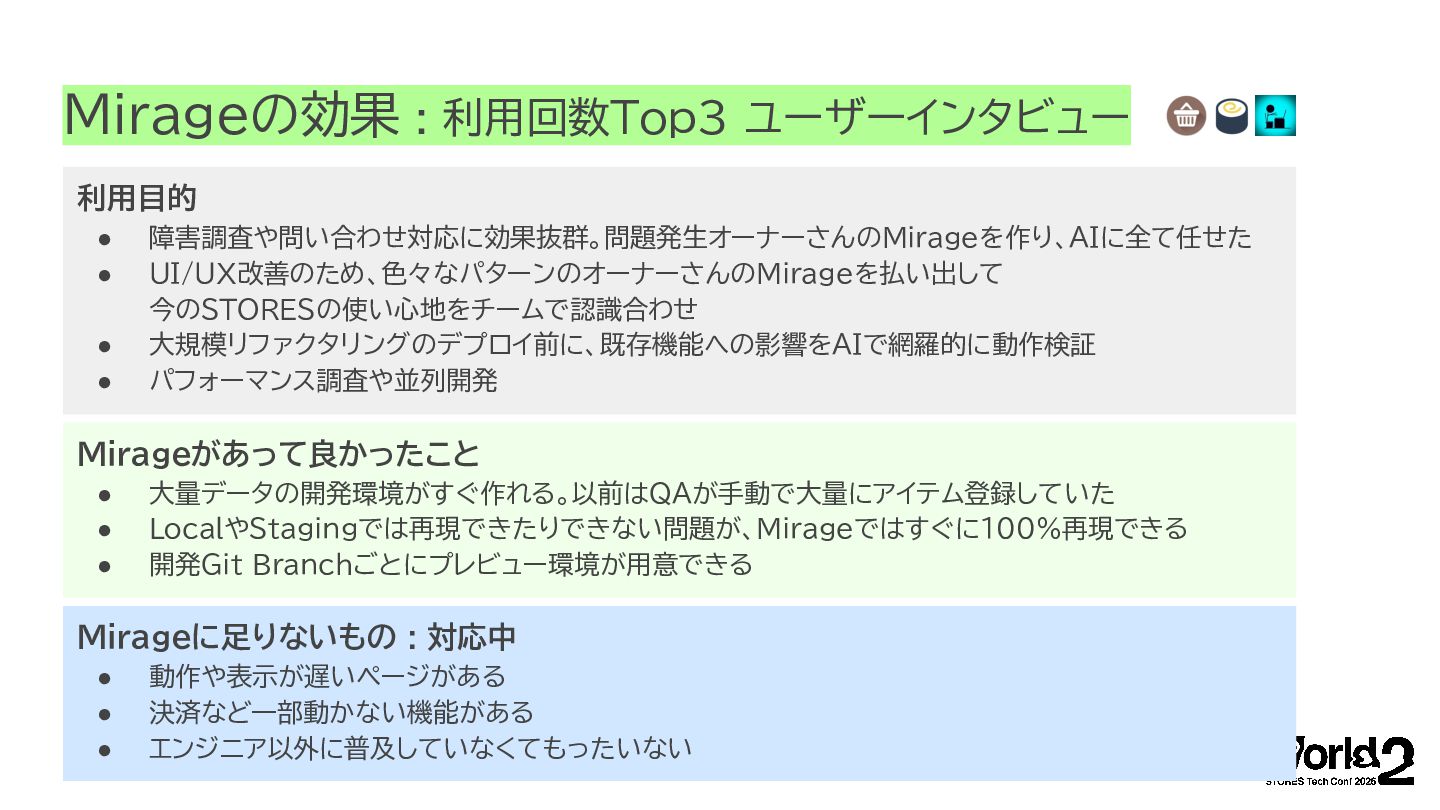
  16. Mirageの効果 : 利用回数Top3 ユーザーインタビュー 利用目的 • • • • 障害調査や問い合わせ対応に効果抜群。問題発生オーナーさんのMirageを作り、AIに全て任せた

    UI/UX改善のため、色々なパターンのオーナーさんのMirageを払い出して 今のSTORESの使い心地をチームで認識合わせ 大規模リファクタリングのデプロイ前に、既存機能への影響をAIで網羅的に動作検証 パフォーマンス調査や並列開発 Mirageがあって良かったこと • • • 大量データの開発環境がすぐ作れる。以前はQAが手動で大量にアイテム登録していた LocalやStagingでは再現できたりできない問題が、Mirageではすぐに100%再現できる 開発Git Branchごとにプレビュー環境が用意できる Mirageに足りないもの : 対応中 • • • 動作や表示が遅いページがある 決済など一部動かない機能がある エンジニア以外に普及していなくてもったいない
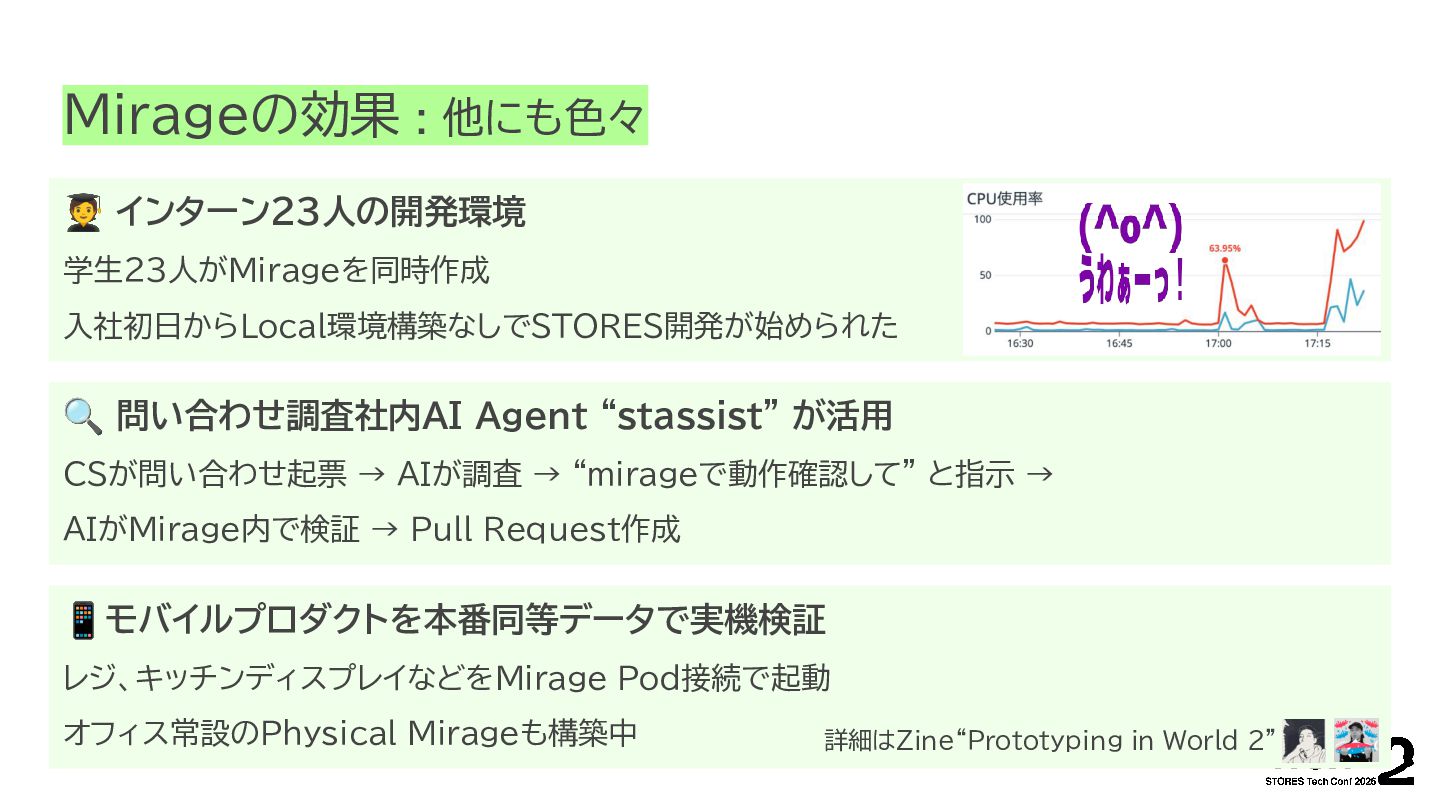
  17. Mirageの効果 : 他にも色々 󰳐 インターン23人の開発環境 学生23人がMirageを同時作成 入社初日からLocal環境構築なしでSTORES開発が始められた 🔍 問い合わせ調査社内AI Agent

    “stassist” が活用 CSが問い合わせ起票 → AIが調査 → “mirageで動作確認して” と指示 → AIがMirage内で検証 → Pull Request作成 📱モバイルプロダクトを本番同等データで実機検証 レジ、キッチンディスプレイなどをMirage Pod接続で起動 オフィス常設のPhysical Mirageも構築中 詳細はZine“Prototyping in World 2”
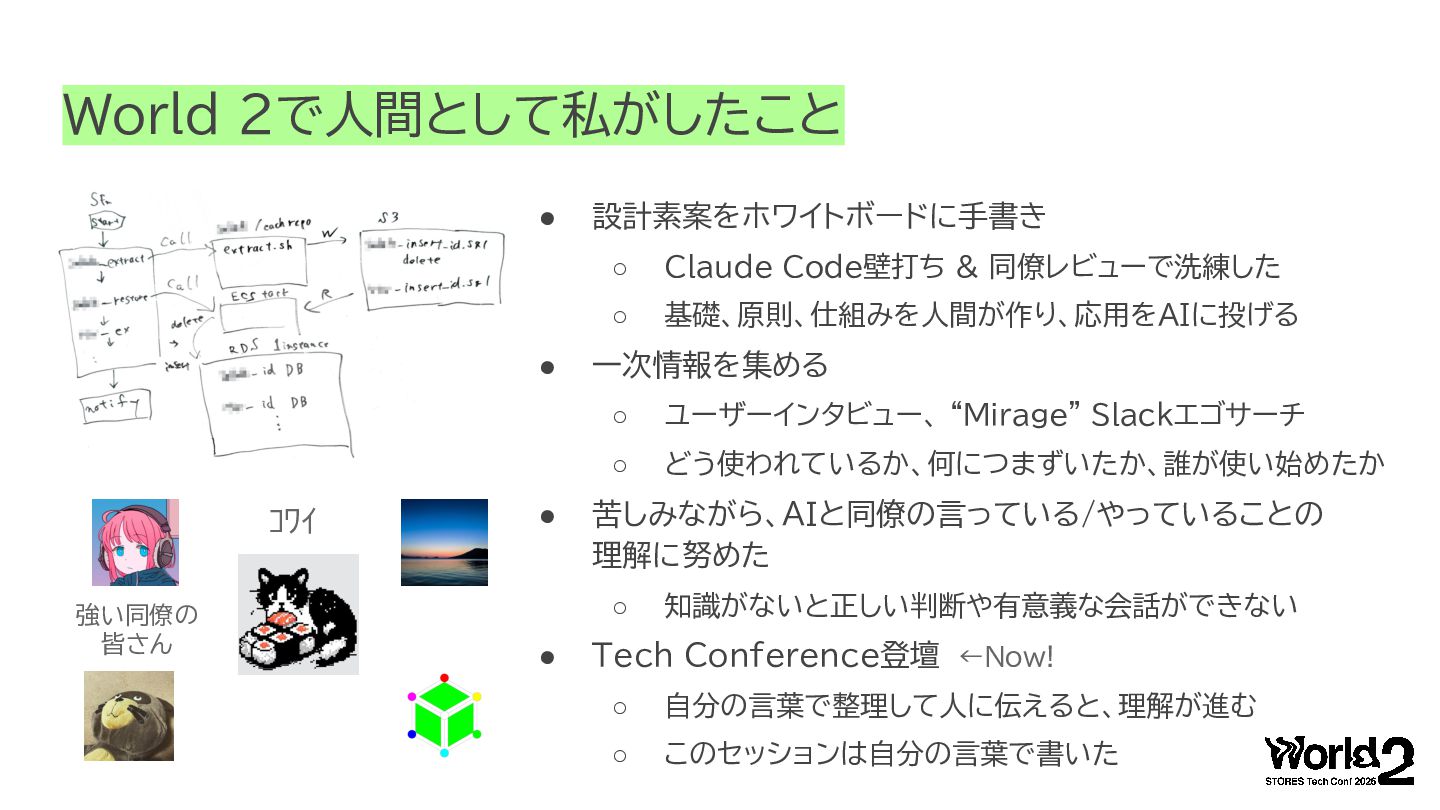
  18. World 2で人間として私がしたこと • • コワイ 強い同僚の 皆さん • 設計素案をホワイトボードに手書き ◦

    Claude Code壁打ち & 同僚レビューで洗練した ◦ 基礎、原則、仕組みを人間が作り、応用をAIに投げる 一次情報を集める ◦ ユーザーインタビュー、 “Mirage” Slackエゴサーチ ◦ どう使われているか、何につまずいたか、誰が使い始めたか 苦しみながら、AIと同僚の言っている/やっていることの 理解に努めた ◦ • 知識がないと正しい判断や有意義な会話ができない Tech Conference登壇 ←Now! ◦ 自分の言葉で整理して人に伝えると、理解が進む ◦ このセッションは自分の言葉で書いた
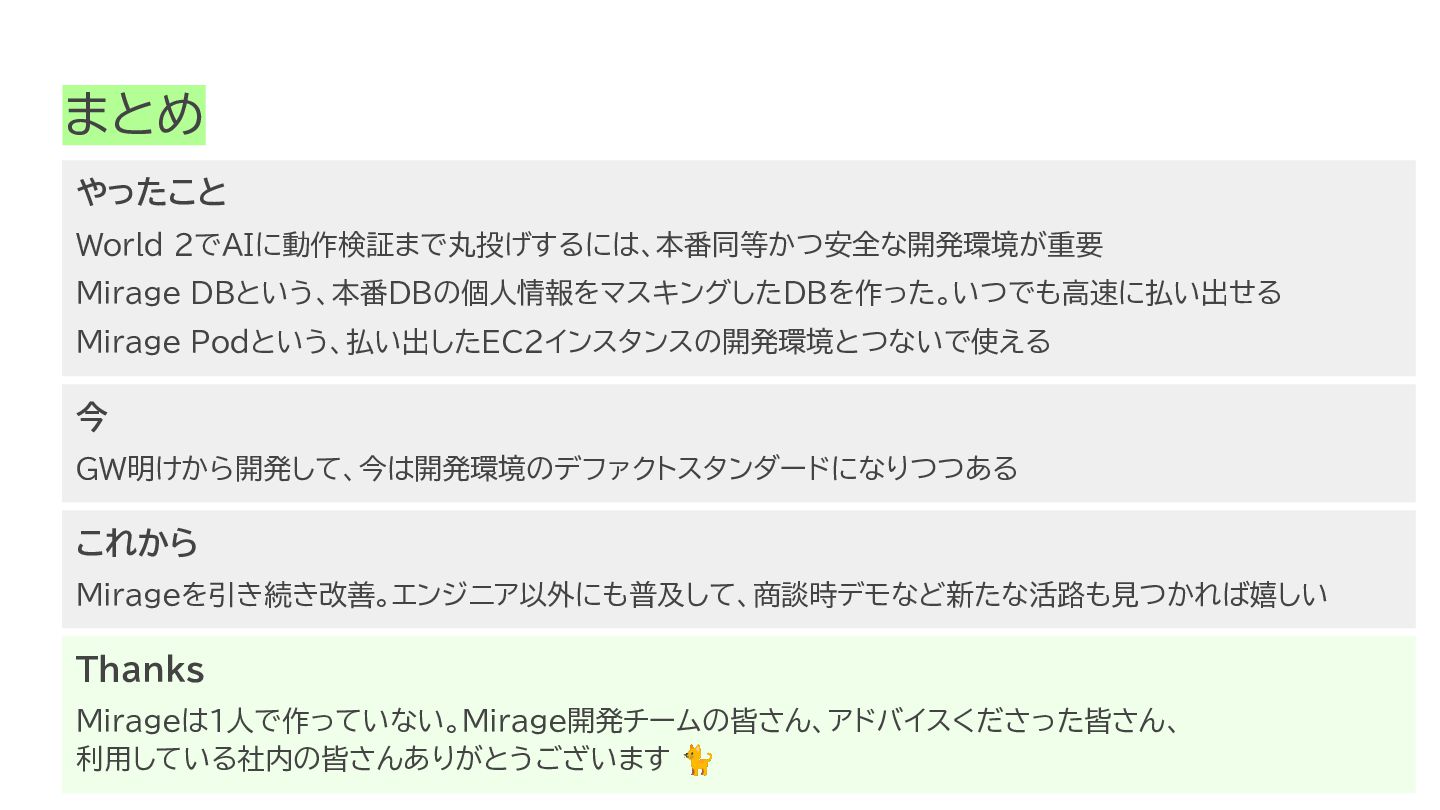
  19. まとめ やったこと World 2でAIに動作検証まで丸投げするには、本番同等かつ安全な開発環境が重要 Mirage DBという、本番DBの個人情報をマスキングしたDBを作った。いつでも高速に払い出せる Mirage Podという、払い出したEC2インスタンスの開発環境とつないで使える 今 GW明けから開発して、今は開発環境のデファクトスタンダードになりつつある

    これから Mirageを引き続き改善。エンジニア以外にも普及して、商談時デモなど新たな活路も見つかれば嬉しい Thanks Mirageは1人で作っていない。Mirage開発チームの皆さん、アドバイスくださった皆さん、 利用している社内の皆さんありがとうございます 🐈
  20. まとめ やったこと World 2でAIに動作検証まで丸投げするには、本番同等かつ安全な開発環境が重要 Mirage DBという、本番DBの個人情報をマスキングしたDBを作った。いつでも高速に払い出せる Mirage Podという、払い出したEC2インスタンスの開発環境とつないで使える 今 みんなもMirage

    DB GW明けから開発して、今は開発環境のデファクトスタンダードになりつつある これから 作ってみてね Mirageを引き続き改善。エンジニア以外にも普及して、商談時デモなど新たな活路も見つかれば嬉しい Thanks Mirageは1人で作っていない。Mirage開発チームの皆さん、アドバイスくださった皆さん、 利用している社内の皆さんありがとうございます 🐈