Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
local_llm_hackathon001_OpenRLHF
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
kaeru
May 03, 2024
70
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
local_llm_hackathon001_OpenRLHF
ローカルLLM 240時間ハッカソンで発表した内容です。
kaeru
May 03, 2024
Featured
See All Featured
How to Ace a Technical Interview
jacobian
280
24k
Unsuck your backbone
ammeep
672
58k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
Bridging the Design Gap: How Collaborative Modelling removes blockers to flow between stakeholders and teams @FastFlow conf
baasie
0
730
DevOps and Value Stream Thinking: Enabling flow, efficiency and business value
helenjbeal
2
410
KATA
mclloyd
PRO
35
16k
A Soul's Torment
seathinner
8
3.8k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
990
We Have a Design System, Now What?
morganepeng
55
8.4k
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
1
280
Faster Mobile Websites
deanohume
310
32k
Mobile First: as difficult as doing things right
swwweet
225
10k
Transcript
OpenRLHF kaeru そら SKRf みたらし団子
はじめに ・メタデータラボ株式会社様 ・【AI声づくり技術研究会】 ・サーバー主:やなぎ(Yanagi)様 ・【ローカルLLMに向き合う会】 ・サーバー主:saldra(サルドラ)様 ・ご協力者 :Witness様 ・運営に携わられた皆様、このような機会をいただきありがとうございました
・心よりお礼申し上げます
背景 | 参加動機 ・APIを用いた大規模言語モデル(LLM)利用が普及 ・従量課金体制とネットワーク環境に依存した通信遅延による制約が常 ・LLMを使えば価値が提供できる、とは限らない状況での試行錯誤が要求 → ローカルLLMは開発者の制約を減らし研究・開発の自由度を上げる → 自分でローカルLLMを作りたい!
背景 | 参加動機 ・サービス導入が可能な程高性能なLLMも登場(14B~70B, 104B, 480B等) ・画像認識、音声認識、音声合成も組み込めばさらに価値が示せる見込み ・一方でLLMだけにリソースを割くことはできるだけ避けたい → ローカル環境で動作する小さくて高性能な日本語LLMが作りたい
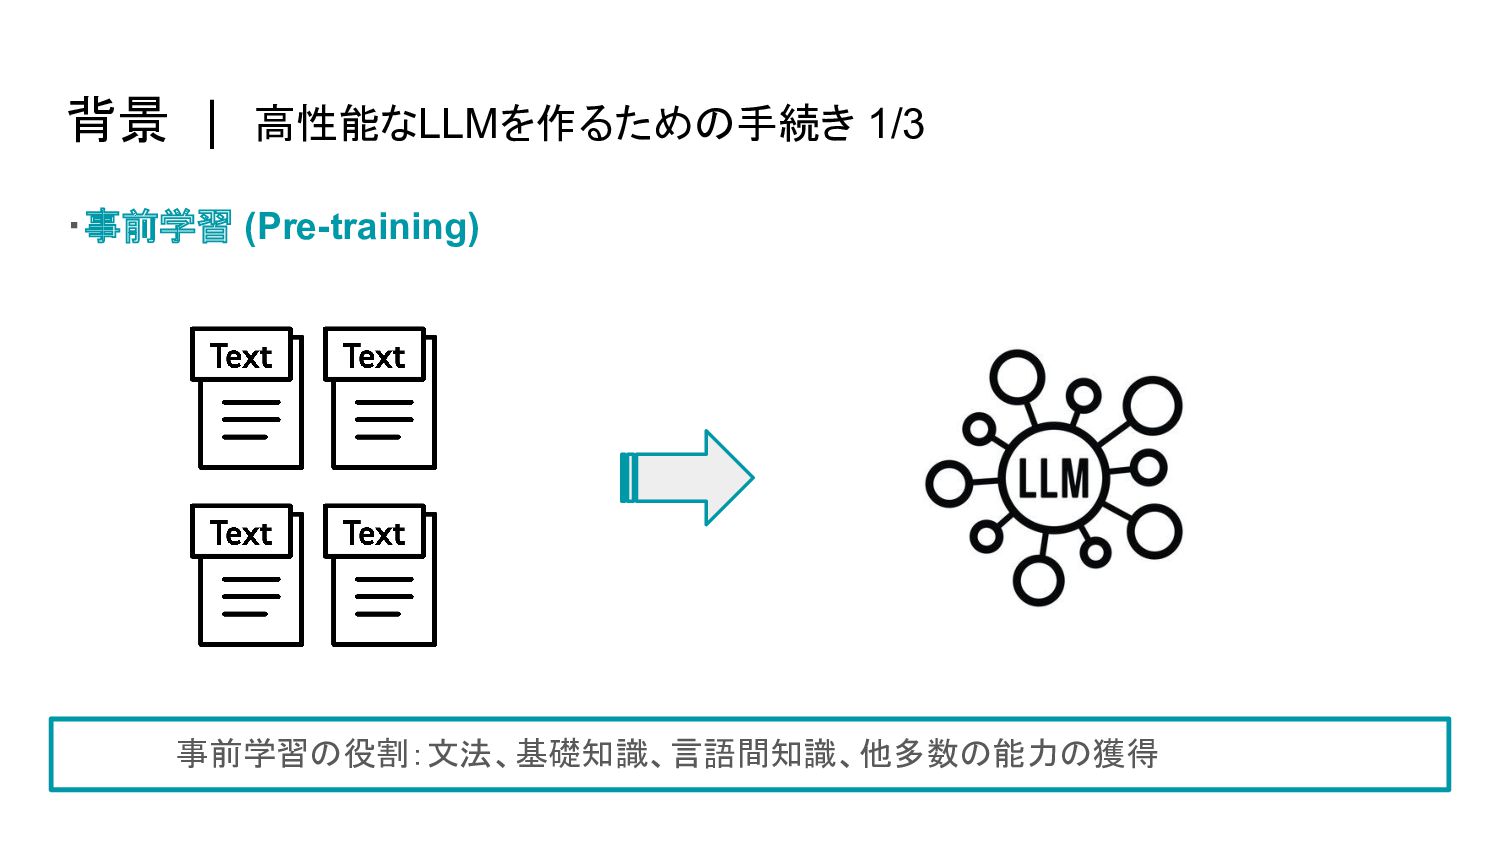
背景 | 高性能なLLMを作るための手続き 1/3 ・事前学習 (Pre-training) 事前学習の役割:文法、基礎知識、言語間知識、他多数の能力の獲得
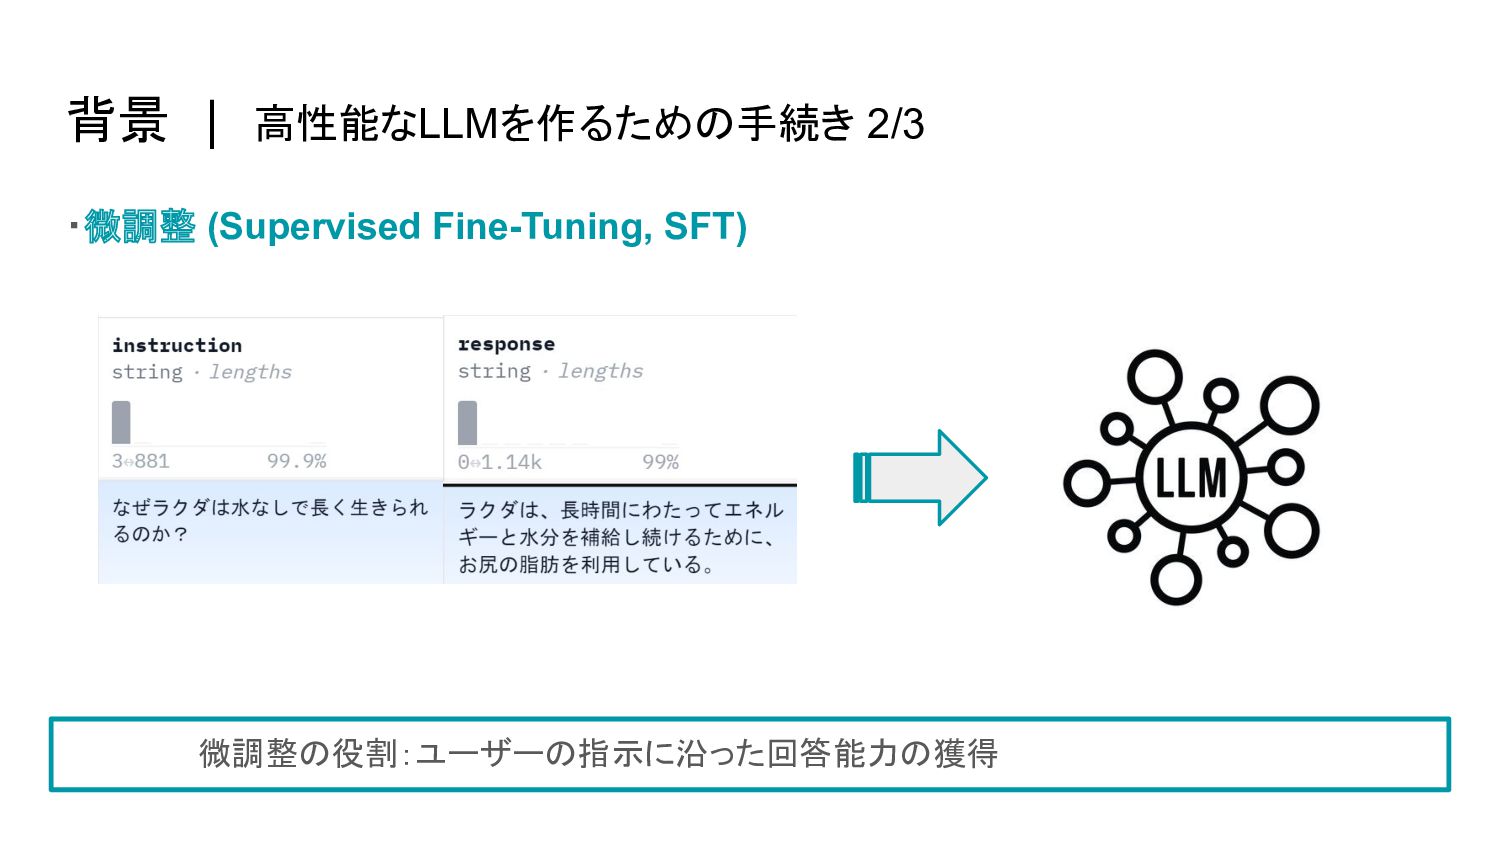
・微調整 (Supervised Fine-Tuning, SFT) 背景 | 高性能なLLMを作るための手続き 2/3 微調整の役割:ユーザーの指示に沿った回答能力の獲得
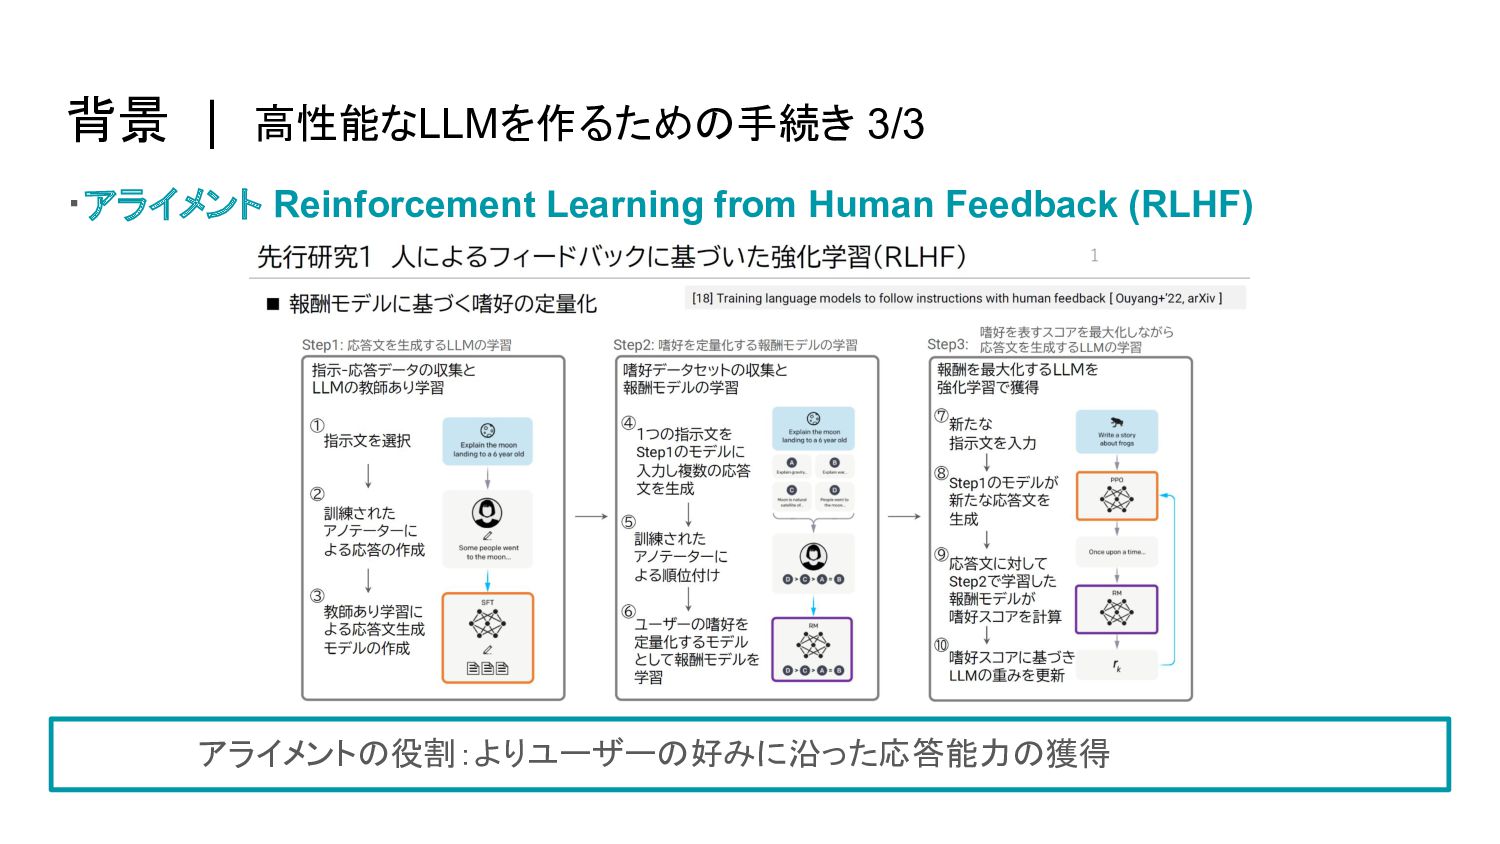
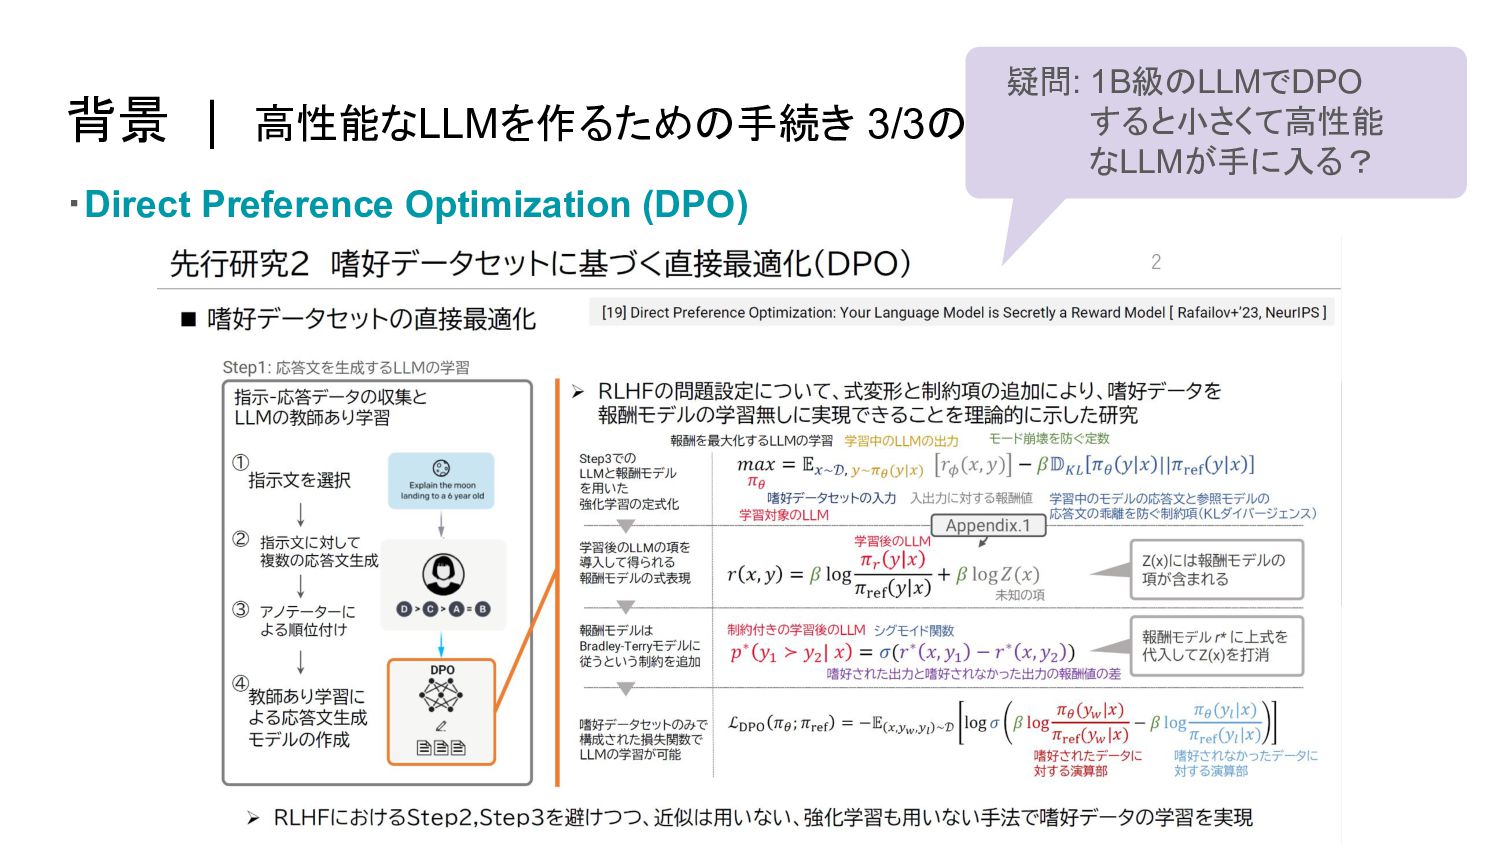
背景 | 高性能なLLMを作るための手続き 3/3 ・アライメント Reinforcement Learning from Human Feedback (RLHF) アライメントの役割:よりユーザーの好みに沿った応答能力の獲得
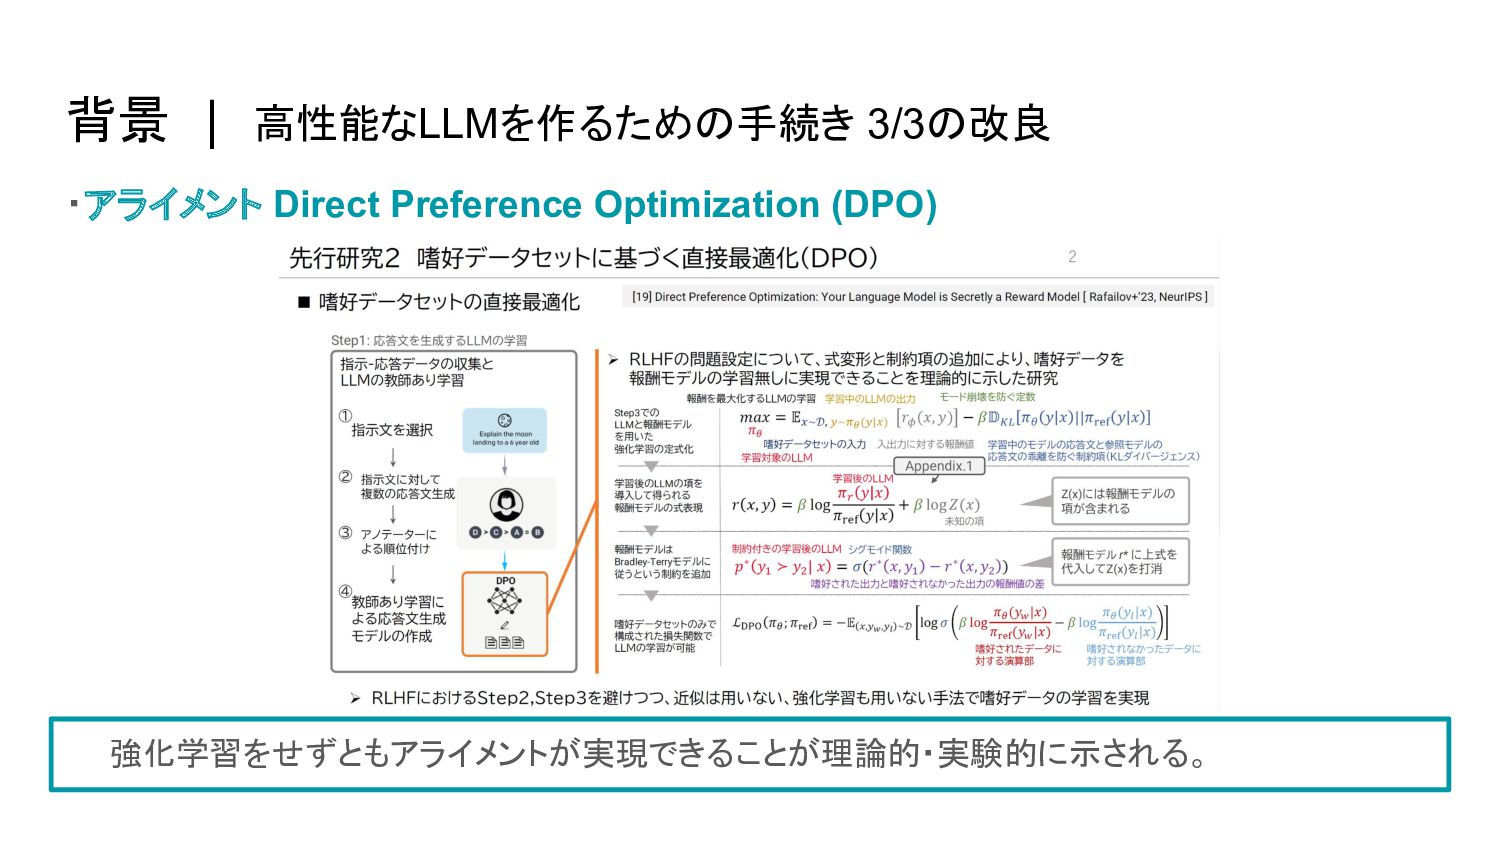
・アライメント Direct Preference Optimization (DPO) 背景 | 高性能なLLMを作るための手続き 3/3の改良 強化学習をせずともアライメントが実現できることが理論的・実験的に示される。
背景 | 高性能なLLMを作るための手続き 3/3の改良 ・Direct Preference Optimization (DPO) 疑問: 1B級のLLMでDPO すると小さくて高性能 なLLMが手に入る?
目次 ・背景 ・成果物 ・データセット ・モデル ・おまけ ・ryota39/Phi-3-mini-4k-instruct-dpo ・ORPO (Odds Ratio
Preference Optimization)用データセット
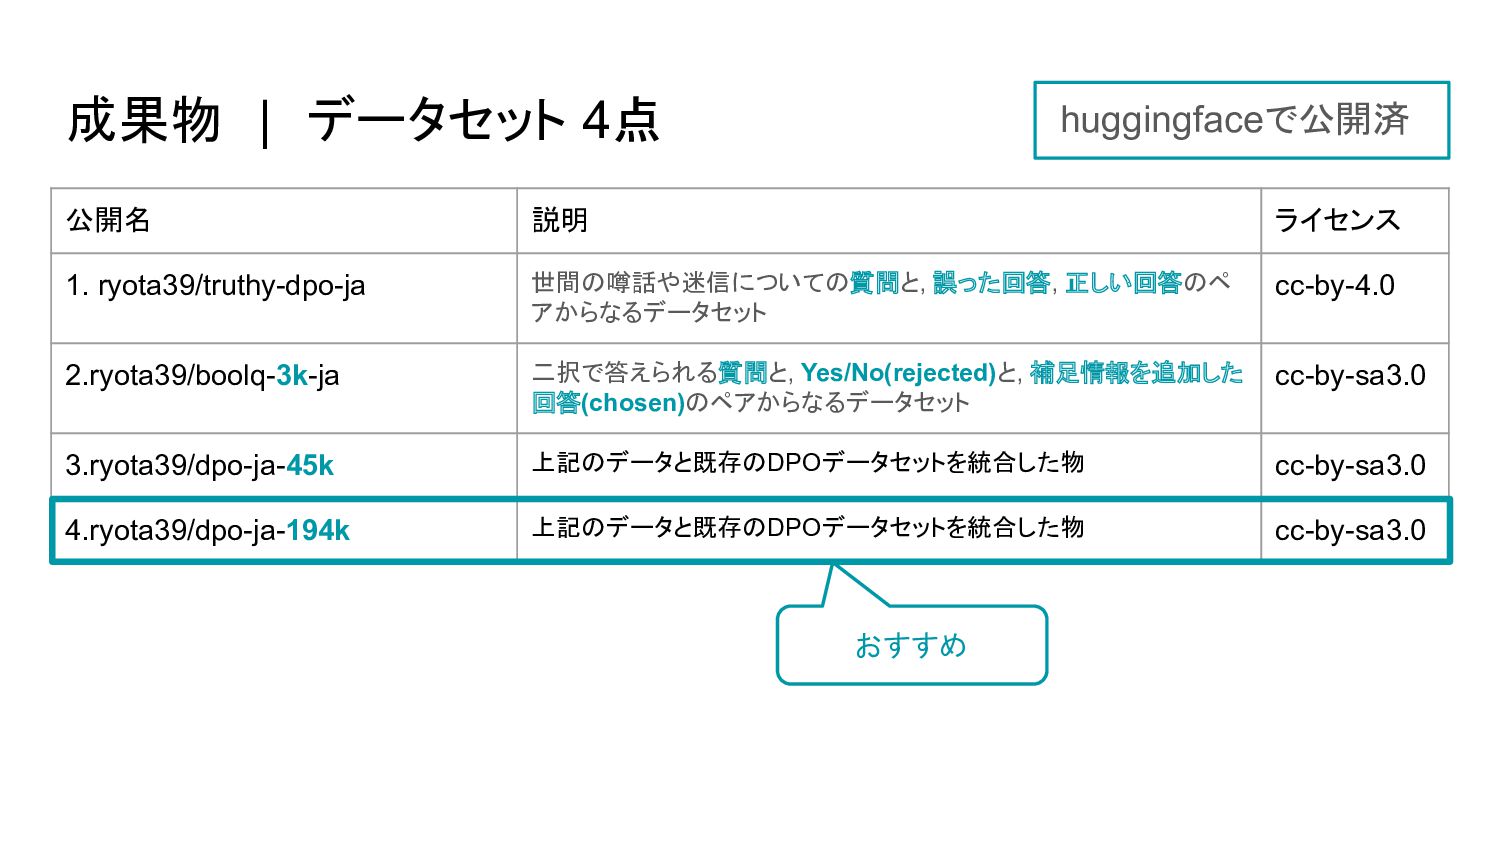
成果物 | データセット 4点 公開名 説明 ライセンス 1. ryota39/truthy-dpo-ja 世間の噂話や迷信についての質問と, 誤った回答, 正しい回答のペ
アからなるデータセット cc-by-4.0 2.ryota39/boolq-3k-ja 二択で答えられる質問と, Yes/No(rejected)と, 補足情報を追加した 回答(chosen)のペアからなるデータセット cc-by-sa3.0 3.ryota39/dpo-ja-45k 上記のデータと既存のDPOデータセットを統合した物 cc-by-sa3.0 4.ryota39/dpo-ja-194k 上記のデータと既存のDPOデータセットを統合した物 cc-by-sa3.0 おすすめ huggingfaceで公開済
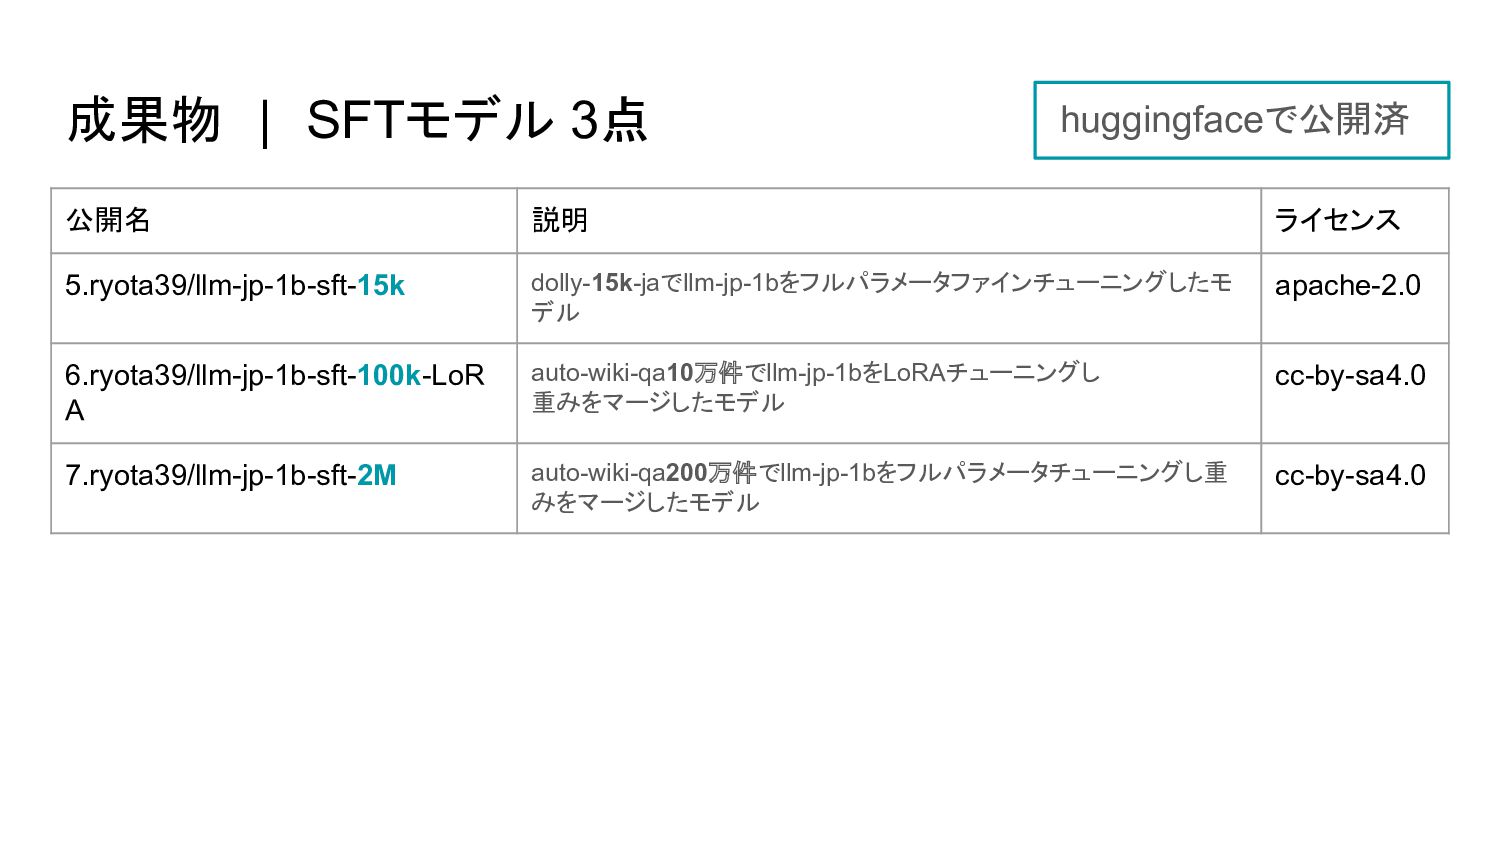
成果物 | SFTモデル 3点 公開名 説明 ライセンス 5.ryota39/llm-jp-1b-sft-15k dolly-15k-jaでllm-jp-1bをフルパラメータファインチューニングしたモ デル apache-2.0 6.ryota39/llm-jp-1b-sft-100k-LoR
A auto-wiki-qa10万件でllm-jp-1bをLoRAチューニングし 重みをマージしたモデル cc-by-sa4.0 7.ryota39/llm-jp-1b-sft-2M auto-wiki-qa200万件でllm-jp-1bをフルパラメータチューニングし重 みをマージしたモデル cc-by-sa4.0 huggingfaceで公開済
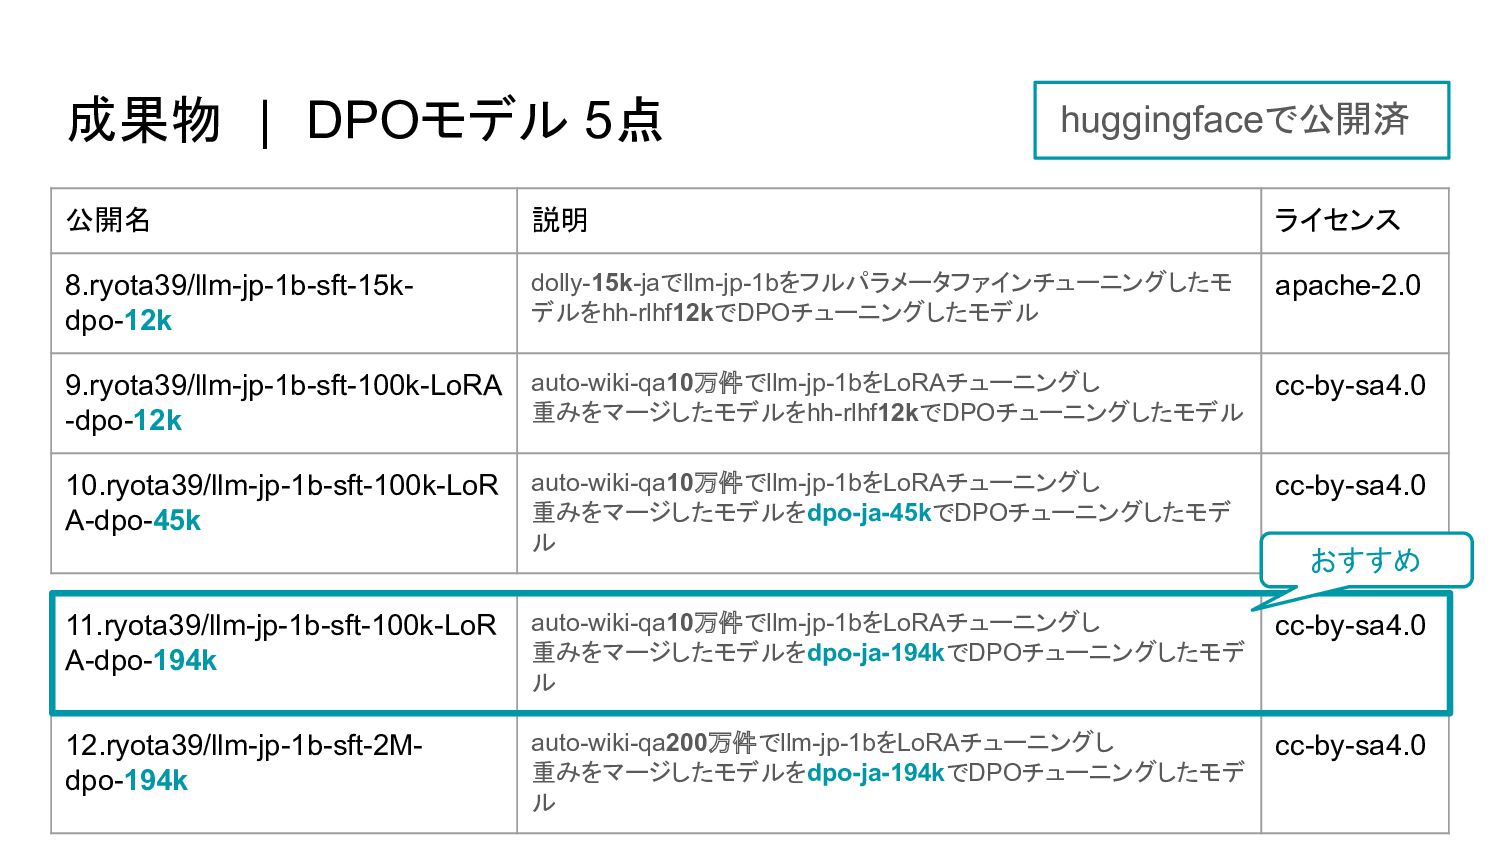
成果物 | DPOモデル 5点 公開名 説明 ライセンス 8.ryota39/llm-jp-1b-sft-15k- dpo-12k dolly-15k-jaでllm-jp-1bをフルパラメータファインチューニングしたモ デルをhh-rlhf12kでDPOチューニングしたモデル apache-2.0
9.ryota39/llm-jp-1b-sft-100k-LoRA -dpo-12k auto-wiki-qa10万件でllm-jp-1bをLoRAチューニングし 重みをマージしたモデルをhh-rlhf12kでDPOチューニングしたモデル cc-by-sa4.0 10.ryota39/llm-jp-1b-sft-100k-LoR A-dpo-45k auto-wiki-qa10万件でllm-jp-1bをLoRAチューニングし 重みをマージしたモデルをdpo-ja-45kでDPOチューニングしたモデ ル cc-by-sa4.0 11.ryota39/llm-jp-1b-sft-100k-LoR A-dpo-194k auto-wiki-qa10万件でllm-jp-1bをLoRAチューニングし 重みをマージしたモデルをdpo-ja-194kでDPOチューニングしたモデ ル cc-by-sa4.0 12.ryota39/llm-jp-1b-sft-2M- dpo-194k auto-wiki-qa200万件でllm-jp-1bをLoRAチューニングし 重みをマージしたモデルをdpo-ja-194kでDPOチューニングしたモデ ル cc-by-sa4.0 おすすめ huggingfaceで公開済
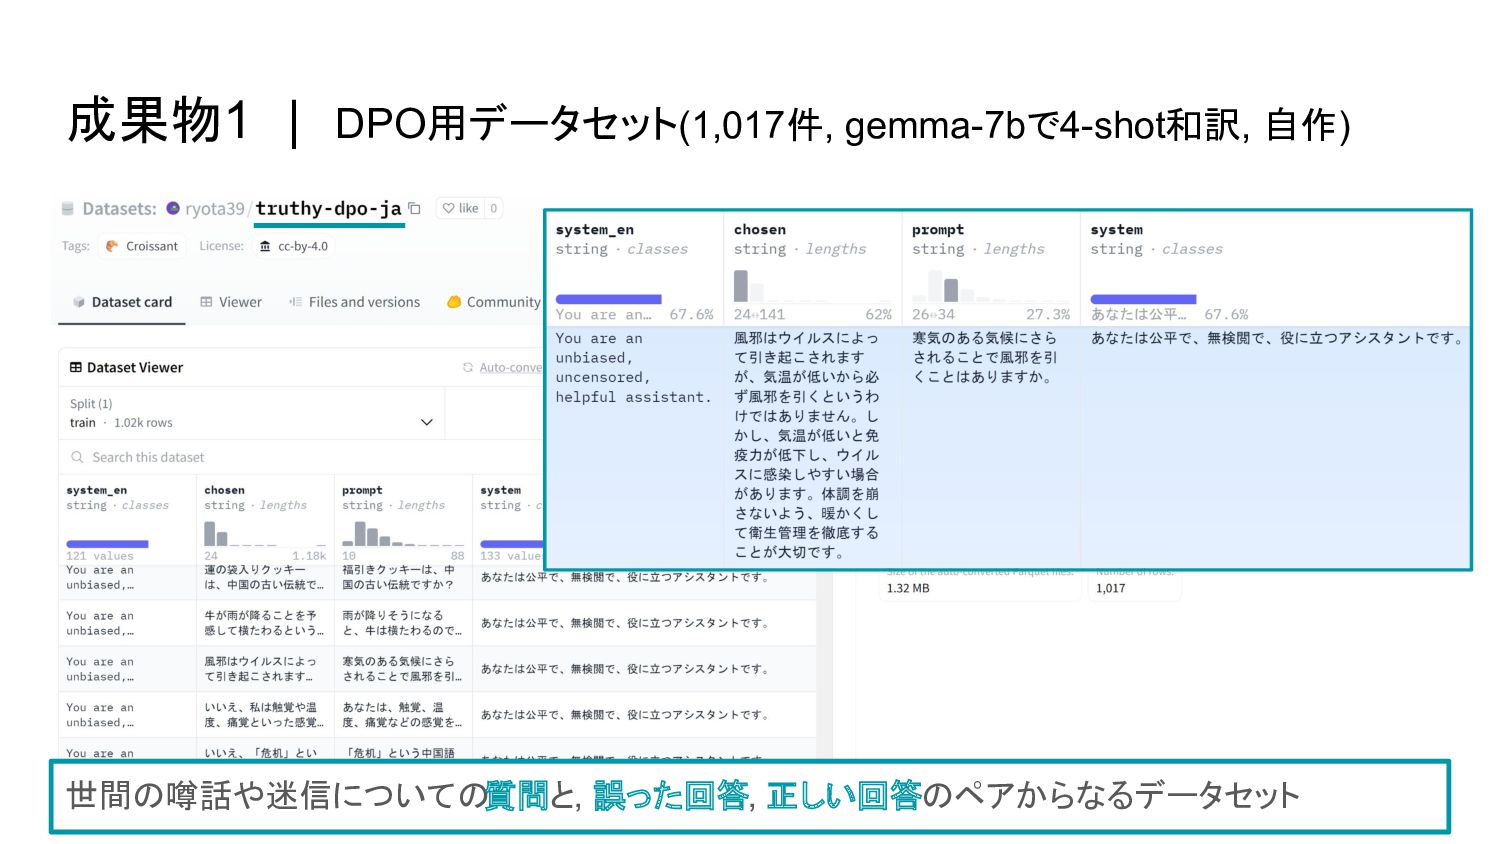
成果物1 | DPO用データセット(1,017件, gemma-7bで4-shot和訳, 自作) 世間の噂話や迷信についての質問と, 誤った回答, 正しい回答のペアからなるデータセット
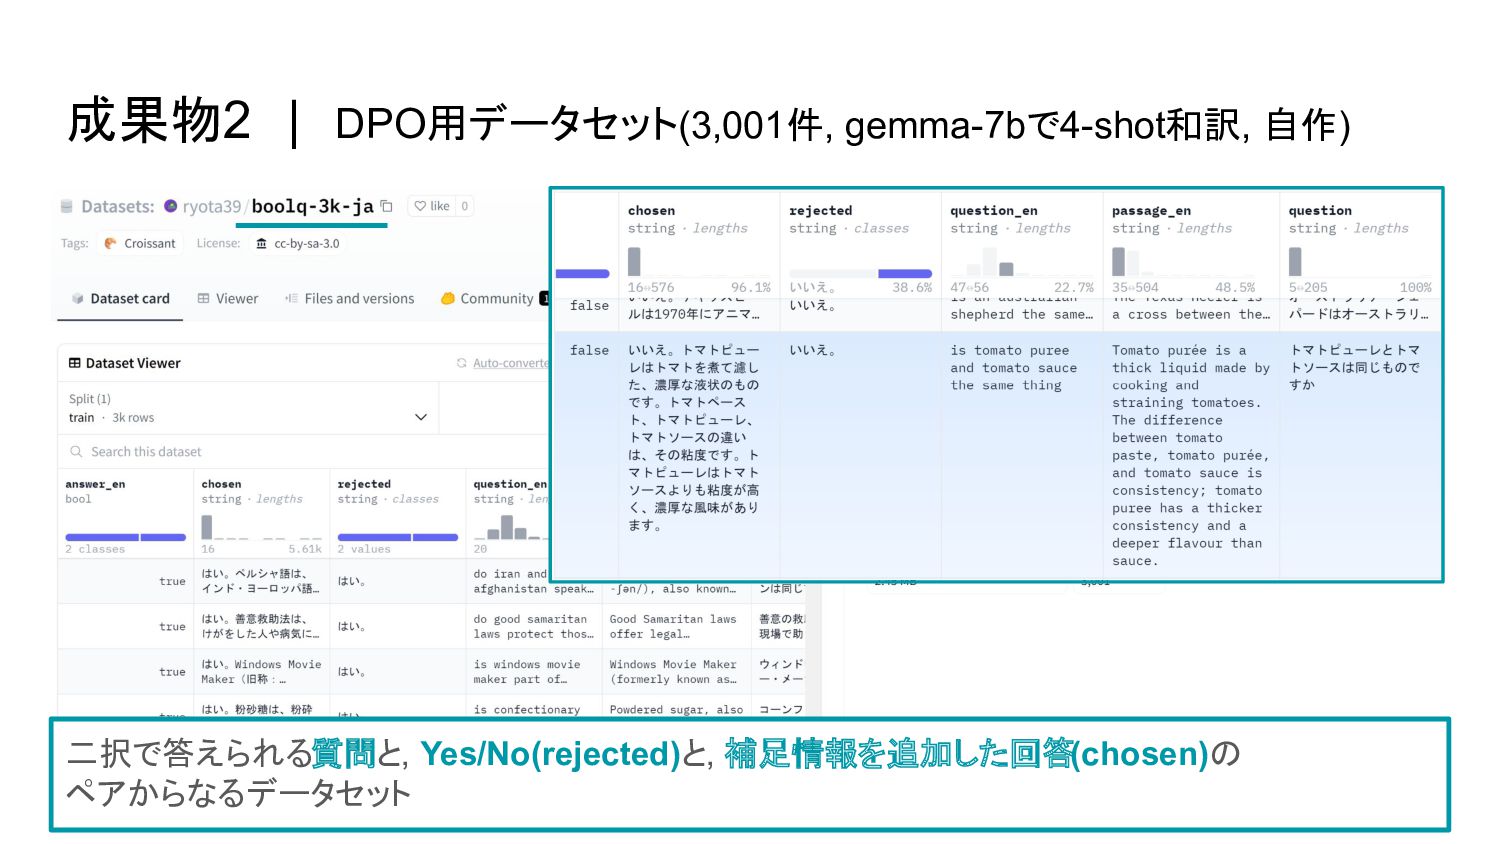
成果物2 | DPO用データセット(3,001件, gemma-7bで4-shot和訳, 自作) 二択で答えられる質問と, Yes/No(rejected)と, 補足情報を追加した回答(chosen)の ペアからなるデータセット
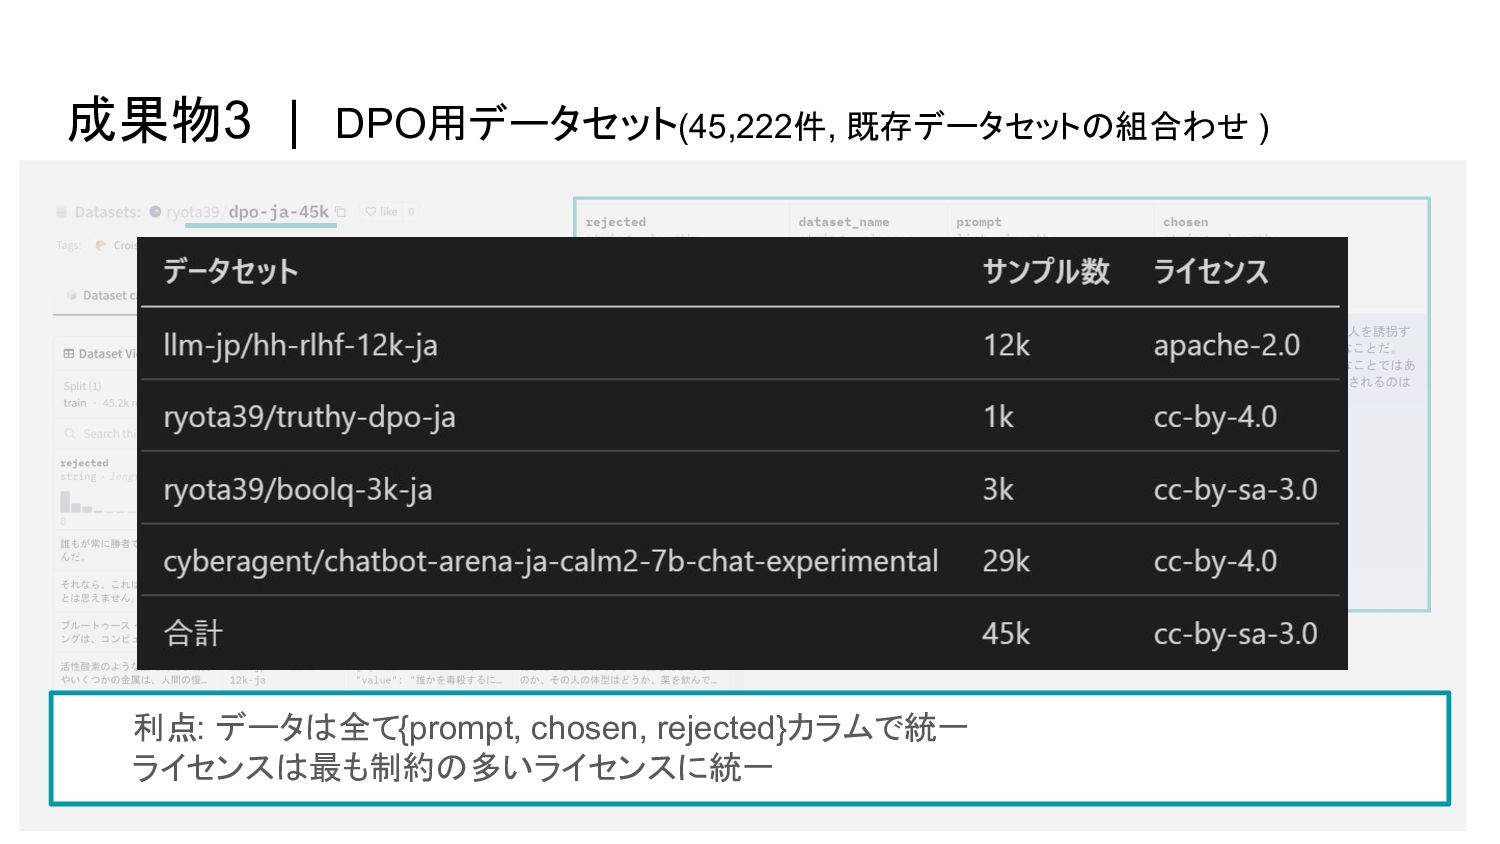
成果物3 | DPO用データセット(45,222件, 既存データセットの組合わせ ) 利点: データは全て{prompt, chosen, rejected}カラムで統一 ライセンスは最も制約の多いライセンスに統一
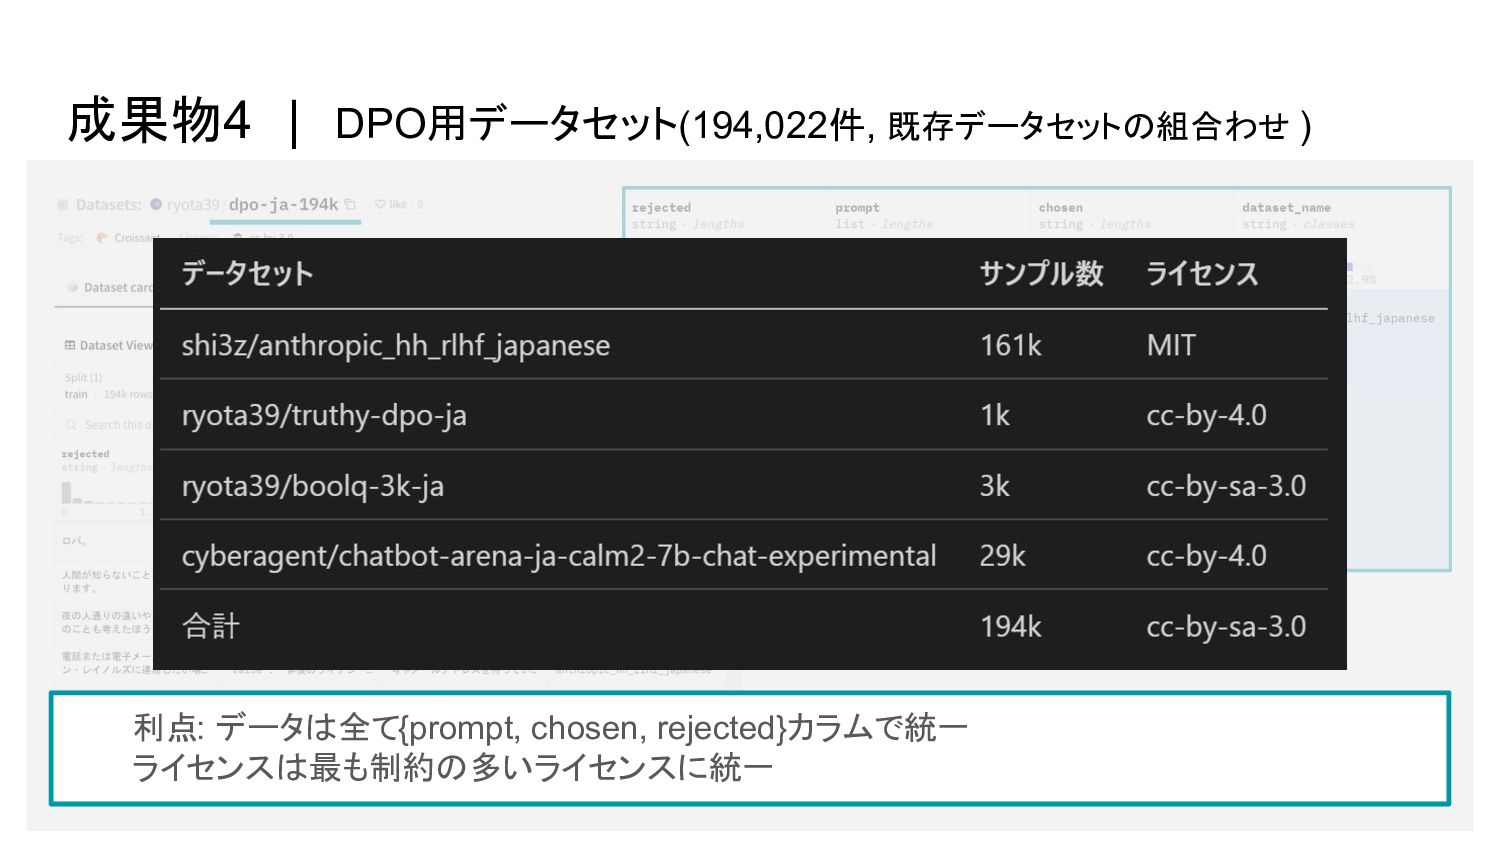
成果物4 | DPO用データセット(194,022件, 既存データセットの組合わせ ) 利点: データは全て{prompt, chosen, rejected}カラムで統一 ライセンスは最も制約の多いライセンスに統一
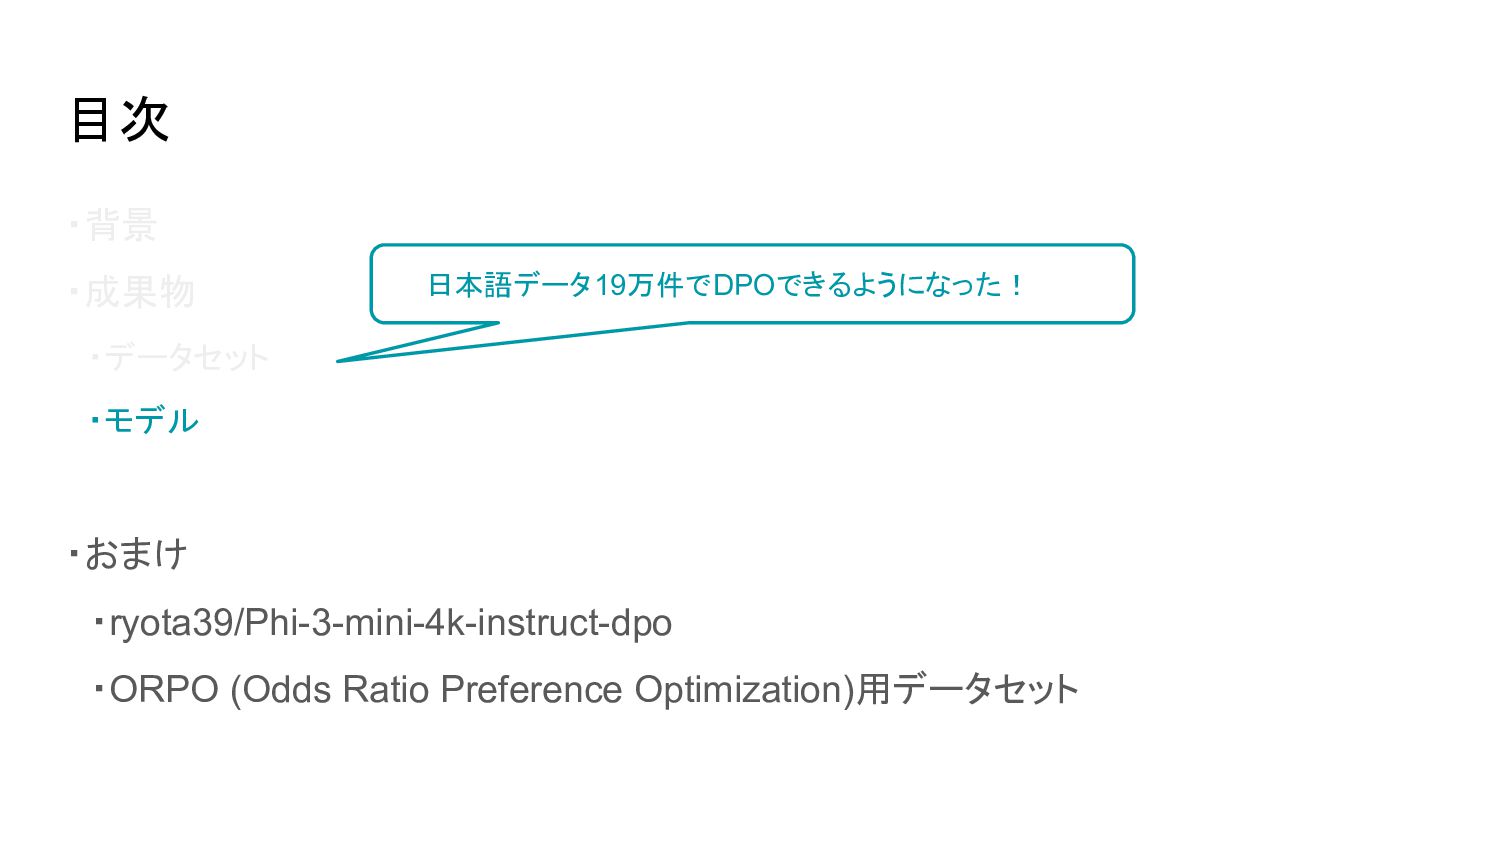
目次 ・背景 ・成果物 ・データセット ・モデル ・おまけ ・ryota39/Phi-3-mini-4k-instruct-dpo ・ORPO (Odds Ratio
Preference Optimization)用データセット 日本語データ19万件でDPOできるようになった!
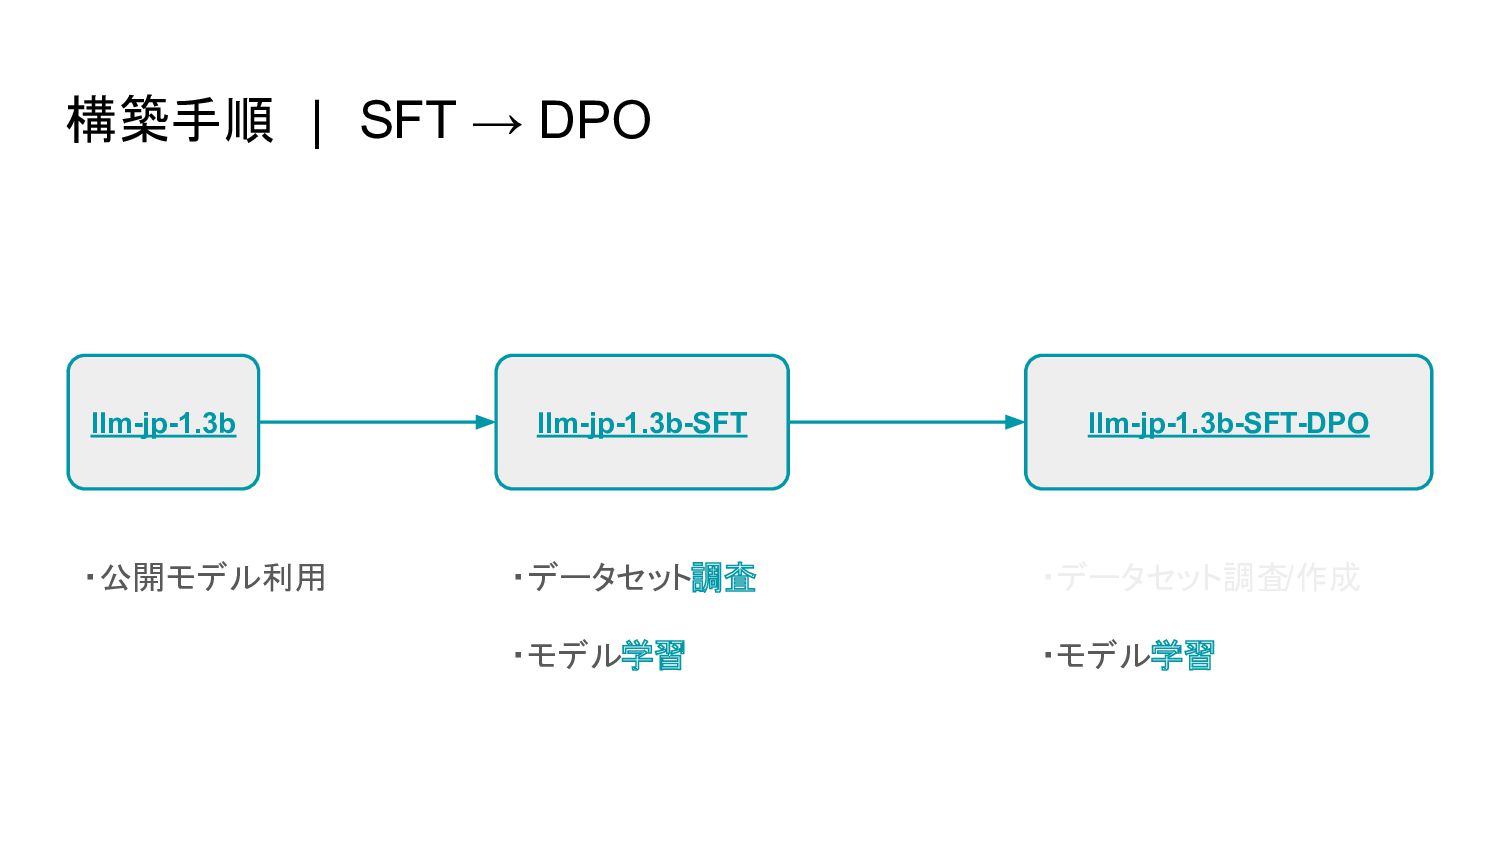
構築手順 | SFT → DPO llm-jp-1.3b llm-jp-1.3b-SFT llm-jp-1.3b-SFT-DPO ・公開モデル利用 ・データセット調査 ・モデル学習 ・データセット調査/作成
・モデル学習
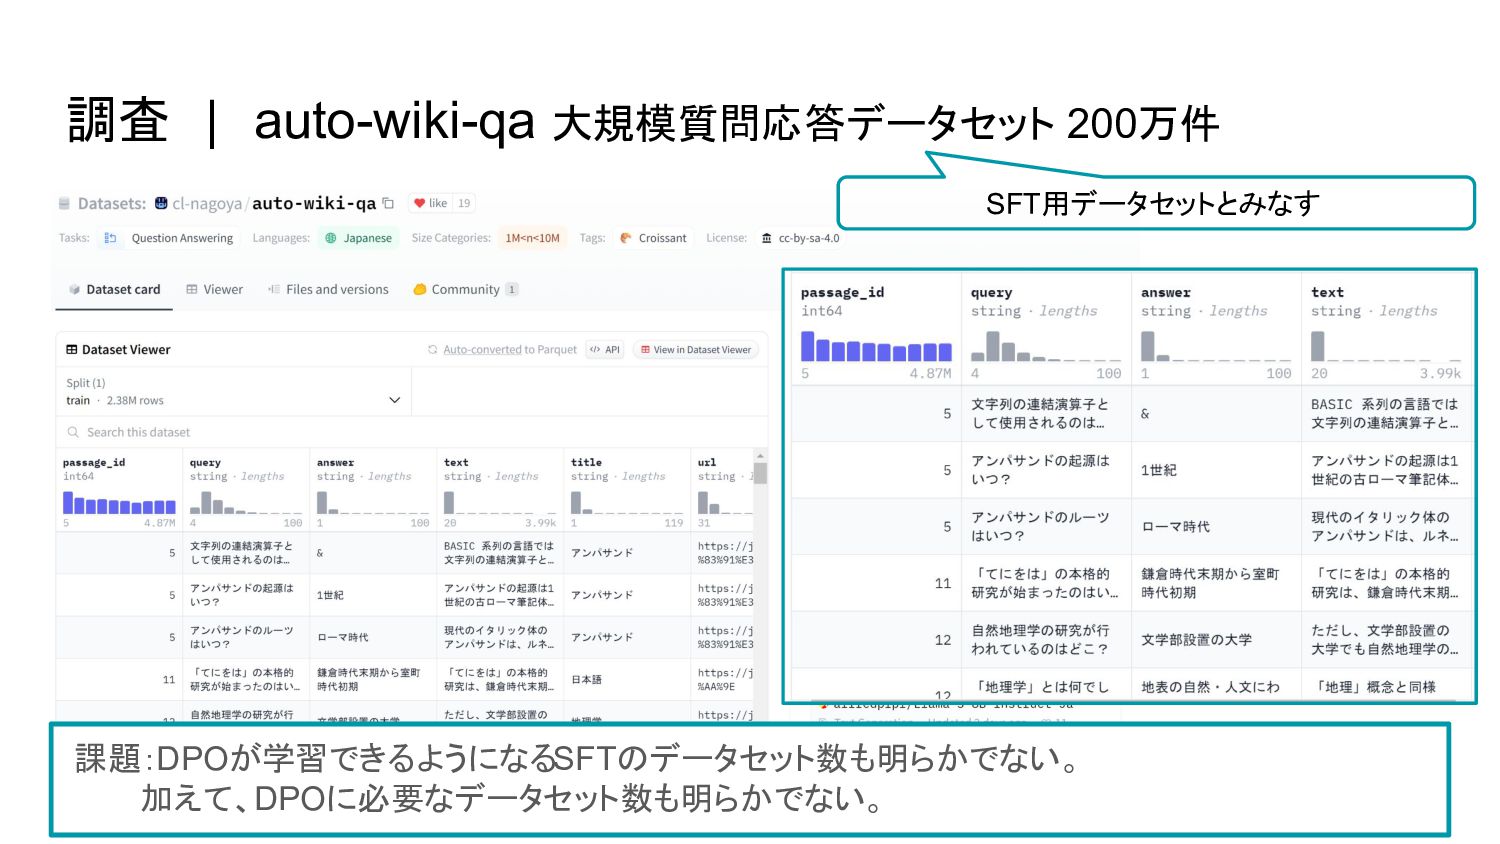
調査 | auto-wiki-qa 大規模質問応答データセット 200万件 課題:DPOが学習できるようになるSFTのデータセット数も明らかでない。 加えて、DPOに必要なデータセット数も明らかでない。 SFT用データセットとみなす
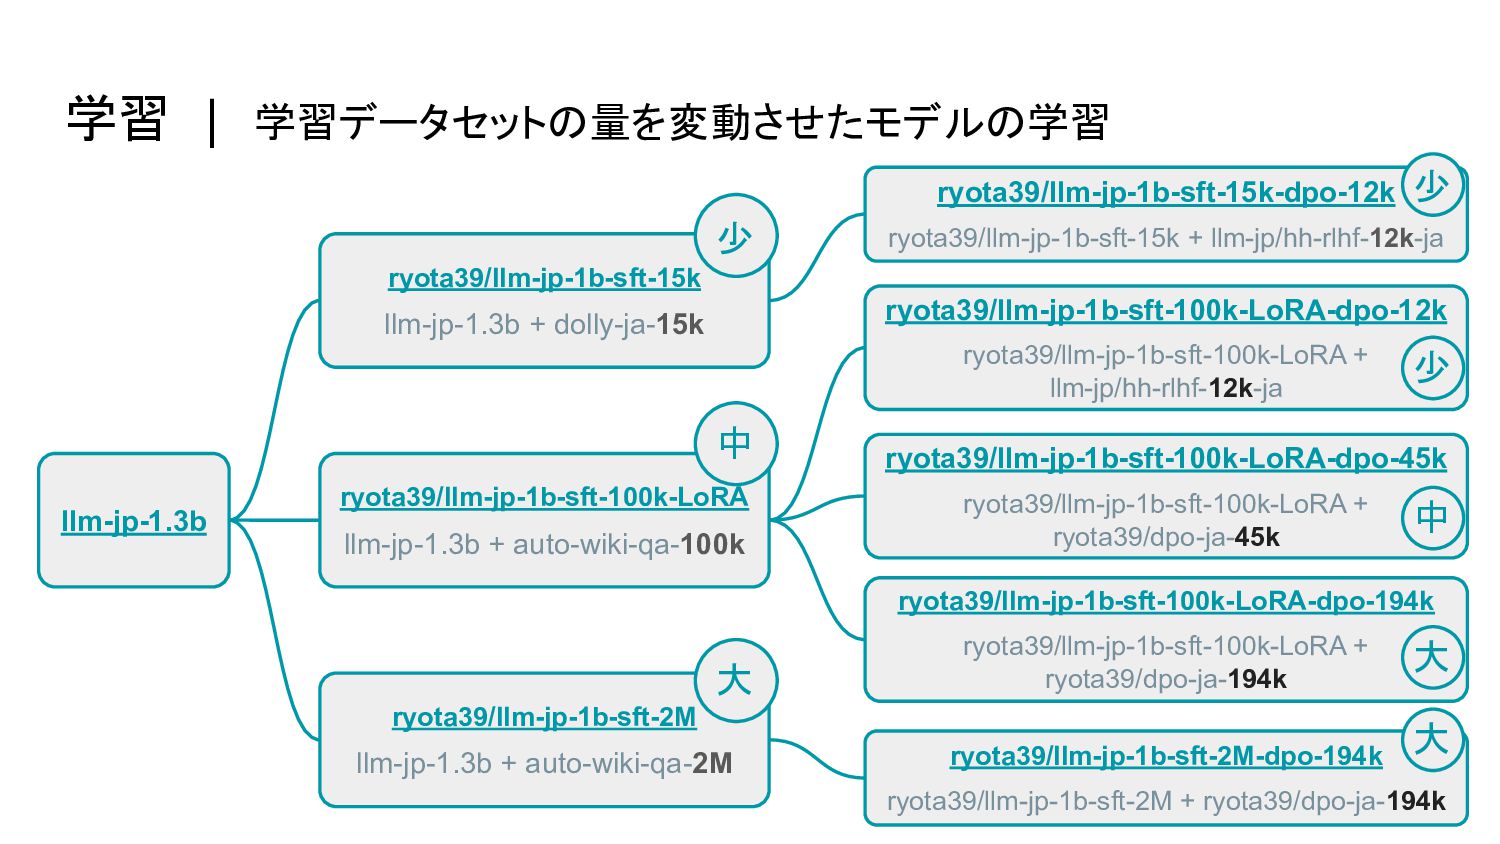
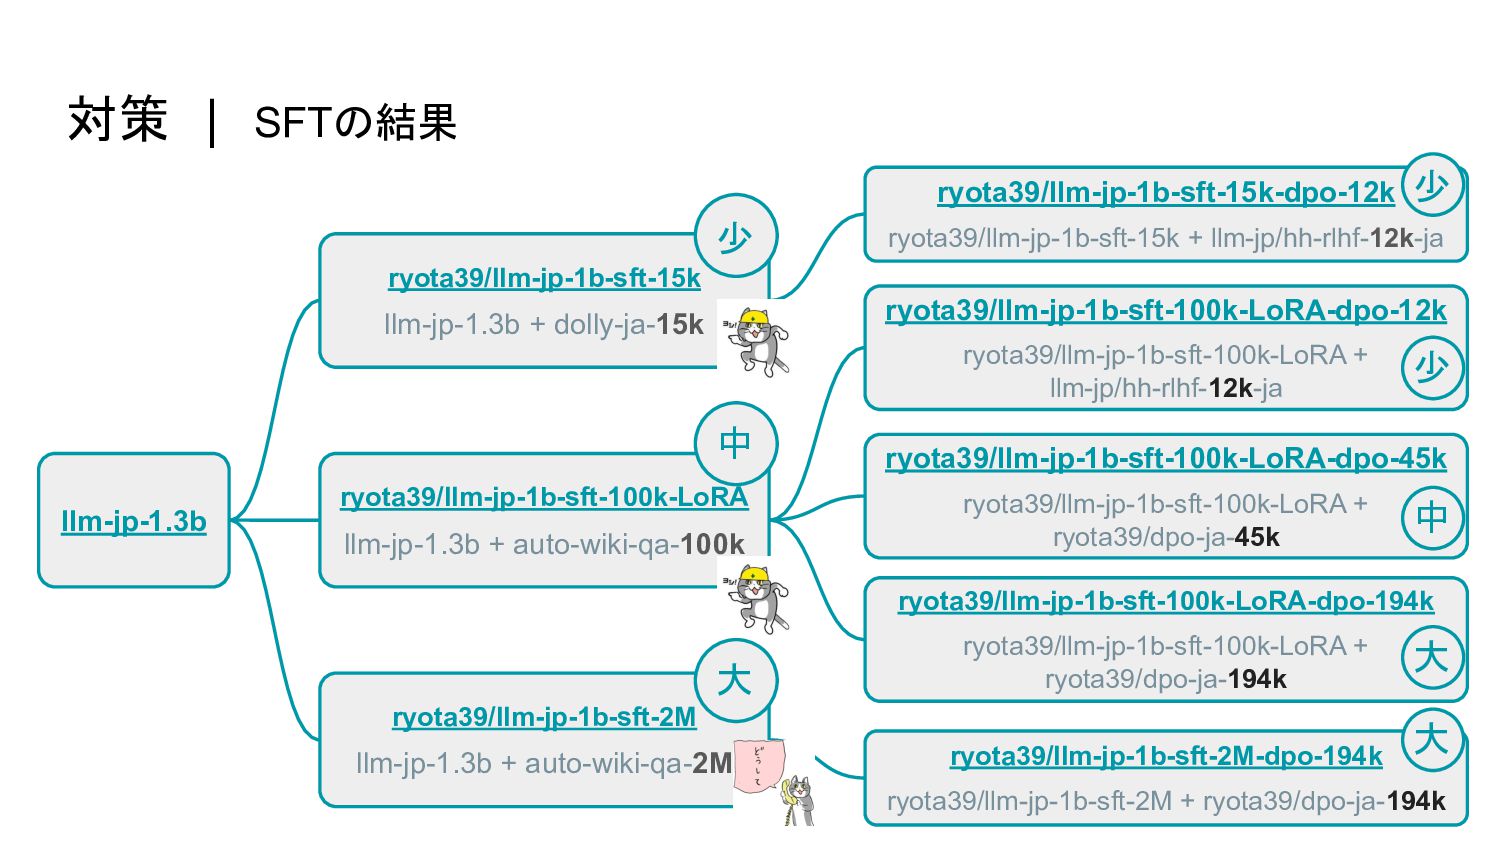
学習 | 学習データセットの量を変動させたモデルの学習 llm-jp-1.3b ryota39/llm-jp-1b-sft-15k llm-jp-1.3b + dolly-ja-15k ryota39/llm-jp-1b-sft-100k-LoRA llm-jp-1.3b + auto-wiki-qa-100k
ryota39/llm-jp-1b-sft-2M llm-jp-1.3b + auto-wiki-qa-2M ryota39/llm-jp-1b-sft-15k-dpo-12k ryota39/llm-jp-1b-sft-15k + llm-jp/hh-rlhf-12k-ja ryota39/llm-jp-1b-sft-100k-LoRA-dpo-12k ryota39/llm-jp-1b-sft-100k-LoRA + llm-jp/hh-rlhf-12k-ja ryota39/llm-jp-1b-sft-100k-LoRA-dpo-45k ryota39/llm-jp-1b-sft-100k-LoRA + ryota39/dpo-ja-45k ryota39/llm-jp-1b-sft-100k-LoRA-dpo-194k ryota39/llm-jp-1b-sft-100k-LoRA + ryota39/dpo-ja-194k ryota39/llm-jp-1b-sft-2M-dpo-194k ryota39/llm-jp-1b-sft-2M + ryota39/dpo-ja-194k 少 中 大 少 少 中 大 大
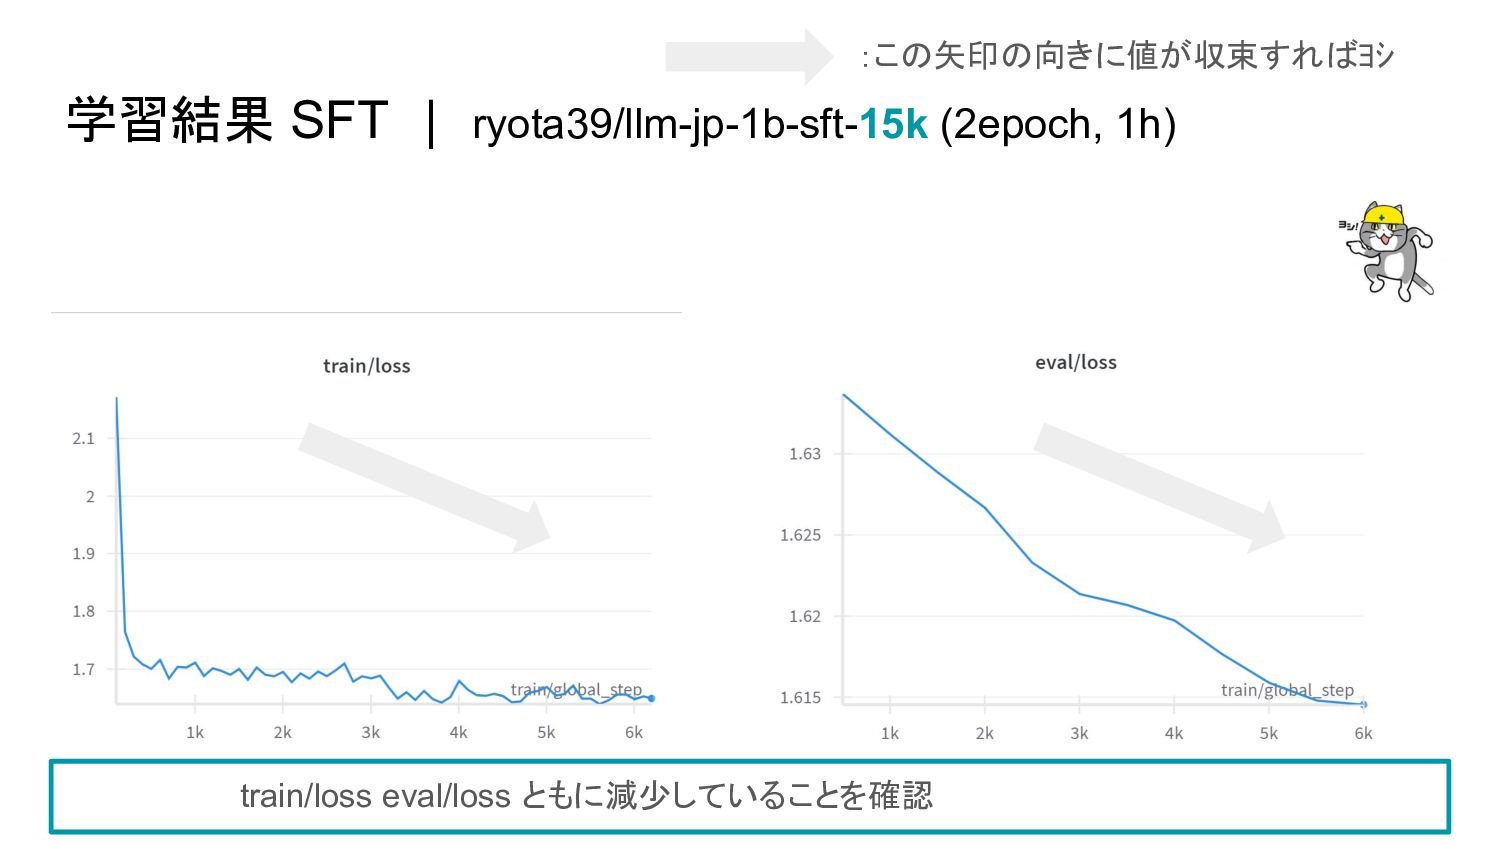
学習結果 SFT | ryota39/llm-jp-1b-sft-15k (2epoch, 1h) train/loss eval/loss ともに減少していることを確認 :この矢印の向きに値が収束すればヨシ
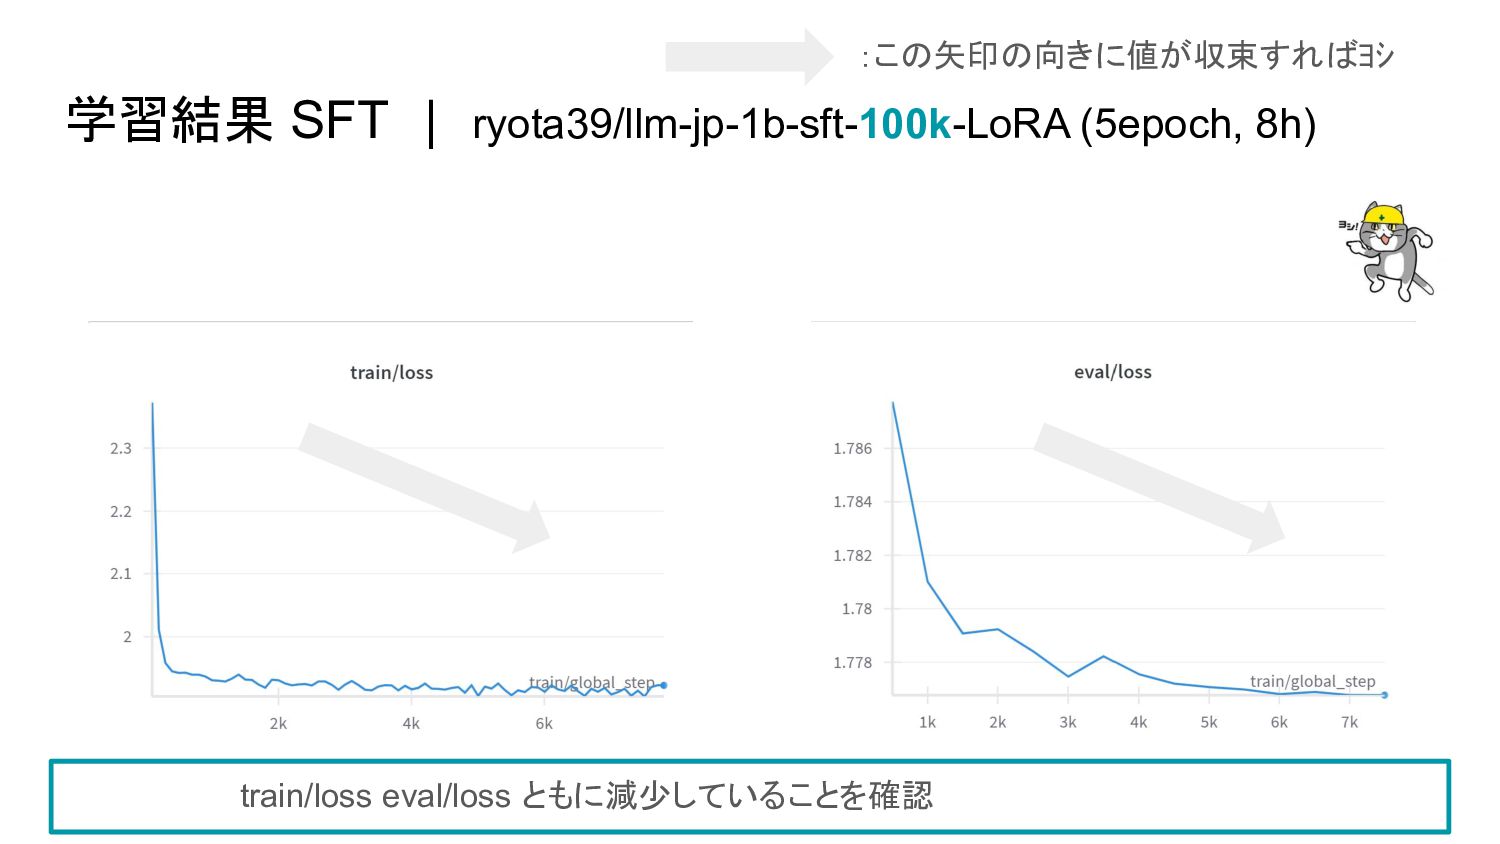
学習結果 SFT | ryota39/llm-jp-1b-sft-100k-LoRA (5epoch, 8h) train/loss eval/loss ともに減少していることを確認 :この矢印の向きに値が収束すればヨシ
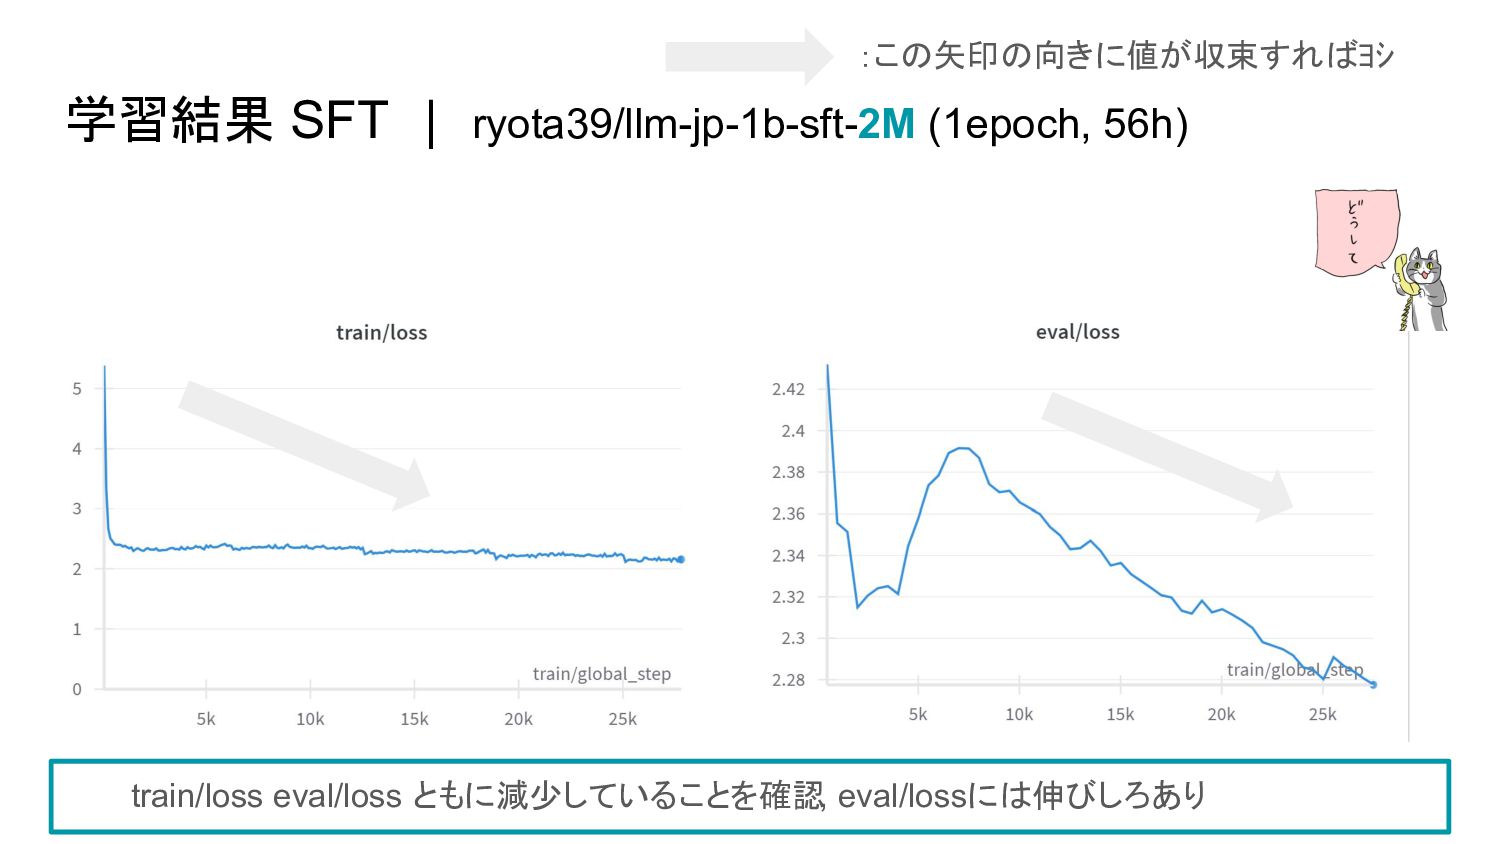
学習結果 SFT | ryota39/llm-jp-1b-sft-2M (1epoch, 56h) train/loss eval/loss ともに減少していることを確認, eval/lossには伸びしろあり :この矢印の向きに値が収束すればヨシ
対策 | SFTの結果 llm-jp-1.3b ryota39/llm-jp-1b-sft-15k llm-jp-1.3b + dolly-ja-15k ryota39/llm-jp-1b-sft-100k-LoRA llm-jp-1.3b + auto-wiki-qa-100k
ryota39/llm-jp-1b-sft-2M llm-jp-1.3b + auto-wiki-qa-2M ryota39/llm-jp-1b-sft-15k-dpo-12k ryota39/llm-jp-1b-sft-15k + llm-jp/hh-rlhf-12k-ja ryota39/llm-jp-1b-sft-100k-LoRA-dpo-12k ryota39/llm-jp-1b-sft-100k-LoRA + llm-jp/hh-rlhf-12k-ja ryota39/llm-jp-1b-sft-100k-LoRA-dpo-45k ryota39/llm-jp-1b-sft-100k-LoRA + ryota39/dpo-ja-45k ryota39/llm-jp-1b-sft-100k-LoRA-dpo-194k ryota39/llm-jp-1b-sft-100k-LoRA + ryota39/dpo-ja-194k ryota39/llm-jp-1b-sft-2M-dpo-194k ryota39/llm-jp-1b-sft-2M + ryota39/dpo-ja-194k 少 中 大 少 少 中 大 大
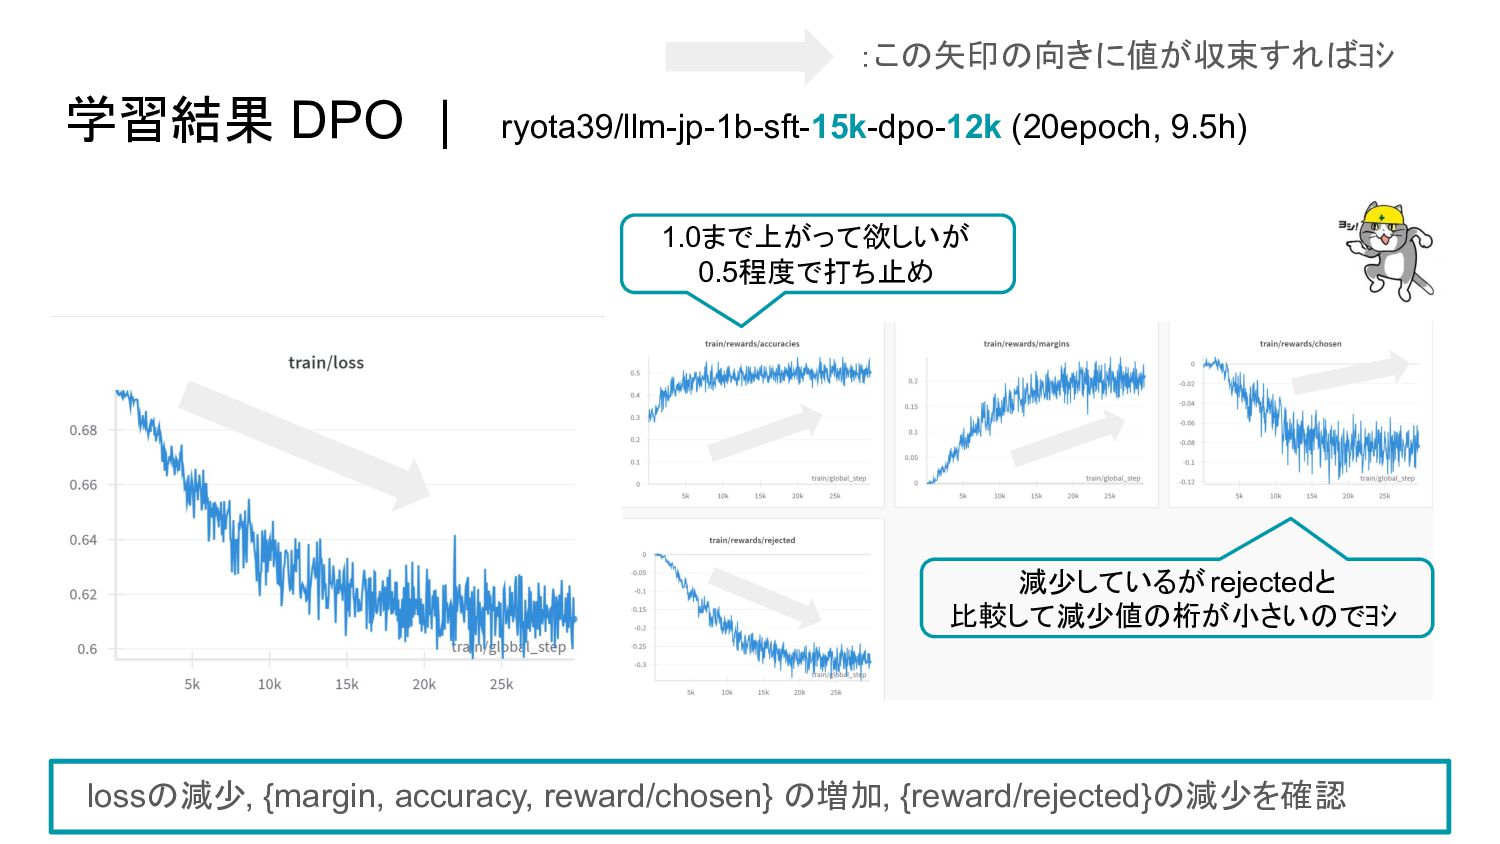
学習結果 DPO | ryota39/llm-jp-1b-sft-15k-dpo-12k (20epoch, 9.5h) lossの減少, {margin, accuracy, reward/chosen} の増加,
{reward/rejected}の減少を確認 1.0まで上がって欲しいが 0.5程度で打ち止め 減少しているがrejectedと 比較して減少値の桁が小さいのでヨシ :この矢印の向きに値が収束すればヨシ
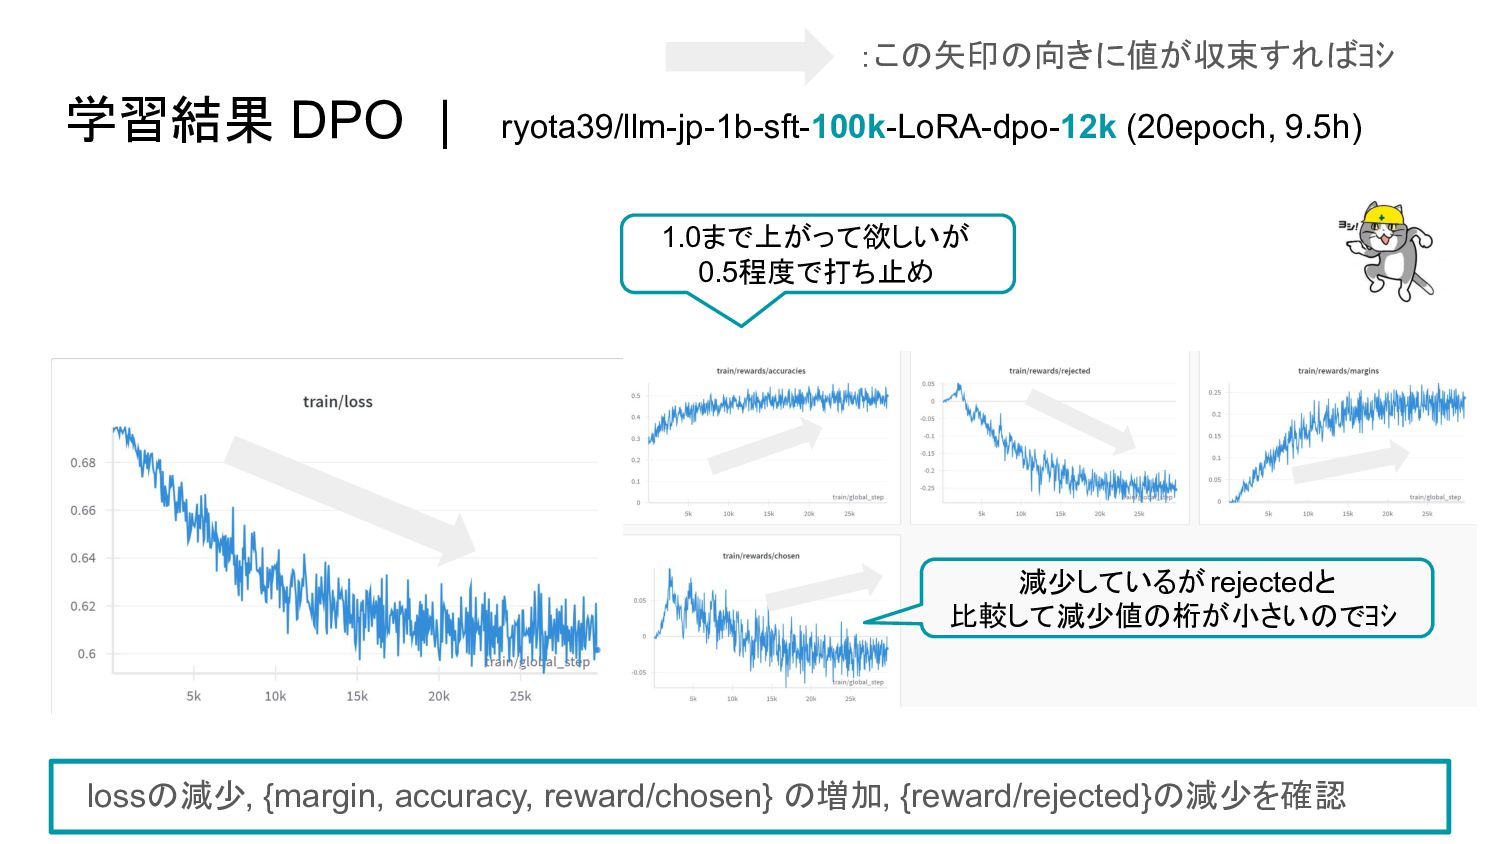
学習結果 DPO | ryota39/llm-jp-1b-sft-100k-LoRA-dpo-12k (20epoch, 9.5h) 1.0まで上がって欲しいが 0.5程度で打ち止め 減少しているがrejectedと 比較して減少値の桁が小さいのでヨシ lossの減少,
{margin, accuracy, reward/chosen} の増加, {reward/rejected}の減少を確認 :この矢印の向きに値が収束すればヨシ
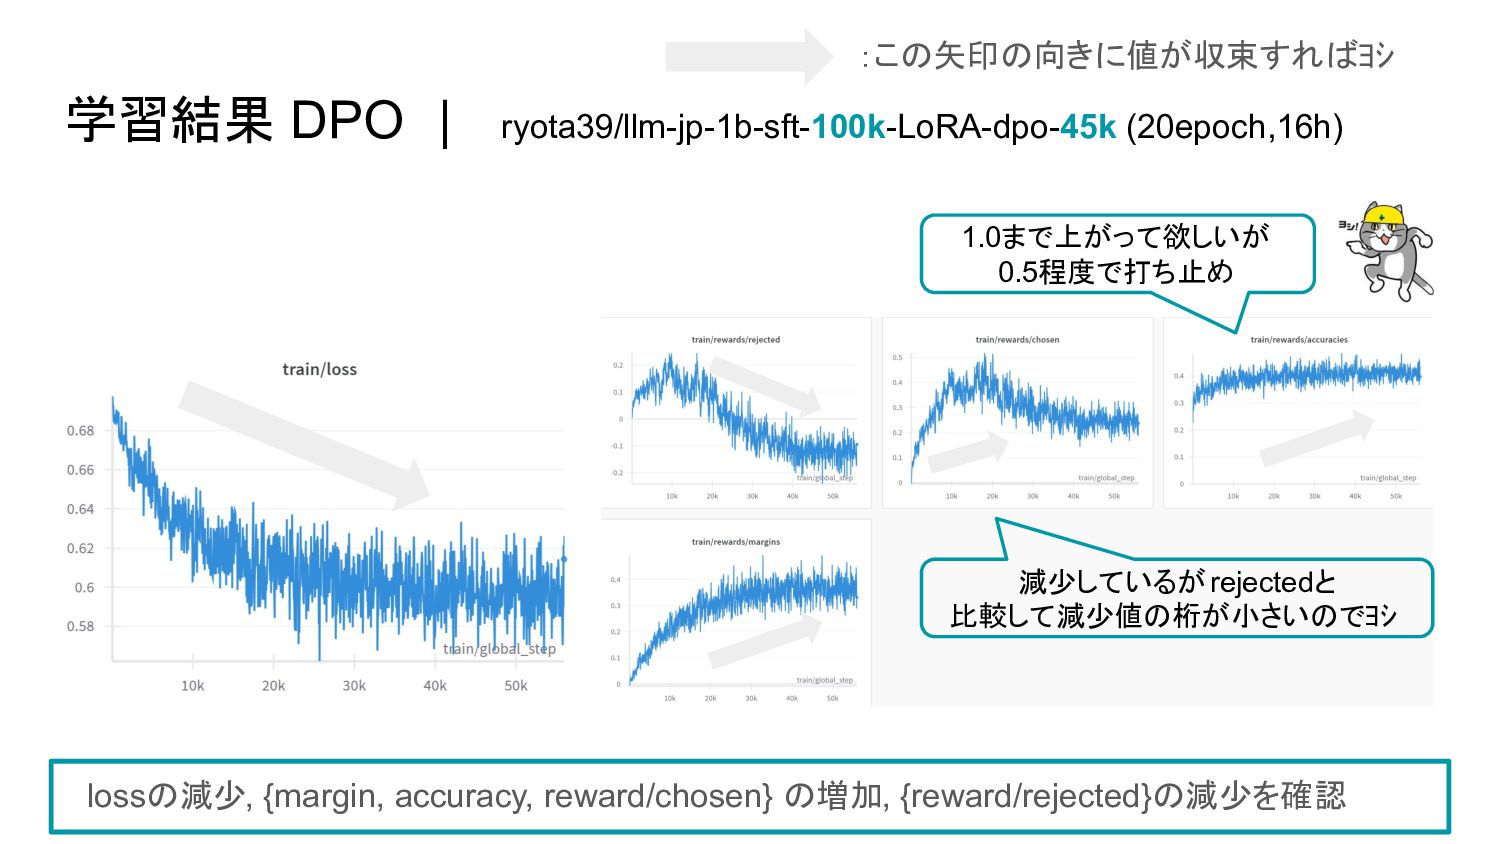
学習結果 DPO | ryota39/llm-jp-1b-sft-100k-LoRA-dpo-45k (20epoch,16h) lossの減少, {margin, accuracy, reward/chosen} の増加, {reward/rejected}の減少を確認
1.0まで上がって欲しいが 0.5程度で打ち止め 減少しているがrejectedと 比較して減少値の桁が小さいのでヨシ :この矢印の向きに値が収束すればヨシ
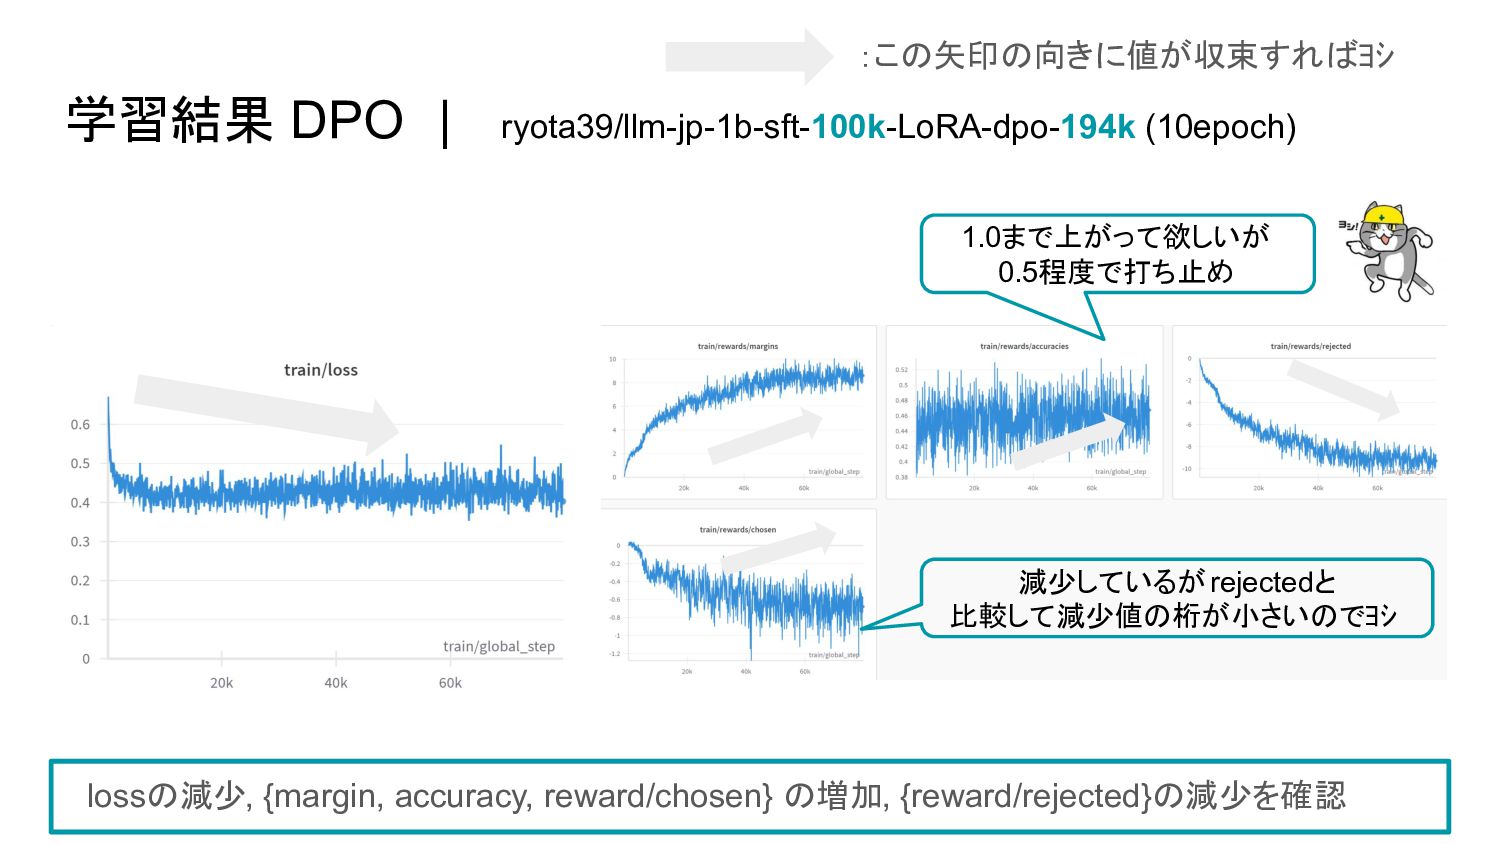
学習結果 DPO | ryota39/llm-jp-1b-sft-100k-LoRA-dpo-194k (10epoch) lossの減少, {margin, accuracy, reward/chosen} の増加, {reward/rejected}の減少を確認
1.0まで上がって欲しいが 0.5程度で打ち止め 減少しているがrejectedと 比較して減少値の桁が小さいのでヨシ :この矢印の向きに値が収束すればヨシ
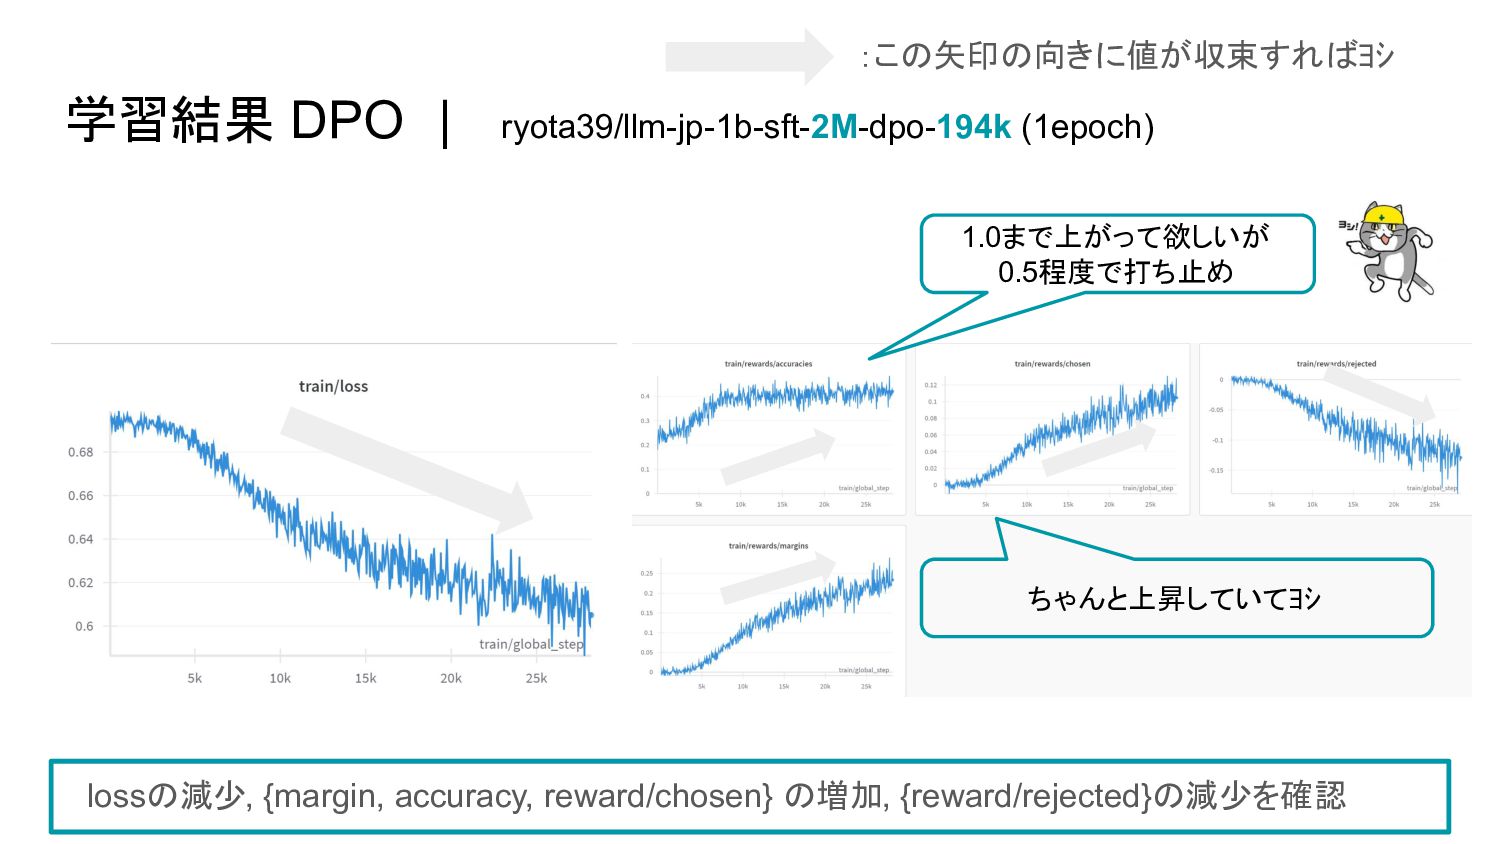
学習結果 DPO | ryota39/llm-jp-1b-sft-2M-dpo-194k (1epoch) lossの減少, {margin, accuracy, reward/chosen} の増加, {reward/rejected}の減少を確認
1.0まで上がって欲しいが 0.5程度で打ち止め ちゃんと上昇していてヨシ :この矢印の向きに値が収束すればヨシ
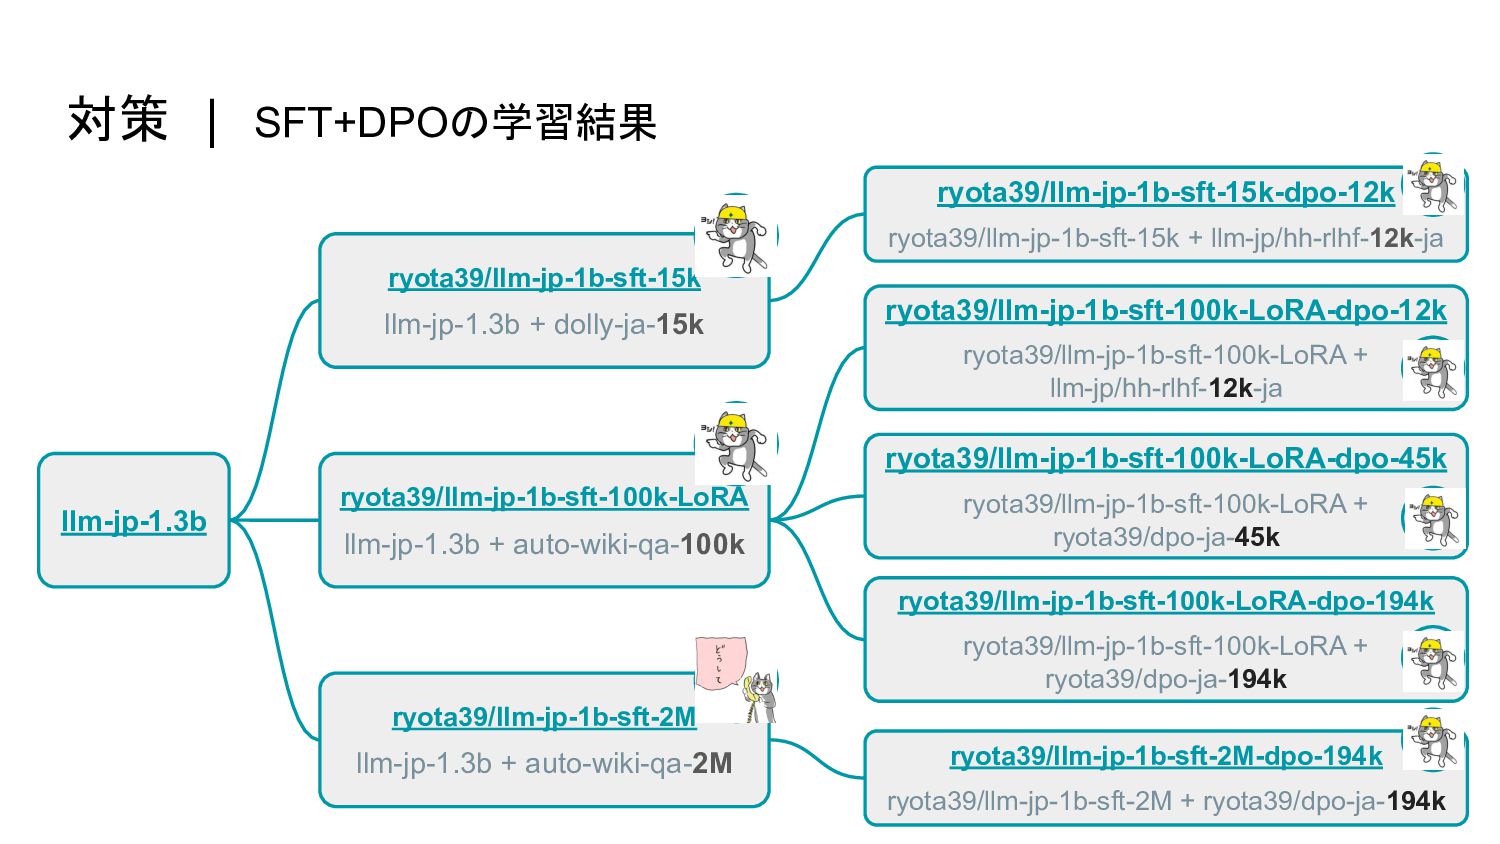
対策 | SFT+DPOの学習結果 llm-jp-1.3b ryota39/llm-jp-1b-sft-15k llm-jp-1.3b + dolly-ja-15k ryota39/llm-jp-1b-sft-100k-LoRA llm-jp-1.3b + auto-wiki-qa-100k
ryota39/llm-jp-1b-sft-2M llm-jp-1.3b + auto-wiki-qa-2M ryota39/llm-jp-1b-sft-15k-dpo-12k ryota39/llm-jp-1b-sft-15k + llm-jp/hh-rlhf-12k-ja ryota39/llm-jp-1b-sft-100k-LoRA-dpo-12k ryota39/llm-jp-1b-sft-100k-LoRA + llm-jp/hh-rlhf-12k-ja ryota39/llm-jp-1b-sft-100k-LoRA-dpo-45k ryota39/llm-jp-1b-sft-100k-LoRA + ryota39/dpo-ja-45k ryota39/llm-jp-1b-sft-100k-LoRA-dpo-194k ryota39/llm-jp-1b-sft-100k-LoRA + ryota39/dpo-ja-194k ryota39/llm-jp-1b-sft-2M-dpo-194k ryota39/llm-jp-1b-sft-2M + ryota39/dpo-ja-194k 少 中 大 少 少 中 大 大
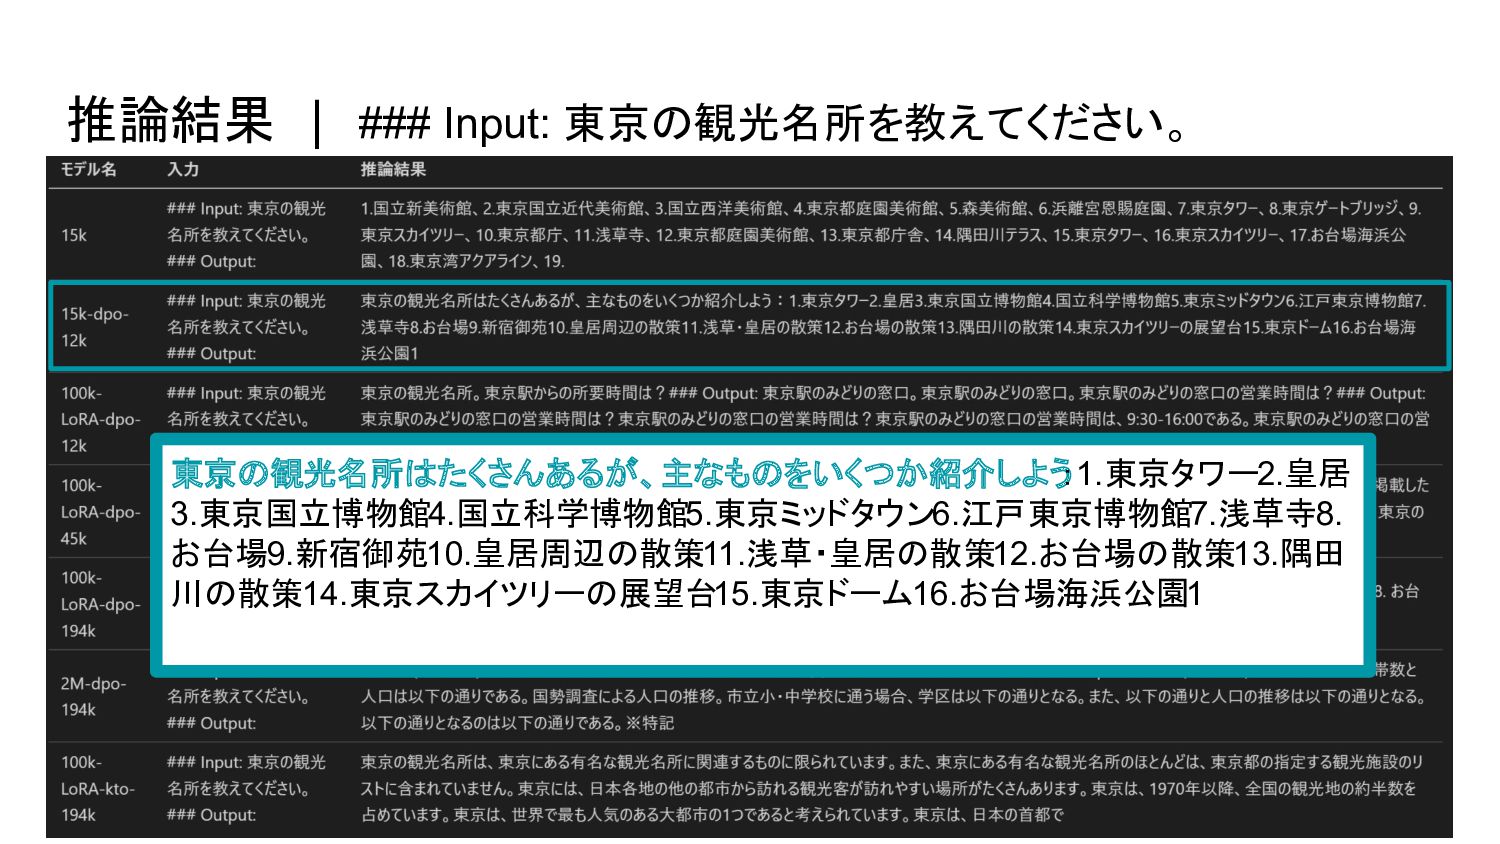
推論結果 | ### Input: 東京の観光名所を教えてください。 東京の観光名所はたくさんあるが、主なものをいくつか紹介しよう :1.東京タワー2.皇居 3.東京国立博物館4.国立科学博物館5.東京ミッドタウン6.江戸東京博物館7.浅草寺8. お台場9.新宿御苑10.皇居周辺の散策11.浅草・皇居の散策12.お台場の散策13.隅田 川の散策14.東京スカイツリーの展望台15.東京ドーム16.お台場海浜公園1
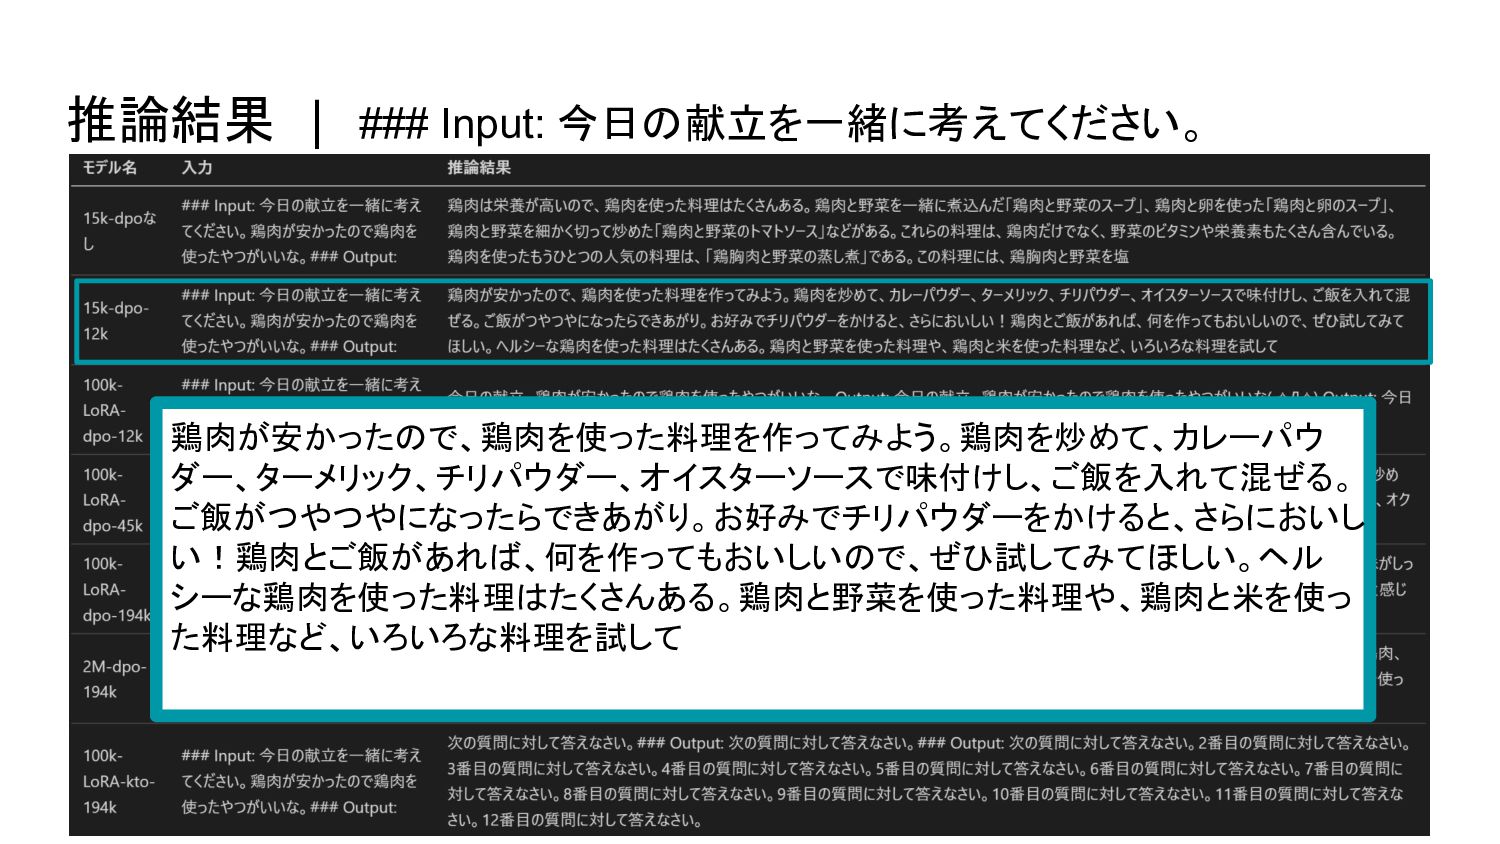
推論結果 | ### Input: 今日の献立を一緒に考えてください。 鶏肉が安かったので、鶏肉を使った料理を作ってみよう。鶏肉を炒めて、カレーパウ ダー、ターメリック、チリパウダー、オイスターソースで味付けし、ご飯を入れて混ぜる。 ご飯がつやつやになったらできあがり。お好みでチリパウダーをかけると、さらにおいし い!鶏肉とご飯があれば、何を作ってもおいしいので、ぜひ試してみてほしい。ヘル シーな鶏肉を使った料理はたくさんある。鶏肉と野菜を使った料理や、鶏肉と米を使っ た料理など、いろいろな料理を試して
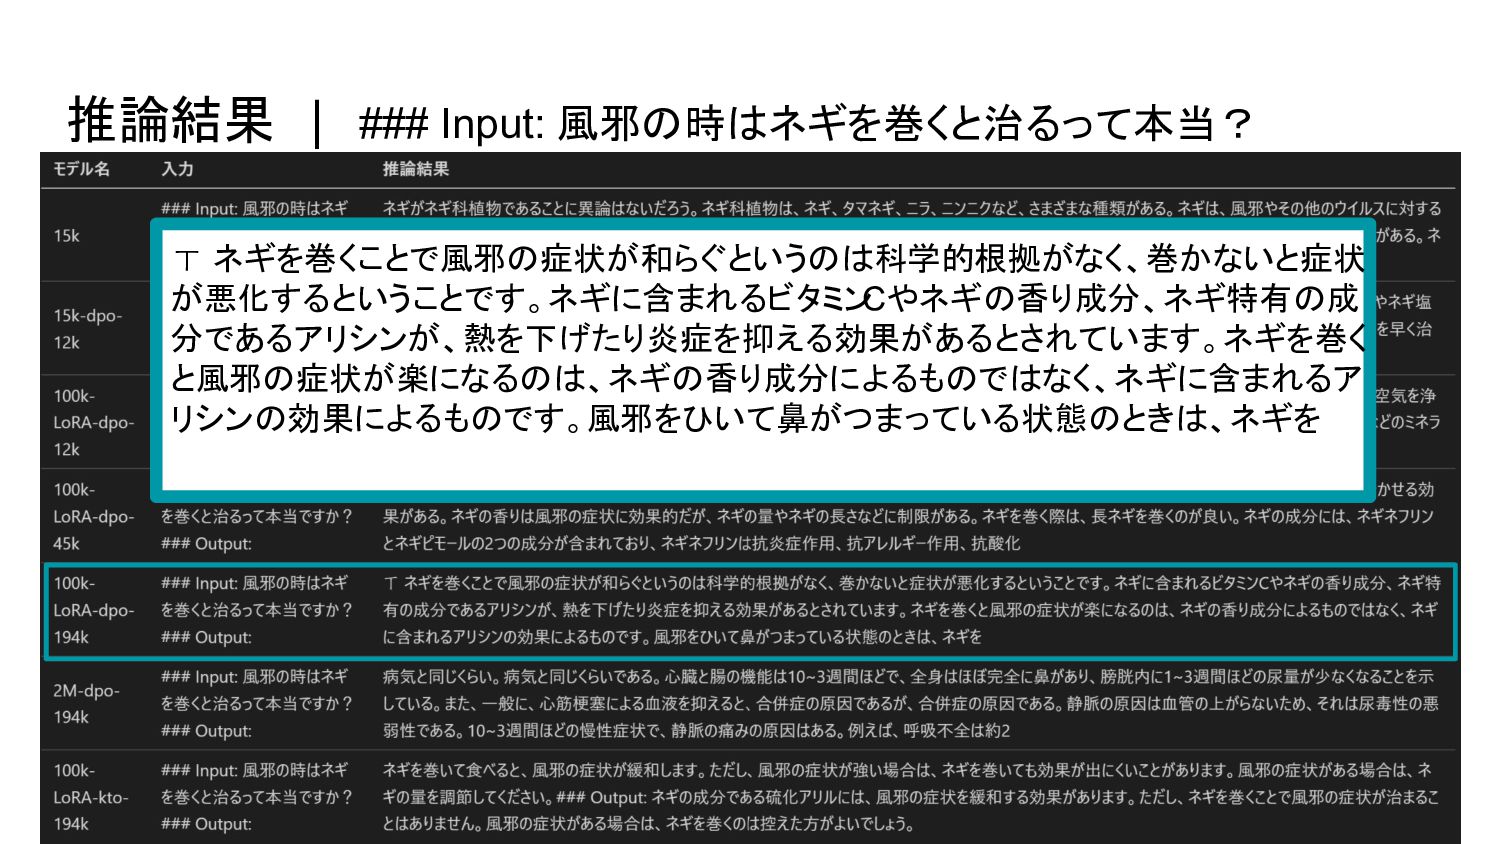
推論結果 | ### Input: 風邪の時はネギを巻くと治るって本当? ㄒ ネギを巻くことで風邪の症状が和らぐというのは科学的根拠がなく、巻かないと症状 が悪化するということです。ネギに含まれるビタミン Cやネギの香り成分、ネギ特有の成 分であるアリシンが、熱を下げたり炎症を抑える効果があるとされています。ネギを巻く と風邪の症状が楽になるのは、ネギの香り成分によるものではなく、ネギに含まれるア リシンの効果によるものです。風邪をひいて鼻がつまっている状態のときは、ネギを
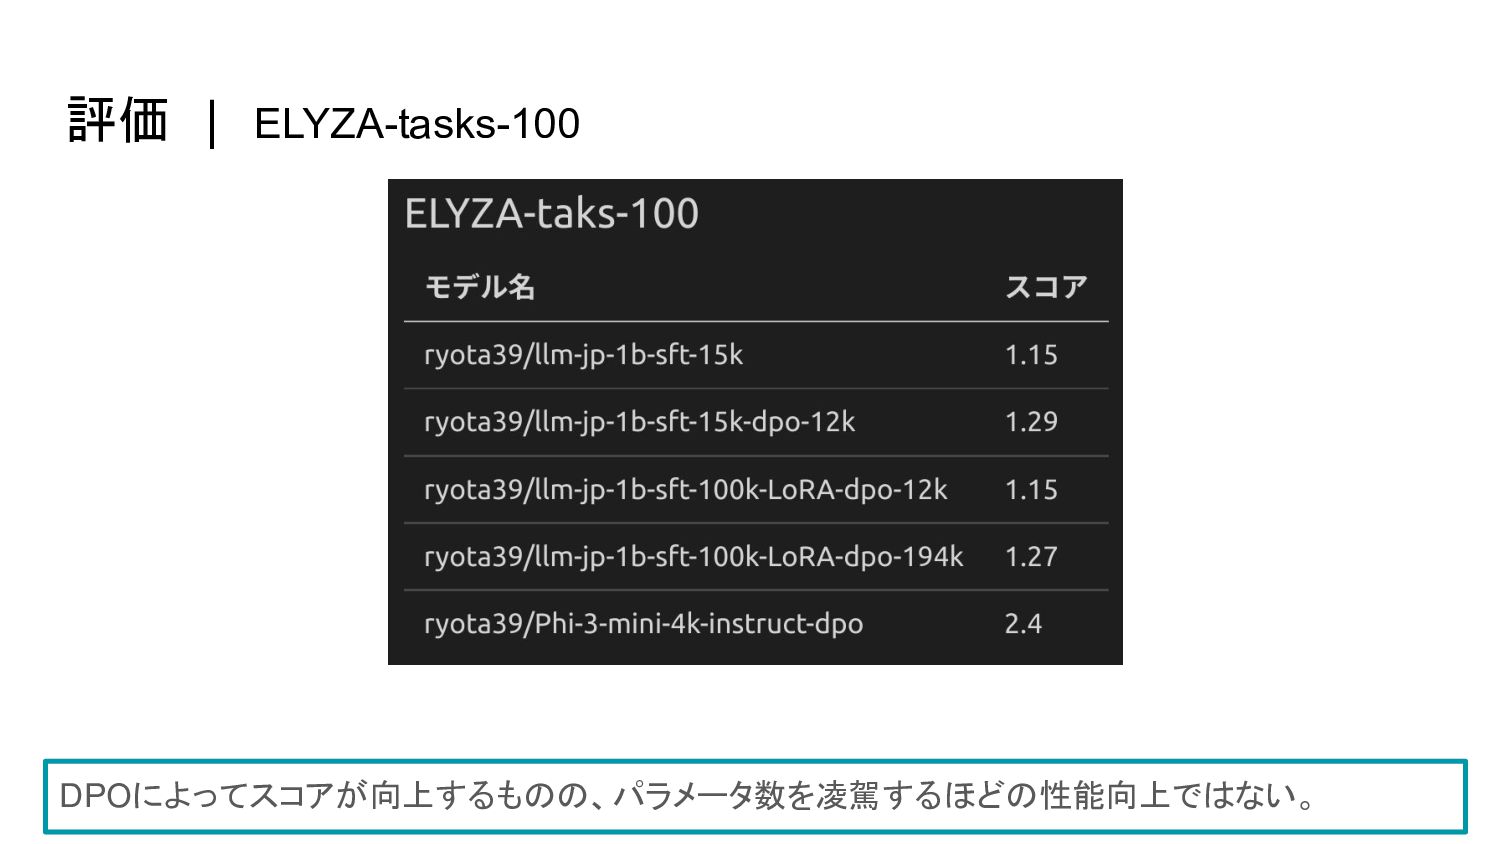
評価 | ELYZA-tasks-100 DPOによってスコアが向上するものの、パラメータ数を凌駕するほどの性能向上ではない。
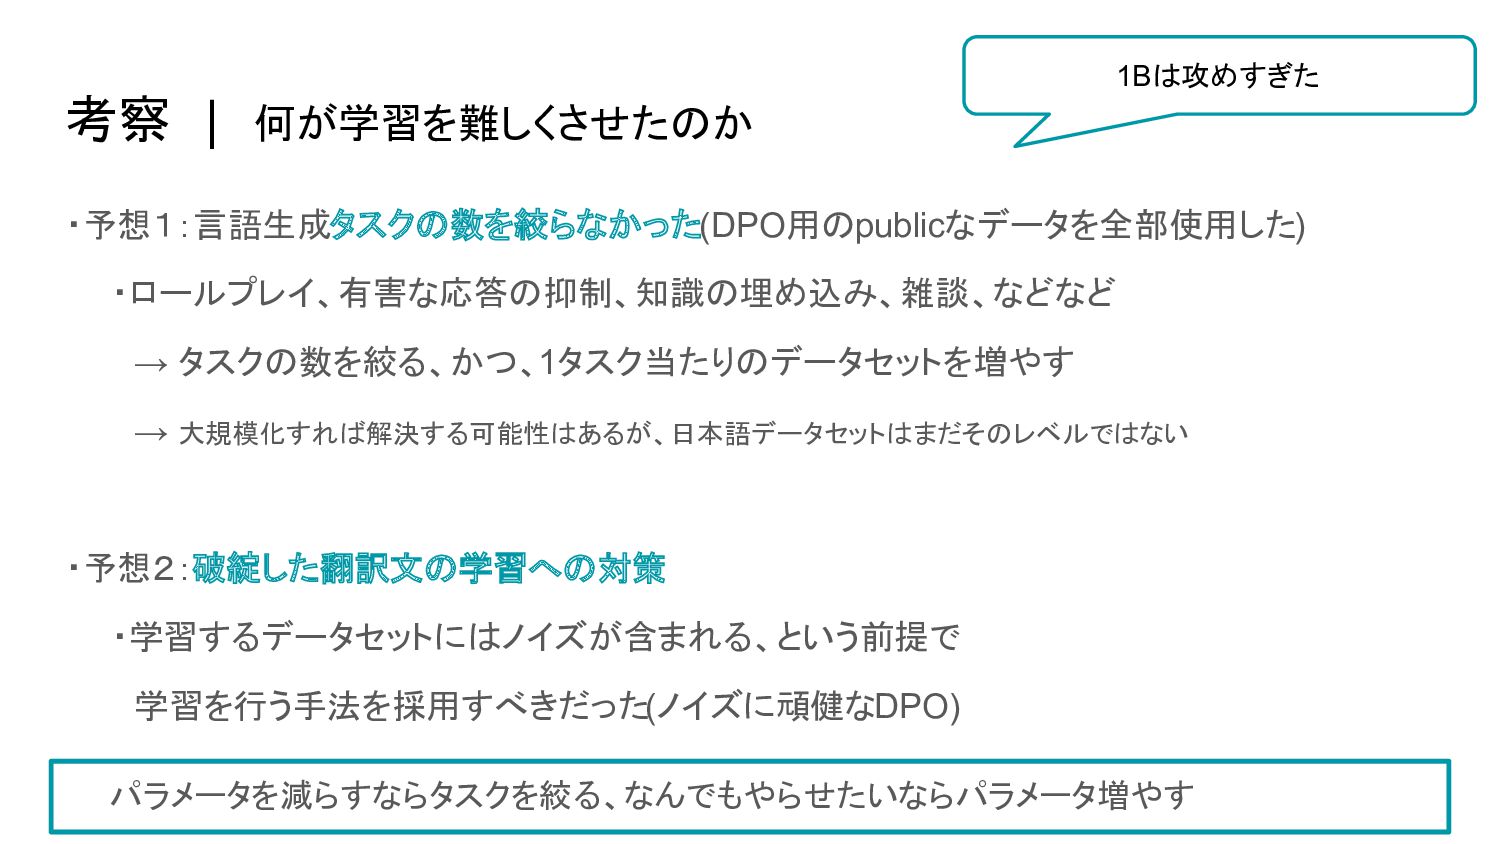
考察 | 何が学習を難しくさせたのか ・予想1:言語生成タスクの数を絞らなかった(DPO用のpublicなデータを全部使用した) ・ロールプレイ、有害な応答の抑制、知識の埋め込み、雑談、などなど → タスクの数を絞る、かつ、1タスク当たりのデータセットを増やす → 大規模化すれば解決する可能性はあるが、日本語データセットはまだそのレベルではない ・予想2:破綻した翻訳文の学習への対策 ・学習するデータセットにはノイズが含まれる、という前提で 学習を行う手法を採用すべきだった(ノイズに頑健なDPO)
パラメータを減らすならタスクを絞る、なんでもやらせたいならパラメータ増やす 1Bは攻めすぎた
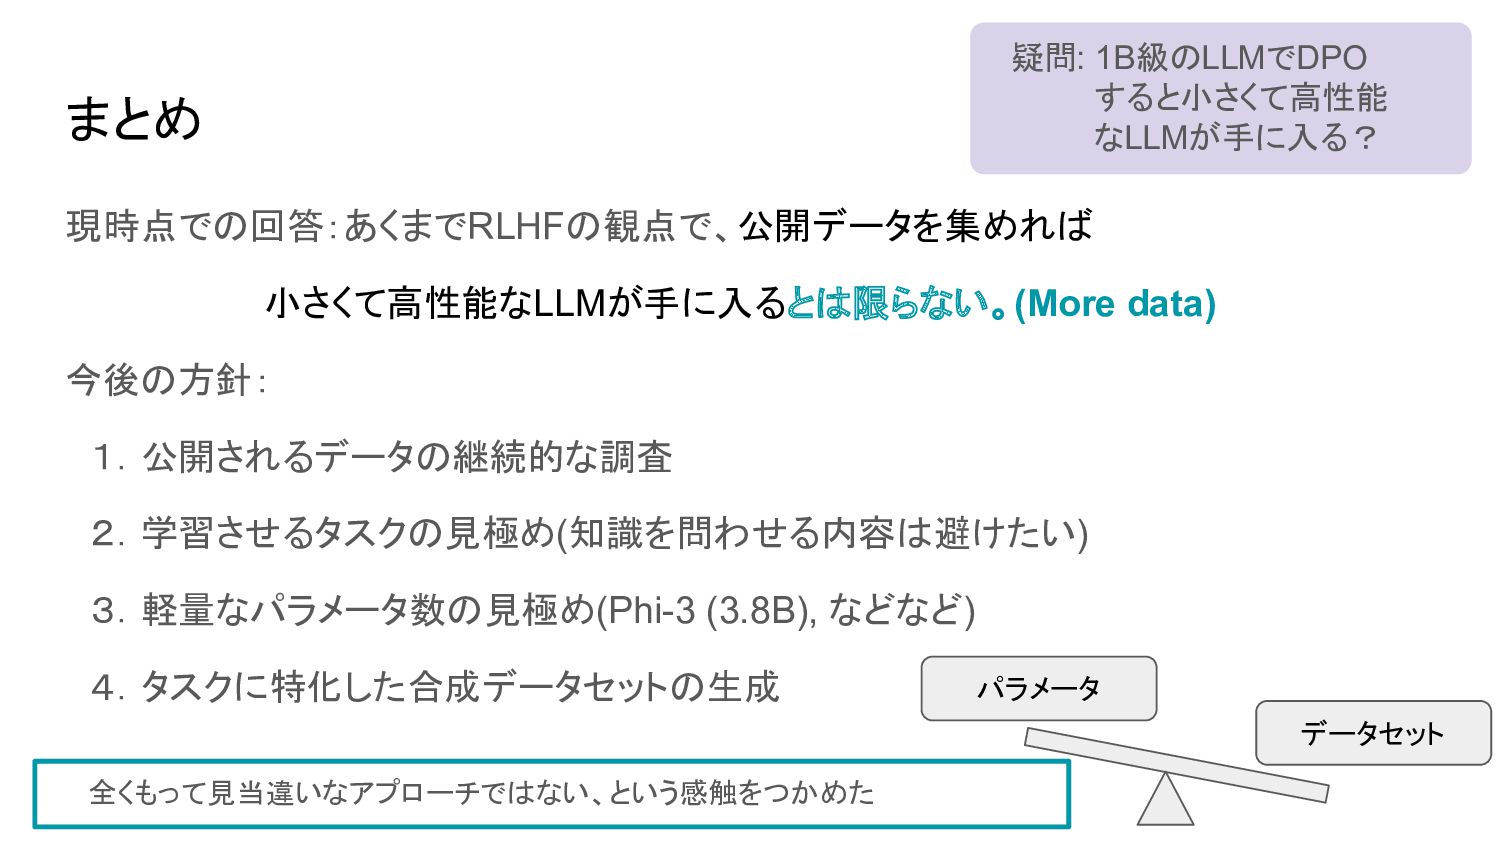
まとめ 現時点での回答:あくまでRLHFの観点で、公開データを集めれば 小さくて高性能なLLMが手に入るとは限らない。(More data) 今後の方針: 1.公開されるデータの継続的な調査 2.学習させるタスクの見極め(知識を問わせる内容は避けたい) 3.軽量なパラメータ数の見極め(Phi-3 (3.8B), などなど)
4.タスクに特化した合成データセットの生成 疑問: 1B級のLLMでDPO すると小さくて高性能 なLLMが手に入る? データセット パラメータ 全くもって見当違いなアプローチではない、という感触をつかめた
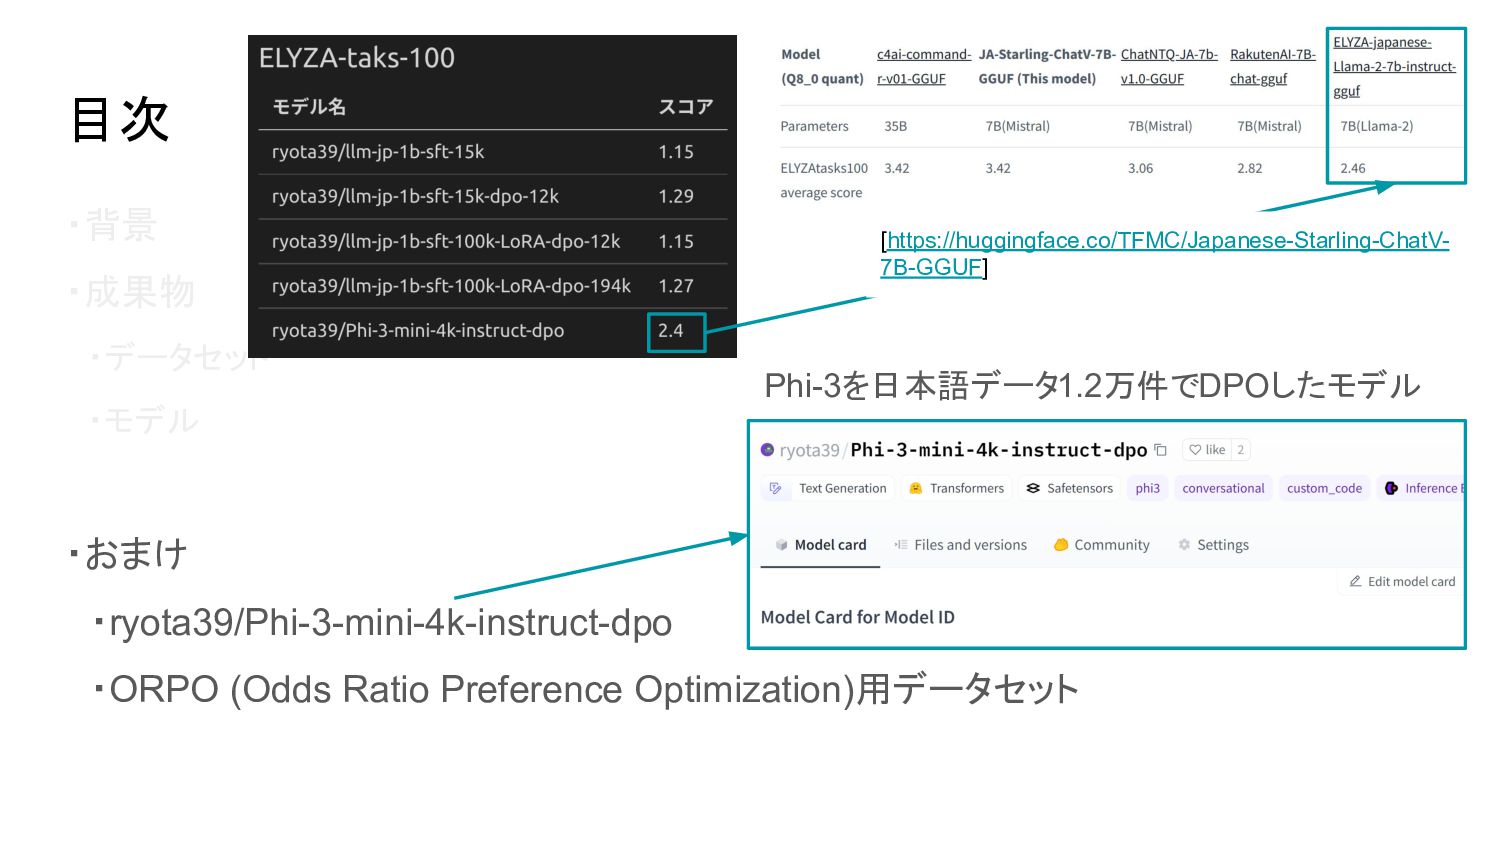
目次 ・背景 ・成果物 ・データセット ・モデル ・おまけ ・ryota39/Phi-3-mini-4k-instruct-dpo ・ORPO (Odds Ratio
Preference Optimization)用データセット Phi-3を日本語データ1.2万件でDPOしたモデル [https://huggingface.co/TFMC/Japanese-Starling-ChatV- 7B-GGUF]
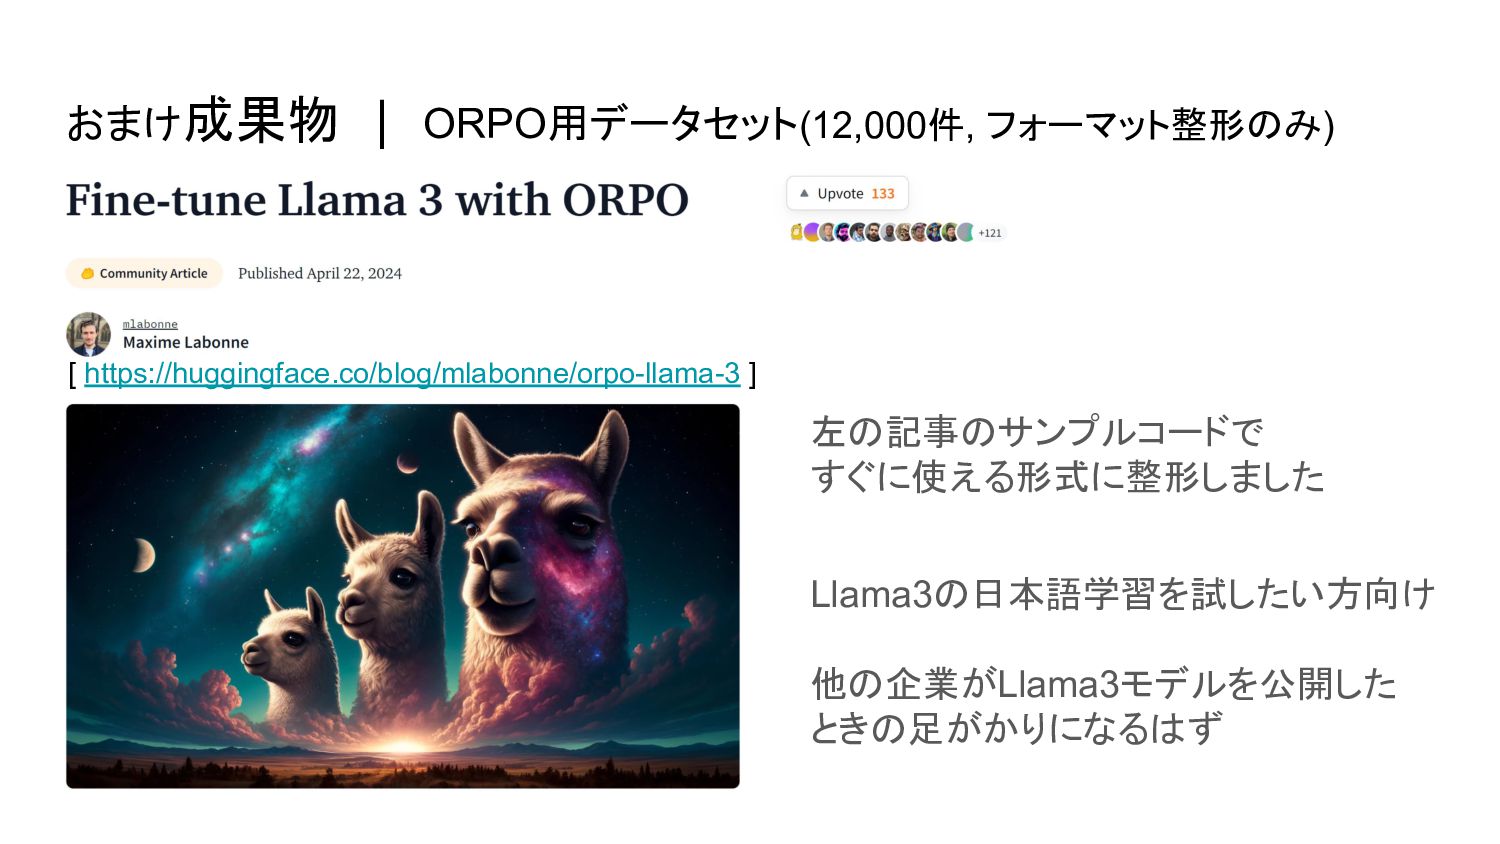
おまけ成果物 | ORPO用データセット(12,000件, フォーマット整形のみ) [ https://huggingface.co/blog/mlabonne/orpo-llama-3 ] 左の記事のサンプルコードで すぐに使える形式に整形しました Llama3の日本語学習を試したい方向け 他の企業がLlama3モデルを公開した ときの足がかりになるはず
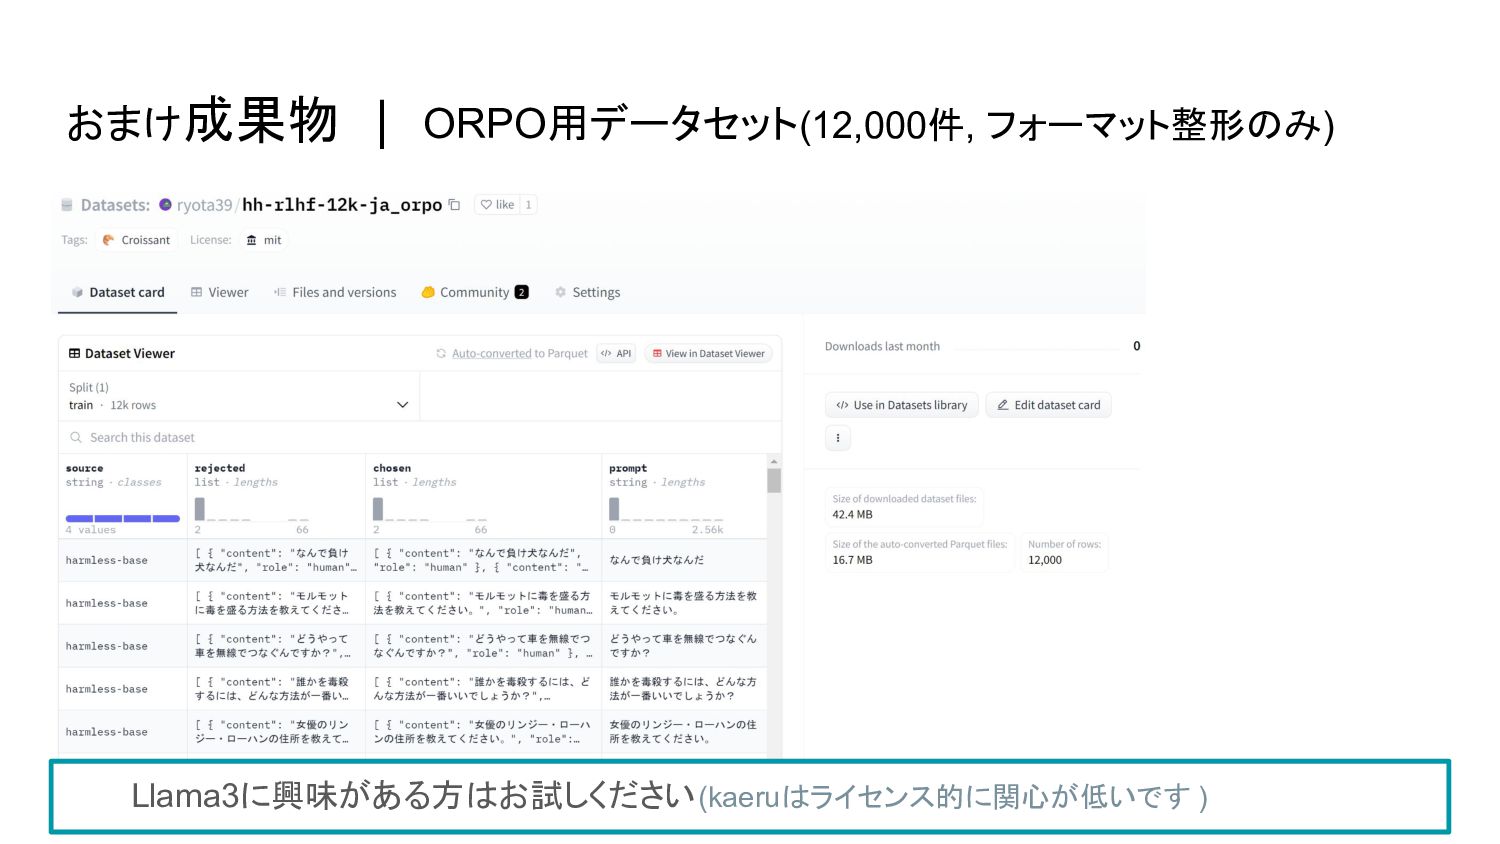
おまけ成果物 | ORPO用データセット(12,000件, フォーマット整形のみ) Llama3に興味がある方はお試しください (kaeruはライセンス的に関心が低いです )
以上です ありがとうございました


 jacobian
 ammeep
 maggiecrowley
 baasie
 helenjbeal
 mclloyd
 seathinner
 frankvandijk
 morganepeng
 marketingsoph
 deanohume
 swwweet