Share
Embed
論文紹介:Coreference-Aware Dialogue Summarization
This deck explains the paper "Coreference-Aware Dialogue Summarization" in Inaba Lab weekly meeting.
Ryutaro Asahara
June 21, 2022
Transcript
24 slides
-
紹介する論文 Zhengyuan Liu, Ke Shi, and Nancy Chen. 2021. Coreference-Aware
Dialogue Summarization. In Proceedings of the 22nd Annual Meeting of the Special Interest Group on Discourse and Dialogue, pages 509–519, Singapore and Online. Association for Computational Linguistics. 紹介する理由 • 対話文における共参照関係をグラフ化して要約するというのが 面白そうだったから • 共参照情報をうまく保持したHead数(Attention)を求める手法を 提案している -
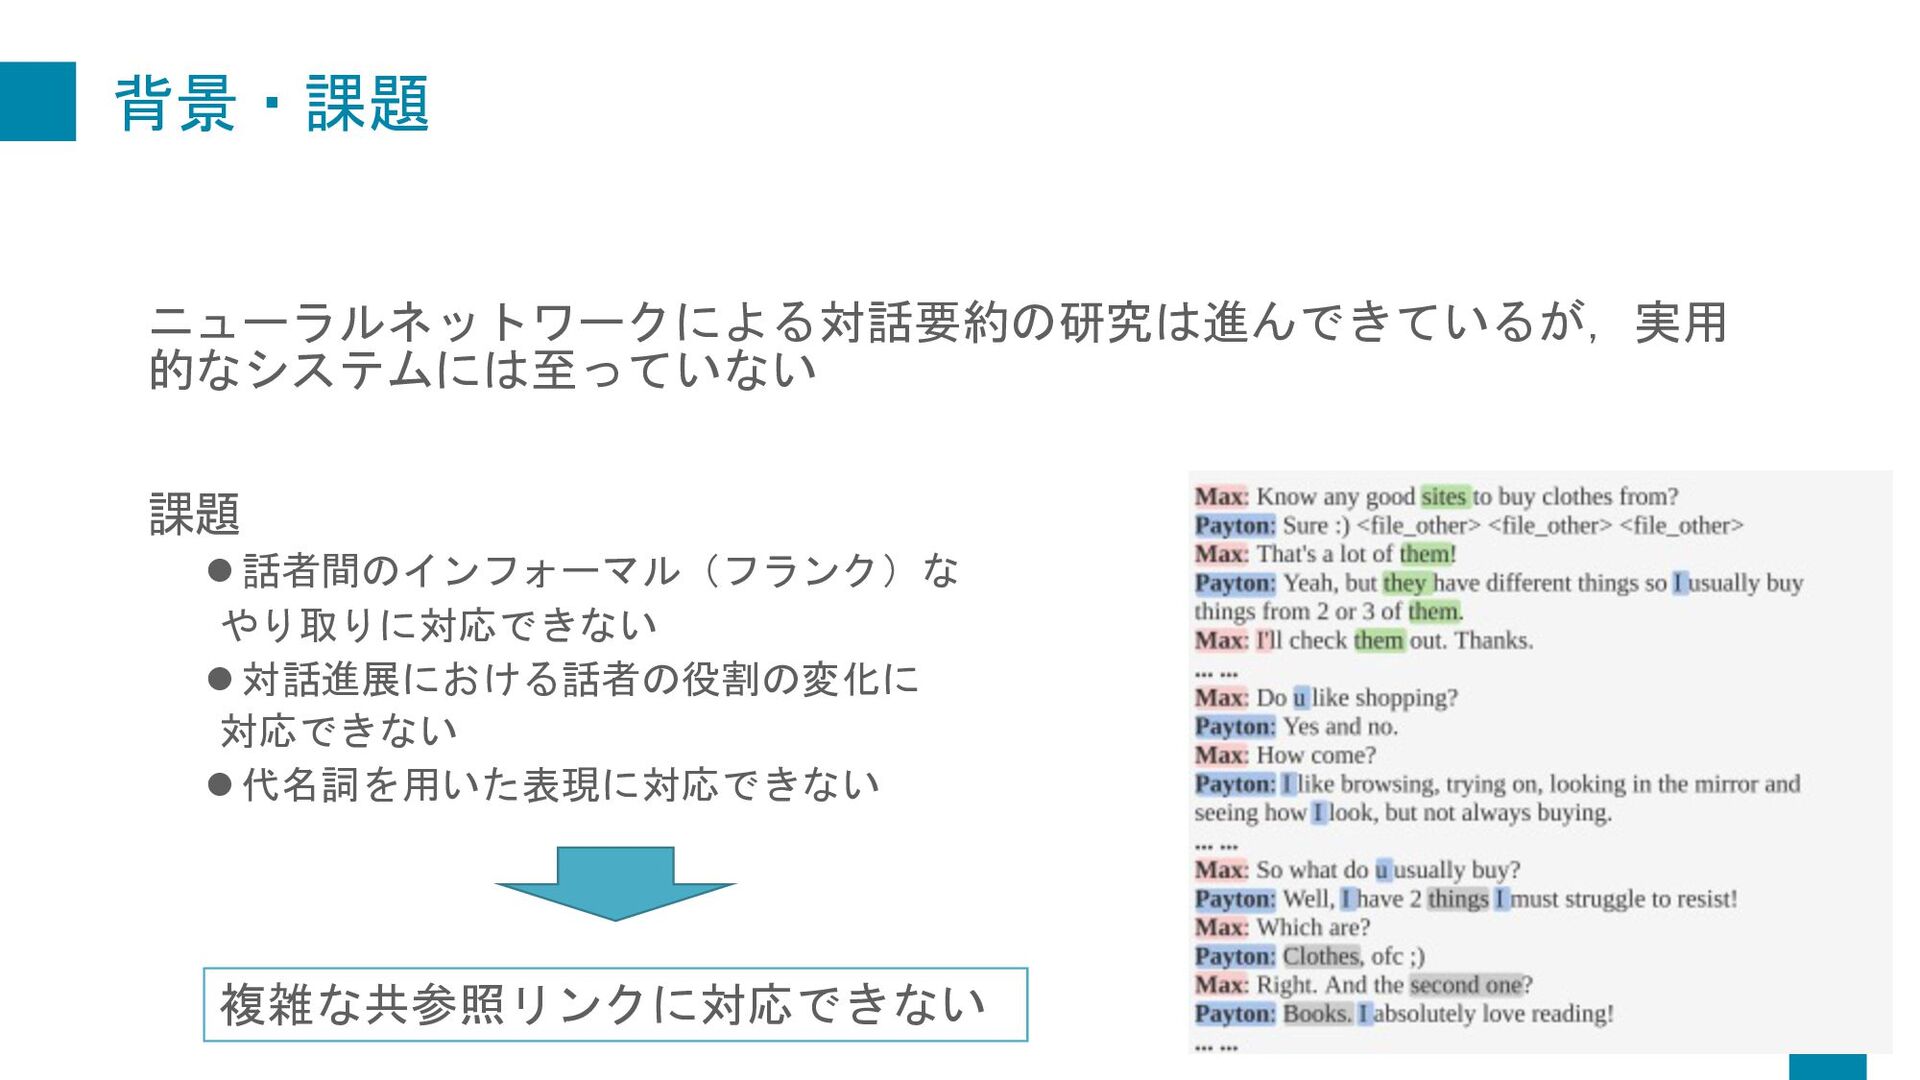
背景・課題 ニューラルネットワークによる対話要約の研究は進んできているが,実用 的なシステムには至っていない 課題 l 話者間のインフォーマル(フランク)な やり取りに対応できない l 対話進展における話者の役割の変化に 対応できない
l 代名詞を用いた表現に対応できない 複雑な共参照リンクに対応できない -
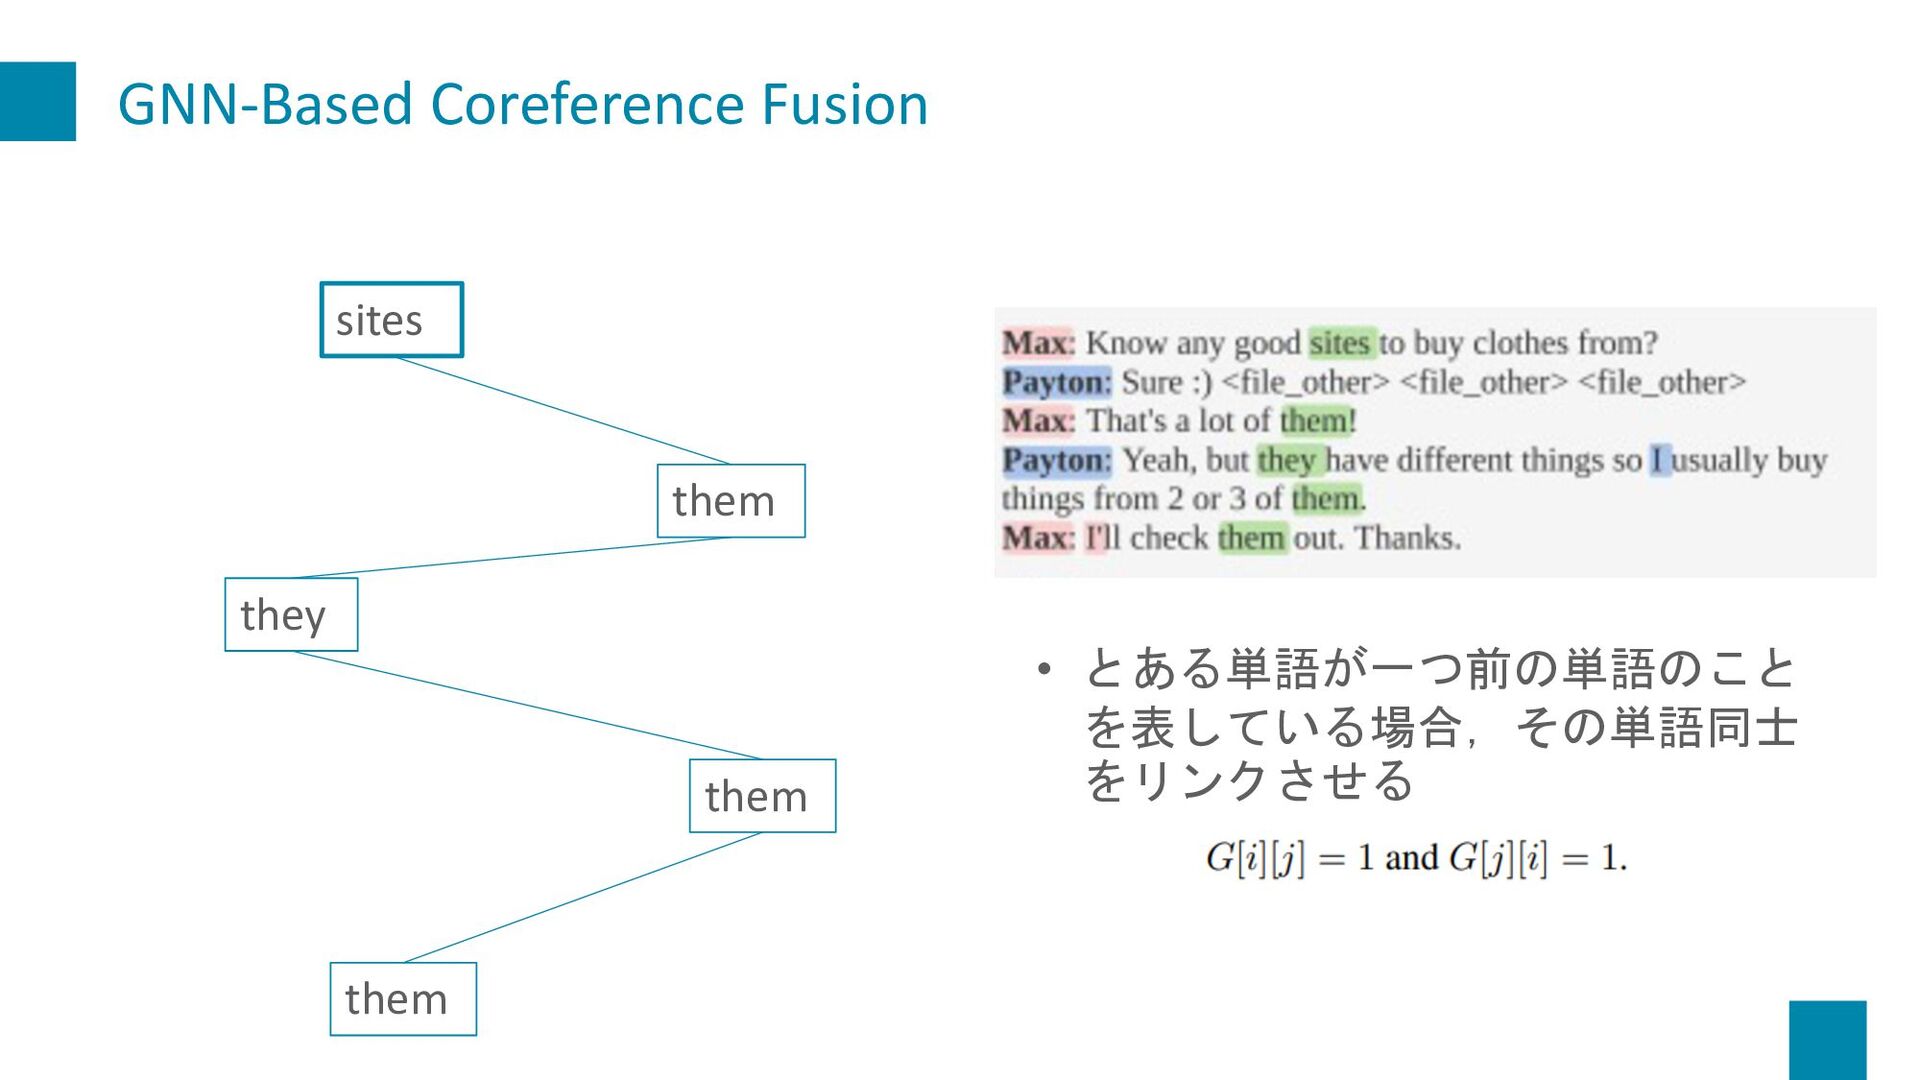
アプローチ 共参照情報を明示的に活用する研究はほとんどない 対話要約モデルに対して明示的に共参照情報を取り込むことを提案 • GNNに基づいた共参照情報の使用 • 共参照情報をGNN(Graph Neural Network)で特徴づける •
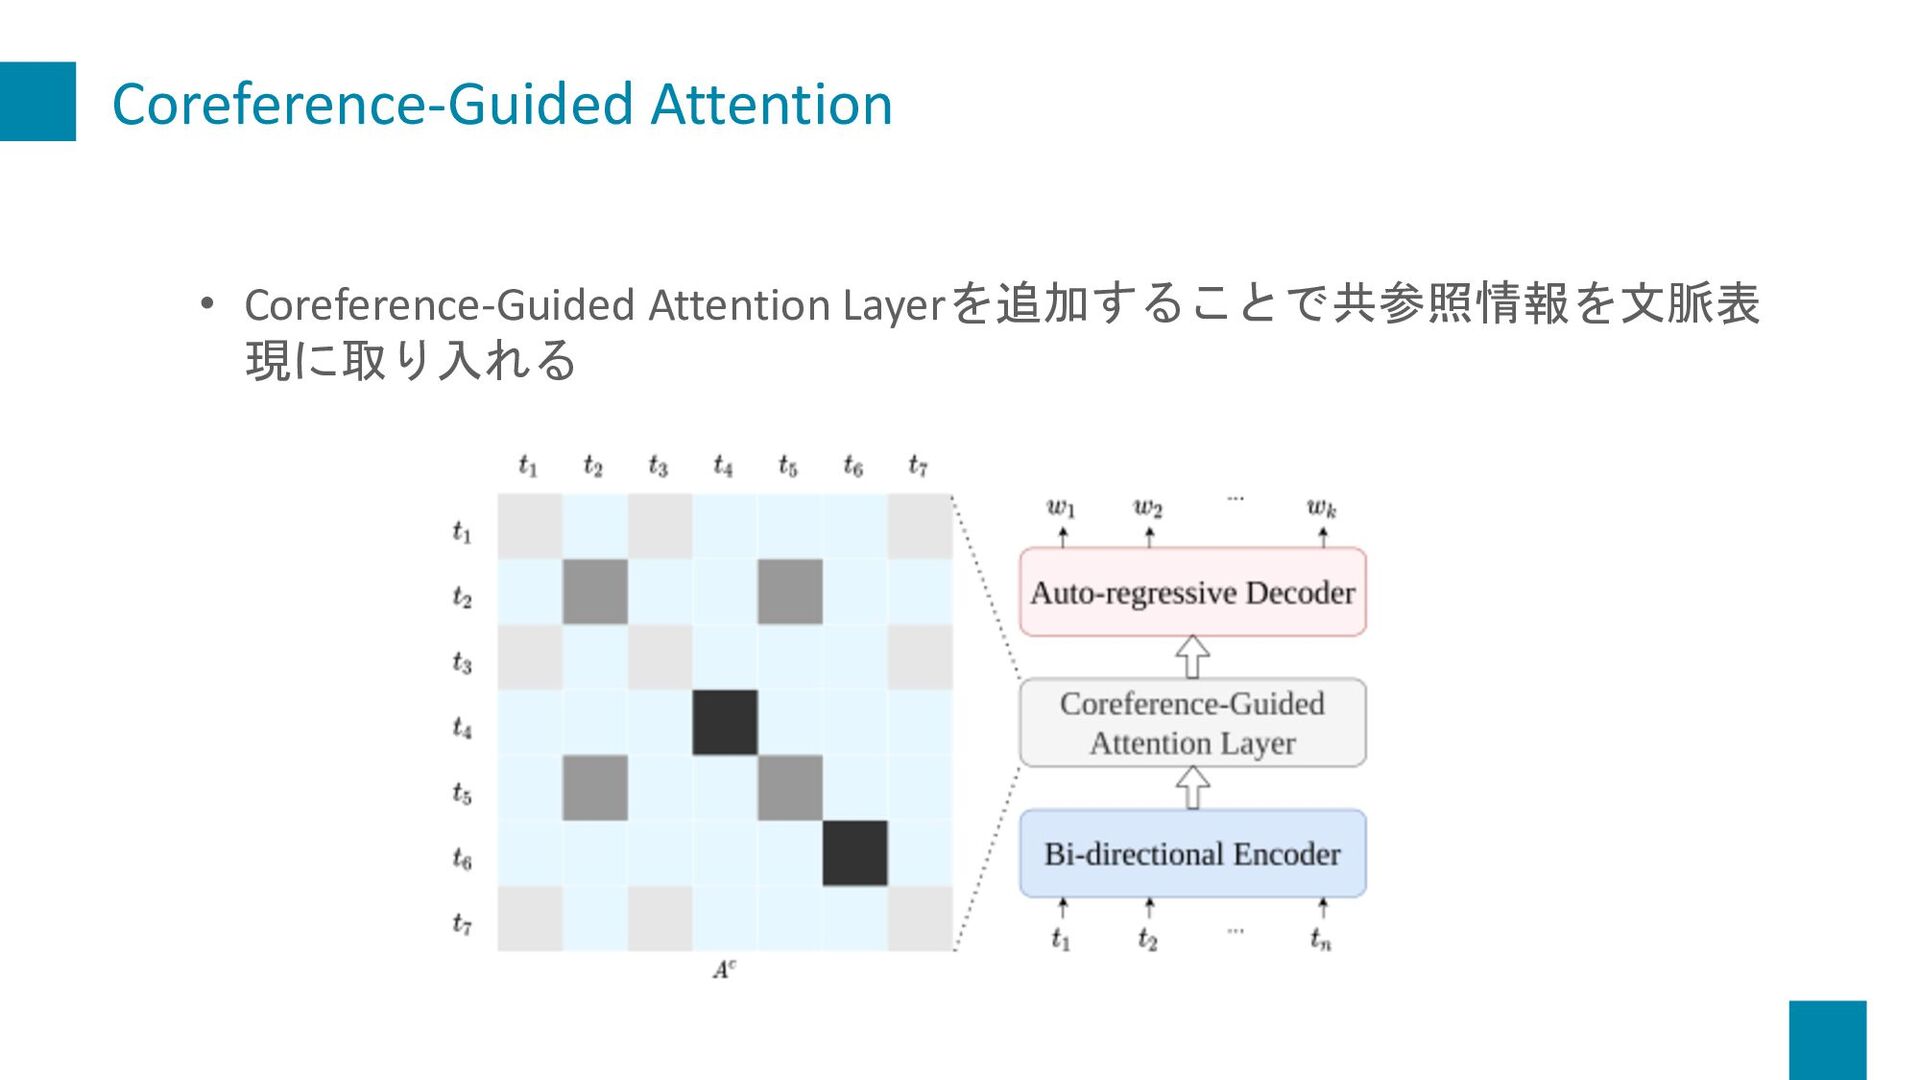
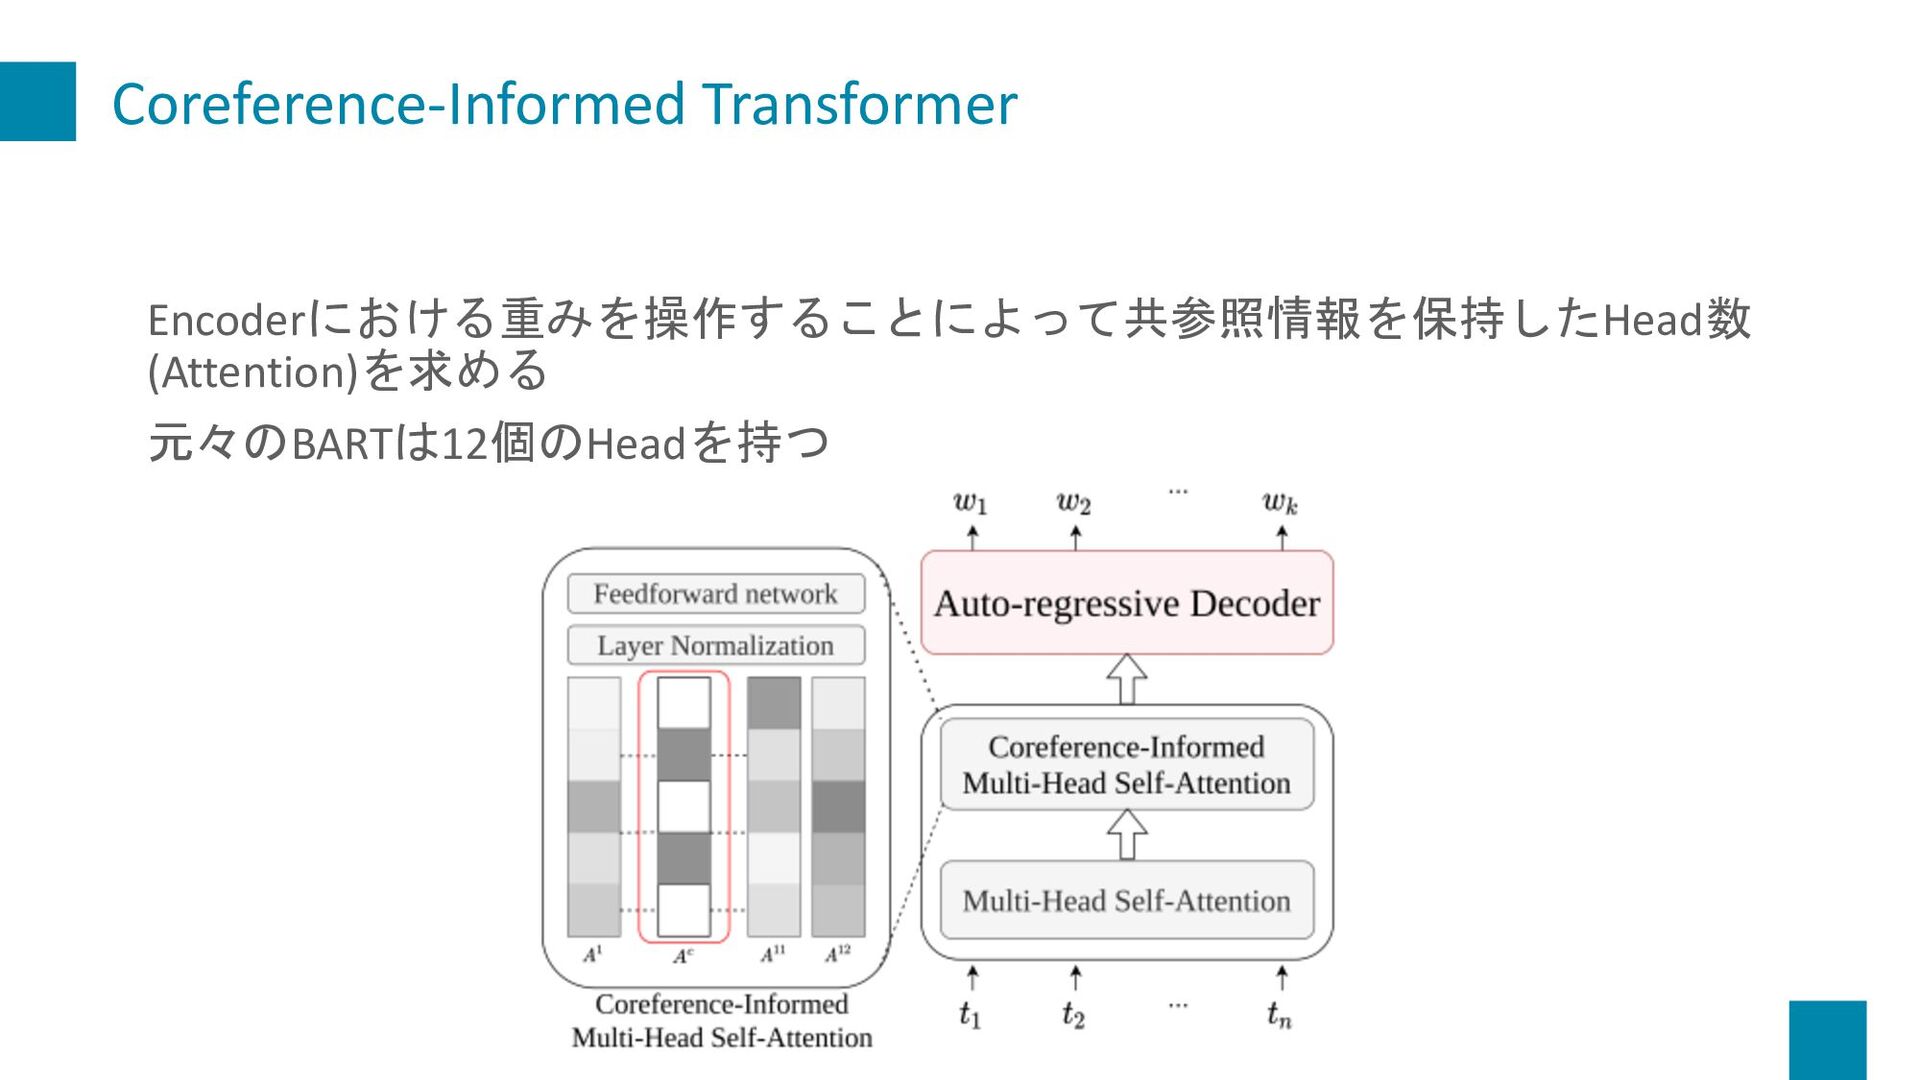
共参照情報によって誘導されたAttention • 共参照情報に基づいたTransformer 3つの具体的なアプローチを提案 -
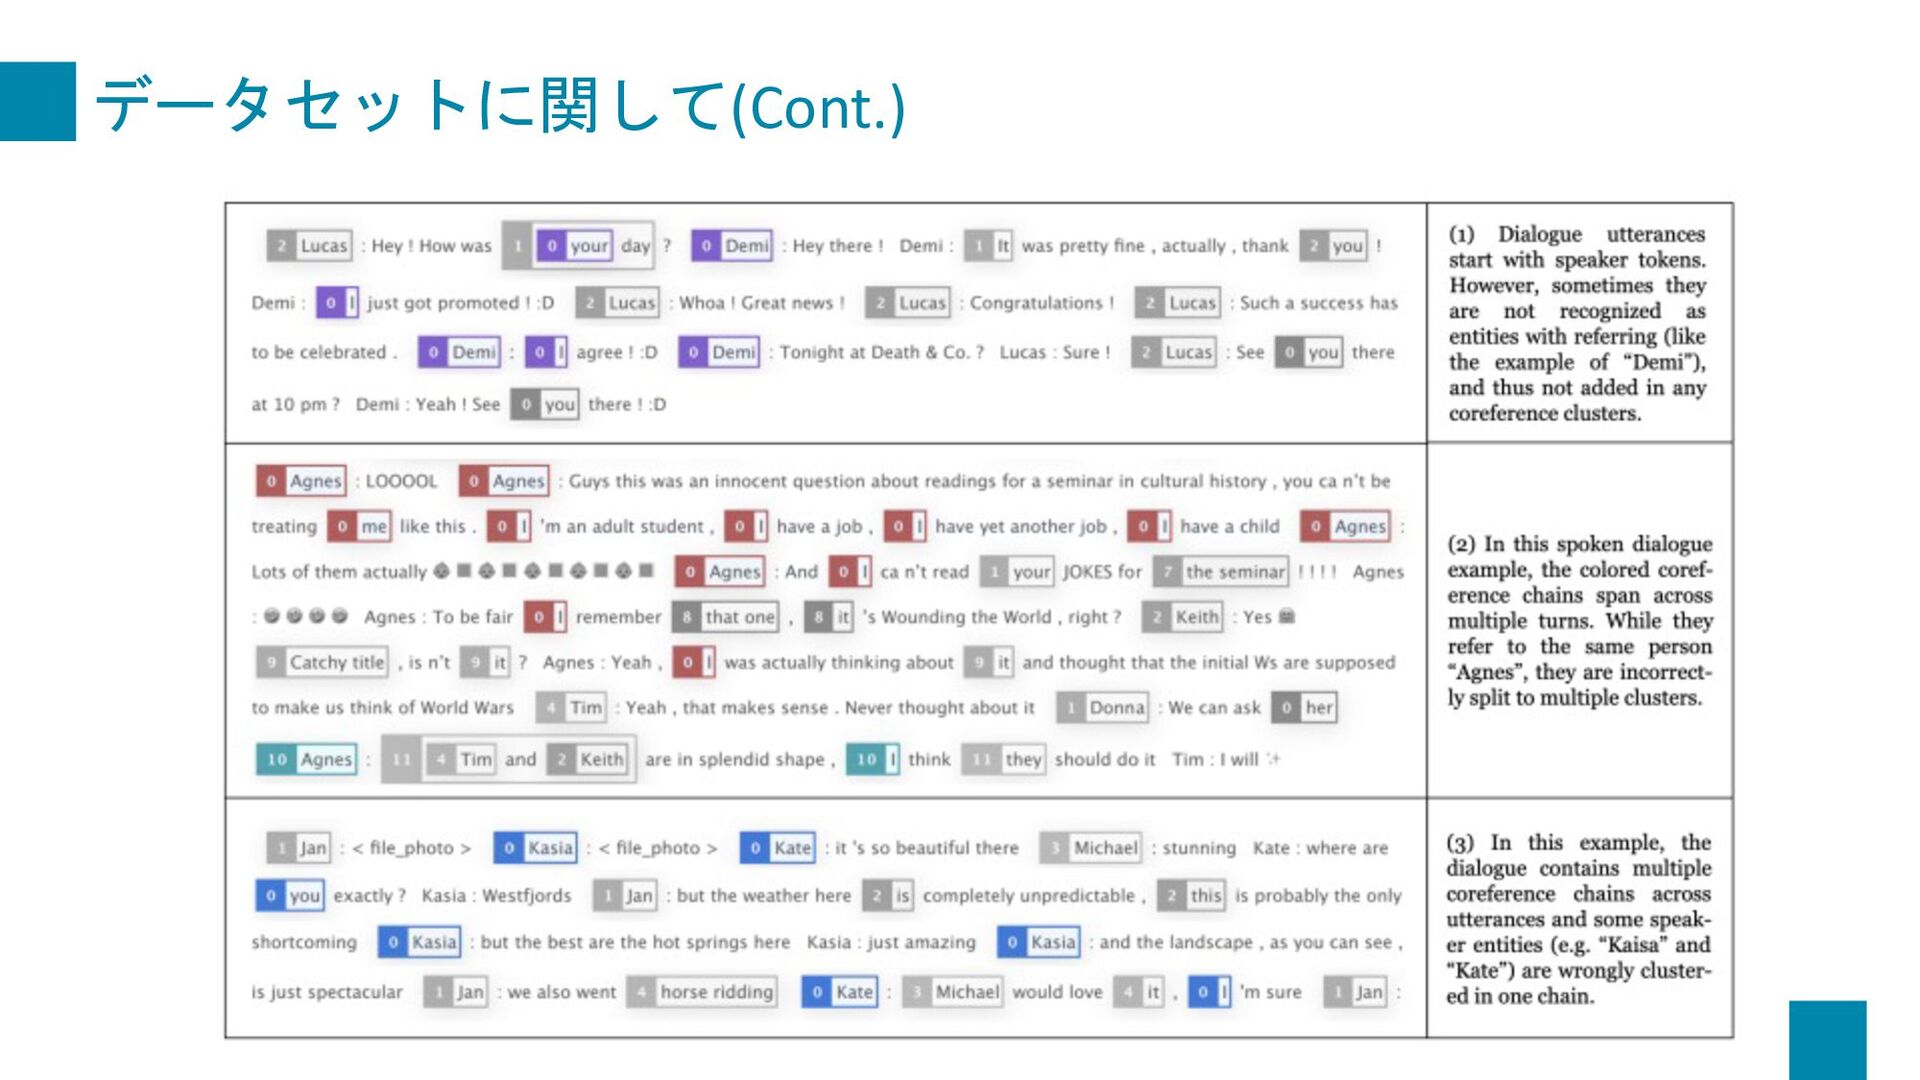
データセットに関して 一般的な要約データセットには共参照の情報は含まれていない Document Coreference Resolution Model (Lee et al., 2018;
Joshi et al., 2020)は文章の ための共参照解析モデルであるため,対話に対しては最適ではない (Joshi et al., 2020)のモデルを対話サンプルに適用したころ以下の3つの問題が見 つかった 1. 話者の名前がどの共参照集合にも分類されない 2. 対話文では複数の発話に共参照表現が跨ることがあるが,それらが別の共参照集合とし て分類されてしまう 3. 対話文では複数の発話に共参照表現が跨ることがあるが,それらが間違った共参照集合 として分類されてしまう -
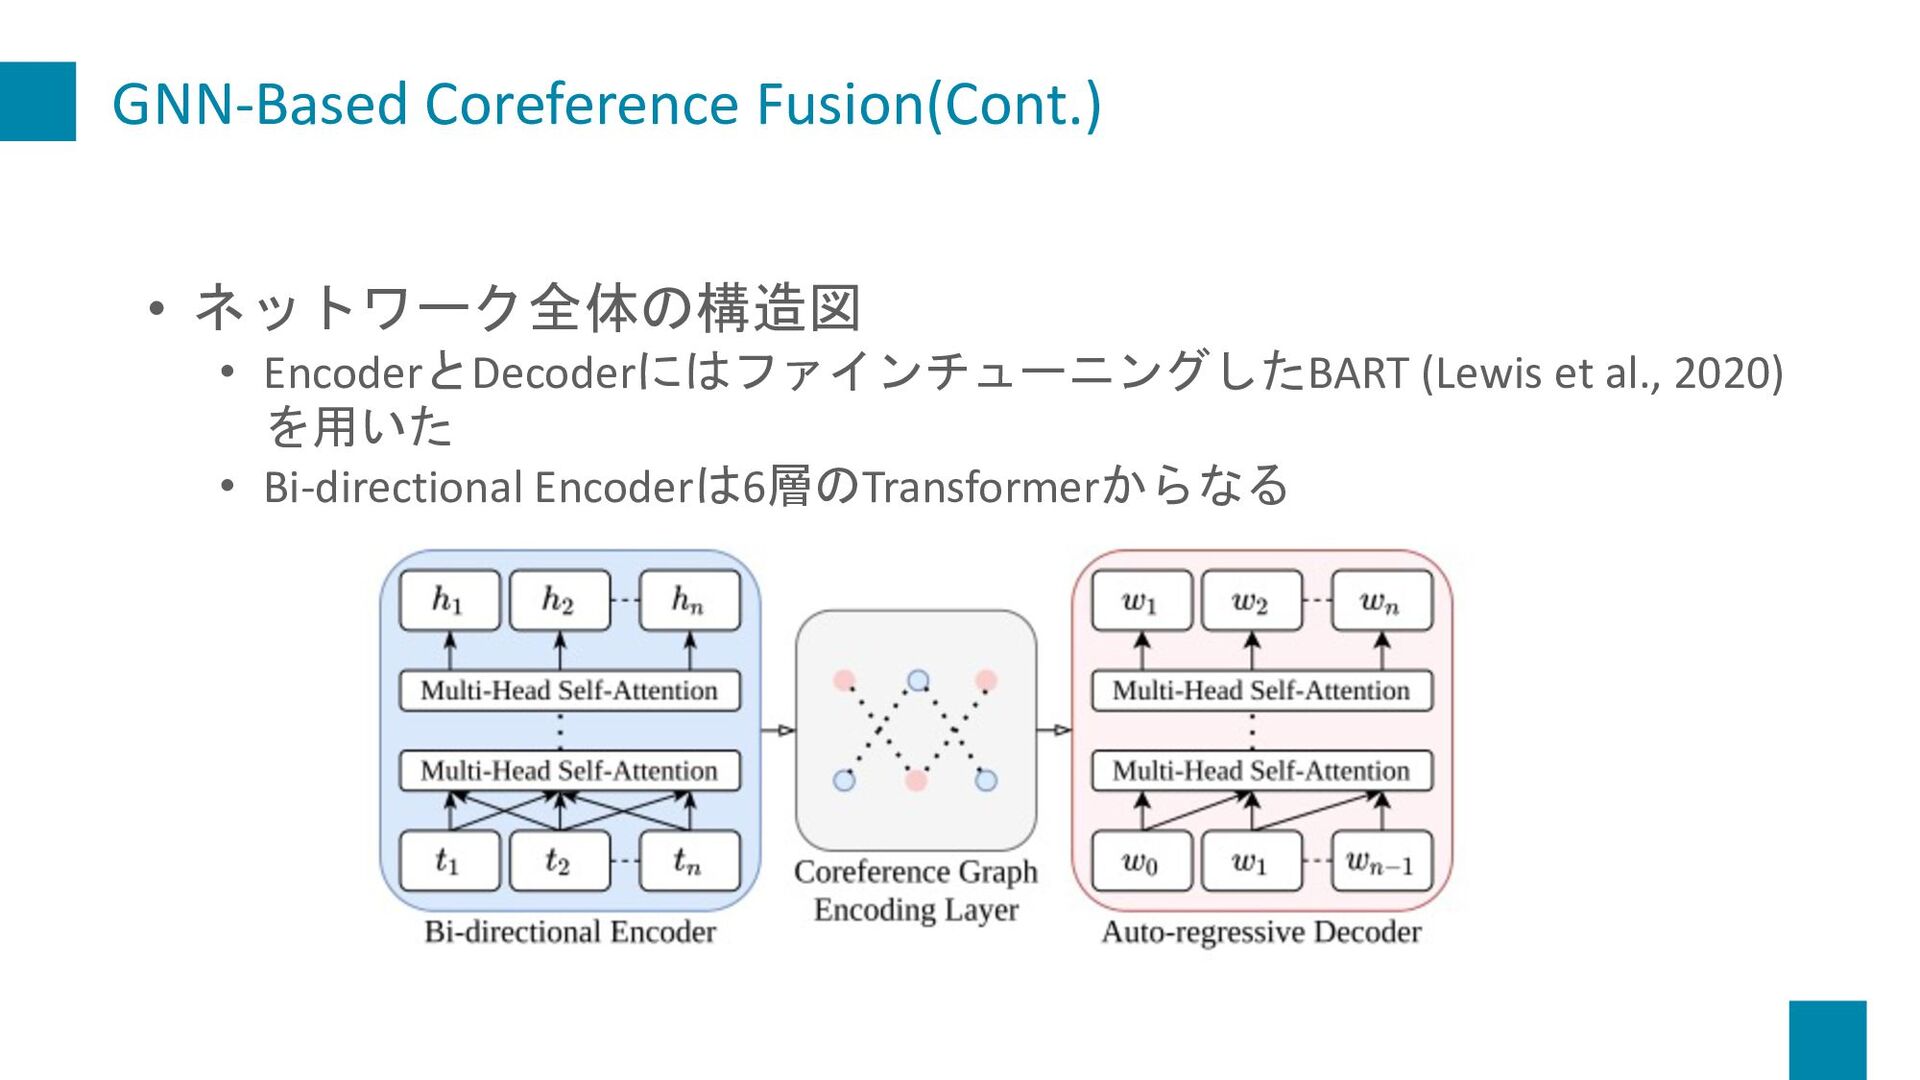
GNN-Based Coreference Fusion(Cont.) • ネットワーク全体の構造図 • EncoderとDecoderにはファインチューニングしたBART (Lewis et al.,
2020) を用いた • Bi-directional Encoderは6層のTransformerからなる -
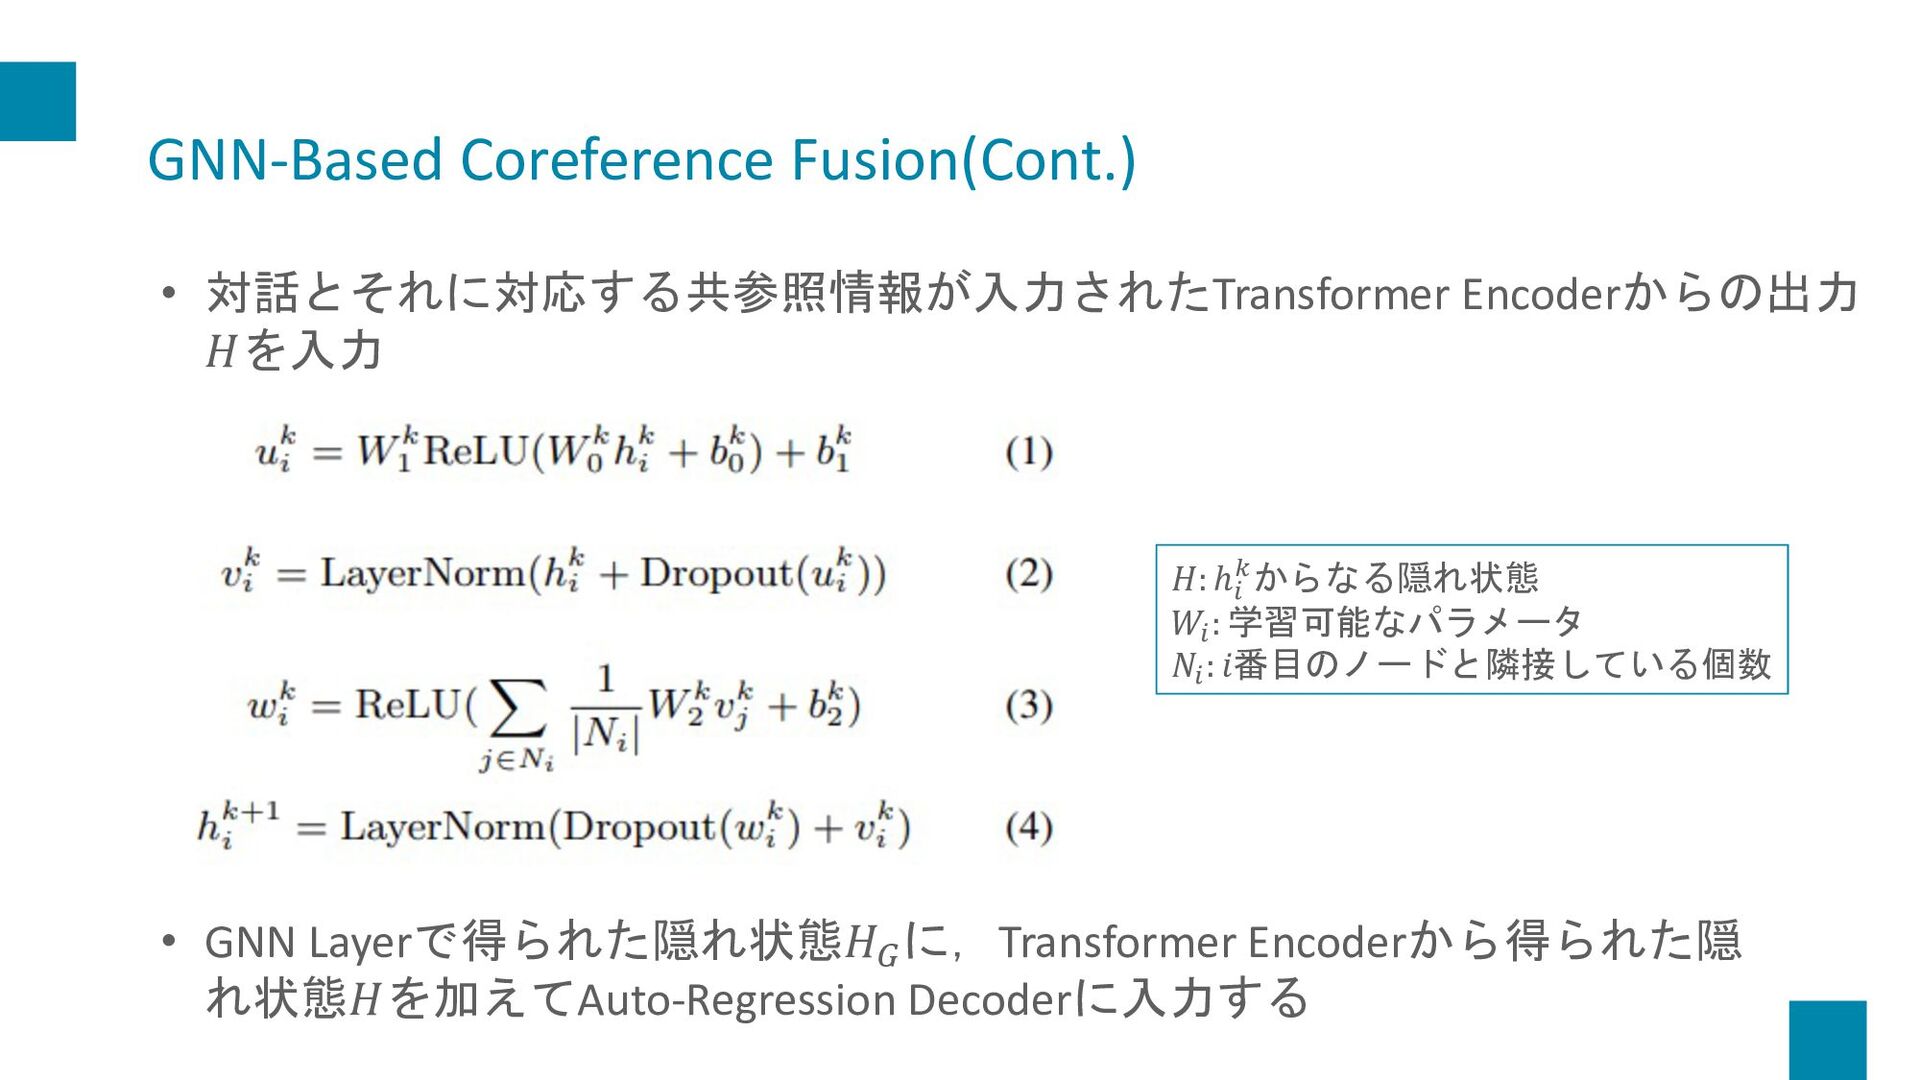
GNN-Based Coreference Fusion(Cont.) • 対話とそれに対応する共参照情報が入力されたTransformer Encoderからの出力 𝐻を入力 • GNN Layerで得られた隠れ状態𝐻!
に,Transformer Encoderから得られた隠 れ状態𝐻を加えてAuto-Regression Decoderに入力する 𝐻: ℎ! "からなる隠れ状態 𝑊! : 学習可能なパラメータ 𝑁! : 𝑖番目のノードと隣接している個数 -
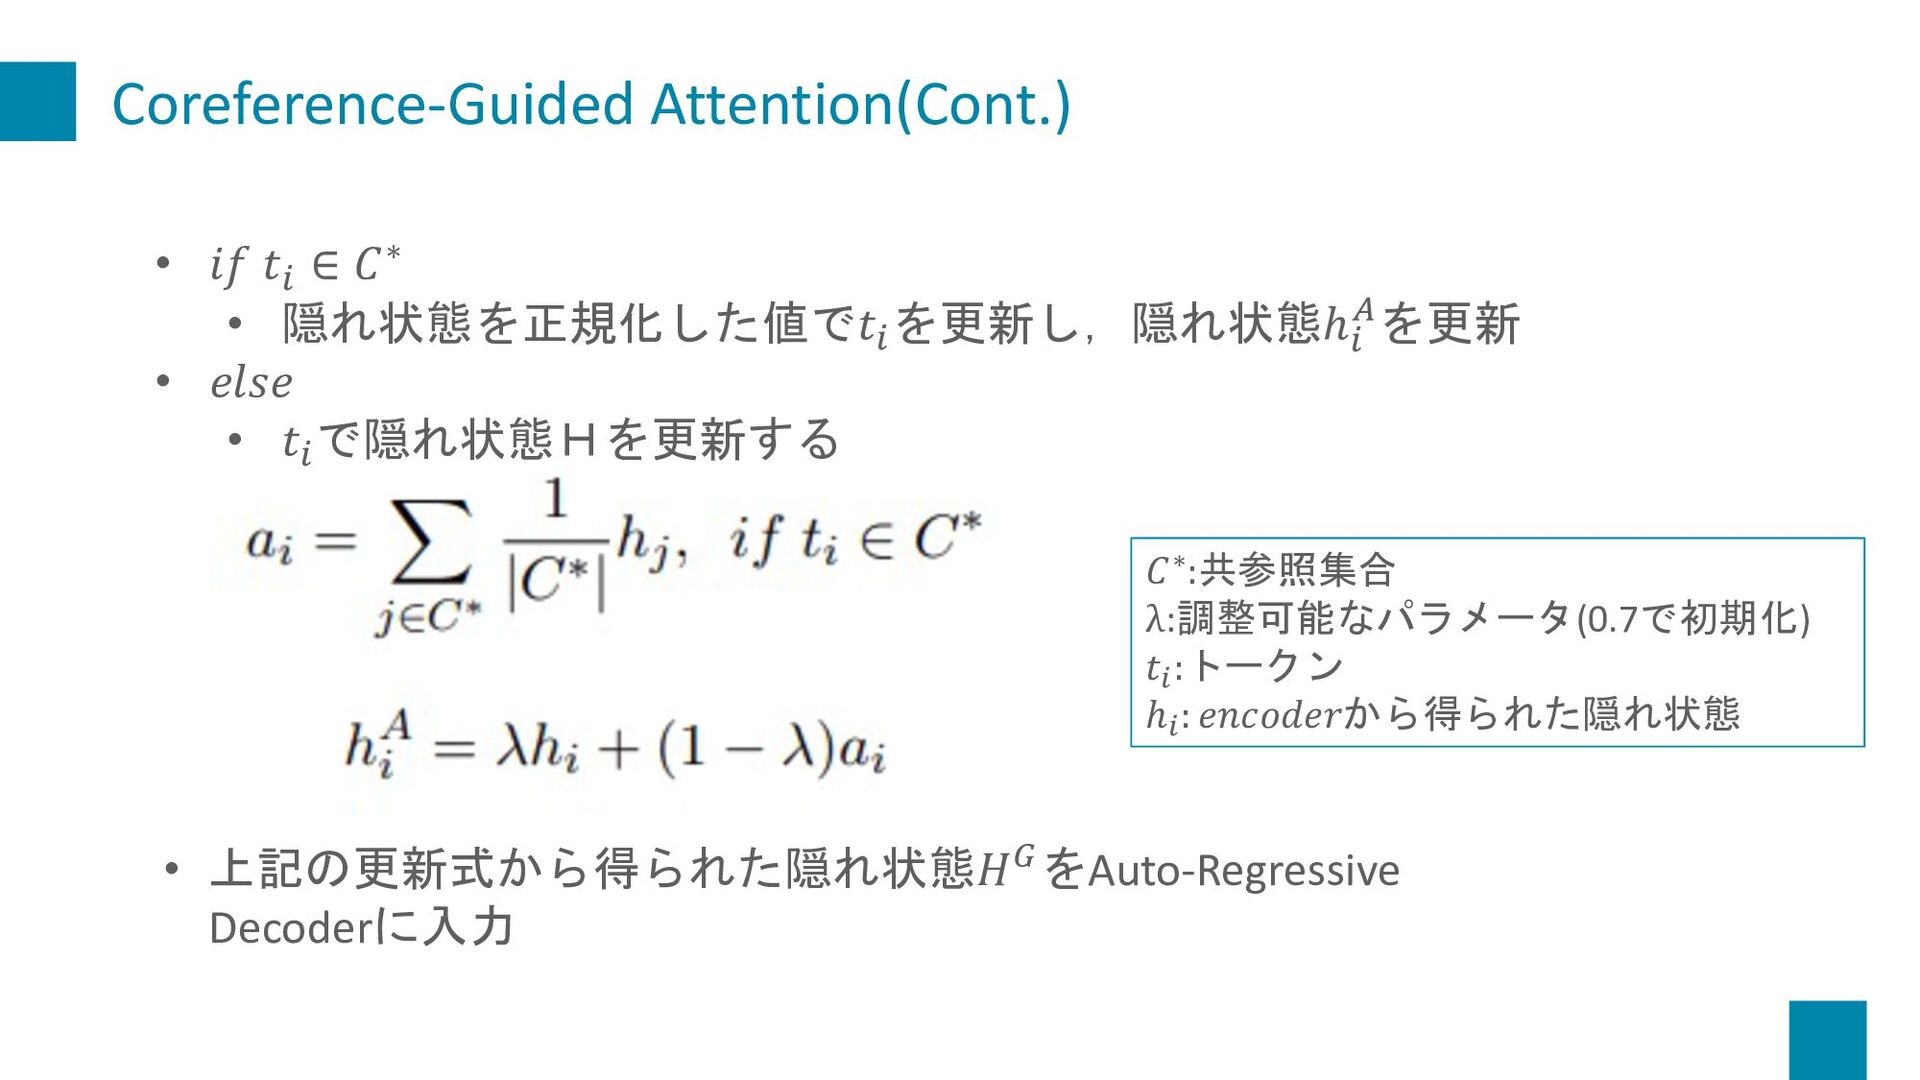
Coreference-Guided Attention(Cont.) 𝐶∗:共参照集合 λ:調整可能なパラメータ(0.7で初期化) 𝑡":トークン ℎ": 𝑒𝑛𝑐𝑜𝑑𝑒𝑟から得られた隠れ状態 • 上記の更新式から得られた隠れ状態𝐻!をAuto-Regressive Decoderに入力
• 𝑖𝑓 𝑡( ∈ 𝐶∗ • 隠れ状態を正規化した値で𝑡( を更新し,隠れ状態ℎ( *を更新 • 𝑒𝑙𝑠𝑒 • 𝑡( で隠れ状態Hを更新する -
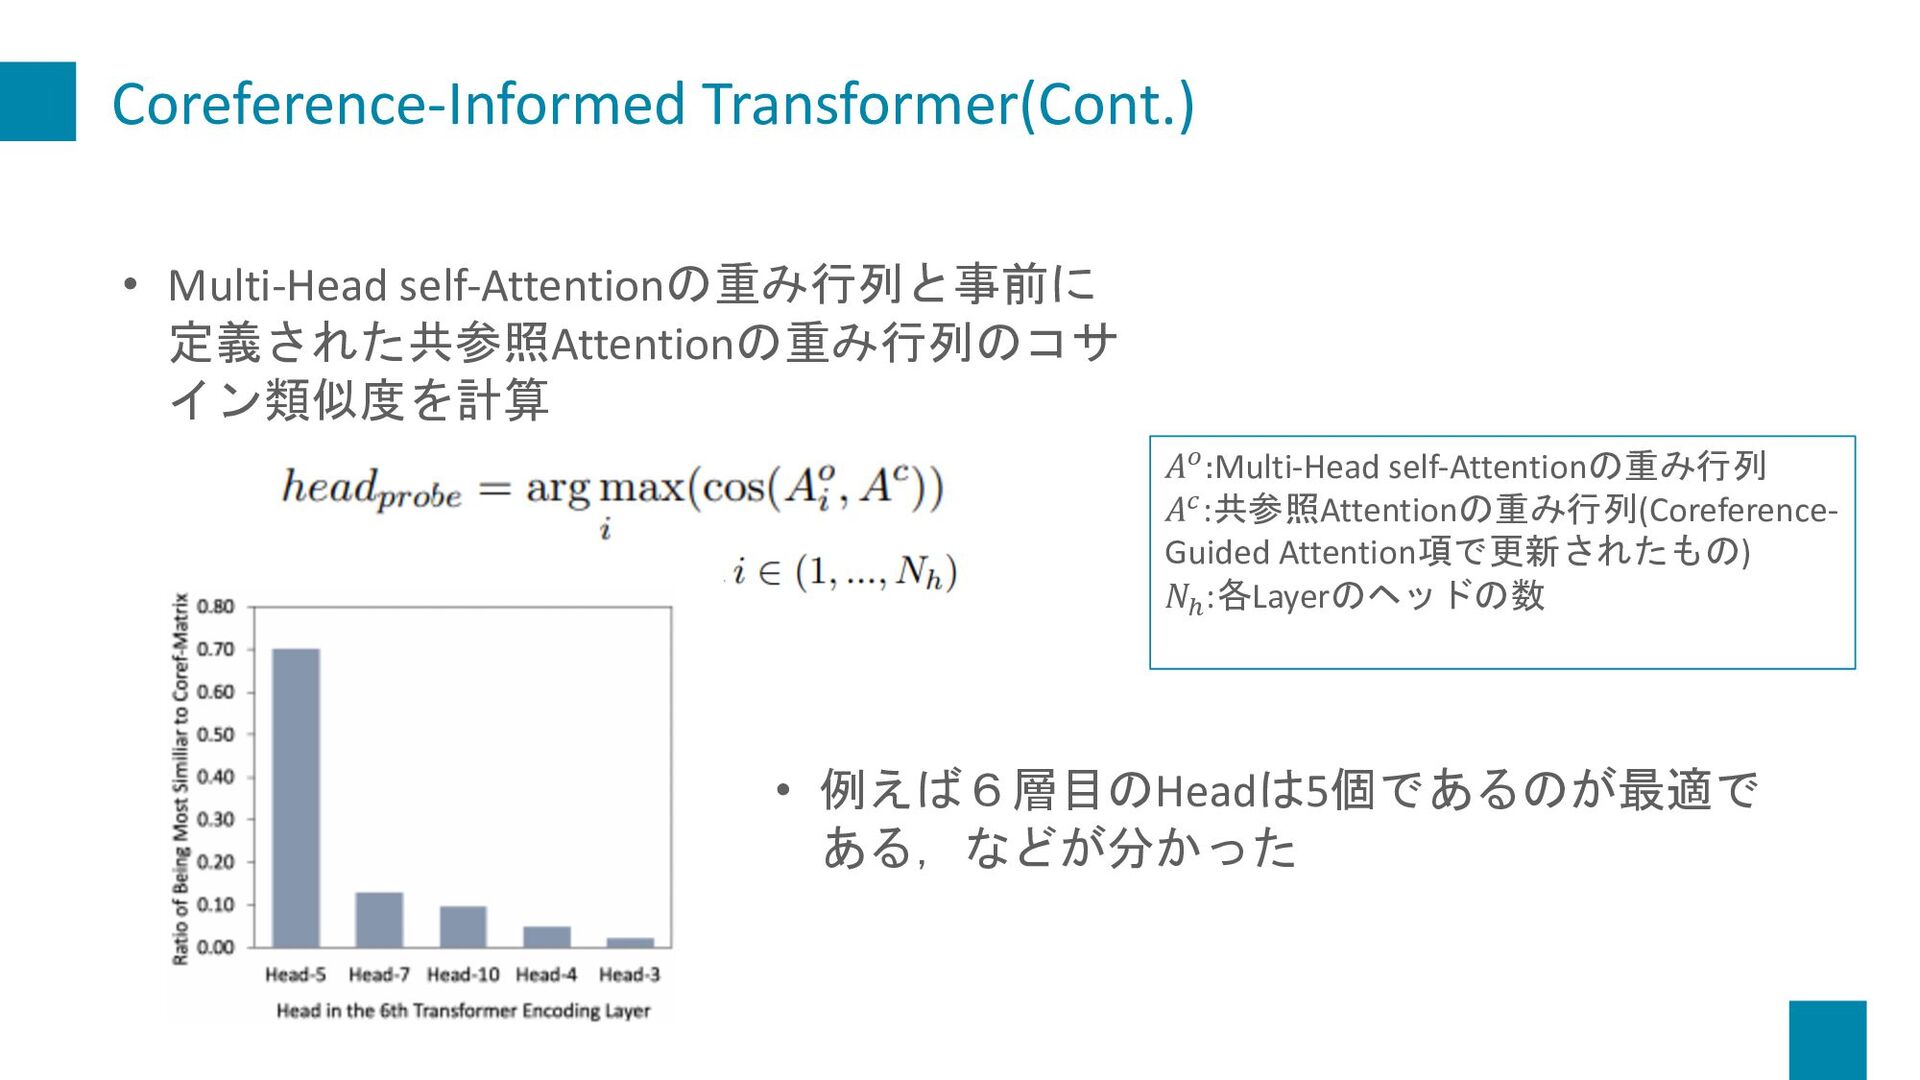
Coreference-Informed Transformer(Cont.) 𝐴#:Multi-Head self-Attentionの重み行列 𝐴$:共参照Attentionの重み行列(Coreference- Guided Attention項で更新されたもの) 𝑁% :各Layerのヘッドの数 •
Multi-Head self-Attentionの重み行列と事前に 定義された共参照Attentionの重み行列のコサ イン類似度を計算 • 例えば6層目のHeadは5個であるのが最適で ある,などが分かった -
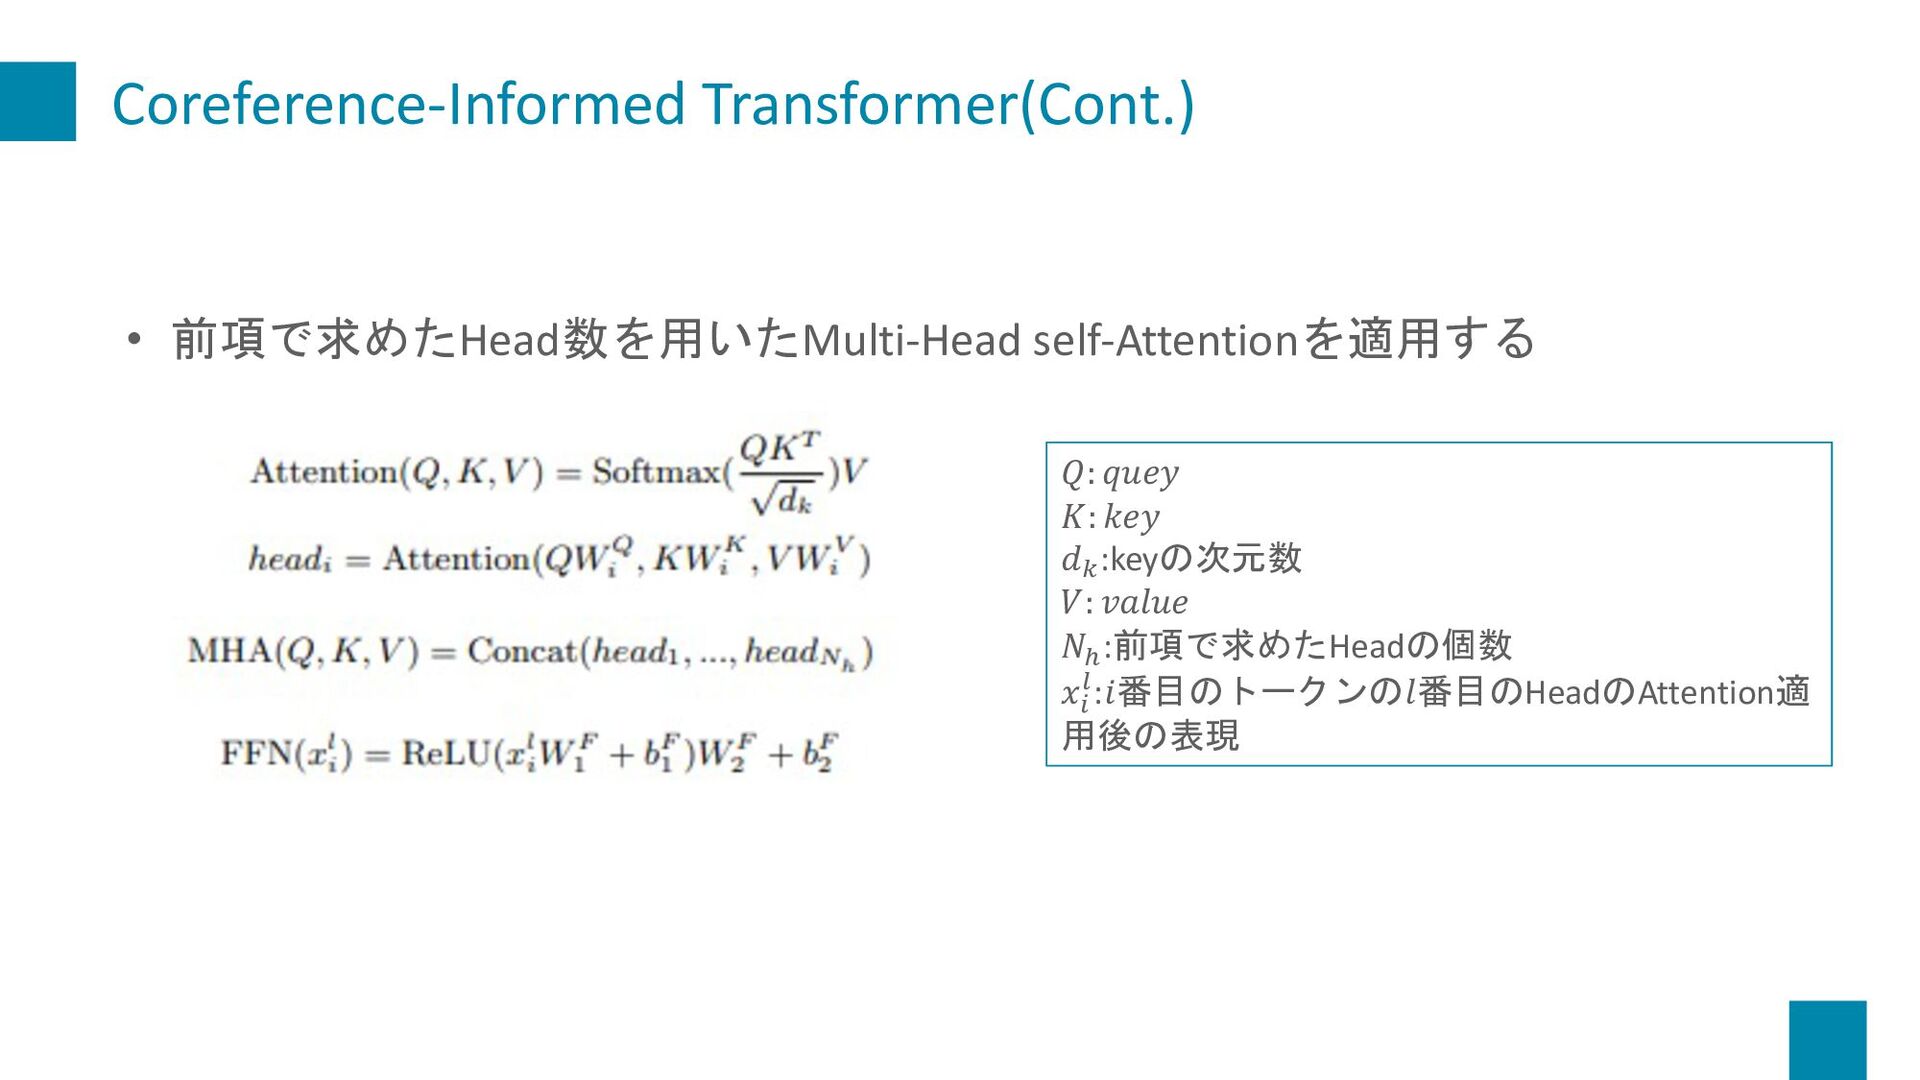
Coreference-Informed Transformer(Cont.) 𝑄: 𝑞𝑢𝑒𝑦 𝐾: 𝑘𝑒𝑦 𝑑":keyの次元数 𝑉: 𝑣𝑎𝑙𝑢𝑒 𝑁%:前項で求めたHeadの個数
𝑥! &:𝑖番目のトークンの𝑙番目のHeadのAttention適 用後の表現 • 前項で求めたHead数を用いたMulti-Head self-Attentionを適用する -
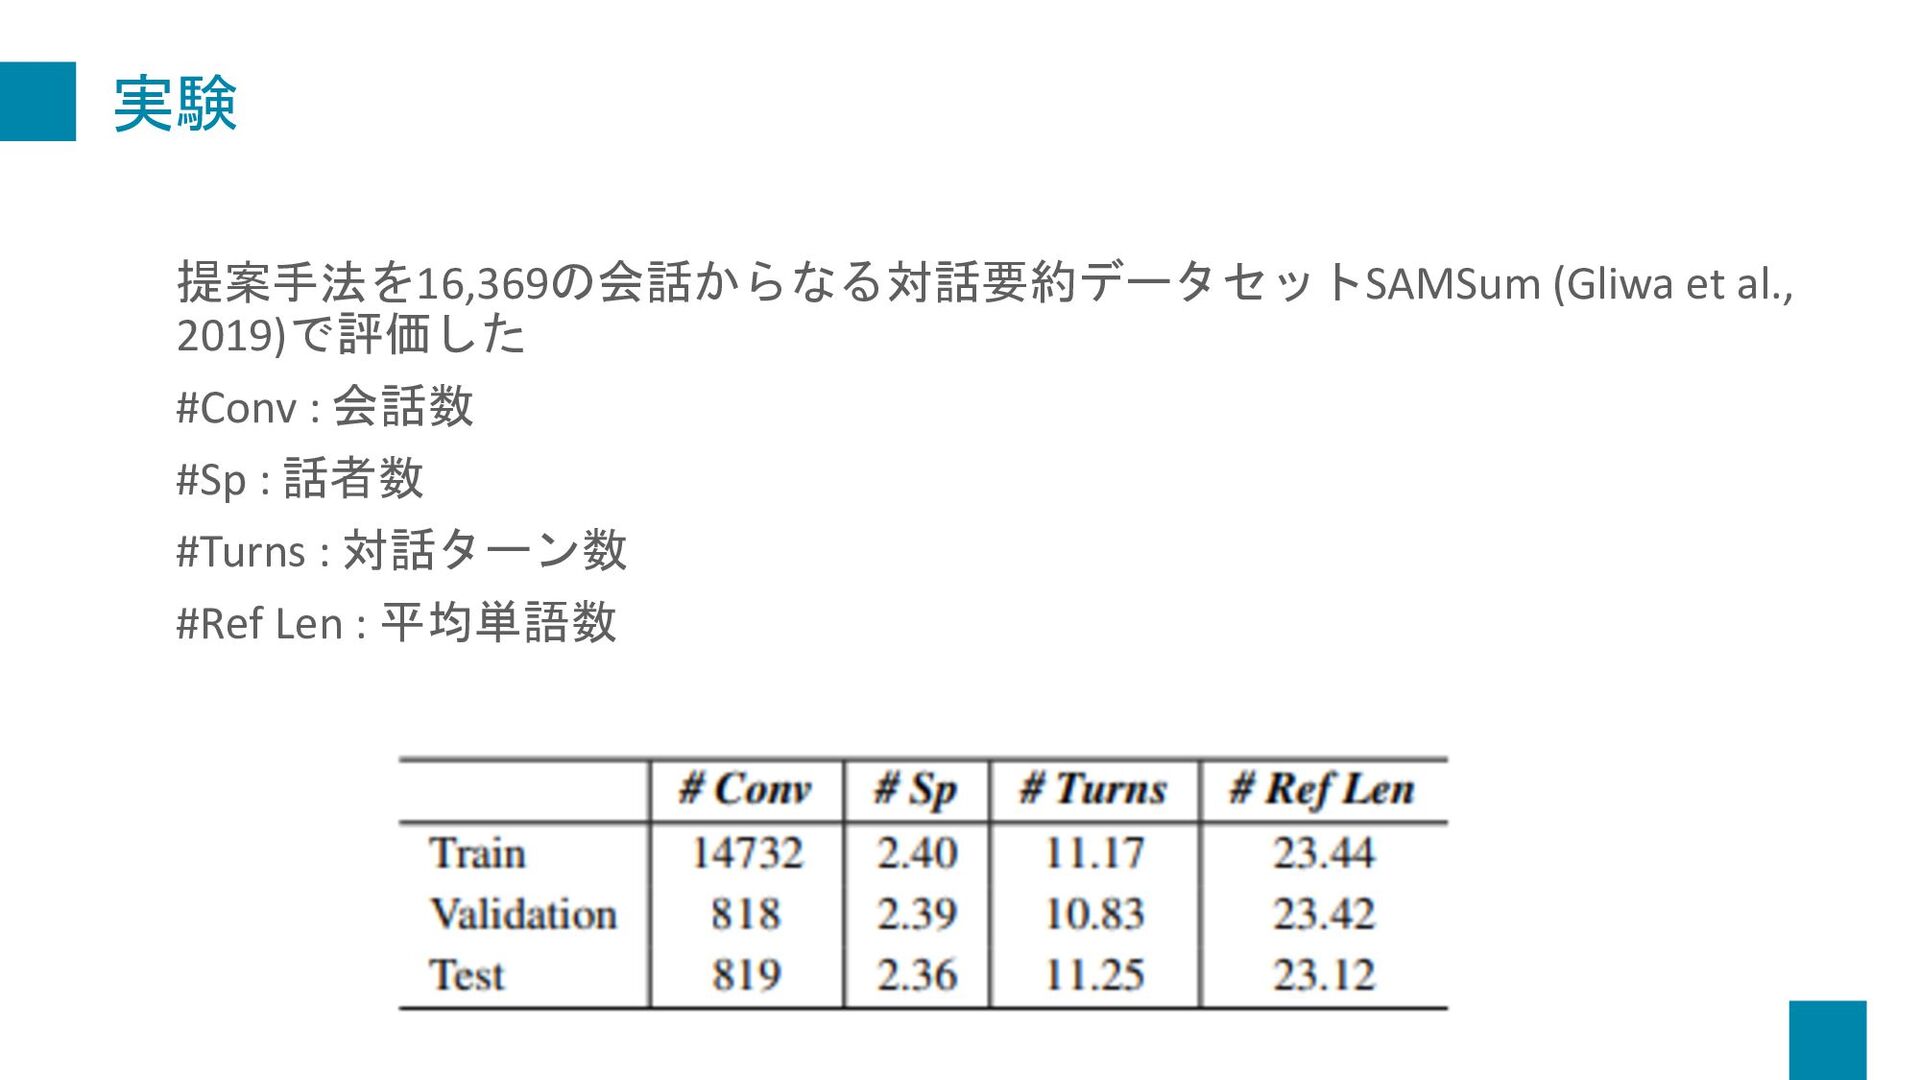
実験 提案手法を16,369の会話からなる対話要約データセットSAMSum (Gliwa et al., 2019)で評価した #Conv : 会話数 #Sp
: 話者数 #Turns : 対話ターン数 #Ref Len : 平均単語数 -
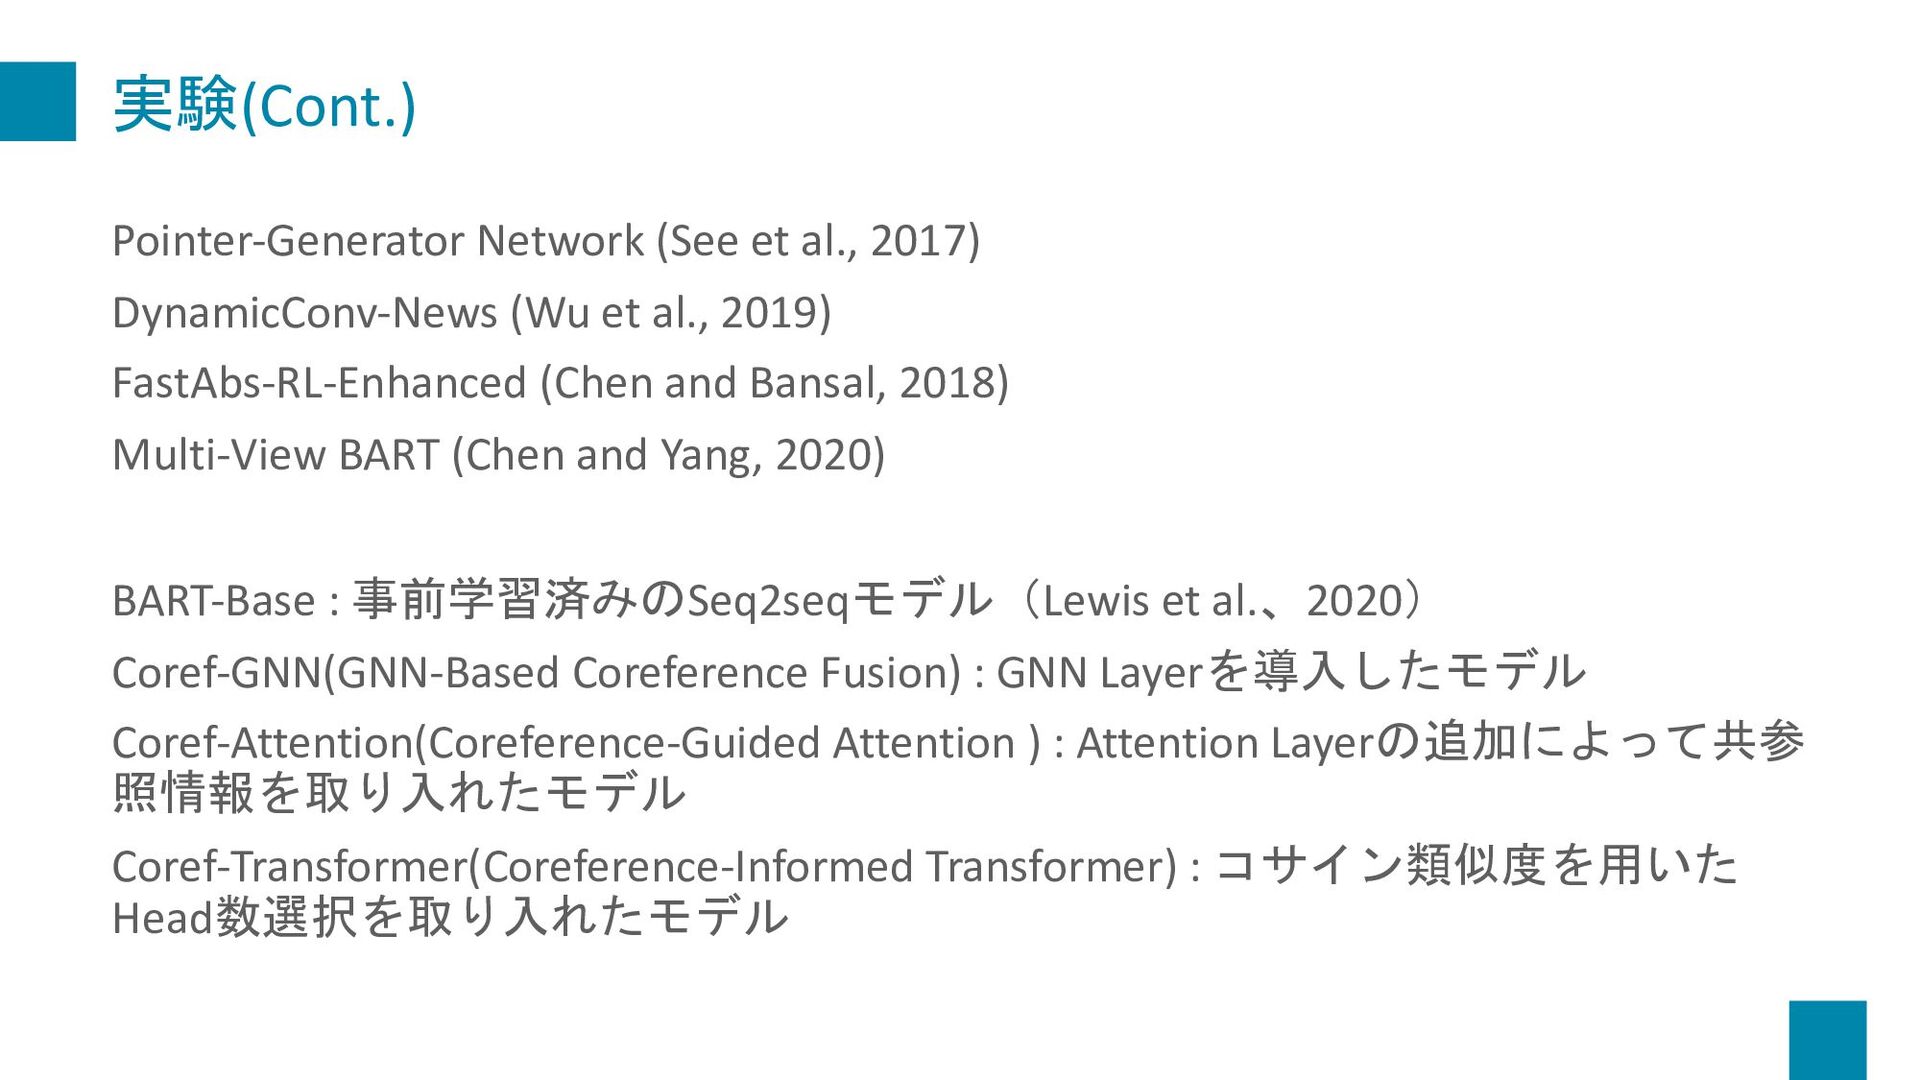
実験(Cont.) Pointer-Generator Network (See et al., 2017) DynamicConv-News (Wu et
al., 2019) FastAbs-RL-Enhanced (Chen and Bansal, 2018) Multi-View BART (Chen and Yang, 2020) BART-Base : 事前学習済みのSeq2seqモデル(Lewis et al.、2020) Coref-GNN(GNN-Based Coreference Fusion) : GNN Layerを導入したモデル Coref-Attention(Coreference-Guided Attention ) : Attention Layerの追加によって共参 照情報を取り入れたモデル Coref-Transformer(Coreference-Informed Transformer) : コサイン類似度を用いた Head数選択を取り入れたモデル -
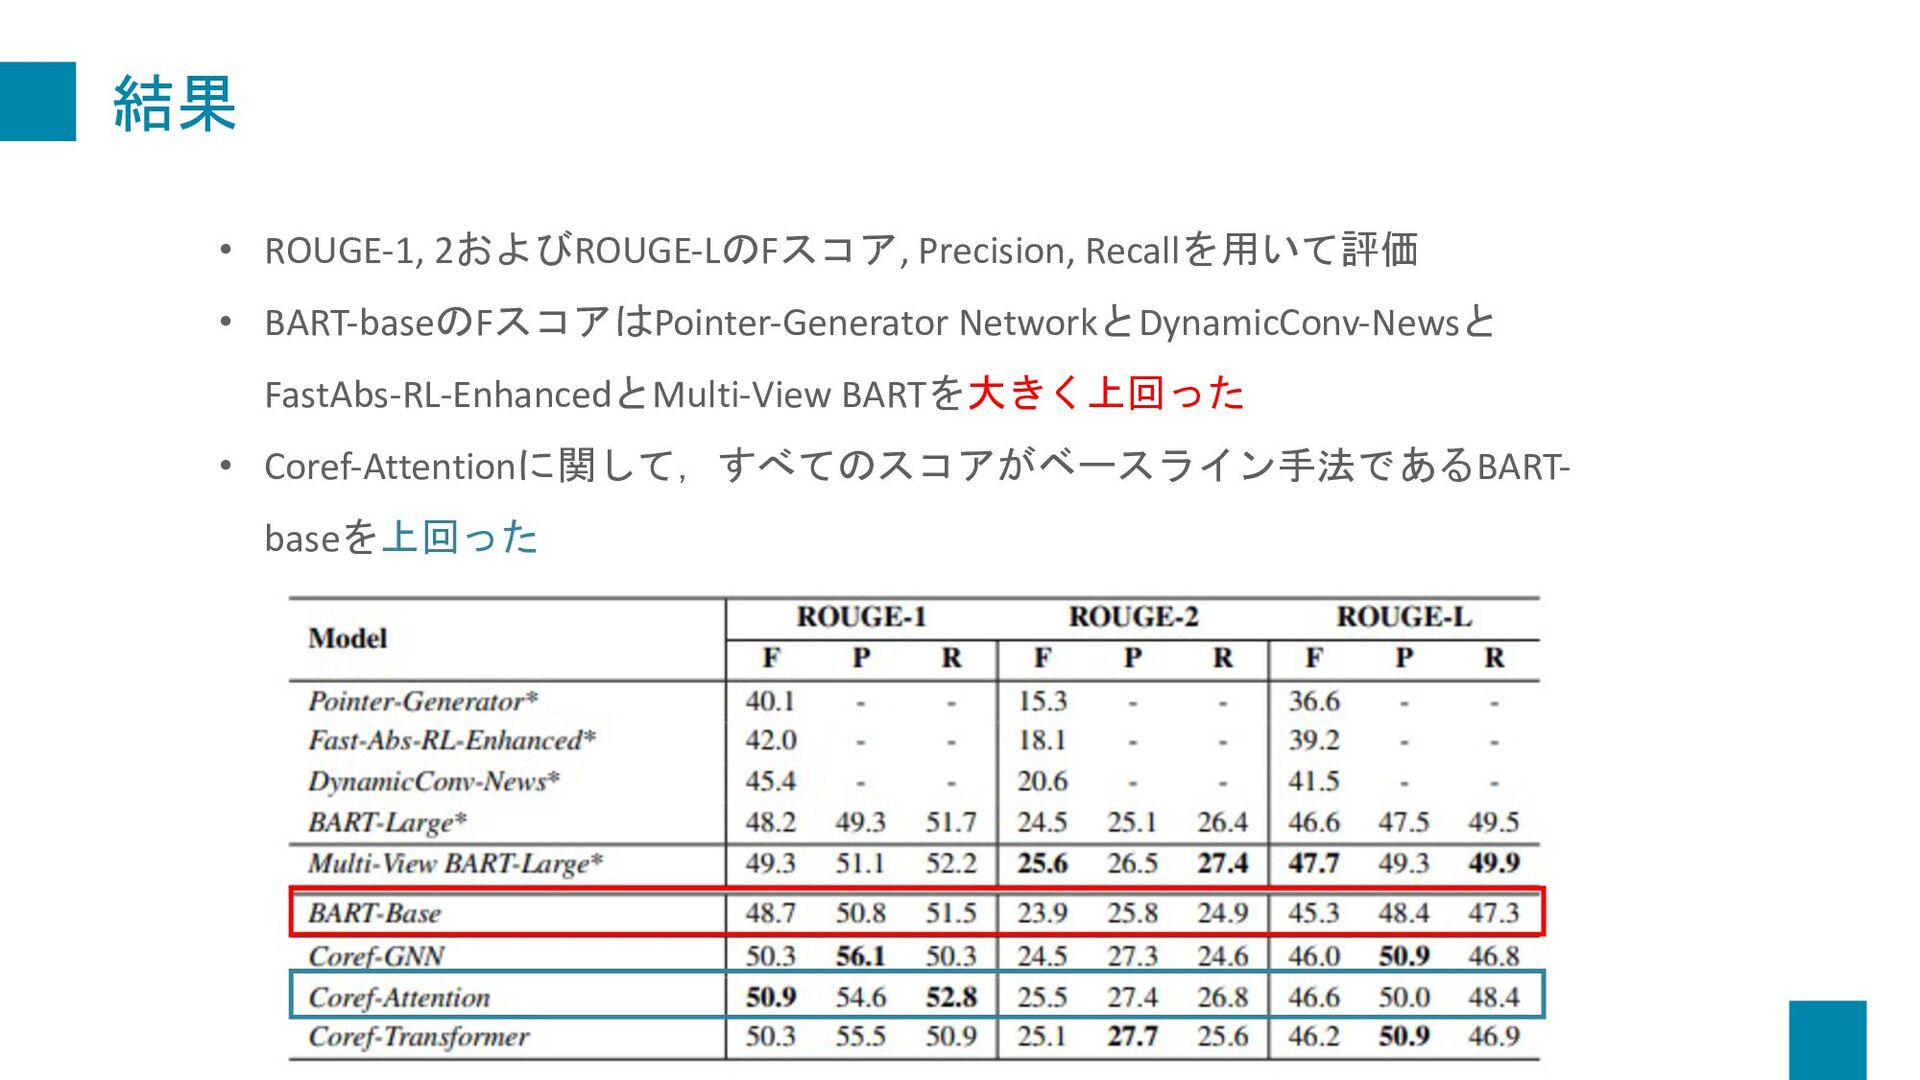
結果 • ROUGE-1, 2およびROUGE-LのFスコア, Precision, Recallを用いて評価 • BART-baseのFスコアはPointer-Generator NetworkとDynamicConv-Newsと FastAbs-RL-EnhancedとMulti-View
BARTを大きく上回った • Coref-Attentionに関して,すべてのスコアがベースライン手法であるBART- baseを上回った -
人間による評価 • 人間による[-2, 0, 2]スケールでの評価 • -2は要約が間違った参照を行っている • 0は許容は出来るが情報が足りない •
2は簡潔で情報量が多く,優れた要約 • Corefモデルはベースライン手法よりも高 いスコアを得ており,これはROUGEによ る定量的評価と一致している 100サンプルの平均値 -
分析 提案モデルの品質と有効性を評価するために,自動要約タスクでよく用いられ る4種類のエラーを100サンプルに対して手動でアノテーションした l情報の欠落 : 人間が書いたものと生成されたものの比較して,間違っている l冗長な情報 : 人間かがいたものと生成されたものを比較して,要約文が冗長 である
l間違った参照 : 間違ったものを参照して要約している(人名が入れ替わって いるなど) l誤った推論 : 会話の文脈的に間違った結論になっている -
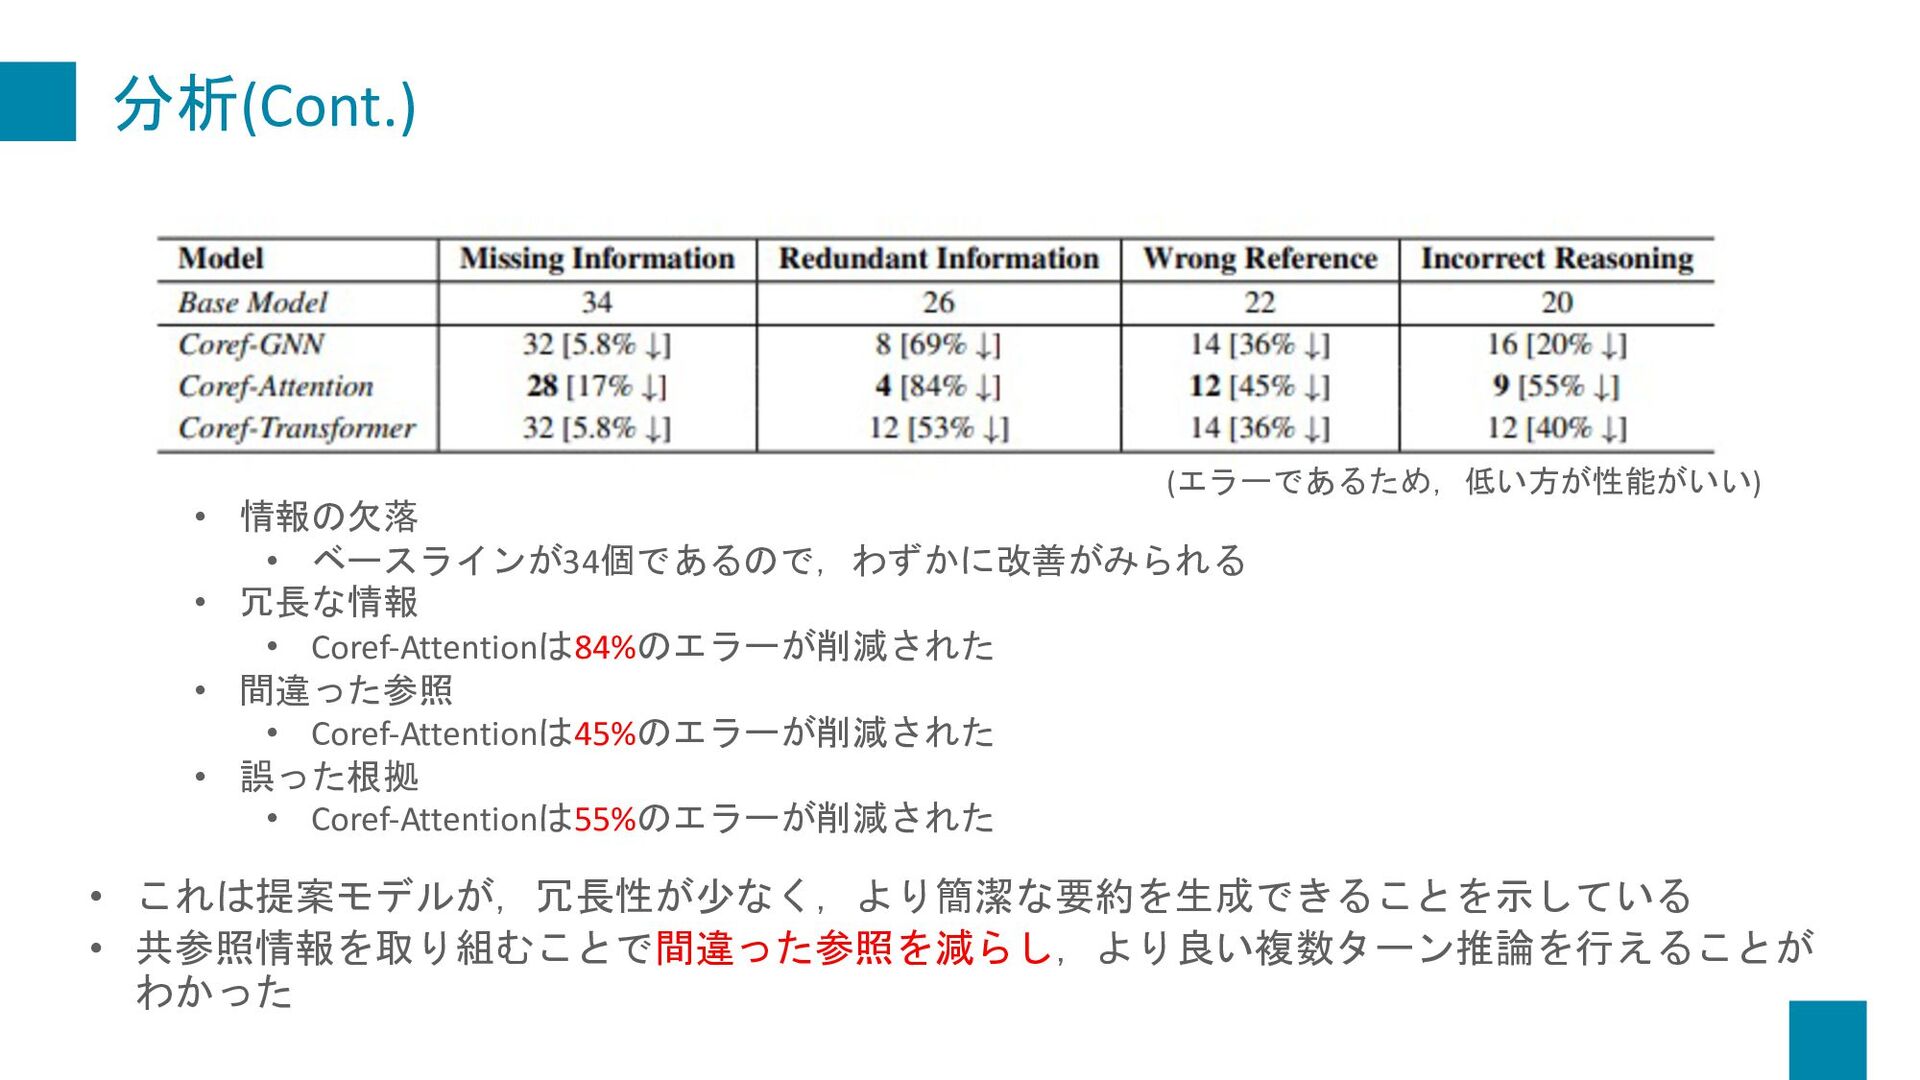
分析(Cont.) • 情報の欠落 • ベースラインが34個であるので,わずかに改善がみられる • 冗長な情報 • Coref-Attentionは84%のエラーが削減された •
間違った参照 • Coref-Attentionは45%のエラーが削減された • 誤った根拠 • Coref-Attentionは55%のエラーが削減された (エラーであるため,低い方が性能がいい) • これは提案モデルが,冗長性が少なく,より簡潔な要約を生成できることを示している • 共参照情報を取り組むことで間違った参照を減らし,より良い複数ターン推論を行えることが わかった -
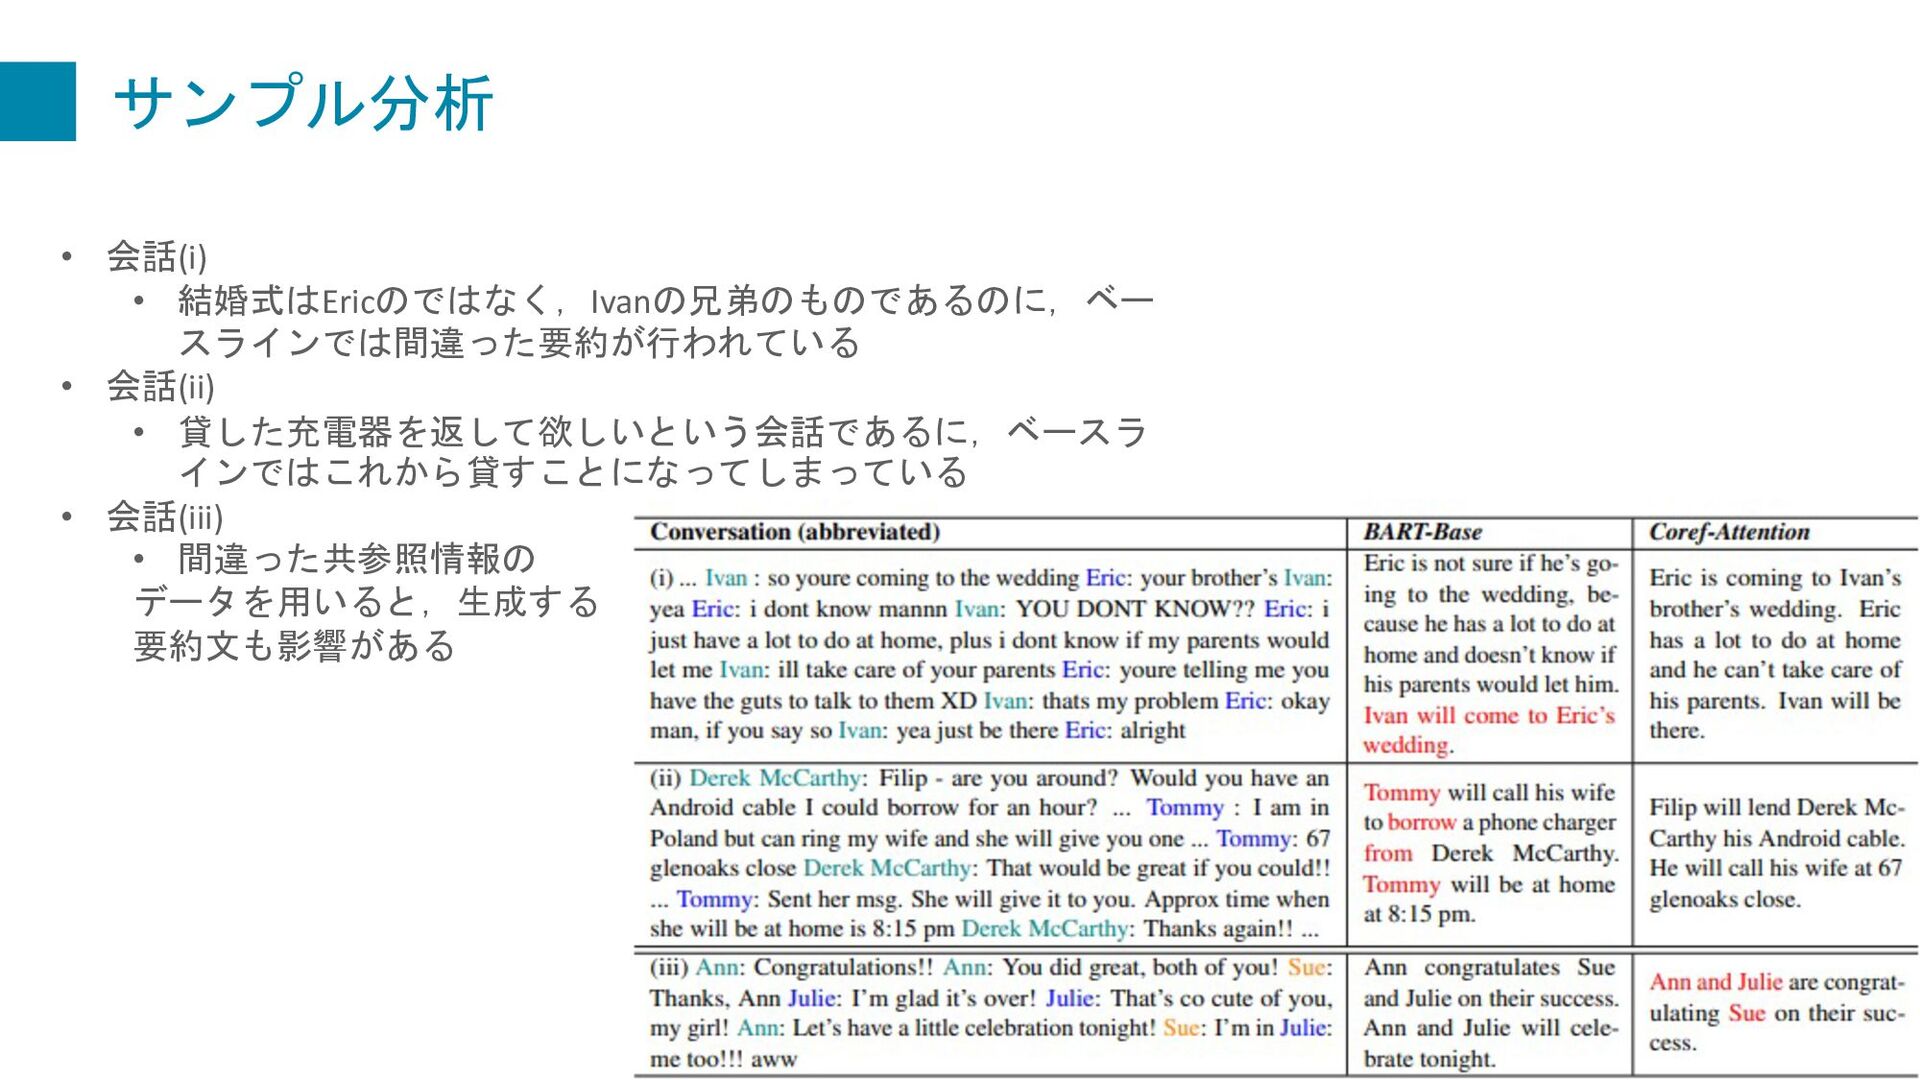
サンプル分析 • 会話(i) • 結婚式はEricのではなく,Ivanの兄弟のものであるのに,ベー スラインでは間違った要約が行われている • 会話(ii) • 貸した充電器を返して欲しいという会話であるに,ベースラ
インではこれから貸すことになってしまっている • 会話(iii) • 間違った共参照情報の データを用いると,生成する 要約文も影響がある