Share
Embed
Большие данные - лекция-6 - тексты - предварительная обработка, NLP - NLTK
Предварительная обработка текста, работа с ЕЯ (NLP), NLTK
Обновлено: 24.03.2020
https://vk.com/video53223390_456239421
Anton
March 20, 2019
Transcript
41 slides
-
ЕЯ — естественные языки (NLP — Natural language processing) •
Библиотеки: re, NLTK • Алгоритмы: Google Word2vec, Porter, ... • Общие рекомендации и подходы -
Python Re — regular expressions • Регулярные выражение в Пайтон
• Стандартная библиотека re docs.python.org/2/library/re.html • Библиотека regex (совместима со стандартной, лучше поддерживает юникод) pypi.org/project/regex/ -
NLTK — natural language toolkit • www.nltk.org/ • pip install
nltk • Содержит готовые наборы данных, в том числе корпусы (corpora) текстов, грамматики, натренированные модели, которые можно скачать командой: nltk.download() - графическое окно для выбора набора или nltk.download('dataset-name') -
Этапы предварительной обработки текста • Очистка от мусора, знаков препинания
• Переработка документа в лексемы (разбивка на слова, словосочетания, предложения) • Выделение основы слов (удаление приставок, окончаний и суффиксов, определение корня) — стемминг -
Очистка текста • От мусора: теги HTML, другая разметка •
Знаки препинания (если не используются в дальнейшем анализе) • Смайлики (если не используются в дальнейшем анализе) • И т. п. • Инструменты: должно хватить регулярных выражений -
Переработка документа в лексемы (разбивка на слова) • По пробелам
• Регулярные выражения • NLTK: регулярные выражения, со словарем • Другие алгоритмы • Универсального решения нет: выбирайте метод исходя из задачи -
Ранее (на прошлой лекции) • Алгоритм «мешок слов» CountVectorizer уже
делал это сам за нас (самостоятельно: посмотрите в документации, что за алгоритм): count = CountVectorizer() docs = np.array([ u'спят усталые игрушки, книжки спят', u'усталые игрушки усталые', u'книжки спят' ]) bag = count.fit_transform(docs) -
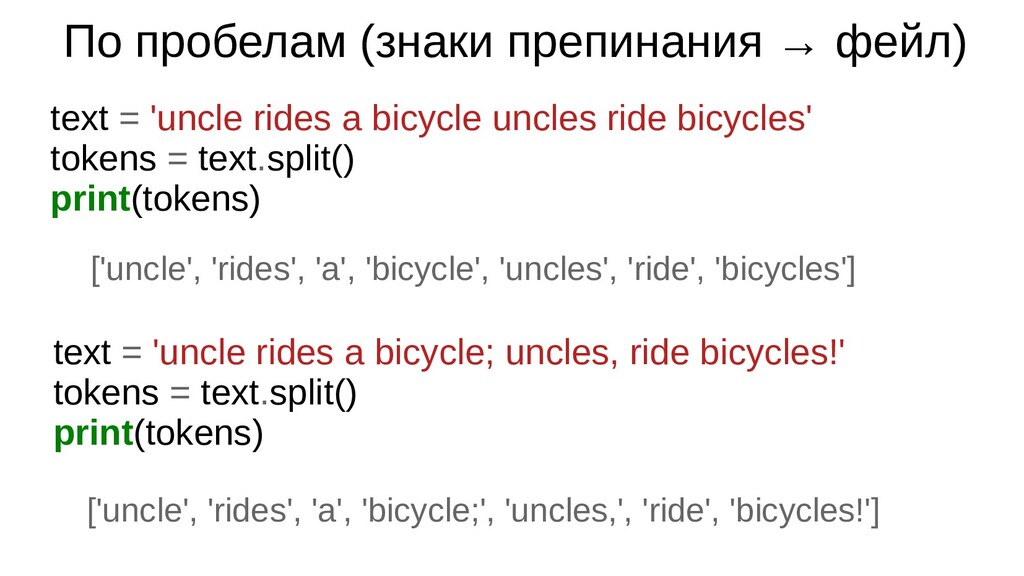
По пробелам (знаки препинания → фейл) text = 'uncle rides
a bicycle uncles ride bicycles' tokens = text.split() print(tokens) ['uncle', 'rides', 'a', 'bicycle', 'uncles', 'ride', 'bicycles'] text = 'uncle rides a bicycle; uncles, ride bicycles!' tokens = text.split() print(tokens) ['uncle', 'rides', 'a', 'bicycle;', 'uncles,', 'ride', 'bicycles!'] -
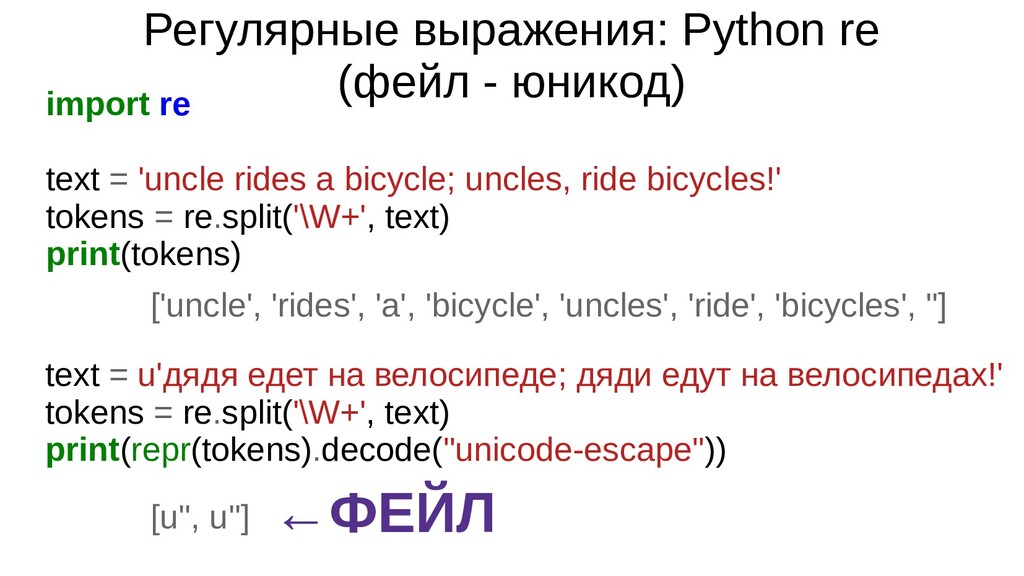
Регулярные выражения: Python re (фейл - юникод) import re text
= 'uncle rides a bicycle; uncles, ride bicycles!' tokens = re.split('\W+', text) print(tokens) text = u'дядя едет на велосипеде; дяди едут на велосипедах!' tokens = re.split('\W+', text) print(repr(tokens).decode("unicode-escape")) ['uncle', 'rides', 'a', 'bicycle', 'uncles', 'ride', 'bicycles', ''] [u'', u''] ←ФЕЙЛ -
Самостоятельно • Фейл выше — на Python 2.7 • Проверить
на Python 3.x • Проверить с библиотекой regex -
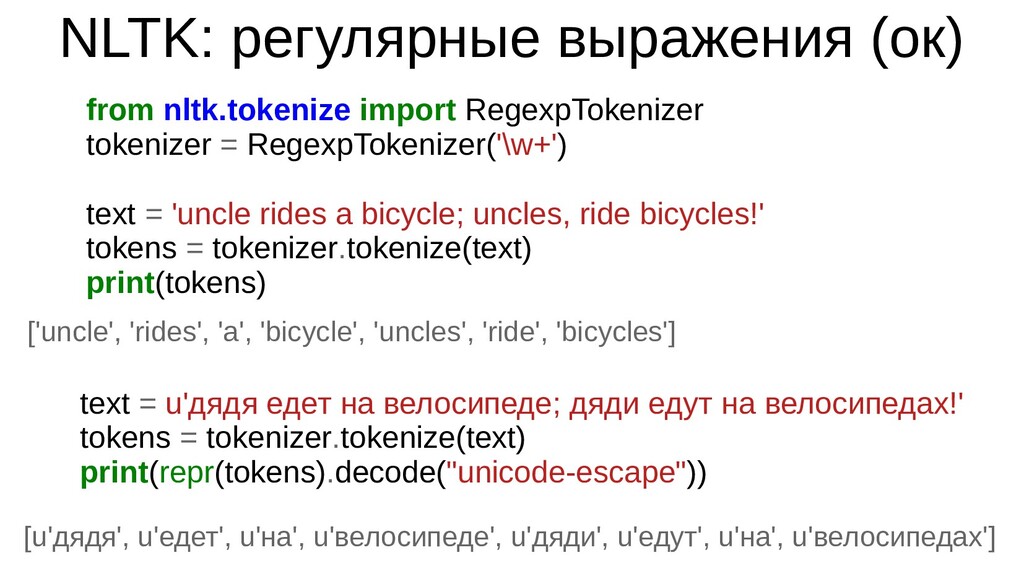
NLTK: регулярные выражения (ок) from nltk.tokenize import RegexpTokenizer tokenizer =
RegexpTokenizer('\w+') text = 'uncle rides a bicycle; uncles, ride bicycles!' tokens = tokenizer.tokenize(text) print(tokens) text = u'дядя едет на велосипеде; дяди едут на велосипедах!' tokens = tokenizer.tokenize(text) print(repr(tokens).decode("unicode-escape")) ['uncle', 'rides', 'a', 'bicycle', 'uncles', 'ride', 'bicycles'] [u'дядя', u'едет', u'на', u'велосипеде', u'дяди', u'едут', u'на', u'велосипедах'] -
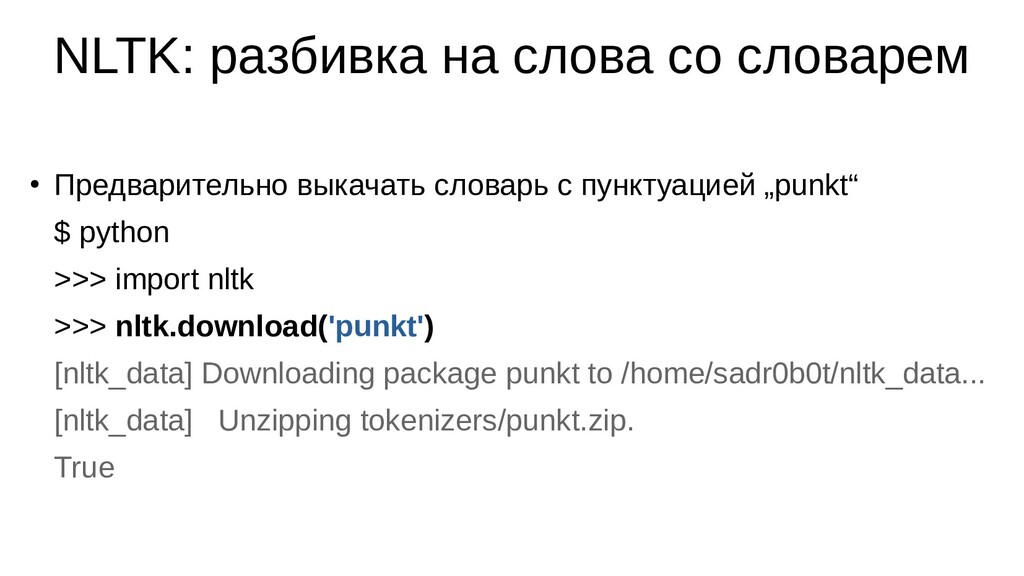
• Предварительно выкачать словарь с пунктуацией „punkt“ $ python >>>
import nltk >>> nltk.download('punkt') [nltk_data] Downloading package punkt to /home/sadr0b0t/nltk_data... [nltk_data] Unzipping tokenizers/punkt.zip. True NLTK: разбивка на слова со словарем -
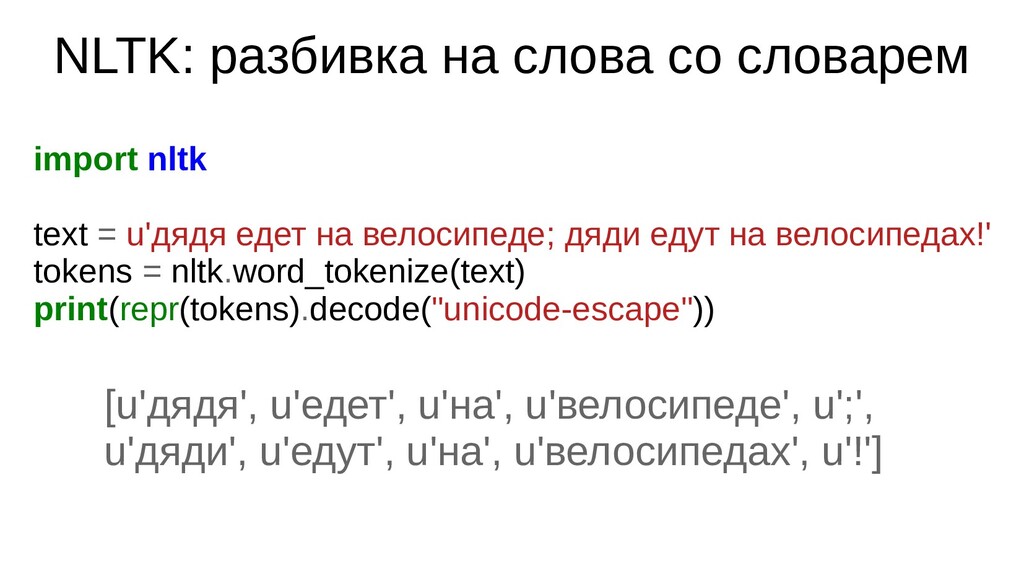
NLTK: разбивка на слова со словарем import nltk text =
u'дядя едет на велосипеде; дяди едут на велосипедах!' tokens = nltk.word_tokenize(text) print(repr(tokens).decode("unicode-escape")) [u'дядя', u'едет', u'на', u'велосипеде', u';', u'дяди', u'едут', u'на', u'велосипедах', u'!'] -
И так далее • How to Clean Text for Machine
Learning with Python machinelearningmastery.com/clean-text-machine- learning-python/ • How to get rid of punctuation using NLTK tokenizer? stackoverflow.com/questions/15547409/how-to-get- rid-of-punctuation-using-nltk-tokenizer • ... -
Выделение основы слова (стемминг): алгоритм Портера • ru.wikipedia.org/wiki/Стемминг • ru.wikipedia.org/wiki/Стеммер_Портера
• Не использует базы с основами слов • Отсекает окончания и суффиксы, основываясь на особенностях языка • Работает быстро, но не всегда правильно -
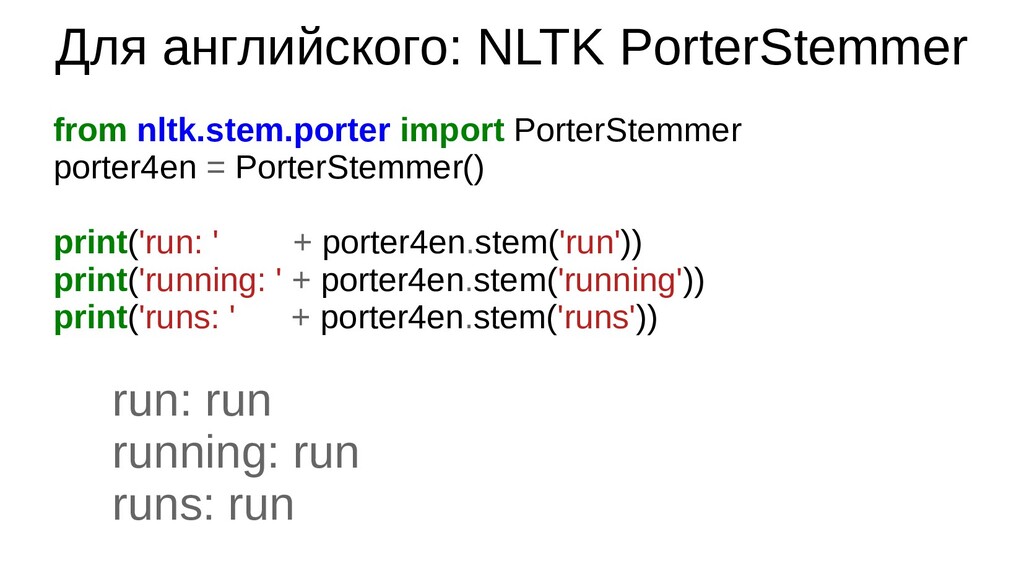
Для английского: NLTK PorterStemmer from nltk.stem.porter import PorterStemmer porter4en =
PorterStemmer() print('run: ' + porter4en.stem('run')) print('running: ' + porter4en.stem('running')) print('runs: ' + porter4en.stem('runs')) run: run running: run runs: run -
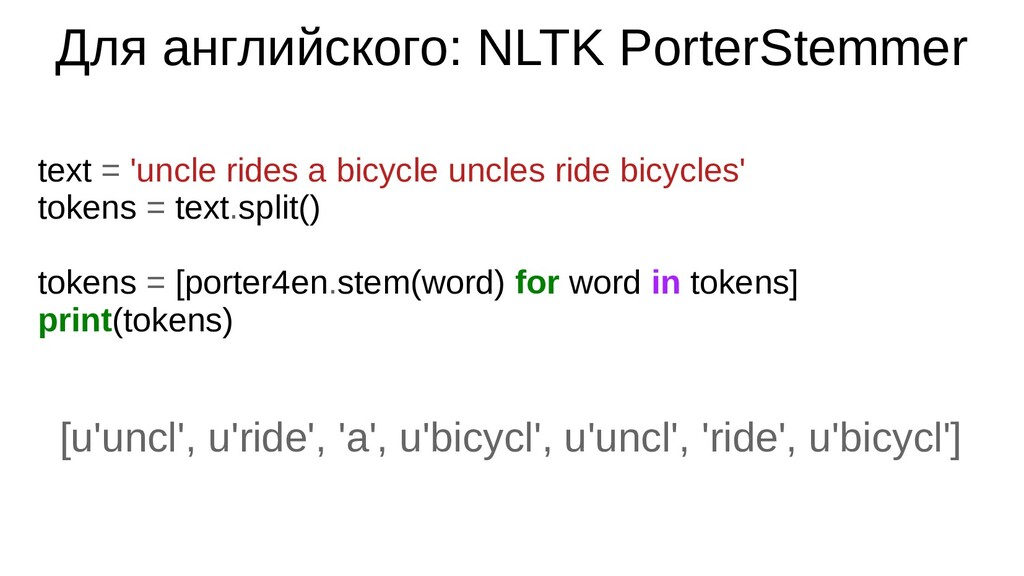
text = 'uncle rides a bicycle uncles ride bicycles' tokens
= text.split() tokens = [porter4en.stem(word) for word in tokens] print(tokens) Для английского: NLTK PorterStemmer [u'uncl', u'ride', 'a', u'bicycl', u'uncl', 'ride', u'bicycl'] -
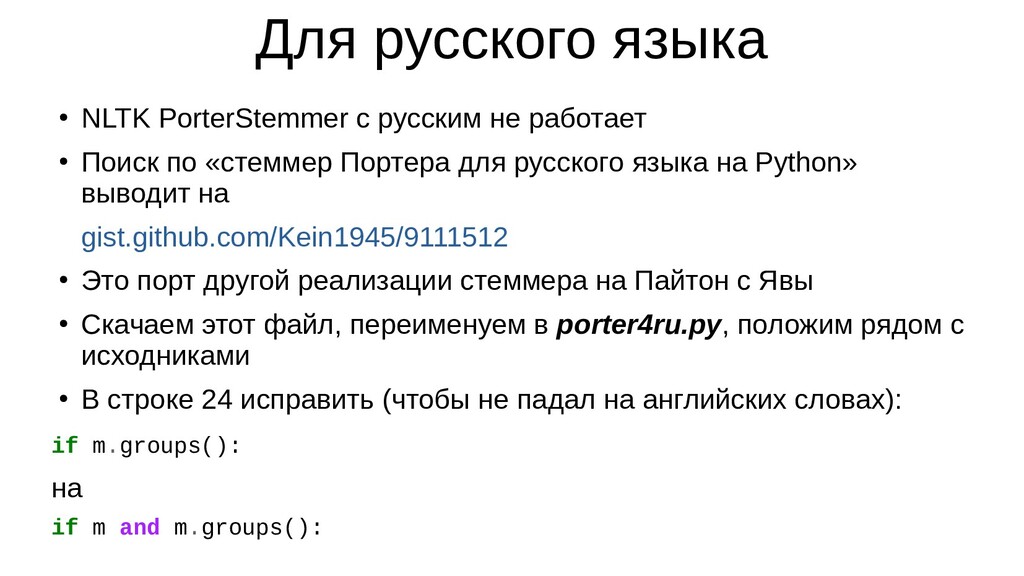
Для русского языка • NLTK PorterStemmer с русским не работает
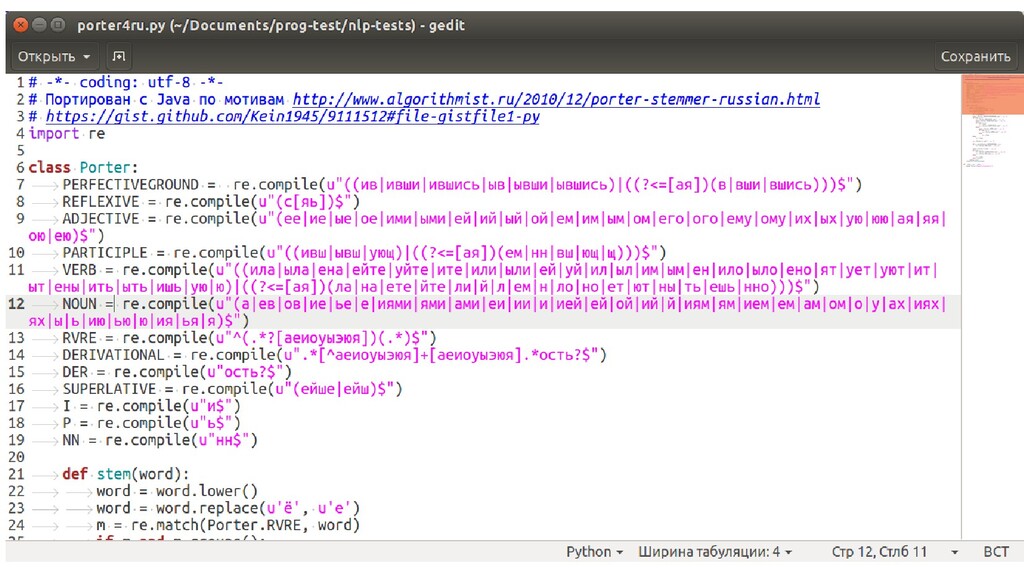
• Поиск по «стеммер Портера для русского языка на Python» выводит на gist.github.com/Kein1945/9111512 • Это порт другой реализации стеммера на Пайтон с Явы • Скачаем этот файл, переименуем в porter4ru.py, положим рядом с исходниками • В строке 24 исправить (чтобы не падал на английских словах): if m.groups(): на if m and m.groups(): -
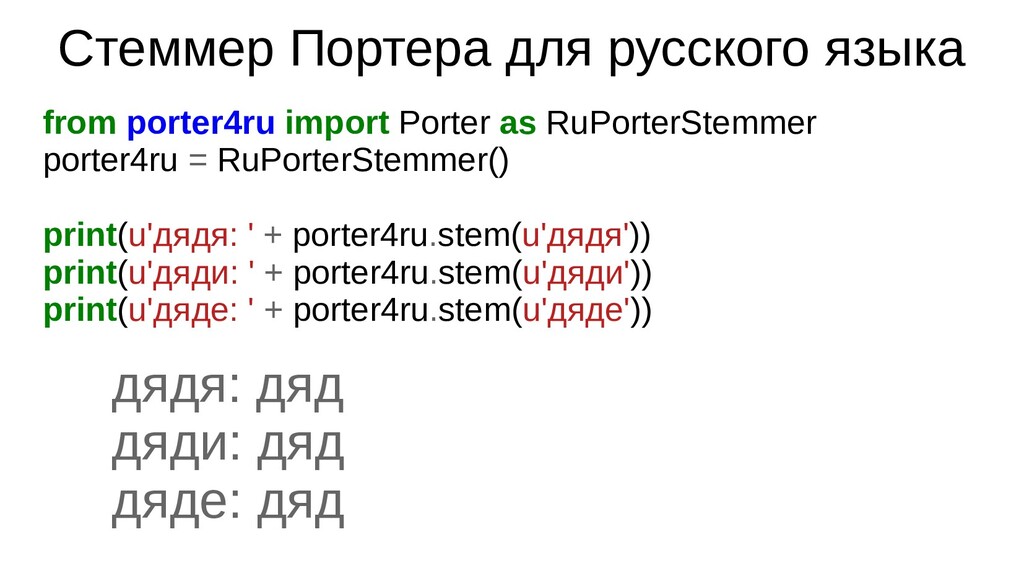
Стеммер Портера для русского языка from porter4ru import Porter as
RuPorterStemmer porter4ru = RuPorterStemmer() print(u'дядя: ' + porter4ru.stem(u'дядя')) print(u'дяди: ' + porter4ru.stem(u'дяди')) print(u'дяде: ' + porter4ru.stem(u'дяде')) дядя: дяд дяди: дяд дяде: дяд -
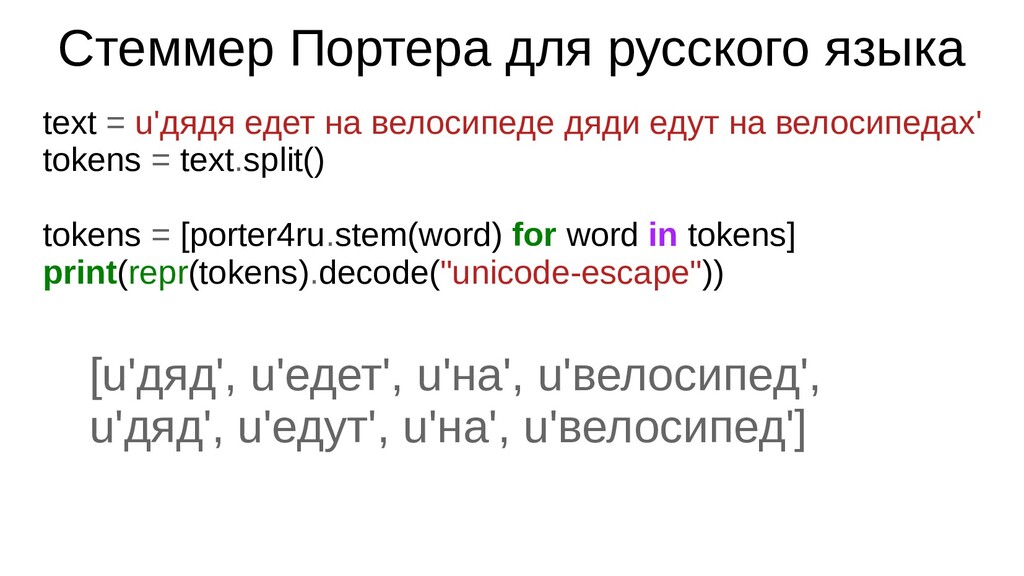
Стеммер Портера для русского языка text = u'дядя едет на
велосипеде дяди едут на велосипедах' tokens = text.split() tokens = [porter4ru.stem(word) for word in tokens] print(repr(tokens).decode("unicode-escape")) [u'дяд', u'едет', u'на', u'велосипед', u'дяд', u'едут', u'на', u'велосипед'] -
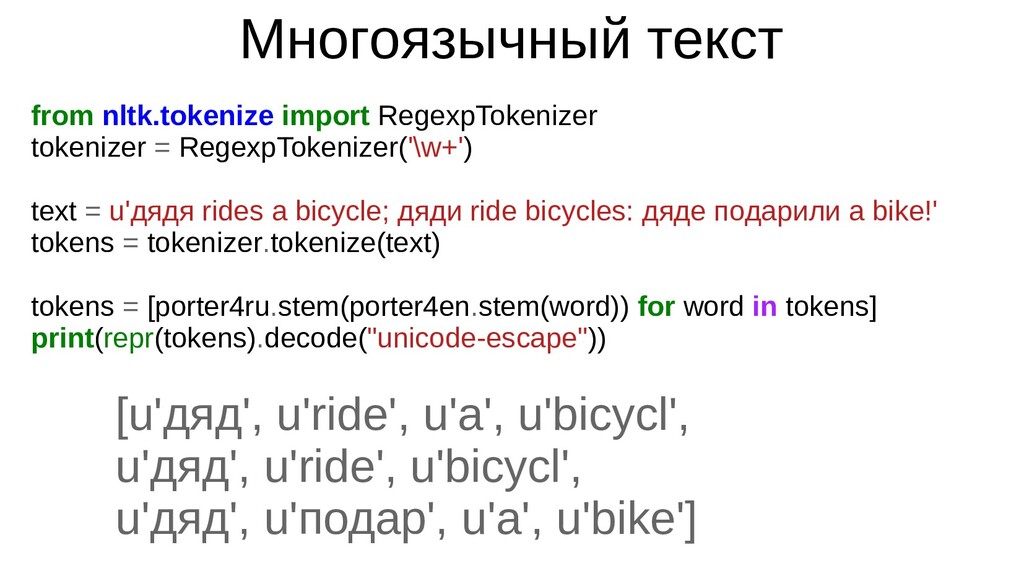
Многоязычный текст from nltk.tokenize import RegexpTokenizer tokenizer = RegexpTokenizer('\w+') text
= u'дядя rides a bicycle; дяди ride bicycles: дяде подарили a bike!' tokens = tokenizer.tokenize(text) tokens = [porter4ru.stem(porter4en.stem(word)) for word in tokens] print(repr(tokens).decode("unicode-escape")) [u'дяд', u'ride', u'a', u'bicycl', u'дяд', u'ride', u'bicycl', u'дяд', u'подар', u'a', u'bike'] -
Еще стеммеры • Стеммер Snowball (Porter2, «английский» стеммер) • Стеммер
Ланкастерского университета (стеммер Пэйс-Хаска) • Много стеммеров www.nltk.org/api/nltk.stem.html -
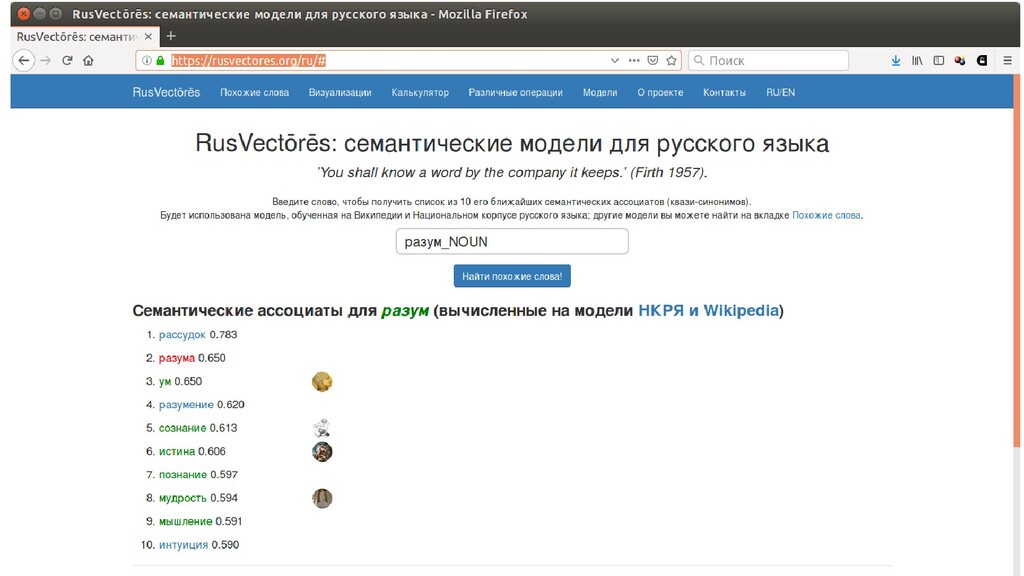
Google word2vec • ru.wikipedia.org/wiki/Word2vec • Вычисляет «семантическое расстояние» между словами,
основываясь на контекстной близости этих слов. • Обучается на больших массивах текстов • Реализация на Python: radimrehurek.com/gensim/models/word2vec.html • Обученная модель для русского языка (обучена на Википедии и Национальном корпусе русского языка): rusvectores.org/ru/# github.com/akutuzov/webvectors/blob/master/preprocessing/rusvectores _tutorial.ipynb -
Области применения • Интерфейсы человек-машина: чат-боты, голосовое общение, умные колонки,
интерфейсы самообслуживания и т. п. • (позволяют заменять живых сотрудников => экономят деньги => повышенный интерес, который может выражаться в живых деньгах) • Юридические тексты (январь 2017: «Сбербанк сократит 3тыс рабочих мест из- за робота-юриста»; февраль 2019: «Сбербанк потерял миллиарды из-за ИИ») • Анализ медиа • Деанон анонимусов (очередного Сатоши Накамото нашли анализом текстовых сообщений на форумах) • Автоматическое распознавание книг (разрешение спорных моментов: наиболее вероятный вариант исходя из контекста) (в мире всего ~120 млн книг, по оценке разработчиков Google Books) • ... -
Где брать данные? • Парсить интернет (сми, соцсети, блоги, форумы,
сервисы с отзывами и т. п.) — берите всё, что есть в интернете, современный интернет генерят пользователи • Википедия (регулярно применяется: IBM Watson + Jeopardy, Rusvectores и т. п.) • Онлайн-библиотеки: libgen.io (~2.7 млн. книг, 58 млн. научных статей, можно скачать базу на торентах) • Научные статьи: Sci-Hub (65.5 млн. научных статей, недавно выложили базу в открытый доступ, ~60терабайт), КиберЛенинка (~1.5 млн научных статей — выложены легально) • Патенты, Архивы, ... • ... -
Национальный корпус русского языка www.ruscorpora.ru/new/ • На этом сайте помещен
корпус современного русского языка общим объемом более 600 млн слов. • Корпус русского языка — это информационно-справочная система, основанная на собрании русских текстов в электронной форме. • Развивается и пополняется профессиональными исследователями, энтузиастами • Хостит Яндекс — на общественных началах -
Частично по материалам • Введение в машинное обучение, ВШЭ, Курсера
• Python и машинное обучение, Себастьян Рашка -
Онлайн-курс: нейронные сети и обработка текста • Бесплатный онлайн-курс от
Samsung по анализу текста при помощи нейросетей • habr.com/ru/company/samsung/blog/476468/ • stepik.org/course/54098/promo -
Машинный перевод: от холодной войны до диплёрнинга vas3k.ru/blog/machine_translation/ • Фундаментальная
статья с обзором алгоритмов работы с текстом с экскурсом в историю • В конце еще список ссылок -
База отзывов на фильмы IMDB • IMDB — internet movie
database • Скачиваемая база отзывов: Large Moview Review Dataset (80 Мб) ai.stanford.edu/~amaas/data/sentiment/ • Задание-0: Скачайте архив, распакуйте, склейте все отзывы в один файл csv с колонками «текст отзыва» + «мнение» (neg=0/pos=1) -
Задание-1 • Мешок слов • Сделайте мешок слов для текста
при помощи sklearn.feature_extraction.text.CountVectorizer Выведите: • топ 5 слов для комментариев с позитивным отзывом, • топ 5 слов для комментариев с негативным отзывом -
Задание-2 • Посчитайте метрики TF-IDF для документов с отзывами IMDB
при помощи sklearn.feature_extraction.text.TfIdfTransformer Выведите: • топ 5 слов (максимальный tf-idf) для комментариев с позитивным отзывом, • топ 5 слов для комментариев с негативным отзывом -
• Как по-вашему, можно ли по этим словам делать вывод
о положительности или отрицательности отзыва? • Будет ли IDF выводить характерные для всего класса слова в топ? • Можно ли улучшить алгоритм? например: считать IDF для каждого позитивного отзыва отдельно в группе только с негативными Задание-3 -
Задание-4 (новое) • Применить методы предварительной обработки текста к базе
отзывов IMDB • Применить стеммер для выделения основы слов • Повторно выполнить задания 1, 2 и 3 на очищенных данных, сравнить результат