Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Steerable Visual Representations

Steerable Visual Representations

■イベント
第68回 コンピュータビジョン勉強会@関東
https://kantocv.connpass.com/event/407846/

■登壇概要
タイトル:Steerable Visual Representations
登壇者:研究開発部 Automationグループ 大竹 ひな

■ 技術本部 採用情報
https://media.sansan-engineering.com

Avatar for SansanTech

SansanTech PRO

October 20, 2026

More Decks by SansanTech

Other Decks in Technology

Transcript

  1. 論⽂情報 - タイトル: Steerable Visual Representations - 著者: Jona Ruthardt,

    Manu Gaur, Deva Ramanan, Makarand Tapaswi, and Yuki M. Asano - 所属:University of Technology Nuremberg(🇩🇪)/ Carnegie Mellon University(🇺🇸)/ IIIT Hyderabad(🇮🇳) - 発表:ECCV 2026 Oral - Project page:jonaruthardt.github.io/project/SteerViT - キーワード:Vision Transformer, text conditioning, early fusion, gated cross-attention
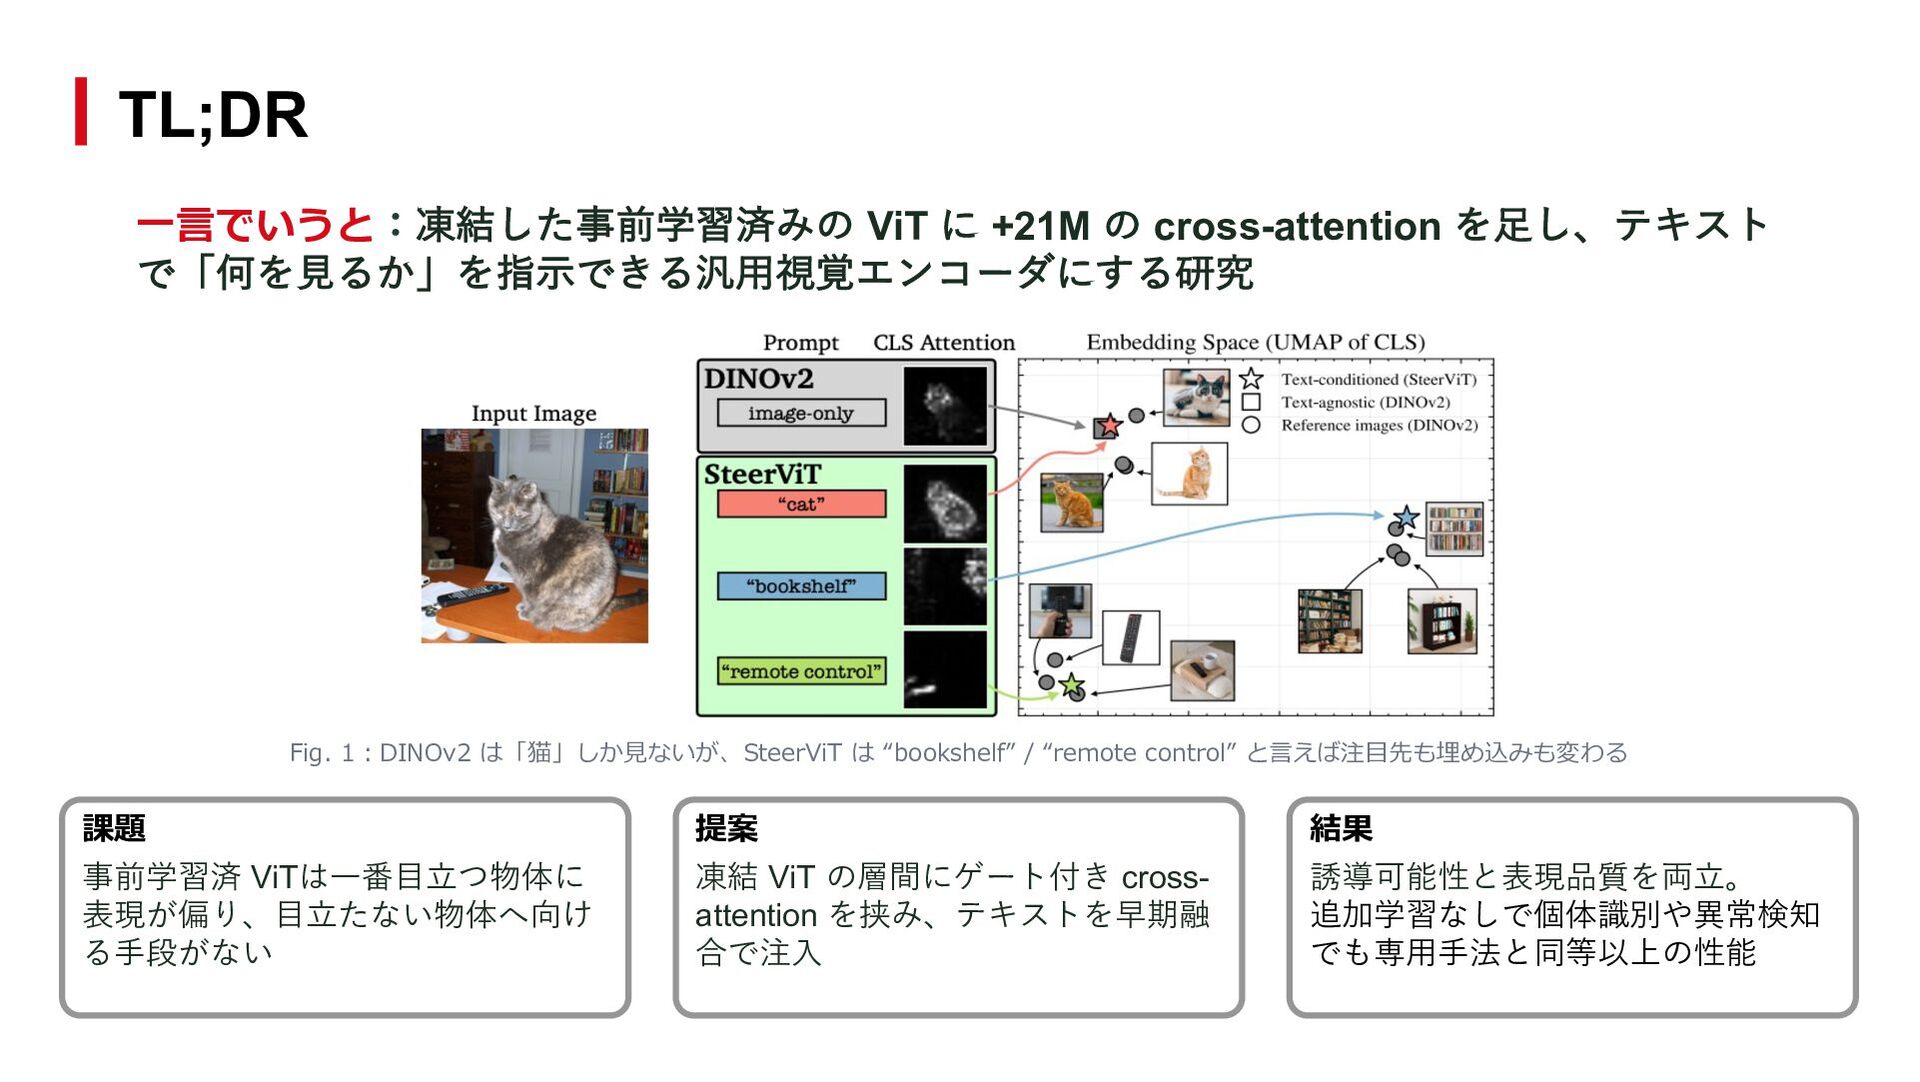
  2. TL;DR ⼀⾔でいうと:凍結した事前学習済みの ViT に +21M の cross-attention を⾜し、テキスト で「何を⾒るか」を指⽰できる汎⽤視覚エンコーダにする研究 Fig.

    1︓DINOv2 は「猫」しか⾒ないが、SteerViT は “bookshelf” / “remote control” と⾔えば注⽬先も埋め込みも変わる 課題 提案 結果 事前学習済 ViTは⼀番⽬⽴つ物体に 表現が偏り、⽬⽴たない物体へ向け る⼿段がない 凍結 ViT の層間にゲート付き crossattention を挟み、テキストを早期融 合で注⼊ 誘導可能性と表現品質を両⽴。 追加学習なしで個体識別や異常検知 でも専⽤⼿法と同等以上の性能
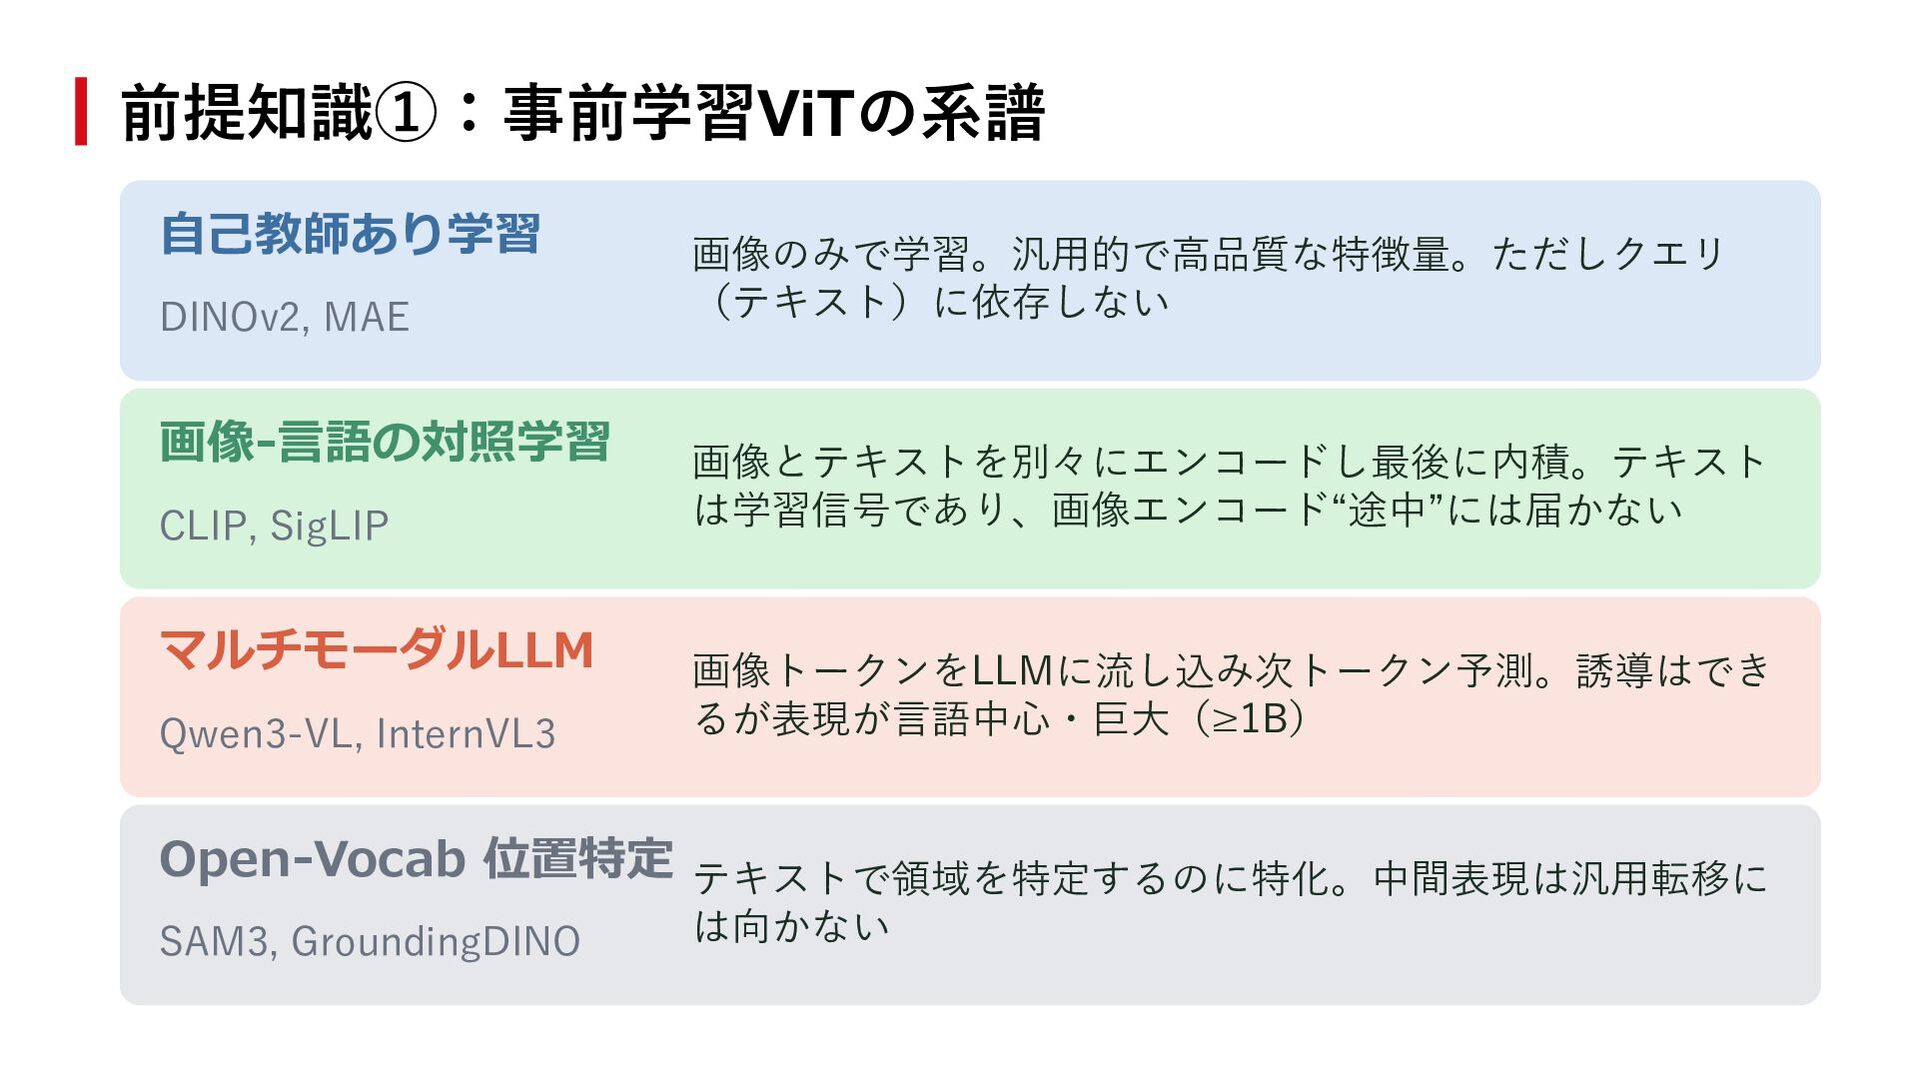
  3. 前提知識①:事前学習ViTの系譜 ⾃⼰教師あり学習 DINOv2, MAE 画像-⾔語の対照学習 CLIP, SigLIP マルチモーダルLLM Qwen3-VL, InternVL3

    画像のみで学習。汎⽤的で⾼品質な特徴量。ただしクエリ (テキスト)に依存しない 画像とテキストを別々にエンコードし最後に内積。テキスト は学習信号であり、画像エンコード“途中”には届かない 画像トークンをLLMに流し込み次トークン予測。誘導はでき るが表現が⾔語中⼼・巨⼤(≥1B) Open-Vocab 位置特定 テキストで領域を特定するのに特化。中間表現は汎⽤転移に SAM3, GroundingDINO は向かない
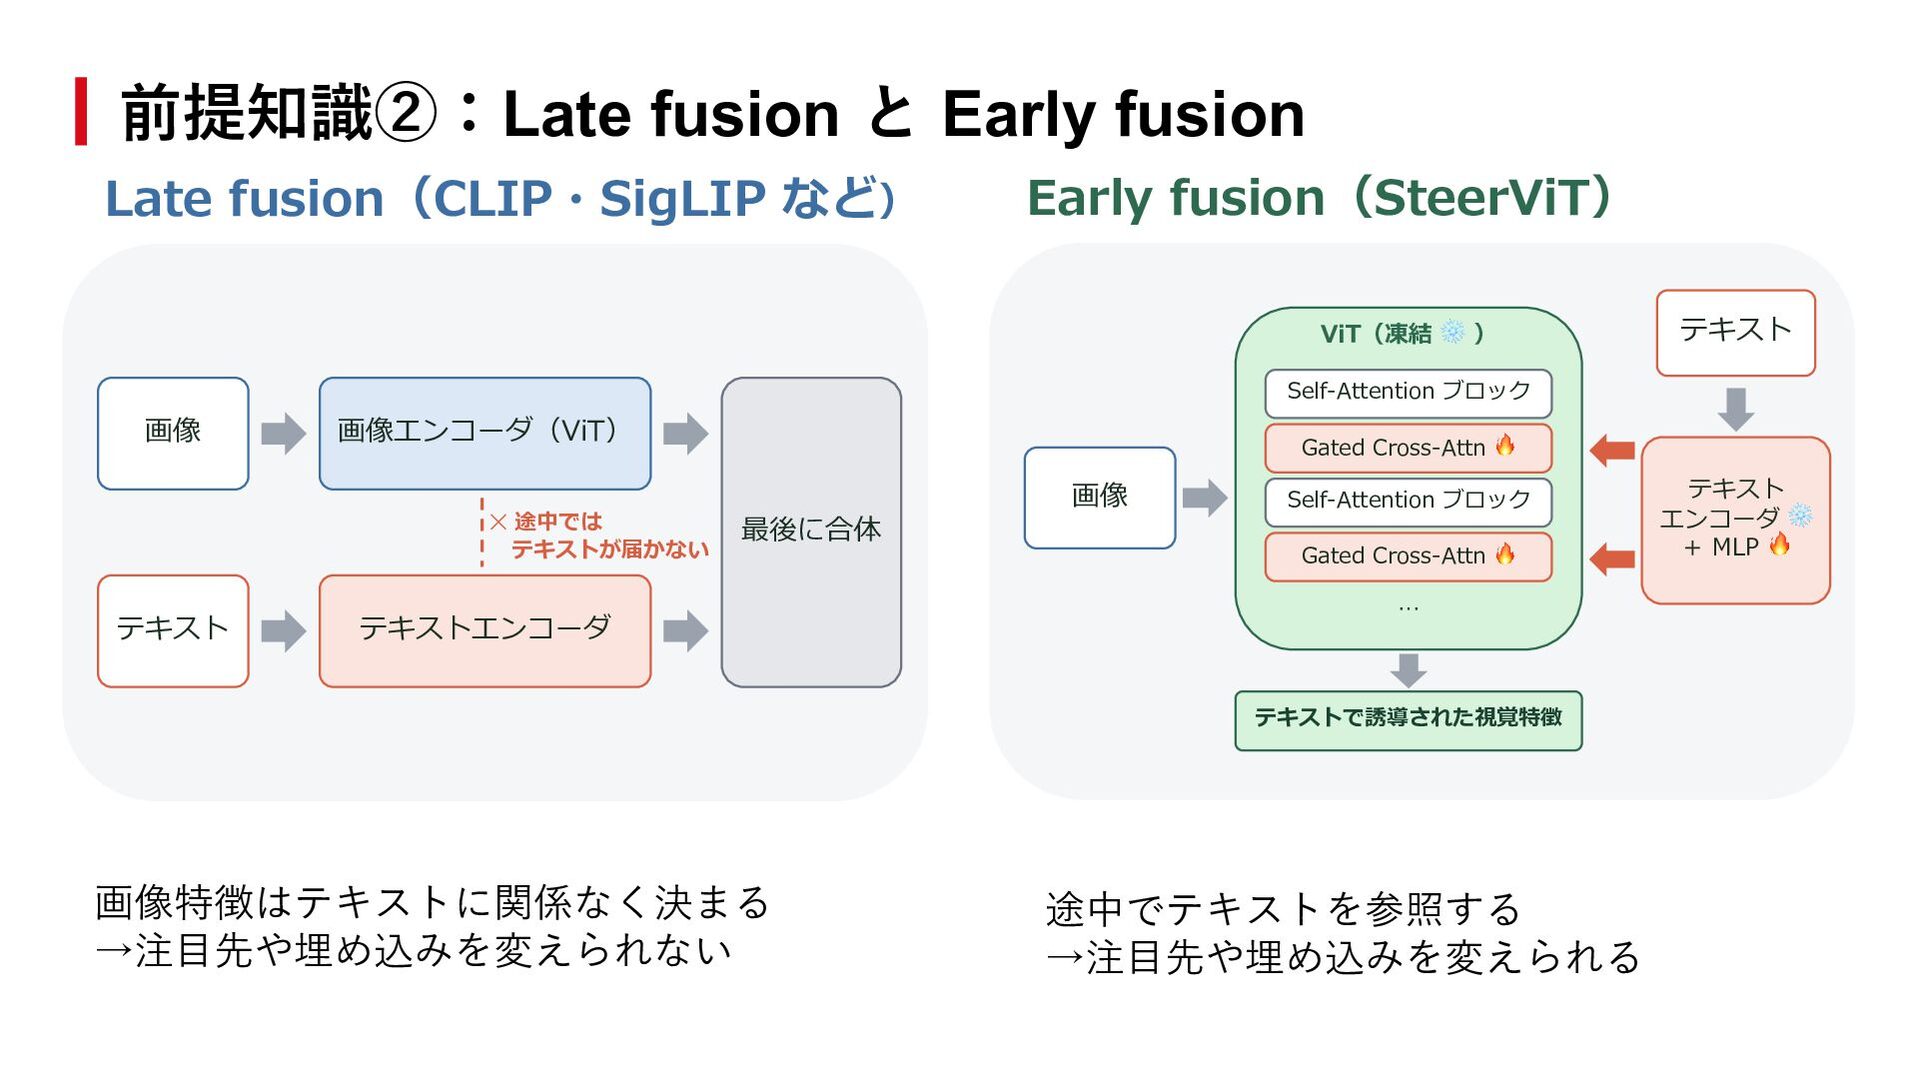
  4. 前提知識②:Late fusion と Early fusion Late fusion(CLIP・SigLIP など) Early fusion(SteerViT)

    ViT(凍結 ❄ ) テキスト Self-Attention ブロック 画像 画像エンコーダ(ViT) ✕ 途中では テキストが届かない テキスト Gated Cross-Attn 🔥 最後に合体 テキストエンコーダ 画像 Self-Attention ブロック Gated Cross-Attn 🔥 … テキストで誘導された視覚特徴 画像特徴はテキストに関係なく決まる →注⽬先や埋め込みを変えられない 途中でテキストを参照する →注⽬先や埋め込みを変えられる テキスト エンコーダ ❄ + MLP 🔥
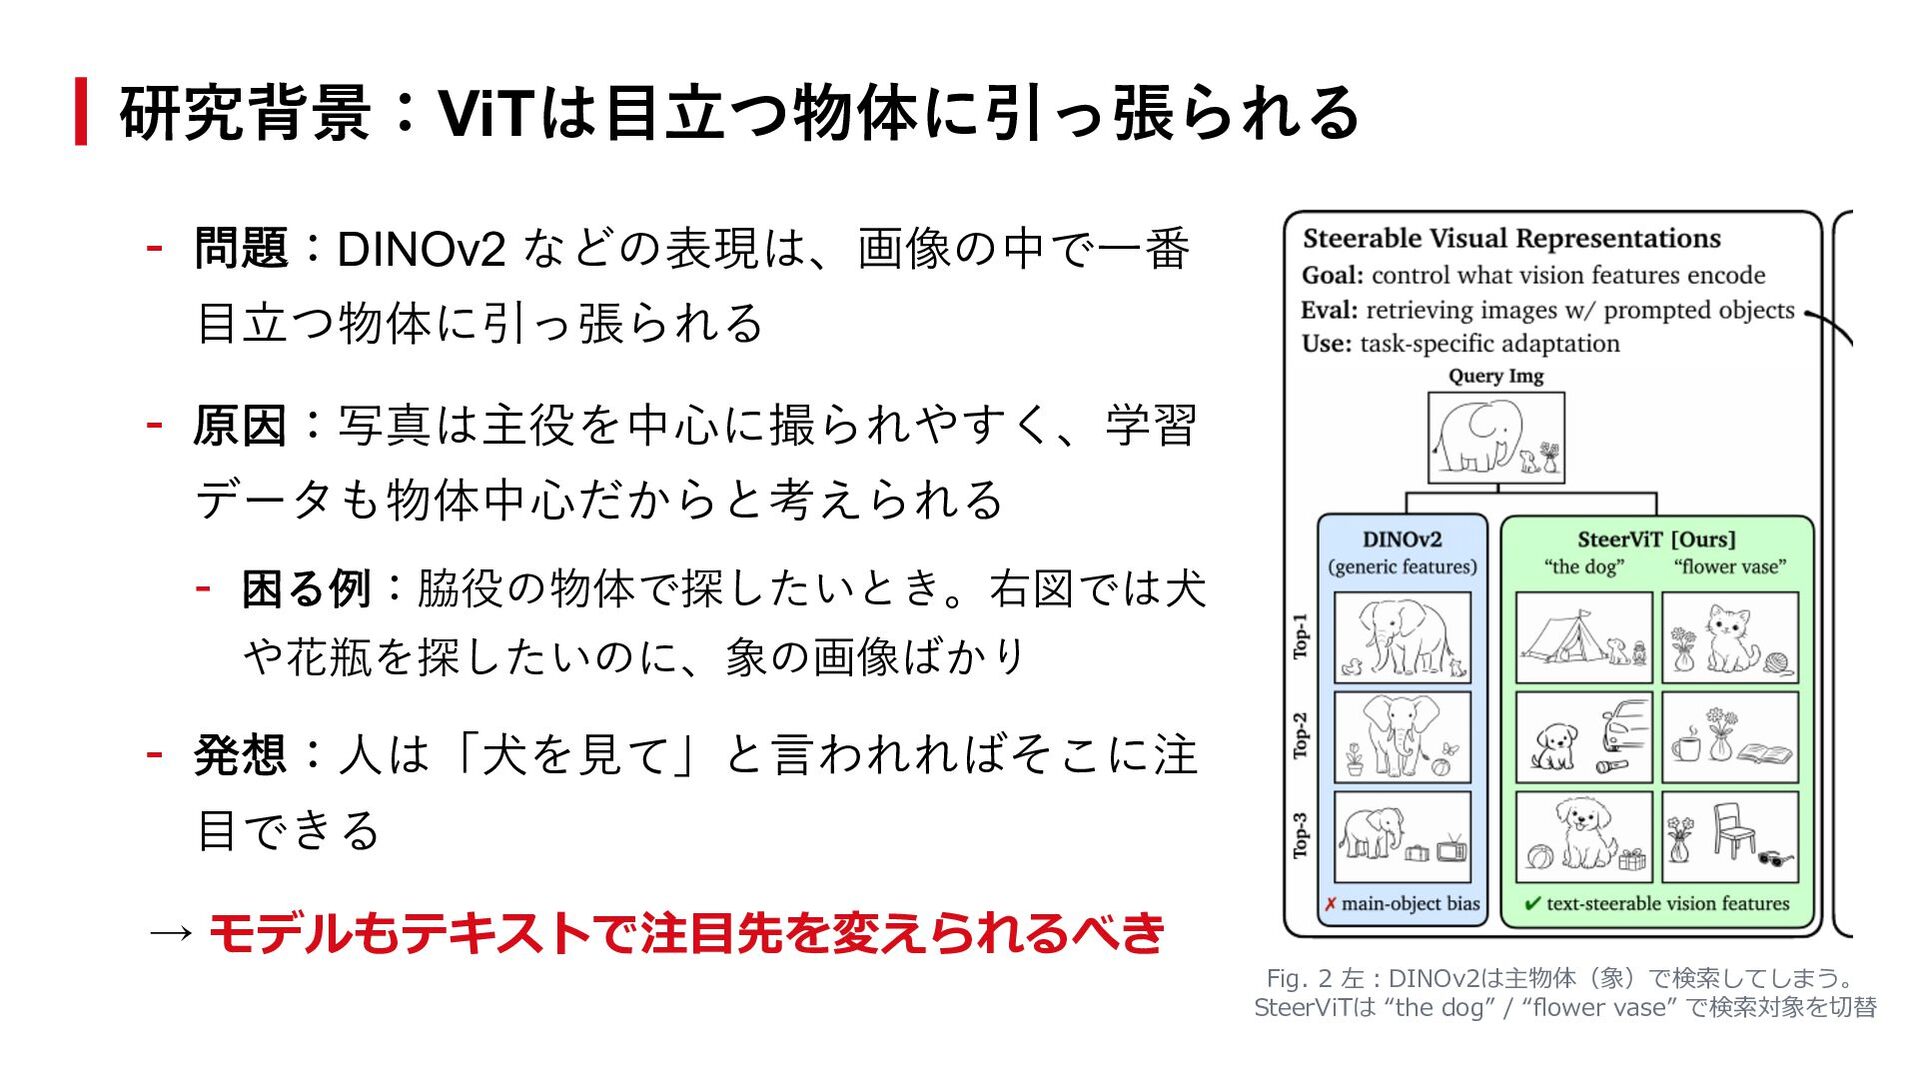
  5. 研究背景:ViTは⽬⽴つ物体に引っ張られる - 問題:DINOv2 などの表現は、画像の中で⼀番 ⽬⽴つ物体に引っ張られる - 原因:写真は主役を中⼼に撮られやすく、学習 データも物体中⼼だからと考えられる - 困る例:脇役の物体で探したいとき。右図では⽝

    や花瓶を探したいのに、象の画像ばかり - 発想:⼈は「⽝を⾒て」と⾔われればそこに注 ⽬できる → モデルもテキストで注⽬先を変えられるべき Fig. 2 左︓DINOv2は主物体(象)で検索してしまう。 SteerViTは “the dog” / “flower vase” で検索対象を切替
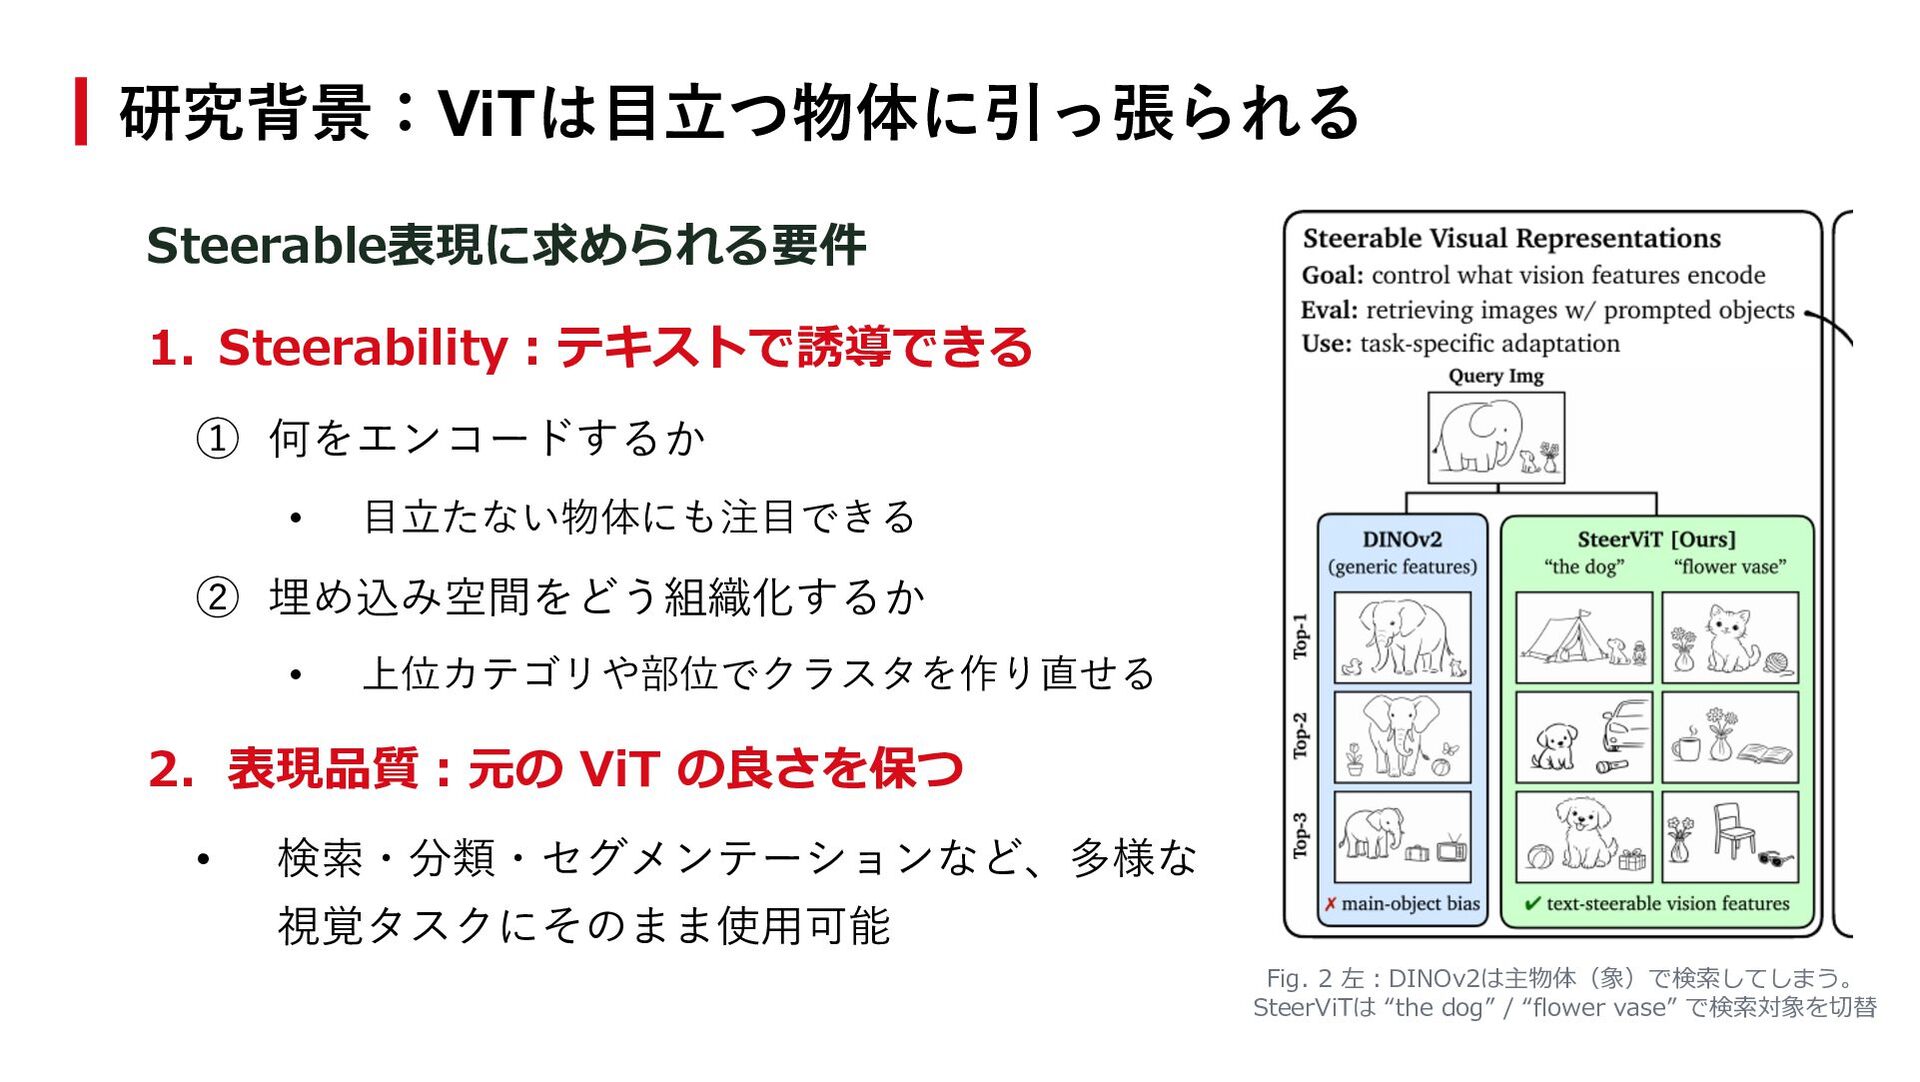
  6. 研究背景:ViTは⽬⽴つ物体に引っ張られる Steerable表現に求められる要件 1. Steerability︓テキストで誘導できる ① 何をエンコードするか • ⽬⽴たない物体にも注⽬できる ② 埋め込み空間をどう組織化するか

    • 上位カテゴリや部位でクラスタを作り直せる 2. 表現品質︓元の ViT の良さを保つ • 検索・分類・セグメンテーションなど、多様な 視覚タスクにそのまま使⽤可能 Fig. 2 左︓DINOv2は主物体(象)で検索してしまう。 SteerViTは “the dog” / “flower vase” で検索対象を切替
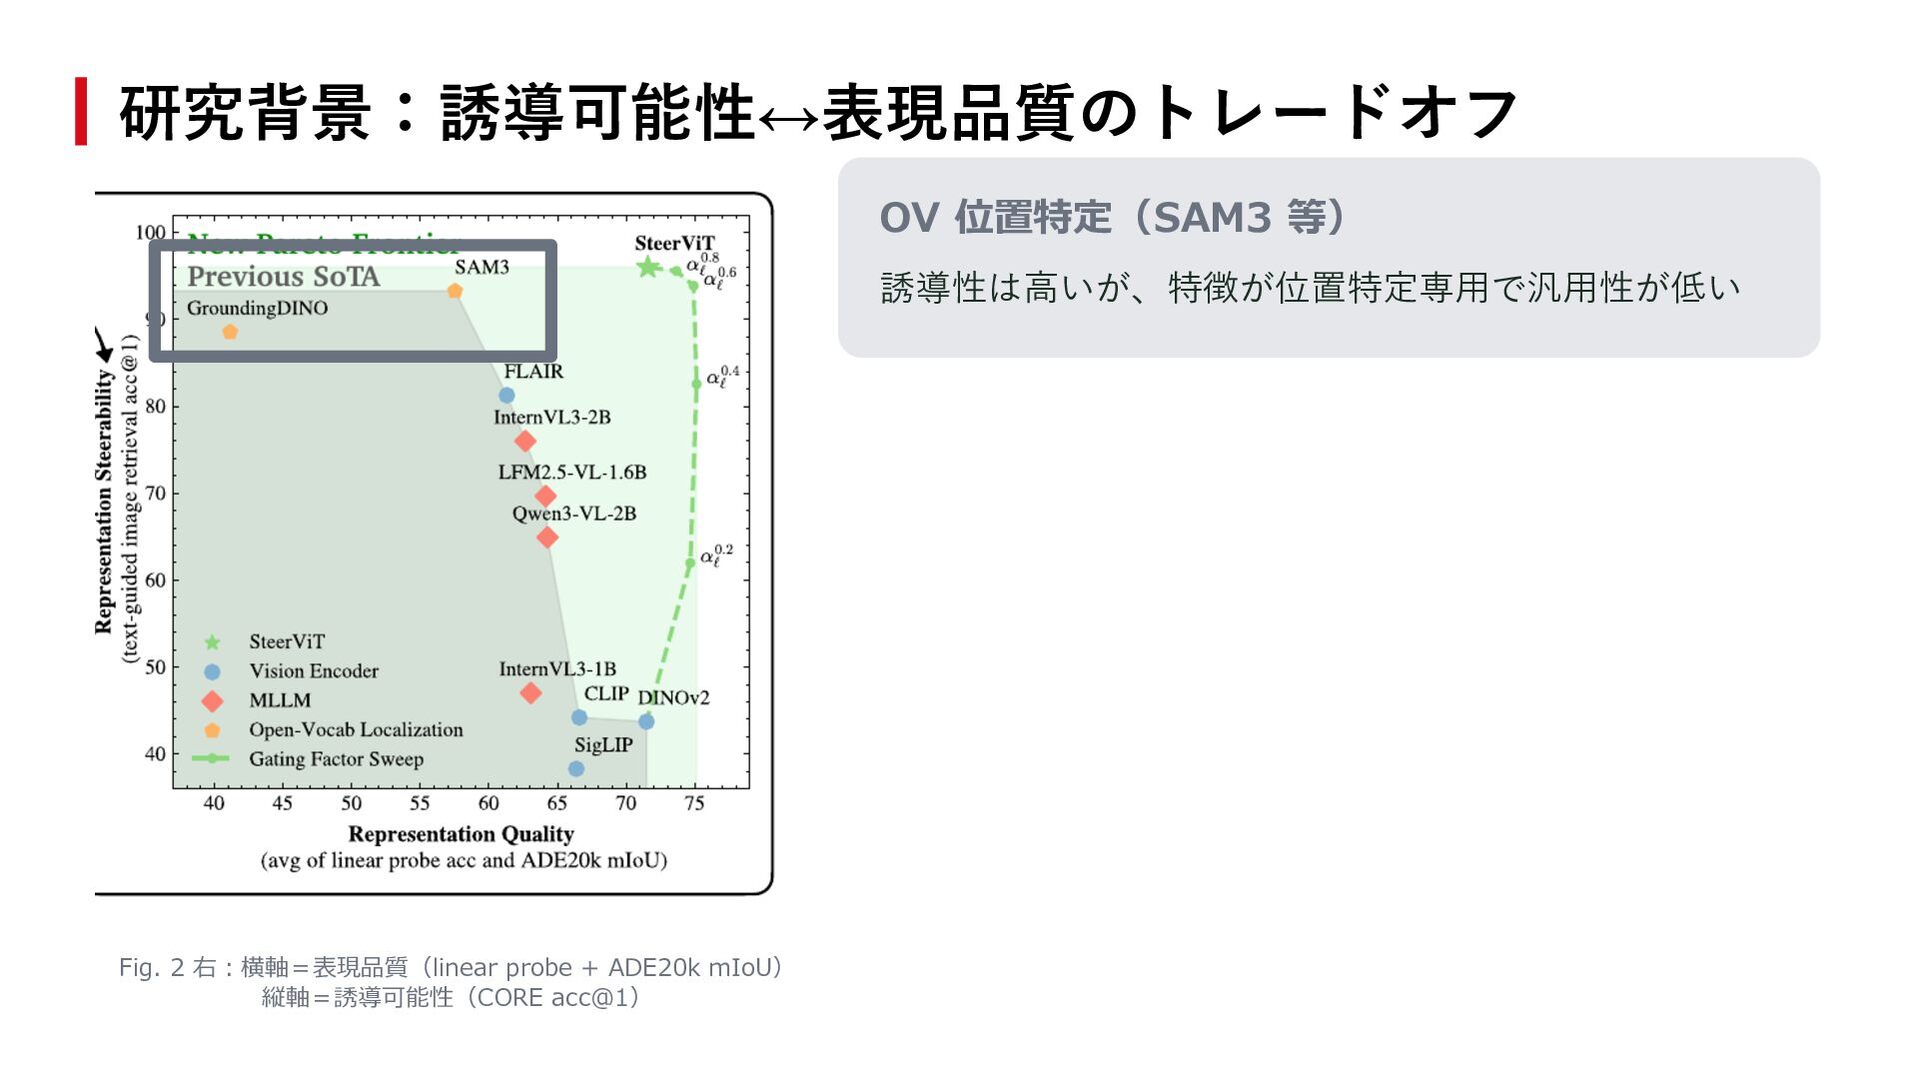
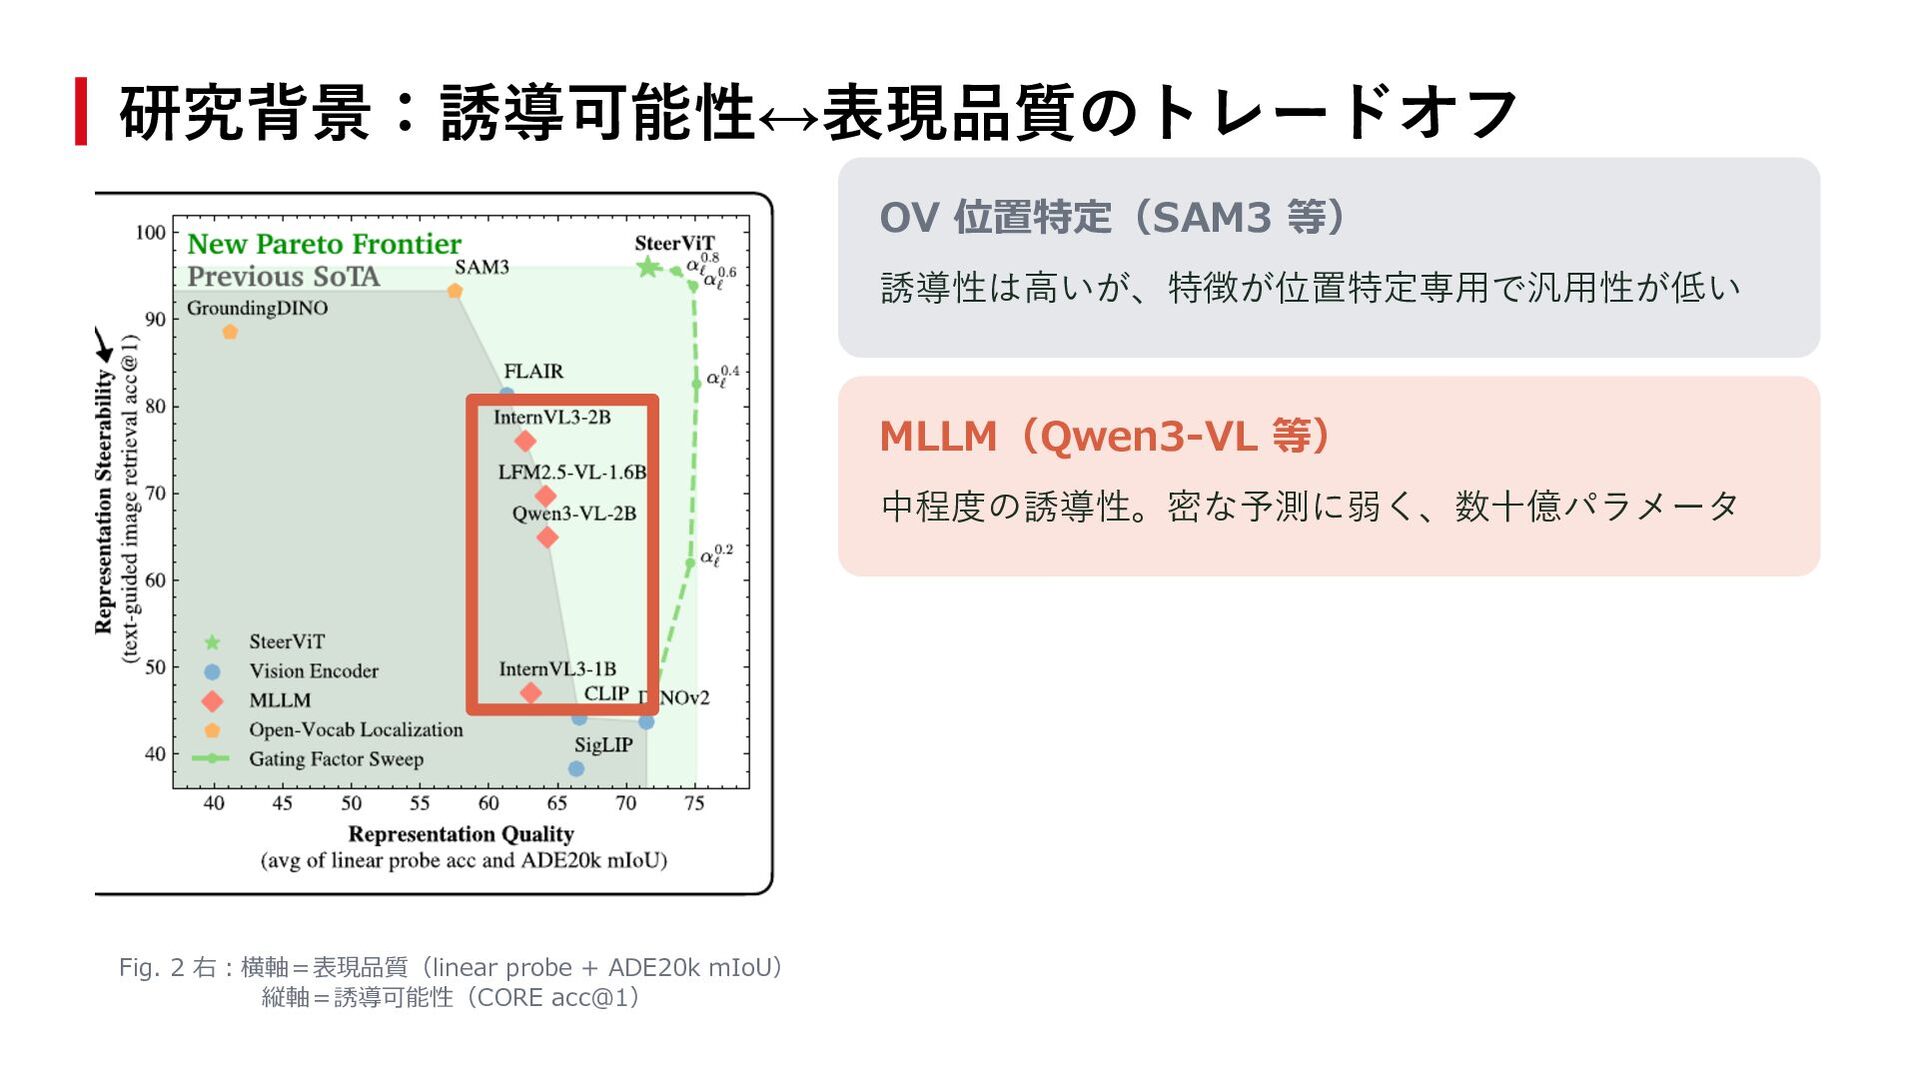
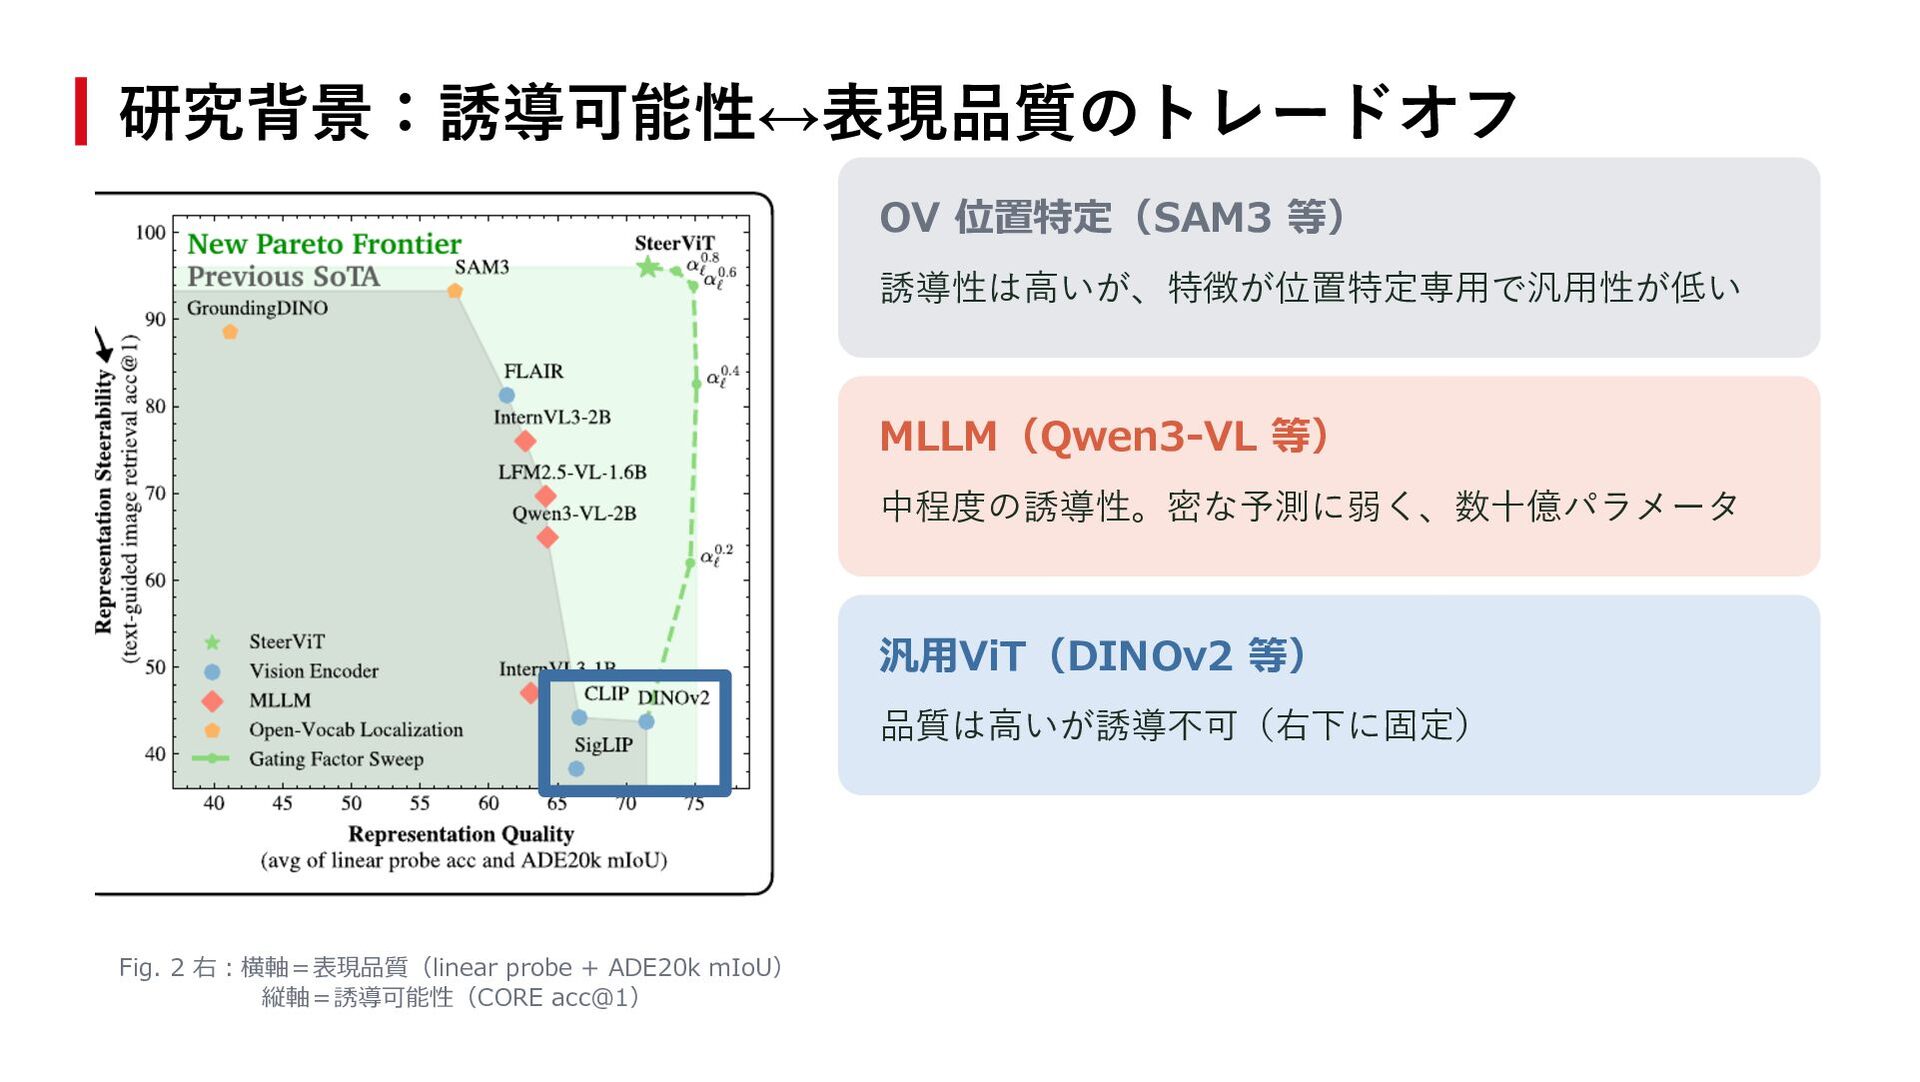
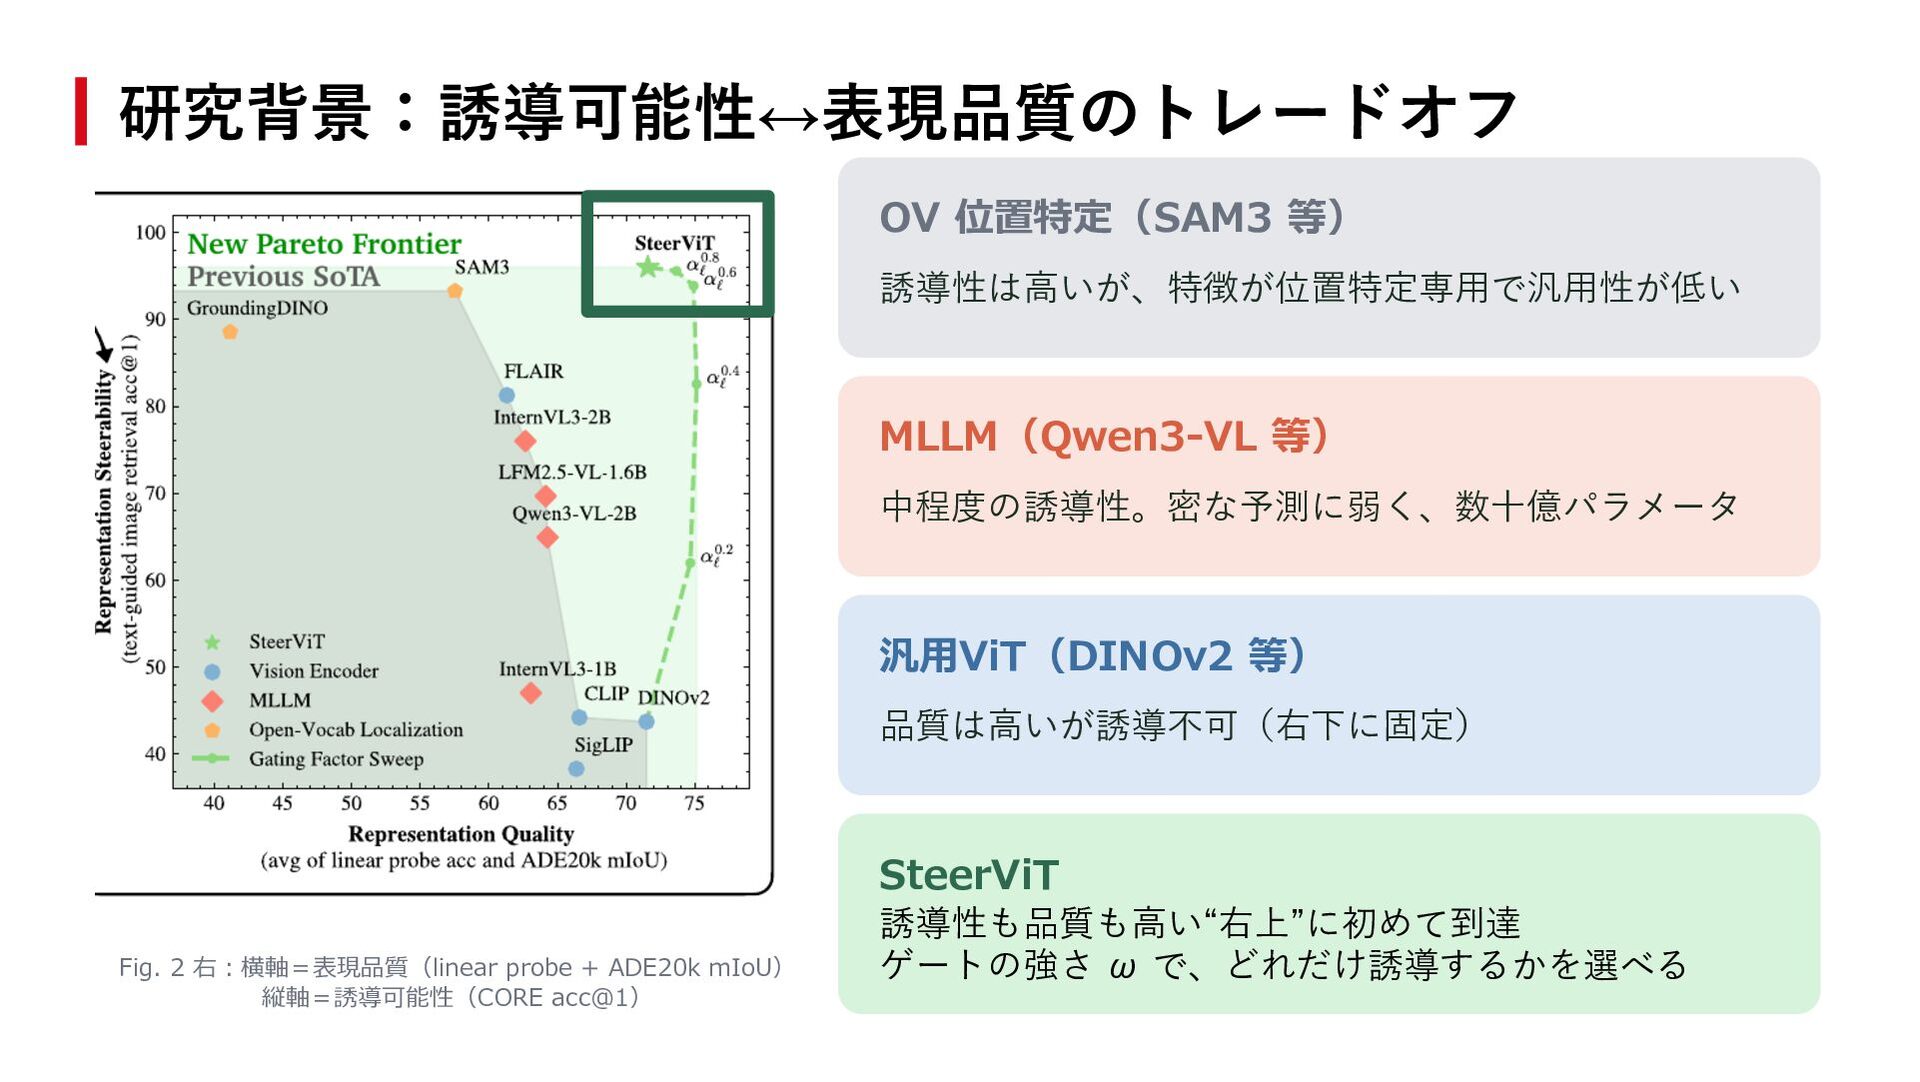
  7. 研究背景:誘導可能性↔表現品質のトレードオフ OV 位置特定(SAM3 等) 誘導性は⾼いが、特徴が位置特定専⽤で汎⽤性が低い MLLM(Qwen3-VL 等) 中程度の誘導性。密な予測に弱く、数⼗億パラメータ 汎⽤ViT(DINOv2 等)

    品質は⾼いが誘導不可(右下に固定) SteerViT Fig. 2 右︓横軸=表現品質(linear probe + ADE20k mIoU) 縦軸=誘導可能性(CORE acc@1) 誘導性も品質も⾼い“右上”に初めて到達 ゲートの強さ ω で、どれだけ誘導するかを選べる
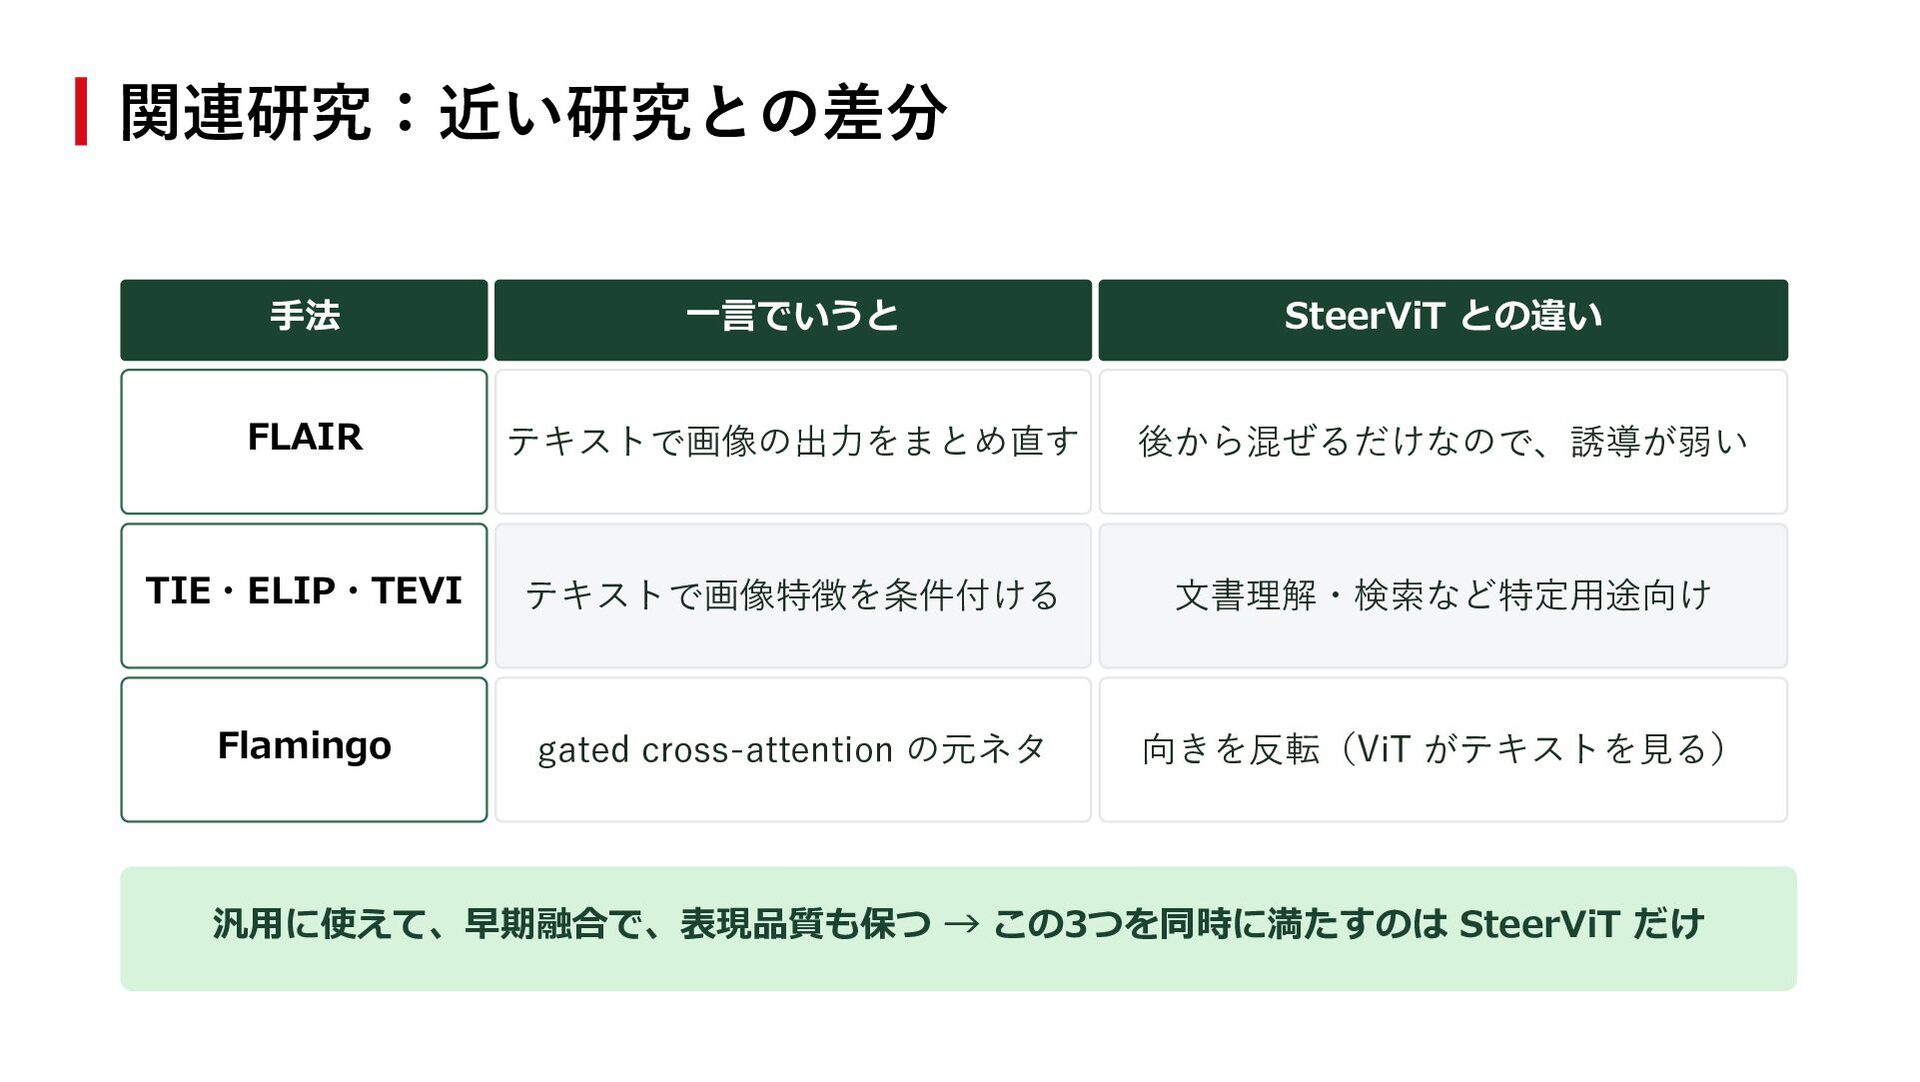
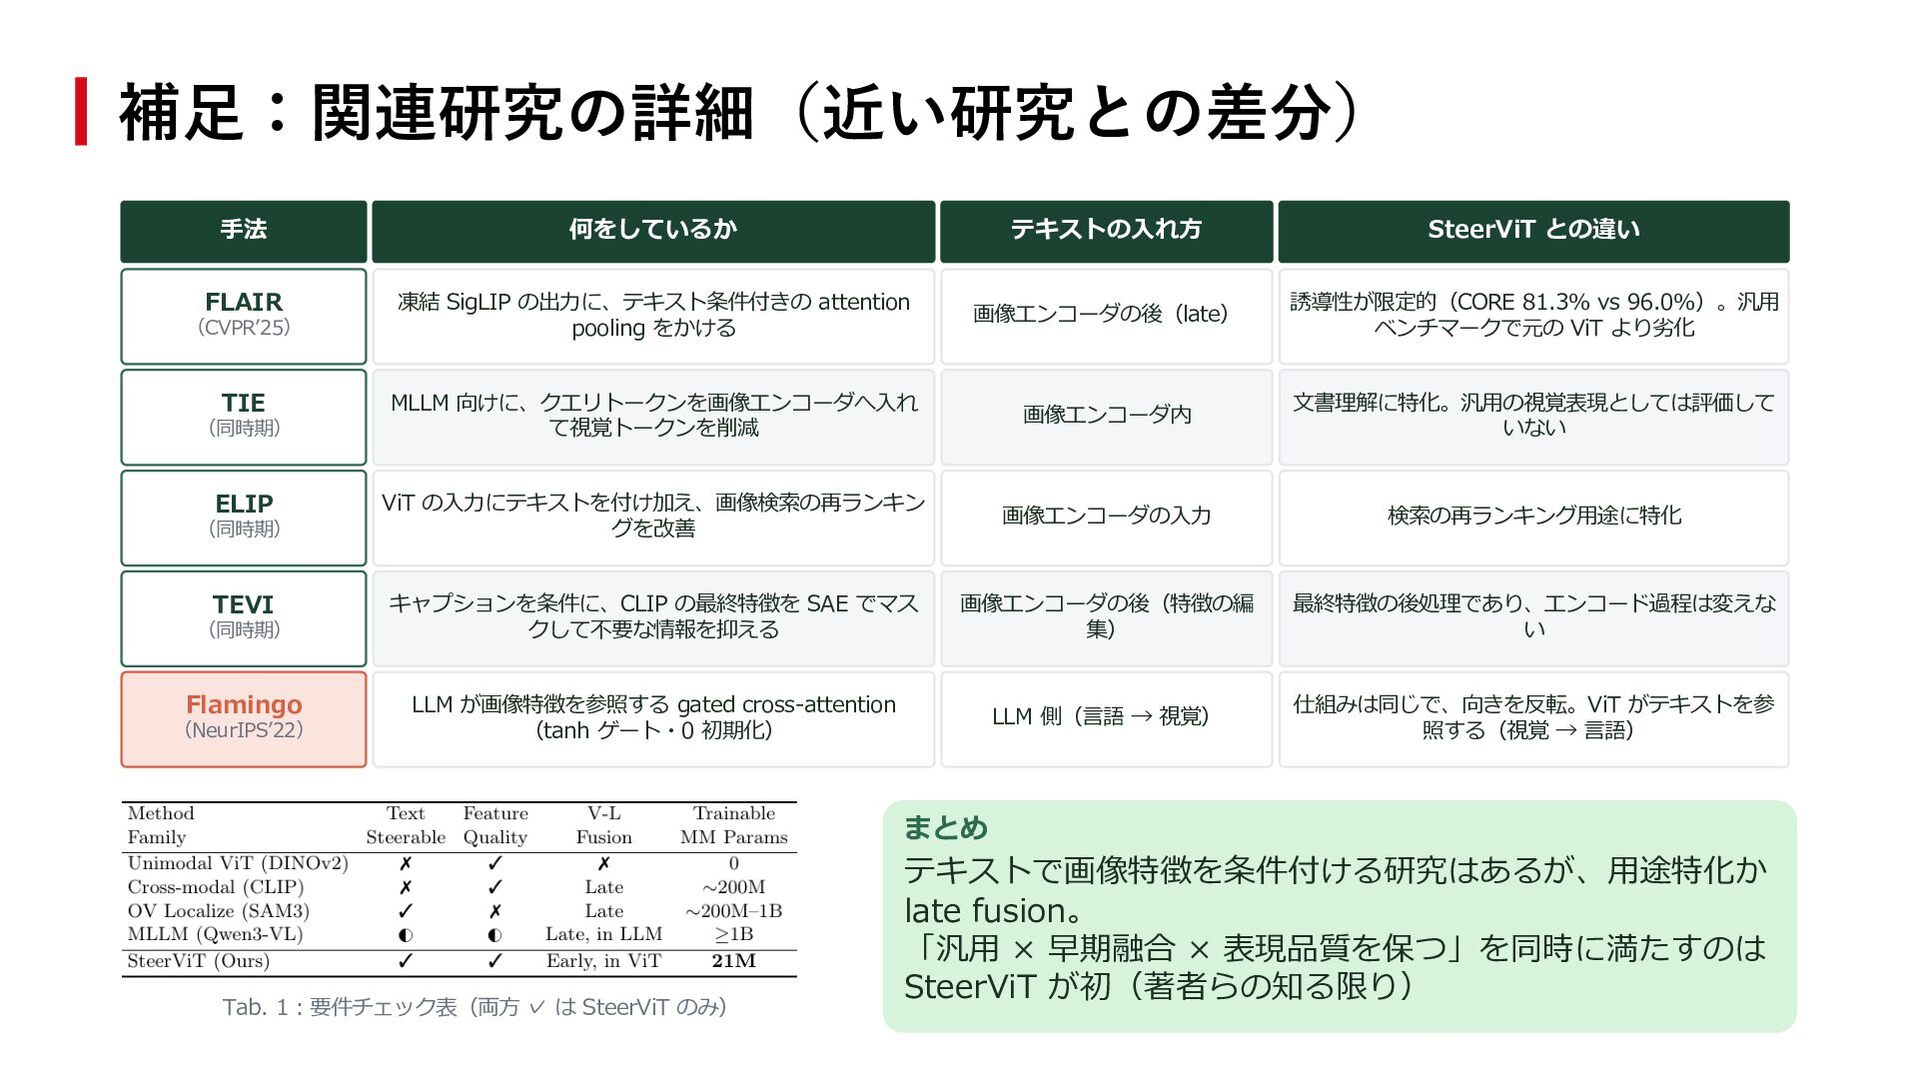
  8. 関連研究:近い研究との差分 ⼿法 ⼀⾔でいうと SteerViT との違い FLAIR テキストで画像の出⼒をまとめ直す 後から混ぜるだけなので、誘導が弱い TIE・ELIP・TEVI テキストで画像特徴を条件付ける

    ⽂書理解・検索など特定⽤途向け Flamingo gated cross-attention の元ネタ 向きを反転(ViT がテキストを⾒る) 汎⽤に使えて、早期融合で、表現品質も保つ → この3つを同時に満たすのは SteerViT だけ
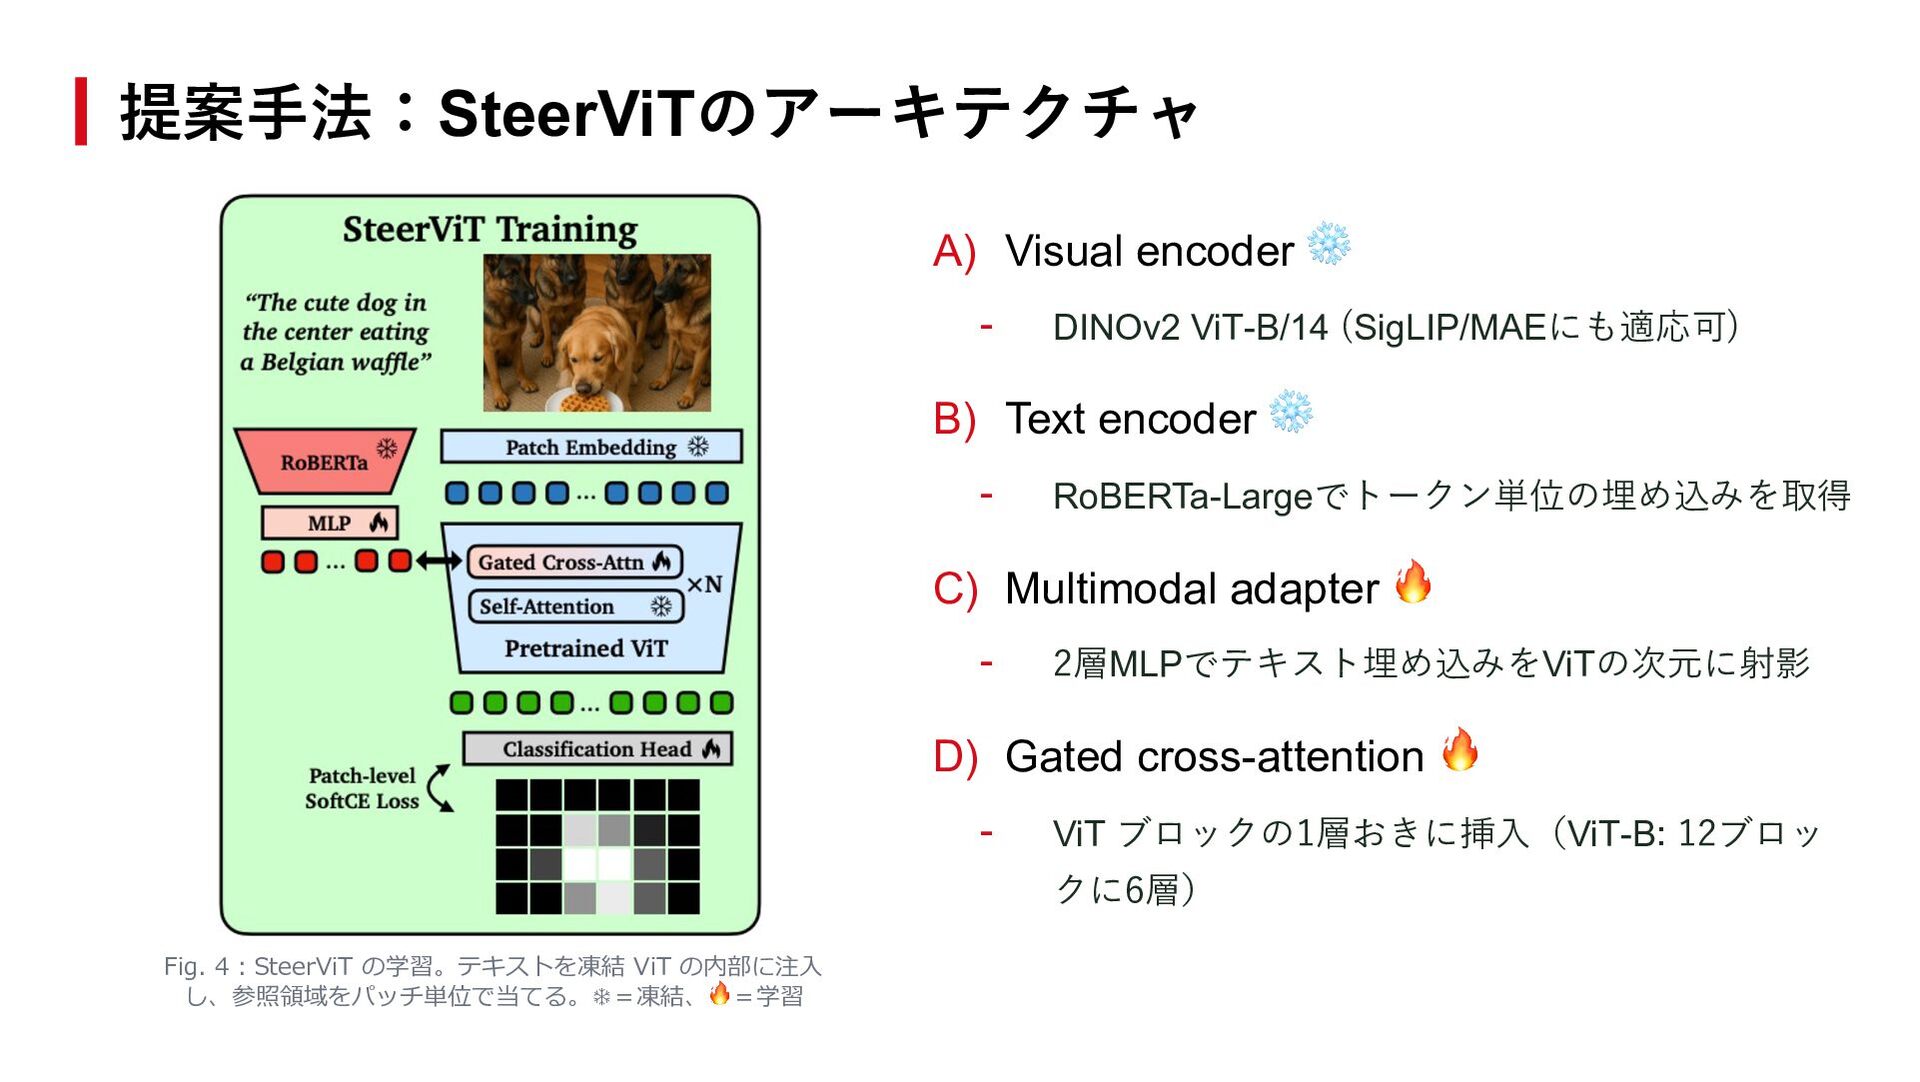
  9. 提案⼿法:SteerViTのアーキテクチャ A) Visual encoder ❄ - DINOv2 ViT-B/14 (SigLIP/MAEにも適応可) B)

    Text encoder ❄ - RoBERTa-Largeでトークン単位の埋め込みを取得 C) Multimodal adapter 🔥 - 2層MLPでテキスト埋め込みをViTの次元に射影 D) Gated cross-attention 🔥 - ViT ブロックの1層おきに挿⼊(ViT-B: 12ブロッ クに6層) Fig. 4︓SteerViT の学習。テキストを凍結 ViT の内部に注⼊ し、参照領域をパッチ単位で当てる。❄=凍結、🔥=学習
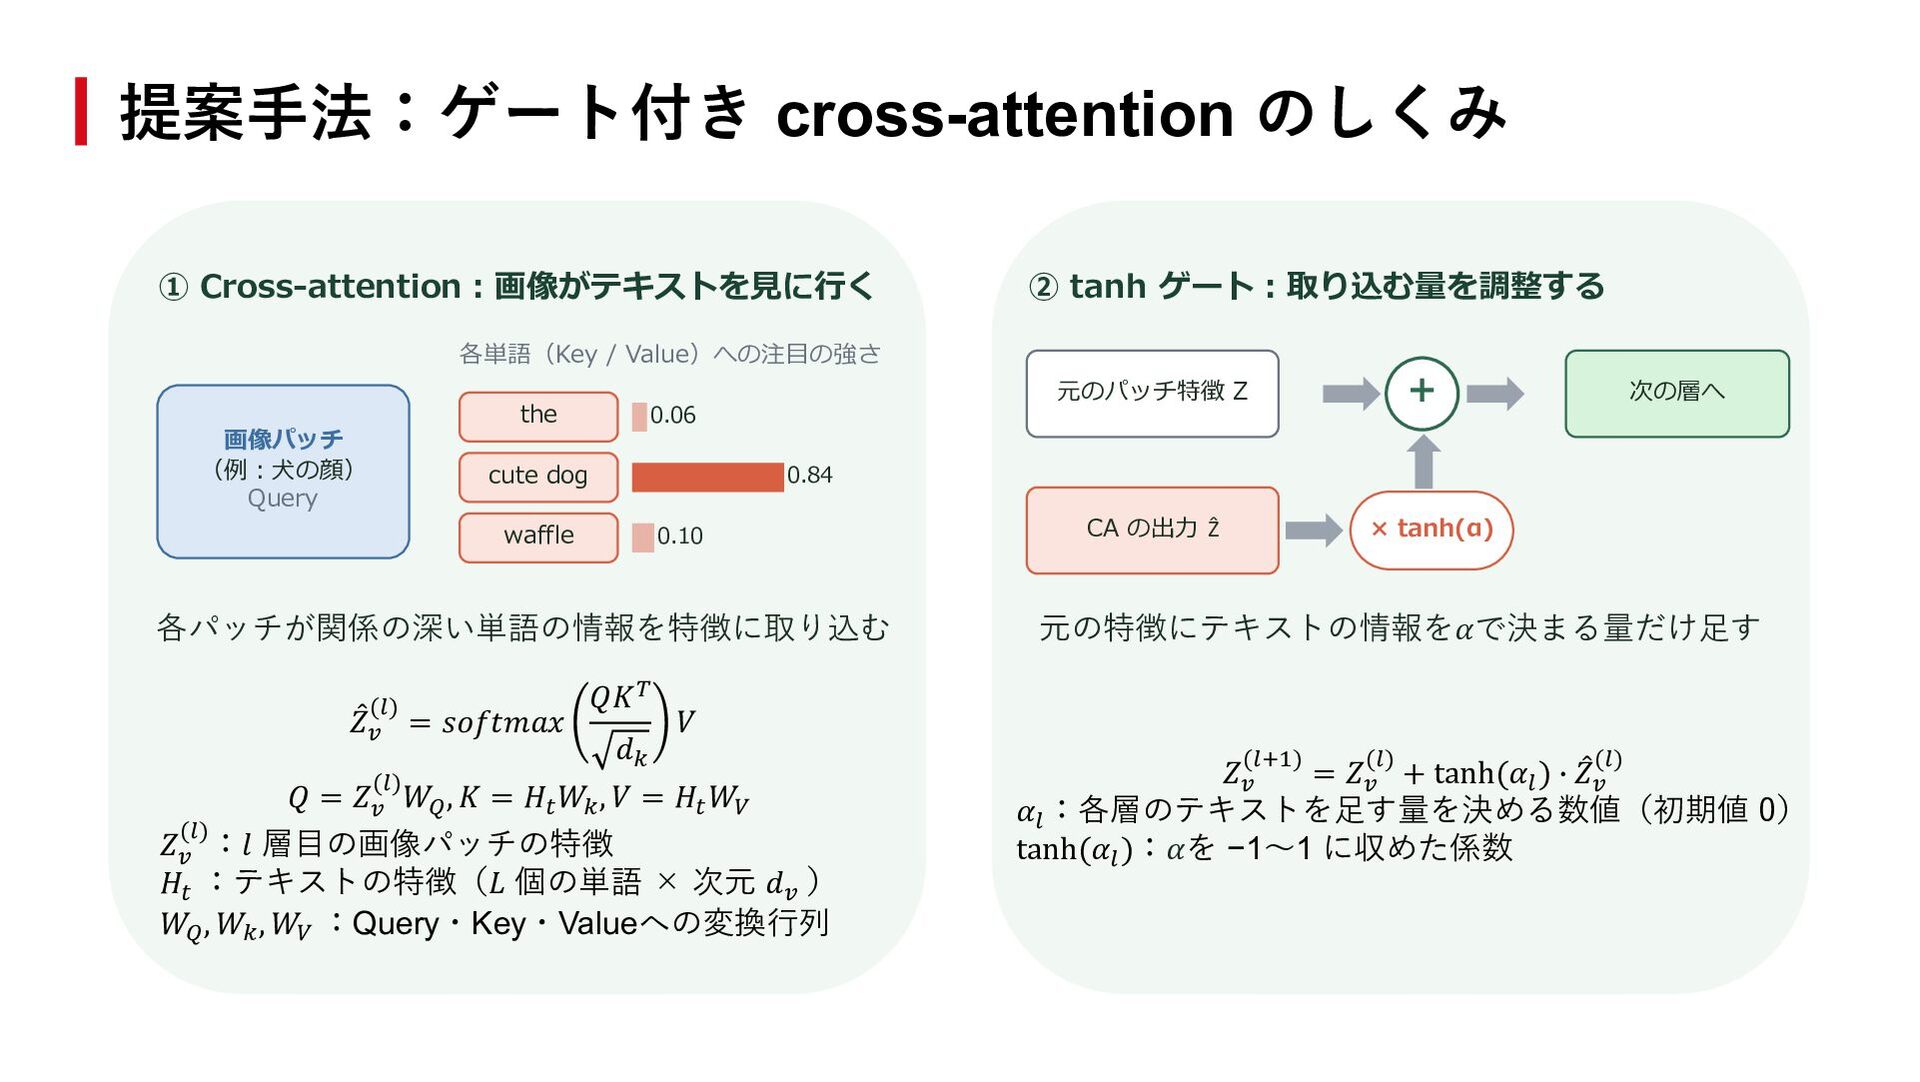
  10. 提案⼿法:ゲート付き cross-attention のしくみ ① Cross-attention︓画像がテキストを⾒に⾏く ② tanh ゲート︓取り込む量を調整する 各単語(Key /

    Value)への注⽬の強さ 画像パッチ (例︓⽝の顔) Query the 0.06 cute dog 0.10 各パッチが関係の深い単語の情報を特徴に取り込む (#) + CA の出⼒ Ẑ × tanh(α) 次の層へ 0.84 waffle (#) 𝑍!! = 𝑠𝑜𝑓𝑡𝑚𝑎𝑥 元のパッチ特徴 Z 𝑄𝐾 % 元の特徴にテキストの情報を𝛼で決まる量だけ⾜す 𝑉 𝑑& (#) 𝑄 = 𝑍! 𝑊' , 𝐾 = 𝐻( 𝑊& , 𝑉 = 𝐻( 𝑊) 𝑍! :𝑙 層⽬の画像パッチの特徴 𝐻( :テキストの特徴(𝐿 個の単語 × 次元 𝑑! ) 𝑊' , 𝑊& , 𝑊) :Query・Key・Valueへの変換⾏列 (#*+) (#) (#) 𝑍! = 𝑍! + tanh(𝛼# ) < 𝑍!! 𝛼# :各層のテキストを⾜す量を決める数値(初期値 0) tanh(𝛼# ):𝛼を −1〜1 に収めた係数
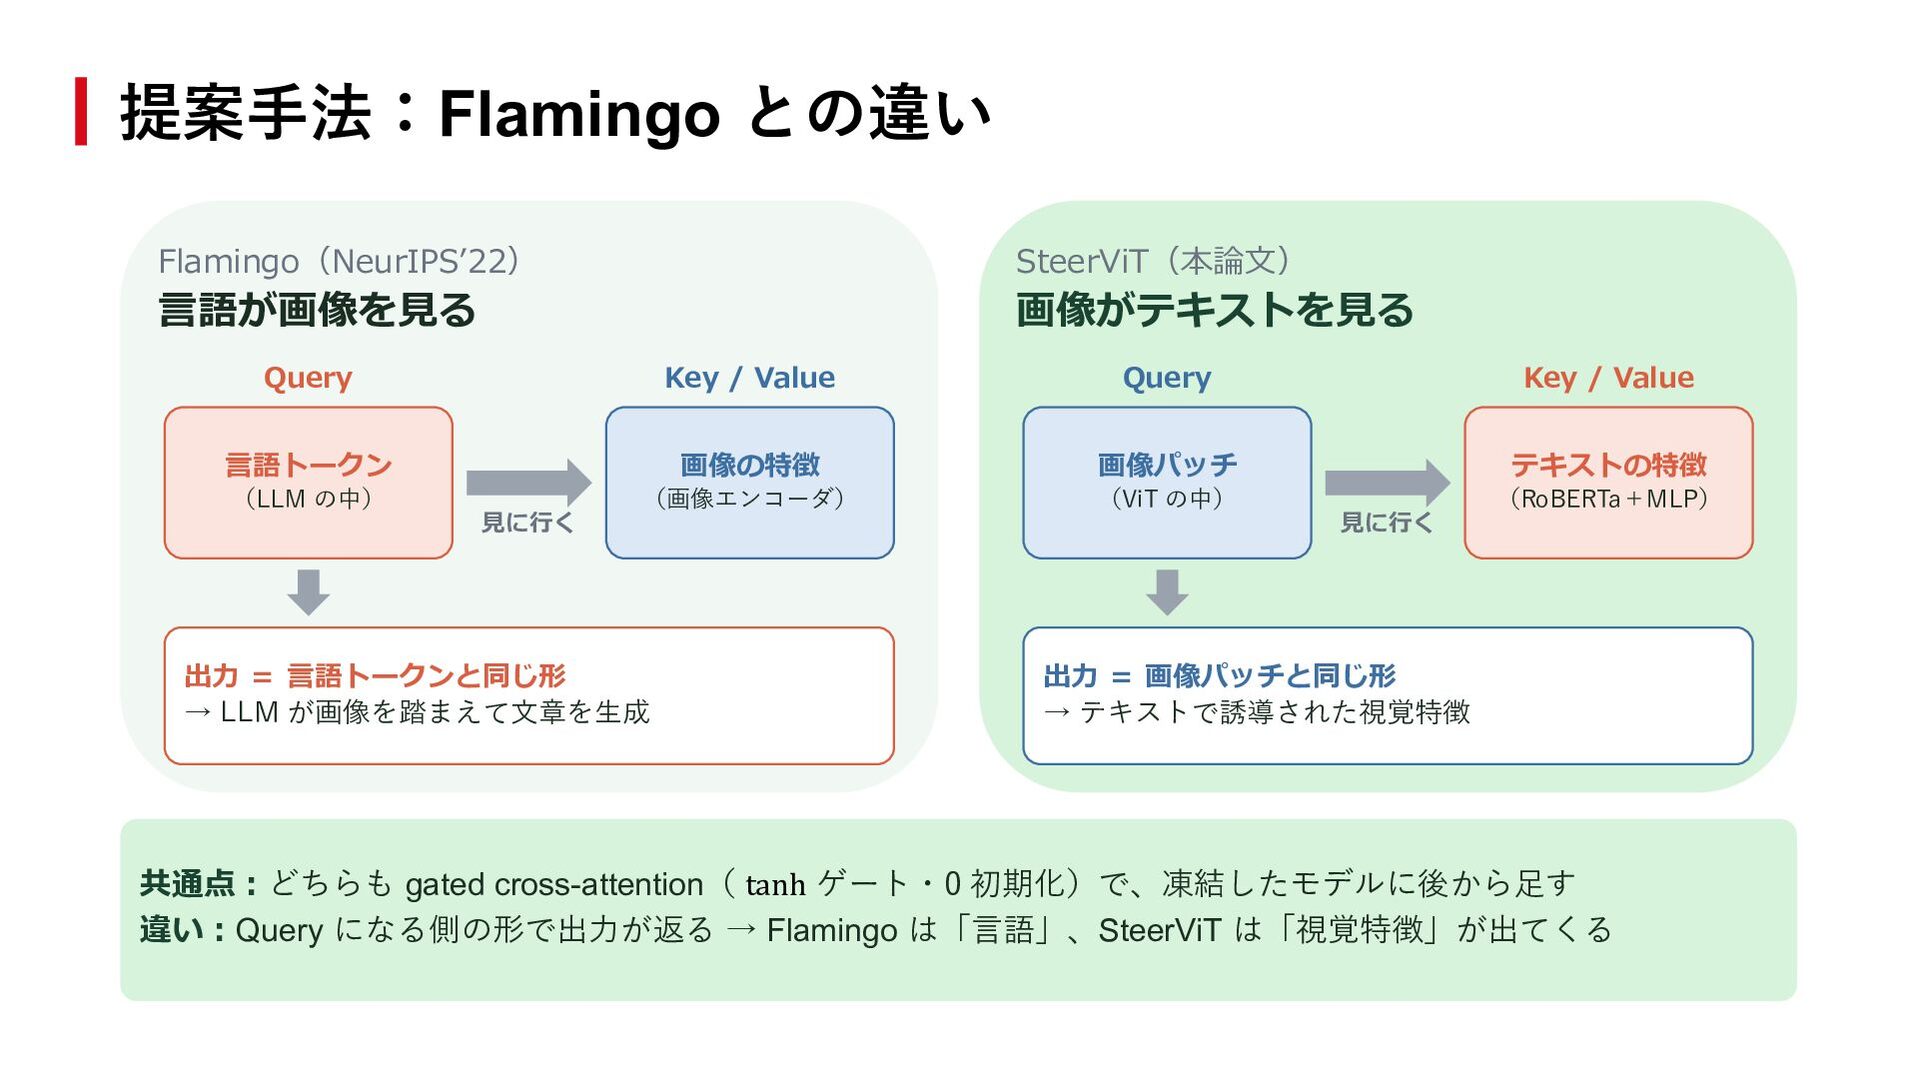
  11. 提案⼿法:Flamingo との違い Flamingo(NeurIPSʼ22) SteerViT(本論⽂) ⾔語が画像を⾒る 画像がテキストを⾒る Query Key / Value

    Query Key / Value ⾔語トークン 画像の特徴 画像パッチ テキストの特徴 (LLM の中) ⾒に⾏く (画像エンコーダ) 出⼒ = ⾔語トークンと同じ形 → LLM が画像を踏まえて⽂章を⽣成 (ViT の中) ⾒に⾏く (RoBERTa+MLP) 出⼒ = 画像パッチと同じ形 → テキストで誘導された視覚特徴 共通点︓どちらも gated cross-attention( tanh ゲート・0 初期化)で、凍結したモデルに後から⾜す 違い︓Query になる側の形で出⼒が返る → Flamingo は「⾔語」、SteerViT は「視覚特徴」が出てくる
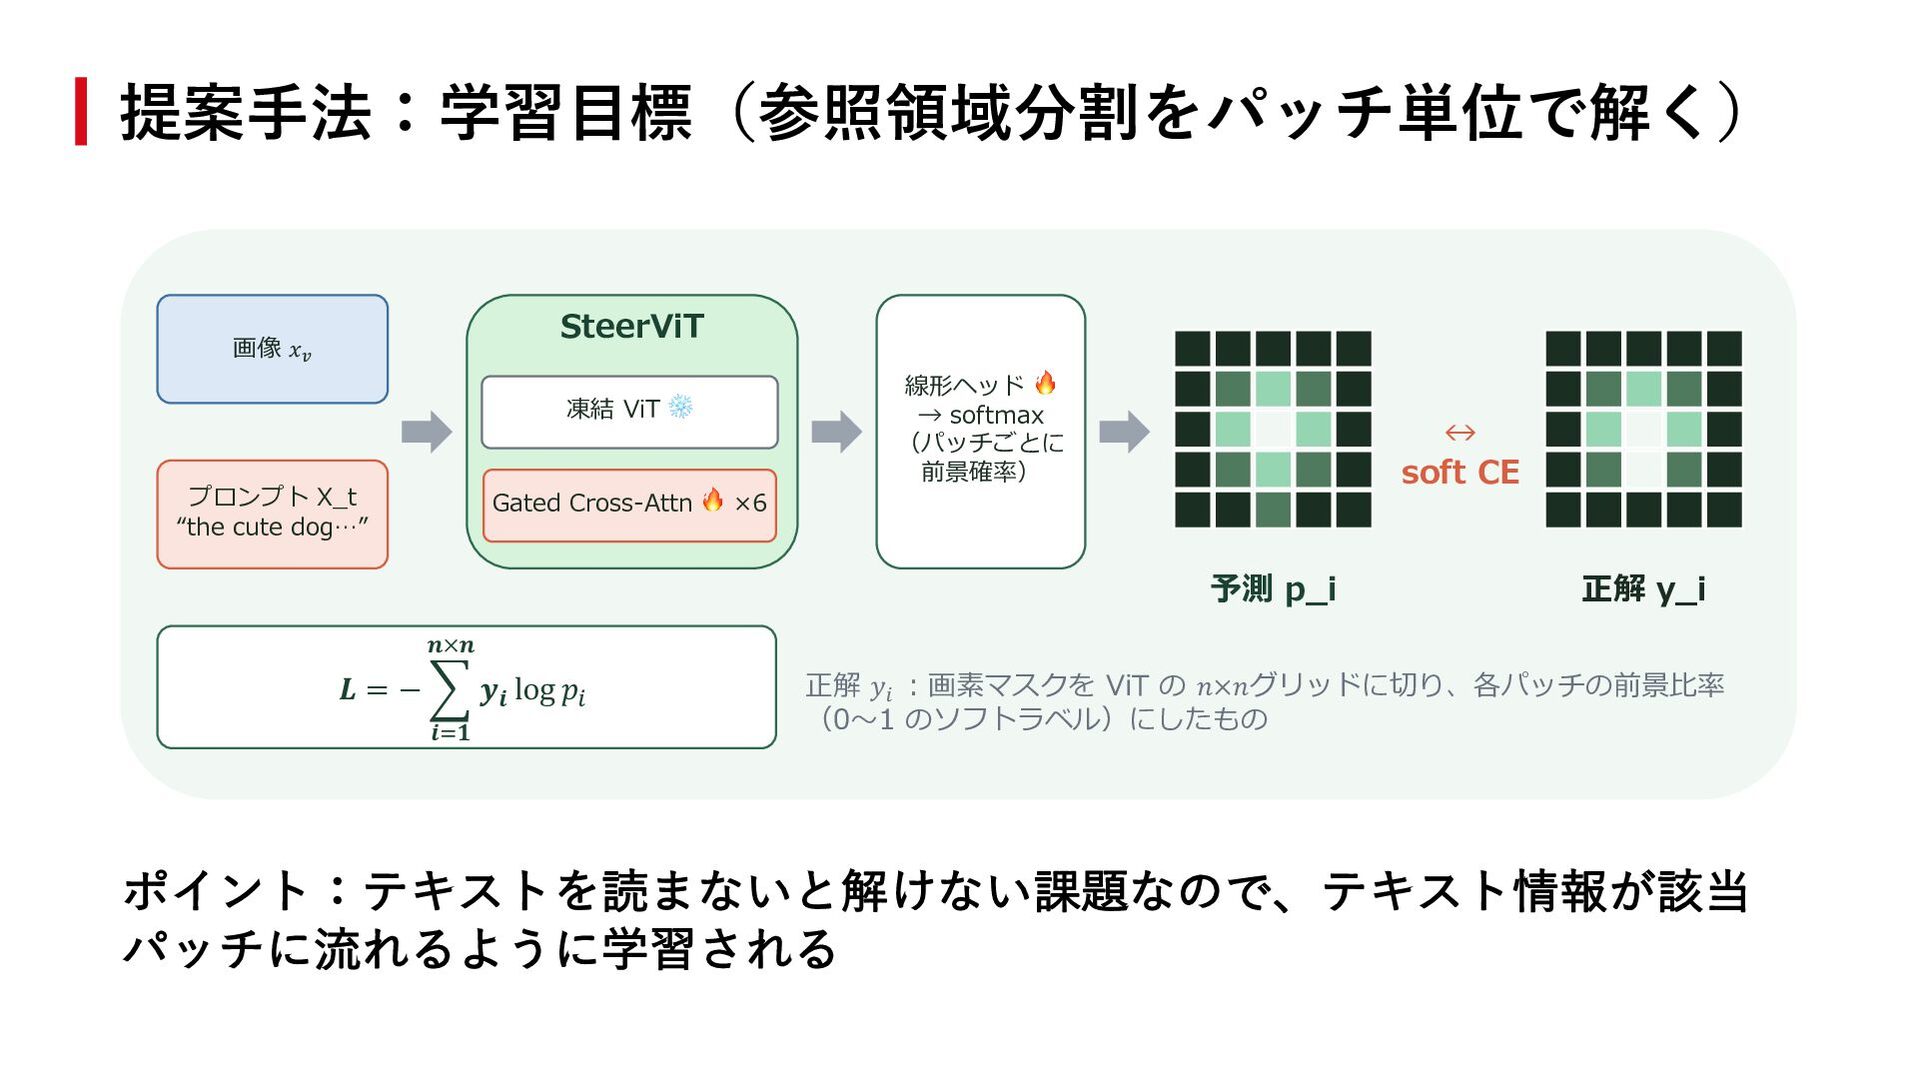
  12. 提案⼿法:学習⽬標(参照領域分割をパッチ単位で解く) SteerViT 画像 𝑥! 凍結 ViT ❄ プロンプト X_t “the

    cute dog…” Gated Cross-Attn 🔥 ×6 線形ヘッド 🔥 → softmax (パッチごとに 前景確率) ↔ soft CE 予測 p_i 正解 y_i 𝒏×𝒏 𝑳 = − ? 𝒚𝒊 log 𝑝2 𝒊.𝟏 正解 𝑦! ︓画素マスクを ViT の 𝑛×𝑛グリッドに切り、各パッチの前景⽐率 (0〜1 のソフトラベル)にしたもの ポイント:テキストを読まないと解けない課題なので、テキスト情報が該当 パッチに流れるように学習される
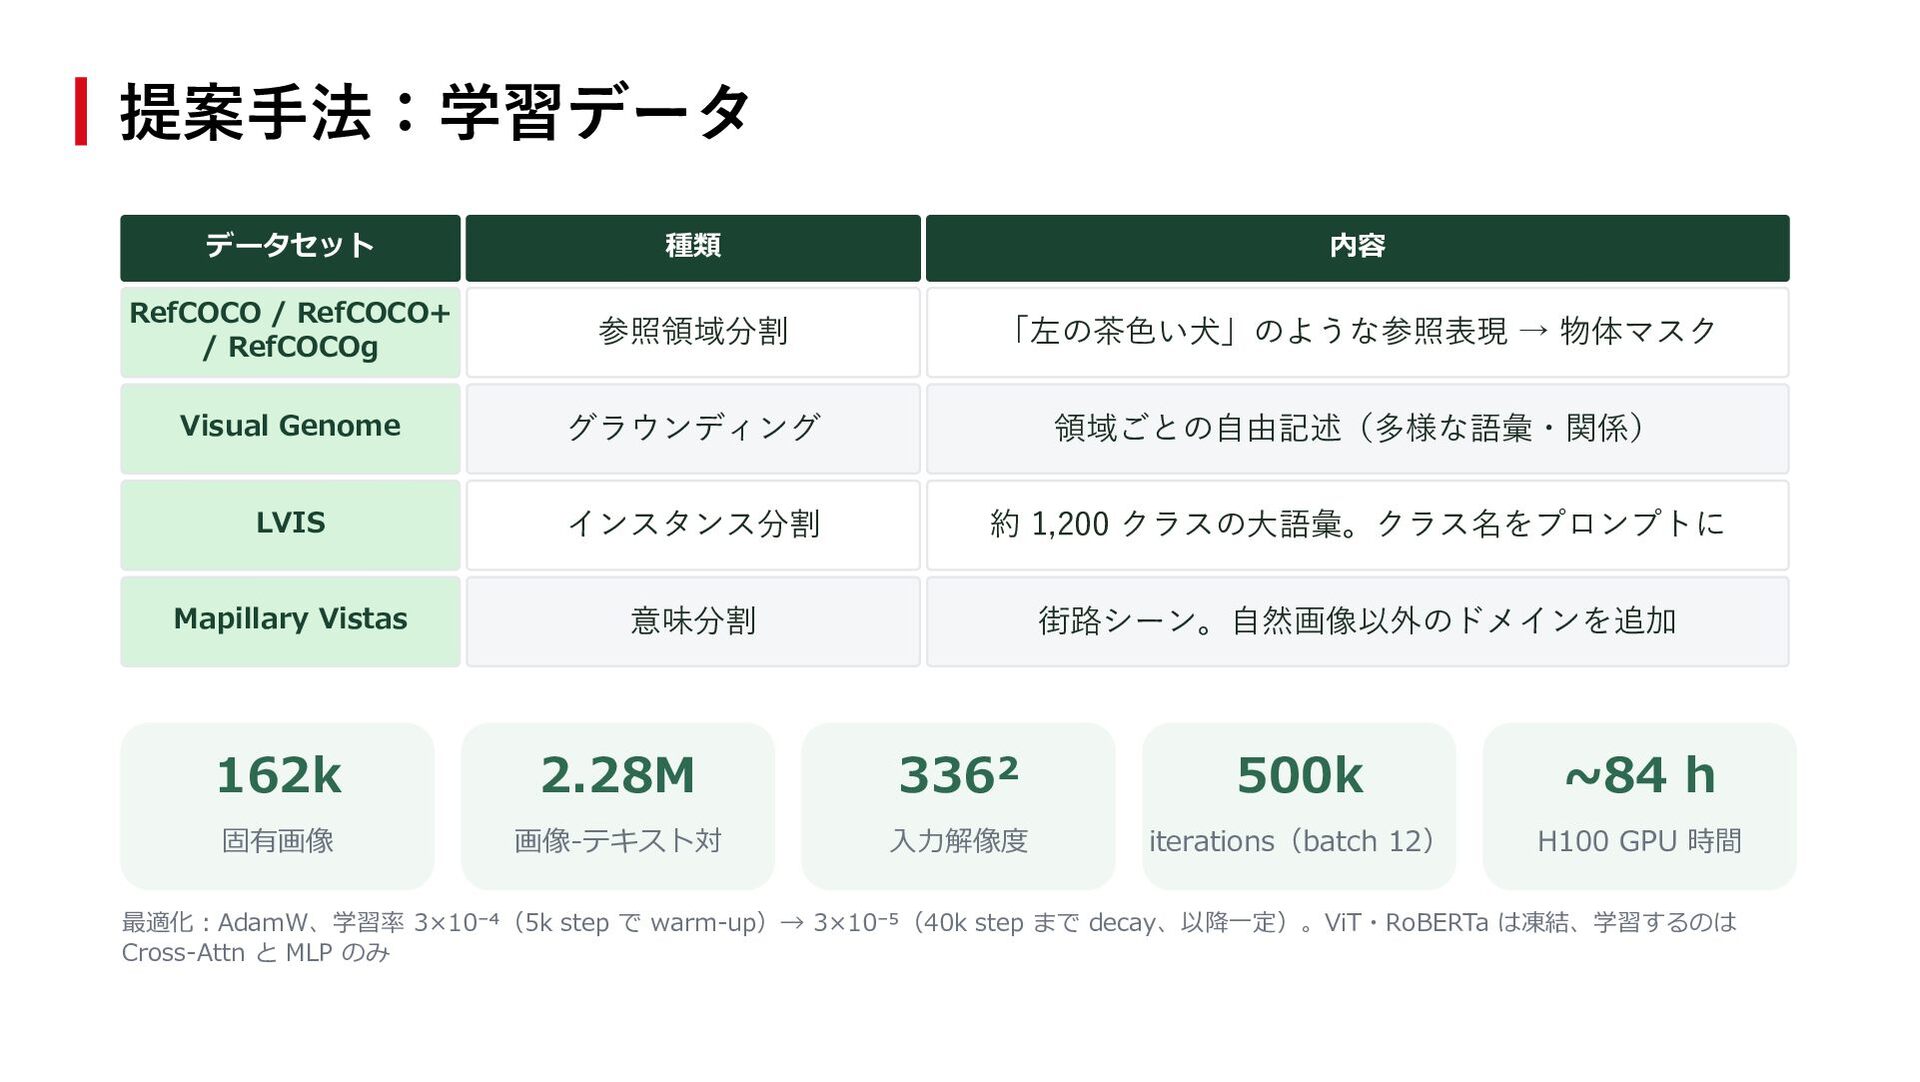
  13. 提案⼿法:学習データ データセット 種類 内容 RefCOCO / RefCOCO+ / RefCOCOg 参照領域分割

    「左の茶⾊い⽝」のような参照表現 → 物体マスク Visual Genome グラウンディング 領域ごとの⾃由記述(多様な語彙・関係) LVIS インスタンス分割 約 1,200 クラスの⼤語彙。クラス名をプロンプトに Mapillary Vistas 意味分割 街路シーン。⾃然画像以外のドメインを追加 162k 2.28M 336² 500k ~84 h 固有画像 画像-テキスト対 ⼊⼒解像度 iterations(batch 12) H100 GPU 時間 最適化︓AdamW、学習率 3×10⁻⁴(5k step で warm-up)→ 3×10⁻⁵(40k step まで decay、以降⼀定)。ViT・RoBERTa は凍結、学習するのは Cross-Attn と MLP のみ
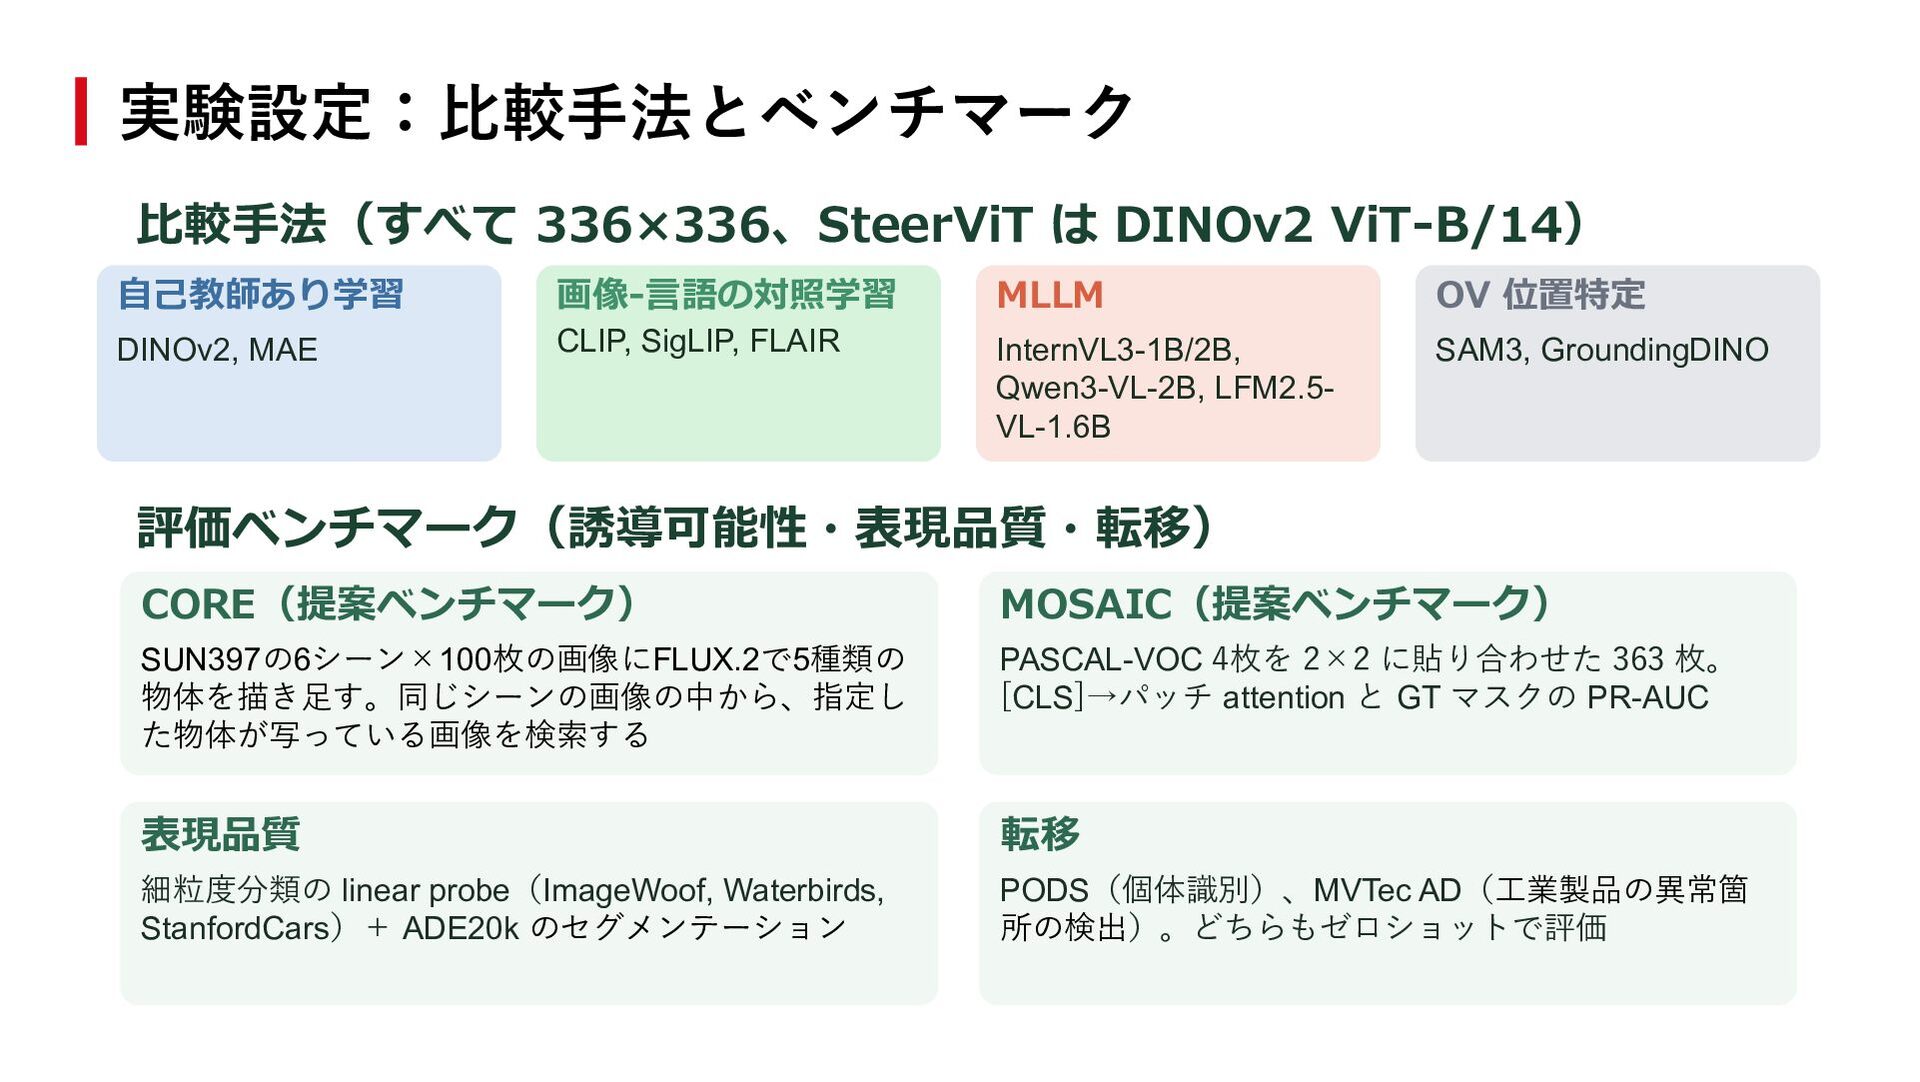
  14. 実験設定:⽐較⼿法とベンチマーク ⽐較⼿法(すべて 336×336、SteerViT は DINOv2 ViT-B/14) ⾃⼰教師あり学習 DINOv2, MAE 画像-⾔語の対照学習

    CLIP, SigLIP, FLAIR MLLM OV 位置特定 InternVL3-1B/2B, Qwen3-VL-2B, LFM2.5VL-1.6B SAM3, GroundingDINO 評価ベンチマーク(誘導可能性・表現品質・転移) CORE(提案ベンチマーク) MOSAIC(提案ベンチマーク) SUN397の6シーン×100枚の画像にFLUX.2で5種類の 物体を描き⾜す。同じシーンの画像の中から、指定し た物体が写っている画像を検索する PASCAL-VOC 4枚を 2×2 に貼り合わせた 363 枚。 [CLS]→パッチ attention と GT マスクの PR-AUC 表現品質 転移 細粒度分類の linear probe(ImageWoof, Waterbirds, StanfordCars)+ ADE20k のセグメンテーション PODS(個体識別)、MVTec AD(⼯業製品の異常箇 所の検出)。どちらもゼロショットで評価
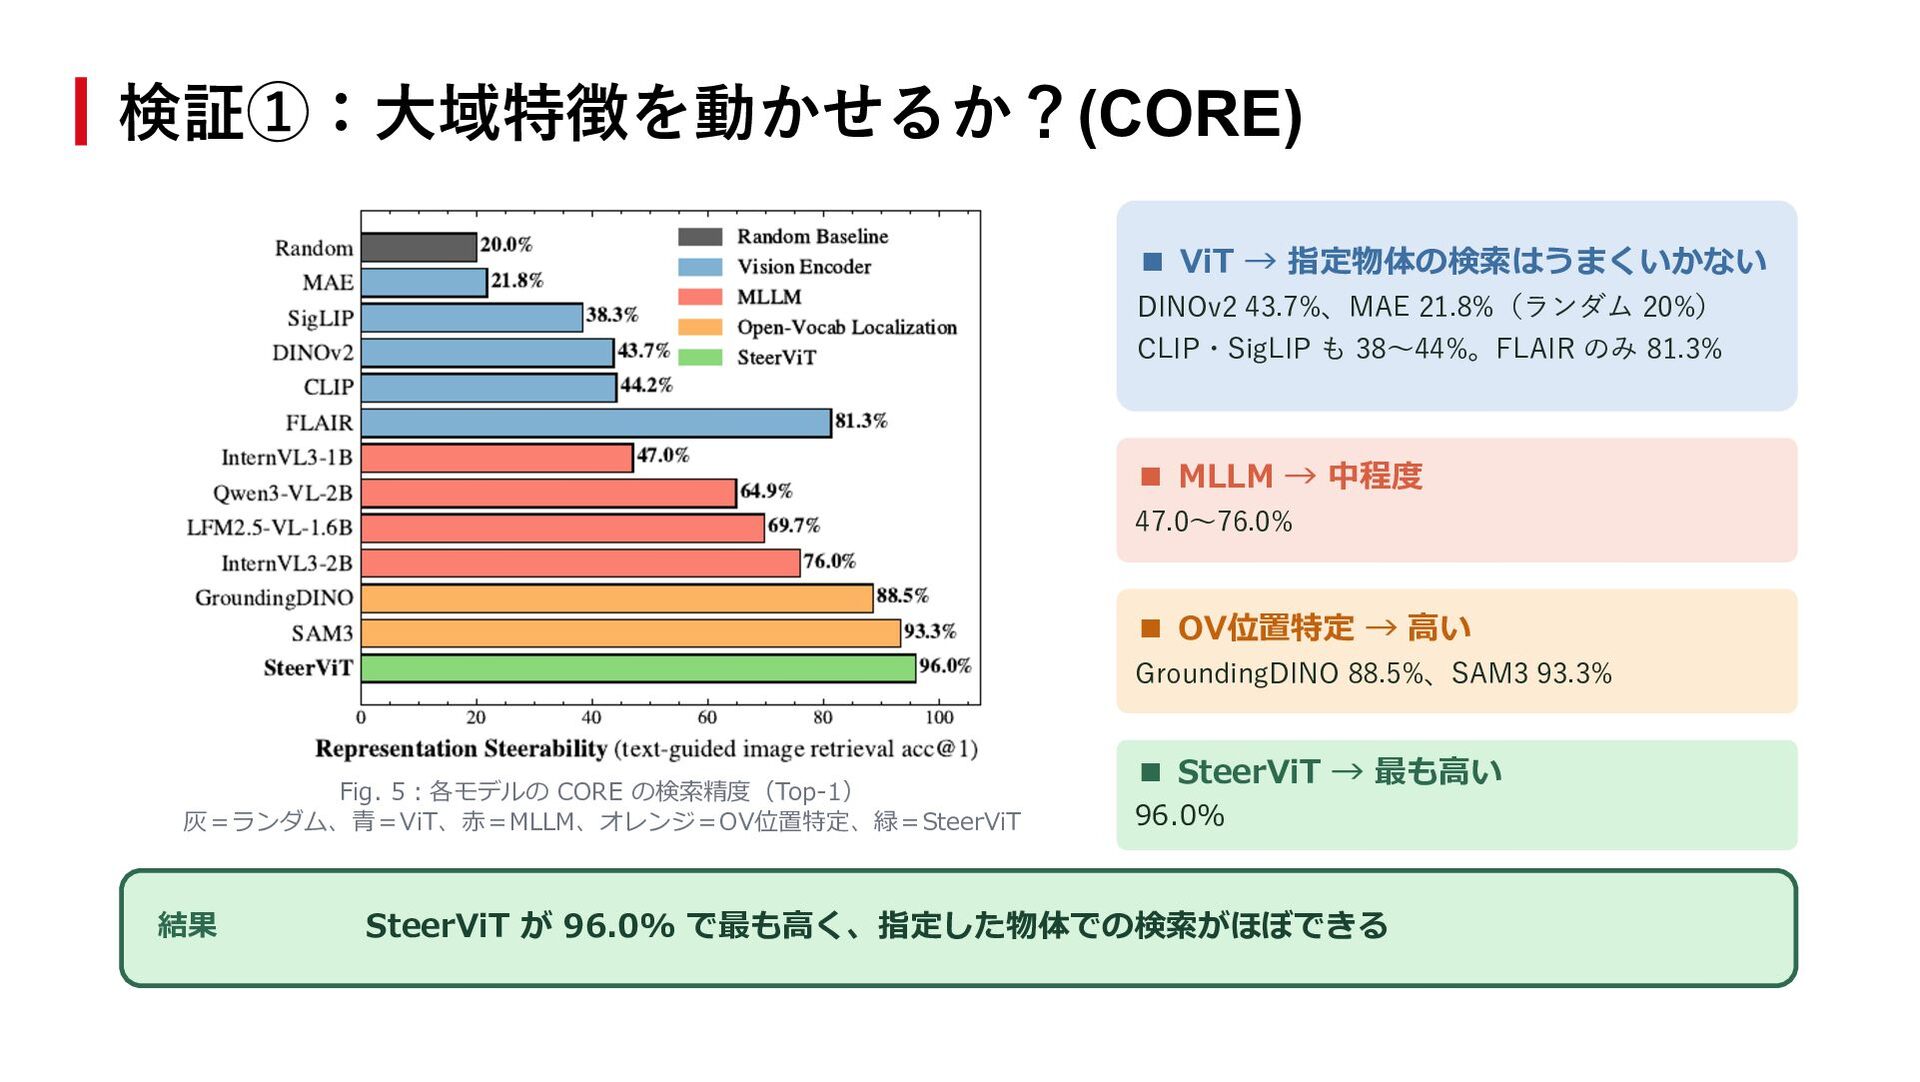
  15. 検証①:⼤域特徴を動かせるか?(CORE) ▪ ViT → 指定物体の検索はうまくいかない DINOv2 43.7%、MAE 21.8%(ランダム 20%) CLIP・SigLIP

    も 38〜44%。FLAIR のみ 81.3% ▪ MLLM → 中程度 47.0〜76.0% ▪ OV位置特定 → ⾼い GroundingDINO 88.5%、SAM3 93.3% Fig. 5︓各モデルの CORE の検索精度(Top-1) 灰=ランダム、⻘=ViT、⾚=MLLM、オレンジ=OV位置特定、緑=SteerViT 結果 ▪ SteerViT → 最も⾼い 96.0% SteerViT が 96.0% で最も⾼く、指定した物体での検索がほぼできる
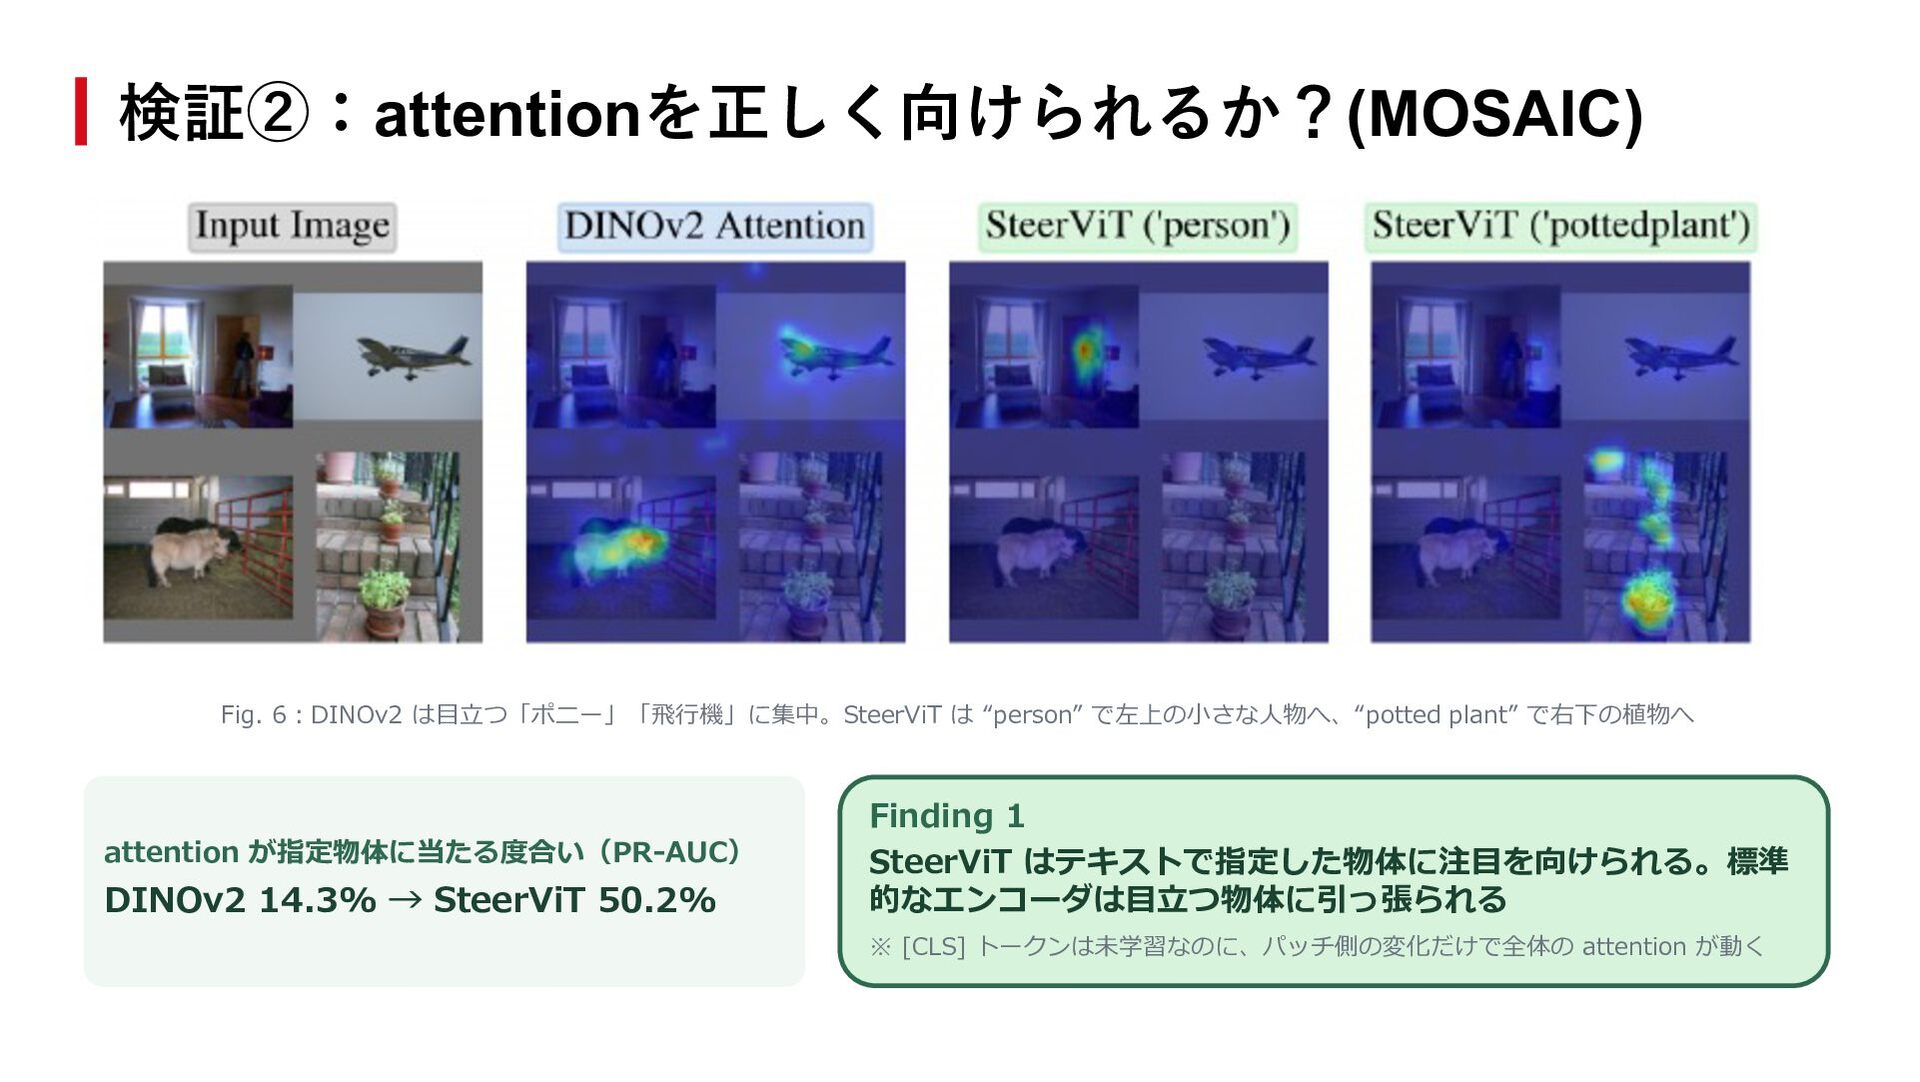
  16. 検証②:attentionを正しく向けられるか?(MOSAIC) Fig. 6︓DINOv2 は⽬⽴つ「ポニー」「⾶⾏機」に集中。SteerViT は “person” で左上の⼩さな⼈物へ、“potted plant” で右下の植物へ attention

    が指定物体に当たる度合い(PR-AUC) DINOv2 14.3% → SteerViT 50.2% Finding 1 SteerViT はテキストで指定した物体に注⽬を向けられる。標準 的なエンコーダは⽬⽴つ物体に引っ張られる ※ [CLS] トークンは未学習なのに、パッチ側の変化だけで全体の attention が動く
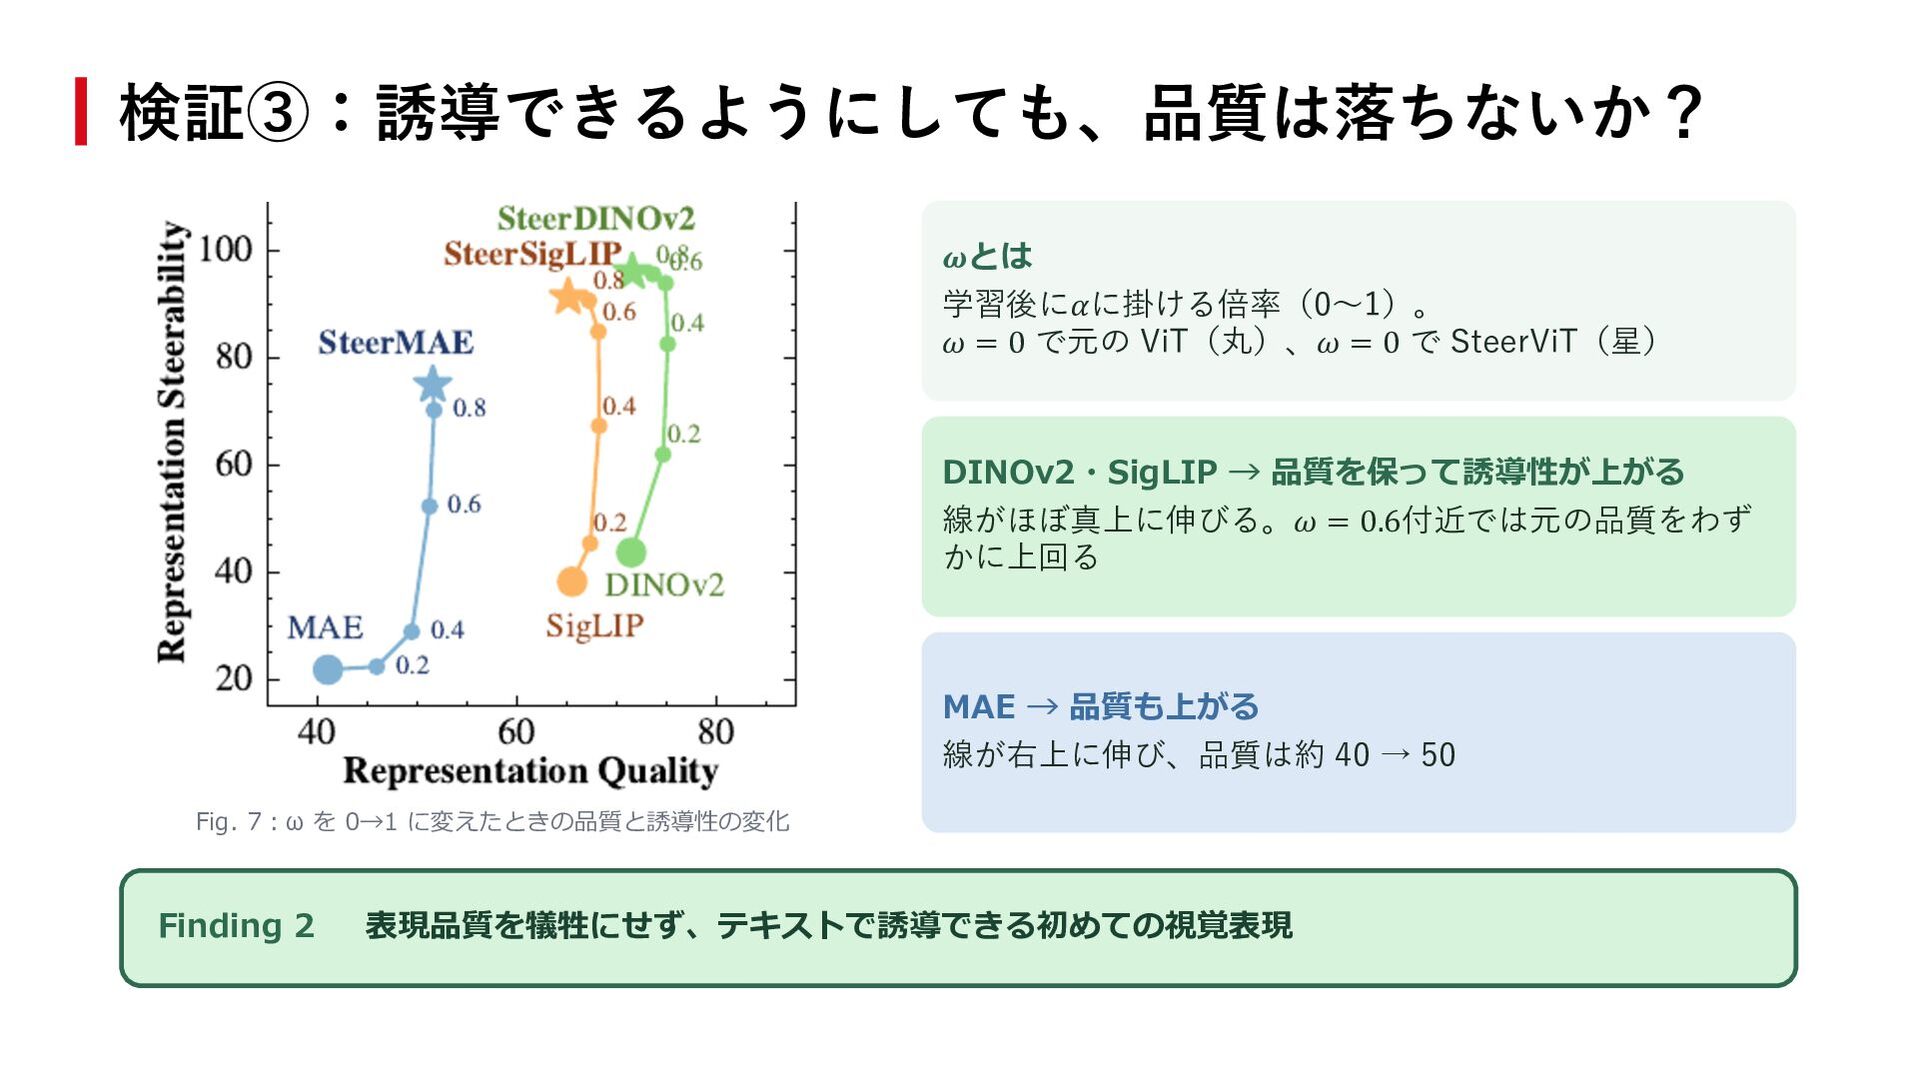
  17. 検証③:誘導できるようにしても、品質は落ちないか? 𝝎とは 学習後に𝛼に掛ける倍率(0〜1)。 𝜔 = 0 で元の ViT(丸)、𝜔 = 0

    で SteerViT(星) DINOv2・SigLIP → 品質を保って誘導性が上がる 線がほぼ真上に伸びる。𝜔 = 0.6付近では元の品質をわず かに上回る MAE → 品質も上がる 線が右上に伸び、品質は約 40 → 50 Fig. 7︓ω を 0→1 に変えたときの品質と誘導性の変化 Finding 2 表現品質を犠牲にせず、テキストで誘導できる初めての視覚表現
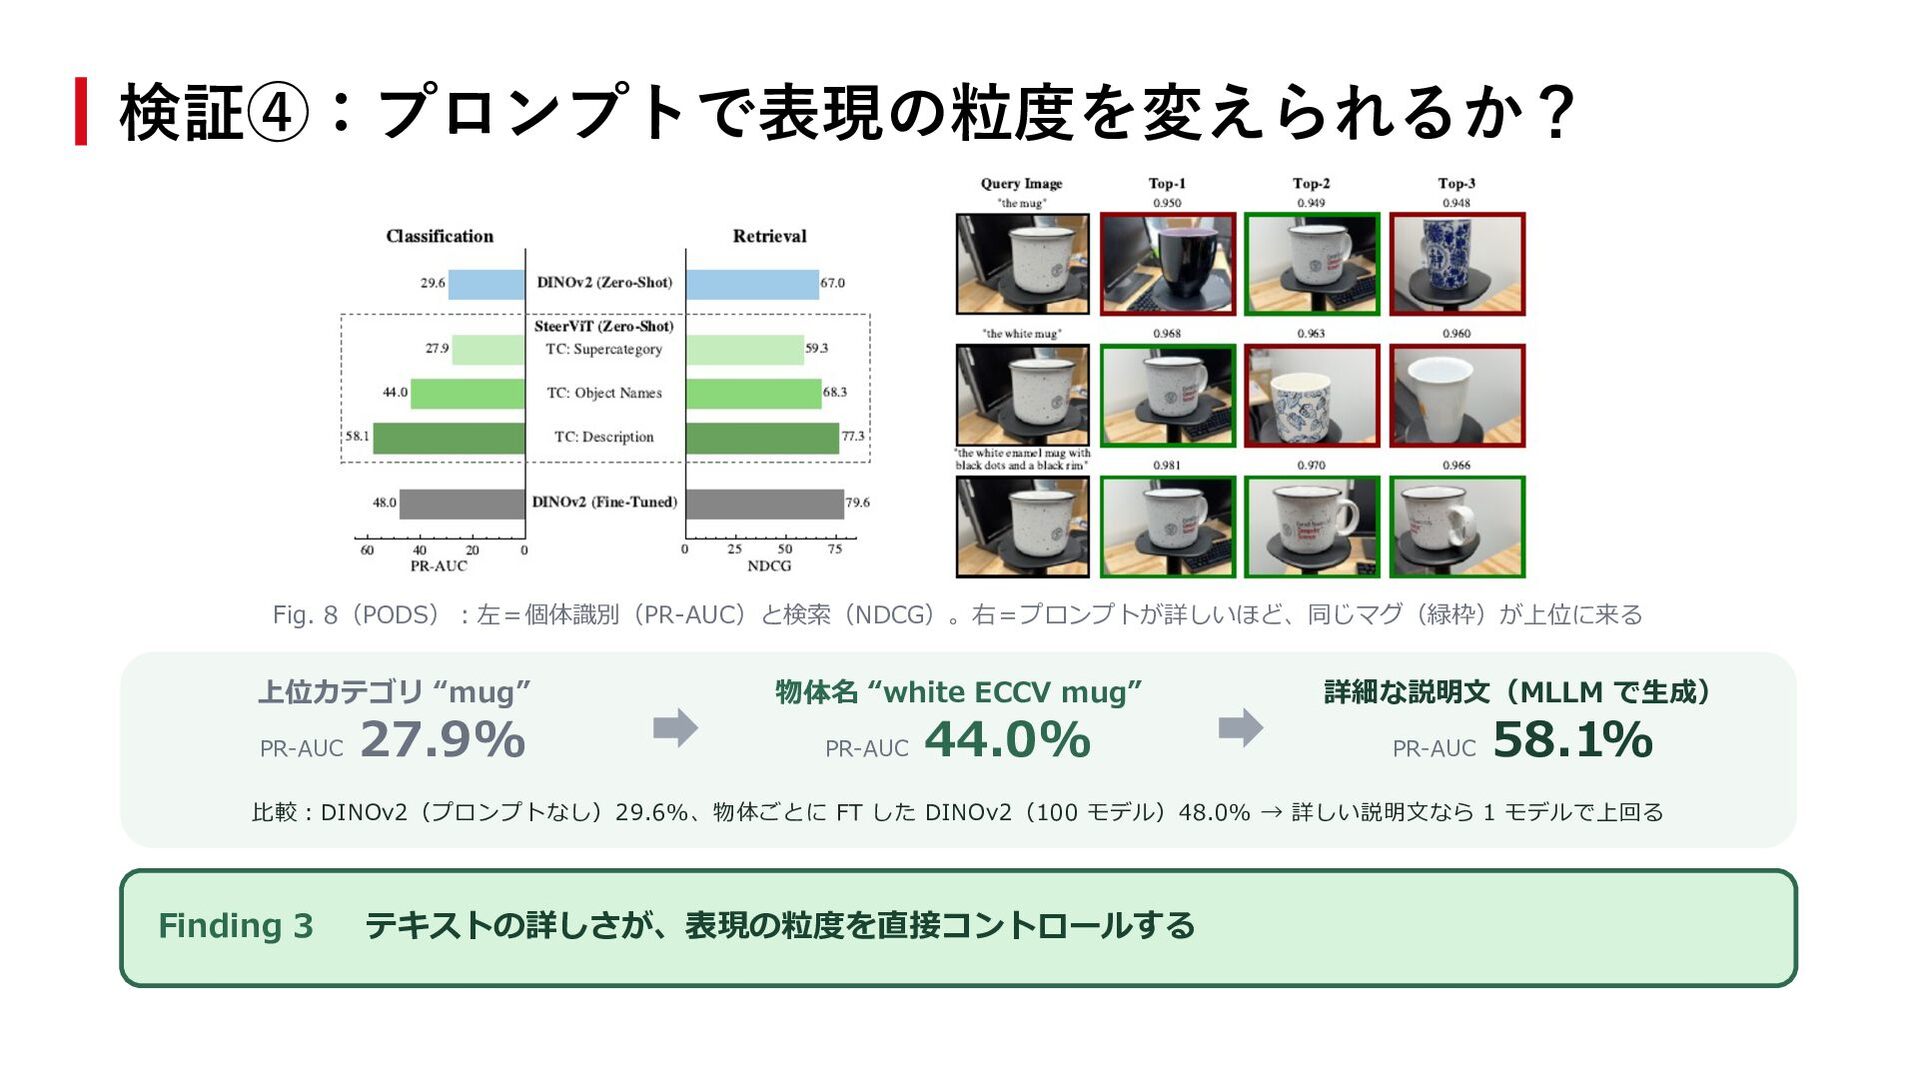
  18. 検証④:プロンプトで表現の粒度を変えられるか? Fig. 8(PODS)︓左=個体識別(PR-AUC)と検索(NDCG)。右=プロンプトが詳しいほど、同じマグ(緑枠)が上位に来る 上位カテゴリ “mug” PR-AUC 27.9% 物体名 “white ECCV

    mug” PR-AUC 44.0% 詳細な説明⽂(MLLM で⽣成) PR-AUC 58.1% ⽐較︓DINOv2(プロンプトなし)29.6%、物体ごとに FT した DINOv2(100 モデル)48.0% → 詳しい説明⽂なら 1 モデルで上回る Finding 3 テキストの詳しさが、表現の粒度を直接コントロールする
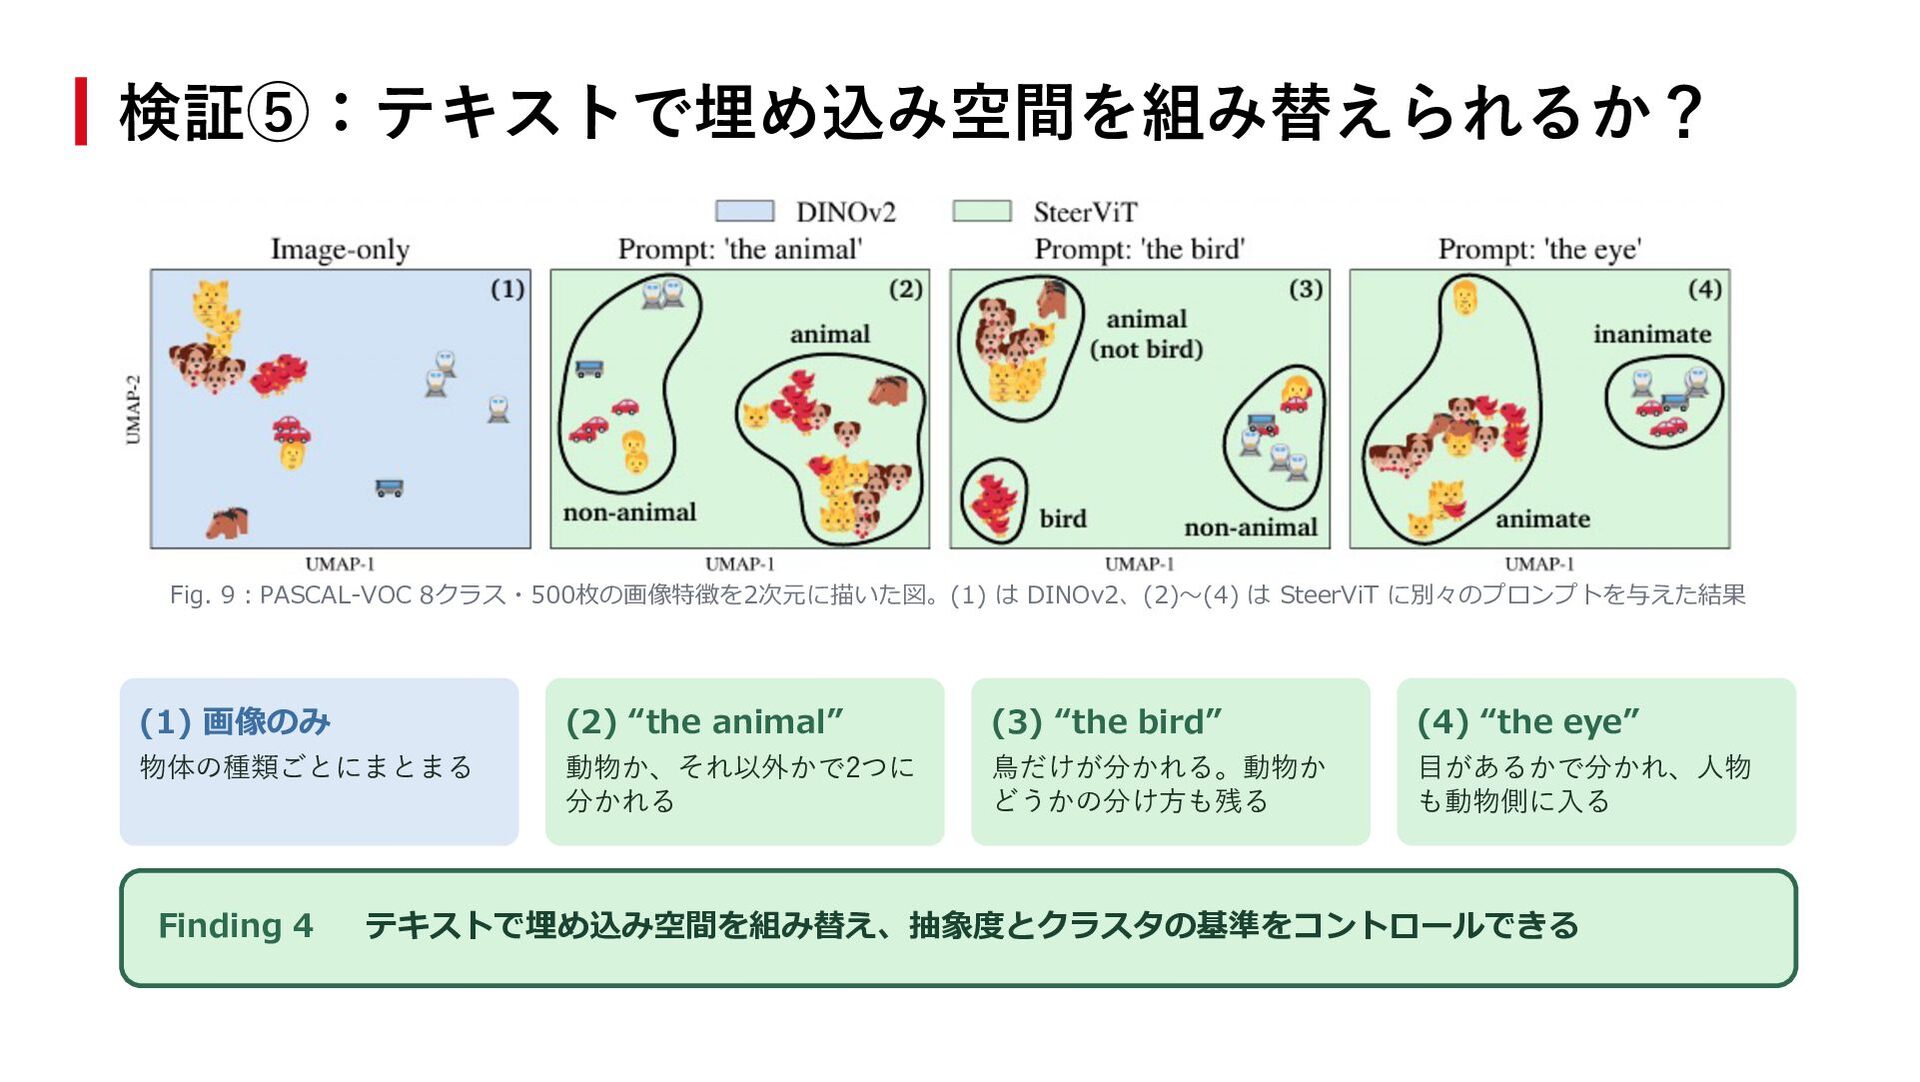
  19. 検証⑤:テキストで埋め込み空間を組み替えられるか? Fig. 9︓PASCAL-VOC 8クラス・500枚の画像特徴を2次元に描いた図。(1) は DINOv2、(2)〜(4) は SteerViT に別々のプロンプトを与えた結果 (1)

    画像のみ (2) “the animal” (3) “the bird” (4) “the eye” 物体の種類ごとにまとまる 動物か、それ以外かで2つに 分かれる ⿃だけが分かれる。動物か どうかの分け⽅も残る ⽬があるかで分かれ、⼈物 も動物側に⼊る Finding 4 テキストで埋め込み空間を組み替え、抽象度とクラスタの基準をコントロールできる
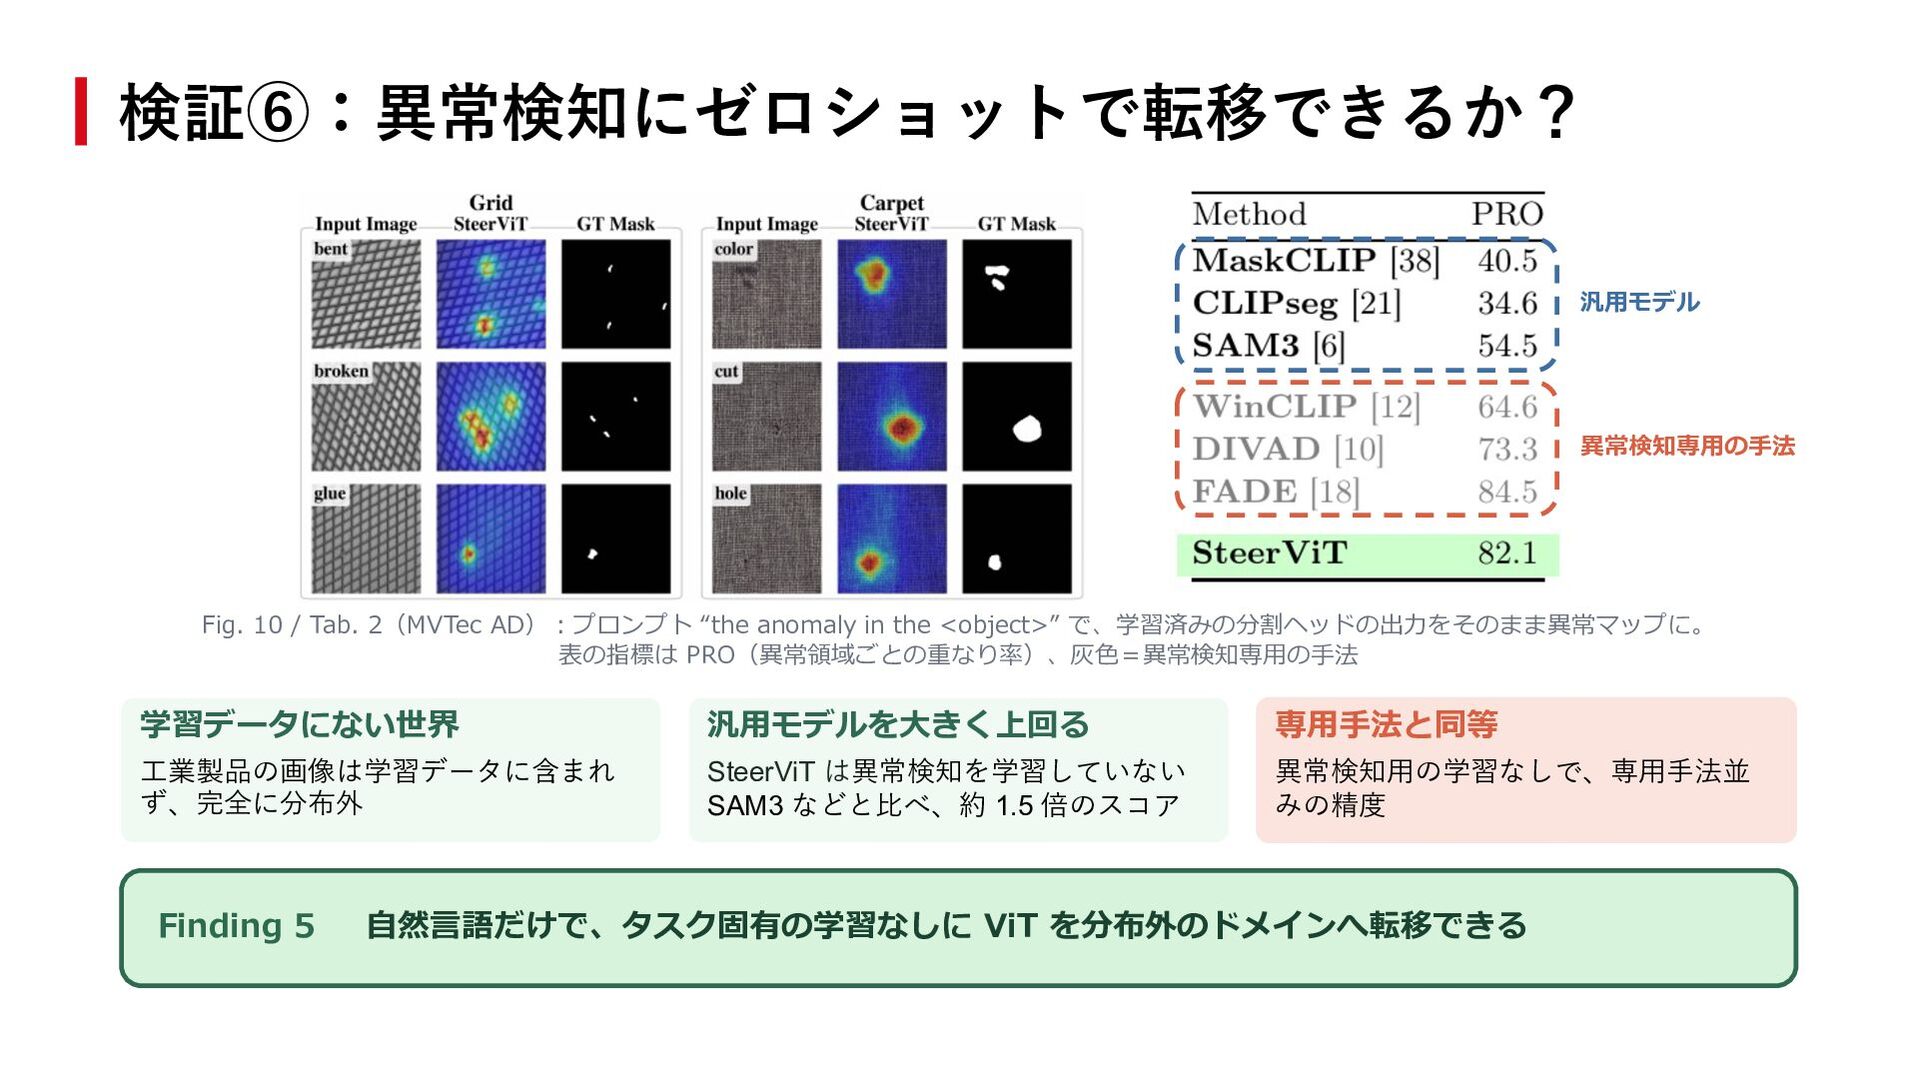
  20. 検証⑥:異常検知にゼロショットで転移できるか? 汎⽤モデル 異常検知専⽤の⼿法 Fig. 10 / Tab. 2(MVTec AD)︓プロンプト “the

    anomaly in the <object>” で、学習済みの分割ヘッドの出⼒をそのまま異常マップに。 表の指標は PRO(異常領域ごとの重なり率)、灰⾊=異常検知専⽤の⼿法 学習データにない世界 汎⽤モデルを⼤きく上回る 専⽤⼿法と同等 ⼯業製品の画像は学習データに含まれ ず、完全に分布外 SteerViT は異常検知を学習していない SAM3 などと⽐べ、約 1.5 倍のスコア 異常検知⽤の学習なしで、専⽤⼿法並 みの精度 Finding 5 ⾃然⾔語だけで、タスク固有の学習なしに ViT を分布外のドメインへ転移できる
  21. 所感 - 発想が明快 - ⼈間の知覚が⾔語で誘導されるように、モデルの視覚も⾔語で誘導するというストーリー - Flamingo のゲート付き cross-attention の向きを反転させるだけ、というシンプルさも良い

    - FT ではなくプロンプトで適応 - LLM のプロンプティングと同じ発想を視覚エンコーダに持ち込んだ - モデルを作り分けなくても、説明⽂を変えるだけで FT 以上の個体識別ができる - 気になる点 - 学習は 21M だが、推論では RoBERTa-Large(約 355M)も毎回動く - 性能を引き出すにはプロンプトの⼯夫が必要
  22. まとめ - 課題 - 汎⽤的な視覚エンコーダの表現は画像中で最も顕著な物体に偏り、注⽬対象を指定で きない - 提案⼿法 - SteerViT:凍結した

    ViT の層間に軽量な cross-attention(約 21M)を挿⼊し、画像 をエンコードする過程でテキストを参照させる(early fusion) - 結果 - テキストにより注⽬領域や埋め込み空間を制御しつつ、元の ViT の表現品質を維持 - プロンプトの変更のみで、個体識別や異常検知などの新規タスクへ追加学習なしで適 ⽤可能
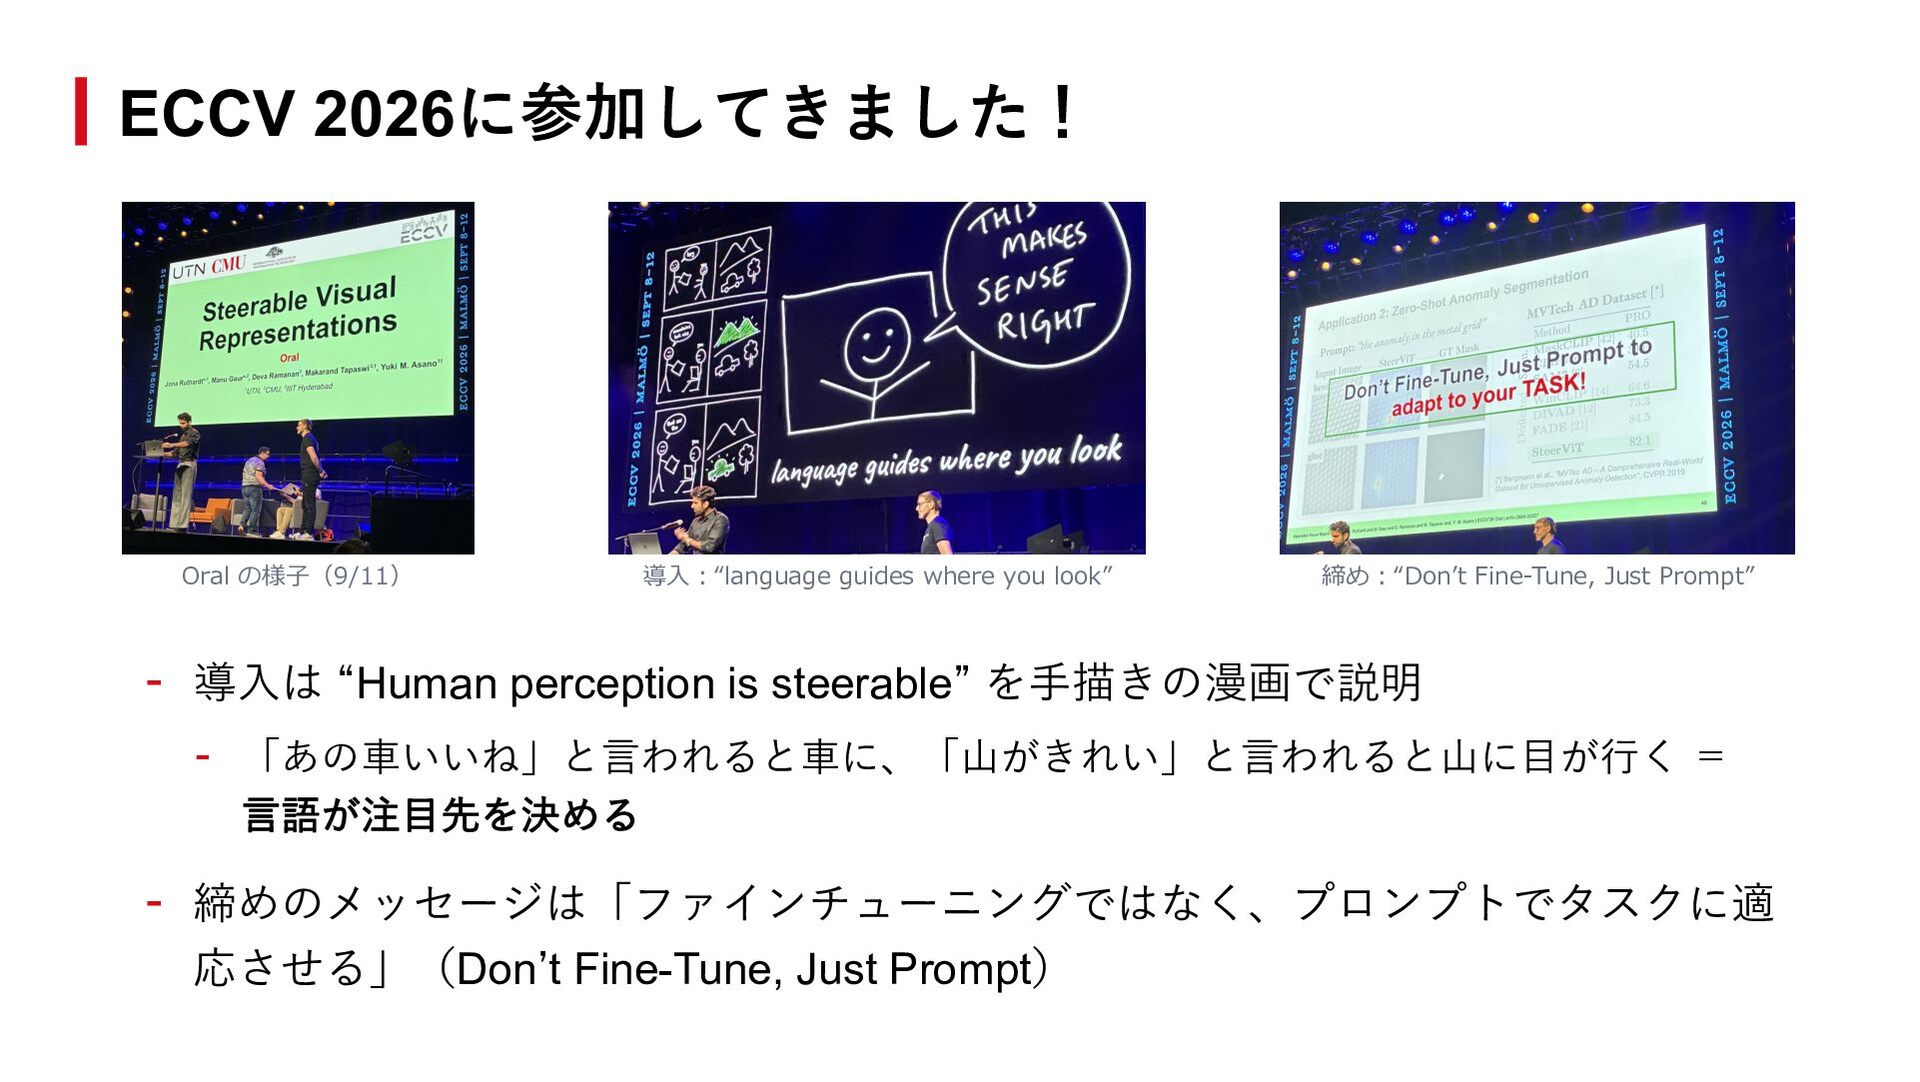
  23. ECCV 2026に参加してきました! Oral の様⼦(9/11) 導⼊︓“language guides where you look” 締め︓“Donʼt

    Fine-Tune, Just Prompt” - 導⼊は “Human perception is steerable” を⼿描きの漫画で説明 - 「あの⾞いいね」と⾔われると⾞に、「⼭がきれい」と⾔われると⼭に⽬が⾏く = ⾔語が注⽬先を決める - 締めのメッセージは「ファインチューニングではなく、プロンプトでタスクに適 応させる」(Donʼt Fine-Tune, Just Prompt)
  24. 参考⽂献(1/2) 本論⽂ MLLM 画像エンコーダ・テキストエンコーダ A. Amini et al. LFM2 Technical

    Report. arXiv:2511.23404, 2025 T. Jiang et al. E5-V: Universal Embeddings with Multimodal Large Language Models. arXiv:2407.12580, 2024 J. Ruthardt, M. Gaur, D. Ramanan, M. Tapaswi, Y. M. Asano. Steerable Visual Representations. ECCV 2026 (Oral). arXiv:2604.02327 プロジェクトページ・公式デモ︓jonaruthardt.github.io/project/SteerViT M. Oquab et al. DINOv2: Learning Robust Visual Features without Supervision. TMLR 2024 K. He et al. Masked Autoencoders Are Scalable Vision Learners. CVPR 2022 A. Radford et al. Learning Transferable Visual Models From Natural Language Supervision (CLIP). ICML 2021 X. Zhai et al. Sigmoid Loss for Language Image Pre-Training (SigLIP). ICCV 2023 Y. Liu et al. RoBERTa: A Robustly Optimized BERT Pretraining Approach. arXiv:1907.11692, 2019 関連研究 J.-B. Alayrac et al. Flamingo: a Visual Language Model for Few-Shot Learning. NeurIPS 2022 R. Xiao et al. FLAIR: VLM with Fine-grained Language-informed Image Representations. CVPR 2025 R. Thirukovalluru et al. Text-Guided Semantic Image Encoder (TIE). arXiv:2511.20770, 2025 G. Zhan et al. ELIP: Enhanced Visual-Language Foundation Models for Image Retrieval. CBMI 2025 S. Mahajan et al. TEVI: Text-conditioned Editing of Visual Representations via Sparse Autoencoders. arXiv:2606.07451, 2026 J. Zhu et al. InternVL3: Exploring Advanced Training and Test-time Recipes for Open-source Multimodal Models. arXiv:2504.10479, 2025 S. Bai et al. Qwen3-VL Technical Report. arXiv:2511.21631, 2025 Open-Vocabulary 位置特定 N. Carion et al. SAM 3: Segment Anything with Concepts. ICLR 2026 S. Liu et al. Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection. ECCV 2024 異常検知の⽐較⼿法 C. Zhou et al. Extract Free Dense Labels from CLIP (MaskCLIP). ECCV 2022 T. Lüddecke, A. Ecker. Image Segmentation Using Text and Image Prompts (CLIPSeg). CVPR 2022 J. Jeong et al. WinCLIP: Zero-/Few-Shot Anomaly Classification and Segmentation. CVPR 2023 S. Hicsonmez et al. Training Free Zero-Shot Visual Anomaly Localization via Diffusion Inversion (DIVAD). arXiv:2601.08022, 2026 Y. Li et al. FADE: Few-shot/zero-shot Anomaly Detection Engine using Large Vision-Language Model. BMVC 2024
  25. 参考⽂献(2/2) 学習データ S. Kazemzadeh et al. ReferItGame: Referring to Objects

    in Photographs of Natural Scenes (RefCOCO). EMNLP 2014 L. Yu et al. Modeling Context in Referring Expressions (RefCOCO+/g). ECCV 2016 R. Krishna et al. Visual Genome. IJCV 2017 A. Gupta et al. LVIS: A Dataset for Large Vocabulary Instance Segmentation. CVPR 2019 G. Neuhold et al. The Mapillary Vistas Dataset for Semantic Understanding of Street Scenes. ICCV 2017 ベンチマーク作成(CORE・MOSAIC) J. Xiao et al. SUN Database: Large-scale Scene Recognition from Abbey to Zoo (SUN397). CVPR 2010 Black Forest Labs. FLUX.2: Frontier Visual Intelligence. 2025 M. Everingham et al. The PASCAL Visual Object Classes (VOC) Challenge. IJCV 2010 表現品質の評価 J. Howard. Imagewoof: a subset of 10 classes from ImageNet. 2019 S. Sagawa et al. Distributionally Robust Neural Networks (Waterbirds). ICLR 2020 J. Krause et al. 3D Object Representations for Fine-Grained Categorization (StanfordCars). ICCVW 2013 B. Zhou et al. Scene Parsing through ADE20K Dataset. CVPR 2017 転移の評価 S. Sundaram et al. Personalized Representation from Personalized Generation (PODS). ICLR 2025 P. Bergmann et al. MVTec AD: A Comprehensive Real-World Dataset for Unsupervised Anomaly Detection. CVPR 2019 可視化 L. McInnes et al. UMAP: Uniform Manifold Approximation and Projection. JOSS 2018 画像について 図表は本論⽂より引⽤。会場写真・デモ結果は発表者が撮影・実⾏したもの
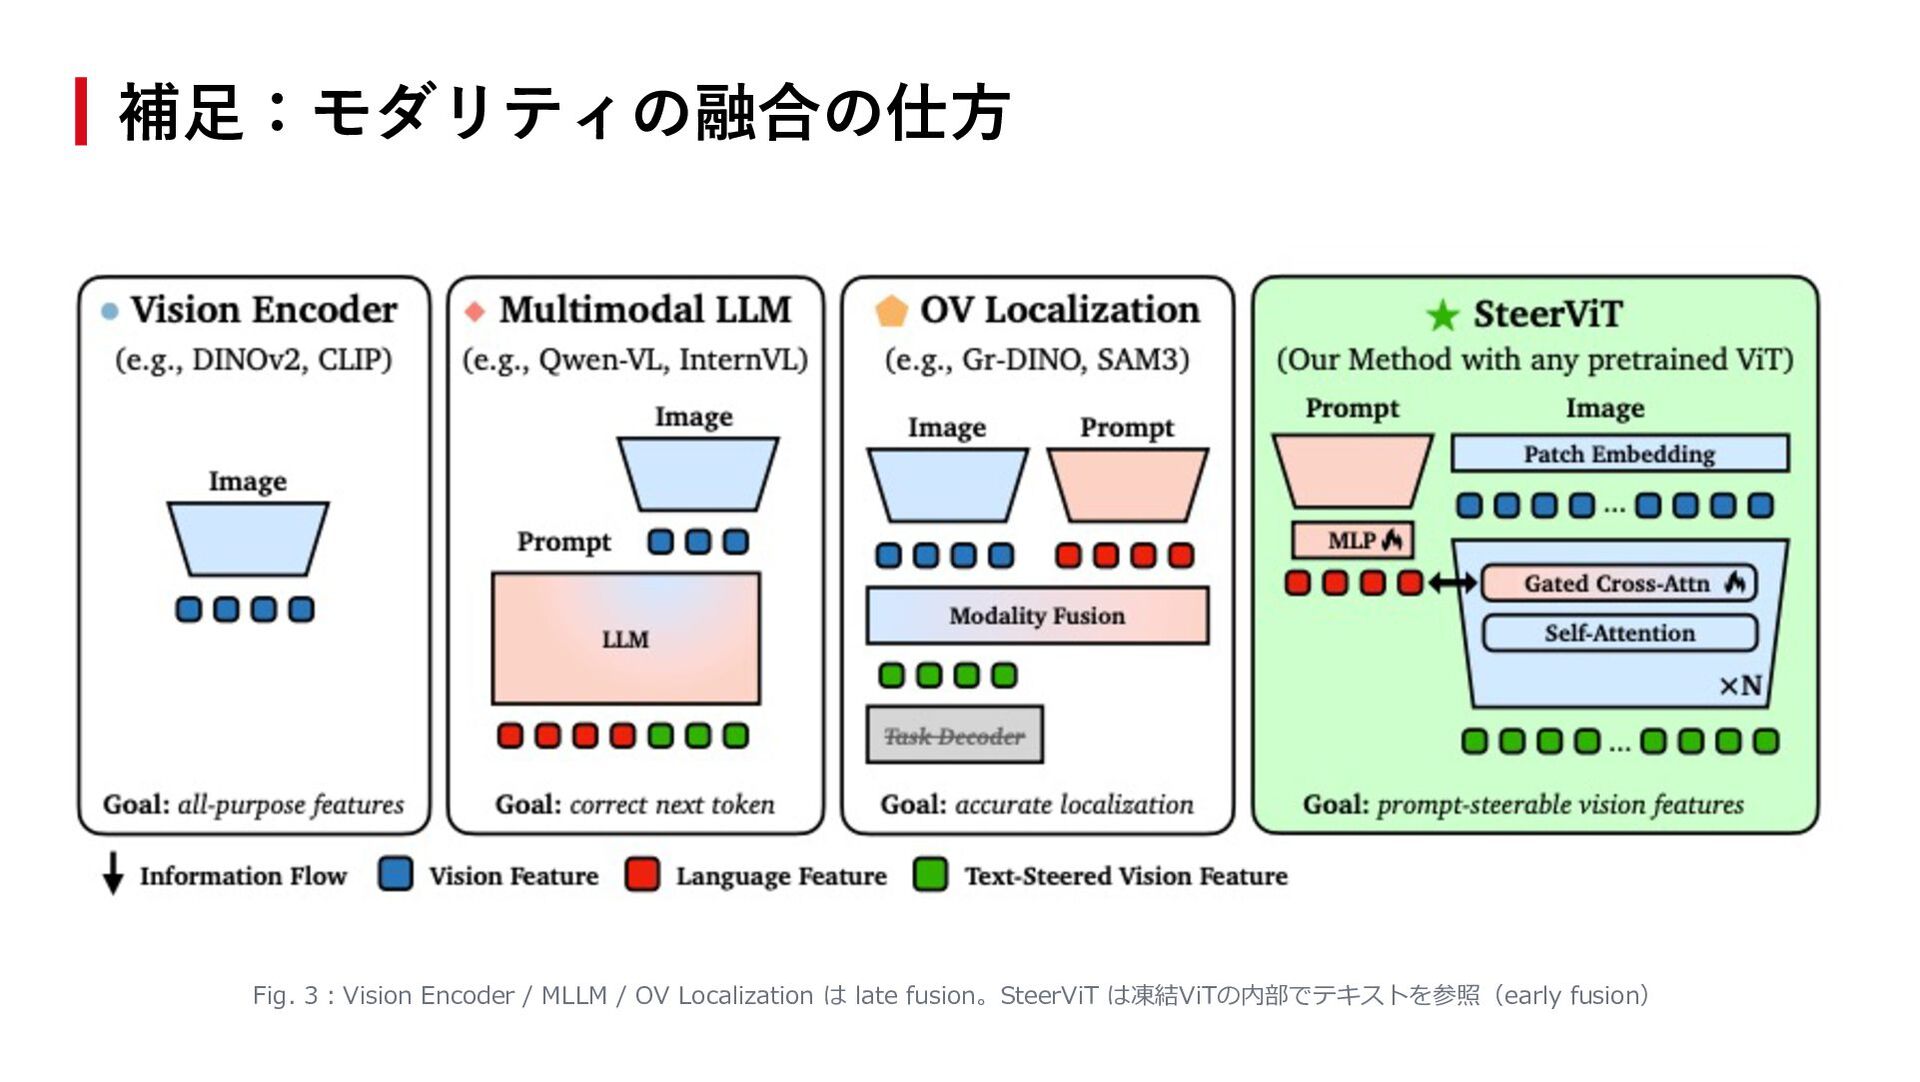
  26. 補⾜:モダリティの融合の仕⽅ Fig. 3︓Vision Encoder / MLLM / OV Localization は

    late fusion。SteerViT は凍結ViTの内部でテキストを参照(early fusion)
  27. 補⾜:関連研究の詳細(近い研究との差分) ⼿法 何をしているか テキストの⼊れ⽅ SteerViT との違い FLAIR 凍結 SigLIP の出⼒に、テキスト条件付きの

    attention pooling をかける 画像エンコーダの後(late) 誘導性が限定的(CORE 81.3% vs 96.0%)。汎⽤ ベンチマークで元の ViT より劣化 TIE MLLM 向けに、クエリトークンを画像エンコーダへ⼊れ て視覚トークンを削減 画像エンコーダ内 ⽂書理解に特化。汎⽤の視覚表現としては評価して いない ELIP ViT の⼊⼒にテキストを付け加え、画像検索の再ランキン グを改善 画像エンコーダの⼊⼒ 検索の再ランキング⽤途に特化 TEVI キャプションを条件に、CLIP の最終特徴を SAE でマス クして不要な情報を抑える 画像エンコーダの後(特徴の編 集) 最終特徴の後処理であり、エンコード過程は変えな い Flamingo LLM が画像特徴を参照する gated cross-attention (tanh ゲート・0 初期化) LLM 側(⾔語 → 視覚) 仕組みは同じで、向きを反転。ViT がテキストを参 照する(視覚 → ⾔語) (CVPRʼ25) (同時期) (同時期) (同時期) (NeurIPSʼ22) まとめ Tab. 1︓要件チェック表(両⽅ ✓ は SteerViT のみ) テキストで画像特徴を条件付ける研究はあるが、⽤途特化か late fusion。 「汎⽤ × 早期融合 × 表現品質を保つ」を同時に満たすのは SteerViT が初(著者らの知る限り)
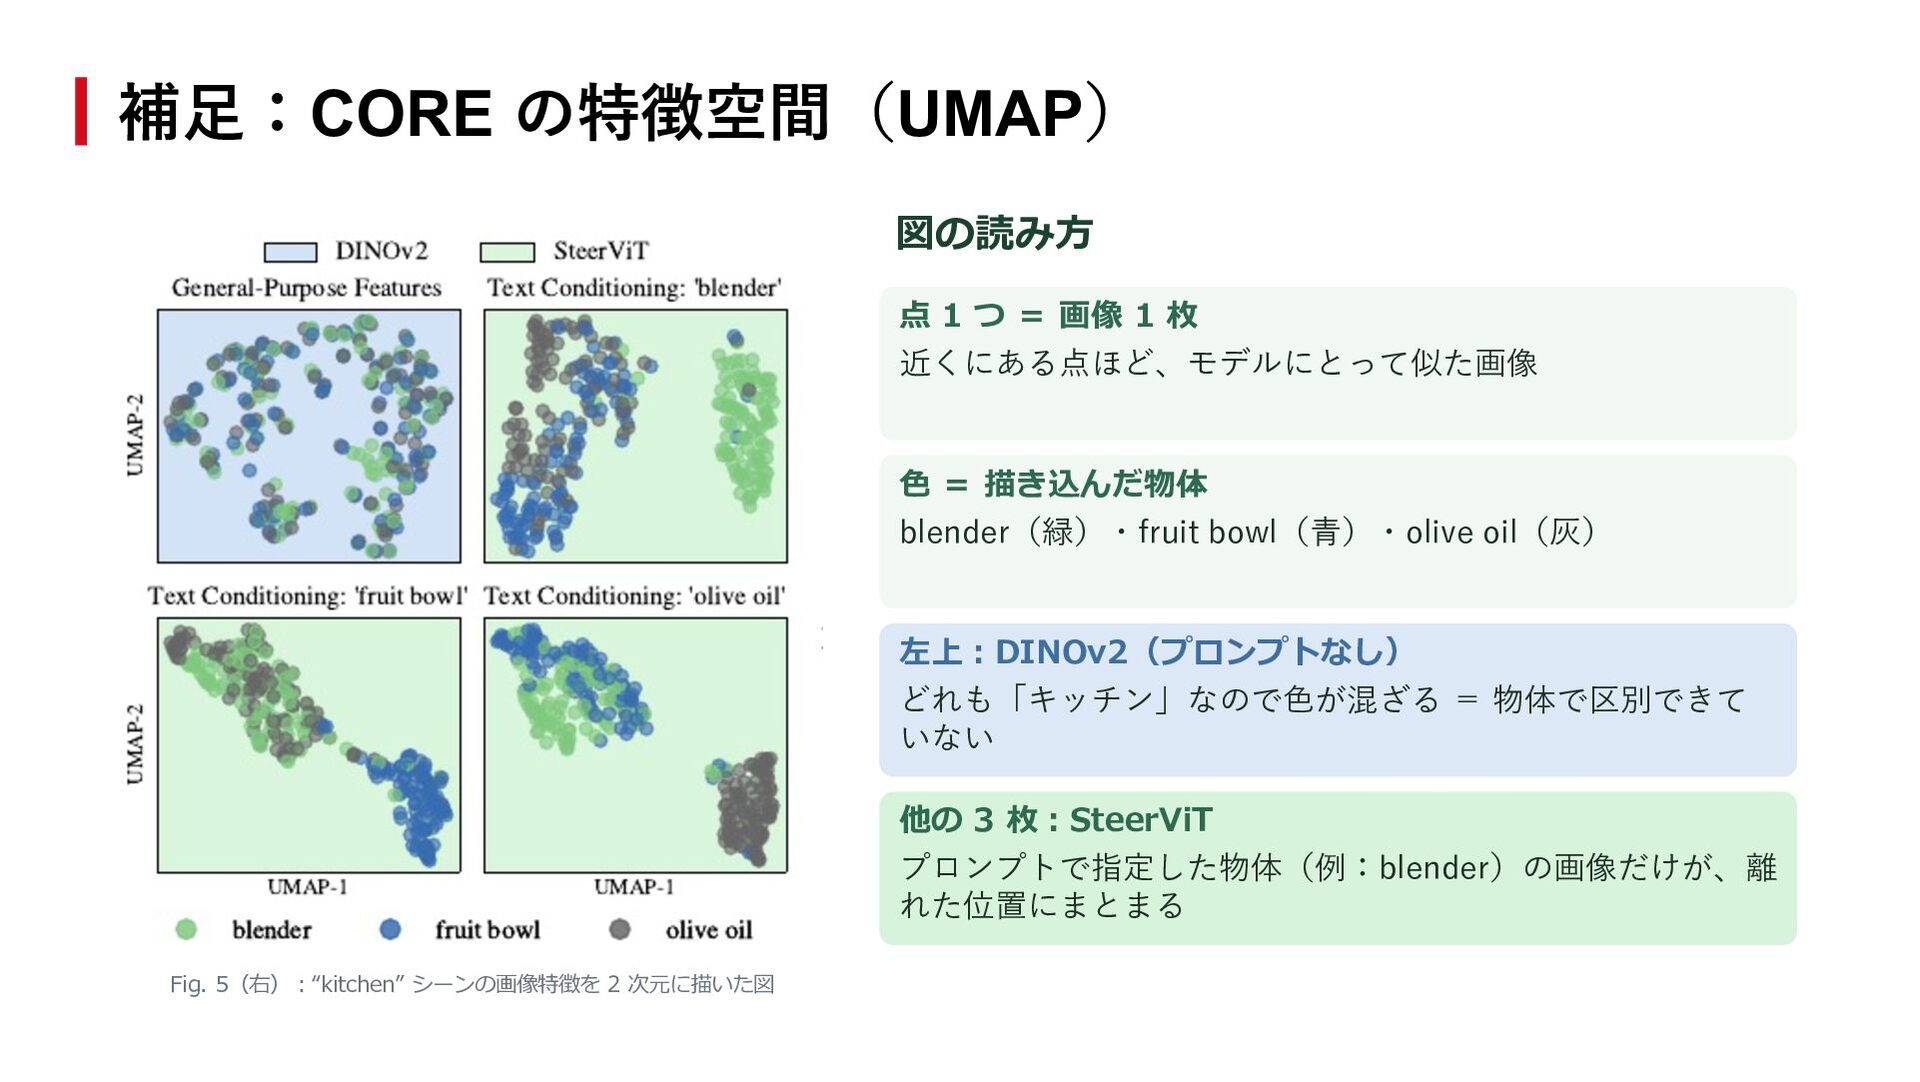
  28. 補⾜:CORE の特徴空間(UMAP) 図の読み⽅ 点 1 つ = 画像 1 枚

    近くにある点ほど、モデルにとって似た画像 ⾊ = 描き込んだ物体 blender(緑)・fruit bowl(⻘)・olive oil(灰) 左上︓DINOv2(プロンプトなし) どれも「キッチン」なので⾊が混ざる = 物体で区別できて いない 他の 3 枚︓SteerViT プロンプトで指定した物体(例:blender)の画像だけが、離 れた位置にまとまる Fig. 5(右)︓“kitchen” シーンの画像特徴を 2 次元に描いた図