Upgrade to Pro — share decks privately, control downloads, hide ads and more …

量⼦化でも活躍?深層学習で離散値を扱う技術「直通推定」の⾯⽩い理論

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

 量⼦化でも活躍?深層学習で離散値を扱う技術「直通推定」の⾯⽩い理論

■イベント
AIをプロダクトにどう活かす? 実践共有会 in Kyoto
https://sansan.connpass.com/event/408198/

■登壇概要
タイトル:量⼦化でも活躍?深層学習で離散値を扱う技術「直通推定」の⾯⽩い理論
登壇者:技術本部 研究開発部 Data Analysisグループ ⼭内 敏嗣

■ 技術本部 採用情報
https://media.sansan-engineering.com

SansanTech PRO

November 13, 2026

Transcript

11 slides
  1. ⼭内 敏嗣(Satoshi Yamauchi) Sansan 株式会社 技術本部 研究開発部 Data Analysisグループ 研究員

    京都⼤学⼤学院⼯学研究科電気⼯学専攻修⼠課程修了。 在学中は制御理論研究に取り組む。⾃動⾞メーカーでの品質保証業務を 経た後、制御システムベンダーでベイズ統計や機械学習を活⽤したモデル 予測制御システム内で⽤いる予測モデルの⾃動更新技術の研究開発に従事。 現在は契約書データ化のためのVLMの研究開発やチームリーダーを務める。
  2. AIのプロダクト活⽤と量⼦化 - AIのプロダクト応⽤では、モデルサイズがボトルネックになりがちであり、 その解決策として量⼦化がよく使われる。 - 量⼦化には、学習後に量⼦化するPost-Training Quantization (PTQ)と 量⼦化しながら学習するQuantization-Aware Training

    (QAT)がある。 - Microsoftの1bit LLM [Wang et al, 2023; Ma et al, 2024]が話題になったが、 そこではQATによる量⼦化が⾏われている。 Wang et al, BitNet: Scaling 1-bit Transformers for Large Language Models, 2023 Ma et al, The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits, 2024
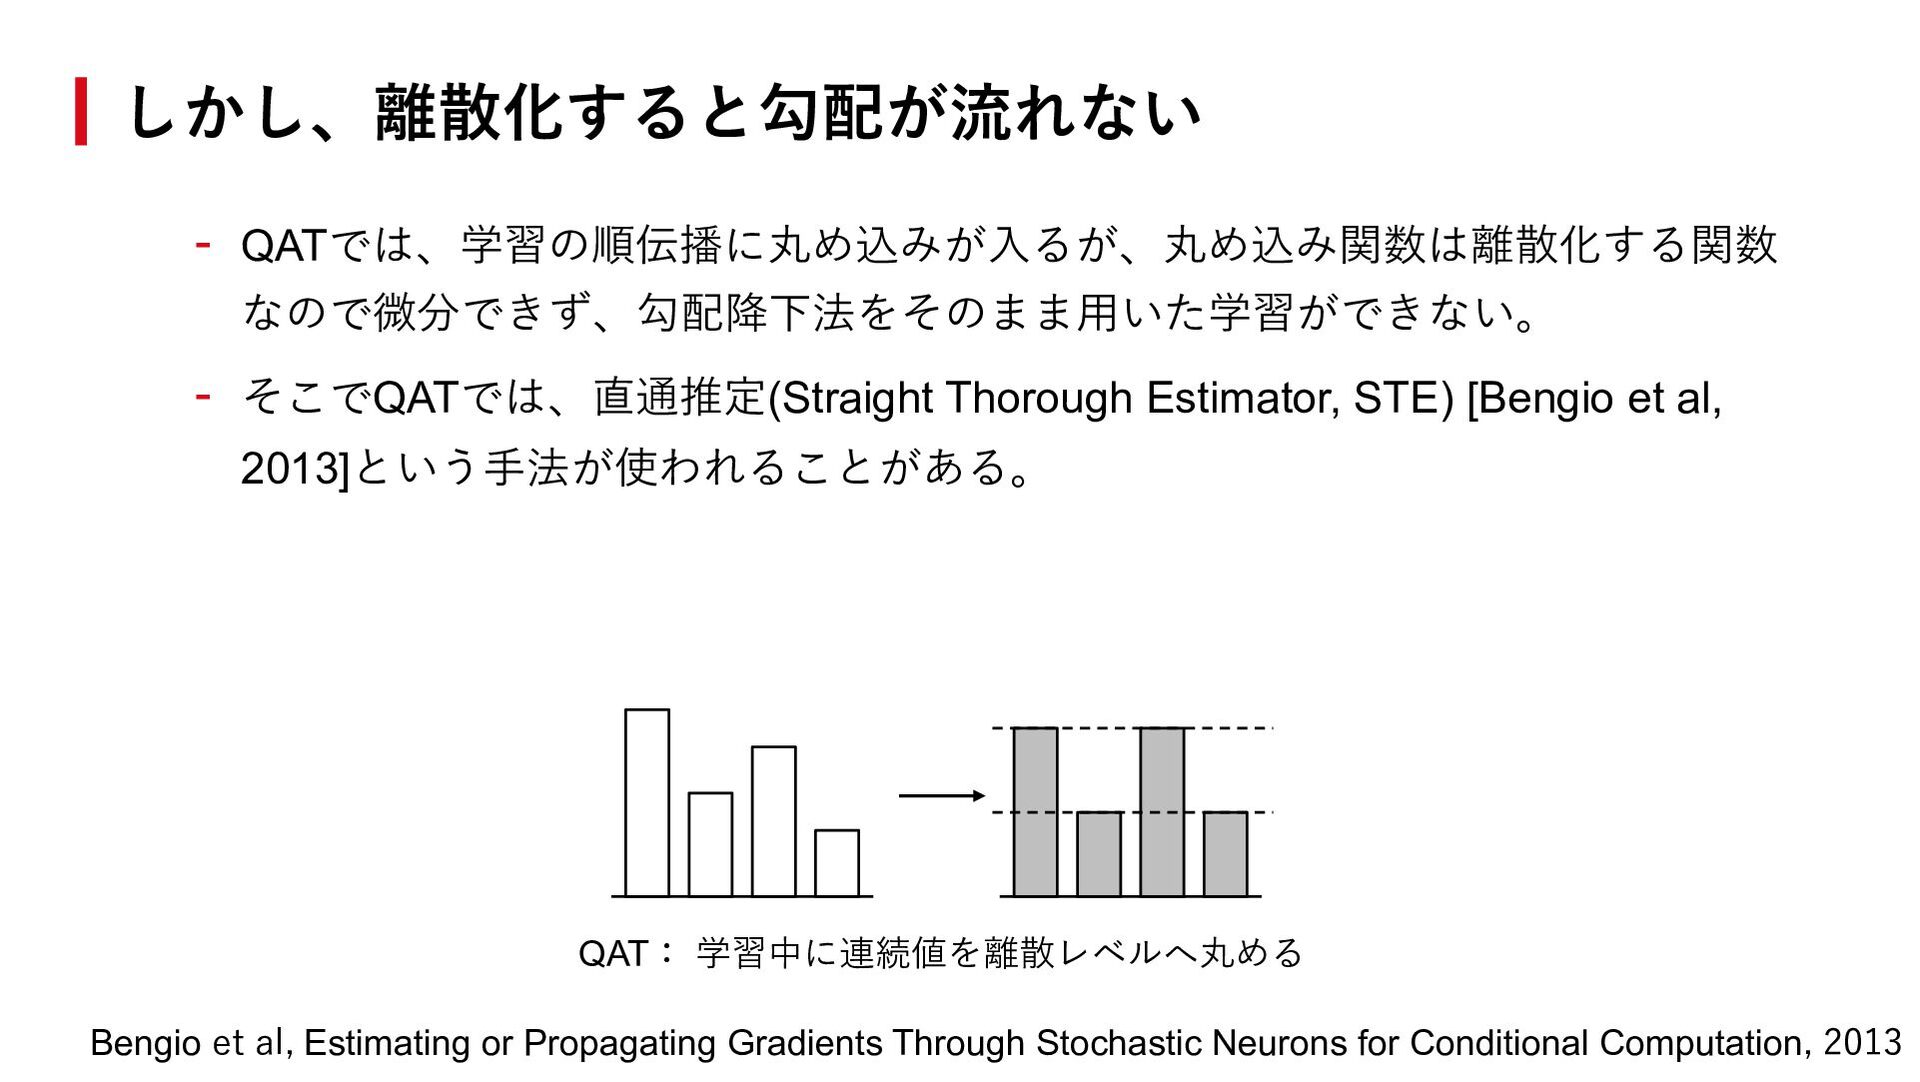
  3. しかし、離散化すると勾配が流れない - QATでは、学習の順伝播に丸め込みが⼊るが、丸め込み関数は離散化する関数 なので微分できず、勾配降下法をそのまま⽤いた学習ができない。 - そこでQATでは、直通推定(Straight Thorough Estimator, STE) [Bengio

    et al, 2013]という⼿法が使われることがある。 QAT: 学習中に連続値を離散レベルへ丸める Bengio et al, Estimating or Propagating Gradients Through Stochastic Neurons for Conditional Computation, 2013
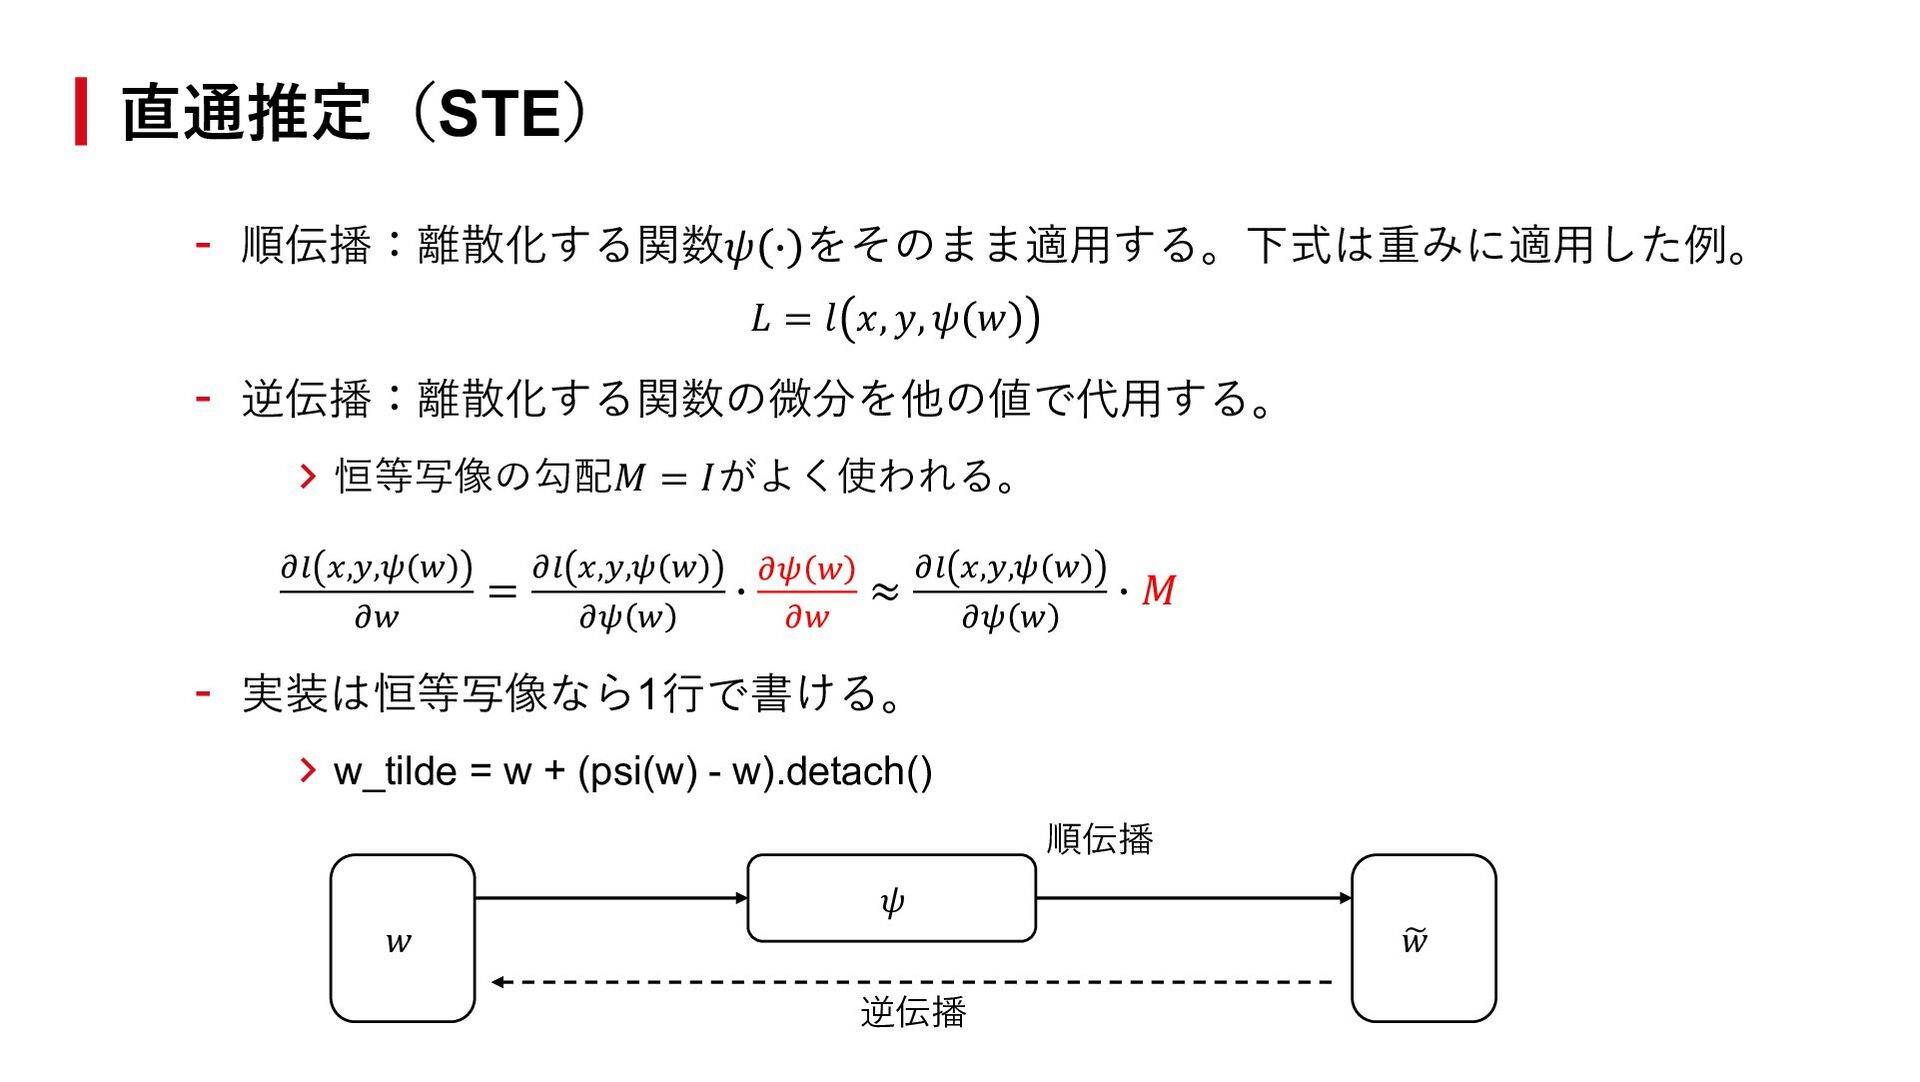
  4. 直通推定(STE) - 順伝播:離散化する関数𝜓 " をそのまま適⽤する。下式は重みに適⽤した例。 𝐿 = 𝑙 𝑥, 𝑦,

    𝜓 𝑤 - 逆伝播:離散化する関数の微分を他の値で代⽤する。 > 恒等写像の勾配𝑀 = 𝐼がよく使われる。 !" #,%,& ' !' = !" #,%,& ' !& ' " !& ' !' ≈ !" #,%,& ' !& ' "𝑀 - 実装は恒等写像なら1⾏で書ける。 > w_tilde = w + (psi(w) - w).detach() 順伝播 𝑤 𝜓 逆伝播 𝑤 #
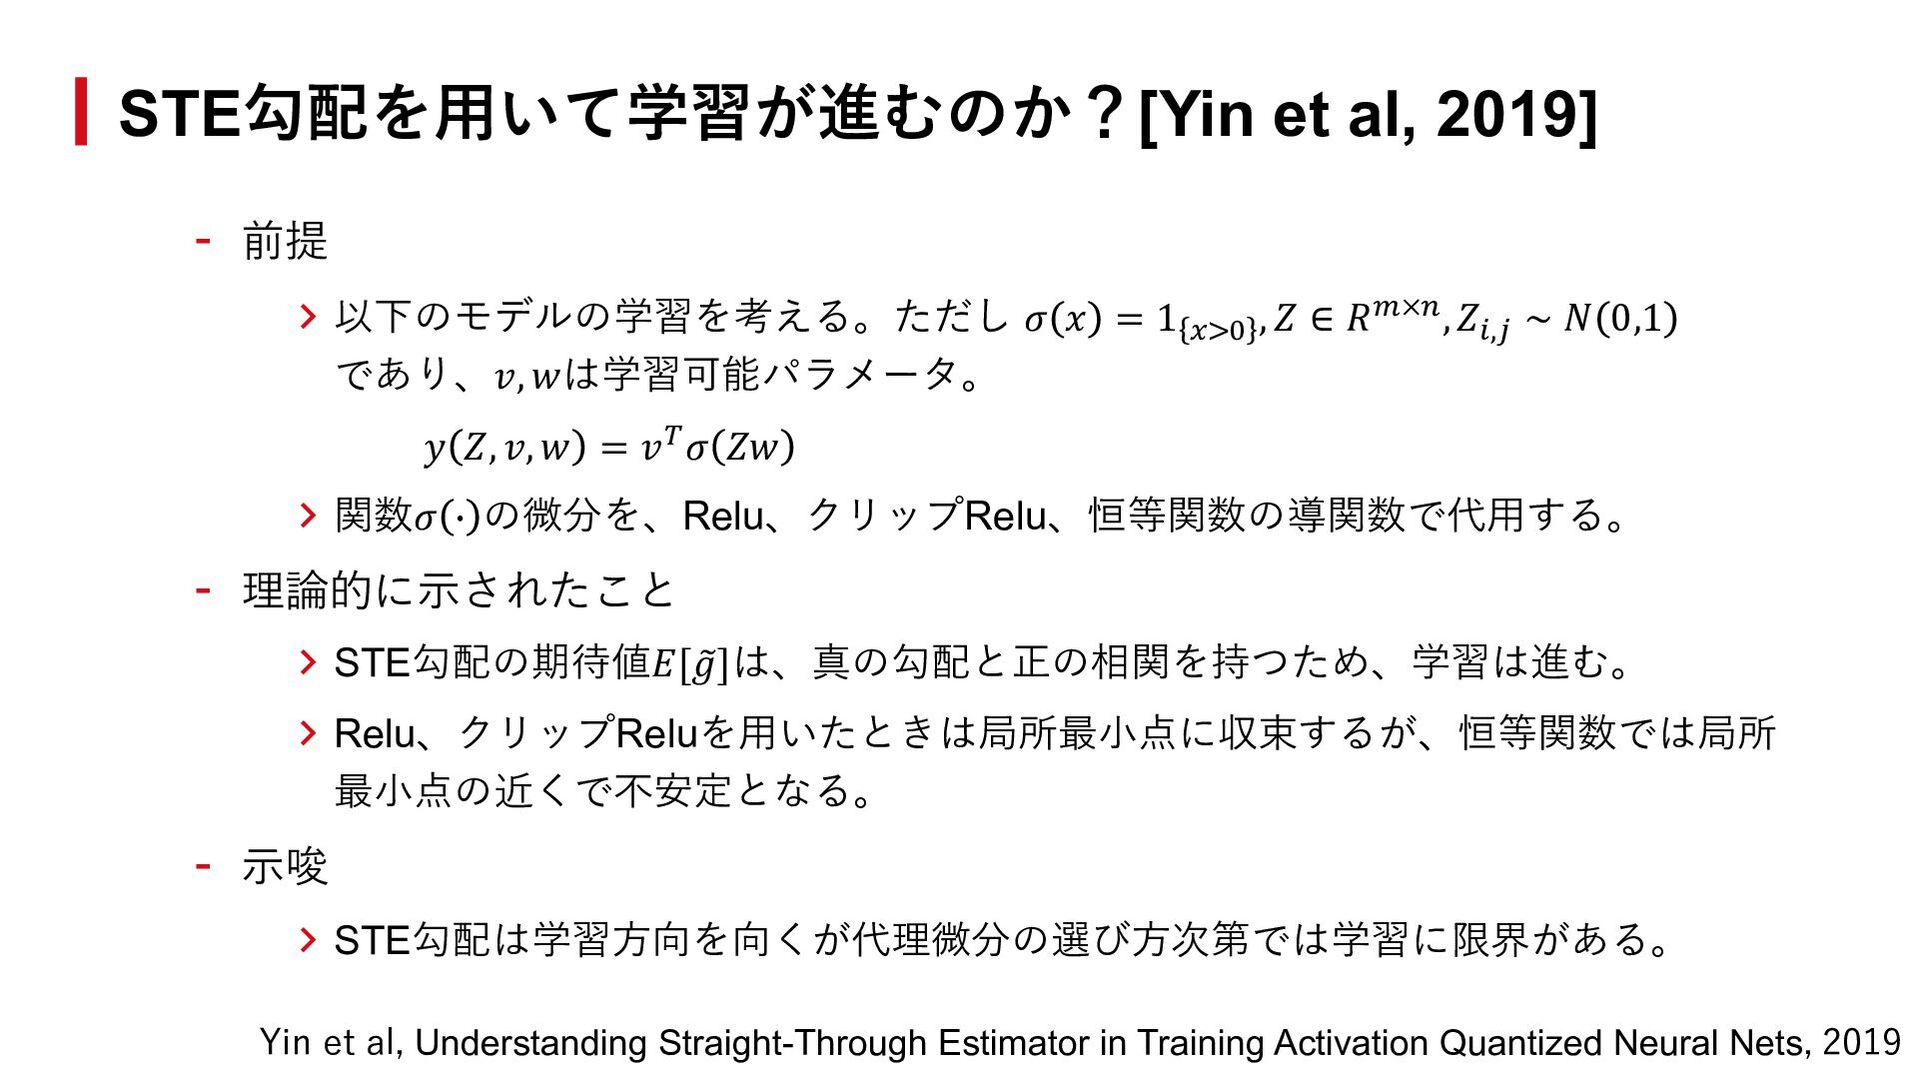
  5. STE勾配を⽤いて学習が進むのか?[Yin et al, 2019] - 前提 > 以下のモデルの学習を考える。ただし 𝜎 𝑥

    = 1 !"# , 𝑍 ∈ 𝑅$×& , 𝑍',) ∼ 𝑁 0,1 であり、𝑣, 𝑤は学習可能パラメータ。 𝑦 𝑍, 𝑣, 𝑤 = 𝑣 * 𝜎 𝑍𝑤 > 関数𝜎 4 の微分を、Relu、クリップRelu、恒等関数の導関数で代⽤する。 - 理論的に⽰されたこと > STE勾配の期待値𝐸[𝑔]は、真の勾配と正の相関を持つため、学習は進む。 7 > Relu、クリップReluを⽤いたときは局所最⼩点に収束するが、恒等関数では局所 最⼩点の近くで不安定となる。 - ⽰唆 > STE勾配は学習⽅向を向くが代理微分の選び⽅次第では学習に限界がある。 Yin et al, Understanding Straight-Through Estimator in Training Activation Quantized Neural Nets, 2019
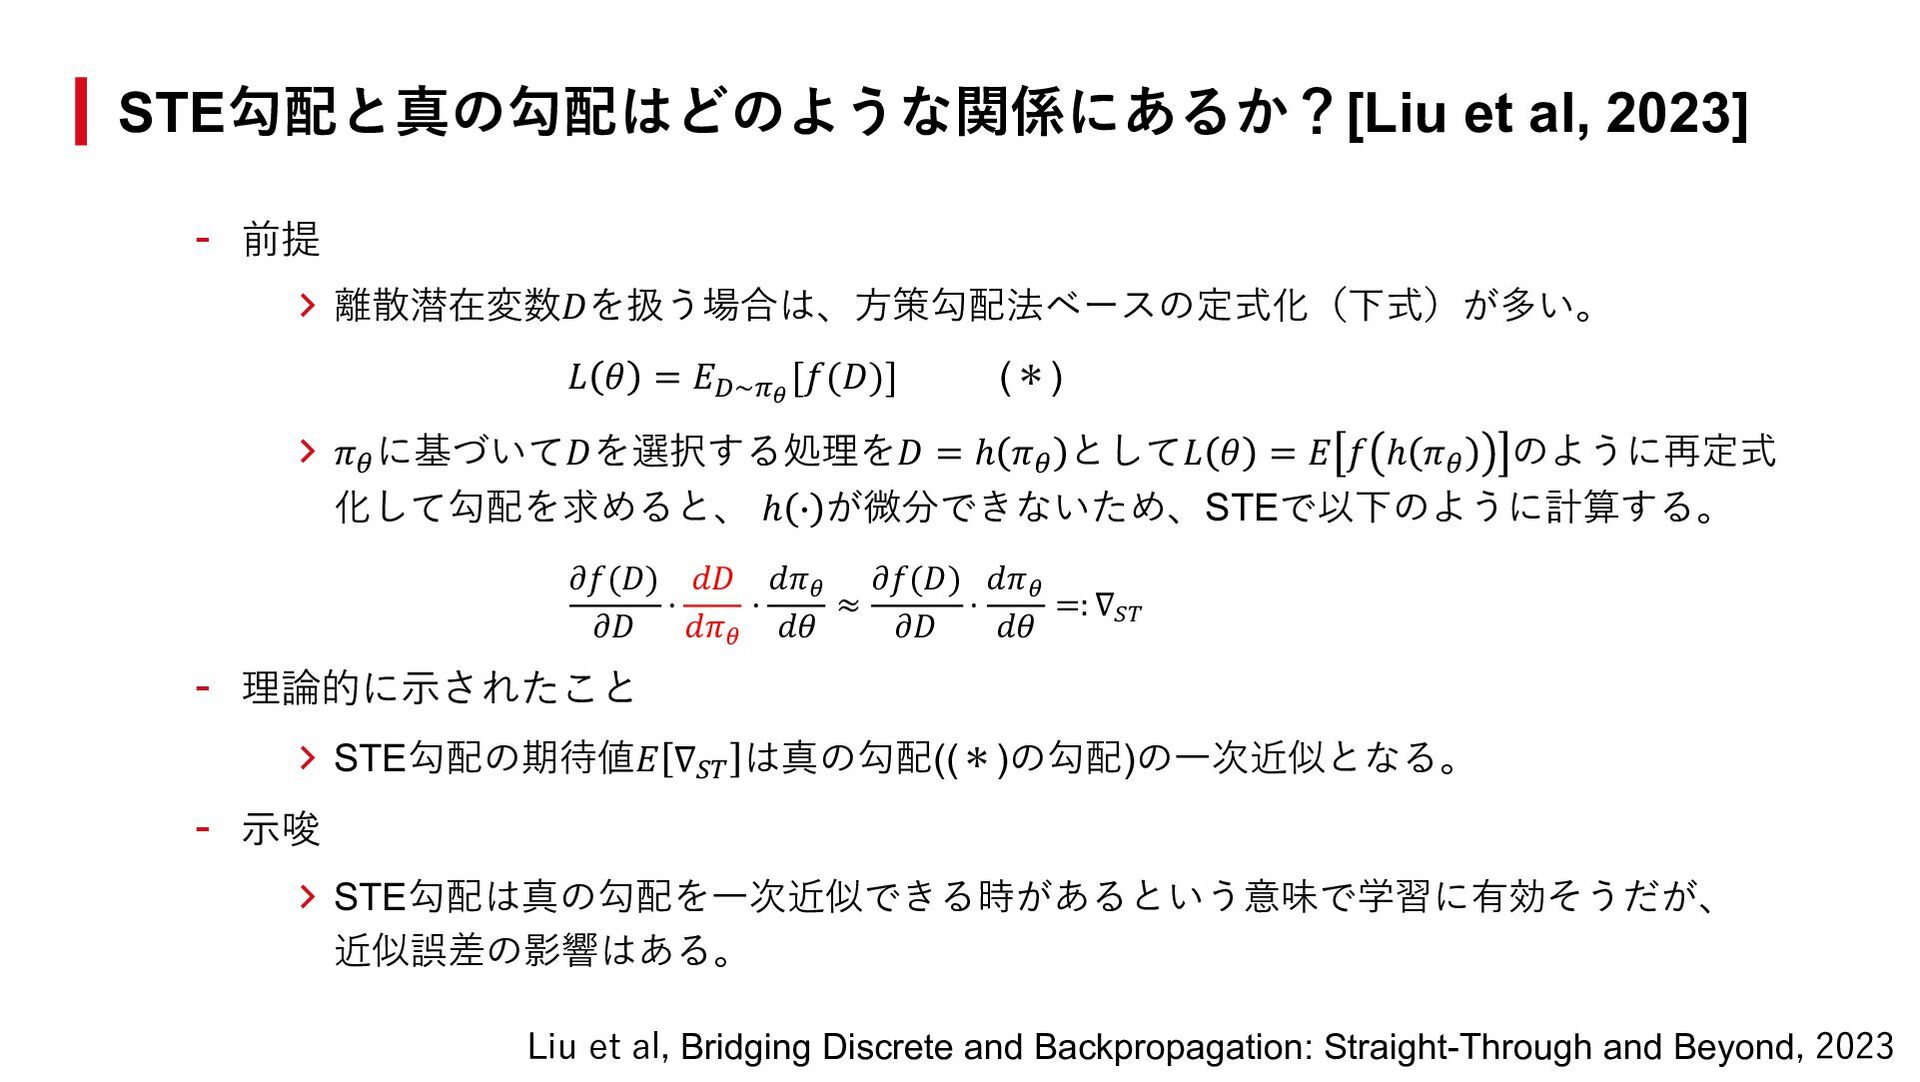
  6. STE勾配と真の勾配はどのような関係にあるか?[Liu et al, 2023] - 前提 > 離散潜在変数𝐷を扱う場合は、⽅策勾配法ベースの定式化(下式)が多い。 𝐿 𝜃

    = 𝐸!∼#! [𝑓(𝐷)] (*) > 𝜋$ に基づいて𝐷を選択する処理を𝐷 = ℎ 𝜋$ として𝐿 𝜃 = 𝐸 𝑓 ℎ 𝜋$ のように再定式 化して勾配を求めると、 ℎ - が微分できないため、STEで以下のように計算する。 𝜕𝑓(𝐷) 𝑑𝐷 𝑑𝜋! 𝜕𝑓(𝐷) 𝑑𝜋! ⋅ ⋅ ≈ ⋅ =: ∇"# 𝜕𝐷 𝑑𝜋! 𝑑𝜃 𝜕𝐷 𝑑𝜃 - 理論的に⽰されたこと > STE勾配の期待値𝐸 ∇%& は真の勾配((*)の勾配)の⼀次近似となる。 - ⽰唆 > STE勾配は真の勾配を⼀次近似できる時があるという意味で学習に有効そうだが、 近似誤差の影響はある。 Liu et al, Bridging Discrete and Backpropagation: Straight-Through and Beyond, 2023
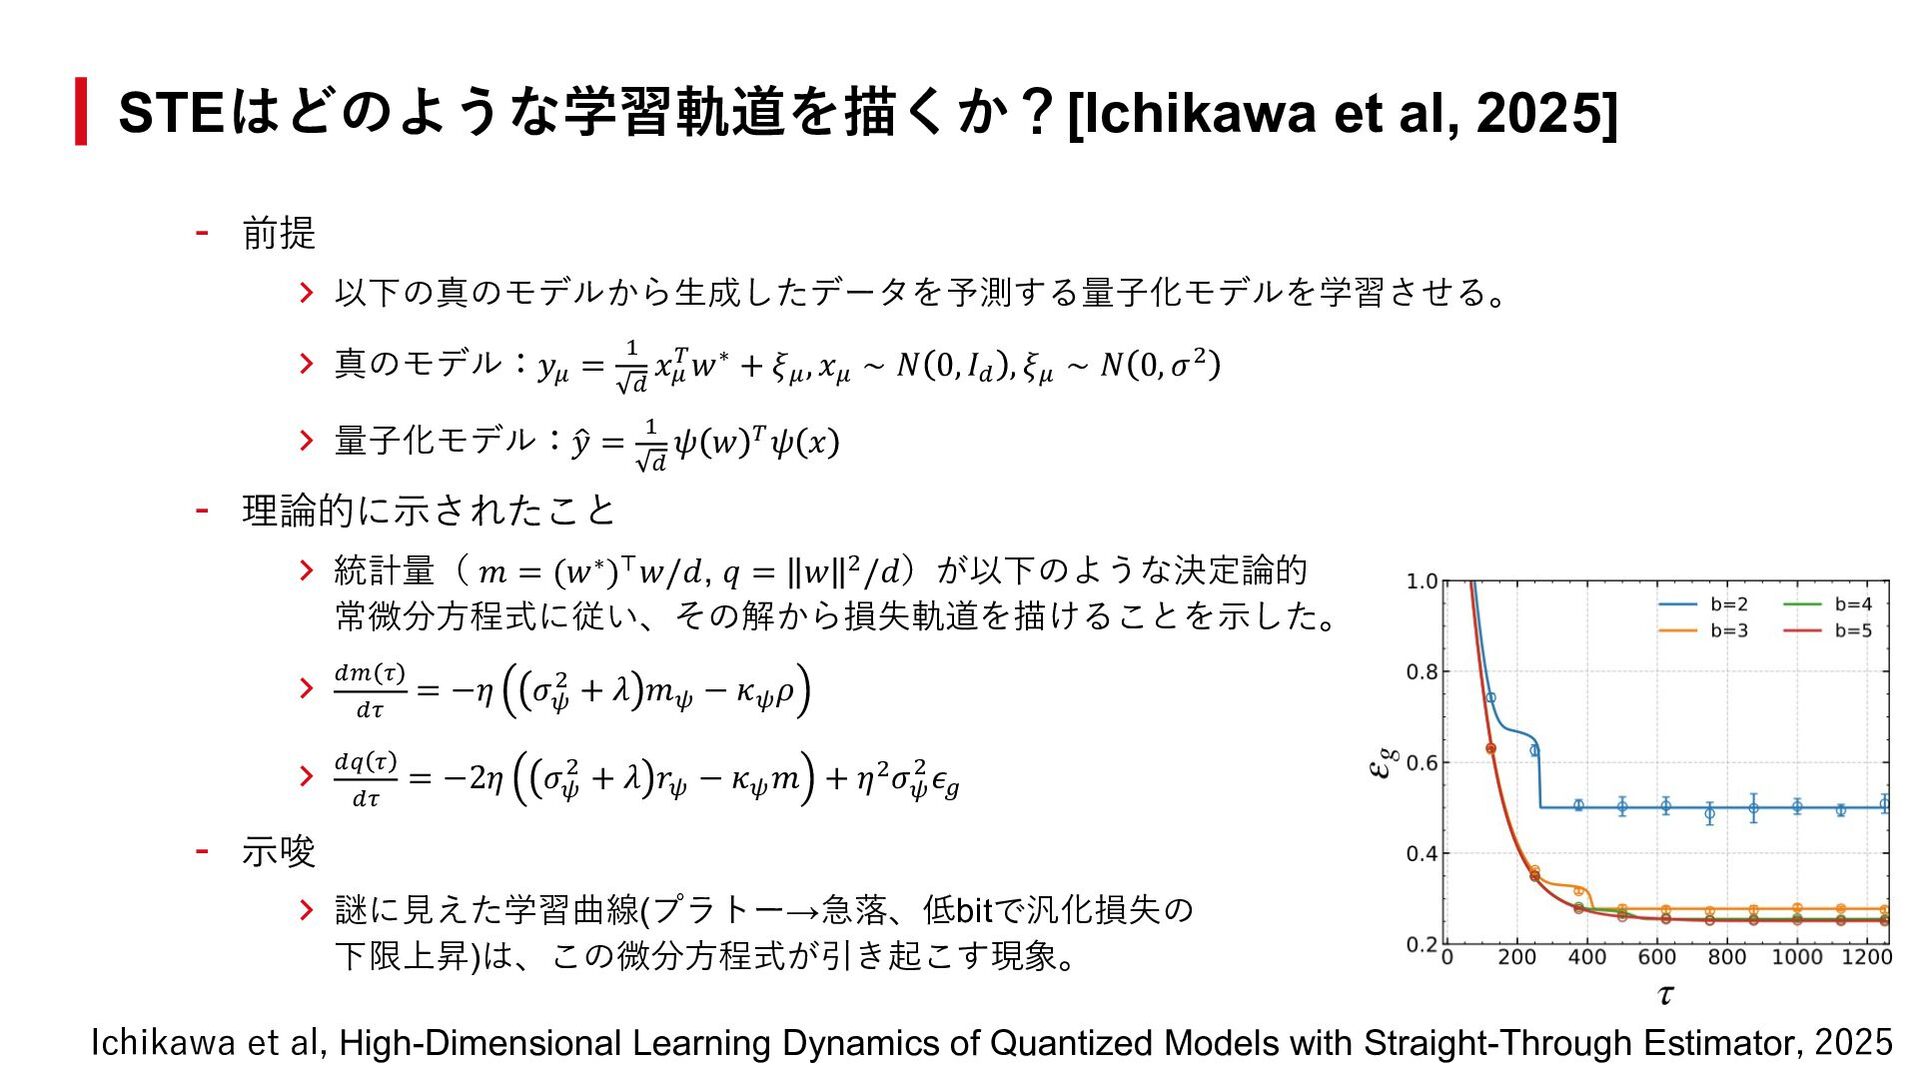
  7. STEはどのような学習軌道を描くか?[Ichikawa et al, 2025] - 前提 > 以下の真のモデルから⽣成したデータを予測する量⼦化モデルを学習させる。 > 真のモデル:𝑦$

    = % > 量⼦化モデル:𝑦9 = # ∗ ( 𝑥 𝑤 + 𝜉 , 𝑥 ∼ 𝑁 0, 𝐼 , 𝜉 ∼ 𝑁 0, 𝜎 $ $ $ & $ & % & 𝜓 𝑤 #𝜓 𝑥 - 理論的に⽰されたこと > 統計量( 𝑚 = (𝑤 ∗ )) 𝑤/𝑑, 𝑞 = 𝑤 ( /𝑑)が以下のような決定論的 常微分⽅程式に従い、その解から損失軌道を描けることを⽰した。 > > &* + &+ &- + &+ = −𝜂 𝜎,( + 𝜆 𝑚, − 𝜅, 𝜌 = −2𝜂 𝜎,( + 𝜆 𝑟, − 𝜅, 𝑚 + 𝜂( 𝜎,( 𝜖. - ⽰唆 > 謎に⾒えた学習曲線(プラトー→急落、低bitで汎化損失の 下限上昇)は、この微分⽅程式が引き起こす現象。 Ichikawa et al, High-Dimensional Learning Dynamics of Quantized Models with Straight-Through Estimator, 2025
  8. まとめ - STEの理論研究から以下の⽰唆が得られる。量⼦化しながら学習する⼿法 であるQATがうまくいかないときは量⼦化そのものの近似誤差だけでなく、 STEによる代理微分の誤差の影響も疑う視点が必要と考えられる。 > STE勾配は学習⽅向を向くが代理微分の選び⽅次第では学習に限界がある。 > STEは真の勾配を⼀次近似できる時があるという意味で学習に有効そうだが、 近似誤差の影響はある。

    > STEの学習ダイナミクスは、プラトー→急落、低bitで床上昇などの現象を 引き起こす。 - STEは⼀⾒ヒューリスティックだが、理論づけが着実に進んでいる。 - ただし、かなり簡略化したケースを想定しているものが多いので、より⼀般化 した理論研究は今後の期待。

More Decks by SansanTech

Other Decks in Technology