Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Lets start mlops
Search
shibuiwilliam
March 17, 2022
Technology
130
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Lets start mlops
https://tier4.connpass.com/event/217726/
shibuiwilliam
March 17, 2022
Transcript
32 slides
今日から始める MLOps 2021/07/29 shibui yusuke 1
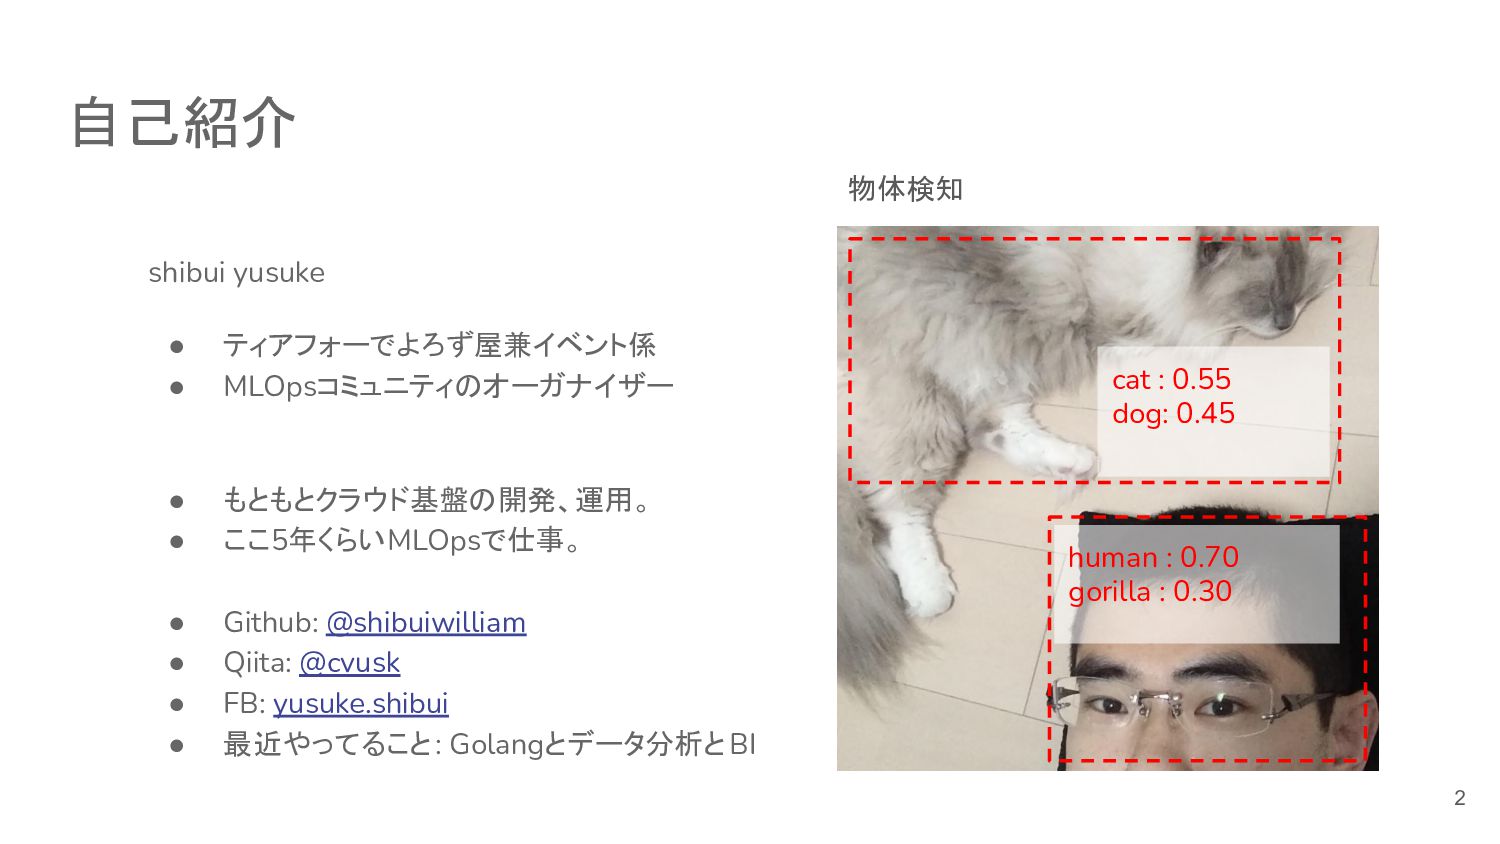
自己紹介 shibui yusuke • ティアフォーでよろず屋兼イベント係 • MLOpsコミュニティのオーガナイザー • もともとクラウド基盤の開発、運用。 •
ここ5年くらいMLOpsで仕事。 • Github: @shibuiwilliam • Qiita: @cvusk • FB: yusuke.shibui • 最近やってること: Golangとデータ分析とBI cat : 0.55 dog: 0.45 human : 0.70 gorilla : 0.30 物体検知 2
今日話すこと • 最近よく聞く「MLOps」について説明します。 • ティアフォーで取り組んでいる事例とともに、 MLOpsの進め方を紹介します。 3
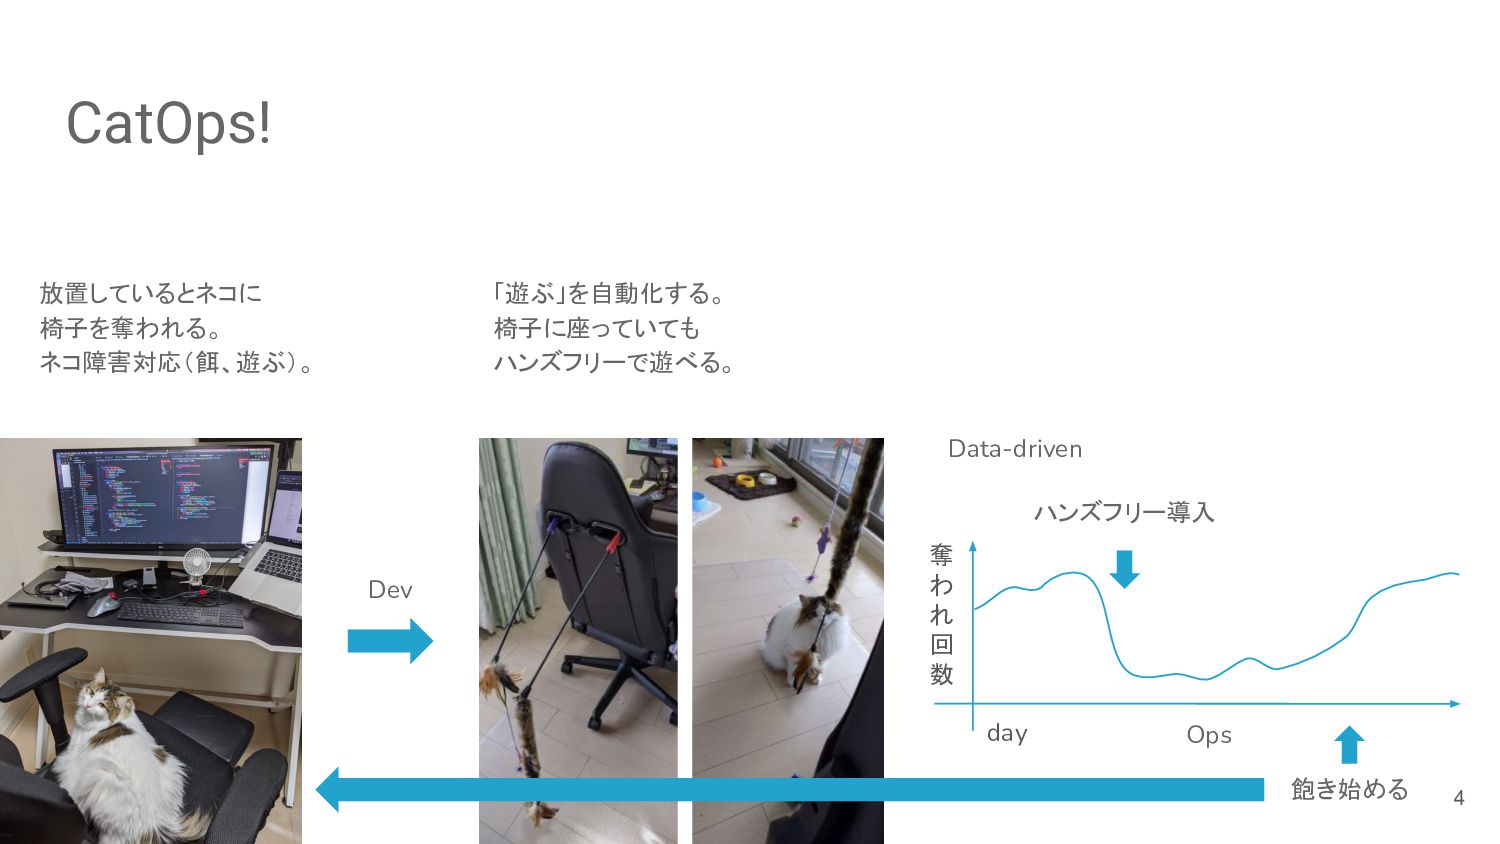
CatOps! 放置しているとネコに 椅子を奪われる。 ネコ障害対応(餌、遊ぶ)。 「遊ぶ」を自動化する。 椅子に座っていても ハンズフリーで遊べる。 day 奪 わ
れ 回 数 ハンズフリー導入 飽き始める Dev Data-driven 4 Ops
なぜ機械学習に DevOpsが必要か 5
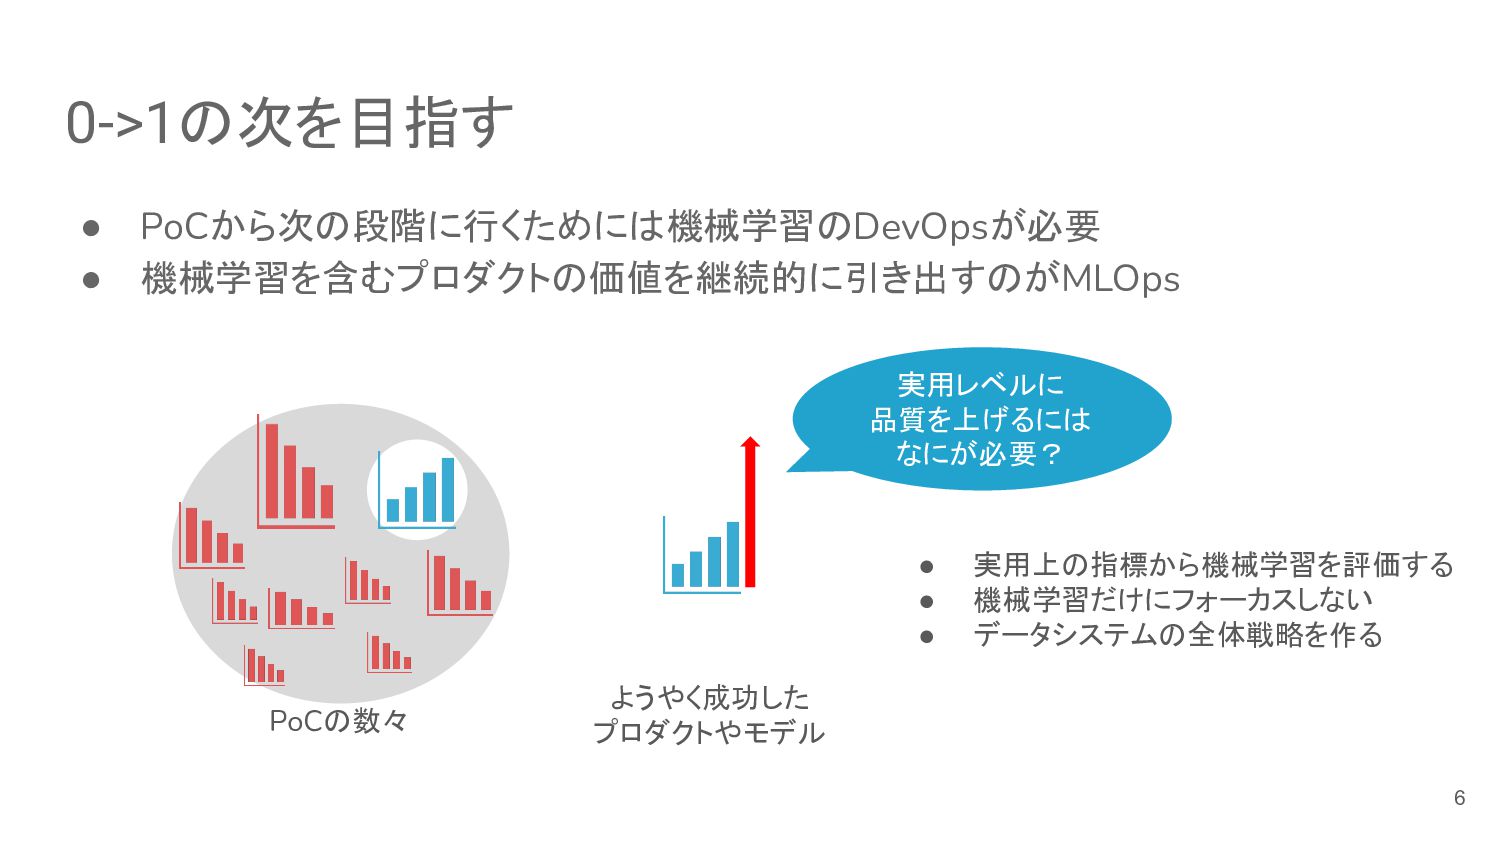
• PoCから次の段階に行くためには機械学習のDevOpsが必要 • 機械学習を含むプロダクトの価値を継続的に引き出すのがMLOps 0->1の次を目指す PoCの数々 ようやく成功した プロダクトやモデル 実用レベルに 品質を上げるには
なにが必要? • 実用上の指標から機械学習を評価する • 機械学習だけにフォーカスしない • データシステムの全体戦略を作る 6
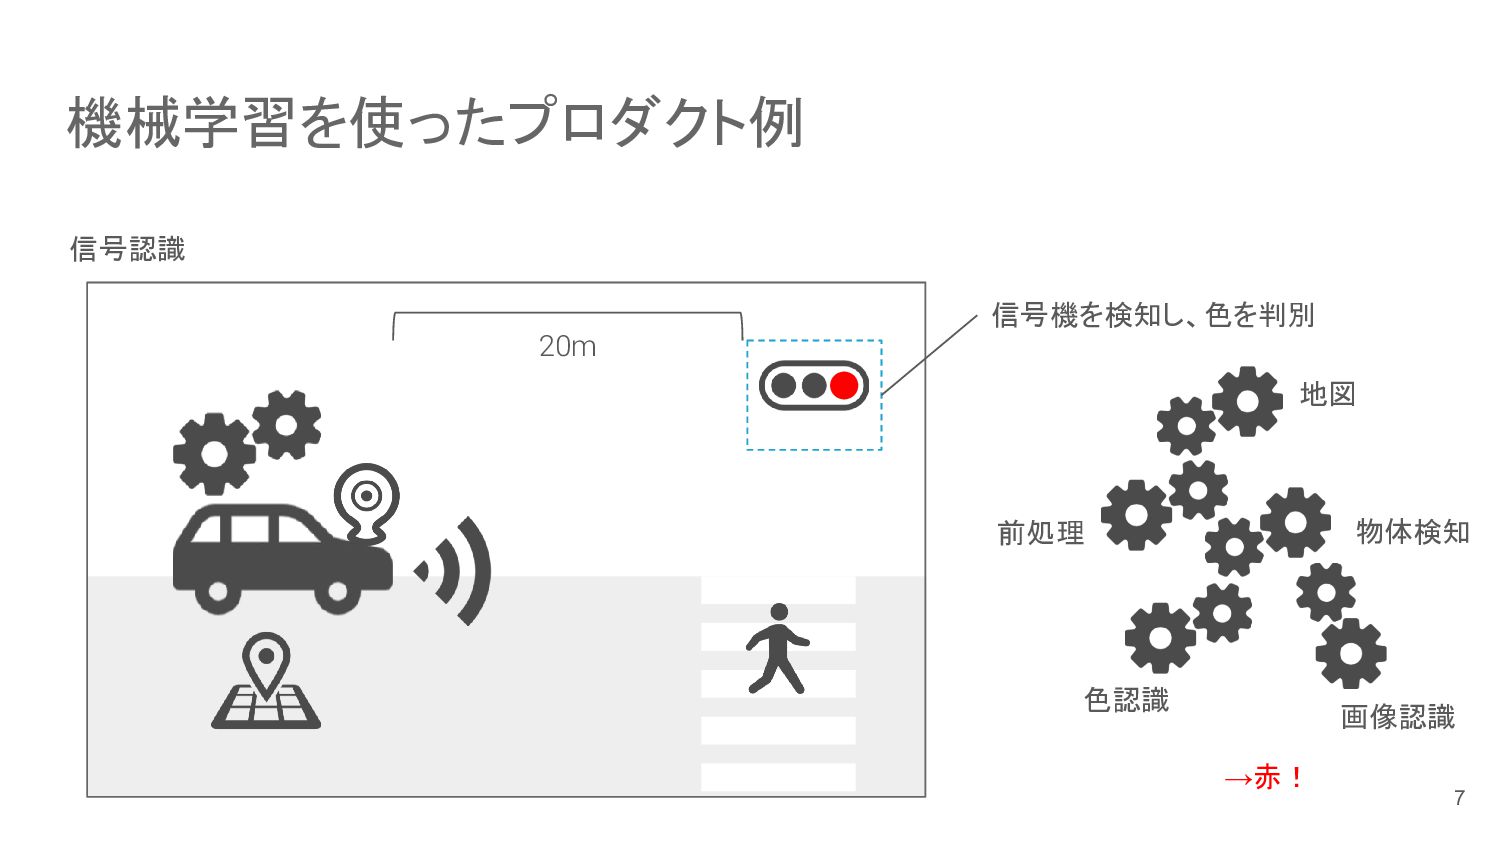
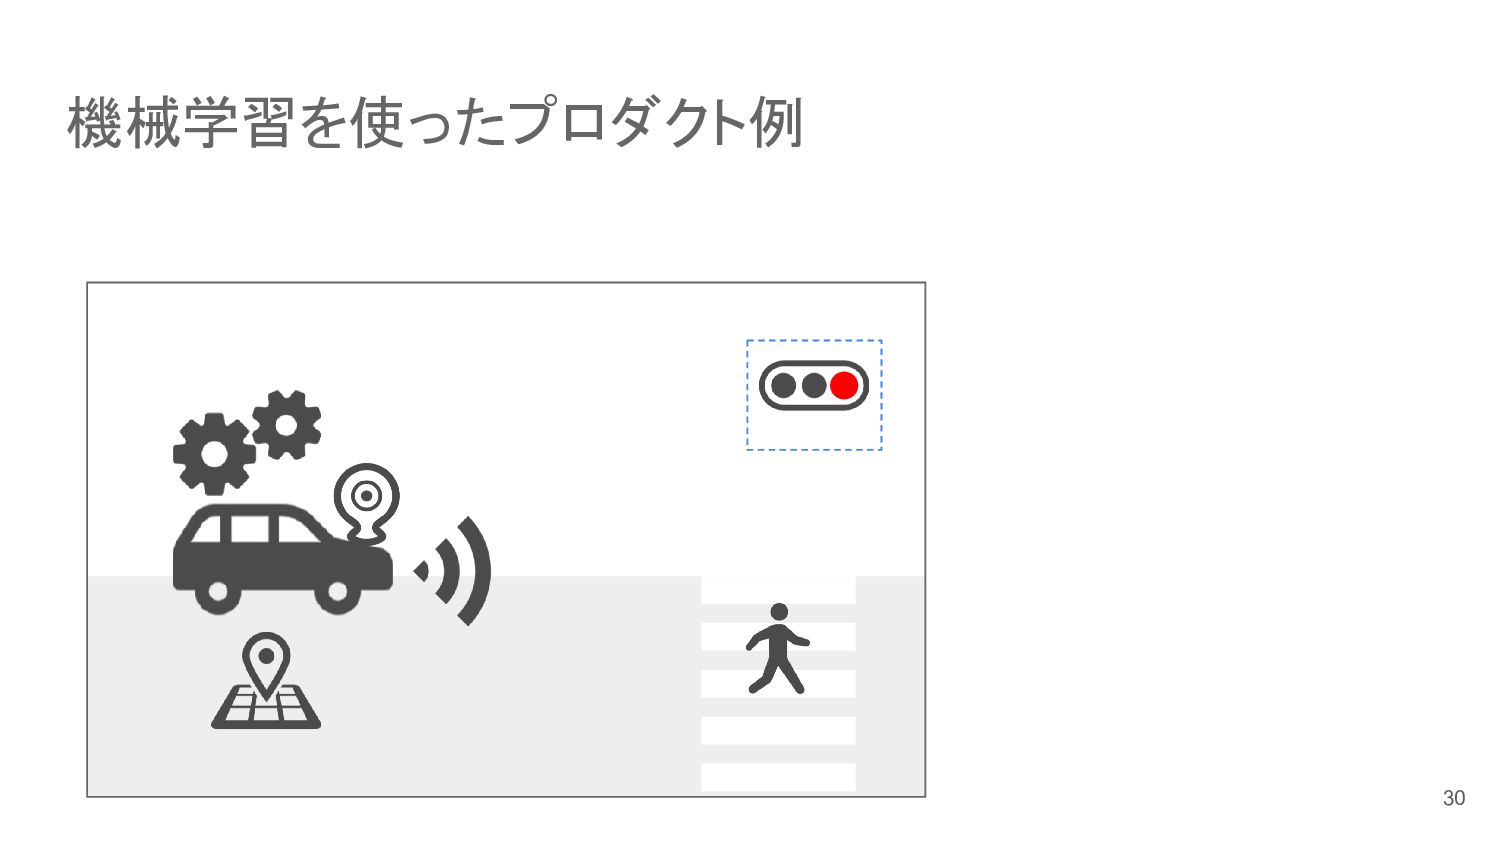
機械学習を使ったプロダクト例 信号認識 信号機を検知し、色を判別 20m 物体検知 画像認識 色認識 前処理 地図 →赤!
7
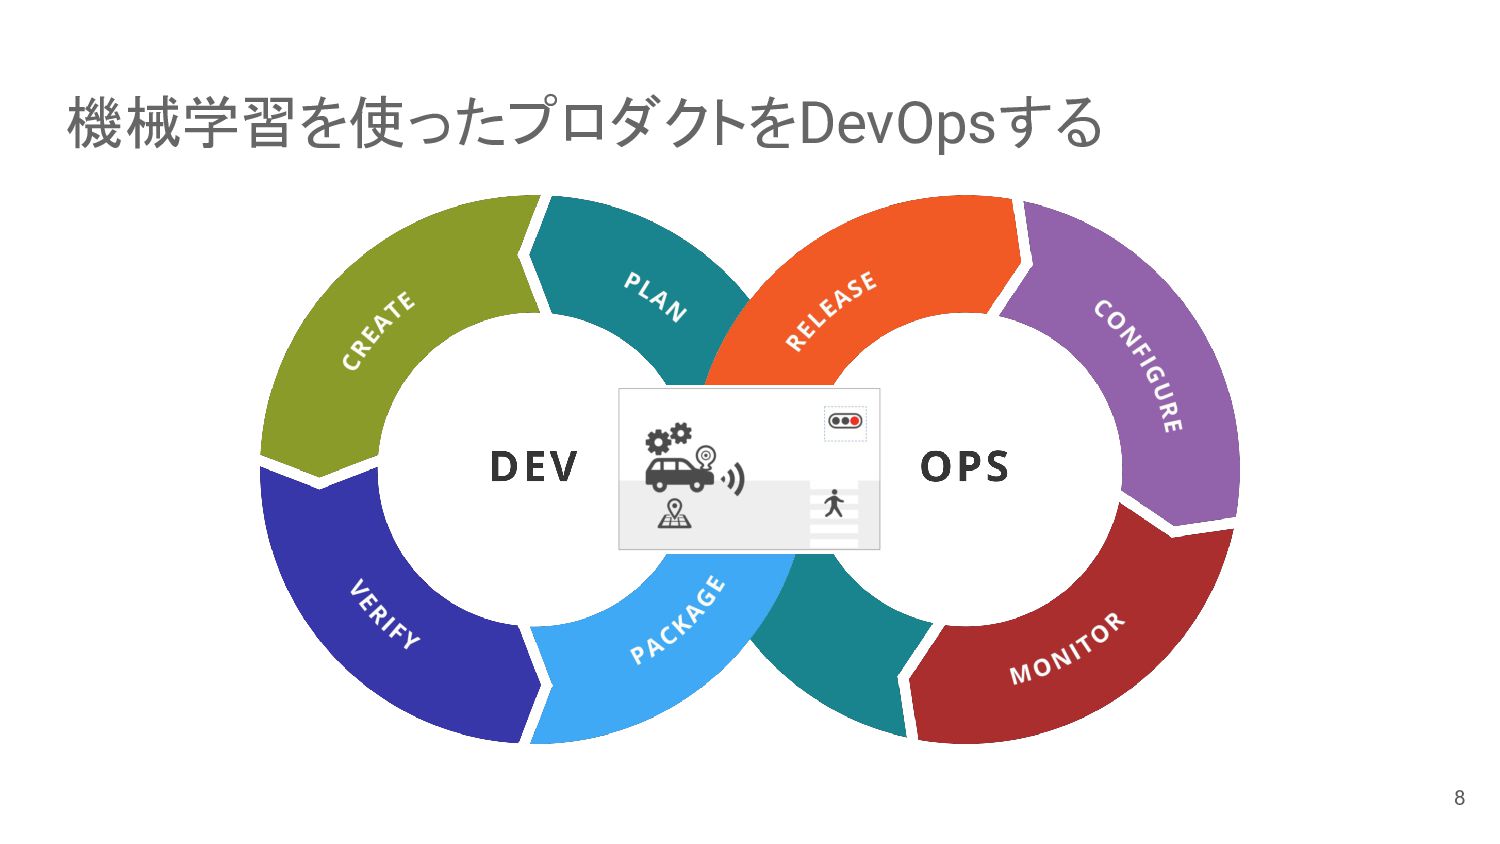
機械学習を使ったプロダクトをDevOpsする 8
MLOpsの始め方 9
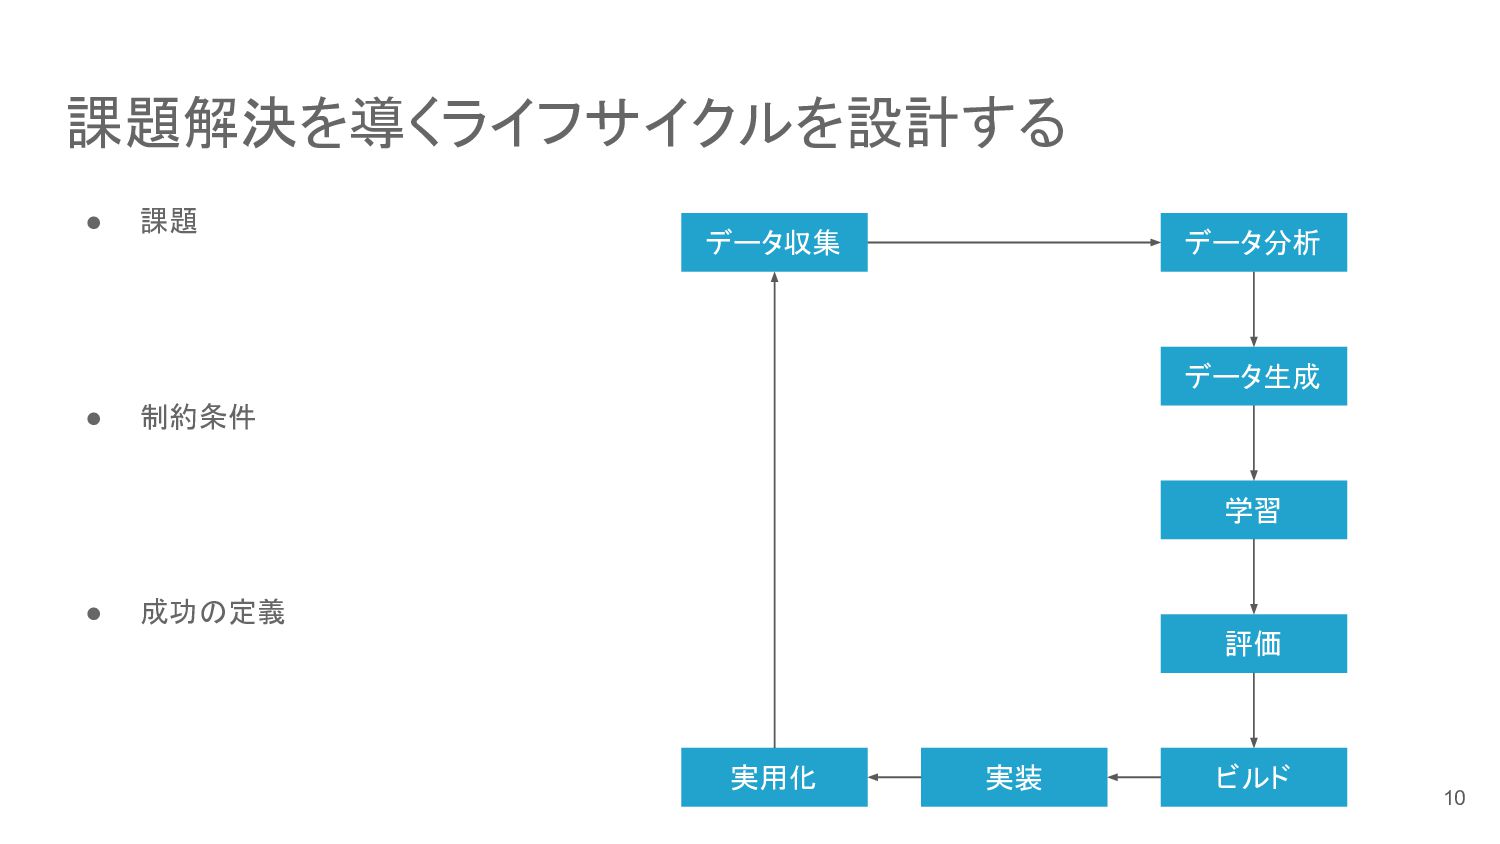
課題解決を導くライフサイクルを設計する • 課題 • 制約条件 • 成功の定義 データ収集 データ分析 データ生成
学習 評価 実用化 ビルド 実装 10
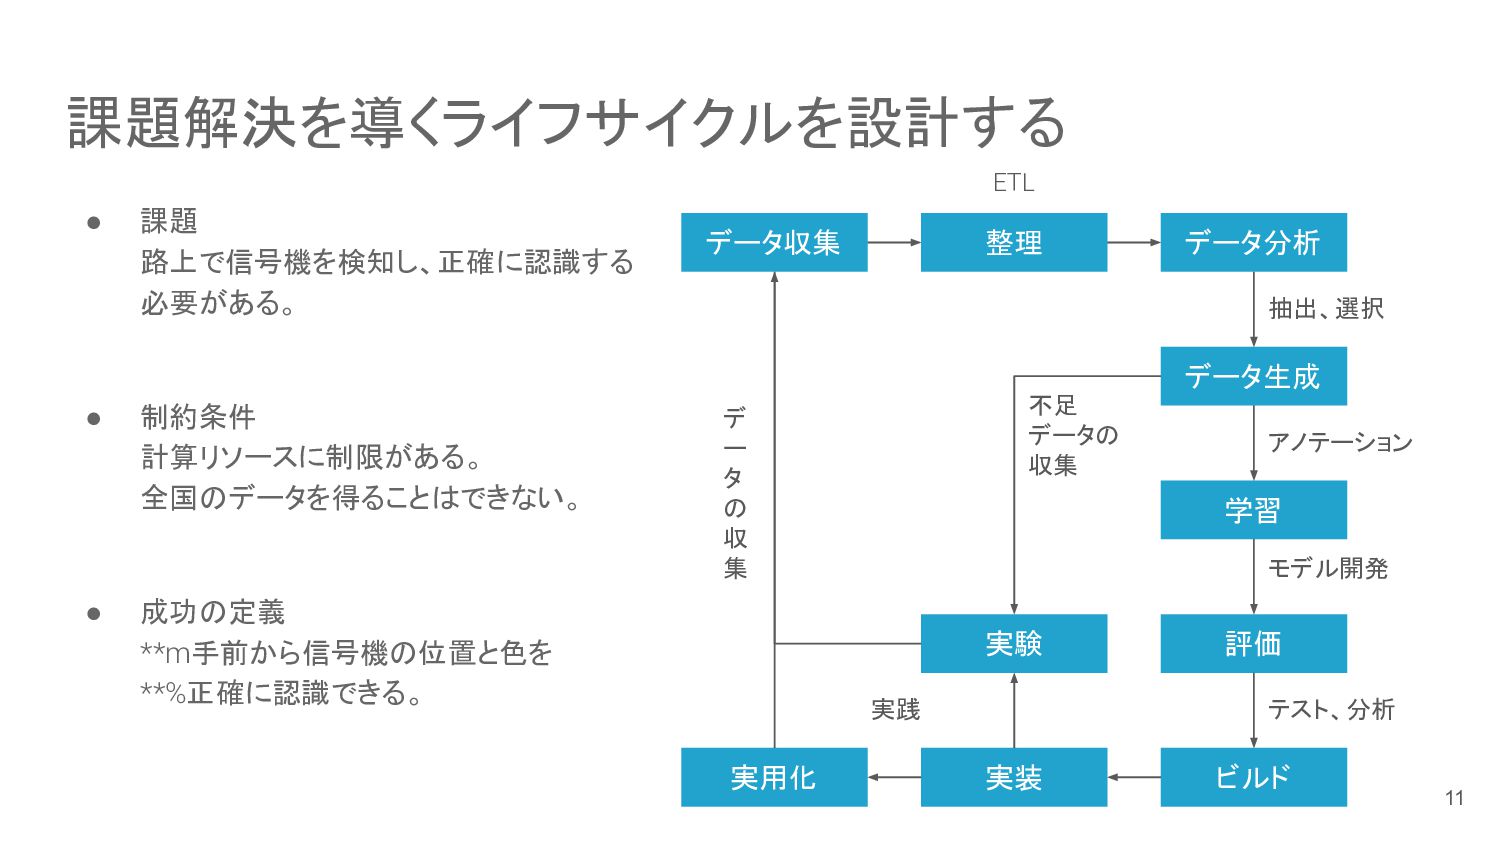
課題解決を導くライフサイクルを設計する • 課題 路上で信号機を検知し、正確に認識する 必要がある。 • 制約条件 計算リソースに制限がある。 全国のデータを得ることはできない。 •
成功の定義 **m手前から信号機の位置と色を **%正確に認識できる。 データ収集 データ分析 データ生成 学習 評価 実用化 ビルド 実装 デ ー タ の 収 集 アノテーション 実験 抽出、選択 整理 ETL モデル開発 テスト、分析 不足 データの 収集 実践 11
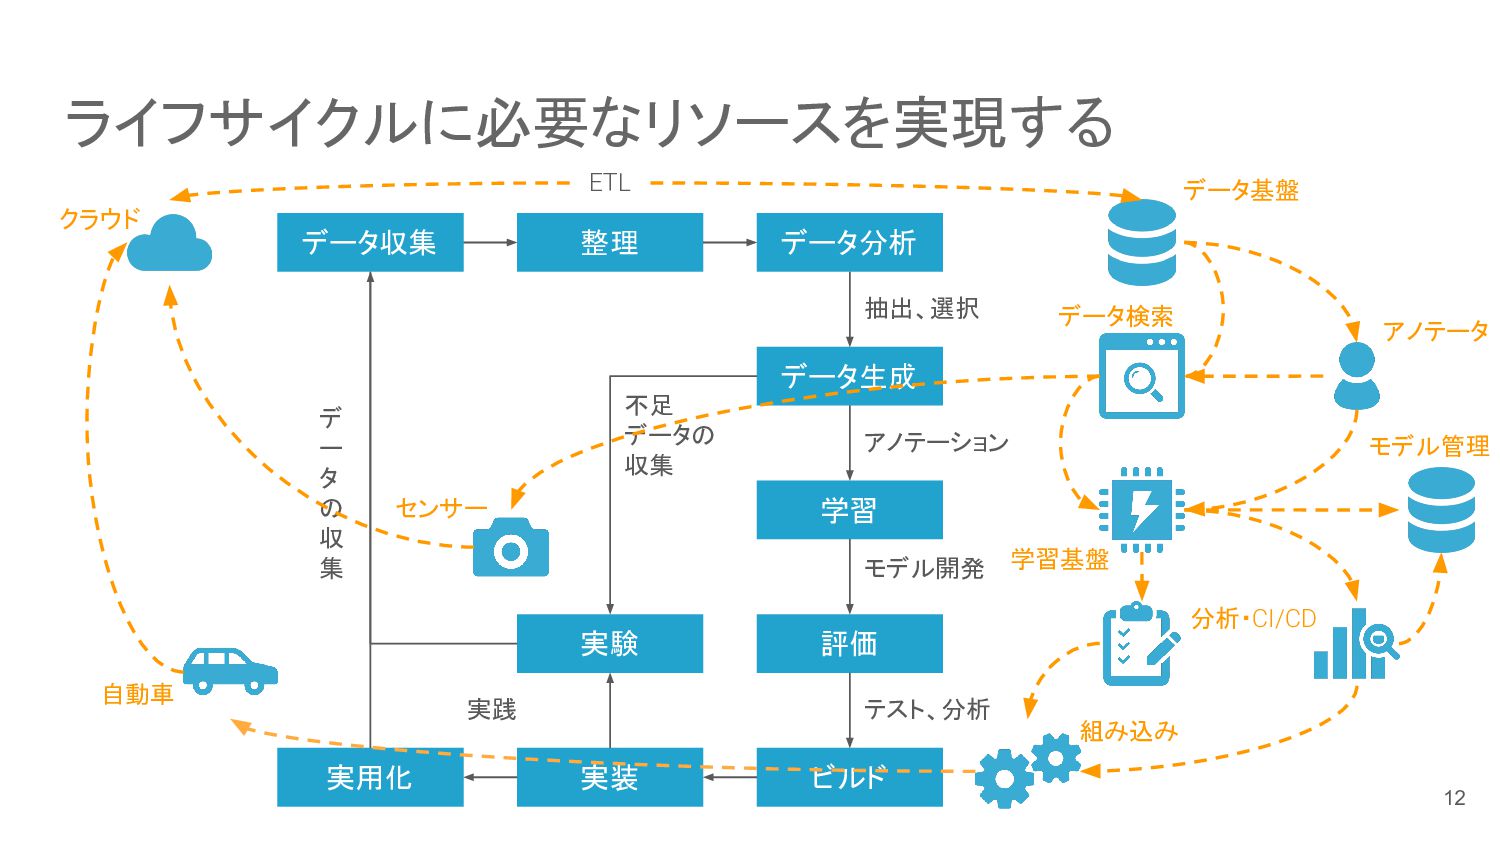
ライフサイクルに必要なリソースを実現する データ収集 データ分析 データ生成 学習 評価 実用化 ビルド 実装 デ
ー タ の 収 集 アノテーション 実験 抽出、選択 整理 ETL モデル開発 テスト、分析 不足 データの 収集 実践 クラウド データ基盤 データ検索 アノテータ 学習基盤 分析・CI/CD 組み込み センサー 自動車 モデル管理 12
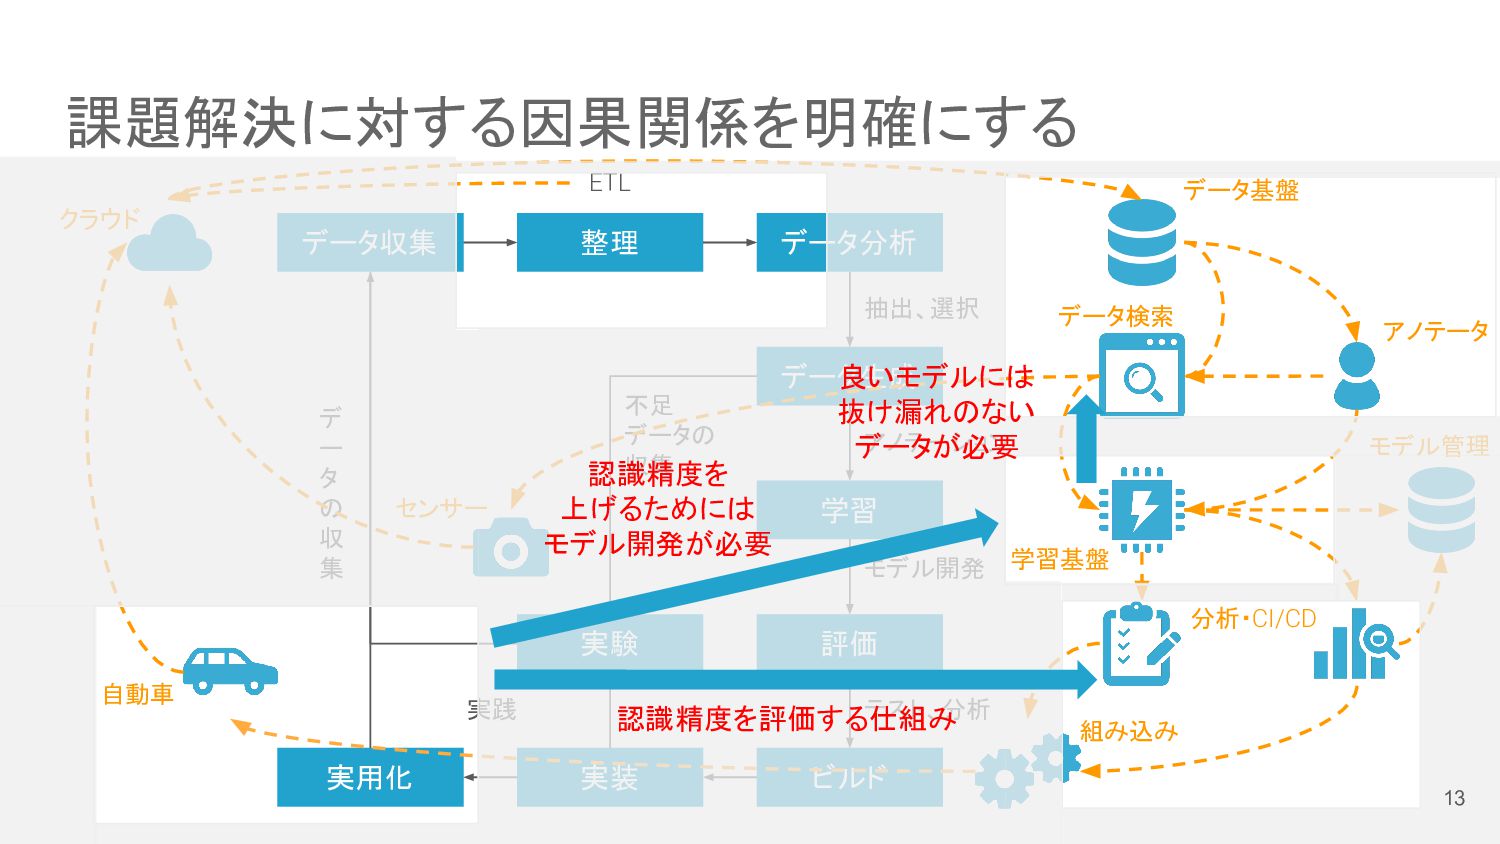
課題解決に対する因果関係を明確にする データ収集 データ分析 データ生成 学習 評価 実用化 ビルド 実装 デ
ー タ の 収 集 アノテーション 実験 抽出、選択 整理 ETL モデル開発 テスト、分析 不足 データの 収集 実践 クラウド データ基盤 データ検索 アノテータ 学習基盤 分析・CI/CD 組み込み センサー 自動車 モデル管理 認識精度を 上げるためには モデル開発が必要 認識精度を評価する仕組み 良いモデルには 抜け漏れのない データが必要 13
データ検索、コードテスト、モデル管理 14
データ検索 15
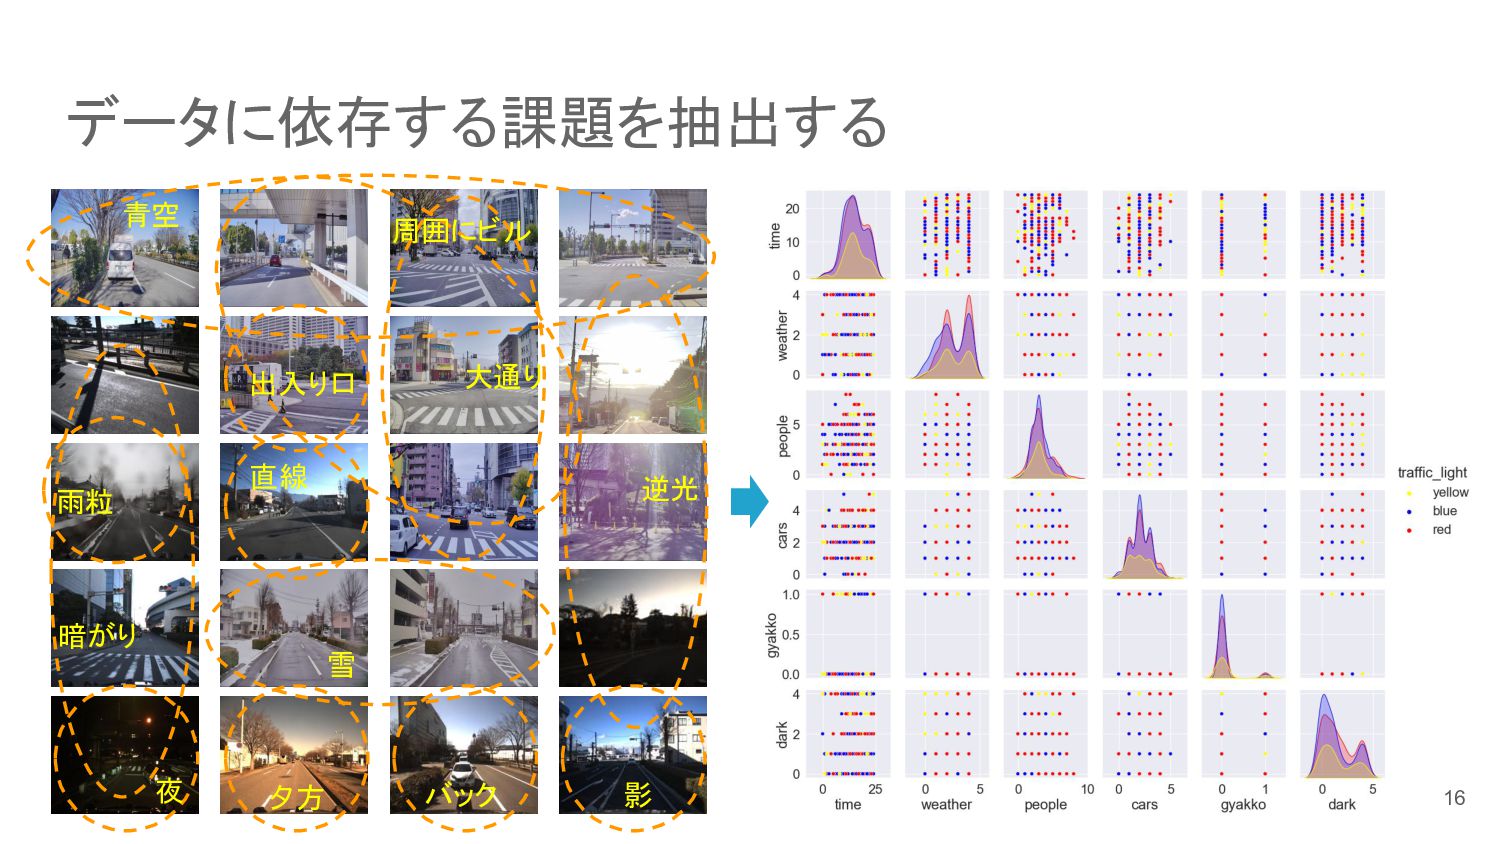
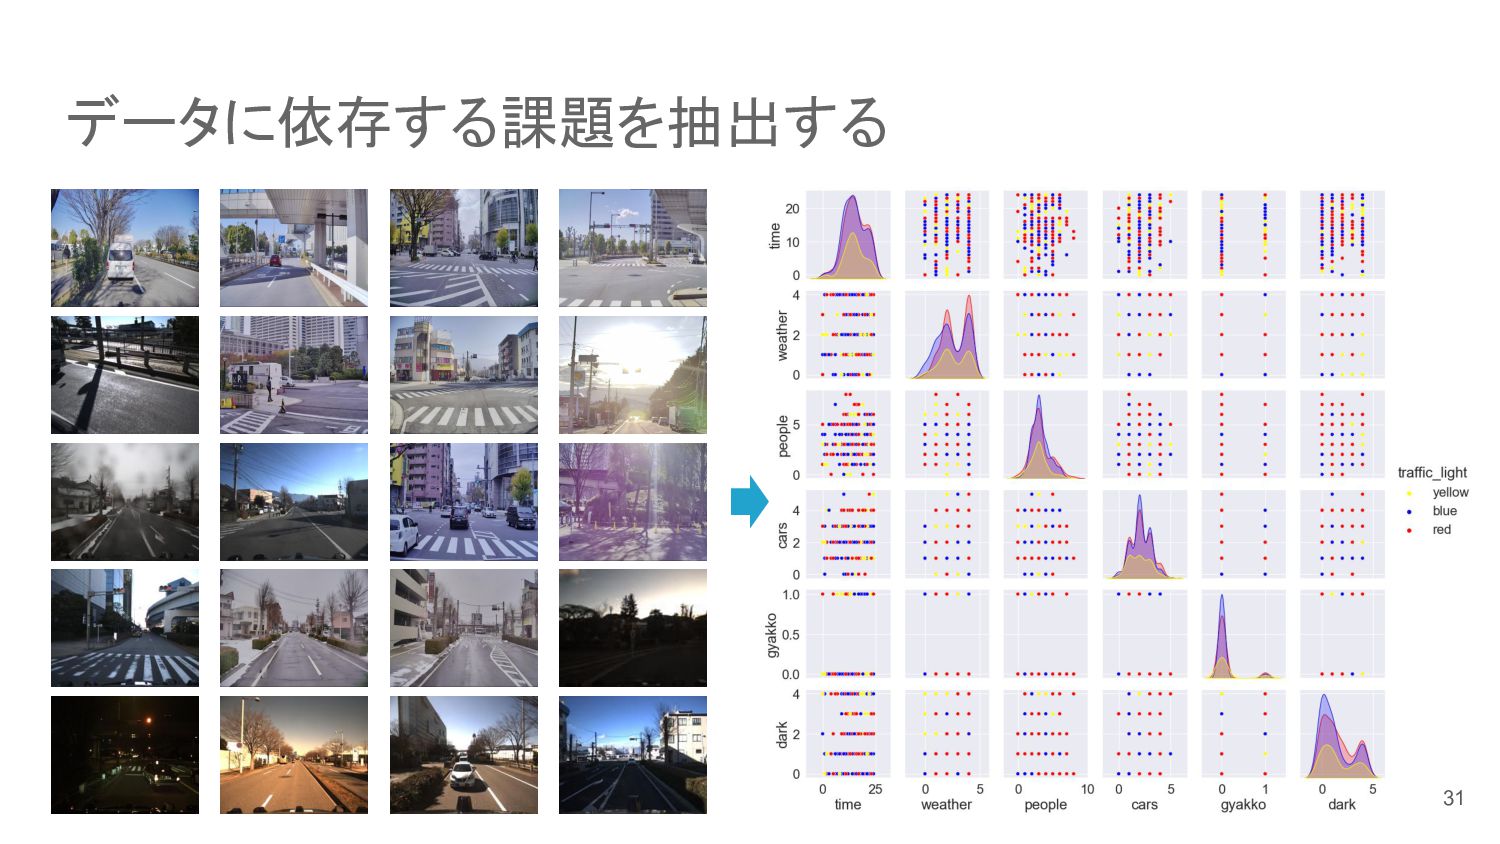
データに依存する課題を抽出する 夜 夕方 逆光 影 バック 雨粒 暗がり 雪 大通り
周囲にビル 出入り口 青空 直線 16
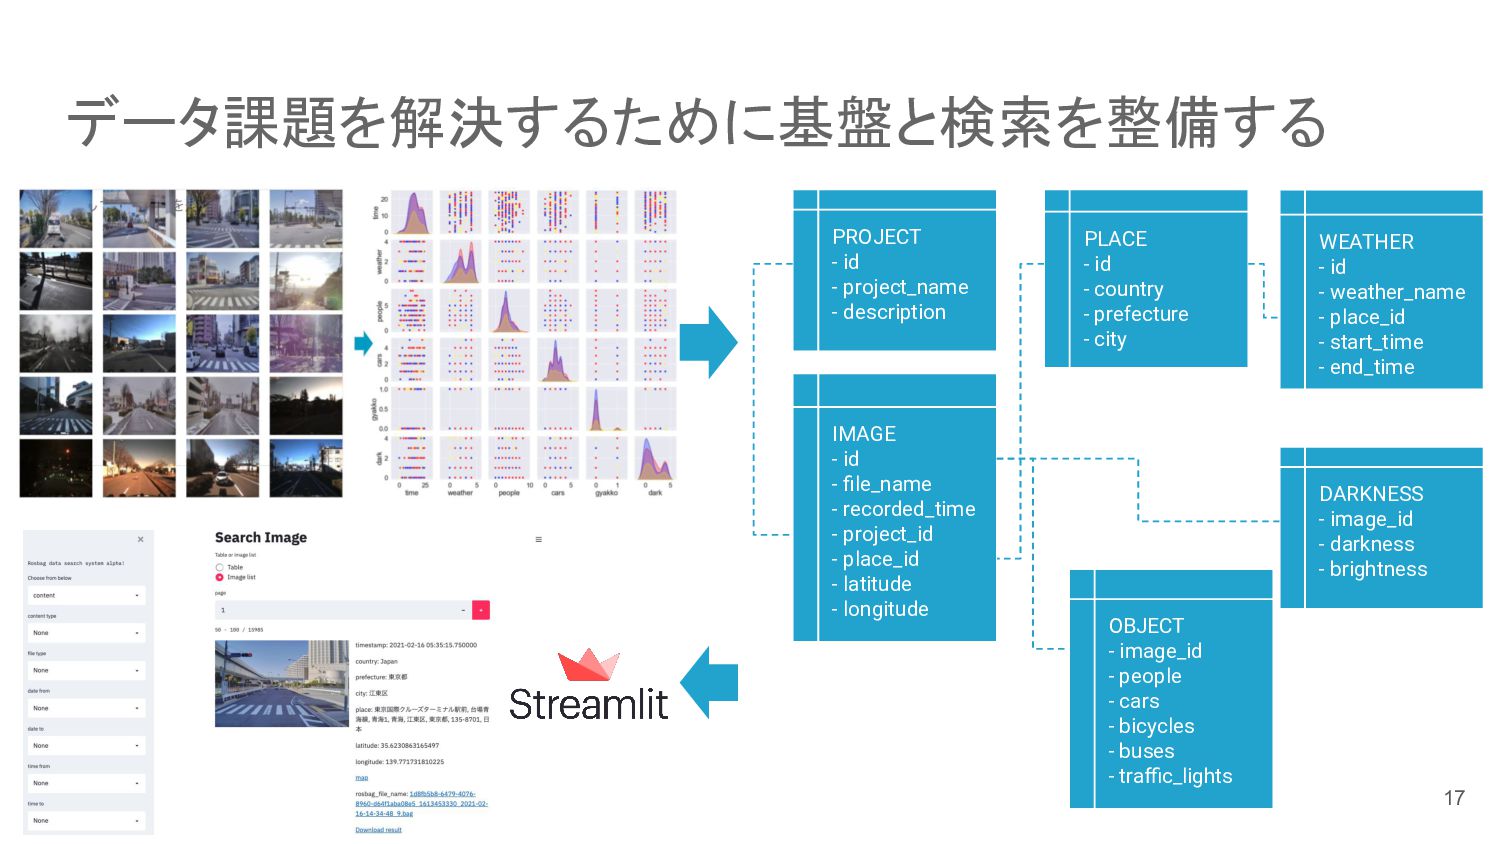
データ課題を解決するために基盤と検索を整備する PROJECT - id - project_name - description PLACE -
id - country - prefecture - city WEATHER - id - weather_name - place_id - start_time - end_time IMAGE - id - file_name - recorded_time - project_id - place_id - latitude - longitude OBJECT - image_id - people - cars - bicycles - buses - traffic_lights DARKNESS - image_id - darkness - brightness 17
検索 18
コードテスト 19
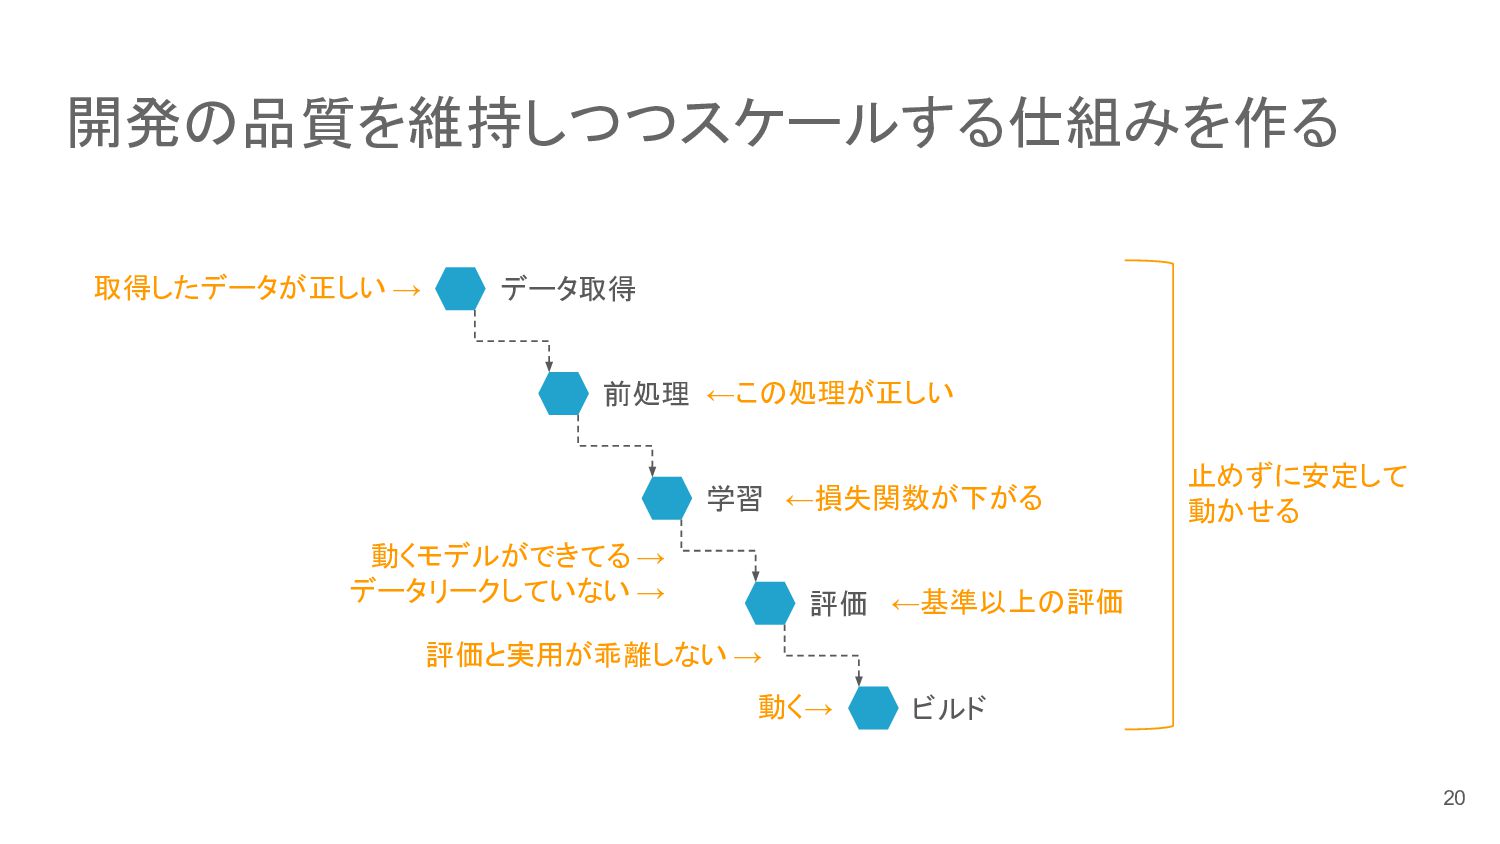
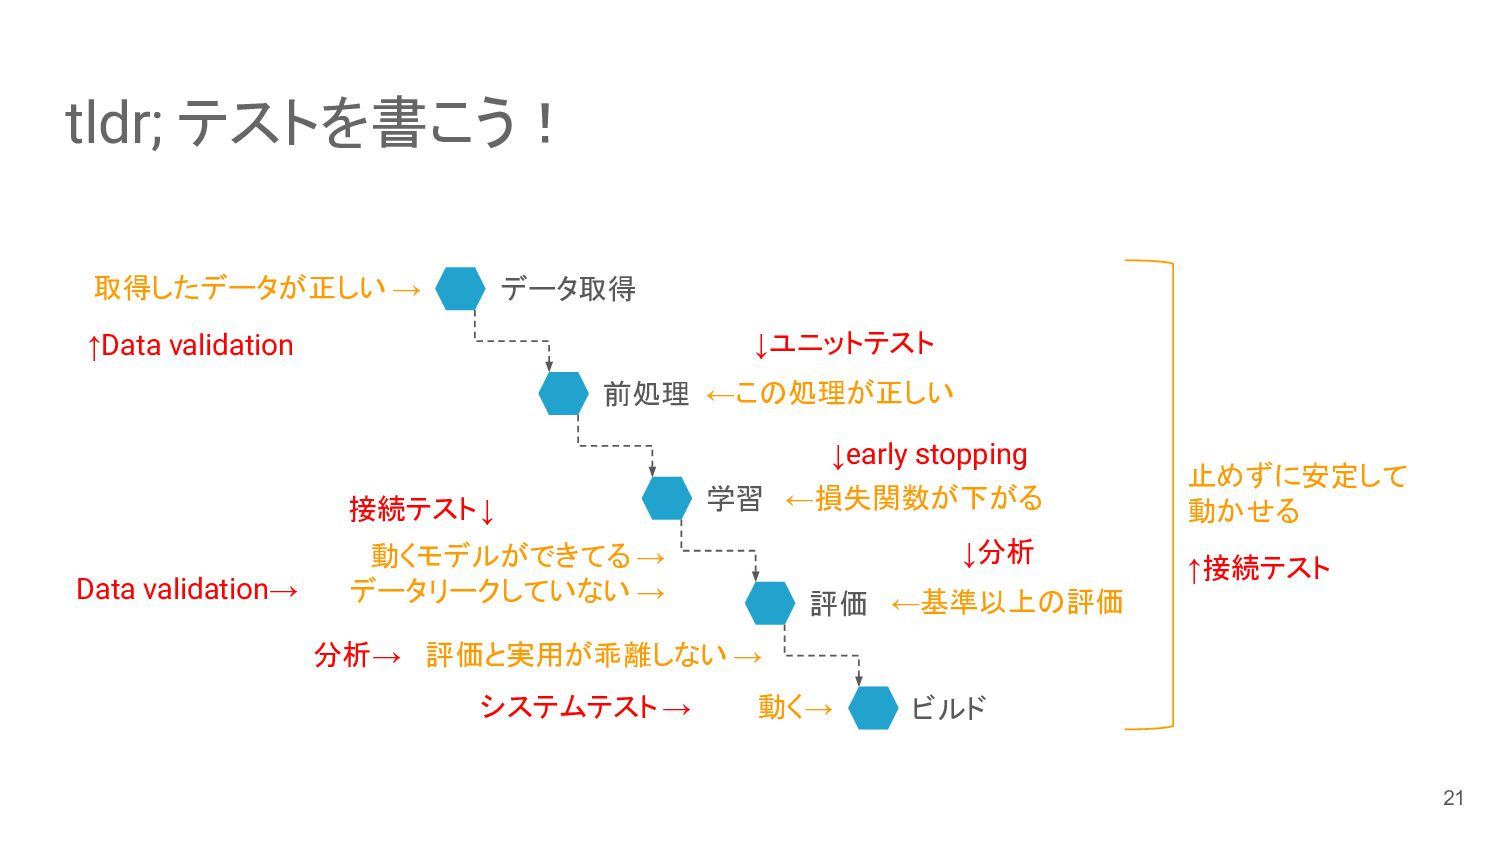
開発の品質を維持しつつスケールする仕組みを作る 取得したデータが正しい → ←この処理が正しい 動くモデルができてる → データリークしていない → ←基準以上の評価 評価と実用が乖離しない
→ 止めずに安定して 動かせる データ取得 前処理 学習 評価 ビルド ←損失関数が下がる 動く→ 20
tldr; テストを書こう! 取得したデータが正しい → ←この処理が正しい 動くモデルができてる → データリークしていない → ←基準以上の評価
評価と実用が乖離しない → 止めずに安定して 動かせる データ取得 前処理 学習 評価 ビルド ←損失関数が下がる 動く→ ↑Data validation ↓ユニットテスト ↓early stopping ↓分析 システムテスト→ ↑接続テスト Data validation→ 接続テスト↓ 分析→ 21
• ソフトウェア開発ではプログラムを通してロジックをテストする • 機械学習ではコードを通してデータで確率をテストする データ モデル以外もテストする YES or NO 0
~ 1 ソフトウェア開発のテスト 機械学習のテスト 入力 正解 出力 assert 関数 指標 推論 evaluate モデル 関数 テスト通過率:95/100 Accuracy:0.99 Precision:0.95 Recall:0.60 22
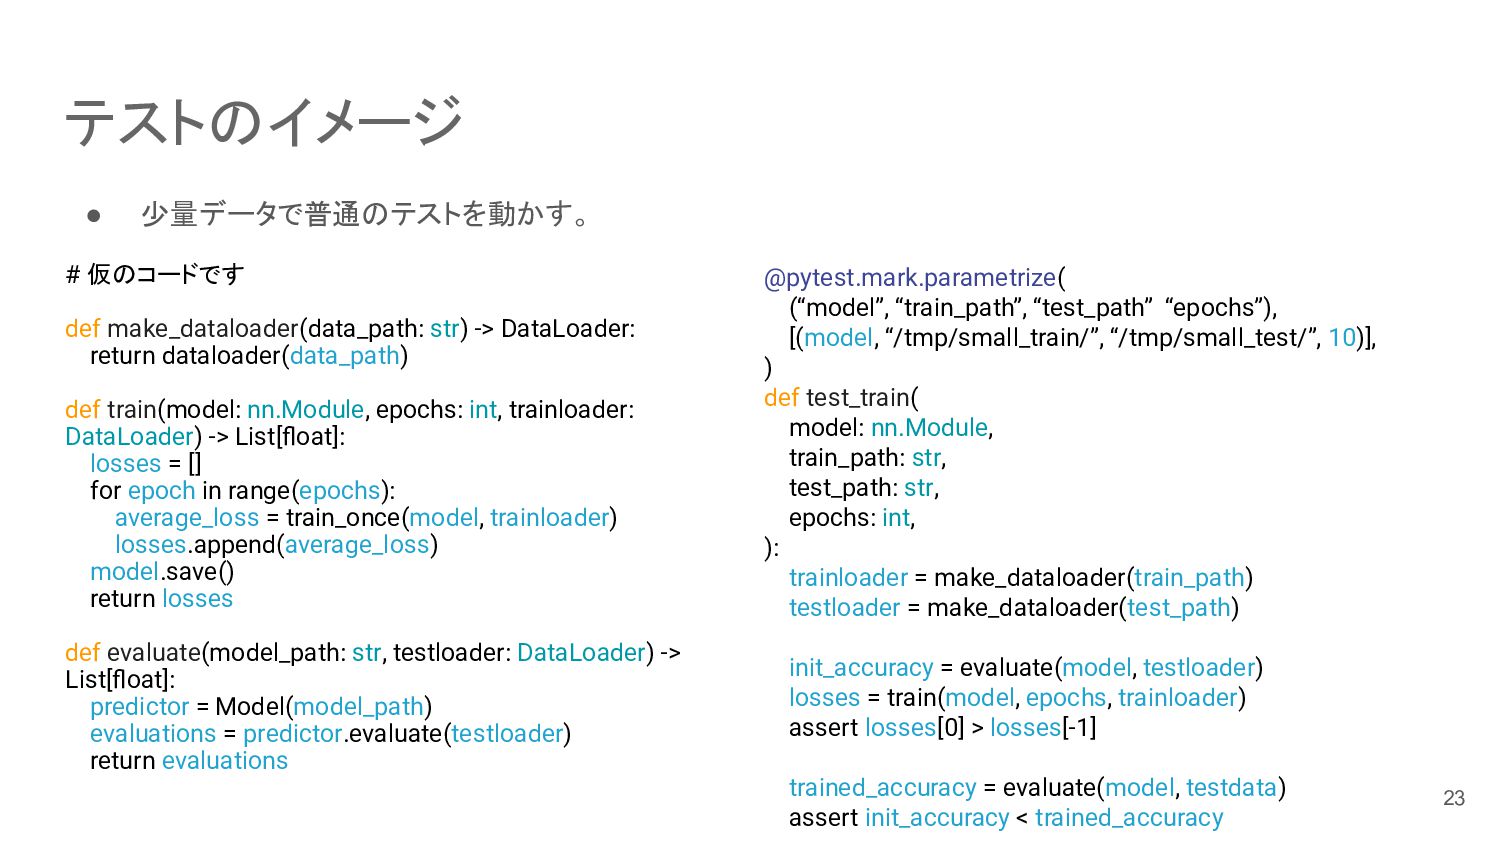
テストのイメージ # 仮のコードです def make_dataloader(data_path: str) -> DataLoader: return dataloader(data_path)
def train(model: nn.Module, epochs: int, trainloader: DataLoader) -> List[float]: losses = [] for epoch in range(epochs): average_loss = train_once(model, trainloader) losses.append(average_loss) model.save() return losses def evaluate(model_path: str, testloader: DataLoader) -> List[float]: predictor = Model(model_path) evaluations = predictor.evaluate(testloader) return evaluations • 少量データで普通のテストを動かす。 @pytest.mark.parametrize( (“model”, “train_path”, “test_path” “epochs”), [(model, “/tmp/small_train/”, “/tmp/small_test/”, 10)], ) def test_train( model: nn.Module, train_path: str, test_path: str, epochs: int, ): trainloader = make_dataloader(train_path) testloader = make_dataloader(test_path) init_accuracy = evaluate(model, testloader) losses = train(model, epochs, trainloader) assert losses[0] > losses[-1] trained_accuracy = evaluate(model, testdata) assert init_accuracy < trained_accuracy 23
モデル管理 24
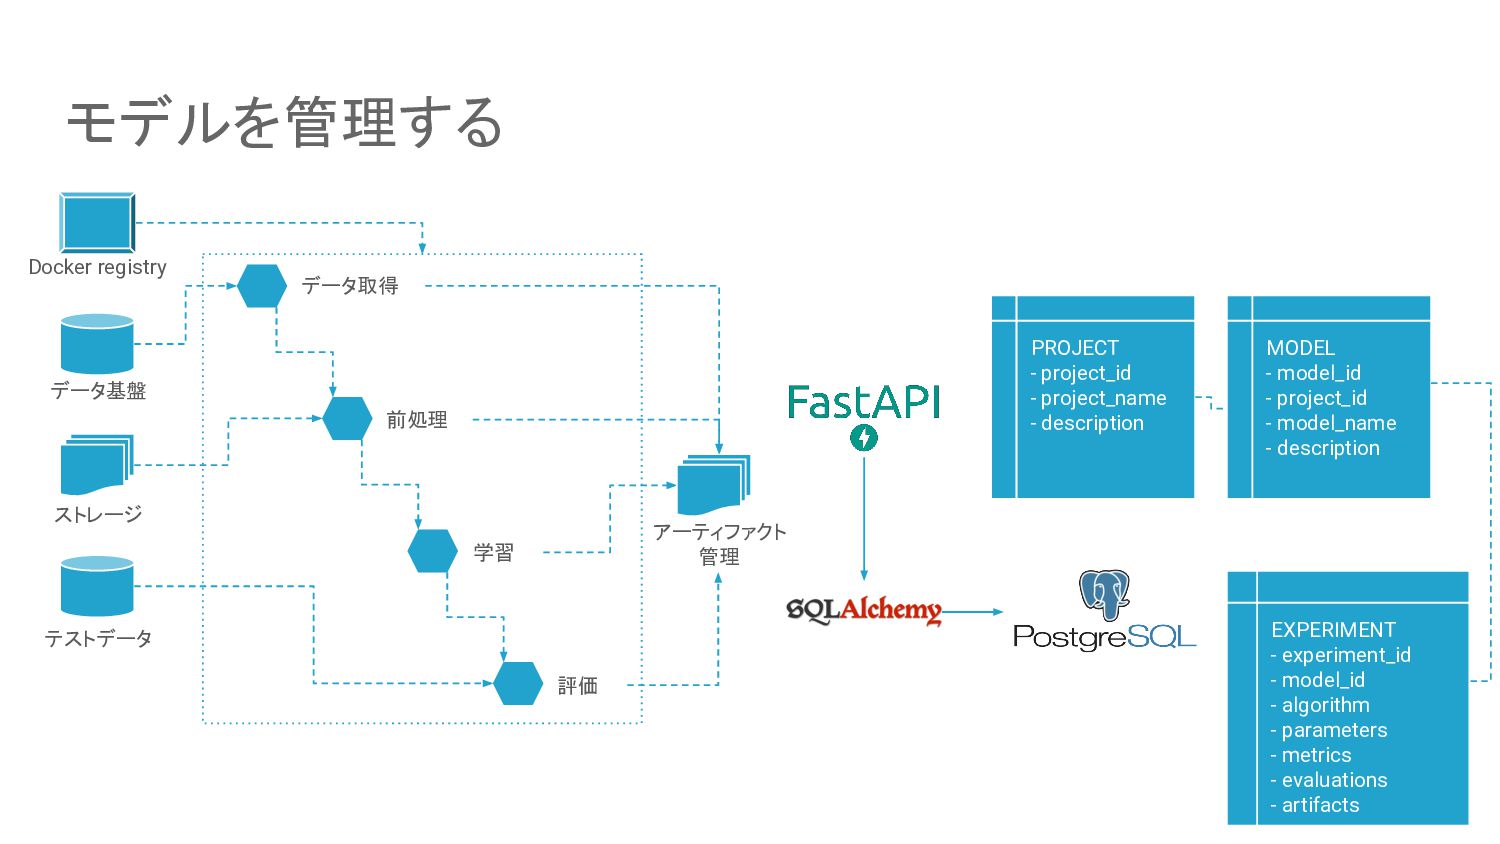
モデルを管理する 25 データ取得 前処理 学習 評価 データ基盤 ストレージ テストデータ アーティファクト
管理 Docker registry 25 PROJECT - project_id - project_name - description MODEL - model_id - project_id - model_name - description EXPERIMENT - experiment_id - model_id - algorithm - parameters - metrics - evaluations - artifacts
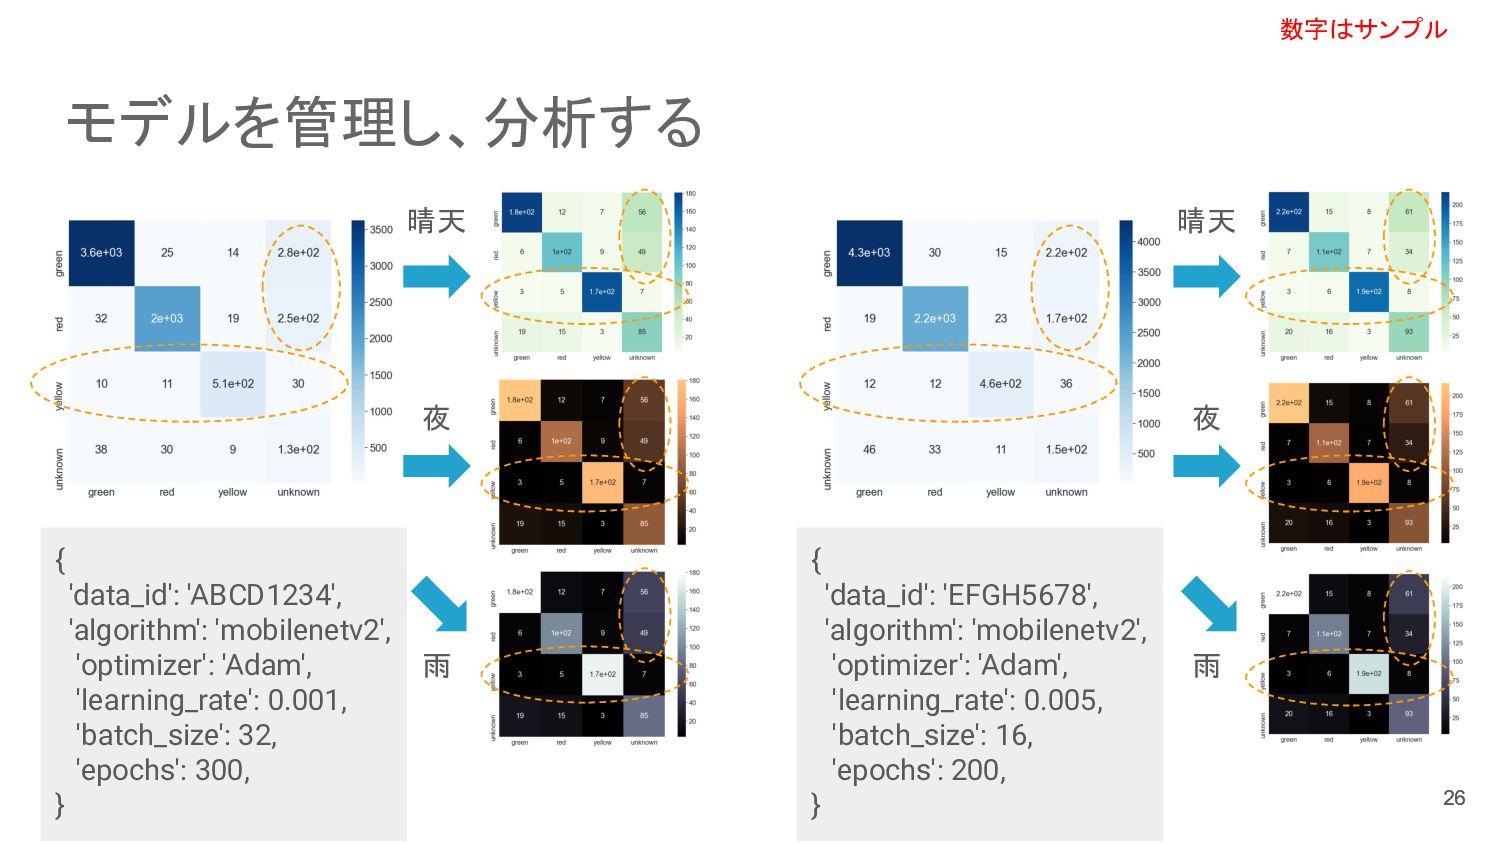
モデルを管理し、分析する 26 26 晴天 夜 雨 数字はサンプル 晴天 夜 雨
{ 'data_id': 'ABCD1234', 'algorithm': 'mobilenetv2', 'optimizer': 'Adam', 'learning_rate': 0.001, 'batch_size': 32, 'epochs': 300, } { 'data_id': 'EFGH5678', 'algorithm': 'mobilenetv2', 'optimizer': 'Adam', 'learning_rate': 0.005, 'batch_size': 16, 'epochs': 200, }
まとめ 27
ティアフォー MLOpsエンジニア募集中! https://herp.careers/v1/tier4/zHA-dVY6ORa4 • 2Dや3Dの物体検出モデル開発および基盤開発 • KubernetesおよびAWSインフラの構築、運用 • Deep Learningのモデル最適化および推論器開発 •
Deep LearningのためのシミュレーションとCI/CD • データパイプライン、データ基盤、検索 • 技術的に難しいことすべて 28
本を出版しました! • AIエンジニアのための機械学習システムデザインパターン • 2021年5月17日出版 • https://www.amazon.co.jp/dp/4798169447/ • Amazon.co.jp ◦
情報学・情報科学部門 1位! ◦ 人工知能部門 1位! ◦ 増刷決定! • 中国語版と韓国語訳も出るらしい! 29
機械学習を使ったプロダクト例 30
データに依存する課題を抽出する 31
機械学習を使ったプロダクトをOpsする データ収集と 整理、検索 フィードバックと ロジック開発 実装と実験 32
More Decks by shibuiwilliam
See All by shibuiwilliam
AIエージェントの「テストは通るのに本番で壊れる」を減らす
shibuiwilliam
3
110
LLM・AIエージェント システムベストプラクティス
shibuiwilliam
2
150
The Conductor Pattern -Multi-Granularity Feedback for Creative Agents-
shibuiwilliam
2
130
LLM・AIエージェントシステムベストプラクティス
shibuiwilliam
8
2.9k
LLMやAIエージェントをソフトウェアに組み込むプラクティス
shibuiwilliam
4
6.7k
From Prompt Engineering to Loop Engineering
shibuiwilliam
2
540
OntologyとLLMOps
shibuiwilliam
4
230
Rule repository
shibuiwilliam
3
120
LLM時代の検索アーキテクチャと技術的意思決定
shibuiwilliam
5
3k
Other Decks in Technology
See All in Technology
Agent Routerで作るマルチテナント 推論基盤 #CNDW2026 / Building Multi-Tenant Inference Platform with Agent Router #CNDW2026
everpeace
5
600
New Relicのアラート対応をClaude Codeで自動修正するワークフローを作った話
manabuseki
2
630
みん強Lightning! データ基盤ひとりでできるかな
endonanana
0
190
Well, that’s weird…
csswizardry
1
200
市販IoT機器や自作IoT機器とHomeAssistantを駆使して家の電気代をできる限り見える化する方法の考案
harutiro
0
420
AWS Well-Arhitected Frameworkセキュリティの柱 について
miu_crescent
PRO
2
250
MCPでネットワーク障害調査を自動化する前に直すべき3つのこと
yama3133
1
660
IP重複は"ランディングVPC"で受け止める ― PrivateLink と Transit Gatewayによるマルチテナント接続基盤の設計
hatahata021
3
270
技術書典で本を売る流れ
yoshimura_datam
0
130
RAGの改善を速く回すための評価基盤
yosukeyoshida
6
3.6k
フロントエンドのテストカバレッジは 100%強制がいい
bengo4com
5
1.5k
共通基盤の実装に Kotlin - Quarkus を選定した理由と採用したアーキテクチャ
nealle
1
160
Featured
See All Featured
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
670
Designing for Performance
lara
612
70k
Templates, Plugins, & Blocks: Oh My! Creating the theme that thinks of everything
marktimemedia
31
3k
Data-driven link building: lessons from a $708K investment (BrightonSEO talk)
szymonslowik
1
1.5k
Facilitating Awesome Meetings
lara
57
7.2k
How Software Deployment tools have changed in the past 20 years
geshan
3
35k
How to Ace a Technical Interview
jacobian
280
24k
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
820
Accessibility Awareness
sabderemane
1
310
Balancing Empowerment & Direction
lara
6
1.4k
It's Worth the Effort
3n
188
29k
Collaborative Software Design: How to facilitate domain modelling decisions
baasie
1
390


 shibuiwilliam
 everpeace
 manabuseki
 endonanana
 csswizardry
 harutiro
 miu_crescent
 yama3133
 hatahata021
 yoshimura_datam
 yosukeyoshida
 bengo4com
 nealle
 marktimemedia
 lara
 szymonslowik
 geshan
 jacobian
 inesmontani
 sabderemane
 3n
 baasie