Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
翌四半期会計期間の売上高増減予測
Search
Shunsuke
March 08, 2020
110
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
翌四半期会計期間の売上高増減予測
Shunsuke
March 08, 2020
Featured
See All Featured
Building a Modern Day E-commerce SEO Strategy
aleyda
45
9.3k
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
ラッコキーワード サービス紹介資料
rakko
1
5.4M
Paper Plane
katiecoart
PRO
5
54k
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
Ruling the World: When Life Gets Gamed
codingconduct
0
400
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Dealing with People You Can't Stand - Big Design 2015
cassininazir
367
27k
Understanding Cognitive Biases in Performance Measurement
bluesmoon
32
3.1k
Technical Leadership for Architectural Decision Making
baasie
3
600
Redefining SEO in the New Era of Traffic Generation
szymonslowik
1
480
The Cult of Friendly URLs
andyhume
79
7k
Transcript
翌四半期会計期間の 売上高増減予測 1 楠瀬 俊祐
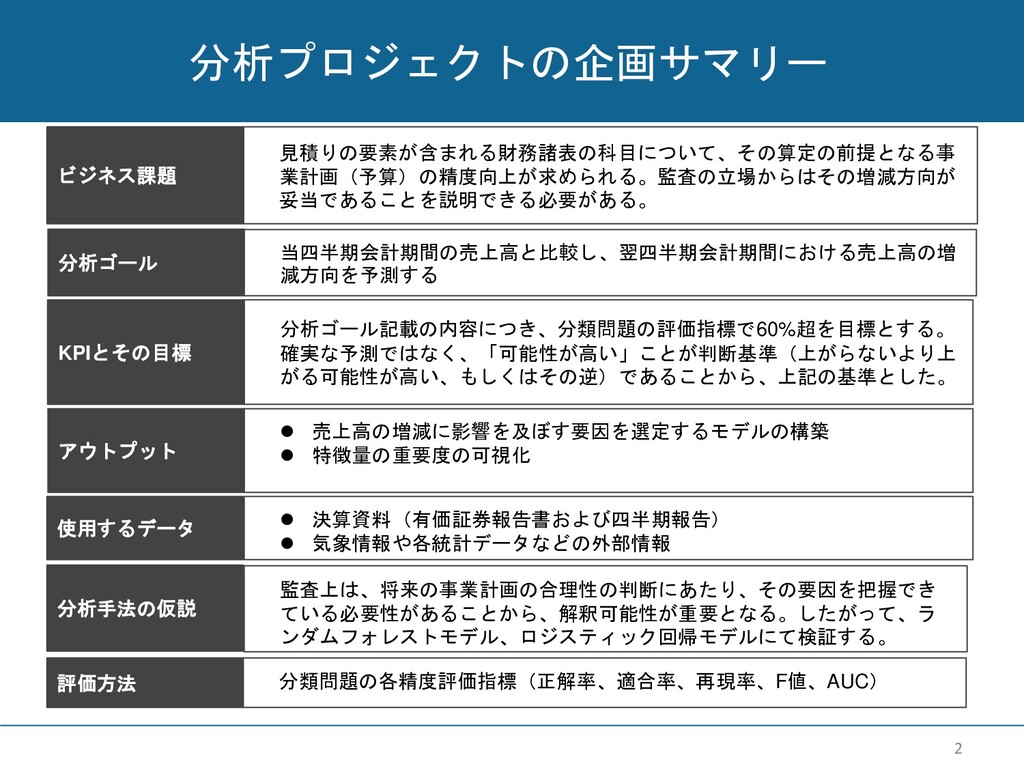
分析プロジェクトの企画サマリー 2 分析ゴール 当四半期会計期間の売上高と比較し、翌四半期会計期間における売上高の増 減方向を予測する アウトプット ⚫ 売上高の増減に影響を及ぼす要因を選定するモデルの構築 ⚫ 特徴量の重要度の可視化
分析手法の仮説 監査上は、将来の事業計画の合理性の判断にあたり、その要因を把握でき ている必要性があることから、解釈可能性が重要となる。したがって、ラ ンダムフォレストモデル、ロジスティック回帰モデルにて検証する。 評価方法 分類問題の各精度評価指標(正解率、適合率、再現率、F値、AUC) 使用するデータ ⚫ 決算資料(有価証券報告書および四半期報告) ⚫ 気象情報や各統計データなどの外部情報 ビジネス課題 見積りの要素が含まれる財務諸表の科目について、その算定の前提となる事 業計画(予算)の精度向上が求められる。監査の立場からはその増減方向が 妥当であることを説明できる必要がある。 KPIとその目標 分析ゴール記載の内容につき、分類問題の評価指標で60%超を目標とする。 確実な予測ではなく、「可能性が高い」ことが判断基準(上がらないより上 がる可能性が高い、もしくはその逆)であることから、上記の基準とした。
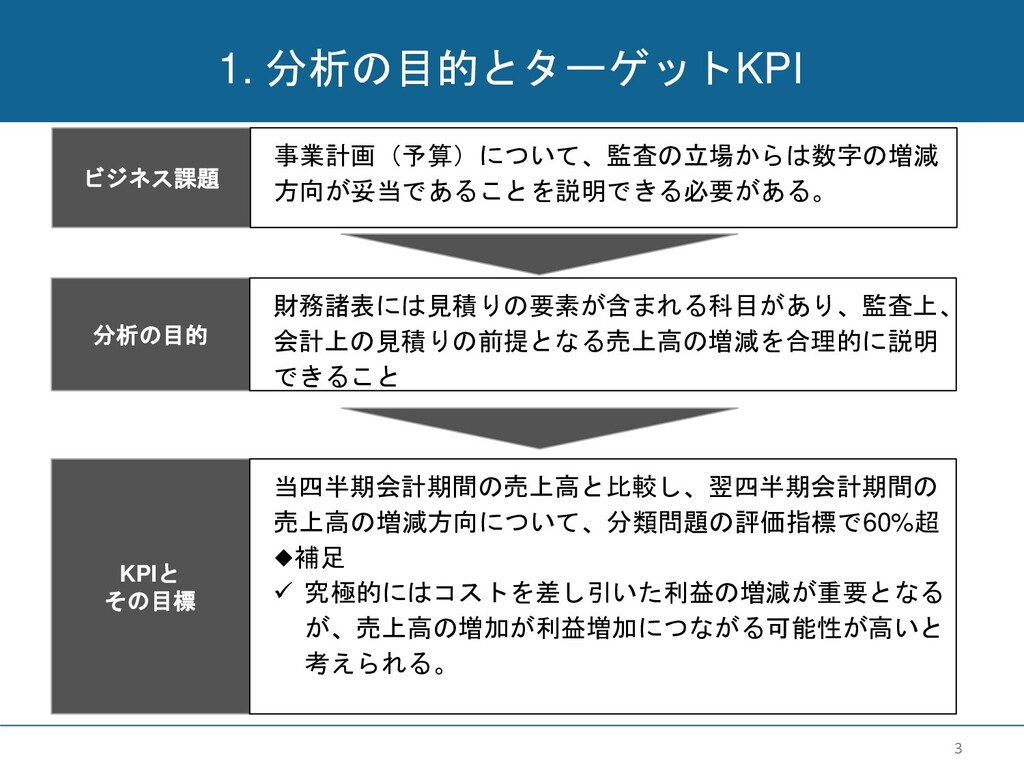
1. 分析の目的とターゲットKPI 3 KPIと その目標 当四半期会計期間の売上高と比較し、翌四半期会計期間の 売上高の増減方向について、分類問題の評価指標で60%超 ◆補足 ✓ 究極的にはコストを差し引いた利益の増減が重要となる
が、売上高の増加が利益増加につながる可能性が高いと 考えられる。 分析の目的 財務諸表には見積りの要素が含まれる科目があり、監査上、 会計上の見積りの前提となる売上高の増減を合理的に説明 できること ビジネス課題 事業計画(予算)について、監査の立場からは数字の増減 方向が妥当であることを説明できる必要がある。
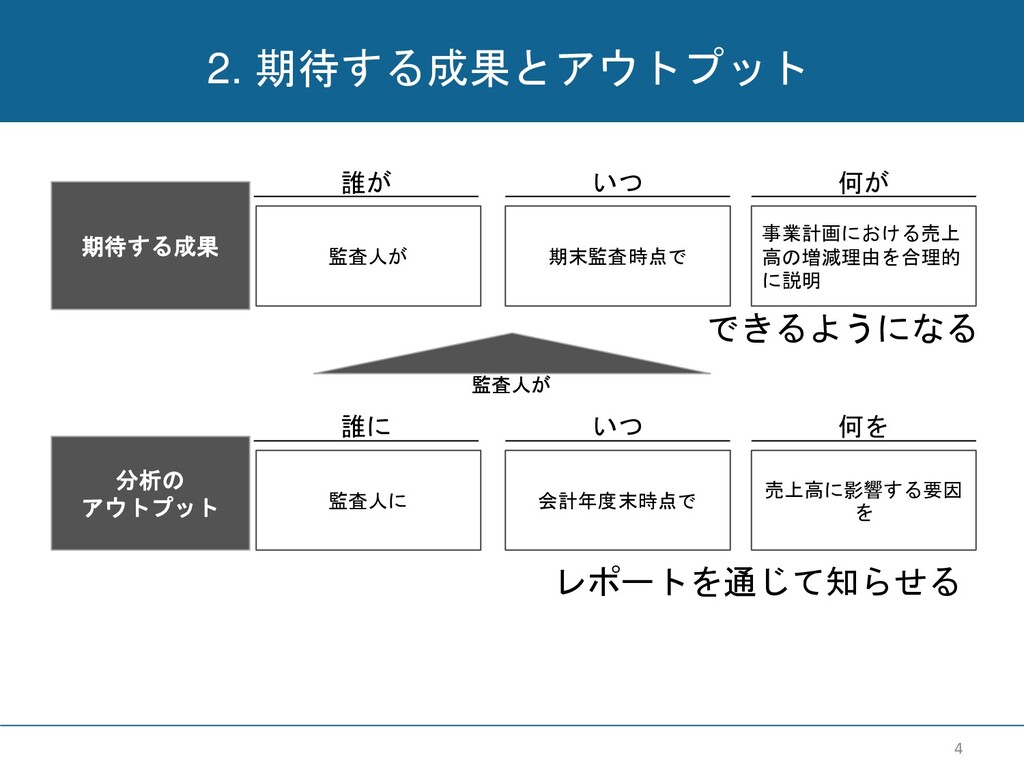
2. 期待する成果とアウトプット 4 誰に いつ 何を 期待する成果 レポートを通じて知らせる 分析の アウトプット
誰が いつ 何が できるようになる 監査人が 監査人が 監査人が 期末監査時点で 事業計画における売上 高の増減理由を合理的 に説明 監査人に 会計年度末時点で 売上高に影響する要因 を
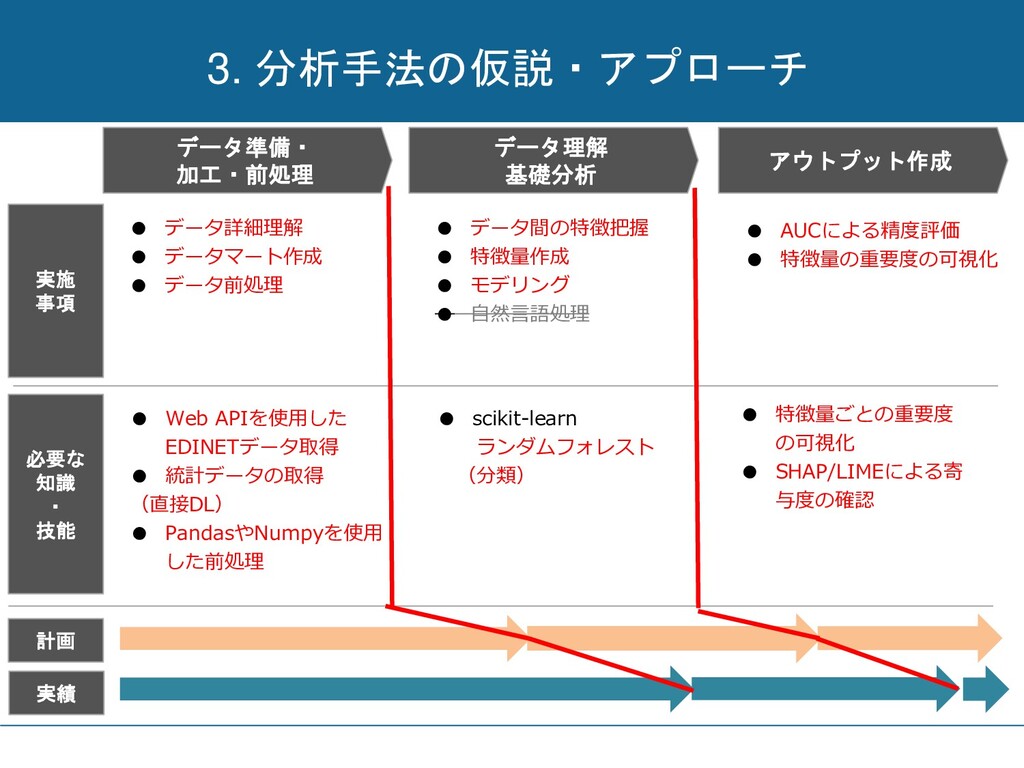
3. 分析手法の仮説・アプローチ データ準備・ 加工・前処理 データ理解 基礎分析 アウトプット作成 実施 事項 必要な
知識 ・ 技能 • データ詳細理解 • データマート作成 • データ前処理 • データ間の特徴把握 • 特徴量作成 • モデリング • 自然言語処理 • AUCによる精度評価 • 特徴量の重要度の可視化 • Web APIを使用した EDINETデータ取得 • 統計データの取得 (直接DL) • PandasやNumpyを使用 した前処理 • scikit-learn ランダムフォレスト (分類) • 特徴量ごとの重要度 の可視化 • SHAP/LIMEによる寄 与度の確認 計画 実績
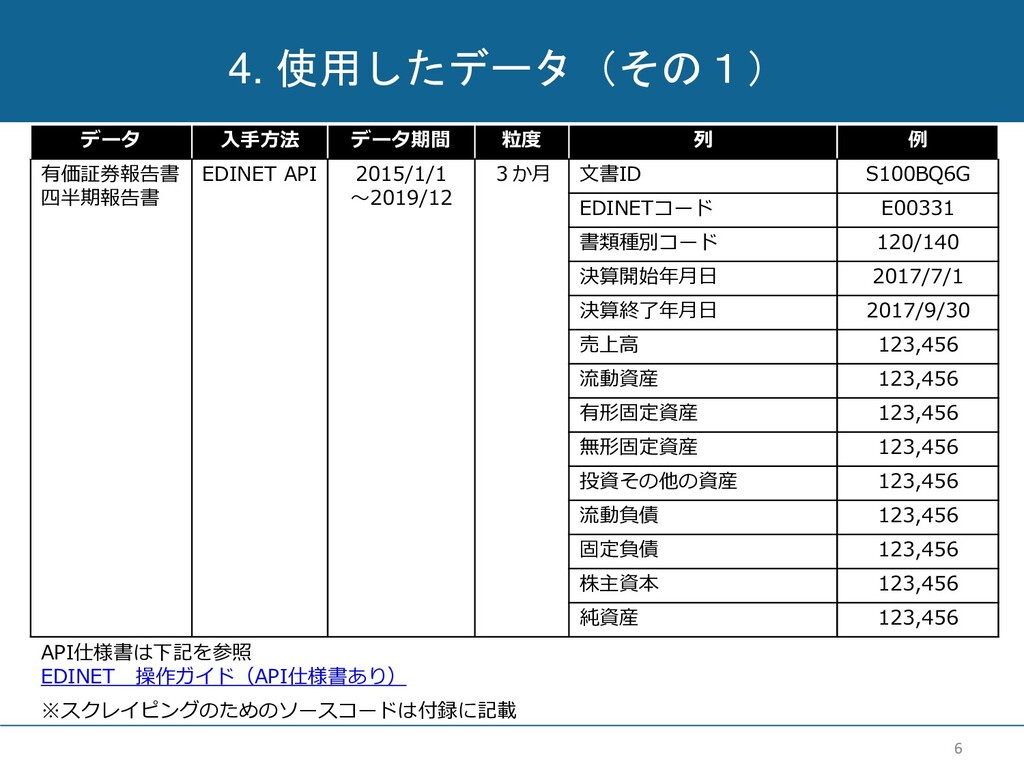
4. 使用したデータ(その1) 6 データ 入手方法 データ期間 粒度 列 例 有価証券報告書
四半期報告書 EDINET API 2015/1/1 ~2019/12 3か月 文書ID S100BQ6G EDINETコード E00331 書類種別コード 120/140 決算開始年月日 2017/7/1 決算終了年月日 2017/9/30 売上高 123,456 流動資産 123,456 有形固定資産 123,456 無形固定資産 123,456 投資その他の資産 123,456 流動負債 123,456 固定負債 123,456 株主資本 123,456 純資産 123,456 API仕様書は下記を参照 EDINET 操作ガイド(API仕様書あり) ※スクレイピングのためのソースコードは付録に記載
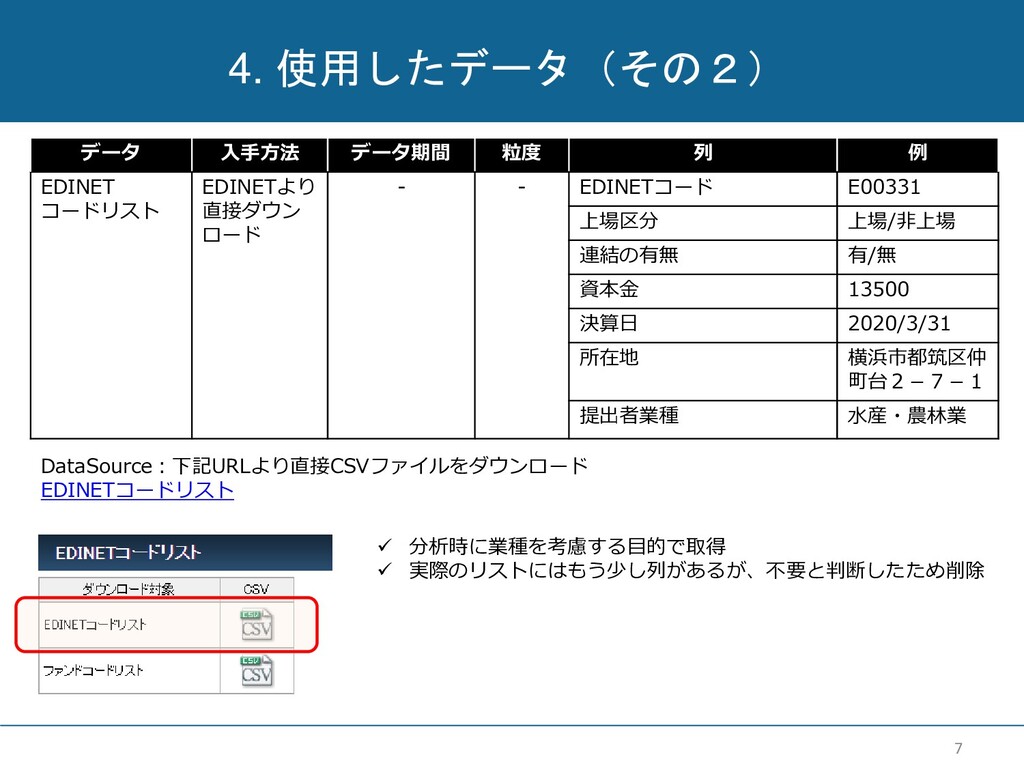
4. 使用したデータ(その2) 7 データ 入手方法 データ期間 粒度 列 例 EDINET
コードリスト EDINETより 直接ダウン ロード - - EDINETコード E00331 上場区分 上場/非上場 連結の有無 有/無 資本金 13500 決算日 2020/3/31 所在地 横浜市都筑区仲 町台2-7-1 提出者業種 水産・農林業 DataSource:下記URLより直接CSVファイルをダウンロード EDINETコードリスト ✓ 分析時に業種を考慮する目的で取得 ✓ 実際のリストにはもう少し列があるが、不要と判断したため削除
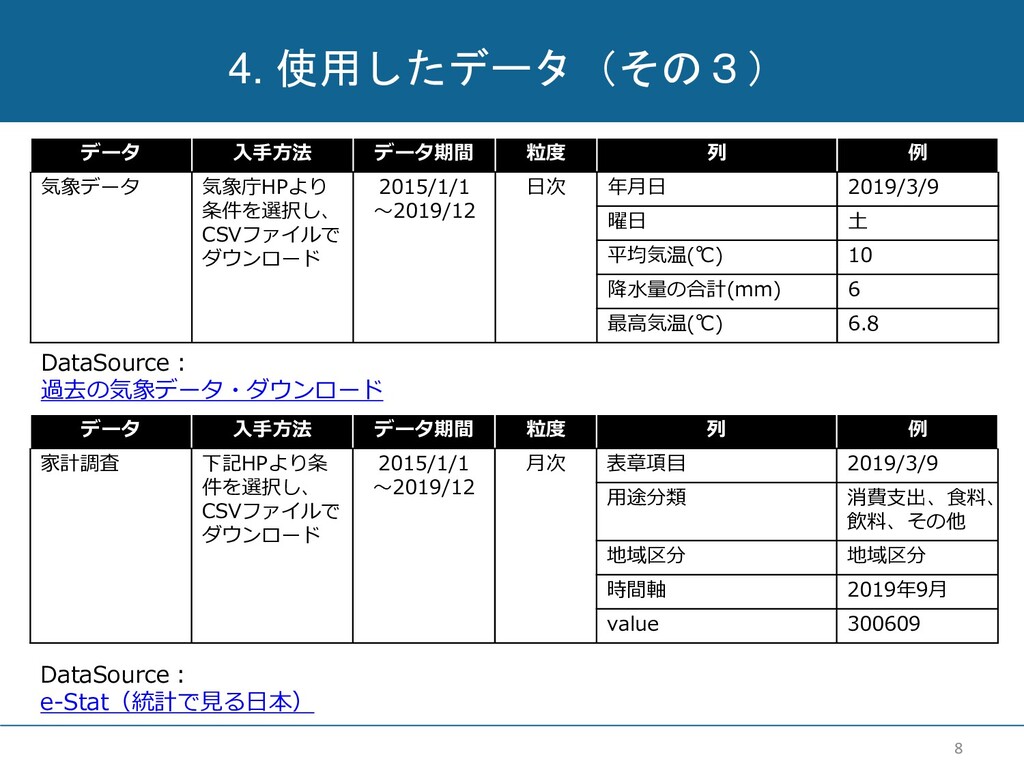
4. 使用したデータ(その3) 8 データ 入手方法 データ期間 粒度 列 例 気象データ
気象庁HPより 条件を選択し、 CSVファイルで ダウンロード 2015/1/1 ~2019/12 日次 年月日 2019/3/9 曜日 土 平均気温(℃) 10 降水量の合計(mm) 6 最高気温(℃) 6.8 DataSource: 過去の気象データ・ダウンロード データ 入手方法 データ期間 粒度 列 例 家計調査 下記HPより条 件を選択し、 CSVファイルで ダウンロード 2015/1/1 ~2019/12 月次 表章項目 2019/3/9 用途分類 消費支出、食料、 飲料、その他 地域区分 地域区分 時間軸 2019年9月 value 300609 DataSource: e-Stat(統計で見る日本)
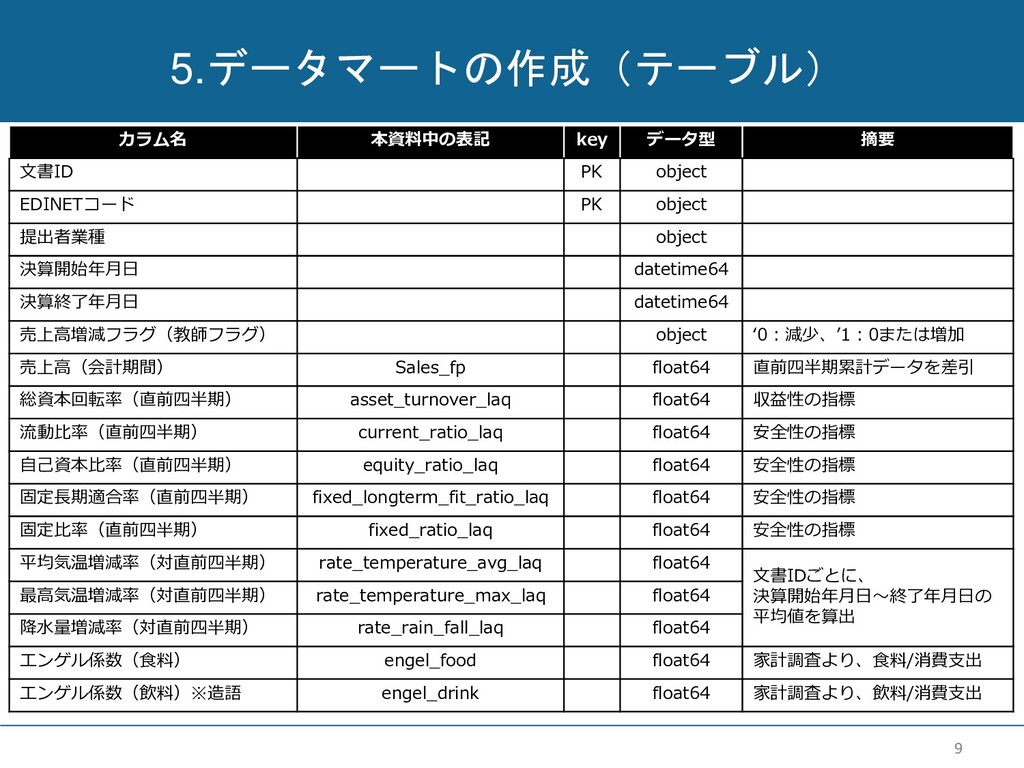
5.データマートの作成(テーブル) 9 カラム名 本資料中の表記 key データ型 摘要 文書ID PK object
EDINETコード PK object 提出者業種 object 決算開始年月日 datetime64 決算終了年月日 datetime64 売上高増減フラグ(教師フラグ) object ‘0:減少、’1:0または増加 売上高(会計期間) Sales_fp float64 直前四半期累計データを差引 総資本回転率(直前四半期) asset_turnover_laq float64 収益性の指標 流動比率(直前四半期) current_ratio_laq float64 安全性の指標 自己資本比率(直前四半期) equity_ratio_laq float64 安全性の指標 固定長期適合率(直前四半期) fixed_longterm_fit_ratio_laq float64 安全性の指標 固定比率(直前四半期) fixed_ratio_laq float64 安全性の指標 平均気温増減率(対直前四半期) rate_temperature_avg_laq float64 文書IDごとに、 決算開始年月日~終了年月日の 平均値を算出 最高気温増減率(対直前四半期) rate_temperature_max_laq float64 降水量増減率(対直前四半期) rate_rain_fall_laq float64 エンゲル係数(食料) engel_food float64 家計調査より、食料/消費支出 エンゲル係数(飲料)※造語 engel_drink float64 家計調査より、飲料/消費支出
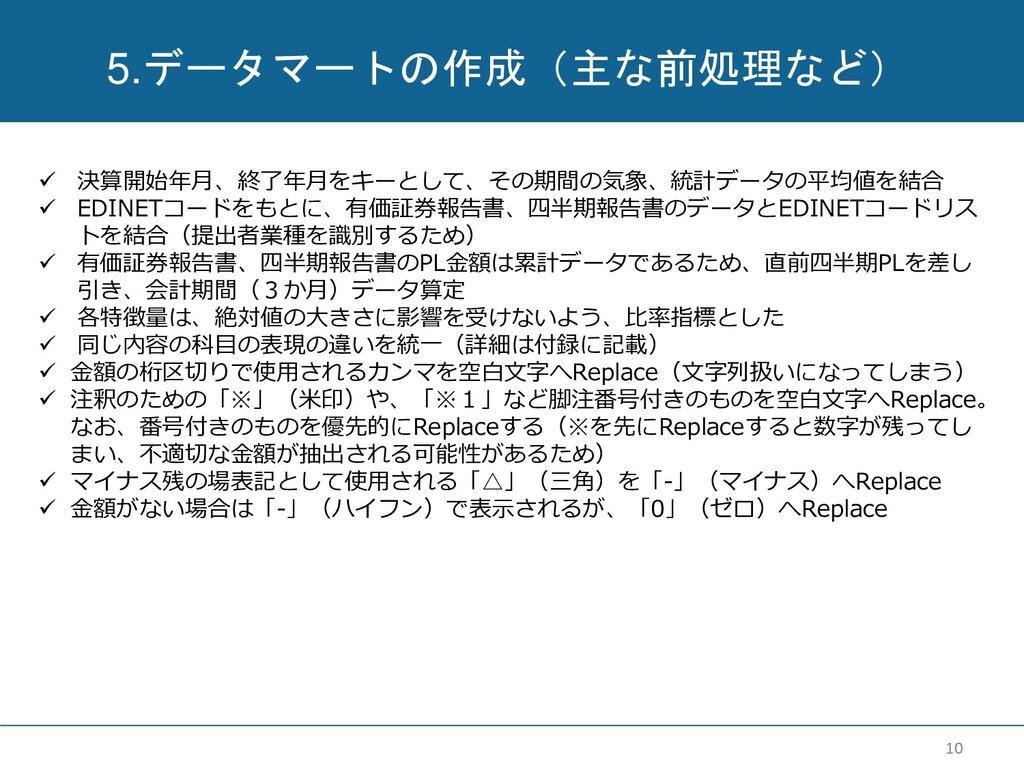
5.データマートの作成(主な前処理など) 10 ✓ 決算開始年月、終了年月をキーとして、その期間の気象、統計データの平均値を結合 ✓ EDINETコードをもとに、有価証券報告書、四半期報告書のデータとEDINETコードリス トを結合(提出者業種を識別するため) ✓ 有価証券報告書、四半期報告書のPL金額は累計データであるため、直前四半期PLを差し 引き、会計期間(3か月)データ算定
✓ 各特徴量は、絶対値の大きさに影響を受けないよう、比率指標とした ✓ 同じ内容の科目の表現の違いを統一(詳細は付録に記載) ✓ 金額の桁区切りで使用されるカンマを空白文字へReplace(文字列扱いになってしまう) ✓ 注釈のための「※」(米印)や、「※1」など脚注番号付きのものを空白文字へReplace。 なお、番号付きのものを優先的にReplaceする(※を先にReplaceすると数字が残ってし まい、不適切な金額が抽出される可能性があるため) ✓ マイナス残の場表記として使用される「△」(三角)を「-」(マイナス)へReplace ✓ 金額がない場合は「-」(ハイフン)で表示されるが、「0」(ゼロ)へReplace
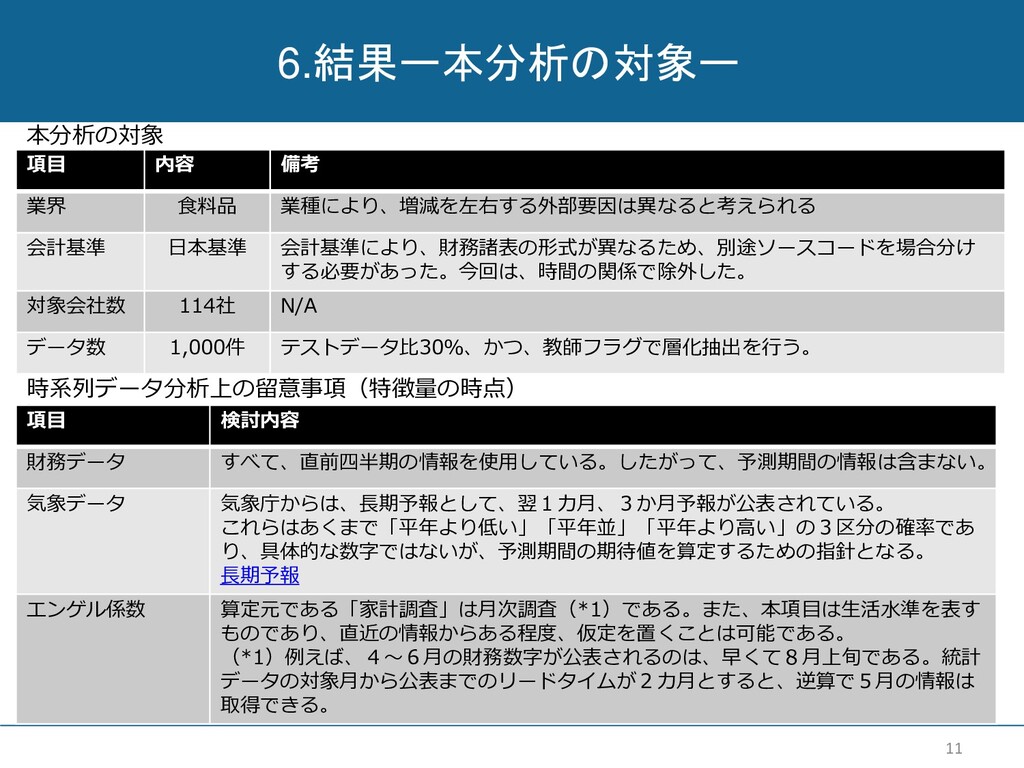
6.結果ー本分析の対象ー 11 本分析の対象 項目 内容 備考 業界 食料品 業種により、増減を左右する外部要因は異なると考えられる 会計基準
日本基準 会計基準により、財務諸表の形式が異なるため、別途ソースコードを場合分け する必要があった。今回は、時間の関係で除外した。 対象会社数 114社 N/A データ数 1,000件 テストデータ比30%、かつ、教師フラグで層化抽出を行う。 時系列データ分析上の留意事項(特徴量の時点) ) 項目 検討内容 財務データ すべて、直前四半期の情報を使用している。したがって、予測期間の情報は含まない。 気象データ 気象庁からは、長期予報として、翌1カ月、3か月予報が公表されている。 これらはあくまで「平年より低い」「平年並」「平年より高い」の3区分の確率であ り、具体的な数字ではないが、予測期間の期待値を算定するための指針となる。 長期予報 エンゲル係数 算定元である「家計調査」は月次調査(*1)である。また、本項目は生活水準を表す ものであり、直近の情報からある程度、仮定を置くことは可能である。 (*1)例えば、4~6月の財務数字が公表されるのは、早くて8月上旬である。統計 データの対象月から公表までのリードタイムが2カ月とすると、逆算で5月の情報は 取得できる。
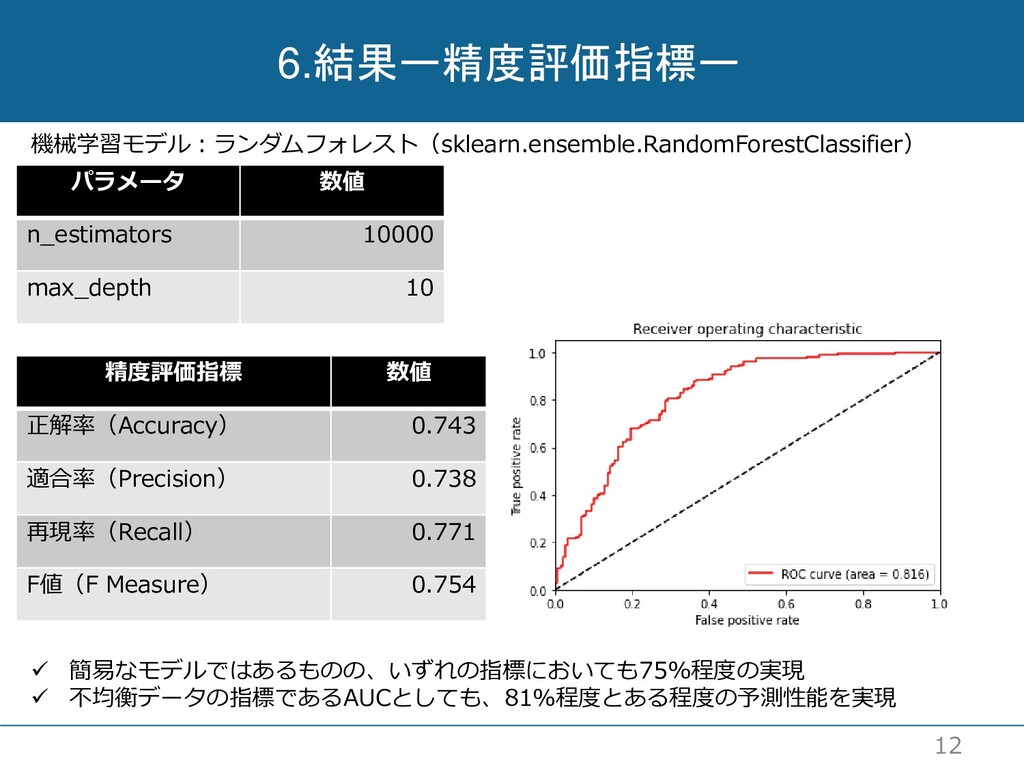
6.結果ー精度評価指標ー 12 精度評価指標 数値 正解率(Accuracy) 0.743 適合率(Precision) 0.738 再現率(Recall) 0.771
F値(F Measure) 0.754 ✓ 簡易なモデルではあるものの、いずれの指標においても75%程度の実現 ✓ 不均衡データの指標であるAUCとしても、81%程度とある程度の予測性能を実現 パラメータ 数値 n_estimators 10000 max_depth 10 機械学習モデル:ランダムフォレスト(sklearn.ensemble.RandomForestClassifier)
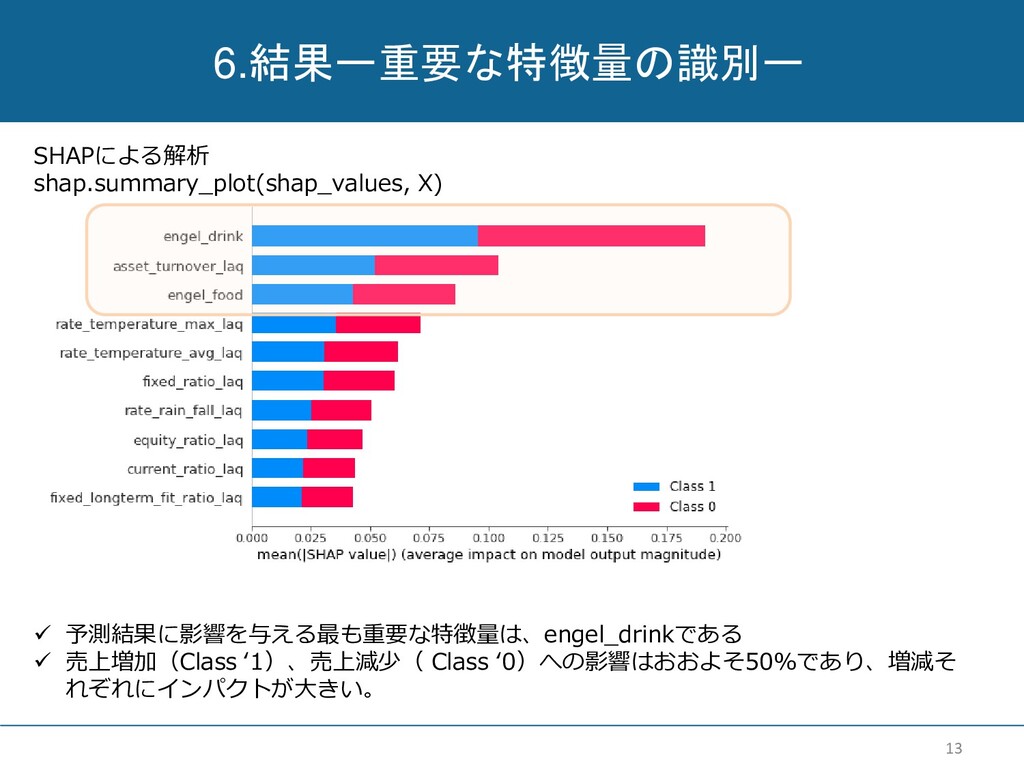
6.結果ー重要な特徴量の識別ー 13 SHAPによる解析 shap.summary_plot(shap_values, X) ✓ 予測結果に影響を与える最も重要な特徴量は、engel_drinkである ✓ 売上増加(Class ‘1)、売上減少(
Class ‘0)への影響はおおよそ50%であり、増減そ れぞれにインパクトが大きい。
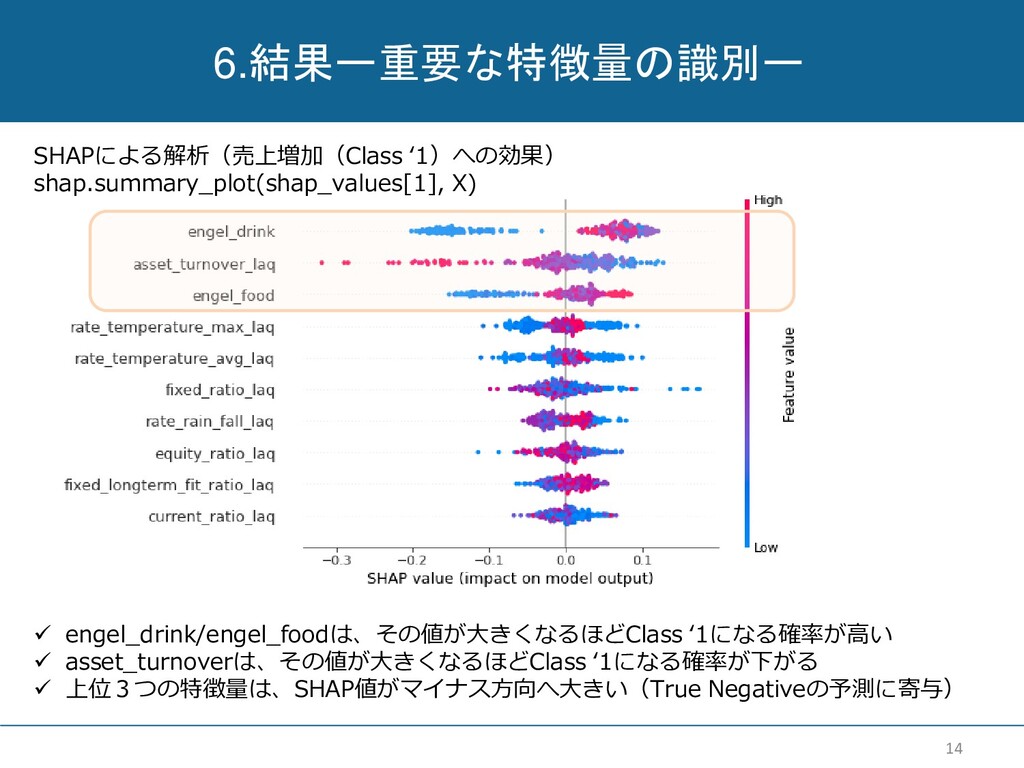
6.結果ー重要な特徴量の識別ー 14 SHAPによる解析(売上増加(Class ‘1)への効果) shap.summary_plot(shap_values[1], X) ✓ engel_drink/engel_foodは、その値が大きくなるほどClass ‘1になる確率が高い ✓
asset_turnoverは、その値が大きくなるほどClass ‘1になる確率が下がる ✓ 上位3つの特徴量は、SHAP値がマイナス方向へ大きい(True Negativeの予測に寄与)
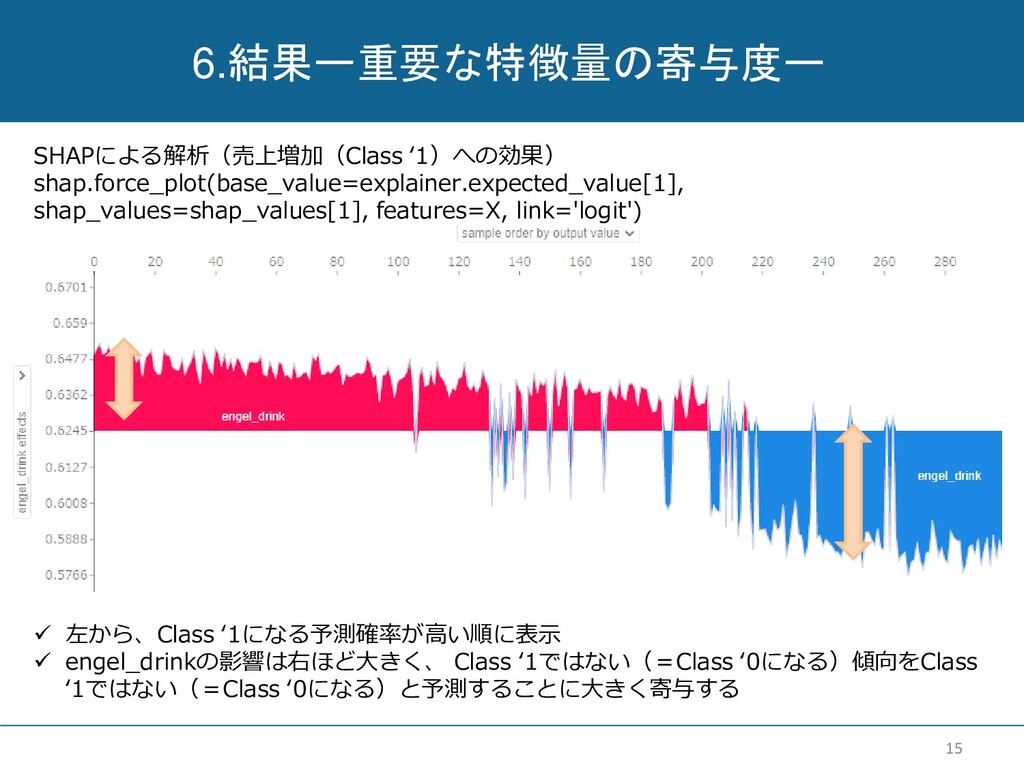
6.結果ー重要な特徴量の寄与度ー 15 SHAPによる解析(売上増加(Class ‘1)への効果) shap.force_plot(base_value=explainer.expected_value[1], shap_values=shap_values[1], features=X, link='logit') ✓ 左から、Class
‘1になる予測確率が高い順に表示 ✓ engel_drinkの影響は右ほど大きく、 Class ‘1ではない(=Class ‘0になる)傾向をClass ‘1ではない(=Class ‘0になる)と予測することに大きく寄与する
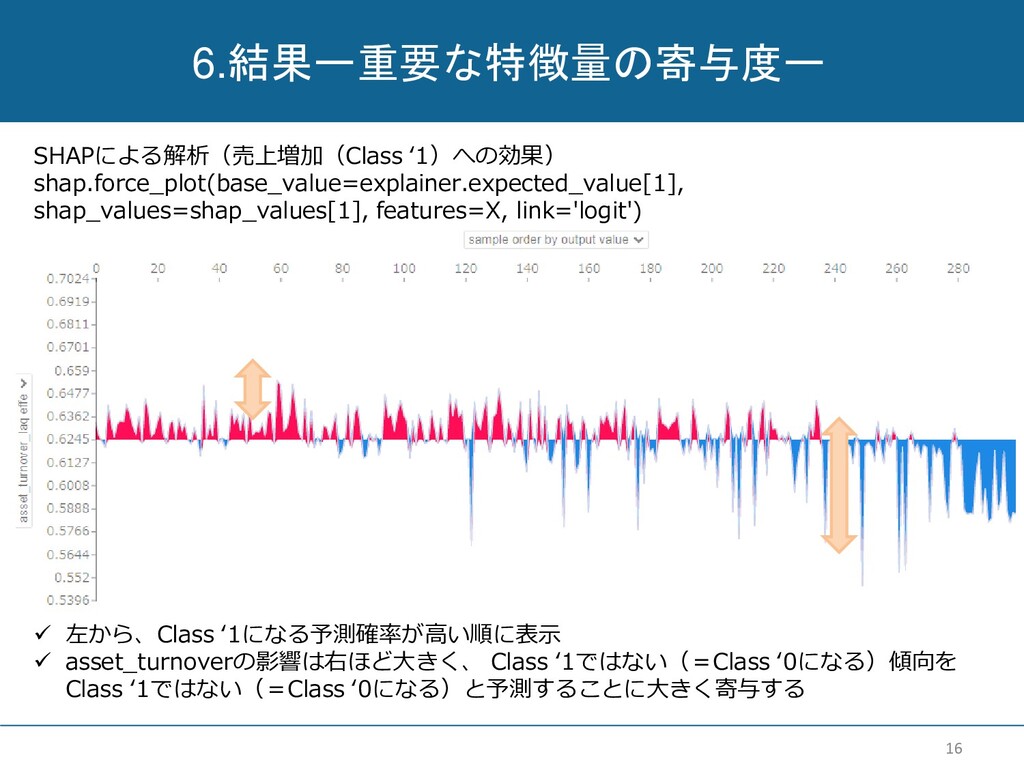
6.結果ー重要な特徴量の寄与度ー 16 SHAPによる解析(売上増加(Class ‘1)への効果) shap.force_plot(base_value=explainer.expected_value[1], shap_values=shap_values[1], features=X, link='logit') ✓ 左から、Class
‘1になる予測確率が高い順に表示 ✓ asset_turnoverの影響は右ほど大きく、 Class ‘1ではない(=Class ‘0になる)傾向を Class ‘1ではない(=Class ‘0になる)と予測することに大きく寄与する
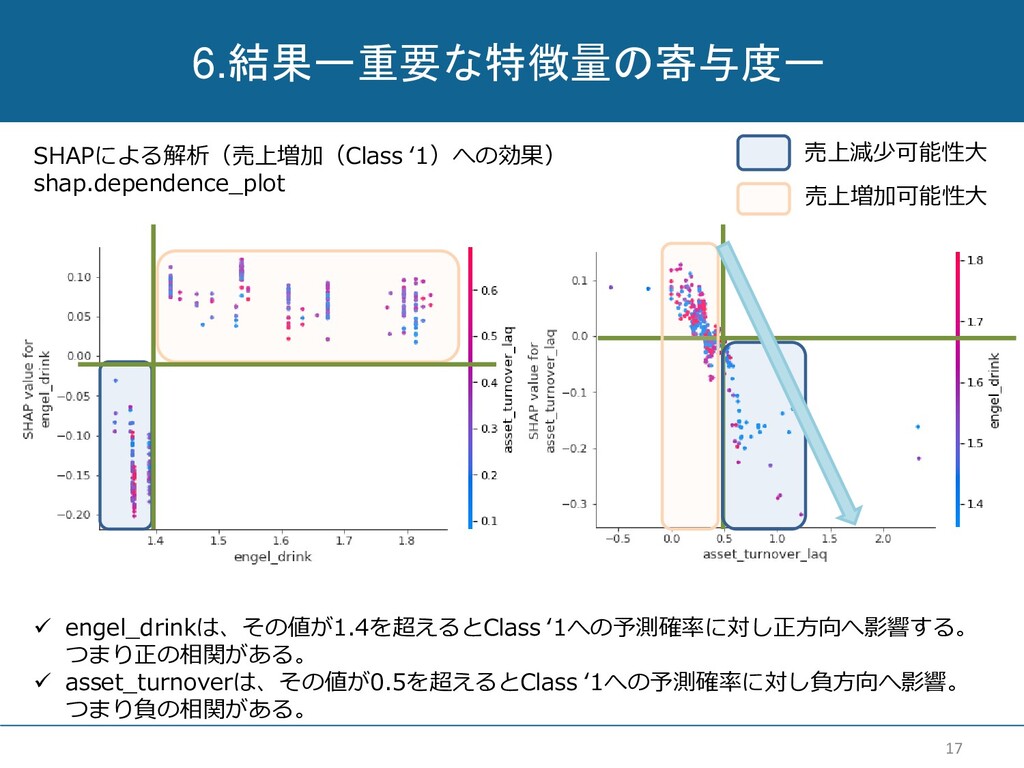
6.結果ー重要な特徴量の寄与度ー 17 SHAPによる解析(売上増加(Class ‘1)への効果) shap.dependence_plot ✓ engel_drinkは、その値が1.4を超えるとClass ‘1への予測確率に対し正方向へ影響する。 つまり正の相関がある。 ✓
asset_turnoverは、その値が0.5を超えるとClass ‘1への予測確率に対し負方向へ影響。 つまり負の相関がある。 売上減少可能性大 売上増加可能性大
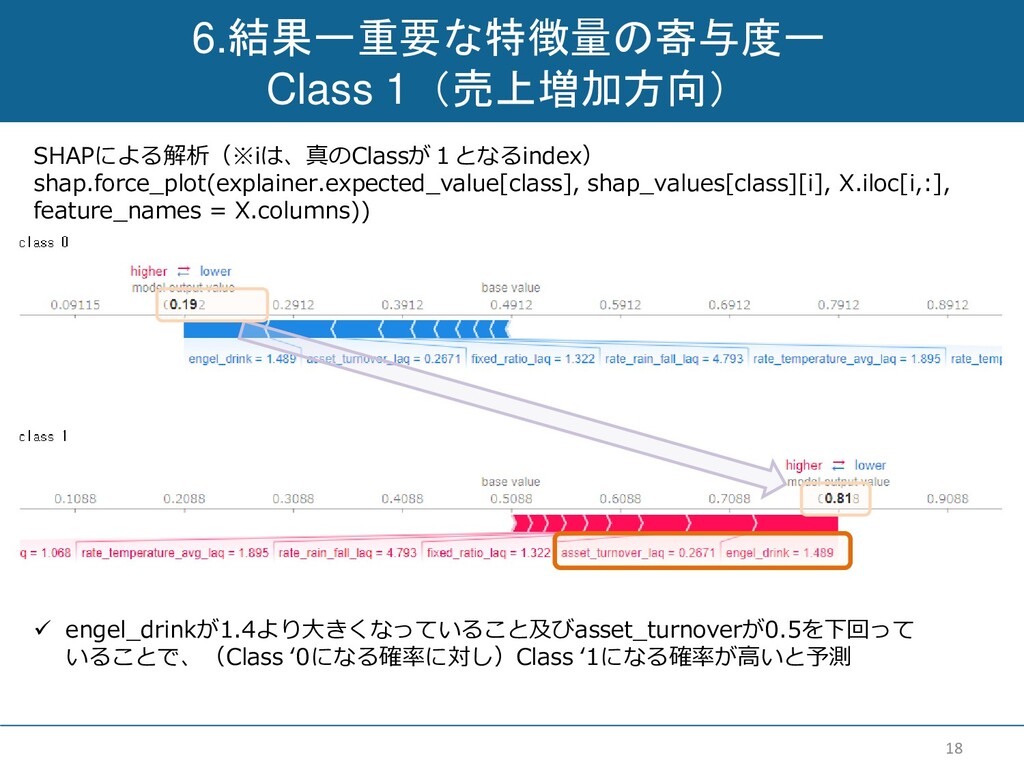
6.結果ー重要な特徴量の寄与度ー Class 1(売上増加方向) 18 SHAPによる解析(※iは、真のClassが1となるindex) shap.force_plot(explainer.expected_value[class], shap_values[class][i], X.iloc[i,:], feature_names =
X.columns)) ✓ engel_drinkが1.4より大きくなっていること及びasset_turnoverが0.5を下回って いることで、(Class ‘0になる確率に対し)Class ‘1になる確率が高いと予測
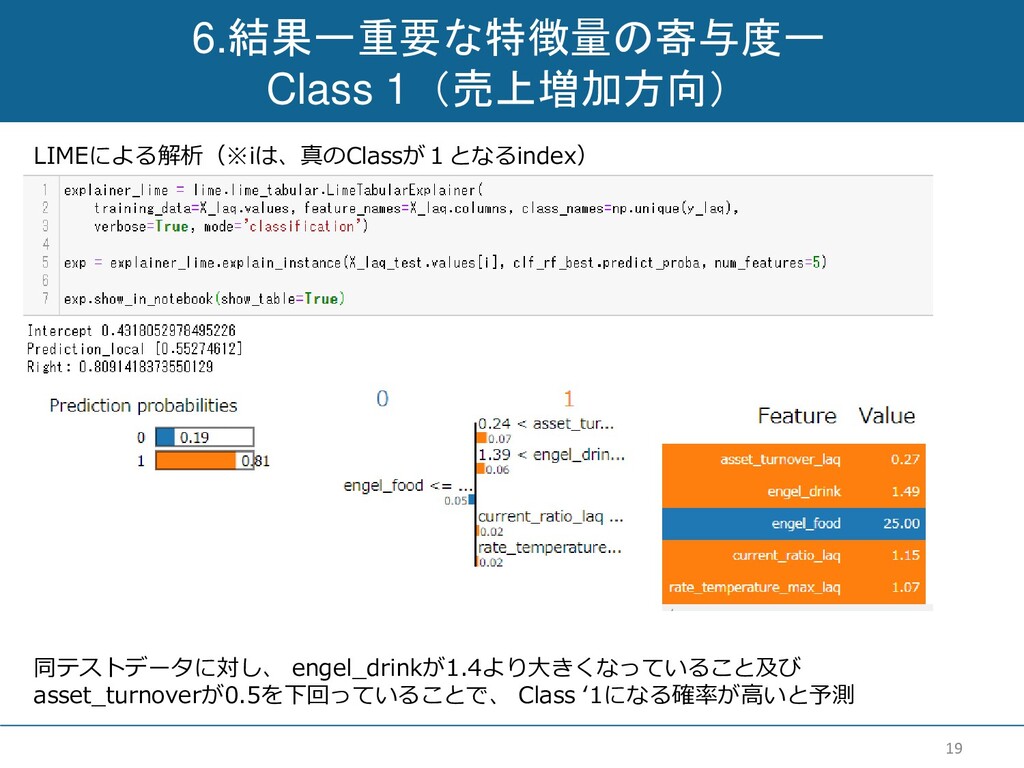
6.結果ー重要な特徴量の寄与度ー Class 1(売上増加方向) 19 LIMEによる解析(※iは、真のClassが1となるindex) 同テストデータに対し、 engel_drinkが1.4より大きくなっていること及び asset_turnoverが0.5を下回っていることで、 Class ‘1になる確率が高いと予測
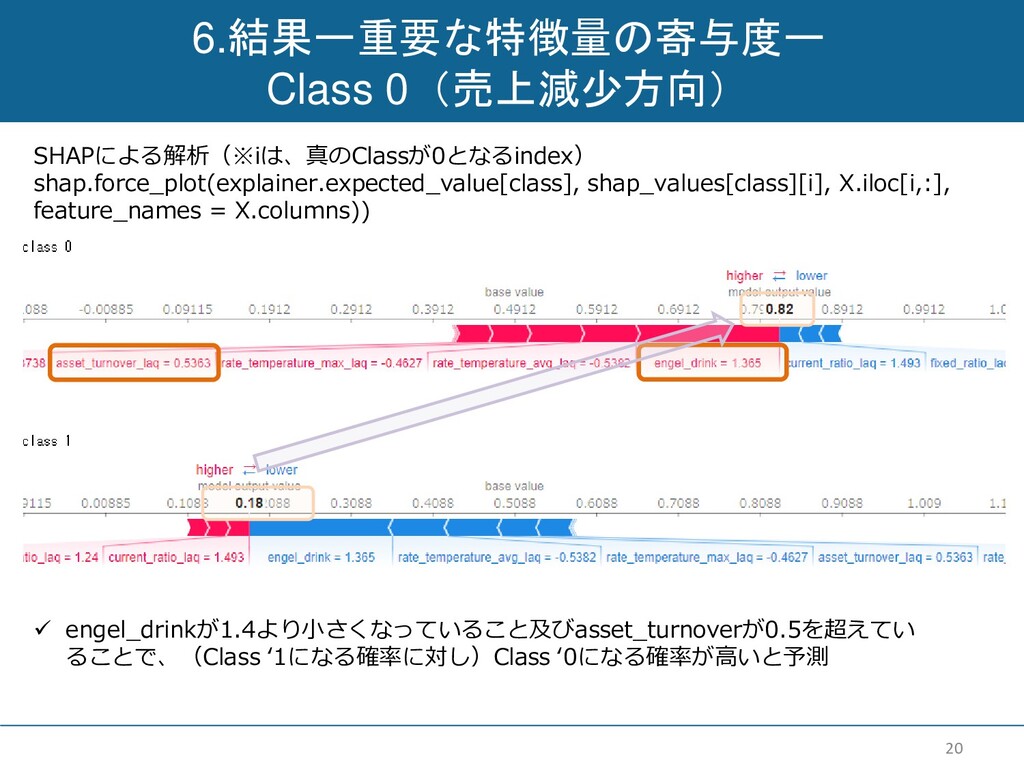
6.結果ー重要な特徴量の寄与度ー Class 0(売上減少方向) 20 SHAPによる解析(※iは、真のClassが0となるindex) shap.force_plot(explainer.expected_value[class], shap_values[class][i], X.iloc[i,:], feature_names =
X.columns)) ✓ engel_drinkが1.4より小さくなっていること及びasset_turnoverが0.5を超えてい ることで、(Class ‘1になる確率に対し)Class ‘0になる確率が高いと予測
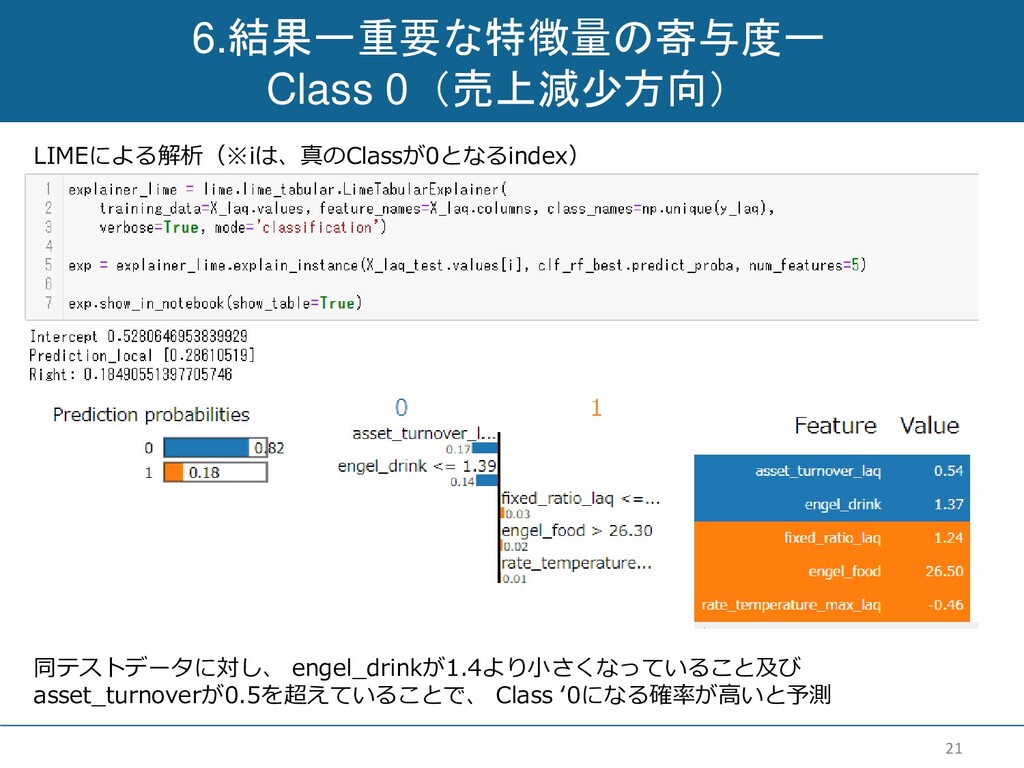
6.結果ー重要な特徴量の寄与度ー Class 0(売上減少方向) 21 LIMEによる解析(※iは、真のClassが0となるindex) 同テストデータに対し、 engel_drinkが1.4より小さくなっていること及び asset_turnoverが0.5を超えていることで、 Class ‘0になる確率が高いと予測
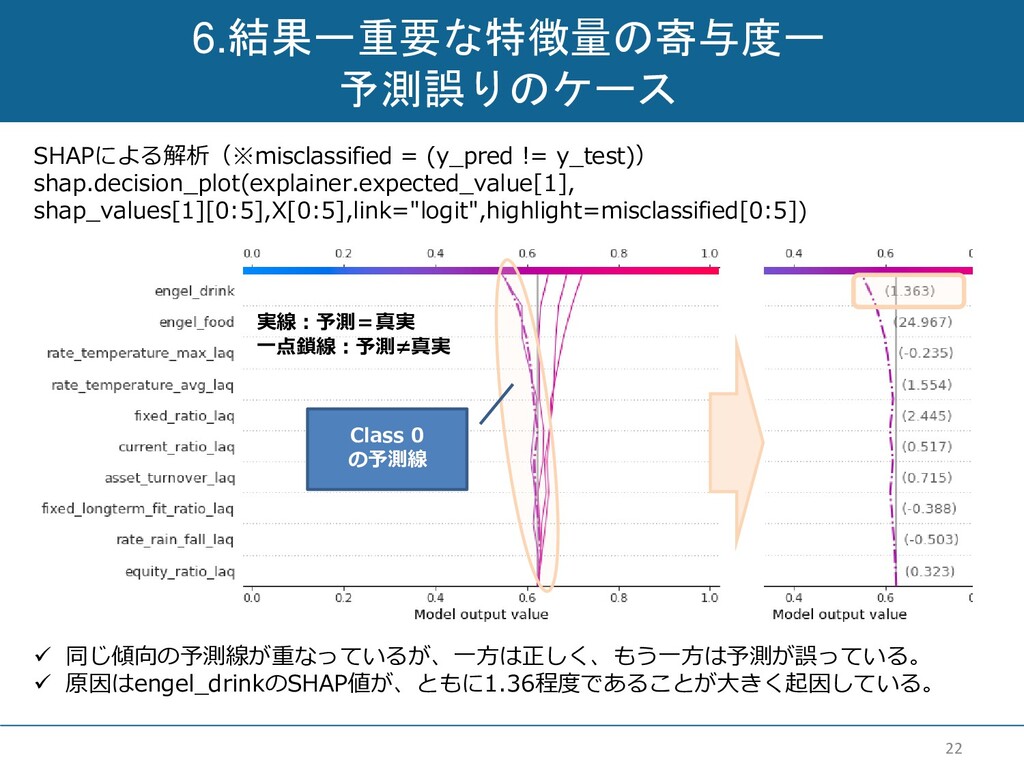
6.結果ー重要な特徴量の寄与度ー 予測誤りのケース 22 SHAPによる解析(※misclassified = (y_pred != y_test)) shap.decision_plot(explainer.expected_value[1], shap_values[1][0:5],X[0:5],link="logit",highlight=misclassified[0:5])
✓ 同じ傾向の予測線が重なっているが、一方は正しく、もう一方は予測が誤っている。 ✓ 原因はengel_drinkのSHAP値が、ともに1.36程度であることが大きく起因している。 Class 0 の予測線 実線:予測=真実 一点鎖線:予測≠真実
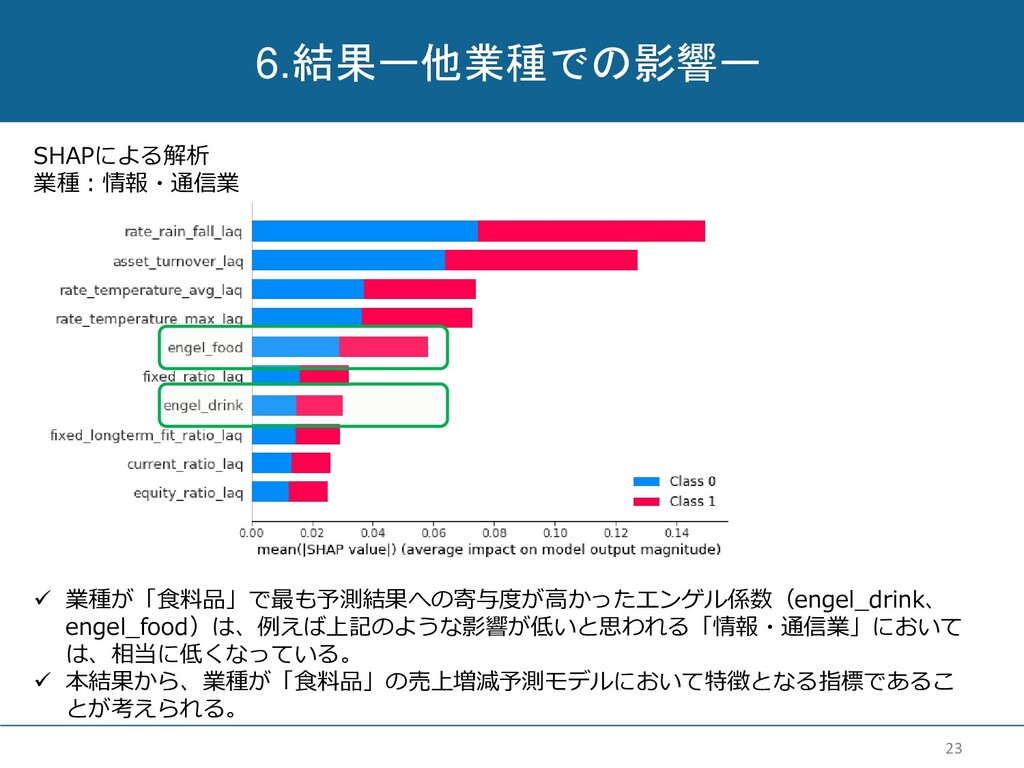
6.結果ー他業種での影響ー 23 SHAPによる解析 業種:情報・通信業 ✓ 業種が「食料品」で最も予測結果への寄与度が高かったエンゲル係数(engel_drink、 engel_food)は、例えば上記のような影響が低いと思われる「情報・通信業」において は、相当に低くなっている。 ✓ 本結果から、業種が「食料品」の売上増減予測モデルにおいて特徴となる指標であるこ
とが考えられる。
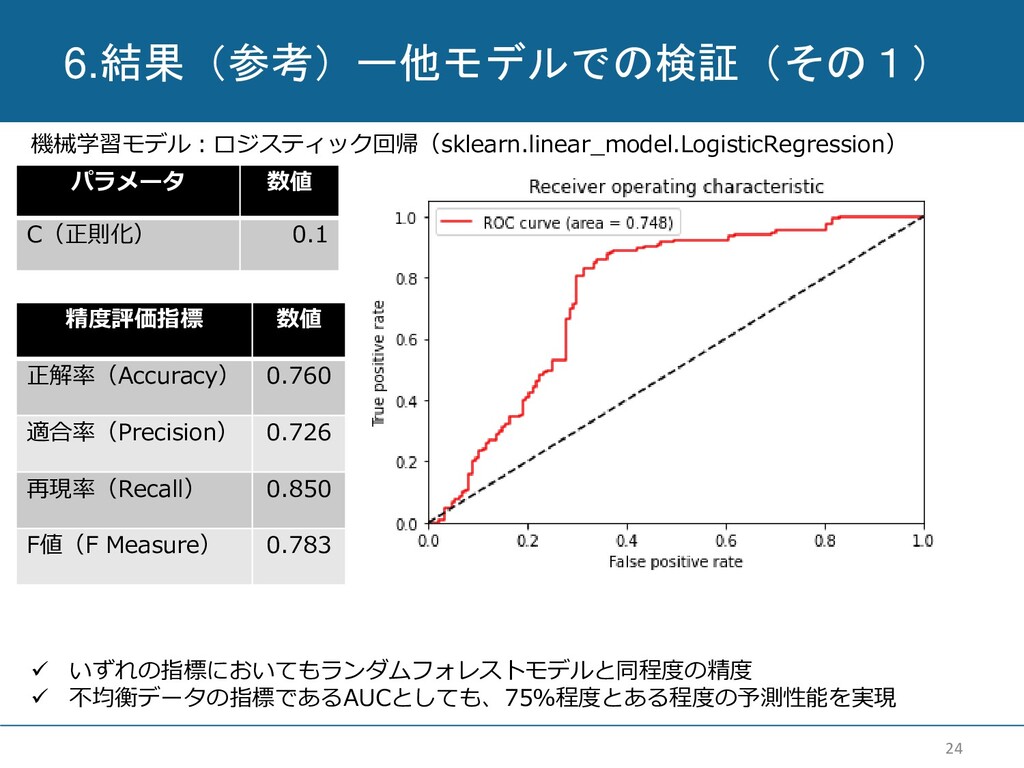
6.結果(参考)ー他モデルでの検証(その1) 24 精度評価指標 数値 正解率(Accuracy) 0.760 適合率(Precision) 0.726 再現率(Recall) 0.850
F値(F Measure) 0.783 ✓ いずれの指標においてもランダムフォレストモデルと同程度の精度 ✓ 不均衡データの指標であるAUCとしても、75%程度とある程度の予測性能を実現 パラメータ 数値 C(正則化) 0.1 機械学習モデル:ロジスティック回帰(sklearn.linear_model.LogisticRegression)
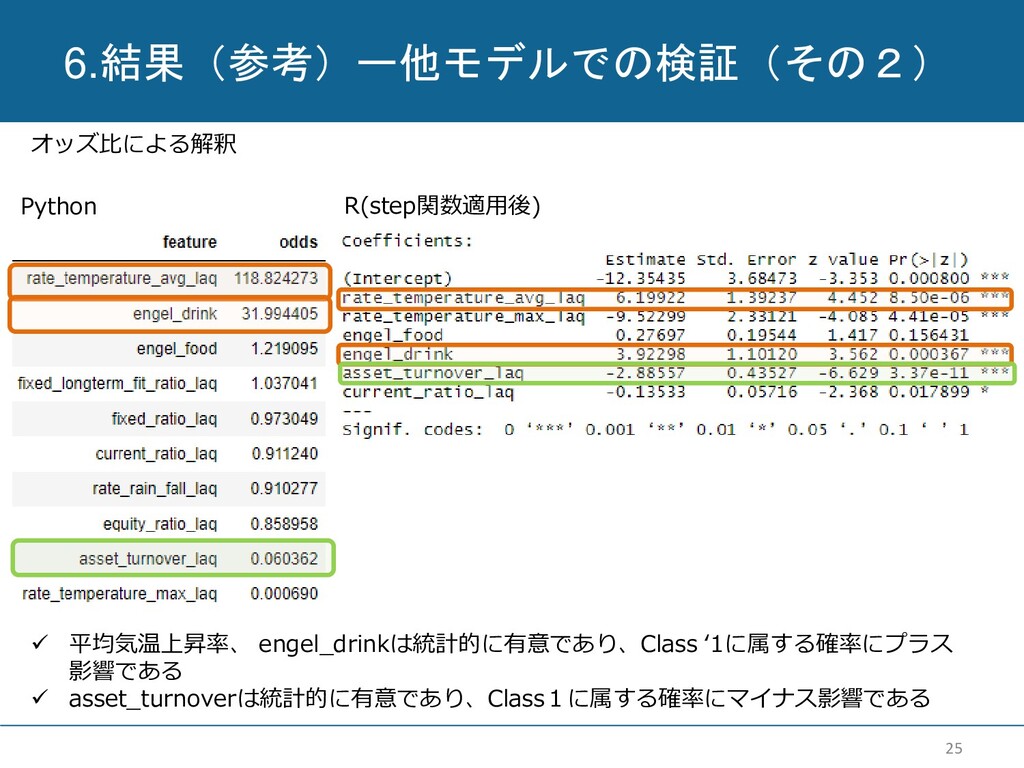
6.結果(参考)ー他モデルでの検証(その2) 25 ✓ 平均気温上昇率、 engel_drinkは統計的に有意であり、Class ‘1に属する確率にプラス 影響である ✓ asset_turnoverは統計的に有意であり、Class1に属する確率にマイナス影響である オッズ比による解釈
Python R(step関数適用後)
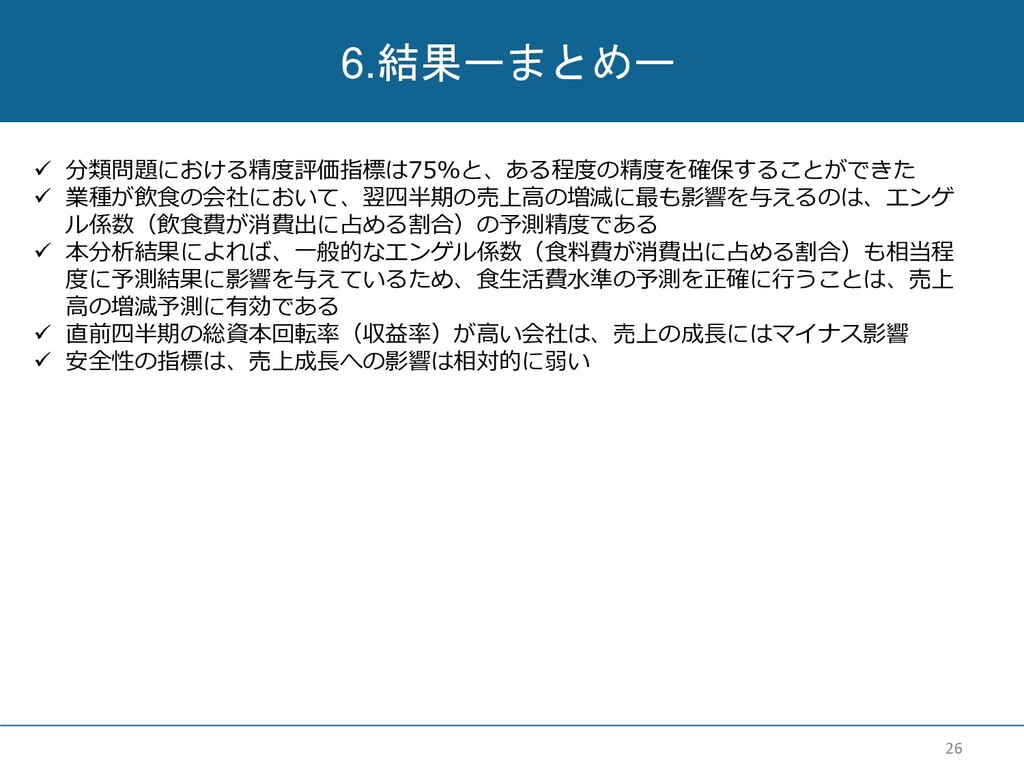
6.結果ーまとめー 26 ✓ 分類問題における精度評価指標は75%と、ある程度の精度を確保することができた ✓ 業種が飲食の会社において、翌四半期の売上高の増減に最も影響を与えるのは、エンゲ ル係数(飲食費が消費出に占める割合)の予測精度である ✓ 本分析結果によれば、一般的なエンゲル係数(食料費が消費出に占める割合)も相当程 度に予測結果に影響を与えているため、食生活費水準の予測を正確に行うことは、売上
高の増減予測に有効である ✓ 直前四半期の総資本回転率(収益率)が高い会社は、売上の成長にはマイナス影響 ✓ 安全性の指標は、売上成長への影響は相対的に弱い
27 付録 ✓ 工夫したこと ✓ 難しかったこと ✓ 今後さらに実施してみたいこと ✓ スクレイピングのためのソースコード
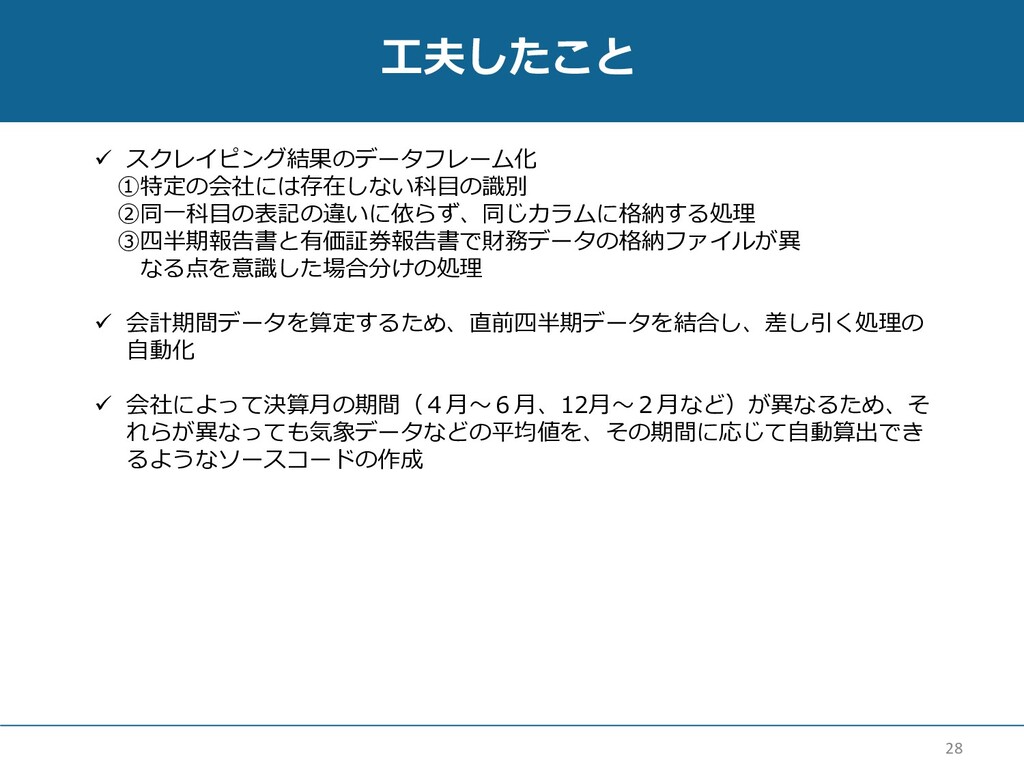
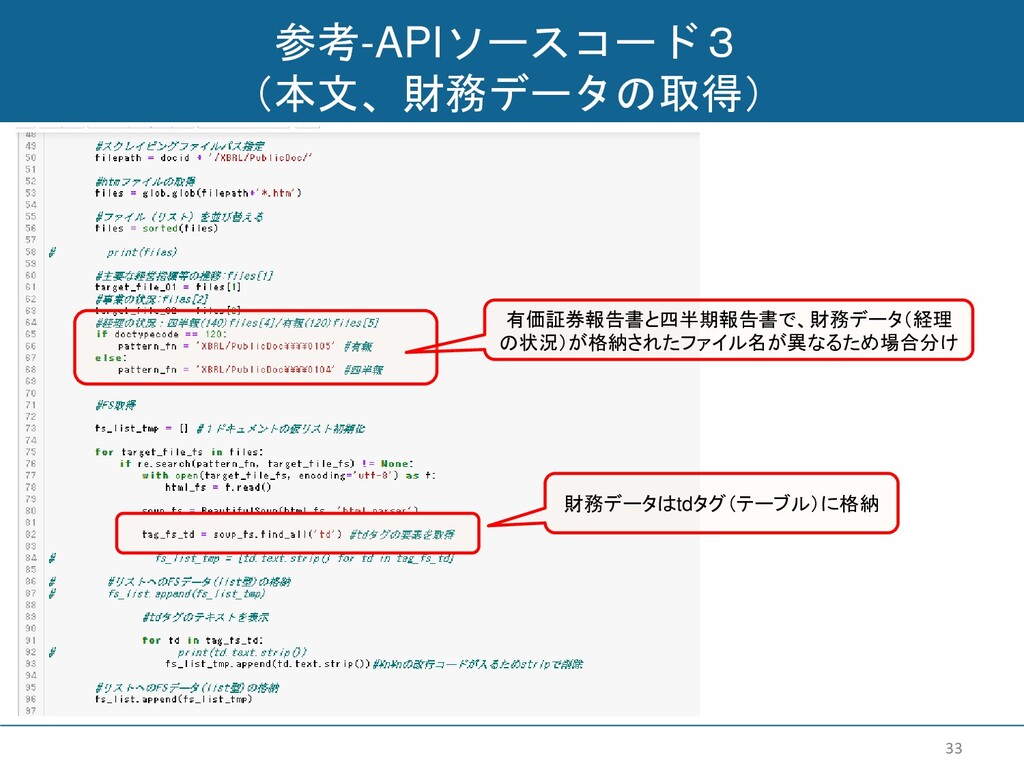
28 工夫したこと ✓ スクレイピング結果のデータフレーム化 ①特定の会社には存在しない科目の識別 ②同一科目の表記の違いに依らず、同じカラムに格納する処理 ③四半期報告書と有価証券報告書で財務データの格納ファイルが異 なる点を意識した場合分けの処理 ✓ 会計期間データを算定するため、直前四半期データを結合し、差し引く処理の
自動化 ✓ 会社によって決算月の期間(4月~6月、12月~2月など)が異なるため、そ れらが異なっても気象データなどの平均値を、その期間に応じて自動算出でき るようなソースコードの作成
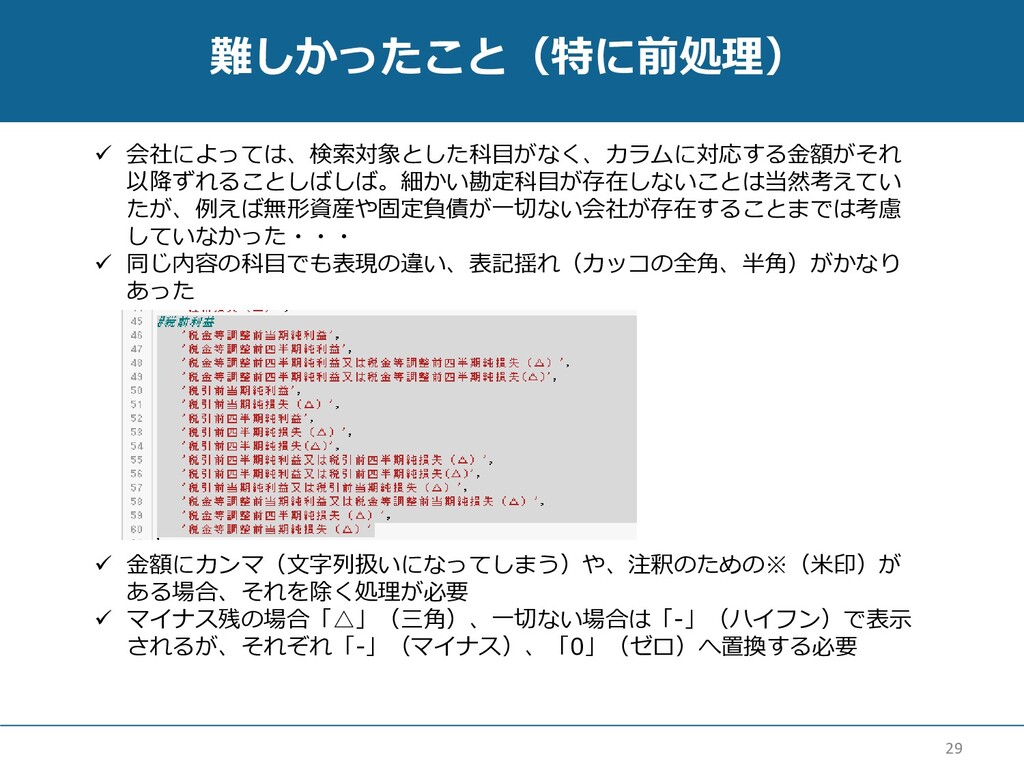
29 難しかったこと(特に前処理) ✓ 会社によっては、検索対象とした科目がなく、カラムに対応する金額がそれ 以降ずれることしばしば。細かい勘定科目が存在しないことは当然考えてい たが、例えば無形資産や固定負債が一切ない会社が存在することまでは考慮 していなかった・・・ ✓ 同じ内容の科目でも表現の違い、表記揺れ(カッコの全角、半角)がかなり あった
✓ 金額にカンマ(文字列扱いになってしまう)や、注釈のための※(米印)が ある場合、それを除く処理が必要 ✓ マイナス残の場合「△」(三角)、一切ない場合は「-」(ハイフン)で表示 されるが、それぞれ「-」(マイナス)、「0」(ゼロ)へ置換する必要
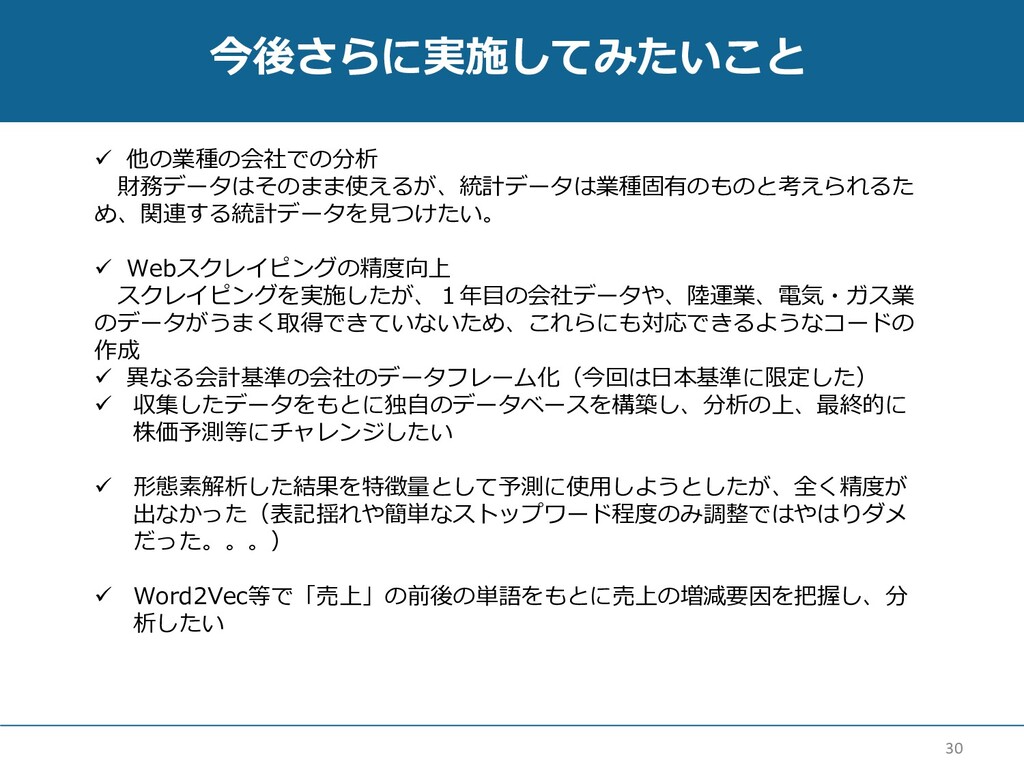
30 今後さらに実施してみたいこと ✓ 他の業種の会社での分析 財務データはそのまま使えるが、統計データは業種固有のものと考えられるた め、関連する統計データを見つけたい。 ✓ Webスクレイピングの精度向上 スクレイピングを実施したが、1年目の会社データや、陸運業、電気・ガス業 のデータがうまく取得できていないため、これらにも対応できるようなコードの
作成 ✓ 異なる会計基準の会社のデータフレーム化(今回は日本基準に限定した) ✓ 収集したデータをもとに独自のデータベースを構築し、分析の上、最終的に 株価予測等にチャレンジしたい ✓ 形態素解析した結果を特徴量として予測に使用しようとしたが、全く精度が 出なかった(表記揺れや簡単なストップワード程度のみ調整ではやはりダメ だった。。。) ✓ Word2Vec等で「売上」の前後の単語をもとに売上の増減要因を把握し、分 析したい
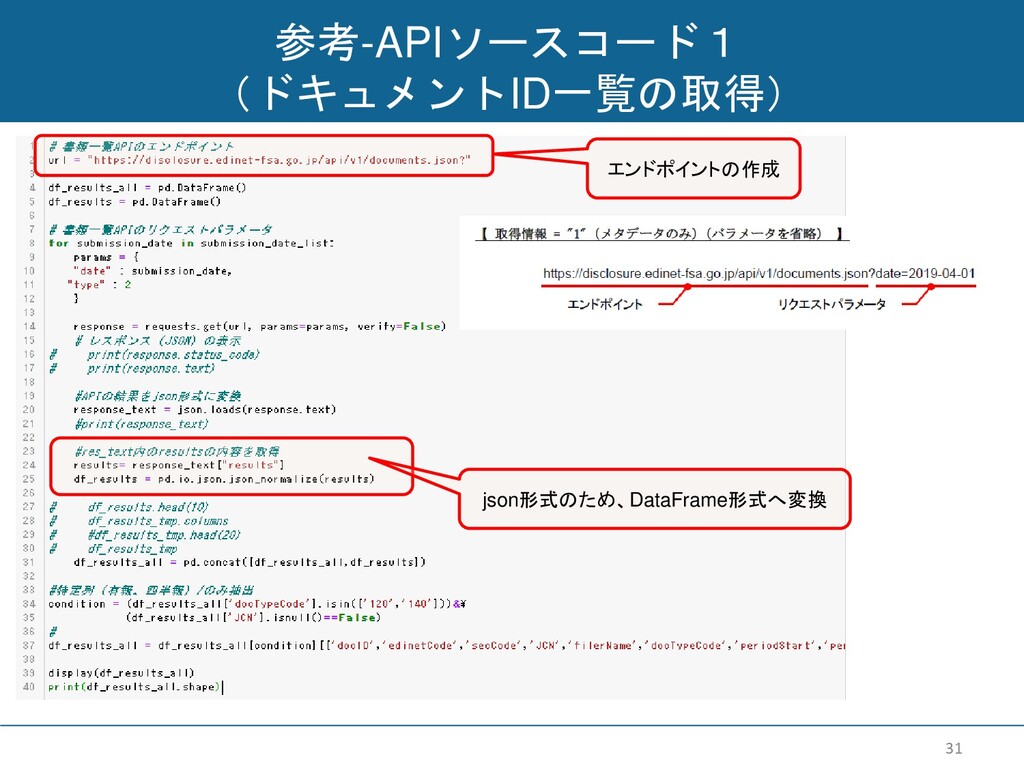
参考-APIソースコード1 (ドキュメントID一覧の取得) 31 エンドポイントの作成 json形式のため、DataFrame形式へ変換
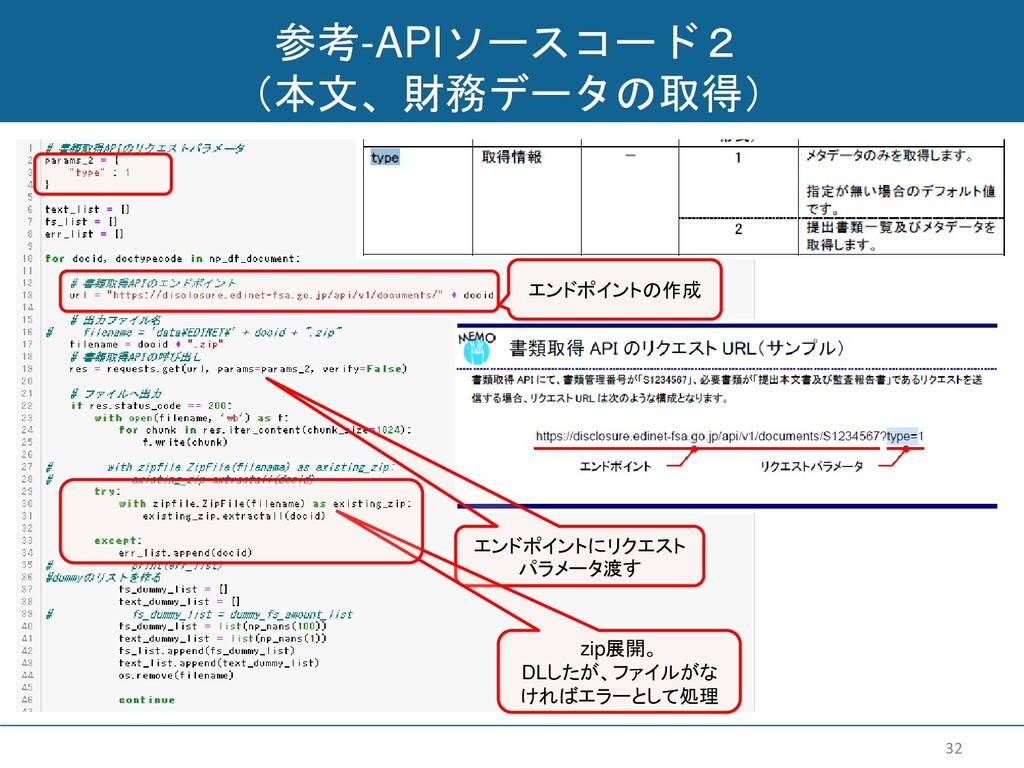
参考-APIソースコード2 (本文、財務データの取得) 32 エンドポイントの作成 エンドポイントにリクエスト パラメータ渡す zip展開。 DLしたが、ファイルがな ければエラーとして処理
参考-APIソースコード3 (本文、財務データの取得) 33 有価証券報告書と四半期報告書で、財務データ(経理 の状況)が格納されたファイル名が異なるため場合分け 財務データはtdタグ(テーブル)に格納
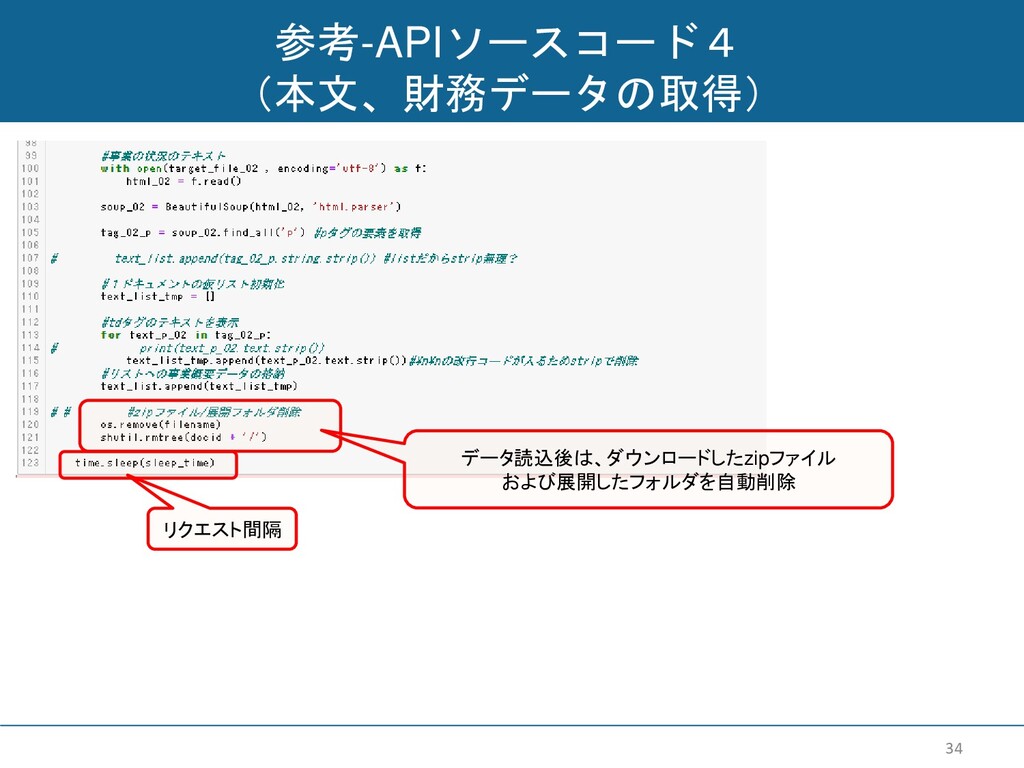
参考-APIソースコード4 (本文、財務データの取得) 34 データ読込後は、ダウンロードしたzipファイル および展開したフォルダを自動削除 リクエスト間隔


 aleyda
 tammyeverts
 rakko
 katiecoart
 keavy
 codingconduct
 lindahogenes
 cassininazir
 bluesmoon
 baasie
 szymonslowik
 andyhume