Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
LLMに評価を任せるということ
Search
S.Masui
January 28, 2026
500
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
LLMに評価を任せるということ
2026/01/28 Findy Hello LT world『2026年これやる宣言!書き初め LT Night』 登壇資料
S.Masui
January 28, 2026
More Decks by S.Masui
See All by S.Masui
答えがすぐ出る時代に、なぜまだ考えるのか
smasui0302
0
710
Featured
See All Featured
Primal Persuasion: How to Engage the Brain for Learning That Lasts
tmiket
0
490
Into the Great Unknown - MozCon
thekraken
41
2.7k
Connecting the Dots Between Site Speed, User Experience & Your Business [WebExpo 2025]
tammyeverts
11
1k
Color Theory Basics | Prateek | Gurzu
gurzu
1
480
Build your cross-platform service in a week with App Engine
jlugia
234
19k
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
Tell your own story through comics
letsgokoyo
1
1.1k
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
250
Rebuilding a faster, lazier Slack
samanthasiow
85
9.7k
RailsConf & Balkan Ruby 2019: The Past, Present, and Future of Rails at GitHub
eileencodes
141
35k
Put a Button on it: Removing Barriers to Going Fast.
kastner
60
4.6k
sira's awesome portfolio website redesign presentation
elsirapls
0
430
Transcript
LLMに評価を任せるということ 2026年1月28日 1
自己紹介 Suguru MASUI ・機械学習・生成AIを用いた業務支援システムの開発・検証 ・最近は LLM/AI Agentの PoC に従事 ・LLMに対する評価をどのように設計すべきか、試行錯誤中
𝕏 @smasui__0302 2
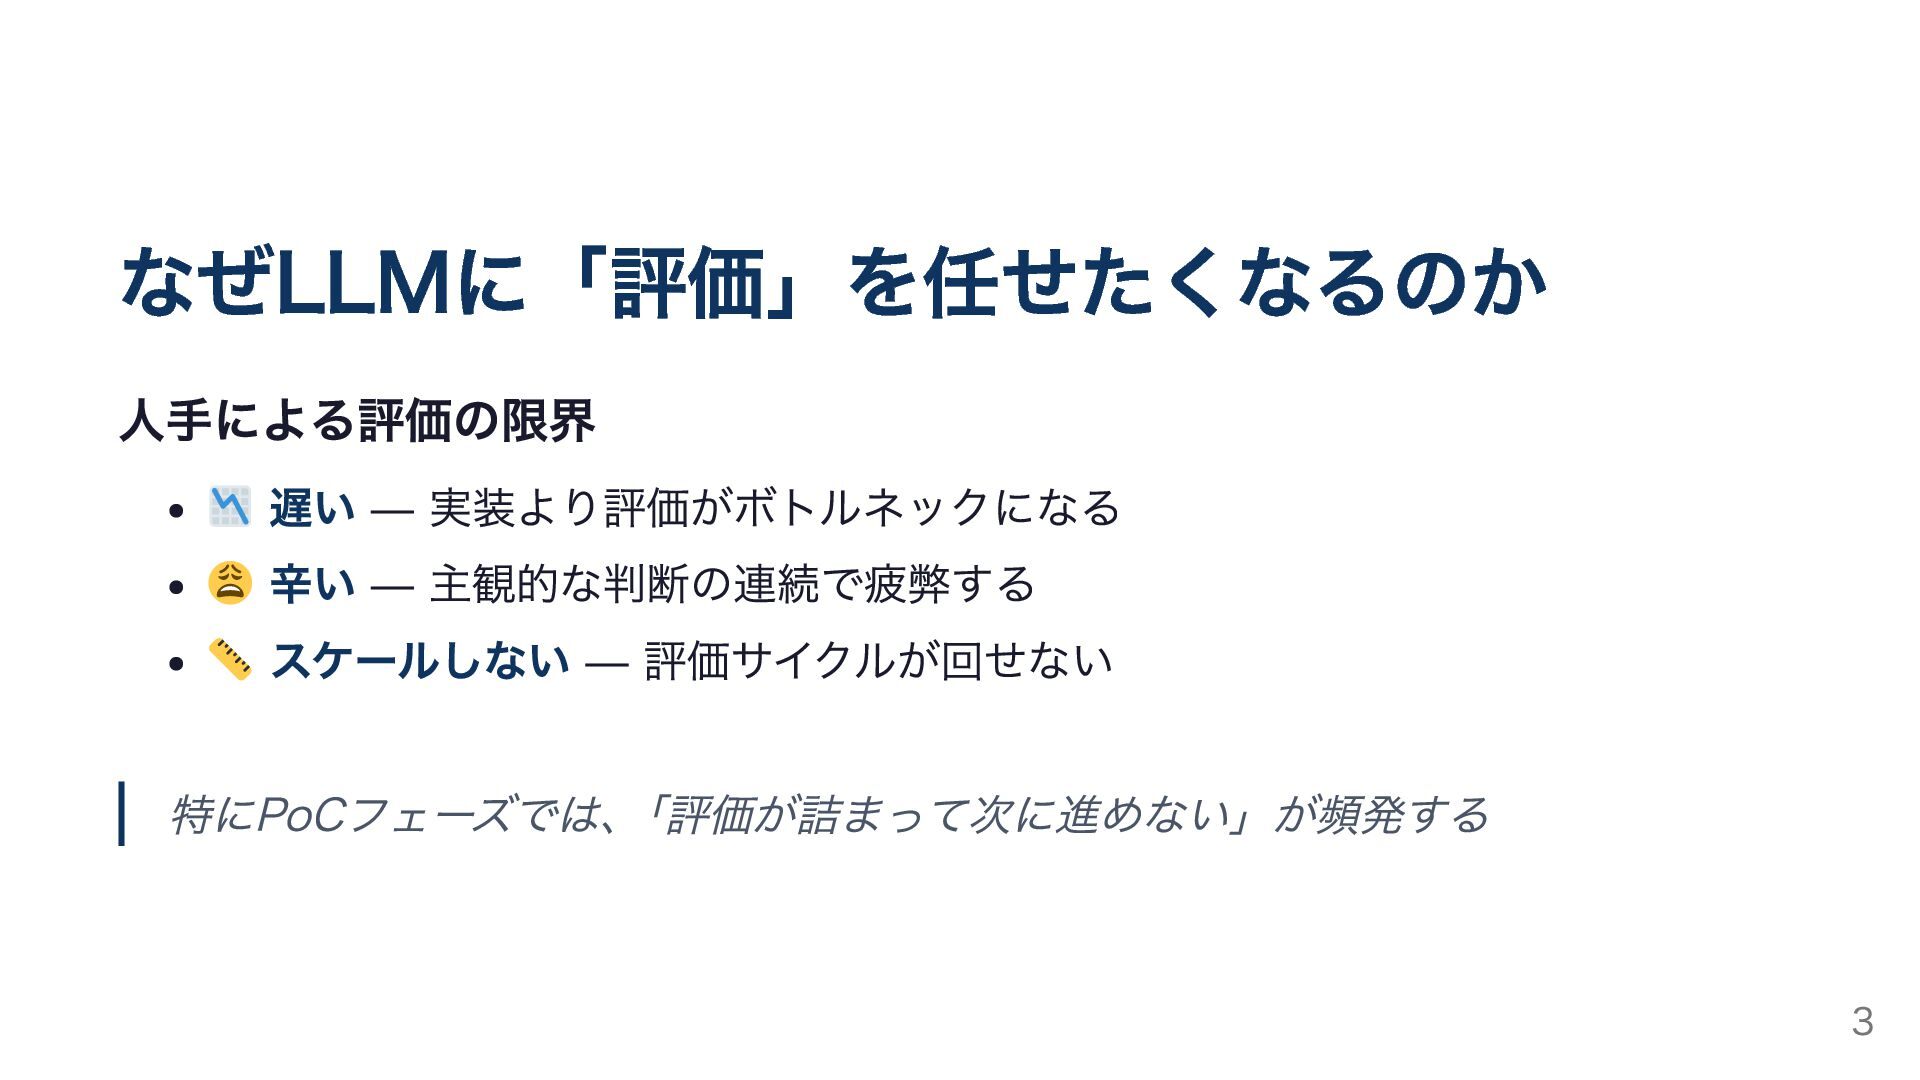
なぜLLMに「評価」を任せたくなるのか 人手による評価の限界 遅い — 実装より評価がボトルネックになる 辛い — 主観的な判断の連続で疲弊する スケールしない —
評価サイクルが回せない 特にPoCフェーズでは、 「評価が詰まって次に進めない」が頻発する 3
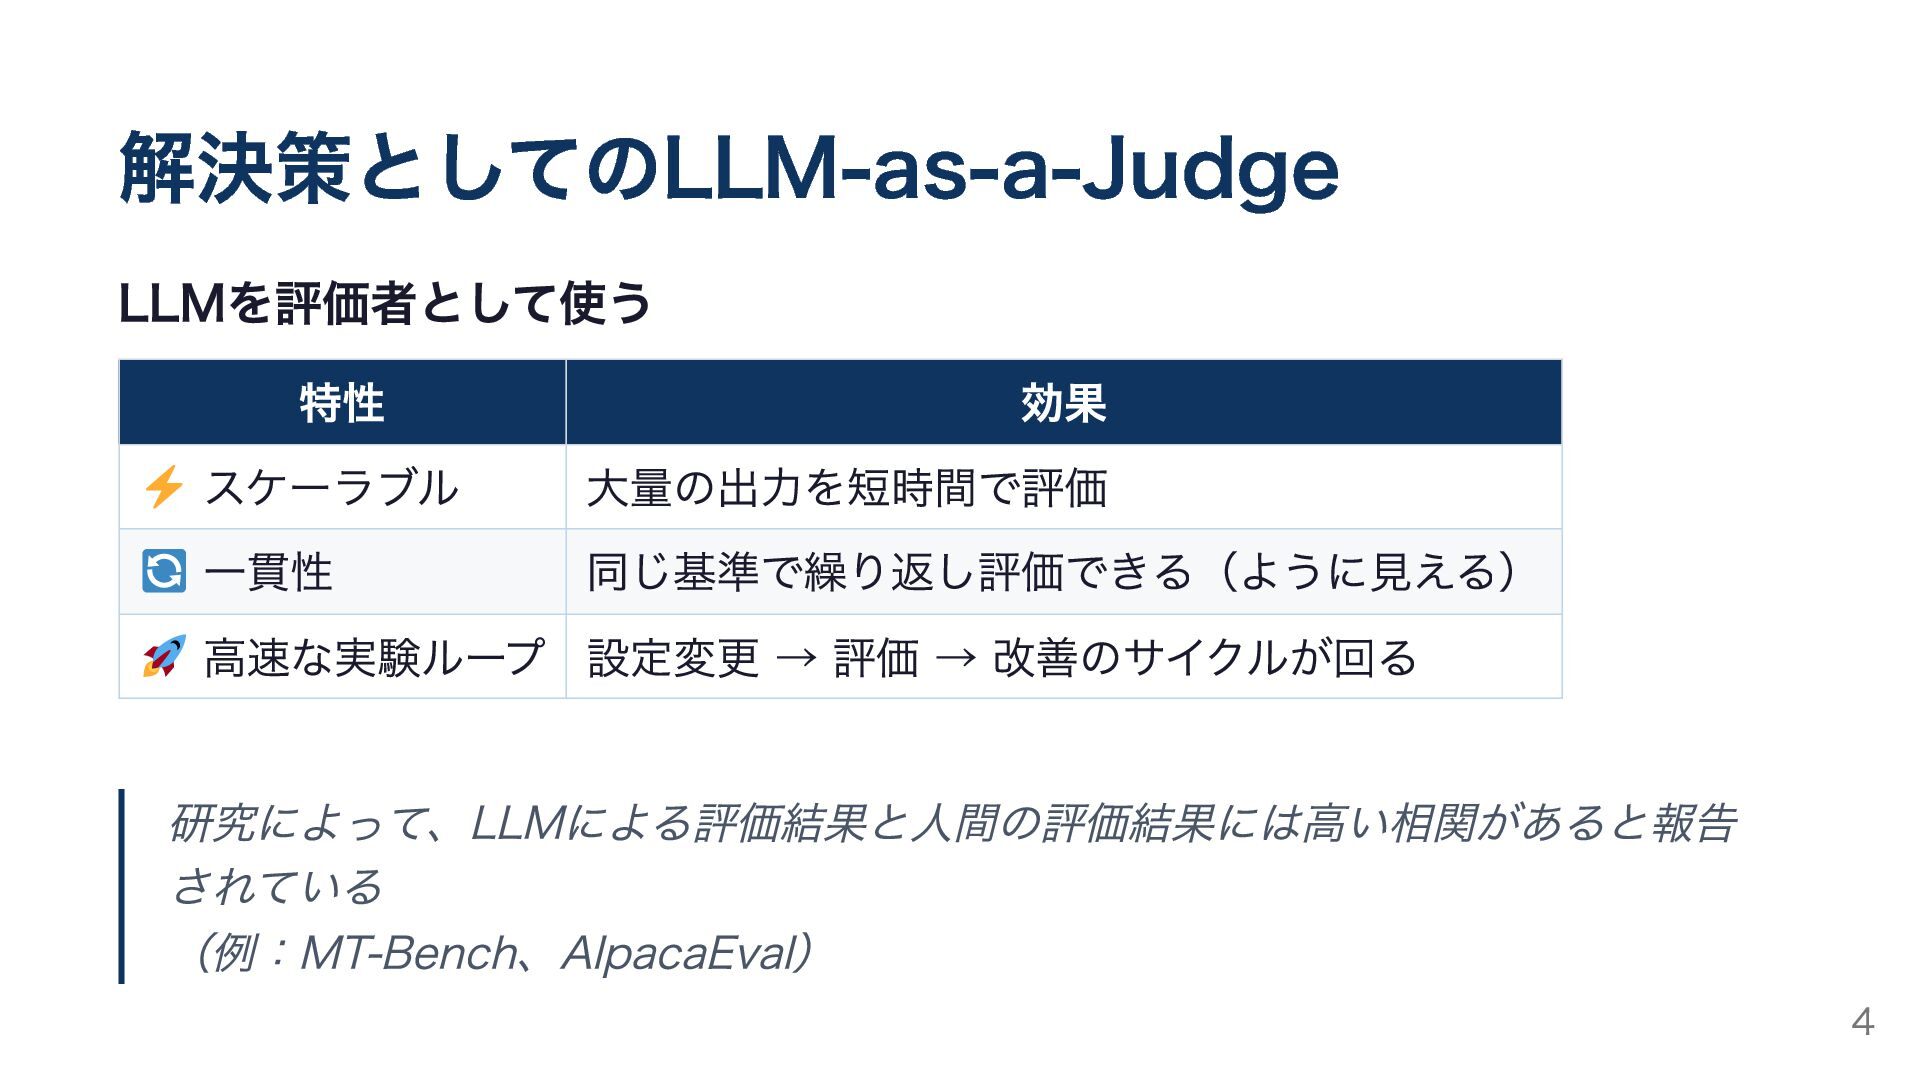
解決策としてのLLM-as-a-Judge LLMを評価者として使う 特性 効果 スケーラブル 大量の出力を短時間で評価 一貫性 同じ基準で繰り返し評価できる(ように見える) 高速な実験ループ 設定変更
→ 評価 → 改善のサイクルが回る 研究によって、LLMによる評価結果と人間の評価結果には高い相関があると報告 されている (例:MT-Bench、AlpacaEval) 4
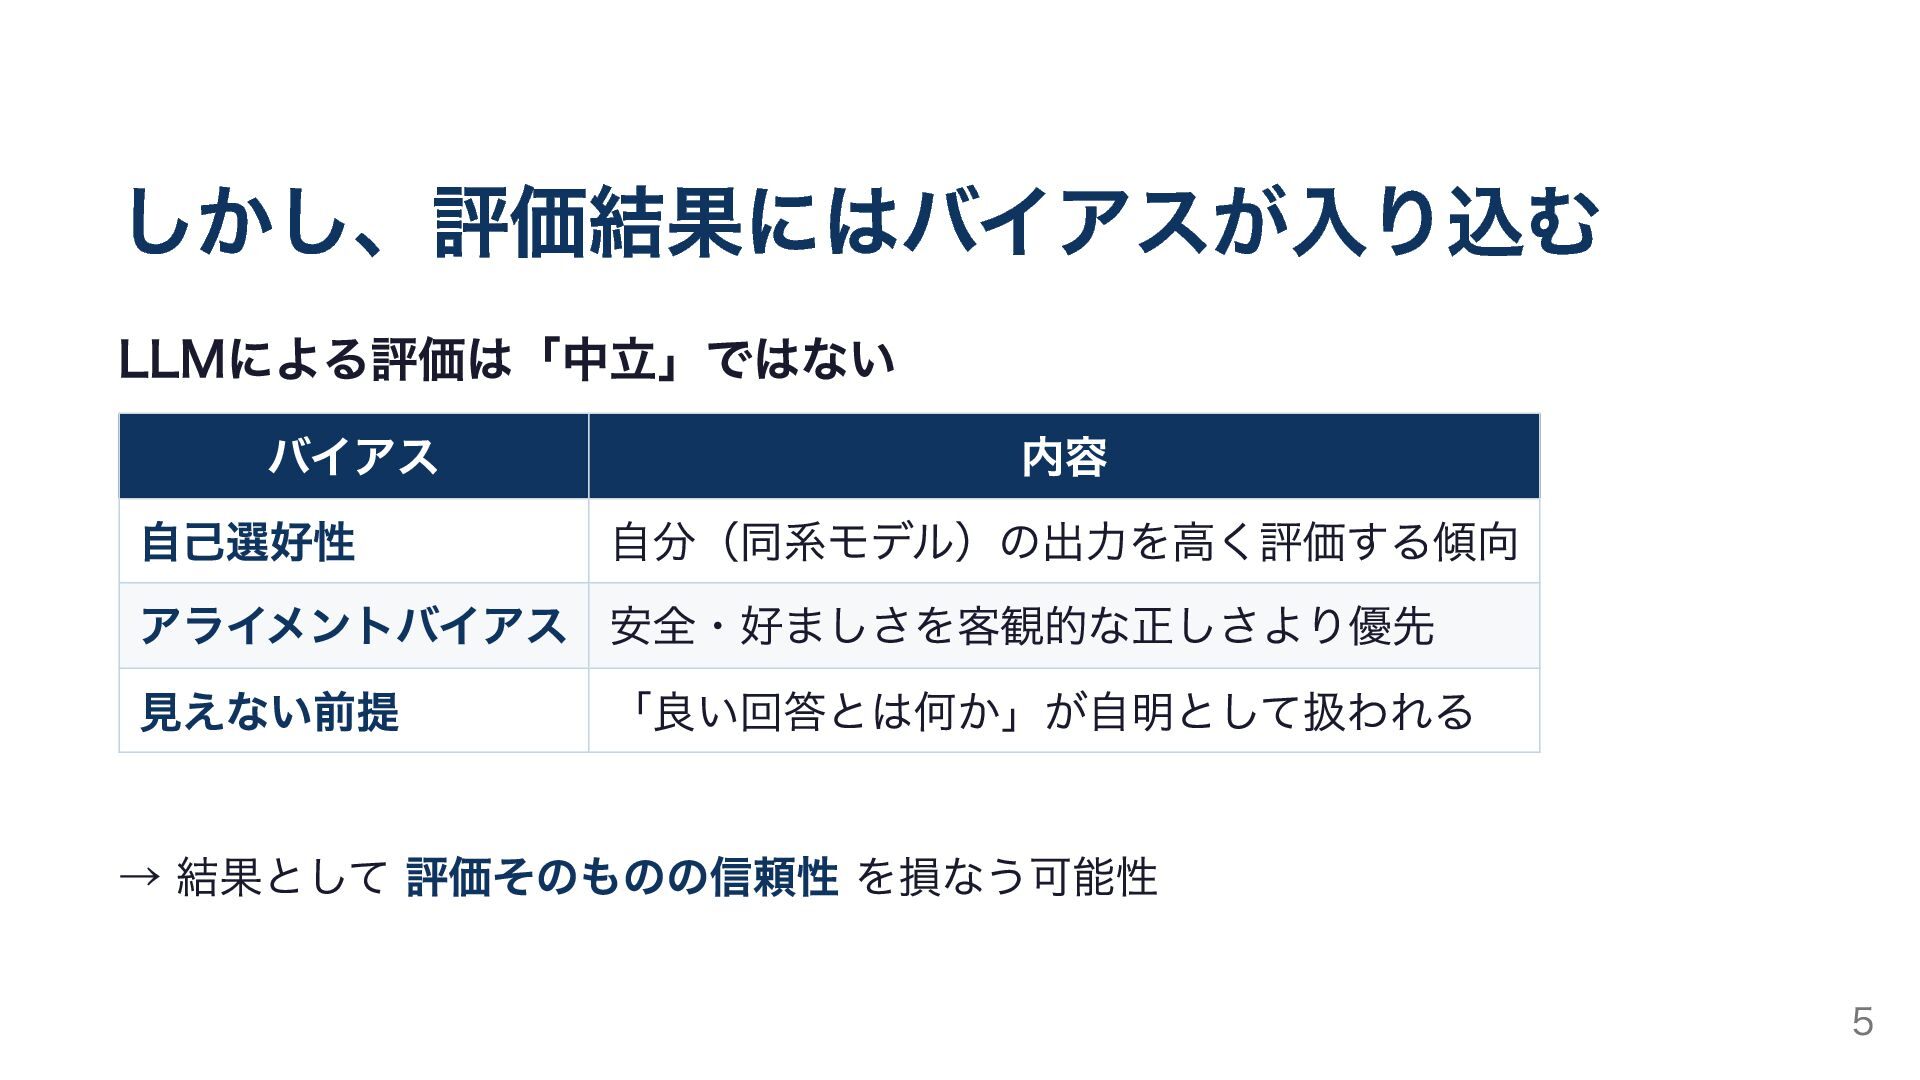
しかし、評価結果にはバイアスが入り込む LLMによる評価は「中立」ではない バイアス 内容 自己選好性 自分(同系モデル)の出力を高く評価する傾向 アライメントバイアス 安全・好ましさを客観的な正しさより優先 見えない前提 「良い回答とは何か」が自明として扱われる
→ 結果として 評価そのものの信頼性 を損なう可能性 5
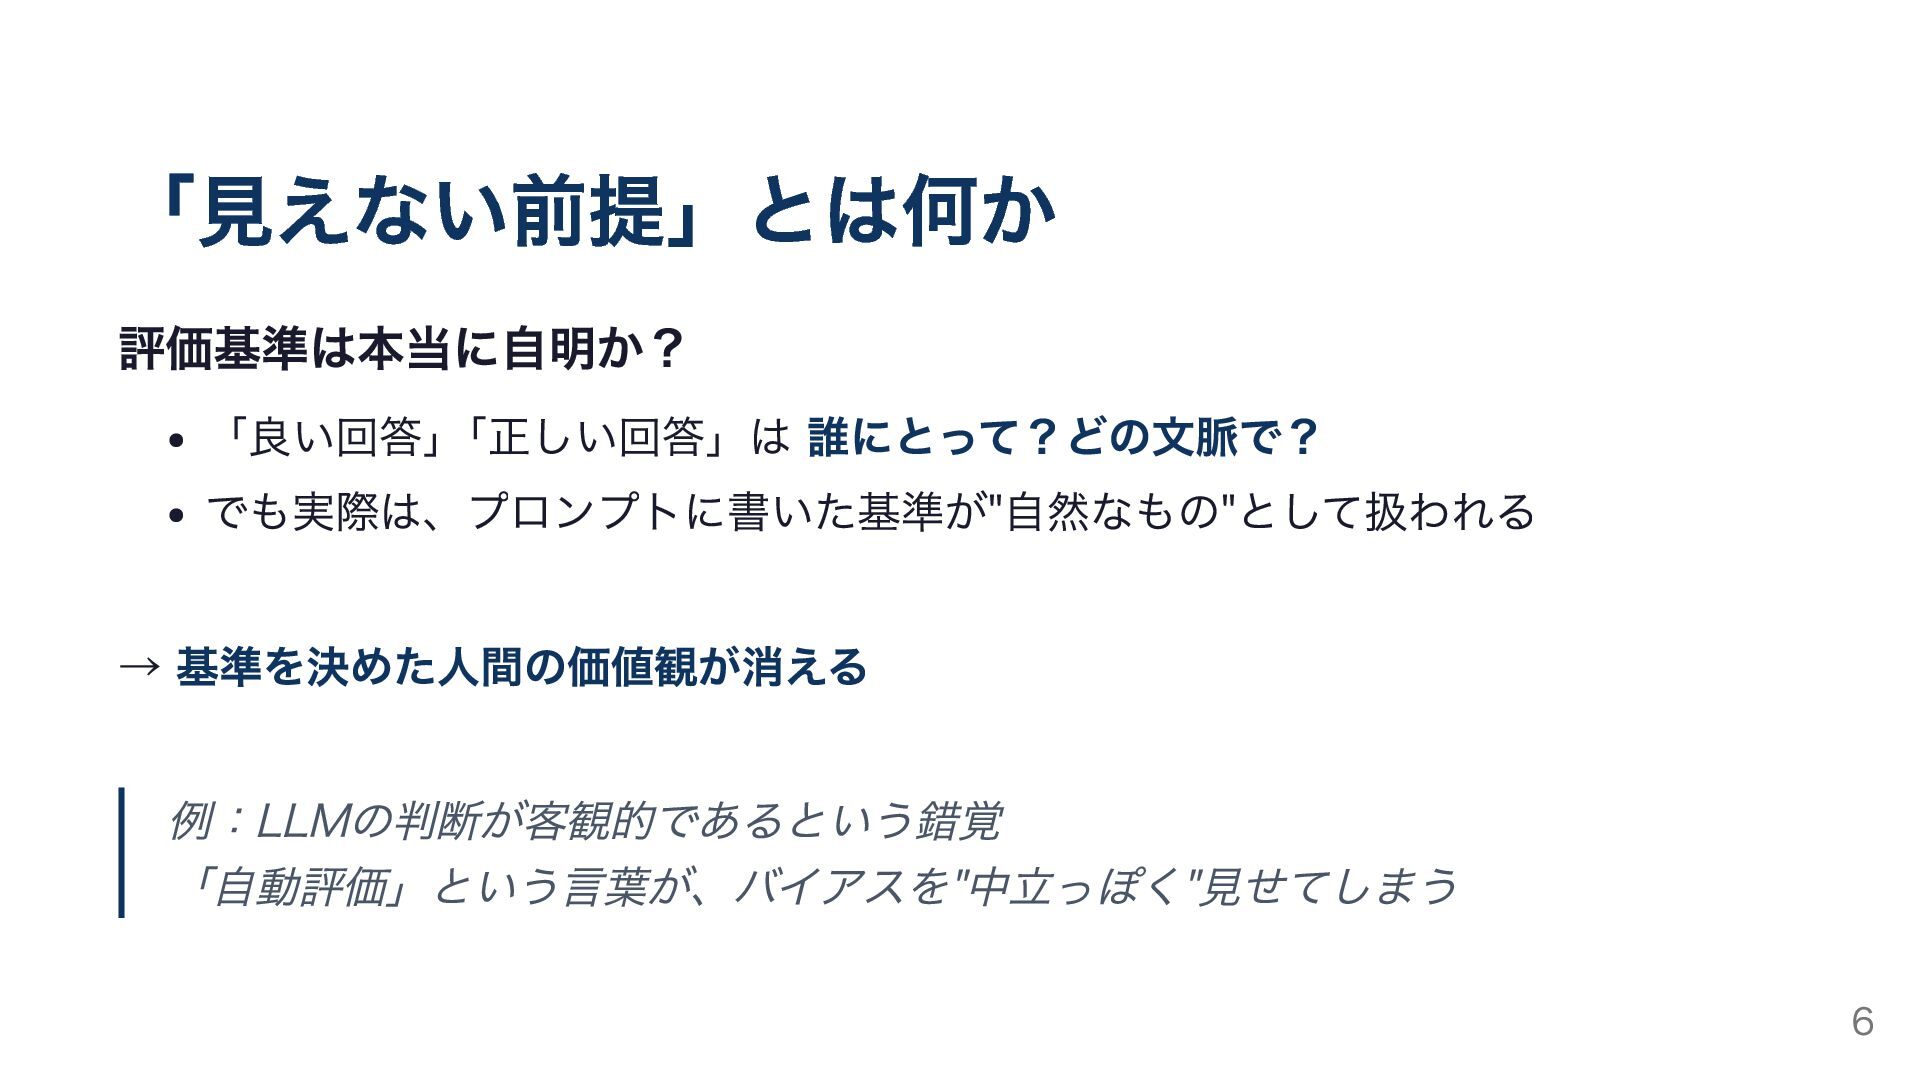
「見えない前提」とは何か 評価基準は本当に自明か? 「良い回答」 「正しい回答」は 誰にとって?どの文脈で? でも実際は、プロンプトに書いた基準が"自然なもの"として扱われる → 基準を決めた人間の価値観が消える 例:LLMの判断が客観的であるという錯覚 「自動評価」という言葉が、バイアスを"中立っぽく"見せてしまう
6
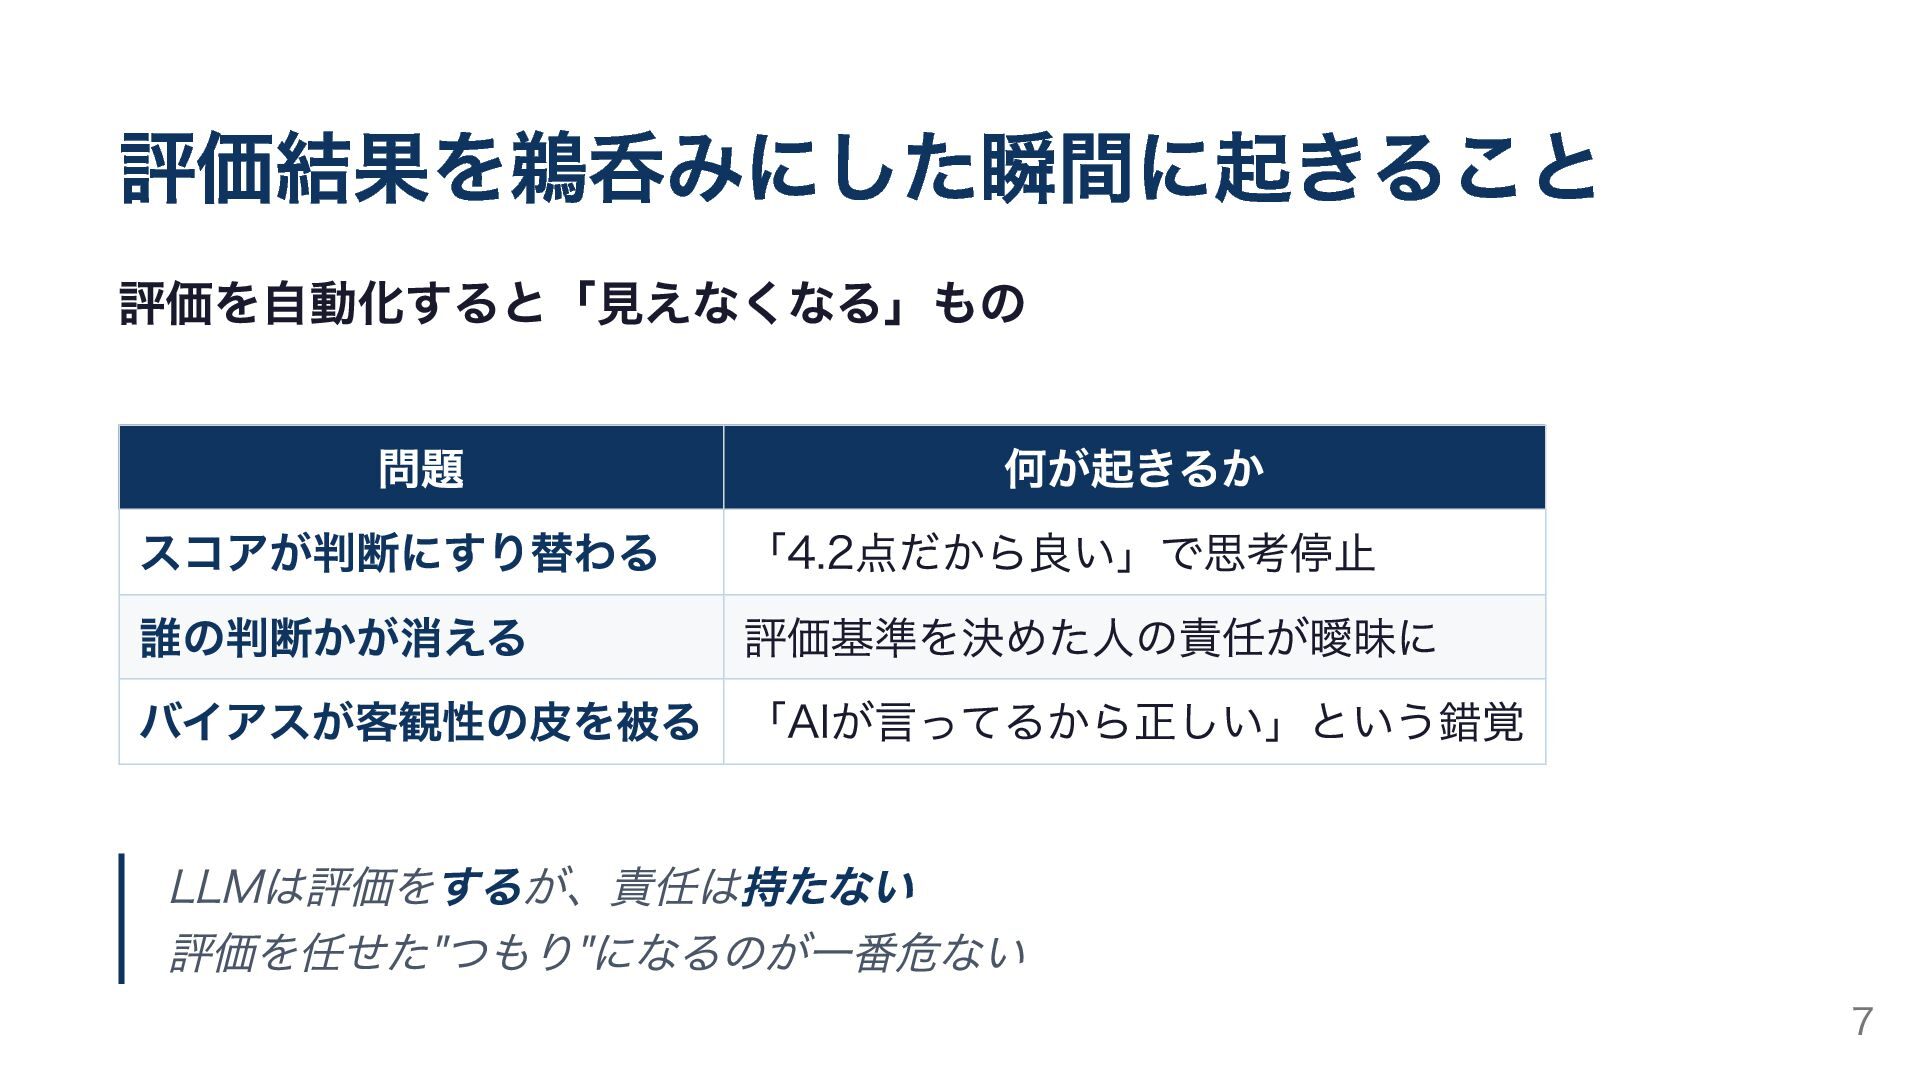
評価結果を鵜呑みにした瞬間に起きること 評価を自動化すると「見えなくなる」もの 問題 何が起きるか スコアが判断にすり替わる 「4.2点だから良い」で思考停止 誰の判断かが消える 評価基準を決めた人の責任が曖昧に バイアスが客観性の皮を被る 「AIが言ってるから正しい」という錯覚
LLMは評価をするが、責任は持たない 評価を任せた"つもり"になるのが一番危ない 7
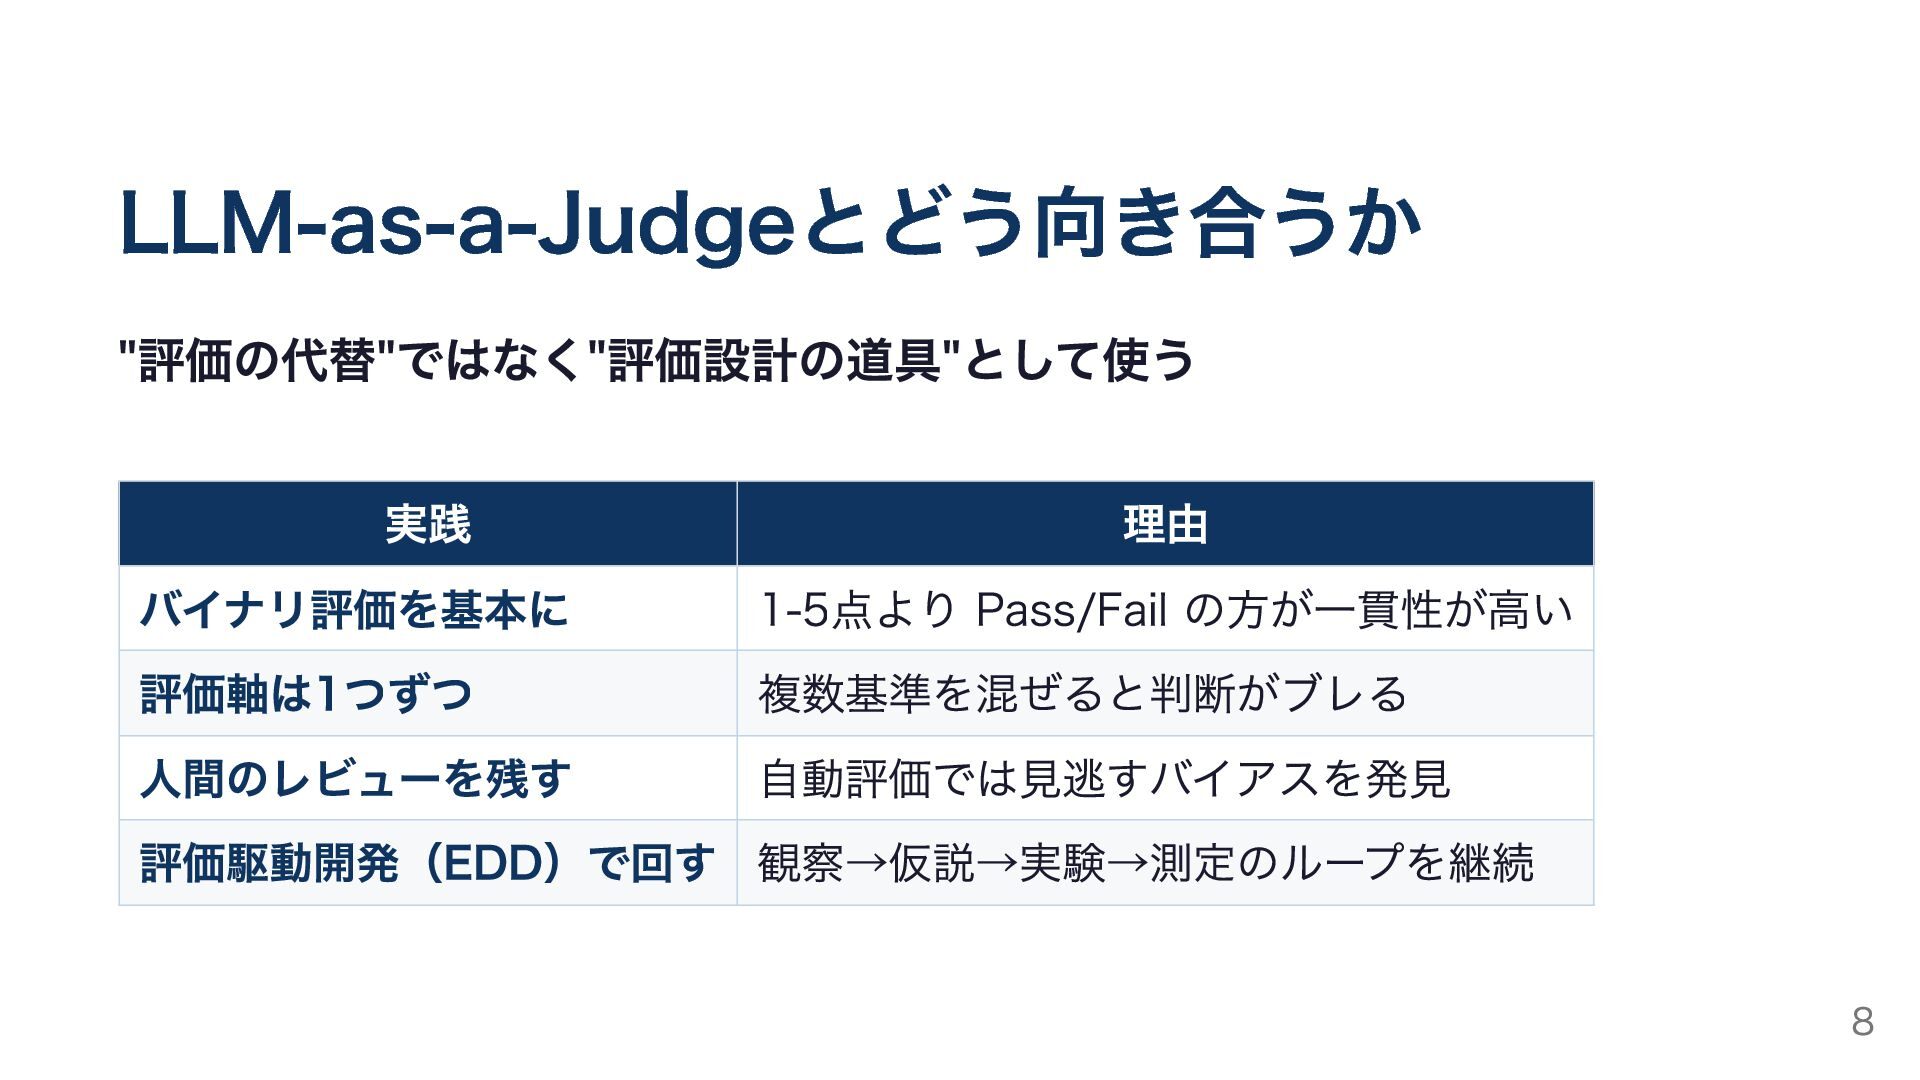
LLM-as-a-Judgeとどう向き合うか "評価の代替"ではなく"評価設計の道具"として使う 実践 理由 バイナリ評価を基本に 1-5点より Pass/Fail の方が一貫性が高い 評価軸は1つずつ 複数基準を混ぜると判断がブレる
人間のレビューを残す 自動評価では見逃すバイアスを発見 評価駆動開発(EDD)で回す 観察→仮説→実験→測定のループを継続 8
評価を設計するのは、結局「人間」 LLM-as-a-Judgeは 評価のスケール手段 責任と判断基準の設計は人間の仕事 ご清聴ありがとうございました 9


 smasui0302
 tmiket
 thekraken
 tammyeverts
 gurzu
 jlugia
 samlambert
 letsgokoyo
 davidcarrasco
 samanthasiow
 eileencodes
 kastner
 elsirapls