Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
第59回名古屋CV・PRMU勉強会
Search
soba_zuruzuru
November 20, 2023
180
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
第59回名古屋CV・PRMU勉強会
ICIP2023現地参加レポート
soba_zuruzuru
November 20, 2023
More Decks by soba_zuruzuru
See All by soba_zuruzuru
第59回名古屋CV・PRMU勉強会
sotakato
0
170
第59回名古屋CV・PRMU勉強会
sotakato
0
210
第59回名古屋CV・PRMU勉強会
sotakato
0
180
Featured
See All Featured
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
340
Leading Effective Engineering Teams in the AI Era
addyosmani
9
2.6k
For a Future-Friendly Web
brad_frost
183
10k
Noah Learner - AI + Me: how we built a GSC Bulk Export data pipeline
techseoconnect
PRO
0
440
Product Roadmaps are Hard
iamctodd
55
13k
エンジニアに許された特別な時間の終わり
watany
109
250k
Art, The Web, and Tiny UX
lynnandtonic
304
22k
Darren the Foodie - Storyboard
khoart
PRO
4
3.9k
Code Review Best Practice
trishagee
74
20k
A Guide to Academic Writing Using Generative AI - A Workshop
ks91
PRO
1
480
The World Runs on Bad Software
bkeepers
PRO
72
12k
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3k
Transcript
第59回名古屋CV・PRMU勉強会 ICIP2023参加報告会
自己紹介 2 発表する人 加藤 聡太 名城大学 堀田研究室 D3 日本学術振興会特別研究員(DC2) 名古屋CV・PRMU勉強会幹事
来年4月~センスタイムジャパン(予定) 研究内容 Class imbalanced learning Medical & biological vision 趣味 古着, 楽器(ドラム), 恋愛リアリティ―ショー @usagisukisuki_ usagisukisuki
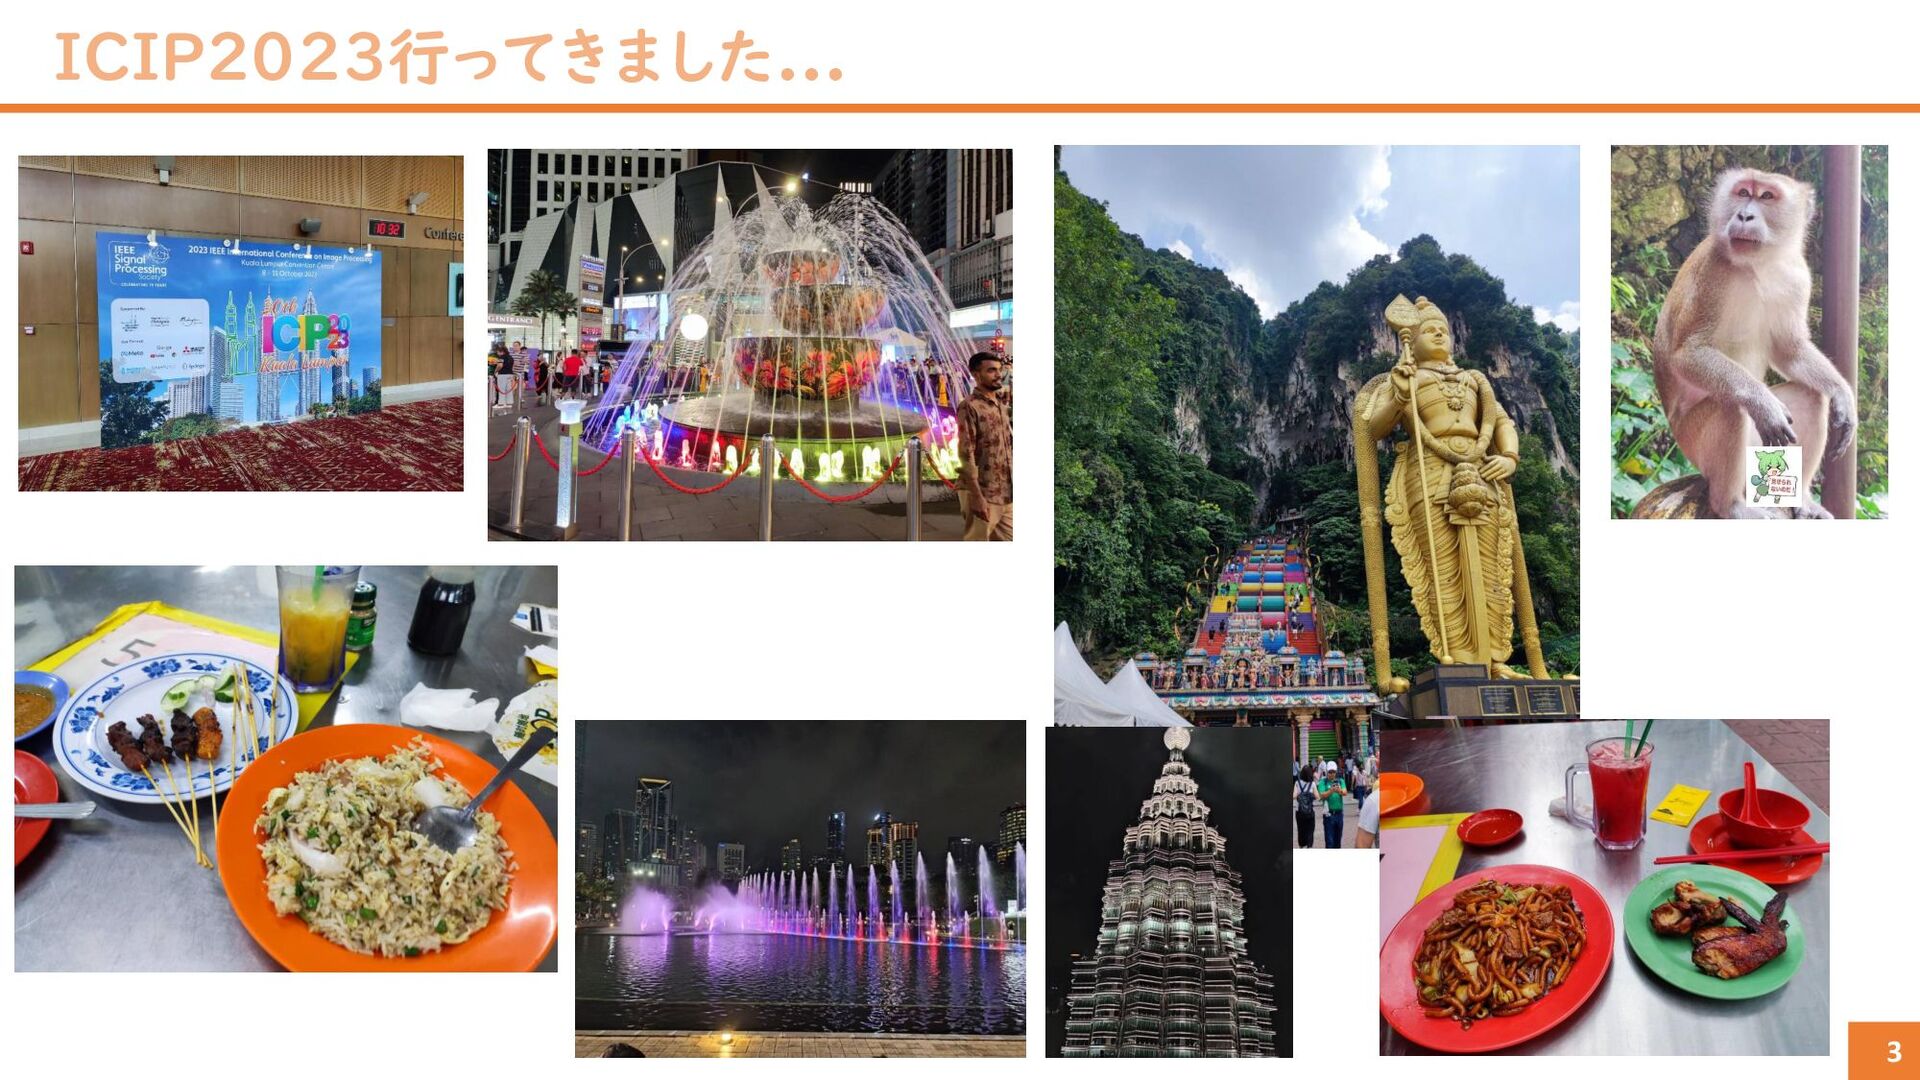
ICIP2023行ってきました... 3
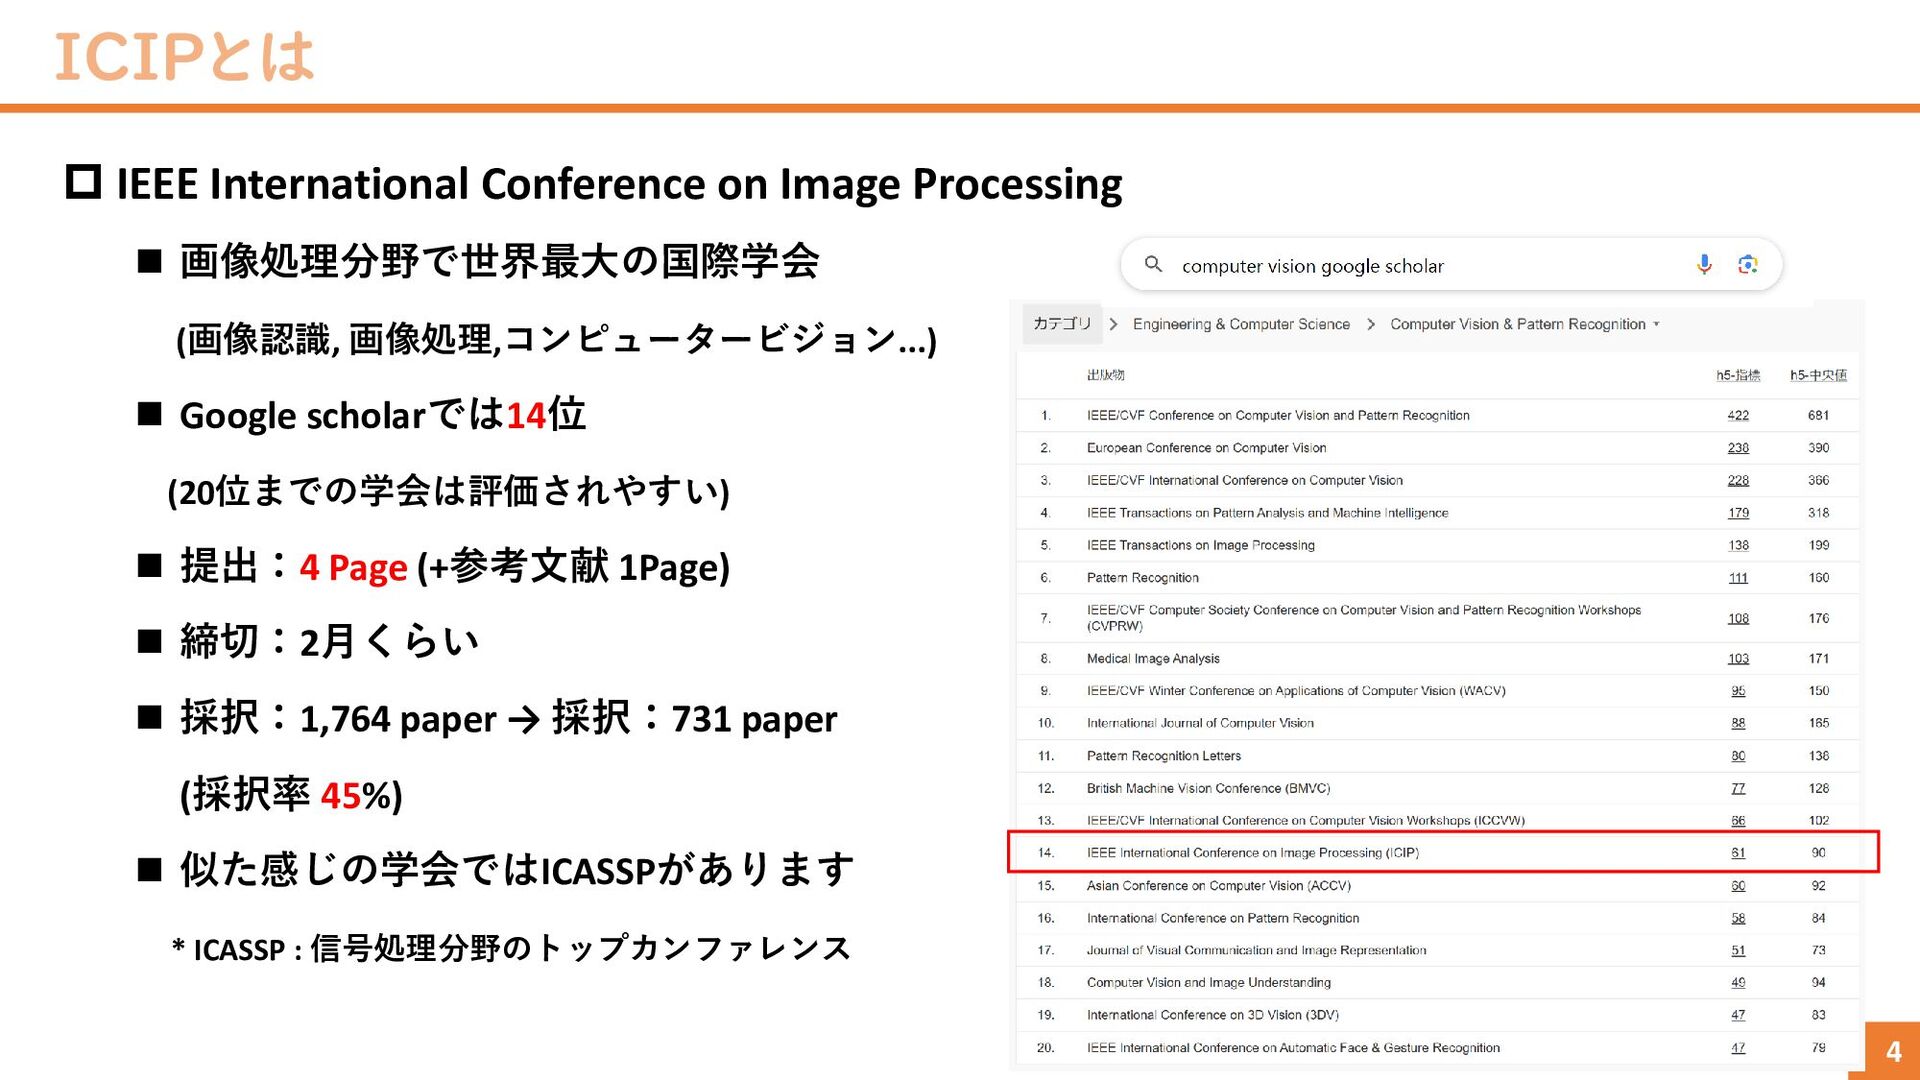
ICIPとは IEEE International Conference on Image Processing 画像処理分野で世界最大の国際学会
(画像認識, 画像処理,コンピュータービジョン...) Google scholarでは14位 (20位までの学会は評価されやすい) 提出:4 Page (+参考文献 1Page) 締切:2月くらい 採択:1,764 paper → 採択:731 paper (採択率 45%) 似た感じの学会ではICASSPがあります * ICASSP : 信号処理分野のトップカンファレンス 4
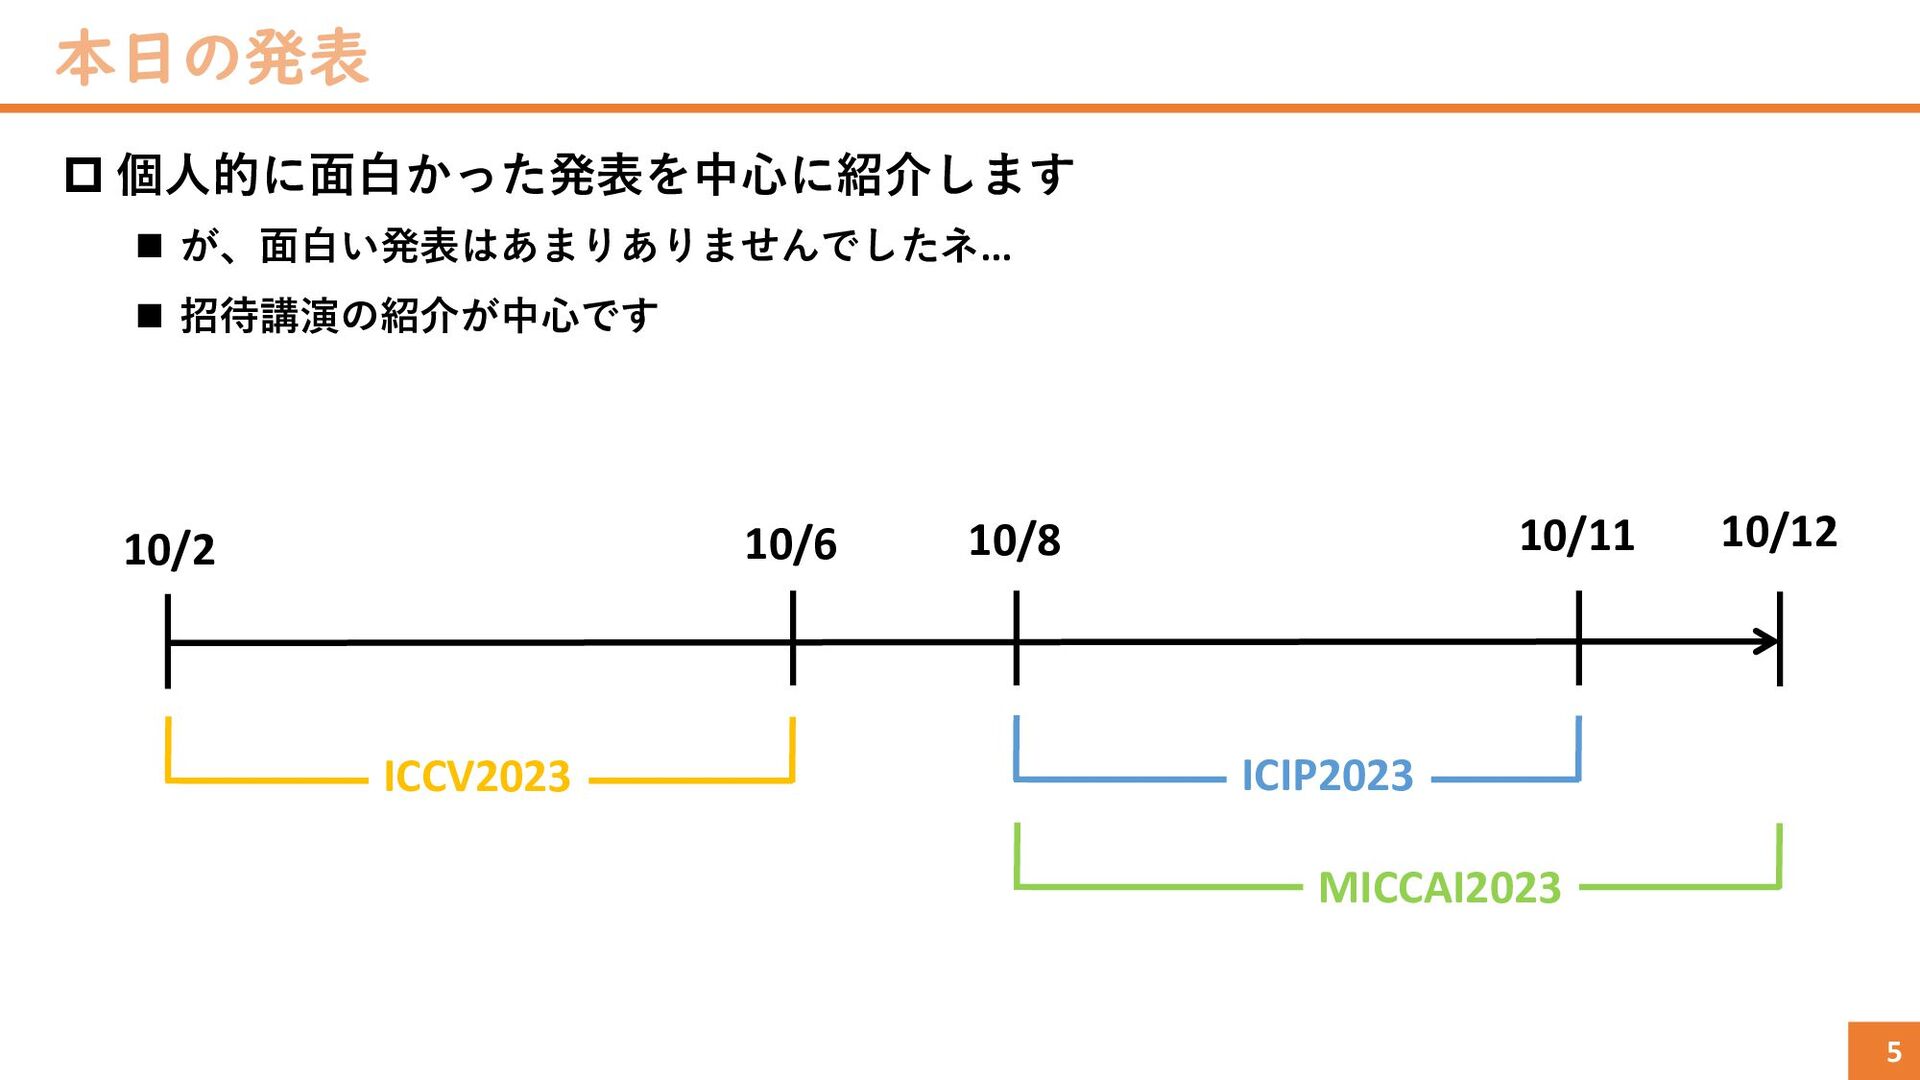
本日の発表 個人的に面白かった発表を中心に紹介します が、面白い発表はあまりありませんでしたネ... 招待講演の紹介が中心です 5 10/8 10/11
10/12 10/6 10/2 ICCV2023 ICIP2023 MICCAI2023
招待講演
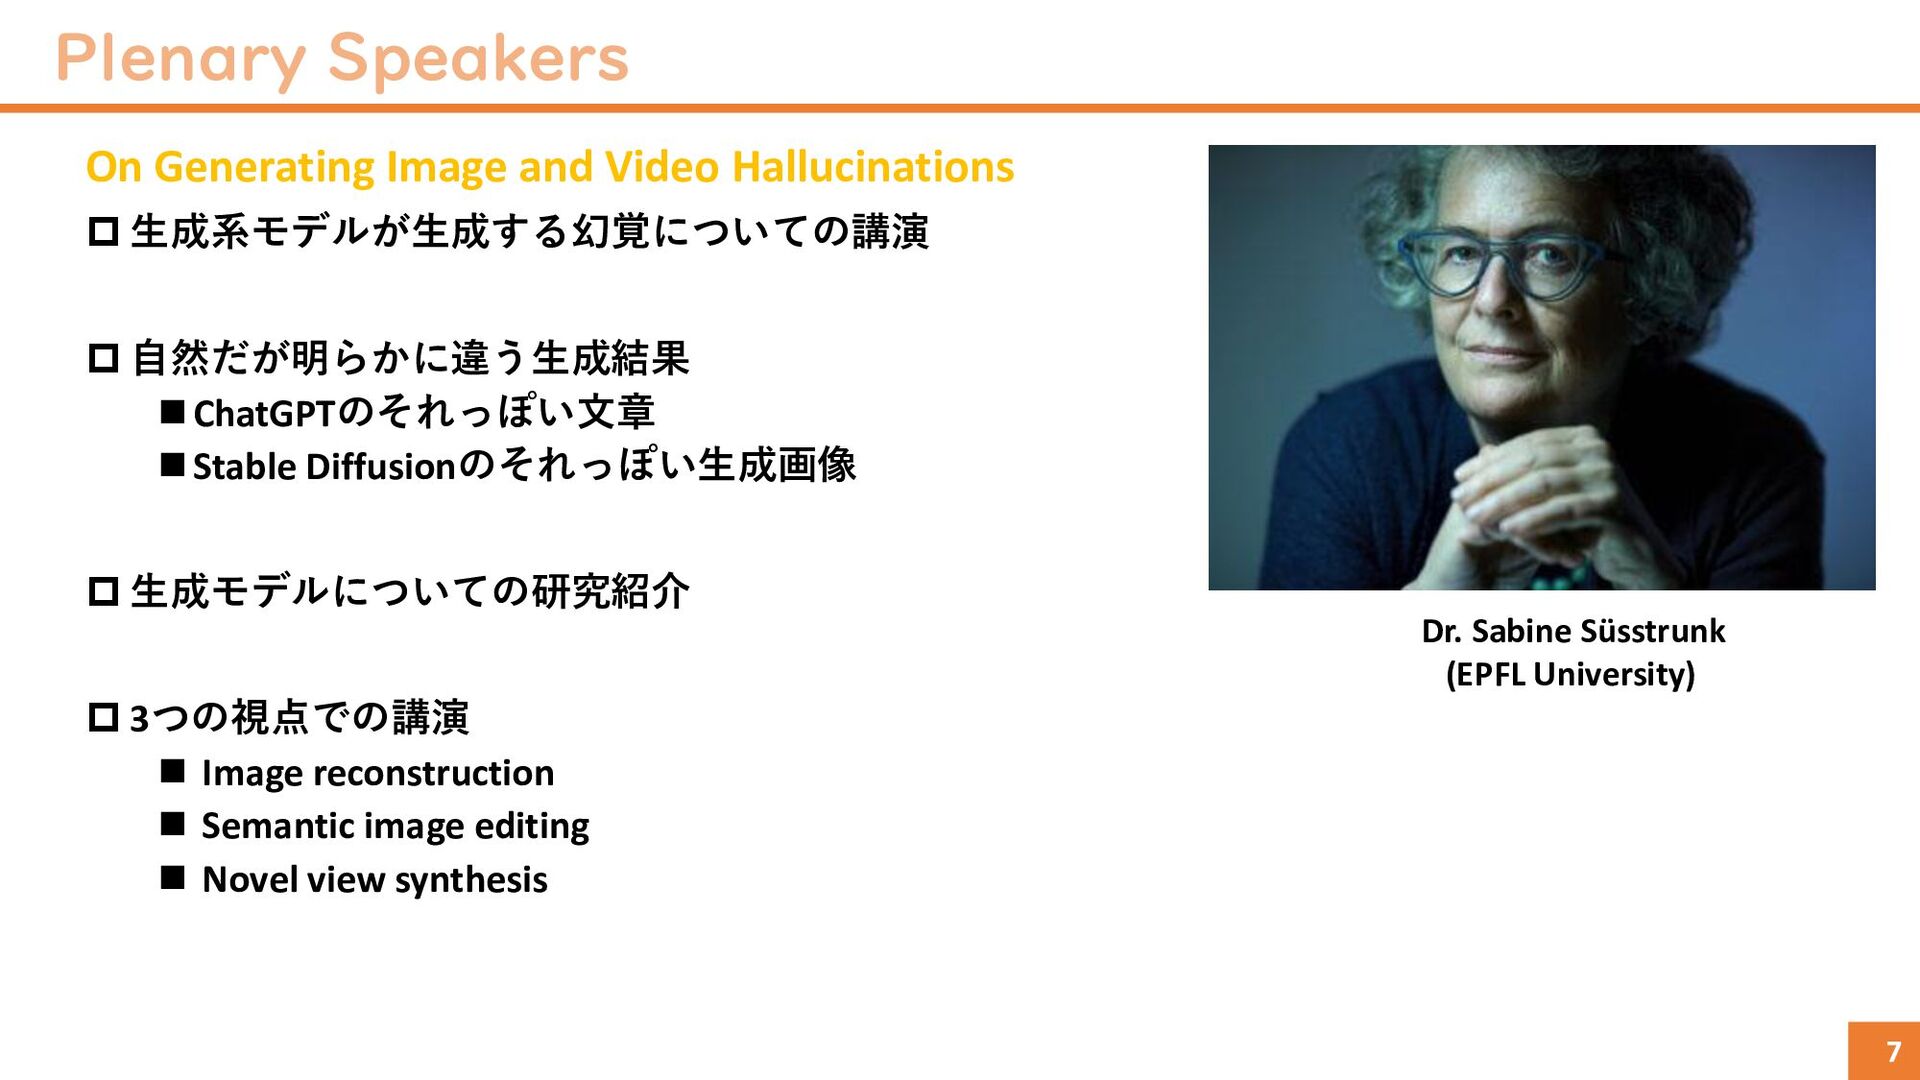
Plenary Speakers 7 On Generating Image and Video Hallucinations
生成系モデルが生成する幻覚についての講演 自然だが明らかに違う生成結果 ChatGPTのそれっぽい文章 Stable Diffusionのそれっぽい生成画像 生成モデルについての研究紹介 3つの視点での講演 Image reconstruction Semantic image editing Novel view synthesis Dr. Sabine Süsstrunk (EPFL University)
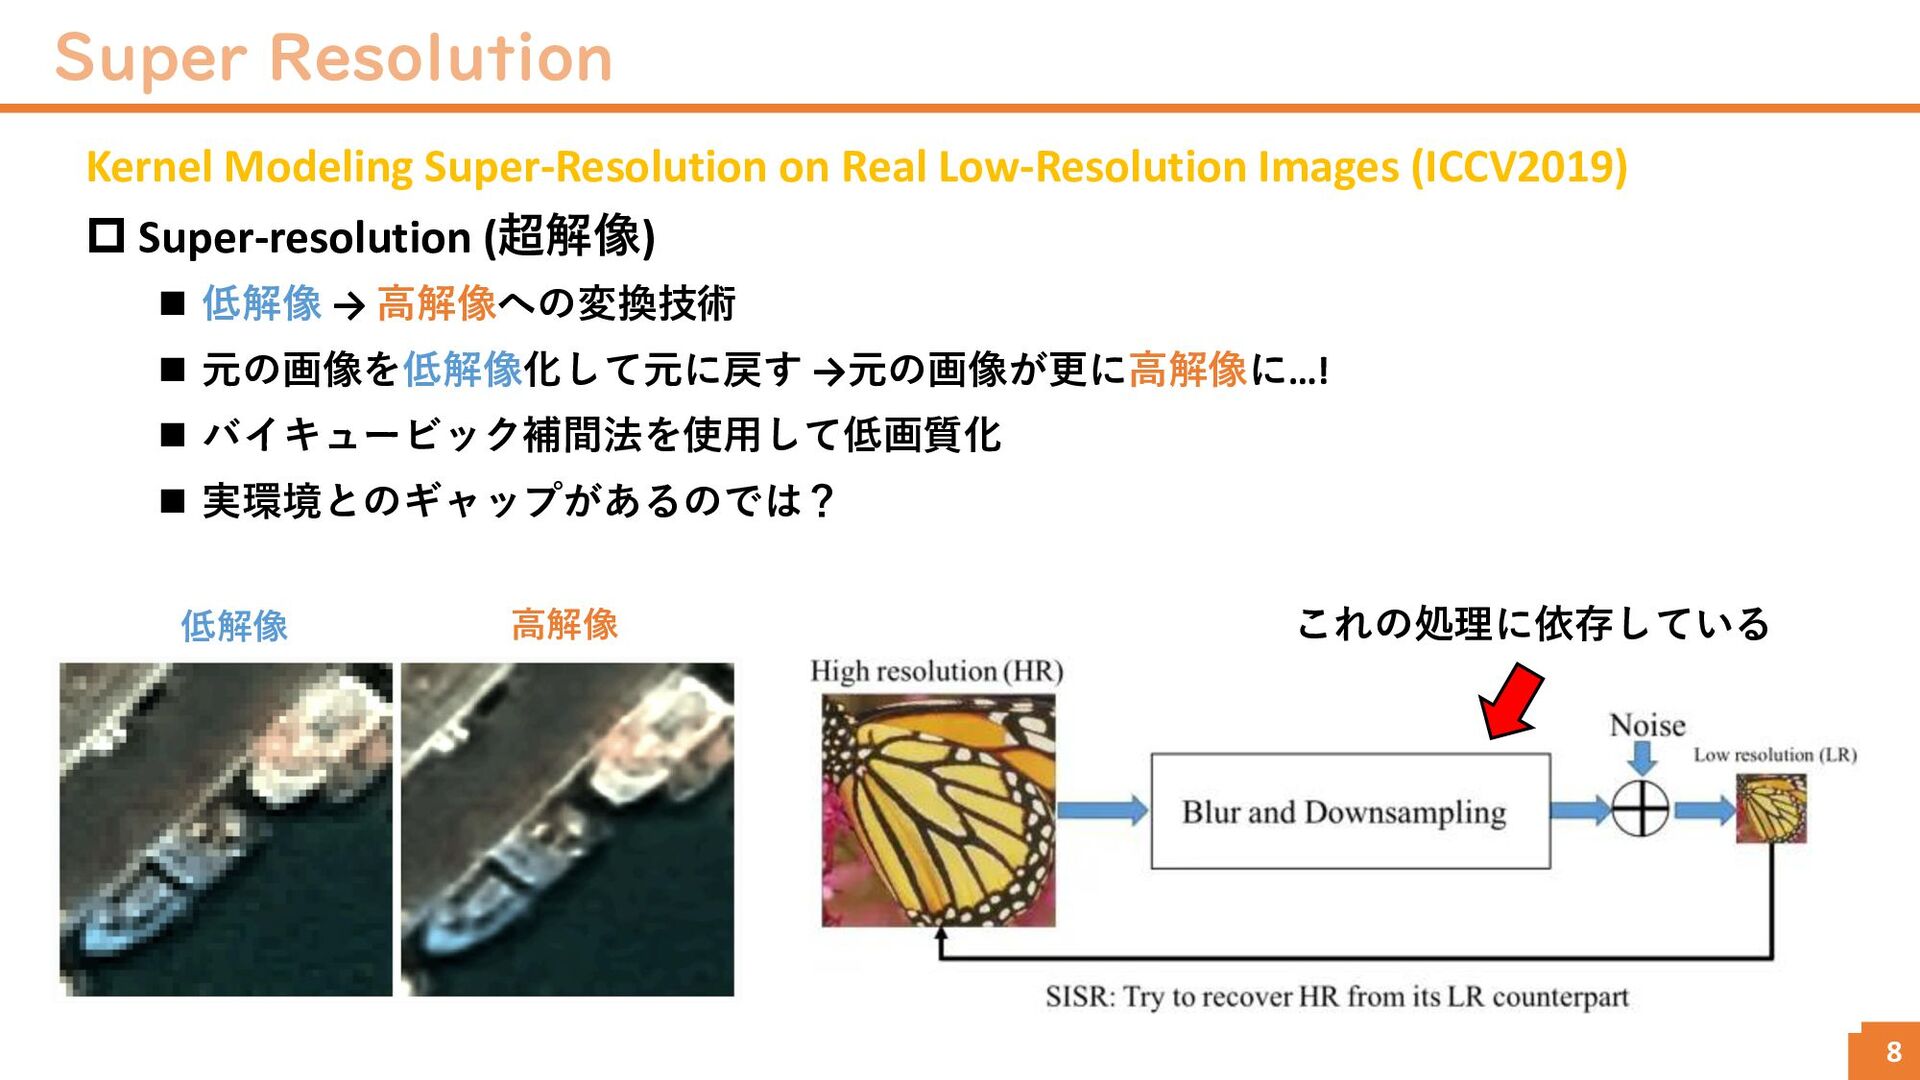
Super Resolution 8 Kernel Modeling Super-Resolution on Real Low-Resolution Images
(ICCV2019) Super-resolution (超解像) 低解像 → 高解像への変換技術 元の画像を低解像化して元に戻す →元の画像が更に高解像に…! バイキュービック補間法を使用して低画質化 実環境とのギャップがあるのでは? これの処理に依存している 低解像 高解像
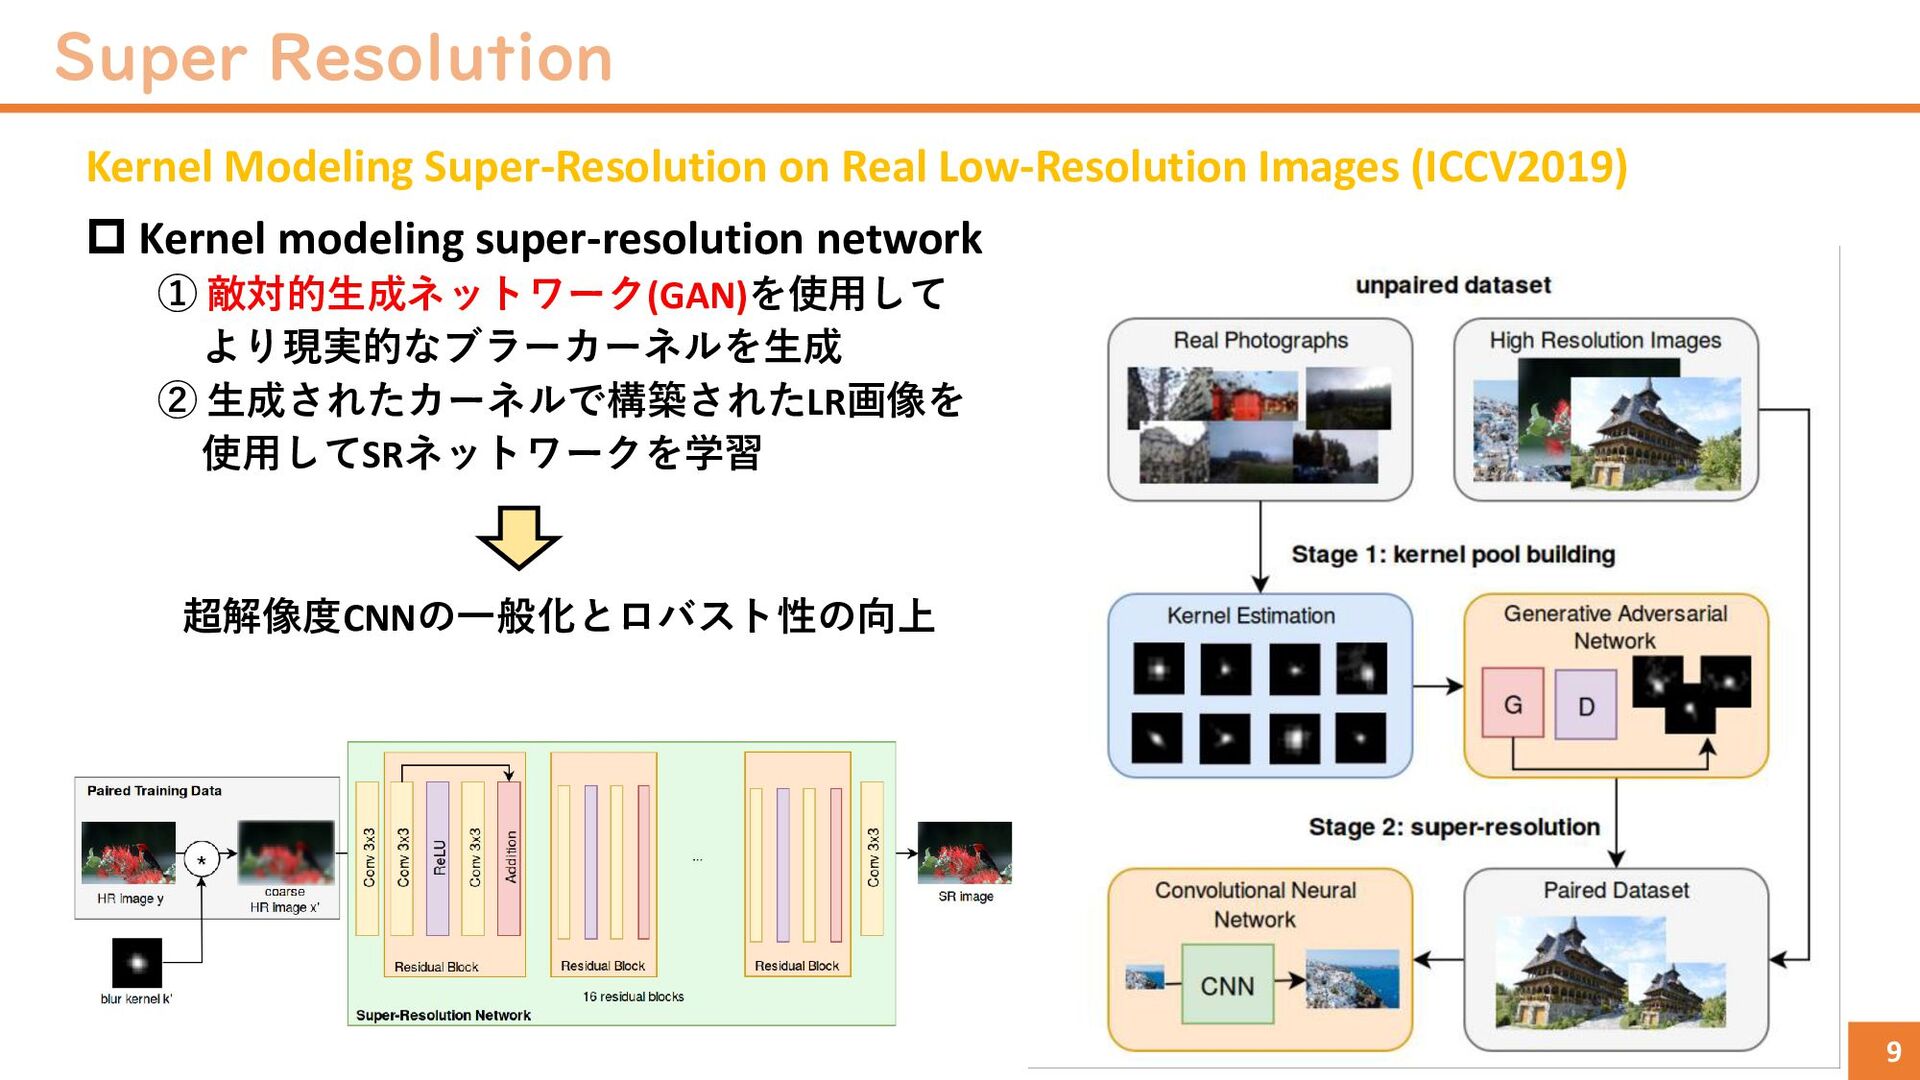
Super Resolution 9 Kernel Modeling Super-Resolution on Real Low-Resolution Images
(ICCV2019) Kernel modeling super-resolution network ① 敵対的生成ネットワーク(GAN)を使用して より現実的なブラーカーネルを生成 ② 生成されたカーネルで構築されたLR画像を 使用してSRネットワークを学習 超解像度CNNの一般化とロバスト性の向上
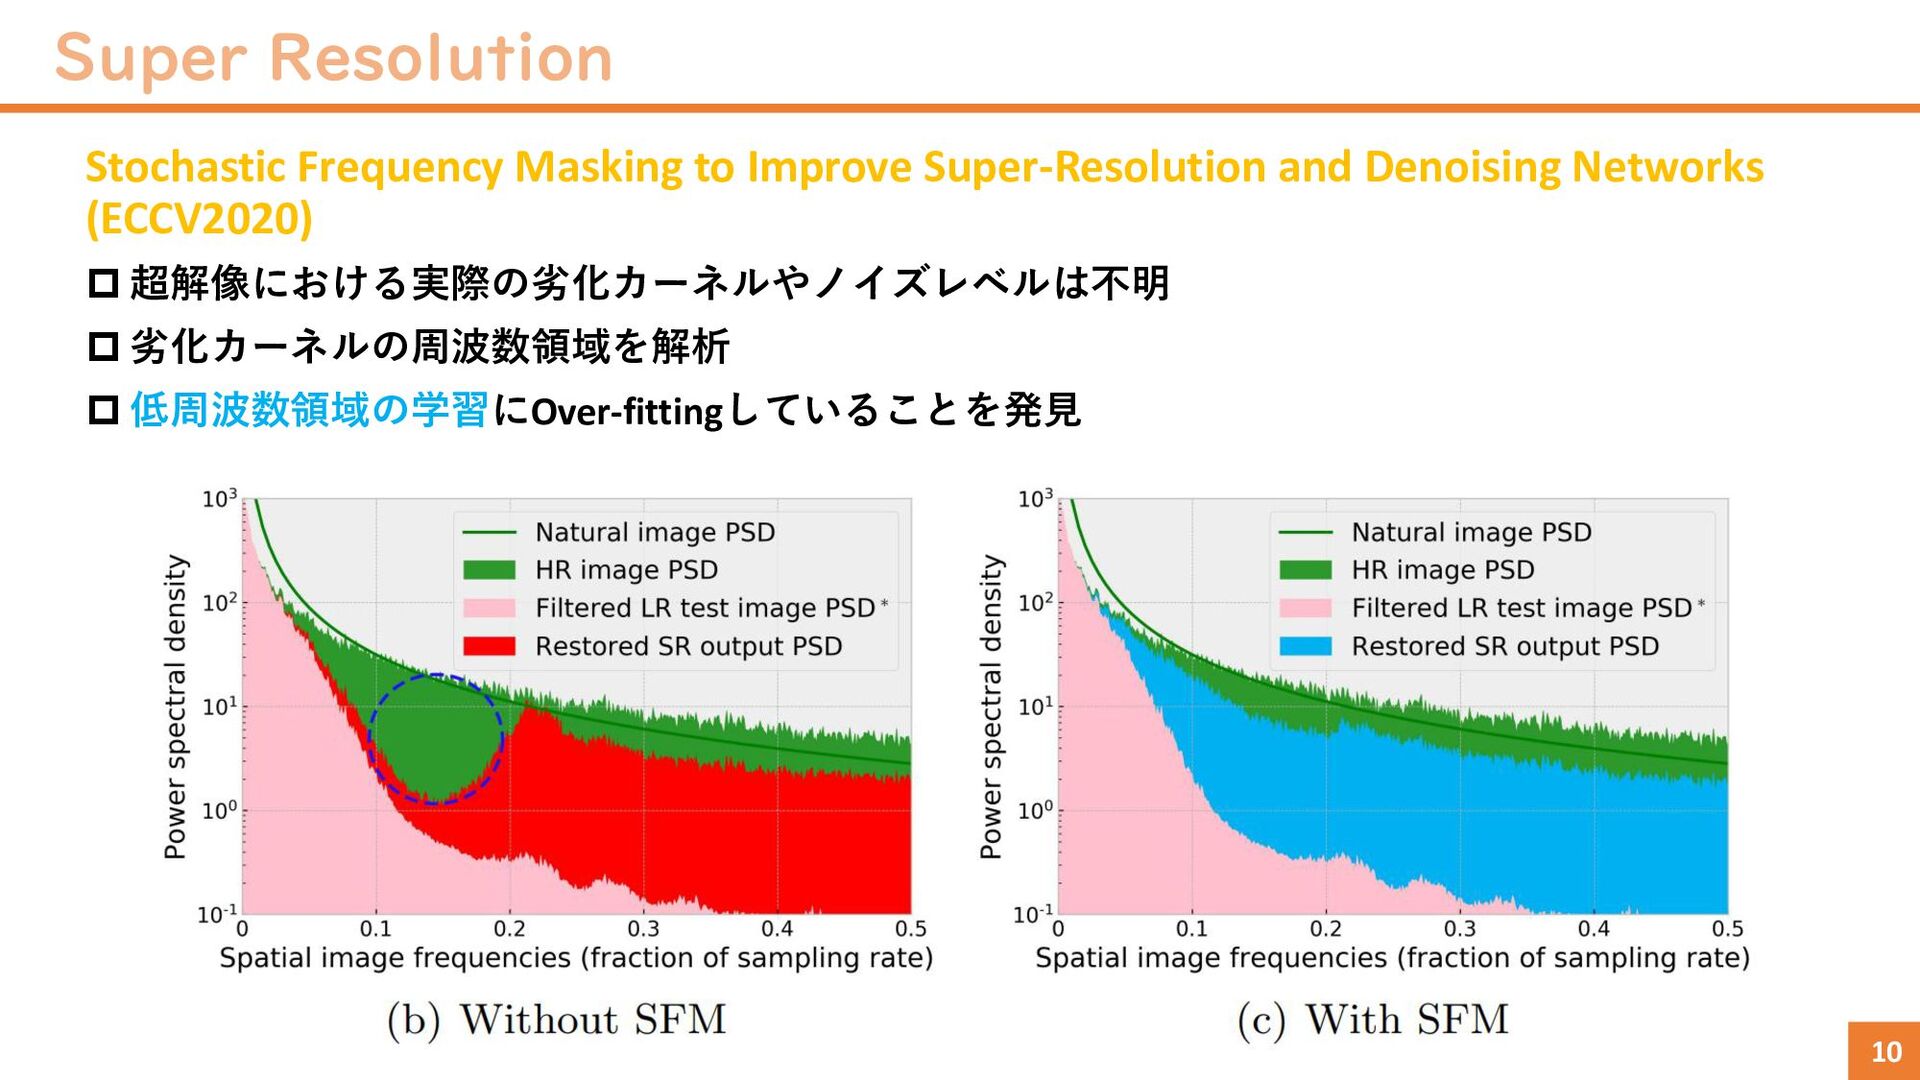
Super Resolution 10 Stochastic Frequency Masking to Improve Super-Resolution and
Denoising Networks (ECCV2020) 超解像における実際の劣化カーネルやノイズレベルは不明 劣化カーネルの周波数領域を解析 低周波数領域の学習にOver-fittingしていることを発見
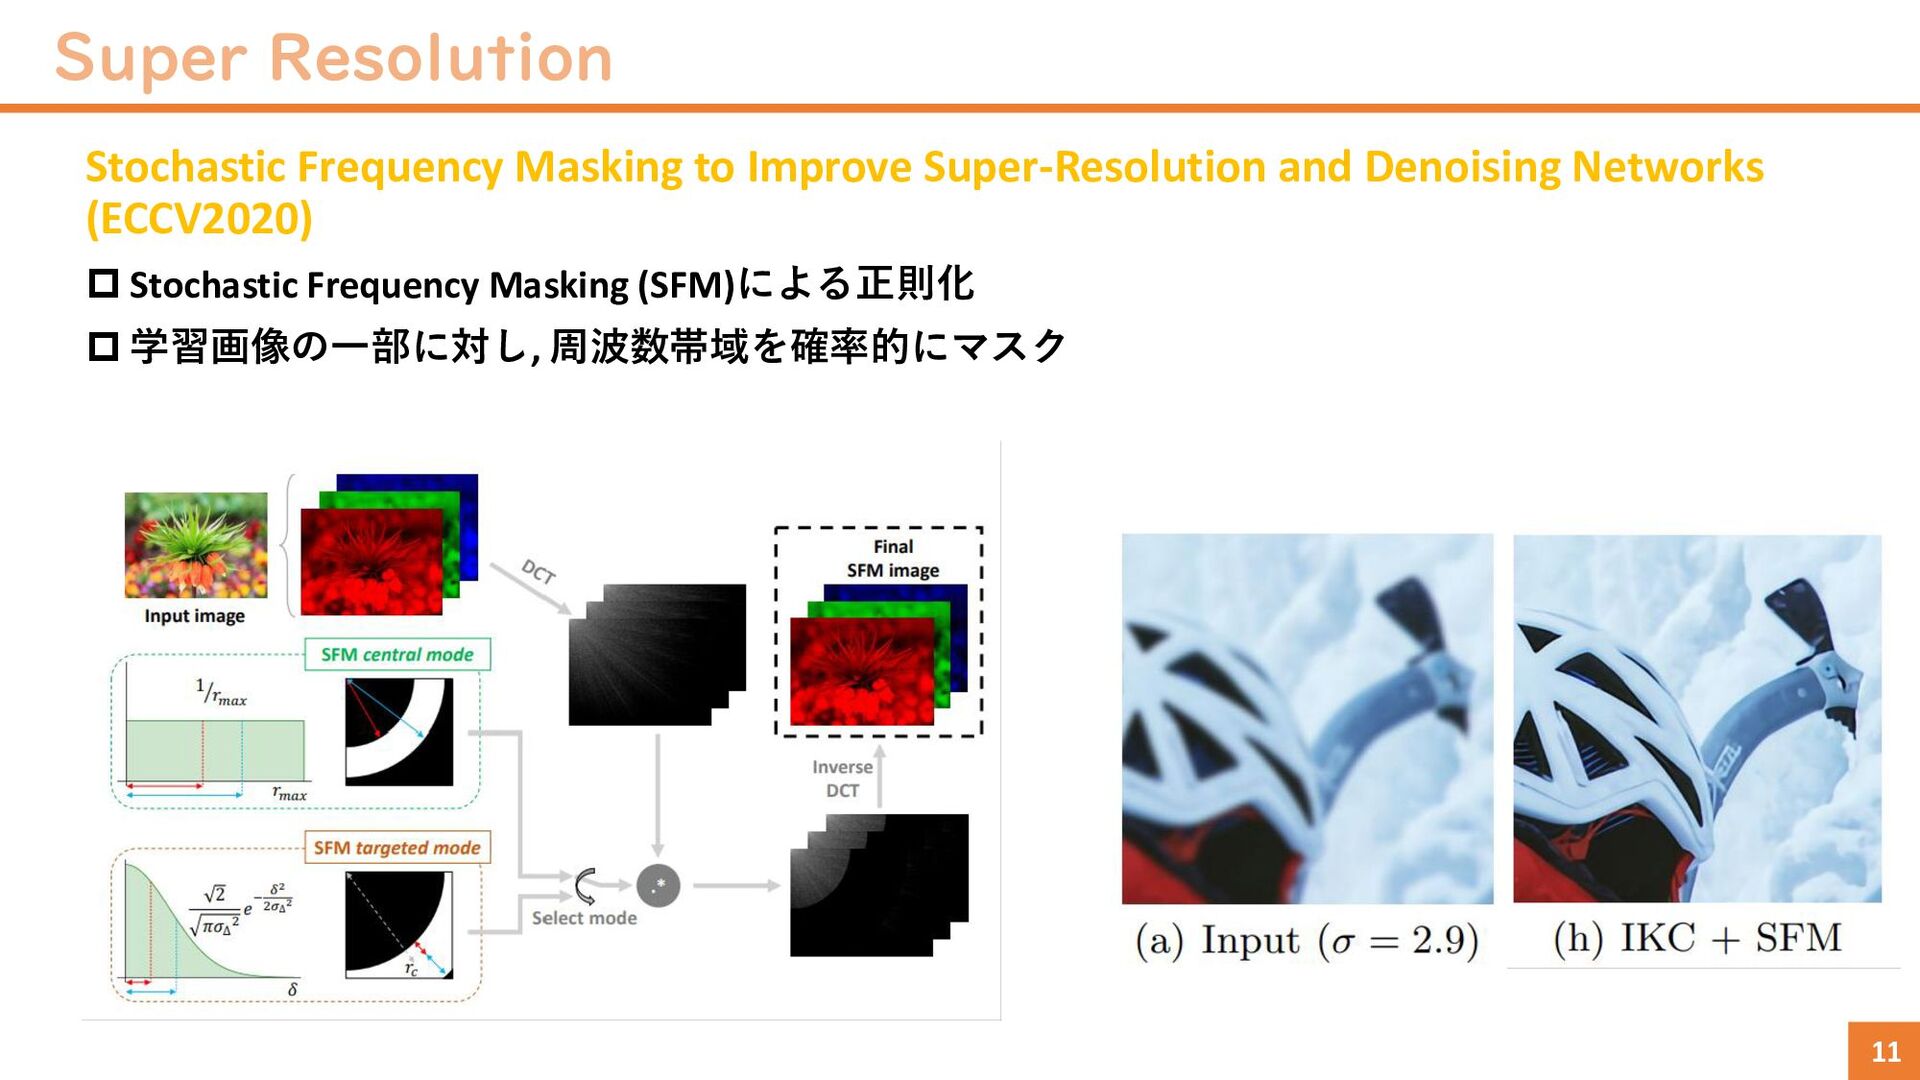
Super Resolution 11 Stochastic Frequency Masking to Improve Super-Resolution and
Denoising Networks (ECCV2020) Stochastic Frequency Masking (SFM)による正則化 学習画像の一部に対し, 周波数帯域を確率的にマスク
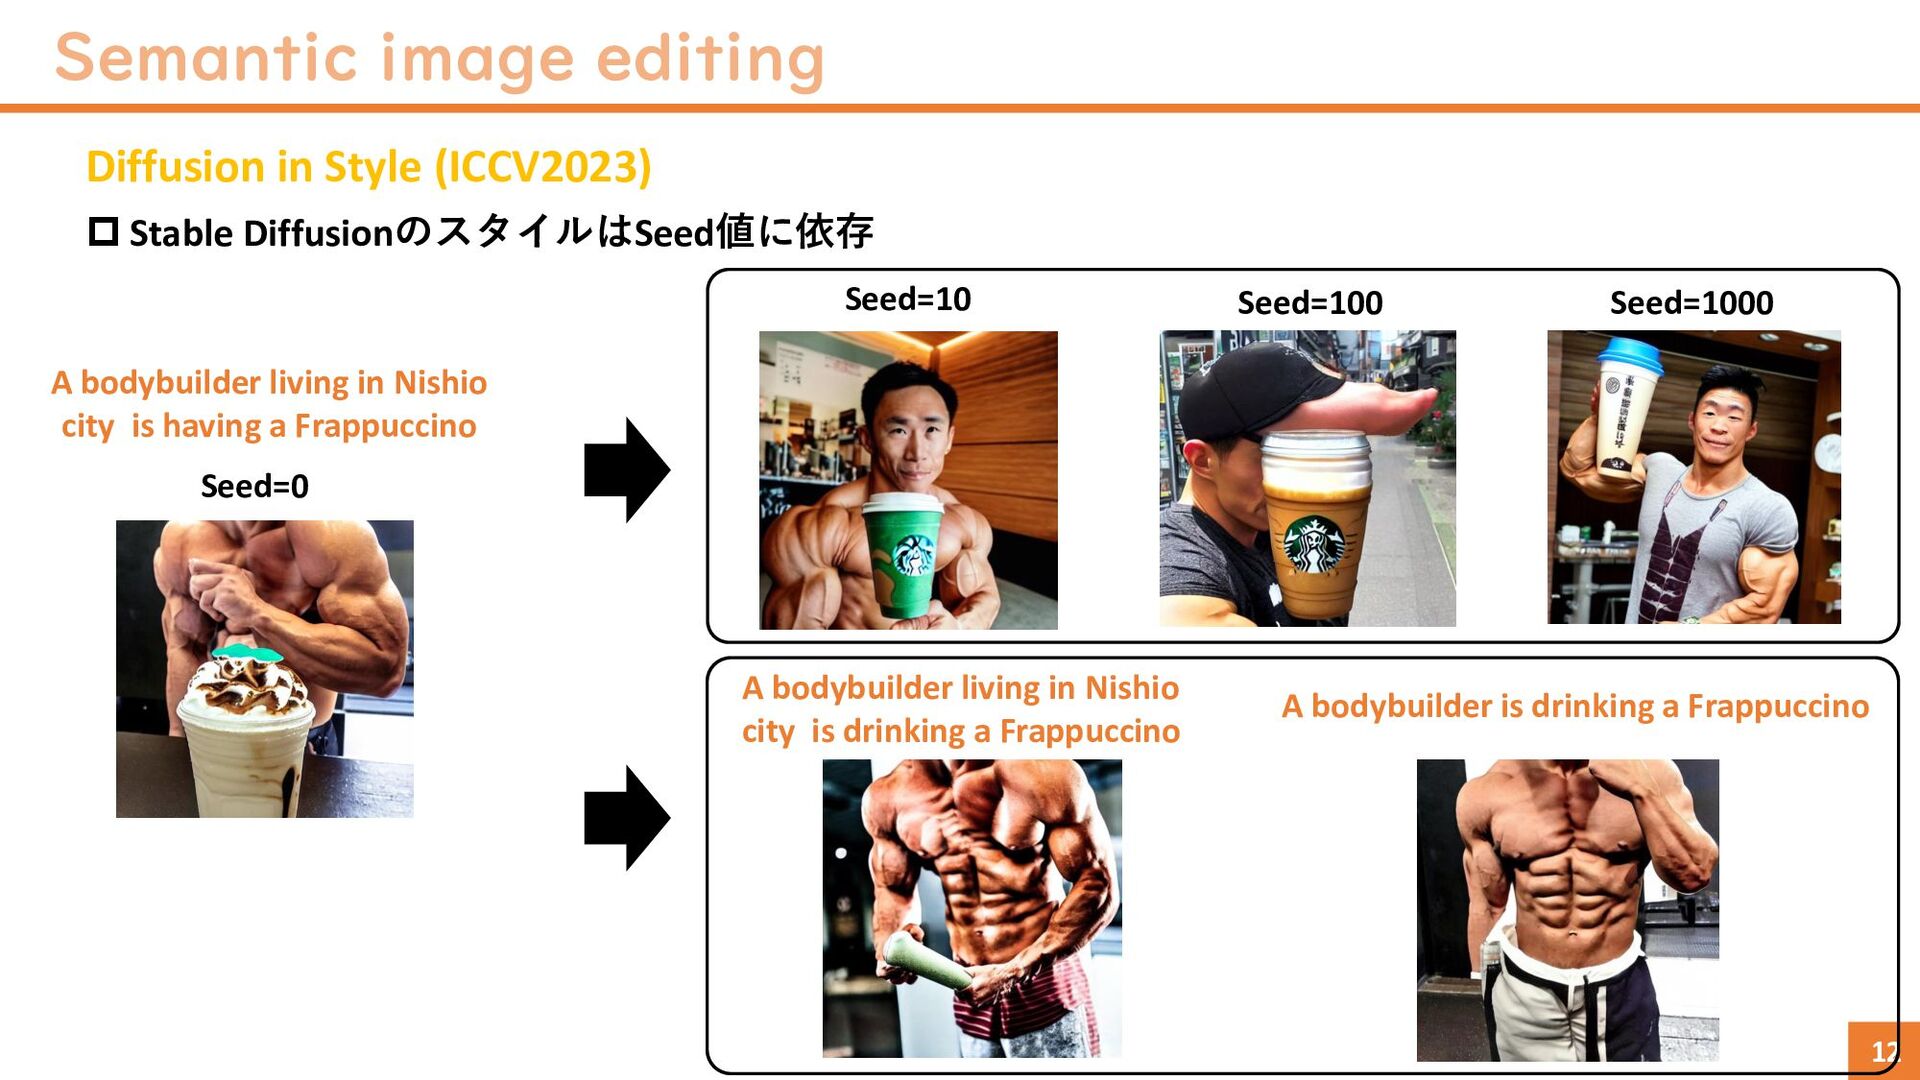
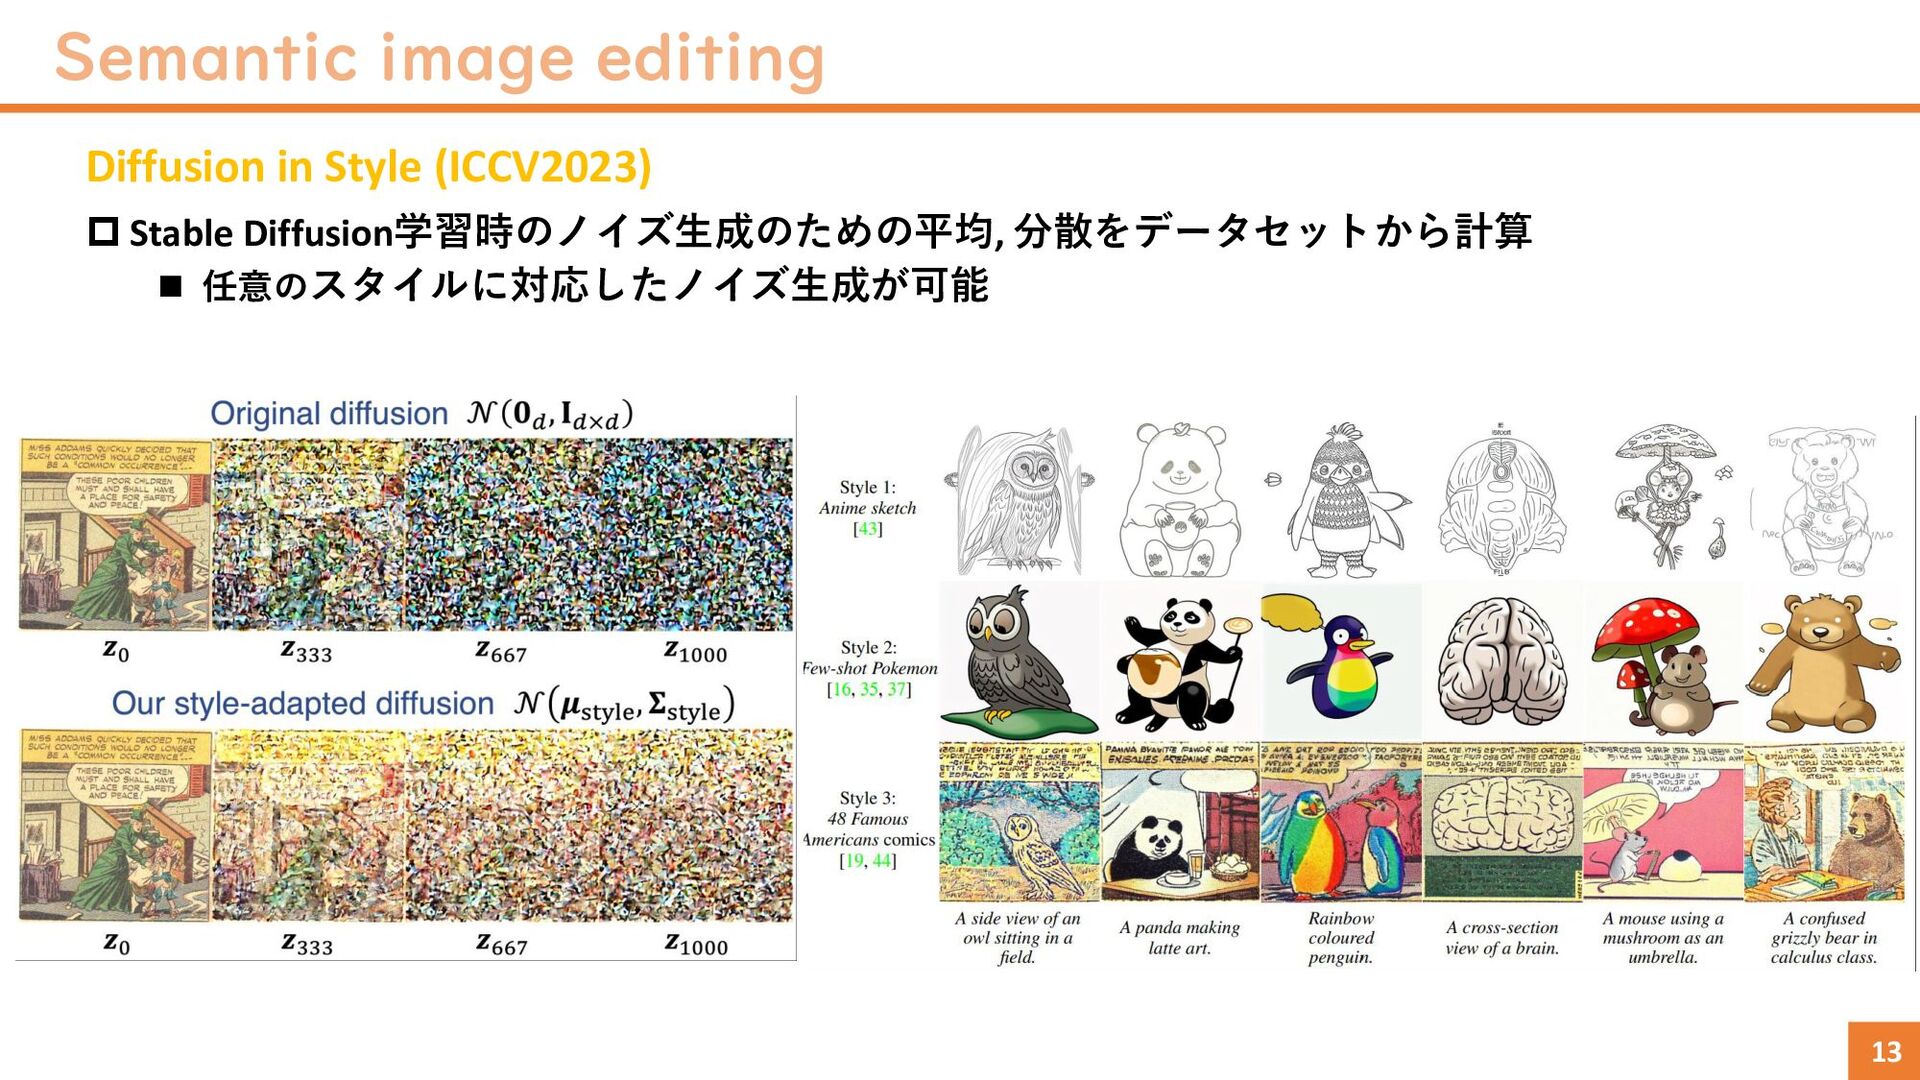
Semantic image editing 12 Diffusion in Style (ICCV2023) Stable
DiffusionのスタイルはSeed値に依存 A bodybuilder living in Nishio city is drinking a Frappuccino A bodybuilder is drinking a Frappuccino A bodybuilder living in Nishio city is having a Frappuccino Seed=10 Seed=100 Seed=1000 Seed=0
Semantic image editing 13 Diffusion in Style (ICCV2023) Stable
Diffusion学習時のノイズ生成のための平均, 分散をデータセットから計算 任意のスタイルに対応したノイズ生成が可能
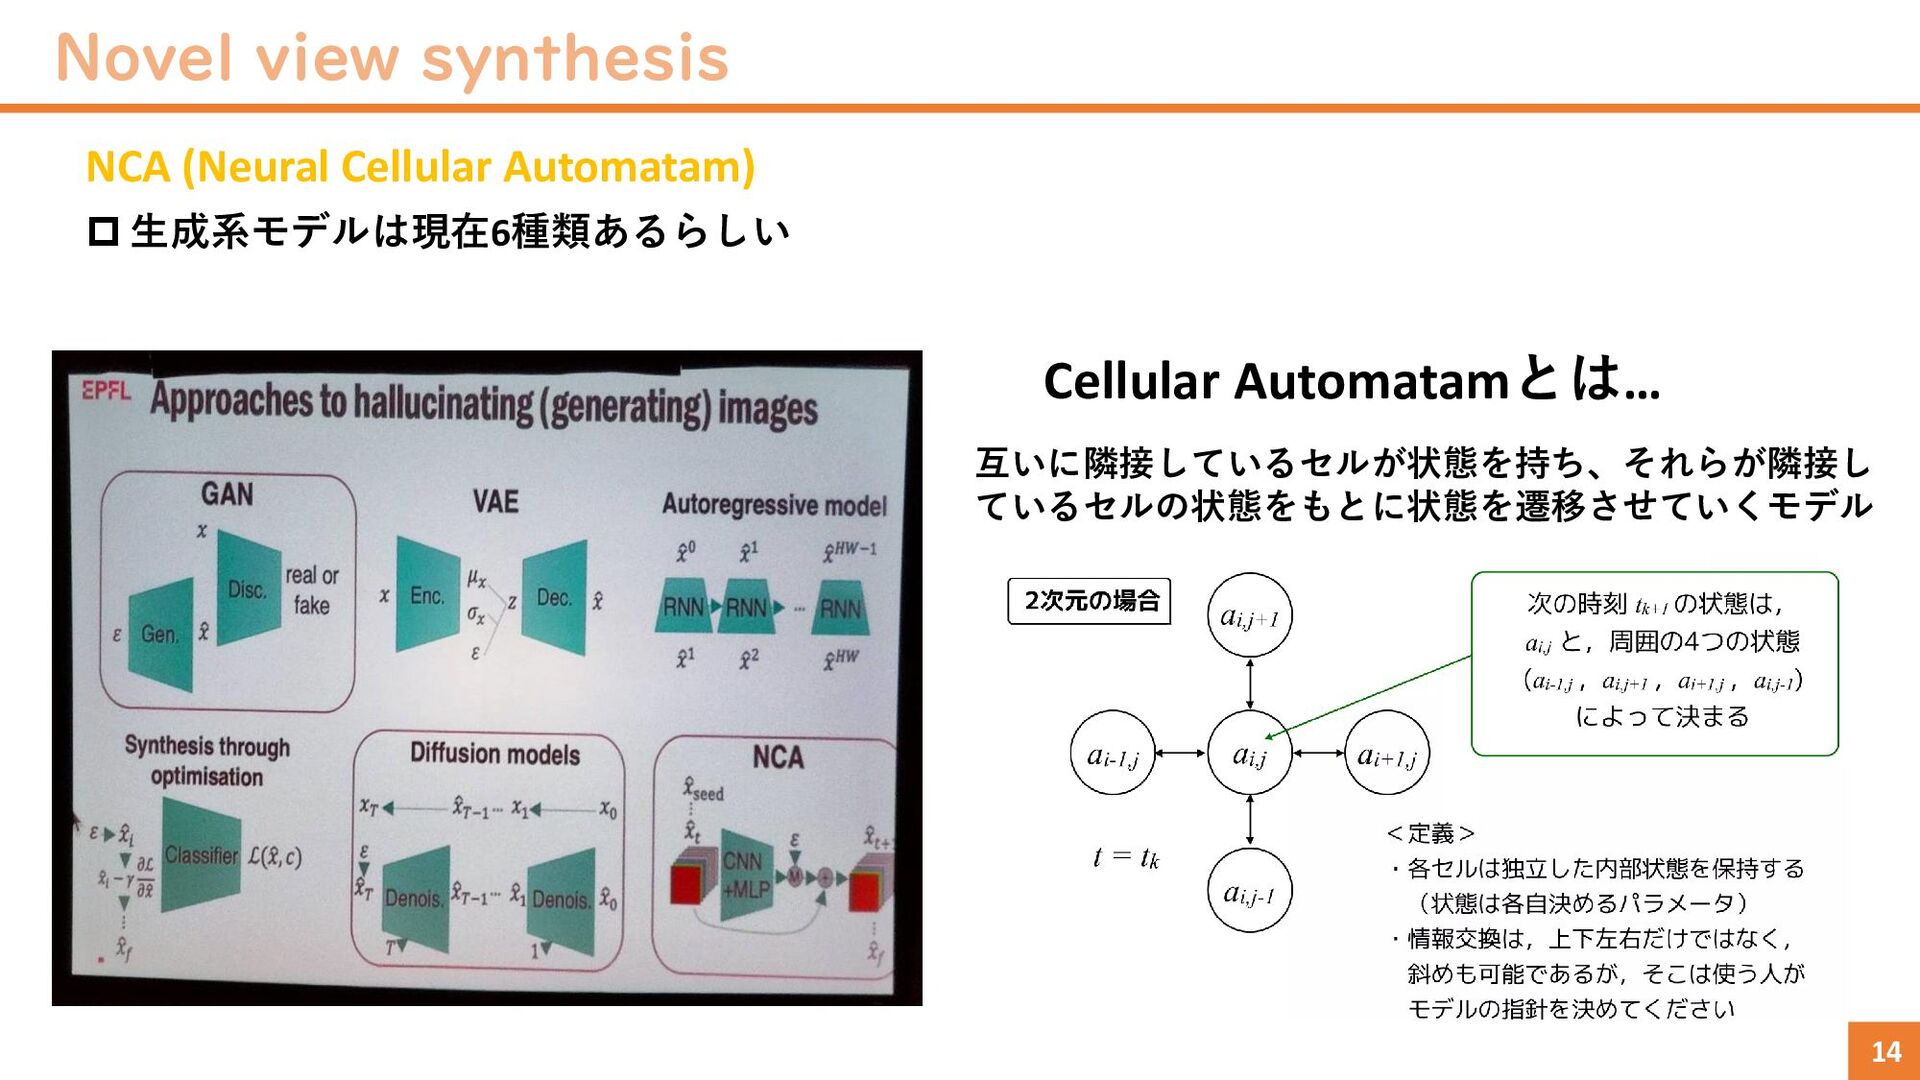
Novel view synthesis 14 NCA (Neural Cellular Automatam) 生成系モデルは現在6種類あるらしい
Cellular Automatamとは… 互いに隣接しているセルが状態を持ち、それらが隣接し ているセルの状態をもとに状態を遷移させていくモデル
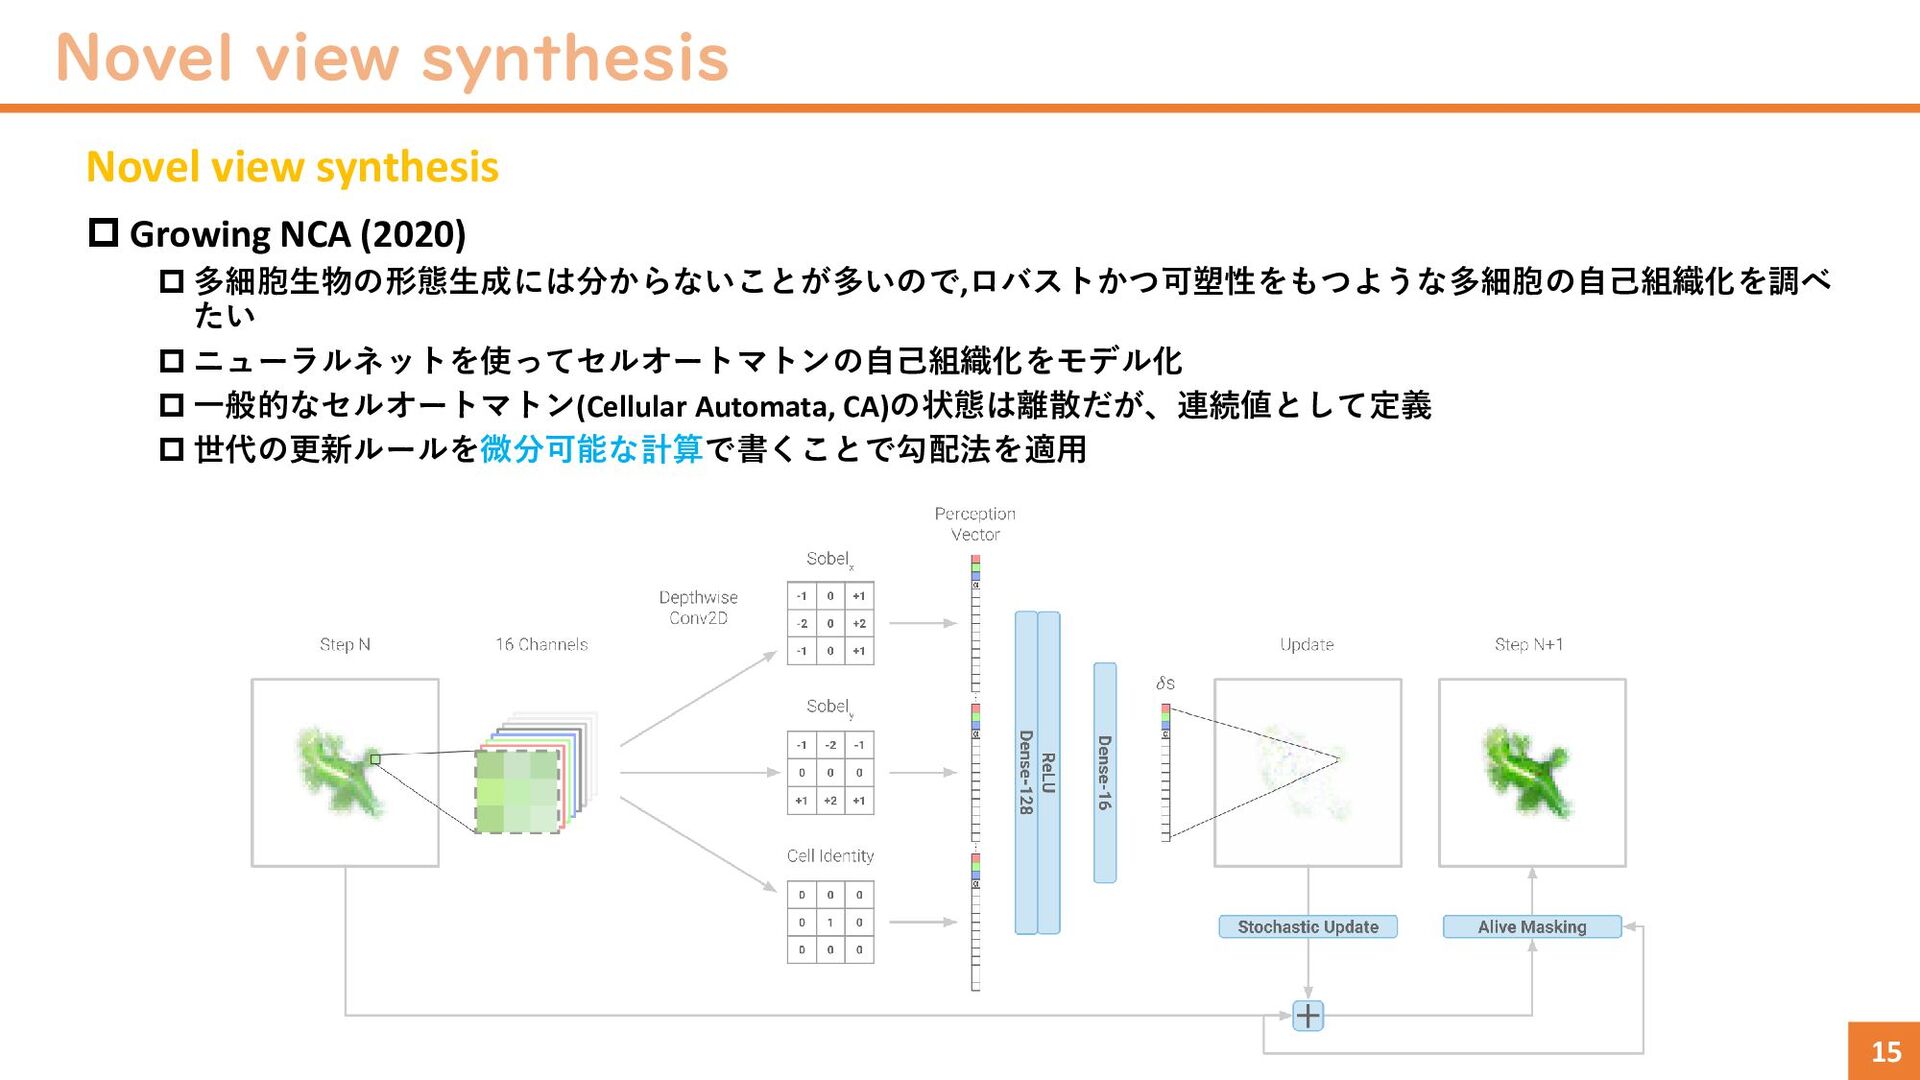
Novel view synthesis 15 Novel view synthesis Growing NCA
(2020) 多細胞生物の形態生成には分からないことが多いので,ロバストかつ可塑性をもつような多細胞の自己組織化を調べ たい ニューラルネットを使ってセルオートマトンの自己組織化をモデル化 一般的なセルオートマトン(Cellular Automata, CA)の状態は離散だが、連続値として定義 世代の更新ルールを微分可能な計算で書くことで勾配法を適用
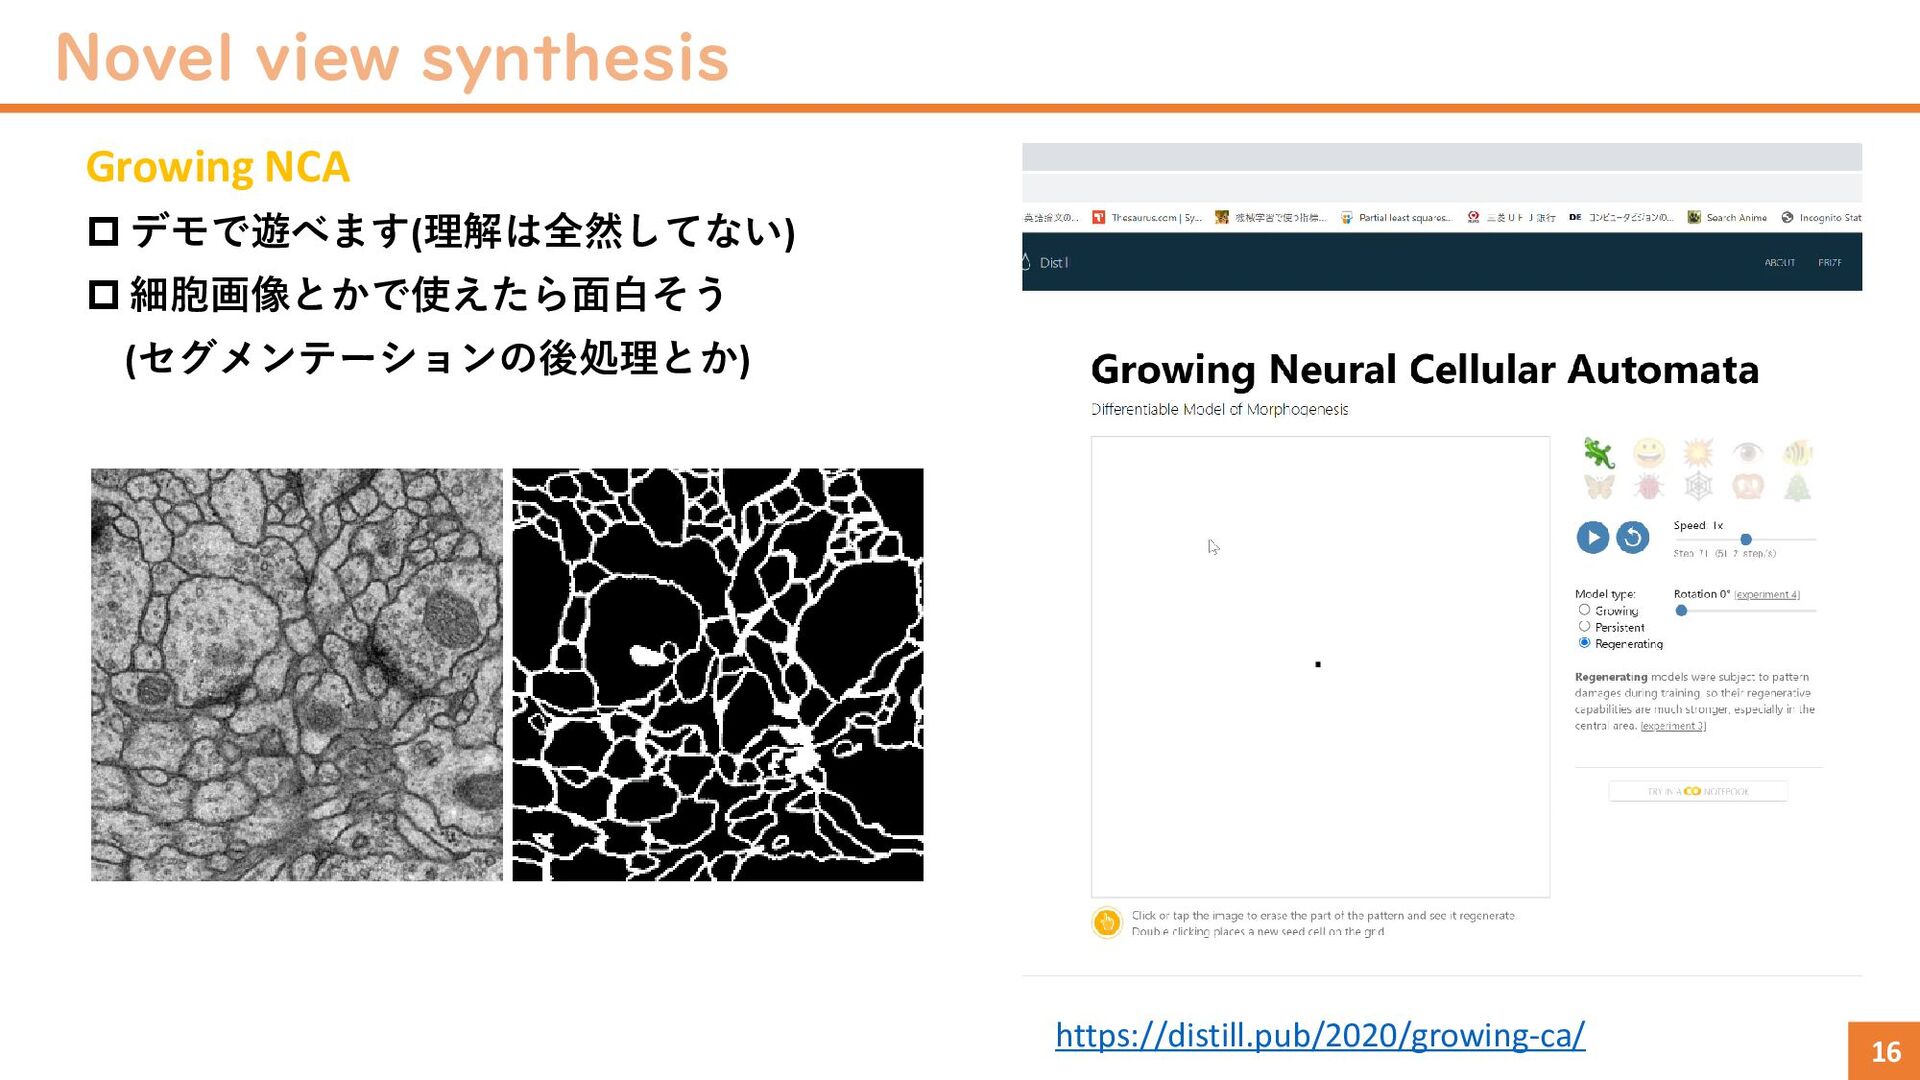
Novel view synthesis 16 Growing NCA デモで遊べます(理解は全然してない) 細胞画像とかで使えたら面白そう
(セグメンテーションの後処理とか) https://distill.pub/2020/growing-ca/
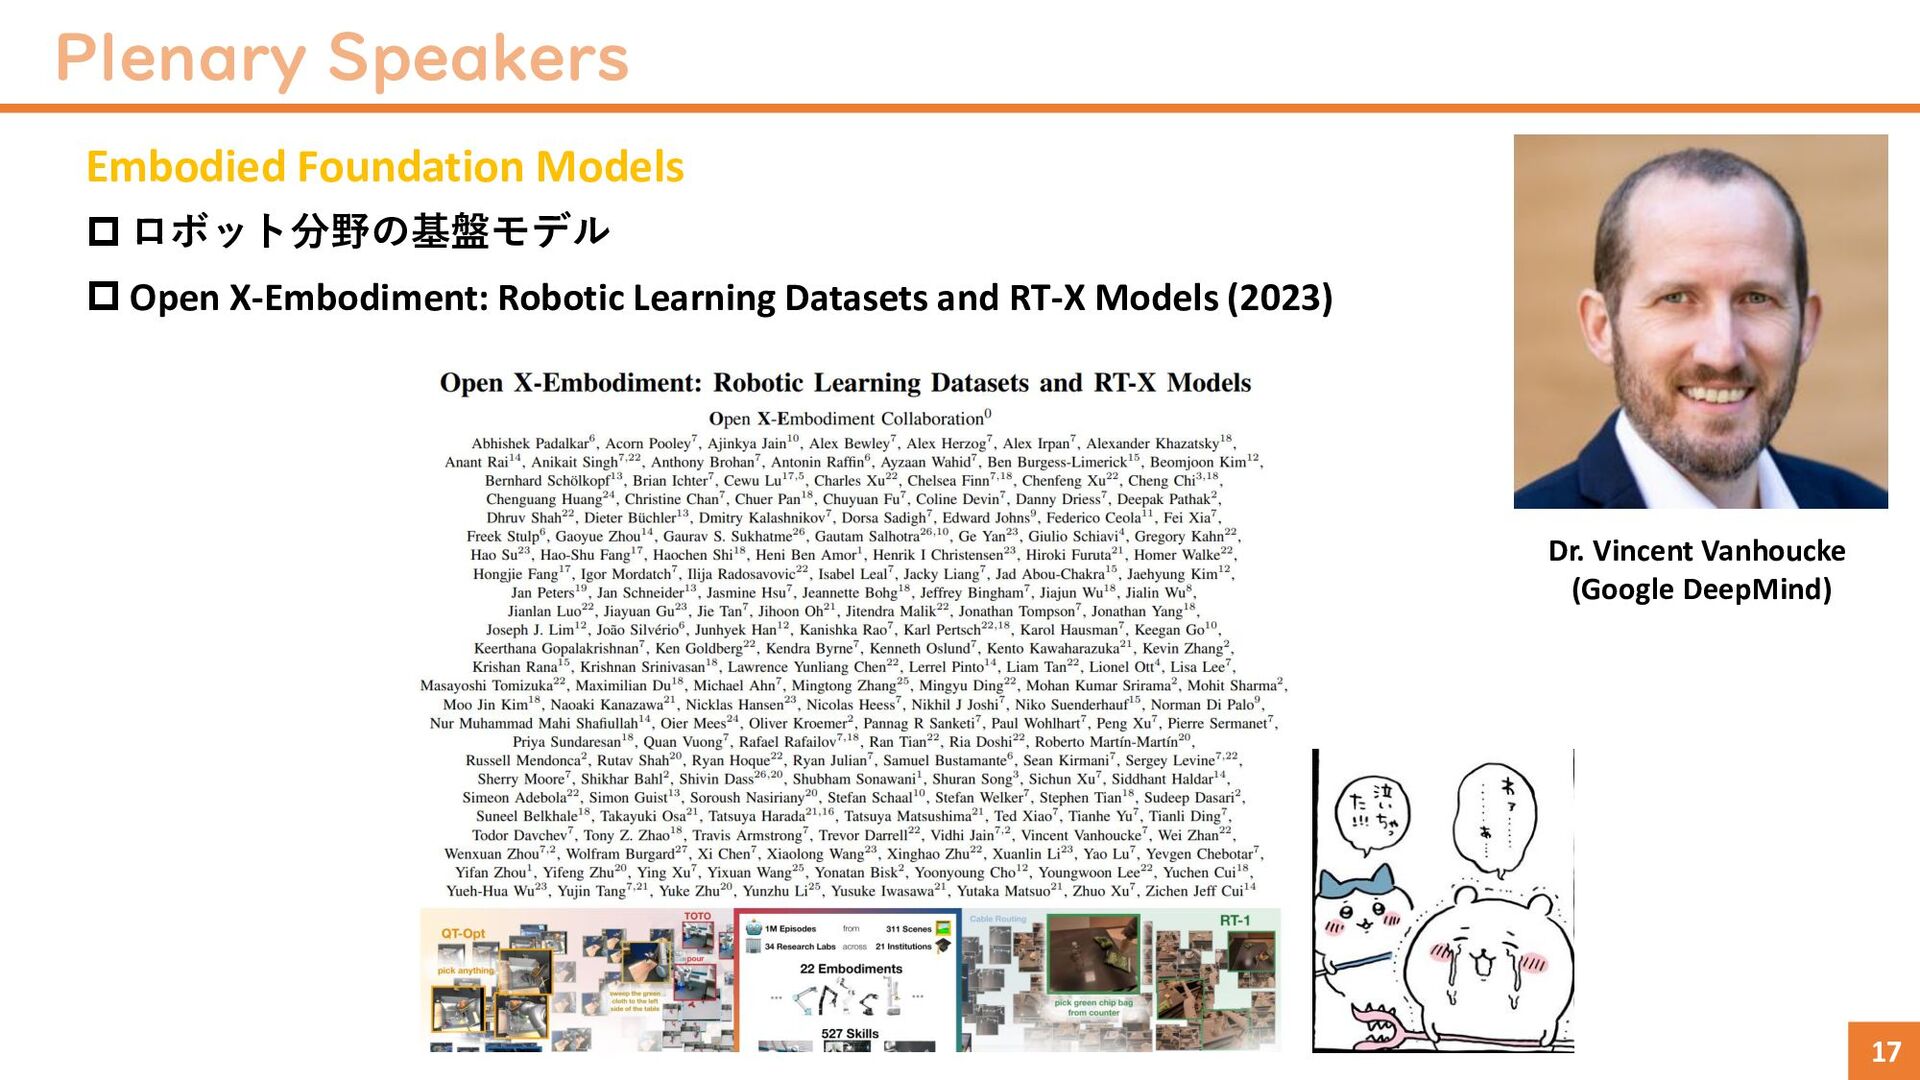
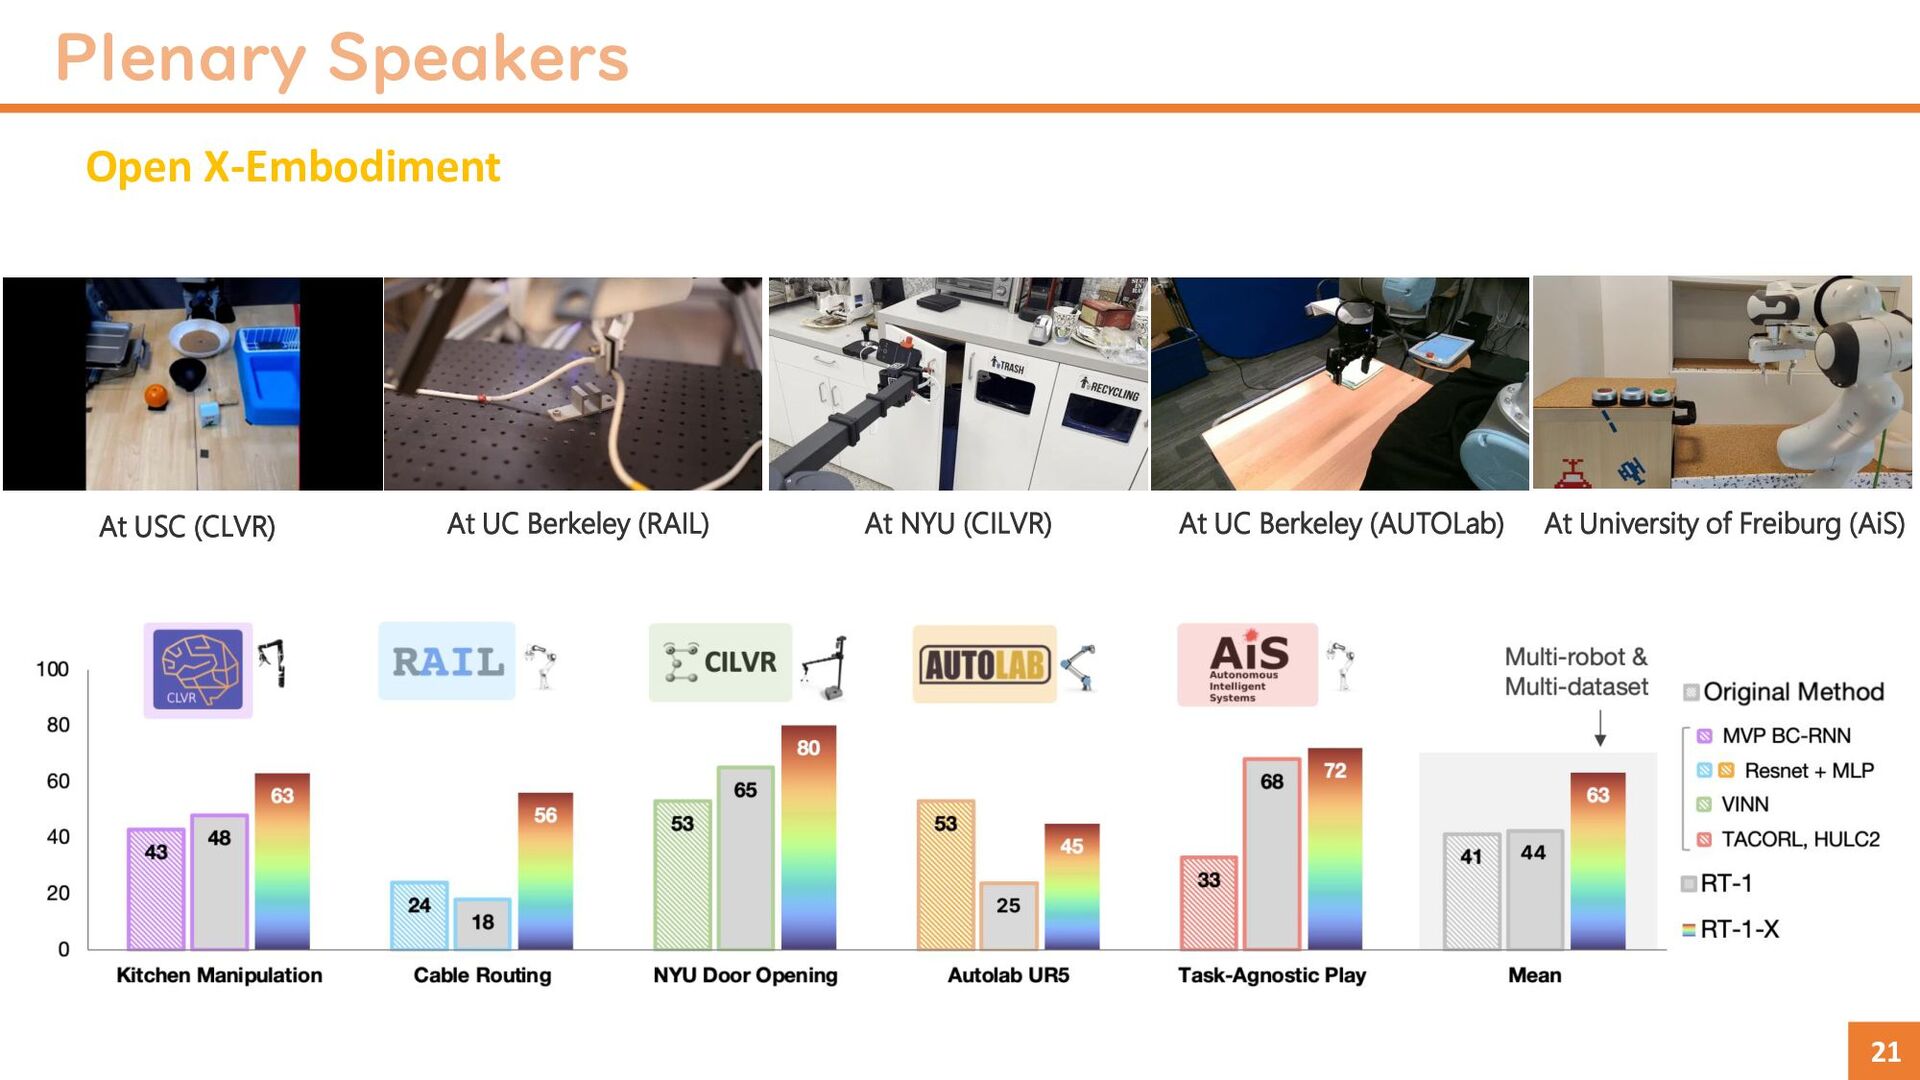
Plenary Speakers 17 Embodied Foundation Models ロボット分野の基盤モデル Open
X-Embodiment: Robotic Learning Datasets and RT-X Models (2023) Dr. Vincent Vanhoucke (Google DeepMind)
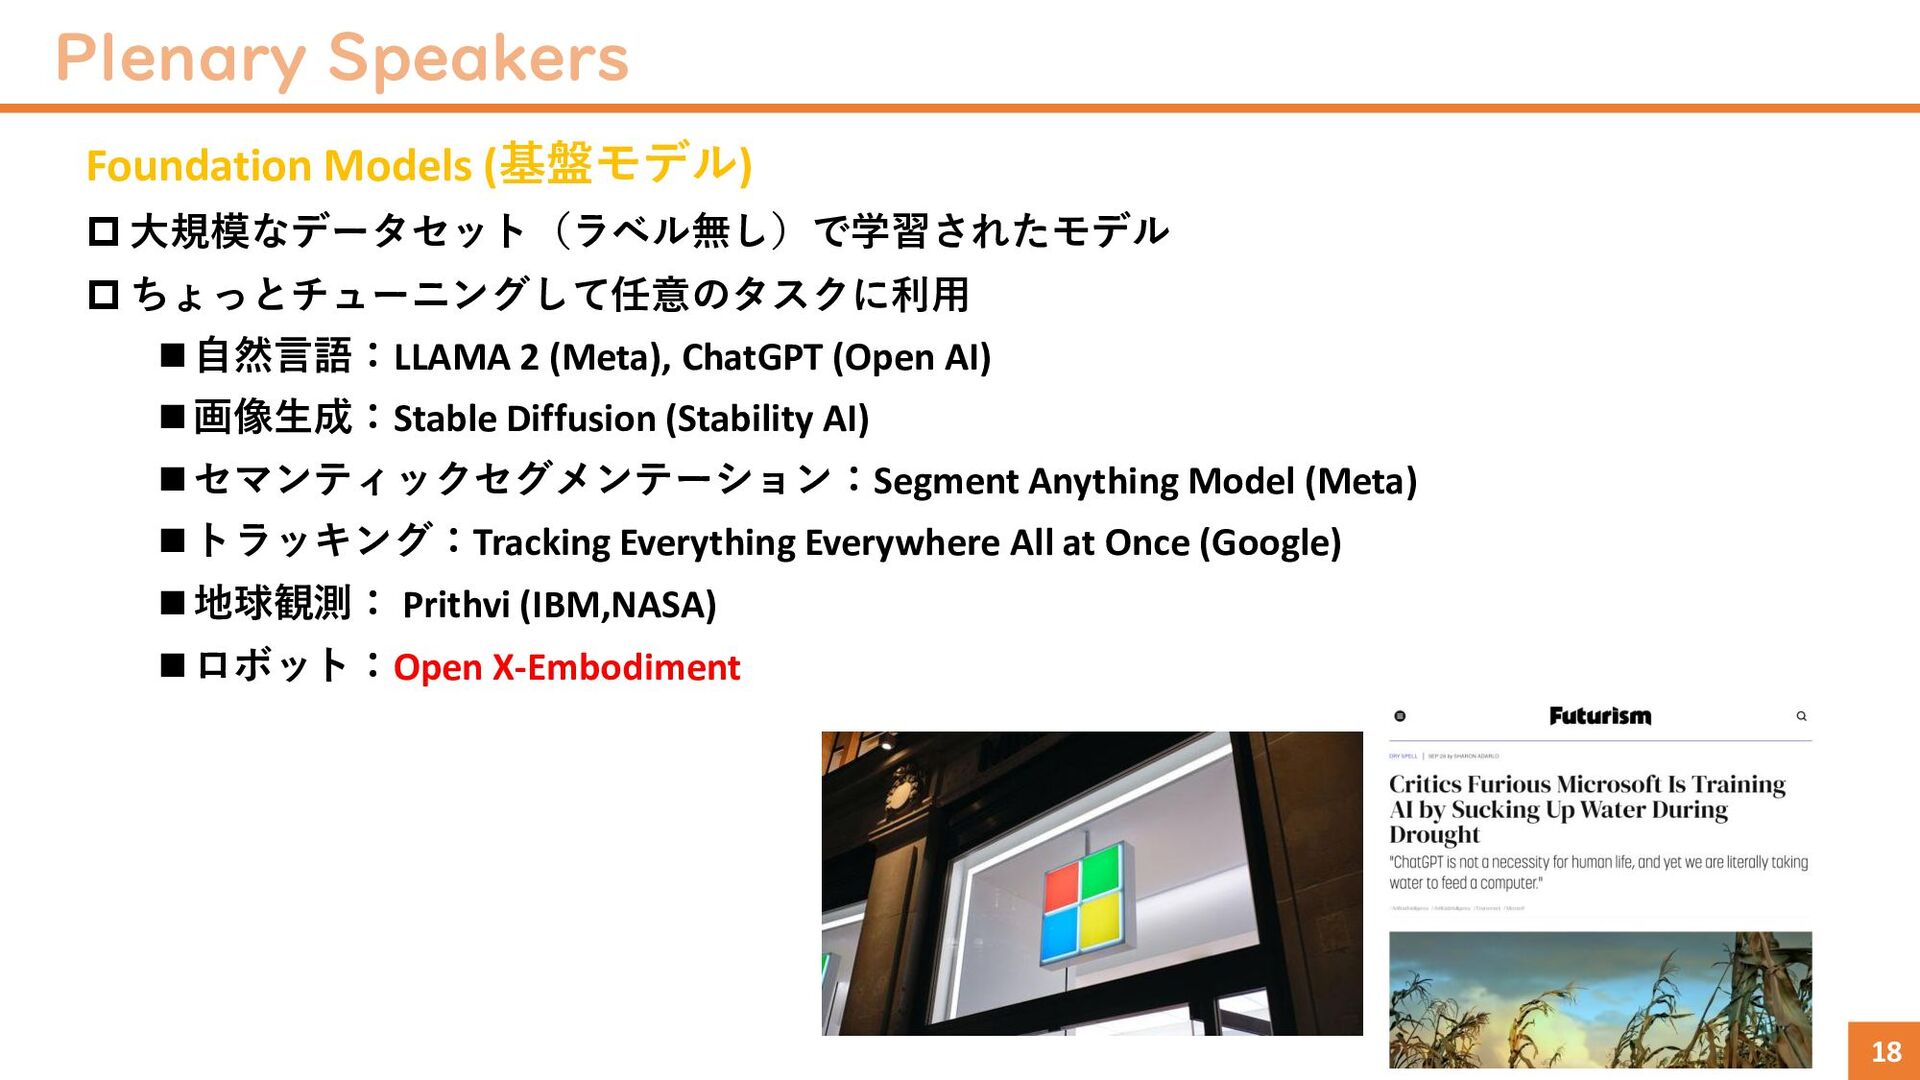
Plenary Speakers 18 Foundation Models (基盤モデル) 大規模なデータセット(ラベル無し)で学習されたモデル ちょっとチューニングして任意のタスクに利用
自然言語:LLAMA 2 (Meta), ChatGPT (Open AI) 画像生成:Stable Diffusion (Stability AI) セマンティックセグメンテーション:Segment Anything Model (Meta) トラッキング:Tracking Everything Everywhere All at Once (Google) 地球観測: Prithvi (IBM,NASA) ロボット:Open X-Embodiment
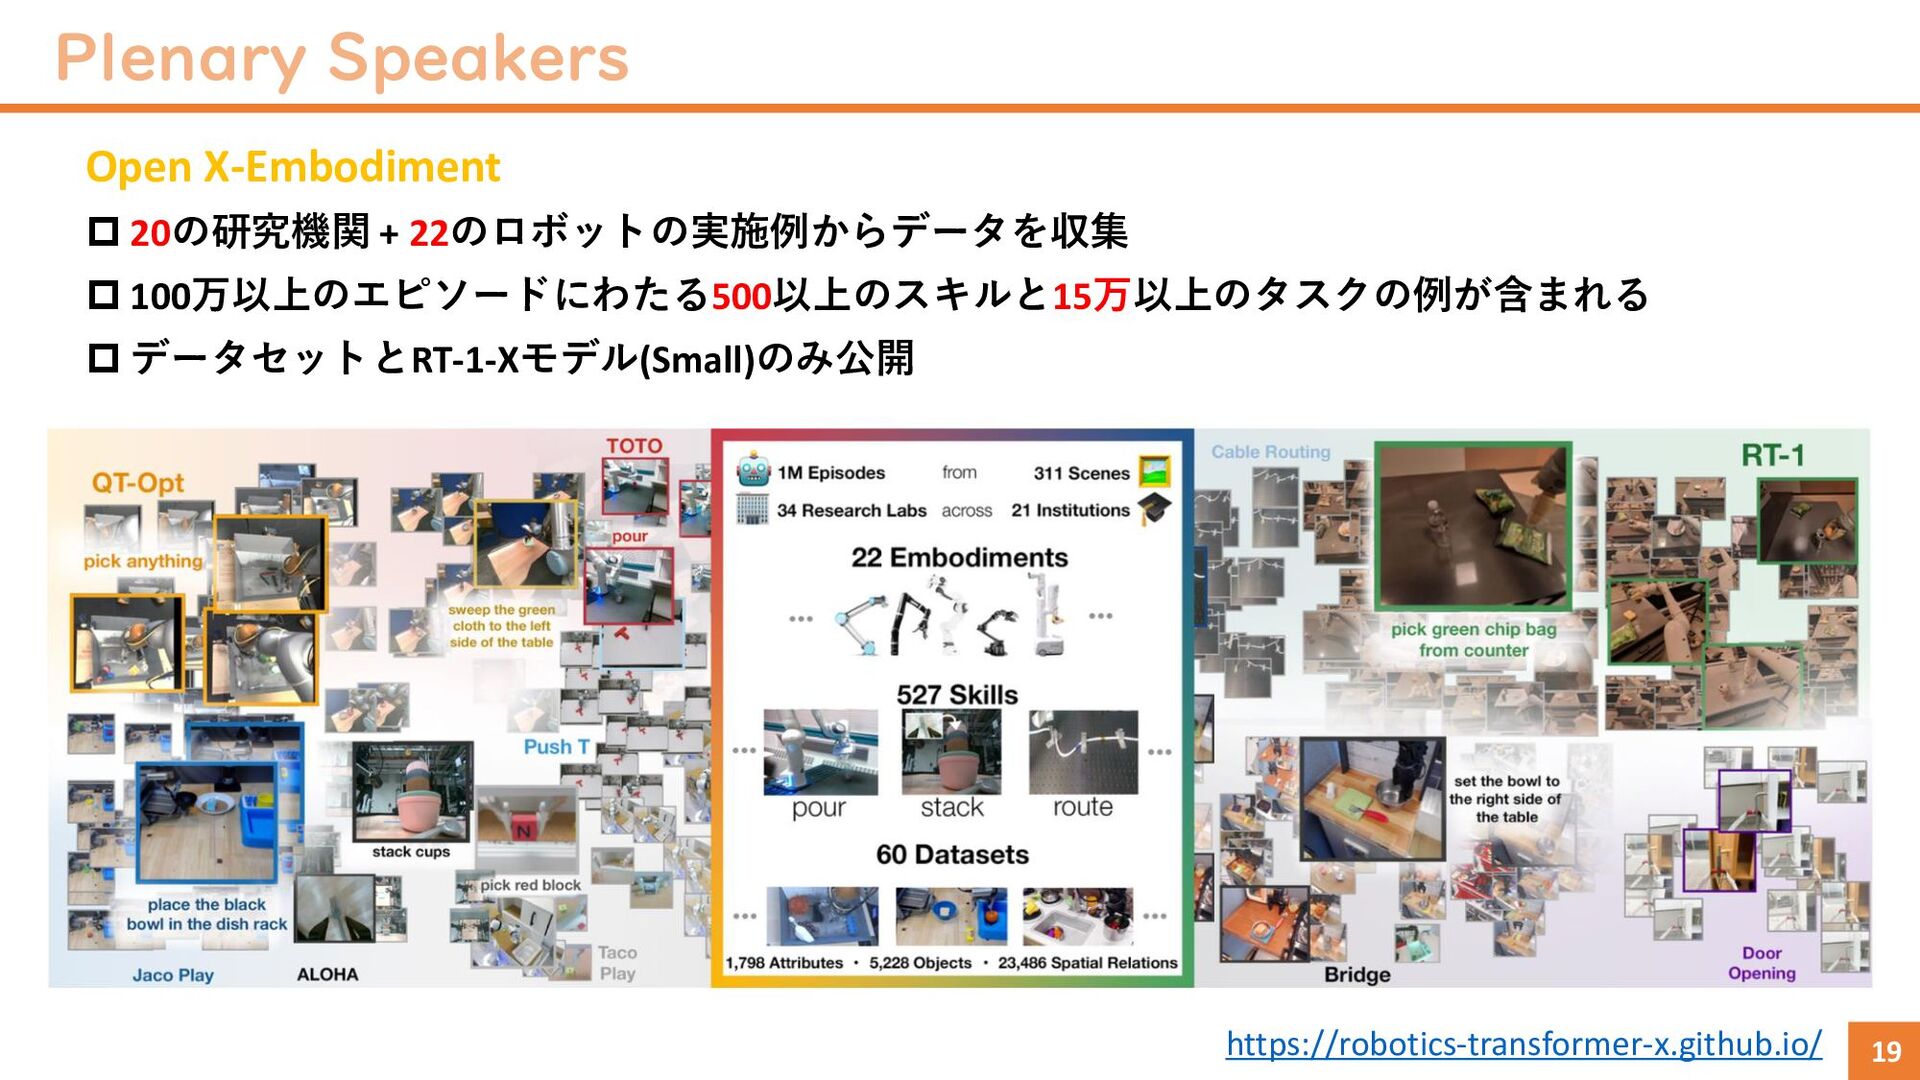
Plenary Speakers 19 Open X-Embodiment 20の研究機関 + 22のロボットの実施例からデータを収集
100万以上のエピソードにわたる500以上のスキルと15万以上のタスクの例が含まれる データセットとRT-1-Xモデル(Small)のみ公開 https://robotics-transformer-x.github.io/
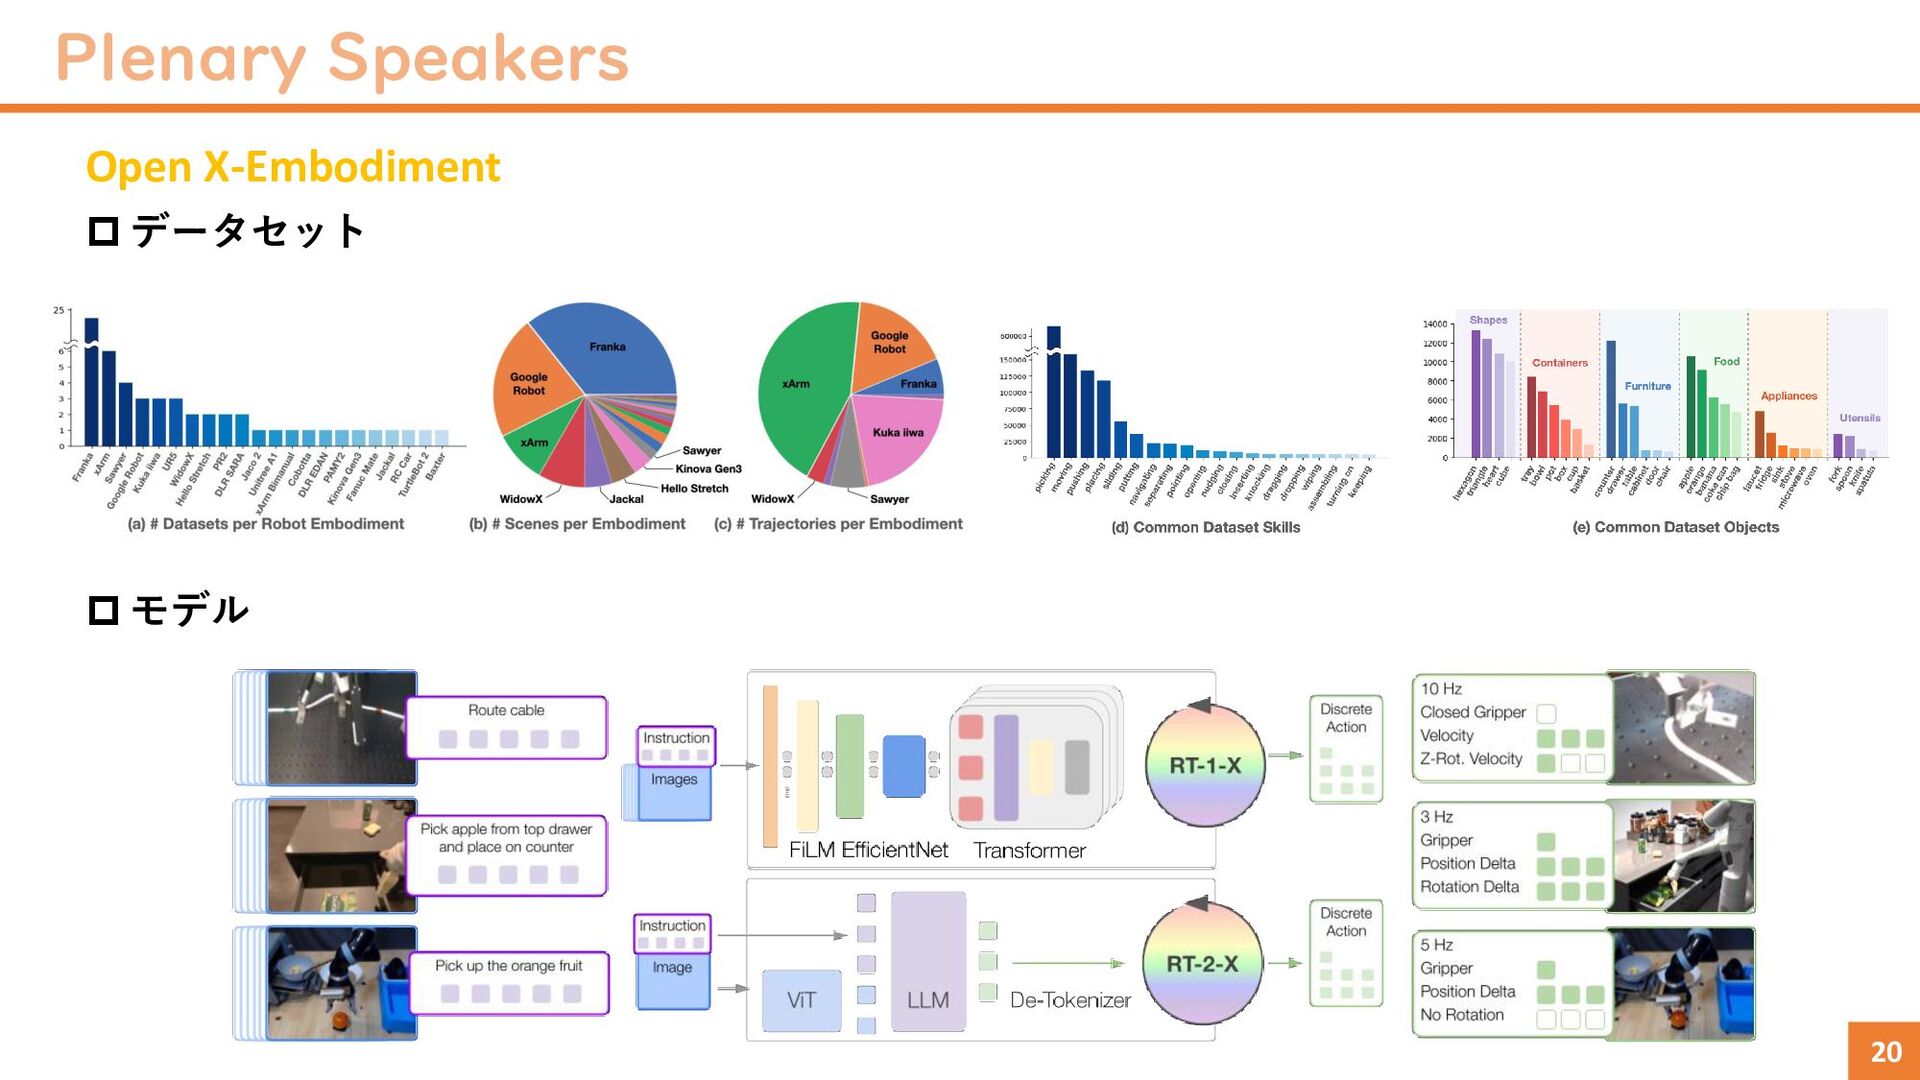
Plenary Speakers 20 Open X-Embodiment データセット モデル
Plenary Speakers 21 Open X-Embodiment At UC Berkeley (RAIL) At
University of Freiburg (AiS) At NYU (CILVR) At UC Berkeley (AUTOLab) At USC (CLVR)
Oral & Poster
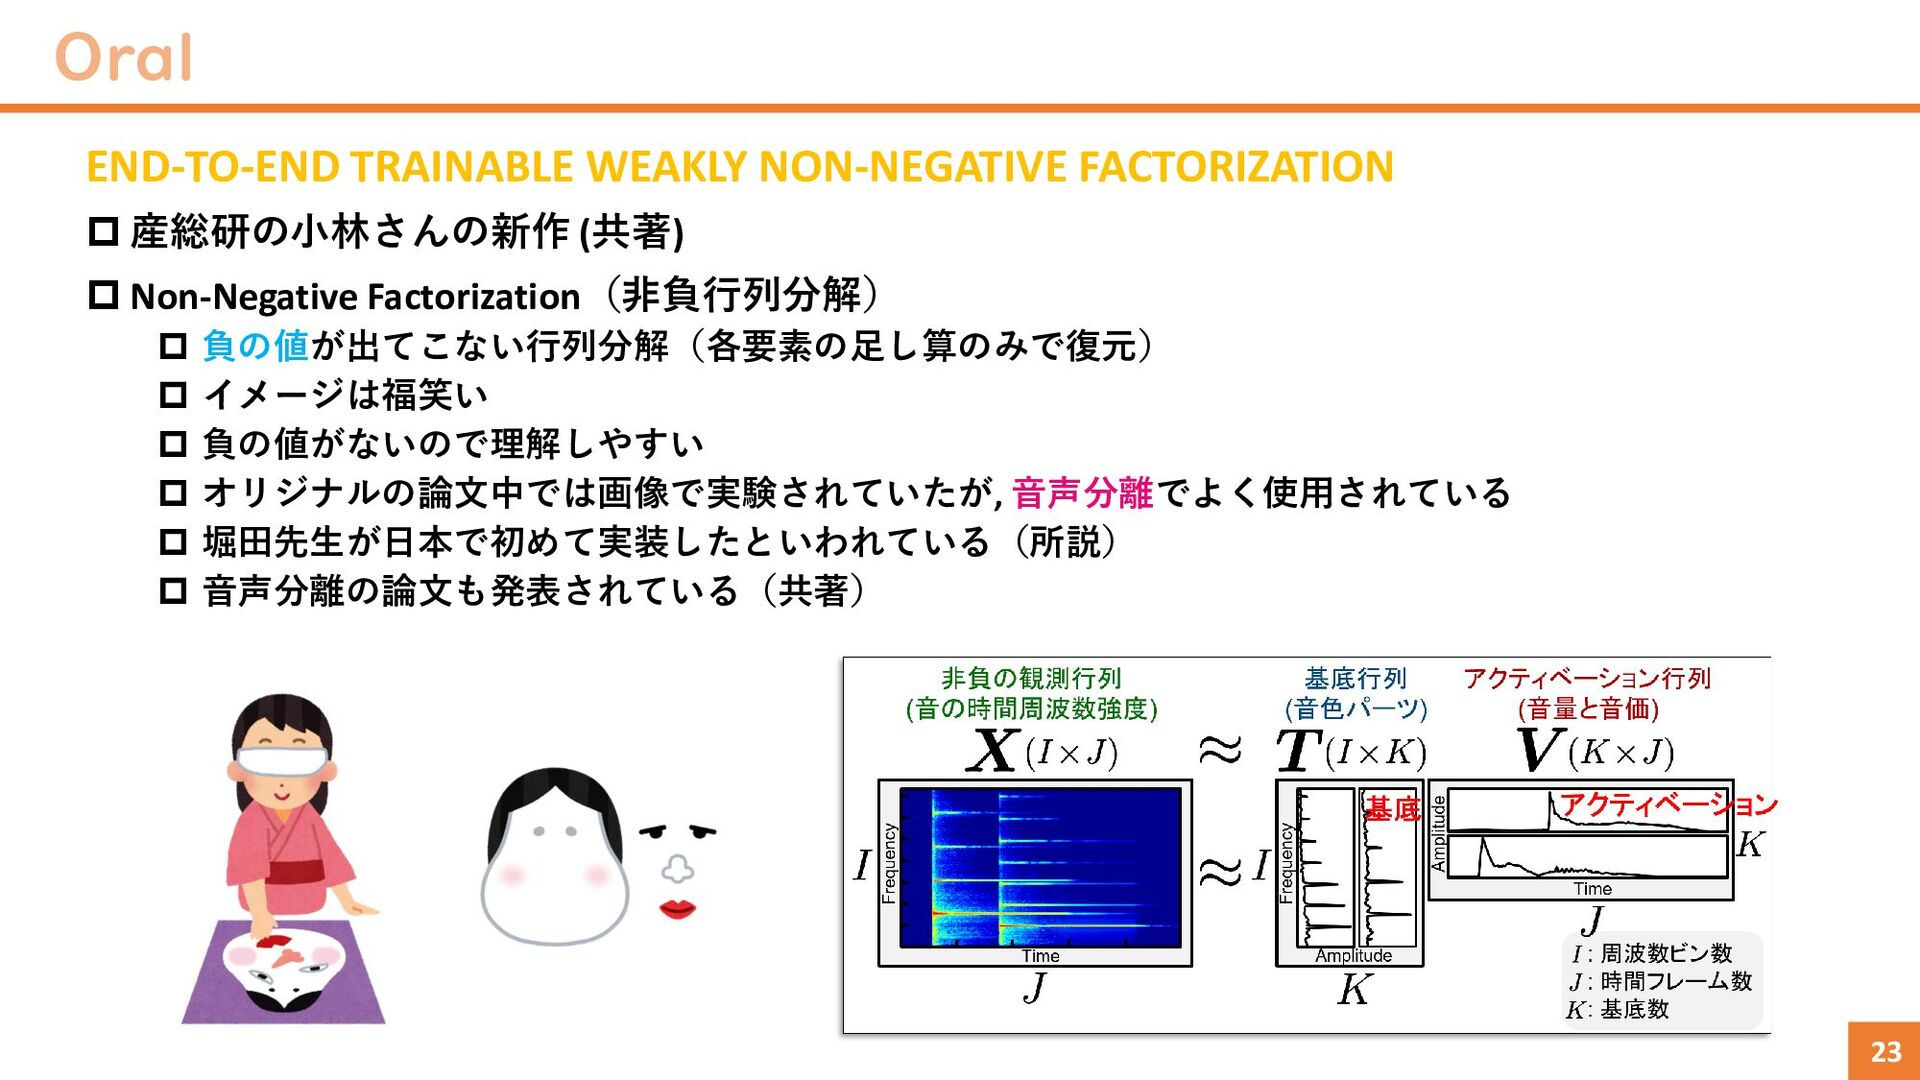
Oral 23 END-TO-END TRAINABLE WEAKLY NON-NEGATIVE FACTORIZATION 産総研の小林さんの新作 (共著)
Non-Negative Factorization(非負行列分解) 負の値が出てこない行列分解(各要素の足し算のみで復元) イメージは福笑い 負の値がないので理解しやすい オリジナルの論文中では画像で実験されていたが, 音声分離でよく使用されている 堀田先生が日本で初めて実装したといわれている(所説) 音声分離の論文も発表されている(共著)
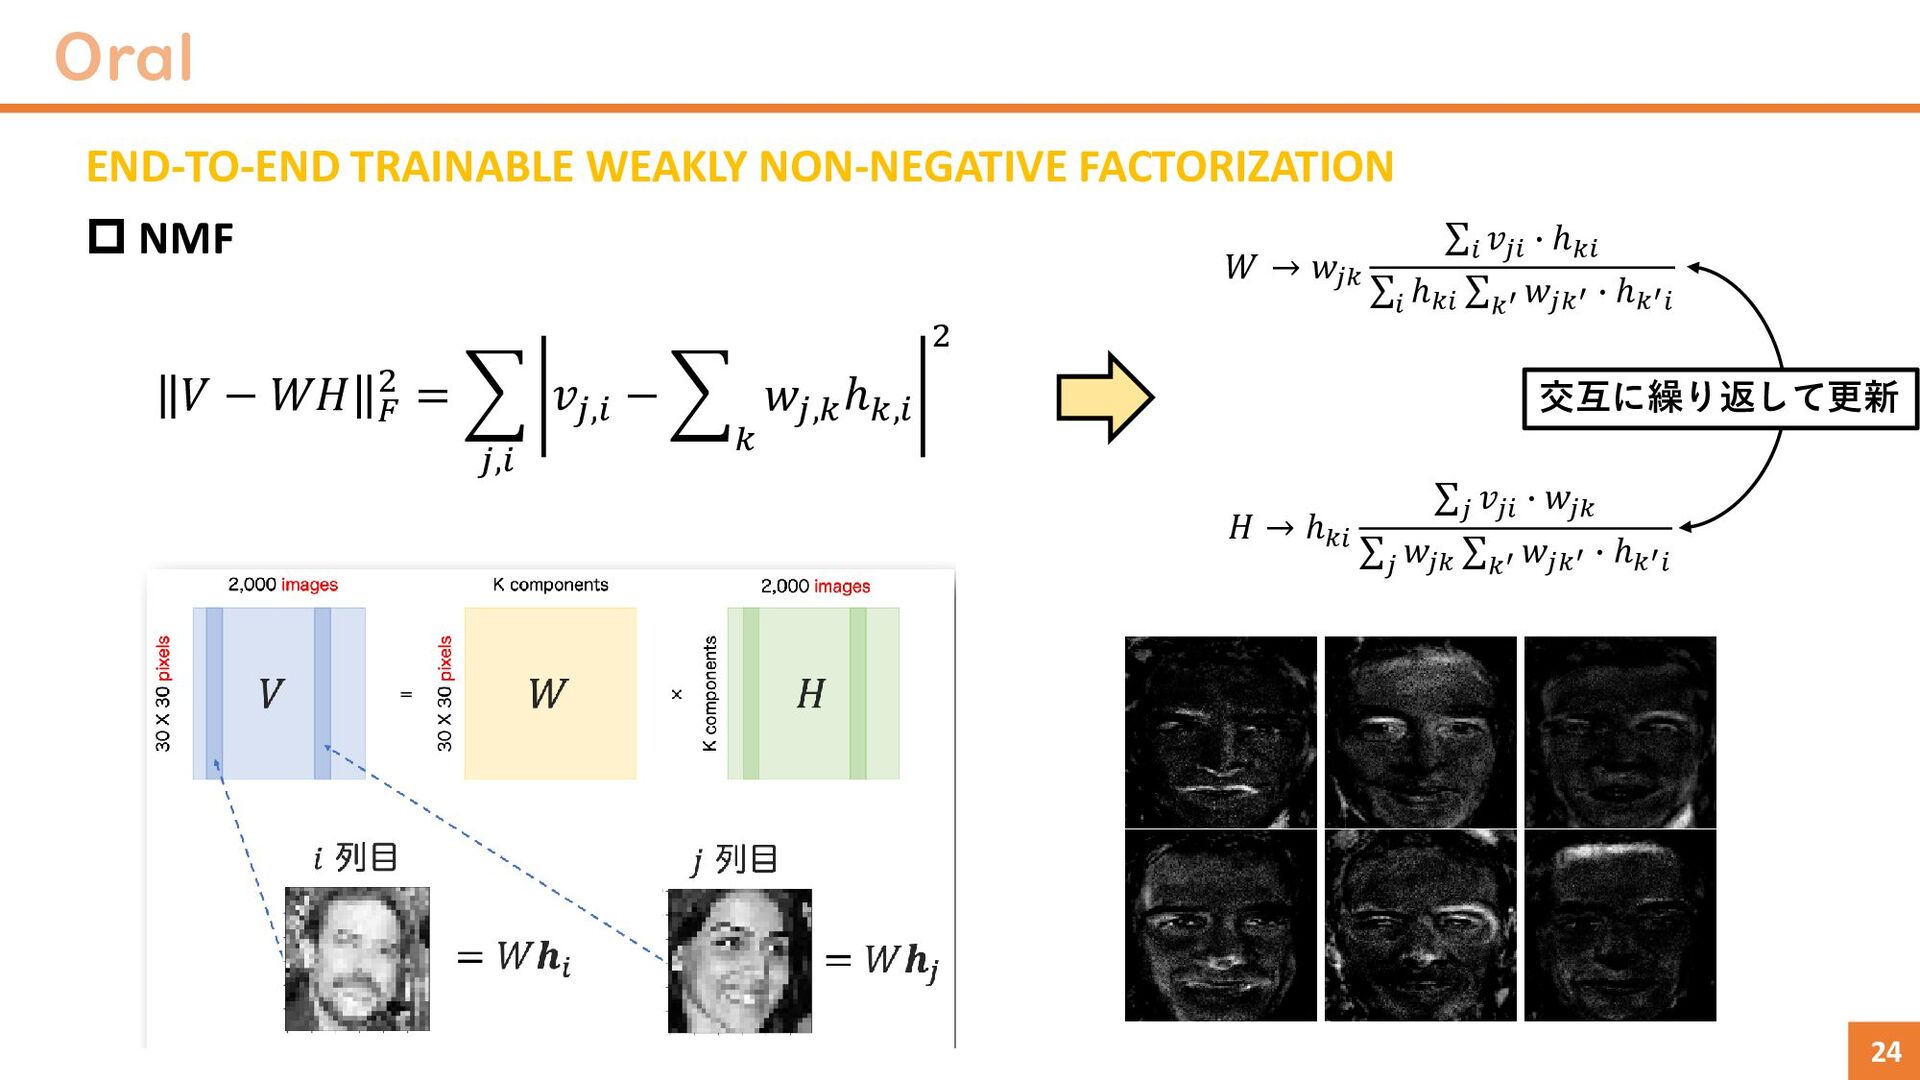
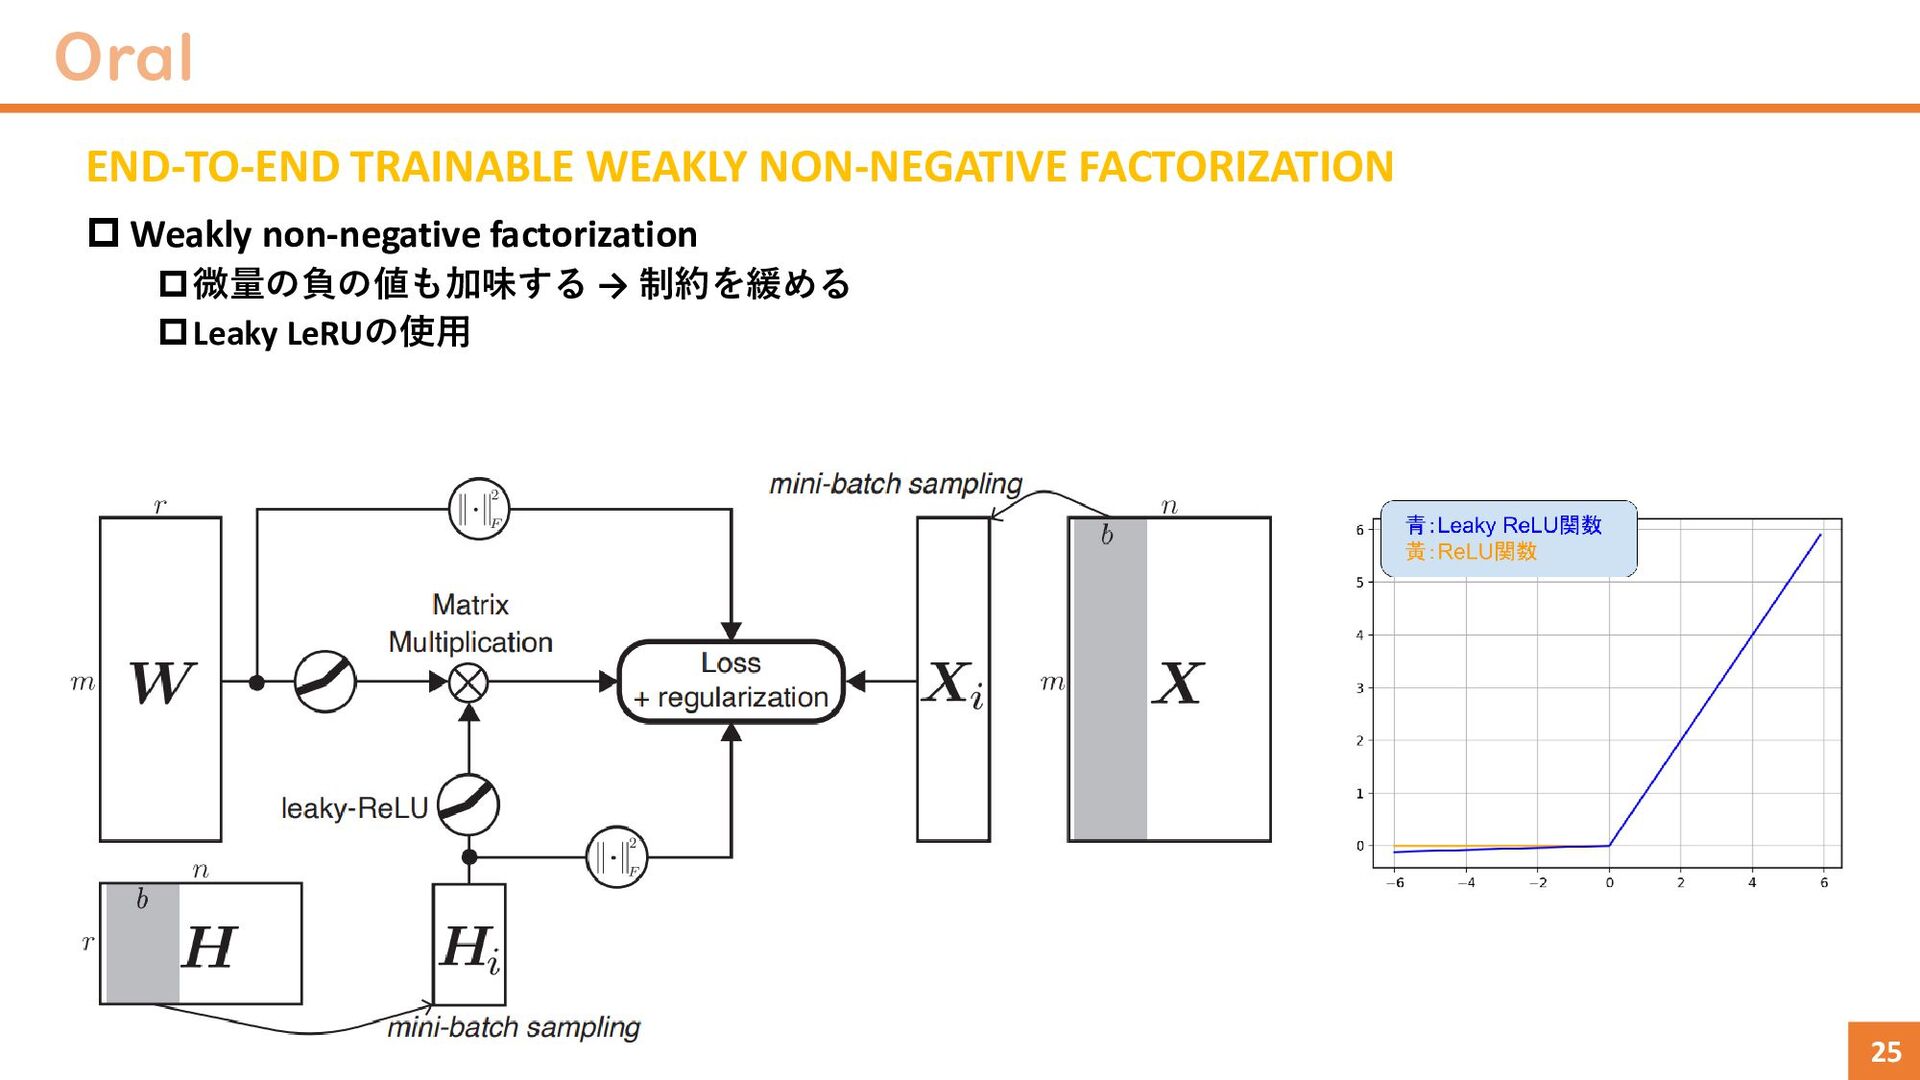
Oral 24 END-TO-END TRAINABLE WEAKLY NON-NEGATIVE FACTORIZATION NMF 𝑉
− 𝑊𝐻 𝐹 2 = 𝑗,𝑖 𝑣𝑗,𝑖 − 𝑘 𝑤𝑗,𝑘 ℎ𝑘,𝑖 2 𝑊 → 𝑤𝑗𝑘 σ𝑖 𝑣𝑗𝑖 ∙ ℎ𝑘𝑖 σ 𝑖 ℎ𝑘𝑖 σ 𝑘′ 𝑤𝑗𝑘′ ∙ ℎ𝑘′𝑖 𝐻 → ℎ𝑘𝑖 σ𝑗 𝑣𝑗𝑖 ∙ 𝑤𝑗𝑘 σ 𝑗 𝑤𝑗𝑘 σ 𝑘′ 𝑤𝑗𝑘′ ∙ ℎ𝑘′𝑖 交互に繰り返して更新
Oral 25 END-TO-END TRAINABLE WEAKLY NON-NEGATIVE FACTORIZATION Weakly non-negative
factorization 微量の負の値も加味する → 制約を緩める Leaky LeRUの使用
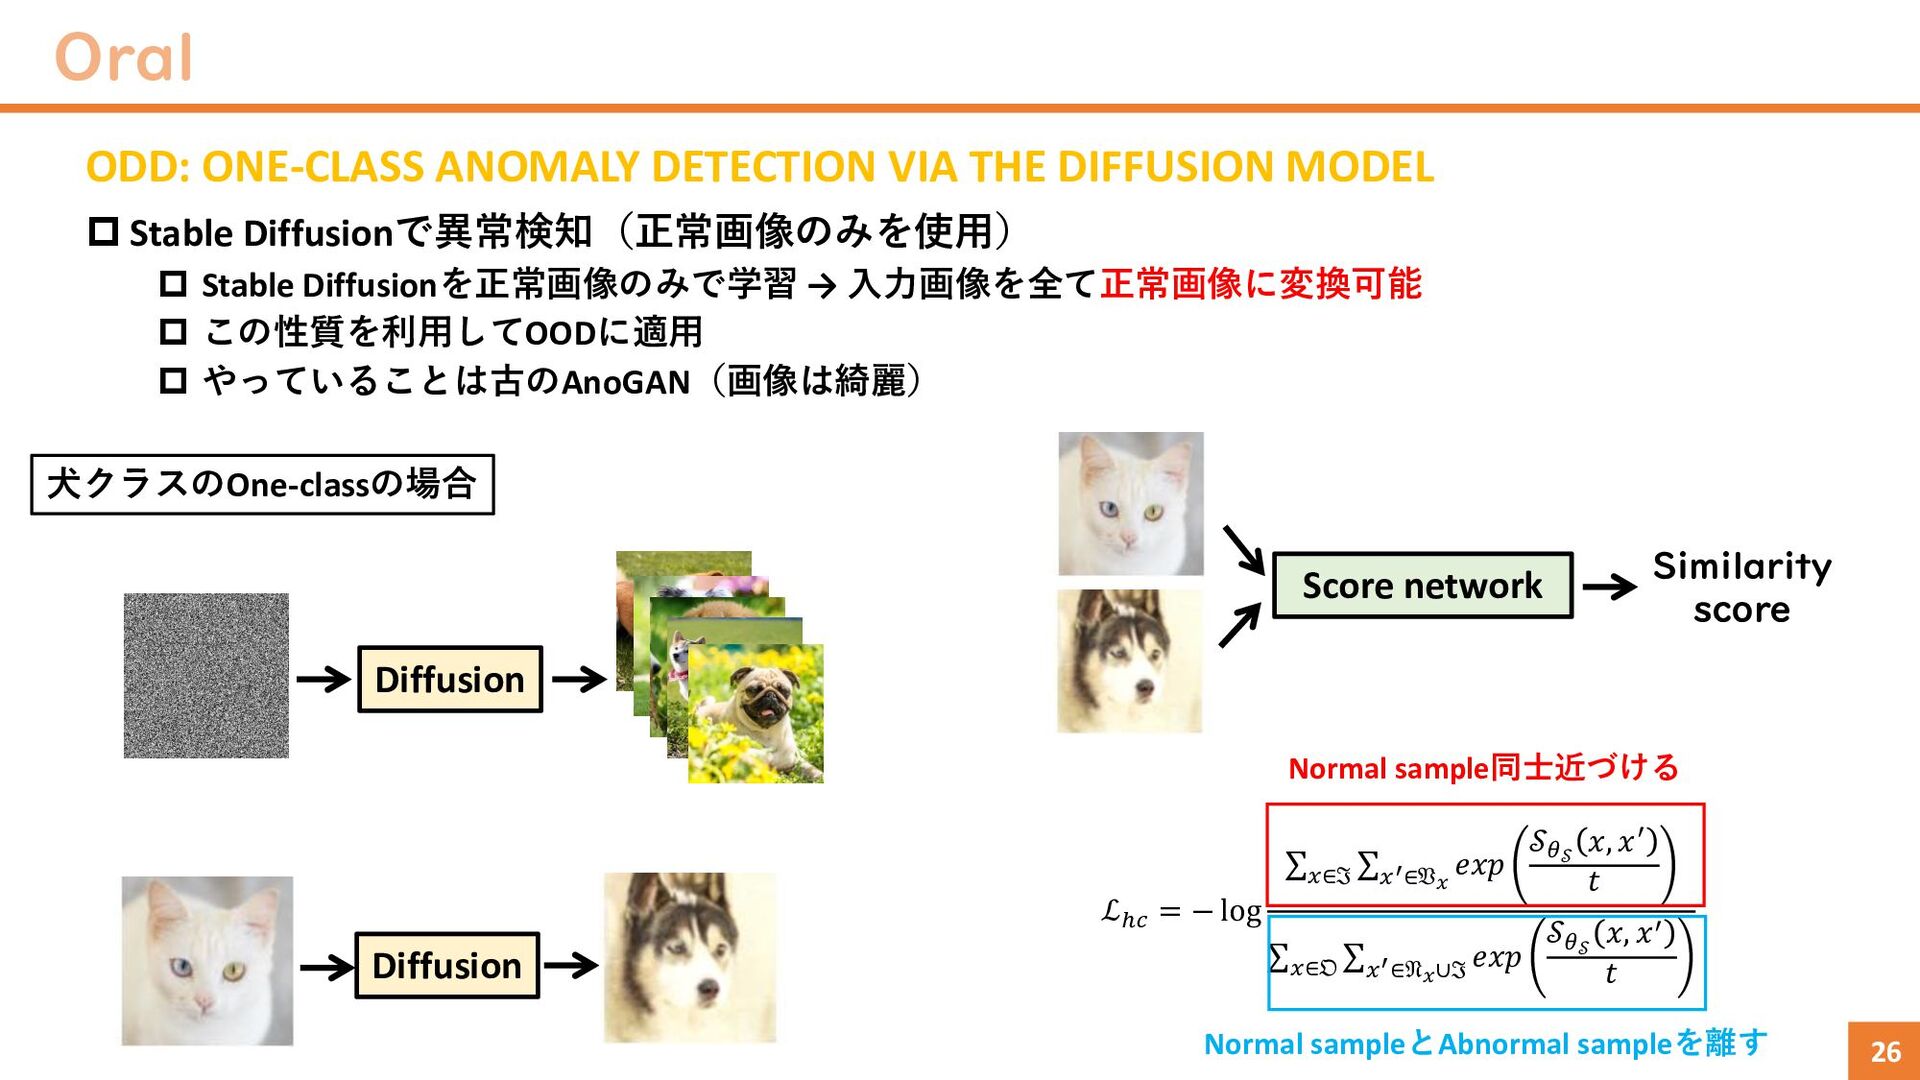
Oral 26 ODD: ONE-CLASS ANOMALY DETECTION VIA THE DIFFUSION MODEL
Stable Diffusionで異常検知(正常画像のみを使用) Stable Diffusionを正常画像のみで学習 → 入力画像を全て正常画像に変換可能 この性質を利用してOODに適用 やっていることは古のAnoGAN(画像は綺麗) Diffusion Diffusion Score network Similarity score ℒℎ𝑐 = − log σ𝑥∈ℑ σ 𝑥′∈𝔙𝑥 𝑒𝑥𝑝 𝒮𝜃𝒮 𝑥, 𝑥′ 𝑡 σ 𝑥∈𝔒 σ 𝑥′∈𝔑𝑥∪ℑ 𝑒𝑥𝑝 𝒮𝜃𝒮 𝑥, 𝑥′ 𝑡 犬クラスのOne-classの場合 Normal sample同士近づける Normal sampleとAbnormal sampleを離す
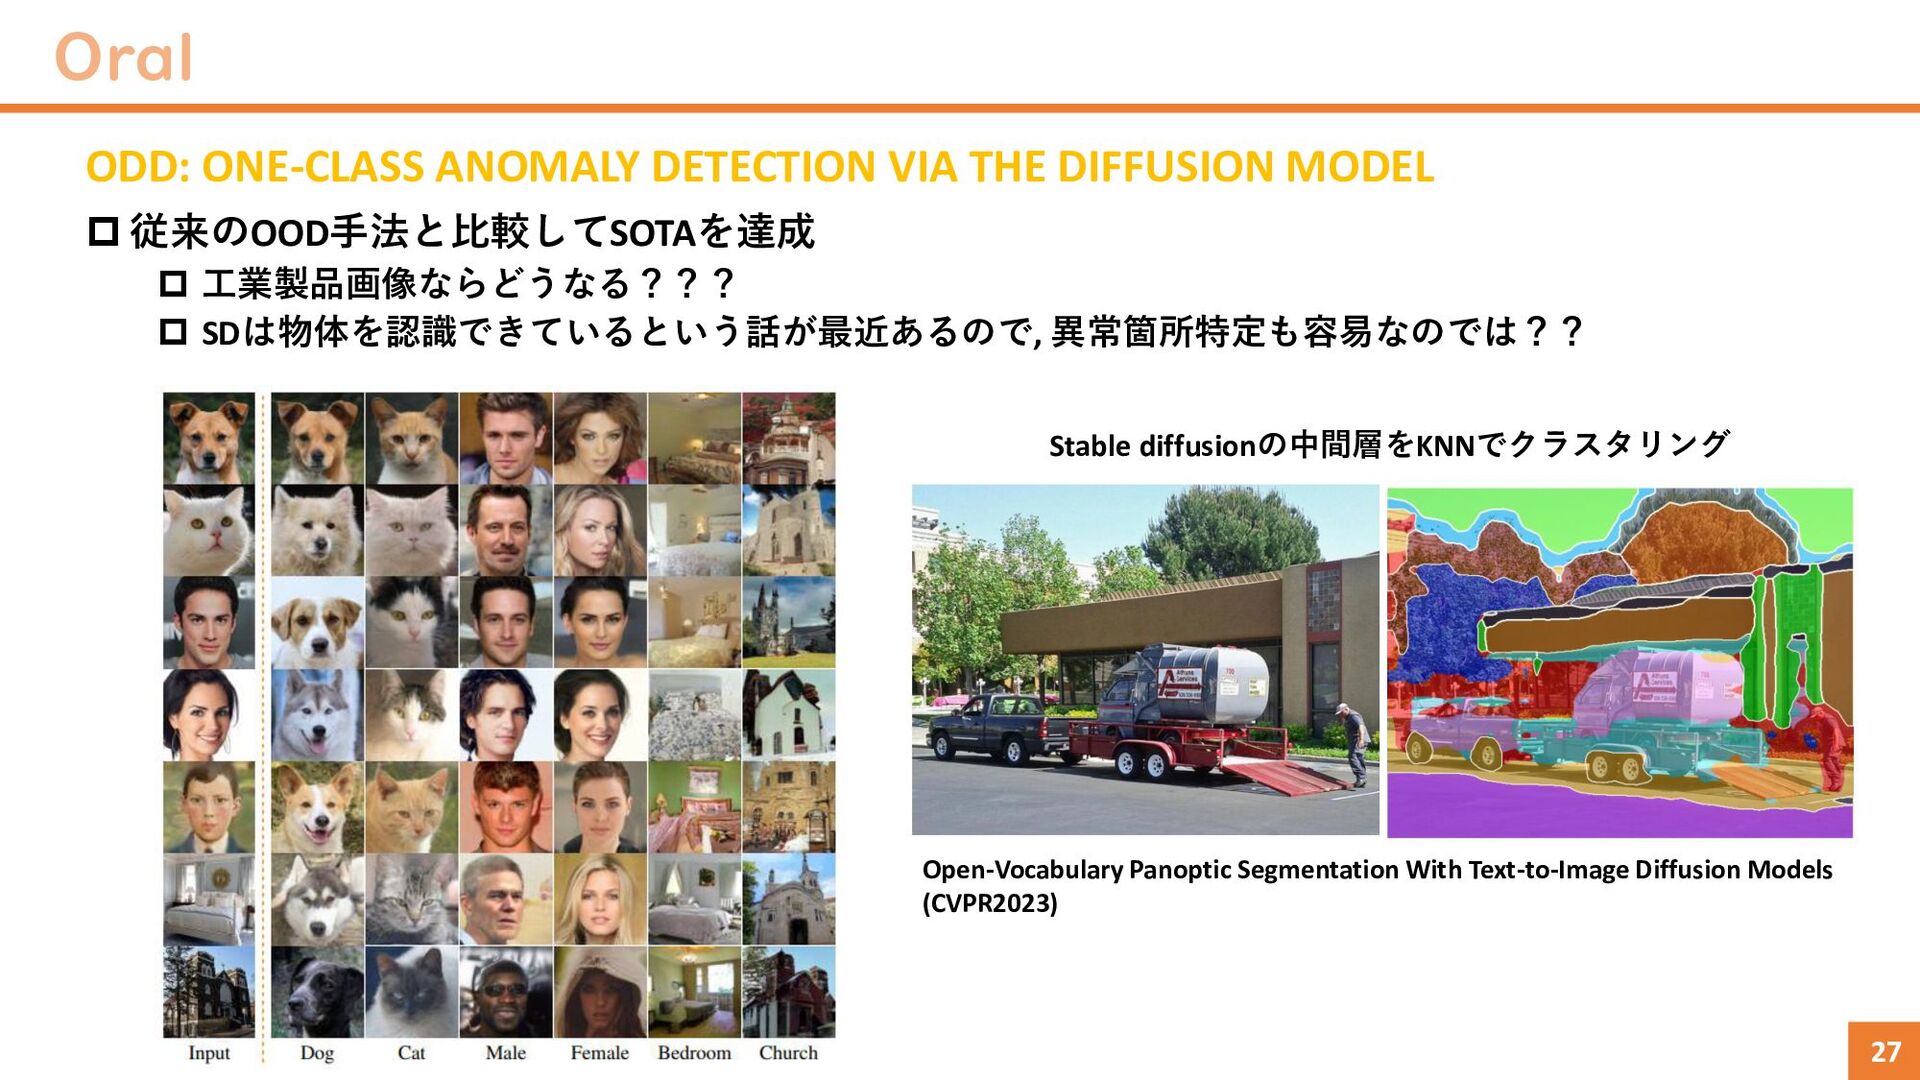
Oral 27 ODD: ONE-CLASS ANOMALY DETECTION VIA THE DIFFUSION MODEL
従来のOOD手法と比較してSOTAを達成 工業製品画像ならどうなる??? SDは物体を認識できているという話が最近あるので, 異常箇所特定も容易なのでは?? Stable diffusionの中間層をKNNでクラスタリング Open-Vocabulary Panoptic Segmentation With Text-to-Image Diffusion Models (CVPR2023)
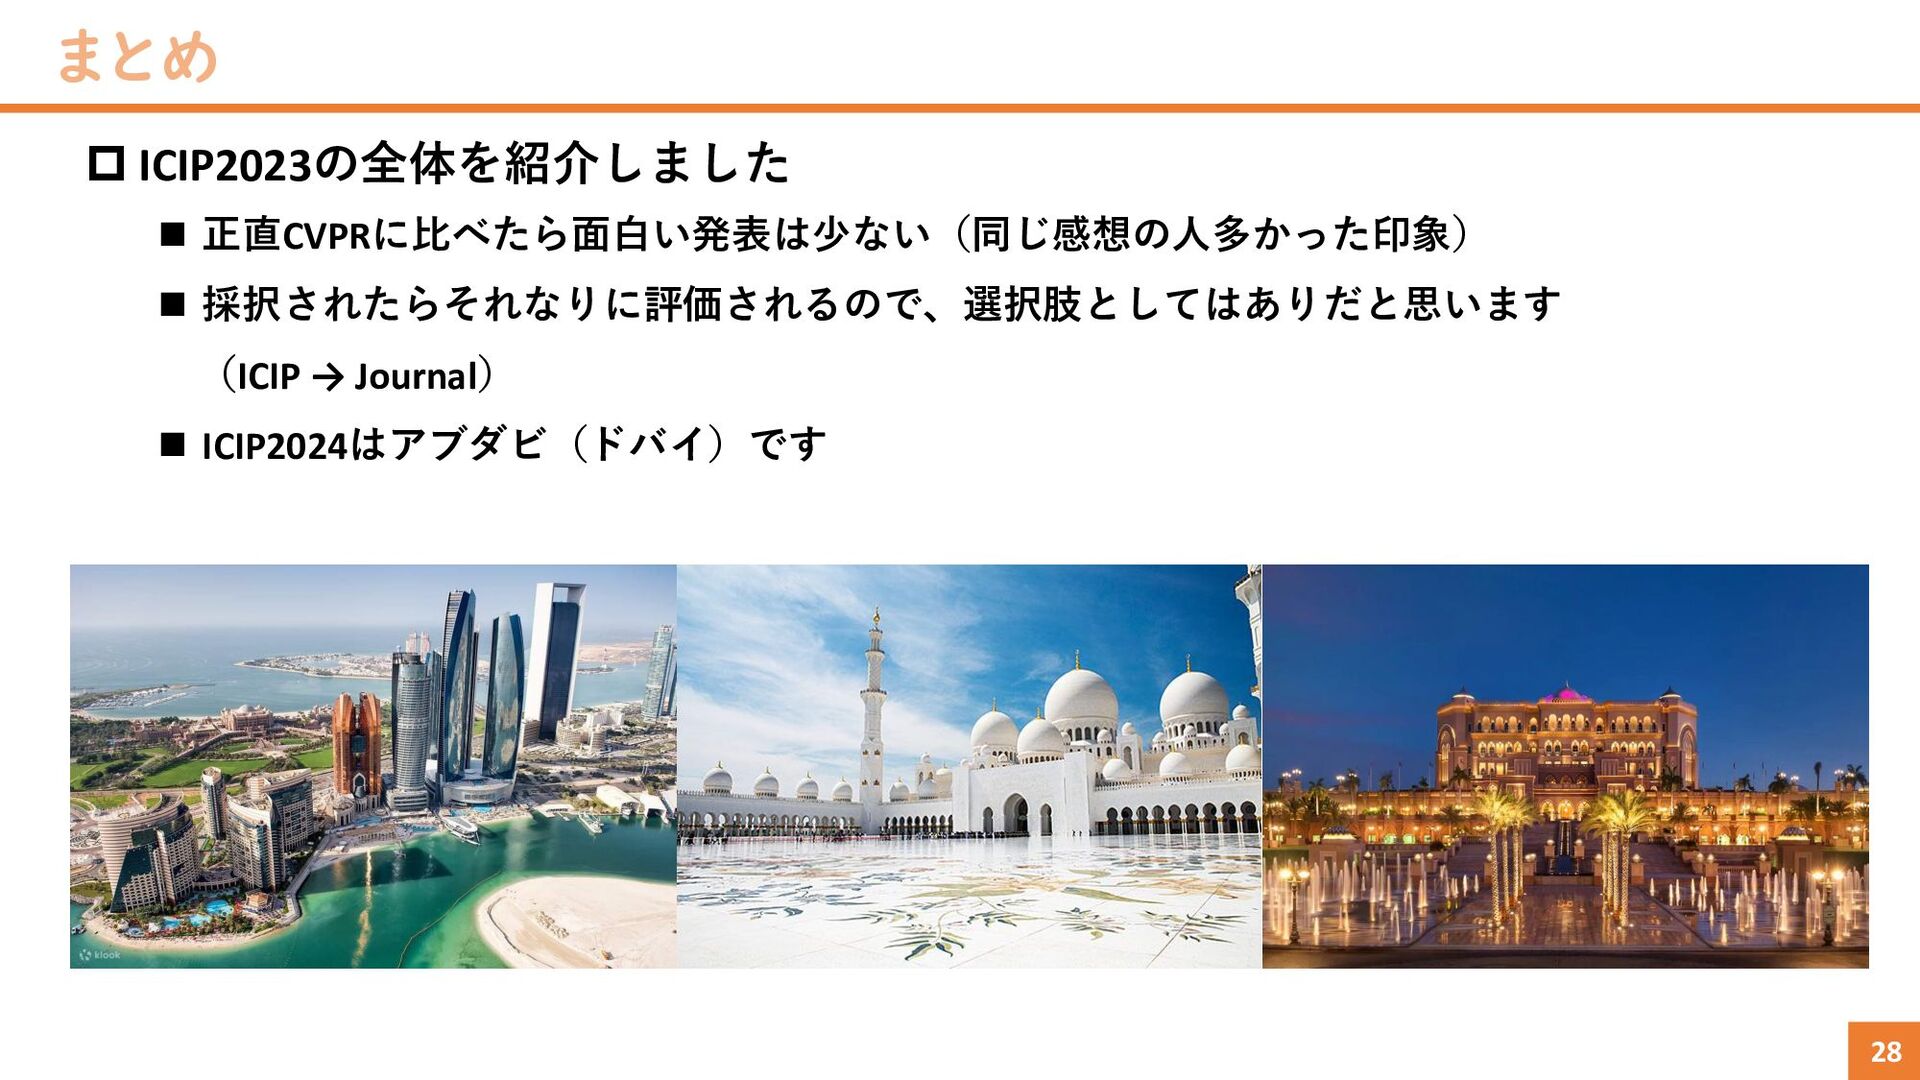
まとめ 28 ICIP2023の全体を紹介しました 正直CVPRに比べたら面白い発表は少ない(同じ感想の人多かった印象) 採択されたらそれなりに評価されるので、選択肢としてはありだと思います (ICIP →
Journal) ICIP2024はアブダビ(ドバイ)です


 sotakato
 dugsong
 addyosmani
 brad_frost
 techseoconnect
 iamctodd
 watany
 lynnandtonic
 khoart
 trishagee
 ks91
 bkeepers
 bcantrill