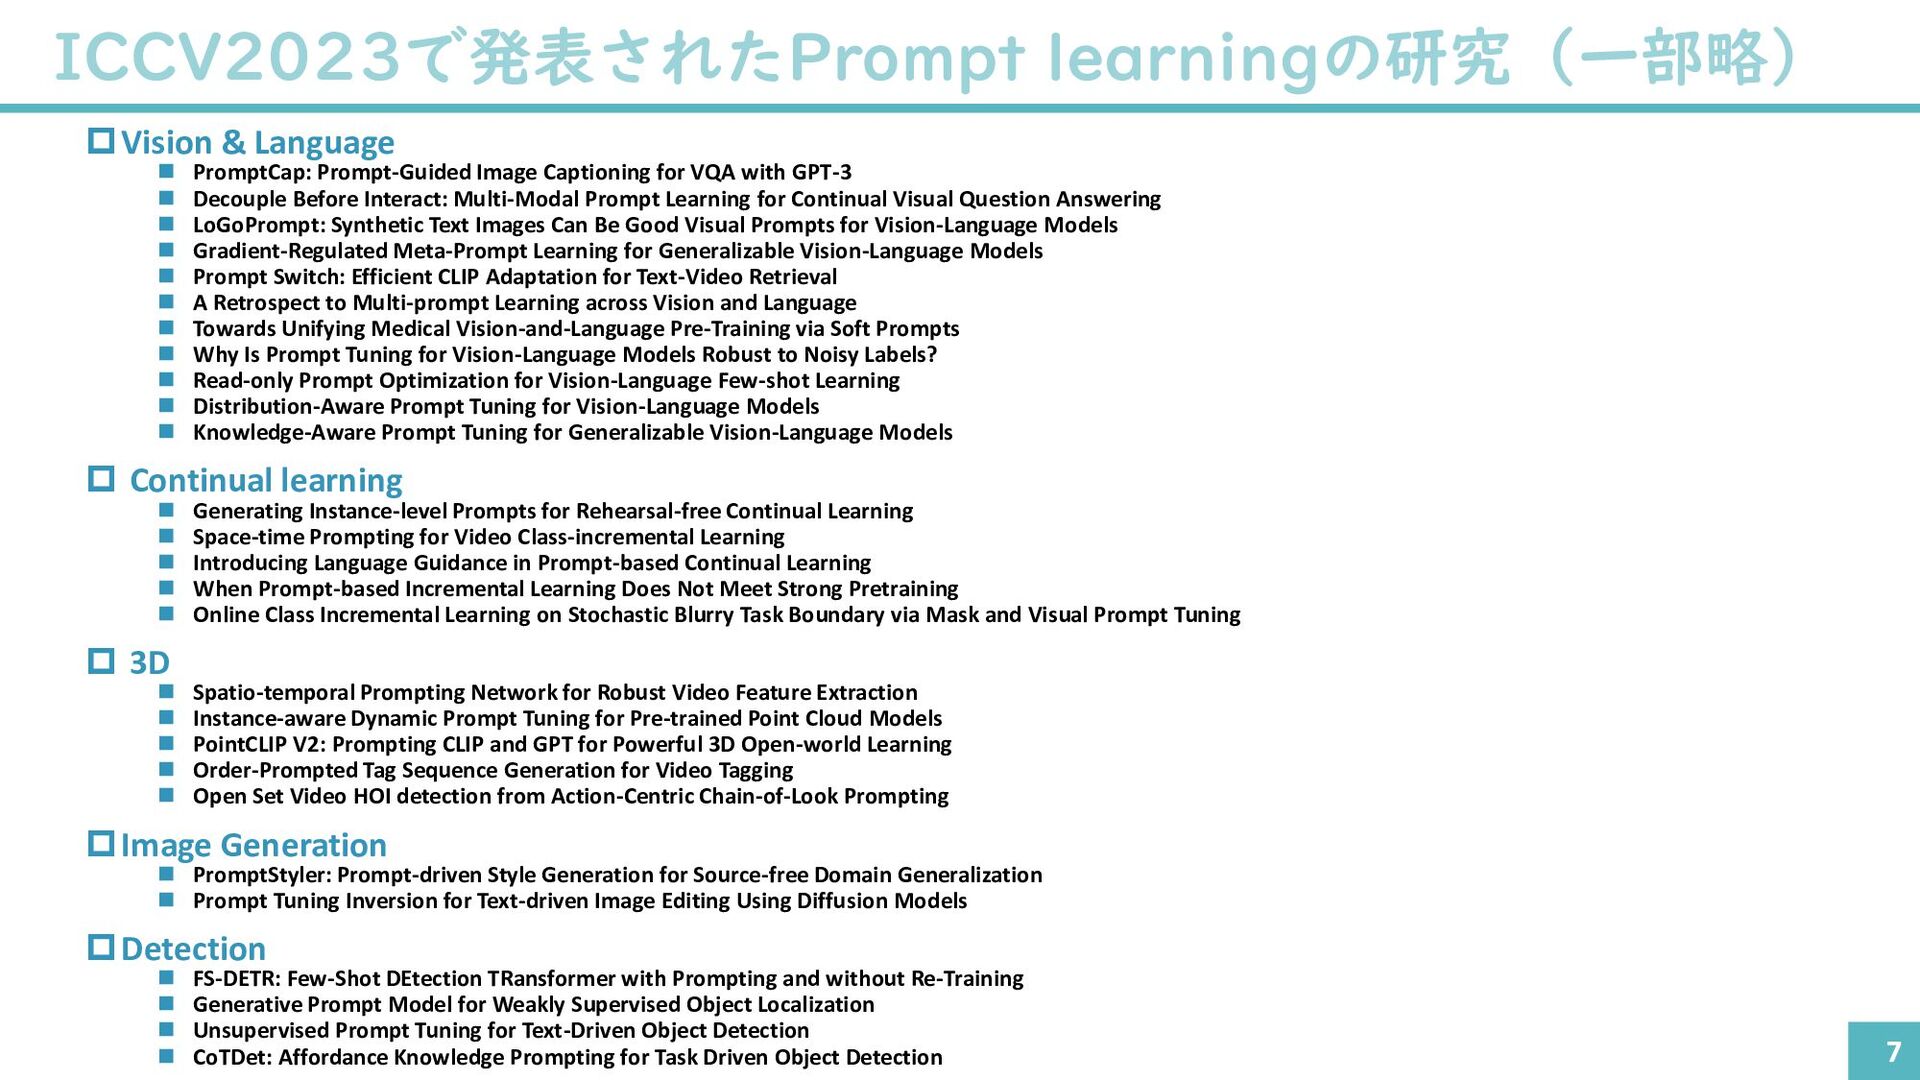
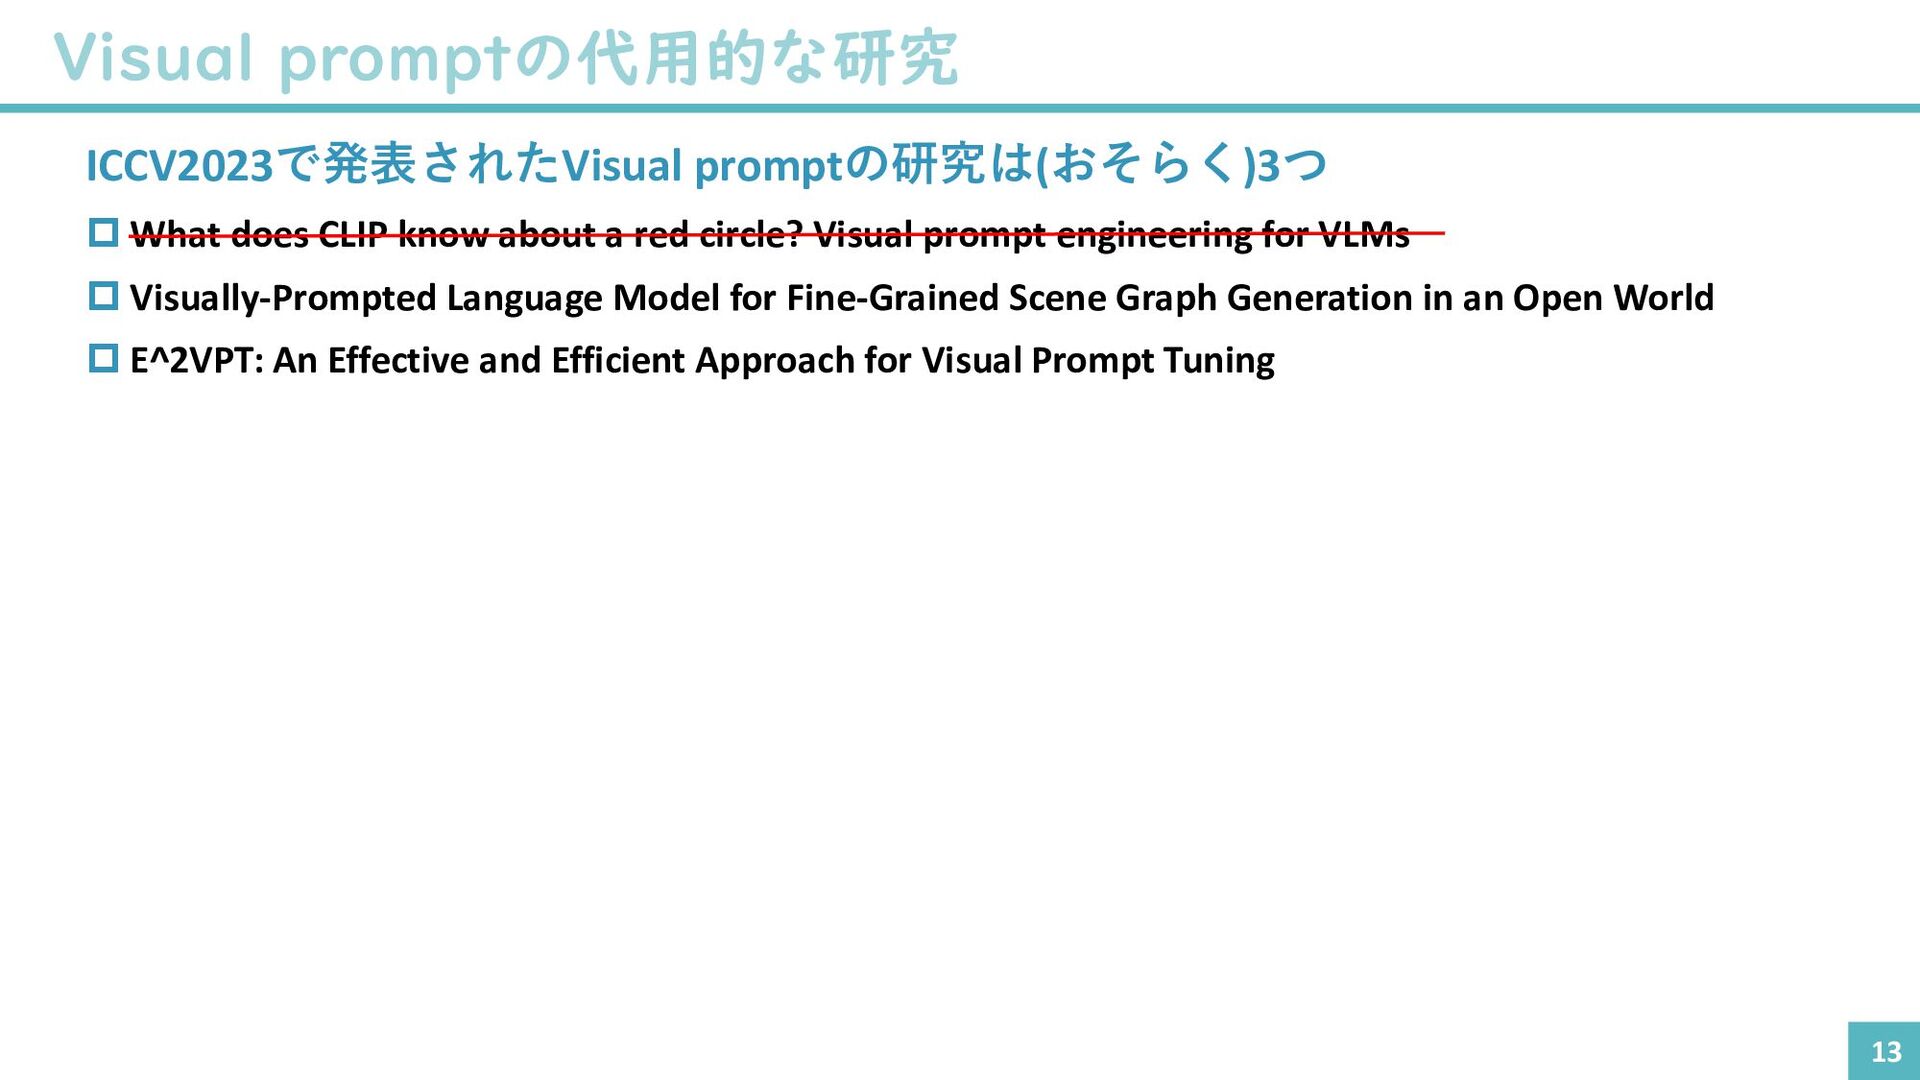
Captioning for VQA with GPT-3 Decouple Before Interact: Multi-Modal Prompt Learning for Continual Visual Question Answering LoGoPrompt: Synthetic Text Images Can Be Good Visual Prompts for Vision-Language Models Gradient-Regulated Meta-Prompt Learning for Generalizable Vision-Language Models Prompt Switch: Efficient CLIP Adaptation for Text-Video Retrieval A Retrospect to Multi-prompt Learning across Vision and Language Towards Unifying Medical Vision-and-Language Pre-Training via Soft Prompts Why Is Prompt Tuning for Vision-Language Models Robust to Noisy Labels? Read-only Prompt Optimization for Vision-Language Few-shot Learning Distribution-Aware Prompt Tuning for Vision-Language Models Knowledge-Aware Prompt Tuning for Generalizable Vision-Language Models Continual learning Generating Instance-level Prompts for Rehearsal-free Continual Learning Space-time Prompting for Video Class-incremental Learning Introducing Language Guidance in Prompt-based Continual Learning When Prompt-based Incremental Learning Does Not Meet Strong Pretraining Online Class Incremental Learning on Stochastic Blurry Task Boundary via Mask and Visual Prompt Tuning 3D Spatio-temporal Prompting Network for Robust Video Feature Extraction Instance-aware Dynamic Prompt Tuning for Pre-trained Point Cloud Models PointCLIP V2: Prompting CLIP and GPT for Powerful 3D Open-world Learning Order-Prompted Tag Sequence Generation for Video Tagging Open Set Video HOI detection from Action-Centric Chain-of-Look Prompting Image Generation PromptStyler: Prompt-driven Style Generation for Source-free Domain Generalization Prompt Tuning Inversion for Text-driven Image Editing Using Diffusion Models Detection FS-DETR: Few-Shot DEtection TRansformer with Prompting and without Re-Training Generative Prompt Model for Weakly Supervised Object Localization Unsupervised Prompt Tuning for Text-Driven Object Detection CoTDet: Affordance Knowledge Prompting for Task Driven Object Detection
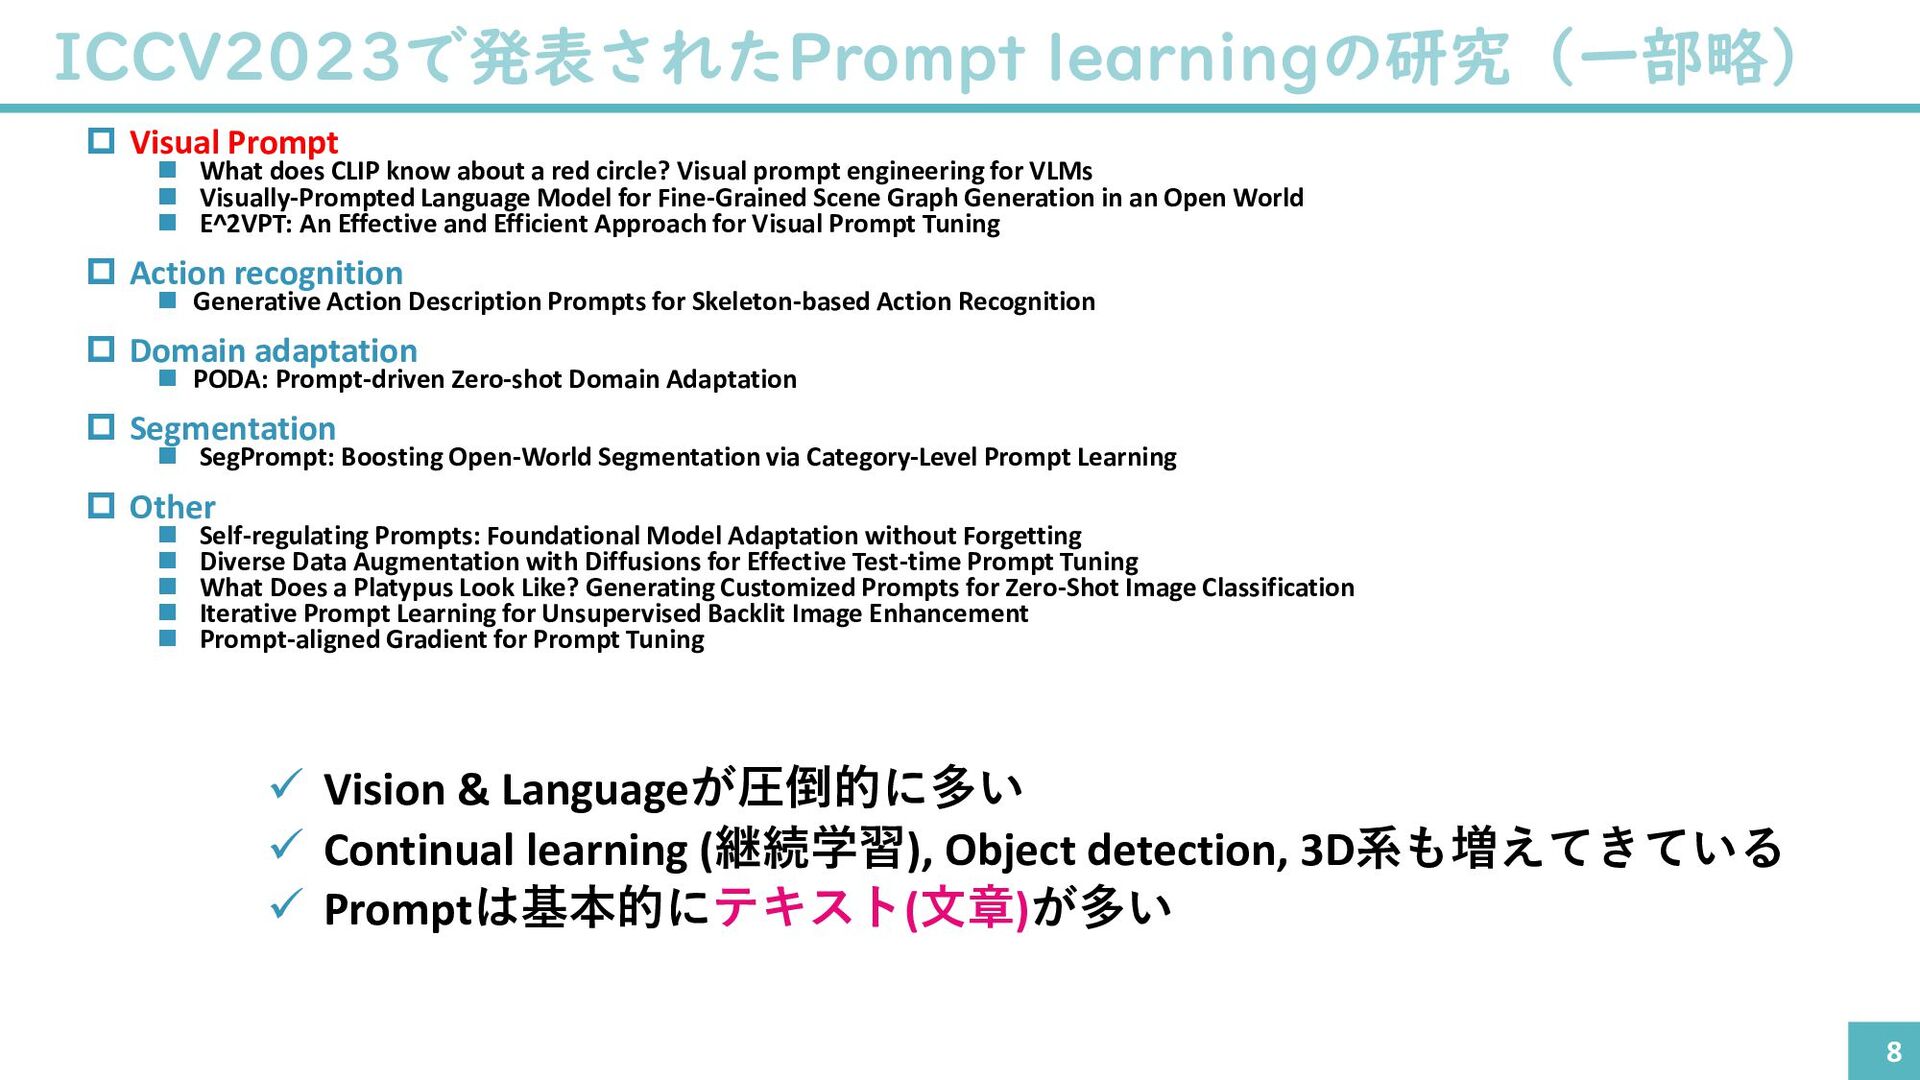
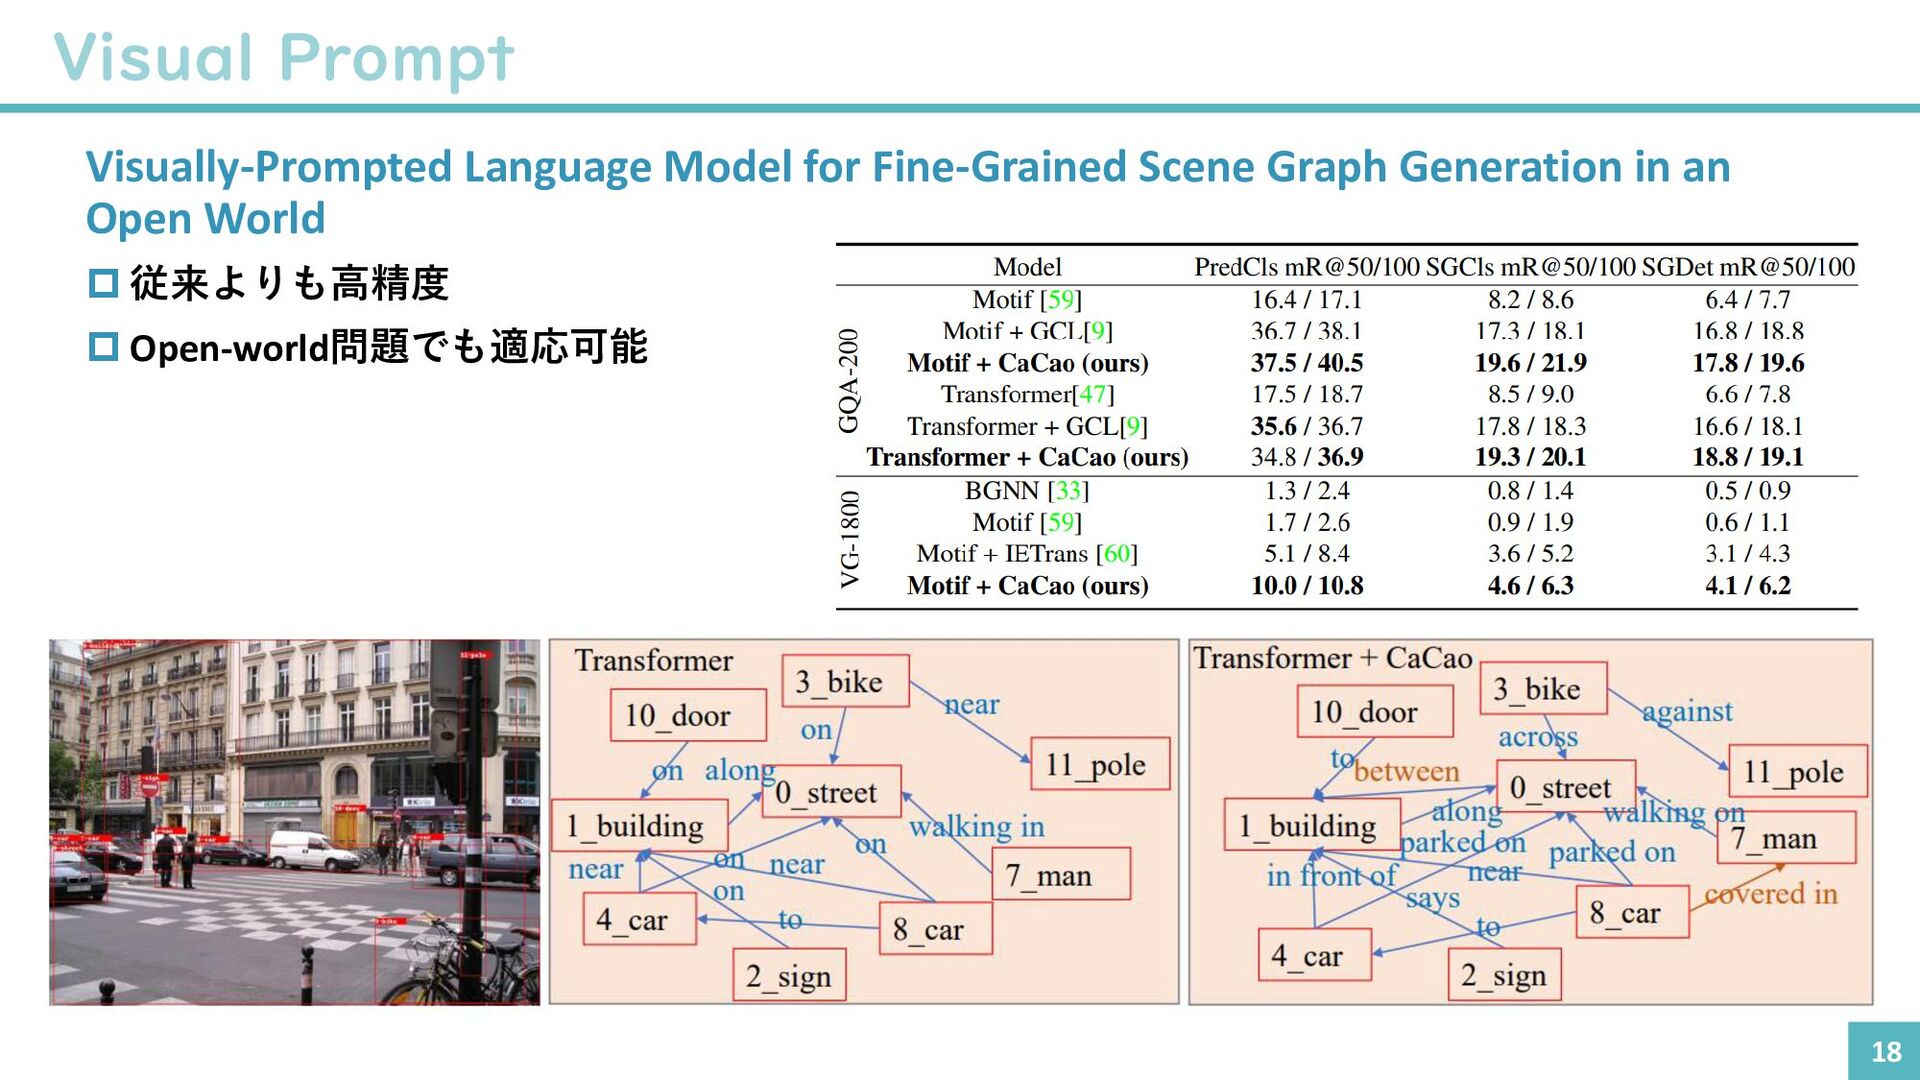
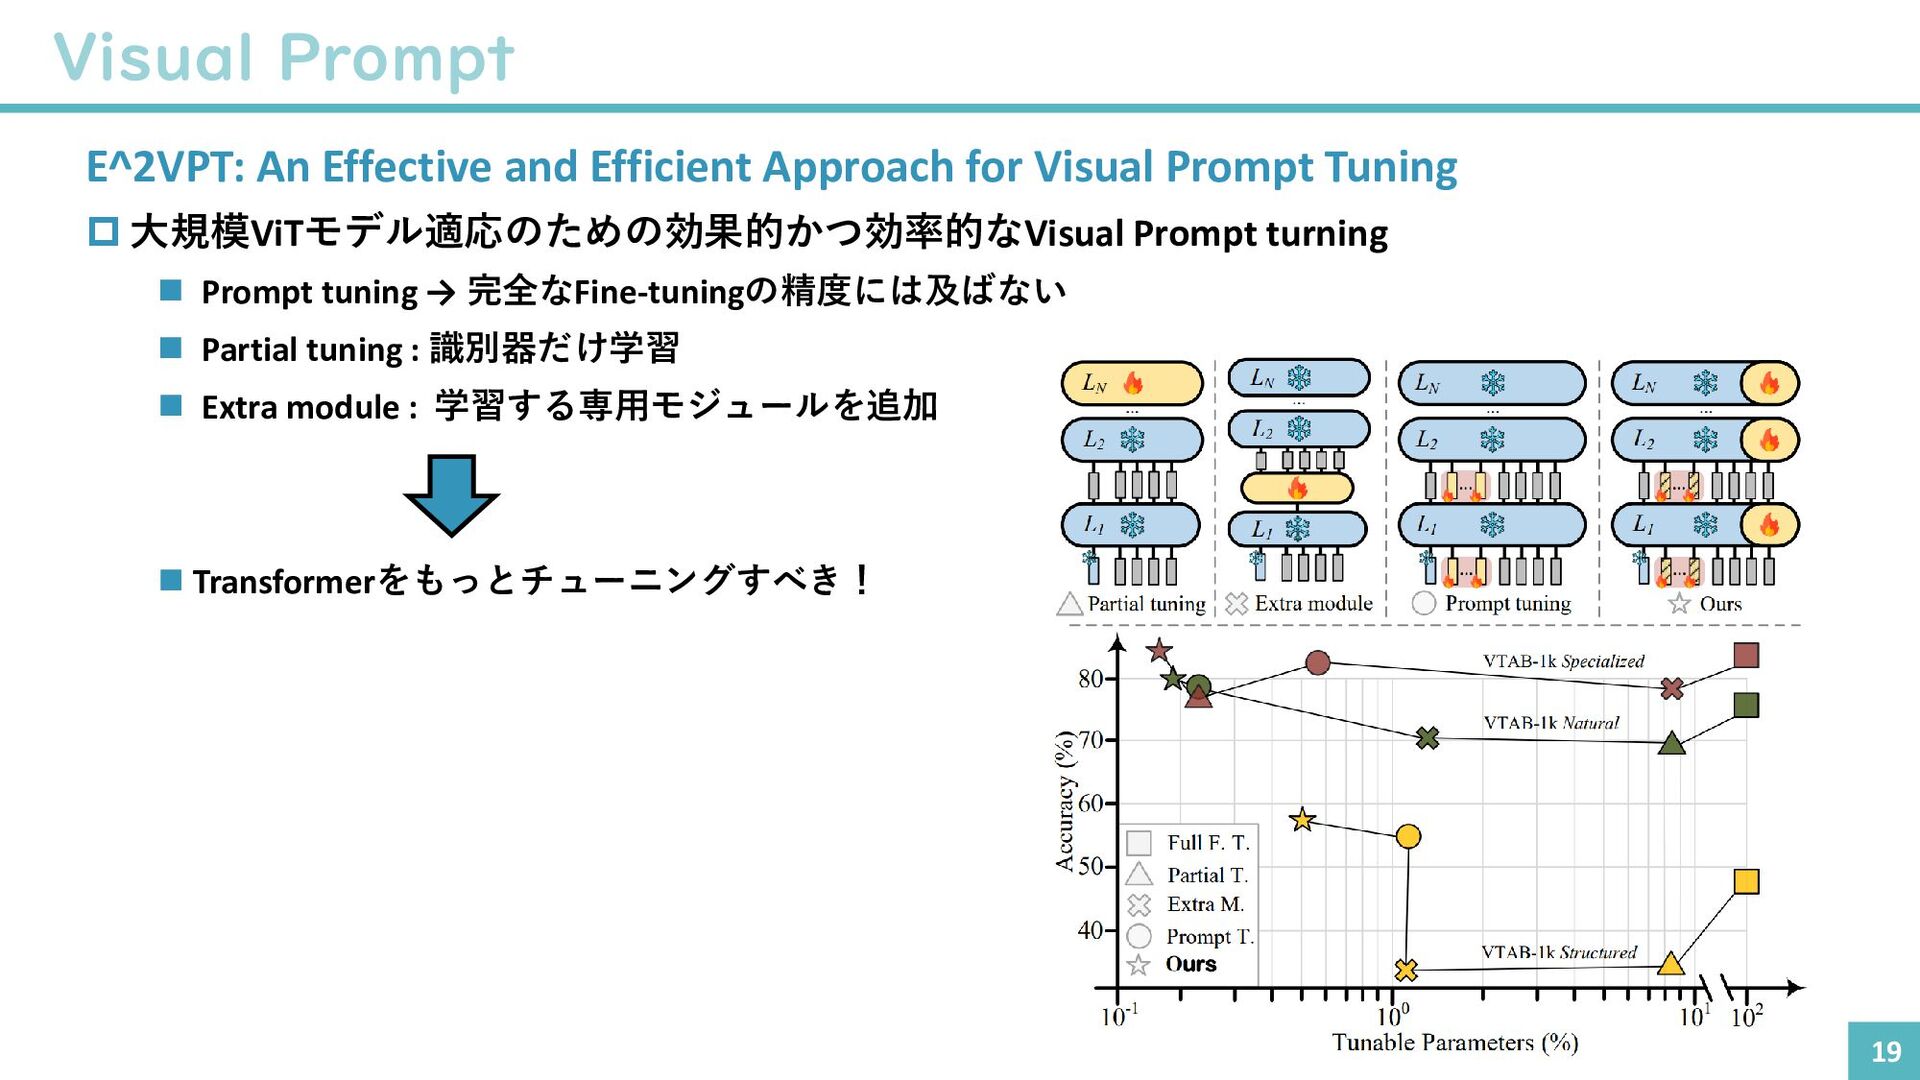
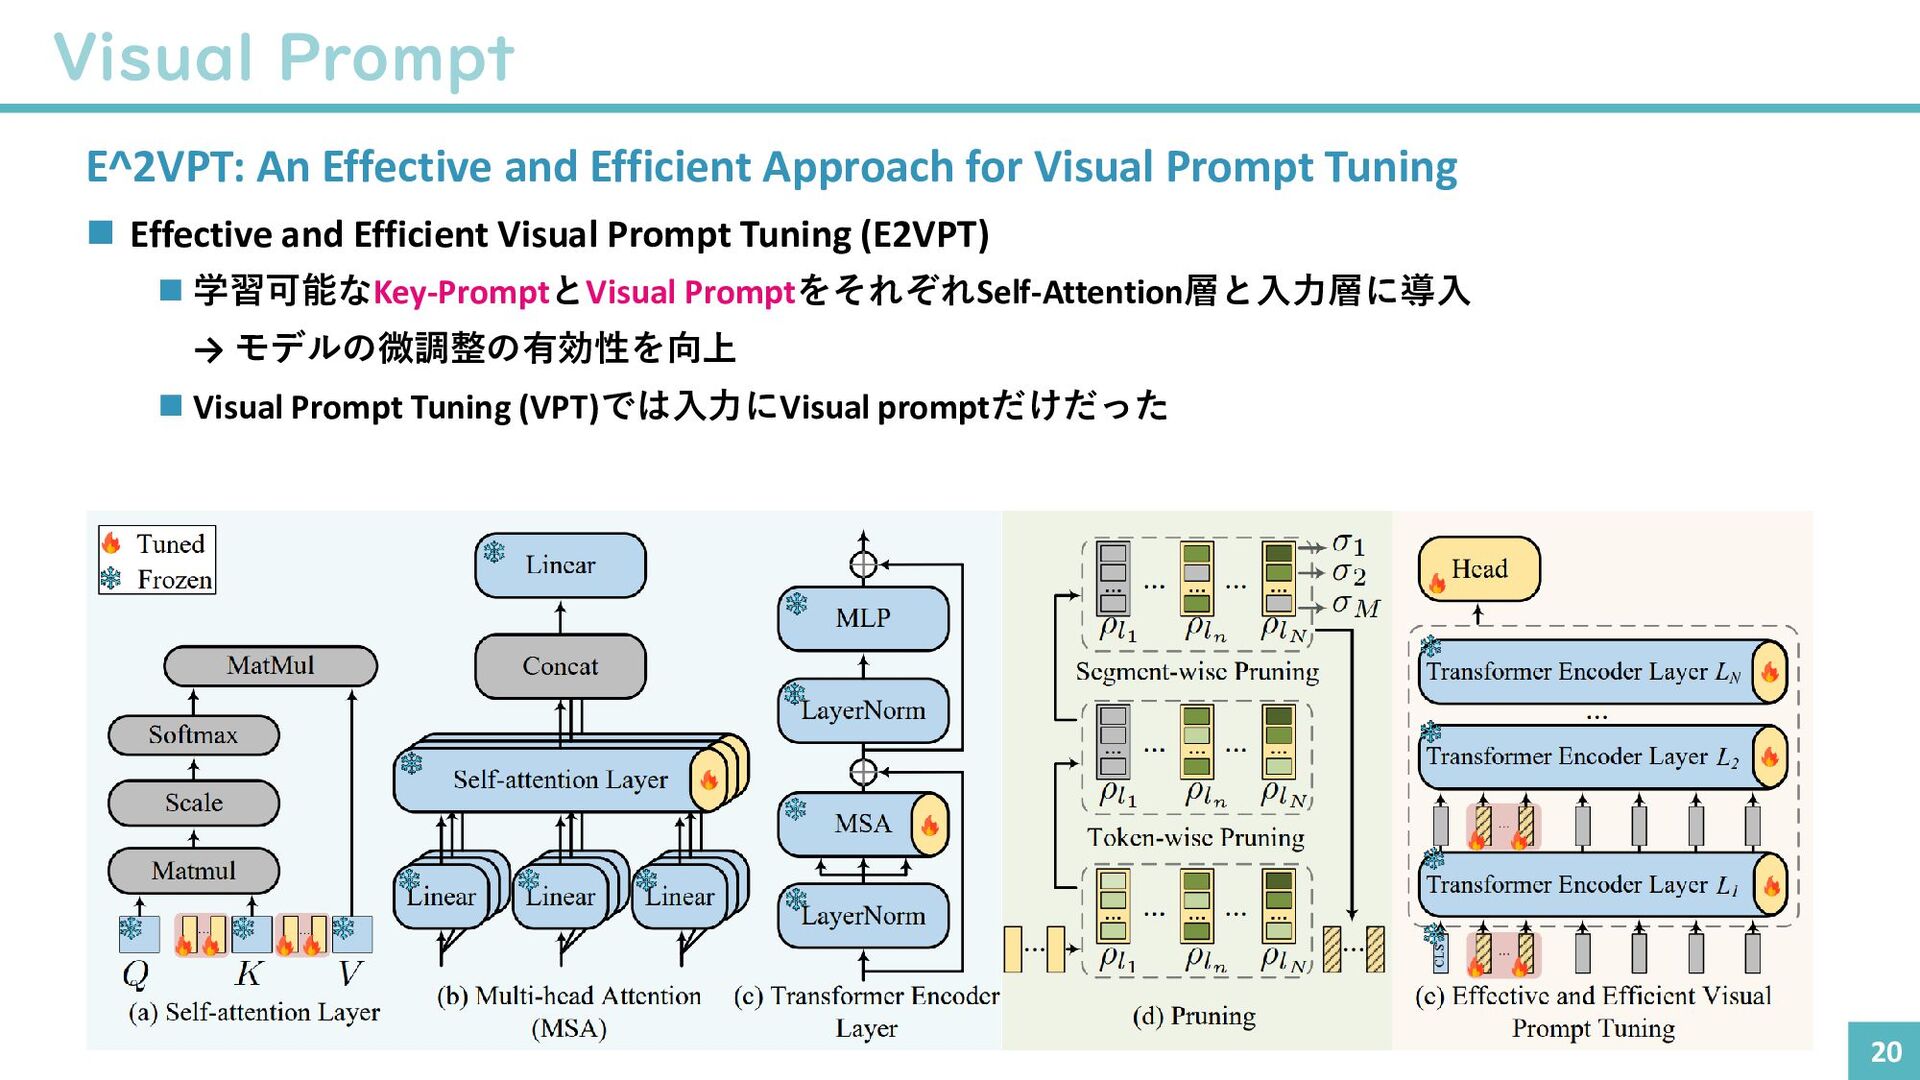
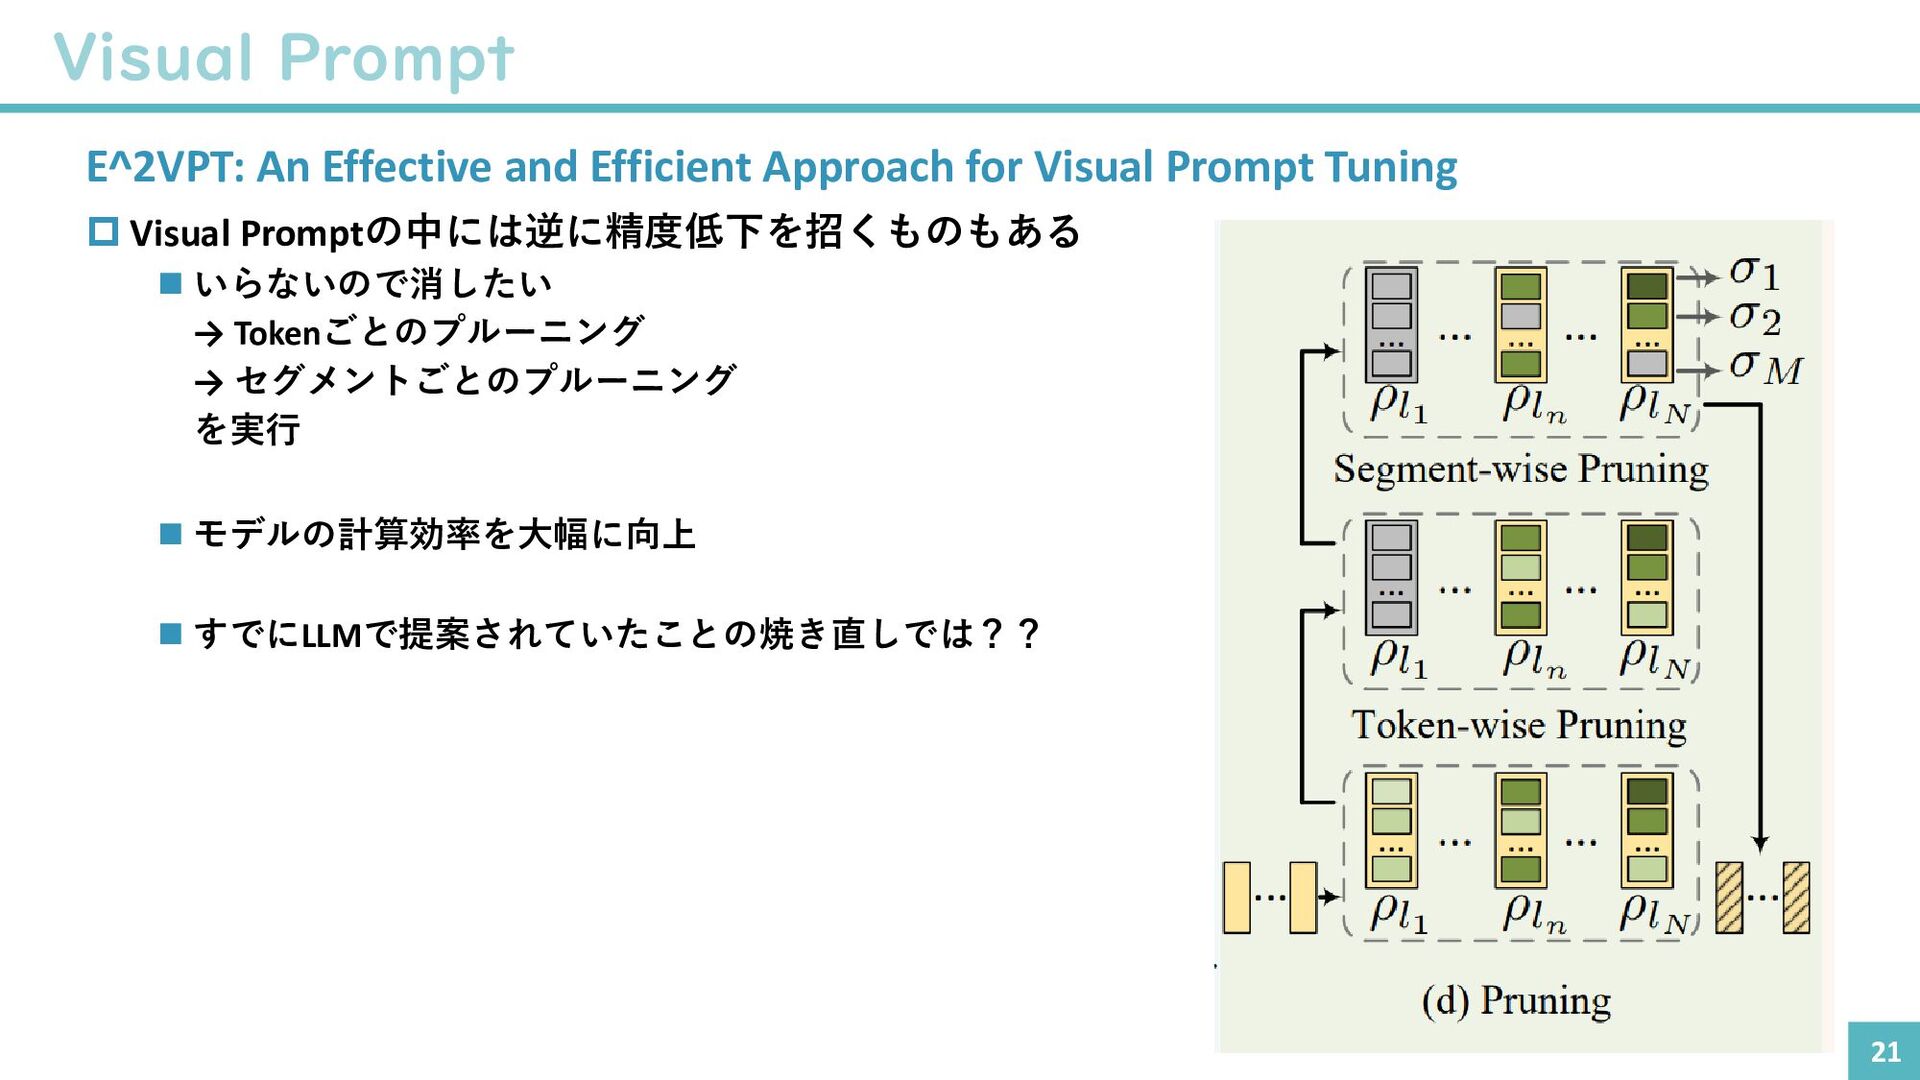
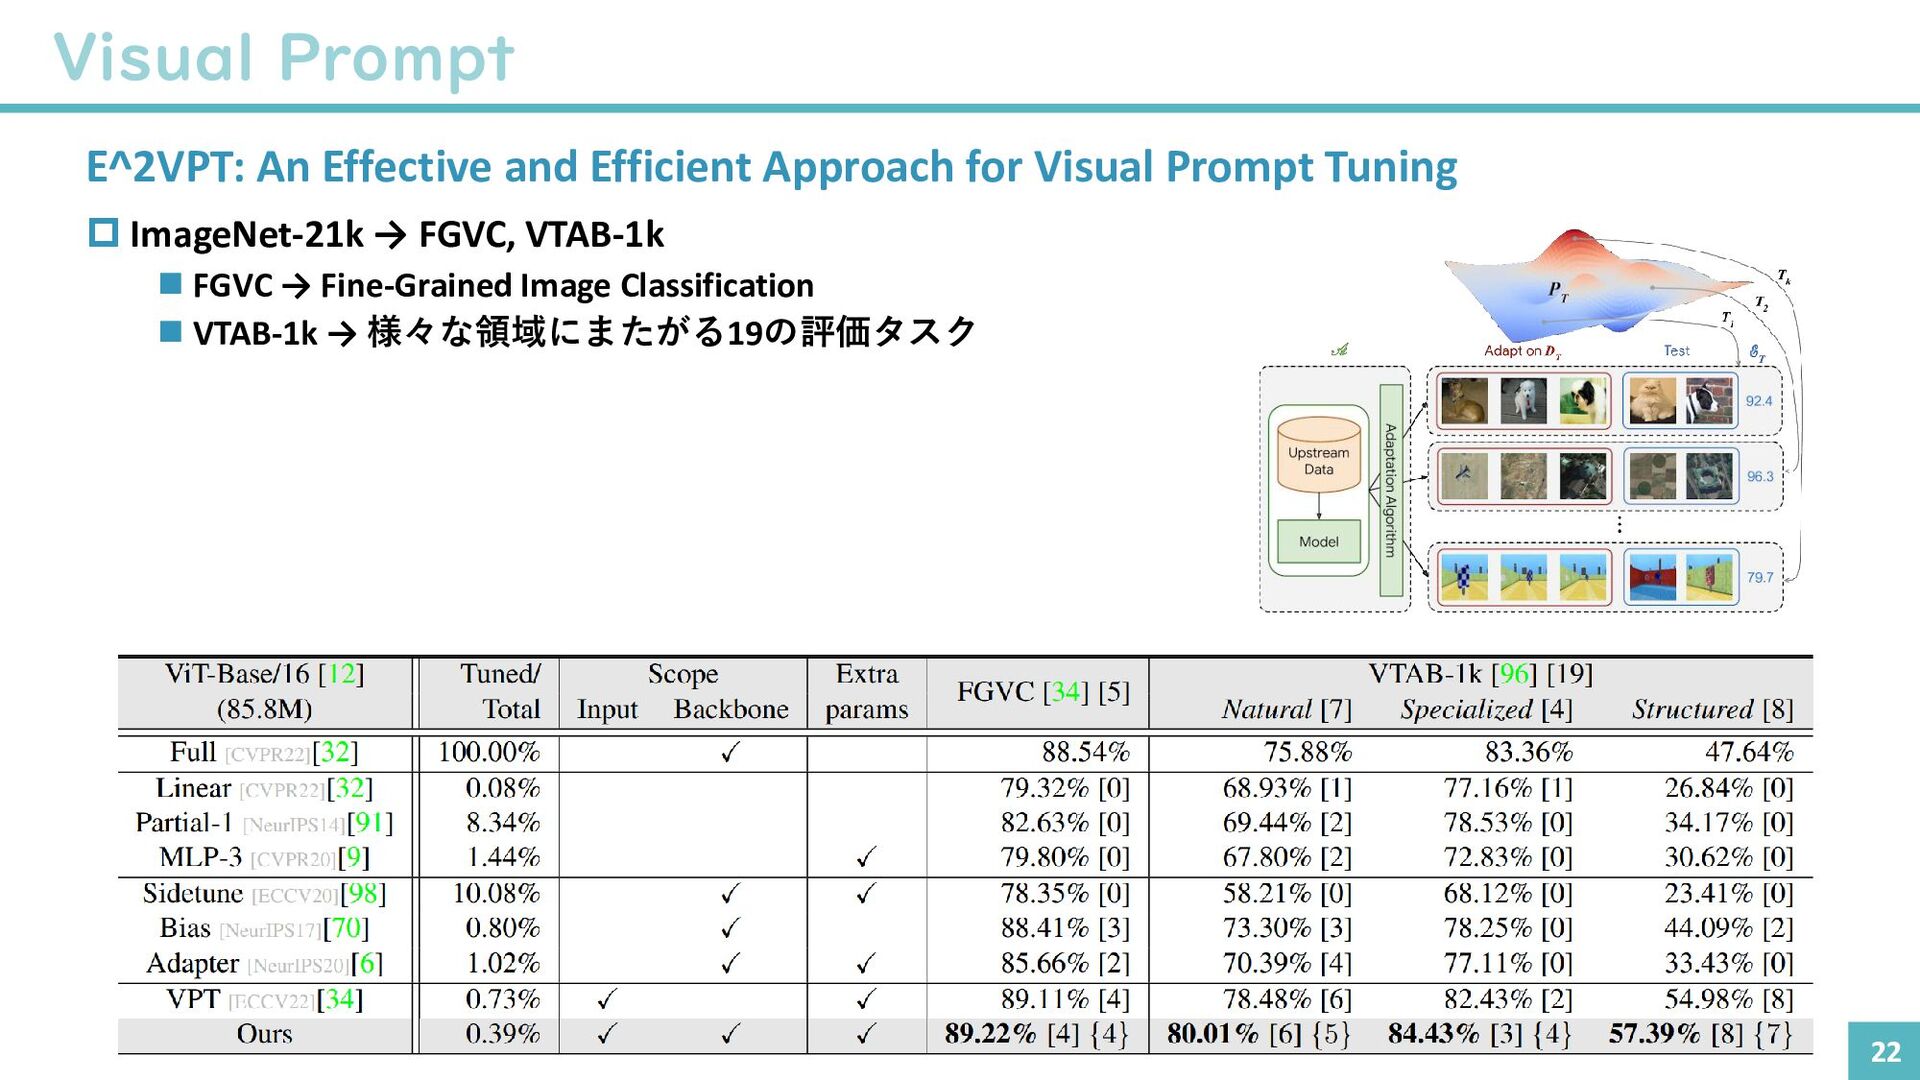
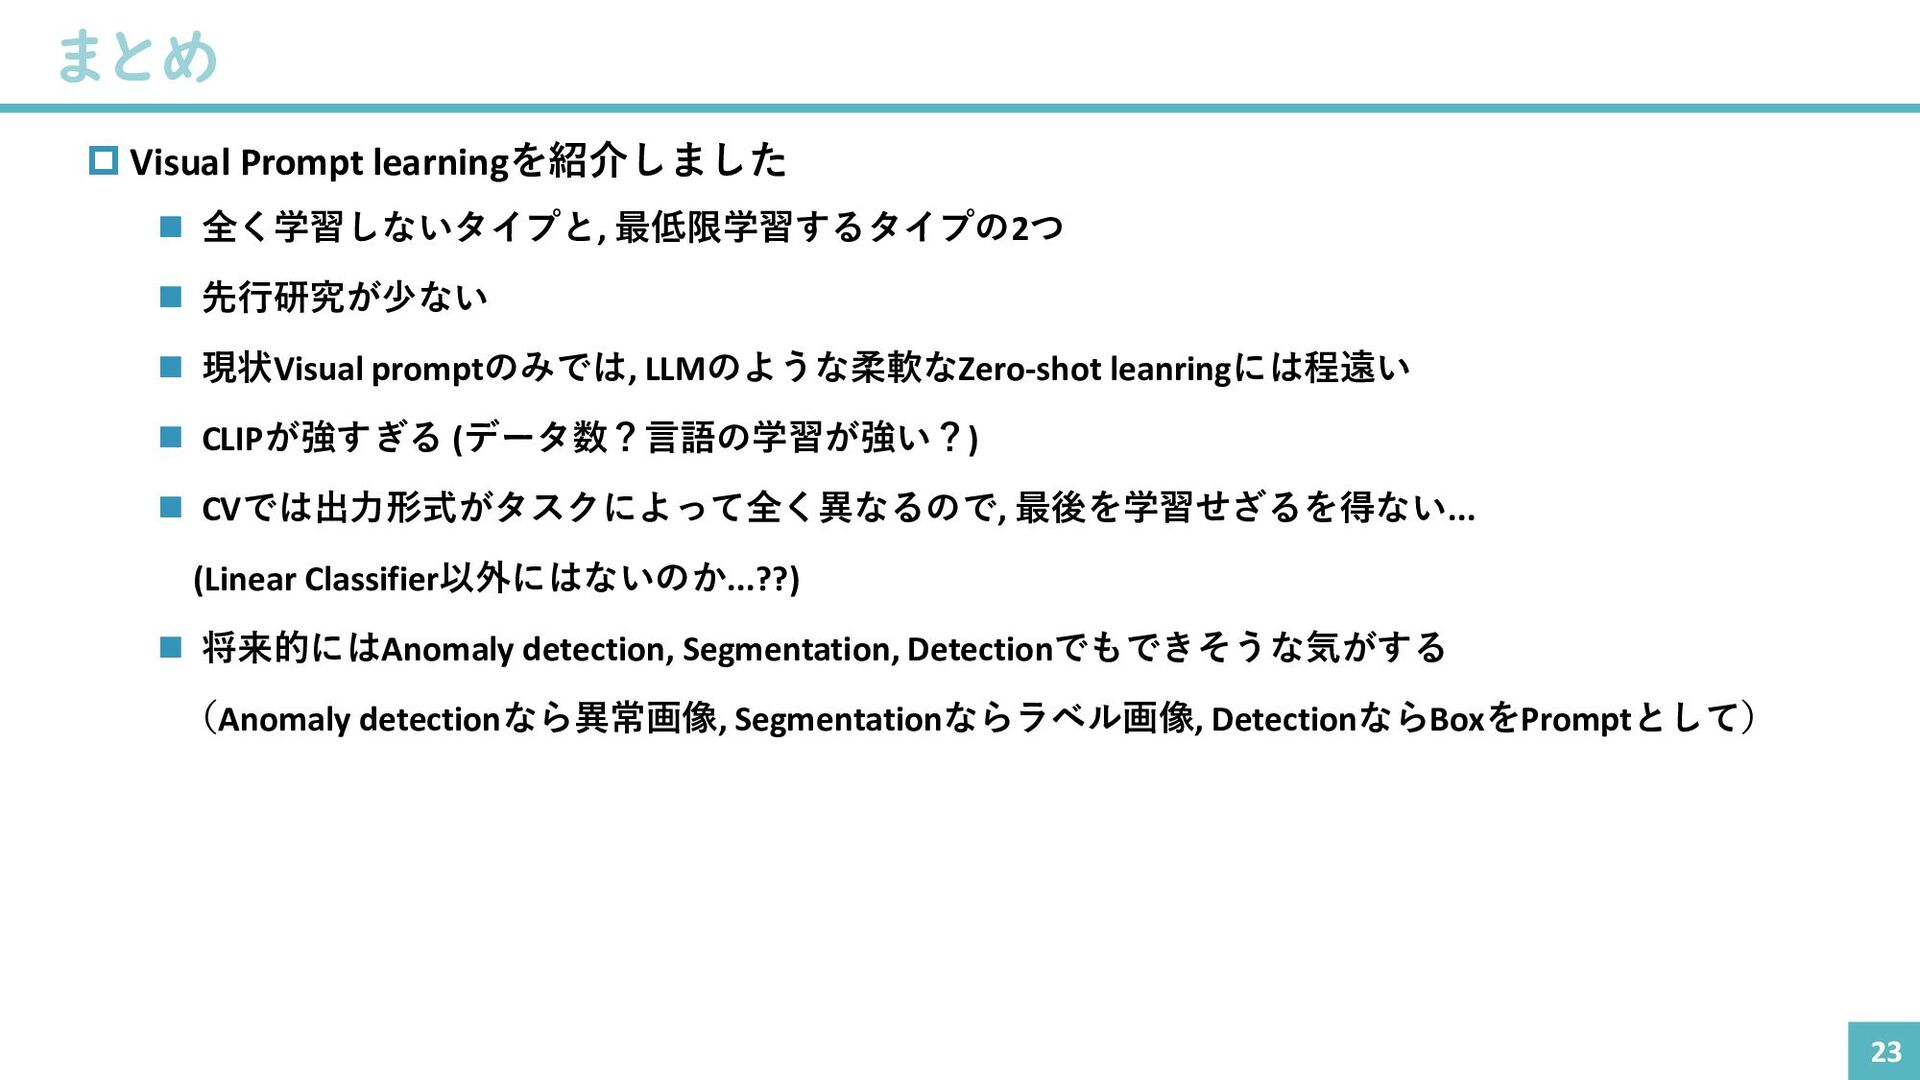
a red circle? Visual prompt engineering for VLMs Visually-Prompted Language Model for Fine-Grained Scene Graph Generation in an Open World E^2VPT: An Effective and Efficient Approach for Visual Prompt Tuning Action recognition Generative Action Description Prompts for Skeleton-based Action Recognition Domain adaptation PODA: Prompt-driven Zero-shot Domain Adaptation Segmentation SegPrompt: Boosting Open-World Segmentation via Category-Level Prompt Learning Other Self-regulating Prompts: Foundational Model Adaptation without Forgetting Diverse Data Augmentation with Diffusions for Effective Test-time Prompt Tuning What Does a Platypus Look Like? Generating Customized Prompts for Zero-Shot Image Classification Iterative Prompt Learning for Unsupervised Backlit Image Enhancement Prompt-aligned Gradient for Prompt Tuning ICCV2023で発表されたPrompt learningの研究(一部略) Vision & Languageが圧倒的に多い Continual learning (継続学習), Object detection, 3D系も増えてきている Promptは基本的にテキスト(文章)が多い
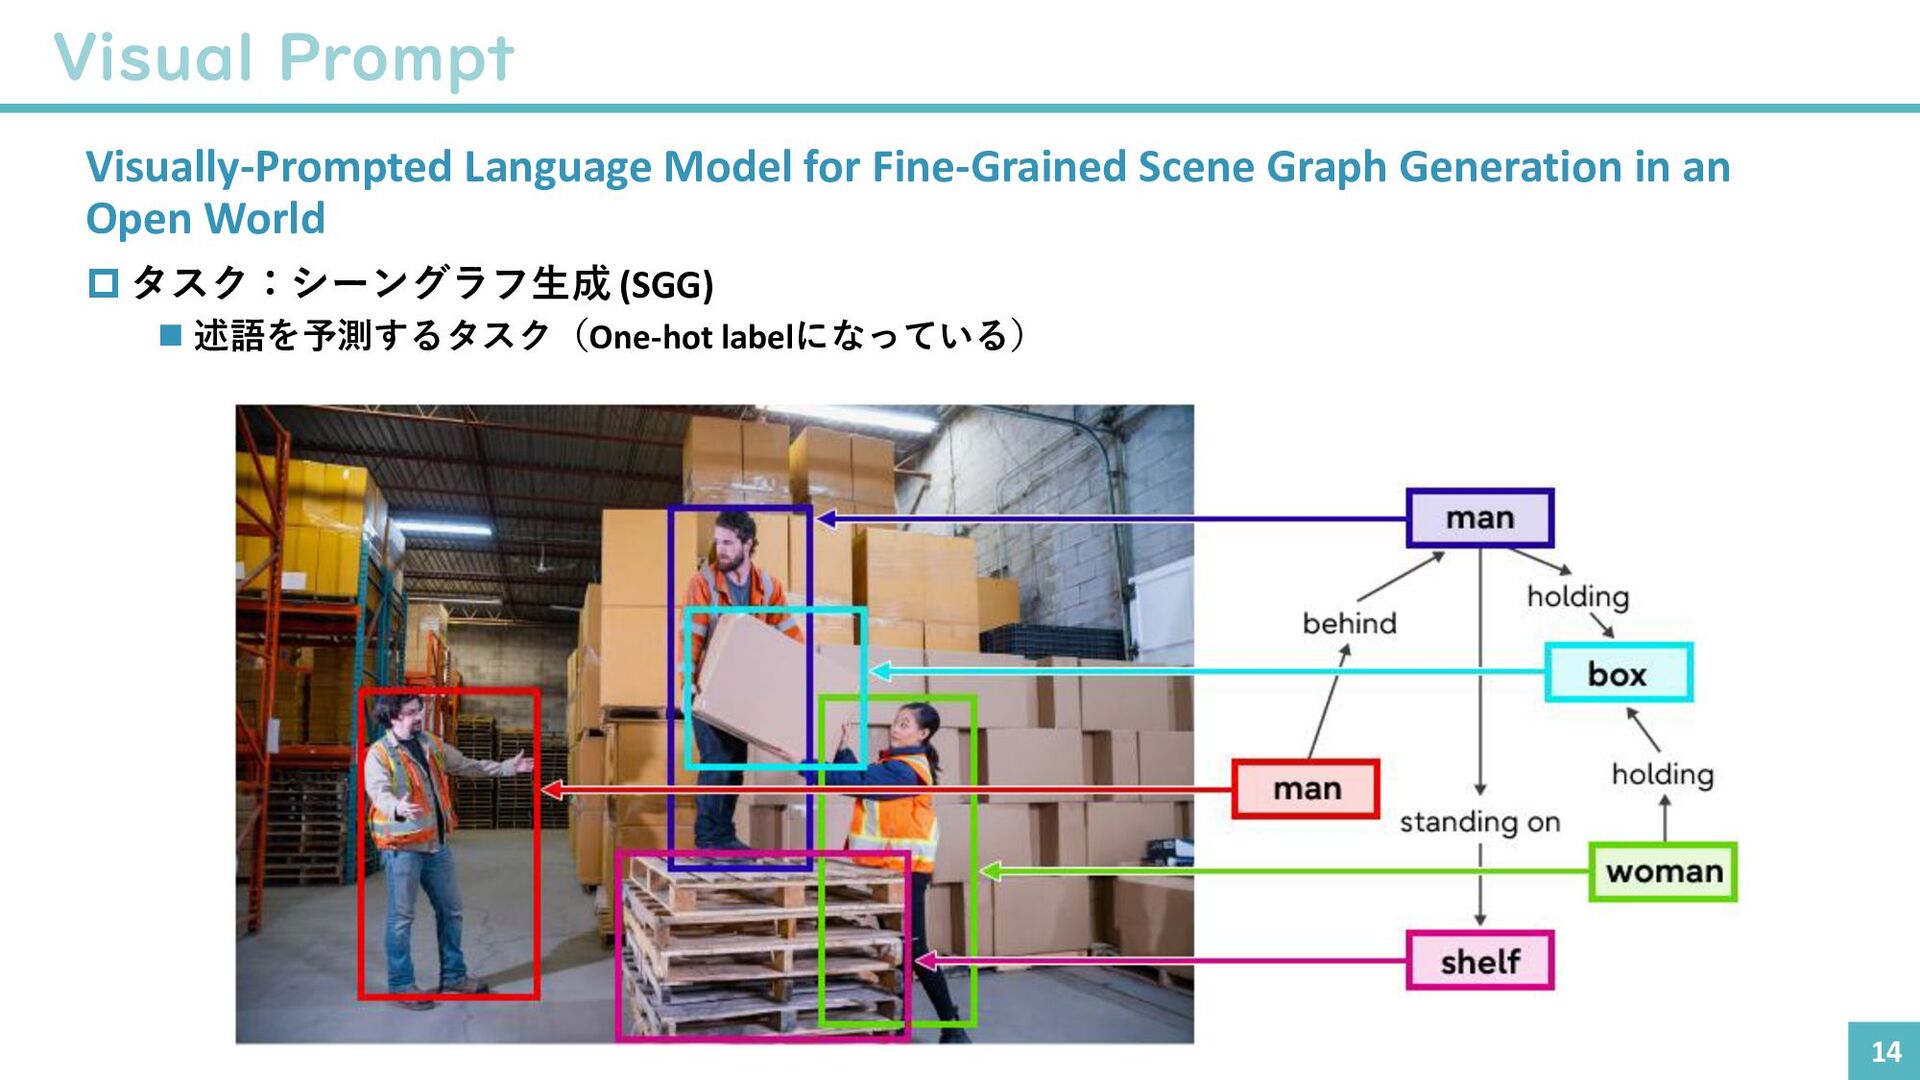
about a red circle? Visual prompt engineering for VLMs Visually-Prompted Language Model for Fine-Grained Scene Graph Generation in an Open World E^2VPT: An Effective and Efficient Approach for Visual Prompt Tuning
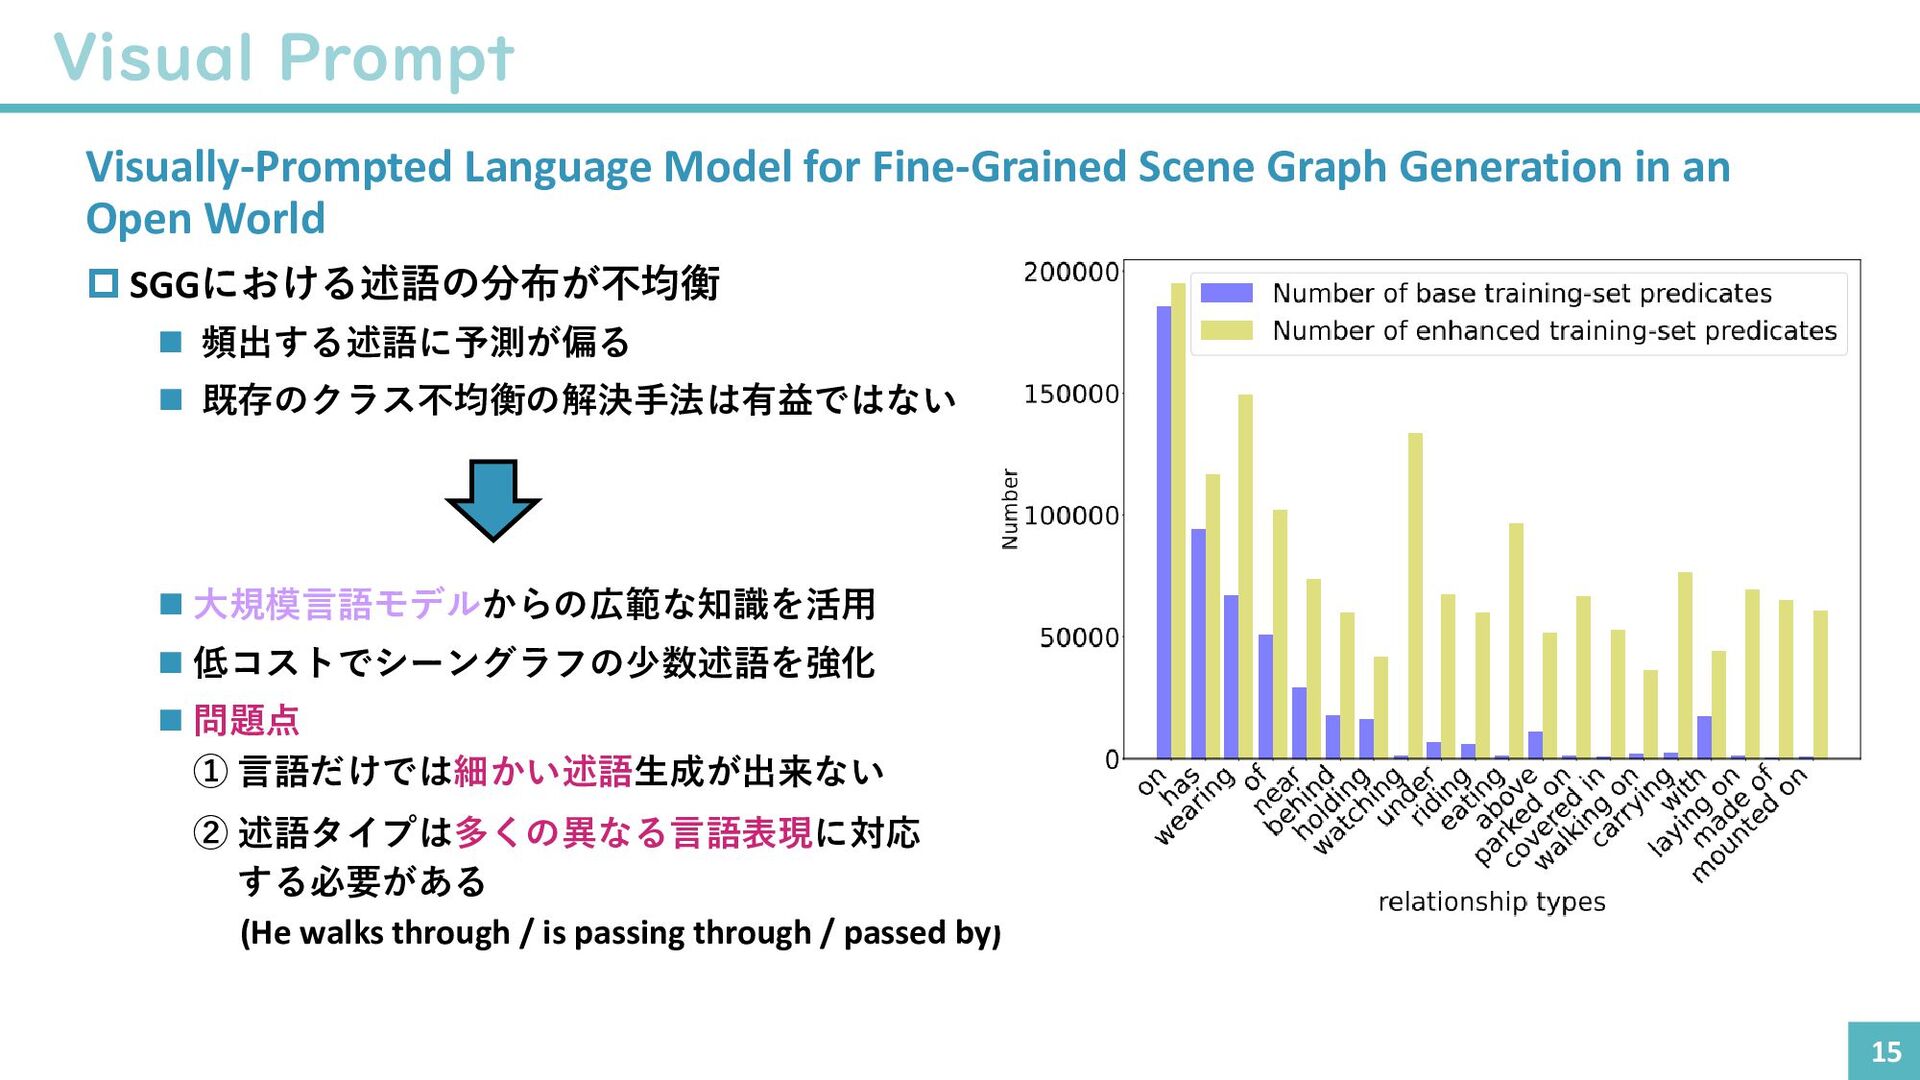
Generation in an Open World SGGにおける述語の分布が不均衡 頻出する述語に予測が偏る 既存のクラス不均衡の解決手法は有益ではない 大規模言語モデルからの広範な知識を活用 低コストでシーングラフの少数述語を強化 問題点 ① 言語だけでは細かい述語生成が出来ない ② 述語タイプは多くの異なる言語表現に対応 する必要がある (He walks through / is passing through / passed by)
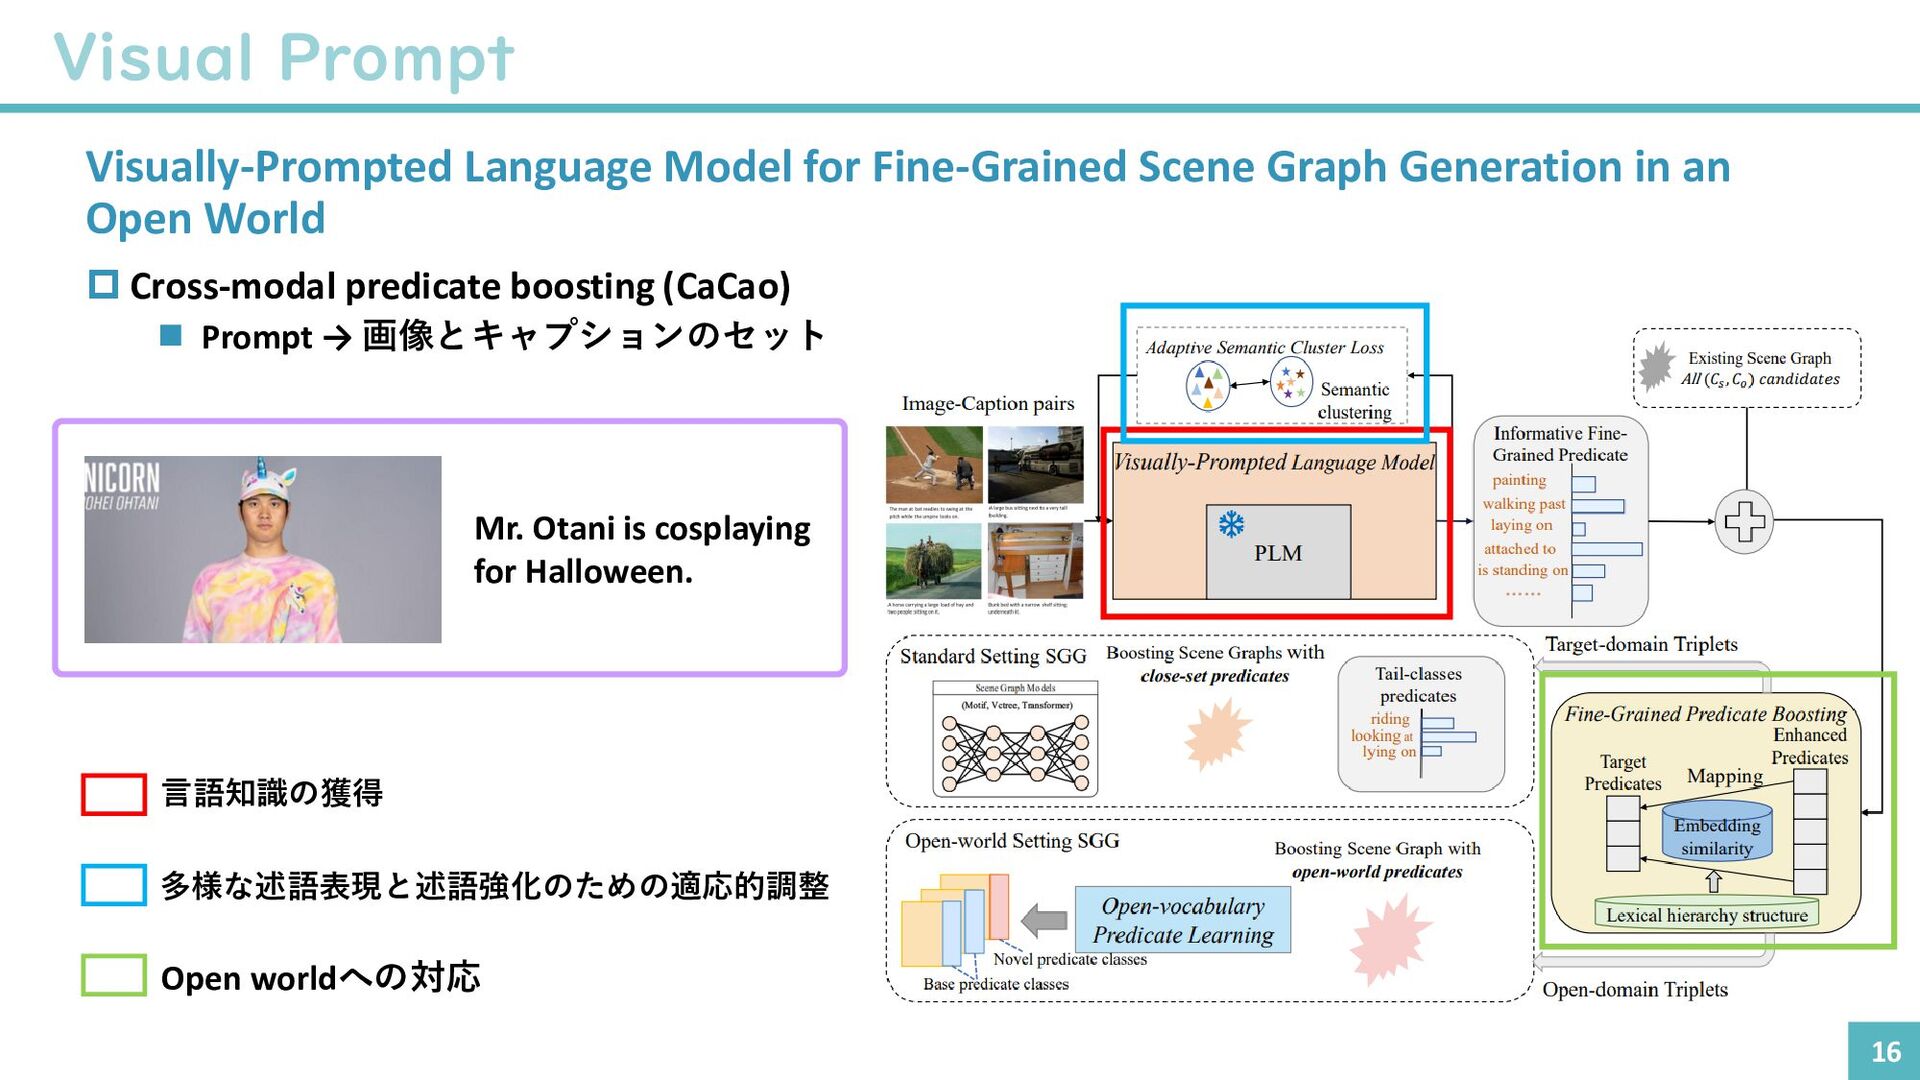
Generation in an Open World Cross-modal predicate boosting (CaCao) Prompt → 画像とキャプションのセット 言語知識の獲得 多様な述語表現と述語強化のための適応的調整 Open worldへの対応 Mr. Otani is cosplaying for Halloween.


 sotakato
 ryanjones
 bluesmoon
 nikkihalliwell
 jonoalderson
 tessaabrams
 brettharned
 addyosmani
 tammielis
 reverentgeek
 mraible
 soudai
 emna__ayadi